Share
Embed
Operating and Migrating OpenTelemetry Collector in a 100-Cluster-Scale Multi-Tenant Environment

Kota Kimura
November 18, 2025
Transcript
73 slides
-
100クラスター規模のマルチテナント環境を支える OpenTelemetry Collector 実践と移行 ~ログ・メトリクス仕様の最前線~ 株式会社サイバーエージェント 青山 真也 / 木村
洸太 CloudNative Days Winter 2025 2025/11/18 -
自己紹介 青山 真也(@amsy810) CIU - Cycloud Div Tech Lead KaaS
Product Owner Developer Expert(CloudNative 領域) Co-Chair: KubeCon + CNCon Japan 2025, CND Board: Cloud Native Community Japan Organizer: Kubernetes Meetup Tokyo, etc 木村 洸太 CIU - Cycloud Div Software Engineer KaaS Sub Product Owner LBaaS Core Developer Envoy Gateway: Maintainer -
アジェンダ 1. 背景 2. OpenTelemetry Collector / Operator 概要 3.
【メトリクス】アップストリーム動向 4. 【メトリクス】OpenTelemetry 対応時の考慮ポイント 5. 【ログ】アップストリーム動向 6. 【ログ】OpenTelemetry 対応時の考慮ポイント 7. Collector の集約パターンとパイプラインサービスに向けて 8. まとめ -
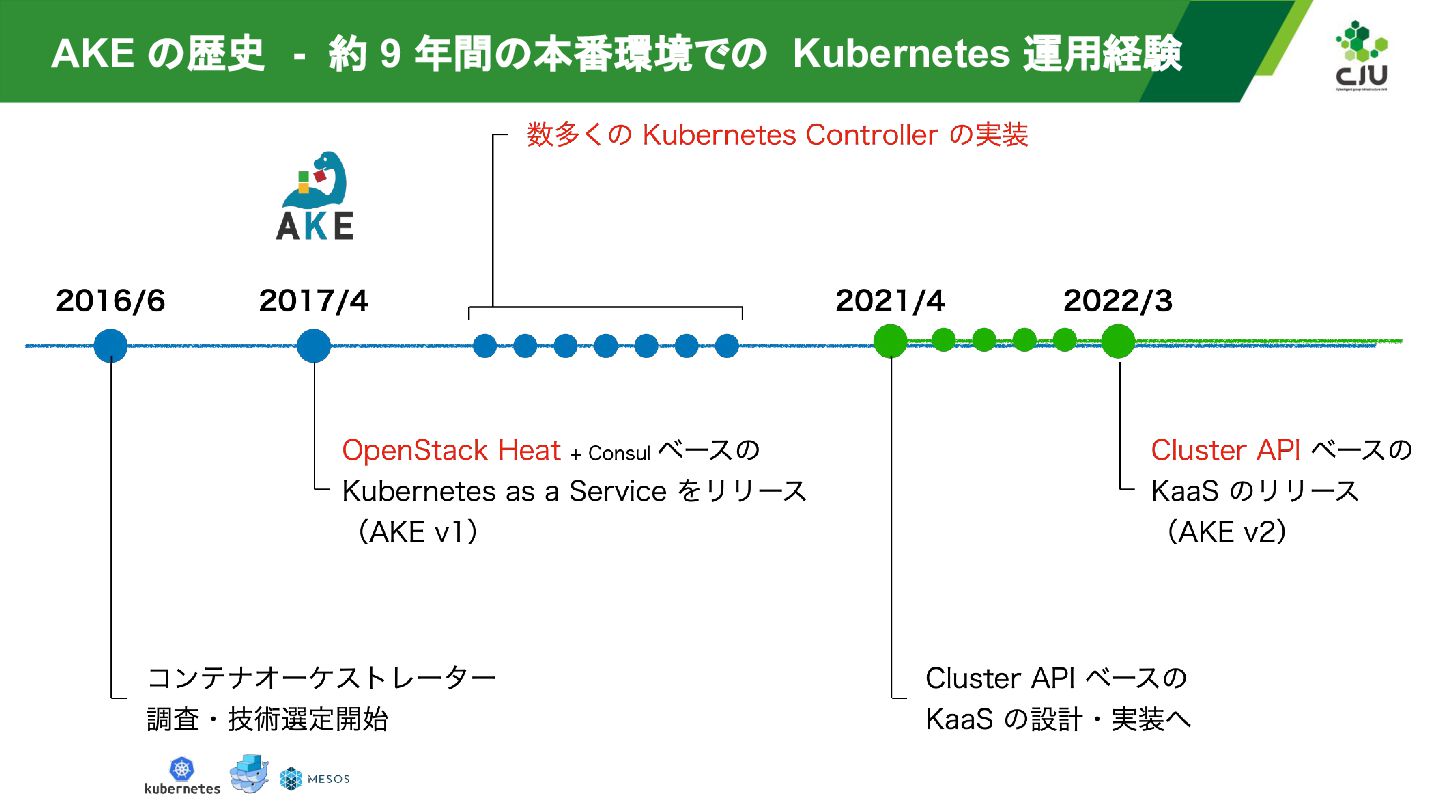
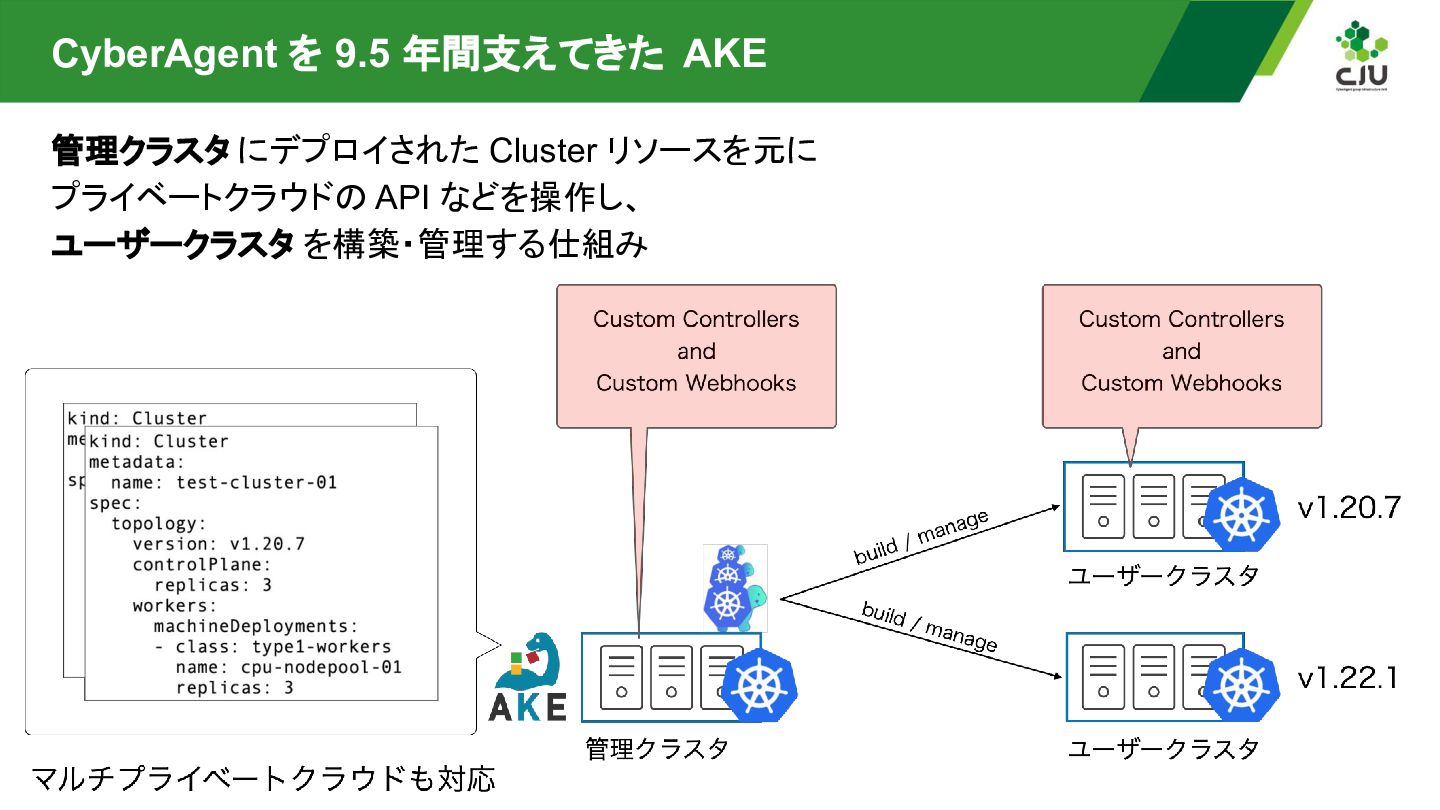
CyberAgent を 9.5 年間支えてきた AKE 管理クラスタ にデプロイされた Cluster リソースを元に プライベートクラウドの
API などを操作し、 ユーザークラスタ を構築・管理する仕組み -
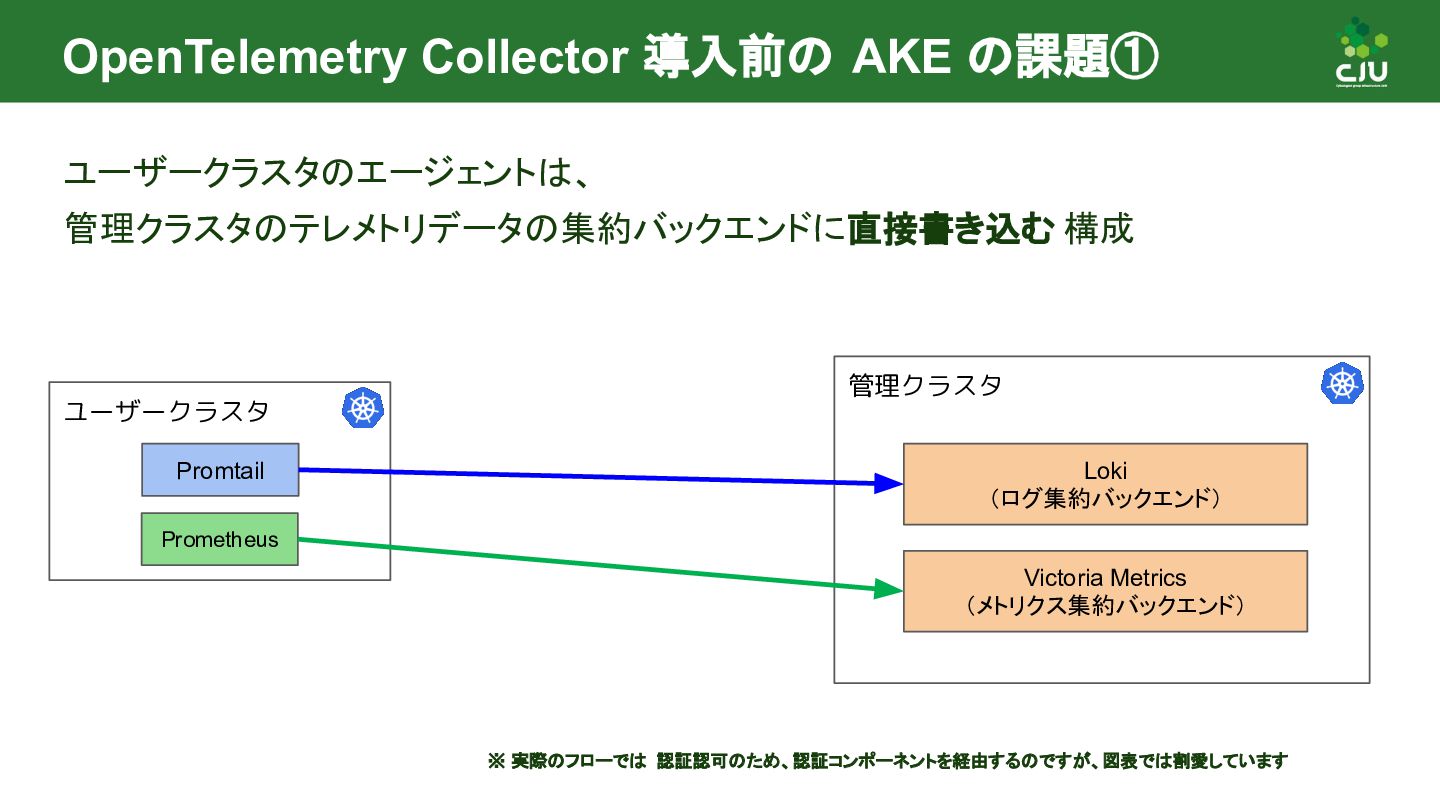
OpenTelemetry Collector 導入前の AKE の課題① ユーザークラスタのエージェントは、 管理クラスタのテレメトリデータの集約バックエンドに直接書き込む 構成 ※ 実際のフローでは
認証認可のため、認証コンポーネントを経由するのですが、図表では割愛しています 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki (ログ集約バックエンド) ユーザークラスタ Promtail Prometheus -
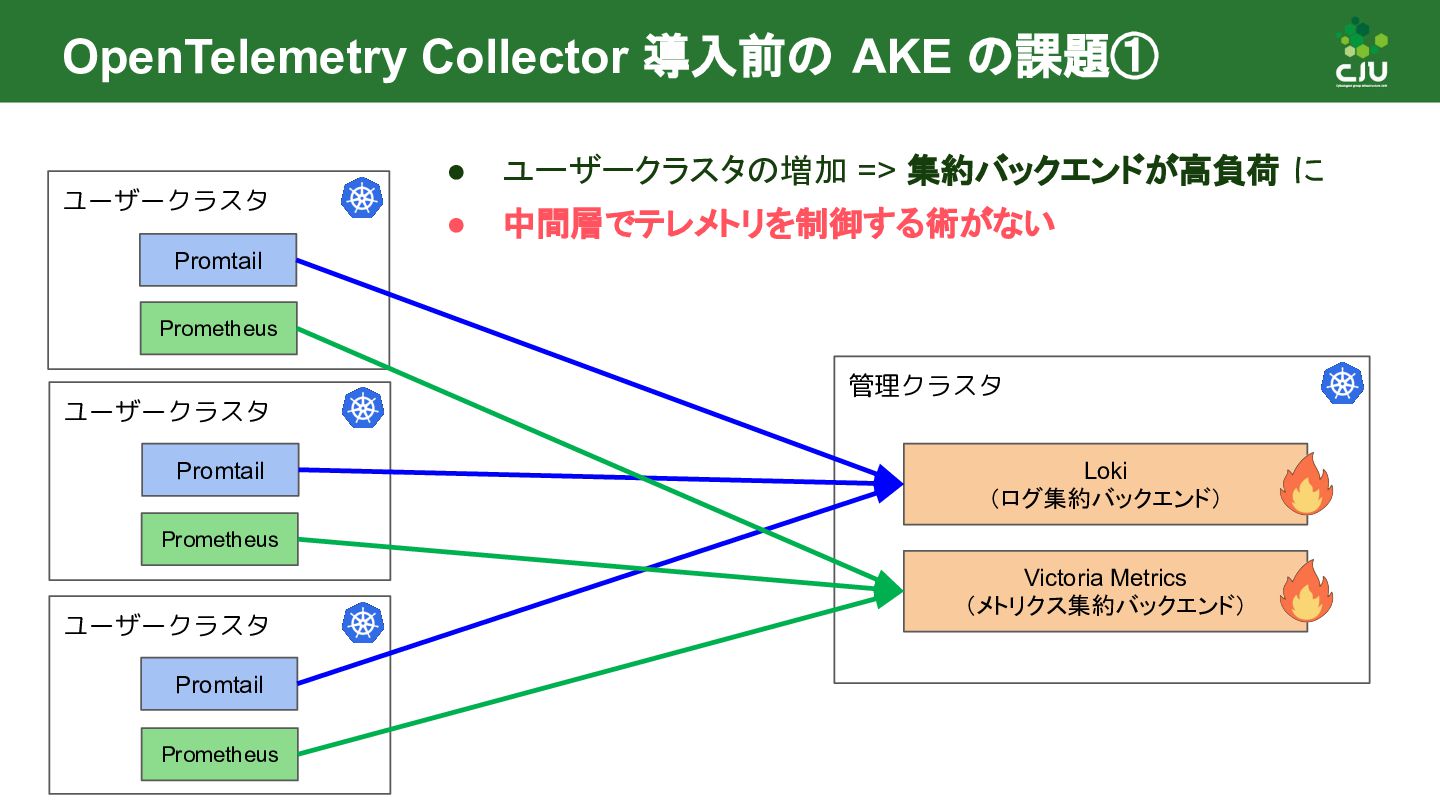
OpenTelemetry Collector 導入前の AKE の課題① ユーザークラスタ 管理クラスタ Promtail Prometheus Victoria
Metrics (メトリクス集約バックエンド) Loki (ログ集約バックエンド) ユーザークラスタ Promtail Prometheus ユーザークラスタ Promtail Prometheus • ユーザークラスタの増加 => 集約バックエンドが高負荷 に • 中間層でテレメトリを制御する術がない -
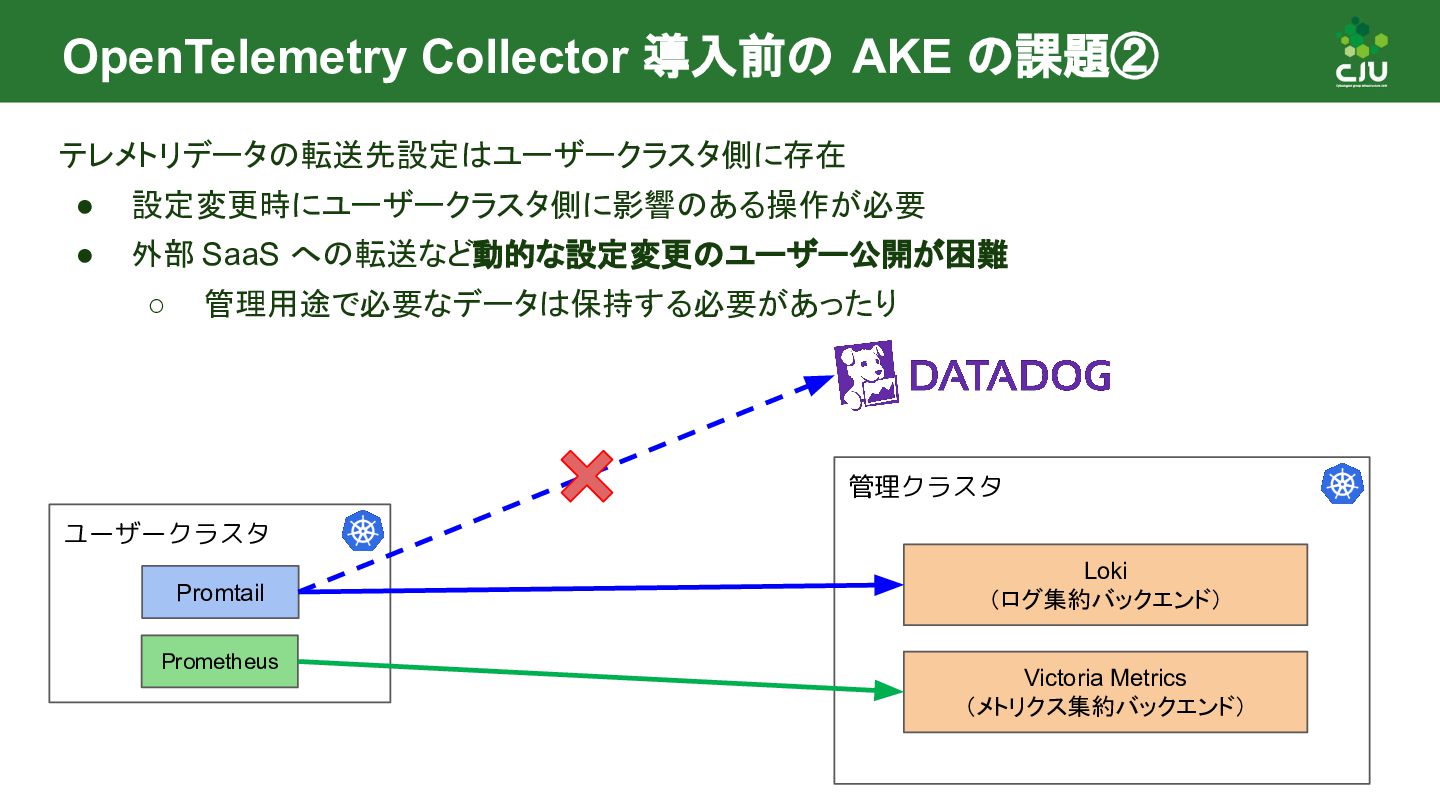
OpenTelemetry Collector 導入前の AKE の課題② テレメトリデータの転送先設定はユーザークラスタ側に存在 • 設定変更時にユーザークラスタ側に影響のある操作が必要 • 外部
SaaS への転送など動的な設定変更のユーザー公開が困難 ◦ 管理用途で必要なデータは保持する必要があったり 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki (ログ集約バックエンド) ユーザークラスタ Promtail Prometheus -
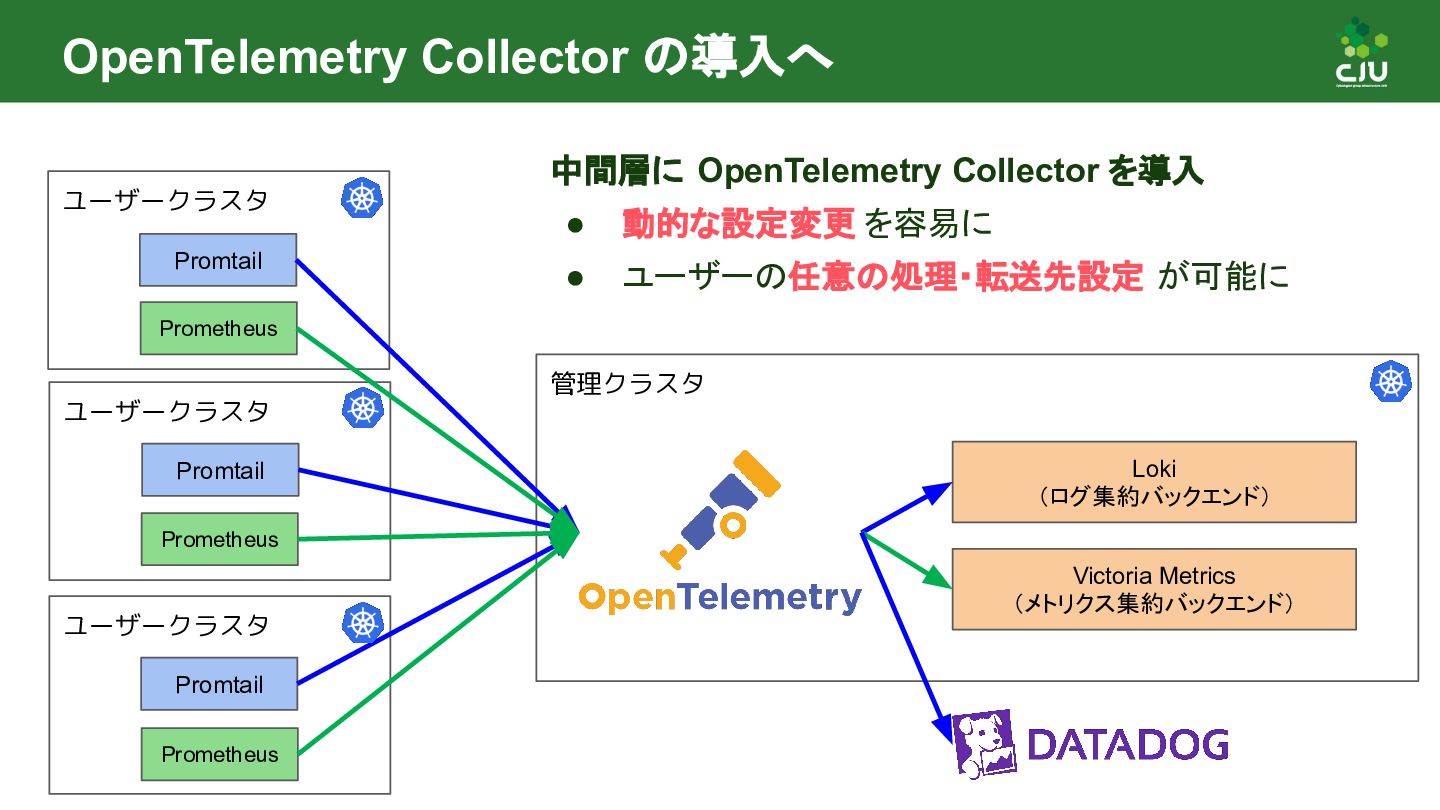
OpenTelemetry Collector の導入へ ユーザークラスタ 管理クラスタ Promtail Prometheus Victoria Metrics (メトリクス集約バックエンド)
Loki (ログ集約バックエンド) ユーザークラスタ Promtail Prometheus ユーザークラスタ Promtail Prometheus 中間層に OpenTelemetry Collector を導入 • 動的な設定変更 を容易に • ユーザーの任意の処理・転送先設定 が可能に -
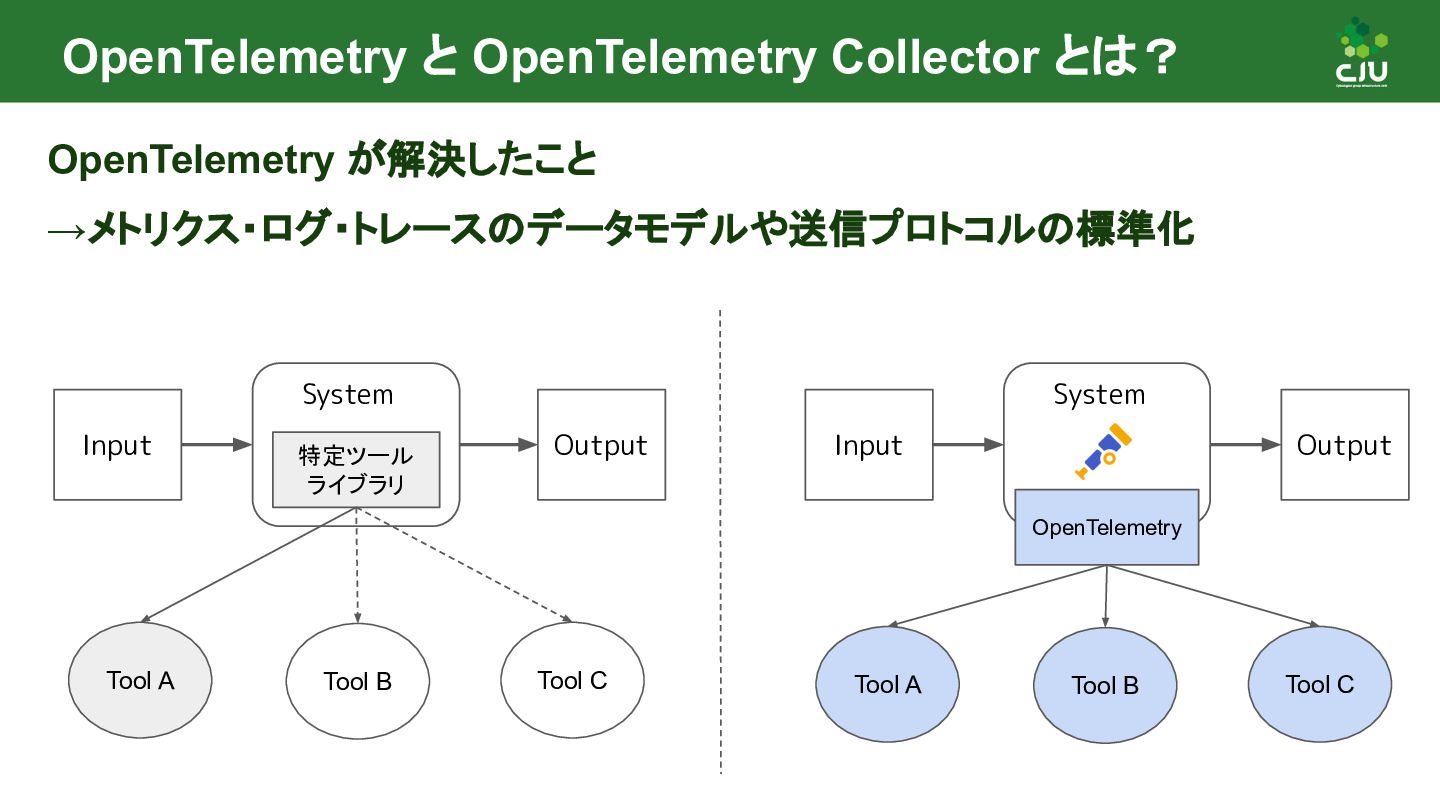
OpenTelemetry と OpenTelemetry Collector とは? OpenTelemetry が解決したこと →メトリクス・ログ・トレースのデータモデルや送信プロトコルの標準化 Input Output
System Input Output System 特定ツール ライブラリ OpenTelemetry Tool A Tool B Tool C Tool A Tool B Tool C -
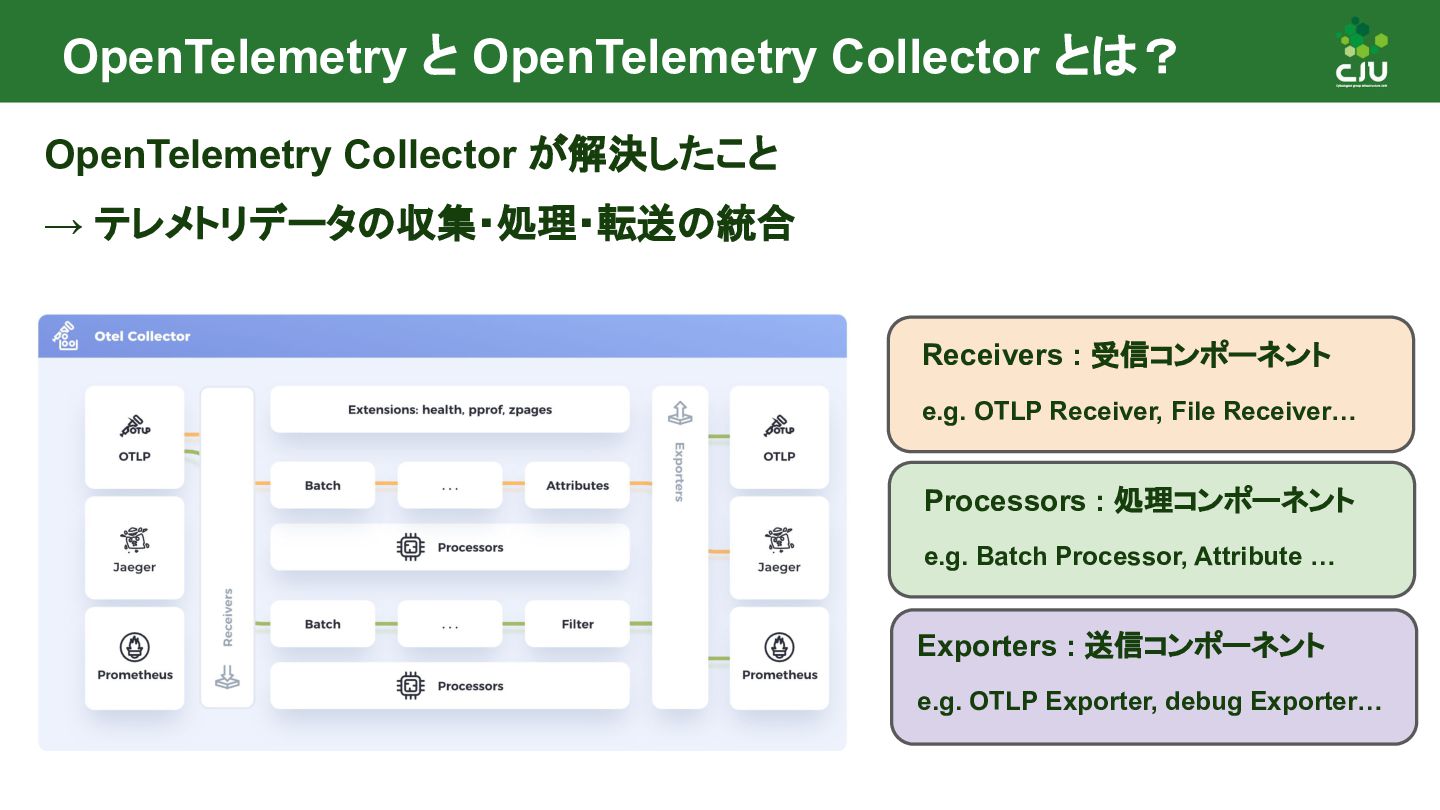
OpenTelemetry と OpenTelemetry Collector とは? OpenTelemetry Collector が解決したこと → テレメトリデータの収集・処理・転送の統合
Receivers : 受信コンポーネント e.g. OTLP Receiver, File Receiver… Processors : 処理コンポーネント e.g. Batch Processor, Attribute … Exporters : 送信コンポーネント e.g. OTLP Exporter, debug Exporter… -
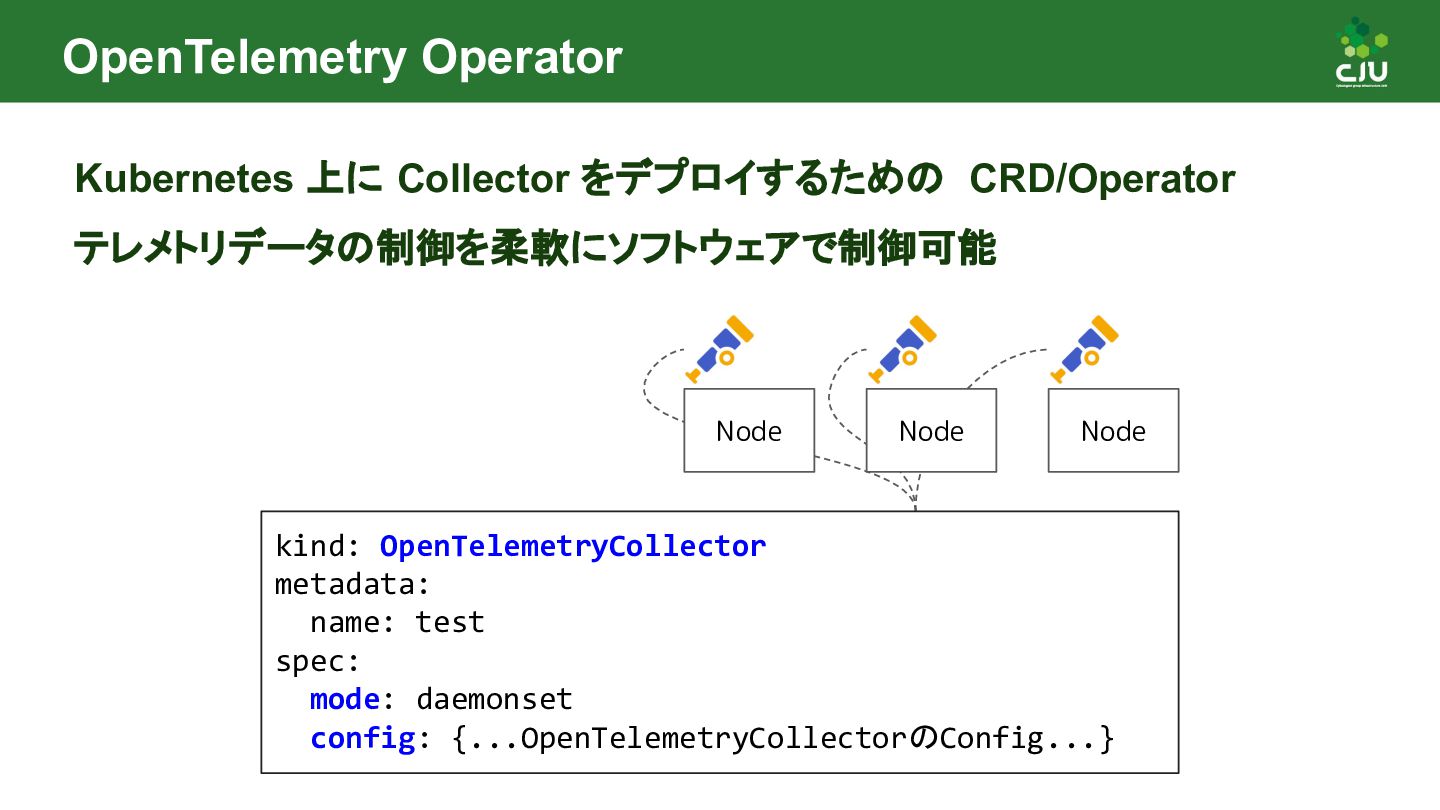
OpenTelemetry Operator Kubernetes 上に Collector をデプロイするための CRD/Operator テレメトリデータの制御を柔軟にソフトウェアで制御可能 kind: OpenTelemetryCollector
metadata: name: test spec: mode: daemonset config: {...OpenTelemetryCollectorのConfig...} Node Node Node -
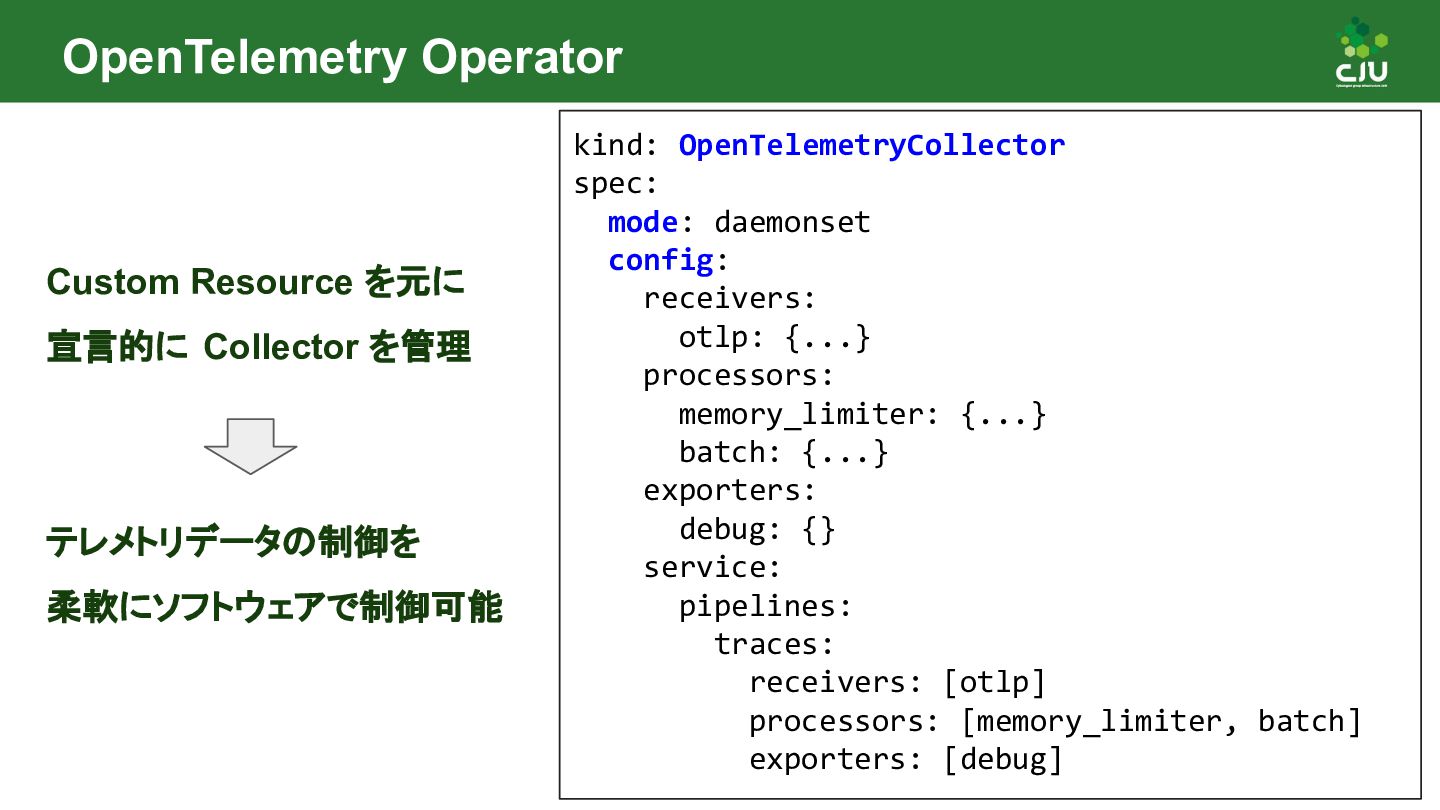
OpenTelemetry Operator Custom Resource を元に 宣言的に Collector を管理 テレメトリデータの制御を 柔軟にソフトウェアで制御可能
kind: OpenTelemetryCollector spec: mode: daemonset config: receivers: otlp: {...} processors: memory_limiter: {...} batch: {...} exporters: debug: {} service: pipelines: traces: receivers: [otlp] processors: [memory_limiter, batch] exporters: [debug] -
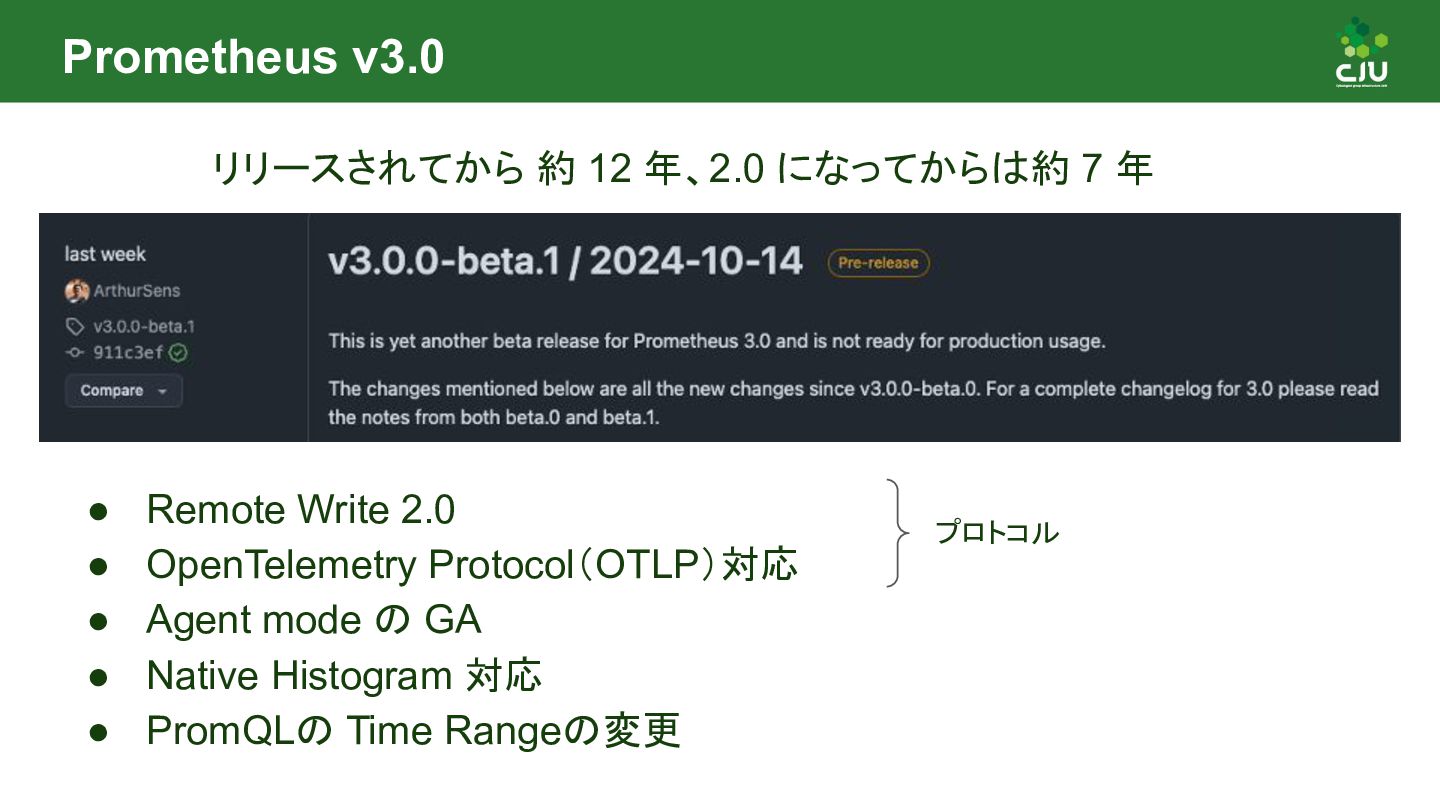
Prometheus v3.0 リリースされてから 約 12 年、2.0 になってからは約 7 年 •
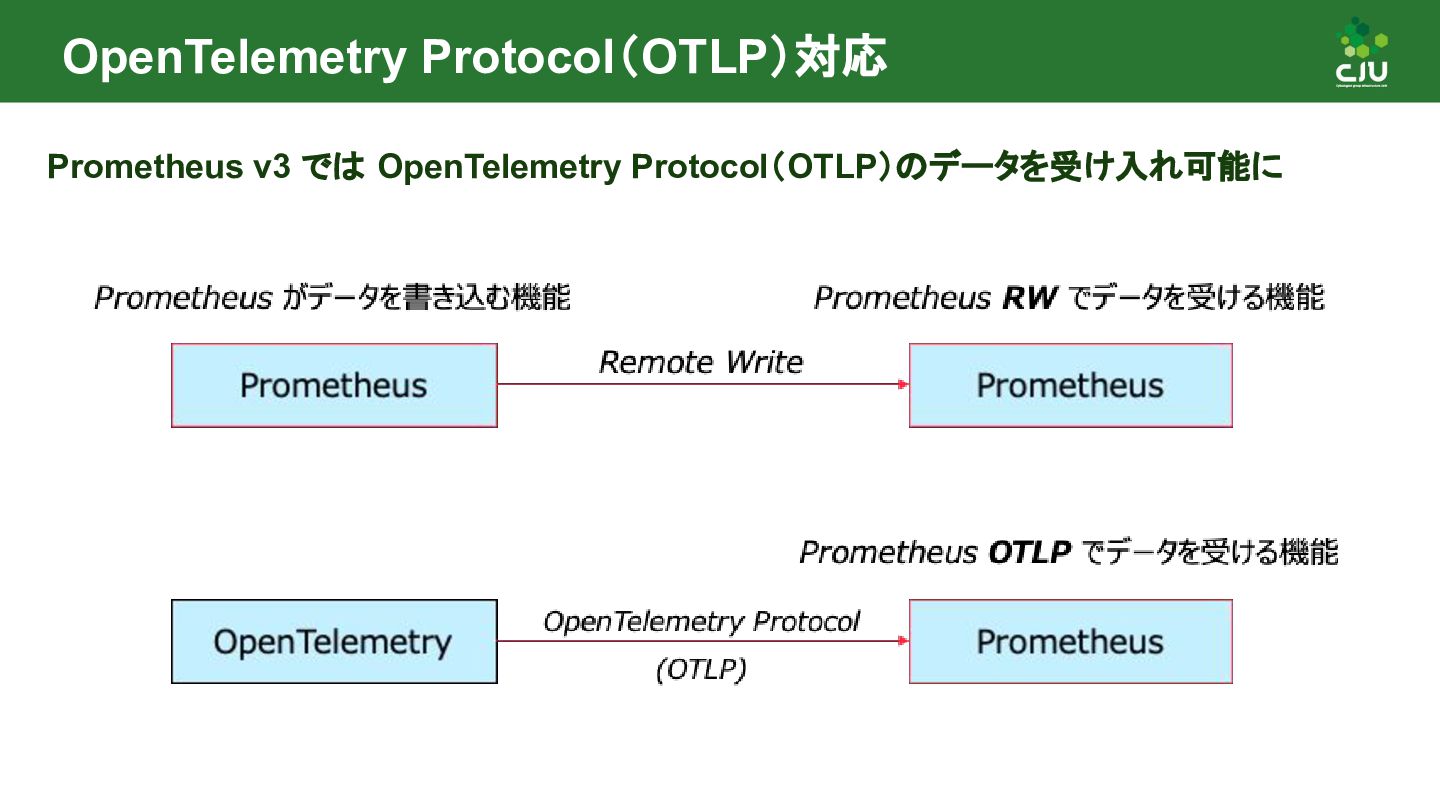
Remote Write 2.0 • OpenTelemetry Protocol(OTLP)対応 • Agent mode の GA • Native Histogram 対応 • PromQLの Time Rangeの変更 プロトコル -
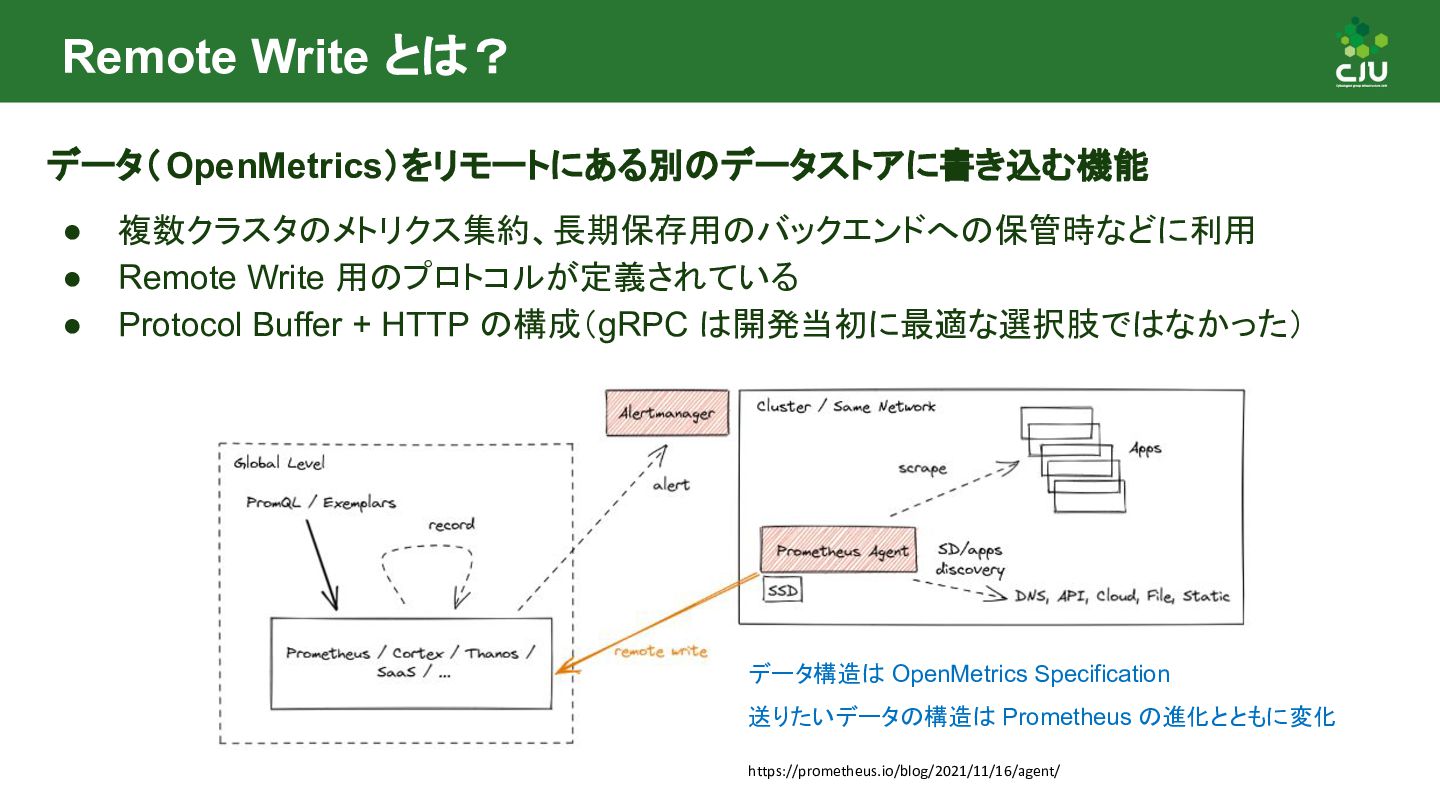
Remote Write とは? データ(OpenMetrics)をリモートにある別のデータストアに書き込む機能 • 複数クラスタのメトリクス集約、長期保存用のバックエンドへの保管時などに利用 • Remote Write 用のプロトコルが定義されている
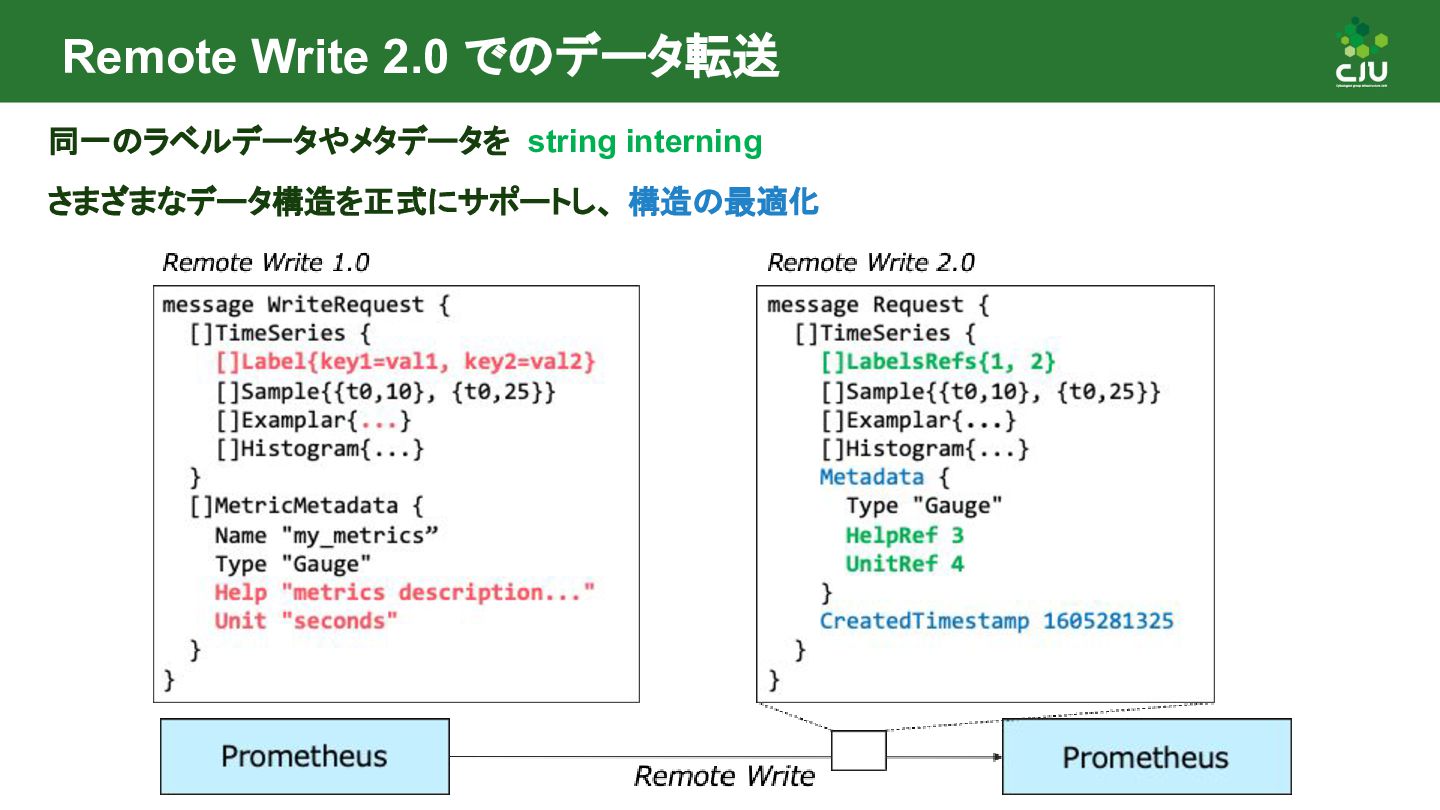
• Protocol Buffer + HTTP の構成(gRPC は開発当初に最適な選択肢ではなかった) https://prometheus.io/blog/2021/11/16/agent/ データ構造は OpenMetrics Specification 送りたいデータの構造は Prometheus の進化とともに変化 -
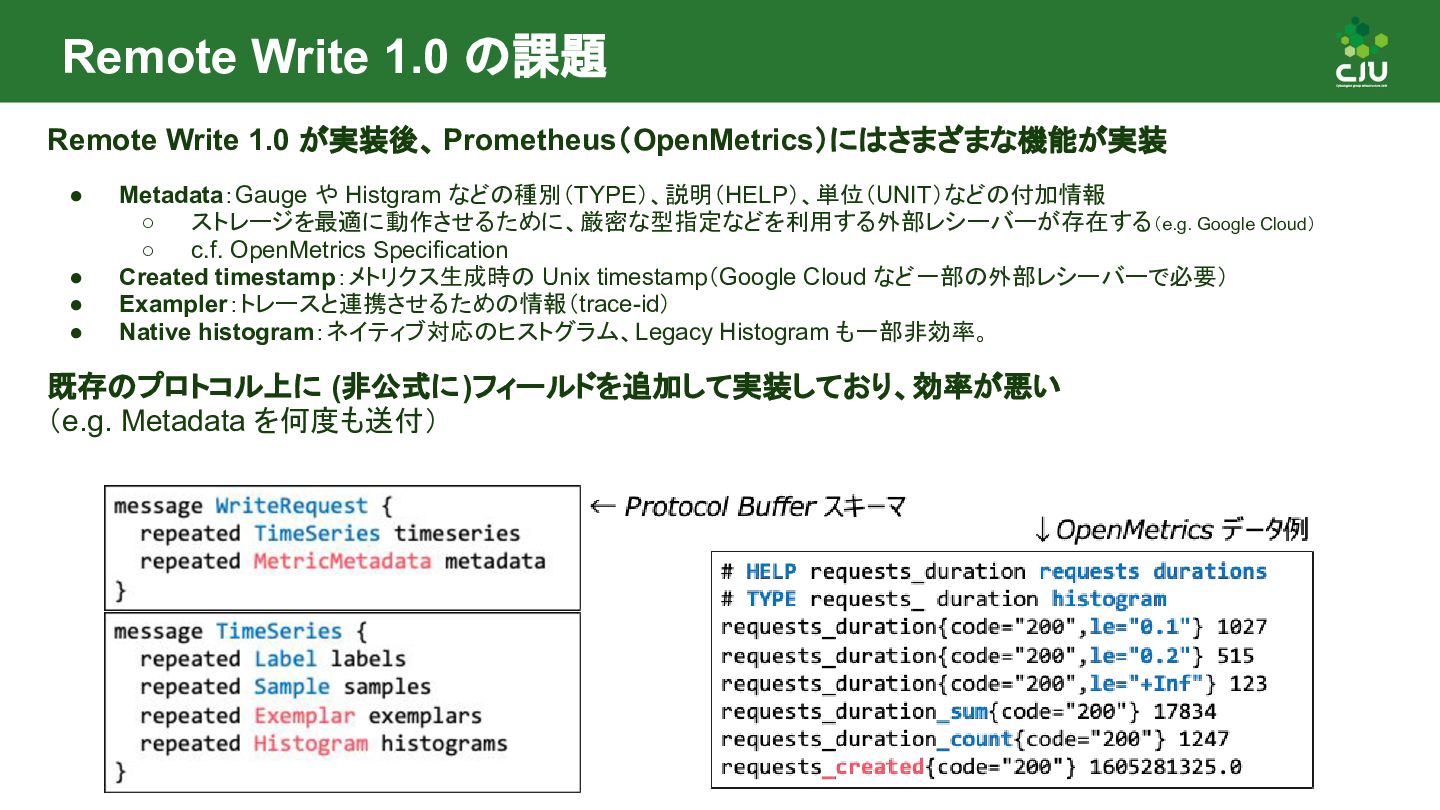
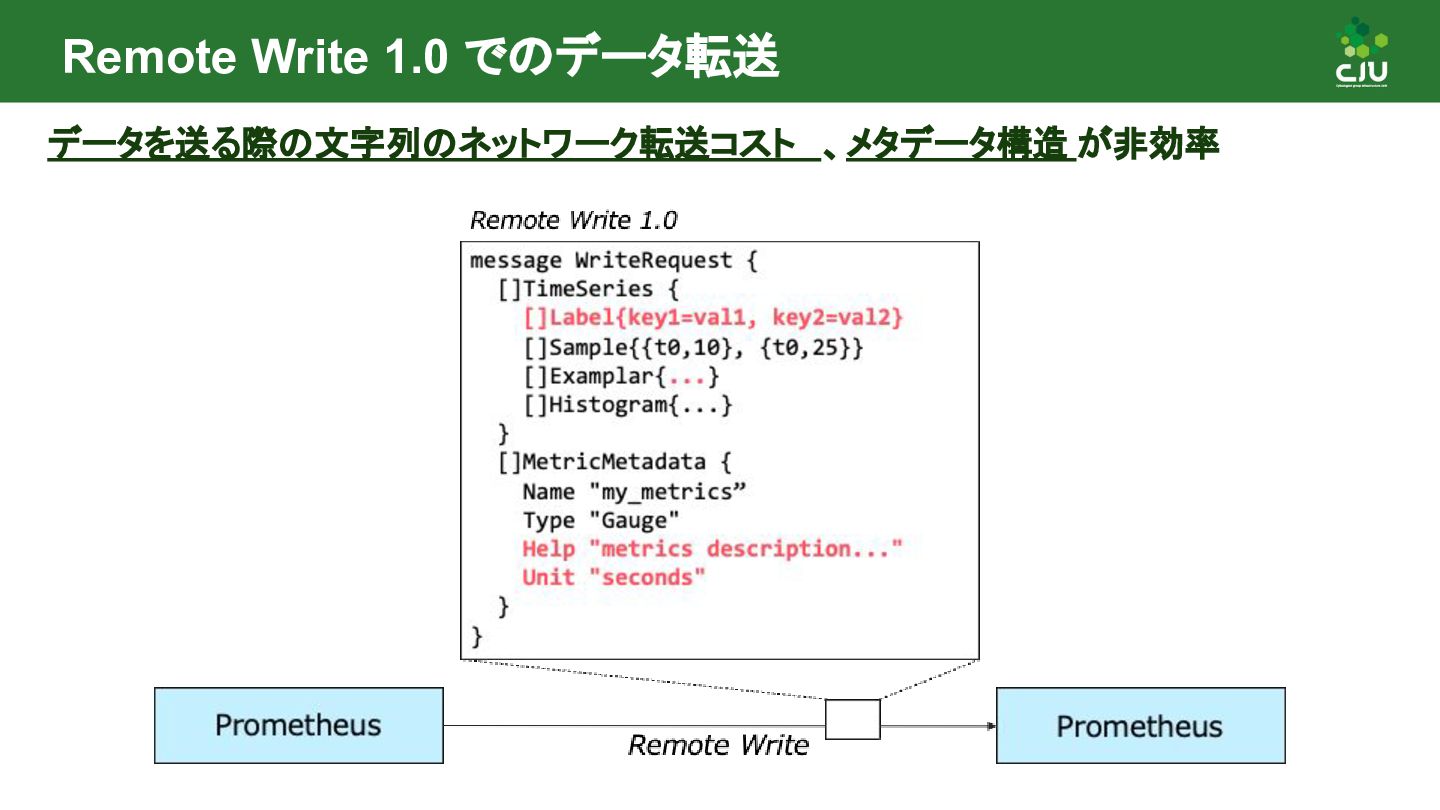
Remote Write 1.0 の課題 Remote Write 1.0 が実装後、 Prometheus(OpenMetrics)にはさまざまな機能が実装 •
Metadata:Gauge や Histgram などの種別(TYPE)、説明(HELP)、単位(UNIT)などの付加情報 ◦ ストレージを最適に動作させるために、厳密な型指定などを利用する外部レシーバーが存在する(e.g. Google Cloud) ◦ c.f. OpenMetrics Specification • Created timestamp:メトリクス生成時の Unix timestamp(Google Cloud など一部の外部レシーバーで必要) • Exampler:トレースと連携させるための情報(trace-id) • Native histogram:ネイティブ対応のヒストグラム、Legacy Histogram も一部非効率。 既存のプロトコル上に (非公式に)フィールドを追加して実装しており、効率が悪い (e.g. Metadata を何度も送付) -
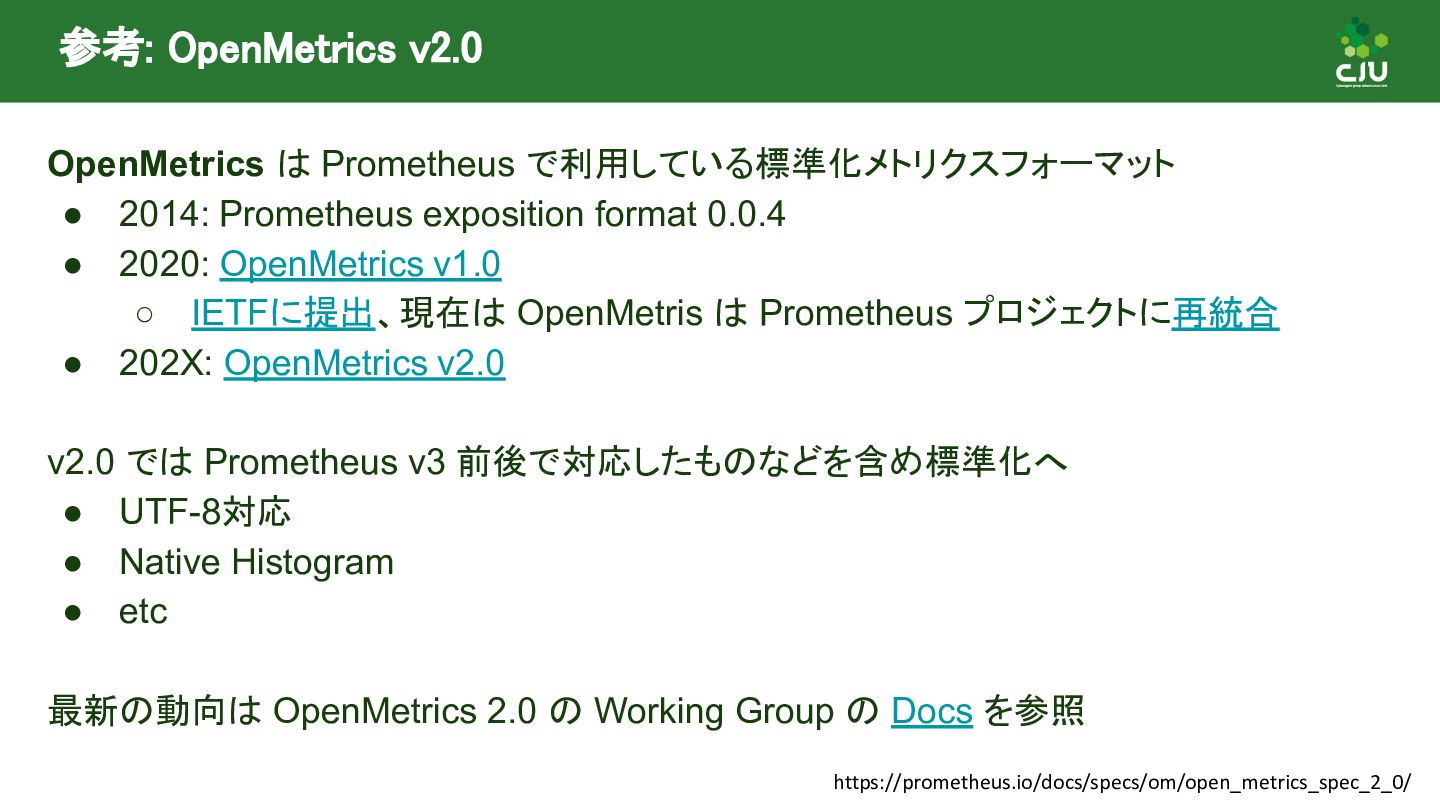
参考: OpenMetrics v2.0 OpenMetrics は Prometheus で利用している標準化メトリクスフォーマット • 2014: Prometheus
exposition format 0.0.4 • 2020: OpenMetrics v1.0 ◦ IETFに提出、現在は OpenMetris は Prometheus プロジェクトに再統合 • 202X: OpenMetrics v2.0 v2.0 では Prometheus v3 前後で対応したものなどを含め標準化へ • UTF-8対応 • Native Histogram • etc 最新の動向は OpenMetrics 2.0 の Working Group の Docs を参照 https://prometheus.io/docs/specs/om/open_metrics_spec_2_0/ -
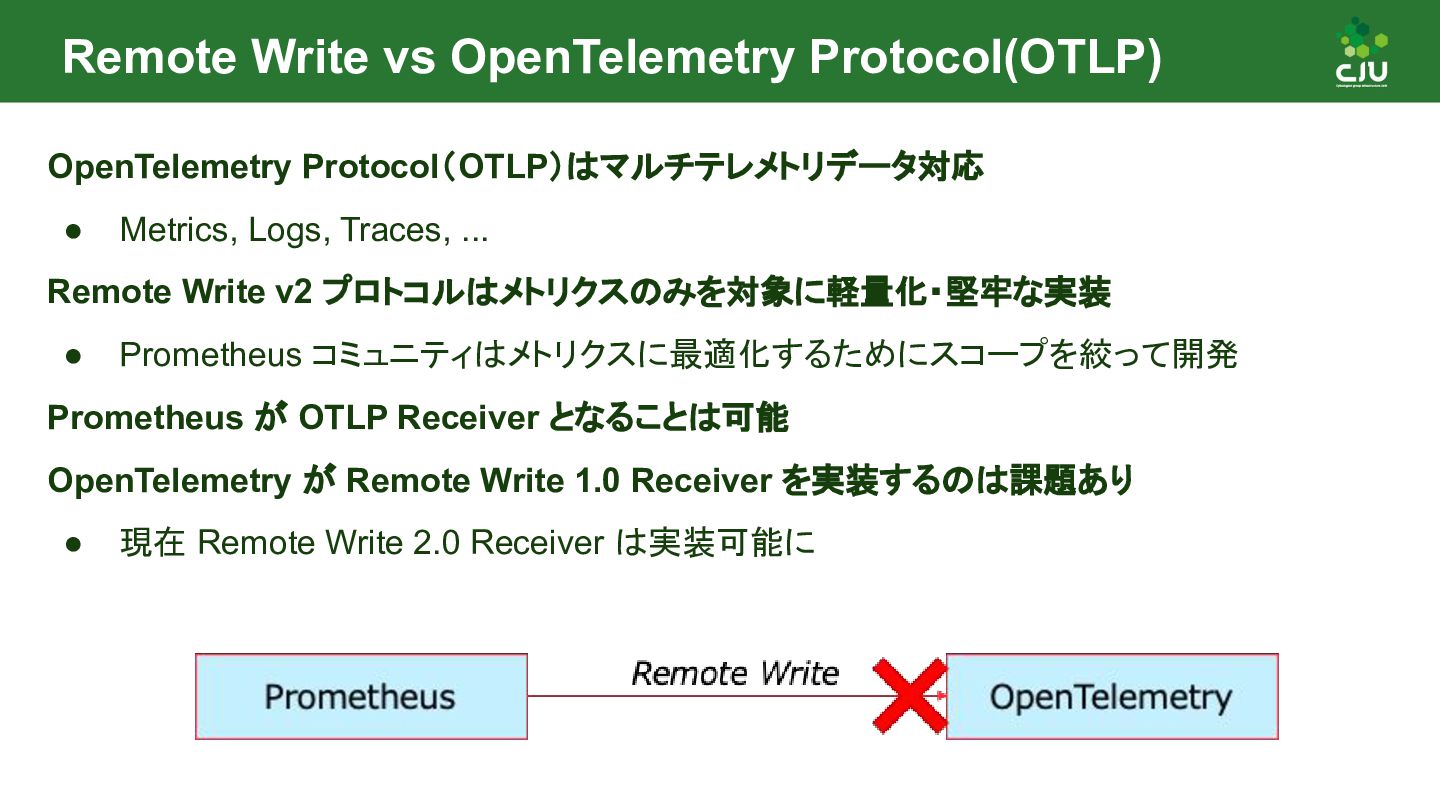
Remote Write vs OpenTelemetry Protocol(OTLP) OpenTelemetry Protocol(OTLP)はマルチテレメトリデータ対応 • Metrics, Logs,
Traces, ... Remote Write v2 プロトコルはメトリクスのみを対象に軽量化・堅牢な実装 • Prometheus コミュニティはメトリクスに最適化するためにスコープを絞って開発 Prometheus が OTLP Receiver となることは可能 OpenTelemetry が Remote Write 1.0 Receiver を実装するのは課題あり • 現在 Remote Write 2.0 Receiver は実装可能に -
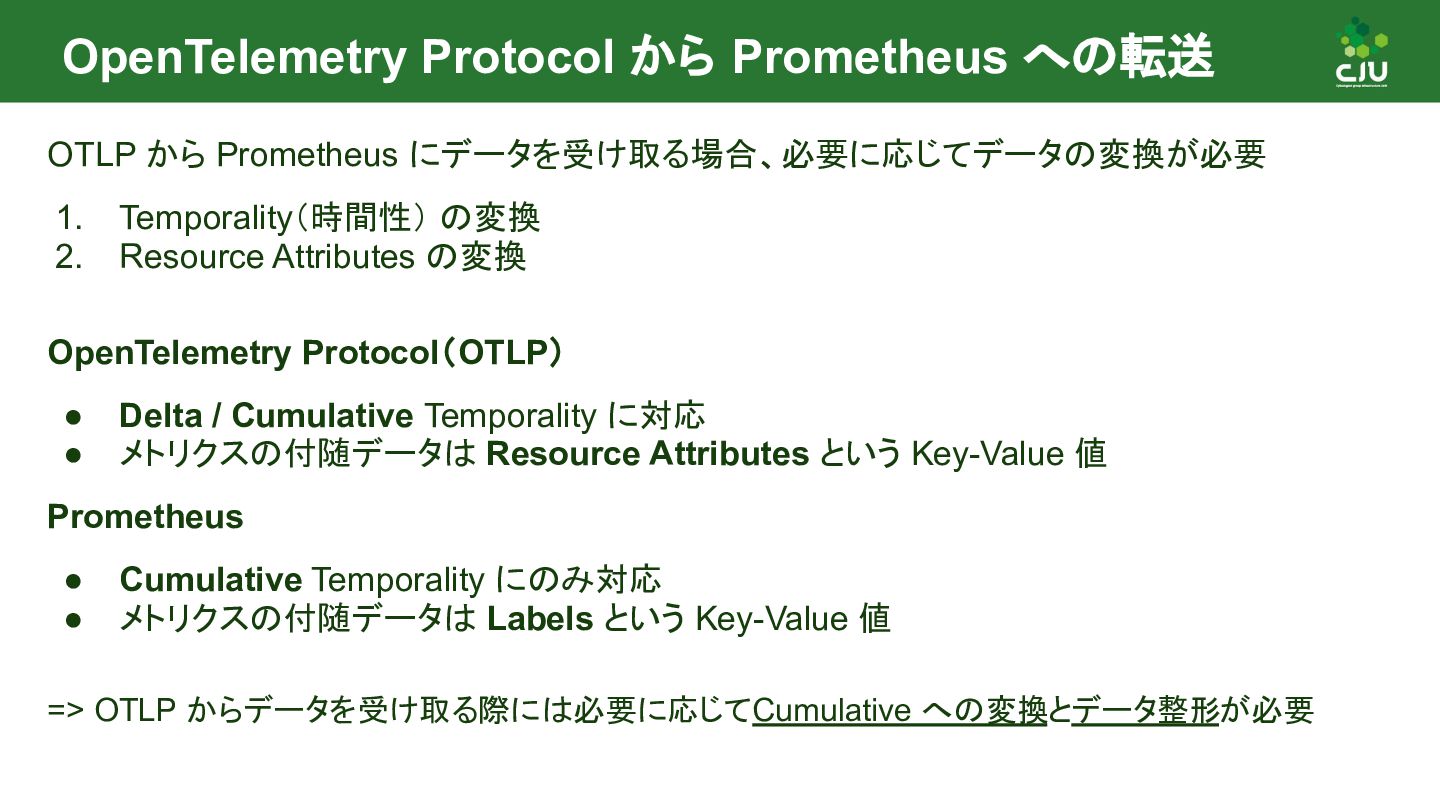
OpenTelemetry Protocol から Prometheus への転送 OTLP から Prometheus にデータを受け取る場合、必要に応じてデータの変換が必要 1.
Temporality(時間性) の変換 2. Resource Attributes の変換 OpenTelemetry Protocol(OTLP) • Delta / Cumulative Temporality に対応 • メトリクスの付随データは Resource Attributes という Key-Value 値 Prometheus • Cumulative Temporality にのみ対応 • メトリクスの付随データは Labels という Key-Value 値 => OTLP からデータを受け取る際には必要に応じて Cumulative への変換とデータ整形が必要 -
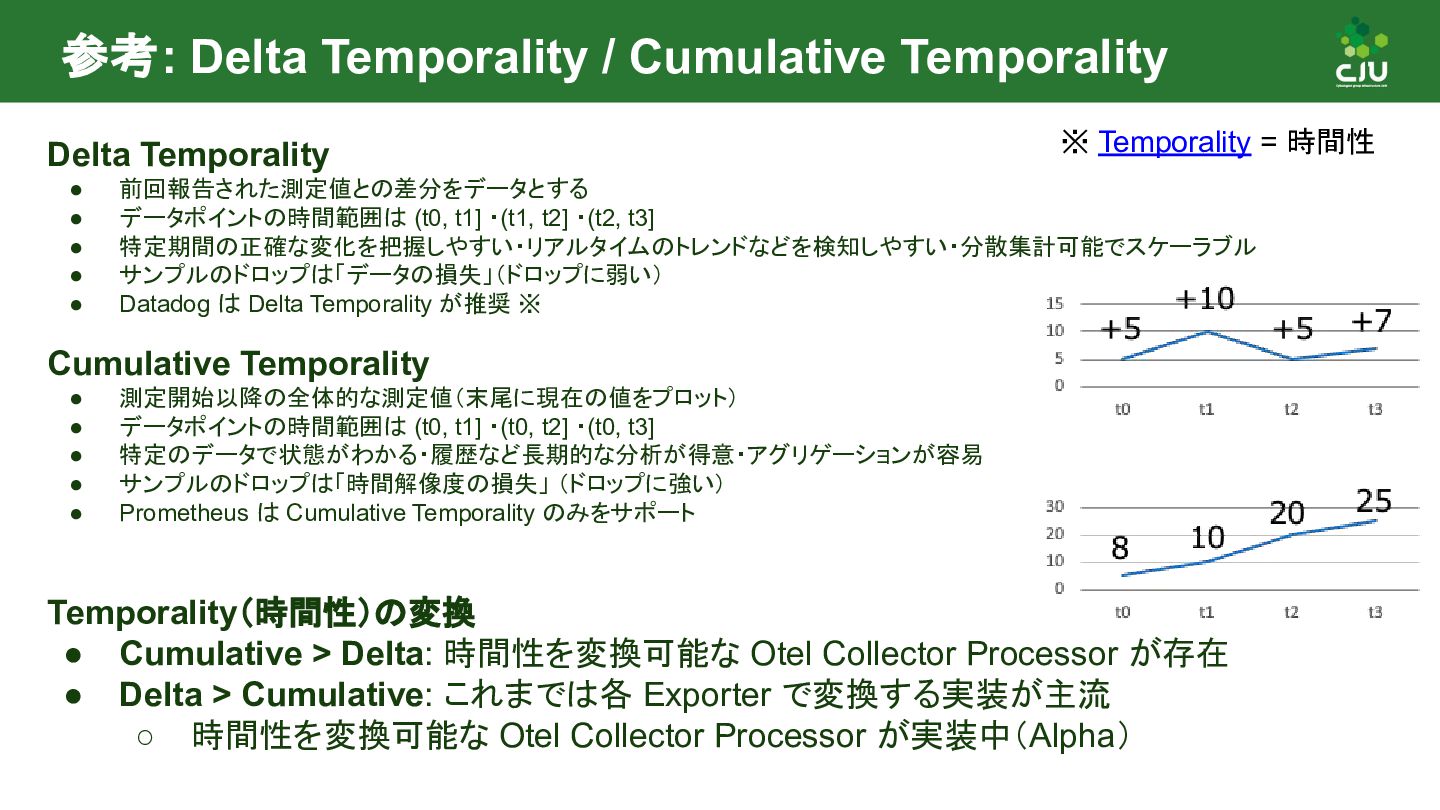
参考: Delta Temporality / Cumulative Temporality Delta Temporality • 前回報告された測定値との差分をデータとする
• データポイントの時間範囲は (t0, t1] ・(t1, t2] ・(t2, t3] • 特定期間の正確な変化を把握しやすい・リアルタイムのトレンドなどを検知しやすい・分散集計可能でスケーラブル • サンプルのドロップは「データの損失」(ドロップに弱い) • Datadog は Delta Temporality が推奨 ※ Cumulative Temporality • 測定開始以降の全体的な測定値(末尾に現在の値をプロット) • データポイントの時間範囲は (t0, t1] ・(t0, t2] ・(t0, t3] • 特定のデータで状態がわかる・履歴など長期的な分析が得意・アグリゲーションが容易 • サンプルのドロップは「時間解像度の損失」 (ドロップに強い) • Prometheus は Cumulative Temporality のみをサポート Temporality(時間性)の変換 • Cumulative > Delta: 時間性を変換可能な Otel Collector Processor が存在 • Delta > Cumulative: これまでは各 Exporter で変換する実装が主流 ◦ 時間性を変換可能な Otel Collector Processor が実装中(Alpha) ※ Temporality = 時間性 -
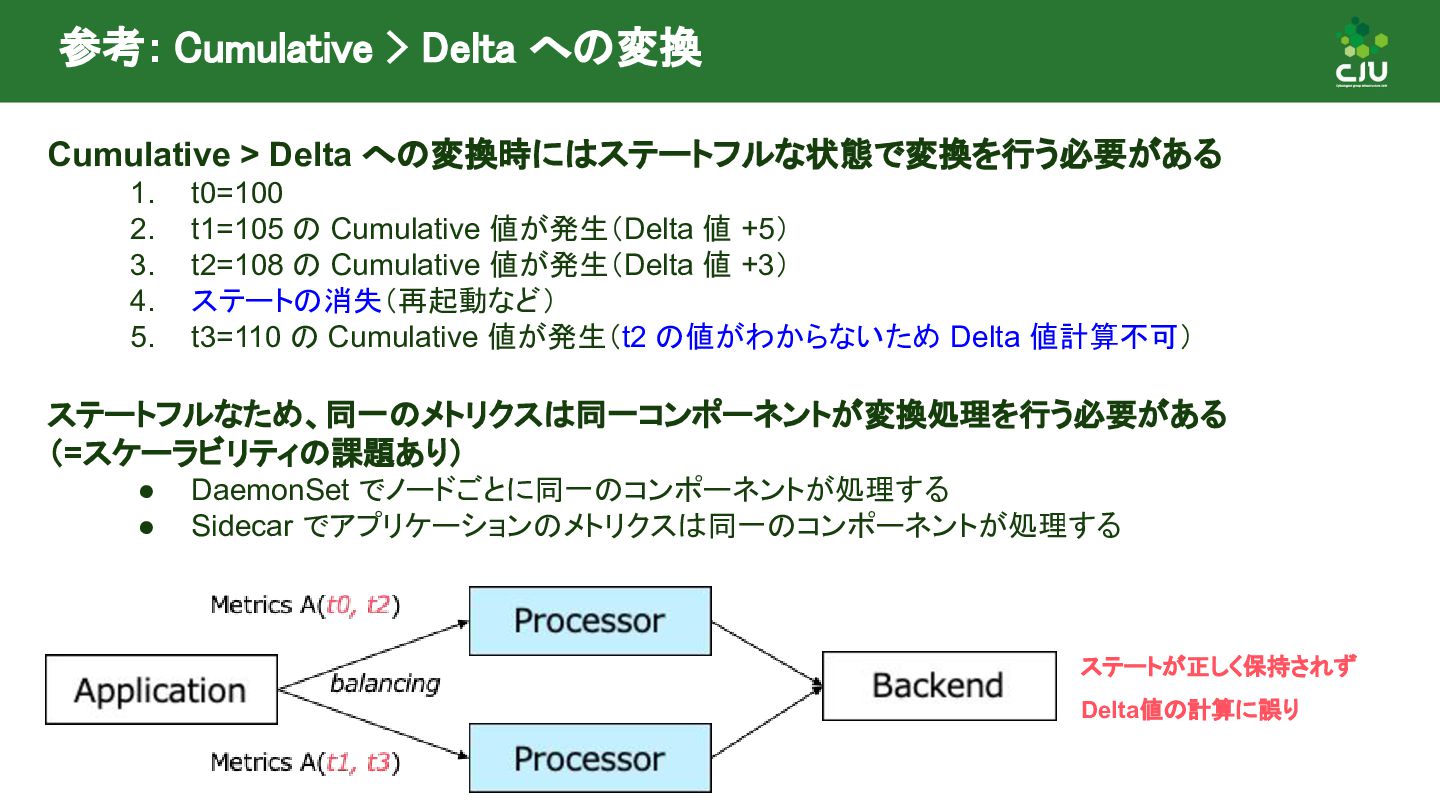
参考: Cumulative > Delta への変換 Cumulative > Delta への変換時にはステートフルな状態で変換を行う必要がある 1.
t0=100 2. t1=105 の Cumulative 値が発生(Delta 値 +5) 3. t2=108 の Cumulative 値が発生(Delta 値 +3) 4. ステートの消失(再起動など) 5. t3=110 の Cumulative 値が発生(t2 の値がわからないため Delta 値計算不可) ステートフルなため、同一のメトリクスは同一コンポーネントが変換処理を行う必要がある (=スケーラビリティの課題あり) • DaemonSet でノードごとに同一のコンポーネントが処理する • Sidecar でアプリケーションのメトリクスは同一のコンポーネントが処理する ステートが正しく保持されず Delta値の計算に誤り -
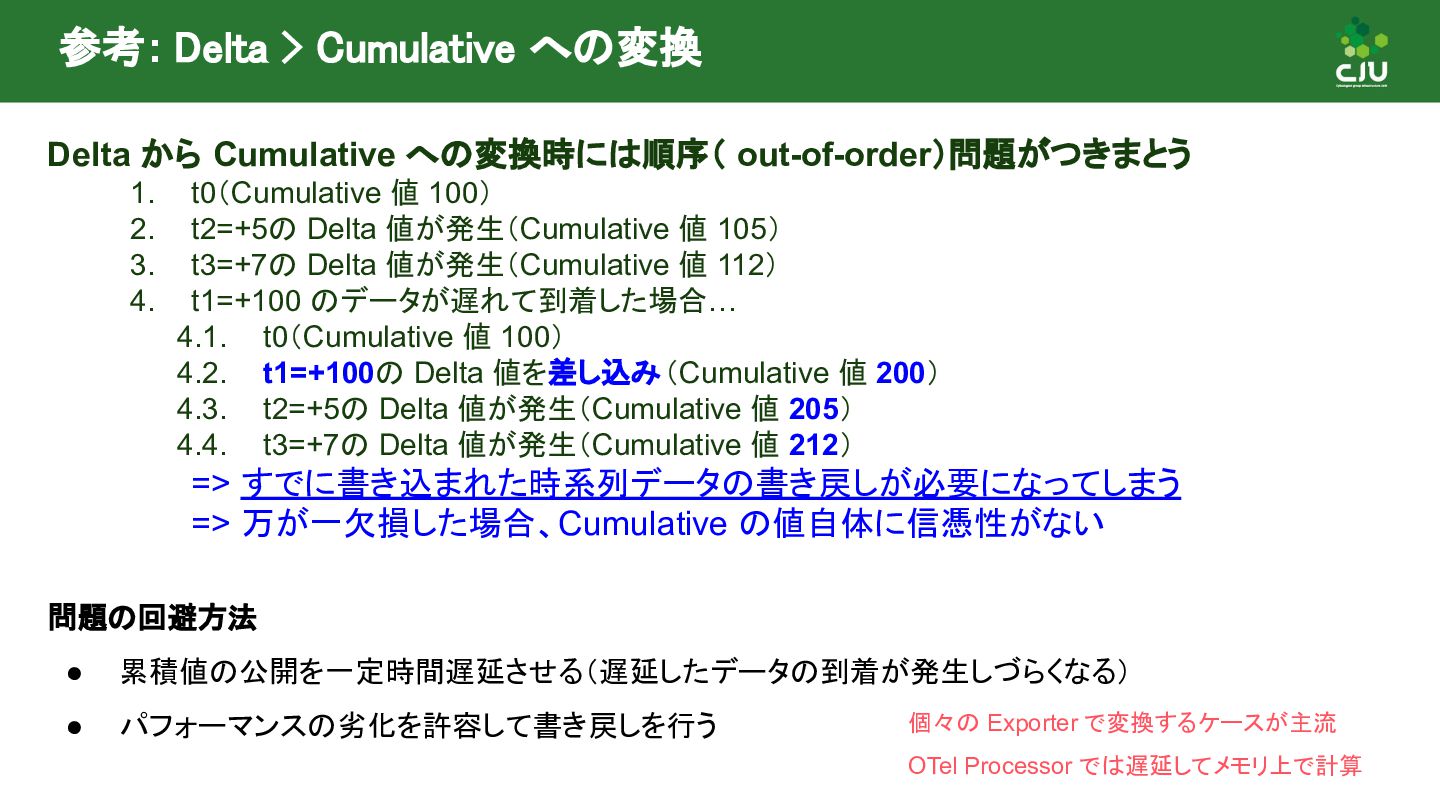
参考: Delta > Cumulative への変換 Delta から Cumulative への変換時には順序( out-of-order)問題がつきまとう
1. t0(Cumulative 値 100) 2. t2=+5の Delta 値が発生(Cumulative 値 105) 3. t3=+7の Delta 値が発生(Cumulative 値 112) 4. t1=+100 のデータが遅れて到着した場合… 4.1. t0(Cumulative 値 100) 4.2. t1=+100の Delta 値を差し込み(Cumulative 値 200) 4.3. t2=+5の Delta 値が発生(Cumulative 値 205) 4.4. t3=+7の Delta 値が発生(Cumulative 値 212) => すでに書き込まれた時系列データの書き戻しが必要になってしまう => 万が一欠損した場合、Cumulative の値自体に信憑性がない 問題の回避方法 • 累積値の公開を一定時間遅延させる(遅延したデータの到着が発生しづらくなる) • パフォーマンスの劣化を許容して書き戻しを行う 個々の Exporter で変換するケースが主流 OTel Processor では遅延してメモリ上で計算 -
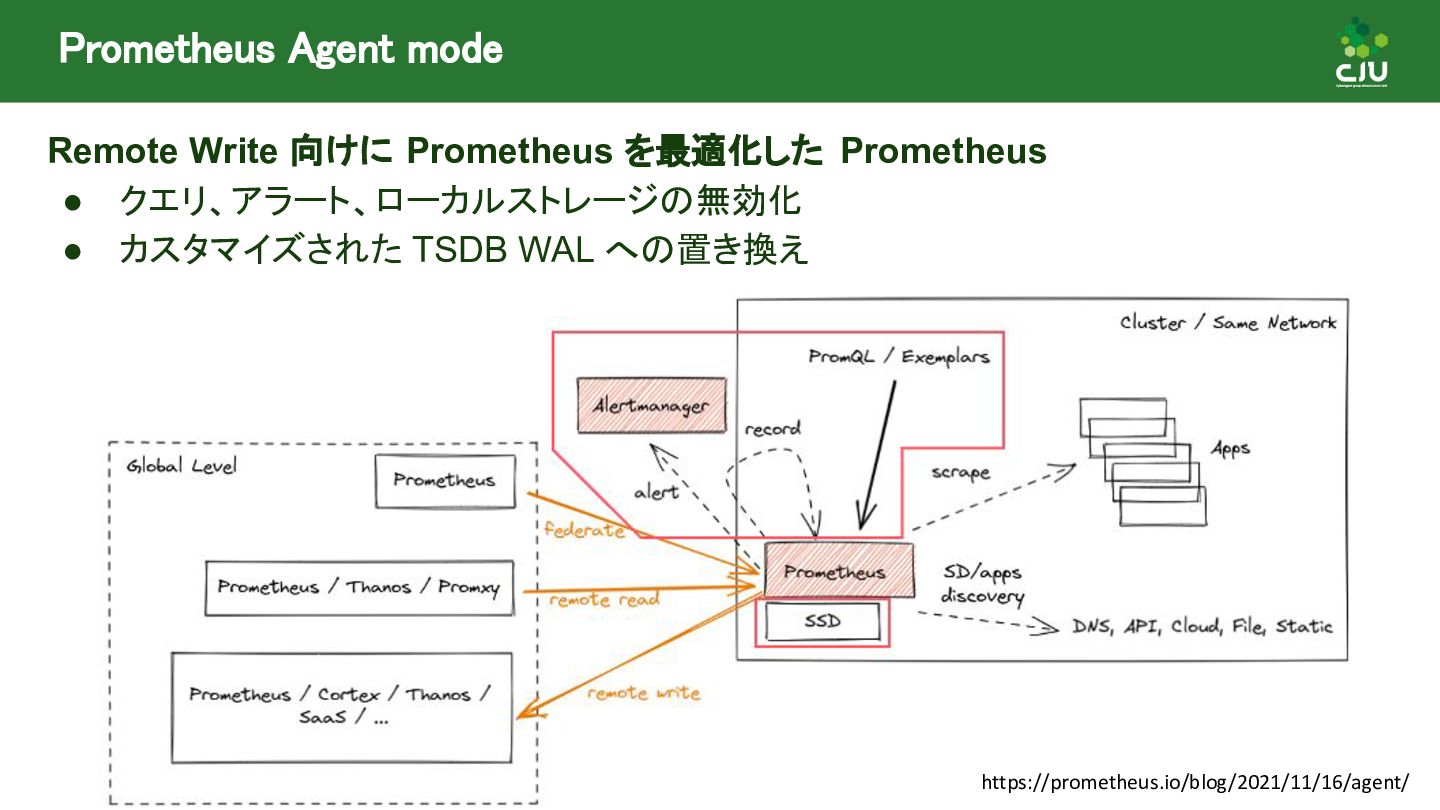
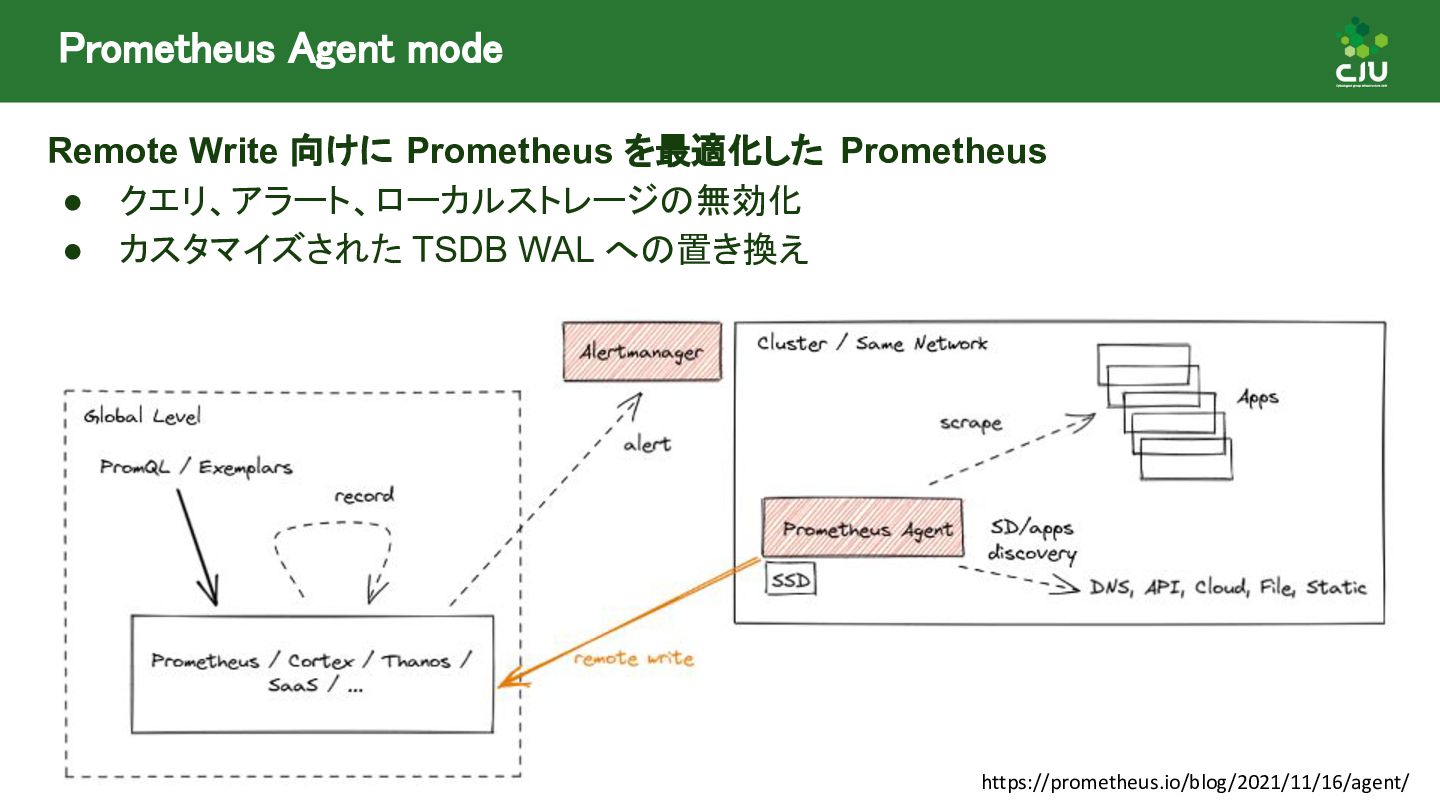
Prometheus Agent mode Remote Write 向けに Prometheus を最適化した Prometheus •
クエリ、アラート、ローカルストレージの無効化 • カスタマイズされた TSDB WAL への置き換え https://prometheus.io/blog/2021/11/16/agent/ -
Prometheus Agent mode Remote Write 向けに Prometheus を最適化した Prometheus •
クエリ、アラート、ローカルストレージの無効化 • カスタマイズされた TSDB WAL への置き換え https://prometheus.io/blog/2021/11/16/agent/ -
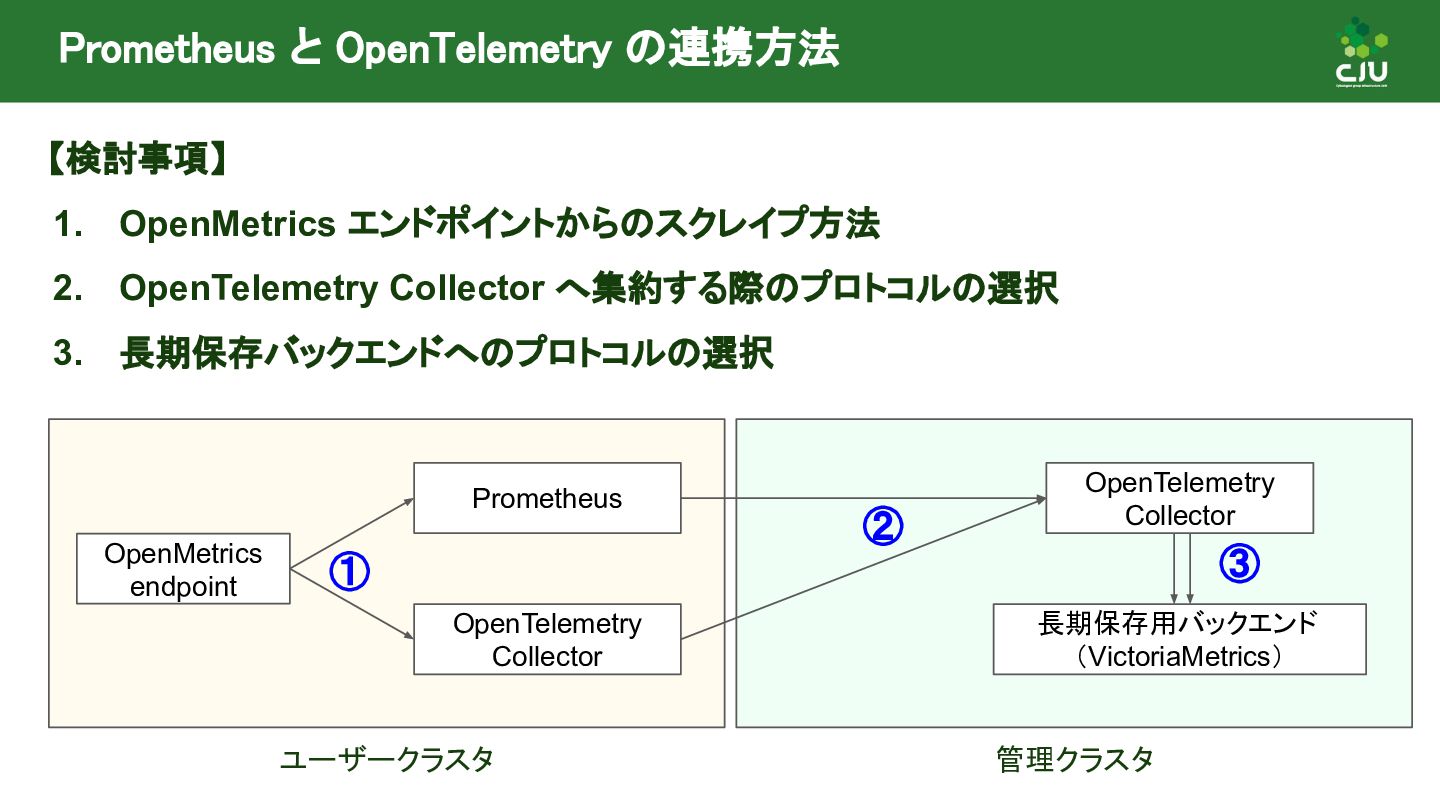
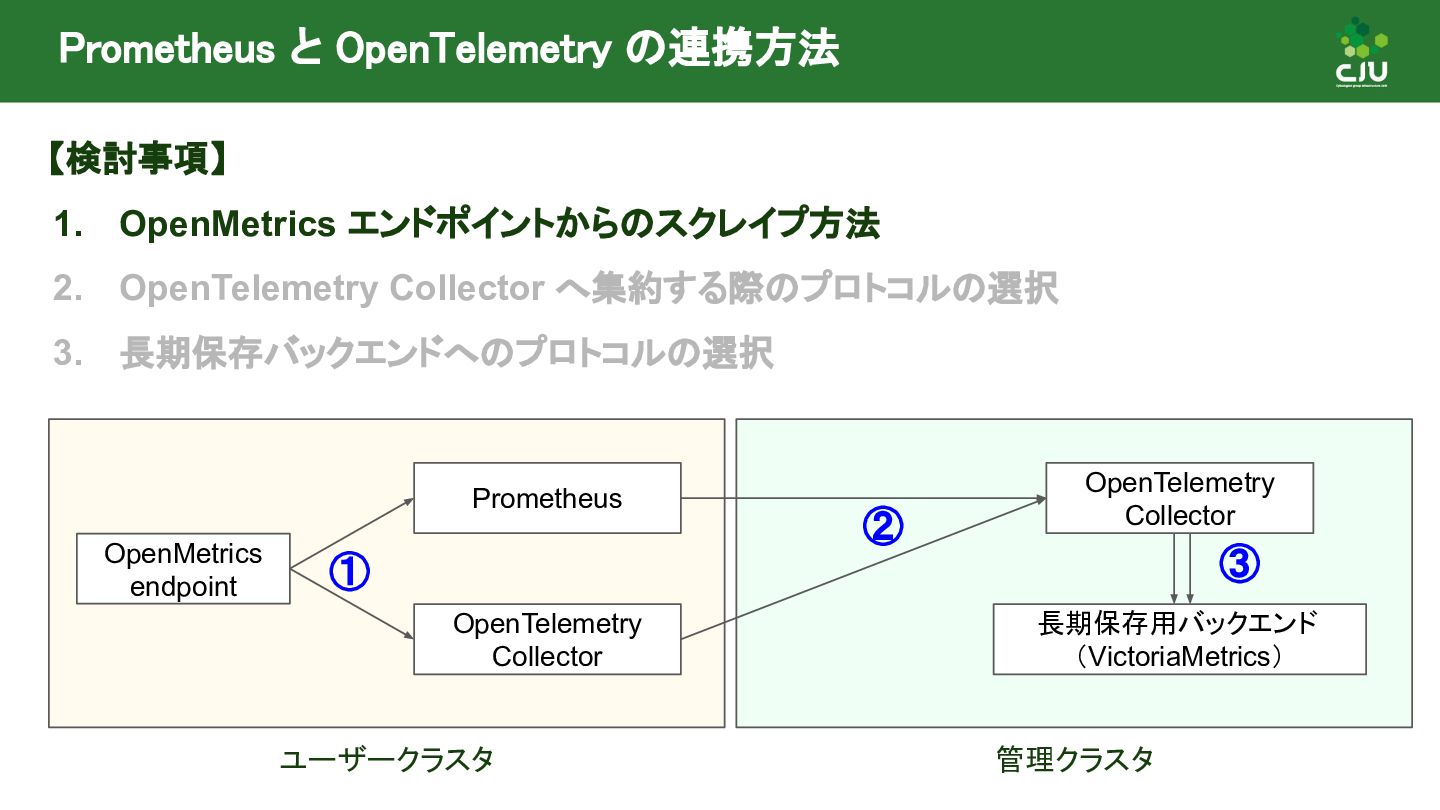
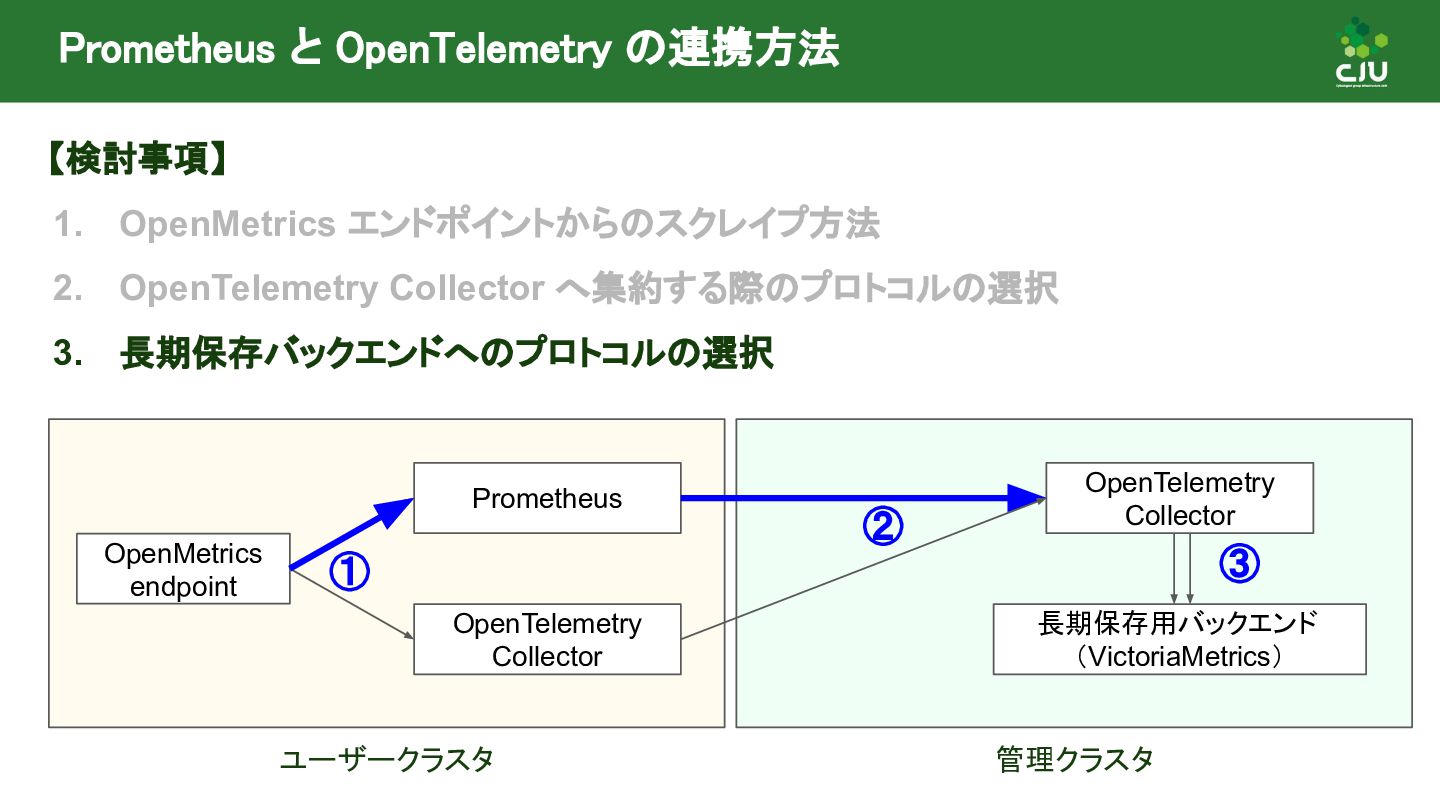
Prometheus と OpenTelemetry の連携方法 【検討事項】 1. OpenMetrics エンドポイントからのスクレイプ方法 2. OpenTelemetry
Collector へ集約する際のプロトコルの選択 3. 長期保存バックエンドへのプロトコルの選択 Prometheus OpenTelemetry Collector OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) OpenMetrics endpoint ユーザークラスタ 管理クラスタ ① ② ③ -
Prometheus と OpenTelemetry の連携方法 【検討事項】 1. OpenMetrics エンドポイントからのスクレイプ方法 2. OpenTelemetry
Collector へ集約する際のプロトコルの選択 3. 長期保存バックエンドへのプロトコルの選択 Prometheus OpenTelemetry Collector OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) OpenMetrics endpoint ユーザークラスタ 管理クラスタ ① ② ③ -
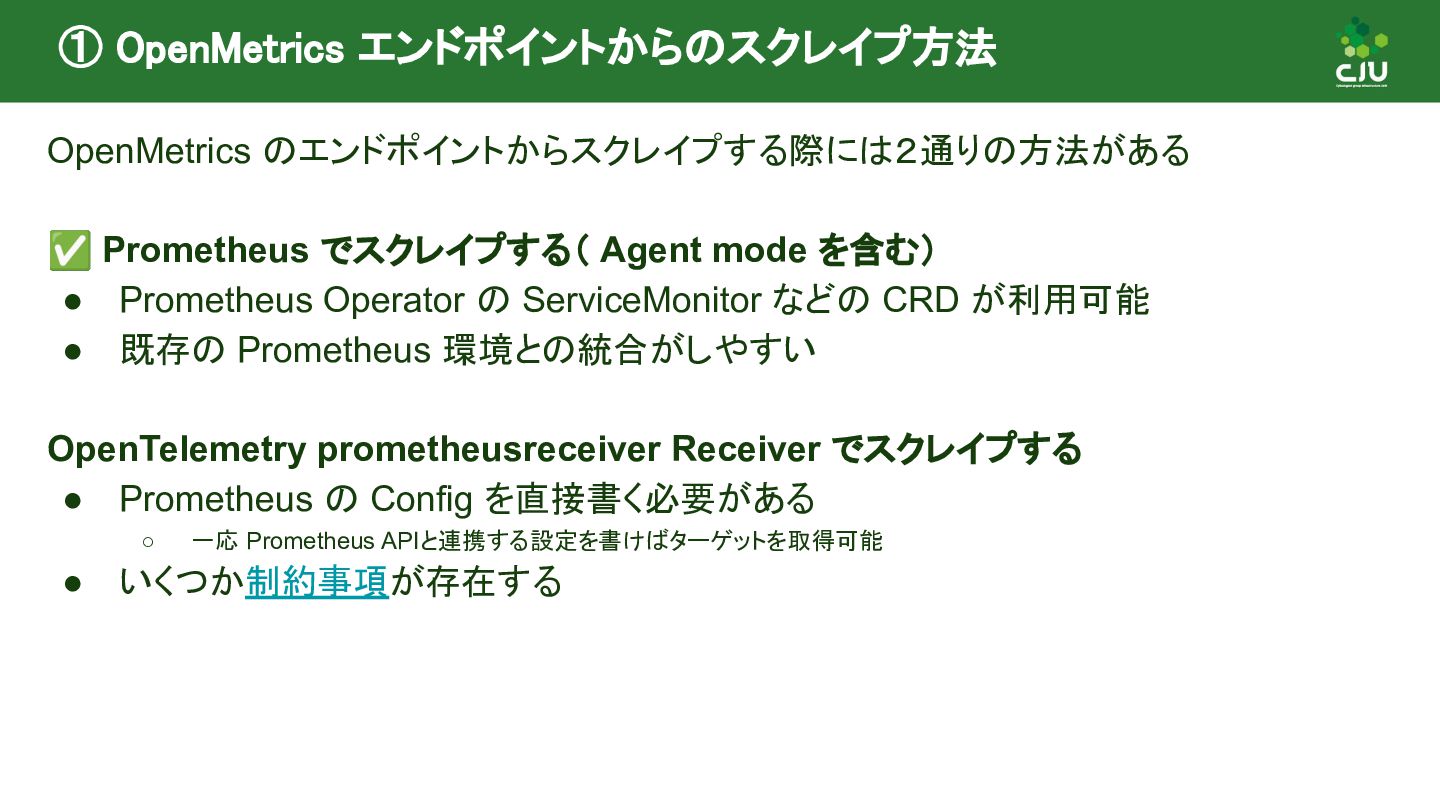
① OpenMetrics エンドポイントからのスクレイプ方法 OpenMetrics のエンドポイントからスクレイプする際には2通りの方法がある ✅ Prometheus でスクレイプする( Agent mode
を含む) • Prometheus Operator の ServiceMonitor などの CRD が利用可能 • 既存の Prometheus 環境との統合がしやすい OpenTelemetry prometheusreceiver Receiver でスクレイプする • Prometheus の Config を直接書く必要がある ◦ 一応 Prometheus APIと連携する設定を書けばターゲットを取得可能 • いくつか制約事項が存在する -
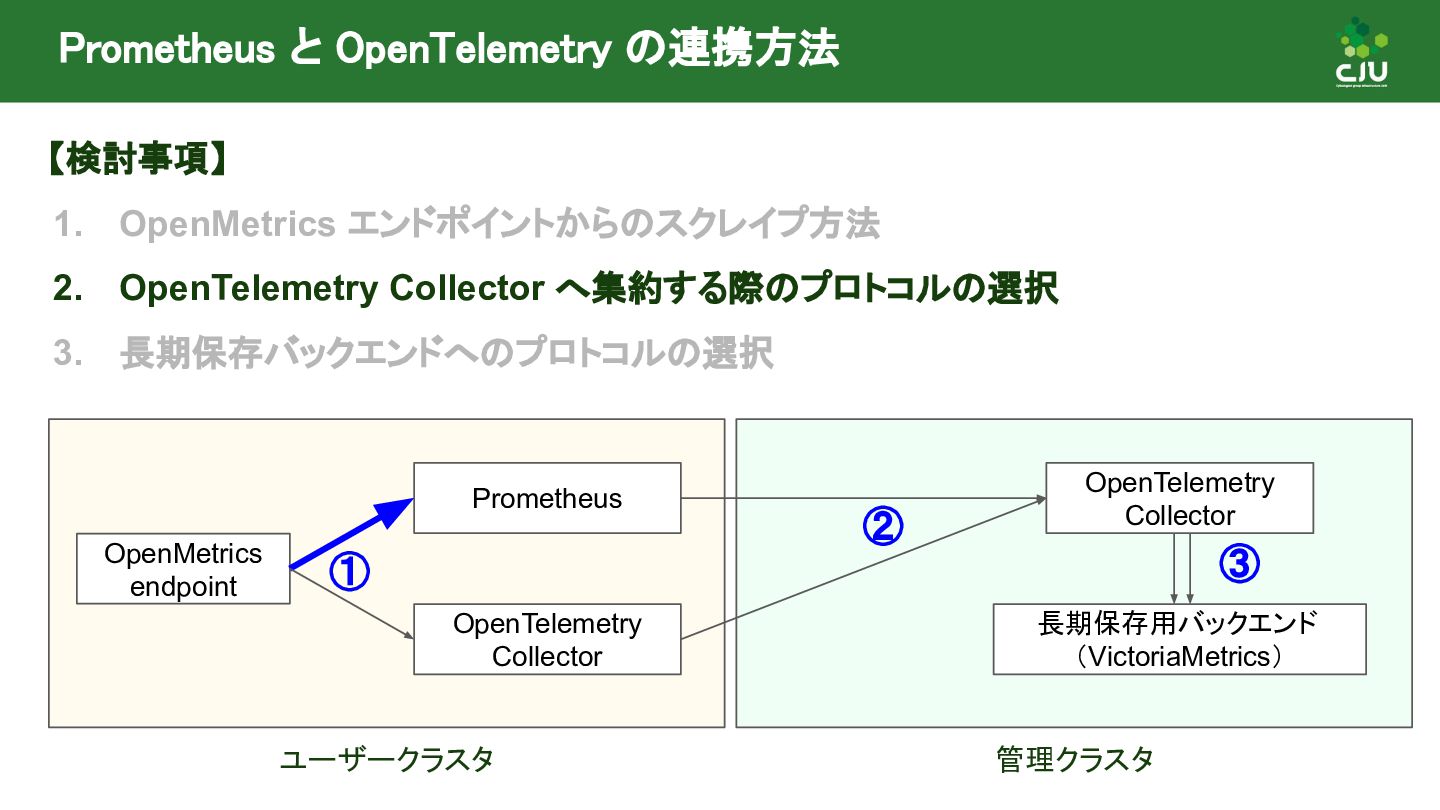
Prometheus と OpenTelemetry の連携方法 【検討事項】 1. OpenMetrics エンドポイントからのスクレイプ方法 2. OpenTelemetry
Collector へ集約する際のプロトコルの選択 3. 長期保存バックエンドへのプロトコルの選択 Prometheus OpenTelemetry Collector OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) OpenMetrics endpoint ユーザークラスタ 管理クラスタ ① ② ③ -
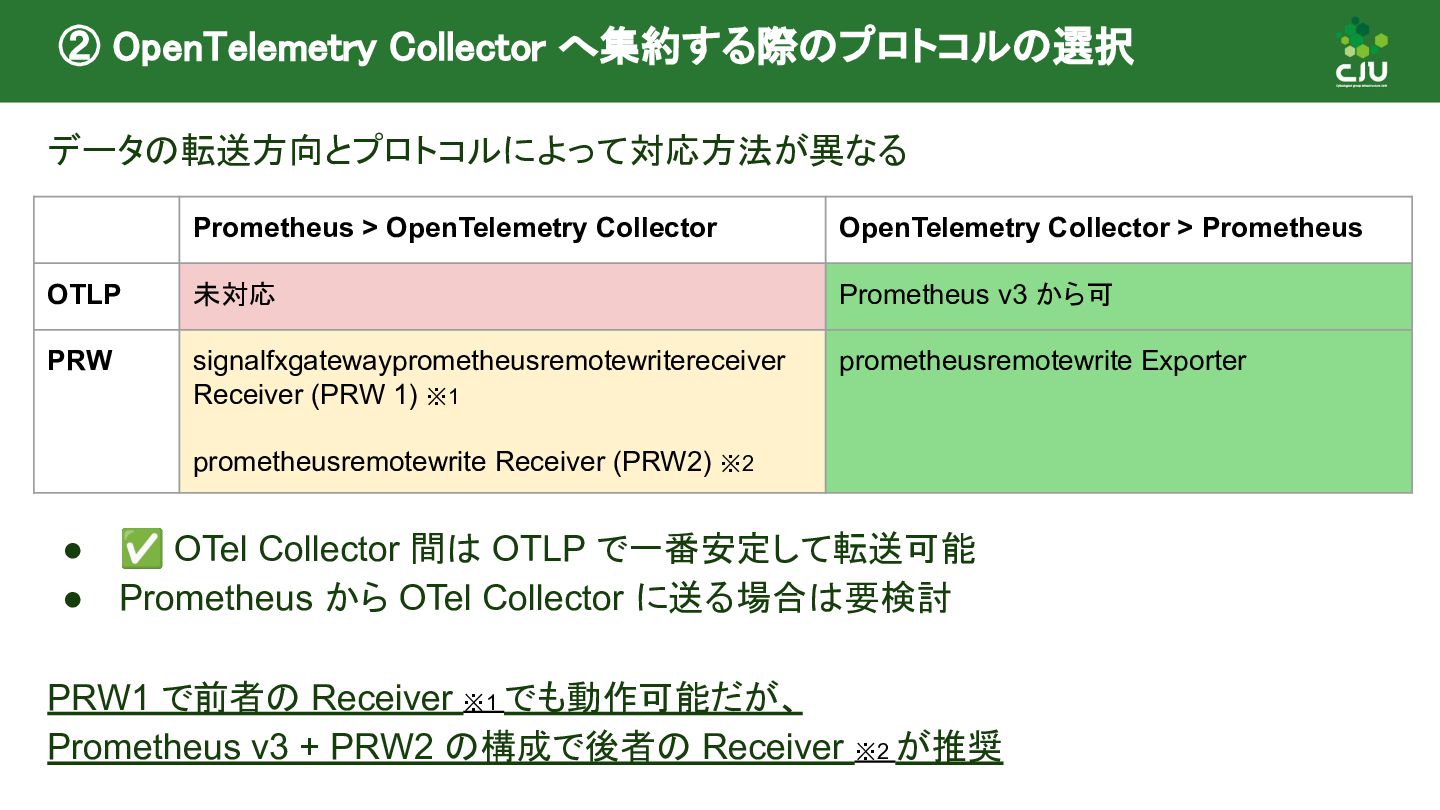
② OpenTelemetry Collector へ集約する際のプロトコルの選択 データの転送方向とプロトコルによって対応方法が異なる • ✅ OTel Collector 間は
OTLP で一番安定して転送可能 • Prometheus から OTel Collector に送る場合は要検討 PRW1 で前者の Receiver ※1 でも動作可能だが、 Prometheus v3 + PRW2 の構成で後者の Receiver ※2 が推奨 Prometheus > OpenTelemetry Collector OpenTelemetry Collector > Prometheus OTLP 未対応 Prometheus v3 から可 PRW signalfxgatewayprometheusremotewritereceiver Receiver (PRW 1) ※1 prometheusremotewrite Receiver (PRW2) ※2 prometheusremotewrite Exporter -
Prometheus と OpenTelemetry の連携方法 【検討事項】 1. OpenMetrics エンドポイントからのスクレイプ方法 2. OpenTelemetry
Collector へ集約する際のプロトコルの選択 3. 長期保存バックエンドへのプロトコルの選択 Prometheus OpenTelemetry Collector OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) OpenMetrics endpoint ユーザークラスタ 管理クラスタ ① ② ③ -
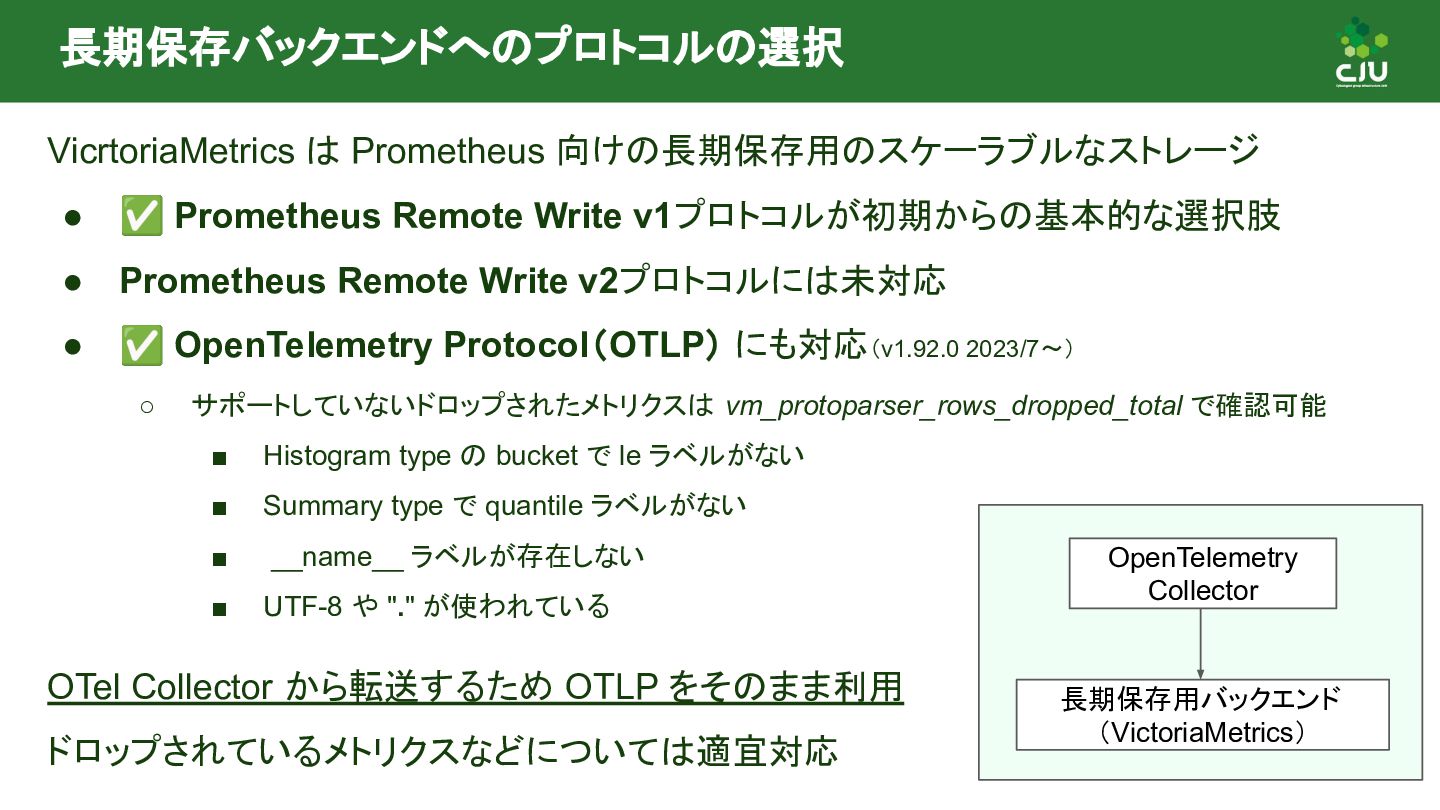
長期保存バックエンドへのプロトコルの選択 VicrtoriaMetrics は Prometheus 向けの長期保存用のスケーラブルなストレージ • ✅ Prometheus Remote Write
v1プロトコルが初期からの基本的な選択肢 • Prometheus Remote Write v2プロトコルには未対応 • ✅ OpenTelemetry Protocol(OTLP) にも対応(v1.92.0 2023/7〜) ◦ サポートしていないドロップされたメトリクスは vm_protoparser_rows_dropped_total で確認可能 ▪ Histogram type の bucket で le ラベルがない ▪ Summary type で quantile ラベルがない ▪ __name__ ラベルが存在しない ▪ UTF-8 や "." が使われている OTel Collector から転送するため OTLP をそのまま利用 ドロップされているメトリクスなどについては適宜対応 OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) -
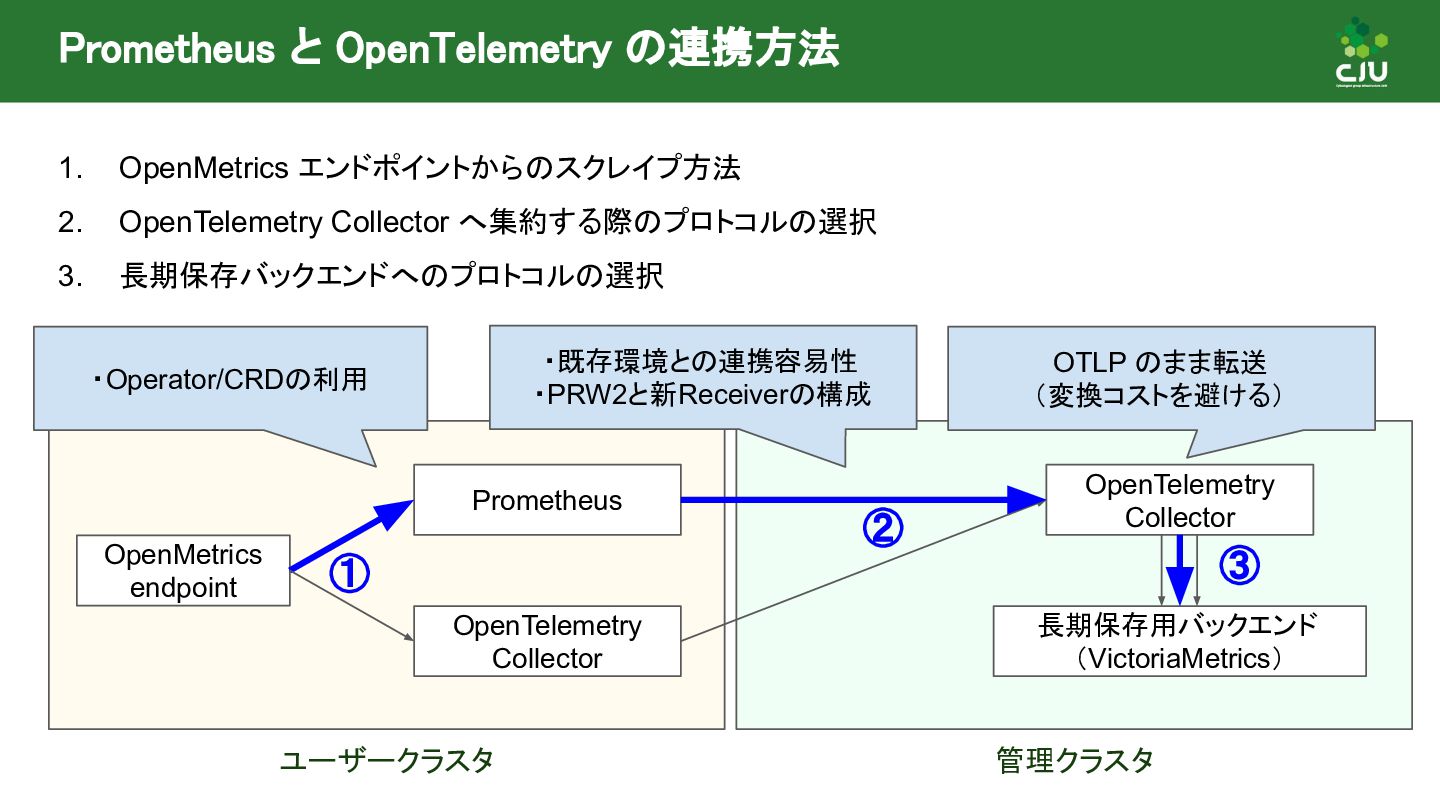
Prometheus と OpenTelemetry の連携方法 1. OpenMetrics エンドポイントからのスクレイプ方法 2. OpenTelemetry Collector
へ集約する際のプロトコルの選択 3. 長期保存バックエンドへのプロトコルの選択 Prometheus OpenTelemetry Collector OpenTelemetry Collector 長期保存用バックエンド (VictoriaMetrics) OpenMetrics endpoint ユーザークラスタ 管理クラスタ ① ② ③ ・Operator/CRDの利用 ・既存環境との連携容易性 ・PRW2と新Receiverの構成 OTLP のまま転送 (変換コストを避ける) -
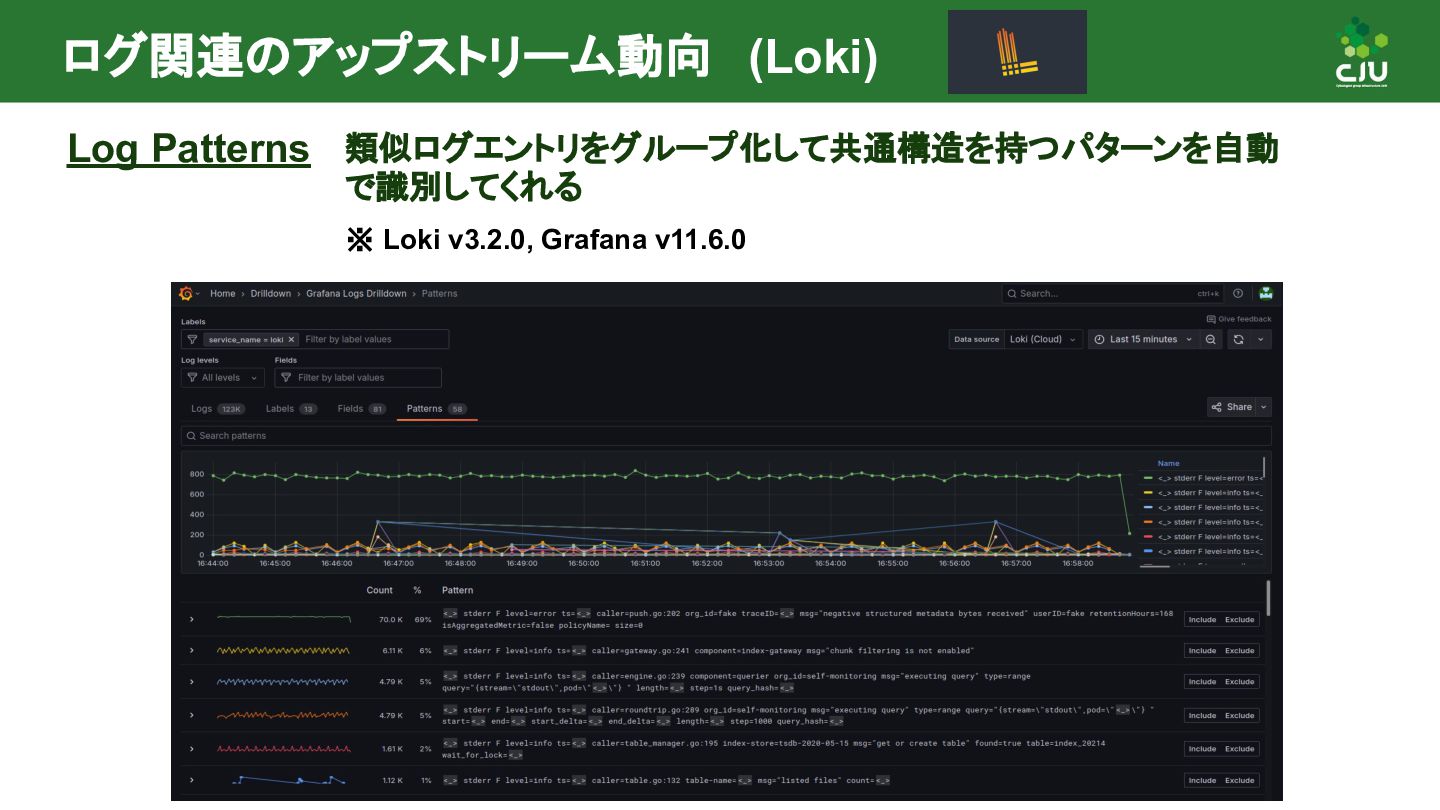
ログ関連のアップストリーム動向 (Loki) • Structured Metadata • Bloom Filter • Log
Patterns • Schema Upgrade • OTLP ネイティブサポート -
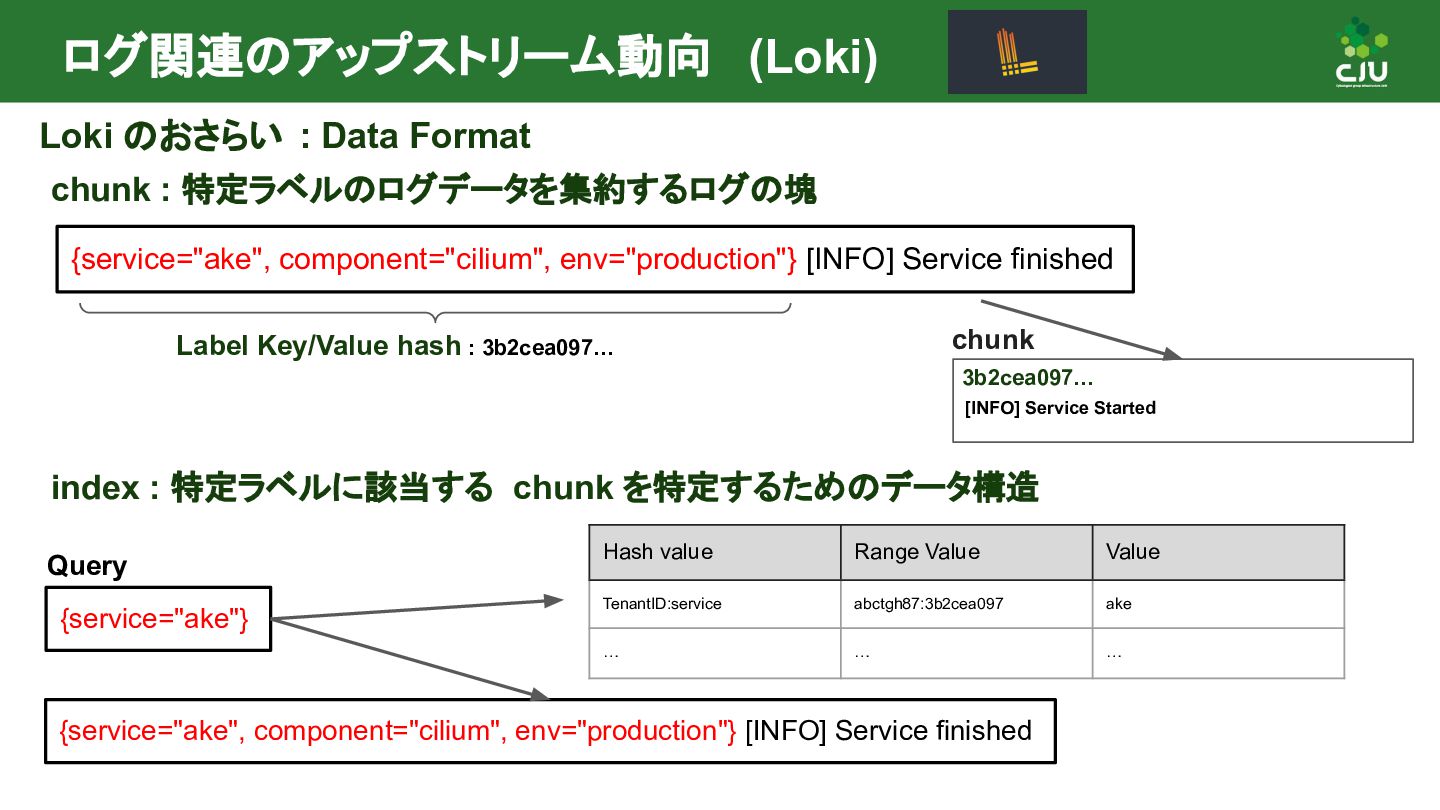
ログ関連のアップストリーム動向 (Loki) Loki のおさらい : Data Format chunk : 特定ラベルのログデータを集約するログの塊
{service="ake", component="cilium", env="production"} [INFO] Service finished Label Key/Value hash : 3b2cea097… 3b2cea097… [INFO] Service Started chunk index : 特定ラベルに該当する chunk を特定するためのデータ構造 {service="ake"} Query {service="ake", component="cilium", env="production"} [INFO] Service finished Hash value Range Value Value TenantID:service abctgh87:3b2cea097 ake … … … -
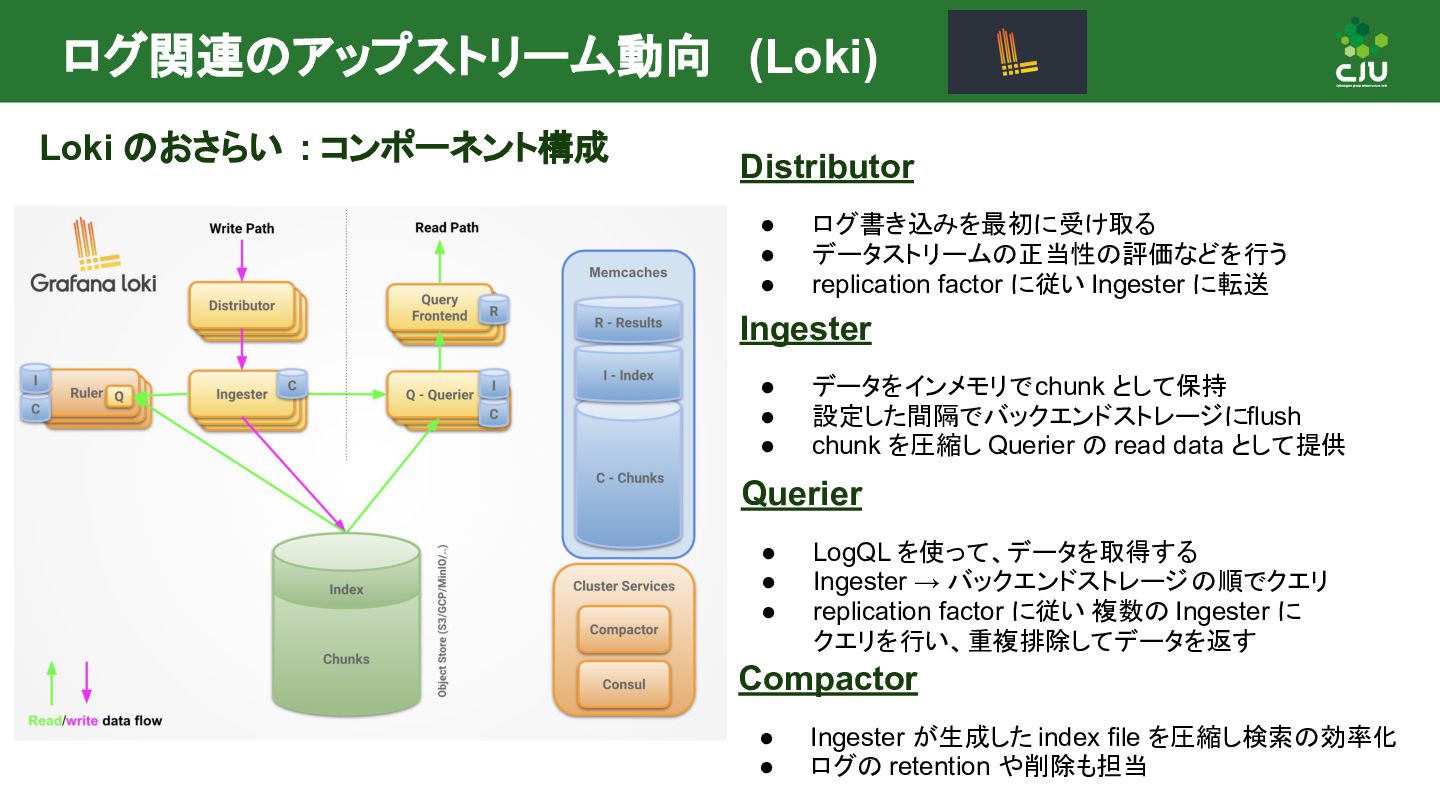
ログ関連のアップストリーム動向 (Loki) Loki のおさらい : コンポーネント構成 Ingester • データをインメモリで chunk
として保持 • 設定した間隔でバックエンドストレージに flush • chunk を圧縮し Querier の read data として提供 Distributor • ログ書き込みを最初に受け取る • データストリームの正当性の評価などを行う • replication factor に従い Ingester に転送 Querier • LogQL を使って、データを取得する • Ingester → バックエンドストレージ の順でクエリ • replication factor に従い 複数の Ingester に クエリを行い、重複排除してデータを返す Compactor • Ingester が生成した index file を圧縮し検索の効率化 • ログの retention や削除も担当 -
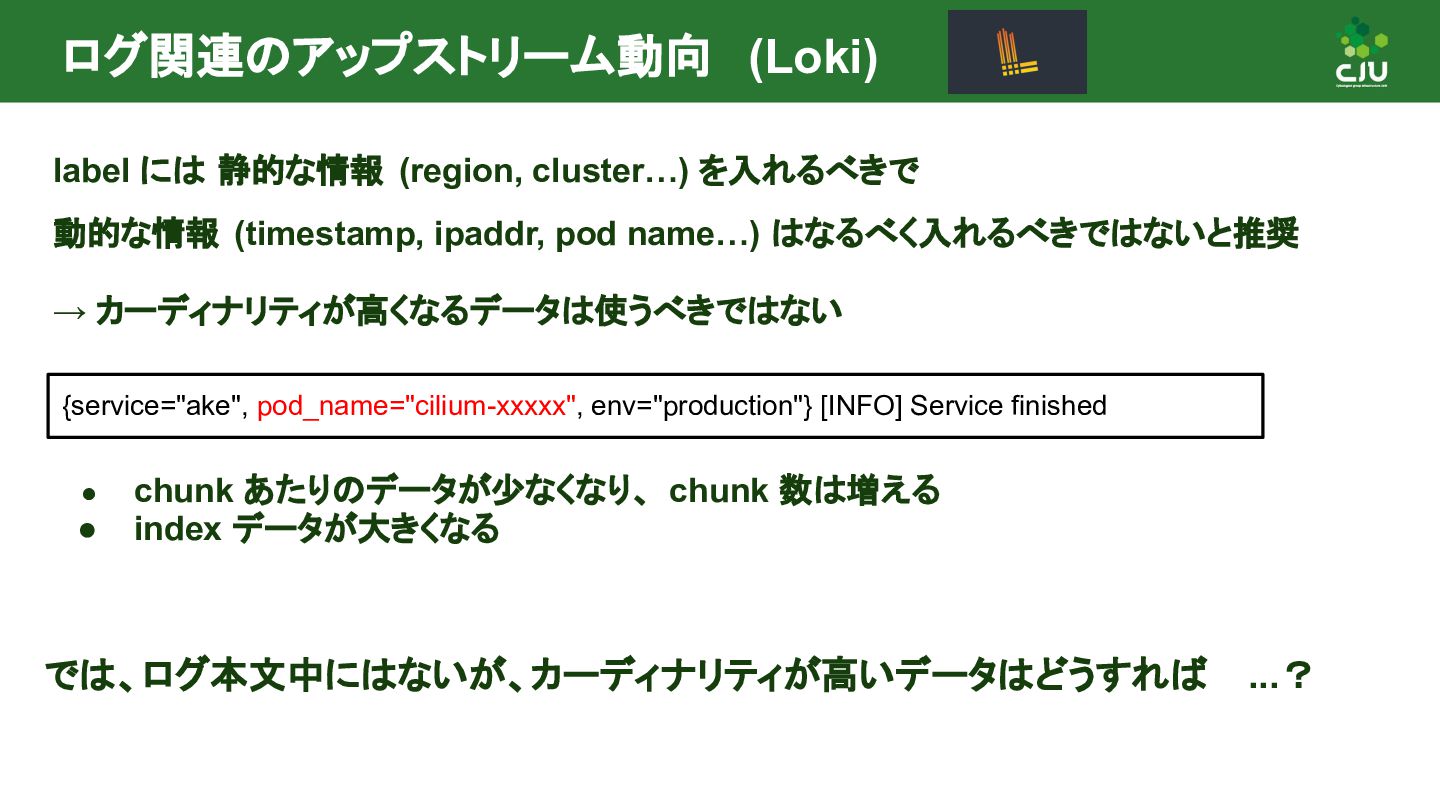
label には 静的な情報 (region, cluster…) を入れるべきで 動的な情報 (timestamp, ipaddr, pod
name…) はなるべく入れるべきではないと推奨 → カーディナリティが高くなるデータは使うべきではない ログ関連のアップストリーム動向 (Loki) {service="ake", pod_name="cilium-xxxxx", env="production"} [INFO] Service finished • chunk あたりのデータが少なくなり、 chunk 数は増える • index データが大きくなる では、ログ本文中にはないが、カーディナリティが高いデータはどうすれば ...? -
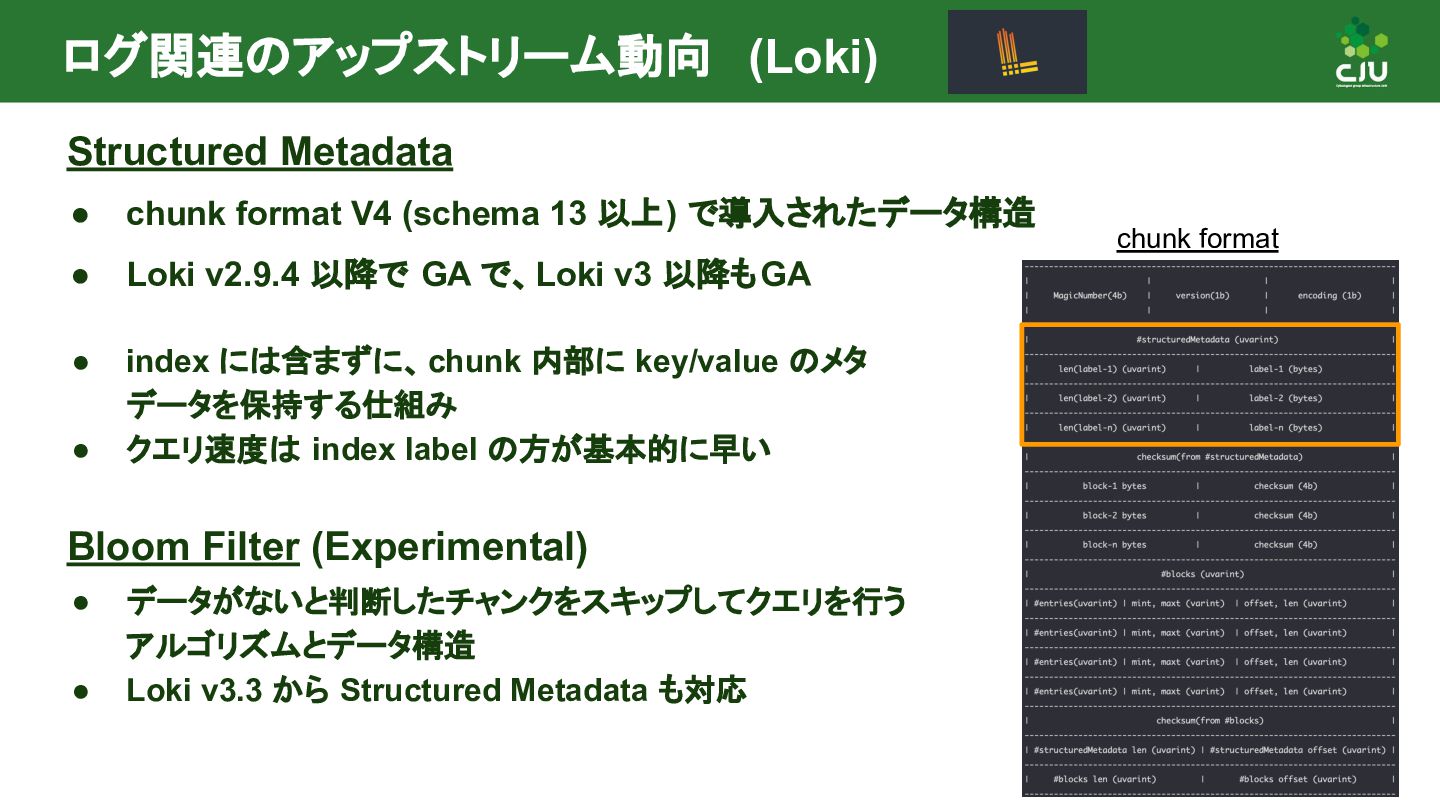
ログ関連のアップストリーム動向 (Loki) Structured Metadata • chunk format V4 (schema 13
以上) で導入されたデータ構造 • Loki v2.9.4 以降で GA で、Loki v3 以降もGA chunk format • index には含まずに、chunk 内部に key/value のメタ データを保持する仕組み • クエリ速度は index label の方が基本的に早い Bloom Filter (Experimental) • データがないと判断したチャンクをスキップしてクエリを行う アルゴリズムとデータ構造 • Loki v3.3 から Structured Metadata も対応 -
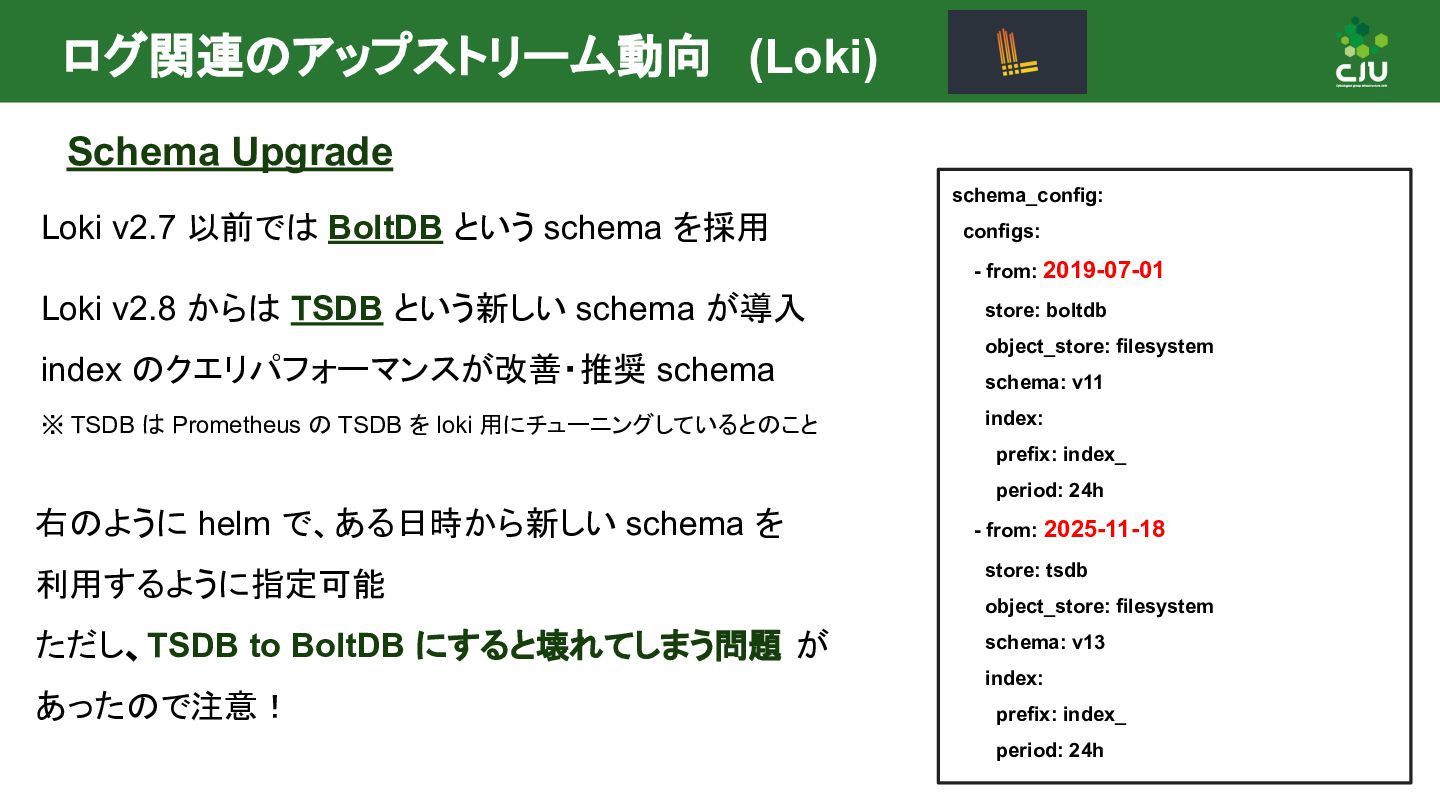
ログ関連のアップストリーム動向 (Loki) Schema Upgrade Loki v2.7 以前では BoltDB という schema
を採用 Loki v2.8 からは TSDB という新しい schema が導入 index のクエリパフォーマンスが改善・推奨 schema ※ TSDB は Prometheus の TSDB を loki 用にチューニングしているとのこと schema_config: configs: - from: 2019-07-01 store: boltdb object_store: filesystem schema: v11 index: prefix: index_ period: 24h - from: 2025-11-18 store: tsdb object_store: filesystem schema: v13 index: prefix: index_ period: 24h 右のように helm で、ある日時から新しい schema を 利用するように指定可能 ただし、TSDB to BoltDB にすると壊れてしまう問題 が あったので注意! -
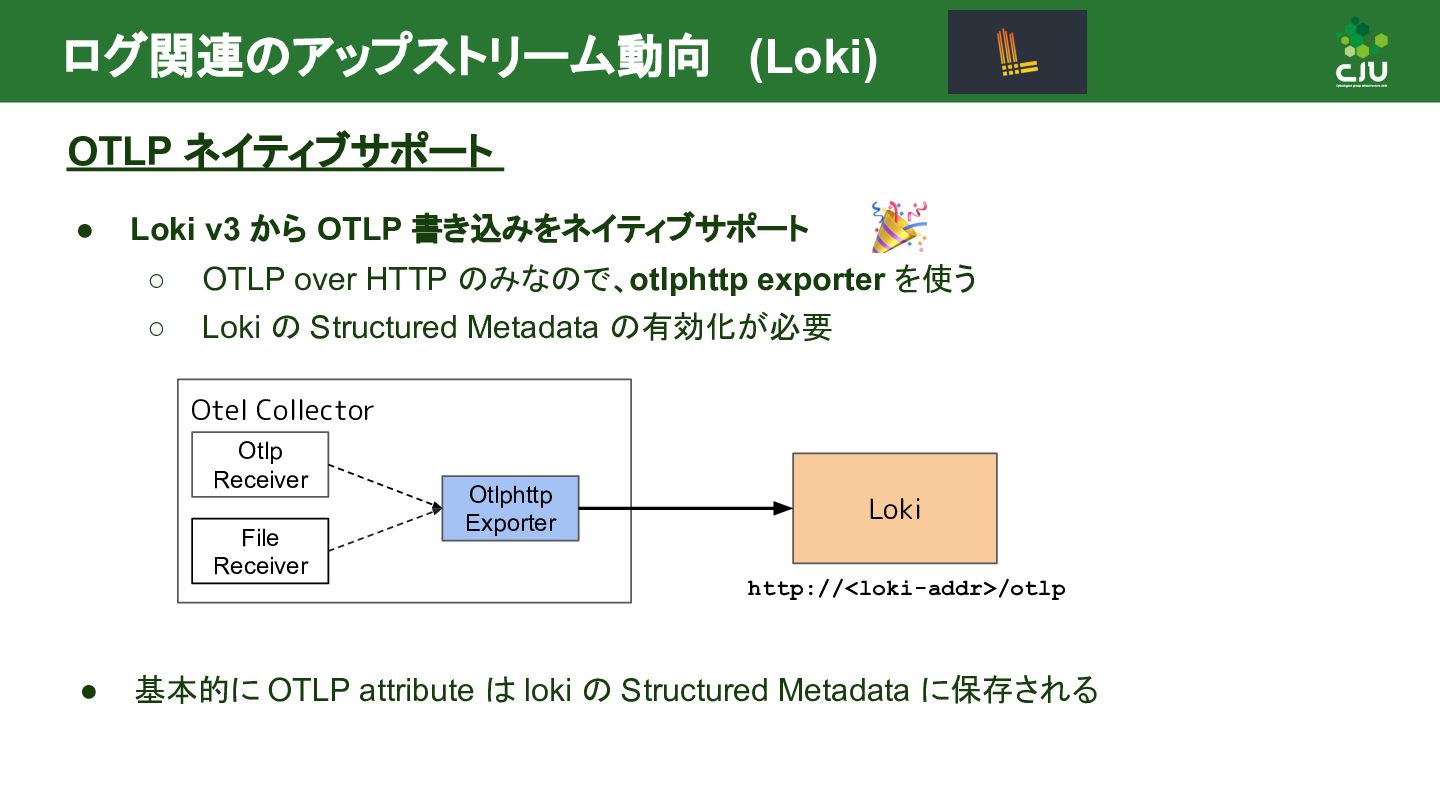
ログ関連のアップストリーム動向 (Loki) • Loki v3 から OTLP 書き込みをネイティブサポート ◦ OTLP
over HTTP のみなので、otlphttp exporter を使う ◦ Loki の Structured Metadata の有効化が必要 Loki Otel Collector Otlphttp Exporter Otlp Receiver File Receiver http://<loki-addr>/otlp OTLP ネイティブサポート • 基本的に OTLP attribute は loki の Structured Metadata に保存される -
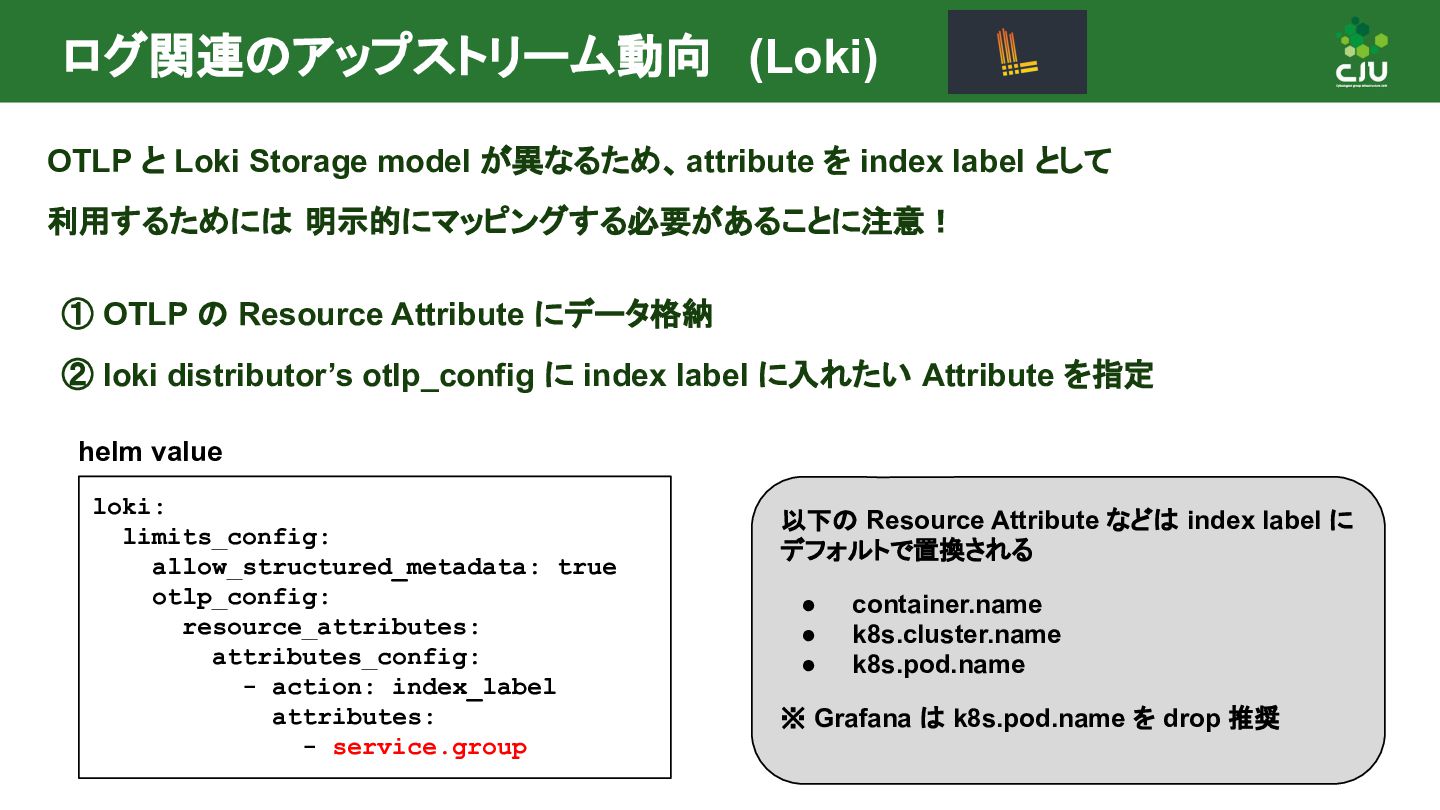
ログ関連のアップストリーム動向 (Loki) OTLP と Loki Storage model が異なるため、attribute を index
label として 利用するためには 明示的にマッピングする必要があることに注意! ① OTLP の Resource Attribute にデータ格納 ② loki distributor’s otlp_config に index label に入れたい Attribute を指定 以下の Resource Attribute などは index label に デフォルトで置換される • container.name • k8s.cluster.name • k8s.pod.name ※ Grafana は k8s.pod.name を drop 推奨 loki: limits_config: allow_structured_metadata: true otlp_config: resource_attributes: attributes_config: - action: index_label attributes: - service.group helm value -
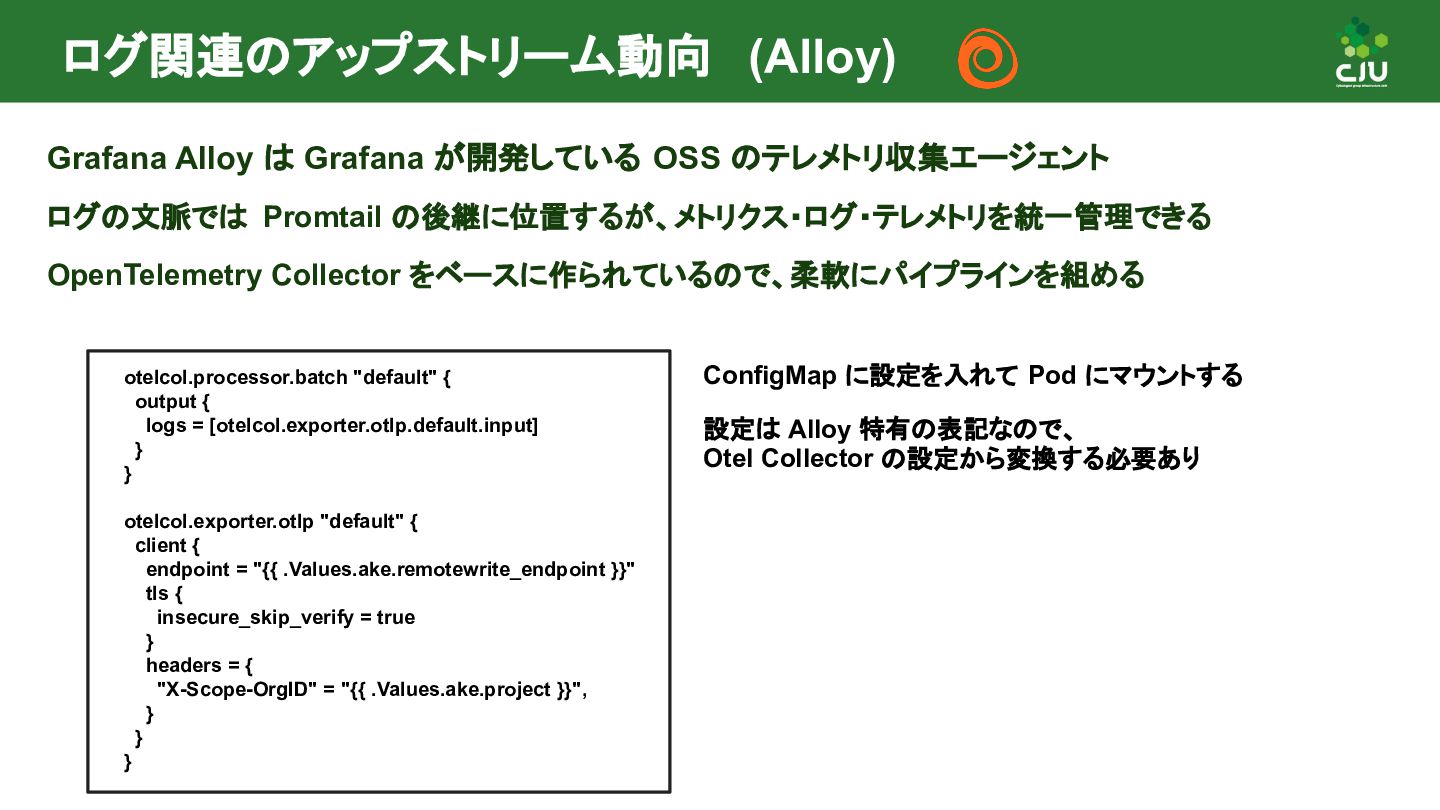
ログ関連のアップストリーム動向 (Alloy) Grafana Alloy は Grafana が開発している OSS のテレメトリ収集エージェント ログの文脈では
Promtail の後継に位置するが、メトリクス・ログ・テレメトリを統一管理できる OpenTelemetry Collector をベースに作られているので、柔軟にパイプラインを組める otelcol.processor.batch "default" { output { logs = [otelcol.exporter.otlp.default.input] } } otelcol.exporter.otlp "default" { client { endpoint = "{{ .Values.ake.remotewrite_endpoint }}" tls { insecure_skip_verify = true } headers = { "X-Scope-OrgID" = "{{ .Values.ake.project }}", } } } ConfigMap に設定を入れて Pod にマウントする 設定は Alloy 特有の表記なので、 Otel Collector の設定から変換する必要あり -
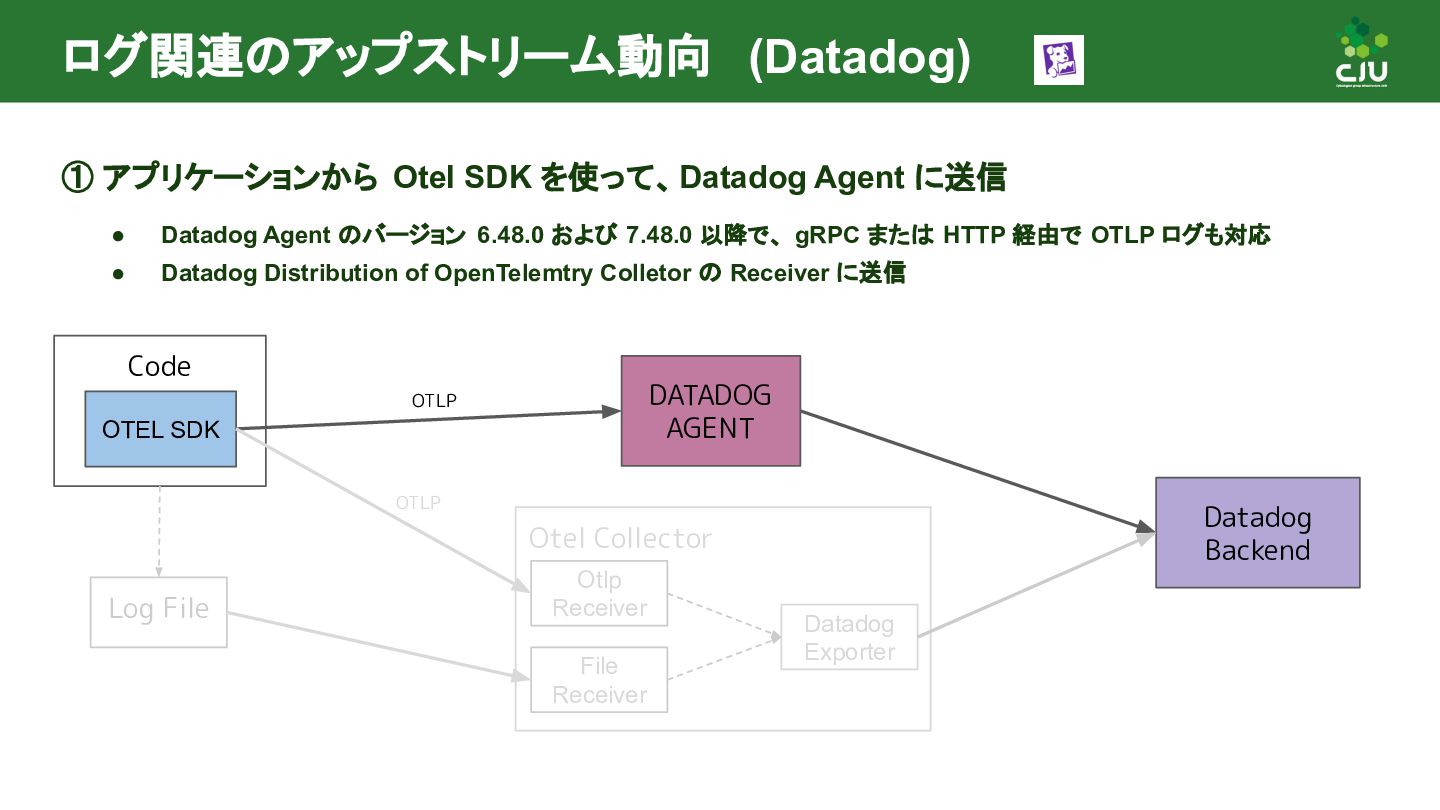
ログ関連のアップストリーム動向 (Datadog) Datadog Backend Code OTEL SDK DATADOG AGENT OTLP
Otel Collector Datadog Exporter Otlp Receiver File Receiver OTLP Log File ① アプリケーションから Otel SDK を使って、Datadog Agent に送信 • Datadog Agent のバージョン 6.48.0 および 7.48.0 以降で、 gRPC または HTTP 経由で OTLP ログも対応 • Datadog Distribution of OpenTelemtry Colletor の Receiver に送信 -
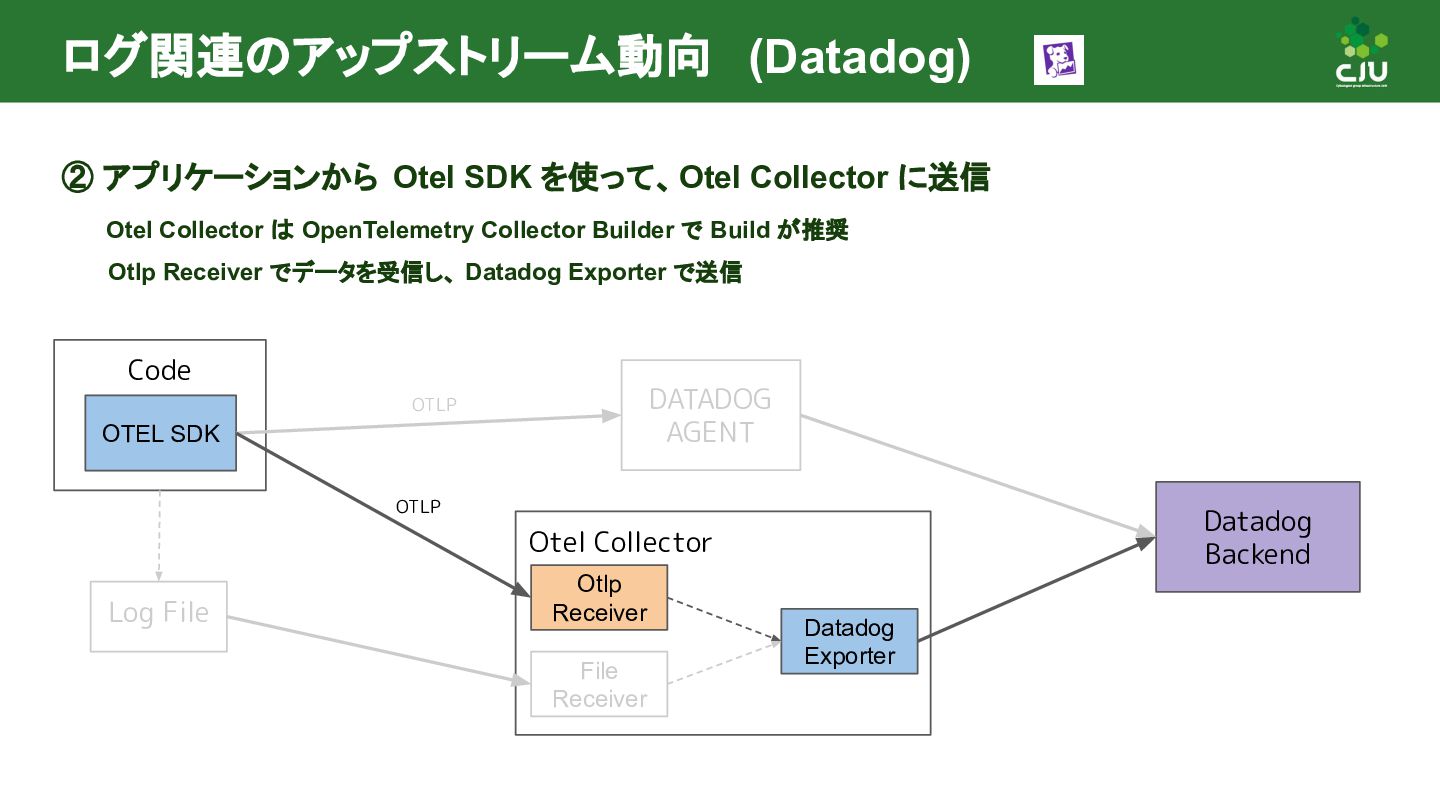
ログ関連のアップストリーム動向 (Datadog) Datadog Backend Code OTEL SDK DATADOG AGENT OTLP
Otel Collector Datadog Exporter Otlp Receiver File Receiver OTLP Log File ② アプリケーションから Otel SDK を使って、Otel Collector に送信 Otel Collector は OpenTelemetry Collector Builder で Build が推奨 Otlp Receiver でデータを受信し、 Datadog Exporter で送信 -
ログ関連のアップストリーム動向 (Datadog) Datadog Backend Code OTEL SDK DATADOG AGENT OTLP
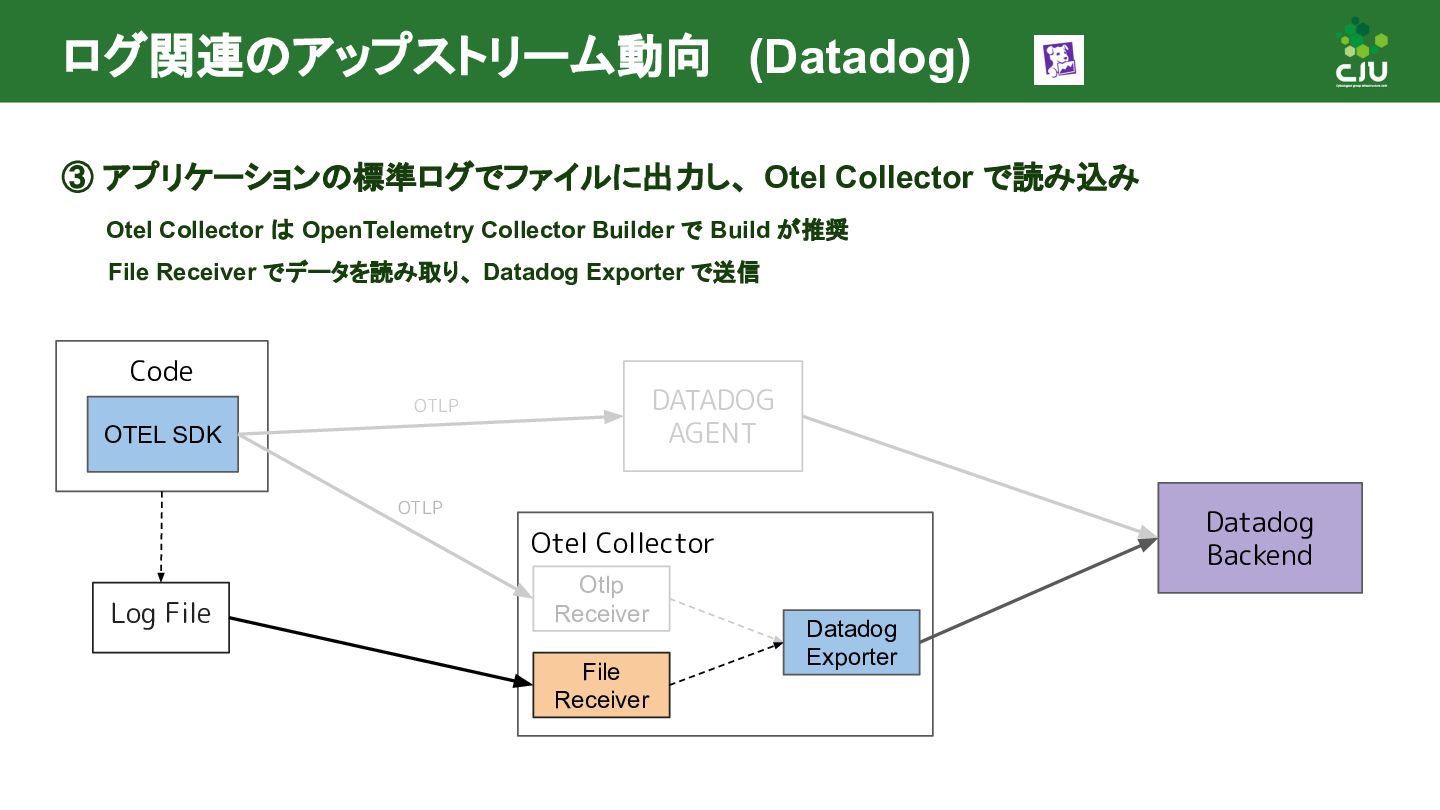
Otel Collector Datadog Exporter Otlp Receiver File Receiver OTLP Log File ③ アプリケーションの標準ログでファイルに出力し、 Otel Collector で読み込み Otel Collector は OpenTelemetry Collector Builder で Build が推奨 File Receiver でデータを読み取り、 Datadog Exporter で送信 -
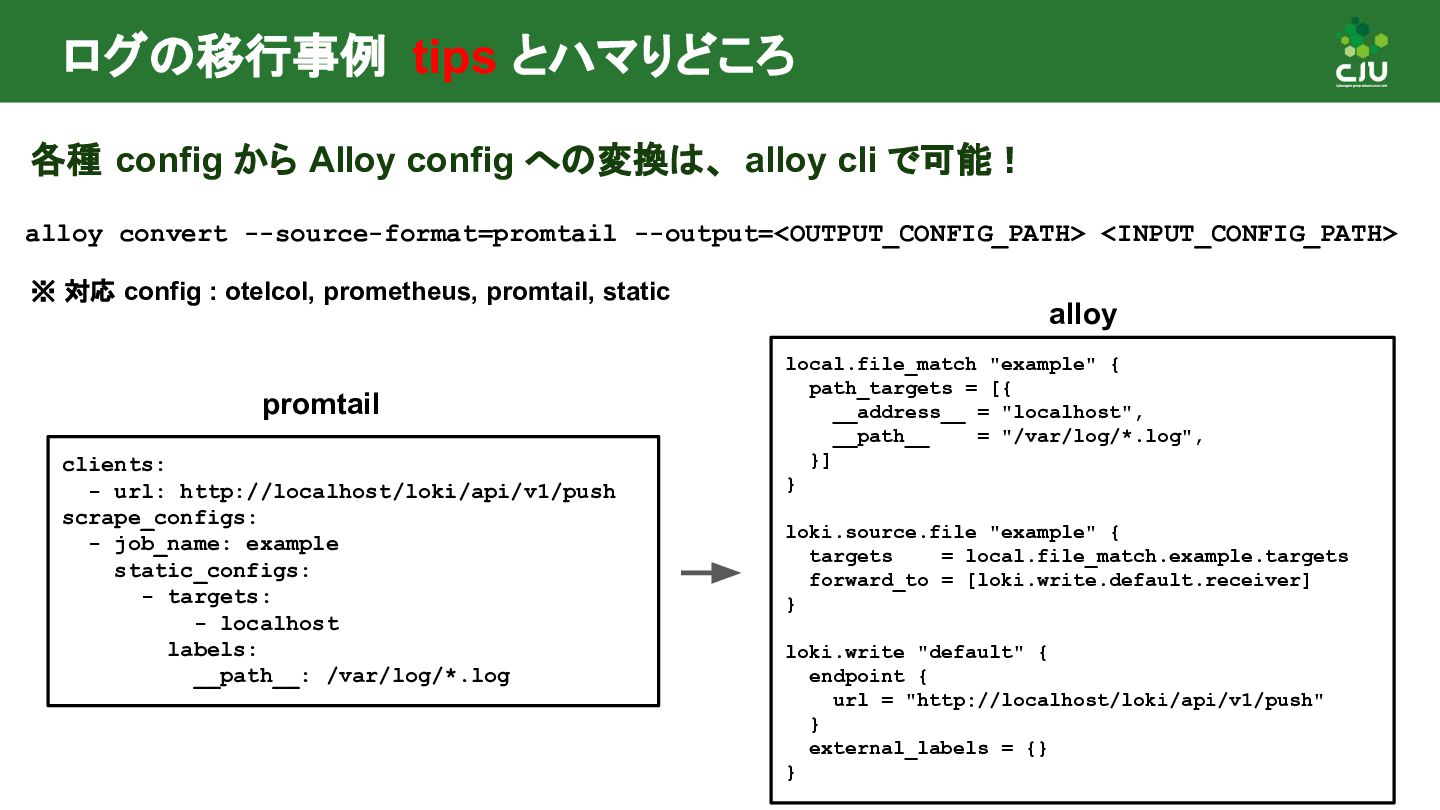
ログの移行事例 tips とハマりどころ alloy convert --source-format=promtail --output=<OUTPUT_CONFIG_PATH> <INPUT_CONFIG_PATH> 各種 config
から Alloy config への変換は、 alloy cli で可能! ※ 対応 config : otelcol, prometheus, promtail, static clients: - url: http://localhost/loki/api/v1/push scrape_configs: - job_name: example static_configs: - targets: - localhost labels: __path__: /var/log/*.log local.file_match "example" { path_targets = [{ __address__ = "localhost", __path__ = "/var/log/*.log", }] } loki.source.file "example" { targets = local.file_match.example.targets forward_to = [loki.write.default.receiver] } loki.write "default" { endpoint { url = "http://localhost/loki/api/v1/push" } external_labels = {} } promtail alloy -
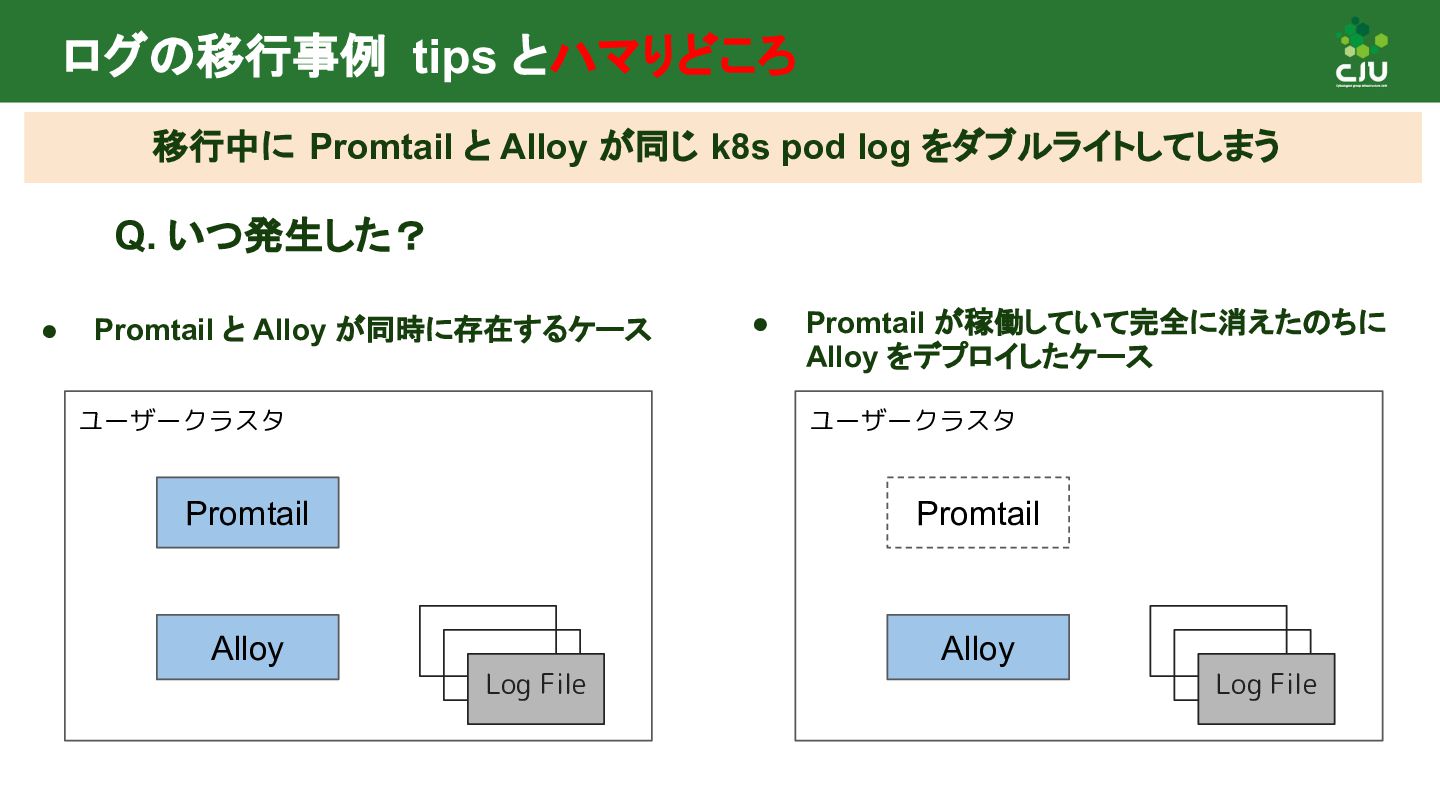
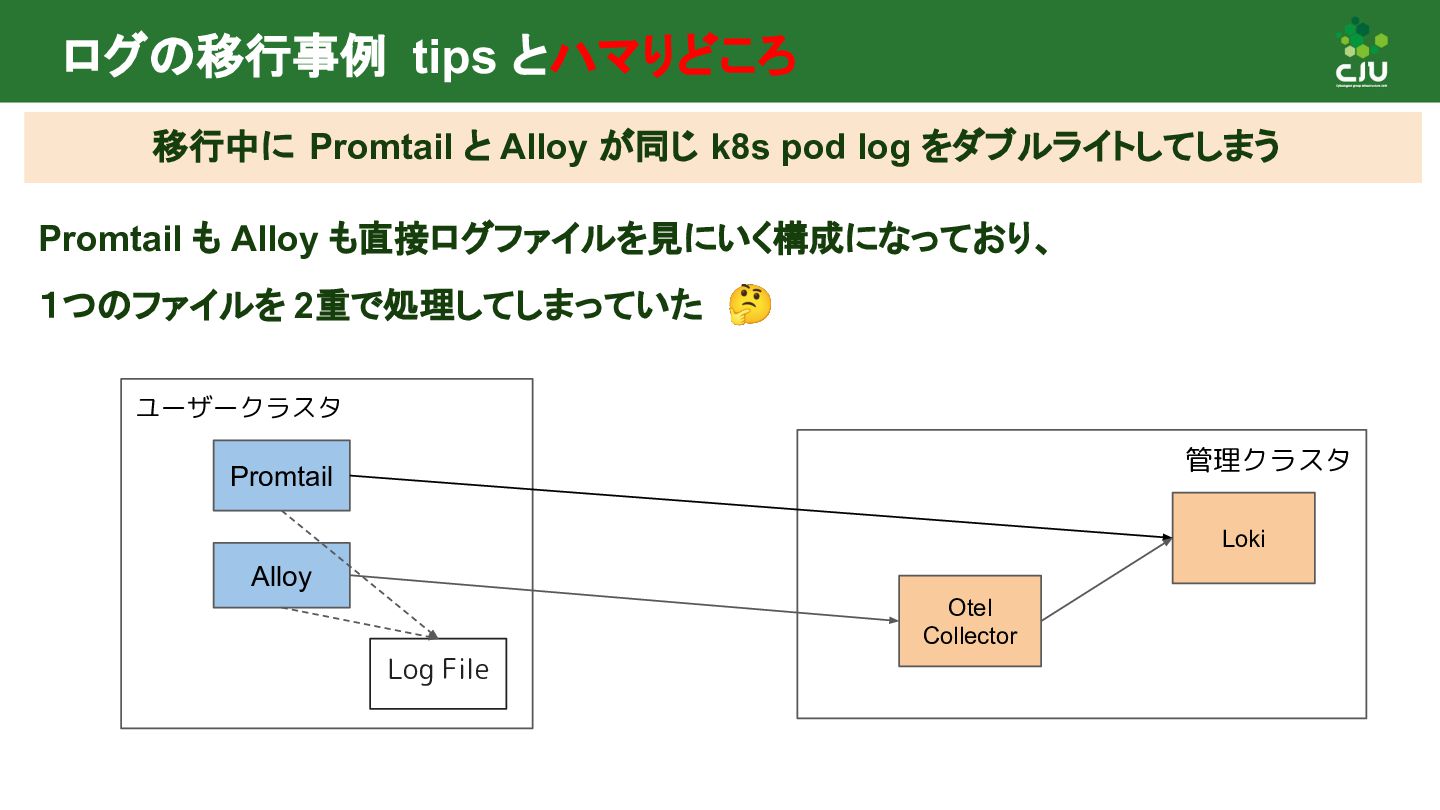
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
log をダブルライトしてしまう • Promtail と Alloy が同時に存在するケース ユーザークラスタ Promtail Alloy Log File • Promtail が稼働していて完全に消えたのちに Alloy をデプロイしたケース ユーザークラスタ Promtail Alloy Log File Q. いつ発生した? -
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
log をダブルライトしてしまう 管理クラスタ Loki ユーザークラスタ Promtail Alloy Otel Collector Log File Promtail も Alloy も直接ログファイルを見にいく構成になっており、 1つのファイルを 2重で処理してしまっていた 🤔 -
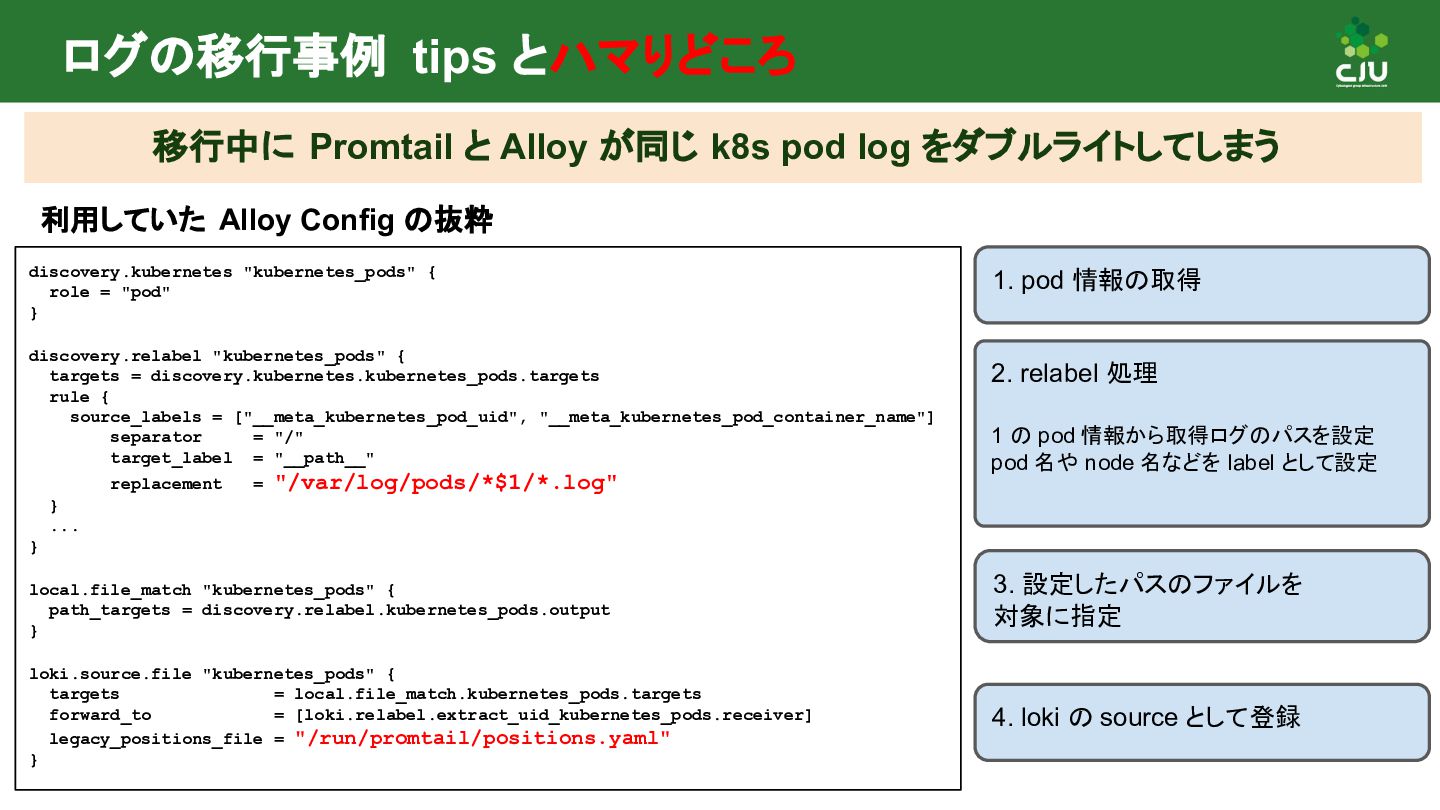
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
log をダブルライトしてしまう discovery.kubernetes "kubernetes_pods" { role = "pod" } discovery.relabel "kubernetes_pods" { targets = discovery.kubernetes.kubernetes_pods.targets rule { source_labels = ["__meta_kubernetes_pod_uid", "__meta_kubernetes_pod_container_name"] separator = "/" target_label = "__path__" replacement = "/var/log/pods/*$1/*.log" } ... } local.file_match "kubernetes_pods" { path_targets = discovery.relabel.kubernetes_pods.output } loki.source.file "kubernetes_pods" { targets = local.file_match.kubernetes_pods.targets forward_to = [loki.relabel.extract_uid_kubernetes_pods.receiver] legacy_positions_file = "/run/promtail/positions.yaml" } 利用していた Alloy Config の抜粋 1. pod 情報の取得 2. relabel 処理 1 の pod 情報から取得ログのパスを設定 pod 名や node 名などを label として設定 3. 設定したパスのファイルを 対象に指定 4. loki の source として登録 -
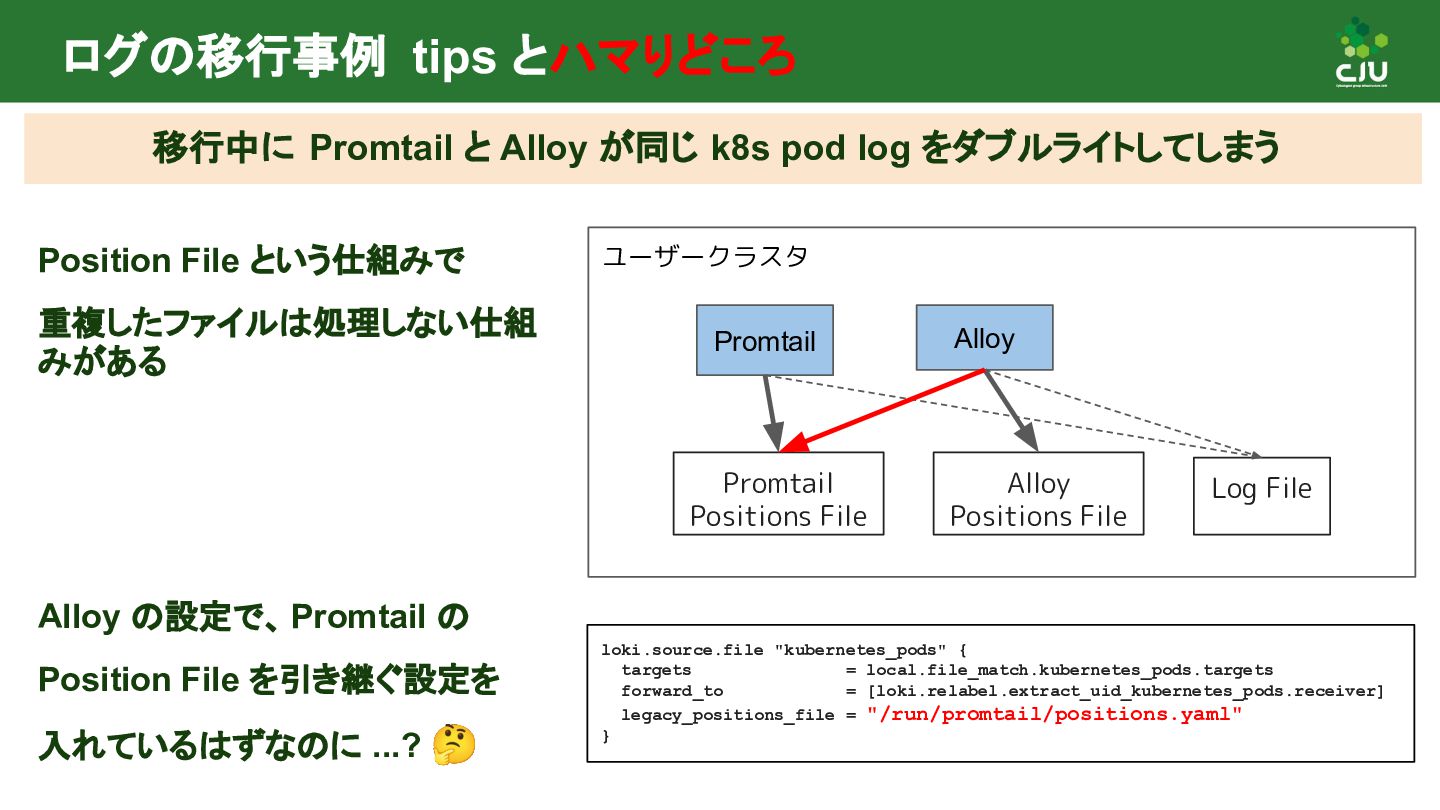
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
log をダブルライトしてしまう Position File という仕組みで 重複したファイルは処理しない仕組 みがある ユーザークラスタ Promtail Alloy Log File Promtail Positions File Alloy Positions File loki.source.file "kubernetes_pods" { targets = local.file_match.kubernetes_pods.targets forward_to = [loki.relabel.extract_uid_kubernetes_pods.receiver] legacy_positions_file = "/run/promtail/positions.yaml" } Alloy の設定で、 Promtail の Position File を引き継ぐ設定を 入れているはずなのに ...? 🤔 -
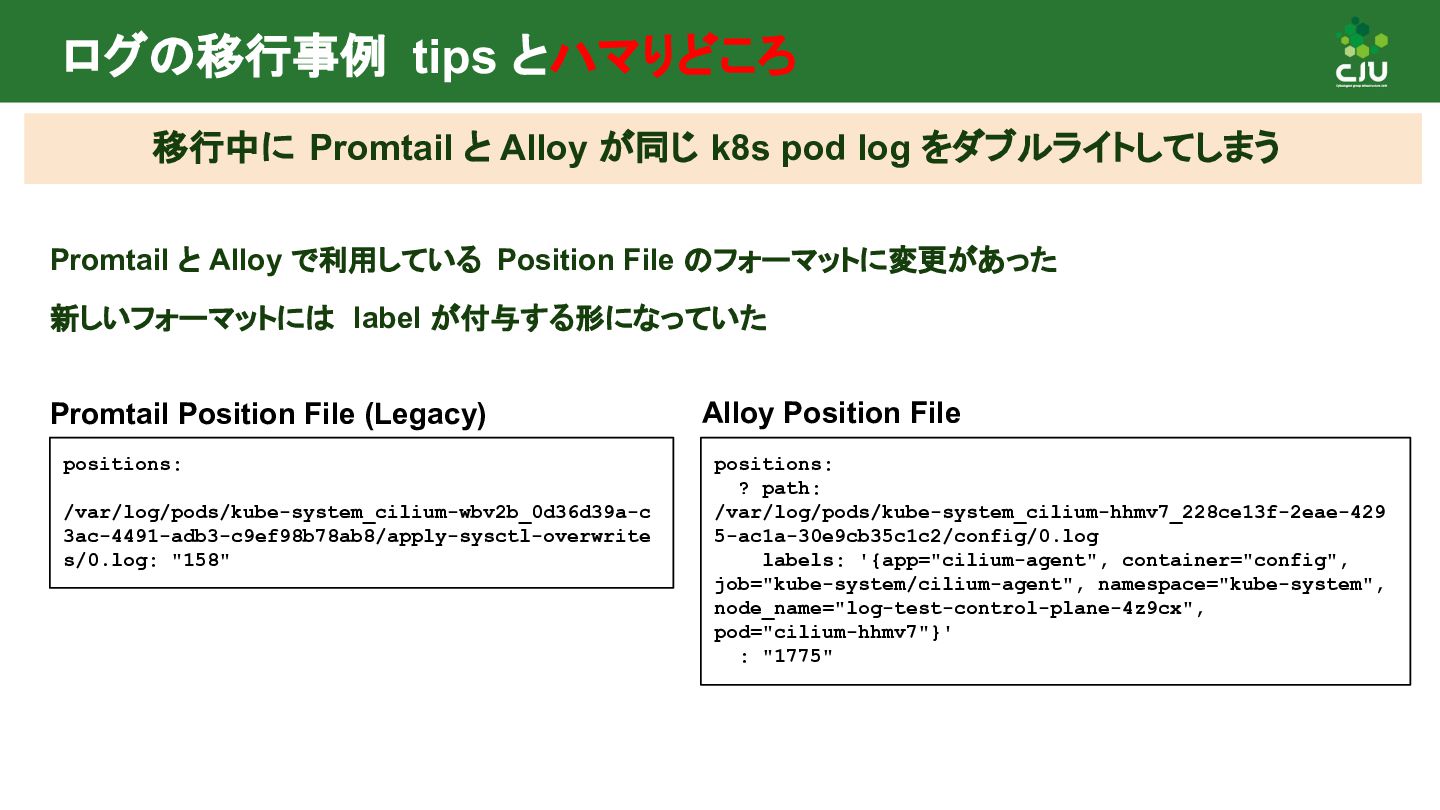
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
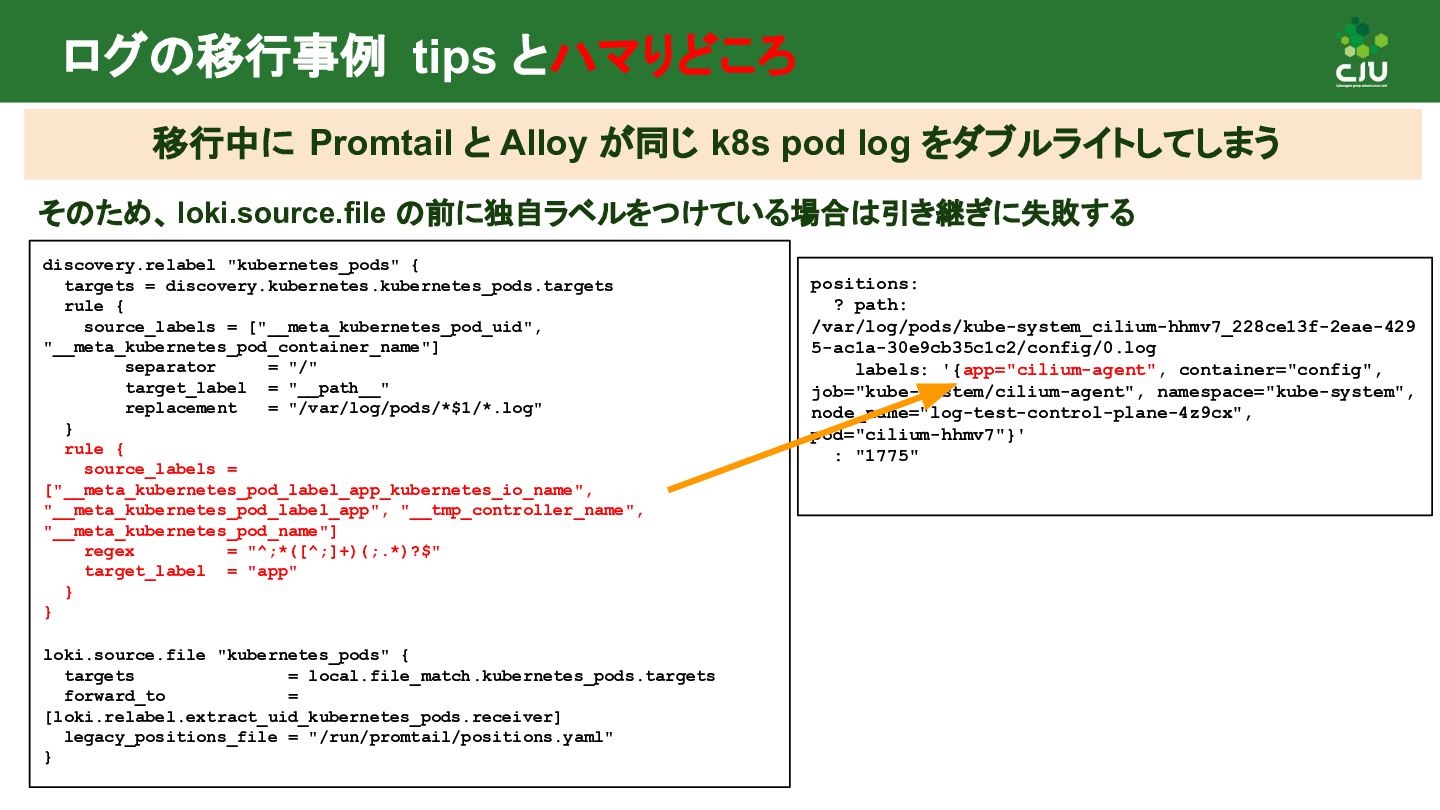
log をダブルライトしてしまう positions: /var/log/pods/kube-system_cilium-wbv2b_0d36d39a-c 3ac-4491-adb3-c9ef98b78ab8/apply-sysctl-overwrite s/0.log: "158" positions: ? path: /var/log/pods/kube-system_cilium-hhmv7_228ce13f-2eae-429 5-ac1a-30e9cb35c1c2/config/0.log labels: '{app="cilium-agent", container="config", job="kube-system/cilium-agent", namespace="kube-system", node_name="log-test-control-plane-4z9cx", pod="cilium-hhmv7"}' : "1775" Alloy Position File Promtail Position File (Legacy) Promtail と Alloy で利用している Position File のフォーマットに変更があった 新しいフォーマットには label が付与する形になっていた -
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
log をダブルライトしてしまう discovery.relabel "kubernetes_pods" { targets = discovery.kubernetes.kubernetes_pods.targets rule { source_labels = ["__meta_kubernetes_pod_uid", "__meta_kubernetes_pod_container_name"] separator = "/" target_label = "__path__" replacement = "/var/log/pods/*$1/*.log" } rule { source_labels = ["__meta_kubernetes_pod_label_app_kubernetes_io_name", "__meta_kubernetes_pod_label_app", "__tmp_controller_name", "__meta_kubernetes_pod_name"] regex = "^;*([^;]+)(;.*)?$" target_label = "app" } } loki.source.file "kubernetes_pods" { targets = local.file_match.kubernetes_pods.targets forward_to = [loki.relabel.extract_uid_kubernetes_pods.receiver] legacy_positions_file = "/run/promtail/positions.yaml" } positions: ? path: /var/log/pods/kube-system_cilium-hhmv7_228ce13f-2eae-429 5-ac1a-30e9cb35c1c2/config/0.log labels: '{app="cilium-agent", container="config", job="kube-system/cilium-agent", namespace="kube-system", node_name="log-test-control-plane-4z9cx", pod="cilium-hhmv7"}' : "1775" そのため、 loki.source.file の前に独自ラベルをつけている場合は引き継ぎに失敗する -
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
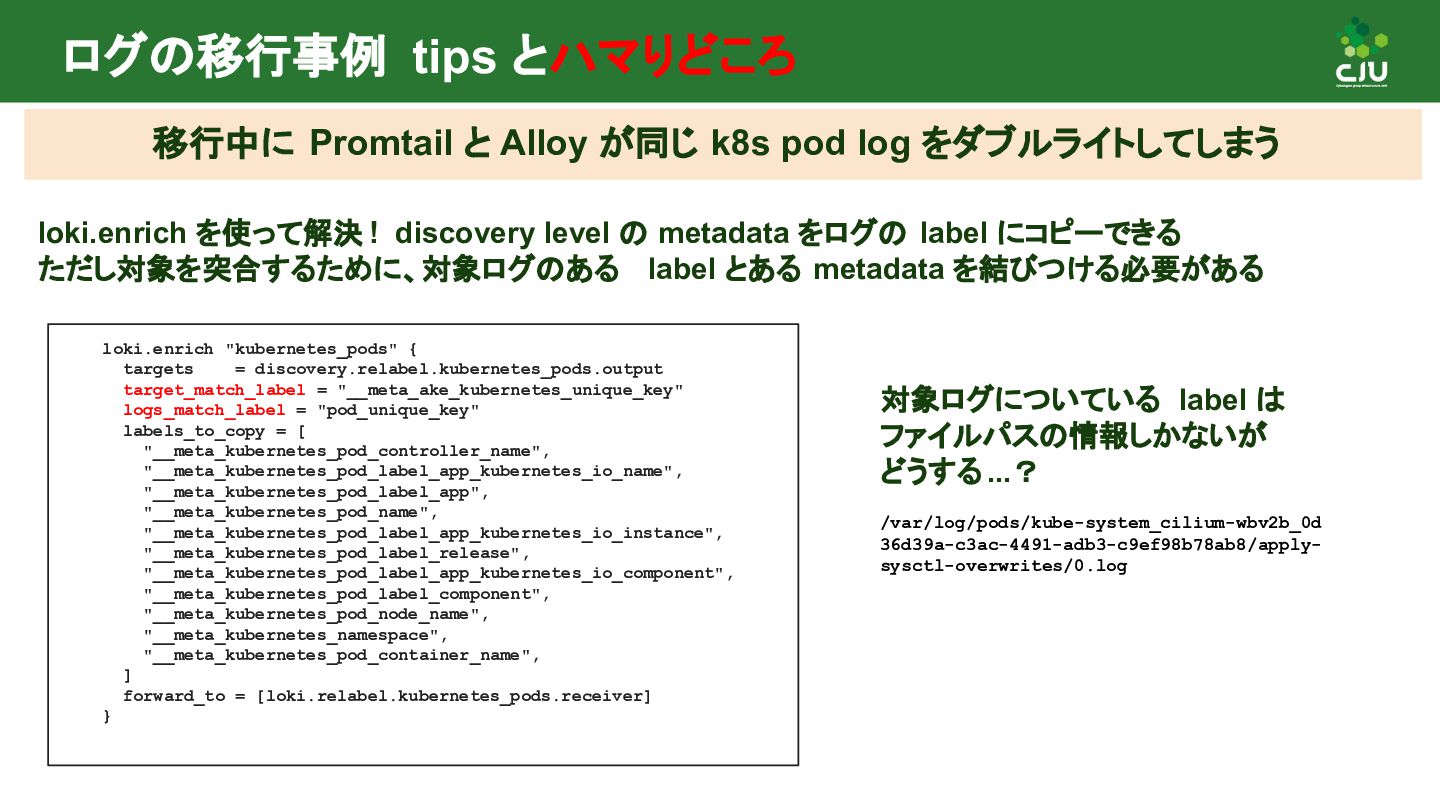
log をダブルライトしてしまう loki.enrich "kubernetes_pods" { targets = discovery.relabel.kubernetes_pods.output target_match_label = "__meta_ake_kubernetes_unique_key" logs_match_label = "pod_unique_key" labels_to_copy = [ "__meta_kubernetes_pod_controller_name", "__meta_kubernetes_pod_label_app_kubernetes_io_name", "__meta_kubernetes_pod_label_app", "__meta_kubernetes_pod_name", "__meta_kubernetes_pod_label_app_kubernetes_io_instance", "__meta_kubernetes_pod_label_release", "__meta_kubernetes_pod_label_app_kubernetes_io_component", "__meta_kubernetes_pod_label_component", "__meta_kubernetes_pod_node_name", "__meta_kubernetes_namespace", "__meta_kubernetes_pod_container_name", ] forward_to = [loki.relabel.kubernetes_pods.receiver] } loki.enrich を使って解決 ! discovery level の metadata をログの label にコピーできる ただし対象を突合するために、対象ログのある label とある metadata を結びつける必要がある /var/log/pods/kube-system_cilium-wbv2b_0d 36d39a-c3ac-4491-adb3-c9ef98b78ab8/apply- sysctl-overwrites/0.log 対象ログについている label は ファイルパスの情報しかないが どうする...? -
ログの移行事例 tips とハマりどころ 移行中に Promtail と Alloy が同じ k8s pod
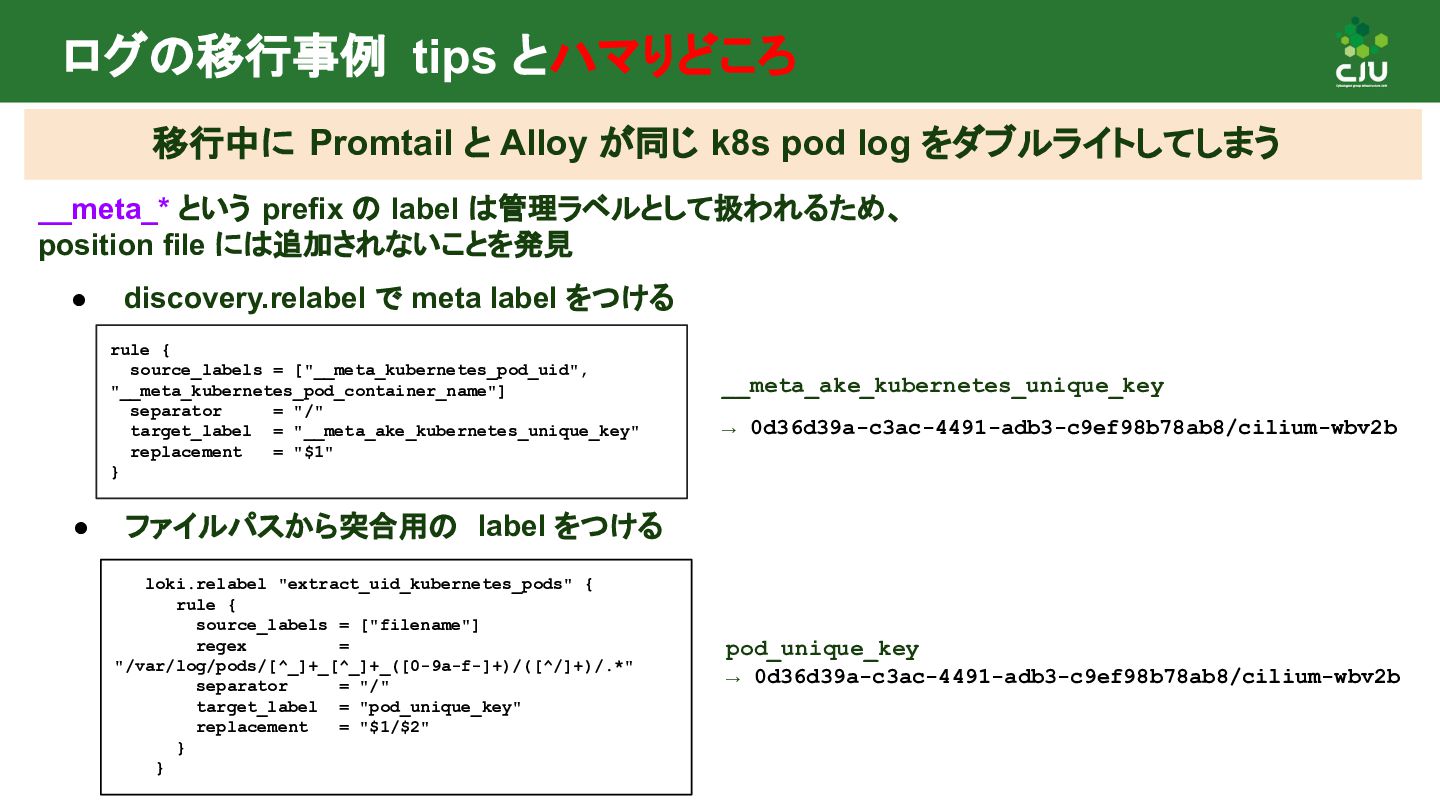
log をダブルライトしてしまう rule { source_labels = ["__meta_kubernetes_pod_uid", "__meta_kubernetes_pod_container_name"] separator = "/" target_label = "__meta_ake_kubernetes_unique_key" replacement = "$1" } __meta_* という prefix の label は管理ラベルとして扱われるため、 position file には追加されないことを発見 __meta_ake_kubernetes_unique_key → 0d36d39a-c3ac-4491-adb3-c9ef98b78ab8/cilium-wbv2b • discovery.relabel で meta label をつける • ファイルパスから突合用の label をつける pod_unique_key → 0d36d39a-c3ac-4491-adb3-c9ef98b78ab8/cilium-wbv2b loki.relabel "extract_uid_kubernetes_pods" { rule { source_labels = ["filename"] regex = "/var/log/pods/[^_]+_[^_]+_([0-9a-f-]+)/([^/]+)/.*" separator = "/" target_label = "pod_unique_key" replacement = "$1/$2" } } -
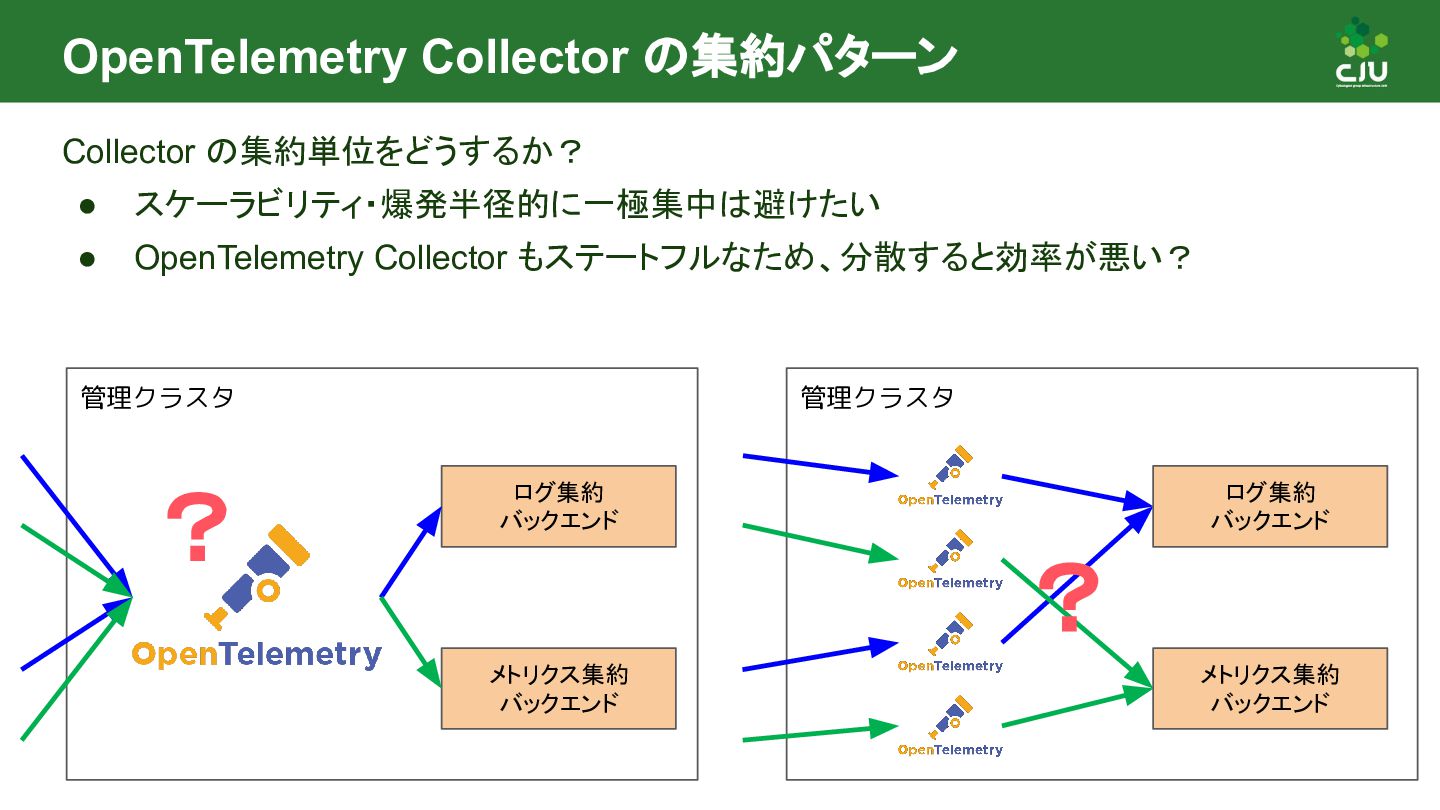
OpenTelemetry Collector の集約パターン 管理クラスタ メトリクス集約 バックエンド ログ集約 バックエンド ? 管理クラスタ
? メトリクス集約 バックエンド ログ集約 バックエンド Collector の集約単位をどうするか? • スケーラビリティ・爆発半径的に一極集中は避けたい • OpenTelemetry Collector もステートフルなため、分散すると効率が悪い? -
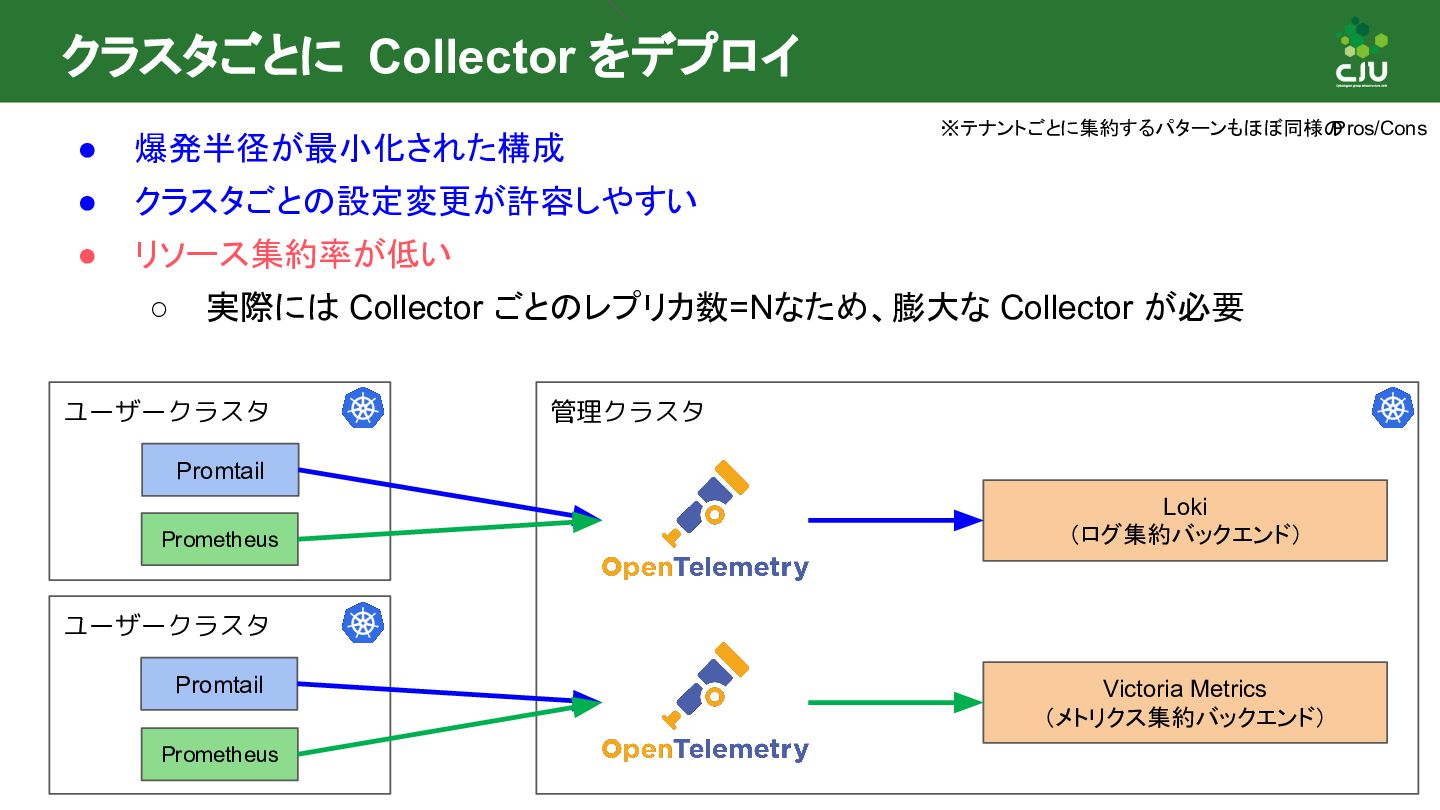
クラスタごとに Collector をデプロイ 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki (ログ集約バックエンド) ユーザークラスタ
Promtail Prometheus ユーザークラスタ Promtail Prometheus • 爆発半径が最小化された構成 • クラスタごとの設定変更が許容しやすい • リソース集約率が低い ◦ 実際には Collector ごとのレプリカ数=Nなため、膨大な Collector が必要 ※テナントごとに集約するパターンもほぼ同様の Pros/Cons -
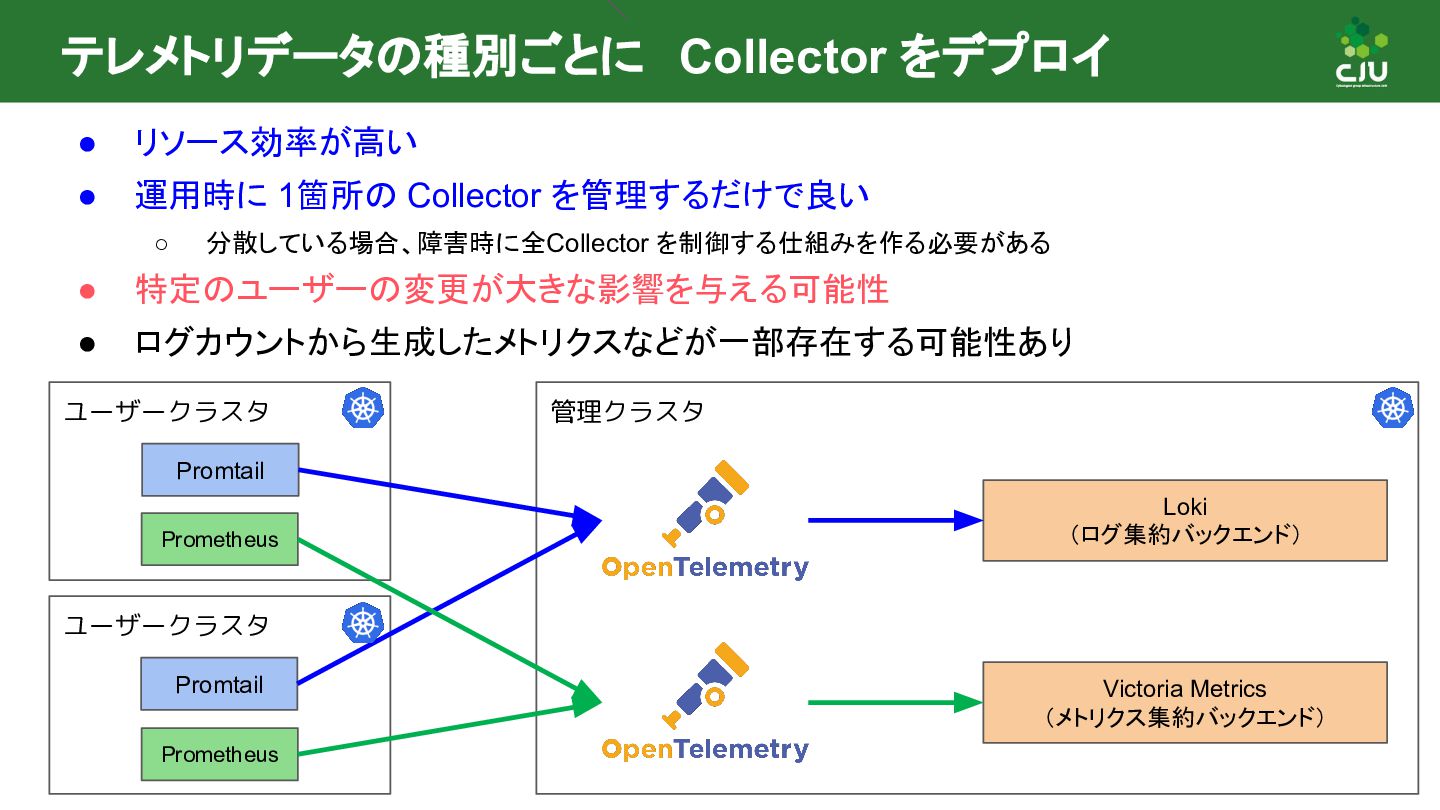
テレメトリデータの種別ごとに Collector をデプロイ 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki (ログ集約バックエンド) ユーザークラスタ
Promtail Prometheus ユーザークラスタ Promtail Prometheus • リソース効率が高い • 運用時に 1箇所の Collector を管理するだけで良い ◦ 分散している場合、障害時に全 Collector を制御する仕組みを作る必要がある • 特定のユーザーの変更が大きな影響を与える可能性 • ログカウントから生成したメトリクスなどが一部存在する可能性あり -
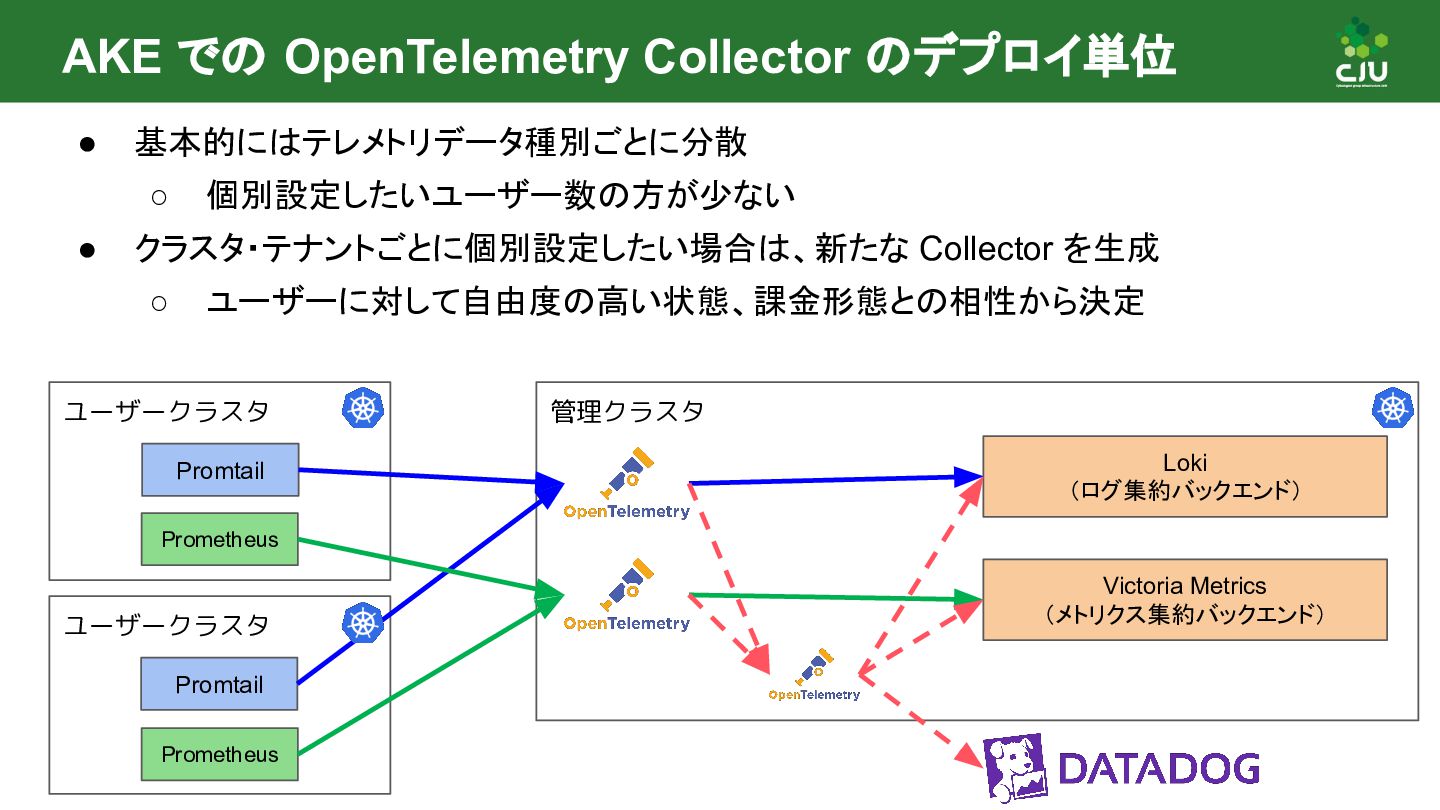
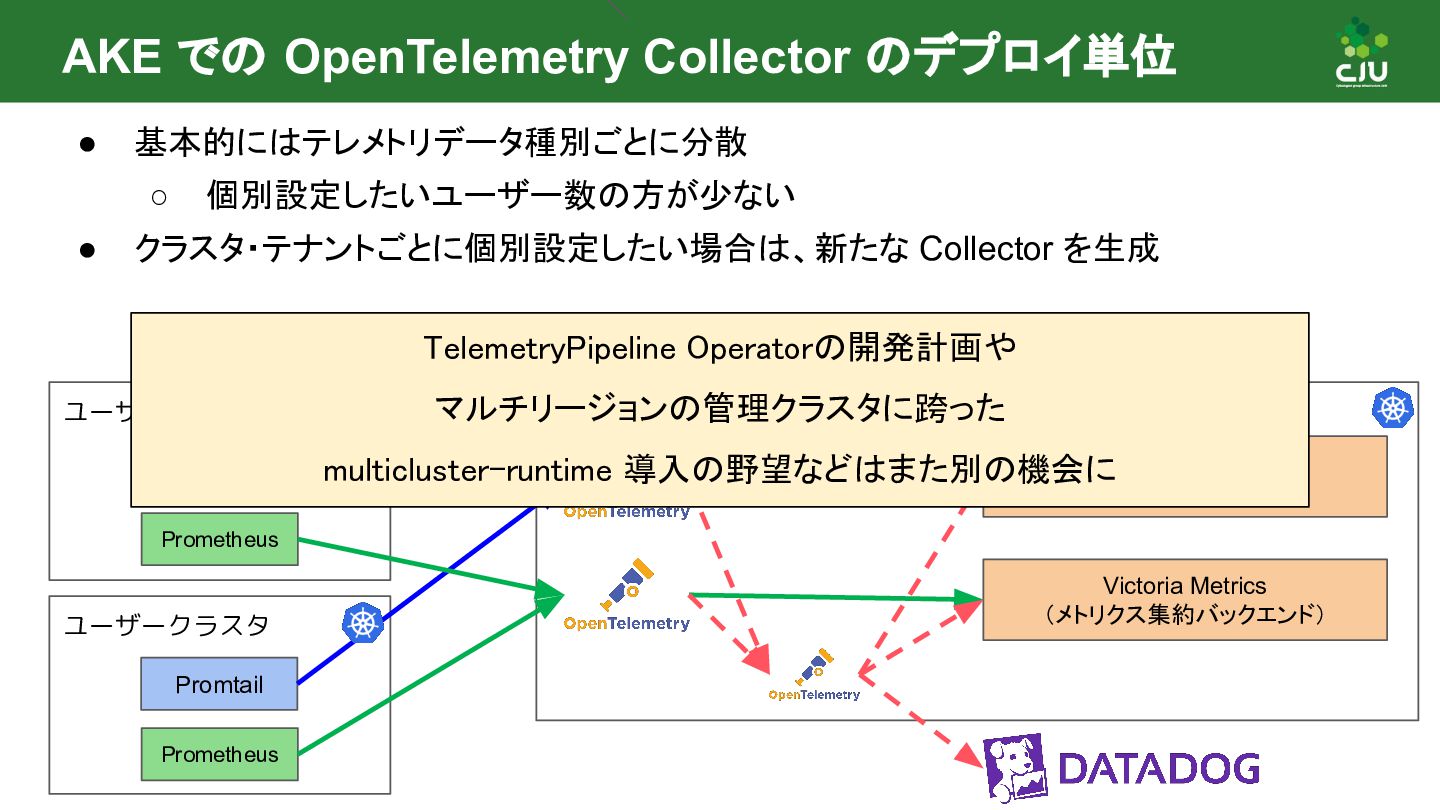
AKE での OpenTelemetry Collector のデプロイ単位 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki
(ログ集約バックエンド) ユーザークラスタ Promtail Prometheus ユーザークラスタ Promtail Prometheus • 基本的にはテレメトリデータ種別ごとに分散 ◦ 個別設定したいユーザー数の方が少ない • クラスタ・テナントごとに個別設定したい場合は、新たな Collector を生成 ◦ ユーザーに対して自由度の高い状態、課金形態との相性から決定 -
AKE での OpenTelemetry Collector のデプロイ単位 管理クラスタ Victoria Metrics (メトリクス集約バックエンド) Loki
(ログ集約バックエンド) ユーザークラスタ Promtail Prometheus ユーザークラスタ Promtail Prometheus • 基本的にはテレメトリデータ種別ごとに分散 ◦ 個別設定したいユーザー数の方が少ない • クラスタ・テナントごとに個別設定したい場合は、新たな Collector を生成 TelemetryPipeline Operatorの開発計画や マルチリージョンの管理クラスタに跨った multicluster-runtime 導入の野望などはまた別の機会に -
Thank you for your attention. CIU では 新しい技術を使ってより良いクラウド を 一緒に作ってくれる方を募集しています!
2025/11/18 CloudNative Days Winter 2025 -
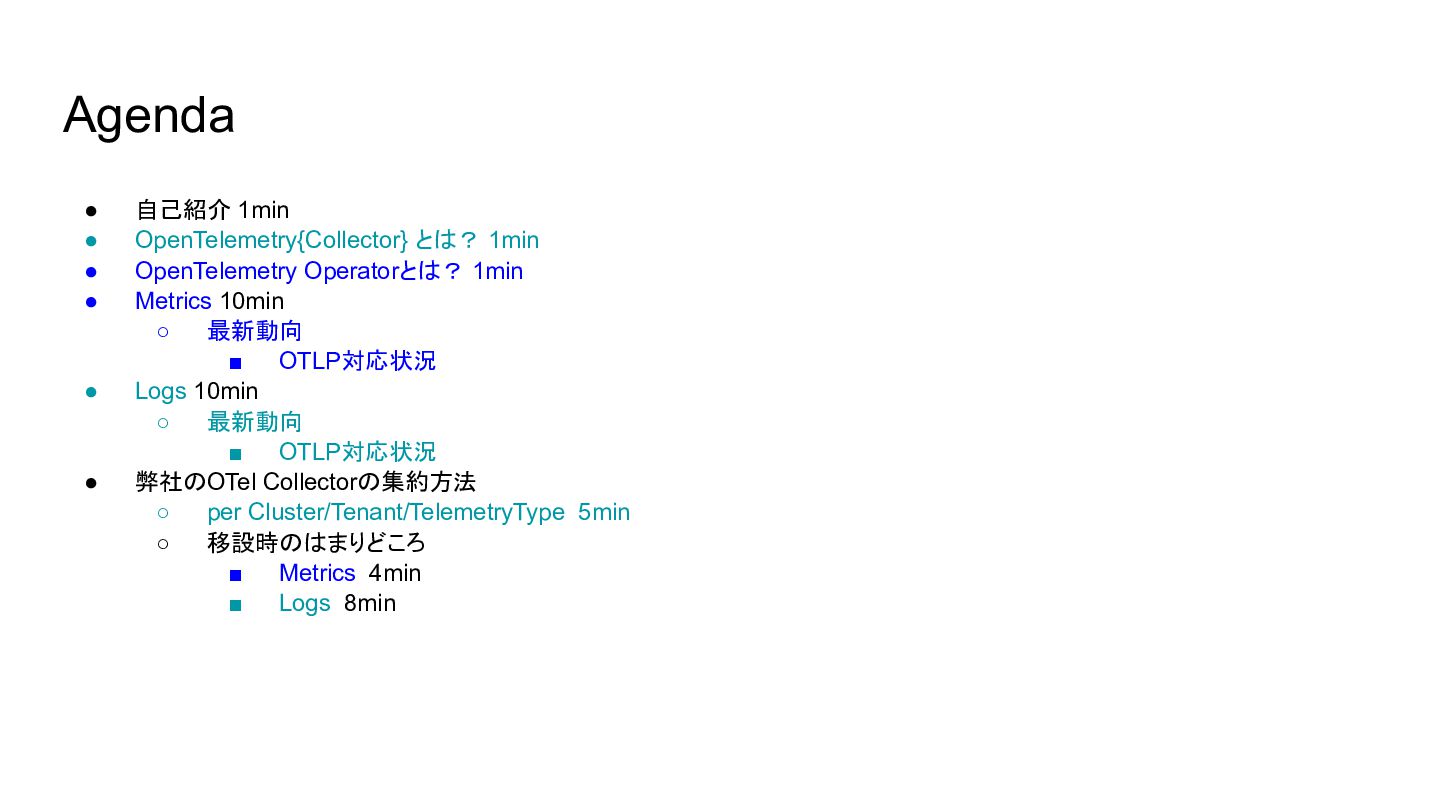
Agenda • 自己紹介 1min • OpenTelemetry{Collector} とは? 1min • OpenTelemetry
Operatorとは? 1min • Metrics 10min ◦ 最新動向 ▪ OTLP対応状況 • Logs 10min ◦ 最新動向 ▪ OTLP対応状況 • 弊社のOTel Collectorの集約方法 ◦ per Cluster/Tenant/TelemetryType 5min ◦ 移設時のはまりどころ ▪ Metrics 4min ▪ Logs 8min -
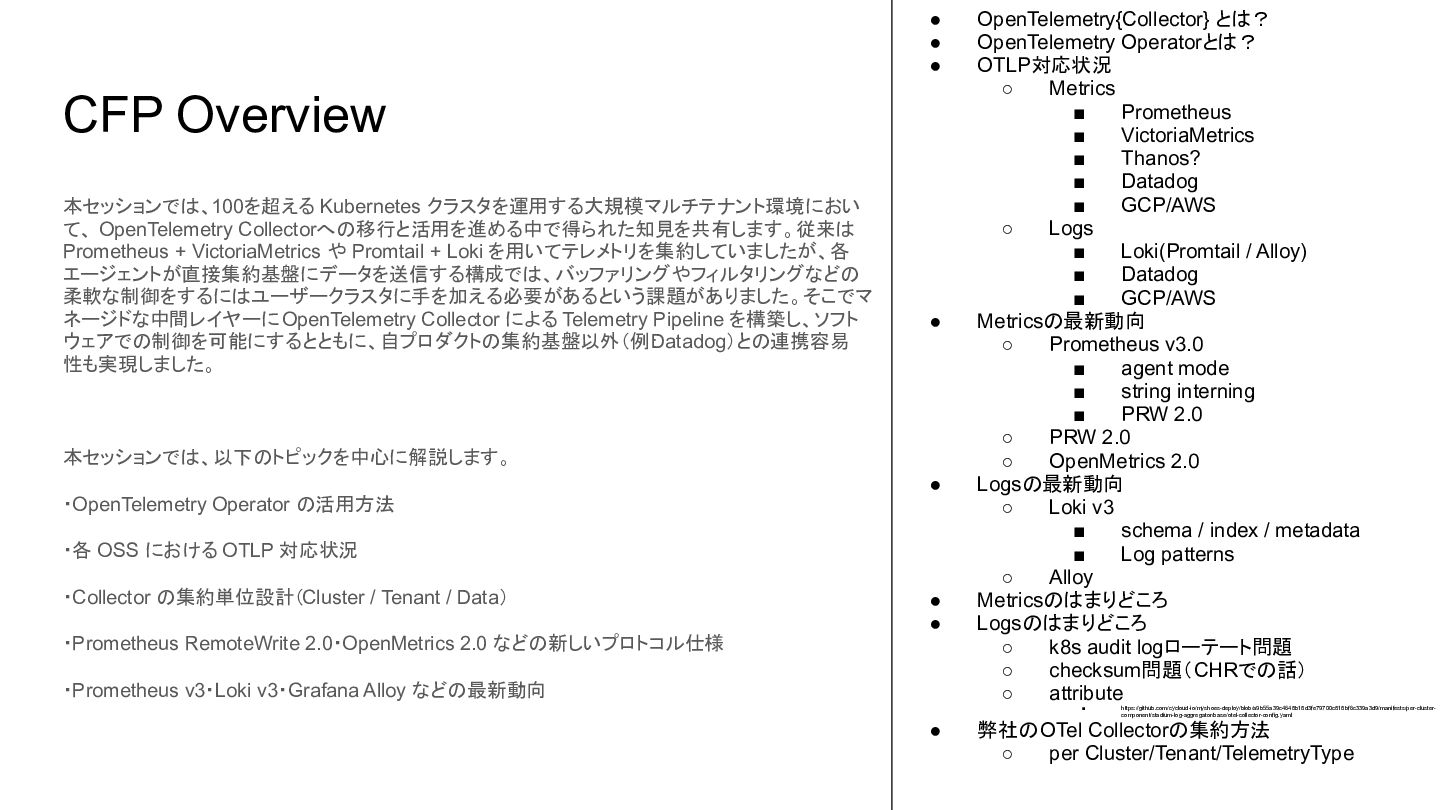
CFP Overview 本セッションでは、100を超える Kubernetes クラスタを運用する大規模マルチテナント環境におい て、 OpenTelemetry Collectorへの移行と活用を進める中で得られた知見を共有します。従来は Prometheus +
VictoriaMetrics や Promtail + Loki を用いてテレメトリを集約していましたが、各 エージェントが直接集約基盤にデータを送信する構成では、バッファリングやフィルタリングなどの 柔軟な制御をするにはユーザークラスタに手を加える必要があるという課題がありました。そこでマ ネージドな中間レイヤーに OpenTelemetry Collector による Telemetry Pipeline を構築し、ソフト ウェアでの制御を可能にするとともに、自プロダクトの集約基盤以外(例: Datadog)との連携容易 性も実現しました。 本セッションでは、以下のトピックを中心に解説します。 ・OpenTelemetry Operator の活用方法 ・各 OSS における OTLP 対応状況 ・Collector の集約単位設計(Cluster / Tenant / Data) ・Prometheus RemoteWrite 2.0・OpenMetrics 2.0 などの新しいプロトコル仕様 ・Prometheus v3・Loki v3・Grafana Alloy などの最新動向 • OpenTelemetry{Collector} とは? • OpenTelemetry Operatorとは? • OTLP対応状況 ◦ Metrics ▪ Prometheus ▪ VictoriaMetrics ▪ Thanos? ▪ Datadog ▪ GCP/AWS ◦ Logs ▪ Loki(Promtail / Alloy) ▪ Datadog ▪ GCP/AWS • Metricsの最新動向 ◦ Prometheus v3.0 ▪ agent mode ▪ string interning ▪ PRW 2.0 ◦ PRW 2.0 ◦ OpenMetrics 2.0 • Logsの最新動向 ◦ Loki v3 ▪ schema / index / metadata ▪ Log patterns ◦ Alloy • Metricsのはまりどころ • Logsのはまりどころ ◦ k8s audit logローテート問題 ◦ checksum問題(CHRでの話) ◦ attribute ▪ https://github.com/cycloud-io/myshoes-deploy/blob/a9b55a39c4648b18d3fe79700c818bf6c339a3d9/manifests/per-cluster- component/stadium-log-aggregator/base/otel-collector-config.yaml • 弊社のOTel Collectorの集約方法 ◦ per Cluster/Tenant/TelemetryType -
kimura memo Logs のはまりどころ - k8s audit log ローテート問題 -
checksum 問題 - chr で全てのファイルで同じ文字列の始まりだと送らない問題があった - Loki の label が resource attribute じゃないと置換できない問題
 kkk777
 holman
 marcelosomers
 addyosmani
 iamctodd
 akademiya2063
 oripsolob
 stephaniewalter
 jonoalderson
 tmiket
 greggifford
 mkilby
 csswizardry