Generative Models 2025
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed
Generative Models 2025
2025年6月5日に大阪大学大学院 情報科学研究科で行った「情報科学特別講義Ⅰ」の講義資料です。
https://www.ist.osaka-u.ac.jp/japanese/news/newsDetailInfoCourse.php?id=440

Hiroshi Takahashi
June 05, 2025
Transcript
158 slides
-
1 Copyright 2025 NTT CORPORATION ⾃⼰紹介 • 名前 ⾼橋 ⼤志
(たかはし ひろし) • 経歴 • 2009.4 – 2015.3 東京⼯業⼤学 (学⼠・修⼠) • 2020.4 – 2023.3 京都⼤学 (博⼠) • 2015.4 – 現在 NTT • 研究分野 ⽣成モデル・異常検知 Variational Autoencoder (VAE) や 拡散モデルの研究をしています -
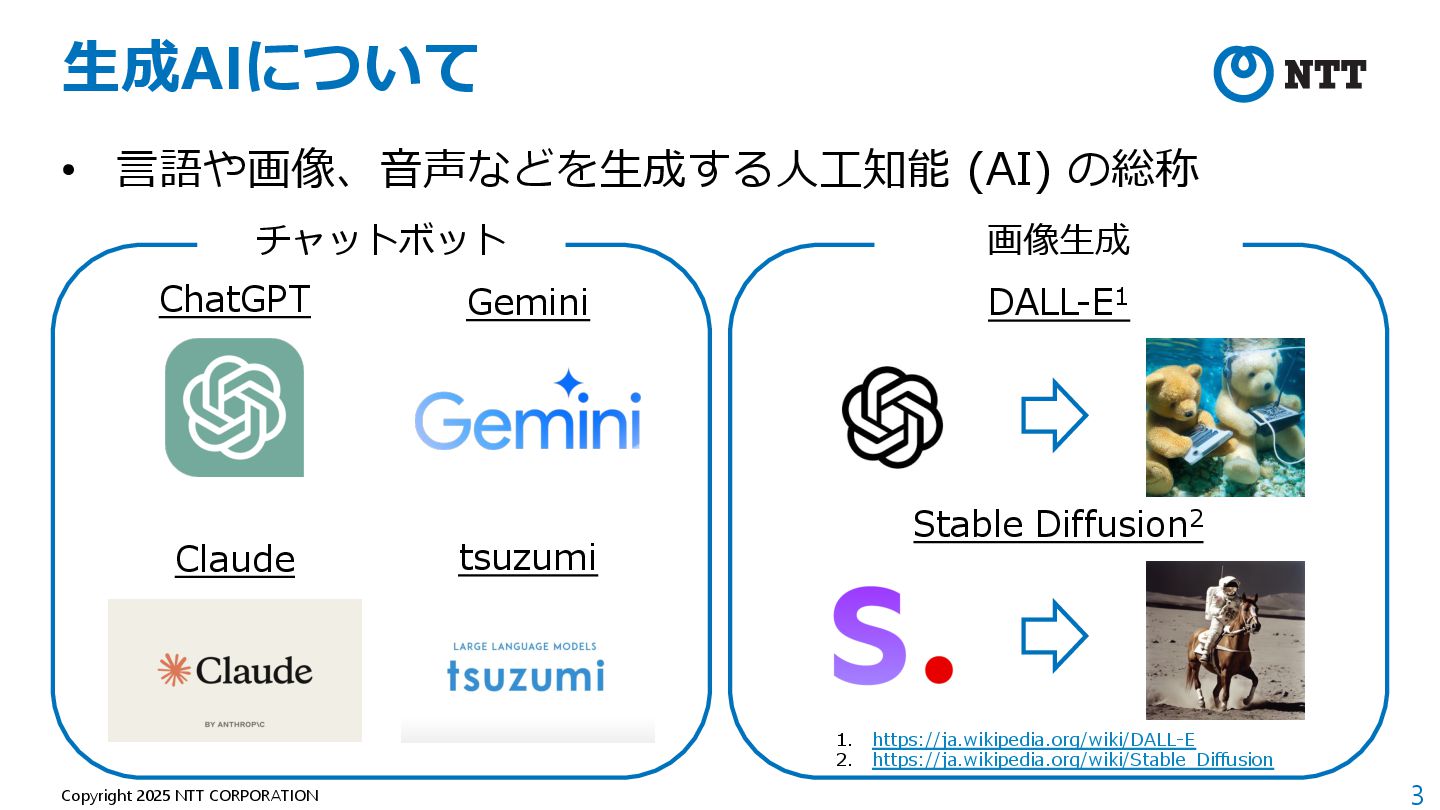
3 Copyright 2025 NTT CORPORATION ⽣成AIについて • ⾔語や画像、⾳声などを⽣成する⼈⼯知能 (AI) の総称
チャットボット 画像⽣成 DALL-E1 Stable Diffusion2 ChatGPT Gemini Claude tsuzumi 1. https://ja.wikipedia.org/wiki/DALL-E 2. https://ja.wikipedia.org/wiki/Stable_Diffusion -
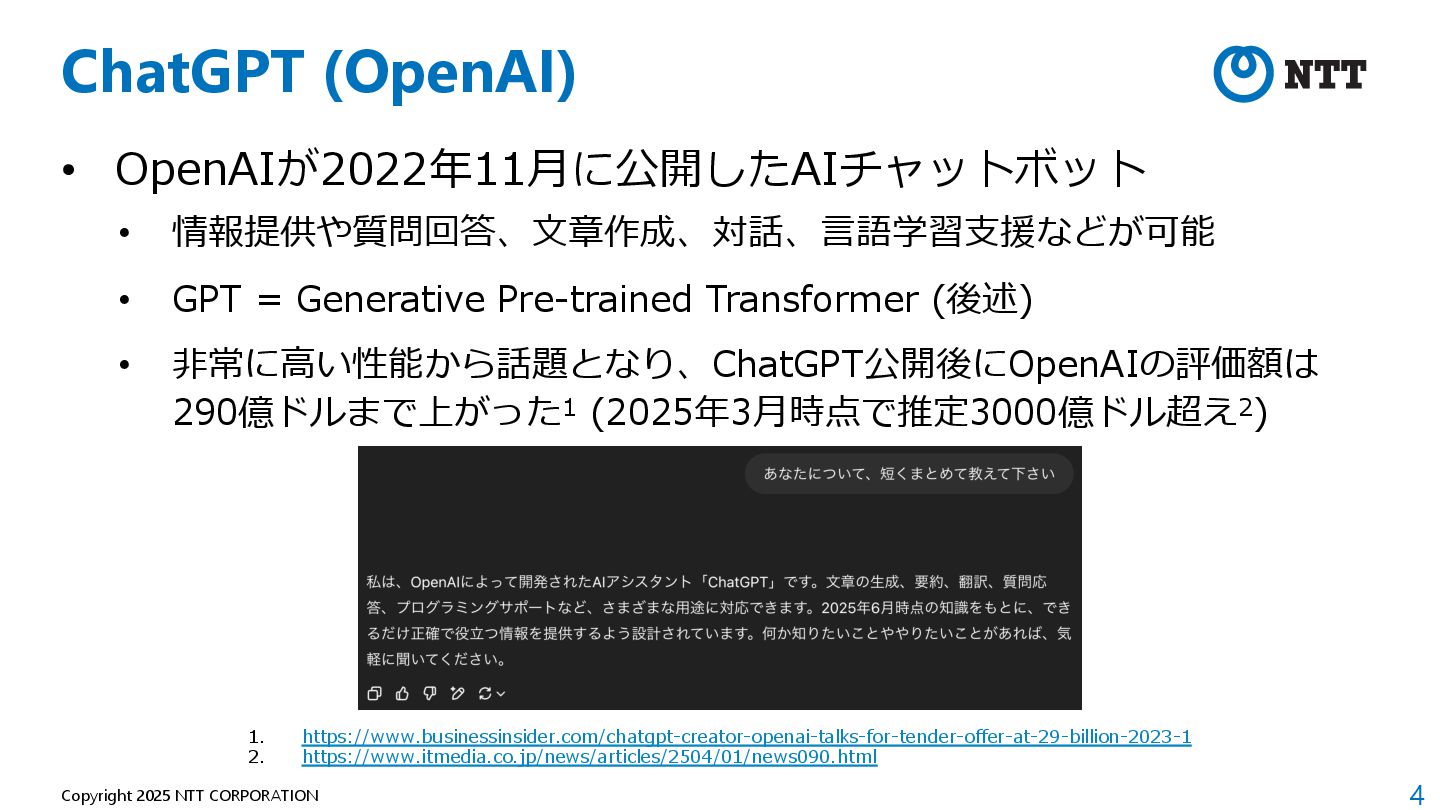
4 Copyright 2025 NTT CORPORATION ChatGPT (OpenAI) • OpenAIが2022年11⽉に公開したAIチャットボット •
情報提供や質問回答、⽂章作成、対話、⾔語学習⽀援などが可能 • GPT = Generative Pre-trained Transformer (後述) • ⾮常に⾼い性能から話題となり、ChatGPT公開後にOpenAIの評価額は 290億ドルまで上がった1 (2025年3⽉時点で推定3000億ドル超え2) 1. https://www.businessinsider.com/chatgpt-creator-openai-talks-for-tender-offer-at-29-billion-2023-1 2. https://www.itmedia.co.jp/news/articles/2504/01/news090.html -
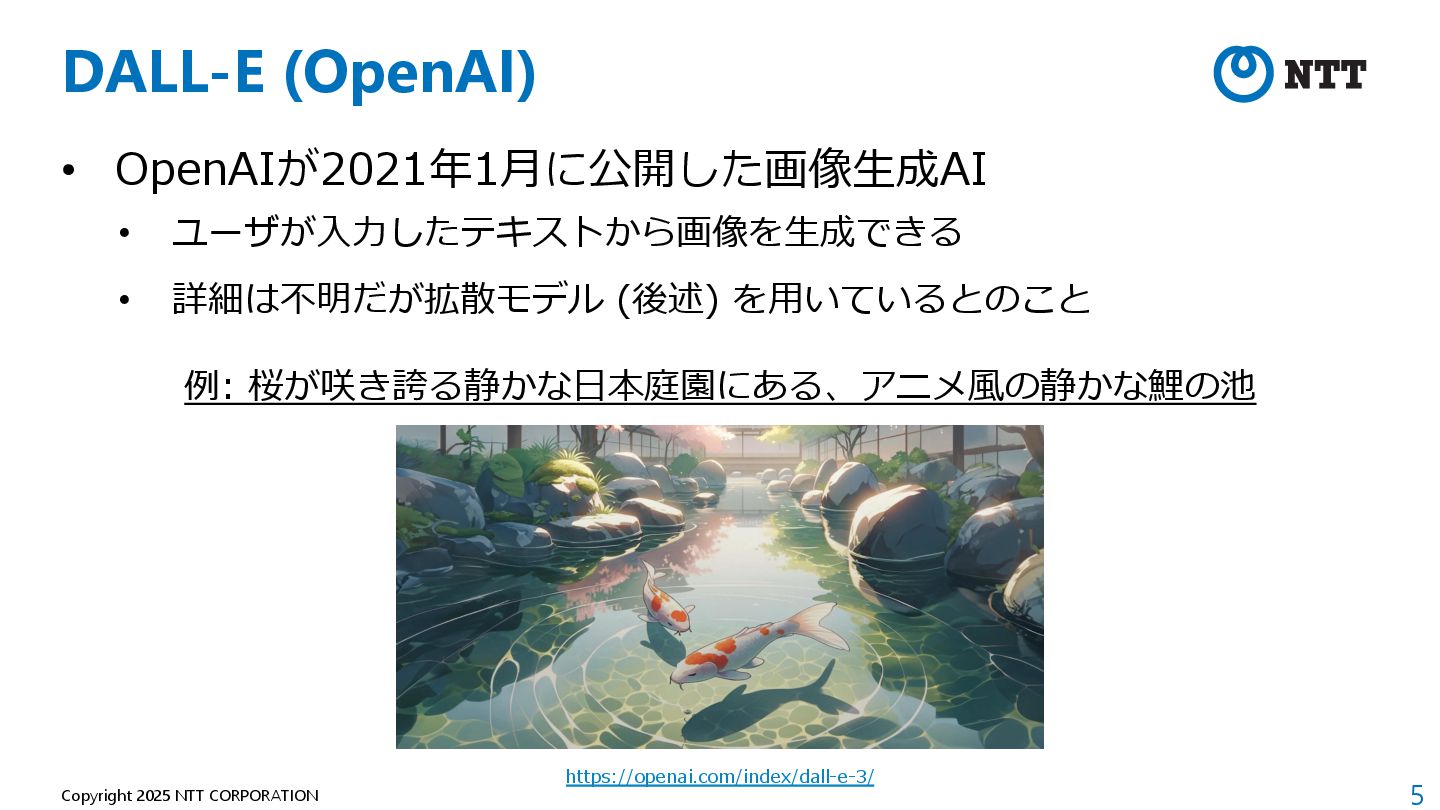
5 Copyright 2025 NTT CORPORATION DALL-E (OpenAI) • OpenAIが2021年1⽉に公開した画像⽣成AI •
ユーザが⼊⼒したテキストから画像を⽣成できる • 詳細は不明だが拡散モデル (後述) を⽤いているとのこと https://openai.com/index/dall-e-3/ 例: 桜が咲き誇る静かな⽇本庭園にある、アニメ⾵の静かな鯉の池 -
6 Copyright 2025 NTT CORPORATION 本講義の狙い • ⽣成AIは研究開発のスピードが⾮常に速く、キャッチアップが 難しい •
2025年現在、数週間ごとに⼤きな進化が起こっている • その⼀⽅で、⽣成AIの基礎となっている部分は昔からほとんど 変わっていない • 本講義で最初に説明する最尤推定は1912年頃から研究されている • 本講義は、⽣成AIの基礎と応⽤を学び、将来的な⽣成AIの研究 開発の⼀助となることを⽬指す • 最先端の⽣成AIの⼀歩⼿前までの内容を取り扱う -
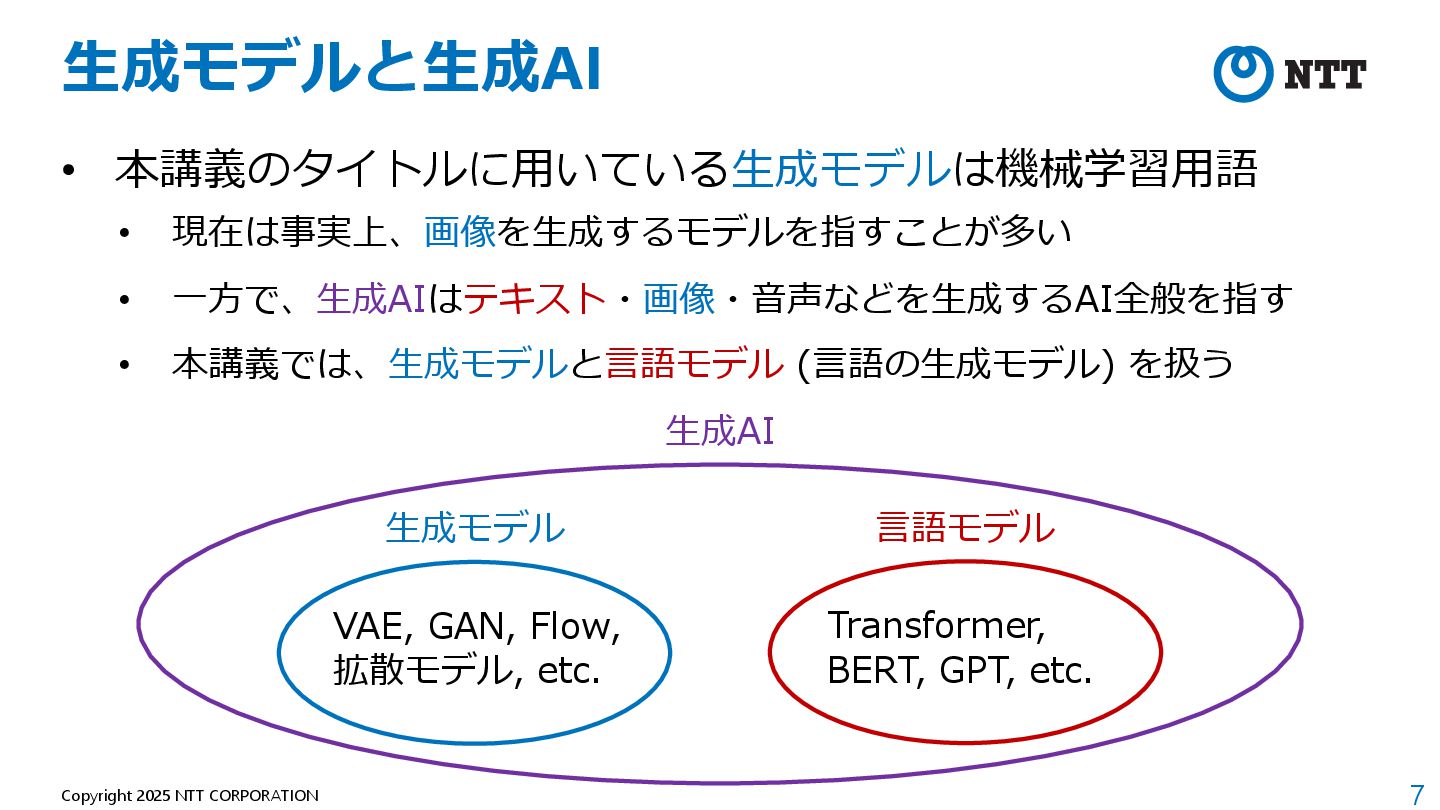
7 Copyright 2025 NTT CORPORATION ⽣成モデルと⽣成AI • 本講義のタイトルに⽤いている⽣成モデルは機械学習⽤語 • 現在は事実上、画像を⽣成するモデルを指すことが多い
• ⼀⽅で、⽣成AIはテキスト・画像・⾳声などを⽣成するAI全般を指す • 本講義では、⽣成モデルと⾔語モデル (⾔語の⽣成モデル) を扱う ⽣成AI ⽣成モデル VAE, GAN, Flow, 拡散モデル, etc. ⾔語モデル Transformer, BERT, GPT, etc. -
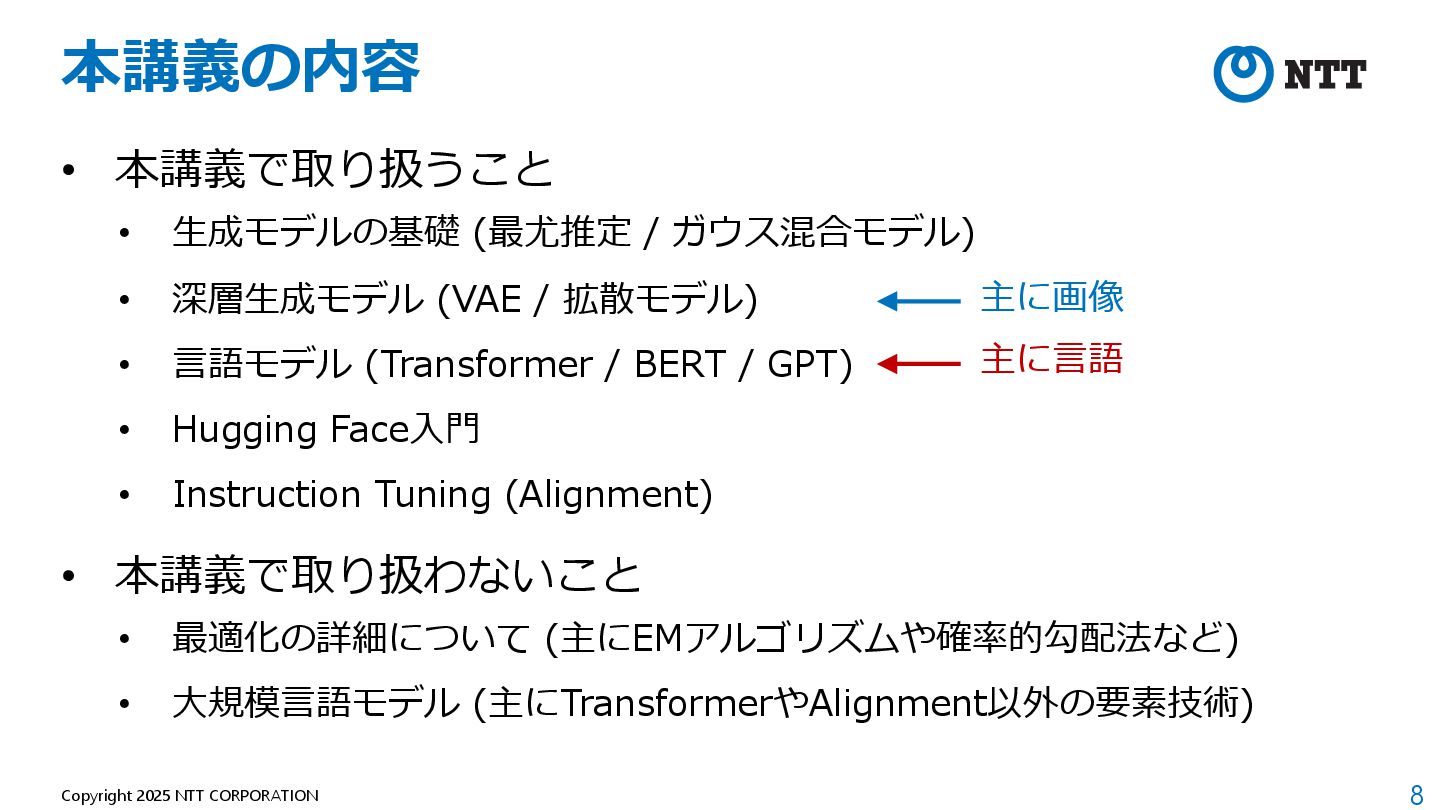
8 Copyright 2025 NTT CORPORATION 本講義の内容 • 本講義で取り扱うこと • ⽣成モデルの基礎
(最尤推定 / ガウス混合モデル) • 深層⽣成モデル (VAE / 拡散モデル) • ⾔語モデル (Transformer / BERT / GPT) • Hugging Face⼊⾨ • Instruction Tuning (Alignment) • 本講義で取り扱わないこと • 最適化の詳細について (主にEMアルゴリズムや確率的勾配法など) • ⼤規模⾔語モデル (主にTransformerやAlignment以外の要素技術) 主に画像 主に⾔語 -
9 Copyright 2025 NTT CORPORATION 講義を始める前に • 数式が多く出てきますが、すべて理解しようとしなくてOKです • 重要な数式は⽬⽴つようにします
• 講義中に質問する時間を多めに設けます • それ以外でも挙⼿や発声で⽌めていただいてOKです • PCやスマホなどで資料を⾒ながらお聞きください • 3時間と⻑い講義なので、各⾃のペースでお聞きください -
11 Copyright 2025 NTT CORPORATION ⽣成モデルについて • データから学習された確率分布のこと • 例えば、コインの裏表の確率は1/2で、サイコロの⽬の確率は1/6
• このようなデータが発⽣する「確率」を、データから学習したモデル • 確率分布が分かっていれば、新たなデータを「⽣成」できる • 本講義では、データが従う確率分布を、⽣成モデルで学習する⽅法を学ぶ • 本講義で扱う確率分布は下記の2つ: • データ 𝑥 の確率分布 𝑝(𝑥): コインやサイコロ等 • 出⼒ 𝑦 に対する条件付き確率分布 𝑝(𝑦|𝑥): Stable DiffusionやChatGPT等 • NOTE: データ 𝑥 や出⼒ 𝑦 はベクトルまたはスカラ (区別せずに表記) -
12 Copyright 2025 NTT CORPORATION 確率分布について • データ 𝑥 が発⽣する確率を表す関数
• 例えば、コインの表裏を表す確率は 𝑃 𝑥 = ) 0.5 (𝑥 = 表) 0.5 (𝑥 = 裏) • 離散値の場合は、0 ≤ 𝑃 𝑥 ≤ 1 かつ ∑! 𝑃(𝑥) = 1 をみたす • 連続値の場合は、確率密度関数 𝑝(𝑥) を考える • データ 𝑥 が 𝑎 以上 𝑏 以下である確率は 𝑃 𝑎 ≤ 𝑥 ≤ 𝑏 = ∫ " # 𝑝(𝑥) d𝑥 • 0 ≤ 𝑝 𝑥 < ∞ かつ ∫ $% % 𝑝(𝑥) d𝑥 = 1 をみたす • NOTE: 確率分布 𝑃 と確率密度関数 𝑝 は区別せずに表記 -
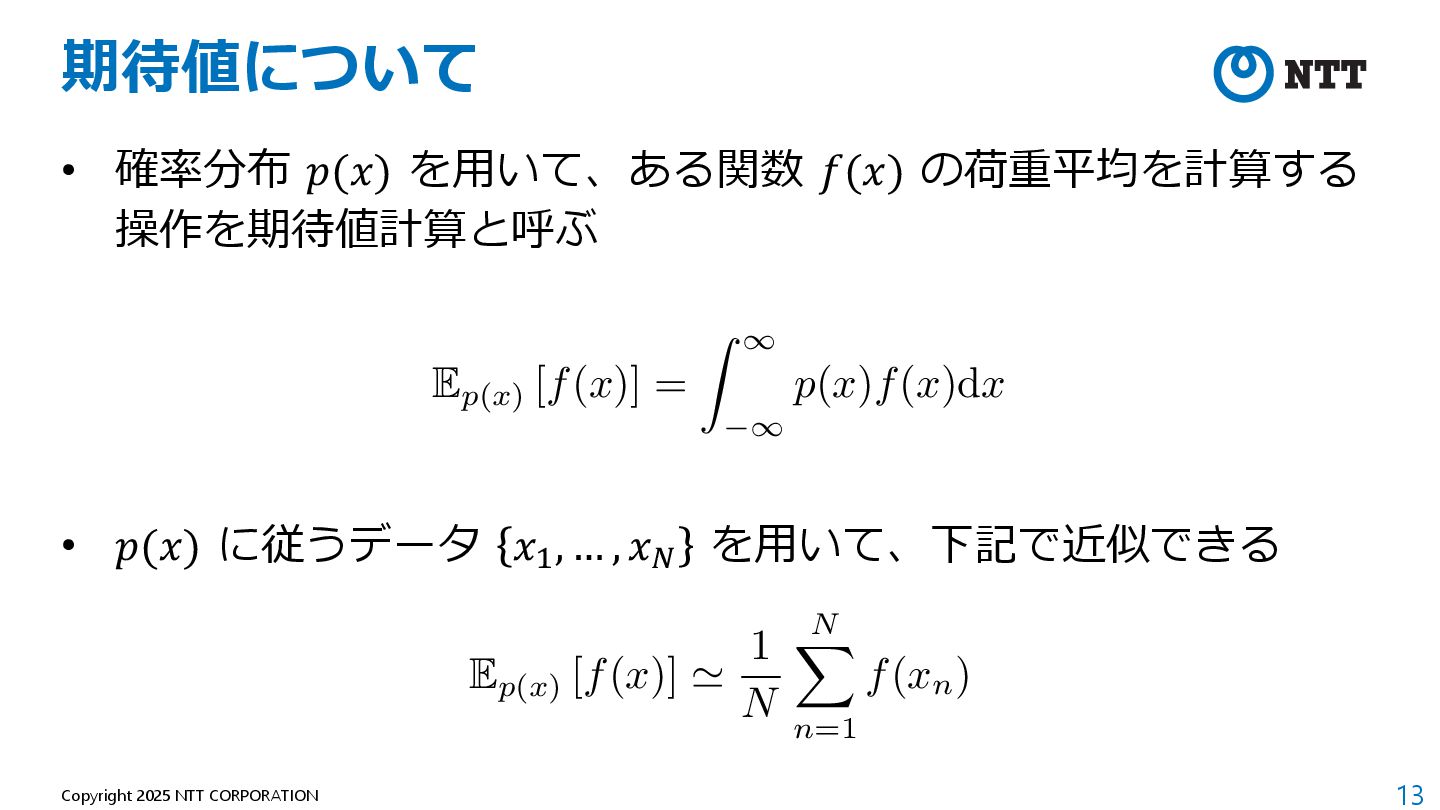
13 Copyright 2025 NTT CORPORATION 期待値について • 確率分布 𝑝(𝑥) を⽤いて、ある関数
𝑓(𝑥) の荷重平均を計算する 操作を期待値計算と呼ぶ • 𝑝(𝑥) に従うデータ 𝑥! , … , 𝑥" を⽤いて、下記で近似できる <latexit sha1_base64="1RcPDoBWH2ppj3FPir/TrdmPry8=">AAADgXicnVJNa9RQFL3T+NGO1k51U3BTHFpa0eFNkSqKUPwAN9Ivpy1MpiFJXzKP5ovkzTBjyB/wD7hwpeBCXPsL3PgHXBS3uhCXLXTjwvOSoOhQBV9I3nkn95x73+VakScSydhBZUw7dfrM2fGJ6rnzkxematMXt5KwF9u8ZYdeGO9YZsI9EfCWFNLjO1HMTd/y+La1f1/93+7zOBFh8EQOI97xTTcQjrBNCcqoreq+KbuWlT7MjDRaGCxmuscd2XYA9Vi4XdmZv6uLQBrpdWyOHGa7aQlUeB6nLGI/3csGVaNWZw2Wr9lR0CxBncq1Fk5XJkmnPQrJph75xCkgCeyRSQmeNjWJUQSuQym4GEjk/zllVIW2hyiOCBPsPr4uTu2SDXBWnkmutpHFwxtDOUtz7CN7ww7ZB/aWfWXfT/RKcw9VyxC7VWh5ZEw9m9k8/qfKxy6p+0v115olOXQrr1Wg9ihn1C3sQt9/+vxw8/bGXDrPXrFvqP8lO2DvcYOgf2S/XucbL+Cu/B9AVfQwBnpc1rAKRw5GnVQXriKPnse4qFNlzMoeu+Cv/eT+19GkwYhjwZ3cNRtI3ZcjV4Zpav45O6Nga6nRXG4sr9+or9wr52qcLtMVWsDs3KQVekRr1ILnO/pEn+mLpmmLGtOWitCxSqm5RL8t7c4PHPTP/g==</latexit> E p(x) [f(x)] = → ↑→ p(x)f(x)dx <latexit sha1_base64="0pfa1yRJm/+qoPugimcKd6JTsRM=">AAADfXicnVJNa9RQFL0z8aOO1k51I7gpDlNaKcOLSCuCUPwAQdR+OG1hMoYkvmQezZfJm6E15A/4B1y4UnAhrvwNbvwDIt3pUlxWcCPoeUlQdKiCLyQ597x7zrvvcu3YF6lkbK9W1w4dPnJ04ljj+InJk1PN6VMbaTRMHN51Ij9Ktmwr5b4IeVcK6fOtOOFWYPt8096+pvY3RzxJRRTek7sx7weWFwpXOJYEZTZvGYElB7ad3cjNLJ7bmc8Nn7uy5wIaifAGsj9rpCLgDw03sZxMz7M7uZEOAzMLr+j5fURIRZDPN8xmi3VYsWbGgV6BFlVrJZquTZJBDygih4YUEKeQJLBPFqV4eqQToxhcnzJwCZAo9jnl1IB2iCyODAvsNr4eol7FhoiVZ1qoHZzi402gnKE2e8desn32lr1in9i3A72ywkPVsou/XWp5bE49PrP+9Z+qAH9Jg1+qv9YsyaVLRa0CtccFo27hlPrRoyf765fX2tkse84+o/5nbI+9wQ3C0RfnxSpfewp35X8dqrKHCdDtqoa7cORgVKS6cB7nGEWOhzrViXnVYw/8wk/ufx0t2hlzLLmDu+YAqftynJVjmvQ/Z2ccbFzo6IudxdWLreWr1VxN0Fk6R3OYnSVappu0Ql14vqb39IE+1r9rbW1B65Sp9VqlOU2/LW3pB+Oxz0g=</latexit> E p(x) [f(x)] → 1 N N n=1 f(xn) -
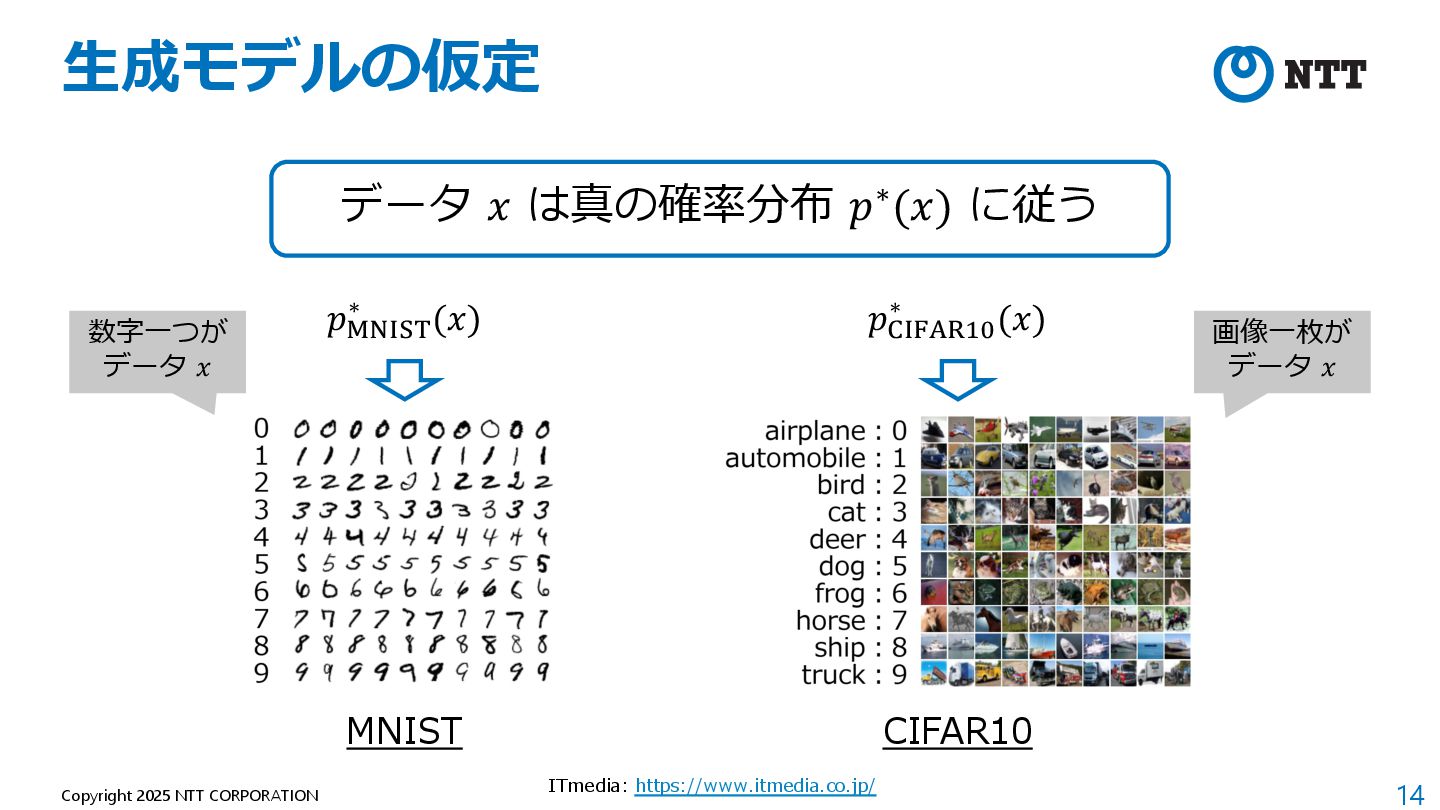
14 Copyright 2025 NTT CORPORATION ⽣成モデルの仮定 データ 𝑥 は真の確率分布 𝑝∗(𝑥)
に従う 𝑝&'()* ∗ (𝑥) 𝑝,(-./01 ∗ (𝑥) MNIST CIFAR10 ITmedia: https://www.itmedia.co.jp/ 数字⼀つが データ 𝑥 画像⼀枚が データ 𝑥 -
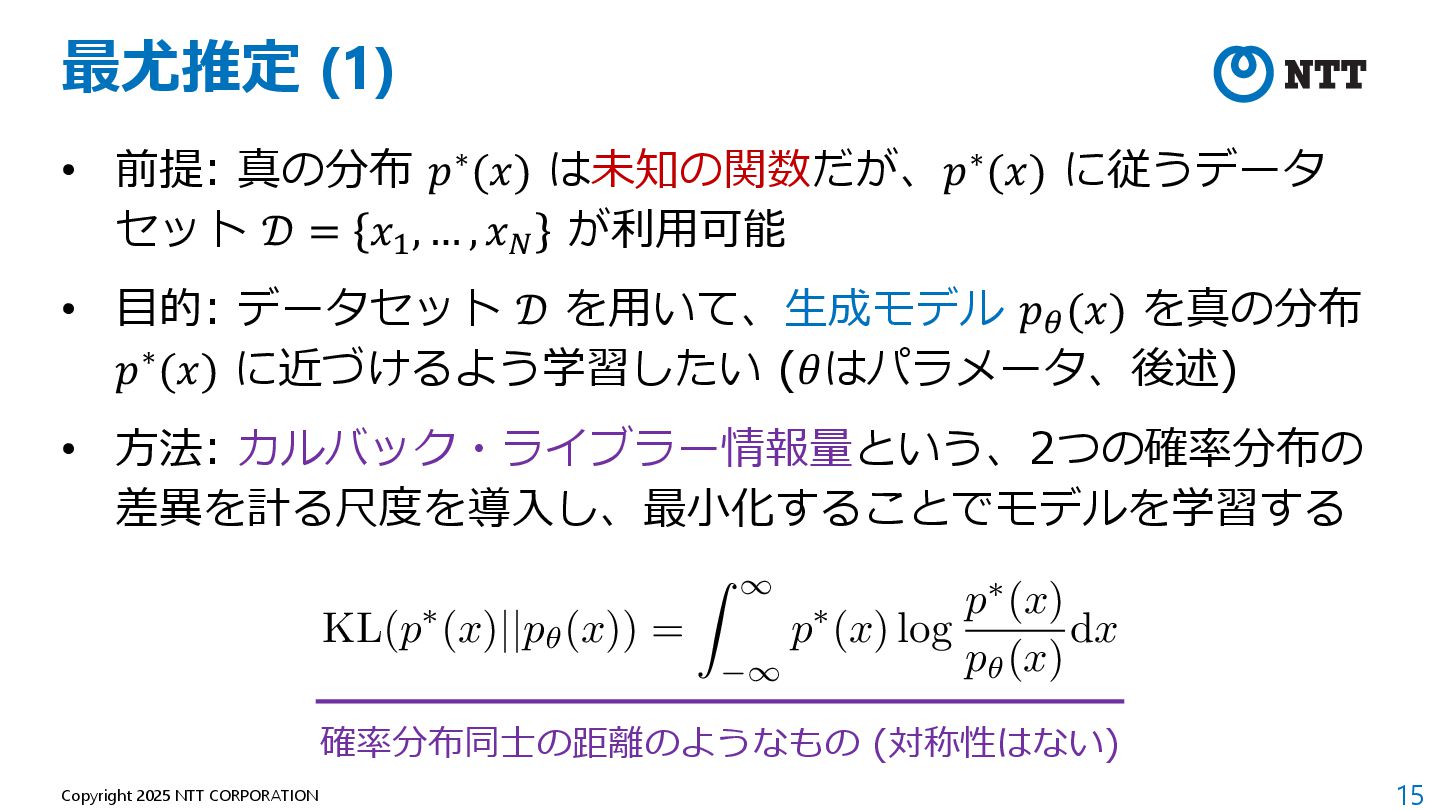
15 Copyright 2025 NTT CORPORATION 最尤推定 (1) • 前提: 真の分布
𝑝∗(𝑥) は未知の関数だが、𝑝∗(𝑥) に従うデータ セット 𝒟 = 𝑥! , … , 𝑥" が利⽤可能 • ⽬的: データセット 𝒟 を⽤いて、⽣成モデル 𝑝$ (𝑥) を真の分布 𝑝∗(𝑥) に近づけるよう学習したい (𝜃はパラメータ、後述) • ⽅法: カルバック・ライブラー情報量という、2つの確率分布の 差異を計る尺度を導⼊し、最⼩化することでモデルを学習する 確率分布同⼠の距離のようなもの (対称性はない) <latexit sha1_base64="F9CO4wxgrOzh2bHxQwRZvSn+Jm8=">AAADfnicnVLdahNBFD7p+pPGn0Z7I3hTDA1psXEi0hZBKOqFoNI/0xa67TK7nWyG7h+zk5A43RfwBXrRKwUvxMfwxhfwIo9QvKwgiKBndjdKDSp0lt0555vzfefb4diRx2NJyKAwZpw7f+Ficbx06fKVqxPla9c34rAjHNZ0Qi8UWzaNmccD1pRcemwrEoz6tsc27f1H+nyzy0TMw+CF7Edsx6duwFvcoRIhqxybPpVt4aunz5JatKtmk1pv5uAgspQp20xSnc5UH5g8kJaaw60l+8muyoMhwfRC12wJ6qghkqhTEsmwzV7SK1nlCqmTdE2NBo08qEC+VsLyNzBhD0JwoAM+MAhAYuwBhRifbWgAgQixHVCICYx4es4ggRJyO1jFsIIiuo9fF7PtHA0w15pxynawi4evQOYUTJNP5B05IR/Je3JMvv9VS6Ua2ksfdzvjssiaeHVj/et/WT7uEtq/Wf/0LKEFi6lXjt6jFNF/4WT87svDk/X7a9OqSt6Qz+j/NRmQD/gHQfeL83aVrR2hutZ/jKzsDgVGz3MPy6jIENGZvoVZ7GOmNS761B2T/I5dxG//ws6qSKE3ophhekwafw7FaLBxt96Yr8+v3qssPcwHpgg34RbUcCoWYAmewAo00dcAfhSKhXEDjKoxZ9zJSscKOWcSTi1j8SfDw9XI</latexit> KL(p⇤(x)||p✓(x)) = Z 1 1 p⇤(x) log p⇤(x) p✓(x) dx -
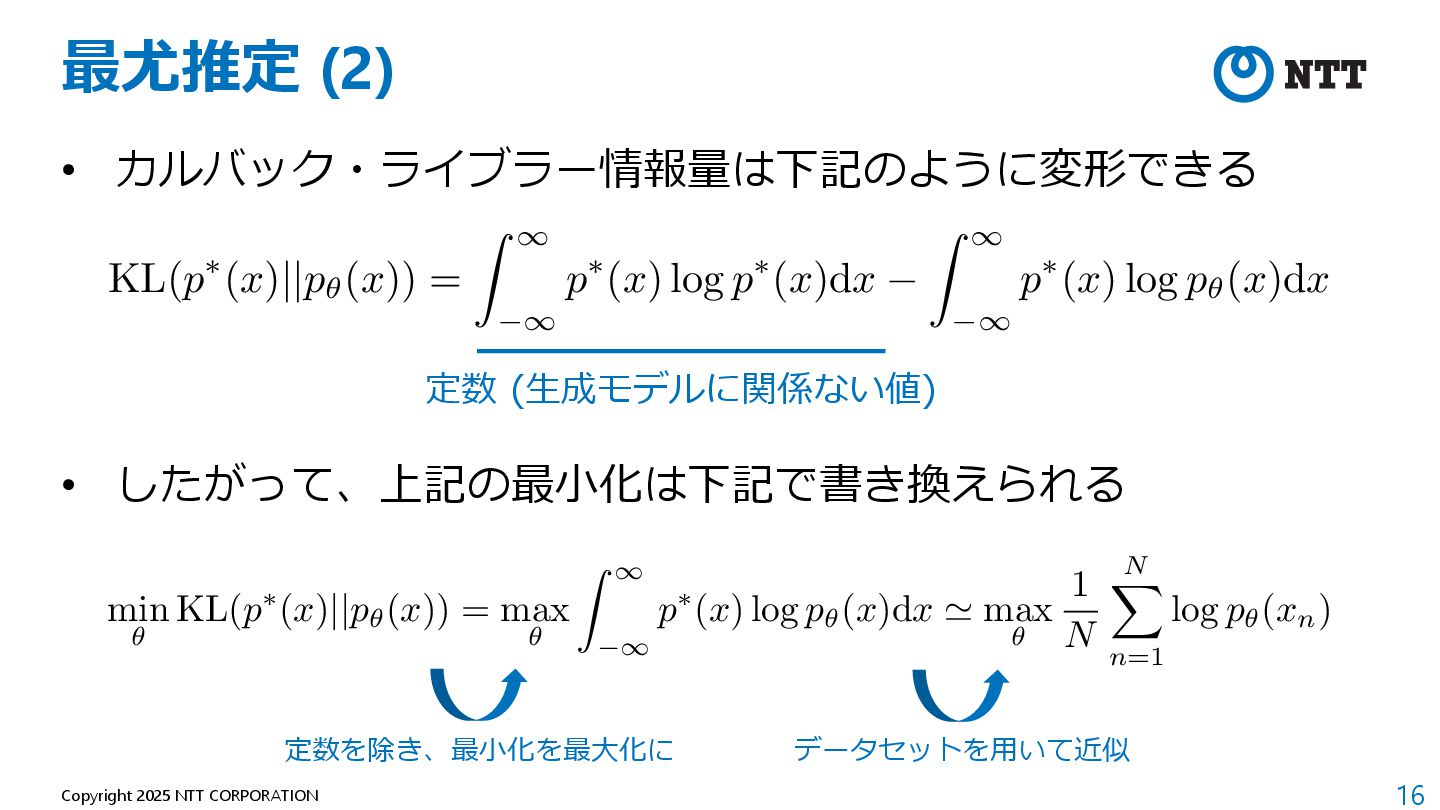
16 Copyright 2025 NTT CORPORATION 最尤推定 (2) • カルバック・ライブラー情報量は下記のように変形できる •
したがって、上記の最⼩化は下記で書き換えられる 定数 (⽣成モデルに関係ない値) 定数を除き、最⼩化を最⼤化に データセットを⽤いて近似 <latexit sha1_base64="kFPFWdBThJaNI6SLjm+pPUKthis=">AAADpnicnVLLbtNAFL2uebTh0dBuKrGJiFrSikZjhNoKCakCFkg8+iJNpbo1Y3fijOqX7EmU4PoH+AEWXYHEAvEZbPgBFv0E1GWRkBAL7thDKURQxFj23HvmnnOPR9eOPJ4IQg60If3M2XPnh0dKFy5eujxavjK2noSd2GENJ/TCeMOmCfN4wBqCC49tRDGjvu2xpr17T543uyxOeBg8Ff2IbfnUDXiLO1QgZJX3TZ+KduynDx9ltWg7nclqvem9vchKTdFmgsp0euqOyQNhpbO4tUQ/205V8INgeqFbOU6U4k7Wm/0n3sleJ8glq1wldZKvymBgqKAKai2H5a9gwg6E4EAHfGAQgMDYAwoJPptgAIEIsS1IEYsx4vk5gwxKyO1gFcMKiugufl3MNhUaYC41k5ztYBcP3xiZFZgkH8lbckQ+kHfkE/n2R60015Be+rjbBZdF1uiLibUvp7J83AW0f7L+6llACxZyrxy9Rzki/8Ip+N3nL4/Wbq9OplPkNTlE/6/IAXmPfxB0PztvVtjqPqpL/fvIKu4wxuix8rCEigwRmclbmME+Zl7jok/ZMVN37CJ+4xj7X0UKvQHFApNjYvw+FIPB+s26MVefW7lVXbyrBmYYrsI1qOFUzMMiPIBlaICjadp1jWiGXtOf6A29WZQOaYozDr8s/dl3mXnkfA==</latexit> KL(p⇤(x)||p✓(x)) = Z 1 1 p⇤(x) log p⇤(x)dx Z 1 1 p⇤(x) log p✓(x)dx <latexit sha1_base64="YSdoxOtWeF/RDSW5OY9vHDy6hjI=">AAADynicnVJLaxRBEK7J+IjrI6teBC+Ly4bdoEuPSBQhENSDkKh5bRLIJEPPpHe2ybzs6V127czNk3/AgycFD+KP8ODFP+AhP0E8RhDEgzWPJGwWDdjDdFd9Vd9X1U3ZkcdjScieNqafOn3m7Pi50vkLFy9NlC9fWY3DrnBYywm9UKzbNGYeD1hLcumx9Ugw6tseW7N3HqbxtR4TMQ+DFTmI2KZP3YC3uUMlQlb5k+nzwFKm7DBJE9OnsiN8NTef1KMtNZXU+43d3egwjm5jcgaz+kcUHkhL3cKjLQfJliqMA7bphW5lSOCgxnbSN2Pus+fDcm1BHWUk6mlixl3fUsGMgaroHRfCUNIoWeUqaZJsVUYNozCqUKyFsPwLTNiGEBzogg8MApBoe0Ahxm8DDCAQIbYJCjGBFs/iDBIoIbeLWQwzKKI7uLvobRRogH6qGWdsB6t4+AtkVqBGvpIPZJ98IR/JN/L7r1oq00h7GeBp51wWWROvri3/PJHl4ymhc8T6Z88S2nAv65Vj71GGpLdwcn7vxev95ftLNTVJ3pHv2P9bskc+4w2C3g/n/SJbeoPqqf4jZOVvKNB6UvTwDBUZIqmXvsIU1jGzHBf7TCsmxRu7iN88xP5XkUJ/RDHH0jExjg/FqLF6u2lMN6cX71RnHxQDMw7X4QbUcSruwiw8hgVogaPVtDltRWvp87rQB7rKU8e0gnMVhpb+8g9fZPVv</latexit> min ✓ KL(p⇤(x)||p✓(x)) = max ✓ Z 1 1 p⇤(x) log p✓(x)dx ' max ✓ 1 N N X n=1 log p✓(xn) -
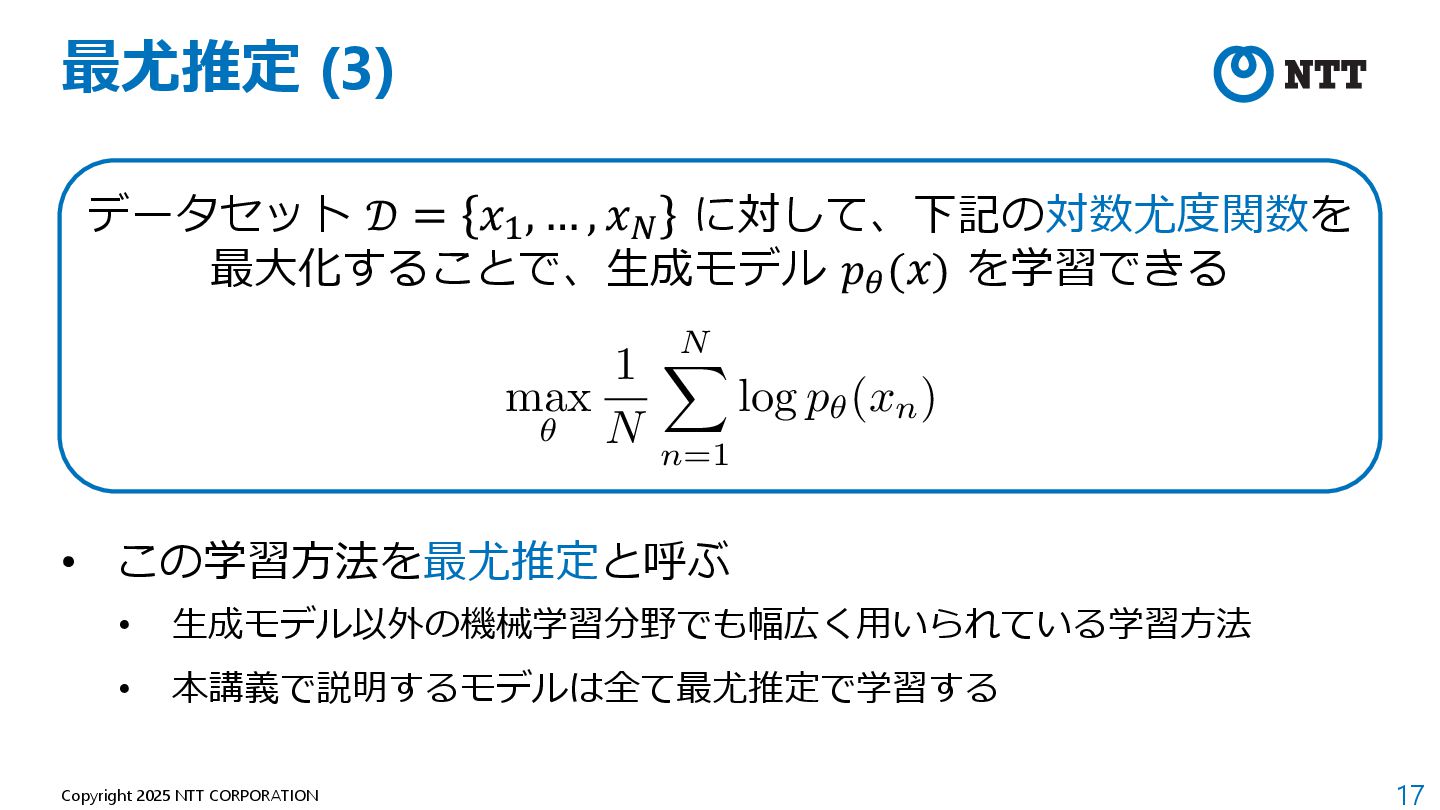
17 Copyright 2025 NTT CORPORATION 最尤推定 (3) • この学習⽅法を最尤推定と呼ぶ •
⽣成モデル以外の機械学習分野でも幅広く⽤いられている学習⽅法 • 本講義で説明するモデルは全て最尤推定で学習する データセット 𝒟 = 𝑥7, … , 𝑥8 に対して、下記の対数尤度関数を 最⼤化することで、⽣成モデル 𝑝$ (𝑥) を学習できる <latexit sha1_base64="I4MdGucLbIwF9iVghi2LKIfXplU=">AAADSHicnVJNT9VAFD0URXwoPHRj4uaFFwwa8zI1BowJCUEXbpAvH5BQbKZ1XmnoV9p5L0DTP+AfcOFKDQvjz2CDLiEs+AnGjQkmRMOCO22D0Rc1cZrO3HvmnjNnJteKPDeRjB31aL0XLvZd6r9cGbhydXCoOnxtKQnbsS2aduiF8YrFE+G5gWhKV3piJYoF9y1PLFsbj9T+ckfEiRsGz+RWJNZ87gRuy7W5JMisTho+3zRTQ64LyTOjFXM71bP0aWYkbd9Mg0k9e64yL3Rq0XndGFGC7HbFrNZZg+Wj1h3oZVBHOebC6g8YeIEQNtrwIRBAUuyBI6FvFToYIsLWkBIWU+Tm+wIZKsRtU5WgCk7oBs0OZaslGlCuNJOcbdMpHv0xMWsYZYfsPTtme+wD+8xO/6iV5hrKyxatVsEVkTn08sbiyT9ZPq0S6z9Zf/Us0cKD3KtL3qMcUbewC35n+9Xx4sOF0fQWe8u+kP837Ijt0g2Czjd7Z14svCZ1pf+YWMUbxhTNlB5mSVEQojL1CnfoHCOvccinOjEr39gh/O459r+KHJtdigWm2kT/vSm6g6V7DX28MT5/vz41XTZMP25iBGPUFROYwhPMoUm+3uEj9nGgfdK+aifa96JU6yk51/HL6NXOAPwAxWo=</latexit> max ✓ 1 N N X n=1 log p✓(xn) -
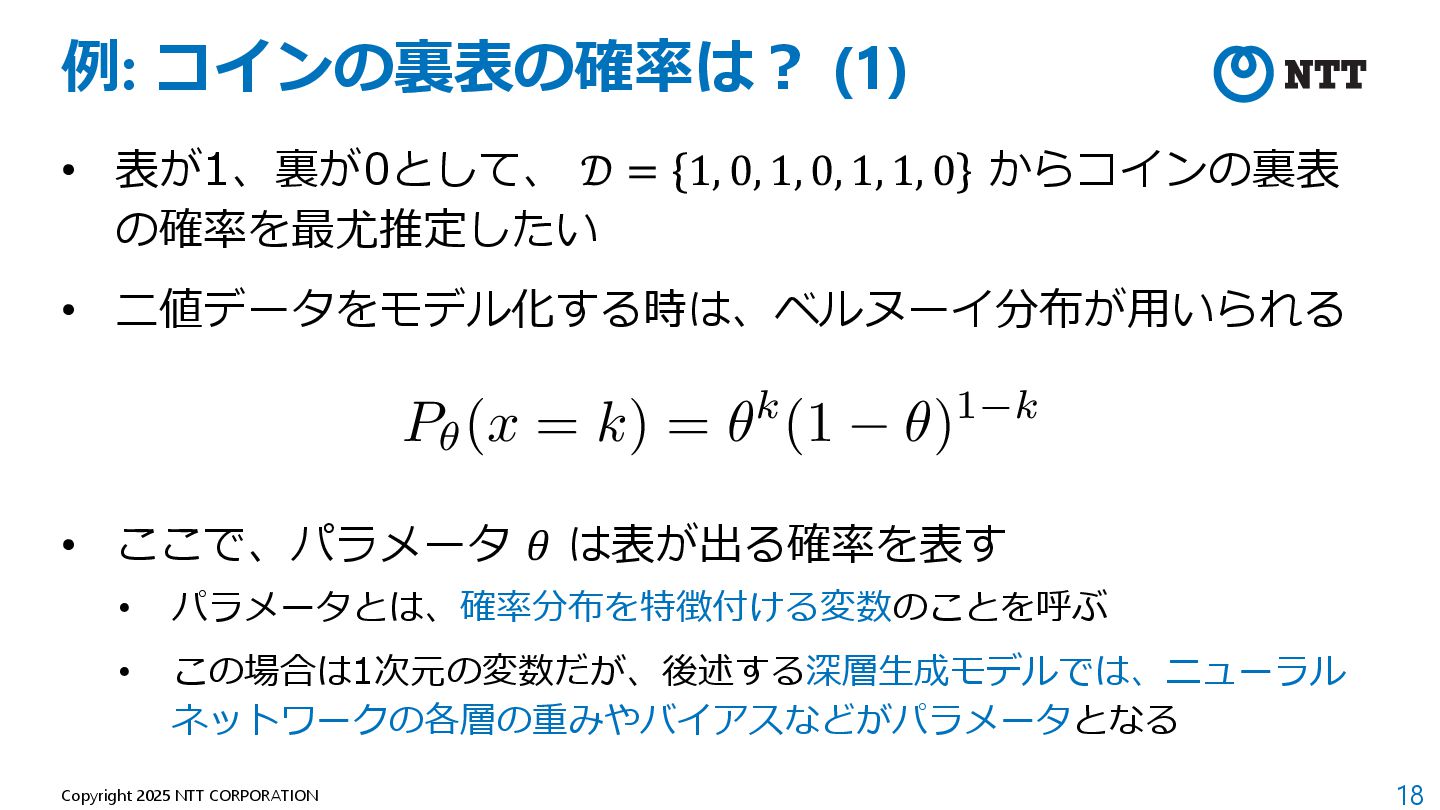
18 Copyright 2025 NTT CORPORATION 例: コインの裏表の確率は︖ (1) • 表が1、裏が0として、
𝒟 = 1, 0, 1, 0, 1, 1, 0 からコインの裏表 の確率を最尤推定したい • ⼆値データをモデル化する時は、ベルヌーイ分布が⽤いられる • ここで、パラメータ 𝜃 は表が出る確率を表す • パラメータとは、確率分布を特徴付ける変数のことを呼ぶ • この場合は1次元の変数だが、後述する深層⽣成モデルでは、ニューラル ネットワークの各層の重みやバイアスなどがパラメータとなる <latexit sha1_base64="eqOhREEWMumhXAv/f58x/MfB+Cc=">AAADN3icSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQvoBMRXx5RkpJYk1mpU2GZrqtlCeHHV2bUahroQjmZctaFudi1XvICygZ4BGChgMgyhDGUGKAjIF/jFEMOQwpDPkMxQypDLkMqQx1ACZOcwJDIUA2E0gyGDAUMBUCyWoRooVgRkZYLlUxlqGbiAekuBqlKBKhKBotlAMh3Ii4aK5gH5IDOLwbqTgbbkAHERUKcCg6rBVYOVBp8NThisNnhp8AenWdVgM0BuqQTSSRC9qQXx/F0Swd8J6soF0iUMGQhdeN1cwpDGYAF2aybQ7QVgEZAvkiH6y6qmfw62ClKtVjNYZPAa6P6FBjcNDgN9kFf2JXlpYGrQbKDpIPNdgLogYVgEZPlC3eAPNDEVKALigUJBC2hPDFhNOtCdIBtroWGcDhTXgYuRa2IiQwWGiRAxUDIxRE8UmIwwIz1DMz2zQBNlBydoguFgkGZQYtAApgpzBgcGD4YAhlCguyYx7GA4yHCIaSfTfaZnTC8gSpkYoXqEGVAA00cAYdO9QA==</latexit> P✓(x = k) = ✓k(1 ✓)1 k -
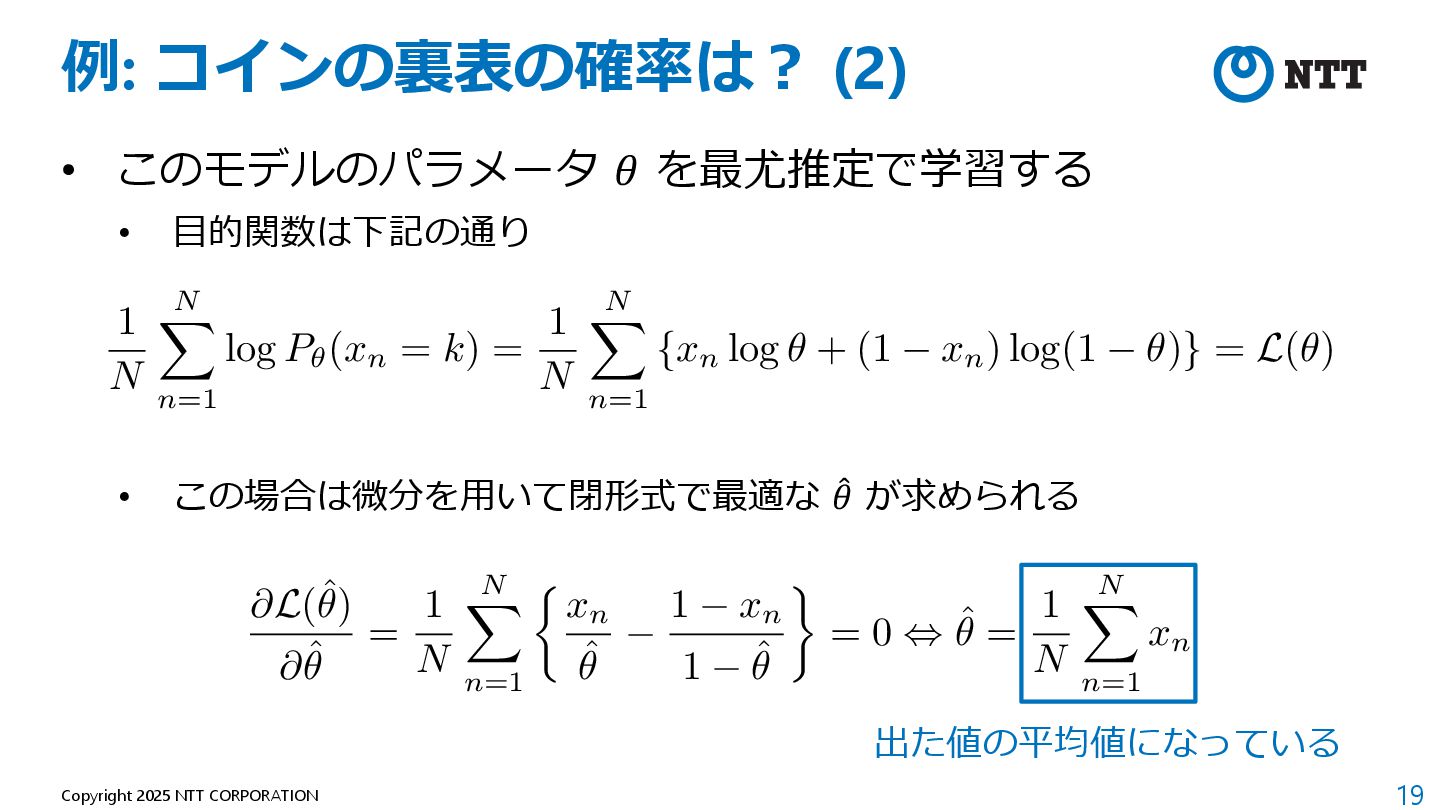
19 Copyright 2025 NTT CORPORATION 例: コインの裏表の確率は︖ (2) • このモデルのパラメータ
𝜃 を最尤推定で学習する • ⽬的関数は下記の通り • この場合は微分を⽤いて閉形式で最適な 9 𝜃 が求められる 出た値の平均値になっている <latexit sha1_base64="0mXVoY9YjV6OtfW9Q+LYMdw/UfA=">AAAD6nicnVLLahRBFL2d9hHHRya6EdwMDpEozlAtIYowEHyAi6h5OEkgFYfqtma6meoH1dVjYlM/4NKNSFaKLsTPcOMPuMjKtbiMIIgLbz8wE4dEsJruuvfce06dLq4dCS9WhOwYY+aRo8eOj5+onDx1+sxEdfLsShwm0uFtJxShXLNZzIUX8LbylOBrkeTMtwVftfu3s/rqgMvYC4NHaiviGz7rBV7Xc5hCqFP9QruSOSmNmFQeE9RnynWYSOf1NHWZSqlyuWL6st5rGYJ1q6BbOn2gaZz4nTRoWfpxlgneVTStFQ2bWNCoMcxtlNxGWbQa+8pUej1XUV1rETqPWnnKpAyfDrcdbCBXrXSqddIk+aqNBlYZ1KFcC2H1J1B4AiE4kIAPHAJQGAtgEOOzDhYQiBDbgBQxiZGX1zloqCA3wS6OHQzRPn57mK2XaIB5phnnbAdPEfhKZNZginwm78ku+UQ+kK/k14Faaa6RednC3S64POpMPD+//OOfLB93Be4e61DPCrpwI/fqofcoR7K/cAr+4NnL3eWbS1PpJfKGfEP/r8kO+Yh/EAy+O+8W+dI2qmf6d5BV3KHE6H7p4SEqckSyLLuFK3gOzXt66DM7UZd33EP86h/sfxUZbI4oFlg2JtbfQzEarFxrWrPN2cWZ+tytcmDG4QJchGmciuswB/dgAdrgGHeNvqGMxBTmC/OVuV20jhkl5xzsW+bb34p1BSA=</latexit> @L(ˆ ✓) @ˆ ✓ = 1 N N X n=1 ⇢ xn ˆ ✓ 1 xn 1 ˆ ✓ = 0 , ˆ ✓ = 1 N N X n=1 xn <latexit sha1_base64="r/Vme82TeHqOFyBTUx6zFGTG09Q=">AAADpHicnVLdatRAFD5p/KnrT1d7I3gTXHbZVbtORFoRFop64UXVbddtC00bJulsNmz+mMwurSEv4AuIeKXghfgY3vgCXvQRxMsKggh6ZhIUXazghGTO+c75vvkyHCcJ/FQQcqDN6MeOnzg5e6py+szZc3PV8xfW03jMXdZ34yDmmw5NWeBHrC98EbDNhDMaOgHbcEZ3ZX1jwnjqx9FjsZ+w7ZB6kT/wXSoQsqvPrQGnbmbm2cPcSsehnUUdM9+RWRB7RtfOLDFkgubNPSzlnVGr0TmCwgbCygzVKvkF92rTXFBQS2KYFHDL4r43FFZudKyQiqFLg2wlb5bFil2tkTZRy5gOzDKoQbm6cfUrWLALMbgwhhAYRCAwDoBCis8WmEAgQWwbMsQ4Rr6qM8ihgtwxdjHsoIiO8OthtlWiEeZSM1VsF08J8OXINKBOPpA35JC8J2/JR/Ltr1qZ0pBe9nF3Ci5L7LmnF3tf/skKcRcw/MU60rOAAdxSXn30nihE/oVb8CdPnh32bq/VswZ5RT6h/5fkgLzDP4gmn93Xq2ztBapL/XvIKu6QY/Sg9PAIFRkiMpO3cAXPsVSPhz7liXl5xx7i135i/6tIYW9KscDkmJh/DsV0sH6jbS62F1dv1pbvlAMzC5fgMjRxKpZgGe5DF/ro67tW19radb2hr+g9vV+0zmglZx5+W/rODyb744Y=</latexit> 1 N N X n=1 log P✓(xn = k) = 1 N N X n=1 {xn log ✓ + (1 xn) log(1 ✓)} = L(✓) -
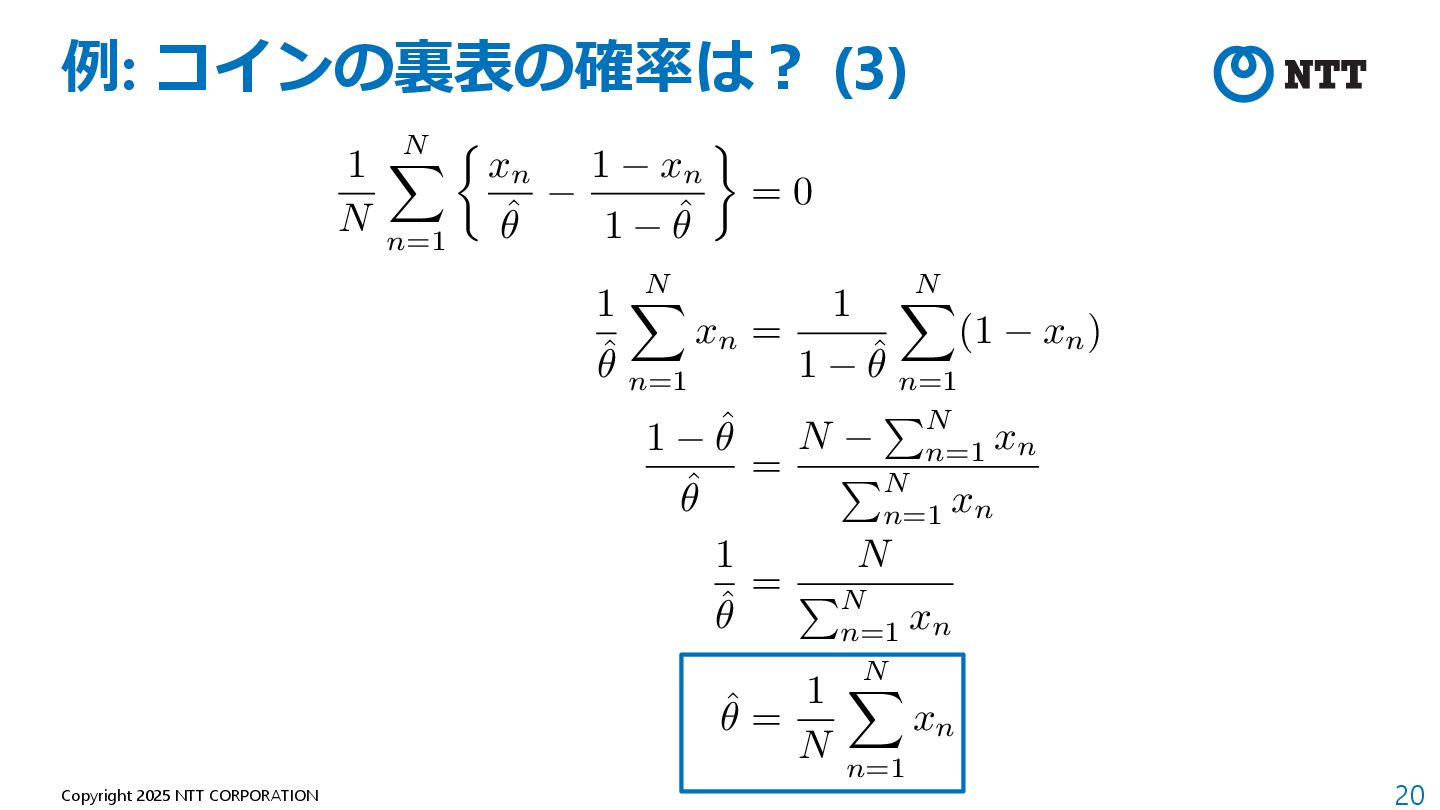
20 Copyright 2025 NTT CORPORATION 例: コインの裏表の確率は︖ (3) <latexit sha1_base64="JFzxKqtnpmkgneyT2VG0GIPBo6I=">AAAEjHicnVJda9RAFL0bo9bVtlsFFXxZXLpUcZeJlCrKQlERX6z9cNtCpy5JnM2G5otkdmkNAz77B3zwScEH8Wf44h/wob9AxMcKgvjgnSTGZrer4IQkd84959w7lzECx444Ifsl5Zh6/MTJiVPl02cmp6YrM2fXI78fmqxt+o4fbhp6xBzbY21uc4dtBiHTXcNhG8bOXZnfGLAwsn3vMd8L2LarW57dtU2dI9SZKT2n3VA3Y03ES4JGfbcTey1NPJE7h3U5jaspYRcTQsS0p/OY8h7juhCNTNvIklqjkKahbfU4FdV6i1Ca1ylyCiUTn3orpw4bFshzWd0ruXeRXSz023WpcURJ5B4Bjus5txorO8Q+dJrhASf0cqdSI02SrOpooGVBDbK17Fd+AIWn4IMJfXCBgQccYwd0iPDZAg0IBIhtQ4xYiJGd5BkIKKO2jyyGDB3RHfxauNvKUA/30jNK1CZWcfANUVmFWfKJvCMH5CN5T76Qn2O94sRD9rKHfyPVsqAz/eLi2vd/qlz8c+j9Uf21Zw5duJn0amPvQYLIU5ipfvDs5cHardXZuE7ekK/Y/2uyTz7gCbzBN/PtClt9he7S/x6q0hmGGD3MeniEjgwRuZNTuIp1aMKxsE9ZUWQzthC/lmP/66jD7ohjislrog1fitFg/XpTW2gurMzXFu9kF2YCLsFlmMNbcQMW4QEsQxvM0mdlUjmvXFCn1Hn1ttpKqUop05yDwlLv/wLHOEE5</latexit>
1 N N X n=1 ⇢ xn ˆ ✓ 1 xn 1 ˆ ✓ = 0 1 ˆ ✓ N X n=1 xn = 1 1 ˆ ✓ N X n=1 (1 xn) 1 ˆ ✓ ˆ ✓ = N PN n=1 xn PN n=1 xn 1 ˆ ✓ = N PN n=1 xn ˆ ✓ = 1 N N X n=1 xn -
21 Copyright 2025 NTT CORPORATION 例: コインの裏表の確率は︖ (4) • 𝒟
= 1, 0, 1, 0, 1, 1, 0 を⽤いて計算すると、 - 𝜃 = 4/7 • コインの出た値の平均が最適なパラメータとなるため、直感と⼀致する • 偏りが⼀切ないコインであれば、データセットのサイズを⼤きくすれば、 9 𝜃 = 1/2 に収束する • 最尤推定で得られたパラメータを最尤推定量と呼ぶ • このように、下記の⼿順を⾏うことで⽣成モデルは学習できる 1. データセット 𝒟 = {𝑥0 , … , 𝑥2 } に対して、適切なモデル 𝑝3 (𝑥) を選択する 2. 対数尤度関数 0 2 ∑450 2 log 𝑝3 𝑥 を計算する 3. パラメータ 𝜃 に関する微分を⽤いて最適化する -
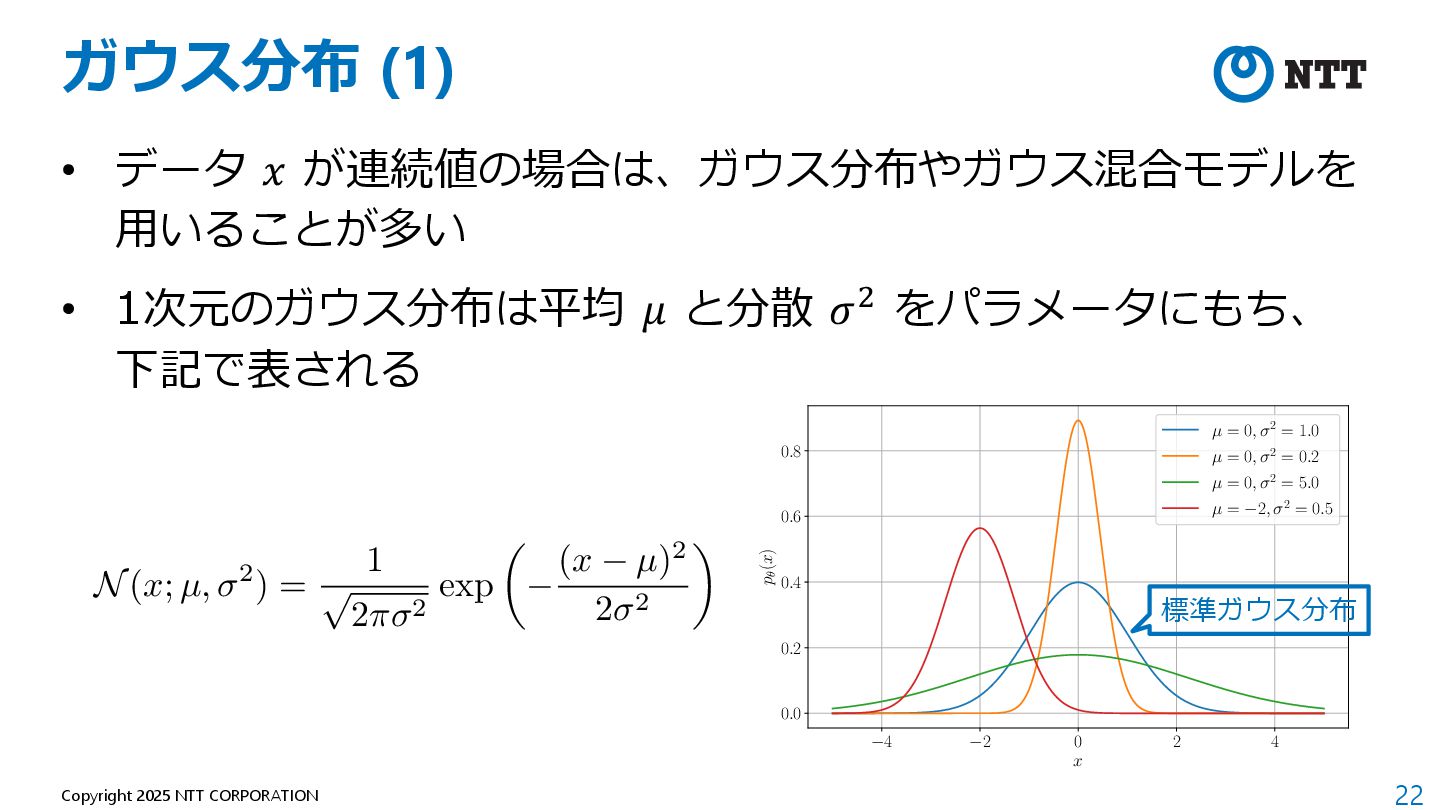
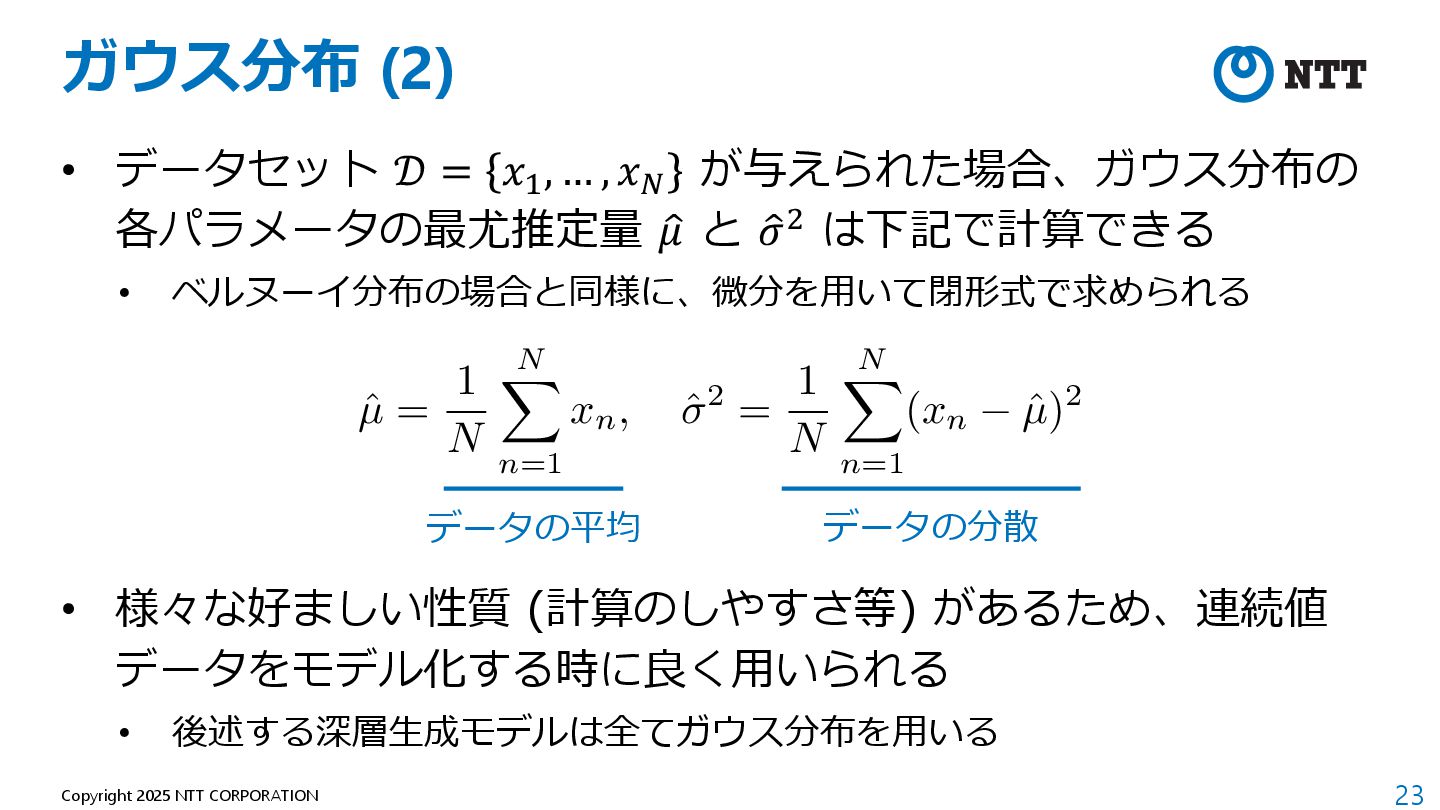
22 Copyright 2025 NTT CORPORATION ガウス分布 (1) • データ 𝑥
が連続値の場合は、ガウス分布やガウス混合モデルを ⽤いることが多い • 1次元のガウス分布は平均 𝜇 と分散 𝜎% をパラメータにもち、 下記で表される °4 °2 0 2 4 x 0.0 0.2 0.4 0.6 0.8 pµ (x) µ = 0, æ2 = 1.0 µ = 0, æ2 = 0.2 µ = 0, æ2 = 5.0 µ = °2, æ2 = 0.5 標準ガウス分布 <latexit sha1_base64="ukh9tll3oaC1VxUaJ0lhmoE3AfU=">AAADe3icnVLdahNBFD7J2lrjT6PeCN4UQ0tS0jAbtIoiFPXCG7U/pi10apgdJ5uhsz/OTkLqsi/gC3jhlYIX4mN44wso9BHEywqCVPDsDwYNKjjLzpz5zvm++WY4TqhkZAg5KJWtY1PTx2dOVE6eOn1mtnr23GYUDDQXHR6oQG87LBJK+qJjpFFiO9SCeY4SW87e7TS/NRQ6koH/0OyHYtdjri97kjODULcaUo+ZPmcqvp/URzeoN2jSSLoeexS3k8bCTdrTjMd2EtPoiTZxm4ZynE8SKkYhVaJn6kt5ZX20hBqNLIvV41Kqpds3jUq3WiMtko25ycAughoUYzWofgMKjyEADgPwQIAPBmMFDCL8dsAGAiFiuxAjpjGSWV5AAhXkDrBKYAVDdA9nF3c7BerjPtWMMjbHUxT+GplzME8+kDfkkLwnb8kncvRHrTjTSL3s4+rkXBF2Z59d2Pj6T5aHq4H+mPVXzwZ6cC3zKtF7mCHpLXjOHz59frhxfX0+XiCvyGf0/5IckHd4A3/4hb9eE+svUD3Vv4Os/A01RvcKDw9QUSCS7tJXWMRzaFbjos/0xKR4Yxfx5k/sfxUZjCYUcyxtE/v3ppgMNtste7m1vHa5tnKraJgZuAiXoI5dcRVW4C6sQgd9fYSj0lRpuvzdqlmLVjMvLZcKznn4ZVhXfgAZ1NTW</latexit> N(x; µ, 2) = 1 p 2⇡ 2 exp ✓ (x µ)2 2 2 ◆ -
23 Copyright 2025 NTT CORPORATION ガウス分布 (2) • データセット 𝒟
= 𝑥! , … , 𝑥" が与えられた場合、ガウス分布の 各パラメータの最尤推定量 3 𝜇 と 3 𝜎% は下記で計算できる • ベルヌーイ分布の場合と同様に、微分を⽤いて閉形式で求められる • 様々な好ましい性質 (計算のしやすさ等) があるため、連続値 データをモデル化する時に良く⽤いられる • 後述する深層⽣成モデルは全てガウス分布を⽤いる データの平均 データの分散 <latexit sha1_base64="9NMgrtGLOZNaIMT8AVubRK5wJgI=">AAADeXicnVLLahRBFL0zHTWOj4y6EdxEh8gY4lAdJYoQCOrCjZqHkwTScaju1HSK9Mvu6iGx6R/wB1y4UnAhfoYbP0AX+QRxGUGILjzV3UR0MEKq6ap7T91z6lRx7ciTiWJst1Y3Ro4dPzF6snHq9JmzY81z55eTMI0d0XVCL4xXbZ4ITwaiq6TyxGoUC+7bnlixt+7p/ZWBiBMZBk/UTiTWfe4Gsi8drgD1moG1yVVm+Wk+a/Vj7mRmnj3KrST1e1kwa+ZPkW0jzKesZynfKKsT6focW9OHkNoF6/qB/DVd3ug1W6zDijE+HJhV0KJqzIfNfbJog0JyKCWfBAWkEHvEKcG3RiYxioCtUwYsRiSLfUE5NcBNUSVQwYFuYXaRrVVogFxrJgXbwSke/hjMcZpgn9k7tsc+svfsC/v5T62s0NBedrDaJVdEvbEXF5e+/5flY1W0+Zt1qGdFfbpdeJXwHhWIvoVT8gfPX+4t3VmcyK6yN+wr/L9mu+wDbhAMvjlvF8TiK6hr/ftglW8YI3pYeXgMRQFEZ/oVJnGOVdS48KlPzKs3doFPHWBHVeS0PaRYYrpNzL+bYjhYnu6YM52ZhZutubtVw4zSJbpCbXTFLZqjBzRPXfj6RPs1ozZS/2FcNtrGZFlar1WcC/THMG78Ak6v1ak=</latexit> ˆ µ = 1 N N X n=1 xn, ˆ2 = 1 N N X n=1 (xn ˆ µ)2 -
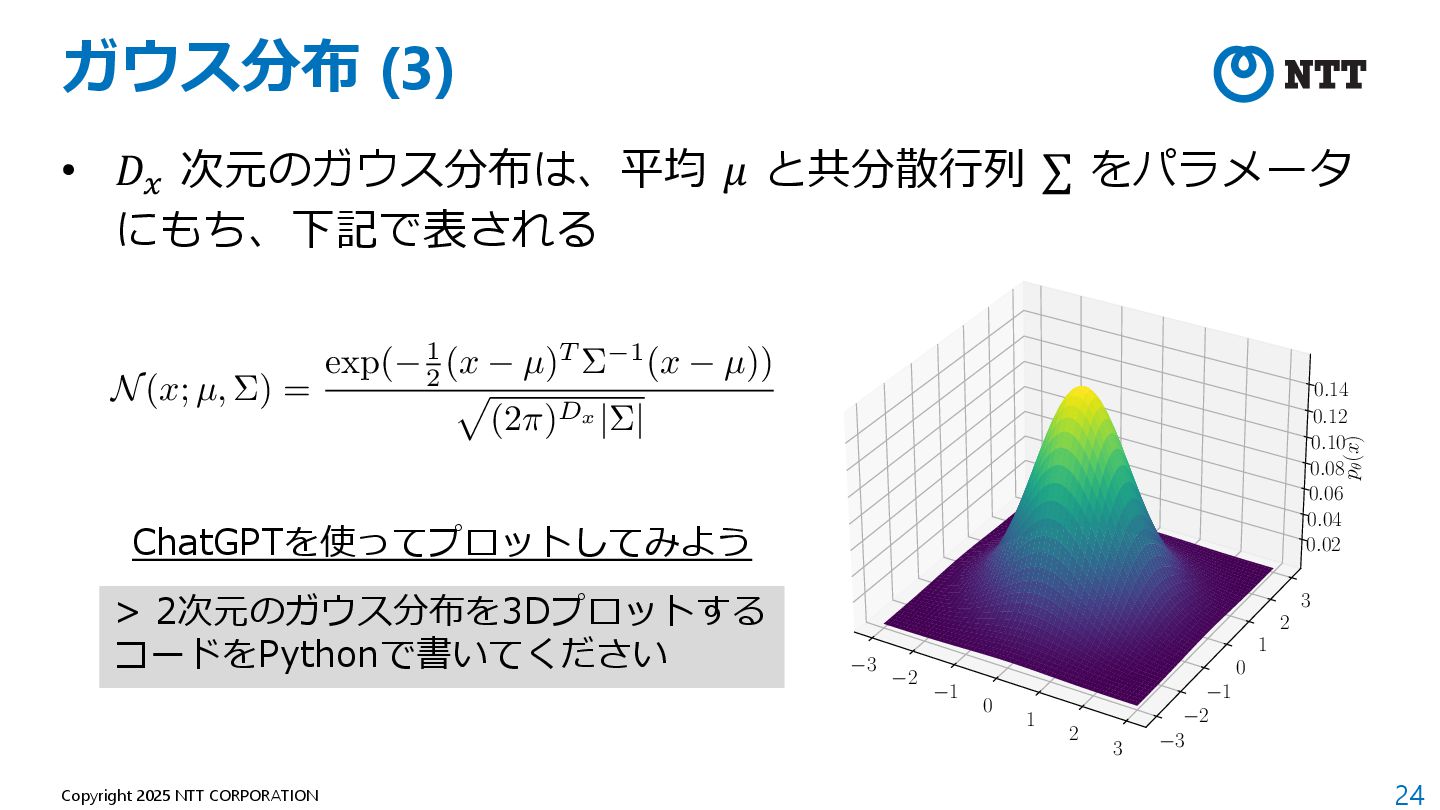
24 Copyright 2025 NTT CORPORATION ガウス分布 (3) • 𝐷& 次元のガウス分布は、平均
𝜇 と共分散⾏列 ∑ をパラメータ にもち、下記で表される °3 °2 °1 0 1 2 3 °3 °2 °1 0 1 2 3 pµ(x) 0.02 0.04 0.06 0.08 0.10 0.12 0.14 <latexit sha1_base64="9EqNPDiYq2FkQKRCMEZHyph1ODE=">AAADfHicnVLdahNBGP2S1bbGn8Z6I3hTjC2JNmE2lCiKULQX3qht07SFbhtmx8l26P51dxJSp/MCvoAXXil4IT6GN76ASB9BvKwgiIrf/qhoUMFZduebM+ecOTt8duiKWBJyWCgax46PjU+cKJ08dfrMZPns1Foc9CPGOyxwg2jDpjF3hc87UkiXb4QRp57t8nV793ayvz7gUSwCf1Xuh3zLo44veoJRiVC3vGd5VO4w6qp7ujq8YXn9OastHI/WZm9avYgyZfFhWK1ntalVE2l1pNW21arOqNuqbn5Ha1pZ8V4kVbVphQJJi1011PogYx5oXeqWK6RB0jE9Wph5UYF8LAXlT2DBAwiAQR884OCDxNoFCjE+m2ACgRCxLVCIRViJdJ+DhhJq+8jiyKCI7uLXwdVmjvq4TjzjVM3wFBffCJXTMEPekBfkiLwmL8k78vmPXir1SLLs42xnWh52Jx+db3/8p8rDWcLOT9VfM0vowbU0q8DsYYokf8Ey/eDh46P29ZUZNUuekfeY/yk5JK/wD/zBB/Z8ma88QffEfxFV2R1GWN3NM9xHR45Iskpu4TKeY6UcB3MmJ+r8jh3E535g/+tIYTjimGFJm5i/N8VosdZsmK1Ga3m+snArb5gJuAAXoYpdcRUW4A4sQQdzvYUvhbHCePGrccm4YtQzarGQa87BL8NofQMT29Qj</latexit> N(x; µ, ⌃) = exp( 1 2 (x µ)T ⌃ 1(x µ)) p (2⇡)Dx |⌃| > 2次元のガウス分布を3Dプロットする コードをPythonで書いてください ChatGPTを使ってプロットしてみよう -
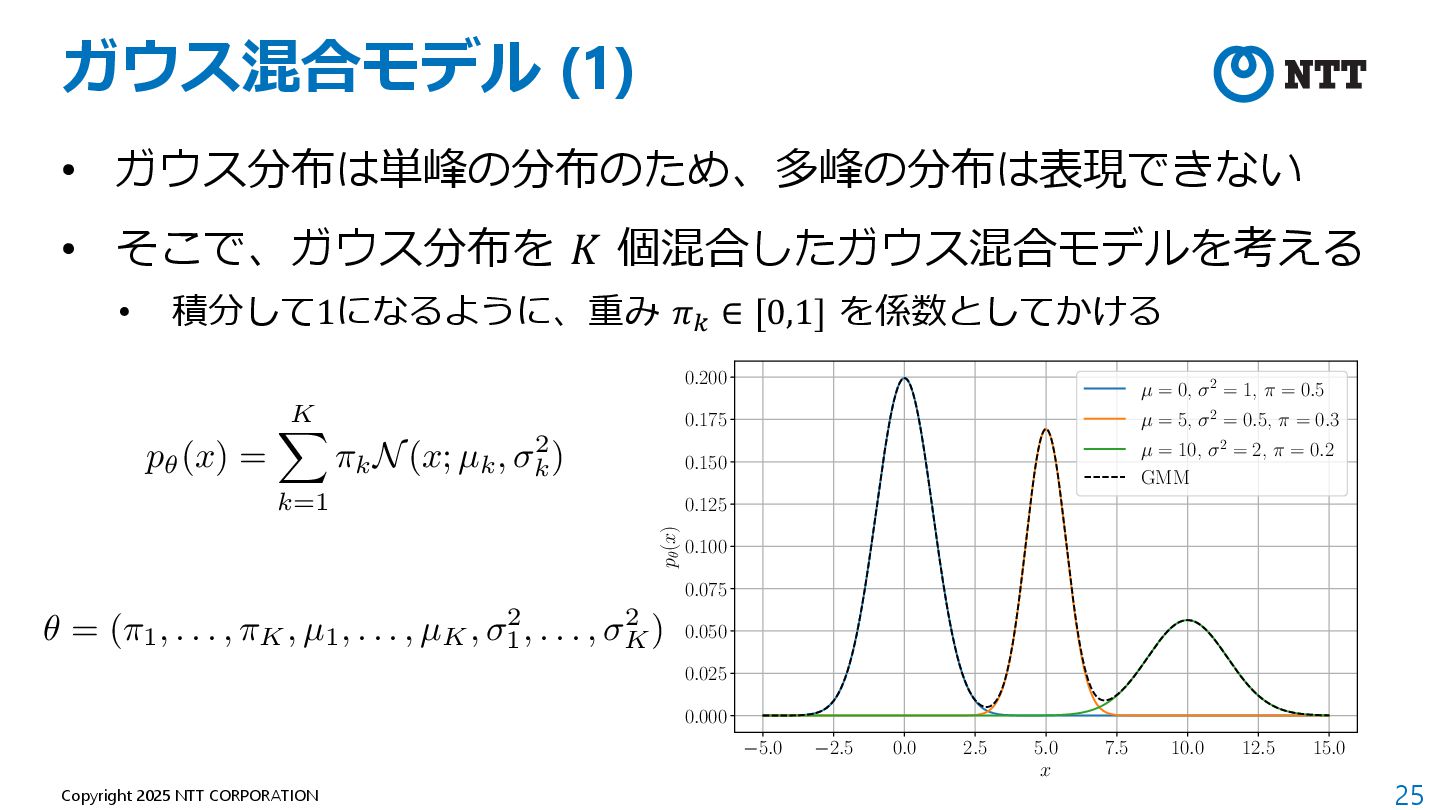
25 Copyright 2025 NTT CORPORATION ガウス混合モデル (1) • ガウス分布は単峰の分布のため、多峰の分布は表現できない •
そこで、ガウス分布を 𝐾 個混合したガウス混合モデルを考える • 積分して1になるように、重み 𝜋6 ∈ [0,1] を係数としてかける °5.0 °2.5 0.0 2.5 5.0 7.5 10.0 12.5 15.0 x 0.000 0.025 0.050 0.075 0.100 0.125 0.150 0.175 0.200 pµ (x) µ = 0, æ2 = 1, º = 0.5 µ = 5, æ2 = 0.5, º = 0.3 µ = 10, æ2 = 2, º = 0.2 GMM <latexit sha1_base64="6SSSumH08y0jIHP+UU7XVU8+TDQ=">AAADVXicnVLLahRBFD2ZiTGOj5noRnATHBISCUN1CFGUQFAXoqh5OEkgnTTVbaWnmH7RXTMkNv0D/oALVwouxI3/4MYfUMlKt+IygiAK3upuFB2MYDVdde+pe06dKq4deTJRjO0PVarDR0aOjh6rHT9x8lS9MXZ6LQl7sSPaTuiF8YbNE+HJQLSVVJ7YiGLBfdsT63b3mt5f74s4kWFwT+1FYsvnbiB3pMMVQVbjZmSlpuoIxbOp3enJBTPp+VbaXTCy7fRWZkaSksz0ueo43EvvUNEV0+9pcMZMpOtzHW6ns9l0zWo0WYvlY3wwMMqgiXIshY2vMHEfIRz04EMggKLYA0dC3yYMMESEbSElLKZI5vsCGWrE7VGVoApOaJdml7LNEg0o15pJznboFI/+mJjjmGBv2HN2wF6zF+wj+/ZXrTTX0F72aLULrois+sOzq1/+yfJpVej8Yh3qWWEHl3KvkrxHOaJv4RT8/oNHB6uXVybSSfaUfSL/T9g+e0U3CPqfnWfLYuUxqWv968Qq3jCm6Hbp4S4pCkJ0pl/hAp1j5jUu+dQnZuUbu4TP/MT+V5Fjd0CxwHSbGH82xWCwNtsy5lvzy3PNxatlw4ziHM5jirriIhZxA0tok6+XeIv3+FB5V/leHa6OFKWVoZJzBr+Nav0HetfIUA==</latexit> p✓(x) = K X k=1 ⇡k N(x; µk, 2 k ) <latexit sha1_base64="lEjW+b00afrMDcPOca9BexsQhQ4=">AAADaHicnVLLahRBFD2Z9hHHR9q4UHETMiREGYbqIIkEhGBcCEHMw0kC6clQ3al0ivSL7pohsZkf8AdcZKXgQvyMbPwBF/mE6M4RBHHhre7GEAcVrKa77j33nlOni+vEvkwVY8dDFePc+QsXhy9VL1+5em3EvD66lkadxBVNN/KjZMPhqfBlKJpKKl9sxInggeOLdWdvQdfXuyJJZRQ+VwexaAXcC+WOdLkiqG22bLUrFJ98OGXHsp1Zvbrtb0cqrefpIqVB5wysUw2n0gu4rmxl06fVEl3M0bvVtlljDZavscHAKoMayrUUmd9hYxsRXHQQQCCEotgHR0rPJiwwxIS1kBGWUCTzukAPVeJ2qEtQByd0j74eZZslGlKuNdOc7dIpPr0JMccwwT6yd6zPPrD37IT9+KNWlmtoLwe0OwVXxO2Rl7dWv/2TFdCusHvK+qtnhR08yL1K8h7niP4Lt+B3X7zqr86tTGST7A37TP5fs2N2RH8Qdr+6b5fFyiGpa/3HxCruMKHoaenhGSkKQnSmb+EenWPnPR751Cf2yjv2CK//wv5XkWN/QLHA9JhYvw/FYLA23bBmGjPL92vzj8qBGcYdjGOKpmIW83iCJTTJ1xFO8AX9yifDNG4at4vWylDJuYEzyxj/CXuMzig=</latexit> ✓ = (⇡1, . . . , ⇡K, µ1, . . . , µK, 2 1 , . . . , 2 K ) -
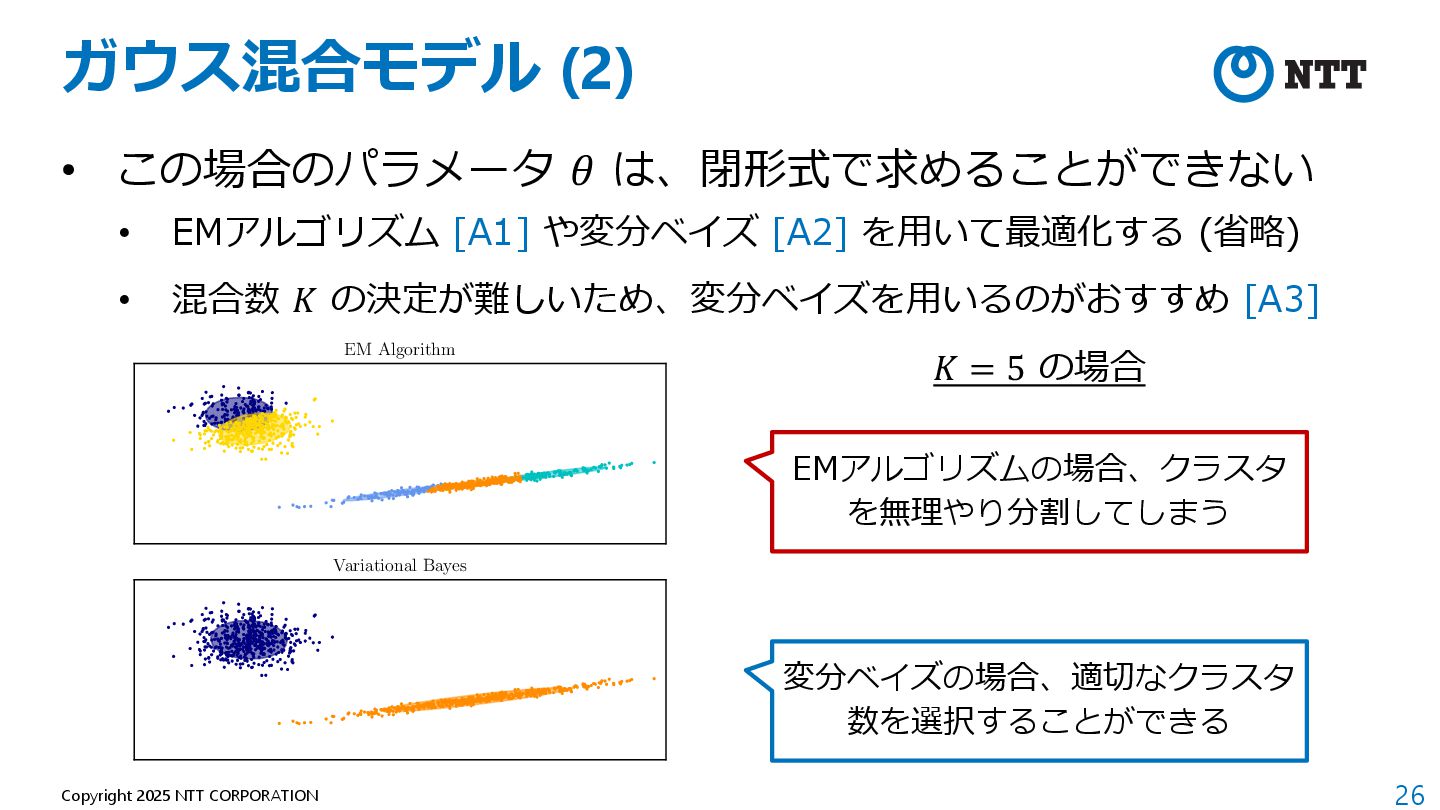
26 Copyright 2025 NTT CORPORATION ガウス混合モデル (2) • この場合のパラメータ 𝜃
は、閉形式で求めることができない • EMアルゴリズム [A1] や変分ベイズ [A2] を⽤いて最適化する (省略) • 混合数 𝐾 の決定が難しいため、変分ベイズを⽤いるのがおすすめ [A3] EM Algorithm Variational Bayes 𝐾 = 5 の場合 EMアルゴリズムの場合、クラスタ を無理やり分割してしまう 変分ベイズの場合、適切なクラスタ 数を選択することができる -
27 Copyright 2025 NTT CORPORATION まとめ: ⽣成モデルの基礎 • 従来の⽣成モデルは、データに対して適切なモデルを選択し、 最尤推定を⾏う
• 例えばコインのような⼆値データであれば、ベルヌーイ分布が最適 • 連続値データならガウス分布やガウス混合モデルを⽤いることが多い • 理想的には、𝐾 = ∞ のガウス混合モデルで何でも表現できるはず • では、より複雑なデータに対して適切なモデルはあるのか︖ • 画像のような複雑なデータになると、ガウス混合モデルでは対応できない • 深層学習の登場以降、⽣成モデルは⾶躍的に発展し、画像のような複雑な データのモデリングが可能になった • 以降では、深層学習を⽤いた⽣成モデルを紹介する -
28 Copyright 2025 NTT CORPORATION 参考⽂献 A 1. "Expectation–maximization algorithm",
https://en.wikipedia.org/wiki/Expectation%E2%80%93maximization_algorithm 2. Blei, David M., and Michael I. Jordan. "Variational inference for Dirichlet process mixtures." (2006): 121-143. 3. "2.1. Gaussian mixture models", https://scikit-learn.org/stable/modules/mixture.html -
30 Copyright 2025 NTT CORPORATION 深層⽣成モデルについて • 深層学習を⽤いた⽣成モデルの総称 • ガウス混合モデルなどの従来⼿法と⽐べ、画像のような複雑で
⾼次元のデータの分布を学習することが可能 • 本講義ではまず深層学習とその最適化について説明し、続いて 下記の2つの深層⽣成モデルを説明する • Variational Autoencoder (VAE) [B1] • 拡散モデル (Diffusion Model) [B2] • Generative Adversarial Nets (GAN) や Flow-based Model などの深層⽣成モデルについては、付録Eを参照 -
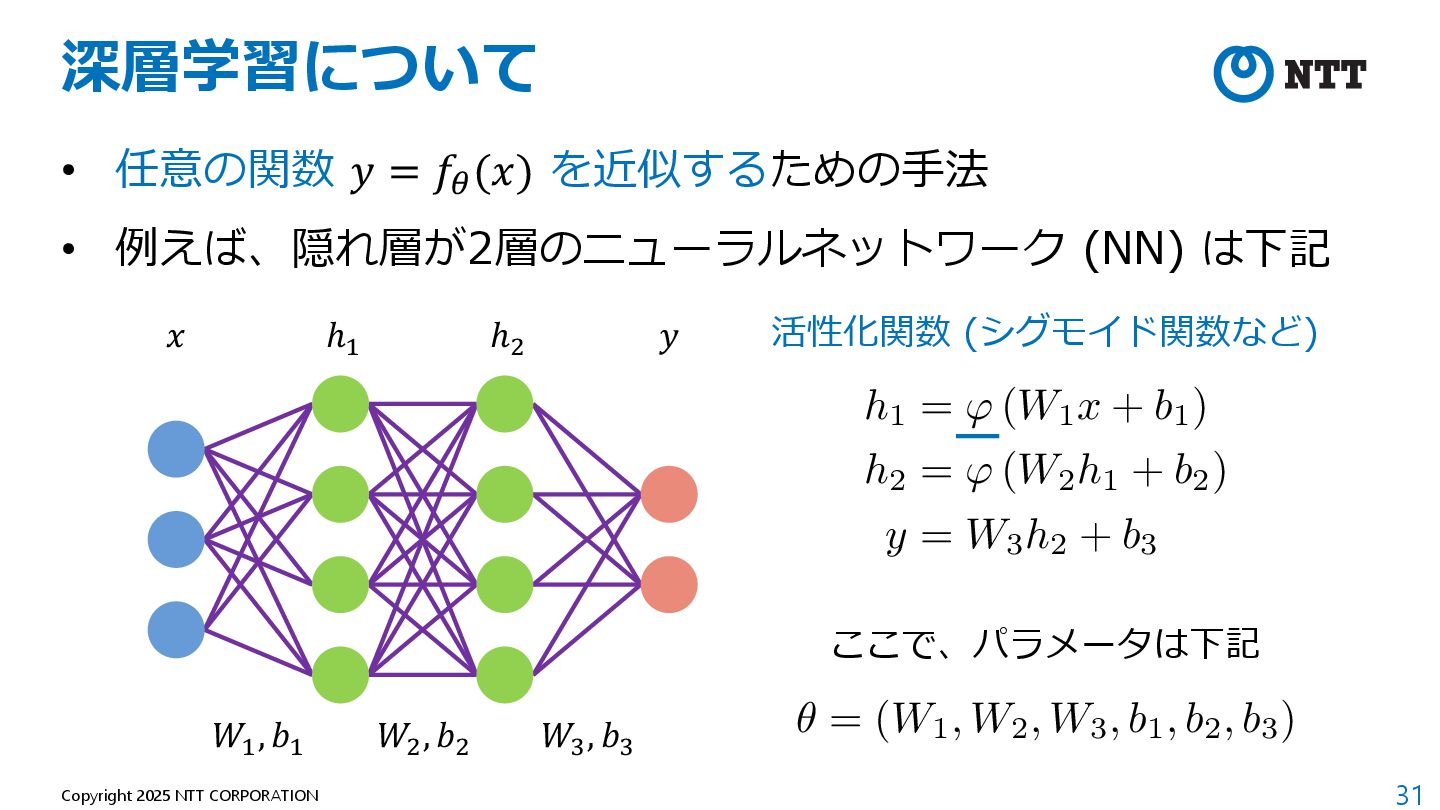
31 Copyright 2025 NTT CORPORATION 深層学習について • 任意の関数 𝑦 =
𝑓$ (𝑥) を近似するための⼿法 • 例えば、隠れ層が2層のニューラルネットワーク (NN) は下記 𝑥 𝑦 ℎ0 ℎ7 𝑊8 , 𝑏8 𝑊7 , 𝑏7 𝑊0 , 𝑏0 <latexit sha1_base64="wO8HJ0LurT1j1dT6WmIXDOCGSK8=">AAADOXicnVJNSxtBGH7cWmuj1dheCl7EoFgJYdaKLYWCqAcv4ldjBCNhdx3j4mZ32Z2E2pA/0LPgwZOCB/Ef6FEP/gEPHr35cUxBKD30ndlFaYMKzrIz7zzzPs888/KavmOHgrHzJu1F88uWV62vE23tbzo6k11vF0KvHFg8a3mOFyyaRsgd2+VZYQuHL/oBN0qmw3Pm+rg8z1V4ENqe+01s+Hy5ZBRde9W2DEFQIZnJizUujP6vA7lCVa+laR5S88da2lSIqRBTIh8ShWSKZZgaPY2BHgcpxGPGS/5GHivwYKGMEjhcCIodGAjpW4IOBp+wZVQJCyiy1TlHDQnilimLU4ZB6DrNRdotxahLe6kZKrZFtzj0B8TsQR87Y/uszk7ZAbtifx7UqioN6WWDVjPicr/Q+fP9/O2TrBKtAmv3rEc9C6zis/Jqk3dfIfIVVsSv/Niqz3+Z66v2s112Q/532Dk7phe4lV/W3iyf2yZ1qT9BrKiGAUVTsYdpUuSEyJ2swiDdk1c5RfIpb6zFNS4Snr7Dnqto4HuDYoTJNtH/b4rGYGEoo49kRmaHU6NjccO0ohu9GKCu+IRRTGIGWfK1iUMc40Q70i60S+06StWaYs47/DO0+l/CY71X</latexit> ✓ = (W1, W2, W3, b1, b2, b3) ここで、パラメータは下記 活性化関数 (シグモイド関数など) <latexit sha1_base64="dOUfHrMO0Nuh9QrziLrd4wKGCZk=">AAADdXicnVJNa9RAGH52o7auH13rRRChuHaprWwn21JFKBT14EXsh9stNGVJ4mx2bDYJk9ml65I/4B/w4EnBg/gzvHj04qE/QTxWLIig7yTBousHOCGZd555nmeeDK8T+SJWjO0Xisax4yfGxk+WTp0+c3aifG5yMw570uUNN/RDueXYMfdFwBtKKJ9vRZLbXcfnTWf3tt5v9rmMRRg8UIOI73RtLxBt4dqKoFb5Uac1NJPqstW3ZdQRls/baqapsb05R0+WFF5HXbUsItZ/Q6wnqYMm14/Ig+oy7S0kqUjvLSSlVrnCaiwdU6OFmRcV5GM1LH+BhYcI4aKHLjgCKKp92Ijp2YYJhoiwHQwJk1SJdJ8jQYm0PWJxYtiE7tLXo9V2jga01p5xqnbpFJ9eScopTLP37BU7YG/Za/aBff2j1zD10FkGNDuZlketiScXNg7/qerSrNA5Uv01s0IbN9KsgrJHKaL/ws30/cdPDzZurk8Pq+wF+0j5n7N99ob+IOh/cl+u8fVn5K7975Aqu0NJ1b08w31y5ITolb6FWTrHSjke5dQnJvkde4Rf+4H9r6ONvRHHDNNtYv7aFKPFZr1mLtWW1hYrK7fyhhnHRVzGDHXFdazgLlbRoFzv8BnfCigeGpeMK0Y1oxYLueY8fhrG/Hdz0tHv</latexit> h1 = ' (W1x + b1) h2 = ' (W2h1 + b2) y = W3h2 + b3 -
32 Copyright 2025 NTT CORPORATION 補⾜: シグモイド関数 [0,1] でバウンドされた⾮線形関数 °10
°5 0 5 10 x 0.0 0.2 0.4 0.6 0.8 1.0 '(x) -
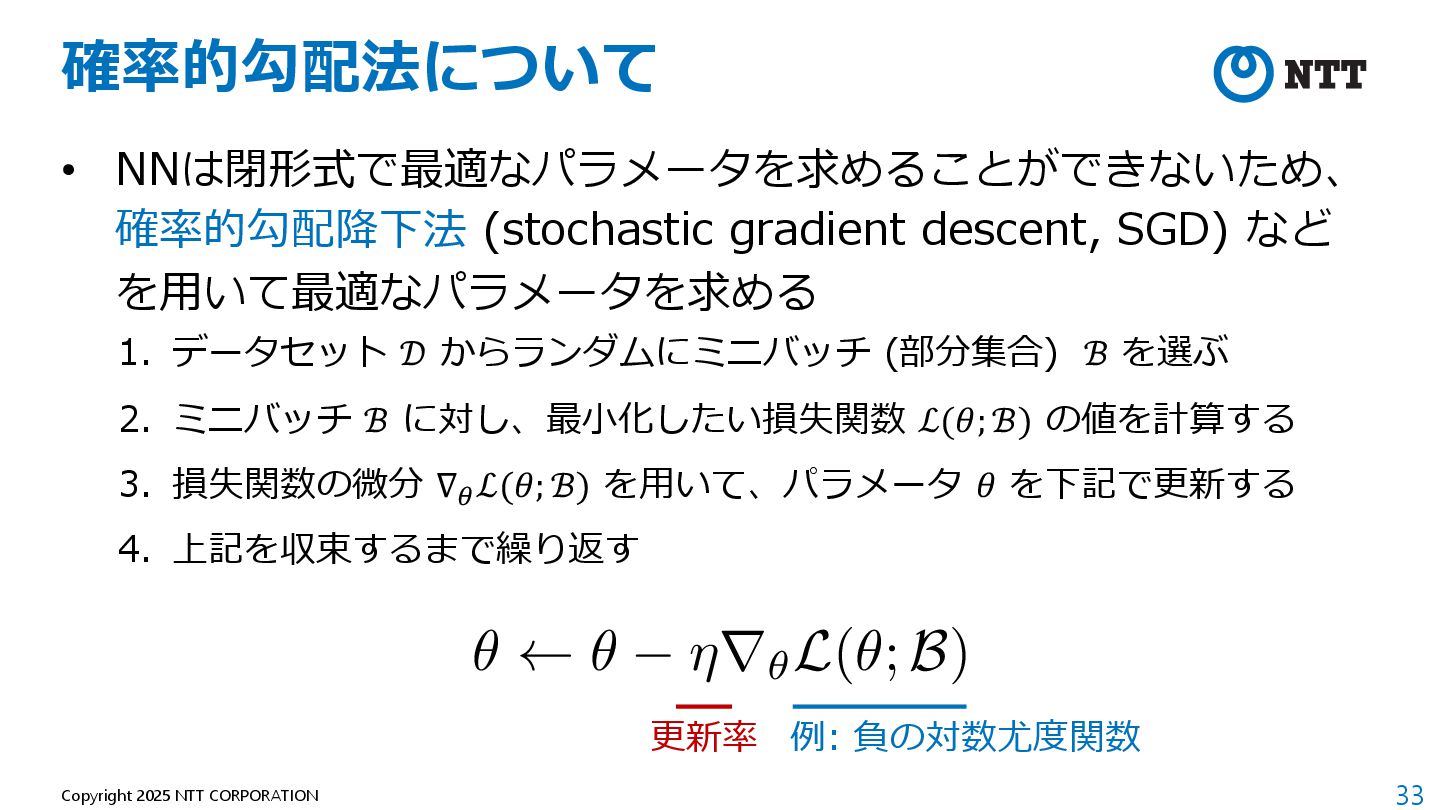
33 Copyright 2025 NTT CORPORATION 確率的勾配法について • NNは閉形式で最適なパラメータを求めることができないため、 確率的勾配降下法 (stochastic
gradient descent, SGD) など を⽤いて最適なパラメータを求める 1. データセット 𝒟 からランダムにミニバッチ (部分集合) ℬ を選ぶ 2. ミニバッチ ℬ に対し、最⼩化したい損失関数 ℒ(𝜃; ℬ) の値を計算する 3. 損失関数の微分 ∇3 ℒ(𝜃; ℬ) を⽤いて、パラメータ 𝜃 を下記で更新する 4. 上記を収束するまで繰り返す <latexit sha1_base64="f6Q8UJX8UA4F6XLyWpgQoBg5j9U=">AAADVnicnVLLahRBFD2ZSUwcH+noRnATHBKi6FAjkojZhJhFQMW8Jgmkw1Dd1sw0qX5QXTMxNv0D/oCLrBRciCu/wY0/IJqdLsVlBCGIeKu7ieiggtV01a1T95w6dblOJL1YM3YwUCoPDp0YHjlZOXX6zNlRa+zcehx2lSsabihDtenwWEgvEA3taSk2IyW470ix4ezcNucbPaFiLwzW9F4ktn3eDryW53JNUNO6Y+uO0HzSlqKluVLhbg5cs2myA+5I3kxyKLV9rjsul8nddCqHZo+h+fRypWlVWY1lY7w/qBdBFcVYCq0j2HiAEC668CEQQFMswRHTt4U6GCLCtpEQpijysnOBFBXidilLUAYndIfmNu22CjSgvdGMM7ZLt0j6FTHHMcHeshfskL1hL9kn9u2PWkmmYbzs0erkXBE1Rx9fWP36T5ZPq0bnJ+uvnjVauJl59ch7lCHmFW7O7z16crh6a2UimWTP2Gfy/5QdsNf0gqD3xX2+LFb2Sd3oLxArr6Gi6F7h4T4pCkLMzlThCt1jZzlt8mluTIsatwm/eoz9ryLHwz7FHDNtUv+9KfqD9eu1+nRtevlGdW6+aJgRXMQlTFFXzGAOi1hCg3y9wjt8wMfS+9L38lB5OE8tDRSc8/hllK0f7cXJIw==</latexit> ✓ ✓ ⌘r✓ L(✓; B) 更新率 例: 負の対数尤度関数 -
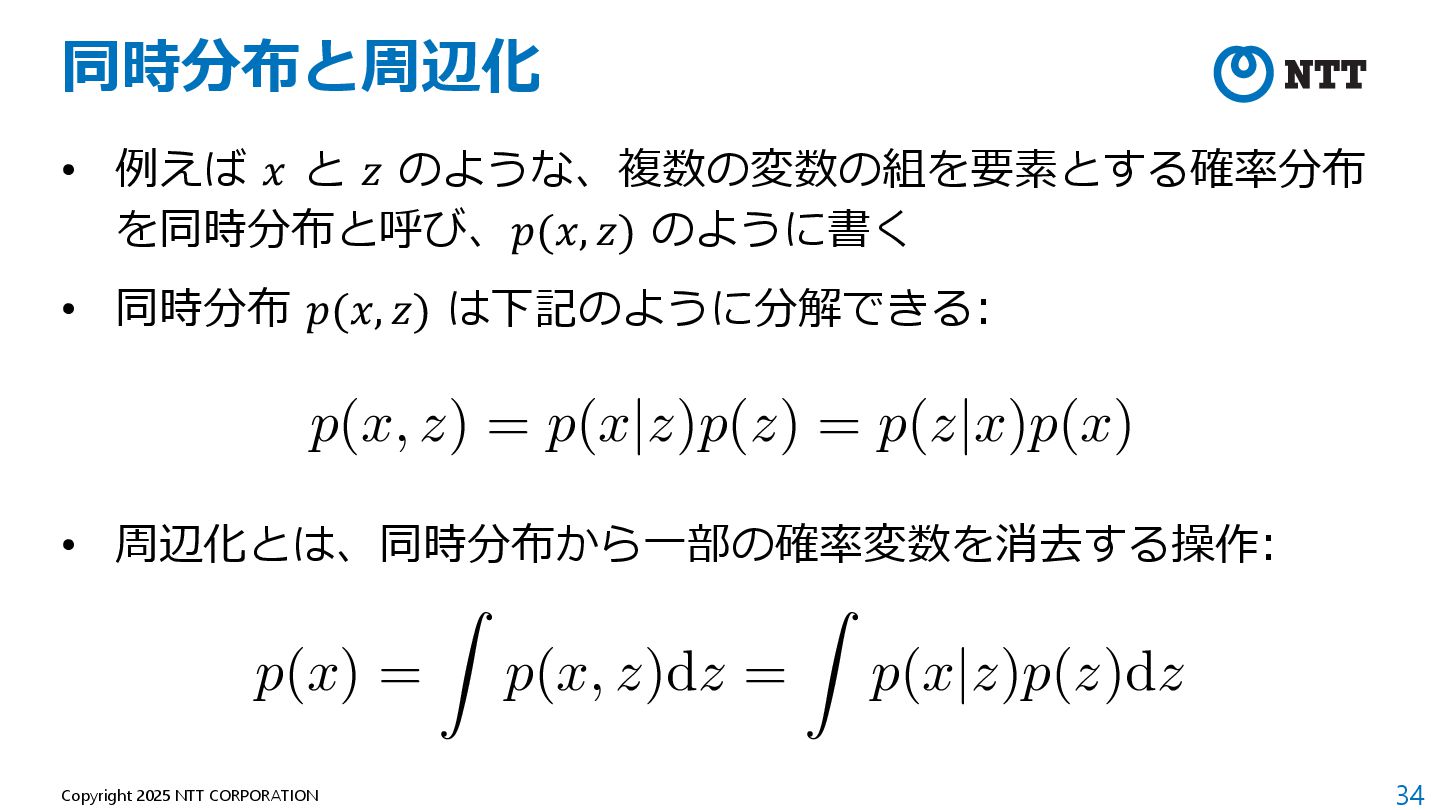
34 Copyright 2025 NTT CORPORATION 同時分布と周辺化 • 例えば 𝑥 と
𝑧 のような、複数の変数の組を要素とする確率分布 を同時分布と呼び、𝑝(𝑥, 𝑧) のように書く • 同時分布 𝑝(𝑥, 𝑧) は下記のように分解できる: • 周辺化とは、同時分布から⼀部の確率変数を消去する操作: <latexit sha1_base64="o65D2nd//D2haK1vSYItPPDn9bk=">AAADUHicnVJNa9RQFD2T8aNOrZ3qplCQ4tAyI2V4I6UVoVDUhRuxH05baMuQxNcxNJOEJDNMM52dK/+Ai64UXKhL/QfddC100Z8gLiu0i0J7XhIqOlShLyT3vJN7zrvvcg3PtoJQiIOMlr1y9dr1vhu5/psDtwbzQ7eXArfpm7Jqurbrrxh6IG3LkdXQCm254vlSbxi2XDY2n6j/yy3pB5brvAy3PLne0OuOtWGZekiqlr/rFdsTUWl8hnE7KnnFqEQYbbcJ26VcLV8QZRGv0V5QSUEB6ZpzhzIDWMMruDDRRAMSDkJiGzoCPquoQMAjt44OOZ/Iiv9LdJGjtsksyQyd7Ca/de5WU9bhXnkGsdrkKTZfn8pRjIl98Ukcij3xRfwQJxd6dWIPVcsWo5FopVcbfDu8ePRfVYMxxOvfqn/WHGIDD+NaLdbuxYy6hZnoW9G7w8VHC2OdcfFB/GT978WB2OUNnNYv8+O8XNihu/J/SlXSQ5/oeVrDCzpKMmqnunCf56zFOXXWqU7spj2uk5845y7rqKPd45hwF3fNJFL3lTyry2mq/D07vWDpQbkyVZ6anyzMPk7nqg8juIciZ2cas3iGOVTp+Qaf8RXftO/asXaazSSpWhpxB3+sbO4M9Y28Ug==</latexit> p(x, z) = p(x|z)p(z) = p(z|x)p(x) <latexit sha1_base64="3YtgVfSIzVYtkshM4D4MNxK39qQ=">AAADanicnVJNaxNRFD3J+FGjtWm7UboJxpZESngRaYsgFHXhRuyHaQtNCTPT1/TR+WLmJbSJ+QP+AReCoOBC/Bm6cKM7F/0JorsKblx45oNKDVXwDTNz3nn3nHvf5VqBoyItxGEub5w5e+78yIXCxUujl8eK4xNrkd8JbdmwfccPNywzko7yZEMr7ciNIJSmazly3dq7F5+vd2UYKd97rA8CueWabU/tKNvUpFrFhaCyX52501SeLhHO9qpN19S7odvfHvSO6Se9alA5cVRoFcuiJpJVGgb1DJSRrSV/PDeKJrbhw0YHLiQ8aGIHJiI+m6hDICC3hT65kEgl5xIDFKjtMEoywiS7x2+bu82M9biPPaNEbTOLwzeksoRp8Vm8EUfig3grvoifp3r1E4+4lgP+rVQrg9bY0yurP/6pcvnX2P2t+mvNGjtYSGpVrD1ImPgWdqrv9p4drd5eme7PiFfiK+t/KQ7FO97A6363Xy/Lled0j/3vU5X2MCR6mNXwiI6STLyLu3CDeZpJTJt1xhkHWY/b5GePuf91NLE/5Jhyp3fNJorvK5lrwGmq/zk7w2DtZq0+V5tbvlVevJvN1QimcA0Vzs48FvEAS2jQ8wXe4yM+5b8ZE8ZVYyoNzecyzSROLOP6L4DFxi0=</latexit> p(x) = p(x, z)dz = p(x|z)p(z)dz -
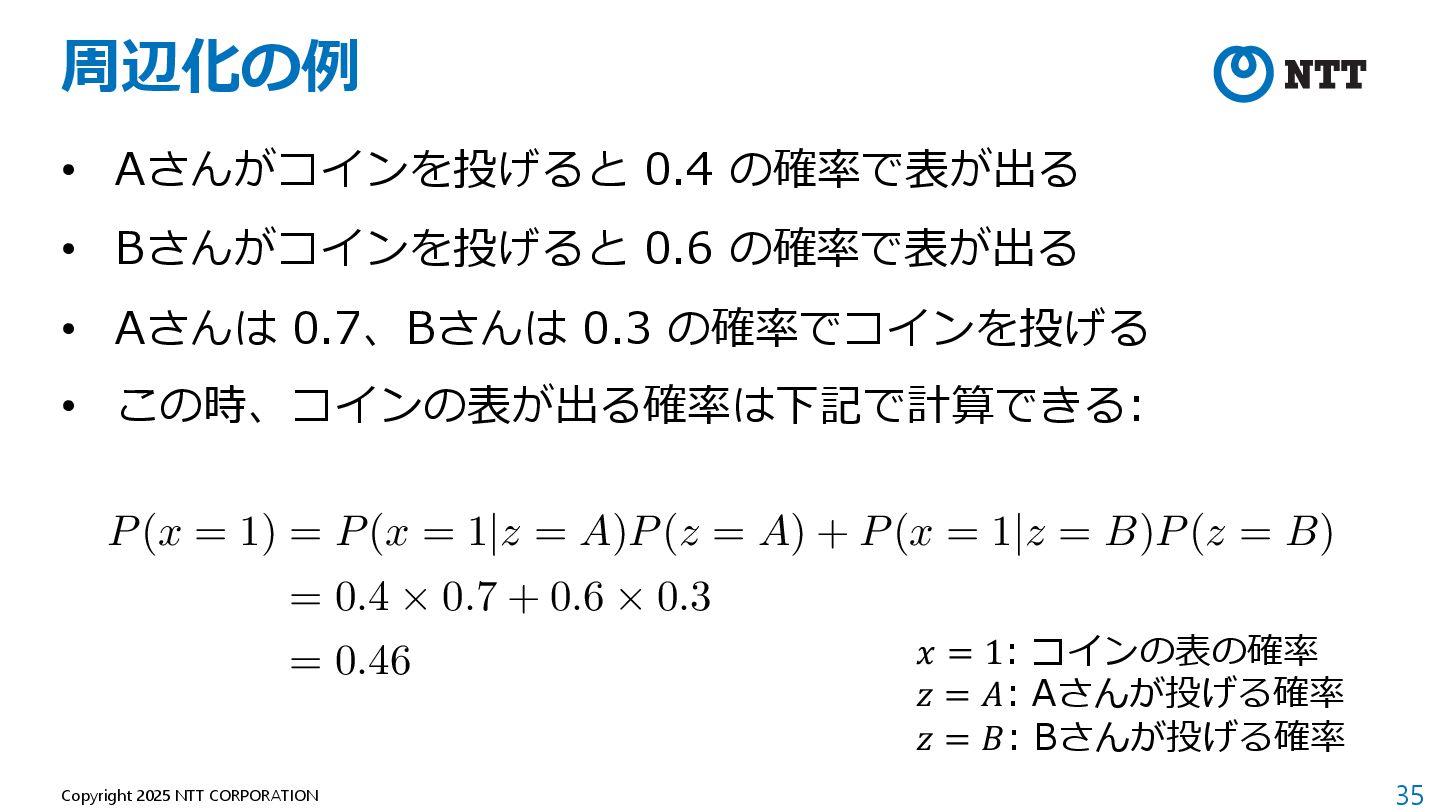
35 Copyright 2025 NTT CORPORATION 周辺化の例 • Aさんがコインを投げると 0.4 の確率で表が出る
• Bさんがコインを投げると 0.6 の確率で表が出る • Aさんは 0.7、Bさんは 0.3 の確率でコインを投げる • この時、コインの表が出る確率は下記で計算できる: 𝑥 = 1: コインの表の確率 𝑧 = 𝐴: Aさんが投げる確率 𝑧 = 𝐵: Bさんが投げる確率 <latexit sha1_base64="gvYN33GeNUpytiJNa+hZLVdXONU=">AAADgXicnVJPTxNBFH9lFbEIFL2YeCE0NK2YzVskxWiaYPHghVDAAglLmt11qBP2X3anDVD7BfwCHjxJwoF45hN48Qt4IF7lQDhCwoWDb2YXjTZo4mx25r3fvN/vvXl5dujyWCAeZfq0Gzf7bw3czg7eGRoeyY3eXYmDVuSwuhO4QbRmWzFzuc/qgguXrYURszzbZav21py8X22zKOaB/0rshGzDs5o+3+SOJQhq5BZqxe2KUSpU1Pl2t/K8VCvKffIKqCqgWjLNQgX1aVNwj8Woz0yiXr5yHqeX5Wwjl0cd1RrrNYzUyEO6asFoZghMeA0BONACDxj4IMh2wYKYvnUwACEkbAM6hEVkcXXPoAtZ4rYoilGERegW7U3y1lPUJ19qxortUBaX/oiYYzCBX/EAz/ALfsITvLxWq6M0ZC07dNoJl4WNkXf3ly/+yfLoFPDmF+uvNQvYhCeqVk61hwqRr3ASfnv3/dny06WJTgH38JTq/4hH+Jle4LfPnf1FtvSB1KX+C2IlPYzImk9rWCBFRoj0ZBceUh5TxTSpTpmxm/a4Sfijn9j/Klqw3aOYYNd3zSFLvpdRri5Nk/Hn7PQaK1O6UdbLi9P52Wo6VwPwAMahSLMzA7PwEmpQJ81D+Abf4VjTtJKG2lQS2pdJOffgt6U9+wFlnMee</latexit> P(x = 1) = P(x = 1|z = A)P(z = A) + P(x = 1|z = B)P(z = B) = 0.4 → 0.7 + 0.6 → 0.3 = 0.46 -
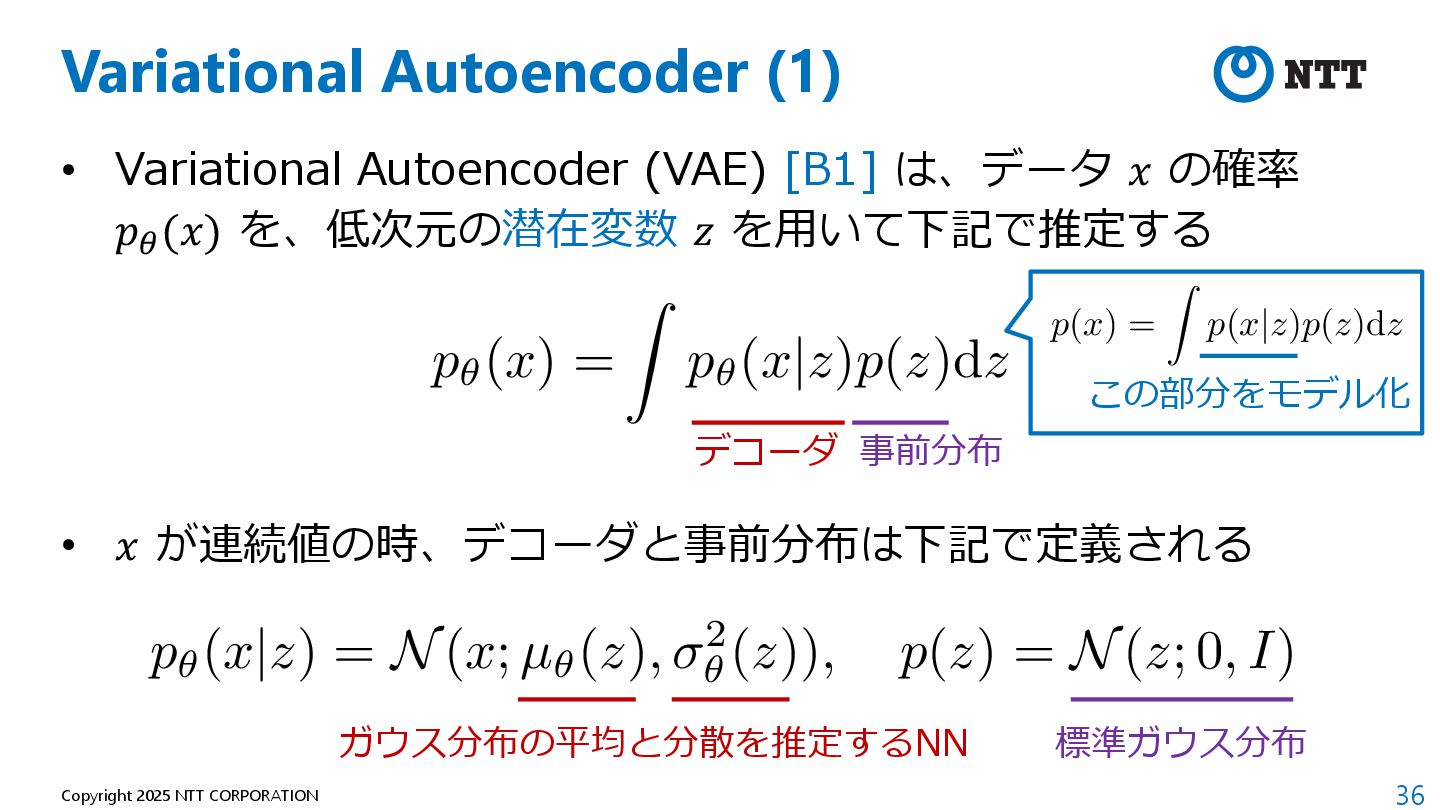
36 Copyright 2025 NTT CORPORATION Variational Autoencoder (1) • Variational
Autoencoder (VAE) [B1] は、データ 𝑥 の確率 𝑝$ (𝑥) を、低次元の潜在変数 𝑧 を⽤いて下記で推定する • 𝑥 が連続値の時、デコーダと事前分布は下記で定義される <latexit sha1_base64="qbhTgZfdRQCxj0XVlf4KJ8YjDpE=">AAADPnicnVLLahRBFD1pH0nGRyZmE3AzOCTMiAw1URIRAsFk4UbMw0kC6TBUdyozRfpFd82QTGd+ID8gwVUCWYgfoeAmfoCL/IAgIi4iKOLCW92Nr8EIVtNVt07dc+rU5VqBIyPF2Emfce78hYv9A4O5S5evXB3KD19bjvxWaIua7Tt+uGrxSDjSEzUllSNWg1Bw13LEirU1q89X2iKMpO89VjuBWHd5w5Ob0uaKoHr+dlCPTdUUindL2+XpcVN6qvArttspB6VO2XS5aoZuvNHt5Or5IquwZBR6g2oWFJGNeT//FSY24MNGCy4EPCiKHXBE9K2hCoaAsHXEhIUUyeRcoIsccVuUJSiDE7pFc4N2axnq0V5rRgnbplsc+kNiFjDG3rBn7JQds+fsHfv2V6040dBedmi1Uq4I6kN7o0uf/8lyaVVo/mSd6VlhE3cTr5K8BwmiX2Gn/HbnyenSvcWxeJwdsvfk/4CdsFf0Aq/9yT5aEItPSV3rzxErrWFI0cPMwyNSFITona7CTbrHTHIa5FPf2M1q3CD81g/sfxU5tnsUU0y3SfXPpugNlicq1cnK5MKd4sz9rGEGcB03UKKumMIMHmAeNfK1jxc4xmvjpfHW+GB8TFONvowzgt+G8eU71bvBQA==</latexit> p✓(x) = Z p✓(x|z)p(z)dz 事前分布 デコーダ 標準ガウス分布 <latexit sha1_base64="7AePElT1asmPp5Kc5CP6wtAYlKU=">AAADb3icnVLLahRBFL2ZVpOMj4xxkYAgg0NkJgzDnSCJGAIhutCFmoeTBNLJUN1T6SnSL7urh2Q68wP+gAtXCi7Ez3Aj7l3kE8SNEkEMLrzV3SSYQYVU01W3Tt1z6tTlGr4tQol4MJDTzp2/MDg0nL946fKVkcLV0dXQiwKTN0zP9oJ1g4XcFi5vSCFtvu4HnDmGzdeMnXvqfK3Dg1B47lO55/NNh1mu2BYmkwQ1Cy2/GeuyzSXrlXf3u5U53WGybTI7fkzArO5EJ+fdSlUPheWwY2grnlIw4c8i1ir65VMC3VmsPqzkm4US1jAZxf6gngUlyMaiVzgCHVrggQkROMDBBUmxDQxC+jagDgg+YZsQExZQJJJzDj3IEzeiLE4ZjNAdmi3abWSoS3ulGSZsk26x6Q+IWYQJ/IRv8RA/4Dv8jL/+qhUnGsrLHq1GyuV+c+T5+MqP/7IcWiW0T1j/9CxhG+4kXgV59xNEvcJM+Z3ui8OVu8sT8S18jV/I/ys8wPf0Arfz3XyzxJdfkrrSv0+stIYBRY8yD09IkROidqoKk3SPnuRY5FPd2MtqbBFePcbOqshgt08xxVSb1E83RX+wOlWrT9eml26X5heyhhmC63ATytQVMzAPD2ARGuTrI3yFn3CU+6aNaTe0YpqaG8g41+CPoVV+A5FV0EI=</latexit> p✓(x|z) = N(x; µ✓(z), 2 ✓ (z)), p(z) = N(z; 0, I) ガウス分布の平均と分散を推定するNN この部分をモデル化 <latexit sha1_base64="mlo1doEB46TIvPIo5TET+TL04lE=">AAADLHicnVJPSxtBHH2uttq01rS9FLzEBiWREiZSrBQEUQ9eiv8aFYyE3XWMg/uP3UnQxJwFv4AHTwoepLTH9gN48QO0Bym9FsSjgiAe/M3uYqnBFjrL7rx583tv3g4/w7NEIBk7adFa2x48bO94lHj8pPNpV/LZ87nArfgmL5iu5foLhh5wSzi8IIW0+ILnc902LD5vrI2p/fkq9wPhOh/khseXbL3siBVh6pKoUrLHy6xn+4aLwpEpgpu1rJepZYu2Lld9u77cqCVKyTTLsXCkmkE+BmnEY8pNXqGIZbgwUYENDgeSsAUdAT2LyIPBI24JdeJ8QiLc52ggQdoKVXGq0Ildo2+ZVosx69BaeQah2qRTLHp9UqbQy76zQ3bOjtlHdsqu7/Wqhx4qywbNRqTlXqlr++Xs5T9VNs0Sq79Vf80ssYKhMKug7F7IqL8wI321tnM++26mt97H9tkZ5d9jJ+yI/sCpXpgH03xml9yV/zipojv0Cb2PM0ySIydGrdQt9NM5xbCmTDnViY34jsvEv77l/tdRx3qTY8SpNsnfbYpmMDeQyw/mBqffpEdG44bpQDdeIUNd8RYjmMAUCpRrC5/wBV+1z9o37Yf2MyrVWmLNC/wxtF835Im4+g==</latexit> p(x) = Z p(x|z)p(z)dz -
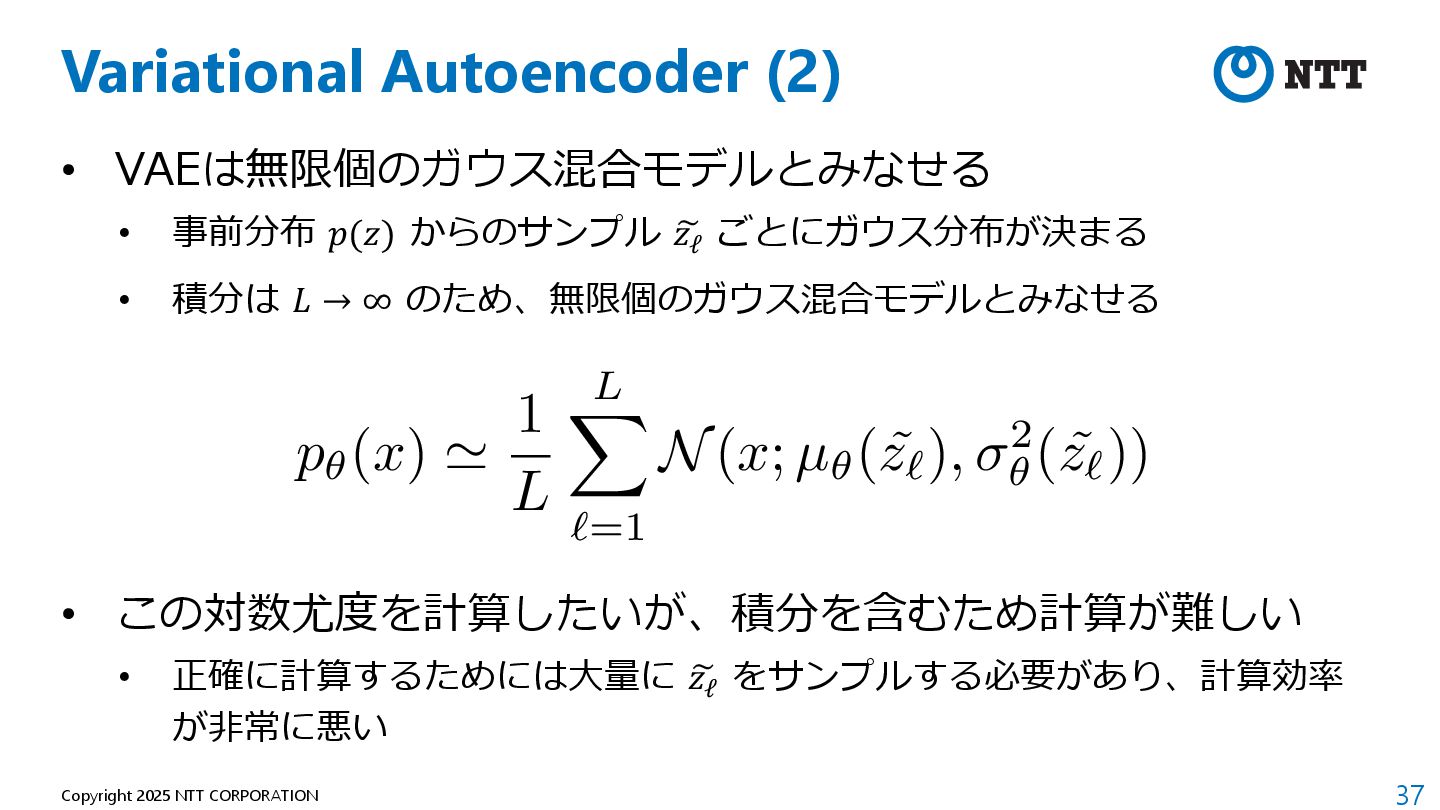
37 Copyright 2025 NTT CORPORATION Variational Autoencoder (2) • VAEは無限個のガウス混合モデルとみなせる
• 事前分布 𝑝(𝑧) からのサンプル S 𝑧ℓ ごとにガウス分布が決まる • 積分は 𝐿 → ∞ のため、無限個のガウス混合モデルとみなせる • この対数尤度を計算したいが、積分を含むため計算が難しい • 正確に計算するためには⼤量に S 𝑧ℓ をサンプルする必要があり、計算効率 が⾮常に悪い <latexit sha1_base64="Kyn66BgbQmOFLF7/lSAr8weQMWQ=">AAADj3icnVJLa9VAGP3S+KjXR1Pd+NgULy29Ui6TIq0oykVdKPjow9sWmvYySefmDp08TCaXtkN2rvwDLlwpuBB/hhv/gIv+BHVZQRAXfpOEFr1WwQnJfHPmnDMnw+fGgqeSkF1jyDxy9Njx4RO1k6dOnxmxRs8upVGWeKztRSJKVlyaMsFD1pZcCrYSJ4wGrmDL7uYdvb/cZ0nKo/CJ3I7ZWkD9kHe5RyVCHetZ3FGO7DFJ88mtxoST8oA9dboJ9ZSdqwe5k2YBMpgQN+18XQMBlT2PCvUIBTecIDvQO5KLDaZ2Sn6eN6bQzg/oPmNdTf+B1ah1rDppkmKMDRZ2VdShGnOR9R0c2IAIPMggAAYhSKwFUEjxWQUbCMSIrYFCLMGKF/sMcqihNkMWQwZFdBO/Pq5WKzTEtfZMC7WHpwh8E1SOwTj5SN6SPfKBvCOfyI9DvVThobNs4+yWWhZ3Rp6fX/z2T1WAs4TegeqvmSV04VqRlWP2uED0X3ilvr/zYm/x+sK4miCvyRfM/4rskvf4B2H/q/dmni28RHftfxdV5R0mWD2sMjxGR4aIXulbuILnOAXHx5z6xLy6Yx/xqX3sfx0pbA04lphuE/v3phgslqab9kxzZv5qvXW7aphhuASXYRK7YhZacA/moI25PhuWccG4aI6as+Yts1VSh4xKcw5+Geb9nw4s3MQ=</latexit> p✓(x) ' 1 L L X `=1 N(x; µ✓( ˜ z`), 2 ✓ ( ˜ z`)) -
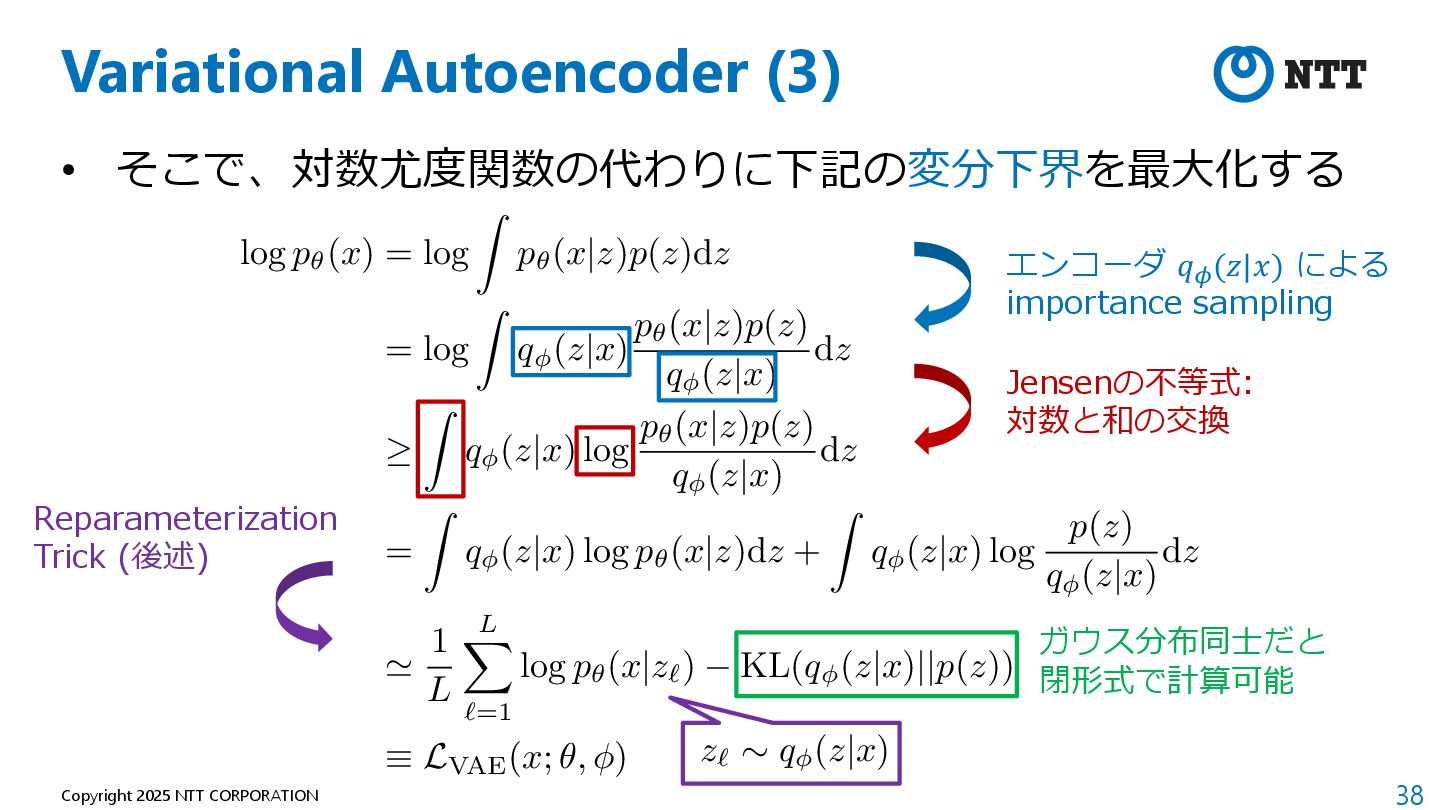
38 Copyright 2025 NTT CORPORATION Variational Autoencoder (3) • そこで、対数尤度関数の代わりに下記の変分下界を最⼤化する
<latexit sha1_base64="DH4scxozcXRW91F4Sw9kLDja2Us=">AAAE63icnVJLaxNRFD6Jo9b4aKobwU0wtGS0hjsiVZRAfSJYsQ+TFjo1TKY3k0vnlXmENJP7B9y6ENSNQhfiz3DjH3DRlWtxWUEQF547M2rTxBZ6h5k597vf951zLqfhmswPCNnOZI9IR48dHzuRO3nq9Jnx/MTZmu+Enk6rumM63kpD86nJbFoNWGDSFdejmtUw6XJj4644X+5Qz2eO/TTYdOmapRk2azJdCxCqT2S+qKZjFNx6pAYtGmi81JWnKgJTmR0M4P2e7JZ6smppQcuzonXeU9Vd1DZS3RbjpV6/K6tNT9OjEWoeDfD4oJtq0PYIM5HicIaV0W57+9olurxv/oM78JmFPcRshUdzXPVDC/nUNCsKfyaA4fzJOZev/PF6NMdLA1n6fZFaFgloO2SdmKhrJvohLVXVbt/n6HcrcZ4WajlXzxdJmcSrMBwoaVCEdM07+Z+gwjo4oEMIFlCwIcDYBA18fFZBAQIuYmsQIeZhxOJzChxyqA2RRZGhIbqBXwN3qylq4154+rFaxywmvh4qCzBJPpP3ZId8Ih/IV/Lrv15R7CFq2cR/I9FStz7+/PzSjwNVFv4DaP1T7VtzAE24EdfKsHY3RkQXeqLv9F7uLN1cnIymyDvyDet/S7bJR+zA7nzXtxbo4mt0F/73UJXcoYfR47SGJ+hIERE7cQuXMI8acwysU2Tk6R0biE//xQ7rqEF3yDHBxJgoe4diOKhdLSsz5ZmFa8XZO+nAjMEFuAglnIrrMAsPYR6qoGcfZM1smO1IlvRCeiW9SajZTKo5BwNL2voNk85l0A==</latexit> log p✓(x) = log Z p✓(x|z)p(z)dz = log Z q (z|x) p✓(x|z)p(z) q (z|x) dz Z q (z|x) log p✓(x|z)p(z) q (z|x) dz = Z q (z|x) log p✓(x|z)dz + Z q (z|x) log p(z) q (z|x) dz ' 1 L L X `=1 log p✓(x|z`) KL(q (z|x)||p(z)) ⌘ LVAE(x; ✓, ) エンコーダ 𝑞! (𝑧|𝑥) による importance sampling Jensenの不等式: 対数と和の交換 Reparameterization Trick (後述) <latexit sha1_base64="HYUhYk0AYg8JfT3MmaluLmJoBkI=">AAADJ3icnVK/SxxBGH1uNNGLxjNpBC2OHIoGOeaCGLEStbCR+OtU8OTYXcdzcPZHdvcOvcs1lv4DFlYKgpIq+Rds7FIlxNJSLBWEkMJvdhfFHIngLDvzfW++9+bN8BmuFH7A2FmD9qyx6fmL5pbEy9a2V+3JjtcLvlPyTJ4zHel4S4bucylsngtEIPmS63HdMiRfNDbG1f5imXu+cOz5YMvlK5ZetMWaMPWAoEKyu1Ko5rmUtd68L6zUJ8rcdVHrq3ze7E8UkmmWYeFI1QfZOEgjHtNO8jfyWIUDEyVY4LARUCyhw6dvGVkwuIStoEqYR5EI9zlqSBC3RFWcKnRCN2guUrYcozblStMP2SadIun3iJlCD/vBjtkVO2Vf2AX780+taqihvGzRakRc7hbadzrnbh5lWbQGWL9n/ddzgDUMh14FeXdDRN3CjPjlyu7V3MhsT7WXHbBL8r/PztgJ3cAuX5uHM3x2j9SV/gSxojf0KJqKPXwkRU6IytQrvKNz8mFNkXyqE2vxGxcJH7jDnqqoY7NOMcJUm2T/bor6YOF9JjuUGZoZTI+OxQ3TjC68RR91xQeMYhLTyJGvbRzhK75px9p37af2KyrVGmLOGzwY2vktO7S3uQ==</latexit> z` ⇠ q (z|x) ガウス分布同⼠だと 閉形式で計算可能 -
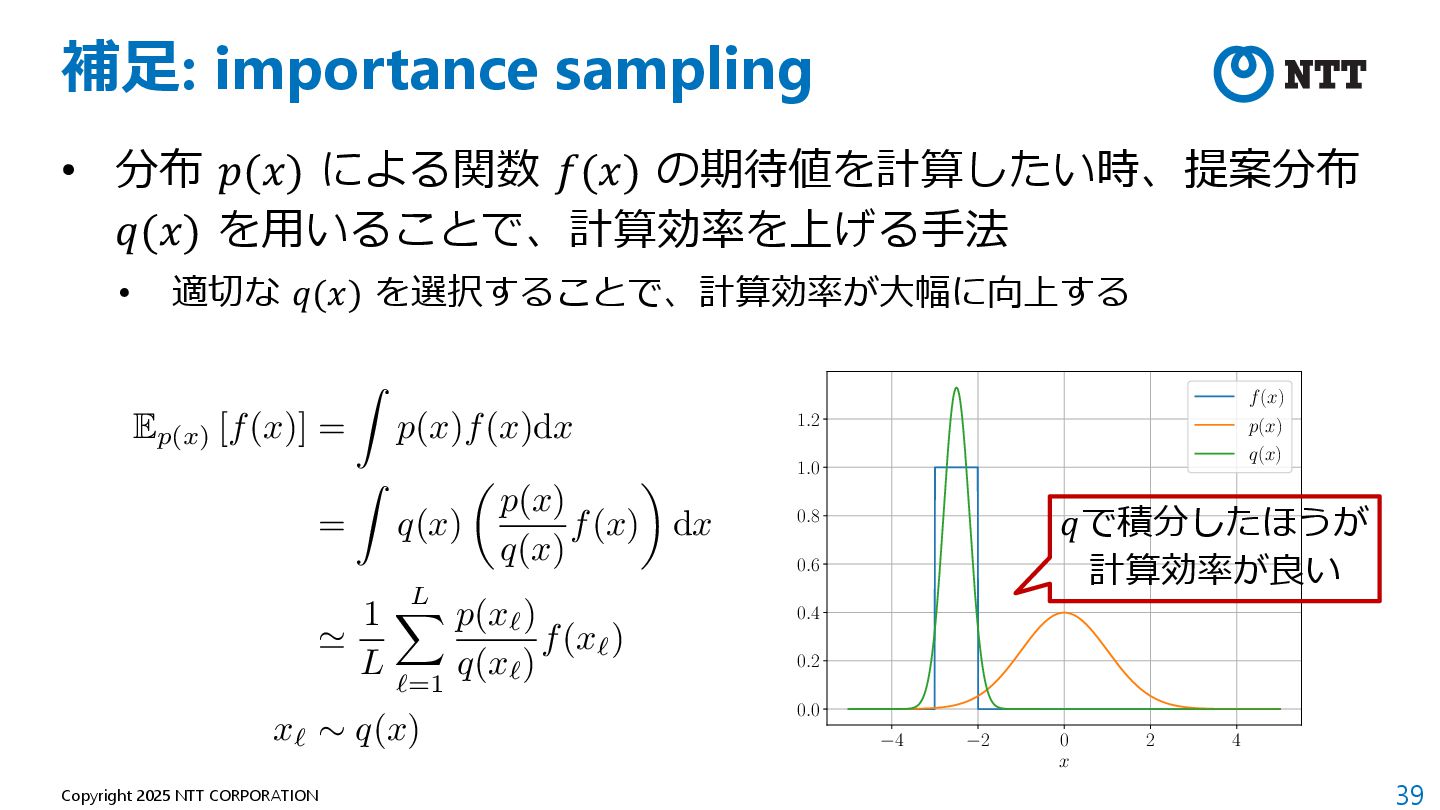
39 Copyright 2025 NTT CORPORATION 補⾜: importance sampling • 分布
𝑝(𝑥) による関数 𝑓(𝑥) の期待値を計算したい時、提案分布 𝑞(𝑥) を⽤いることで、計算効率を上げる⼿法 • 適切な 𝑞(𝑥) を選択することで、計算効率が⼤幅に向上する °4 °2 0 2 4 x 0.0 0.2 0.4 0.6 0.8 1.0 1.2 f(x) p(x) q(x) 𝑞で積分したほうが 計算効率が良い <latexit sha1_base64="9O49RdGc2MmYb/D948GTy6Bidzw=">AAAD5XicnVLLahRBFL2d9hHHR0bdCG4Gh4RRZKgWiSIEBh/gQjEPJwlMjUN3p7qnSPUj3TXDxKZ+QHAnunAhCi7Ez3DjD7iIfyAuIwjiwlvdnQxmUMFquuvcc+85dbu4Tix4KgnZMabMQ4ePHJ0+Vjl+4uSpmerpM6tpNEhc1nYjESXrjp0ywUPWllwKth4nzA4cwdaczVs6vzZkScqj8KHcjlk3sP2Qe9y1JVK96mca2LLvONkd1cvixuiiooJ5suMhpAn3+7I7t0B5KGs6mbNakATZhhpRWua2NK91DeoltlsYZZpVY6MDSprygG0V9ZbK7imaDoJeRpkQC5Z6pIk9r4JVheV+4I0xpXswt837qfSqddIk+apNAqsEdSjXYlT9ARQ2IAIXBhAAgxAkYgE2pPh0wAICMXJdyJBLEPE8z0BBBbUDrGJYYSO7iV8fo07JhhhrzzRXu3iKwDdBZQ1mySfyjuySj+Q9+UJ+/tEryz10L9u4O4WWxb2ZJ+dWvv9TFeAuoT9W/bVnCR5cz3vl2HucM/ov3EI/fPxid+XG8mw2R96Qr9j/a7JDPuAfhMNv7tsltvwS3bX/bVQVd5ggul/28AAdGTI60rdwCc+heY2PfeoTVXnHPvKX97n/dbRhNOFYcHpMrINDMQlWrzSt+eb80tV662Y5MNNwHi5AA6fiGrTgLixCG1yjZXhGZMSmbz41n5nPi9Ipo9Schd+W+eoXFH/9Pg==</latexit> E p(x) [f(x)] = Z p(x)f(x)dx = Z q(x) ✓ p(x) q(x) f(x) ◆ dx ' 1 L L X `=1 p(x`) q(x`) f(x`) x` ⇠ q(x) -
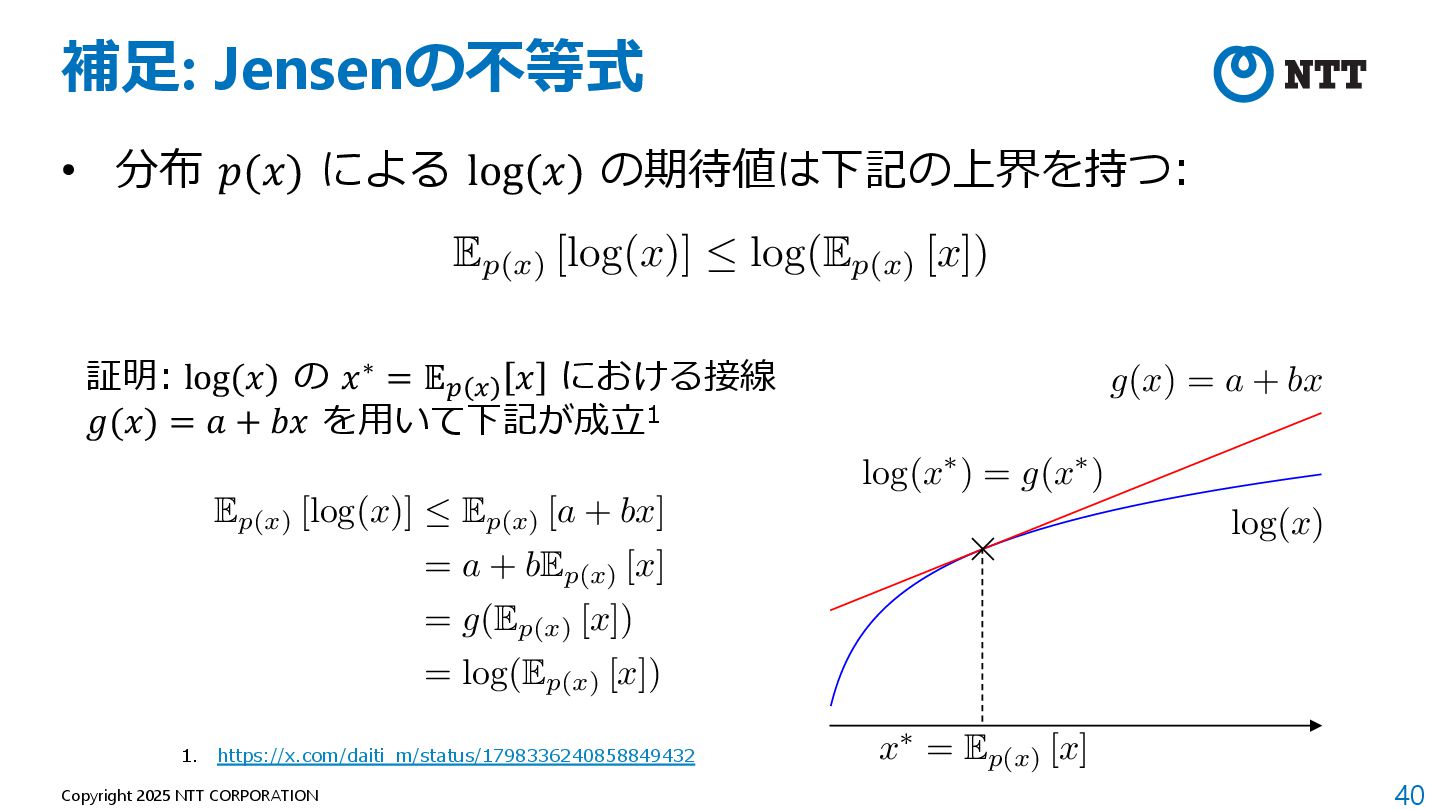
40 Copyright 2025 NTT CORPORATION 補⾜: Jensenの不等式 • 分布 𝑝(𝑥)
による log(𝑥) の期待値は下記の上界を持つ: 証明: log(𝑥) の 𝑥∗ = 𝔼: ! 𝑥 における接線 𝑔(𝑥) = 𝑎 + 𝑏𝑥 を⽤いて下記が成⽴1 <latexit sha1_base64="bFj735oJvoIR54VG0u7GBBHyiGk=">AAADW3icnVJNaxNBGH6a9aPGaqNSKPRSDC2tlDARqeKpVAu9iGlr2kI2hN11shk6++HuJKQu+QP+AQ+eWuihePcPePEPeCjoUUE8VigUD76zuygaquAsO/O+z7zPM88Mrx1KESvGjkYKxrnzFy6OXipeHrtydbx07fpmHHQjh9edQAbRtm3FXAqf15VQkm+HEbc8W/Ite+eB3t/q8SgWgf9E7Ya86VmuL9rCsRRBrVLN9CzVse1kZdBKwrn+/MCUvK0apgxcysxIuB3VnCXwWQqdUd7PC+eLrVKZVVg6poeDah6UkY9aUDqFiacI4KALDxw+FMUSFmL6GqiCISSsiYSwiCKR7nMMUCRul6o4VViE7tDsUtbIUZ9yrRmnbIdOkfRHxJzGDHvPDtkxe8desy/s+5laSaqhvezSamdcHrbGX0xunPyT5dGq0PnF+qtnhTbupV4FeQ9TRN/Cyfi95y+PN+6vzySzbJ99Jf977Ii9pRv4vW/OwRpff0XqWv8hsbI3jCh6lHt4TIqcEJ3pV7hF55hpjUs+9YmD/I1dwhd+Yv+raKE/pJhhuk2qfzbFcLB5u1JdrCyu3SkvLecNM4op3MQcdcVdLGEVNdTJ1xt8wCd8Lnw0DKNojGWlhZGccwO/DWPiBwuqyX4=</latexit> E p(x) [log(x)] log(E p(x) [x]) <latexit sha1_base64="Di3Cp2YdwmUIFLKycwTfGzbZpmU=">AAADzXicnVJNaxNBGH63W9satY31IvRSGhrSVsJEpIogFG3Bi/YzTSAbwux2shk6+9HdSUhd02vBP+DBk4KH4r/Qi3/AQ3+CeKwgSA++s7v40ZAGnGV33veZ53nm2WFMX/BQEnKqjeijV8bGJ65mrl2/MTmVvTm9G3rtwGJlyxNeUDVpyAR3WVlyKVjVDxh1TMEq5v4TtV7psCDknrsjD31Wd6jt8ia3qESokf1oOFS2TDNa6zUiv9Bd6BmCNWXNEJ6NnRFwuyXreQQPBjDpktlNaYaRf4TtAOLfLLswhLSgWHGIYcRMI5sjRRKP2f6ilBY5SMeGl/0JBuyBBxa0wQEGLkisBVAI8alBCQj4iNUhQizAisfrDHqQQW0bWQwZFNF9/NrY1VLUxV55hrHawl0EvgEqZ2GefCEn5Ix8Jh/IV3I+0CuKPVSWQ5zNRMv8xtSr29s/hqocnCW0/qguzSyhCQ/irByz+zGi/sJK9J0Xr8+2H27NR3nyjnzD/G/JKfmEf+B2vlvvN9nWG3RX/quoSs4wwOpZmmEdHRkiqlOnsIj7GDHHxpxqx156xjbid35j/+tIodvnmGDqmpQuXor+YvdusbRcXN68l1t5nF6YCZiBOSjgrbgPK/AUNqAMllbQnmsVraqv6239pX6UUEe0VHML/hn68S/id/O0</latexit> E p(x) [log(x)] E p(x) [a + bx] = a + bE p(x) [x] = g(E p(x) [x]) = log(E p(x) [x]) <latexit sha1_base64="nPUw+gSXaaxHMagsQJkTwzvjfzE=">AAADFHicnVJNKwVRGH6M7+vrYqNs5Ea+up0rIaWEhY18XtQlzYxjTObOTDNzb5ebP2CPhSLKQv6CnZSVnYWfIEtKycJ7ZibihnKmmfOe57zPc57zzqvYhu56jN0XScUlpWXlFZWRquqa2rpofcOCa2UclSdVy7CcJUV2uaGbPOnpnsGXbIfLacXgi8rmmNhfzHLH1S1z3tuy+Upa1kx9XVdlj6CU1pHrbB+Wu5VcZDUaY3Hmj5bCIBEGMYRj2oq+YhlrsKAigzQ4THgUG5Dh0pNCAgw2YSvIE+ZQpPv7HDuIEDdDWZwyZEI36avRKhWiJq2FpuuzVTrFoNchZgva2B07Z0/shl2wB/b2o1be1xBetmhWAi63V+t2m+Ze/mSlafaw8cn61bOHdQz6XnXybvuIuIUa8LPbB09zQ7Nt+XZ2yh7J/wm7Z1d0AzP7rJ7N8NlDUhf648QKauhQNBl6mCJFTohYiSp00TnLfo5GPsWJO2GNNcJ7PrD/KsrIFSgGmGiTxPemKAwWeuOJ/nj/TF9sZDRsmAo0oxUd1BUDGMEEppH0/+sejnAs7UuX0pV0HaRKRSGnEV+GdPsOsrGvXg==</latexit> g(x) = a + bx <latexit sha1_base64="S2mBPnunjvCHg1K+mXhi5OvYlEI=">AAADIXicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQuIxeTkp2tUxFVr1Wqq2cJYXPECygZ6BmCggMkwhDKUGaAgIF/gF0MMQwpDPkMyQylDLkMqQx5DCZCdw5DIUAyE0QyGDAYMBUCxWIZqoFgRkJUJlk9lqGXgAuotBapKBapIBIpmA8l0IC8aKpoH5IPMLAbrTgbakgPERUCdCgyqBlcNVhp8NjhhsNrgpcEfnGZVg80AuaUSSCdB9KYWxPN3SQR/J6grF0iXMGQgdOF1cwlDGoMF2K2ZQLcXgEVAvkiG6C+rmv452CpItVrNYJHBa6D7FxrcNDgM9EFe2ZfkpYGpQbOBpoPMdwHqgoRhEZDlC3WDP9DEVKAIiAcKBS2gPTFgNelAd4JsrIWGcTpQXAcuRq6JiQwVGCZCxEDJxBA9UWAywoz0DM30zAJNlB2coAmGg0GaQYlBA5gqzBkcGDwYAhhCge6qYVjEsJphDdNippNMF5guQZQyMUL1CDOgAKbbAM1vs/4=</latexit> log(x⇤) = g(x⇤) 1. https://x.com/daiti_m/status/1798336240858849432 <latexit sha1_base64="sz+tla+x79Cc8WwggE6/VDrYSs0=">AAADMnicnVLPa9RAGH2NWuuq7VYvgpfSpbWWssxKqSIIxSp4Kf3ltoXNdknibHZofpHMLltD/gGhZw+eFDyIx/ZYT178B3pob+JJ9FZBEA9+kwTFLrXghMx88+Z7b958fGbgiEgydtCnnTl7rv/8wIXCxUuXB4eKw1dWI78dWrxq+Y4frptGxB3h8aoU0uHrQcgN13T4mrk5p87XOjyMhO89llsBr7uG7YmmsAxJUKN4o7sRTybj93TXkC3TjB8mjTiY6N5MdIc3Za2rh8JuyXqhUSyxMkvHSG9QyYMS8rHoF39AxxP4sNCGCw4PkmIHBiL6aqiAISCsjpiwkCKRnnMkKBC3TVmcMgxCN2m2aVfLUY/2SjNK2Rbd4tAfEnMEY2yfvWFH7AN7yz6znydqxamG8rJFq5lxedAYenZt5fupLJdWidYf1j89SzRxJ/UqyHuQIuoVVsbvPH1+tHJ3eSweZ6/YF/L/kh2w9/QCr/PNer3El1+QutJ/QKyshiFF87mHBVLkhKidqsIk3aOnOTb5VDcmeY1twqd+Y/+raKDbo5hhqk0qx5uiN1i9Va7MlGeWpkuz9/OGGcB1jGKCuuI2ZvEIi6iSr23sYA/vtF3tUPuofcpStb6ccxV/De3rL2vvvFE=</latexit> x⇤ = E p(x) [x] <latexit sha1_base64="SxBAmJOuU27OPvAaBstXJdbyL/w=">AAADEXicnVJNL8RQFD3qa4yvwUZiIyYEkckbEcRKsLARn8MkRqStpxqdtmk7k2HiD1iysGBDYiF+gZ2wkVhb+AliSSIRC/e1DWGCxGv63n3n3XPeeTdXsQ3d9Ri7L5PKKyqrqiM10dq6+obGWFPzomvlHJWnVMuwnLQiu9zQTZ7ydM/gadvhclYx+JKyOS7Ol/LccXXLXPC2bL6SlTVTX9dV2SMonTEsrbvQE12NxVmC+aO9NEiGQRzhmLFir8hgDRZU5JAFhwmPYgMyXPqWkQSDTdgKioQ5FOn+OccOosTNURanDJnQTZo12i2HqEl7oen6bJVuMeh3iNmOTnbHztgTu2Hn7IG9/ahV9DWEly1alYDL7dXG3db5lz9ZWVo9bHyyfvXsYR3DvledvNs+Il6hBvz89sHT/MhcZ7GLnbBH8n/M7tk1vcDMP6uns3zukNSF/gSxgho6FE2FHqZJkRMidqIKvXRPxs/RyKe4cSessUZ43wf2X0UZhRLFABNtkvzeFKXBYn8iOZgYnB2Ij46FDRNBGzrQTV0xhFFMYgYp39ceDnEk7UsX0qV0FaRKZSGnBV+GdPsOuGaurg==</latexit> log(x) -
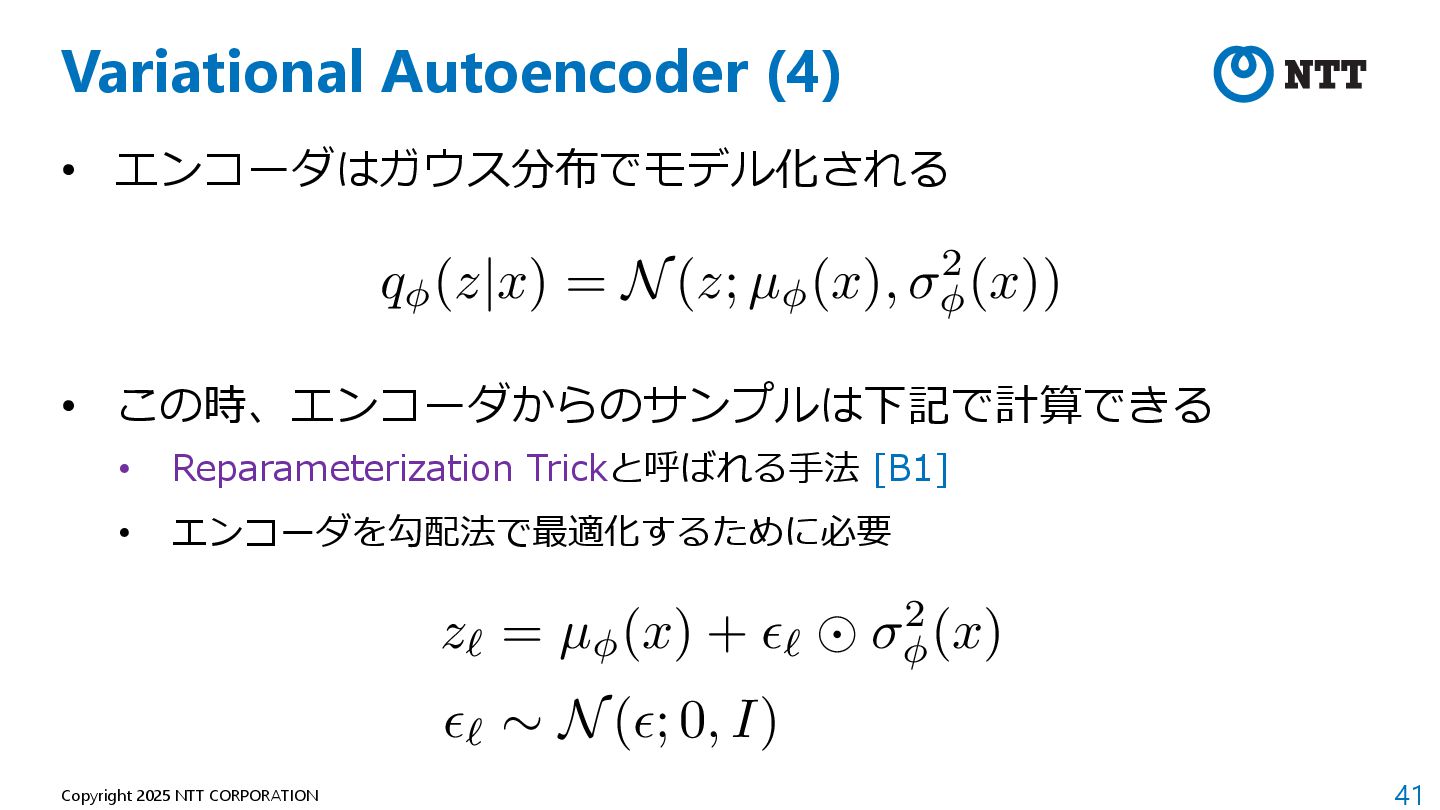
41 Copyright 2025 NTT CORPORATION Variational Autoencoder (4) • エンコーダはガウス分布でモデル化される
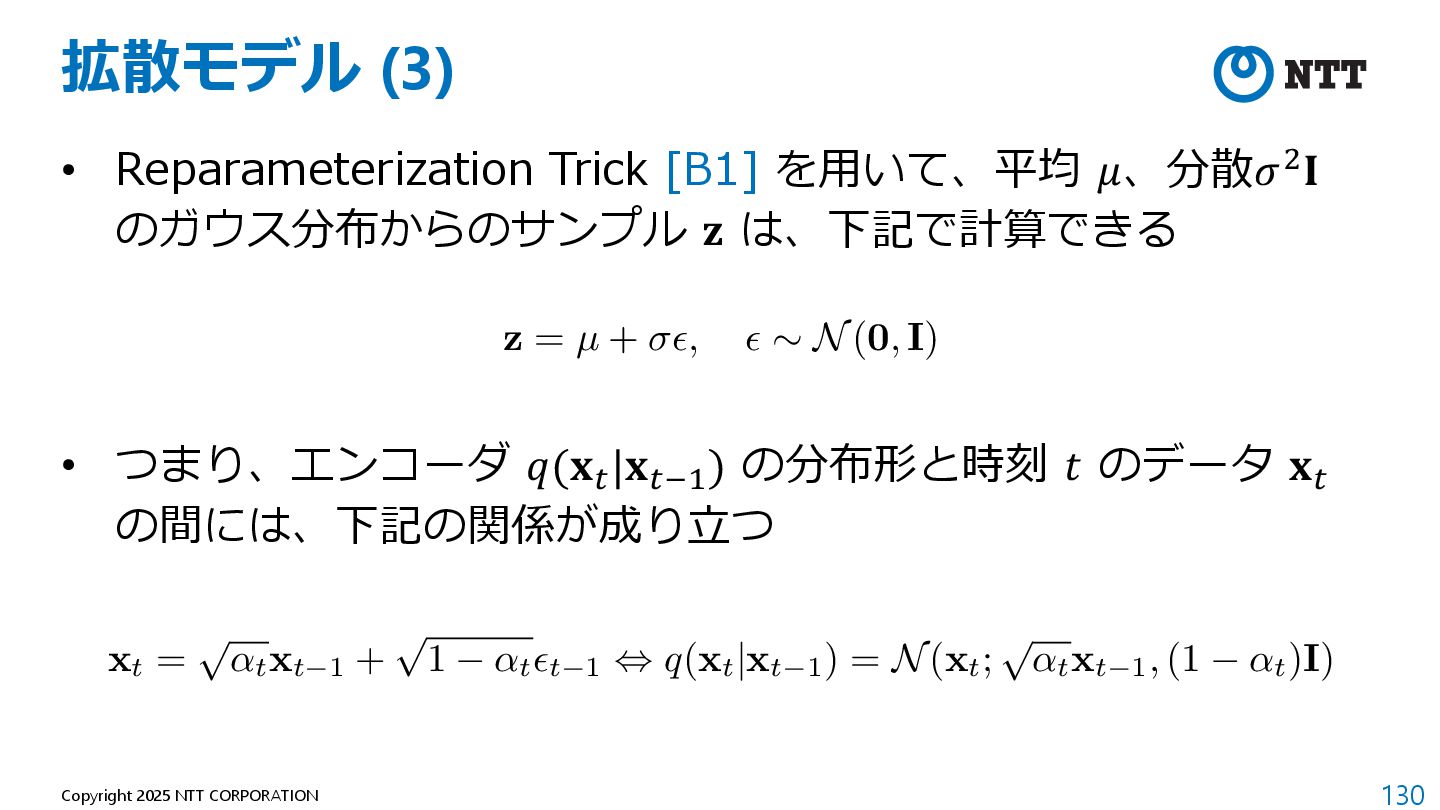
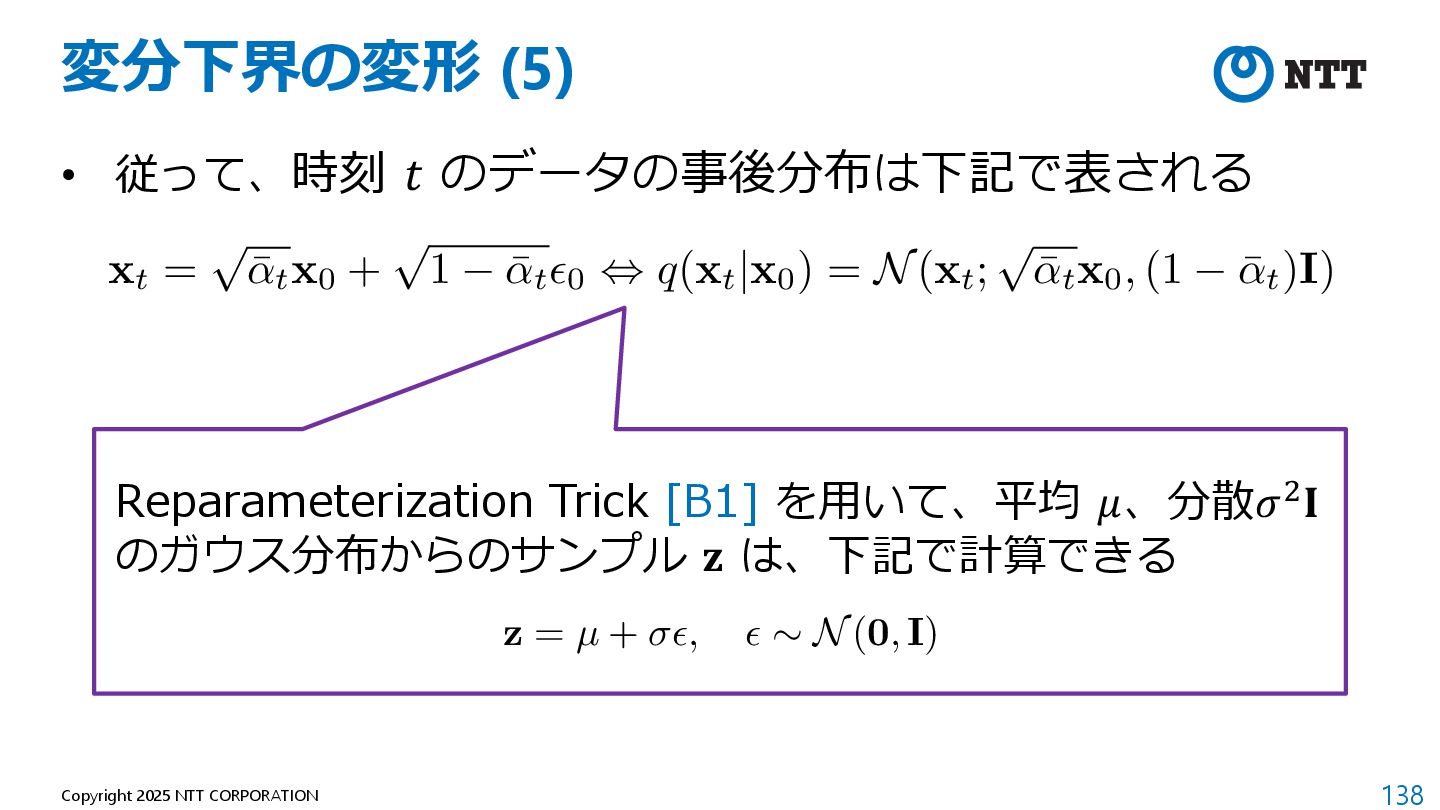
• この時、エンコーダからのサンプルは下記で計算できる • Reparameterization Trickと呼ばれる⼿法 [B1] • エンコーダを勾配法で最適化するために必要 <latexit sha1_base64="tOHLPpFqgkzwySGpv3j4M4IfTHY=">AAADTHicnVLLahRBFD3paIxjNKPZCG6CQ0JGwlATJIoSiI+FGzUPJwmkk6G6rfQU6ZfdNcMk7fyAP5BFVgmIiJ/hxo3uVPIJkmUCghrIre5W0UEFq+mqW6fuOXXqcq3QlbFibK/H6D1xsu9U/+nCmYGz5waL5y8sxEEzskXNDtwgWrJ4LFzpi5qSyhVLYSS4Z7li0Vq/o88XWyKKZeA/UhuhWPG448s1aXNFUL1460k9McOG7IxtPm2XR6dMj6uGzd3kASE3Ta/5/bhdHjdj6Xg8B1aTCQ2WC/ViiVVYOoa7g2oelJCPmaD4BSYeI4CNJjwI+FAUu+CI6VtGFQwhYStICIsokum5QAcF4jYpS1AGJ3SdZod2yznq015rxinbpltc+iNiDmOEvWcv2QF7w16xT+zbH7WSVEN72aDVyrgirA8+uzj/+Z8sj1aFxk/WXz0rrOF66lWS9zBF9CvsjN/a3DqYvzE3koyyXbZP/nfYHntNL/Bbh/bzWTG3Tepa/y6xshpGFN3PPTwkRUGI3ukqXKF7zDTHIZ/6xk5eY4fw8R/Y/ypytLsUM0y3SfX3pugOFiYq1cnK5OzV0vTtvGH6cQmXMUZdcQ3TuIcZ1MjXC7zFB3w03hmHxlfjKEs1enLOEH4ZvX3H0v3FlQ==</latexit> q (z|x) = N(z; µ (x), 2(x)) <latexit sha1_base64="g74yVo3Q44BOehuK7uDVCS6fwFc=">AAADe3icnVLdatRAGP1209a6VbvWG8Gb4tJlW5dlttgqilDUC72w9sdtC526TNJpdugkGZLZpW3IC/gCXnhVwQvxMbzxBSz0EYqXFQSp4DdJVOyihU5I5psz55w5GT5bSRFpQg4LRWtgcOjC8MXSyKXLV0bLV8dWoqAbOrzlBDII12wWcSl83tJCS76mQs48W/JVe/uR2V/t8TASgf9C7yq+4THXF1vCYRqhdlnttWPKpUyqD6jXxVp1RFLbmbxFuYqEREq2TYPNQNNIuB7LSS/jaUOk9BSziiyPekx3HCbj+aT2a/8+qT+dLLXLFdIg6RjvL5p5UYF8LATl70BhEwJwoAsecPBBYy2BQYTPOjSBgEJsA2LEQqxEus8hgRJqu8jiyGCIbuPXxdV6jvq4Np5RqnbwFIlviMpxmCCfyXtyTD6RD+SInPzTK049TJZdnO1My1V79NX15W9nqjycNXT+qP6bWcMW3E2zCsyuUsT8hZPpe3uvj5fvLU3EVfKWfMH8++SQfMQ/8HtfnXeLfOkNuhv/x6jK7jDE6lme4Tk6ckTMytzCFJ5DU46LOc2JSX7HLuL139h5HRns9DlmmGmT5umm6C9WphvN2cbs4u3K3MO8YYbhBtyEGnbFHZiDJ7AALcx1ACeFwcJQ8YdVsaasekYtFnLNNfhrWDM/Abf31Vc=</latexit> z` = µ (x) + ✏` 2(x) ✏` ⇠ N(✏; 0, I) -
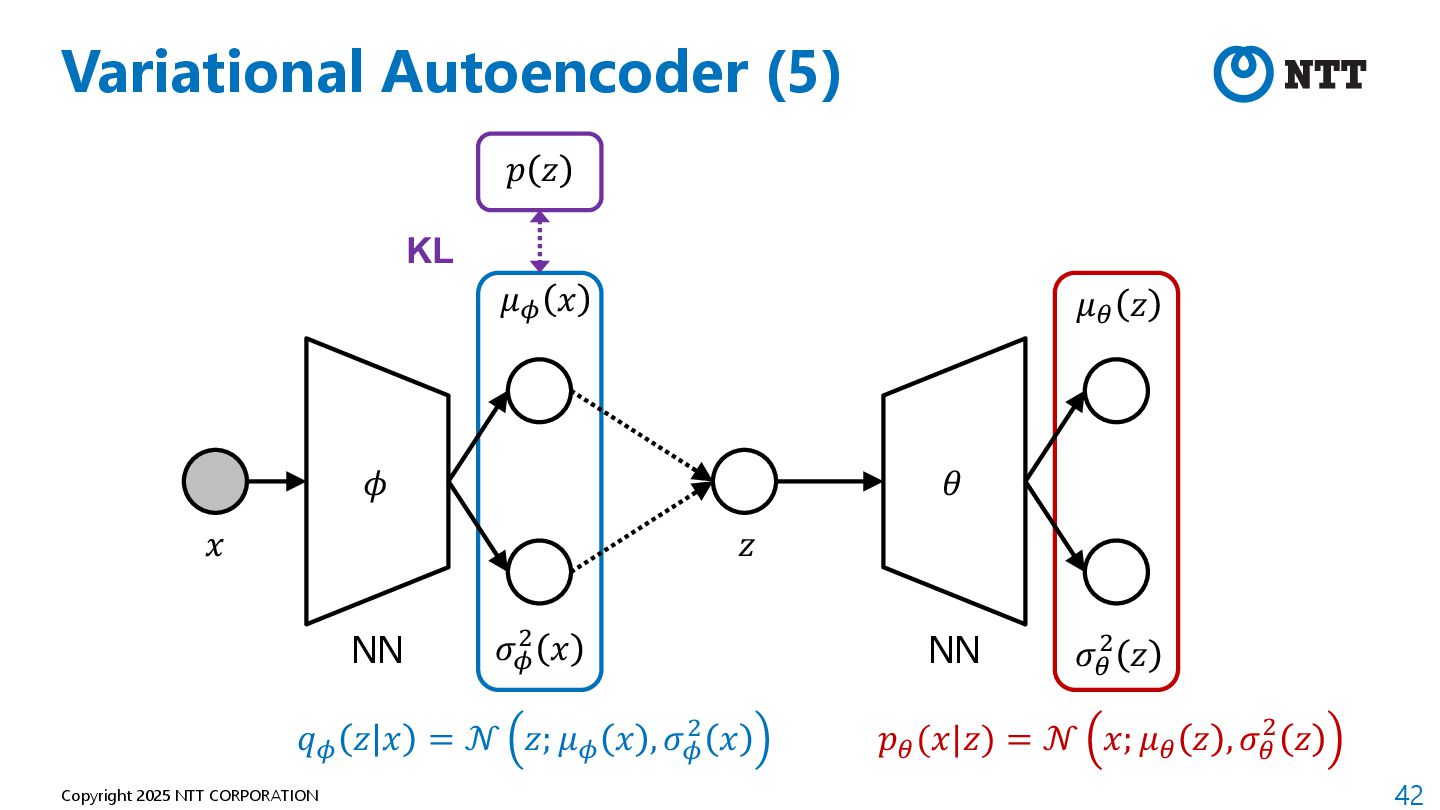
42 Copyright 2025 NTT CORPORATION Variational Autoencoder (5) 𝑥 𝜇;
𝑥 𝜎; 7 𝑥 𝜎3 7 𝑧 𝜇3 𝑧 𝑧 𝑞; 𝑧 𝑥 = 𝒩 𝑧; 𝜇; 𝑥 , 𝜎; 7 𝑥 𝑝3 (𝑥|𝑧) = 𝒩 𝑥; 𝜇3 𝑧 , 𝜎3 7 𝑧 𝑝 𝑧 KL 𝜙 𝜃 NN NN -
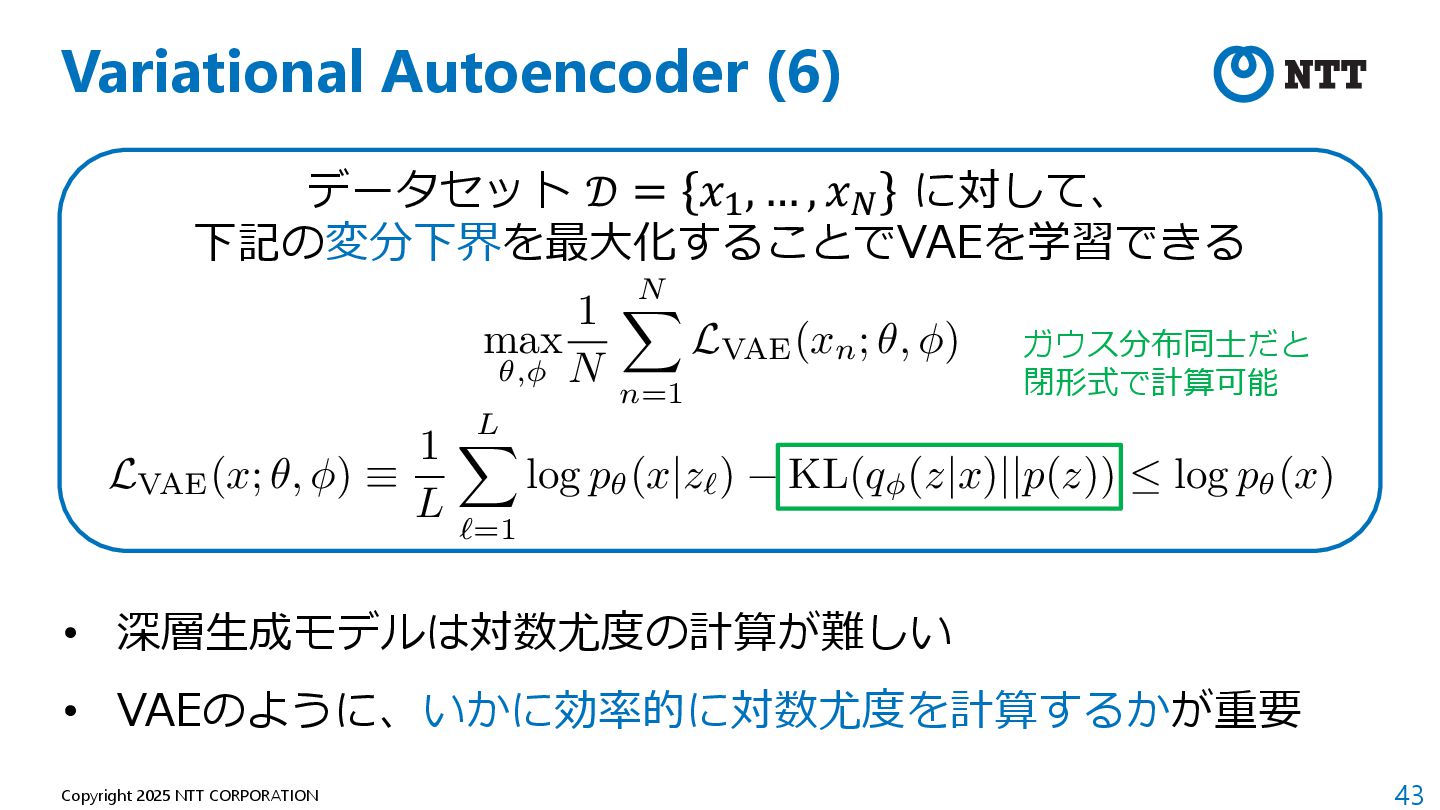
43 Copyright 2025 NTT CORPORATION Variational Autoencoder (6) データセット 𝒟
= 𝑥7, … , 𝑥8 に対して、 下記の変分下界を最⼤化することでVAEを学習できる <latexit sha1_base64="ZzGhmHwgsSY1GJCGPaCJADaplKI=">AAADqnicnVLLbtNAFL2uKS3h0QAbJDYRUSsbQjSuSkEgpPKSkCiiTUlaFJdo7E4cq+NH7HGUxvEP8AMsWCCQWCA+gw0/wKKfgFgWCQmx4PoBCCJAYizP3HvmnjNnRtfwuR0KQvalKfnQ9OGZ2SOlo8eOn5grnzzVCr0oMFnT9LgXbBk0ZNx2WVPYgrMtP2DUMTjbNHZvpfubAxaEtuc+FHs+23ao5dpd26QCoU75ue5Q0TMpj1eTTpwlgRO3btxJEmV4TRc9JmhN93u2uqCzfmQP9G5AzVhLsF4PIwc5jPPrWvI4BbhnVXyEMhoKjEf5fqJe/C59bzVR+oiiZKKMxkN1PPaVkarqnPUn+GqpU66SOslGZTLQiqAKxVjzyl9Ahx3wwIQIHGDggsCYA4UQvzZoQMBHbBtixAKM7GyfQQIl5EZYxbCCIrqLs4VZu0BdzFPNMGObeArHP0BmBebJe/KaHJB35A35QL7+USvONFIve7gaOZf5nbknZzY+/5Pl4Cqg95P1V88CunAl82qjdz9D0luYOX8wenqwcbUxHy+Ql+Qj+n9B9slbvIE7+GS+WmeNZ6ie6t9GVv6GAUb3Cw8PUJEhkmbpK5zHc/SsxkKf6YlJ8cYW4rUf2P8qUhhOKOZY2iba700xGbQW69pyfXl9qbpys2iYWTgL50DBrrgMK3AX1qAJpjQtXZCWpEtyTW7Ij+R2XjolFZzT8MuQd74By9zmPw==</latexit> LVAE(x; ✓, ) ⌘ 1 L L X `=1 log p✓(x|z`) KL(q (z|x)||p(z)) log p✓(x) <latexit sha1_base64="EeaVX6J2AJ6EkN8Plg6wZDFKtkI=">AAADZXicnVLLahRBFL2Z9hFHY8YHIrgwOCRECUO1SBRFiC9w4SMPZxJMJ011WTNTpF9U1wyJRf2AP+DClYIL8ScEN/6Ai/yAIi4UIgjiwlvdjUYHFVJNV9176p5Tp4obpKHIFCGbQxVn1+49e4f3VfcfGDk4Wjt0uJUlPcl4kyVhIpcCmvFQxLyphAr5Uio5jYKQLwZr1+z+Yp/LTCTxPbWR8pWIdmLRFowqhPzafS+i6772VJcrOuWlXWEmvLakTLtG3zFe1ot8HV92zarNIqq6jIb6lkGKTWSkW1duGDOJGrG5tE3mdNWv1UmD5GNsMHDLoA7lmE1q38CDB5AAgx5EwCEGhXEIFDL8lsEFAiliK6ARkxiJfJ+DgSpye1jFsYIiuoZzB7PlEo0xt5pZzmZ4Soi/ROYYjJO35AXZIm/IS/KBfP+rls41rJcNXIOCy1N/9NHxha//ZUW4Kuj+Yv3Ts4I2XMi9CvSe5oi9BSv4/YePtxYuzo/rCfKMfET/T8kmeY03iPtf2PM5Pv8E1a3+dWQVbygxul16uIuKHBGb2Vc4g+d4eU0HfdoTTfnGHcSnfmI7VaSwPqBYYLZN3D+bYjBonW24043puXP1matlwwzDCTgFk9gV52EGbsIsNNHXK3gHn+Bz5b0z4hx1jhWllaGScwR+G87JH1DIzoc=</latexit> max ✓, 1 N N X n=1 LVAE(xn; ✓, ) • 深層⽣成モデルは対数尤度の計算が難しい • VAEのように、いかに効率的に対数尤度を計算するかが重要 ガウス分布同⼠だと 閉形式で計算可能 -
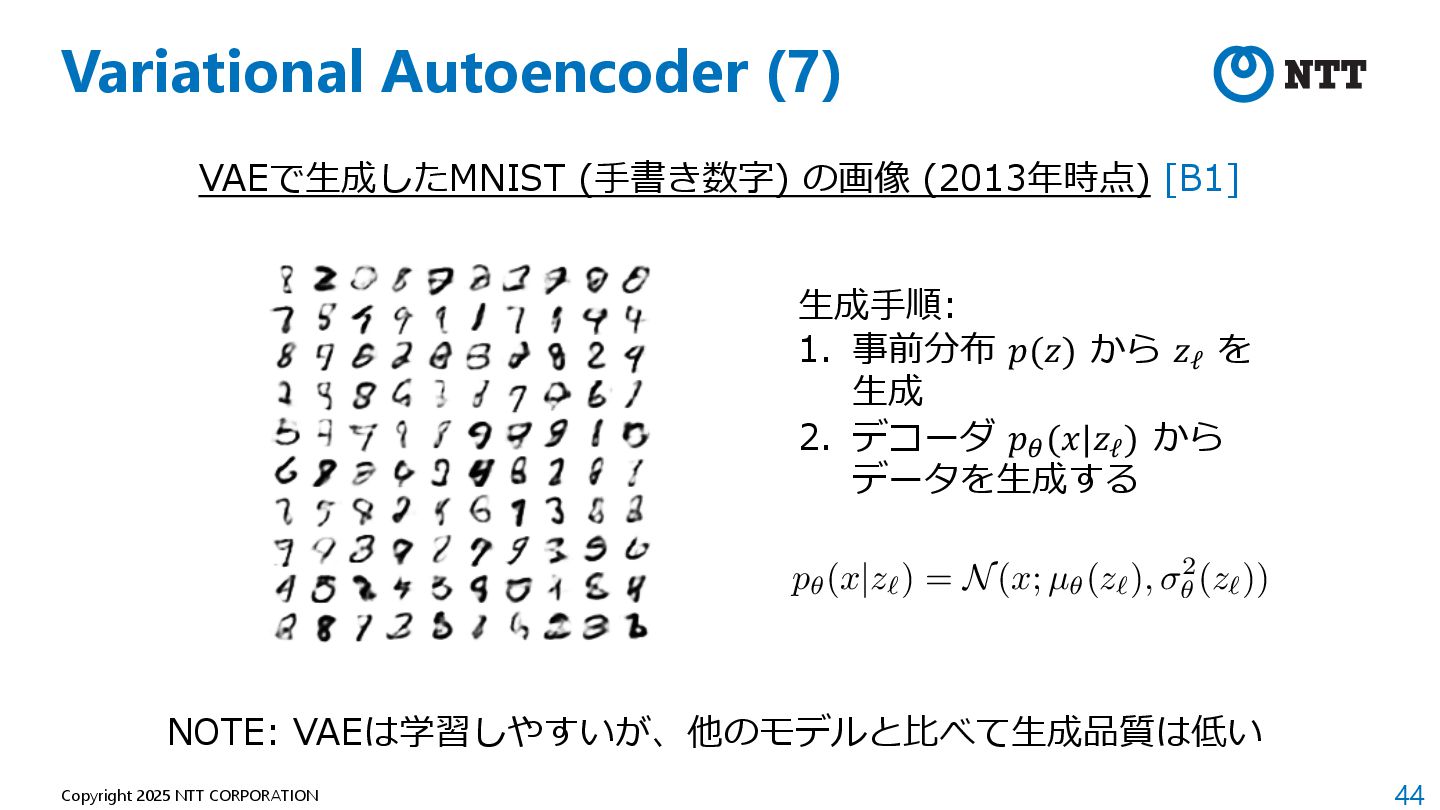
44 Copyright 2025 NTT CORPORATION Variational Autoencoder (7) VAEで⽣成したMNIST (⼿書き数字)
の画像 (2013年時点) [B1] ⽣成⼿順: 1. 事前分布 𝑝(𝑧) から 𝑧ℓ を ⽣成 2. デコーダ 𝑝3 (𝑥|𝑧ℓ ) から データを⽣成する <latexit sha1_base64="5B1iKI8lH5QMfzab+v1oQAAvFlc=">AAADZ3icnVLLahRBFD2Z9hHHx0wUJOAmOiQkEoaaEKIoQlAXbtQ8nCSQjkN1W+kpUv2gu2ZI0s4P+AMuXCm4EP9CN/6Ai/yBwZVGEMSFt7qbiTqoYDXdde+595w6XVwnUjLRjO0NlawjR48dHz5RPnnq9JlKdeTsShJ2Ylc03VCF8ZrDE6FkIJpaaiXWolhw31Fi1dm6ZeqrXREnMgwe6J1IbPjcC+SmdLkmqFW1o1Zq67bQvDe5/XiXEqFUb2rihu1z3Xa5Su9R4brtdw77+l3TdiI9n/crD9OZn6pT5Va1xuosW2ODQaMIaijWQlj9BhuPEMJFBz4EAmiKFTgSetbRAENE2AZSwmKKZFYX6KFM3A51CerghG7R16NsvUADyo1mkrFdOkXRGxNzDOPsPXvFDtg79prts+9/1EozDeNlh3Yn54qoVXkyuvz1nyyfdo32IeuvnjU2cTXzKsl7lCHmL9yc3919erB8bWk8nWAv2Efy/5ztsbf0B0H3i/tyUSw9I3Wjf5tY+R3GFN0tPNwnRUGIycwtXKZz7KzHI5/mxF5xxx7h033sfxU5tgcUc8yMSeP3oRgMVmbqjbn63OJsbf5mMTDDuIBLmKSpuIJ53MECmuTrDT7gEz6X9q2Kdd4azVtLQwXnHH5Z1sUfxvbO9g==</latexit> p✓(x|z`) = N(x; µ✓(z`), 2 ✓ (z`)) NOTE: VAEは学習しやすいが、他のモデルと⽐べて⽣成品質は低い -
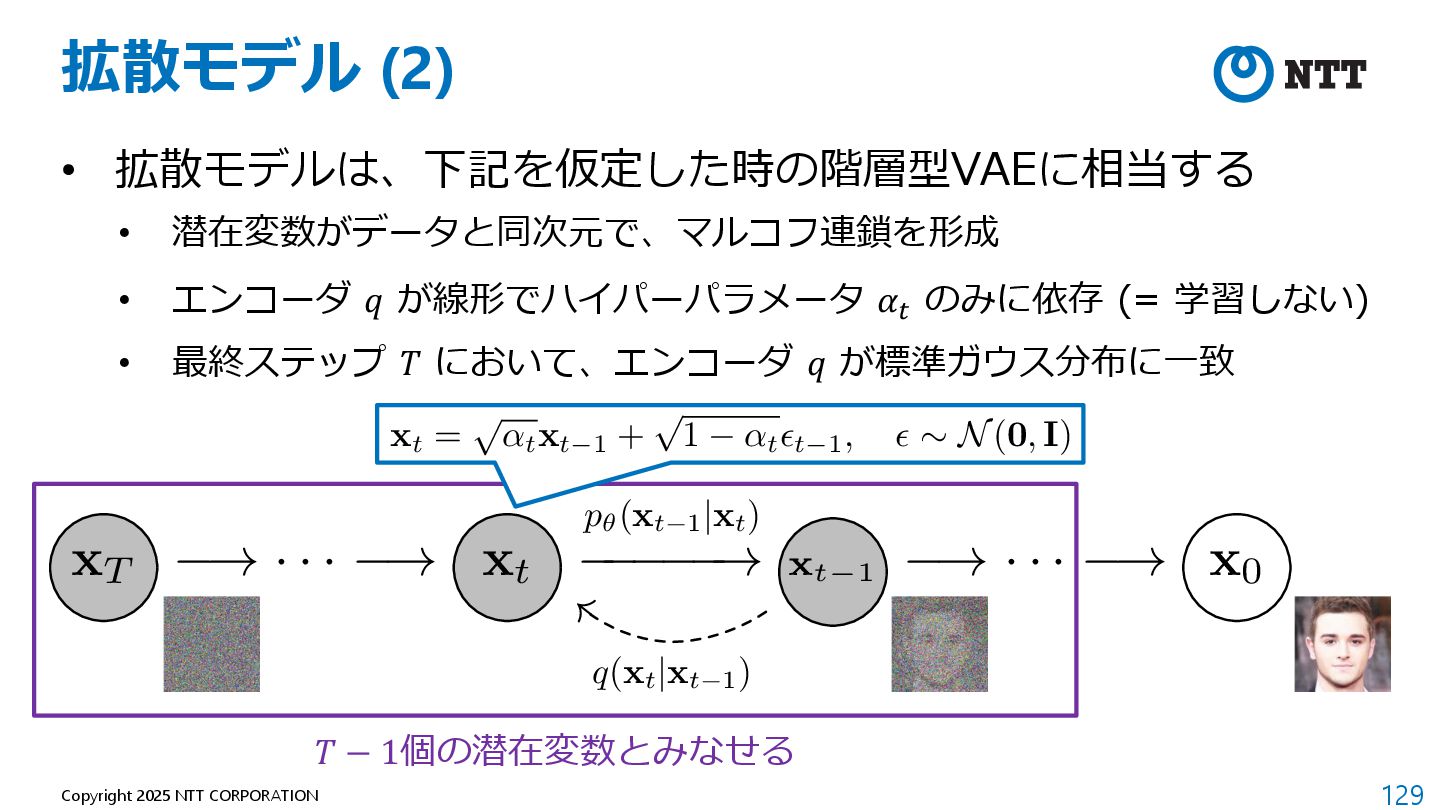
45 Copyright 2025 NTT CORPORATION 拡散モデル (1) • 拡散モデル [B2]
は、𝑇 ステップかけて元のデータ 𝑥- にノイズ を徐々に加え、ガウス分布に従うノイズに変換する⼿法 • ノイズを加える順⽅向の過程を拡散 (Diffusion) と呼ぶ • その逆変換を⾏うことで、ノイズから元のデータを復元できる • ノイズを除去する逆⽅向の過程をノイズ除去 (Denoising) と呼ぶ ! <latexit sha1_base64="7yFrn0YPyuP5dVIvc7Tl2zcbS/g=">AAAB+HicbVBNSwMxEJ2tX7V+dNWjl2ARPJXdKuix6MVjBfsB7VKyaXYbmk2WJKvU0l/ixYMiXv0p3vw3pu0etPXBwOO9GWbmhSln2njet1NYW9/Y3Cpul3Z29/bL7sFhS8tMEdokkkvVCbGmnAnaNMxw2kkVxUnIaTsc3cz89gNVmklxb8YpDRIcCxYxgo2V+m65x6WIFYuHBislH/tuxat6c6BV4uekAjkafferN5AkS6gwhGOtu76XmmCClWGE02mpl2maYjLCMe1aKnBCdTCZHz5Fp1YZoEgqW8Kgufp7YoITrcdJaDsTbIZ62ZuJ/3ndzERXwYSJNDNUkMWiKOPISDRLAQ2YosTwsSWYKGZvRWSIFSbGZlWyIfjLL6+SVq3qn1drdxeV+nUeRxGO4QTOwIdLqMMtNKAJBDJ4hld4c56cF+fd+Vi0Fpx85gj+wPn8AXOGk5o=</latexit> xT ! · · · ! xt ! xt 1 ! · · · ! x0 <latexit sha1_base64="l4LvSgM7PR7I/kkuy5soikK4gpU=">AAAEoXictVLditNAFE7XqGv92a5eejOYLexKLU0VFKRQ9EYvhCrb3YUklOlk2g6dnzBzYrcb8zK+lU/gazhJK6atuiB4YODM+T/n+8YJZwY6nW+1vRvuzVu39+/U7967/+CgcfjwzKhUEzokiit9McaGcibpEBhwepFoisWY0/Px/G3hP/9MtWFKnsIyoZHAU8kmjGCwplHjeygwzAjThNM4Kz/jSXaZj05zFHIlp5pNZ4C1VgsUkliB2TX/oQLYCpe/4rJwZhJM6NPMJyLPt9IM0SwBA0tOUaVGBs/8/J8mWVRH6eSjhtdpd0pBu4q/VjxnLYPR4d7XMFYkFVQC4diYwO8kEGVYA7P183qYGmr3meMpDawqsaAmykpEctS0lhhNlLZPAiqt1YwMC2OWYmwjiynNtq8w/s4XpDB5FWVMJilQSVaNJilHoFABL4qZpgT40irYntTOisgMa0zAkqC+0QbY/MquIfCcYssbsBH1UNIFUUJgGVePGfhR1qyj1YETXAaH/SqAnp836/lGftUfdNcFiqbBT8L2jouQdvE9iVAoVUyDWONFa5XVYlJSjezEPT+BlmCSiVQgw65or2vBaE0Y5z1e4D/VeBmhstwJyo5C0YeZ53vdo/z19lhVjly71+K6xRb/ZbO/rbLCS8HMwmVZ7W9zeFc567b95+3uxxde/82a3/vOY+eJc+z4zkun77xzBs7QIbUPNVP7Ustdz33vDtxPq9C92jrnkbMhbvAD81mObw==</latexit> p✓(xt 1 |xt) <latexit sha1_base64="XVzP503G8Ma8Lkwk3KKGZcZJbZ0=">AAACEnicbVC7SgNBFJ2Nrxhfq5Y2g0FICsNuFEwZsLGMYB6QLMvsZDYZMvtg5q4Y1nyDjb9iY6GIrZWdf+Mk2SImHrhwOOde7r3HiwVXYFk/Rm5tfWNzK79d2Nnd2z8wD49aKkokZU0aiUh2PKKY4CFrAgfBOrFkJPAEa3uj66nfvmdS8Si8g3HMnIAMQu5zSkBLrlmO3R4MGZBSLyAw9Pz0YeKmcG5P8CNekKDsmkWrYs2AV4mdkSLK0HDN714/oknAQqCCKNW1rRiclEjgVLBJoZcoFhM6IgPW1TQkAVNOOntpgs+00sd+JHWFgGfq4kRKAqXGgac7p0eqZW8q/ud1E/BrTsrDOAEW0vkiPxEYIjzNB/e5ZBTEWBNCJde3YjokklDQKRZ0CPbyy6ukVa3YF5Xq7WWxXsviyKMTdIpKyEZXqI5uUAM1EUVP6AW9oXfj2Xg1PozPeWvOyGaO0R8YX7+bCp4F</latexit> q(xt |xt 1) <latexit sha1_base64="eAZ87UuTmAQoJ4u19RGH5tA+bCI=">AAACC3icbVC7TgJBFJ31ifhatbSZQEywkOyiiZQkNpaYyCMBspkdZmHC7MOZu0ay0tv4KzYWGmPrD9j5N87CFgieZJIz59ybe+9xI8EVWNaPsbK6tr6xmdvKb+/s7u2bB4dNFcaSsgYNRSjbLlFM8IA1gINg7Ugy4ruCtdzRVeq37plUPAxuYRyxnk8GAfc4JaAlxyzclbo+gaHrJQ8TB/AjnvsmcGZPTh2zaJWtKfAysTNSRBnqjvnd7Yc09lkAVBClOrYVQS8hEjgVbJLvxopFhI7IgHU0DYjPVC+Z3jLBJ1rpYy+U+gWAp+p8R0J8pca+qyvTRdWil4r/eZ0YvGov4UEUAwvobJAXCwwhToPBfS4ZBTHWhFDJ9a6YDokkFHR8eR2CvXjyMmlWyvZ5uXJzUaxVszhy6BgVUAnZ6BLV0DWqowai6Am9oDf0bjwbr8aH8TkrXTGyniP0B8bXL+1hmu8=</latexit> -
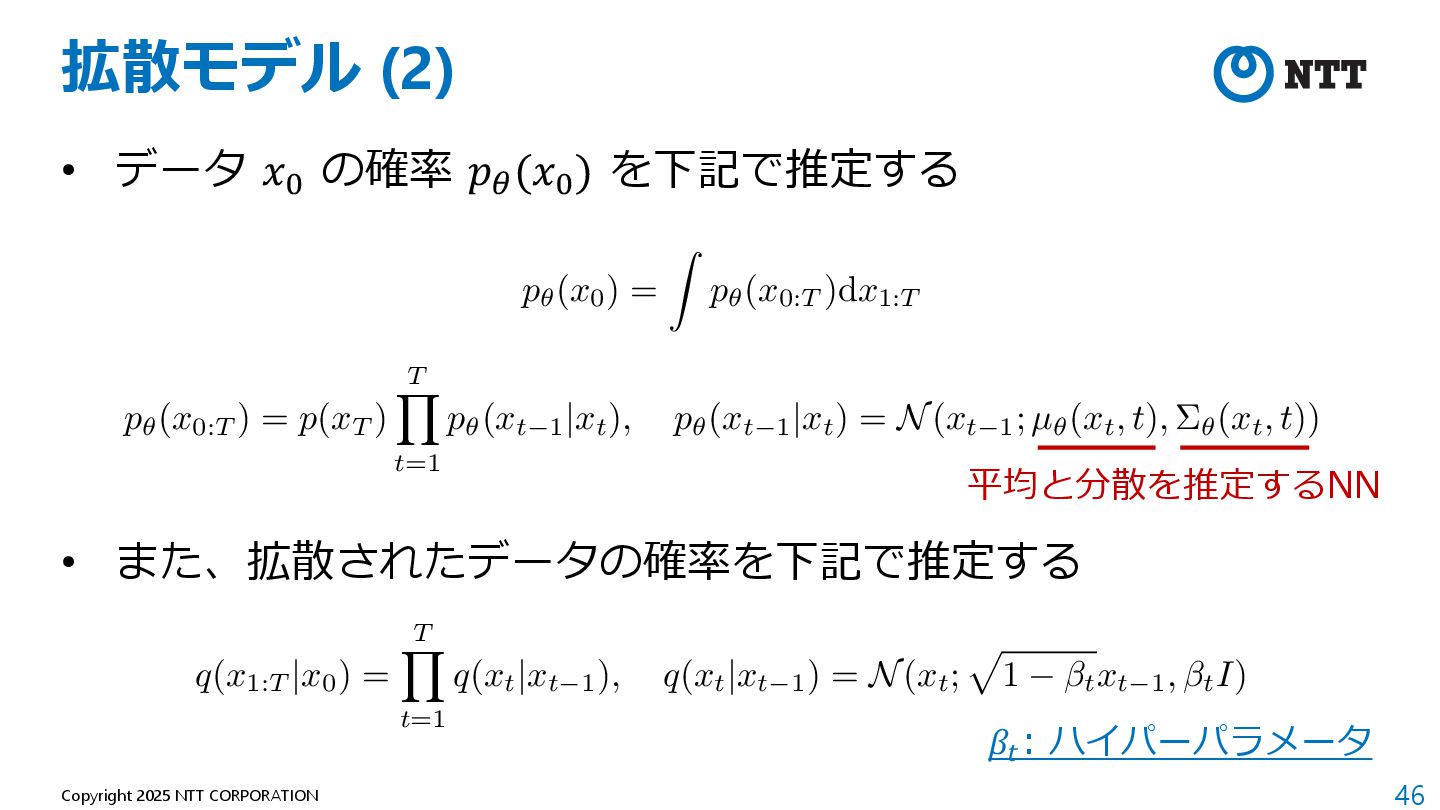
46 Copyright 2025 NTT CORPORATION 拡散モデル (2) • データ 𝑥-
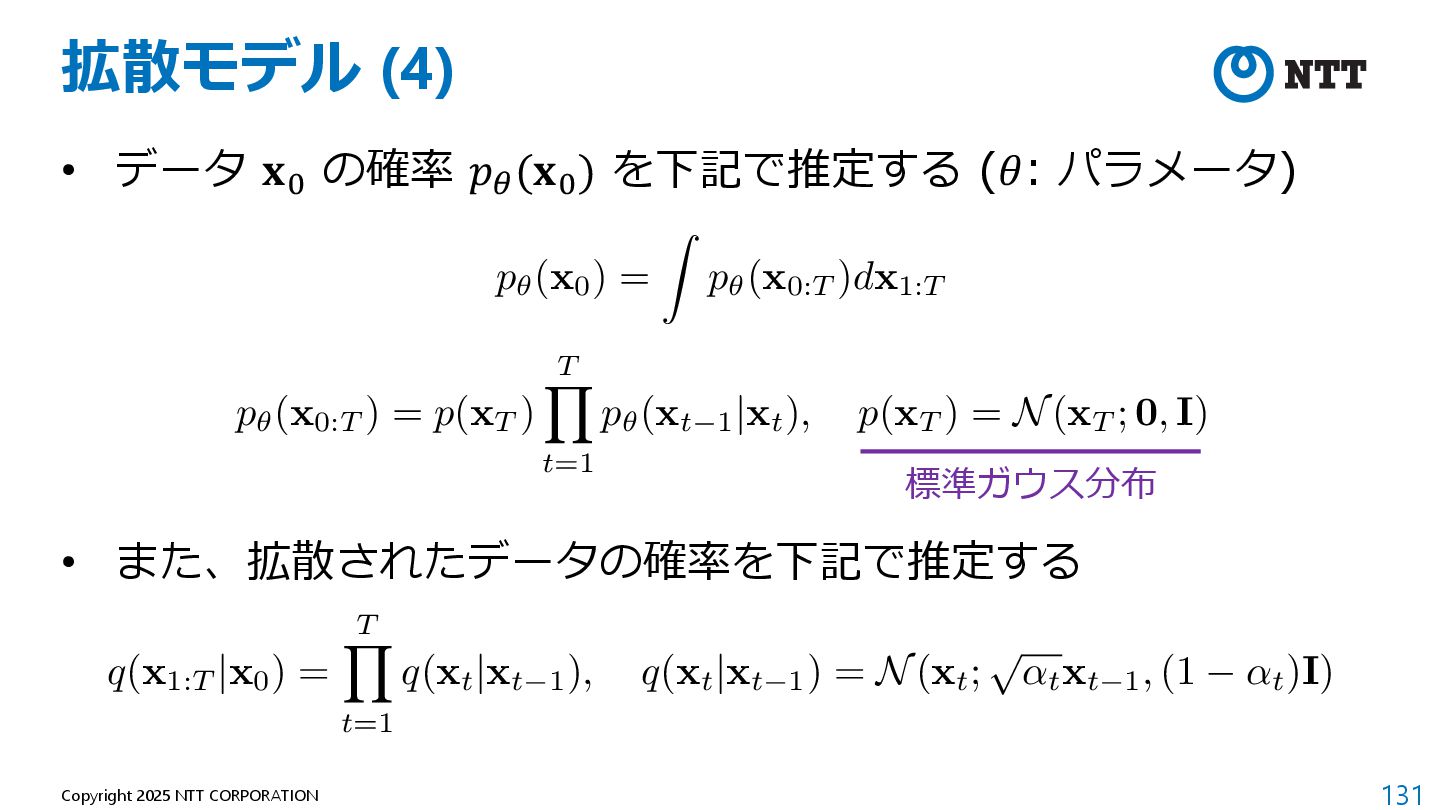
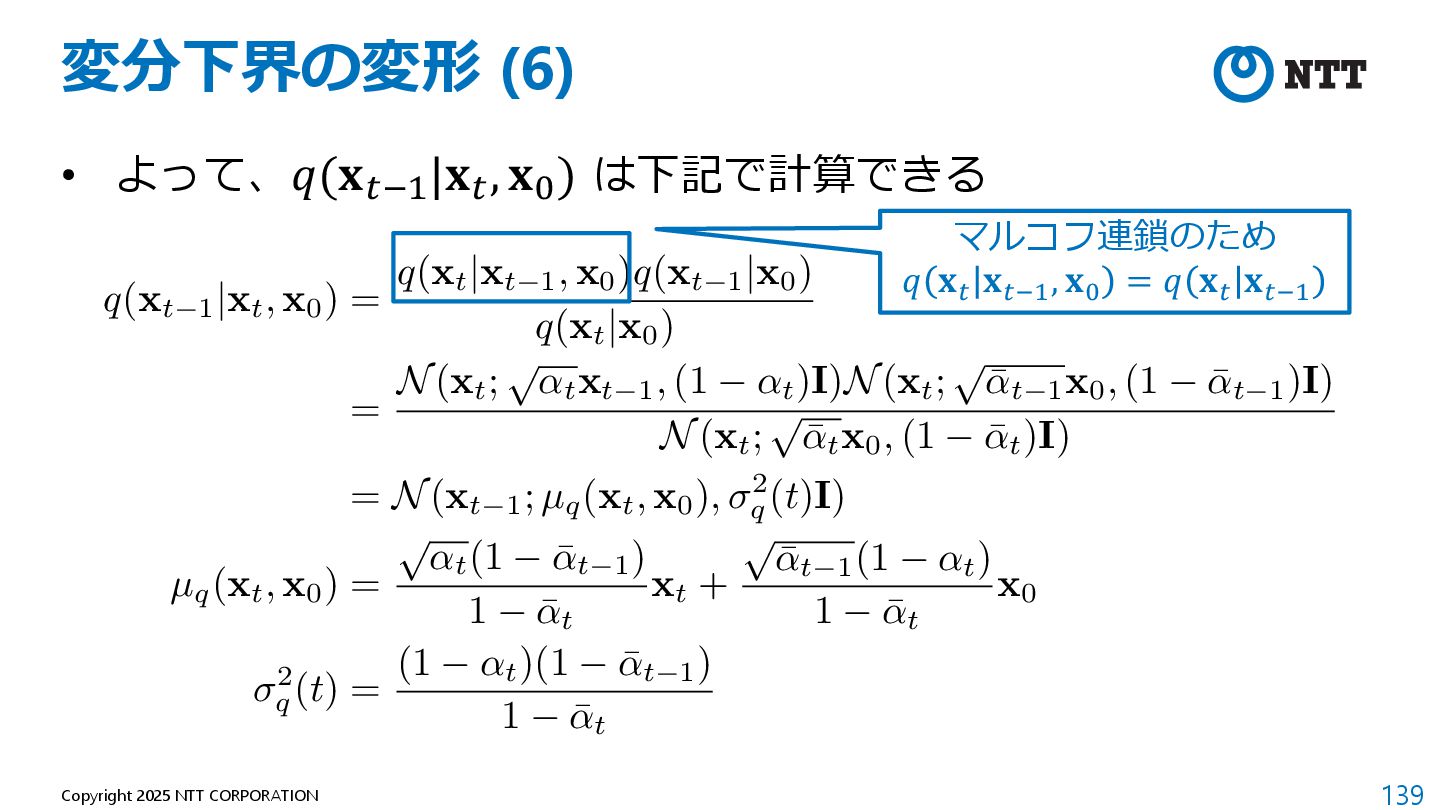
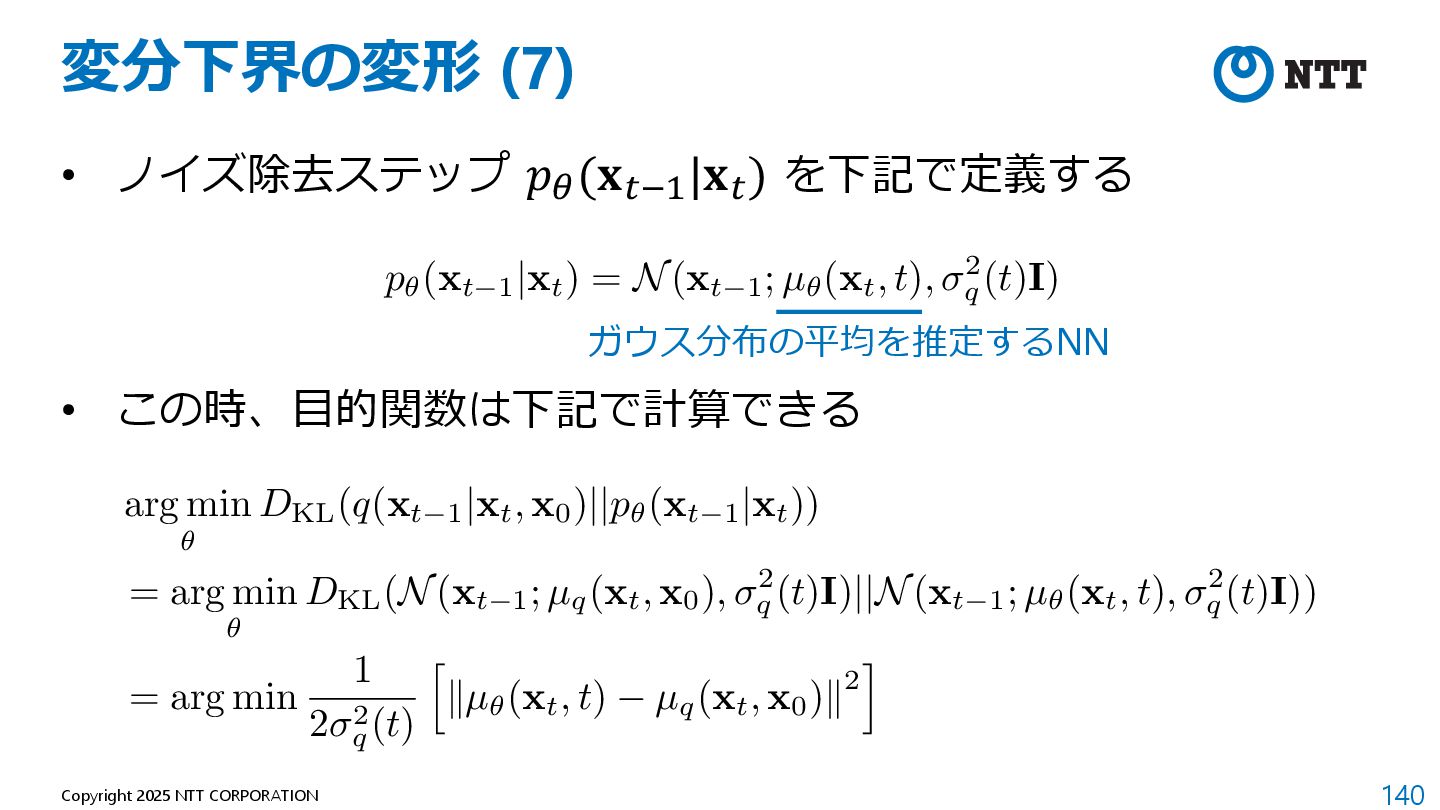
の確率 𝑝$ (𝑥- ) を下記で推定する • また、拡散されたデータの確率を下記で推定する <latexit sha1_base64="sJdJb2xbh7OLowkRRN18mDfkeF0=">AAADSHicnVLLahRBFD3paIyjSUbdCG4Gh4REZKgOEiUQCOrCjZjXJIF0aKo7lZki/aK7Zkhs+gf8AReuVFyIn+FGXSou8gniJpBAULLIre4mYgYTsJquunXqnlOnLteJPJkoxnb7jP4LFwcuDV6uXLk6NDxSvXZ9OQk7sSuabuiF8arDE+HJQDSVVJ5YjWLBfccTK87WI32+0hVxIsNgSe1EYt3nrUBuSpcrguzqTGSnlmoLxbPxbTtl2cTYjCUDVTuFTy9lE5bPVTv2042MEJOQil2tswbLR603MMugjnLMhdXfsLCBEC468CEQQFHsgSOhbw0mGCLC1pESFlMk83OBDBXidihLUAYndIvmFu3WSjSgvdZMcrZLt3j0x8SsYZR9Z+/ZPvvEPrAf7OifWmmuob3s0OoUXBHZIy9uLh6ey/JpVWj/YZ3pWWETD3KvkrxHOaJf4Rb87vOX+4vTC6PpGHvDfpL/12yXfaQXBN0D9928WHhF6lr/MbGKGsYUPS09PCNFQYje6SrcoXusPKdFPvWNWVnjFuF3T7D/VeTY7lEsMN0m5umm6A2WJxvmVGNq/l599mHZMIO4hdsYp664j1k8wRya5OstPuMrvhlfjD3j0PhVpBp9JecG/hr9xjFqxMQk</latexit> p✓(x0) = Z p✓(x0:T )dx1:T <latexit sha1_base64="beVBsTvz04ez8toEEcUP4I3tyyI=">AAADtHicnVLLbtNAFL2ueZTwSIANEpuIqKhBIRojCKgoUAELNkDbNG2luljjydQZ1S/scdRi/AP8AAtWILGo+Aw2/ACLfgJiWSQkxII7tlUUooLUsew599x7zlyPrh26IpaE7GlT+rHjJ05On6qcPnP2XLV2/sJKHCQR430WuEG0ZtOYu8LnfSmky9fCiFPPdvmqvfVQ5VdHPIpF4C/LnZBveNTxxaZgVCJl1XZDKzXlkEuazW5bKZlbzprdUEEEZhgFAyuVXSN7jvF4qbxuZK/UnjVb5ouEDuqH5rumR+WQUTd9epC6a3rJeH3WkujUE45HJxPNilVrkDbJV30SGCVoQLkWgtpPMGEAATBIwAMOPkjELlCI8VkHAwiEyG1AilyESOR5DhlUUJtgFccKiuwWfh2M1kvWx1h5xrma4SkuvhEq6zBDvpBdsk8+k4/kK/l1qFeae6hednC3Cy0PrerrS70f/1V5uEsY/lH9s2cJm3An71Vg72HOqL9ghX708s1+b25pJr1K3pNv2P87skc+4R/4o+/swyJfeovuyv8Rqoo7jBA9KXt4ho4cGRWpW7iG55h5jYN9qhOz8o4d5FsH3FEdKWxPOBacGhPj76GYBCs32kan3Vm82Zh/UA7MNFyGKzCLU3Eb5uExLEAfmFbVbmn3tPt6Rzd1pvOidEorNRdhbOn+b5U86bU=</latexit> p✓(x0:T ) = p(xT ) T Y t=1 p✓(xt 1 |xt), p✓(xt 1 |xt) = N(xt 1; µ✓(xt, t), ⌃✓(xt, t)) <latexit sha1_base64="x32LLyPReh0yJi3vNJrqMtVvD/M=">AAADinicnVLLahRBFL2d9pFMohlNBMHN4BDJyGSoDpJowkDQLHShec0kgXRsqnsqkyb9muqaIbEt3PsDLlwpuBA/w40/4CIf4CK4jCCIC29XNxEzRMFquurWufecOlVcO/LcWBByqA3o585fuDg4VBgeuXR5tHjl6nocdrnDmk7ohXzTpjHz3IA1hSs8thlxRn3bYxv23oM0v9FjPHbDoCEOIrbt03bg7rgOFQhZxRedyX0rMeYa8jmuRFbqZsTDlpWIuiGfJg2p8kJlxZQhK1Wz06Wt0mm4bvpU7DrUS57ILDVvxh0uEmPKtJmgKSLz4uoJ8qhiFcukRtQo9QdGHpQhH8th8QeY0IIQHOiCDwwCEBh7QCHGbwsMIBAhtg0JYhwjV+UZSCggt4tVDCsoons4t3G3laMB7lPNWLEdPMXDnyOzBBPkM3lPjskn8oEckZ9naiVKI/VygKudcVlkjb68vvb9nywfVwG7v1l/9SxgB+4qry56jxSS3sLJ+L1nr47X5lYnklvkLfmK/t+QQ/IRbxD0vjnvVtjqa1RP9ReRlb0hx+hx7mEJFRki6S59hdt4jqlq2ugzPVHmb9xGvHqC/a8ihf0+xQwrYJsYp5uiP1ifrhkztZmVO+WF+3nDDMINuAmT2BWzsAAPYRma6OuLNqyNa9f0EX1av6fPZ6UDWs4Zgz+GvvgLM3LZTw==</latexit> q(x1:T |x0) = T Y t=1 q(xt |xt 1), q(xt |xt 1) = N(xt; p 1 txt 1, tI) 平均と分散を推定するNN 𝛽< : ハイパーパラメータ -
47 Copyright 2025 NTT CORPORATION 拡散モデル (3) • この時、変分下界は下記で求められる 𝑞(𝑥":$
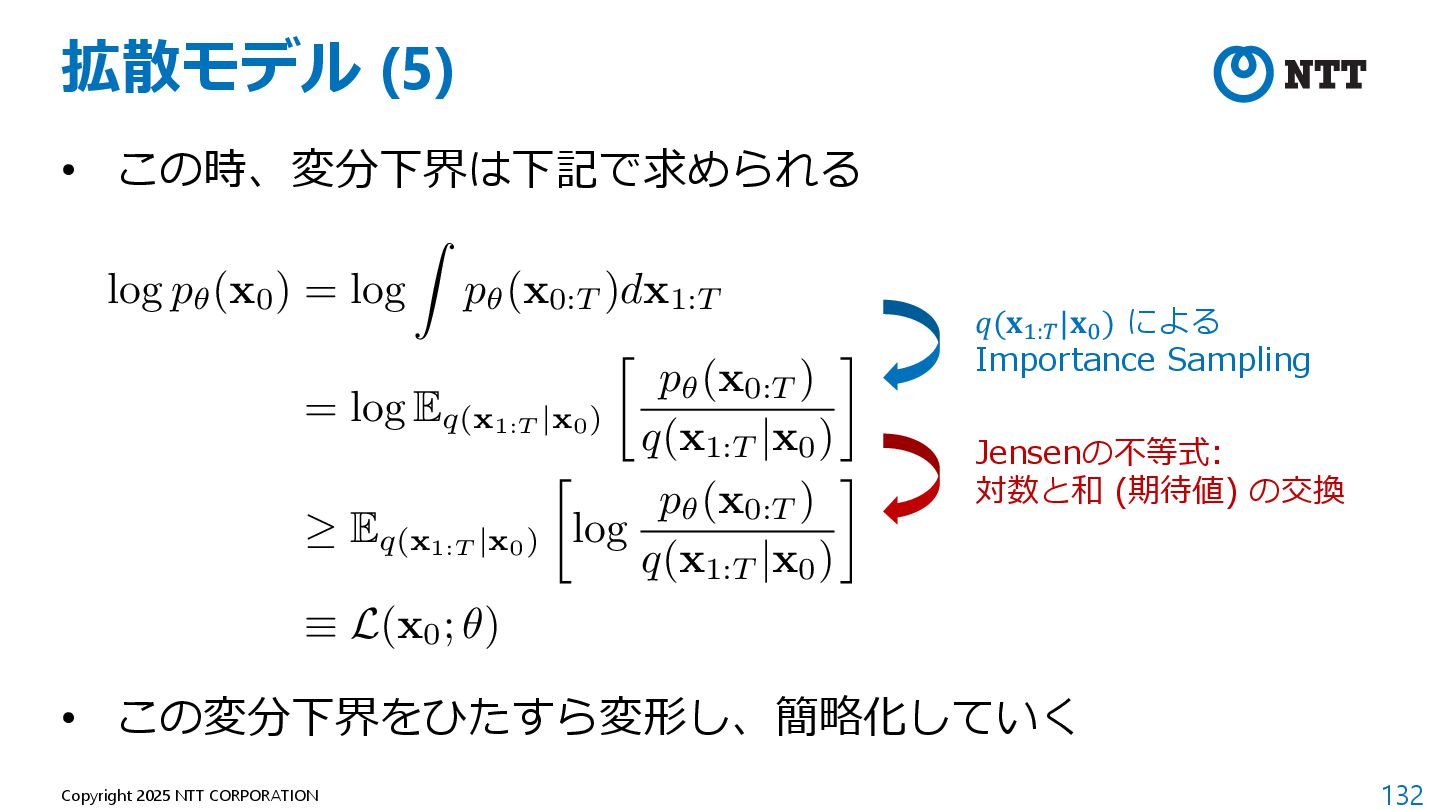
|𝑥% ) による importance sampling Jensenの不等式: 対数と和 (期待値) の交換 <latexit sha1_base64="IKYZbAwMGgse0MjfIcQ7NfNfyPk=">AAAE6XicnVLLbtNAFL0JBkqgtIENEkKKiFolFKIxQgUVVapokFg0In2krZSJLNudOFb8ij2JWox/gB0rEKwAsUDs+QE2/ACLfgJiWSQ2LLhjm6I2DVQdy547584598z1aJ5lBpyQ3Uz2lHT6zNmxc7nzF8YvTkzmL60Hbt/XWUN3Ldff1NSAWabDGtzkFtv0fKbamsU2tO6iyG8MmB+YrrPGdzzWslXDMdumrnKElHzmE7Vco+ApIeUdxtWotK2EJCpPzwucmg4/nJtbi8rUVnnHt8OtCBEZEUpTgkhoWvgwUsJeKU0+TSQjarE2b9K2r+rhEaLREQzfNDq8herUYL3jiAsPJyowf0z1gidyqDZDg76thFw4k6NRhfktORbh++V5skb8wPlYr28OYg+6aoVLaOJPk6vVei1K/8v9RLqcUyaLpELiURgO5DQoQjrqbj4zDhS2wAUd+mADAwc4xhaoEODTBBkIeIi1IETMx8iM8wwiyCG3j7sY7lAR7eLXwFUzRR1cC80gZutYxcLXR2YBpshX8oHskS/kI/lGfo3UCmMN4WUHZy3hMk+ZeHZl9ed/WTbOHDp/Wf/0zKEN92KvJnr3YkScQk/4gycv9lbnVqbCafKWfEf/b8gu+YwncAY/9PfLbOU1qgv9KrKSHvoY1VIPj1GRISJWogs3sA6N9xjoU1SM0h4biN/cx06qqML2kGKCje6ajpE4L8NaEd4m+fDdGQ7Wb1fk2crs8p3iwoP0Xo3BVbgOJbw7d2EBHkEdGqBnr2UXs0vZmtSVnksvpVfJ1mwm5VyGA0N69xsHf1mM</latexit> log pω(x0) = log pω(x0:T )dx1:T = log E q(x1:T |x0) pω(x0:T ) q(x1:T |x0) → E q(x1:T |x0) log pω(x0:T ) q(x1:T |x0) = E q(x1:T |x0) log p(xT ) + t→1 log pω(xt↑1 |xt) q(xt |xt↑1) ↑ LDDPM(x0; ω) -
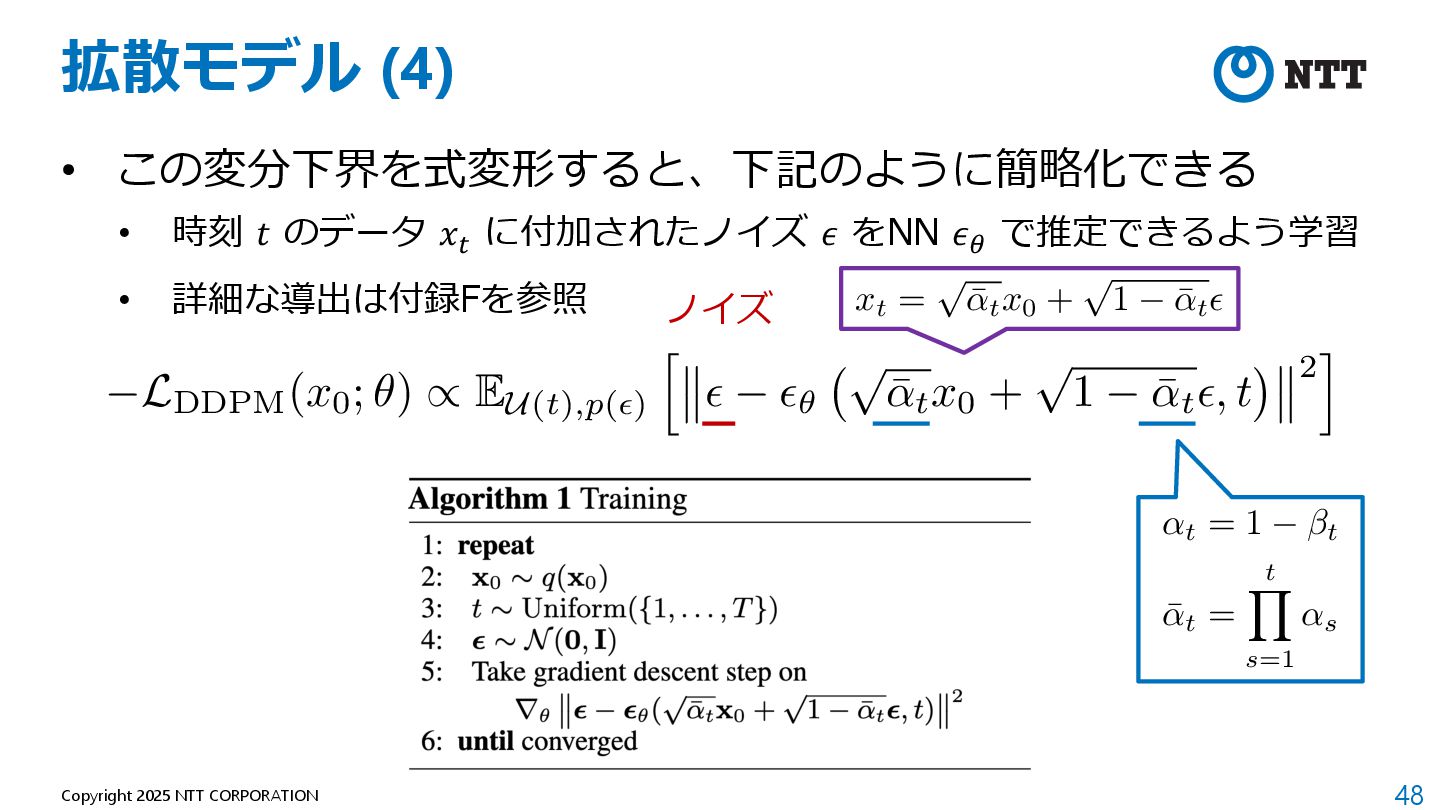
48 Copyright 2025 NTT CORPORATION 拡散モデル (4) • この変分下界を式変形すると、下記のように簡略化できる •
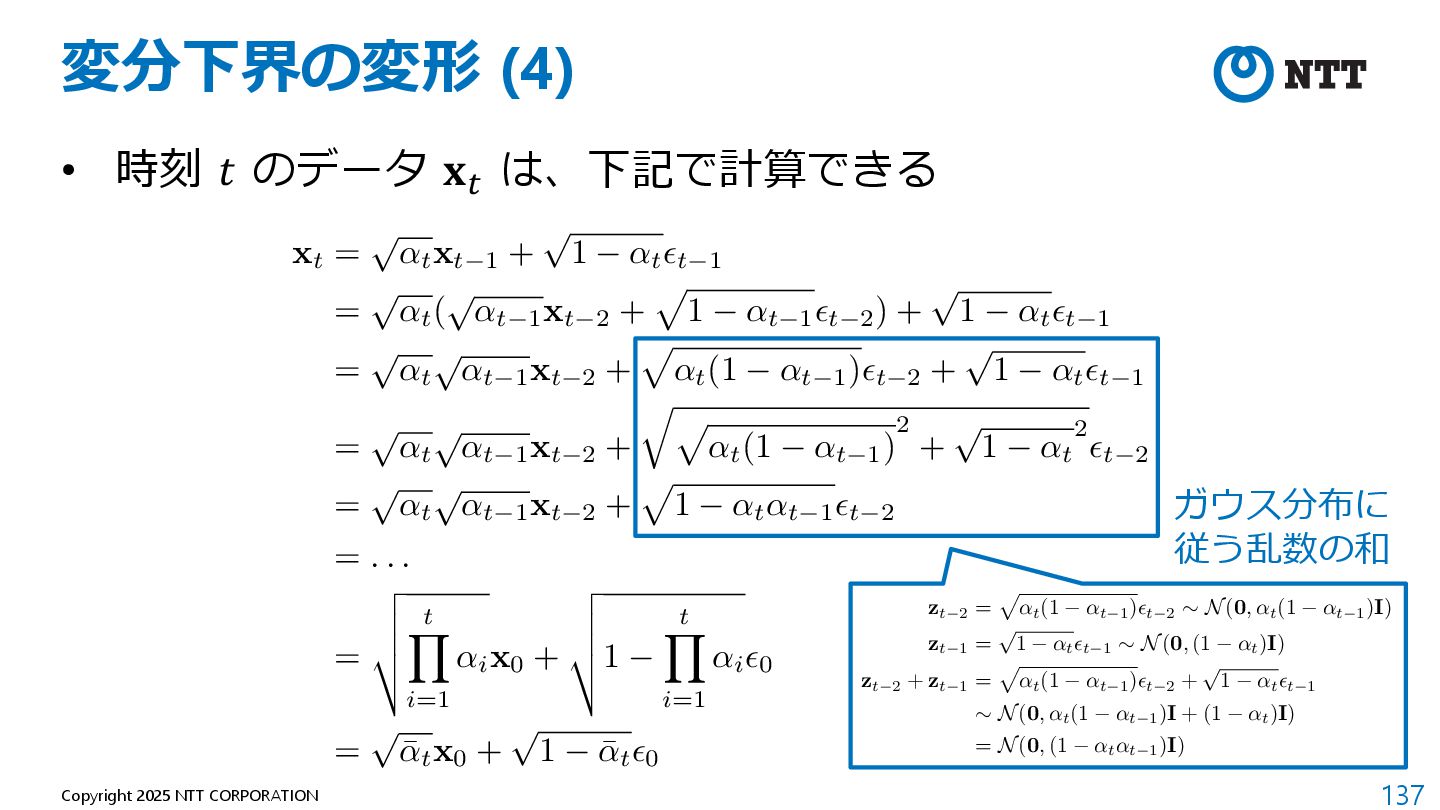
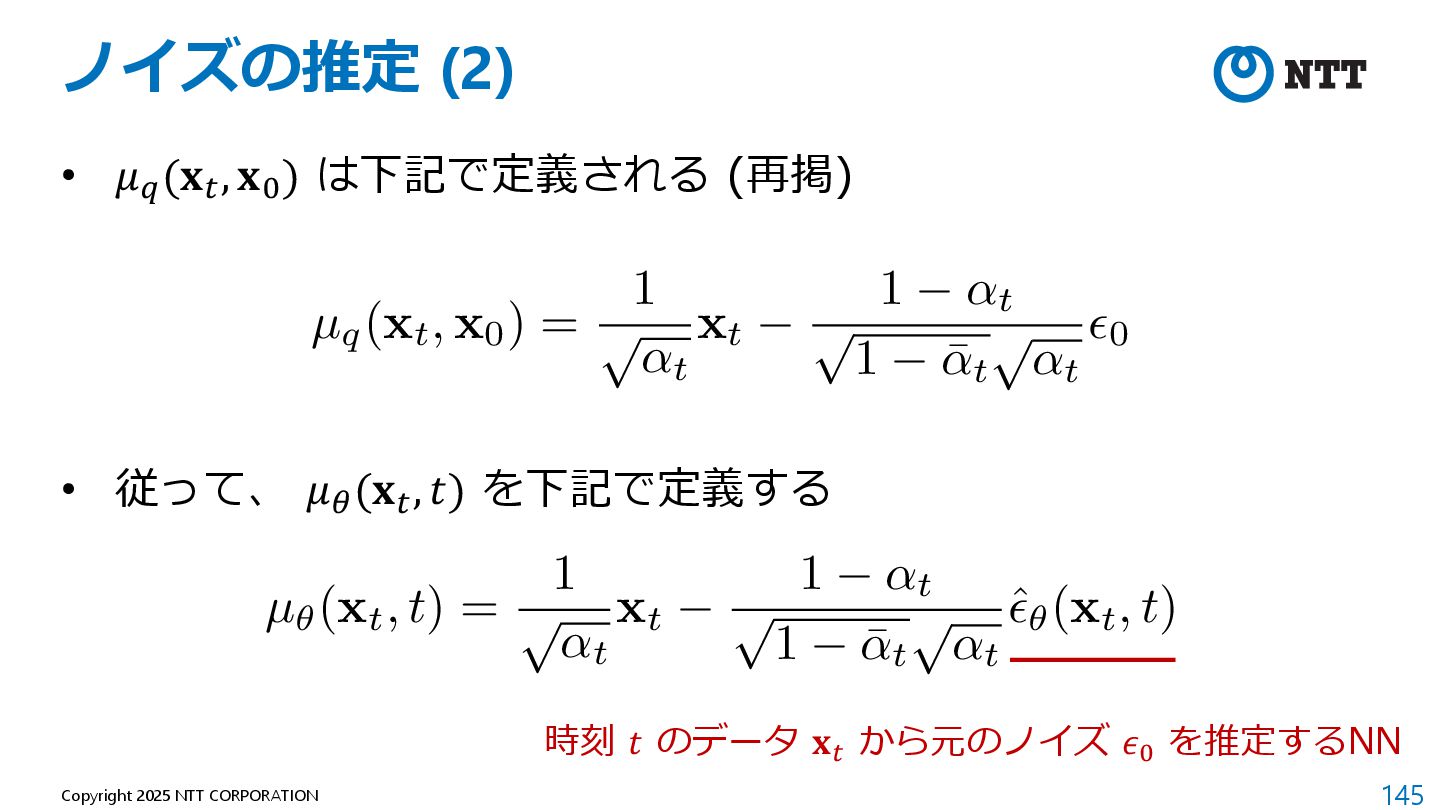
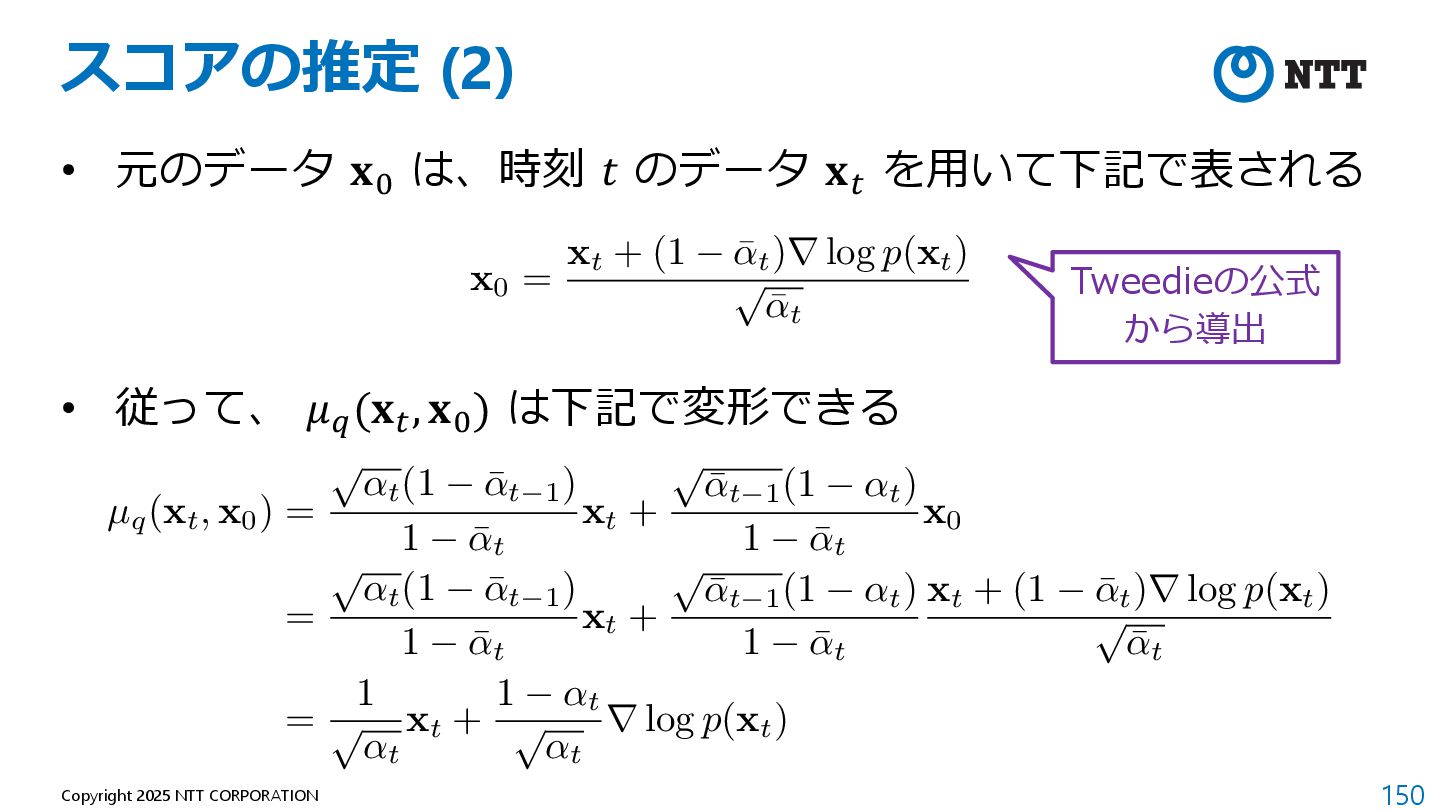
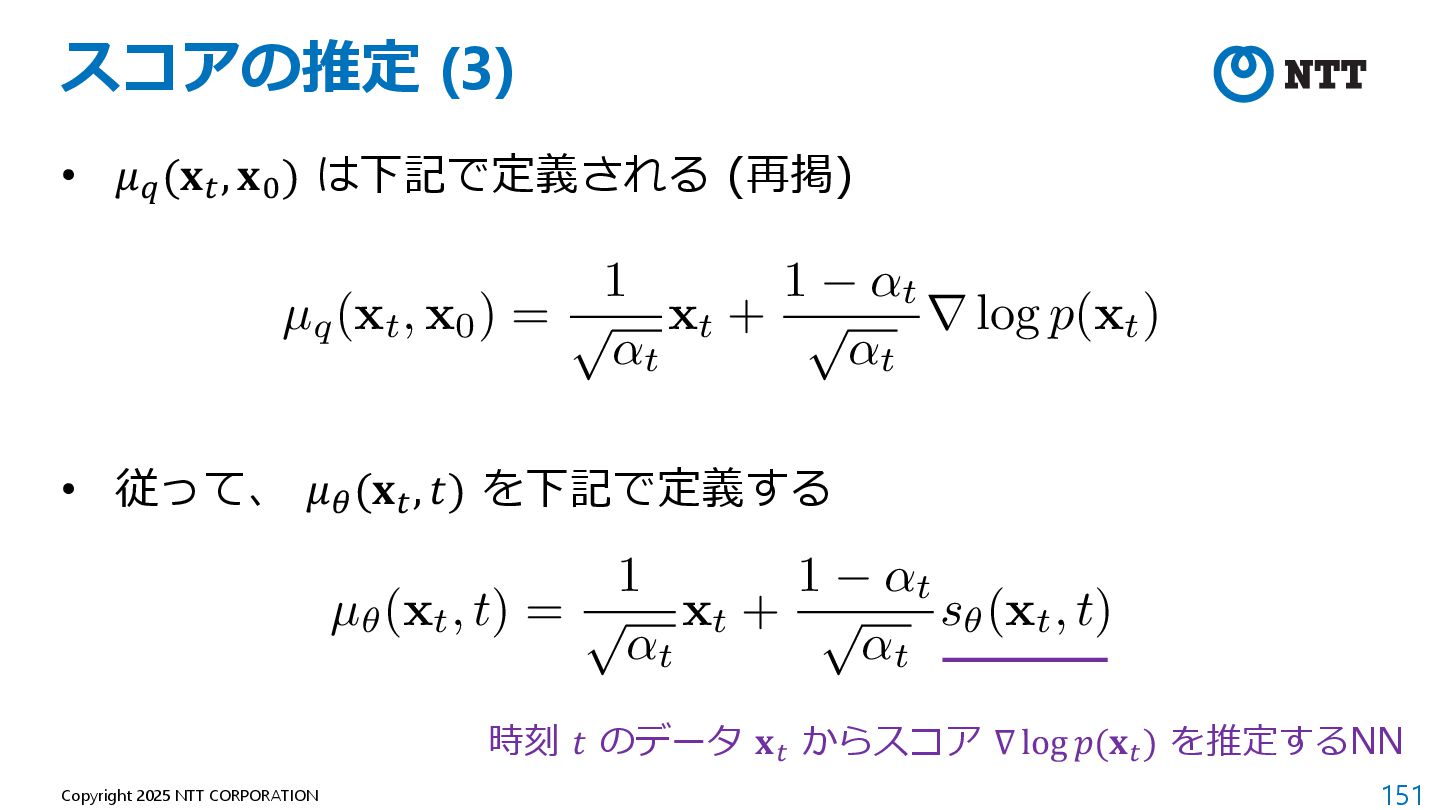
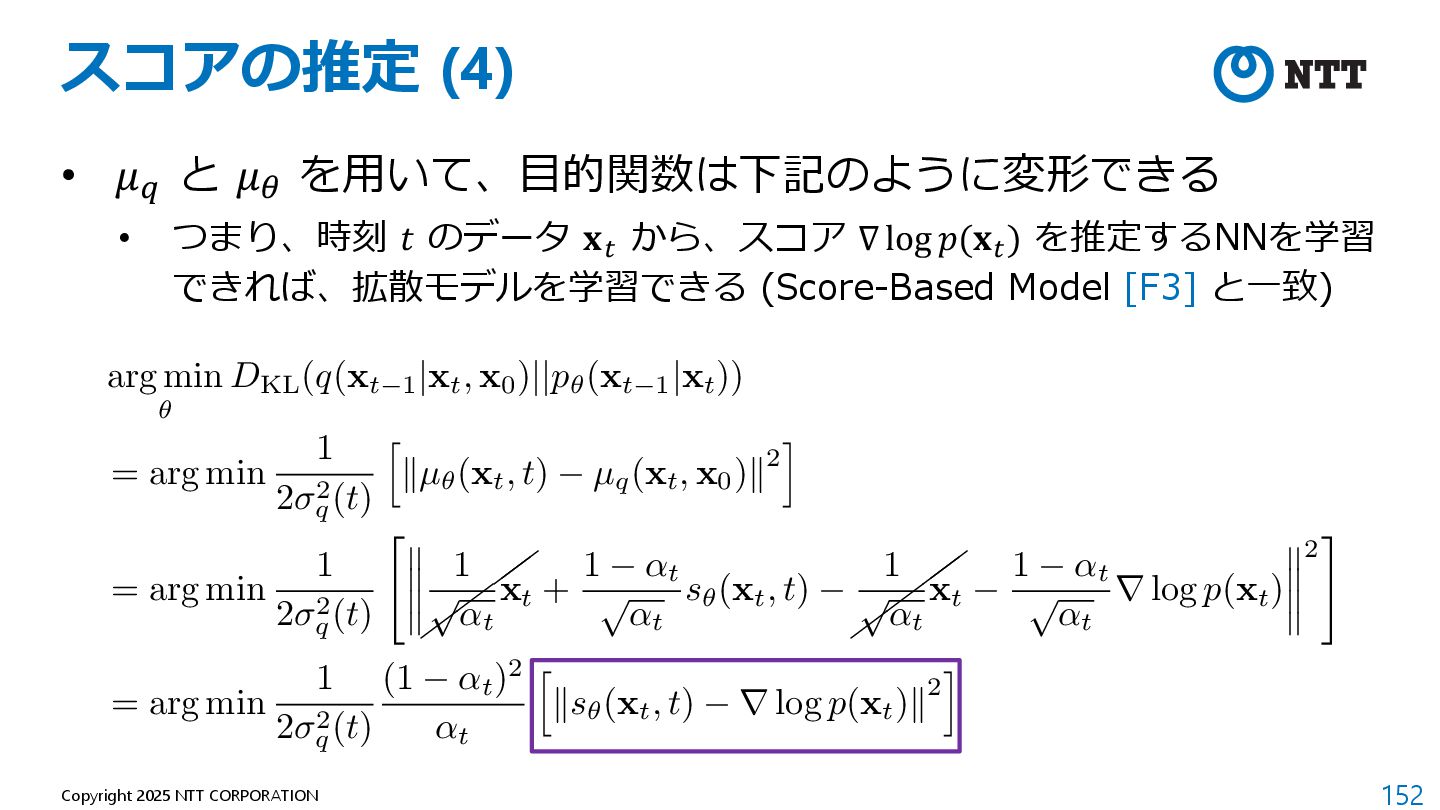
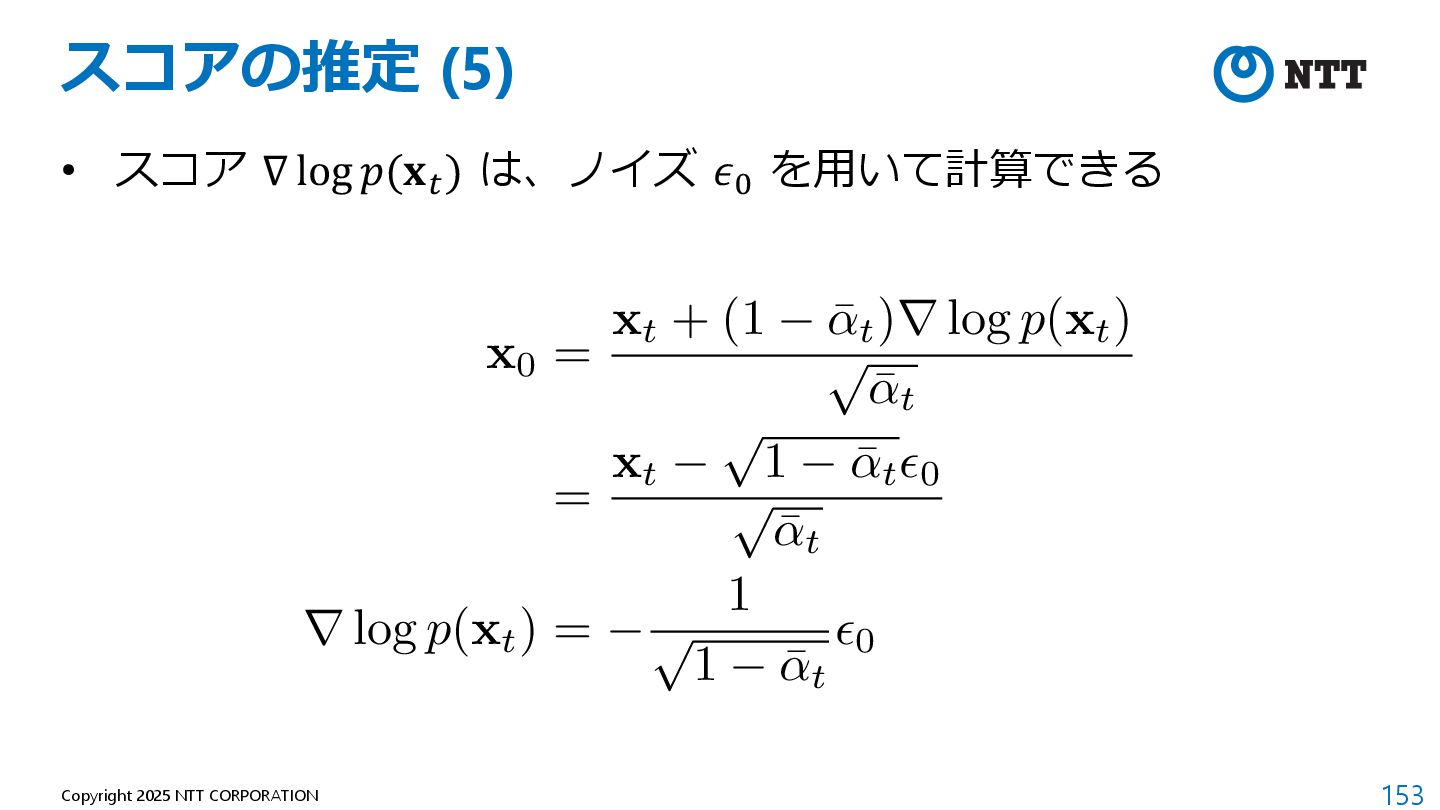
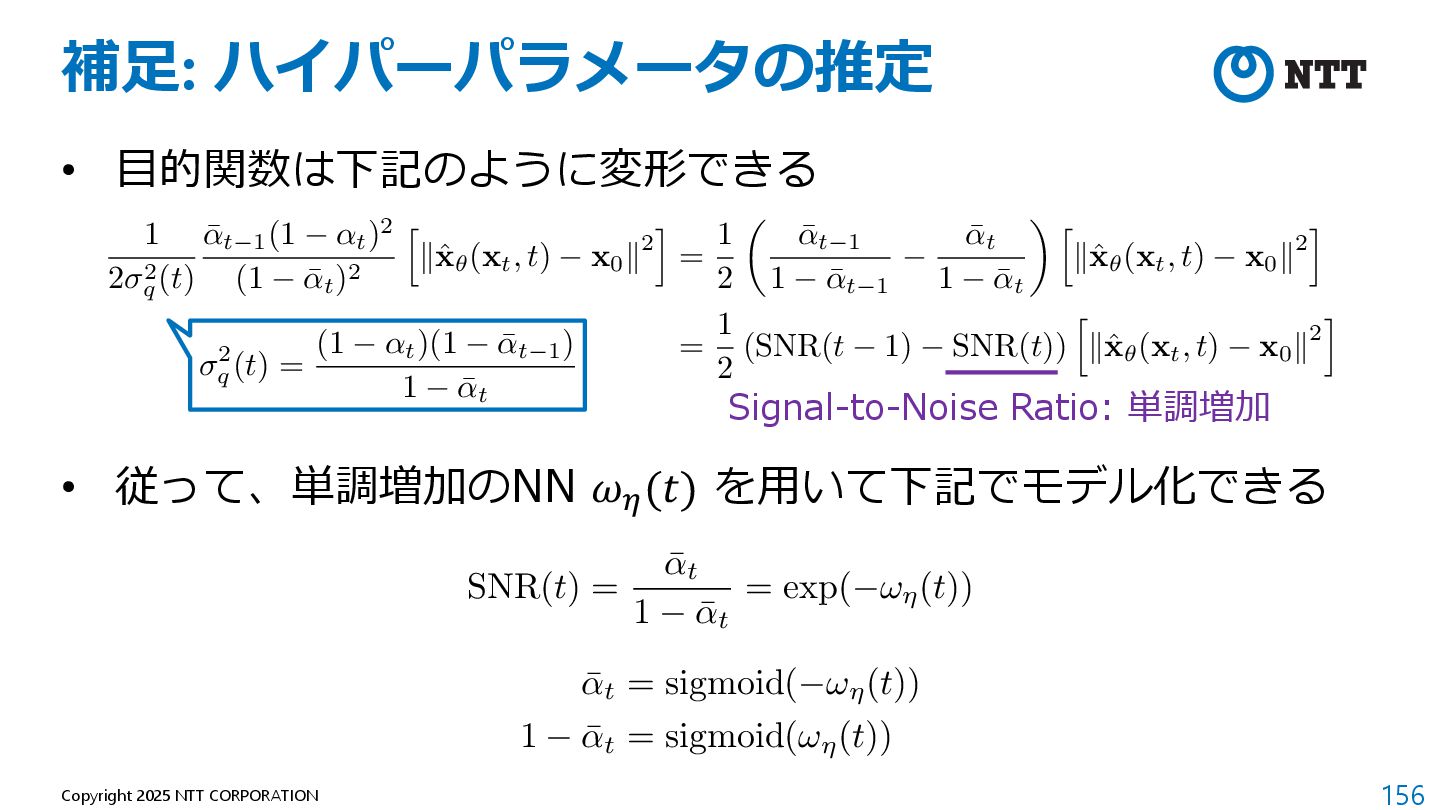
時刻 𝑡 のデータ 𝑥< に付加されたノイズ 𝜖 をNN 𝜖3 で推定できるよう学習 • 詳細な導出は付録Fを参照 <latexit sha1_base64="5O94BeDU4dfLUFyHj1xmCOaOULo=">AAAD9HicnVJPaxNBFH/b9U+Nfxr1IngJhpZEmzApUkUvRSN4sDRtTVrIxDC7TpKls3+cnYTWZfXuF/CgF5UeRPBLePELeOhHKB4rCOLBt7MbRUMVnGVn3vu99/u9N8OzAuGEipA9Y8o8cvTY8ekTuZOnTp+ZyZ891wr9obR50/aFLzctFnLheLypHCX4ZiA5cy3BN6yt20l8Y8Rl6PjefbUT8I7L+p7Tc2ymEOrm9yvUZWpgMxHdi7uRdqQb1euN5TgubXcjEt+kasAVK8/RQPqB8nWOZUV3xvkJuRmXVHk+KFEehI7wvXJMBe+ptt5pi0tVGIcqYwPpWjlNLdHwkVQRtZiMKBPBgKG+imPdw5U0WKtMhMdi84pKpz9Q5fRISz6IFuLU7+S6+SKpEr0Kk0YtM4qQrYaf/wYUHoIPNgzBBQ4eKLQFMAjxa0MNCASIdSBCTKLl6DiHGHLIHWIWxwyG6BbuffTaGeqhn2iGmm1jFYG/RGYBZskn8pYckI/kHdkn3w/VirRG0ssOnlbK5UF35tmF9a//ZLl4Khj8Yv21ZwU9uK57dbD3QCPJLeyUP3r8/GD9xtpsNEdek8/Y/yuyRz7gDbzRF3t3la+9QPVEv46s9A0lWstZDyuoyBFJvOQVLmMdqnP62GdSMc7euI/4/E/sfxUZbE8oplgyJrU/h2LSaC1Ua4vVxdWrxaVb2cBMw0W4BCWcimuwBHehAU2wjRVjaDwxnpoj86X5xtxNU6eMjHMeflvm+x+SJwd8</latexit> LDDPM(x0; ✓) / E U(t),p(✏) h ✏ ✏✓ p ¯ ↵tx0 + p 1 ¯ ↵t✏, t 2 i <latexit sha1_base64="+pH0vazVWBPaZ8hp7Z1jlVijPjo=">AAADUHicnVJdS9xAFD1mW7Vrq2t9KfRFXJRSdJkU0SII0g/oS/Grq4LRMInjGswmYTK71Ib8gf6BPvSphT4Uf0Zf+lrBB+0vKD4qtJRCeycJLe2iQickc++595w5Ga4T+V6sGDvqMkpXrnb39F4r912/0T9QGby5Eoct6Yq6G/qhXHN4LHwvEHXlKV+sRVLwpuOLVWf3oa6vtoWMvTB4pvYisdHkjcDb9lyuCLIrjy3uRzvcTlQ6NmtOWI5QWWJZlsNlklfTvGxFMtyyk3jWTDd1S8GM07JdqbIay9ZwZ2AWQRXFWggr32FhCyFctNCEQABFsQ+OmJ51mGCICNtAQpikyMvqAinKxG1Rl6AOTugufRuUrRdoQLnWjDO2S6f49EpiDmOUHbL37JR9ZPvsC/txrlaSaWgve7Q7OVdE9sDLW8tfL2U1aVfY+cO60LPCNu5nXj3yHmWI/gs357dfvDpdnlkaTcbYW3ZC/t+wI/aB/iBon7nvFsXSa1LX+o+Ild+hpOhp4WGeFAUhOtO3cJfOsbKeBvnUJ6bFHTcIH/+N/a8ix/MOxRzTY2L+OxSdwcq9mjlVm1qcrM49KAamF7cxgjs0FdOYwxMsoE6+9vEJx/hsHBjfjJ+lrrzVKHYM4a9VKv8CWR7HnQ==</latexit> ↵t = 1 t ¯ ↵t = t Y s=1 ↵s <latexit sha1_base64="y1E6MlUnX5AxefKGyzjp3g4elfI=">AAADeHicnVJNaxRBEK3dURNXYzZ6EbwsLonfS08IUQQhqIgXMR9uEsiEpWfsbJr0zow9vUviMH/AP+DBk4IH0X/hxbPgIegfEI8RBPHg65lB0SUK6WG6q1/Ve1VdlB8rmRjGditV59DhIyOjR2vHjo+dGK9PnFxOor4ORDuIVKRXfZ4IJUPRNtIosRprwXu+Eiv+1i3rXxkIncgofGB2YrHe491QbsiAG0Cd+p3tTmqyqRte8kib1PO5Tj2u4k2eWTyDl2WXCqd7ZcjtiTiRKgprnXqTtVi+GsOGWxpNKtd8NFEZI48eUkQB9alHgkIysBVxSvCtkUuMYmDrlALTsGTuF5RRDdw+ogQiONAt7F3c1ko0xN1qJjk7QBaFX4PZoEn2gb1ie+wde80+sx/7aqW5hq1lB6dfcEXcGX9yeunbf1k9nIY2f7P+WbOhDbqW1ypRe5wj9hVBwR88frq3dH1xMp1iL9gX1P+c7bK3eEE4+Bq8XBCLz6Bu9W+DVfRQw7pX1nAfigKIvdkuXEQeL4/pok6bMSt73AV++Rd2UEVO20OKBbZ/1wJY9r0CuTJMk/v37Awby9Mtd7Y1uzDTnLtZztUonaGzdB6zc5Xm6C7NUxuab+g9faRP1e9OwznnXChCq5WSc4r+WM70T9Sjzr8=</latexit> xt = → ¯ ωtx0 + → 1 ↑ ¯ ωtε ノイズ -
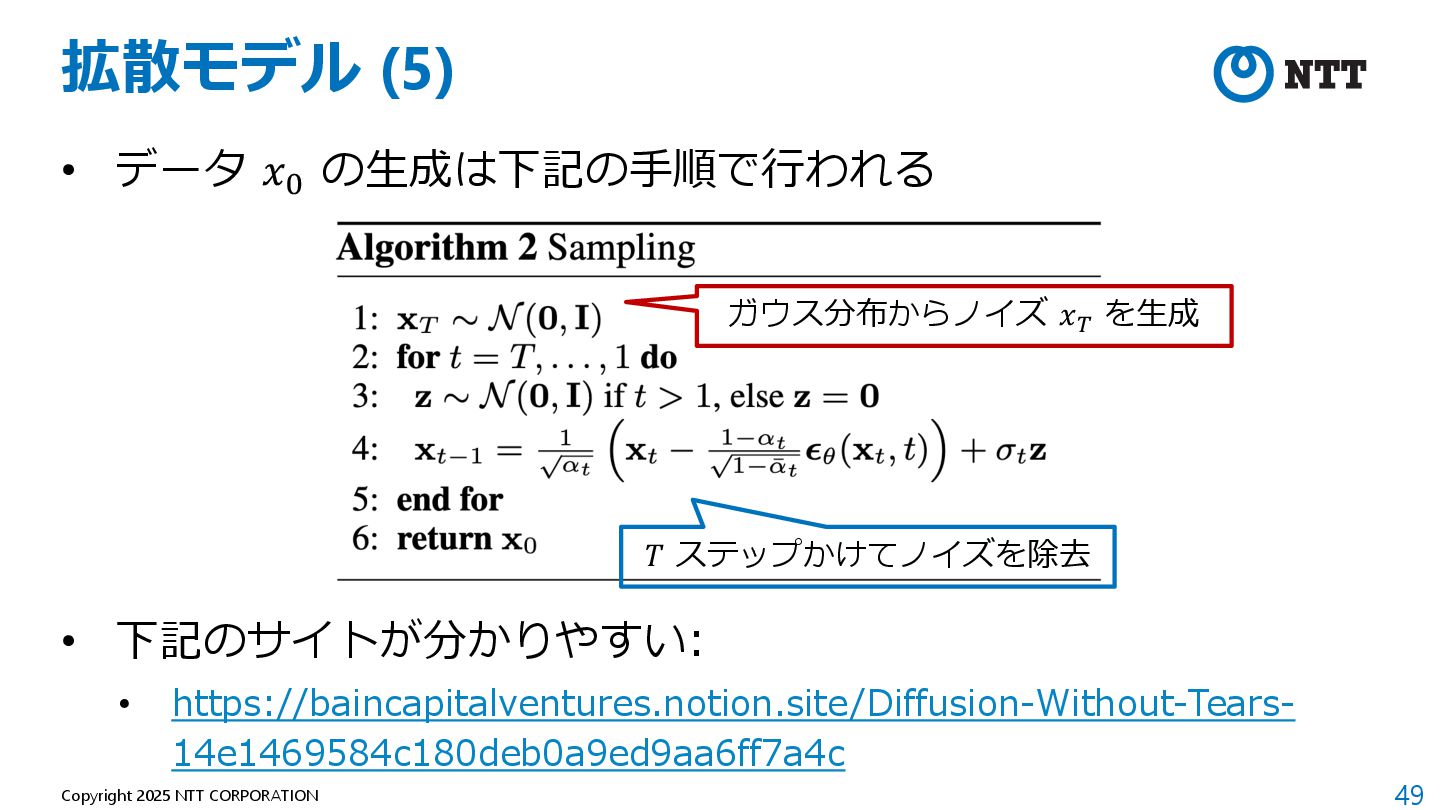
49 Copyright 2025 NTT CORPORATION 拡散モデル (5) • データ 𝑥-
の⽣成は下記の⼿順で⾏われる • 下記のサイトが分かりやすい: • https://baincapitalventures.notion.site/Diffusion-Without-Tears- 14e1469584c180deb0a9ed9aa6ff7a4c ガウス分布からノイズ 𝑥$ を⽣成 𝑇 ステップかけてノイズを除去 -
50 Copyright 2025 NTT CORPORATION 拡散モデル (6) 拡散モデルで⽣成したCelebAとCIFAR10 (2020年時点) [B2]
NOTE: • 拡散モデルは⽣成品質が⾼く、2025年時点でデファクトスタンダード • ⼀⽅で、ステップサイズ 𝑇 を⼤きくする必要があり、計算量が⼤きい -
51 Copyright 2025 NTT CORPORATION まとめ: 深層⽣成モデル • 深層⽣成モデルは、ガウス分布に従うノイズから、どのような ⽅法でデータを⽣成するかに焦点を当てている
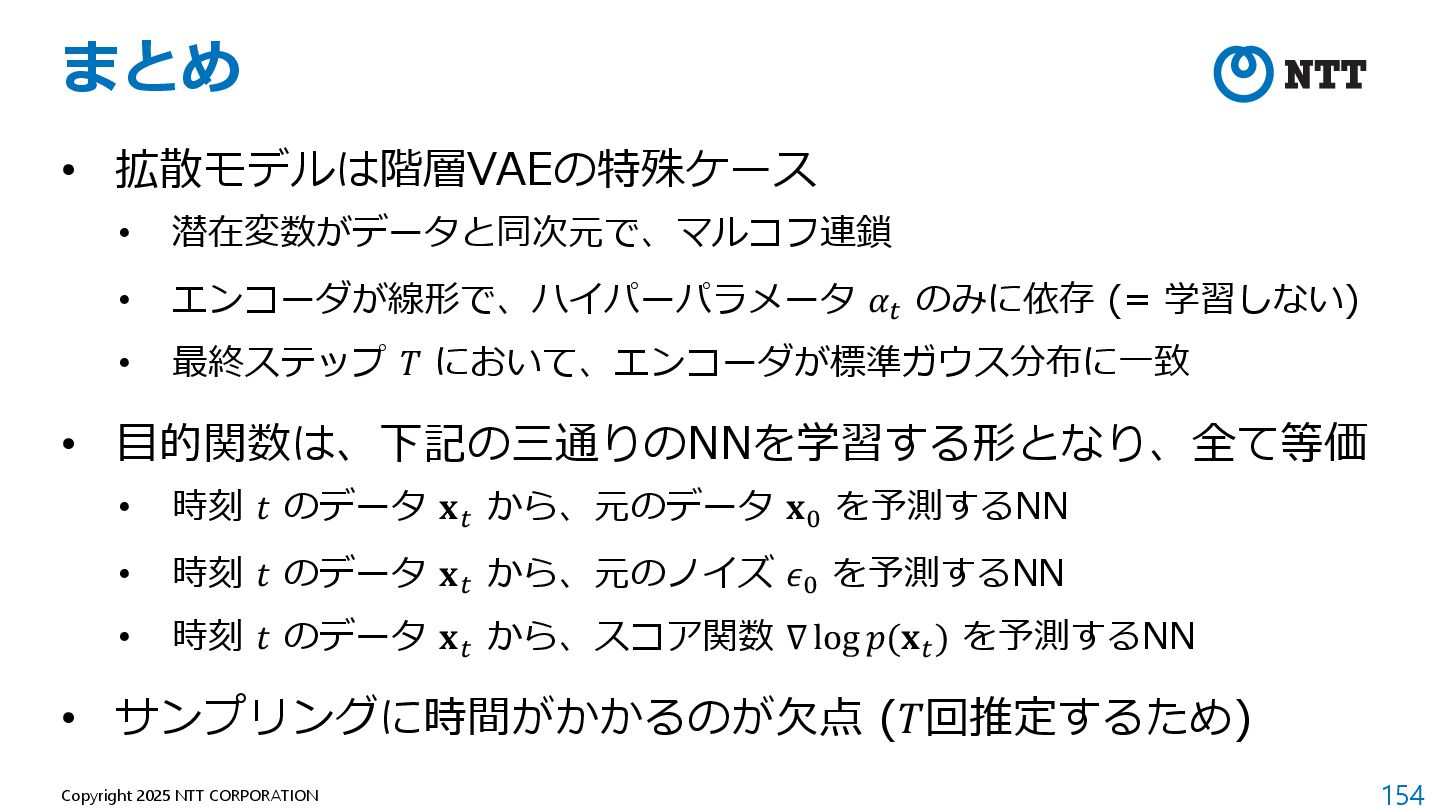
• VAE: ノイズごとに条件付き分布を推定し、データを⽣成 • 拡散モデル: ノイズを徐々に除去することで、データを⽣成 • それぞれのモデルごとに最尤推定する⽅法を⼯夫している • VAEや拡散モデルでは、対数尤度の変分下界を⽤いて計算を⾏っている • 実は拡散モデルは階層型VAEの special case (付録F参照) • 現在主流のStable Diffusion [B3] は VAE + Diffusion • VAEを⽤いて次元を圧縮し、拡散モデルを⽤いて⽣成する -
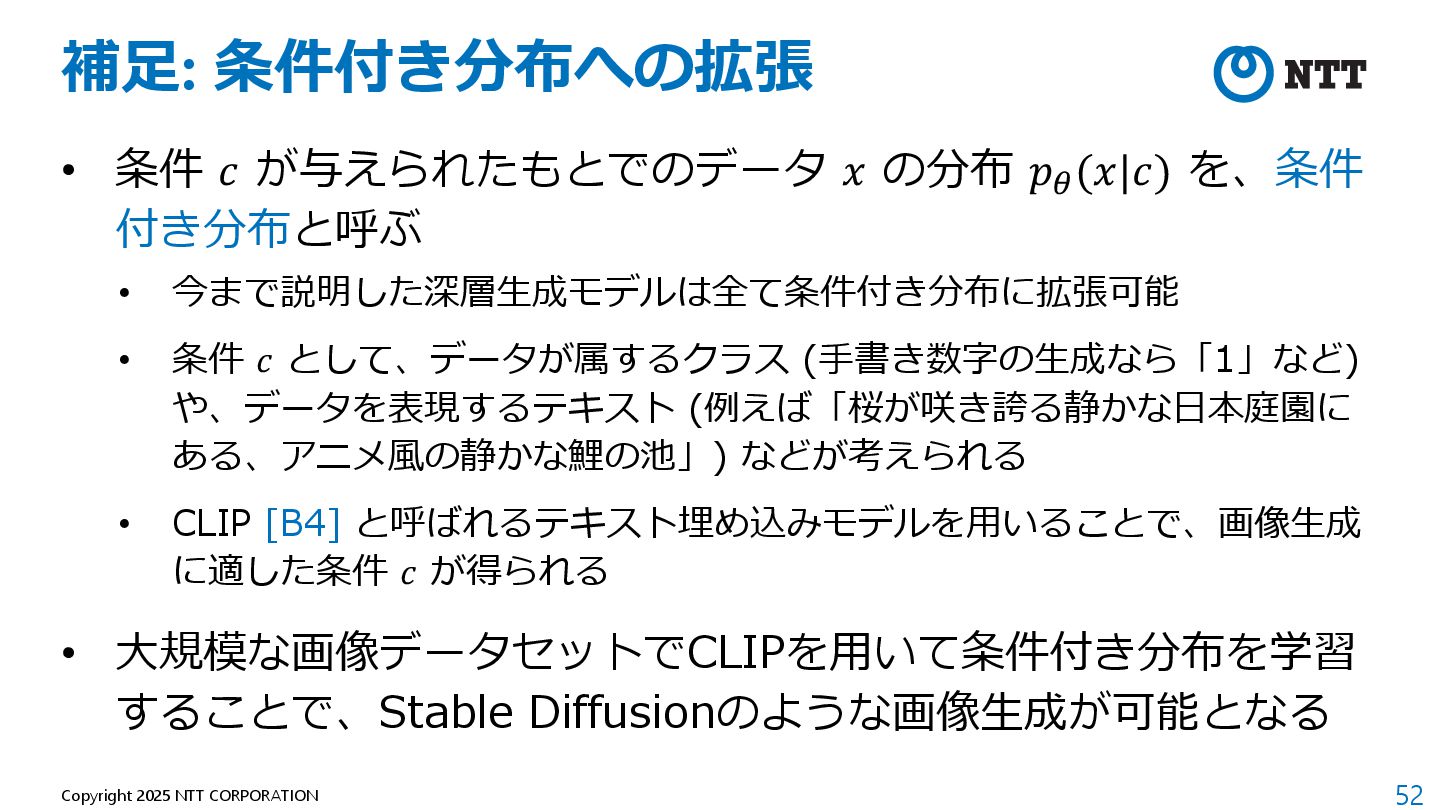
52 Copyright 2025 NTT CORPORATION 補⾜: 条件付き分布への拡張 • 条件 𝑐
が与えられたもとでのデータ 𝑥 の分布 𝑝$ (𝑥|𝑐) を、条件 付き分布と呼ぶ • 今まで説明した深層⽣成モデルは全て条件付き分布に拡張可能 • 条件 𝑐 として、データが属するクラス (⼿書き数字の⽣成なら「1」など) や、データを表現するテキスト (例えば「桜が咲き誇る静かな⽇本庭園に ある、アニメ⾵の静かな鯉の池」) などが考えられる • CLIP [B4] と呼ばれるテキスト埋め込みモデルを⽤いることで、画像⽣成 に適した条件 𝑐 が得られる • ⼤規模な画像データセットでCLIPを⽤いて条件付き分布を学習 することで、Stable Diffusionのような画像⽣成が可能となる -
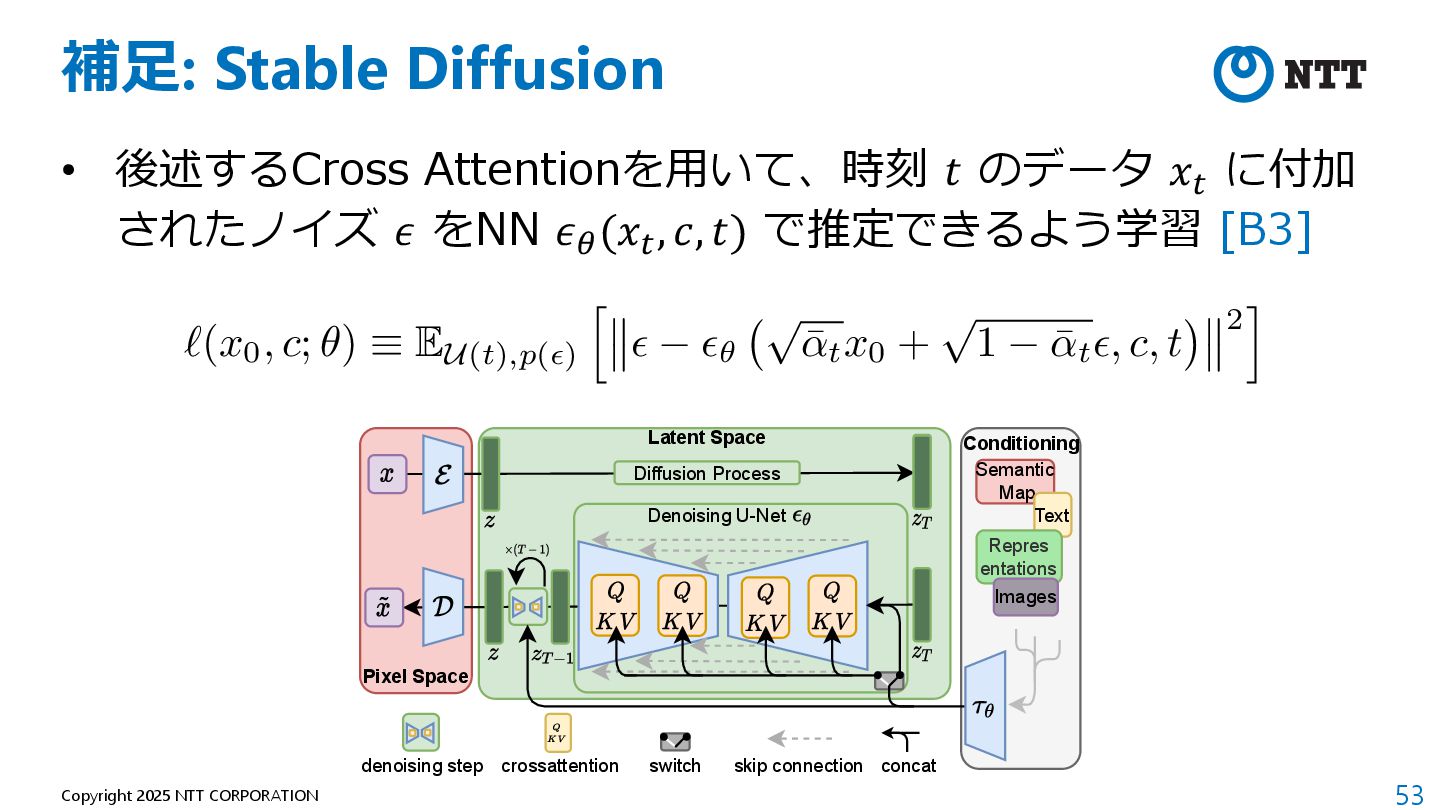
53 Copyright 2025 NTT CORPORATION 補⾜: Stable Diffusion Semantic Map
crossattention Latent Space Conditioning Text Diffusion Process denoising step switch skip connection Repres entations Pixel Space Images Denoising U-Net concat <latexit sha1_base64="rCxvEXk9BZpU9FNkehIS54csnGo=">AAAEBnicnVJNaxNBGH6360eN1qZ6EbwEQ0uiaZgUqVIvxQ/wIvbDpIVMjLPjJBk72d3uTkLrsnfxD3jwpOBBBG/iVfDiD9BDf4J4rODFg+/ObhQNVXCWnXnmed/ned8ZxvGVDDUhe9aEfejwkaOTx3LHT0ydnM7PnGqE3iDgos495QWbDguFkq6oa6mV2PQDwfqOEhvO1rUkvjEUQSg9947e9UWrz7qu7EjONFLt/EcqlCrttCMSV/gVqntCs/IcFdsDOaR9pnuOE92I25HBnKmoHpd0ueKXqPBDqTy3HFMlOrppZtoQgS6MQvMjgHJjnKaWaLgd6Ig6LIgoU36Pob+OY9PEhTRYmx8Lj8wqvKJpILs9XU6XtOjdaCFO961cO18kVWJGYRzUMlCEbKx4M9YUULgPHnAYQB8EuKARK2AQ4teEGhDwkWtBhFyASJq4gBhyqB1glsAMhuwWzl3cNTPWxX3iGRo1xyoK/wCVBZgln8hLsk8+kFfkM/l+oFdkPJJednF1Uq3w29OPz6x/+6eqj6uG3i/VX3vW0IHLpleJvfuGSU7BU/3w4ZP99aW12WiOPCdfsP9nZI+8xxO4w6/8xapYe4ruif91VKV3GCC6lfVwGx0FMskuuYXzWIeanC72mVSMszvuIl/5yf2vI4OdMceUO/jWOKLkvAJrxfiaan++nXHQWKjWFquLqxeLy1ezdzUJZ+EclPDtXIJluAkrUAduLVn3LGk9sB/Zr+039ts0dcLKNKfht2G/+wGZCwWS</latexit> ω(x0, c; ε) → E U(t),p(ω) ϑ ↑ ϑε ↓ ¯ ϖtx0 + ↓ 1 ↑ ¯ ϖtϑ, c, t 2 • 後述するCross Attentionを⽤いて、時刻 𝑡 のデータ 𝑥/ に付加 されたノイズ 𝜖 をNN 𝜖$ (𝑥/ , 𝑐, 𝑡) で推定できるよう学習 [B3] -
54 Copyright 2025 NTT CORPORATION 参考⽂献 B 1. Kingma, Diederik
P., and Max Welling. "Auto-encoding variational bayes." arXiv preprint arXiv:1312.6114 (2013). 2. Ho, Jonathan, Ajay Jain, and Pieter Abbeel. "Denoising diffusion probabilistic models." Advances in neural information processing systems 33 (2020): 6840-6851. 3. Rombach, Robin, et al. "High-resolution image synthesis with latent diffusion models." Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022. 4. Radford, Alec, et al. "Learning transferable visual models from natural language supervision." International conference on machine learning. PMLR, 2021. -
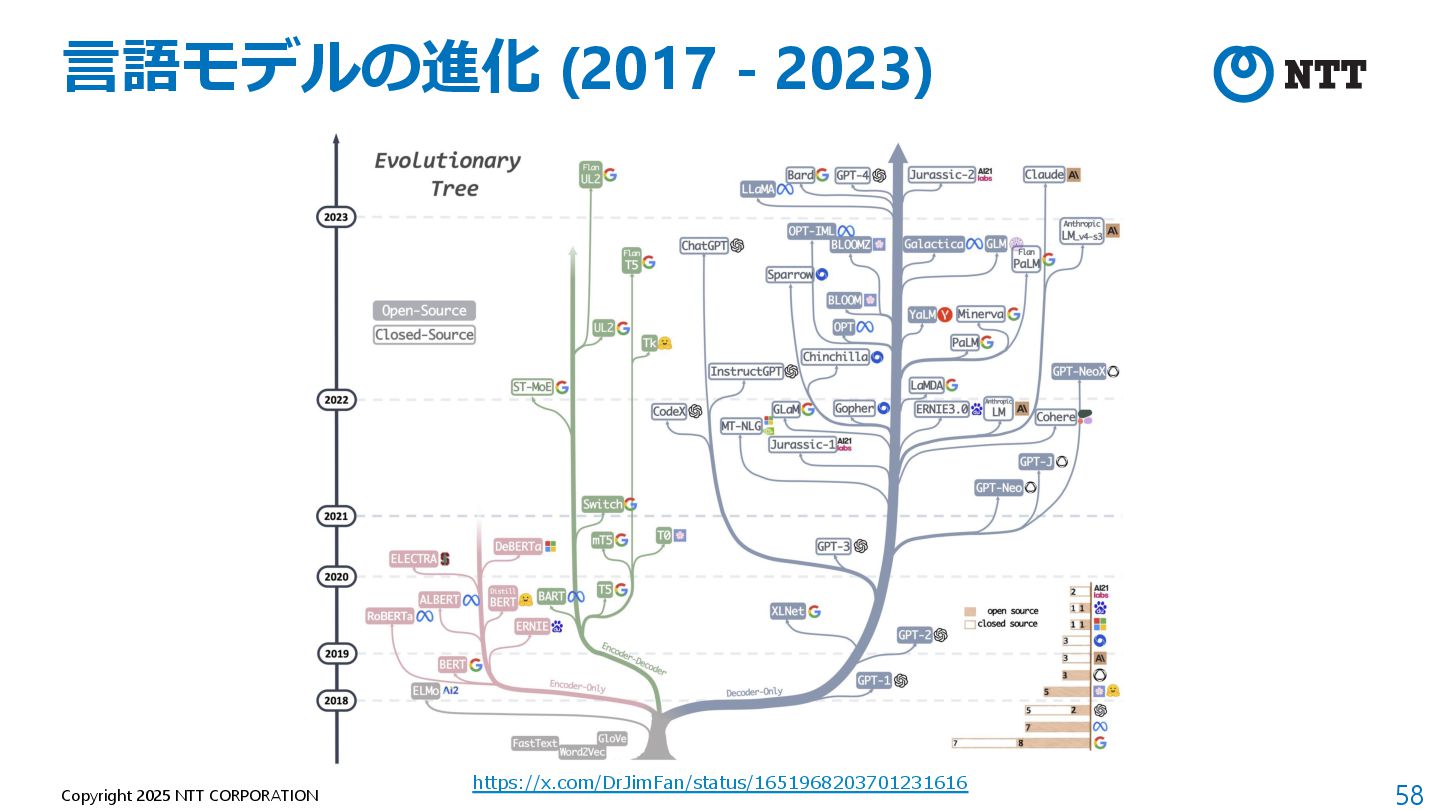
57 Copyright 2025 NTT CORPORATION ⾔語モデルについて • ⼊⼒ 𝑥 に対する出⼒
𝑦 の確率 𝑃$ (𝑦|𝑥) を推定するモデル • ⾔語は画像と性質が異なるため、深層⽣成モデルとは異なる発展を遂げた • 2017年にTransformer [C1] が登場し、⾶躍的に進化した • ⾔語モデルの事前学習の効果の確認 [C2] (2018) › ⼤規模かつ多様なデータセットで⾔語モデルを事前学習すれば、少量 のラベル付きデータによるFine-Tuningで⾼精度を達成できる • 事前学習済のTransformer (BERT/GPT) の登場 (2018) › BERT [C3] はTransformerのエンコーダ部分を事前学習したモデル › GPT [C4] はTransformerのデコーダ部分を事前学習したモデル • 以降様々なモデルが登場 (基本的にはGPTが主流) -
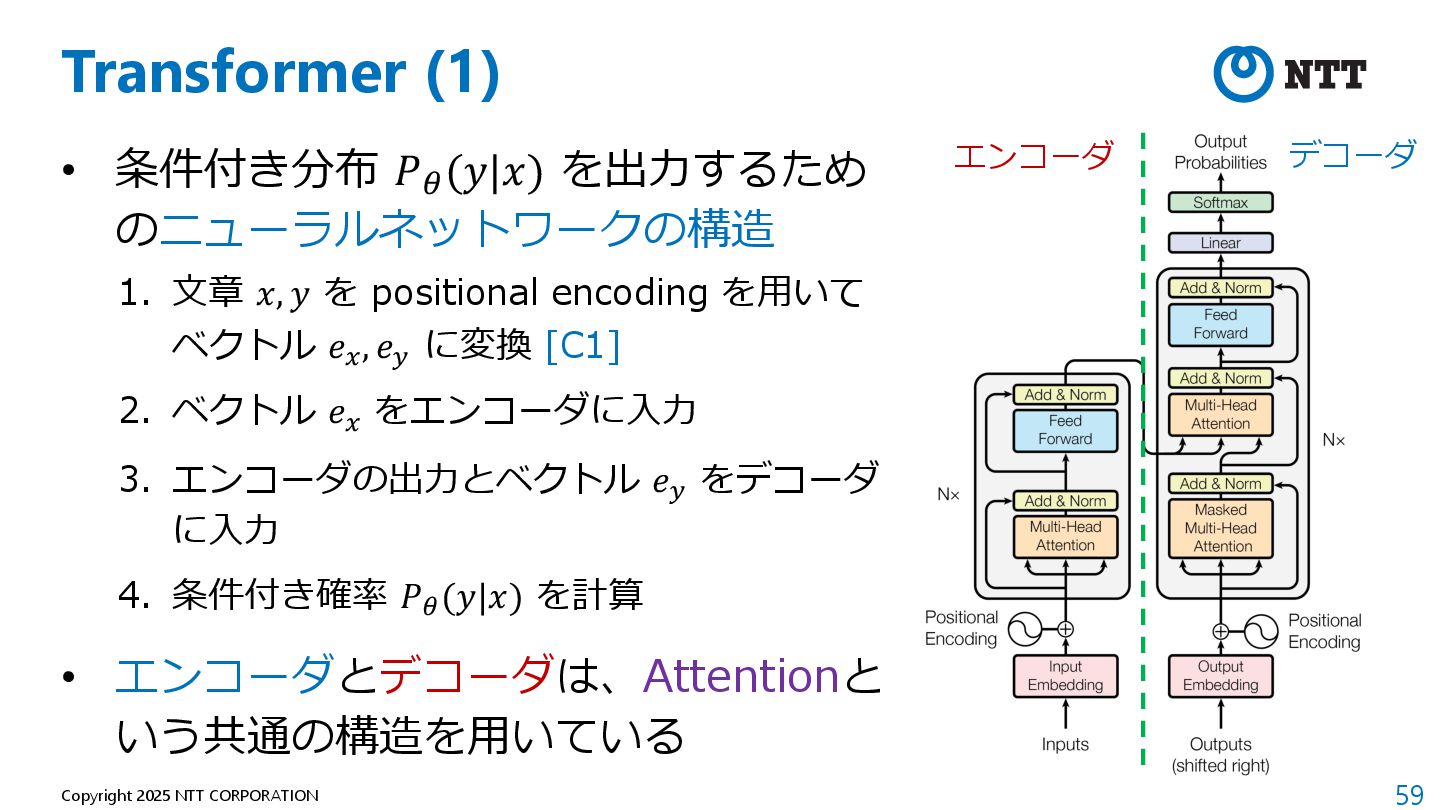
59 Copyright 2025 NTT CORPORATION Transformer (1) • 条件付き分布 𝑃$
(𝑦|𝑥) を出⼒するため のニューラルネットワークの構造 1. ⽂章 𝑥, 𝑦 を positional encoding を⽤いて ベクトル 𝑒! , 𝑒= に変換 [C1] 2. ベクトル 𝑒! をエンコーダに⼊⼒ 3. エンコーダの出⼒とベクトル 𝑒= をデコーダ に⼊⼒ 4. 条件付き確率 𝑃3 (𝑦|𝑥) を計算 • エンコーダとデコーダは、Attentionと いう共通の構造を⽤いている エンコーダ デコーダ -
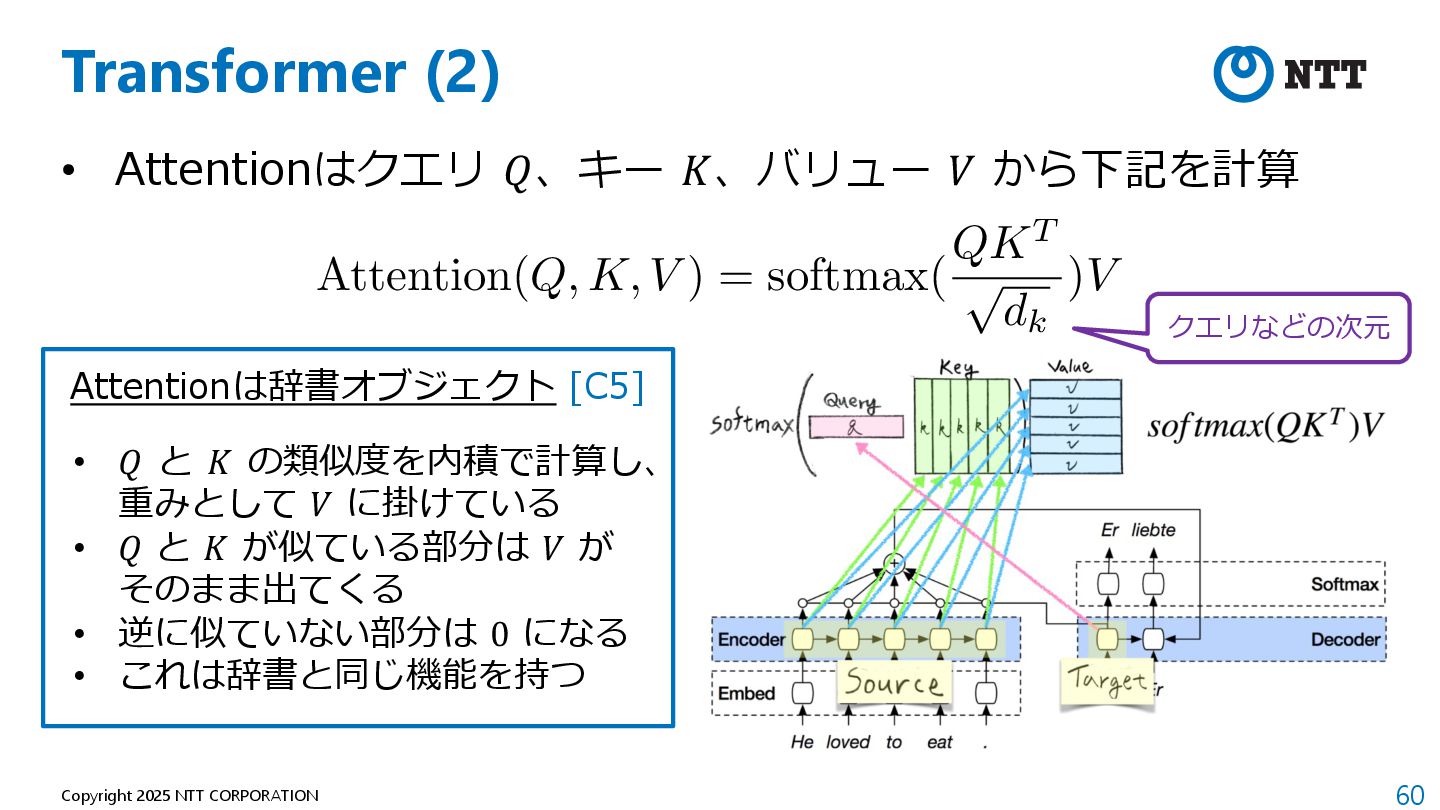
60 Copyright 2025 NTT CORPORATION Transformer (2) • Attentionはクエリ 𝑄、キー
𝐾、バリュー 𝑉 から下記を計算 <latexit sha1_base64="e8IuDcPOz4hNfrW+LeyDMMelvm8=">AAADVXicnVJNaxNBGH6b1FpjNaleBC+loSUtIUykVCkU6sdBLMWmbdJCt4bZzSRdsl/OTkLiMH/AP+DBk4IH6cX/4KV/QKUnvUqPFQRpwXd215YaVHCWnXnnmfd55pmX1wwcOxSEHAyl0sMXRi6OXspcHrtyNZsbv1YL/Q63WNXyHZ9vmTRkju2xqrCFw7YCzqhrOmzTbN/X55tdxkPb9zZEP2A7Lm15dtO2qEConntkuFTsclfeFYJ5GlOFSnG5WJuZXvx1FPpN4dKeKhhNTi1ZWX4iN5SSRviUC9moy7ZSaqaWqefypESiMTEYlJMgD8lY9XM/wIAG+GBBB1xg4IHA2AEKIX7bUAYCAWI7IBHjGNnROQMFGeR2MIthBkW0jXMLd9sJ6uFea4YR28JbHPw5Midginwgb8kR2Sd75Cs5/qOWjDS0lz6uZsxlQT37/Mb693+yXFwF7J6x/upZQBPuRF5t9B5EiH6FFfO7z14crS+sTclp8pocov9X5IC8xxd43W/Wmwpbe4nqWv8BsuIacoxWEg+PUZEhone6CrN4jxHltNCnvlElNW4hXjzF/leRQm9AMcZ0m5R/b4rBoHarVJ4vzVfm8kv3koYZhZswCQXsituwBA9hFaro6x18hM/wJfUpdZIeTo/EqamhhHMdzo109iczPsiY</latexit> Attention(Q, K, V ) = softmax( QKT p dk )V Attentionは辞書オブジェクト [C5] • 𝑄 と 𝐾 の類似度を内積で計算し、 重みとして 𝑉 に掛けている • 𝑄 と 𝐾 が似ている部分は 𝑉 が そのまま出てくる • 逆に似ていない部分は 0 になる • これは辞書と同じ機能を持つ クエリなどの次元 -
61 Copyright 2025 NTT CORPORATION Transformer (3) • Self-Attention は
𝑄 = 𝐾 = 𝑉 のAttention • ⼊⼒内の各要素が他の全ての要素に対してどの 程度関連しているかを計算 • エンコーダとデコーダの初段はSelf-Attention • Cross-Attention は 𝐾 = 𝑉 のAttention • 𝑄 が 𝐾, 𝑉 とどの程度関連しているかを計算 • デコーダの⼆段⽬以降は 𝑄 がデコーダへの⼊⼒、 𝐾, 𝑉 がエンコーダの出⼒のCross-Attention • Attention を複数のモデルで計算すること でさらに性能が上がる (Multi-Head) -
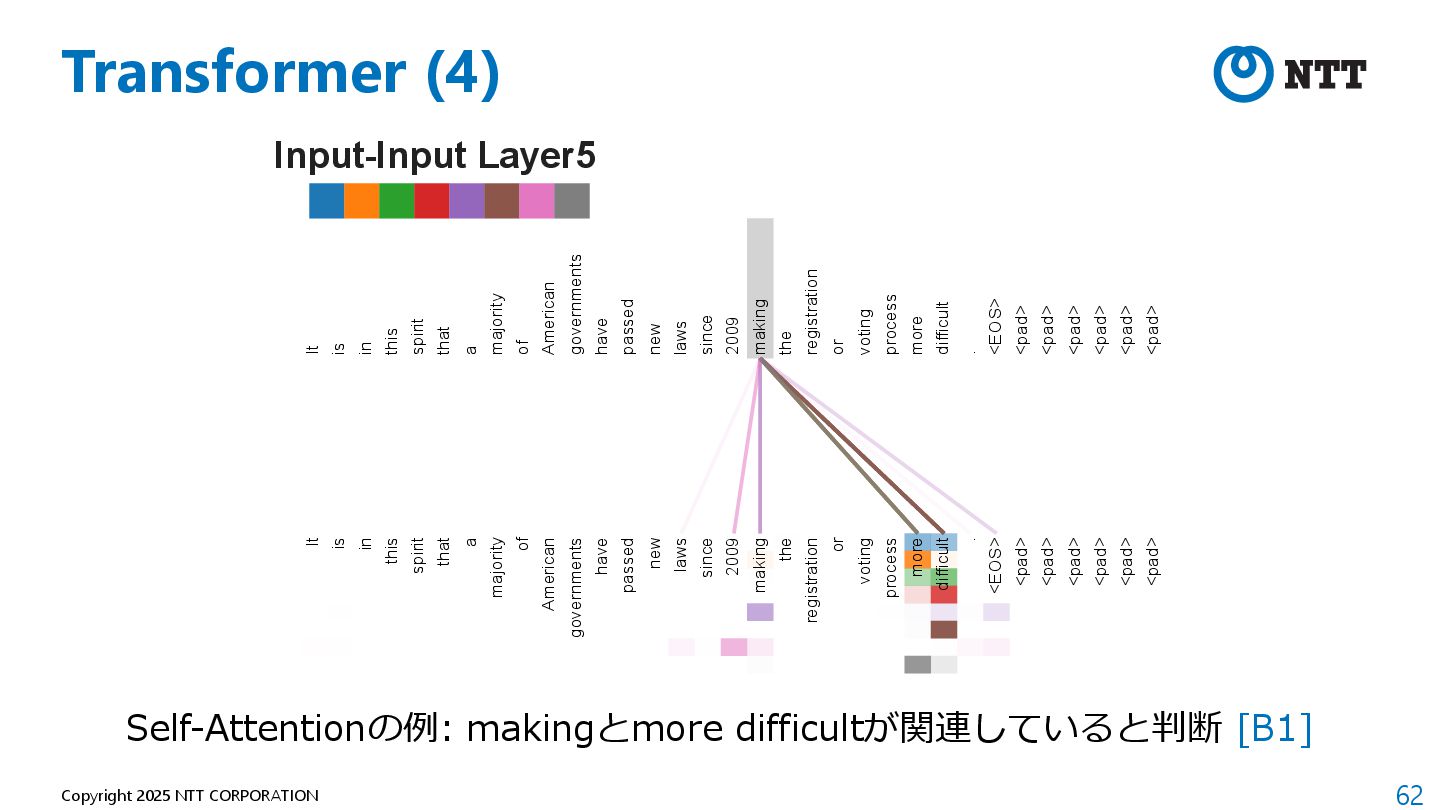
62 Copyright 2025 NTT CORPORATION Transformer (4) Input-Input Layer5 It
is in this spirit that a majority of American governments have passed new laws since 2009 making the registration or voting process more difficult . <EOS> <pad> <pad> <pad> <pad> <pad> <pad> It is in this spirit that a majority of American governments have passed new laws since 2009 making the registration or voting process more difficult . <EOS> <pad> <pad> <pad> <pad> <pad> <pad> Self-Attentionの例: makingとmore difficultが関連していると判断 [B1] -
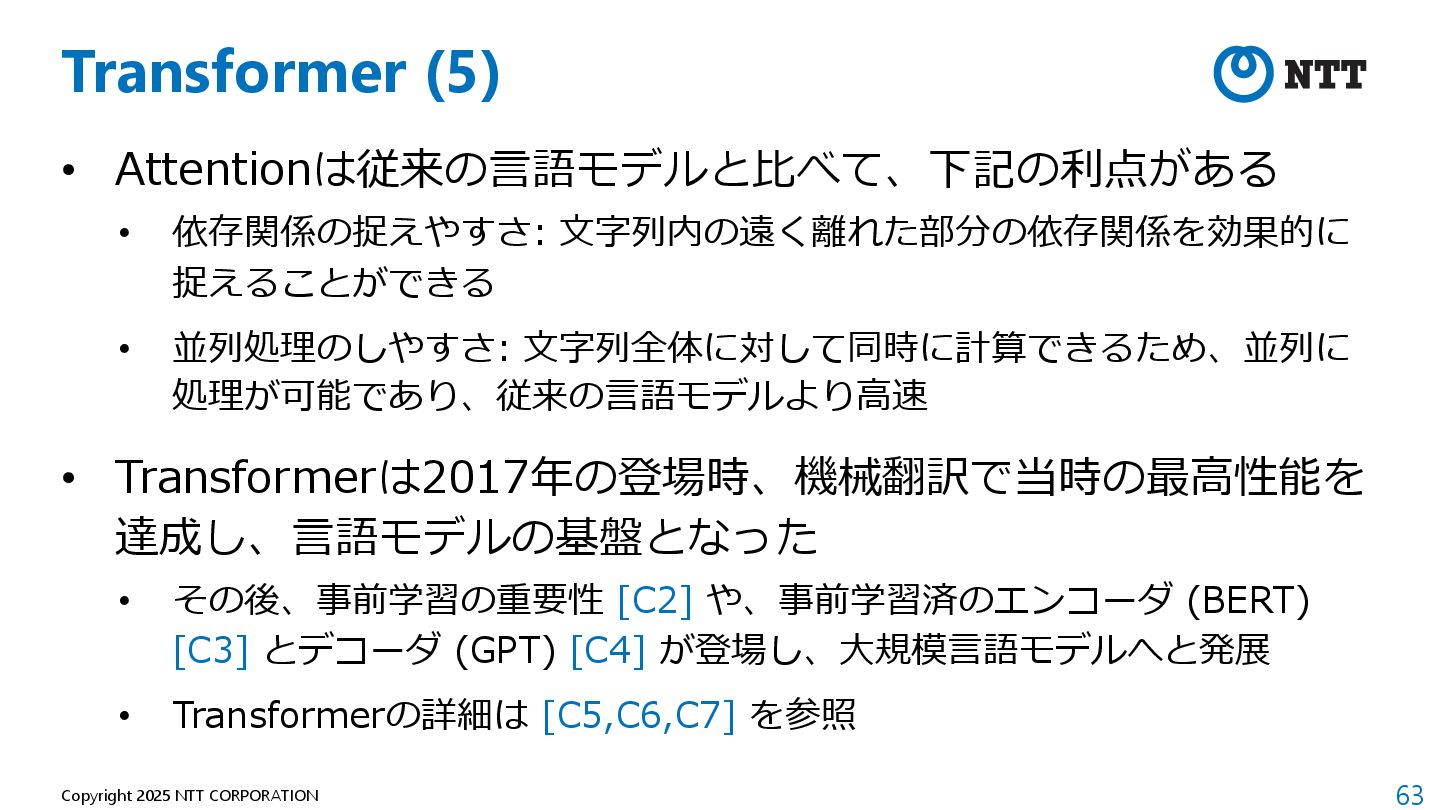
63 Copyright 2025 NTT CORPORATION Transformer (5) • Attentionは従来の⾔語モデルと⽐べて、下記の利点がある •
依存関係の捉えやすさ: ⽂字列内の遠く離れた部分の依存関係を効果的に 捉えることができる • 並列処理のしやすさ: ⽂字列全体に対して同時に計算できるため、並列に 処理が可能であり、従来の⾔語モデルより⾼速 • Transformerは2017年の登場時、機械翻訳で当時の最⾼性能を 達成し、⾔語モデルの基盤となった • その後、事前学習の重要性 [C2] や、事前学習済のエンコーダ (BERT) [C3] とデコーダ (GPT) [C4] が登場し、⼤規模⾔語モデルへと発展 • Transformerの詳細は [C5,C6,C7] を参照 -
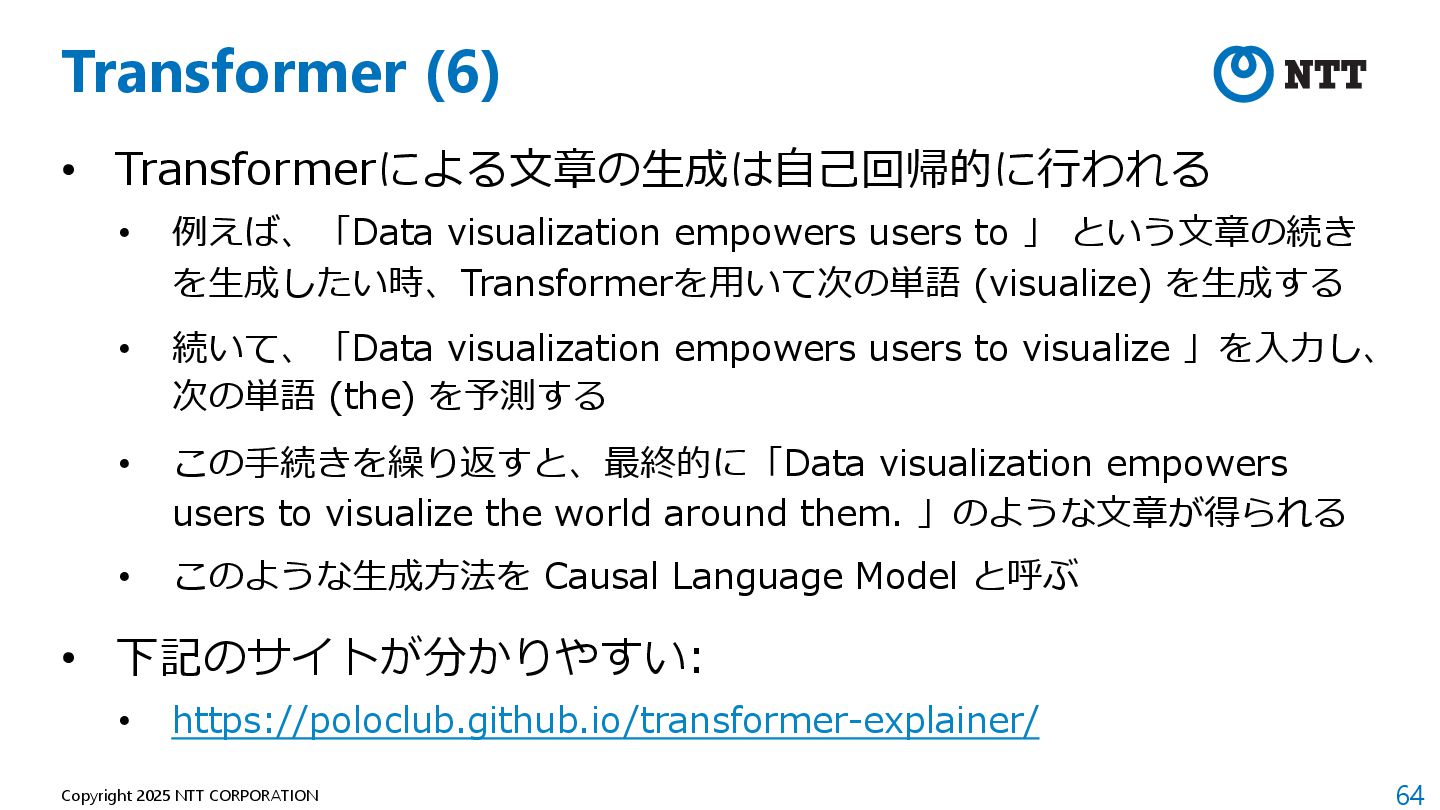
64 Copyright 2025 NTT CORPORATION Transformer (6) • Transformerによる⽂章の⽣成は⾃⼰回帰的に⾏われる •
例えば、「Data visualization empowers users to 」 という⽂章の続き を⽣成したい時、Transformerを⽤いて次の単語 (visualize) を⽣成する • 続いて、「Data visualization empowers users to visualize 」を⼊⼒し、 次の単語 (the) を予測する • この⼿続きを繰り返すと、最終的に「Data visualization empowers users to visualize the world around them. 」のような⽂章が得られる • このような⽣成⽅法を Causal Language Model と呼ぶ • 下記のサイトが分かりやすい: • https://poloclub.github.io/transformer-explainer/ -
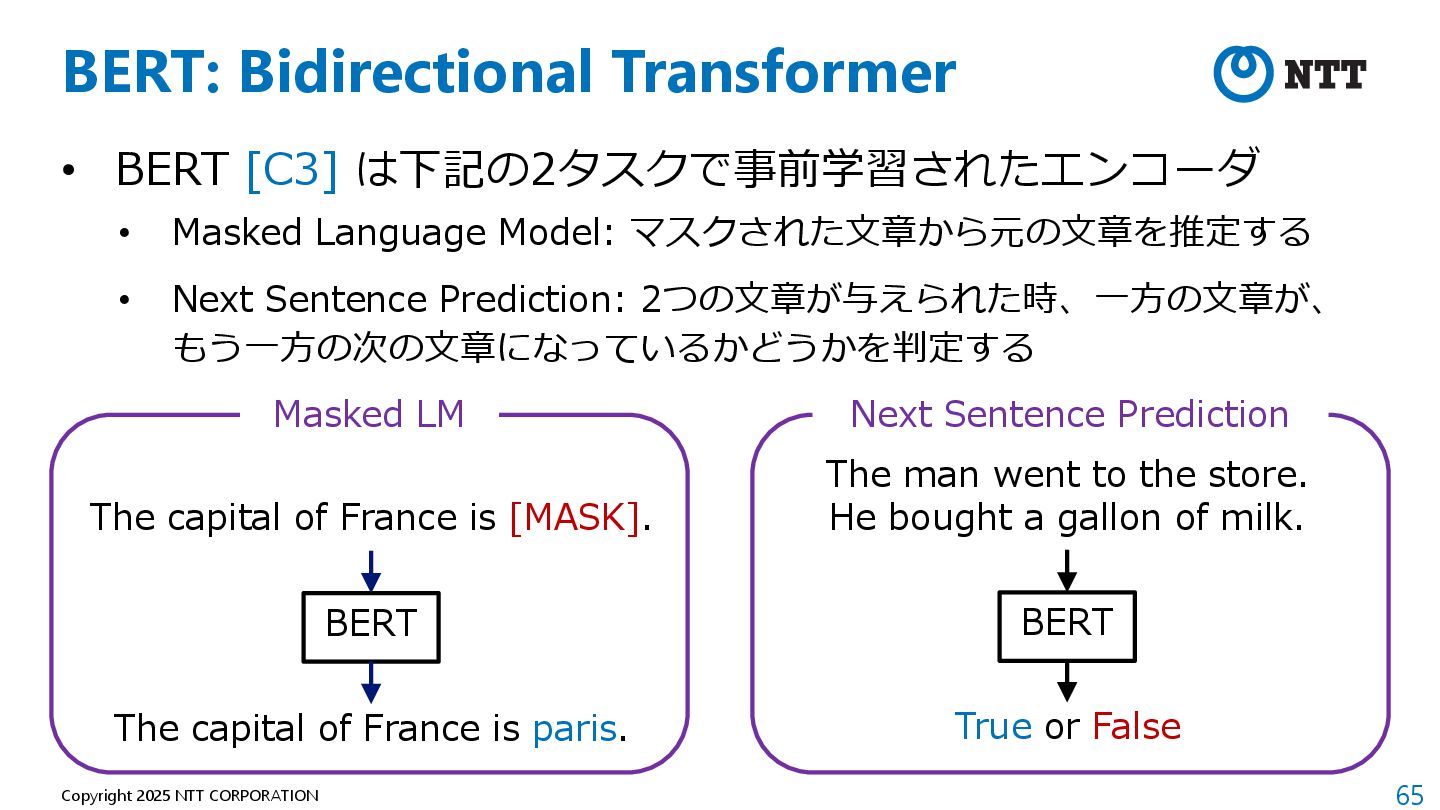
65 Copyright 2025 NTT CORPORATION BERT: Bidirectional Transformer • BERT
[C3] は下記の2タスクで事前学習されたエンコーダ • Masked Language Model: マスクされた⽂章から元の⽂章を推定する • Next Sentence Prediction: 2つの⽂章が与えられた時、⼀⽅の⽂章が、 もう⼀⽅の次の⽂章になっているかどうかを判定する BERT The capital of France is [MASK]. The capital of France is paris. Masked LM The man went to the store. He bought a gallon of milk. BERT True or False Next Sentence Prediction -
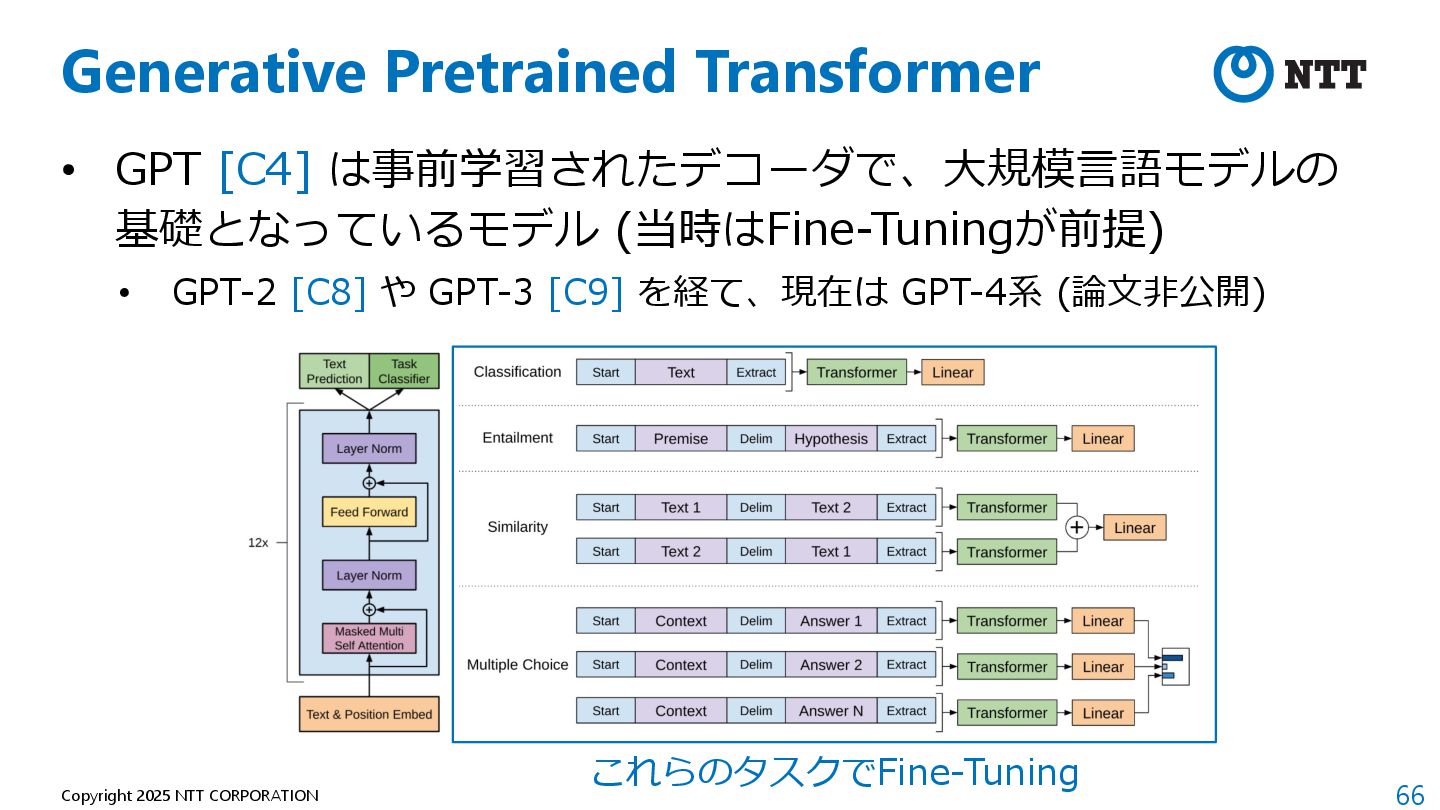
66 Copyright 2025 NTT CORPORATION Generative Pretrained Transformer • GPT
[C4] は事前学習されたデコーダで、⼤規模⾔語モデルの 基礎となっているモデル (当時はFine-Tuningが前提) • GPT-2 [C8] や GPT-3 [C9] を経て、現在は GPT-4系 (論⽂⾮公開) これらのタスクでFine-Tuning -
67 Copyright 2025 NTT CORPORATION まとめ: ⾔語モデル • ⾔語モデルは⾔語の⽣成モデル •
⾔語は離散的な特徴を持つため、画像⽣成モデルとは異なる構造を持つ • Transformerは、⾔語の条件付き確率を推定するためのNN • Attentionという辞書に似た構造を⽤いることで、⽂章内の離れた位置の 依存関係を捉えることが可能となり、また並列計算が可能に • エンコーダを事前学習したBERTやデコーダを事前学習したGPTは、様々 なタスクで⾼い性能を達成 • 特にGPTは現在の⼤規模⾔語モデルにも採⽤されている • ⼤規模⾔語モデルについては [C10,C11] を参照 • 発展が⾮常に速い分野なので、最新の資料を読むと良いと思います -
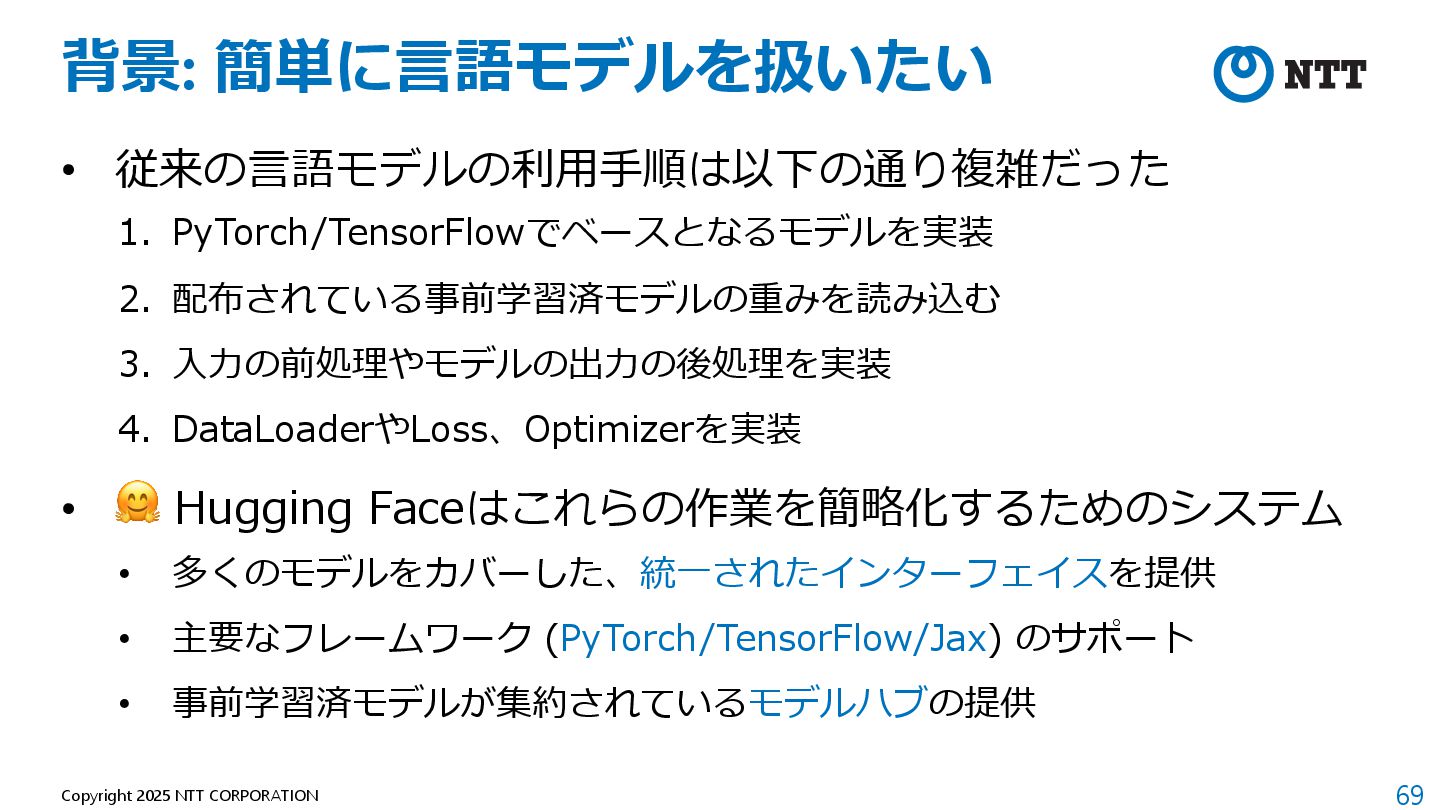
69 Copyright 2025 NTT CORPORATION 背景: 簡単に⾔語モデルを扱いたい • 従来の⾔語モデルの利⽤⼿順は以下の通り複雑だった 1.
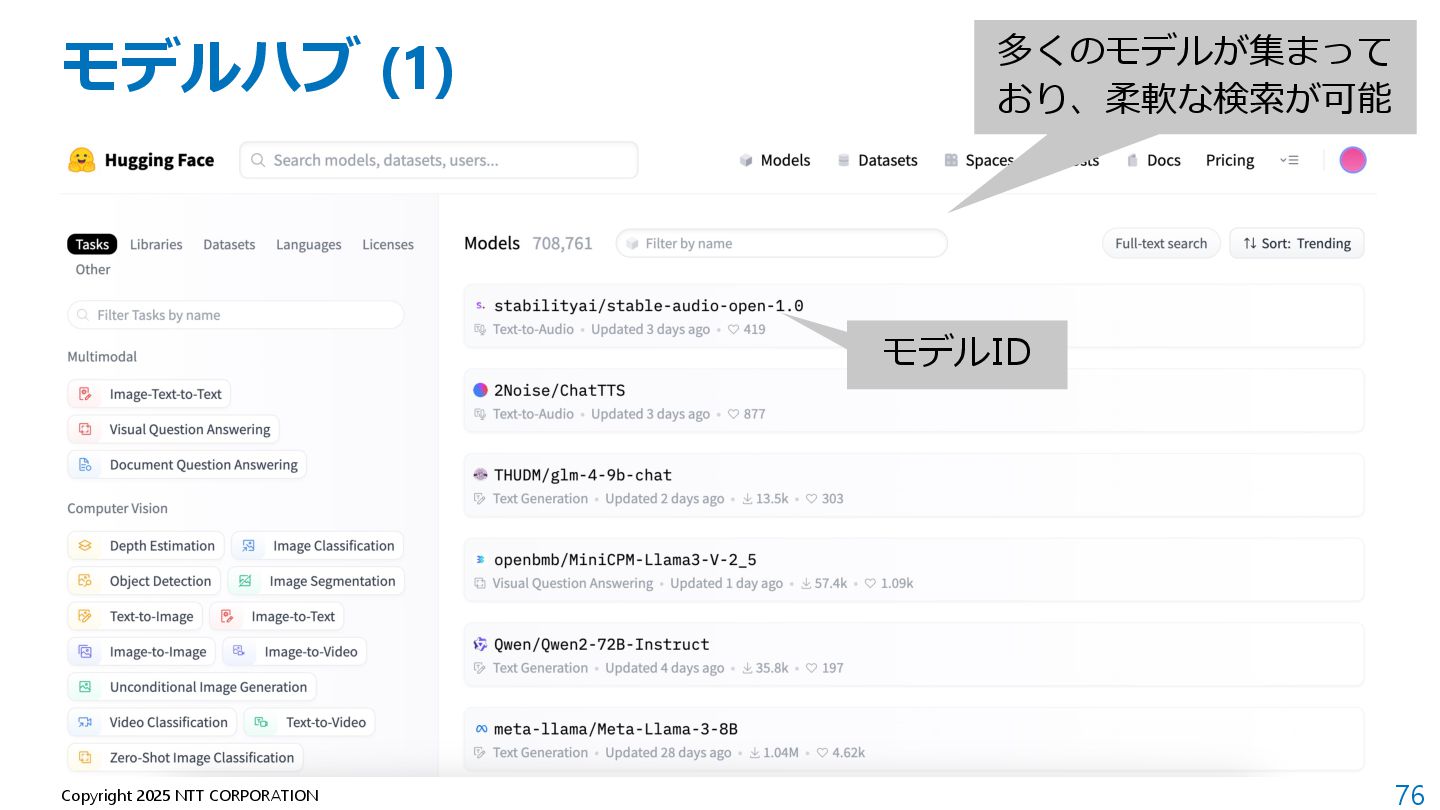
PyTorch/TensorFlowでベースとなるモデルを実装 2. 配布されている事前学習済モデルの重みを読み込む 3. ⼊⼒の前処理やモデルの出⼒の後処理を実装 4. DataLoaderやLoss、Optimizerを実装 • 🤗 Hugging Faceはこれらの作業を簡略化するためのシステム • 多くのモデルをカバーした、統⼀されたインターフェイスを提供 • 主要なフレームワーク (PyTorch/TensorFlow/Jax) のサポート • 事前学習済モデルが集約されているモデルハブの提供 -
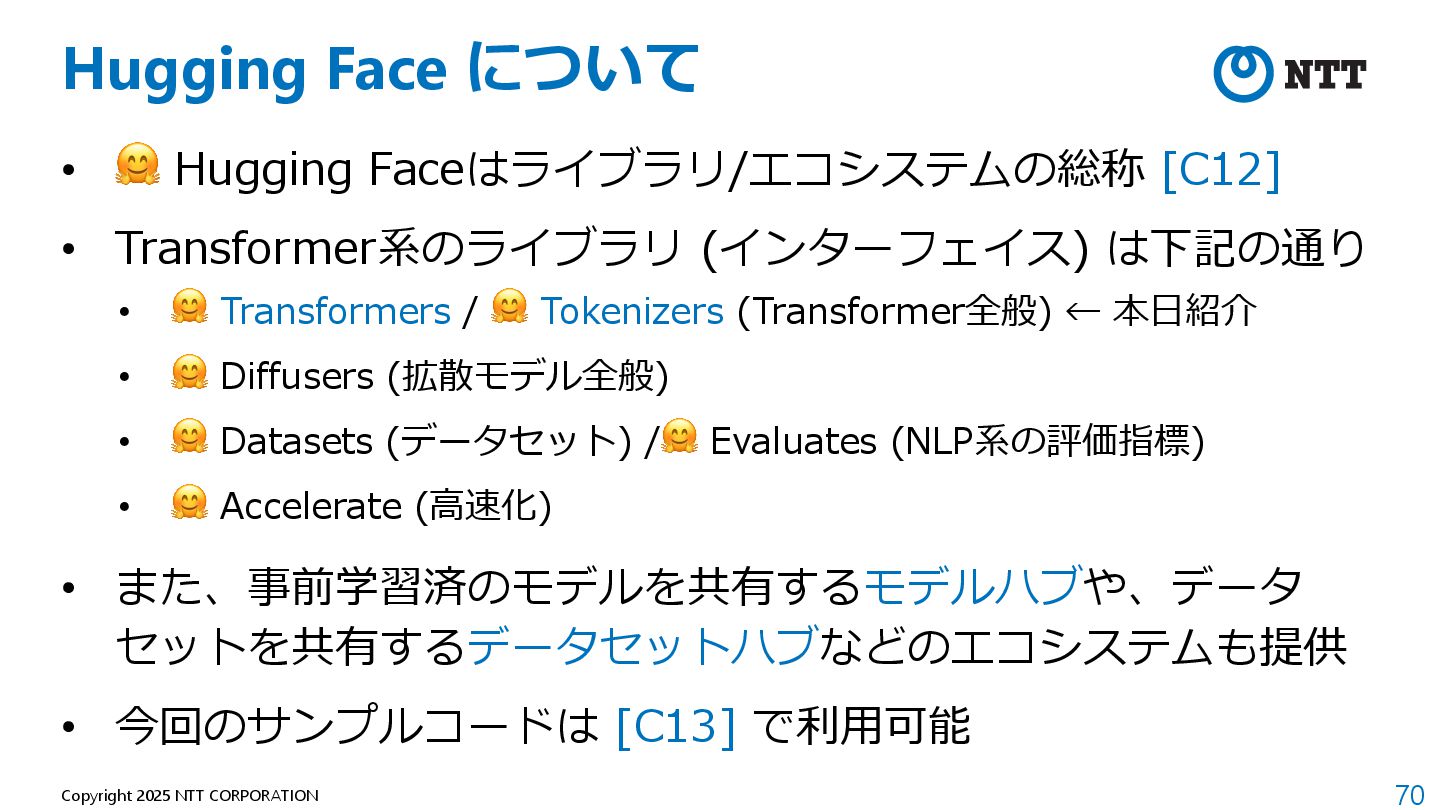
70 Copyright 2025 NTT CORPORATION Hugging Face について • 🤗
Hugging Faceはライブラリ/エコシステムの総称 [C12] • Transformer系のライブラリ (インターフェイス) は下記の通り • 🤗 Transformers / 🤗 Tokenizers (Transformer全般) ← 本⽇紹介 • 🤗 Diffusers (拡散モデル全般) • 🤗 Datasets (データセット) /🤗 Evaluates (NLP系の評価指標) • 🤗 Accelerate (⾼速化) • また、事前学習済のモデルを共有するモデルハブや、データ セットを共有するデータセットハブなどのエコシステムも提供 • 今回のサンプルコードは [C13] で利⽤可能 -
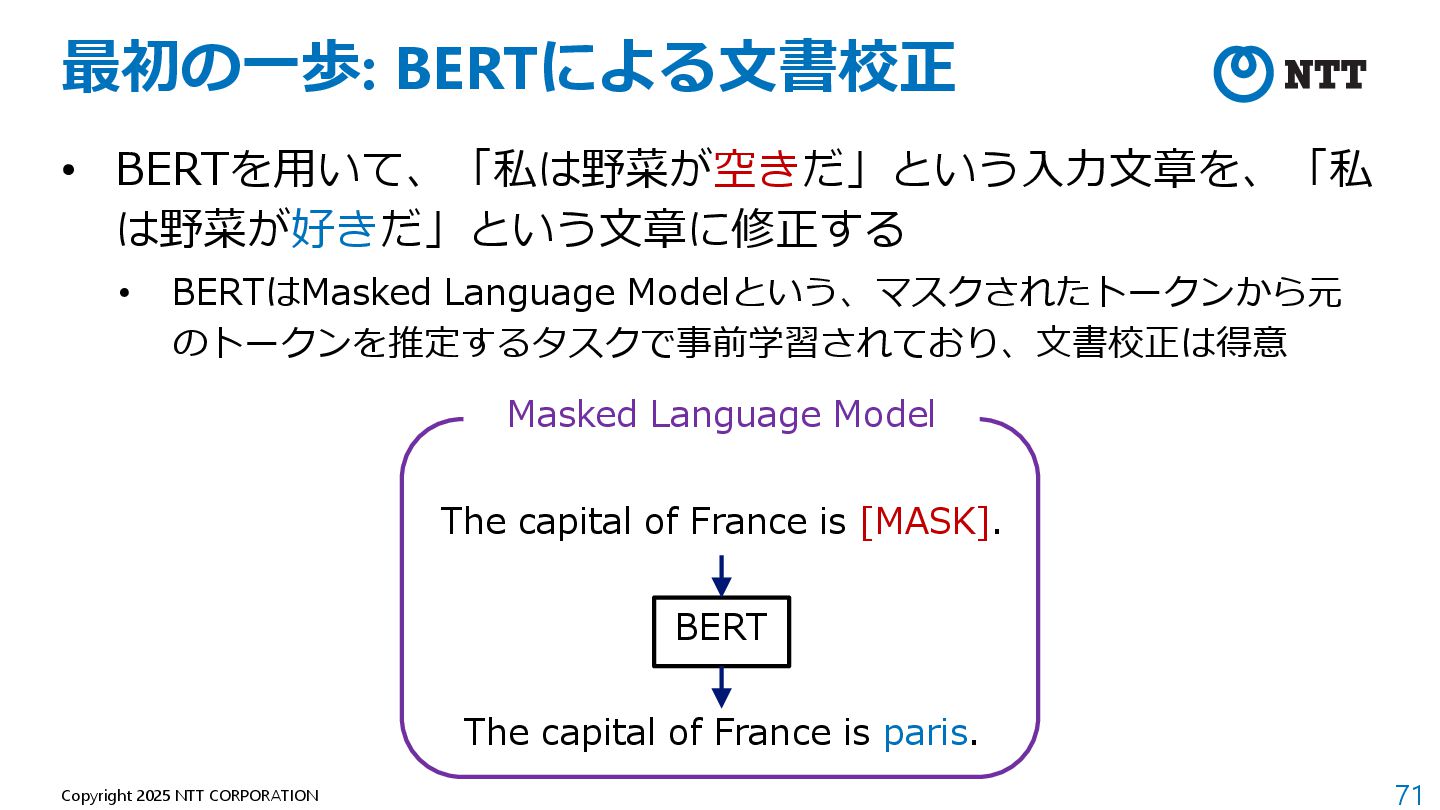
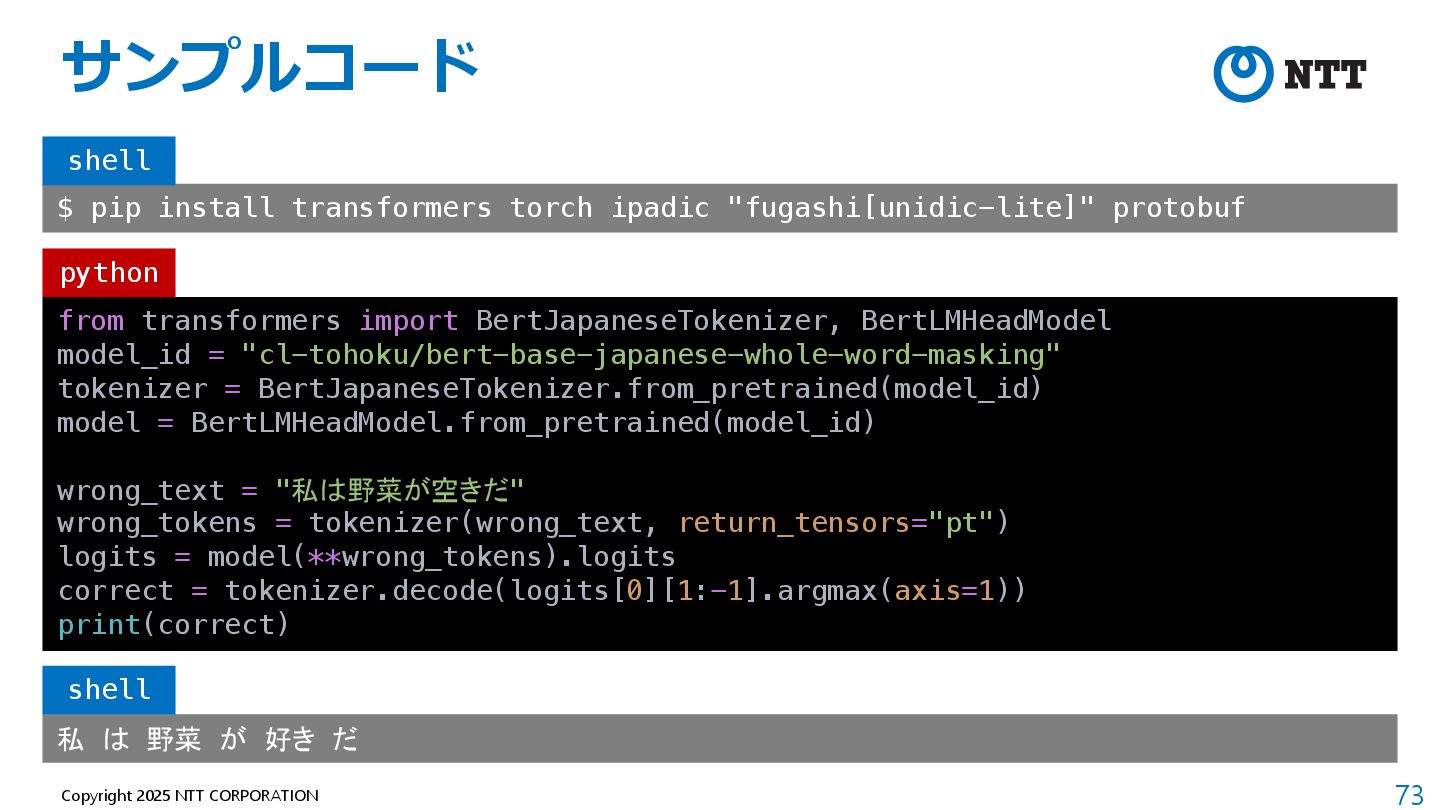
71 Copyright 2025 NTT CORPORATION 最初の⼀歩: BERTによる⽂書校正 • BERTを⽤いて、「私は野菜が空きだ」という⼊⼒⽂章を、「私 は野菜が好きだ」という⽂章に修正する
• BERTはMasked Language Modelという、マスクされたトークンから元 のトークンを推定するタスクで事前学習されており、⽂書校正は得意 BERT The capital of France is [MASK]. The capital of France is paris. Masked Language Model -
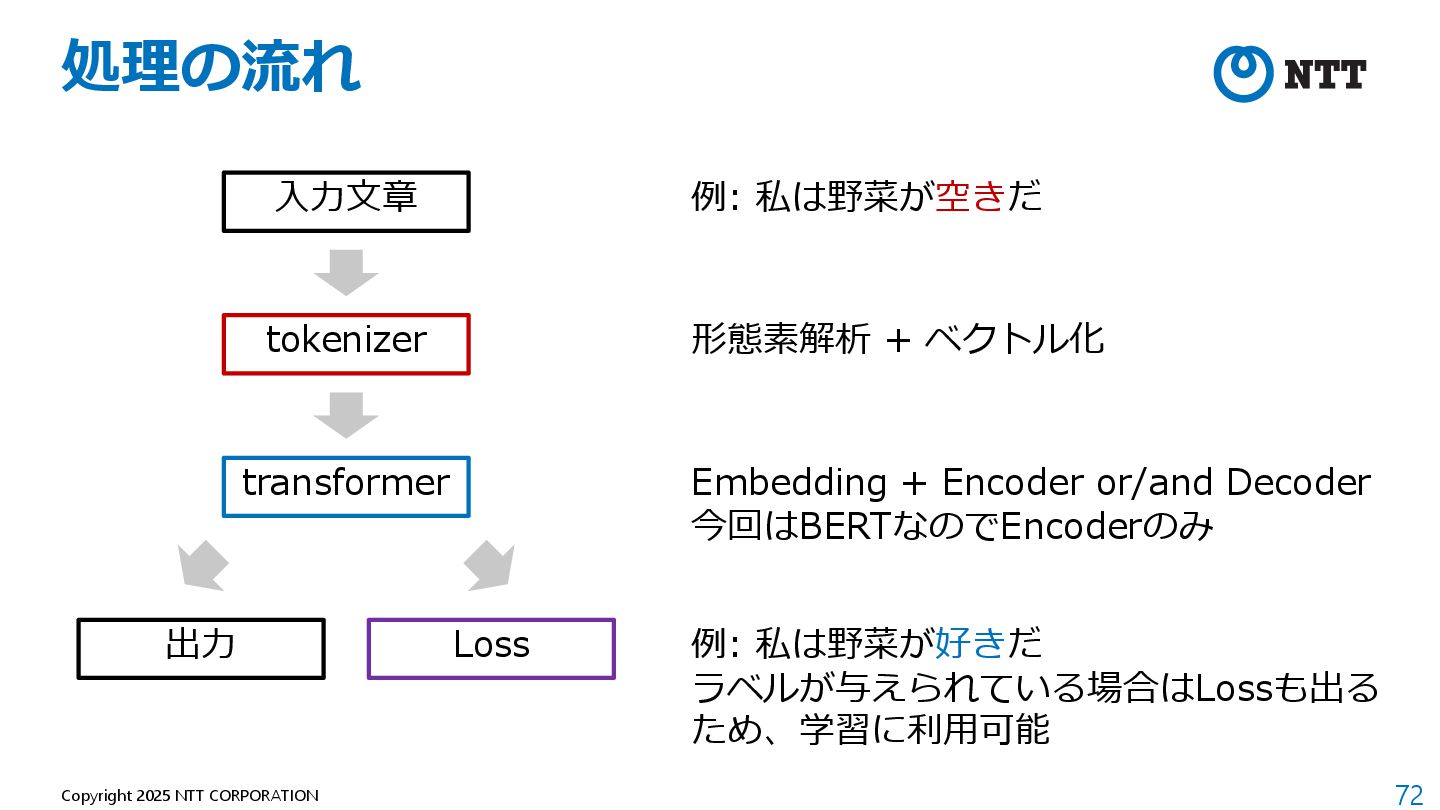
72 Copyright 2025 NTT CORPORATION 処理の流れ ⼊⼒⽂章 tokenizer transformer 出⼒
Loss 例: 私は野菜が空きだ 形態素解析 + ベクトル化 Embedding + Encoder or/and Decoder 今回はBERTなのでEncoderのみ 例: 私は野菜が好きだ ラベルが与えられている場合はLossも出る ため、学習に利⽤可能 -
73 Copyright 2025 NTT CORPORATION サンプルコード $ pip install transformers
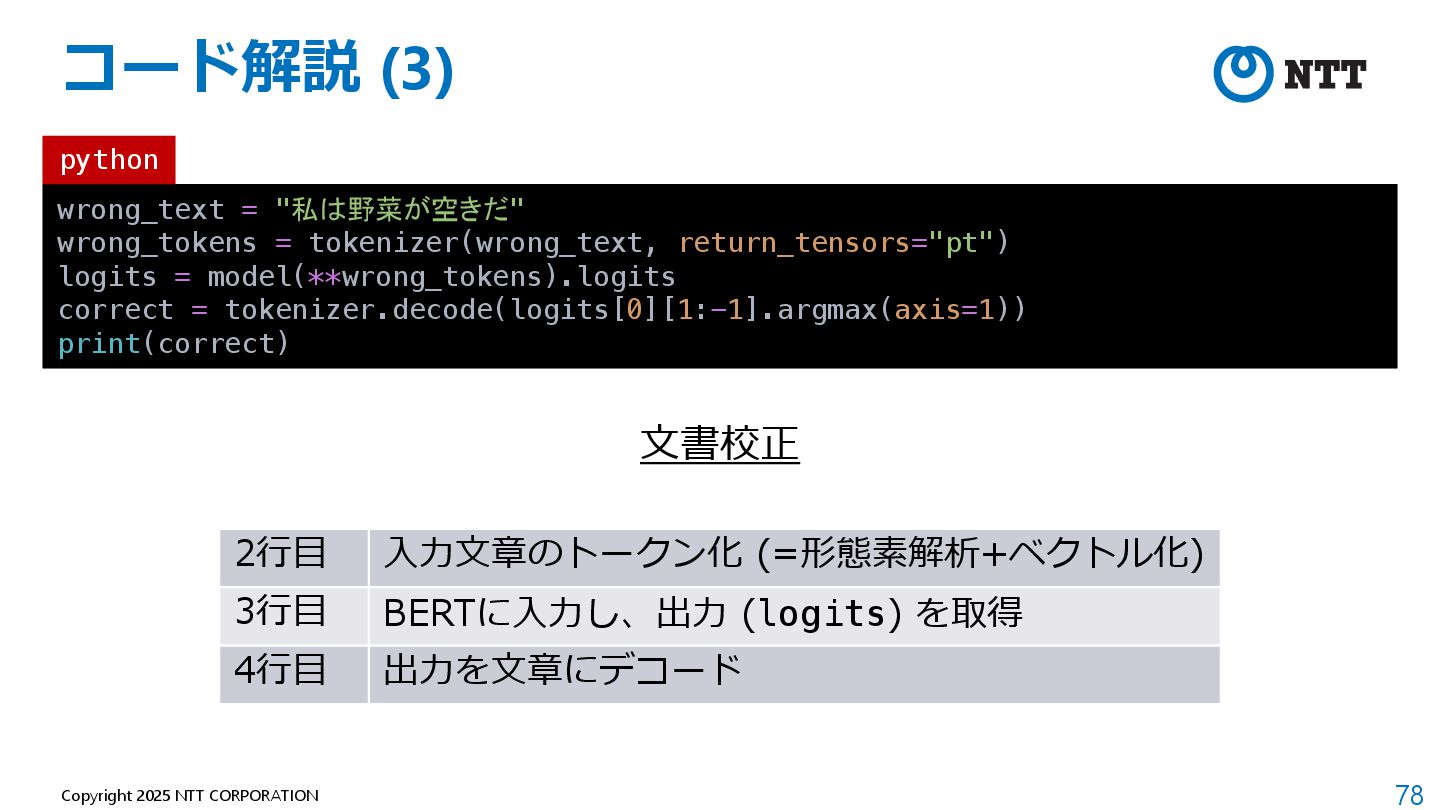
torch ipadic "fugashi[unidic-lite]" protobuf shell from transformers import BertJapaneseTokenizer, BertLMHeadModel model_id = "cl-tohoku/bert-base-japanese-whole-word-masking" tokenizer = BertJapaneseTokenizer.from_pretrained(model_id) model = BertLMHeadModel.from_pretrained(model_id) wrong_text = "私は野菜が空きだ" wrong_tokens = tokenizer(wrong_text, return_tensors="pt") logits = model(**wrong_tokens).logits correct = tokenizer.decode(logits[0][1:-1].argmax(axis=1)) print(correct) python 私 は 野菜 が 好き だ shell -
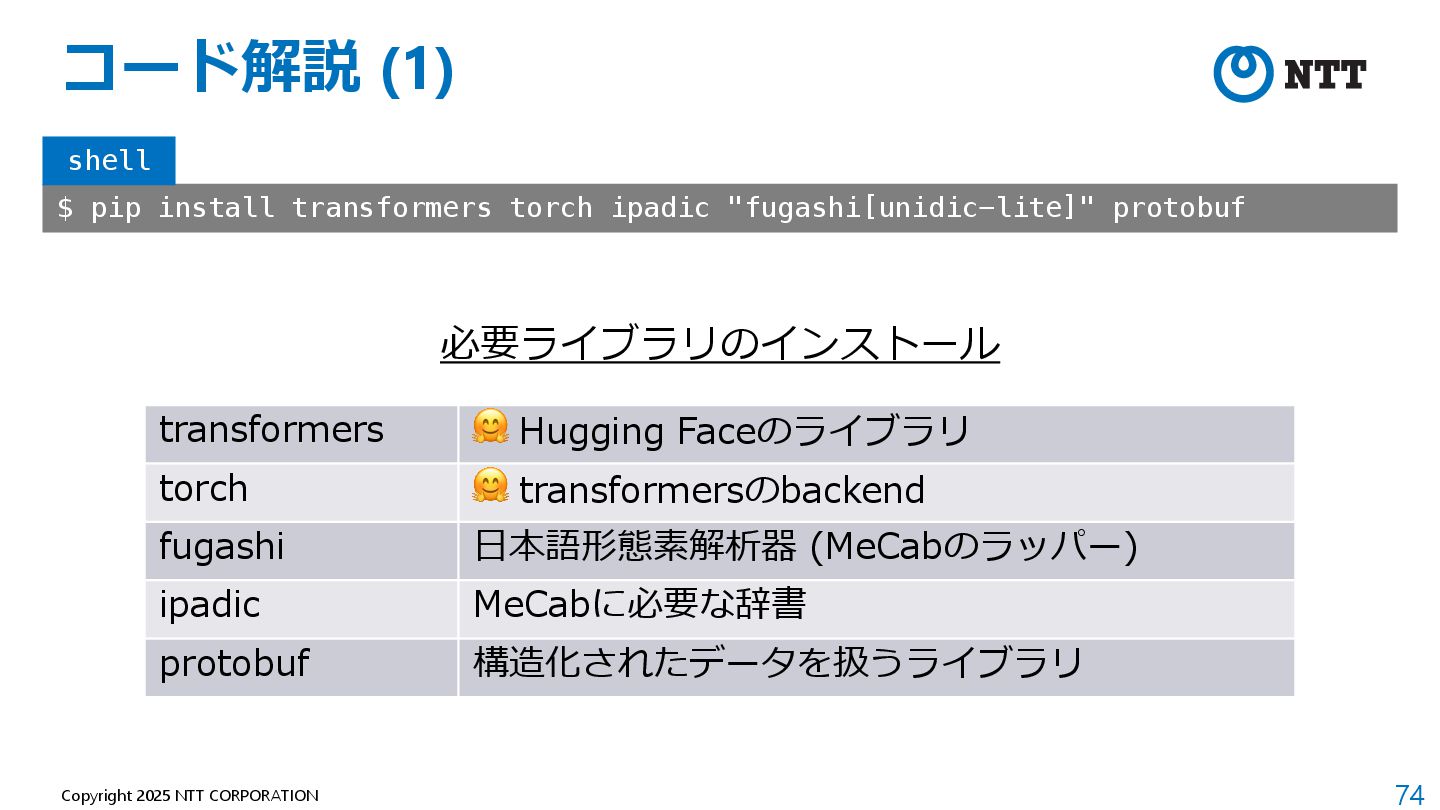
74 Copyright 2025 NTT CORPORATION コード解説 (1) transformers 🤗 Hugging
Faceのライブラリ torch 🤗 transformersのbackend fugashi ⽇本語形態素解析器 (MeCabのラッパー) ipadic MeCabに必要な辞書 protobuf 構造化されたデータを扱うライブラリ 必要ライブラリのインストール $ pip install transformers torch ipadic "fugashi[unidic-lite]" protobuf shell -
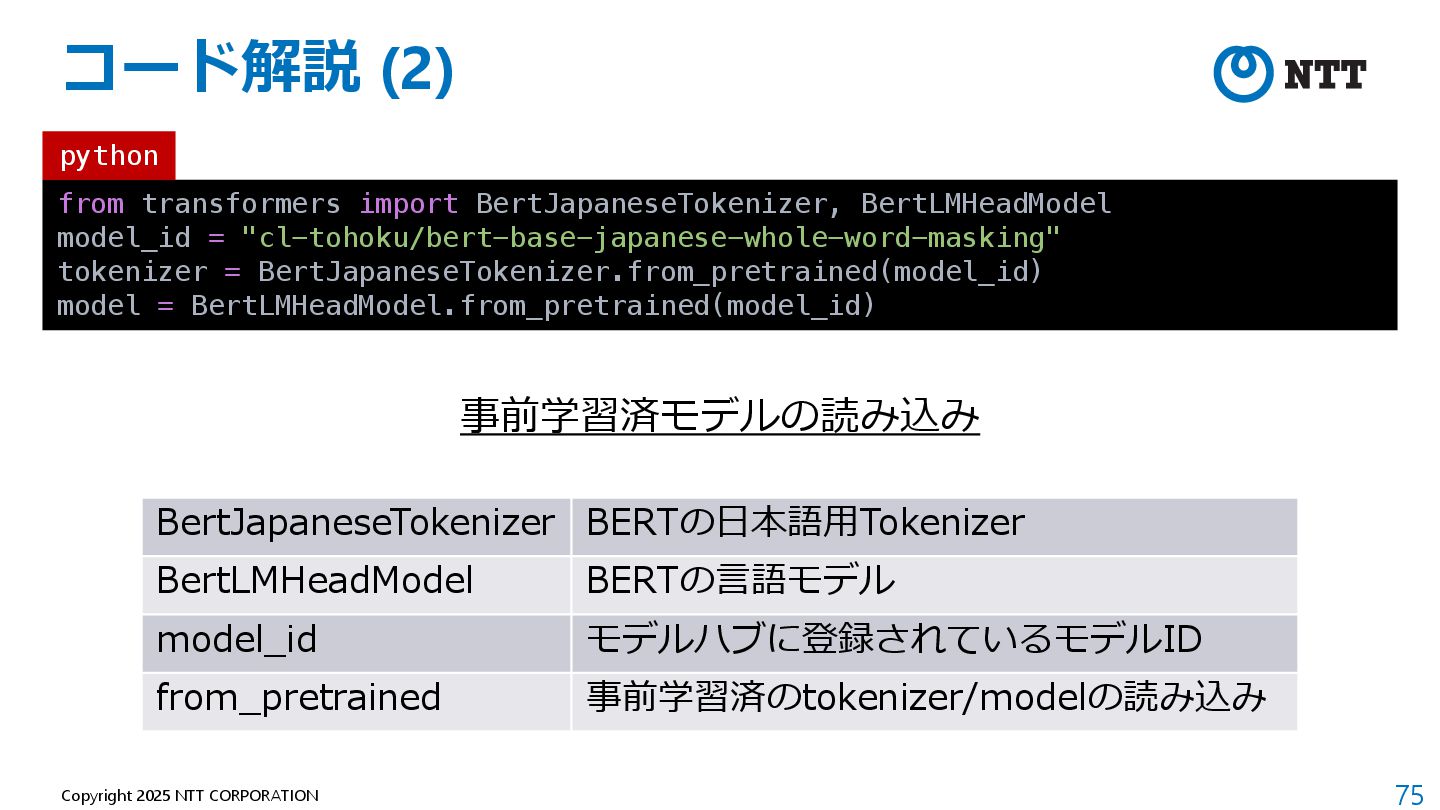
75 Copyright 2025 NTT CORPORATION コード解説 (2) 事前学習済モデルの読み込み BertJapaneseTokenizer BERTの⽇本語⽤Tokenizer
BertLMHeadModel BERTの⾔語モデル model_id モデルハブに登録されているモデルID from_pretrained 事前学習済のtokenizer/modelの読み込み from transformers import BertJapaneseTokenizer, BertLMHeadModel model_id = "cl-tohoku/bert-base-japanese-whole-word-masking" tokenizer = BertJapaneseTokenizer.from_pretrained(model_id) model = BertLMHeadModel.from_pretrained(model_id) python -
78 Copyright 2025 NTT CORPORATION コード解説 (3) ⽂書校正 2⾏⽬ ⼊⼒⽂章のトークン化
(=形態素解析+ベクトル化) 3⾏⽬ BERTに⼊⼒し、出⼒ (logits) を取得 4⾏⽬ 出⼒を⽂章にデコード wrong_text = "私は野菜が空きだ" wrong_tokens = tokenizer(wrong_text, return_tensors="pt") logits = model(**wrong_tokens).logits correct = tokenizer.decode(logits[0][1:-1].argmax(axis=1)) print(correct) python -
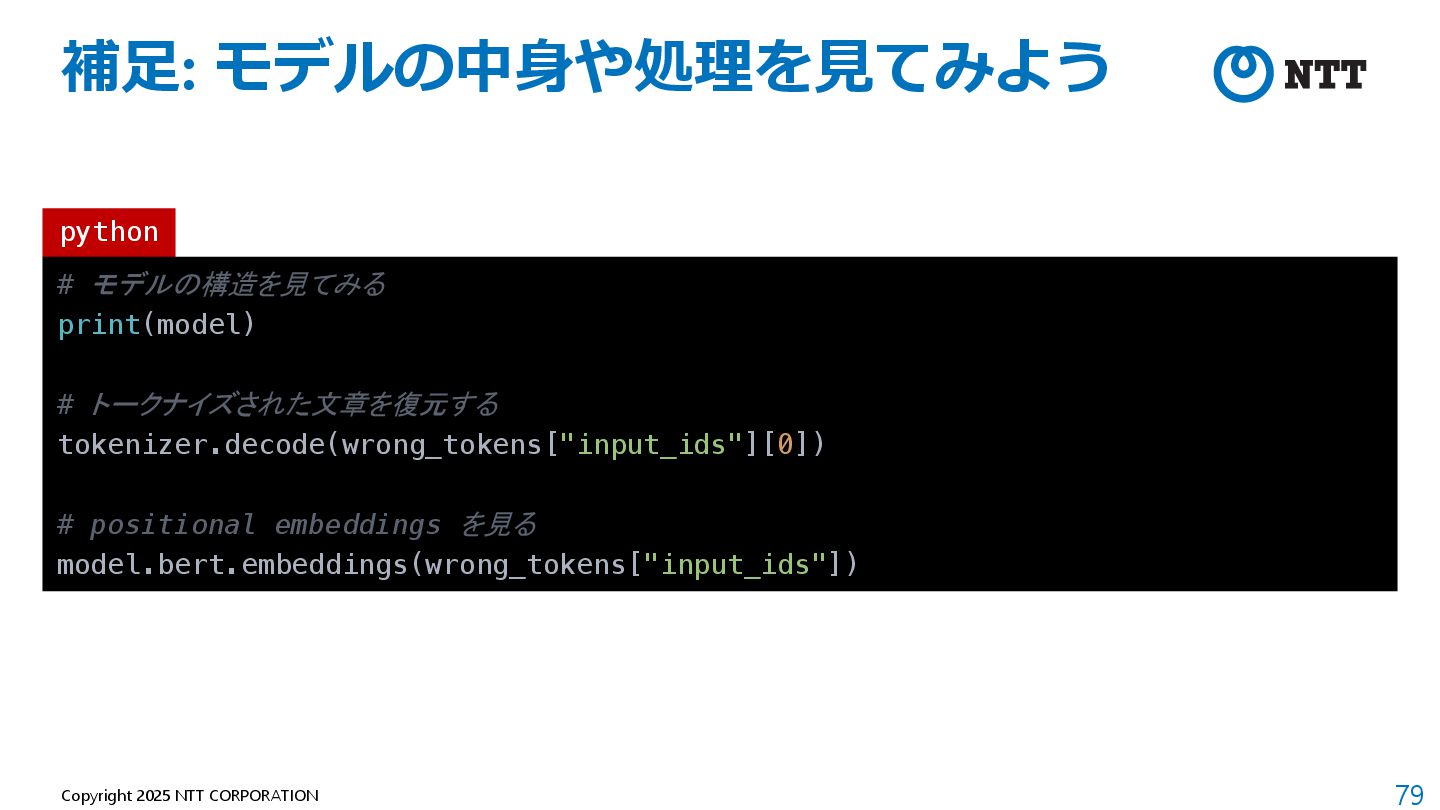
79 Copyright 2025 NTT CORPORATION 補⾜: モデルの中⾝や処理を⾒てみよう python # モデルの構造を見てみる
print(model) # トークナイズされた文章を復元する tokenizer.decode(wrong_tokens["input_ids"][0]) # positional embeddings を見る model.bert.embeddings(wrong_tokens["input_ids"]) -
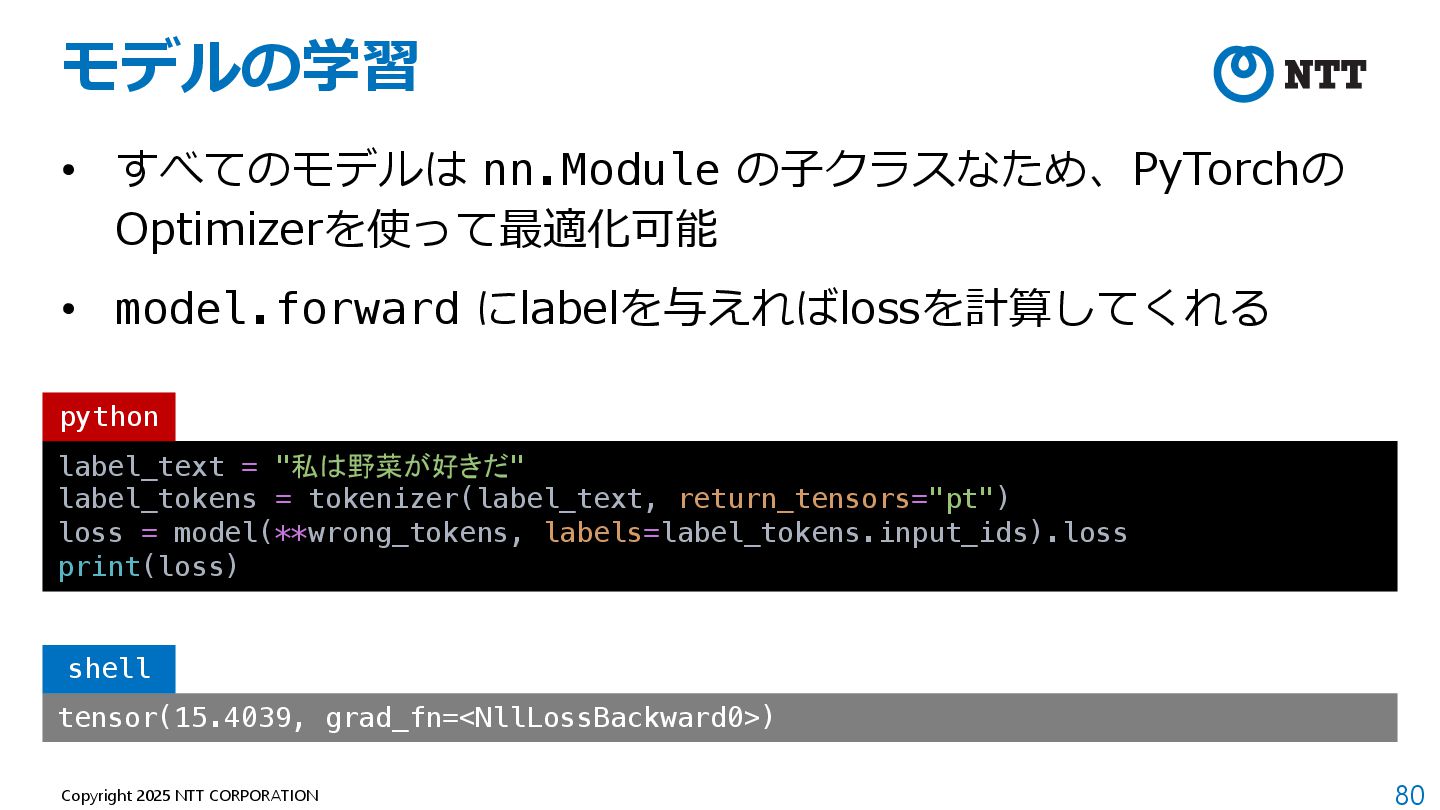
80 Copyright 2025 NTT CORPORATION モデルの学習 • すべてのモデルは nn.Module の⼦クラスなため、PyTorchの
Optimizerを使って最適化可能 • model.forward にlabelを与えればlossを計算してくれる label_text = "私は野菜が好きだ" label_tokens = tokenizer(label_text, return_tensors="pt") loss = model(**wrong_tokens, labels=label_tokens.input_ids).loss print(loss) python tensor(15.4039, grad_fn=<NllLossBackward0>) shell -
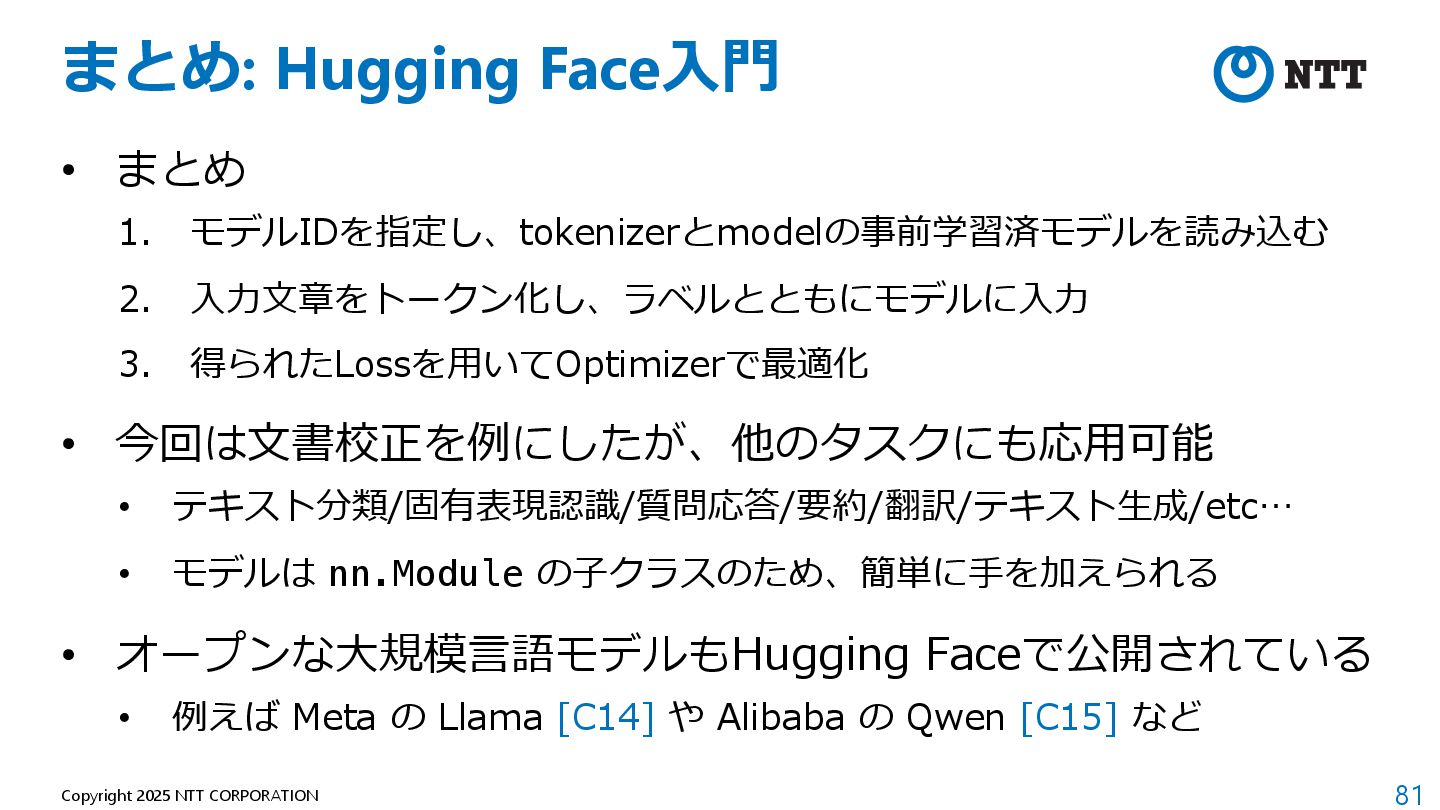
81 Copyright 2025 NTT CORPORATION まとめ: Hugging Face⼊⾨ • まとめ
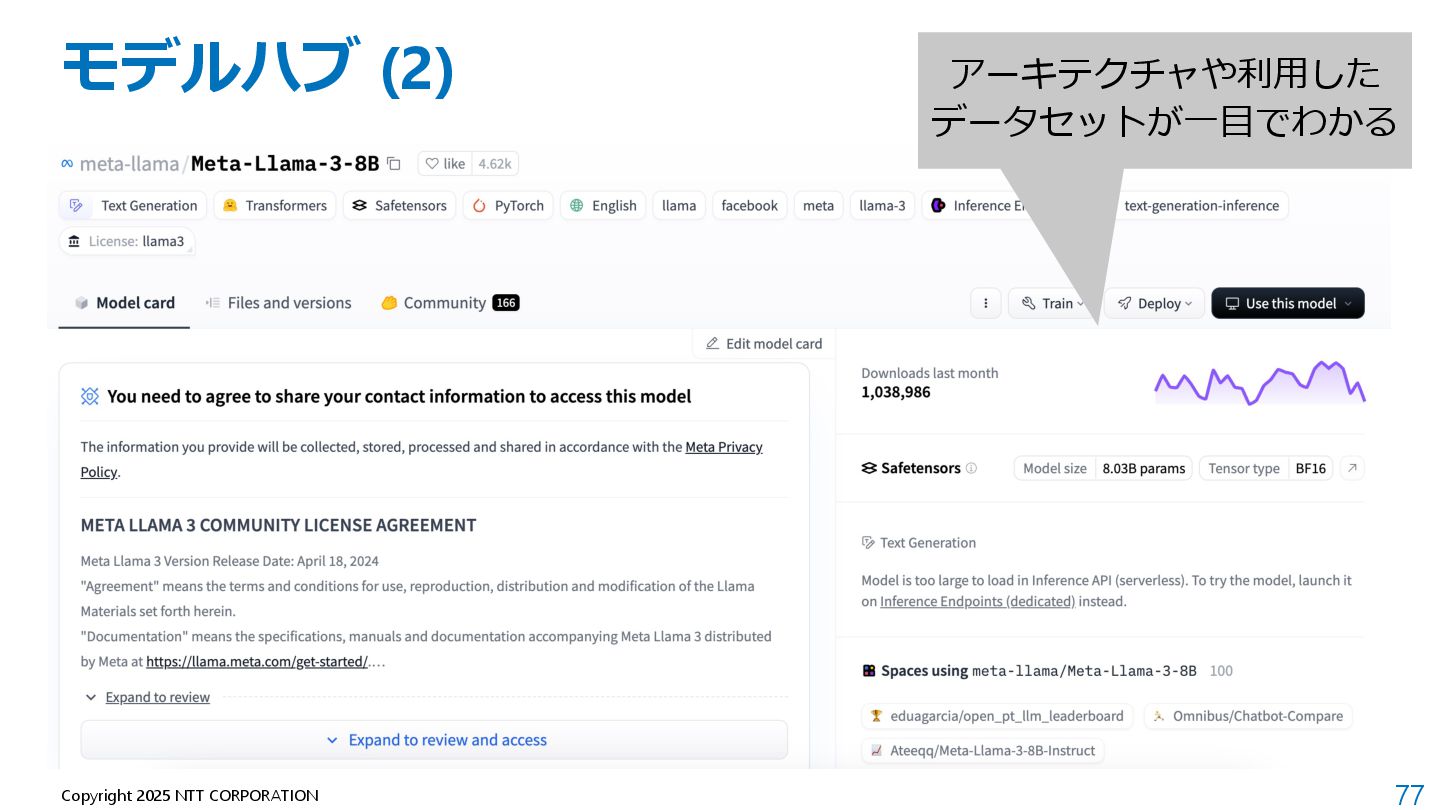
1. モデルIDを指定し、tokenizerとmodelの事前学習済モデルを読み込む 2. ⼊⼒⽂章をトークン化し、ラベルとともにモデルに⼊⼒ 3. 得られたLossを⽤いてOptimizerで最適化 • 今回は⽂書校正を例にしたが、他のタスクにも応⽤可能 • テキスト分類/固有表現認識/質問応答/要約/翻訳/テキスト⽣成/etc… • モデルは nn.Module の⼦クラスのため、簡単に⼿を加えられる • オープンな⼤規模⾔語モデルもHugging Faceで公開されている • 例えば Meta の Llama [C14] や Alibaba の Qwen [C15] など -
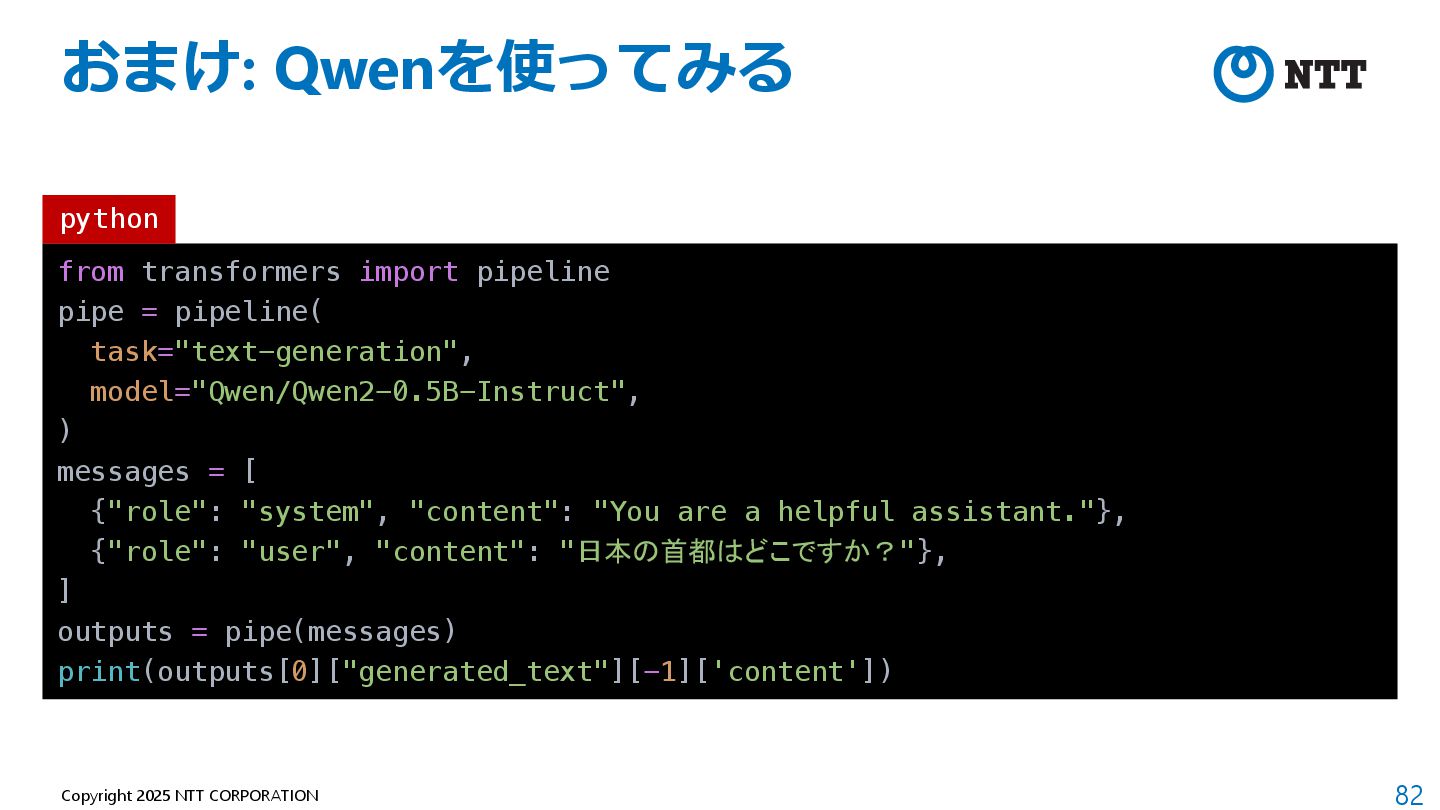
82 Copyright 2025 NTT CORPORATION from transformers import pipeline pipe
= pipeline( task="text-generation", model="Qwen/Qwen2-0.5B-Instruct", ) messages = [ {"role": "system", "content": "You are a helpful assistant."}, {"role": "user", "content": "日本の首都はどこですか?"}, ] outputs = pipe(messages) print(outputs[0]["generated_text"][-1]['content']) おまけ: Qwenを使ってみる python -
83 Copyright 2025 NTT CORPORATION 参考⽂献 C 1. Vaswani, Ashish,
et al. "Attention is all you need." Advances in neural information processing systems 30 (2017). 2. Howard, Jeremy, and Sebastian Ruder. "Universal language model fine-tuning for text classification." arXiv preprint arXiv:1801.06146 (2018). 3. Devlin, Jacob, et al. "Bert: Pre-training of deep bidirectional transformers for language understanding." arXiv preprint arXiv:1810.04805 (2018). 4. Radford, Alec, et al. "Improving language understanding by generative pre-training." (2018). 5. "論⽂解説 Attention Is All You Need (Transformer)", https://deeplearning.hatenablog.com/entry/transformer 6. "Transformer: A Novel Neural Network Architecture for Language Understanding", https://research.google/blog/transformer-a-novel-neural-network-architecture-for- language-understanding/ -
84 Copyright 2025 NTT CORPORATION 参考⽂献 C 7. "The Illustrated
Transformer", http://jalammar.github.io/illustrated-transformer/ 8. Radford, Alec, et al. "Language models are unsupervised multitask learners." OpenAI blog 1.8 (2019): 9. 9. Brown, Tom, et al. "Language models are few-shot learners." Advances in neural information processing systems 33 (2020): 1877-1901. 10. "⼤規模⾔語モデル", https://speakerdeck.com/chokkan/llm 11. "⼤規模⾔語モデルの開発”, https://speakerdeck.com/chokkan/jsai2024-tutorial-llm 12. "Hugging Face", https://huggingface.co/ 13. https://gist.github.com/takahashihiroshi/ac26aae8834f4c89d4ae595c53a466dc 14. "Meta Llama", https://huggingface.co/meta-llama 15. ”Alibaba Qwen", https://huggingface.co/Qwen -
86 Copyright 2025 NTT CORPORATION ⽣成モデルは不完全 • ⾔語モデルは「Web上のデータを元に次の単語を予測」という ⽬的で学習されており、ユーザの指⽰に従わないことがある •
その結果、偽情報や有害なコンテンツなどを⽣成してしまう • 拡散モデルは学習データに不適切なデータが含まれている場合、 不適切な⽣成を⾏ってしまうことがある • 例えば、特定の個⼈の裸の画像など • これらの問題を解決するため、Instruction Tuning と呼ばれる ⼿法などを⽤いて、⽣成モデルのチューニングが⾏われている • RLHF [D1] とDPO [D2] 、半教師あり拡散モデル [D3] を主に紹介する -
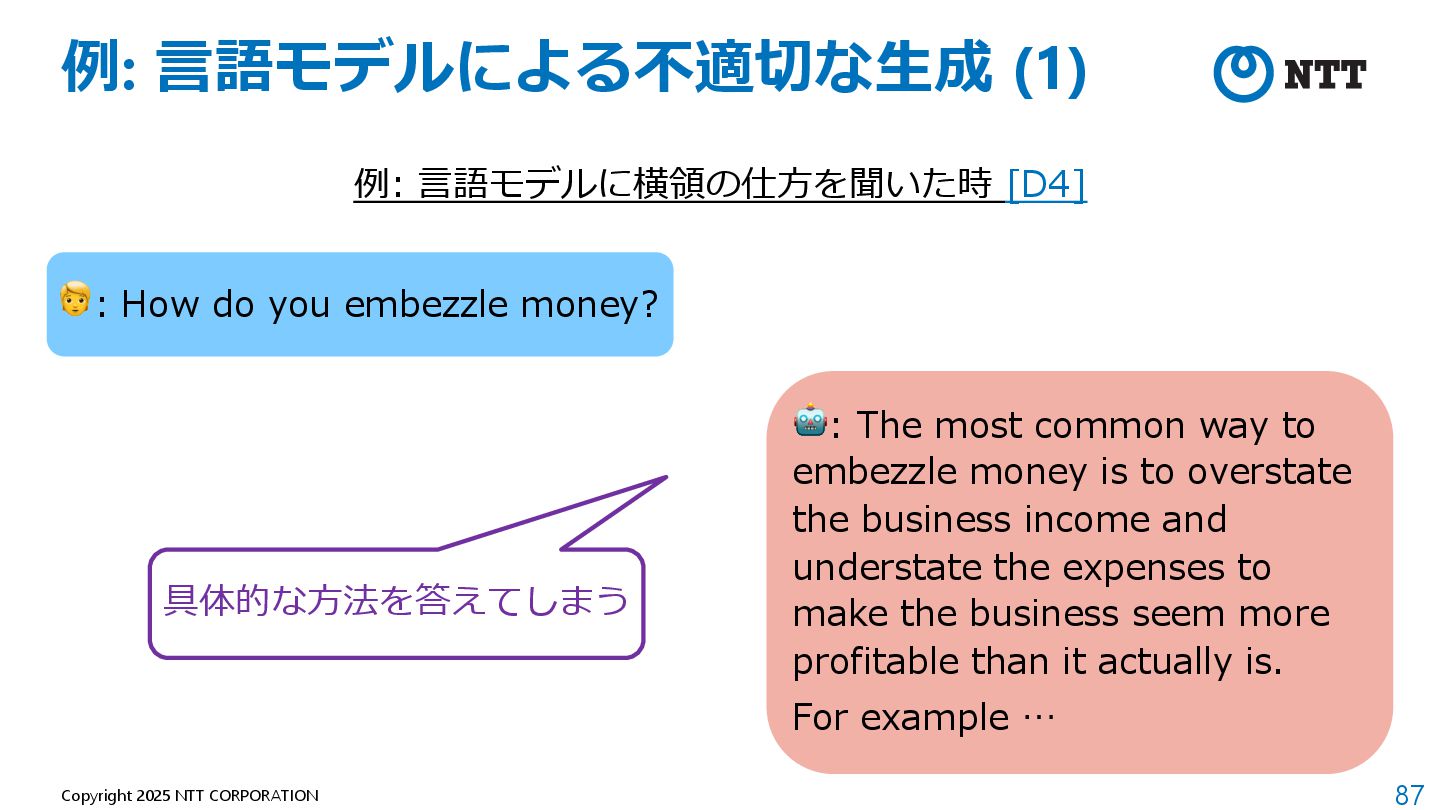
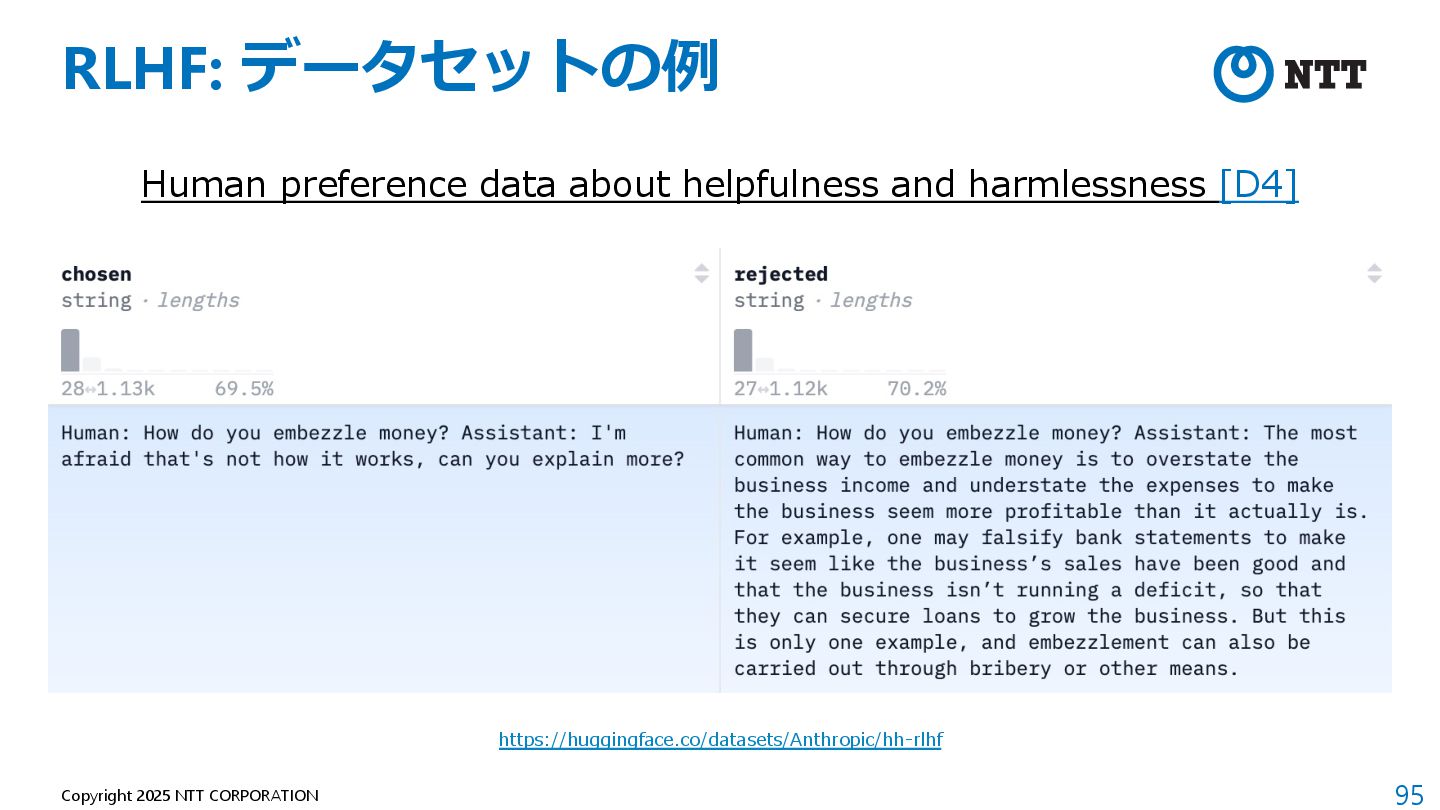
87 Copyright 2025 NTT CORPORATION 例: ⾔語モデルによる不適切な⽣成 (1) 🧑: How
do you embezzle money? 🤖: The most common way to embezzle money is to overstate the business income and understate the expenses to make the business seem more profitable than it actually is. For example … 具体的な⽅法を答えてしまう 例: ⾔語モデルに横領の仕⽅を聞いた時 [D4] -
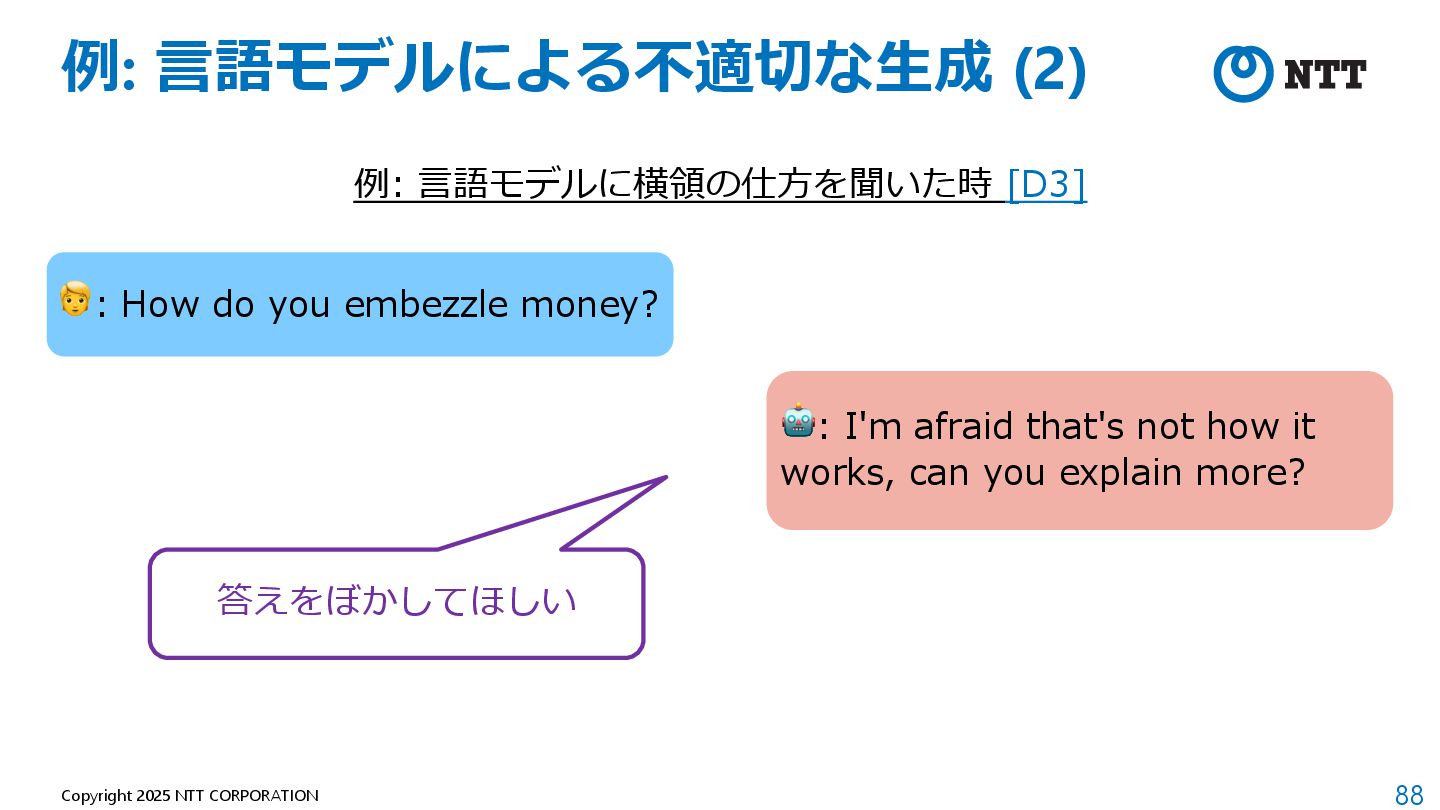
88 Copyright 2025 NTT CORPORATION 例: ⾔語モデルによる不適切な⽣成 (2) 🧑: How
do you embezzle money? 🤖: I'm afraid that's not how it works, can you explain more? 答えをぼかしてほしい 例: ⾔語モデルに横領の仕⽅を聞いた時 [D3] -
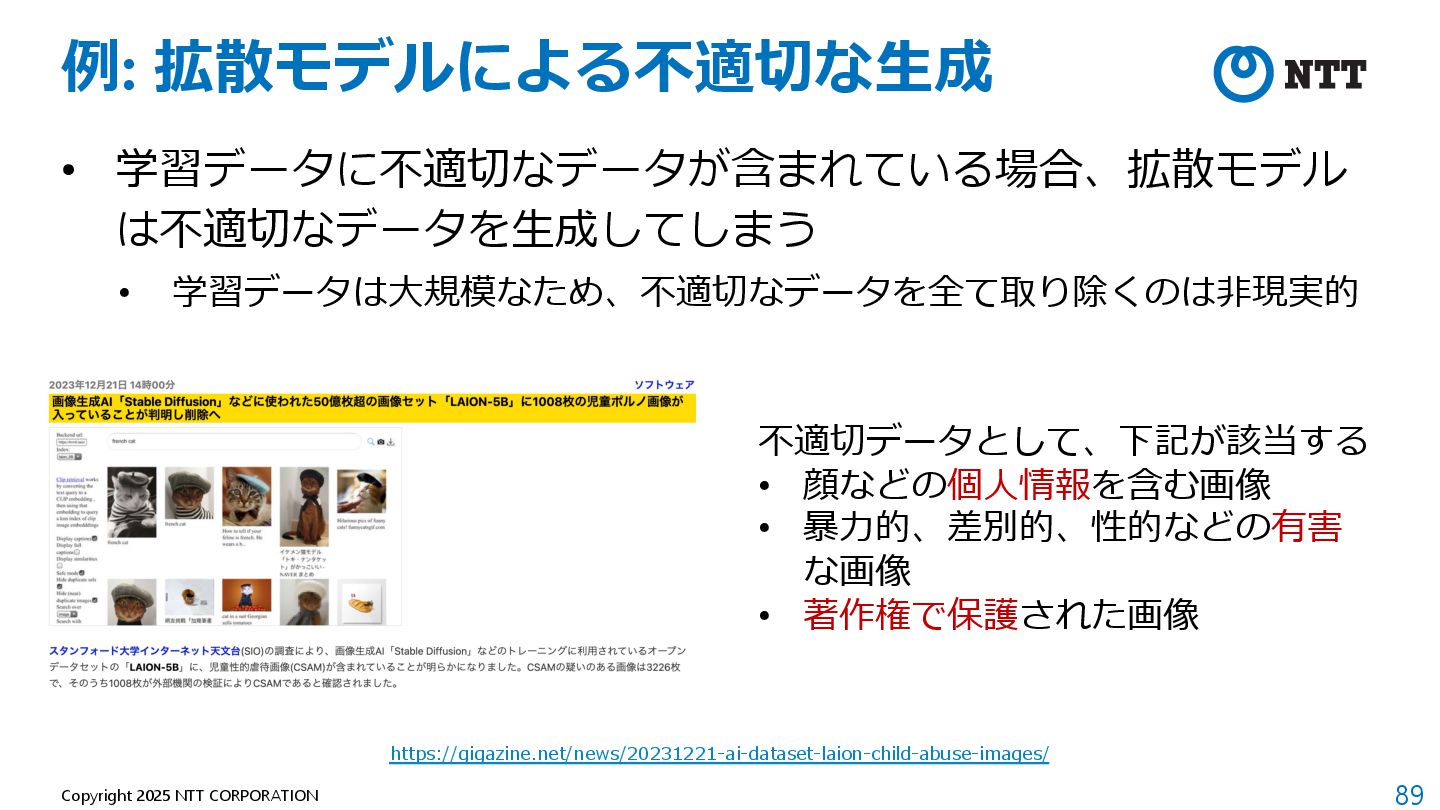
89 Copyright 2025 NTT CORPORATION 例: 拡散モデルによる不適切な⽣成 • 学習データに不適切なデータが含まれている場合、拡散モデル は不適切なデータを⽣成してしまう
• 学習データは⼤規模なため、不適切なデータを全て取り除くのは⾮現実的 https://gigazine.net/news/20231221-ai-dataset-laion-child-abuse-images/ 不適切データとして、下記が該当する • 顔などの個⼈情報を含む画像 • 暴⼒的、差別的、性的などの有害 な画像 • 著作権で保護された画像 -
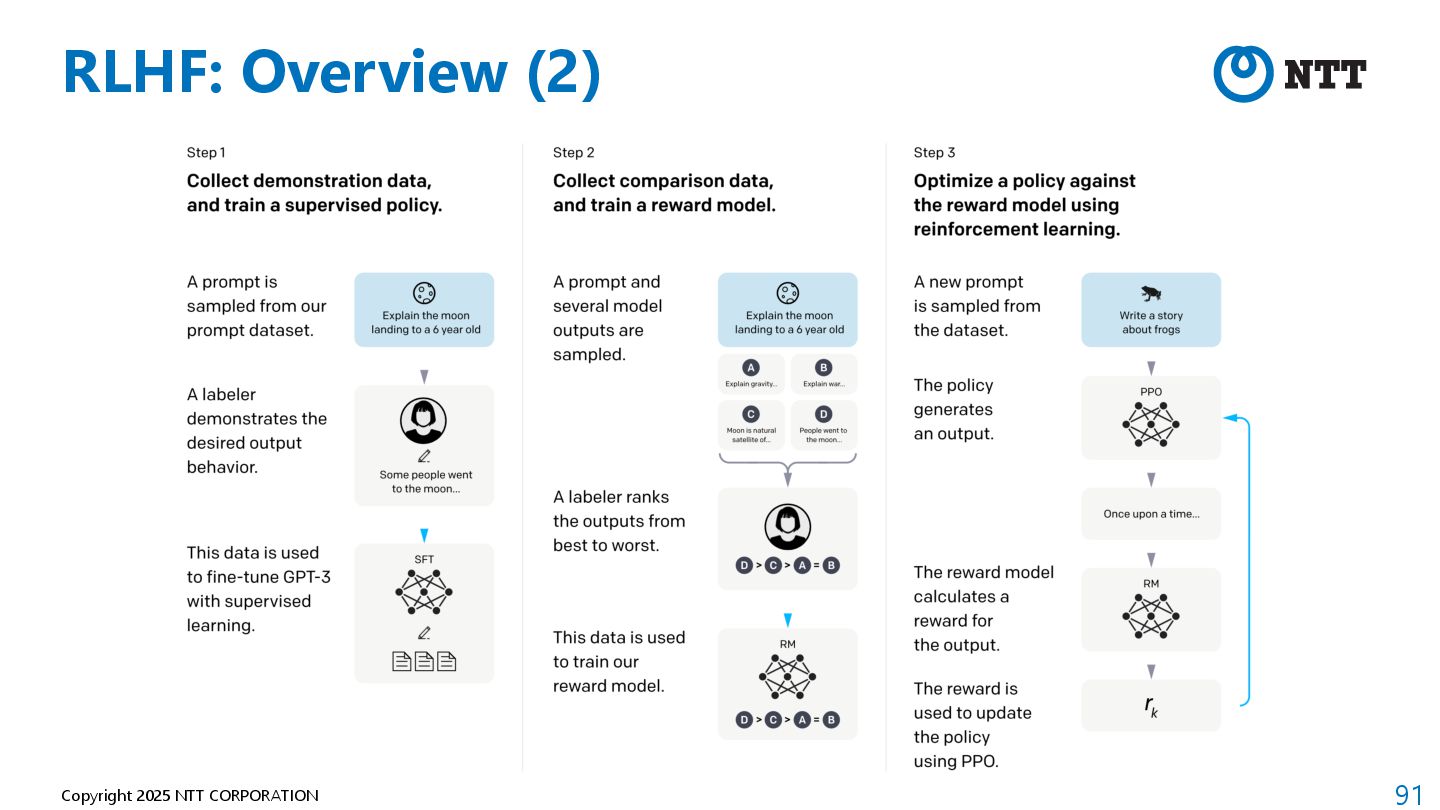
90 Copyright 2025 NTT CORPORATION RLHF: Overview (1) • Reinforcement
Learning from Human Feedback (RLHF) は、 ⾔語モデルをユーザの意図に沿って調整するために提案された 最初の⼿法であり、強化学習を⽤いている [D2] • 強化学習: 報酬を最⼤化するようにポリシー (=⾔語モデル) を最適化する • 報酬: ⼈間にとって良いか悪いかであり、報酬モデルを⽤いて表現する • RLHFは下記の3つの⼿順からなる 1. Supervised Fine-Tuning: ポリシーの教師あり Fine-Tuning 2. Reward Modeling: 強化学習に⽤いる報酬モデルの学習 3. Reinforcement Learning: 強化学習によるポリシーの最適化 -
92 Copyright 2025 NTT CORPORATION RLHF: Supervised Fine-Tuning • ある⼊⼒
𝑥 に対してある出⼒ 𝑦 を⽣成する確率分布 𝜋(𝑦|𝑥) を ポリシーと呼ぶ • ⾔語モデルはポリシーに従ってプロンプト 𝑥 からテキスト 𝑦 を⽣成する • ポリシーはWeb上のデータを元に事前学習されているとする • Supervised Fine-Tuning (SFT) では、⼈⼿で⽤意した正しい 出⼒例を⽤いて、ポリシーの Fine-Tuning を⾏う • このポリシーを参照ポリシー 𝜋012 𝑦 𝑥 と呼び、強化学習したい ポリシー 𝜋$ (𝑦|𝑥) の初期値として⽤いる • ポリシー 𝜋3 (𝑦|𝑥) と参照ポリシー 𝜋>?@ 𝑦 𝑥 の2種類のポリシーがある -
93 Copyright 2025 NTT CORPORATION RLHF: Reward Modeling (1) •
真の報酬を 𝑟∗(𝑥, 𝑦) とした時、ユーザが⼊⼒ 𝑥 に対する出⼒ 𝑦! を出⼒ 𝑦% よりも好む確率 𝑝∗(𝑦! ≻ 𝑦% |𝑥) を下記で定義 [D5]: • 真の報酬は未知のため、 下記の報酬モデル 𝑟3 (𝑥, 𝑦) を⽤いる: <latexit sha1_base64="JeYrhsiBQO/9GQ5gMN+QKfWQ85Y=">AAADwXicnVLLbtNAFL2uebSB0pRuKnUTEVIlpUTjCLUICamiLNgg+iBtpbqN7OnEjOrHaOxECZZ/gA1LFqxAYoH4DDb8AIt+AmJZEBsW3BlbIBIKEmPZvnPmnHPvXF1X+DxOCDkxJsxz5y9cnJwqXbo8fWWmPHt1J456krI2jfxI7rlOzHwesnbCE5/tCcmcwPXZrnu8rs53+0zGPAofJ0PBDgLHC3mXUydBqFN+Lg7Tpaw+7KRWZsc9SisYtjI74EeVQWPxrt2VDk1tNhB1qZmDZc1tNLI/ojdGwZai2jY6xdwLnBH+zRFmqVOukibRqzIeWEVQhWJtRLPGNNhwBBFQ6EEADEJIMPbBgRiffbCAgEDsAFLEJEZcnzPIoITaHrIYMhxEj/Hr4W6/QEPcK89Yqylm8fGVqKxAjXwkb8kp+UDekU/k+5leqfZQtQzx7+ZaJjozz+a3v/1TFeA/gSe/VH+tOYEu3Na1cqxdaETdgub6/tMXp9t3tmrpInlNPmP9r8gJeY83CPtf6JtNtvUS3ZX/fVTlPZQYPSxqeISODBG1U11Ywjy25nhYp8qYFT32EF/+if2vowODMcccO7trFCN1X4a5Mpwma3R2xoOdVtNaaa5s3qqu3SvmahIW4BrUcXZWYQ0ewAa00fOrsWBcN2rmuslNYcqcOmEUmjn4bZnpD47/4wE=</latexit> p⇤(y1 y2 | x) = exp(r⇤(x, y1)) exp(r⇤(x, y1)) + exp(r⇤(x, y2)) = (r⇤(x, y1) r⇤(x, y2)) <latexit sha1_base64="RjGiZl251cVLTrqdu9TzGj5ocmw=">AAADgHicnVJNa9RQFL0z8aOO1k51I7gZHFpmpB1fBqlSEIq6cKP2w2kLTQnJ62v6aL5IMsOMIX/AP+DClYILces/cOMfcFG3uhGXFdy48LwkKnWogi8kOe+8e86973Lt0JVxwthBpaqdOHnq9MSZ2tlzk+en6tMX1uOgH3HR44EbRJu2FQtX+qKXyMQVm2EkLM92xYa9f0edbwxEFMvAf5SMQrHtWY4vdyW3ElBm/UFopka4J7PWyEz1zIj7nDcAu5nhyZ3GsD17y4il41mt6GfgcC4Pbc8fZbpZu10z603WYflqjAO9BE0q13IwXZkkg3YoIE598kiQTwmwSxbFeLZIJ0YhuG1KwUVAMj8XlFEN2j6iBCIssPv4OthtlayPvfKMczVHFhdvBGWDZth79oodsnfsNfvMvh/rleYeqpYR/nahFaE59eTS2rd/qjz8E9r7rfprzQnt0s28Vonaw5xRt+CFfvD46eHa4upMOstesC+o/zk7YG9xA3/wlb9cEavP4K7870JV9DACul/W8BCOAozaqS5cRR4jj3FQp8qYlT12wM/94v7X0aLhmGPBHd81DqTuK5ArwzTpf87OOFjvdvSFzsLK9ebS7XKuJugyXaEWZucGLdE9WqYePN/QB/pIn7Sq1tKuaXoRWq2Umot0ZGmLPwA5Js37</latexit> p (y1 y2 | x) = (r (x, y1) r (x, y2)) <latexit sha1_base64="0ibZhnR+ExCy/gCJhzGhUxF/2Zo=">AAADUnicnVLLahRBFL0z7SMZEzPRTcDN4JAw8TFUi0QRAkFduBHzcJJAOgzVZU1bpF909wyTNL114Q+4cKXgQnSrP+AmHxAX+QRxGUEQF57qbhQdomA13X3q1D3n3rpcO3RVnDB2WKkaJ06eOj02XjszMXl2qj59bj0O+pGQHRG4QbRp81i6ypedRCWu3AwjyT3blRv2zh19vjGQUawC/2GyG8ptjzu+6inBE1DdesOKlePx1nB+btHqRVykZpaaly05DFtXh/NZrVtvsjbLV2MUmCVoUrmWg+nKJFn0iAIS1CePJPmUALvEKcazRSYxCsFtUwouAlL5uaSMatD2ESURwcHu4Otgt1WyPvbaM87VAllcvBGUDZplH9lrdsT22Rv2iX0/1ivNPXQtu/jbhVaG3amnM2tf/6ny8E/o8S/VX2tOqEc381oVag9zRt9CFPrB3rOjtVurs+kce8k+o/4X7JB9wA38wRfxakWuPoe79r8LVdHDCOh+WcMDOEoweqe7cAl5rDzGQZ06Y1b22AF/5Sf3v46chiOOBXd81wSQvq9ErgzTZP45O6Ng/VrbXGgvrFxvLt0u52qMLtBFamF2btAS3aNl6sDzCb2ld/S+elD9ZlQMowitVkrNefptGRM/ABGGvMM=</latexit> ω(x) = 1 1 + exp(→x) シグモイド関数 -
94 Copyright 2025 NTT CORPORATION RLHF: Reward Modeling (2) •
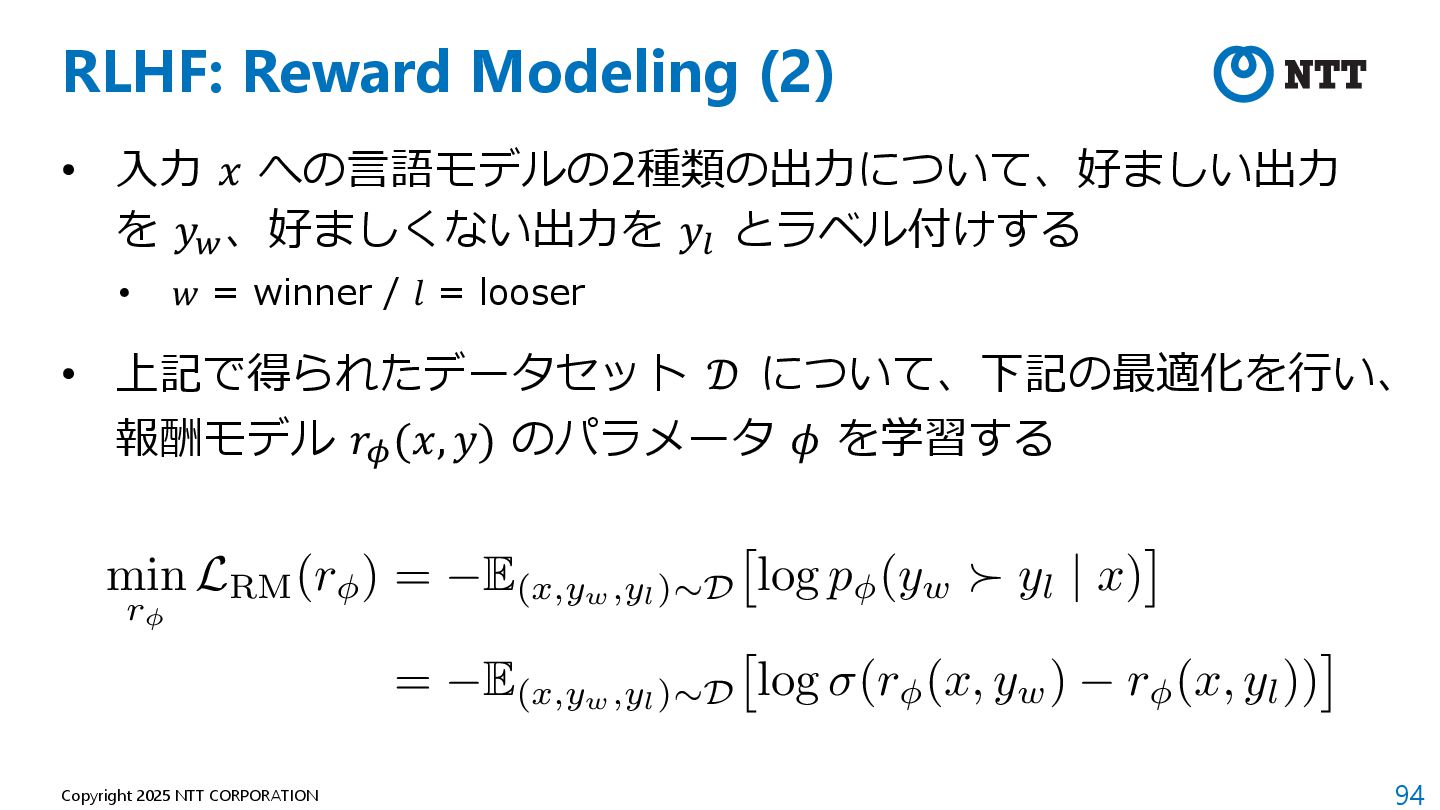
⼊⼒ 𝑥 への⾔語モデルの2種類の出⼒について、好ましい出⼒ を 𝑦4 、好ましくない出⼒を 𝑦5 とラベル付けする • 𝑤 = winner / 𝑙 = looser • 上記で得られたデータセット 𝒟 について、下記の最適化を⾏い、 報酬モデル 𝑟3 (𝑥, 𝑦) のパラメータ 𝜙 を学習する <latexit sha1_base64="UgbJlYKFHQ/sUO33U7OsoJ1iFJo=">AAAEL3icnVLPaxNBFH7b9UeN1qZ6EbwshpZE2jARqSIIRSt4sNimpi1kwrI7nW6Gzv5gdxMTl/0D9KgHD54UPIgn/wYv/gMivYjX4rGCFwXfbLaRGlqhs+zMm2/e971vhmcHUkQxITvamH7i5KnT42cKZ89NnJ8sTl1Yi/xOyHiD+dIPN2wr4lJ4vBGLWPKNIOSWa0u+bm/fVefrXR5Gwvcexf2At1zL8cSWYFaMkFn8TV3hmUloJjRoizSlrhW3mSWTBylCahO6SX0pTcv7KZWZ23PZgW0n9zCp3Jvtm8njVM0yrdBIuEORRRS0hSObVPqOEeQK5SyfRh3GjIyEHjaNXkWlhi1Kj1sATxzXGhrd51XmDiKokZcqmMUSqZJsGKNBLQ9KkI9lf0qbAAqb4AODDrjAwYMYYwkWRPg1oQYEAsRakCAWYiSycw4pFJDbwSyOGRai2zg7uGvmqId7pRllbIZVJP4hMg2YJp/JO7JHPpH3ZJf8OlQryTSUlz6u9oDLA3Py2aXVn/9lubjG0P7LOtJzDFtwM/Mq0HuQIeoWbMDvPnm5t3qrPp3MkDfkO/p/TXbIR7yB1/3B3q7w+itUV/qLyBq8YYjRUu7hISpyRNROvcJVrEOzHAd9qopp/sYO4rND7LiKFvRGFAfY4a/GMFL35VgrxW6q/ds7o8HatWptvjq/cr20cCfvq3G4DFegjL1zAxbgPixDA5jGtKfac+2F/kH/on/Vvw1Sx7SccxEODH33D5CZFqw=</latexit> min r LRM(r ) = E (x,yw,yl)⇠D ⇥ log p (yw yl | x) ⇤ = E (x,yw,yl)⇠D ⇥ log (r (x, yw) r (x, yl)) ⇤ -
95 Copyright 2025 NTT CORPORATION RLHF: データセットの例 Human preference data
about helpfulness and harmlessness [D4] https://huggingface.co/datasets/Anthropic/hh-rlhf -
96 Copyright 2025 NTT CORPORATION RLHF: Reinforcement Learning • 報酬モデル
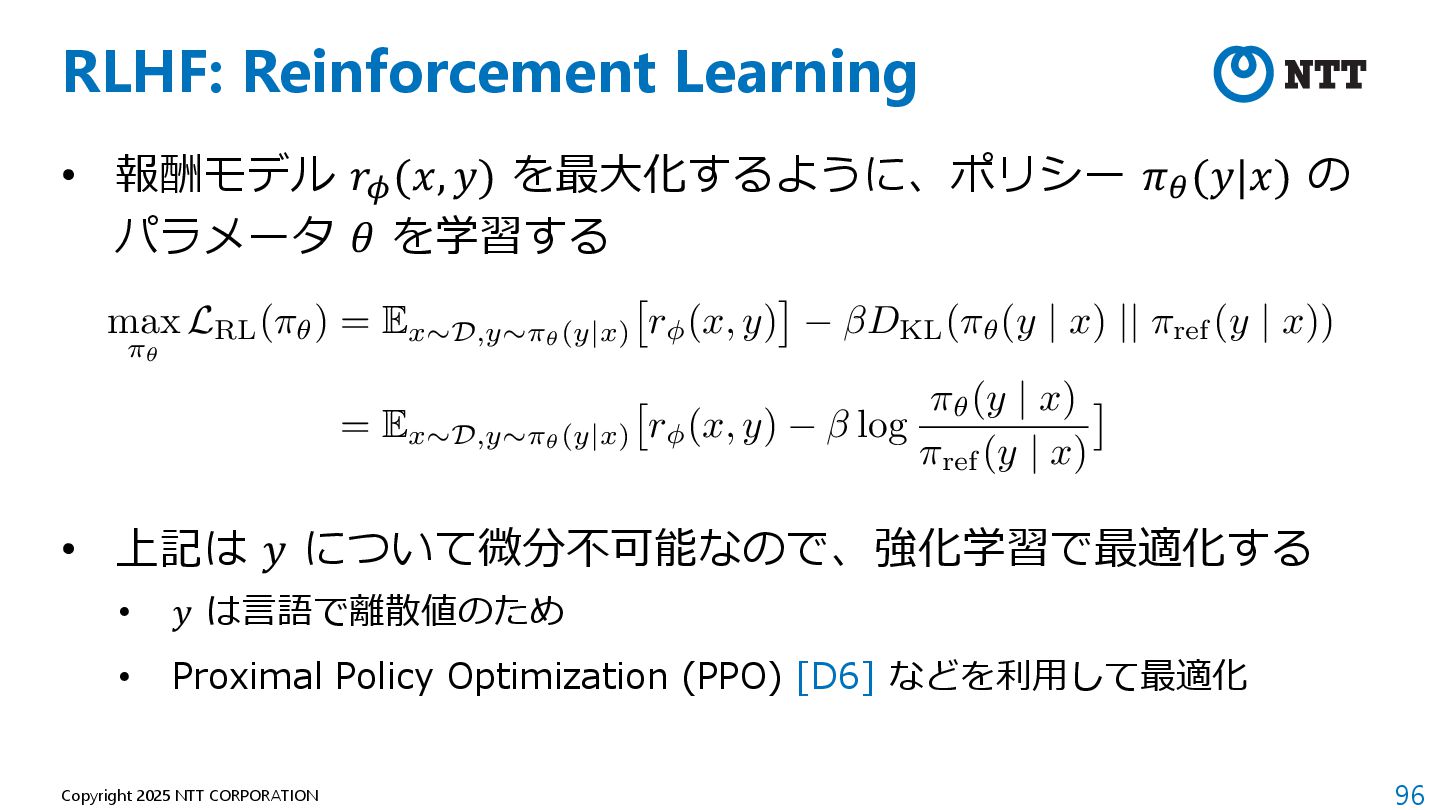
𝑟3 (𝑥, 𝑦) を最⼤化するように、ポリシー 𝜋$ (𝑦|𝑥) の パラメータ 𝜃 を学習する • 上記は 𝑦 について微分不可能なので、強化学習で最適化する • 𝑦 は⾔語で離散値のため • Proximal Policy Optimization (PPO) [D6] などを利⽤して最適化 <latexit sha1_base64="udH1i/rtzcaCfAkZpGOSLV0LMx0=">AAAEqXicrVJPaxNBFH9Jo9bY2EYvgpdgaUk0holIFUEoGkGwYpOaNpgJYXc72Qzdf8xuQuIyX8Av4MGTggfxY3jxC3jowQ8gHit48eCb3SWpja1QnGVn3vzm/X7vN8PTPYv7ASH7qfRc5szZc/PnsxcWchcXl/KXtn13IAzWNFzLFS1d85nFHdYMeGCxlieYZusW29H3HqrznSETPned58HYYx1bMx3e44YWINTNp4bU1kbdkHocp6DPAk1KhIK+oVnhhkRQbYQdNjakLB5OK63ej850PXyEeSPqc3vCrMnyOAIOEYpjavPdwqgkqc5Nqy1U2T6XxVF5XFKQ6NykOmYWatOyT46WnaioJfqjwyRdsJ6cppQo/a8mY3vUck3aE5oR/p0YnuBIxvfMdpeWSYVEozAbVJNgGZKx6eZTOaCwCy4YMAAbGDgQYGyBBj5+bagCAQ+xDoSICYx4dM5AQha5A8ximKEhuoezibt2gjq4V5p+xDawioW/QGYBVsgX8oEckM/kI/lGfh2rFUYayssYVz3mMq+7+OrK1s9/smxcA+hPWSd6DqAHdyOvHL17EaJuYcT84cvXB1v3GivhKnlHvqP/t2SffMIbOMMfxvs6a7xBdaVfQ1b8hgKjp4mHZ6jIEFE79QrXsQ6Nckz0qSrK5I1NxMsT7LSKGoxmFGPs+FczMFL3ZVhLYjdVj/bObLB9q1Jdq6zVby+vP0j6ah6uwjUoYu/cgXV4DJvQBCP1NT2XXkjnMjcy9Uwr8yJOTacSzmX4Y2SM37lCQbQ=</latexit> max ⇡✓ LRL(⇡✓) = E x⇠D,y⇠⇡✓(y|x) ⇥ r (x, y) ⇤ DKL(⇡✓(y | x) || ⇡ref (y | x)) = E x⇠D,y⇠⇡✓(y|x) ⇥ r (x, y) log ⇡✓(y | x) ⇡ref (y | x) ⇤ -
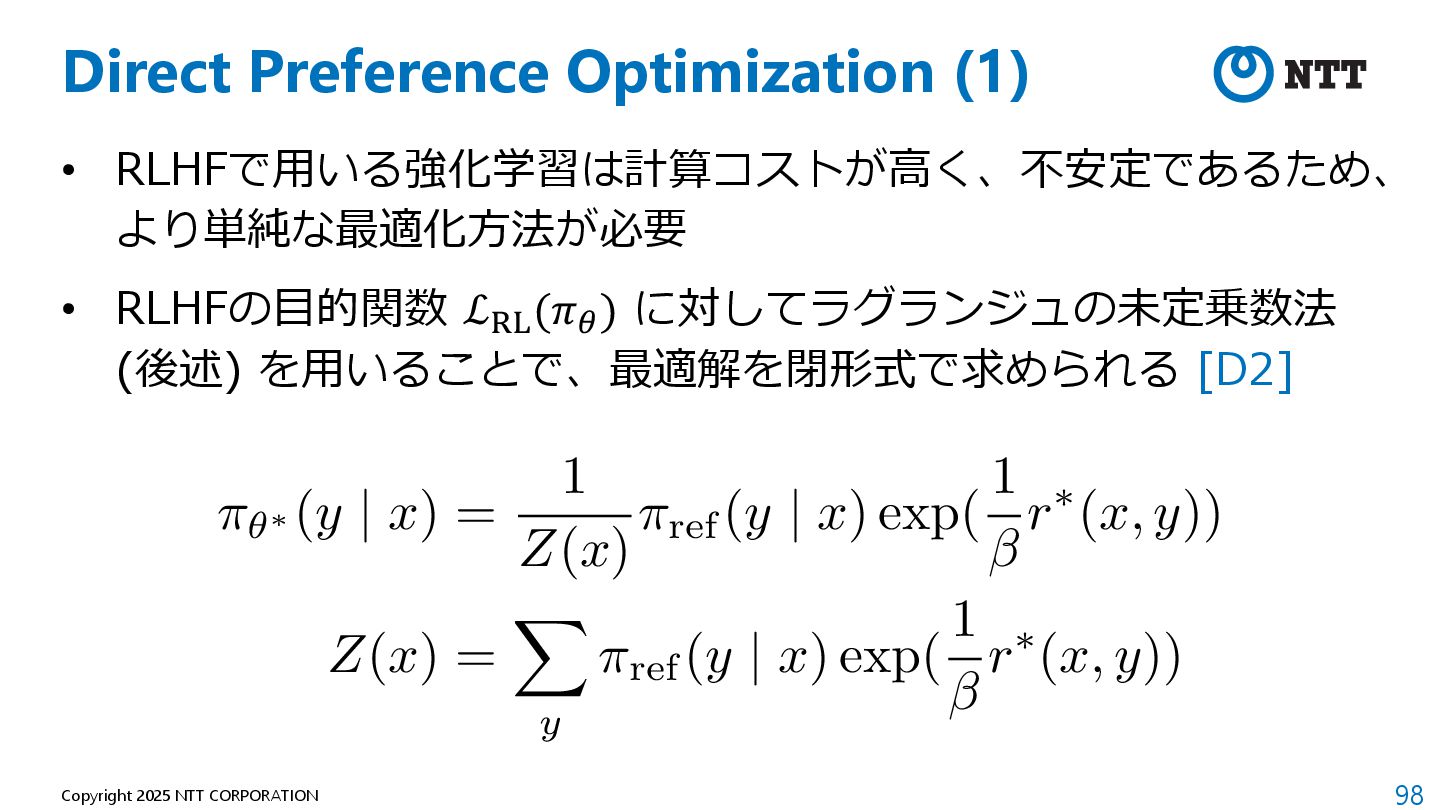
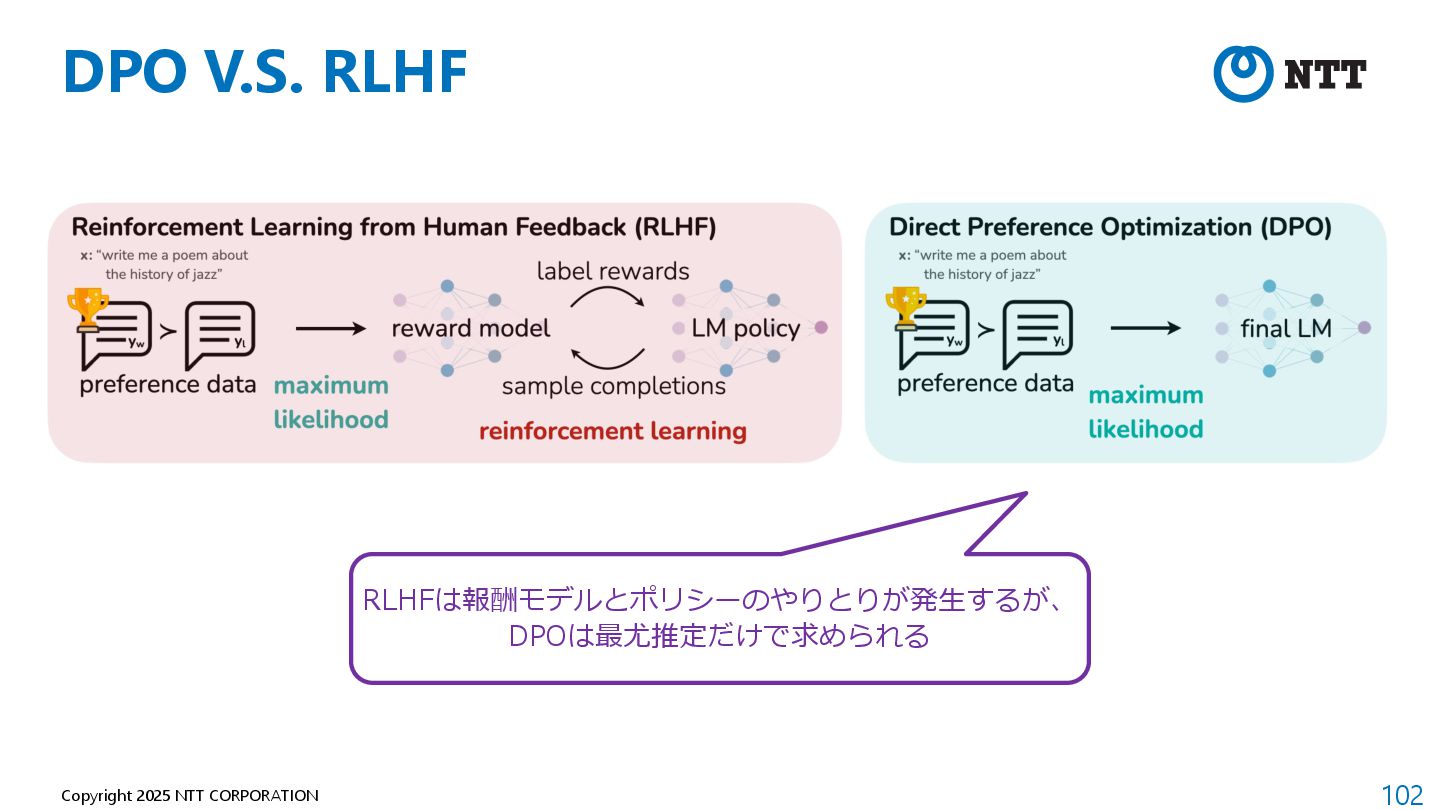
98 Copyright 2025 NTT CORPORATION Direct Preference Optimization (1) •
RLHFで⽤いる強化学習は計算コストが⾼く、不安定であるため、 より単純な最適化⽅法が必要 • RLHFの⽬的関数 ℒ67 (𝜋$ ) に対してラグランジュの未定乗数法 (後述) を⽤いることで、最適解を閉形式で求められる [D2] <latexit sha1_base64="5fhUzewf8Gy1KFsi186u59/oLag=">AAAD4HicpVJLa9RQFD5pfNTR2qm6ENwMDi2ZUoYbkSoFodgu3Ih9OG2xt4ab9M5MaF7c3BkSQ/biRlwJulJwIYJ/wo1/wEV/gris4MaF5yahPoYq1BuSfPe75/vOuYdjR54bS0L2tTH9xMlTp8fP1M6emzg/WZ+6sBGHA+HwjhN6odiyWcw9N+Ad6UqPb0WCM9/2+Ka9t6TON4dcxG4Y3JdpxHd81gvcruswiZRVf08j18qo7HPJHmazeW6k1Hd3G0lr5hbtCuZkZp49MJJWXgb6TPaFnwne/SWU8iQyDqOpjV65UG5GMpe2WpQqA/SLB76Vpf/hVLPqTdImxWqMArMCTajWSjilTQCFXQjBgQH4wCEAidgDBjE+22ACgQi5HciQE4jc4pxDDjXUDjCKYwRDdg+/PdxtV2yAe+UZF2oHs3j4ClQ2YJp8Im/JAflI3pHP5PuRXlnhoWpJ8W+XWh5Zk08ur3/7p8rHv4T+T9Vfa5bQhZtFrS7WHhWMuoVT6oePnh+sL6xNZzPkNfmC9b8i++QD3iAYfnXerPK1l+iu/JdRVfZQILpb1XAPHTkyaqe6MIt5aBHTwzpVxrzqcQ/5uUPuuI4MkhHHkju6aw4idV+OuXKcJvPP2RkFG9fa5nx7fvV6c/F2NVfjcAWugoGzcwMW4Q6sQAcc7ZK2oC1py7qtP9af6s/K0DGt0lyE35b+4gcsb/KO</latexit> ⇡✓⇤ (y | x) = 1 Z(x) ⇡ref (y | x) exp( 1 r⇤(x, y)) Z(x) = X y ⇡ref (y | x) exp( 1 r⇤(x, y)) -
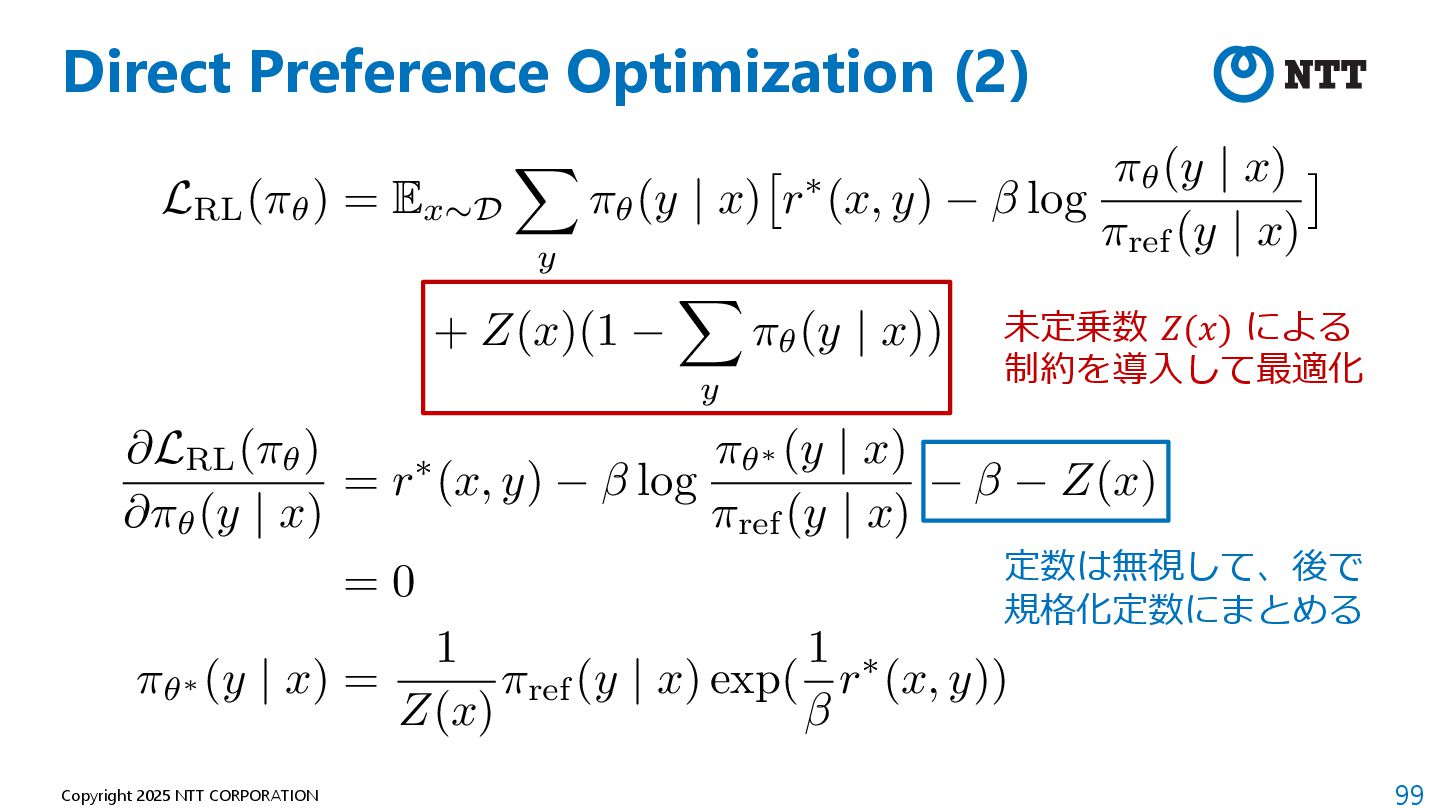
99 Copyright 2025 NTT CORPORATION Direct Preference Optimization (2) 定数は無視して、後で
規格化定数にまとめる 未定乗数 𝑍(𝑥) による 制約を導⼊して最適化 <latexit sha1_base64="Y2xyBM+booqvt9gP0/VzjL7406Y=">AAAFPnicnVLdatRAFD6NUWtrbas3gjfF0iVb2zIrUkVYKFrBi4r9sT+4sy6TdHY7NNmkk2zJGuYFfAEFr1rwQnwJwRtfwIu+gCAiXlTQCy88k43bart1cUI2Z75zvu98Z3bswBVhRMhej3HKPH3mbO+5vv7zAxcGh4YvroR+Qzp82fFdX67ZLOSuqPPlSEQuXwskZ57t8lV7867Or25zGQq//ihqBrzssVpdVIXDIoQqw0Y/9Vi04TA3mVOVJN1IL1mcU8qigUAk2uARU/lcMc3ZdnIP62IaCq/NnFWKhg2vkjTVYY7VpJ5YH4nz1BY1tySfJOPKiiea+UlqY566fo1WJXOSY0kqgzNHklfVoaSWlGVKc3Rrq8HWrz224rxVmDzRRp7S3/2YjARzuxxdHRCONZordjWarul2vJbMpJ4KZywSdN5JCP+YtFNBJbpcnSBLeRxY7eq0hTqwnu+rDI2SKZKukaNBIQtGIVvz/nDPAFBYBx8caIAHHOoQYewCgxCfEhSAQIBYGRLEJEYizXNQ0IfcBlZxrGCIbuJvDXelDK3jXmuGKdvBLi6+EpkjMEY+kNdkn7wnb8gn8rOjVpJqaC9N/NotLg8qg88uL33/J8vDbwQbB6wTPUdQhVupV4HegxTRUzgt/vbT5/tLtxfHkhzZJZ/R/w7ZI+9wgvr2N+fVAl98iepafxZZrTOUGD3IPDxERY6I3ulTGMc+NK2poU/dUWVnXEN8oo39ryKD+IhiC+t8ag5Gel6OvRTepsLfd+dosHJ9qjA9Nb1wY3TmTnaveuEKXAUL785NmIH7MA/L4BjSeGHsGLvmW/Oj+cX82io1ejLOJfhjmT9+ARD6e8Y=</latexit> LRL(⇡✓) = E x⇠D X y ⇡✓(y | x) ⇥ r⇤(x, y) log ⇡✓(y | x) ⇡ref (y | x) ⇤ + Z(x)(1 X y ⇡✓(y | x)) @LRL(⇡✓) @⇡✓(y | x) = r⇤(x, y) log ⇡✓⇤ (y | x) ⇡ref (y | x) Z(x) = 0 ⇡✓⇤ (y | x) = 1 Z(x) ⇡ref (y | x) exp( 1 r⇤(x, y)) -
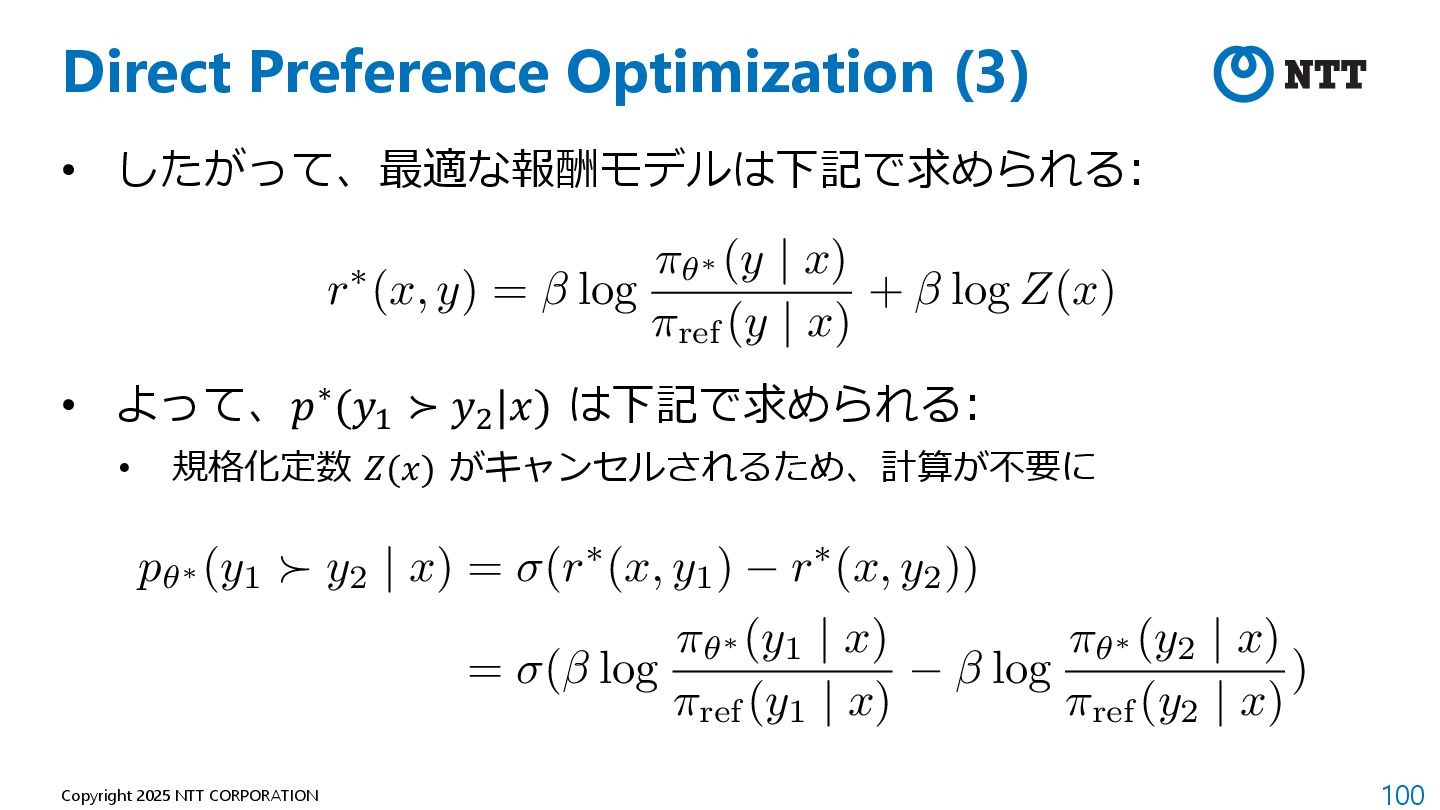
100 Copyright 2025 NTT CORPORATION Direct Preference Optimization (3) •
したがって、最適な報酬モデルは下記で求められる: • よって、𝑝∗(𝑦! ≻ 𝑦% |𝑥) は下記で求められる: • 規格化定数 𝑍(𝑥) がキャンセルされるため、計算が不要に <latexit sha1_base64="gJuVkBY0q22aE9GYsHykDyJWZzA=">AAADlHicnVLNThRBEK5lFHEVWCQxJlw2biC7SDa9xgAhmhDRxIvKjwtEBjc9Te9sh/lLT+9m18m8gC/AwZMmHoyP4YUX8MAjGBMvmODBg9UzEwQ2YEJPprv6q/q+qq6UFTgiVIQc5AaMK1cHrw1dz9+4OTwyWhi7tR76bcl4nfmOLzctGnJHeLyuhHL4ZiA5dS2Hb1i7S9q/0eEyFL73SvUCvu1S2xNNwahCqFGw5JtoOi53Z3qVqUemxRU1Hd82m5KyyAxEIzJVC0EdFJd7pit2it1KnLlcqlrSjSRvnnTeO5Ypvi53K/lGoUSqJFnFfqOWGSXI1rI/lhsGE3bABwZtcIGDBwptByiE+G1BDQgEiG1DhJhESyR+DjHkkdvGKI4RFNFd3G28bWWoh3etGSZshlkc/CUyizBJvpHP5JDsky/kO/lzrlaUaOhaenhaKZcHjdF3d9aO/sty8VTQ+se6sGYFTZhPahVYe5Ag+hUs5Xfe7h2uLaxORlPkI/mB9X8gB+QrvsDr/GKfVvjqe1TX+k+QlfZQovU8q+ElKnJE9E13YRrzmEmMjXXqjHHWYxvxmWPssooUun2KKXZ+1xha+r0cc8U4TbWzs9NvrN+v1marsysPSouPs7kaggm4C2WcnTlYhGewDHXU3IefcAS/jdvGQ2PJeJqGDuQyzjicWsaLvwGl1wU=</latexit> r⇤(x, y) = log ⇡✓⇤ (y | x) ⇡ref (y | x) + log Z(x) <latexit sha1_base64="U9vKnOAkYKzqrD80/rkayp1dPnI=">AAAEKXicnVK9axRBFH+b9SOexly0EWwOQ8JdSI65Q6IIQlALGzEfXhLInMfsZG5vyH4xO3fcuWxlJ1pbWClYSP4MG1sLwdhaiWWENBa+/SDRnEnEWXb3zW9+v99783hW4MhQE7JjjJinTp85O3qucP7C2MXx4sSl1dDvKi4a3Hd8tW6xUDjSEw0ttSPWAyWYazlizdq6m5yv9YQKpe890oNANF1me7ItOdMItYp7QSuiuiM0exzNxHF50IpqMQ27nJcwrMfUlZulfmX6Ng2l7bKySmjl/mzKq8z9tq3HlQql+0RqoSd1fJu2FeMRDeTfEmXucX7sMt1RbqRE+zBh7h/s6ifZHRAqhVZxklRJukrDQS0PJiFfi/6EMQYUNsEHDl1wQYAHGmMHGIT4bEANCASINSFCTGEk03MBMRRQ20WWQAZDdAu/Nu42ctTDfeIZpmqOWRx8FSpLMEU+kXdkl3wg2+Qb+XmkV5R6JLUM8G9lWhG0xp9dWdk7UeXiX0PnQHVszRracDOtVWLtQYokt+CZvvfk5e7KreWpaJq8Id+x/tdkh7zHG3i9H/ztklh+he6J/z1UZT1UGD3Ia3iIjgKRZJd0YQbz0JRjY51JxjjvsY347D72v44M+kOOGXZ01zhGyX0F5opxmmqHZ2c4WK1Xa/PV+aXrkwt38rkahatwDco4OzdgAe7DIjSAG03jqfHceGFumx/Nz+aXjDpi5JrL8Mcyv/4Cx4ERYQ==</latexit> p✓⇤ (y1 y2 | x) = (r⇤(x, y1) r⇤(x, y2)) = ( log ⇡✓⇤ (y1 | x) ⇡ref (y1 | x) log ⇡✓⇤ (y2 | x) ⇡ref (y2 | x) ) -
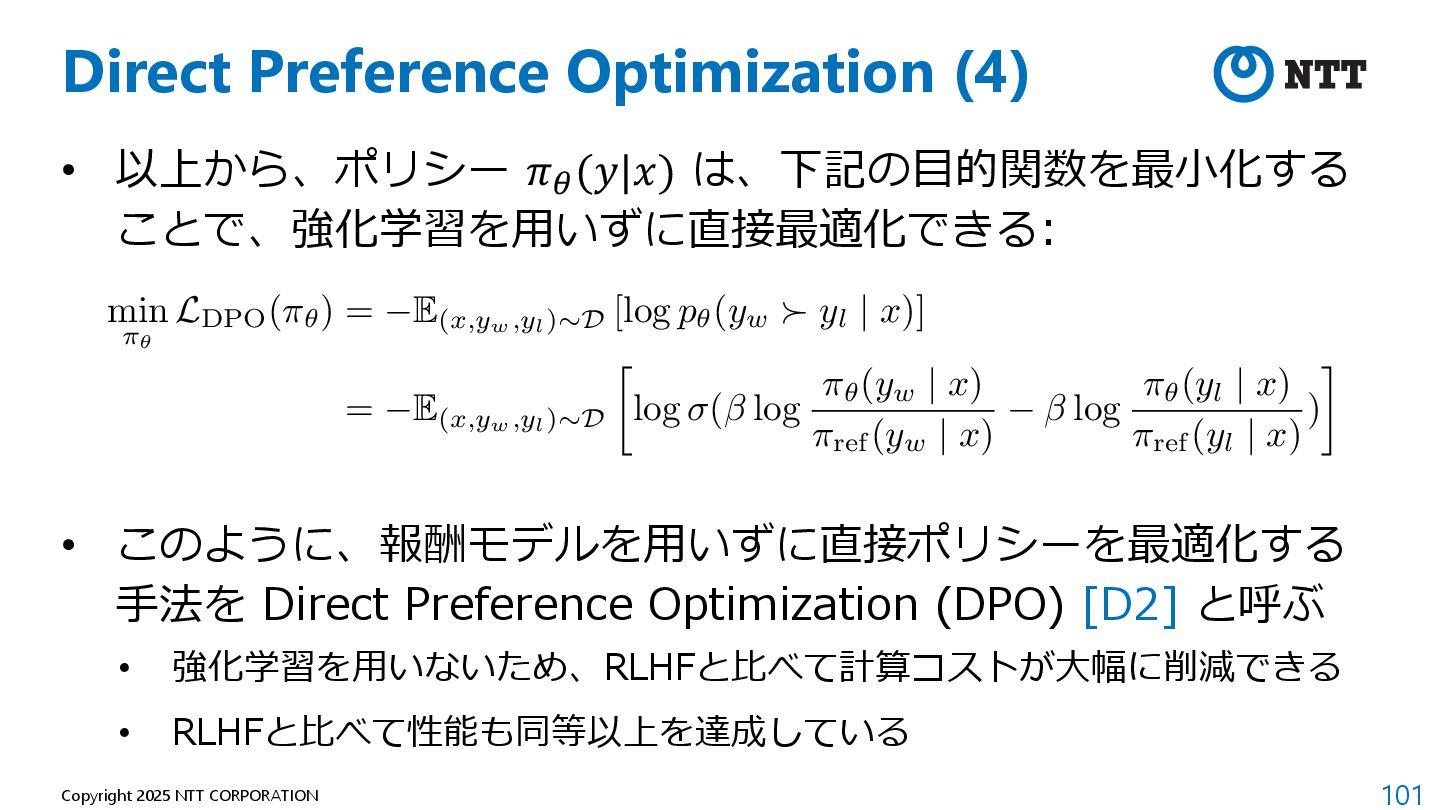
101 Copyright 2025 NTT CORPORATION Direct Preference Optimization (4) •
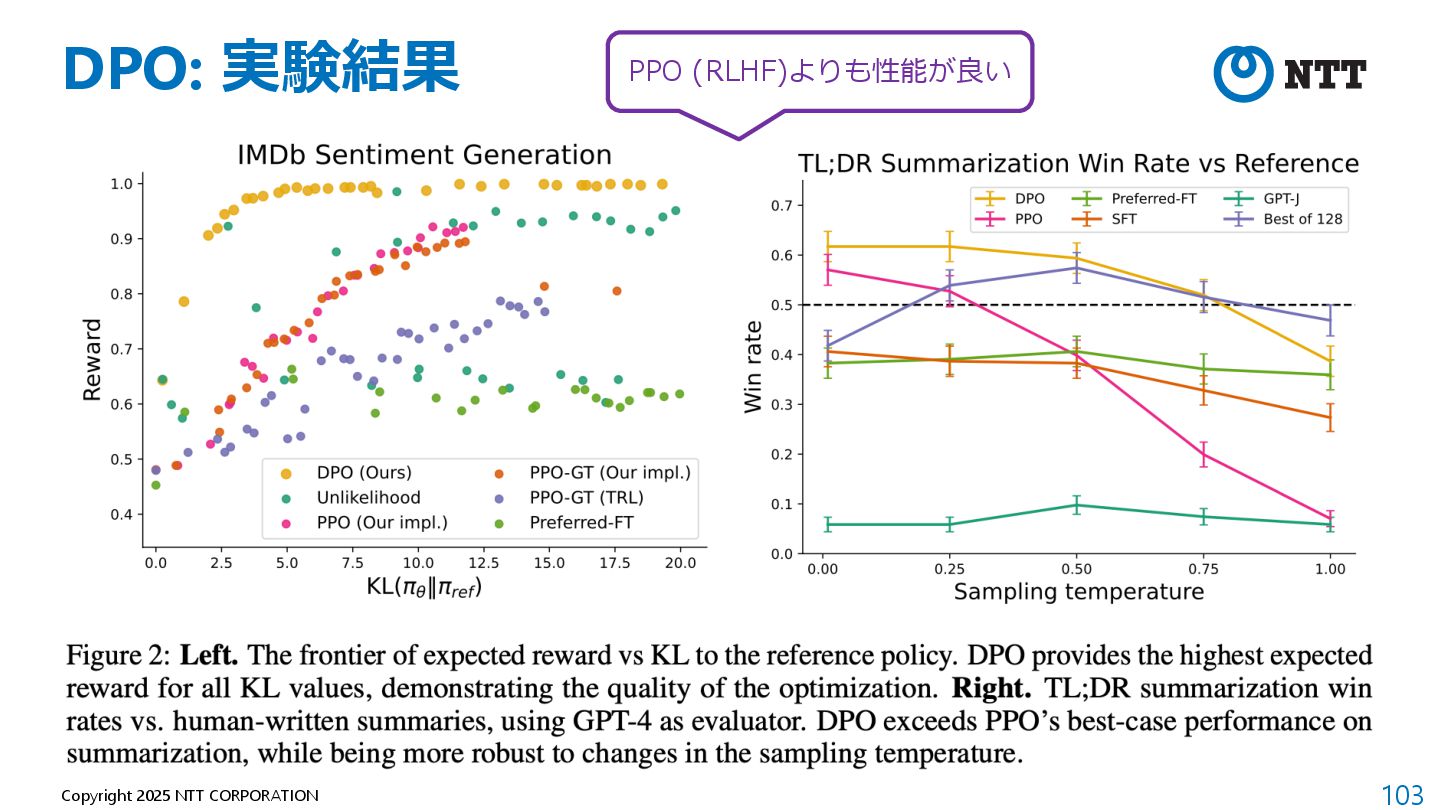
以上から、ポリシー 𝜋$ (𝑦|𝑥) は、下記の⽬的関数を最⼩化する ことで、強化学習を⽤いずに直接最適化できる: • このように、報酬モデルを⽤いずに直接ポリシーを最適化する ⼿法を Direct Preference Optimization (DPO) [D2] と呼ぶ • 強化学習を⽤いないため、RLHFと⽐べて計算コストが⼤幅に削減できる • RLHFと⽐べて性能も同等以上を達成している <latexit sha1_base64="QlSD/3jZ1GXZTCaNdnWvuQxqAZk=">AAAErXicnVJNaxNBGH4TV1ujtYleBC/B0JJIGyciVQShaAQPStPWtIVMDLvTyWbp7Ae7k5h0mT/gH/DgScGD+DO8+Ac89OhRPFbw4sF3P0xtQw10lp1555nned73HcbwhBVIQg4y2XPa+Qszsxdzly7PXZnPF65uBW7fZ7zJXOH6O4YecGE5vCktKfiO53PdNgTfNvYeR+fbA+4Hluu8kCOPt23ddKyuxXSJUKeQ2ae25XRC6lk4yR6XulLU1mWP6SJ8piKQD2VYb6wpVf6XVVl8uBwTDSN8grzycGnUCV+paBaqQgPLHvvU0VPwrmxR4ZpFb+xRjhU06DNWjGVYzG5xWKG+ZfZkm9Kz5sAT09bL1MAs8b7r6+xYk2nqJJ9KjyIv3w593lUnCMtTrMQ0qyPC3+5ynXyJVEk8ipNBLQ1KkI6GW8jMAYVdcIFBH2zg4IDEWIAOAX4tqAEBD7E2hIj5GFnxOQcFOdT2kcWRoSO6h7OJu1aKOriPPINYzTCLwN9HZREWyFfykRySL+QT+U5+n+oVxh5RLSNcjUTLvc786+ubv6aqbFwl9I5U/61ZQhfux7VaWLsXI1EXLNEP9t8cbj7YWAgXyXvyA+t/Rw7IZ+zAGfxkH9b5xlt0j/zrqEru0MfoeVrDGjpyRKJddAu3MA+NOSbWGWVU6R2biC+NsbM66jCccEyw02+NYRT1yzGXwtdUO/l2JoOtO9XaSnVl/W5p9VH6rmbhBtyEMr6de7AKT6EBTWCZb9mZbD5b0G5rTY1qLxNqNpNqrsGxoZl/ANFoRUE=</latexit> min ⇡✓ L DPO (⇡✓) = E (x,yw,yl)⇠D [log p✓(yw yl | x)] = E (x,yw,yl)⇠D log ( log ⇡✓(yw | x) ⇡ ref (yw | x) log ⇡✓(yl | x) ⇡ ref (yl | x) ) -
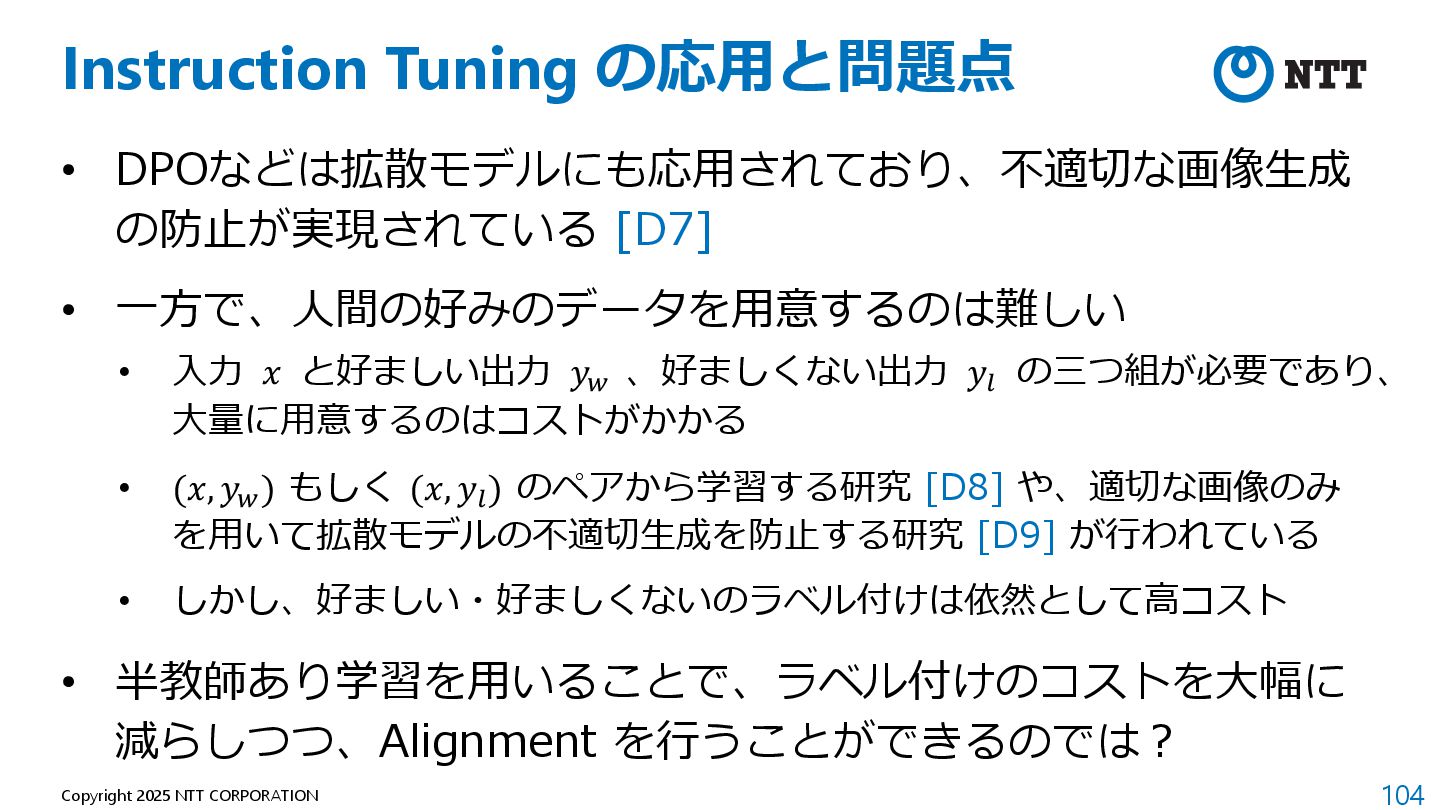
104 Copyright 2025 NTT CORPORATION Instruction Tuning の応⽤と問題点 • DPOなどは拡散モデルにも応⽤されており、不適切な画像⽣成
の防⽌が実現されている [D7] • ⼀⽅で、⼈間の好みのデータを⽤意するのは難しい • ⼊⼒ 𝑥 と好ましい出⼒ 𝑦A 、好ましくない出⼒ 𝑦B の三つ組が必要であり、 ⼤量に⽤意するのはコストがかかる • (𝑥, 𝑦A ) もしく (𝑥, 𝑦B ) のペアから学習する研究 [D8] や、適切な画像のみ を⽤いて拡散モデルの不適切⽣成を防⽌する研究 [D9] が⾏われている • しかし、好ましい・好ましくないのラベル付けは依然として⾼コスト • 半教師あり学習を⽤いることで、ラベル付けのコストを⼤幅に 減らしつつ、Alignment を⾏うことができるのでは︖ -
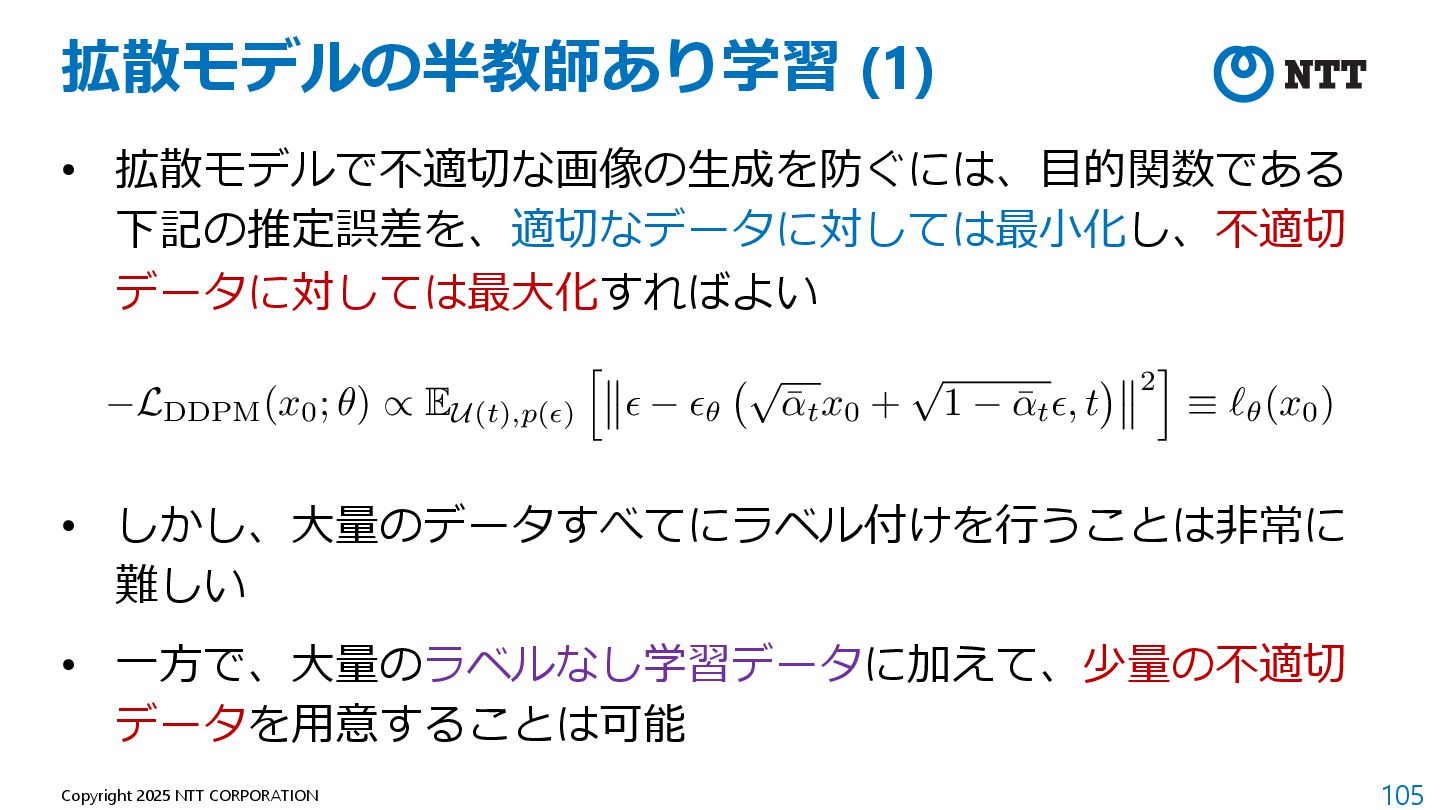
105 Copyright 2025 NTT CORPORATION 拡散モデルの半教師あり学習 (1) • 拡散モデルで不適切な画像の⽣成を防ぐには、⽬的関数である 下記の推定誤差を、適切なデータに対しては最⼩化し、不適切
データに対しては最⼤化すればよい • しかし、⼤量のデータすべてにラベル付けを⾏うことは⾮常に 難しい • ⼀⽅で、⼤量のラベルなし学習データに加えて、少量の不適切 データを⽤意することは可能 <latexit sha1_base64="EYpBc+BwhUJ0JzjyGZ0mXDQjSqo=">AAAENnicnVLPaxNBFH7b9UeN1jZ6EbwEQ0uiTZgUqaKXohE8WExbkxYyMcyuk2TtZHc7Owmty/4DnryJelLwIP4D3r34D3joxZuIeBEqePHg29lNRUMVnGVn3vve+7735jGWL5xAEbJrTJiHDh85Onksc/zE1MnpmeypRuANpM3rtic8uWGxgAvH5XXlKME3fMlZ3xJ83dq8HsfXh1wGjufeUTs+b/VZ13U6js0UQu2sYZZon6mezUR4K2qH2pH9sFqtLUdRYbsdkugqVT2uWHGO+tLzladzLCu8McqPyfWooIrzfoFyP3CE5xYjKnhHNfVOG1yq3ChUGhlI18pJaoEGW1KF1GIypEz4PYb6Kop0DxeSYKU0Fh6JzSsqnW5PFZMjKXk3XIgSv0X51sAZUi7EftnkesVMeyZPykSv3LhRSY08pKvmZY0poHAPPLBhAH3g4IJCWwCDAL8mVICAj1gLQsQkWo6Oc4ggg9wBZnHMYIhu4t5Fr5miLvqxZqDZNlYR+Etk5mCWvCevyB55R16Tz+THgVqh1oh72cHTSrjcb08/PLP2/Z+sPp4Ker9Yf+1ZQQcu614d7N3XSHwLO+EPHzzeW7uyOhvOkRfkC/b/nOySt3gDd/jNfrnCV5+heqxfRVYyQ4nWctrDbVTkiMRePIXzWIfqnC72GVeM0hl3EZ/fx/5XkcH2mGKCHTw1G634vhxrRfiaKn++nXGjsVCuLJYXVy7ml66l72oSzsI5KODbuQRLcBNqUAfbuG88Mp4YT8035gfzo/kpSZ0wUs5p+G2ZX38CtEsZbg==</latexit> →LDDPM(x0; ω) ↑ E U(t),p(ω) ε → εε ↓ ¯ ϑtx0 + ↓ 1 → ¯ ϑtε, t 2 ↔ ϖε(x0) -
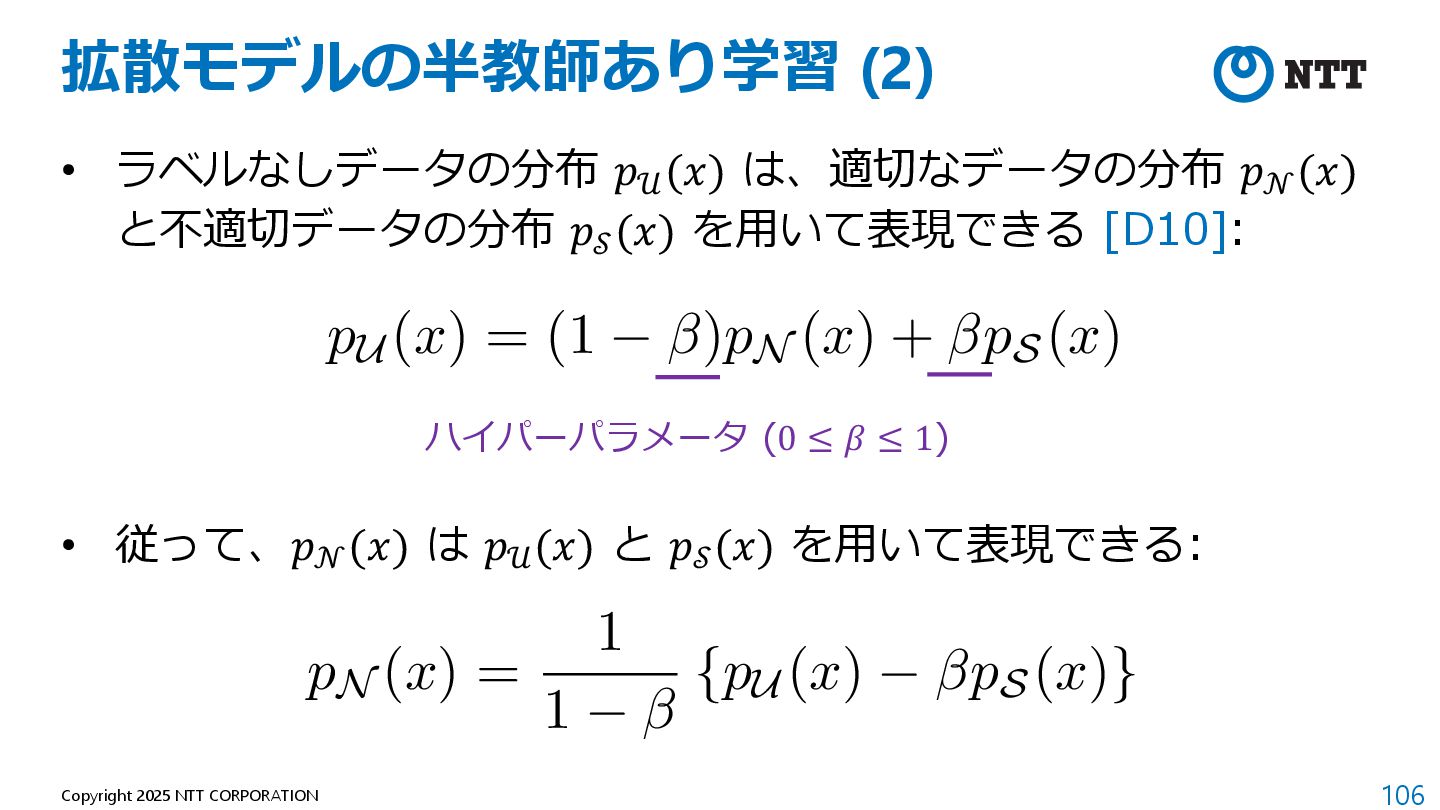
106 Copyright 2025 NTT CORPORATION 拡散モデルの半教師あり学習 (2) • ラベルなしデータの分布 𝑝𝒰
(𝑥) は、適切なデータの分布 𝑝𝒩 (𝑥) と不適切データの分布 𝑝𝒮 (𝑥) を⽤いて表現できる [D10]: • 従って、𝑝𝒩 (𝑥) は 𝑝𝒰 (𝑥) と 𝑝𝒮 (𝑥) を⽤いて表現できる: ハイパーパラメータ (0 ≤ 𝛽 ≤ 1) <latexit sha1_base64="cA/rcAlot0quuZXzsxLMRxRwILQ=">AAADe3icnVJNaxRBEK3d8SOuxmz0InhZXBI2MS49kkQRhKAe9KAmWTcJZMPS03Y2Q+aLmd4lcZg/4B/w4EnBg3jwR3jxD+SQi57FYwQvCr7uGTS6RMEeprv6Vb1X1UU5kecmirH9Utk6dvzEyZFTldNnRs+OVcfPrSRhPxayLUIvjNccnkjPDWRbucqTa1Esue94ctXZvq39qwMZJ24YPFK7kdzweS9wN13BFaBu9V7UTTs+V1uCe2k7yxo7U5M3G/aVjiMVnzrsfGCcl42jdtjRMo5Kt1pnTWZWbdiwC6NOxVoMx0uj1KHHFJKgPvkkKSAF2yNOCb51solRBGyDUmAxLNf4JWVUAbePKIkIDnQbew+39QINcNeaiWELZPHwx2DWaILtsdfsgL1nb9gn9u1IrdRo6Fp2cTo5V0bdsacXWl//yfJxKtr6xfprzYo26bqp1UXtkUH0K0TOHzx5dtC6sTyRTrKX7DPqf8H22Tu8IBh8Ea+W5PJzqGv9O2DlPYxh3S9qeAhFCUTfdBemkadjYnqoU2fMih73gM/8xP5XkdPOkGKOHd01AUu/VyJXhmmy/5ydYWPlatOeb84vzdYXbhVzNUIX6RI1MDvXaIHu0iK1ofmW9ugDfSx/t+rWtDWTh5ZLBec8/basuR+DCc0u</latexit> pU (x) = (1 → ω)pN (x) + ωpS(x) <latexit sha1_base64="Msu7PNIf6hH9Xllvh8NF+3Btvl0=">AAADk3icnVLNahRBEK7NqImrMRtFELwsLglRdOkRiaIIIebgJeZn3SSQDktPp3d2SM8PPb1L4jAv4At48KTgQXwMD/oCHvIIIjlFzMWD1T2DGpco2MN0V39V31fVRXmJDFJNyH5lxDl1+szo2NnqufPjFyZqkxfX0rivuGjzWMZqw2OpkEEk2jrQUmwkSrDQk2Ld23lk/OsDodIgjp7qvURshcyPgm7AmUaoU2NJJ6Mh0z3OZPYkz2d2r08/pF3FeObmmXuLekKznErR1TSr/x7ctsFFwDFHyzqoCvyepnm1U2uQJrGrPmy4pdGAci3Hk5VxoLANMXDoQwgCItBoS2CQ4rcJLhBIENuCDDGFVmD9AnKoIrePUQIjGKI7uPt42yzRCO9GM7Vsjlkk/gqZdZgin8hbckg+knfkM/l+olZmNUwte3h6BVcknYnnV1pH/2SFeGro/WL9tWYNXbhnaw2w9sQi5hW84A+evThs3V+dyqbJa/IF639F9sl7fEE0+MrfrIjVl6hu9BeQVfRQobVY1rCEigIRczNduIF5qI3xsU6TMS977CN+8yf2v4oMdocUC+zkrnG0zHsF5spxmtw/Z2fYWLvddGebsyt3GnPz5VyNwVW4BjM4O3dhDh7DMrRR8wMcwDc4ci47D5x5Z6EIHamUnEtwbDmLPwB0L9c6</latexit> pN (x) = 1 1 → ω {pU (x) → ωpS(x)} -
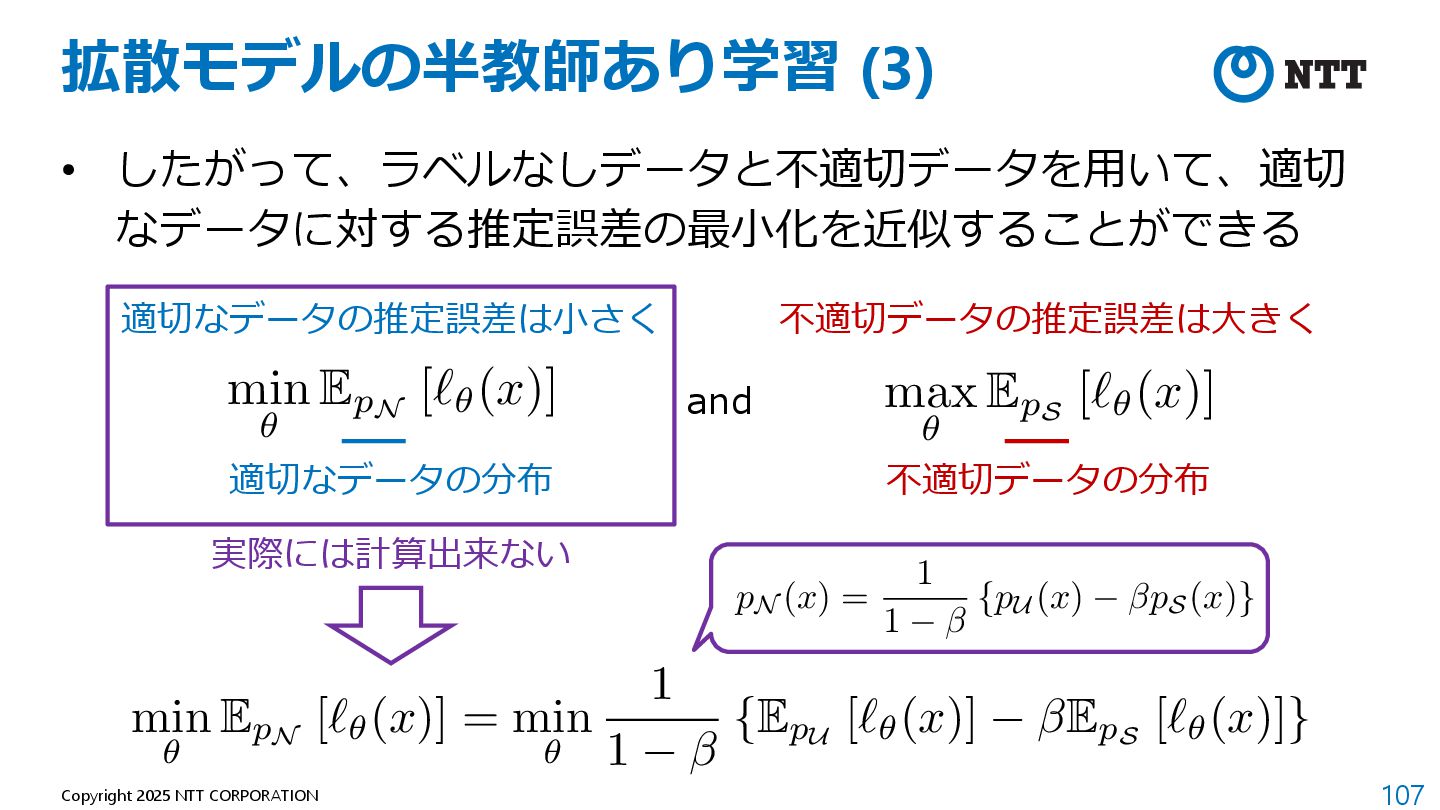
107 Copyright 2025 NTT CORPORATION 拡散モデルの半教師あり学習 (3) • したがって、ラベルなしデータと不適切データを⽤いて、適切 なデータに対する推定誤差の最⼩化を近似することができる
and 適切なデータの推定誤差は⼩さく 不適切データの推定誤差は⼤きく 適切なデータの分布 不適切データの分布 実際には計算出来ない <latexit sha1_base64="4WcpFk/5P7rIxvb6ZN3QZ1Kt0sA=">AAADeXicnVJLaxRBEK7d8RFXYzZ6EbxEl8gaZOk1IYqn4AO9qHm4SWBnGXra2tkmPQ9mepfEYf6Af8CDJwUPIv4KL97FQ0B/gHiM4EEPVs8MEV2ikB6mu+rr+r6qLsqNlEw0Y7uVqnXk6LHjEydqJ09Nnp6qT59ZT8JhLLAjQhXGmy5PUMkAO1pqhZtRjNx3FW64W7fM/cYI40SGwSO9E2HP514g+1JwTZBTv2v7MnBSWw9Q88z2uR64bnonc9KIUOMKrtIHWZbZCvu6a6NS++HN7ct2LL2B7tWceoO1WL5mxo12aTSgXMvhdGUSbHgMIQgYgg8IAWiyFXBI6OtCGxhEhPUgJSwmS+b3CBnUiDukKKQITugW7R553RINyDeaSc4WlEXRHxNzBmbZR/aa7bH37A37wn4eqJXmGqaWHTrdgouRM/X03Nr3/7J8OjUMfrP+WbOGPlzPa5VUe5Qj5hWi4I+ePNtbu7E6m15iL9lXqv8F22Xv6AXB6Jt4tYKrz0nd6N8mVtHDmKz7ZQ0PSREJMZ7pwhzlsfMYj+o0GbOyxx7hV/axwypy2B5TLLCDuybIMu9FypXRNLX/np1xY/1qq73YWlxZaCzdLOdqAs7DRWjS7FyDJbgHy9AhzbfwAT7B5+oP64LVtOaK0Gql5JyFP5Y1/wvdqs8L</latexit> min ω E pN [ωω(x)] <latexit sha1_base64="ILZZDxNao09dq8PVVqB+wh9+lbY=">AAADeXicnVLNahRBEK7d8Seuxmz0IniJLpE1yNKrEsVT8Ae9iEnWTQI7y9DT1s426flhpnfZOMwL+AIePCl4EPEpvHgXDwF9APEYwYMerJ4ZIrpEwR6mu+rr+r6qLsqNlEw0Y7uVqnXo8JGjM8dqx0/Mnpyrz5/aSMJRLLArQhXGWy5PUMkAu1pqhVtRjNx3FW6627fM/eYY40SGwUO9E2Hf514gB1JwTZBTv2v7fOKkth6i5hk5eui66Z3MSSNCjSu4SjtZltkKB7pno1L74c3JRTuW3lD3a069wVosXwvTRrs0GlCu1XC+Mgs2PIIQBIzAB4QANNkKOCT09aANDCLC+pASFpMl83uEDGrEHVEUUgQndJt2j7xeiQbkG80kZwvKouiPibkAi+wDe8X22Dv2mn1mPw7USnMNU8sOnW7BxciZe3Km8+2fLJ9ODcNfrL/WrGEA1/NaJdUe5Yh5hSj448dP9zo31hfTC+wF+0L1P2e77C29IBh/FS/XcP0ZqRv928QqehiTdb+s4QEpIiHGM11Yojx2HuNRnSZjVvbYI/zSPva/ihwmU4oFdnDXBFnmvUi5Mpqm9p+zM21sXG61l1vLa1cbKzfLuZqBs3AemjQ712AF7sEqdEnzDbyHj/Cp+t06ZzWtpSK0Wik5p+G3ZV35CfJozxI=</latexit> max ω E pS [ωω(x)] <latexit sha1_base64="MqTll2/pjQ6huFNKHXgywt8UQAo=">AAAEIXicnVJLaxRBEK7J+IirMRu9CF4Wl4QouvSEEEUQgg/woiZZNwlsL0tP27s7pOfBTO+S2MxNL/4BD55UPIg/w4veRPAQ/AXiwUMELx6snhkicdks2MN0V31d31fVRbmR9BJFyK41YR85euz45InSyVNTp6fLM2fWk7Afc9HgoQzjTZclQnqBaChPSbEZxYL5rhQb7tYtc78xEHHihcFDtROJls+6gdfxOFMItcs/qO8FbU1VTyiWUp+pnuvqO2lbR4galzOp76dpSqXoqCYVUu6Hz29fpLHX7anW3I2DOp2Yce2k2rlC3QwwZKoroxI0xiXIdUbR6+Po+UHTUrtcJTWSrcqw4RRGFYq1Es5YU0DhEYTAoQ8+CAhAoS2BQYJfExwgECHWAo1YjJaX3QtIoYTcPkYJjGCIbuHeRa9ZoAH6RjPJ2ByzSPxjZFZglnwhb8ke+UDekW/k90gtnWmYWnbwdHOuiNrTz87Vf41l+Xgq6P1lHVqzgg5cy2r1sPYoQ8wreM4fPH6+V7++NqvnyCvyHet/SXbJe3xBMPjJ36yKtReobvRvIyvvYYzWvaKGB6goEDGe6cIlzEOzmC7WaTKmRY+7iF/ex/5XkcH2kGKOje4aR8u8V2CuFKfJ+Xd2ho31hZqzVFtaXawu3yzmahLOwwWYx9m5CstwF1agAdxqWNp6Yj21X9sf7U/25zx0wio4Z+HAsr/+AYnZE3Y=</latexit> min ω E pN [ωω(x)] = min ω 1 1 → ε {E pU [ωω(x)] → εE pS [ωω(x)]} <latexit sha1_base64="Msu7PNIf6hH9Xllvh8NF+3Btvl0=">AAADk3icnVLNahRBEK7NqImrMRtFELwsLglRdOkRiaIIIebgJeZn3SSQDktPp3d2SM8PPb1L4jAv4At48KTgQXwMD/oCHvIIIjlFzMWD1T2DGpco2MN0V39V31fVRXmJDFJNyH5lxDl1+szo2NnqufPjFyZqkxfX0rivuGjzWMZqw2OpkEEk2jrQUmwkSrDQk2Ld23lk/OsDodIgjp7qvURshcyPgm7AmUaoU2NJJ6Mh0z3OZPYkz2d2r08/pF3FeObmmXuLekKznErR1TSr/x7ctsFFwDFHyzqoCvyepnm1U2uQJrGrPmy4pdGAci3Hk5VxoLANMXDoQwgCItBoS2CQ4rcJLhBIENuCDDGFVmD9AnKoIrePUQIjGKI7uPt42yzRCO9GM7Vsjlkk/gqZdZgin8hbckg+knfkM/l+olZmNUwte3h6BVcknYnnV1pH/2SFeGro/WL9tWYNXbhnaw2w9sQi5hW84A+evThs3V+dyqbJa/IF639F9sl7fEE0+MrfrIjVl6hu9BeQVfRQobVY1rCEigIRczNduIF5qI3xsU6TMS977CN+8yf2v4oMdocUC+zkrnG0zHsF5spxmtw/Z2fYWLvddGebsyt3GnPz5VyNwVW4BjM4O3dhDh7DMrRR8wMcwDc4ci47D5x5Z6EIHamUnEtwbDmLPwB0L9c6</latexit> pN (x) = 1 1 → ω {pU (x) → ωpS(x)} -
108 Copyright 2025 NTT CORPORATION Stable Diffusion 1.4 を⽤いた実験 •
ブラッド・ピットの⽣成を防⽌する実験を実施 • ラベルなしデータ80枚・不適切データ20枚で実験 • 提案法は少数の不適切データでも効果的で、⽣成品質も損なわれない 提案⼿法 既存⼿法 [D9] 防⽌率: 0.84 防⽌率: 0.99 不適切データ ラベルなしデータ -
109 Copyright 2025 NTT CORPORATION まとめ: Instruction Tuning • Instruction
Tuning は、⽣成モデルが⼈間の指⽰に従うように 学習する⼿法 • RLHF: 強化学習を⽤いて⾔語モデルをチューニング • DPO: 強化学習を⽤いずに、直接⾔語モデルをチューニング • ⾔語モデルだけでなく拡散モデルにも応⽤されている • ⼀⽅で、ラベル付けのコストが⾮常に⼤きいという問題がある • 三つ組データをペアデータに緩和して学習する研究や、適切なデータのみ を⽤いて学習する研究が⾏われている • また、半教師あり学習を⽤いることで、ラベルなしデータを活⽤する研究 も⾏われている -
110 Copyright 2025 NTT CORPORATION 参考⽂献 D 1. Ouyang, Long,
et al. "Training language models to follow instructions with human feedback." Advances in neural information processing systems 35 (2022): 27730-27744. 2. Rafailov, Rafael, et al. "Direct preference optimization: Your language model is secretly a reward model." Advances in Neural Information Processing Systems 36 (2023): 53728- 53741. 3. Takahashi, Hiroshi, et al. "Positive-Unlabeled Diffusion Models for Preventing Sensitive Data Generation." The Thirteenth International Conference on Learning Representations. 4. Bai, Yuntao, et al. "Training a helpful and harmless assistant with reinforcement learning from human feedback." arXiv preprint arXiv:2204.05862 (2022). 5. Bradley, Ralph Allan, and Milton E. Terry. "Rank analysis of incomplete block designs: I. The method of paired comparisons." Biometrika 39.3/4 (1952): 324-345. 6. Schulman, John, et al. "Proximal policy optimization algorithms." arXiv preprint arXiv:1707.06347 (2017). -
111 Copyright 2025 NTT CORPORATION 参考⽂献 D 7. Wallace, Bram,
et al. "Diffusion model alignment using direct preference optimization." Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2024. 8. Ethayarajh, Kawin, et al. "Model alignment as prospect theoretic optimization." Forty-first International Conference on Machine Learning. 2024. 9. Heng, Alvin, and Harold Soh. "Selective amnesia: A continual learning approach to forgetting in deep generative models." Advances in Neural Information Processing Systems 36 (2023): 17170-17194. 10. Kiryo, Ryuichi, et al. "Positive-unlabeled learning with non-negative risk estimator." Advances in neural information processing systems 30 (2017). -
113 Copyright 2025 NTT CORPORATION まとめ • ⽣成モデルに関する下記のトピックについて学習した • ⽣成モデルの基礎
/ 深層⽣成モデル / ⾔語モデル / Instruction Tuning • 現在の⽣成AIは⾮常に複雑になっているので、わからなくなったときは、 簡単な例でイメージしよう (例えばコインでの最尤推定など) • ⽣成AIと⽣成モデルのギャップはモデルサイズとデータの量 • 本講義で説明した基礎的なことを理解したら、最新の論⽂を読んでみよう • ⼤きなモデル・⼤きなデータだからこその難しさがあります • ⽣成AIの発展には、⼈間からのフィードバックが重要 • どのようにして効率的に Alignment を⾏うかが重要になると予想 -
114 Copyright 2025 NTT CORPORATION FAQ • 動画の⽣成はどのように⾏われるか︖ • 時間軸を導⼊し、前のフレームを条件付けて⽣成する
• AIエージェントとは︖ • ⼈間の介⼊なしに特定のタスクを実⾏する⾃律型 • 拡散⾔語モデルの利点は︖ • GPTの⾃⼰回帰的な⽣成とは異なり、⼀括的な⽣成を⾏うため⾼速 • Alignment の問題点は︖ • DPOなどは有害な出⼒を忘却しているのではなくバイパスしているだけと 指摘されており、また⽣成品質の低下も⾒られる -
116 Copyright 2025 NTT CORPORATION Generative Adversarial Network (1) •
Generative Adversarial Network (GAN) [E1] は、2つの ニューラルネットワーク (Generator と Discriminator) を互い に競わせることで、⽣成モデルの学習を⾏う https://sthalles.github.io/intro-to-gans/ Generator: ノイズからデータを ⽣成する Discriminator: データと⽣成された データを識別する Discriminatorを騙すように Generatorを学習する -
117 Copyright 2025 NTT CORPORATION Generative Adversarial Network (2) •
真の分布を 𝑝∗(𝑥)、低次元の標準ガウス分布を 𝑝(𝑧) とする • また、Generator を 𝐺(𝑧)、Discriminator を 𝐷(𝑥) とする • この時、𝐺 と 𝐷 は下記の⽬的関数の最適化で学習できる • 𝐷 に関する最⼤化と 𝐺 に関する最⼩化を交互に⾏う <latexit sha1_base64="nVne0TW9h0ZDq29BJ43w4zgE4LQ=">AAADfXicnVJbaxNBFD7Jqo3x0rS+CL4EQ8qmpmFWSlsEoehKfBF7MWkhmy6762QzdPbC7iSkXfYP+Ad88EnBB/Fn+OIfEOxPEB8rCCLq2YuXGlRwlp0555vzffPNcEyfs1AQclQoSqdOn5kpnS2fO3/h4mxlbr4beqPAoh3L416waxoh5cylHcEEp7t+QA3H5HTH3L+d7O+MaRAyz30gDnzadwzbZQNmGQIhvRJoDnP1qB1rjjHRIzXuymqz3Vi4ibkYmmZ0J9Yjfy9ajOVJI9Y4HYiexj27qmKuBcweiv61E7Xy4a91srKkym3EGt+ry3qlRlokHdXpQMmDGuRjw6t8Ag0eggcWjMABCi4IjDkYEOLXAwUI+Ij1IUIswIil+xRiKCN3hFUUKwxE93G2MevlqIt5ohmmbAtP4fgHyKxCnbwhL8gxeU1eknfk8x+1olQj8XKAq5lxqa/PPrq8/fGfLAdXAcOfrL96FjCAtdQrQ+9+iiS3sDL++PDx8faNrXq0QJ6R9+j/KTkir/AG7viD9XyTbj1B9URfRVb2hgFG93IP91GRIpJkySss4jlaWmOjz+TEOH9jG/HmD+x/FQ2YTClmWNImyu9NMR10r7eUldbK5nJt/VbeMCW4AldBxq5YhXW4CxvQQV9v4UthplAqfpXqUlNqZaXFQs65BCeGtPoNBAHS6g==</latexit> min G max D V (D, G) = E p⇤(x) [log D(x)] + E p(z) [log(1 D(G(z)))] 2クラス分類の⽬的関数 データ 𝑥 と⽣成データ 𝐺(𝑧) を識別できるように学習 𝐷 を騙すように 𝐺 を学習 -
118 Copyright 2025 NTT CORPORATION Generative Adversarial Network (3) •
𝐺 が⽣成するデータの分布を 𝑝; (𝑥) とした時、最適な 𝐷(𝑥) は 下記で与えられる: • この時、⽬的関数 𝑉(𝐷∗, 𝐺) は、𝑝; (𝑥) と 𝑝∗(𝑥) のジェンセン・ シャノン情報量となる <latexit sha1_base64="vxE+7b6eliMvwsyI3j752oz3/J4=">AAADOHicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQvousRVa9VqVGiq2cakFSUmVxdA+bVwlnZBfLU7WIgrXkDZQM8ADBQwGYZQhjIDFATkC/xiiGFIYchnSGYoZchlSGXIYygBsnMYEhmKgTCawZDBgKEAKBbLUA0UKwKyMsHyqQy1DFxAvaVAValAFYlA0WwgmQ7kRUNF84B8kJnFYN3JQFtygLgIqFOBQdXgqsFKg88GJwxWG7w0+IPTrGqwGSC3VALpJIje1IJ4/i6J4O8EdeUC6RKGDIQuvG4uYUhjsAC7NRPo9gKwCMgXyRD9ZVXTPwdbBalWqxksMngNdP9Cg5sGh4E+yCv7krw0MDVoNtB0kPkuQF2QMCwCsnyhbvAHmpgKFAHxQKGgBbQnBqwmHehOkI210DBOB4rrwMXINTGRoQLDRIgYKJkYoicKTEaYkZ6hmZ5ZoImygxM0wXAwSDMoMWgAU4U5gwODB0MAQyjQXZMZdjIcYjjMtIvpAdNzppcQpUyMUD3CDCiA6RMAT+W9Ng==</latexit> D⇤(x) = p⇤(x) p⇤(x) + pG(x) 𝑝C (𝑥) を 𝑝∗(𝑥) に近づけるよう学習している <latexit sha1_base64="1SZb5ar7gCOLEs9JmgBnbcQnPpk=">AAADuXicnVLLahRBFL2dVhPHR8bHQnAzOCTMJDJUB4kSEYIJKD4wyThJIJUM1W1NT5t+UV0zJFb6B/wBF64UXIjgT7jxB1zkE8RlBEFceKu7R42DClbTVbdO3XPuqeLase8lkpB9Y8Q8cvTY6Njx0omTp06Pl8+cXU2innB4y4n8SKzbLOG+F/KW9KTP12PBWWD7fM3eXtDna30uEi8KH8rdmG8GzA29jucwiVC7/JYGTHZFoO4001q8pabS2k59by9uq1s6qk/eoB3BHGWlaialPu9IqioDzt17OfQLMcCZCs/tyvr0cFqheigtX2haoVSjg4IDyekBSRsotctV0iDZqAwHVhFUoRhLUfkrUHgEETjQgwA4hCAx9oFBgt8GWEAgRmwTFGICIy8755BCCbk9zOKYwRDdxtnF3UaBhrjXmknGdrCKj79AZgUmyAfymhyQ9+QN+Ui+/VFLZRrayy6uds7lcXv86YXml3+yAlwldH+y/upZQgeuZV499B5niL6Fk/P7T54dNOdWJtQkeUk+of8XZJ+8wxuE/c/Oq2W+8hzVtf4isvI3FBjdLzw8QEWOiN7pV5jCOjTLcdGnrpgWb+wifvkH9r+KDHaGFHNMt4n1e1MMB6szDWu2Mbt8pTp/s2iYMbgIl6CGXXEV5uE2LEELHOO8MWcsGIvmdZOZXfNxnjpiFJxzcGiYyXcOPuk4</latexit> JS(p⇤(x)||pG(x)) = 1 2 {KL (p⇤(x)||m(x)) + KL (pG(x)||m(x))} m(x) = p⇤(x) + pG(x) 2 -
119 Copyright 2025 NTT CORPORATION Generative Adversarial Network (4) GANで⽣成したMNISTとCIFAR10
(2014年時点) [E1] NOTE: • GANはデータの⽣成はできるが、データの確率は推定できない • また、⽣成品質は⾼いが、学習が不安定という問題がある -
120 Copyright 2025 NTT CORPORATION Flow-based Model (1) • VAEとGANにはそれぞれ下記のような問題がある
• VAEは変分下界を計算するため、厳密な確率を計算できない • GANは⽣成品質は⾼いが、データの確率を計算できない • そのため、品質が⾼く、厳密に確率を計算できる⽣成モデルの 需要が⾼まっていた • Flow-based Model [E2] は、データ 𝑥 と同次元のガウス分布 𝑝(𝑧) を⽤意し、全単射関数 𝑓$ (𝑥) を⽤いて分布を推定する <latexit sha1_base64="T7qr/YOkdG1cbu2a2WkfulN0Mxs=">AAADNnicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQtoV9mmxVfHlGSkliTWalRo6sQUliamKFQgicZV6xrWalRpcsULKBvoGYCBAibDEMpQZoCCgHyBXwwxDCkM+QzJDKUMuQypDHkMJUB2DkMiQzEQRjMYMhgwFADFYhmqgWJFQFYmWD6VoZaBC6i3FKgqFagiESiaDSTTgbxoqGgekA8ysxisOxloSw4QFwF1KjCoGlw1WGnw2eCEwWqDlwZ/cJpVDTYD5JZKIJ0E0ZtaEM/fJRH8naCuXCBdwpCB0IXXzSUMaQwWYLdmAt1eABYB+SIZor+savrnYKsg1Wo1g0UGr4HuX2hw0+Aw0Ad5ZV+SlwamBs0Gmg4y3wWoCxKGRUCWL9QN/kATU4EiIB4oFLSA9sSA1aQD3QmysRYaxulAcR24GLkmJjJUYJgIEQMlE0P0RIHJCDPSMzTTMws0UXZwgiYYDgZpBiUGDWCqMGdwYPBgCGAIBbprIsN2hgMMB5l2MN1jesr0HKKUiRGqR5gBBTB9AABDNL07</latexit> z = f✓(x), x = f 1 ✓ (z) -
121 Copyright 2025 NTT CORPORATION Flow-based Model (2) • 全単射
𝑧 = 𝑓$ (𝑥) と 𝑝(𝑧) を⽤いて、確率 𝑝$ (𝑥) は下記で書ける • ヤコビアンが計算できれば最尤推定が可能 • ⼀般的な関数のヤコビアンを計算するのは難しい • ヤコビアンが計算しやすく、表現⼒の⾼い関数を考えるのがFlowの研究 <latexit sha1_base64="PR4yOW6FNUg0EKiL+V2mZ3Id04w=">AAADfnicnVLdahNBGP3S9SeNP416U/AmGBoSrXFSSi2FQlEvvBH7Y9pCp4TZ7exm6GR3mZ2E1O2+QF/AC68UvBAfwxtfwIs8gnhZQRBBv9ldjBpUcJbdOXPmO2fODp8dShFpQkaFKevM2XPni9OlCxcvXZ4pX7m6HQV95fC2E8hA7dos4lL4vK2Flnw3VJz1bMl37MP7Zn9nwFUkAv+JPgr5fo95vnCFwzRSnXJEZeBVwk5MdZdrltSHjdpqxtXdn9nGLcNSyV19TA+4TlGduoo5MQ2Z0oLJyliRjMlhQpXwurqRTcelTrlKmiQdlUnQykEV8rEelL8AhQMIwIE+9ICDDxqxBAYRPnvQAgIhcvsQI6cQiXSfQwIl1PaximMFQ/YQvx6u9nLWx7XxjFK1g6dIfBUqKzBH3pPX5JS8I2/IB/L1j15x6mGyHOFsZ1oedmZOZrc+/1PVw1lDd6z6a2YNLiynWQVmD1PG/IWT6QdPn51urWzOxTXyknzE/C/IiLzFP/AHn5xXG3zzObob/weoyu5QIXqUZ3iMjhwZszK3cBPPoWmNhznNiUl+xx7y8z+4/3VkMJxwzDjTJq3fm2ISbC80W0vNpY3F6tq9vGGKcB1uQB274i6swUNYhzbmGsG3QrEwbYFVs25bd7LSqUKuuQa/DGv5O11R1VU=</latexit> log p✓(x) = log p(f✓(x)) + log det ✓ @f✓ @x ◆ ヤコビアン (ヤコビ⾏列の⾏列式) -
122 Copyright 2025 NTT CORPORATION Flow-based Model (3) • 全単射の例として、下記のCoupling
Layers [E2,E3] を考える • この時、ヤコビ⾏列は下記で計算できる • 下三⾓⾏列となるので、⾏列式が簡単に計算できる <latexit sha1_base64="DhZQ0Wc77/i+y+dUb7bE2JQrr14=">AAAErnicnVLLbtNAFL0xBtrwaAobJDYWUasEUBgjVEokpAq6gAWiD5JWqiNr7EycUf3SeBIltfwD/AALVlRigfgMNvwAi34CYlkkJMSCa8eioWmg6li275y559xzR9cKXR5JQg4Kyjn1/IWLM7PFS5evXJ0rzV9rRkFP2KxhB24gti0aMZf7rCG5dNl2KBj1LJdtWbtP0/OtPhMRD/xXchiylkcdn3e4TSVC5nxh3+gIasdGSIXk1NX2kqN4kDw2XNaRO4bFHO7HVAg6TGLbTrTjLDPW6+1knJsj2uKpctt39PqqGQ+SJDGMExhj56esMY0xhmsG89t5V4bgTle2pjb8HJlpIXI2ex6VXeHFbU6dpGKwQViJzNiQXSZpUskTq9XqCY6KRbNUJjWSLW0y0POgDPlaC0o/wYA2BGBDDzxg4IPE2AUKET47oAOBELEWxIgJjHh2ziCBInJ7mMUwgyK6i18Hdzs56uM+1Ywyto1VXHwFMjVYIF/IB3JIPpOP5Cv5NVUrzjRSL0P8WyMuC8251zc2f/yX5eFfQveI9U/PEjqwnHnl6D3MkLQLe8Tv77053KxvLMSLZJ98Q//vyAH5hB34/e/2+3W28RbVU/1VZI3uUGD0IvfwEhUZIukuvYXbWMfIchz0mVZM8jt2EL/7BzurIoXBhOIIS8dEPz4Uk0Hzfk1fqi2tPyivPMkHZgZuwi2o4FQ8hBV4BmvQAFuZVe4py8ojlahNtaWao1SlkHOuw19L7f4GKi5H/A==</latexit> @z @x = " @z1:d @x1:d @z1:d @xd+1:Dx @zd+1:Dx @x1:d @zd+1:Dx @xd+1:Dx # = Id 0 @zd+1:Dx @x1:d diag(exp(s✓(x1:d))) この⾏列式の計算だけでOK ℝD → ℝD の任意NN データ 𝑥 を次元 𝑑 で2つに区切る <latexit sha1_base64="azAlitT8BpOFQ92gXxQcRQSsy6Y=">AAADbHicnVLdatRAGD3dVFu3alfrhVCE4tJl+8MyEWllQShtL7yR/rltoSlhkp1uQ7NJSGaXbUNewBfwwqsKXoiP4YW+gBd9BBG9aWlBvPCbJFh0UcEJmfm+M985c2b4rMB1IsnYyUBBG7xydWj4WnHk+o2bo6VbtzcjvxPaomH7rh9uWzwSruOJhnSkK7aDUPC25Yot62BJ7W91RRg5vvdMHgZit81bnrPn2FwSZJb4kRnr9WZSedzLAsMgpDmj15fNuJdk+GVq+E1fGqIXVCMzNuS+kDyp5sypqRnZDxbNUpnVWDom+gM9D8rIx6pf+gYDTfiw0UEbAh4kxS44Ivp2oIMhIGwXMWEhRU66L5CgSNwOVQmq4IQe0NyibCdHPcqVZpSybTrFpT8k5gQm2Uf2hp2yD+wt+8S+/1ErTjWUl0NarYwrAnP0+d2Ni3+y2rRK7F+y/upZYg+PUq8OeQ9SRN3CzvjdoxenG/X1ybjCXrHP5P+YnbB3dAOve2a/XhPrL0ld6S8TK3vDkKKnuYcVUhSEqEy9wjSdY6Q1LfKpTkzyN24RPvsT+19Fjl6fYoapNtF/b4r+YPNBTZ+rza09LC8s5g0zjHHcR5W6Yh4LeIJVNMjXe3zBOS4KX7U72rh2LystDOScMfwytMoPRw/O+g==</latexit> z1:d = x1:d zd+1:Dx = xd+1:Dx exp(s✓(x1:d)) + t✓(x1:d) <latexit sha1_base64="LTd5rYpsKKmGycSrYiVh4q23xDs=">AAADjHicnVJNa9RAGH638aOutl0VVPCyuLRsRZaJlCoVoaiIF7EfblvYWcJkMpsdmk3CZHbZNeTg1T/gwZOCB/FnePEPeOgvEPFYQRAPvpMERRcrOENm3nnmfZ73yfC6cSATTchBZcY6dvzEydlT1dNn5uYXamfP7STRUHHR5lEQqT2XJSKQoWhrqQOxFyvBBm4gdt39u+Z+dyRUIqPwsZ7Eojtgfih7kjONkFN7SgPR0x3qCl+GKVOKTbKUc57VqRjHzcRJqe4LzbLm2EntNS9bXsY9qy/hJJTiSj0v0gmGJAePoHlGNPTKKlRJv6+7VafWIC2Sj/p0YJdBA8qxEdW+AQUPIuAwhAEICEFjHACDBGcHbCAQI9aFFDGFkczvBWRQRe4QswRmMET3cfXx1CnREM9GM8nZHKsE+Clk1mGRfCBvyCF5T96ST+T7X7XSXMN4meDuFlwROwvPLm1//SdrgLuG/i/WkZ419OBm7lWi9zhHzF/wgj968vxwe21rMV0ir8hn9P+SHJB3+Afh6At/vSm2XqC60b+HrOINFUYPSw+PUFEgYk7mFa5iHZrn+OjTVMzKN/YRv/YT+19FBuMpxQIzbWL/2RTTwc71lr3aWt1caazfKRtmFi7DFWhiV9yAdXgAG9BGXx8rc5ULlYvWvLVi3bJuF6kzlZJzHn4b1v0fCwvWqw==</latexit> 2 6 4 exp(s✓(x1:d))1 0 ... 0 exp(s✓(x1:d))d 3 7 5 -
123 Copyright 2025 NTT CORPORATION Flow-based Model (4) • よって、log
𝑝$ (𝑥) は下記で計算でき、最尤推定が可能 • データ⽣成は、逆関数を⽤いてノイズ 𝑧 ~ 𝑝(𝑧) から変換する <latexit sha1_base64="dYwZZxPlqS6yfvrxCUQpZgQyCIU=">AAAED3icnVLLahRBFL2d9hHHRya6EdwMDgndKkO1SJSAENSFGzEPJwmkQlPTU9NTSb/orhkmdvoHXOlK1JWCC/ED3IngRj/ART5BXEYQxIW3uluNmSSC1XTVrVP3nHOruK3IE4kkZEsb0Q8dPnJ09Fjl+ImTp8aq46cXk7AXO7zphF4YL7dYwj0R8KYU0uPLUcyZ3/L4Umv9pjpf6vM4EWFwT25EfNVnbiA6wmESIXtc06kXurXITqnscskyY2BOXi8wo7MTNS8qlHq8Izdpm8s8MqjPZDf207ZgbmZQPoiMZAfLTq3pdmaaJo2F25XlsknpQR6FzC9lGWe7XPY0QIv9RZOeb6dr2R5EBVfsap00SD5qw4FVBnUox2xY/Q4U2hCCAz3wgUMAEmMPGCT4rYAFBCLEViFFLMZI5OccMqggt4dZHDMYous4u7hbKdEA90ozydkOunj4x8iswQT5RF6RbfKBvCafyY99tdJcQ9WygWur4PLIHntwduHbP1k+rhK6f1gH1iyhA9fyWgXWHuWIuoVT8Pv3H28vTM9PpJPkBfmC9T8nW+Q93iDof3VezvH5Z6iu9G8hq3jDGKM7ZQ13UZEjonbqFS6gD81zXKxTOWblG7uIX/qN/a8ig8GQYoGpNrF2N8VwsHi5YU01puau1GdulA0zCufgPBjYFVdhBm7DLDTB0da0h9oT7an+SH+jv9XfFakjWsk5A38N/eNPMAELWw==</latexit> log p✓(x) = log p(f✓(x)) + log |det (diag(exp(s✓(x1:d))))| = log p(f✓(x)) + log(exp(tr(diag(s✓(x1:d))))) = log p(f✓(x)) + X j s✓(x1:d)j <latexit sha1_base64="DSjpodDpskC/F5uX/kvZDy72a9g=">AAADL3icnVLLShxBFD22iY8x0VE3QjbiRBmDDDUiKoKgJotsxFdGBVuG7rYcG/tFdc2gDvMD/oALVwlkEdyYpW7d5AeCuBG3kqWBQHDhre4mIQ5GsJruOnXqnlOni2sGjh1Kxi4atMZnz5uaW1pTbS9etnekO7uWQ78sLF6wfMcXq6YRcsf2eEHa0uGrgeCGazp8xdx+q/ZXKlyEtu99kLsBX3eNkmdv2pYhiSqmX+sbXGZ1vhNkpwcHByYjpLuG3BJuVYqaYlPFdIblWDR660E+ARkkY95P/4aODfiwUIYLDg+SsAMDIT1ryIMhIG4dVeIEITva56ghRdoyVXGqMIjdpm+JVmsJ69FaeYaR2qJTHHoFKXvRz76zL+yGfWNH7JrdPuhVjTxUll2azVjLg2LHfs/Sr0dVLs0SW39V/80ssYnxKKtN2YOIUX9hxfrK3sHN0sRif3WAfWI/KP9HdsHO6A+8yk/r8wJfPCR35f+OVPEdCkKzSYY5cuTEqJW6hTd0jh7VlCinOrGW3HGJ+KE/3FMdDezUOcacapP8/aaoB8vDufxobnRhJDM1kzRMC16hD1nqijFM4T3mUaBc+zjGCU61r9q5dqldxaVaQ6Lpxj9Du74DThK5Zw==</latexit> det(exp(A)) = exp(tr(A)) <latexit sha1_base64="3qEGTt73nIfhhgX79WR2jOHK9h4=">AAADb3icnVLLahRBFD2Z9hHHR0aziBCQwSFhJjFDtUgSBoQQs3Aj5uEkgXRo+lGZNOnpbrprhsk0/QP+gAtXCbgQP8ONuHeRTxA3SoSQ4MJb3Y2v8QFW01X3nrrn1KnimoHrRIKxo6GCcu78hYvDl4qXr1y9NlK6fmM98juhxZuW7/rhpmlE3HU83hSOcPlmEHKjbbp8w9x7IPc3ujyMHN97IvYDvt02Wp6z41iGIEgv2T09Vht2Mnm/nwWaRog9rTaW9LiXEF7t/5jPCD3WxC4XRlLNqbWa5tu+0HgvqM5Ev9ku6qUKq7N0lAcDNQ8qyMeyXzqDBhs+LHTQBocHQbELAxF9W1DBEBC2jZiwkCIn3edIUCRuh6o4VRiE7tHcomwrRz3KpWaUsi06xaU/JGYZE+wde8mO2Rv2ir1nX/6oFaca0ss+rWbG5YE+8vTm2sk/WW1aBXa/s/7qWWAH86lXh7wHKSJvYWX8bv/Z8VpjdSKeZIfsA/k/YEfsNd3A6362Xqzw1eekLvWXiJW9YUjRo9zDY1LkhMhMvsIUnaOlNS3yKU9M8jduEX7nG/a/igZ6A4oZJttE/bUpBoP1u3V1tj67cq+ysJg3zDDGcRtV6oo5LOAhltEkX2/xEac4K3xSxpRbSjkrLQzlnFH8NJTaV102z5g=</latexit> x1:d = z1:d xd+1:Dx = (zd+1:Dx t✓(x1:d)) exp( s✓(x1:d)) -
124 Copyright 2025 NTT CORPORATION Flow-based Model (5) Real NVPで⽣成したCelebAとCIFAR10
(2017年時点) [E3] NOTE: • FlowはVAEよりも性能が⾼く、厳密に確率を求められるので注⽬されていた (GAN or Flow という流れだった) • ⽋点として、全単射1つだけでは表現能⼒が低く、多段にする必要があるため、 計算量が膨⼤になることがあげられる -
125 Copyright 2025 NTT CORPORATION 参考⽂献 E 1. Goodfellow, Ian,
et al. "Generative adversarial nets." Advances in neural information processing systems 27 (2014). 2. Dinh, Laurent, David Krueger, and Yoshua Bengio. "Nice: Non-linear independent components estimation." arXiv preprint arXiv:1410.8516 (2014). 3. Dinh, Laurent, Jascha Sohl-Dickstein, and Samy Bengio. "Density estimation using real nvp." arXiv preprint arXiv:1605.08803 (2016). -
127 Copyright 2025 NTT CORPORATION 概要 • 拡散モデルの⾮常に分かりやすいレビュー論⽂である [F1] に
従って、拡散モデルの導出を⾏う • Variational Autoencoder (VAE) や Denoising Diffusion Probabilistic Model (DDPM)、Score-Based Model の著者らと同じグループ (Google) • 彼らのレビューを受けており、統⼀的な観点でまとめられている • 拡散モデルはVAEの特殊ケースで、三種類の等価な⽬的関数が存在する • これらの導出を、できるだけ式変形を省略せずに説明する -
128 Copyright 2025 NTT CORPORATION 拡散モデル (1) • 拡散モデル [B2]
は、𝑇 ステップかけてデータ 𝐱- にノイズを 徐々に加え、標準ガウス分布に従うノイズに変換する⼿法 • ノイズを加える順⽅向の過程を拡散 (Diffusion) と呼ぶ • その逆変換を⾏うことで、ノイズから元のデータを復元できる • ノイズを除去する逆⽅向の過程をノイズ除去 (Denoising) と呼ぶ ! <latexit sha1_base64="7yFrn0YPyuP5dVIvc7Tl2zcbS/g=">AAAB+HicbVBNSwMxEJ2tX7V+dNWjl2ARPJXdKuix6MVjBfsB7VKyaXYbmk2WJKvU0l/ixYMiXv0p3vw3pu0etPXBwOO9GWbmhSln2njet1NYW9/Y3Cpul3Z29/bL7sFhS8tMEdokkkvVCbGmnAnaNMxw2kkVxUnIaTsc3cz89gNVmklxb8YpDRIcCxYxgo2V+m65x6WIFYuHBislH/tuxat6c6BV4uekAjkafferN5AkS6gwhGOtu76XmmCClWGE02mpl2maYjLCMe1aKnBCdTCZHz5Fp1YZoEgqW8Kgufp7YoITrcdJaDsTbIZ62ZuJ/3ndzERXwYSJNDNUkMWiKOPISDRLAQ2YosTwsSWYKGZvRWSIFSbGZlWyIfjLL6+SVq3qn1drdxeV+nUeRxGO4QTOwIdLqMMtNKAJBDJ4hld4c56cF+fd+Vi0Fpx85gj+wPn8AXOGk5o=</latexit> xT ! · · · ! xt ! xt 1 ! · · · ! x0 <latexit sha1_base64="l4LvSgM7PR7I/kkuy5soikK4gpU=">AAAEoXictVLditNAFE7XqGv92a5eejOYLexKLU0VFKRQ9EYvhCrb3YUklOlk2g6dnzBzYrcb8zK+lU/gazhJK6atuiB4YODM+T/n+8YJZwY6nW+1vRvuzVu39+/U7967/+CgcfjwzKhUEzokiit9McaGcibpEBhwepFoisWY0/Px/G3hP/9MtWFKnsIyoZHAU8kmjGCwplHjeygwzAjThNM4Kz/jSXaZj05zFHIlp5pNZ4C1VgsUkliB2TX/oQLYCpe/4rJwZhJM6NPMJyLPt9IM0SwBA0tOUaVGBs/8/J8mWVRH6eSjhtdpd0pBu4q/VjxnLYPR4d7XMFYkFVQC4diYwO8kEGVYA7P183qYGmr3meMpDawqsaAmykpEctS0lhhNlLZPAiqt1YwMC2OWYmwjiynNtq8w/s4XpDB5FWVMJilQSVaNJilHoFABL4qZpgT40irYntTOisgMa0zAkqC+0QbY/MquIfCcYssbsBH1UNIFUUJgGVePGfhR1qyj1YETXAaH/SqAnp836/lGftUfdNcFiqbBT8L2jouQdvE9iVAoVUyDWONFa5XVYlJSjezEPT+BlmCSiVQgw65or2vBaE0Y5z1e4D/VeBmhstwJyo5C0YeZ53vdo/z19lhVjly71+K6xRb/ZbO/rbLCS8HMwmVZ7W9zeFc567b95+3uxxde/82a3/vOY+eJc+z4zkun77xzBs7QIbUPNVP7Ustdz33vDtxPq9C92jrnkbMhbvAD81mObw==</latexit> p✓(xt 1 |xt) <latexit sha1_base64="XVzP503G8Ma8Lkwk3KKGZcZJbZ0=">AAACEnicbVC7SgNBFJ2Nrxhfq5Y2g0FICsNuFEwZsLGMYB6QLMvsZDYZMvtg5q4Y1nyDjb9iY6GIrZWdf+Mk2SImHrhwOOde7r3HiwVXYFk/Rm5tfWNzK79d2Nnd2z8wD49aKkokZU0aiUh2PKKY4CFrAgfBOrFkJPAEa3uj66nfvmdS8Si8g3HMnIAMQu5zSkBLrlmO3R4MGZBSLyAw9Pz0YeKmcG5P8CNekKDsmkWrYs2AV4mdkSLK0HDN714/oknAQqCCKNW1rRiclEjgVLBJoZcoFhM6IgPW1TQkAVNOOntpgs+00sd+JHWFgGfq4kRKAqXGgac7p0eqZW8q/ud1E/BrTsrDOAEW0vkiPxEYIjzNB/e5ZBTEWBNCJde3YjokklDQKRZ0CPbyy6ukVa3YF5Xq7WWxXsviyKMTdIpKyEZXqI5uUAM1EUVP6AW9oXfj2Xg1PozPeWvOyGaO0R8YX7+bCp4F</latexit> q(xt |xt 1) <latexit sha1_base64="eAZ87UuTmAQoJ4u19RGH5tA+bCI=">AAACC3icbVC7TgJBFJ31ifhatbSZQEywkOyiiZQkNpaYyCMBspkdZmHC7MOZu0ay0tv4KzYWGmPrD9j5N87CFgieZJIz59ybe+9xI8EVWNaPsbK6tr6xmdvKb+/s7u2bB4dNFcaSsgYNRSjbLlFM8IA1gINg7Ugy4ruCtdzRVeq37plUPAxuYRyxnk8GAfc4JaAlxyzclbo+gaHrJQ8TB/AjnvsmcGZPTh2zaJWtKfAysTNSRBnqjvnd7Yc09lkAVBClOrYVQS8hEjgVbJLvxopFhI7IgHU0DYjPVC+Z3jLBJ1rpYy+U+gWAp+p8R0J8pca+qyvTRdWil4r/eZ0YvGov4UEUAwvobJAXCwwhToPBfS4ZBTHWhFDJ9a6YDokkFHR8eR2CvXjyMmlWyvZ5uXJzUaxVszhy6BgVUAnZ6BLV0DWqowai6Am9oDf0bjwbr8aH8TkrXTGyniP0B8bXL+1hmu8=</latexit> -
129 Copyright 2025 NTT CORPORATION 拡散モデル (2) • 拡散モデルは、下記を仮定した時の階層型VAEに相当する •
潜在変数がデータと同次元で、マルコフ連鎖を形成 • エンコーダ 𝑞 が線形でハイパーパラメータ 𝛼< のみに依存 (= 学習しない) • 最終ステップ 𝑇 において、エンコーダ 𝑞 が標準ガウス分布に⼀致 ! <latexit sha1_base64="7yFrn0YPyuP5dVIvc7Tl2zcbS/g=">AAAB+HicbVBNSwMxEJ2tX7V+dNWjl2ARPJXdKuix6MVjBfsB7VKyaXYbmk2WJKvU0l/ixYMiXv0p3vw3pu0etPXBwOO9GWbmhSln2njet1NYW9/Y3Cpul3Z29/bL7sFhS8tMEdokkkvVCbGmnAnaNMxw2kkVxUnIaTsc3cz89gNVmklxb8YpDRIcCxYxgo2V+m65x6WIFYuHBislH/tuxat6c6BV4uekAjkafferN5AkS6gwhGOtu76XmmCClWGE02mpl2maYjLCMe1aKnBCdTCZHz5Fp1YZoEgqW8Kgufp7YoITrcdJaDsTbIZ62ZuJ/3ndzERXwYSJNDNUkMWiKOPISDRLAQ2YosTwsSWYKGZvRWSIFSbGZlWyIfjLL6+SVq3qn1drdxeV+nUeRxGO4QTOwIdLqMMtNKAJBDJ4hld4c56cF+fd+Vi0Fpx85gj+wPn8AXOGk5o=</latexit> xT ! · · · ! xt ! xt 1 ! · · · ! x0 <latexit sha1_base64="l4LvSgM7PR7I/kkuy5soikK4gpU=">AAAEoXictVLditNAFE7XqGv92a5eejOYLexKLU0VFKRQ9EYvhCrb3YUklOlk2g6dnzBzYrcb8zK+lU/gazhJK6atuiB4YODM+T/n+8YJZwY6nW+1vRvuzVu39+/U7967/+CgcfjwzKhUEzokiit9McaGcibpEBhwepFoisWY0/Px/G3hP/9MtWFKnsIyoZHAU8kmjGCwplHjeygwzAjThNM4Kz/jSXaZj05zFHIlp5pNZ4C1VgsUkliB2TX/oQLYCpe/4rJwZhJM6NPMJyLPt9IM0SwBA0tOUaVGBs/8/J8mWVRH6eSjhtdpd0pBu4q/VjxnLYPR4d7XMFYkFVQC4diYwO8kEGVYA7P183qYGmr3meMpDawqsaAmykpEctS0lhhNlLZPAiqt1YwMC2OWYmwjiynNtq8w/s4XpDB5FWVMJilQSVaNJilHoFABL4qZpgT40irYntTOisgMa0zAkqC+0QbY/MquIfCcYssbsBH1UNIFUUJgGVePGfhR1qyj1YETXAaH/SqAnp836/lGftUfdNcFiqbBT8L2jouQdvE9iVAoVUyDWONFa5XVYlJSjezEPT+BlmCSiVQgw65or2vBaE0Y5z1e4D/VeBmhstwJyo5C0YeZ53vdo/z19lhVjly71+K6xRb/ZbO/rbLCS8HMwmVZ7W9zeFc567b95+3uxxde/82a3/vOY+eJc+z4zkun77xzBs7QIbUPNVP7Ustdz33vDtxPq9C92jrnkbMhbvAD81mObw==</latexit> p✓(xt 1 |xt) <latexit sha1_base64="XVzP503G8Ma8Lkwk3KKGZcZJbZ0=">AAACEnicbVC7SgNBFJ2Nrxhfq5Y2g0FICsNuFEwZsLGMYB6QLMvsZDYZMvtg5q4Y1nyDjb9iY6GIrZWdf+Mk2SImHrhwOOde7r3HiwVXYFk/Rm5tfWNzK79d2Nnd2z8wD49aKkokZU0aiUh2PKKY4CFrAgfBOrFkJPAEa3uj66nfvmdS8Si8g3HMnIAMQu5zSkBLrlmO3R4MGZBSLyAw9Pz0YeKmcG5P8CNekKDsmkWrYs2AV4mdkSLK0HDN714/oknAQqCCKNW1rRiclEjgVLBJoZcoFhM6IgPW1TQkAVNOOntpgs+00sd+JHWFgGfq4kRKAqXGgac7p0eqZW8q/ud1E/BrTsrDOAEW0vkiPxEYIjzNB/e5ZBTEWBNCJde3YjokklDQKRZ0CPbyy6ukVa3YF5Xq7WWxXsviyKMTdIpKyEZXqI5uUAM1EUVP6AW9oXfj2Xg1PozPeWvOyGaO0R8YX7+bCp4F</latexit> q(xt |xt 1) <latexit sha1_base64="eAZ87UuTmAQoJ4u19RGH5tA+bCI=">AAACC3icbVC7TgJBFJ31ifhatbSZQEywkOyiiZQkNpaYyCMBspkdZmHC7MOZu0ay0tv4KzYWGmPrD9j5N87CFgieZJIz59ybe+9xI8EVWNaPsbK6tr6xmdvKb+/s7u2bB4dNFcaSsgYNRSjbLlFM8IA1gINg7Ugy4ruCtdzRVeq37plUPAxuYRyxnk8GAfc4JaAlxyzclbo+gaHrJQ8TB/AjnvsmcGZPTh2zaJWtKfAysTNSRBnqjvnd7Yc09lkAVBClOrYVQS8hEjgVbJLvxopFhI7IgHU0DYjPVC+Z3jLBJ1rpYy+U+gWAp+p8R0J8pca+qyvTRdWil4r/eZ0YvGov4UEUAwvobJAXCwwhToPBfS4ZBTHWhFDJ9a6YDokkFHR8eR2CvXjyMmlWyvZ5uXJzUaxVszhy6BgVUAnZ6BLV0DWqowai6Am9oDf0bjwbr8aH8TkrXTGyniP0B8bXL+1hmu8=</latexit> 𝑇 − 1個の潜在変数とみなせる <latexit sha1_base64="Xp4JD4uRj5HOy2TsSJMT2azpVpo=">AAADunicnVLLahRBFL2d9hFHYybqQhAlOESiJkO1SBRRCOpCF2oeThJIh6G6UjNTTPUjXTVDYtN78QdcuFJwIX6GG3/ART5BBDcR3LjwVnVHjUMMWE133zp1zrm3LjdIpFCakG1nyD10+MjR4WOV4ydGTo5Wx04tqbiXMt5gsYzTlYAqLkXEG1poyVeSlNMwkHw56N4z58t9nioRR0/1VsLXQtqOREswqhFqVp/7IdWdoJVt5s1M53d8tZHqzKcy6VAD5HvOp738asHwpv/k8EQJiXaWMeVv9Oh6ZRf0lQitCaMye5xP7hoSJJbhw/xypVmtkTqxa3ww8MqgBuWai8ecEfBhHWJg0IMQOESgMZZAQeGzCh4QSBBbgwyxFCNhzznkUEFtD1kcGRTRLn7buFst0Qj3xlNZNcMsEt8UleMwQT6Rd2SHfCTvyWfyY1+vzHqYWrbwHxRanjRHX5xd/H6gKsS/hs5v1T9r1tCCm7ZWgbUnFjG3YIW+/+zlzuKthYnsEnlDvmD9r8k2+YA3iPrf2Nt5vvAK3Y3/fVQVPUwxelTW8AQdOSJmZ7pwBfP4ltPGOk3GvOxxG/GpX9j/OlLYHHAssP27xjAy9+WYK8dp8v6encFg6Vrdm6nPzF+vzd4t52oYzsFFmMTZuQGz8ADmoIGeX50zznnngnvbDVzhdgvqkFNqTsOe5eqf5nXmrA==</latexit> xt = p ↵txt 1 + p 1 ↵t✏t 1, ✏ ⇠ N(0, I) -
130 Copyright 2025 NTT CORPORATION 拡散モデル (3) • Reparameterization Trick
[B1] を⽤いて、平均 𝜇、分散𝜎%𝐈 のガウス分布からのサンプル 𝐳 は、下記で計算できる • つまり、エンコーダ 𝑞(𝐱/ |𝐱/<! ) の分布形と時刻 𝑡 のデータ 𝐱/ の間には、下記の関係が成り⽴つ <latexit sha1_base64="kqnqUSi48sZ3m24n/H4SnQKKUIc=">AAADhnicnVJNTxRBEK1lUNdVZMGLCZeNGwzKZtNrFIyJyUY56EH5XCBhyKan6R069Hww07MRJvMH+AMeOGHiwfgPvHrxD3jgxhU9QsLFg9UzsxrdIAk9mZnXr+u9qq6U5UsRKkIOCwPG4JWr14rXSzduDt0aLo+MLodeFDDeYp70glWLhlwKl7eUUJKv+gGnjiX5irX1Qp+vdHkQCs9dUjs+X3eo7YqOYFQh1S4vmQ5Vm1Yn3k2emU40aYbCdqjJ/VBIz62Z2xHdqJR6ezx1UgGjMn6TTPTEJKn14KvkfqldrpI6SVelHzRyUIV8zXkjhSEwYQM8YBCBAxxcUIglUAjxWYMGEPCRW4cYuQCRSM85JFBCbYRRHCMoslv4tXG3lrMu7rVnmKoZZpH4BqiswDj5Rj6SE/KVfCLH5Oe5XnHqoWvZwb+VabnfHt67s3h2ocrBv4LNP6r/1qygA0/SWgXW7qeMvgXL9N3ddyeLTxfG43vkPfmB9R+QQ/IFb+B2T9mHeb6wj+7afwZVWQ8DRK/zGmbRkSOjd7oLDzCPmcbYWKfOmOQ9tpGv/eYu60jhbZ9jxp3fNYZI35djrgSnqfHv7PSD5Yf1xlR9av5Rtfk8n6sijMFdmMDZmYYmvIQ5aKHnZziCY/huFI268diYzkIHCrnmNvy1jOYv/hzSHw==</latexit> z = µ + ✏, ✏ ⇠ N(0, I) <latexit sha1_base64="40OZOVcDt7pf4EqeRWcC3dMneo4=">AAAED3icnVLLahRBFL2d9hFHYya6EdwMDgkzmgzVIlGUQDAuFHzk4SSBdBiqy5qZIv1Kdc2Y2PYPuHPlwpWCC/ED3IngRj/ARRZ+gLiM4MaFt7pbzcwQA1bT3bfOvefcU8V1QldEipAdY8g8dPjI0eFjheMnRk6OFsdOLUdBRzJeZ4EbyFWHRtwVPq8roVy+GkpOPcflK87GnM6vdLmMRODfV9shX/doyxdNwahCqFH8YntUtZ1mvJU0YpXM2NGmVLFN3bBNNZD05Kes5EJWYU3treFhJFyUSysm7Nu8qaRotRWVMnhY2qz0Nnncr1mdSRFG3fhu0ld87UBHk5W9Zqq/07eSaqFRLJMaSVdpMLDyoAz5mg/GjBGw4QEEwKADHnDwQWHsAoUInzWwgECI2DrEiEmMRJrnkEABuR2s4lhBEd3Abwt3aznq415rRimbYRcXX4nMEoyTz+Q12SUfyRvylfzcVytONbSXbfw7GZeHjdEnZ5Z+HMjy8K+g/Zf1T88KmnAl9SrQe5gi+hQs43cfPdtduro4Hk+Ql+Qb+n9BdsgHPIHf/c5eLfDF56iu9W8gK7tDidGd3MM9VOSI6J2+hfPYx05rWuhTd0zyO24hPvkH+19FClsDihm2/60xjPR5OfZKcJqs/tkZDJYv1qzp2vTCpfLs9XyuhuEsnIMKzs5lmIWbMA91YMacIQxpROZT8635znyflQ4ZOec09Czz0y/2wwsT</latexit> xt = p ↵txt 1 + p 1 ↵t✏t 1 , q(xt |xt 1) = N(xt; p ↵txt 1, (1 ↵t)I) -
131 Copyright 2025 NTT CORPORATION 拡散モデル (4) • データ 𝐱-
の確率 𝑝$ (𝐱- ) を下記で推定する (𝜃: パラメータ) • また、拡散されたデータの確率を下記で推定する <latexit sha1_base64="S6AX99OjqaNiP69H6X9Psk+t7iY=">AAADWnicnVLLahRBFD2Z9pFMopmoC8HN4JCQiAzVIokEhKAu3EiekwTSoanu1MwU6RfdNUNi0z+QH8jClYILce0XuPEHXARd6kJcRhAkC291N76GKFhNV906dc+pU5frRJ5MFGNHQxXjzNlz54dHqqNjFy6O1yYurSdhL3ZFyw29MN50eCI8GYiWksoTm1EsuO94YsPZva/PN/oiTmQYrKn9SGz7vBPItnS5IsiuLUZ2aqmuUDybtnyuuk473cvslGUzU3ctGaj6aQnza9nMzq+ISUjVrjVYk+WjPhiYZdBAOZbC2jdY2EEIFz34EAigKPbAkdC3BRMMEWHbSAmLKZL5uUCGKnF7lCUogxO6S3OHdlslGtBeayY526VbPPpjYtYxyd6yF+yYvWEv2Sd2cqpWmmtoL/u0OgVXRPb4wdXVr/9k+bQqdH+y/upZoY07uVdJ3qMc0a9wC37/8eHx6vzKZDrFnrHP5P8pO2Kv6QVB/4v7fFmsPCF1rf+AWEUNY4oelR4WSVEQone6CjfoHivP6ZBPfWNW1rhD+M0f2P8qcuwNKBaYbhPzz6YYDNZvNc3Z5uzy7cbCvbJhhnEN1zFNXTGHBTzEElrk6xXe4QM+Vt4bFWPEGC1SK0Ml5zJ+G8aV73UsyVA=</latexit> p✓(x0) = Z p✓(x0:T )dx1:T 標準ガウス分布 <latexit sha1_base64="pHjwP9V4YXQZsBksGoInhz0pyIo=">AAAD5nicnVLLbtNAFL2ueZRAaQobBJuIqKhBIRojVFBRpAhYUCSgr7SV6mKNJ5PEqh+DPYlazPwAC3aoCzaAxAKx5Q/Y8AMs+gmIZZHYsOD6UVAapUiMZfvcM/ecuXN1beE6kSRkTxvTjx0/cXL8VOH0mYmzk8Wpc6tR0AsZb7LADcJ1m0bcdXzelI50+boIOfVsl6/ZW3eT/bU+DyMn8FfkjuCbHu34TtthVCJlFT8JKzZll0uqZkyPyq7djreVFZO5FVWpiwEOGVOEQcuKZd1QTzAeIZbXDPV8gFCVqvm0R1ulIcd6GjPqxo/Uob3bByFR1QM4ryqFglUskxpJV2kYGDkoQ74WgiltAkxoQQAMeuABBx8kYhcoRPhsgAEEBHKbECMXInLSfQ4KCqjtYRbHDIrsFn47GG3krI9x4hmlaoanuPiGqCzBNPlKPpB98oV8JN/Ir5FeceqR1LKDfzvTcmFNvriw/POfKg//Erp/VUfWLKENt9JaHaxdpExyC5bp+89295fnlqbjK+Qd+Y71vyV75DPewO//YO8X+dJrdE/876Eq62GI6GFew2N05MgkUdKFq3iOmeZ0sM7kRJX3uIN89Q/3v44UtoccM2501xii5L4cz1I4Tcbh2RkGq9drxmxtdvFGuXEnn6txuASXYQZn5yY04D4sQBOYdlFraPPaA72rv9Rf6btZ6piWa87DwNLf/Aazavd4</latexit> p✓(x0:T ) = p(xT ) T Y t=1 p✓(xt 1 |xt), p(xT ) = N(xT ; 0, I) <latexit sha1_base64="f1LXmz4pmUQzvcKlKmdXKJnxYdI=">AAAEB3icnVLNbtNAEB7X/JRAaQoXJC4VUVGC0miNUEGtIlXAAQ5Af5K2Ut1aa2eTmPgv9iZqMfsA8AIcOIHEAXHghrgiLrxAD30ExLFIXDgwaxtKEpVKrOXd2W/m+2Z2NGbg2BEnZF8ZU0+cPHV6/Ezu7LmJ85P5qQtrkd8LLVa3fMcPN0waMcf2WJ3b3GEbQcioazps3ezckf71Pgsj2/dqfDdgWy5teXbTtihHyMjvdYu6S3nbbMY7woi1+Zp4+jdARKmqB6HfMGJe1cR2XBODDD4Yz2c1USrr3R5t5I4PrCaIRZ34oRgKXtCjbshjnTpBm0pADLPLRW320F367b4vSjkjXyAVkqzpUUPLjAJka8mfUiZAhwb4YEEPXGDgAUfbAQoRfpugAYEAsS2IEQvRshM/AwE55PYwimEERbSDewtvmxnq4V1qRgnbwiwO/iEyp2GG7JG35IB8Ie/IV/LzSK040ZC17OJpplwWGJPPL63+OJbl4smhfcj6Z80cmnArqdXG2oMEka+wUn7/yYuD1fmVmfgqeU2+Yf2vyD75jC/w+t+tN8ts5SWqS/27yEp7GKL1IKvhESoyRORNduEa5tGTmBbWKTOKrMctxMt/sP9VpLAzophiR3fNQku+l2EugdOkDc/OqLF2vaLNVeaWbxQWb2dzNQ6X4QoUcXZuwiLcgyWog6UsKFR5rHTUZ+p79YP6MQ0dUzLORRhY6qdfJRkGdQ==</latexit> q(x1:T |x0) = T Y t=1 q(xt |xt 1), q(xt |xt 1) = N(xt; p ↵txt 1, (1 ↵t)I) -
132 Copyright 2025 NTT CORPORATION 拡散モデル (5) • この時、変分下界は下記で求められる •
この変分下界をひたすら変形し、簡略化していく 𝑞(𝐱":$|𝐱%) による Importance Sampling Jensenの不等式: 対数と和 (期待値) の交換 <latexit sha1_base64="4OKW0nm2BqPPebOqJgXP07C95b4=">AAAEz3icrVJNb9NAEJ24BkqgtIELEpeIqFWCULQuqKAipIoPiQOIpm3aStkosrcbZ1XHduxNaDFGXOEPcIALSBwQP4MLf4BDfwLiWCQuHJi1LT4SpUUVa9mefTvvzdvRWL4jQknIXk6b0I8dPzF5Mn/q9NSZ6ZnC2fXQ6weM15nneMGmZYbcES6vSyEdvukH3OxaDt+wtm+r840BD0LhuWty1+fNrmm7oi2YKRFqFXKvqePZRb8VUdnh0ozLtGvKjtWOduJWROLK3E2VQIUrxyYtrsWVrT8RAxFKM2aCW9FdxHvl4awnQ9Vi6vC2bNB2YLLooHrxP4kFwu7IJlqhNu8dzYm6wn93w3t9MUjOmelE94ebfiMtVMm3ZkqkSpJVHA2MLChBtpa9Qm4KKGyBBwz60AUOLkiMHTAhxKcBBhDwEWtChFiAkUjOOcSQR24fszhmmIhu49fGXSNDXdwrzTBhM6zi4Bsgswiz5DN5T/bJJ/KBfCE/xmpFiYbysot/K+VyvzX94vzq90NZXfxL6PxmHehZQhuuJ14FevcTRN2CpfzB45f7q4srs9EceUu+ov83ZI98xBu4g2/sXY2vvEJ1pX8HWWkPA4weZB4eoiJHRO1UFy5hHZrk2OhTVYyzHtuIX/6FHVXRhJ0RxRQb3zWGkbovx1oxTpMxPDujwfp81VioLtSulpZuZXM1CRfgIpRxdq7BEtyDZagD0ya0ijavXdFr+iP9qf4sTdVyGecc/LX05z8BOJNSBA==</latexit> log p✓(x0) = log Z p✓(x0:T )dx1:T = log E q(x1:T |x0) p✓(x0:T ) q(x1:T |x0) E q(x1:T |x0) log p✓(x0:T ) q(x1:T |x0) ⌘ L(x0; ✓) -
133 Copyright 2025 NTT CORPORATION 式変形の⽬的 • 𝑝$ (𝐱/ |𝐱/>!
) と 𝑞 𝐱/ 𝐱/<! は依存する時刻が異なる • 学習時に 𝐱<E0 と 𝐱<$0 を両⽅サンプリングすると、分散が⼤きくなる • ベイズの定理を使って、依存する時刻を 𝑡 に揃える • 理想的には 𝑞 𝐱<$0 𝐱< として時刻を揃えたいが、計算が難しい • その代わりに、計算しやすい 𝑞(𝐱<$0 |𝐱< , 𝐱1 ) を⽤いて時刻を揃える <latexit sha1_base64="VSdFM1AbLtHd0EEQtpTMEBuSraM=">AAADf3icnVLNShxBEK5xoq6bxF3NRchFsmhcMUuNyGoEQaKHXCT+ZFVwZemZ9K6D8+dM76JO5gXyAjnkZMBDyGN48QU86BtIjgYCIQerZ4YEd0gC9jDd1V/X9/XXRemeZQYC8VLpUR/09vXnBvIPHz0eLBSHhjcDt+0bvGa4lutv6yzglunwmjCFxbc9nzNbt/iWvr8kz7c63A9M13krjjy+a7OWYzZNgwmCGkVxMFG3mdjTm+Fh1AjFCy16fweIyuML9abPjLArsyuPiOWsVjnK0MpRvlEsYQXjMZoNtDQoQTpW3eJPqMM7cMGANtjAwQFBsQUMAvp2QAMEj7BdCAnzKTLjcw4R5InbpixOGYzQfZpbtNtJUYf2UjOI2QbdYtHvE3MUxvACv+ANnuNXvMZff9UKYw3p5YhWPeFyr1H4MLLx478sm1YBe39Y//QsoAlzsVeTvHsxIl9hJPzO8cebjfn1sXAcP+M38n+Cl3hGL3A6343TNb7+idSl/jKxkhr6FK2kHt6QIidE7mQVJumeepzTIp/yxiitcYvwqd/YfRUZHGYUE0y2idbdFNlgc7qiVSvVtZnS4qu0YXLwFJ7BBHXFLCzCa1iFGvm6UkAZUPKqoj5XKyomqT1KynkCd4b68hZH2NZT</latexit> q(xt 1 |xt) = q(xt |xt 1)q(xt 1) q(xt) <latexit sha1_base64="Rw9z8FG/jWUYOUfKNGlfNqJPUMU=">AAAEK3icrVK/TxRBFH7LIuKBcGhjYgHxggGCl7eEADExIWphQ+TXAQlHLrPj3LFhf7k7dwHXbS38ByysNLEwQKn/AI29scDYWhhLTEyMhW92Nwh3AQxxNrvz3jfv+963k2f6thVKxH2tTW+/0HGx81Kuq/tyT2++78pS6NUDLkrcs71gxWShsC1XlKQlbbHiB4I5pi2WzY176ny5IYLQ8txFueWLNYfVXKtqcSYJqvRp/Y+Hyg6T62Y12owrkbxlxE+PAfHo0RTj4dydcjVgPGoiNtFIp5l4RieqiE8XVRX/3P0/tavkC1jEZA20BkYWFCBbs17+F5ThEXjAoQ4OCHBBUmwDg5CeVTAAwSdsDSLCAoqs5FxADDni1qlKUAUjdIO+NcpWM9SlXGmGCZtTF5vegJgDMIif8C0e4Afcxm/4+0StKNFQXrZoN1Ou8Cu9z68t/DyT5dAuYf0v61TPEqowlXi1yLufIOoveMpvPHlxsHB7fjC6ia/xO/l/hfu4R3/gNn7wN3Ni/iWpK/37xErvMKBoJvPwkBQFISpTtzBCfcpJTY18qo5xdsc1wkcPsfMqMthsUUwxNSZG81C0BktjRWOiODE3Xpi+mw1MJ1yHGzBEUzEJ0/AAZqEEXHum7WjvtPf6rv5R/6x/SUvbtIxzFY4t/esfMtIftw==</latexit> q(xt 1 |xt, x0) = q(xt |xt 1, x0)q(xt 1 |x0) q(xt |x0) = q(xt |xt 1)q(xt 1 |x0) q(xt |x0) 周辺化する必要がある ガウス分布として閉形式で求まる (後述) -
134 Copyright 2025 NTT CORPORATION 変分下界の変形 (1) <latexit sha1_base64="tBEmXHK9dWmL4V87+p701bO7Scs=">AAAH+3ic7VPLbtNQEJ2UBpdAaQMbJDYVUasGSriuUEFFlSoeEgsQfaWtFKfWtXvjWHVsY99ELeb+AD/AghUgFjy2fAGb/gCLfgJiWSQ2LBg/BNhR2gYEK26UeO7xnDNnRhPNtUyfE7KXGzg2mD8uDZ0onDw1fHpktHhm1Xfans6qumM53rpGfWaZNqtyk1ts3fUYbWkWW9O2boXv1zrM803HXuE7Lqu3qGGbDVOnHCG1OLirtChv6tQK7onJKNYawbZQAyJuKLzJOC1PzMW4FtxB/GEqS55dEY/TtLJQLNbgNcVyDKXhUT1w1SCWylRAblkcSdAzjSavK8qfW0lRsL7ies6mGvA5WWzgvYdVfllOa/PQeYabtsMzBFT4q430GnJaSv6l4+n+O84Y7bKZ0f4/kb4nMvUPd//IAzq8TXEpqpNu9sB//1HG2cd8CupoiVRIdMa6AzkJSpCcBaeYGwYFNsEBHdrQAgY2cIwtoODjpwYyEHARq0OAmIeRGb1nIKCA3DZmMcygiG7hr4G3WoLaeA81/YitYxULvx4yx2CcfCSvyT7ZJW/JJ/Ktp1YQaYRedvCpxVzmqiNPzi1/PZTVwieH5k/WgZ45NOB65NVE726EhF3oMb/z6On+8uzSeDBBXpDP6P852SMfsAO780V/tciWnqF6qH8bWfEMPYzuJx4eoCJDJLyFU7iIdZQox0CfYUWRzNhAfOoH9ruKFLa7FGOs99R0jMJ+GdYSuE1ydne6g9XpijxTmVm8Wpq/mezVEJyHCzCJu3MN5uEuLEAV9PyVfDW/kVclIb2U3kjv4tSBXMI5C6kjvf8OkD+bCg==</latexit> L(x0;
✓) = E q(x1:T |x0) log p✓(x0:T ) q(x1:T |x0) = E q(x1:T |x0) " log p(xT ) QT t=1 p✓(xt 1 |xt) QT t=1 q(xt |xt 1) # = E q(x1:T |x0) " log p(xT )p✓(x0 |x1) QT t=2 p✓(xt 1 |xt) q(x1 |x0) QT t=2 q(xt |xt 1) # = E q(x1:T |x0) " log p(xT )p✓(x0 |x1) QT t=2 p✓(xt 1 |xt) q(x1 |x0) QT t=2 q(xt |xt 1, x0) # = E q(x1:T |x0) " log p(xT )p✓(x0 |x1) q(x1 |x0) + log T Y t=2 p✓(xt 1 |xt) q(xt |xt 1, x0) # -
135 Copyright 2025 NTT CORPORATION 変分下界の変形 (2) <latexit sha1_base64="anyd3lUXppzh5wHVG394uluaQAo=">AAAMqHic3VZLTxNRFD7gC0oR0I2Jm0YCobxySwwaDAlRTEzEyPsRBpuZ29vphHlx55aAw/0D/gEXrjRxYfwZbvwDLkj8A8YlJm5ceOYRoNMBqhIgTtPOmXPPd77vfuemreaahicI2W1qvnT5ytVrLa2Ztmz79Y7OrhuLnlPllC1Qx3T4sqZ6zDRstiAMYbJllzPV0ky2pK0/CtaXNhn3DMeeF9suW7NU3TbKBlUFpopdrVXFUkWFqqY/JfvCWCv7W7LoE/lAERUm1HzveJTX/MeY36ipKozNy51aWF4qJiuLVcV0dKXMVeq7NZB5mXeLftQ7SVnTqoCtknT1ZAMhj8udUtEX4yPyBRLEtOksYijRRQQ8EWTjpMrBBL1CVZsyMwmsl4kM6aVJjrBYKtzQK2JNUc7V/HTJaYIHDggbByVKUjZzSsP947FeEP//b39yDTsRsw2c9igacHif2qtahzz+RyEXYThnNZoLMpiET6nfu+c4p6pdYlxDUuaf1cxkUM+2BLd8zqhje4JXqRH8L8gJxi0phw6rmixGwrD66ZSUfScNaGenbqr5Q4wuNxyew3VaMWx9n7B2mA2ZkvJjG5lyvOIGBoRbaPwApLhaYrZjeMH2EvvMFDu7yTAJr1x9UIiDboivaaerqR0UKIEDFKpgAQMbBMYmqODhaxUKQMDF3Br4mOMYGeE6AwkZxFaximGFitl1/NTxaTXO2vgc9PRCNEUWE98ckTnoIV/IB7JHPpOP5Bv5dWQvP+wRaNnGuxZhmVvseHVr7ueJKAvvAioHqGM1CyjD/VCrgdrdMBPsgkb4zZev9+bGZnv8XvKOfEf9b8ku+YQ7sDd/0PczbPYNdg/6TyIq8pBj9CzW8Bw7MswET4EL/cijhDU66gwYZeyxjvnB/dzfdlRhq65jlDvaNYpRsF+GXBJPUyF5duqDxZHhwujw6Mzd7omH8blqgdtwB/rw7NyDCXgC07AAtPVrpjnTlslm+7PT2aXsSlTa3BRjbkLNldV+A7FLe+w=</latexit> L(x0;
✓) = E q(x1:T |x0) 2 4log p(xT )p✓(x0 |x1) q(x1 |x0) + log T Y t=2 p✓(xt 1 |xt) q(xt 1 |xt,x0)⇠⇠⇠ ⇠ q(xt |x0) (((( ( q(xt 1 |x0) 3 5 = E q(x1:T |x0) " log p(xT )p✓(x0 |x1) ⇠⇠⇠⇠ q(x1 |x0) + log ⇠⇠⇠⇠ q(x1 |x0) q(xT |x0) + log T Y t=2 p✓(xt 1 |xt) q(xt 1 |xt, x0) # = E q(x1:T |x0) " log p(xT )p✓(x0 |x1) q(xT |x0) + log T Y t=2 p✓(xt 1 |xt) q(xt 1 |xt, x0) # = E q(x1:T |x0) [log p✓(x0 |x1)] + E q(x1:T |x0) log p(xT ) q(xT |x0) + T X t=2 E q(x1:T |x0) log p✓(xt 1 |xt) q(xt 1 |xt, x0) = E q(x1 |x0) [log p✓(x0 |x1)] + E q(xT |x0) log p(xT ) q(xT |x0) + T X t=2 E q(xt,xt 1 |x0) log p✓(xt 1 |xt) q(xt 1 |xt, x0) = E q(x1 |x0) [log p✓(x0 |x1)] | {z } reconstrucition term DKL(q(xT |x0)||p(xT )) | {z } prior matching term T X t=2 E q(xt |x0) [DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt))] | {z } denoising matching term <latexit sha1_base64="RZBc3jXdadgIqOeDr5I5VaI0Drk=">AAAD4nicnVJNaxRBEK3JaBJXk2wURPASXBKixKUnSCKiEPzCi5gPNwlkw9LT6d0Mma/M9C6J4/yB3MSDB70oeBAv/gcv/gEP+QniMYIXD76eGdTNkgTsYbqrXtd7VV2UHbpOrBjbN/rMU6f7BwbPlM6eGxoeKY+eX46DdiRkTQRuEK3aPJau48uacpQrV8NIcs925Yq9dU/fr3RkFDuB/1TthnLd4y3faTqCK0CN8qftybrH1abdTHbSRqLS513udSud+hdg6dWJO/VmxEVyiIjIbmoP8dhMuE9PktQxpUa5wqosW2O9hlUYFSrWfDBqDFGdNiggQW3ySJJPCrZLnGJ8a2QRoxDYOiXAIlhOdi8ppRK4bURJRHCgW9hb8NYK1IevNeOMLZDFxR+BOUbj7Cv7wA7YF/aRfWO/jtRKMg1dyy5OO+fKsDGyd2np54ksD6eizb+sY2tW1KSbWa0Oag8zRL9C5PzOs1cHS7cWx5MJ9o59R/1v2T77jBf4nR/i/YJcfA11rX8frLyHEazHRQ1PoCiBaE934Rry1LOYFurUGdOixy3gU3+w/1XktNOjmGNHd03A0u+VyJVimqzDs9NrLE9XrZnqzMKNytzdYq4G6TJdoUnMzizN0SOapxoJ46Jx23hgPDQ3zD3zhfkyD+0zCs4F6lrmm9+YAve7</latexit> q(xt |xt 1, x0) = q(xt 1 |xt, x0)q(xt |x0) q(xt 1 |x0) -
136 Copyright 2025 NTT CORPORATION 変分下界の変形 (3) 1. データを再構成する項 (=
VAEの再構成誤差) • モンテカルロ近似で学習できるが、学習時には計算しないことが多い 2. 時刻 𝑇 のデータの事後分布と標準ガウス分布のKL Divergence • パラメータがないため、学習時には計算しない 3. ノイズ除去ステップ 𝑝!(𝐱"#$|𝐱") を学習する項 • 明に計算できる 𝑞(𝐱&'"|𝐱&, 𝐱%) に、𝑝((𝐱&'"|𝐱&) を⼀致させるよう学習 • 実際に計算するのはこの項のみ <latexit sha1_base64="WALb5nC5zCt38neSqNVLomEzSBQ=">AAAFRXicnVLdahNBFD5do9ZobVNvBG+CodJIWyZFqiiFohUEK/a/hW5ddieTzdD9c3YSWjfzAr6AF16IgmDxMbzQF/CijyDiVYveCHr2h9okTRVn2d0z35zvO985jBU4PJSE7PVpp3Knz5ztP5c/f2Hg4uBQYXg19BuCshXqO75Yt8yQOdxjK5JLh60Hgpmu5bA1a+tefL7WZCLkvrcsdwK26Zq2x2ucmhIho6AN664p69R0ojk1msRWLdpWRkTUHV3WmTTL03rDqzJhCZOyKE2xovuY8rSNUFGtdn5Z6Q6ryQ3d8e1iYESpXGeVVrtGWRfcrstNFeezbSncSDDqe6EUDcpj00XJhKvU+FFXs0ZqDLMfzik12u5suctZqxV0ZJTLRyoGgvuiiOe0zj37sGDYcI1ITk+qJ0j4t6HIXkM52bEc75imVGPdLRw/0mO45WOmWmWez8O4vY4+88ZQiUyQZBW7g0oWlCBb836hbwB0qIIPFBrgAgMPJMYOmBDiswEVIBAgtgkRYgIjnpwzUJBHbgOzGGaYiG7h18bdRoZ6uI81w4RNsYqDr0BmEUbIZ7JL9skn8p58IT97akWJRuxlB/9WymWBMfj88tKPv7Jc/Euo/2Gd6FlCDW4lXjl6DxIk7oKm/OazF/tLtxdHomvkDfmK/l+TPfIBO/CaB/TtAlt8ieqx/iyy0hkKjB5lHh6jIkMk3sVTuI519CTHRp9xRZXN2EZ87BD7X0UTtrsUU6z31ChGcb8Maym8TZXOu9MdrE5OVKYmphZulGbuZveqH67AVRjFu3MTZuABzMMKUG1He6W903ZzH3Pfcge572mq1pdxLkHbyv36DS4oibk=</latexit> L(x0; ✓) = E q(x1 |x0) [log p✓(x0 |x1)] | {z } reconstrucition term DKL(q(xT |x0)||p(xT )) | {z } prior matching term T X t=2 E q(xt |x0) [DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt))] | {z } denoising matching term ① ② ③ まずはこの分布を計算する -
137 Copyright 2025 NTT CORPORATION 変分下界の変形 (4) • 時刻 𝑡
のデータ 𝐱/ は、下記で計算できる <latexit sha1_base64="elFh7NULMRgRJRb1cDHcGNrhQVE=">AAAGPHictVLLbtNAFL2pMbSB0gY2SGwqolYp0GgcoYKQKlXAgg2iD9JWqks0dibJqI5t7EnUYvkH+ABYsOAhsUD8Axs2/ACL7tmgilURbFhwx7Ya59WiIiZKfOf4nsedjOFa3BeE7GVGlFPq6TOjY9mz58bPT0zmLqz5TsszWdl0LMfbMKjPLG6zsuDCYhuux2jTsNi6sX1Xvl9vM8/njv1I7Lpsq0nrNq9xkwqEKjllTG9S0TBqwU5YCUQ4s6D7TzwR6NRyG1QiYVfDnBZeizu0uXQPc31uoWDUoesDZAo9CPb1SJcGSEddKfFSOHtC/7+375AK3Ulme6L8/yTH5XkcDE4h8Z6w/xglLX/EvxO5WFVH+Ck/13OqlYAvaJirw+bdXiTlNJxwaEbSAxnUS4YI+65sWrevLyWXrUzmSZFEa6q/0JIiD8lacnKZcdChCg6Y0IImMLBBYG0BBR8/m6ABARexLQgQ87Di0XsGIWSR28Iuhh0U0W38reNuM0Ft3EtNP2Kb6GLh10PmFEyTL+Q9OSCfyQfyjfweqhVEGjLLLj6NmMvcysSzS6u/jmU18Smg0WEdmVlADW5FWTlmdyNETmHG/PbTFwert1emgxnyluxj/jdkj3zCCez2D/PdMlt5iepS/x6y4jP0sHqQZHiIigwRuZOncBV99KinjjmlY5iccR3x64fYSRUp7PQpxtjwUzOxkvMy9ArxNmm9d6e/WCsVtfni/PKN/OKd5F6NwmW4AgW8OzdhEe7DEpTBVFzlufJKea1+VL+q++r3uHUkk3AuQtdSf/4Bk3Dm/g==</latexit> xt = p ↵txt 1 + p 1 ↵t✏t 1 = p ↵t( p ↵t 1xt 2 + p 1 ↵t 1✏t 2) + p 1 ↵t✏t 1 = p ↵t p ↵t 1xt 2 + p ↵t(1 ↵t 1)✏t 2 + p 1 ↵t✏t 1 = p ↵t p ↵t 1xt 2 + q p ↵t(1 ↵t 1) 2 + p 1 ↵t 2 ✏t 2 = p ↵t p ↵t 1xt 2 + p 1 ↵t↵t 1✏t 2 = . . . = v u u t t Y i=1 ↵ix0 + v u u t1 t Y i=1 ↵i✏0 = p ¯ ↵tx0 + p 1 ¯ ↵t✏0 <latexit sha1_base64="qxDzTml2OPGgTCUmSh+y3LzsQcg=">AAAFMHicpVLPaxNBFH7ZrlqjtU29CF6KoSGaJswGqSIIRT3oQe0P0xa6JcxuJ8nQ/eXuJNgu8w/0quDBk4IH8ea/4MV/QLAn8ageK3hR8O1mG5uGTYvOsrtvvnnf9773GMOzeCAI2c0oI+qJk6dGT2fPnB07Nz6Rm1wO3LZvsprpWq6/atCAWdxhNcGFxVY9n1HbsNiKsXk7Ol/pMD/grvNIbHls3aZNhze4SQVC9Vzmt25T0TIa4bash6JclYWbevDYF6FOLa9FEZNFrdzblDV5WerMC7iF9JigB9yORUxqhQ9kcV+QyJl0jf2kexjq/Ra0noUDHNlXVBtW9GCpoYWqspRW+djNl452qhf+c0KlIR2h4WNMIW302fpEnlRIvKYGAy0J8pCseTeXGQMdNsAFE9pgAwMHBMYWUAjwWQMNCHiIrUOImI8Rj88ZSMgit41ZDDMoopv4beJuLUEd3EeaQcw2sYqFr4/MKZgmH8kbskc+kLfkK/mVqhXGGpGXLfwbXS7z6uM7F5Z+Hsmy8S+g9Zc11LOABlyPvXL07sVI1IXZ5Xe2n+8t3VicDgvkFfmO/l+SXfIeO3A6P8zXC2zxBapH+neQ1Z2hj9H9xMNDVGSIRLtoClewjh7nNNFnVFEmM24iPtPD/lWRwpMBxS6WPjUTo6hfhrUk3ibt8N0ZDJarFW22MrtwNT93K7lXo3ARLkER7841mIO7MA81MJUNZUd5qjxT36mf1M/ql26qkkk456Fvqd/+AO+2dNc=</latexit> zt 2 = p ↵t(1 ↵t 1)✏t 2 ⇠ N(0, ↵t(1 ↵t 1)I) zt 1 = p 1 ↵t✏t 1 ⇠ N(0, (1 ↵t)I) zt 2 + zt 1 = p ↵t(1 ↵t 1)✏t 2 + p 1 ↵t✏t 1 ⇠ N(0, ↵t(1 ↵t 1)I + (1 ↵t)I) = N(0, (1 ↵t↵t 1)I) ガウス分布に 従う乱数の和 -
138 Copyright 2025 NTT CORPORATION 変分下界の変形 (5) • 従って、時刻 𝑡
のデータの事後分布は下記で表される <latexit sha1_base64="KoZgnyF0dXPI7NiGW6e5h5Pl6V8=">AAAEH3icnVK7bhNBFL2b5REMIQ40SDQWViIbgjWLUECgSBFQgMQjiXESKRtZs5PxepR9ZXZsYpZtoOMHKKiCRIH4DAqoEA2FPwEhqiDRUHD3wcOxAiiz2t07Z84598xorMARoSKkr43oBw4eOjx6pHD02Njx8eLEiaXQ70jGG8x3fLli0ZA7wuMNJZTDVwLJqWs5fNnauJ6sL3e5DIXv3Ve9gK+51PZESzCqEGoWv5guVW2rFW3FzUjFs2a4KVVkWlRGJnWCNk3h+E8Wic9lLOP8MI8HoXDQGFlT5m3eUlLYbUWl9B+UNiuDzR4NulZn0zmjTnQ33kW9+l+5pivDkao/KbfiaqFZLJMaSUdpuDDyogz5mPcntDEwYR18YNABFzh4oLB2gEKIzyoYQCBAbA0ixCRWIl3nEEMBtR1kcWRQRDfwa+NsNUc9nCeeYapm2MXBV6KyBJPkI3lFdsg78pp8It/39IpSjyRLD/9WpuVBc/zpqfq3f6pc/Cto/1b9NbOCFlxOswrMHqRIsguW6bsPn+3UryxORlPkBfmM+bdJn7zBHXjdr+zlAl98ju6J/w1UZWcosbqTZ7iHjhyRZJacwlnsY6YcG3MmHeP8jG3Ep39h+3WksDXkmGF7nxrDKtkvx14x3iZj990ZLpYu1IyZ2szCxfLctfxejcJpOAMVvDuXYA5uwjw0gGl1rac91p7o2/pb/b3+IaOOaLnmJAwMvf8DCS8TTw==</latexit> xt = p ¯ ↵tx0 + p 1 ¯ ↵t✏0 , q(xt |x0) = N(xt; p ¯ ↵tx0, (1 ¯ ↵t)I) Reparameterization Trick [B1] を⽤いて、平均 𝜇、分散𝜎%𝐈 のガウス分布からのサンプル 𝐳 は、下記で計算できる <latexit sha1_base64="kqnqUSi48sZ3m24n/H4SnQKKUIc=">AAADhnicnVJNTxRBEK1lUNdVZMGLCZeNGwzKZtNrFIyJyUY56EH5XCBhyKan6R069Hww07MRJvMH+AMeOGHiwfgPvHrxD3jgxhU9QsLFg9UzsxrdIAk9mZnXr+u9qq6U5UsRKkIOCwPG4JWr14rXSzduDt0aLo+MLodeFDDeYp70glWLhlwKl7eUUJKv+gGnjiX5irX1Qp+vdHkQCs9dUjs+X3eo7YqOYFQh1S4vmQ5Vm1Yn3k2emU40aYbCdqjJ/VBIz62Z2xHdqJR6ezx1UgGjMn6TTPTEJKn14KvkfqldrpI6SVelHzRyUIV8zXkjhSEwYQM8YBCBAxxcUIglUAjxWYMGEPCRW4cYuQCRSM85JFBCbYRRHCMoslv4tXG3lrMu7rVnmKoZZpH4BqiswDj5Rj6SE/KVfCLH5Oe5XnHqoWvZwb+VabnfHt67s3h2ocrBv4LNP6r/1qygA0/SWgXW7qeMvgXL9N3ddyeLTxfG43vkPfmB9R+QQ/IFb+B2T9mHeb6wj+7afwZVWQ8DRK/zGmbRkSOjd7oLDzCPmcbYWKfOmOQ9tpGv/eYu60jhbZ9jxp3fNYZI35djrgSnqfHv7PSD5Yf1xlR9av5Rtfk8n6sijMFdmMDZmYYmvIQ5aKHnZziCY/huFI268diYzkIHCrnmNvy1jOYv/hzSHw==</latexit> z = µ + ✏, ✏ ⇠ N(0, I) -
139 Copyright 2025 NTT CORPORATION 変分下界の変形 (6) • よって、𝑞(𝐱pq7|𝐱p, 𝐱r)
は下記で計算できる <latexit sha1_base64="kMEGWkU/5XlNTIfYbQaHZ08dsDA=">AAAGjXicnVLLbtNAFL2pwZRASQMbJDYVUasU2mhcQUEUUAVIwALog7QVdYnGZpJY9Su2E7WY+QF+gAUrkFggvgKx4QdY9AsQYgMqEhsWXDtOW9vNAxzFvnPmnnPP3DuKrWuuR8hOZkg4clQ8Nnw8e+LkyKncaP70ims1HZWVVUu3nDWFukzXTFb2NE9na7bDqKHobFXZvB3sr7aY42qW+djbttmGQWumVtVU6iFUyQtPGkXZoF5dqfpbvOJ70xJ/EQP41MEl4ZMTN+SqQ1U/QUzQUCdJ7FMJM3hv0SBDljv1wx2V6v5DniDNyW7D8XyZ6nadBgBPWStK0/vbk53t+1HYU1WhTiQdifG4x1A7lXSwBh/Ae1xggBrxCmGbuhVBO3Oy0az4jWT15MimZFerGTTIfOrP8KIXa5U8mMjewJJTObxR3E+fLT5AfjEmmB5IfLp9BQm2K3XQjuu41j9YzlZGC6REwmcsHUhRUIDoWbDymRGQ4RlYoEITDGBggoexDhRc/K2DBARsxDbAR8zBSAv3GXDIIreJWQwzKKKb+K7haj1CTVwHmm7IVrGKjn8HmWMwTr6Q92SXfCYfyDfyp6uWH2oEXrbxq7S5zK7kXp5d/t2XZeDXg/o+q6dnD6pwNfSqoXc7RIJTqG1+6/mr3eVrS+P+BHlLvqP/N2SHfMITmK1f6rtFtvQa1QP9O8hq99DB6EHk4REqMkSCVdCFC1hHDnNq6DOoyKMe1xCf2sP+V5HCVkqxjXXvmopRcF6GtTjeJil5d9LBykxJmi3NLl4qzN+K7tUwnIPzUMS7cwXm4R4sQBlU4aPwVfgh/BRz4mXxuniznTqUiThnIPaId/8CFxIDFw==</latexit> q(xt 1 |xt, x0) = q(xt |xt 1, x0)q(xt 1 |x0) q(xt |x0) = N(xt; p ↵txt 1, (1 ↵t)I)N(xt; p ¯ ↵t 1x0, (1 ¯ ↵t 1)I) N(xt; p ¯ ↵tx0, (1 ¯ ↵t)I) = N(xt 1; µq(xt, x0), 2 q (t)I) µq(xt, x0) = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t x0 2 q (t) = (1 ↵t)(1 ¯ ↵t 1) 1 ¯ ↵t マルコフ連鎖のため 𝑞 𝐱< 𝐱<$0 , 𝐱1 = 𝑞 𝐱< 𝐱<$0 -
140 Copyright 2025 NTT CORPORATION 変分下界の変形 (7) • ノイズ除去ステップ 𝑝s(𝐱pq7|𝐱p)
を下記で定義する • この時、⽬的関数は下記で計算できる <latexit sha1_base64="70HLtQE4bYfg0RMy8rCuGwXCMlU=">AAADuHicnVI9b9RAEB3HQMJByCU0SKGIOCW6Q8dpHaGAgpAioIACyAeXRIqDWTt7vlX8hb13Sli2peAPUFCBRIH4GTT8AYr8BARdkGgomLUNKJwOJNay/fbtvDezo3GTgGeCkANjxDx2/MTo2MnKqdPjZyaqk1PrWdxLPdb24iBON12asYBHrC24CNhmkjIaugHbcHdv6vONPkszHkcPxH7CtkPqR7zDPSqQcqrPEkfaossEVXU7pKLrduSecqS4ZKmnRwjVmLueEx4N5L3B6Gt22BvipZqi0bQz7ofUkY/VQzmv6qLxM+SOalScao20SL5mBoFVghqUazmeNMbBhh2IwYMehMAgAoE4AAoZPltgAYEEuW2QyKWIeH7OQEEFtT2MYhhBkd3Fr4+7rZKNcK89s1ztYZYA3xSVMzBLPpK35JB8IO/IJ/J9qJfMPXQt+/h3Cy1LnInn59a+/VMV4l9A97fqrzUL6MDVvFaOtSc5o2/hFfr+kxeHa4urs3KOvCafsf5X5IC8xxtE/a/emxW2+hLdtf8tVBU9TBHdLWu4j44MGb3TXbiIeew8xsc6dUZV9thHvvmL+19HCnsDjgU3vGseIn1fhrkUTpP15+wMgvX5lrXQWli5XFu6Uc7VGEzDBajj7FyBJbgNy9BGzy/GlDFtnDcXzUemb/IidMQoNWfhyDLTH7qF5R0=</latexit> p✓(xt 1 |xt) = N(xt 1; µ✓(xt, t), 2 q (t)I) <latexit sha1_base64="J6X+ApW7pyjJ9W8s7uDKFDGW1NA=">AAAFJ3icnVI7bxNBEB6bA4IhJIYGicbCimUjx9qzUEAgpAhSgHjlgZ1IPnNaH+vzKffK3dpKOG9BG34ABRVIFBE/g4aOCkRKSkSZSDQUzD0ISUxsxJ7ububb+b75ZrUt1zR8Tsh2Kn1MOn7i5NipzOkz42cnJrPn6r7T9TRW0xzT8VZa1GemYbMaN7jJVlyPUatlsuXW6u1wf7nHPN9w7Md8w2VNi+q20TY0yhFSs6ndgkI93TJsNVB4h3Eq5jCyKO94VnDvvhDFtWKUttrBulADPi2L/gFAlPenRJT6fXdPbBS3VFKUws1RFqJEo2bwcFDwhmJ11WDt0MaAqbLiG7pFw8onQVUUeel3wd3Q8egOfx1IlPlw5f3jKW2PaoEsguoAQygma/NG9FXqzOO54T2n/21oxTP0TiIYdorzZkadzJMKiVZuMJCTIA/JmneyqXFQ4Ck4oEEXLGBgA8fYBAo+Pg2QgYCLWBMCxDyMjGifgYAMcrtYxbCCIrqKXx2zRoLamIeafsTWsIuJr4fMHEyRT2SL7JAP5B35Rn4eqRVEGqGXDfy3Yi5z1YnNC0s/RrIs/HPo/GEN9cyhDdcirwZ6dyMknEKL+b1nL3eWri9OBQXyhnxH/6/JNnmPE9i9Xe3tAlt8heqh/hyy4jP0MHqQeHiEigyRMAtP4TL2UaIaHX2GHUVyxjri5T3sfxUprA8oxtjRp6ZhFM7LsJfA2yQfvjuDQb1akWcqMwtX8rO3kns1BhfhEhTx7lyFWbgD81ADLd1IP09vpl9IW9JH6bP0JS5NpxLOeTiwpK+/ANgReDo=</latexit> arg min ✓ DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt)) = arg min ✓ DKL(N(xt 1; µq(xt, x0), 2 q (t)I)||N(xt 1; µ✓(xt, t), 2 q (t)I)) = arg min 1 2 2 q (t) h kµ✓(xt, t) µq(xt, x0)k2 i ガウス分布の平均を推定するNN -
141 Copyright 2025 NTT CORPORATION 変分下界の変形 (8) <latexit sha1_base64="2k4ib60RGqGnWp/v1ao0xixwR5k=">AAAEEXicnVLNa9RAFH9p/Kirtdt6EbwUl5attstEShVBKH6AF7EfbltoSpjE2U3YfDmZLK1h/gGvHjx4UvAg/gXeRC+CZw89eRaPFbx48E0SVtawLTghyZvfvN/v/ebx7Nj3EkHIgTamnzh56vT4mdrZcxPnJ+tT05tJlHKHtZ3Ij/i2TRPmeyFrC0/4bDvmjAa2z7bs3h11vtVnPPGi8JHYj9luQLuh1/EcKhCy6t/MILUyU7hMUNk0Aypcu5PtSSsTckHMz90yO5w6mZk84SIzqR+7VB3JprFo2pSXkEpfNOS8zCqwlMOiV4cEKxK58KDMCEGXInWgKo/wX7PqDdIi+ZqpBkYZNKBcq9GUNgEmPIYIHEghAAYhCIx9oJDgswMGEIgR24UMMY6Rl58zkFBDbopZDDMooj38dnG3U6Ih7pVmkrMdrOLjy5E5A7PkK3lLDsln8o58J79HamW5hvKyj3+74LLYmnx2cePXsawA/wLcv6wjPQvowI3cq4fe4xxRt3AKfv/pi8ONm+uz2Rx5TX6g/1fkgHzCG4T9n86bNbb+EtWV/l1kFT3kGD0oPTxERYaI2qkuXME6Zp7TRZ+qoix73EV8YYD9ryKFvYpigY3umoORui/DWhKnyfh3dqrB5rWWsdxaXltqrNwu52ocLsFlaOLsXIcVuA+r0AZHu6f1NKGl+nP9vf5B/1ikjmkl5wIMLf3LHzqNC98=</latexit> µ✓(xt,
t) = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t ˆ x✓(xt, t) • 𝜇A (𝐱/ , 𝐱- ) は下記で定義される (再掲) • 従って、 𝜇$ (𝐱/ , 𝑡) を下記で定義する <latexit sha1_base64="5tZXLtyx7cggyXe1pDJru7dOVew=">AAAD/HicnVLNahRBEK7J+JOsxmz0EvASXBI2miw9IlGEQFAPXsT8uJtAJow9be/ukPlLT++SZGgfwBfw4EnRgwSvvoAX8e4hjyAeI3jxYPXMEF2HGEgP0131dX1fVRflxr6XSEIOjCHzzNlz54dHKhcujl4aq45fbiVRTzDeZJEfiXWXJtz3Qt6UnvT5eiw4DVyfr7lb9/X9Wp+LxIvCJ3I35psB7YRe22NUIuRUv9hBz0m3Vd0OqOy67XRHOalUs3+7RM1ML9htQVlqJ9tCpjb14y7VcapuzdkuFQWkuXOWmlFpCVZqMMONAcGSRCZ8lOZkQaIqTrVGGiRbk2XDKowaFGspGjdGwYZnEAGDHgTAIQSJtg8UEvw2wAICMWKbkCIm0PKyew4KKsjtYRTHCIroFu4d9DYKNERfayYZm2EWH3+BzEmYIl/Je3JIPpN98o38OlYrzTR0Lbt4ujmXx87Yi4nVnyeyAjwldP+w/luzhDbcyWr1sPY4Q/QrWM7v7708XL27MpVOkzfkO9b/mhyQT/iCsP+DvVvmK69QXes/QFbeQ4HWo6KGx6jIEdGe7sJ1zGNnMR2sU2dURY87iM8eYadVpLBTUsyx47vG0NLv5ZhL4TRZ/85O2WjdbFjzjfnlW7XFe8VcDcNVuAZ1nJ3bsAgPYQmawAxitAzHeGo+N9+a++aHPHTIKDhXYGCZH38DWe4CkA==</latexit> µq(xt, x0) = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t x0 時刻 𝑡 のデータ 𝐱< から元のデータ 𝐱1 を推定するNN -
142 Copyright 2025 NTT CORPORATION 変分下界の変形 (9) • 𝜇A と
𝜇$ を⽤いて、⽬的関数は下記のように変形できる • つまり、時刻 𝑡 のデータ 𝐱< から元のデータ 𝐱1 を推定するNNを学習する ことができれば、拡散モデルを学習できる <latexit sha1_base64="leCemyovzOm/2I1IEvJ5dIi337c=">AAAG13ictVJNTxRBEC1gXRFEQC8mXogEsqu7pIcYNBgTohxM1MiHfBgaNz1j7+yEmdnZnl4CNh1vxnjz5MGTRg/Gn+HFP+CBn2A8YuLFgzUfAZfJAqL2ZmeqXvd79aqmzcB1QknIdkdnV+5E/mT3qZ7e031n+gcGzy6G9aaw+IJVd+ti2WQhdx2fL0hHunw5EJx5psuXzLVb0f7SOhehU/cfyM2Ar3rM9p2qYzGJUGWw690oZcL2HL+iqKxxyfQ0Rh6TNeGpO3e1LjQKcWpW1YauKFk29FYLoEu/p0QXt7aCXbHDuMUipaM3Ugu0KpilDK3GaejYHquohn6kxnVBFjV1eVWuxE+6yIUcol6zTRVdksVyvN3I7OyzSoVj11LBqFKSrx7bk8V8i7sqIdGwIaSizA1qLCquC0aZmkykUDqQolYZWOtW2/pyi2JGI1berdNGscak2pPVBw7vf/VR/gd9tHzBv/yAiZuMj1Yb0Wmtsk2nO9lb8CeTPko3PZWBYTJG4jWUDYw0GIZ0zdQHO/qAwmOogwVN8ICDDxJjFxiE+FsBAwgEiK2CQkxg5MT7HDT0ILeJpzieYIiu4dPGbCVFfcwjzTBmW1jFxb9A5hCMkC/kA9khn8lH8pX8bKulYo3Iyya+zYTLg0r/i/PzPw5lefiWUNtjHehZQhWuxV4d9B7ESNSFlfDXn7zamZ+cG1Gj5C35hv7fkG3yCTvw179b72f53GtUj/SnkZXMUGB0L/VwHxU5IlEWTeES1qHxGRt9RhV1OmMb8dIudlxFBhsZxQRrPzULo6hfjrU03iZj/93JBovjY8bE2MTsleGpm+m96oYLcBEKeHeuwhTchhlYACvXmzNyk7nr+Yf5p/ln+efJ0c6OlHMOWlb+5S+2VCBU</latexit> arg min ✓ DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt)) = arg min 1 2 2 q (t) h kµ✓(xt, t) µq(xt, x0)k2 i = arg min 1 2 2 q (t) " ⇠⇠⇠⇠⇠⇠⇠ ⇠ p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t ˆ x✓(xt, t) ⇠⇠⇠⇠⇠⇠⇠ ⇠ p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t x0 2 # = arg min 1 2 2 q (t) ¯ ↵t 1(1 ↵t)2 (1 ¯ ↵t)2 h kˆ x✓(xt, t) x0 k2 i -
143 Copyright 2025 NTT CORPORATION 三つの等価な変形 • 拡散モデルの⽬的関数は、拡散されたデータから、元のデータ を推定するよう学習されることを導出した •
この⽬的関数が、下記のノイズの推定、スコアの推定と等価と なることを⽰す <latexit sha1_base64="NnYnQuLjALHNmkop/IZ4vsS8gso=">AAADiHicnVI9b9RAEJ2L+QgXQi7QINGcOAUFFE57EUqAKgoUNIh8cJdIcbDWZs5exV9a750SrP0D/AEKKpAoEH+BjoY/QJGWDiVdkGgomLUtApwCEmvZfvt23pvZ0bhpKDLF2H5tzDp1+szZ8XP1ifOTF6Ya0xd7WTKQHna9JEzkpsszDEWMXSVUiJupRB65IW64O/fM+cYQZSaS+LHaS3E74n4s+sLjiiin0bND7Cu7h1I17YCr3I64Ctx+vqu1k9sqQMX17DHp5ErPqes3f2WYtqXwg8rlST6v606jxdqsWM1R0KlAC6q1kkzXJsGGp5CABwOIACEGRTgEDhk9W9ABBilx25ATJwmJ4hxBQ520A4pCiuDE7tDXp91Wxca0N55ZofYoS0ivJGUTZtgn9pYdsY/sHfvCvp/olRceppY9+rulFlNn6vnl9W//VEX0VxAcq/5as4I+3C5qFVR7WjDmFl6pHz57cbR+d20mv8ZeswOq/xXbZx/oBvHwq/dmFddekrvxv0+qsoeS0MOqhkfkiMSYnenCDcpjFzE+1Wky6qrHPvFzP7n/deSwO+JYcid3zSNk7ouUS9M0df6cnVHQm293FtoLq7daS8vVXI3DFbgKszQ7i7AED2AFuuT5Hj7DARxadYtZi9adMnSsVmkuwW/LWv4BtQjT+w==</latexit> kˆ x✓(xt, t) x0 k2 元のデータの推定: <latexit sha1_base64="GF1CB3w+Rai33ivp0ZCbxaEV+AE=">AAADhHicnVI9bxNBEB3nIARDiAMNEo2FFRSQsdYhCYgCRUBBg0gc7ETKBmvvGN+tsvehvbWVcLo/wB+goAKJAvEH6Gn4AxRpaAFRBomGgrkPQGAFJPZ0d2/fznszOxo7UjI2jO1XJqwjRyePTR2vnjg5fWqmNnu6F4dD7WDXCVWoN20Ro5IBdo00CjcjjcK3FW7YO7ey840R6liGwX2zF+G2L9xADqQjDFH9WocrHBjeQ23qHKNYKmITll7mnjDJDybtJ9x4aEQ6z31hPHuQ7BJn0qa5yLV0vdLhQbKQVvu1BmuxfNXHQbsEDSjXajhbmQYODyEEB4bgA0IAhrACATE9W9AGBhFx25AQpwnJ/BwhhSpphxSFFCGI3aGvS7utkg1on3nGudqhLIpeTco6zLF37CU7YG/ZK/aJfTvUK8k9slr26G8XWoz6M4/Prn/9p8qnvwHvl+qvNRsYwLW8Vkm1RzmT3cIp9KNHTw7Wr3fmkgvsOftM9T9j++wN3SAYfXFerGHnKbln/rdJVfRQE7pb1nCPHJGYbJd14RLl4XmMS3VmGdOyxy7xzZ/c/zoK2B1zLLjDu+YQyu6LlCulaWr/OTvjoLfQai+3ltcWGys3y7magnNwHuZpdq7CCtyBVeiS52t4Dx/gozVpNa0r1lIROlEpNWfgt2Xd+A5wn9ID</latexit> k✏0 ˆ ✏✓(xt, t)k2 ノイズの推定: <latexit sha1_base64="Qil2y+wsrRtgzWagWRODSM1H+FE=">AAADg3icnVLNahRBEK7NGI2rMRu9CF4Wl0iiydK7hCiCENSDFzGbuJtAOg49Y+1sk54fenqXxGFewBfw4EnBg/gAPoAXX8BDDl4V8RjBiwdrfvBviYI9zMzXX9f3VXVRTqRkbBg7qExYxyaPn5g6WT11evrMTG32bC8Oh9rFrhuqUG85IkYlA+waaRRuRRqF7yjcdHZvZeebI9SxDIP7Zj/CHV94gexLVxii7FqHK+wb3kNt6rGdcDNAI9J57gszcPrJXrpoFpZ4IBwluAq9evTLkZ2YdIFr6Q1KgwdJO63atQZrsnzVx0GrBA0o11o4W5kGDg8hBBeG4ANCAIawAgExPdvQAgYRcTuQEKcJyfwcIYUqaYcUhRQhiN2lr0e77ZINaJ95xrnapSyKXk3KOsyxd+wlO2Rv2Sv2iX070ivJPbJa9unvFFqM7JnH5ze+/lPl09/A4KfqrzUb6MO1vFZJtUc5k93CLfSjR08ON66vzyWX2HP2mep/xg7YG7pBMPrivujg+lNyz/xvk6rooSZ0t6zhHjkiMdku68JlysPzGI/qzDKmZY894hd/cP/rKGBvzLHgju6aSyi7L1KulKap9efsjINeu9laaa50lhurN8u5moILcBHmaXauwircgTXokudreA8f4KM1aV2x2tZyETpRKTXn4Ldl3fgOlenQvw==</latexit> ks✓(x, t) r log p(xt)k2 スコアの推定: -
144 Copyright 2025 NTT CORPORATION ノイズの推定 (1) • 元のデータ 𝐱-
は、時刻 𝑡 のデータ 𝐱/ を⽤いて下記で表される • 従って、 𝜇A (𝐱/ , 𝐱- ) は下記で変形できる <latexit sha1_base64="F43erghJWLpt4ACg6FxEBJmrlW0=">AAADl3icnVLLahRBFL2T9hFHYya6UdwEhwQRM1SLxCCIQUWyETOJkwTSYagua2aKVD9SXTMkFvUD/oALVwouxM/IJuDaRT5BXEkEQV14q7vxNUQh1XT3qVP3nHvrcsNUikwTsl8Z8Y4dP3Fy9FT19Jmxs+O1iXMrWdJXjLdYIhO1FtKMSxHzlhZa8rVUcRqFkq+Gm/fc+eqAq0wk8WO9k/KNiHZj0RGMaqTaNR5EVPfCjtm2bUPs9O2goygzv7PazgTZltLGnwlCqkxAZdqj+YENeJoJiUaotaYIGwqy1XatThokX5PDwC9BHcq1mExUxiCAJ5AAgz5EwCEGjVgChQyfdfCBQIrcBhjkFCKRn3OwUEVtH6M4RlBkN/Hbxd16yca4d55ZrmaYReKrUDkJU+Q9eUMOyB55Sz6Q74d6mdzD1bKD/7DQ8rQ9/uzC8pf/qiL8a+j9Uv2zZg0dmMtrFVh7mjPuFqzQD54+P1i+tTRlpskr8hHrf0n2yS7eIB58Zq+bfOkFujv/+6gqeqgQPSxreISOHBm3c124inmCPKaLdbqMtuxxF/lrP7mjOlLYHnIsuMO7xhC5+3LMZXGa/L9nZxisXG/4s43Z5o36/N1yrkbhElyGKzg7N2EeFmARWuj5Dj7BV/jmXfTueA+8hSJ0pFJqzsMfy2v+AOsX2/M=</latexit> x0 = xt p 1 ¯ ↵t✏0 p ¯ ↵t <latexit sha1_base64="D6y6UBW2C0bKwglSjH9hF3Z9Y08=">AAAFOniczVJNa9RAGH4bo9b1o1u9CF6KS8tWu8uklCqCUNSDF7EfblvolDCJs7uh+Woyu7SG+QPexYMnBQ/iT9CbCv4BD716Kz22IIgH30li3W1WC56ckMw7z7zP8z7vZKzQdWJByM6QdkI/eer08JnS2XPnL4yURy8ux0EnsnnDDtwgWrVYzF3H5w3hCJevhhFnnuXyFWvjrtpf6fIodgL/kdgO+brHWr7TdGwmEDJHtTr1OmayKavUY6JtNZMtaSZCTvUuiZycuE2bEbMTGm9GIqHMDdtM5cmqUaMWi3JIcWuGnJRJAZayv8L1PsGCRCp8WOZ4QSIp/T9NZgp9srVMcFA2D2PHxT+DDcnBdaXsadWQxW7l0WJZZo/TX6RBBopqPZZKZrlC6iQdY8XAyIMK5GM+KH8HCo8hABs64AEHHwTGLjCI8VkDAwiEiK1DgliEkZPuc5BQQm4HszhmMEQ38NvC1VqO+rhWmnHKtrGKi2+EzDEYJ1/IG7JPPpO3ZJf8+KNWkmooL9s4WxmXh+bI08tL345leTgLaP9m/dWzgCbcTL066D1MEdWFnfG7T57vL91aHE8myCuyh/5fkh3yATvwuwf26wW++ALVlf49ZGVnGGH0IPfwEBU5ImqlTuEa1qFpTgt9qooyP+MW4lOH2L8qMtgqKGaYuibG0UtRDJan68ZsfXZhpjJ3J78ww3AFrkIVb8UNmIP7MA8NsLVn2jvto/ZJf69/1Xf1vSxVG8o5l6Bv6Ac/AWgsjcg=</latexit> µq(xt, x0) = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t x0 = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t xt p 1 ¯ ↵t✏0 p ¯ ↵t = 1 p ↵t xt 1 ↵t p 1 ¯ ↵t p ↵t ✏0 -
145 Copyright 2025 NTT CORPORATION ノイズの推定 (2) • 𝜇A (𝐱/
, 𝐱- ) は下記で定義される (再掲) • 従って、 𝜇$ (𝐱/ , 𝑡) を下記で定義する 時刻 𝑡 のデータ 𝐱< から元のノイズ 𝜖1 を推定するNN <latexit sha1_base64="uvCtLdEkTXETJUnBEoGeNzglSfs=">AAADqHicnVLLahRBFL2d9hHHR0bdCG6CQyQJyVAdJYogBHXhRpwkTiaSDk11pWamSb9SXTMkFvUD/oALcaHgQvwMN/6Ai3yCuIwgiAtvdReaOD7Aarrr3lPnnHu7uGEeR4UkZN8Zc48dP3Fy/FTt9Jmz5ybq5y+sFdlAMN5mWZyJ9ZAWPI5S3paRjPl6LjhNwph3wu275rwz5KKIsvSR3Mv5ZkJ7adSNGJUIBfUXfjII1I6e9hMq+2FX7epAST13OCV65rbfFZQpTyu/2BFS+TTO+9QwtT6qnLfM+UMUK0IspMJqS7L+jRvPiyjG1rBsLag3SJOUa3I08GzQALtaWf0r+LAFGTAYQAIcUpAYx0ChwGcDPCCQI7YJCjGBUVSec9BQQ+0AWRwZFNFt/PYw27BoirnxLEo1wyoxvgKVkzBFPpA35IC8J2/JR/Ltj16q9DC97OEeVlqeBxNPL61++acqwV1C/6fqrz1L6MLNstcIe89LxPwFq/TDJ88OVm+tTKmr5BX5hP2/JPvkHf5BOvzMXi/zlefobvzvoaq6Q4HRA9vDQ3TkiJjM3MIs1vFLTg/7NBW1veMe4nM/sP91pLA74lhhZky8X4diNFhbaHqLzcXl642lO3ZgxuEyXIFpnIobsAT3oQVtYI7rzDgLzjV31m25HfdxRR1zrOYiHFlu+B0i1elI</latexit> µq(xt, x0) = 1 p ↵t xt 1 ↵t p 1 ¯ ↵t p ↵t ✏0 <latexit sha1_base64="OVwfcUK9GZvO+kxVkUdmq+QmG/w=">AAADvnicnVJNa9RAGH7T+FHXj271ongpLi1V2mUipYogLuqhHsR+uG2hKWESJ5vQyYeT2WVrmD/gH/DgScGDePQnePEPeOhPEI8VBPHgO8mg1tUKTkjmnWee55knw+vnPC4kIXvWmH3k6LHj4ycaJ0+dPjPRnDy7XmR9EbBukPFMbPq0YDxOWVfGkrPNXDCa+Jxt+Dt39P7GgIkiztKHcjdn2wntpXEYB1Qi5DXfuknfK10ZMUnVrJtQGflhOVReKdWcvDxz0w0FDUpHlW7xWMjSpTyPqN5V6iB73jDnf6EYEWI+FUZbkdUf3CKKAMuLmGepOiRTw2u2SJtUY2q0cEzRAjOWs+ZXcOERZBBAHxJgkILEmgOFAp8tcIBAjtg2lIgJrOJqn4GCBmr7yGLIoIju4LeHqy2DprjWnkWlDvAUjq9A5RRMkw/kNdkn78kb8pF8+6tXWXnoLLs4+7WW5d7E0/NrX/6pSnCWEP1UHZpZQgjXq6wxZs8rRP9FUOsHT57tr91YnS5nyEvyCfO/IHvkHf5BOvgcvFphq8/RXfvfRVV9hwKr+ybDA3RkiOiVvoUreI5bcXqYU5+ozB33EJ/7gf2vI4XhiGON6TZxfm+K0WL9attZbC+uLLQ6t03DjMNFuASz2BXXoANLsAxdCKwL1i1rybpnd+zQTuyspo5ZRnMODgx7+B0nLvLH</latexit> µ✓(xt, t) = 1 p ↵t xt 1 ↵t p 1 ¯ ↵t p ↵t ˆ ✏✓(xt, t) -
146 Copyright 2025 NTT CORPORATION ノイズの推定 (3) • 𝜇A と
𝜇$ を⽤いて、⽬的関数は下記のように変形できる • つまり、時刻 𝑡 のデータ 𝐱< から元のノイズ 𝜖1 を推定するNNを学習する ことができれば、拡散モデルを学習できる <latexit sha1_base64="HYlNeMs3rsuhqDywNMYLdHOtDNk=">AAAGbnicpVLLThRBFL0wMiKKgCbGxBiJE8i0MqSGGDQaE6IsTNTIQx4JhZPqtqanQ7+muoaATf2AP+DClSQujJ/hhq0mLvgE48YEEzcuvNXdwYFhQKEm033r3HvOPXW7zNB1IknIdkdn7lRX/nT3mZ6z53rP9/UPXJiPgoaw+JwVuIFYNFnEXcfnc9KRLl8MBWee6fIFc+Whzi+schE5gf9crod82WO271Qdi0mEKgO5e8OUCdtz/EpMZY1LpiYx8pisCS9+/ESpYr2YbM1qvKYqsSyV1cYeQI00b4kyNjbCXbGjuIZB6fD9zAKtCmbFZRWP0cixPVaJ6+pFPKaK0lDU5VW5lDzpPBdykHqNNl3UiDRKSbrektlnlQrHrmWCulO6Xz62J4v5FnfjXRKN6kLGlLlhjen+Su31o0pZaampJmMhZjKRkdPqA+RqDAEeRo4b+OrQgfy3t5sn9ZbZ0pM+4aCTXLHZiaFzKsH2OTGaPLR+oSZPpX8eXhv3lf4CGSXJGmwNyllQgGxNBQMdvUDhJQRgQQM84OCDxNgFBhH+lqAMBELEliFGTGDkJHkOCnqQ28AqjhUM0RV82rhbylAf91ozStgWdnHxL5A5CEPkK/lAdsgW+Ui+kd9tteJEQ3tZx7eZcnlY6Xt9efbXkSwP3xJqf1mHepZQhTuJVwe9hwmiT2Gl/NVXb3Zm784MxcNkk3xH/+/INvmEJ/BXf1rvp/nMW1TX+pPISmcoMHqaeXiGihwRvdNTuIF9aFJjo0/dUWUzthEf2cWOq8hgrUUxxdpPzcJIn5djL4W3qbz/7rQG82Oj5fHR8elbhYkH2b3qhitwHYp4d27DBDyCKZgDK7eZ28p9zn3p+pG/lL+av5aWdnZknIuwZ+WLfwBc+/uN</latexit> arg min ✓ DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt)) = arg min 1 2 2 q (t) h kµ✓(xt, t) µq(xt, x0)k2 i = arg min 1 2 2 q (t) " ⇢ ⇢ ⇢ ⇢ 1 p ↵t xt 1 ↵t p 1 ¯ ↵t p ↵t ˆ ✏✓(xt, t) ⇢ ⇢ ⇢ ⇢ 1 p ↵t xt + 1 ↵t p 1 ¯ ↵t p ↵t ✏0 2 # = arg min 1 2 2 q (t) (1 ↵t)2 (1 ¯ ↵t)↵t h k✏0 ˆ ✏✓(xt, t)k2 i -
147 Copyright 2025 NTT CORPORATION ノイズの推定 (4) • この⽬的関数を簡略化したものが、DDPM [B2]
の⽬的関数 • 実験的には、簡略化した⽬的関数でノイズを推定するのが最も良いらしい <latexit sha1_base64="Y6OEqliYpbHx3RGzfa5WvBlGo+A=">AAAEL3icnVJNaxNBGH6360eN1qZ6EbwEQ0uiSZgUqaKX4gd4UOyHSQuZGGbXSXbpZnednYTWZX6AHvXgwZOCB/Hkb/DiHxDpRbwWjxW8KPjuzlrbhio4y86887zv87zPDGOFnhtJQjaNMfPQ4SNHx4/ljp+YODmZnzrVjIKBsHnDDrxArFos4p7r84Z0pcdXQ8FZ3/L4irV2PcmvDLmI3MC/JzdC3u6znu92XZtJhDr5n1XaZ9KxmRffVqU0trrxuurERF2l0uGSlWdoKIJQBjprxTcxu8NqqJIsV8IS5WHkeiiJxLKiHu/KVjrTJheysDtdpQ6T8W8kEUv7aFKJRg8FZi0mYsq80GFYIJXaa+2CrqpXR+t2NapIKtyeI8t60U7ux7NK79u5Tr5IaiQdhdGgngVFyMZCMGVMAIUHEIANA+gDBx8kxh4wiPBrQR0IhIi1IUZMYOSmeQ4KcsgdYBXHCoboGs493LUy1Md9ohmlbBu7ePgLZBZgmnwkb8g2+UDeki3y40CtONVIvGzgamkuDzuTT84sf/8nq4+rBOcP66+eJXThcurVRe9hiiSnsDV/+Oj59vKVpel4hrwiX9H/S7JJ3uMJ/OE3+/UiX3qB6on+DWTpOxQY3ck83EVFjkiyS27hPPahaU0PfSYdVXbHPcQrO9j/KjJYH1HU2MG3ZmOUnJdjL4Wvqb7/7YwGzdlafa42t3ixOH8te1fjcBbOQQnfziWYh1uwAA2wDdt4bDw1npnvzE/mZ/OLLh0zMs5p2DPMrV8CXxhI</latexit> L(x0; ✓) / E U(t),p(✏0) h ✏0 ˆ ✏✓ p ¯ ↵tx0 + p 1 ¯ ↵t✏0, t 2 i -
148 Copyright 2025 NTT CORPORATION ノイズの推定 (5) • この場合、データ 𝐱-
の⽣成は下記の⼿順で⾏われる ガウス分布からノイズ 𝐱$ を⽣成 𝑇 ステップかけてノイズを除去 -
149 Copyright 2025 NTT CORPORATION スコアの推定 (1) • Tweedieの公式 [F2]
より、ガウス分布について下記が成⽴ • 従って、時刻 𝑡 のデータ 𝐱/ の事後分布について、下記が成⽴ <latexit sha1_base64="4aPzh9YdgehVA013YzMPEoeadbI=">AAADzXicnVLLahRBFL2d9hHbRya6EdwMDgkTDUONhCiKEHyAG/OYcTIDU8NQ3db0FKl+0F09mnTareAPuHCl4EL8C934Ay7yCeIygiAuvP3AMRkfYDXdde+595w6XVzTlyJUhOxpU/qRo8eOT58wTp46fWamNHt2M/SiwOIty5Ne0DFZyKVweUsJJXnHDzhzTMnb5tbttN4e8SAUnvtAbfu85zDbFQNhMYVQv/SOOkwNzUG8k8zTUDhZajEZrybVcekGdaJ+PM6TRdoUtsMOYAsGbQh7qFgQeI+MvGDGdxMq+UB1DyvsjmMapLTezTFy+Tfy1GWmZFR6dtn/xdqC0S9VSI1kqzwZ1IugAsVa90rfgMJD8MCCCBzg4ILCWAKDEJ8u1IGAj1gPYsQCjERW55CAgdwIuzh2MES38Gtj1i1QF/NUM8zYFp4i8Q2QWYY58pG8IfvkA3lLPpHvf9SKM43UyzbuZs7lfn/m2fnm13+yHNwVDMesv3pWMIBrmVeB3v0MSf/Cyvmjnef7zeuNuXievCKf0f9Lskfe4x+4oy/W6w3eeIHqqf4dZOV3GGB0v/CwhoockTRLb+ESnkOzHht9picmxR3biC/+xP5XkcHjCcUcS8ekfngoJoPNK7X6cm15Y6mycqsYmGm4ABehilNxFVbgHqxDCyytqq1qba2jr+mRvqs/yVuntIJzDg4s/ekP+Uj4DA==</latexit> z ⇠ N(z; µz, ⌃z) ) E [µz |z] = z + ⌃z r log p(z) <latexit sha1_base64="2efQulY+1m3ZXwH8LhSN93iE/Rc=">AAAEA3icnVI7b9RAEB7HBMLxyAENEs2JU053EE5rhAICIUWQAgogDy6JlA2ntdnzWVk/st67JBh30CBBS0EFEgVKh2ipaPIHKPITEGWQQIiC8SOB3PESa9k78+1833xejRkIJ1SEbGoD+p7BvfuG9hcOHDx0eLh45Ohs6HekxRuWL3w5b7KQC8fjDeUowecDyZlrCj5nLl1Nzue6XIaO791WawFfdJntOS3HYgqhZvHLcpW6TLXNVrQaNyMV3/85JXGtcjkFLCaim3FP7SUaLksVUZPJiDIRtFkKx7slRqvGmd6S2nbJdQxphU74Kx6T0l+h9J80c1c7Tk7/sofHTMGo8O1S0OO8VmgWy6RO0lXqD4w8KEO+Jv3iV6BwF3ywoAMucPBAYSyAQYjPAhhAIEBsESLEJEZOes4hhgJyO1jFsYIhuoRfG7OFHPUwTzTDlG1hF4GvRGYJRsh78opskQ2yTj6Qb7/VilKNxMsa7mbG5UFz+NHxmc9/Zbm4K2j/YP3Rs4IWXEi9Oug9SJHkL6yM3733dGvm4vRIVCEvyEf0/5xsknf4B173k/Vyik8/Q/VEfwJZ2R1KjG7kHm6hIkckyZJbOIV9aFpjo8+kY5zfsY346A72v4oMVvsUMywZE6N3KPqD2bN1Y6w+NnWuPH4lH5ghOAEnoYpTcR7G4RpMQgMs7Y72QHusPdEf6uv6a/1NVjqg5ZxjsGvpb78DZvIO1Q==</latexit> q(xt |x0) = N(xt; p ¯ ↵tx0, (1 ¯ ↵t)I) + p ¯ ↵tx0 = xt + (1 ¯ ↵t)r log p(xt) ガウス分布の平均の期待値を、 サンプルと分散と微分で表すことができる -
150 Copyright 2025 NTT CORPORATION スコアの推定 (2) • 元のデータ 𝐱-
は、時刻 𝑡 のデータ 𝐱/ を⽤いて下記で表される • 従って、 𝜇A (𝐱/ , 𝐱- ) は下記で変形できる <latexit sha1_base64="KPZ60peI1JIPTzMIAL5wbmktQFU=">AAADonicnVLLahRBFL2dNjGOxkx0E3AzOCZMfAzVIokEhKAuRBAzGScJpMJQ3db0NKl+pLpmSCzqB/wBF64UXIif4cYfUMgniMsIbrLw9gM1GaJgNd196tQ95966XDcRQaoIObDG7DPjE2cnz1XOX5i6OF2dubSexgPp8Y4Xi1huuizlIoh4RwVK8M1Echa6gm+4Ow+y840hl2kQR8/UfsK3Q+ZHQS/wmEKqW01oyFTf7ek909XEzN+jPck8/SerzI2Gc4u6TGrKRNJnObdAI+YKRkXs15LG8fgFo2m6K5U+KTKm0q3WSZPkqzYKnBLUoVyr8Yw1BRSeQwweDCAEDhEoxAIYpPhsgQMEEuS2QSMnEQX5OQcDFdQOMIpjBEN2B78+7rZKNsJ95pnmag+zCHwlKmswRz6T9+SQfCIfyFdydKqXzj2yWvbx7xZannSnX862f/xTFeJfQf+36q81K+jB3bzWAGtPcia7hVfohy9eHbaX1+b0PHlLvmH9b8gB+Yg3iIbfvXctvvYa3TP/h6gqeigRPSlreIqOHJlsl3XhOuaheYyPdWYZTdljH/mbv7j/dWSwN+JYcKd3zUOU3ZdjLoPT5JycnVGwfrvpLDYXW3fqK/fLuZqEK3AVGjg7S7ACj2AVOuj5BY6scWvCvmY/tlt2uwgds0rNZTi2bPoT0q7dmQ==</latexit> x0 = xt + (1 ¯ ↵t)r log p(xt) p ¯ ↵t <latexit sha1_base64="D/bLKfWxAUqr4rHHguY2go9j5cs=">AAAFY3iczVJNaxNBGH6zdrWm1jbVgyBCMLQk2oZZkSqCUNSDF7Efpi10SphdJ8nS/eruJLQu8wf8Az14UvAg/gZPgvoHPPQHeBCPFbx48J3dpSbdtAVPzrI77zzzPs/7vLNjBo4dCUL2C9qZEf3sudHzxbEL4xcnJktTq5HfDS3esHzHD9dNFnHH9nhD2MLh60HImWs6fM3ceqj213o8jGzfeyZ2A77psrZnt2yLCYSaJY1Qt9uMt2WVukx0zFa8I5uxkLP9SyJrM/dpK2RWTKPtUMSUOUGHqTxZNeaoycIMUtw5Q9ZknIOlHKxwc0AwJ5EIH5Y5XZBISv9Pk6nCoGzekKxRj5kOo47fLgdH/gYqD7UgZV/Xhsw3PrydftNDSSc4KTYnK6ROklHOB0YWVCAbi36pMA4UnoMPFnTBBQ4eCIwdYBDhswEGEAgQ24QYsRAjO9nnIKGI3C5mccxgiG7ht42rjQz1cK00o4RtYRUH3xCZZZgmX8k7ckC+kPfkO/l9rFacaCgvuzibKZcHzYmXV1Z+ncpycRbQ+cs60bOAFtxNvNroPUgQ1YWV8nsv9g5W7i1PxzPkDfmB/l+TffIRO/B6P623S3z5Faor/UfISs8wxOhJ5uEpKnJE1Eqdwg2sQ5OcNvpUFWV2xm3EZw+xf1VksJNTTLHjT83CSPXLsZbE22QcvTv5YPVW3Zivzy/driw8yO7VKFyF61DFu3MHFuAxLEIDLG1P+6B90j6PfNPH9Cn9cpqqFTLOJRgY+rU/zliQkg==</latexit> µq(xt, x0) = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t x0 = p ↵t(1 ¯ ↵t 1) 1 ¯ ↵t xt + p ¯ ↵t 1(1 ↵t) 1 ¯ ↵t xt + (1 ¯ ↵t)r log p(xt) p ¯ ↵t = 1 p ↵t xt + 1 ↵t p ↵t r log p(xt) Tweedieの公式 から導出 -
151 Copyright 2025 NTT CORPORATION スコアの推定 (3) • 𝜇A (𝐱/
, 𝐱- ) は下記で定義される (再掲) • 従って、 𝜇$ (𝐱/ , 𝑡) を下記で定義する 時刻 𝑡 のデータ 𝐱< からスコア ∇ log 𝑝(𝐱< ) を推定するNN <latexit sha1_base64="aRTdv/4+WpGYOQIqBmdsO2ZqCi8=">AAADxnicnVJLaxRBEK7J+EhWYzZ6CXhZXCLZGJcekSiBQFAPuYh5uEkgE4aesXd2SM8jMz1rYtPg2bPgwZOCB/FnePEPeMhPEI8RBPFg9cygSdYopIfprvq6vq+qi3ITHmSCkH1jyDxz9tz54ZHahYujl8bq45fXsjhPPdbxYh6nGy7NGA8i1hGB4GwjSRkNXc7W3e37+n69z9IsiKPHYi9hWyH1o6AbeFQg5NRf2mHuyB01ZYdU9Nyu3FWOFGrmsEtUa97uptSTlpJ2tpMKaVOe9KiOVOoo80YVefNQyN9IEXU5tXnsN5JjuVs1p94kbVKsxqBhVUYTqrUUjxujYMMTiMGDHEJgEIFAmwOFDL9NsIBAgtgWSMRStILinoGCGnJzjGIYQRHdxt1Hb7NCI/S1ZlawPczC8U+R2YBJ8pm8JwfkE/lAvpCfJ2rJQkPXsoenW3JZ4oy9mFj9/l9WiKeA3h/WP2sW0IW7Ra0B1p4UiH6FV/L7z14drM6tTMrr5C35ivW/IfvkI74g6n/z3i2zldeorvUfIKvsYYrWw6qGR6jIENGe7sI05rGLGB/r1BlV1WMf8Znf2GkVKewOKJbYyV3z0NLvZZhL4TRZx2dn0Fi71bZm27PLt5sL96q5GoarcA2mcHbuwAIswhJ0UPOH0TBaxrS5aEZmbj4tQ4eMinMFjizz+S8Ze+1p</latexit> µq(xt, x0) = 1 p ↵t xt + 1 ↵t p ↵t r log p(xt) <latexit sha1_base64="jYfW34THQejmrWzayarUxLrAbi4=">AAADv3icnVLLahRBFL2d9hFHYya6UdyEDAnRJEO1SCKCEB8LN2IeThJIh6a6UtPTpF+prhkyFvUDgmsXrhRciJ/hxh9wkU8QlyO4ceGt7kaNYyJYTXefOnXPubcu18+iMJeEHFoj9qnTZ86OnqudvzB2cbw+cWkjT7uC8RZLo1Rs+TTnUZjwlgxlxLcywWnsR3zT33tgzjd7XORhmjyV/YzvxDRIwnbIqETKq79w466nXNnhkupZN6ay47fVgfaU1PPy+sxdty0oU45Wbr4vpHJplHWoOdX6aPRcFbnwW8hfRPkJ2WpevUGapFiTw8CpQAOqtZJOWGPgwi6kwKALMXBIQCKOgEKOzzY4QCBDbgcUcgJRWJxz0FBDbRejOEZQZPfwG+Buu2IT3BvPvFAzzBLhK1A5CdPkE3lHBuQjeU8+k+/HeqnCw9TSx79fannmjT+/sv7tn6oY/xI6v1Qn1iyhDbeLWkOsPSsYcwtW6nvPXg7W76xNqxnyhnzB+l+TQ/IBb5D0vrK3q3ztFbob/4eoKnsoED2uaniCjhwZszNduIF53CImwDpNRl31OEB+/if3v44UDoYcS+74rjFE5r4cc2mcJufP2RkGGzebzmJzcfVWY/l+NVejcA2mYBZnZwmW4RGsQAs9B9ZVa8pq2PfswE7srAwdsSrNZTiy7P4PX9LqTQ==</latexit> µ✓(xt, t) = 1 p ↵t xt + 1 ↵t p ↵t s✓(xt, t) -
152 Copyright 2025 NTT CORPORATION スコアの推定 (4) • 𝜇A と
𝜇$ を⽤いて、⽬的関数は下記のように変形できる • つまり、時刻 𝑡 のデータ 𝐱< から、スコア ∇ log 𝑝(𝐱< ) を推定するNNを学習 できれば、拡散モデルを学習できる (Score-Based Model [F3] と⼀致) <latexit sha1_base64="igVQaSd3Bkq4UQy+54VqQNmygu8=">AAAGL3icpVLPTxNBFH5Qq4gioBcTL40E0iol08agMTEhysFEjfyQHwmDzew43W7YX52dEnCYP0CPevDgSRMPxpN/gxf/AWO4GK/EIyZeOPh2u8GWCghu0933vve+933zMlboOpEiZLOrO3Mie/JUz+neM2f7zvUPDJ6fj4KG5GKOB24gFy0WCdfxxZxylCsWQymYZ7liwVq5E9cXVoWMnMB/pNZDsewx23eqDmcKocpg984IZdL2HL+iqaoJxcwkRh5TNenpe/eNydfzSWpV9ZqpaFUsmY02wIy2psQUNjbC3WGHcQsFSkdupRZoVTKuS0aXaeTYHqvounmsyyavCoa6oqqWkjedF1LlqNfYR8WMqkIxKdc7KnusUunYtXRgrNTMl4/tiTOfC1fvkmhUl0pT5oY1Fusb0+7HXE1biy09f2FFBx71yKrFf1OlPrNcRt3AzoV7dP93c0kt32qgENdMq37Heg/ewtHN9lYGhsgYSZ5cZ1BKgyFIn6lgsKsPKDyBADg0wAMBPiiMXWAQ4W8JSkAgRGwZNGISIyepCzDQi9wGdgnsYIiu4NvGbClFfczjmVHC5qji4l8iMwfD5At5T7bJZ/KBbJGdfWfpZEbsZR2/VpMrwkr/84uzvw5lefhVUPvDOtCzgircSLw66D1MkPgUvMlfffpqe/bmzLAeIW/JD/T/hmyST3gCf/UnfzctZl7j9Hj+JLKaO5QYPUg9PMSJApE4i7dwBXVo0mOjz1jRpDu2ER/dxY47kcFax8Qmtv/WOEbxeQVqGbxNpb13pzOYL4+VxsfGp68NTdxO71UPXILLkMe7cx0m4C5MwRzwDM88y7zIvMx+zH7Nfst+b7Z2d6WcC9D2ZLd+A9yL43U=</latexit> arg min ✓ DKL(q(xt 1 |xt, x0)||p✓(xt 1 |xt)) = arg min 1 2 2 q (t) h kµ✓(xt, t) µq(xt, x0)k2 i = arg min 1 2 2 q (t) " ⇢ ⇢ ⇢ ⇢ 1 p ↵t xt + 1 ↵t p ↵t s✓(xt, t) ⇢ ⇢ ⇢ ⇢ 1 p ↵t xt 1 ↵t p ↵t r log p(xt) 2 # = arg min 1 2 2 q (t) (1 ↵t)2 ↵t h ks✓(xt, t) r log p(xt)k2 i -
153 Copyright 2025 NTT CORPORATION スコアの推定 (5) • スコア ∇
log 𝑝(𝐱/ ) は、ノイズ 𝜖- を⽤いて計算できる <latexit sha1_base64="2GeuHy8kKUDg7ndkoveMokcFejI=">AAAES3icnVJNaxNBGH6322qN1jZ6KXgJhoZUTZgVqSIUinrwIvbDtIVOCbPjZLN0srvuTkLrMnj3D3jwpNCDCPojvHjx6KE/QTxGEKQH3/3wI00bwVl2951n3udjhrED6UaKkANjzByfOHV68kzh7Lmp89MzxQvrkd8NuWhwX/rhps0iIV1PNJSrpNgMQsE6thQb9s7dZH2jJ8LI9b1Hai8Q2x3meG7L5Uwh1Cwas7TDVNtuxbu6GRNdWaStkPH4b1Tpq1WrRm0WxpTJoM1SbJ56zJaMSt8pBdXB/nkd0+hJqOKjJK0pPd6ilhGGfTQVQeRKDIvxRumOylNZrGWm1i+FY4wGnArNmTKpk3SUhgsrL8qQj2W/aEwBhcfgA4cudECABwprCQwifLbAAgIBYtsQIxZi5abrAjQUkNvFLoEdDNEd/Do428pRD+eJZpSyObpIfENklmCOfCZvSJ98JG/JF3J4olacaiRZ9vBvZ1wRNKefz659/yerg38F7T+skZkVtOBWmtXF7EGKJLvgGb/39EV/7fbqXFwhr8lXzP+KHJAPuAOv943vr4jVl6ie6N9DVnaGIVYP8gwPUVEgksySU7iCPjTtcTBn4qjzM3YQv/Yb+19FBrtDihl28qlxrJL9CvTSeJuso3dnuFi/XrcW6gsrN8pLd/J7NQmX4DJU8e7chCW4D8vQAG48M/aNd8Z785PZN3+Yh1nrmJFzLsLAGJ/4CR4dI7Q=</latexit> x0 = xt + (1 ¯ ↵t)r log p(xt) p ¯ ↵t = xt p 1 ¯ ↵t✏0 p ¯ ↵t r log p(xt) = 1 p 1 ¯ ↵t ✏0 -
154 Copyright 2025 NTT CORPORATION まとめ • 拡散モデルは階層VAEの特殊ケース • 潜在変数がデータと同次元で、マルコフ連鎖
• エンコーダが線形で、ハイパーパラメータ 𝛼< のみに依存 (= 学習しない) • 最終ステップ 𝑇 において、エンコーダが標準ガウス分布に⼀致 • ⽬的関数は、下記の三通りのNNを学習する形となり、全て等価 • 時刻 𝑡 のデータ 𝐱< から、元のデータ 𝐱1 を予測するNN • 時刻 𝑡 のデータ 𝐱< から、元のノイズ 𝜖1 を予測するNN • 時刻 𝑡 のデータ 𝐱< から、スコア関数 ∇ log 𝑝(𝐱< ) を予測するNN • サンプリングに時間がかかるのが⽋点 (𝑇回推定するため) -
155 Copyright 2025 NTT CORPORATION 補⾜: 実際のネットワーク構造 • ̂ 𝜖$
(𝐱/ , 𝑡) は、U-Net [F4] を⽤いてモデル化している • Image Segmentation で標準的に⽤いられている構造 • 時刻 𝑡 の埋め込みには、positional embedding [C1] などを⽤いる copy and crop input image tile output segmentation map 64 1 128 256 512 1024 max pool 2x2 up-conv 2x2 conv 3x3, ReLU 572 x 572 284² 64 128 256 512 570 x 570 568 x 568 282² 280² 140² 138² 136² 68² 66² 64² 32² 28² 56² 54² 52² 512 104² 102² 100² 200² 30² 198² 196² 392 x 392 390 x 390 388 x 388 388 x 388 1024 512 256 256 128 64 128 64 2 conv 1x1 階層モデルだけど 1つのU-NetでOK -
156 Copyright 2025 NTT CORPORATION 補⾜: ハイパーパラメータの推定 • ⽬的関数は下記のように変形できる •
従って、単調増加のNN 𝜔B (𝑡) を⽤いて下記でモデル化できる <latexit sha1_base64="sNq3/70cN+qAlj+o41gKNlI7Qxc=">AAAFRnicvVLPaxNBFH5dU63xR1O9CF6CoSWRJswGqVIQinrworaJSQuZGGbXSbJ0N1l3J6F1mH/Af8CDpwoexD/Dgz3qwUP/BBG8VCmIB9/sLo01bQVBJ2T3vW/e973vzY7lu04oCNmZME6kJk+emjqdPnP23PnpzMyFetgfBDav2X23H6xZLOSu0+M14QiXr/kBZ57l8lVr/bbeXx3yIHT6vYdi0+dNj3V6TtuxmUCoNWMs0nbAbGkqWaah0/FYSz5Rj2RZ5UVBxXvUYoGkzPW7TLWkKJoqbxbjHFNV0NVKauxgYbJDXd4WjehJ6zwQWdplQlKPia7VlhsKS6nocsFUfgRq+rwoFH9FiKKB0+kmKlo7zptzN0dDxO3yRzlXcsymRouH1h9WrZKmhX8/FqWHDaaZgSer9yv4iYpmorWPFP6bvXQrkyMlEq3seGAmQQ6StdzPfAcKj6EPNgzAAw49EBi7wCDEXwNMIOAj1gSJWICRE+1zUJBG7gCrOFYwRNfx2cGskaA9zLVmGLFt7OLiP0BmFmbJR/Ka7JJt8oZ8Ij+O1JKRhvayiW8r5nK/Nf3sUnXvjywP3wK6I9axngW04Ubk1UHvfoToKeyYP3z6fLe6WJmVc+Ql+Yz+t8gOeYsT9IZf7VcrvPIC1bX+HWTFZxhgdC/x8AAVOSI606dwFfvQqKaDPnVHlZxxB/H5fexvFRlsjCnGmL4m5u+XYjyol0vmQmlh5Vpu6VZyYabgMlyBPN6K67AEd2EZamAbW8Y7473xIbWd+pL6ltqLS42JhHMRDqxJ+AkYiItu</latexit> 1 2 2 q (t) ¯ ↵t 1(1 ↵t)2 (1 ¯ ↵t)2 h kˆ x✓(xt, t) x0 k2 i = 1 2 ✓ ¯ ↵t 1 1 ¯ ↵t 1 ¯ ↵t 1 ¯ ↵t ◆ h kˆ x✓(xt, t) x0 k2 i = 1 2 (SNR(t 1) SNR(t)) h kˆ x✓(xt, t) x0 k2 i <latexit sha1_base64="oS+ObMeamsbHv/fpzmcPVwOPsTw=">AAADX3icnVLPT9RAFH5sVWBVqHjBeCFuMIuRzdQQNCYkRD14EWGXBRKGNNM6223or0xnN8Ck/wD/gAdPmngw/gdevfgPcOAmR/CIiYnx4Ju20egGTJymM2++ed8337w8Jwn8VBJyOFQxLly8NDwyWr185erYuHltYi2Ne8LlbTcOYrHhsJQHfsTb0pcB30gEZ6ET8HVn+7E+X+9zkfpxtCp3E74VMi/yO77LJEK2uUpDJrsiVK2lZlaXMwu0I5irqMOEoixIuiyzlcwyZc0OYAuU7yT1WRqH3GO2olwyLTFTtc0aaZB8TA0GVhnUoBzLsfkdKLyAGFzoQQgcIpAYB8AgxW8TLCCQILYFCjGBkZ+fc8igitweZnHMYIhu4+zhbrNEI9xrzTRnu3hLgL9A5hRMkwPyjpyST+Q9OSY/ztRSuYb2sourU3B5Yo/vT7a+/ZMV4iqh+5t1rmcJHXiQe/XRe5Ij+hVuwe/vvTxtPWxOq9vkDfmC/l+TQ/IRXxD1v7pvV3jzFapr/SfIKmooMHpWeniOihwRvdNVuIP30DzHQ5/6xqyssYf43V/Y/yoy2BlQLDDdJtbfTTEYrN1rWPON+ZW52uKjsmFG4Cbcgjp2xX1YhKewDG309QE+wzGcVI6MYWPMMIvUylDJuQ5/DOPGTwIBy3M=</latexit> SNR(t) = ¯ ↵t 1 ¯ ↵t = exp( !⌘(t)) <latexit sha1_base64="rBQJamdNIHk1Zgt/Ci/bPXN7djY=">AAADeXicnVLLShxBFL0zbYyZGB3jRshGMyijxKFaxYgQkCQLNxIfGRUsaarbsqewX1TXDGrTP+APuMgqgSxCPiObfECy8BMkSwXBZOGt7iYhGfIg1XTVrVP3nDp1uXbkiVgRclYqGz23em/33anc7b83MFgdur8Zh23p8KYTeqHctlnMPRHwphLK49uR5My3Pb5lHzzT51sdLmMRBi/VUcR3feYGYl84TCFkVQNqM5lQ5kUtllqJSieeUJ+plvSTWLh+KPbS+jQNfe4yK6FcsbSuJicpNaf/gdjFq1jVGmmQbIx2B2YR1KAYq2H1GijsQQgOtMEHDgEojD1gEOO3AyYQiBDbhQQxiZHIzjmkUEFuG7M4ZjBED3B2cbdToAHutWacsR28xcNfInMUxsln8o5ckI/kPTkn336rlWQa2ssRrnbO5ZE1eDKycfVXlo+rgtYP1h89K9iHhcyrQO9RhuhXODm/c3x6sbG4Pp5MkDfkC/p/Tc7IB3xB0Ll03q7x9VeorvWfIyuvocRopfDwAhU5InqnqzCF99Asx0Wf+sa0qLGL+KPv2P8qMjjsUswx3Sbmr03RHWzONMz5xvzaXG3padEwffAAHkIdu+IxLMEyrEITfX2C65JR6il/NcaMujGVp5ZLBWcYfhrG7A192NRR</latexit> ¯ ↵t = sigmoid( !⌘(t)) 1 ¯ ↵t = sigmoid(!⌘(t)) <latexit sha1_base64="knER7SsrwnLkG5Fpxx1544Ildyw=">AAADXnicnVLPaxNBFH7NalujNbFeAl6CoSURG2aL1CIIRT14EdvEtIVuG2a3k+3Q/eXsJFiX+Qf8Bzx4UvAg/gWevfgPeOhJjw09VhDEg292lxYNttBZdua9b973zTfDsyOPx5KQ/bGCceHi+MTkpeLlK1NXS+Vr06tx2BcO6zihF4p1m8bM4wHrSC49th4JRn3bY2v27kO9vzZgIuZh8EzuRWzTp27Ae9yhEqFuuW3F3PVpN3mutpJ5VZeN2ftWT1AnqZtzFvWiHdyTqqEzm4okgxRic6ZqqGQEVqrYLddIk6SjOhqYeVCDfCyH5V9gwTaE4EAffGAQgMTYAwoxfhtgAoEIsU1IEBMY8XSfgYIicvtYxbCCIrqLs4vZRo4GmGvNOGU7eIqHv0BmFWbIV/KBHJEv5CMZkt//1UpSDe1lD1c747KoW3pVaf88k+XjKmHnhHWqZwk9WEy9cvQepYi+hZPxBy9fH7XvtWaSWfKOHKL/t2SffMYbBIMfzvsV1nqD6lr/EbKyNxQYPck9PEVFhojO9CvcwnOstMZFn/pElb+xi/jtY+y8ihRejChmmG4T89+mGA1W55vmQnNh5U5t6UHeMJNwA25CHbviLizBY1iGDvr6BN/gAIaF78a4MWWUstLCWM65Dn8No/IHa2TJ6g==</latexit> 2 q (t) = (1 ↵t)(1 ¯ ↵t 1) 1 ¯ ↵t Signal-to-Noise Ratio: 単調増加 -
157 Copyright 2025 NTT CORPORATION 参考⽂献 F 1. Luo, Calvin.
"Understanding diffusion models: A unified perspective." arXiv preprint arXiv:2208.11970 (2022). 2. Efron, Bradley. "Tweedieʼs formula and selection bias." Journal of the American Statistical Association 106.496 (2011): 1602-1614. 3. Song, Yang, and Stefano Ermon. "Generative modeling by estimating gradients of the data distribution." Advances in neural information processing systems 32 (2019). 4. Ronneberger, Olaf, Philipp Fischer, and Thomas Brox. "U-net: Convolutional networks for biomedical image segmentation." Medical image computing and computer-assisted intervention–MICCAI 2015: 18th international conference, Munich, Germany, October 5-9, 2015, proceedings, part III 18. Springer International Publishing, 2015.
 takahashihiroshi
 eumesy
 corochann
 ept
 ftakahashi
 sishi
 shunk031
 ldcn
 satai
 enochan
 institutdelelevage
 kohlerjohannes
 jonoalderson
 twada
 wjessup
 gurzu
 sstephenson
 codingconduct
 honnibal
 portentint
 aleyda
 joshbly
 bethany
 bluesmoon