Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【基本情報対策】探索・整列と計算量

 【基本情報対策】探索・整列と計算量

Avatar for 赤神青空

赤神青空 PRO

October 17, 2026

Video

More Decks by 赤神青空

Other Decks in Programming

Transcript

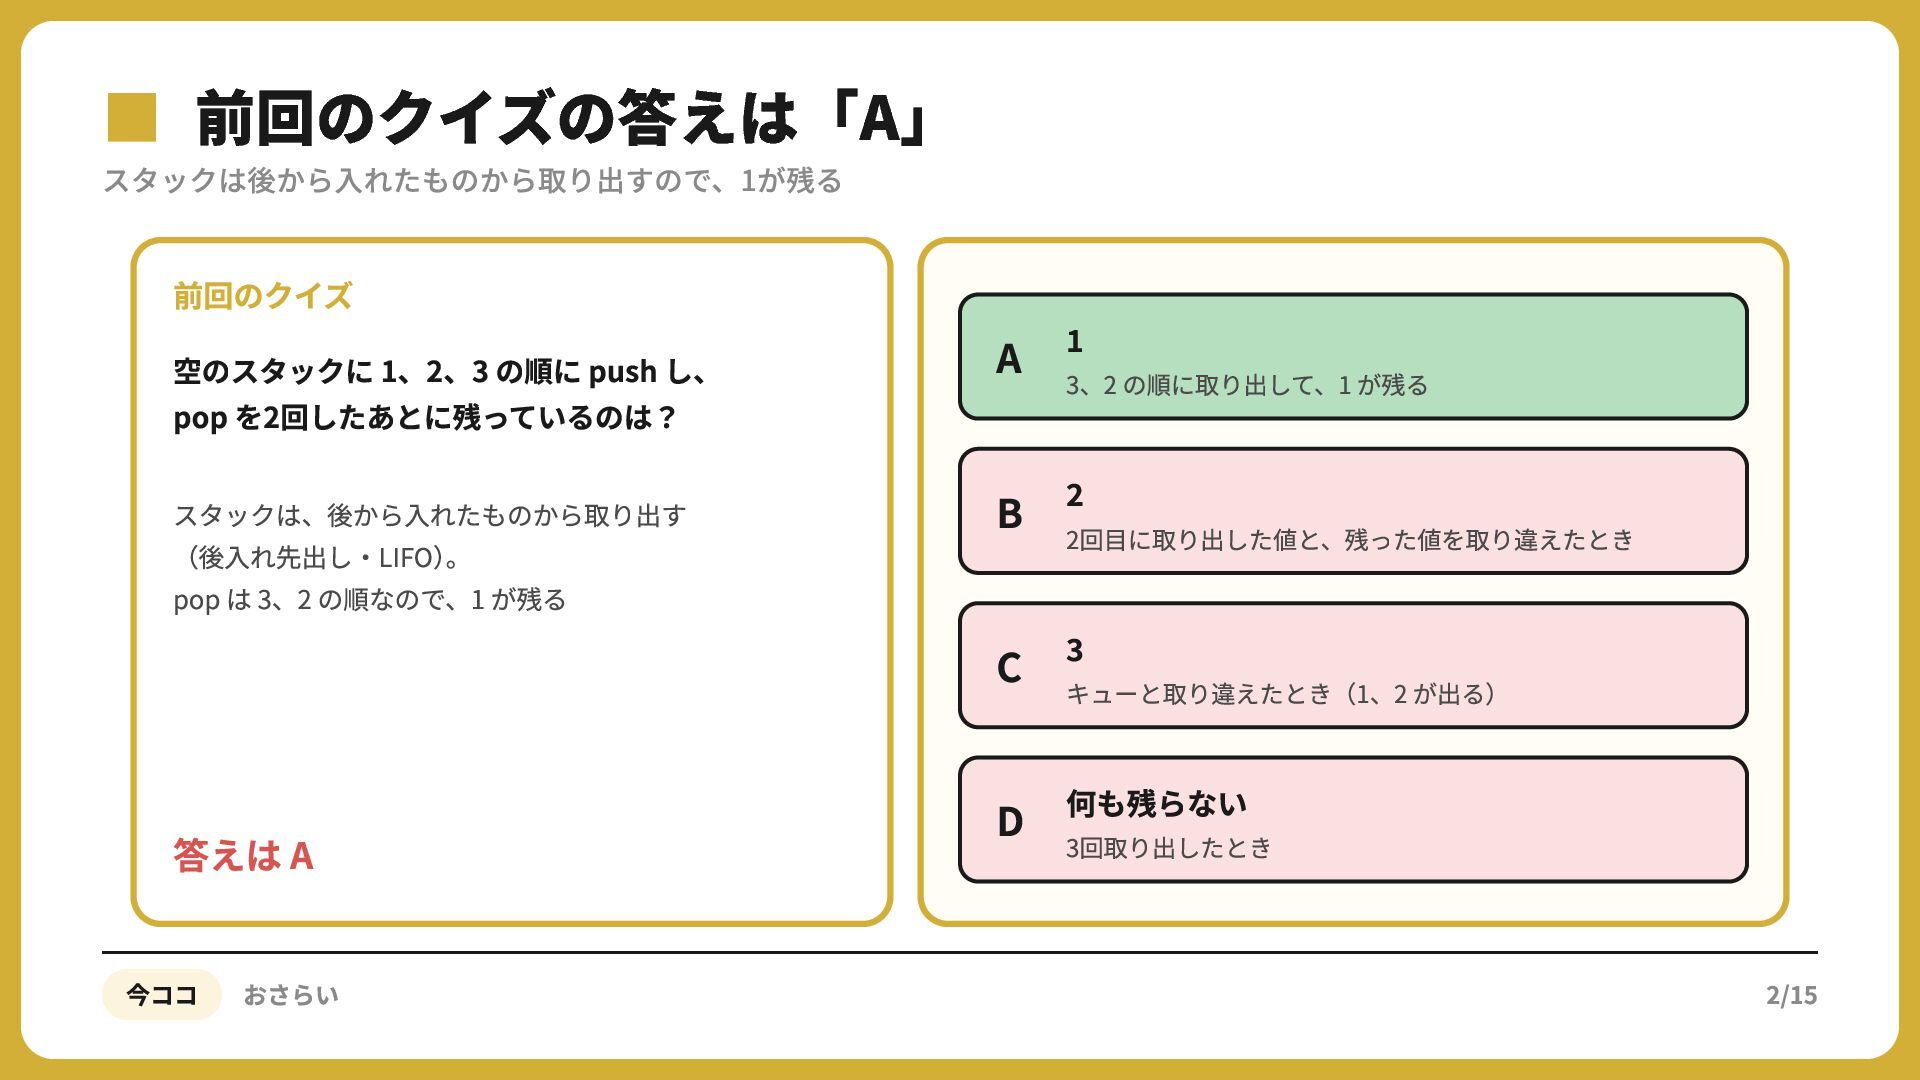
  1. ▪スタックは後から入れたものから取り出すので、1が残る 前回のクイズの答えは「A」 前回のクイズ 空のスタックに 1、2、3 の順に push し、 pop を2回したあとに残っているのは?

    スタックは、後から⼊れたものから取り出す (後⼊れ先出し‧LIFO)。 pop は 3、2 の順なので、1 が残る 答えは A 今ココ おさらい A 3、2 の順に取り出して、1 が残る B 2回⽬に取り出した値と、残った値を取り違えたとき C キューと取り違えたとき(1、2 が出る) D 何も残らない 3回取り出したとき 2/15
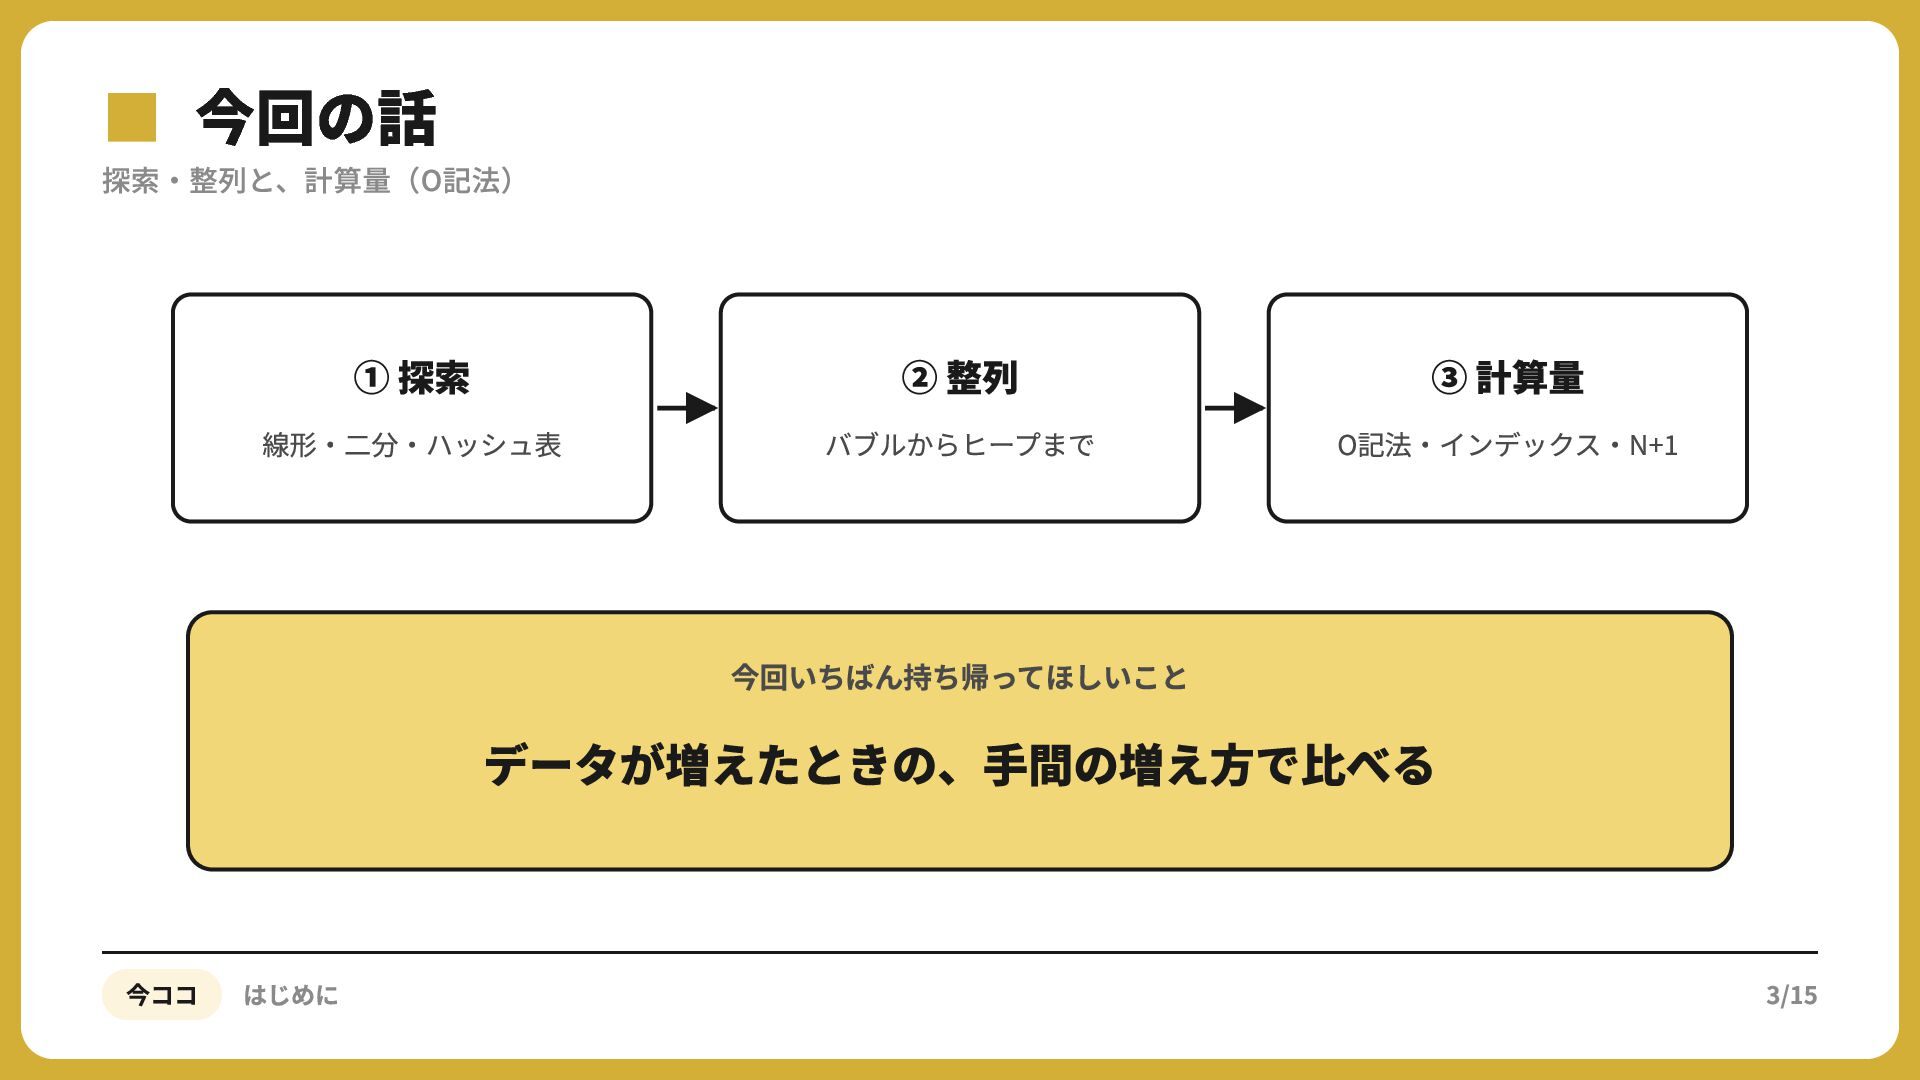
  2. ▪探索・整列と、計算量(O記法) 今回の話 ① 探索 線形‧⼆分‧ハッシュ表 ② 整列 バブルからヒープまで ③ 計算量

    O記法‧インデックス‧N+ 今回いちばん持ち帰ってほしいこと データが増えたときの、⼿間の増え⽅で⽐べる 今ココ はじめに 3/15
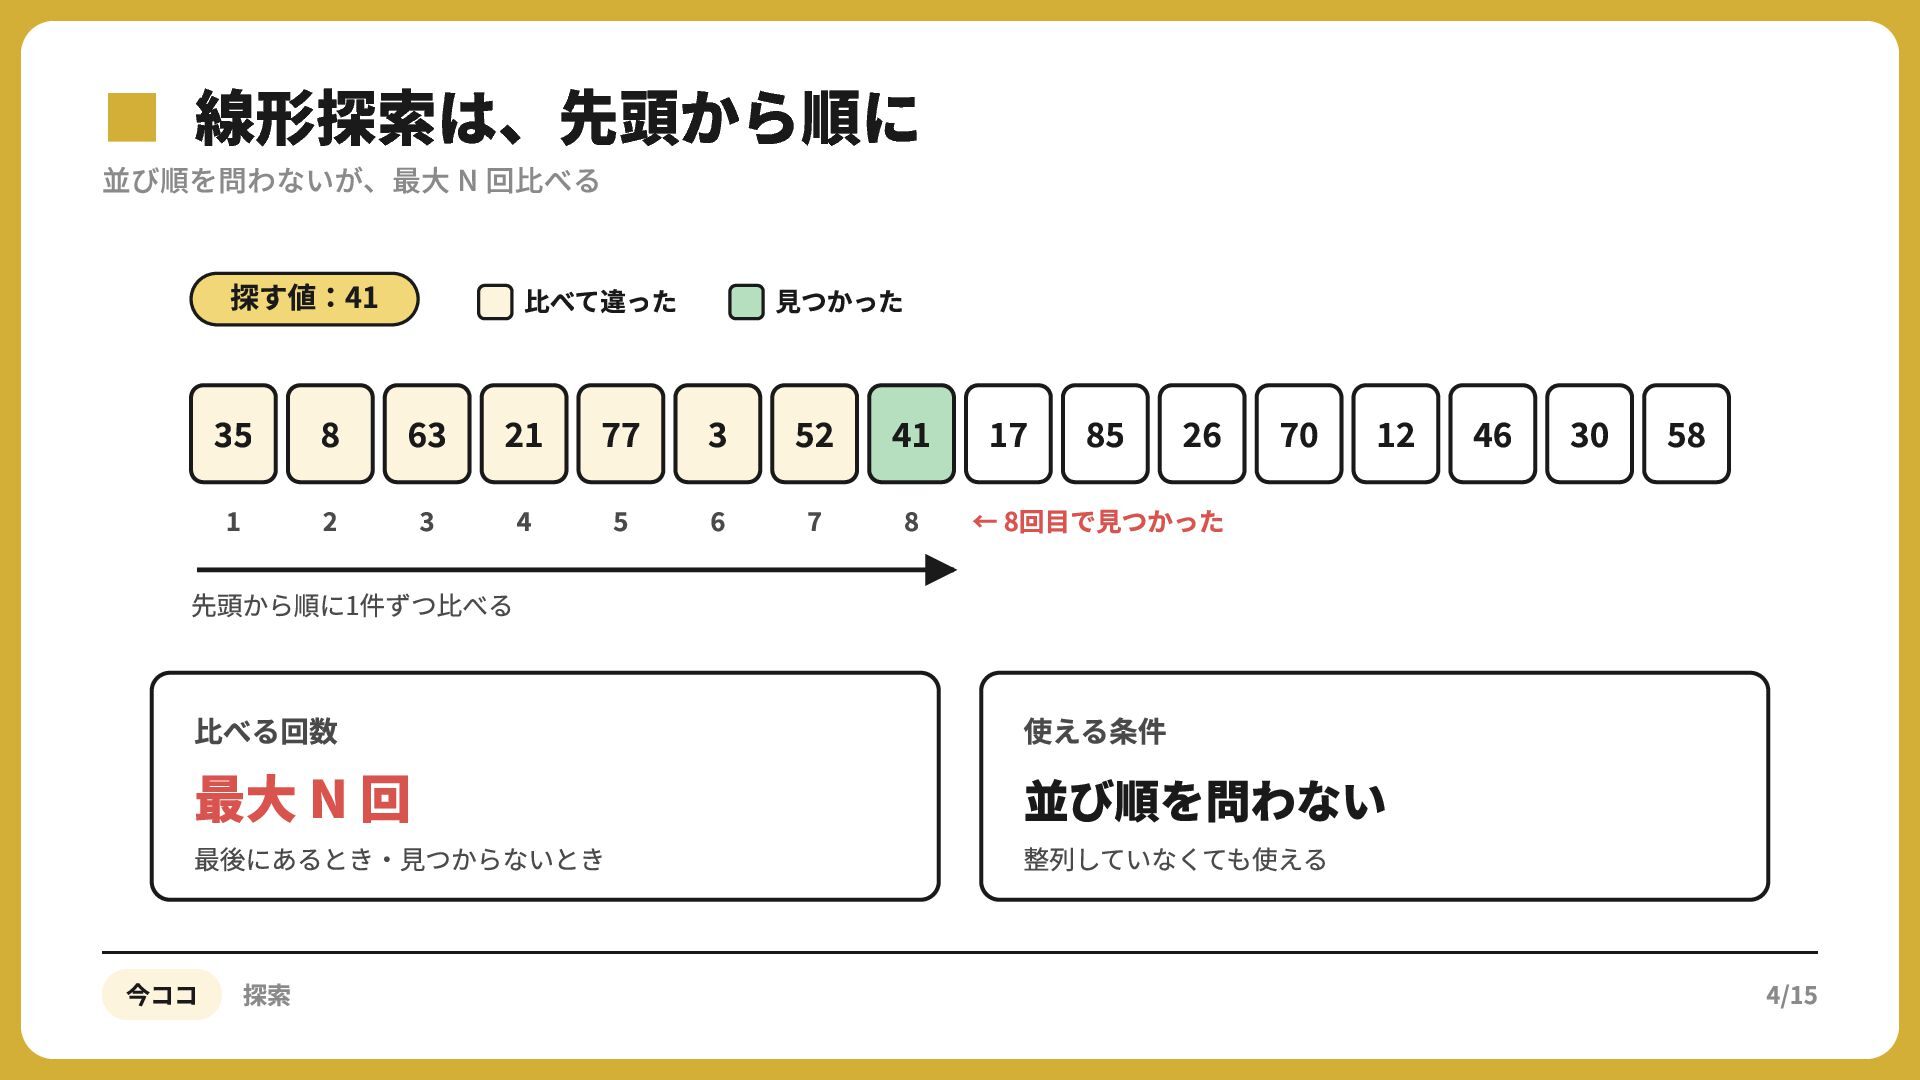
  3. ▪並び順を問わないが、最大 線形探索は、先頭から順に N 回比べる 探す値:41 ⽐べて違った ⾒つかった ← 8回⽬で⾒つかった 先頭から順に1件ずつ⽐べる

    ⽐べる回数 使える条件 最後にあるとき‧⾒つからないとき 整列していなくても使える 最⼤ N 回 今ココ 探索 並び順を問わない 4/15
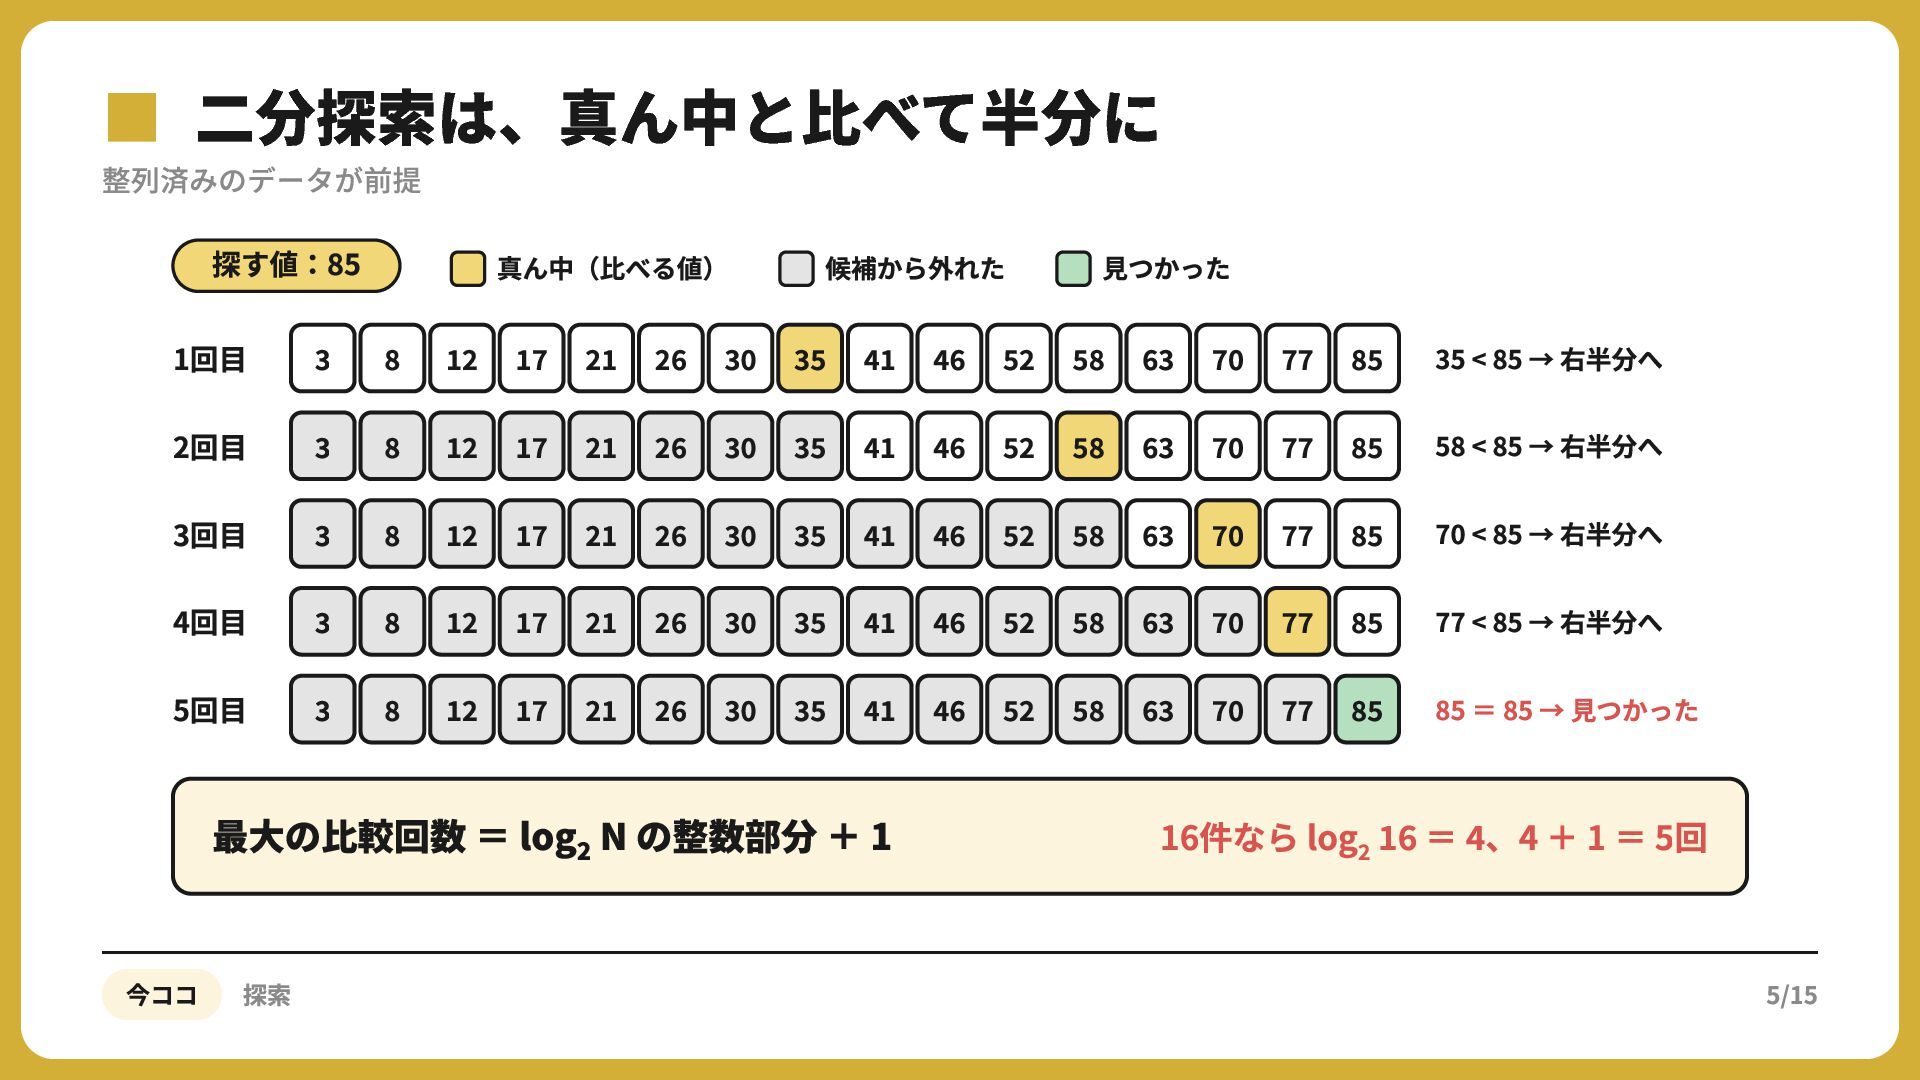
  4. ▪整列済みのデータが前提 二分探索は、真ん中と比べて半分に 探す値:85 真ん中(⽐べる値) 候補から外れた ⾒つかった 1回⽬ 35 < 85

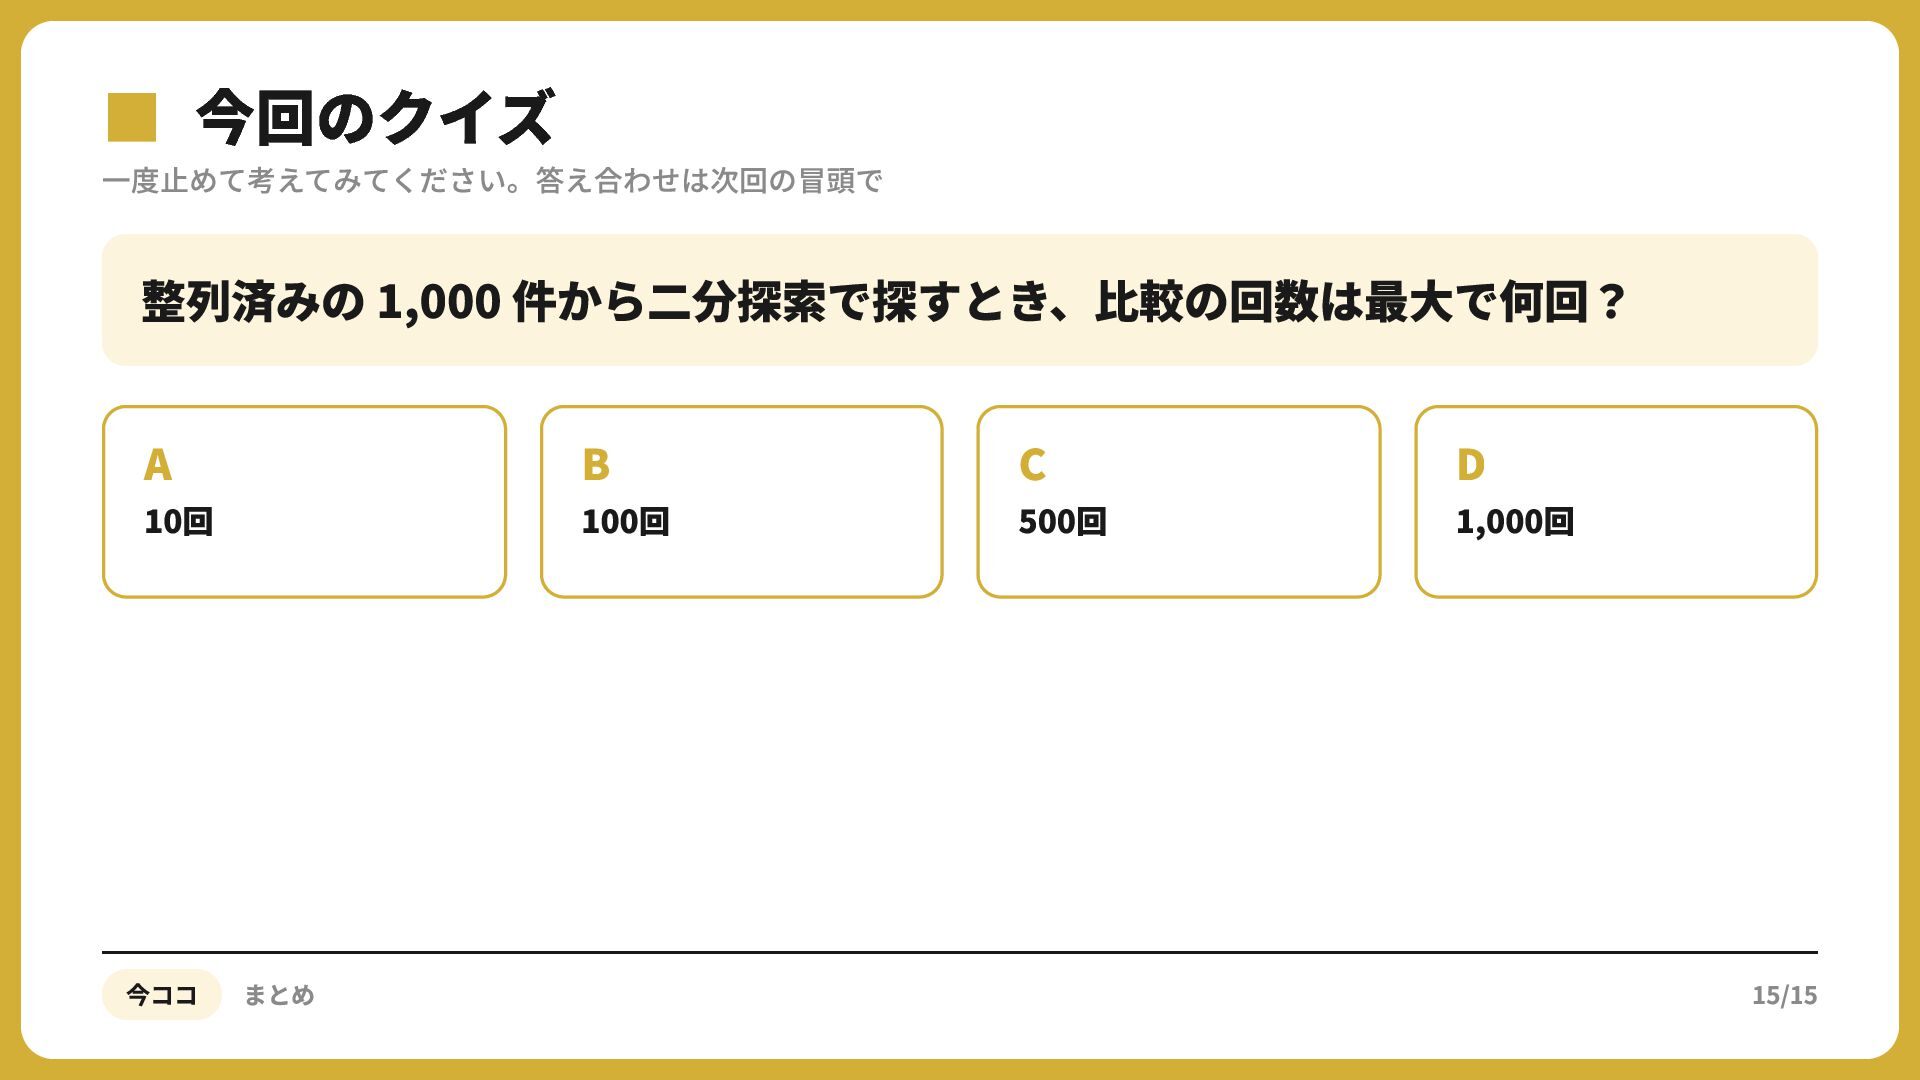
    → 右半分へ 2回⽬ 58 < 85 → 右半分へ 3回⽬ 70 < 85 → 右半分へ 4回⽬ 77 < 85 → 右半分へ 5回⽬ 85 = 85 → ⾒つかった 最⼤の⽐較回数 = log N の整数部分 + 1 今ココ 探索 16件なら log = 、4 + 1 = 5回 5/15
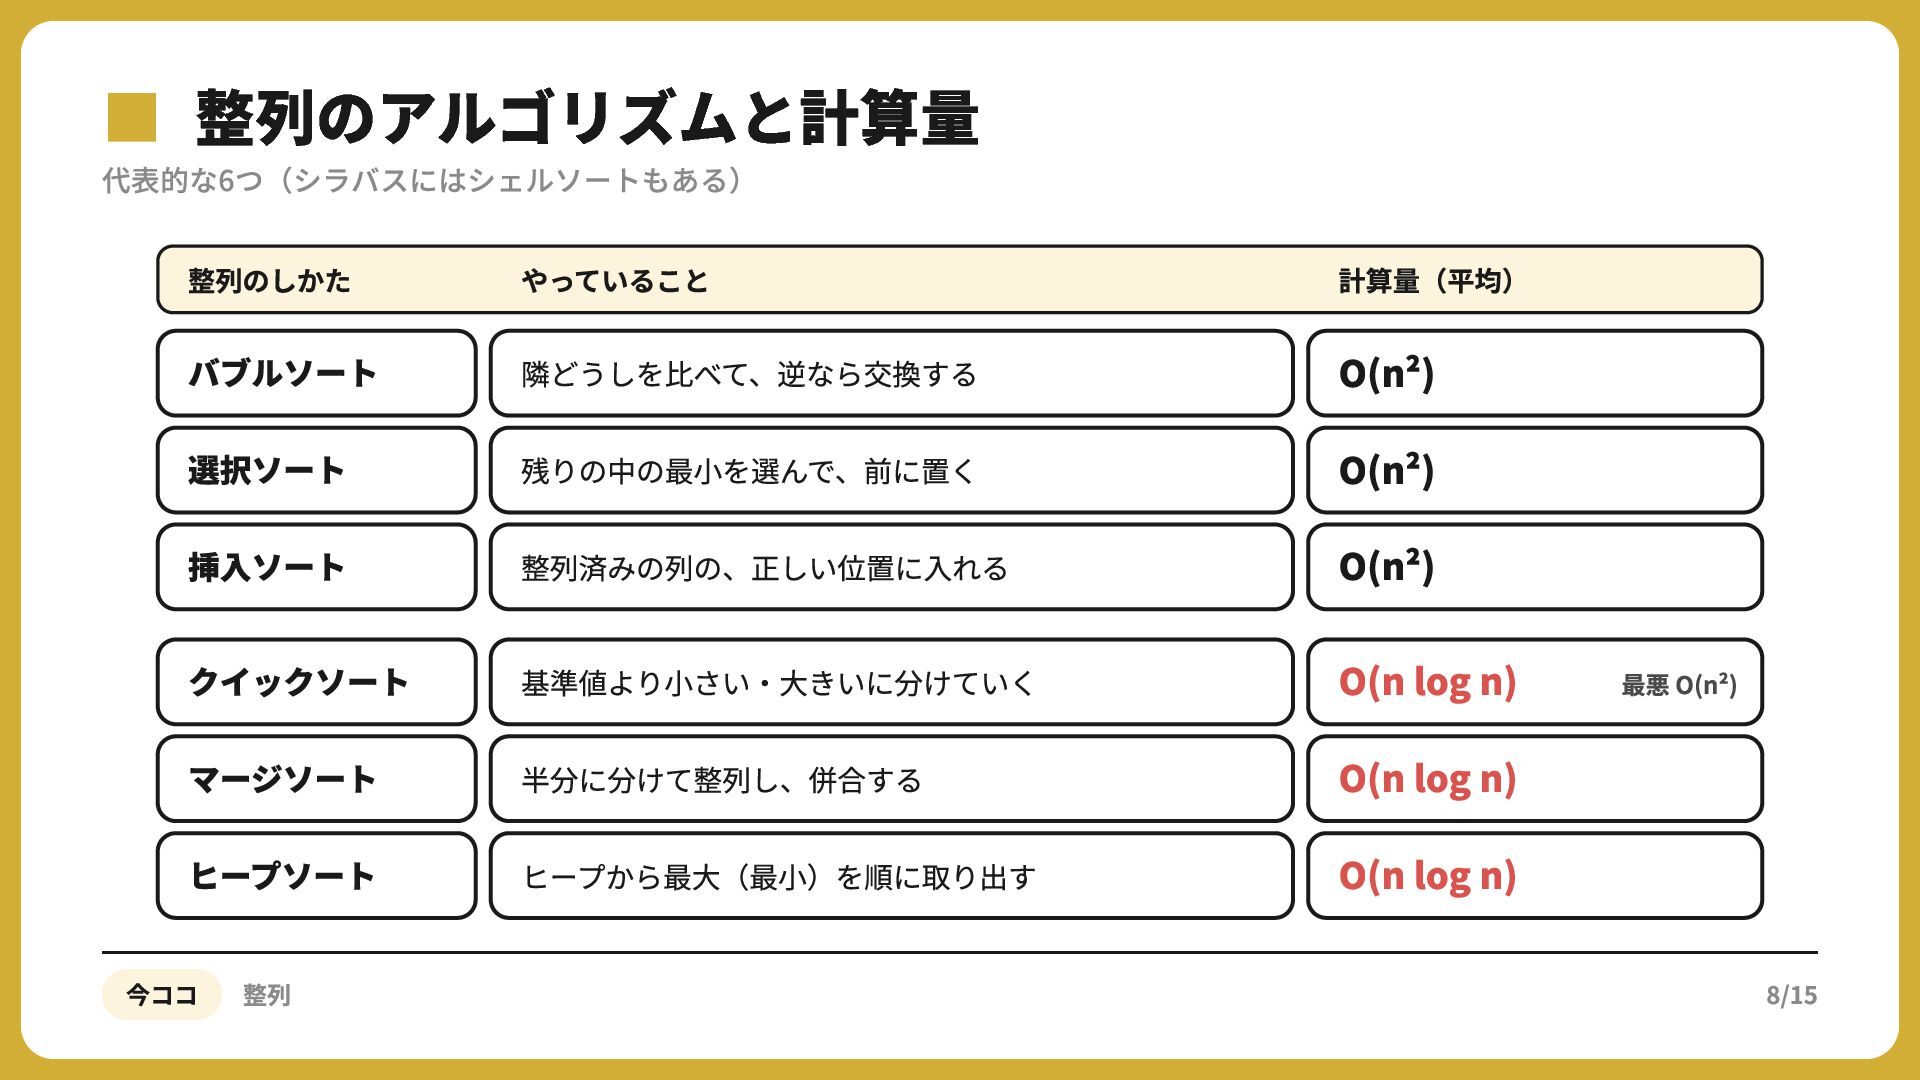
  5. ▪代表的な6つ(シラバスにはシェルソートもある) 整列のアルゴリズムと計算量 整列のしかた やっていること 計算量(平均) バブルソート 隣どうしを⽐べて、逆なら交換する 選択ソート 残りの中の最⼩を選んで、前に置く 挿⼊ソート

    整列済みの列の、正しい位置に⼊れる O(n²) O(n²) O(n²) クイックソート 基準値より⼩さい‧⼤きいに分けていく マージソート 半分に分けて整列し、併合する ヒープソート ヒープから最⼤(最⼩)を順に取り出す 今ココ 整列 O(n log n) O(n log n) O(n log n) 最悪 O(n²) 8/15
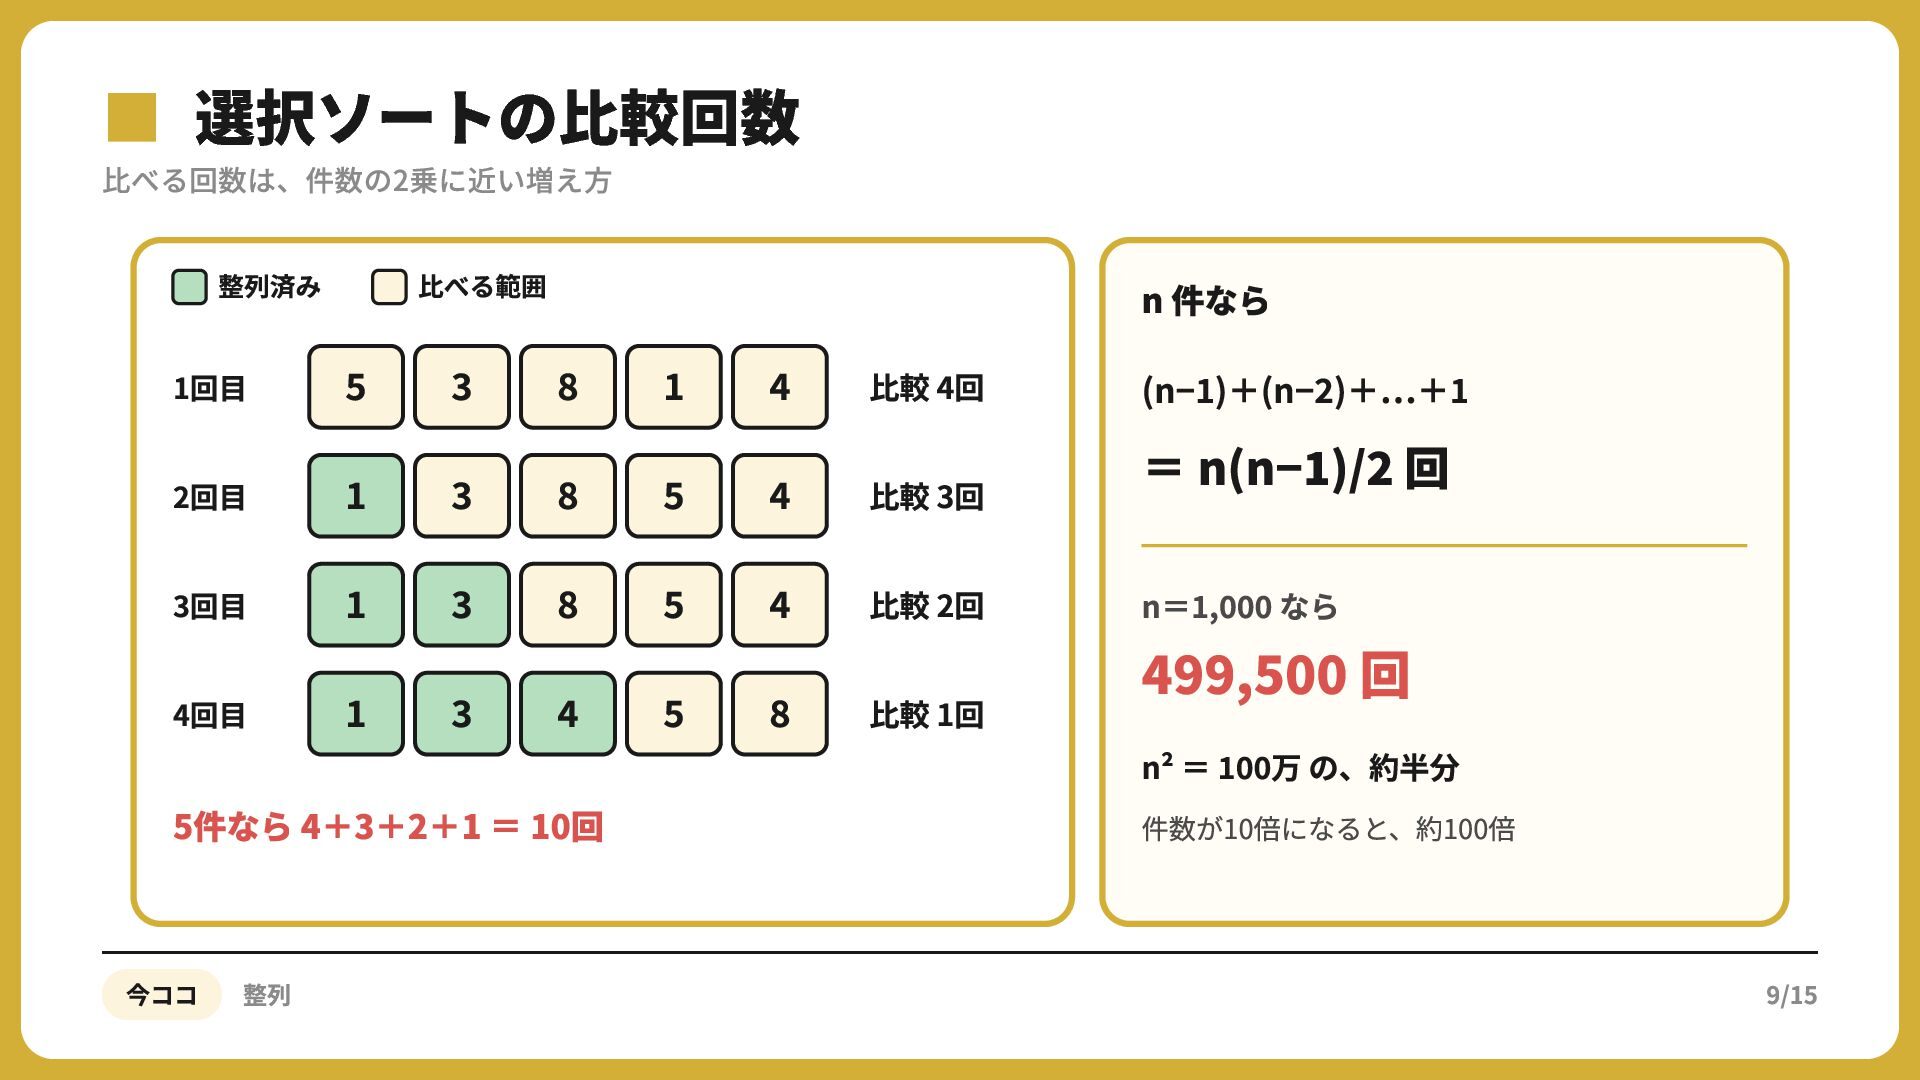
  6. ▪比べる回数は、件数の2乗に近い増え方 選択ソートの比較回数 整列済み ⽐べる範囲 n 件なら (n− )+(n− )+ +

    1回⽬ ⽐較 4回 2回⽬ ⽐較 3回 = n(n− )/ 回 3回⽬ ⽐較 2回 n= , なら 4回⽬ ⽐較 1回 5件なら 4+3+2+1 = 10回 今ココ 整列 499,500 回 n² = 万 の、約半分 件数が10倍になると、約100倍 9/15
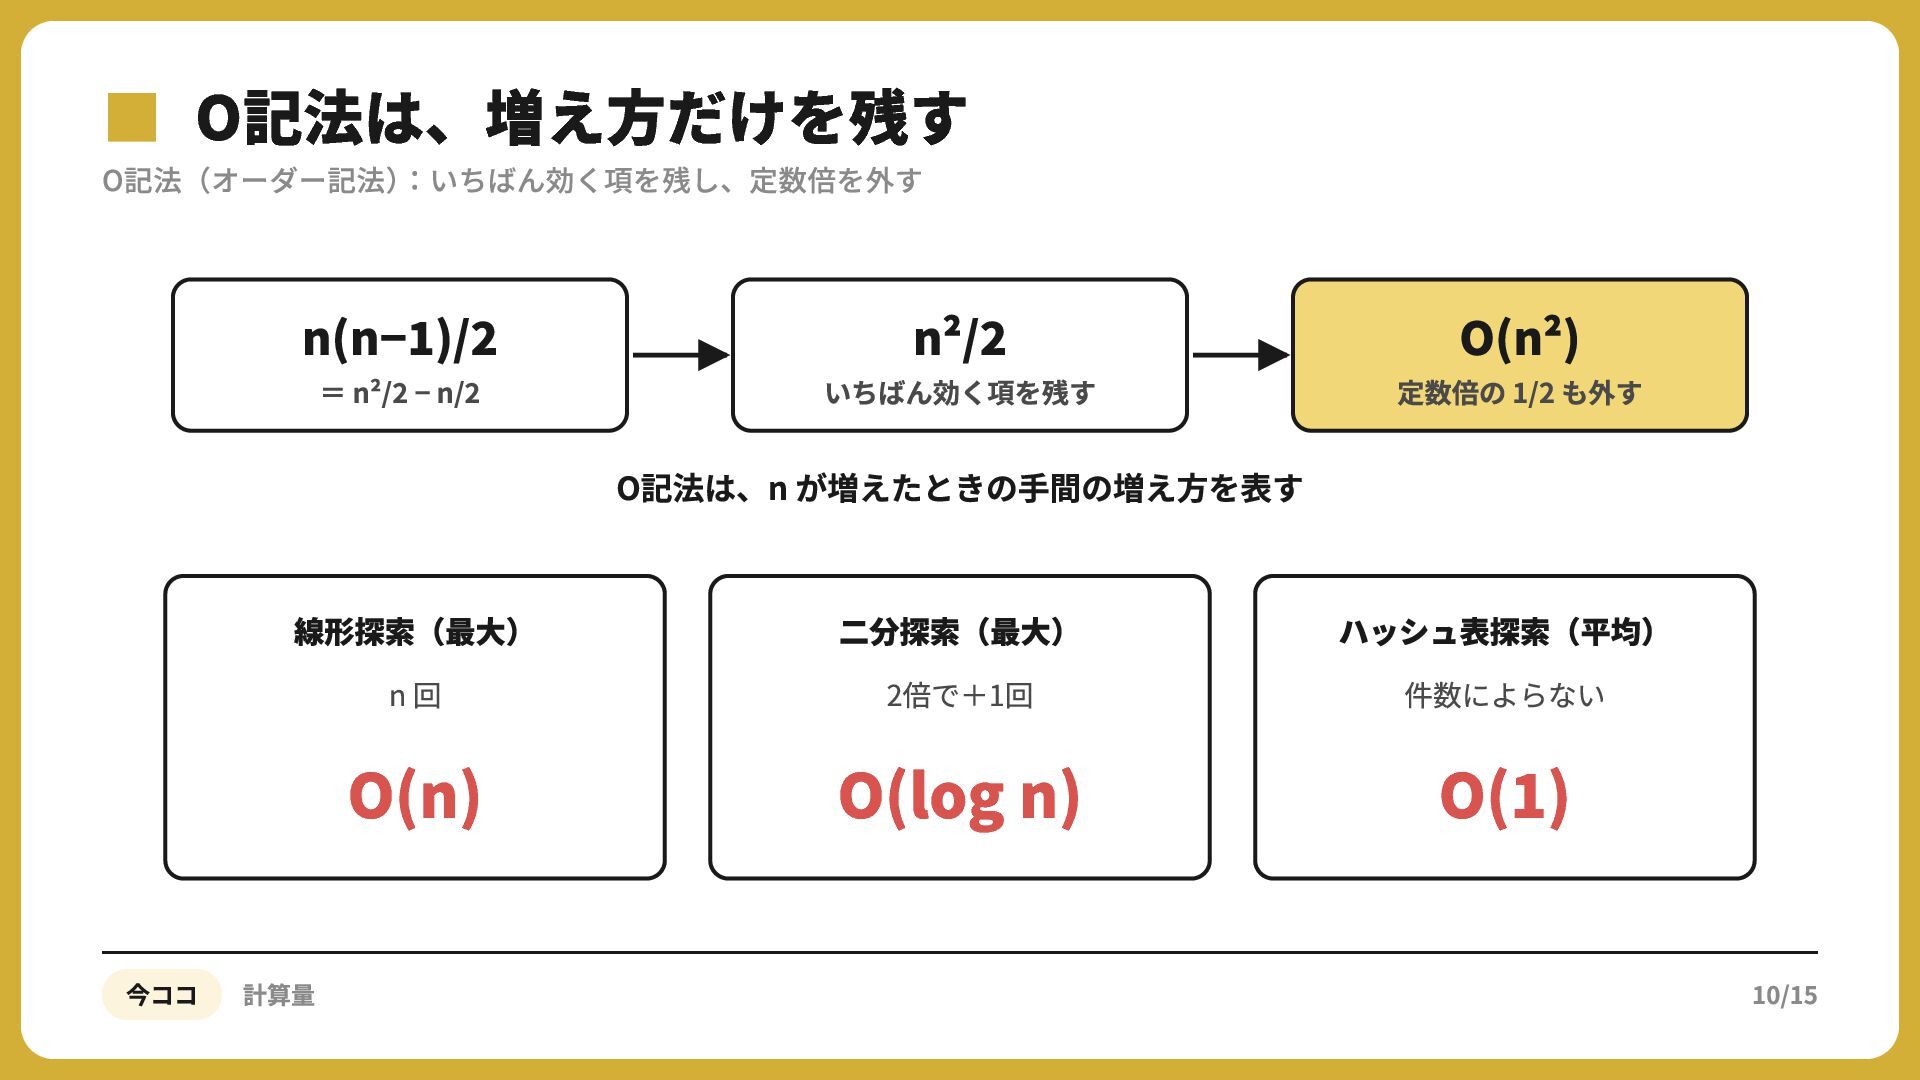
  7. ▪O記法(オーダー記法) O記法は、増え方だけを残す :いちばん効く項を残し、定数倍を外す n(n− )/ = n²/ − n/ n²/

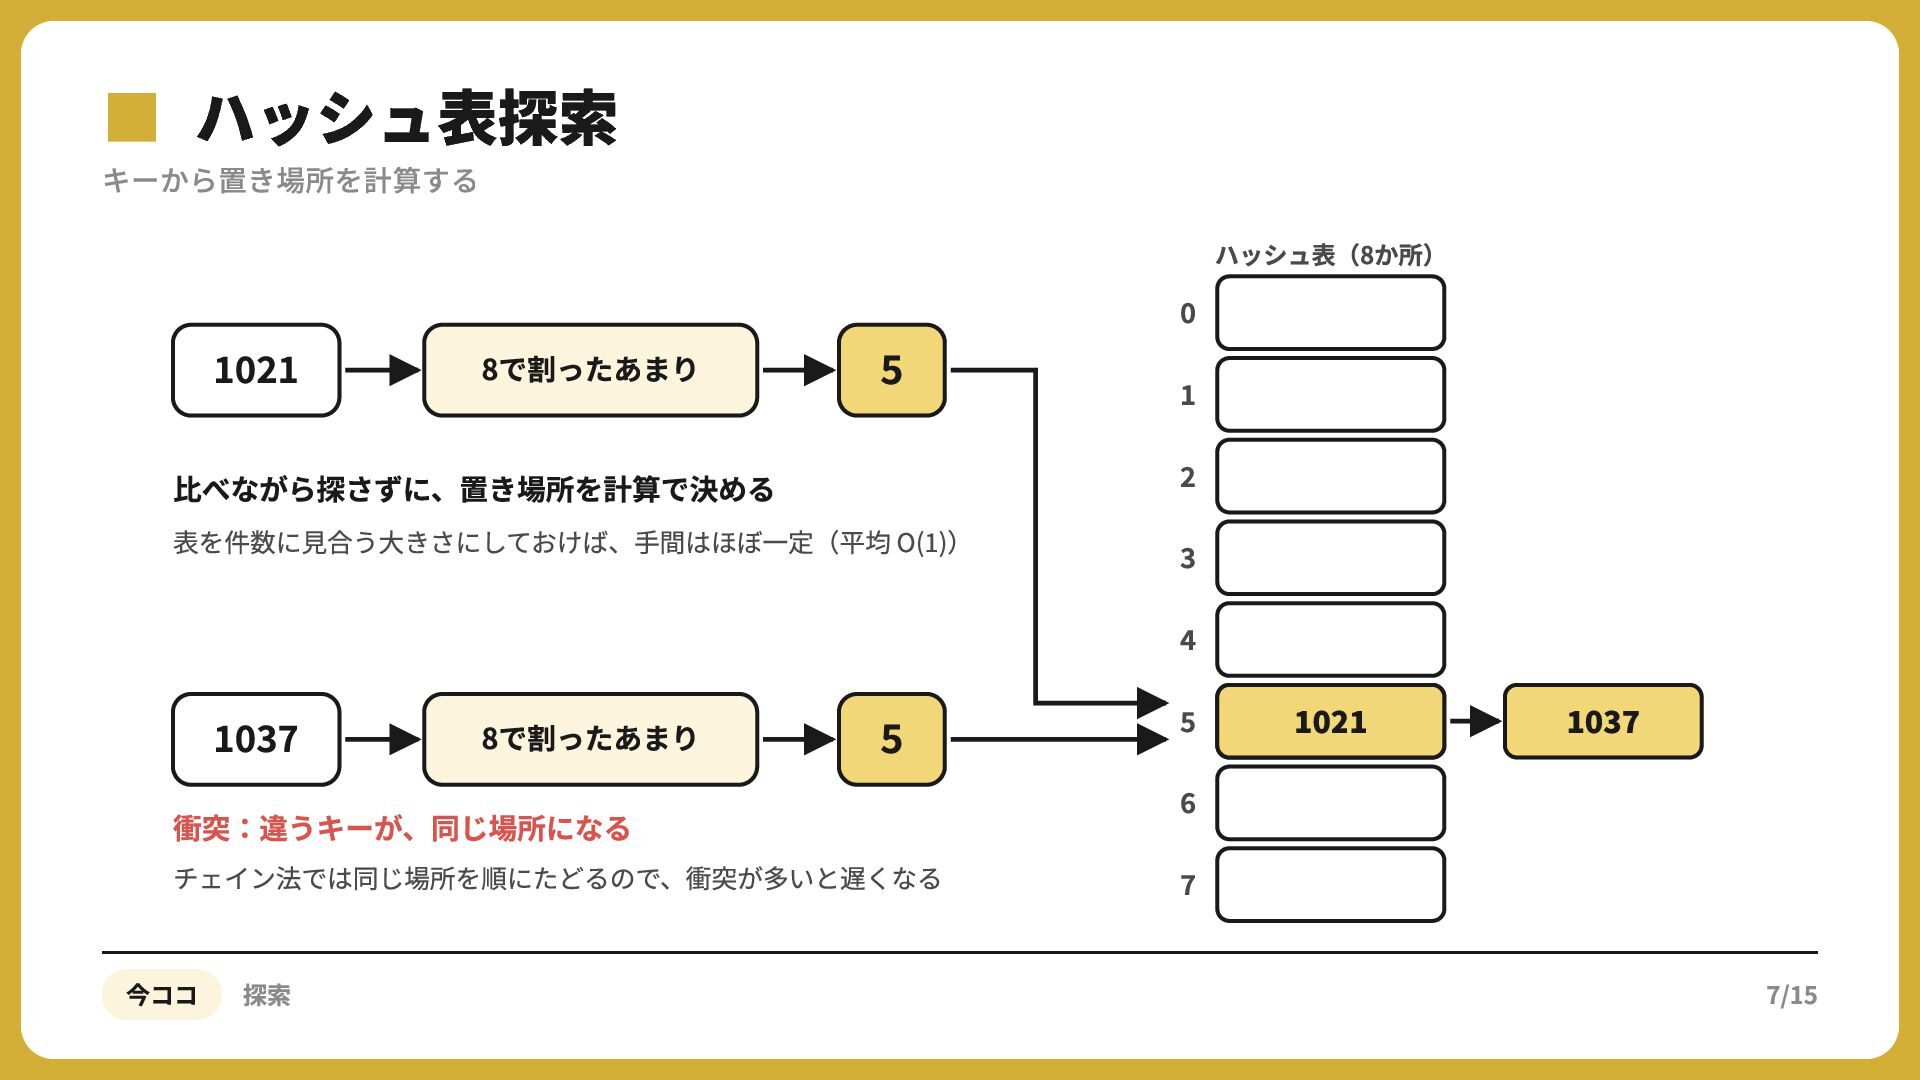
    いちばん効く項を残す O(n²) 定数倍の 1/2 も外す O記法は、n が増えたときの⼿間の増え⽅を表す 線形探索(最⼤) ⼆分探索(最⼤) ハッシュ表探索(平均) O(n) O(log n) O( ) n回 今ココ 計算量 2倍で+1回 件数によらない 10/15
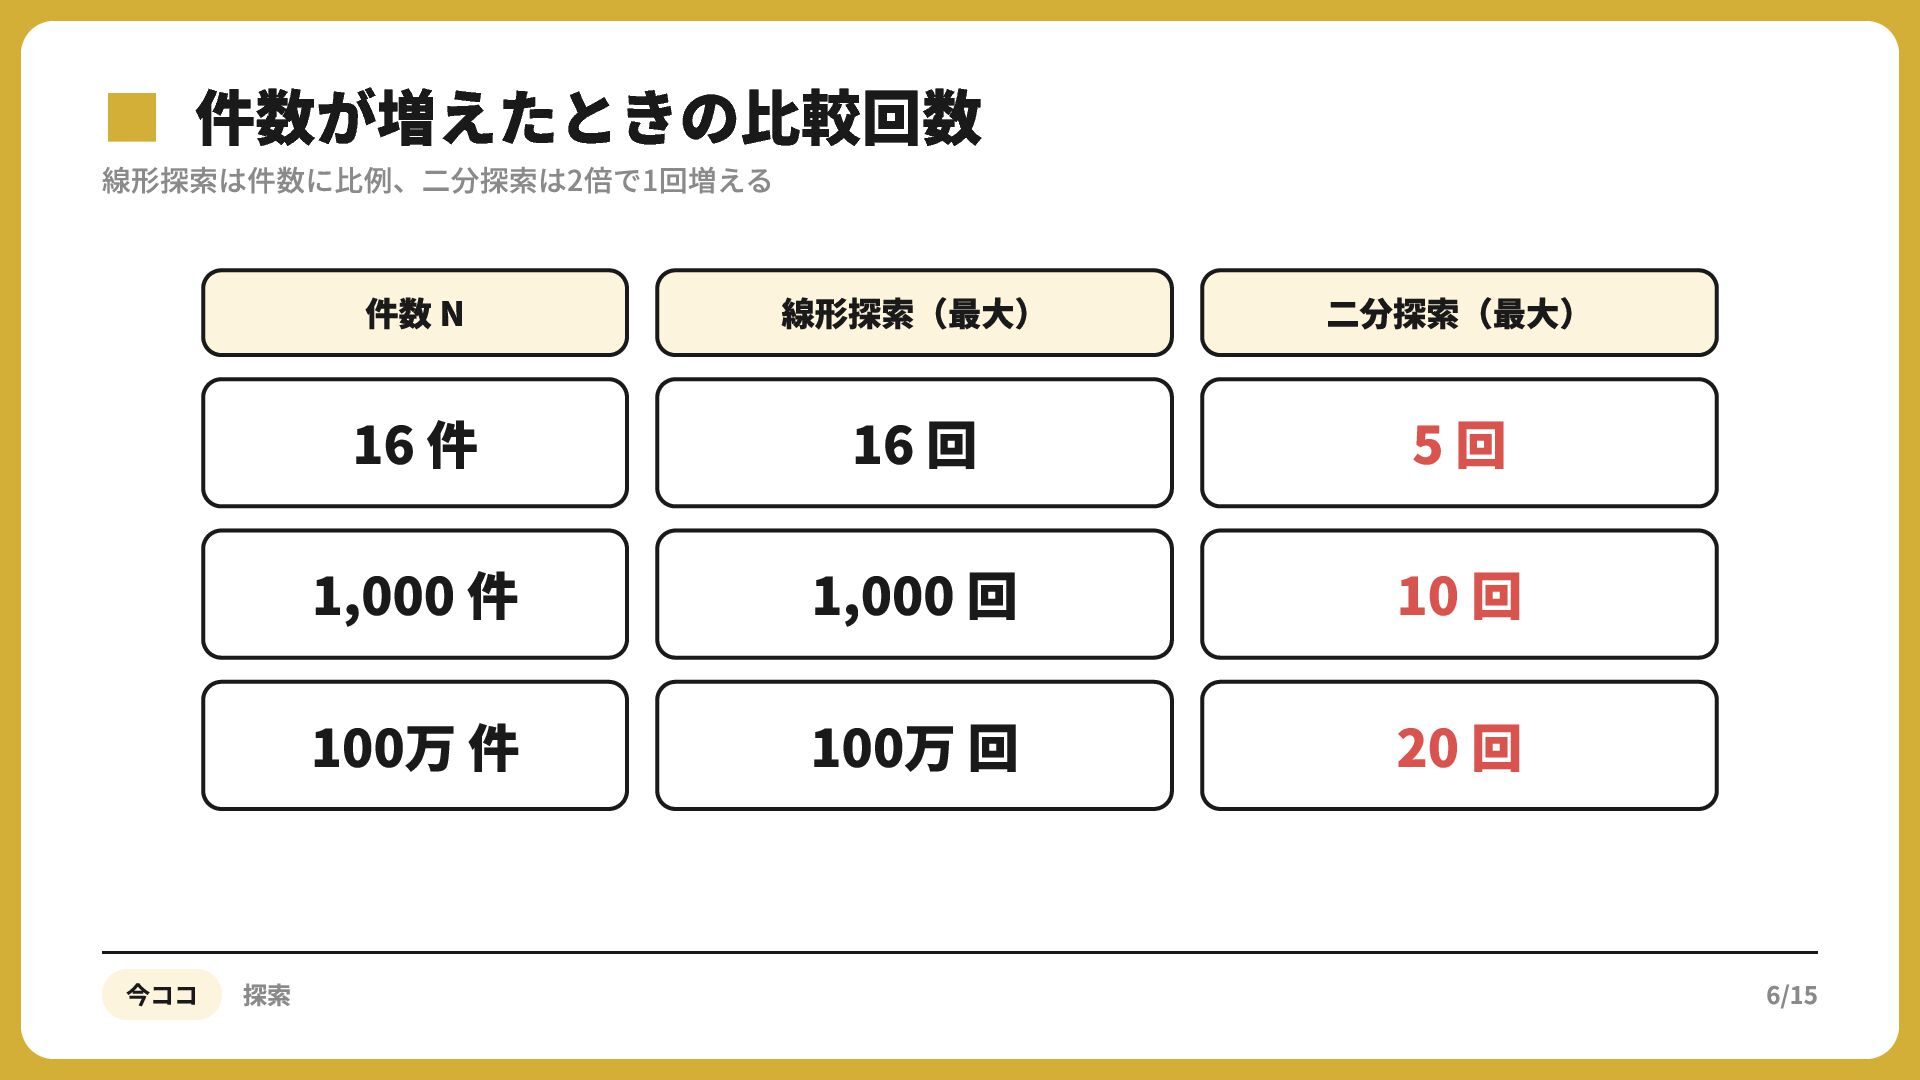
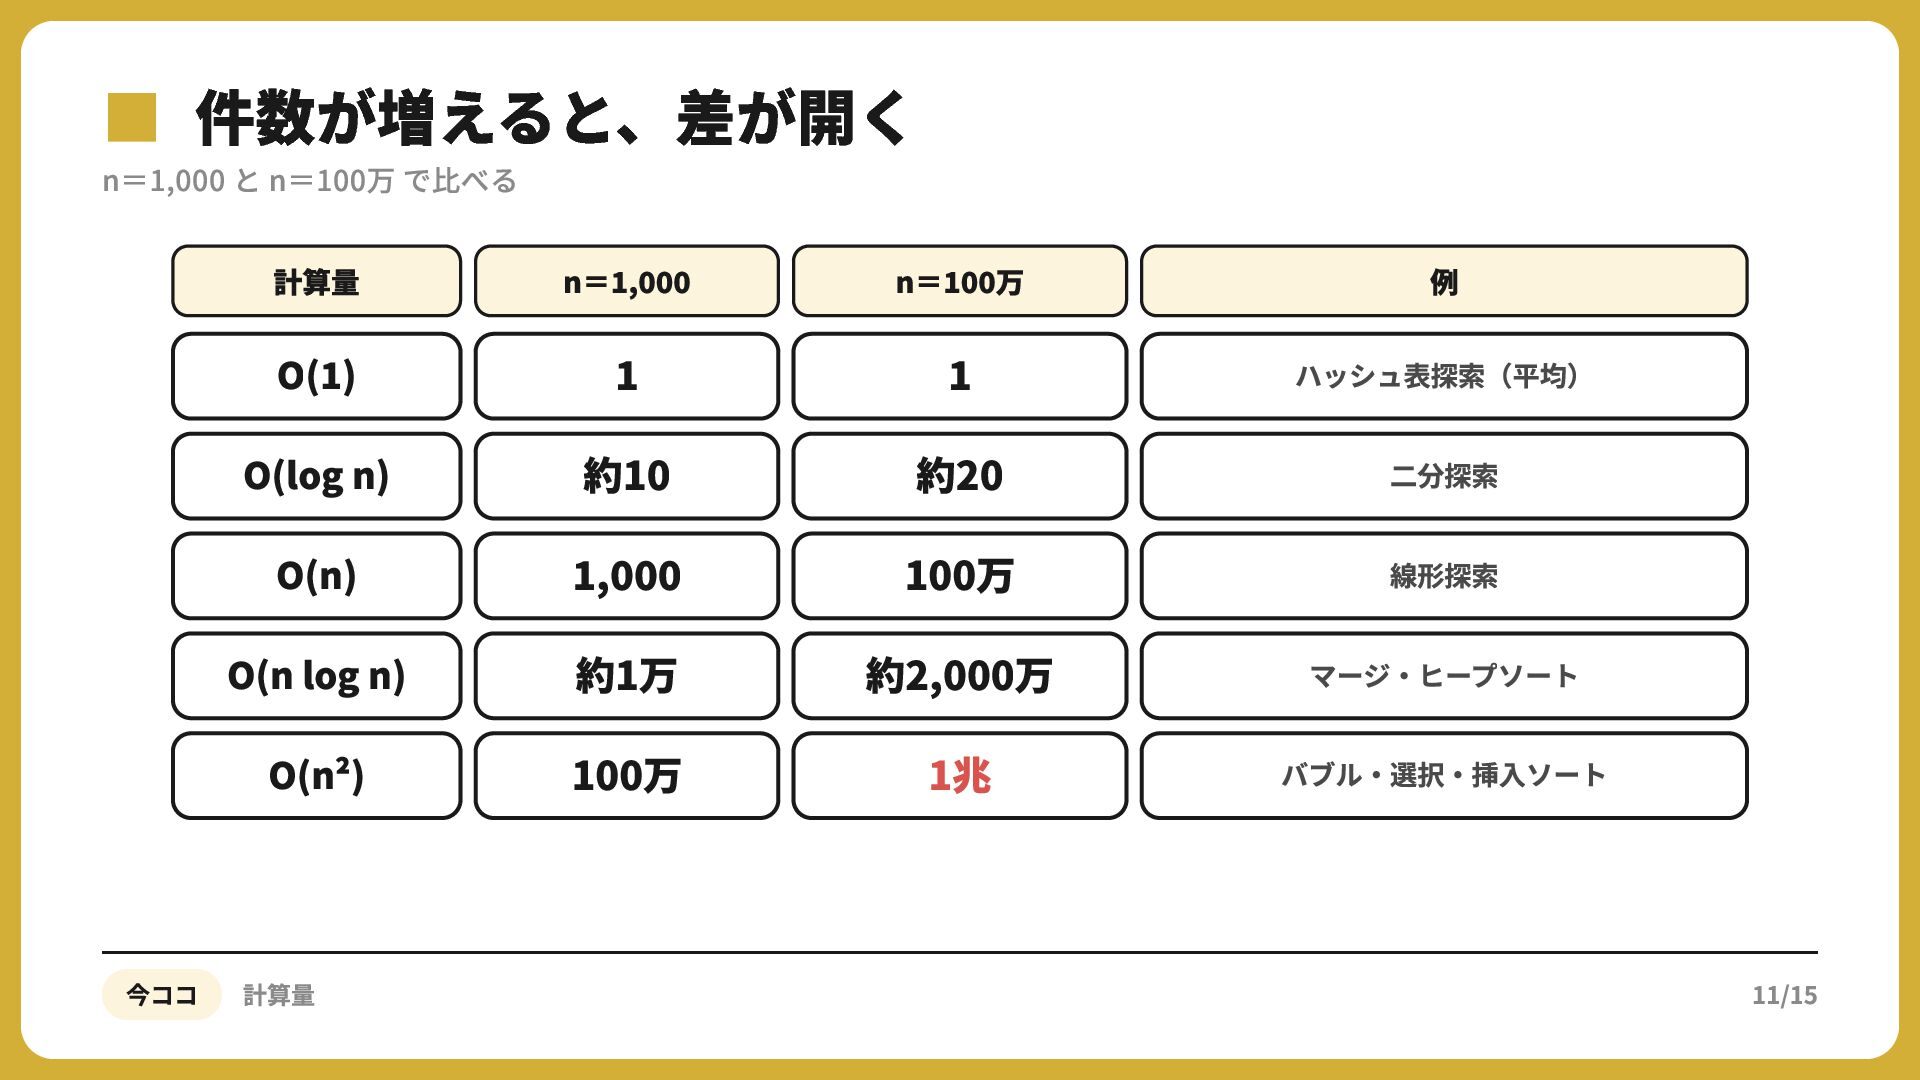
  8. ▪n=1,000件数が増えると、差が開く と n=100万 で比べる 計算量 O( ) O(log n) O(n)

    O(n log n) O(n²) 今ココ 計算量 n= , n= 万 例 ハッシュ表探索(平均) 約10 , 約1万 100万 約20 100万 約2,000万 1兆 ⼆分探索 線形探索 マージ‧ヒープソート バブル‧選択‧挿⼊ソート 11/15
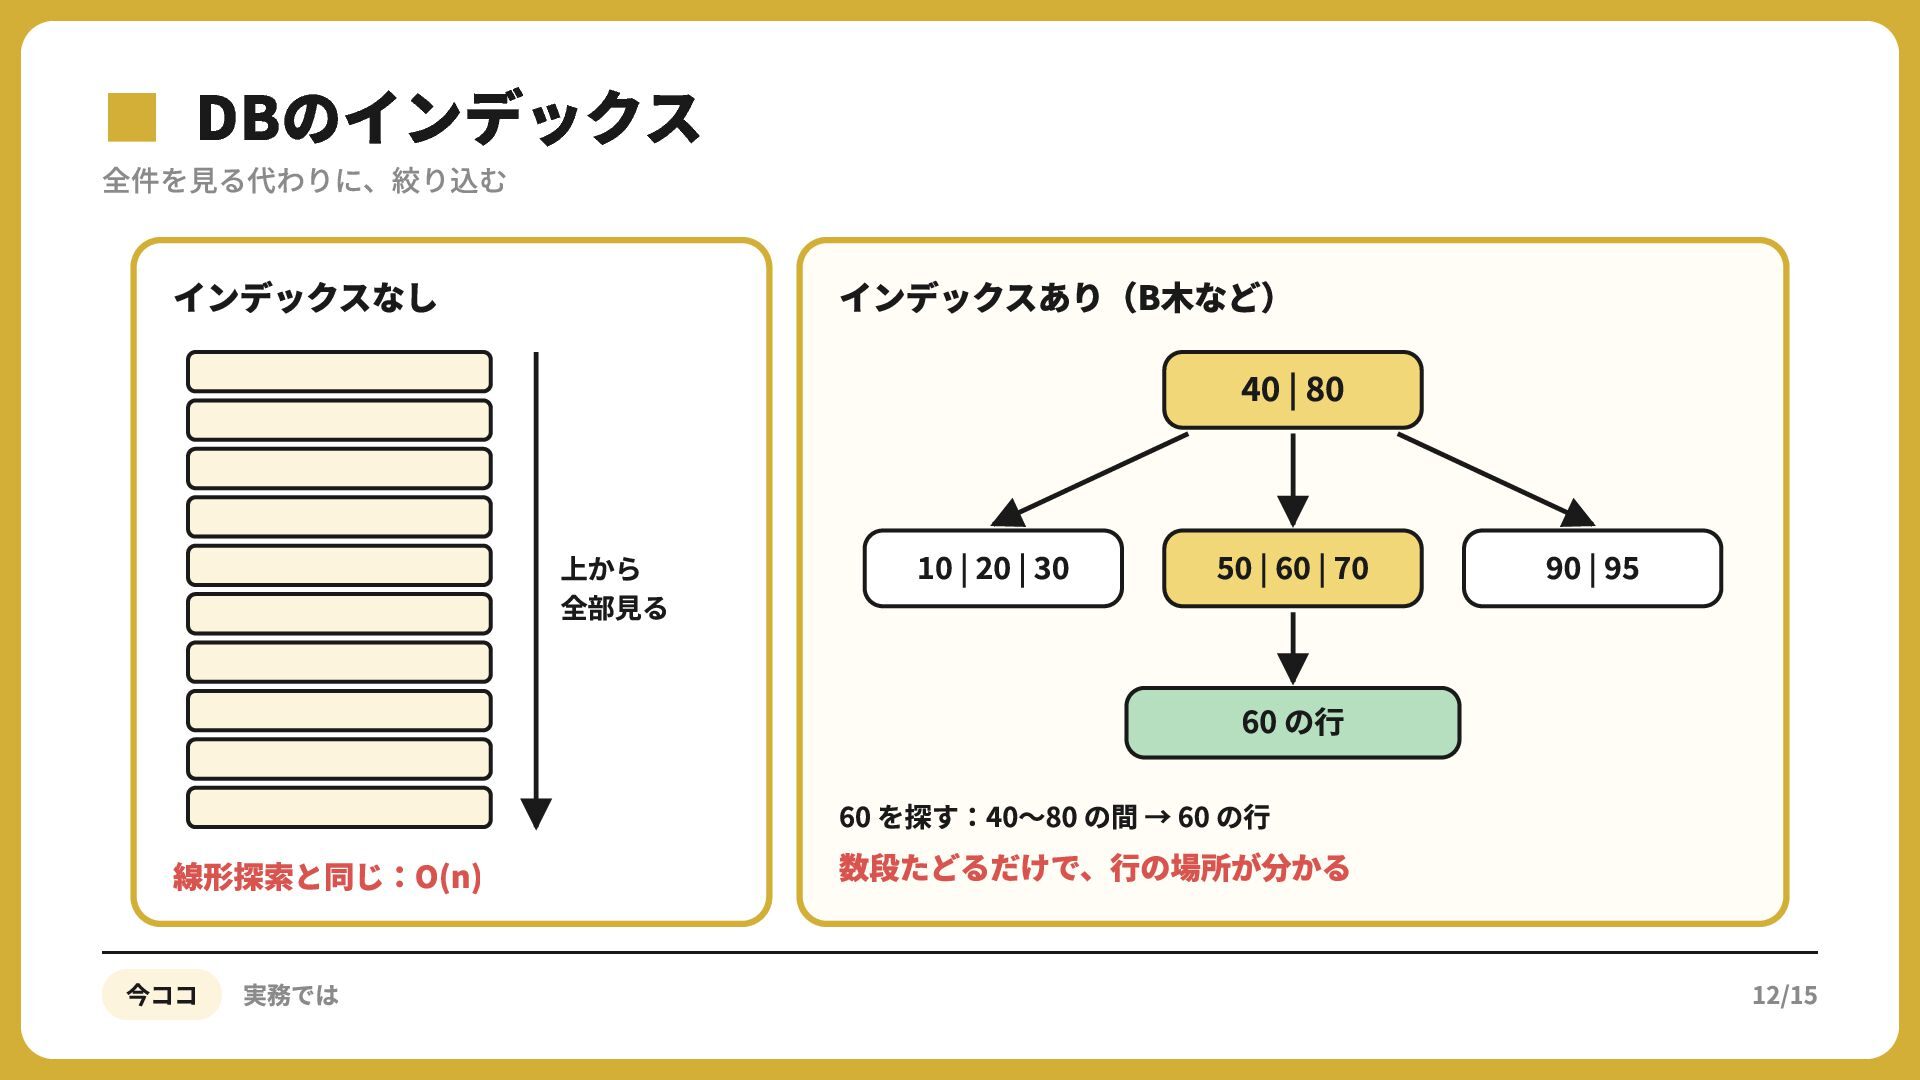
  9. ▪全件を見る代わりに、絞り込む DBのインデックス インデックスなし インデックスあり(B⽊など) | 上から 全部⾒る | | |

    | | 60 の⾏ 線形探索と同じ:O(n) 今ココ 実務では 60 を探す:40〜80 の間 → 60 の⾏ 数段たどるだけで、⾏の場所が分かる 12/15
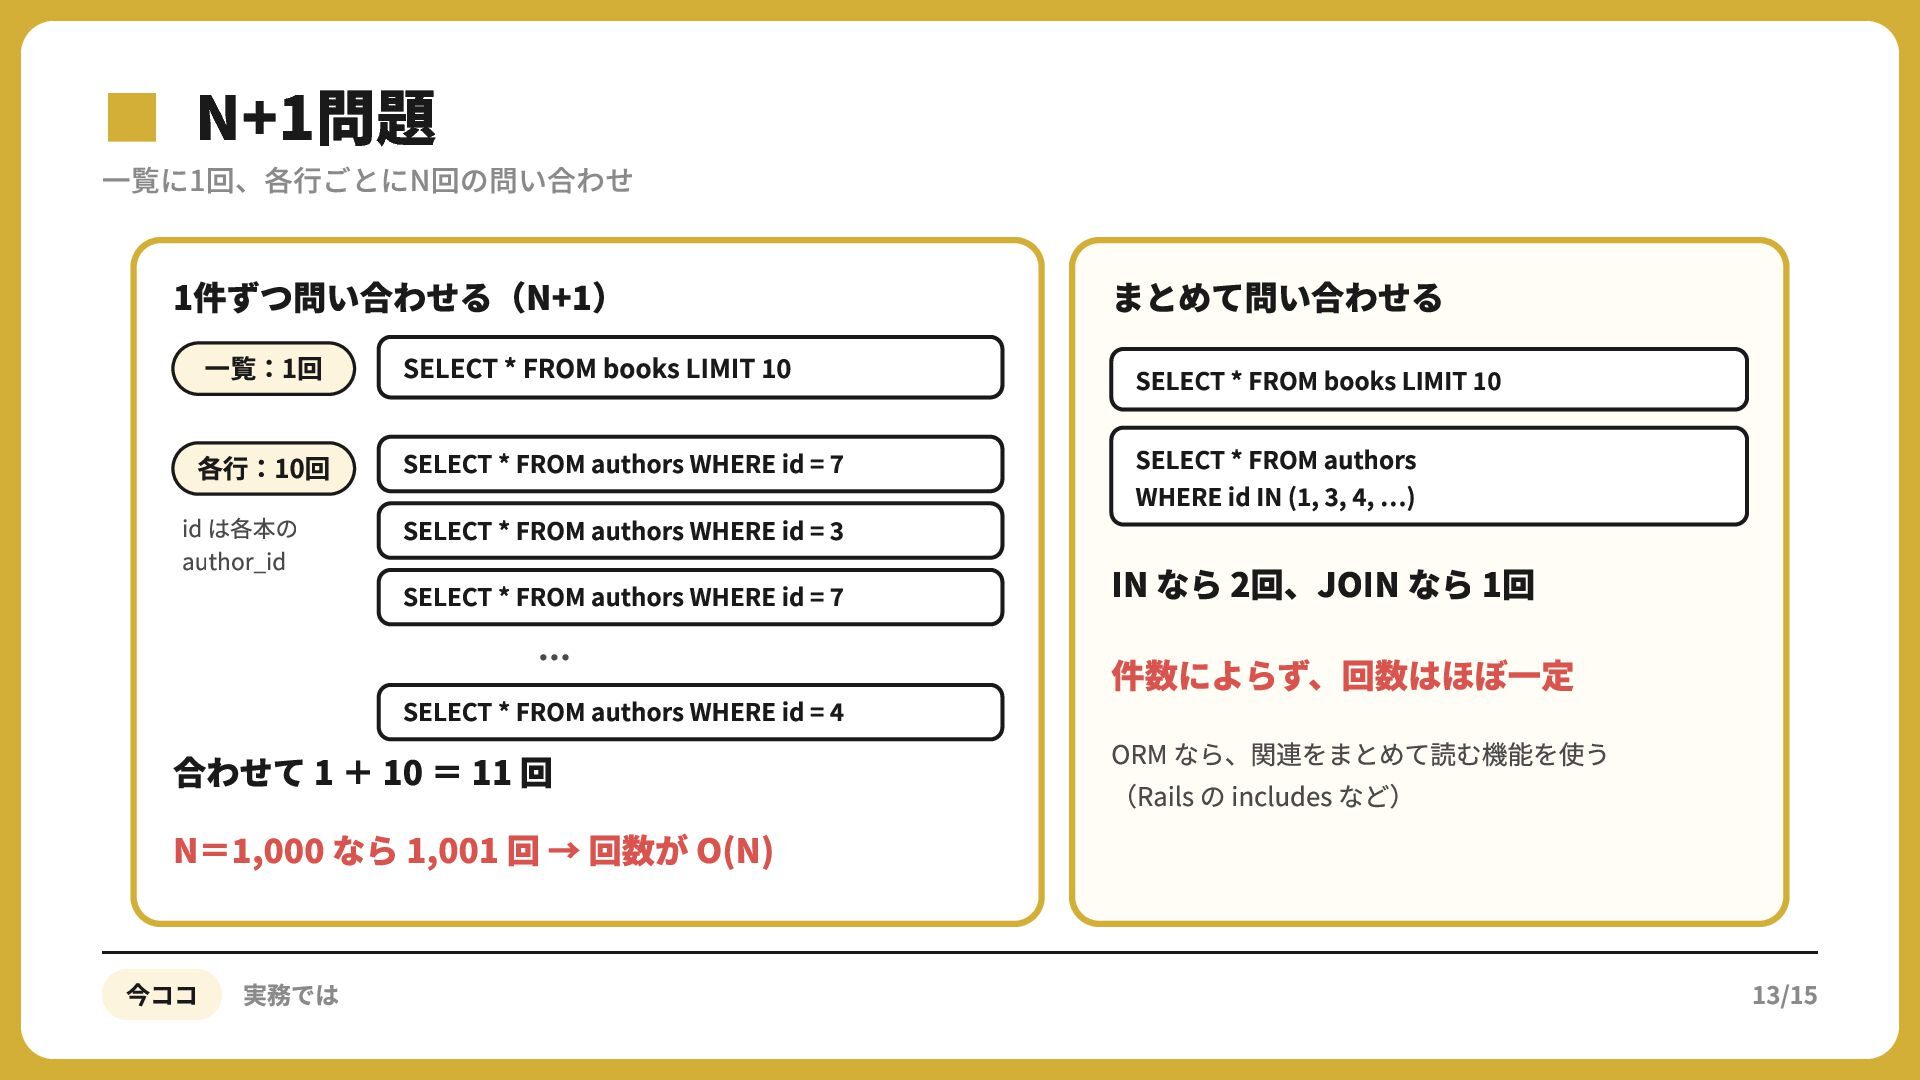
  10. ▪一覧に1回、各行ごとにN回の問い合わせ N+1問題 1件ずつ問い合わせる(N+ ) ⼀覧:1回 SELECT * FROM books LIMIT

    各⾏:10回 SELECT * FROM authors WHERE id = SELECT * FROM authors WHERE id = SELECT * FROM authors WHERE id = id は各本の author_id … SELECT * FROM authors WHERE id = 合わせて 1 + 10 = 11 回 N= , なら 1,001 回 → 回数が O(N) 今ココ 実務では まとめて問い合わせる SELECT * FROM books LIMIT SELECT * FROM authors WHERE id IN ( , , , ) IN なら 2回、JOIN なら 1回 件数によらず、回数はほぼ⼀定 ORM なら、関連をまとめて読む機能を使う (Rails の includes など) 13/15
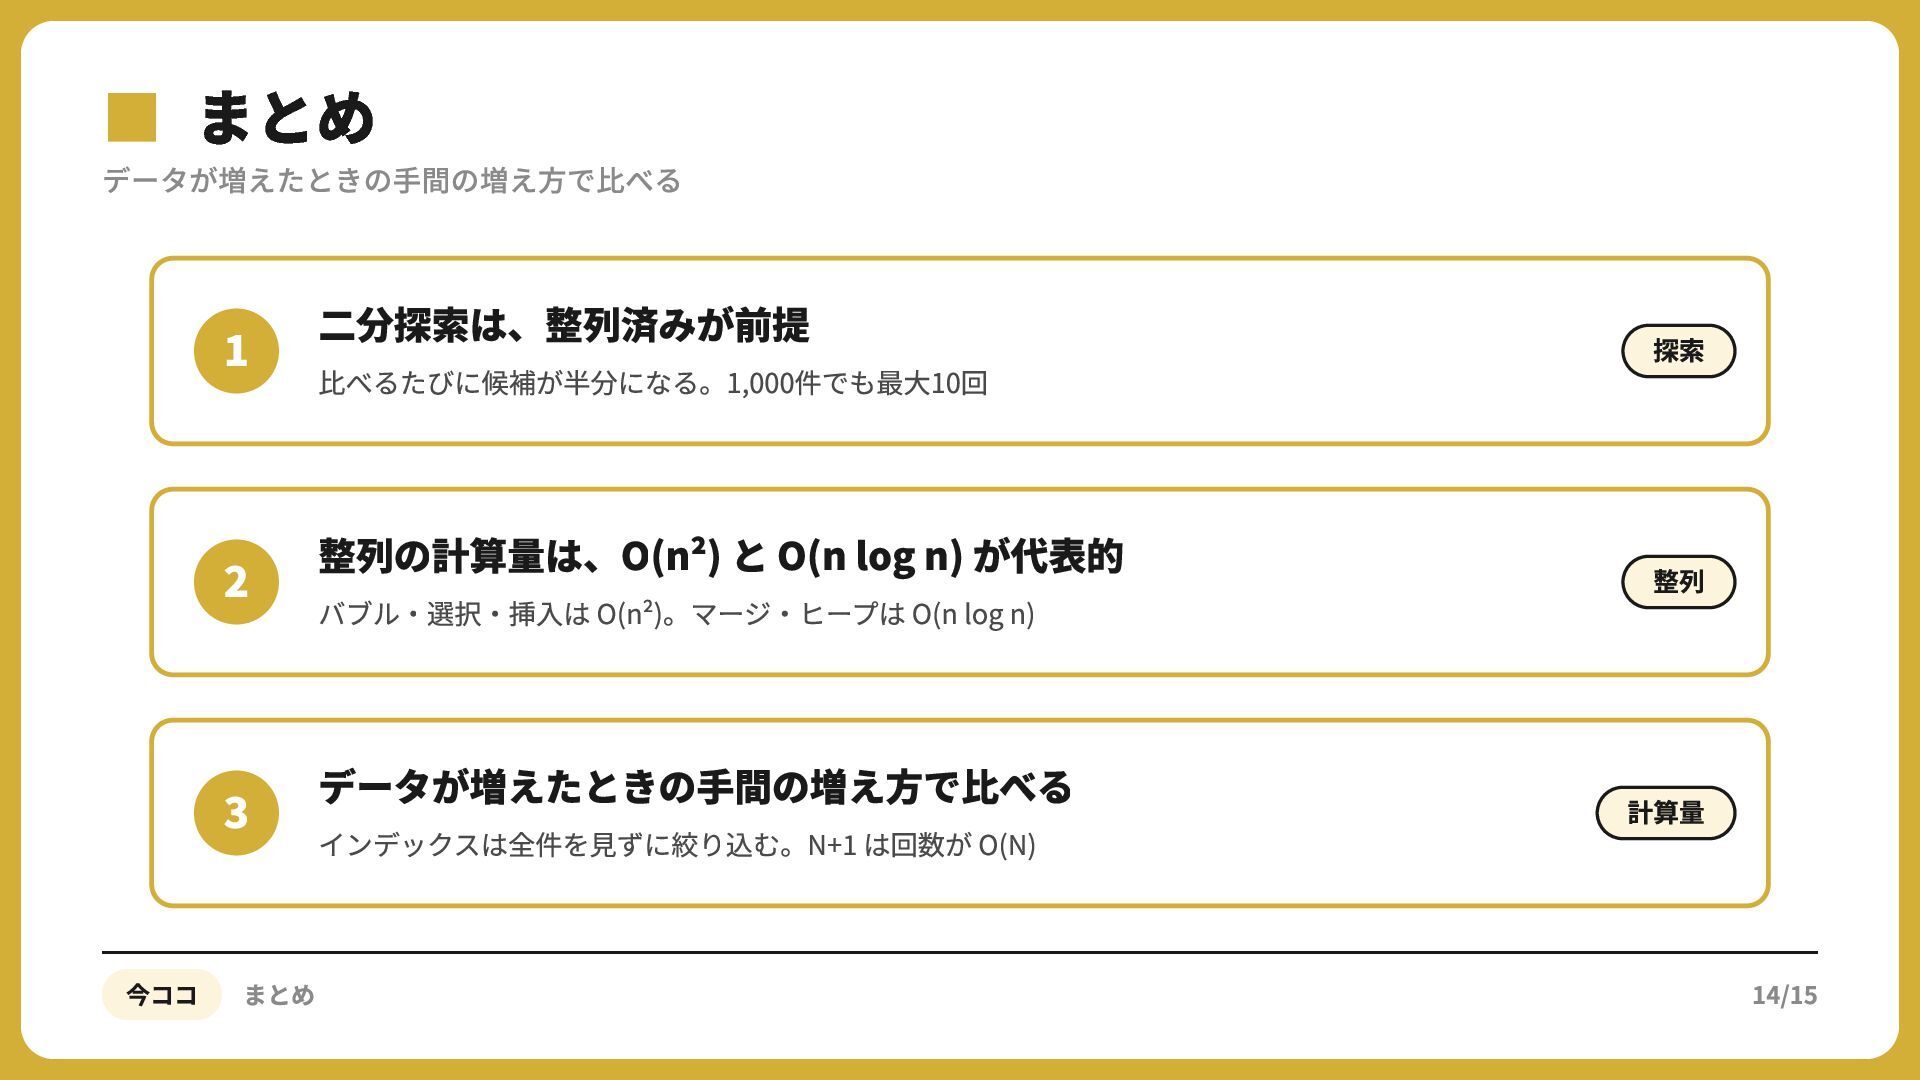
  11. ▪データが増えたときの手間の増え方で比べる まとめ ⼆分探索は、整列済みが前提 探索 整列の計算量は、O(n²) と O(n log n) が代表的

    整列 データが増えたときの⼿間の増え⽅で⽐べる 計算量 ⽐べるたびに候補が半分になる。1,000件でも最⼤10回 バブル‧選択‧挿⼊は O(n²)。マージ‧ヒープは O(n log n) インデックスは全件を⾒ずに絞り込む。N+ は回数が O(N) 今ココ まとめ 14/15