Share
Embed
Kamipo on Rails 2026
kamipo
September 22, 2026
Transcript
62 slides
-
名古屋 Ruby 会議 05 Kamipo on Rails 2026 Ryuta Kamizono
2026年9月19日 / 大須演芸場 -
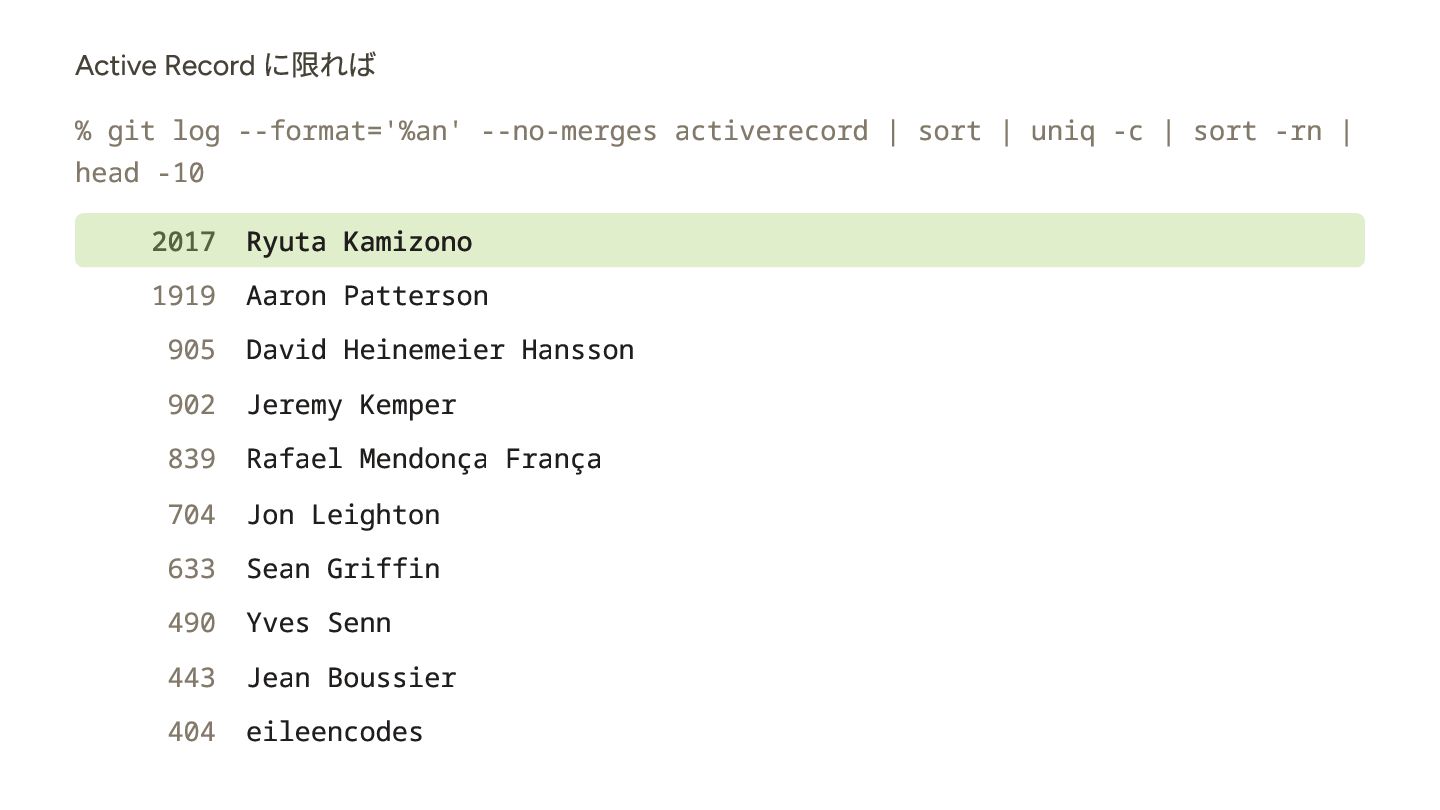
Active Record に限れば % git log --format='%an' --no-merges activerecord |
sort | uniq -c | sort -rn | head -10 2017 Ryuta Kamizono 1919 Aaron Patterson 905 David Heinemeier Hansson 902 Jeremy Kemper 839 Rafael Mendonça França 704 Jon Leighton 633 Sean Griffin 490 Yves Senn 443 Jean Boussier 404 eileencodes -
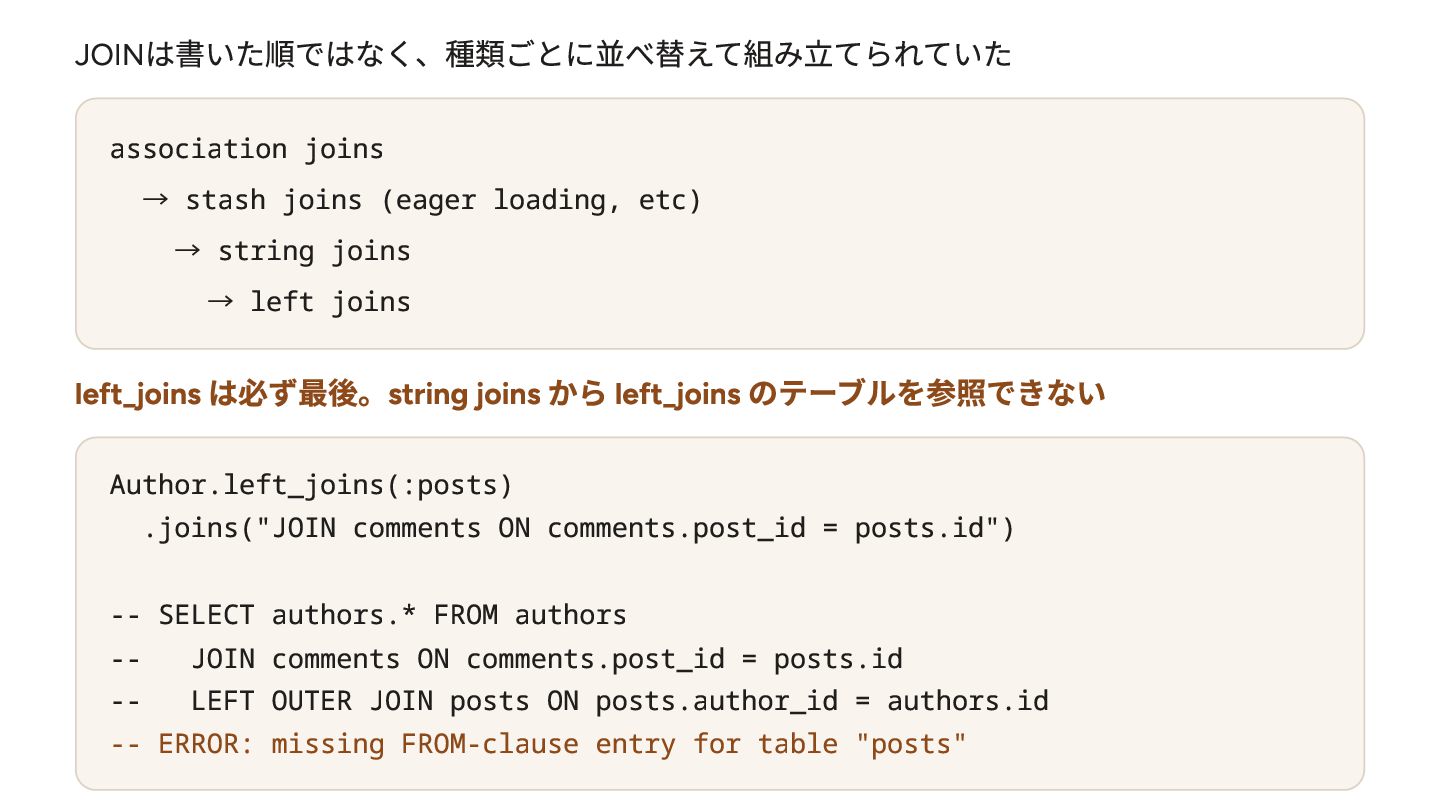
JOINは書いた順ではなく、種類ごとに並べ替えて組み立てられていた association joins → stash joins (eager loading, etc) →
string joins → left joins left_joins は必ず最後。string joins から left_joins のテーブルを参照できない Author.left_joins(:posts) .joins("JOIN comments ON comments.post_id = posts.id") -- SELECT authors.* FROM authors -- JOIN comments ON comments.post_id = posts.id -- LEFT OUTER JOIN posts ON posts.author_id = authors.id -- ERROR: missing FROM-clause entry for table "posts" -
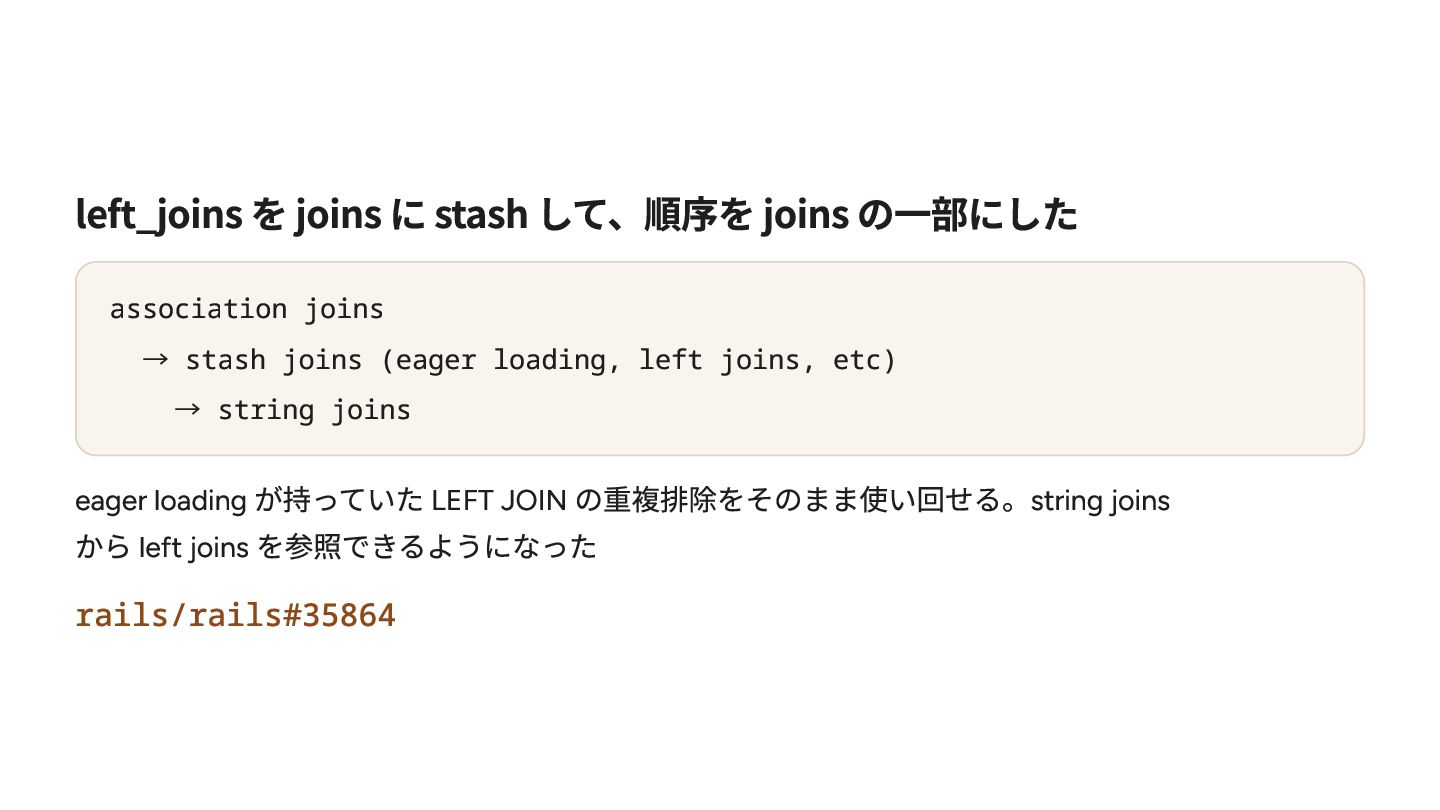
left_joins を joins に stash して、順序を joins の一部にした association joins
→ stash joins (eager loading, left joins, etc) → string joins eager loading が持っていた LEFT JOIN の重複排除をそのまま使い回せる。string joins から left joins を参照できるようになった rails/rails#35864 -
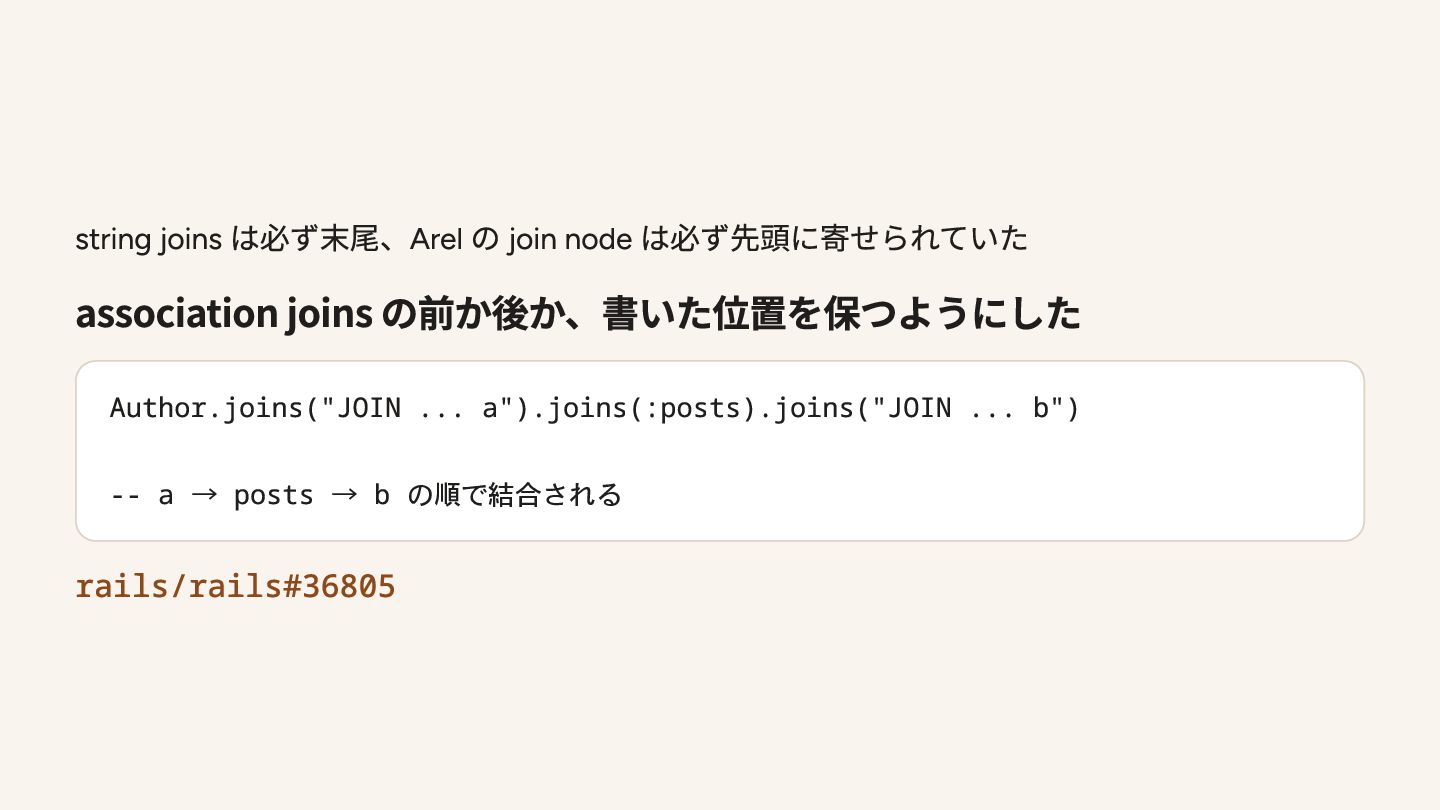
string joins は必ず末尾、Arel の join node は必ず先頭に寄せられていた association joins の前か後か、書いた位置を保つようにした
Author.joins("JOIN ... a").joins(:posts).joins("JOIN ... b") -- a → posts → b の順で結合される rails/rails#36805 -
through association の順序を正すため、暗黙の JOIN を先頭に寄せていたが、ユーザが 渡した Arel joins まで先頭に飛んでいた 暗黙の
JOIN だけを leading joins としてマークするようにした Arel joins を joins に渡すのは string joins と違って正式にサポートされていないが、 deprecation なしで壊すつもりはない rails/rails#39305 -
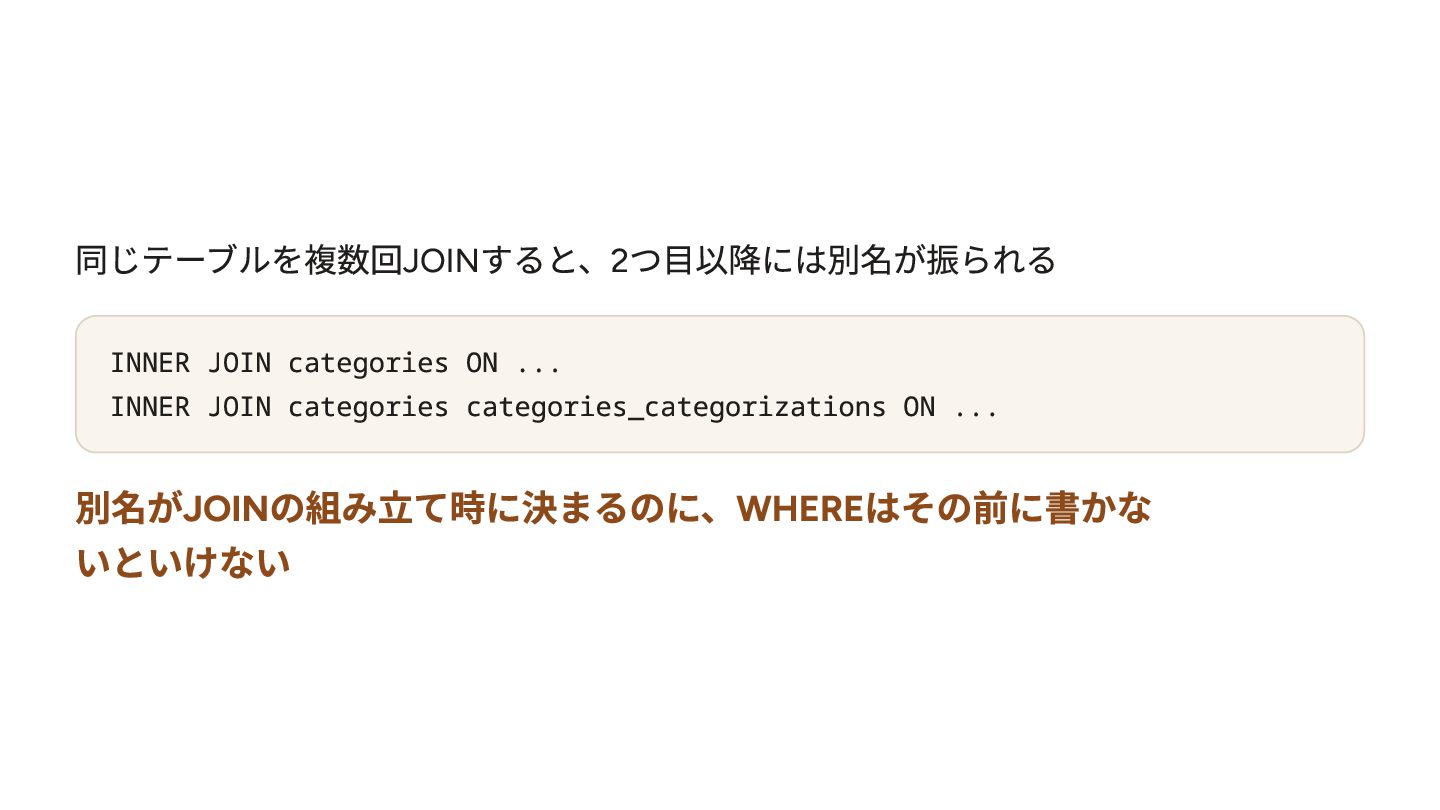
同じテーブルを複数回JOINすると、2つ目以降には別名が振られる INNER JOIN categories ON ... INNER JOIN categories categories_categorizations
ON ... 別名がJOINの組み立て時に決まるのに、WHEREはその前に書かな いといけない -
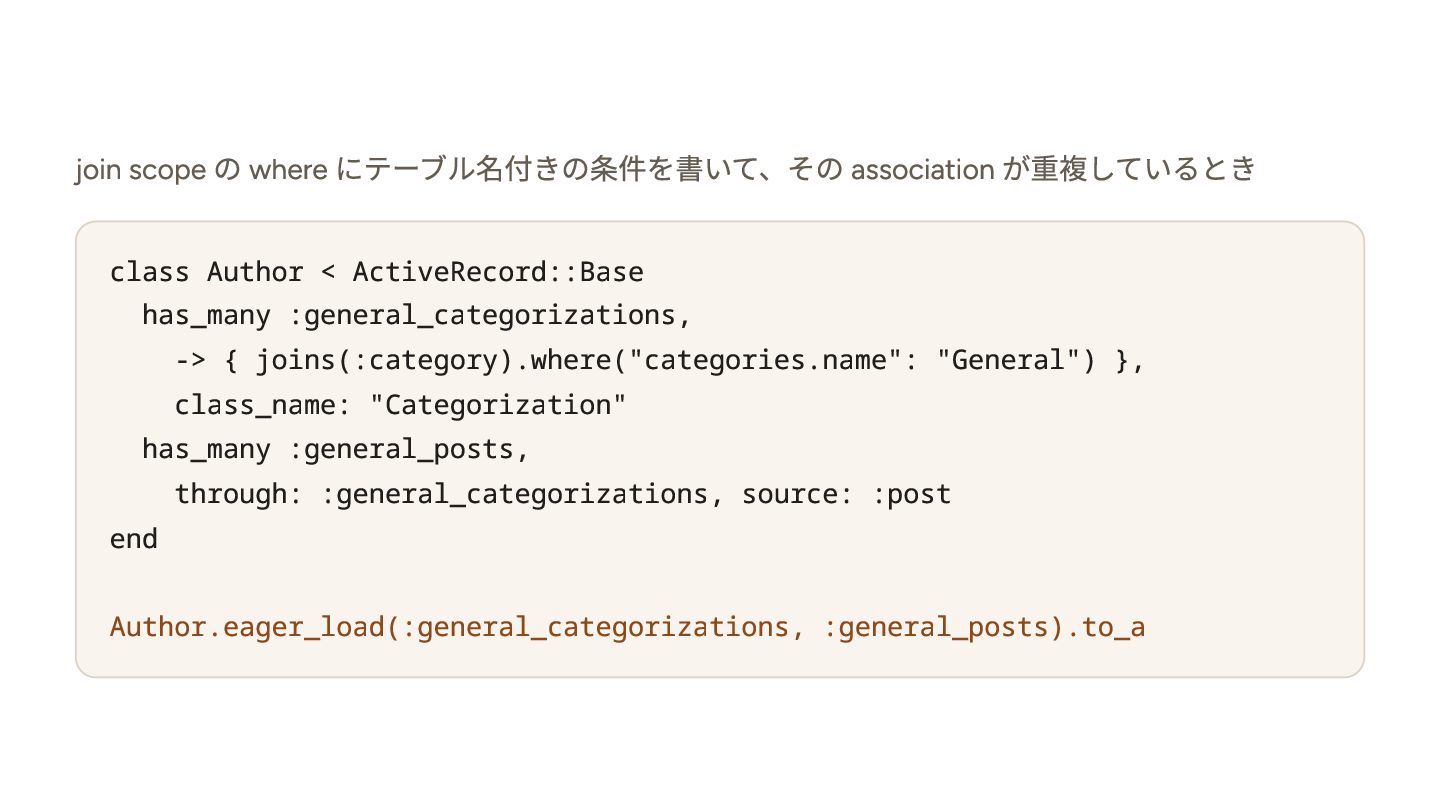
join scope の where にテーブル名付きの条件を書いて、その association が重複しているとき class Author <
ActiveRecord::Base has_many :general_categorizations, -> { joins(:category).where("categories.name": "General") }, class_name: "Categorization" has_many :general_posts, through: :general_categorizations, source: :post end Author.eager_load(:general_categorizations, :general_posts).to_a -
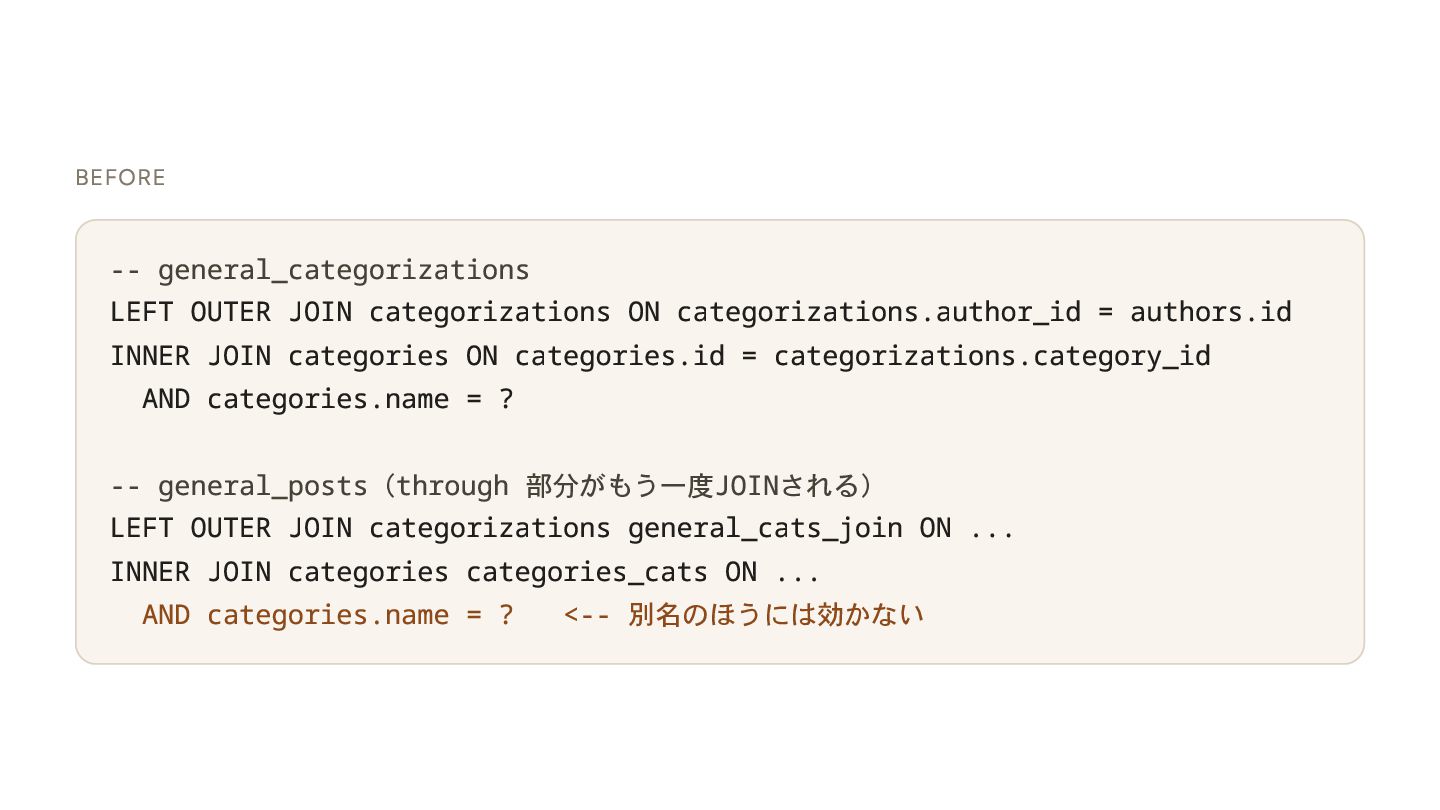
BEFORE -- general_categorizations LEFT OUTER JOIN categorizations ON categorizations.author_id =
authors.id INNER JOIN categories ON categories.id = categorizations.category_id AND categories.name = ? -- general_posts(through 部分がもう一度JOINされる) LEFT OUTER JOIN categorizations general_cats_join ON ... INNER JOIN categories categories_cats ON ... AND categories.name = ? <-- 別名のほうには効かない -
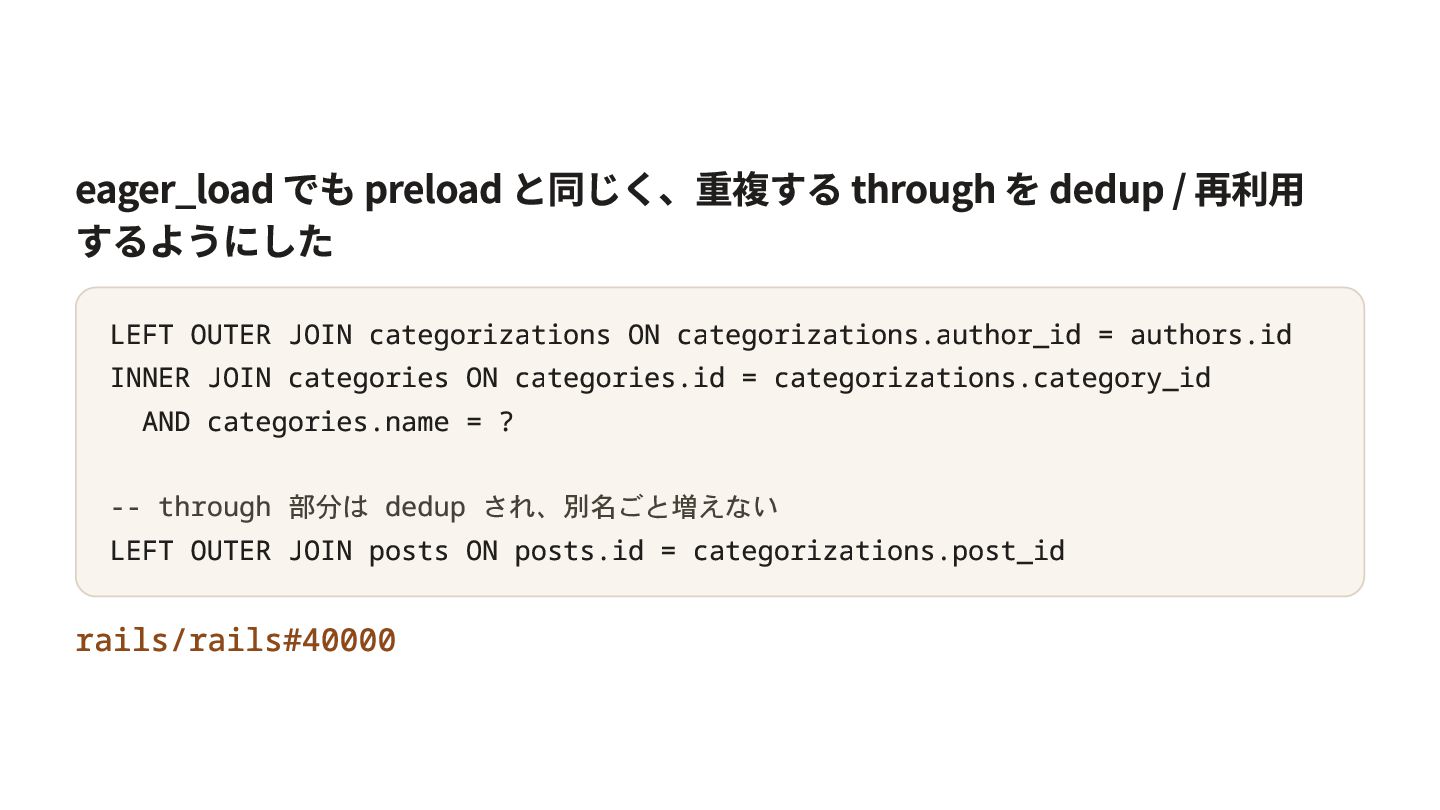
eager_load でも preload と同じく、重複する through を dedup / 再利用 するようにした
LEFT OUTER JOIN categorizations ON categorizations.author_id = authors.id INNER JOIN categories ON categories.id = categorizations.category_id AND categories.name = ? -- through 部分は dedup され、別名ごと増えない LEFT OUTER JOIN posts ON posts.id = categorizations.post_id rails/rails#40000 -
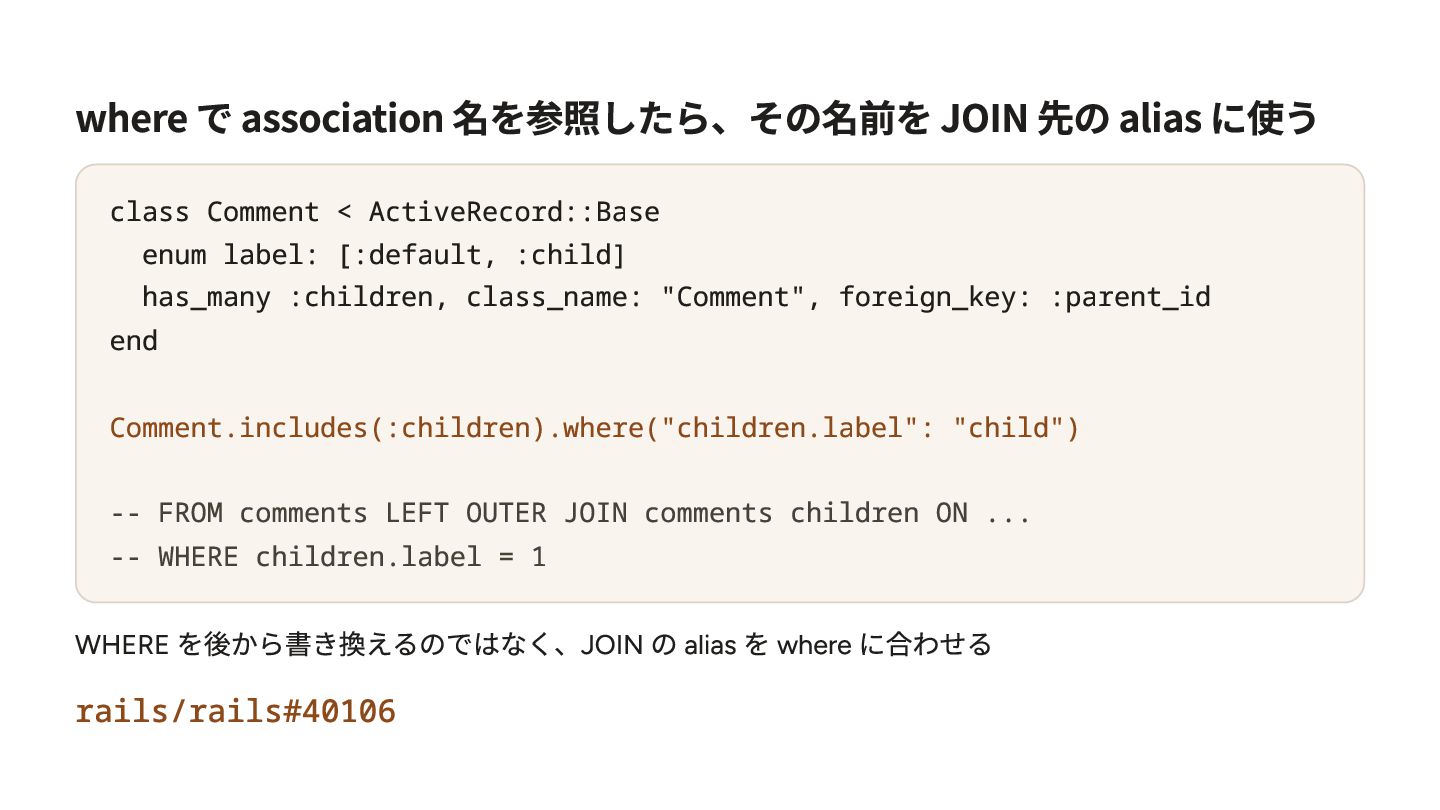
where で association 名を参照したら、その名前を JOIN 先の alias に使う class Comment
< ActiveRecord::Base enum label: [:default, :child] has_many :children, class_name: "Comment", foreign_key: :parent_id end Comment.includes(:children).where("children.label": "child") -- FROM comments LEFT OUTER JOIN comments children ON ... -- WHERE children.label = 1 WHERE を後から書き換えるのではなく、JOIN の alias を where に合わせる rails/rails#40106 -
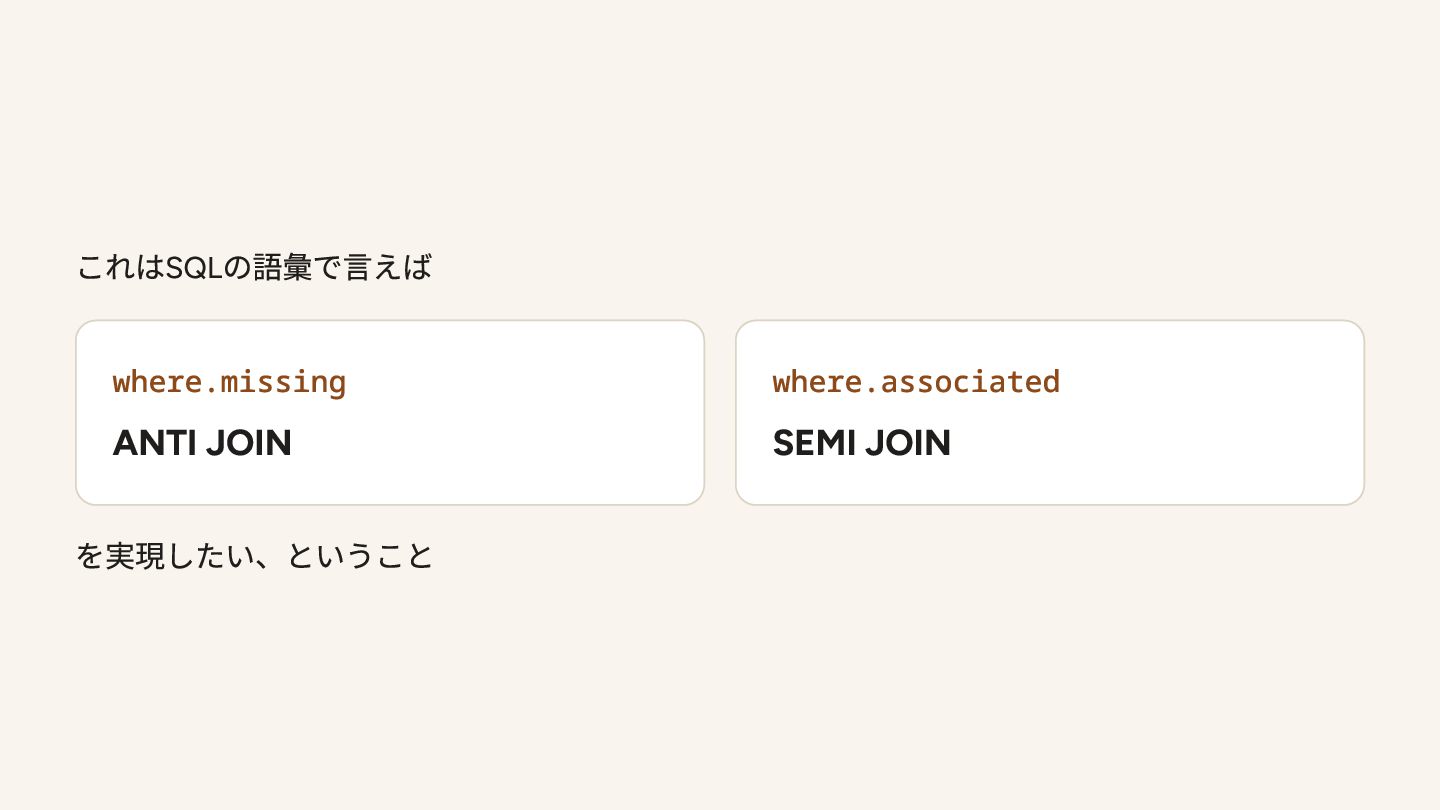
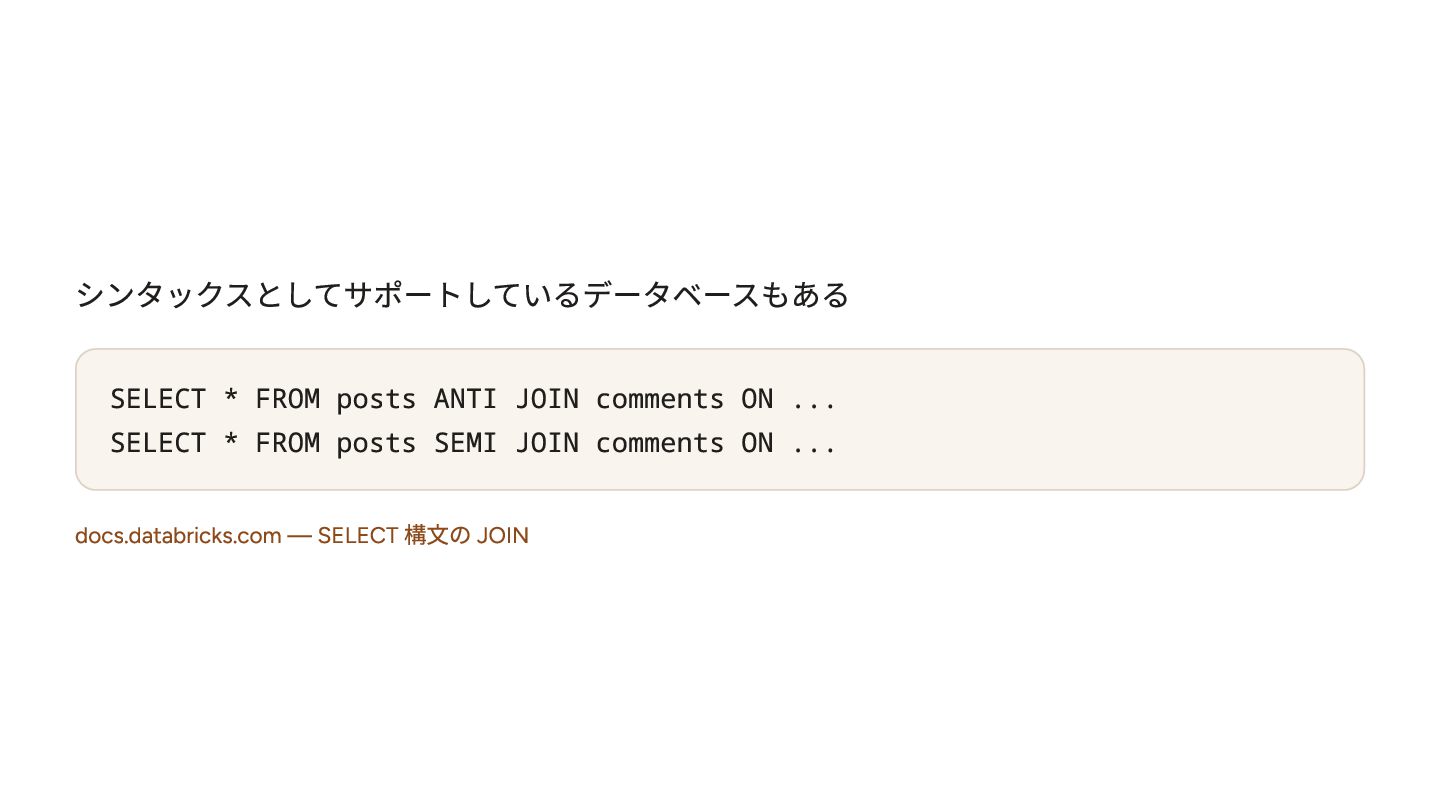
シンタックスとしてサポートしているデータベースもある SELECT * FROM posts ANTI JOIN comments ON ...
SELECT * FROM posts SEMI JOIN comments ON ... docs.databricks.com — SELECT 構文の JOIN -
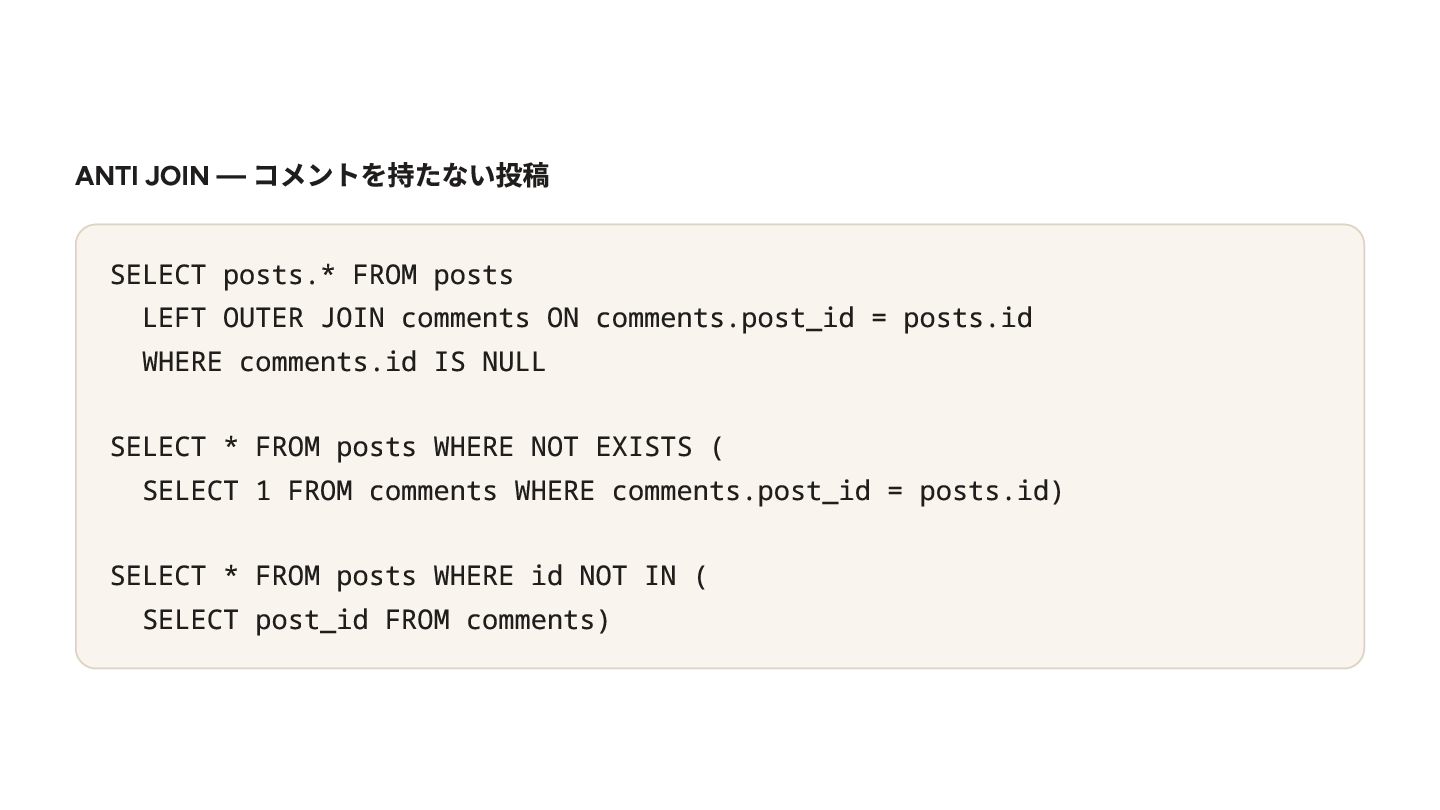
ANTI JOIN — コメントを持たない投稿 SELECT posts.* FROM posts LEFT OUTER
JOIN comments ON comments.post_id = posts.id WHERE comments.id IS NULL SELECT * FROM posts WHERE NOT EXISTS ( SELECT 1 FROM comments WHERE comments.post_id = posts.id) SELECT * FROM posts WHERE id NOT IN ( SELECT post_id FROM comments) -
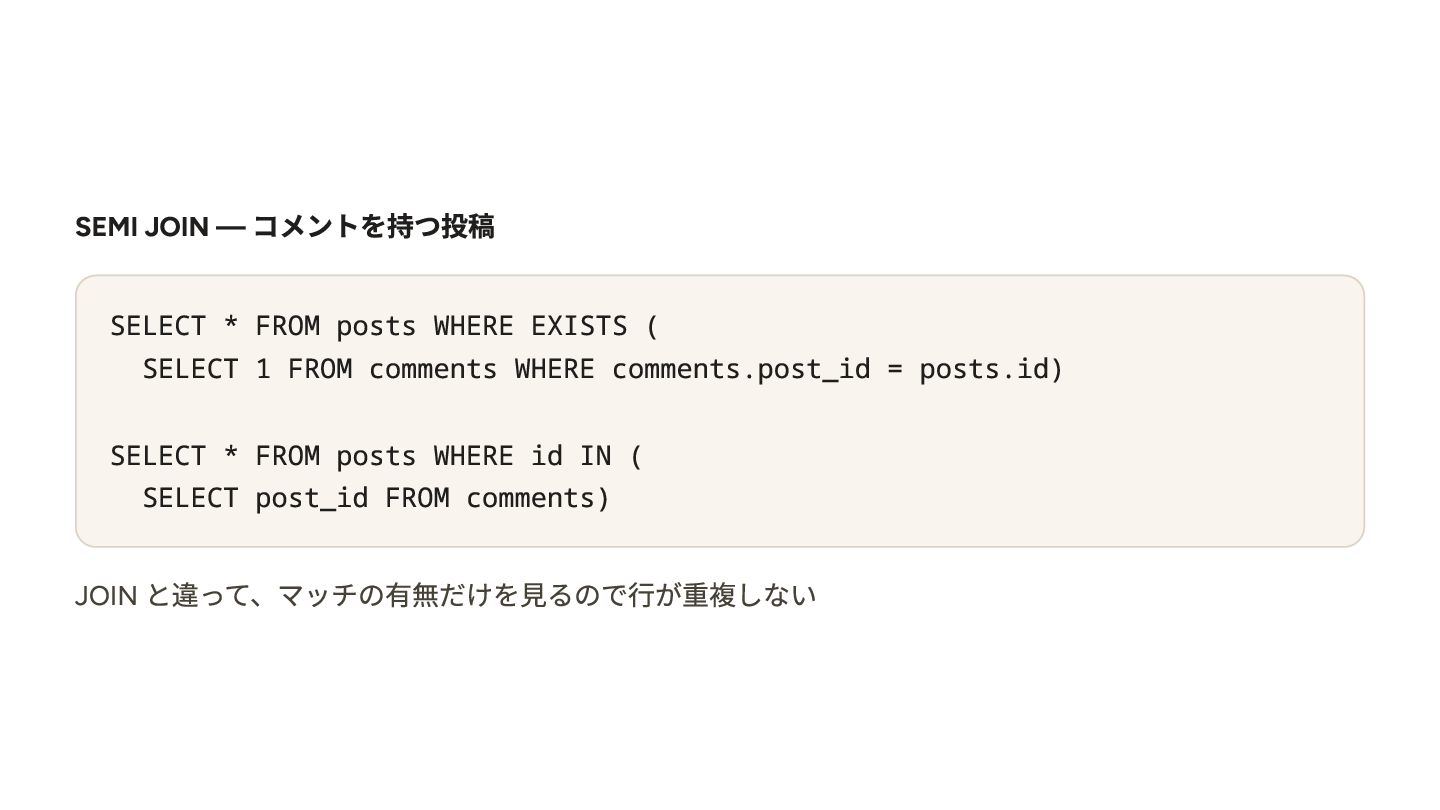
SEMI JOIN — コメントを持つ投稿 SELECT * FROM posts WHERE EXISTS
( SELECT 1 FROM comments WHERE comments.post_id = posts.id) SELECT * FROM posts WHERE id IN ( SELECT post_id FROM comments) JOIN と違って、マッチの有無だけを見るので行が重複しない -
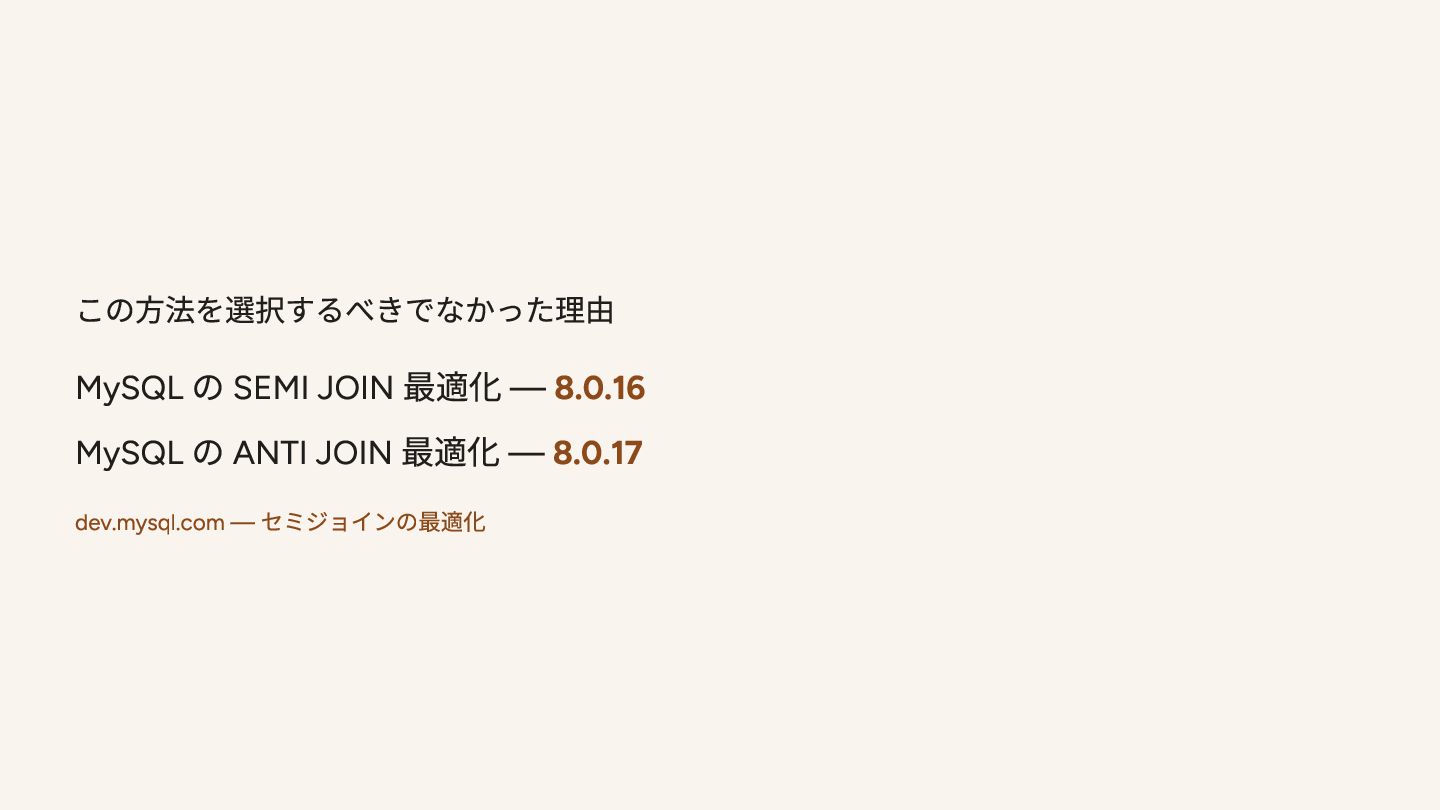
この方法を選択するべきでなかった理由 MySQL の SEMI JOIN 最適化 — 8.0.16 MySQL の
ANTI JOIN 最適化 — 8.0.17 dev.mysql.com — セミジョインの最適化 -
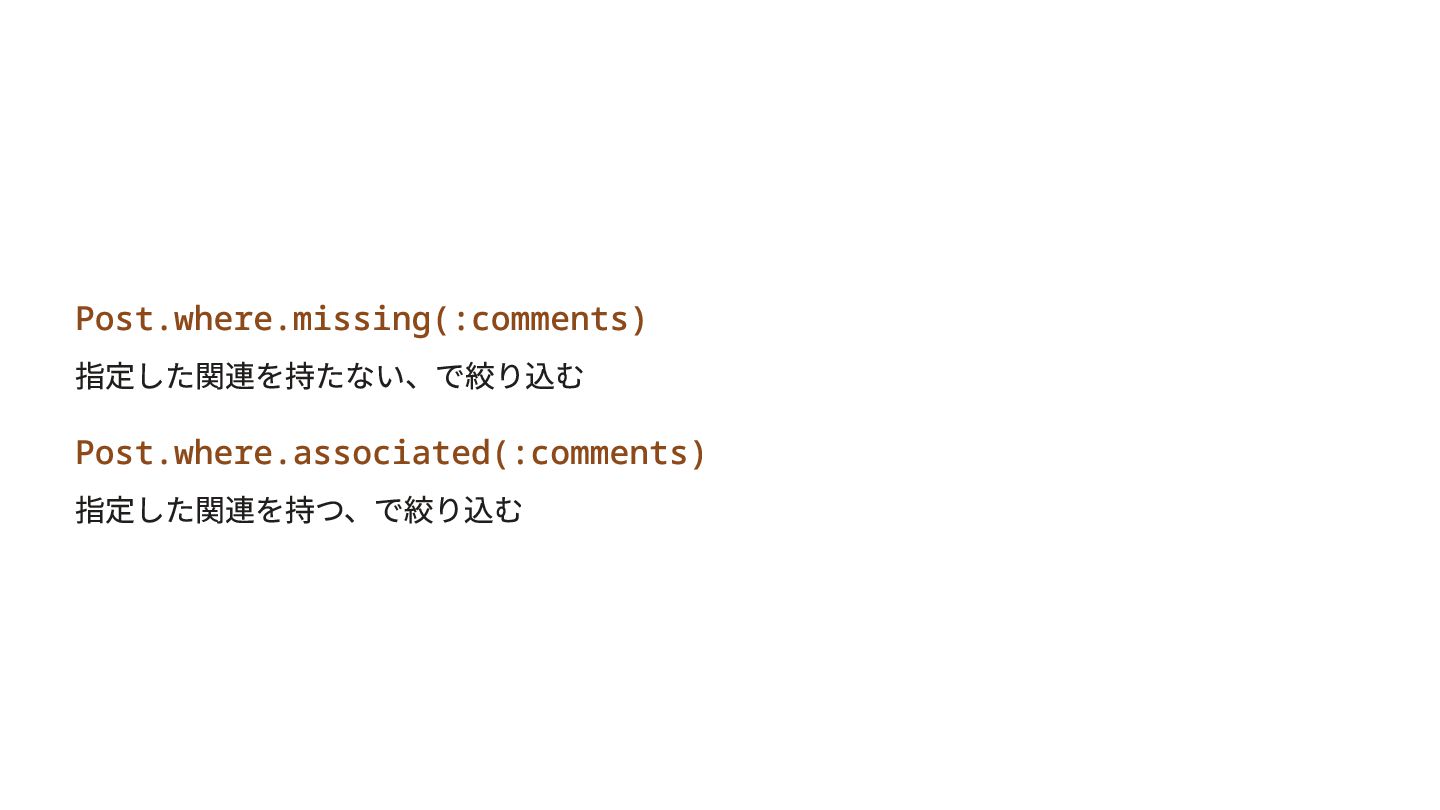
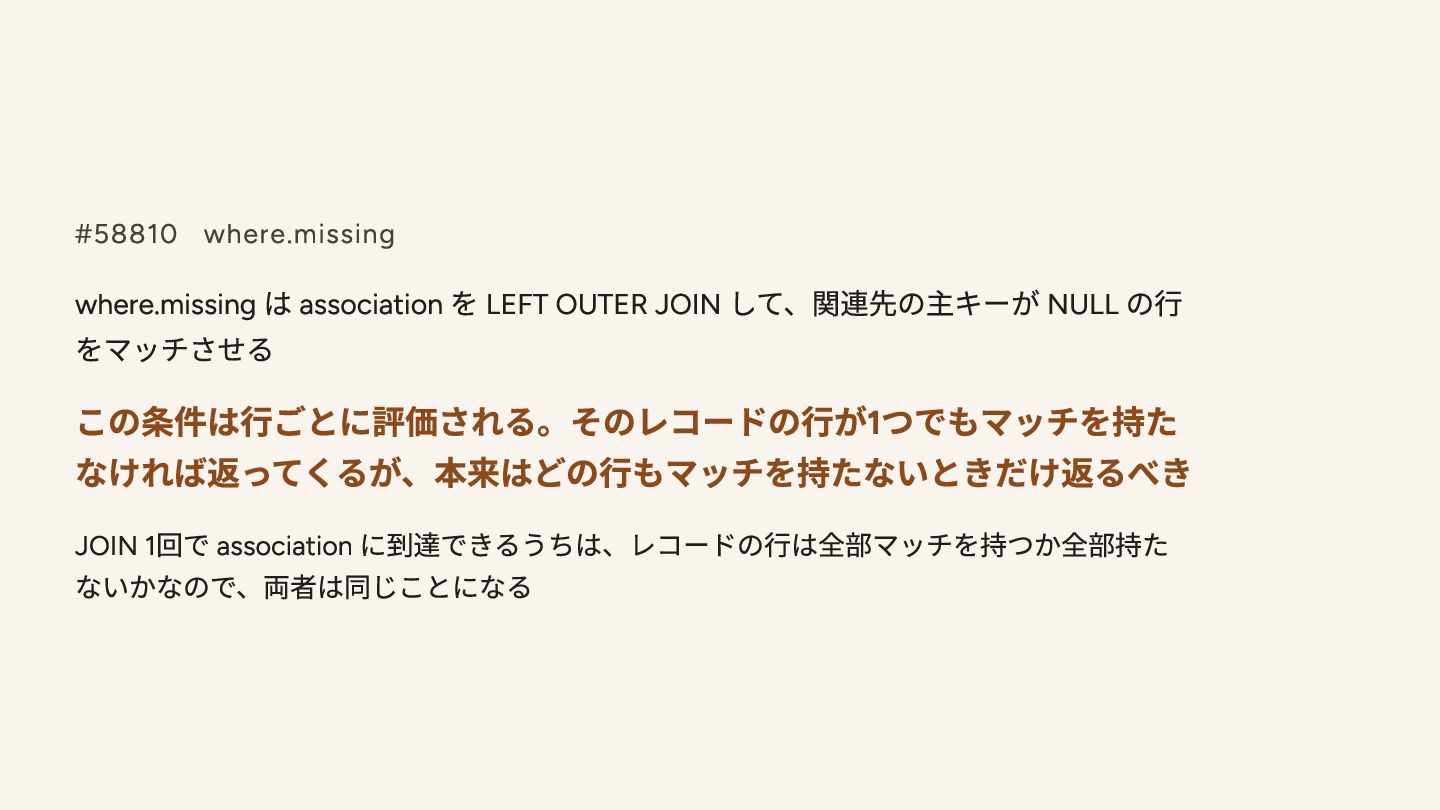
#58810 where.missing where.missing は association を LEFT OUTER JOIN して、関連先の主キーが
NULL の行 をマッチさせる この条件は行ごとに評価される。そのレコードの行が1つでもマッチを持た なければ返ってくるが、本来はどの行もマッチを持たないときだけ返るべき JOIN 1回で association に到達できるうちは、レコードの行は全部マッチを持つか全部持た ないかなので、両者は同じことになる -
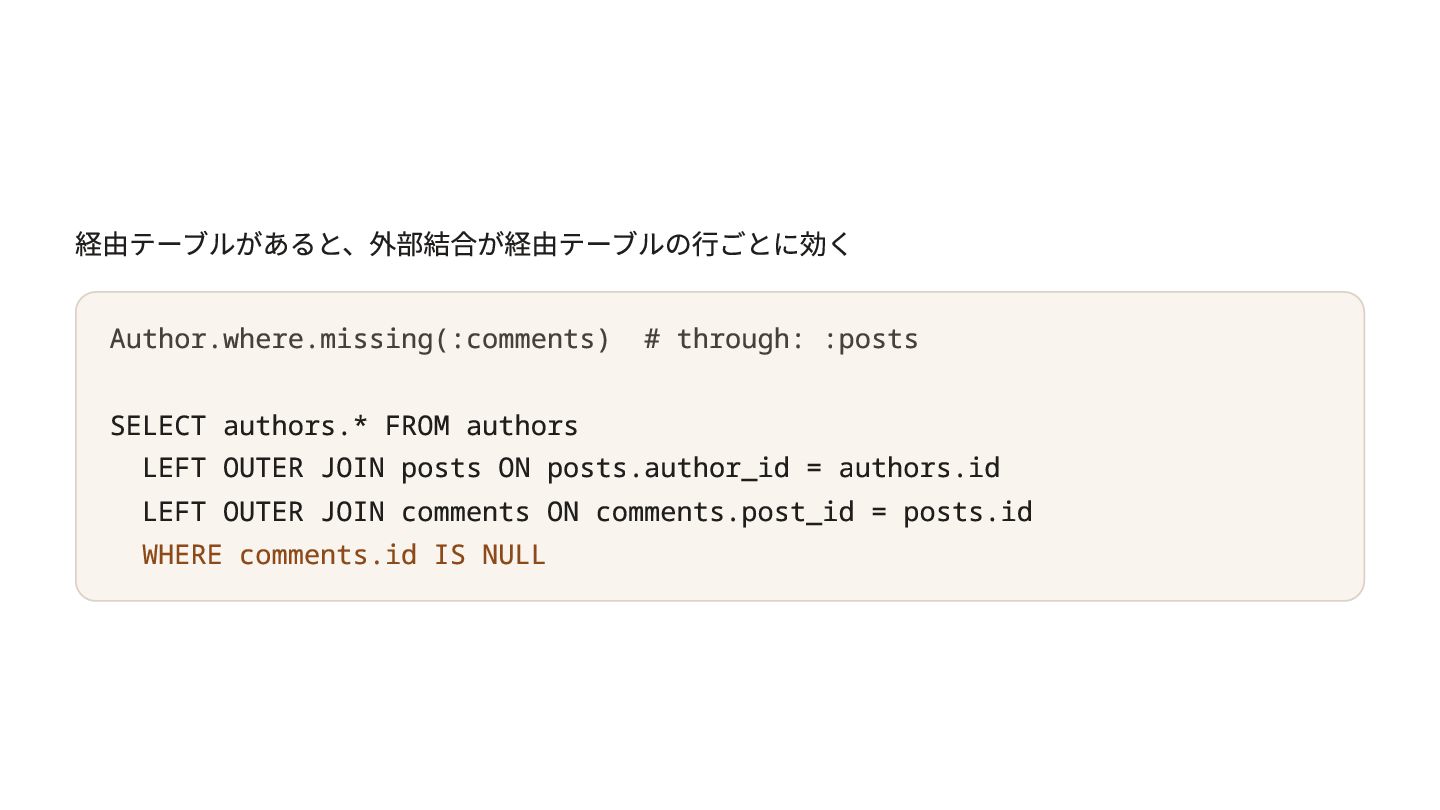
経由テーブルがあると、外部結合が経由テーブルの行ごとに効く Author.where.missing(:comments) # through: :posts SELECT authors.* FROM authors LEFT
OUTER JOIN posts ON posts.author_id = authors.id LEFT OUTER JOIN comments ON comments.post_id = posts.id WHERE comments.id IS NULL -
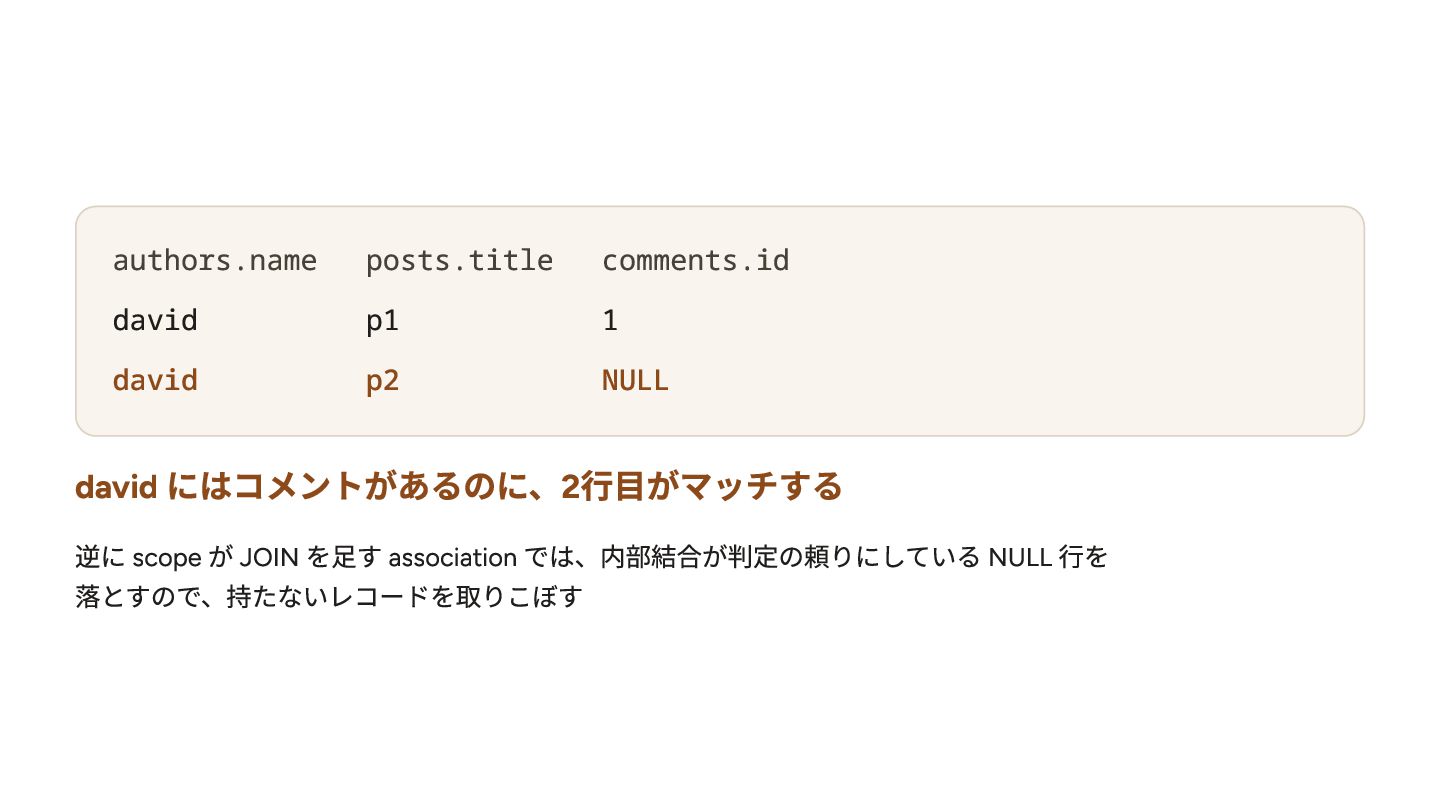
authors.name posts.title comments.id david p1 1 david p2 NULL david
にはコメントがあるのに、2行目がマッチする 逆に scope が JOIN を足す association では、内部結合が判定の頼りにしている NULL 行を 落とすので、持たないレコードを取りこぼす -
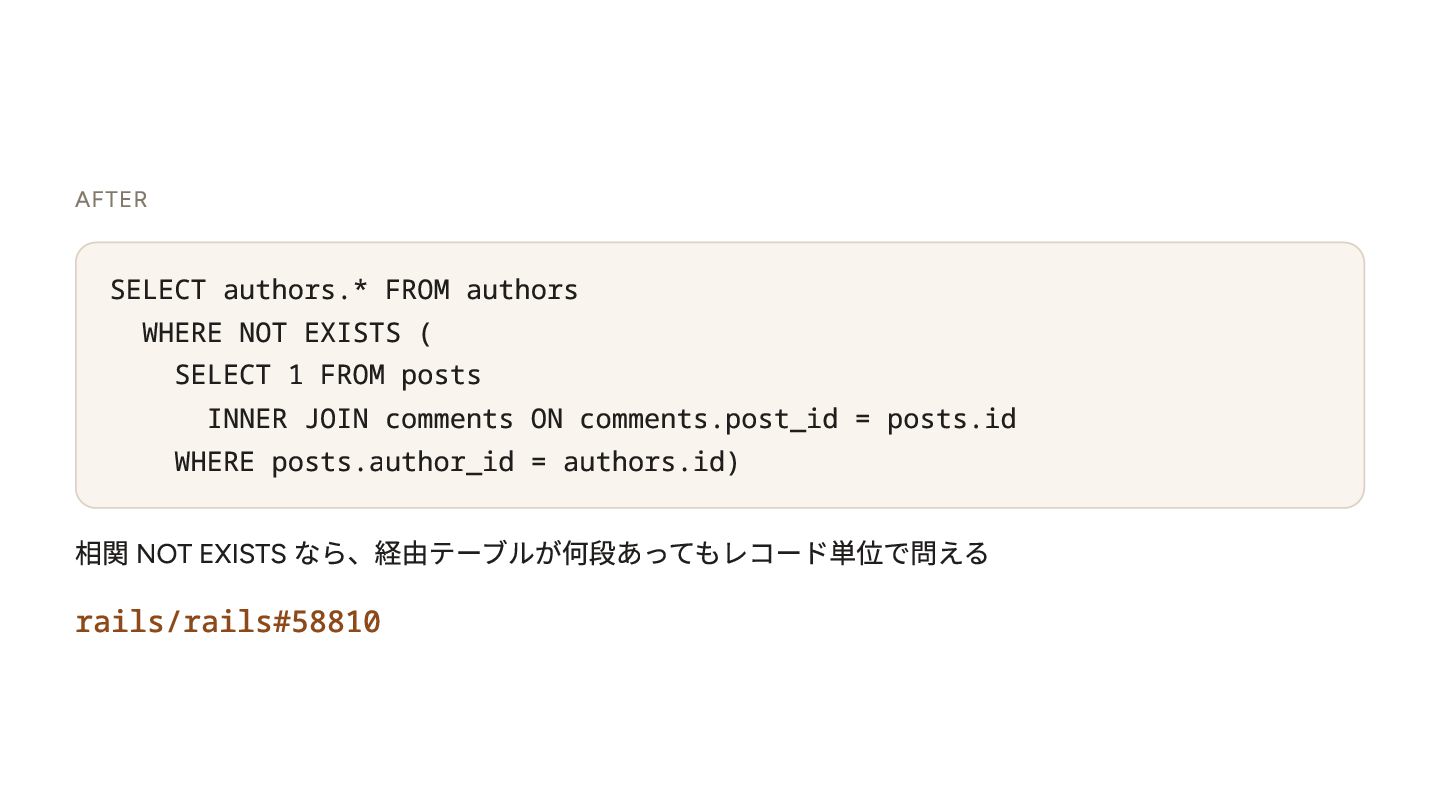
AFTER SELECT authors.* FROM authors WHERE NOT EXISTS ( SELECT
1 FROM posts INNER JOIN comments ON comments.post_id = posts.id WHERE posts.author_id = authors.id) 相関 NOT EXISTS なら、経由テーブルが何段あってもレコード単位で問える rails/rails#58810 -
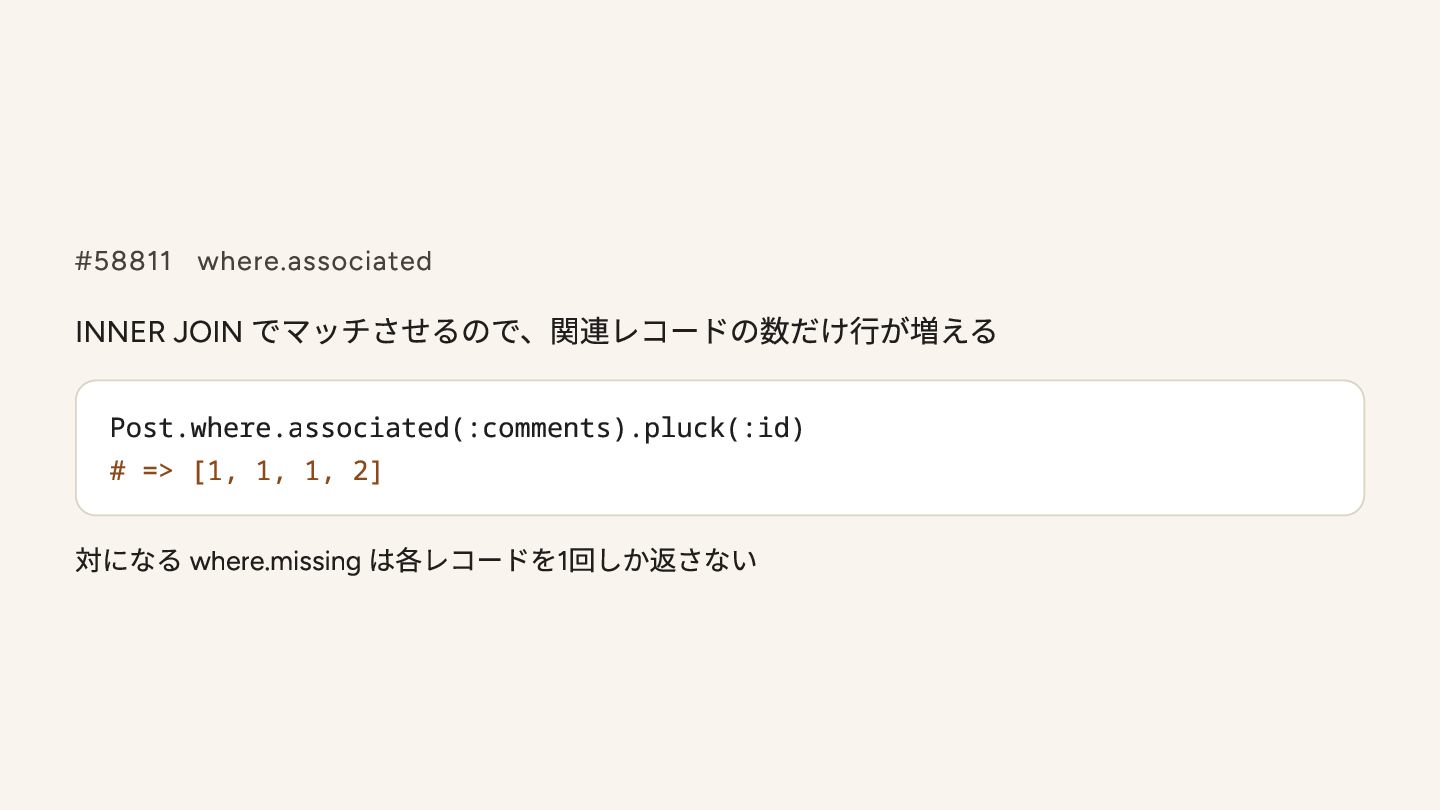
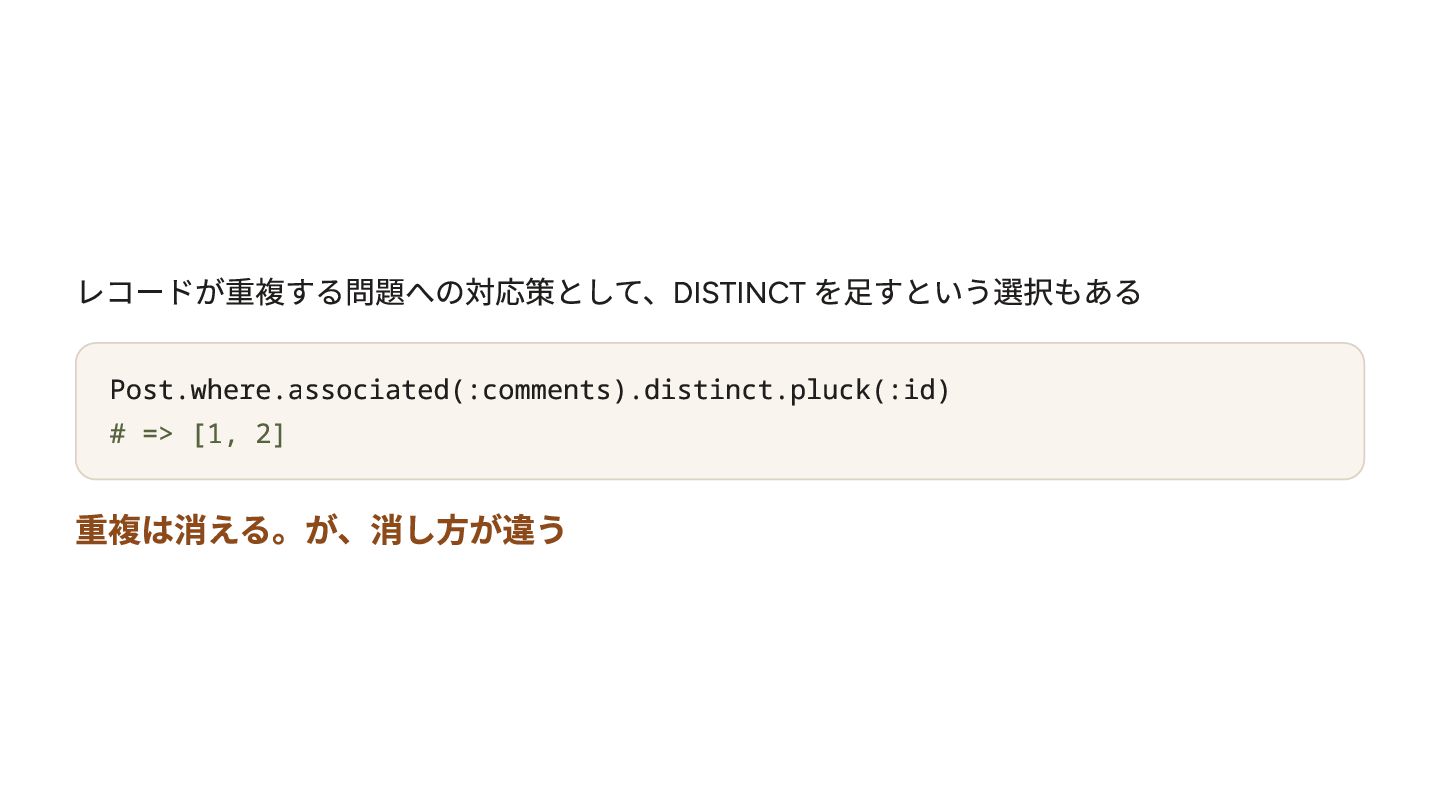
#58811 where.associated INNER JOIN でマッチさせるので、関連レコードの数だけ行が増える Post.where.associated(:comments).pluck(:id) # => [1, 1,
1, 2] 対になる where.missing は各レコードを1回しか返さない -
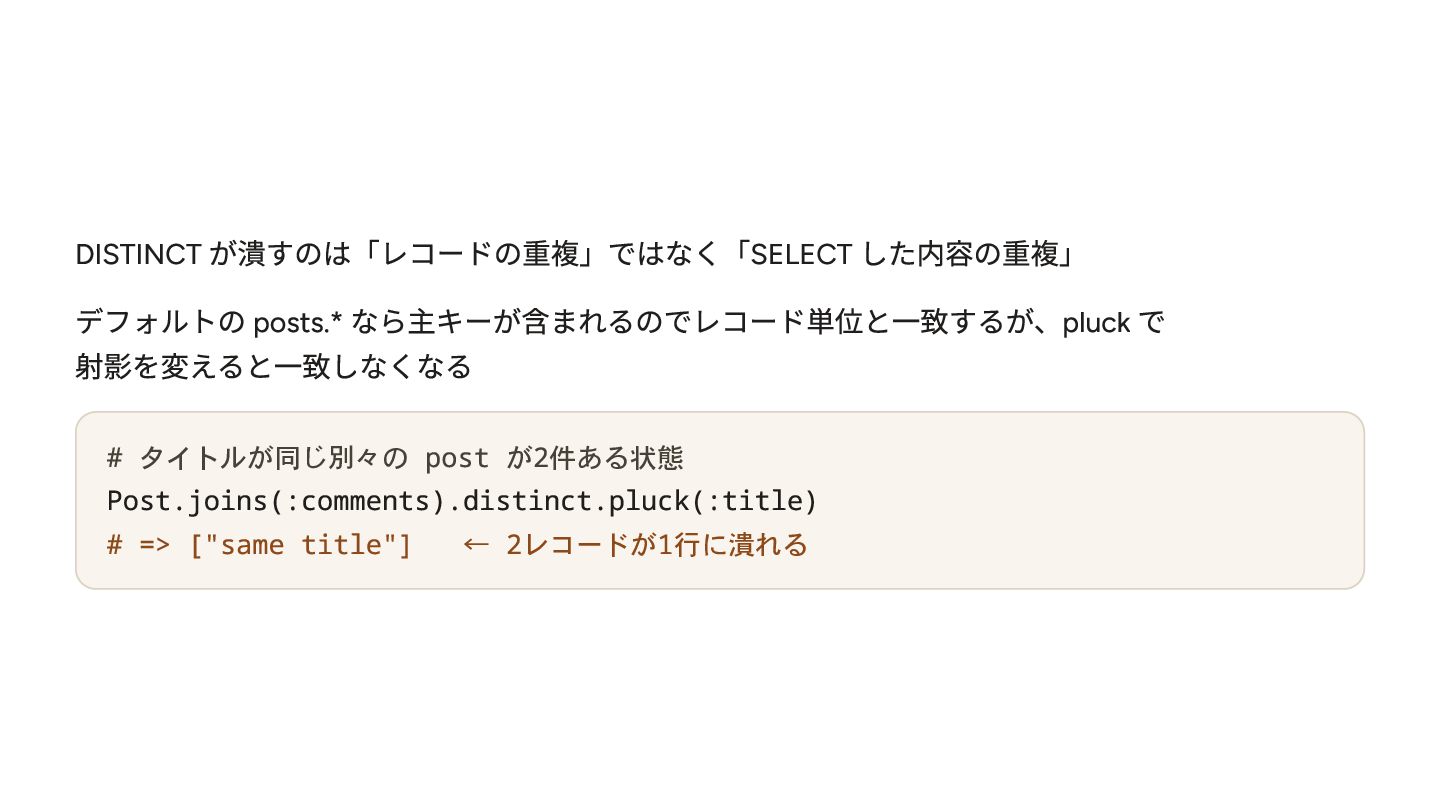
DISTINCT が潰すのは「レコードの重複」ではなく「SELECT した内容の重複」 デフォルトの posts.* なら主キーが含まれるのでレコード単位と一致するが、pluck で 射影を変えると一致しなくなる # タイトルが同じ別々の
post が2件ある状態 Post.joins(:comments).distinct.pluck(:title) # => ["same title"] ← 2レコードが1行に潰れる -
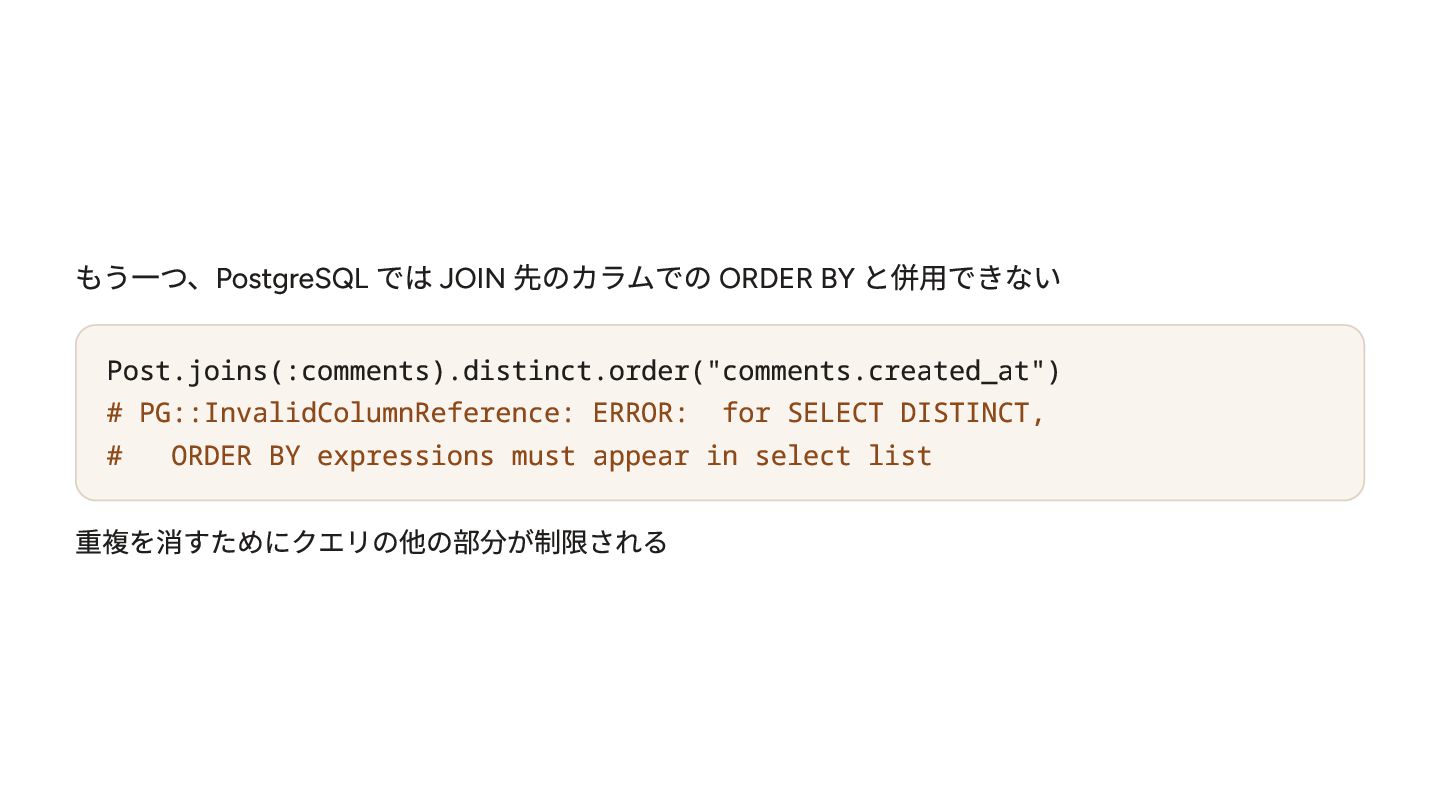
もう一つ、PostgreSQL では JOIN 先のカラムでの ORDER BY と併用できない Post.joins(:comments).distinct.order("comments.created_at") # PG::InvalidColumnReference:
ERROR: for SELECT DISTINCT, # ORDER BY expressions must appear in select list 重複を消すためにクエリの他の部分が制限される -
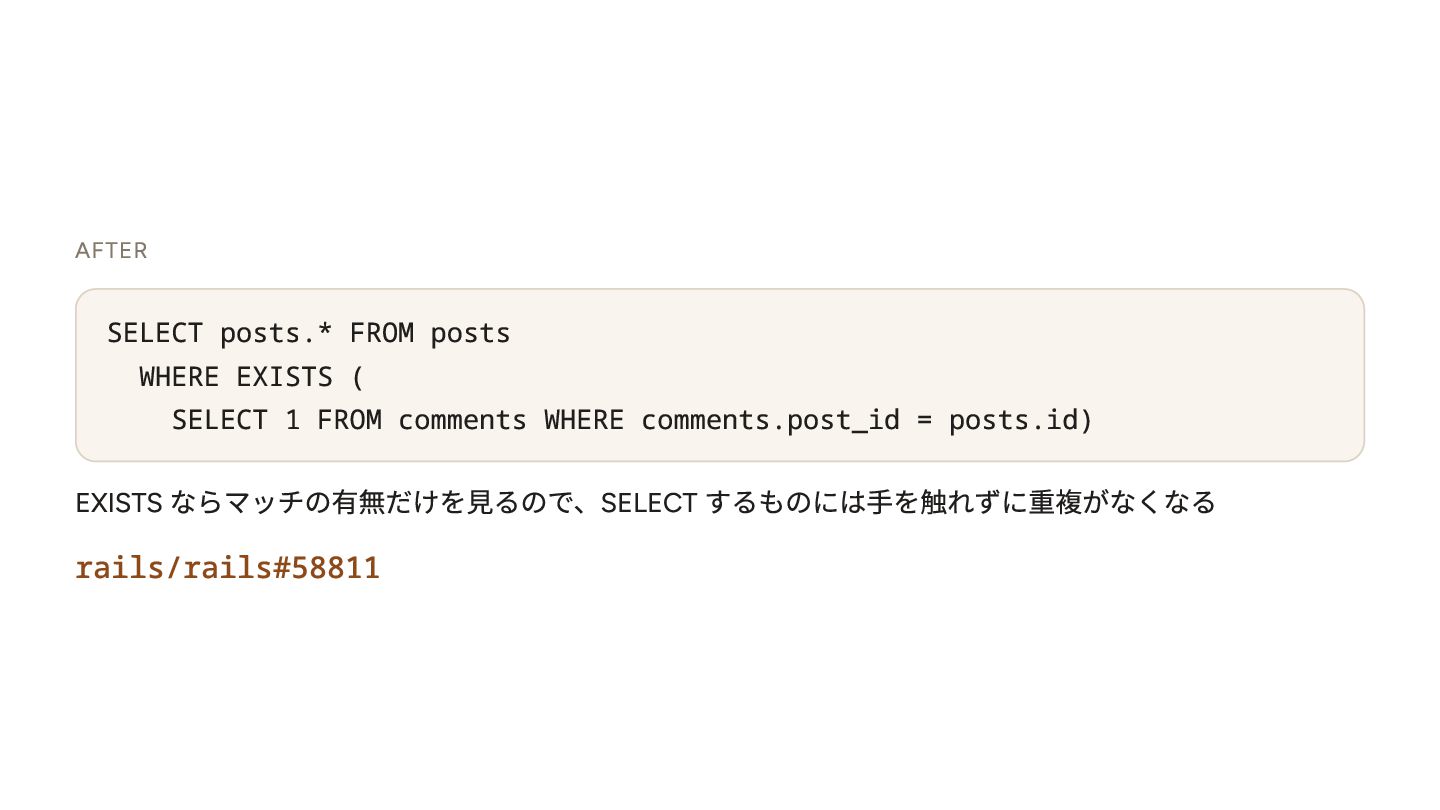
AFTER SELECT posts.* FROM posts WHERE EXISTS ( SELECT 1
FROM comments WHERE comments.post_id = posts.id) EXISTS ならマッチの有無だけを見るので、SELECT するものには手を触れずに重複がなくなる rails/rails#58811 -
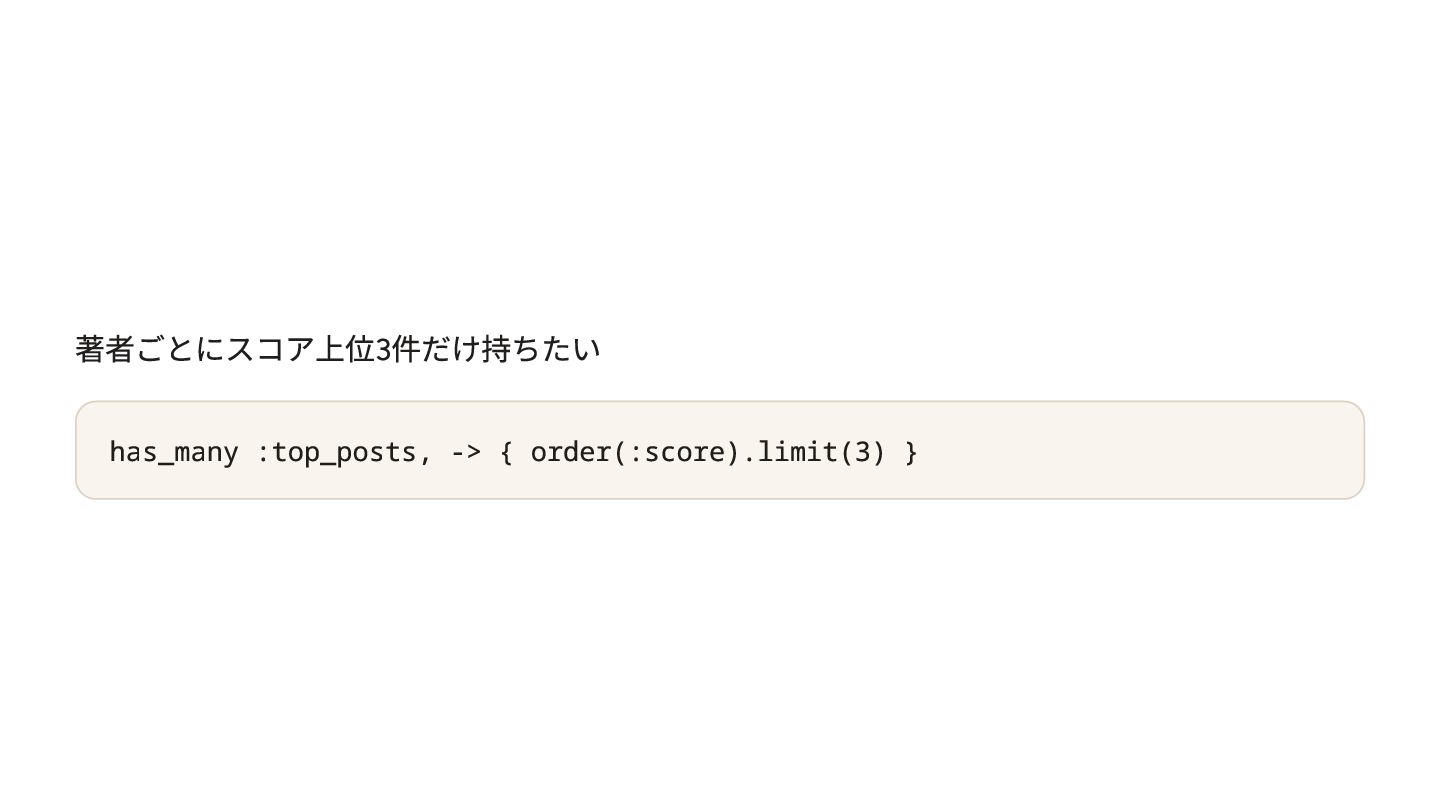
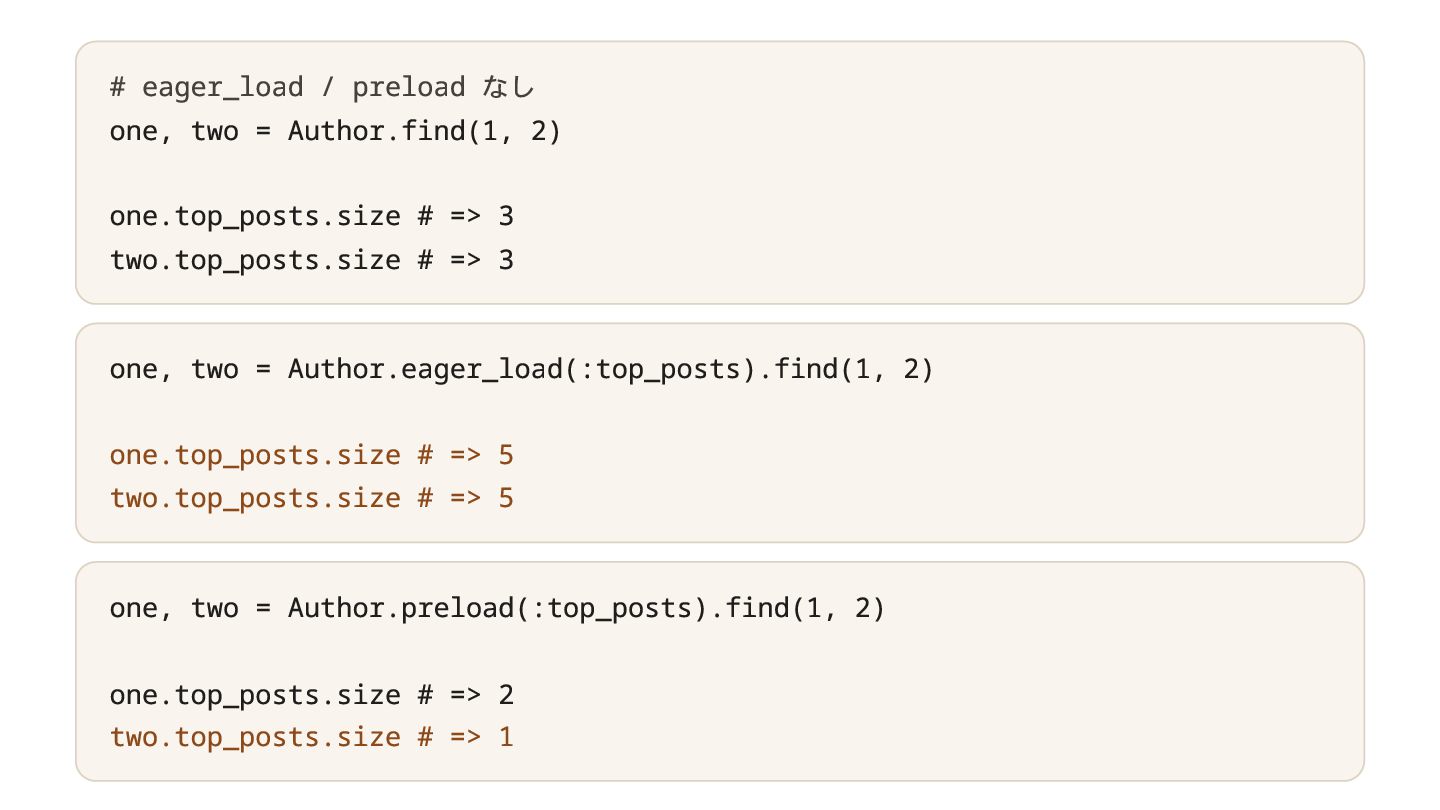
# eager_load / preload なし one, two = Author.find(1, 2)
one.top_posts.size # => 3 two.top_posts.size # => 3 one, two = Author.eager_load(:top_posts).find(1, 2) one.top_posts.size # => 5 two.top_posts.size # => 5 one, two = Author.preload(:top_posts).find(1, 2) one.top_posts.size # => 2 two.top_posts.size # => 1 -
#58814 eager_load eager_load は scope の WHERE 述語だけで JOIN を組み立てていた。limit
も offset も、どの行が選ばれるかを決める order も落ちる 結果、どの著者も投稿が全件返ってきていた -
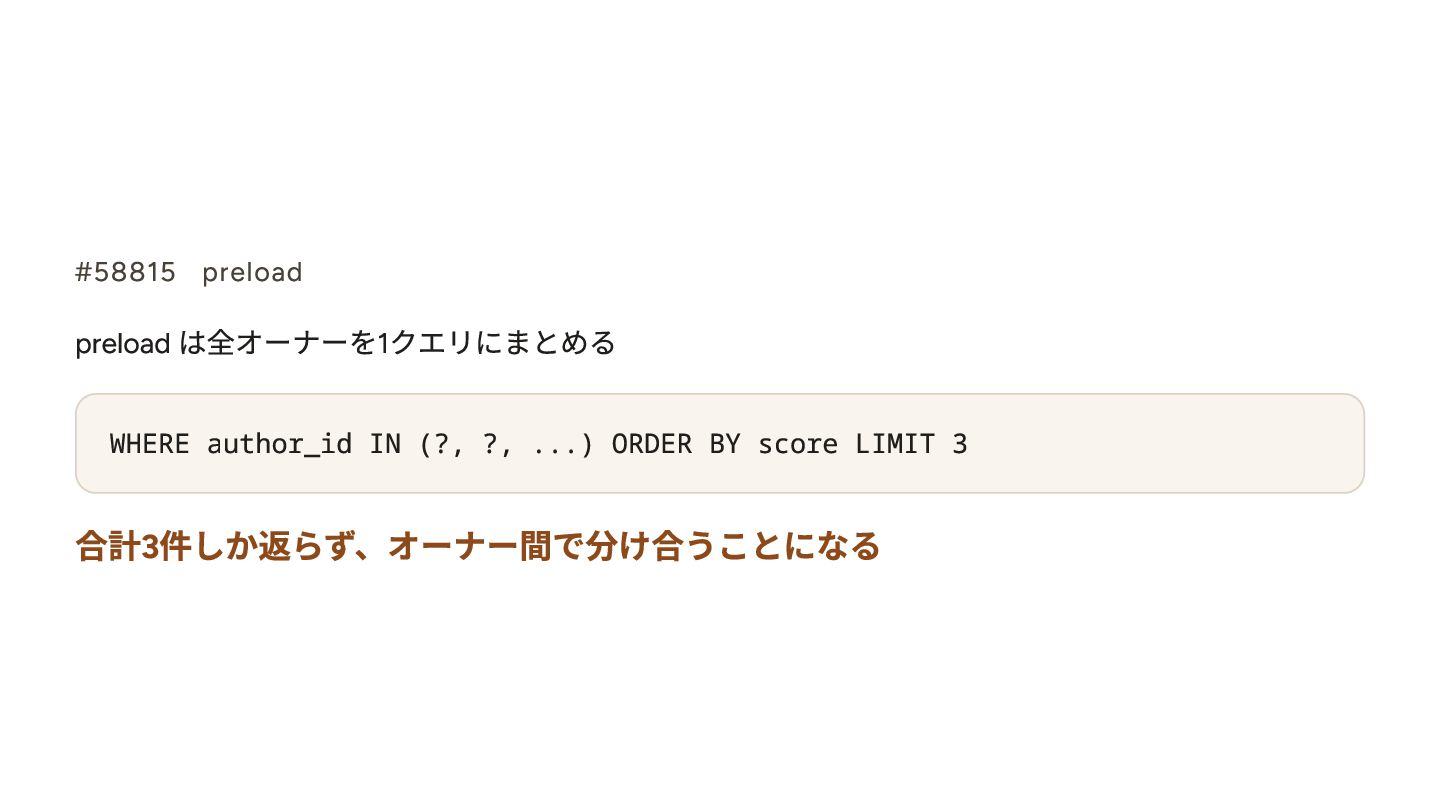
#58815 preload preload は全オーナーを1クエリにまとめる WHERE author_id IN (?, ?, ...)
ORDER BY score LIMIT 3 合計3件しか返らず、オーナー間で分け合うことになる -
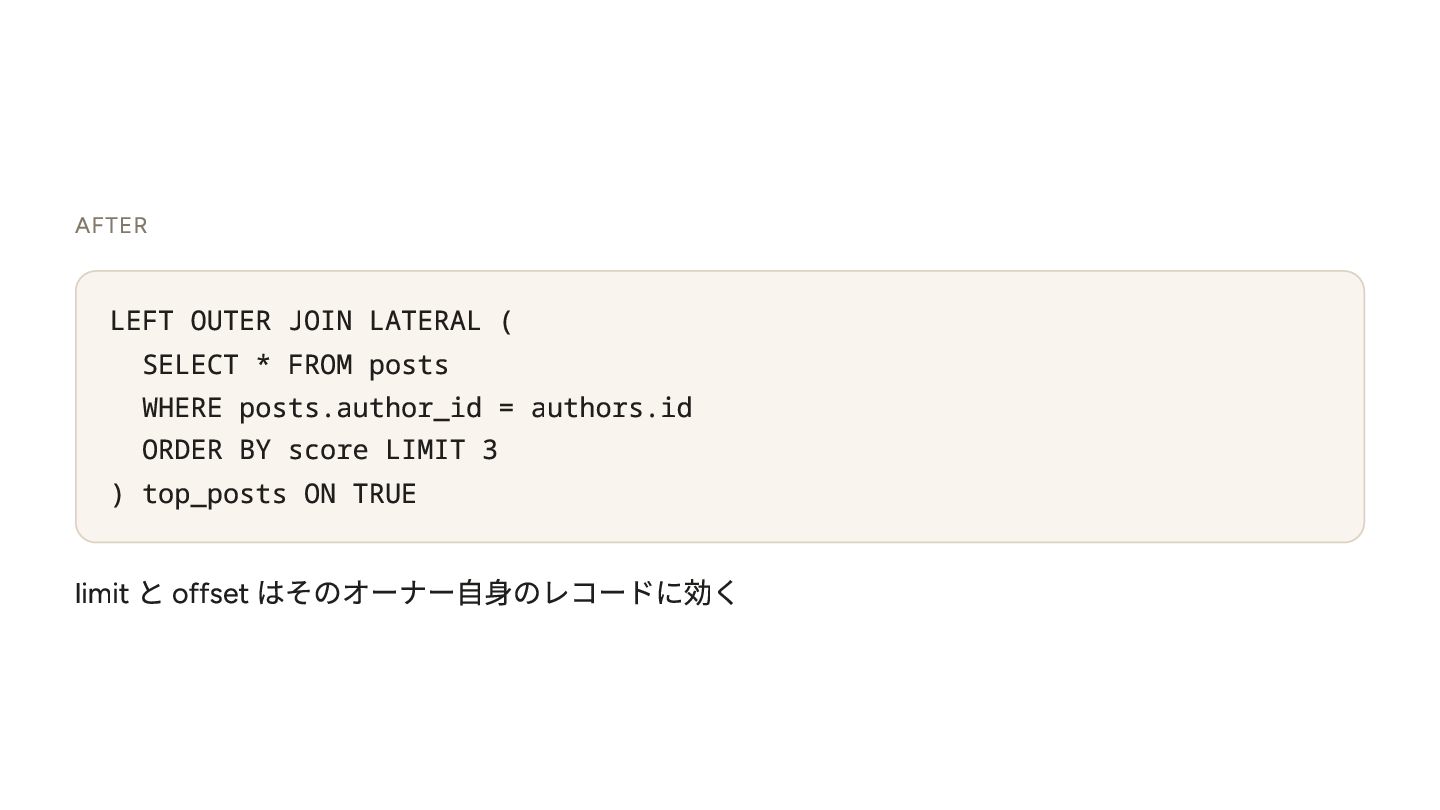
AFTER LEFT OUTER JOIN LATERAL ( SELECT * FROM posts
WHERE posts.author_id = authors.id ORDER BY score LIMIT 3 ) top_posts ON TRUE limit と offset はそのオーナー自身のレコードに効く -
eager_load のほうは LATERAL JOIN で SQL をきれいに組み立て られている preload のほうは
LATERAL JOIN を使っても SQL をきれいに 組み立てるのが難しかった -
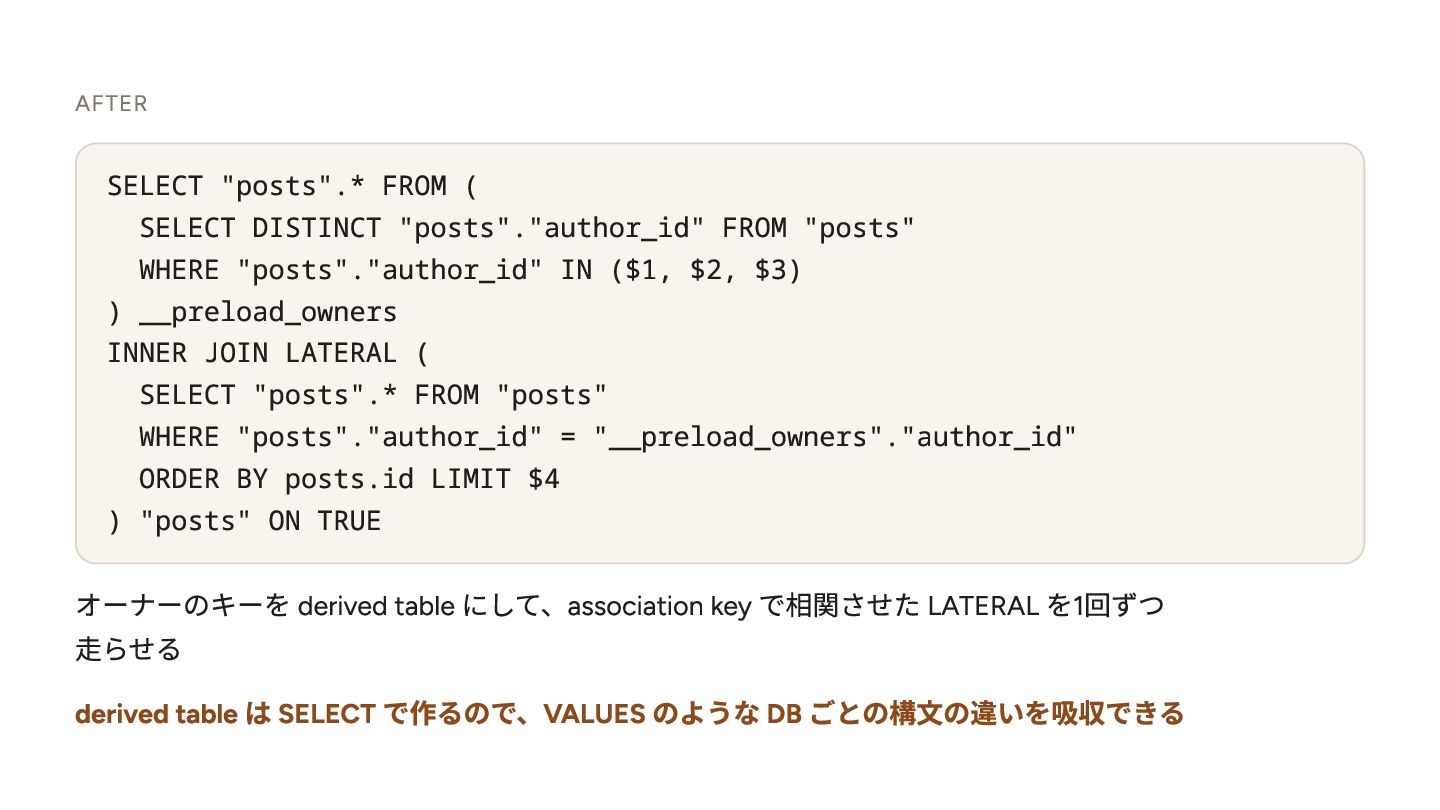
AFTER SELECT "posts".* FROM ( SELECT DISTINCT "posts"."author_id" FROM "posts"
WHERE "posts"."author_id" IN ($1, $2, $3) ) __preload_owners INNER JOIN LATERAL ( SELECT "posts".* FROM "posts" WHERE "posts"."author_id" = "__preload_owners"."author_id" ORDER BY posts.id LIMIT $4 ) "posts" ON TRUE オーナーのキーを derived table にして、association key で相関させた LATERAL を1回ずつ 走らせる derived table は SELECT で作るので、VALUES のような DB ごとの構文の違いを吸収できる -
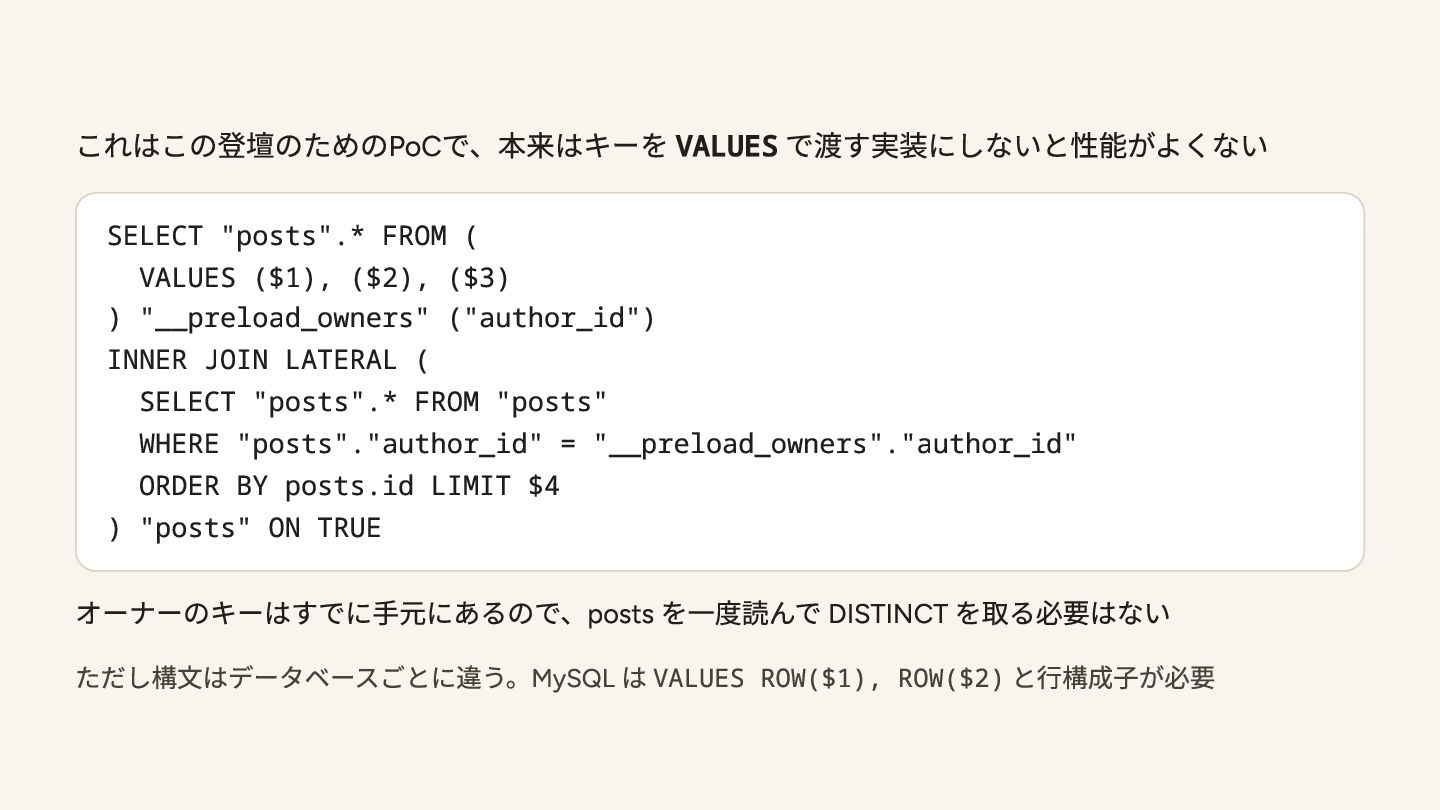
これはこの登壇のためのPoCで、本来はキーを VALUES で渡す実装にしないと性能がよくない SELECT "posts".* FROM ( VALUES ($1), ($2),
($3) ) "__preload_owners" ("author_id") INNER JOIN LATERAL ( SELECT "posts".* FROM "posts" WHERE "posts"."author_id" = "__preload_owners"."author_id" ORDER BY posts.id LIMIT $4 ) "posts" ON TRUE オーナーのキーはすでに手元にあるので、posts を一度読んで DISTINCT を取る必要はない ただし構文はデータベースごとに違う。MySQL は VALUES ROW($1), ROW($2) と行構成子が必要 -
性能も、PostgreSQL では十分な性能が出ているが、MySQL だと行数が多いと 破滅的に遅くなる MySQL は LATERAL の中の ORDER BY
... LIMIT で、インデックス順に読んで N 件で打ち切る Top-N の最適化が効かない。オーナーごとに該当行を全件読んでソートしてしまう まだ時は来てないのかもしれない