Share
Embed
LaneSegNet: Map Learning with Lane Segment Perception for Autonomous Driving - ICLR2024論文読み会
Kohei Iwamasa
June 04, 2024
Transcript
21 slides
-
LaneSegNet: Map Learning with Lane Segment Perception for Autonomous Driving
岩政 公平 Turing株式会社 ICLR2024読み会 -
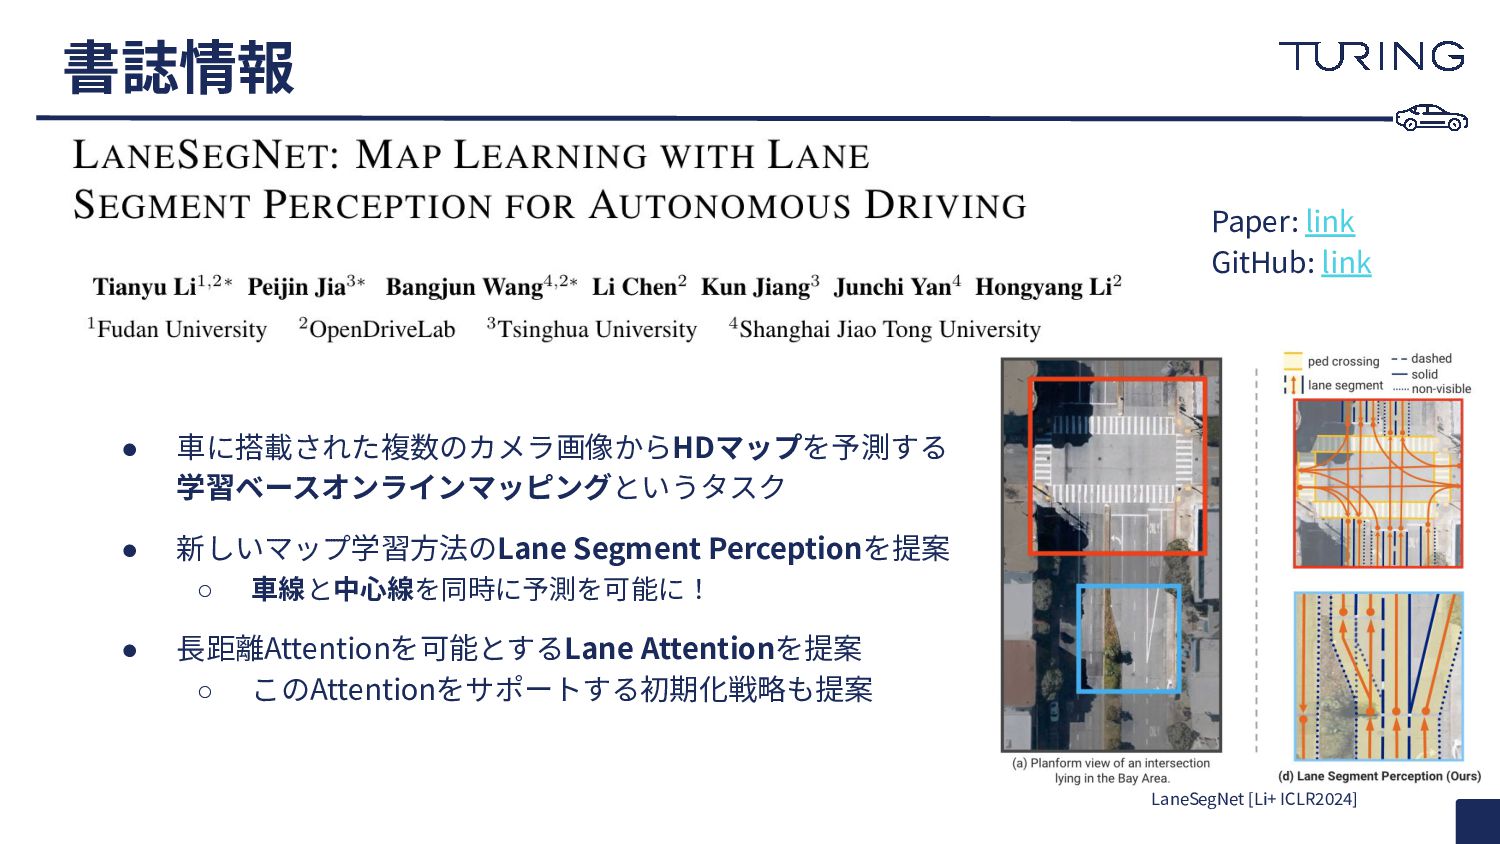
書誌情報 • ⾞に搭載された複数のカメラ画像からHDマップを予測する 学習ベースオンラインマッピングというタスク • 新しいマップ学習⽅法のLane Segment Perceptionを提案 ◦ ⾞線と中⼼線を同時に予測を可能に!
• ⻑距離Attentionを可能とするLane Attentionを提案 ◦ このAttentionをサポートする初期化戦略も提案 Paper: link GitHub: link LaneSegNet [Li+ ICLR2024] -
データセット - OpenLane-V2 [Wang+ NeruIPS2023] • 既存のデータセットをもとに⾞線や中⼼線、交通要素(e.g., 標識、信号機)が付与 ◦ 加えて、中⼼線間のトポロジーや中⼼線と交通要素のトポロジーも付与
• LaneSegNetでは主に⾞線と中⼼線、中⼼線間のトポロジーを⽤いる -
先⾏研究 MapTR [Liao+ ICLR2023] TopoNet [Li+ 2023] ⭕ ⾞線‧中⼼線検出やトポロジー認識をEnd-to-Endに予測、リアルタイム性 ❌
中⼼線は⾞線に密に連携している制約を⽤いたモデルが存在しない → ⾞線と中⼼線およびそのトポロジーをシームレスに組み込むLane Segmentを提案! -
モデル構造 • Encoder: マルチカメラ画像からBEV特徴(Bird’s-Eye-View)をBEVFormer[Li+ ECCV2022]で抽出 • Decoder: Lane Attentionを⽤いてBEV特徴からLane Segment
Queryを更新 • Predictor: 更新されたLaneSeg QueryからMLPでLane Segmentを予測 LaneSegNet [Li+ ICLR2024] -
*DETR [Carion+ ECCV2020] • Transformerを⽤いた物体検出フレームワークで、LaneSegNetはDETR-likeな構造 ◦ 特徴マップに位置埋め込みを⾏いtransformer-encoderで処理してKey, Valueとし、 学習可能なObject Queryにtransformer-decoderで処理して更新した各QueryをMLPで物体予測
• LaneSegNetは、EncoderがBEVFormer、DecoderのCross-Attention構造がLane Attention ◦ Predictorも⾃⼰回帰せずに並列的に出⼒ DETR[Carion+ ECCV2020] -
*Deformable Attention [Zhu+ ICLR2021] • DETRのtransformerを効率的なAttentionに変換して10倍少ないepoch数で収束 • 各特徴マップのQuery座標の参照点(x, y)、Queryを⼊⼒とした線形層でoffsets(Δx, Δy)とattention
weightsを出⼒し(x+Δx, y+Δy)の位置をbilinear補間で特徴を抽出、weightsから加重平均する構造 • BEVFormer、Lane Attentionに重要な構造! Deformable DETR [Zhu+ ICLR2021] -
*BEVFormer [Li+ ECCV2022] • Deformable AttentionベースでBEV Queryを構築するモデル • 各カメラ画像の特徴マップをKey, ValueとしてBEV
Queryに対して空間⽅向のCross-Attention、 時系列情報は過去のBEV Queryを⽤いたSelf-Attentionで処理する BEVFormer [Li+ ECCV2022] -
*BEVFormer [Li+ ECCV2022] • BEV Queryは実世界スケールの平⾯であり、[Height×Width×Channel]のテンソル • Spatial Attentionは各グリッドセルの3次元点(x, y,
z)を各カメラパラメータで特徴マップ上に投影 もし投影可能なら2次元点(x’, y’)を参照点として特徴マップに対しDeform Attn. • Temporal Attentionは⾞の移動量をもとに参照点を計算してBEV Queryに対しDeform Attn. BEVFormer[Li+ ECCV2022] -
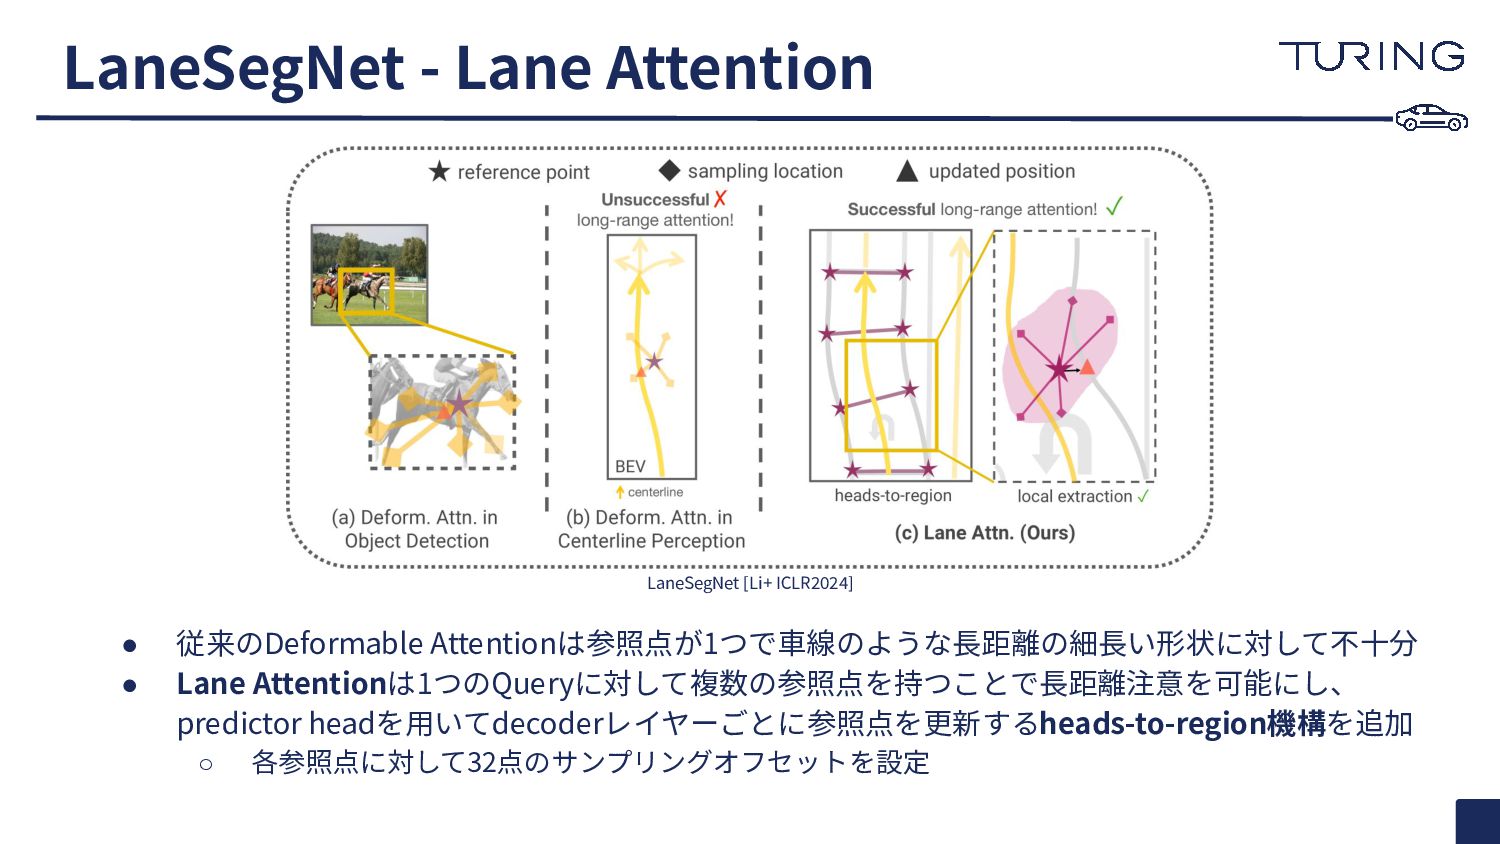
LaneSegNet - Lane Attention • 従来のDeformable Attentionは参照点が1つで⾞線のような⻑距離の細⻑い形状に対して不⼗分 • Lane Attentionは1つのQueryに対して複数の参照点を持つことで⻑距離注意を可能にし、
predictor headを⽤いてdecoderレイヤーごとに参照点を更新するheads-to-region機構を追加 ◦ 各参照点に対して32点のサンプリングオフセットを設定 LaneSegNet [Li+ ICLR2024] -
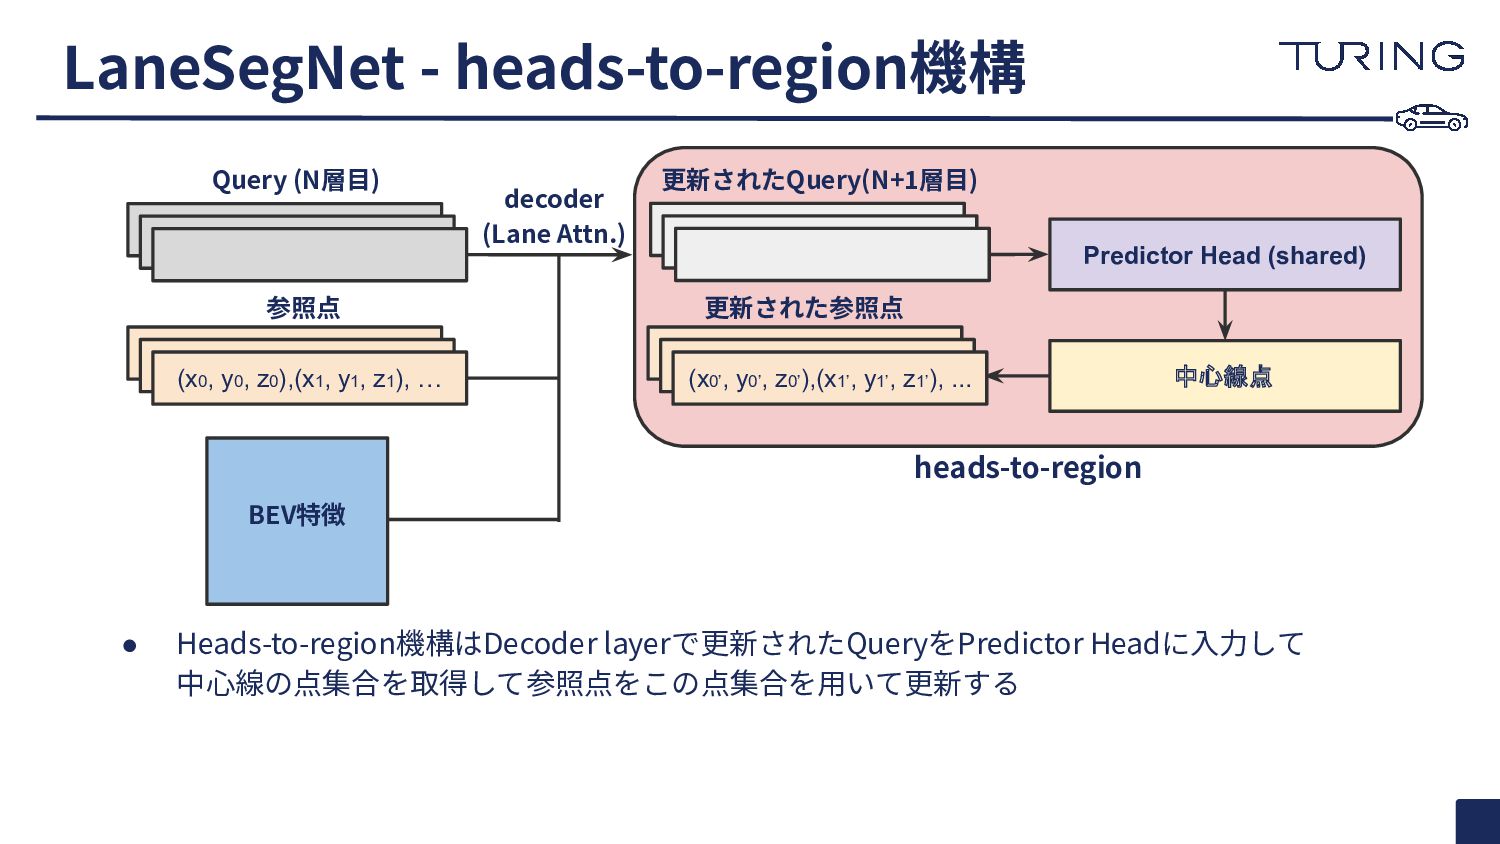
LaneSegNet - heads-to-region機構 • Heads-to-region機構はDecoder layerで更新されたQueryをPredictor Headに⼊⼒して 中⼼線の点集合を取得して参照点をこの点集合を⽤いて更新する decoder (Lane
Attn.) (x0, y0, z0), (x1, y1, z1), … Query (N層⽬) 参照点 (x0, y0, z0), (x1, y1, z1), … (x0, y0, z0),(x1, y1, z1), … BEV特徴 更新されたQuery(N+1層⽬) Predictor Head (shared) (x0, y0, z0), (x1, y1, z1), … (x0, y0, z0), (x1, y1, z1), … 更新された参照点 中心線点 heads-to-region (x0’, y0’, z0’),(x1’, y1’, z1’), ... -
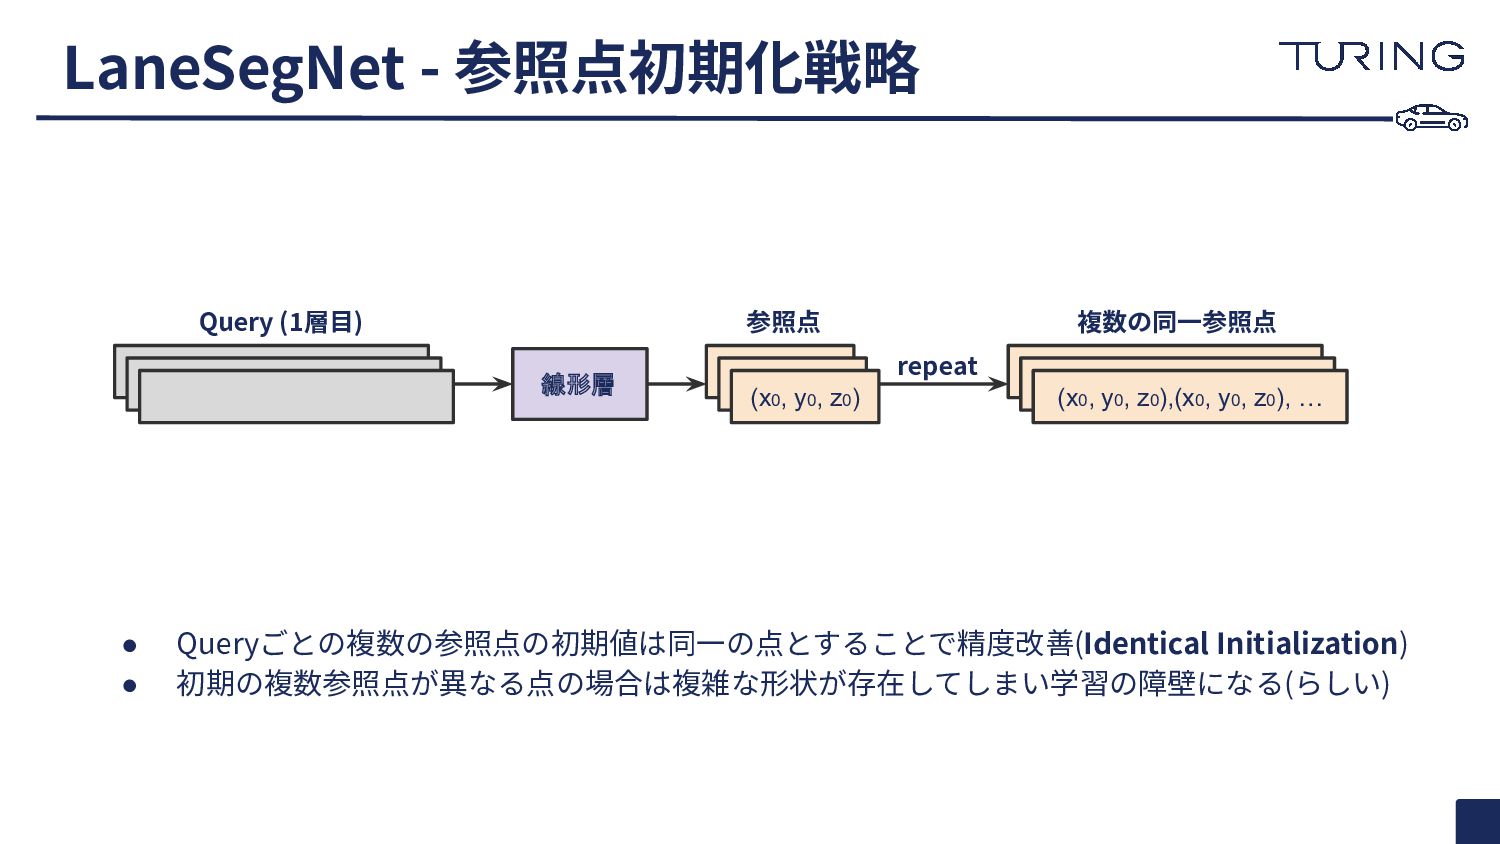
repeat LaneSegNet - 参照点初期化戦略 • Queryごとの複数の参照点の初期値は同⼀の点とすることで精度改善(Identical Initialization) • 初期の複数参照点が異なる点の場合は複雑な形状が存在してしまい学習の障壁になる(らしい) Query
(1層⽬) 線形層 (x0, y0, z0) (x0, y0, z0) (x0, y0, z0) (x0, y0, z0),(x1, y1, z1), … (x0, y0, z0),(x1, y1, z1), … (x0, y0, z0),(x0, y0, z0), … 参照点 複数の同⼀参照点 -
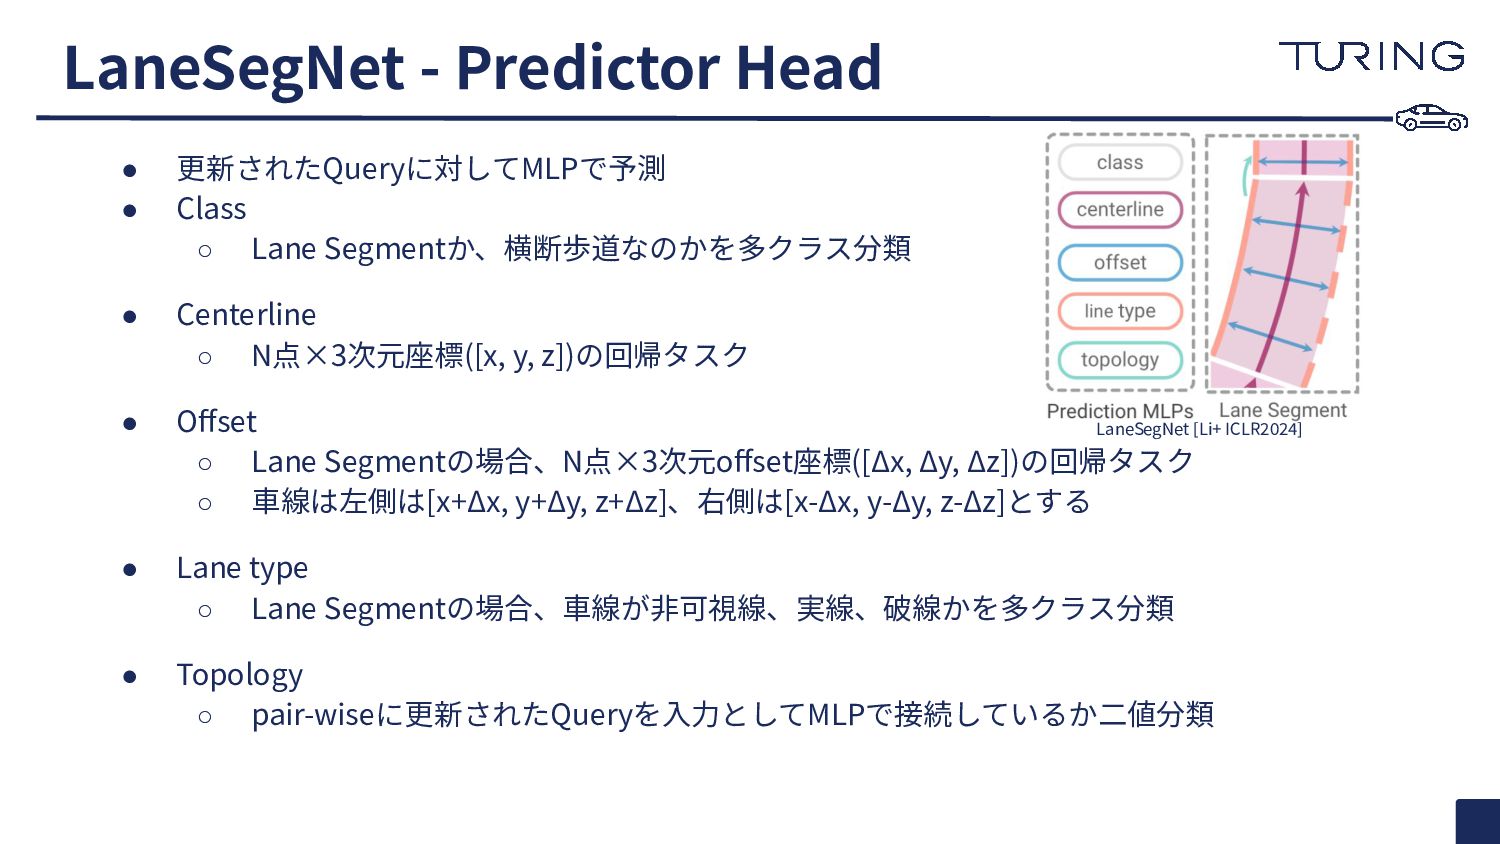
LaneSegNet - Predictor Head • 更新されたQueryに対してMLPで予測 • Class ◦ Lane
Segmentか、横断歩道なのかを多クラス分類 • Centerline ◦ N点×3次元座標([x, y, z])の回帰タスク • Offset ◦ Lane Segmentの場合、N点×3次元offset座標([Δx, Δy, Δz])の回帰タスク ◦ ⾞線は左側は[x+Δx, y+Δy, z+Δz]、右側は[x-Δx, y-Δy, z-Δz]とする • Lane type ◦ Lane Segmentの場合、⾞線が⾮可視線、実線、破線かを多クラス分類 • Topology ◦ pair-wiseに更新されたQueryを⼊⼒としてMLPで接続しているか⼆値分類 LaneSegNet [Li+ ICLR2024] -
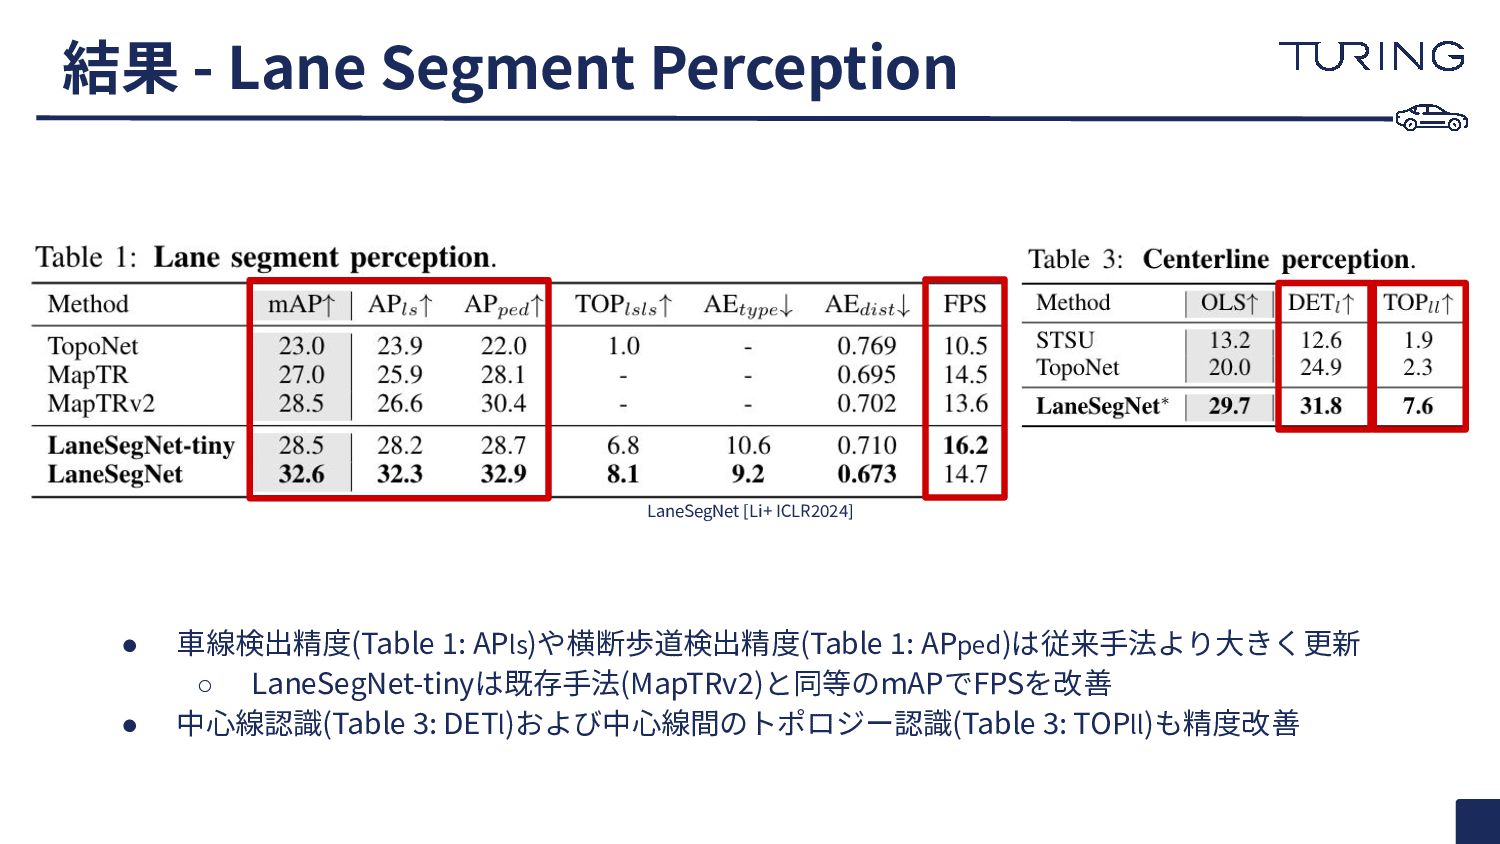
結果 - Lane Segment Perception • ⾞線検出精度(Table 1: APls)や横断歩道検出精度(Table 1:
APped)は従来⼿法より⼤きく更新 ◦ LaneSegNet-tinyは既存⼿法(MapTRv2)と同等のmAPでFPSを改善 • 中⼼線認識(Table 3: DETl)および中⼼線間のトポロジー認識(Table 3: TOPll)も精度改善 LaneSegNet [Li+ ICLR2024] -
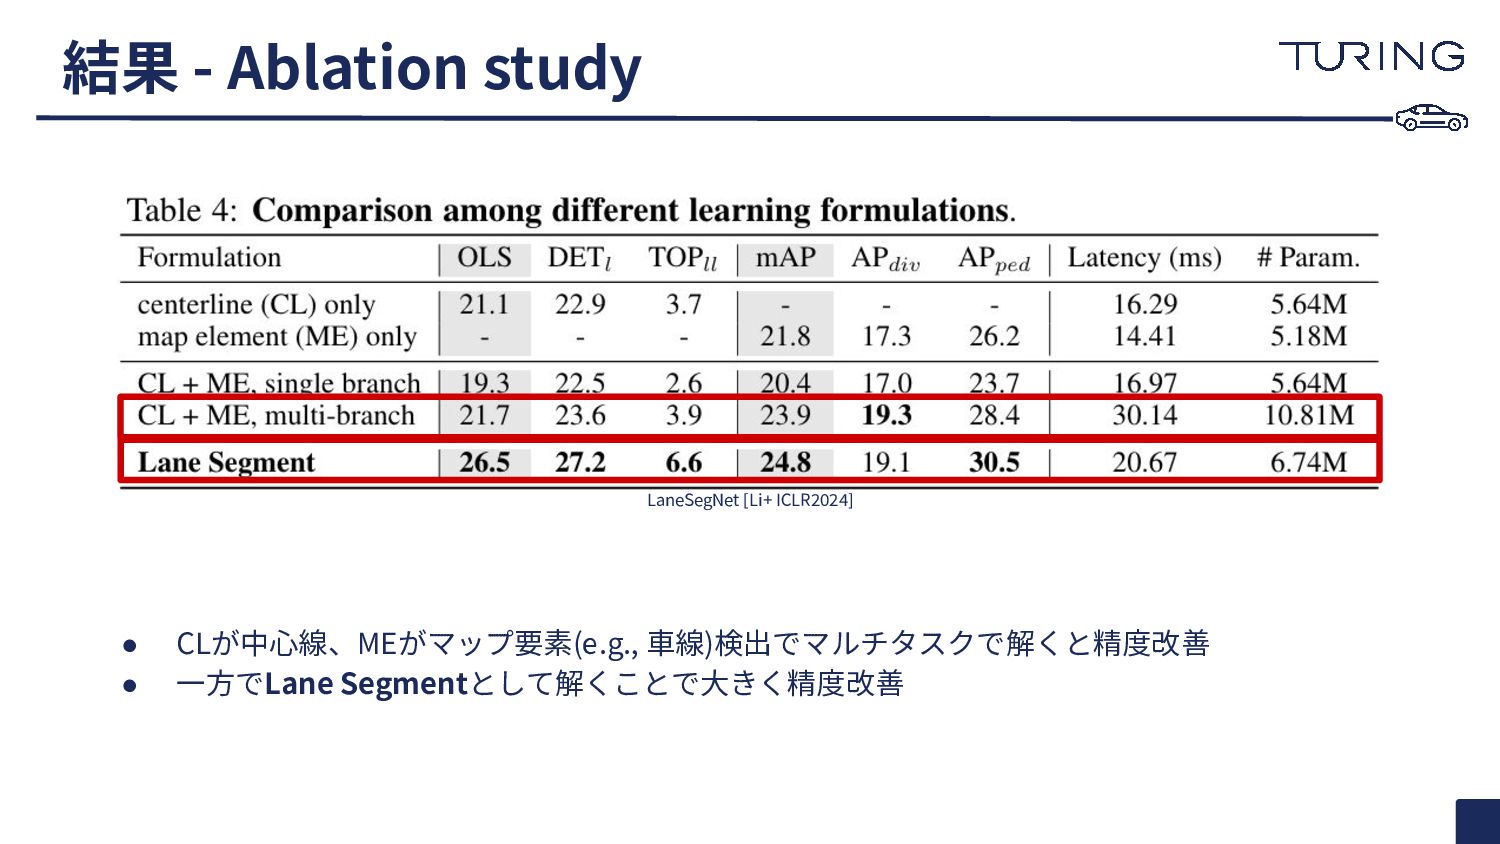
結果 - Ablation study • CLが中⼼線、MEがマップ要素(e.g., ⾞線)検出でマルチタスクで解くと精度改善 • ⼀⽅でLane Segmentとして解くことで⼤きく精度改善
LaneSegNet [Li+ ICLR2024] -
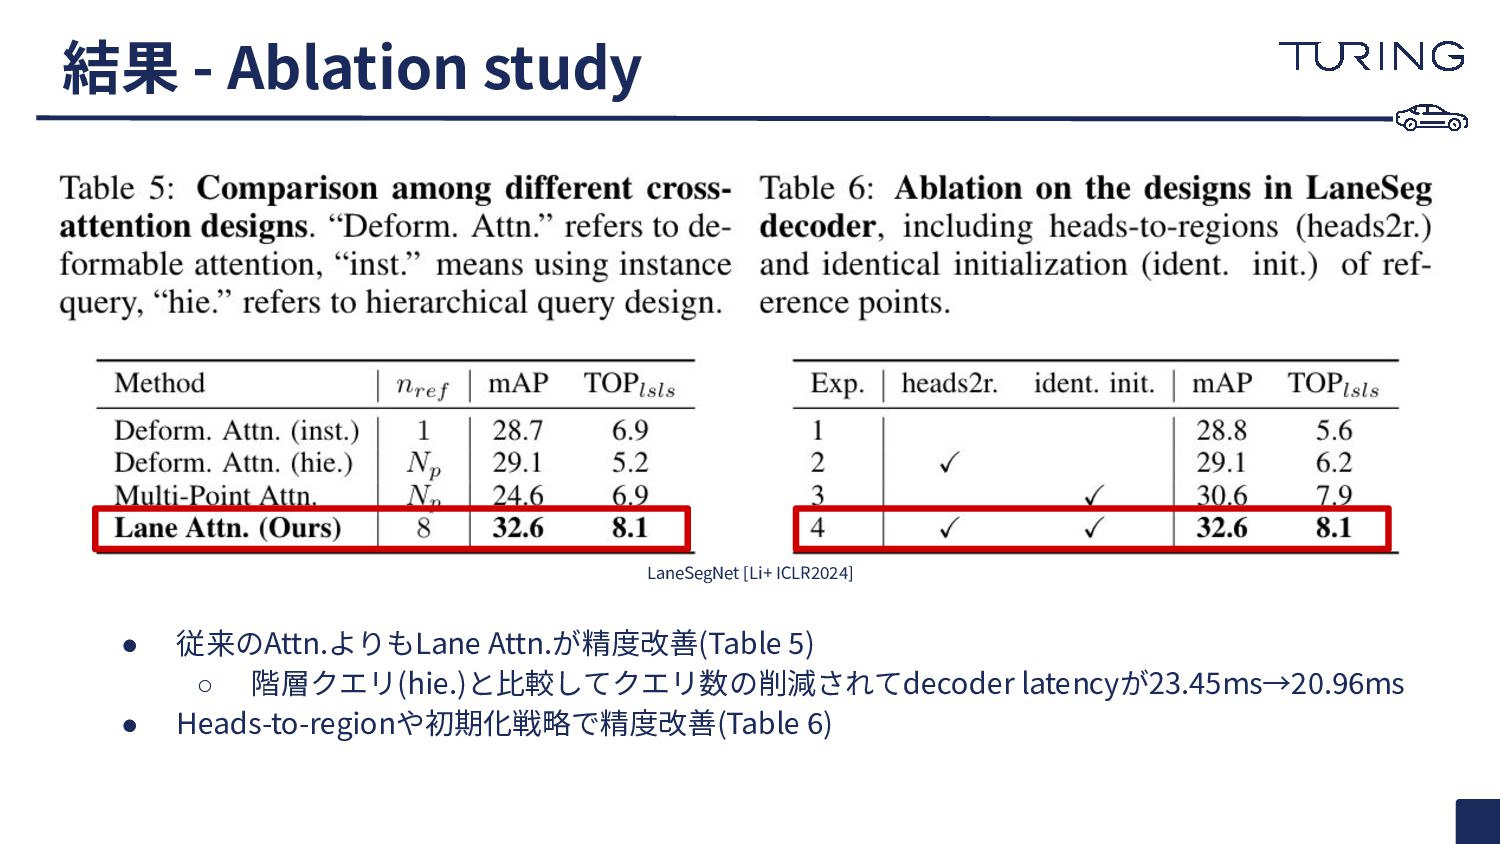
結果 - Ablation study • 従来のAttn.よりもLane Attn.が精度改善(Table 5) ◦ 階層クエリ(hie.)と⽐較してクエリ数の削減されてdecoder
latencyが23.45ms→20.96ms • Heads-to-regionや初期化戦略で精度改善(Table 6) LaneSegNet [Li+ ICLR2024] -
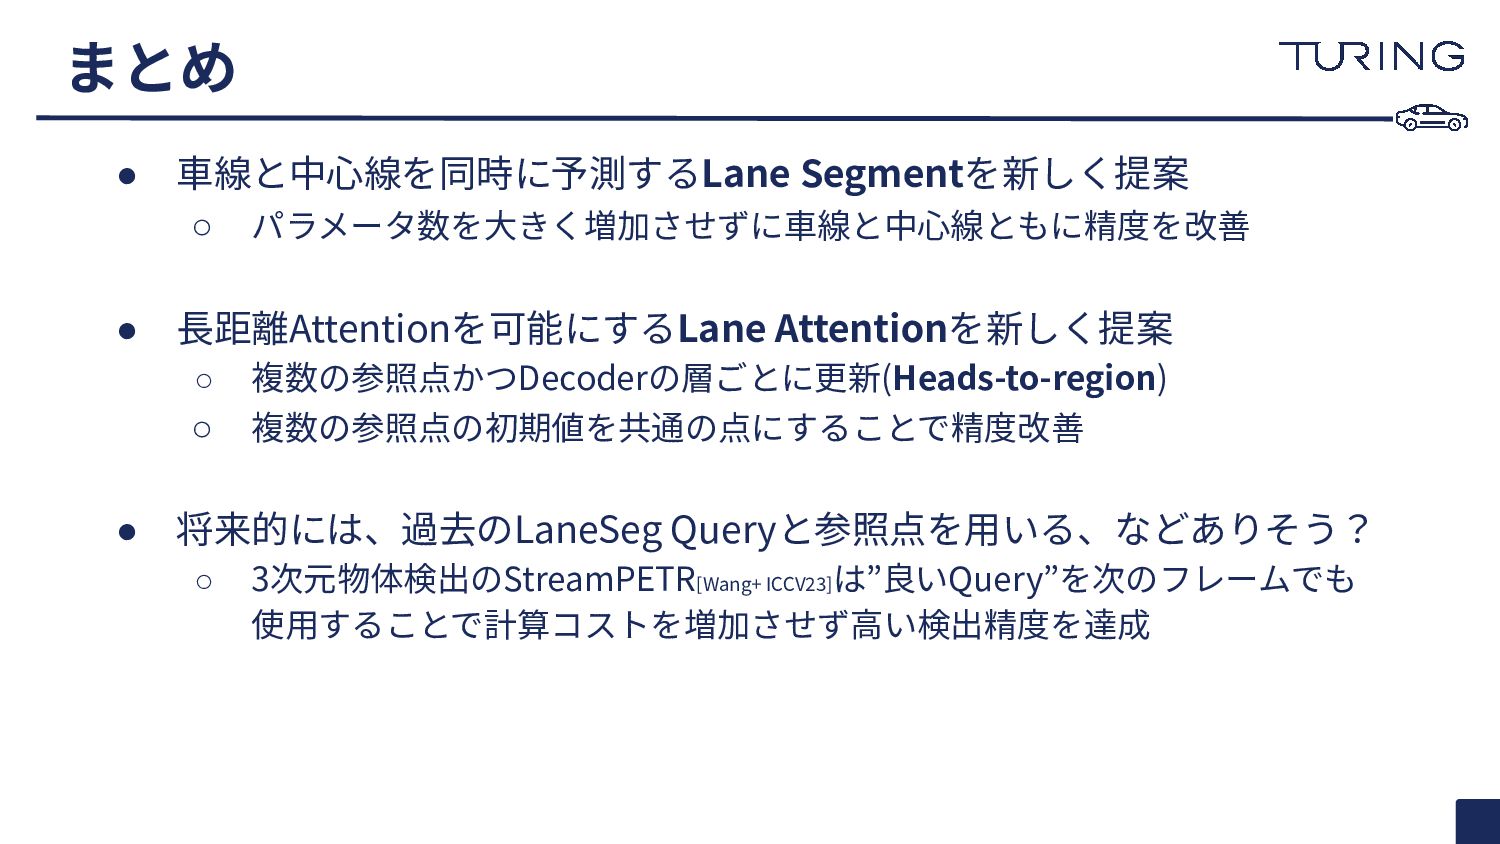
まとめ • ⾞線と中⼼線を同時に予測するLane Segmentを新しく提案 ◦ パラメータ数を⼤きく増加させずに⾞線と中⼼線ともに精度を改善 • ⻑距離Attentionを可能にするLane Attentionを新しく提案 ◦
複数の参照点かつDecoderの層ごとに更新(Heads-to-region) ◦ 複数の参照点の初期値を共通の点にすることで精度改善 • 将来的には、過去のLaneSeg Queryと参照点を⽤いる、などありそう? ◦ 3次元物体検出のStreamPETR[Wang+ ICCV23] は”良いQuery”を次のフレームでも 使⽤することで計算コストを増加させず⾼い検出精度を達成 -
参考⽂献 1. Tianyu Li, Peijin Jia, Bangjun Wang, Li Chen,
Kun Jiang, Junchi Yan and Hongyang Li. LaneSegNet: Map Learning with Lane Segment Perception for Autonomous Driving. In ICLR, 2024. 2. Huijie Wang, Tianyu Li, Yang Li, Li Chen, Chonghao Sima, Zhenbo Liu, Yuting Wang, Shengyin Jiang, Peijin Jia, Bangjun Wang, Feng Wen, Hang Xu, Ping Luo, Junchi Yan, Wei Zhang, and Hongyang Li. Openlane-v2: A topology reasoning benchmark for scene understanding in autonomous driving. In NeurIPS, 2023. 3. Bencheng Liao, Shaoyu Chen, Xinggang Wang, Tianheng Cheng, Qian Zhang, Wenyu Liu, and Chang Huang. MapTR: Structured modeling and learning for online vectorized HD map construction. In ICLR, 2023. 4. Tianyu Li, Li Chen, Huijie Wang, Yang Li, Jiazhi Yang, Xiangwei Geng, Shengyin Jiang, Yuting Wang, Hang Xu, Chunjing Xu, Junchi Yan, Ping Luo, and Hongyang Li. Graph-based topology reasoning for driving scenes. arXiv preprint arXiv:2304.05277, 2023. 5. Nicolas Carion, Francisco Massa, Gabriel Synnaeve, Nicolas Usunier, Alexander Kirillov and Sergey Zagoruyko. End-to-End Object Detection with Transformers. In ECCV, 2020. 6. Xizhou Zhu, Weijie Su, Lewei Lu, Bin Li, Xiaogang Wang, and Jifeng Dai. Deformable detr: Deformable transformers for end-to-end object detection. In ICLR, 2020. 7. Zhiqi Li, Wenhai Wang, Hongyang Li, Enze Xie, Chonghao Sima, Tong Lu, Qiao Yu, and Jifeng Dai. BEVFormer: Learning bird’s-eye-view representation from multi-camera images via spatiotemporal transformers. In ECCV, 2022. 8. Shihao Wang, Yingfei Liu, Tiancai Wang, Ying Li and Xiangyu Zhang. Exploring Object-Centric Temporal Modeling for Efficient Multi-View 3D Object Detection. In ICCV, 2023.