Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
MoAコンペで気づいたこと
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
fkubota
December 19, 2020
Programming
810
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
MoAコンペで気づいたこと
fkubota
December 19, 2020
More Decks by fkubota
See All by fkubota
相対性理論の入門の入門
fkubota
0
130
データドリブンな組織の不正検知
fkubota
0
2.5k
JupyterNotebookでのdebug入門(サンプルは説明欄にあります)
fkubota
6
14k
ルールベース画像処理のススメ
fkubota
17
16k
Kaggle日記について
fkubota
2
2.8k
鳥コンペで惨敗した話とコンペの取り組み方
fkubota
1
7.1k
クロマベクトルって何?
fkubota
3
2.8k
生産性と戦った僕の1年の記録とツールたち
fkubota
6
6.8k
Other Decks in Programming
See All in Programming
Starting & Sustaining Code-Based E2E Testing for Non-Coding QA Teams( #jasstniigata )
teyamagu
PRO
1
840
AWS CDKのカスタムリソースでContinuum(旧Security Agent)を実装した話 | Implementing Continuum (formerly Security Agent) via AWS CDK Custom Resource
akihisaikeda
2
120
wkhtmltopdfの次どうするか問題2026
willnet
2
1.8k
JAWS-UG 東京支部が始める、JAWS-UG支部コラボ / JAWS-UG lunchtime LT Collaboration
y0hgi
0
170
re:Inventに行く前に知っておきたい現地参加のノウハウ
nokomoro3
0
310
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
5.9k
Verilogで学ぶCPU自作入門.pdf
uyuki234
7
3.9k
巨大モノリシックアプリ モダン化大作戦
ktcryomm
1
1.2k
SONY CISC-NEWS NWS-1750 + NWB-225 フレームバッファの NetBSD/news68k ドライバ実装 / OSC2026Hiroshima
tsutsui
0
160
Workers Cache を知る
syumai
0
320
コードレビューのボトルネックを"する側"と"される側"の両面から解消する
yub0n
2
1.4k
手動確認はもう限界 〜XCUITestでCustom URL Schemeの遷移を起動種別ごとに自動テストする〜 / Testing Custom URL Schemes with XCUITest
otouto
0
370
Featured
See All Featured
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
260
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
The untapped power of vector embeddings
frankvandijk
2
1.9k
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
550
Darren the Foodie - Storyboard
khoart
PRO
4
4k
The agentic SEO stack - context over prompts
schlessera
0
950
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.2k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
It's Worth the Effort
3n
188
29k
30 Presentation Tips
portentint
PRO
1
410
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Transcript
MoAコンペで気づいたこと fkubota https://www.kaggle.com/fkubota
さっそくですが モデルの性能をtarget_columnごとで評価したことありますか? 僕はあります。 今回のコンペのmetricを見てみましょう。 これを変形してみます。 https://www.kaggle.com/c/lish-moa/overview/evaluation
row方向 column方向 mのみに依存
各カラム毎にscoreを出力できた!
ターゲットカラム毎に評価はできました。 1つ1つ結果を確認するのもいいですが、 もう少しおもしろいことをしましょう。
1の数(n)を数えてみる 17 18 24 190 301 仮説: nが小さいほど(学習が困難になって)lossが大きいのでは? n =
n vs logloss でプロット nが小さいほどうまく学習ができていない? ---> nが小さいほどloglossは大きくなる? 右のグラフを見る限りそうでもない。 仮説は否定された。なんでこうなるの? あと、右上に単調増加する意味ありげな形
これはなにかあるぞ。。。
そもそも、nが1とかだったら、 モデルに予測させるのではなく、 全部0埋めすればいいのでは? こいつら学習させることで きるんですか?
0で埋めるのが最適かはわからない。 0に近い値で埋めたほうがいいのは確か。 どの程度の一定値で埋めればいい? n=1, 2, 3, 4, 5のときに、様々な一定値で埋めて score_colを計算した。 横軸は、埋めた一定値の値。
縦軸はscore_col の値。 最適な一定値はnによって変わる。
実はこの最適な一定値は解析的に計算できる。 簡単に紹介(自分で計算してみてね)。
score_colを最小とするようなCをC_0とする (記号の雑さ、数学的な厳密性の欠如は今は目を瞑ってください m(_ _)m) これを解くと... 美しい感じの解出た! 直感的!!
求めた解を使って、nごとにプロットしてみる おっ??
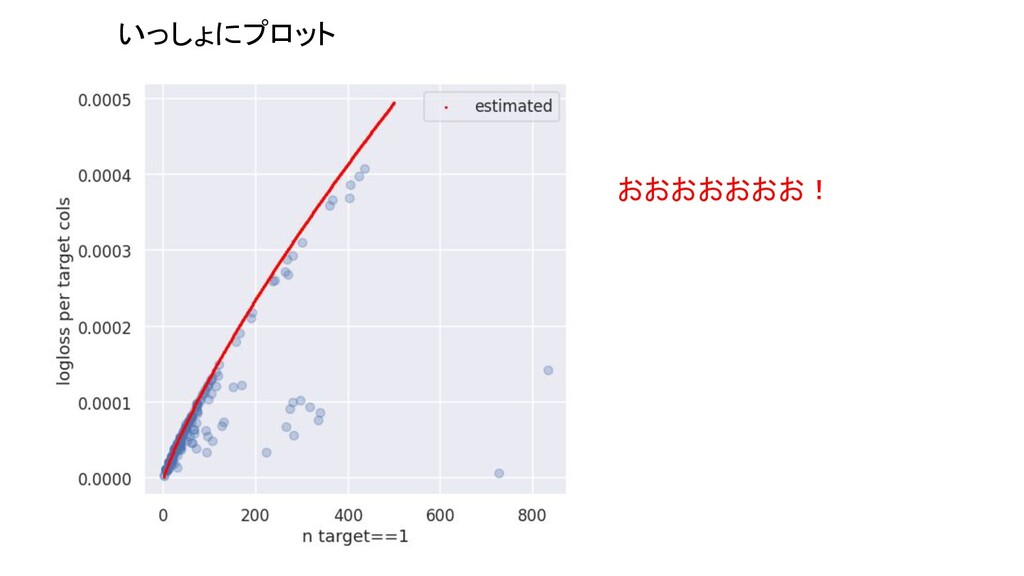
いっしょにプロット おおおおおおお!
つまり? 計算したloglossを赤色でプロットした。 見事に一致している部分が多くある。 赤色と重なっている青い部分はこう解釈できる。 「1は予測できないが、たまに1がtargetにある。すべて0 にpredictしてしまうとペナルティが大きくなってしまうの で、ちょうどいい感じの値を出しておこう」 モデルは、1を頑張って予測しようとしているのではな く、ペナルティが最小限になるような値を出力しているに 過ぎないと言える。
赤い線に近い値を取っているカラムは 全く学習していない!!!
シェイクの予感 - ほとんどの参加者は、この事に気づいていない - スコアに大きな影響があるのはnが大きいターゲット - おそらくほとんどのモデルはnが小さいターゲットはほとんど学習で きていない - モデルは、nが小さなターゲットではn(1が何個含まれているか?)し
か見ていない。 - testとtrainでnの数に大きな差があれば性能は極端に落ちる。 nが小さいtargetで性能を出せればシェイクアップはできる!!
コンペ後半は、n<200の部分だけの性能アップに注力 - focal loss - mixup - LabelSmoothing - etc….
mixupが一番効く!!
cool_rabbitさんによる実験 黄色: mixup なし 青色: mixupあり 良くなってる 悪くなってる アンサンブルの時、 このモデルはN<200
の部分だけを使うなどの工 夫をした
シェイクアップ!!!!
None


 fkubota
 teyamagu
 akihisaikeda
 willnet
 y0hgi
 nokomoro3
 po3rin
 uyuki234
 ktcryomm
 tsutsui
 syumai
 yub0n
 otouto
 tmiket
 smashingmag
 frankvandijk
 marktimemedia
 khoart
 schlessera
 soysaucechin
 malarkey
 3n
 portentint
 sergeychernyshev
 garrettdimon