Share
Embed
CVPR2025論文紹介:動画像分類
hinako0123
August 11, 2025
Transcript
31 slides
-
自己紹介 • 村田晴彦 • 名城大学 堀田研究室 M2 • 研究 •
Video Classification • Video Visualization • 教師なし学習 • 年一の楽しみ:初日の出!!! -
タスクと論文 • Video Classification (Action Recognition) • Action Detail Matters:
Refining Video Recognition with Local Action Queries • 以降、FocusVideo • Few-Shot Action Recognition • Temporal Alignment-Free Video Matching for Few-shot Action Recognition -
発表分野 • Video Classification (Action Recognition) • Action Detail Matters:
Refining Video Recognition with Local Action Queries -
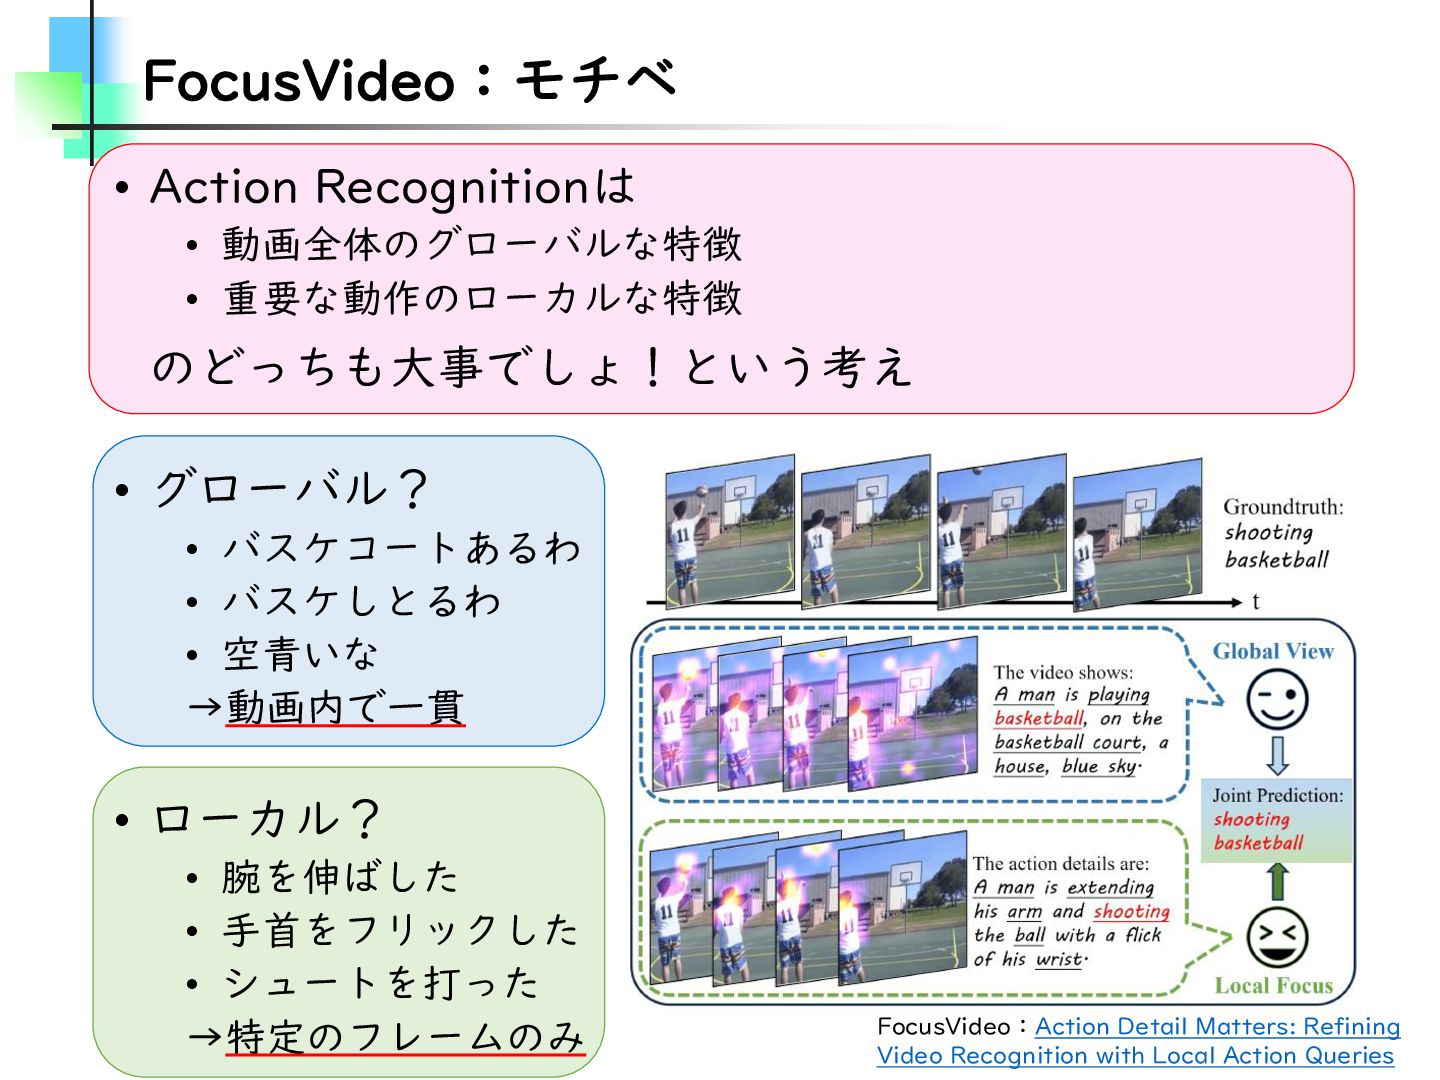
• Action Recognitionは • 動画全体のグローバルな特徴 • 重要な動作のローカルな特徴 • グローバル? •
バスケコートあるわ • バスケしとるわ • 空青いな →動画内で一貫 • ローカル? • 腕を伸ばした • 手首をフリックした • シュートを打った →特定のフレームのみ FocusVideo:モチベ のどっちも大事でしょ!という考え FocusVideo:Action Detail Matters: Refining Video Recognition with Local Action Queries -
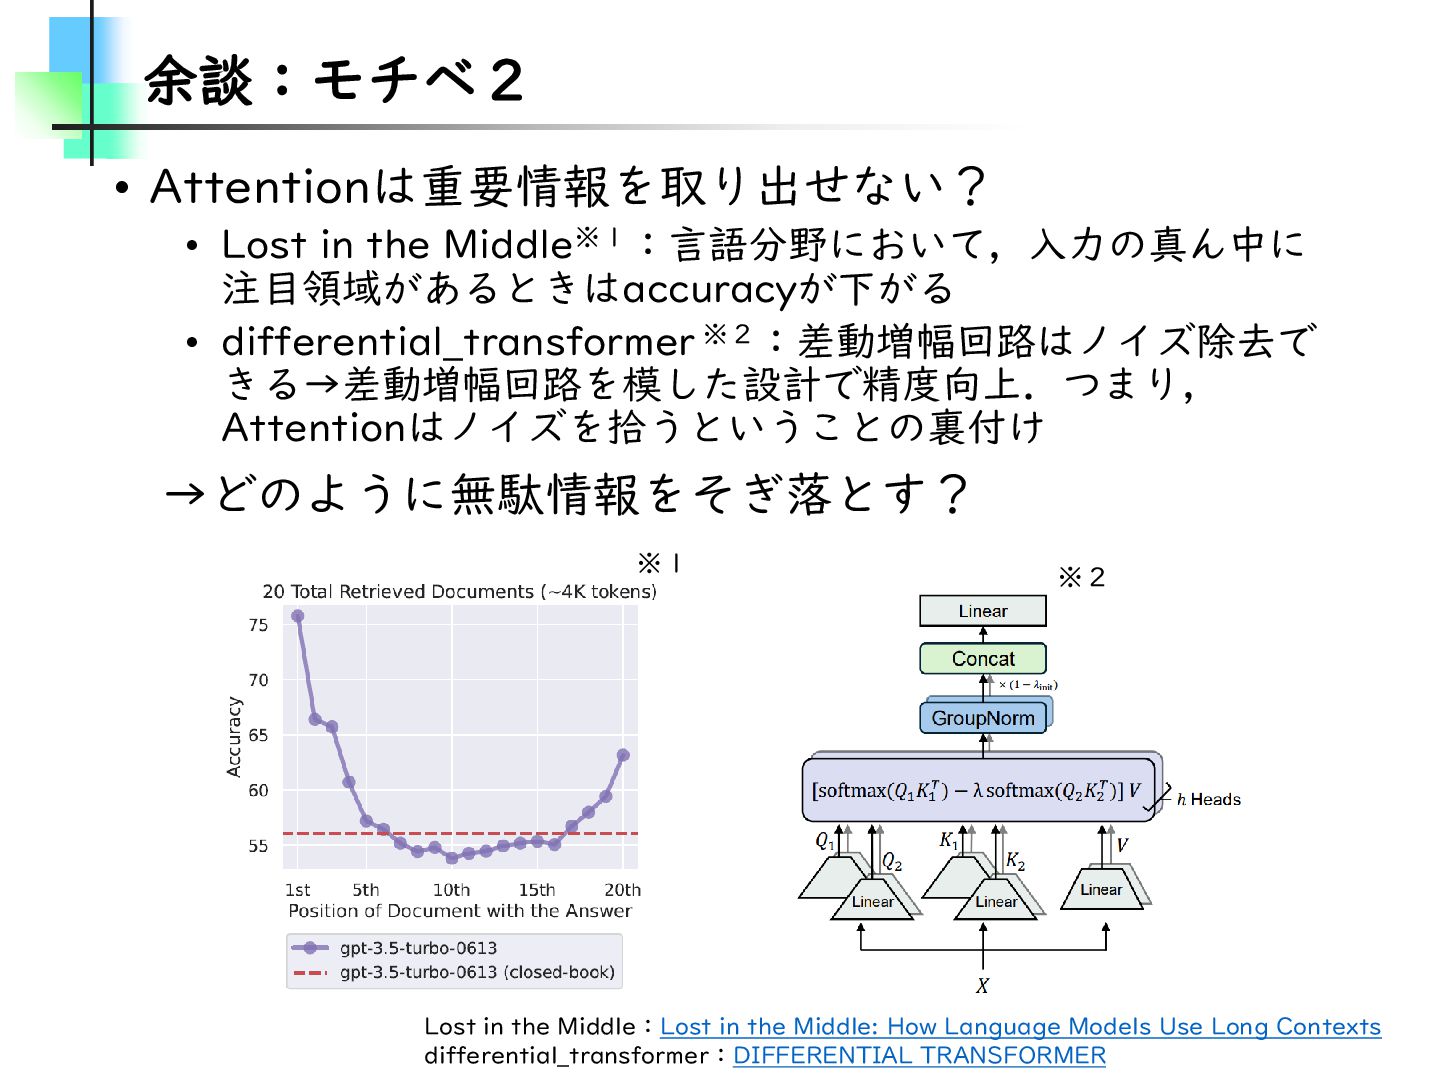
余談:モチベ2 • Attentionは重要情報を取り出せない? • Lost in the Middle※1:言語分野において,入力の真ん中に 注目領域があるときはaccuracyが下がる •
differential_transformer ※2:差動増幅回路はノイズ除去で きる→差動増幅回路を模した設計で精度向上.つまり, Attentionはノイズを拾うということの裏付け →どのように無駄情報をそぎ落とす? Lost in the Middle:Lost in the Middle: How Language Models Use Long Contexts differential_transformer:DIFFERENTIAL TRANSFORMER ※1 ※2 -
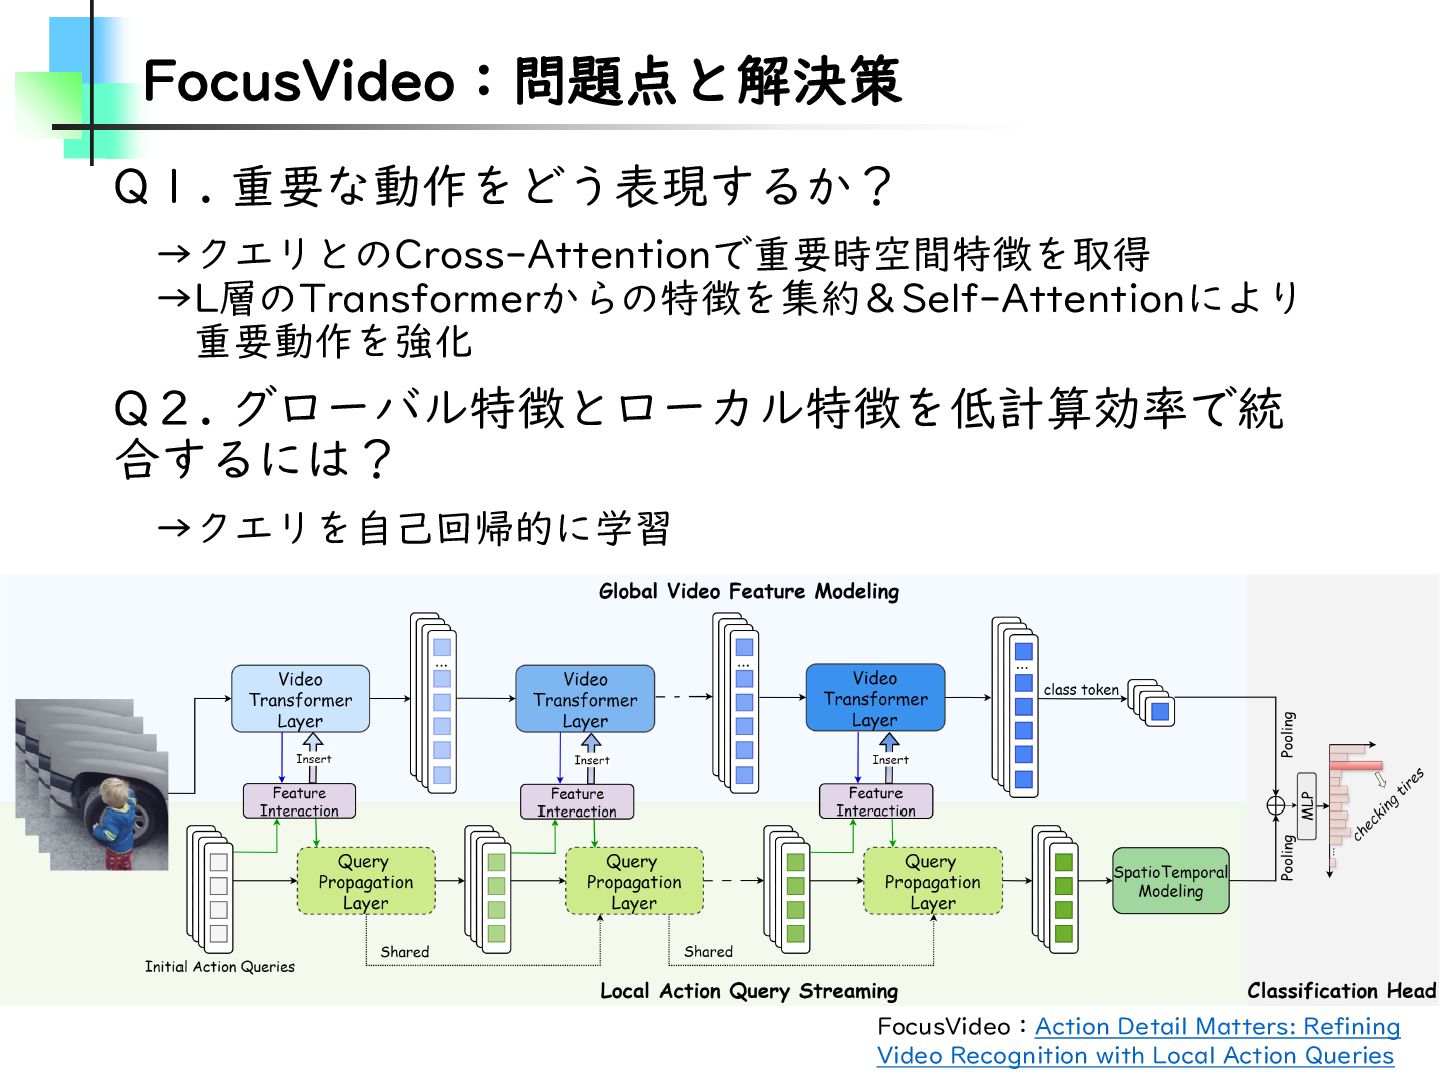
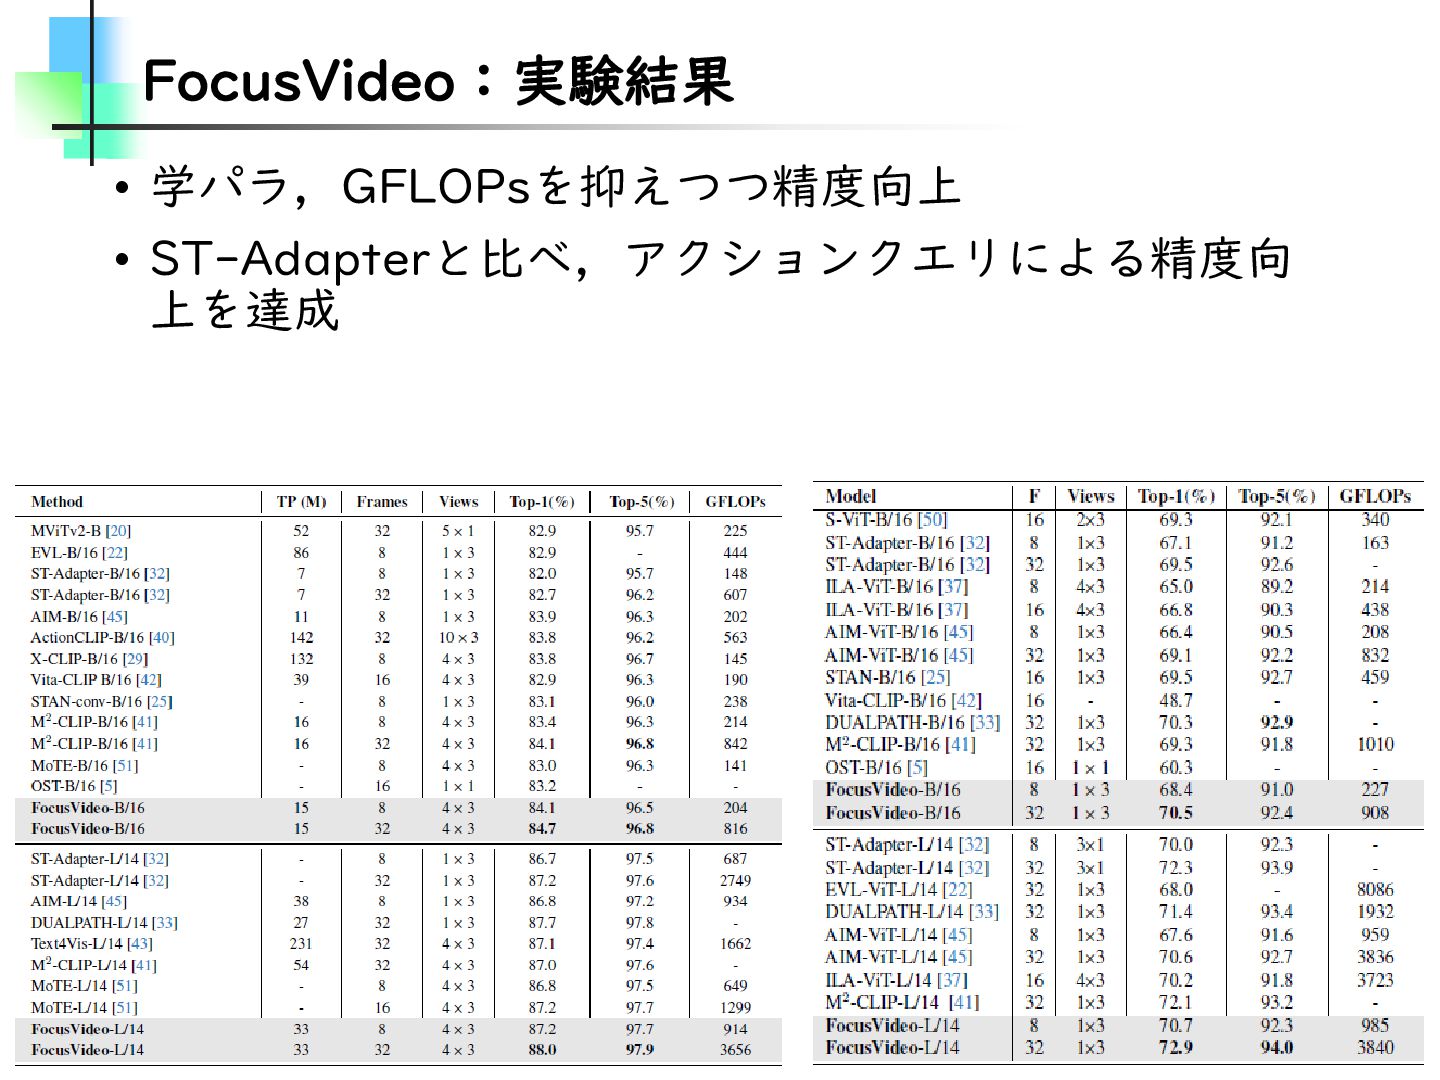
FocusVideo:問題点と解決策 Q1. 重要な動作をどう表現するか? →クエリとのCross-Attentionで重要時空間特徴を取得 →L層のTransformerからの特徴を集約&Self-Attentionにより 重要動作を強化 Q2. グローバル特徴とローカル特徴を低計算効率で統 合するには? →クエリを自己回帰的に学習
FocusVideo:Action Detail Matters: Refining Video Recognition with Local Action Queries -
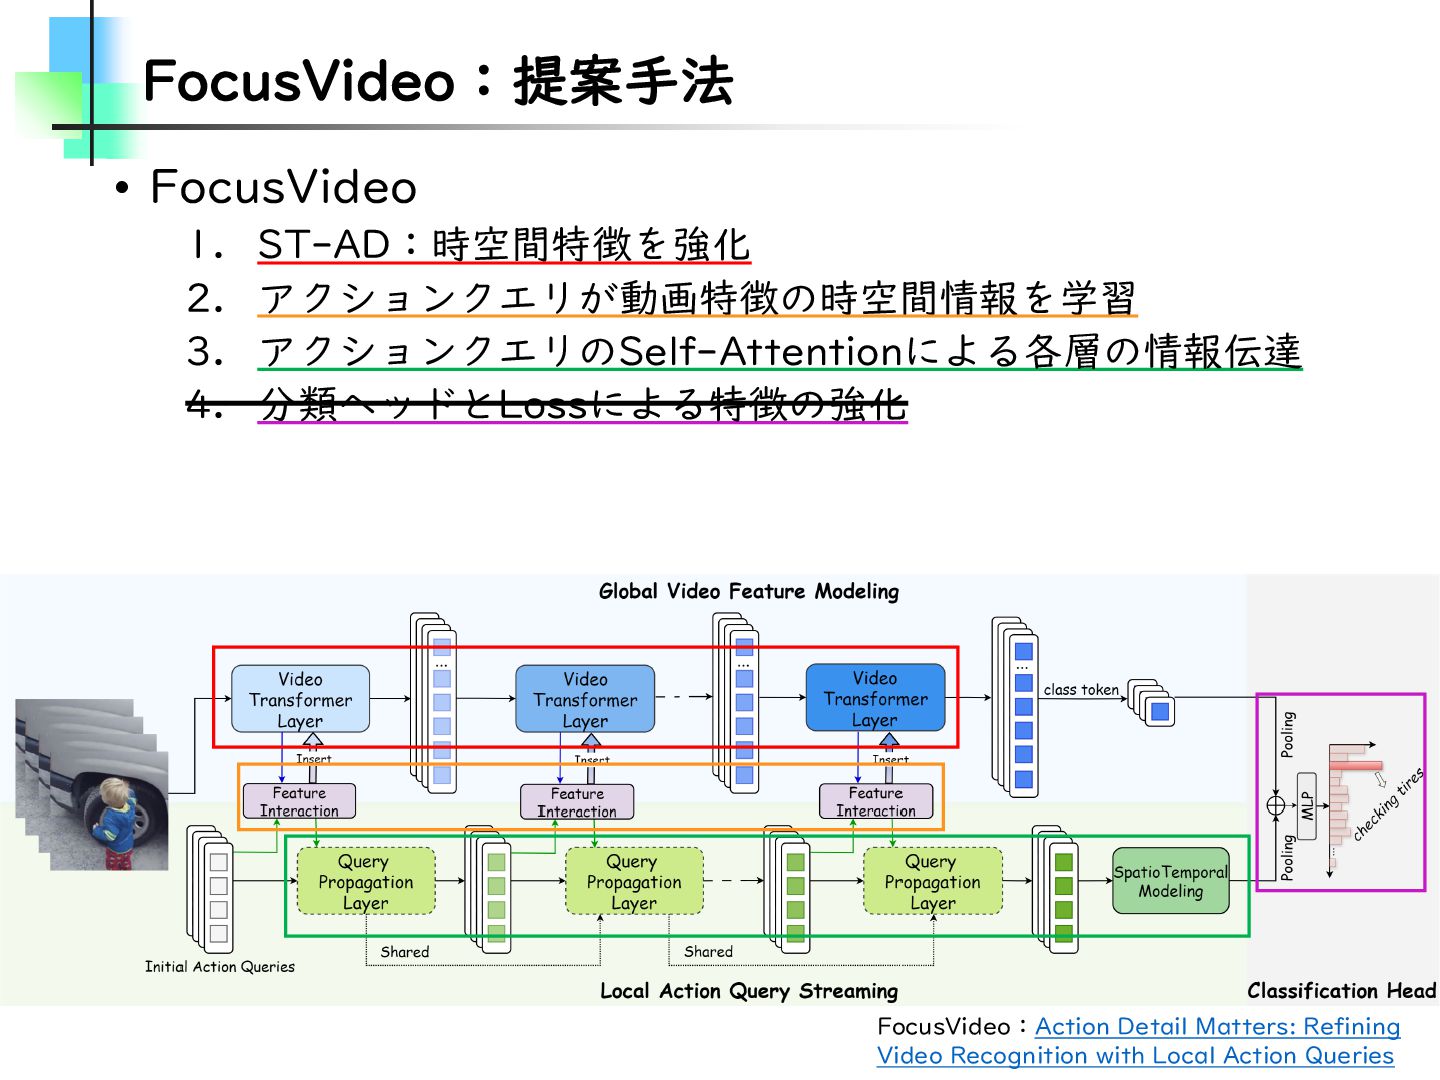
FocusVideo:提案手法 • FocusVideo 1. ST-AD:時空間特徴を強化 2. アクションクエリが動画特徴の時空間情報を学習 3. アクションクエリのSelf-Attentionによる各層の情報伝達 4.
分類ヘッドとLossによる特徴の強化 FocusVideo:Action Detail Matters: Refining Video Recognition with Local Action Queries -
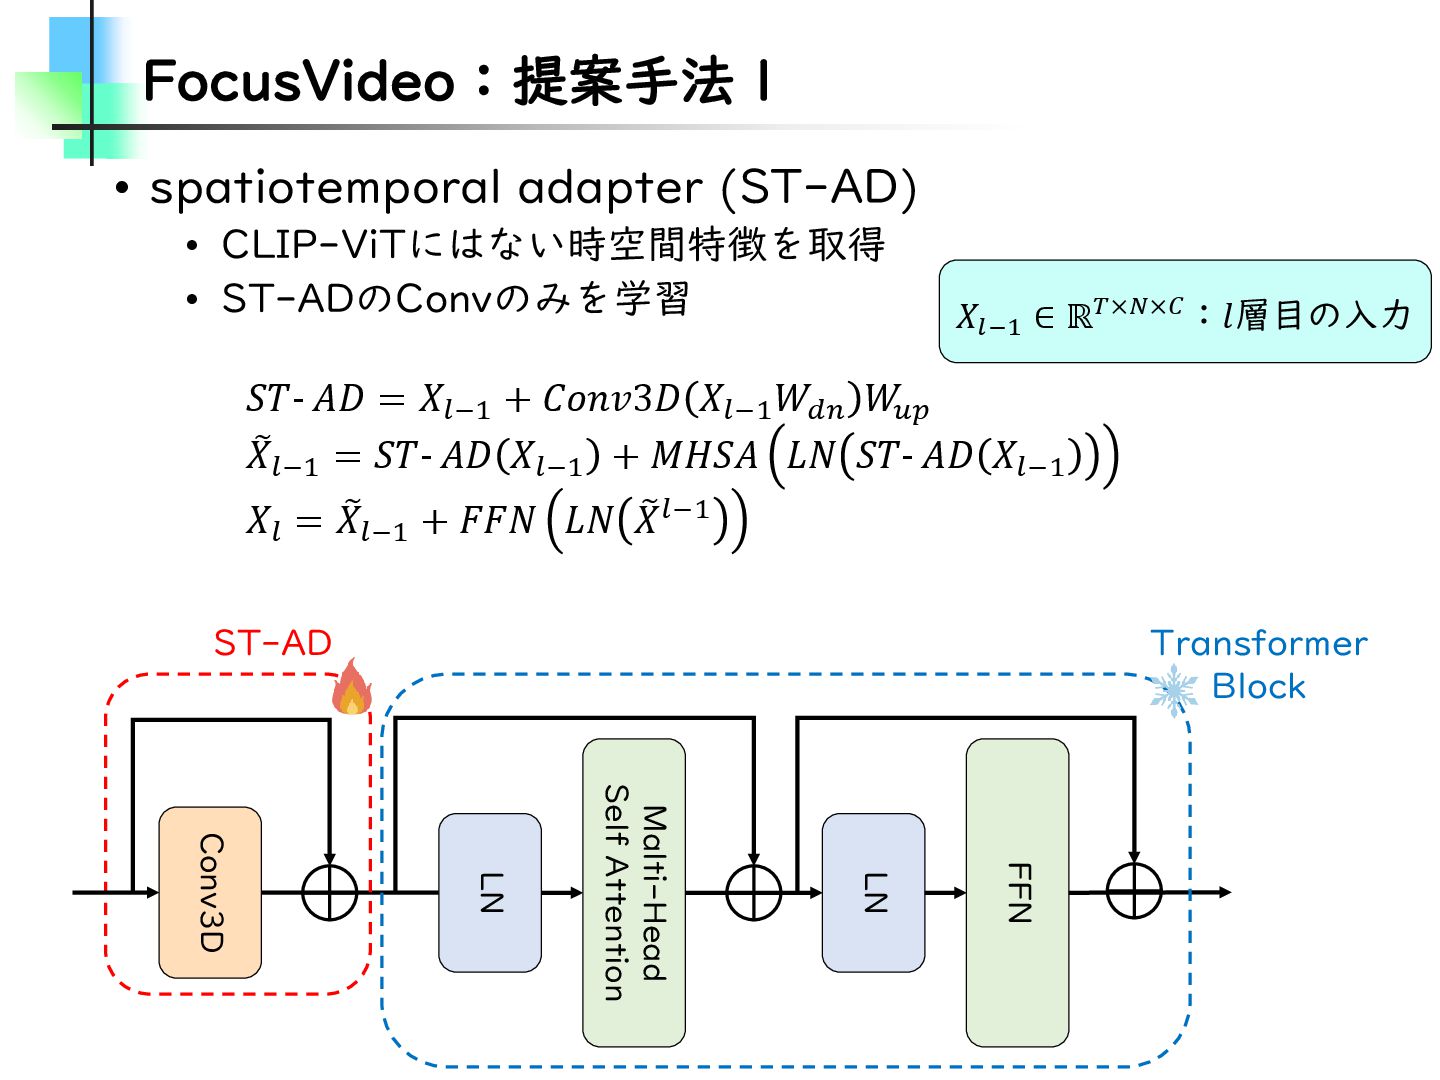
FocusVideo:提案手法1 • spatiotemporal adapter (ST-AD) • CLIP-ViTにはない時空間特徴を取得 • ST-ADのConvのみを学習 𝑆𝑇‐
𝐴𝐷 = 𝑋𝑙−1 + 𝐶𝑜𝑛𝑣3𝐷 𝑋𝑙−1 𝑊𝑑𝑛 𝑊 𝑢𝑝 ෨ 𝑋𝑙−1 = 𝑆𝑇‐ 𝐴𝐷 𝑋𝑙−1 + 𝑀𝐻𝑆𝐴 𝐿𝑁 𝑆𝑇‐ 𝐴𝐷 𝑋𝑙−1 𝑋𝑙 = ෨ 𝑋𝑙−1 + 𝐹𝐹𝑁 𝐿𝑁 ෨ 𝑋𝑙−1 Malti-Head Self Attention LN FFN LN Conv3D ST-AD Transformer Block 𝑋𝑙−1 ∈ ℝ𝑇×𝑁×𝐶:𝑙層目の入力 -
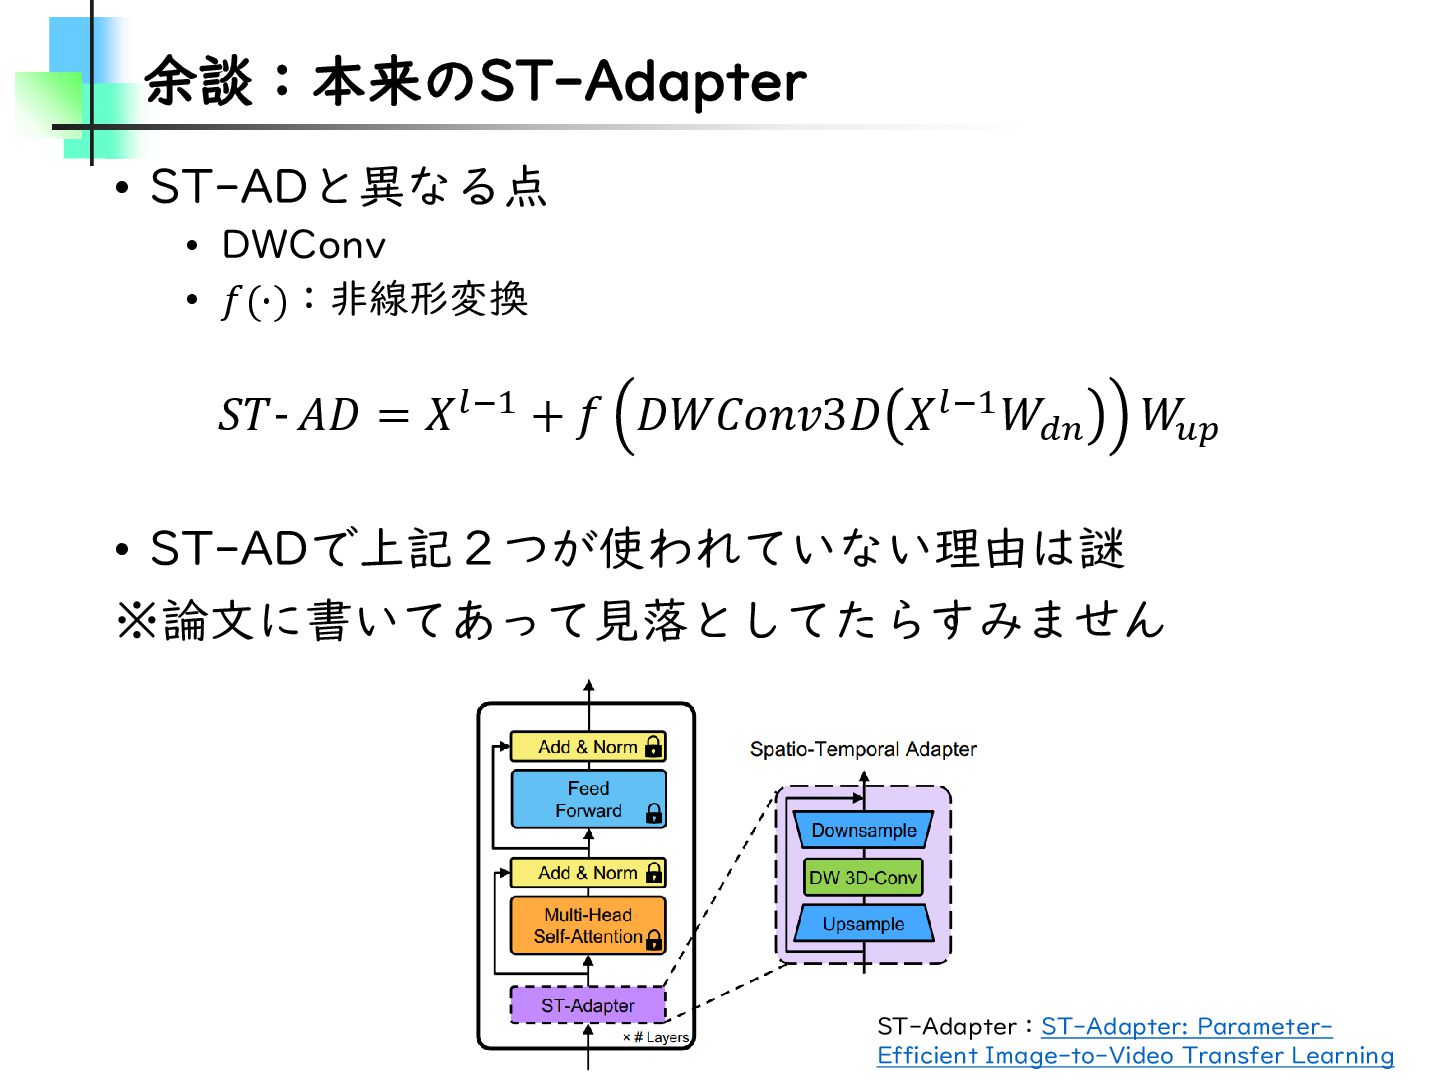
余談:本来のST-Adapter • ST-ADと異なる点 • DWConv • 𝑓(∙):非線形変換 𝑆𝑇‐ 𝐴𝐷 =
𝑋𝑙−1 + 𝑓 𝐷𝑊𝐶𝑜𝑛𝑣3𝐷 𝑋𝑙−1𝑊𝑑𝑛 𝑊 𝑢𝑝 • ST-ADで上記2つが使われていない理由は謎 ※論文に書いてあって見落としてたらすみません ST-Adapter:ST-Adapter: Parameter- Efficient Image-to-Video Transfer Learning -
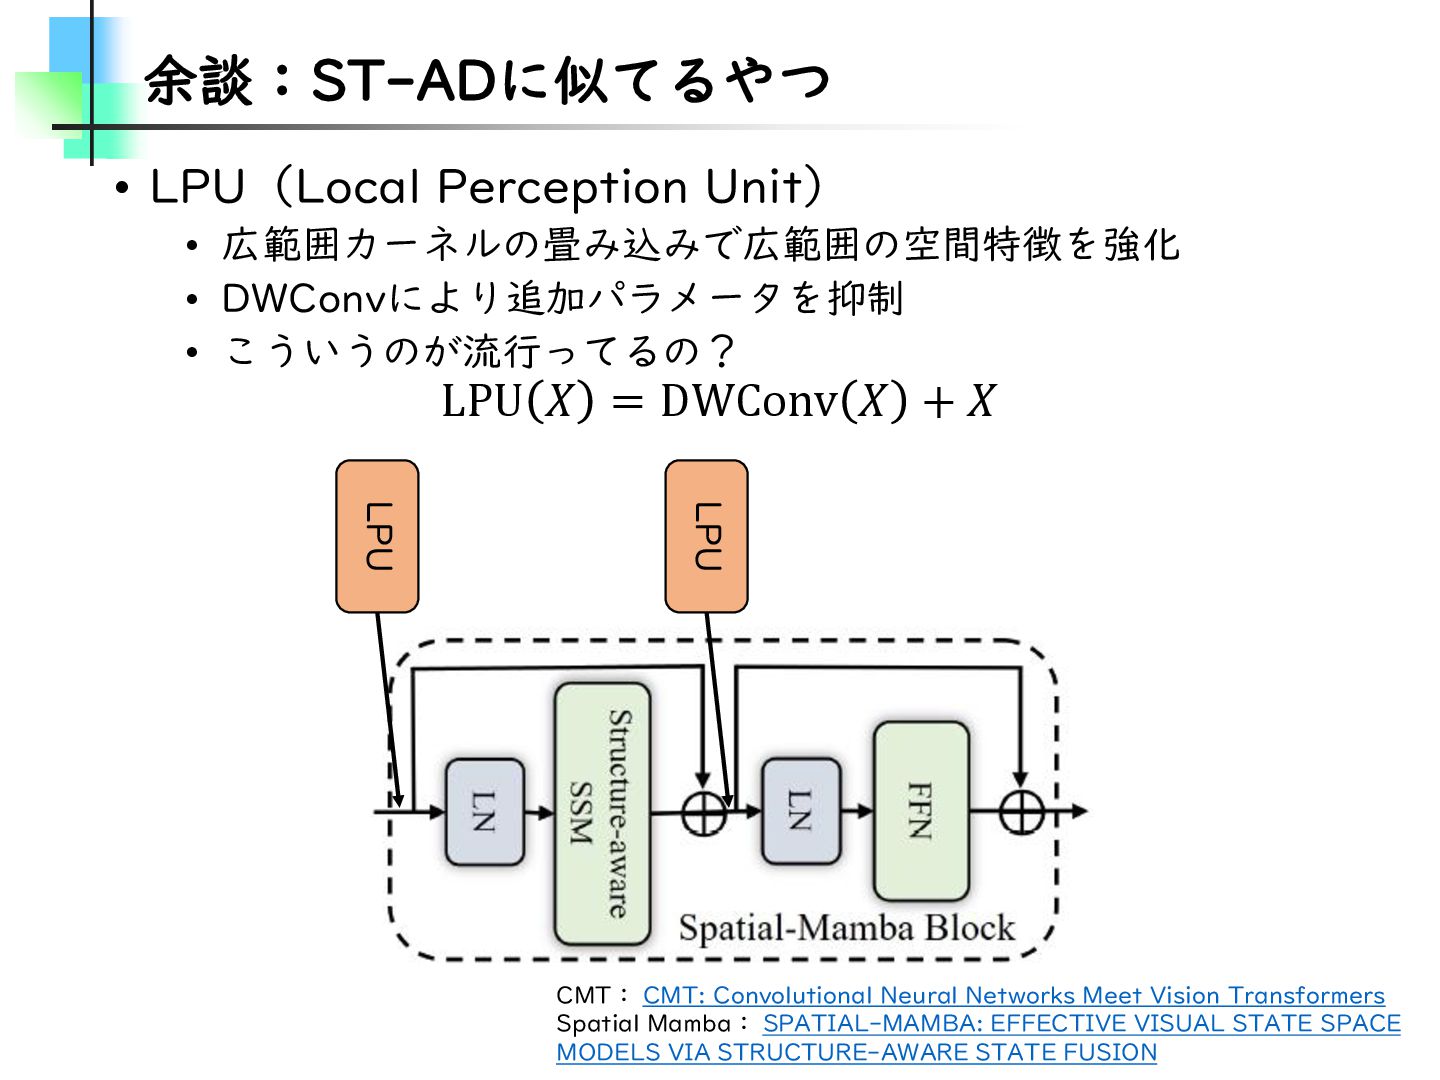
余談:ST-ADに似てるやつ • LPU(Local Perception Unit) • 広範囲カーネルの畳み込みで広範囲の空間特徴を強化 • DWConvにより追加パラメータを抑制 •
こういうのが流行ってるの? LPU 𝑋 = DWConv 𝑋 + 𝑋 LPU LPU CMT: CMT: Convolutional Neural Networks Meet Vision Transformers Spatial Mamba: SPATIAL-MAMBA: EFFECTIVE VISUAL STATE SPACE MODELS VIA STRUCTURE-AWARE STATE FUSION -
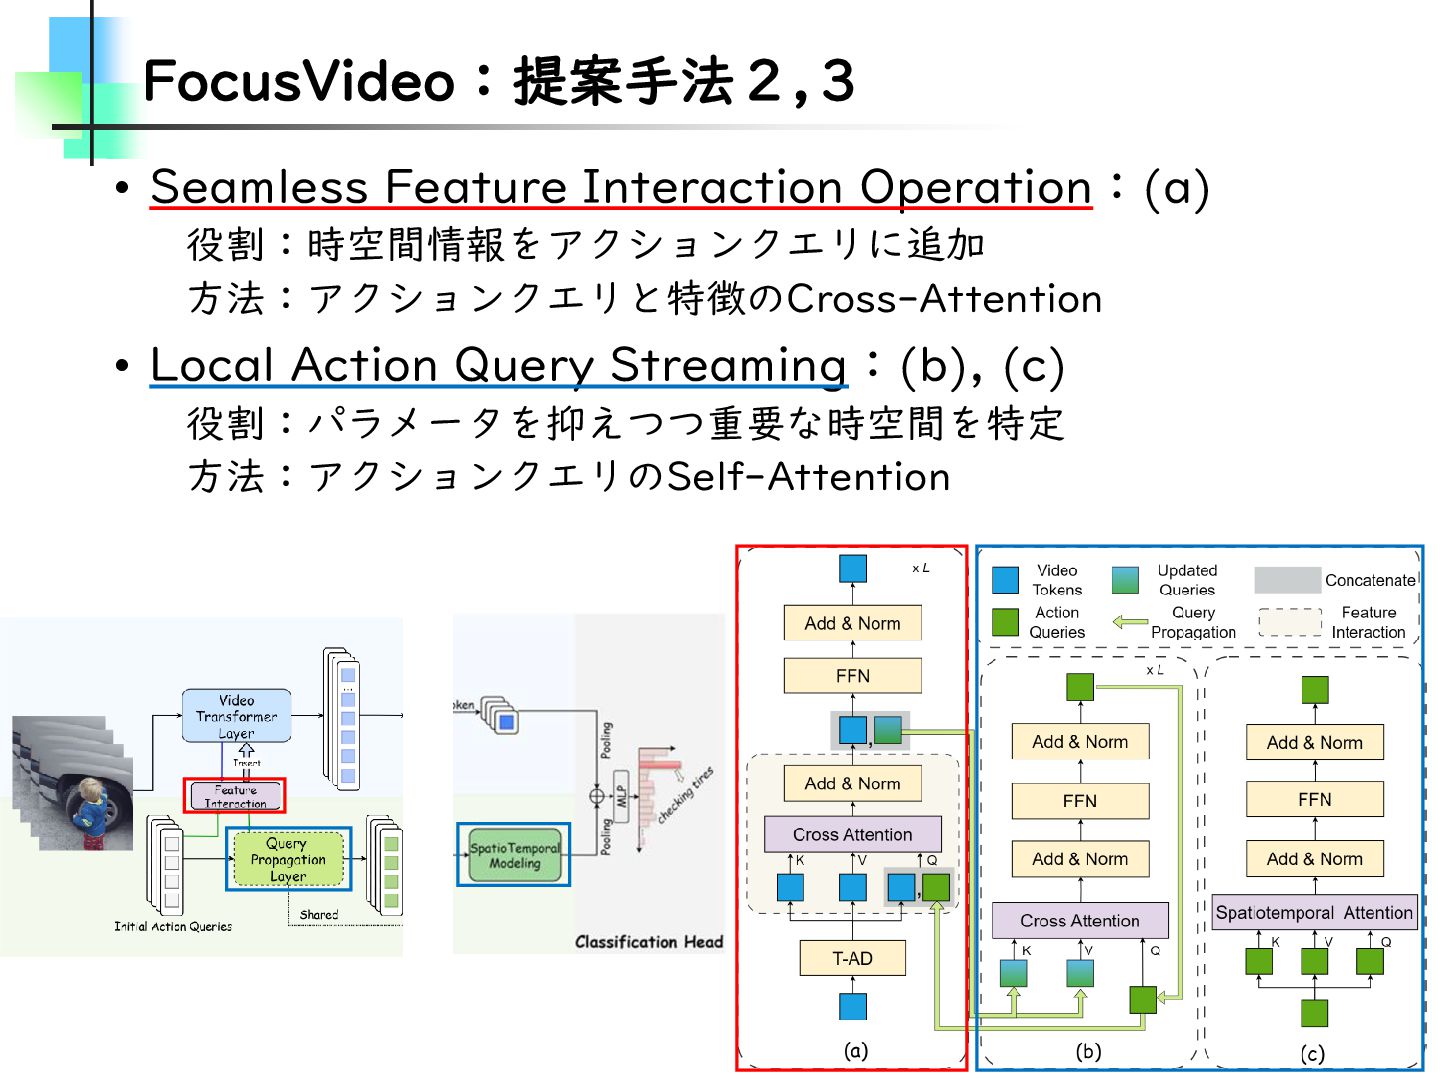
FocusVideo:提案手法2,3 • Seamless Feature Interaction Operation:(a) 役割:時空間情報をアクションクエリに追加 方法:アクションクエリと特徴のCross-Attention • Local
Action Query Streaming:(b), (c) 役割:パラメータを抑えつつ重要な時空間を特定 方法:アクションクエリのSelf-Attention -
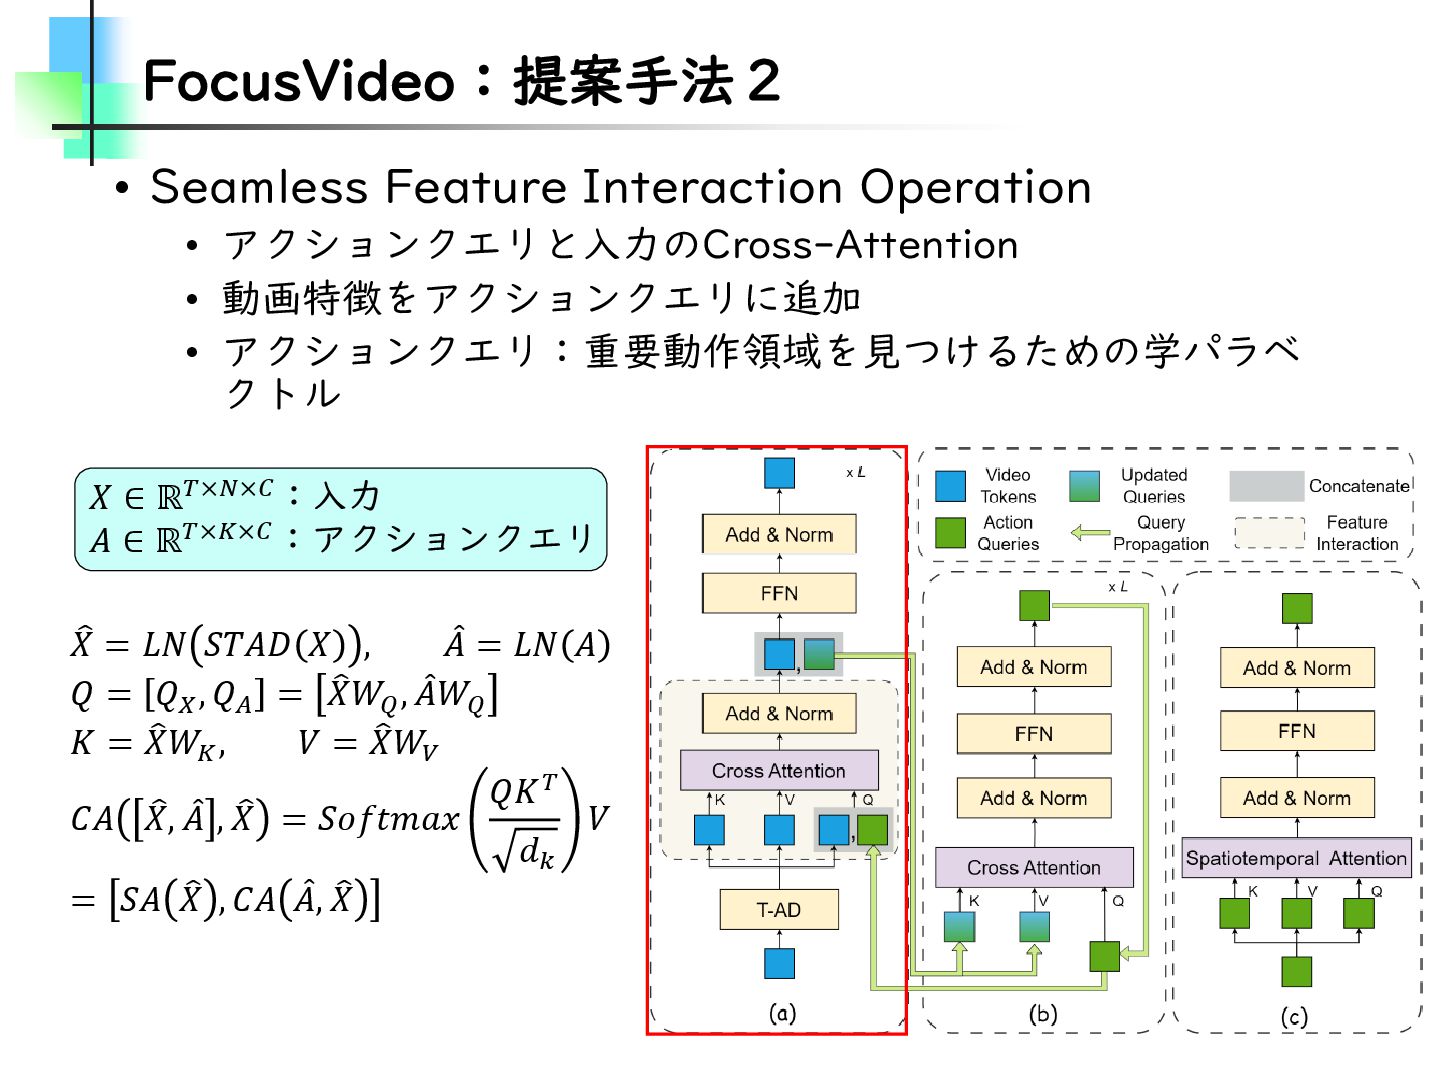
FocusVideo:提案手法2 • Seamless Feature Interaction Operation • アクションクエリと入力のCross-Attention • 動画特徴をアクションクエリに追加
• アクションクエリ:重要動作領域を見つけるための学パラベ クトル 𝑋 ∈ ℝ𝑇×𝑁×𝐶:入力 𝐴 ∈ ℝ𝑇×𝐾×𝐶:アクションクエリ 𝑋 = 𝐿𝑁 𝑆𝑇𝐴𝐷 𝑋 , መ 𝐴 = 𝐿𝑁 𝐴 𝑄 = 𝑄𝑋 , 𝑄𝐴 = 𝑋𝑊𝑄 , መ 𝐴𝑊𝑄 𝐾 = 𝑋𝑊𝐾 , 𝑉 = 𝑋𝑊𝑉 𝐶𝐴 𝑋, መ 𝐴 , 𝑋 = 𝑆𝑜𝑓𝑡𝑚𝑎𝑥 𝑄𝐾𝑇 𝑑𝑘 𝑉 = 𝑆𝐴 𝑋 , 𝐶𝐴 መ 𝐴, 𝑋 -
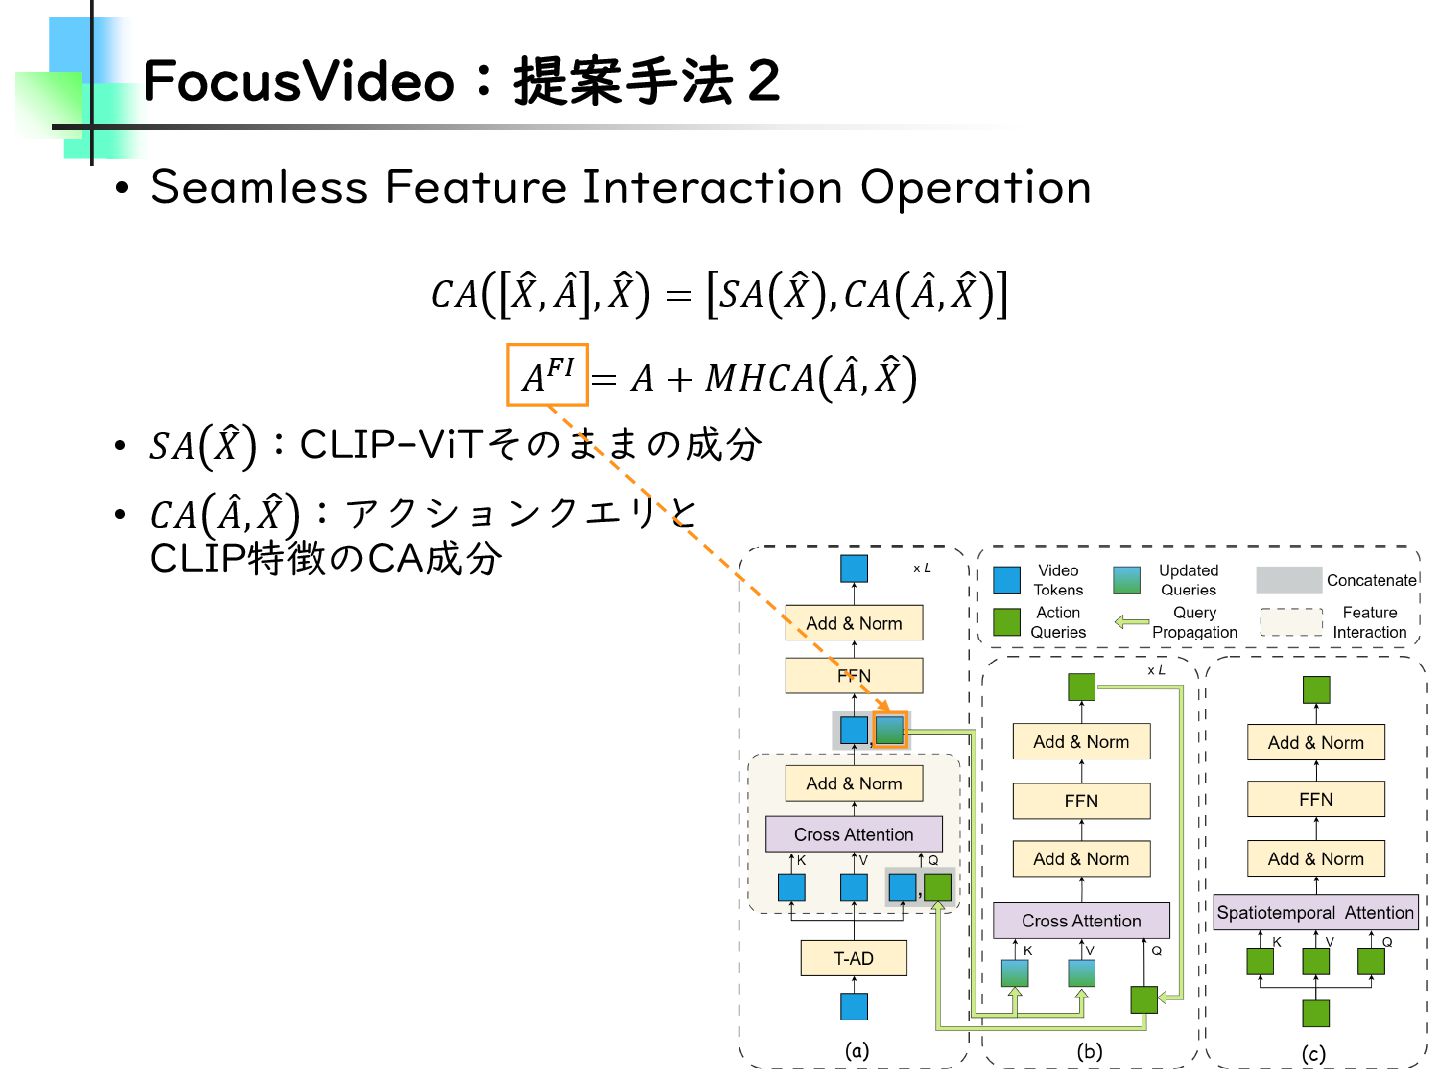
FocusVideo:提案手法2 • Seamless Feature Interaction Operation 𝐶𝐴 𝑋, መ
𝐴 , 𝑋 = 𝑆𝐴 𝑋 , 𝐶𝐴 መ 𝐴, 𝑋 𝐴𝐹𝐼 = 𝐴 + 𝑀𝐻𝐶𝐴 መ 𝐴, 𝑋 • 𝑆𝐴 𝑋 :CLIP-ViTそのままの成分 • 𝐶𝐴 መ 𝐴, 𝑋 :アクションクエリと CLIP特徴のCA成分 -
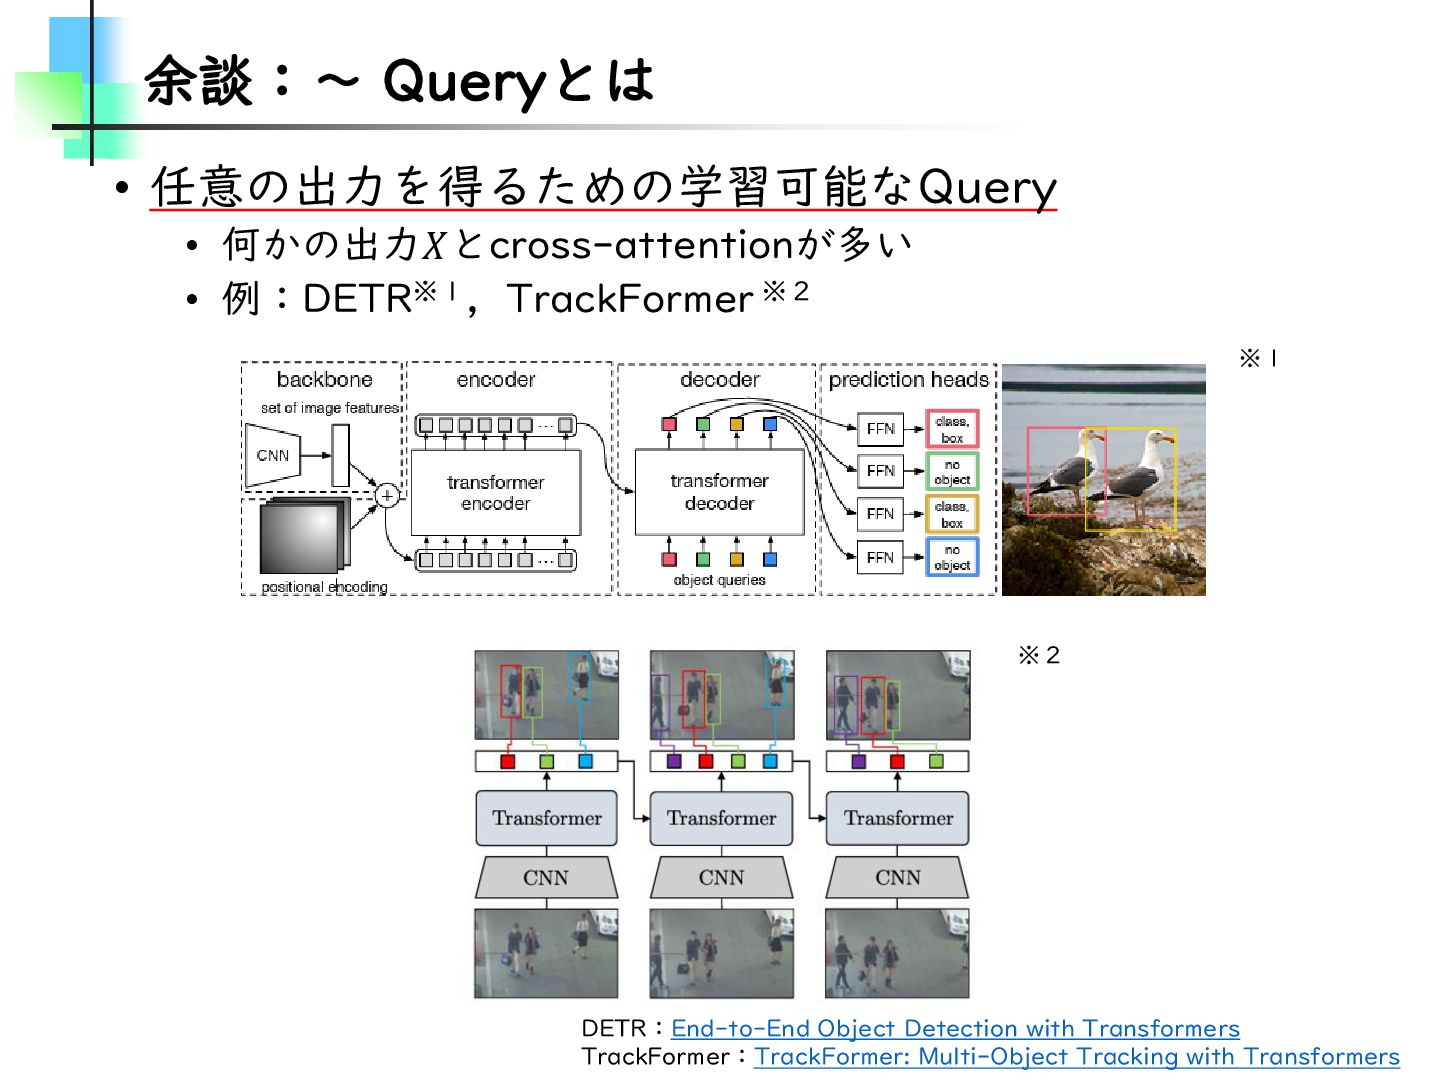
余談:~ Queryとは • 任意の出力を得るための学習可能なQuery • 何かの出力𝑋とcross-attentionが多い • 例:DETR※1,TrackFormer ※2 DETR:End-to-End
Object Detection with Transformers TrackFormer:TrackFormer: Multi-Object Tracking with Transformers ※1 ※2 -
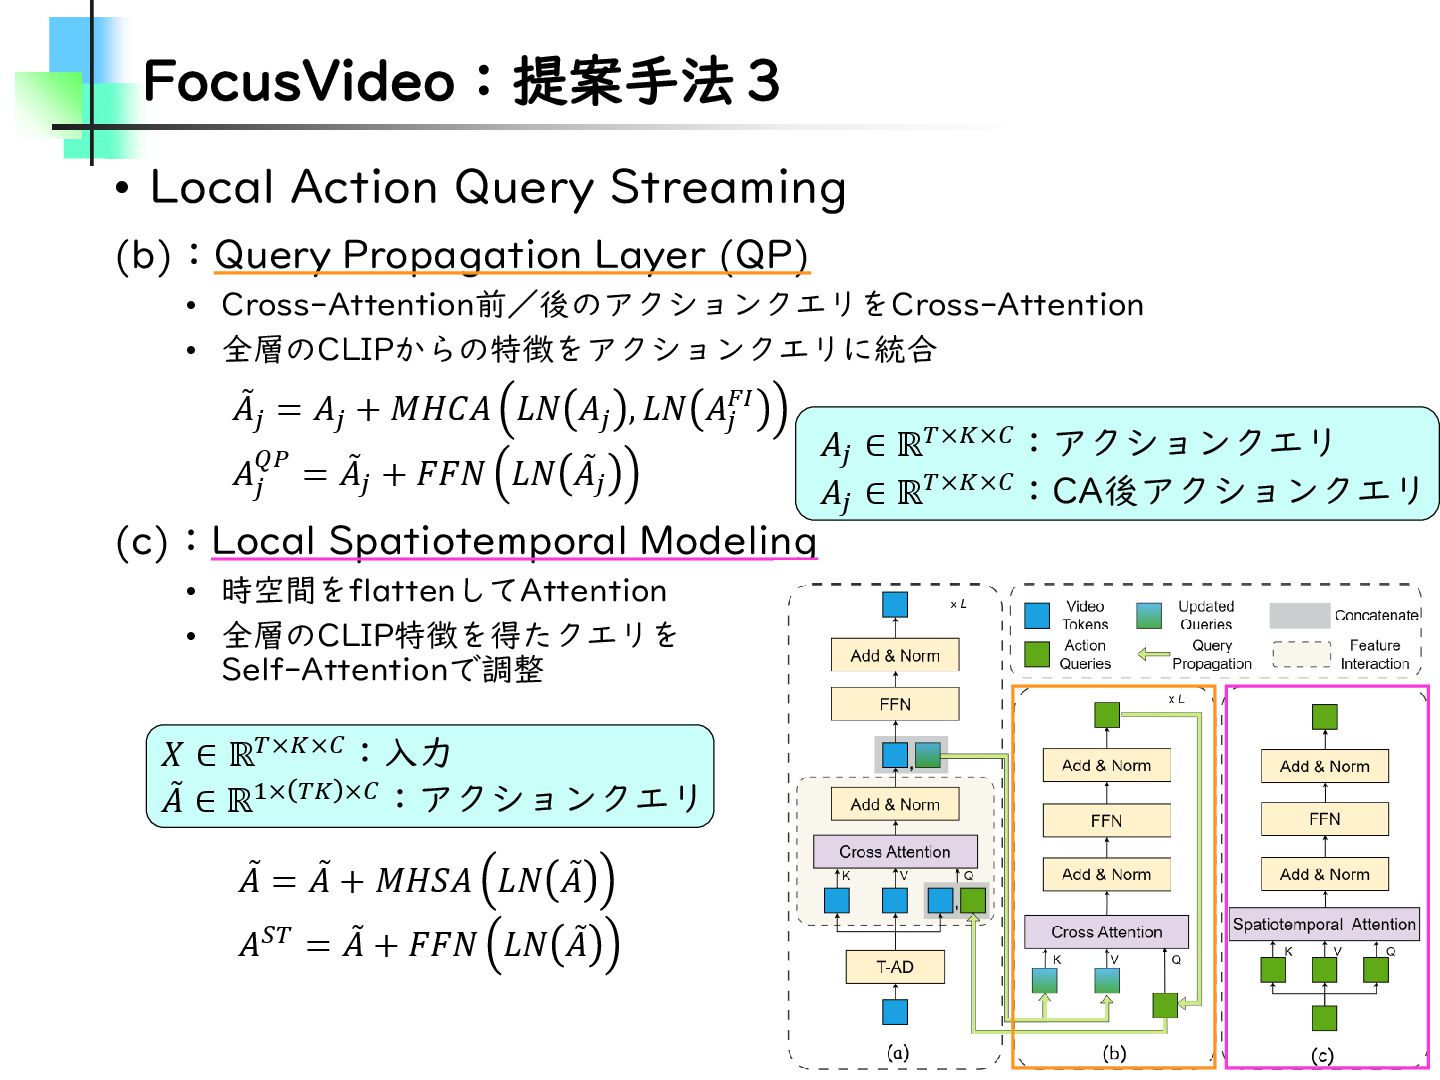
FocusVideo:提案手法3 • Local Action Query Streaming (b):Query Propagation Layer (QP)
• Cross-Attention前/後のアクションクエリをCross-Attention • 全層のCLIPからの特徴をアクションクエリに統合 (c):Local Spatiotemporal Modeling • 時空間をflattenしてAttention • 全層のCLIP特徴を得たクエリを Self-Attentionで調整 ሚ 𝐴 = ሚ 𝐴 + 𝑀𝐻𝑆𝐴 𝐿𝑁 ሚ 𝐴 𝐴𝑆𝑇 = ሚ 𝐴 + 𝐹𝐹𝑁 𝐿𝑁 ሚ 𝐴 𝑋 ∈ ℝ𝑇×𝐾×𝐶:入力 ሚ 𝐴 ∈ ℝ1× 𝑇𝐾 ×𝐶:アクションクエリ 𝐴𝑗 ∈ ℝ𝑇×𝐾×𝐶:アクションクエリ 𝐴𝑗 ∈ ℝ𝑇×𝐾×𝐶:CA後アクションクエリ ሚ 𝐴𝑗 = 𝐴𝑗 + 𝑀𝐻𝐶𝐴 𝐿𝑁 𝐴𝑗 , 𝐿𝑁 𝐴𝑗 𝐹𝐼 𝐴 𝑗 𝑄𝑃 = ሚ 𝐴𝑗 + 𝐹𝐹𝑁 𝐿𝑁 ሚ 𝐴𝑗 -
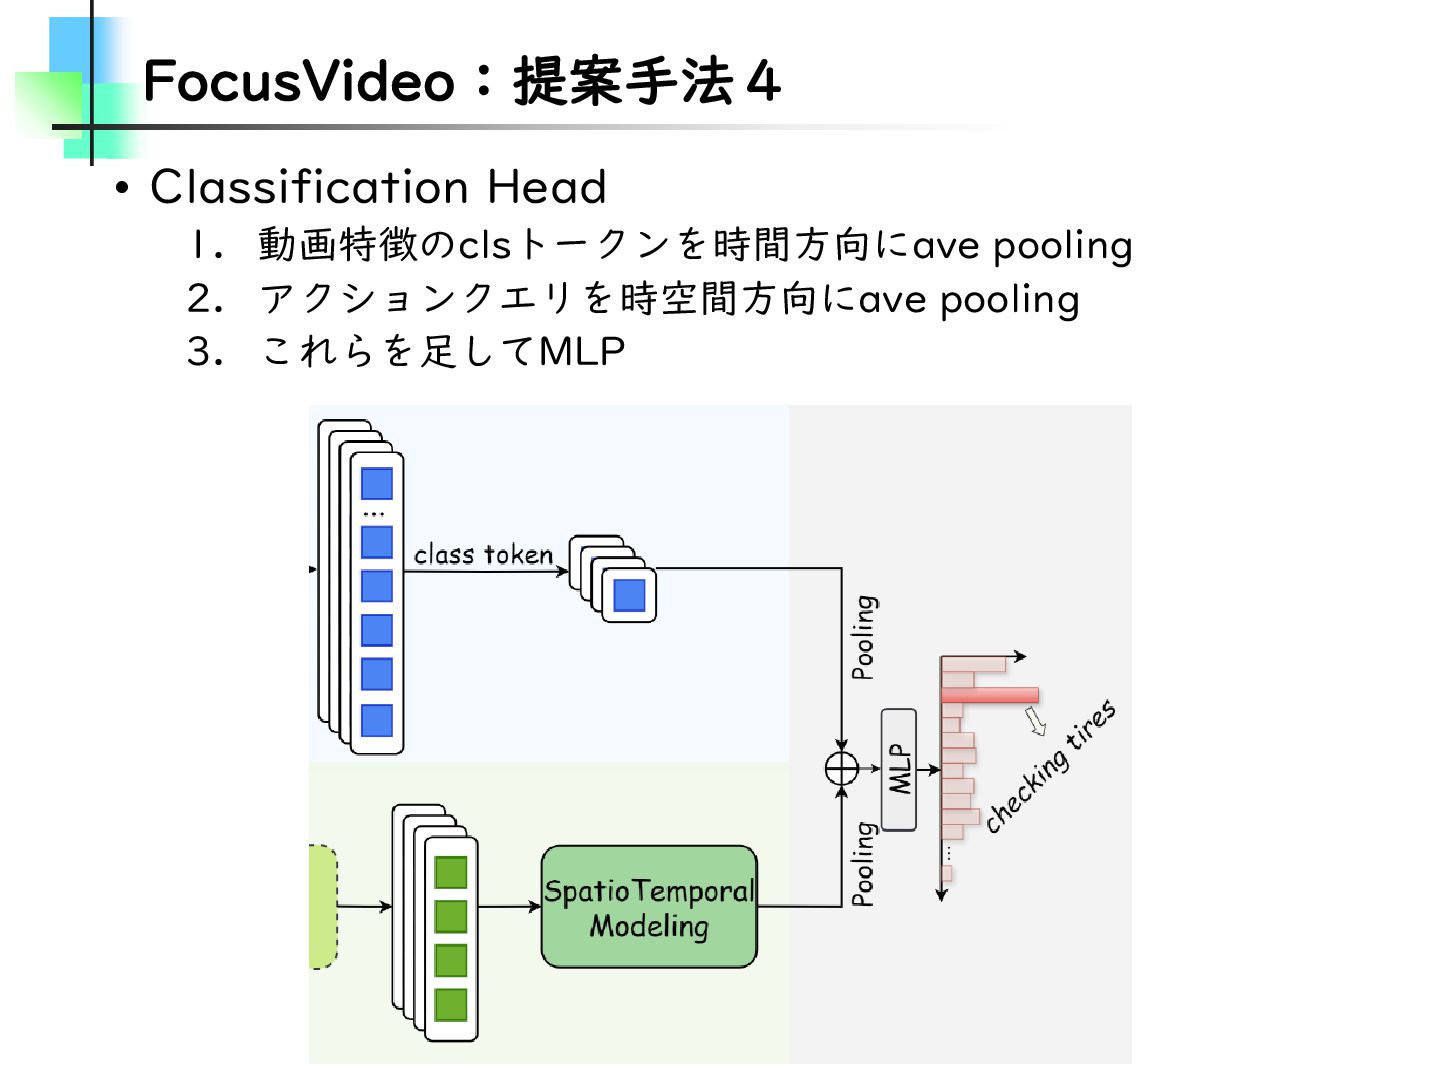
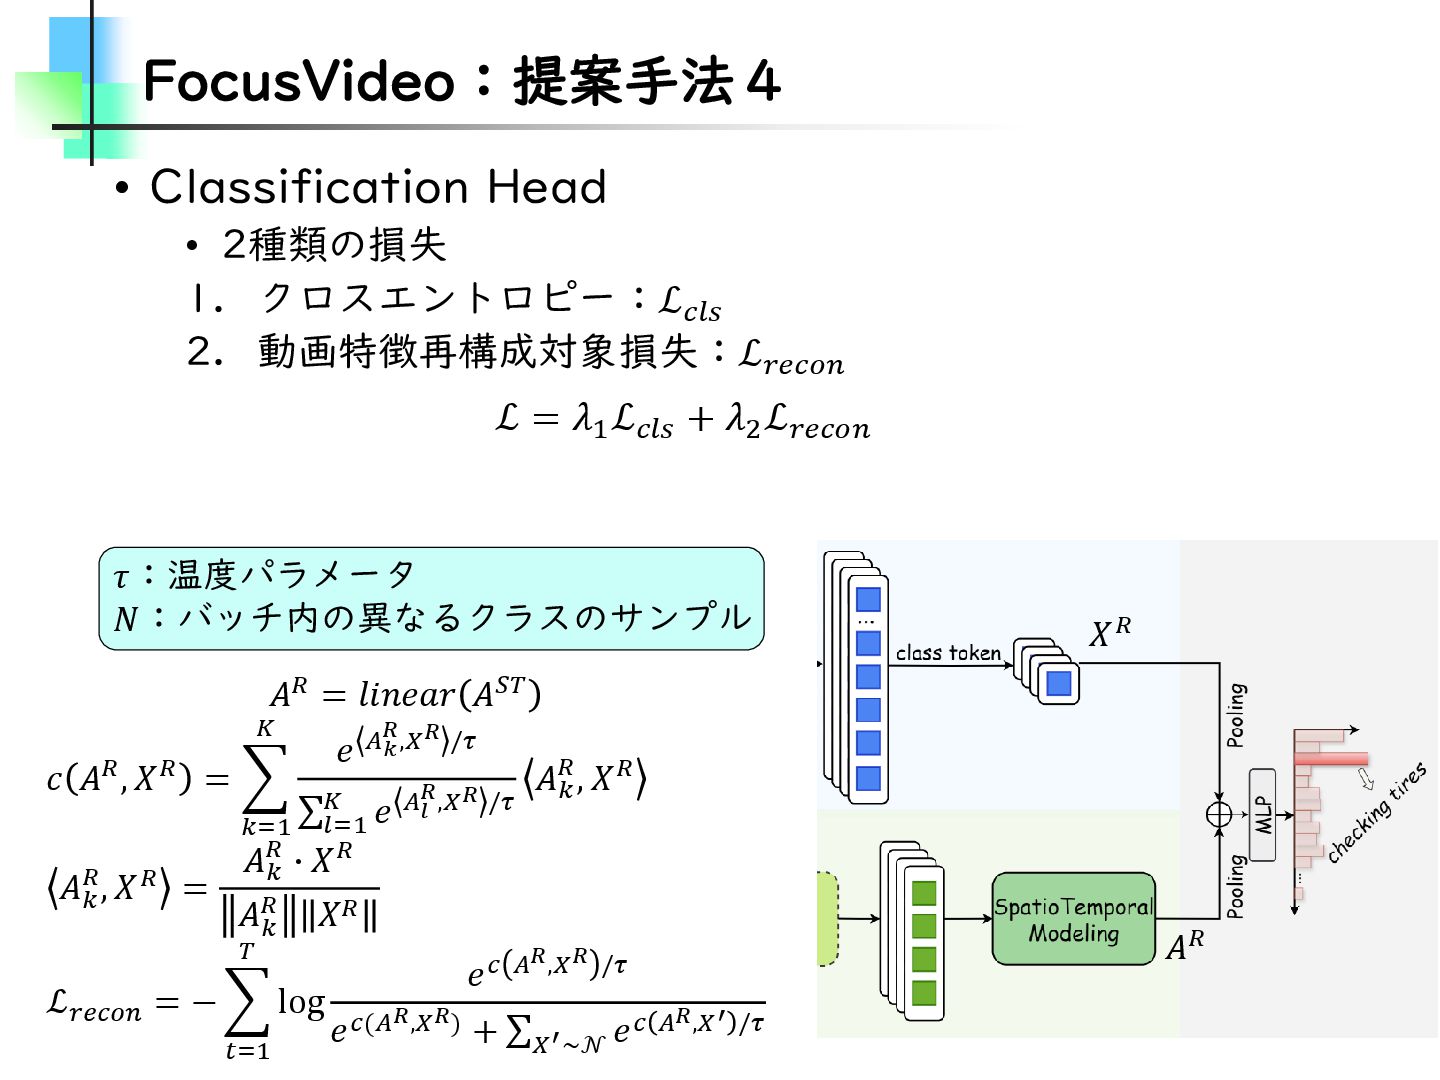
FocusVideo:提案手法4 • Classification Head • 2種類の損失 1. クロスエントロピー:ℒ𝑐𝑙𝑠 2. 動画特徴再構成対象損失:ℒ𝑟𝑒𝑐𝑜𝑛
ℒ = 𝜆1 ℒ𝑐𝑙𝑠 + 𝜆2 ℒ𝑟𝑒𝑐𝑜𝑛 𝐴𝑅 = 𝑙𝑖𝑛𝑒𝑎𝑟 𝐴𝑆𝑇 𝑐 𝐴𝑅, 𝑋𝑅 = 𝑘=1 𝐾 𝑒 𝐴𝑘 𝑅,𝑋𝑅 /𝜏 σ 𝑙=1 𝐾 𝑒 𝐴𝑙 𝑅,𝑋𝑅 /𝜏 𝐴𝑘 𝑅, 𝑋𝑅 𝐴𝑘 𝑅, 𝑋𝑅 = 𝐴𝑘 𝑅 ∙ 𝑋𝑅 𝐴𝑘 𝑅 𝑋𝑅 ℒ𝑟𝑒𝑐𝑜𝑛 = − 𝑡=1 𝑇 log 𝑒𝑐 𝐴𝑅,𝑋𝑅 /𝜏 𝑒𝑐(𝐴𝑅,𝑋𝑅) + σ 𝑋′~𝒩 𝑒𝑐 𝐴𝑅,𝑋′ /𝜏 𝜏:温度パラメータ 𝑁:バッチ内の異なるクラスのサンプル 𝐴𝑅 𝑋𝑅 -
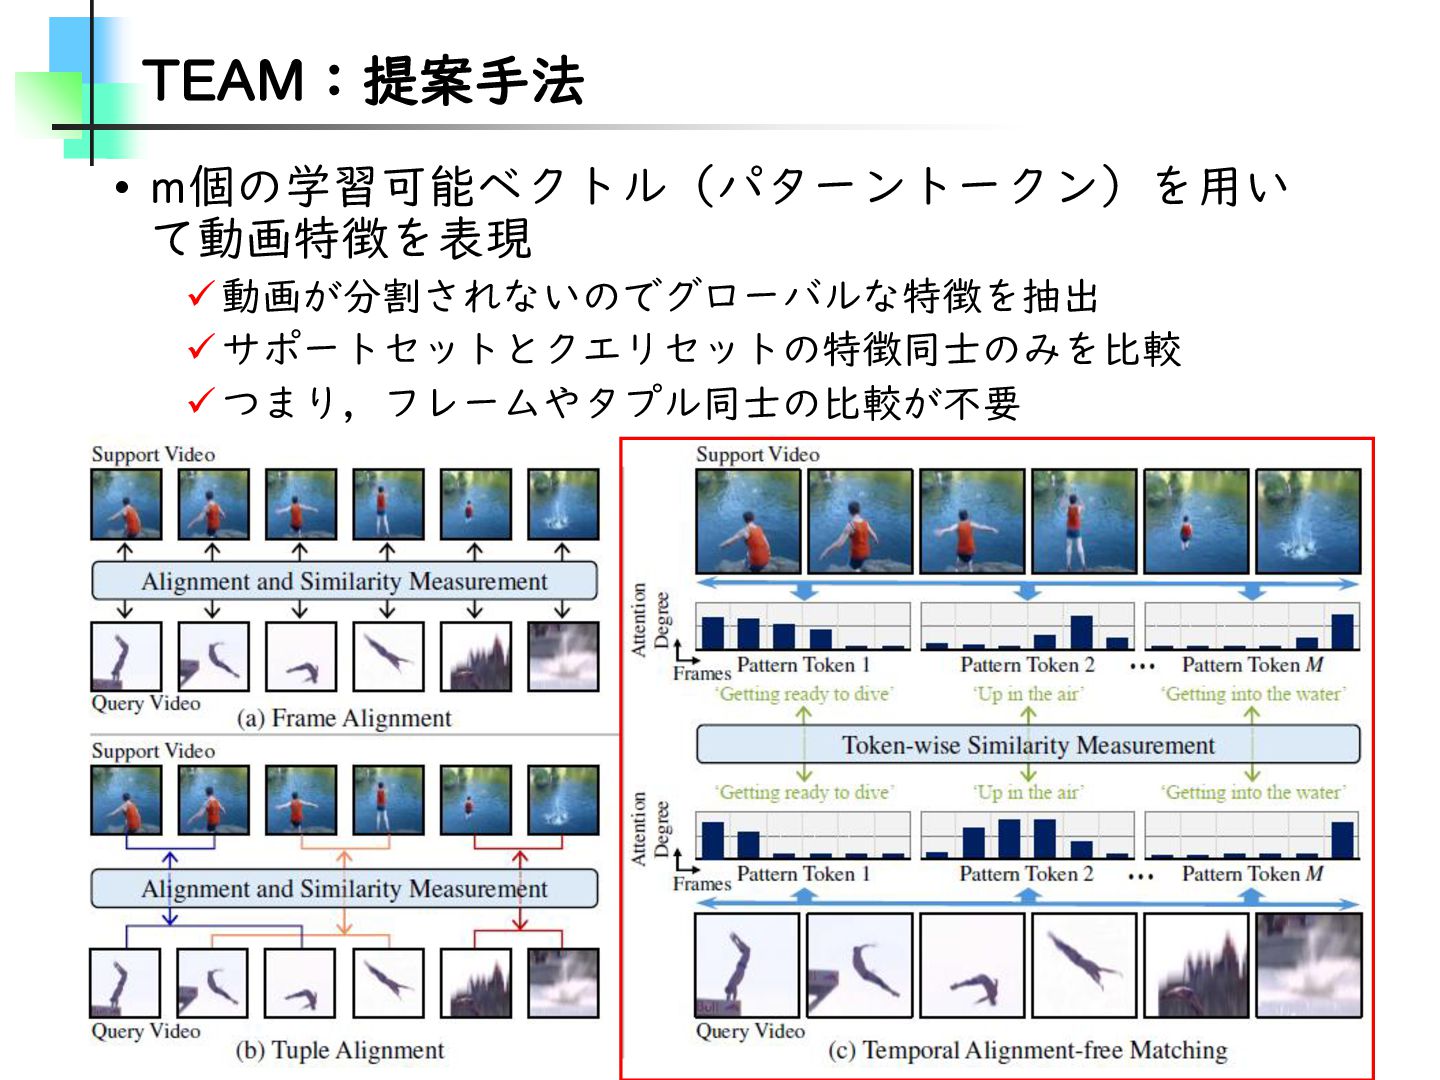
発表分野 • Few-Shot Action Recognition • Temporal Alignment-Free Video Matching
for Few-shot Action Recognition -
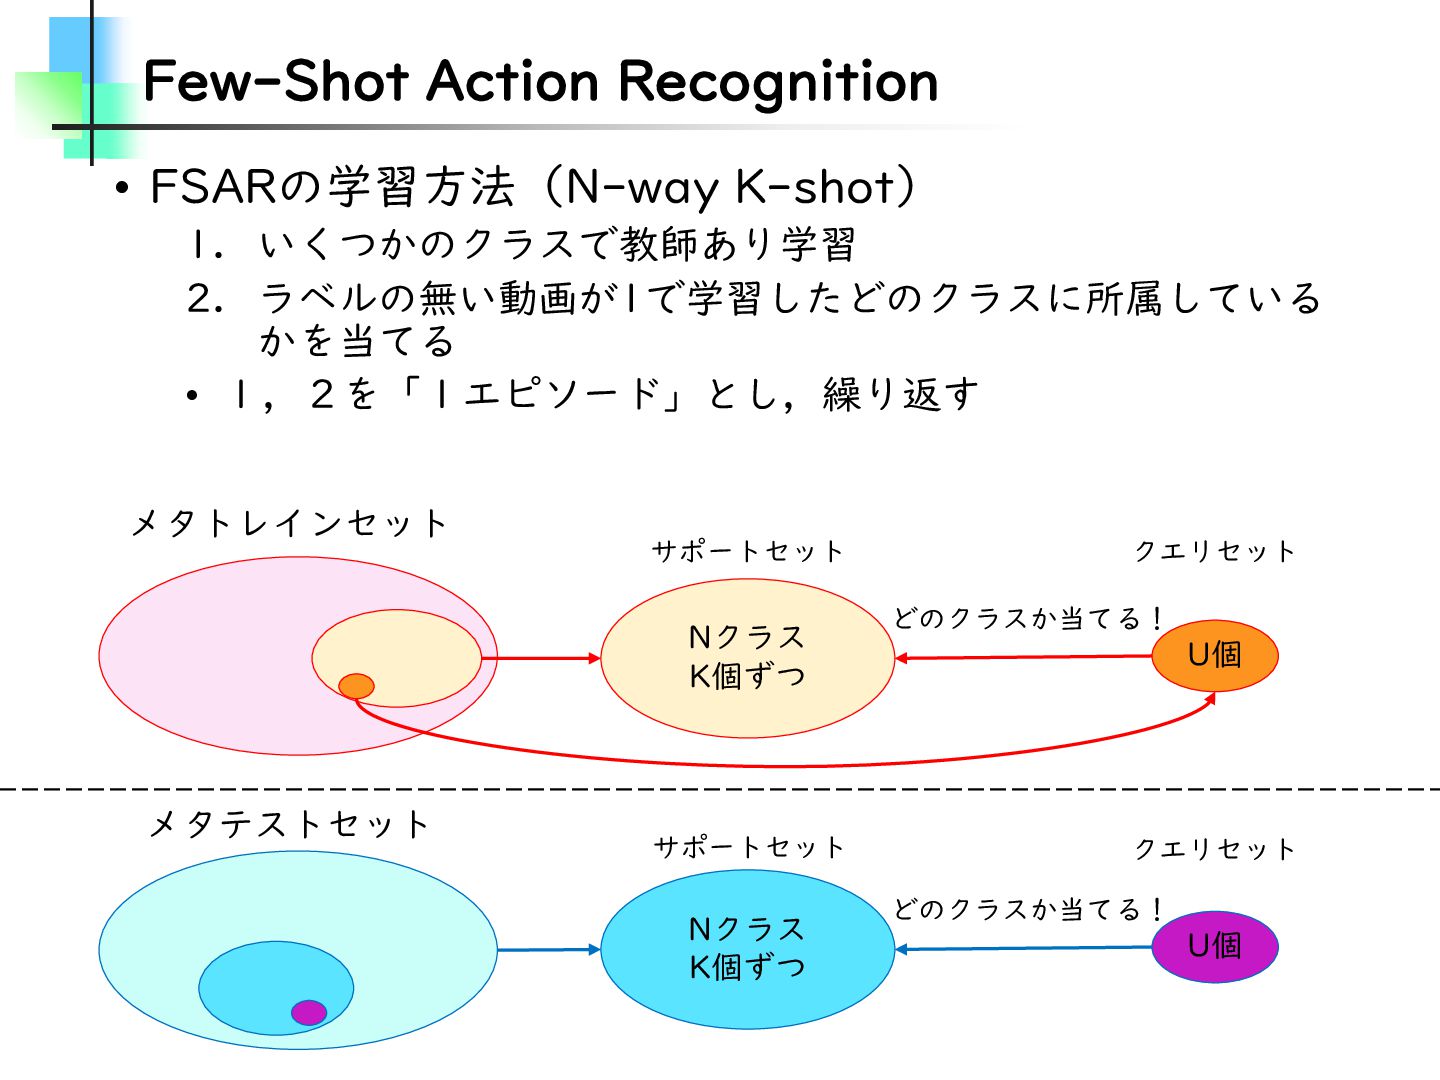
Few-Shot Action Recognition • FSARの学習方法(N-way K-shot) 1. いくつかのクラスで教師あり学習 2. ラベルの無い動画が1で学習したどのクラスに所属している
かを当てる • 1,2を「1エピソード」とし,繰り返す Nクラス K個ずつ U個 どのクラスか当てる! メタトレインセット メタテストセット Nクラス K個ずつ U個 どのクラスか当てる! サポートセット サポートセット クエリセット クエリセット -
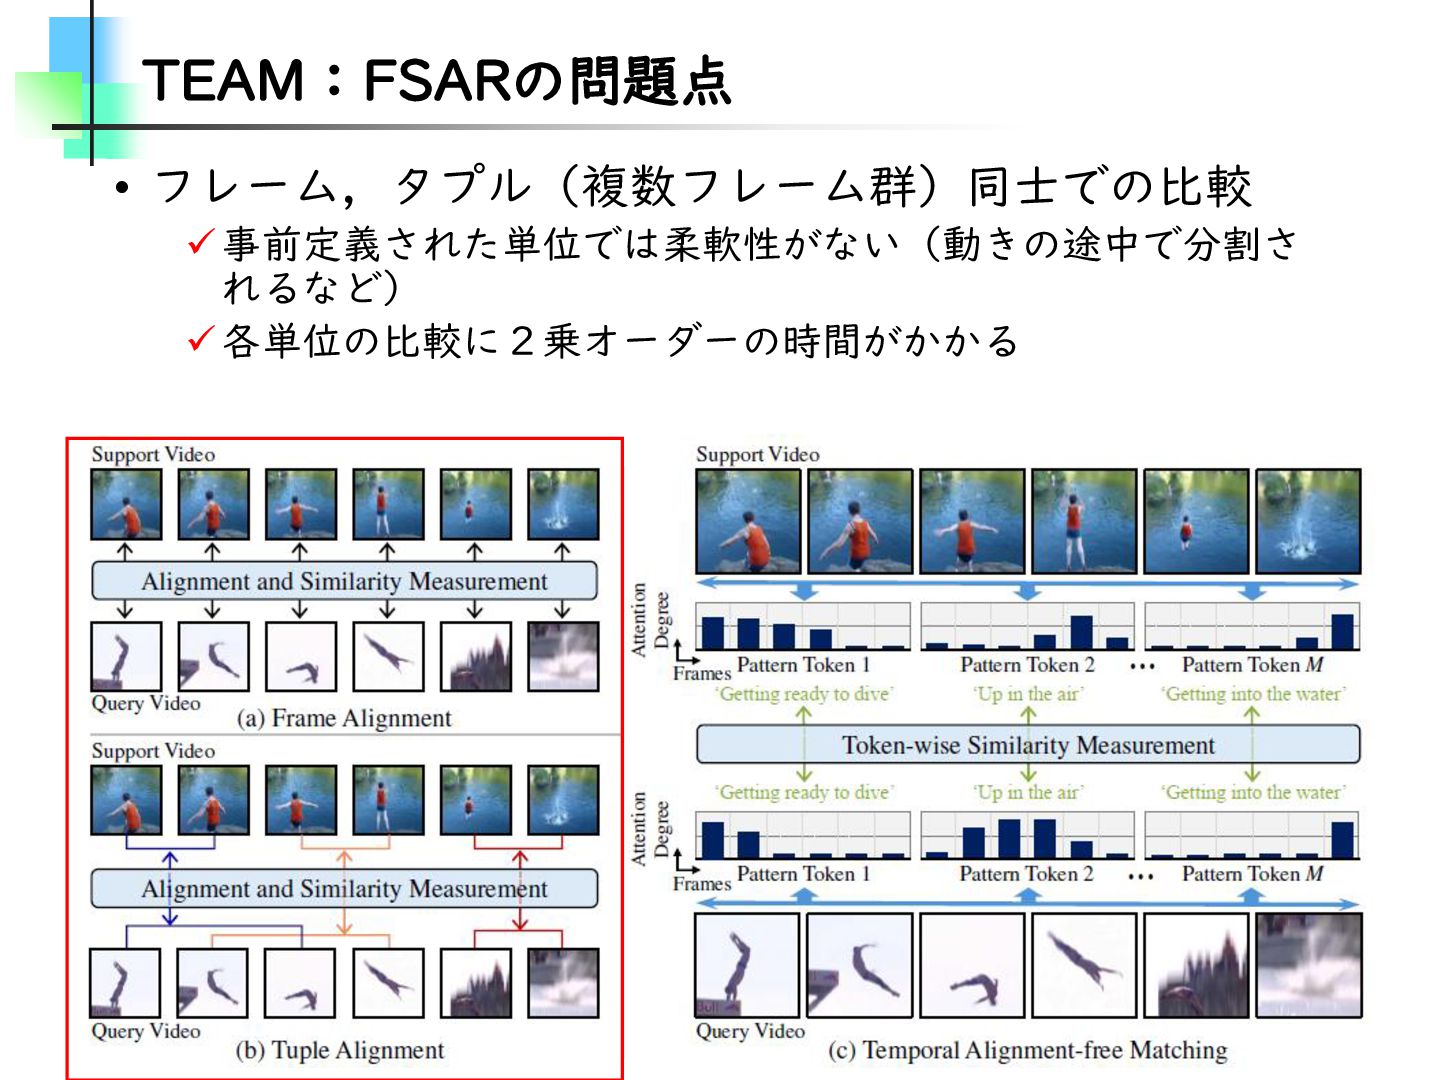
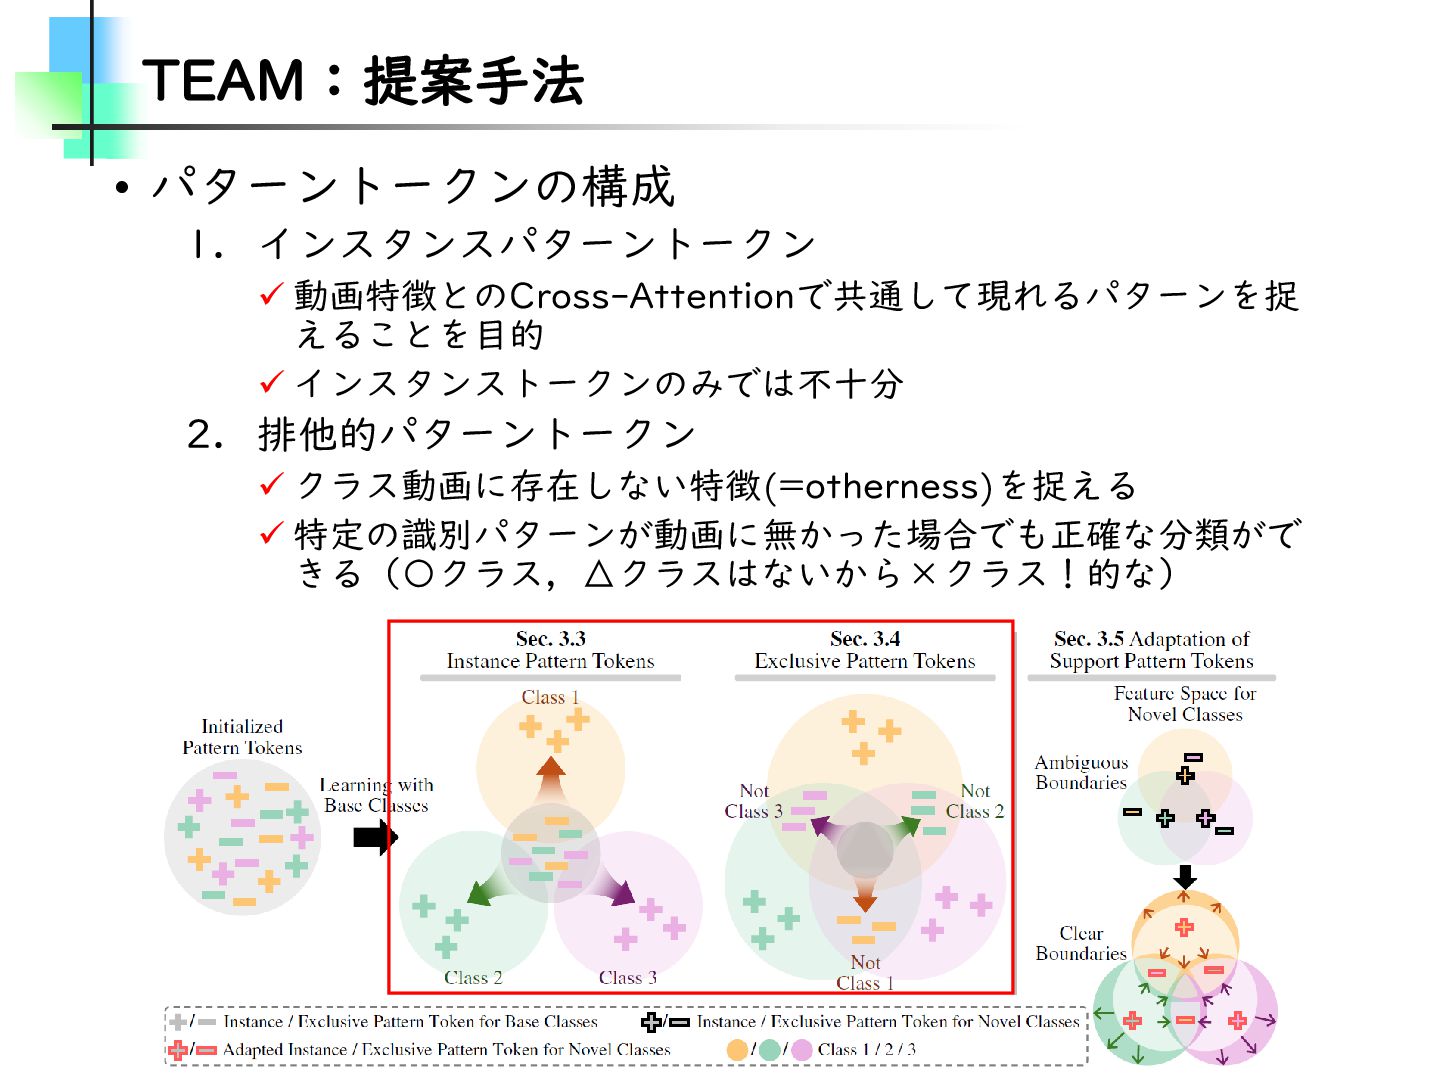
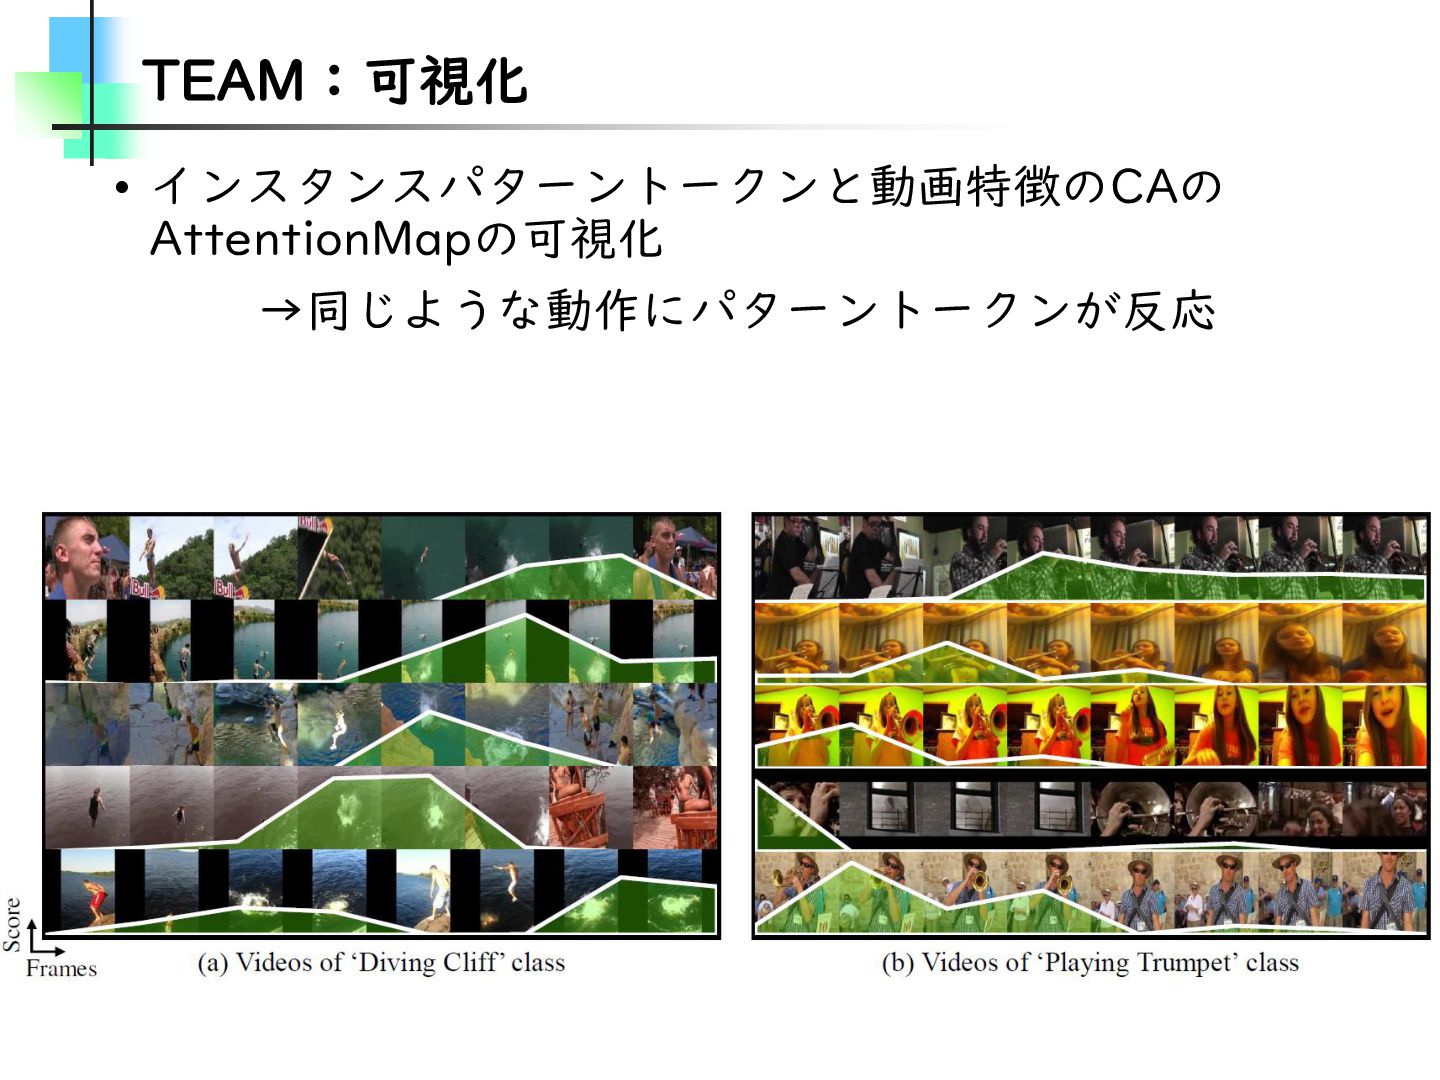
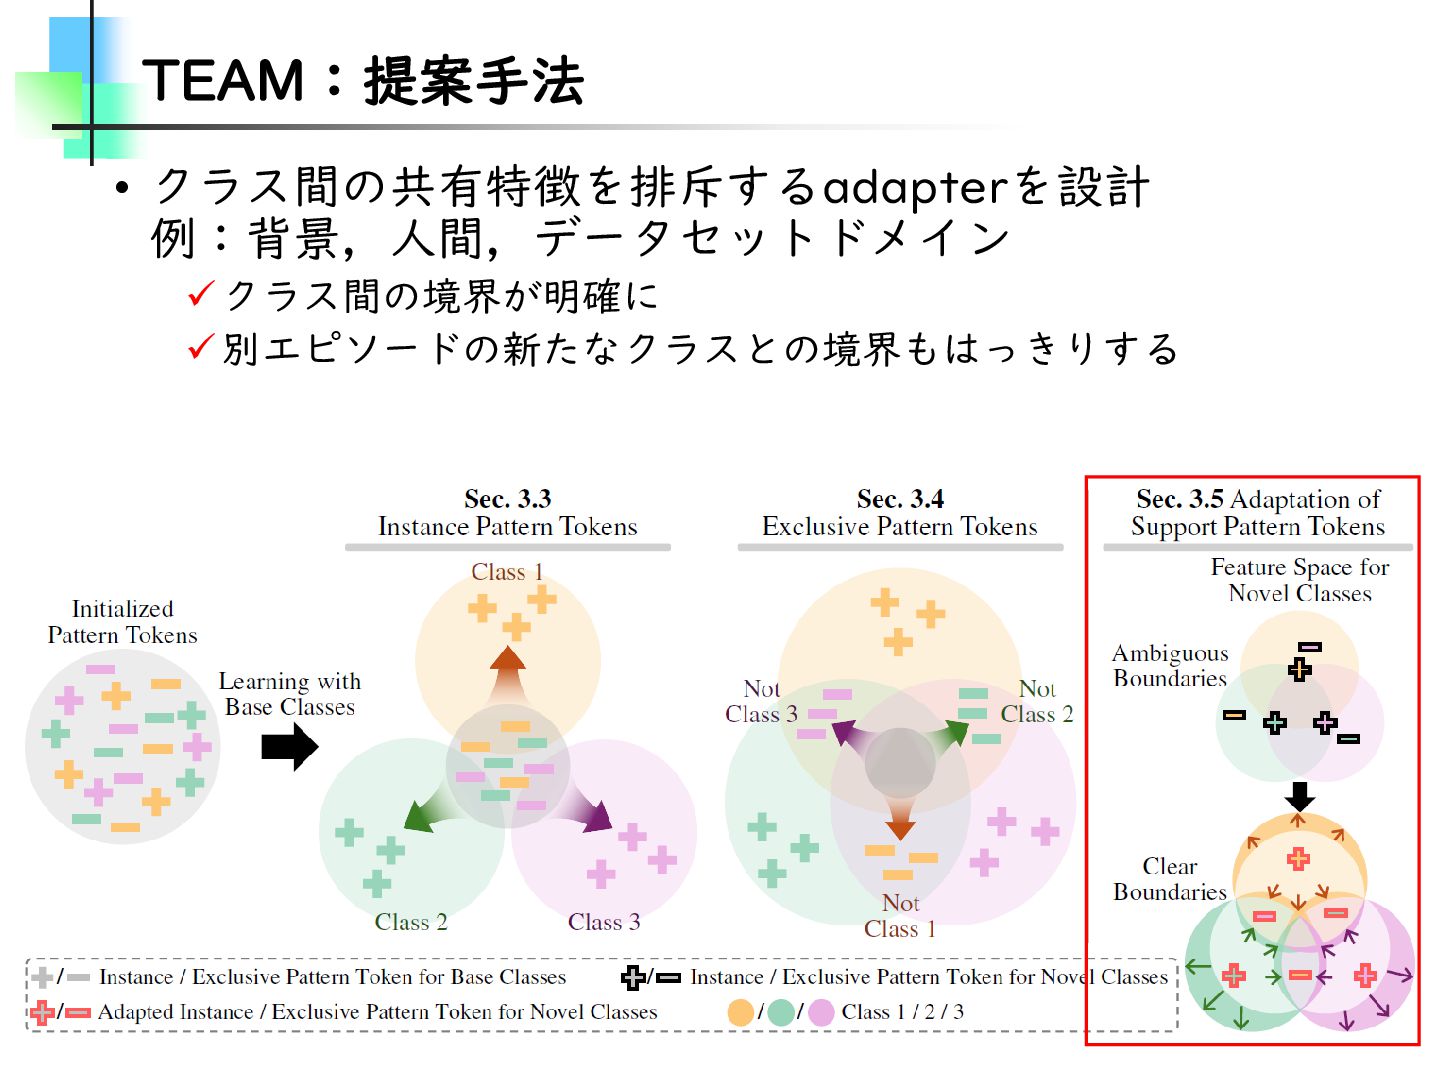
TEAM:提案手法 • パターントークンの構成 1. インスタンスパターントークン ✓ 動画特徴とのCross-Attentionで共通して現れるパターンを捉 えることを目的 ✓ インスタンストークンのみでは不十分
2. 排他的パターントークン ✓ クラス動画に存在しない特徴(=otherness)を捉える ✓ 特定の識別パターンが動画に無かった場合でも正確な分類がで きる(〇クラス,△クラスはないから×クラス!的な) -
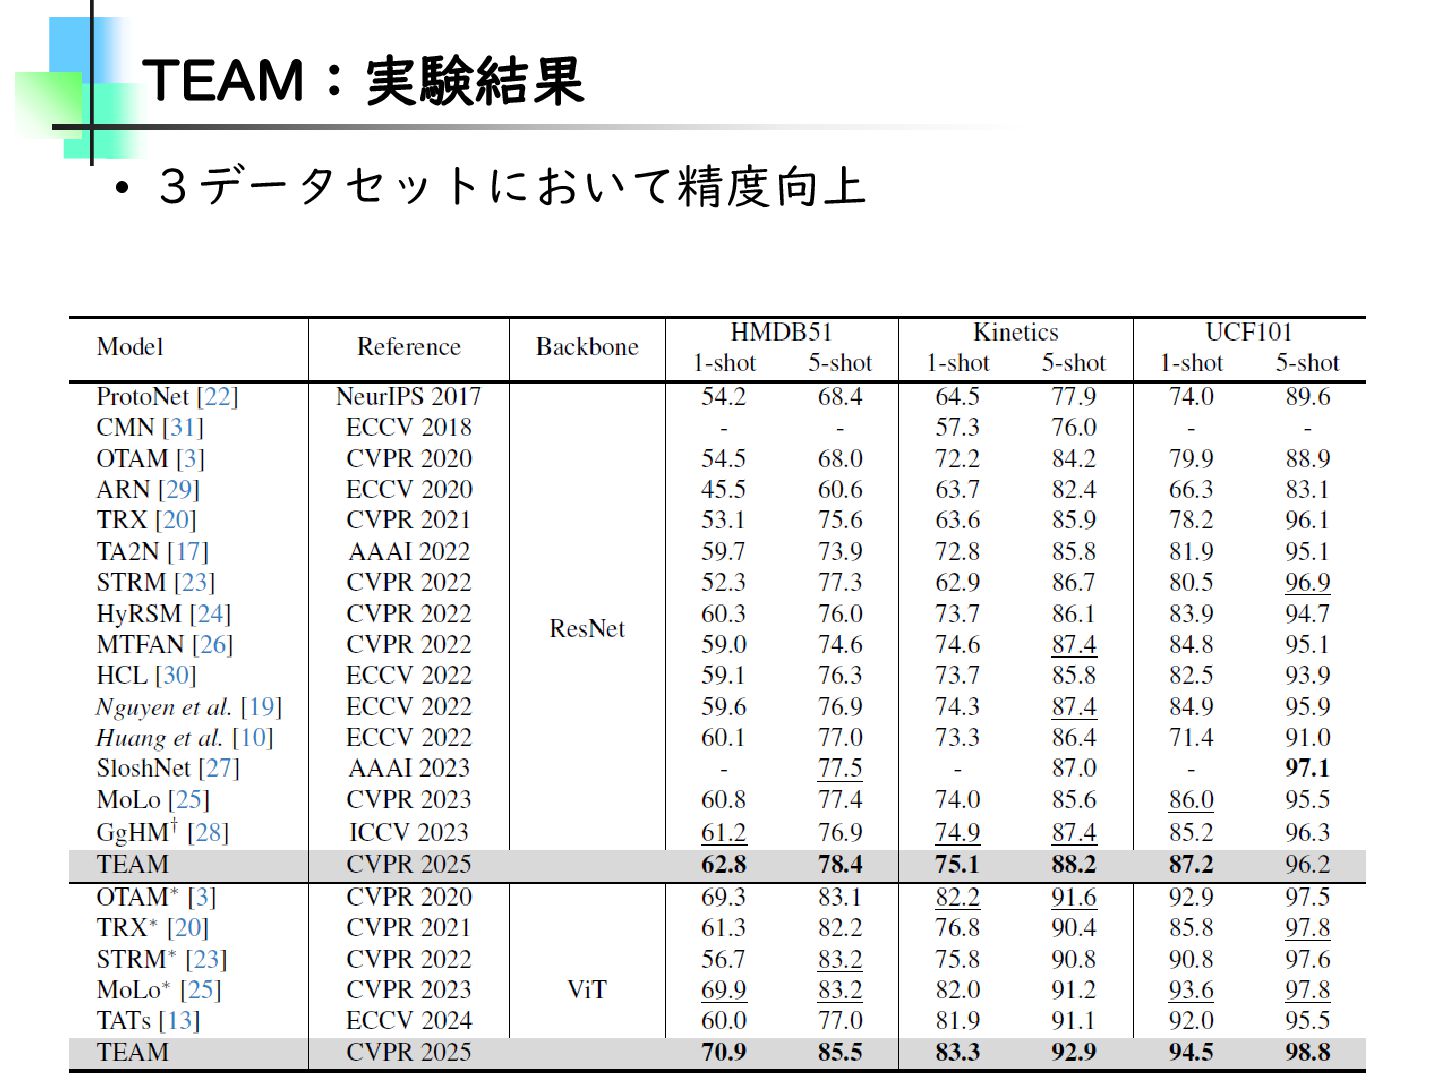
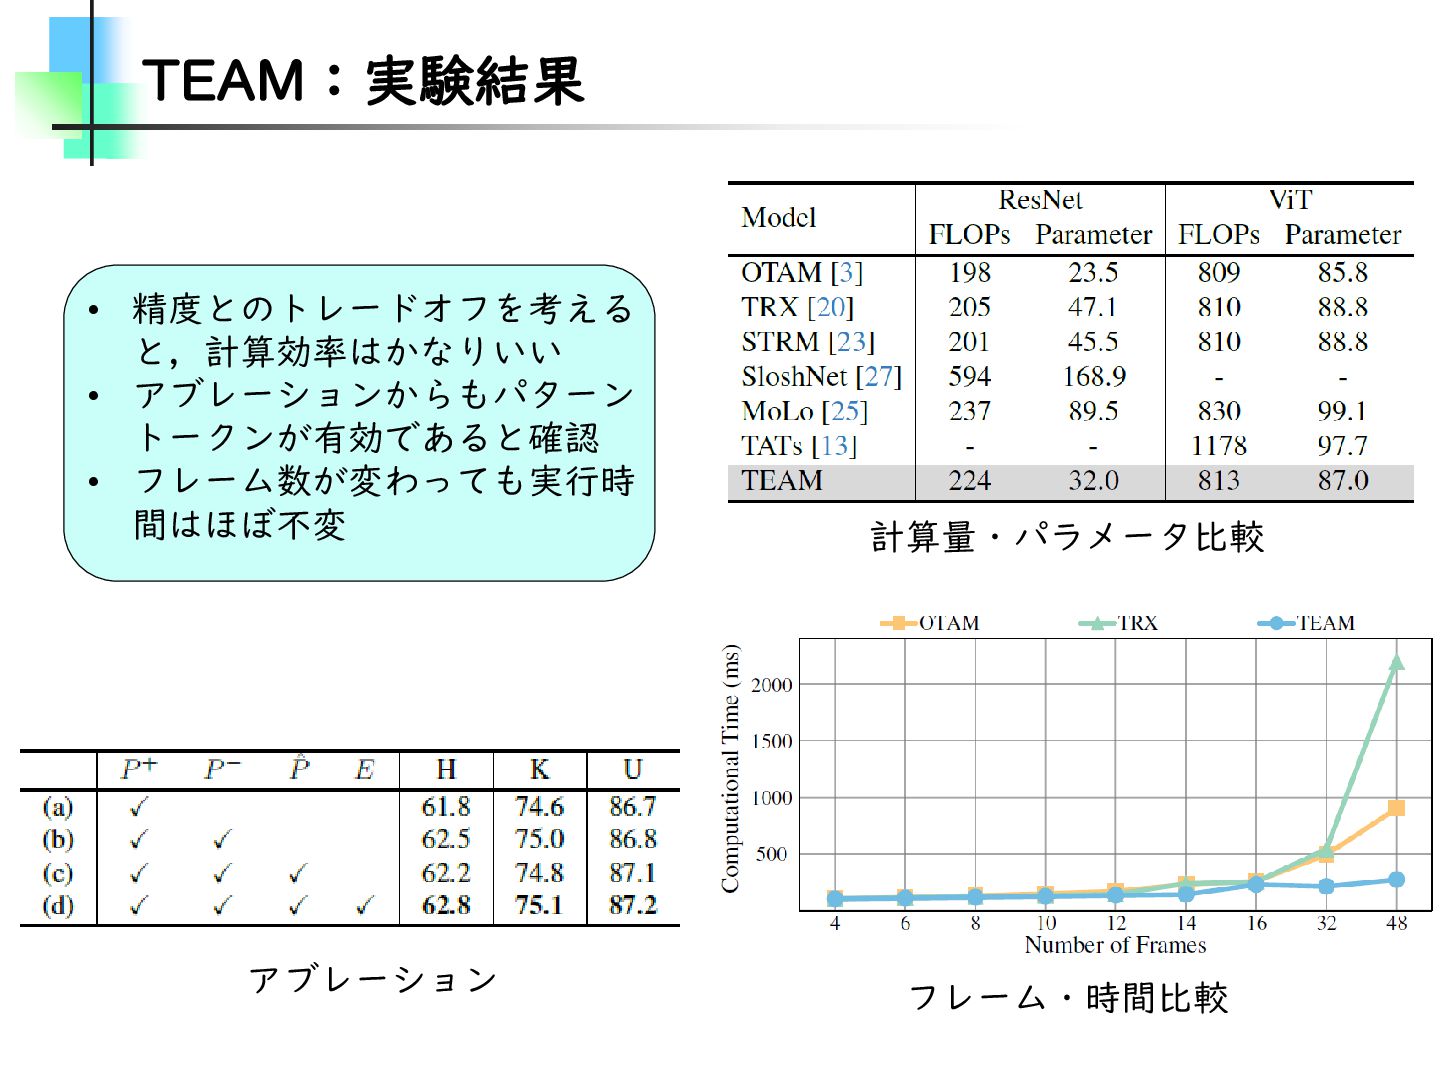
TEAM:実験結果 計算量・パラメータ比較 フレーム・時間比較 • 精度とのトレードオフを考える と,計算効率はかなりいい • アブレーションからもパターン トークンが有効であると確認 •
フレーム数が変わっても実行時 間はほぼ不変 アブレーション -
まとめ • FocusVideo • アダプターによる時空間特徴の抽出 • クエリの自己回帰型の学習による少パラメータでのチューニ ングを実現 • TEAM
• 学習可能パラメータを用いてグローバルな動画特徴により, フレーム・タプルにとらわれない特徴を取得 • サポートセット-クエリセットの比較回数を,2乗オーダーか ら1乗オーダーへ • クラス間共通特徴を排斥することによるクラス境界の明確化