Share
Embed
Context Engineeringが企業で不可欠になる理由
2026/2/5に実施されたセミナで使用した資料です。
そもそもコンテキストエンジニアリングって何?コンテキストって何?どんな技術があるの?といったところを纏めています。
https://events.elastic.co/context-engineering-joint-seminar-jp
Hirosato Gamo PRO
February 06, 2026
Transcript
27 slides
-
2 HIROSATO GAMO @hiro_gamo ➢ Microsoft AI Cloud Solution Architect
LLM隆盛の黎明期からAzure AIを通じたLLM企業導入の技術支援を推進。 ➢ Microsoft Evangelist SNS上での技術情報の発信や登壇活動に従事。「ChatGPT - Azure OpenAI大全」などの資 料が10万ビューを超え「2023 Most Viewed Deck 25」にランクイン。2023 - Most Viewed Decks (speakerdeck.com) ➢ 上智大学大学院 応用データサイエンス学位プログラム LLM概論担当 非常勤講師 ➢ 著書「LLMの原理、RAG・エージェント開発から読み解く コンテキストエンジニアリング」 共著「Azure OpenAI ServiceではじめるChatGPT/LLMシステム構築入門」 マイクロソフト エバンジェリスト -
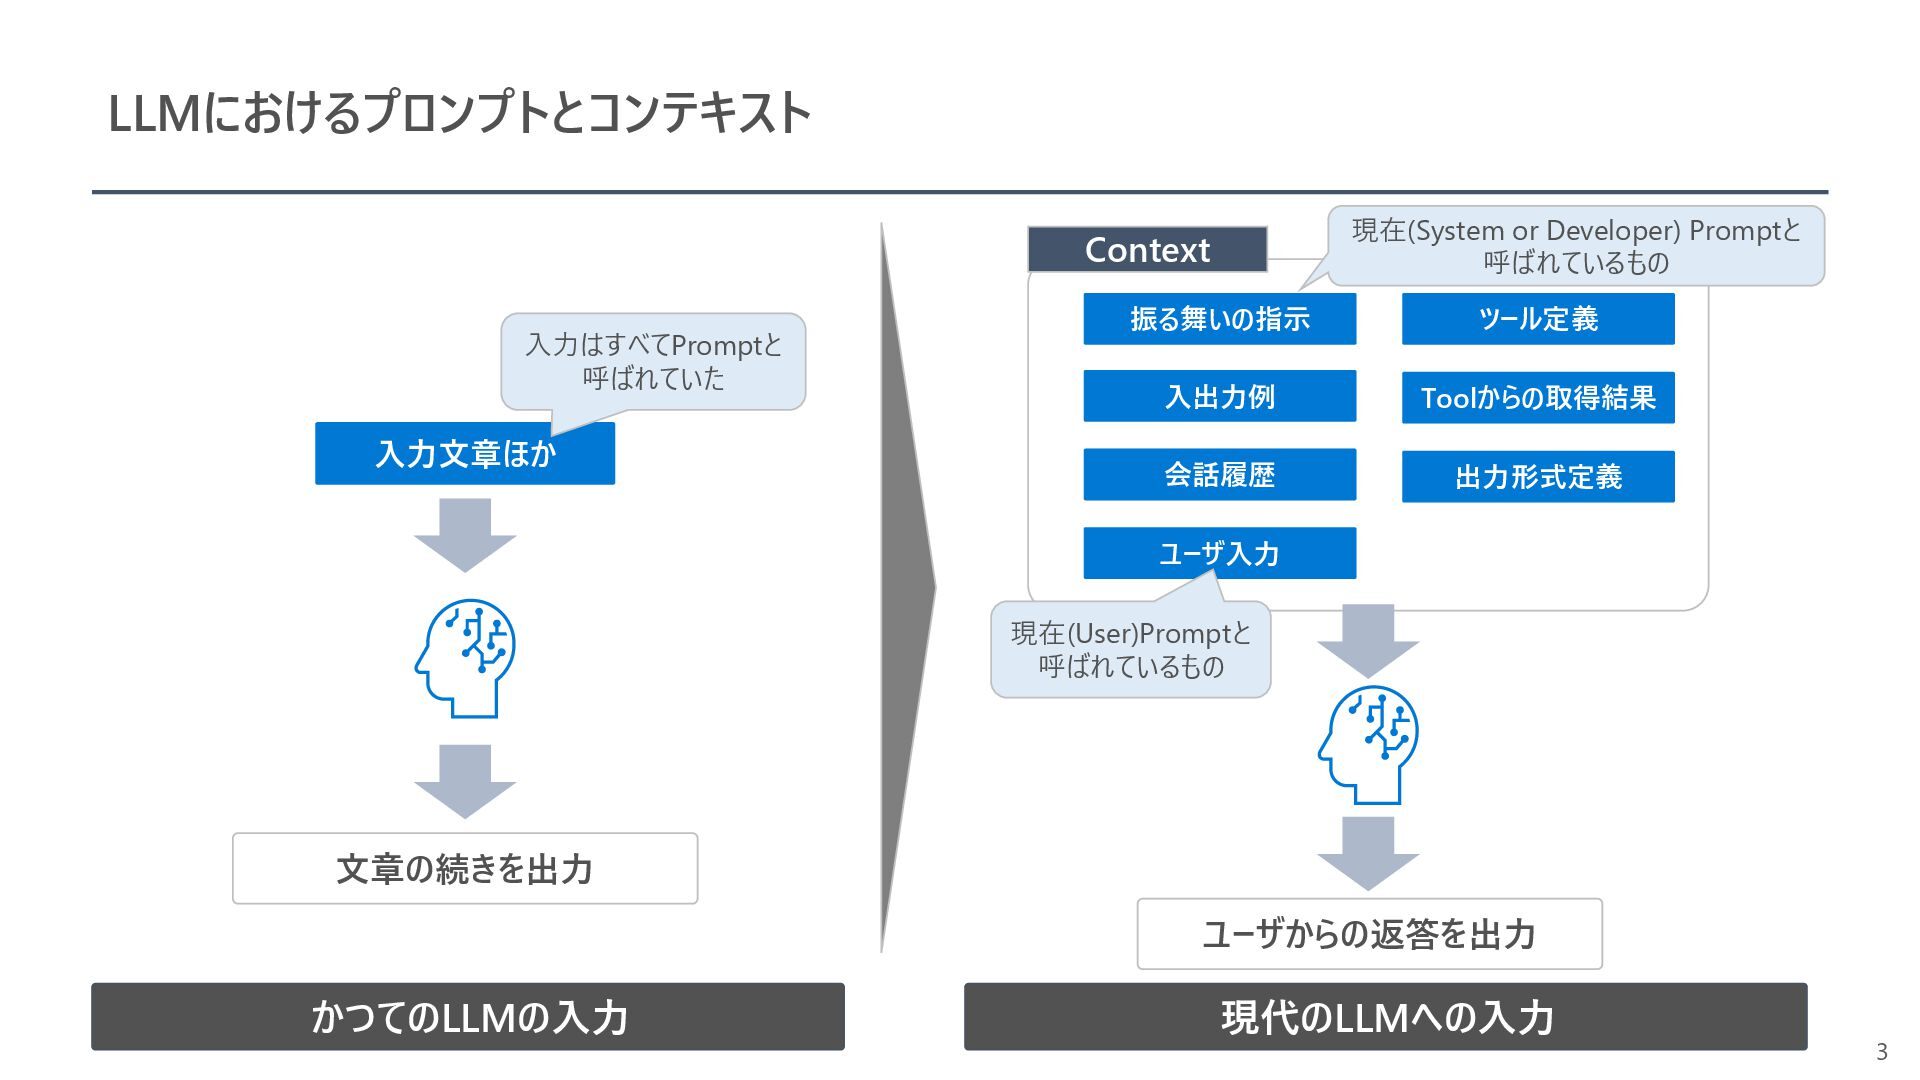
LLMにおけるプロンプトとコンテキスト 3 振る舞いの指示 入出力例 ユーザ入力 会話履歴 ツール定義 Toolからの取得結果 出力形式定義 入力文章ほか
入力はすべてPromptと 呼ばれていた 現在(System or Developer) Promptと 呼ばれているもの 現在(User)Promptと 呼ばれているもの Context かつてのLLMの入力 現代のLLMへの入力 ユーザからの返答を出力 文章の続きを出力 -
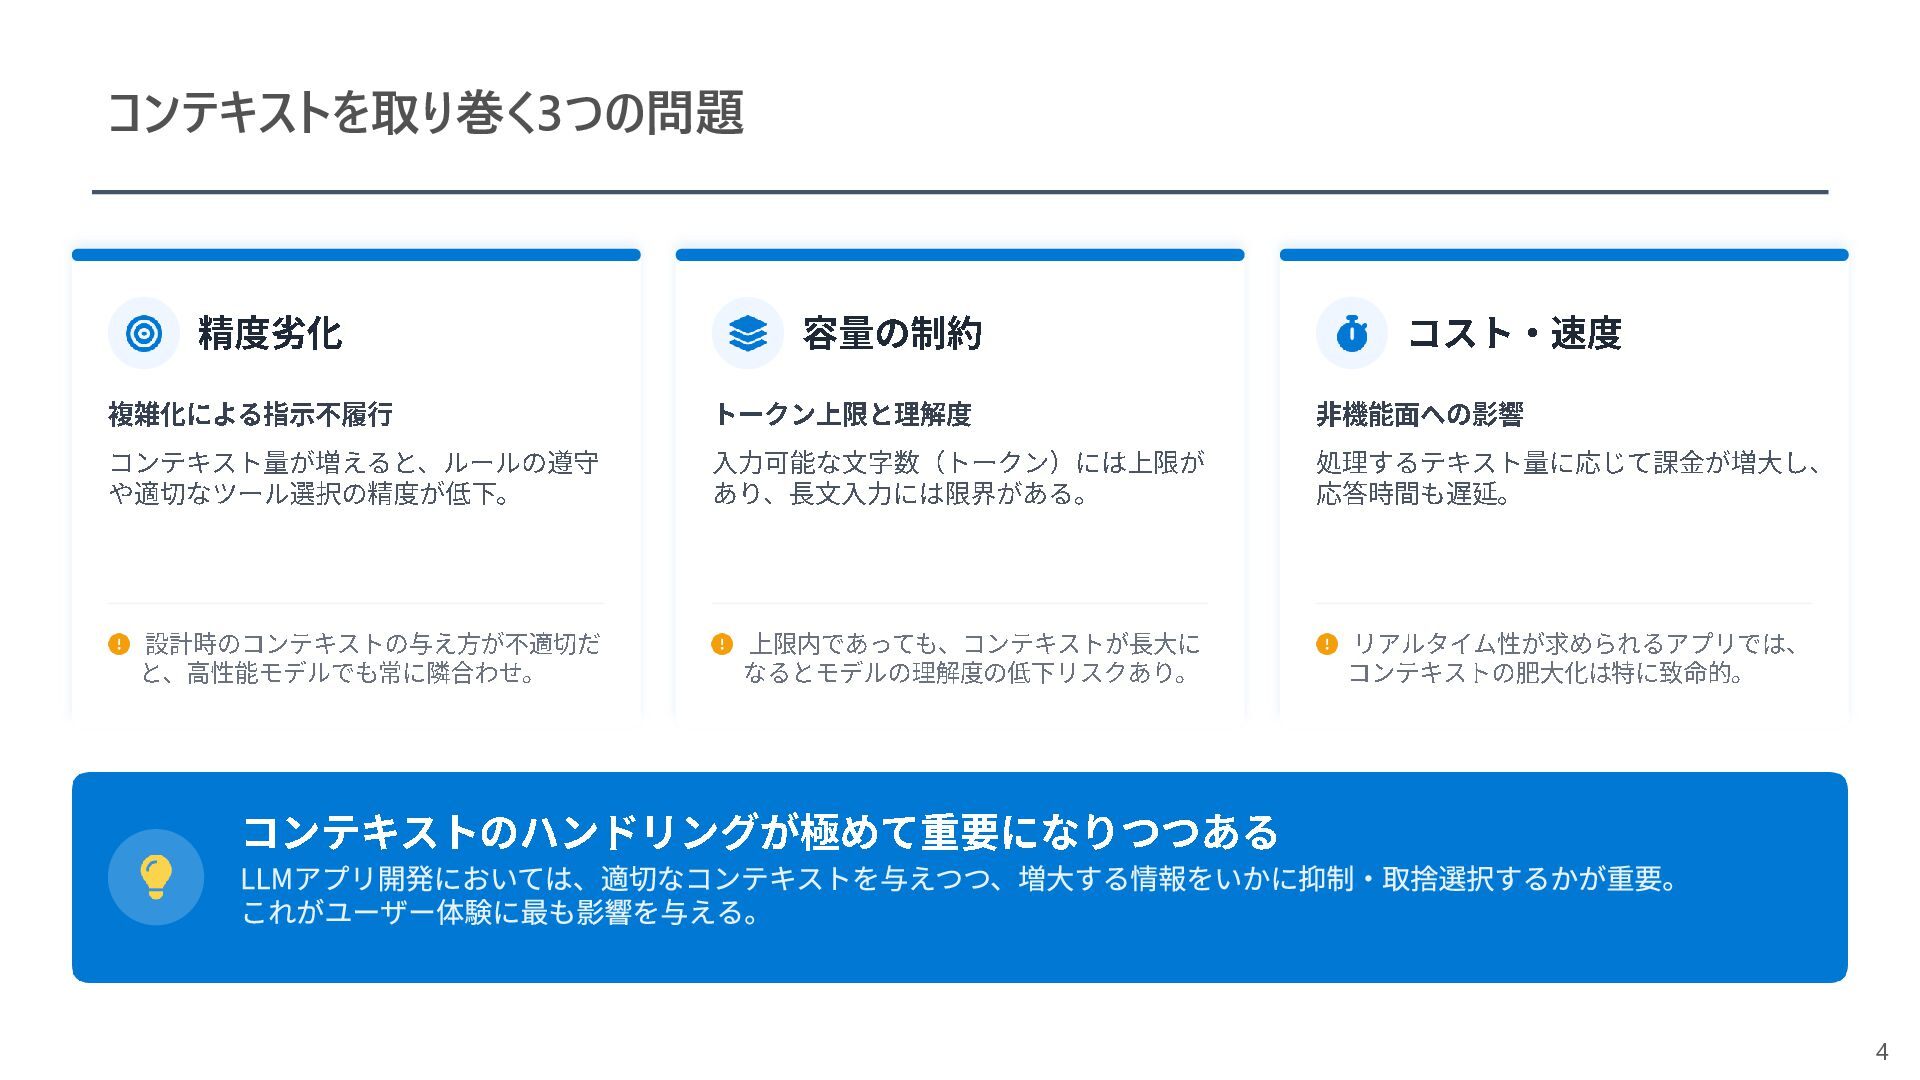
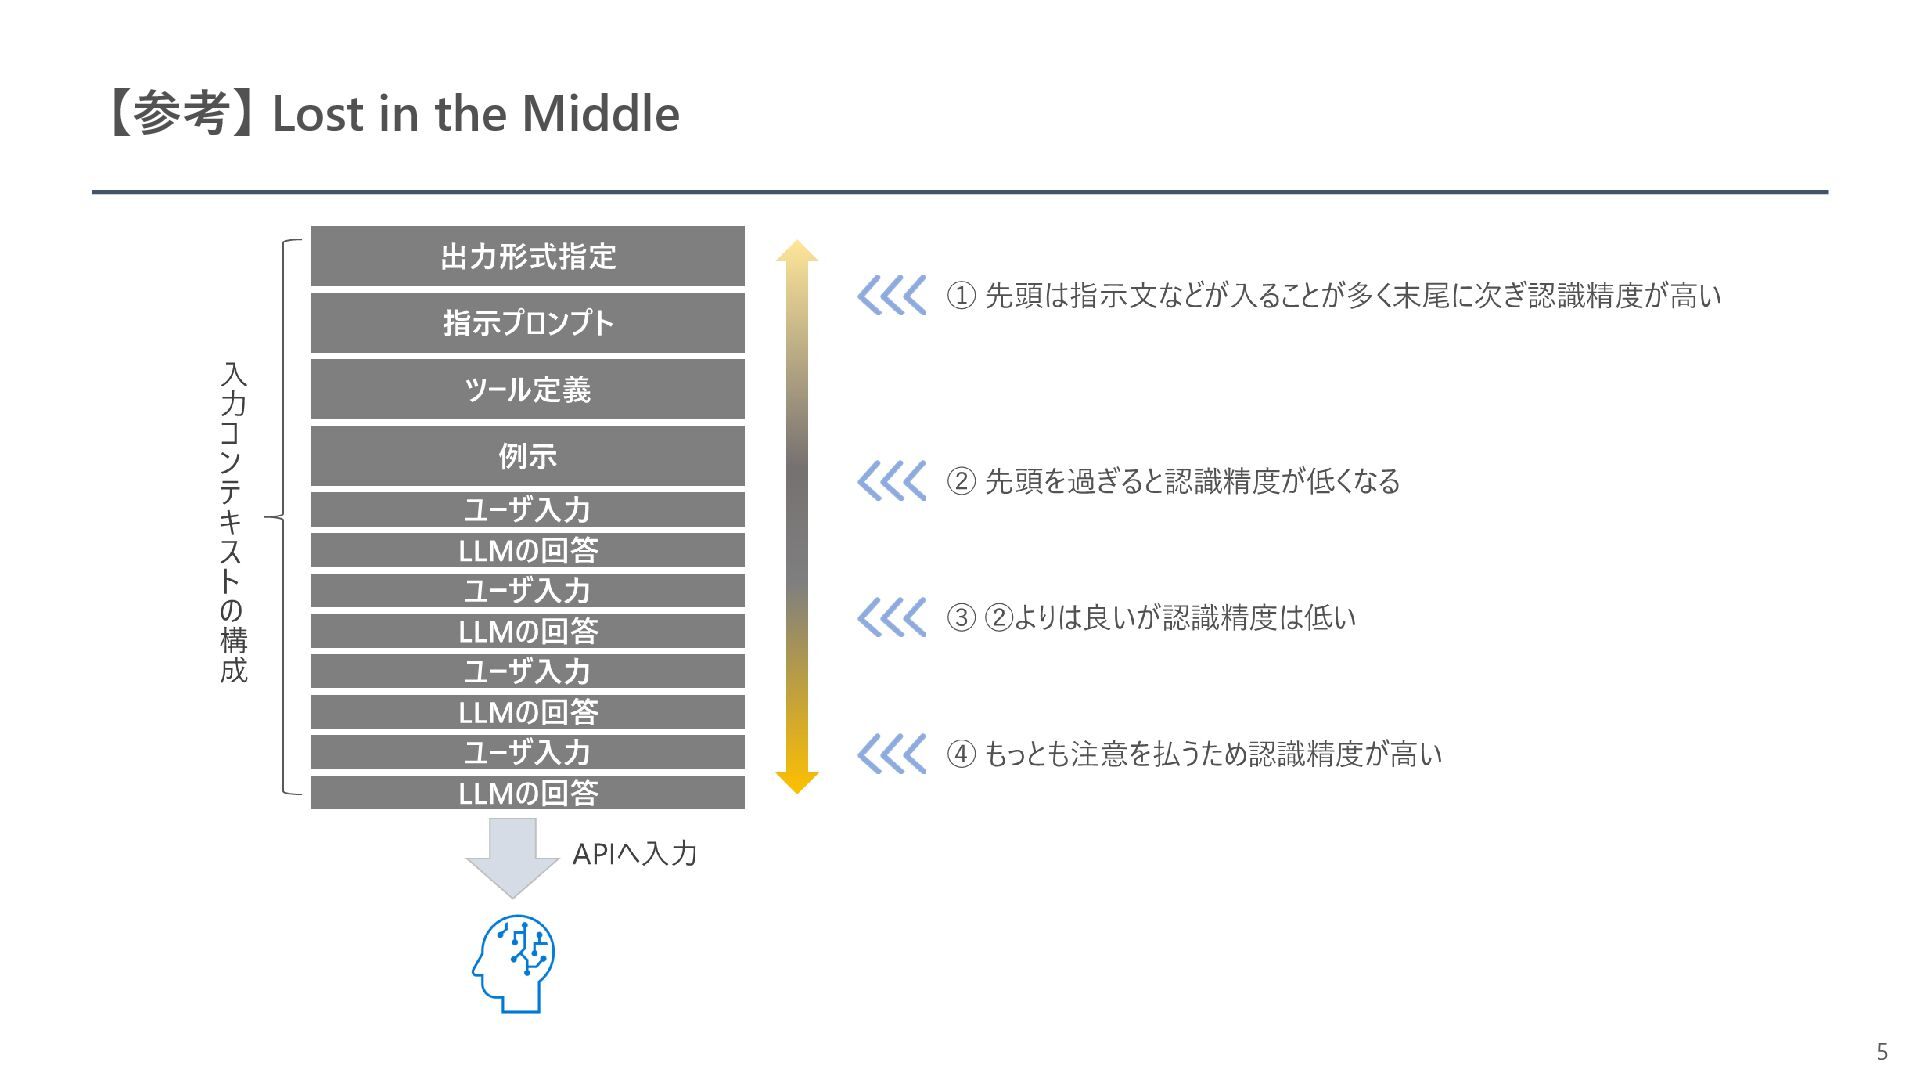
コンテキストを取り巻く3つの問題 4 精度劣化 複雑化による指示不履行 コンテキスト量が増えると、ルールの遵守 や適切なツール選択の精度が低下 。 設計時のコンテキストの与え方が不適切だ と、高性能モデルでも 常に隣合わせ。
容量の制約 トークン上限と理解度 入力可能な文字数(トークン)には上限が あり、長文入力には限界があ る。 上限内であっても、コンテキストが長大に なるとモデルの理解度 の低下リスクあり 。 コスト・速度 非機能面への影響 処理するテキスト量に応じて課金が増大し、 応答時間も遅延 。 リアルタイム性が求められるアプリでは、 コンテキストの肥大化は 特に致命的。 コンテキスト のハンドリングが極めて重要になりつつある -
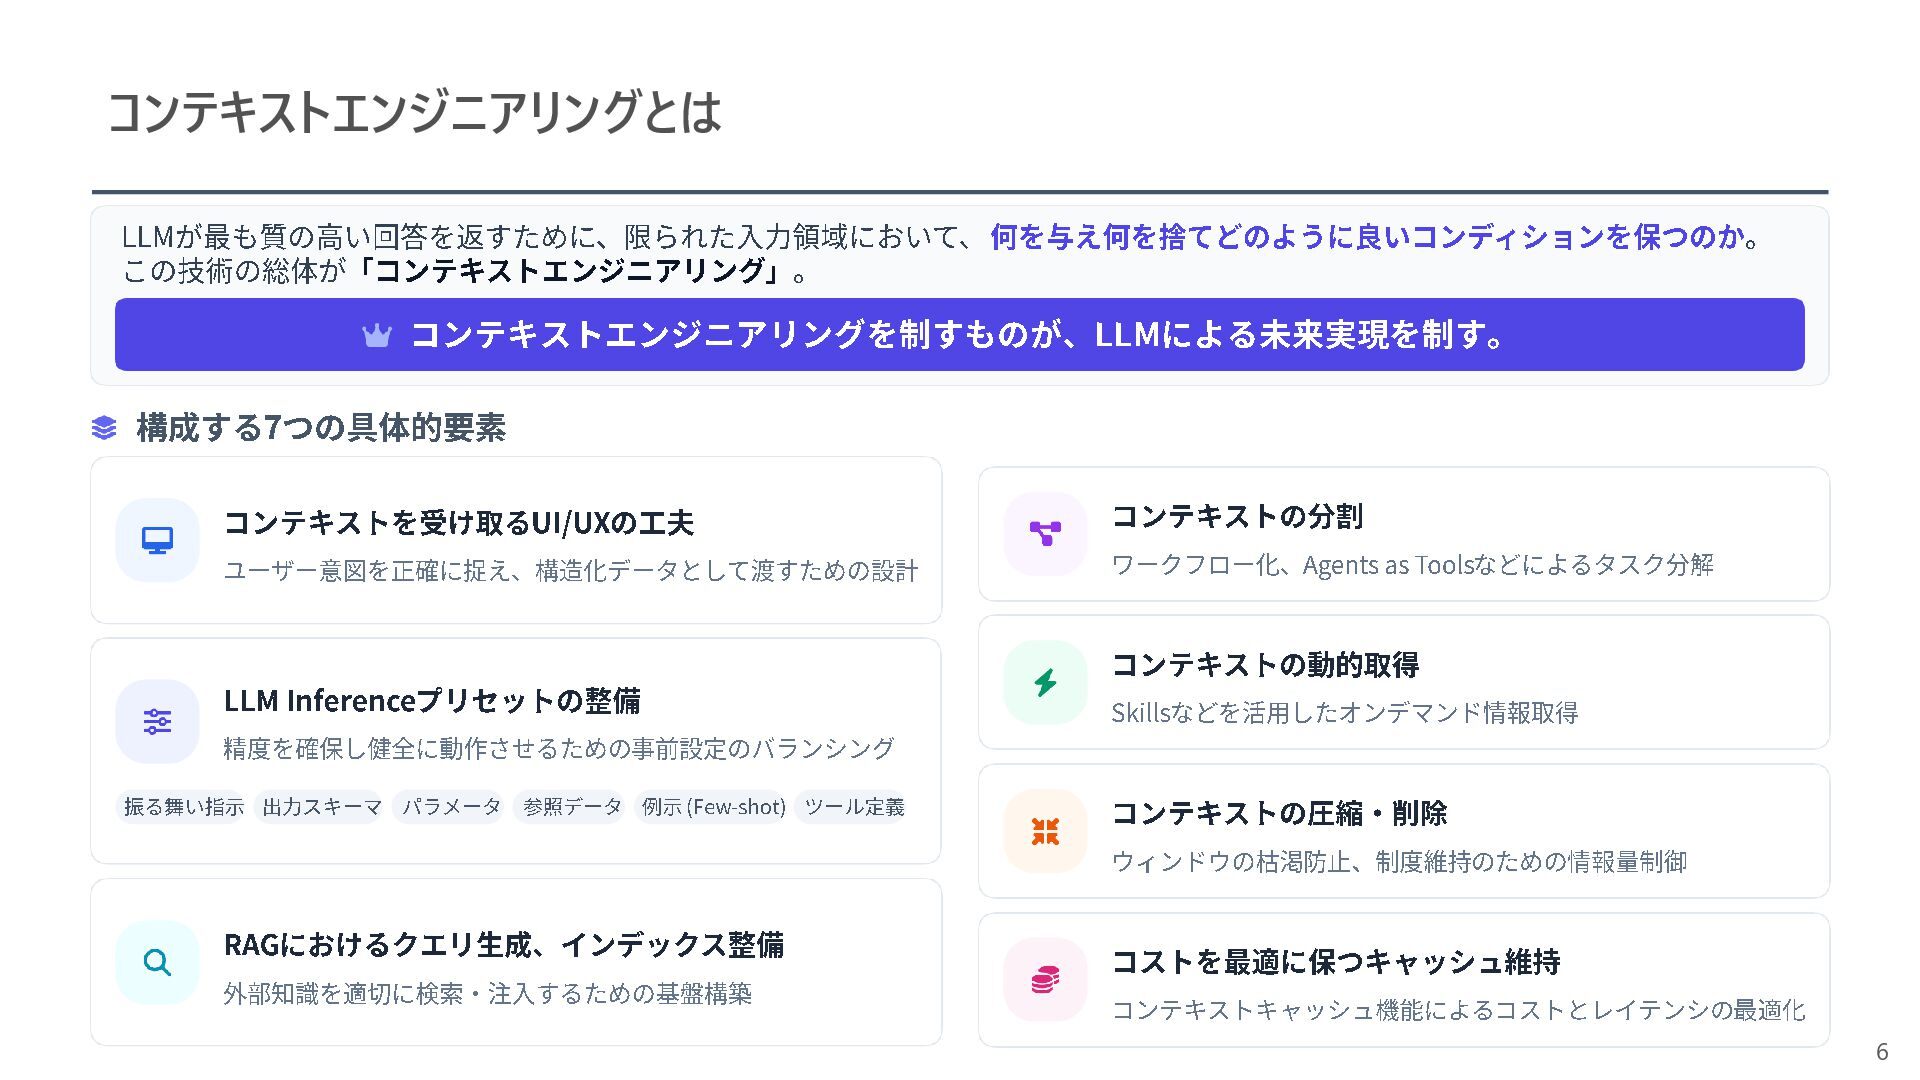
コンテキストエンジニアリングとは 6 構成する 7つの具体的要素 コンテキストを受け取る UI/UX の工夫 ユーザー意図を正確に捉え、構造化データとして渡すための設計 LLM Inference
プリセットの整備 精度を確保し健全に動作させるための 事前設定のバランシング 振る舞い指示 出力スキーマ パラメータ 参照データ 例示 (Few -shot) ツール定義 RAGにおけるクエリ生成、インデックス整備 外部知識を適切に検索・注入するための基盤構築 コンテキストの分割 ワークフロー化、 Agents as Tools などによるタスク分解 コンテキストの動的取得 Skills など を活用したオンデマンド情報取得 コンテキストの圧縮・削除 ウィンドウの枯渇 防止、制度維持 のための情報量制御 コストを最適に保つキャッシュ維持 コンテキストキャッシュ機能による コストとレイテンシの 最適化 LLMが最も質の高い回答を返すために、限られた入力領域において、 何を与え何を捨てどのように良いコンディションを保つのか 。 この技術の総体が 「コンテキストエンジニアリング 」 。 コンテキストエンジニアリングを制すものが、 LLM による未来実現 を制す 。 -
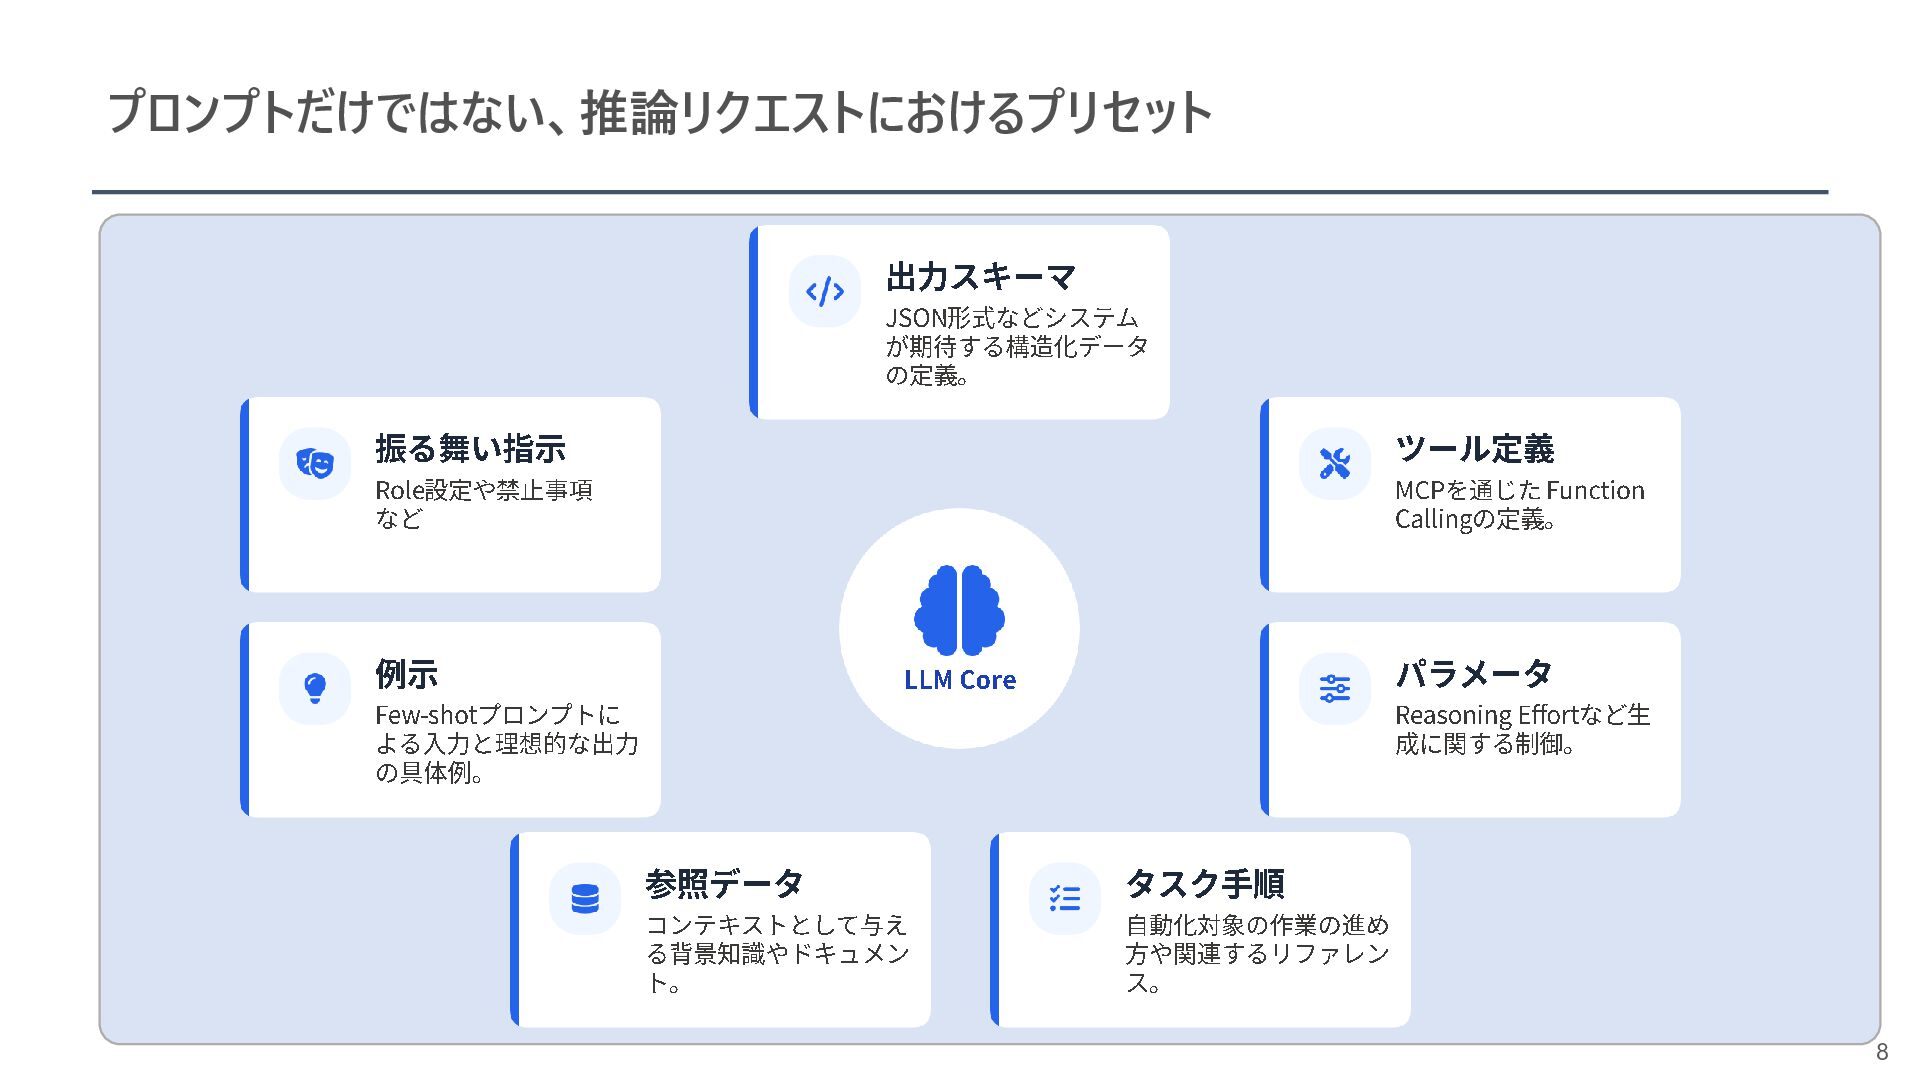
プロンプトだけではない、推論リクエストにおけるプリセット 8 出力スキーマ JSON形式などシステム が期待する構造化データ の定義。 振る舞い指示 Role 設定や禁止事項 など
例示 Few -shot プロンプトに よる入力と理想的な出力 の具体例。 ツール定義 MCPを通じた Function Calling の定義。 パラメータ Reasoning Effort など 生 成に関する 制御。 参照データ コンテキストとして与え る背景知識やドキュメン ト 。 タスク手順 自動化対象の作業の進め 方や関連するリファレン ス。 LLM Core -
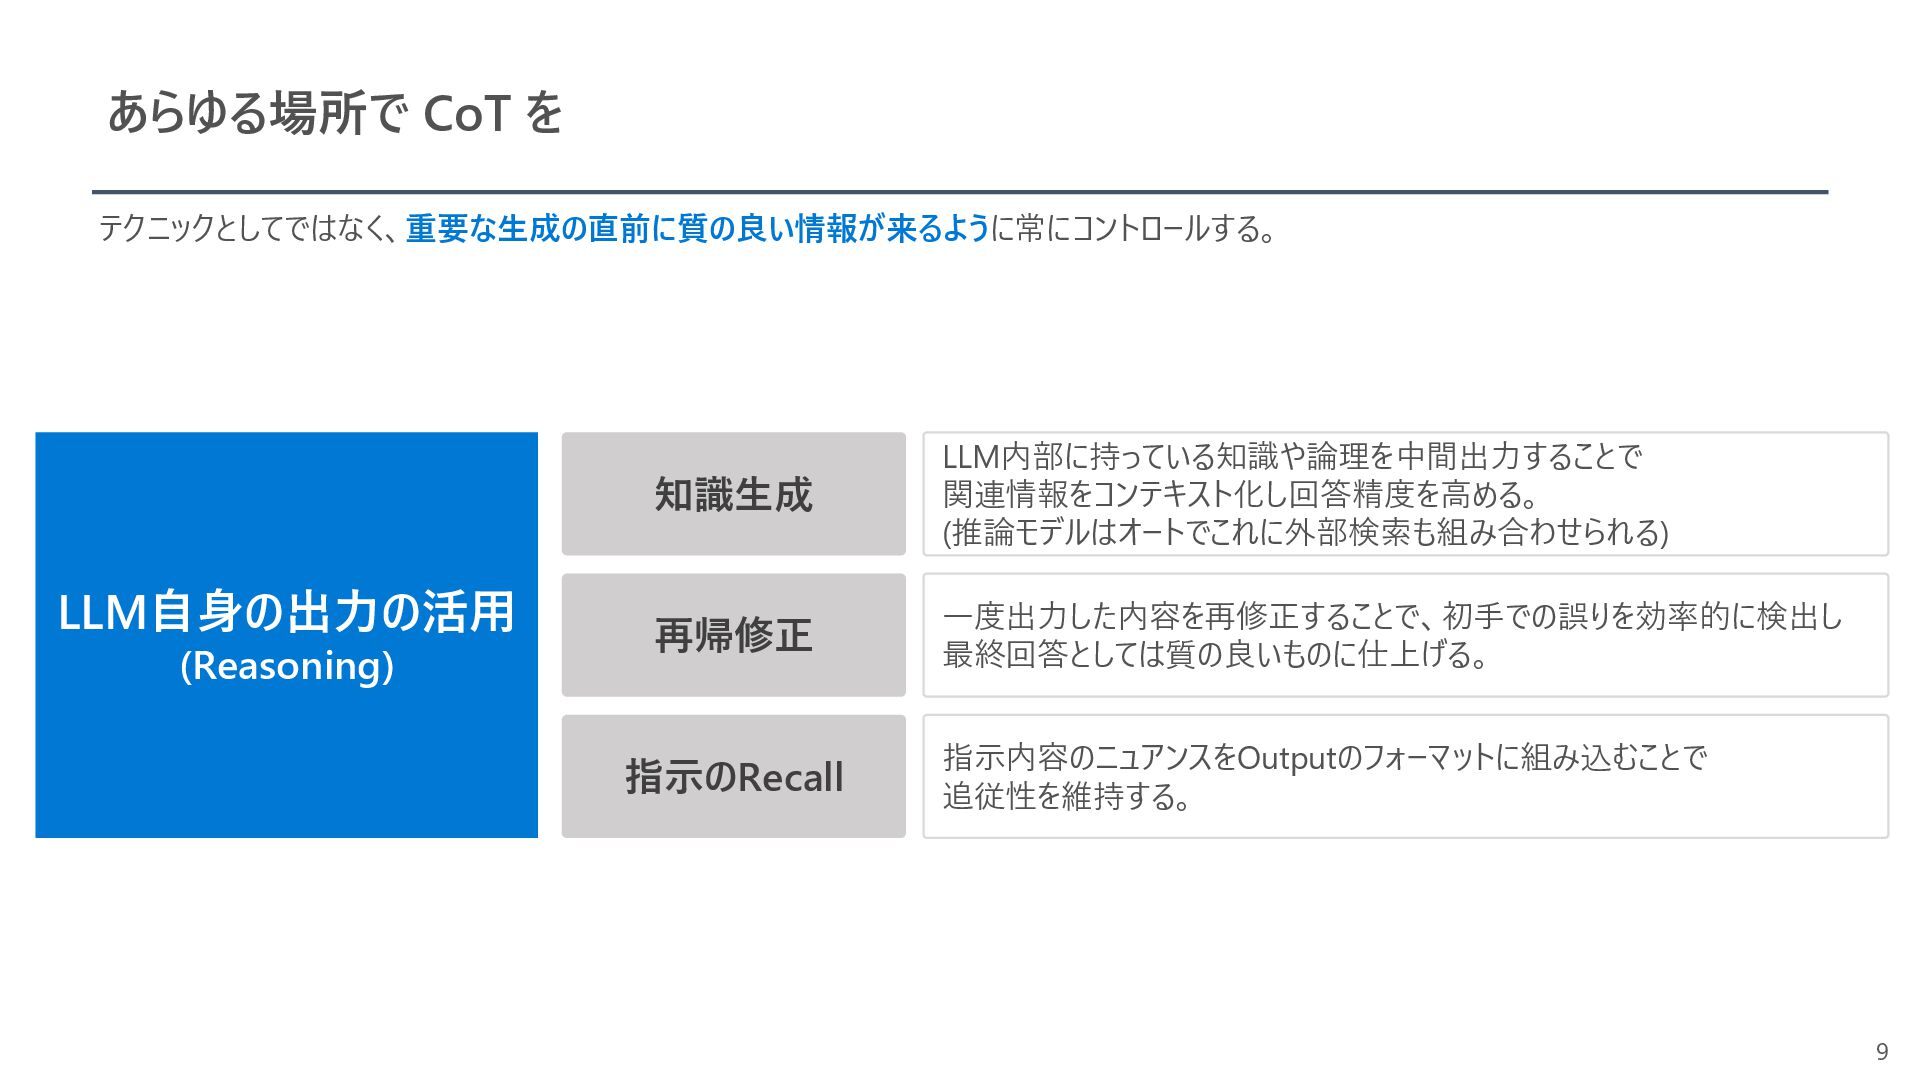
あらゆる場所で CoT を 9 LLM自身の出力の活用 (Reasoning) 再帰修正 一度出力した内容を再修正することで、初手での誤りを効率的に検出し 最終回答としては質の良いものに仕上げる。 知識生成
LLM内部に持っている知識や論理を中間出力することで 関連情報をコンテキスト化し回答精度を高める。 (推論モデルはオートでこれに外部検索も組み合わせられる) 指示のRecall 指示内容のニュアンスをOutputのフォーマットに組み込むことで 追従性を維持する。 テクニックとしてではなく、重要な生成の直前に質の良い情報が来るように常にコントロールする。 -
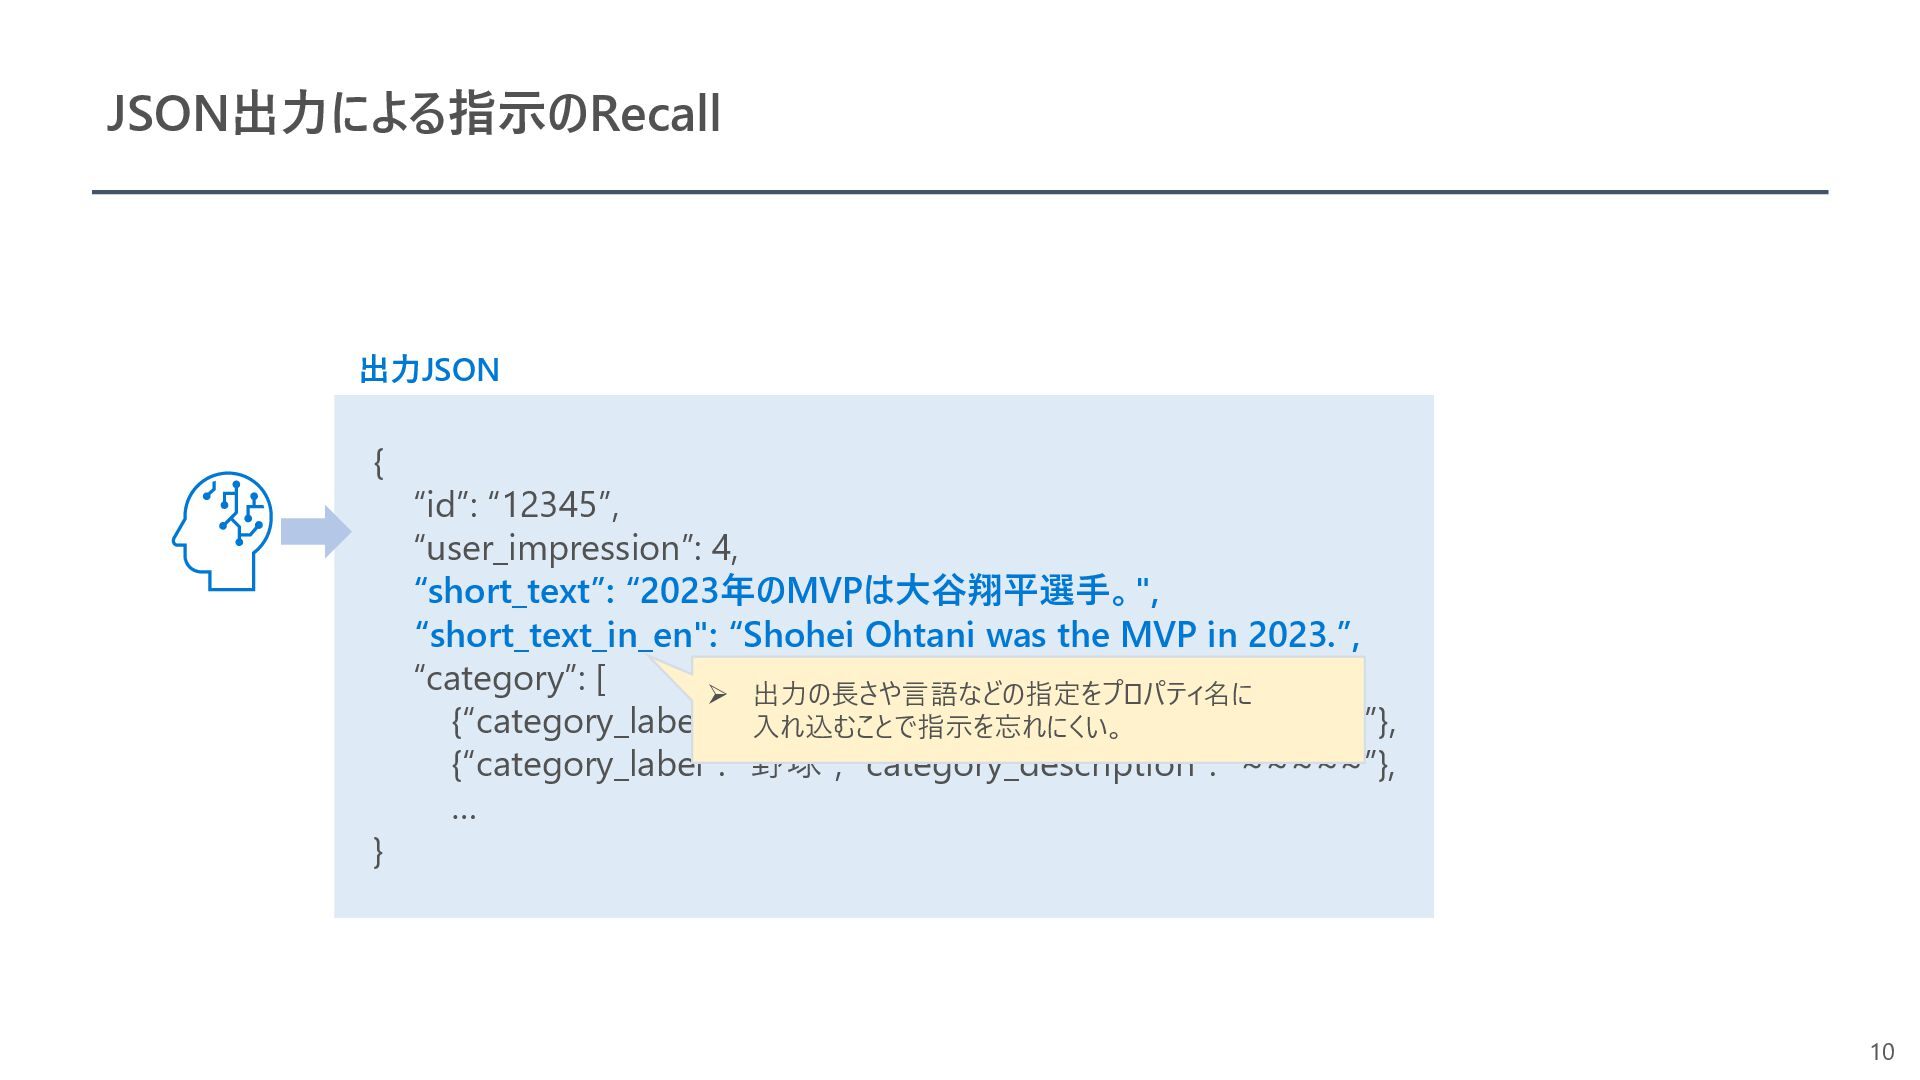
JSON出力による指示のRecall { “id”: “12345”, “user_impression”: 4, “short_text”: “2023年のMVPは大谷翔平選手。", “short_text_in_en": “Shohei
Ohtani was the MVP in 2023.”, “category”: [ {“category_label”: “野球”, “category_description”: “~~~~~”}, {“category_label”: “野球”, “category_description”: “~~~~~”}, … } 出力JSON ➢ 出力の長さや言語などの指定をプロパティ名に 入れ込むことで指示を忘れにくい。 10 -
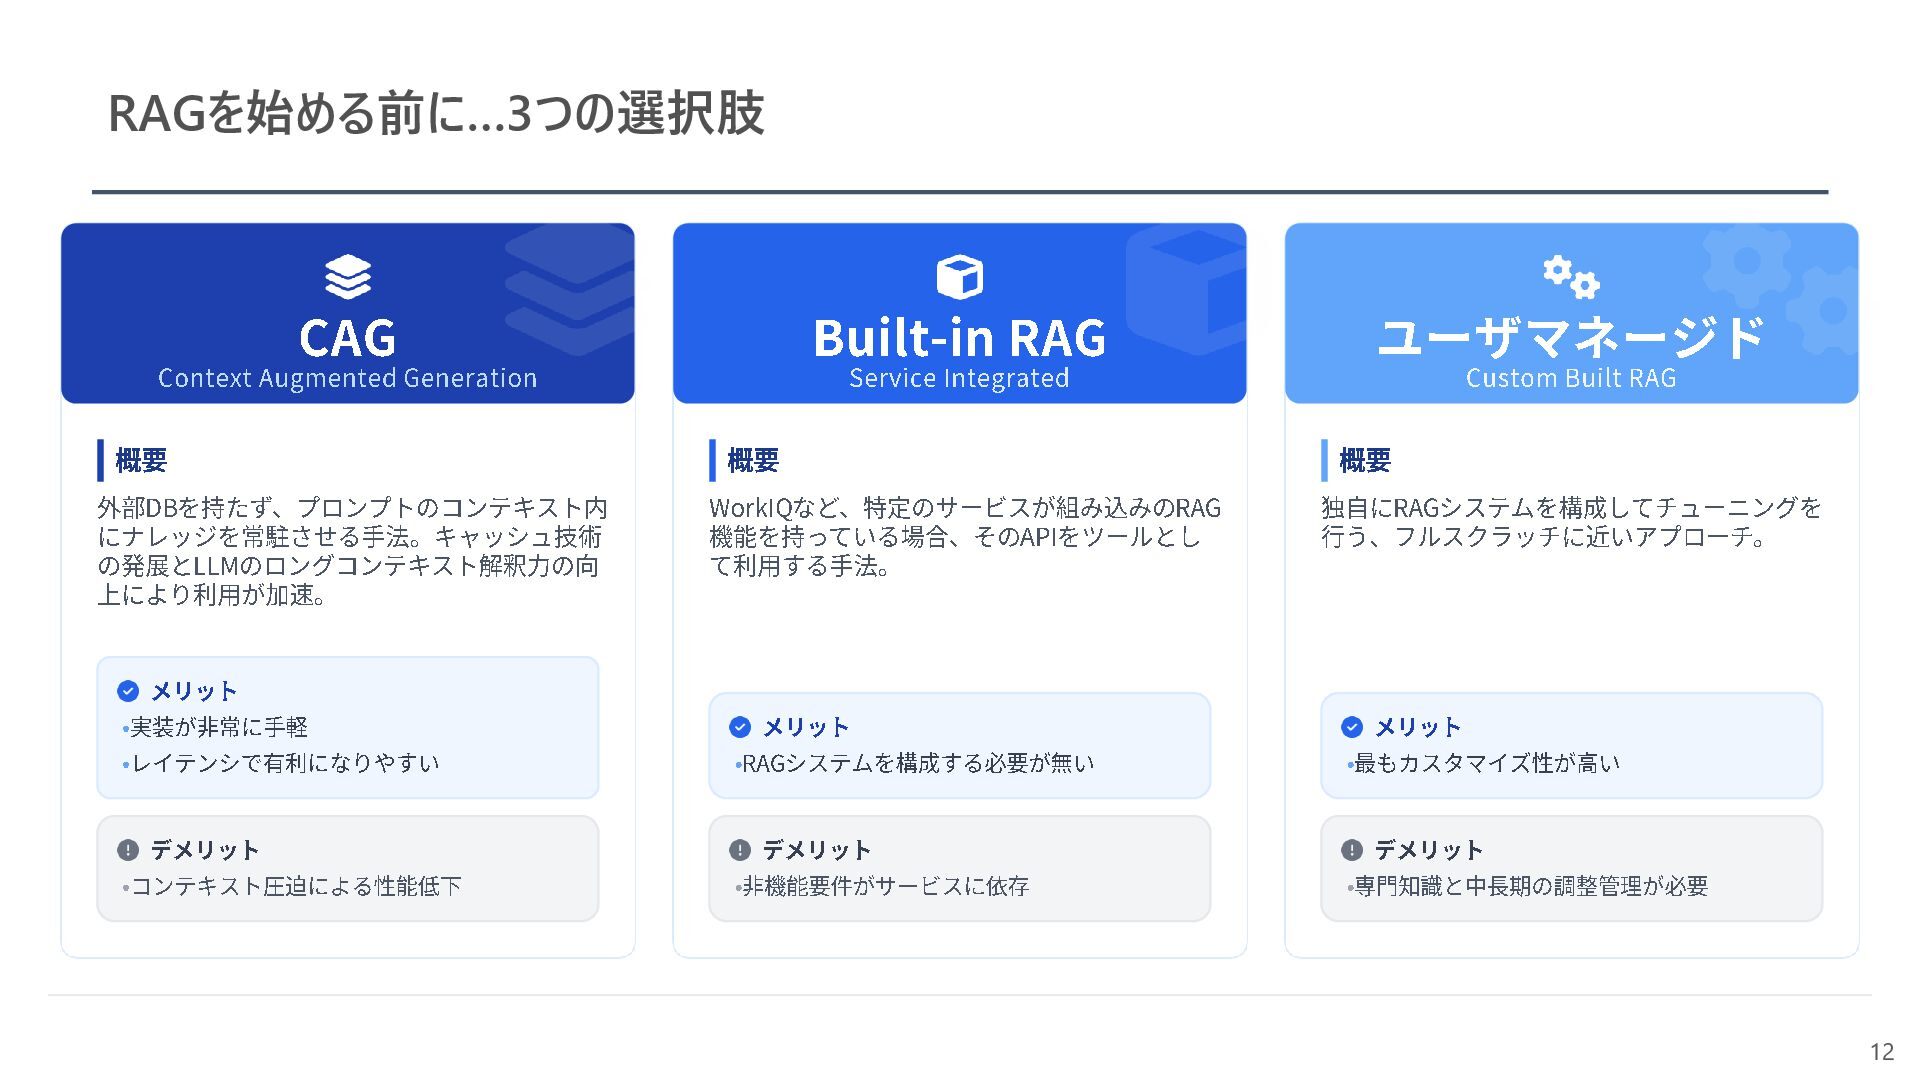
RAGを始める前に…3つの選択肢 12 概要 外部DBを持たず、プロンプトのコンテキスト内 にナレッジを常駐させる手法。キャッシュ技術 の発展と LLMのロングコンテキスト解釈力の向 上により利用が加速。 メリット •実装が非常に手軽
•レイテンシで有利になりやすい デメリット •コンテキスト圧迫による性能低下 CAG Context Augmented Generation 概要 WorkIQ など、特定のサービスが組み込みの RAG 機能を持っている場合、その APIをツールとし て利用する手法。 メリット •RAGシステムを構成する必要が無い デメリット •非機能要件がサービスに依存 Built -in RAG Service Integrated 概要 独自にRAGシステムを構成してチューニングを 行う、フルスクラッチに近いアプローチ。 メリット •最もカスタマイズ性が高い デメリット •専門知識と中長期の調整管理が必要 ユーザマネージド Custom Built RAG -
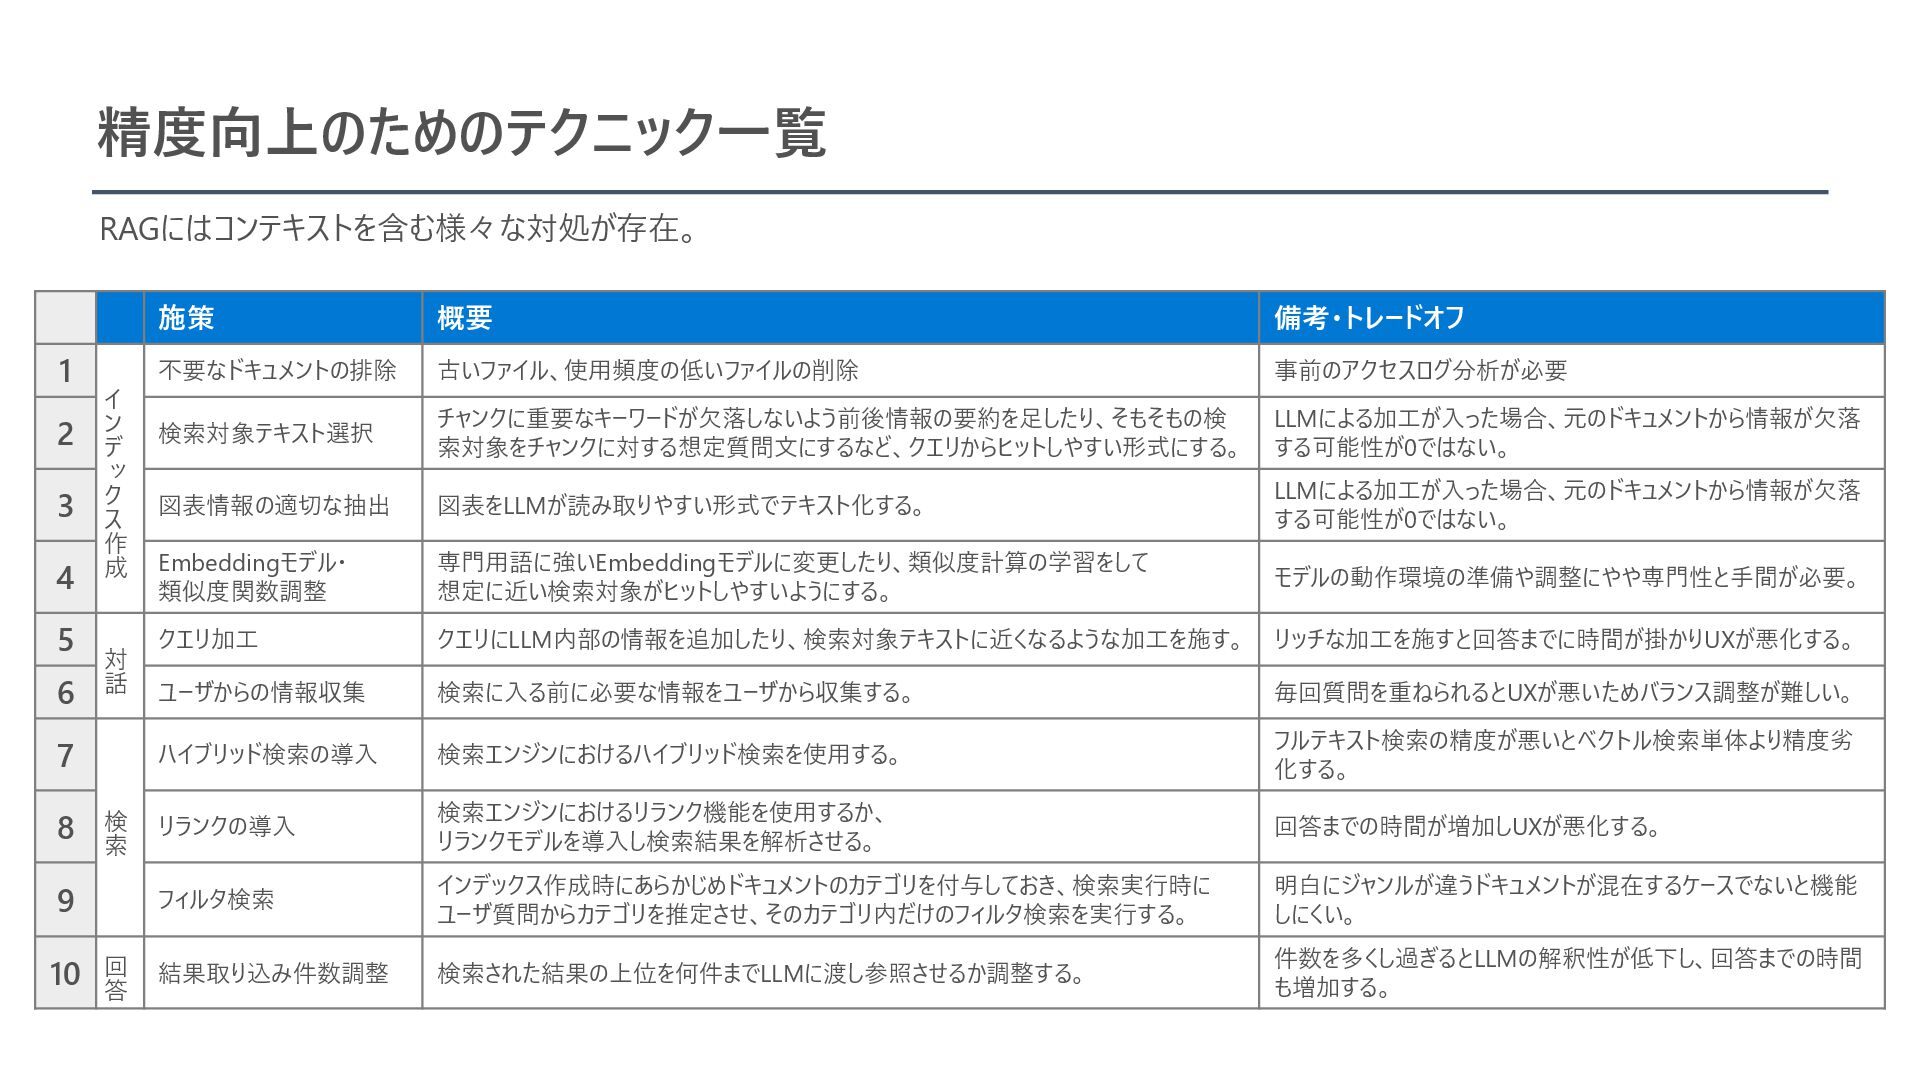
精度向上のためのテクニック一覧 RAGにはコンテキストを含む様々な対処が存在。 施策 概要 備考・トレードオフ 1 イ ン デ ッ
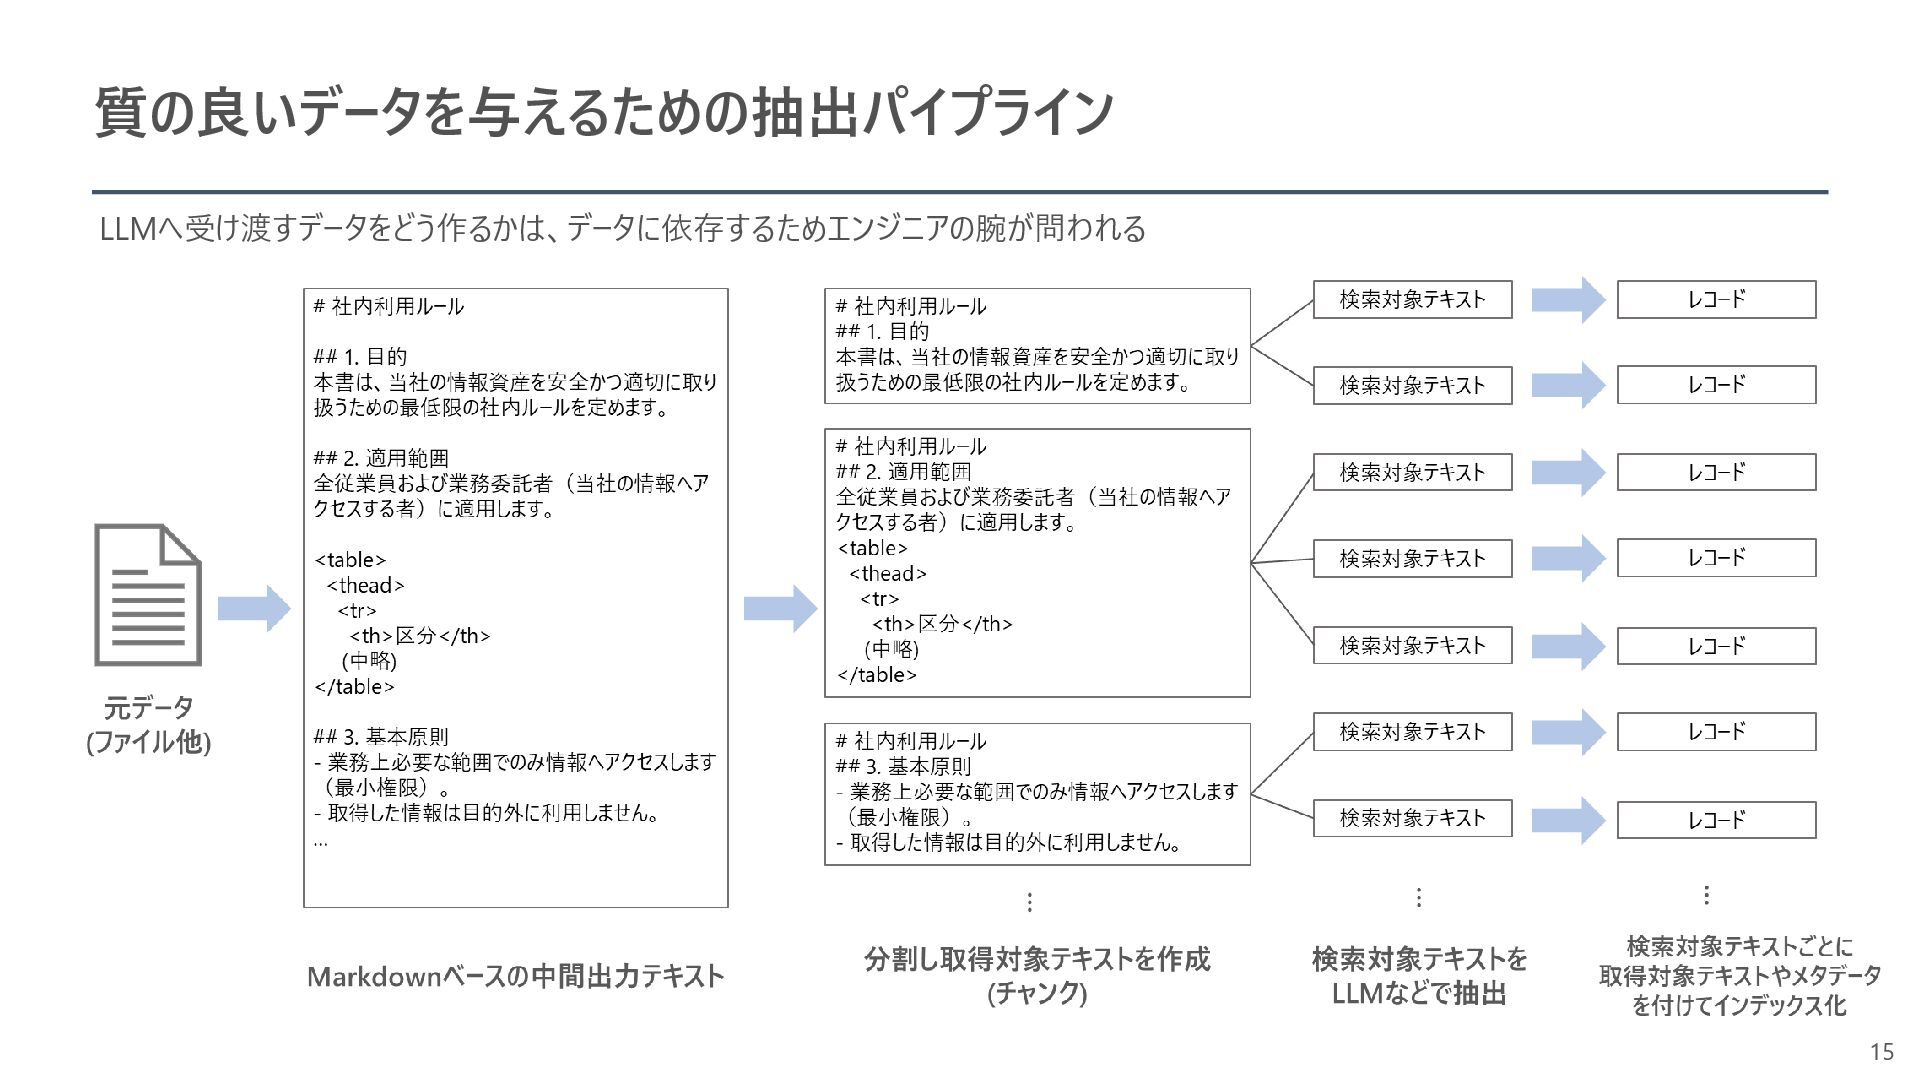
ク ス 作 成 不要なドキュメントの排除 古いファイル、使用頻度の低いファイルの削除 事前のアクセスログ分析が必要 2 検索対象テキスト選択 チャンクに重要なキーワードが欠落しないよう前後情報の要約を足したり、そもそもの検 索対象をチャンクに対する想定質問文にするなど、クエリからヒットしやすい形式にする。 LLMによる加工が入った場合、元のドキュメントから情報が欠落 する可能性が0ではない。 3 図表情報の適切な抽出 図表をLLMが読み取りやすい形式でテキスト化する。 LLMによる加工が入った場合、元のドキュメントから情報が欠落 する可能性が0ではない。 4 Embeddingモデル・ 類似度関数調整 専門用語に強いEmbeddingモデルに変更したり、類似度計算の学習をして 想定に近い検索対象がヒットしやすいようにする。 モデルの動作環境の準備や調整にやや専門性と手間が必要。 5 対 話 クエリ加工 クエリにLLM内部の情報を追加したり、検索対象テキストに近くなるような加工を施す。 リッチな加工を施すと回答までに時間が掛かりUXが悪化する。 6 ユーザからの情報収集 検索に入る前に必要な情報をユーザから収集する。 毎回質問を重ねられるとUXが悪いためバランス調整が難しい。 7 検 索 ハイブリッド検索の導入 検索エンジンにおけるハイブリッド検索を使用する。 フルテキスト検索の精度が悪いとベクトル検索単体より精度劣 化する。 8 リランクの導入 検索エンジンにおけるリランク機能を使用するか、 リランクモデルを導入し検索結果を解析させる。 回答までの時間が増加しUXが悪化する。 9 フィルタ検索 インデックス作成時にあらかじめドキュメントのカテゴリを付与しておき、検索実行時に ユーザ質問からカテゴリを推定させ、そのカテゴリ内だけのフィルタ検索を実行する。 明白にジャンルが違うドキュメントが混在するケースでないと機能 しにくい。 10 回 答 結果取り込み件数調整 検索された結果の上位を何件までLLMに渡し参照させるか調整する。 件数を多くし過ぎるとLLMの解釈性が低下し、回答までの時間 も増加する。 -
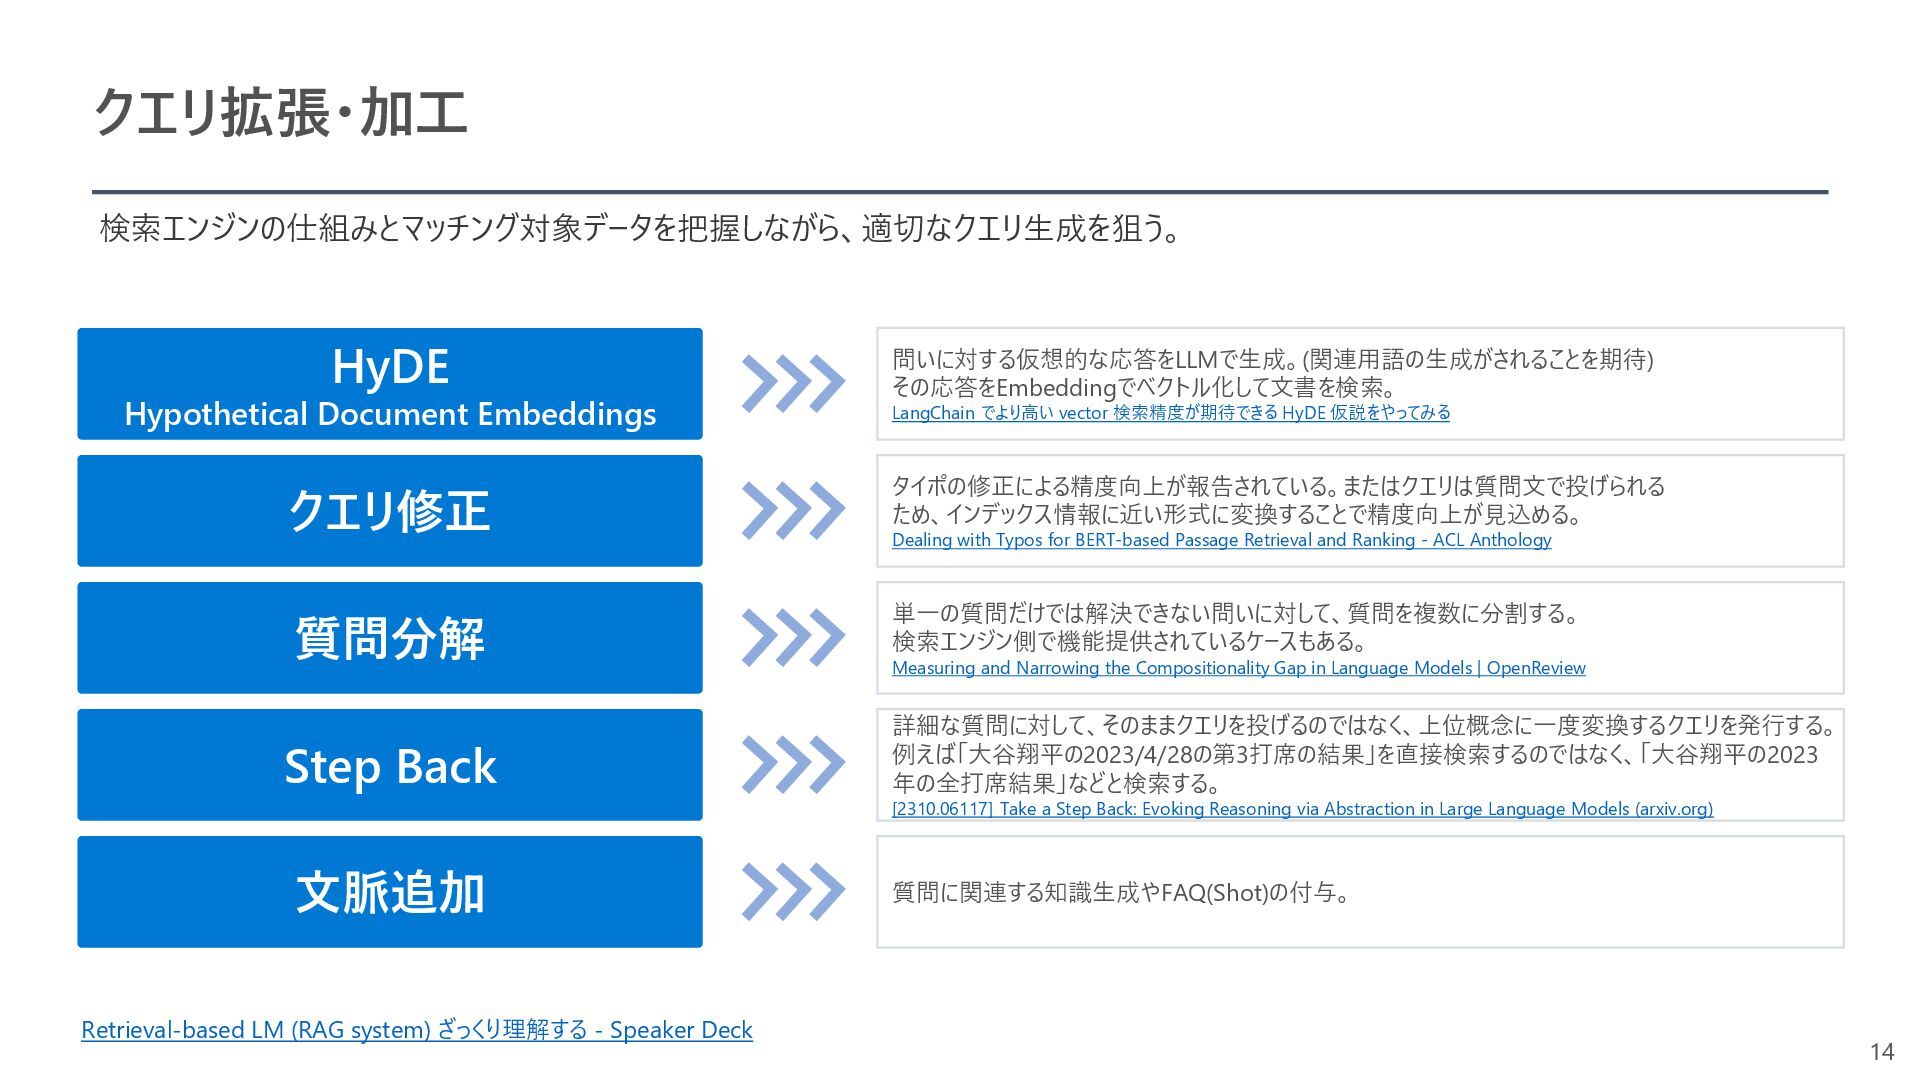
クエリ拡張・加工 質問分解 HyDE Hypothetical Document Embeddings クエリ修正 問いに対する仮想的な応答をLLMで生成。(関連用語の生成がされることを期待) その応答をEmbeddingでベクトル化して文書を検索。 LangChain
でより高い vector 検索精度が期待できる HyDE 仮説をやってみる タイポの修正による精度向上が報告されている。またはクエリは質問文で投げられる ため、インデックス情報に近い形式に変換することで精度向上が見込める。 Dealing with Typos for BERT-based Passage Retrieval and Ranking - ACL Anthology 単一の質問だけでは解決できない問いに対して、質問を複数に分割する。 検索エンジン側で機能提供されているケースもある。 Measuring and Narrowing the Compositionality Gap in Language Models | OpenReview Step Back 詳細な質問に対して、そのままクエリを投げるのではなく、上位概念に一度変換するクエリを発行する。 例えば「大谷翔平の2023/4/28の第3打席の結果」を直接検索するのではなく、「大谷翔平の2023 年の全打席結果」などと検索する。 [2310.06117] Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models (arxiv.org) 文脈追加 質問に関連する知識生成やFAQ(Shot)の付与。 Retrieval-based LM (RAG system) ざっくり理解する - Speaker Deck 検索エンジンの仕組みとマッチング対象データを把握しながら、適切なクエリ生成を狙う。 14 -
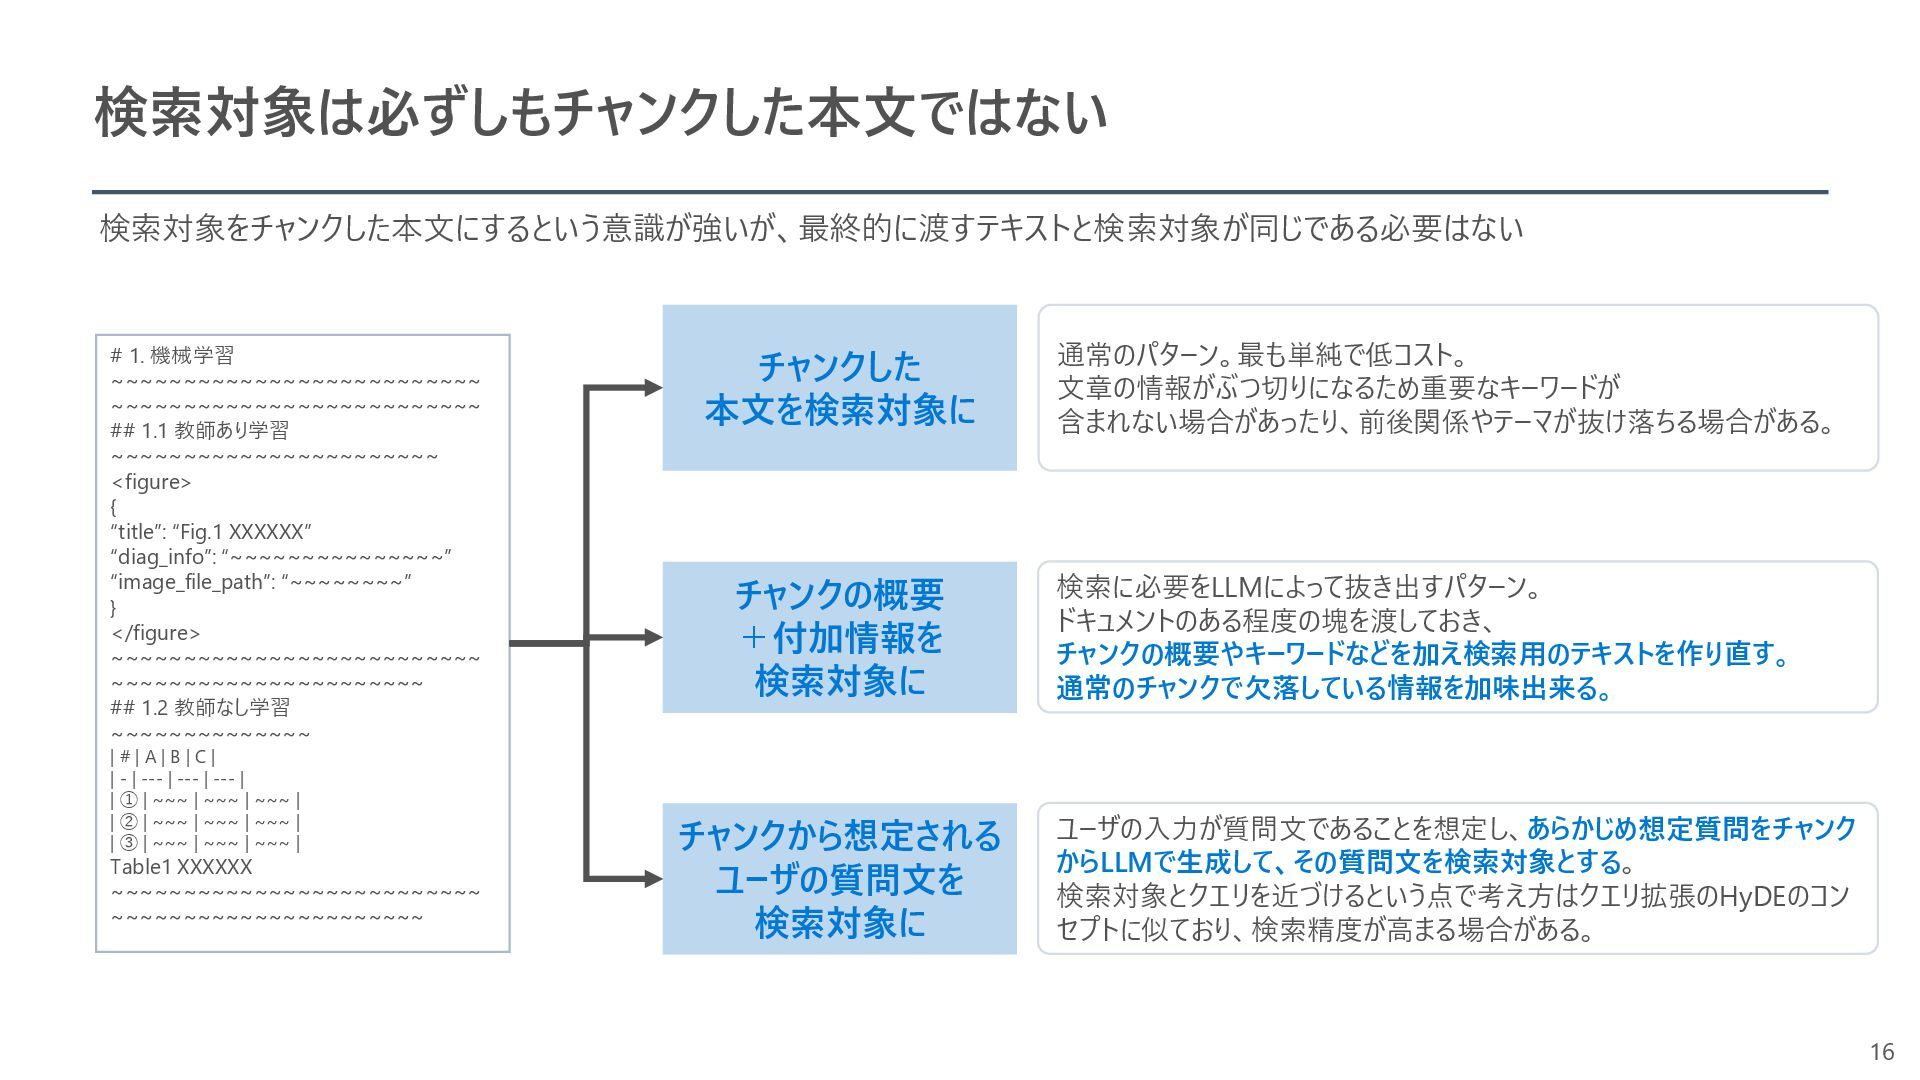
検索対象は必ずしもチャンクした本文ではない # 1. 機械学習 ~~~~~~~~~~~~~~~~~~~~~~~~~~ ~~~~~~~~~~~~~~~~~~~~~~~~~~ ## 1.1 教師あり学習 ~~~~~~~~~~~~~~~~~~~~~~~
<figure> { “title”: “Fig.1 XXXXXX” “diag_info”: “~~~~~~~~~~~~~~~” “image_file_path”: “~~~~~~~~” } </figure> ~~~~~~~~~~~~~~~~~~~~~~~~~~ ~~~~~~~~~~~~~~~~~~~~~~ ## 1.2 教師なし学習 ~~~~~~~~~~~~~~ | # | A | B | C | | - | --- | --- | --- | | ① | ~~~ | ~~~ | ~~~ | | ② | ~~~ | ~~~ | ~~~ | | ③ | ~~~ | ~~~ | ~~~ | Table1 XXXXXX ~~~~~~~~~~~~~~~~~~~~~~~~~~ ~~~~~~~~~~~~~~~~~~~~~~ チャンクした 本文を検索対象に チャンクの概要 +付加情報を 検索対象に 通常のパターン。最も単純で低コスト。 文章の情報がぶつ切りになるため重要なキーワードが 含まれない場合があったり、前後関係やテーマが抜け落ちる場合がある。 検索に必要をLLMによって抜き出すパターン。 ドキュメントのある程度の塊を渡しておき、 チャンクの概要やキーワードなどを加え検索用のテキストを作り直す。 通常のチャンクで欠落している情報を加味出来る。 チャンクから想定される ユーザの質問文を 検索対象に ユーザの入力が質問文であることを想定し、あらかじめ想定質問をチャンク からLLMで生成して、その質問文を検索対象とする。 検索対象とクエリを近づけるという点で考え方はクエリ拡張のHyDEのコン セプトに似ており、検索精度が高まる場合がある。 検索対象をチャンクした本文にするという意識が強いが、最終的に渡すテキストと検索対象が同じである必要はない 16 -
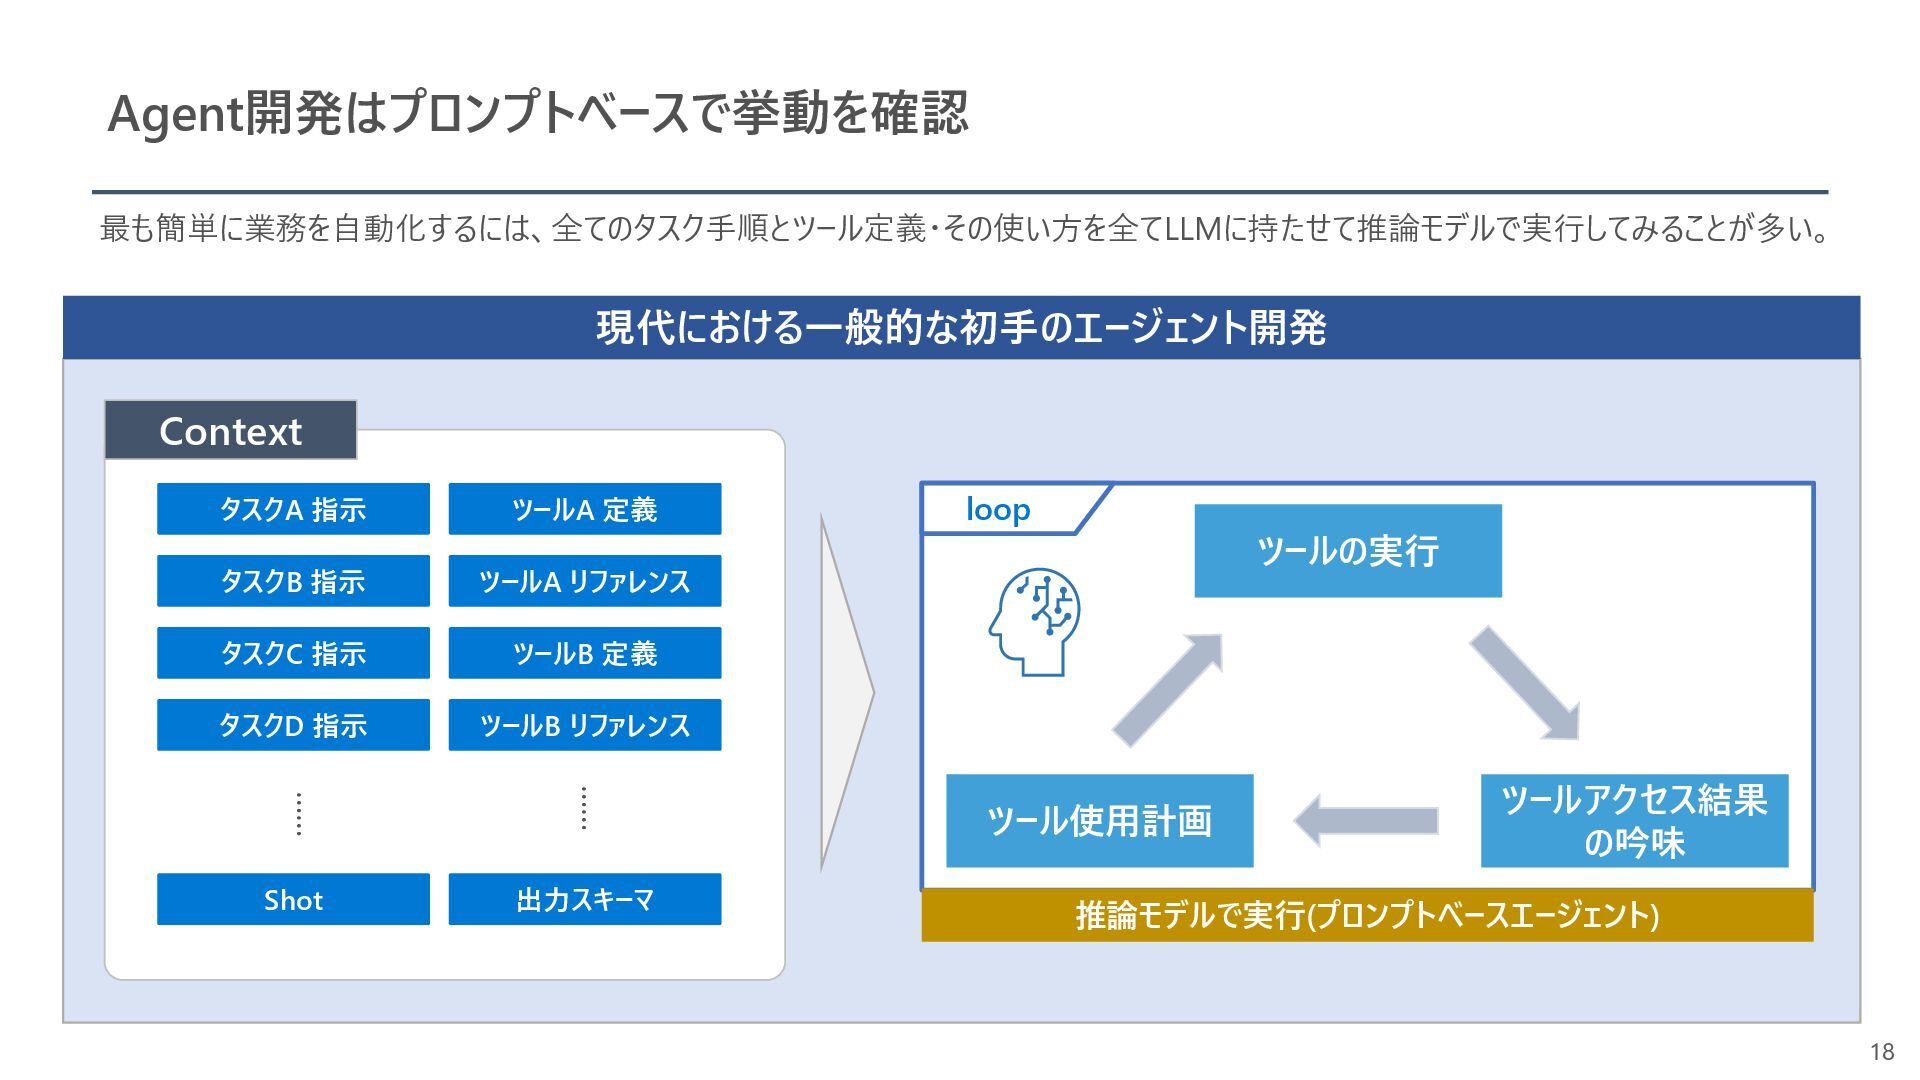
Agent開発はプロンプトベースで挙動を確認 18 ツール使用計画 ツールの実行 ツールアクセス結果 の吟味 loop 最も簡単に業務を自動化するには、全てのタスク手順とツール定義・その使い方を全てLLMに持たせて推論モデルで実行してみることが多い。 Context 現代における一般的な初手のエージェント開発
推論モデルで実行(プロンプトベースエージェント) ツールA リファレンス ツールB 定義 ツールB リファレンス タスクB 指示 タスクC 指示 タスクD 指示 Shot 出力スキーマ …… …… ツールA 定義 タスクA 指示 -
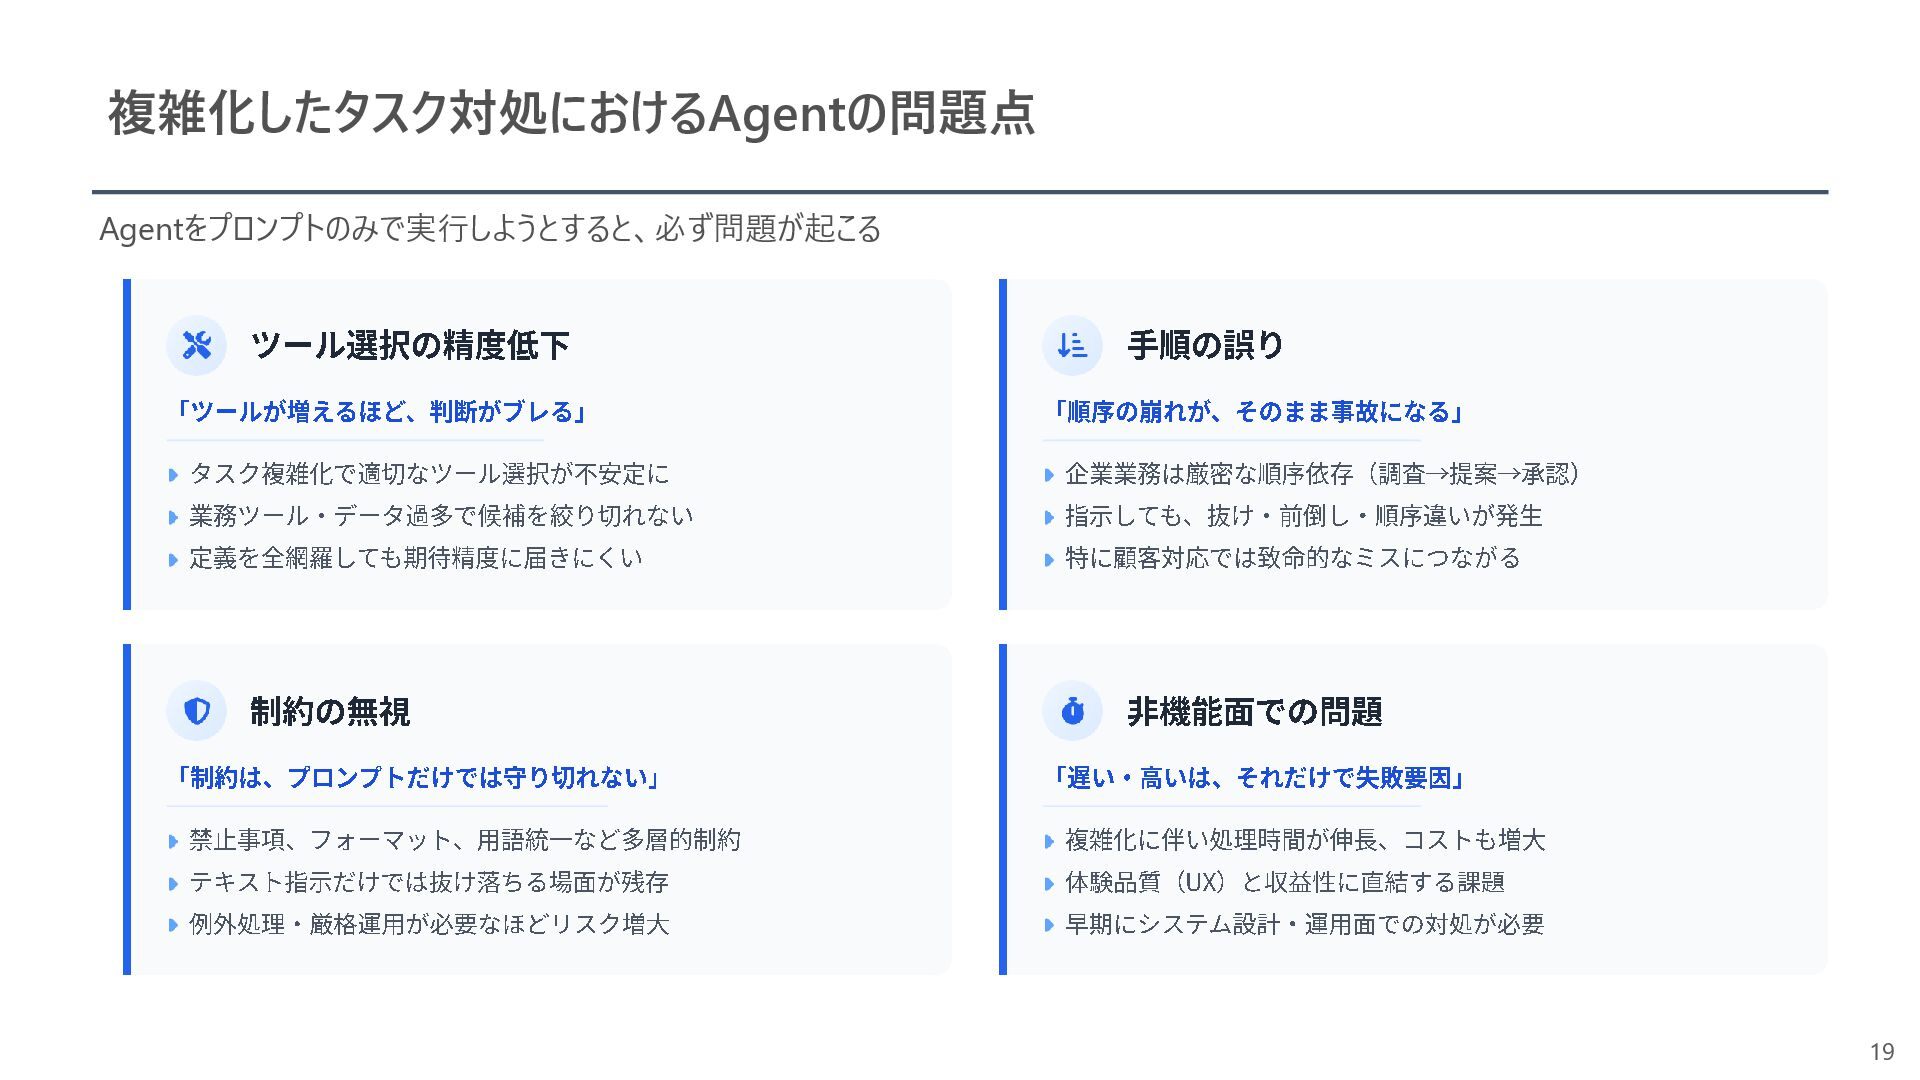
複雑化したタスク対処におけるAgentの問題点 19 Agentをプロンプトのみで実行しようとすると、必ず問題が起こる ツール選択の精度低下 タスク複雑化で適切なツール選択が不安定に 業務ツール・データ過多で候補を絞り切れない 定義を全網羅しても期待精度に届きにくい 手順の誤り 企業業務は厳密な順序依存(調査 →提案→承認)
指示しても、抜け・前倒し・順序違いが発生 特に顧客対応では致命的なミスにつながる 制約の無視 禁止事項、フォーマット、用語統一など多層的制約 テキスト指示だけでは抜け落ちる場面が残存 例外処理・厳格運用が必要なほどリスク増大 非機能面での問題 複雑化に伴い処理時間が伸長、コストも増大 体験品質( UX)と収益性に直結する課題 早期にシステム設計・運用面での対処が必要 「ツールが増えるほど、判断がブレる」 「順序の崩れが、そのまま事故になる」 「制約は、プロンプトだけでは守り切れない」 「遅い・高いは、それだけで失敗要因」 -
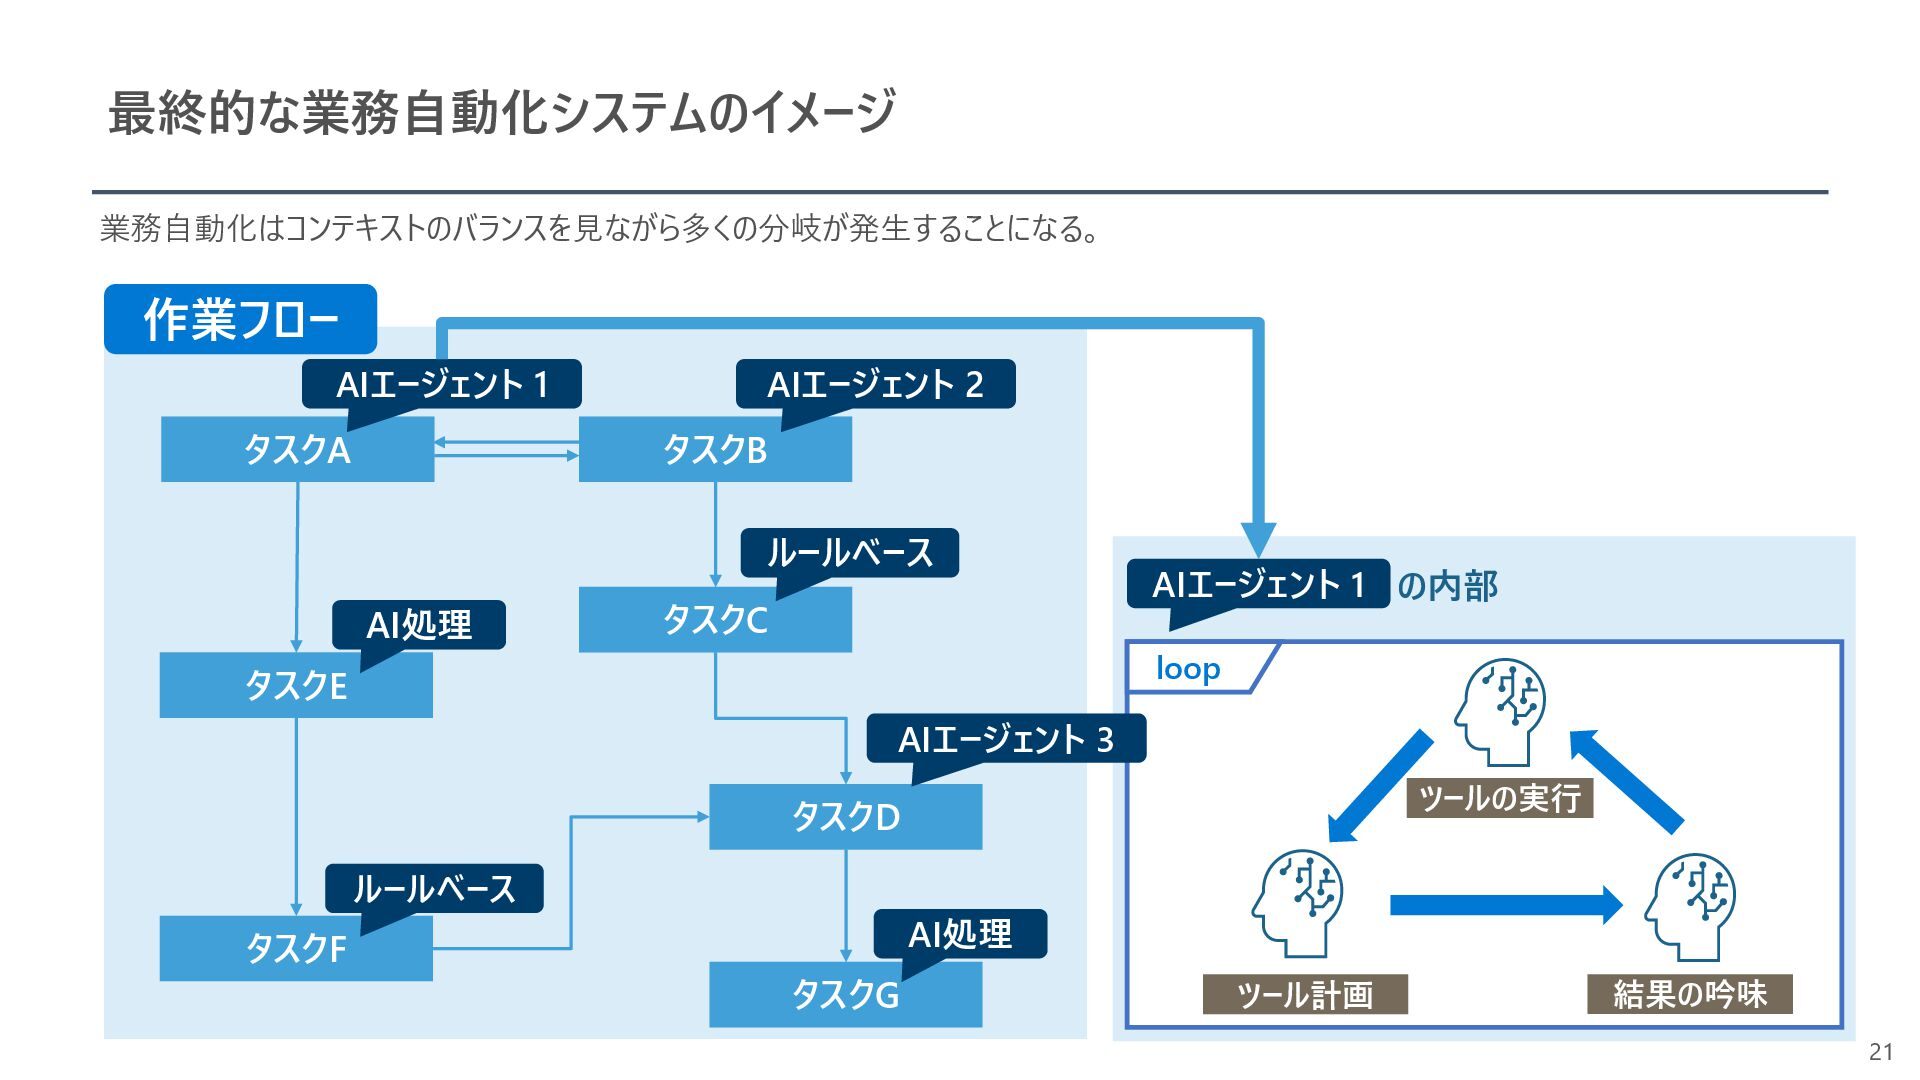
最終的な業務自動化システムのイメージ 21 タスクA タスクB タスクE タスクF タスクG タスクD タスクC AIエージェント
1 作業フロー ルールベース AI処理 ルールベース AI処理 AIエージェント 1 loop AIエージェント 2 AIエージェント 3 業務自動化はコンテキストのバランスを見ながら多くの分岐が発生することになる。 ツールの実行 の内部 ツール計画 結果の吟味 -
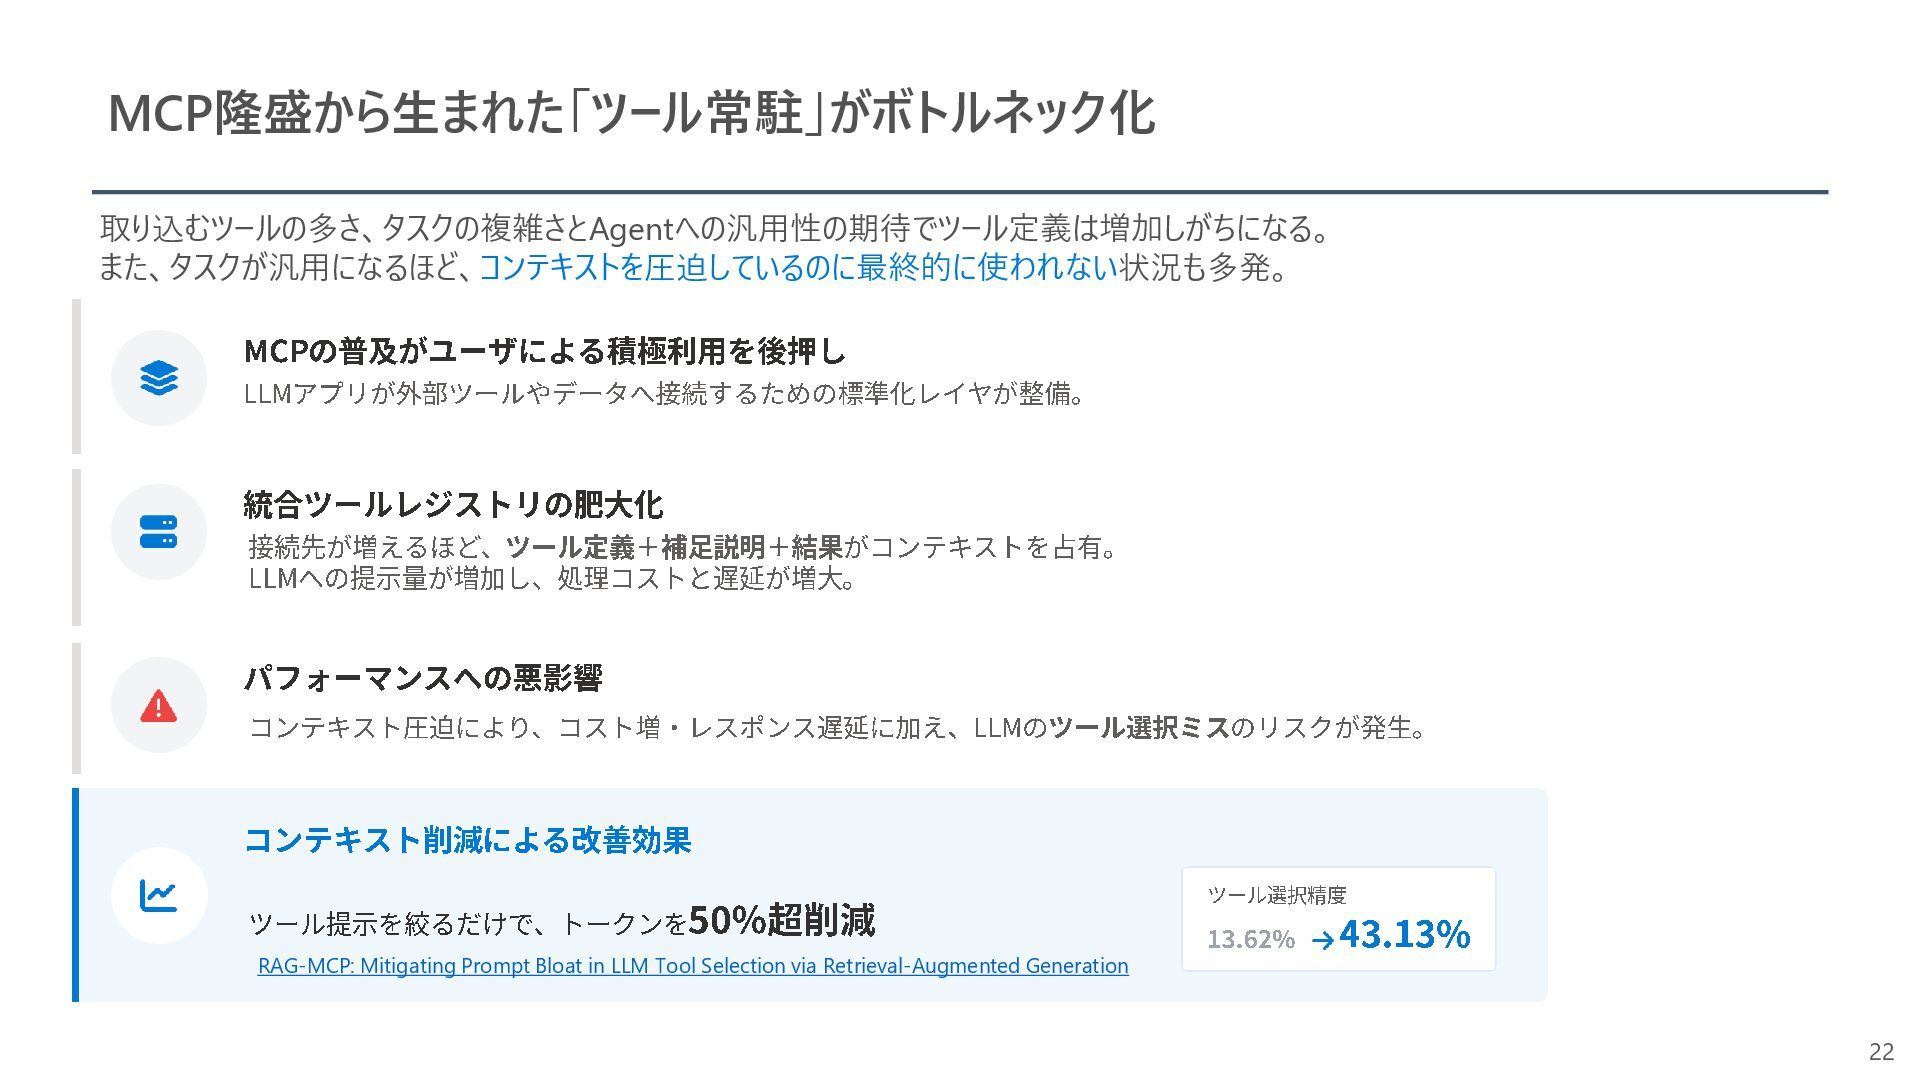
MCP隆盛から生まれた「ツール常駐」がボトルネック化 22 取り込むツールの多さ、タスクの複雑さとAgentへの汎用性の期待でツール定義は増加しがちになる。 また、タスクが汎用になるほど、コンテキストを圧迫しているのに最終的に使われない状況も多発。 MCP の普及がユーザによる積極利用を後押し LLMアプリが外部ツールやデータへ接続するための標準化レイヤ が整備。 統合ツールレジストリの肥大化 接続先が増えるほど、
ツール定義+補足説明+結果 がコンテキストを占有。 LLMへの提示量が増加し、処理コストと遅延が増大 。 パフォーマンスへの悪影響 コンテキスト圧迫により、コスト増・レスポンス遅延に加え、 LLMのツール選択ミス のリスク が発生。 コンテキスト削減 による改善効果 ツール提示を絞るだけで、トークンを 50 %超削減 ツール選択精度 13.62% 43.13% RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation -
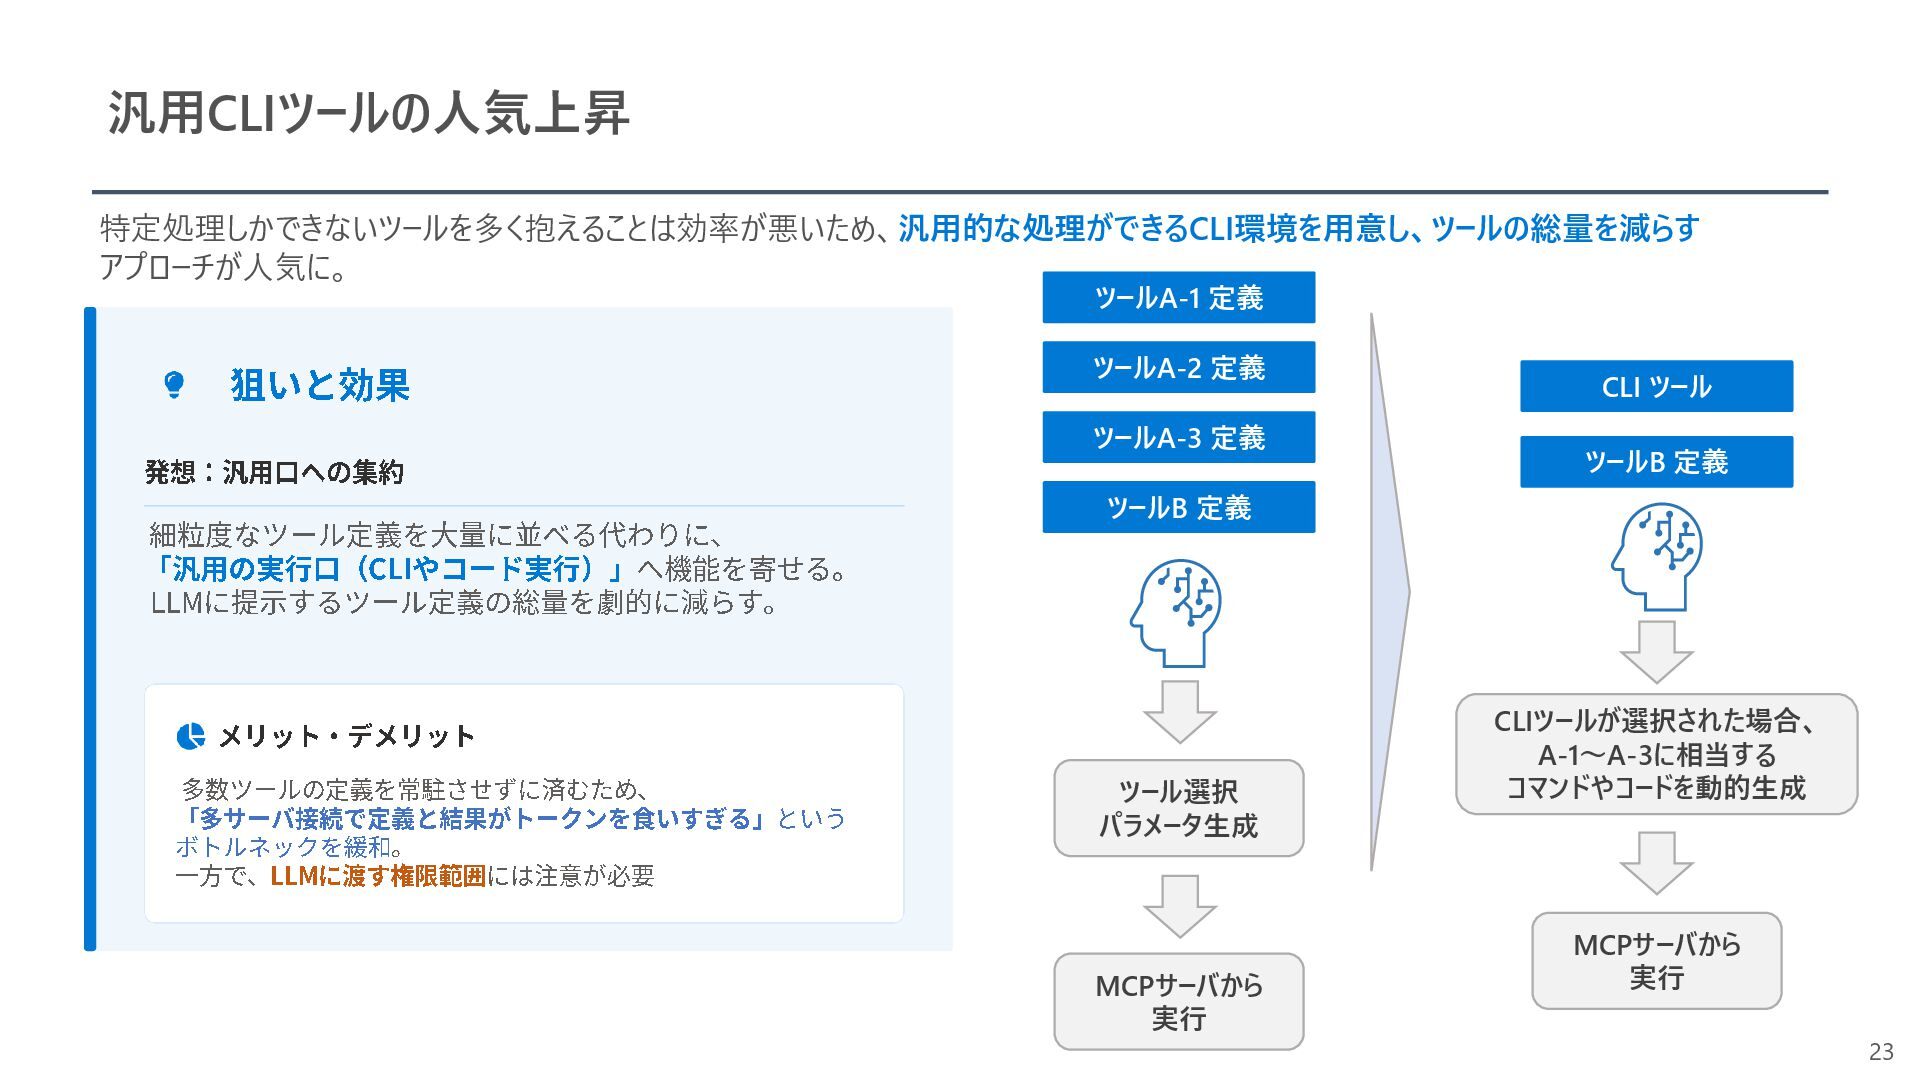
汎用CLIツールの人気上昇 23 狙いと効果 発想:汎用口への集約 細粒度なツール定義を大量に並べる代わりに 、 「汎用の実行口( CLIやコード実行)」 へ機能を寄せる。 LLMに提示するツール定義の総量を劇的に減ら
す。 メリット ・デメリット 多数ツールの 定義を常駐させずに済むため 、 「 多サーバ接続で定義と結果がトークンを食いすぎる」 という ボトルネックを緩和 。 一方で、 LLM に渡す権限範囲には注意が必要 特定処理しかできないツールを多く抱えることは効率が悪いため、汎用的な処理ができるCLI環境を用意し、ツールの総量を減らす アプローチが人気に。 ツールA-2 定義 ツールA-1 定義 ツールA-3 定義 CLI ツール ツール選択 パラメータ生成 ツールB 定義 ツールB 定義 CLIツールが選択された場合、 A-1~A-3に相当する コマンドやコードを動的生成 MCPサーバから 実行 MCPサーバから 実行 -
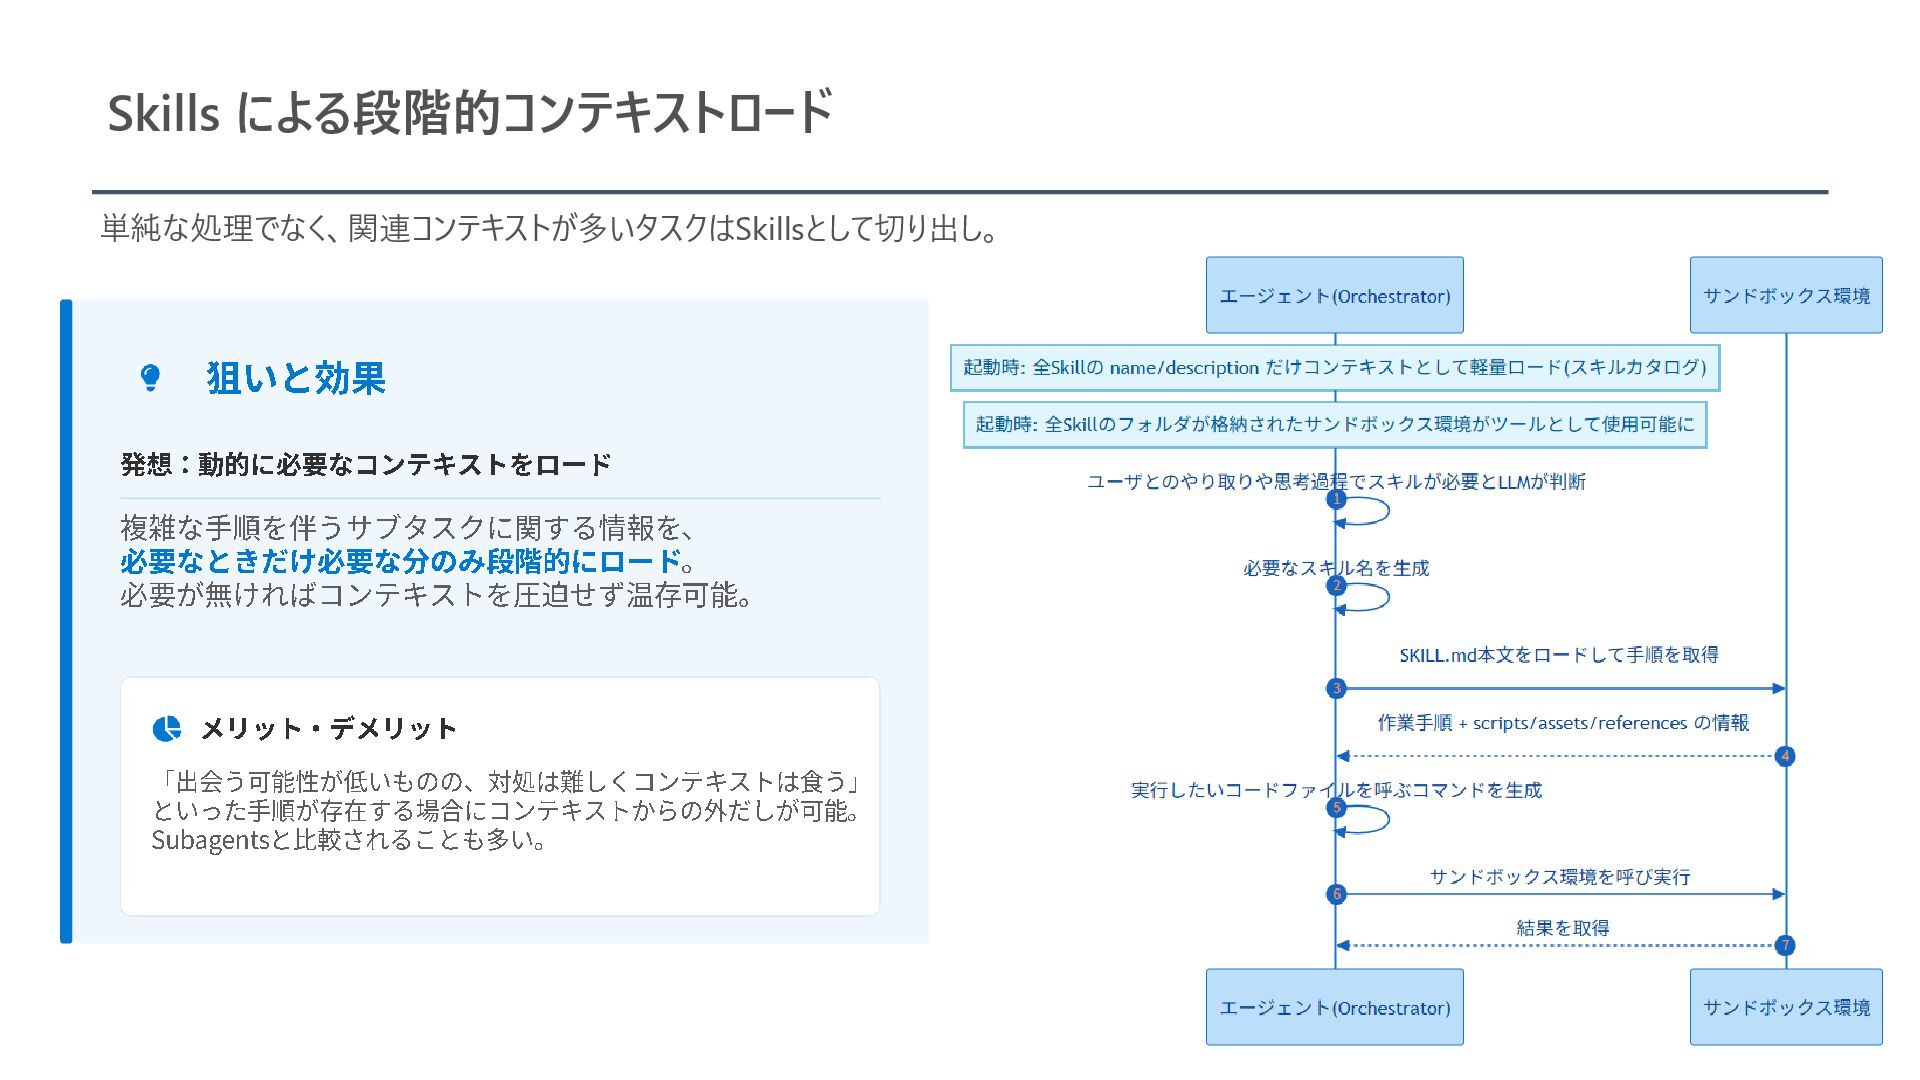
Skills による段階的コンテキストロード 24 狙いと効果 発想: 動的に必要なコンテキストをロード 複雑な手順を伴うサブタスクに関する情報を 、 必要なときだけ必要な分のみ段階的にロード 。
必要が無ければコンテキストを圧迫せず温存可能。 メリット ・デメリット 「出会う可能性が低いものの、対処は難しくコンテキストは食う」 といった手順が存在する場合にコンテキストからの外だしが可能 。 Subagents と比較されることも多い。 単純な処理でなく、関連コンテキストが多いタスクはSkillsとして切り出し。 -
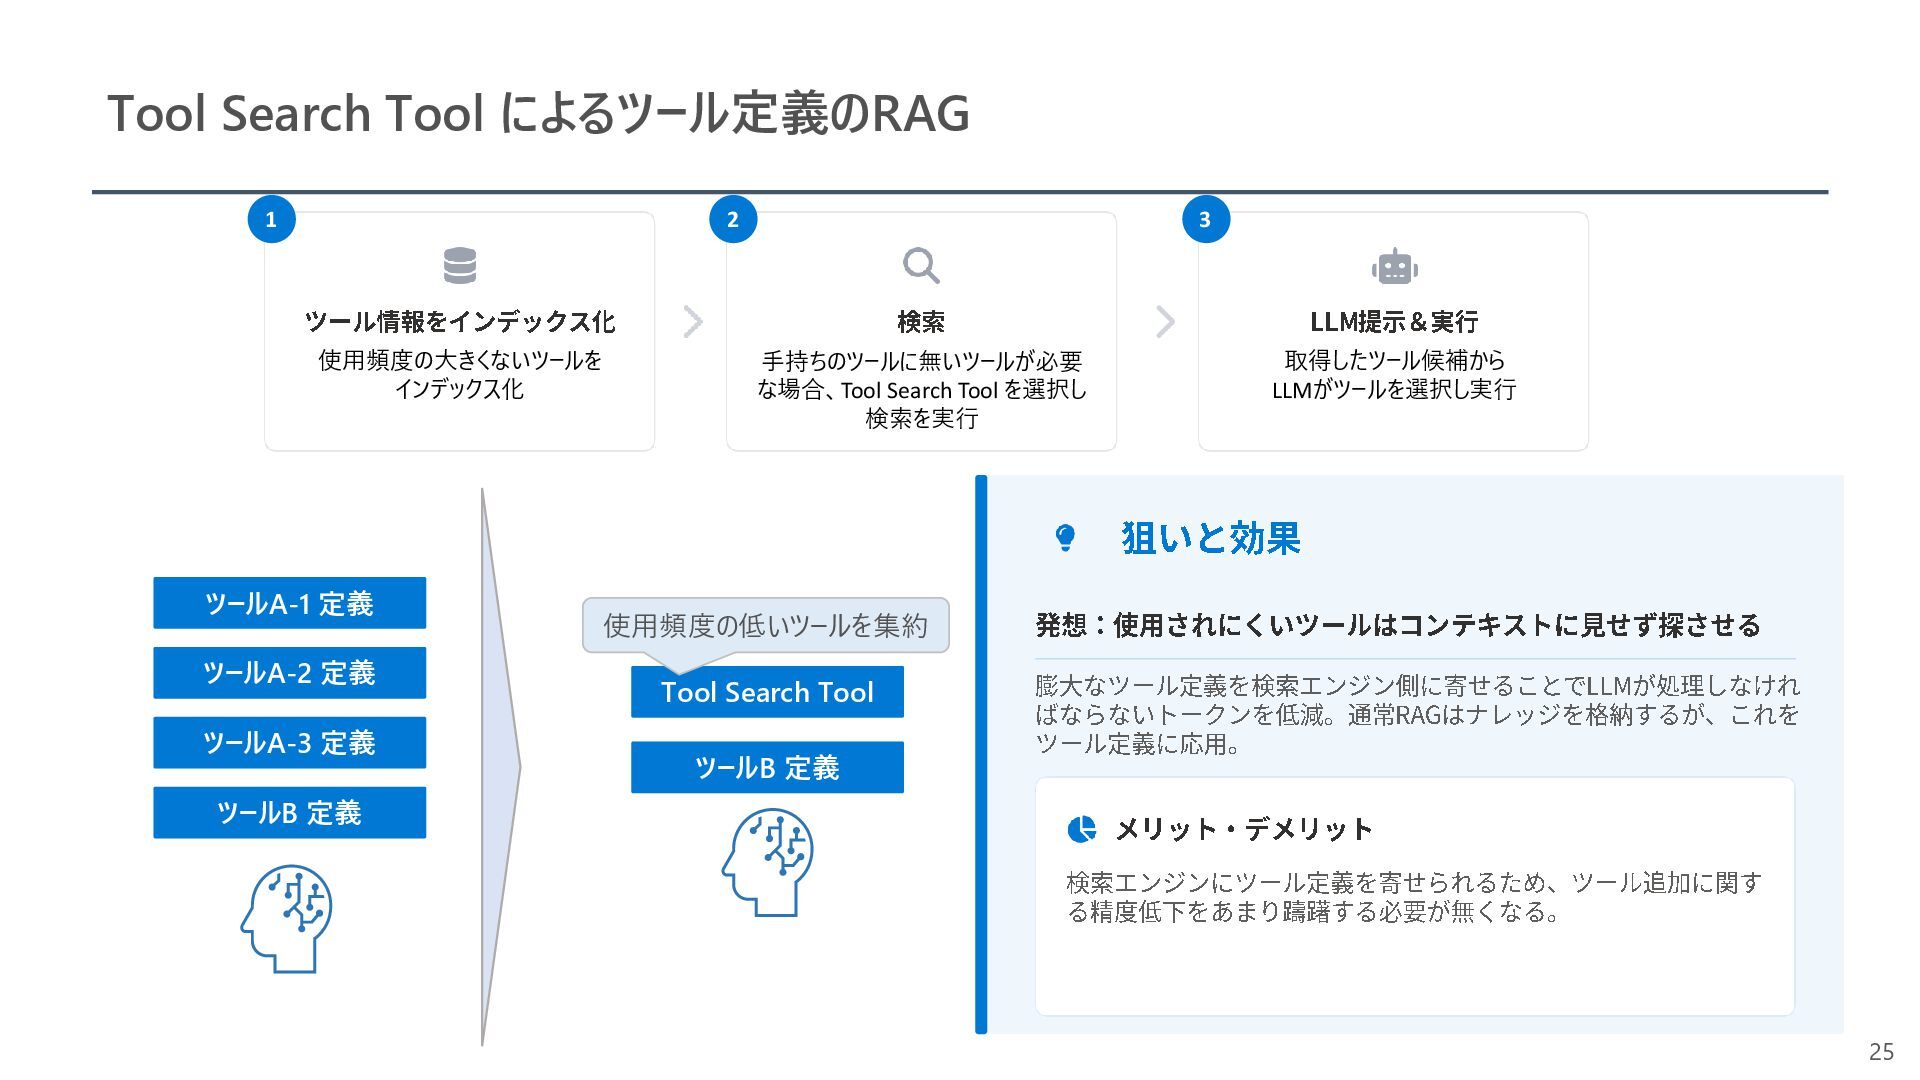
Tool Search Tool によるツール定義のRAG 25 ツール情報を インデックス化 使用頻度の大きくないツールを インデックス化 検索
手持ちのツールに無いツールが必要 な場合、Tool Search Tool を選択し 検索を実行 LLM 提示&実行 取得したツール候補から LLMがツールを選択し実行 1 2 3 狙いと効果 発想: 使用されにくいツールはコンテキストに見せず探させる 膨大なツール定義を検索エンジン側に寄せることで LLMが処理しなけれ ばならないトークンを低減。通常 RAGはナレッジを格納するが、これを ツール定義に応用。 メリット ・デメリット 検索エンジンにツール定義を寄せられるため、ツール追加に関す る精度低下をあまり躊躇する必要が無くなる。 ツールA-2 定義 ツールA-1 定義 ツールA-3 定義 Tool Search Tool ツールB 定義 ツールB 定義 使用頻度の低いツールを集約