Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AI時代のGraphQL

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →
Avatar for joe_re joe_re
October 22, 2026

 AI時代のGraphQL

GraphQL Tokyo(2026-10-22)のLT資料です。

Apolloが2026年9月に公開した「GraphQL経由のMCPツールはREST経由よりtoken効率が良い」というベンチマークを4モデルで追試しました。公開値は再現しました。GraphQLが有利な理由は、フィールド選択とjoinを文法で強制していることでした。ただし、エージェントがその場でクエリを書く条件は、対象1件の質問ではスキーマ探索のコストでRESTに負けます。

GraphQL AI Working Groupはこの探索の問題を「難しいのはクエリを書くことではなく、正しいフィールドを見つけること」と診断し、仕様(Semantic Introspection)・モデル(GraphQL専用Embedding)・ツールの3層で回答を進めています。手元で検証したところ、descriptionを1行足すだけで探索の空振りが消え、スキーマを丸ごと1回渡すとRESTより安くなりました。

GraphQLがスキーマをネイティブに持っていることが、そのままAI時代の利点になります。人間向けに書いてきたスキーマドキュメントが、エージェント向けの資産になるという話です。

元記事:https://zenn.dev/peoplex_blog/articles/b45be40596c4f0
追試のコード:https://github.com/joe-re/graphql-mcp-benchmarks/tree/claude-code-verification/cc

Avatar for joe_re

joe_re

October 22, 2026

More Decks by joe_re

Other Decks in Technology

Transcript

  1. 自己紹介 X: @joe_re / GitHub: @joe-re Work for PeopleX Inc.

    AI製品開発責任者 GraphQL Tokyo オーガナイザー
  2. GraphQL can and must be the language of AI GraphQLConf

    2026(2026-05)基調講演、Matt DeBergalis(Apollo CEO) https://www.youtube.com/watch?v=fG7NcUxWzt8
  3. Apollo の主張 2026-05 GraphQLConf 2026、Apollo CEO Matt DeBergalis の基調講演 1

    年前の予測「GraphQL は AI アプリケーションの基盤インフラになる」は現 実になった。様々な企業で AI の取り組みを支えている 宣言的でエンティティ中心の設計は、エージェントに向いている。エージェント は型付きで構造化されたデータを推論したい。 2026-09 Apollo が graphql-mcp-benchmarks を公開 GraphQL 経由の MCP ツールは、REST 経由より token 効率が良い ことを示 すベンチマーク 同じデータを REST と GraphQL の MCP ツールで扱わせ、エージェントの token 消費を比べた
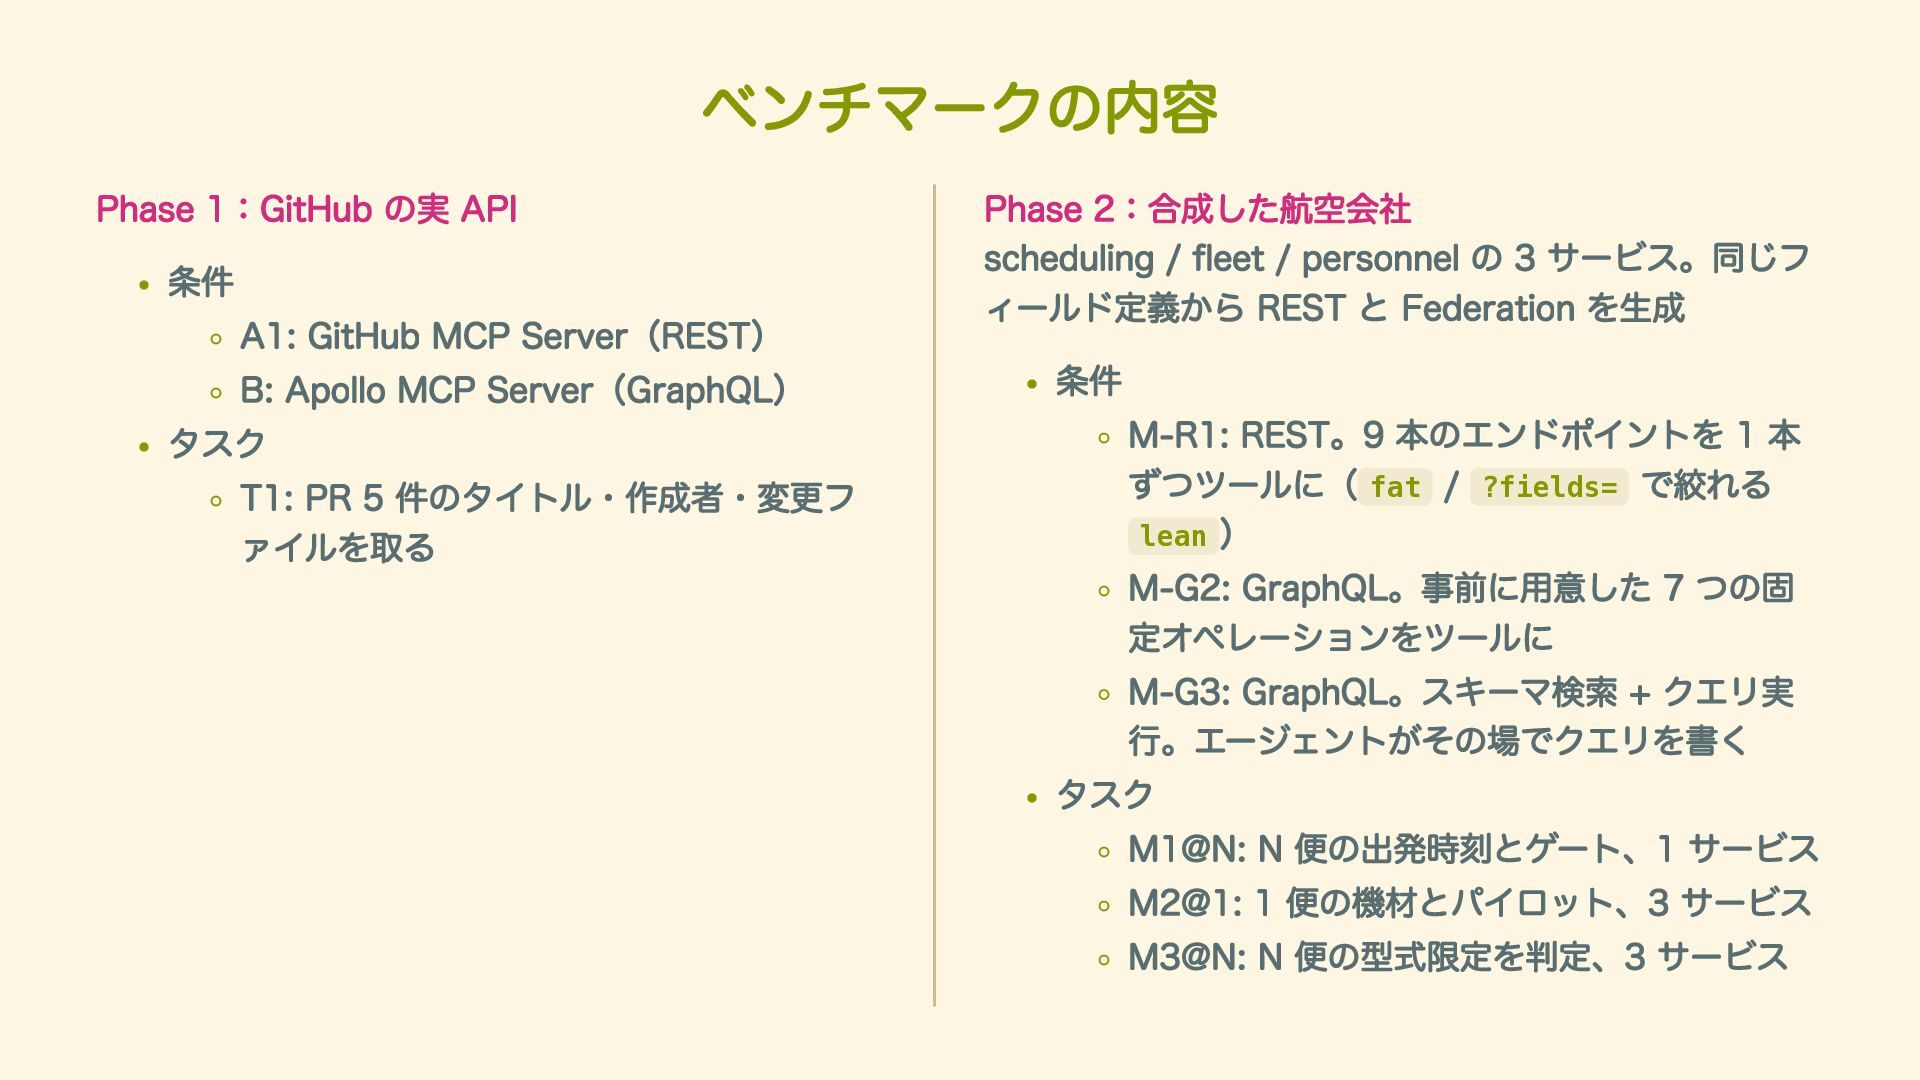
  4. ベンチマークの内容 Phase 1:GitHub の実 API 条件 A1: GitHub MCP Server(REST)

    B: Apollo MCP Server(GraphQL) タスク T1: PR 5 件のタイトル・作成者・変更フ ァイルを取る Phase 2:合成した航空会社 scheduling / fleet / personnel の 3 サービス。同じフ ィールド定義から REST と Federation を生成 条件 M-R1: REST。9 本のエンドポイントを 1 本 ずつツールに( fat / ?fields= で絞れる lean ) M-G2: GraphQL。事前に用意した 7 つの固 定オペレーションをツールに M-G3: GraphQL。スキーマ検索 + クエリ実 行。エージェントがその場でクエリを書く タスク M1@N: N 便の出発時刻とゲート、1 サービス M2@1: 1 便の機材とパイロット、3 サービス M3@N: N 便の型式限定を判定、3 サービス
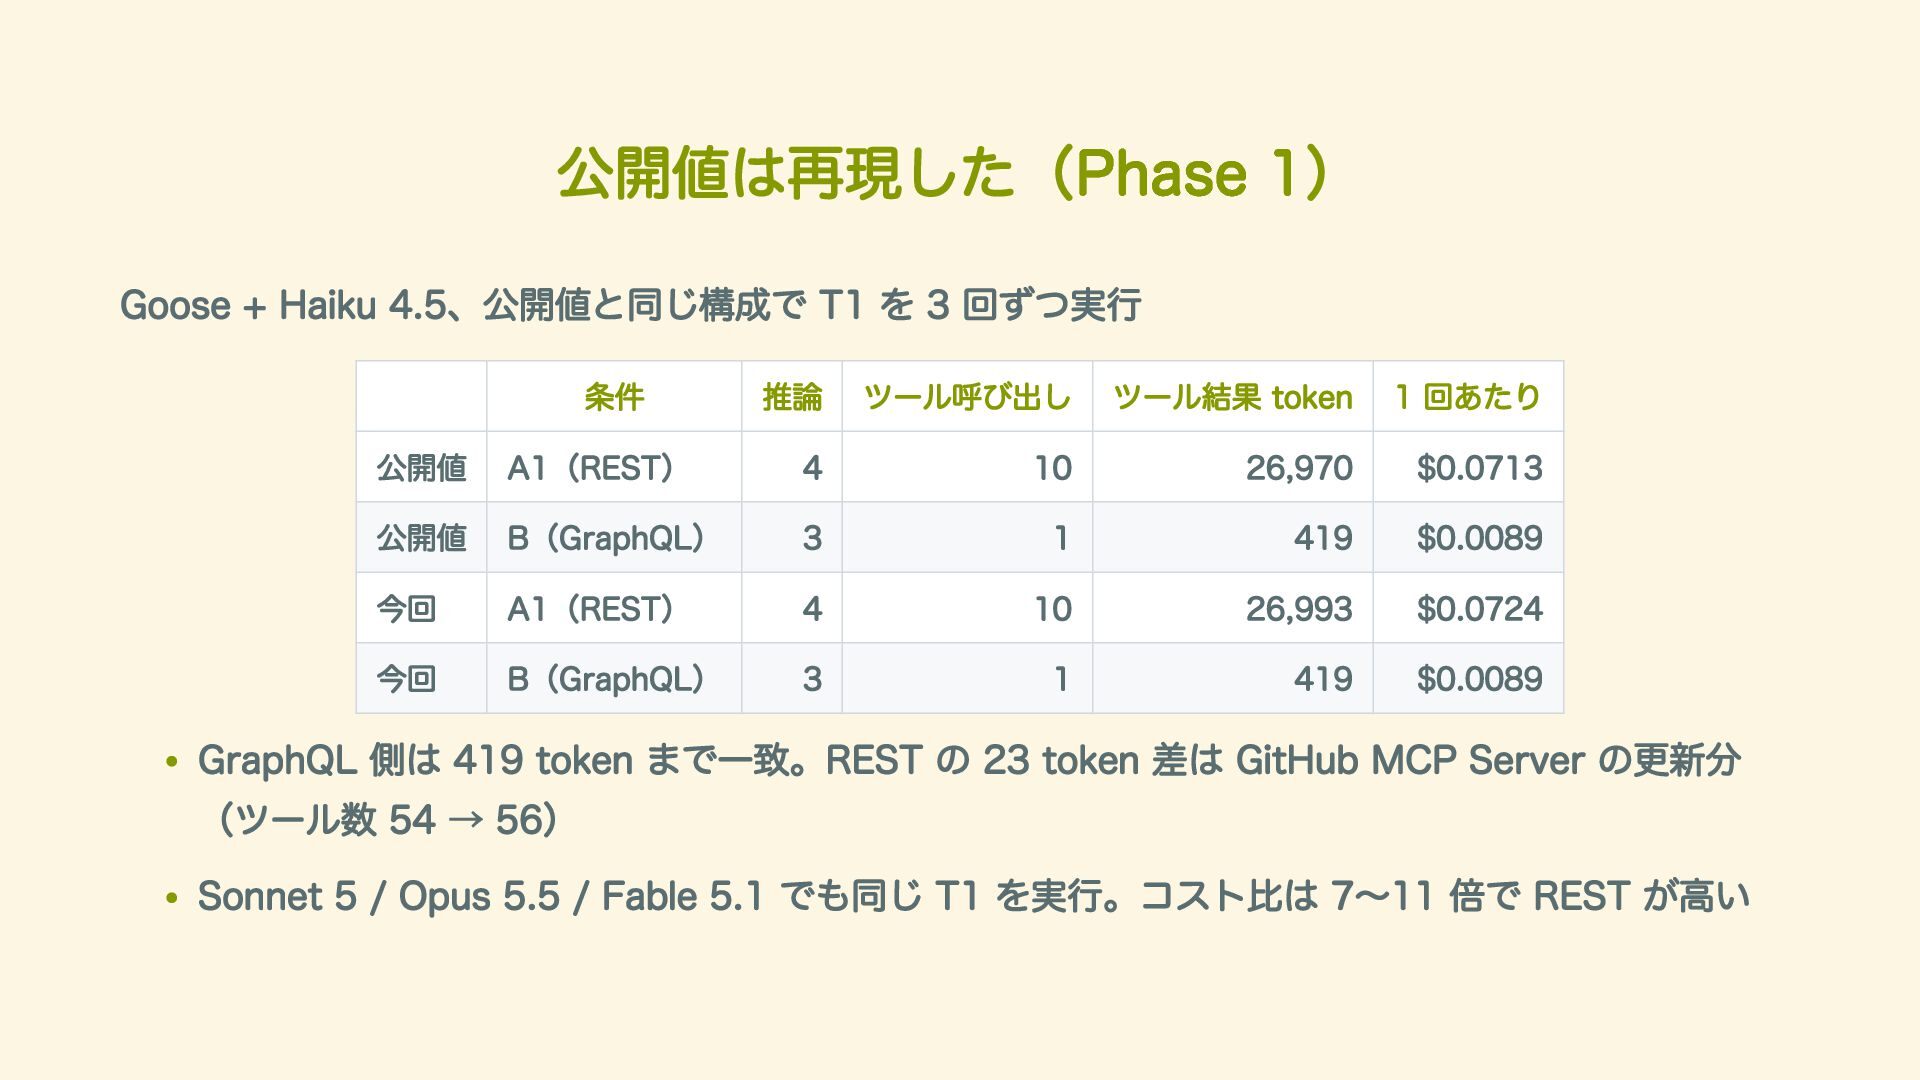
  5. 公開値は再現した(Phase 1) Goose + Haiku 4.5、公開値と同じ構成で T1 を 3 回ずつ実行

    条件 推論 ツール呼び出し ツール結果 token 1 回あたり 公開値 A1(REST) 4 10 26,970 $0.0713 公開値 B(GraphQL) 3 1 419 $0.0089 今回 A1(REST) 4 10 26,993 $0.0724 今回 B(GraphQL) 3 1 419 $0.0089 GraphQL 側は 419 token まで一致。REST の 23 token 差は GitHub MCP Server の更新分 (ツール数 54 → 56) Sonnet 5 / Opus 5.5 / Fable 5.1 でも同じ T1 を実行。コスト比は 7〜11 倍で REST が高い
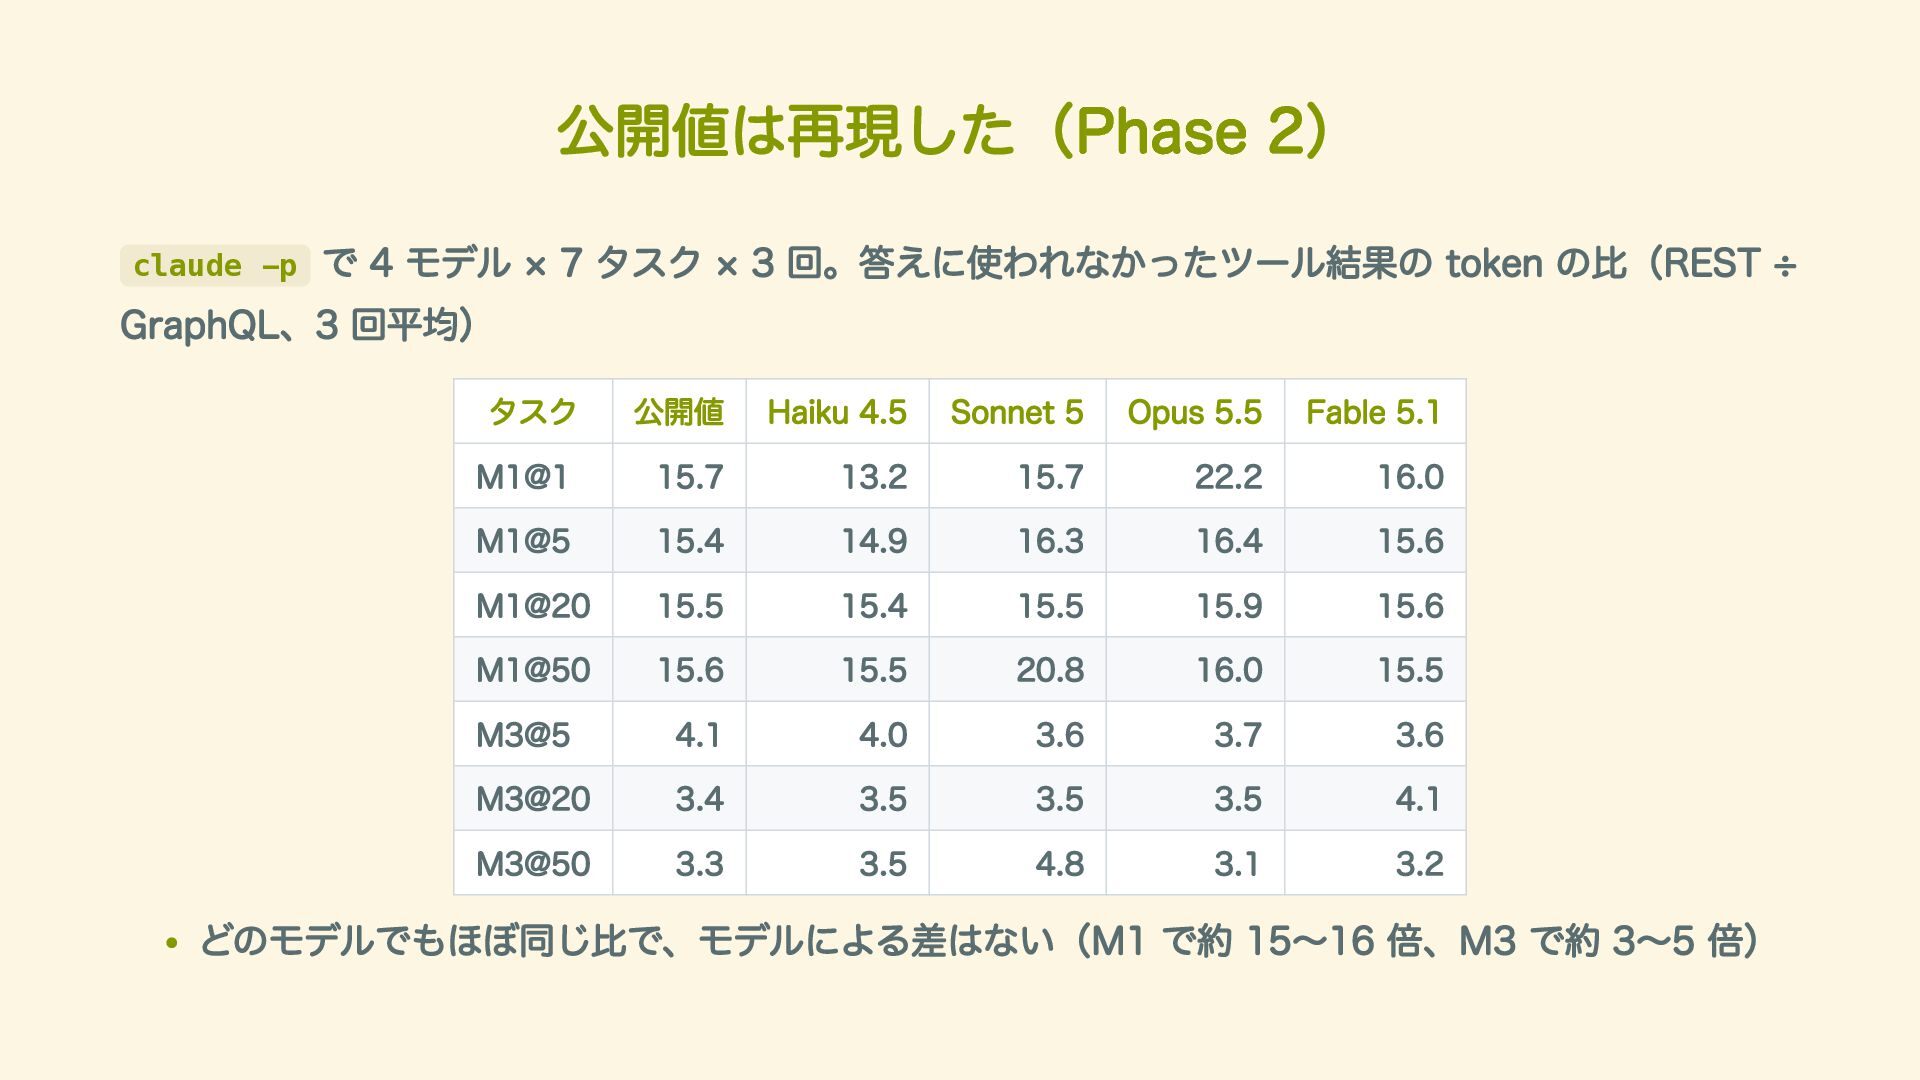
  6. 公開値は再現した(Phase 2) で 4 モデル × 7 タスク × 3

    回。答えに使われなかったツール結果の token の比(REST ÷ GraphQL、3 回平均) claude -p タスク 公開値 Haiku 4.5 Sonnet 5 Opus 5.5 Fable 5.1 M1@1 15.7 13.2 15.7 22.2 16.0 M1@5 15.4 14.9 16.3 16.4 15.6 M1@20 15.5 15.4 15.5 15.9 15.6 M1@50 15.6 15.5 20.8 16.0 15.5 M3@5 4.1 4.0 3.6 3.7 3.6 M3@20 3.4 3.5 3.5 3.5 4.1 M3@50 3.3 3.5 4.8 3.1 3.2 どのモデルでもほぼ同じ比で、モデルによる差はない(M1 で約 15〜16 倍、M3 で約 3〜5 倍)
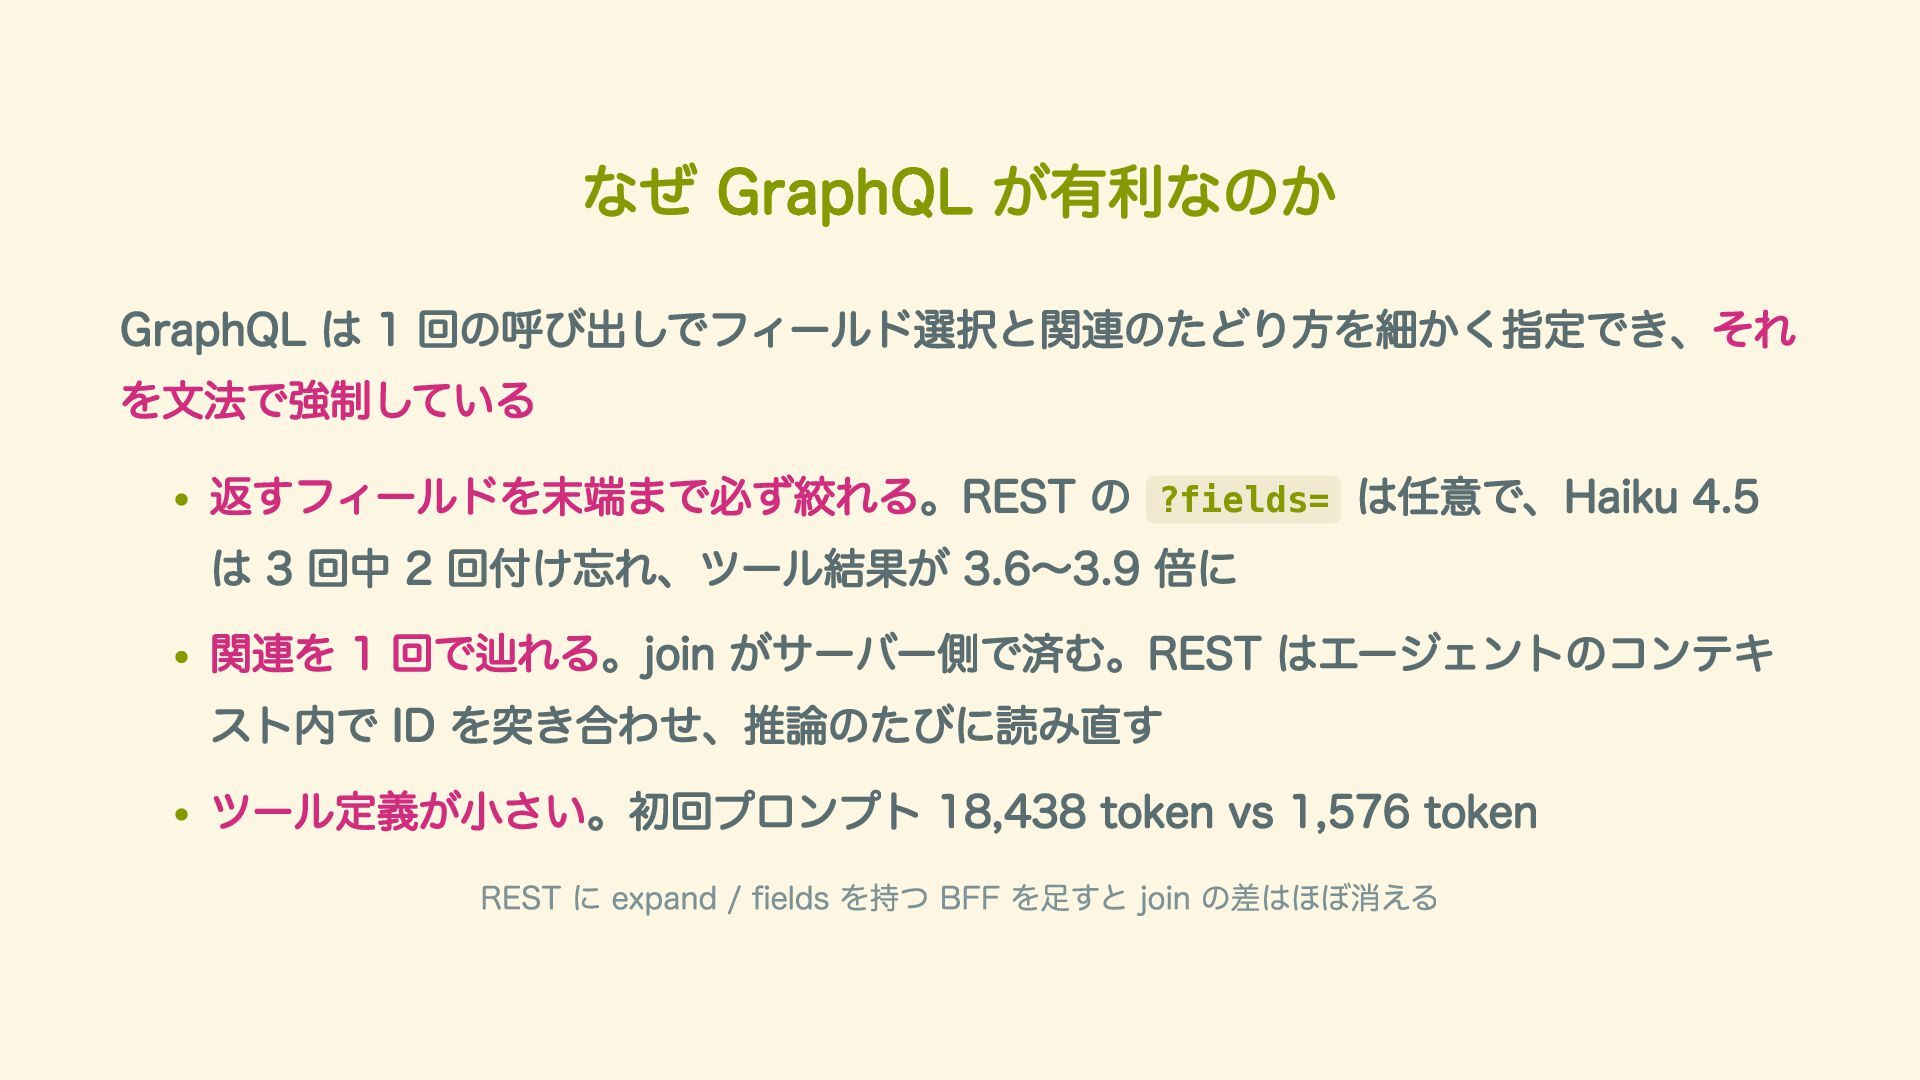
  7. なぜ GraphQL が有利なのか GraphQL は 1 回の呼び出しでフィールド選択と関連のたどり方を細かく指定でき、それ を文法で強制している 返すフィールドを末端まで必ず絞れる。REST の

    ?fields= は任意で、Haiku 4.5 は 3 回中 2 回付け忘れ、ツール結果が 3.6〜3.9 倍に 関連を 1 回で辿れる。join がサーバー側で済む。REST はエージェントのコンテキ スト内で ID を突き合わせ、推論のたびに読み直す ツール定義が小さい。初回プロンプト 18,438 token vs 1,576 token REST に expand / fields を持つ BFF を足すと join の差はほぼ消える
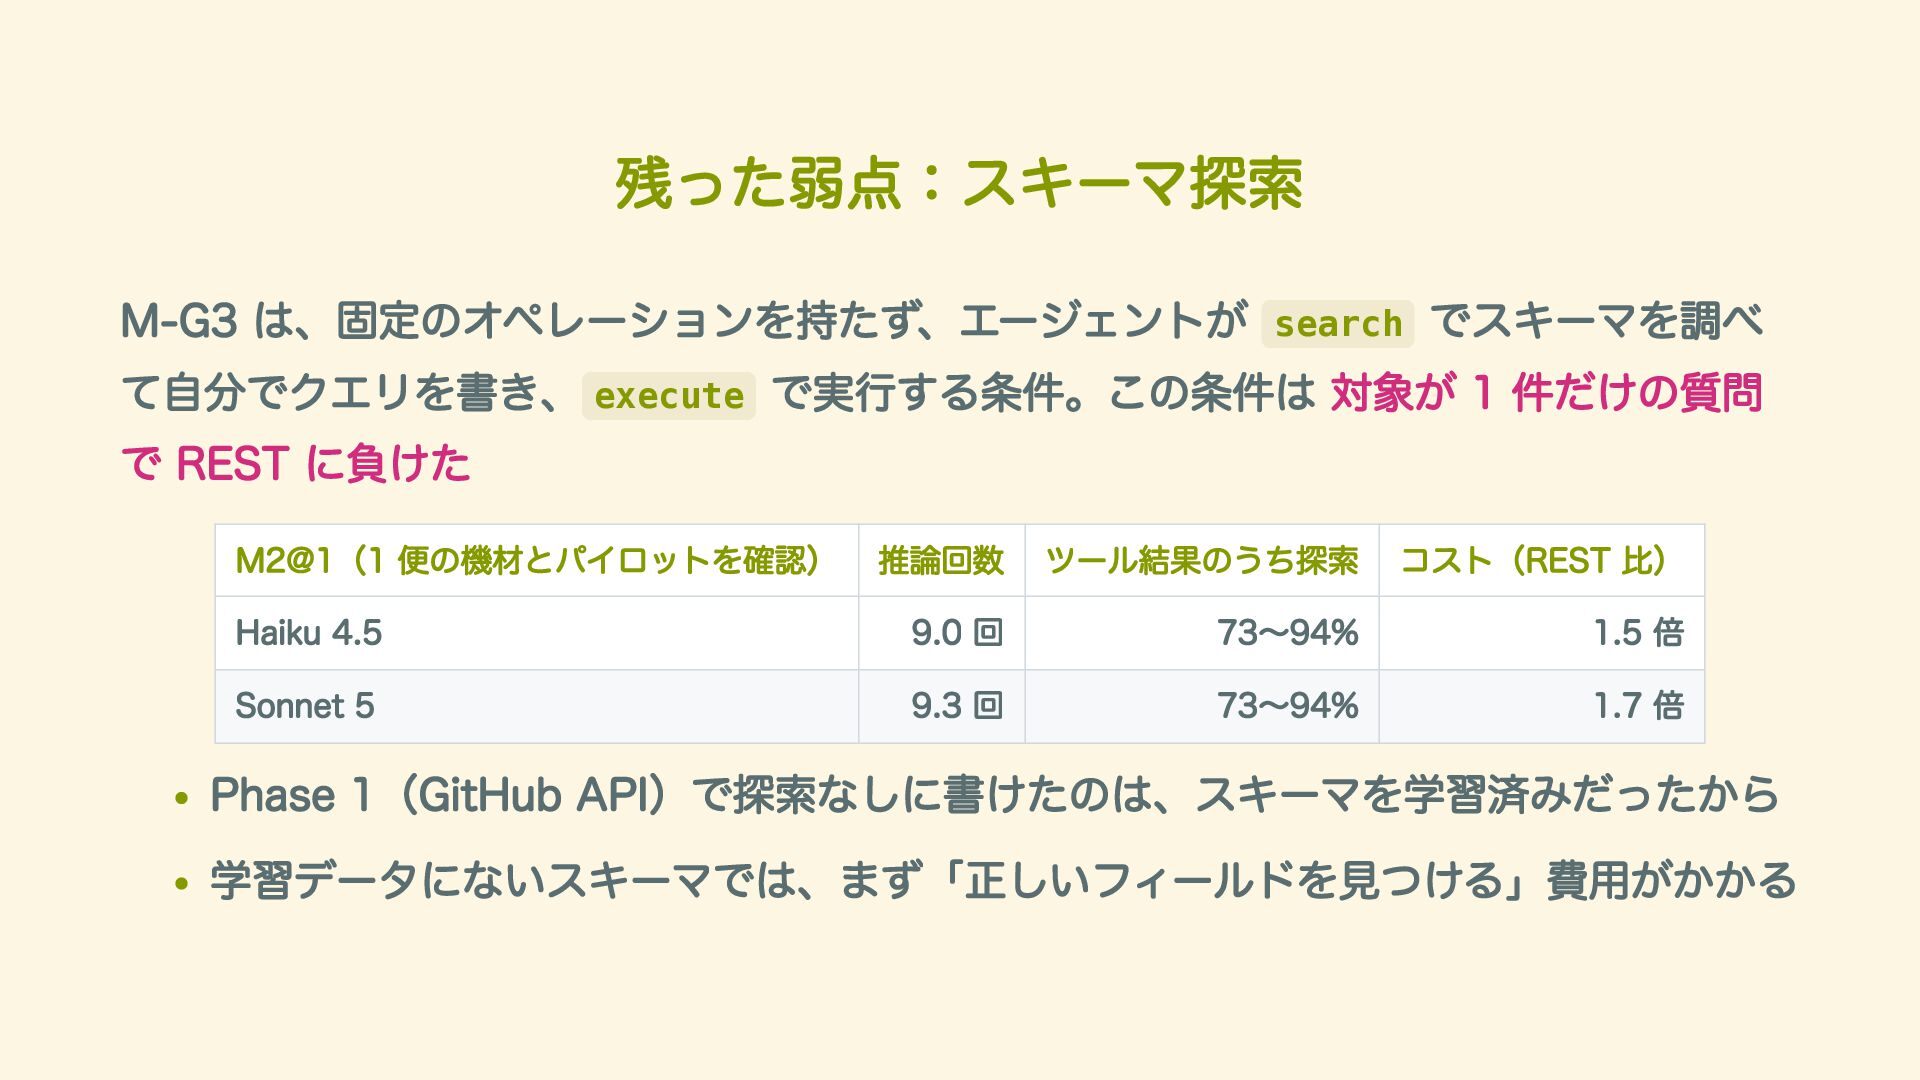
  8. 残った弱点:スキーマ探索 M-G3 は、固定のオペレーションを持たず、エージェントが search でスキーマを調べ て自分でクエリを書き、 execute で実行する条件。この条件は 対象が 1

    件だけの質問 で REST に負けた M2@1(1 便の機材とパイロットを確認) 推論回数 ツール結果のうち探索 コスト(REST 比) Haiku 4.5 9.0 回 73〜94% 1.5 倍 Sonnet 5 9.3 回 73〜94% 1.7 倍 Phase 1(GitHub API)で探索なしに書けたのは、スキーマを学習済みだったから 学習データにないスキーマでは、まず「正しいフィールドを見つける」費用がかかる
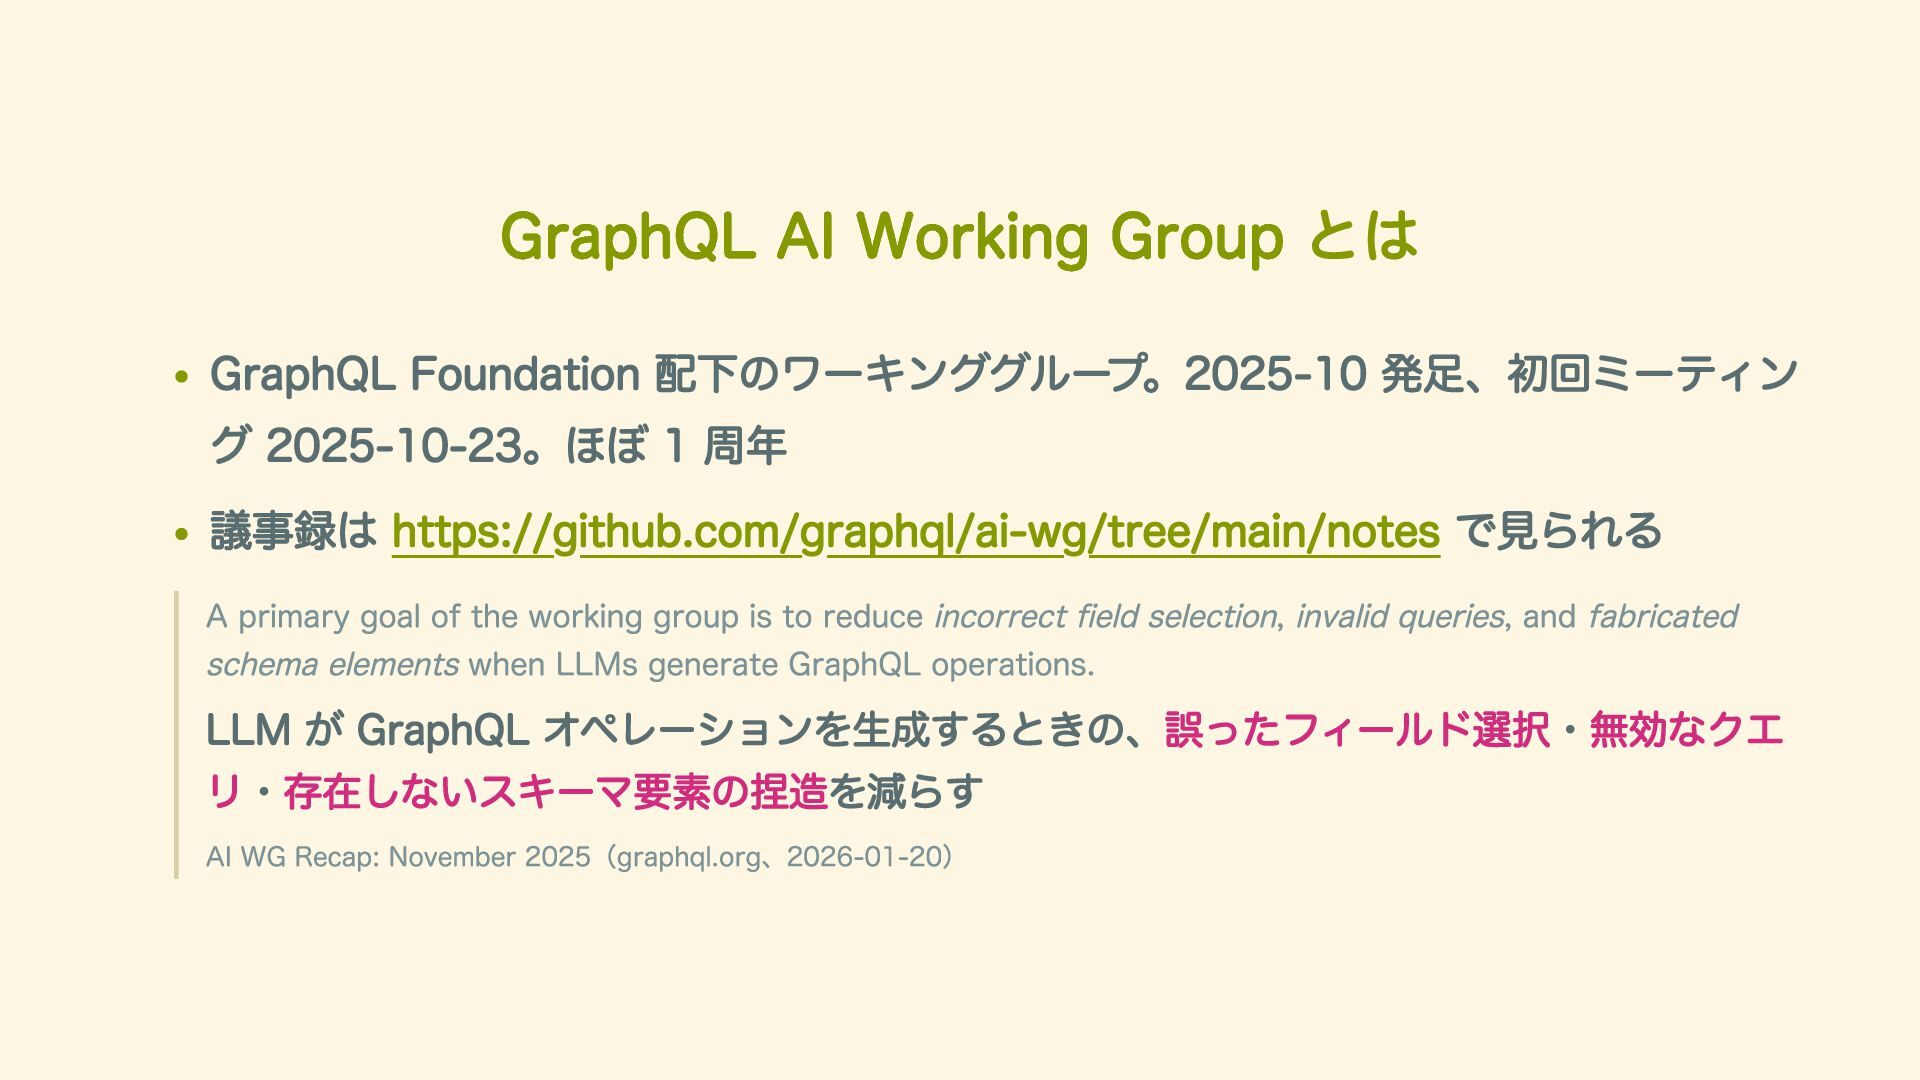
  9. GraphQL AI Working Group とは GraphQL Foundation 配下のワーキンググループ。2025-10 発足、初回ミーティン グ

    2025-10-23。ほぼ 1 周年 議事録は https://github.com/graphql/ai-wg/tree/main/notes で見られる A primary goal of the working group is to reduce incorrect field selection, invalid queries, and fabricated schema elements when LLMs generate GraphQL operations. LLM が GraphQL オペレーションを生成するときの、誤ったフィールド選択・無効なクエ リ・存在しないスキーマ要素の捏造を減らす AI WG Recap: November 2025(graphql.org、2026-01-20)
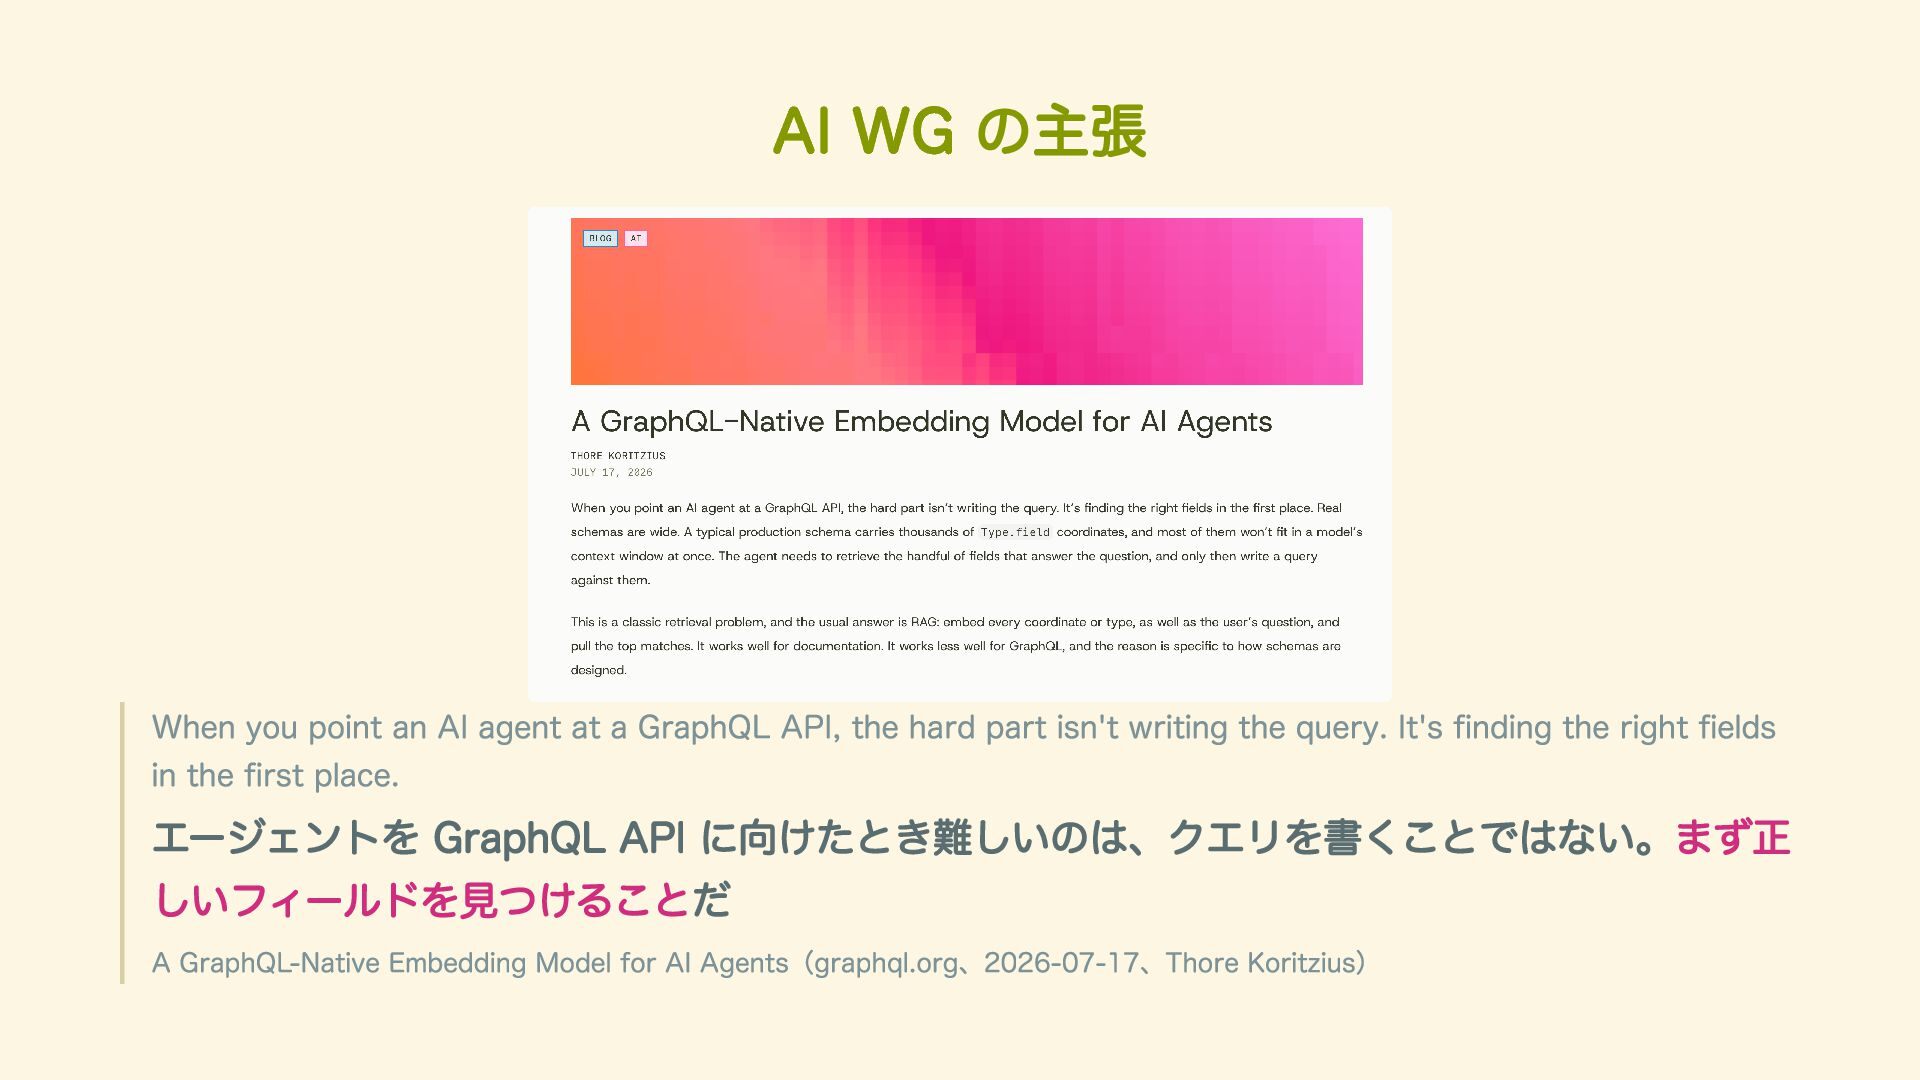
  10. AI WG の主張 When you point an AI agent at

    a GraphQL API, the hard part isn't writing the query. It's finding the right fields in the first place. エージェントを GraphQL API に向けたとき難しいのは、クエリを書くことではない。まず正 しいフィールドを見つけることだ A GraphQL-Native Embedding Model for AI Agents(graphql.org、2026-07-17、Thore Koritzius)
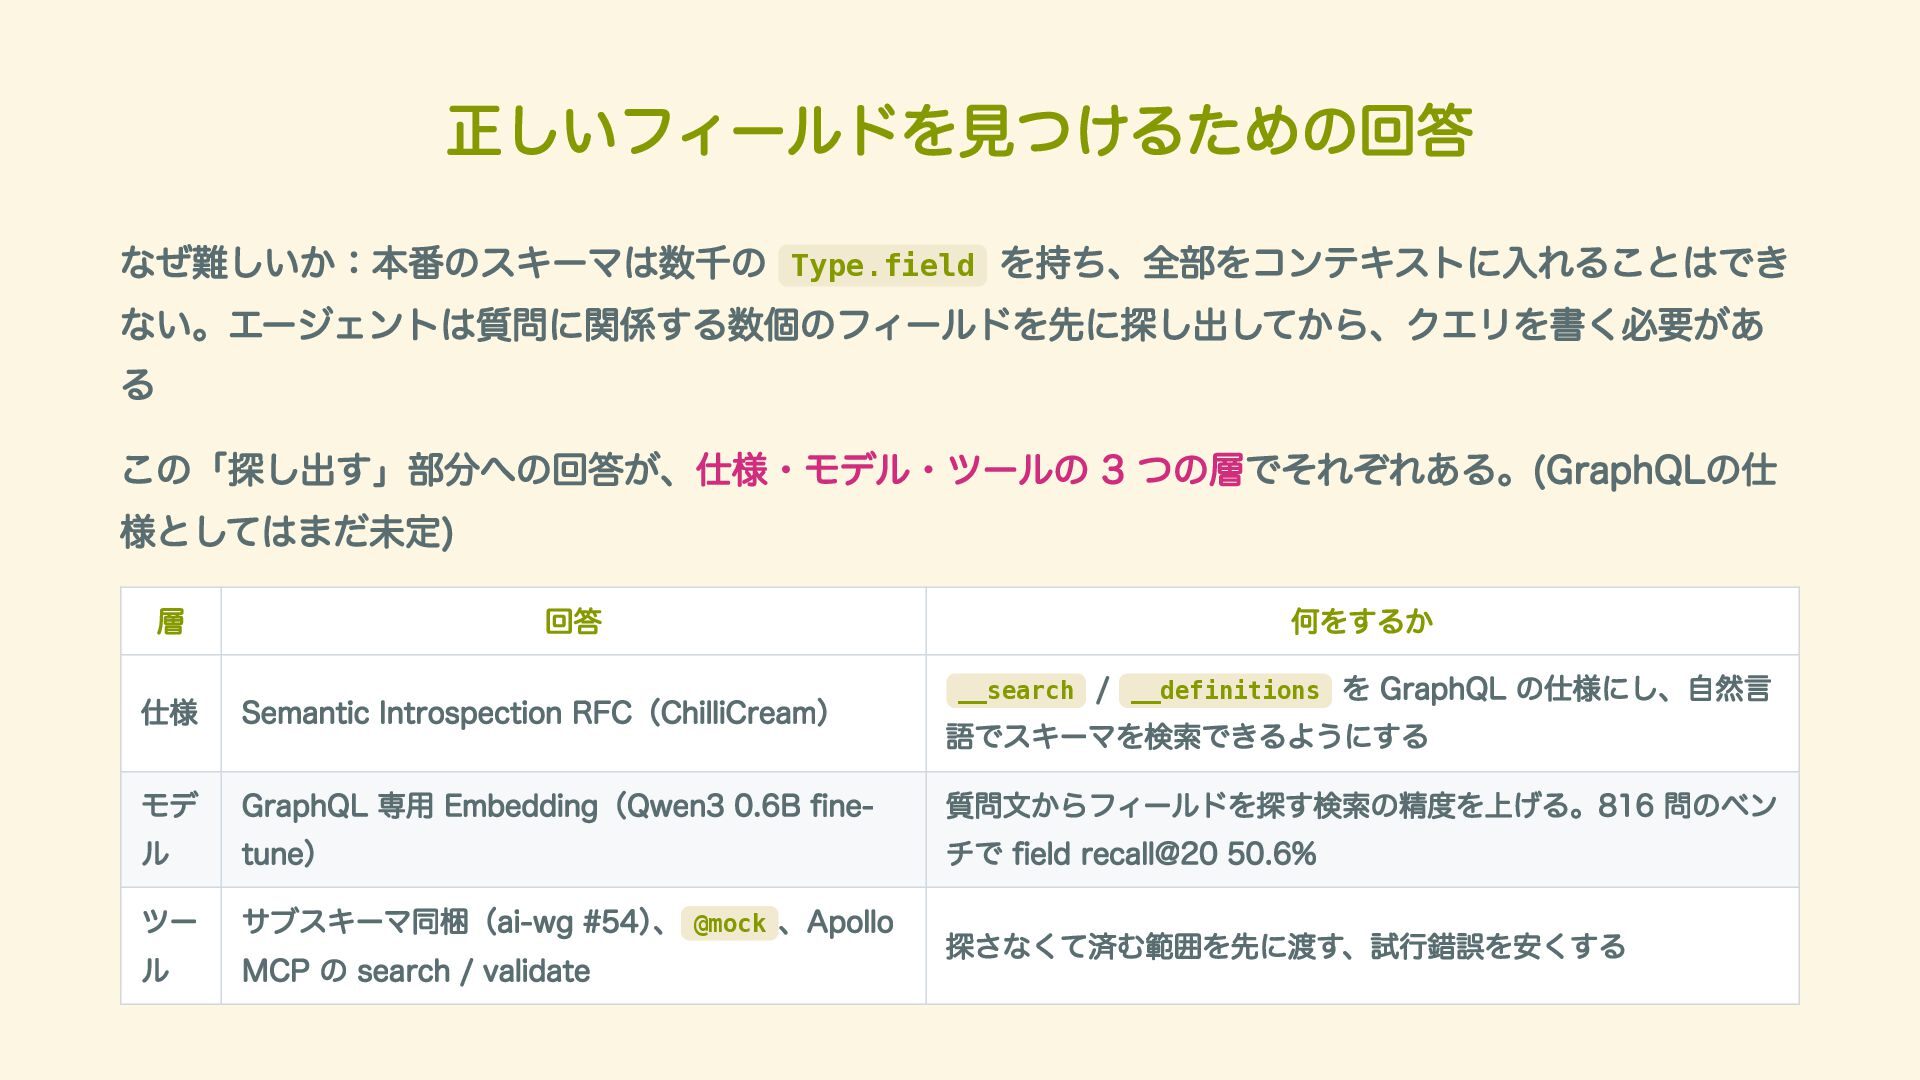
  11. 正しいフィールドを見つけるための回答 なぜ難しいか:本番のスキーマは数千の Type.field を持ち、全部をコンテキストに入れることはでき ない。エージェントは質問に関係する数個のフィールドを先に探し出してから、クエリを書く必要があ る この「探し出す」部分への回答が、仕様・モデル・ツールの 3 つの層でそれぞれある。(GraphQLの仕 様としてはまだ未定)

    層 回答 仕様 Semantic Introspection RFC(ChilliCream) モデ ル ツー ル 何をするか __search / __definitions を GraphQL の仕様にし、自然言 語でスキーマを検索できるようにする 質問文からフィールドを探す検索の精度を上げる。816 問のベン チで field recall@20 50.6% GraphQL 専用 Embedding(Qwen3 0.6B finetune) サブスキーマ同梱(ai-wg #54)、 @mock 、Apollo 探さなくて済む範囲を先に渡す、試行錯誤を安くする MCP の search / validate
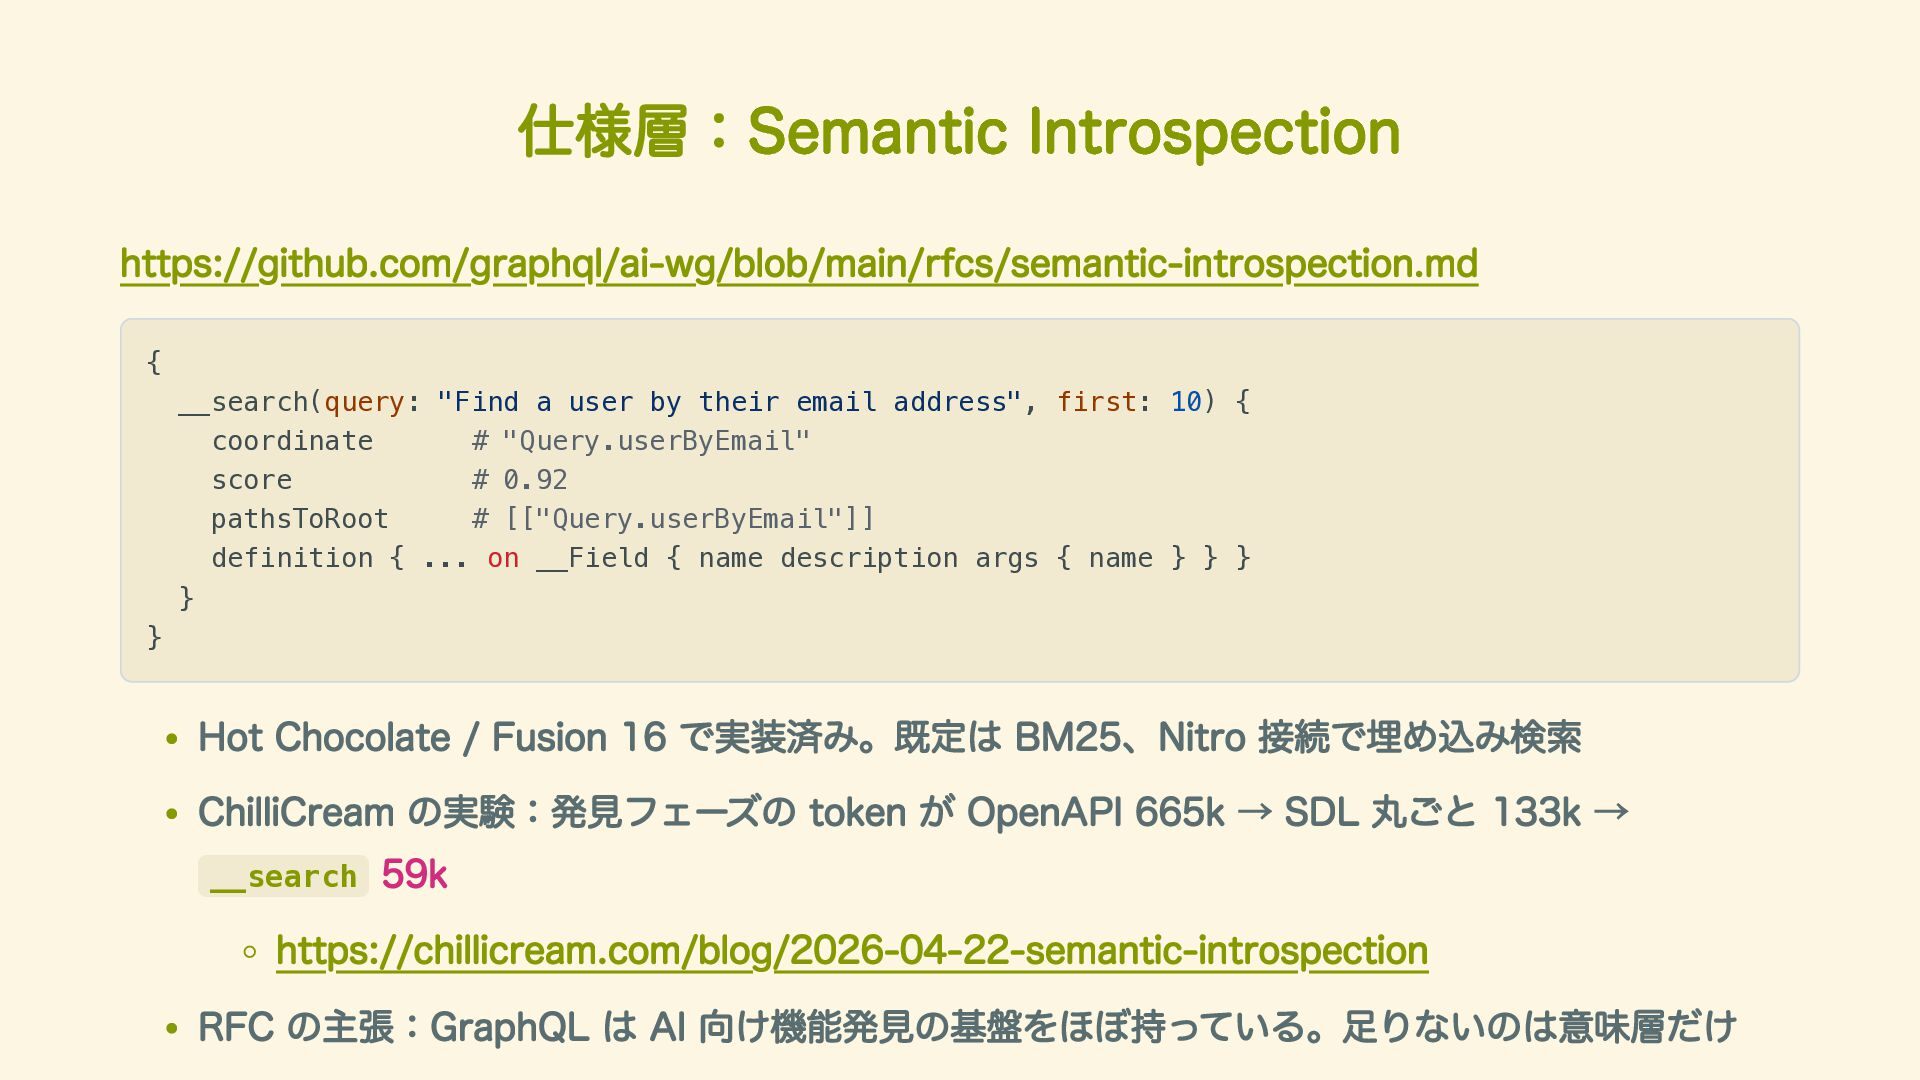
  12. 仕様層:Semantic Introspection https://github.com/graphql/ai-wg/blob/main/rfcs/semantic-introspection.md { __search(query: "Find a user by their

    email address", first: 10) { coordinate # "Query.userByEmail" score # 0.92 pathsToRoot # [["Query.userByEmail"]] definition { ... on __Field { name description args { name } } } } } Hot Chocolate / Fusion 16 で実装済み。既定は BM25、Nitro 接続で埋め込み検索 ChilliCream の実験:発見フェーズの token が OpenAPI 665k → SDL 丸ごと 133k → __search 59k https://chillicream.com/blog/2026-04-22-semantic-introspection RFC の主張:GraphQL は AI 向け機能発見の基盤をほぼ持っている。足りないのは意味層だけ
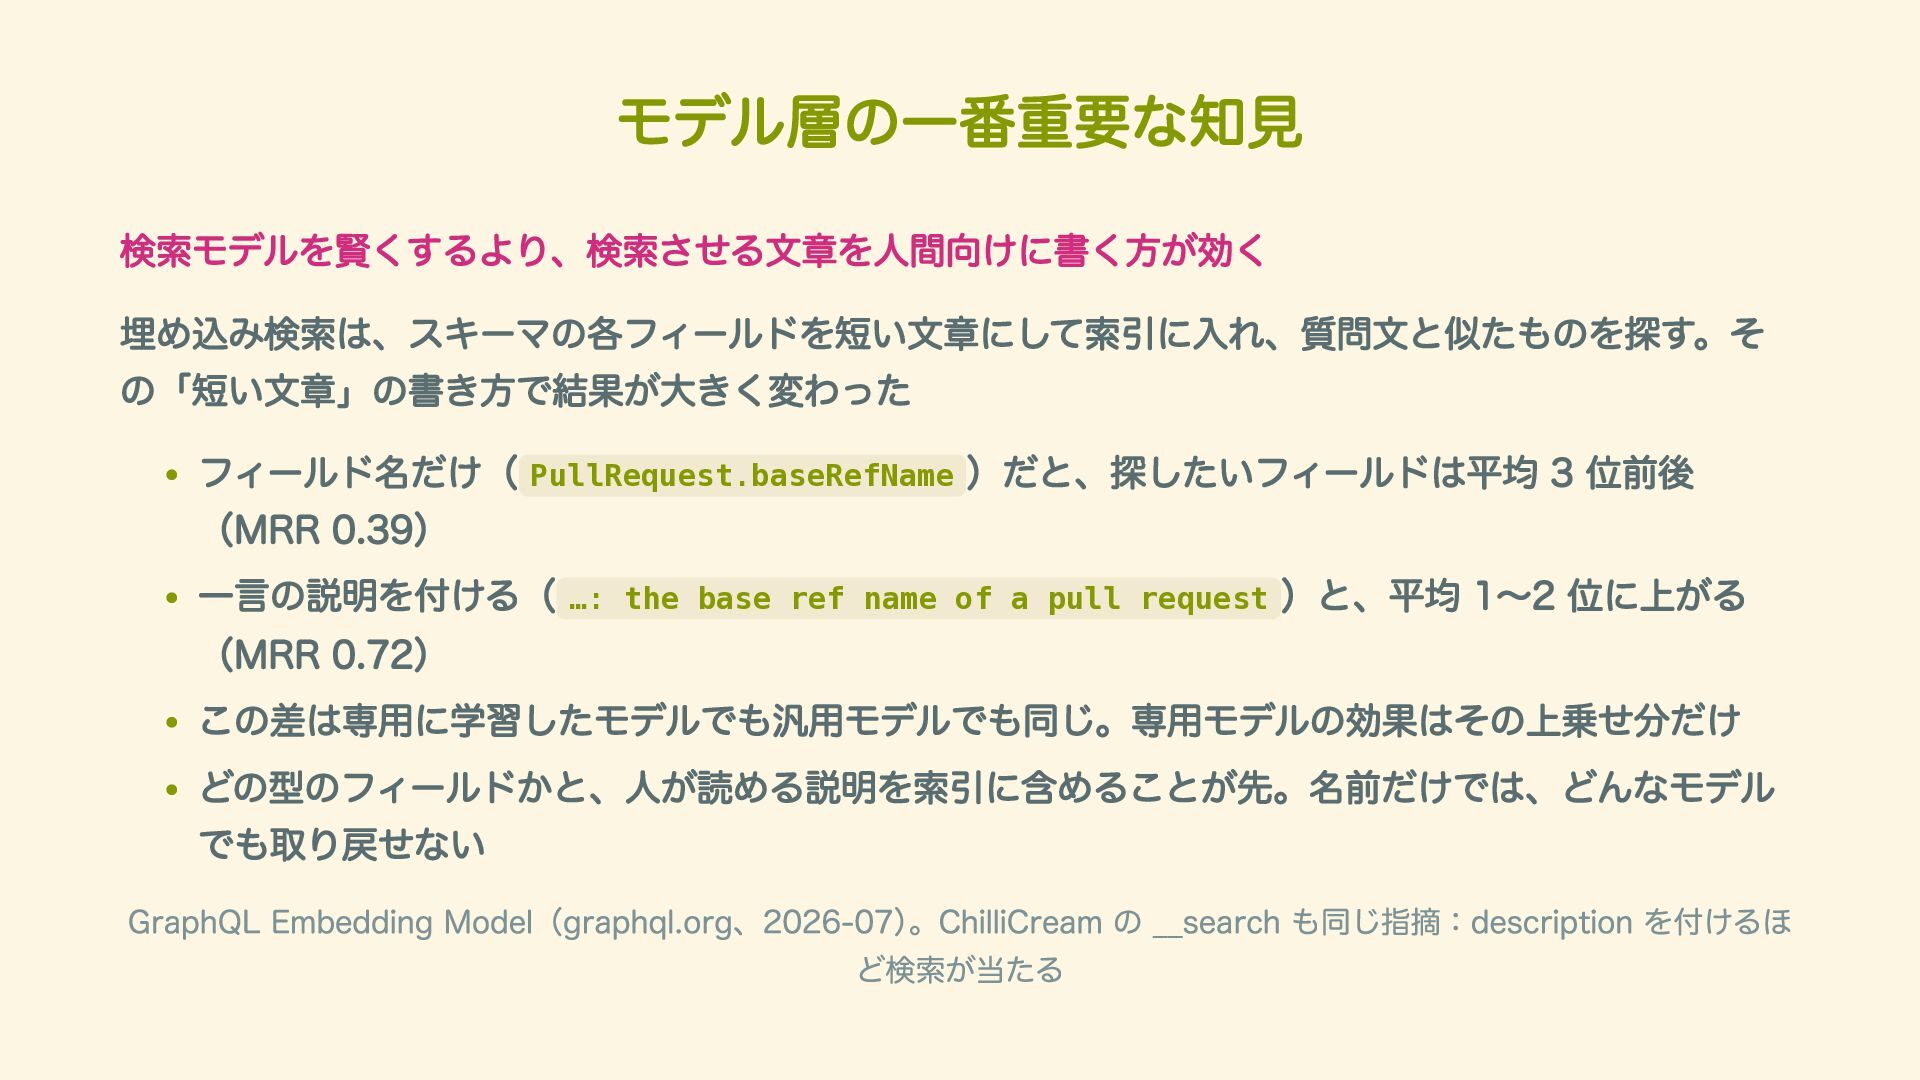
  13. モデル層の一番重要な知見 検索モデルを賢くするより、検索させる文章を人間向けに書く方が効く 埋め込み検索は、スキーマの各フィールドを短い文章にして索引に入れ、質問文と似たものを探す。そ の「短い文章」の書き方で結果が大きく変わった フィールド名だけ( PullRequest.baseRefName )だと、探したいフィールドは平均 3 位前後 (MRR

    0.39) 一言の説明を付ける( …: the base ref name of a pull request )と、平均 1〜2 位に上がる (MRR 0.72) この差は専用に学習したモデルでも汎用モデルでも同じ。専用モデルの効果はその上乗せ分だけ どの型のフィールドかと、人が読める説明を索引に含めることが先。名前だけでは、どんなモデル でも取り戻せない GraphQL Embedding Model(graphql.org、2026-07)。ChilliCream の __search も同じ指摘:description を付けるほ ど検索が当たる
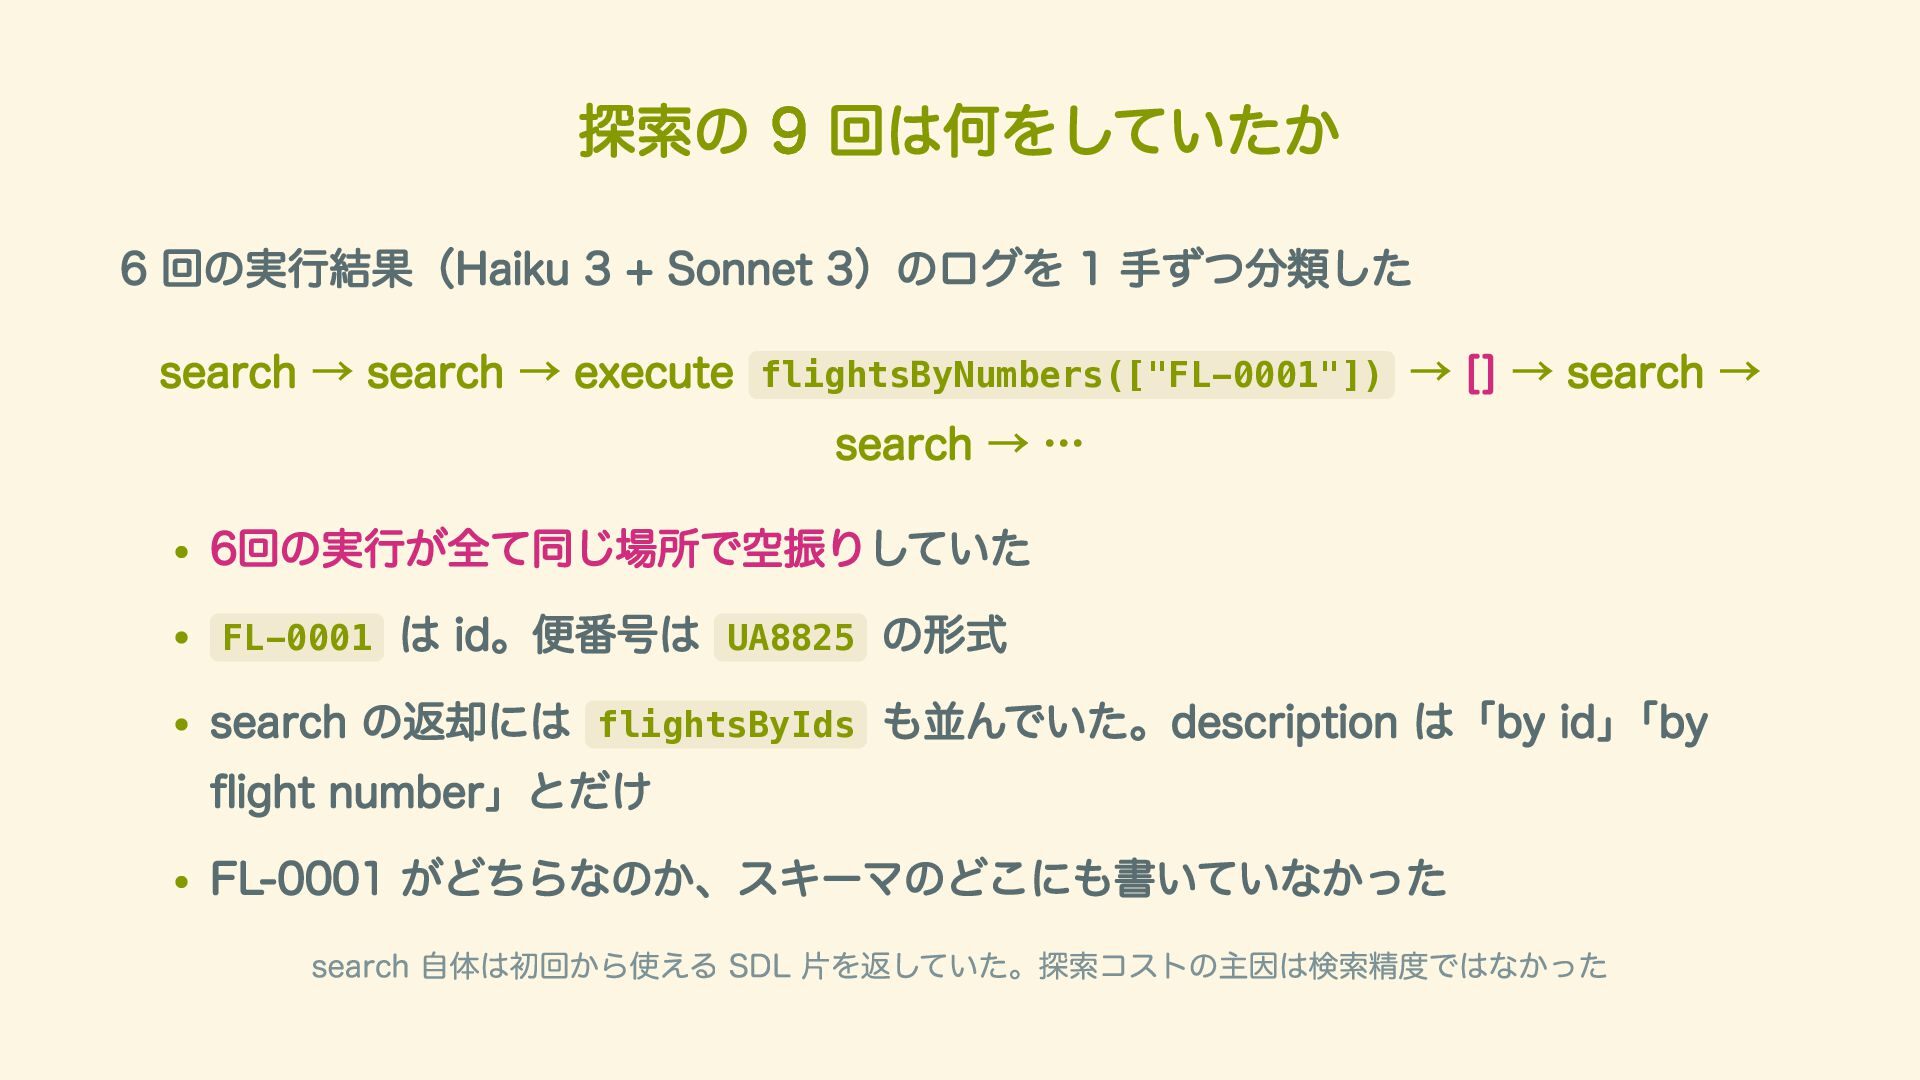
  14. 探索の 9 回は何をしていたか 6 回の実行結果(Haiku 3 + Sonnet 3)のログを 1

    手ずつ分類した search → search → execute flightsByNumbers(["FL-0001"]) → [] → search → search → … 6回の実行が全て同じ場所で空振りしていた FL-0001 は id。便番号は UA8825 の形式 search の返却には flightsByIds も並んでいた。description は「by id」「by flight number」とだけ FL-0001 がどちらなのか、スキーマのどこにも書いていなかった search 自体は初回から使える SDL 片を返していた。探索コストの主因は検索精度ではなかった
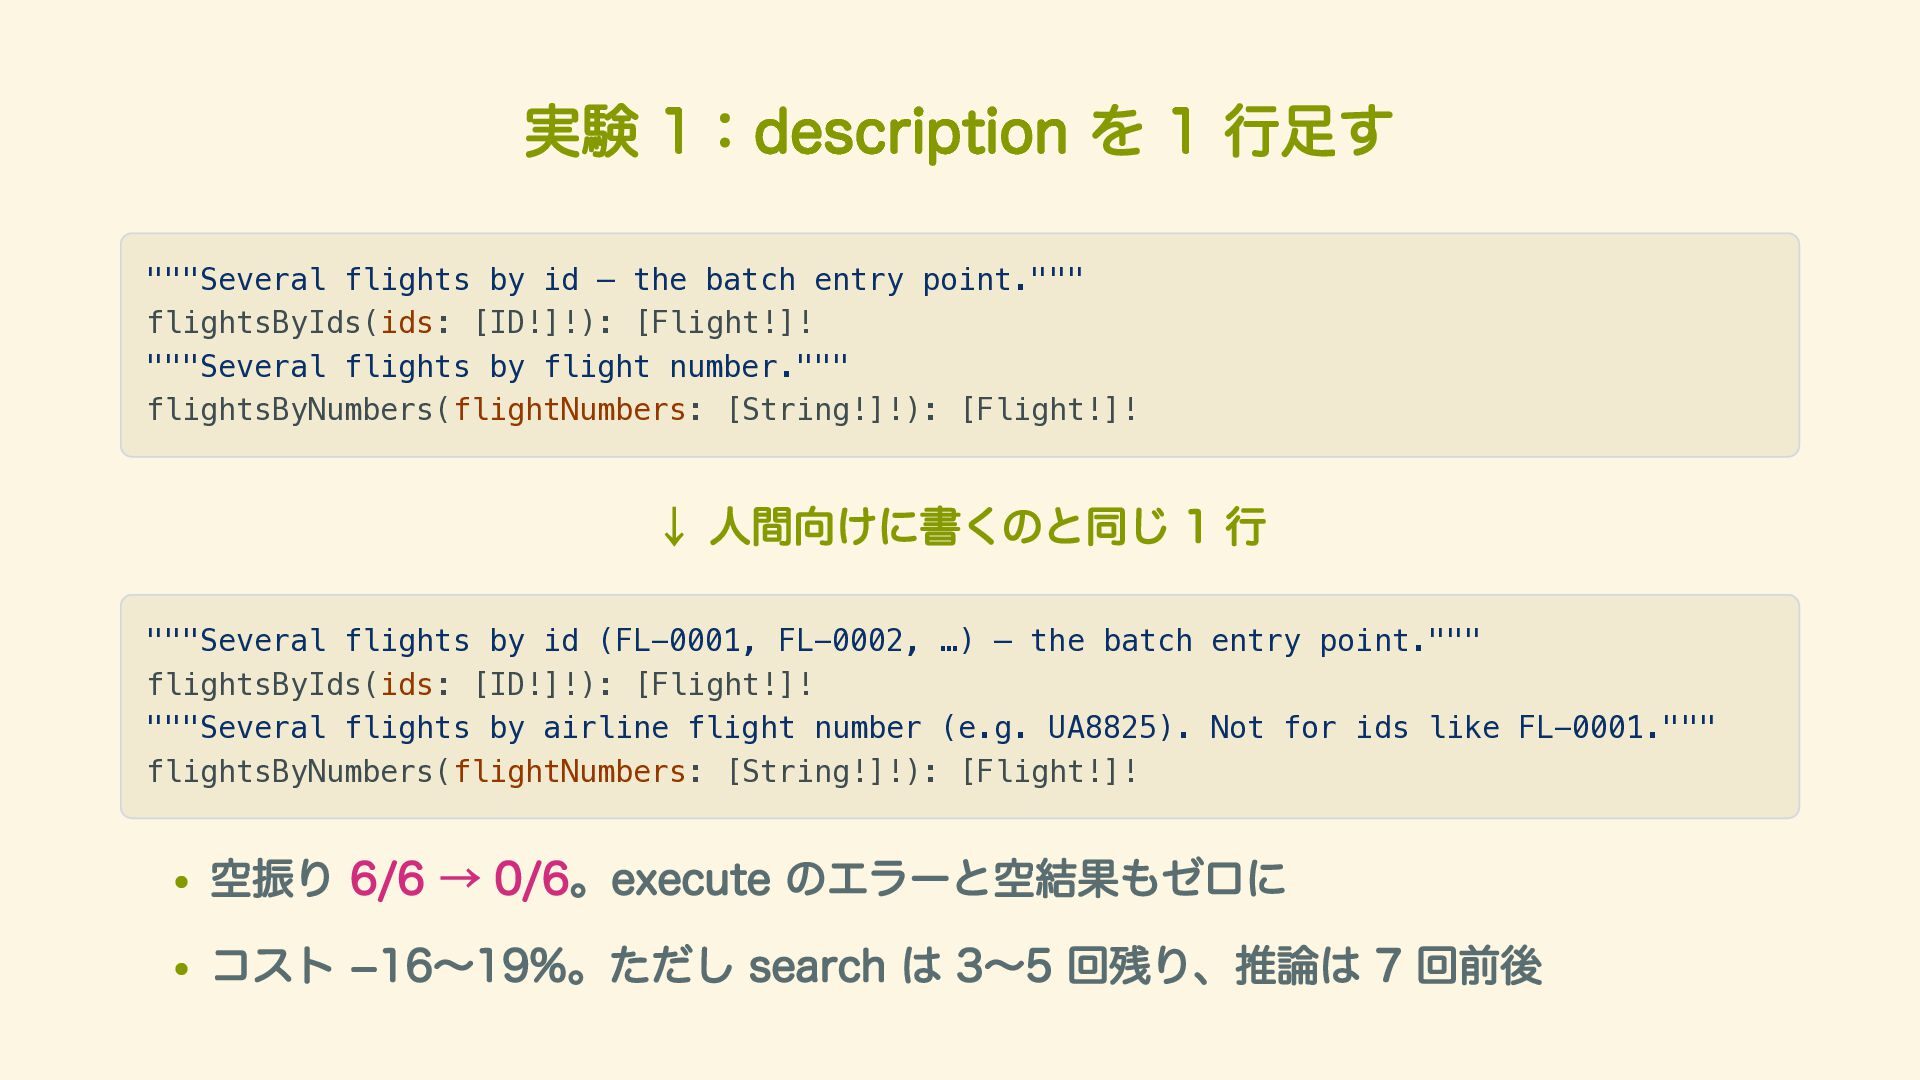
  15. 実験 1:description を 1 行足す """Several flights by id —

    the batch entry point.""" flightsByIds(ids: [ID!]!): [Flight!]! """Several flights by flight number.""" flightsByNumbers(flightNumbers: [String!]!): [Flight!]! ↓ 人間向けに書くのと同じ 1 行 """Several flights by id (FL-0001, FL-0002, …) — the batch entry point.""" flightsByIds(ids: [ID!]!): [Flight!]! """Several flights by airline flight number (e.g. UA8825). Not for ids like FL-0001.""" flightsByNumbers(flightNumbers: [String!]!): [Flight!]! 空振り 6/6 → 0/6。execute のエラーと空結果もゼロに コスト −16〜19%。ただし search は 3〜5 回残り、推論は 7 回前後
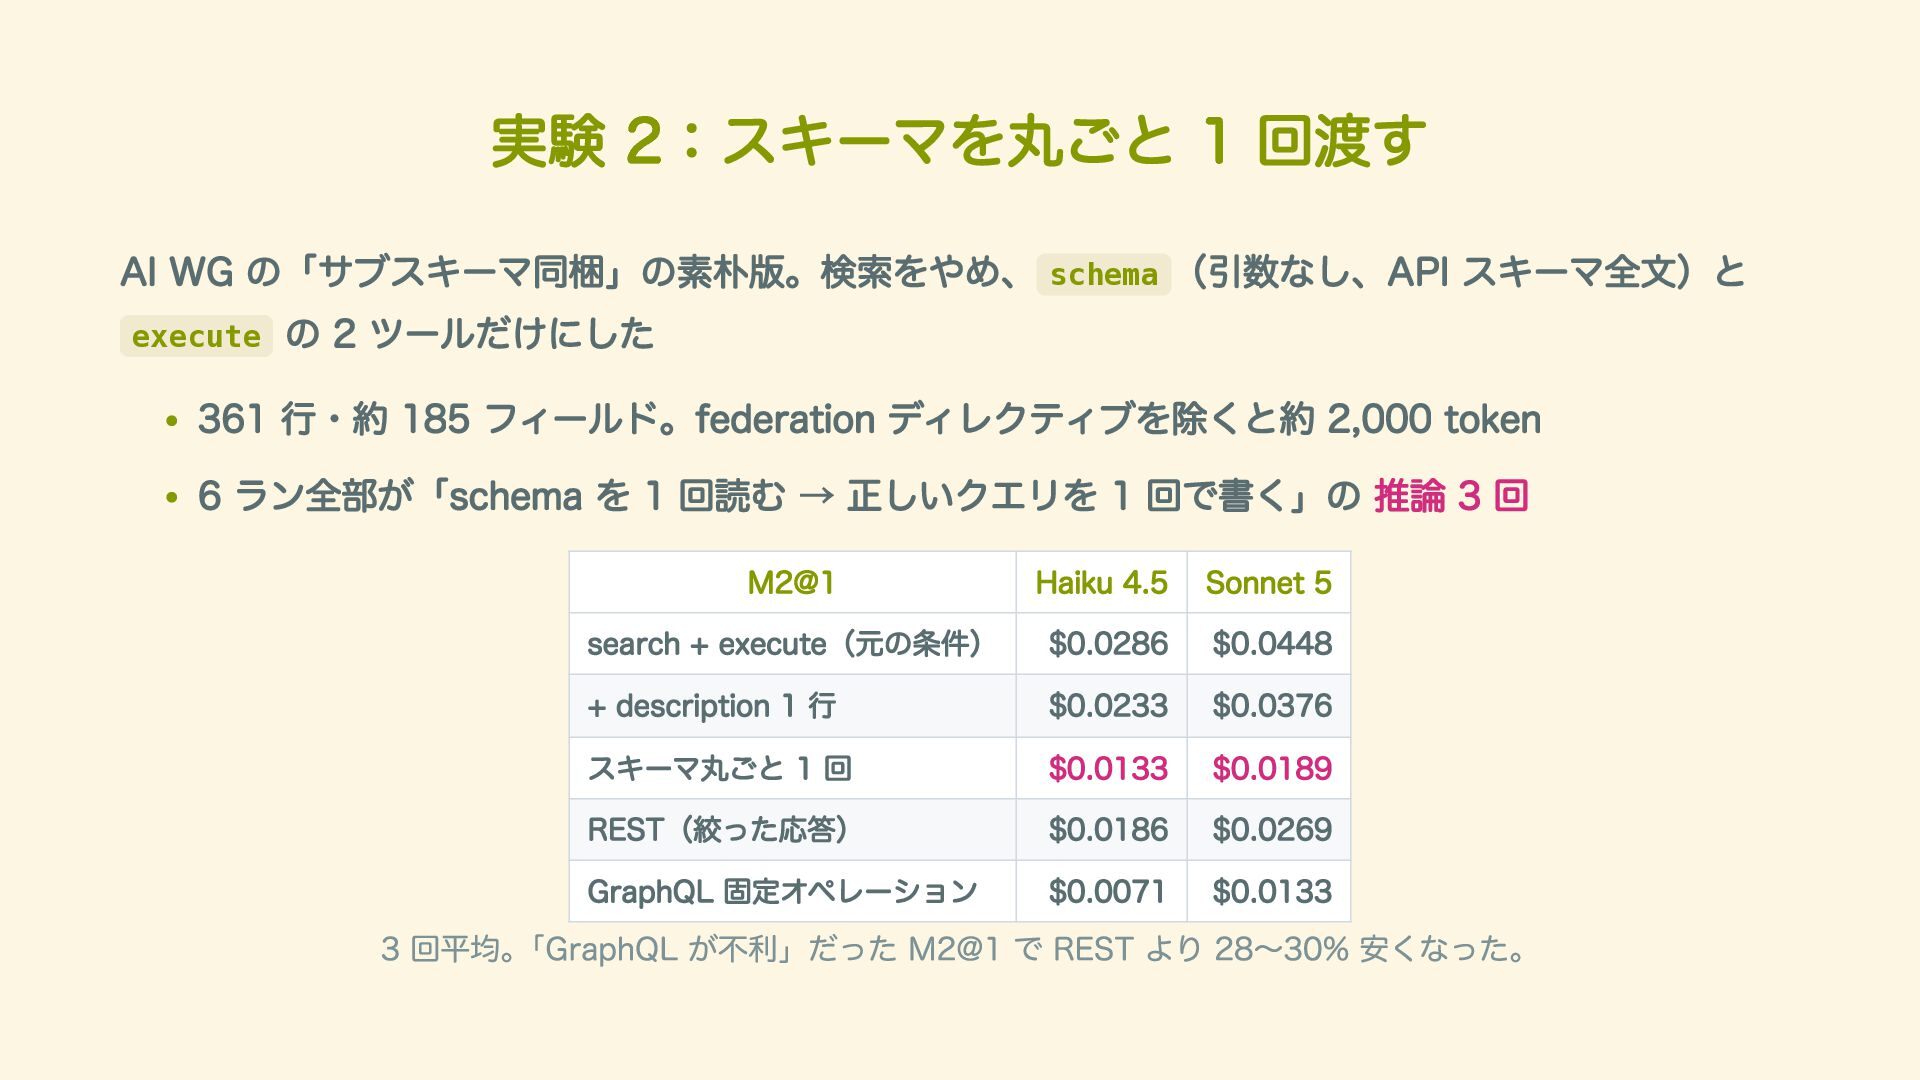
  16. 実験 2:スキーマを丸ごと 1 回渡す AI WG の「サブスキーマ同梱」の素朴版。検索をやめ、 schema (引数なし、API スキーマ全文)と

    execute の 2 ツールだけにした 361 行・約 185 フィールド。federation ディレクティブを除くと約 2,000 token 6 ラン全部が「schema を 1 回読む → 正しいクエリを 1 回で書く」の 推論 3 回 M2@1 Haiku 4.5 Sonnet 5 search + execute(元の条件) $0.0286 $0.0448 + description 1 行 $0.0233 $0.0376 スキーマ丸ごと 1 回 $0.0133 $0.0189 REST(絞った応答) $0.0186 $0.0269 GraphQL 固定オペレーション $0.0071 $0.0133 3 回平均。「GraphQL が不利」だった M2@1 で REST より 28〜30% 安くなった。
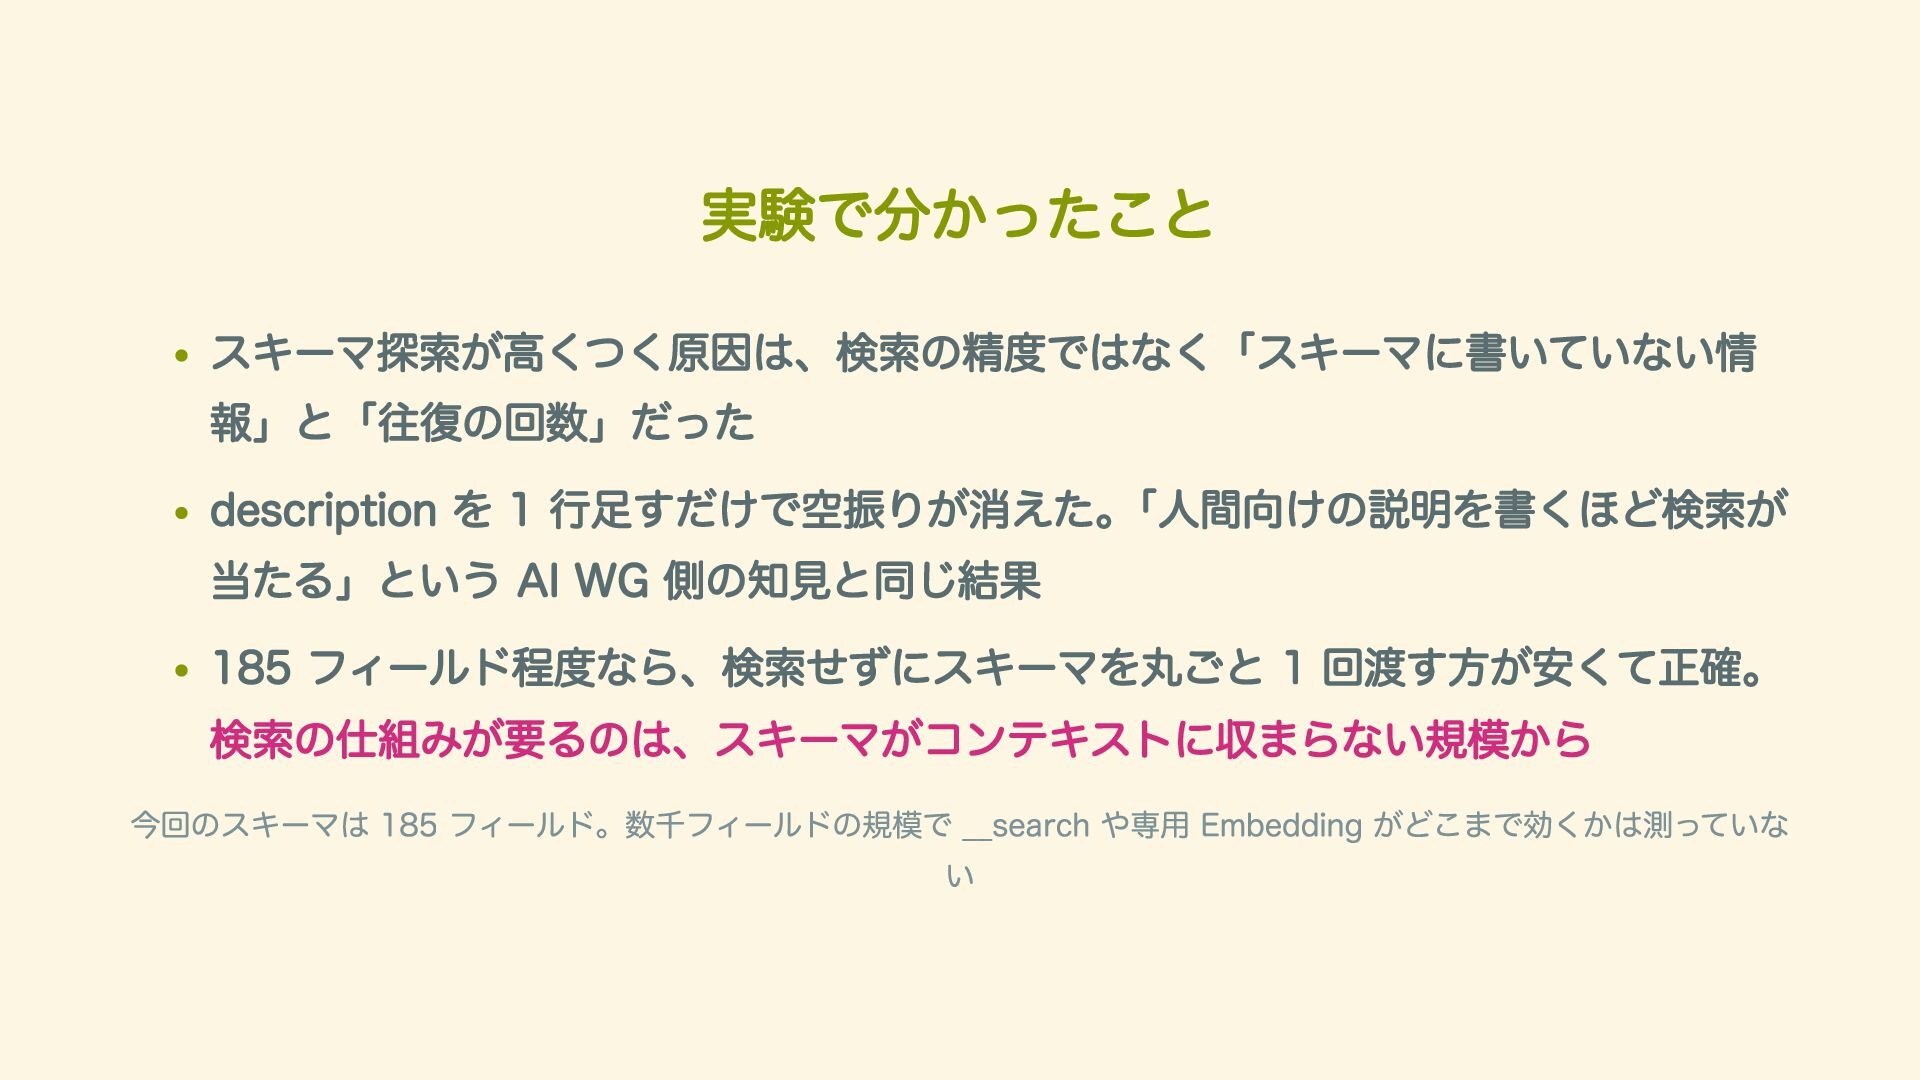
  17. 実験で分かったこと スキーマ探索が高くつく原因は、検索の精度ではなく「スキーマに書いていない情 報」と「往復の回数」だった description を 1 行足すだけで空振りが消えた。「人間向けの説明を書くほど検索が 当たる」という AI WG

    側の知見と同じ結果 185 フィールド程度なら、検索せずにスキーマを丸ごと 1 回渡す方が安くて正確。 検索の仕組みが要るのは、スキーマがコンテキストに収まらない規模から 今回のスキーマは 185 フィールド。数千フィールドの規模で __search や専用 Embedding がどこまで効くかは測っていな い
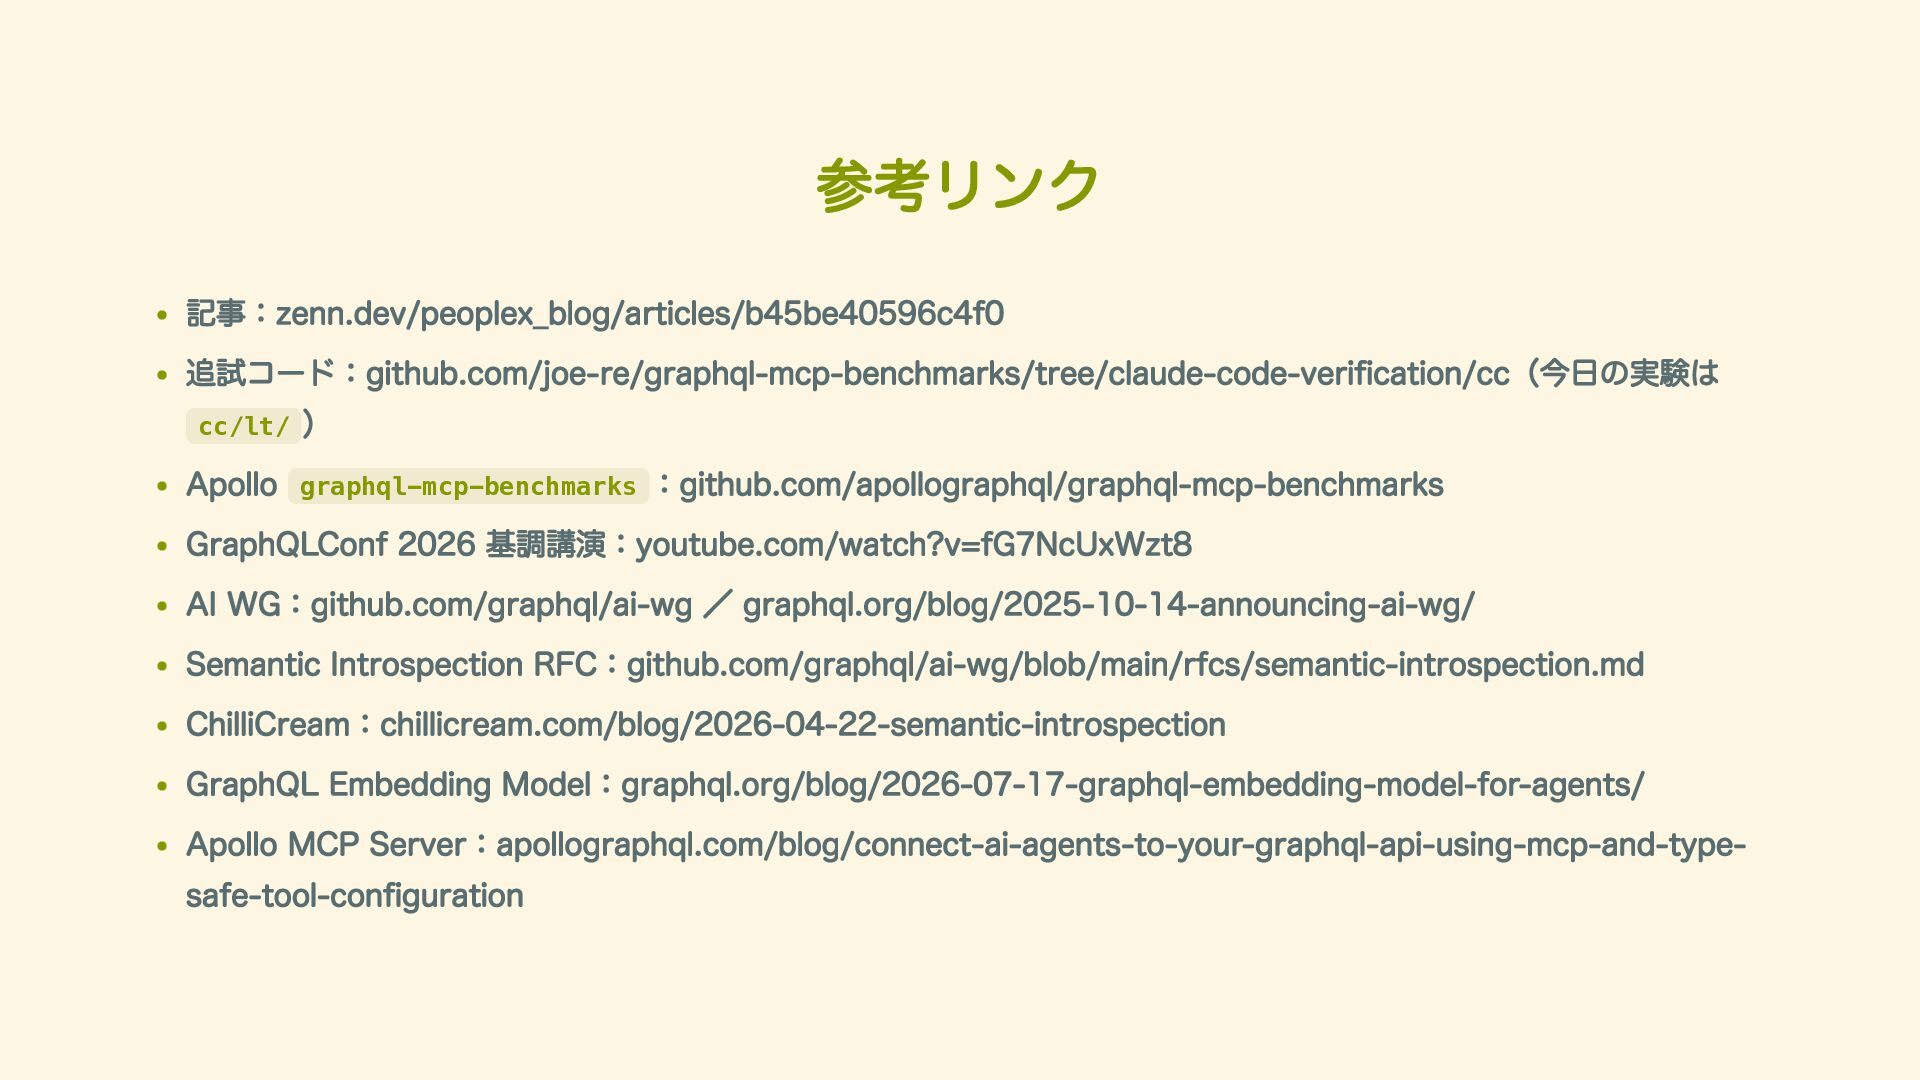
  18. 参考リンク 記事:zenn.dev/peoplex_blog/articles/b45be40596c4f0 追試コード:github.com/joe-re/graphql-mcp-benchmarks/tree/claude-code-verification/cc(今日の実験は cc/lt/ ) Apollo graphql-mcp-benchmarks :github.com/apollographql/graphql-mcp-benchmarks GraphQLConf 2026

    基調講演:youtube.com/watch?v=fG7NcUxWzt8 AI WG:github.com/graphql/ai-wg / graphql.org/blog/2025-10-14-announcing-ai-wg/ Semantic Introspection RFC:github.com/graphql/ai-wg/blob/main/rfcs/semantic-introspection.md ChilliCream:chillicream.com/blog/2026-04-22-semantic-introspection GraphQL Embedding Model:graphql.org/blog/2026-07-17-graphql-embedding-model-for-agents/ Apollo MCP Server:apollographql.com/blog/connect-ai-agents-to-your-graphql-api-using-mcp-and-typesafe-tool-configuration