Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
動画生成と三次元生成を融合して最強の生成モデルを作ろう
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
小島瑞貴
June 01, 2026
Science
73
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
動画生成と三次元生成を融合して最強の生成モデルを作ろう
小島瑞貴
June 01, 2026
More Decks by 小島瑞貴
See All by 小島瑞貴
視覚若手の会LENSって何??
mickey_0226
0
320
画像生成モデルは1つの損失関数(FID)を入れるだけで性能が激変するらしい
mickey_0226
0
1.7k
【Zozo Research 技術共有会】三次元領域の現在と展望
mickey_0226
3
660
学術バーQってどんなところ??
mickey_0226
0
200
さわって動かす人工知能
mickey_0226
0
90
CVPR2026_VGGTとその仲間たち
mickey_0226
0
1.2k
Transformerの推論を線形時間にして皆を驚かせましょう
mickey_0226
0
74
Other Decks in Science
See All in Science
社内で活躍できるデータサイエンティストになるために
aikinohara
1
170
[第67回 CV勉強会@関東] CV × Scientific Figures / kantoCV 67th CVPR 2026
lychee1223
0
240
データベース02: データベースの概念
trycycle
PRO
2
1.4k
サンプル対応のない複数遺伝子発現プロファイルに対するテンソル分解型統合解析の要約
tagtag
PRO
0
260
コーヒー豆様核 (Coffee-bean nuclei) における形態学的サブタイピングと精選・焙煎特性の同定
jagupath
PRO
0
180
生成AIが科学とRAにもたらしていること:メタサイエンスの視点から
rmaruy
0
140
データベース08: 実体関連モデルとは?
trycycle
PRO
0
1.7k
勾配流から乖離した学習ダイナミクス
hanbao
1
1.1k
ゲームと人工知能
miyayou
0
240
[TMLR 2026, Featured Certification] Double Bounded α-Divergence Optimization for Density Estimation
gkazunii
1
120
Build your own LLM, Live, with MicroGPT
ianozsvald
0
150
自社のレビュー履歴からAIコードレビュアーをつくる方法
estie
0
450
Featured
See All Featured
Marketing to machines
jonoalderson
1
5.8k
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
290
Everyday Curiosity
cassininazir
0
330
Building an army of robots
kneath
307
47k
Git: the NoSQL Database
bkeepers
PRO
432
67k
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.3k
Site-Speed That Sticks
csswizardry
13
1.5k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Building a Modern Day E-commerce SEO Strategy
aleyda
45
9.2k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
440
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
540
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
590
Transcript
Vist3A 東京科学大学 小島 瑞貴 Text-to-3D by stitching a multi-view reconstruction
network to a video generator
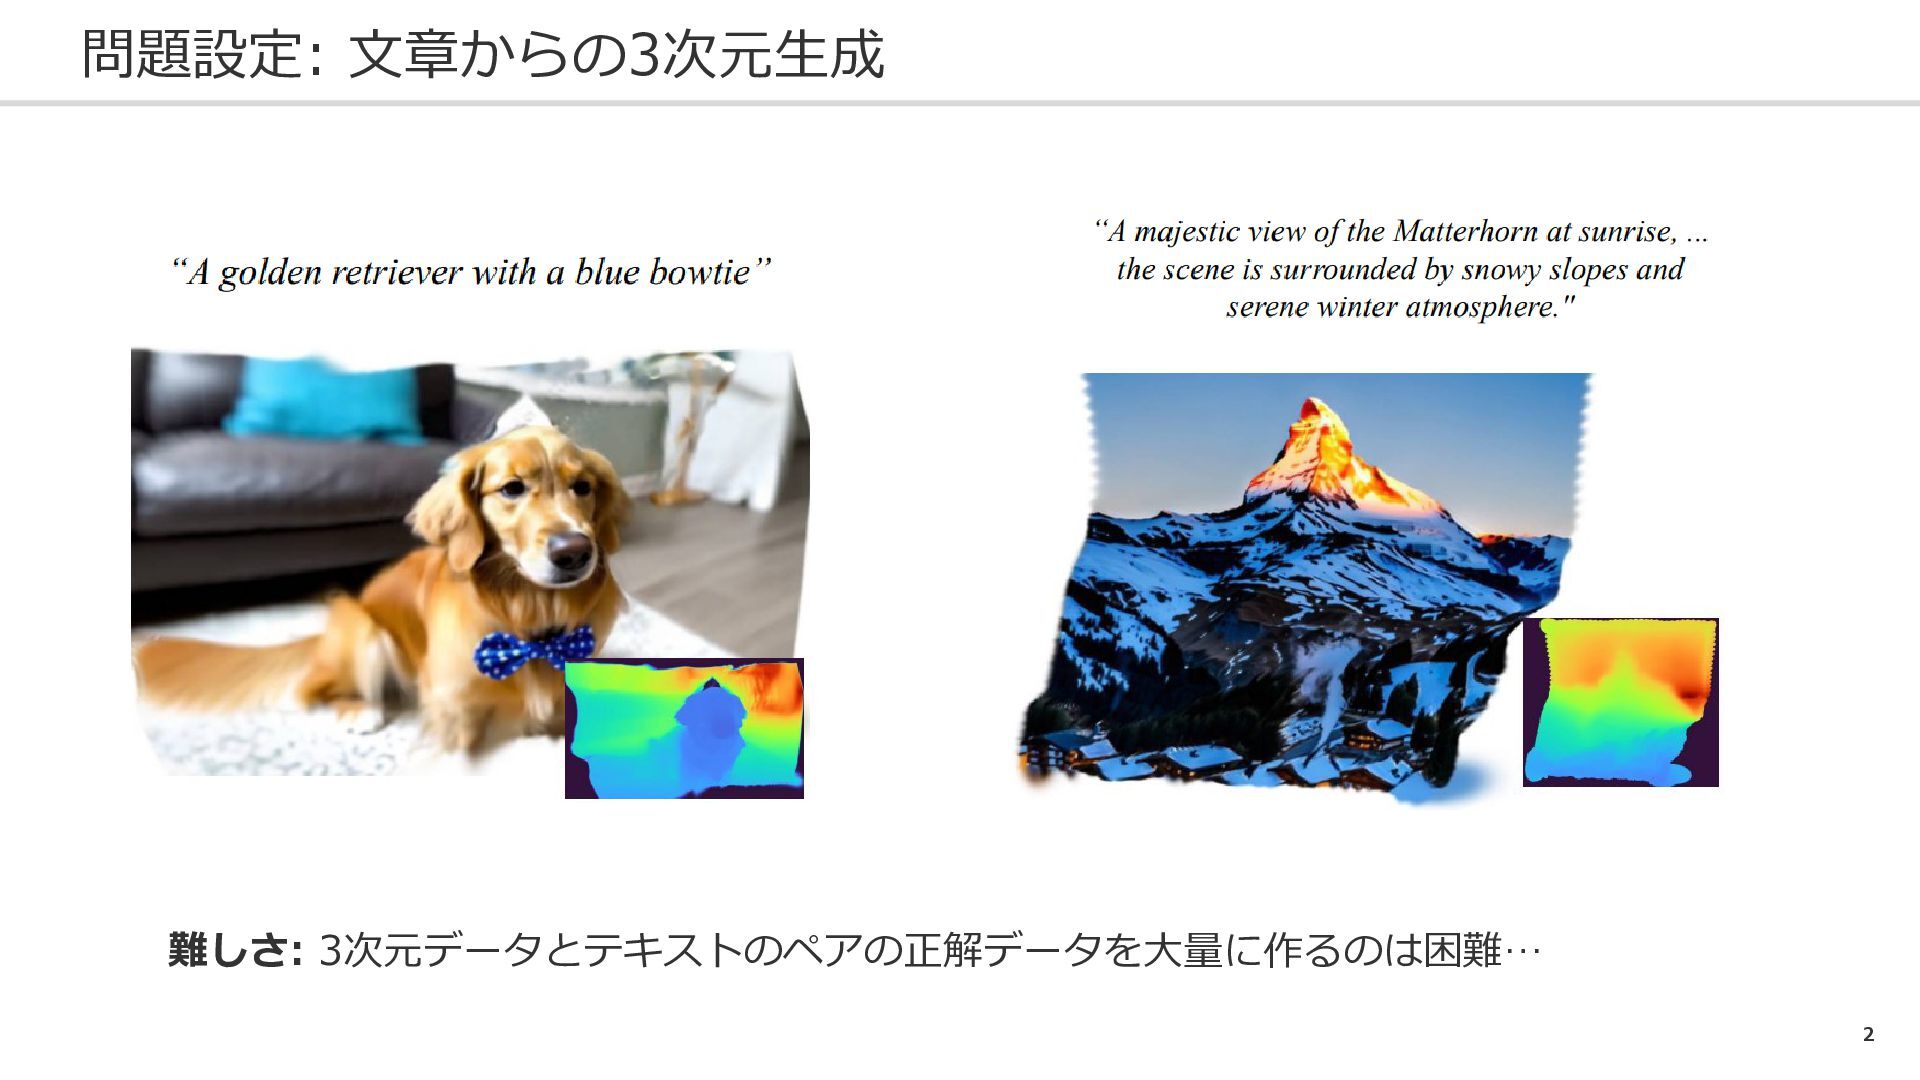
2 問題設定: 文章からの3次元生成 難しさ: 3次元データとテキストのペアの正解データを大量に作るのは困難…
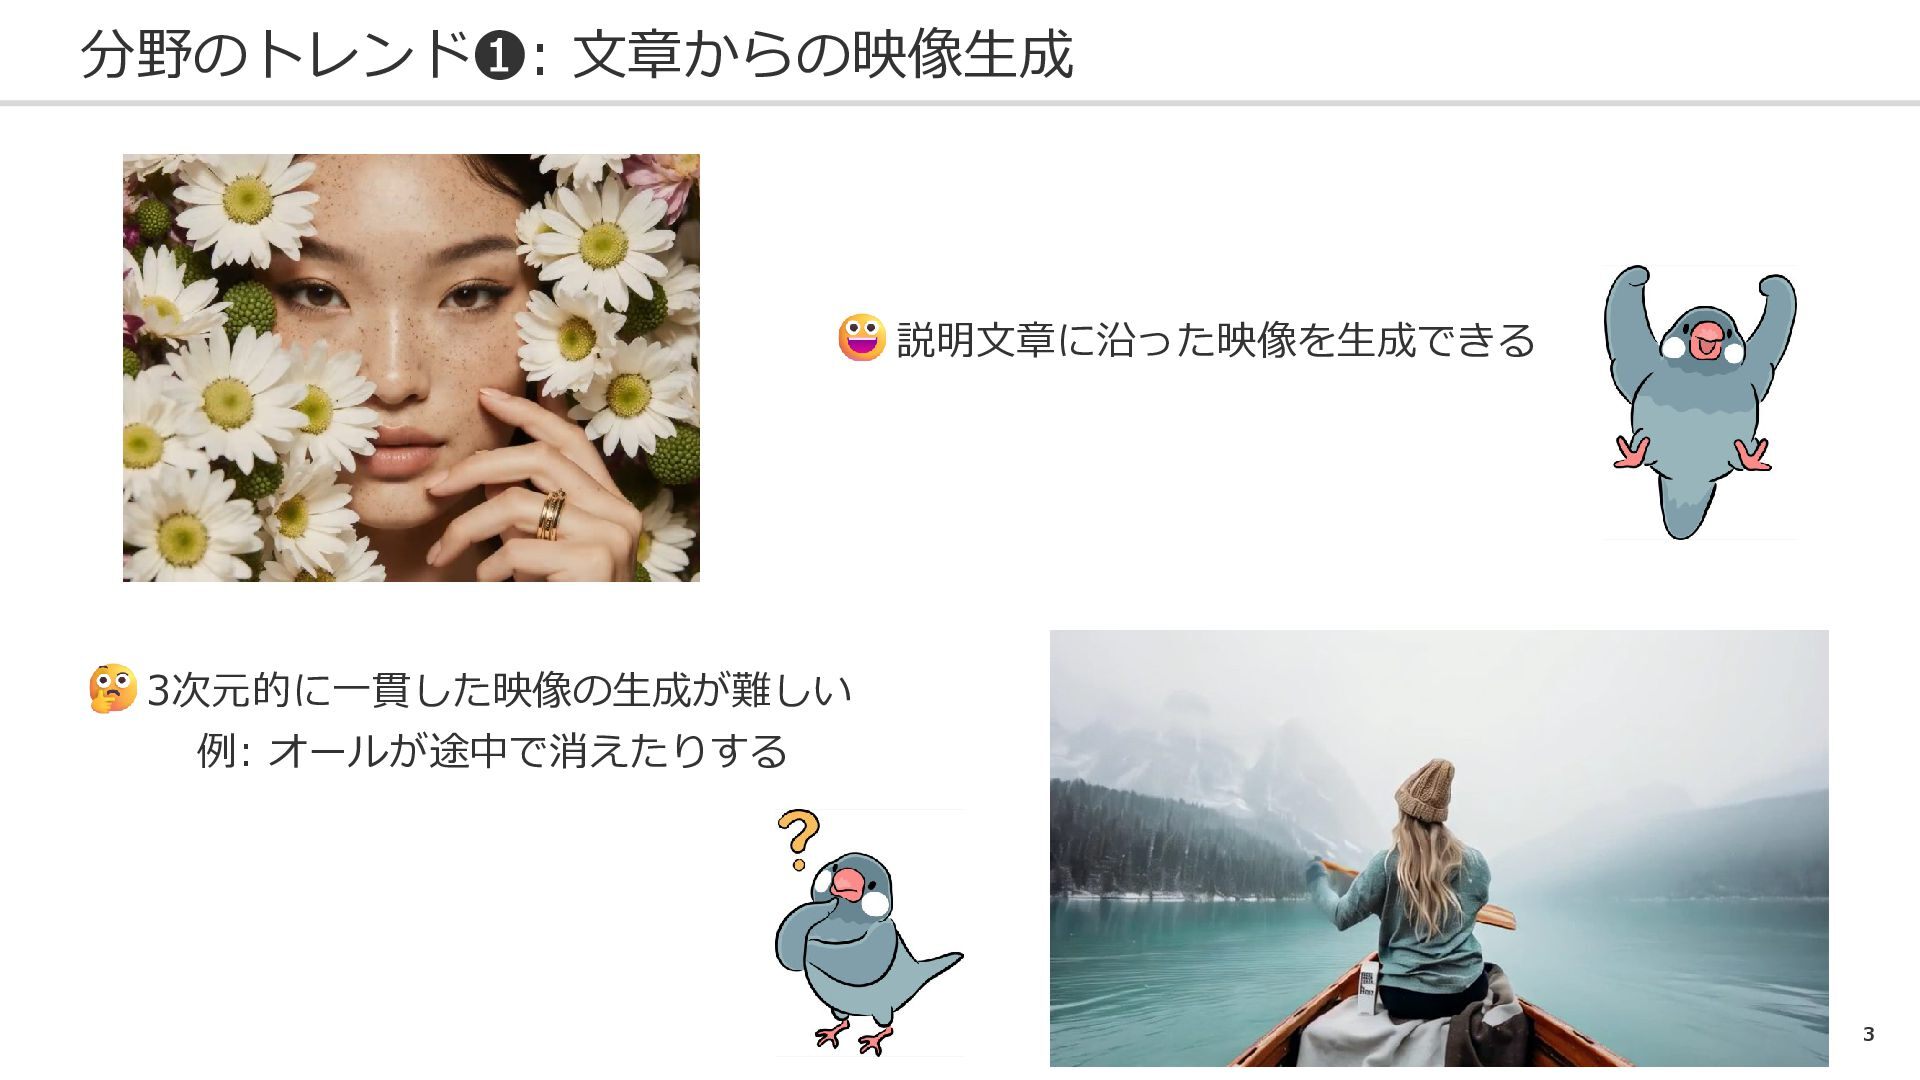
3 分野のトレンド❶: 文章からの映像生成 説明文章に沿った映像を生成できる 3次元的に一貫した映像の生成が難しい 例: オールが途中で消えたりする
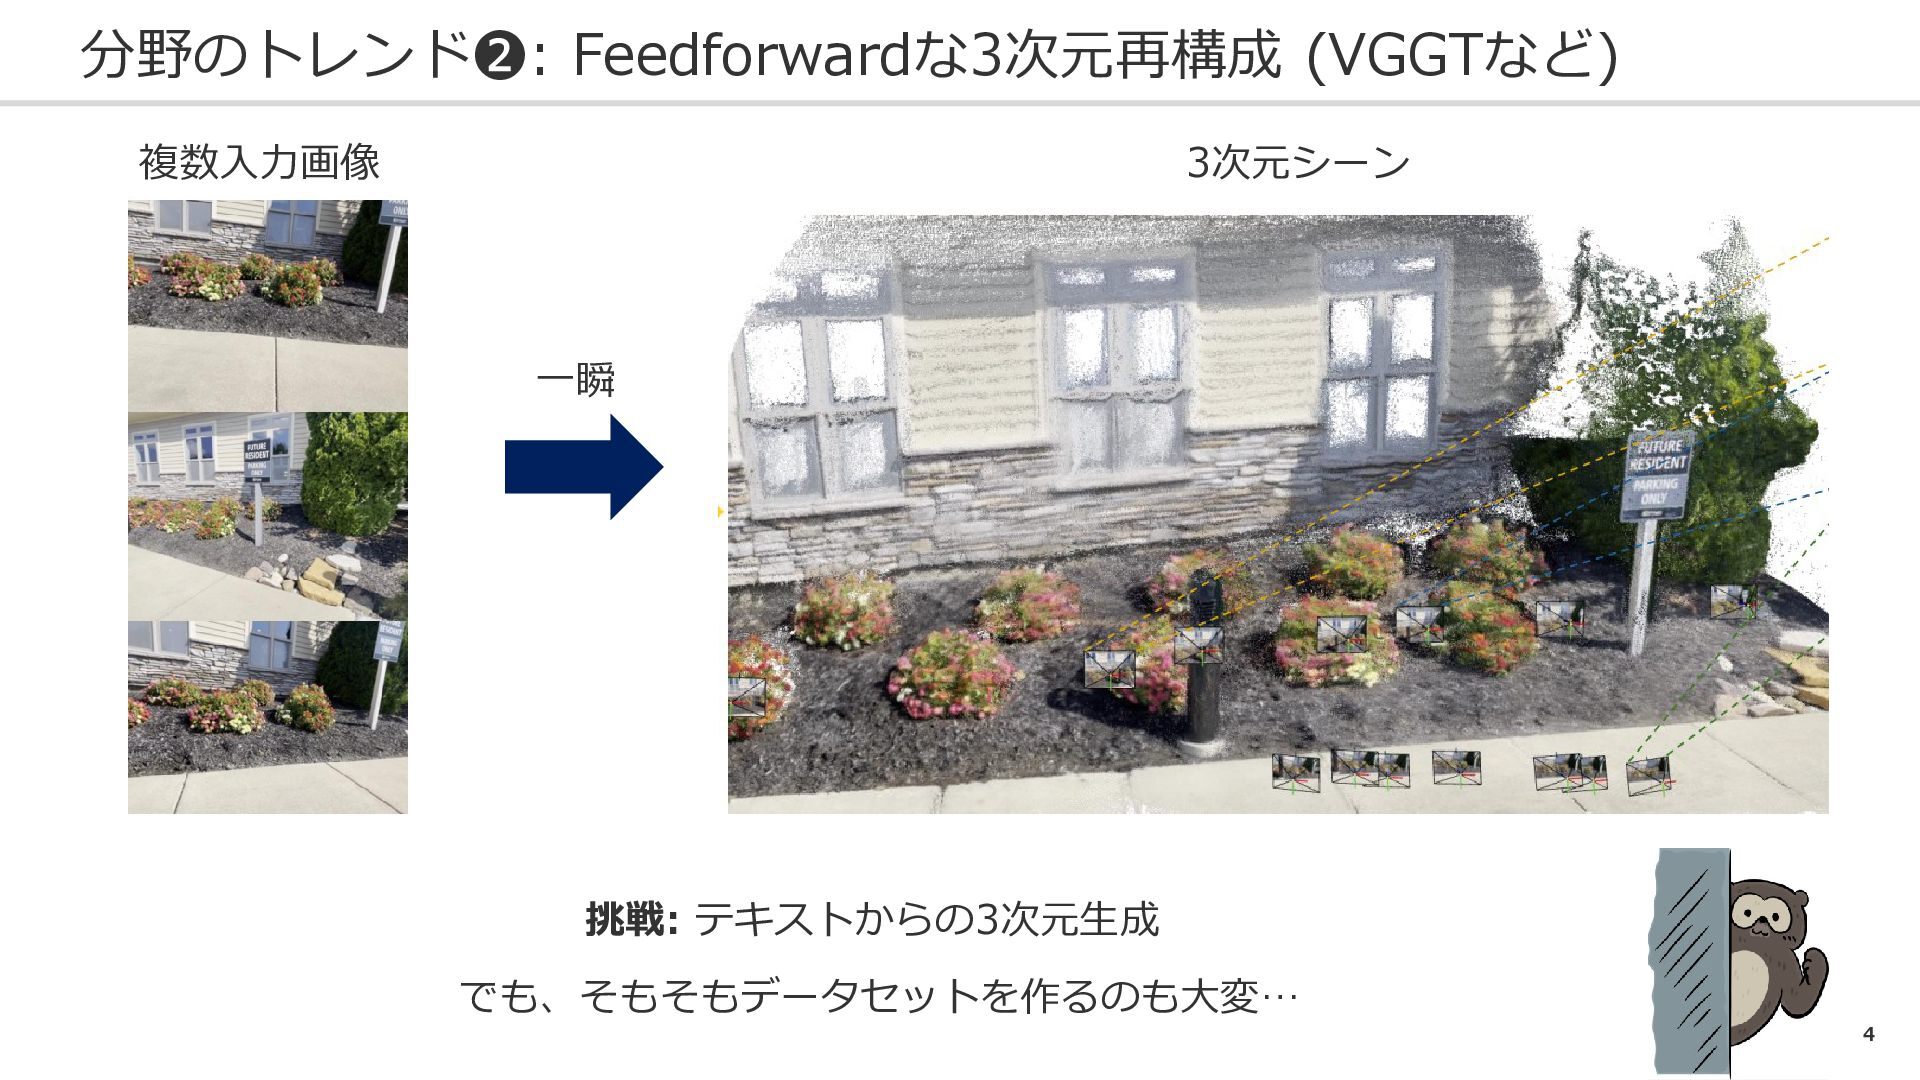
4 分野のトレンド❷: Feedforwardな3次元再構成 (VGGTなど) 複数入力画像 3次元シーン 一瞬 挑戦: テキストからの3次元生成 でも、そもそもデータセットを作るのも大変…
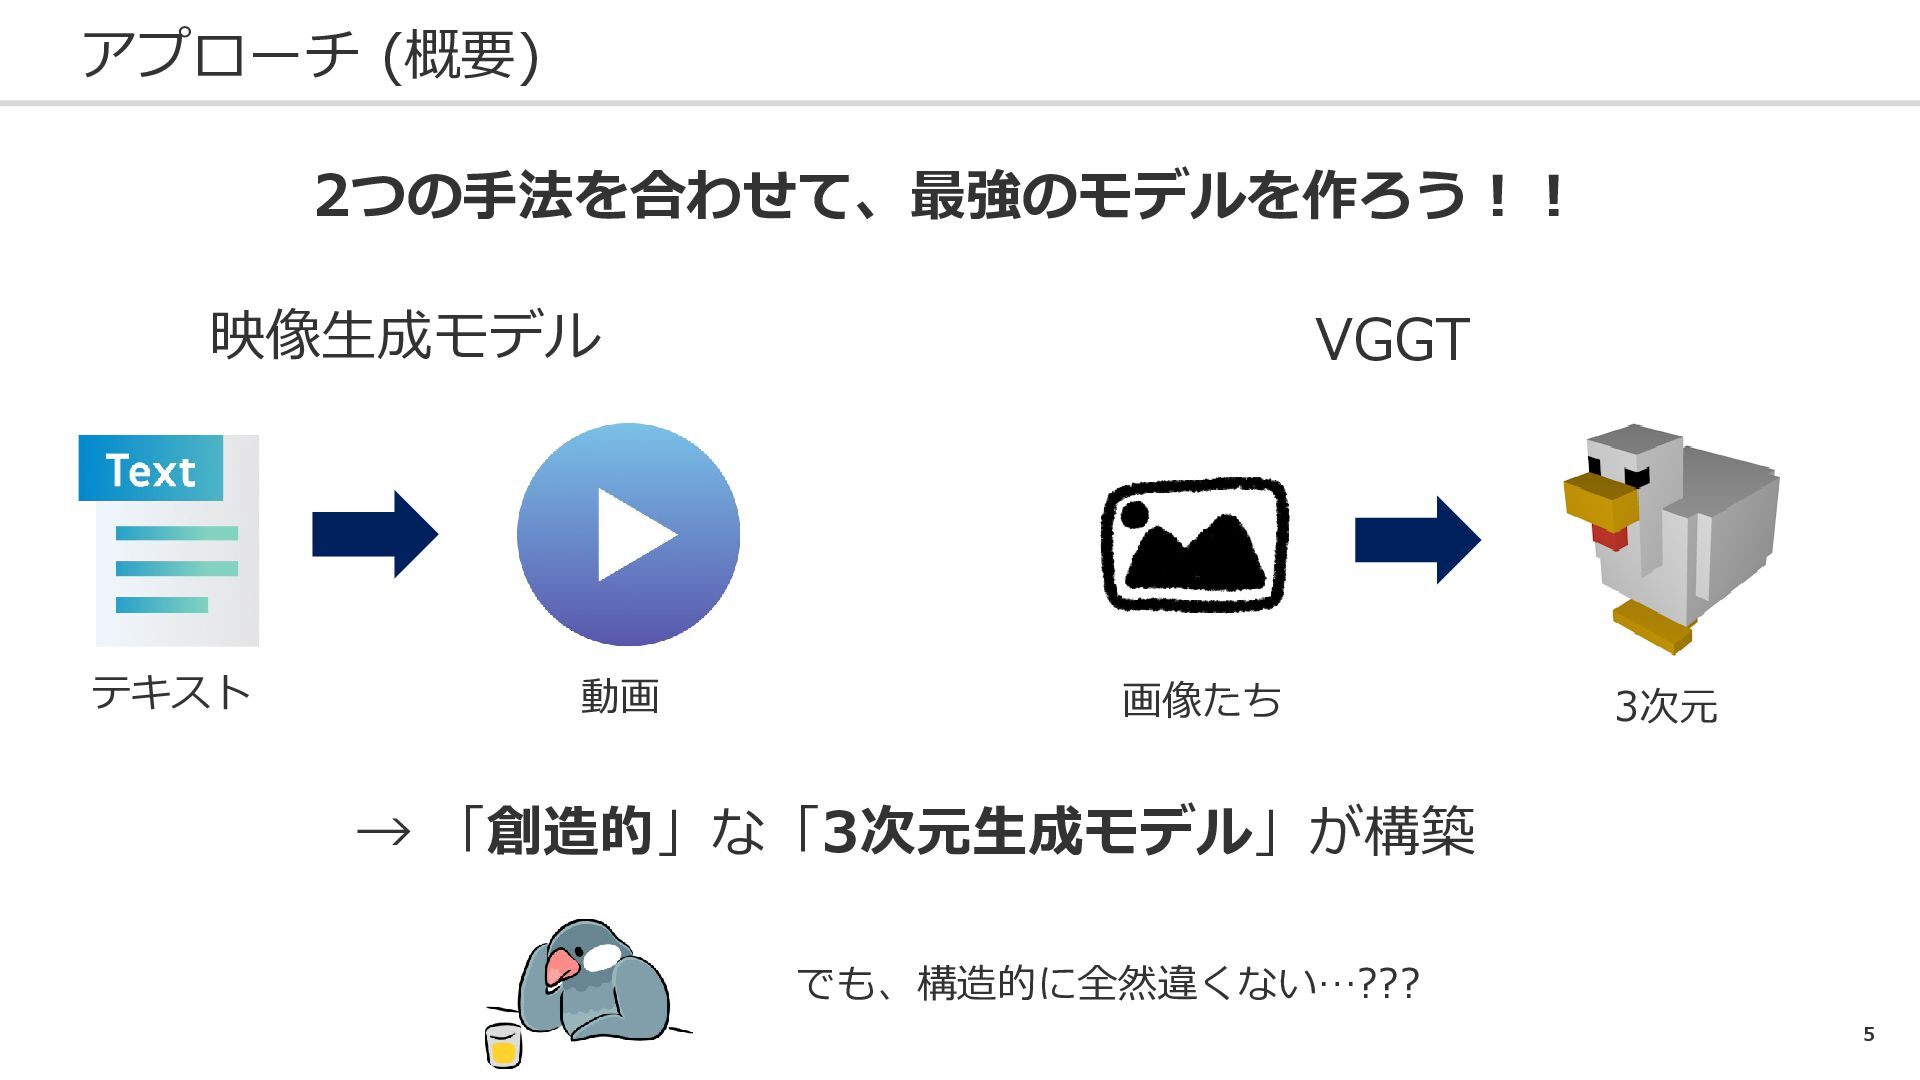
5 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 画像たち 3次元 2つの手法を合わせて、最強のモデルを作ろう!!
でも、構造的に全然違くない…??? → 「創造的」な「3次元生成モデル」が構築
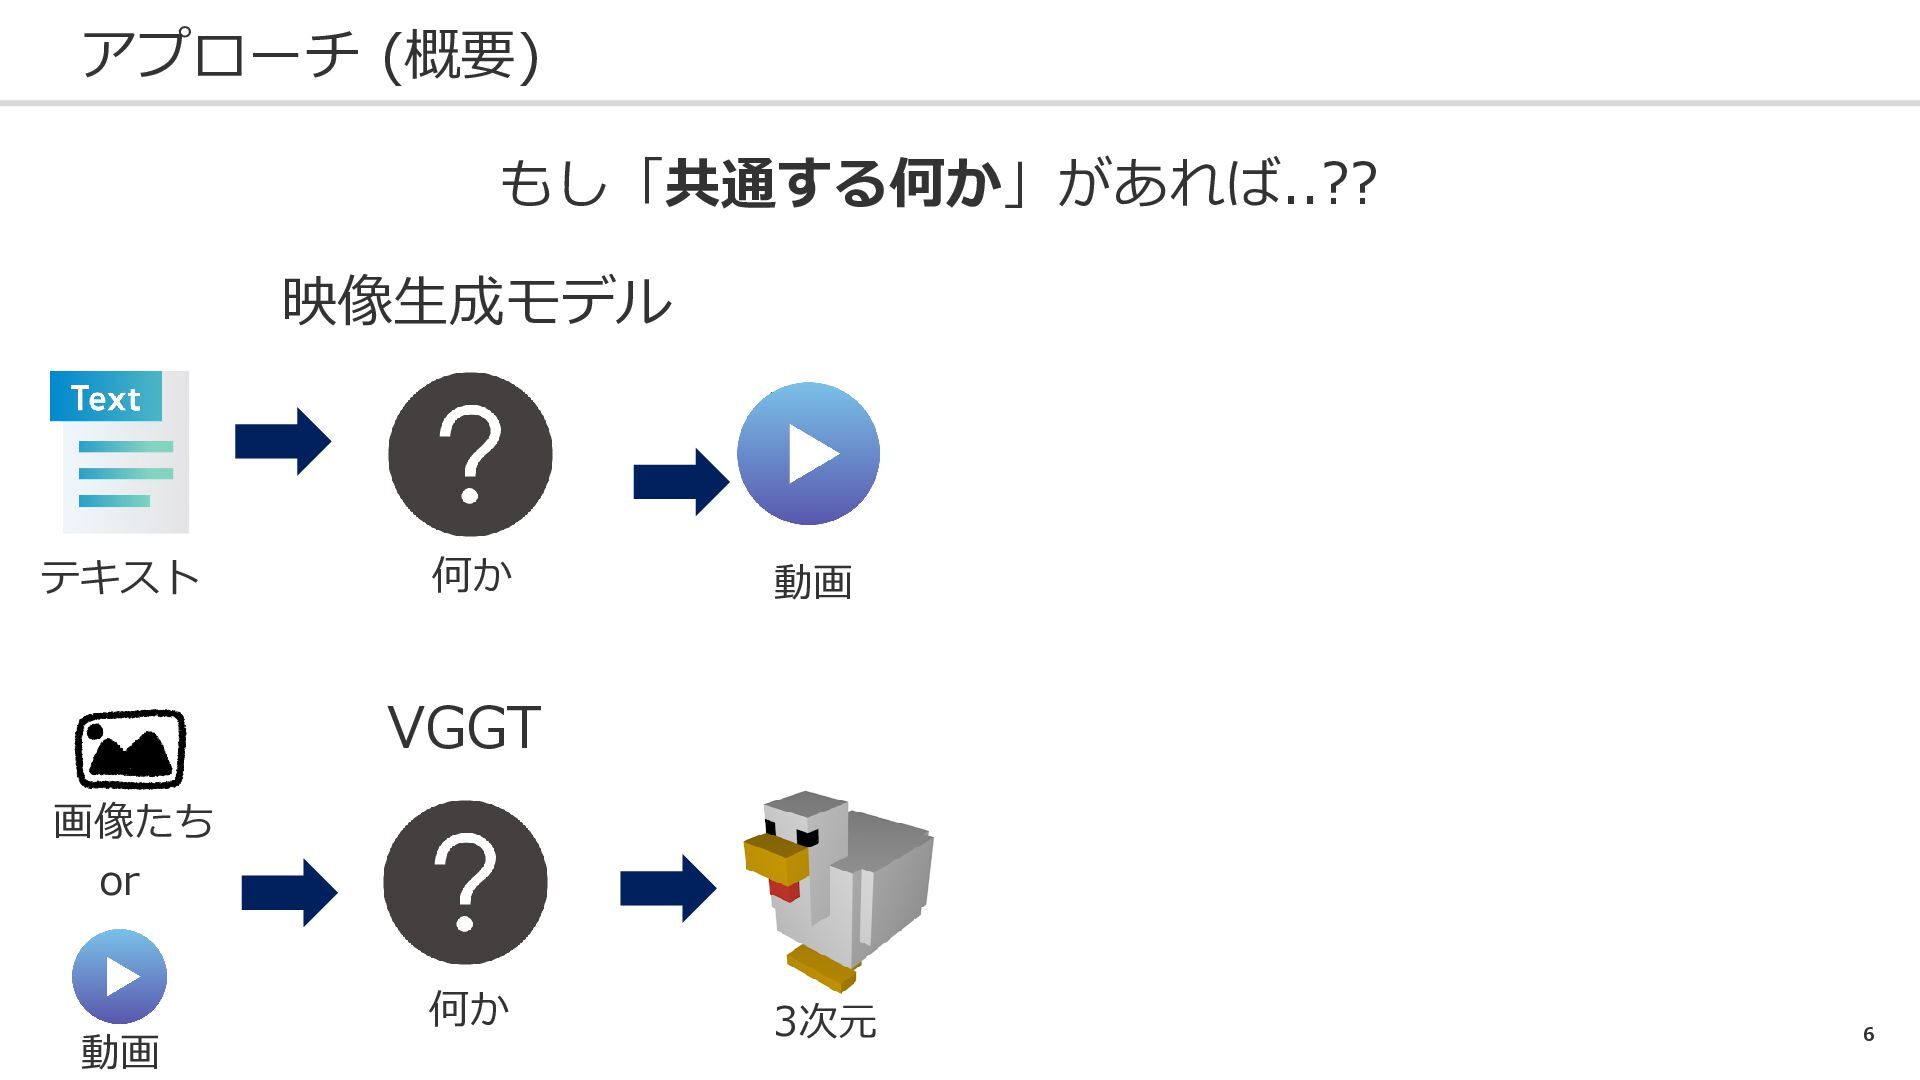
6 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 3次元 もし「共通する何か」があれば..?? 何か
何か 画像たち or 動画
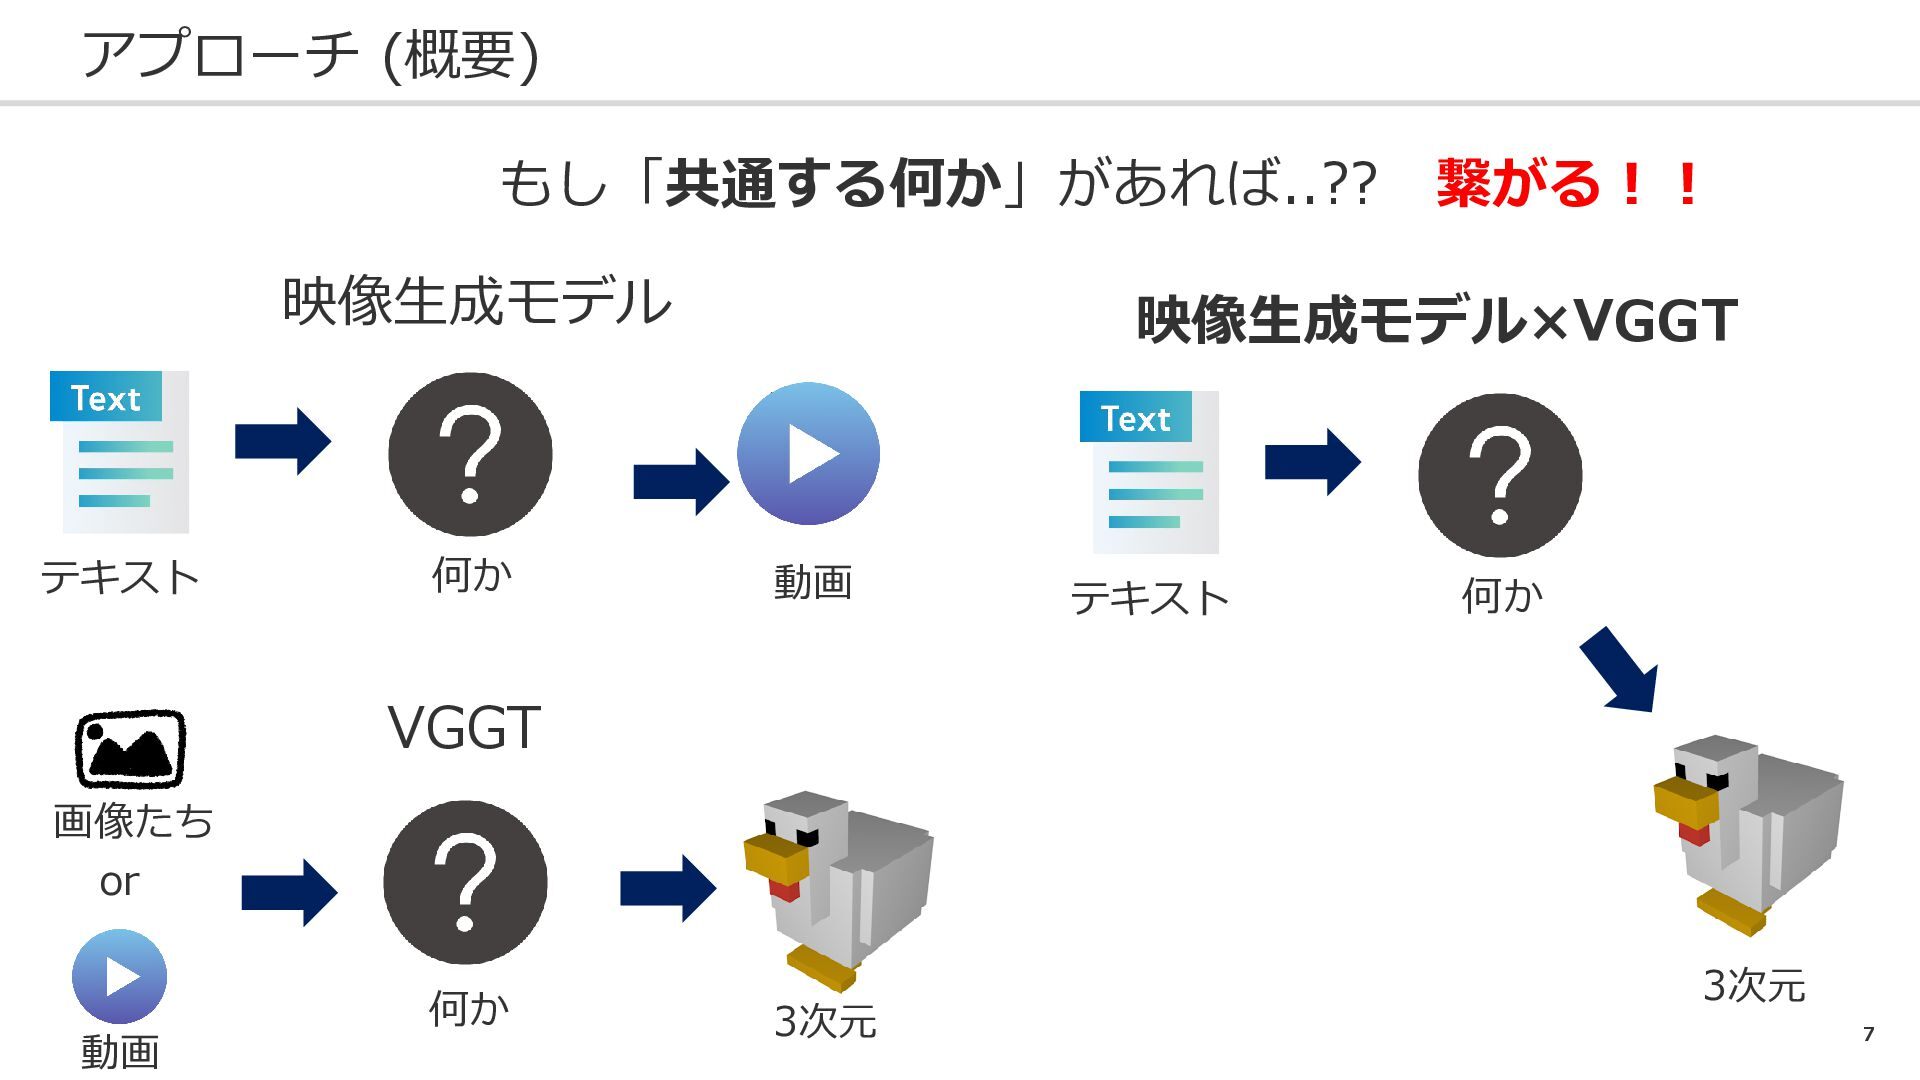
7 アプローチ (概要) 映像生成モデル VGGT テキスト 動画 画像たち 3次元 もし「共通する何か」があれば..??
繋がる!! 何か 何か テキスト 何か 3次元 映像生成モデル×VGGT or 動画
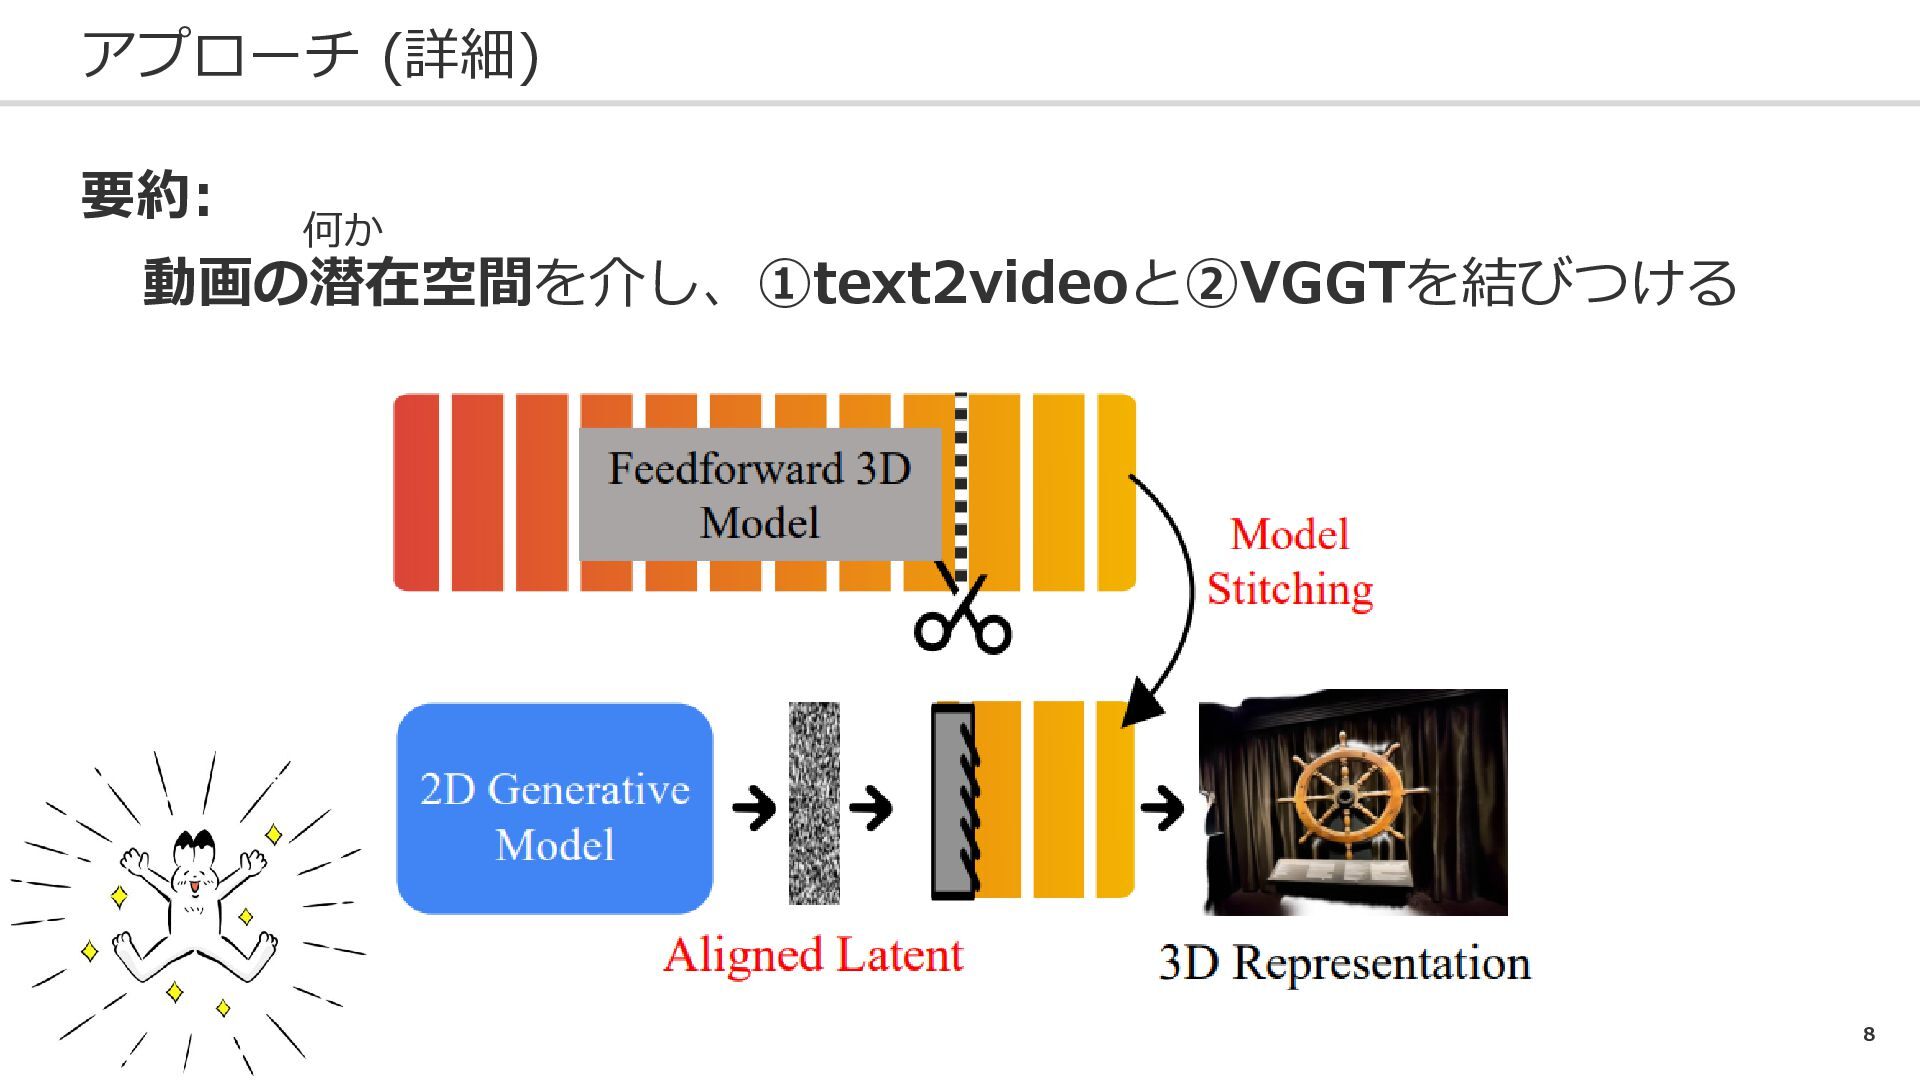
8 アプローチ (詳細) 要約: 動画の潜在空間を介し、①text2videoと②VGGTを結びつける 何か
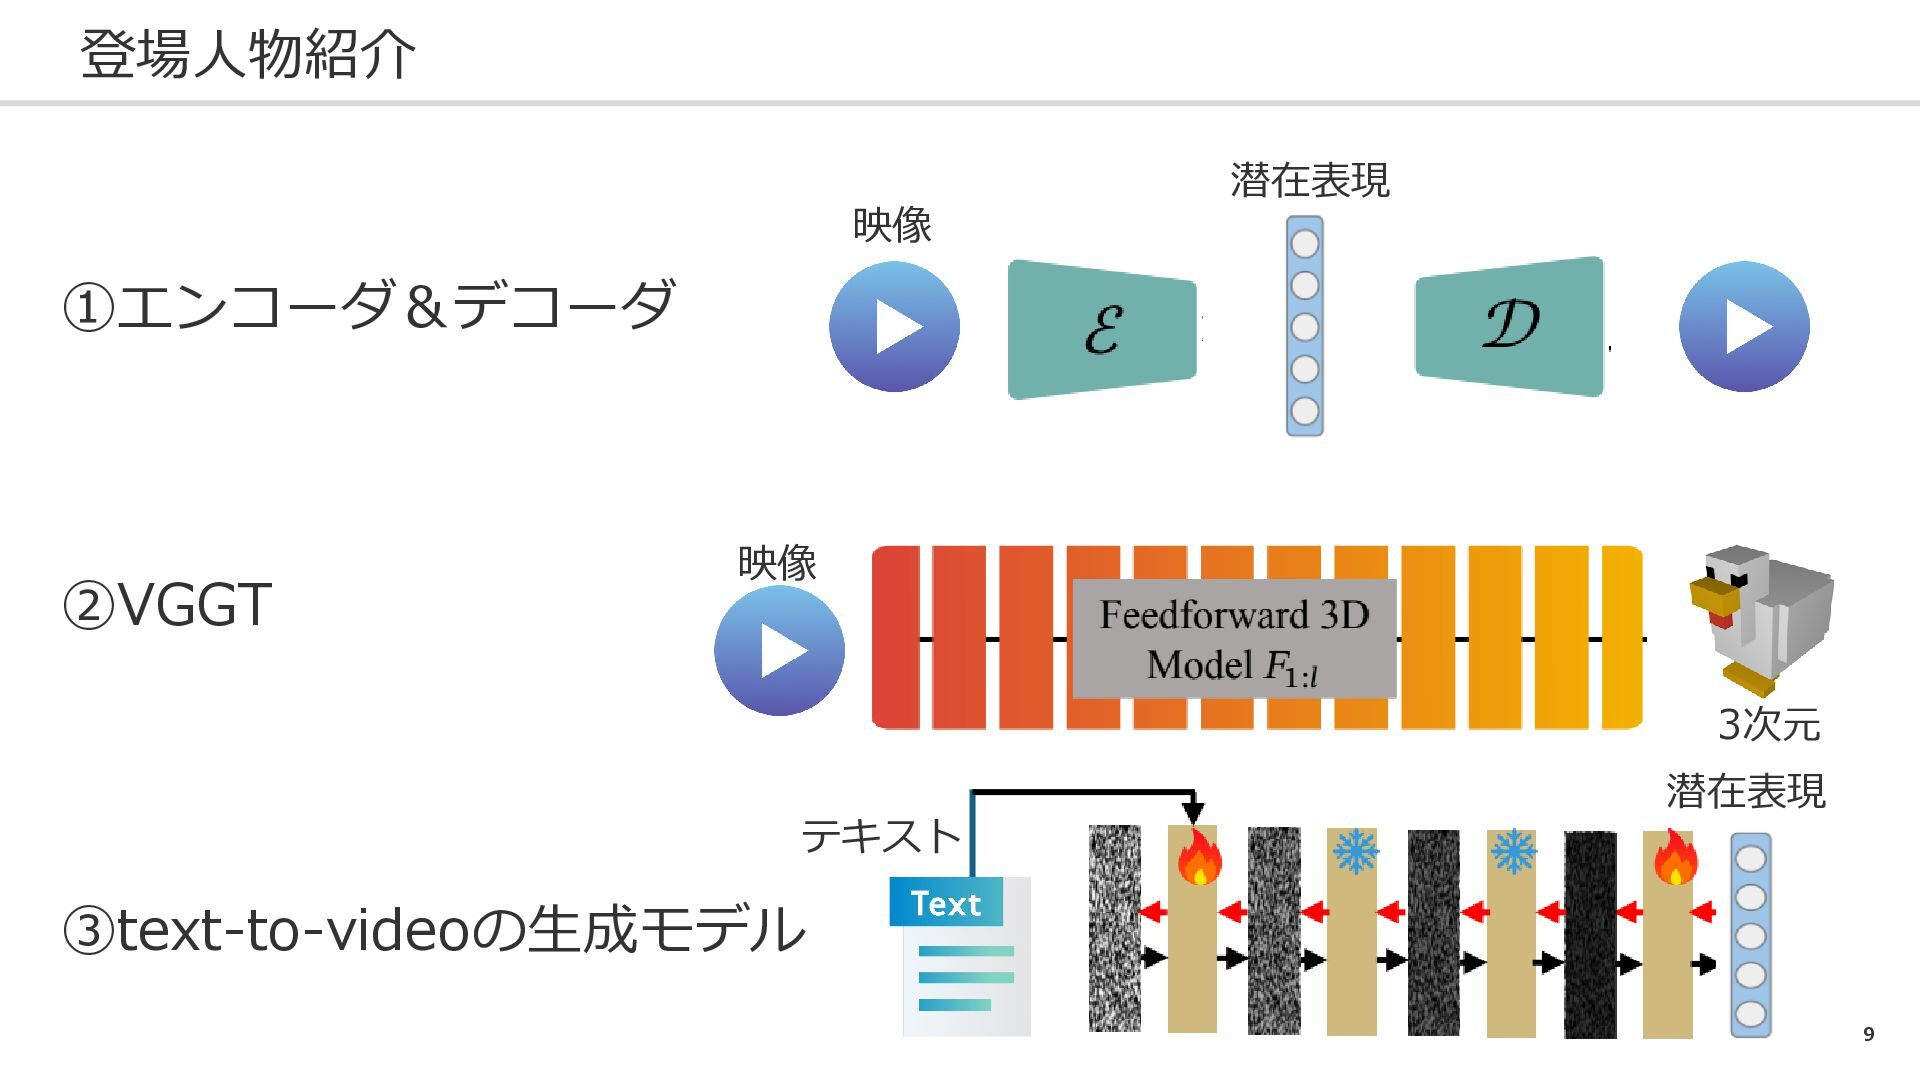
9 登場人物紹介 ①エンコーダ&デコーダ ②VGGT ③text-to-videoの生成モデル 潜在表現 映像 テキスト 潜在表現 映像
3次元
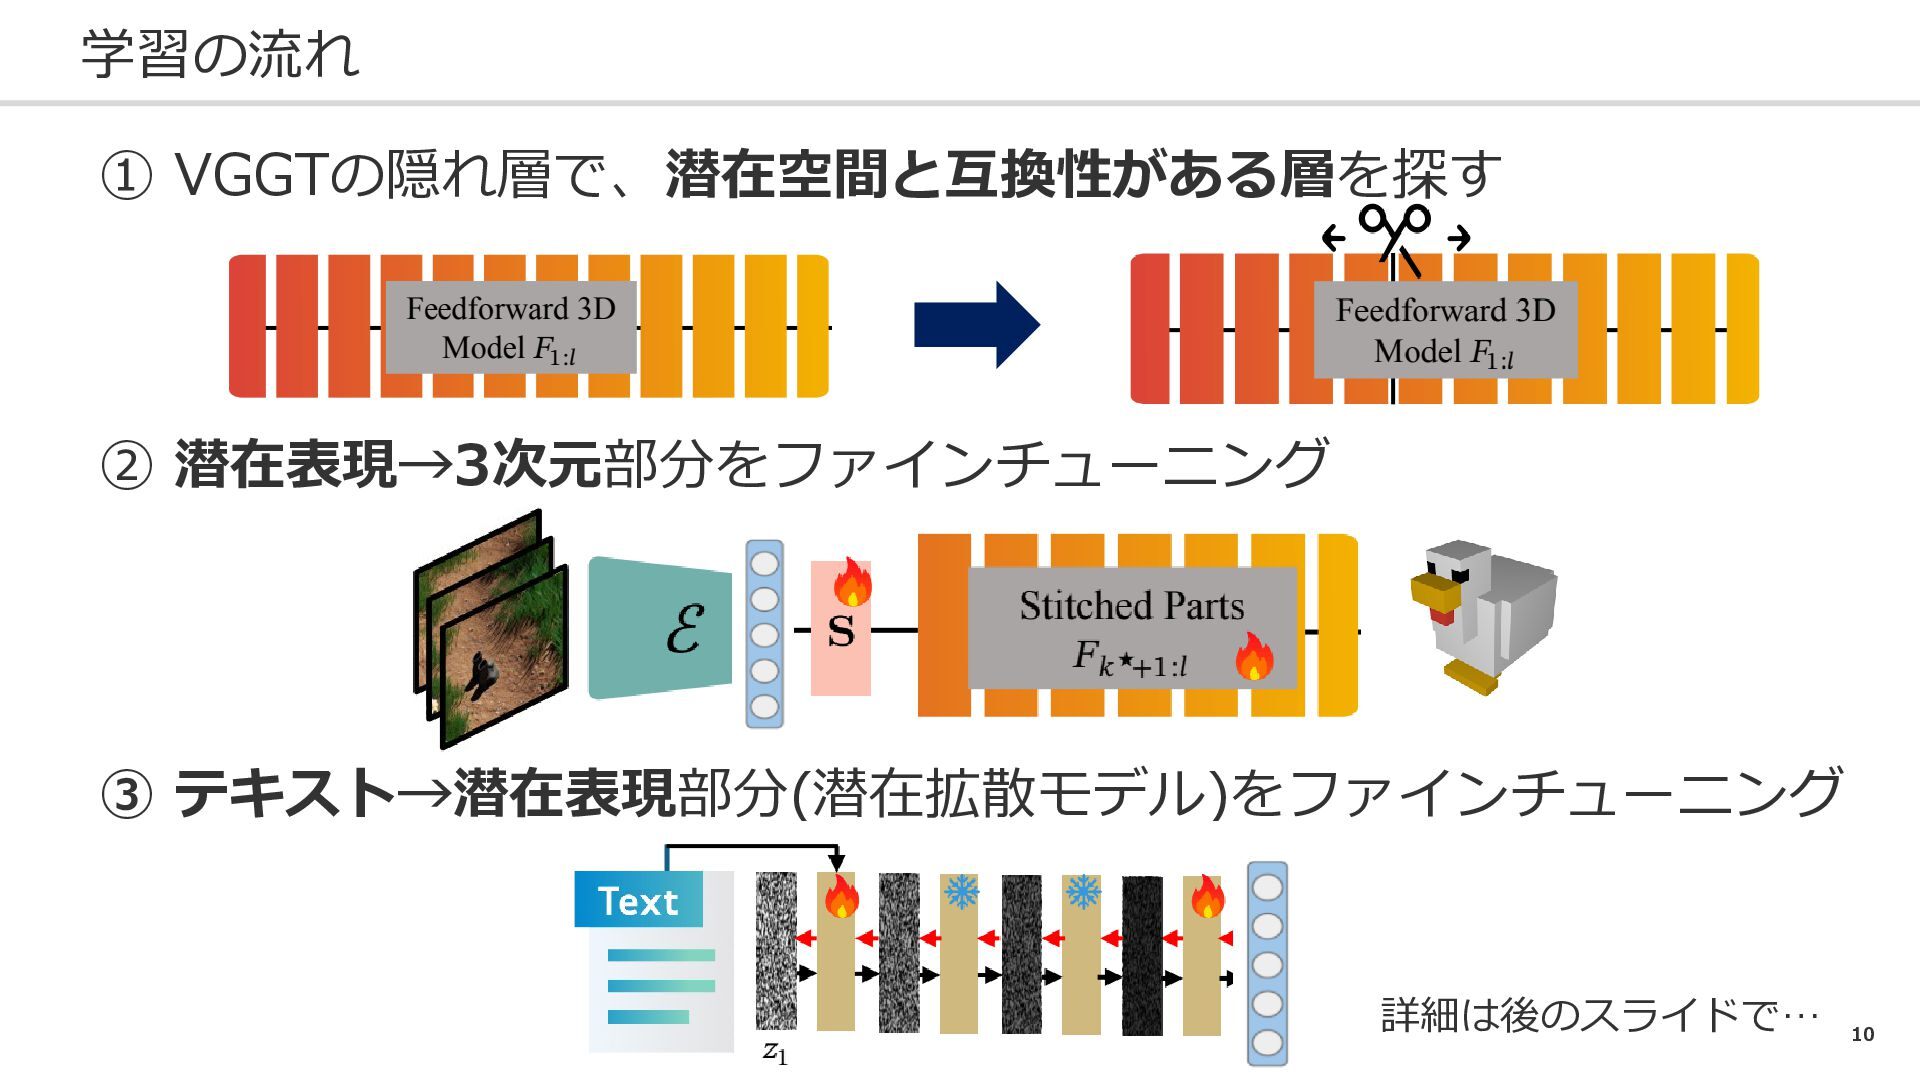
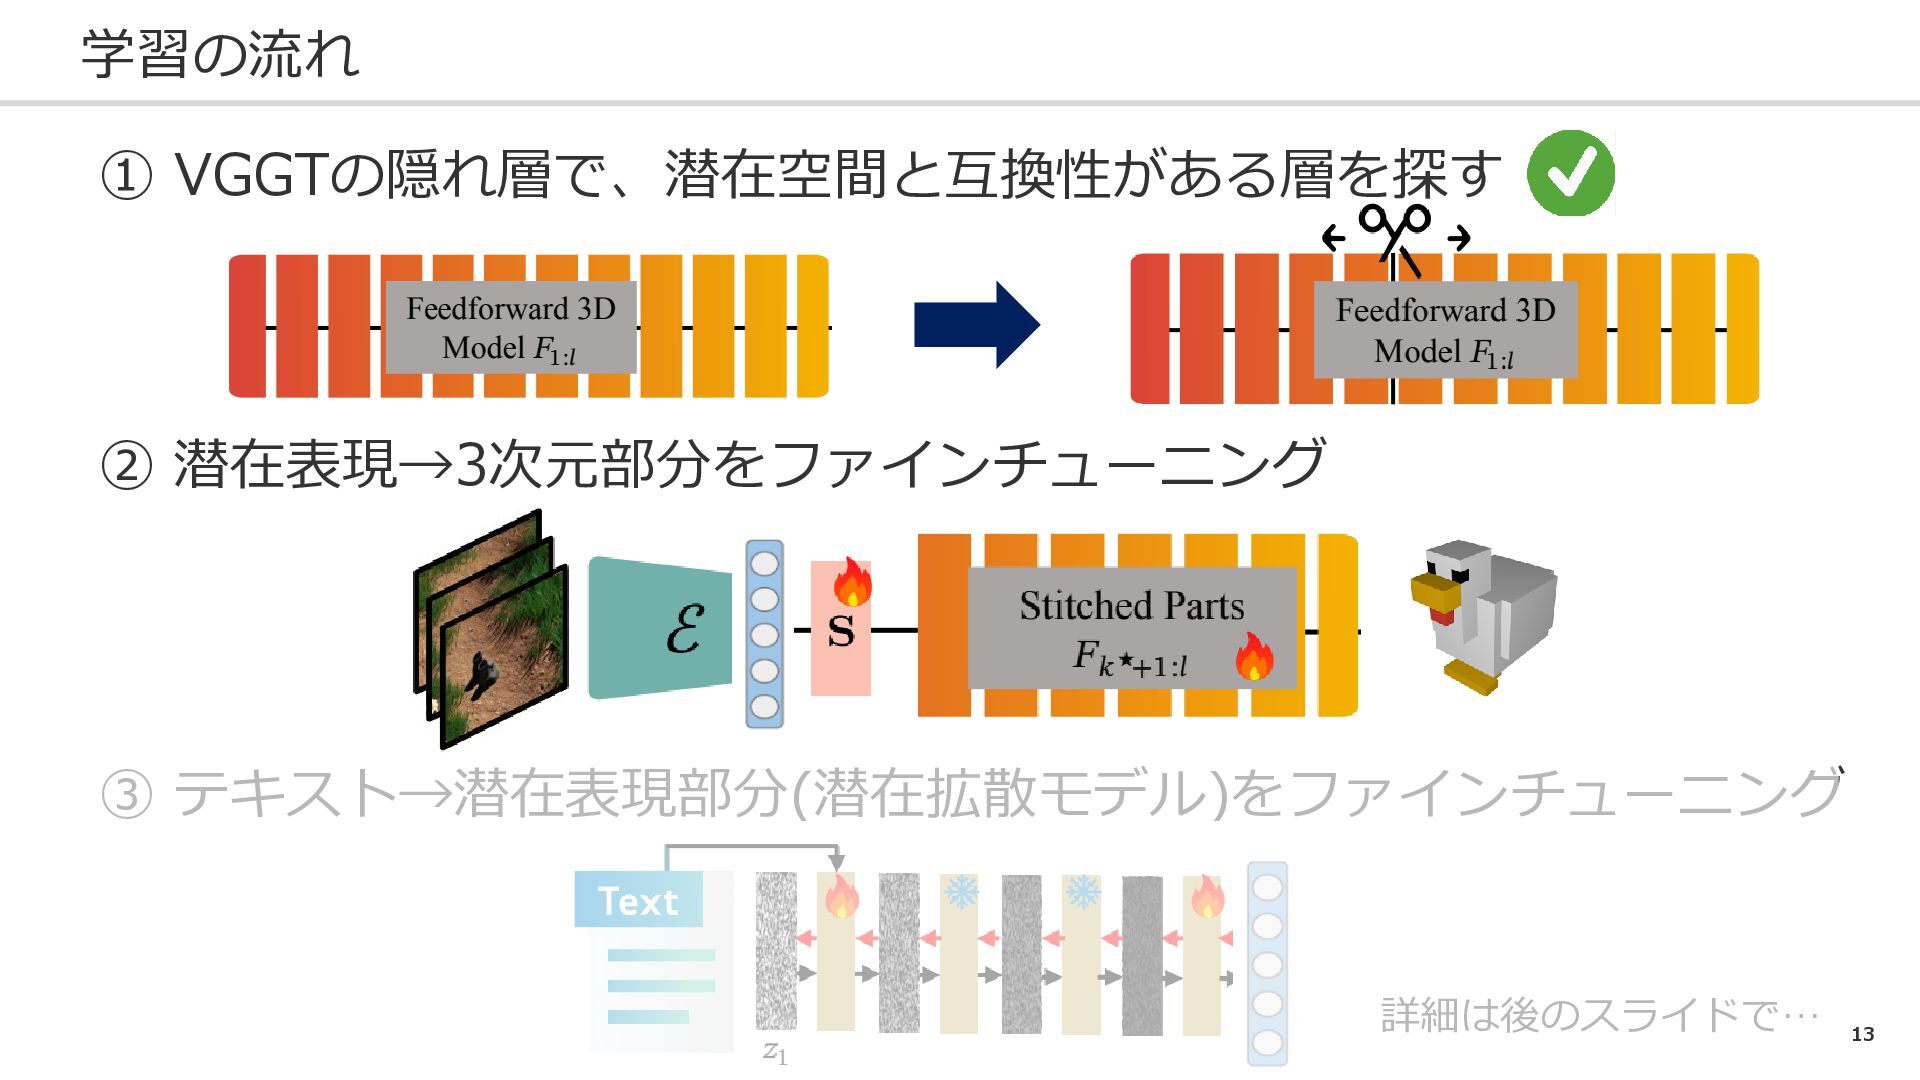
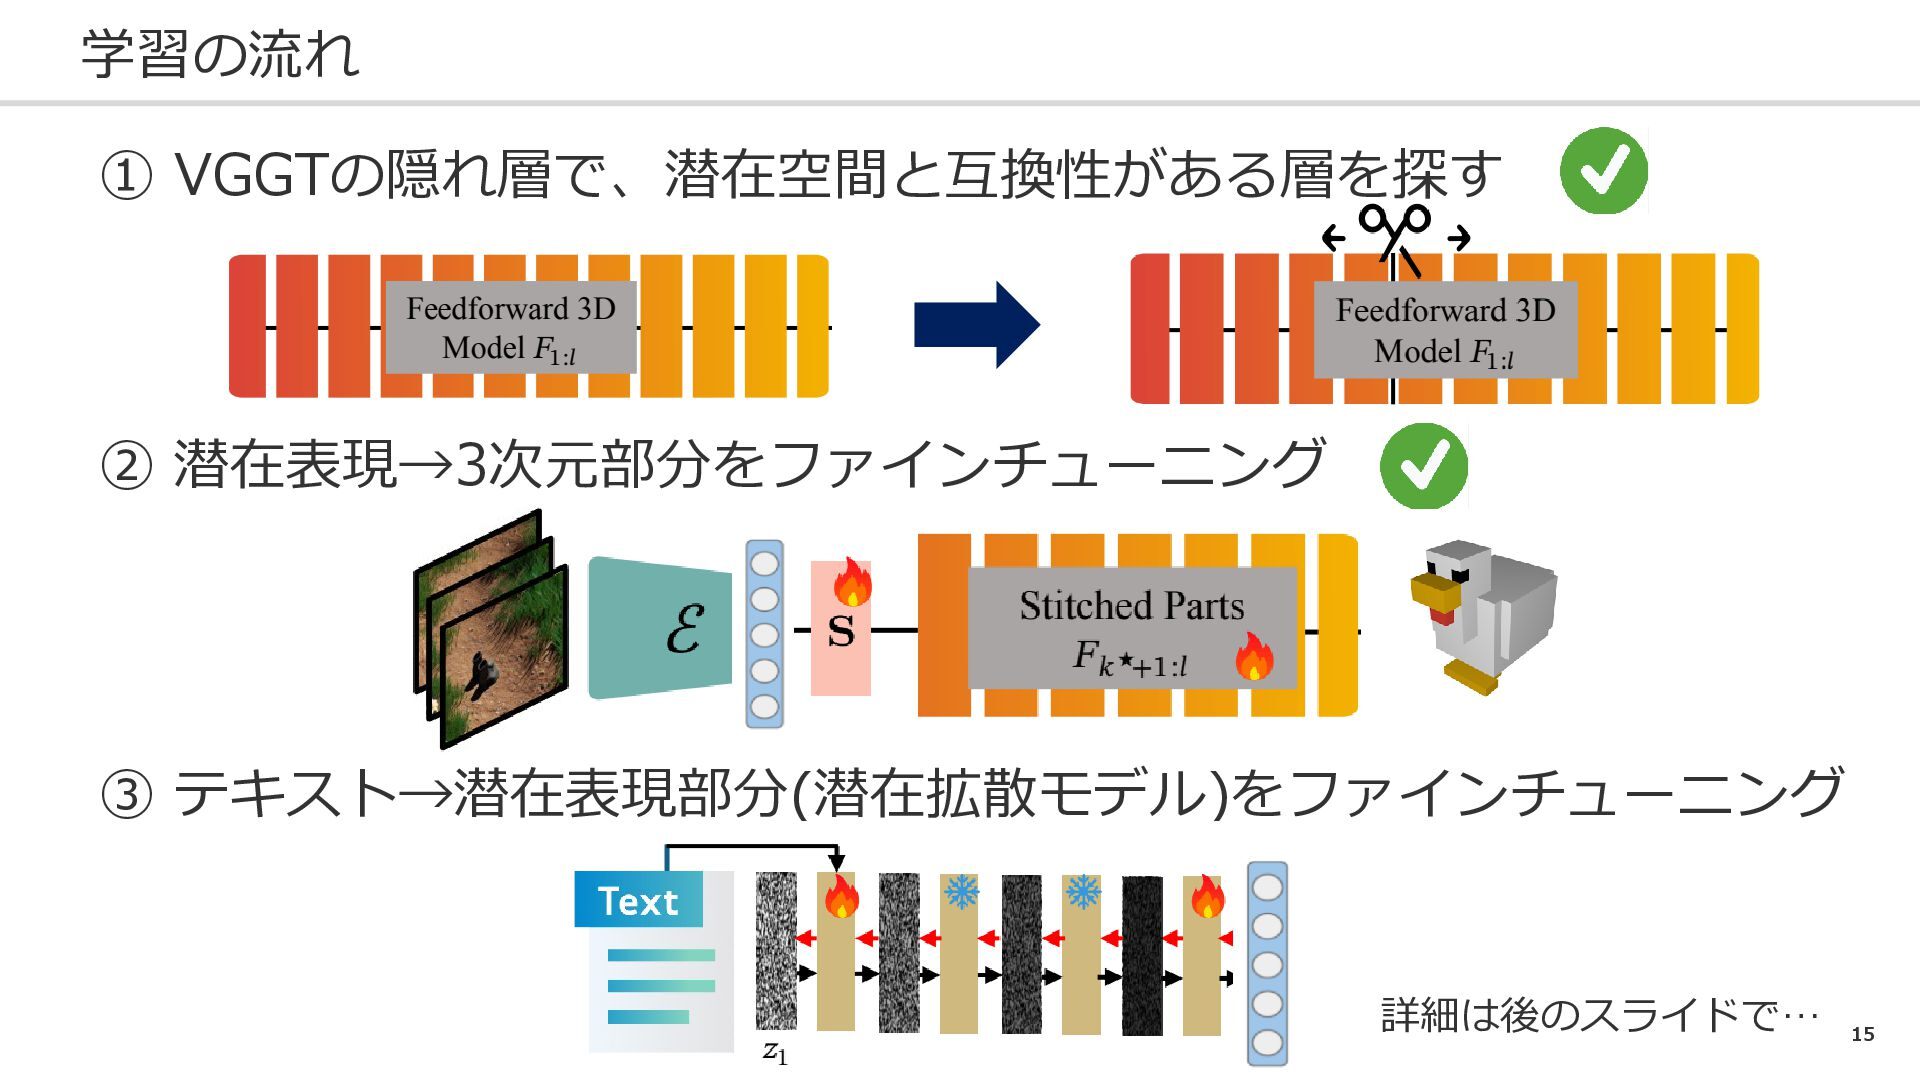
10 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
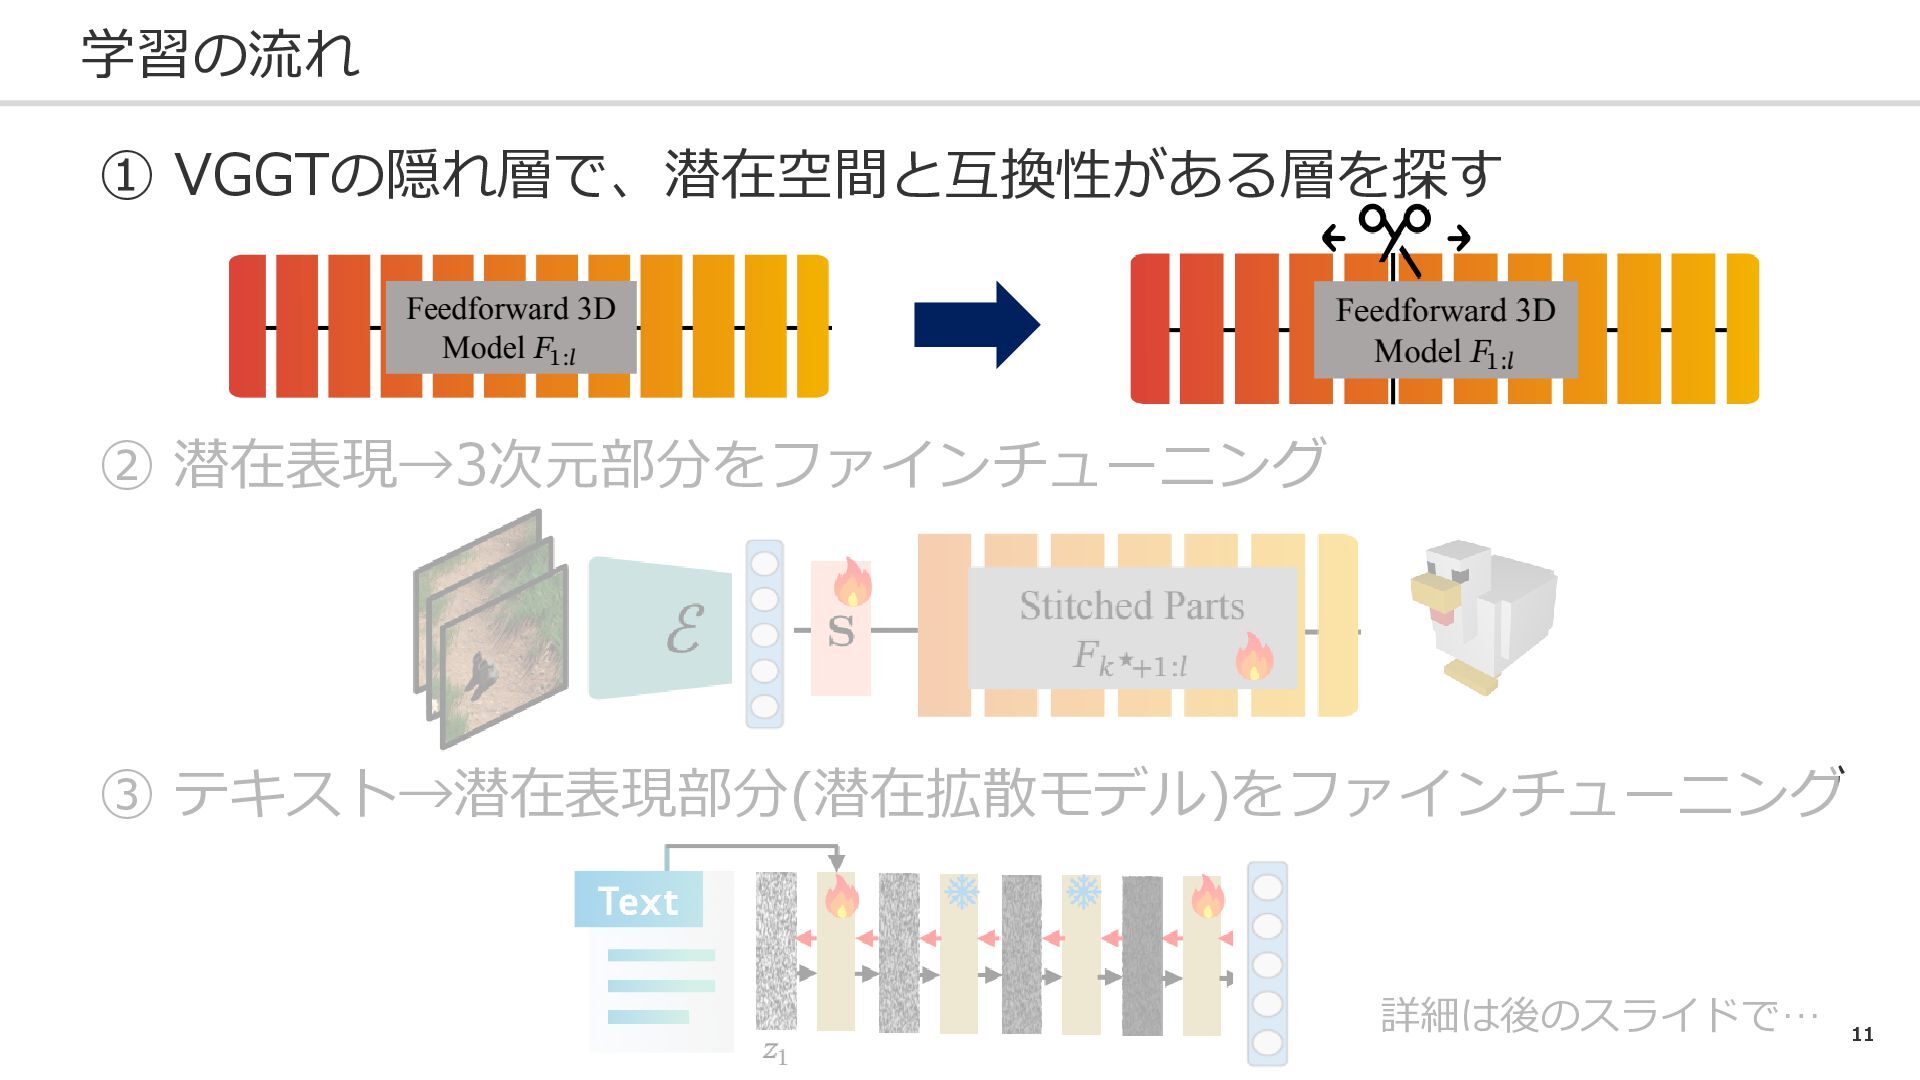
11 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
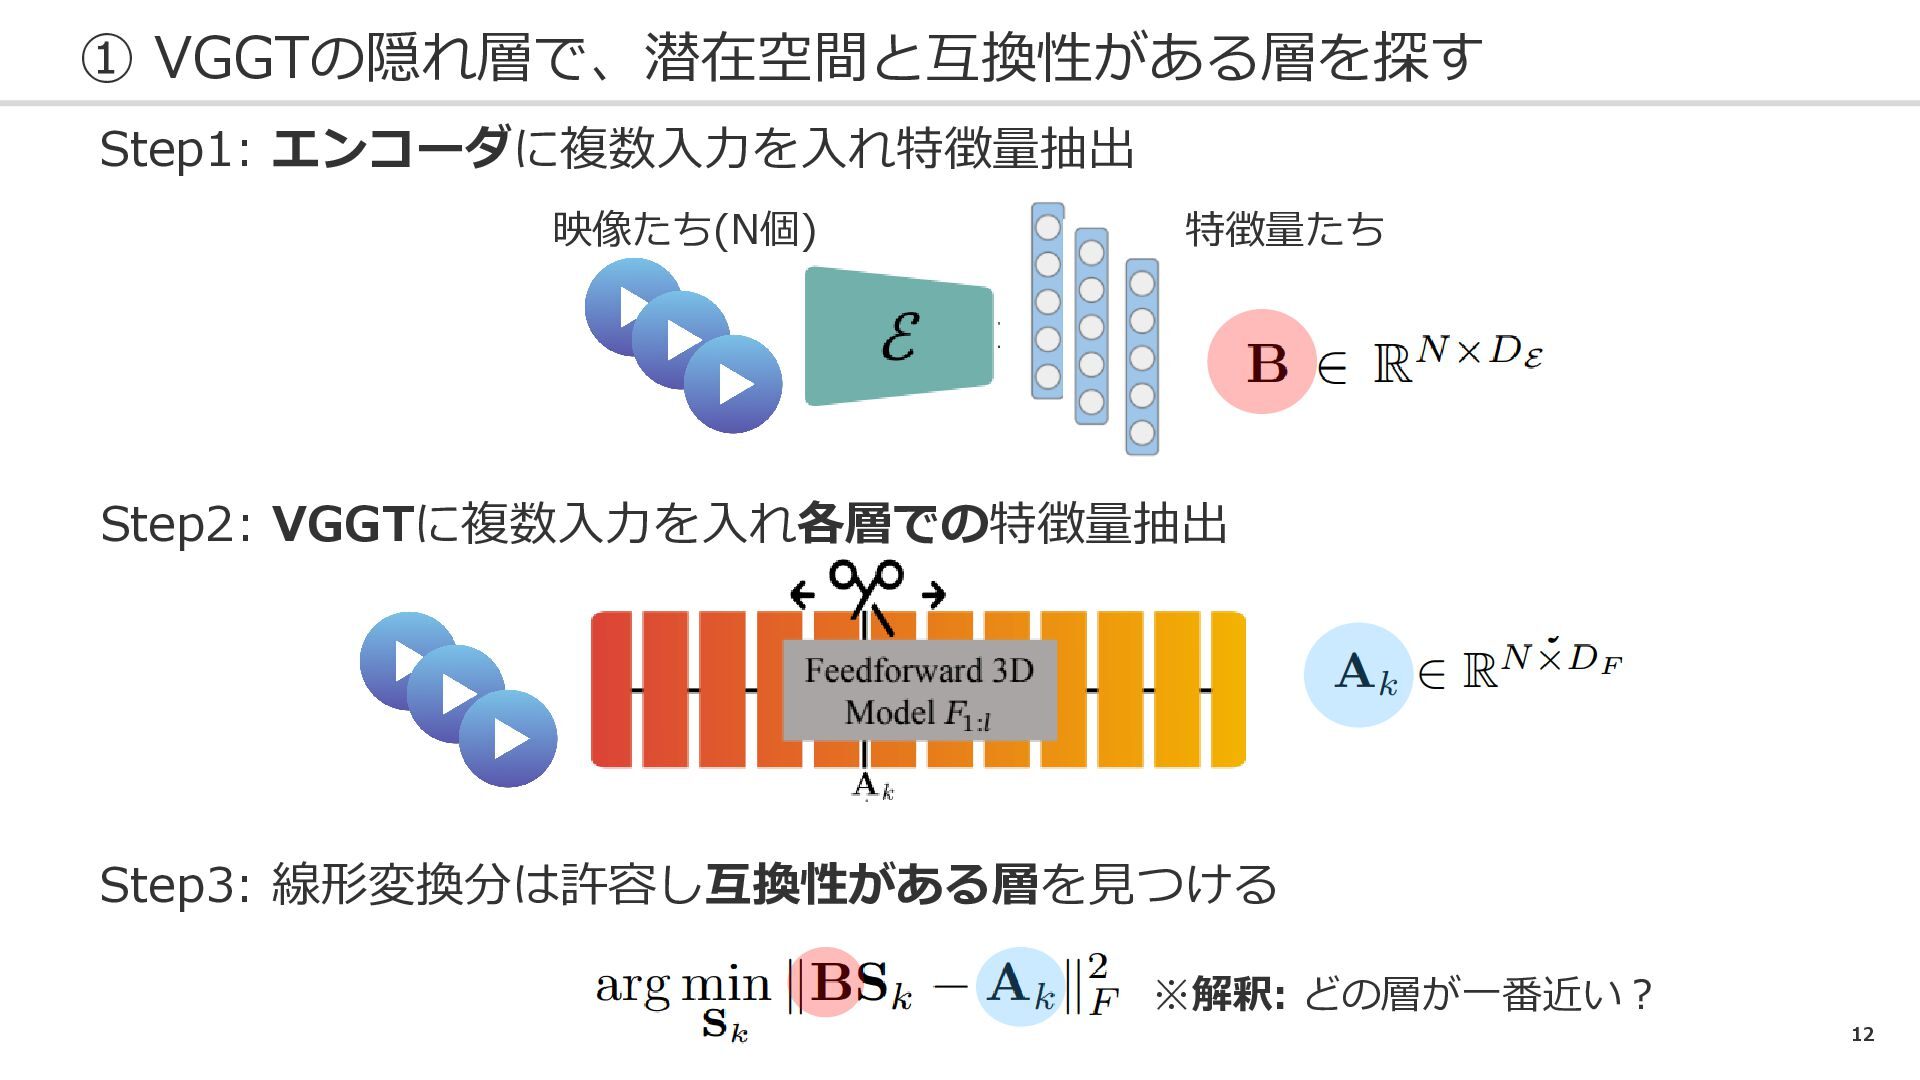
12 ① VGGTの隠れ層で、潜在空間と互換性がある層を探す Step1: エンコーダに複数入力を入れ特徴量抽出 映像たち(N個) 特徴量たち Step2: VGGTに複数入力を入れ各層での特徴量抽出 Step3:
線形変換分は許容し互換性がある層を見つける ※解釈: どの層が一番近い?
13 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
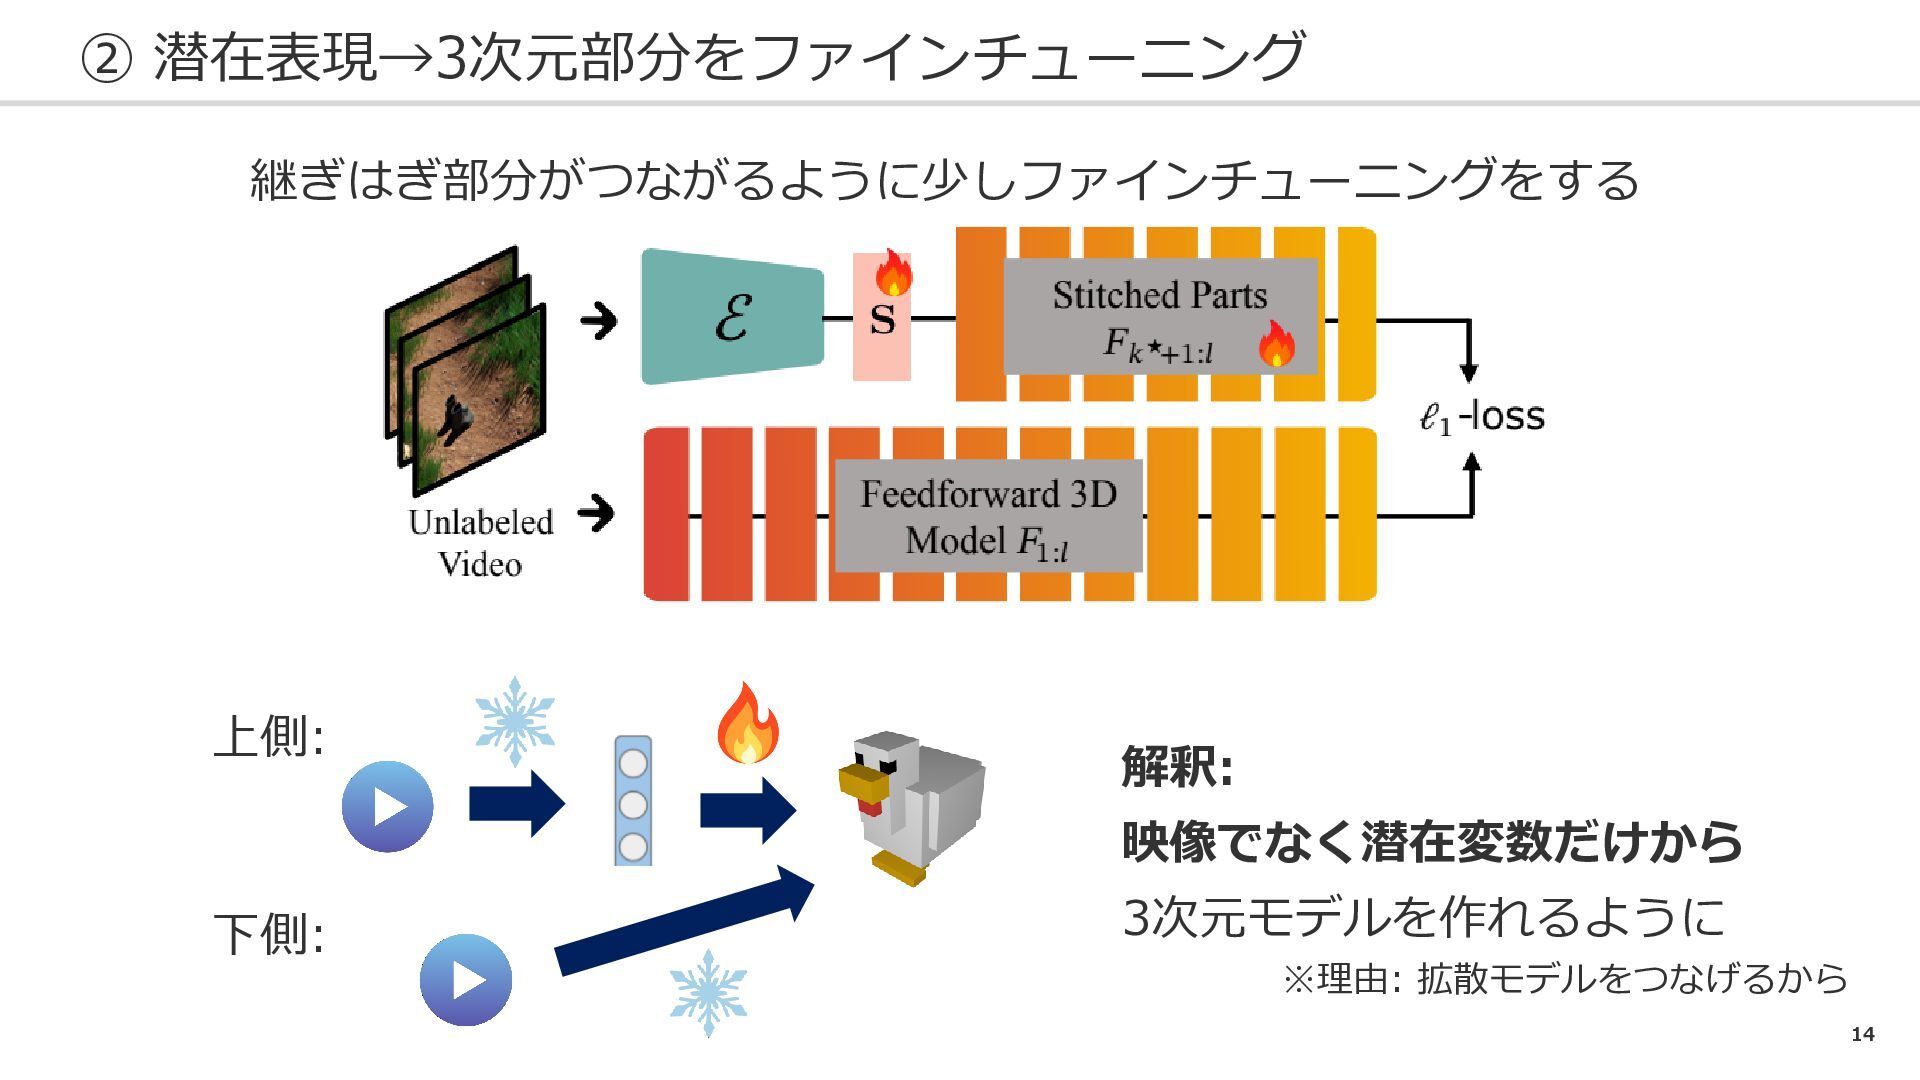
14 ② 潜在表現→3次元部分をファインチューニング 上側: 下側: 継ぎはぎ部分がつながるように少しファインチューニングをする 解釈: 映像でなく潜在変数だけから 3次元モデルを作れるように ※理由:
拡散モデルをつなげるから
15 学習の流れ ① VGGTの隠れ層で、潜在空間と互換性がある層を探す ② 潜在表現→3次元部分をファインチューニング ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 詳細は後のスライドで…
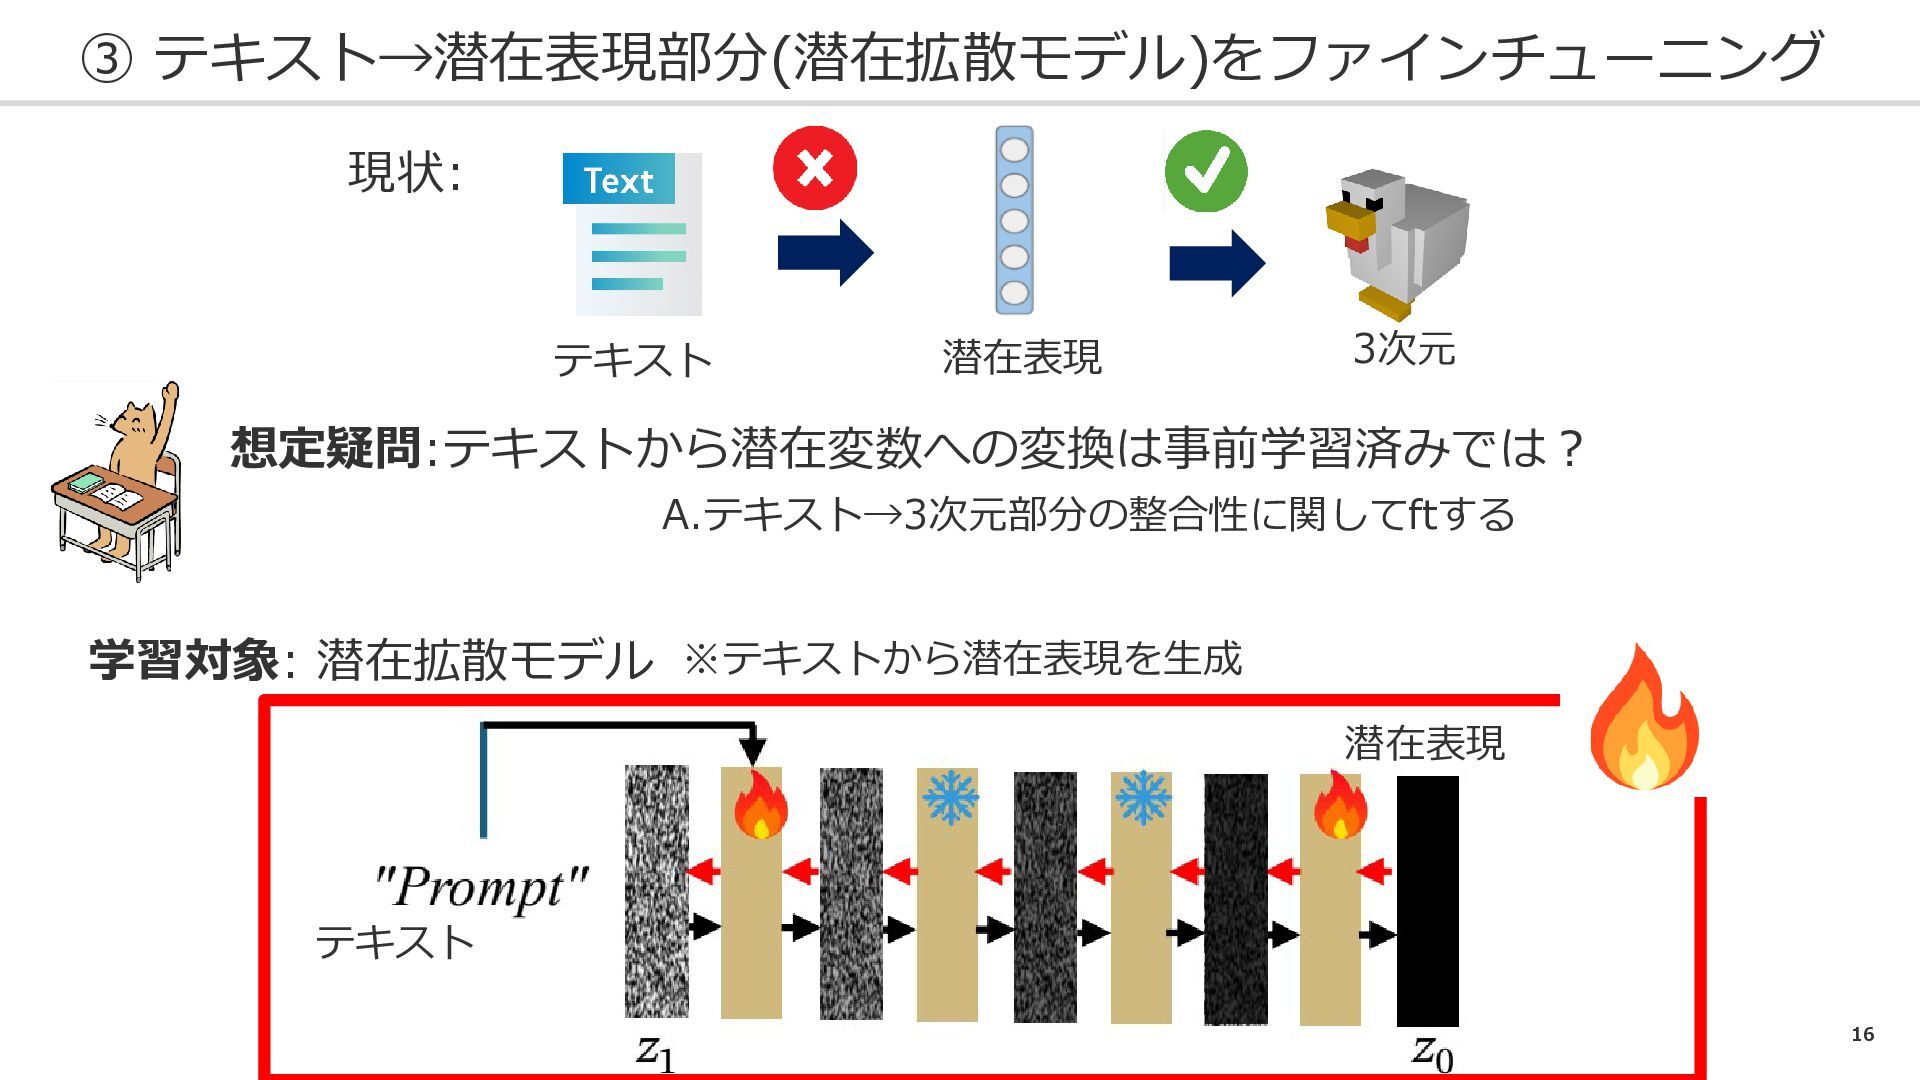
16 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 現状: テキスト 潜在表現 3次元 学習対象: 潜在拡散モデル ※テキストから潜在表現を生成
潜在表現 テキスト 想定疑問:テキストから潜在変数への変換は事前学習済みでは? A.テキスト→3次元部分の整合性に関してftする
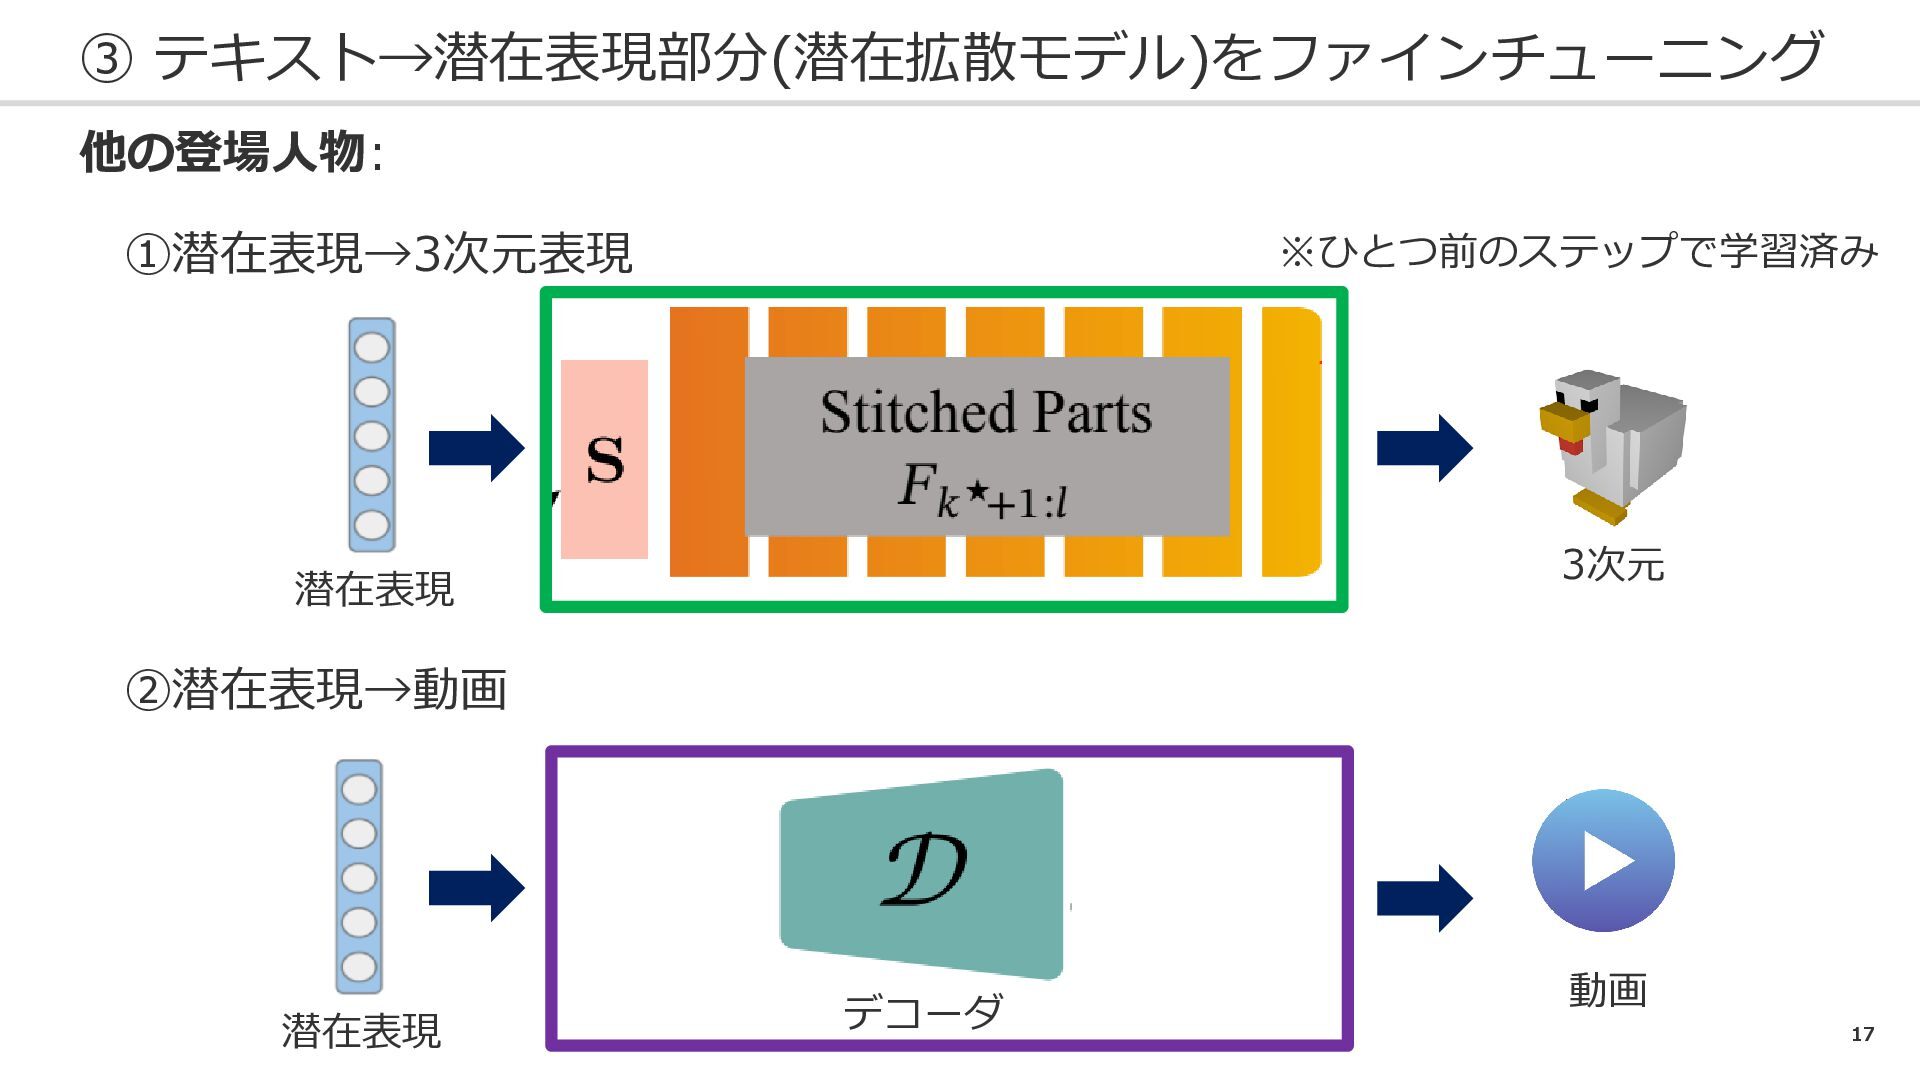
17 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 他の登場人物: ①潜在表現→3次元表現 潜在表現 3次元 ※ひとつ前のステップで学習済み ②潜在表現→動画 潜在表現
デコーダ 動画
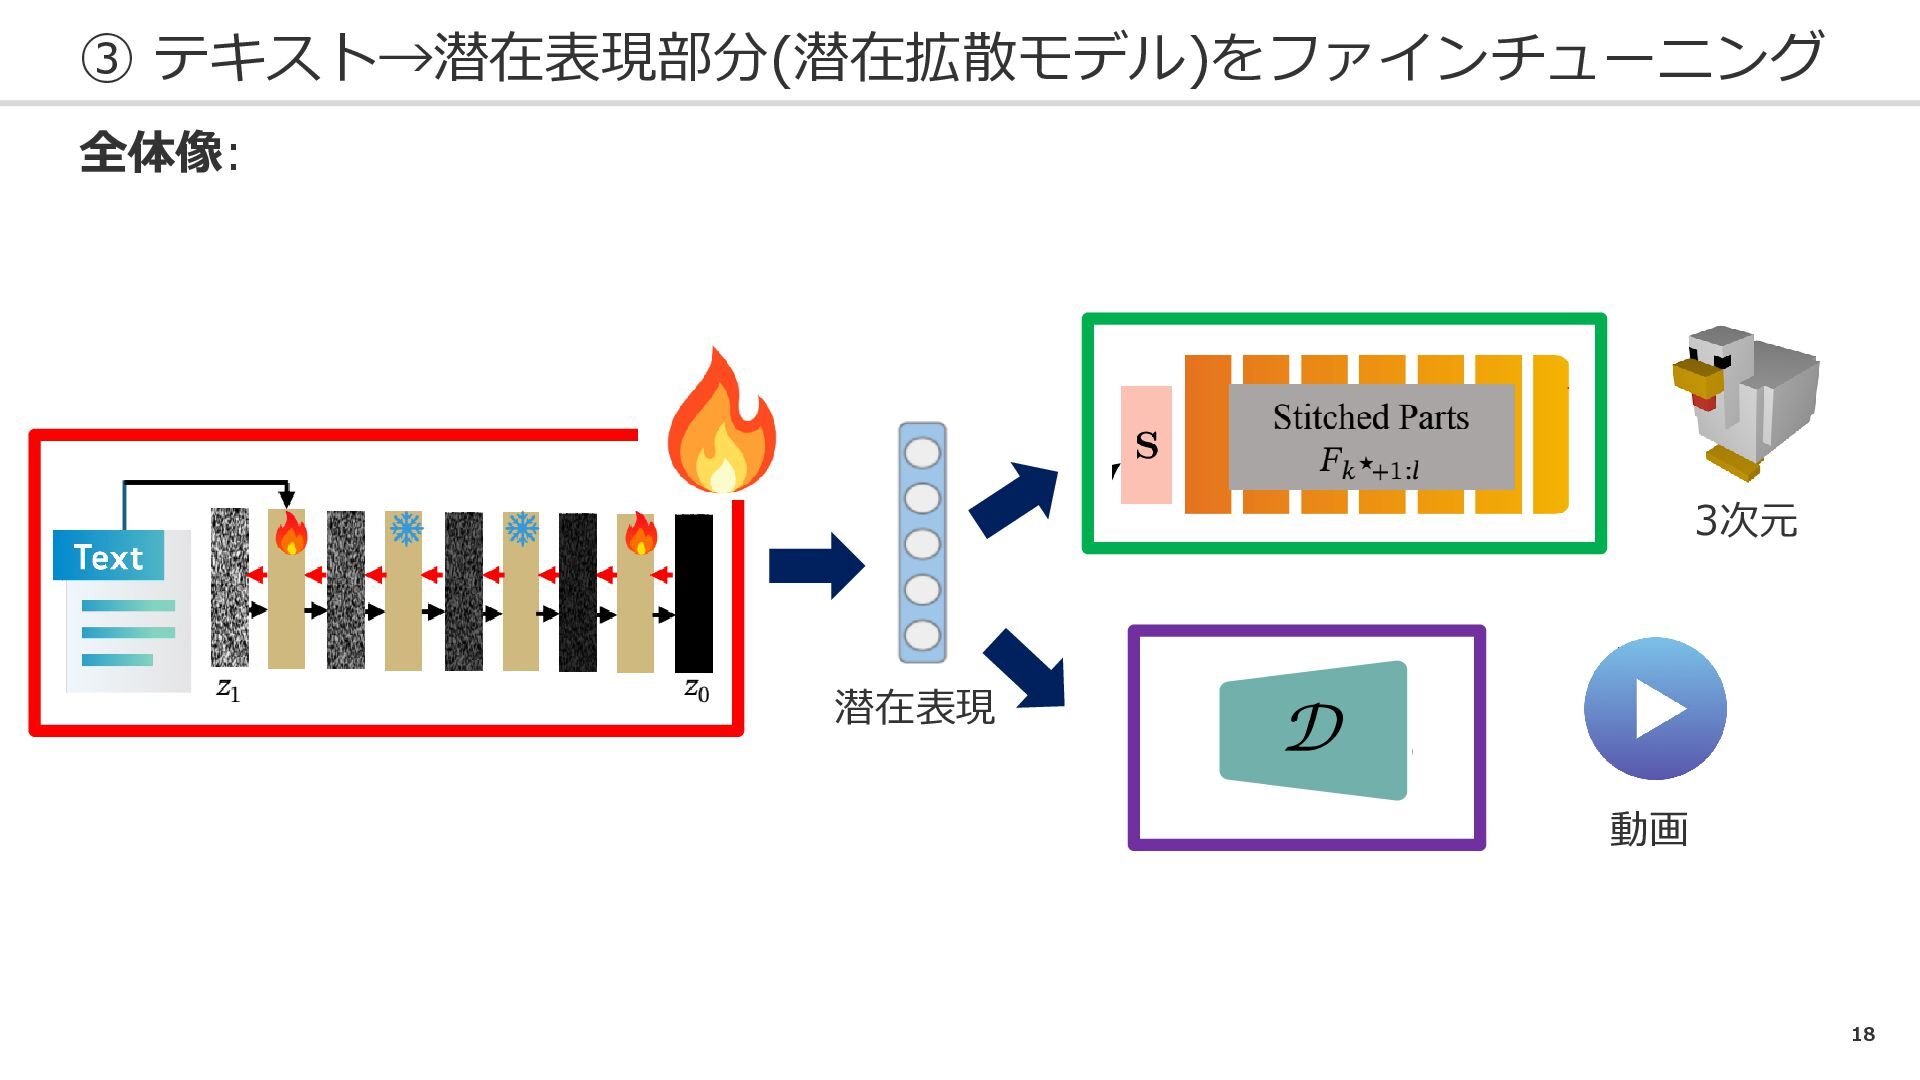
18 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 全体像: 潜在表現 3次元 動画
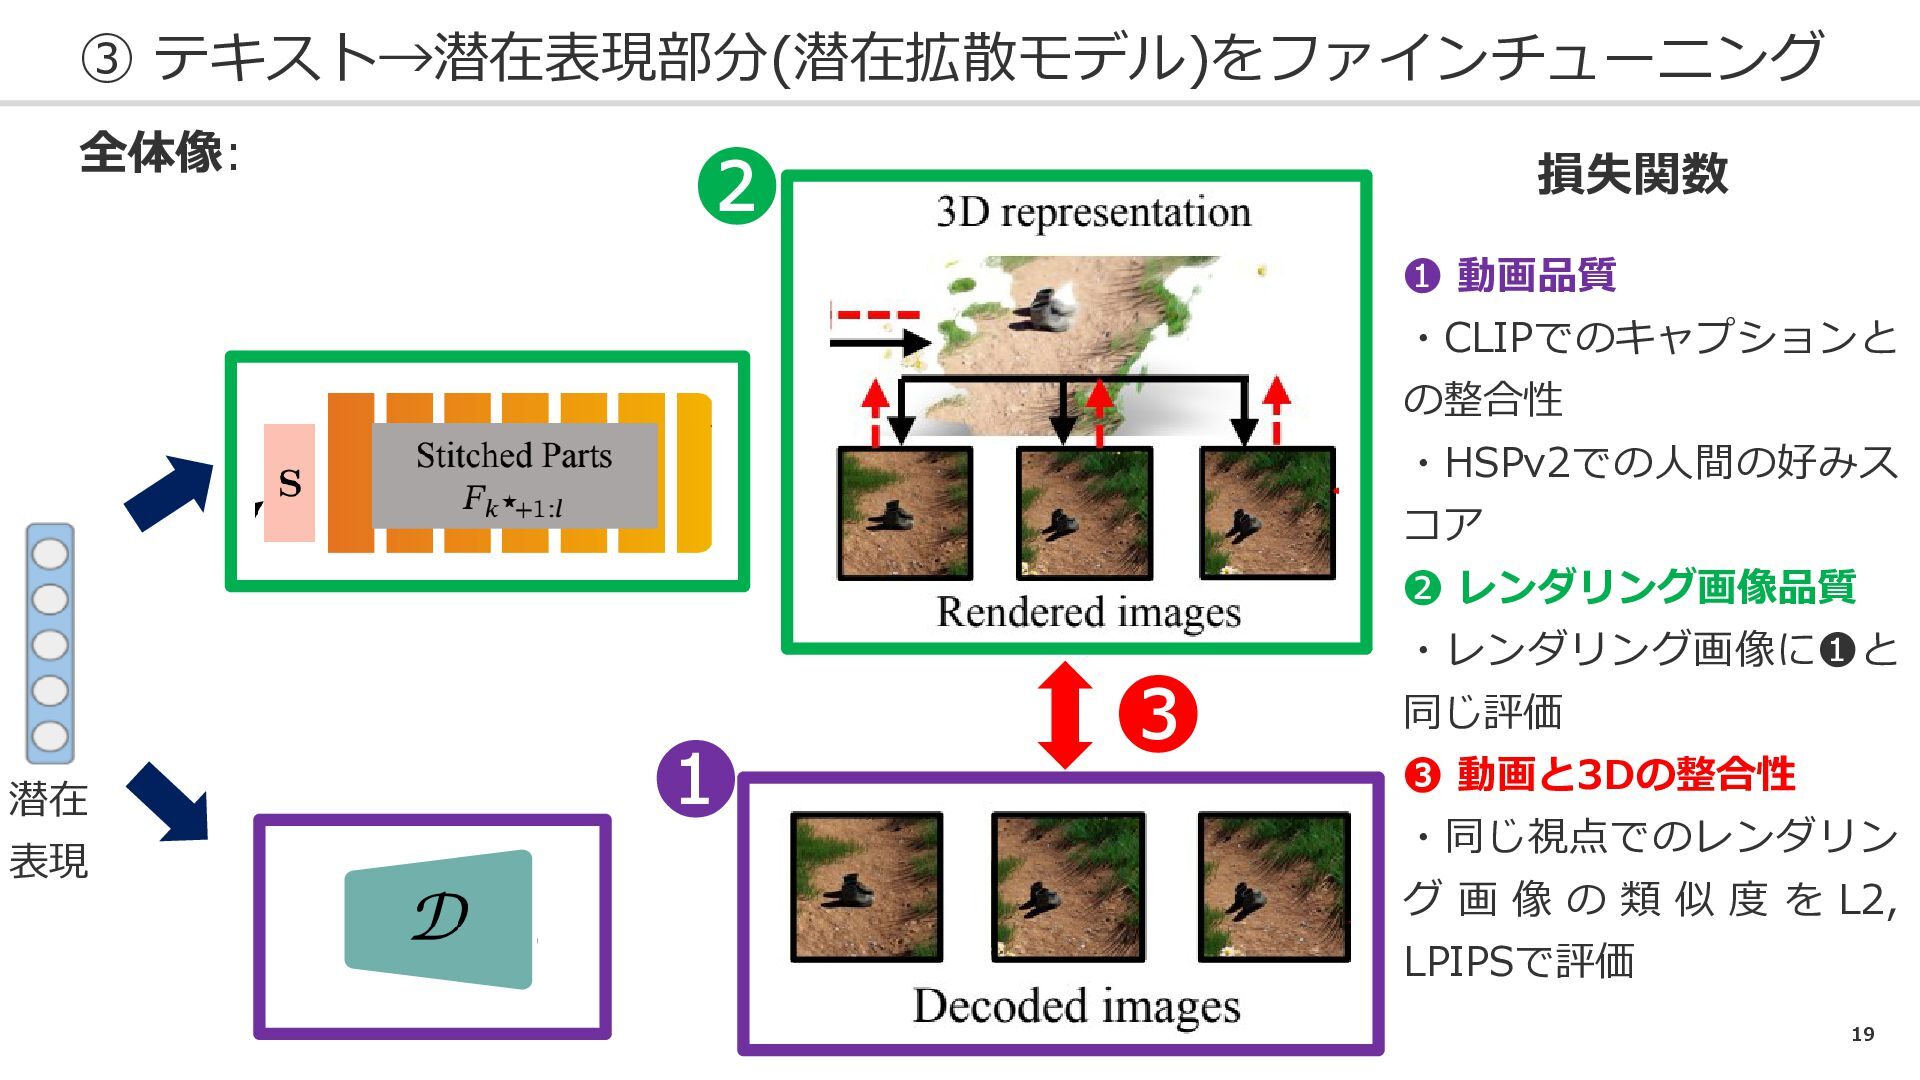
19 ③ テキスト→潜在表現部分(潜在拡散モデル)をファインチューニング 全体像: 損失関数 ❶ 動画品質 ・CLIPでのキャプションと の整合性 ・HSPv2での人間の好みス
コア ❷ レンダリング画像品質 ・レンダリング画像に❶と 同じ評価 ❸ 動画と3Dの整合性 ・同じ視点でのレンダリン グ 画 像 の 類 似 度 を L2, LPIPSで評価 ❶ ❷ ❸ 潜在 表現
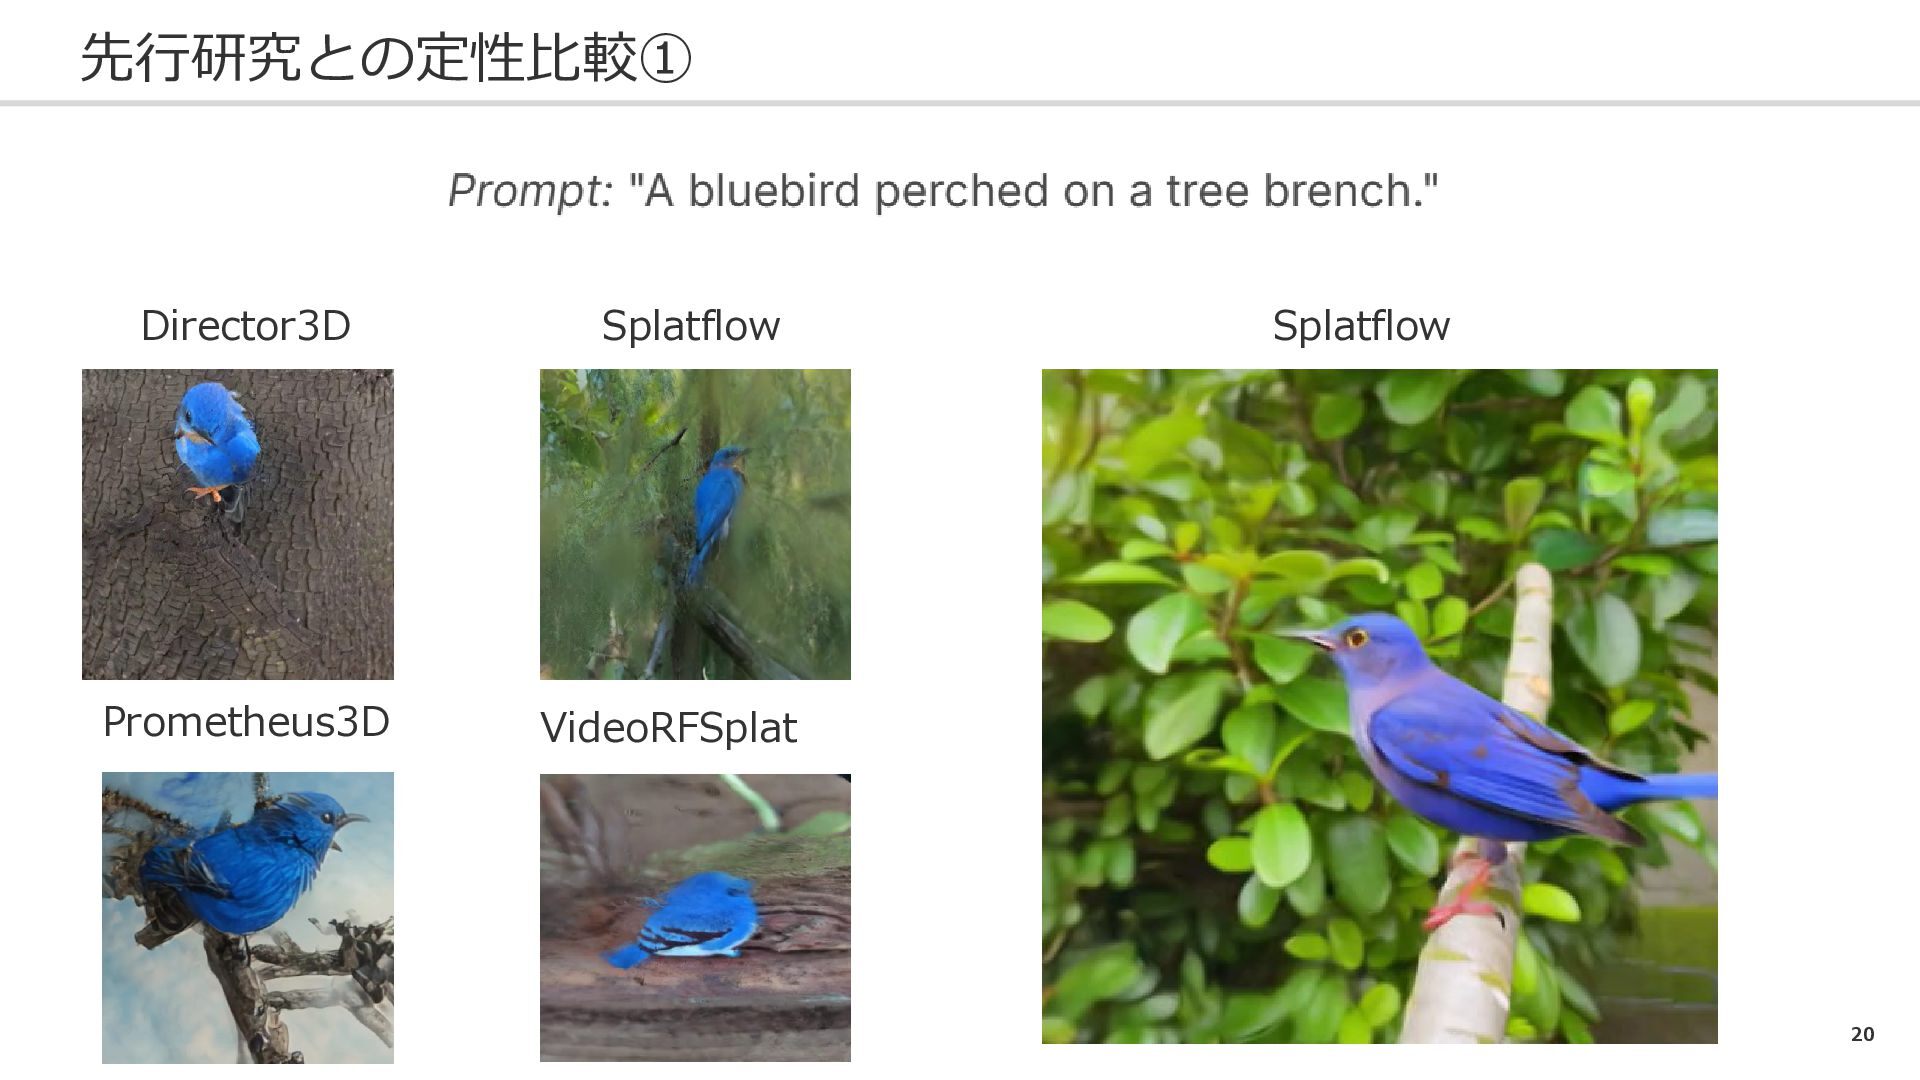
20 先行研究との定性比較① Director3D Splatflow Prometheus3D VideoRFSplat Splatflow
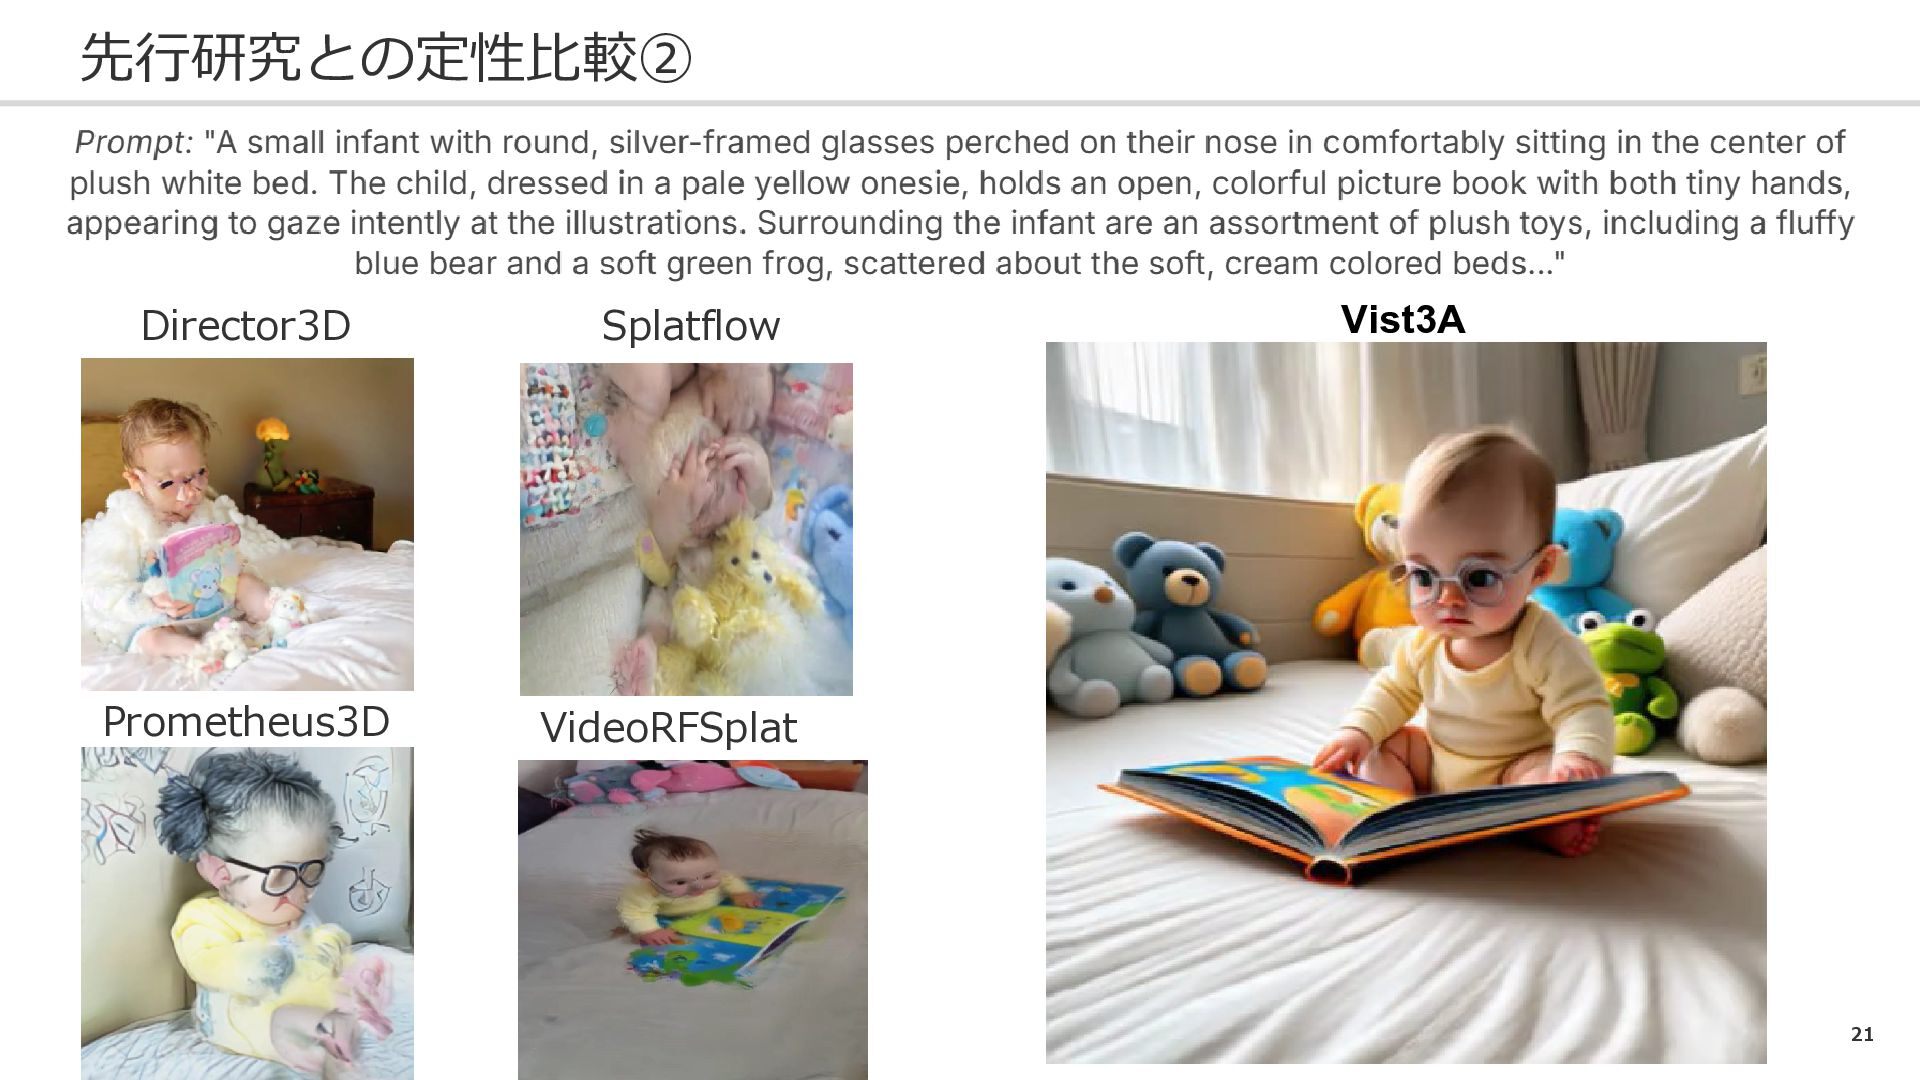
21 先行研究との定性比較② Director3D Splatflow Prometheus3D VideoRFSplat Vist3A


 mickey_0226
 aikinohara
 lychee1223
 trycycle
 tagtag
 jagupath
 rmaruy
 hanbao
 miyayou
 gkazunii
 ianozsvald
 estie
 jonoalderson
 sarafernandez
 cassininazir
 kneath
 bkeepers
 eileencodes
 csswizardry
 bermonpainter
 aleyda
 axbom
 katarinadahlin
 retrage