Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
弊社の基幹システム、telemetry samplingしづらいんですけど...
Search
MonotaRO
PRO
November 13, 2026
85
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
弊社の基幹システム、telemetry samplingしづらいんですけど...
MonotaRO
PRO
November 13, 2026
Transcript
35 slides
弊社の基幹システム、 telemetry samplingしづらいんですけど... 株式会社MonotaRO SRE Kazuki Iwanaga © 2026 MonotaRO
Co., Ltd.
自己紹介 岩永 一希 / Kazuki Iwanaga 株式会社MonotaRO SRE 2023年入社 レガシーな基幹システムの改善に取り組んでいます!
2/34
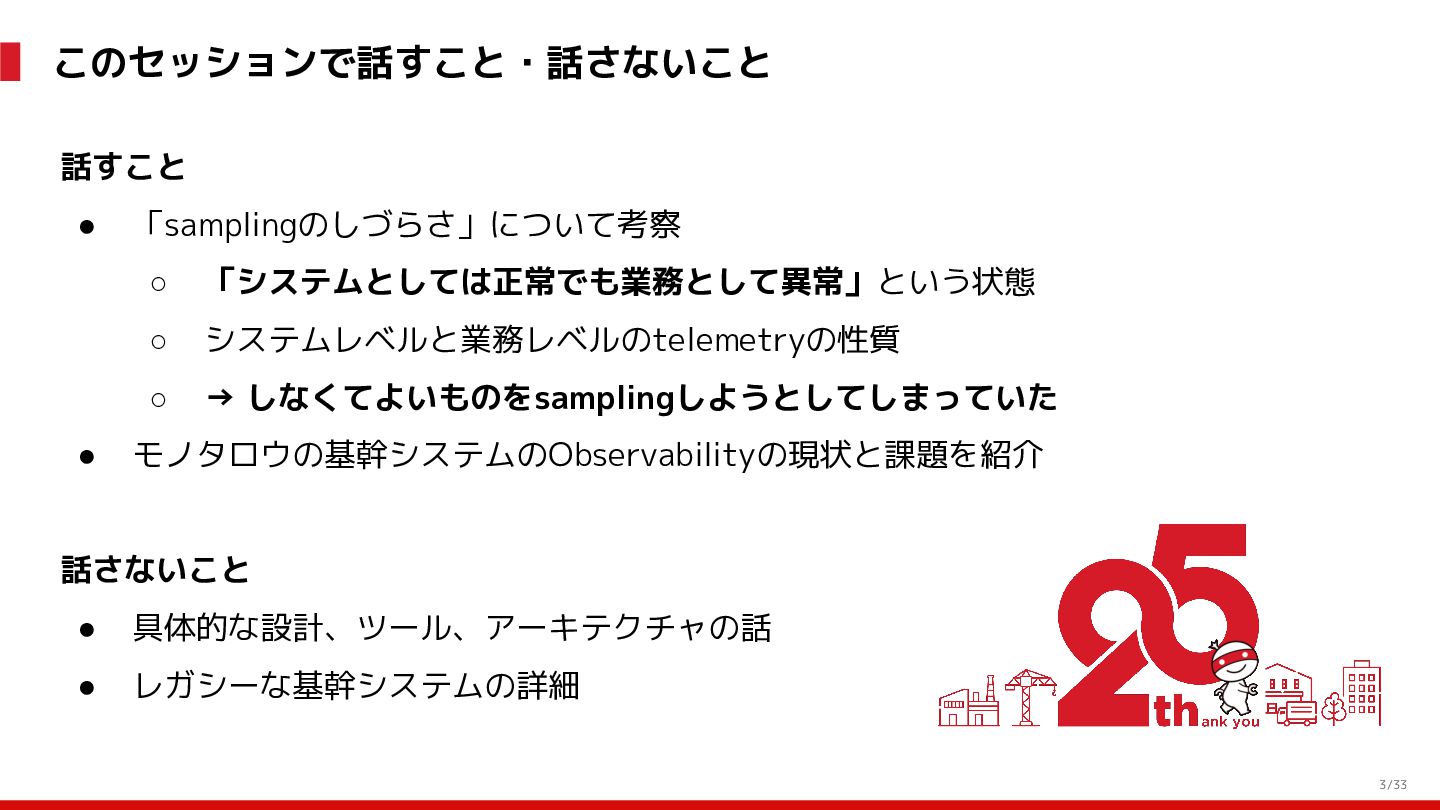
このセッションで話すこと・話さないこと 話すこと • • 「samplingのしづらさ」について考察 ◦ 「システムとしては正常でも業務として異常」という状態 ◦ システムレベルと業務レベルのtelemetryの性質 ◦
→ しなくてよいものをsamplingしようとしてしまっていた モノタロウの基幹システムのObservabilityの現状と課題を紹介 話さないこと • samplingの手法そのもの • 具体的な設計、ツール、アーキテクチャの話 • レガシーな基幹システムの詳細 3/34
会社紹介&導入
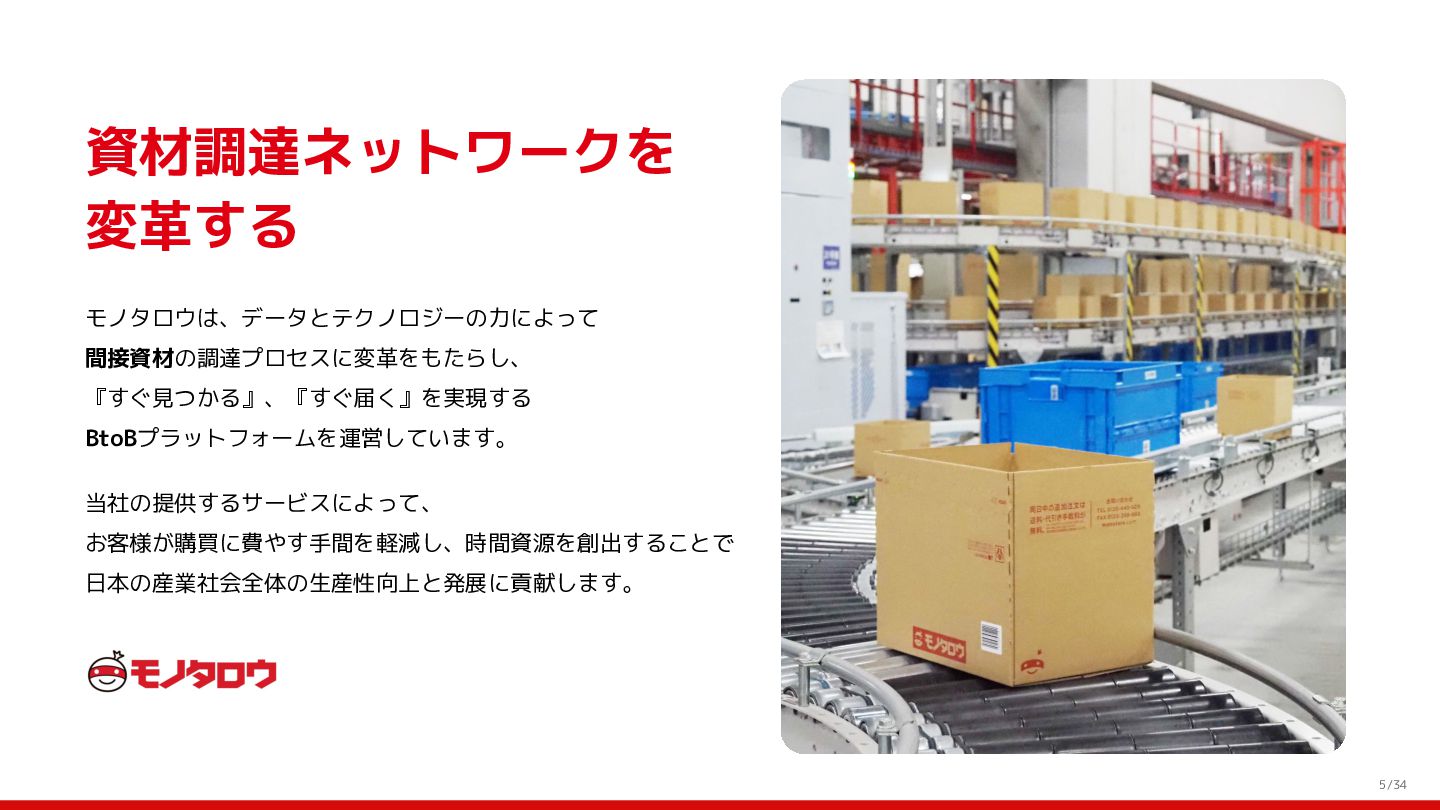
資材調達ネットワークを 変革する モノタロウは、データとテクノロジーの力によって 間接資材の調達プロセスに変革をもたらし、 『すぐ見つかる』、『すぐ届く』を実現する BtoBプラットフォームを運営しています。 当社の提供するサービスによって、 お客様が購買に費やす手間を軽減し、時間資源を創出することで 日本の産業社会全体の生産性向上と発展に貢献します。 5/34
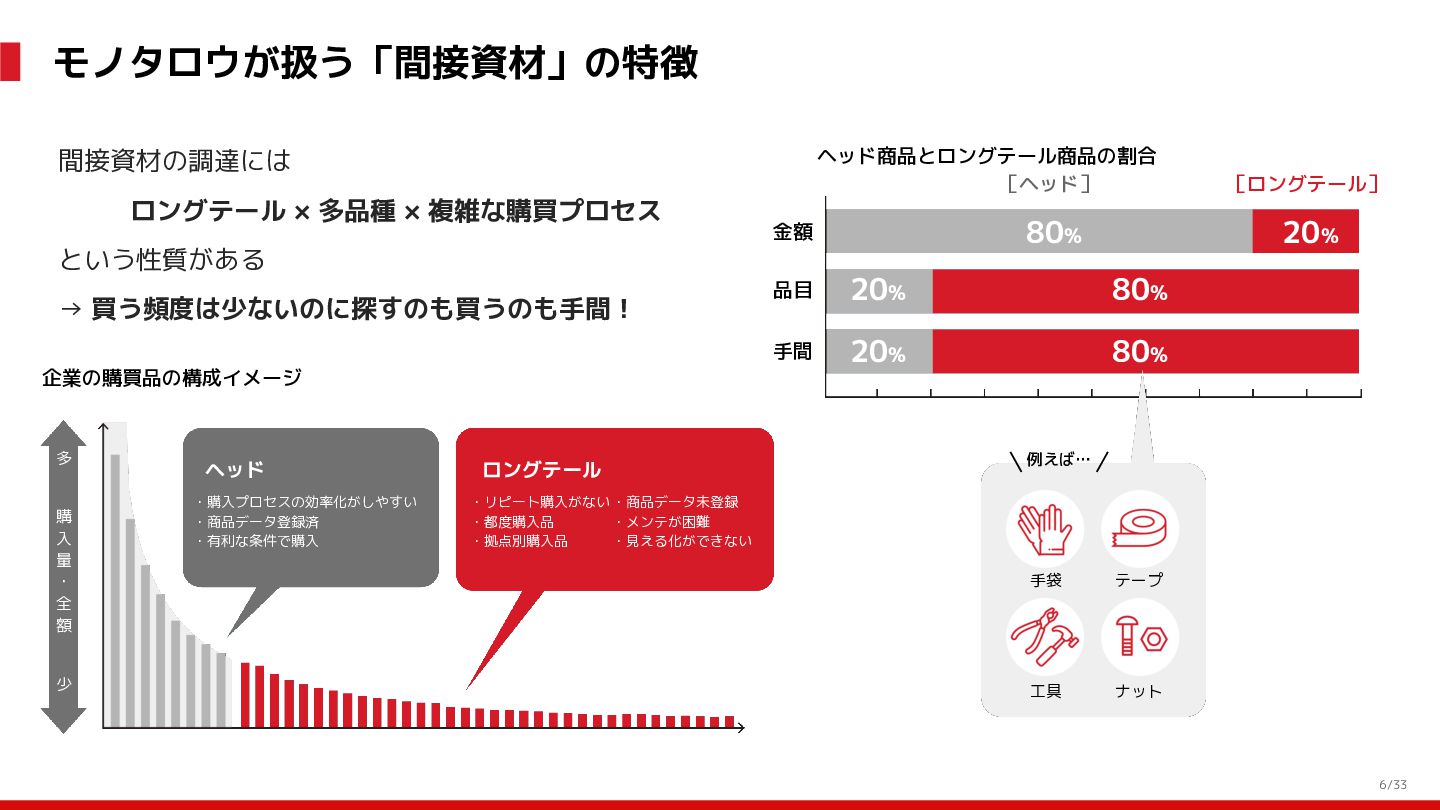
モノタロウが扱う「間接資材」の特徴 ヘッド商品とロングテール商品の割合 [ヘッド] 間接資材の調達には ロングテール × 多品種 × 複雑な購買プロセス 80%
金額 という性質がある → 買う頻度は少ないのに探すのも買うのも手間! [ロングテール] 20% 品目 20% 80% 手間 20% 80% 企業の購買品の構成イメージ 多 購 入 量 ・ 全 額 少 ヘッド ・購入プロセスの効率化がしやすい ・商品データ登録済 ・有利な条件で購入 ロングテール 例えば… ・リピート購入がない ・商品データ未登録 ・都度購入品 ・メンテが困難 ・拠点別購入品 ・見える化ができない 手袋 テープ 工具 ナット 6/34
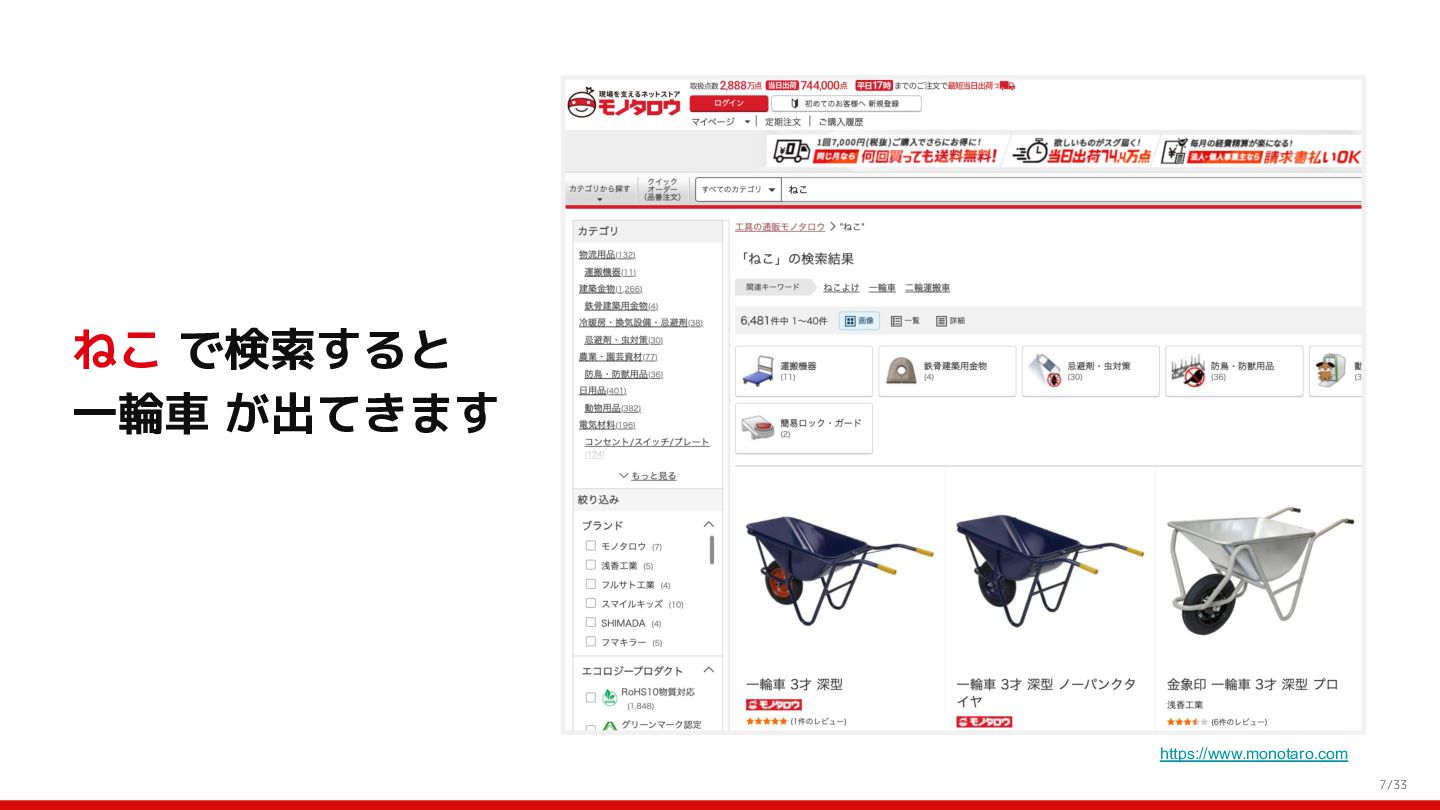
ねこ で検索すると 一輪車 が出てきます https://www.monotaro.com 7/34
詳しく知りたい方へ 統合報告書2026(2025年12月期) https://corp.monotaro.com/ir/library/library_11.html 8/34
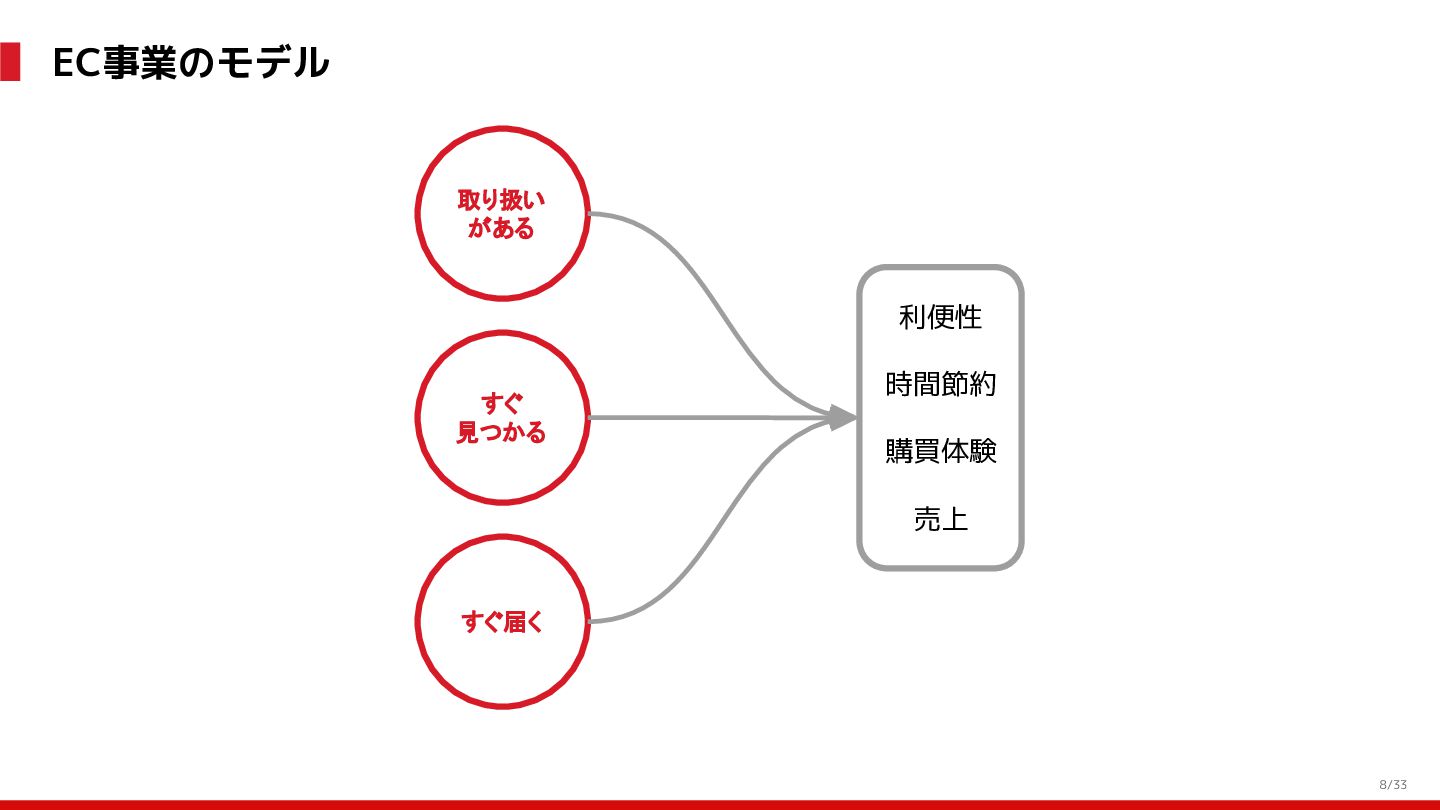
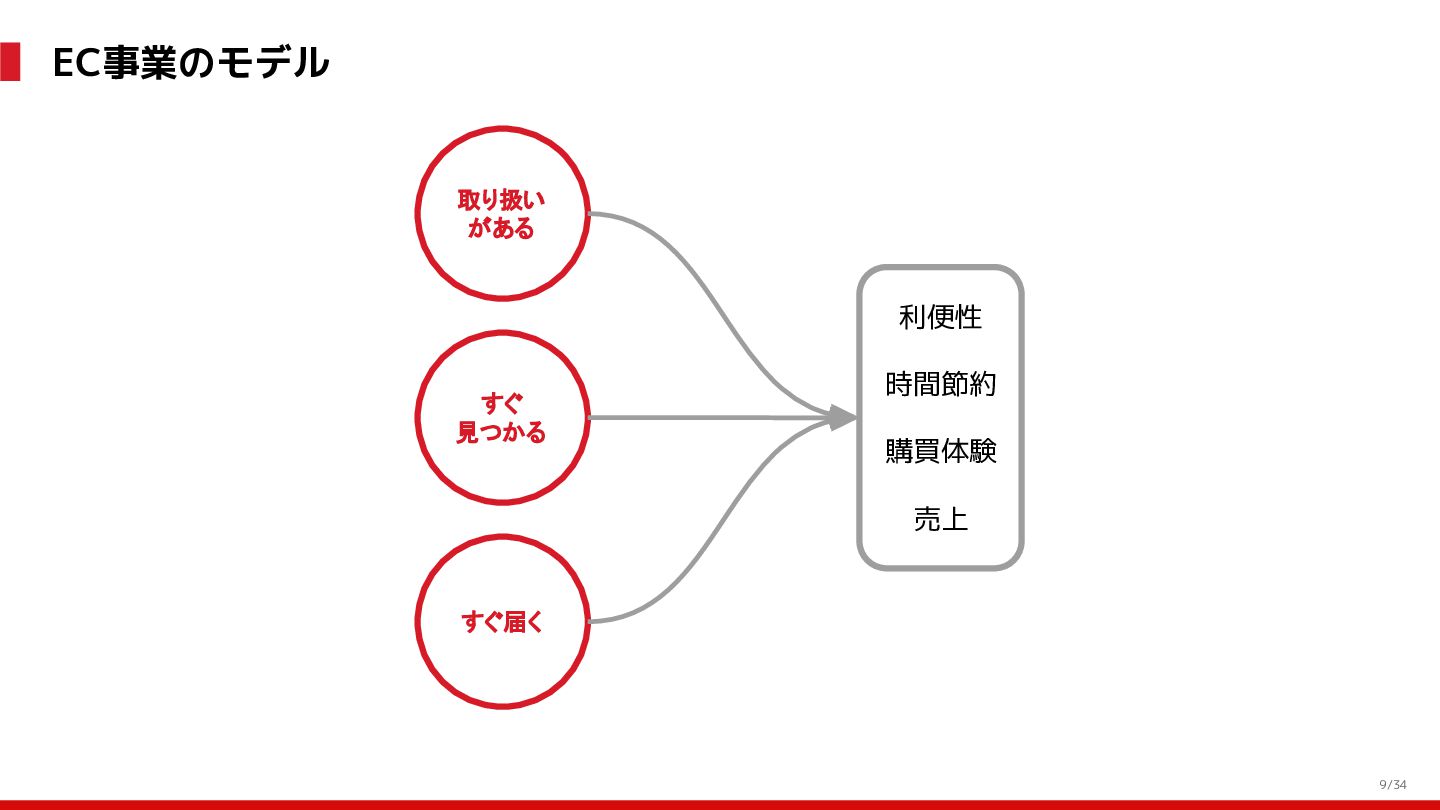
EC事業のモデル 取り扱い がある 利便性 すぐ 見つかる 時間節約 購買体験 売上 すぐ届く
9/34
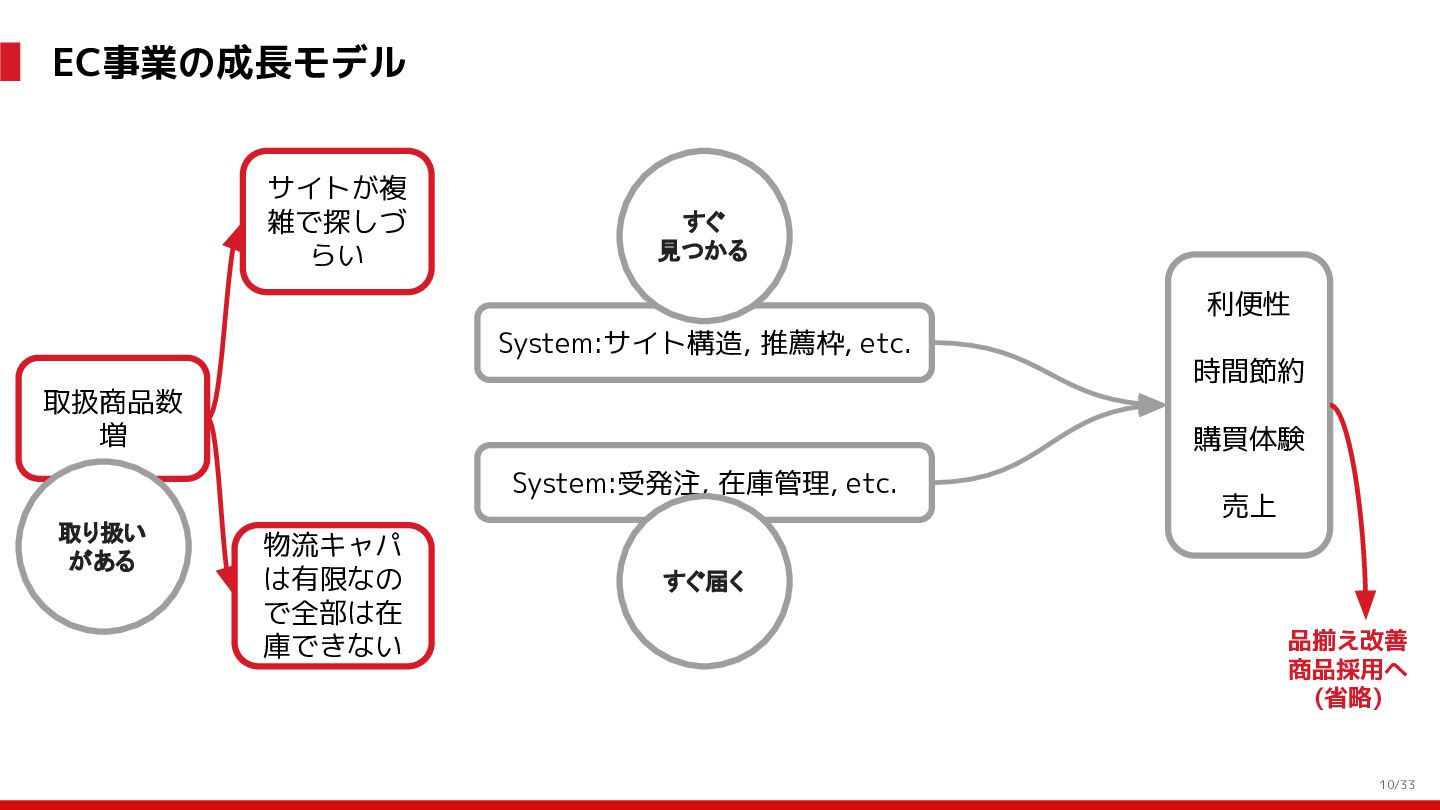
EC事業の成長モデル すぐ 見つかる 利便性 System:サイト構造, 推薦枠, etc. 時間節約 購買体験 System:受発注,
在庫管理, etc. 取り扱い がある 売上 すぐ届く 10/34
EC事業の成長モデル サイトが複 雑で探しづ らい すぐ 見つかる 利便性 System:サイト構造, 推薦枠, etc.
時間節約 取扱商品数 増 購買体験 System:受発注, 在庫管理, etc. 取り扱い がある 物流キャパ は有限なの で全部は在 庫できない 売上 すぐ届く 品揃え改善 商品採用へ (省略) 11/34
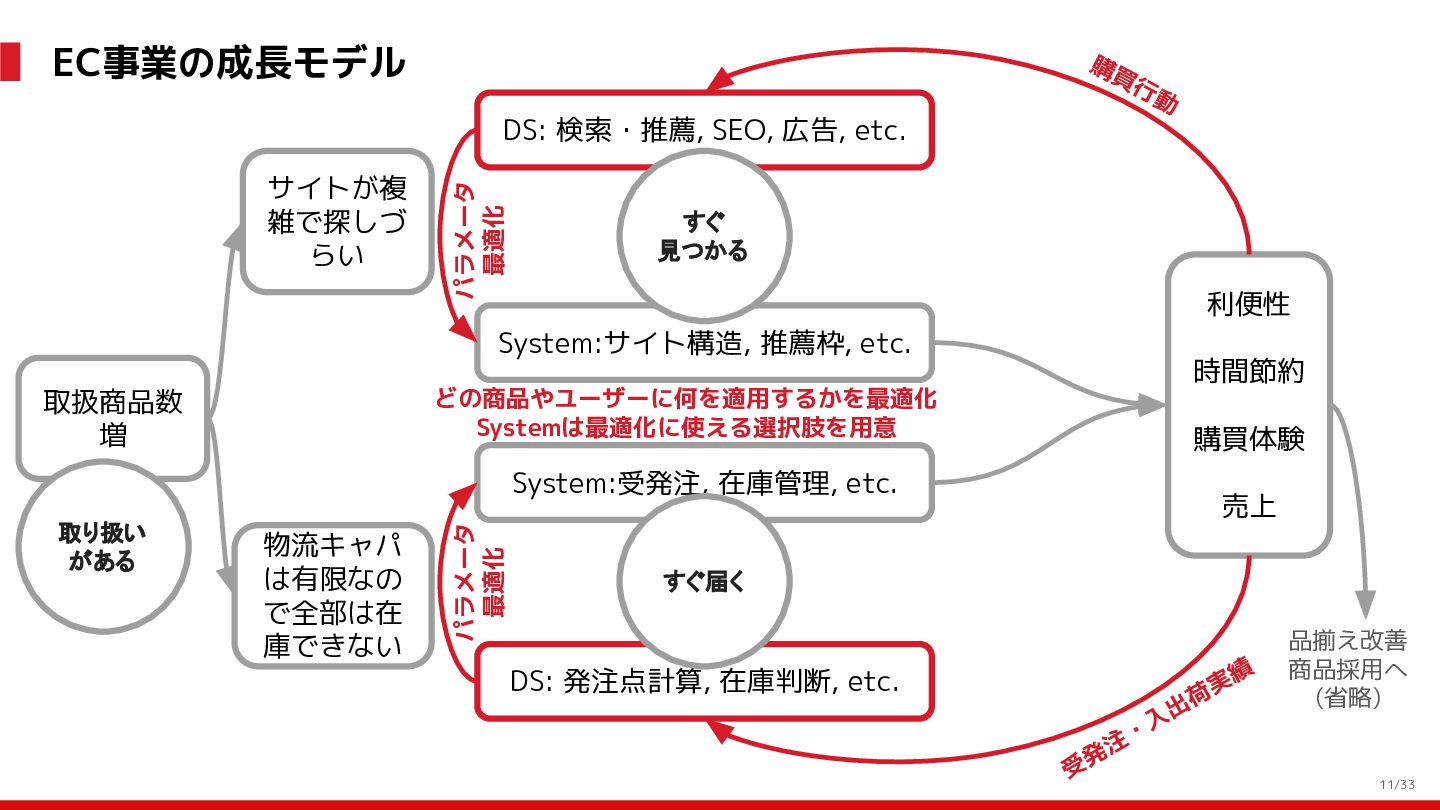
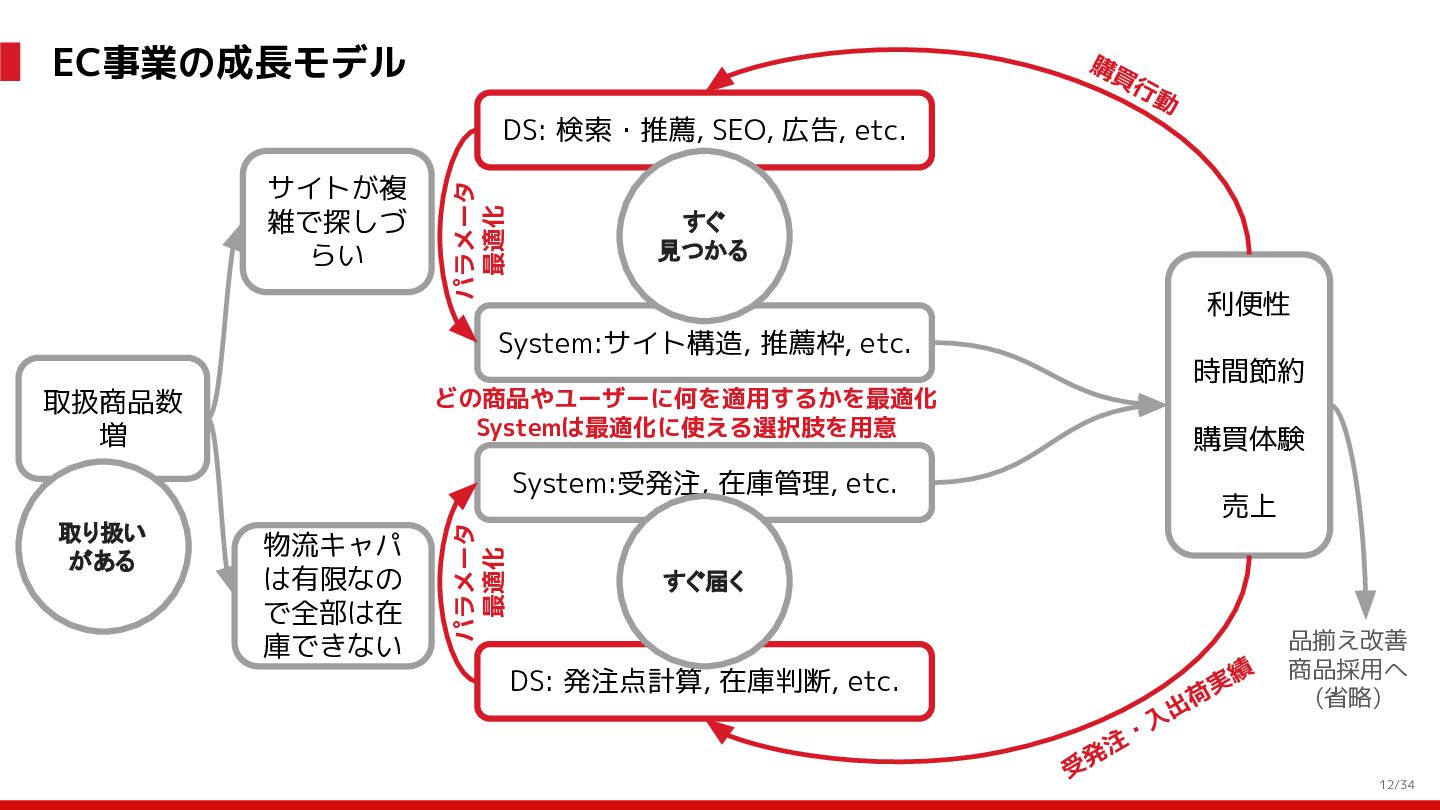
EC事業の成長モデル 購買 行動 サイトが複 雑で探しづ らい パラメータ 最適化 DS: 検索・推薦,
SEO, 広告, etc. すぐ 見つかる 利便性 System:サイト構造, 推薦枠, etc. 時間節約 どの商品やユーザーに何を適用するかを最適化 Systemは最適化に使える選択肢を用意 取扱商品数 増 購買体験 取り扱い がある 物流キャパ は有限なの で全部は在 庫できない パラメータ 最適化 System:受発注, 在庫管理, etc. 売上 すぐ届く 績 DS: 発注点計算, 在庫判断, etc. 実 荷 出 品揃え改善 商品採用へ (省略) 入 ・ 注 発 受 12/34
モノタロウの強み 購買 行動 サイトが複 雑で探しづ らい ビジネス要求を 反映しやすい 内製システム 取扱商品数
増 パラメータ 最適化 DS: 検索・推薦, SEO, 広告, etc. すぐ 見つかる 利便性 蓄積した 購買行動や実績 時間節約 のデータ 購買体験 System:サイト構造, 推薦枠, etc. どの商品やユーザーに何を適用するかを最適化 Systemは最適化に使える選択肢を用意 取り扱い がある 物流キャパ は有限なの で全部は在 間接資材 庫できない 在庫しづらい ロングテール パラメータ 最適化 System:受発注, 在庫管理, etc. 売上 すぐ届く 績 DS: 発注点計算, 在庫判断, etc. 実 荷 出 品揃え改善 商品採用へ (省略) 入 ・ 注 発 受 13/34
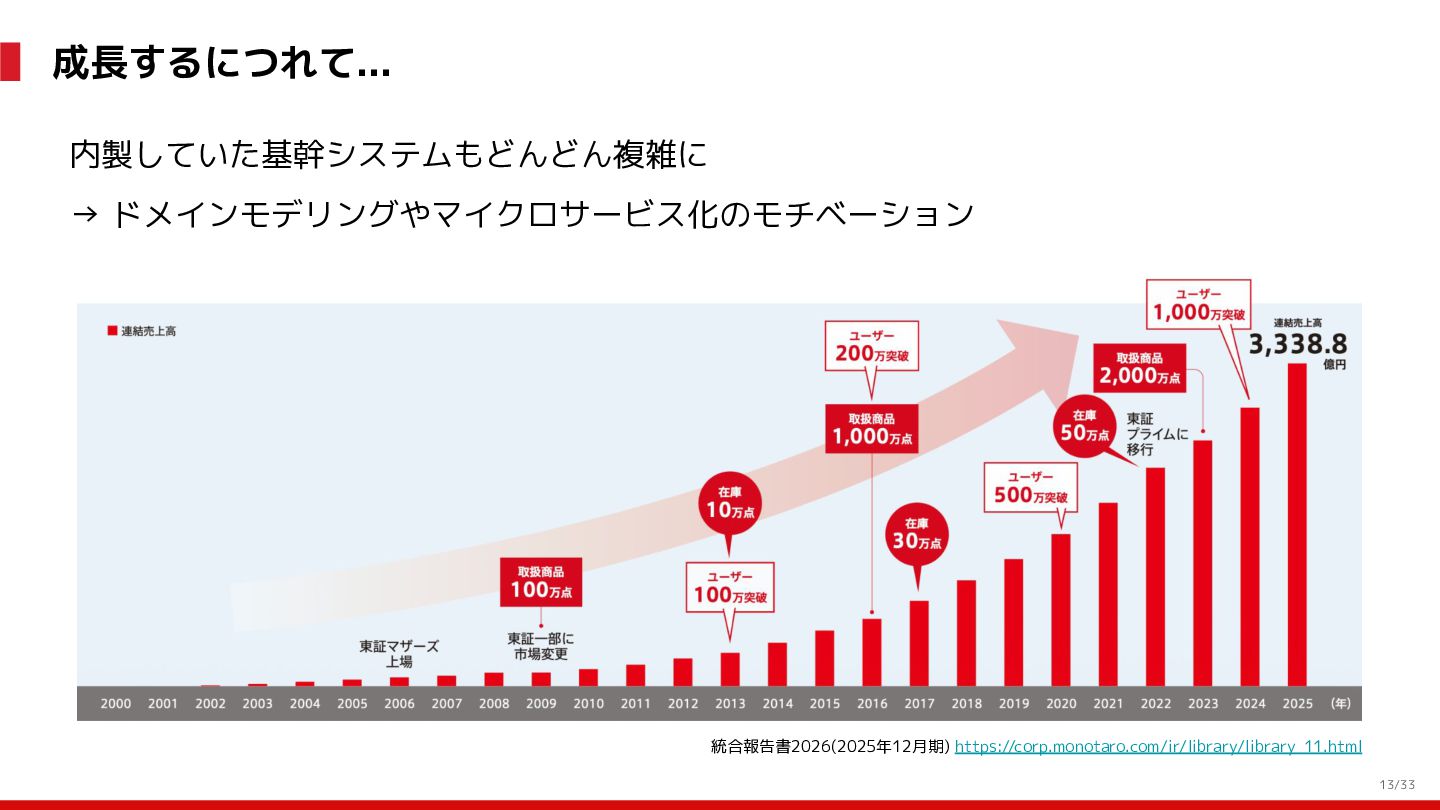
成長するにつれて... 内製していた基幹システムもどんどん複雑に → ドメインモデリングやマイクロサービス化のモチベーション 統合報告書2026(2025年12月期) https://corp.monotaro.com/ir/library/library_11.html 14/34
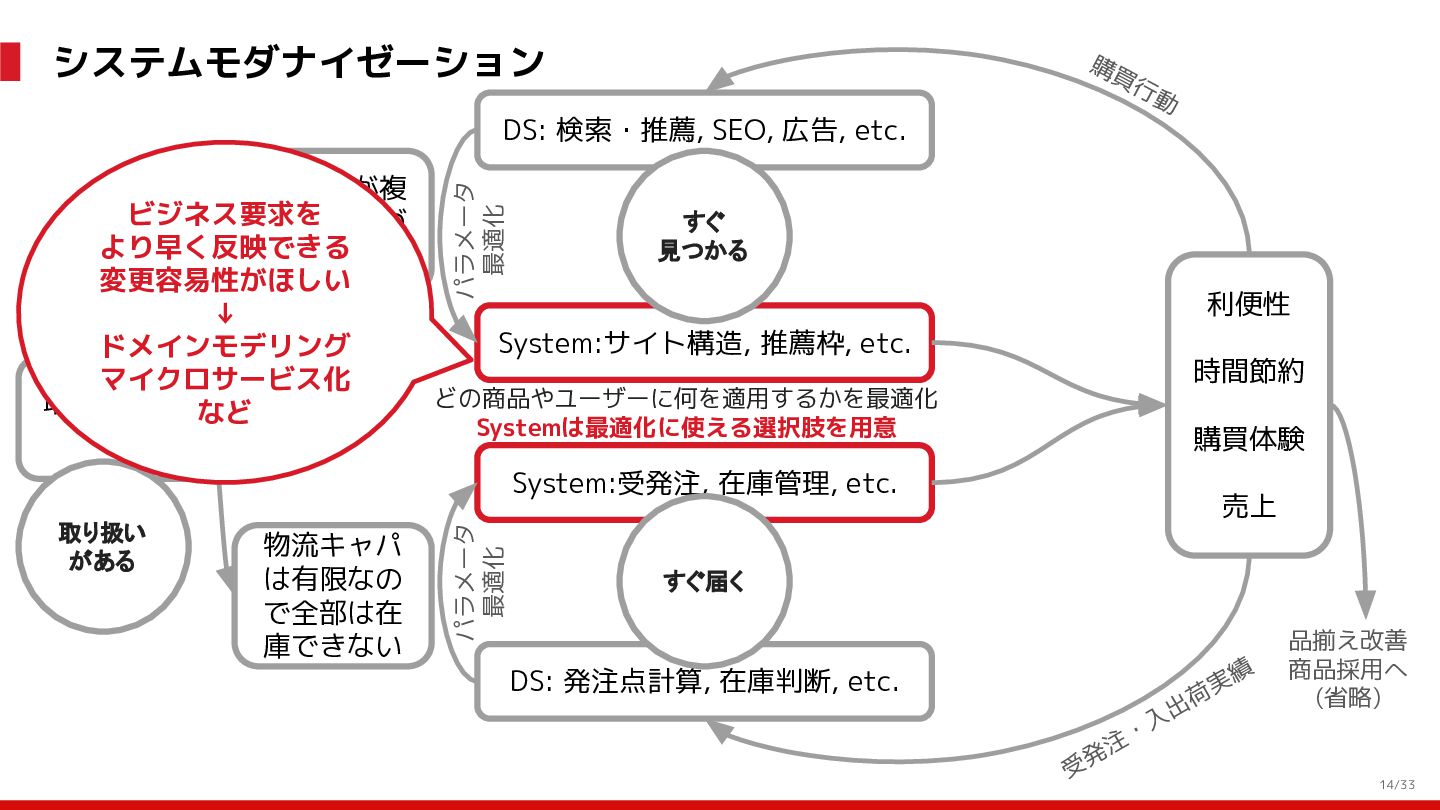
システムモダナイゼーション 購買 行動 DS: 検索・推薦, SEO, 広告, etc. パラメータ 最適化
サイトが複 ビジネス要求を すぐ 雑で探しづ より早く反映できる 見つかる らい 変更容易性がほしい ↓ System:サイト構造, 推薦枠, etc. ドメインモデリング マイクロサービス化 どの商品やユーザーに何を適用するかを最適化 取扱商品数 など Systemは最適化に使える選択肢を用意 増 利便性 時間節約 購買体験 取り扱い がある 物流キャパ は有限なの で全部は在 庫できない パラメータ 最適化 System:受発注, 在庫管理, etc. 売上 すぐ届く 績 DS: 発注点計算, 在庫判断, etc. 実 荷 出 品揃え改善 商品採用へ (省略) 入 ・ 注 発 受 15/34
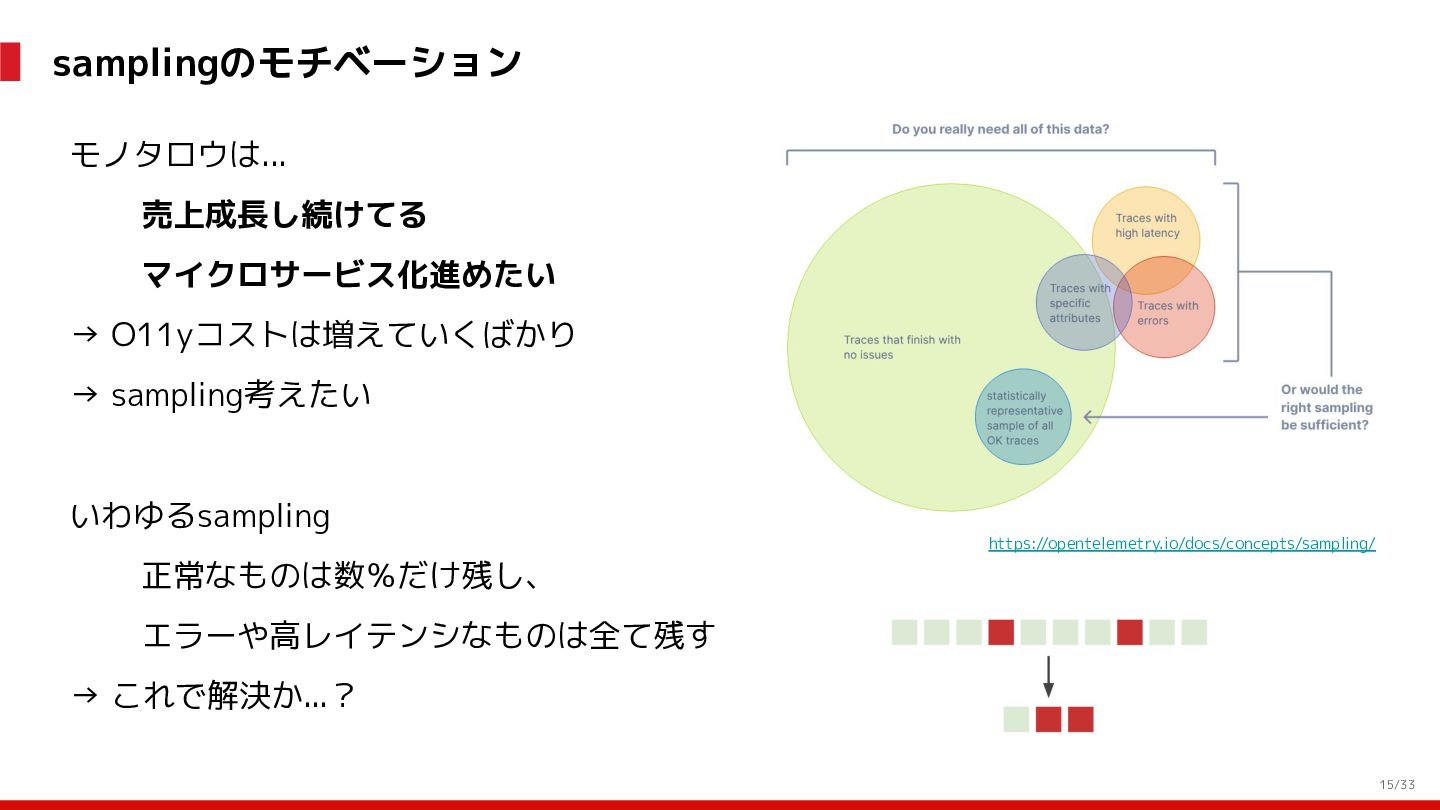
samplingのモチベーション モノタロウは... 売上成長し続けてる マイクロサービス化進めたい → O11yコストは増えていくばかり → sampling考えたい いわゆるsampling https://opentelemetry.io/docs/concepts/sampling/
正常なものは数%だけ残し、 エラーや高レイテンシなものは全て残す → これで解決か...? 16/34
「うちの基幹システム、samplingしづらいな...?」
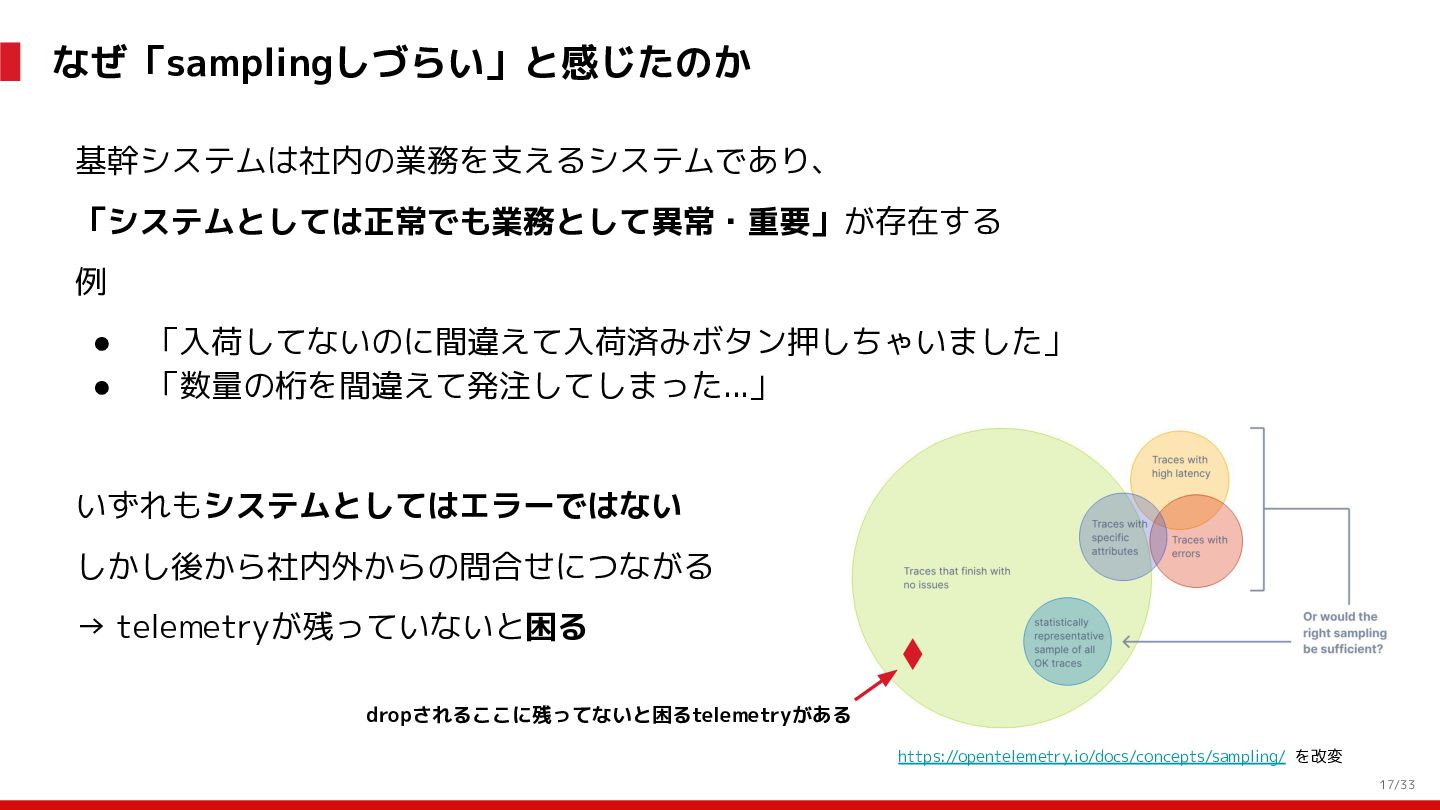
なぜ「samplingしづらい」と感じたのか 基幹システムは社内の業務を支えるシステムであり、 「システムとしては正常でも業務として異常・重要」が存在する 例 • • 「入荷してないのに間違えて入荷済みボタン押しちゃいました」 「数量の桁を間違えて発注してしまった...」 いずれもシステムとしてはエラーではない しかし後から社内外からの問合せにつながる
→ telemetryが残っていないと困る dropされるここに残ってないと困るtelemetryがある https://opentelemetry.io/docs/concepts/sampling/ を改変 18/34
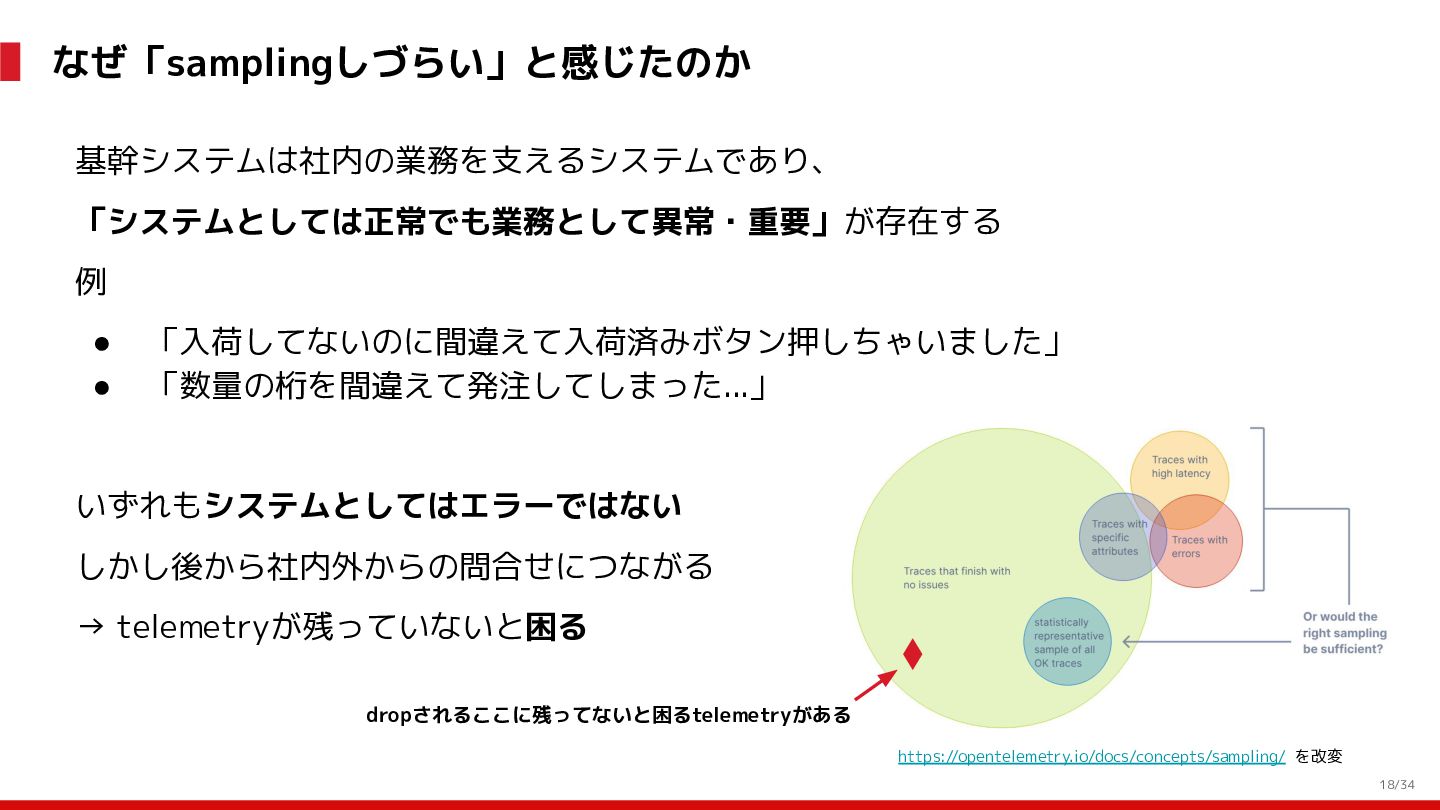
「システムとしては正常でも業務として異常・重要」の特徴 システムとしては正常系 → システムエラーやレイテンシを使ったsampling判定ができない 「業務として異常・重要である」は数日〜数ヶ月後に判明するものもある → telemetryが発生したその場でsampling判定ができない 問合せに対応する一連のtelemetryをN=1で 追えないといけない →
そもそもsamplingするものじゃない 業務が絡むtelemetryは別で考えた方がいいのかも dropされるここに残ってないと困るtelemetryがある https://opentelemetry.io/docs/concepts/sampling/ を改変 19/34
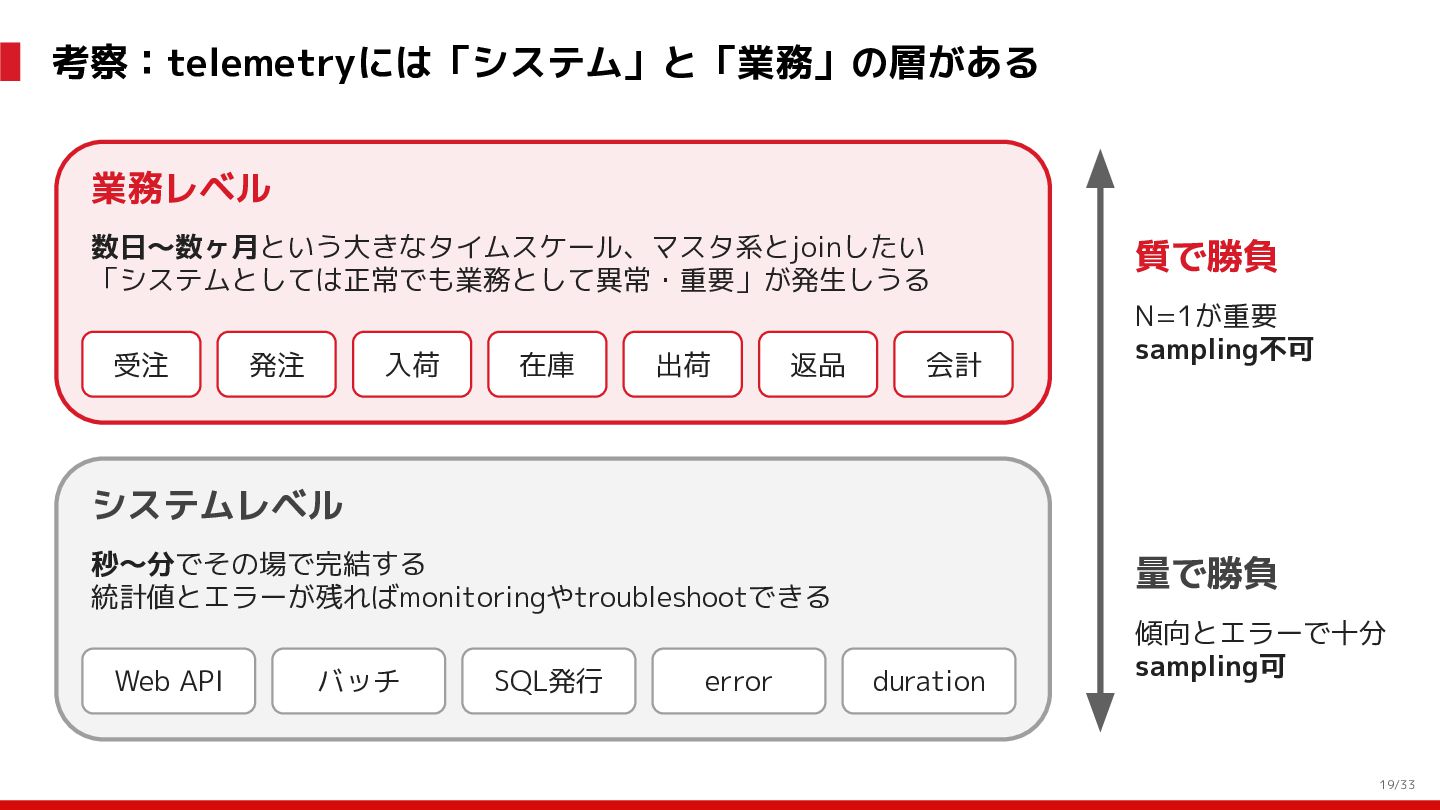
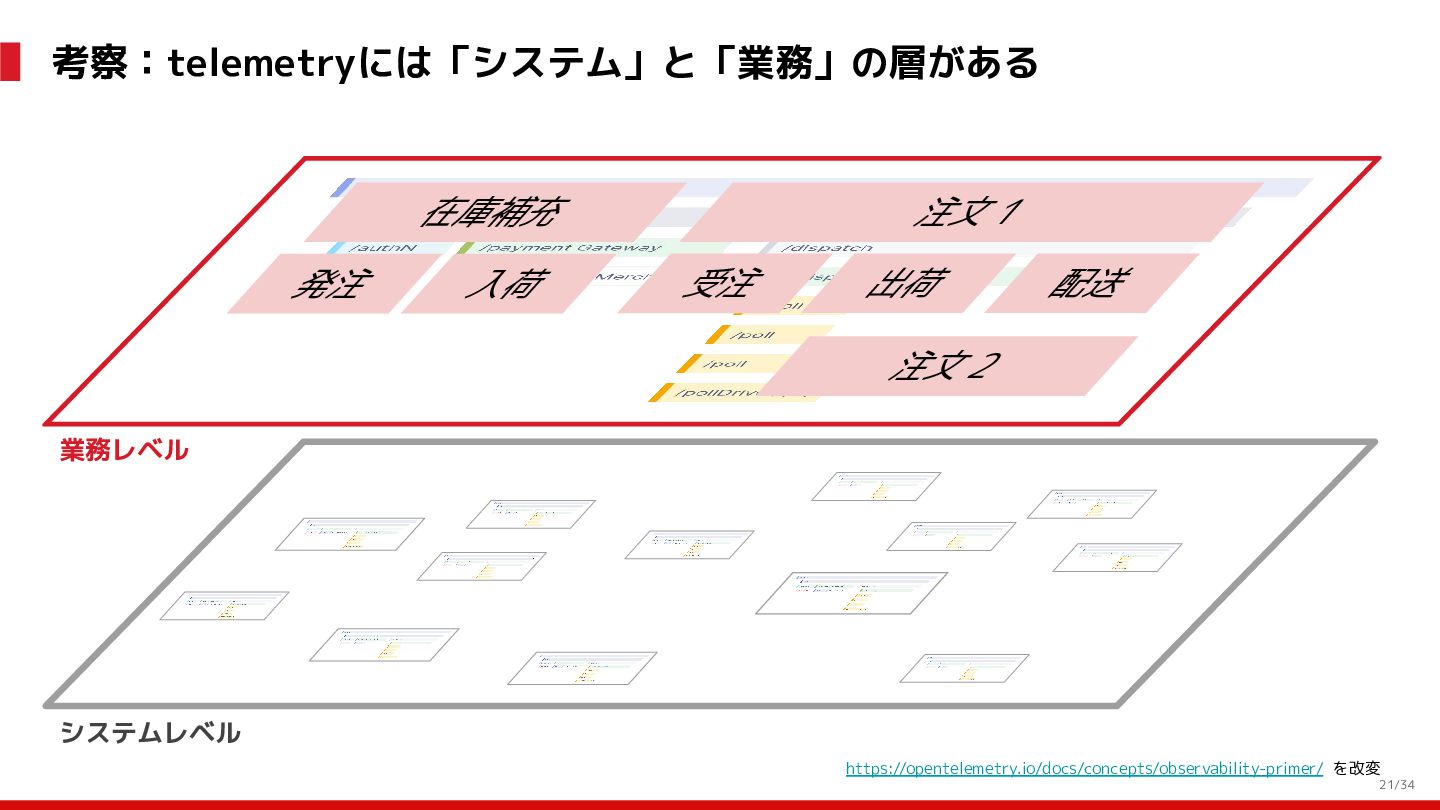
考察:telemetryには「システム」と「業務」の層がある 業務レベル 数日〜数ヶ月という大きなタイムスケール、マスタ系とjoinしたい 「システムとしては正常でも業務として異常・重要」が発生しうる 受注 発注 入荷 在庫 出荷 返品
会計 質で勝負 N=1が重要 sampling不可 システムレベル 秒〜分でその場で完結する 統計値とエラーが残ればmonitoringやtroubleshootできる Web API バッチ SQL発行 error 量で勝負 duration 傾向とエラーで十分 sampling可 20/34
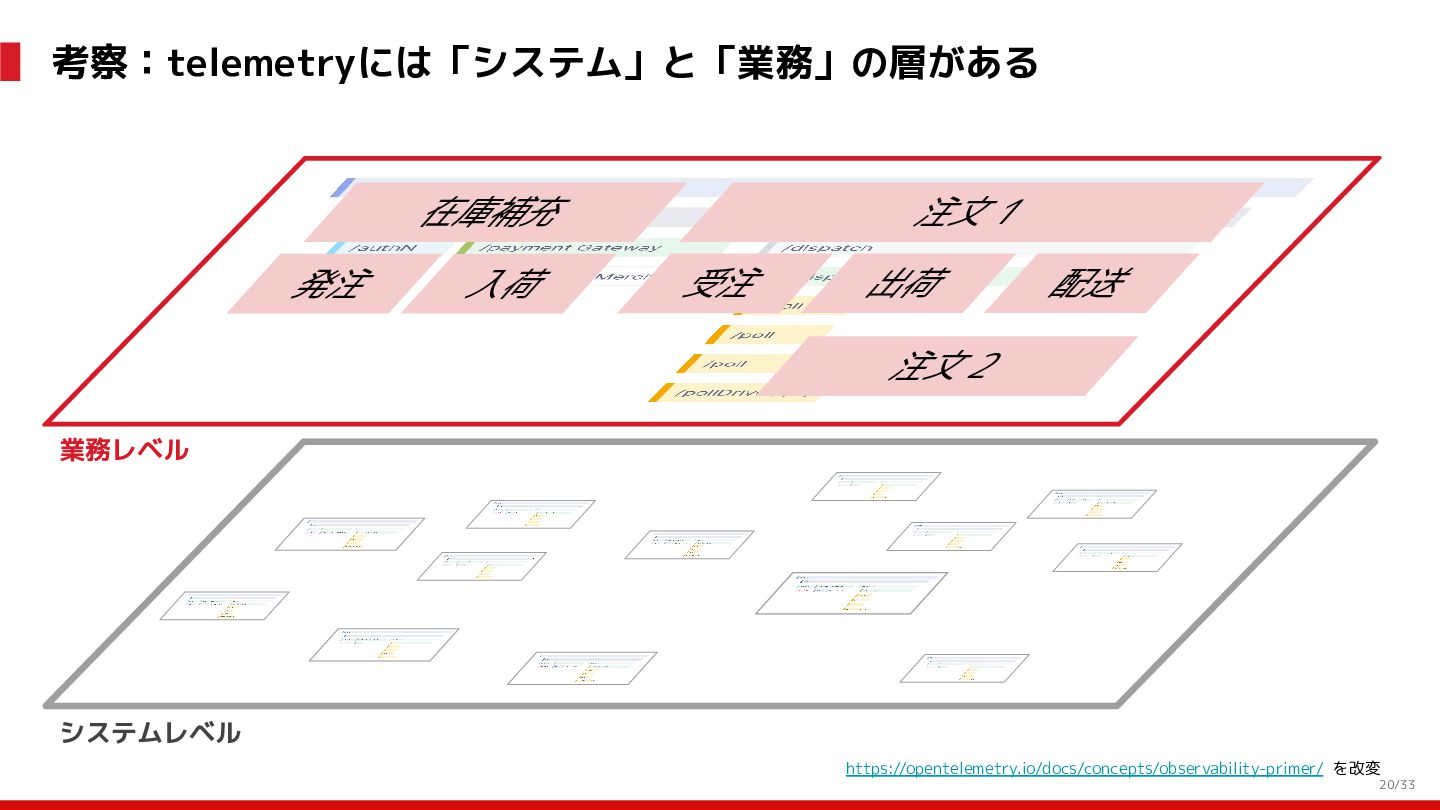
考察:telemetryには「システム」と「業務」の層がある 在庫補充 発注 入荷 注文 1 受注 出荷 配送 注文
2 業務レベル システムレベル https://opentelemetry.io/docs/concepts/observability-primer/ を改変 21/34
システムレベルのObservability 購買 行動 サイトが複 雑で探しづ らい パラメータ 最適化 DS: 検索・推薦,
SEO, 広告, etc. すぐ 見つかる システムが正しく動作し、 価値提供を行えているか 利便性 System:サイト構造, 推薦枠, etc. 時間節約 どの商品やユーザーに何を適用するかを最適化 Systemは最適化に使える選択肢を用意 取扱商品数 増 購買体験 取り扱い がある 物流キャパ は有限なの で全部は在 庫できない パラメータ 最適化 System:受発注, 在庫管理, etc. 売上 すぐ届く 績 DS: 発注点計算, 在庫判断, etc. 実 荷 出 品揃え改善 商品採用へ (省略) 入 ・ 注 発 受 22/34
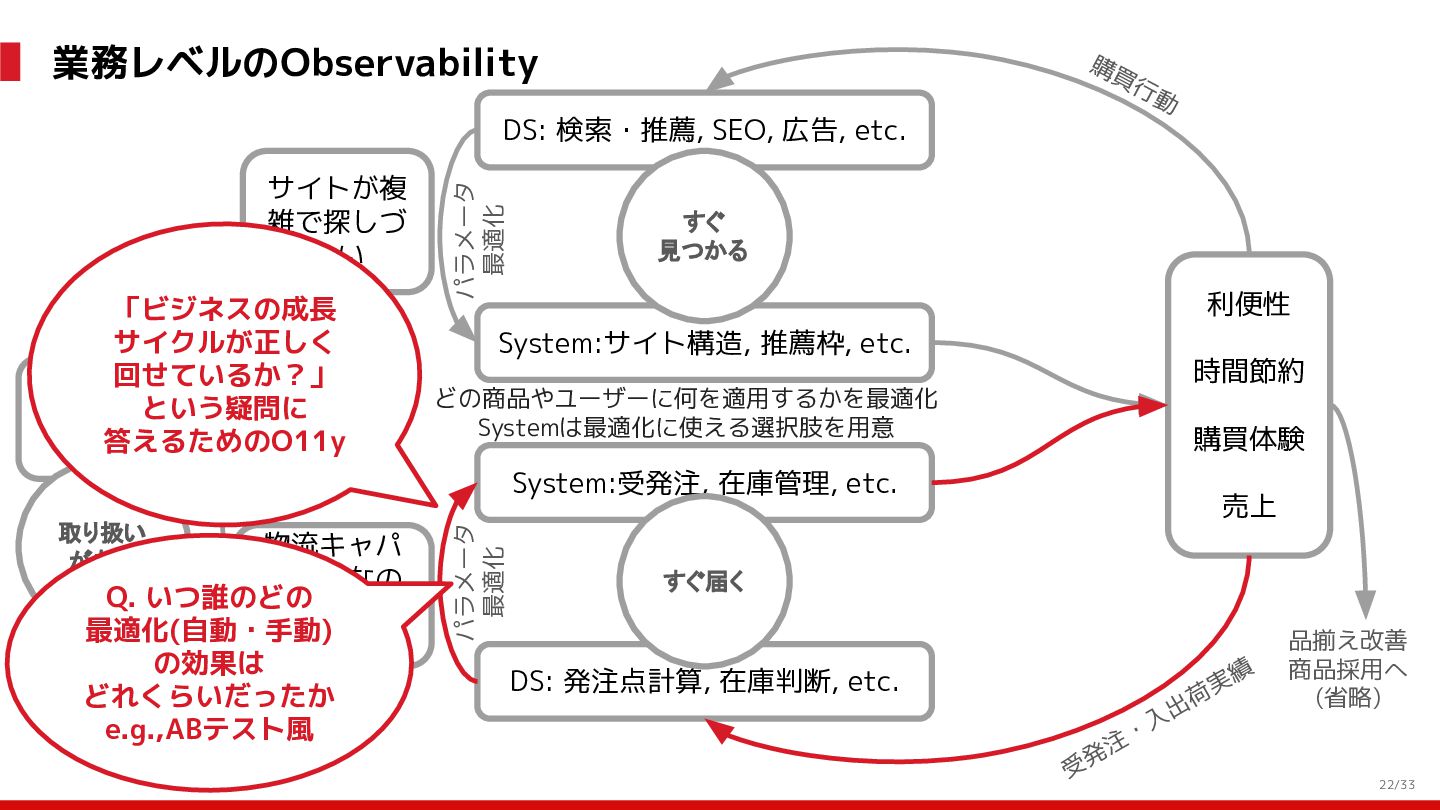
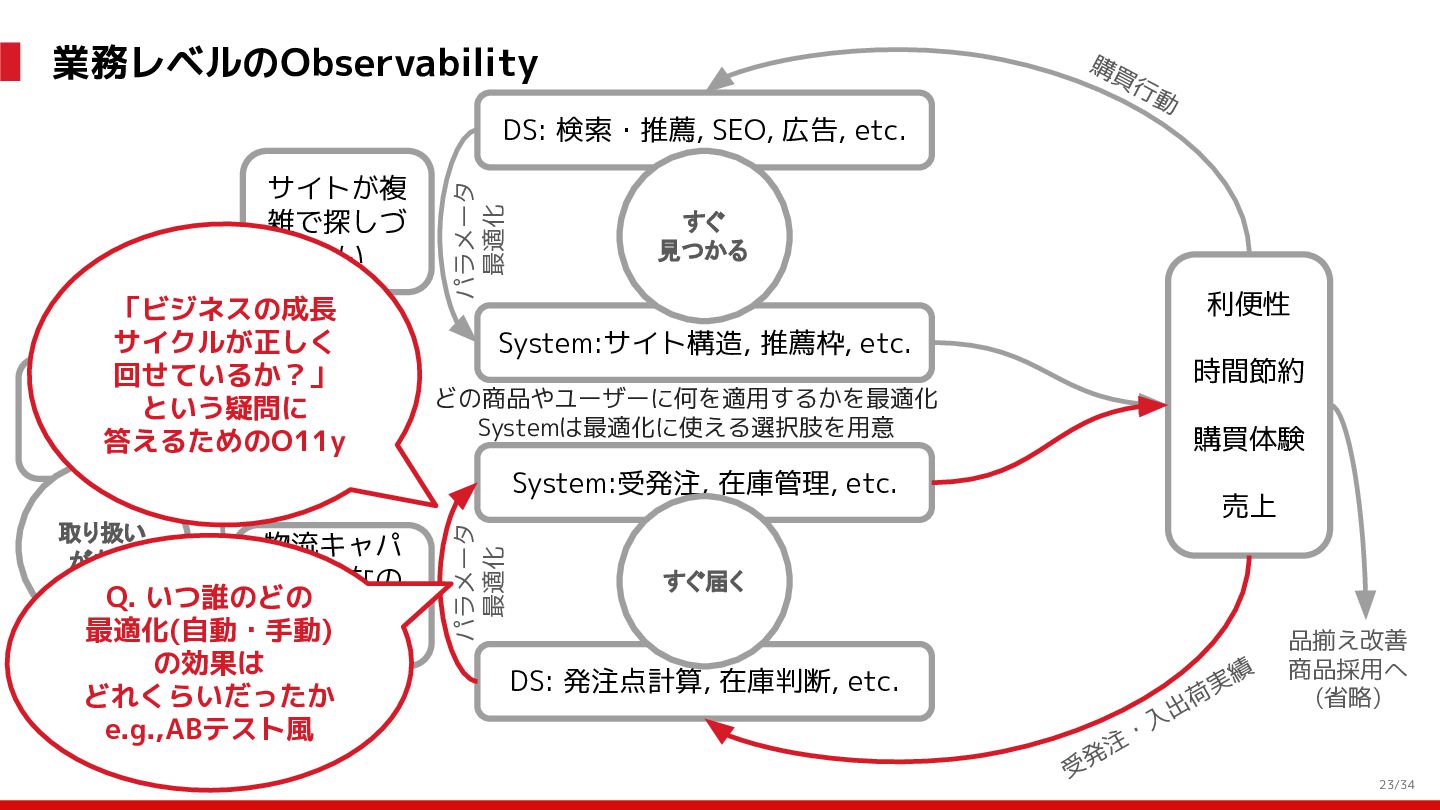
業務レベルのObservability 購買 行動 サイトが複 雑で探しづ らい 「ビジネスの成長 サイクルが正しく 回せているか?」 取扱商品数
という疑問に 増 答えるためのO11y パラメータ 最適化 DS: 検索・推薦, SEO, 広告, etc. すぐ 見つかる 利便性 System:サイト構造, 推薦枠, etc. 時間節約 どの商品やユーザーに何を適用するかを最適化 Systemは最適化に使える選択肢を用意 購買体験 取り扱い がある 物流キャパ は有限なの Q. いつ誰のどの で全部は在 最適化(自動・手動) 庫できない の効果は どれくらいだったか e.g.,ABテスト風 パラメータ 最適化 System:受発注, 在庫管理, etc. 売上 すぐ届く 績 DS: 発注点計算, 在庫判断, etc. 実 荷 出 品揃え改善 商品採用へ (省略) 入 ・ 注 発 受 23/34
考察:telemetryには「システム」と「業務」の層がある • • 業務レベルのtelemetry ◦ N=1(完全性)が重要 → DB等に確実に記録する ◦ いわゆるO11yのパイプラインでは欠損可能性がある
システムレベルのtelemetry ◦ 統計値やエラーサンプルがあれば良いので、N=1を捨てて流量稼ぐ DB等で確実に記録 揮発覚悟で流量稼ぐ 24/34
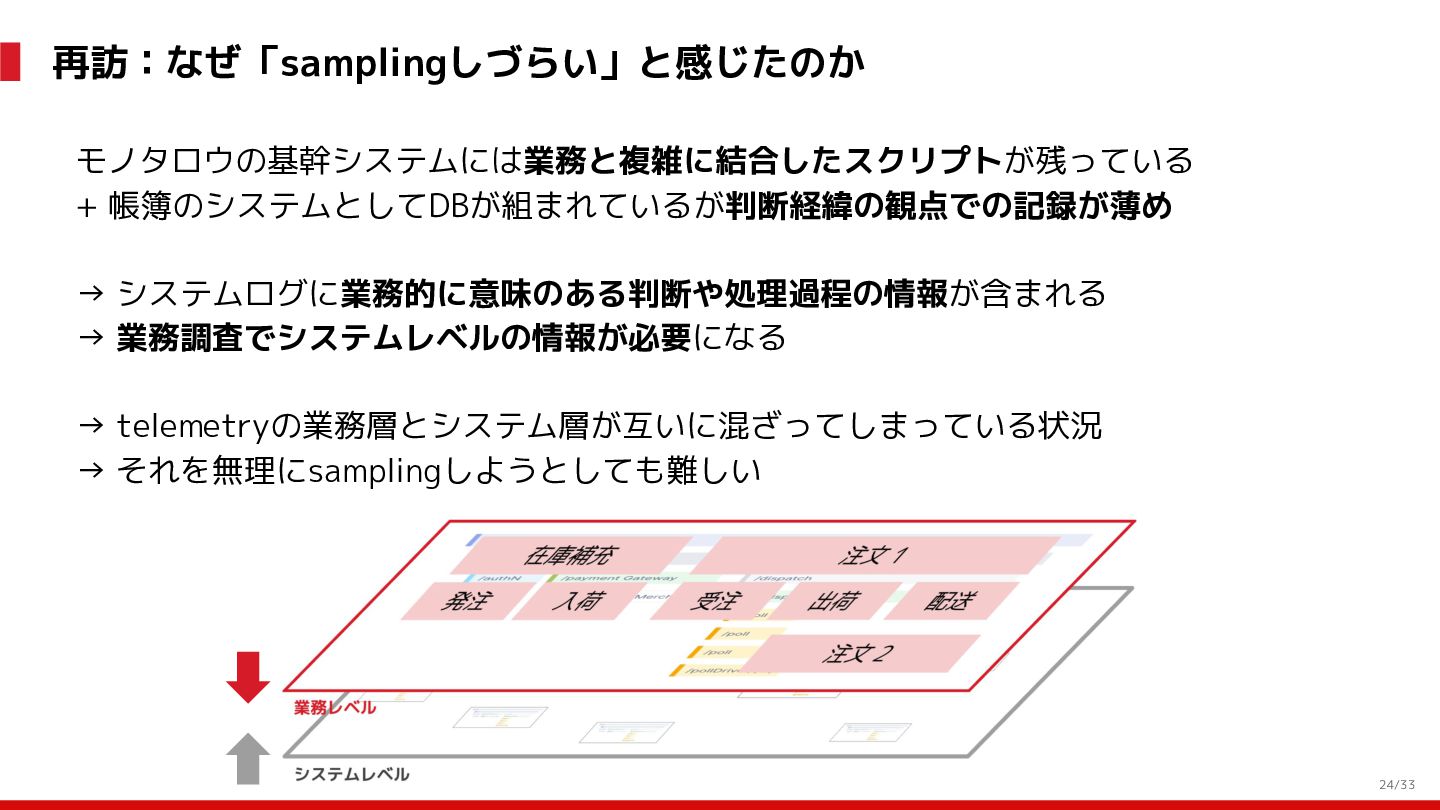
再訪:なぜ「samplingしづらい」と感じたのか モノタロウの基幹システムには業務と複雑に結合したスクリプトが残っている + 帳簿のシステムとしてDBが組まれているが判断経緯の観点での記録が薄め → システムログに業務的に意味のある判断や処理過程の情報が含まれる → 業務調査でシステムレベルの情報が必要になる → telemetryの業務層とシステム層が互いに混ざってしまっている状況
→ それを無理にsamplingしようとしても難しい 25/34
再訪:なぜ「samplingしづらい」と感じたのか Q. なぜ「samplingしづらい」と感じたのか A. 次の2つの合わせ技 • レガシーな部分(業務とシステムが結合)が残っていて、 業務レベルとシステムレベルのtelemetryの境界が曖昧 → 業務調査にシステムレベルのtelemetryが必要になることもある
• 「システム的には正常だが業務として異常・重要」が後から判明するため、その 場でsampling判定することはできない → 本来samplingするべきでないものをsamplingしようとしてしまっていた 26/34
モノタロウの現状と課題
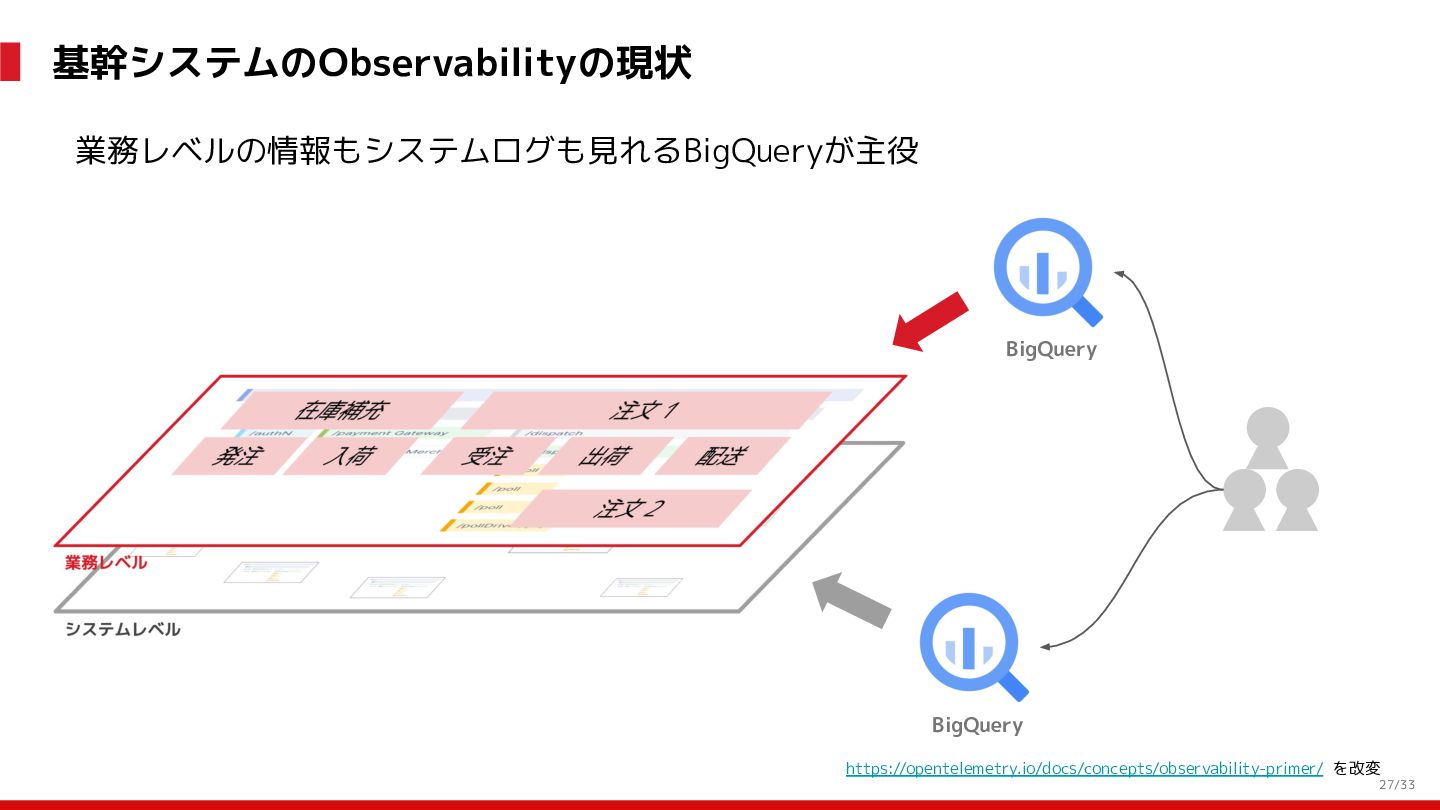
基幹システムのObservabilityの現状 業務レベルの情報もシステムログも見れるBigQueryが主役 BigQuery BigQuery https://opentelemetry.io/docs/concepts/observability-primer/ を改変 28/34
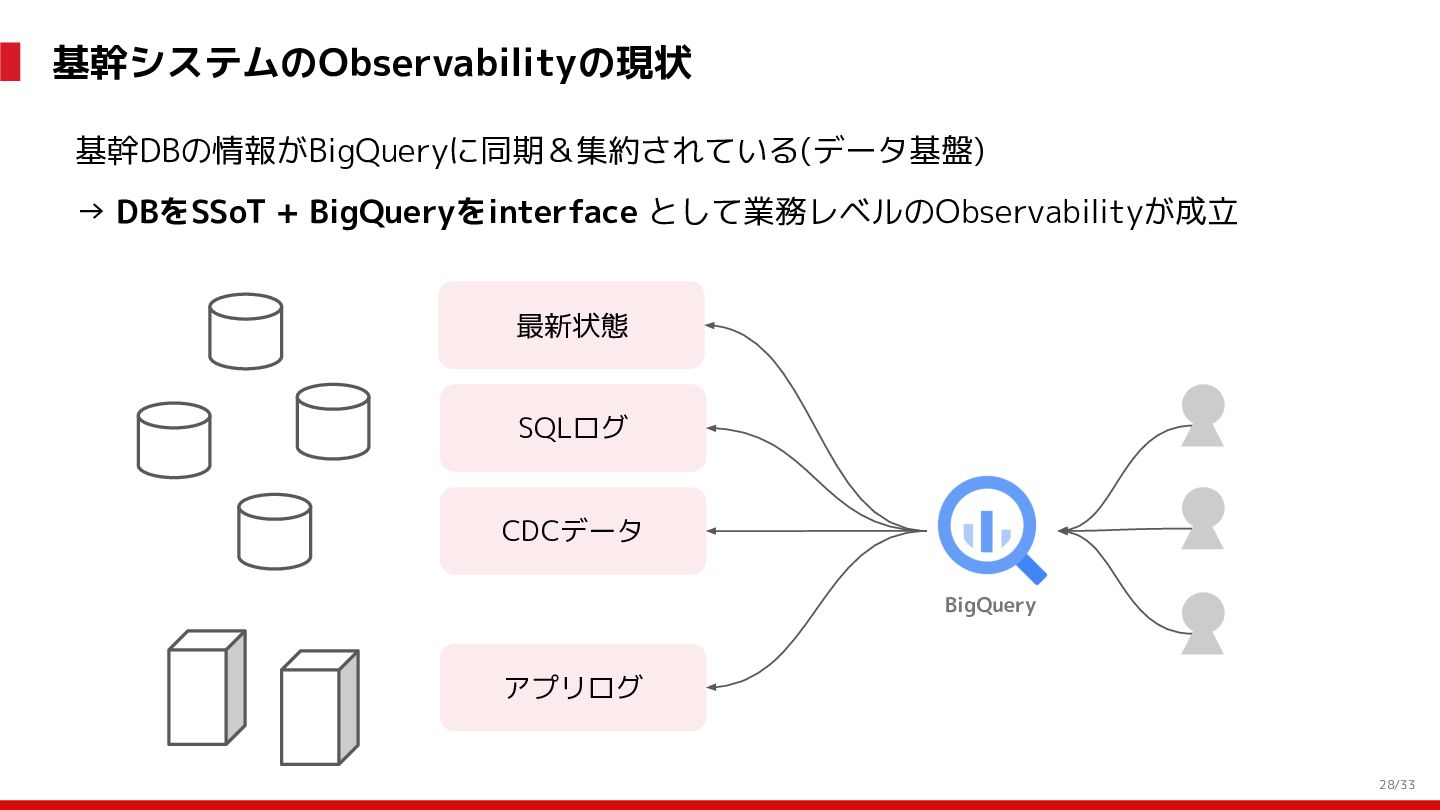
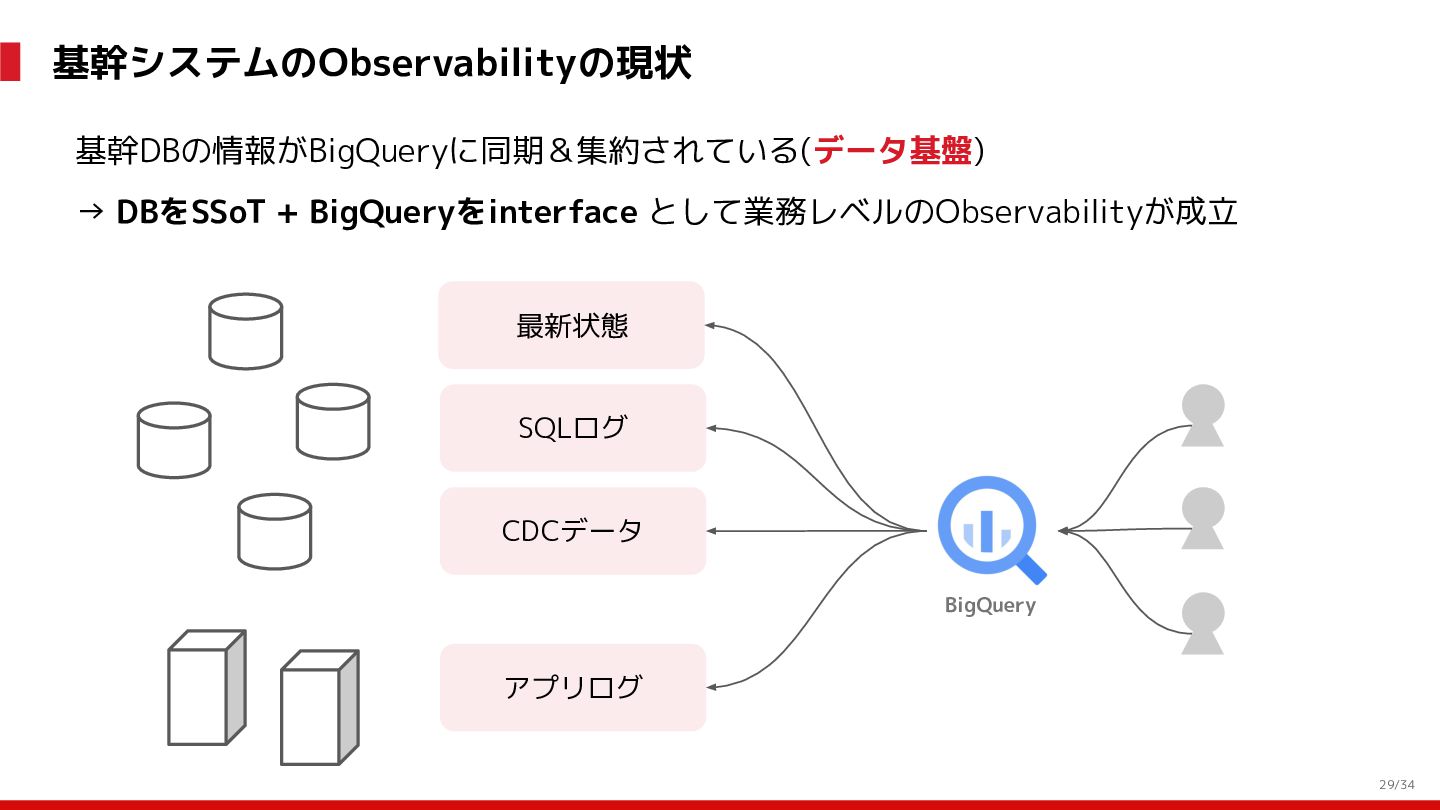
基幹システムのObservabilityの現状 基幹DBの情報がBigQueryに同期&集約されている(データ基盤) → DBをSSoT + BigQueryをinterface として業務レベルのObservabilityが成立 最新状態 SQLログ CDCデータ
BigQuery アプリログ 29/34
詳しく知りたい方へ https://speakerdeck.com/monotaro 30/34
モダナイズを進めるとどう変わっていくか ドメインモデリングやらマイクロサービス化やらのもとで... • • 業務とシステムの密結合が改善 → 業務とシステムtelemetryの対応が複雑に システムコンポーネントが増えていく→ 分散tracingが必要に ◦
分散システム特有の中途半端な障害モードも生まれていくかも BigQuery https://opentelemetry.io/docs/concepts/observability-primer/ を改変 31/34
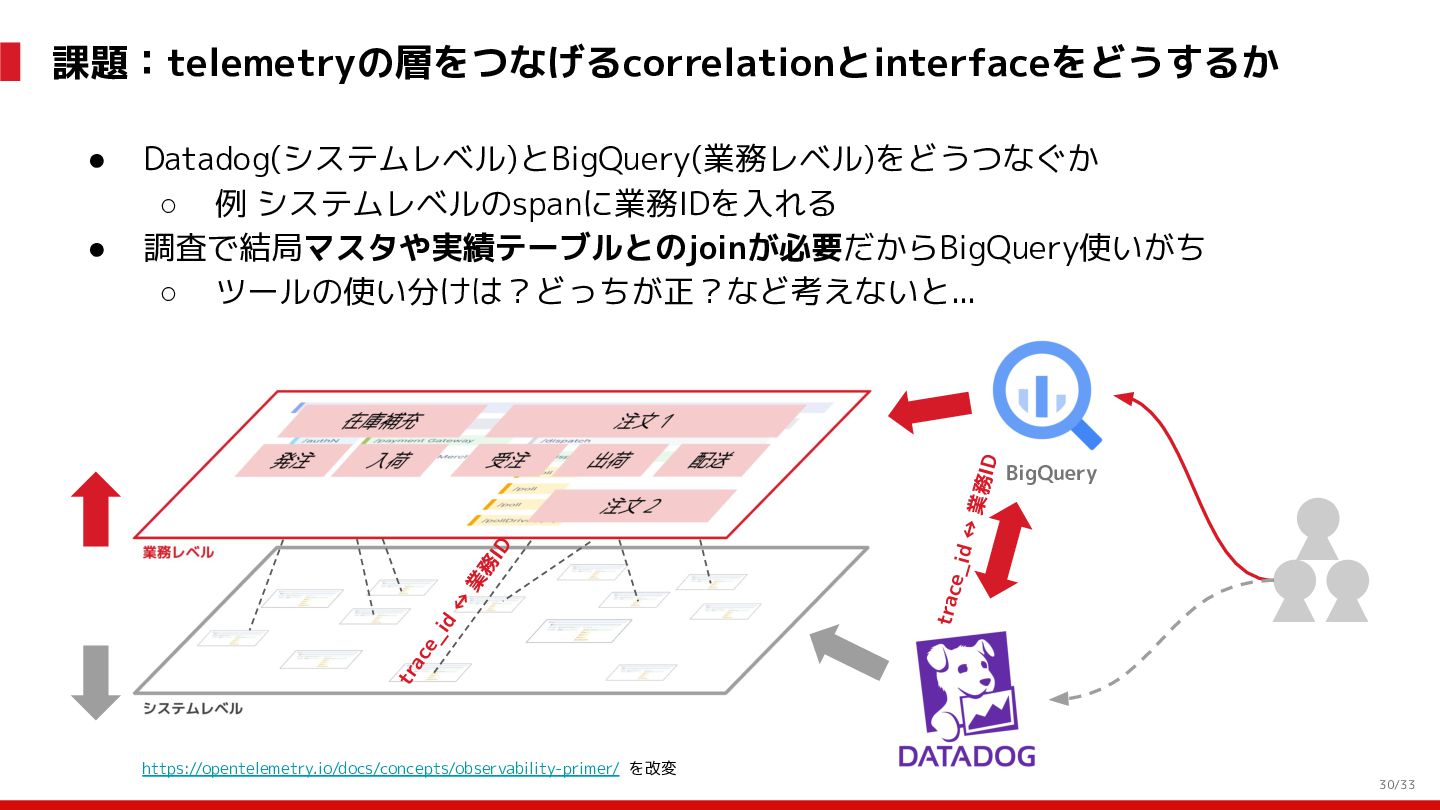
課題:telemetryの層をつなげるcorrelationとinterfaceをどうするか 業務 ID e_id ↔ trac ID 務 業 ↔
d BigQuery e_ i • Datadog(システムレベル)とBigQuery(業務レベル)をどうつなぐか ◦ 例 システムレベルのspanに業務IDを入れる 調査で結局マスタや実績テーブルとのjoinが必要だからBigQuery使いがち ◦ ツールの使い分けは?どっちが正?など考えないと... tr ac • https://opentelemetry.io/docs/concepts/observability-primer/ を改変 32/34
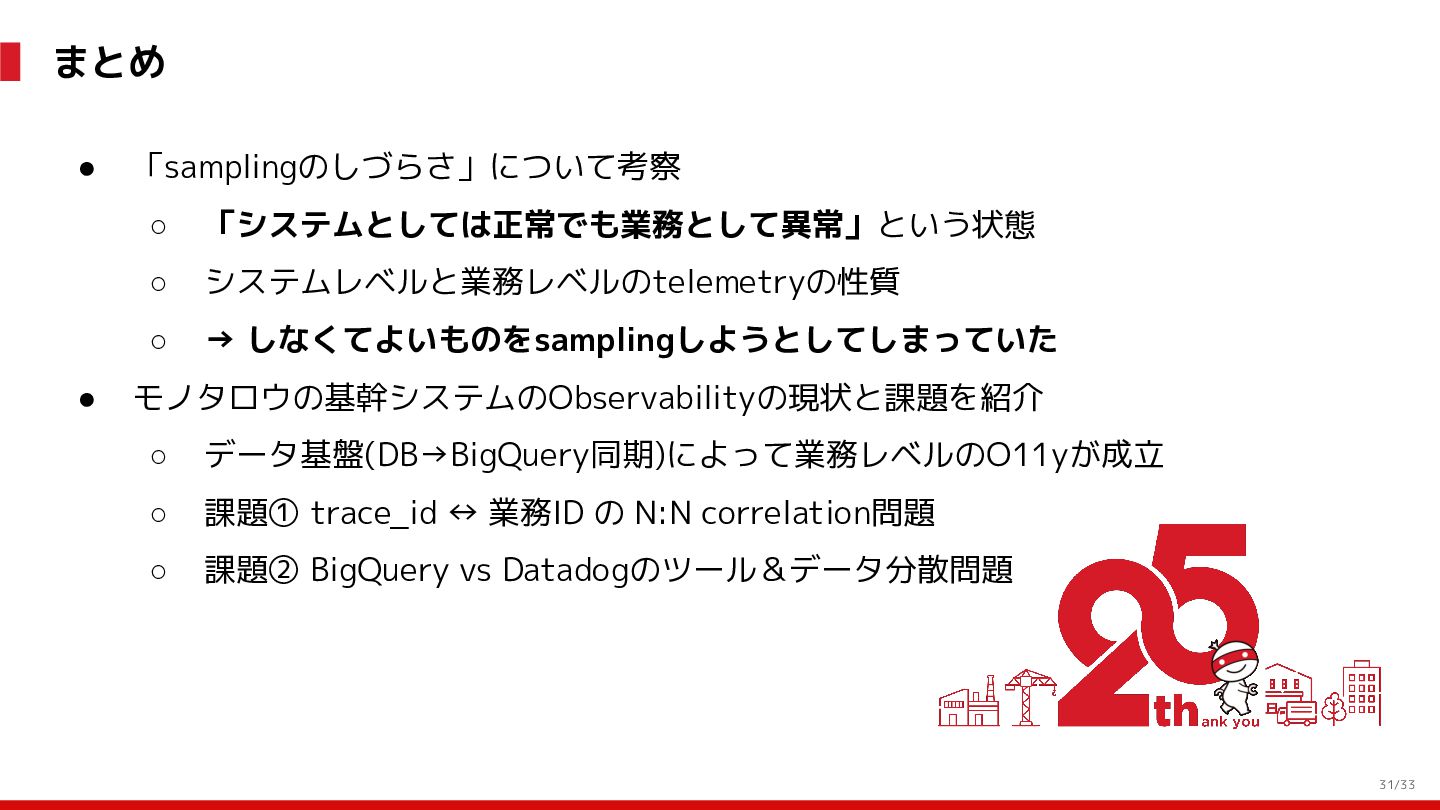
まとめ • • 「samplingのしづらさ」について考察 ◦ 「システムとしては正常でも業務として異常」という状態 ◦ システムレベルと業務レベルのtelemetryの性質 ◦ →
しなくてよいものをsamplingしようとしてしまっていた モノタロウの基幹システムのObservabilityの現状と課題を紹介 ◦ データ基盤(DB→BigQuery同期)によって業務レベルのO11yが成立 ◦ 課題① trace_id ↔ 業務ID の N:N correlation問題 ◦ 課題② BigQuery vs Datadogのツール&データ分散問題 33/34
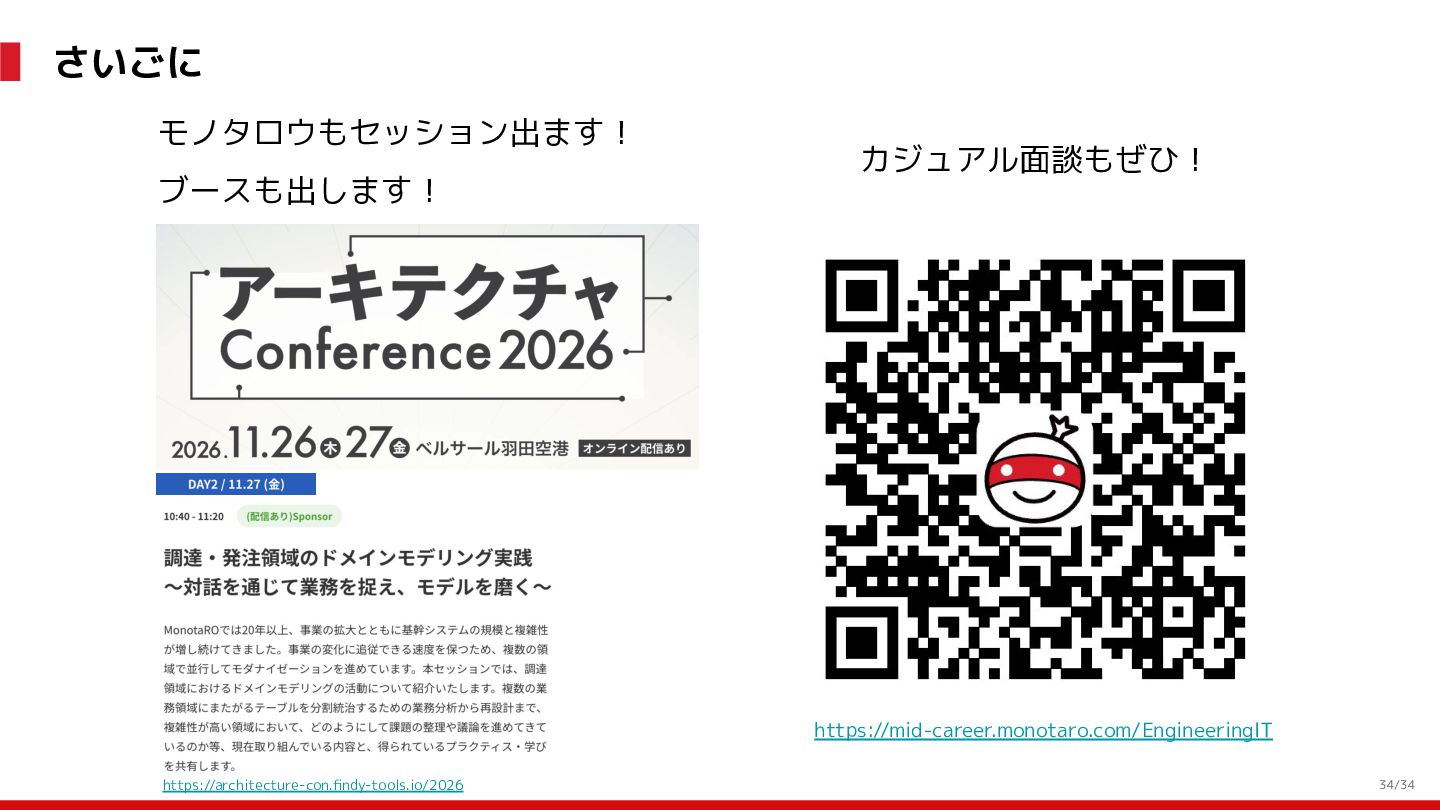
さいごに モノタロウもセッション出ます! ブースも出します! カジュアル面談もぜひ! https://mid-career.monotaro.com/EngineeringIT https://architecture-con.findy-tools.io/2026 34/34
© 2026 MonotaRO Co., Ltd.
More Decks by MonotaRO
See All by MonotaRO
作れることと、作るべきことは違う: 生成AI時代のデータ基盤とプロダクト思考 - Data Engineering Summit 2026
monotaro
PRO
0
210
AIでSDLCは変わろうとしている では、人と組織をどう再設計すべきか
monotaro
PRO
0
330
モノタロウにおけるSREの現在地:モダナイゼーションの過程で変化していく組織に、SREはどう向き合ったか
monotaro
PRO
2
880
AIと共に、組織をどう進化させるか?
monotaro
PRO
1
490
ビジネスを駆動するアーキテクチャへ ~AI-Agentという新しいアクター
monotaro
PRO
2
17k
事業成長を支えるためのデータ アーキテクチャの取り組み - Data Engineering Summit
monotaro
PRO
0
830
AIと共に進化するモノタロウ - AI駆動開発 Conference Autumn 2025
monotaro
PRO
8
4.6k
映えないObservability
monotaro
PRO
3
1.1k
Datadogを活用した マイクロサービスの可観測性向上 ~モノタロウの導入効果と実践ノウハウ~
monotaro
PRO
0
460
Featured
See All Featured
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
980
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Amusing Abliteration
ianozsvald
1
390
Code Review Best Practice
trishagee
74
20k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.2k
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Discover your Explorer Soul
emna__ayadi
2
1.3k
The Language of Interfaces
destraynor
162
27k
Six Lessons from altMBA
skipperchong
29
4.6k
Ruling the World: When Life Gets Gamed
codingconduct
0
440
The Cost Of JavaScript in 2023
addyosmani
56
10k


 monotaro
 panda_program
 nmsamuel
 marcelosomers
 ianozsvald
 trishagee
 aleyda
 geoffreycrofte
 emna__ayadi
 destraynor
 skipperchong
 codingconduct
 addyosmani