Upgrade to Pro — share decks privately, control downloads, hide ads and more …

JPUG勉強会 OSSデータベースの内部構造を理解しよう(第2回)

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on.
Avatar for Atsushi Ogawa Atsushi Ogawa
September 11, 2026

JPUG勉強会 OSSデータベースの内部構造を理解しよう(第2回)

Avatar for Atsushi Ogawa

Atsushi Ogawa

September 11, 2026

More Decks by Atsushi Ogawa

Other Decks in Programming

Transcript

  1. 自己紹介 • 氏名:小川 淳 • PostgreSQLへの貢献 • PostgreSQL: regexp_replace •

    高速化 • PostgreSQL: Cache last known per-tuple offsets to speed long tuple access • PostgreSQL: FunctionCallN improvement. • PostgreSQL: AllocSetReset improvement • github: https://github.com/oga5 • X: @AOga51748099 OSSデータベースの内部構造を理解しよう
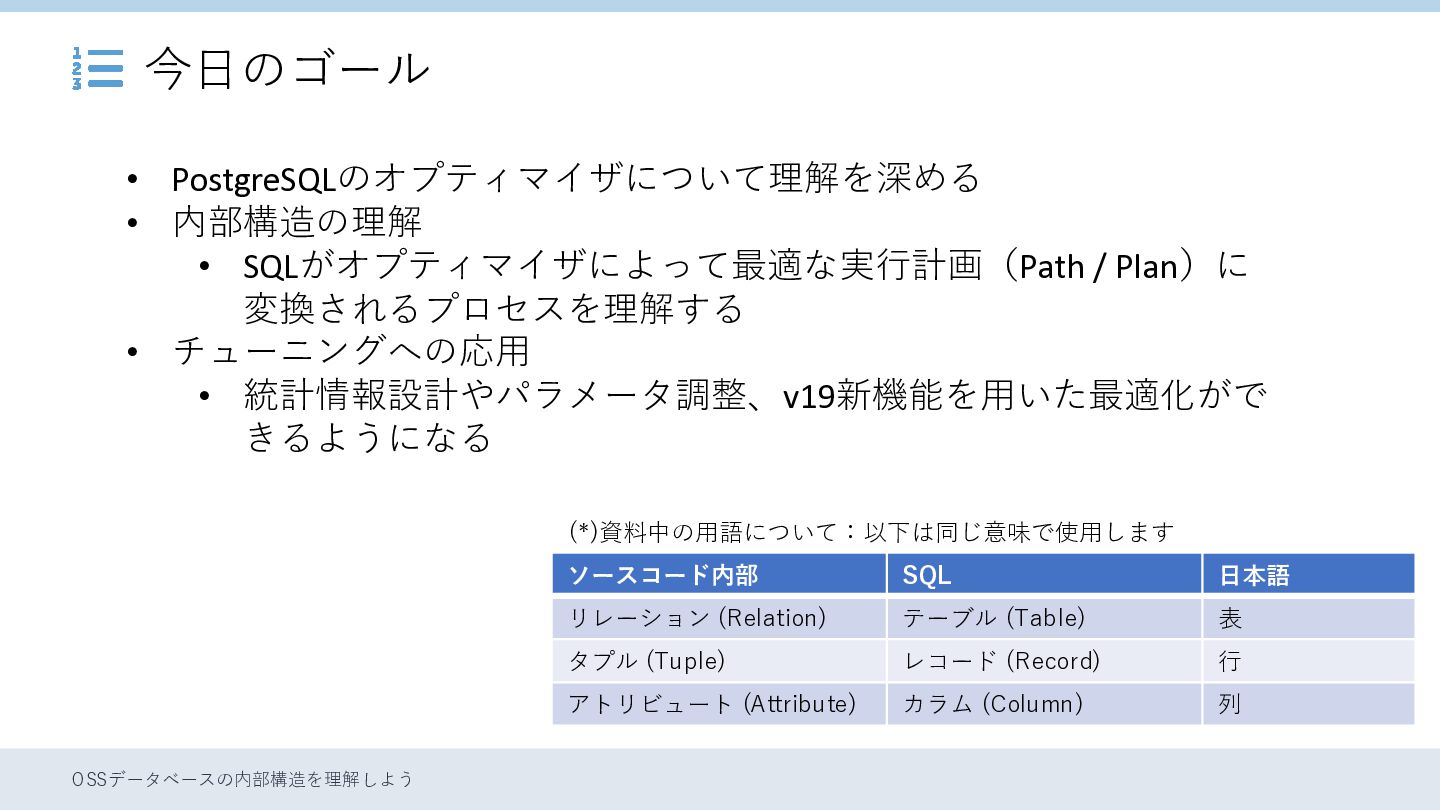
  2. 今日のゴール • PostgreSQLのオプティマイザについて理解を深める • 内部構造の理解 • SQLがオプティマイザによって最適な実行計画(Path / Plan)に 変換されるプロセスを理解する

    • チューニングへの応用 • 統計情報設計やパラメータ調整、v19新機能を用いた最適化がで きるようになる (*)資料中の用語について:以下は同じ意味で使用します OSSデータベースの内部構造を理解しよう ソースコード内部 SQL 日本語 リレーション (Relation) テーブル (Table) 表 タプル (Tuple) レコード (Record) 行 アトリビュート (Attribute) カラム (Column) 列
  3. デモの環境について • Windows11のWSL環境を利用します • PC環境 • ThinkPad T14s • CPU:

    Intel Core Ultra 7 255H (16core) • Memory: 32GB • WSL環境: Ubuntu 24.04 • PostgreSQL: Version 19 beta3 • ソースコードビューア o https://oga5.github.io/source-wiki-postgresql19beta3/overview.html OSSデータベースの内部構造を理解しよう
  4. アジェンダ 1. オプティマイザ概要 2. 前処理 3. パス探索 4. 後処理 5.

    コスト計算 6. PostgreSQL 19 (beta3)のオプティマイザに関する新機能 OSSデータベースの内部構造を理解しよう
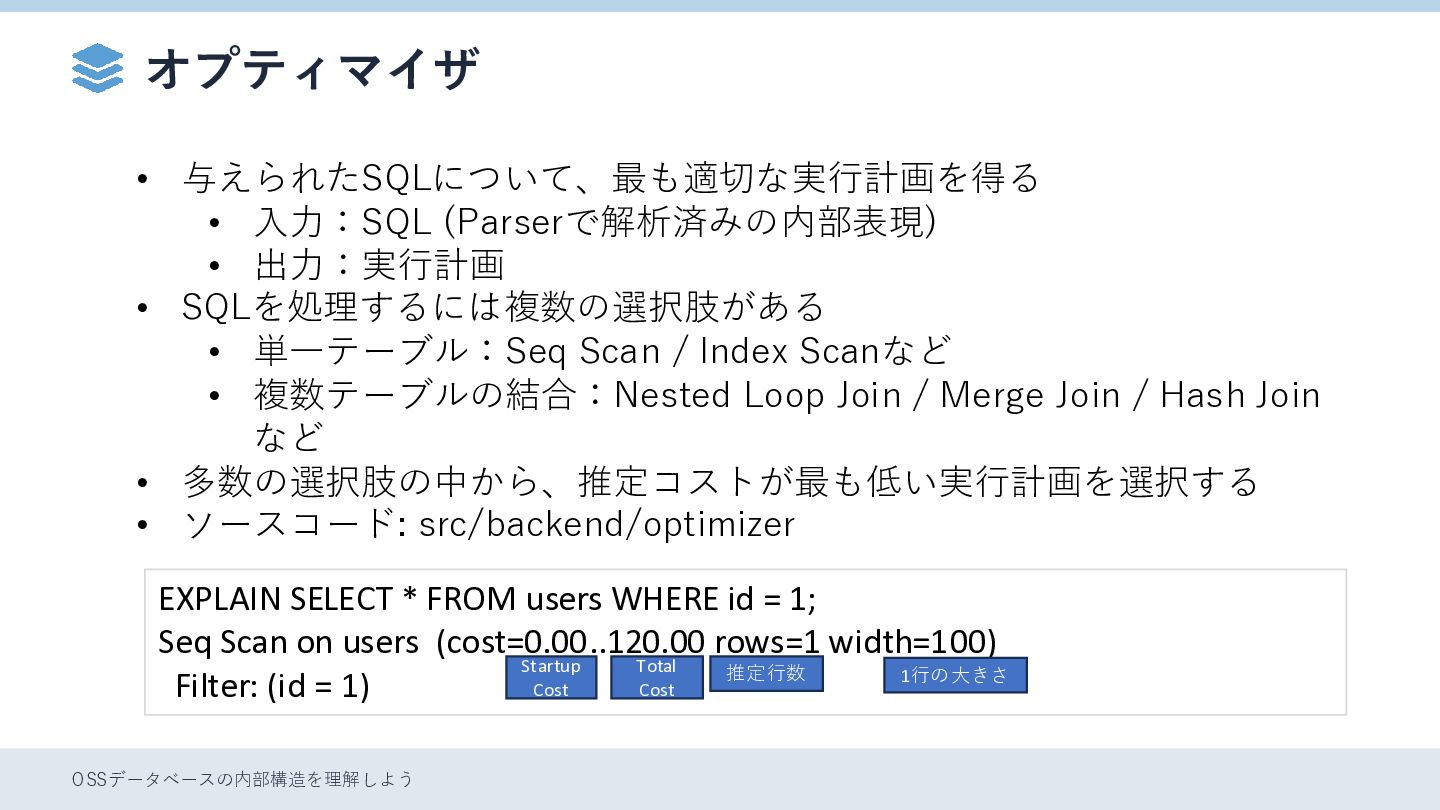
  5. オプティマイザ • 与えられたSQLについて、最も適切な実行計画を得る • 入力:SQL (Parserで解析済みの内部表現) • 出力:実行計画 • SQLを処理するには複数の選択肢がある

    • 単一テーブル:Seq Scan / Index Scanなど • 複数テーブルの結合:Nested Loop Join / Merge Join / Hash Join など • 多数の選択肢の中から、推定コストが最も低い実行計画を選択する • ソースコード: src/backend/optimizer EXPLAIN SELECT * FROM users WHERE id = 1; Seq Scan on users (cost=0.00..120.00 rows=1 width=100) Startup Total 推定行数 1行の大きさ Cost Cost Filter: (id = 1) OSSデータベースの内部構造を理解しよう
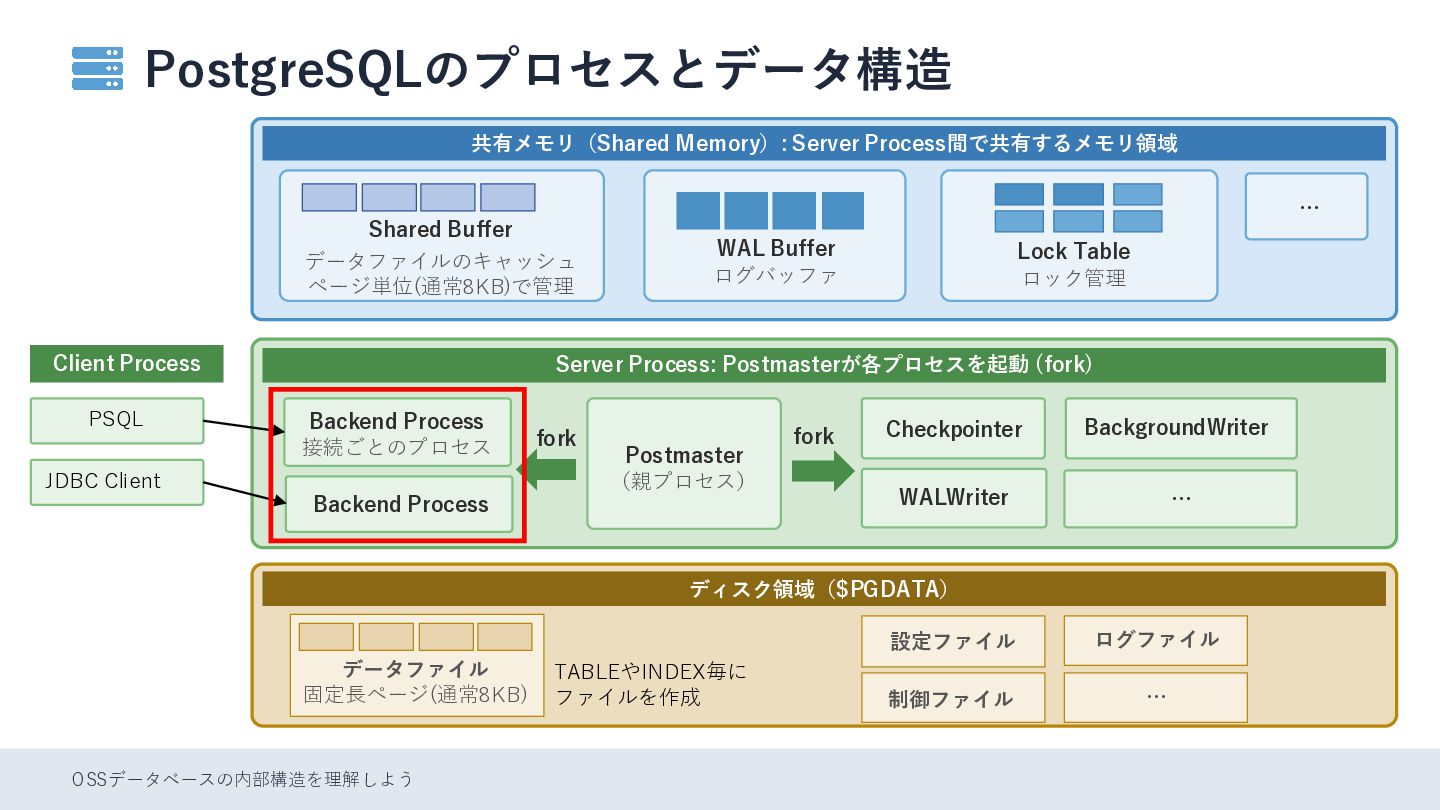
  6. PostgreSQLのプロセスとデータ構造 共有メモリ(Shared Memory): Server Process間で共有するメモリ領域 … Shared Buffer データファイルのキャッシュ ページ単位(通常8KB)で管理

    Client Process PSQL WAL Buffer ログバッファ Lock Table ロック管理 Server Process: Postmasterが各プロセスを起動 (fork) Backend Process 接続ごとのプロセス JDBC Client Backend Process fork Postmaster (親プロセス) fork Checkpointer BackgroundWriter WALWriter … ディスク領域($PGDATA) データファイル 固定長ページ(通常8KB) OSSデータベースの内部構造を理解しよう TABLEやINDEX毎に ファイルを作成 設定ファイル ログファイル 制御ファイル …
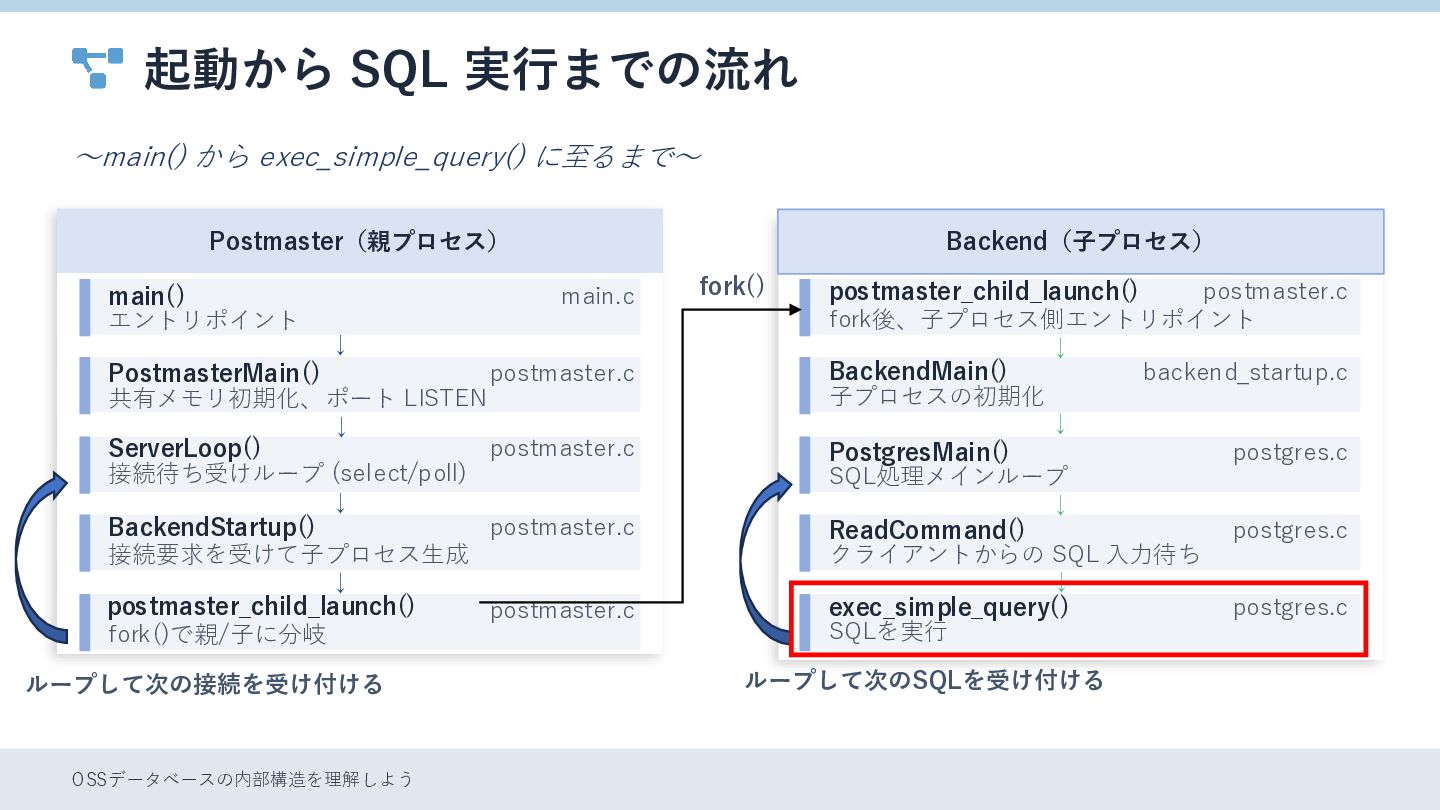
  7. 起動から SQL 実行までの流れ 〜main() から exec_simple_query() に至るまで〜 Postmaster(親プロセス) main() エントリポイント

    Backend(子プロセス) main.c ↓ PostmasterMain() postmaster.c 共有メモリ初期化、ポート LISTEN ↓ ServerLoop() postmaster.c 接続待ち受けループ (select/poll) ↓ BackendStartup() postmaster.c 接続要求を受けて子プロセス生成 ↓ postmaster_child_launch() postmaster.c fork()で親/子に分岐 ループして次の接続を受け付ける OSSデータベースの内部構造を理解しよう fork() postmaster.c postmaster_child_launch() fork後、子プロセス側エントリポイント ↓ BackendMain() backend_startup.c 子プロセスの初期化 ↓ PostgresMain() postgres.c SQL処理メインループ ↓ ReadCommand() postgres.c クライアントからの SQL 入力待ち ↓ exec_simple_query() postgres.c SQLを実行 ループして次のSQLを受け付ける
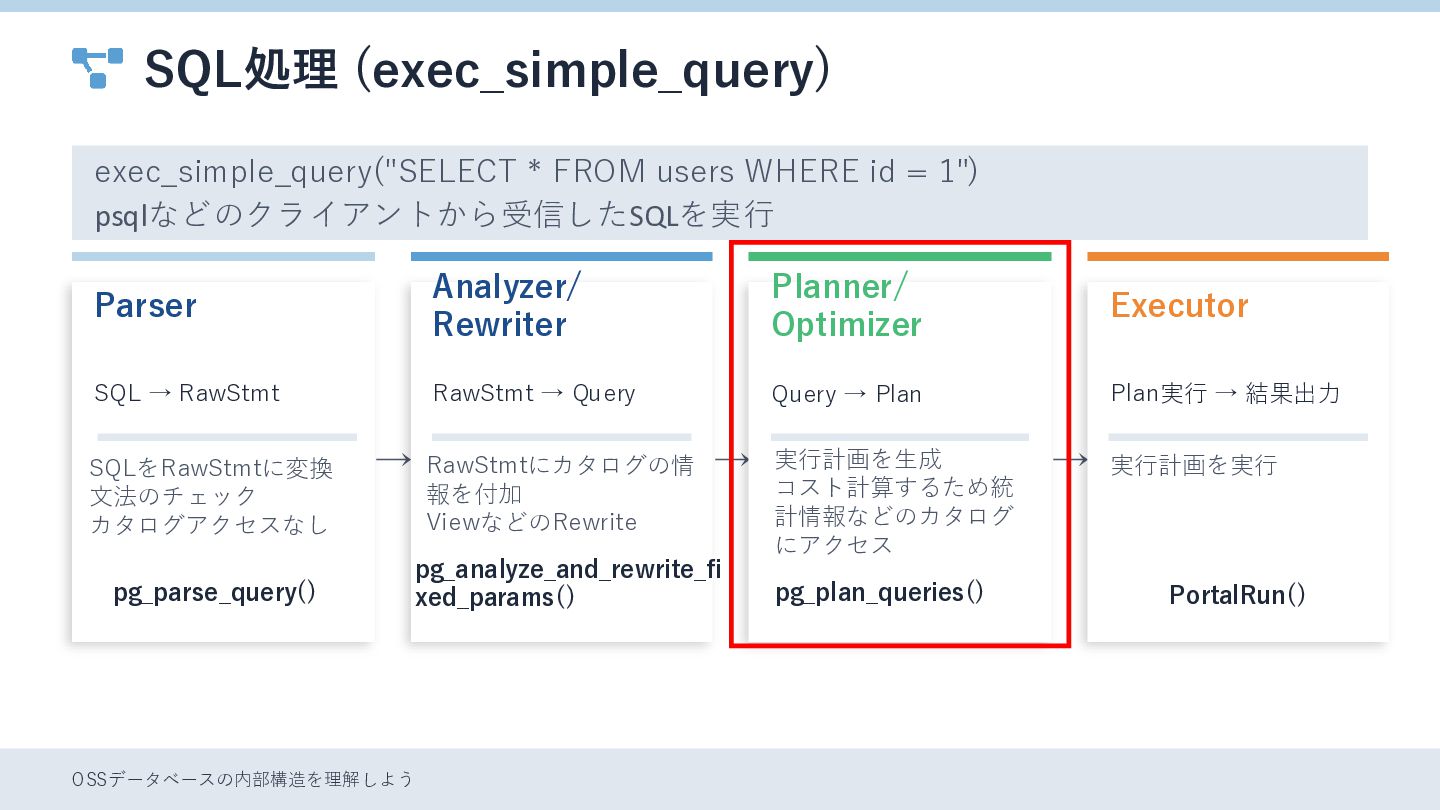
  8. SQL処理 (exec_simple_query) exec_simple_query("SELECT * FROM users WHERE id = 1")

    psqlなどのクライアントから受信したSQLを実行 Parser Analyzer/ Rewriter Planner/ Optimizer Executor SQL → RawStmt RawStmt → Query Query → Plan Plan実行 → 結果出力 SQLをRawStmtに変換 文法のチェック カタログアクセスなし → RawStmtにカタログの情 → 実行計画を生成 pg_parse_query() OSSデータベースの内部構造を理解しよう 報を付加 ViewなどのRewrite pg_analyze_and_rewrite_fi xed_params() コスト計算するため統 計情報などのカタログ にアクセス pg_plan_queries() → 実行計画を実行 PortalRun()
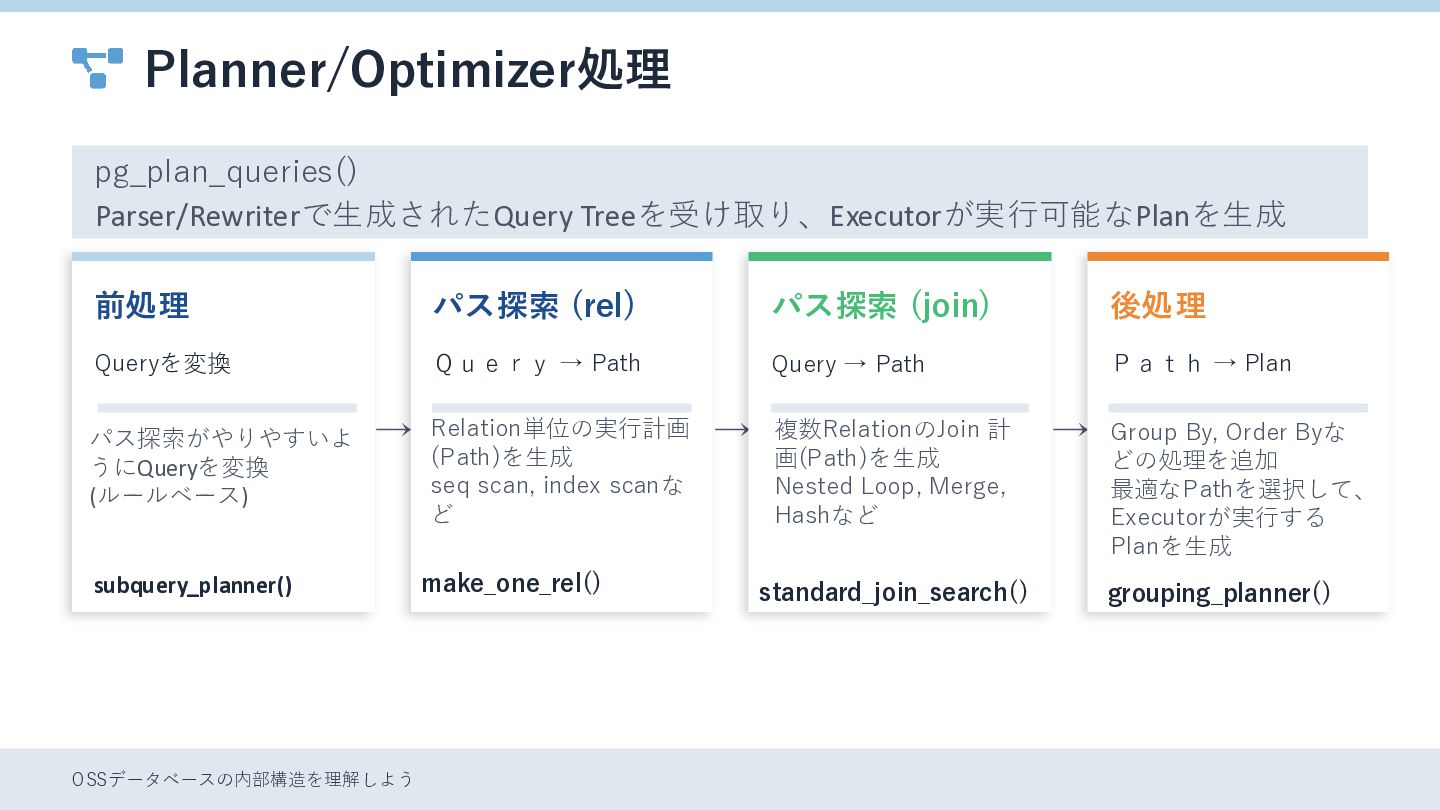
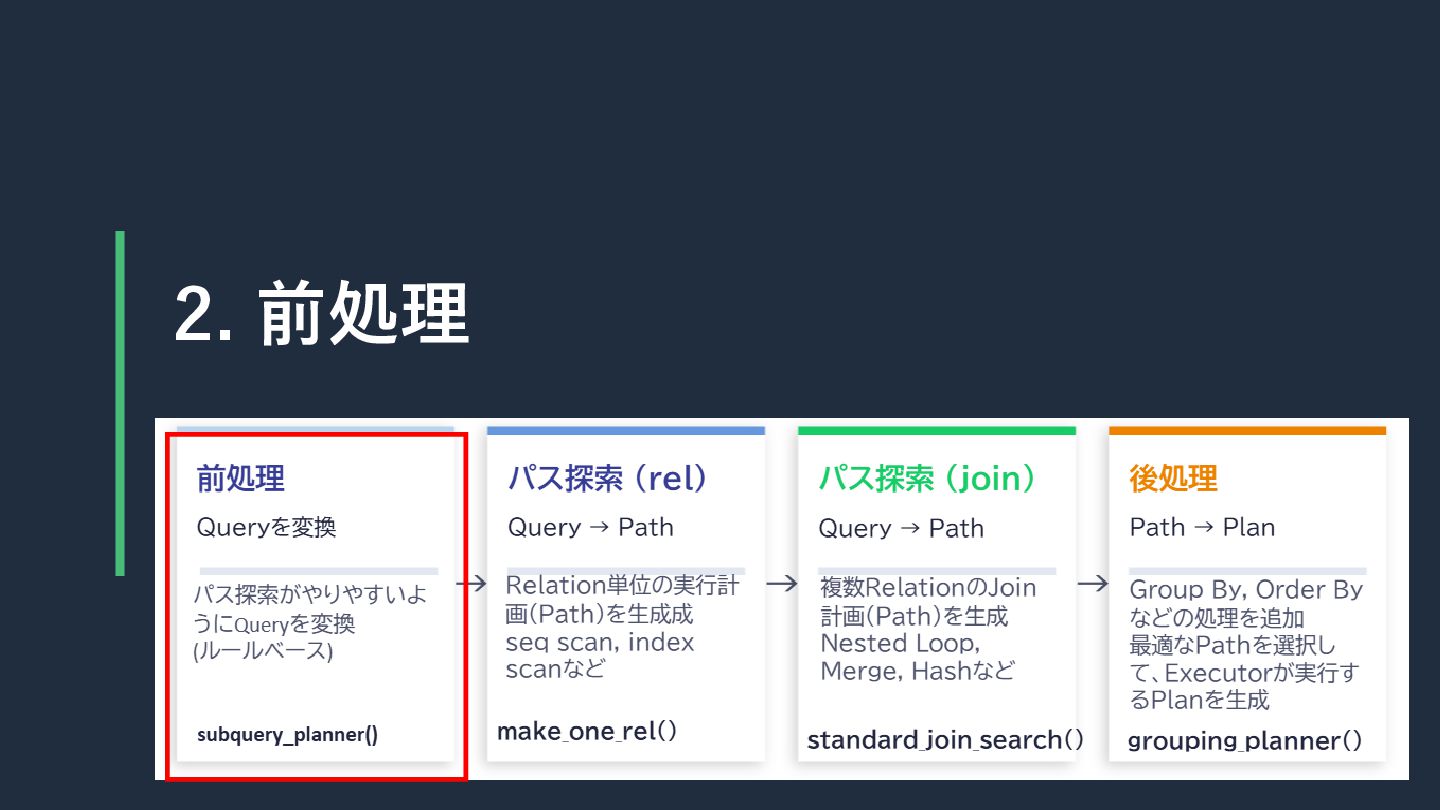
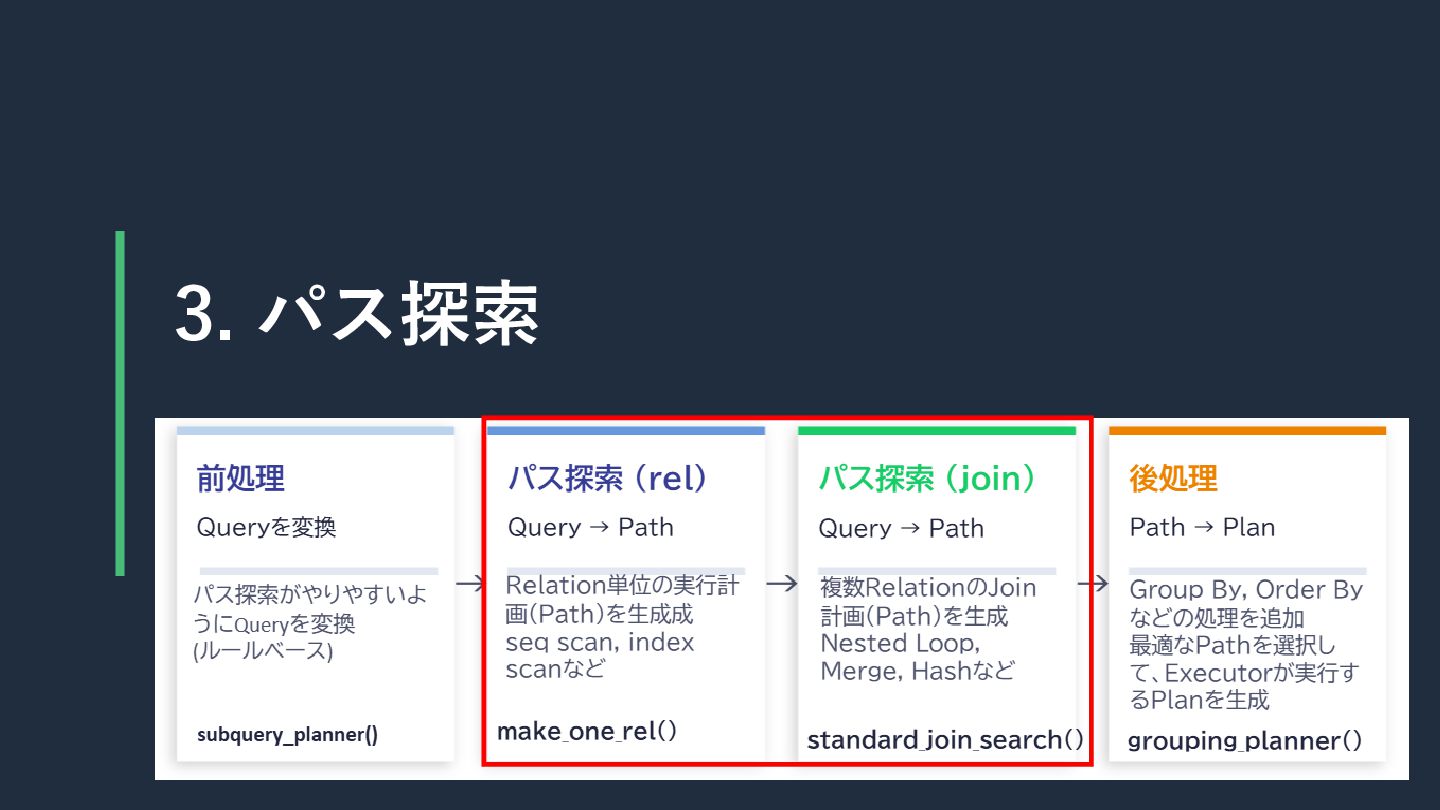
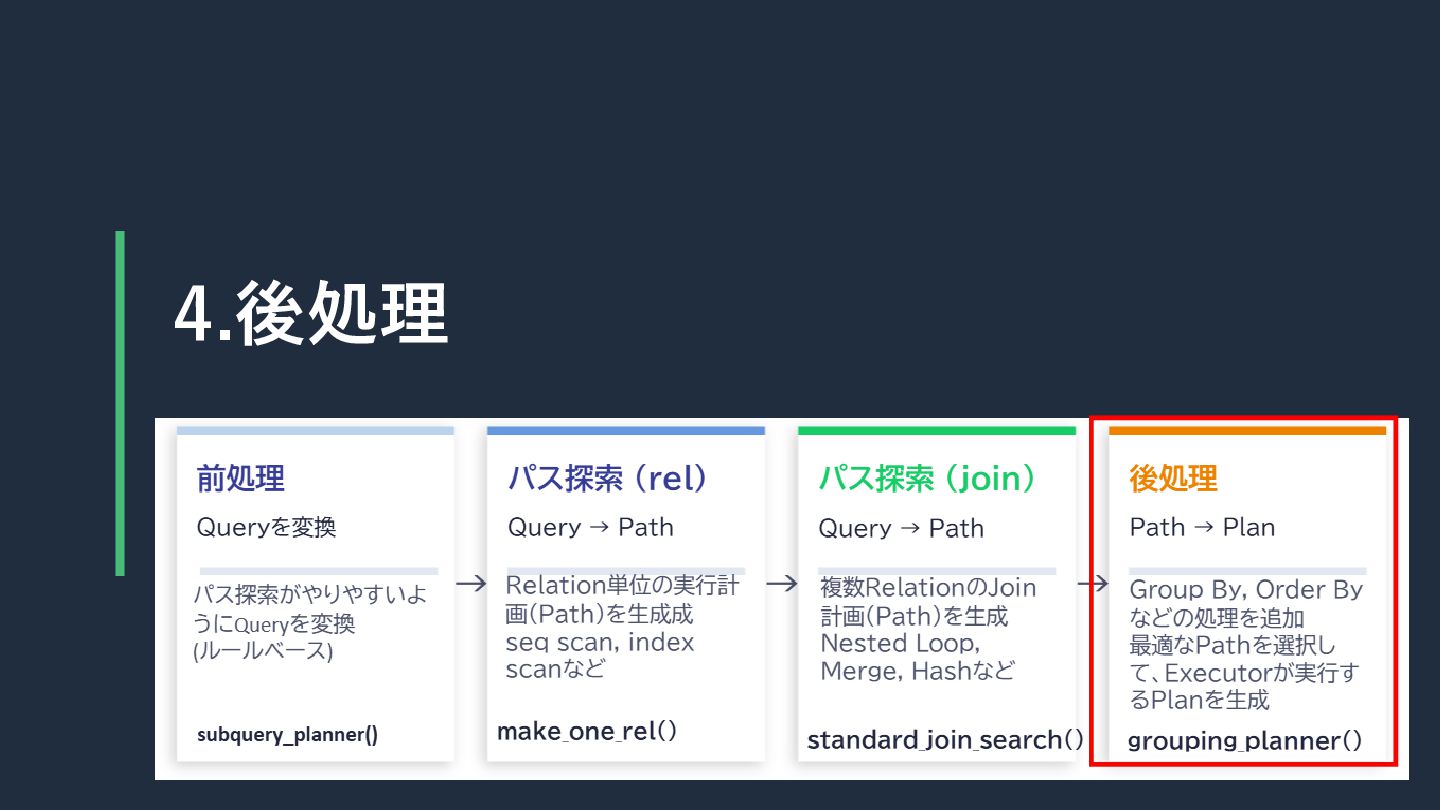
  9. Planner/Optimizer処理 pg_plan_queries() Parser/Rewriterで生成されたQuery Treeを受け取り、Executorが実行可能なPlanを生成 前処理 パス探索 (rel) パス探索 (join) 後処理

    Queryを変換 Query → Path Query → Path Path → Plan パス探索がやりやすいよ うにQueryを変換 (ルールベース)​ → Relation単位の実行計画 → 複数RelationのJoin 計 → Group By, Order Byな subquery_planner() OSSデータベースの内部構造を理解しよう (Path)を生成 seq scan, index scanな ど 画(Path)を生成 Nested Loop, Merge, Hashなど どの処理を追加 最適なPathを選択して、 Executorが実行する Planを生成 make_one_rel() standard_join_search() grouping_planner()
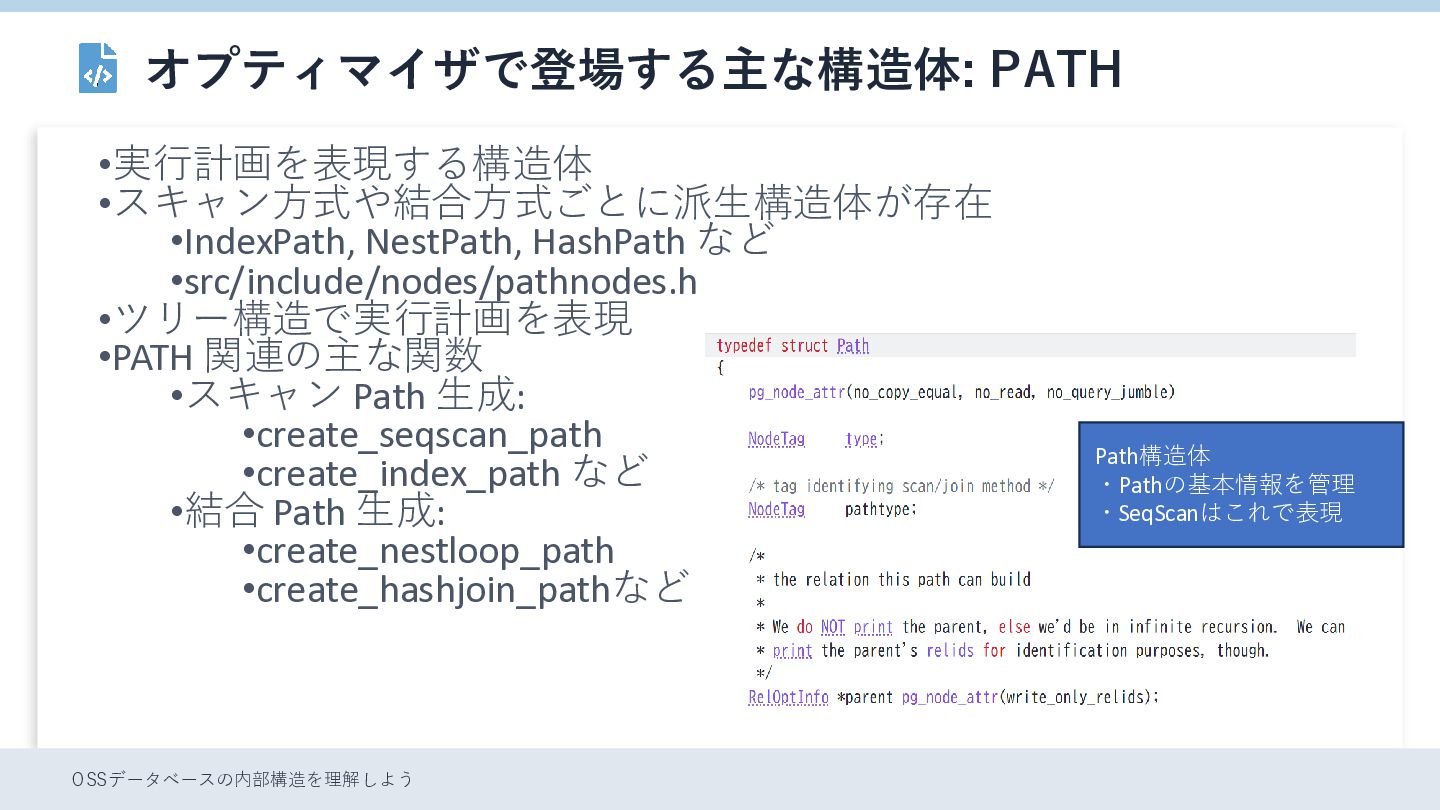
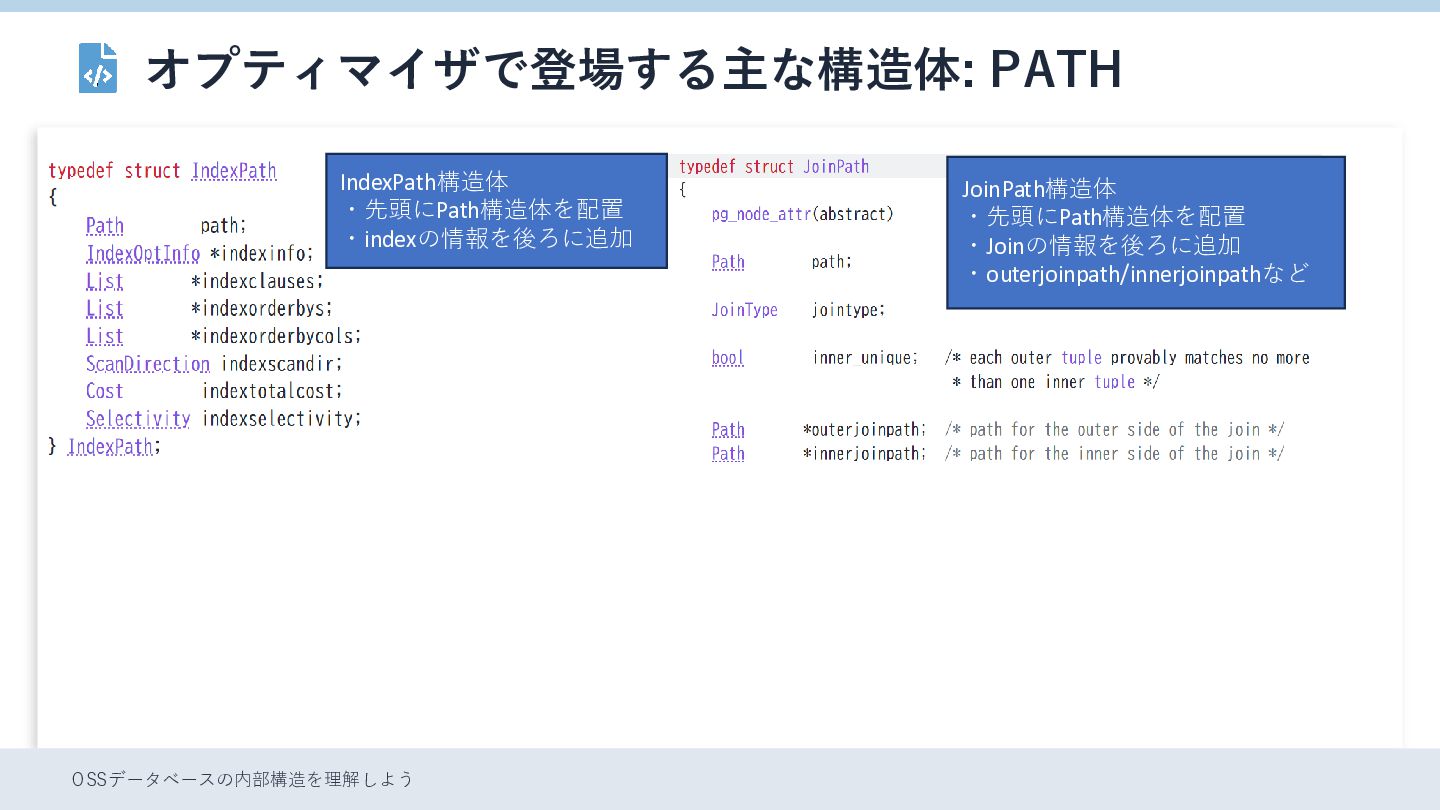
  10. オプティマイザで登場する主な構造体: PATH •実行計画を表現する構造体 •スキャン方式や結合方式ごとに派生構造体が存在 •IndexPath, NestPath, HashPath など •src/include/nodes/pathnodes.h •ツリー構造で実行計画を表現

    •PATH 関連の主な関数 •スキャン Path 生成: •create_seqscan_path •create_index_path など •結合 Path 生成: •create_nestloop_path •create_hashjoin_pathなど OSSデータベースの内部構造を理解しよう Path構造体 ・Pathの基本情報を管理 ・SeqScanはこれで表現
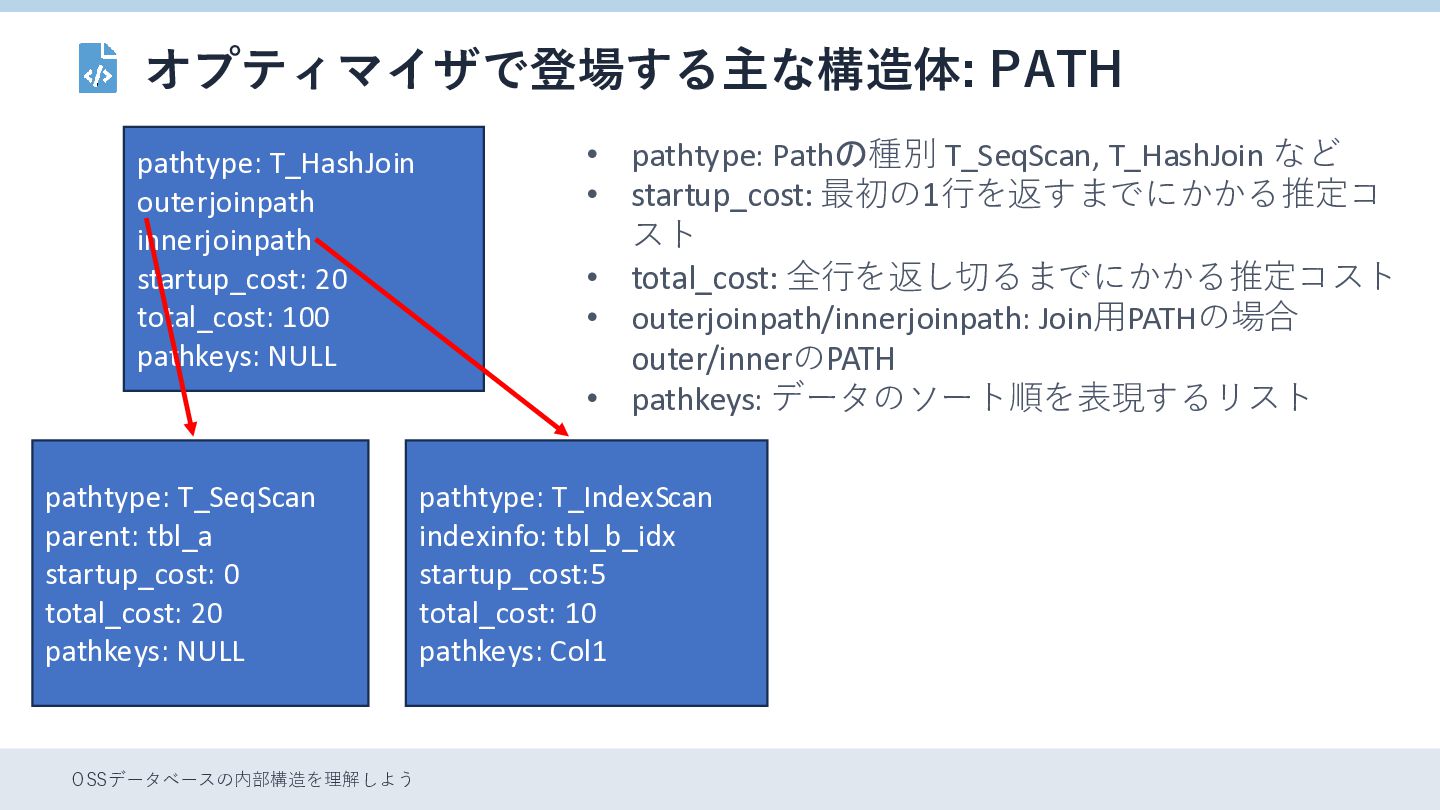
  11. オプティマイザで登場する主な構造体: PATH pathtype: T_HashJoin outerjoinpath innerjoinpath startup_cost: 20 total_cost: 100

    pathkeys: NULL pathtype: T_SeqScan parent: tbl_a startup_cost: 0 total_cost: 20 pathkeys: NULL OSSデータベースの内部構造を理解しよう • pathtype: Pathの種別 T_SeqScan, T_HashJoin など • startup_cost: 最初の1行を返すまでにかかる推定コ スト • total_cost: 全行を返し切るまでにかかる推定コスト • outerjoinpath/innerjoinpath: Join用PATHの場合 outer/innerのPATH • pathkeys: データのソート順を表現するリスト pathtype: T_IndexScan indexinfo: tbl_b_idx startup_cost:5 total_cost: 10 pathkeys: Col1
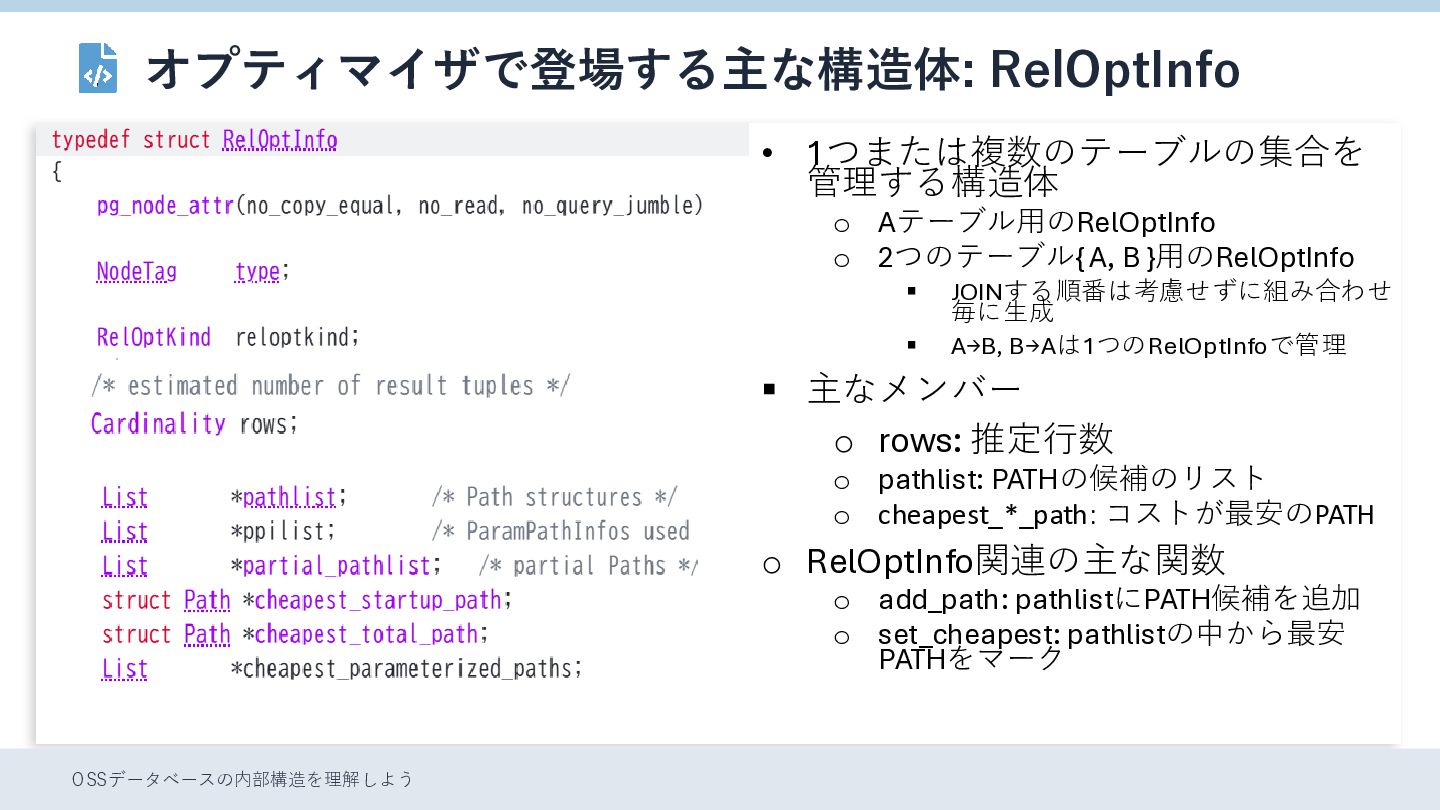
  12. オプティマイザで登場する主な構造体: RelOptInfo • 1つまたは複数のテーブルの集合を 管理する構造体 o Aテーブル用のRelOptInfo o 2つのテーブル{ A,

    B }用のRelOptInfo ▪ ▪ JOINする順番は考慮せずに組み合わせ 毎に生成 A→B, B→Aは1つのRelOptInfoで管理 ▪ 主なメンバー o rows: 推定行数 o pathlist: PATHの候補のリスト o cheapest_*_path: コストが最安のPATH o RelOptInfo関連の主な関数 o add_path: pathlistにPATH候補を追加 o set_cheapest: pathlistの中から最安 PATHをマーク OSSデータベースの内部構造を理解しよう
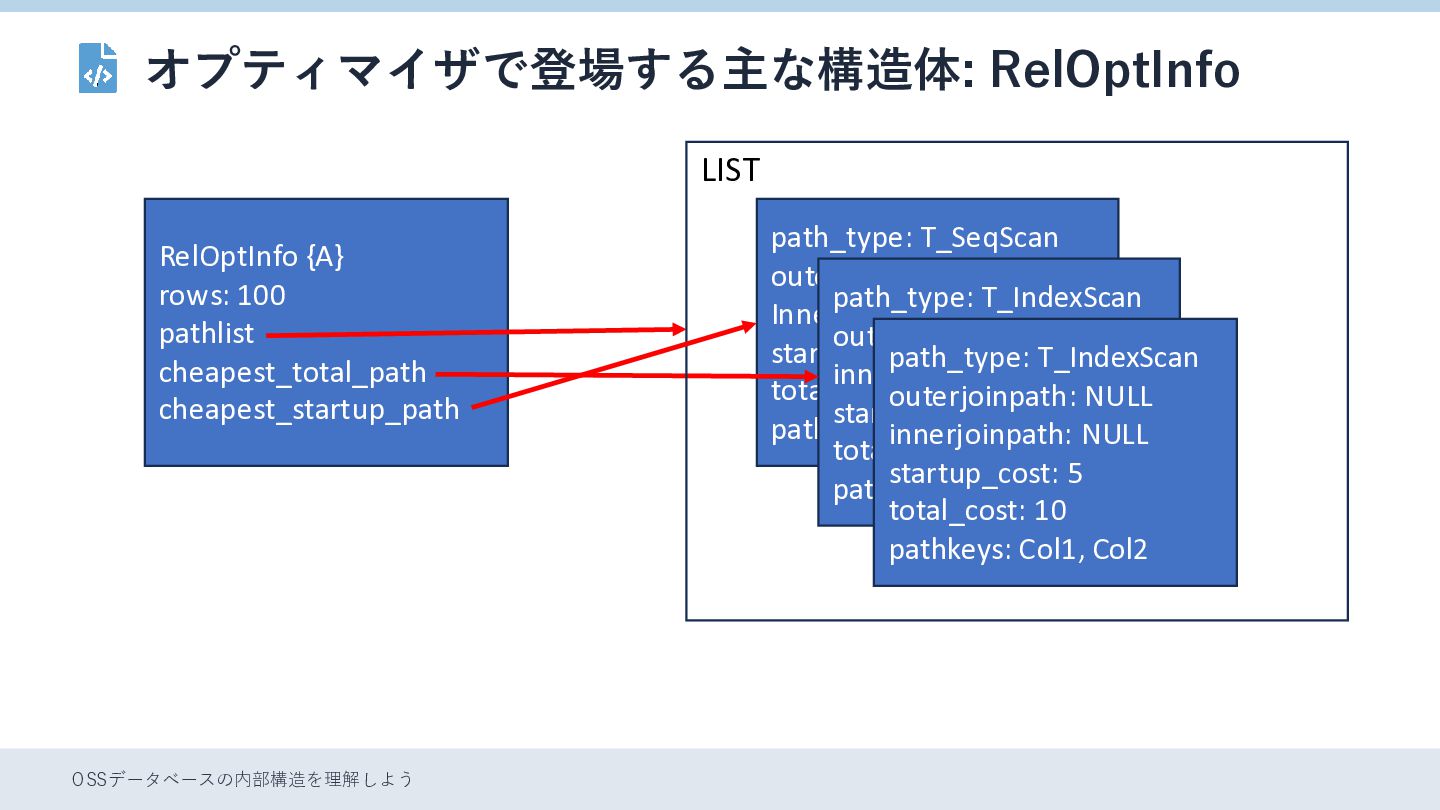
  13. オプティマイザで登場する主な構造体: RelOptInfo LIST RelOptInfo {A} rows: 100 pathlist cheapest_total_path cheapest_startup_path

    OSSデータベースの内部構造を理解しよう path_type: T_SeqScan outerjoinpath path_type: T_IndexScan Innerjoinpath outerjoinpath startup_cost: 0 path_type: T_IndexScan innerjoinpath total_cost: 20 outerjoinpath: NULL startup_cost: 5 pathkeys:innerjoinpath: NULL NULL total_cost: 10 startup_cost: 5 pathkeys: Col1 total_cost: 10 pathkeys: Col1, Col2
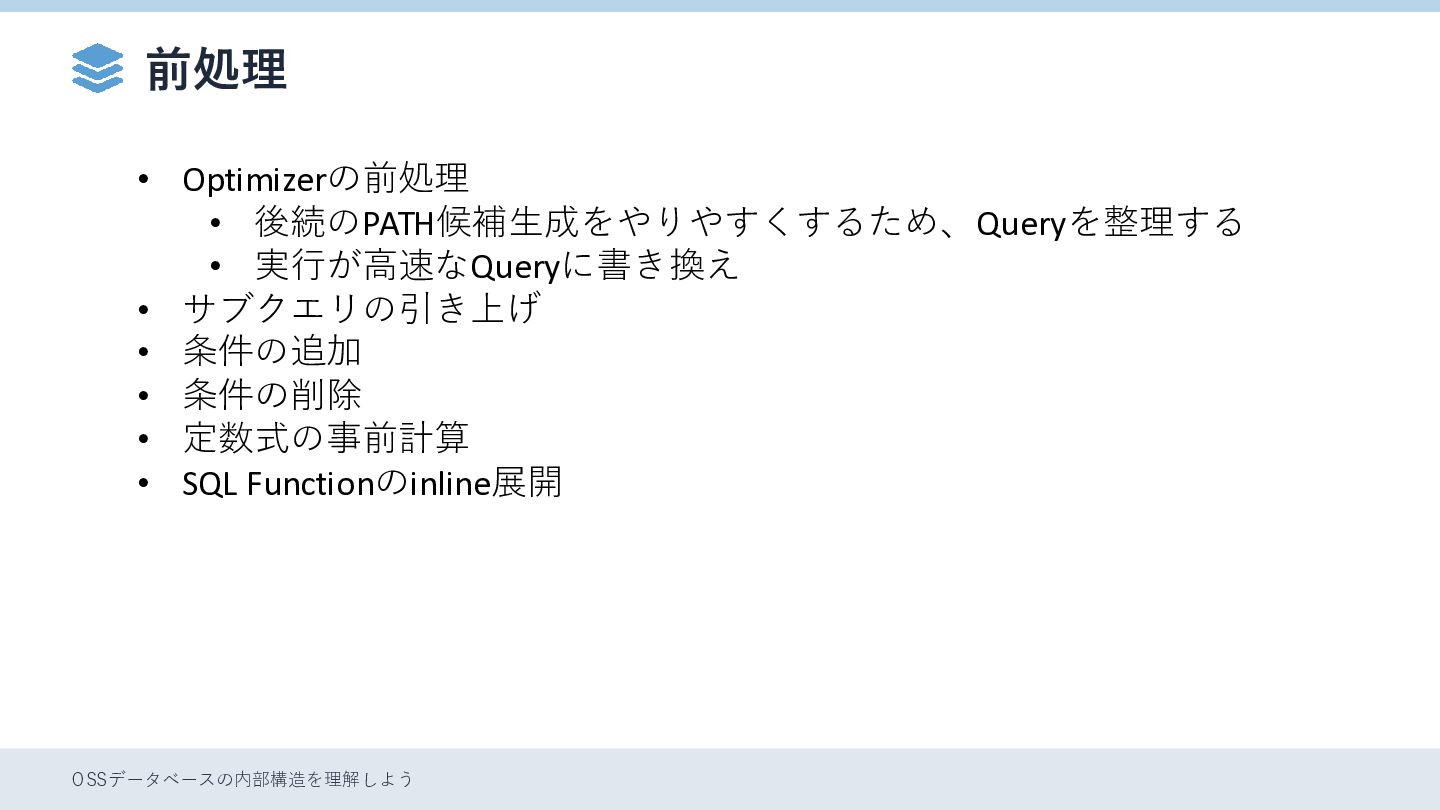
  14. 前処理 • Optimizerの前処理 • 後続のPATH候補生成をやりやすくするため、Queryを整理する • 実行が高速なQueryに書き換え • サブクエリの引き上げ •

    条件の追加 • 条件の削除 • 定数式の事前計算 • SQL Functionのinline展開 OSSデータベースの内部構造を理解しよう
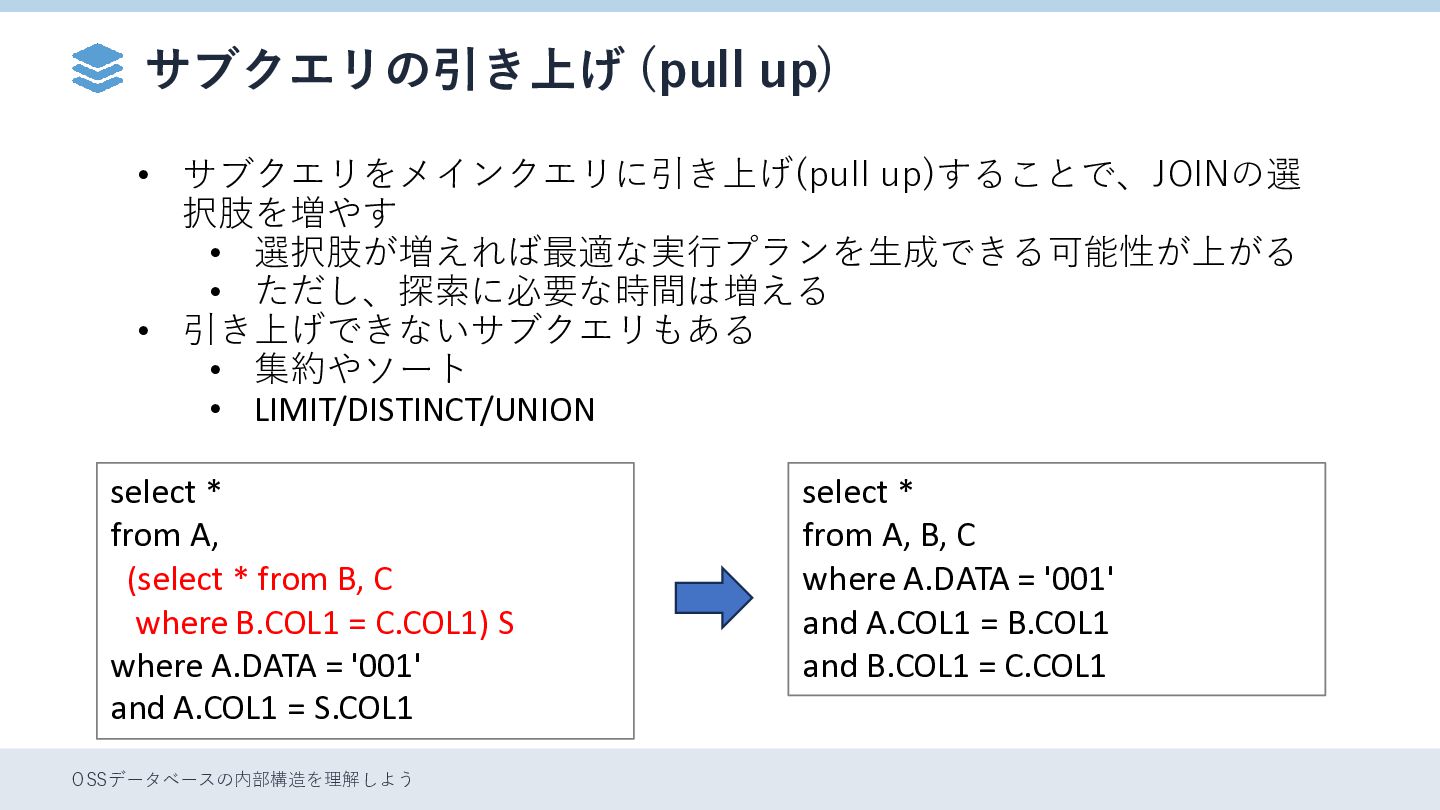
  15. サブクエリの引き上げ (pull up) • サブクエリをメインクエリに引き上げ(pull up)することで、JOINの選 択肢を増やす • 選択肢が増えれば最適な実行プランを生成できる可能性が上がる •

    ただし、探索に必要な時間は増える • 引き上げできないサブクエリもある • 集約やソート • LIMIT/DISTINCT/UNION select * from A, (select * from B, C where B.COL1 = C.COL1) S where A.DATA = '001' and A.COL1 = S.COL1 OSSデータベースの内部構造を理解しよう select * from A, B, C where A.DATA = '001' and A.COL1 = B.COL1 and B.COL1 = C.COL1
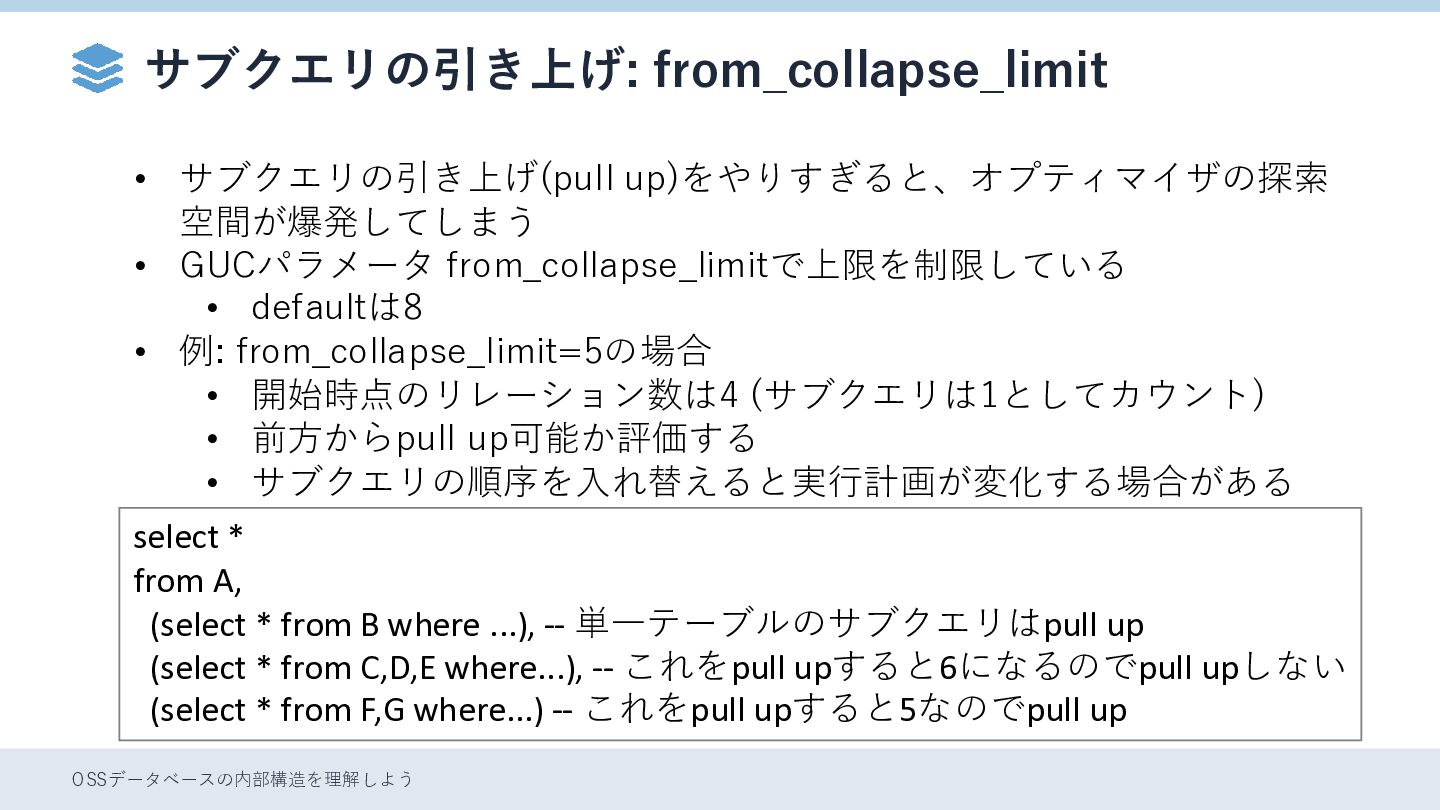
  16. サブクエリの引き上げ: from_collapse_limit • サブクエリの引き上げ(pull up)をやりすぎると、オプティマイザの探索 空間が爆発してしまう • GUCパラメータ from_collapse_limitで上限を制限している •

    defaultは8 • 例: from_collapse_limit=5の場合 • 開始時点のリレーション数は4 (サブクエリは1としてカウント) • 前方からpull up可能か評価する • サブクエリの順序を入れ替えると実行計画が変化する場合がある select * from A, (select * from B where ...), -- 単一テーブルのサブクエリはpull up (select * from C,D,E where...), -- これをpull upすると6になるのでpull upしない (select * from F,G where...) -- これをpull upすると5なのでpull up OSSデータベースの内部構造を理解しよう
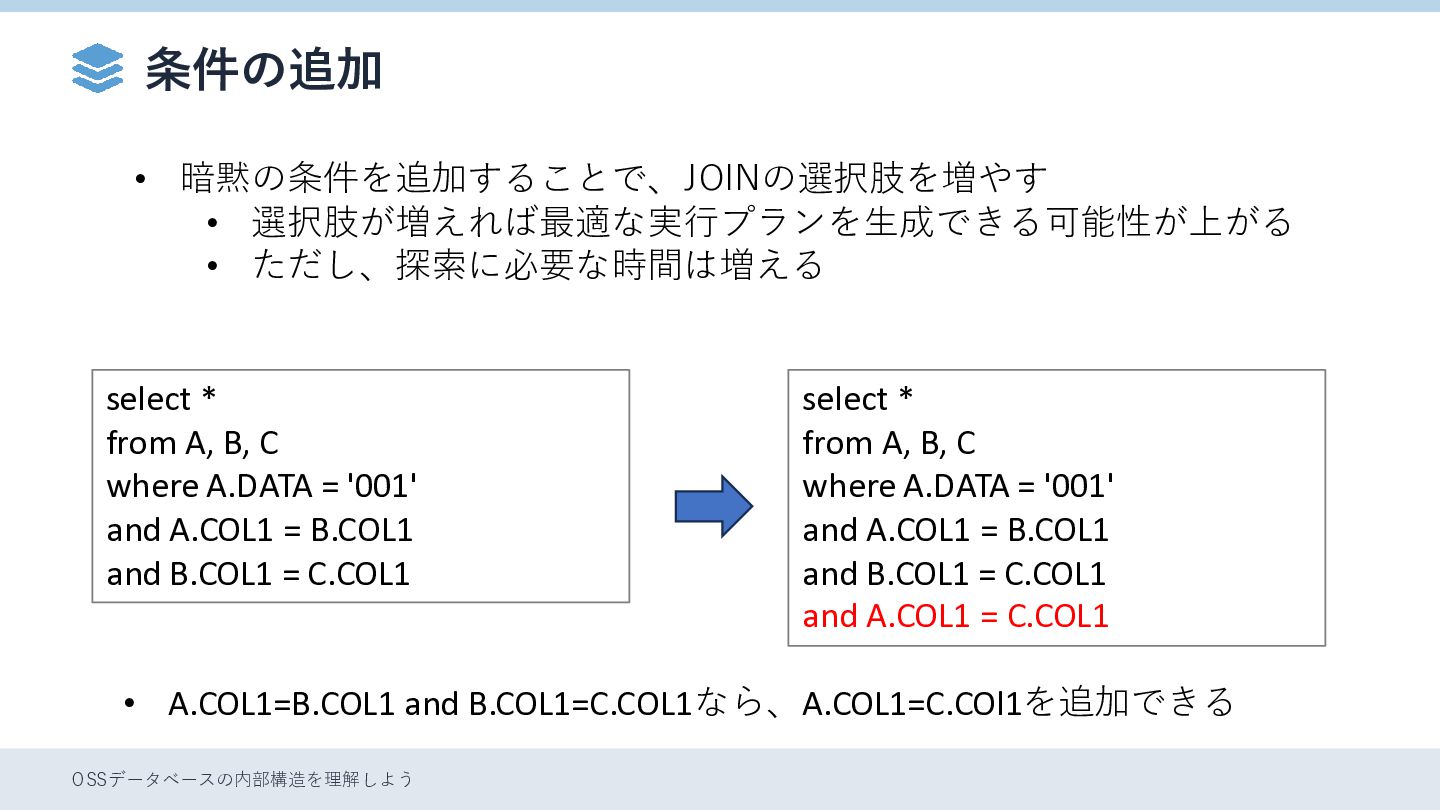
  17. 条件の追加 • 暗黙の条件を追加することで、JOINの選択肢を増やす • 選択肢が増えれば最適な実行プランを生成できる可能性が上がる • ただし、探索に必要な時間は増える select * from

    A, B, C where A.DATA = '001' and A.COL1 = B.COL1 and B.COL1 = C.COL1 select * from A, B, C where A.DATA = '001' and A.COL1 = B.COL1 and B.COL1 = C.COL1 and A.COL1 = C.COL1 • A.COL1=B.COL1 and B.COL1=C.COL1なら、A.COL1=C.COl1を追加できる OSSデータベースの内部構造を理解しよう
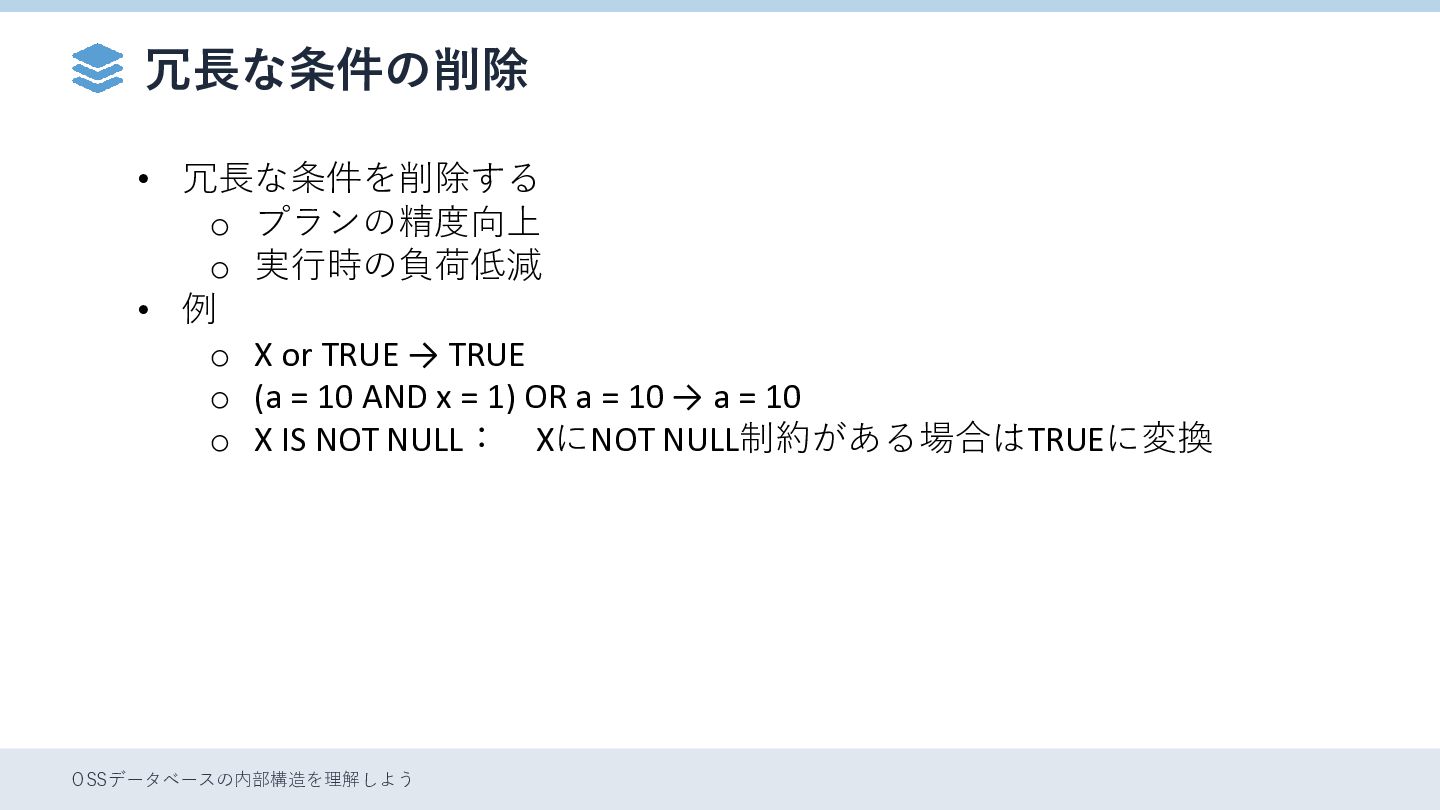
  18. 冗長な条件の削除 • 冗長な条件を削除する o プランの精度向上 o 実行時の負荷低減 • 例 o

    X or TRUE → TRUE o (a = 10 AND x = 1) OR a = 10 → a = 10 o X IS NOT NULL: XにNOT NULL制約がある場合はTRUEに変換 OSSデータベースの内部構造を理解しよう
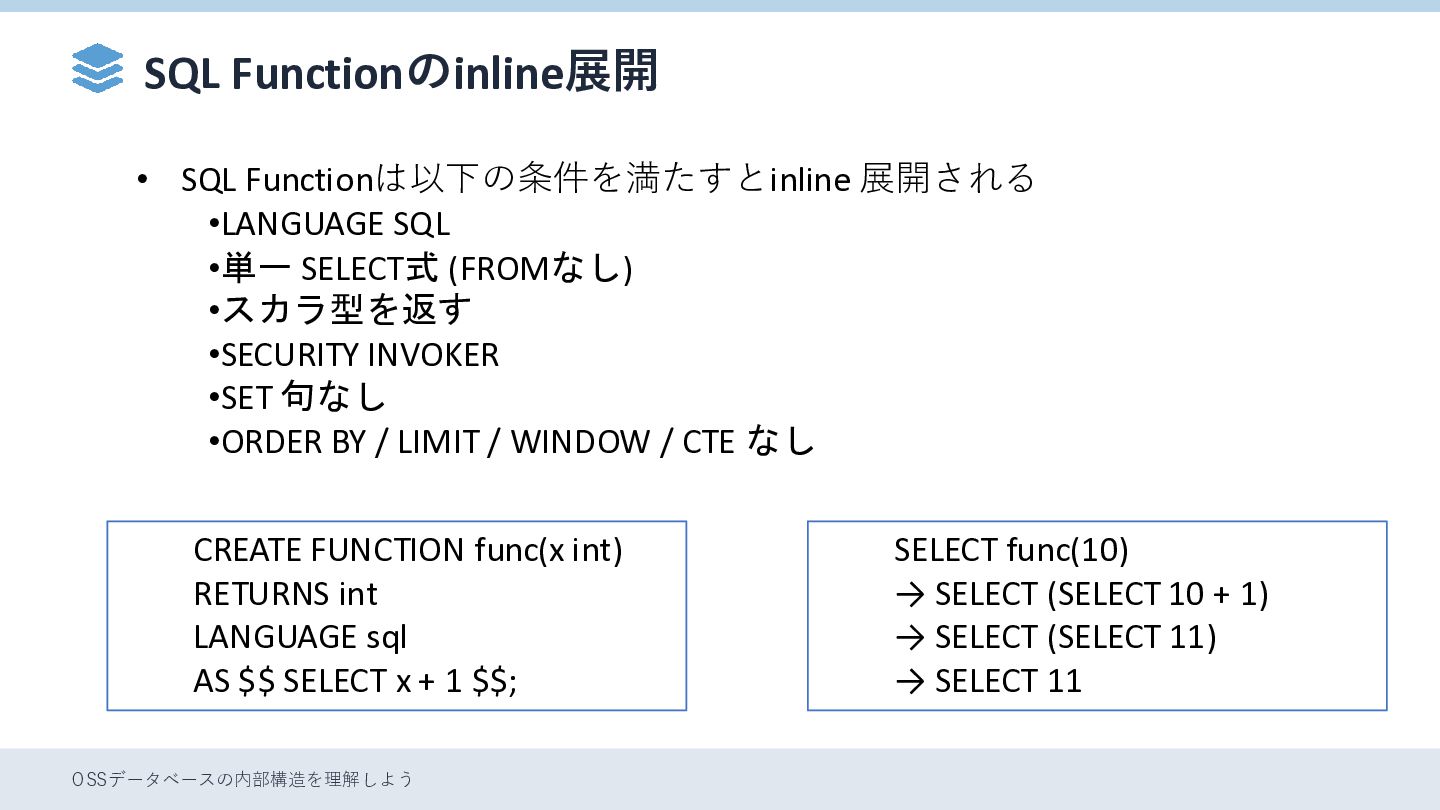
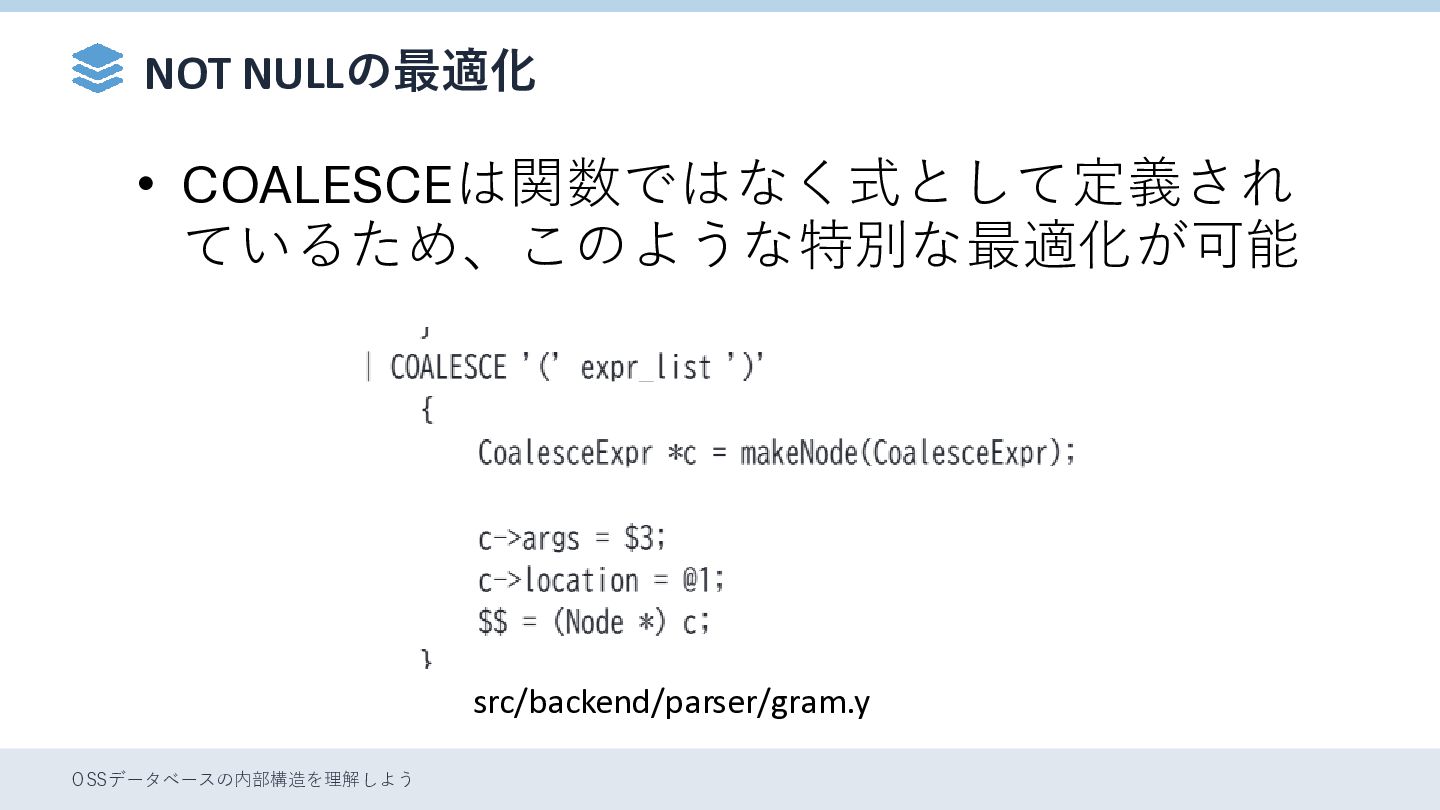
  19. SQL Functionのinline展開 • SQL Functionは以下の条件を満たすとinline 展開される •LANGUAGE SQL •単一 SELECT式

    (FROMなし) •スカラ型を返す •SECURITY INVOKER •SET 句なし •ORDER BY / LIMIT / WINDOW / CTE なし CREATE FUNCTION func(x int) RETURNS int LANGUAGE sql AS $$ SELECT x + 1 $$; OSSデータベースの内部構造を理解しよう SELECT func(10) → SELECT (SELECT 10 + 1) → SELECT (SELECT 11) → SELECT 11
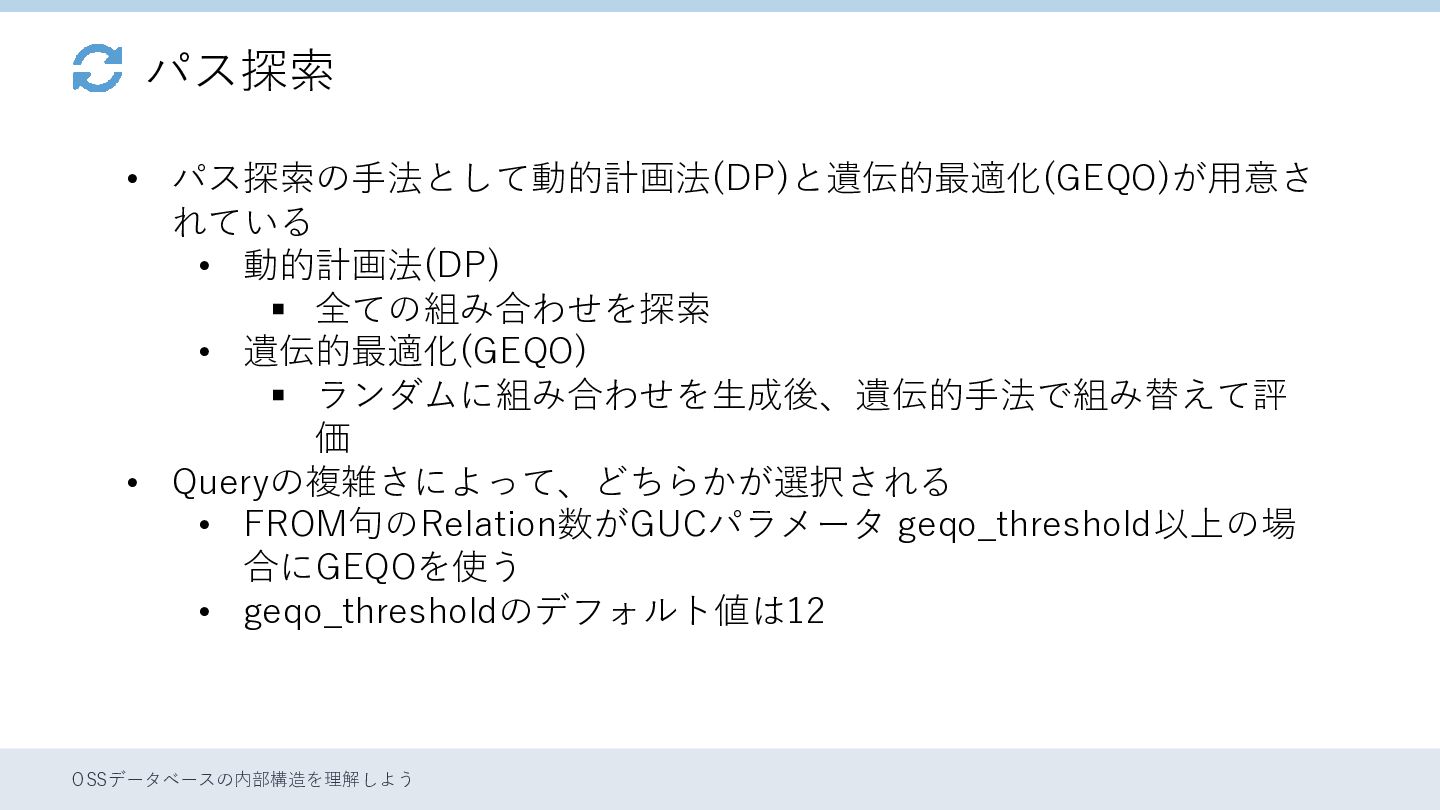
  20. パス探索 • パス探索の手法として動的計画法(DP)と遺伝的最適化(GEQO)が用意さ れている • 動的計画法(DP) ▪ 全ての組み合わせを探索 • 遺伝的最適化(GEQO)

    ▪ ランダムに組み合わせを生成後、遺伝的手法で組み替えて評 価 • Queryの複雑さによって、どちらかが選択される • FROM句のRelation数がGUCパラメータ geqo_threshold以上の場 合にGEQOを使う • geqo_thresholdのデフォルト値は12 OSSデータベースの内部構造を理解しよう
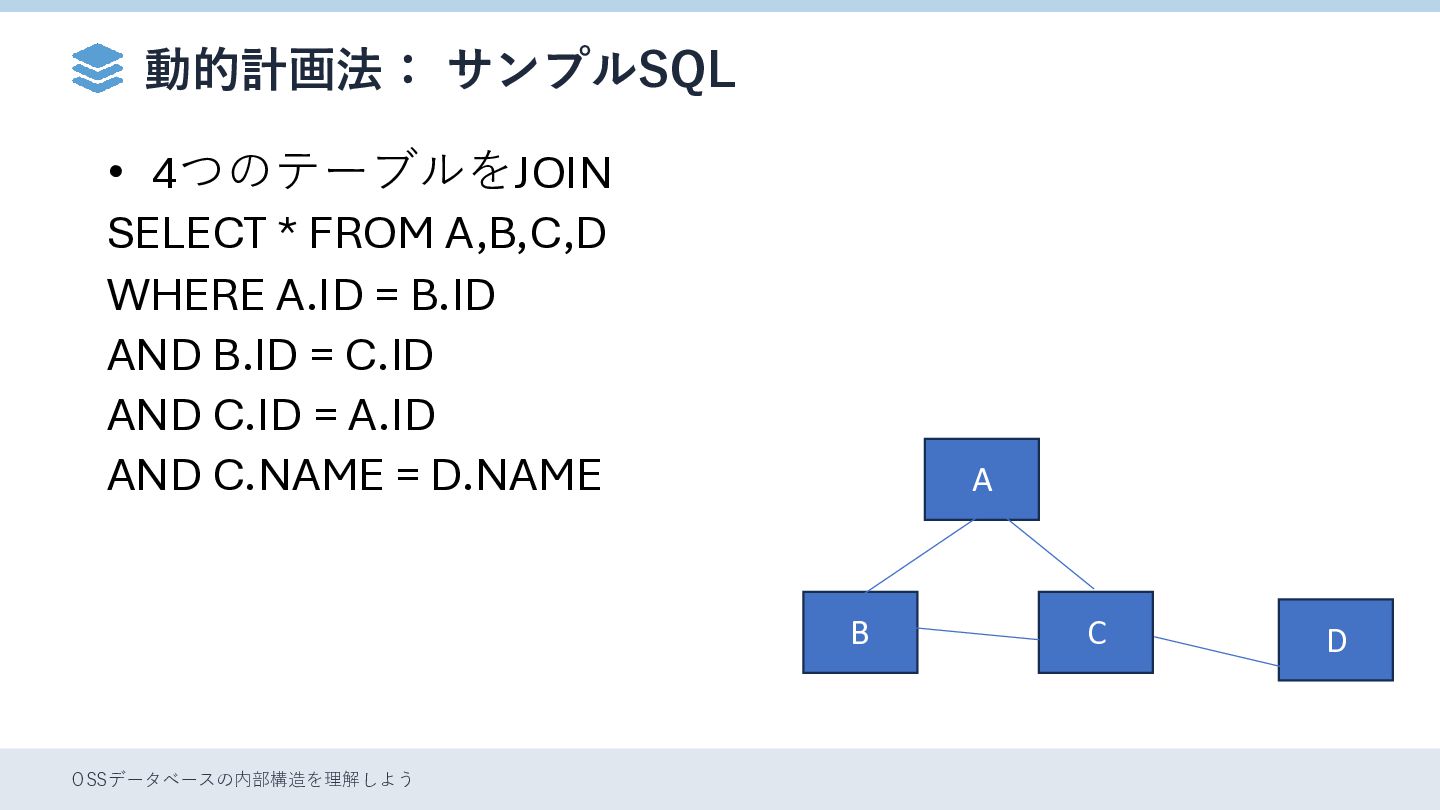
  21. 動的計画法: サンプルSQL • 4つのテーブルをJOIN SELECT * FROM A,B,C,D WHERE A.ID

    = B.ID AND B.ID = C.ID AND C.ID = A.ID AND C.NAME = D.NAME A B OSSデータベースの内部構造を理解しよう C D
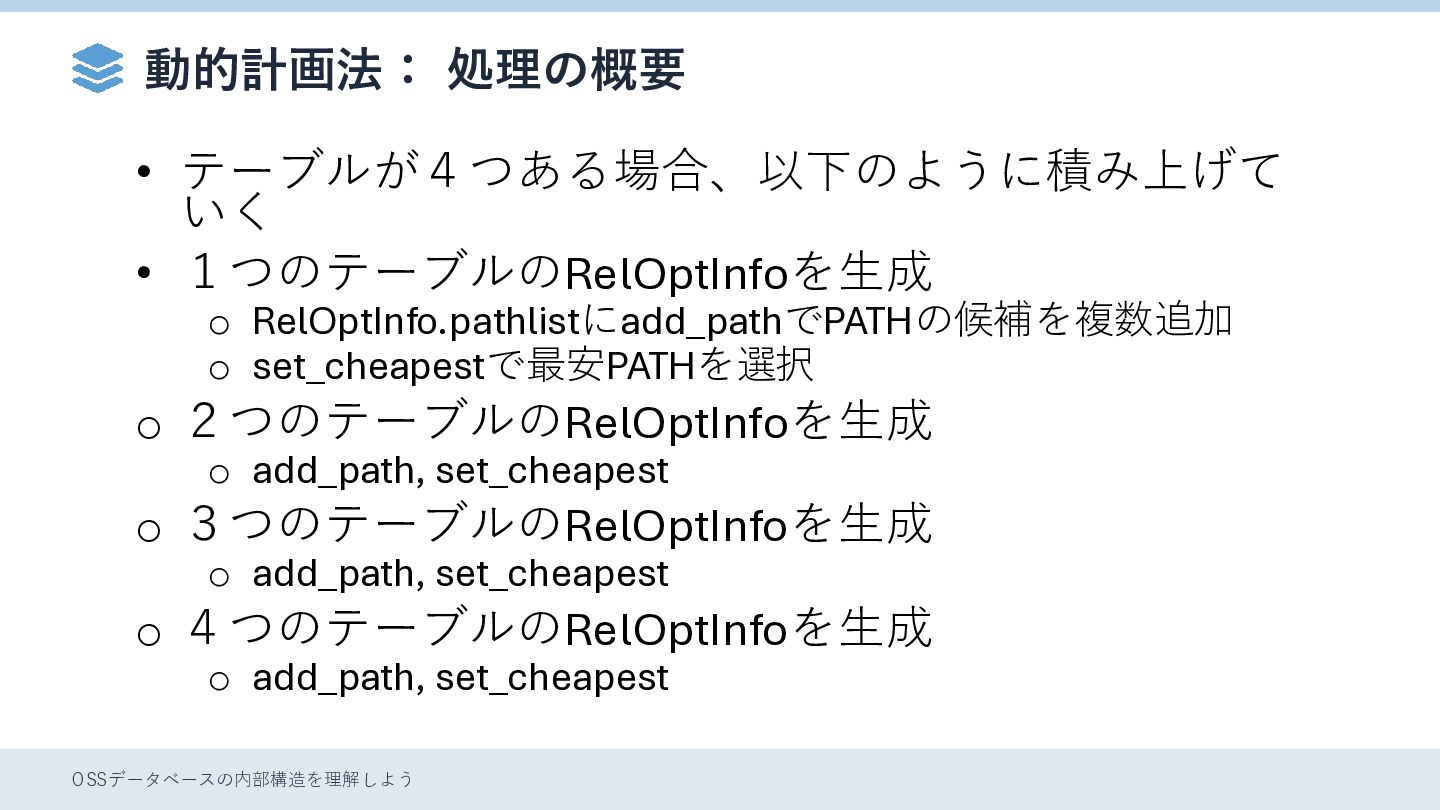
  22. 動的計画法: 処理の概要 • テーブルが4つある場合、以下のように積み上げて いく • 1つのテーブルのRelOptInfoを生成 o RelOptInfo.pathlistにadd_pathでPATHの候補を複数追加 o

    set_cheapestで最安PATHを選択 o 2つのテーブルのRelOptInfoを生成 o add_path, set_cheapest o 3つのテーブルのRelOptInfoを生成 o add_path, set_cheapest o 4つのテーブルのRelOptInfoを生成 o add_path, set_cheapest OSSデータベースの内部構造を理解しよう
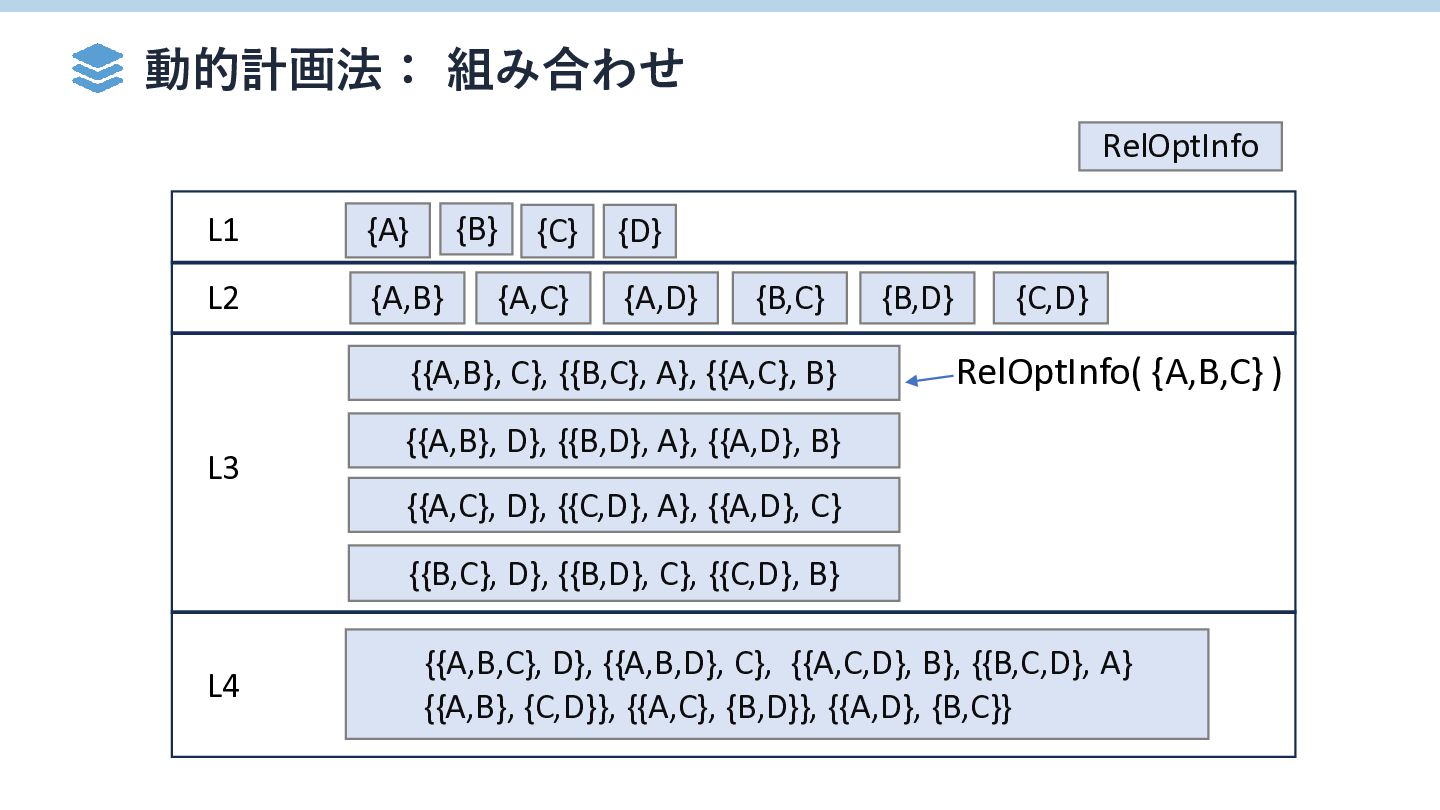
  23. 動的計画法: 組み合わせ RelOptInfo {B} L1 {A} L2 {A,B} {C} {D}

    {A,C} {A,D} {B,C} {{A,B}, C}, {{B,C}, A}, {{A,C}, B} L3 {B,D} {C,D} RelOptInfo( {A,B,C} ) {{A,B}, D}, {{B,D}, A}, {{A,D}, B} {{A,C}, D}, {{C,D}, A}, {{A,D}, C} {{B,C}, D}, {{B,D}, C}, {{C,D}, B} L4 {{A,B,C}, D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} {{A,B}, {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}}
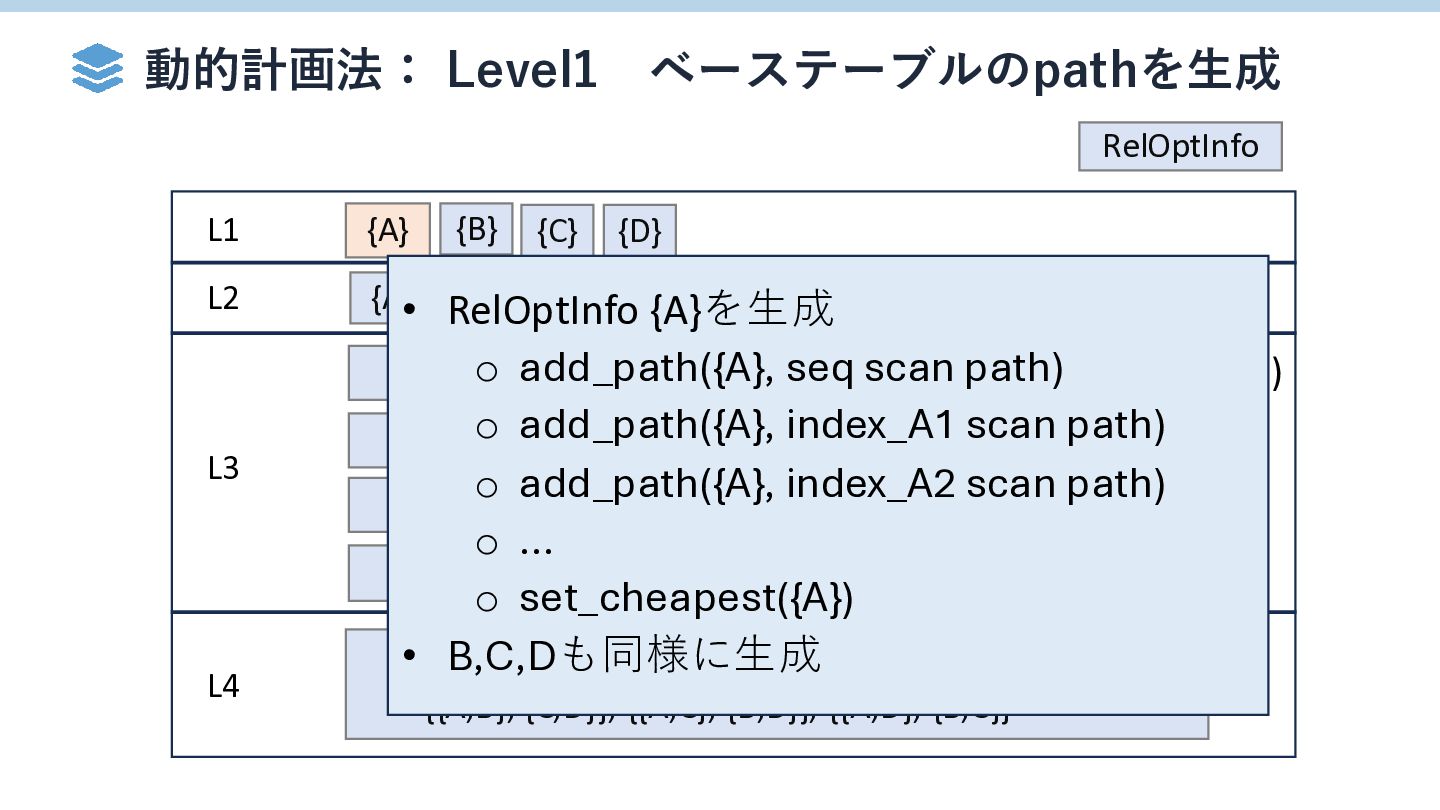
  24. 動的計画法: Level1 ベーステーブルのpathを生成 RelOptInfo {B} L1 {A} L2 {A,B} {A,C}

    {A,D} {B,C} • RelOptInfo {A}を生成 {C} {D} {B,D} {C,D} o C}, add_path({A}, path) {A,B,C} ) {{A,B}, {{B,C}, A}, {{A,C},seq B} scanRelOptInfo( L3 L4 o D}, add_path({A}, scan path) {{A,B}, {{B,D}, A}, {{A,D},index_A1 B} o add_path({A}, index_A2 scan path) o … {{B,C}, D}, {{B,D}, C}, {{C,D}, B} o set_cheapest({A}) • {{A,B,C}, B,C,Dも同様に生成 D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} {{A,C}, D}, {{C,D}, A}, {{A,D}, C} {{A,B}, {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}}
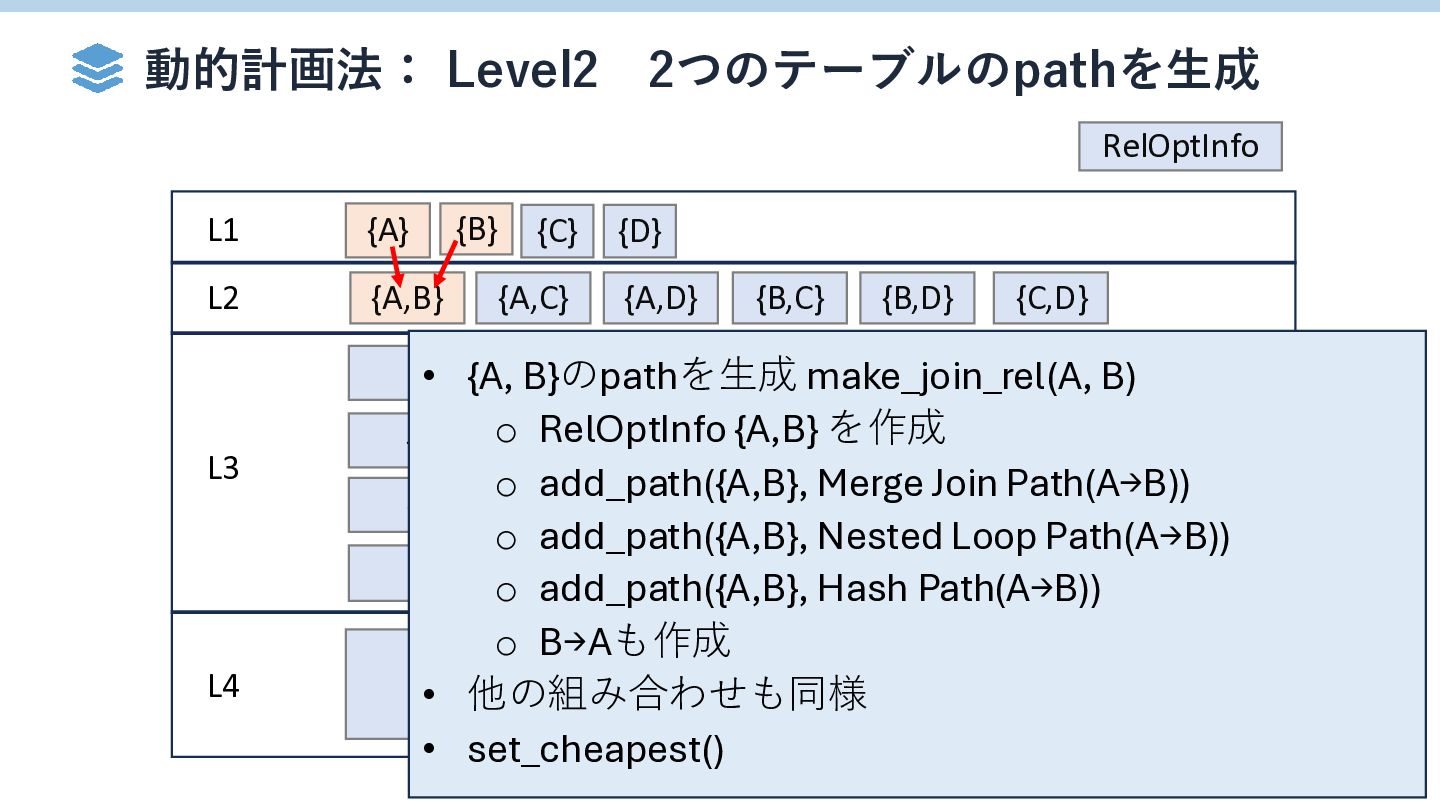
  25. 動的計画法: Level2 2つのテーブルのpathを生成 RelOptInfo {B} L1 {A} L2 {A,B} {C}

    {D} {A,C} {A,D} {B,C} {B,D} {C,D} RelOptInfo( {{A,B}, {{B,C}, A}, {{A,C}, B} • {A,C}, B}のpathを生成 make_join_rel(A, B) {A,B,C} ) L3 L4 {A,B}B}を作成 {{A,B},oD},RelOptInfo {{B,D}, A}, {{A,D}, o add_path({A,B}, Merge Join Path(A→B)) o add_path({A,B}, Nested Loop Path(A→B)) {{B,C},oD},add_path({A,B}, {{B,D}, C}, {{C,D}, B} Hash Path(A→B)) o B→Aも作成 {{A,B,C}, D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} •{{A,B}, 他の組み合わせも同様 {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}} • set_cheapest() {{A,C}, D}, {{C,D}, A}, {{A,D}, C}
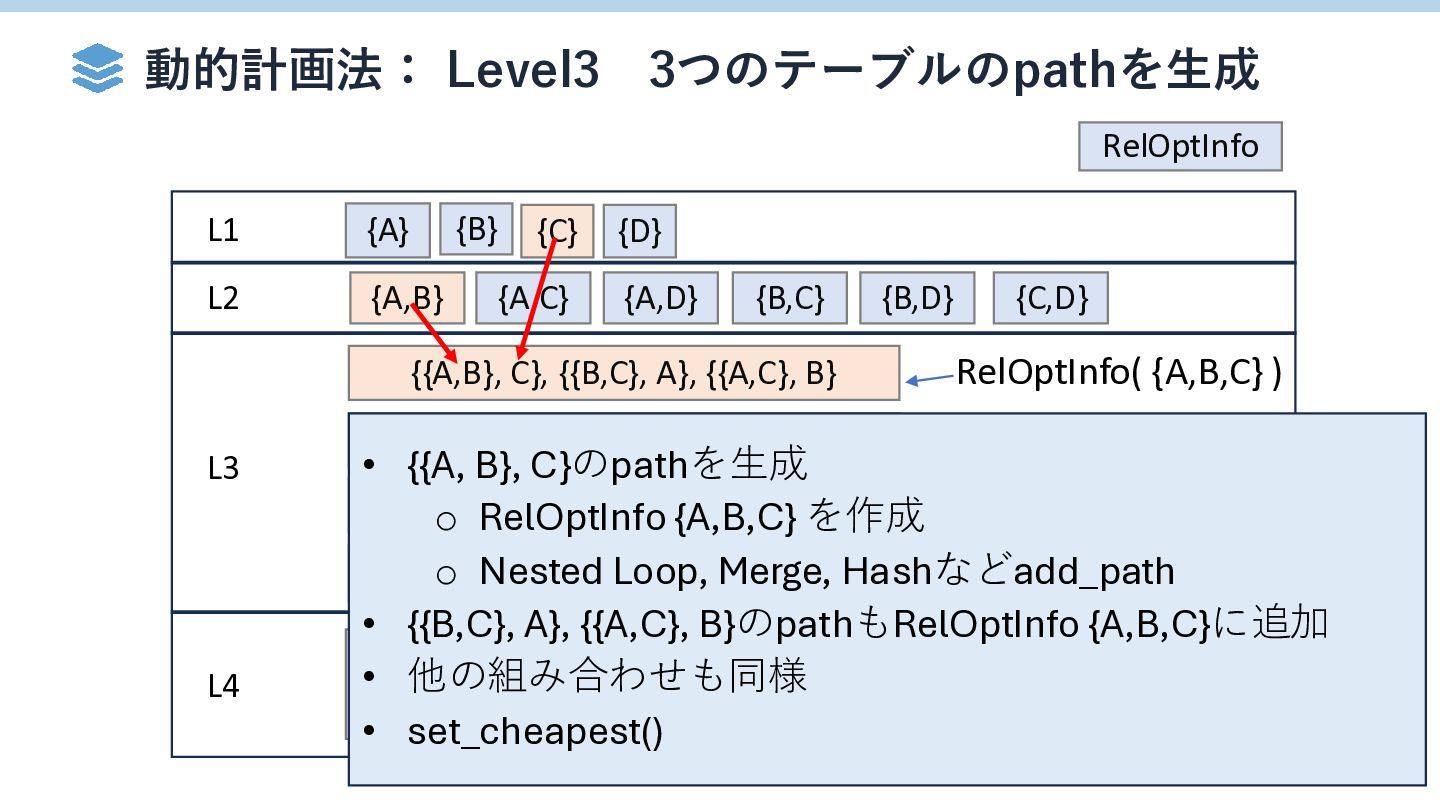
  26. 動的計画法: Level3 3つのテーブルのpathを生成 RelOptInfo {B} L1 {A} L2 {A,B} {C}

    {D} {A,C} {A,D} {B,C} {{A,B}, C}, {{B,C}, A}, {{A,C}, B} L3 L4 {{A,B}, D}, {{B,D}, A}, {{A,D}, B} {B,D} {C,D} RelOptInfo( {A,B,C} ) • {{A, B}, C}のpathを生成 {{A,C}, D}, {{C,D}, A}, {{A,D}, を作成 C} o RelOptInfo {A,B,C} o Nested Loop, Merge, {{B,C}, D}, {{B,D}, C}, {{C,D}, B} Hashなどadd_path • {{B,C}, A}, {{A,C}, B}のpathもRelOptInfo {A,B,C}に追加 {{A,B,C}, D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} • 他の組み合わせも同様 {{A,B}, {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}} • set_cheapest()
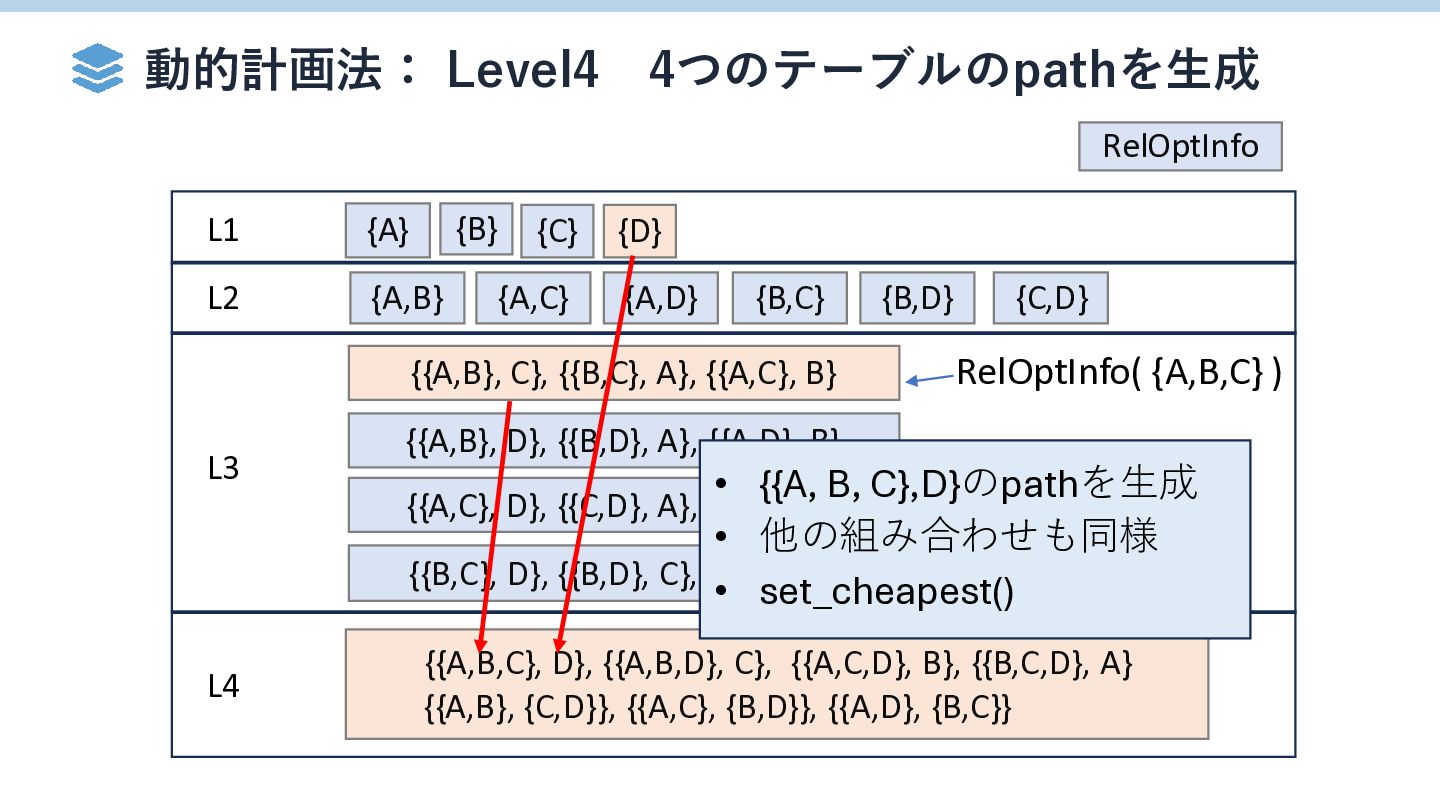
  27. 動的計画法: Level4 4つのテーブルのpathを生成 RelOptInfo {B} L1 {A} L2 {A,B} {C}

    {D} {A,C} {A,D} {B,C} {{A,B}, C}, {{B,C}, A}, {{A,C}, B} L3 L4 {B,D} {C,D} RelOptInfo( {A,B,C} ) {{A,B}, D}, {{B,D}, A}, {{A,D}, B} • {{A, B, C},D}のpathを生成 • 他の組み合わせも同様 {{B,C}, D}, {{B,D}, C}, {{C,D}, B} • set_cheapest() {{A,C}, D}, {{C,D}, A}, {{A,D}, C} {{A,B,C}, D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} {{A,B}, {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}}
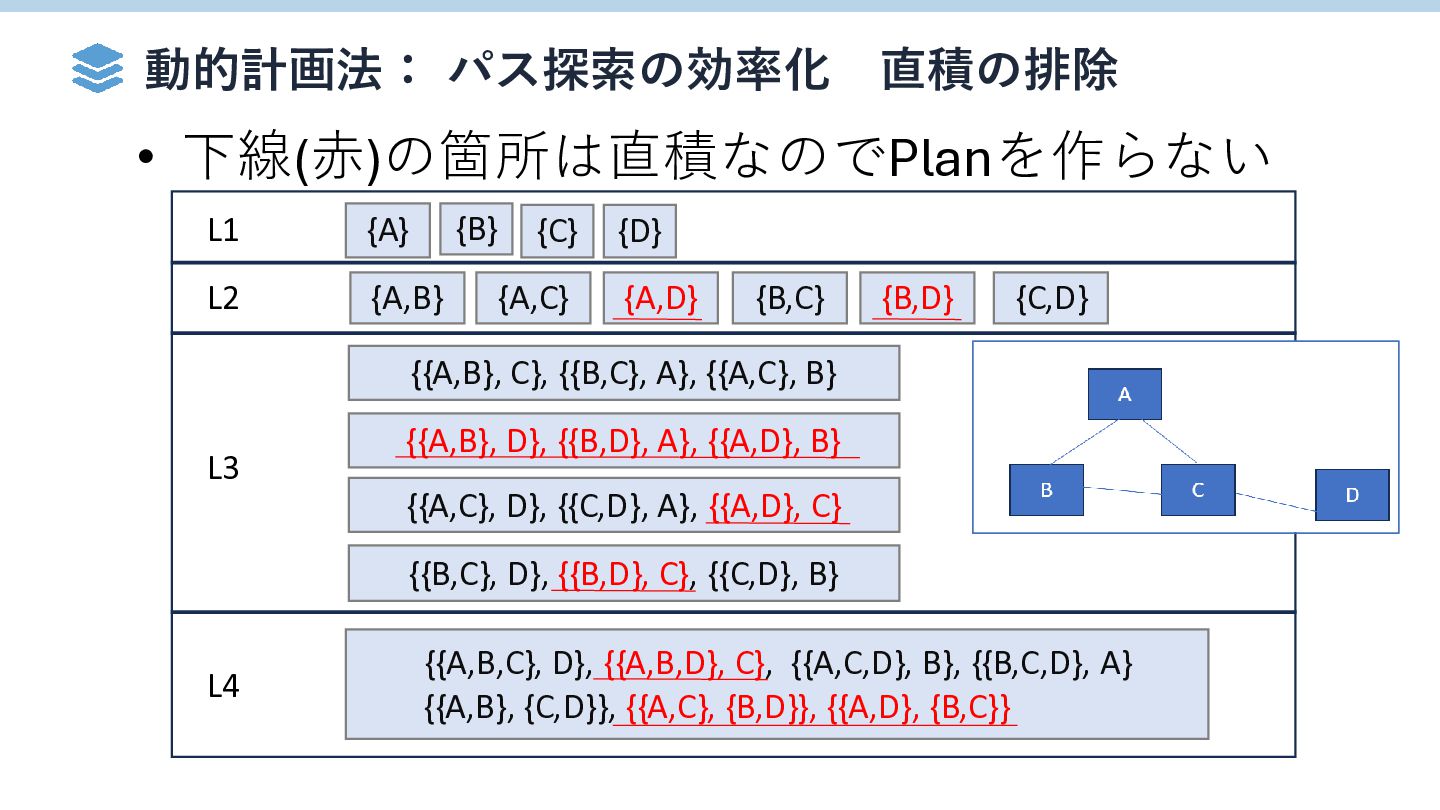
  28. 動的計画法: パス探索の効率化 直積の排除 • 下線(赤)の箇所は直積なのでPlanを作らない {B} L1 {A} L2 {A,B}

    {C} {D} {A,C} {A,D} {B,C} {B,D} {C,D} {{A,B}, C}, {{B,C}, A}, {{A,C}, B} L3 {{A,B}, D}, {{B,D}, A}, {{A,D}, B} {{A,C}, D}, {{C,D}, A}, {{A,D}, C} {{B,C}, D}, {{B,D}, C}, {{C,D}, B} L4 {{A,B,C}, D}, {{A,B,D}, C}, {{A,C,D}, B}, {{B,C,D}, A} {{A,B}, {C,D}}, {{A,C}, {B,D}}, {{A,D}, {B,C}}
  29. 動的計画法: パス探索の効率化 add_path • RelOptInfo.pathlistにpathを追加する o ただし無条件に追加するわけではない • pathlistの既存のpathと比較、負けた方は削除 o

    比較はコストだけでなく、pathkeys (デー タのソート状況)などの要素があり、1つで も勝っている箇所があればpathlistに登録す る OSSデータベースの内部構造を理解しよう
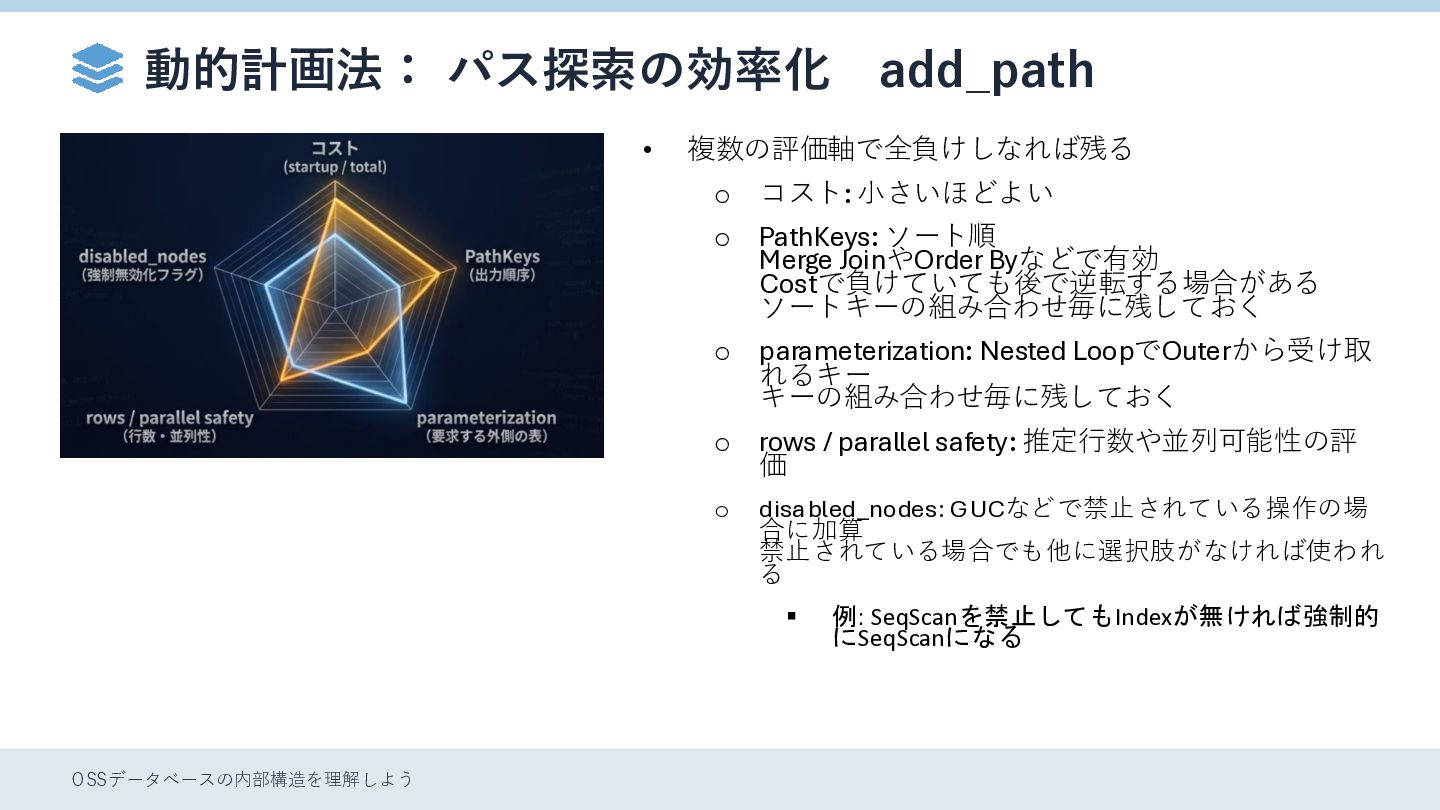
  30. 動的計画法: パス探索の効率化 add_path • 複数の評価軸で全負けしなれば残る o コスト: 小さいほどよい o PathKeys:

    ソート順 Merge JoinやOrder Byなどで有効 Costで負けていても後で逆転する場合がある ソートキーの組み合わせ毎に残しておく o parameterization: Nested LoopでOuterから受け取 れるキー キーの組み合わせ毎に残しておく o rows / parallel safety: 推定行数や並列可能性の評 価 o disabled_nodes: GUCなどで禁止されている操作の場 合に加算 禁止されている場合でも他に選択肢がなければ使われ る ▪ OSSデータベースの内部構造を理解しよう 例: SeqScanを禁止してもIndexが無ければ強制的 にSeqScanになる
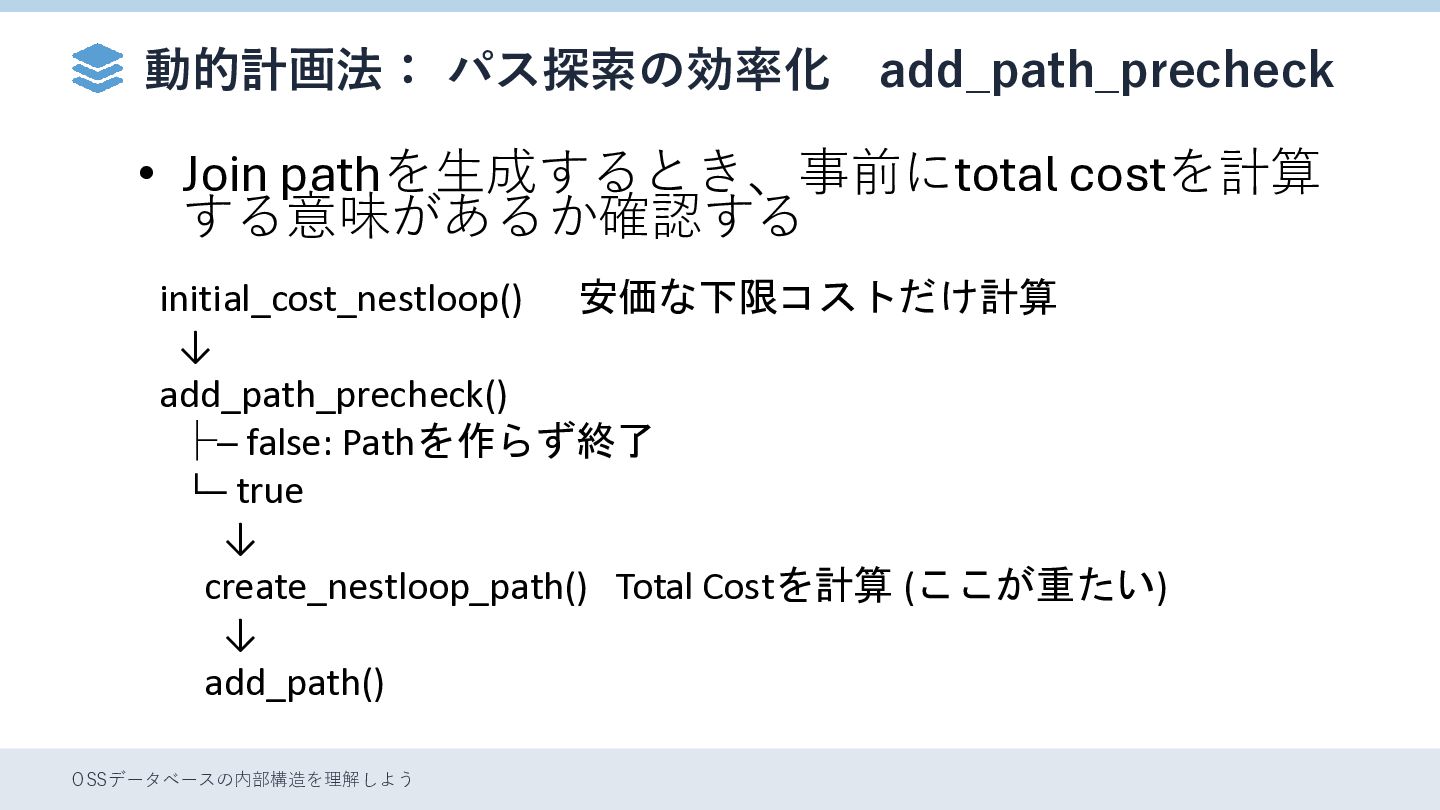
  31. 動的計画法: パス探索の効率化 add_path_precheck • Join pathを生成するとき、事前にtotal costを計算 する意味があるか確認する initial_cost_nestloop() 安価な下限コストだけ計算

    ↓ add_path_precheck() ├─ false: Pathを作らず終了 └─ true ↓ create_nestloop_path() Total Costを計算 (ここが重たい) ↓ add_path() OSSデータベースの内部構造を理解しよう
  32. 動的計画法: パス探索の効率化 set_cheapest • pathlist中の最安PATHをマークして、後続のPATH選択を効率よく実行で きるようにする (最安PATHは3種類ある) • cheapest_startup_path •

    最初の1行を返すまでのコスト(startup cost)が最も小さい Path • Nested Loop Join の inner 側などで早期に結果が欲しい場合に重視 • cheapest_total_path • 全行を取り切るまでの総コスト(total cost)が最も小さい Path • 全件取得や Hash Join の outer/inner 側などで選択 • cheapest_parameterized_paths • パラメータの組み合わせごとに、最も安価な候補を保持するリス ト • Nested Loopでinner側の候補として探索される OSSデータベースの内部構造を理解しよう
  33. GEQO: 遺伝的最適化 • リレーションが多くなるほど、動的計画法の処理時間が長くな る o リレーションがn個の場合、処理時間が指数関数的に増大 ▪ 動的計画法の計算量はO(2^n)〜O(3^n) o

    動的計画法によるプラン生成時間が爆発しないようにGE QOが用意されている o GEQOはランダムにJOIN順序を生成 ▪ 完全にランダムではないが望ましい実行計画がつくられ る保証がない ▪ 詳細はappendixを参照 o いかにしてGEQOを発火させないようにするかが重要 OSSデータベースの内部構造を理解しよう
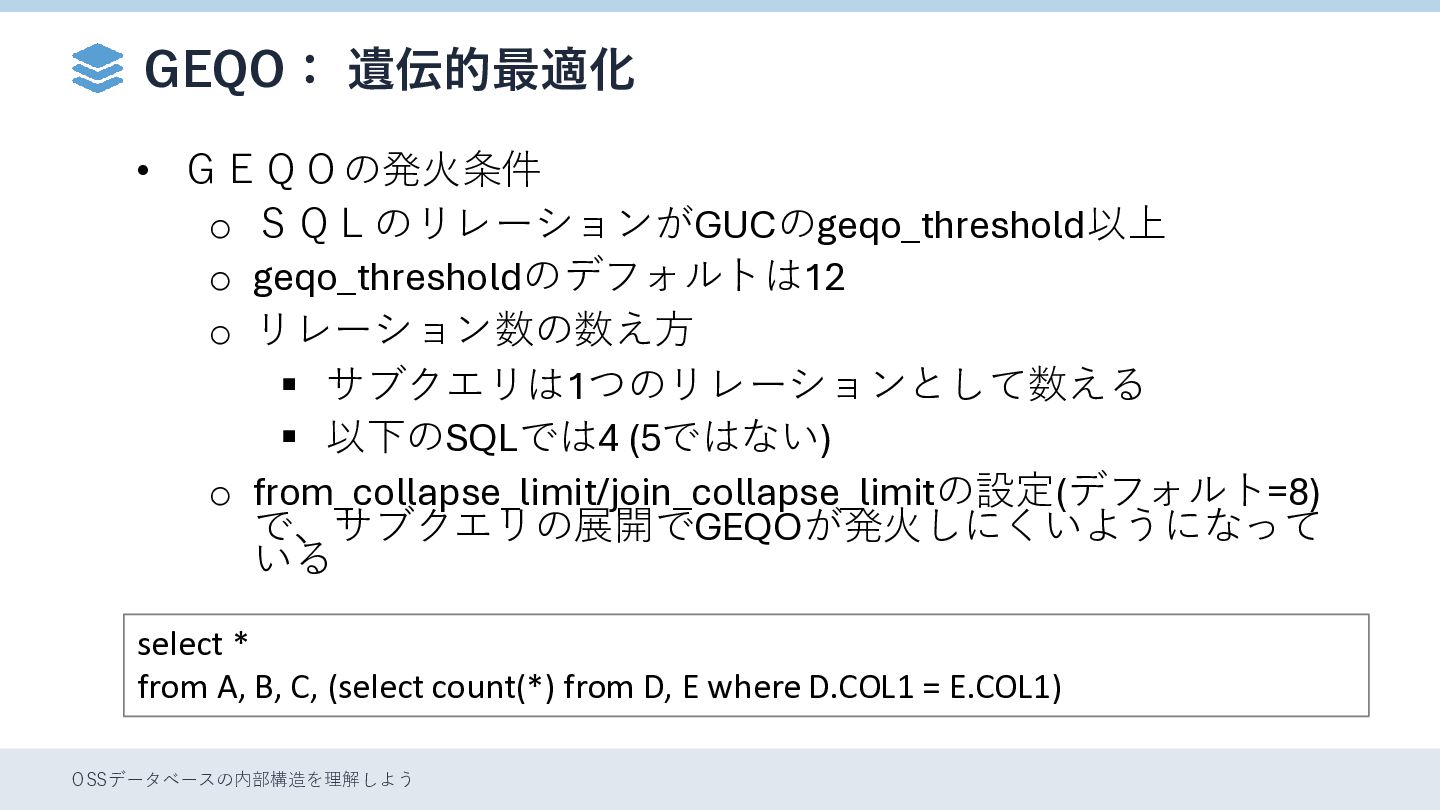
  34. GEQO: 遺伝的最適化 • GEQOの発火条件 o SQLのリレーションがGUCのgeqo_threshold以上 o geqo_thresholdのデフォルトは12 o リレーション数の数え方

    ▪ サブクエリは1つのリレーションとして数える ▪ 以下のSQLでは4 (5ではない) o from_collapse_limit/join_collapse_limitの設定(デフォルト=8) で、サブクエリの展開でGEQOが発火しにくいようになって いる select * from A, B, C, (select count(*) from D, E where D.COL1 = E.COL1) OSSデータベースの内部構造を理解しよう
  35. 後処理 • ORDER BY, GROUP BY などの処理を追加 o ここでPATHのコストが逆転する場合もある •

    最安PATHを選択 • PATHをPLANに変換 • 選択した最安PATHをExecutorが実行可能なPLANに変換 o PATHのTree構造とPLANのTree構造はほとんど同じ o PLANにはExecutorで必要な情報がセットされる OSSデータベースの内部構造を理解しよう
  36. コスト計算のために必要な情報 • CPUやストレージのコスト o GUCパラメータで設定 • テーブル、INDEXの構造 o システムカタログから取得 •

    統計情報 o テーブルのレコード数 o データの分布 : MCV/ヒストグラム/n_distinct o 平均データサイズ • 統計情報 → 選択度の推定 → コスト計算 OSSデータベースの内部構造を理解しよう
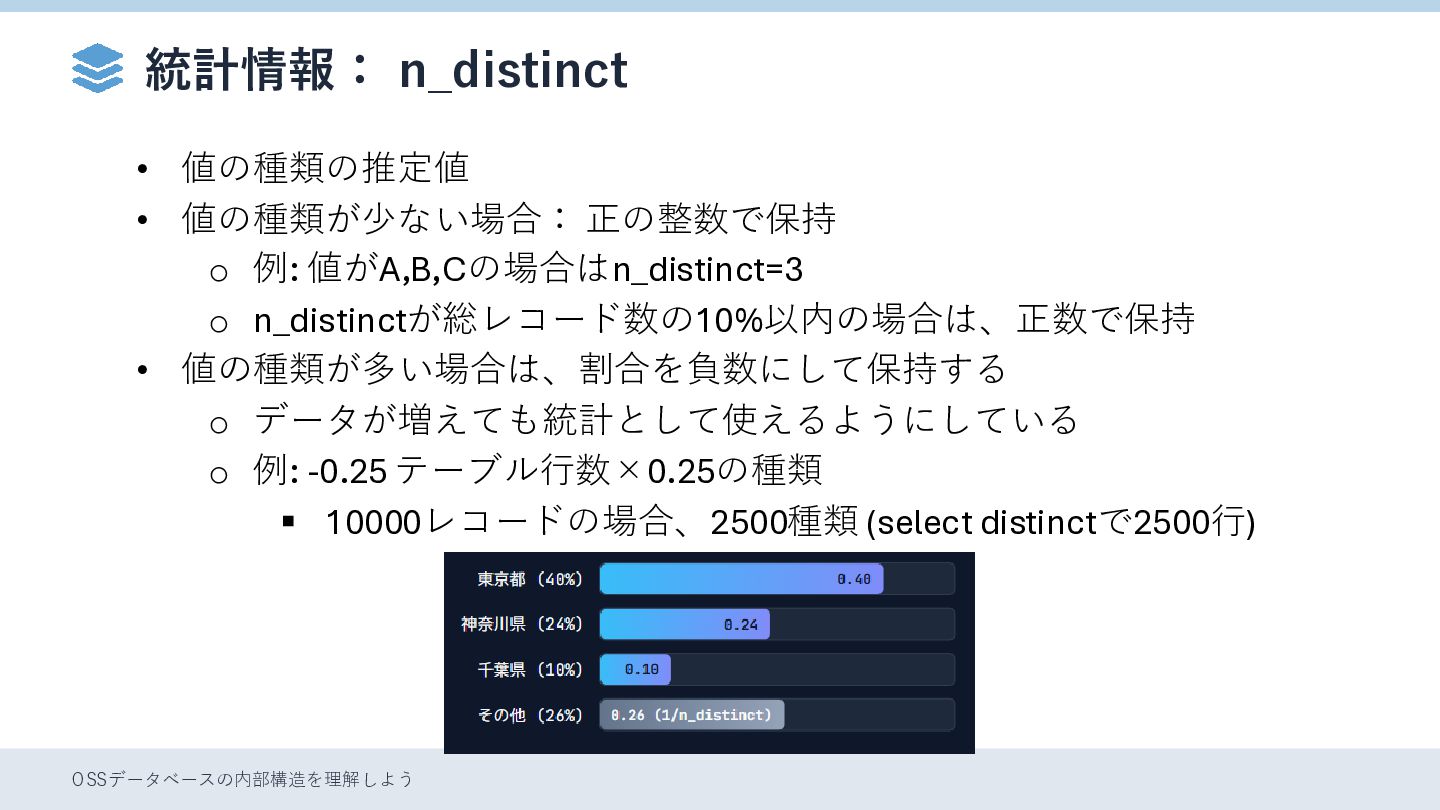
  37. 統計情報: n_distinct • 値の種類の推定値 • 値の種類が少ない場合: 正の整数で保持 o 例: 値がA,B,Cの場合はn_distinct=3

    o n_distinctが総レコード数の10%以内の場合は、正数で保持 • 値の種類が多い場合は、割合を負数にして保持する o データが増えても統計として使えるようにしている o 例: -0.25 テーブル行数×0.25の種類 ▪ 10000レコードの場合、2500種類 (select distinctで2500行) OSSデータベースの内部構造を理解しよう
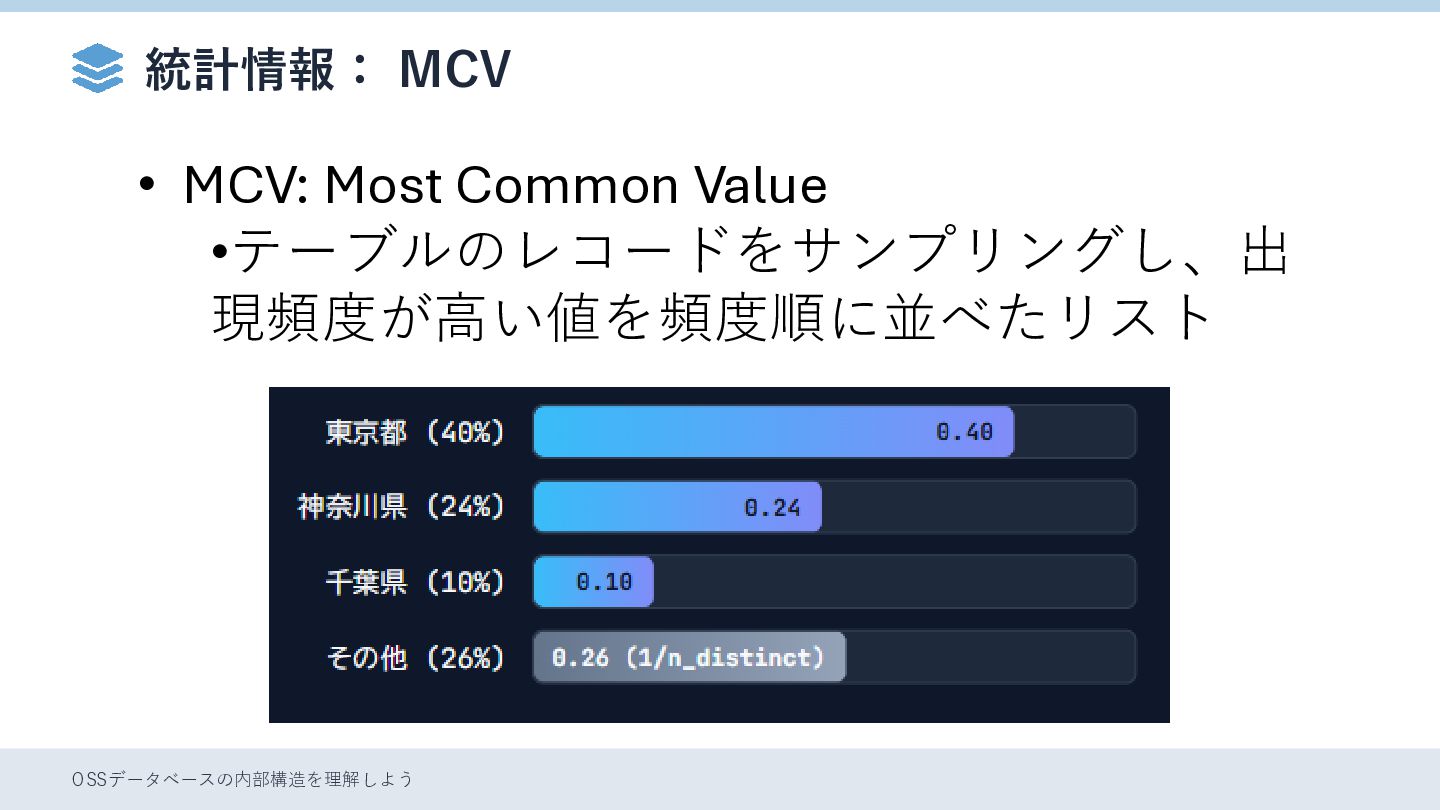
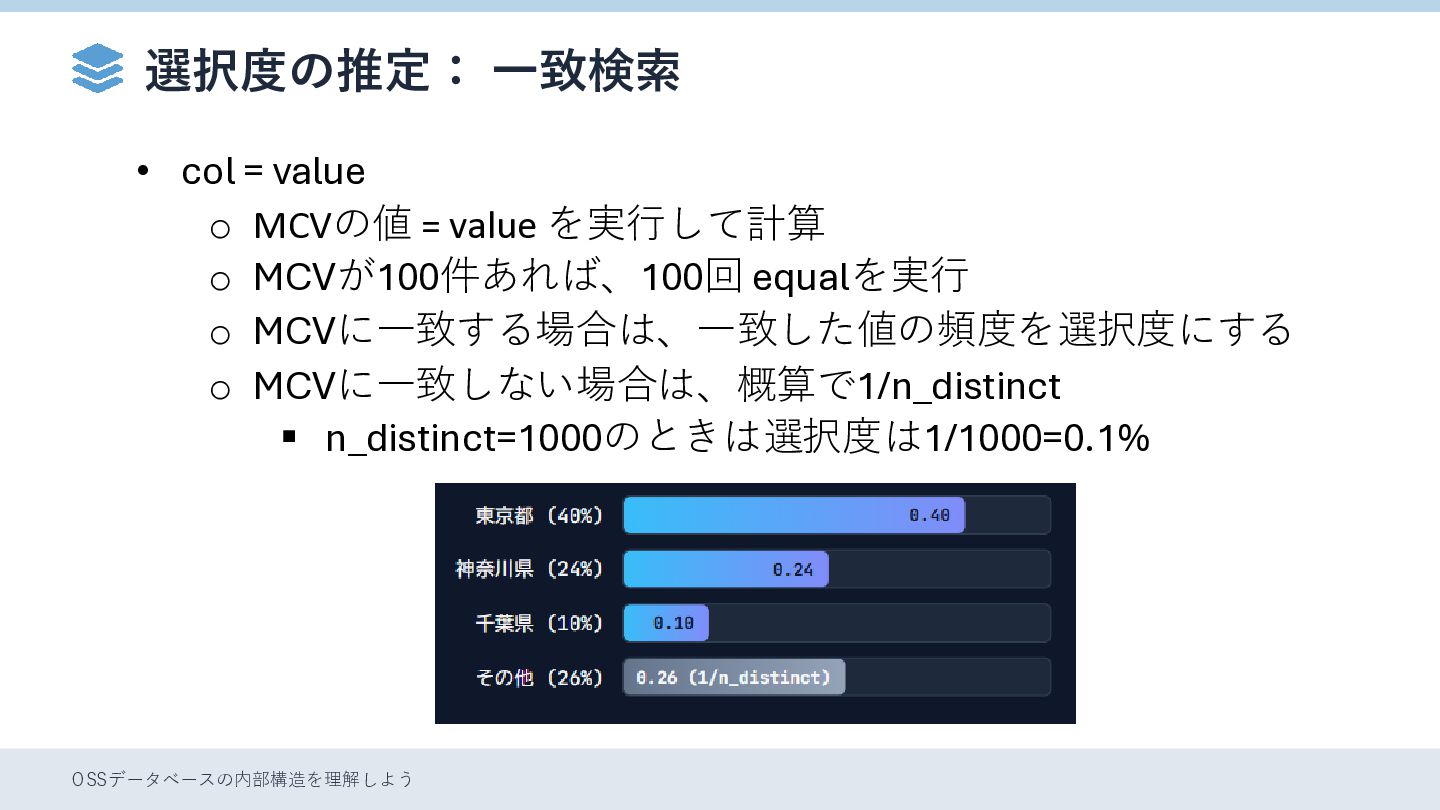
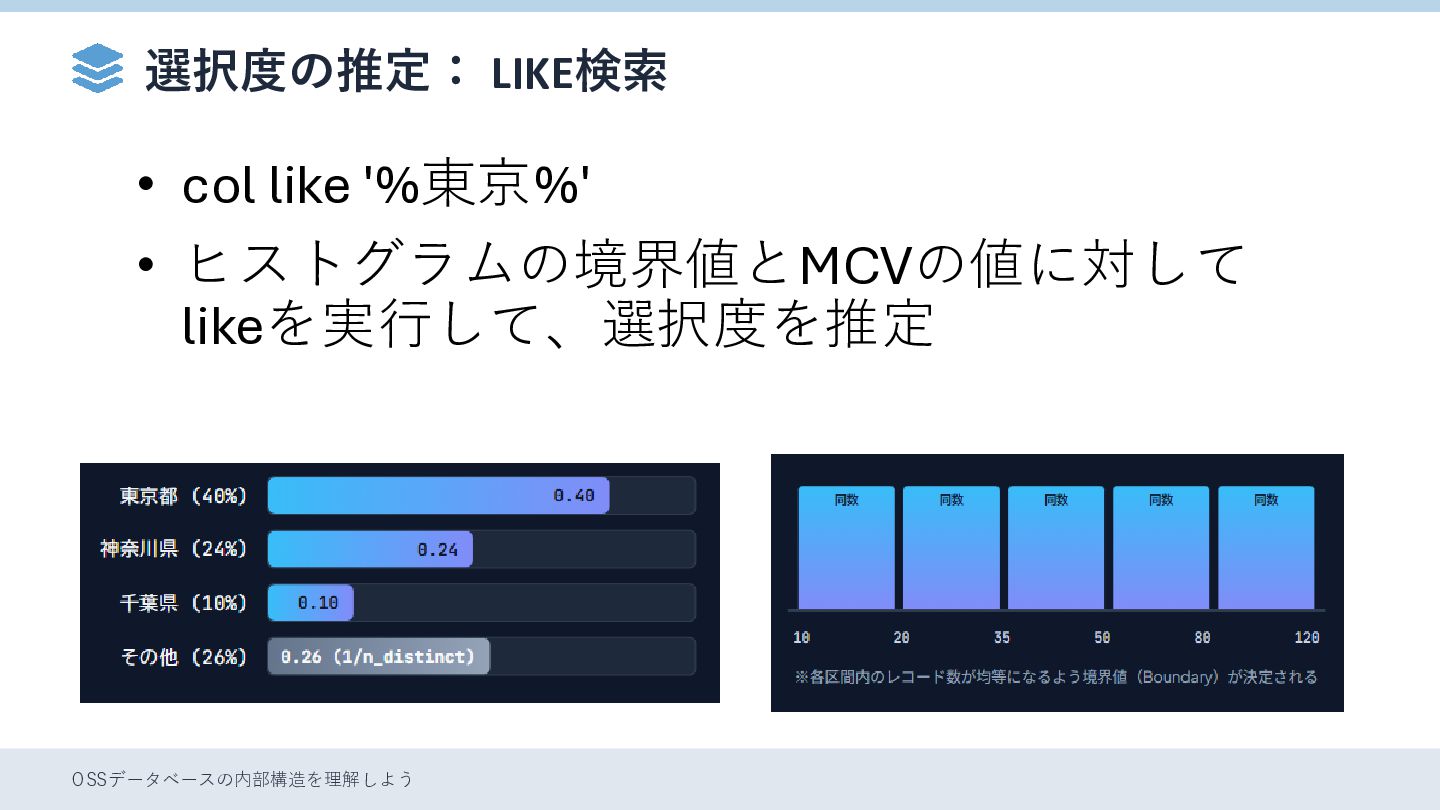
  38. 選択度の推定: 一致検索 • col = value o MCVの値 = value

    を実行して計算 o MCVが100件あれば、100回 equalを実行 o MCVに一致する場合は、一致した値の頻度を選択度にする o MCVに一致しない場合は、概算で1/n_distinct ▪ n_distinct=1000のときは選択度は1/1000=0.1% OSSデータベースの内部構造を理解しよう
  39. 選択度の推定: JOIN • a.col = b.col • aとbのMCV同士のequalを実施 o 2重ループで実行するため、MCVが多いと計算時

    間が増大 o aとbのMCVが100ずつある場合、100×100=10000 回equalを実行 • 非MCVの選択度を加算する (以下は概算の式) o 1/max(outer_n_distinct, inner_n_distinct) o n_distinctが大きいとヒット率は低いはずと計算 OSSデータベースの内部構造を理解しよう
  40. 選択度の推定: JOINの選択度 (PostgreSQL 19 beta3) • PostgreSQL 19 (beta3)ではJOINの選択度計算にHASHを使った方 式が追加

    • 2つのリレーションのMCVの合計が200以上の場合はHASH方式に なる o Hash計算が可能なデータ型のみサポート ▪ Hash可能: 数字、文字列、時刻など ▪ Hash不可: JSONなど o 200より小さい場合は、これまでと同様の2重ループ o 計算量 (n, m: 各リレーションのMCV件数) ▪ 2重ループ: O(n*m) ▪ HASH: O(n+m) OSSデータベースの内部構造を理解しよう
  41. コスト計算 • オプティマイザは推定行数をたよりにコストを計 算 o 推定行数=レコード数×選択度 o コスト= 推定行数×CPUコスト +

    推定ページ数×I/Oコスト • PATHの種類ごとに計算式がある o 実装はcostsize.c o cost_seqscan(), cost_nestloop()など • 計算式を詳しく理解するよりは、動作の仕組みや コスト決定の主要因を知ることが大切 OSSデータベースの内部構造を理解しよう
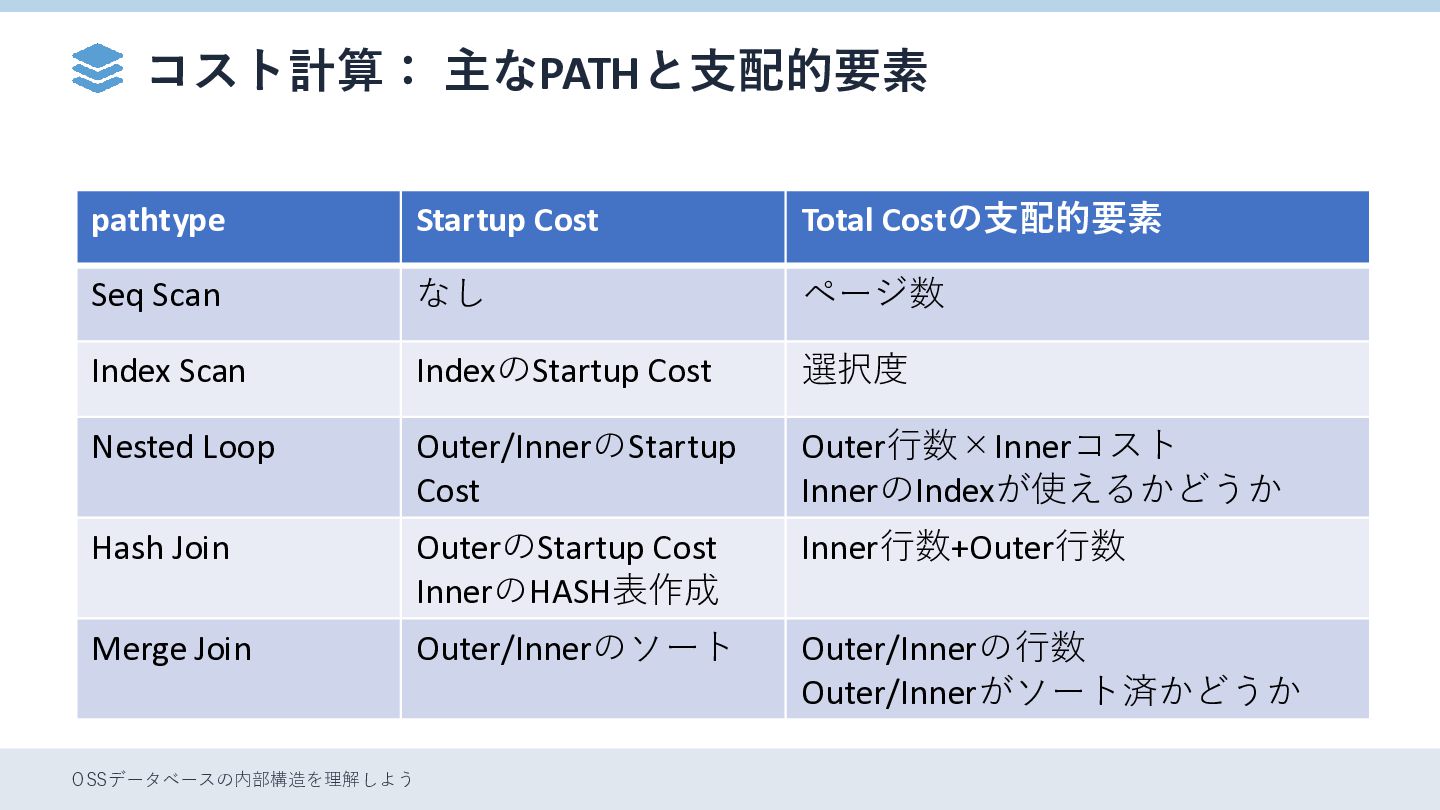
  42. コスト計算: 主なPATHと支配的要素 pathtype Startup Cost Total Costの支配的要素 Seq Scan なし

    ページ数 Index Scan IndexのStartup Cost 選択度 Nested Loop Outer​/InnerのStartup Cost Outer行数×Innerコスト InnerのIndexが使えるかどうか Hash Join OuterのStartup Cost InnerのHASH表作成 Inner行数+Outer行数 Merge Join Outer/Innerのソート Outer/Innerの行数 Outer/Innerがソート済かどうか OSSデータベースの内部構造を理解しよう
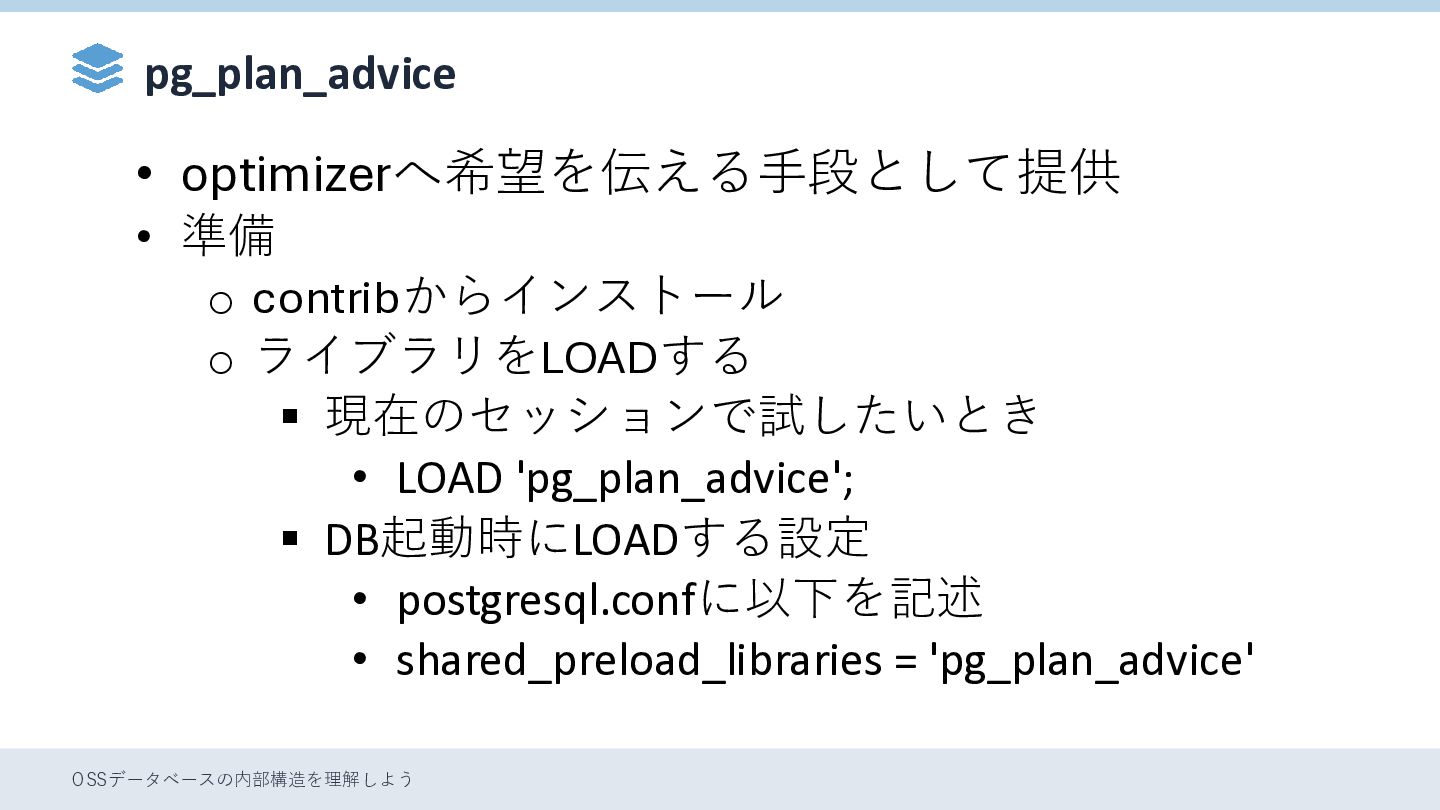
  43. pg_plan_advice • optimizerへ希望を伝える手段として提供 • 準備 o contribからインストール o ライブラリをLOADする ▪

    現在のセッションで試したいとき • LOAD 'pg_plan_advice'; ▪ DB起動時にLOADする設定 • postgresql.confに以下を記述 • shared_preload_libraries = 'pg_plan_advice' OSSデータベースの内部構造を理解しよう
  44. pg_plan_advice: 使い方 • 使い方 o adviceのセット ▪ SET pg_plan_advice.advice =

    '...'; o SQLを実行 o adviceのクリア ▪ RESET pg_plan_advice.advice; ▪ クリアしないと後続のSQLにも適用されて しまい、意図しない計画になってしまう OSSデータベースの内部構造を理解しよう
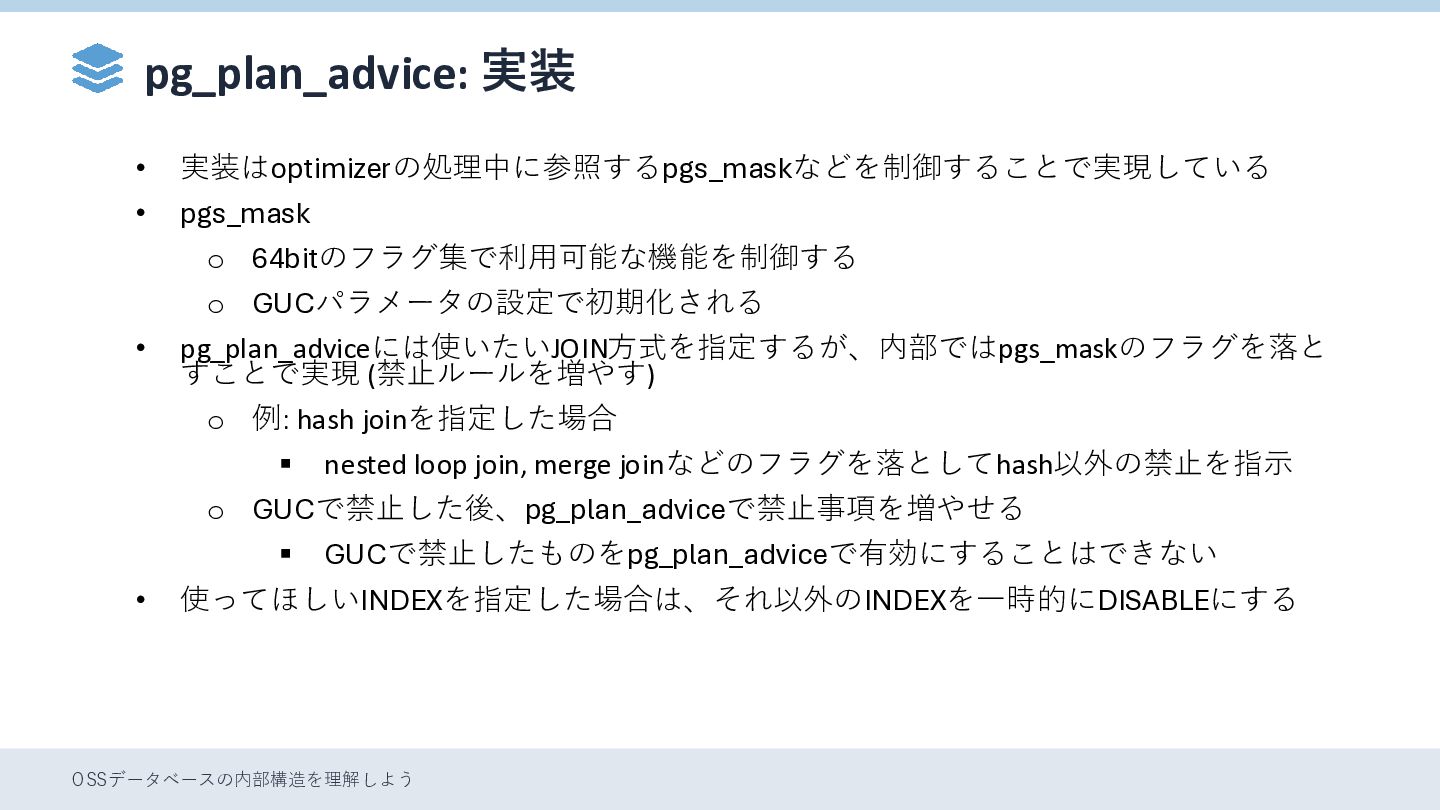
  45. pg_plan_advice: 実装 • • 実装はoptimizerの処理中に参照するpgs_maskなどを制御することで実現している pgs_mask o 64bitのフラグ集で利用可能な機能を制御する • o

    GUCパラメータの設定で初期化される pg_plan_adviceには使いたいJOIN方式を指定するが、内部ではpgs_maskのフラグを落と すことで実現 (禁止ルールを増やす) o 例: hash joinを指定した場合 ▪ nested loop join, merge joinなどのフラグを落としてhash以外の禁止を指示 o GUCで禁止した後、pg_plan_adviceで禁止事項を増やせる ▪ • GUCで禁止したものをpg_plan_adviceで有効にすることはできない 使ってほしいINDEXを指定した場合は、それ以外のINDEXを一時的にDISABLEにする OSSデータベースの内部構造を理解しよう
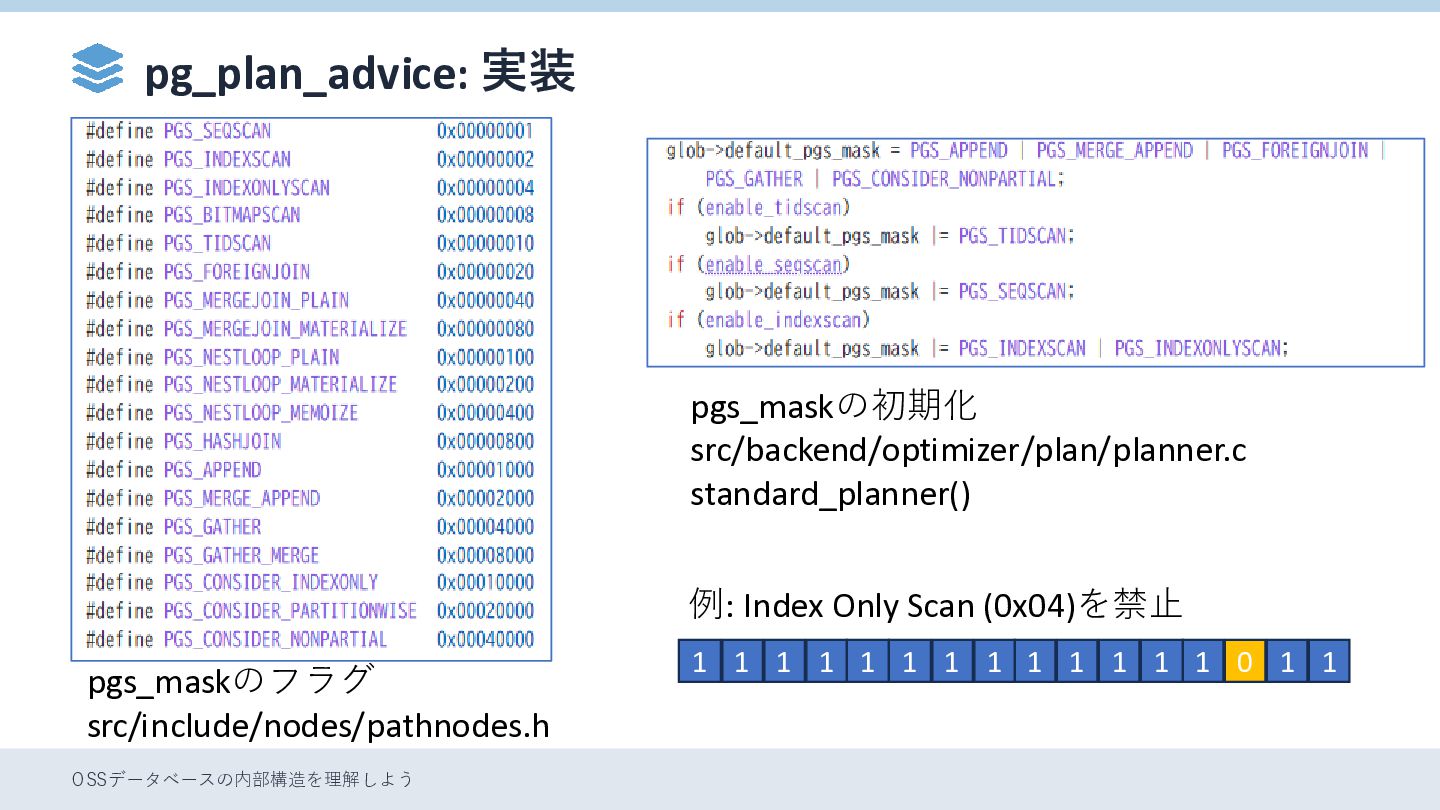
  46. pg_plan_advice: 実装 pgs_maskの初期化 src/backend/optimizer/plan/planner.c standard_planner() 例: Index Only Scan (0x04)を禁止

    pgs_maskのフラグ src/include/nodes/pathnodes.h OSSデータベースの内部構造を理解しよう 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1
  47. pg_plan_advice: 実装 • GUCやpgs_maskで禁止した場合でも、特定の PATHは生成される o Seq Scanを禁止してもIndexがなければSeq Scanするしかないのでpath生成は実行される o

    禁止されているpathはdisabled_nodesメン バーを++する o disabled_nodesが小さいpathから優先的に選 択 OSSデータベースの内部構造を理解しよう
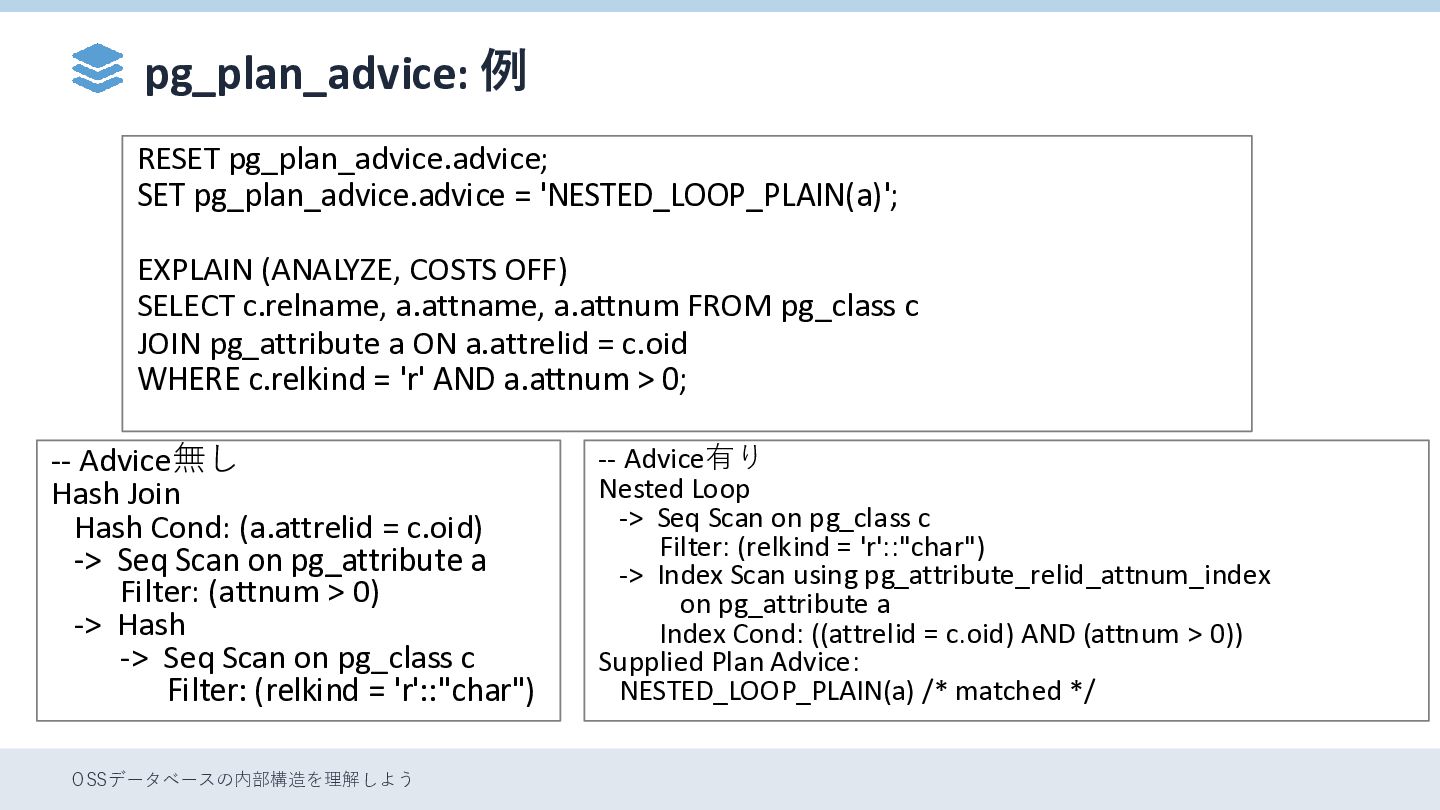
  48. pg_plan_advice: 例 RESET pg_plan_advice.advice; SET pg_plan_advice.advice = 'NESTED_LOOP_PLAIN(a)'; EXPLAIN (ANALYZE,

    COSTS OFF) SELECT c.relname, a.attname, a.attnum FROM pg_class c JOIN pg_attribute a ON a.attrelid = c.oid WHERE c.relkind = 'r' AND a.attnum > 0; -- Advice無し Hash Join Hash Cond: (a.attrelid = c.oid) -> Seq Scan on pg_attribute a Filter: (attnum > 0) -> Hash -> Seq Scan on pg_class c Filter: (relkind = 'r'::"char") OSSデータベースの内部構造を理解しよう -- Advice有り Nested Loop -> Seq Scan on pg_class c Filter: (relkind = 'r'::"char") -> Index Scan using pg_attribute_relid_attnum_index on pg_attribute a Index Cond: ((attrelid = c.oid) AND (attnum > 0)) Supplied Plan Advice: NESTED_LOOP_PLAIN(a) /* matched */
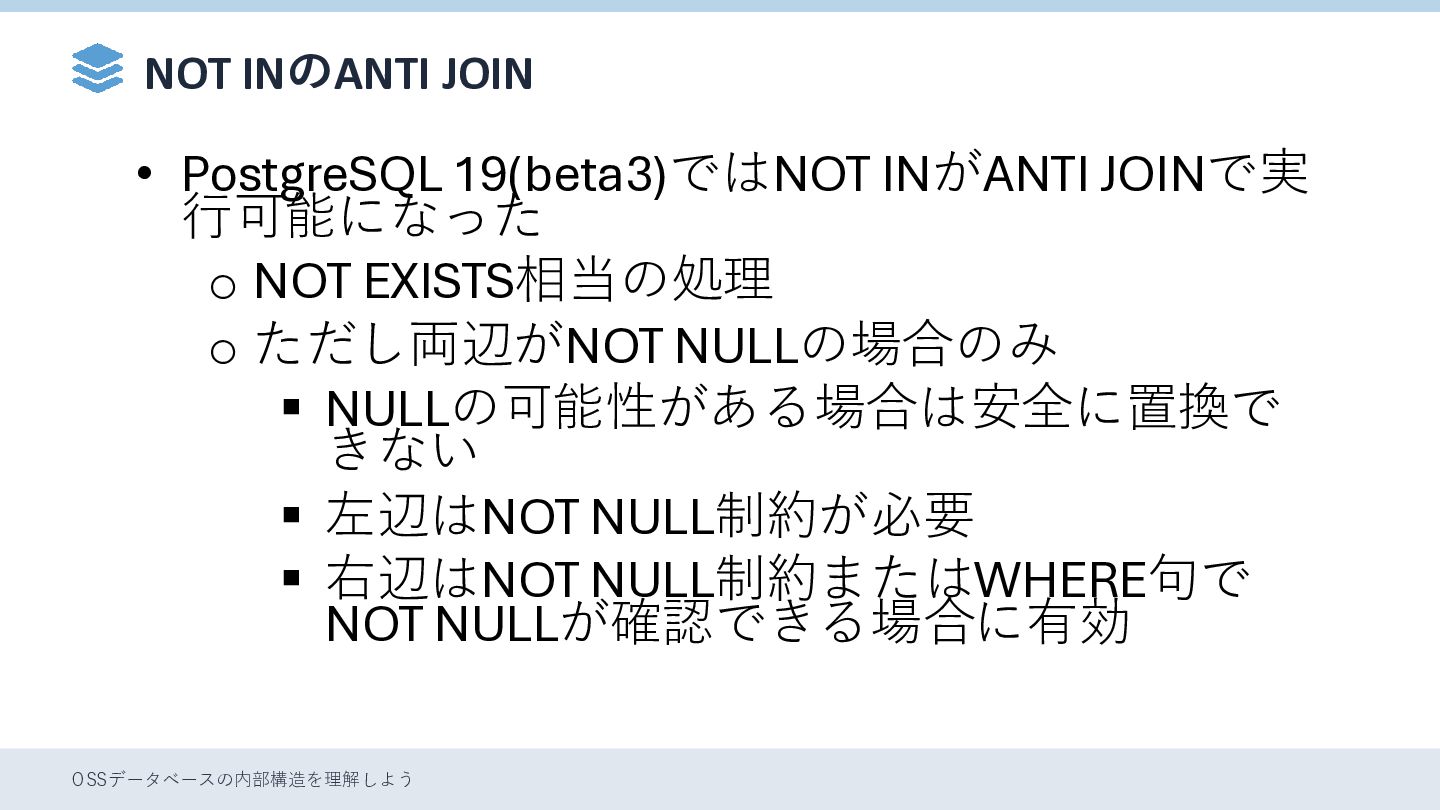
  49. NOT INのANTI JOIN • PostgreSQL 19(beta3)ではNOT INがANTI JOINで実 行可能になった o

    NOT EXISTS相当の処理 o ただし両辺がNOT NULLの場合のみ ▪ NULLの可能性がある場合は安全に置換で きない ▪ 左辺はNOT NULL制約が必要 ▪ 右辺はNOT NULL制約またはWHERE句で NOT NULLが確認できる場合に有効 OSSデータベースの内部構造を理解しよう
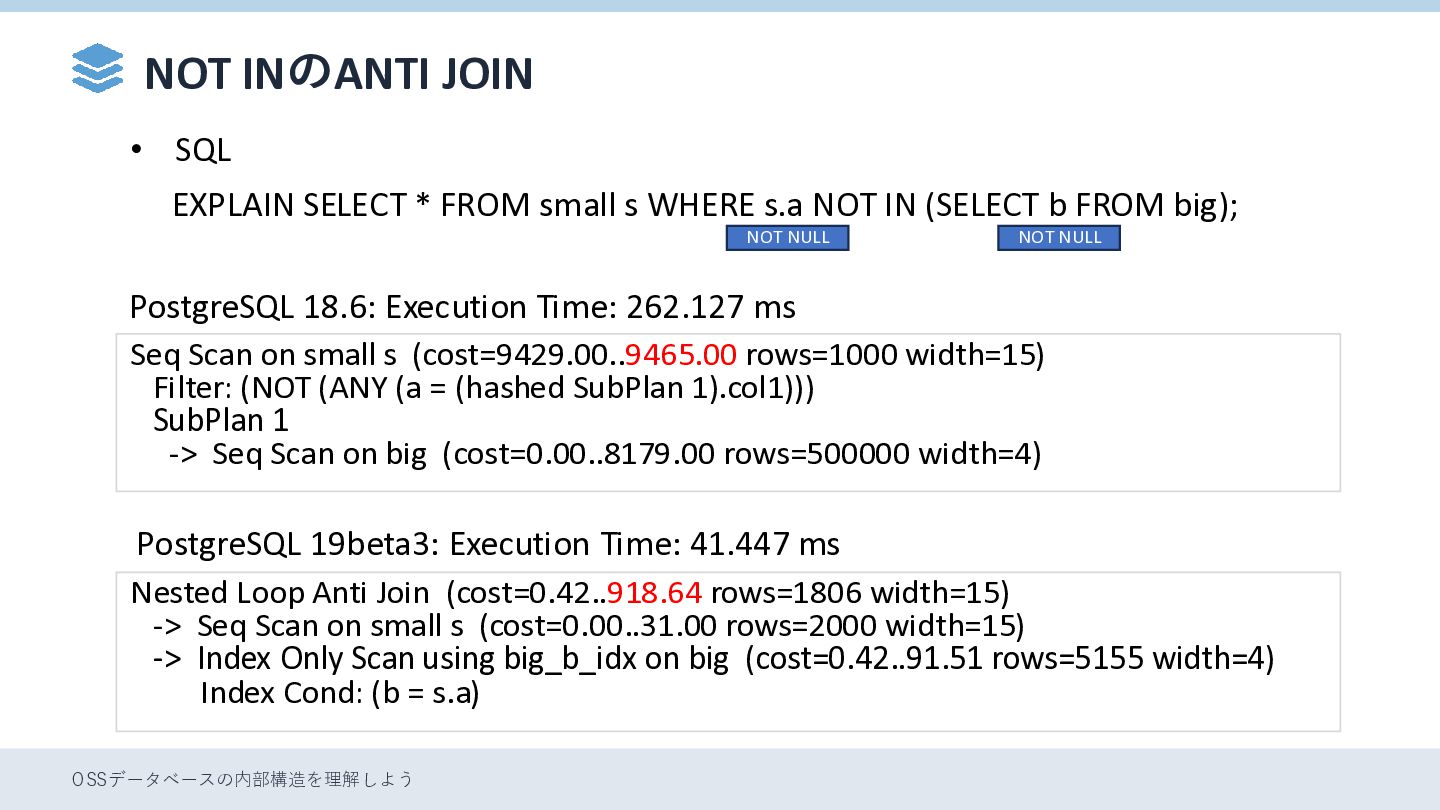
  50. NOT INのANTI JOIN • SQL EXPLAIN SELECT * FROM small

    s WHERE s.a NOT IN (SELECT b FROM big); NOT NULL NOT NULL PostgreSQL 18.6: Execution Time: 262.127 ms Seq Scan on small s (cost=9429.00..9465.00 rows=1000 width=15) Filter: (NOT (ANY (a = (hashed SubPlan 1).col1))) SubPlan 1 -> Seq Scan on big (cost=0.00..8179.00 rows=500000 width=4) PostgreSQL 19beta3: Execution Time: 41.447 ms Nested Loop Anti Join (cost=0.42..918.64 rows=1806 width=15) -> Seq Scan on small s (cost=0.00..31.00 rows=2000 width=15) -> Index Only Scan using big_b_idx on big (cost=0.42..91.51 rows=5155 width=4) Index Cond: (b = s.a) OSSデータベースの内部構造を理解しよう
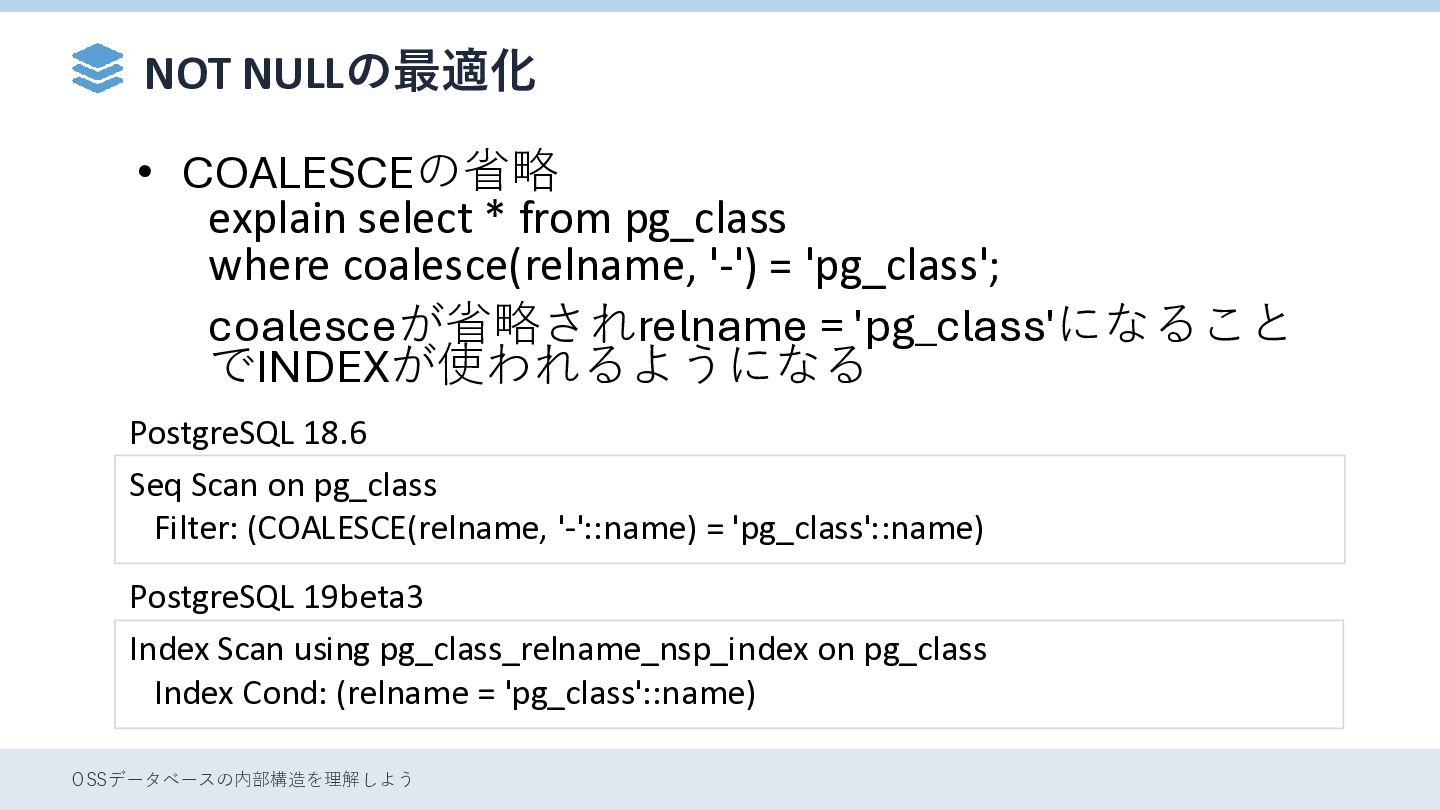
  51. NOT NULLの最適化 • COALESCEの省略 explain select * from pg_class where

    coalesce(relname, '-') = 'pg_class'; coalesceが省略されrelname = 'pg_class'になること でINDEXが使われるようになる PostgreSQL 18.6 Seq Scan on pg_class Filter: (COALESCE(relname, '-'::name) = 'pg_class'::name) PostgreSQL 19beta3 Index Scan using pg_class_relname_nsp_index on pg_class Index Cond: (relname = 'pg_class'::name) OSSデータベースの内部構造を理解しよう
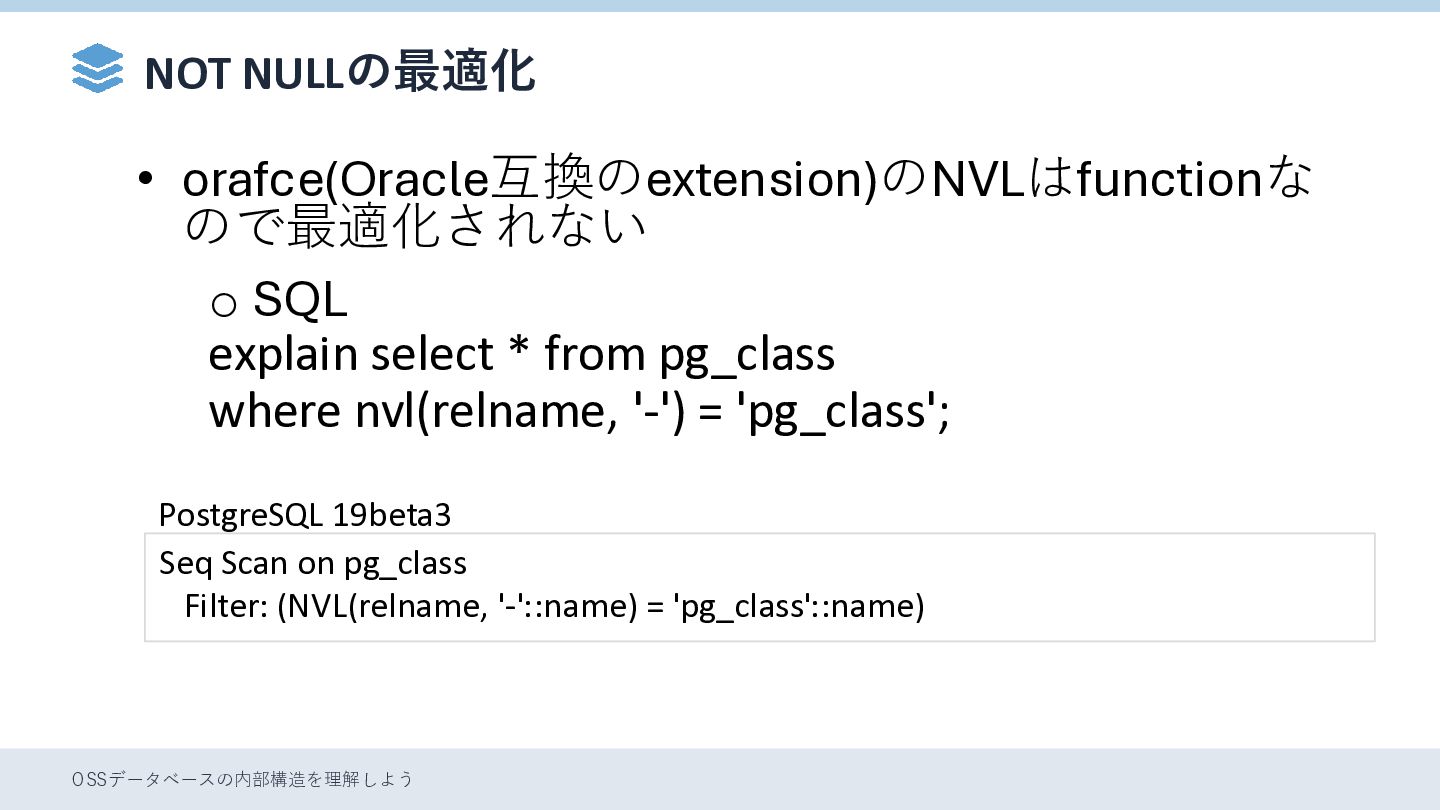
  52. NOT NULLの最適化 • orafce(Oracle互換のextension)のNVLはfunctionな ので最適化されない o SQL explain select *

    from pg_class where nvl(relname, '-') = 'pg_class'; PostgreSQL 19beta3 Seq Scan on pg_class Filter: (NVL(relname, '-'::name) = 'pg_class'::name) OSSデータベースの内部構造を理解しよう
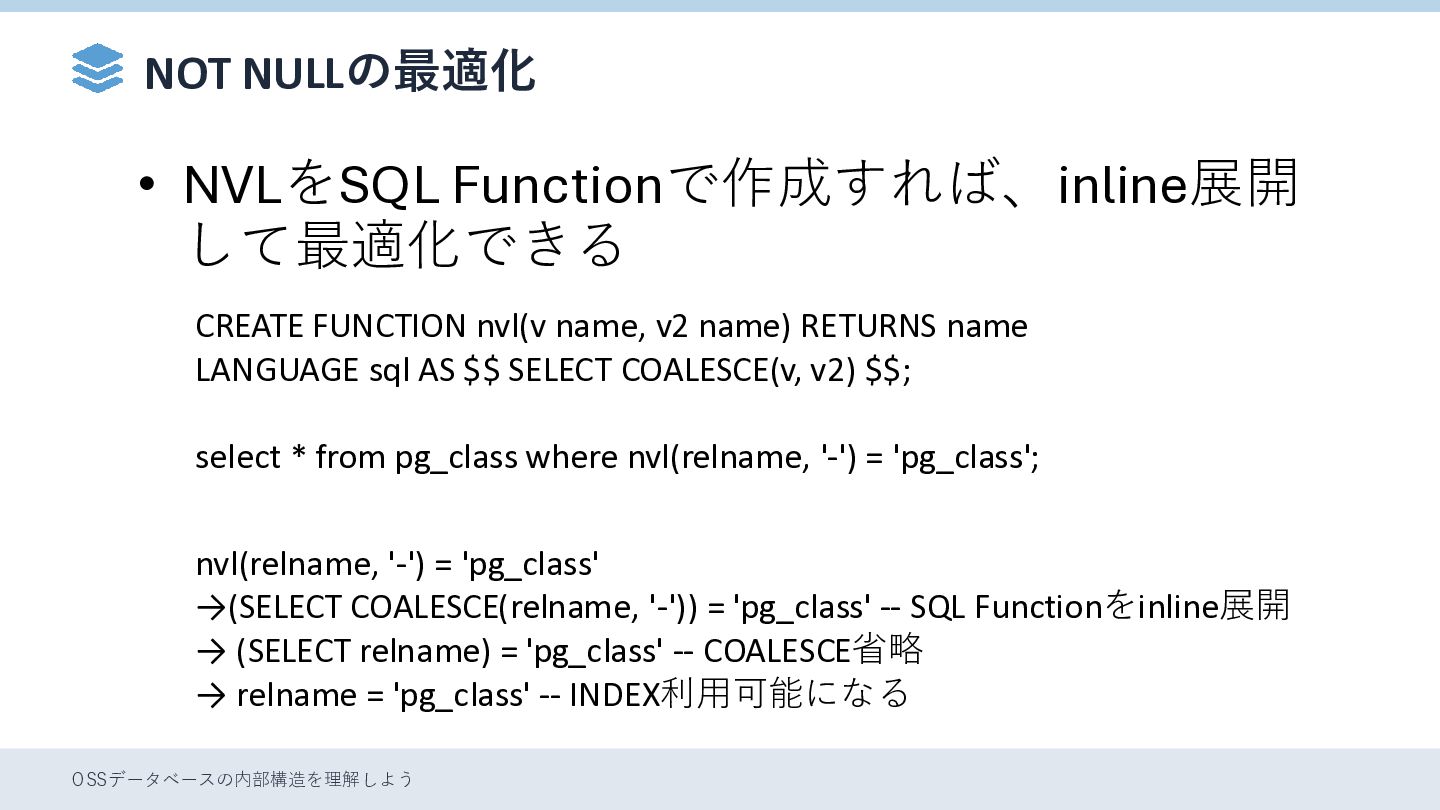
  53. NOT NULLの最適化 • NVLをSQL Functionで作成すれば、inline展開 して最適化できる CREATE FUNCTION nvl(v name,

    v2 name) RETURNS name LANGUAGE sql AS $$ SELECT COALESCE(v, v2) $$; select * from pg_class where nvl(relname, '-') = 'pg_class'; nvl(relname, '-') = 'pg_class' →(SELECT COALESCE(relname, '-')) = 'pg_class' -- SQL Functionをinline展開 → (SELECT relname) = 'pg_class' -- COALESCE省略 → relname = 'pg_class' -- INDEX利用可能になる OSSデータベースの内部構造を理解しよう
  54. 参考資料 • 「とことんわかるPostgreSQLインサイド」講演資料集 (2006/4/24) o 問い合わせ最適化インサイド (板垣貴裕氏) • JPUG勉強会 OSSデータベースの内部構造を理解しよう(第1回)

    o ソースコードからビルド、デバッグ手法 o システムカタログ o https://speakerdeck.com/oga5/jpugmian-qiang-hui-ossdetabesunoneibu-gou-zao-woli-jie-siyou • ソースコードビューア o https://oga5.github.io/source-wiki-postgresql-19beta3/overview.html OSSデータベースの内部構造を理解しよう
  55. Q&A

  56. GUC:オプティマイザ関連の設定 •基本的なコスト関連 •seq_page_cost oSeq Scan のページ読み取りコスト oデフォルトは1 で他のcostパラメータとの比較 の基準になる (これはあまり変更せずに他を調

    整) •random_page_cost oIndex Scan のランダム読み取りコスト o SSDでは1.1〜1.8程度にしてもよい ▪ デフォルトの4.0 はHDD前提 OSSデータベースの内部構造を理解しよう
  57. GUC:オプティマイザ関連の設定 •JOIN戦略 •geqo_threshold •リレーション数がこの値以上で GEQO が発火 •デフォルト 12 •from_collapse_limit /

    join_collapse_limit •サブクエリや JOIN の引き上げ(pull up)を制御 •大規模クエリで探索空間が爆発するのを防ぐ OSSデータベースの内部構造を理解しよう
  58. GUC:オプティマイザ関連の設定 •メモリ関連: work_mem •Sort / Hash のコスト計算に直接影響 •小さすぎるとハッシュ表がメモリに収まらないと判 定される ▪その結果、Hash

    Join の total_cost が高く見積も られ、選択されにくくなる •大規模 JOIN や GROUP BY では十分な work_mem が 必要 •実務では 64MB〜256MB 程度がよく使われる(クエ リ単位で SET 可能) OSSデータベースの内部構造を理解しよう
  59. GUC:オプティマイザ関連の設定 •メモリ関連: effective_cache_size •OS のページキャッシュサイズの「推定値」 •Index Scan がどれくらいキャッシュヒットする かを推定するために使われる •値が大きいほど

    Index Scan のコストが下がり、 Nested Loop が選ばれやすくなる •値が小さいほど Seq Scan や Hash Join が選ばれ やすくなる OSSデータベースの内部構造を理解しよう
  60. GEQO: 遺伝的最適化の処理 (1) • 初期化 • ランダムにJOIN順序の組み合わせを生成 o {A, B,

    C, D}, {B, C, D, A}など o 重複しても気にしないで生成 • 各候補のコストを計算して、PATHリストをコ スト順にソート OSSデータベースの内部構造を理解しよう
  61. GEQO: 遺伝的最適化の処理 (2) • 遺伝的探索 • PATHリストから親のペアをランダムに選択 o 低コストなPATHが選択されやすいように重みづけ されている

    • 両親のJOIN順序をある程度維持しながら、新しい JOIN順序を生成しコストを計算 o コスト順に並んだPATHリストの適切な位置に挿入 o 追い出された候補は削除 • これを一定回数繰り返して、PATHリストの上位に なった候補を選択する OSSデータベースの内部構造を理解しよう
  62. GEQO: ランダムについて • GEQO用の乱数発生器はGUCパラメータの geqo_seedをSEED値として使う o geqo_seedを変更しない場合は、GEQOを実行 するたびに、毎回同じ数字列が生成される • 同じSQLをGEQOにかけた場合は、同じ結果にな

    る o 繰り返し実行するSQLで毎回異なる実行PATH が選択されるわけではない o 統計情報が更新されれば変わる可能性がある OSSデータベースの内部構造を理解しよう
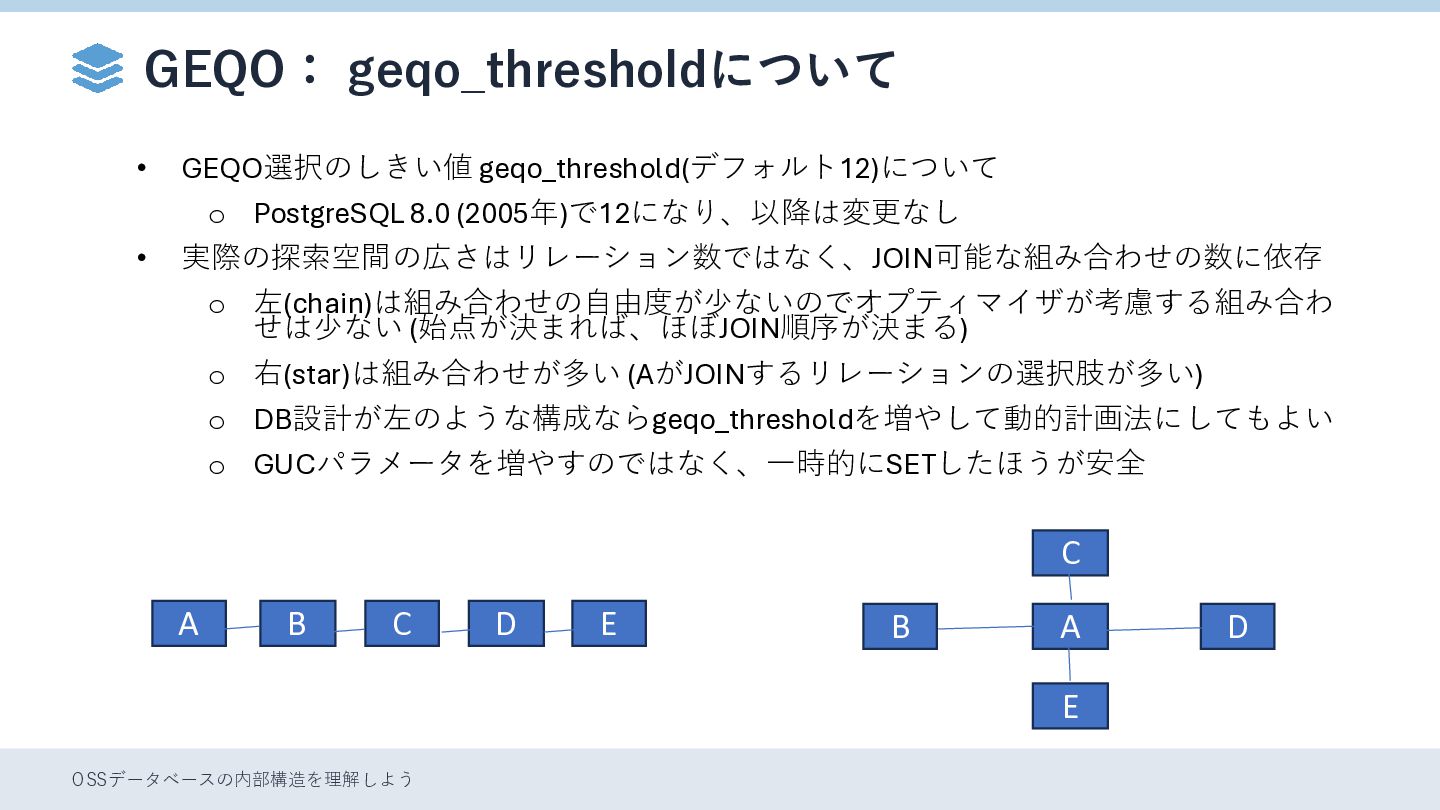
  63. GEQO: geqo_thresholdについて • GEQO選択のしきい値 geqo_threshold(デフォルト12)について o PostgreSQL 8.0 (2005年)で12になり、以降は変更なし •

    実際の探索空間の広さはリレーション数ではなく、JOIN可能な組み合わせの数に依存 o 左(chain)は組み合わせの自由度が少ないのでオプティマイザが考慮する組み合わ せは少ない (始点が決まれば、ほぼJOIN順序が決まる) o 右(star)は組み合わせが多い (AがJOINするリレーションの選択肢が多い) o DB設計が左のような構成ならgeqo_thresholdを増やして動的計画法にしてもよい o GUCパラメータを増やすのではなく、一時的にSETしたほうが安全 C A B C D E B A E OSSデータベースの内部構造を理解しよう D
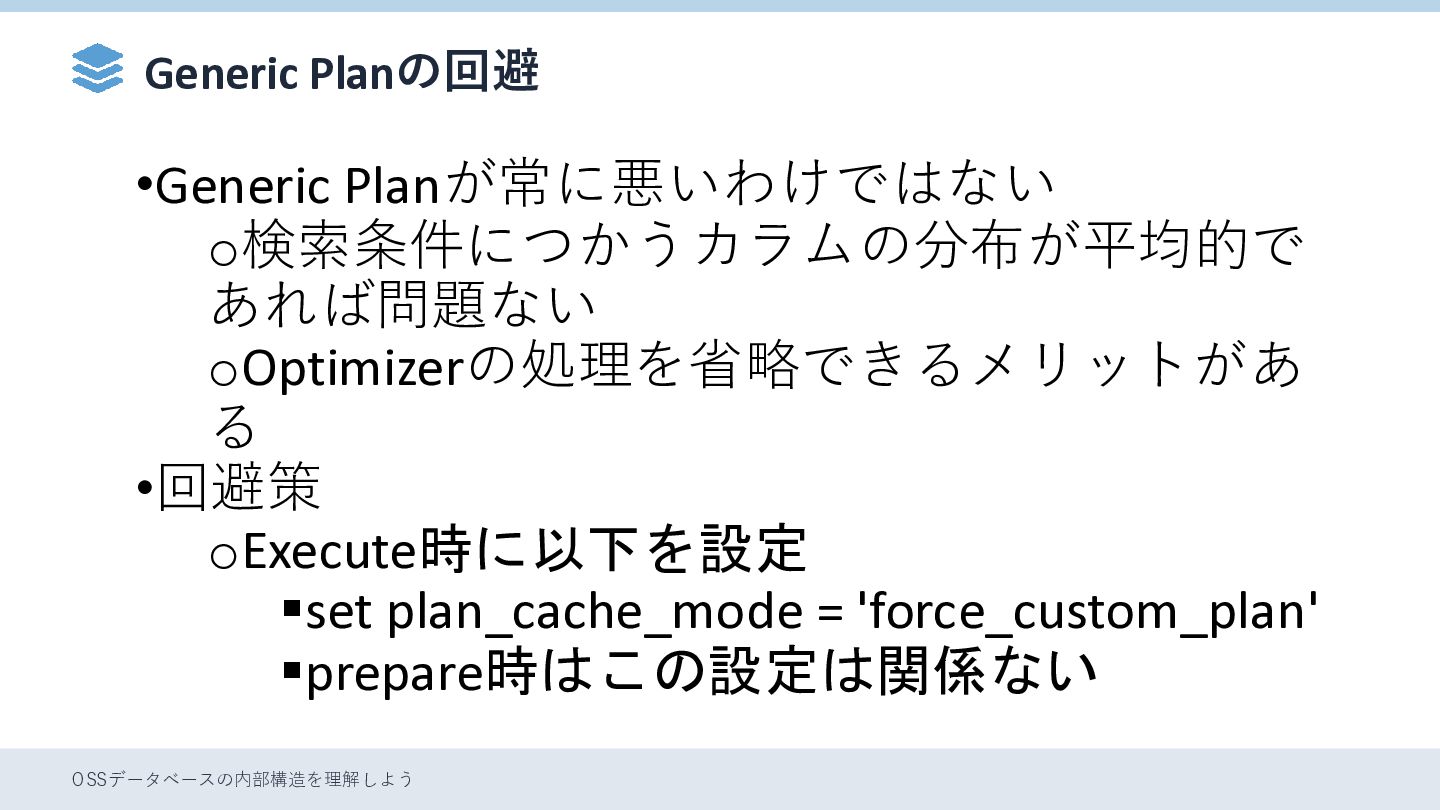
  64. Custom Plan / Generic Plan •Custom Plan oSQL実行時のパラメータ値を使って最適な実行計画を生成す る o例:WHERE

    id = $1 の $1 が 1 のときだけ Index Scan が有効 oパラメータ値に応じて選択度が変わる場合に有効 o毎回プランを作るためコストが高い(プラン生成時間) •Generic Plan oパラメータ値を使わず、統計情報だけで一般的な実行計画を 生成する oどんな値が来ても同じプラン oプラン生成コストが低い o特定の値で高速になるケースを拾えない(性能劣化の原因) OSSデータベースの内部構造を理解しよう
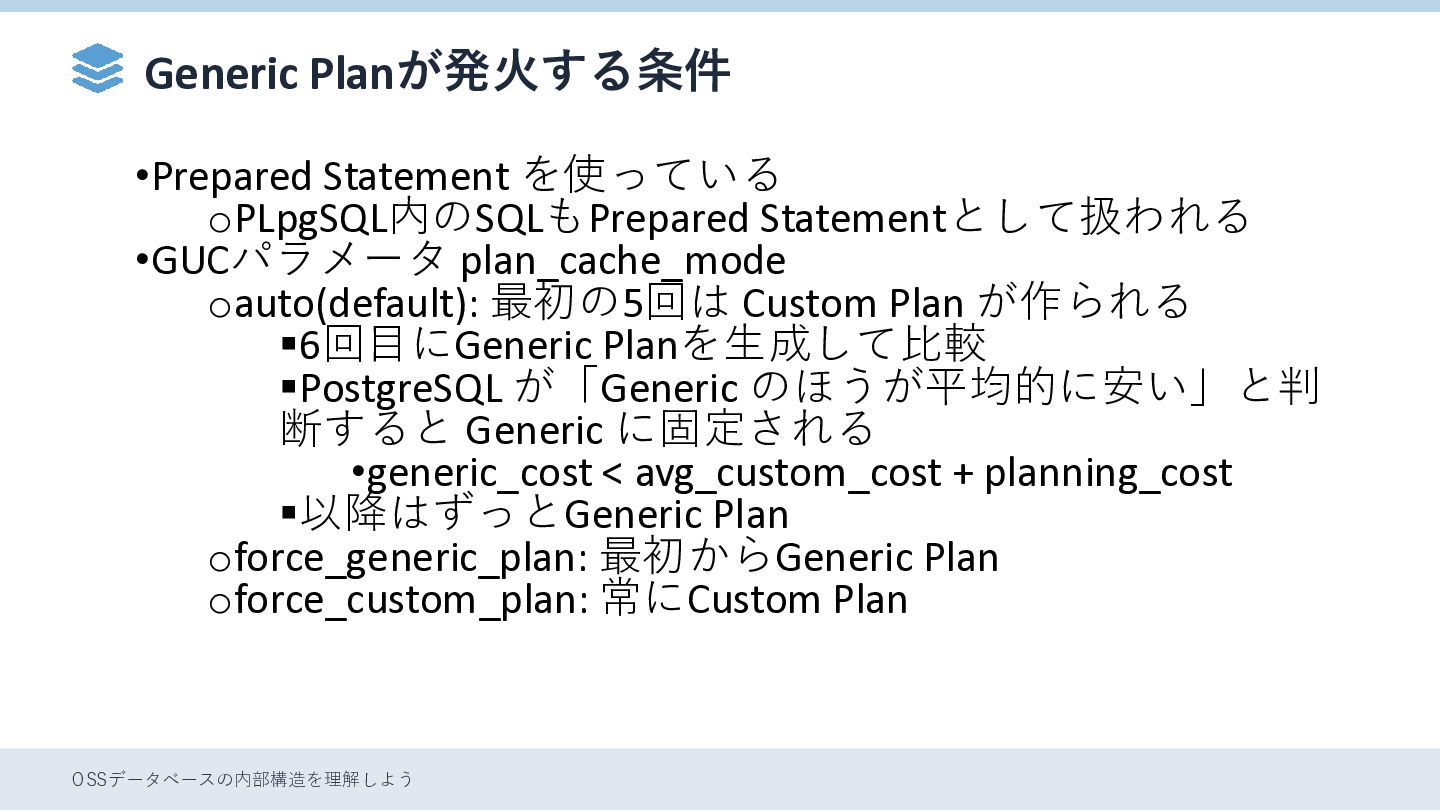
  65. Generic Planが発火する条件 •Prepared Statement を使っている oPLpgSQL内のSQLもPrepared Statementとして扱われる •GUCパラメータ plan_cache_mode oauto(default):

    最初の5回は Custom Plan が作られる ▪6回目にGeneric Planを生成して比較 ▪PostgreSQL が「Generic のほうが平均的に安い」と判 断すると Generic に固定される •generic_cost < avg_custom_cost + planning_cost ▪以降はずっとGeneric Plan oforce_generic_plan: 最初からGeneric Plan oforce_custom_plan: 常にCustom Plan OSSデータベースの内部構造を理解しよう
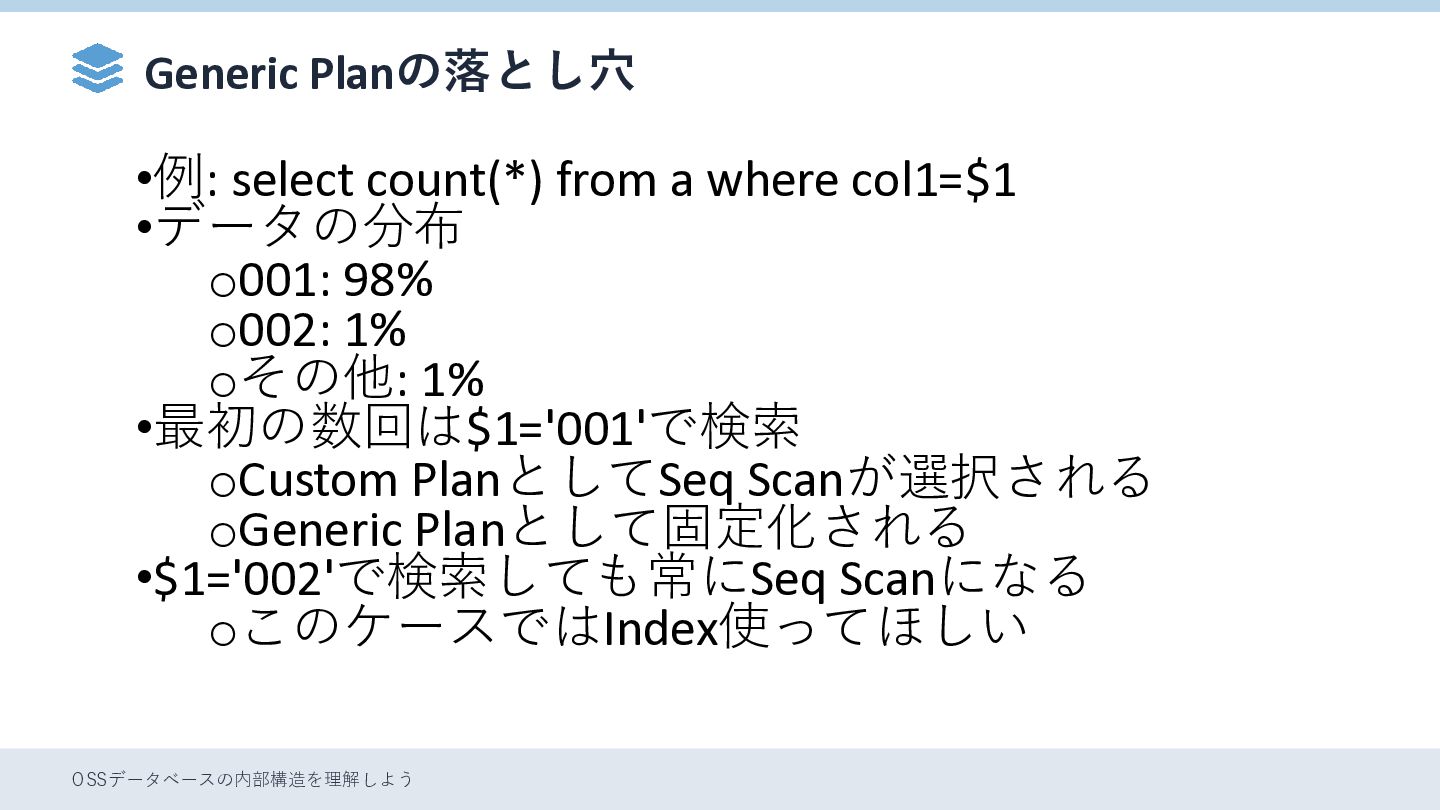
  66. Generic Planの落とし穴 •例: select count(*) from a where col1=$1 •データの分布

    o001: 98% o002: 1% oその他: 1% •最初の数回は$1='001'で検索 oCustom PlanとしてSeq Scanが選択される oGeneric Planとして固定化される •$1='002'で検索しても常にSeq Scanになる oこのケースではIndex使ってほしい OSSデータベースの内部構造を理解しよう
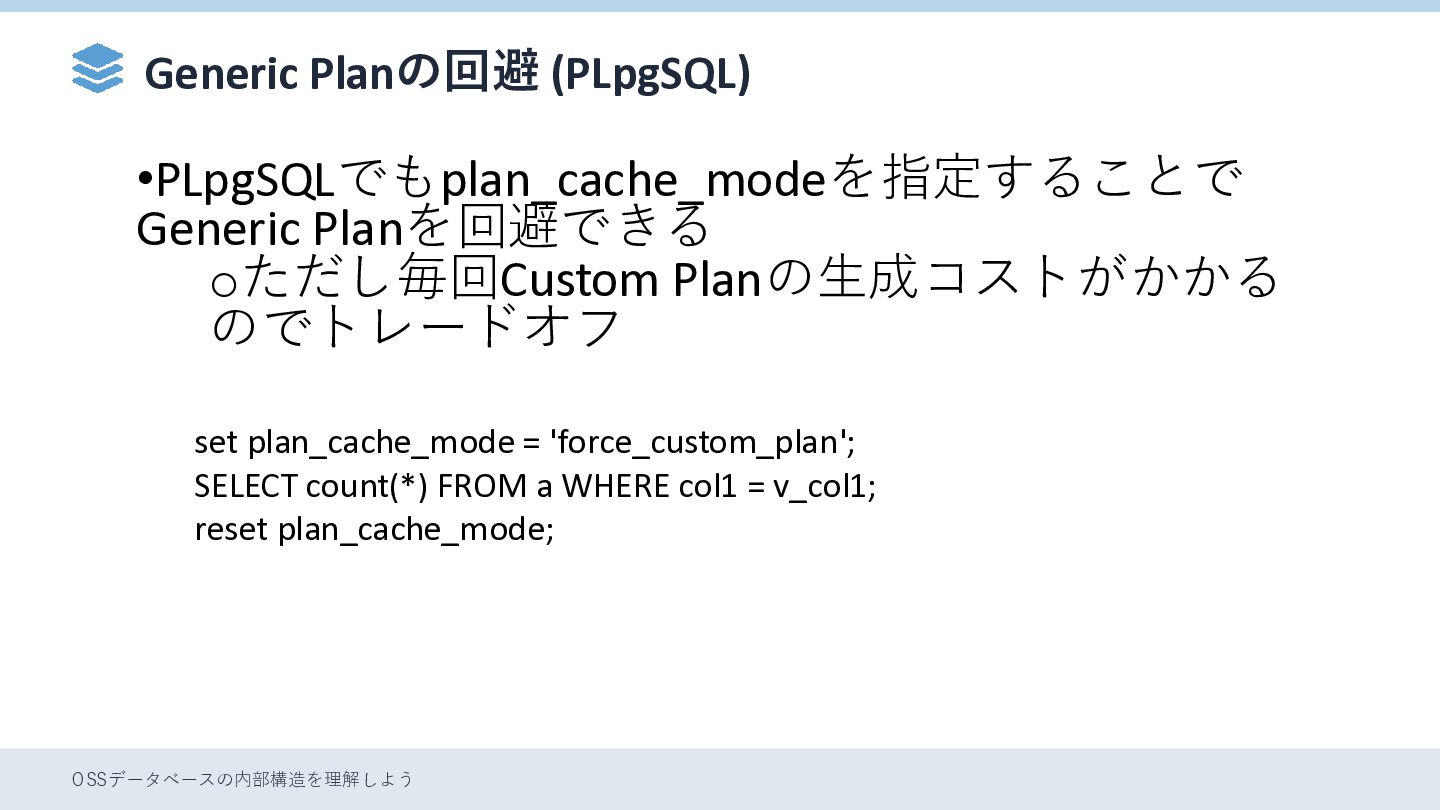
  67. Generic Planの回避 (PLpgSQL) •PLpgSQLでもplan_cache_modeを指定することで Generic Planを回避できる oただし毎回Custom Planの生成コストがかかる のでトレードオフ set

    plan_cache_mode = 'force_custom_plan'; SELECT count(*) FROM a WHERE col1 = v_col1; reset plan_cache_mode; OSSデータベースの内部構造を理解しよう
  68. 統計情報 • 統計情報 o テーブルやINDEXをサンプリングして収集 した情報 o ANALYZEコマンドやAUTO VACUUMで収集 ▪

    統計情報が無かったり、古かったりす ると正確なコスト見積もりができない o pg_stats viewで参照可能 OSSデータベースの内部構造を理解しよう
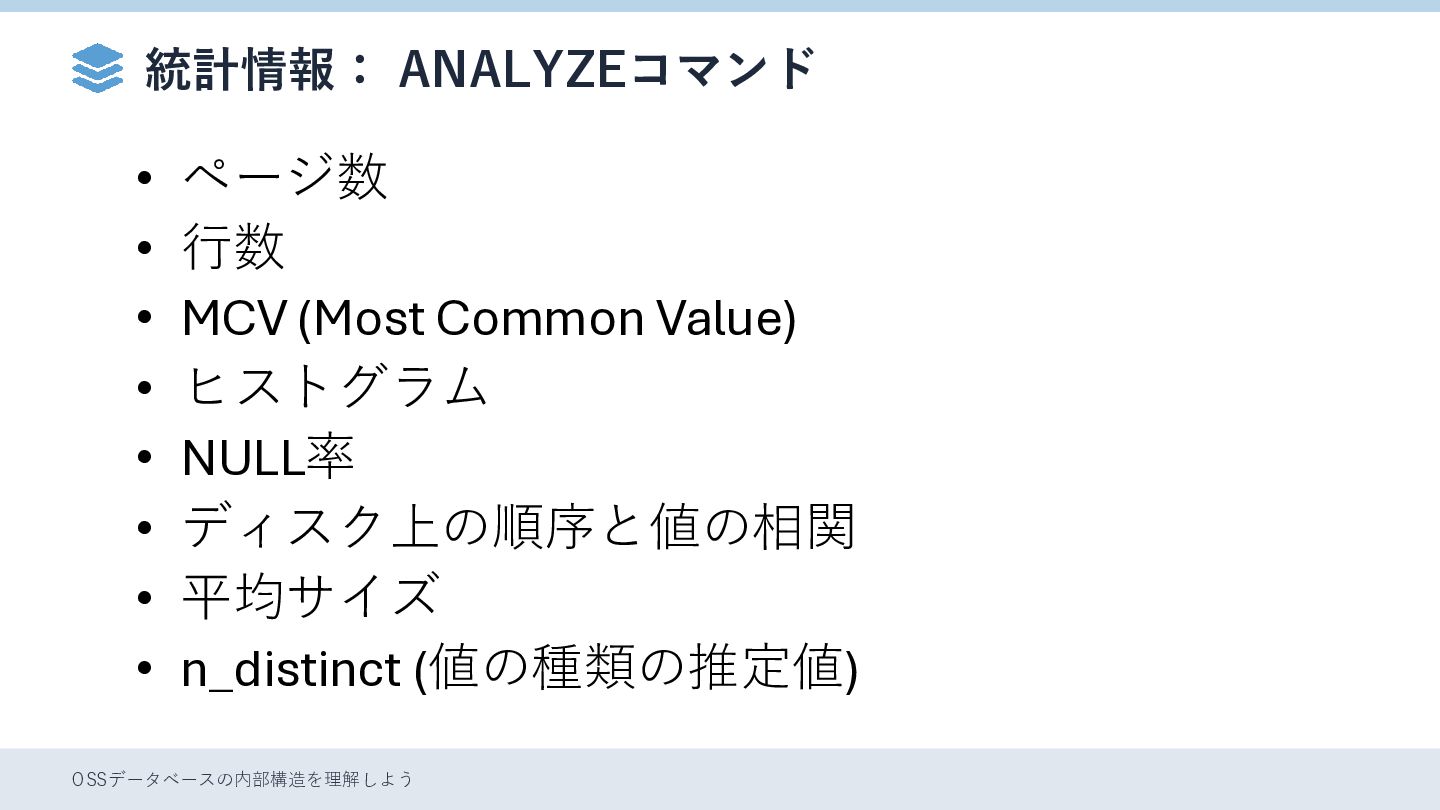
  69. 統計情報: ANALYZEコマンド • ページ数 • 行数 • MCV (Most Common

    Value) • ヒストグラム • NULL率 • ディスク上の順序と値の相関 • 平均サイズ • n_distinct (値の種類の推定値) OSSデータベースの内部構造を理解しよう
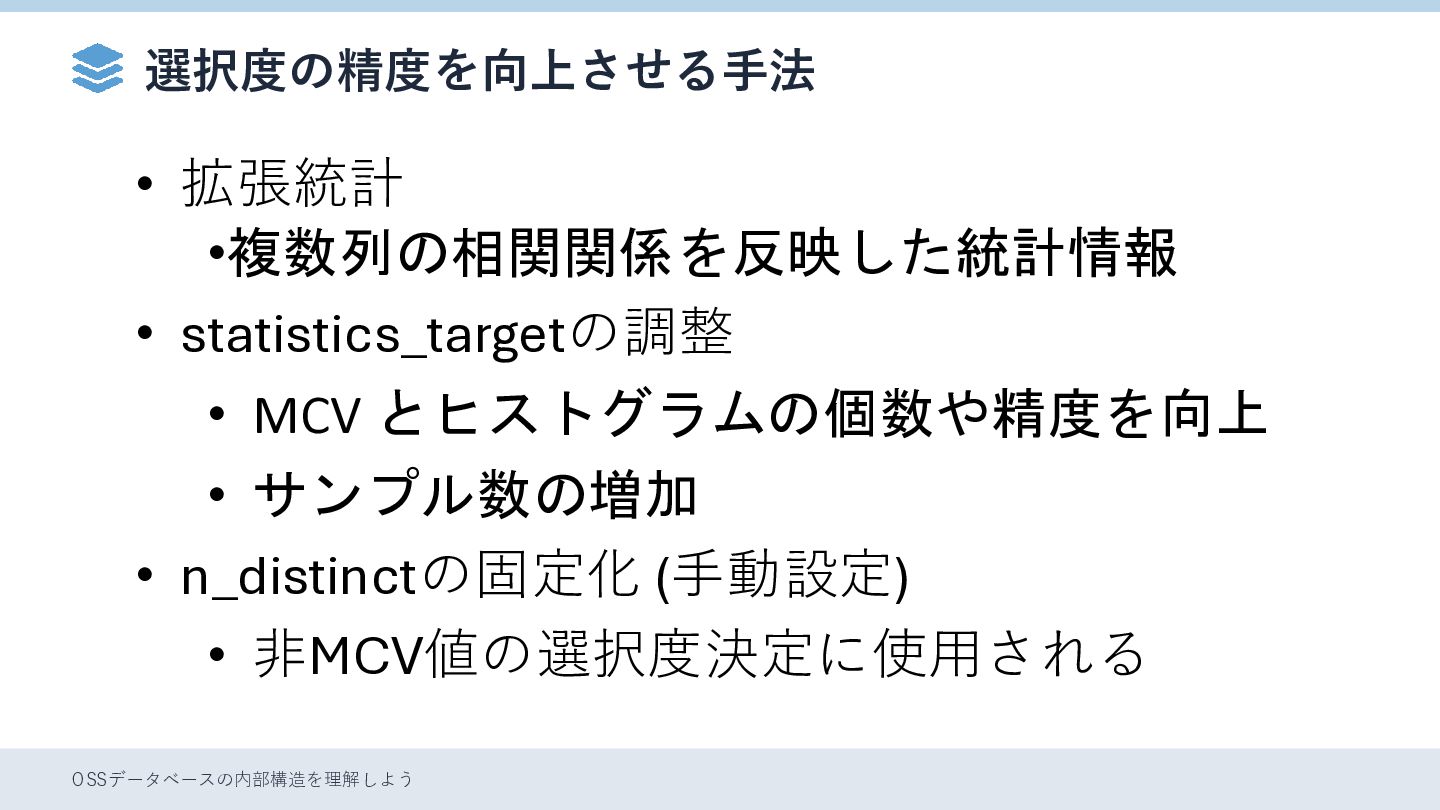
  70. 選択度の精度を向上させる手法 • 拡張統計 •複数列の相関関係を反映した統計情報 • statistics_targetの調整 • MCV とヒストグラムの個数や精度を向上 •

    サンプル数の増加 • n_distinctの固定化 (手動設定) • 非MCV値の選択度決定に使用される OSSデータベースの内部構造を理解しよう
  71. 選択度の推定: 複合カラム • col1 = val1 and col2 = val2

    • それぞれの選択度は独立しているとみなす o col1の選択度 × col2の選択度 o col1とcol2に相関関係がある場合、行数推 定が小さくなりすぎる可能性がある ▪ col1(大分類), col2(中分類)のような場合、 相関関係がある o 複合カラムの統計収集 (extended statistics) OSSデータベースの内部構造を理解しよう
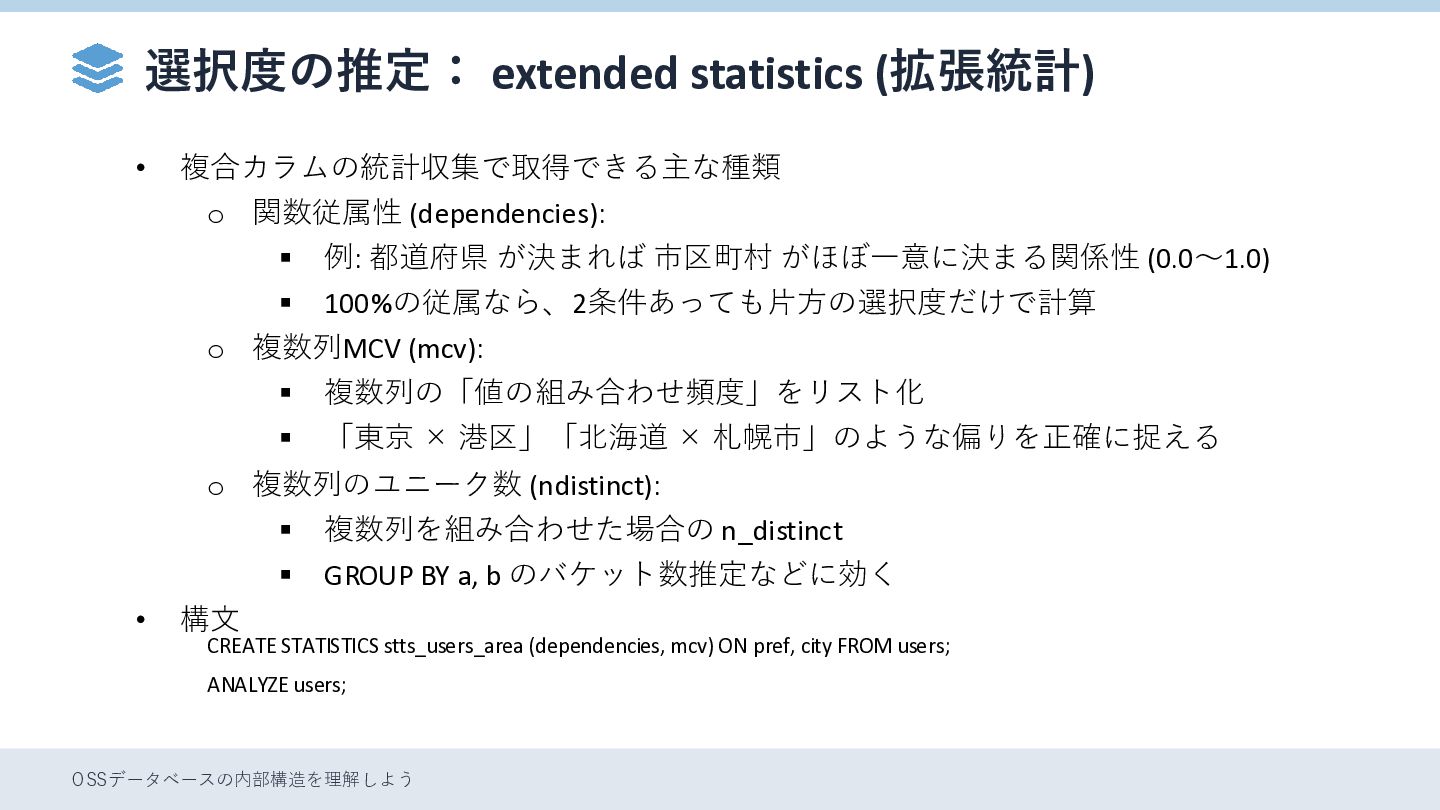
  72. 選択度の推定: extended statistics (拡張統計) • 複合カラムの統計収集で取得できる主な種類 o 関数従属性 (dependencies): ▪

    例: 都道府県 が決まれば 市区町村 がほぼ一意に決まる関係性 (0.0〜1.0) ▪ 100%の従属なら、2条件あっても片方の選択度だけで計算 o 複数列MCV (mcv): • ▪ 複数列の「値の組み合わせ頻度」をリスト化 ▪ 「東京 × 港区」「北海道 × 札幌市」のような偏りを正確に捉える o 複数列のユニーク数 (ndistinct): ▪ 複数列を組み合わせた場合の n_distinct ▪ GROUP BY a, b のバケット数推定などに効く 構文 CREATE STATISTICS stts_users_area (dependencies, mcv) ON pref, city FROM users; ANALYZE users; OSSデータベースの内部構造を理解しよう
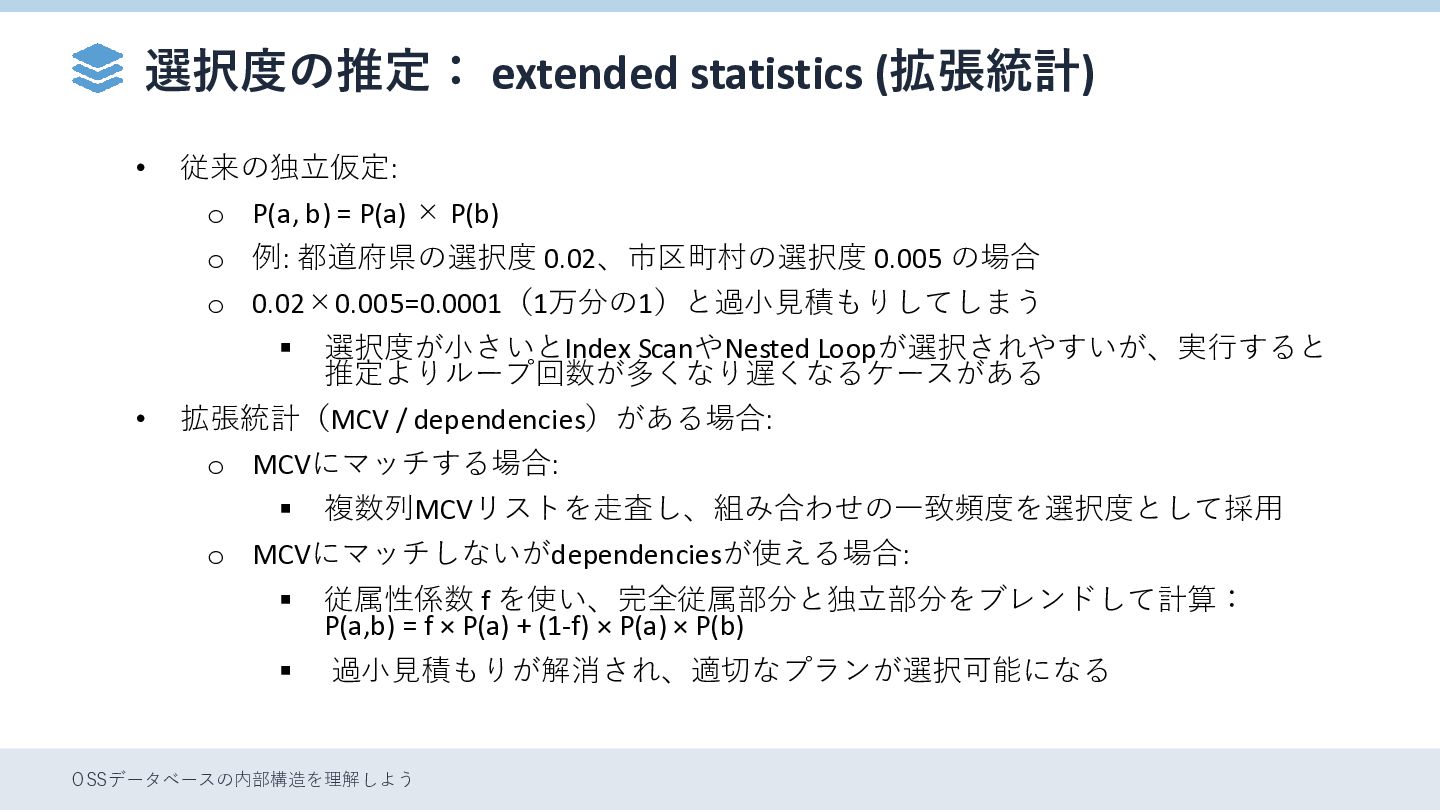
  73. 選択度の推定: extended statistics (拡張統計) • 従来の独立仮定: o P(a, b) =

    P(a) × P(b) o 例: 都道府県の選択度 0.02、市区町村の選択度 0.005 の場合 o 0.02×0.005=0.0001(1万分の1)と過小見積もりしてしまう ▪ 選択度が小さいとIndex ScanやNested Loopが選択されやすいが、実行すると 推定よりループ回数が多くなり遅くなるケースがある • 拡張統計(MCV / dependencies)がある場合: o MCVにマッチする場合: ▪ 複数列MCVリストを走査し、組み合わせの一致頻度を選択度として採用 o MCVにマッチしないがdependenciesが使える場合: ▪ 従属性係数 f を使い、完全従属部分と独立部分をブレンドして計算: P(a,b) = f × P(a) + (1-f) × P(a) × P(b) ▪ 過小見積もりが解消され、適切なプランが選択可能になる OSSデータベースの内部構造を理解しよう
  74. statistics_targetの調整 • statistics_targetを調整して統計情報の量を制御で きる o MCV、ヒストグラムの最大個数 o analyze時のサンプルレコード数 ▪ 300

    × statistics_target ▪ statistics_target=100の場合 • 300×100=30000レコードをサンプルと して統計情報を収集 OSSデータベースの内部構造を理解しよう
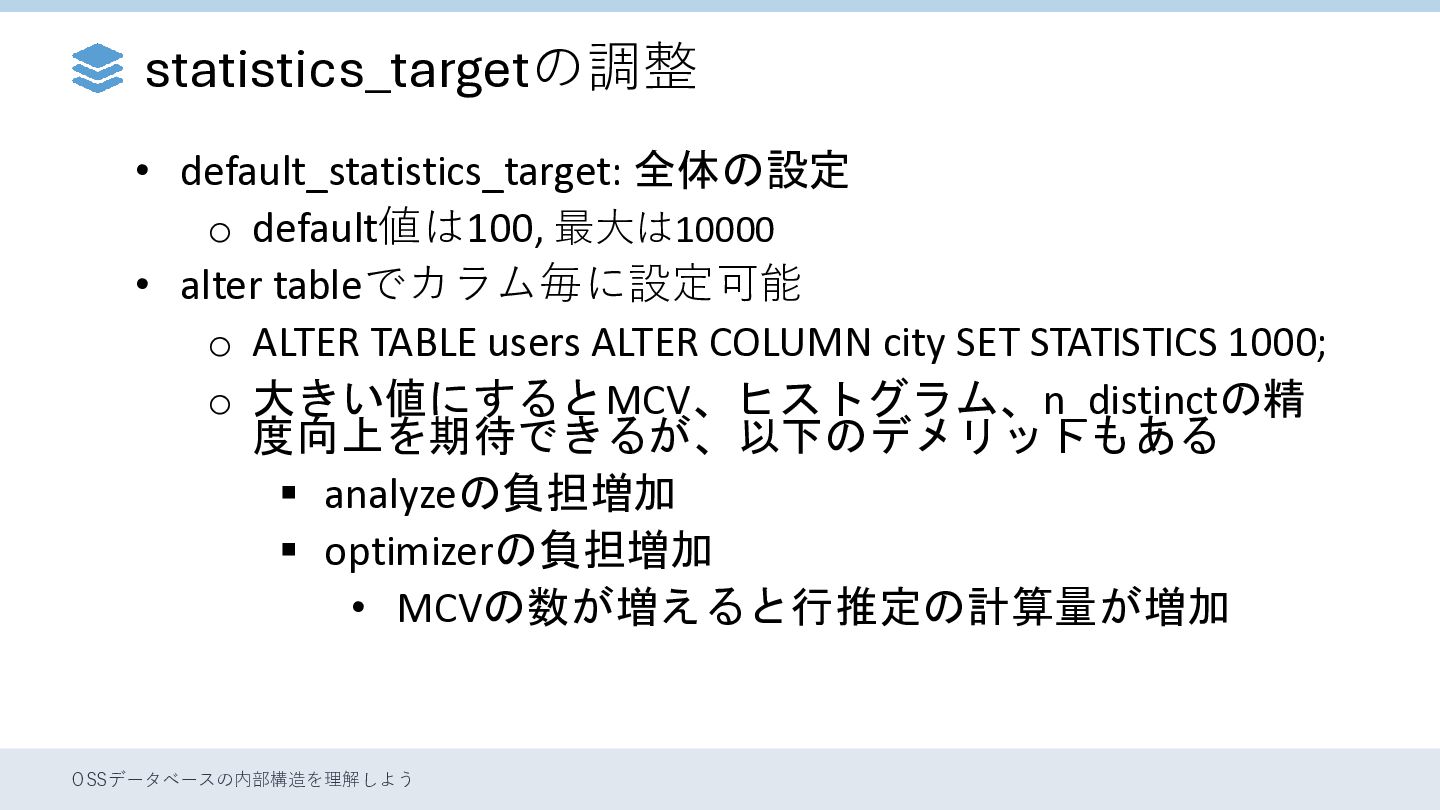
  75. statistics_targetの調整 • default_statistics_target: 全体の設定 o default値は100, 最大は10000 • alter tableでカラム毎に設定可能

    o ALTER TABLE users ALTER COLUMN city SET STATISTICS 1000; o 大きい値にするとMCV、ヒストグラム、n_distinctの精 度向上を期待できるが、以下のデメリットもある ▪ analyzeの負担増加 ▪ optimizerの負担増加 • MCVの数が増えると行推定の計算量が増加 OSSデータベースの内部構造を理解しよう
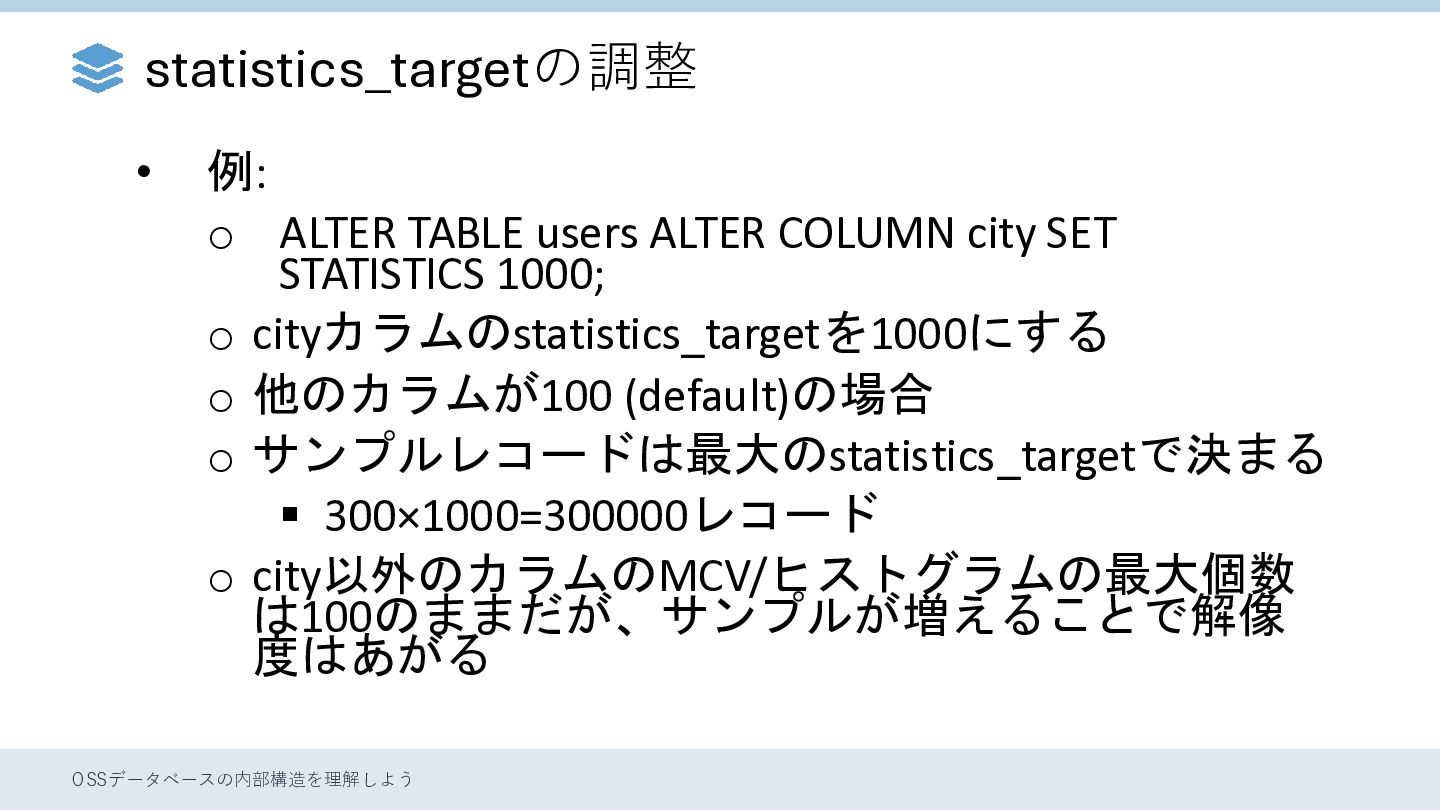
  76. statistics_targetの調整 • 例: o ALTER TABLE users ALTER COLUMN city

    SET STATISTICS 1000; o cityカラムのstatistics_targetを1000にする o 他のカラムが100 (default)の場合 o サンプルレコードは最大のstatistics_targetで決まる ▪ 300×1000=300000レコード o city以外のカラムのMCV/ヒストグラムの最大個数 は100のままだが、サンプルが増えることで解像 度はあがる OSSデータベースの内部構造を理解しよう
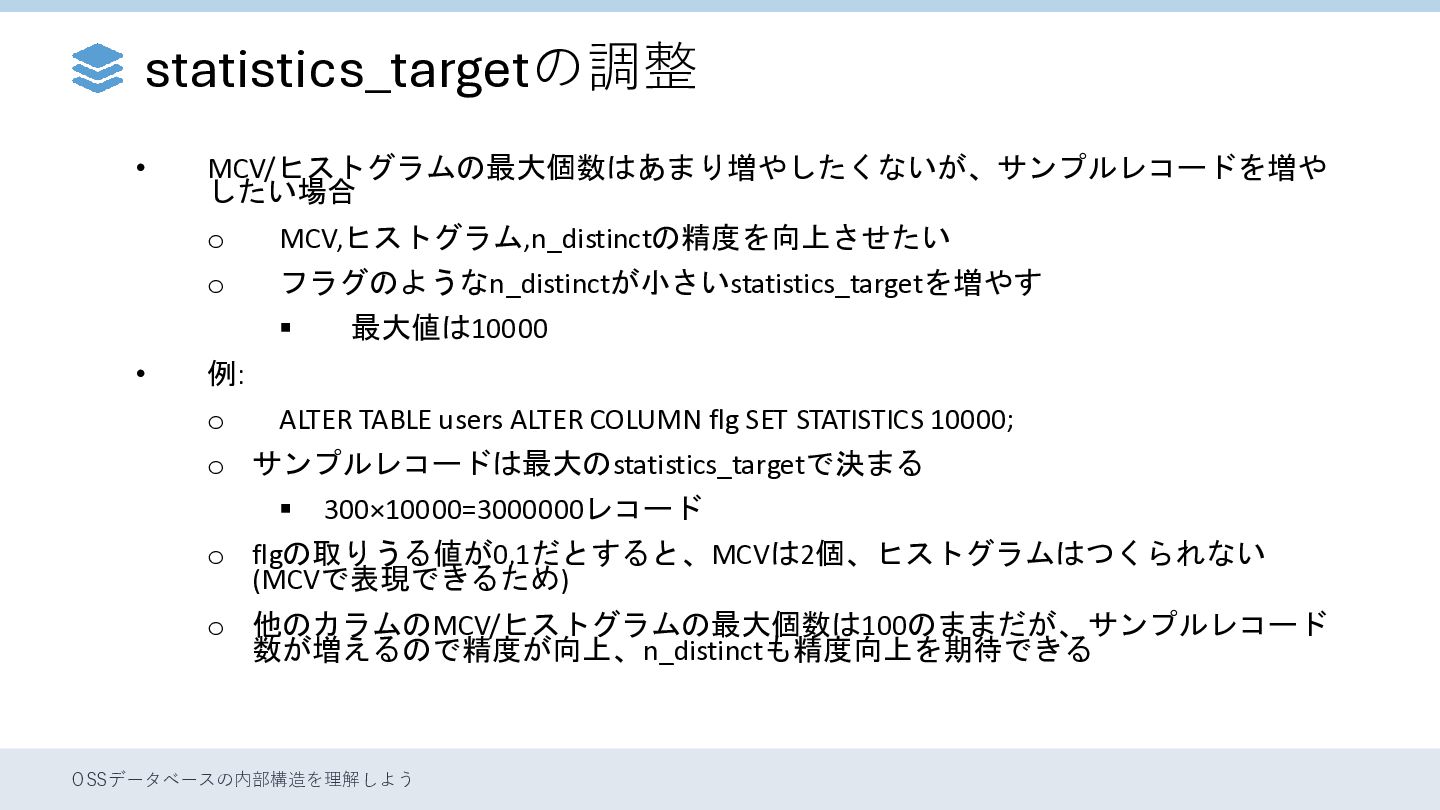
  77. statistics_targetの調整 • MCV/ヒストグラムの最大個数はあまり増やしたくないが、サンプルレコードを増や したい場合 o MCV,ヒストグラム,n_distinctの精度を向上させたい o フラグのようなn_distinctが小さいstatistics_targetを増やす ▪ •

    最大値は10000 例: o ALTER TABLE users ALTER COLUMN flg SET STATISTICS 10000; o サンプルレコードは最大のstatistics_targetで決まる ▪ 300×10000=3000000レコード o flgの取りうる値が0,1だとすると、MCVは2個、ヒストグラムはつくられない (MCVで表現できるため) o 他のカラムのMCV/ヒストグラムの最大個数は100のままだが、サンプルレコード 数が増えるので精度が向上、n_distinctも精度向上を期待できる OSSデータベースの内部構造を理解しよう
  78. n_distinctの固定(手動設定) • alter tableでカラム単位にn_distinctを設定可能 • ALTER TABLE users ALTER COLUMN

    city SET (n_distinct = 200); • これで設定すると、次回以降のanalyzeし てもn_distinctは更新されない (固定でき る) OSSデータベースの内部構造を理解しよう