Share
Embed
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
本資料はSatAI.challengeのサーベイメンバーと共に作成したものです。
SatAI.challengeは、リモートセンシング技術にAIを適用した論文の調査や、より俯瞰した技術トレンドの調査や国際学会のメタサーベイを行う研究グループです。speakerdeckではSatAI.challenge内での勉強会で使用した資料をWeb上で共有しています。
https://x.com/sataichallenge
本研究では、霧や雲がある場合Open-ocabulary egmentation(OVS)性能向上ために光学画像とA融合方法を提案しています。
従来のOVSでは、光学画像を用いてテキストからのセグメンテーションを行なっていましたが、霧や雲が画像中に含まれると性能が劣化する課題がありました。本研究ではこの課題に対処するために、光学画像のDINO埋め込みに近づくようにSARを処理するDINO encoderを学習させま。その後、本研究では、2つのDINOエンコーダーとテキストと画像のCLRPの特徴量をFusionするDual-Encoder Fusionと呼ばれる構造によりOVSを実現しています。
SatAI.challenge
June 13, 2026
Transcript
19 slides
-
中村凌 1 MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in
Remote Sensing [ CVPR 2026 ] 第28回 SatAI.challenge勉強会 -
中村 凌 株式会社天地人 / SatAI.challenge 主宰 / cvpaper.challenge HQ •
株式会社天地人 AI Tech Lead (2024/04 - 現在) • SatAI.challenge 主宰(2024/09 - 現在) • cvpaper.challenge HQ(2021/1 - 現在 ) • 福岡大学大学院 理学研究科 応用数学専攻 博士課程(2021/04 - 2024/03) • 産業技術総合研究所 コンピュータビジョンチーム RA(2021/05 - 2024/03) • 福岡大学大学院 理学研究科 応用数学専攻 修士課程(2019/04 - 2021/03) 自己紹介 Twitter LinkedIn 2 これまでの個人的な活動 • 研究効率化Tips (ViEW2021招待講演) • 国際会議への論文採択実績(IROS / ICCV 2023, ICASSP / ECCV2024) • CCCS,W2021/2022 GC PC(登録者800名超え) • SSII2023オーディエンス賞受賞 • SatAI.challenge運営(国際論文の日本語資料・動画のアーカイブ化) -
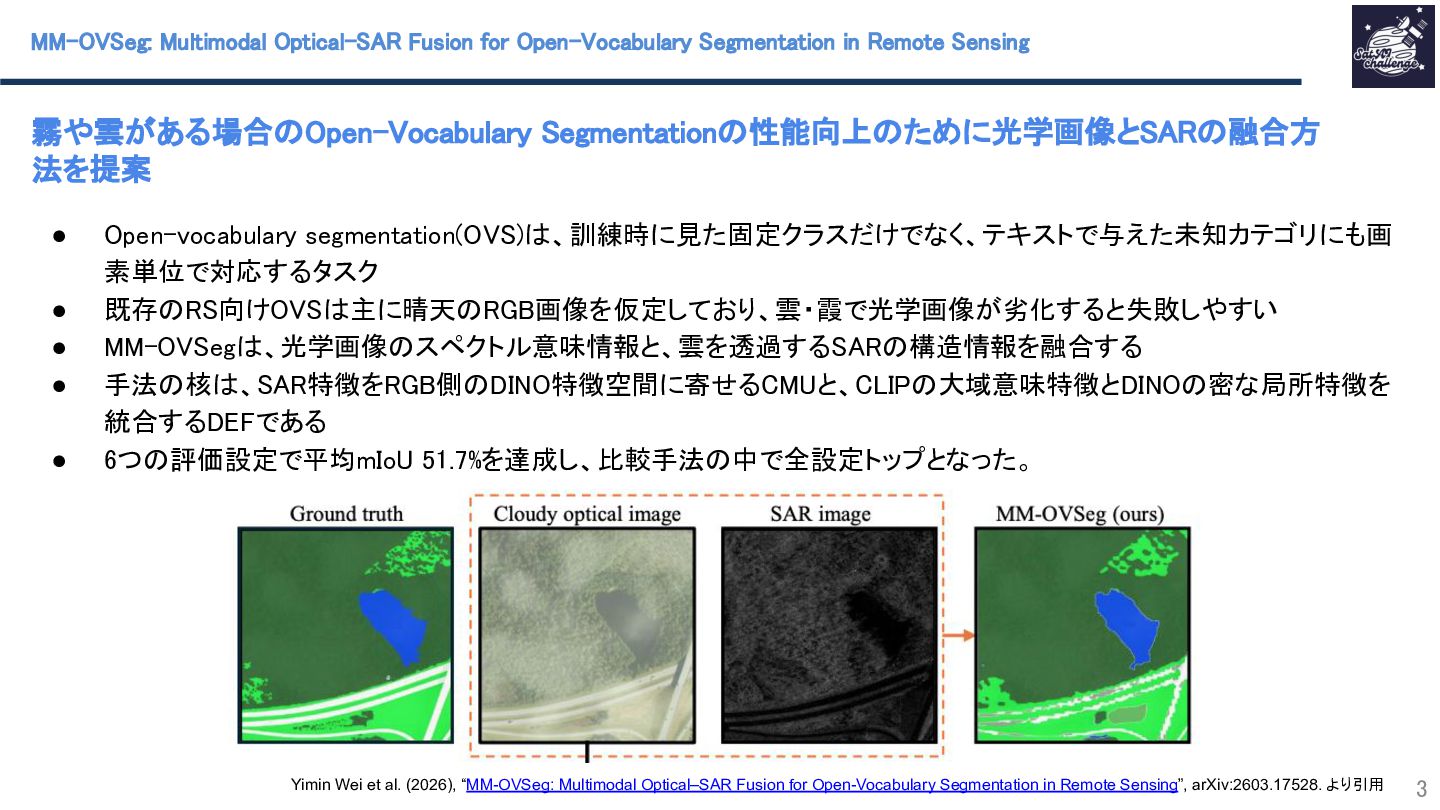
霧や雲がある場合のOpen-Vocabulary Segmentationの性能向上のために光学画像とSARの融合方 法を提案 3 MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary
Segmentation in Remote Sensing • Open-vocabulary segmentation(OVS)は、訓練時に見た固定クラスだけでなく、テキストで与えた未知カテゴリにも画 素単位で対応するタスク • 既存のRS向けOVSは主に晴天のRGB画像を仮定しており、雲・霞で光学画像が劣化すると失敗しやすい • MM-OVSegは、光学画像のスペクトル意味情報と、雲を透過するSARの構造情報を融合する • 手法の核は、SAR特徴をRGB側のDINO特徴空間に寄せるCMUと、CLIPの大域意味特徴とDINOの密な局所特徴を 統合するDEFである • 6つの評価設定で平均mIoU 51.7%を達成し、比較手法の中で全設定トップとなった。 Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
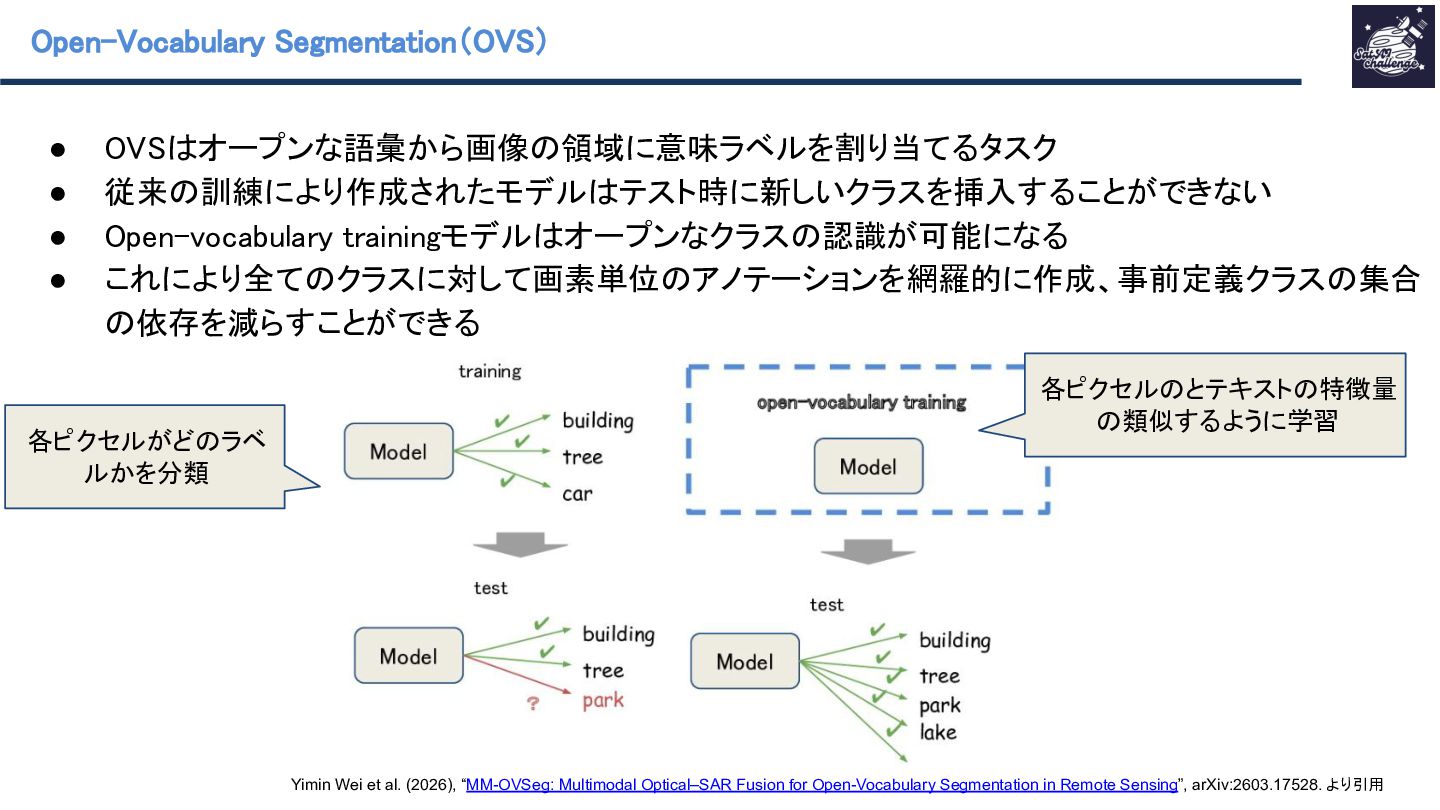
Open-Vocabulary Segmentation(OVS) Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR
Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 • OVSはオープンな語彙から画像の領域に意味ラベルを割り当てるタスク • 従来の訓練により作成されたモデルはテスト時に新しいクラスを挿入することができない • Open-vocabulary trainingモデルはオープンなクラスの認識が可能になる • これにより全てのクラスに対して画素単位のアノテーションを網羅的に作成、事前定義クラスの集合 の依存を減らすことができる 各ピクセルがどのラベ ルかを分類 各ピクセルのとテキストの特徴量 の類似するように学習 -
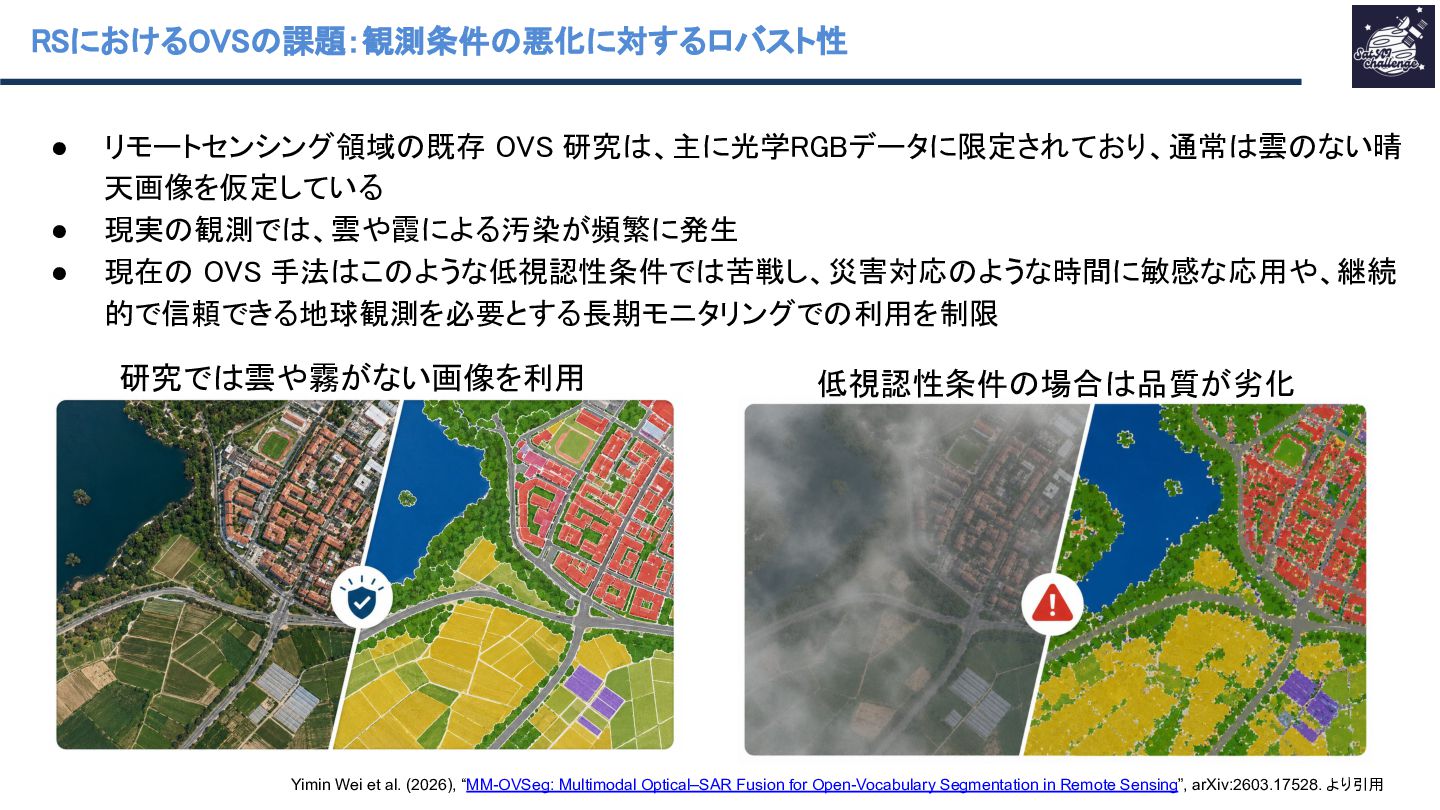
RSにおけるOVSの課題:観測条件の悪化に対するロバスト性 Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion
for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 • リモートセンシング領域の既存 OVS 研究は、主に光学RGBデータに限定されており、通常は雲のない晴 天画像を仮定している • 現実の観測では、雲や霞による汚染が頻繁に発生 • 現在の OVS 手法はこのような低視認性条件では苦戦し、災害対応のような時間に敏感な応用や、継続 的で信頼できる地球観測を必要とする長期モニタリングでの利用を制限 研究では雲や霧がない画像を利用 低視認性条件の場合は品質が劣化 -
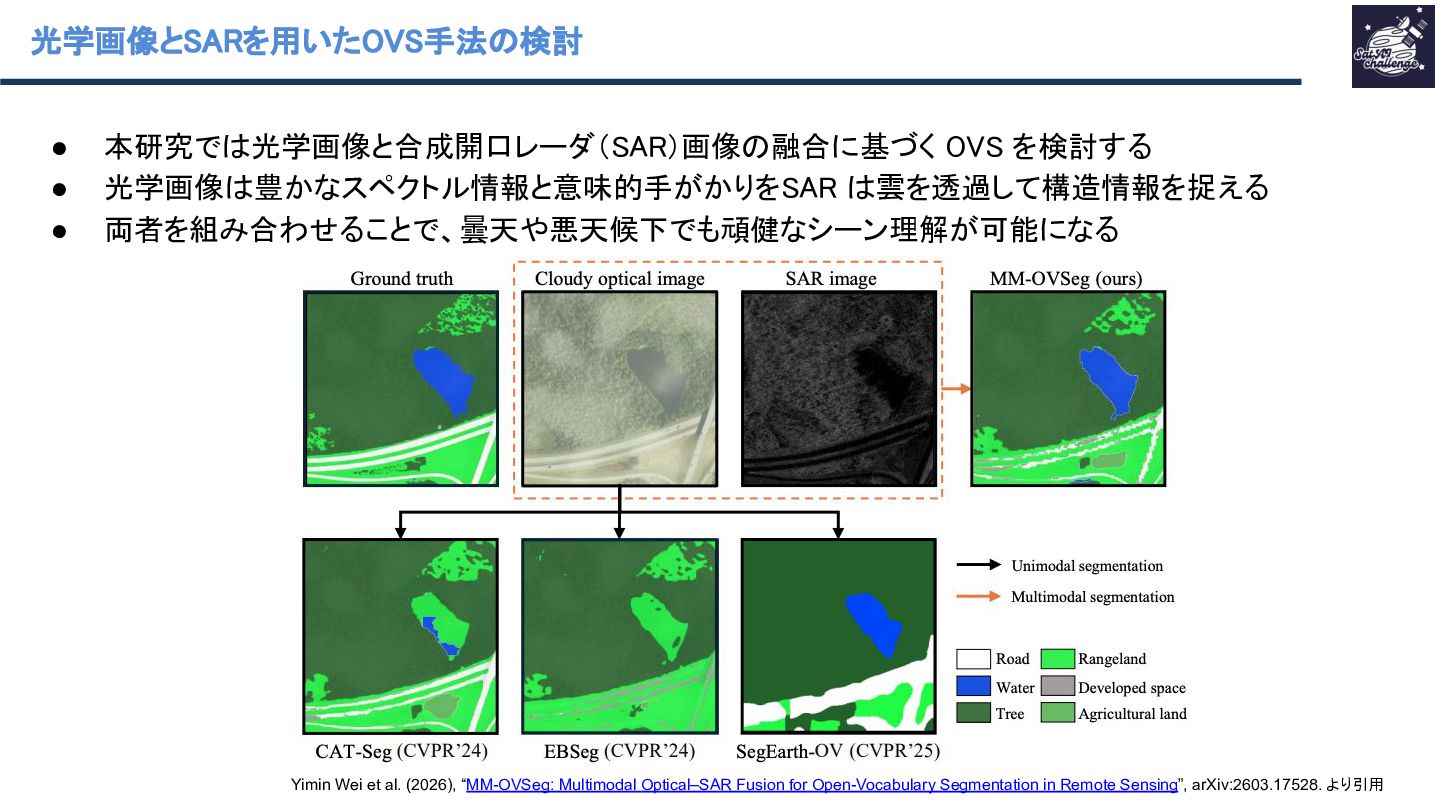
光学画像とSARを用いたOVS手法の検討 • 本研究では光学画像と合成開口レーダ(SAR)画像の融合に基づく OVS を検討する • 光学画像は豊かなスペクトル情報と意味的手がかりをSAR は雲を透過して構造情報を捉える • 両者を組み合わせることで、曇天や悪天候下でも頑健なシーン理解が可能になる
Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
光学画像とSARを用いたOVS手法の2つの課題 • SARをOVSフレームワークに統合するのは難しく2つの困難が存在 ◦ 1. 視覚基盤モデルの多くは RGB 画像で訓練されているが、SAR は後方散乱特性やテクスチャ パターンが大きく異なるため、RGBとSARの表現の間には大きなドメインギャップが存在
◦ 2. CLIP や ALIGN のような視覚言語モデルは画像に対するテキストとの対照学習で訓練され ており、セグメンテーションに必要な 画素単位の予測を生成する能力が限られている(そのよ うなセグメンテーション向けに学習されてない) Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
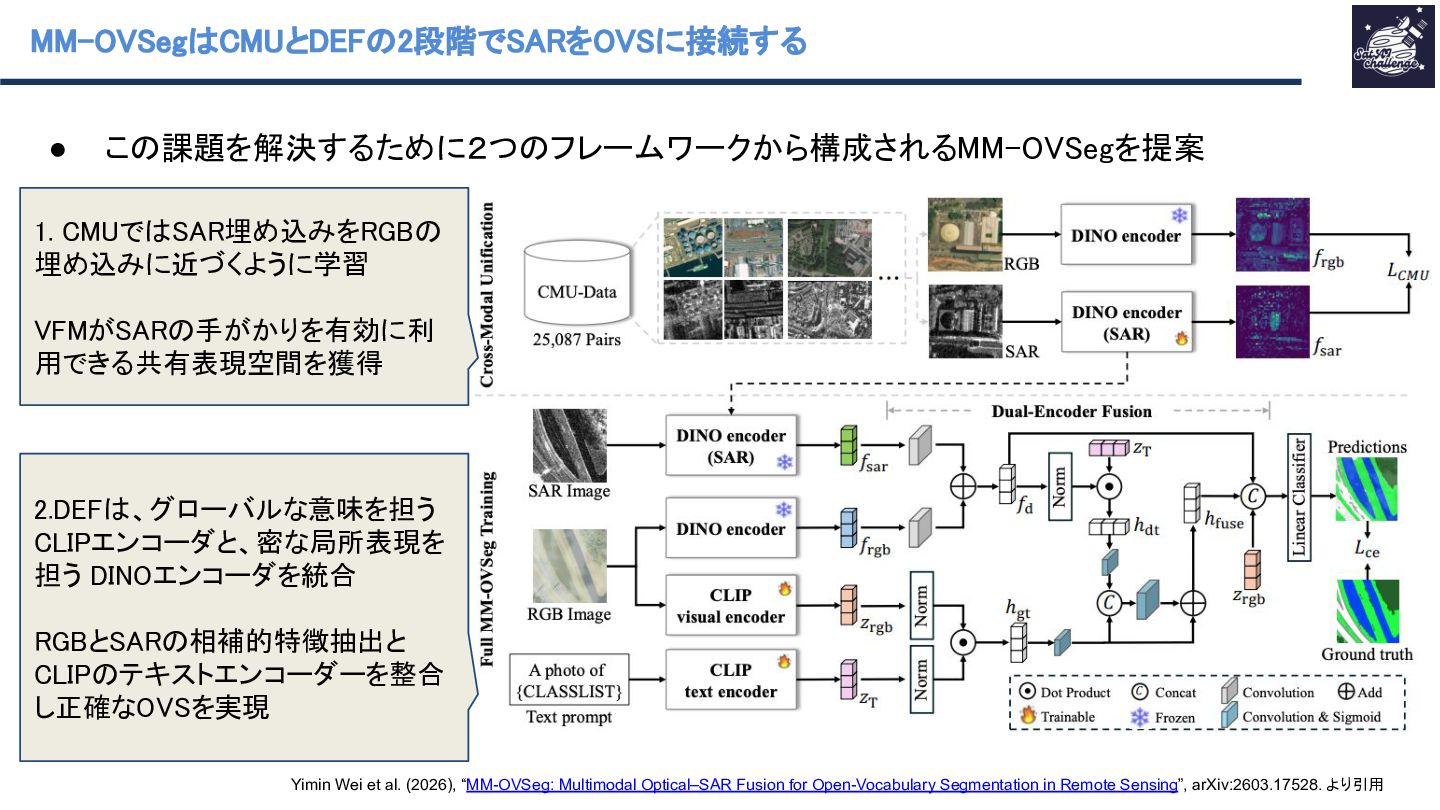
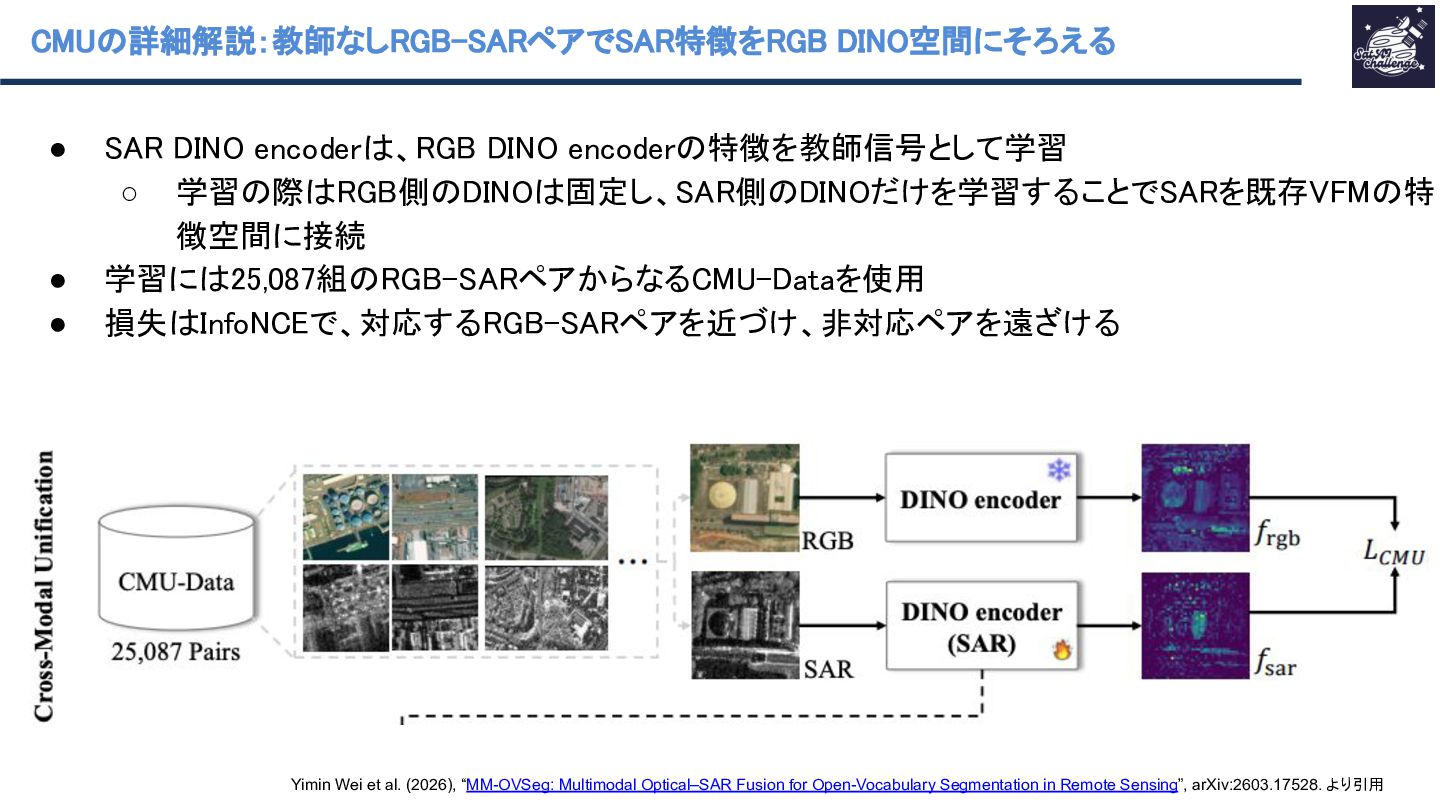
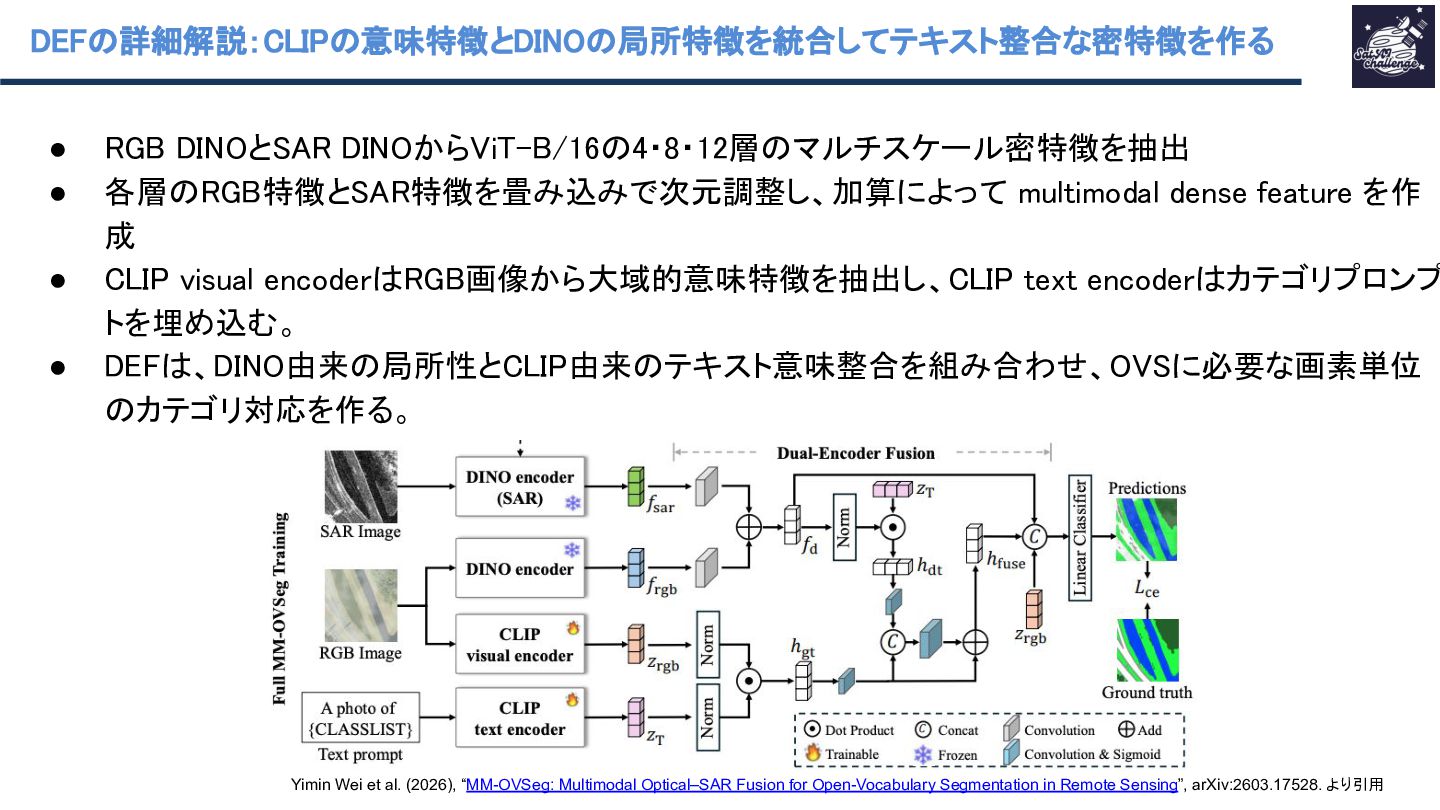
• この課題を解決するために2つのフレームワークから構成されるMM-OVSegを提案 MM-OVSegはCMUとDEFの2段階でSARをOVSに接続する Yimin Wei et al. (2026), “MM-OVSeg: Multimodal
Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 1. CMUではSAR埋め込みをRGBの 埋め込みに近づくように学習 VFMがSARの手がかりを有効に利 用できる共有表現空間を獲得 2.DEFは、グローバルな意味を担う CLIPエンコーダと、密な局所表現を 担う DINOエンコーダを統合 RGBとSARの相補的特徴抽出と CLIPのテキストエンコーダーを整合 し正確なOVSを実現 -
• SAR DINO encoderは、RGB DINO encoderの特徴を教師信号として学習 ◦ 学習の際はRGB側のDINOは固定し、SAR側のDINOだけを学習することでSARを既存VFMの特 徴空間に接続 •
学習には25,087組のRGB-SARペアからなるCMU-Dataを使用 • 損失はInfoNCEで、対応するRGB-SARペアを近づけ、非対応ペアを遠ざける CMUの詳細解説:教師なしRGB-SARペアでSAR特徴をRGB DINO空間にそろえる Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
• RGB DINOとSAR DINOからViT-B/16の4・8・12層のマルチスケール密特徴を抽出 • 各層のRGB特徴とSAR特徴を畳み込みで次元調整し、加算によって multimodal dense feature を作
成 • CLIP visual encoderはRGB画像から大域的意味特徴を抽出し、CLIP text encoderはカテゴリプロンプ トを埋め込む。 • DEFは、DINO由来の局所性とCLIP由来のテキスト意味整合を組み合わせ、OVSに必要な画素単位 のカテゴリ対応を作る。 DEFの詳細解説:CLIPの意味特徴とDINOの局所特徴を統合してテキスト整合な密特徴を作る Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
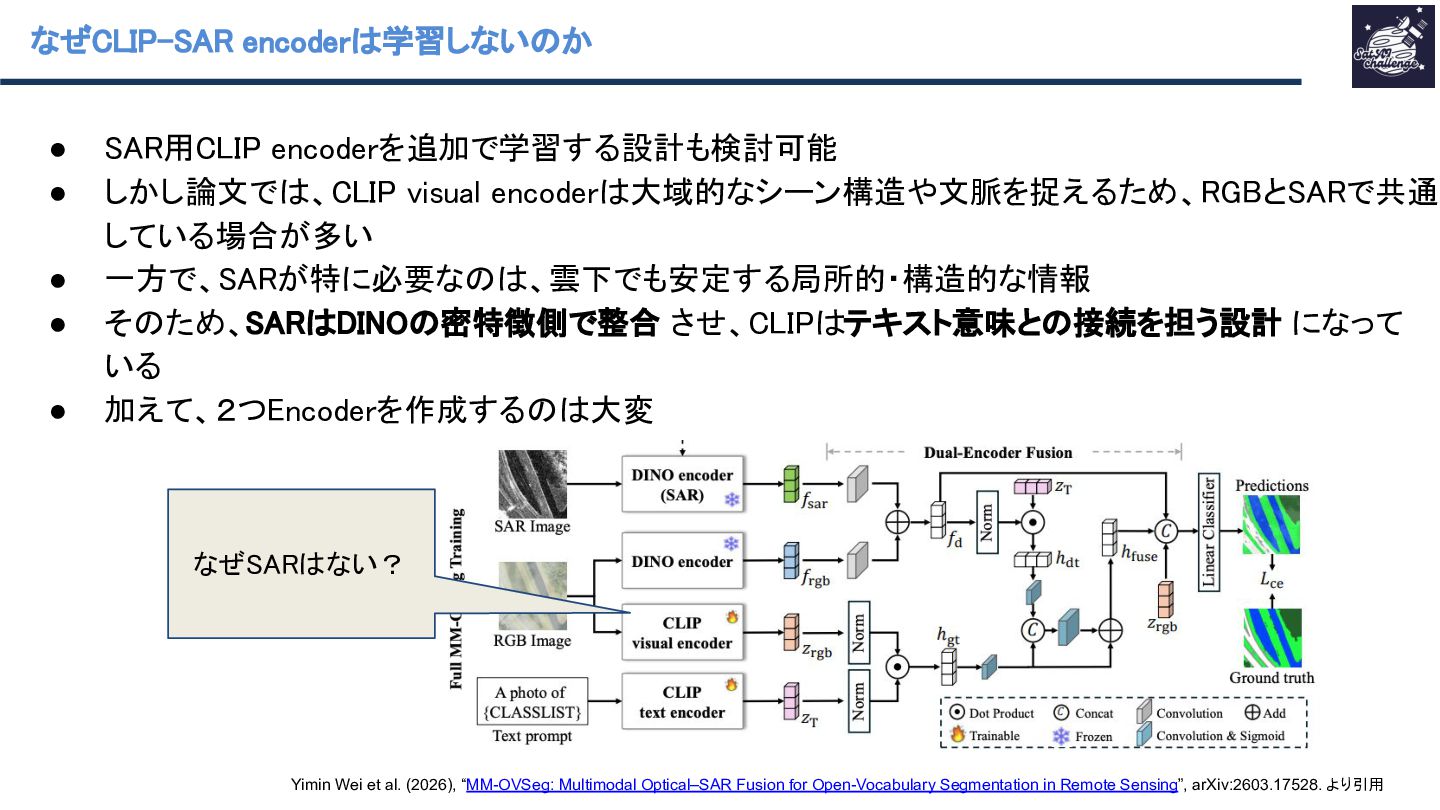
• SAR用CLIP encoderを追加で学習する設計も検討可能 • しかし論文では、CLIP visual encoderは大域的なシーン構造や文脈を捉えるため、RGBとSARで共通 している場合が多い • 一方で、SARが特に必要なのは、雲下でも安定する局所的・構造的な情報
• そのため、SARはDINOの密特徴側で整合 させ、CLIPはテキスト意味との接続を担う設計 になって いる • 加えて、2つEncoderを作成するのは大変 なぜCLIP-SAR encoderは学習しないのか Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 なぜSARはない? -
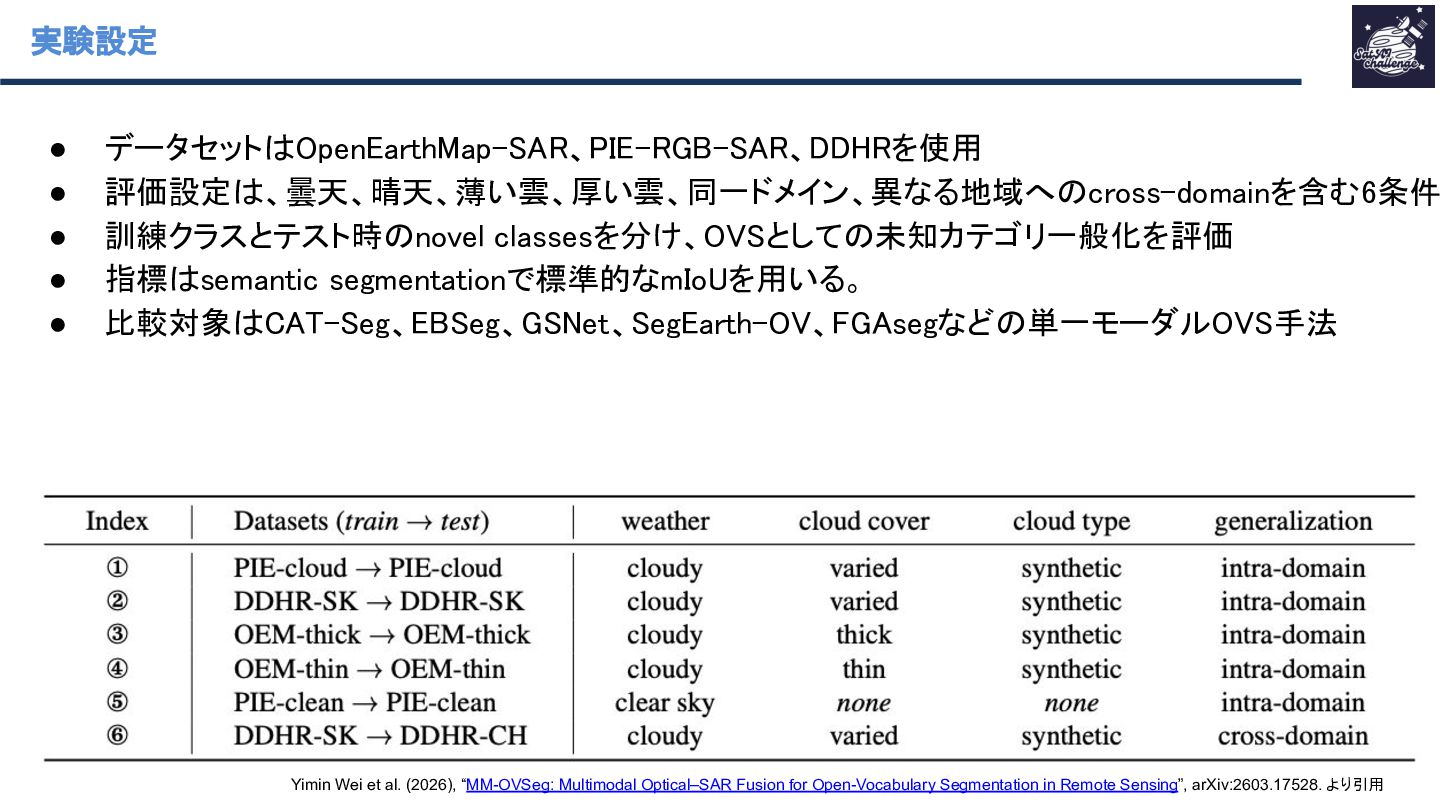
• データセットはOpenEarthMap-SAR、PIE-RGB-SAR、DDHRを使用 • 評価設定は、曇天、晴天、薄い雲、厚い雲、同一ドメイン、異なる地域へのcross-domainを含む6条件 • 訓練クラスとテスト時のnovel classesを分け、OVSとしての未知カテゴリ一般化を評価 • 指標はsemantic segmentationで標準的なmIoUを用いる。
• 比較対象はCAT-Seg、EBSeg、GSNet、SegEarth-OV、FGAsegなどの単一モーダルOVS手法 実験設定 Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
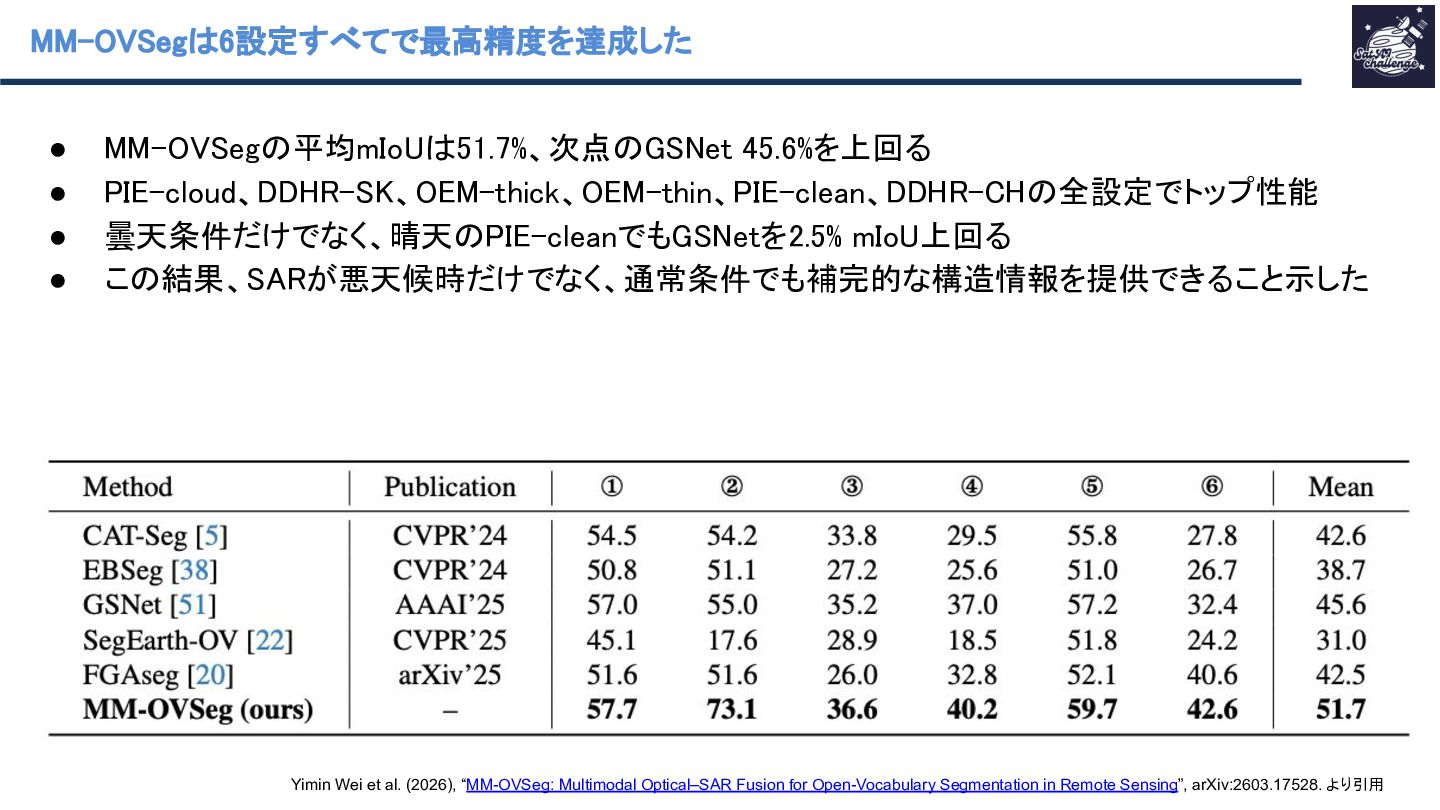
• MM-OVSegの平均mIoUは51.7%、次点のGSNet 45.6%を上回る • PIE-cloud、DDHR-SK、OEM-thick、OEM-thin、PIE-clean、DDHR-CHの全設定でトップ性能 • 曇天条件だけでなく、晴天のPIE-cleanでもGSNetを2.5% mIoU上回る • この結果、SARが悪天候時だけでなく、通常条件でも補完的な構造情報を提供できること示した
MM-OVSegは6設定すべてで最高精度を達成した Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
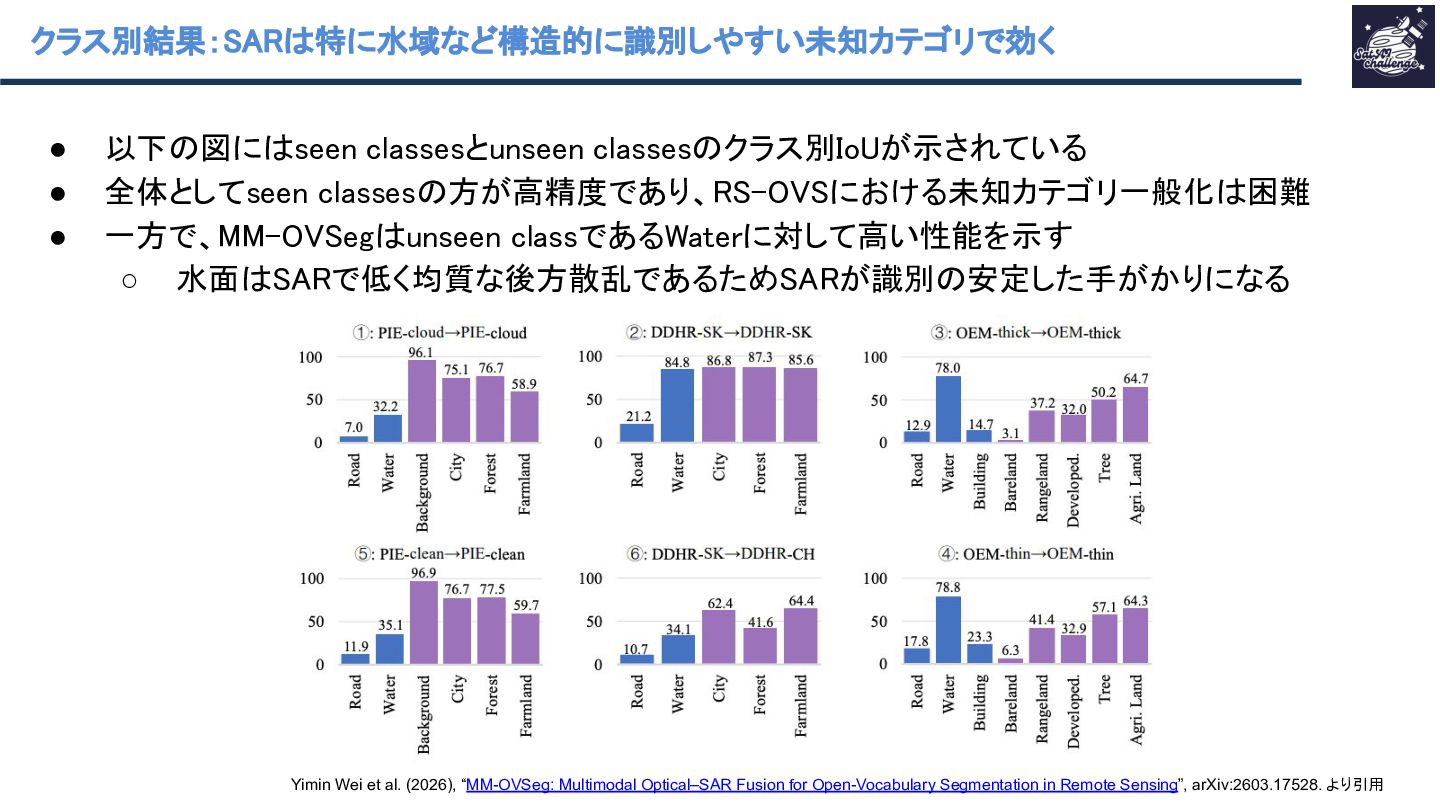
• 以下の図にはseen classesとunseen classesのクラス別IoUが示されている • 全体としてseen classesの方が高精度であり、RS-OVSにおける未知カテゴリ一般化は困難 • 一方で、MM-OVSegはunseen classであるWaterに対して高い性能を示す
◦ 水面はSARで低く均質な後方散乱であるためSARが識別の安定した手がかりになる クラス別結果:SARは特に水域など構造的に識別しやすい未知カテゴリで効く Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
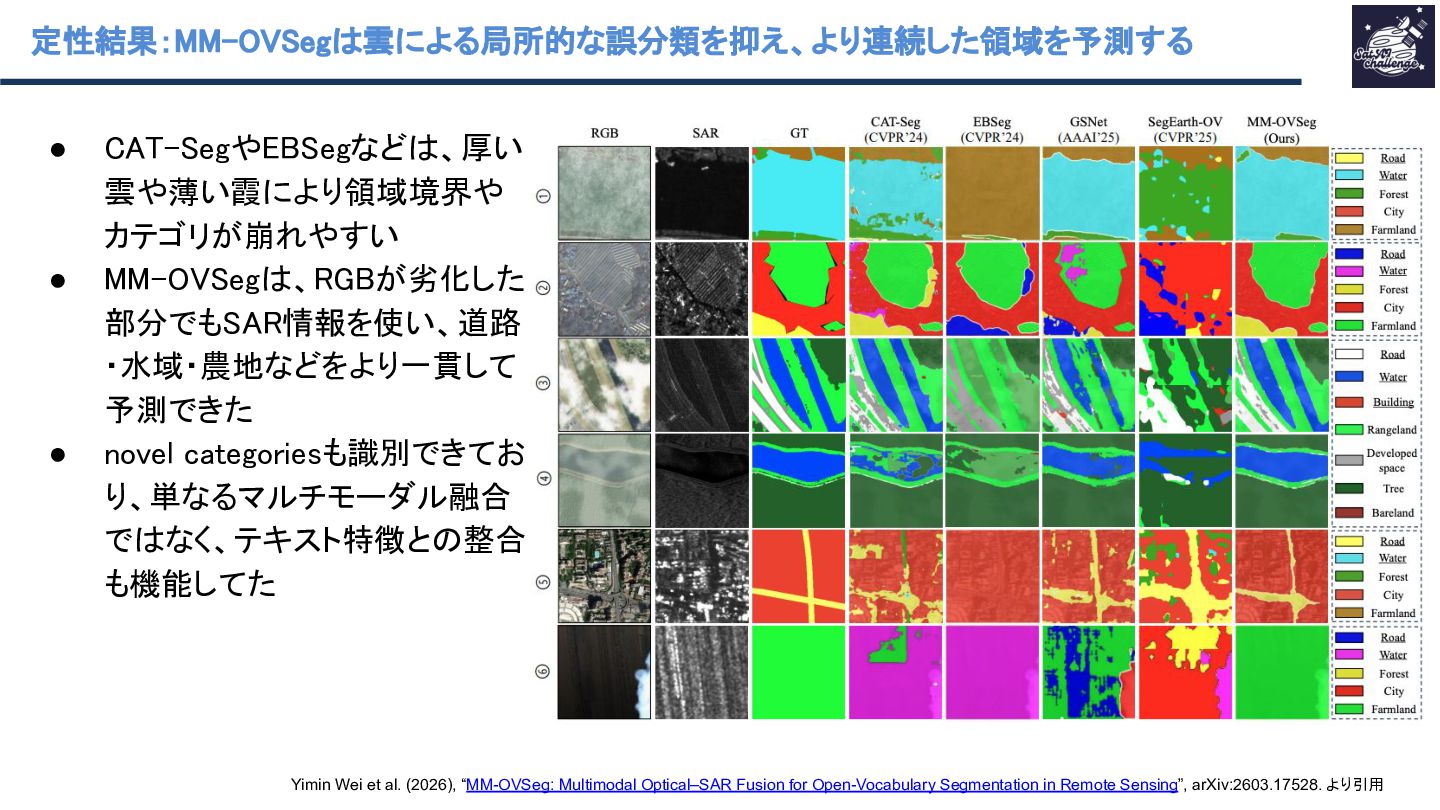
定性結果:MM-OVSegは雲による局所的な誤分類を抑え、より連続した領域を予測する Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion
for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 • CAT-SegやEBSegなどは、厚い 雲や薄い霞により領域境界や カテゴリが崩れやすい • MM-OVSegは、RGBが劣化した 部分でもSAR情報を使い、道路 ・水域・農地などをより一貫して 予測できた • novel categoriesも識別できてお り、単なるマルチモーダル融合 ではなく、テキスト特徴との整合 も機能してた -
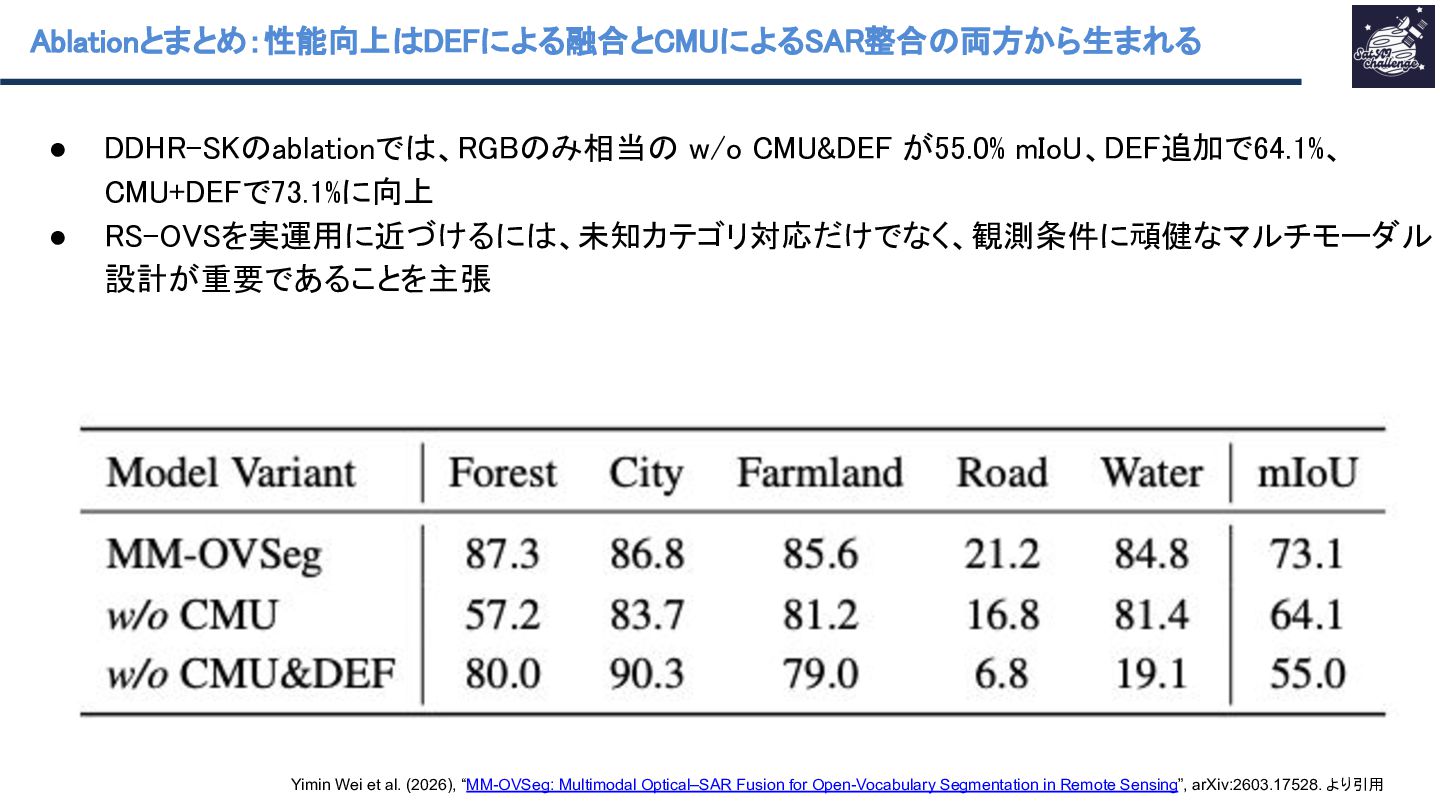
• DDHR-SKのablationでは、RGBのみ相当の w/o CMU&DEF が55.0% mIoU、DEF追加で64.1%、 CMU+DEFで73.1%に向上 • RS-OVSを実運用に近づけるには、未知カテゴリ対応だけでなく、観測条件に頑健なマルチモーダル 設計が重要であることを主張
Ablationとまとめ:性能向上はDEFによる融合とCMUによるSAR整合の両方から生まれる Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
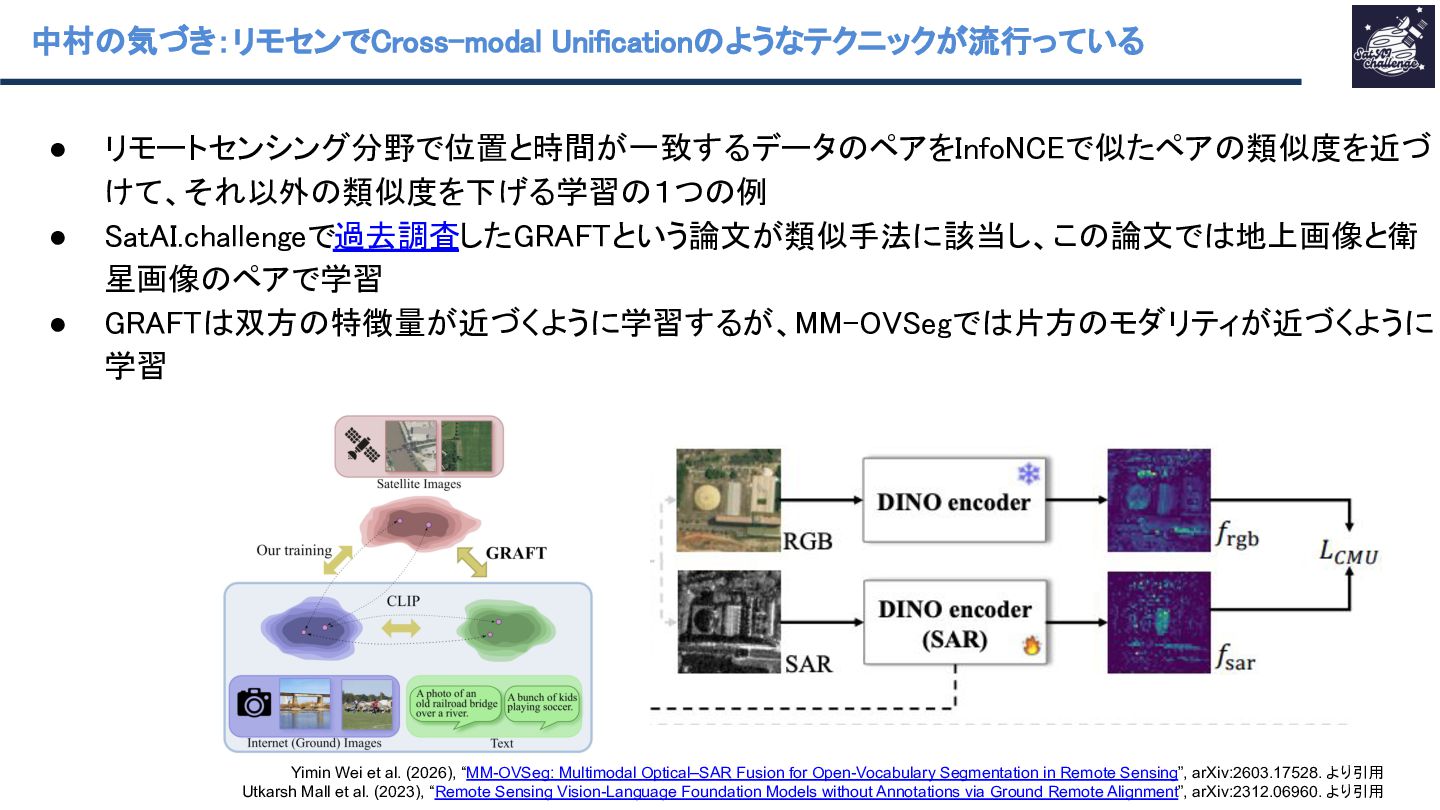
• リモートセンシング分野で位置と時間が一致するデータのペアをInfoNCEで似たペアの類似度を近づ けて、それ以外の類似度を下げる学習の1つの例 • SatAI.challengeで過去調査したGRAFTという論文が類似手法に該当し、この論文では地上画像と衛 星画像のペアで学習 • GRAFTは双方の特徴量が近づくように学習するが、MM-OVSegでは片方のモダリティが近づくように 学習 中村の気づき:リモセンでCross-modal
Unificationのようなテクニックが流行っている Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 Utkarsh Mall et al. (2023), “Remote Sensing Vision-Language Foundation Models without Annotations via Ground Remote Alignment”, arXiv:2312.06960. より引用 -
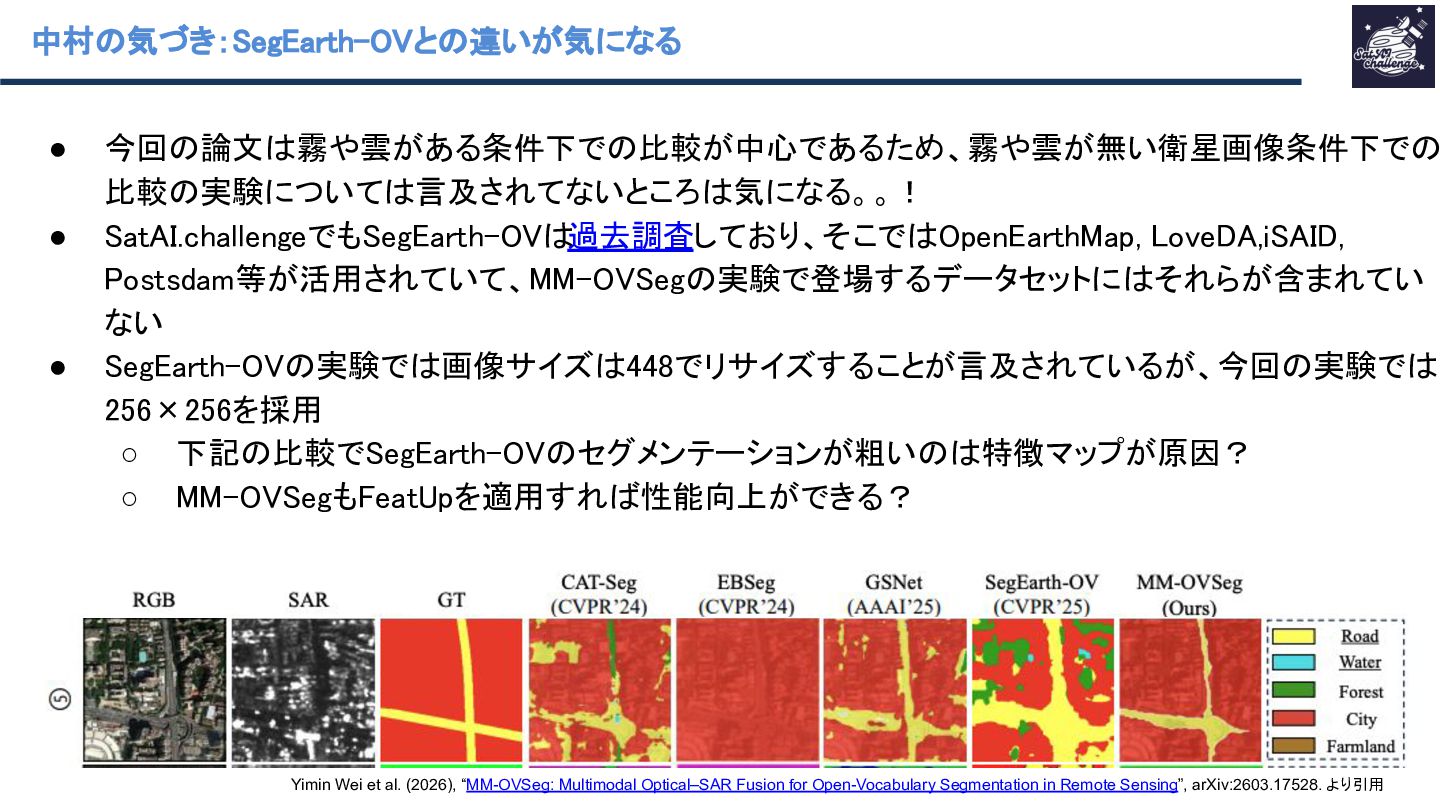
• 今回の論文は霧や雲がある条件下での比較が中心であるため、霧や雲が無い衛星画像条件下での 比較の実験については言及されてないところは気になる。。! • SatAI.challengeでもSegEarth-OVは 過去調査しており、そこではOpenEarthMap, LoveDA,iSAID, Postsdam等が活用されていて、MM-OVSegの実験で登場するデータセットにはそれらが含まれてい ない •
SegEarth-OVの実験では画像サイズは448でリサイズすることが言及されているが、今回の実験では 256×256を採用 ◦ 下記の比較でSegEarth-OVのセグメンテーションが粗いのは特徴マップが原因? ◦ MM-OVSegもFeatUpを適用すれば性能向上ができる? 中村の気づき:SegEarth-OVとの違いが気になる Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用 -
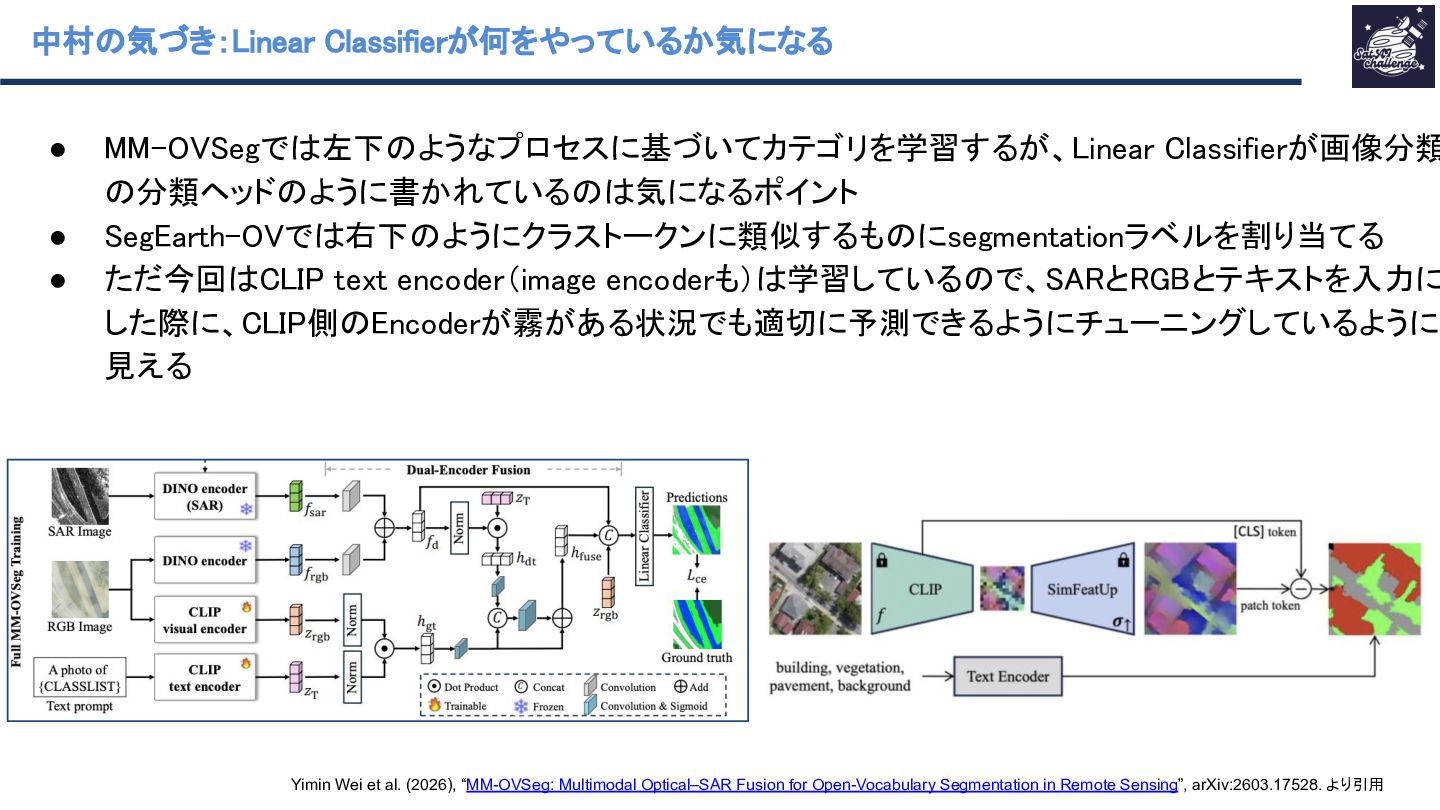
• MM-OVSegでは左下のようなプロセスに基づいてカテゴリを学習するが、Linear Classifierが画像分類 の分類ヘッドのように書かれているのは気になるポイント • SegEarth-OVでは右下のようにクラストークンに類似するものにsegmentationラベルを割り当てる • ただ今回はCLIP text encoder(image
encoderも)は学習しているので、SARとRGBとテキストを入力に した際に、CLIP側のEncoderが霧がある状況でも適切に予測できるようにチューニングしているように 見える 中村の気づき:Linear Classifierが何をやっているか気になる Yimin Wei et al. (2026), “MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing”, arXiv:2603.17528. より引用