Share
Embed
Apache Spark もくもく会
こちらのもくもく会の冒頭の資料です。
Databricks無料版で始めるSpark入門もくもく会 - connpass https://jedai.connpass.com/event/365277/
Takaaki Yayoi
September 16, 2025
Transcript
34 slides
-
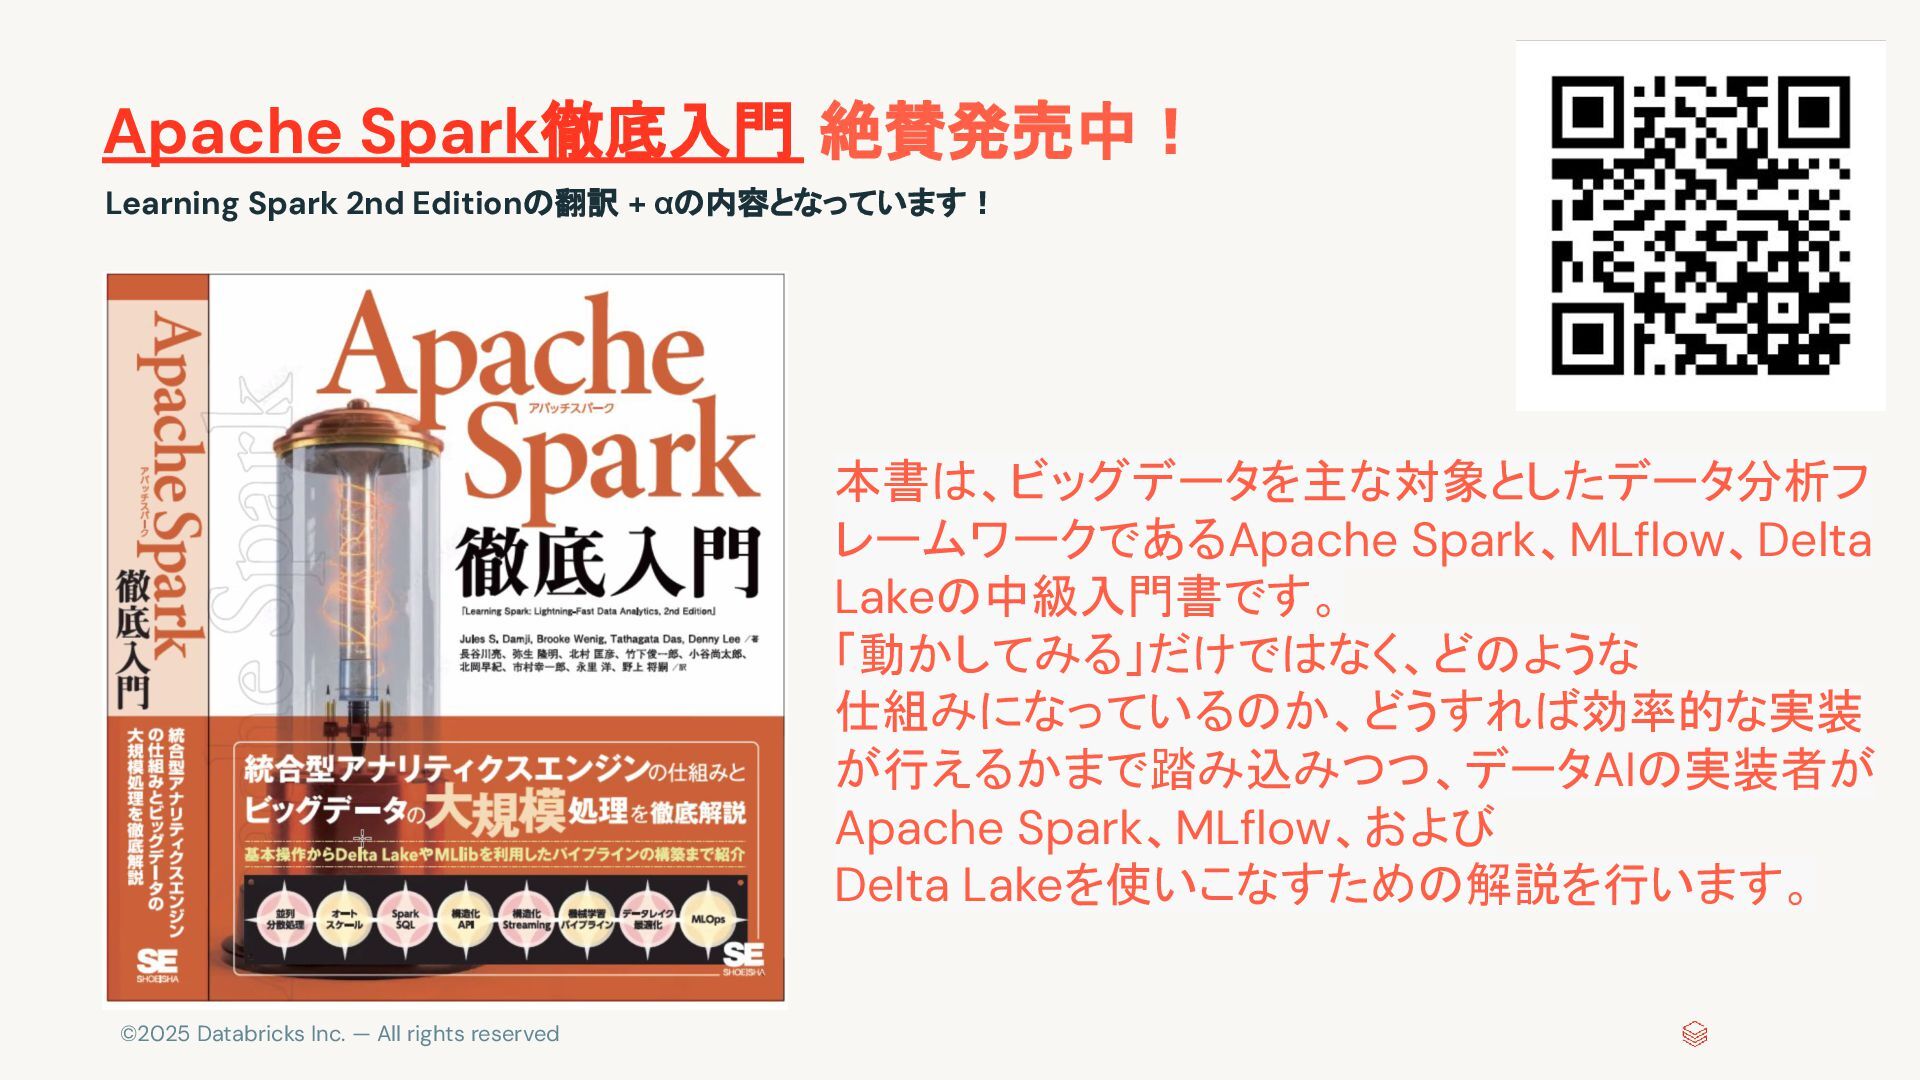
©2025 Databricks Inc. — All rights reserved Apache Spark徹底入門 絶賛発売中!
Learning Spark 2nd Editionの翻訳 + αの内容となっています! 本書は、ビッグデータを主な対象としたデータ分析フ レームワークであるApache Spark、MLflow、Delta Lakeの中級入門書です。 「動かしてみる」だけではなく、どのような 仕組みになっているのか、どうすれば効率的な実装 が行えるかまで踏み込みつつ、データAIの実装者が Apache Spark、MLflow、および Delta Lakeを使いこなすための解説を行います。 -
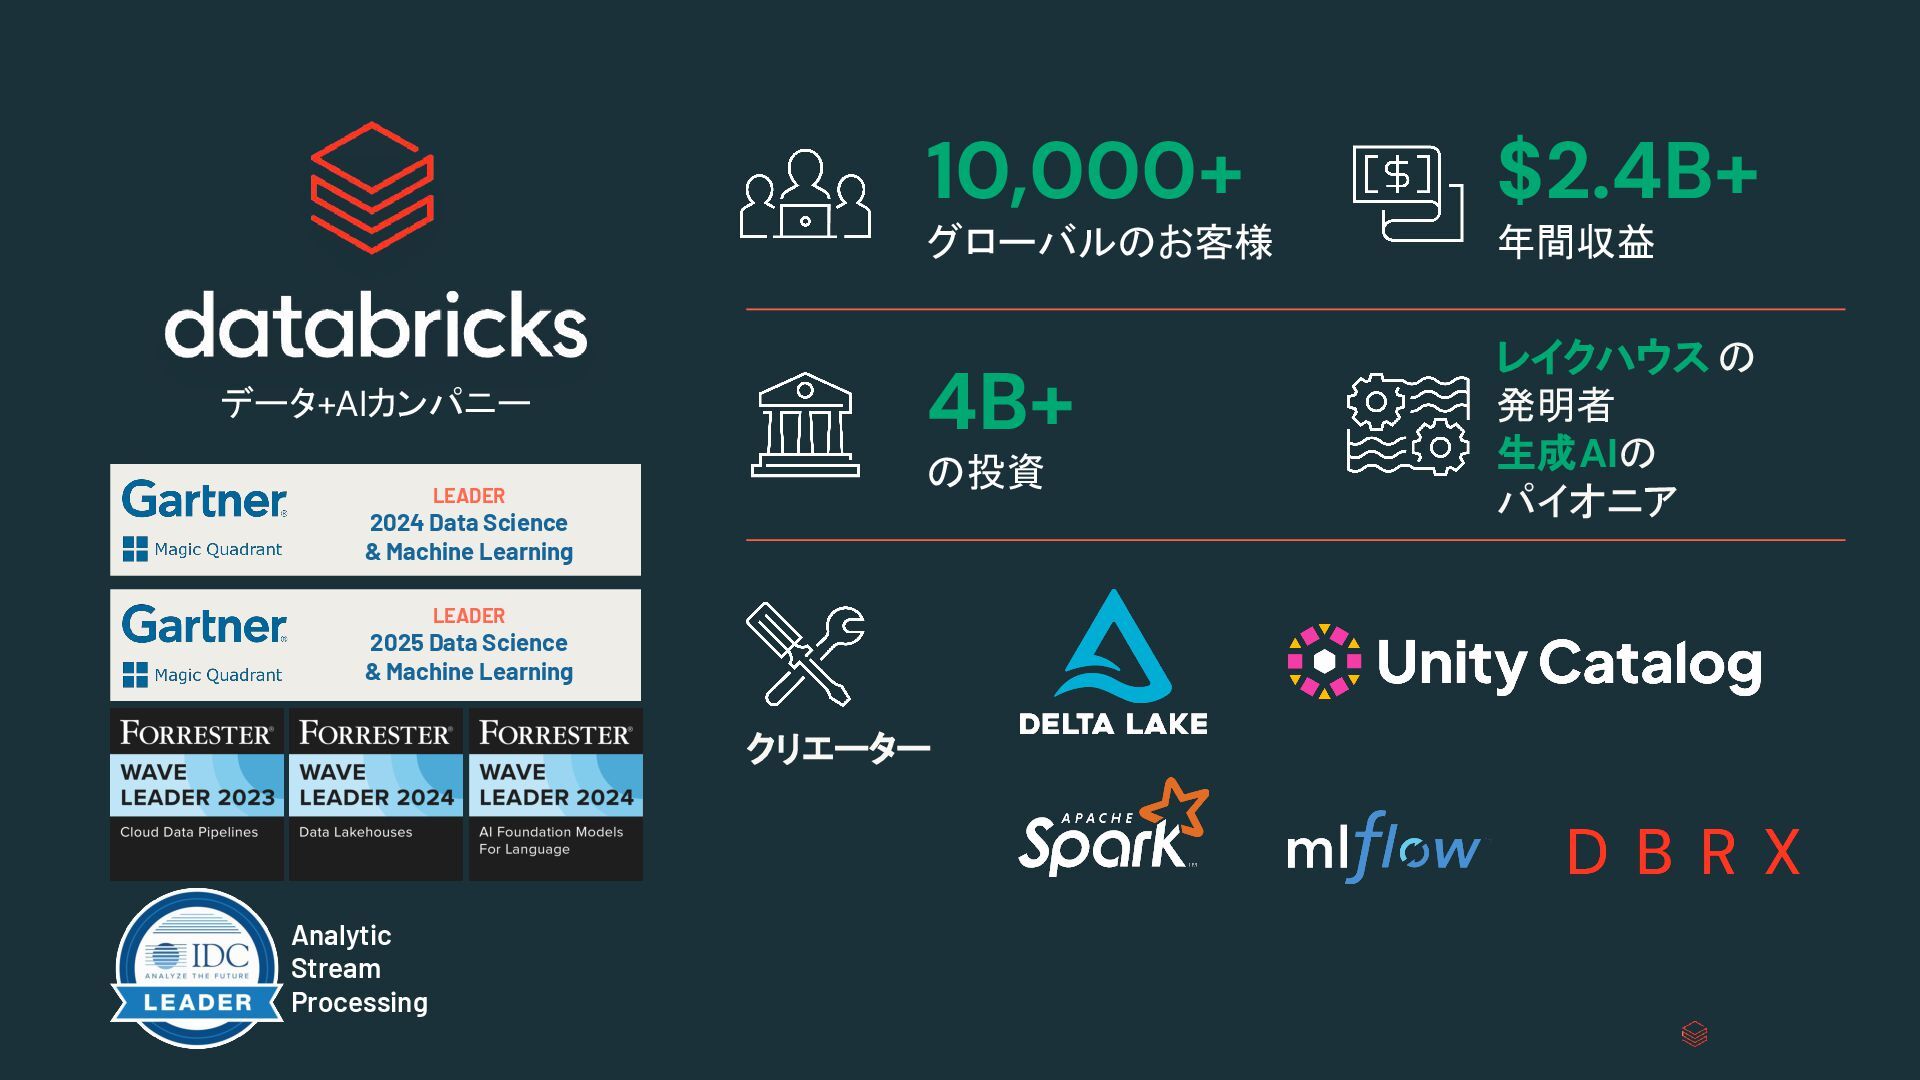
データ+AIカンパニー クリエーター 10,000+ グローバルのお客様 $2.4B+ 年間収益 4B+ の投資 レイクハウス の
発明者 生成AIの パイオニア LEADER 2025 Data Science & Machine Learning Analytic Stream Processing LEADER 2024 Data Science & Machine Learning -
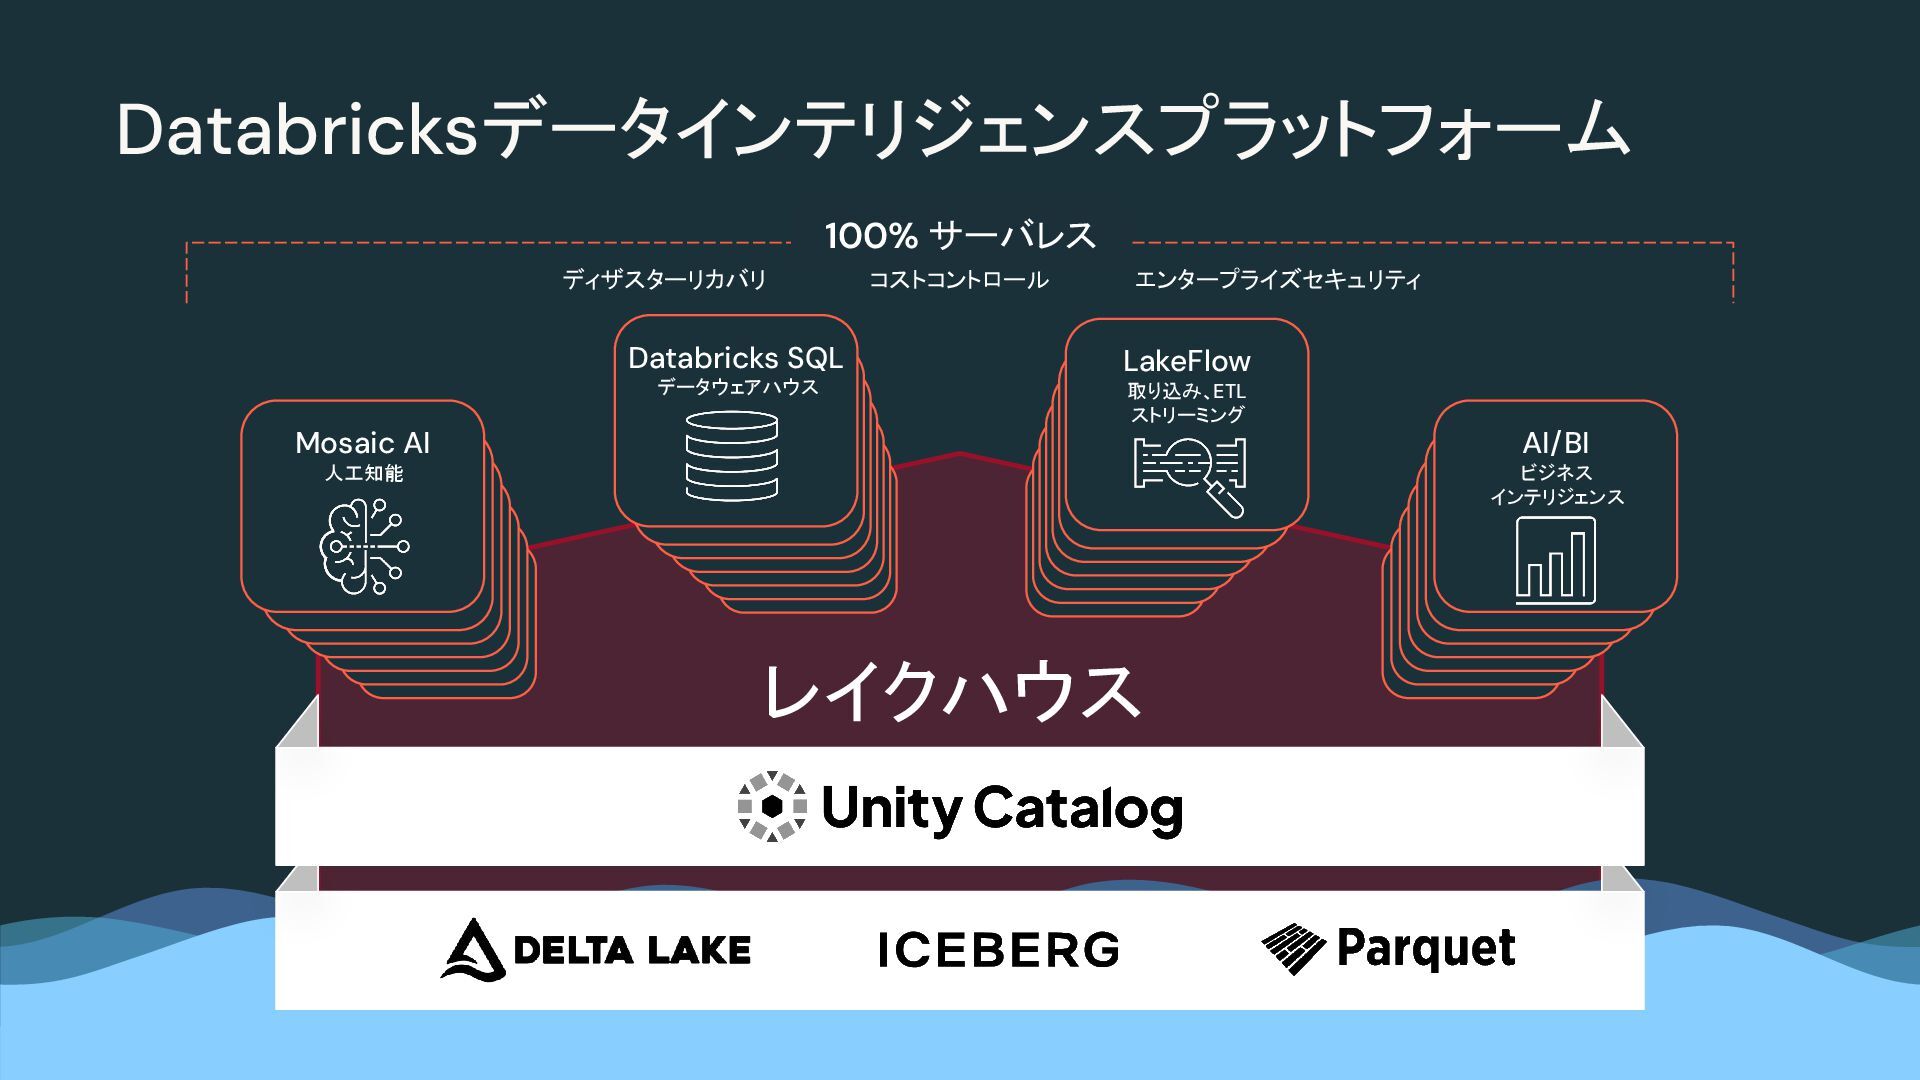
ディザスターリカバリ コストコントロール エンタープライズセキュリティ 100% サーバレス レイクハウス AI/BI ビジネス インテリジェンス Databricks
SQL データウェアハウス LakeFlow 取り込み、ETL ストリーミング Mosaic AI 人工知能 Databricksデータインテリジェンスプラットフォーム -
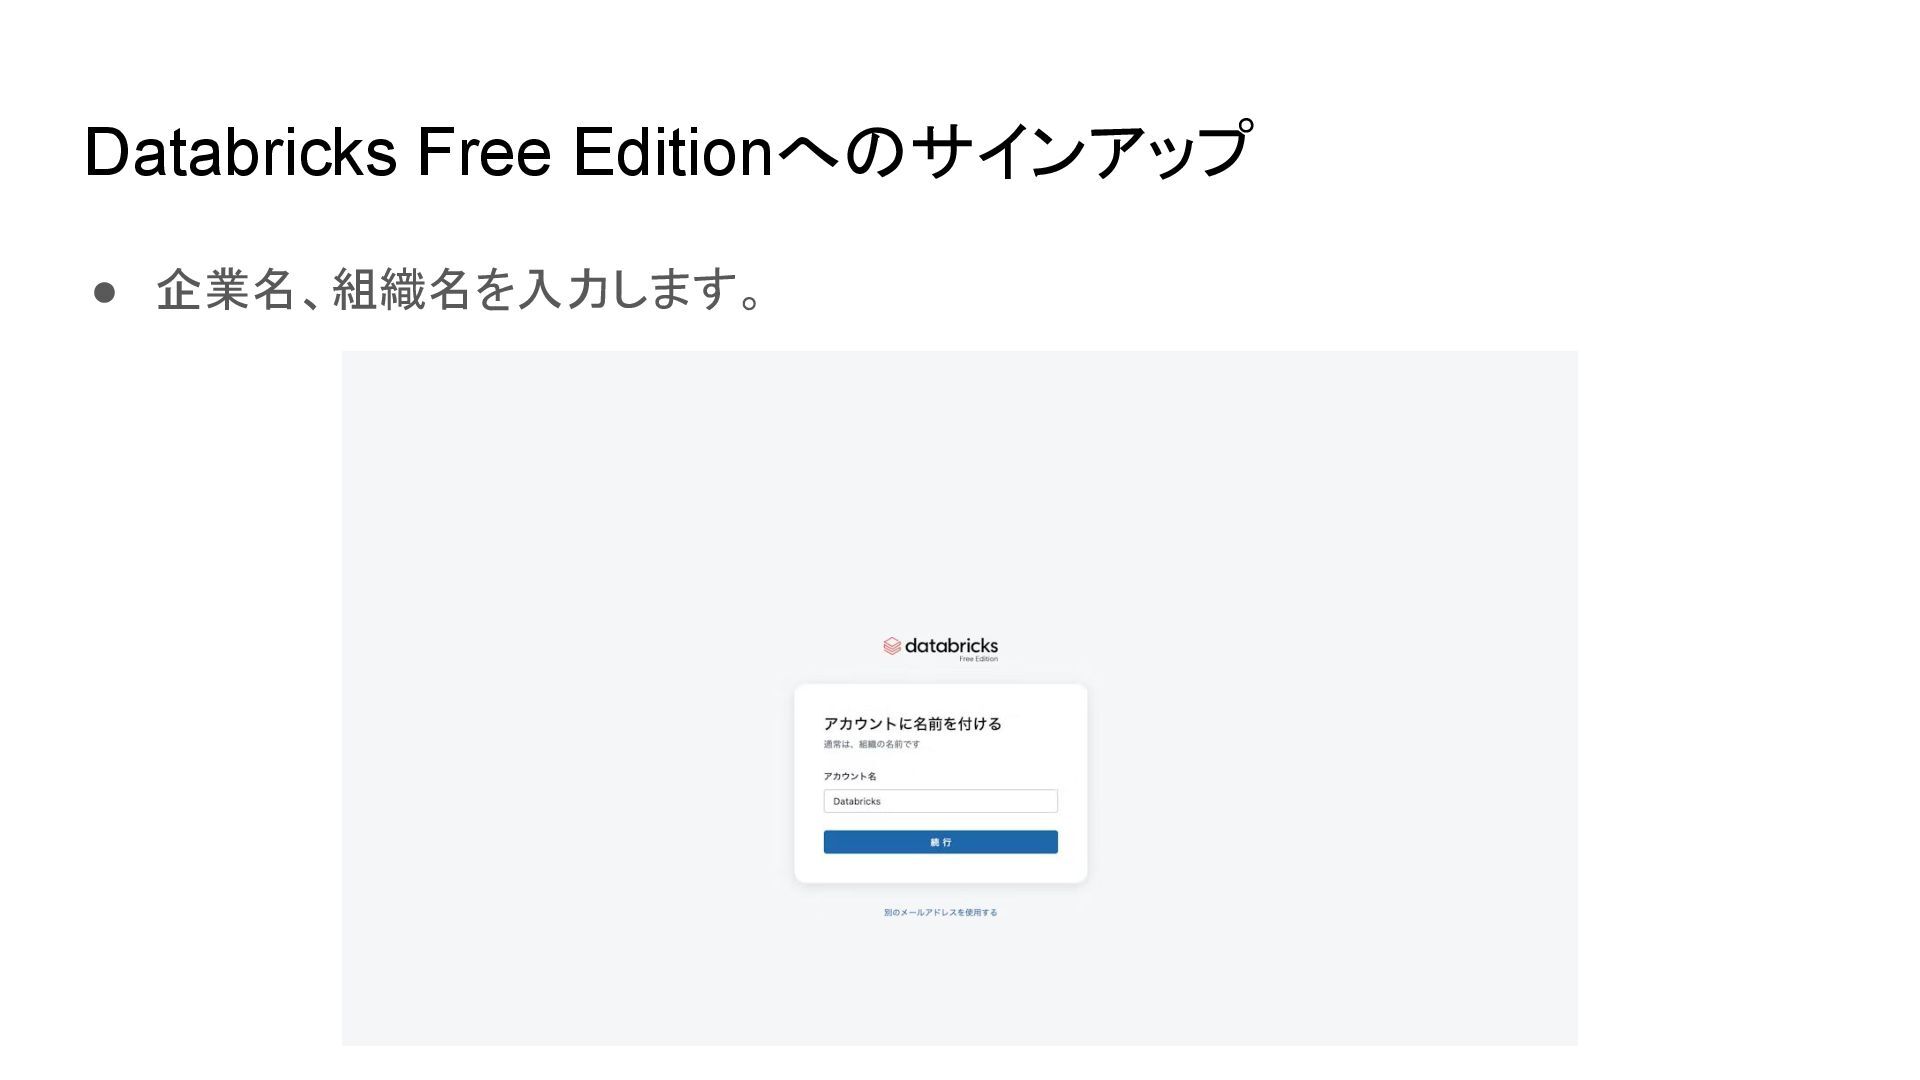
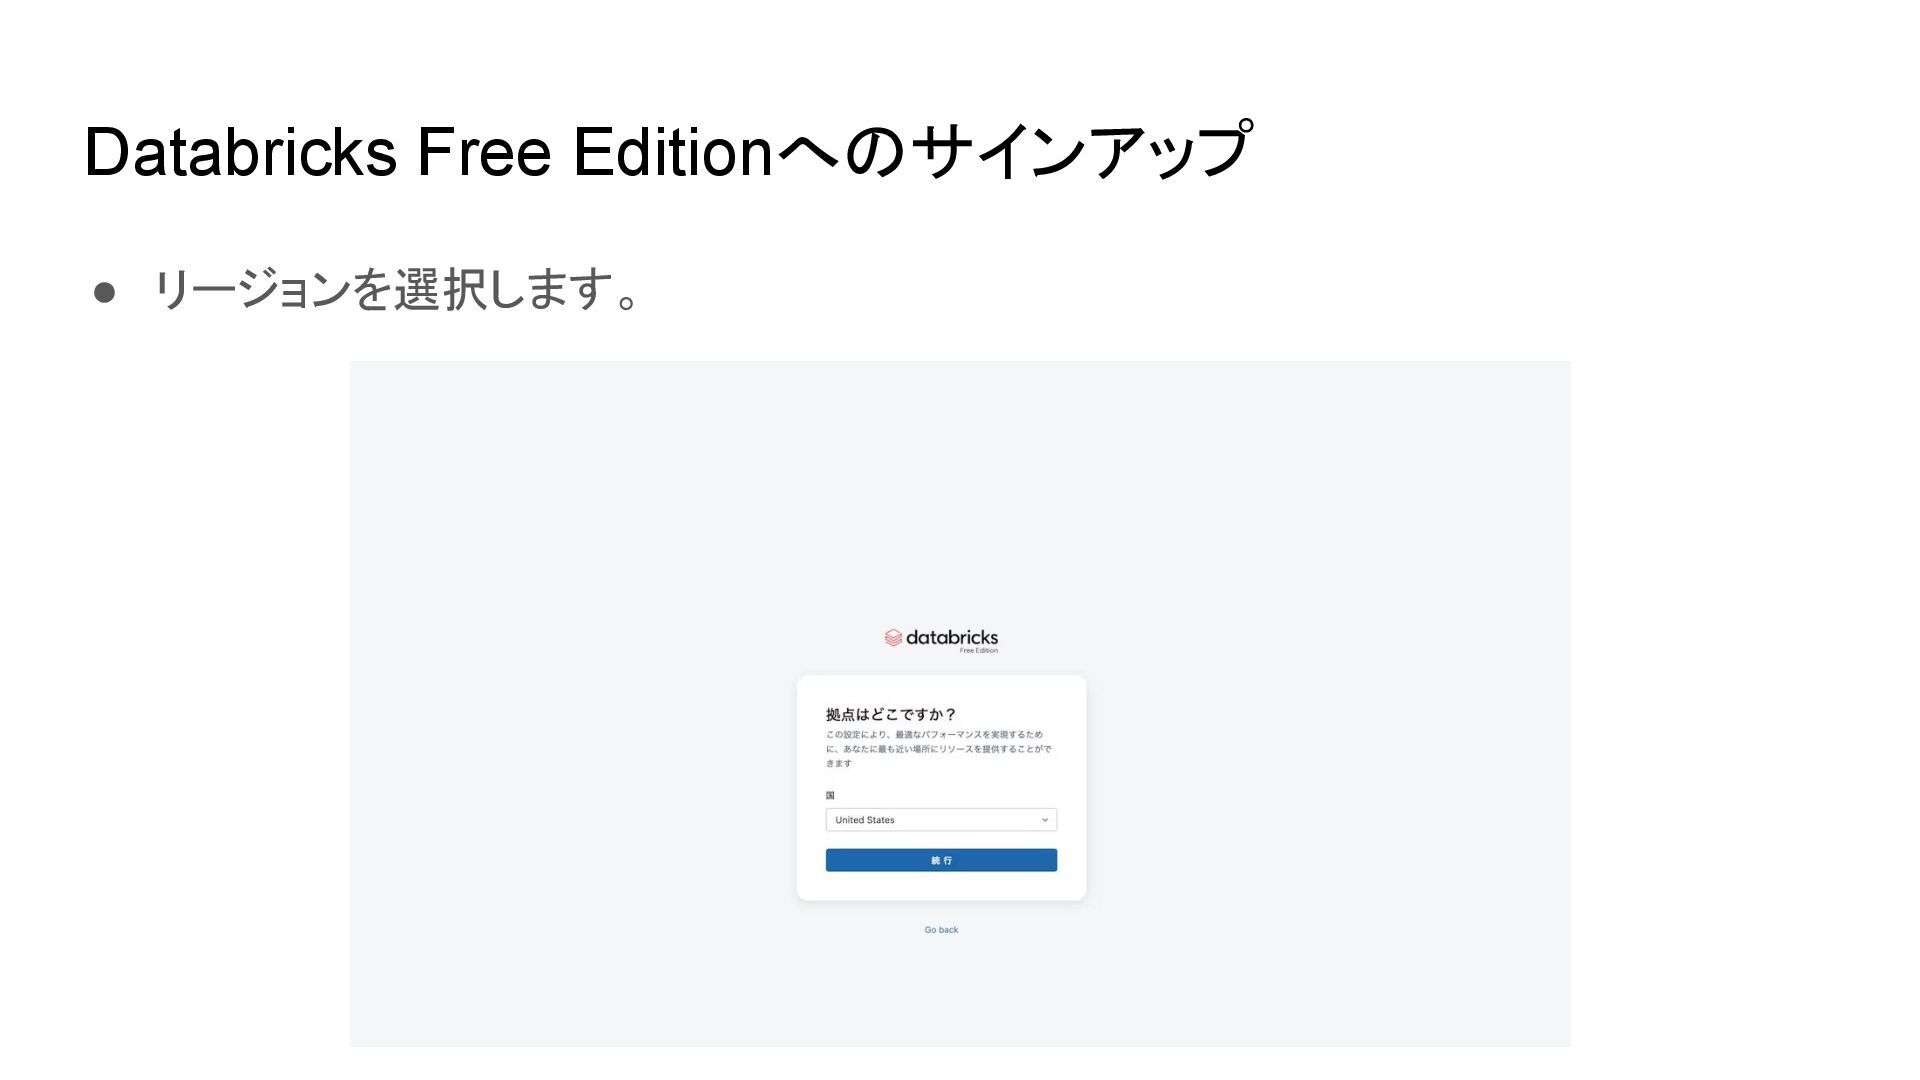
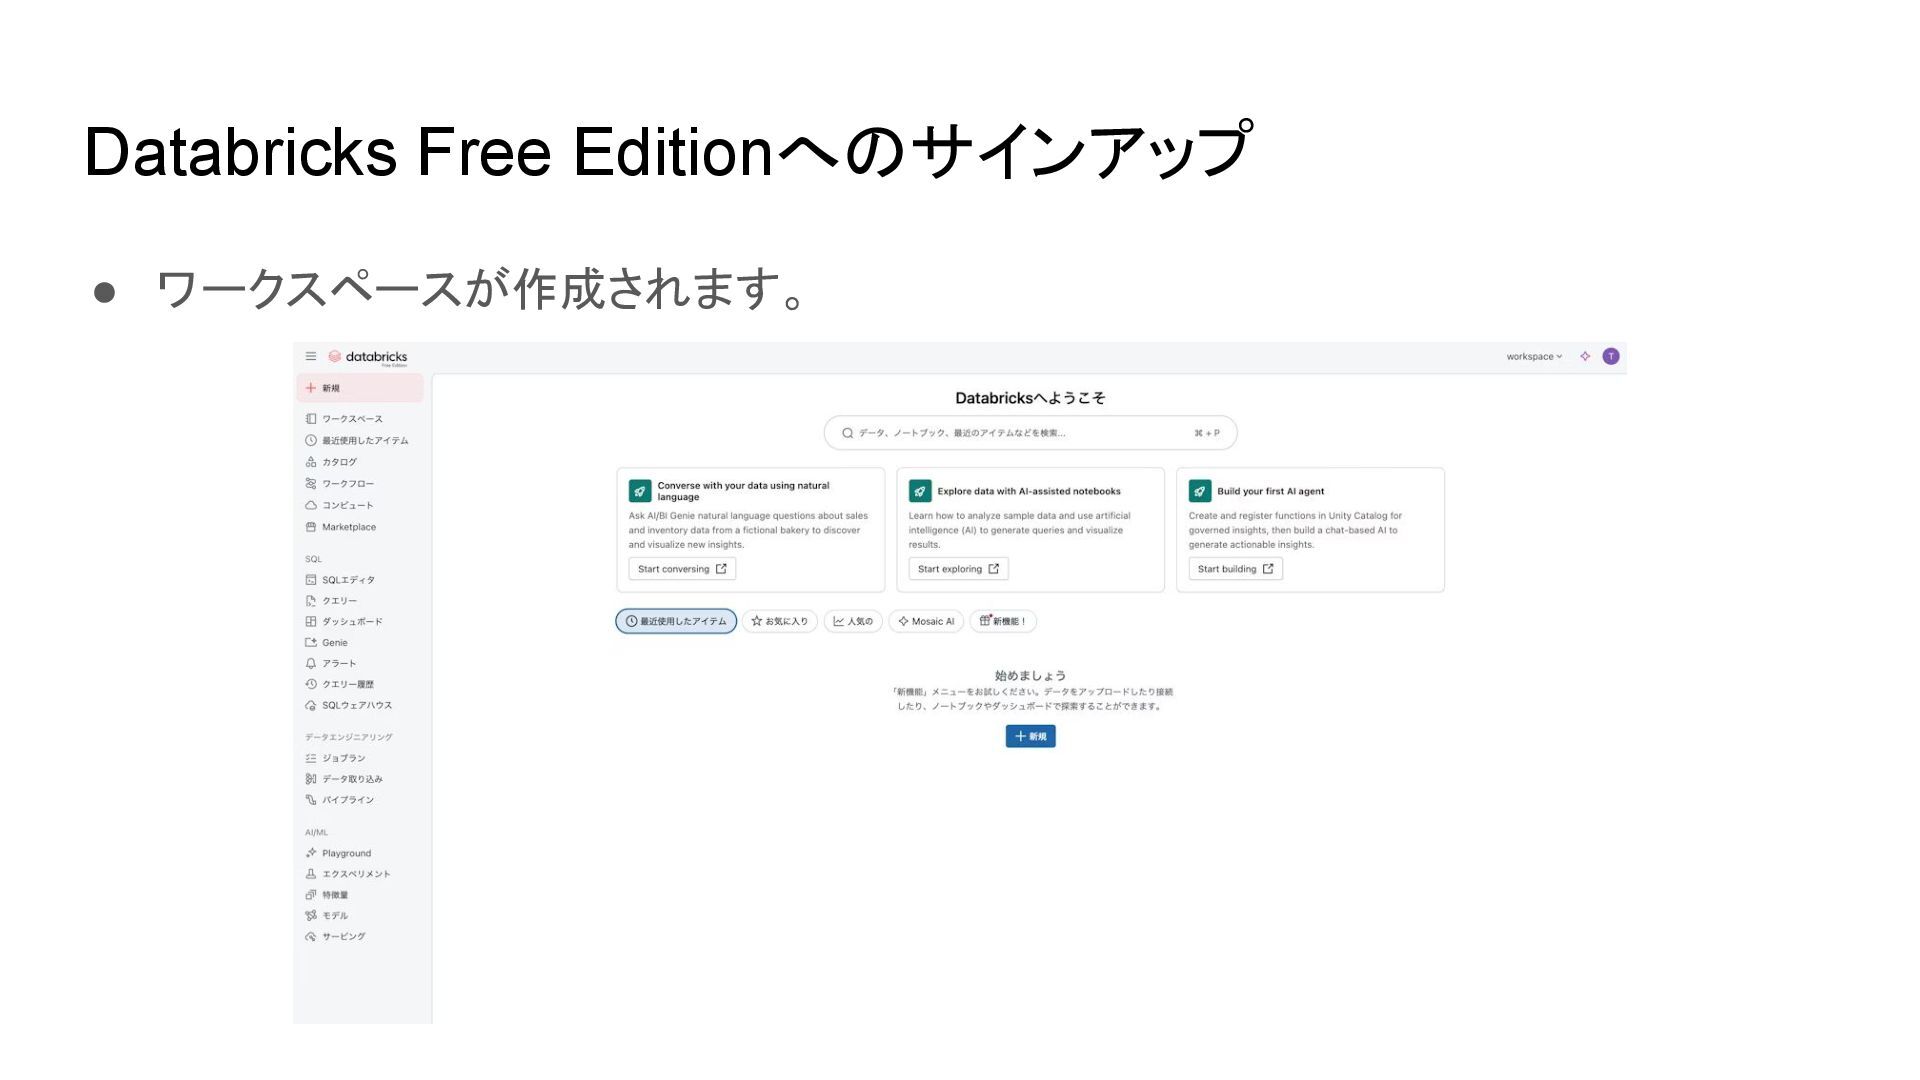
Databricks Free Edition • Databricksは基本的にコンピュートリソースの従量課金であり有料でしか利用できま せんでした。 • Community Editionという無料版は存在していましたが、機能、計算リソースの制限 が厳しく、学習に使うにも困難さを伴っていました。
• 今回リリースされたFree Editionはほとんど全ての Databricksの機能を利用 できつ つも無料で提供 されているサービスです。 • なお、以下の点にご注意ください。詳細はDatabricks Free Editionの制限事項をご 覧ください。 ◦ 営利目的では利用できません。学習目的でご利用ください。 ◦ 一部利用できない機能があります。 ◦ 無料と言っても無限にリソースを利用できるわけではありません。割り当てられたクォータを使い切る と、リセットされるまでは計算リソースを使用することはできません。 -
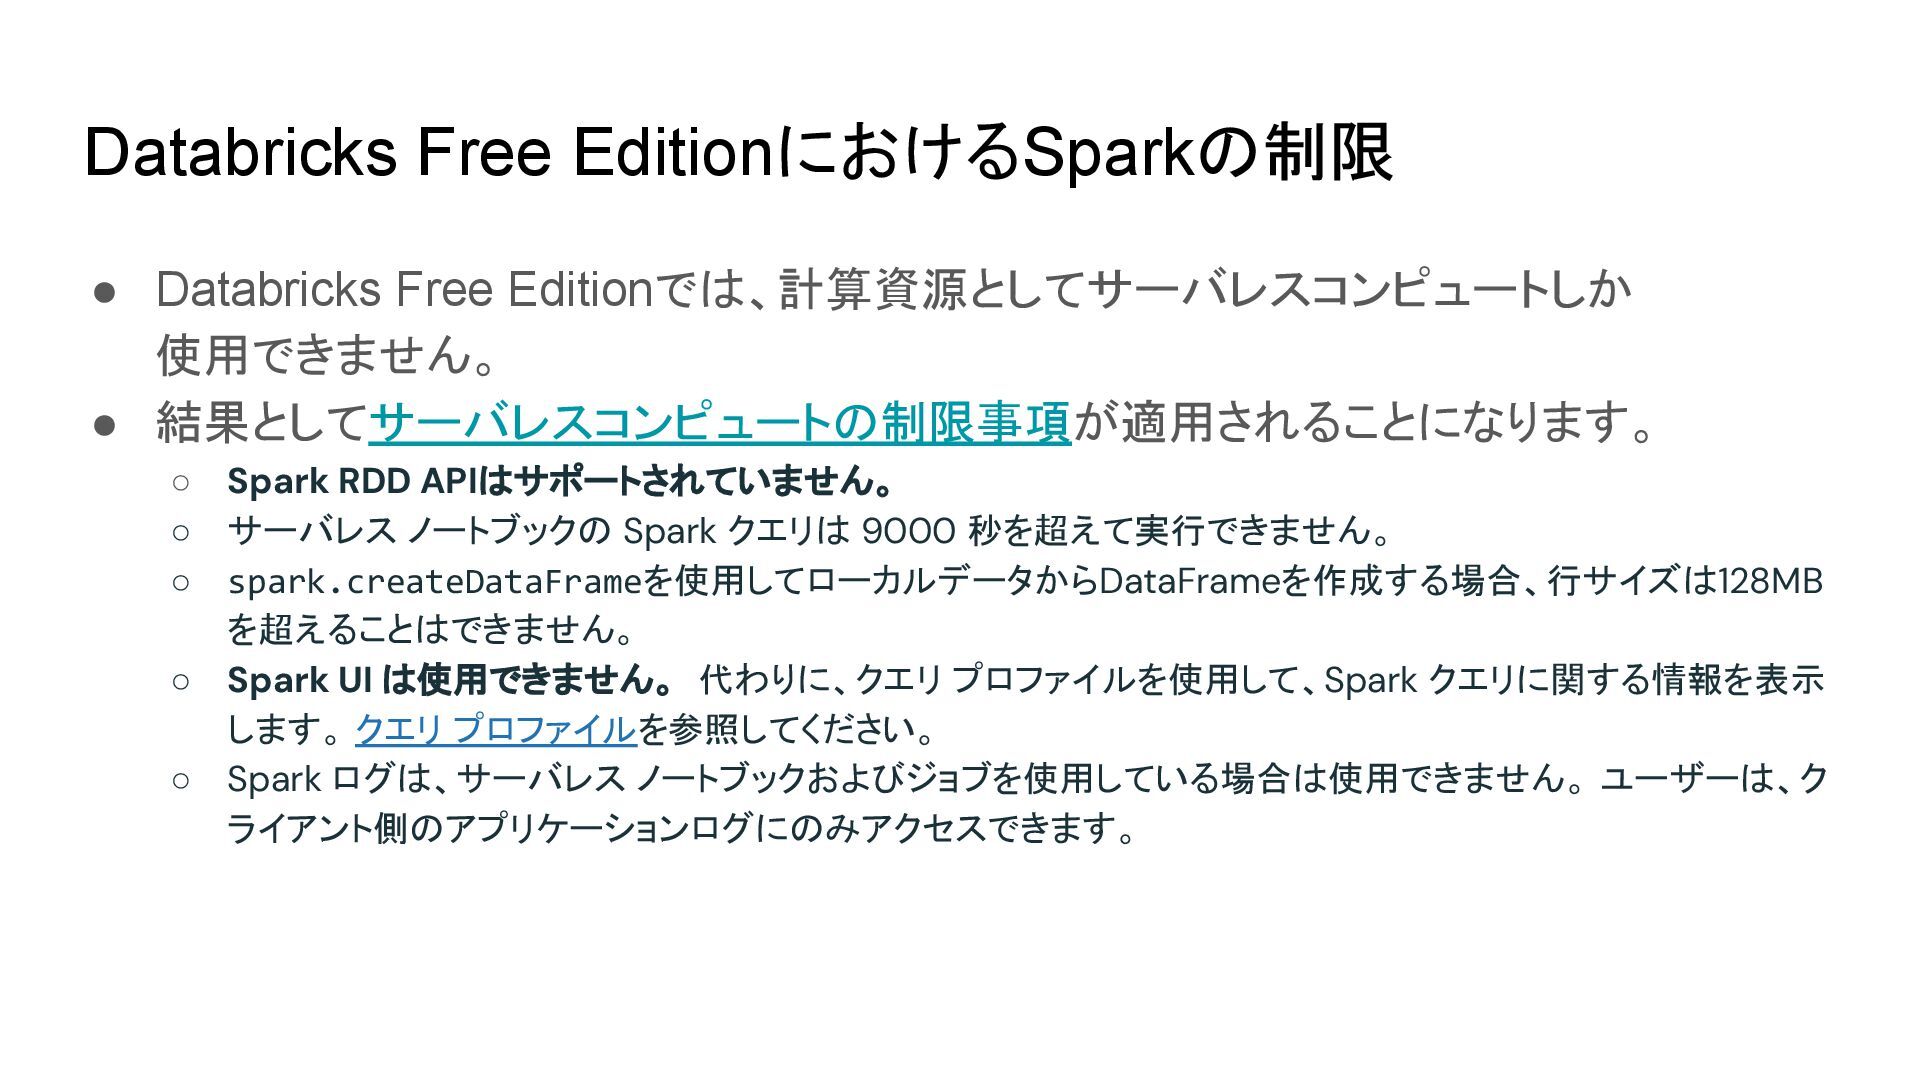
Databricks Free EditionにおけるSparkの制限 • Databricks Free Editionでは、計算資源としてサーバレスコンピュートしか 使用できません。 • 結果としてサーバレスコンピュートの制限事項が適用されることになります。
◦ Spark RDD APIはサポートされていません。 ◦ サーバレス ノートブックの Spark クエリは 9000 秒を超えて実行できません。 ◦ spark.createDataFrameを使用してローカルデータからDataFrameを作成する場合、行サイズは128MB を超えることはできません。 ◦ Spark UI は使用できません。 代わりに、クエリ プロファイルを使用して、Spark クエリに関する情報を表示 します。 クエリ プロファイルを参照してください。 ◦ Spark ログは、サーバレス ノートブックおよびジョブを使用している場合は使用できません。 ユーザーは、ク ライアント側のアプリケーションログにのみアクセスできます。 -
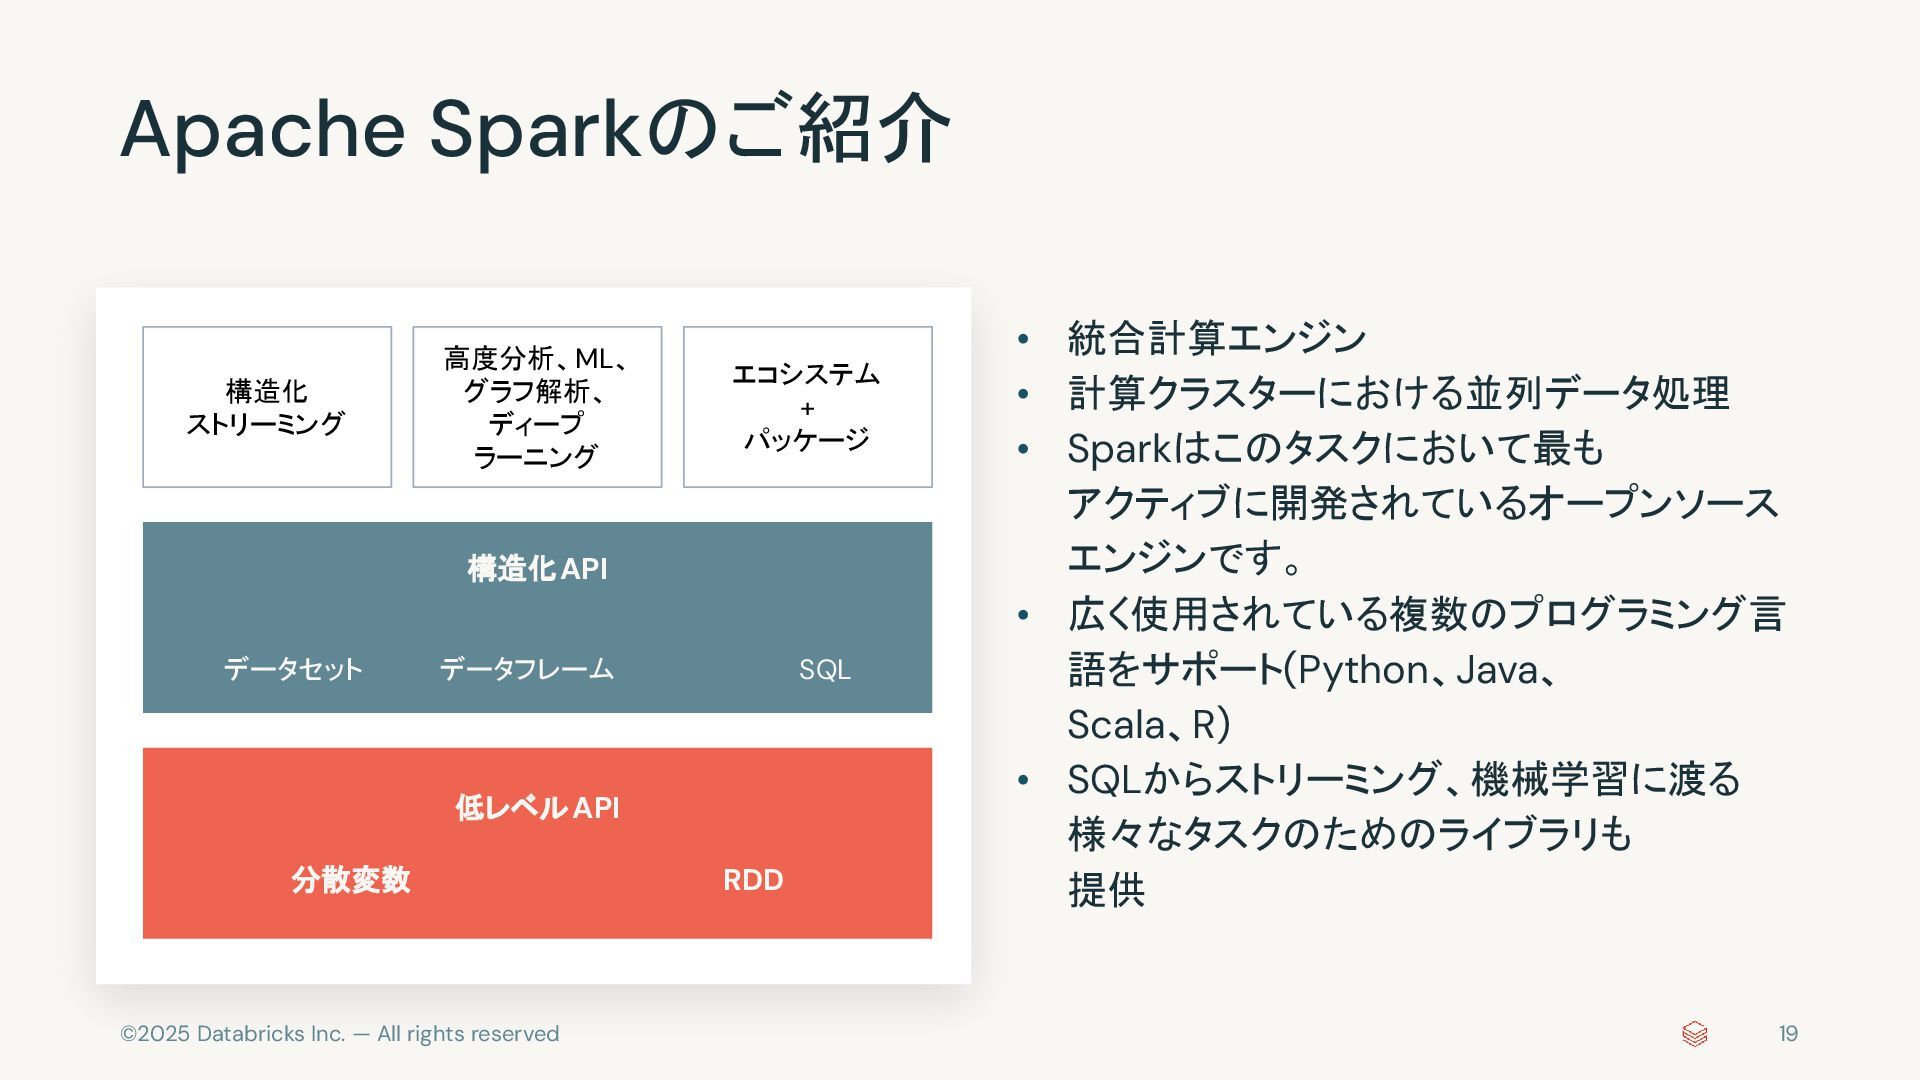
©2025 Databricks Inc. — All rights reserved Apache Sparkのご紹介 •
統合計算エンジン • 計算クラスターにおける並列データ処理 • Sparkはこのタスクにおいて最も アクティブに開発されているオープンソース エンジンです。 • 広く使用されている複数のプログラミング言 語をサポート(Python、Java、 Scala、R) • SQLからストリーミング、機械学習に渡る 様々なタスクのためのライブラリも 提供 19 構造化 ストリーミング 構造化API データセット データフレーム SQL 高度分析、ML、 グラフ解析、 ディープ ラーニング エコシステム + パッケージ 低レベルAPI 分散変数 RDD -
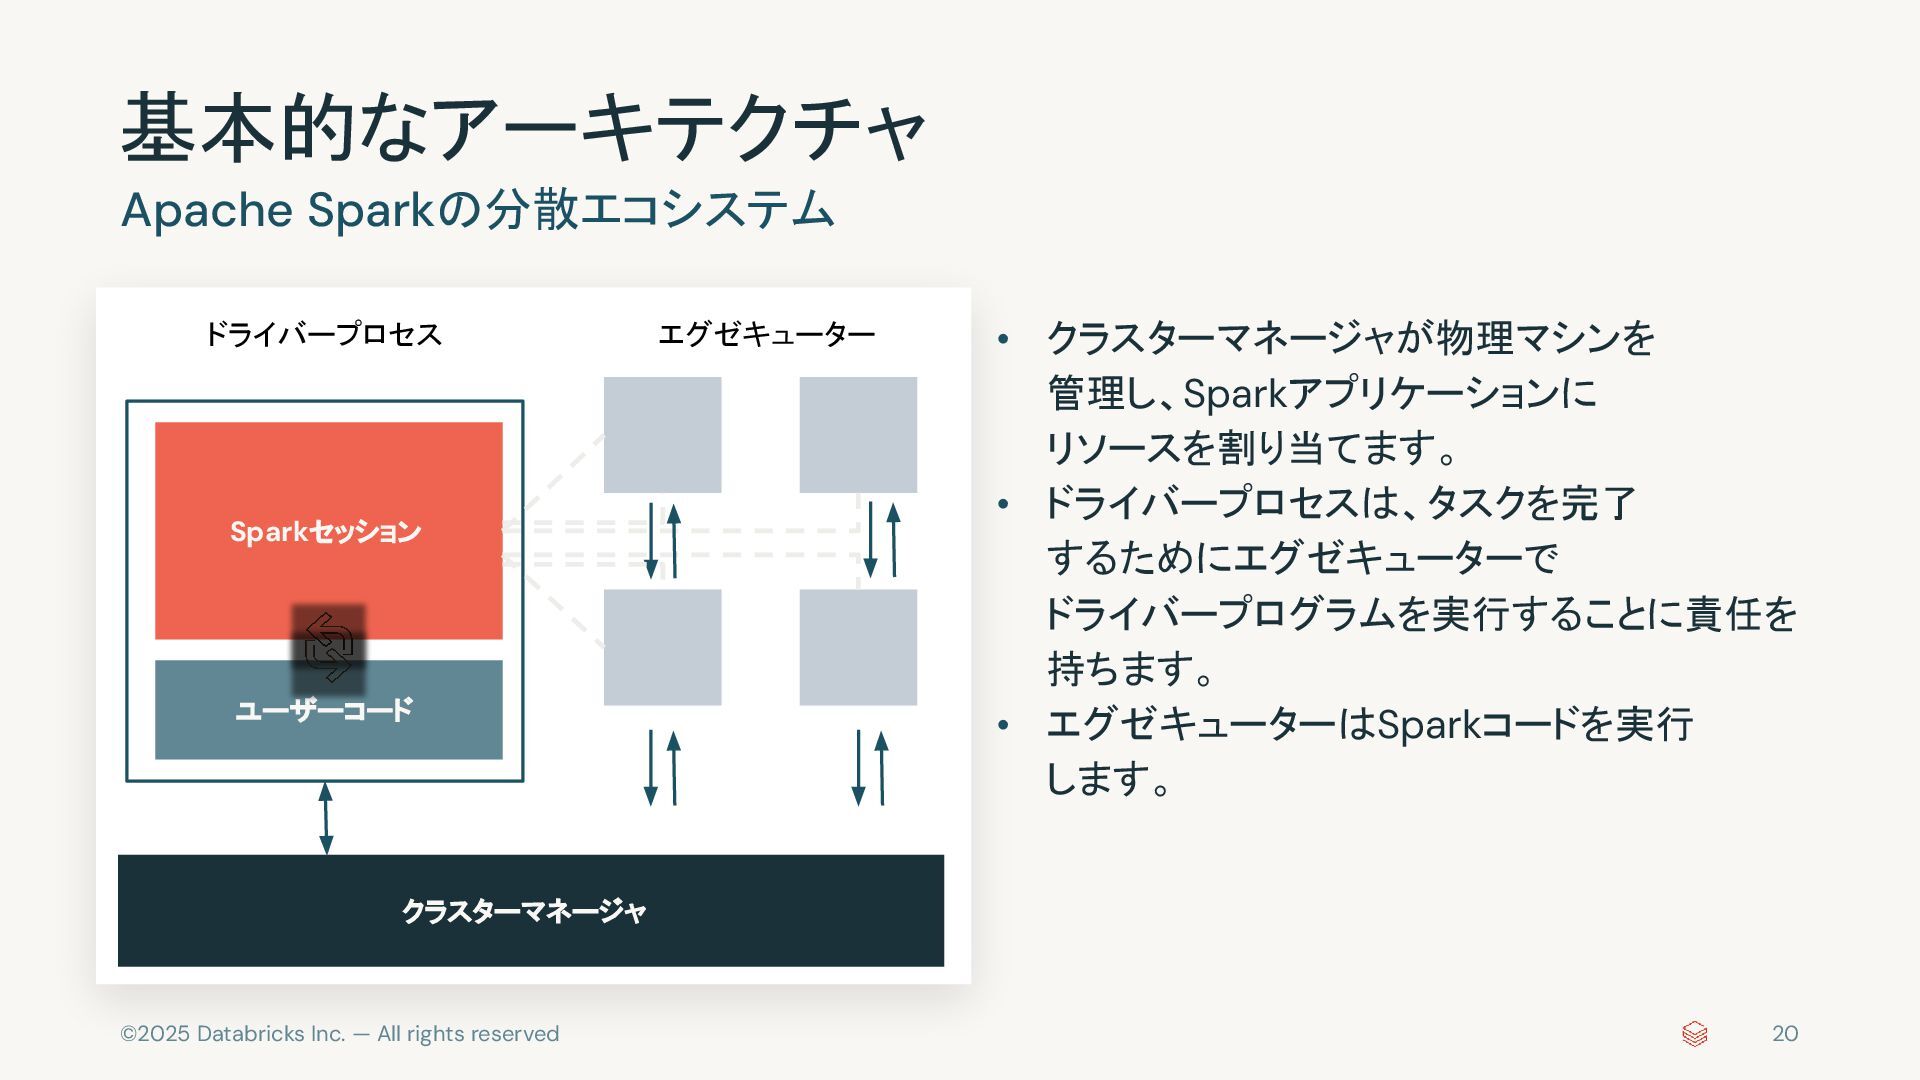
©2025 Databricks Inc. — All rights reserved 基本的なアーキテクチャ • クラスターマネージャが物理マシンを
管理し、Sparkアプリケーションに リソースを割り当てます。 • ドライバープロセスは、タスクを完了 するためにエグゼキューターで ドライバープログラムを実行することに責任を 持ちます。 • エグゼキューターはSparkコードを実行 します。 Apache Sparkの分散エコシステム クラスターマネージャ 20 Sparkセッション ユーザーコード ドライバープロセス エグゼキューター -
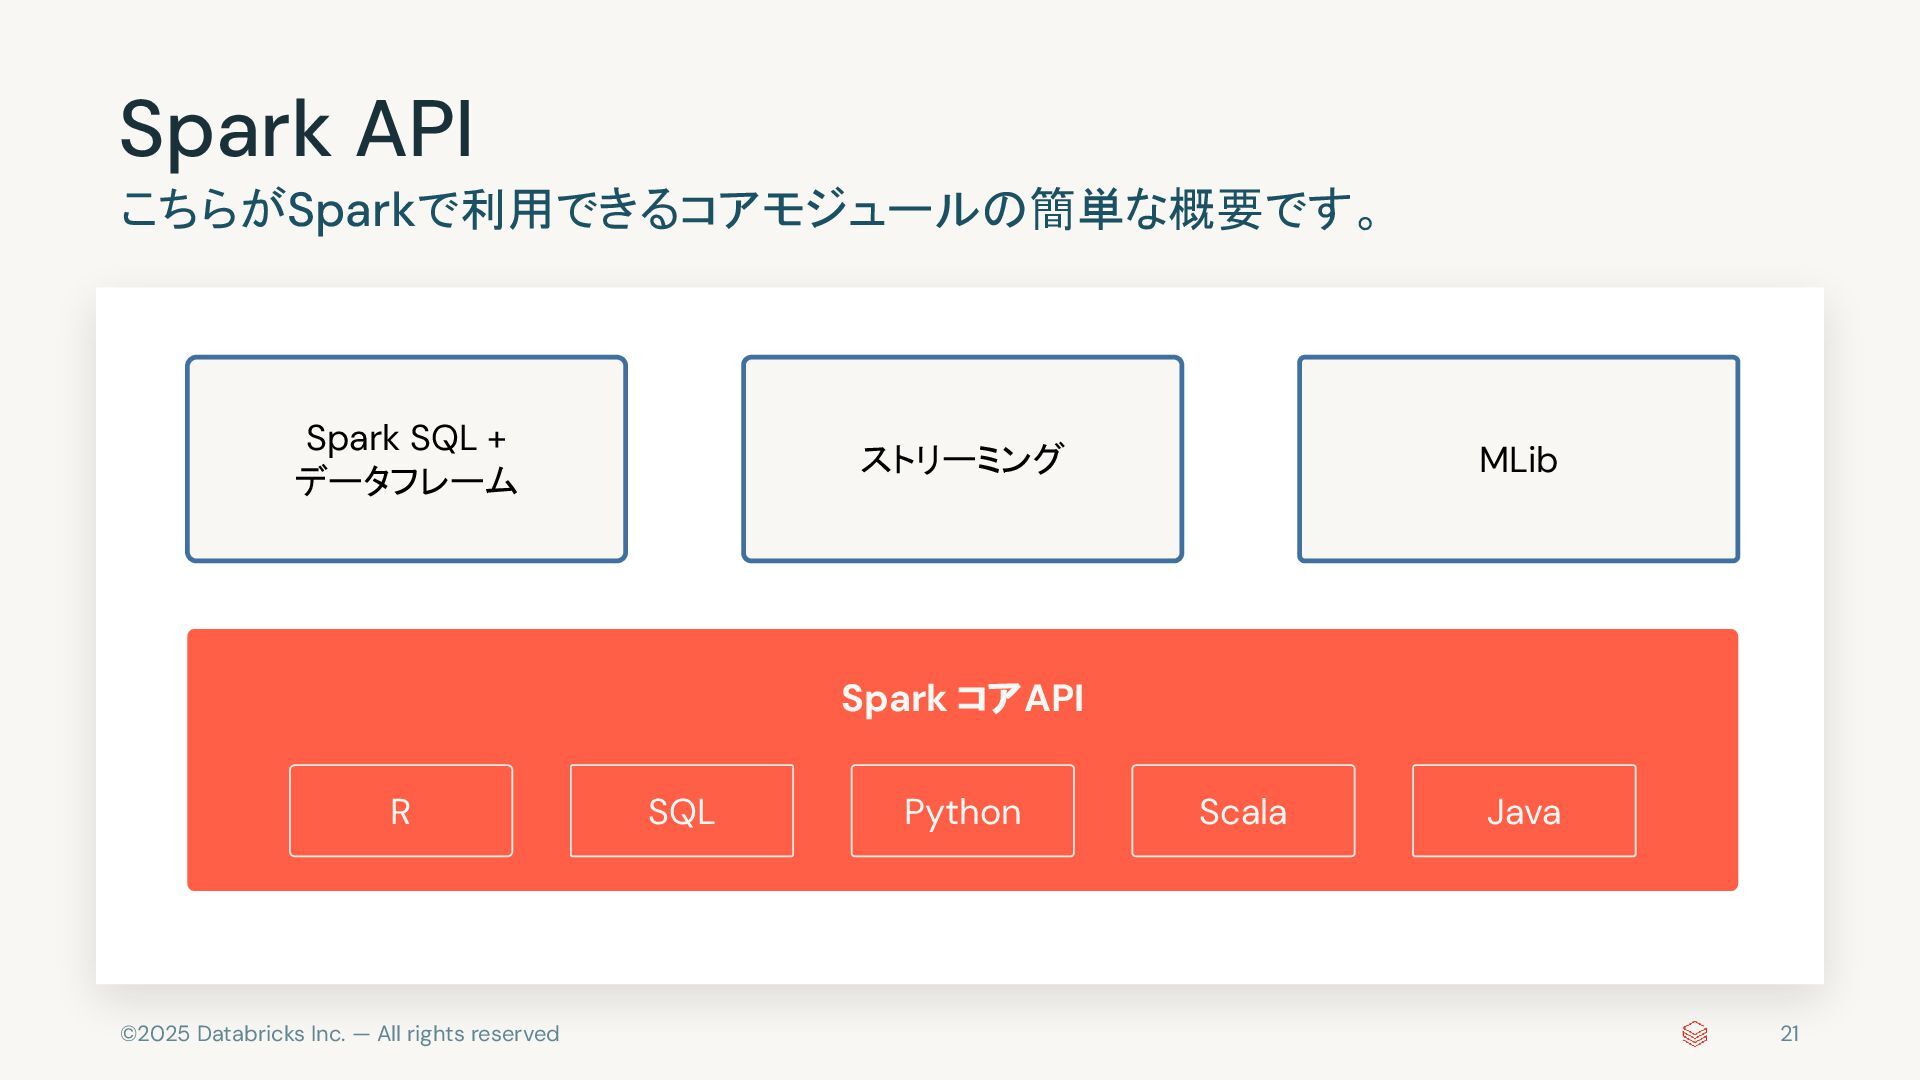
©2025 Databricks Inc. — All rights reserved Spark API こちらがSparkで利用できるコアモジュールの簡単な概要です。
21 Spark SQL + データフレーム ストリーミング MLib SQL Python Scala Java R Spark コアAPI -
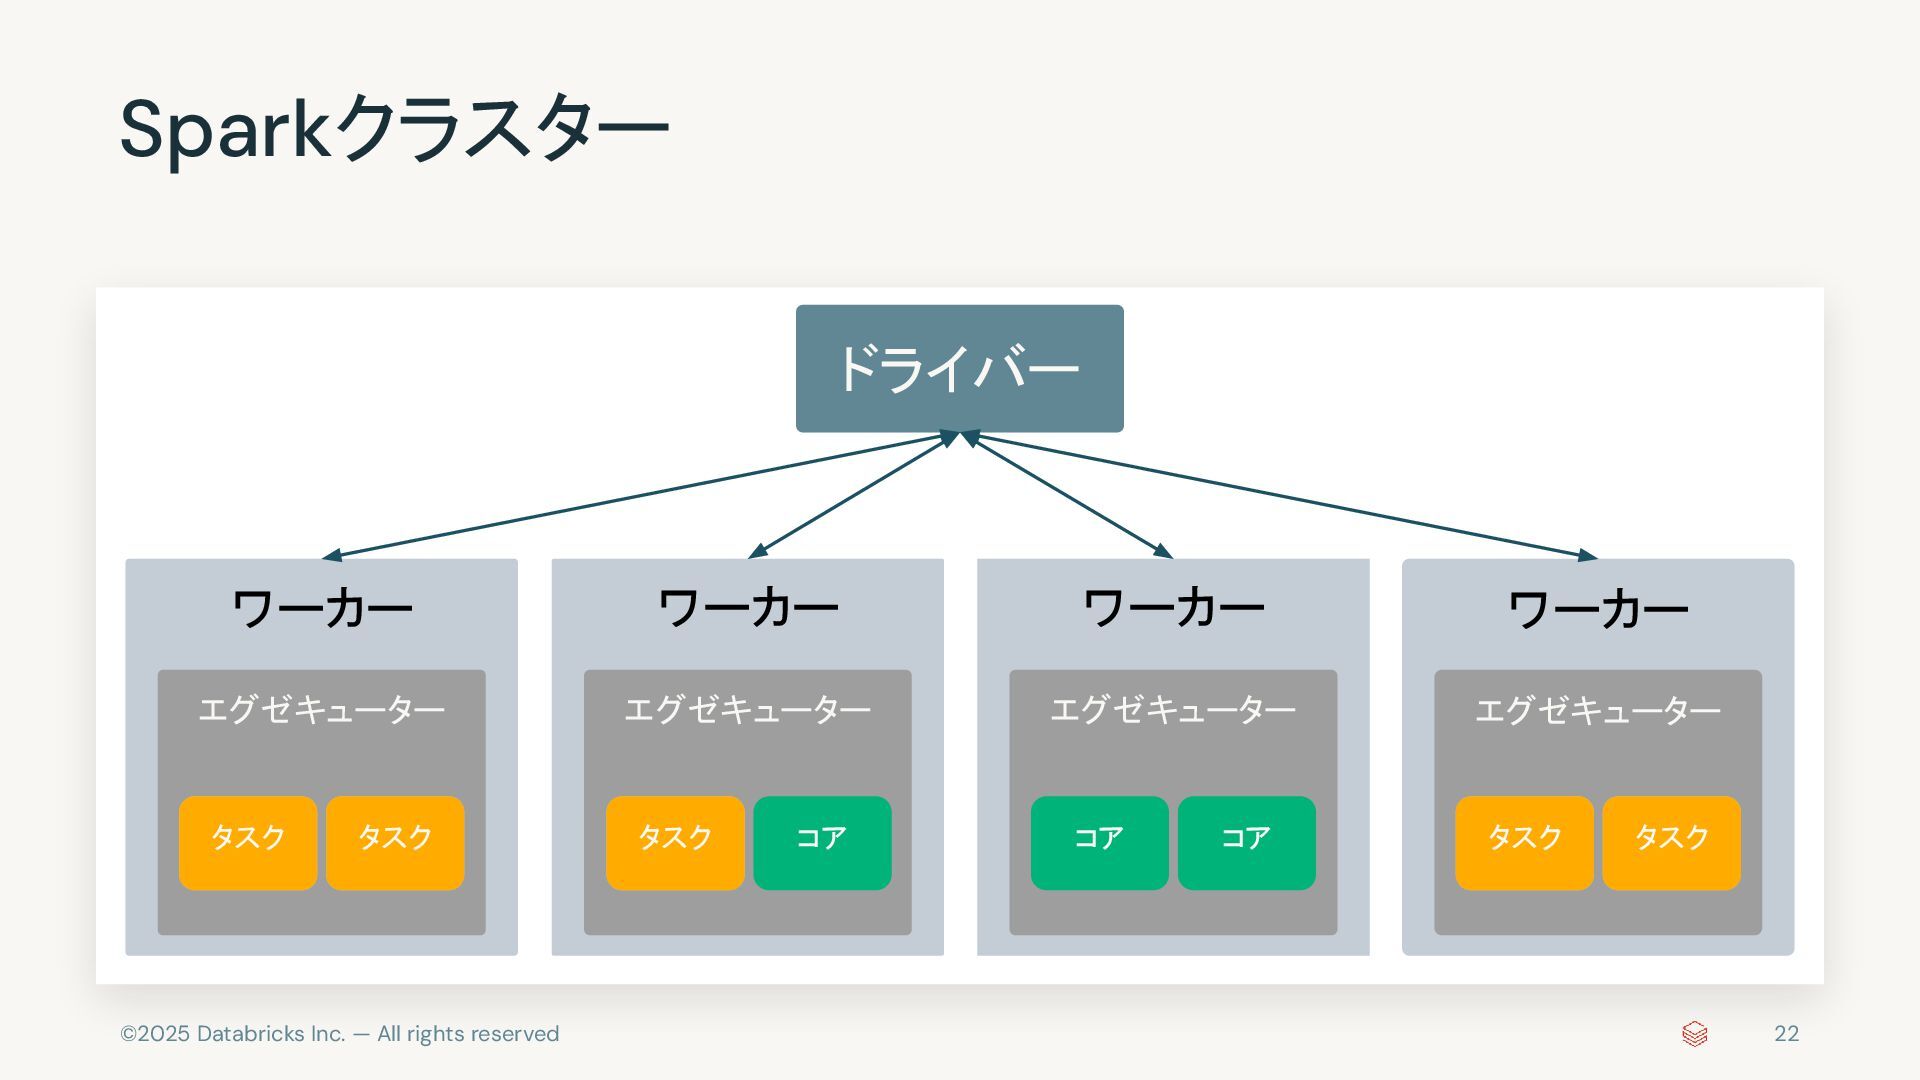
©2025 Databricks Inc. — All rights reserved ワーカー ワーカー ワーカー
ワーカー ドライバー エグゼキューター エグゼキューター エグゼキューター エグゼキューター Core Core Core コア コア コア Core Core Sparkクラスター タスク タスク タスク タスク タスク 22 -
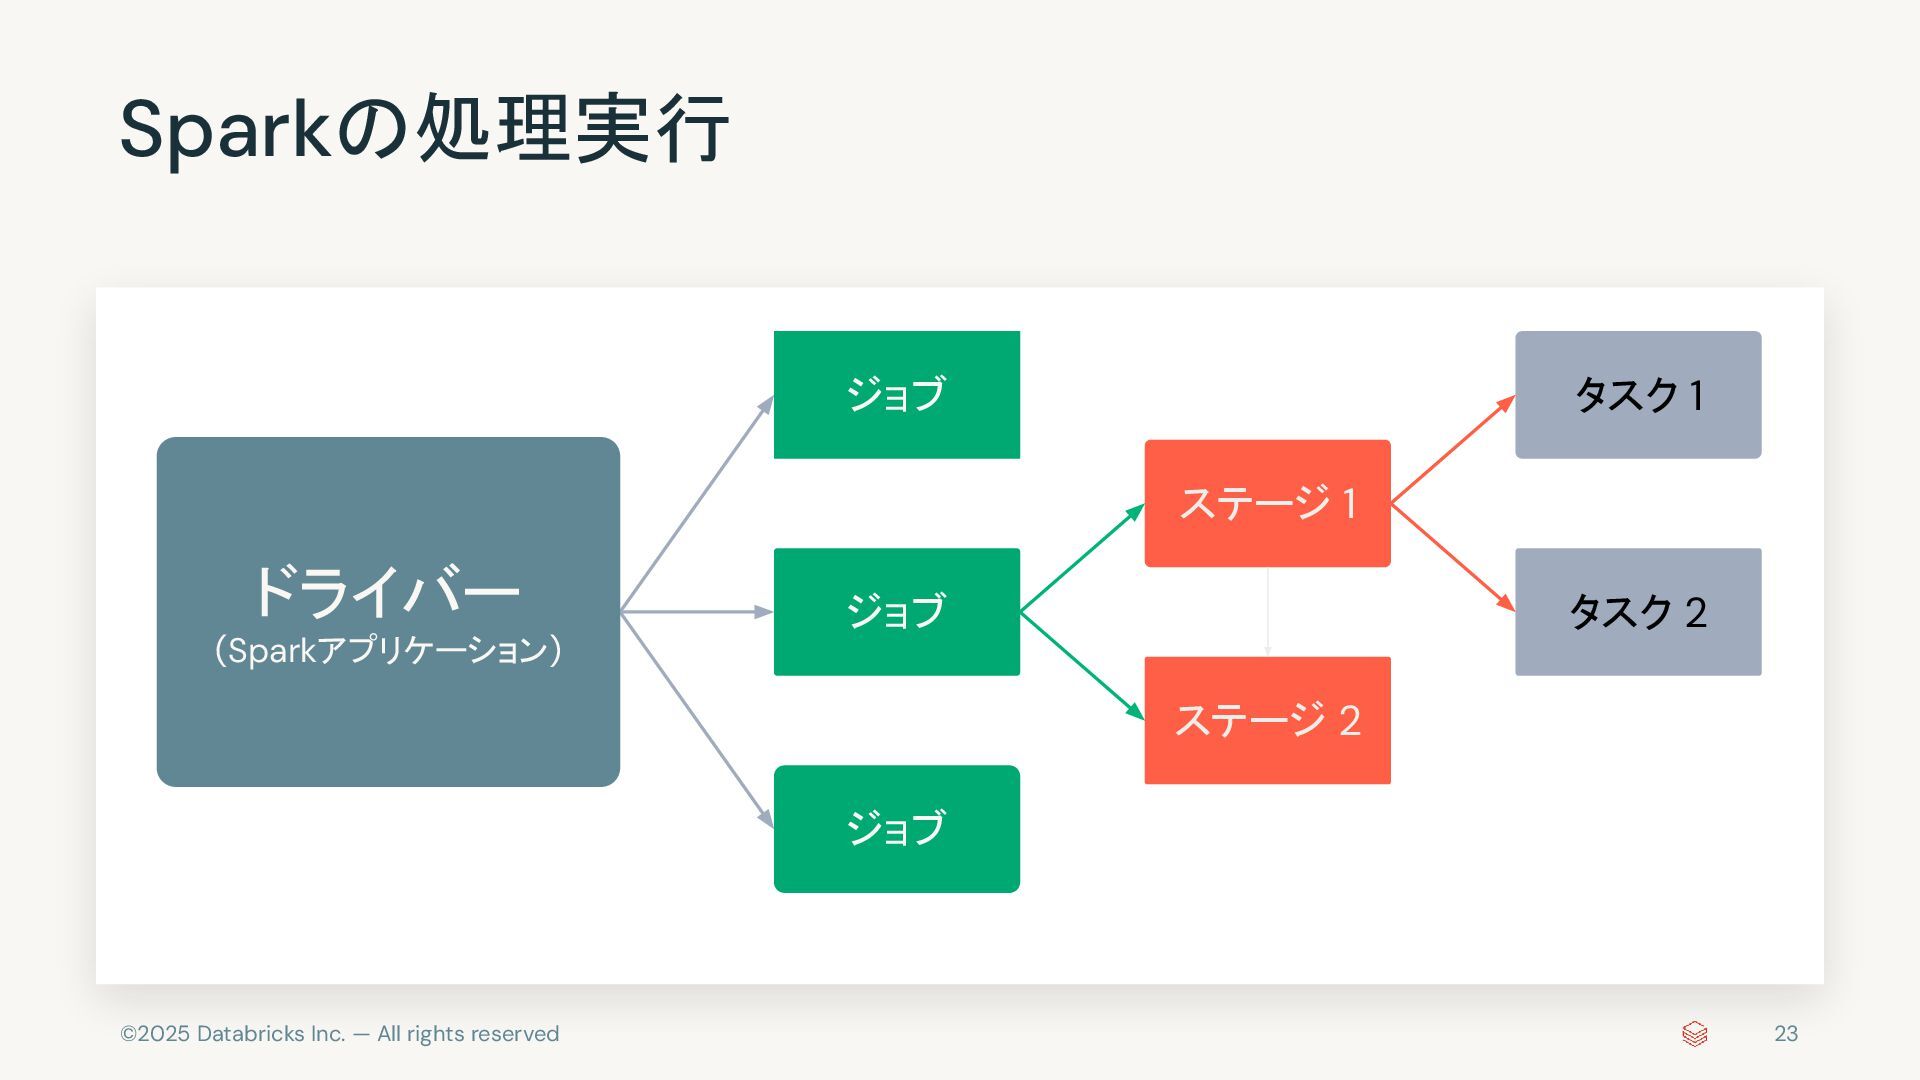
©2025 Databricks Inc. — All rights reserved Sparkの処理実行 ジョブ ジョブ
ジョブ ステージ 1 ステージ 2 タスク 1 タスク 2 23 ドライバー (Sparkアプリケーション) -
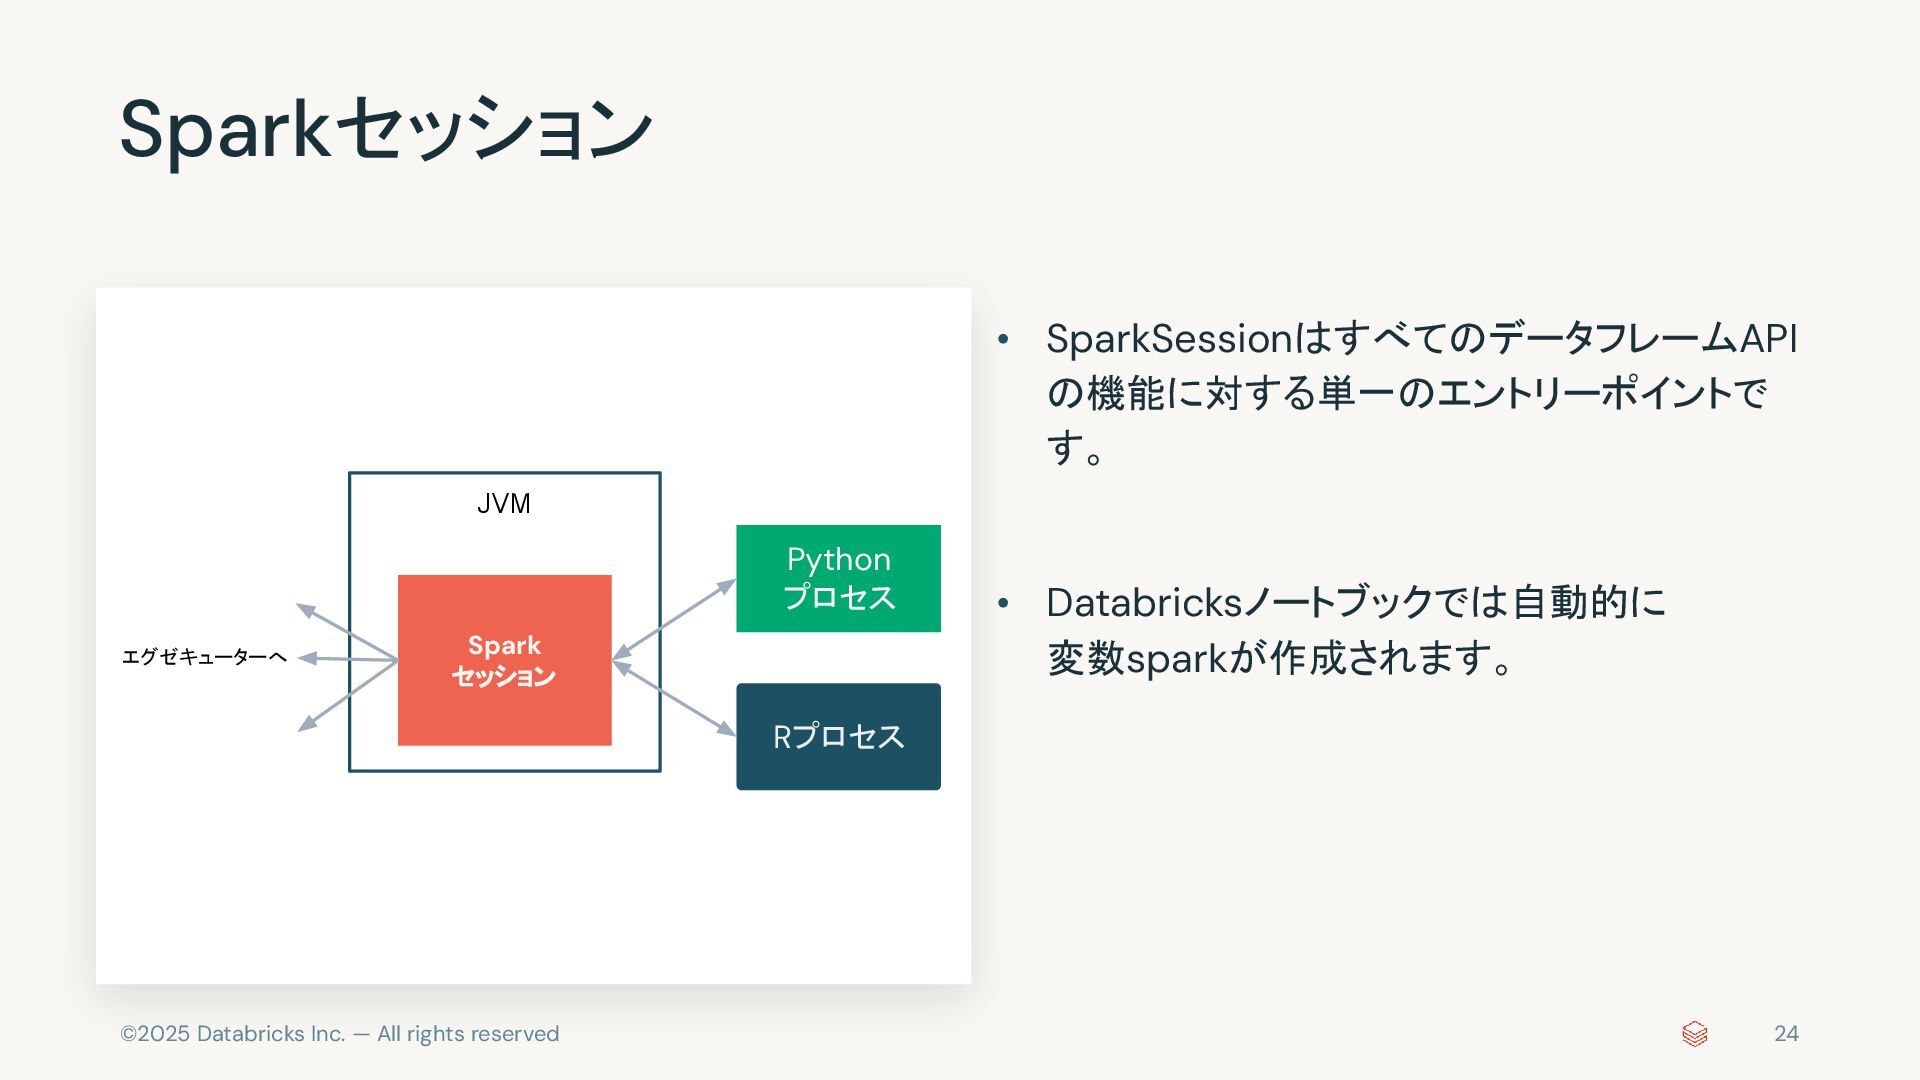
©2025 Databricks Inc. — All rights reserved Sparkセッション • SparkSessionはすべてのデータフレームAPI
の機能に対する単一のエントリーポイントで す。 • Databricksノートブックでは自動的に 変数sparkが作成されます。 24 JVM Spark セッション Python プロセス Rプロセス エグゼキューターへ -
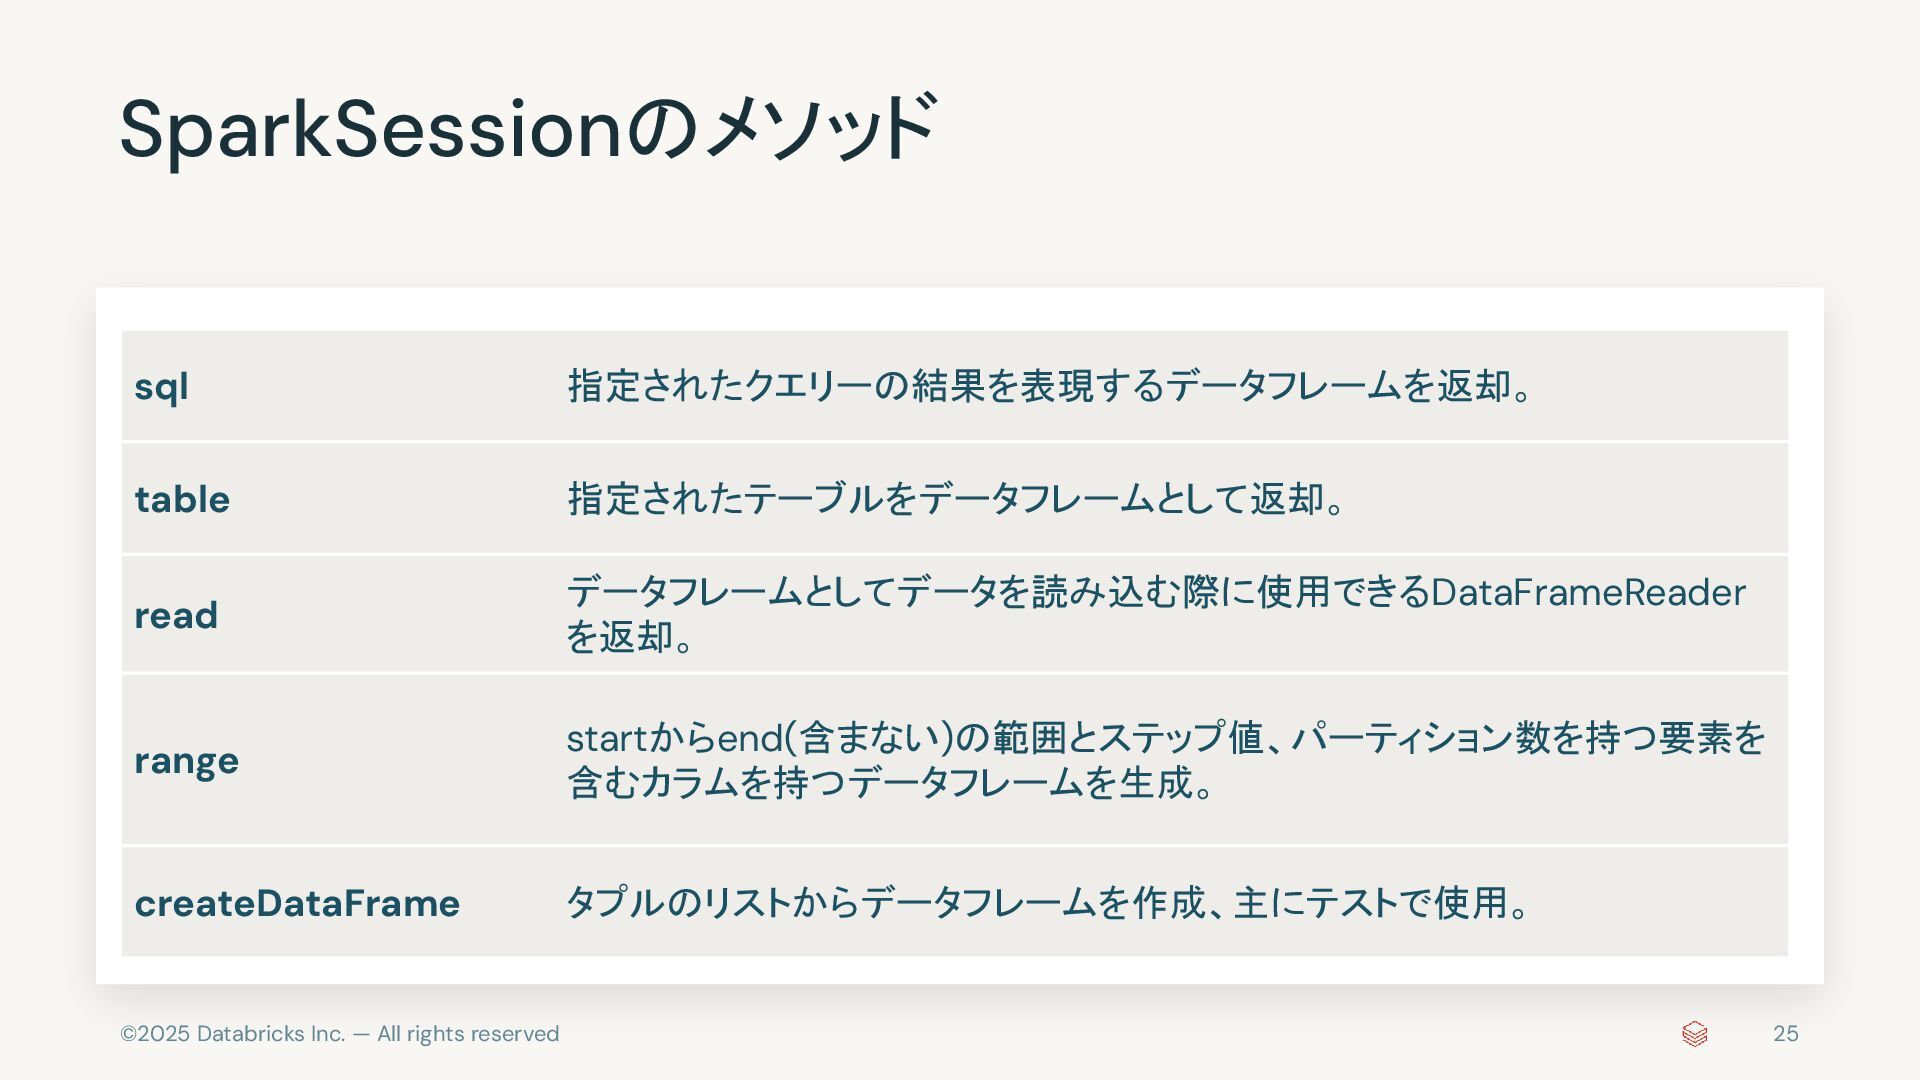
©2025 Databricks Inc. — All rights reserved SparkSessionのメソッド 25 sql
指定されたクエリーの結果を表現するデータフレームを返却。 table 指定されたテーブルをデータフレームとして返却。 read データフレームとしてデータを読み込む際に使用できるDataFrameReader を返却。 range startからend(含まない)の範囲とステップ値、パーティション数を持つ要素を 含むカラムを持つデータフレームを生成。 createDataFrame タプルのリストからデータフレームを作成、主にテストで使用。 -
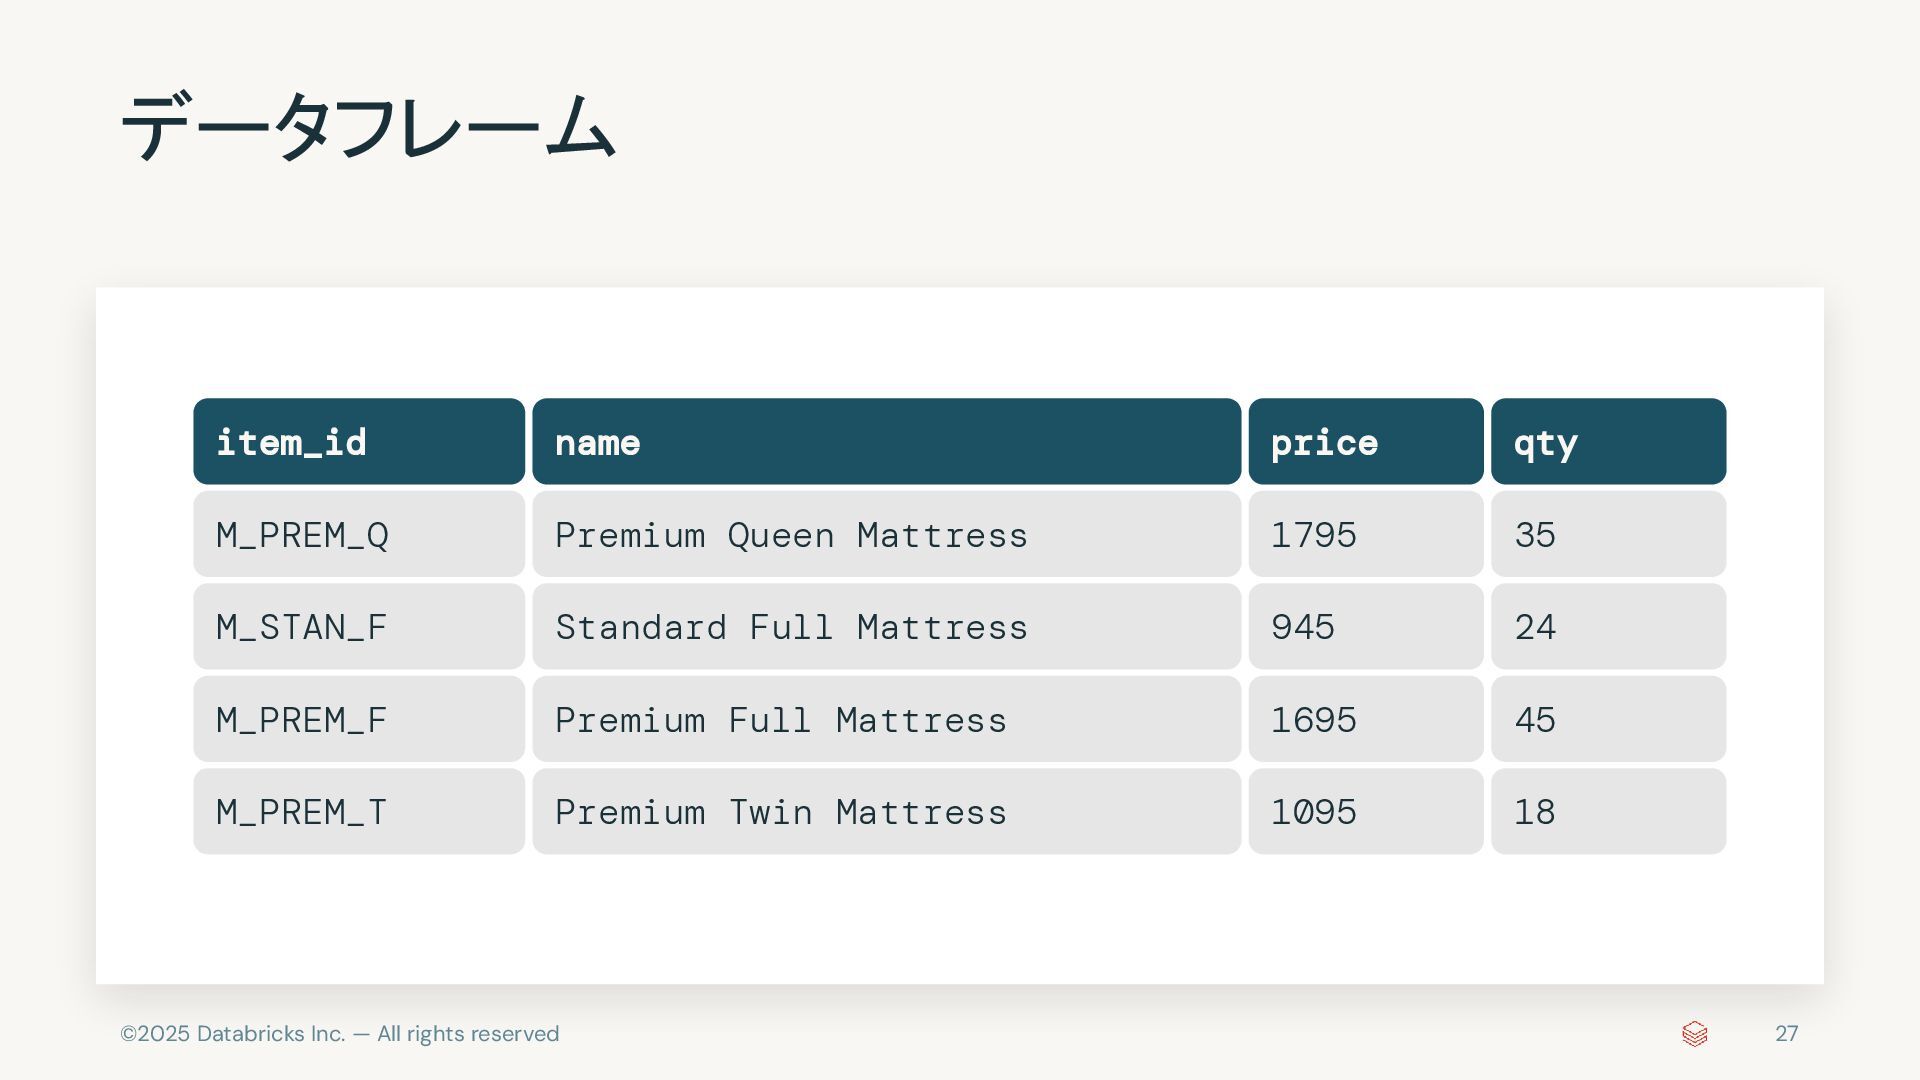
©2025 Databricks Inc. — All rights reserved データフレーム 27 item_id
name price M_PREM_Q Premium Queen Mattress 1795 M_STAN_F Standard Full Mattress 945 M_PREM_F Premium Full Mattress 1695 M_PREM_T Premium Twin Mattress 1095 qty 35 24 45 18 -
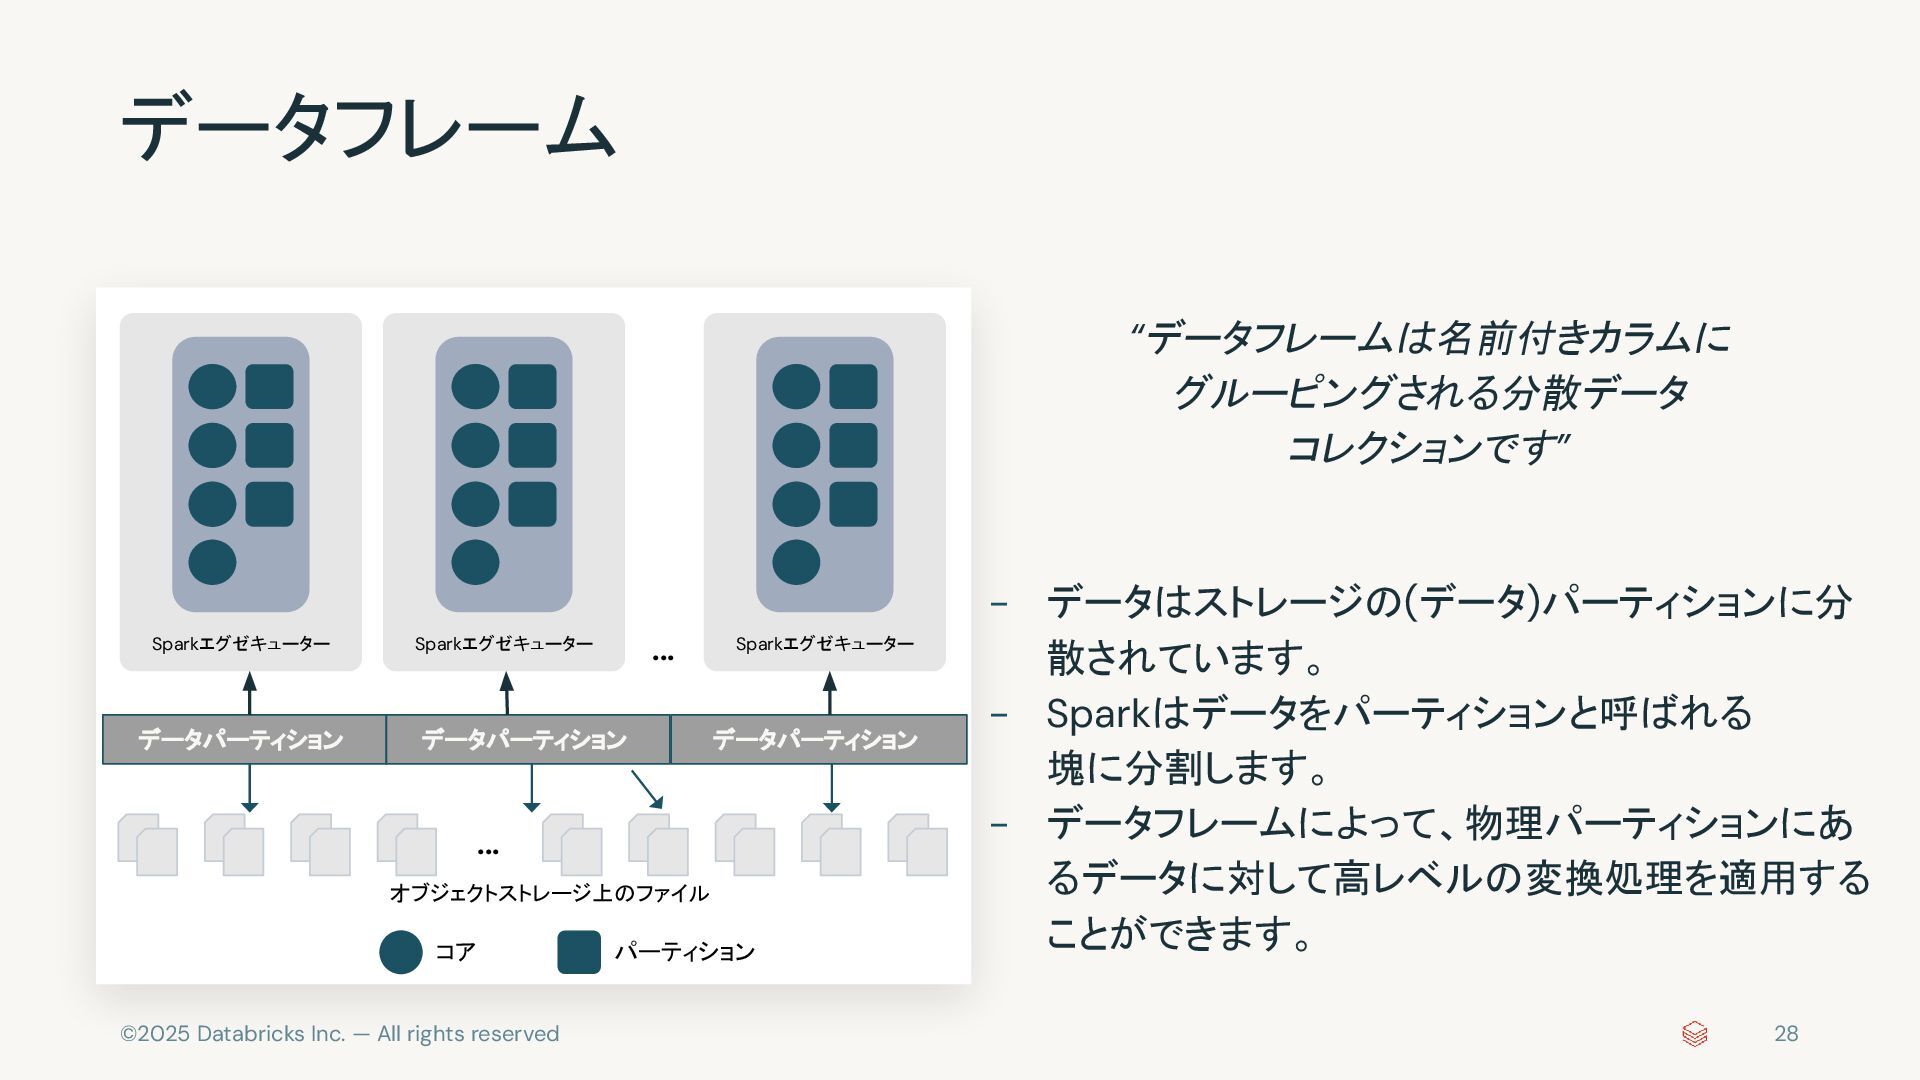
©2025 Databricks Inc. — All rights reserved データフレーム “データフレームは名前付きカラムに グルーピングされる分散データ
コレクションです” - データはストレージの(データ)パーティションに分 散されています。 - Sparkはデータをパーティションと呼ばれる 塊に分割します。 - データフレームによって、物理パーティションにあ るデータに対して高レベルの変換処理を適用する ことができます。 28 オブジェクトストレージ上のファイル データパーティション データパーティション データパーティション Sparkエグゼキューター Sparkエグゼキューター Sparkエグゼキューター ... コア パーティション ... -
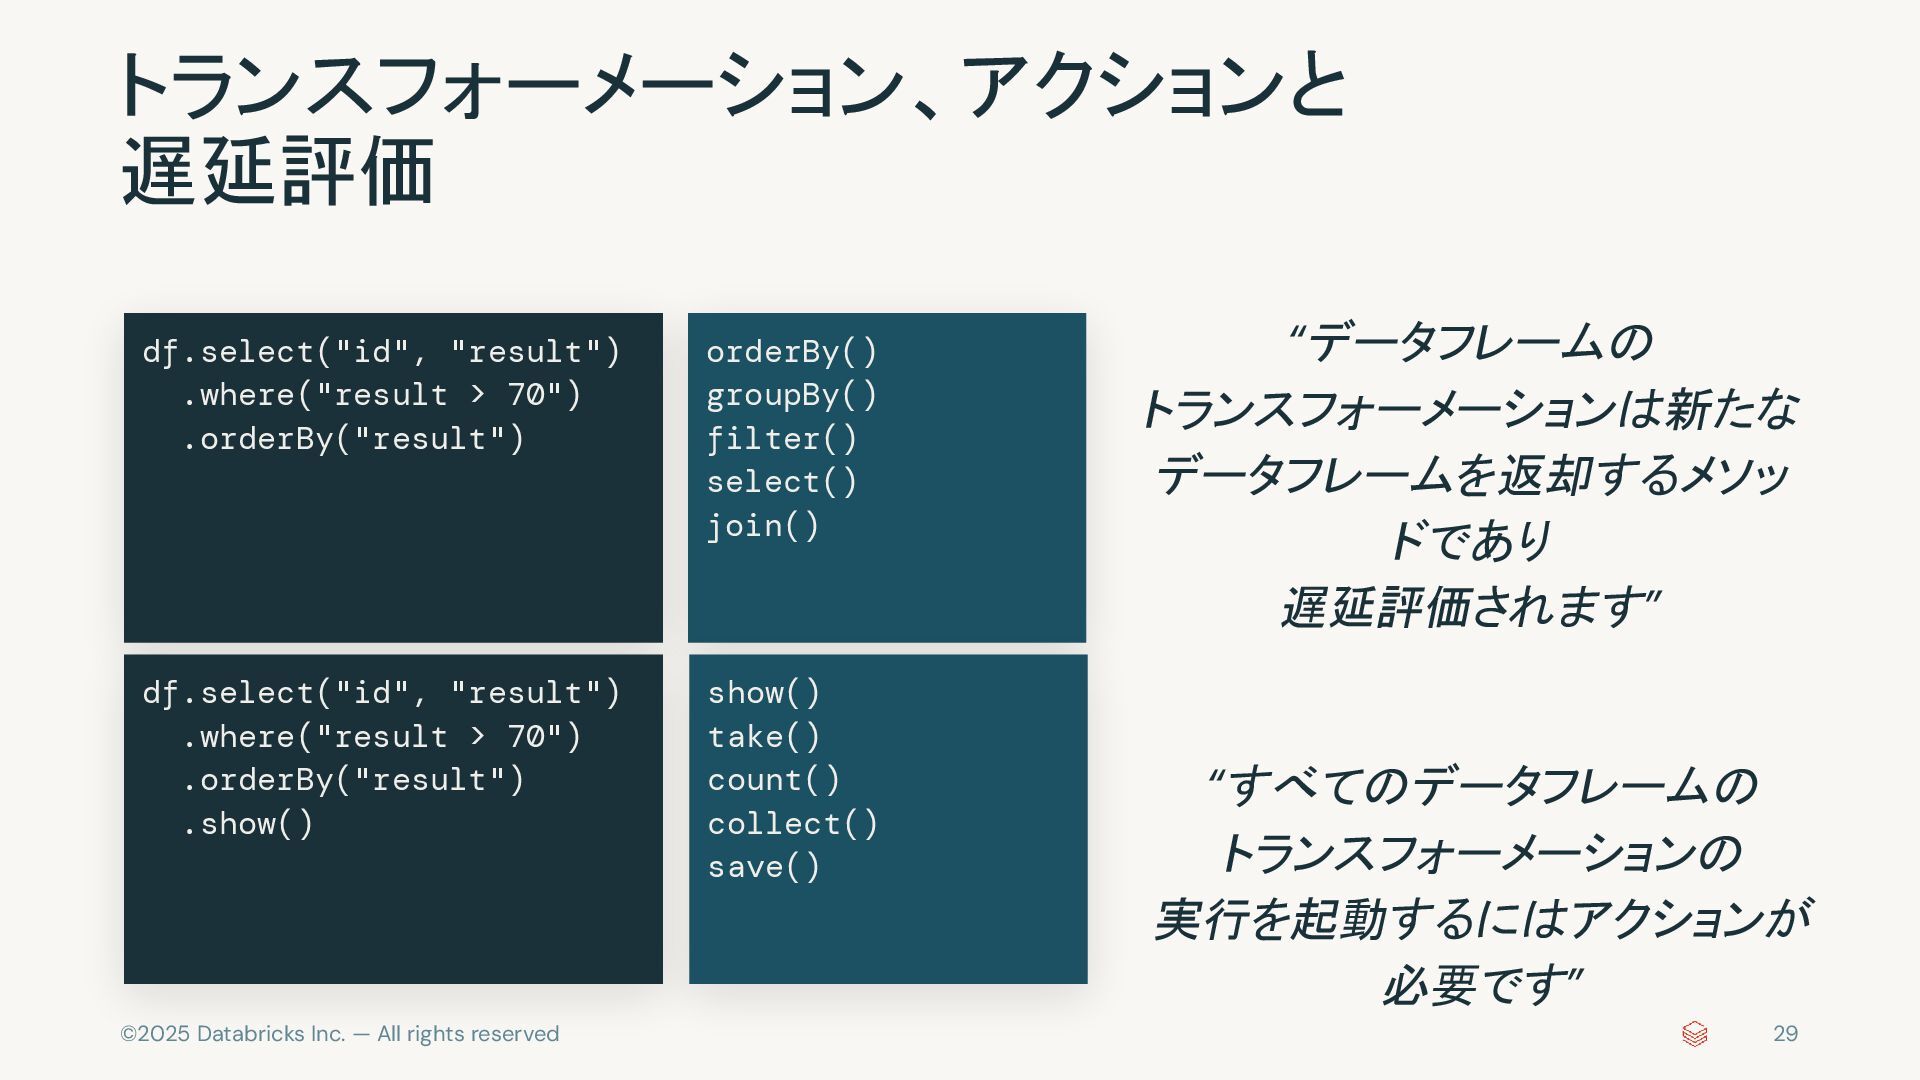
©2025 Databricks Inc. — All rights reserved トランスフォーメーション、アクションと 遅延評価 “データフレームの
トランスフォーメーションは新たな データフレームを返却するメソッ ドであり 遅延評価されます” 29 “すべてのデータフレームの トランスフォーメーションの 実行を起動するにはアクションが 必要です” df.select("id", "result") .where("result > 70") .orderBy("result") df.select("id", "result") .where("result > 70") .orderBy("result") .show() orderBy() groupBy() filter() select() join() show() take() count() collect() save() -
参考資料 • Databricks Free Editionで始めるApache Spark #Databricks_Free_Edition - Qiita •
Apache Sparkとは何か #Databricks - Qiita • PySparkことはじめ #Databricks - Qiita • DatabricksとSpark UIで学ぶSparkのパーティション • Apache Spark徹底入門 -
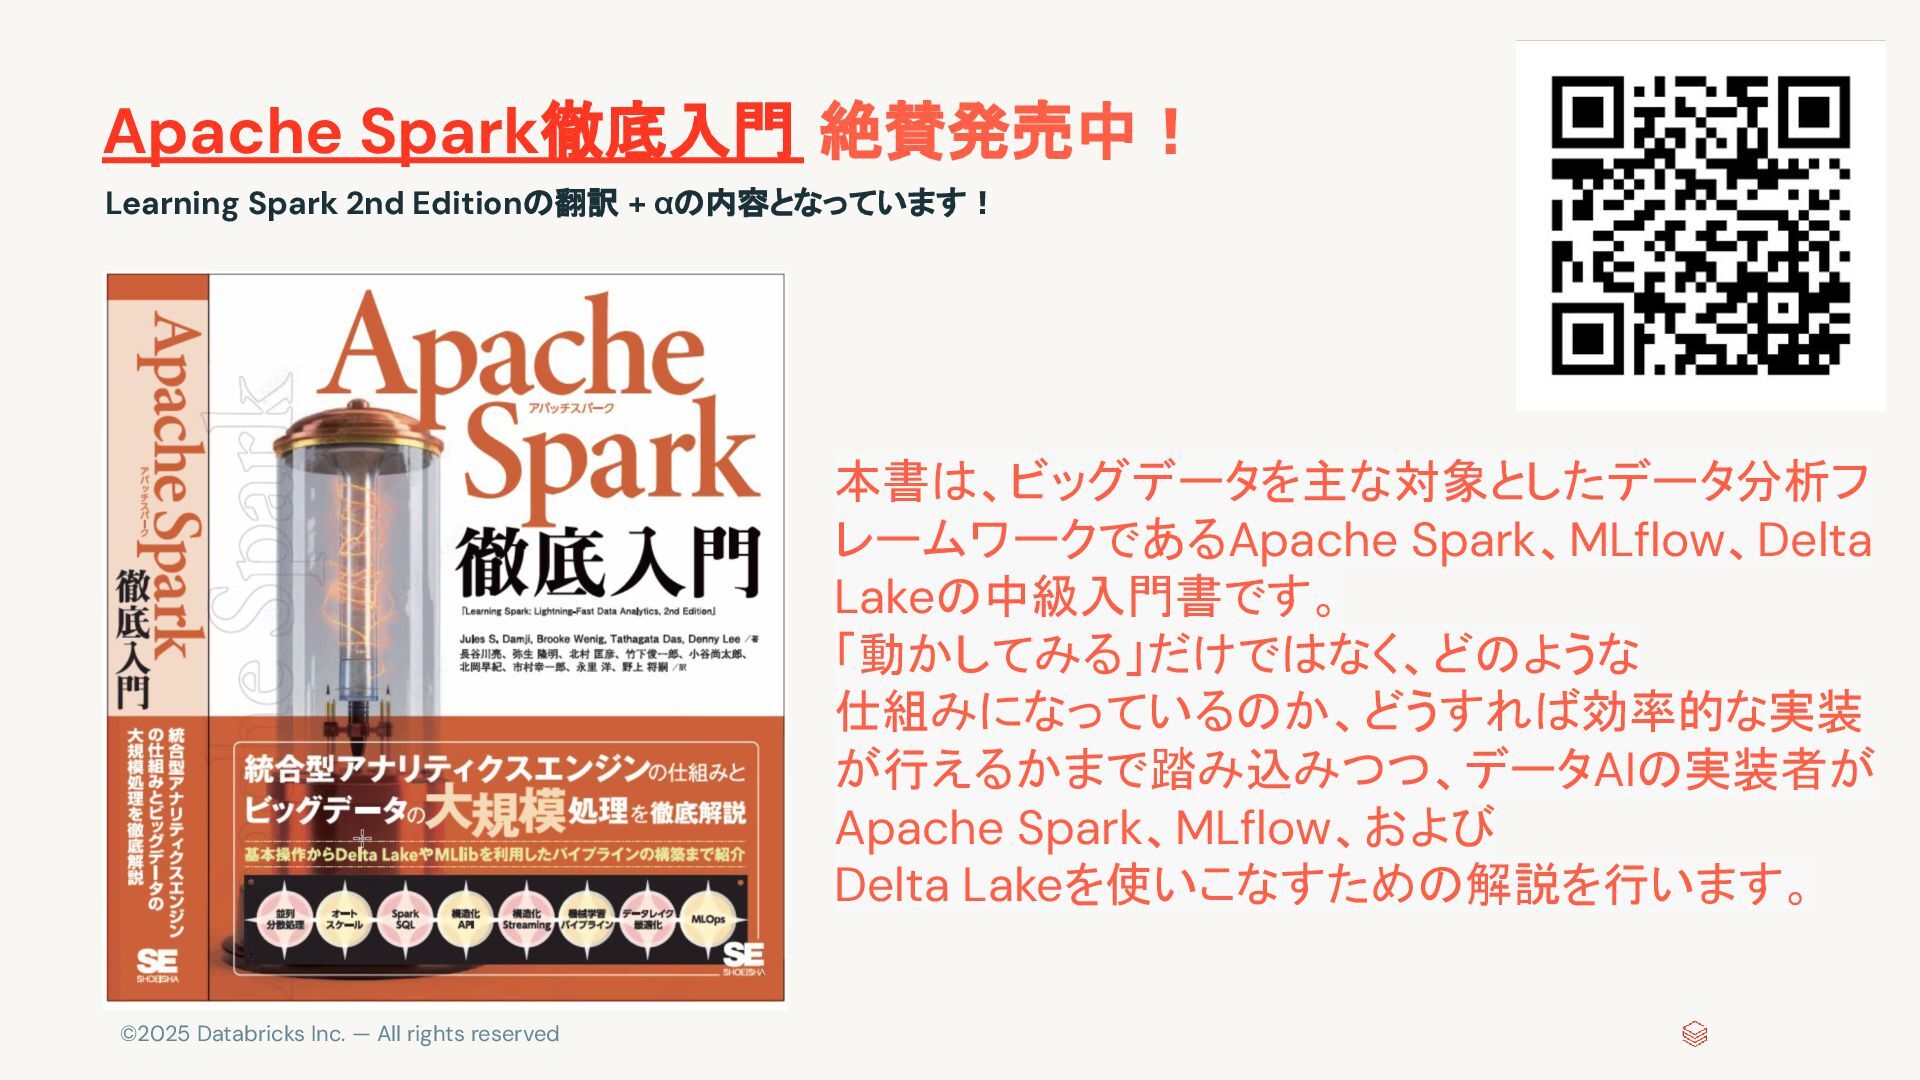
©2025 Databricks Inc. — All rights reserved Apache Spark徹底入門 絶賛発売中!
Learning Spark 2nd Editionの翻訳 + αの内容となっています! 本書は、ビッグデータを主な対象としたデータ分析フ レームワークであるApache Spark、MLflow、Delta Lakeの中級入門書です。 「動かしてみる」だけではなく、どのような 仕組みになっているのか、どうすれば効率的な実装 が行えるかまで踏み込みつつ、データAIの実装者が Apache Spark、MLflow、および Delta Lakeを使いこなすための解説を行います。