Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
From Vanilla Kubernetes to a Batteries-Included...
Search
yosshi_
September 08, 2026
Technology
770
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
From Vanilla Kubernetes to a Batteries-Included Platform: Developer Experience at 1,300+ Clusters
yosshi_
September 08, 2026
Transcript
52 slides
From Vanilla Kubernetes to a Batteries-Included Platform: Developer Experience at
1,300+ Clusters Shota Yoshimura Senior Platform Engineer, LY Corporation
關於本場演講 • 本場投影⽚為 AI 翻譯的中⽂版本 • 演講本⾝將以英⽂進⾏ 本場投影片的 QR code
2
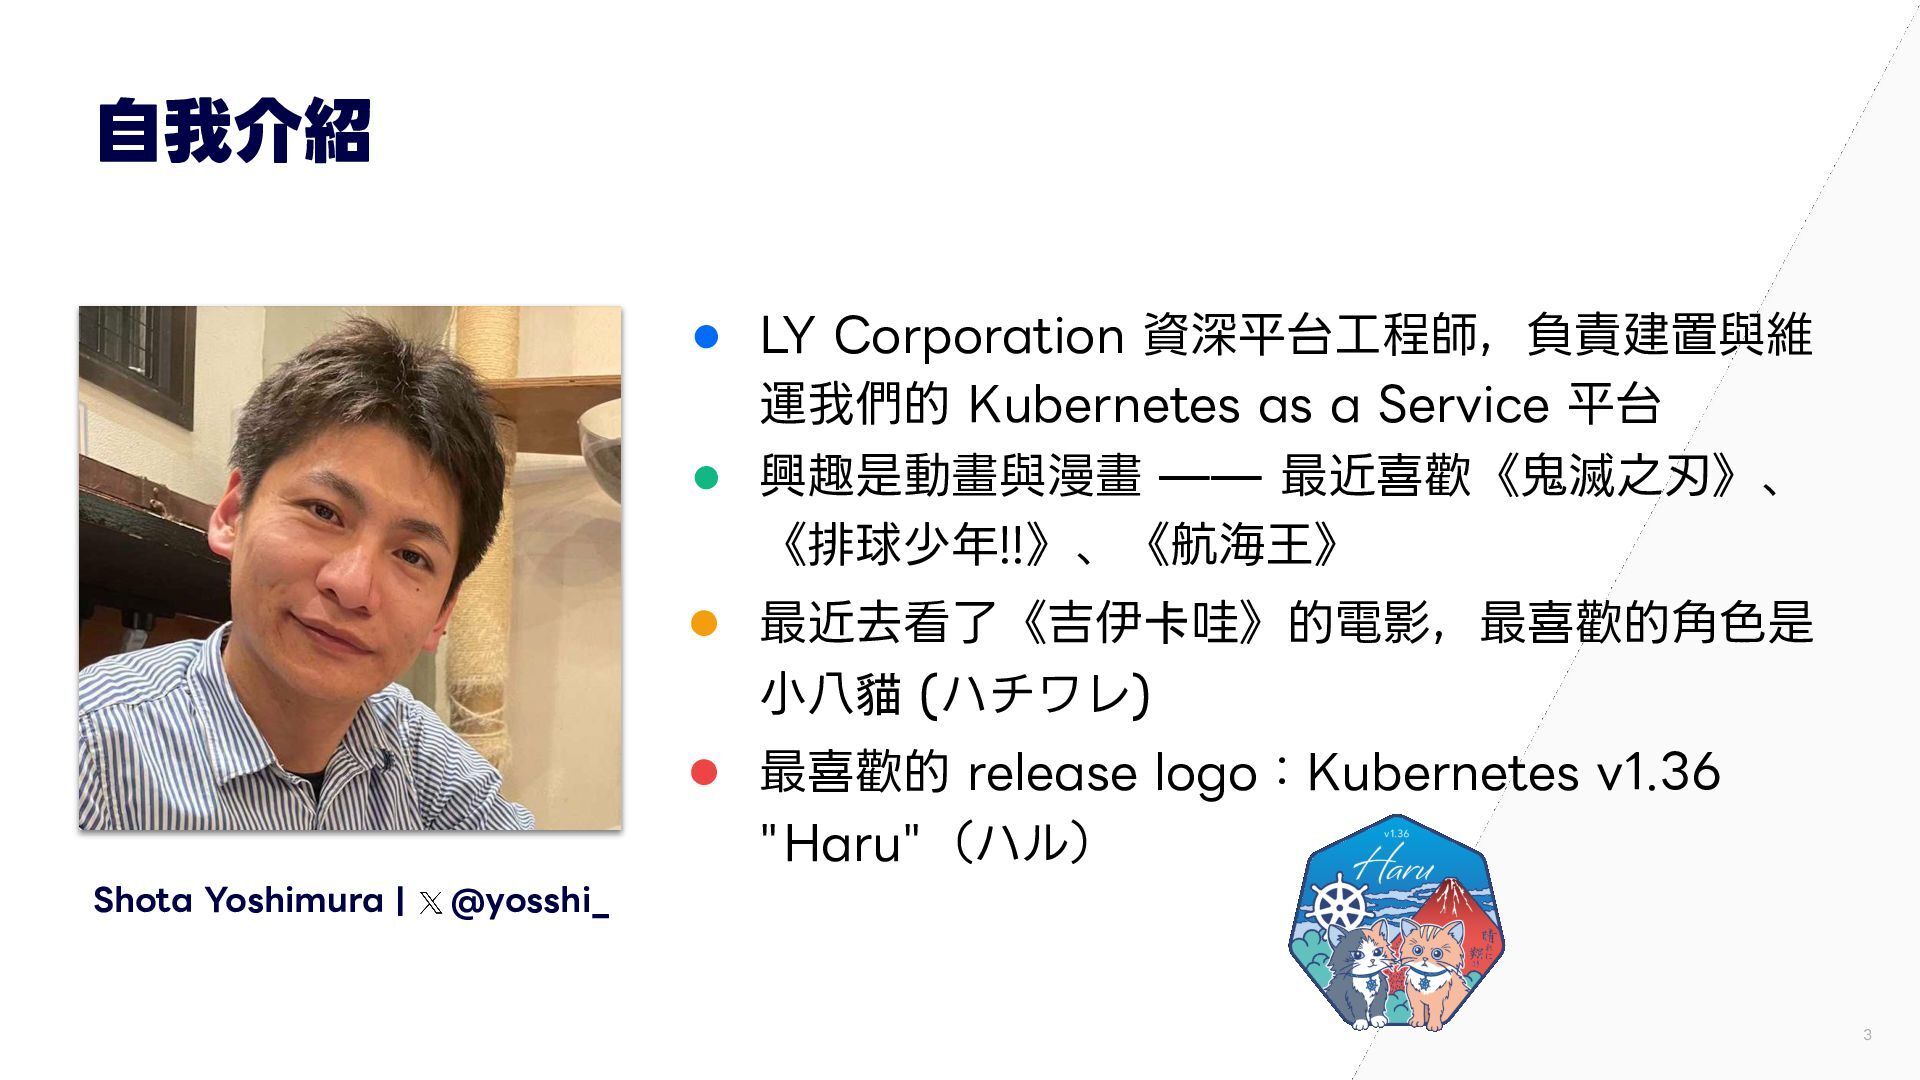
⾃我介紹 • LY Corporation 資深平台⼯程師,負責建置與維 運我們的 Kubernetes as a Service
平台 • 興趣是動畫與漫畫 ̶̶ 最近喜歡《⻤滅之刃》、 《排球少年!!》、《航海王》 • 最近去看了《吉伊卡哇》的電影,最喜歡的⾓⾊是 ⼩⼋貓 (ハチワレ) • 最喜歡的 release logo:Kubernetes v1.36 "Haru"(ハル) Shota Yoshimura | @yosshi_ 3
我們為什麼要打造 Kubernetes as a Service (KaaS) 2016 年,我們在地端 (on-premise) 以
OpenStack 管理 VM 為主的基礎架構,當時遇到以下問題: • 建立一套環境要花超過一週。 • VM 一旦建立就長期沒有更新,存在安全風險。 • 節點發生故障時會發出通知,即使凌晨三點也必須有人處理。 於是我們開始著手解決「以宣告式方式建置基礎架構」這個課題。 4
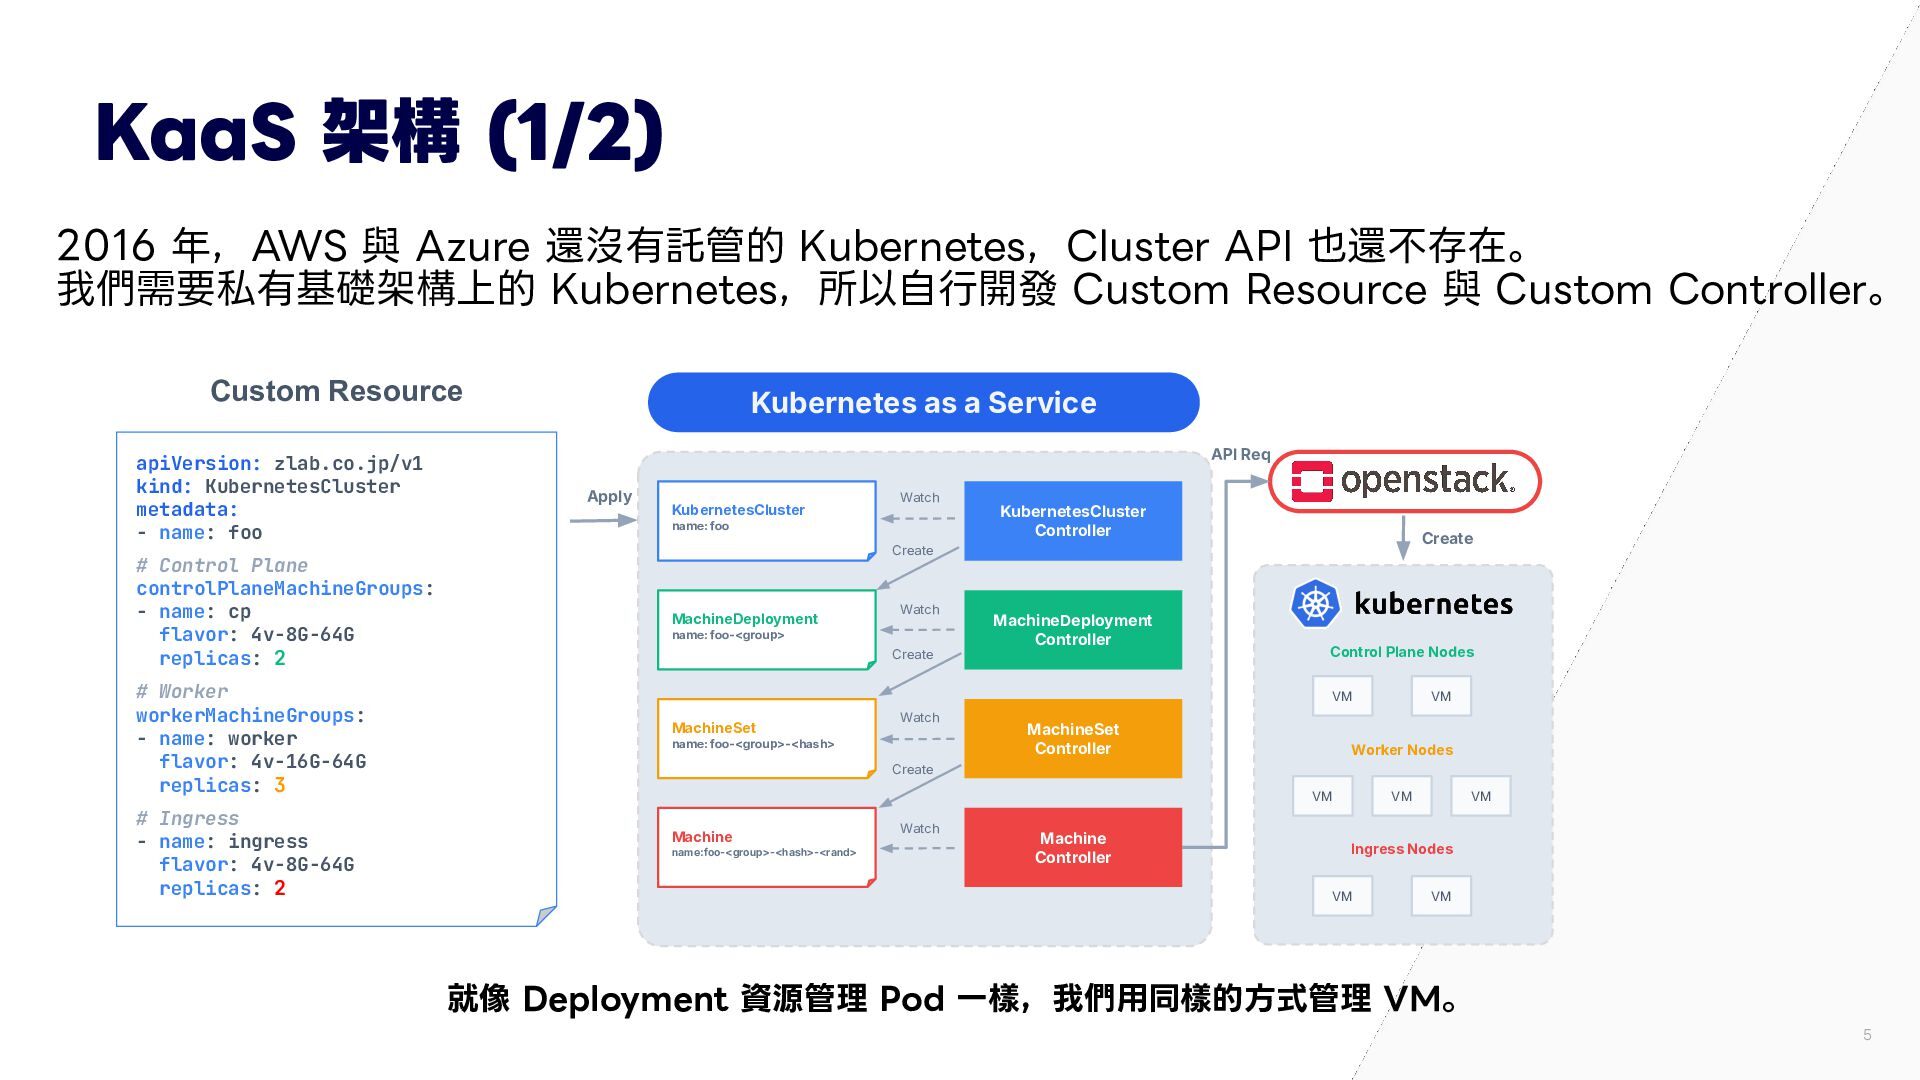
KaaS 架構 (1/2) 2016 年,AWS 與 Azure 還沒有託管的 Kubernetes,Cluster API
也還不存在。 Kubernetes Kubernetes,所以⾃⾏開發 as a Service (KaaS) Architecture 我們需要私有基礎架構上的 Custom Resource 與 Custom Controller。 Custom Resource apiVersion: zlab.co.jp/v1 kind: KubernetesCluster metadata: - name: foo # Control Plane controlPlaneMachineGroups: - name: cp flavor: 4v-8G-64G replicas: 2 # Worker workerMachineGroups: - name: worker flavor: 4v-16G-64G replicas: 3 # Ingress - name: ingress flavor: 4v-8G-64G replicas: 2 Kubernetes as a Service API Req Apply KubernetesCluster Watch name: foo KubernetesCluster Controller Create Create MachineDeployment Watch name: foo-<group> Create MachineDeployment Controller Control Plane Nodes VM MachineSet Watch name: foo-<group>-<hash> MachineSet Controller VM Worker Nodes Create VM Machine name:foo-<group>-<hash>-<rand> Watch Machine Controller VM VM Ingress Nodes VM VM 就像 Deployment 資源管理 Pod ⼀樣,我們⽤同樣的⽅式管理 VM。 5
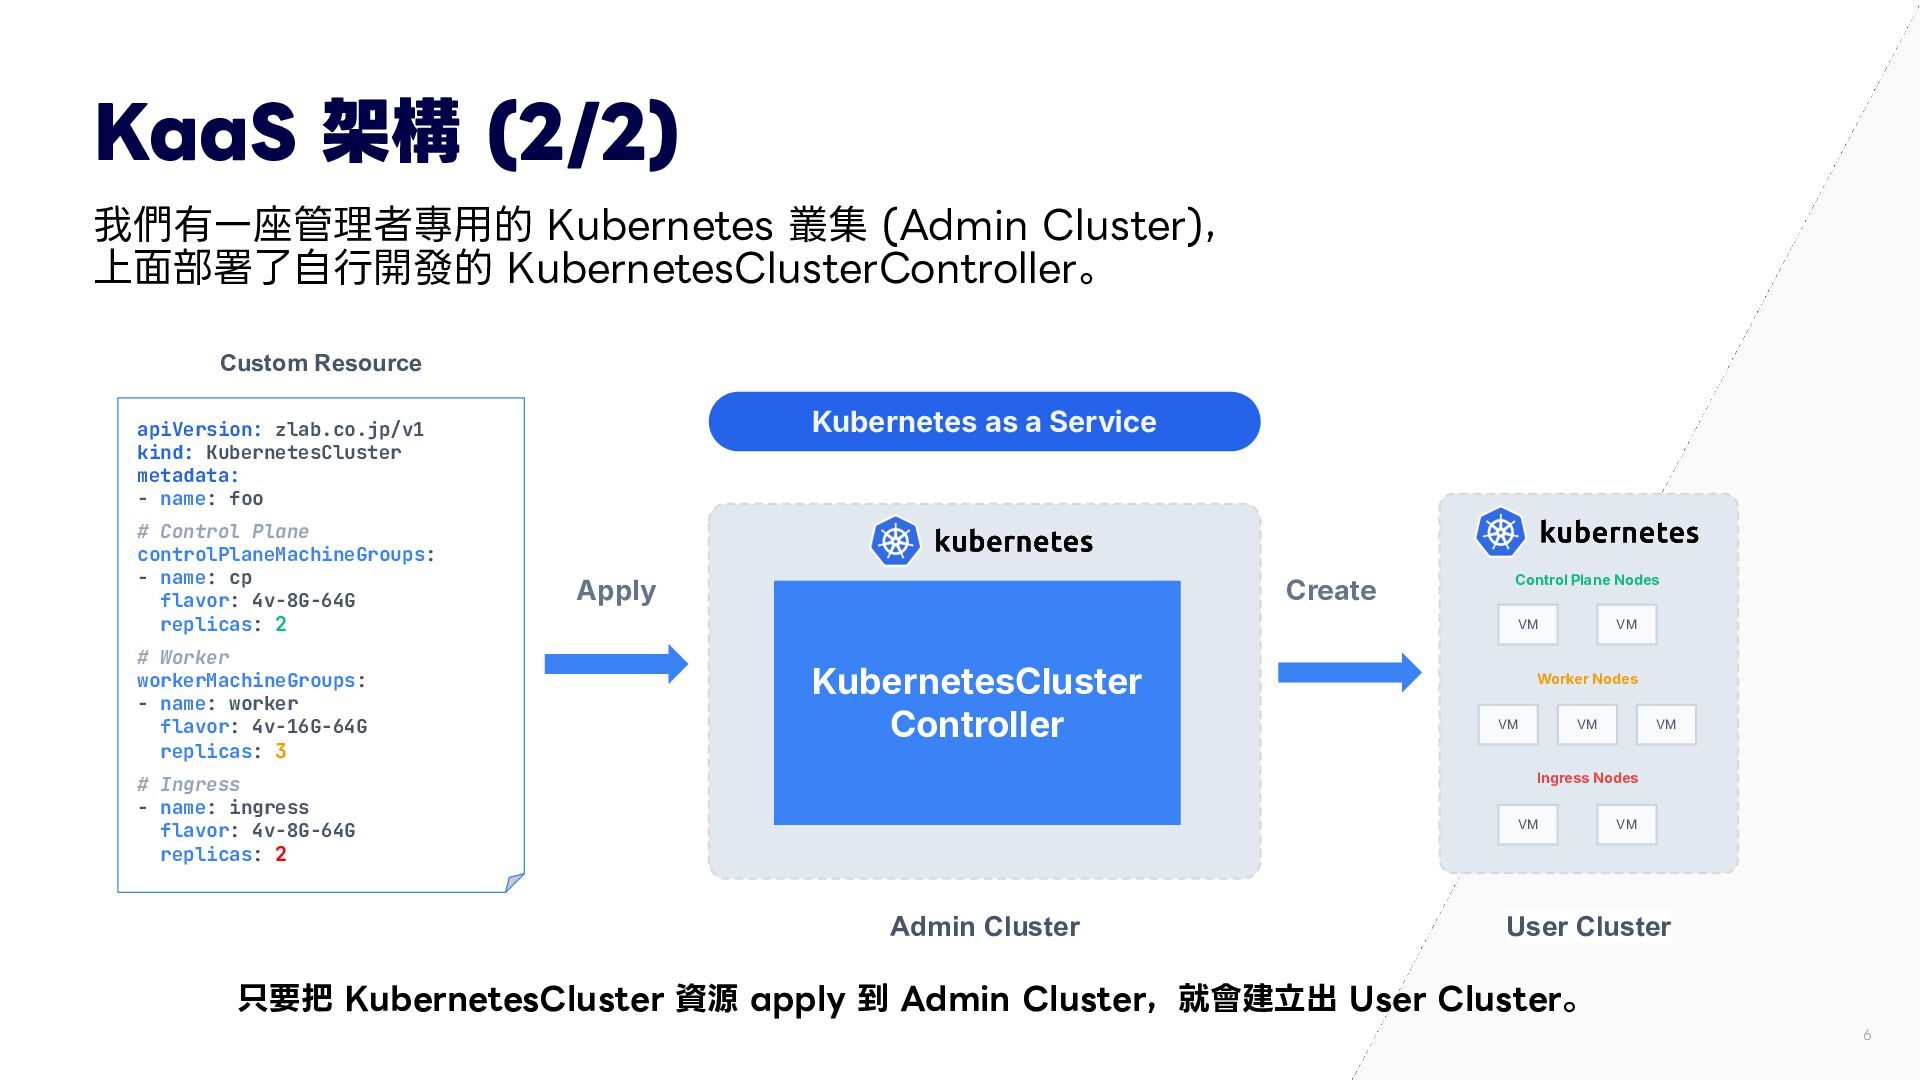
KaaS 架構 (2/2) 我們有⼀座管理者專⽤的 Kubernetes 叢集 (Admin Cluster), 上⾯部署了⾃⾏開發的 KubernetesClusterController。
Custom Resource Kubernetes as a Service apiVersion: zlab.co.jp/v1 kind: KubernetesCluster metadata: - name: foo # Control Plane controlPlaneMachineGroups: - name: cp flavor: 4v-8G-64G replicas: 2 # Worker workerMachineGroups: - name: worker flavor: 4v-16G-64G replicas: 3 Apply Create Control Plane Nodes VM KubernetesCluster Controller VM Worker Nodes VM VM VM Ingress Nodes # Ingress - name: ingress flavor: 4v-8G-64G replicas: 2 VM Admin Cluster VM User Cluster 只要把 KubernetesCluster 資源 apply 到 Admin Cluster,就會建⽴出 User Cluster。 6
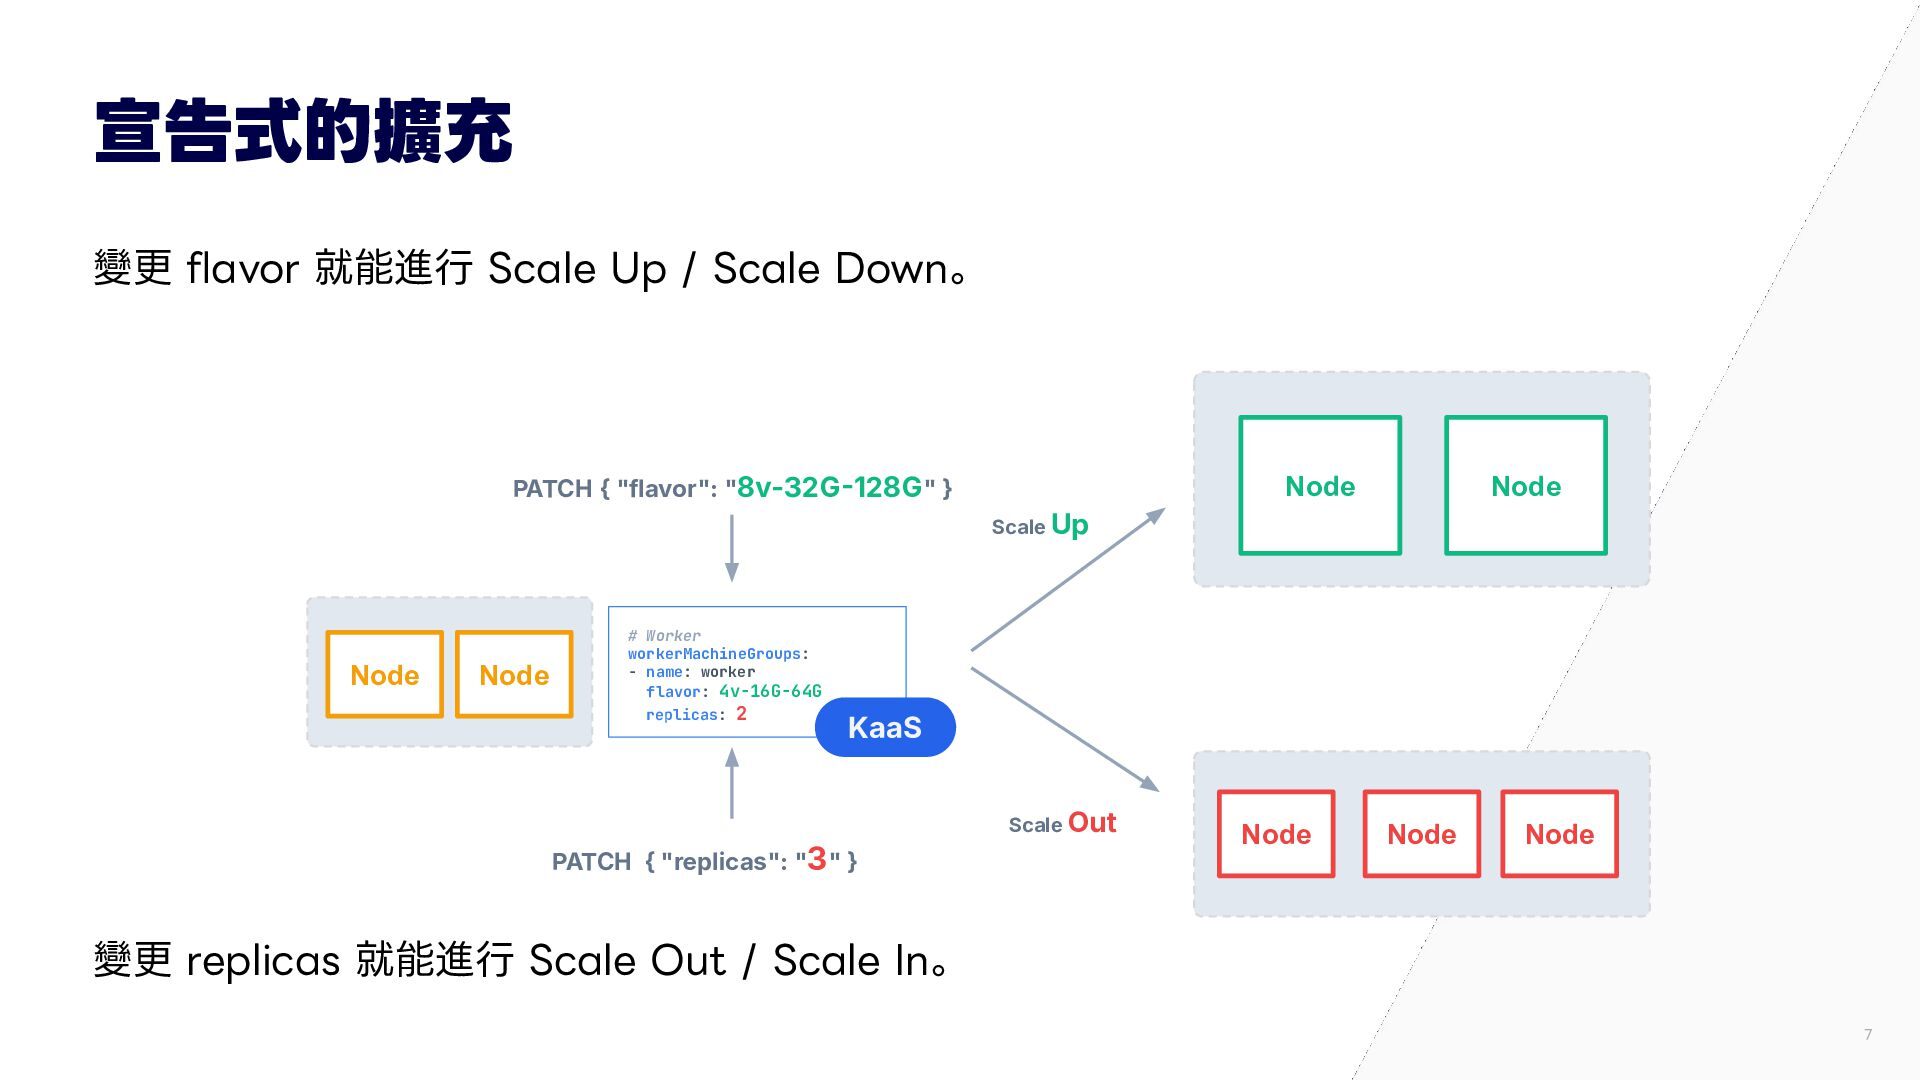
宣告式的擴充 Scaling Up and Out Are Easy 變更 flavor 就能進⾏
Scale Up / Scale Down。 Node Node PATCH { "flavor": "8v-32G128G" } Node Scale Up Node Node # Worker workerMachineGroups: - name: worker flavor: 4v-16G-64G replicas: 2 KaaS Scale Out PATCH { "replicas": "3" } Node Node Node 變更 replicas 就能進⾏ Scale Out / Scale In。 7
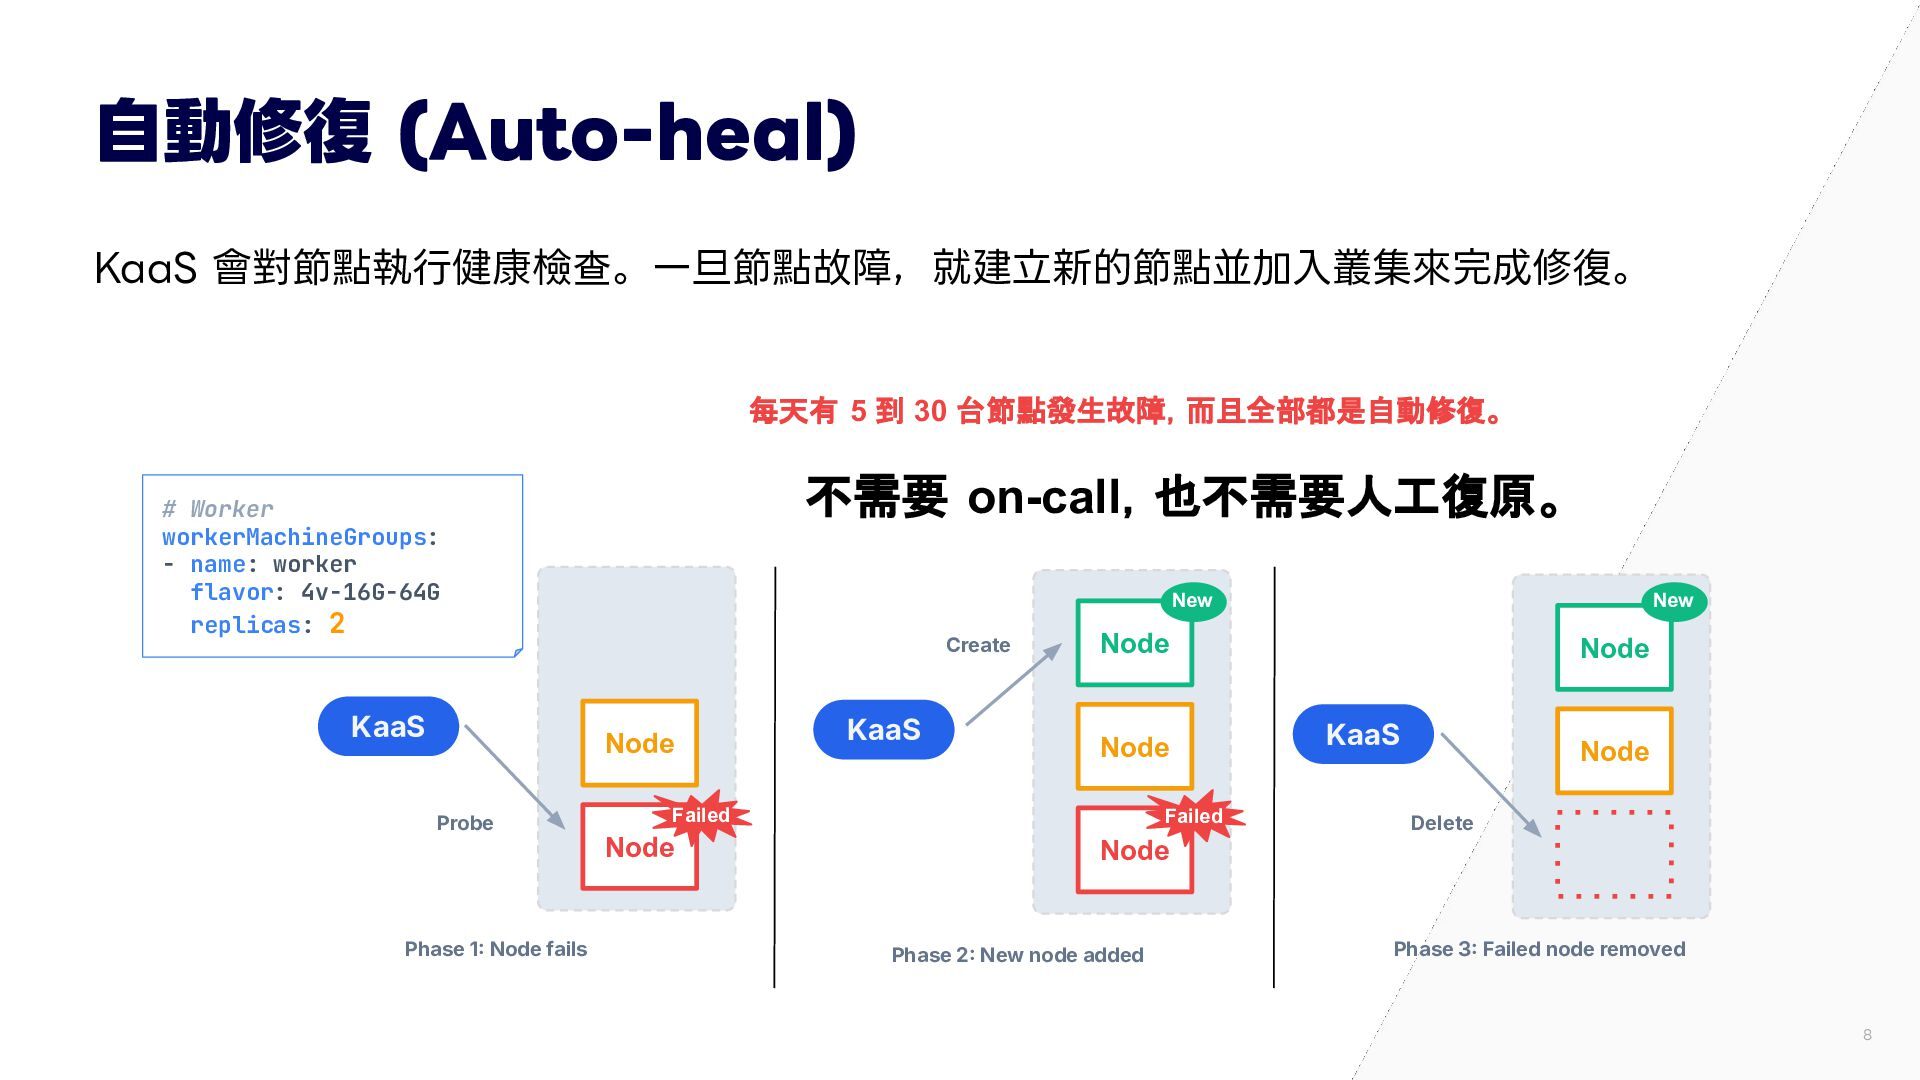
⾃動修復 (Auto-heal) KaaS 會對節點執⾏健康檢查。⼀旦節點故障,就建⽴新的節點並加⼊叢集來完成修復。 每天有 5 到 30 台節點發生故障,而且全部都是自動修復。 不需要
on-call,也不需要人工復原。 # Worker workerMachineGroups: - name: worker flavor: 4v-16G-64G replicas: 2 KaaS New Create Node Probe Node Node Failed Node Phase 1 Node fails KaaS New Failed Node KaaS Node Delete Node Phase 2 New node added Phase 3 Failed node removed 8
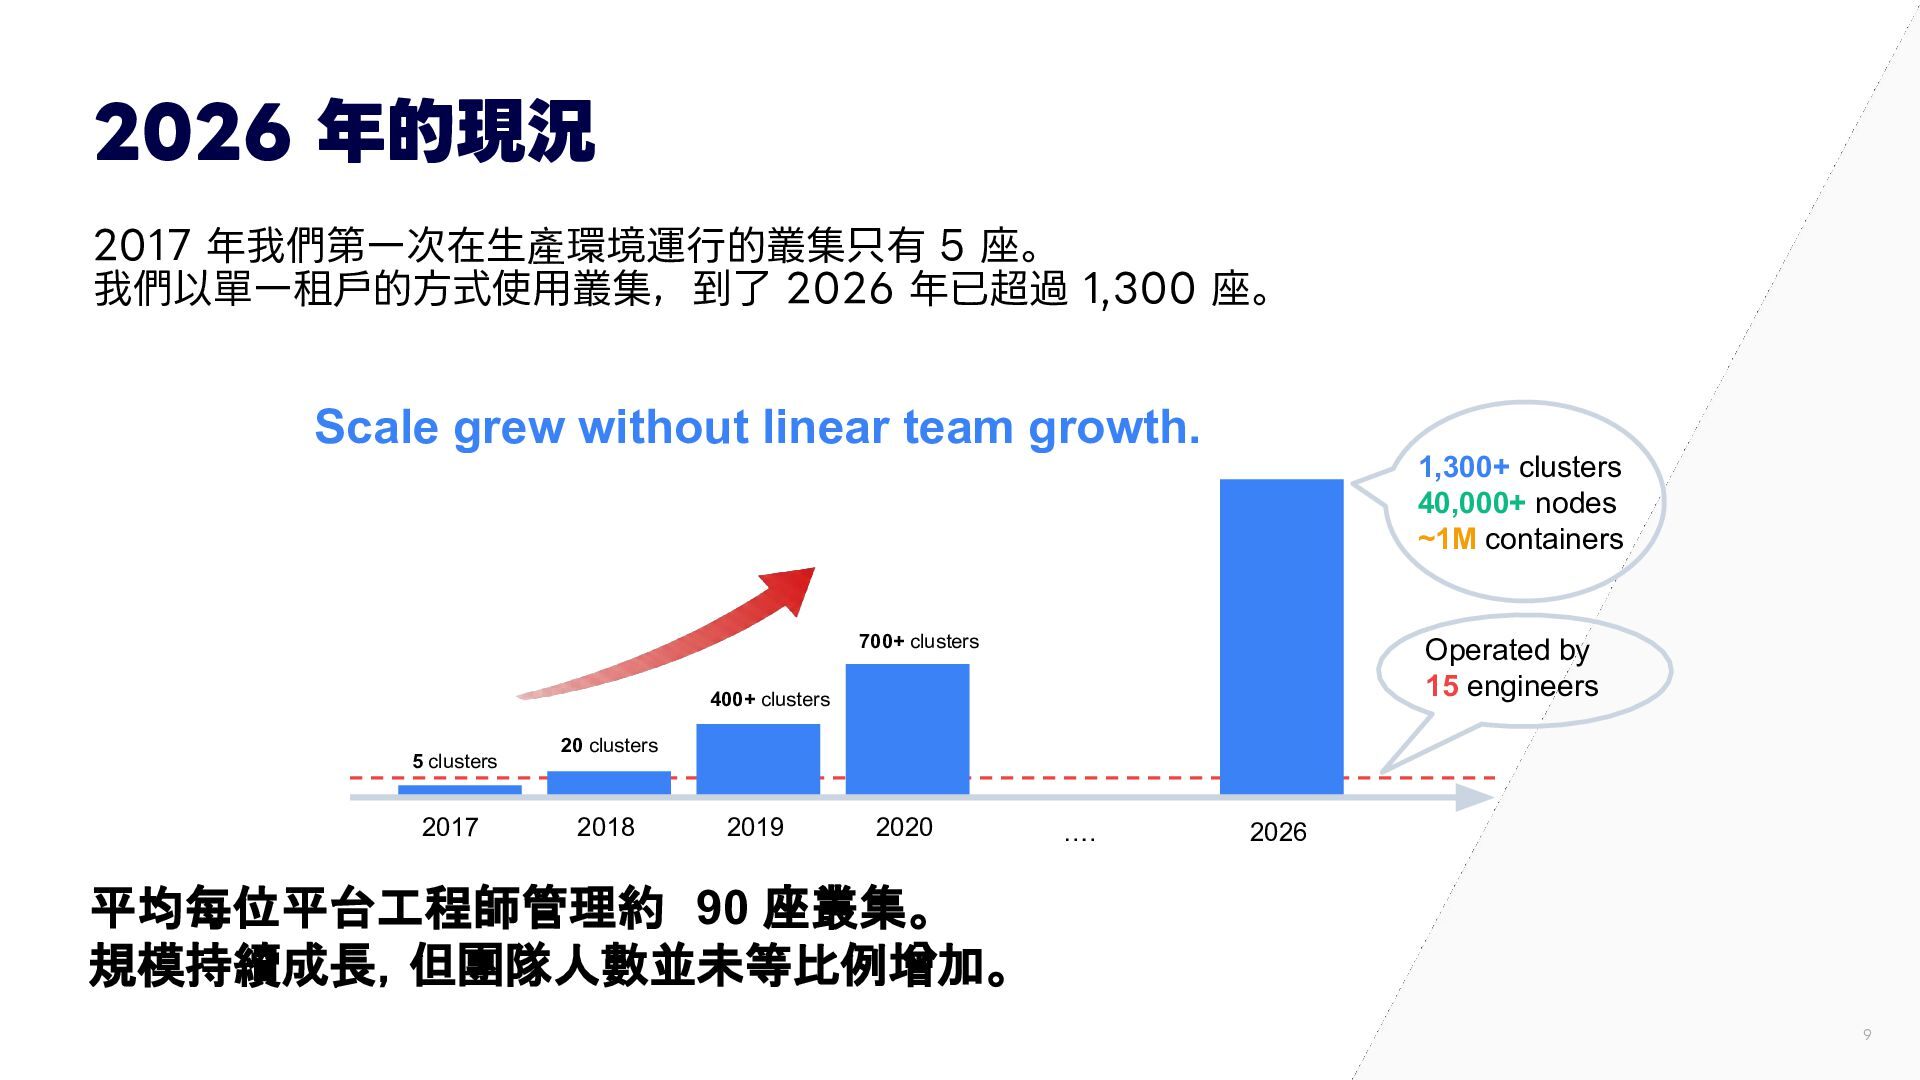
2026 年的現況 2017 年我們第⼀次在⽣產環境運⾏的叢集只有 5 座。 我們以單⼀租戶的⽅式使⽤叢集,到了 2026 年已超過 1,300
座。 Scale grew without linear team growth. 1,300+ clusters 40,000+ nodes ~1M containers 700+ clusters Operated by 15 engineers 400+ clusters 5 clusters 2017 20 clusters 2018 2019 2020 …. 2026 平均每位平台工程師管理約 90 座叢集。 規模持續成長,但團隊人數並未等比例增加。 9
原⽣ Kubernetes 並不簡單 10
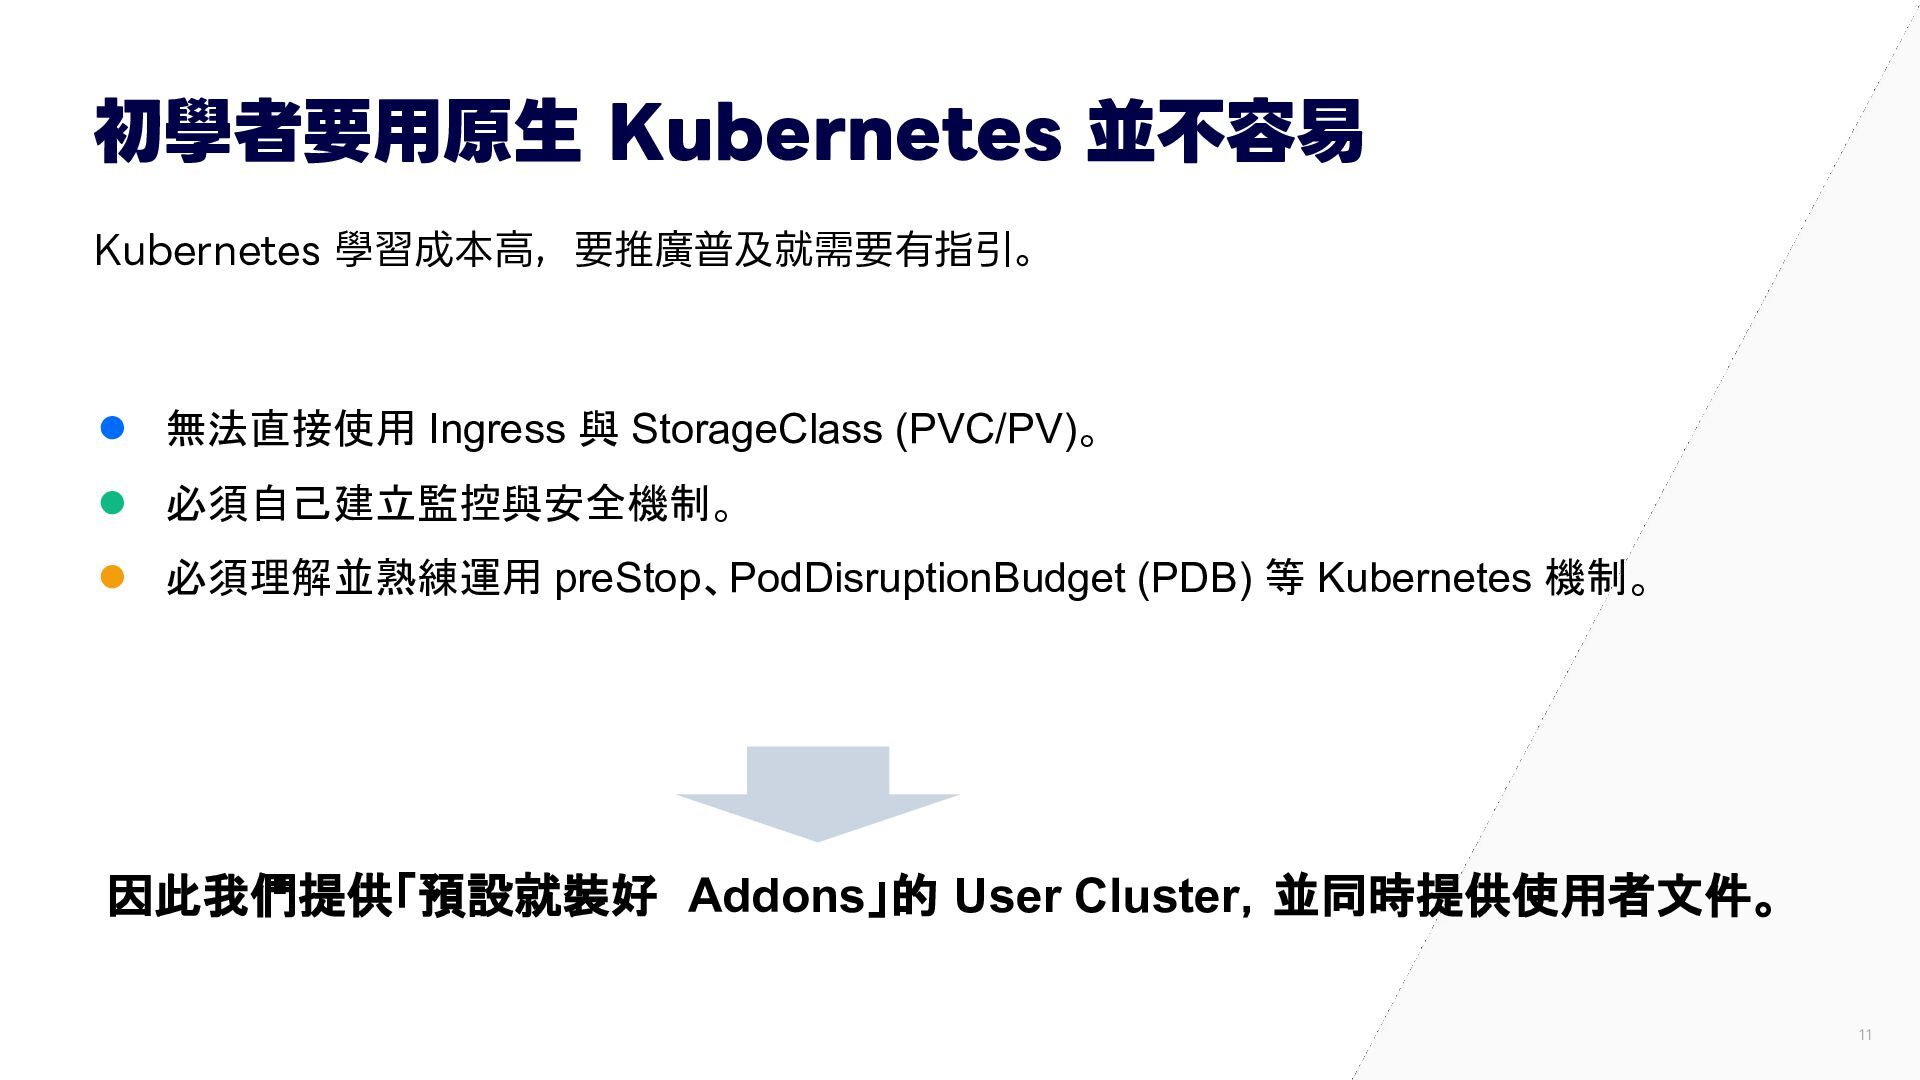
初學者要⽤原⽣ Kubernetes 並不容易 Kubernetes 學習成本⾼,要推廣普及就需要有指引。 • 無法直接使用 Ingress 與 StorageClass
(PVC/PV)。 • 必須自己建立監控與安全機制。 • 必須理解並熟練運用 preStop、PodDisruptionBudget (PDB) 等 Kubernetes 機制。 因此我們提供「預設就裝好 Addons」的 User Cluster,並同時提供使用者文件。 11
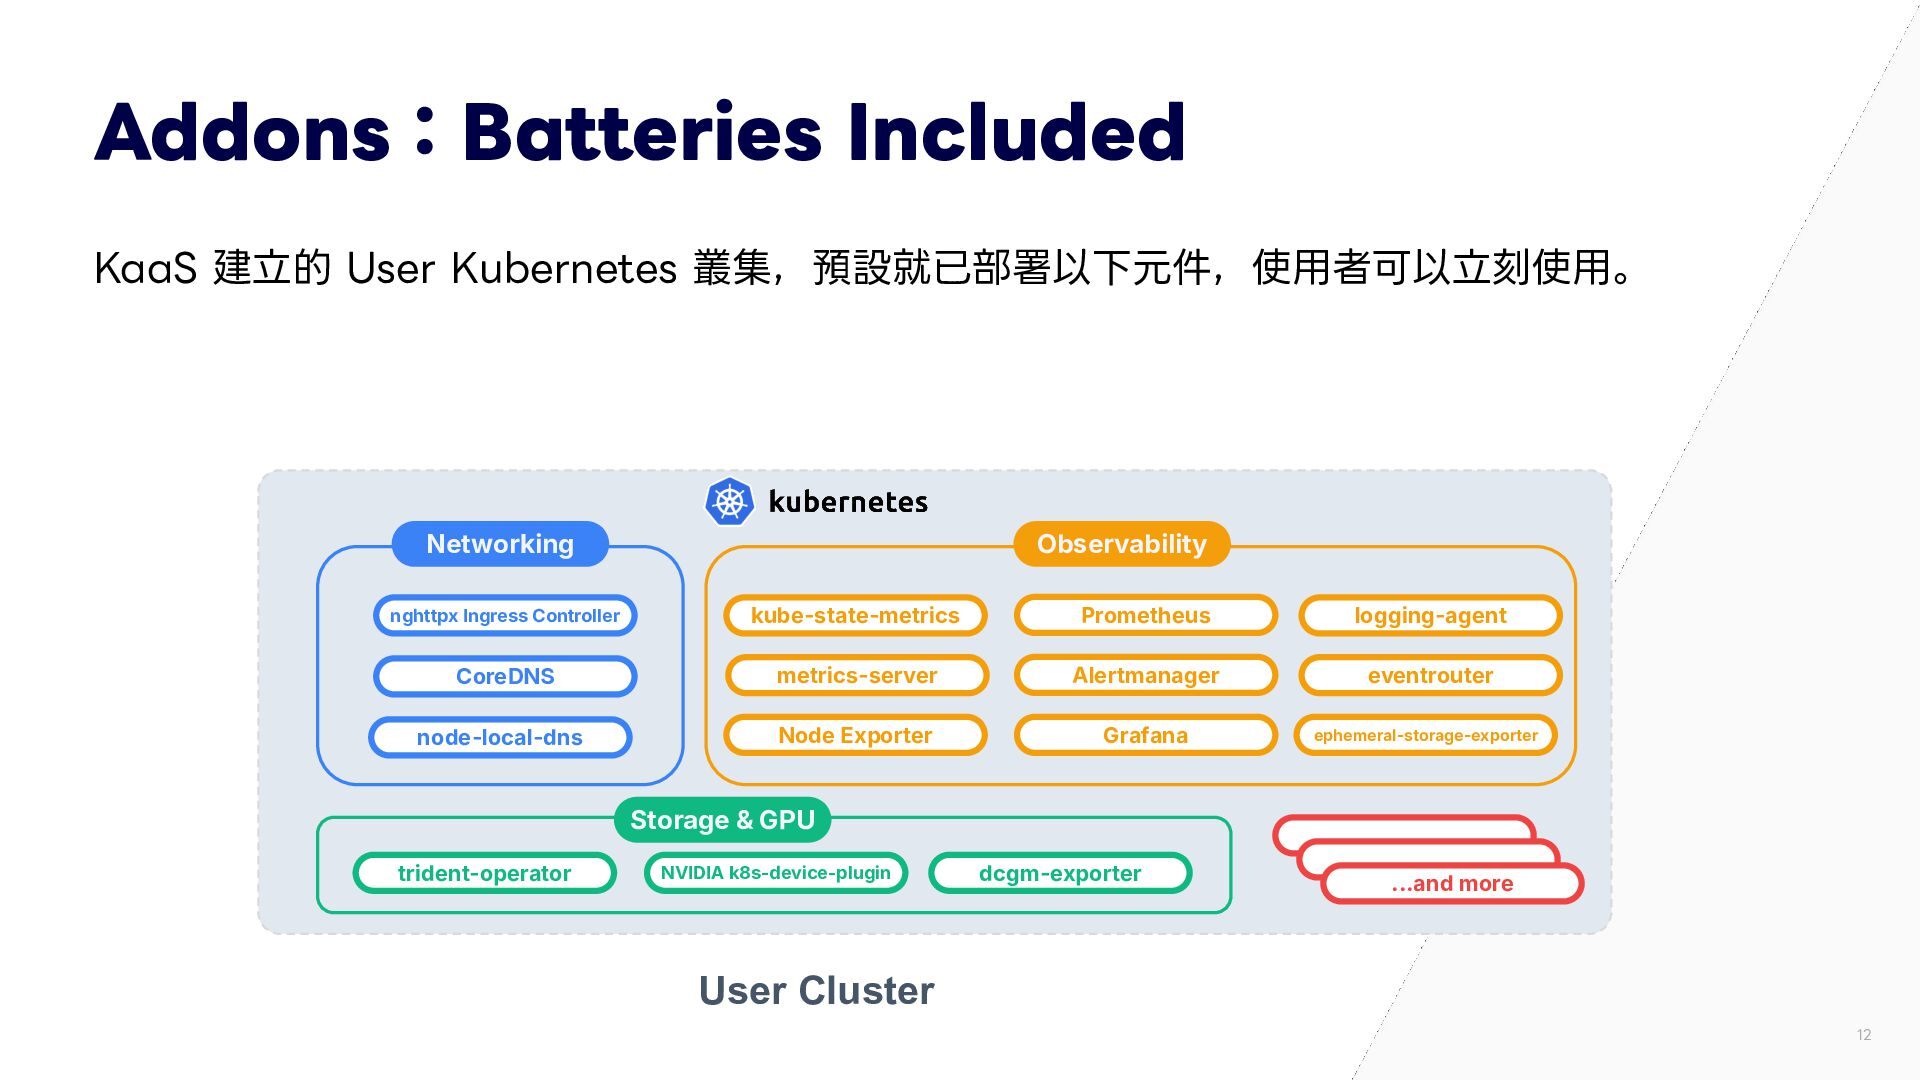
Addons:Batteries Included KaaS 建⽴的 User Kubernetes 叢集,預設就已部署以下元件,使⽤者可以⽴刻使⽤。 Batteries Included Networking
Observability nghttpx Ingress Controller kube-state-metrics Prometheus logging-agent CoreDNS metrics-server Alertmanager eventrouter node-local-dns Node Exporter Grafana ephemeral-storage-exporter Storage & GPU trident-operator NVIDIA k8s-device-plugin dcgm-exporter ...and more User Cluster 12
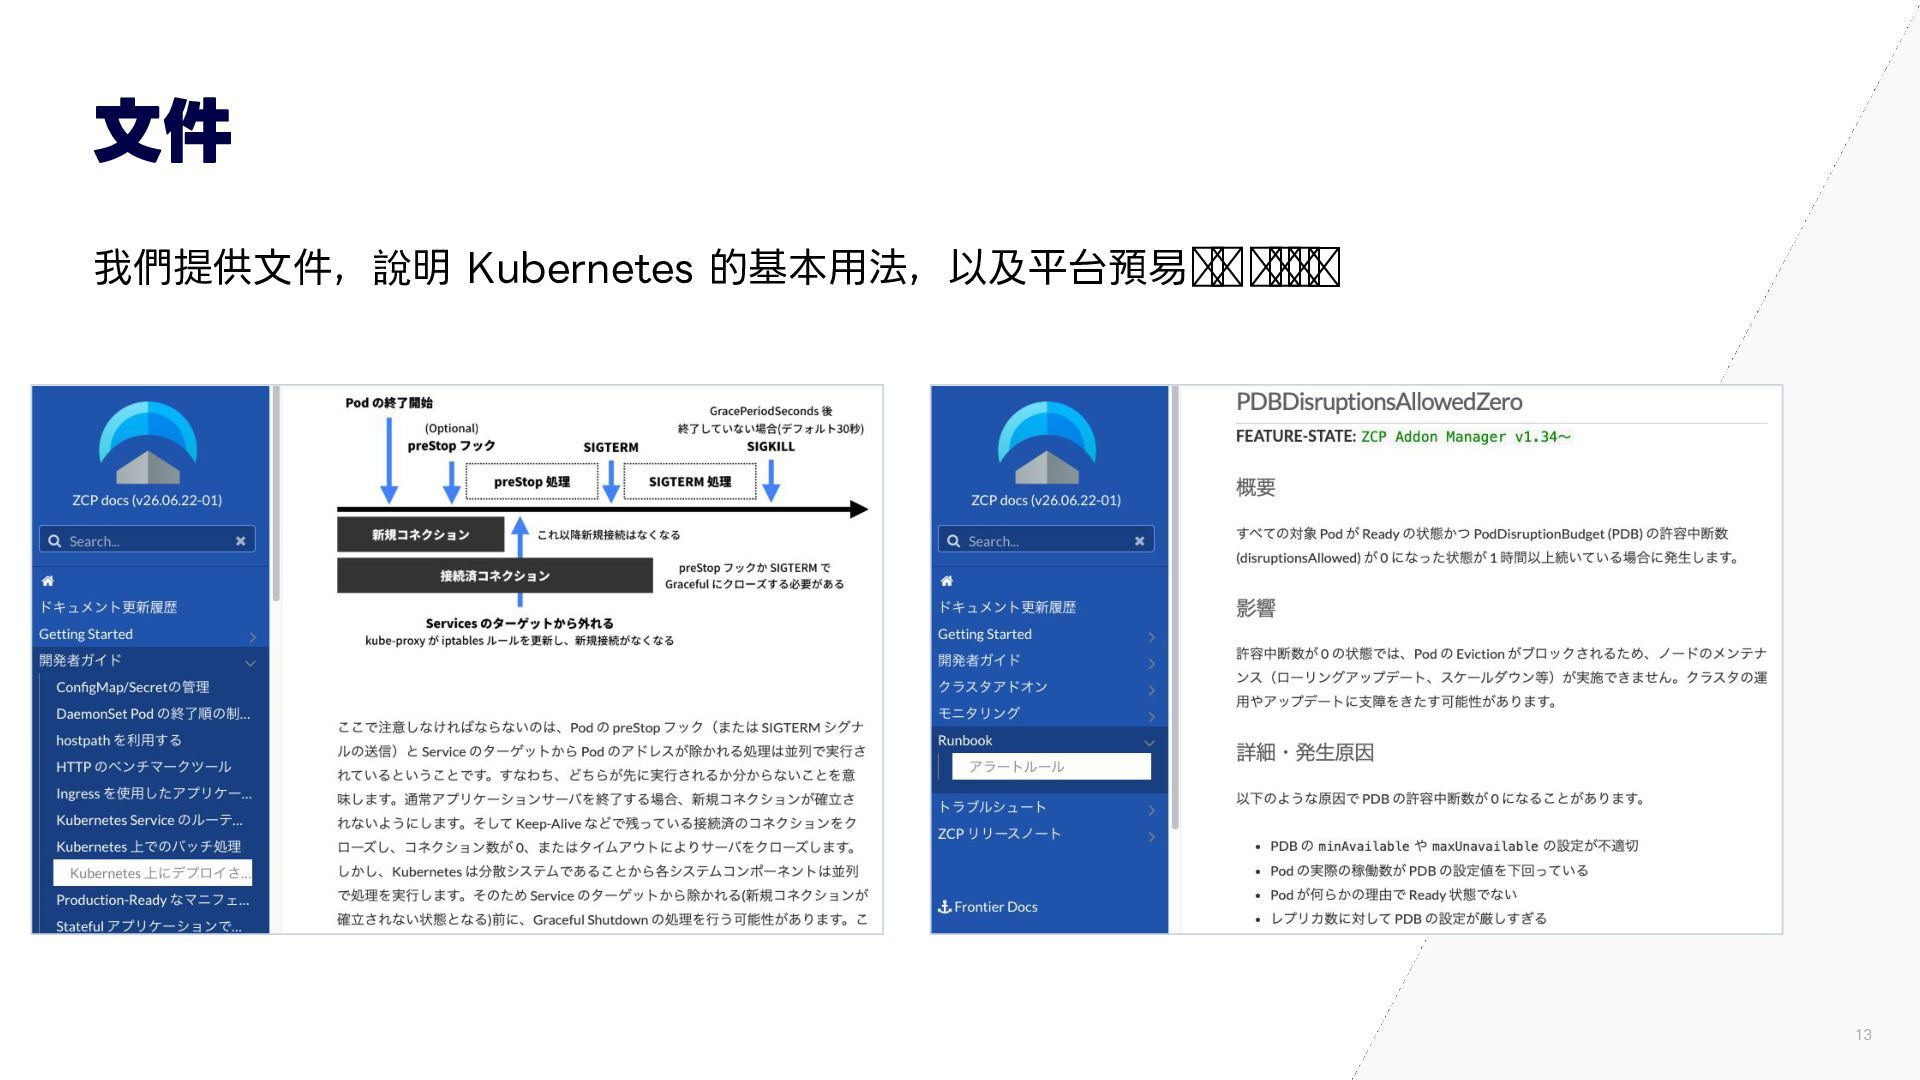
⽂件 我們提供⽂件,說明 Kubernetes 的基本⽤法,以及平台預先安裝的各項功能。 13
基本功能 14
Ingress 與 StorageClass Kubernetes 有些功能只提供了資源 (resource),Controller 必須⾃⼰準備: • 要使用 Ingress,需要
Ingress Controller。 • 要使用 StorageClass、PVC/PV,需要 CSI Driver 或 Volume Provisioner。 在 KaaS 建立的 User Kubernetes 叢集中,這些都已經是可直接使用的狀態。 15
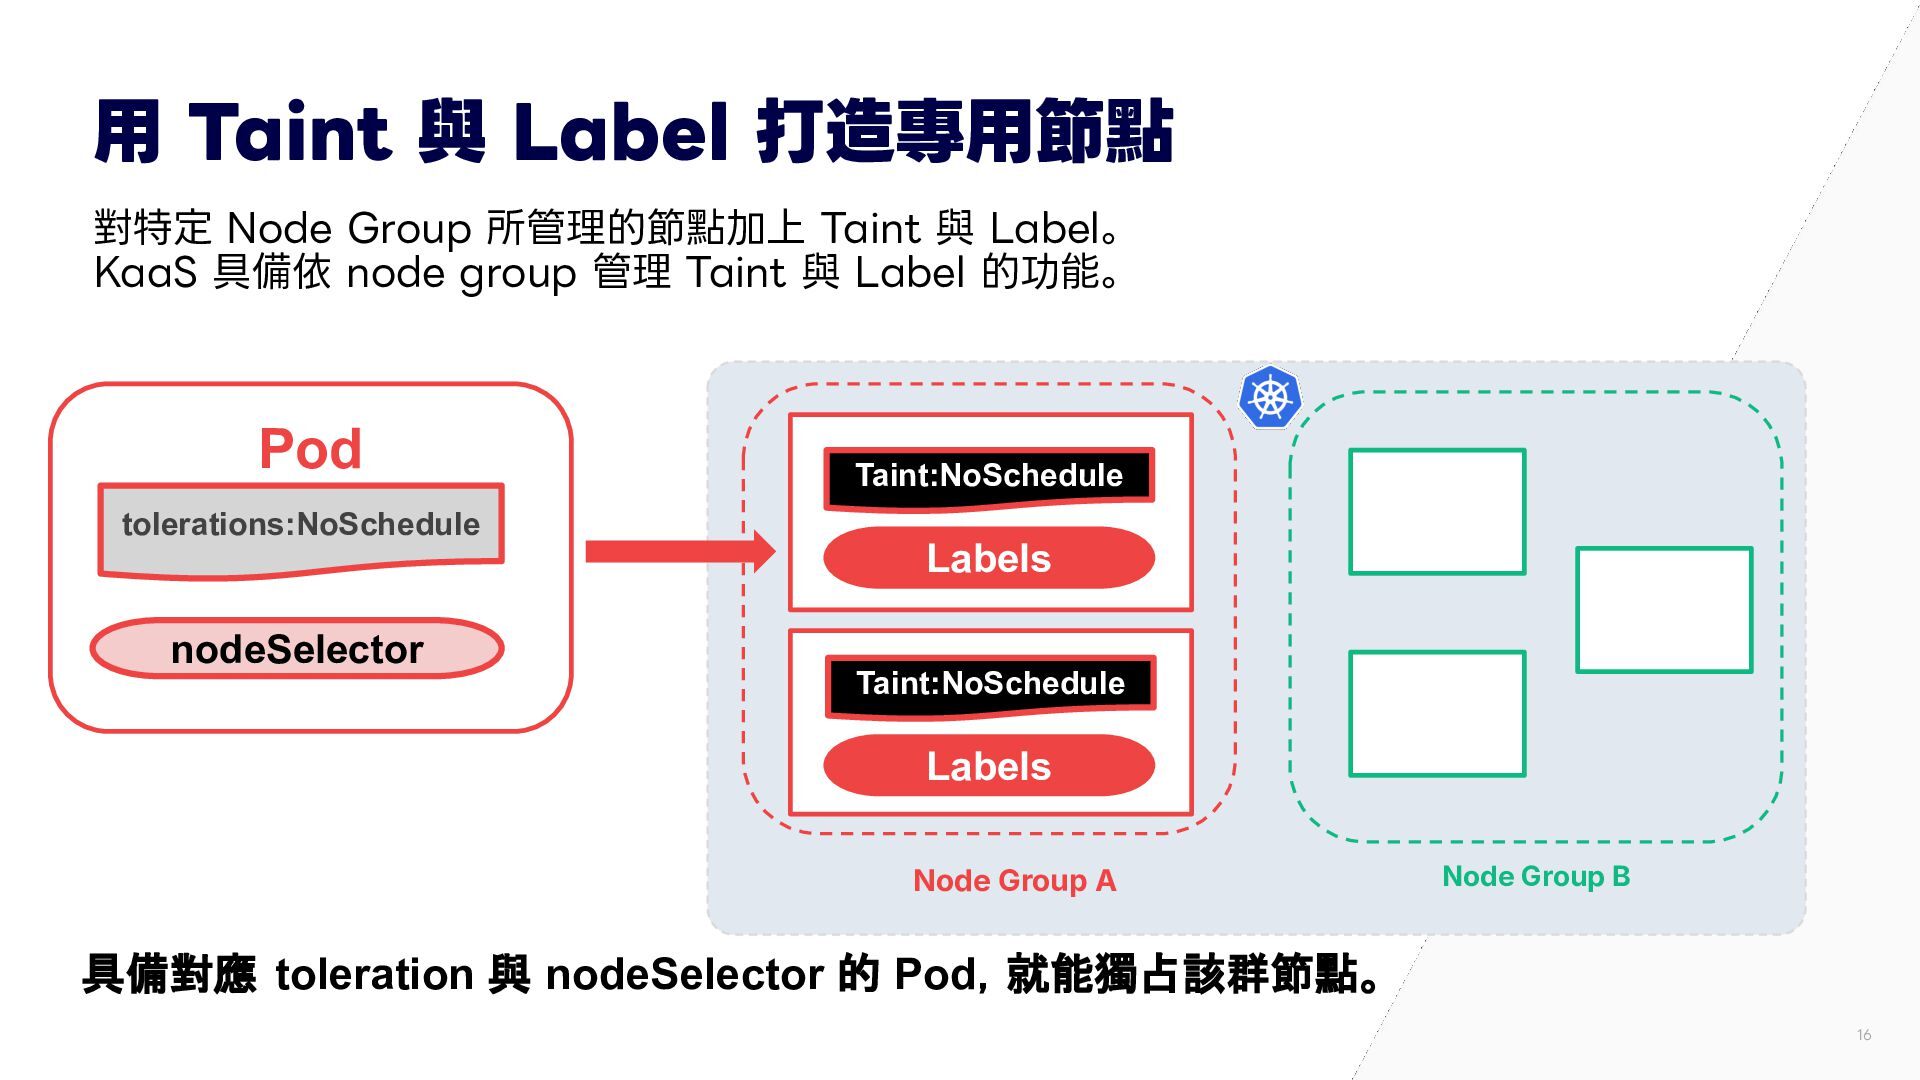
⽤ Taint 與 Label 打造專⽤節點 對特定 Node Group 所管理的節點加上 Taint
與 Label。 KaaS 具備依 node group 管理 Taint 與 Label 的功能。 Pod Taint:NoSchedule tolerations:NoSchedule Labels nodeSelector Taint:NoSchedule Labels Node Group A Node Group B 具備對應 toleration 與 nodeSelector 的 Pod,就能獨占該群節點。 16
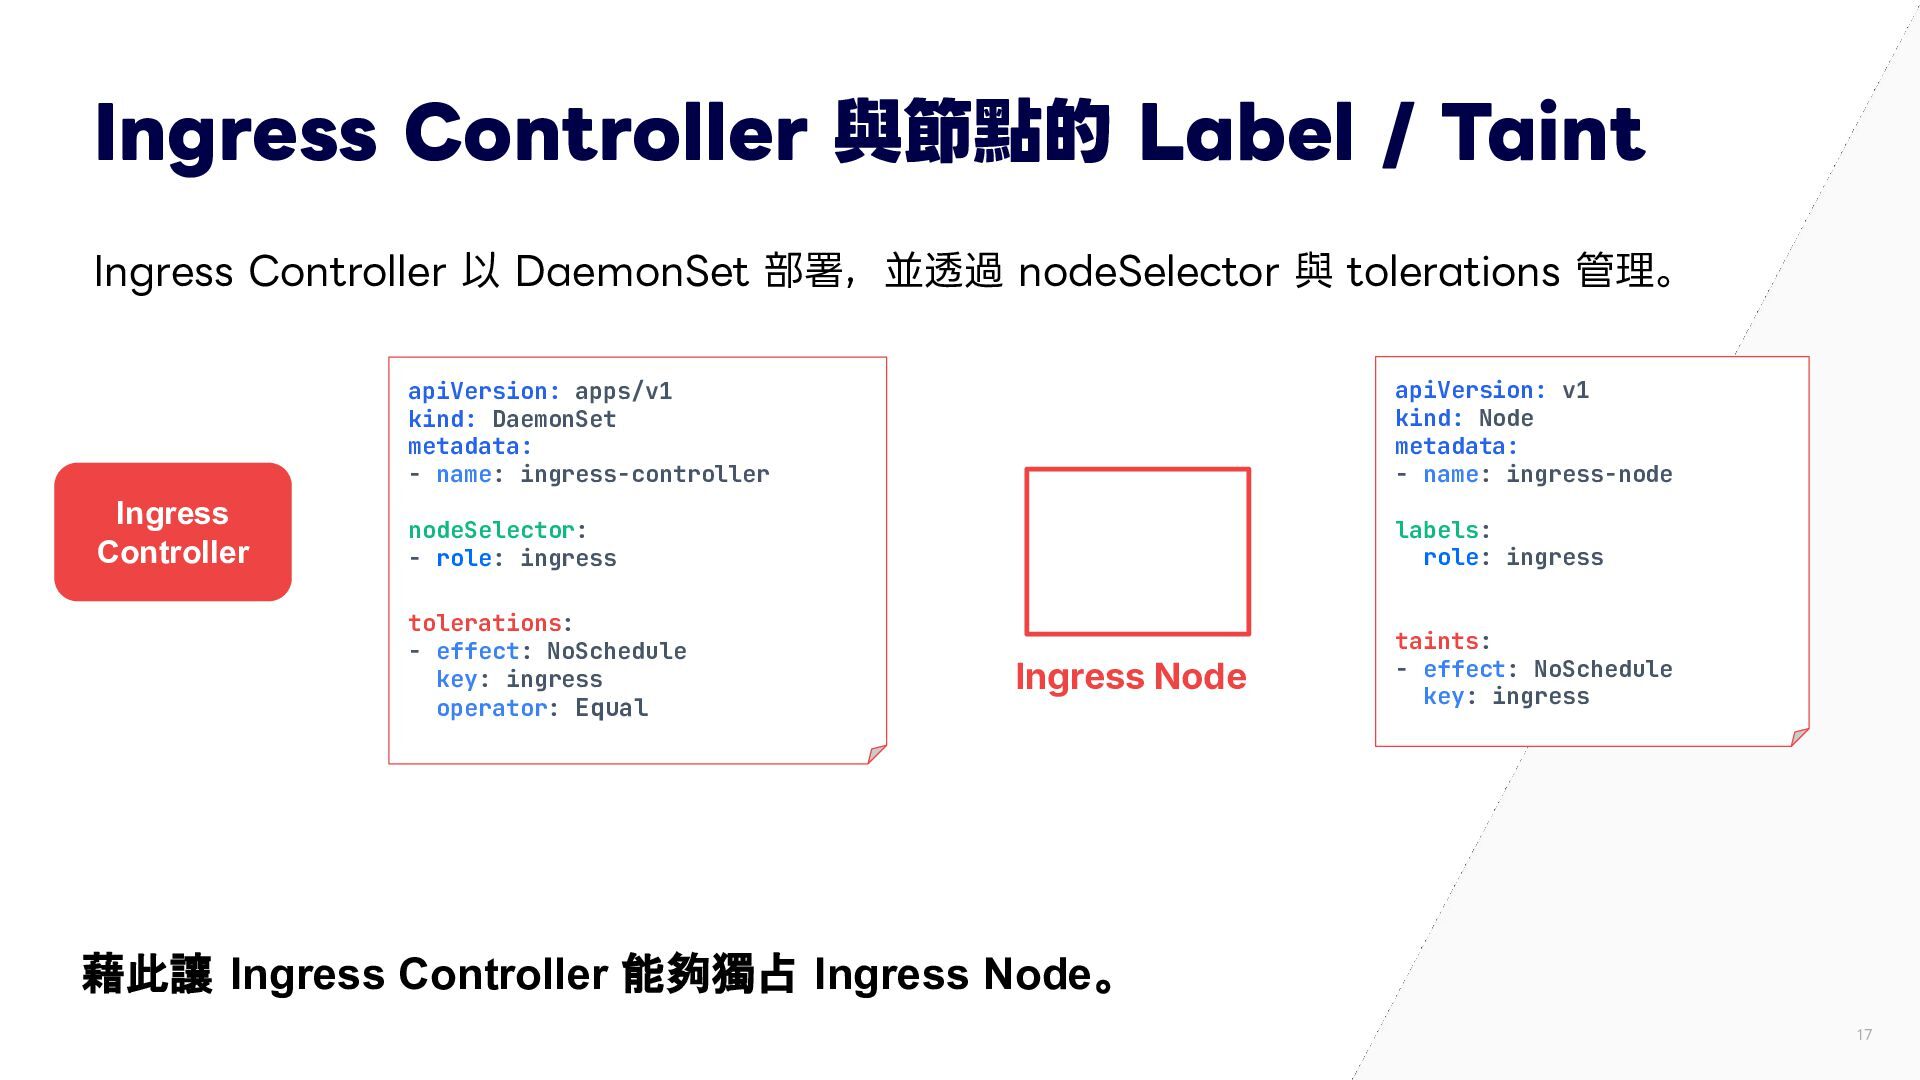
Ingress Controller 與節點的 Label / Taint Ingress Controller 以 DaemonSet
部署,並透過 nodeSelector 與 tolerations 管理。 Ingress Controller apiVersion: apps/v1 kind: DaemonSet metadata: - name: ingress-controller apiVersion: v1 kind: Node metadata: - name: ingress-node nodeSelector: - role: ingress labels: role: ingress tolerations: - effect: NoSchedule key: ingress operator: Equal taints: - effect: NoSchedule key: ingress Ingress Node 藉此讓 Ingress Controller 能夠獨占 Ingress Node。 17
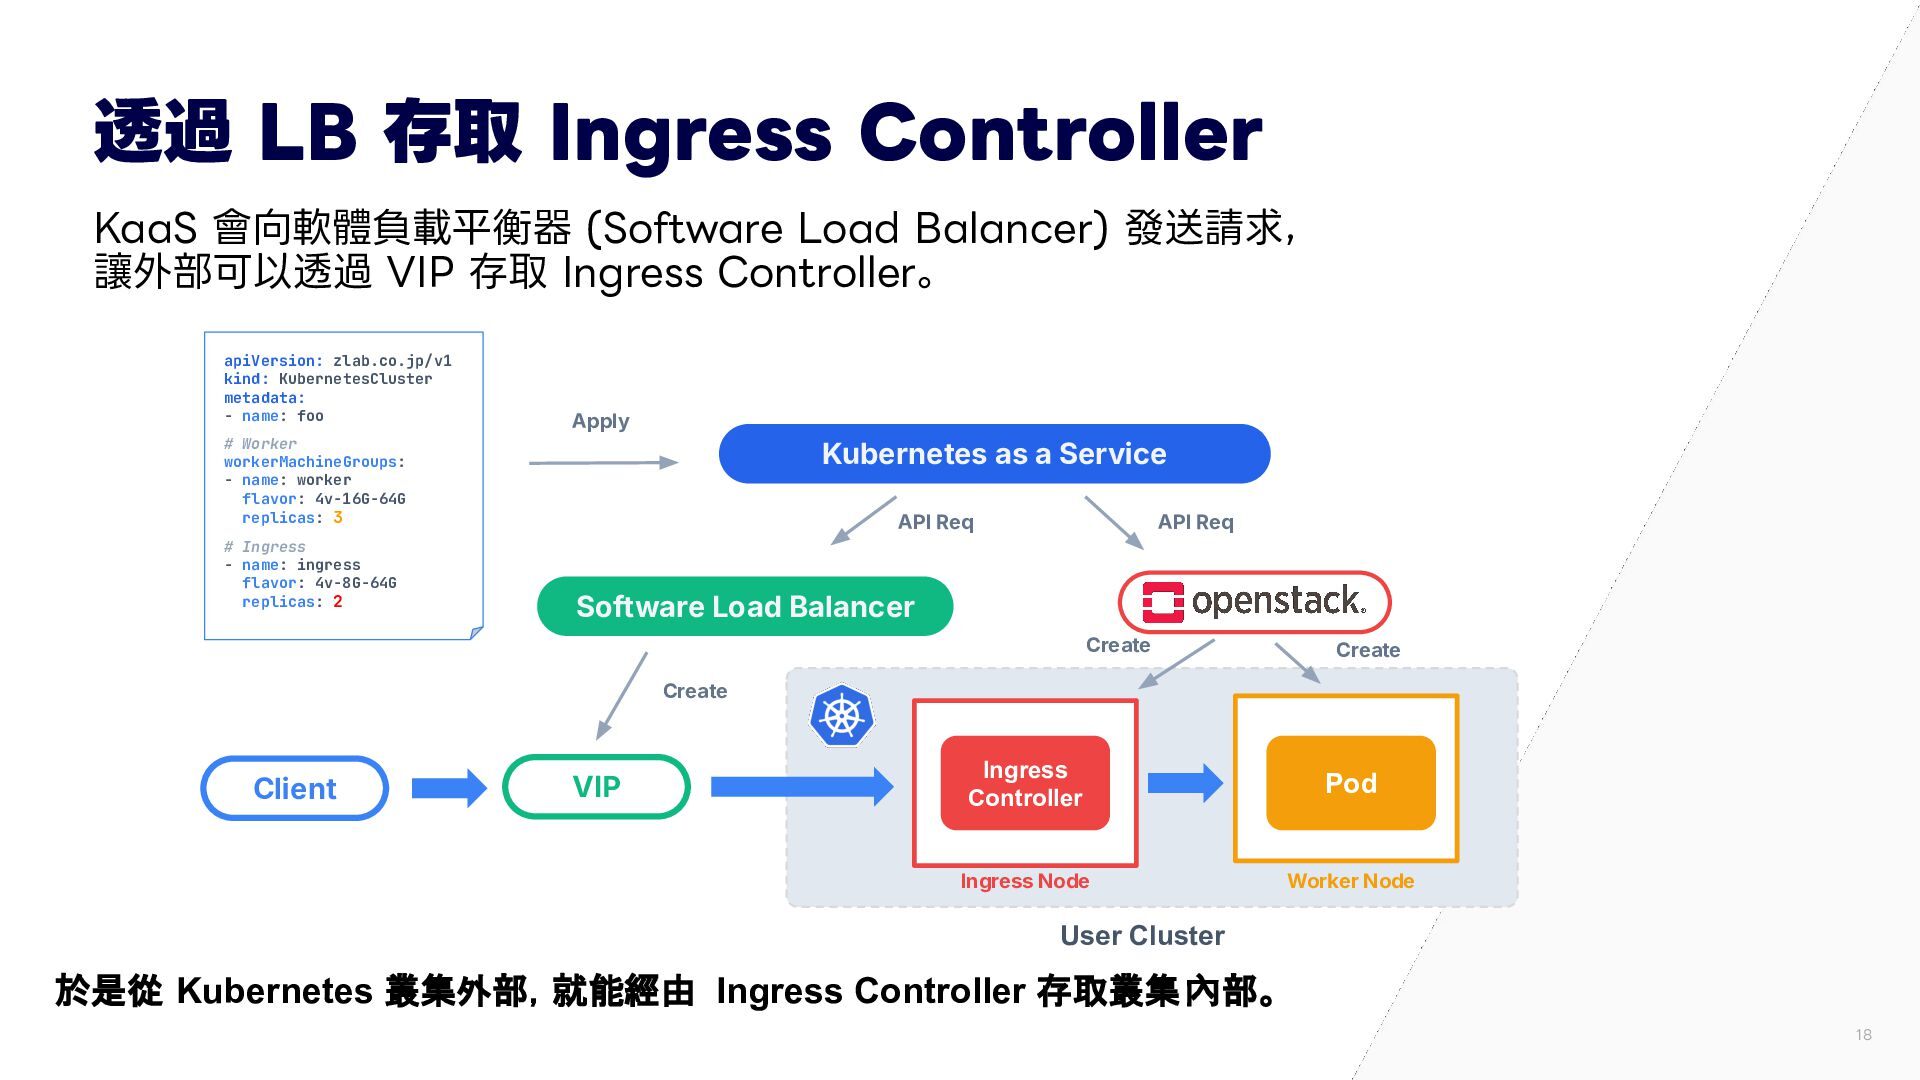
透過 LB 存取 Ingress Controller KaaS 會向軟體負載平衡器 (Software Load Balancer)
發送請求, 讓外部可以透過 VIP 存取 Ingress Controller。 apiVersion: zlab.co.jp/v1 kind: KubernetesCluster metadata: - name: foo Apply # Worker workerMachineGroups: - name: worker flavor: 4v-16G-64G replicas: 3 # Ingress - name: ingress flavor: 4v-8G-64G replicas: 2 Kubernetes as a Service API Req API Req Software Load Balancer Create Create Create Client VIP Ingress Controller Pod Ingress Node Worker Node User Cluster 於是從 Kubernetes 叢集外部,就能經由 Ingress Controller 存取叢集 內部。 18
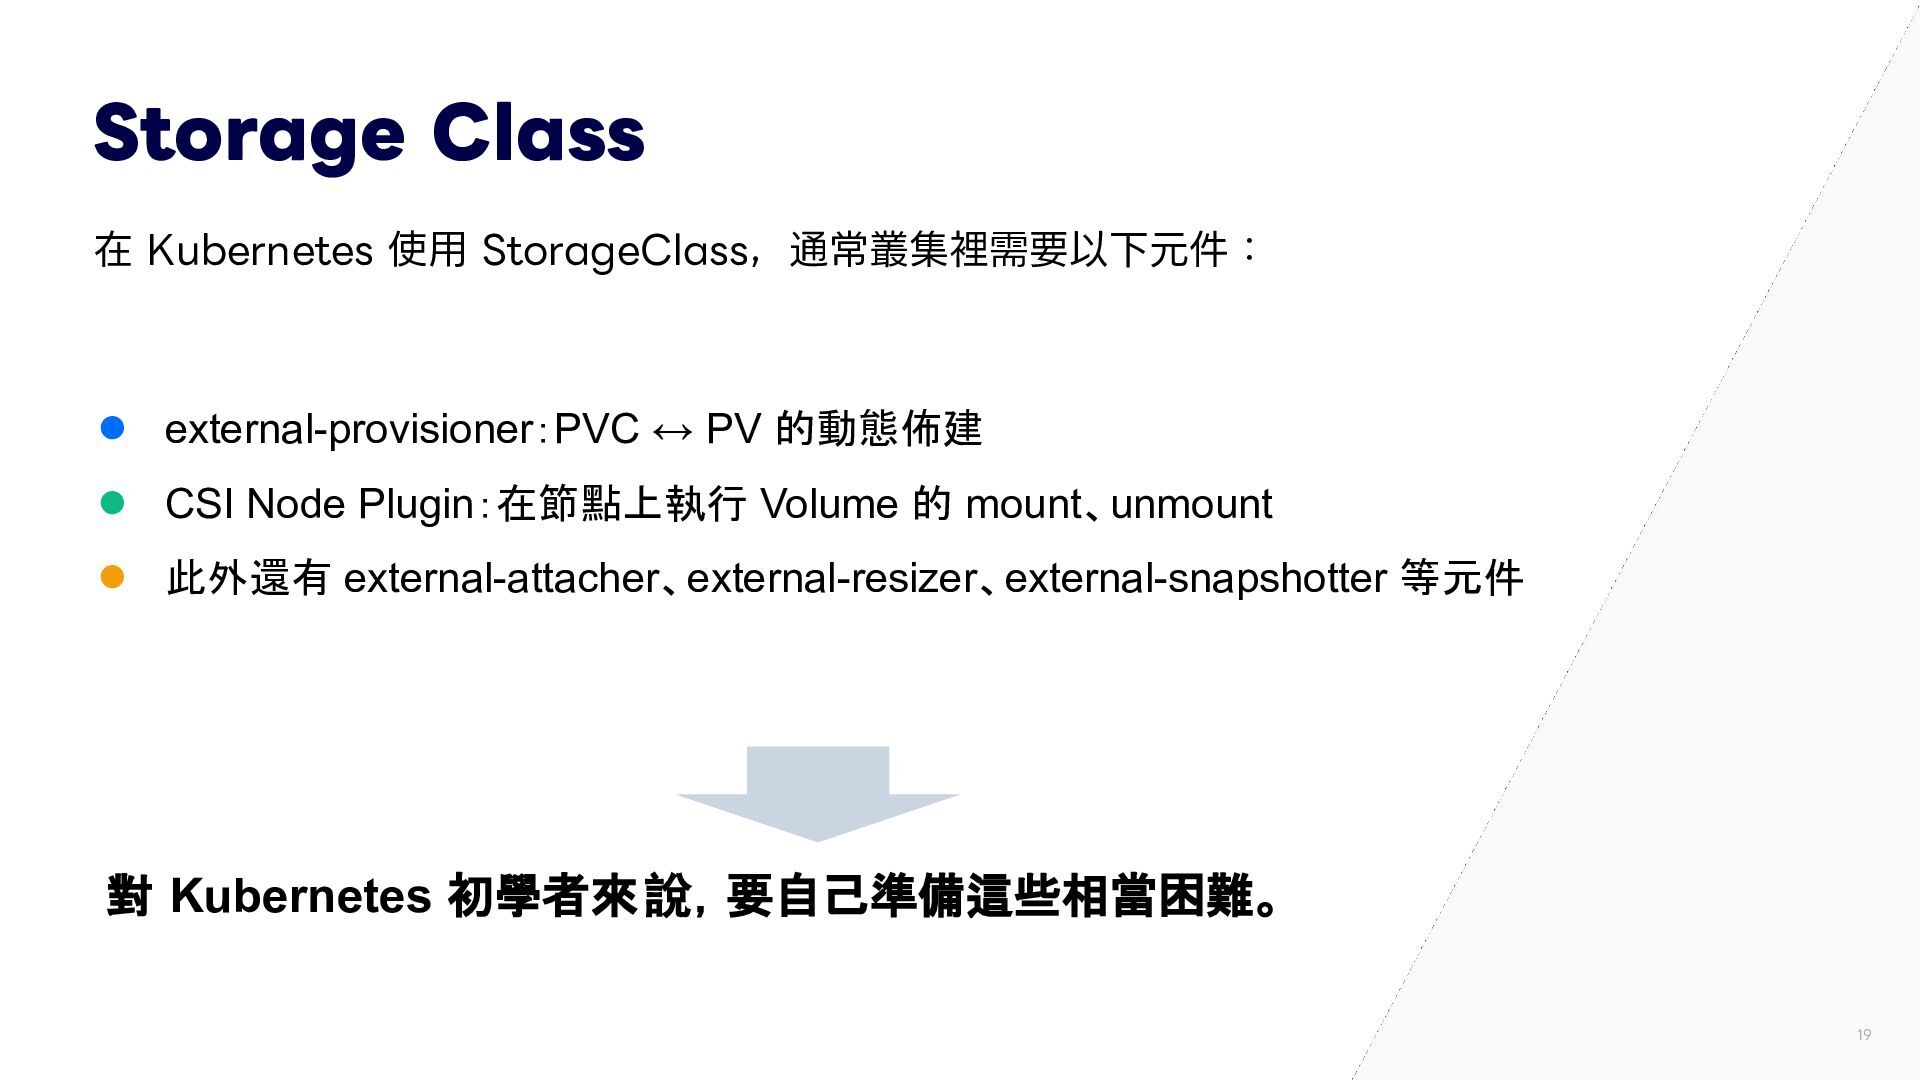
Storage Class 在 Kubernetes 使⽤ StorageClass,通常叢集裡需要以下元件: • external-provisioner:PVC ↔ PV
的動態佈建 • CSI Node Plugin:在節點上執行 Volume 的 mount、unmount • 此外還有 external-attacher、external-resizer、external-snapshotter 等元件 對 Kubernetes 初學者來 說,要自己準備這些相當困難。 19
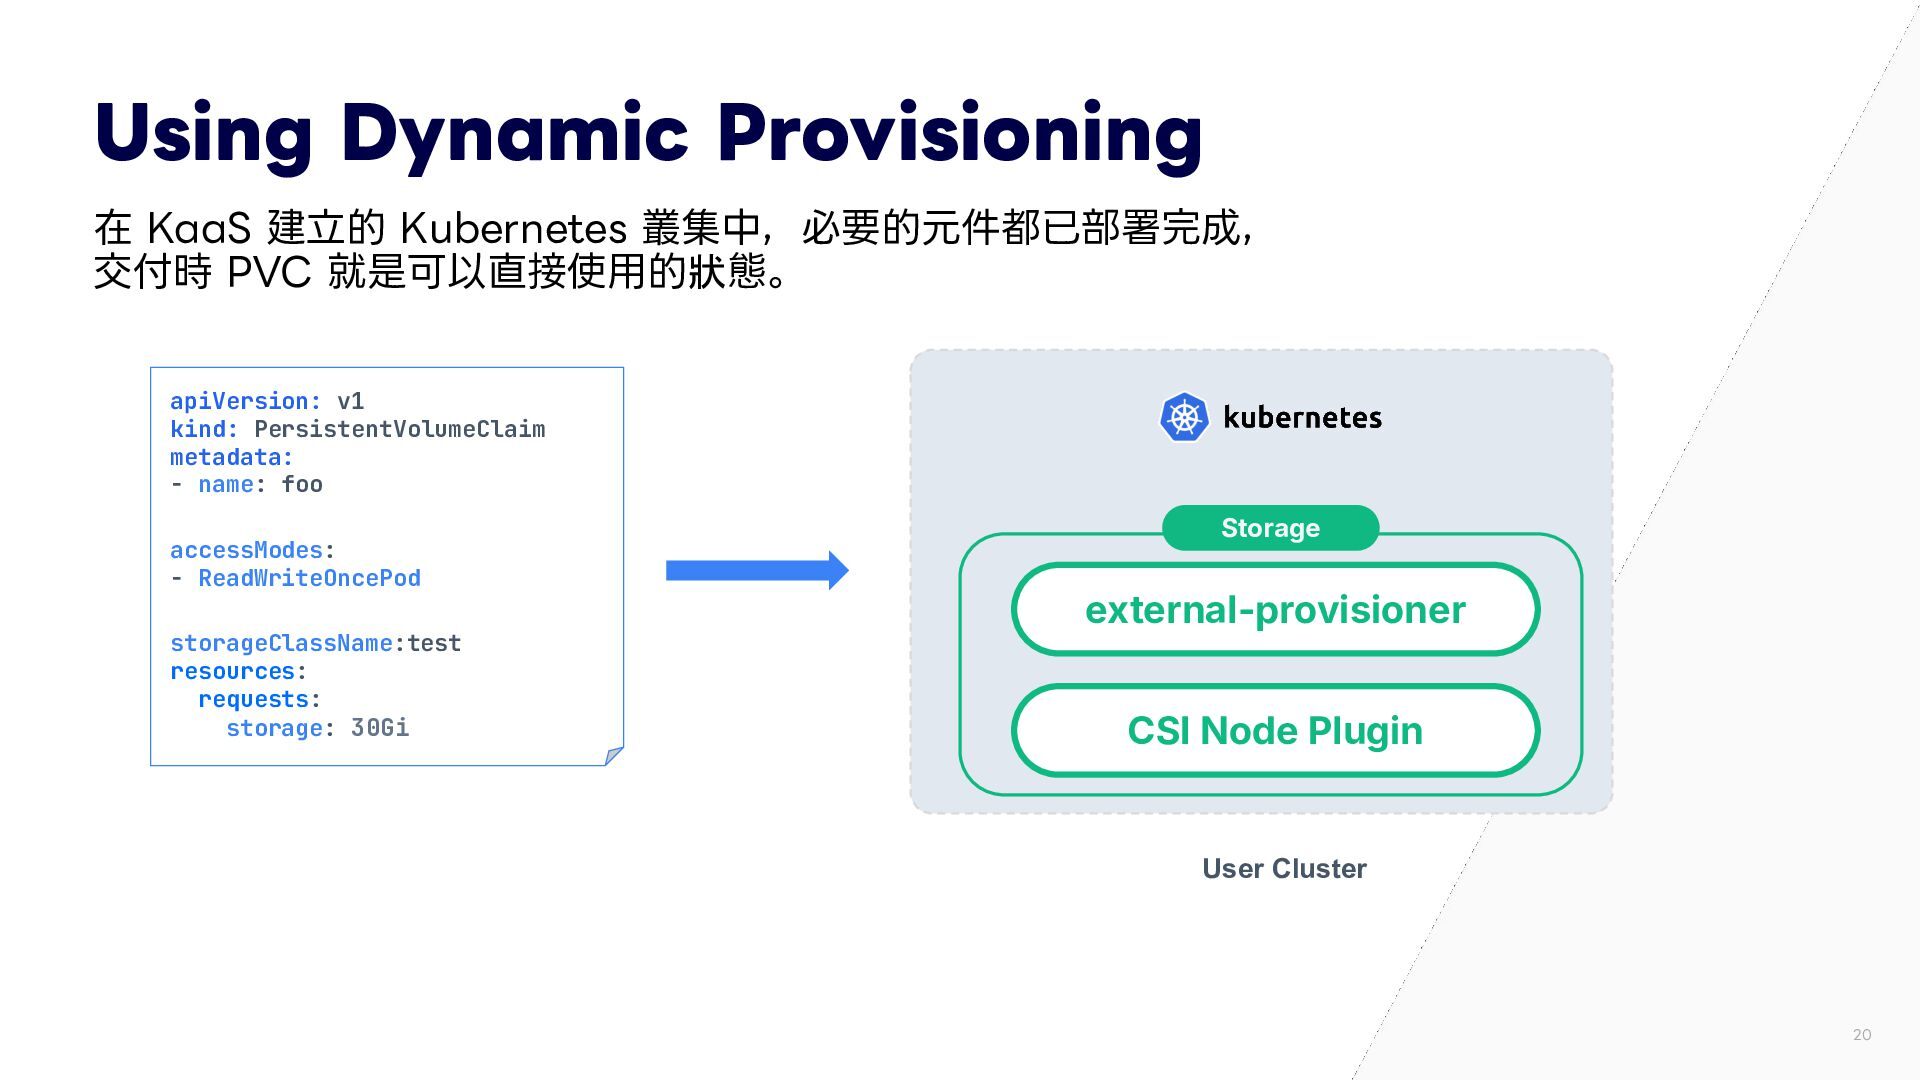
Using Dynamic Provisioning 在 KaaS 建⽴的 Kubernetes 叢集中,必要的元件都已部署完成, 交付時 PVC
就是可以直接使⽤的狀態。 apiVersion: v1 kind: PersistentVolumeClaim metadata: - name: foo accessModes: - ReadWriteOncePod storageClassName:test resources: requests: storage: 30Gi Storage external-provisioner CSI Node Plugin User Cluster 20
監控 21
監控 要達到 production ready,還必須準備好監控機制: • 輸出指標的 exporter 需要自己準備。 • 收集與儲存指標和日誌的機制需要自己準備。
• 發送告警的機制也同樣需要。 User Kubernetes 叢集在交付時,監控機制就已經部署完成。 22
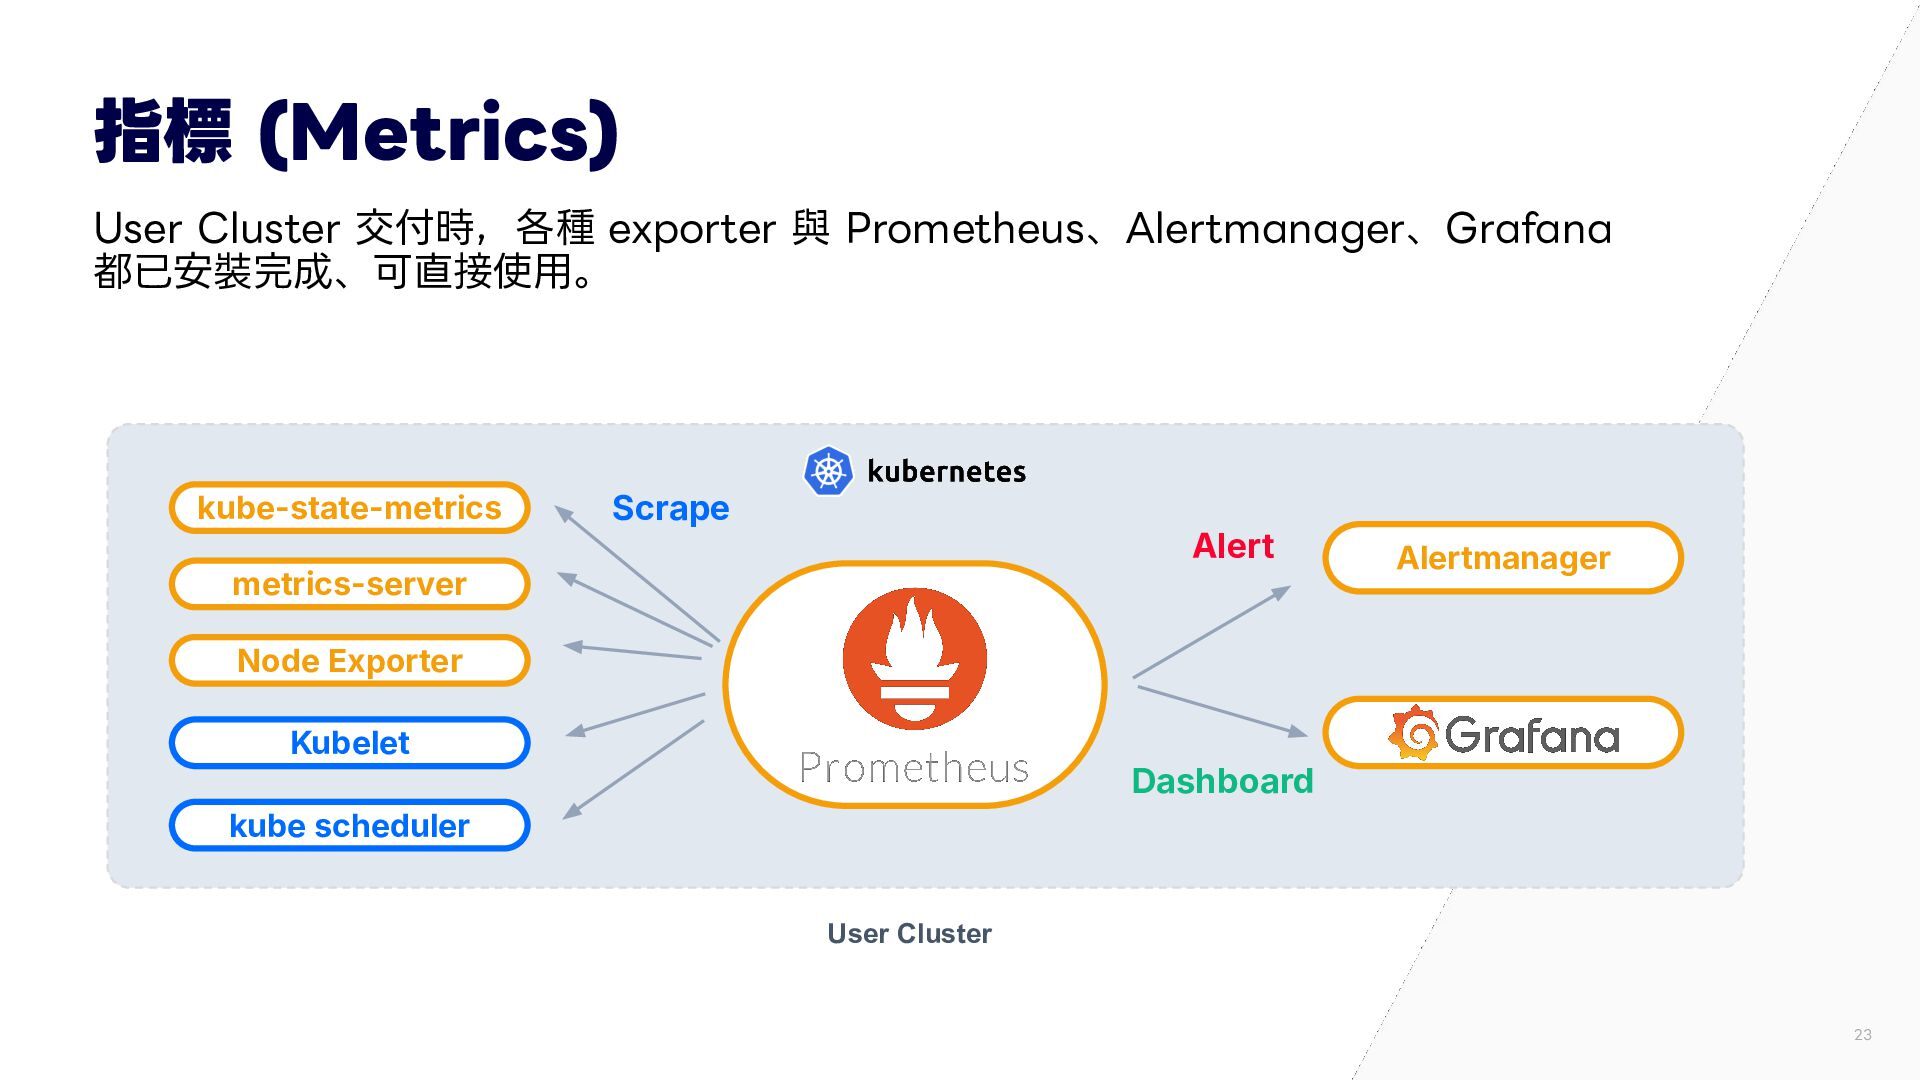
指標 (Metrics) User Cluster 交付時,各種 exporter 與 Prometheus、Alertmanager、Grafana 都已安裝完成、可直接使⽤。 kube-state-metrics
Scrape Alert metrics-server Alertmanager Node Exporter Kubelet Dashboard kube scheduler User Cluster 23
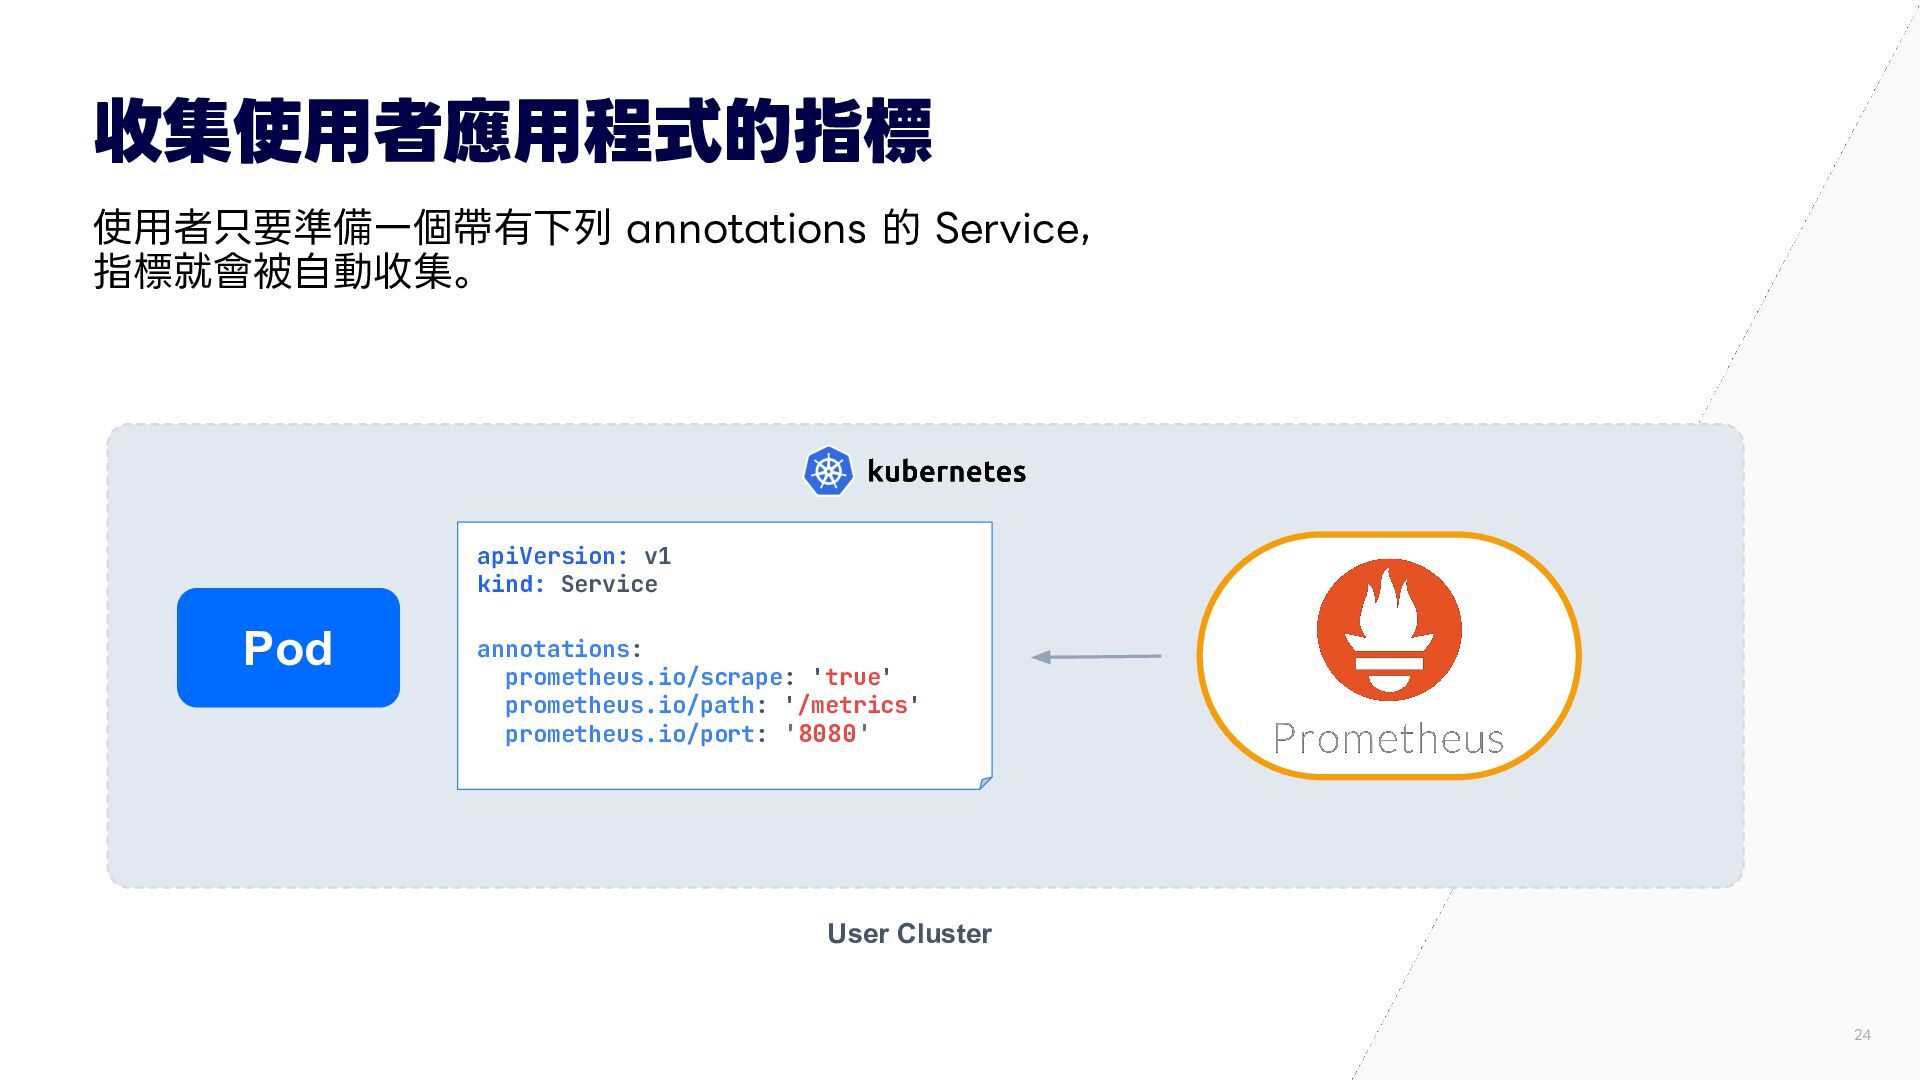
收集使⽤者應⽤程式的指標 使⽤者只要準備⼀個帶有下列 annotations 的 Service, 指標就會被⾃動收集。 apiVersion: v1 kind: Service
Pod annotations: prometheus.io/scrape: 'true' prometheus.io/path: '/metrics' prometheus.io/port: '8080' User Cluster 24
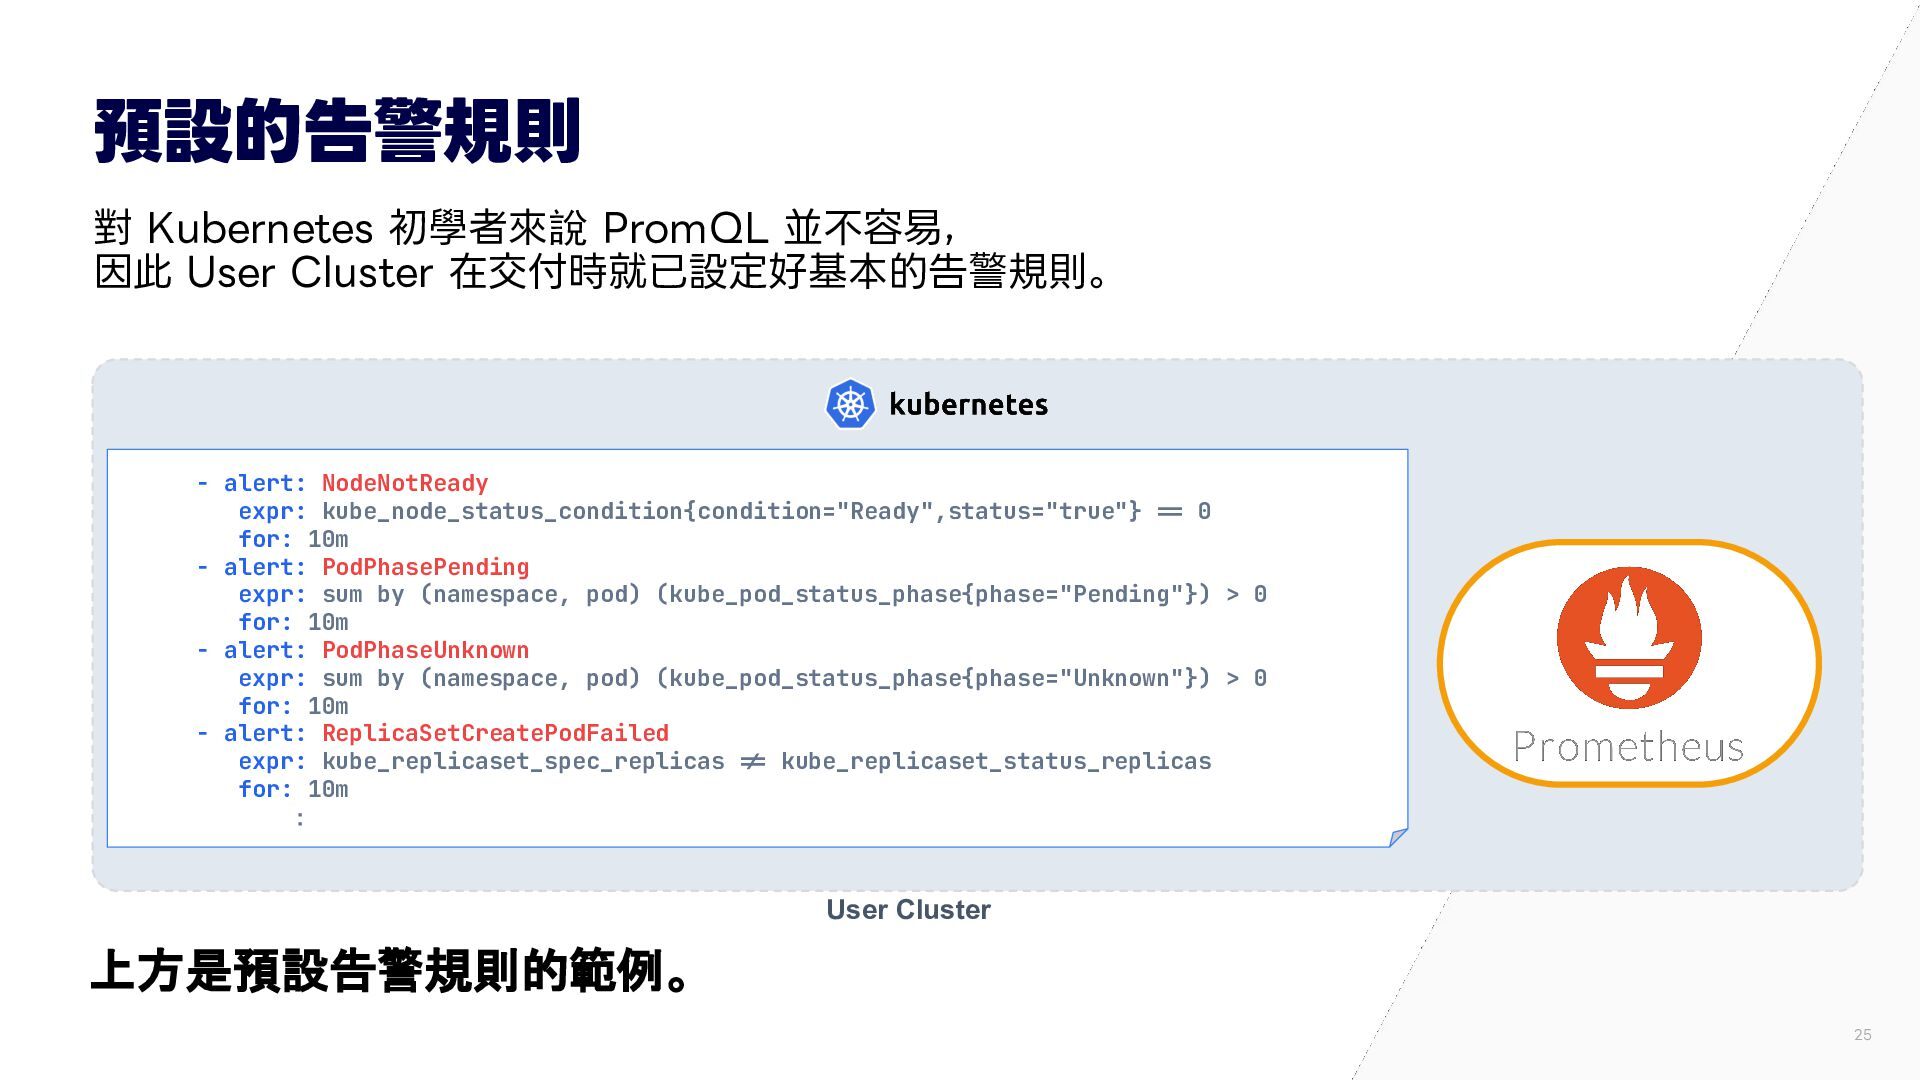
預設的告警規則 對 Kubernetes 初學者來說 PromQL 並不容易, 因此 User Cluster 在交付時就已設定好基本的告警規則。
- alert: NodeNotReady expr: kube_node_status_condition{condition="Ready",status="true"} != 0 for: 10m - alert: PodPhasePending expr: sum by (namespace, pod) (kube_pod_status_phase{phase="Pending"}) > 0 for: 10m - alert: PodPhaseUnknown expr: sum by (namespace, pod) (kube_pod_status_phase{phase="Unknown"}) > 0 for: 10m - alert: ReplicaSetCreatePodFailed expr: kube_replicaset_spec_replicas != kube_replicaset_status_replicas for: 10m : User Cluster 上方是預設告警規則的範例。 25
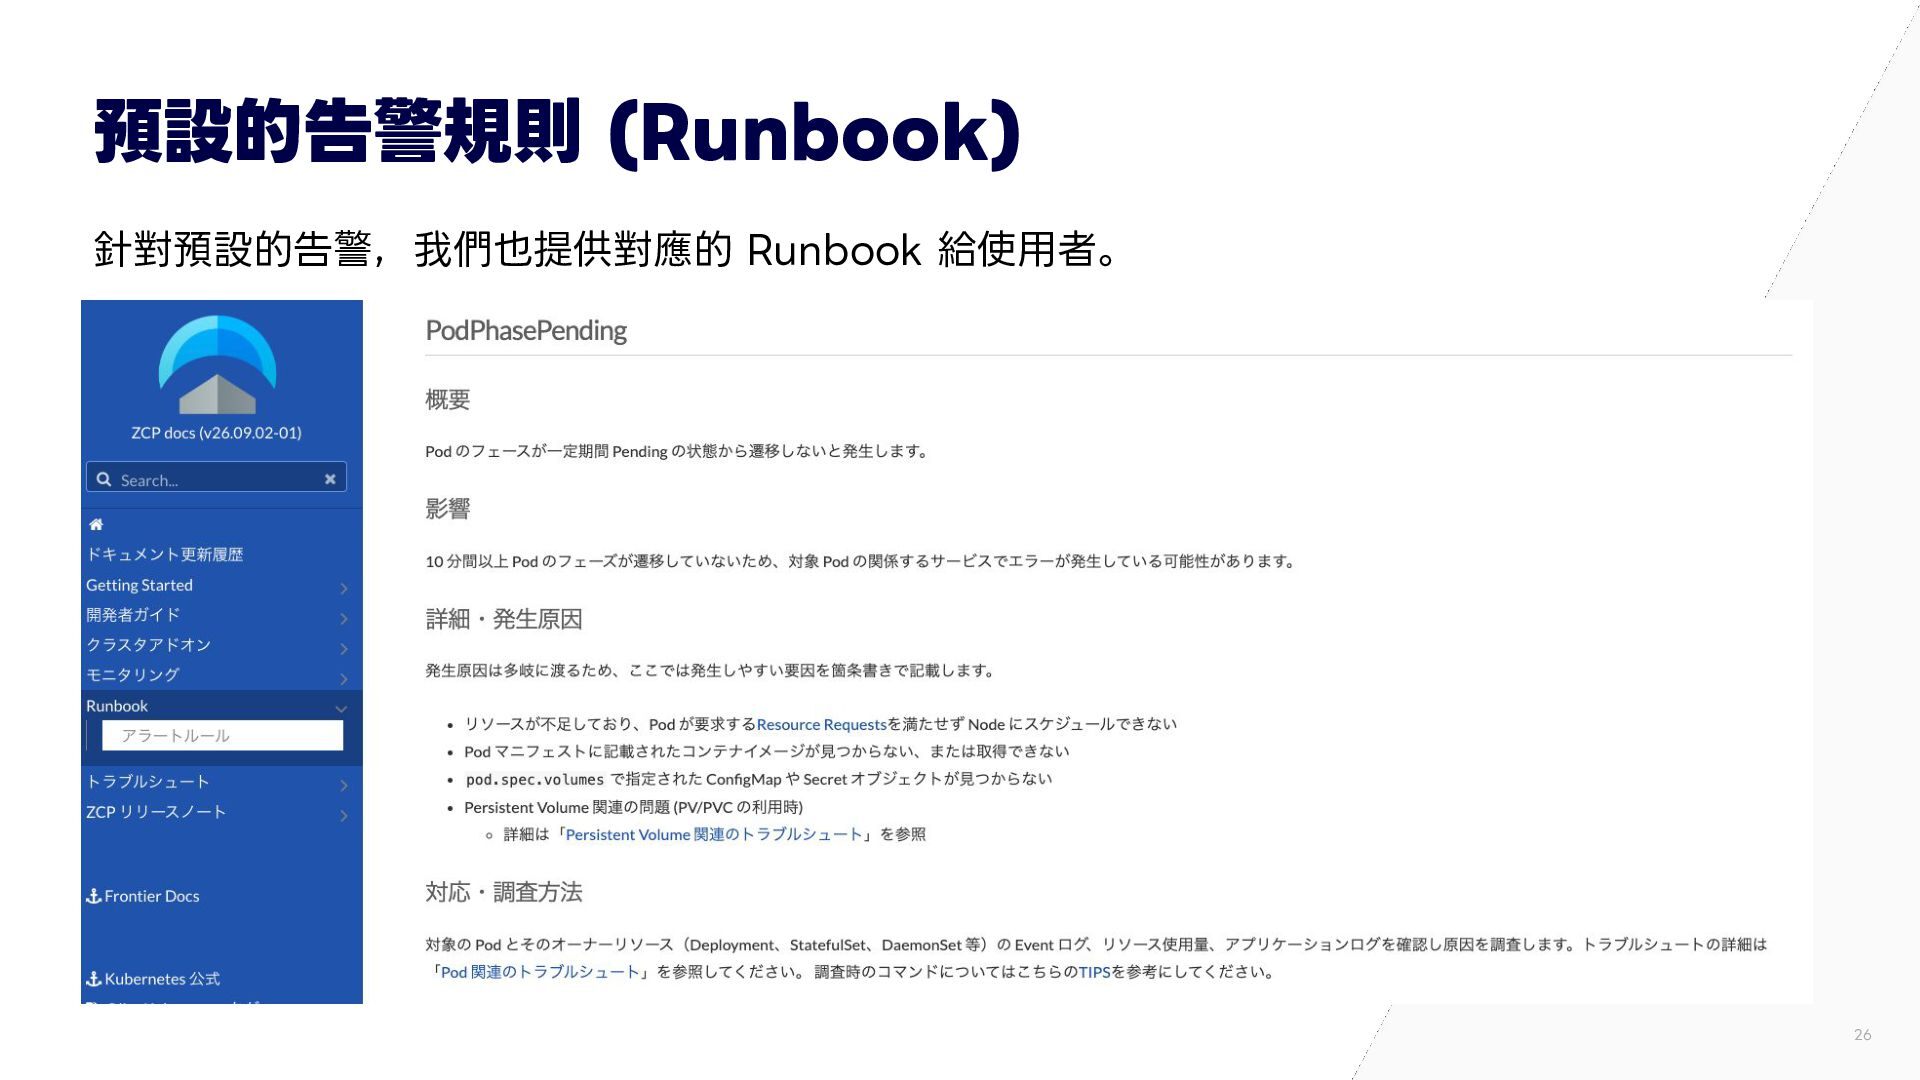
預設的告警規則 (Runbook) 針對預設的告警,我們也提供對應的 Runbook 給使⽤者。 26
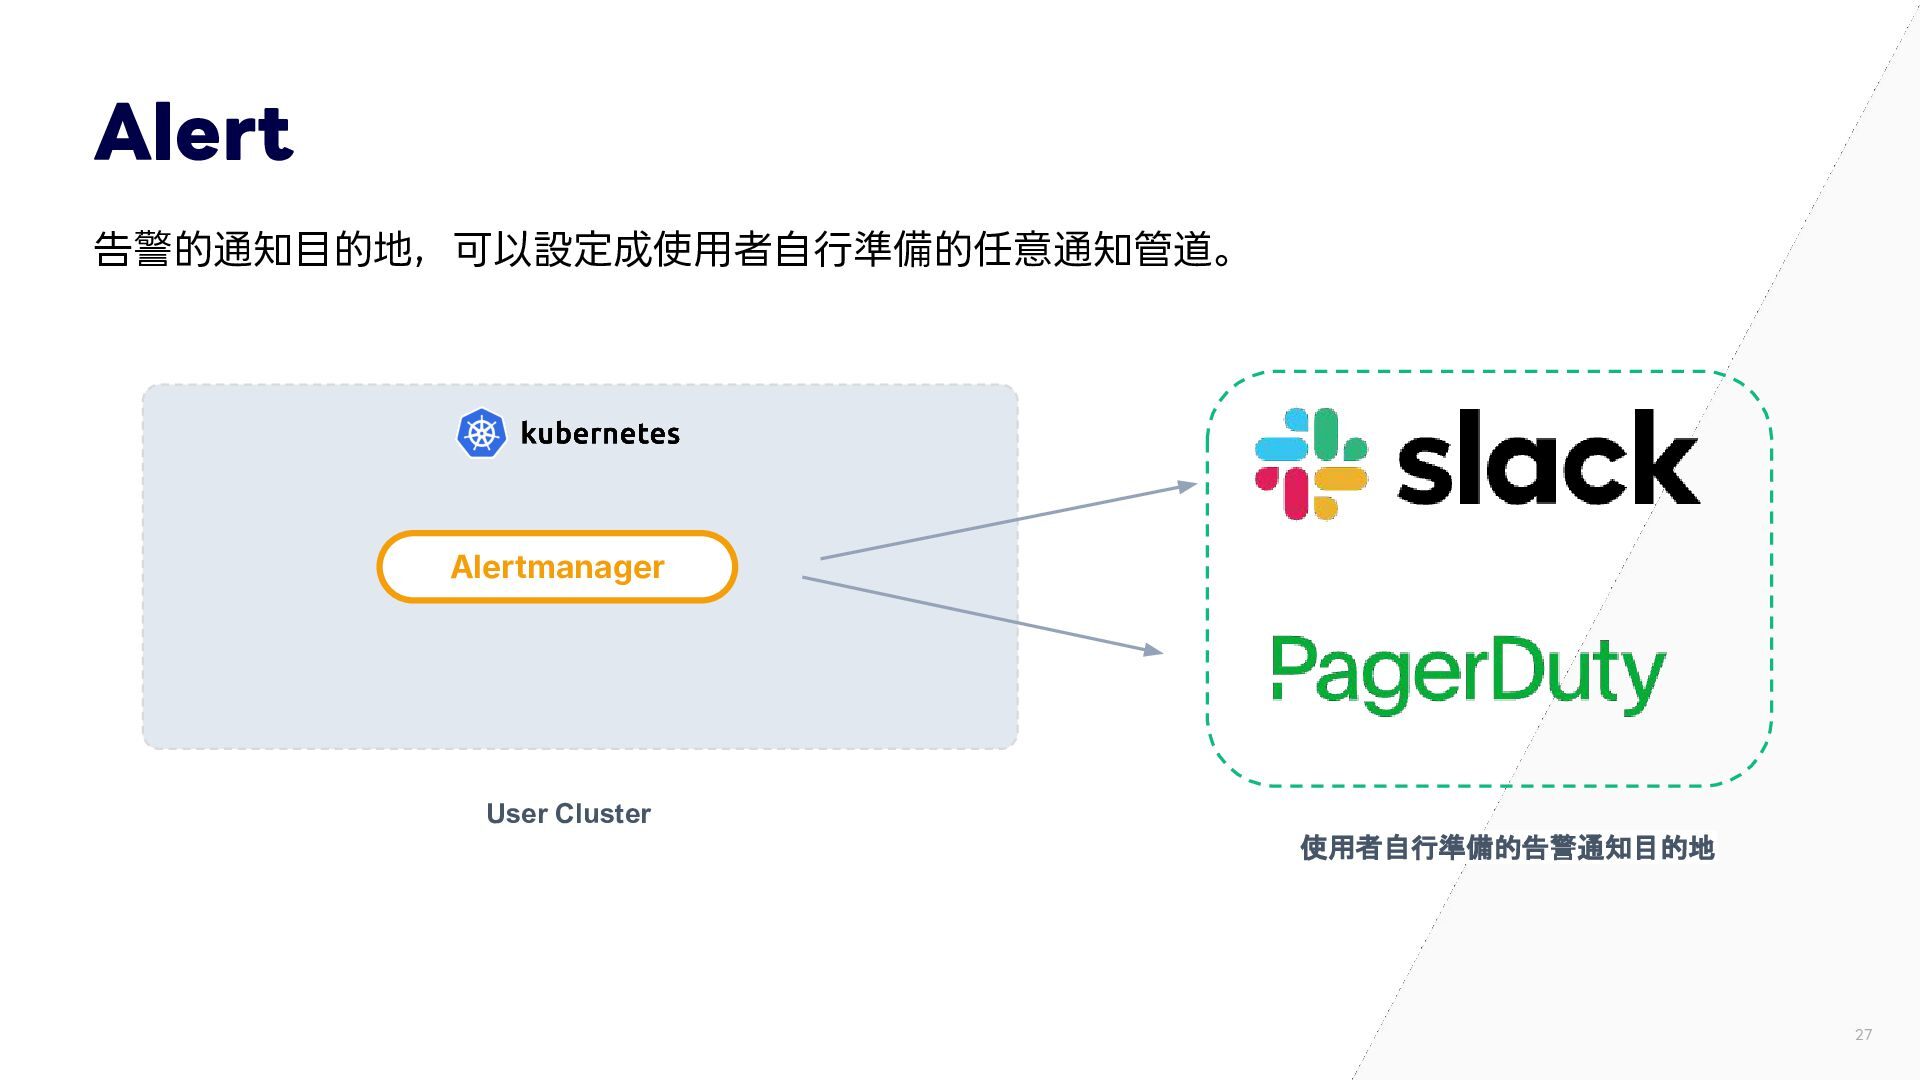
Alert 告警的通知⽬的地,可以設定成使⽤者⾃⾏準備的任意通知管道。 Alertmanager User Cluster 使用者自行準備的告警通知目的地 27
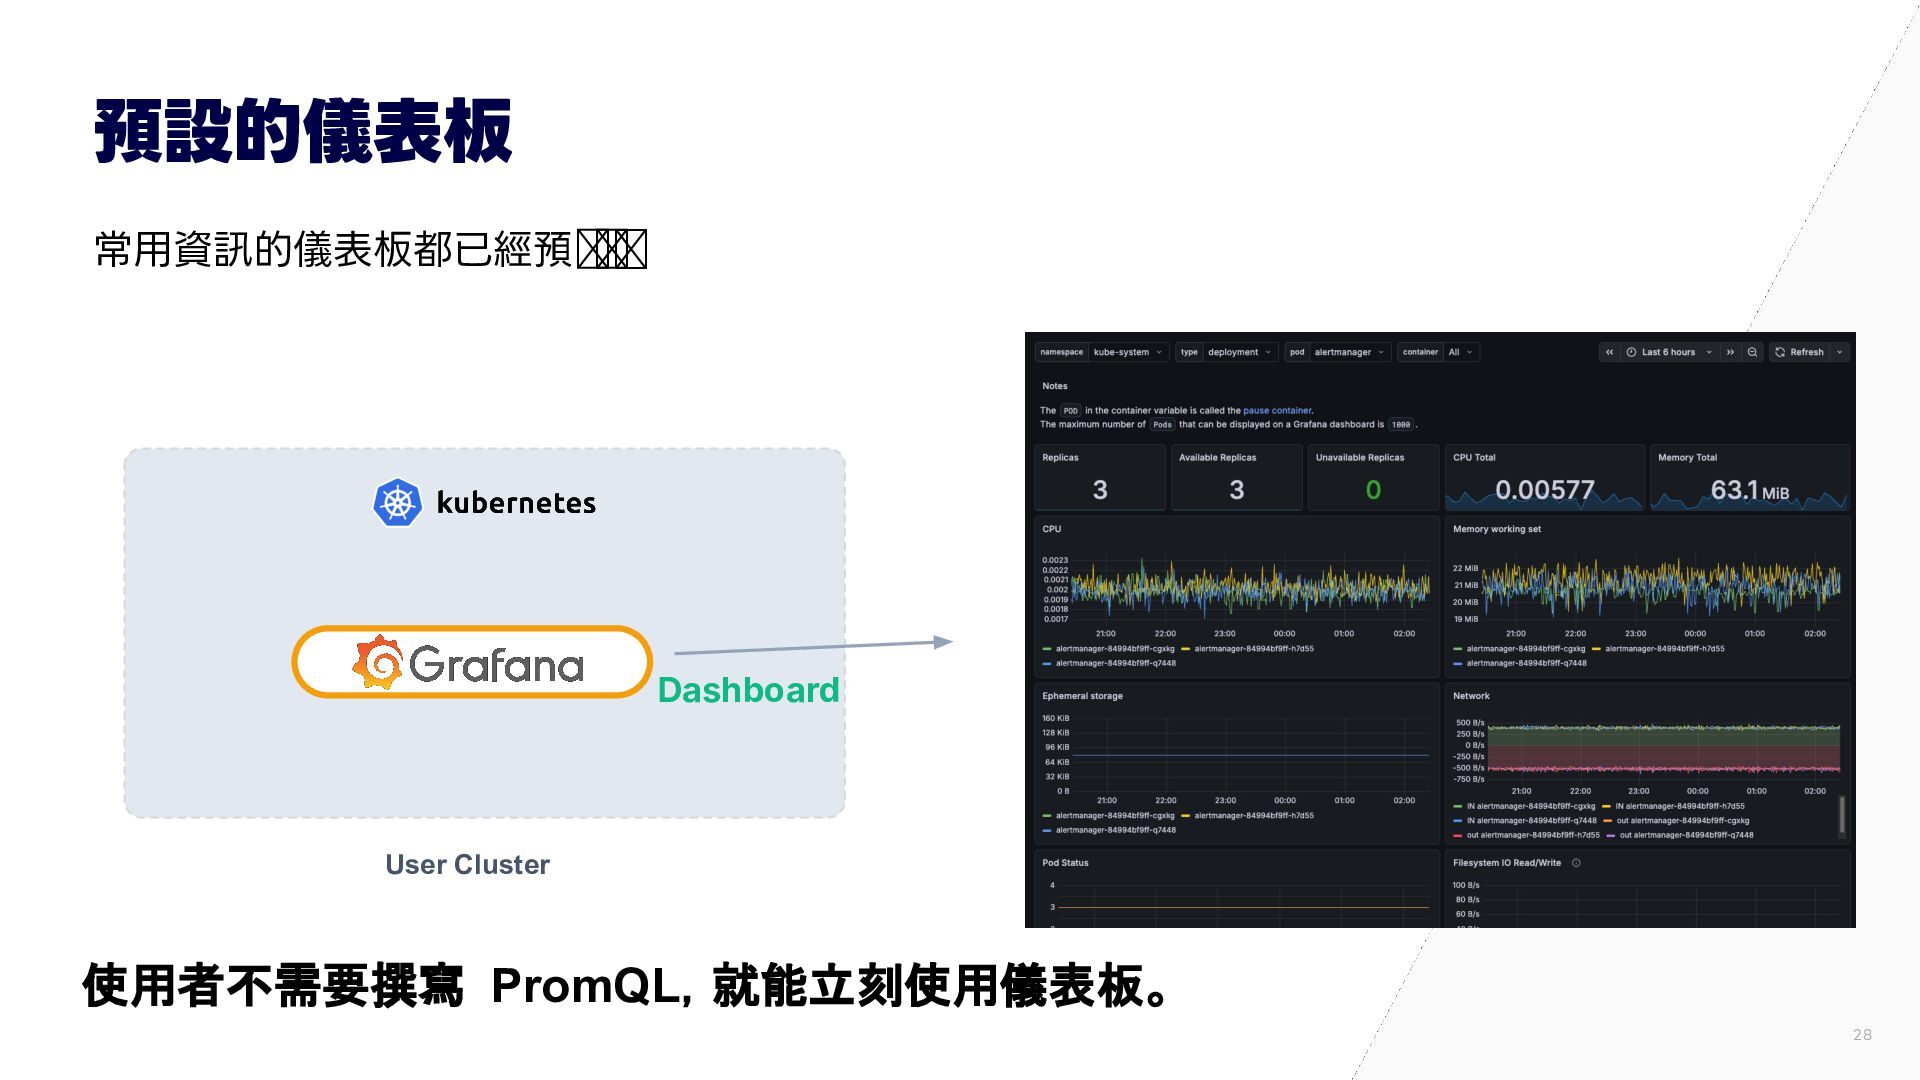
預設的儀表板 常⽤資訊的儀表板都已經預先建好。 Dashboard User Cluster 使用者不需要撰寫 PromQL,就能立刻使用儀表板。 28
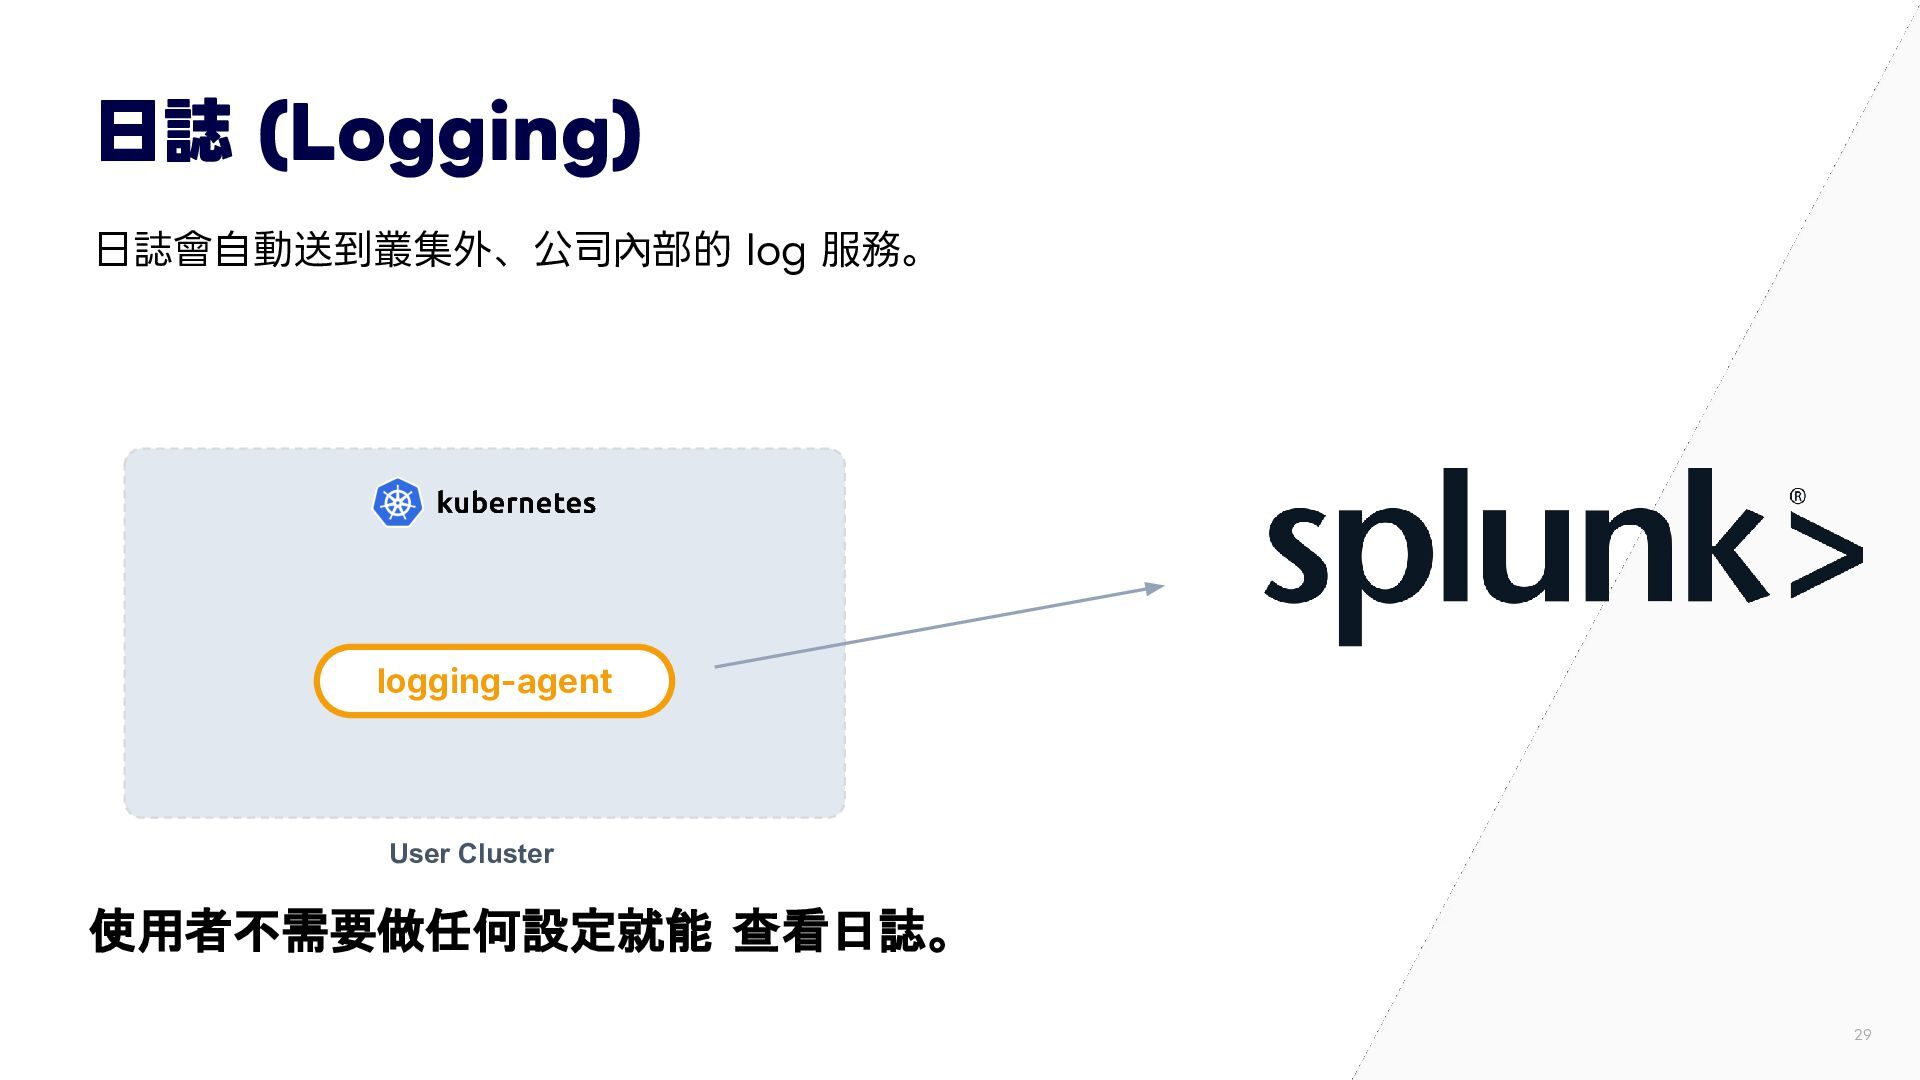
⽇誌 (Logging) ⽇誌會⾃動送到叢集外、公司內部的 log 服務。 logging-agent User Cluster 使用者不需要做任何設定就能 查看日誌。
29
安全性 30
初學者要⽤原⽣ Kubernetes 並不容易 Kubernetes 學習成本⾼,要推廣普及就需要有指引。 • 憑證的簽發與輪替相當費工。 • 必須自己思考 Secret
的管理方式。 • 稽核日誌 (Audit Log) 也需要自行收集。 由平台方預先準備,就能減少使用者的負擔。 31
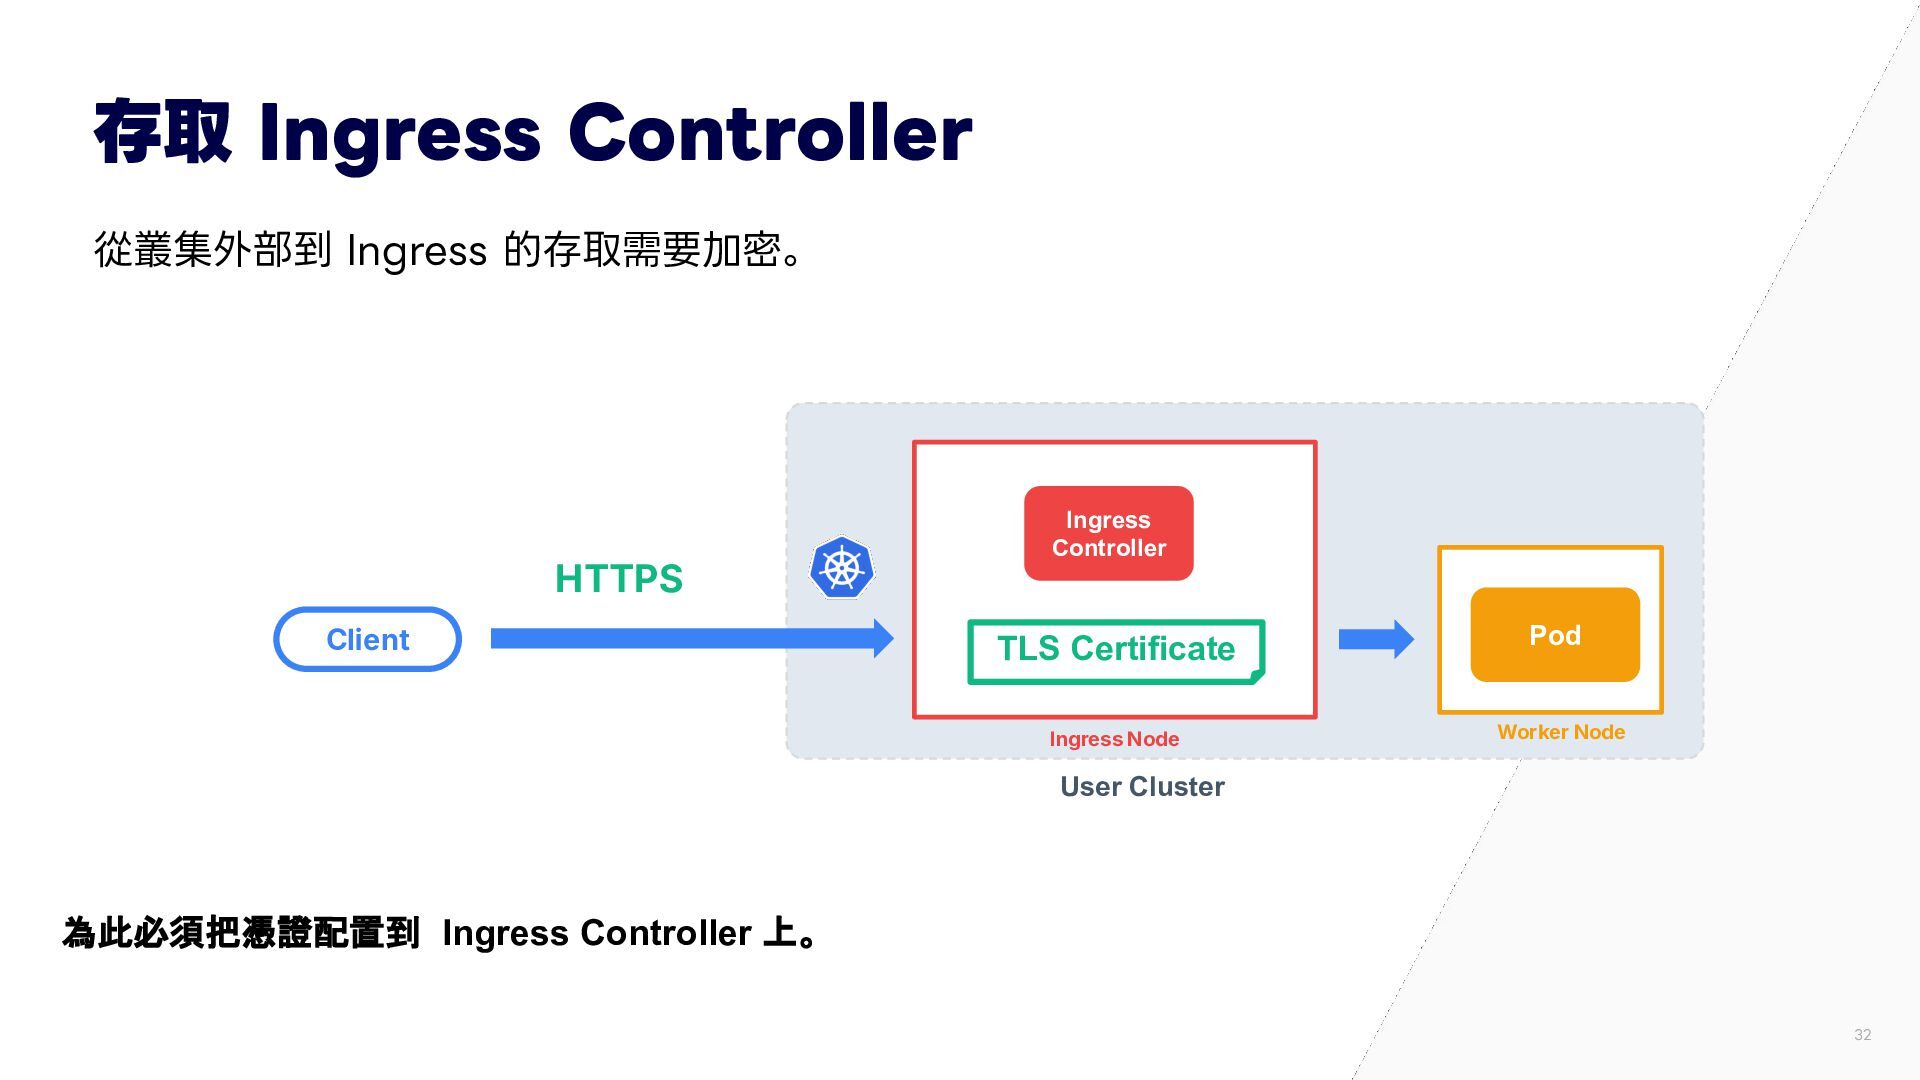
存取 Ingress Controller 從叢集外部到 Ingress 的存取需要加密。 HTTPS Client Ingress Controller
TLS Certificate Ingress Node Pod Worker Node User Cluster 為此必須把憑證配置到 Ingress Controller 上。 32
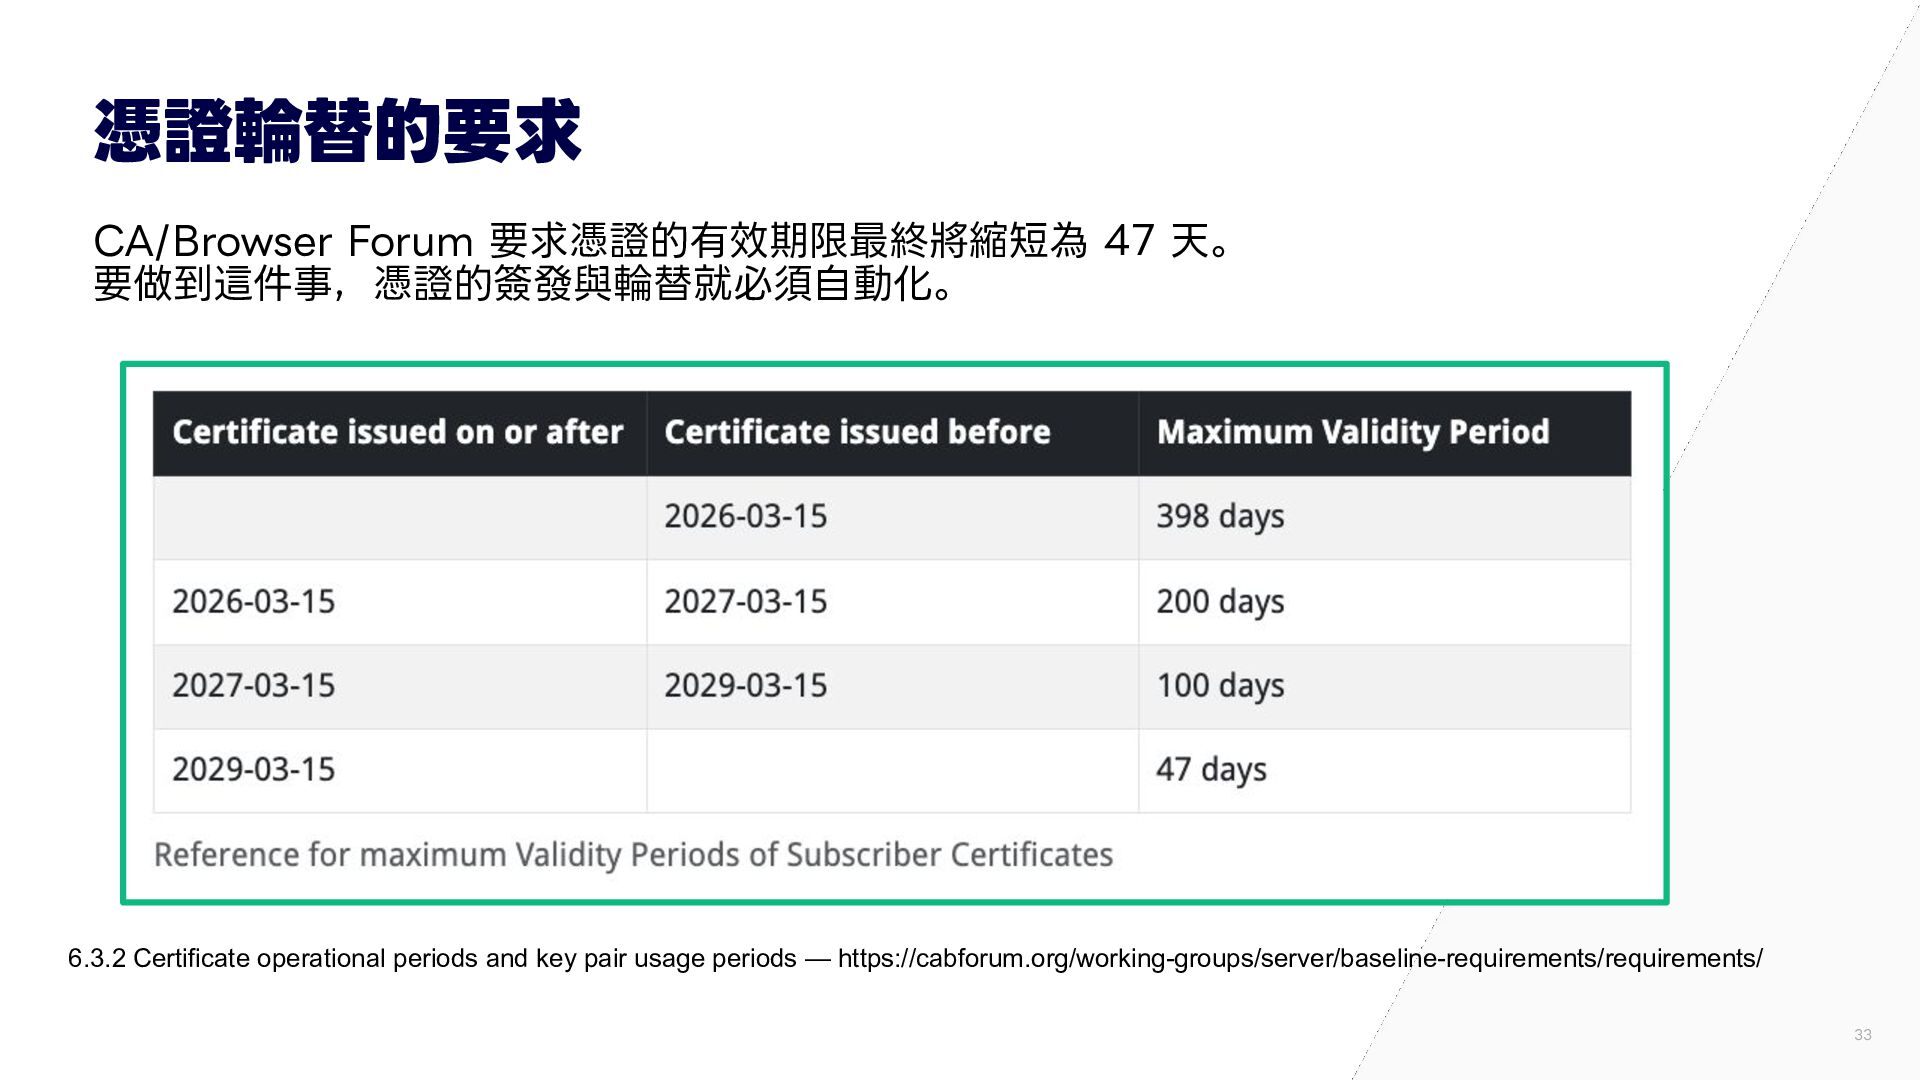
憑證輪替的要求 CA/Browser Forum 要求憑證的有效期限最終將縮短為 47 天。 要做到這件事,憑證的簽發與輪替就必須⾃動化。 6.3.2 Certificate operational
periods and key pair usage periods — https://cabforum.org/working-groups/server/baseline-requirements/requirements/ 33
憑證簽發與輪替的⾃動化 在 User Cluster 準備以下兩個元件即可實現: • cert-manager:管理憑證的生命週期 • External Issuer:與外部的自建憑證機構
(Private CA) 整合 與公司內部的 Private CA 整合,實現憑證的自動簽發。 34
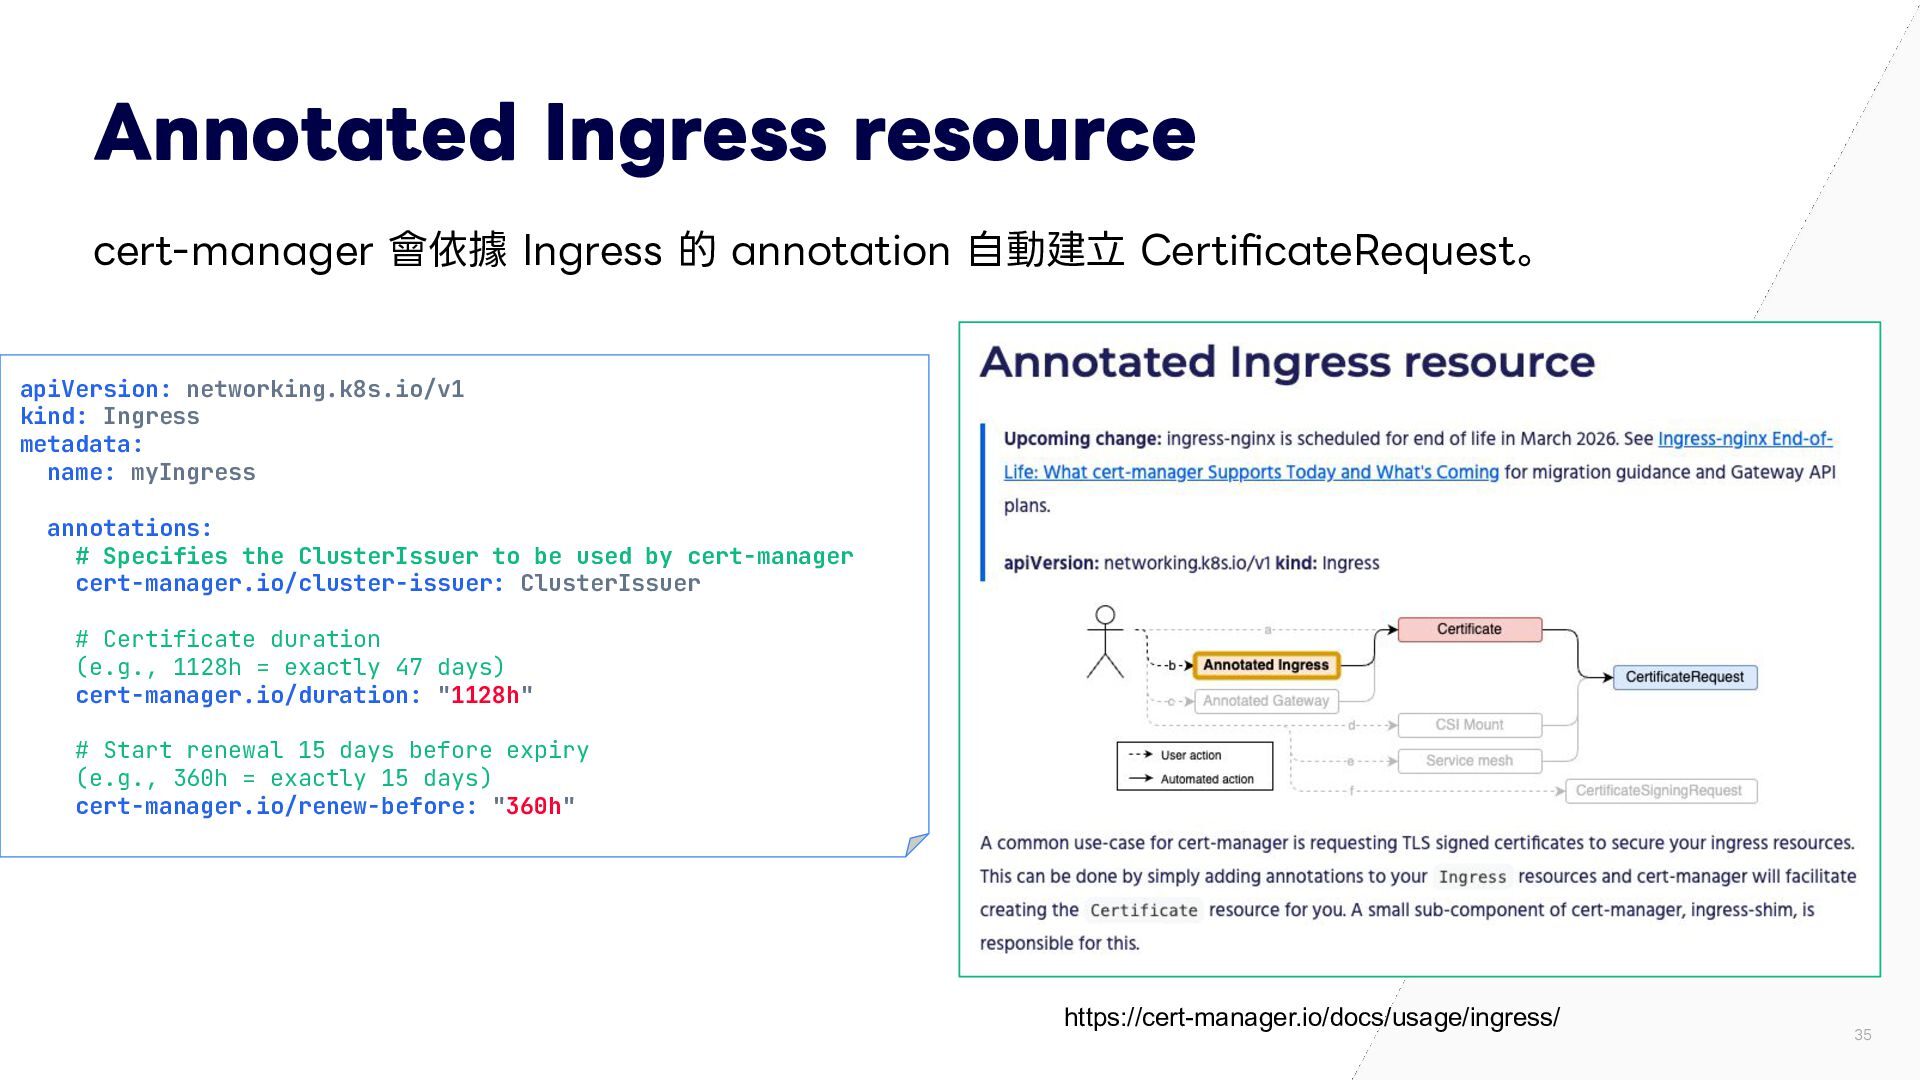
Annotated Ingress resource cert-manager 會依據 Ingress 的 annotation ⾃動建⽴ CertificateRequest。
apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: myIngress annotations: # Specifies the ClusterIssuer to be used by cert-manager cert-manager.io/cluster-issuer: ClusterIssuer # Certificate duration (e.g., 1128h = exactly 47 days) cert-manager.io/duration: "1128h" # Start renewal 15 days before expiry (e.g., 360h = exactly 15 days) cert-manager.io/renew-before: "360h" https://cert-manager.io/docs/usage/ingress/ 35
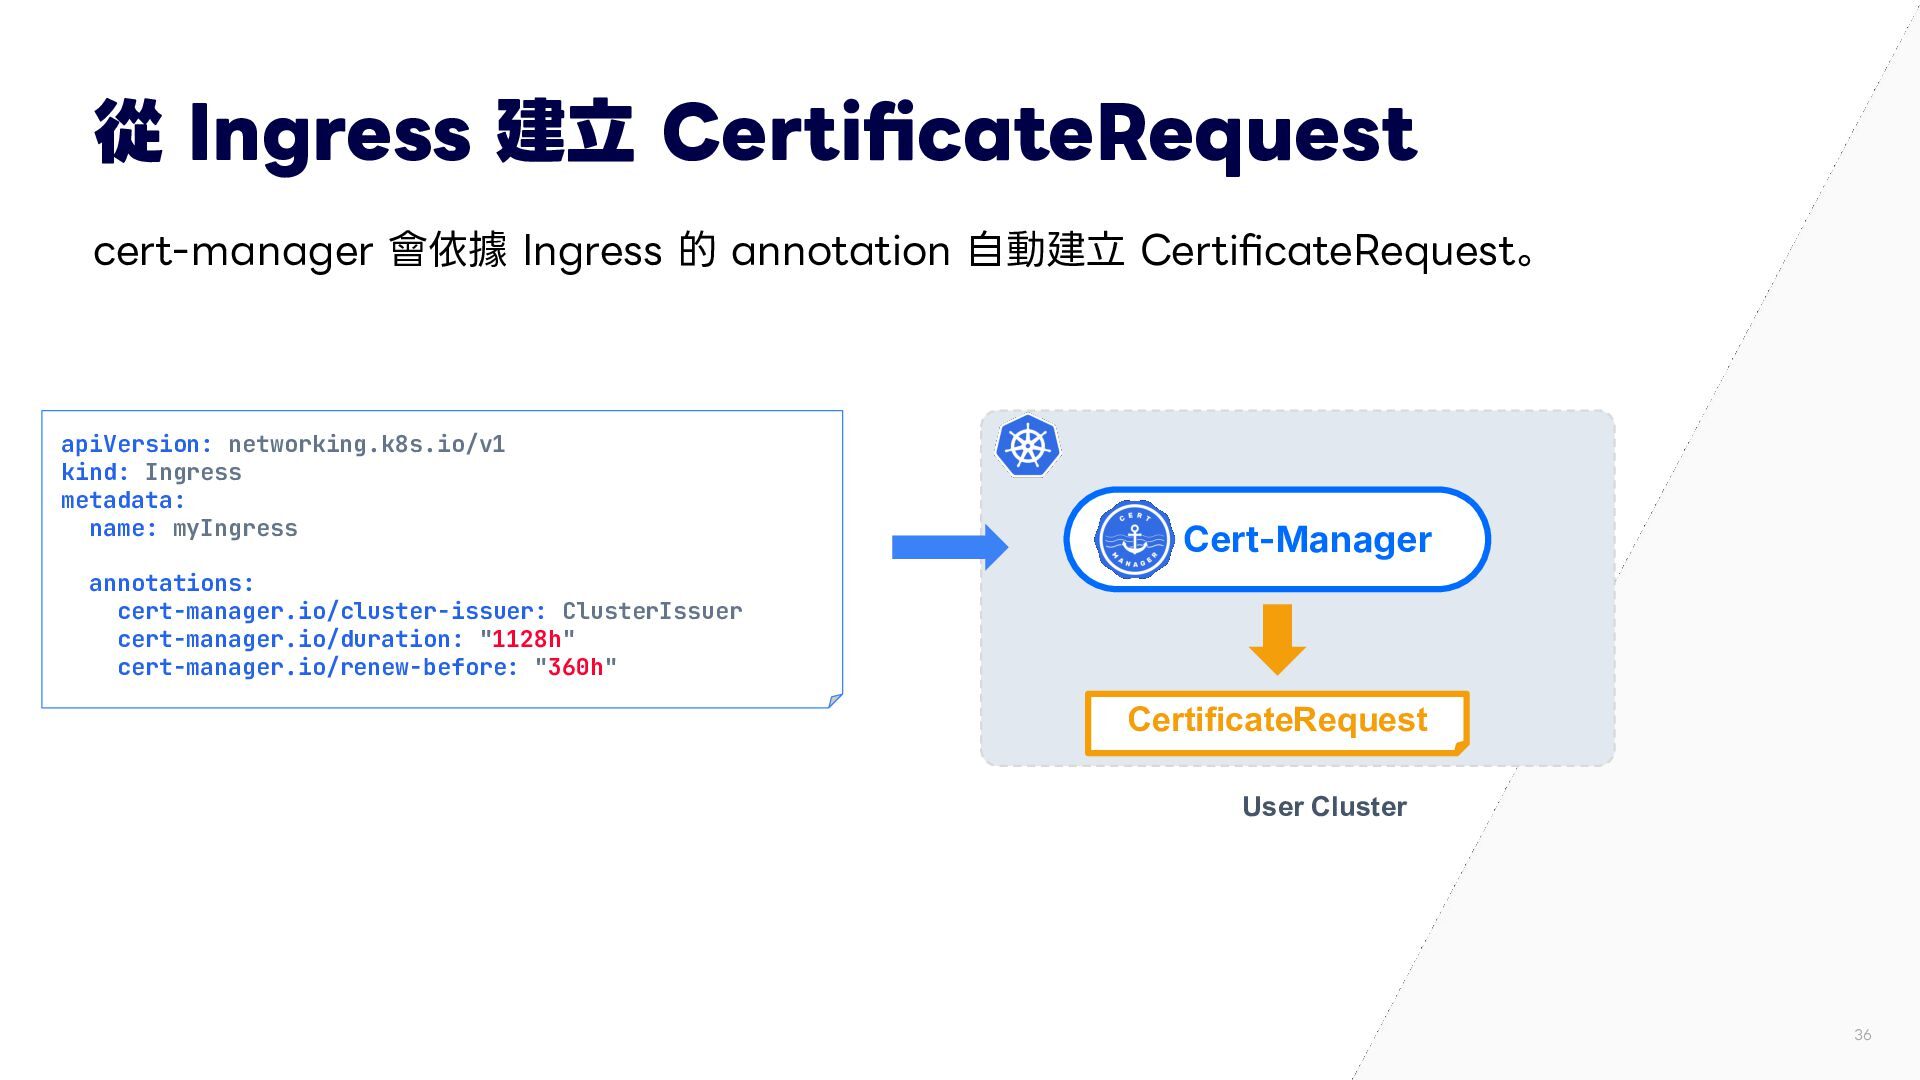
從 Ingress 建⽴ CertificateRequest cert-manager 會依據 Ingress 的 annotation ⾃動建⽴
CertificateRequest。 apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: myIngress Cert-Manager annotations: cert-manager.io/cluster-issuer: ClusterIssuer cert-manager.io/duration: "1128h" cert-manager.io/renew-before: "360h" CertificateRequest User Cluster 36
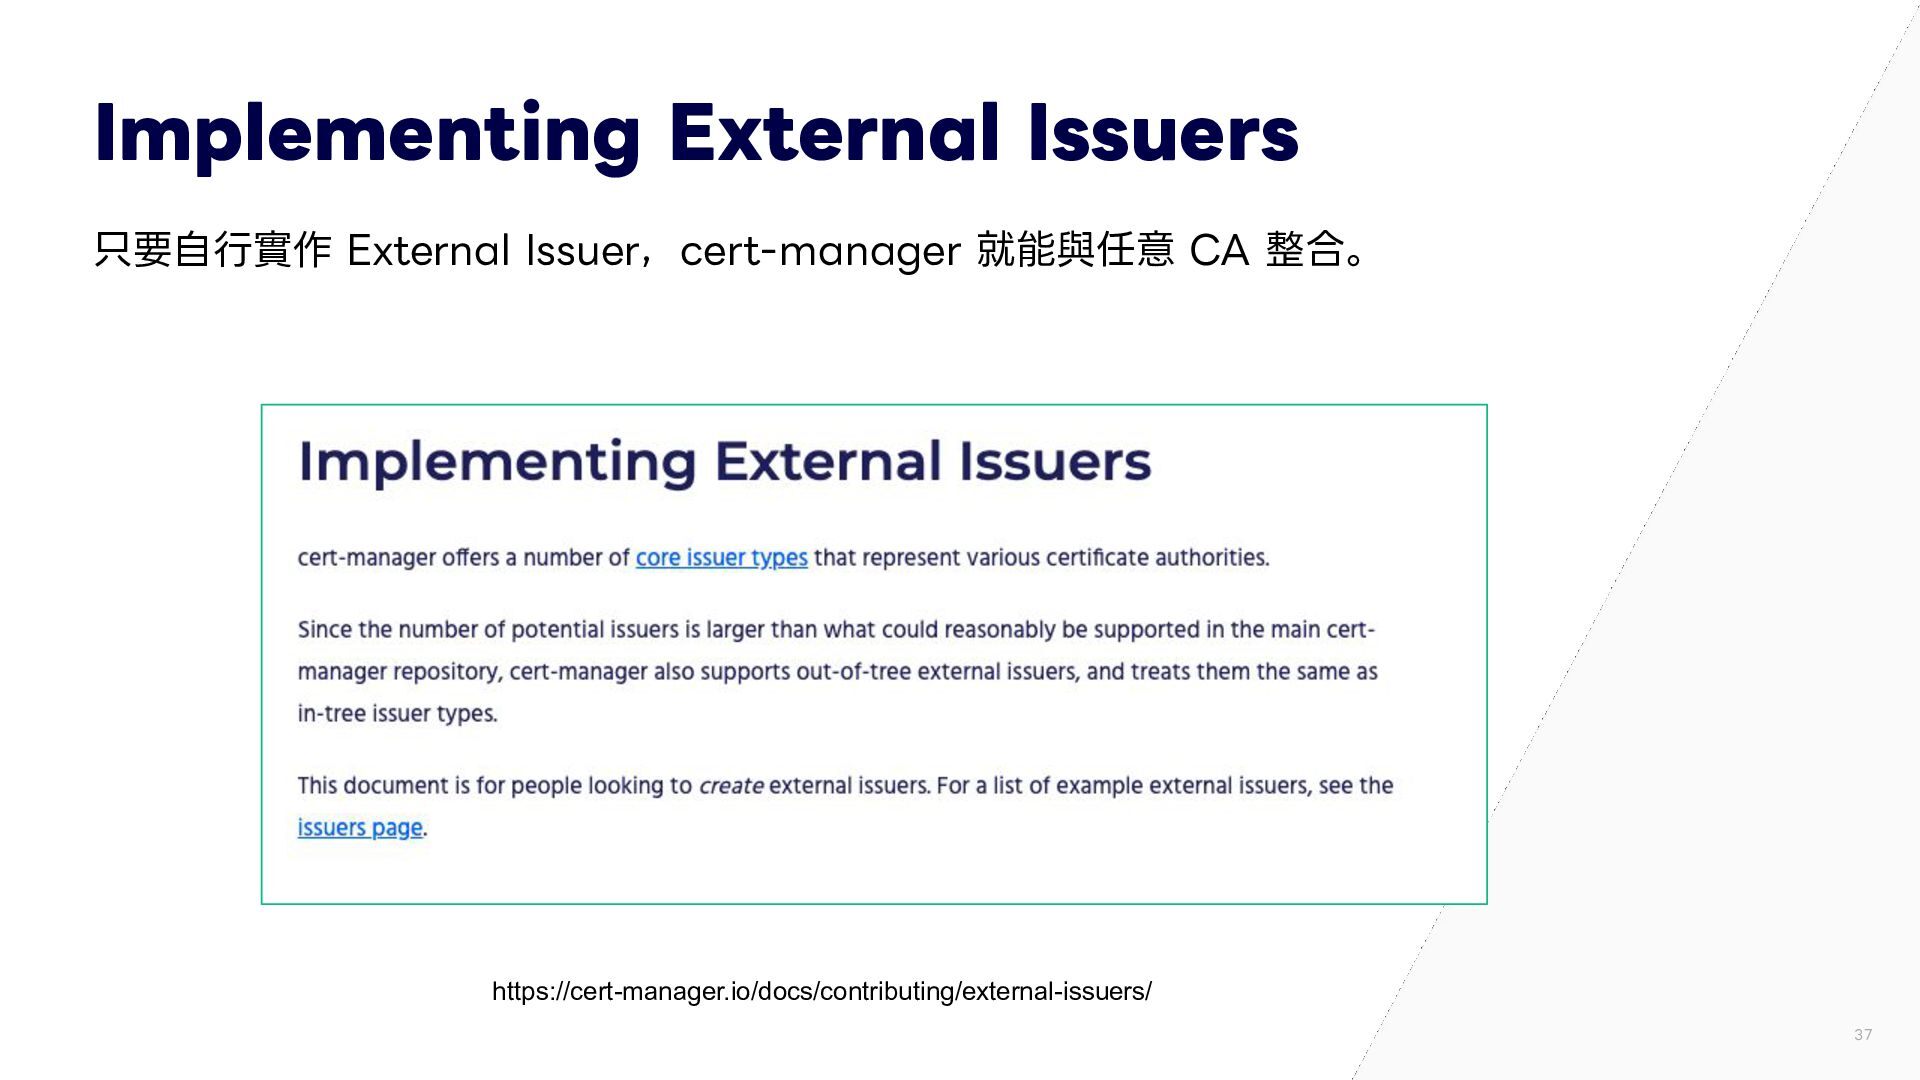
Implementing External Issuers 只要⾃⾏實作 External Issuer,cert-manager 就能與任意 CA 整合。 https://cert-manager.io/docs/contributing/external-issuers/
37
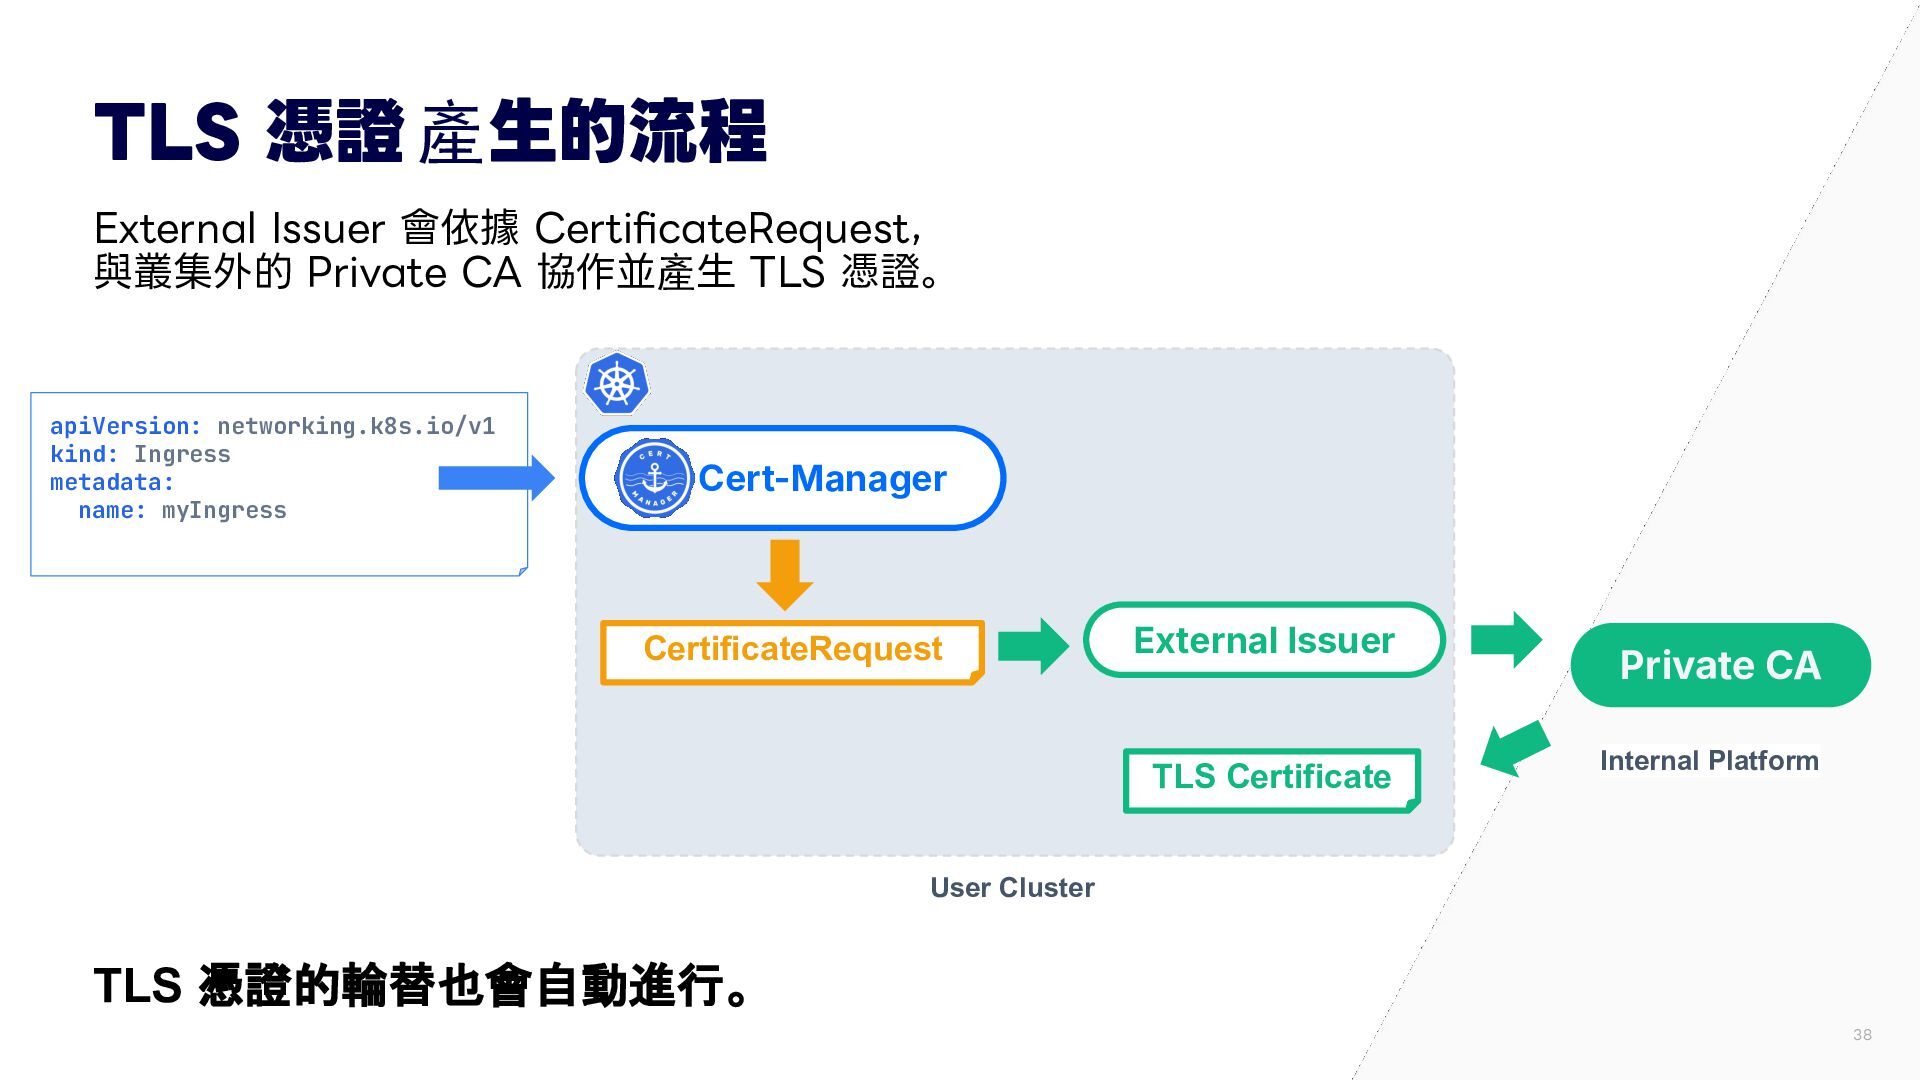
TLS 憑證 產⽣的流程 External Issuer 會依據 CertificateRequest, 與叢集外的 Private CA
協作並產⽣ TLS 憑證。 apiVersion: networking.k8s.io/v1 kind: Ingress metadata: name: myIngress Cert-Manager CertificateRequest External Issuer TLS Certificate Private CA Internal Platform User Cluster TLS 憑證的輪替也會自動進行。 38
我們想在 Kubernetes 中處理 Secret 資訊 有些情境需要在 Kubernetes 中使⽤ Secret 資訊,例如資料庫的連線資訊。
• Kubernetes 的 Secret 資源只是經過 Base64 編碼,很容易就能還原。 • 把 Secret 資源掛載到 Pod 時,會在節點上以檔案的形式產生。 我們希望用 Secret Store 管理 Secret 資訊,並與 Kubernetes 整合。 39
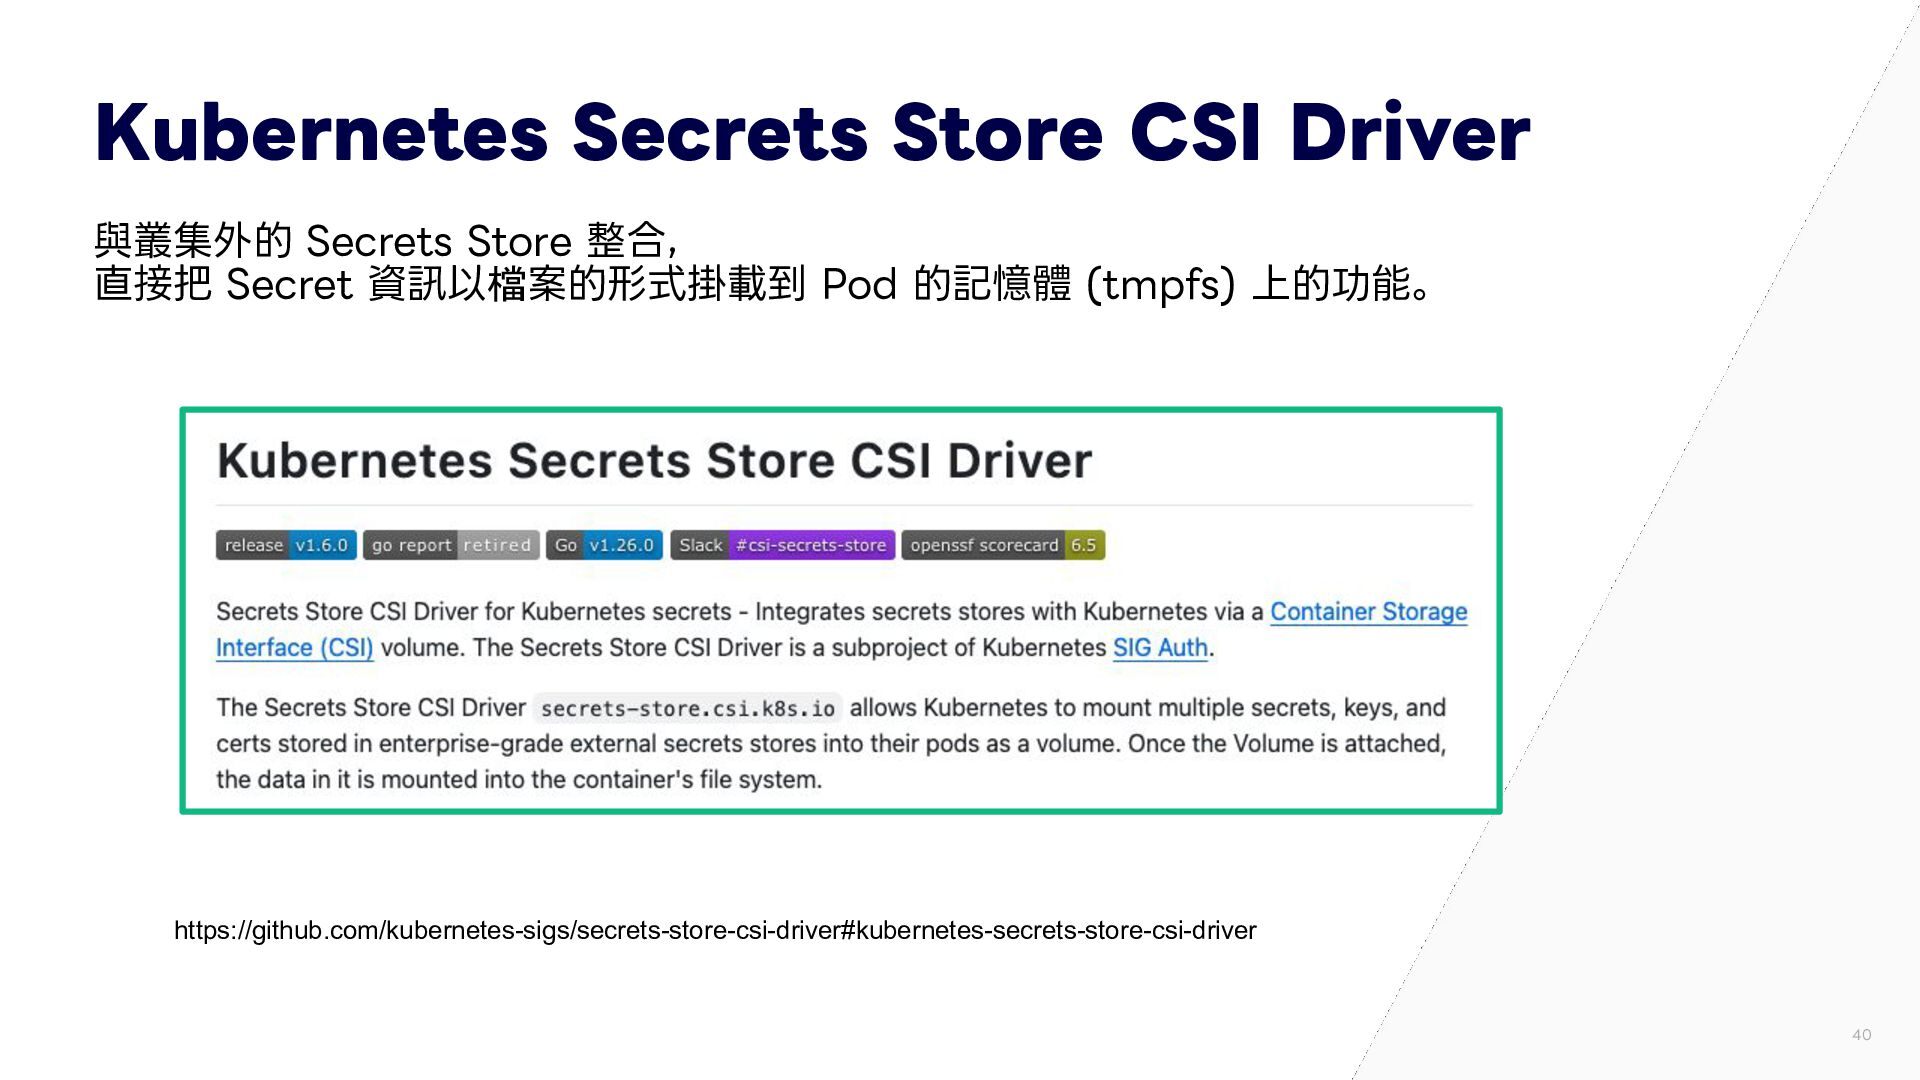
Kubernetes Secrets Store CSI Driver 與叢集外的 Secrets Store 整合, 直接把
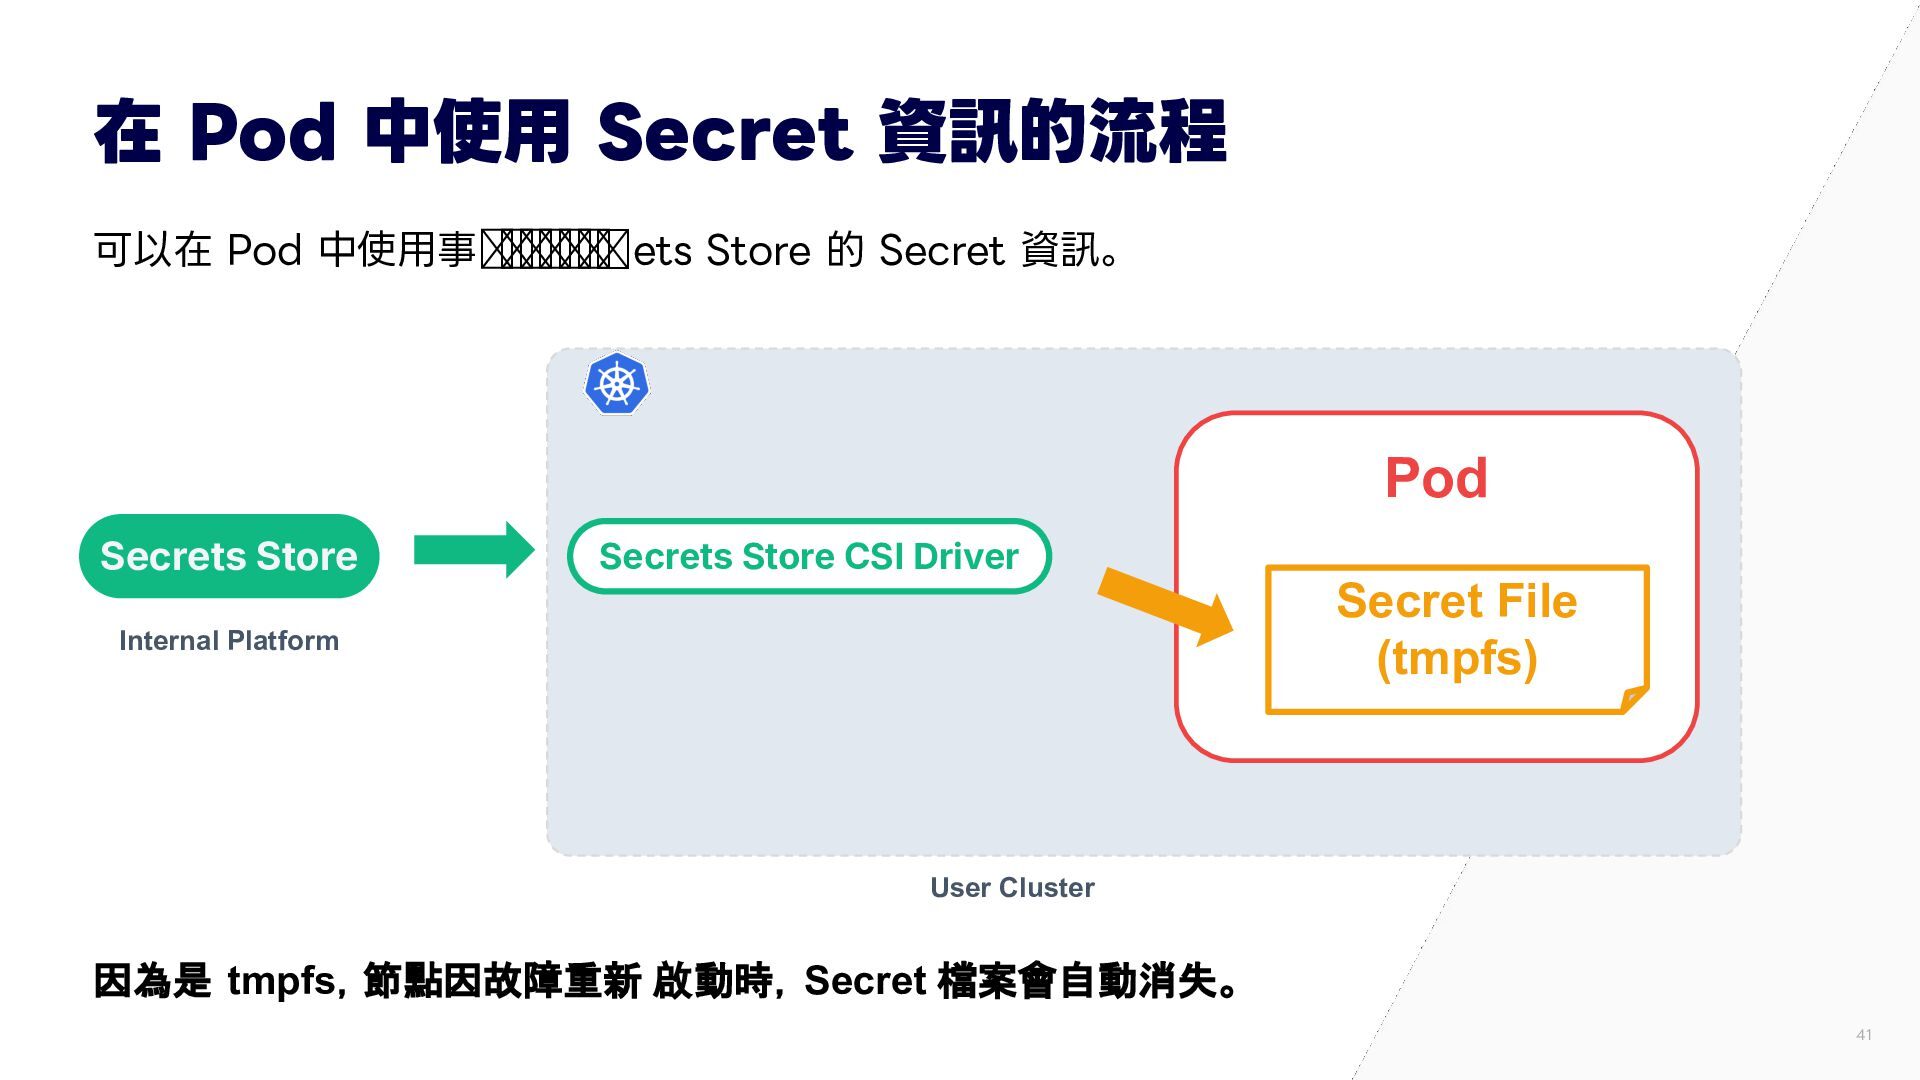
Secret 資訊以檔案的形式掛載到 Pod 的記憶體 (tmpfs) 上的功能。 https://github.com/kubernetes-sigs/secrets-store-csi-driver#kubernetes-secrets-store-csi-driver 40
在 Pod 中使⽤ Secret 資訊的流程 可以在 Pod 中使⽤事先註冊在 Secrets Store
的 Secret 資訊。 Pod Secrets Store Secrets Store CSI Driver Secret File (tmpfs) Internal Platform User Cluster 因為是 tmpfs,節點因故障重新 啟動時,Secret 檔案會自動消失。 41
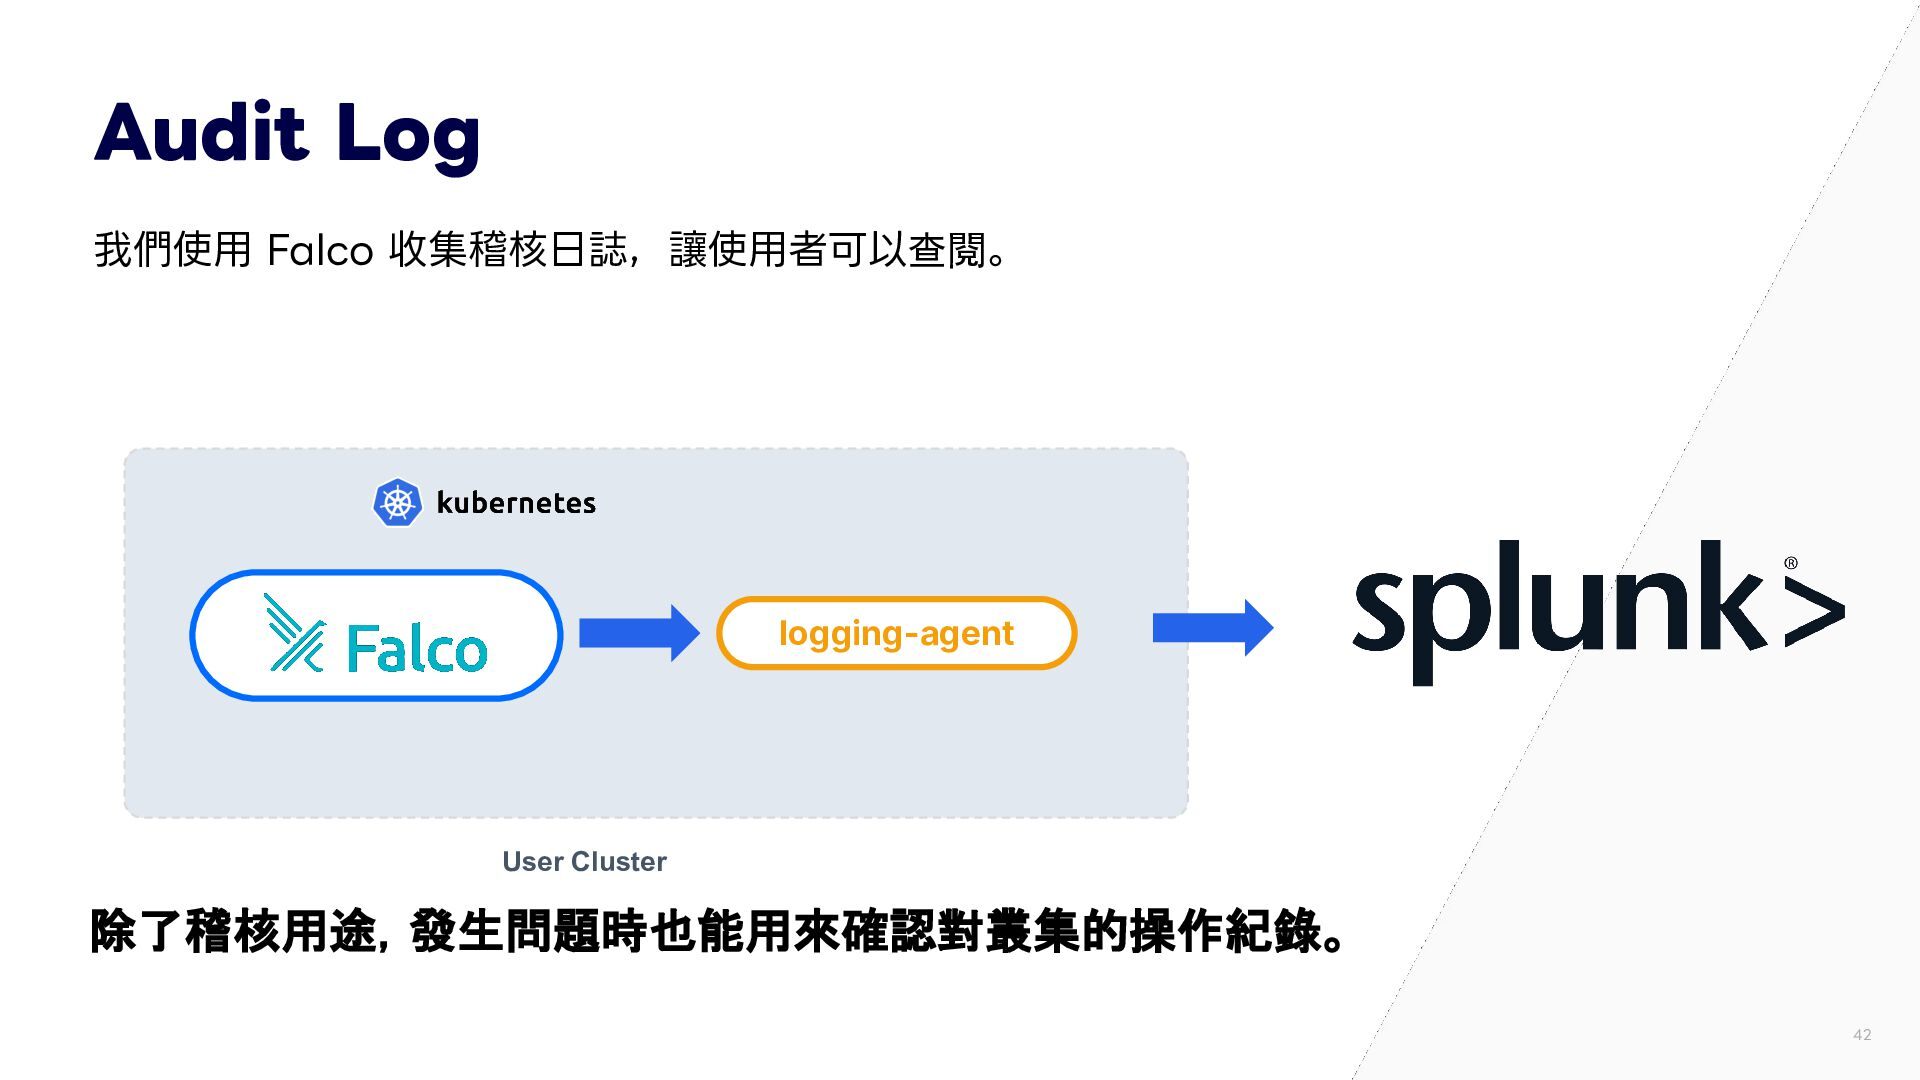
Audit Log 我們使⽤ Falco 收集稽核⽇誌,讓使⽤者可以查閱。 logging-agent User Cluster 除了稽核用途,發生問題時也能用來確認對叢集的操作紀錄。 42
為了達到 Production-Ready 43
光是增加功能還不 夠 Kubernetes 學習成本⾼,光是熟練運⽤基本功能,對初學者來說就已經不容易。 要真正發揮 Kubernetes 的價值,必須讓 Pod 處於「叢集執⾏滾動更新也不會出問題」的狀態。 •
Pod 必須能夠 graceful shutdown。 • 要讓自動修復發揮作用,必須設定 Liveness / Readiness Probe。 • 要讓排程正確運作,必須設定 CPU / Memory / Ephemeral-Storage 的 Request。 由平台方預先準備,就能減少使用者的負擔。 44
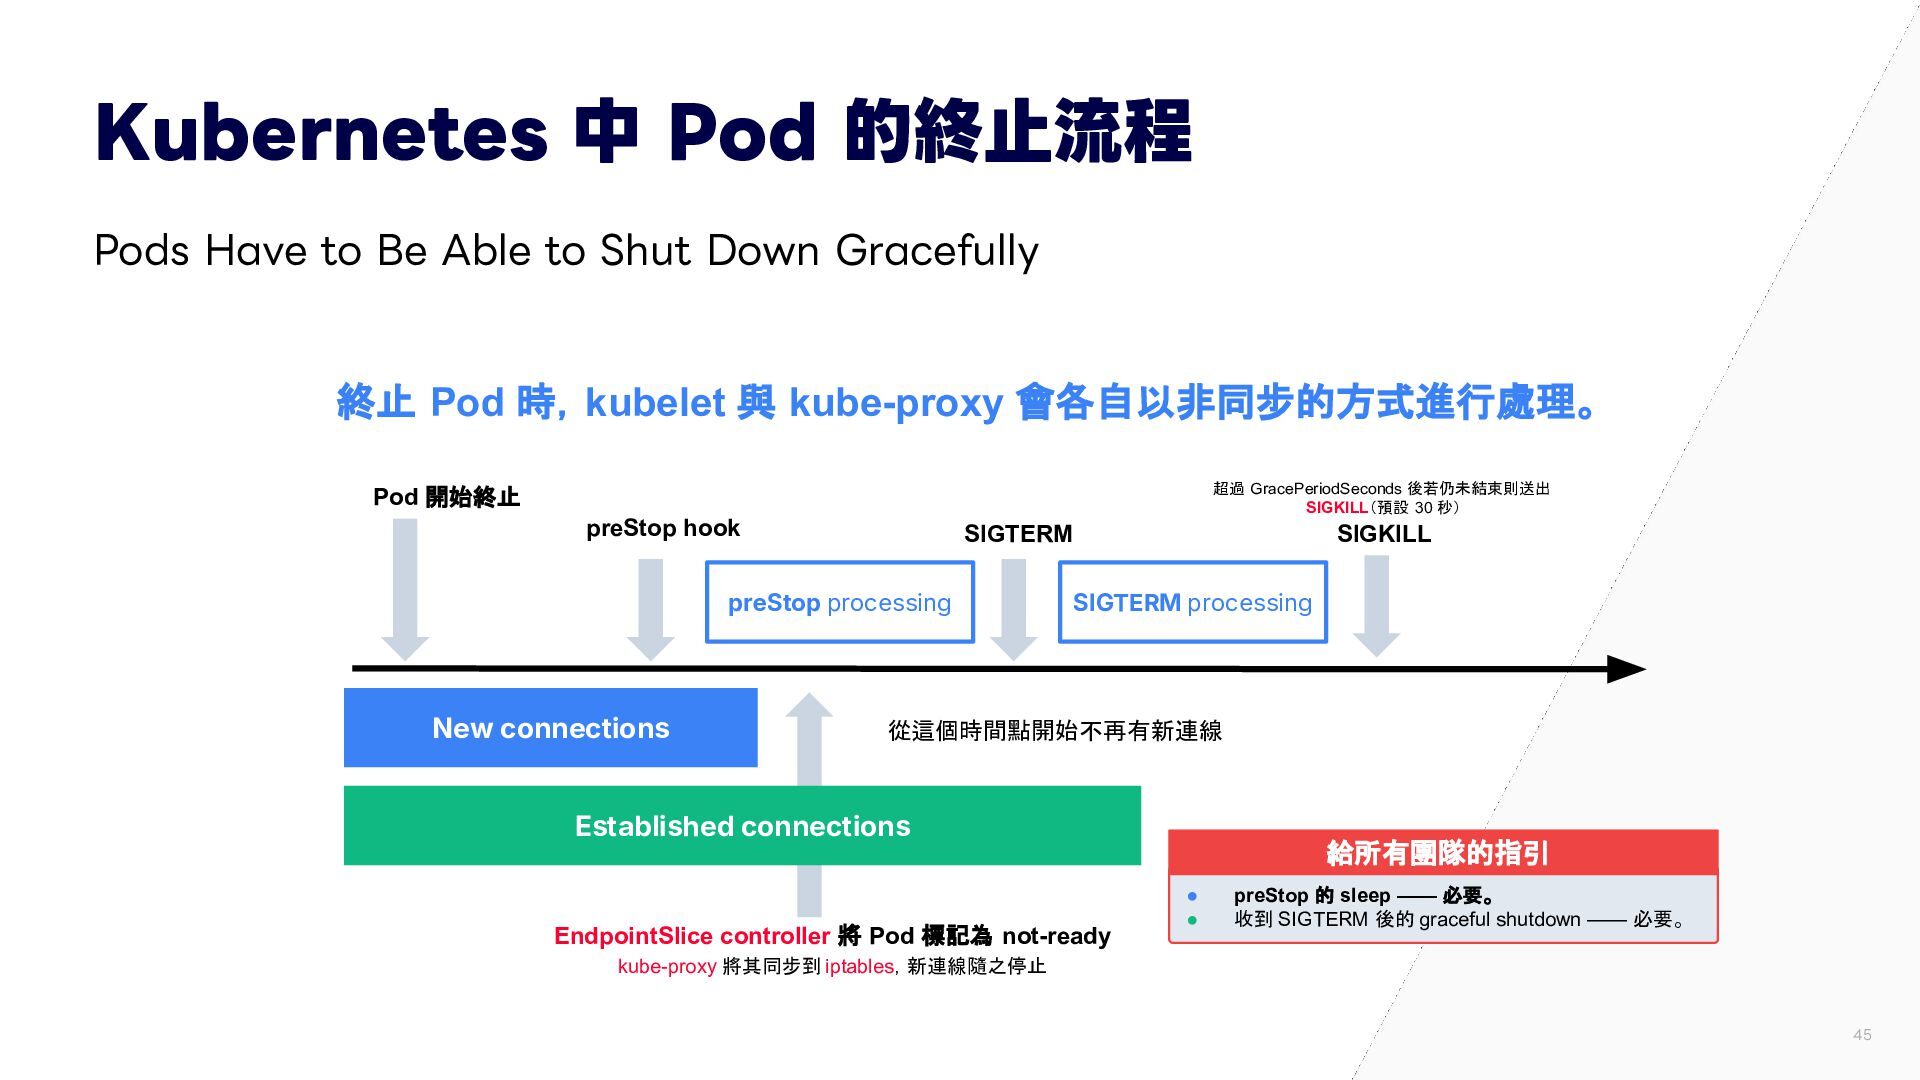
Kubernetes 中 Pod 的終⽌流程 Pods Have to Be Able to
Shut Down Gracefully 終止 Pod 時,kubelet 與 kube-proxy 會各自以非同步的方式進行處理。 超過 GracePeriodSeconds 後若仍未結束則送出 SIGKILL(預設 30 秒) Pod 開始終止 preStop hook SIGTERM preStop processing New connections SIGKILL SIGTERM processing 從這個時間點開始不再有新連線 Established connections EndpointSlice controller 將 Pod 標記為 not-ready 給所有團隊的指引 • • preStop 的 sleep —— 必要。 收到 SIGTERM 後的 graceful shutdown —— 必要。 kube-proxy 將其同步到 iptables,新連線隨之停止 45
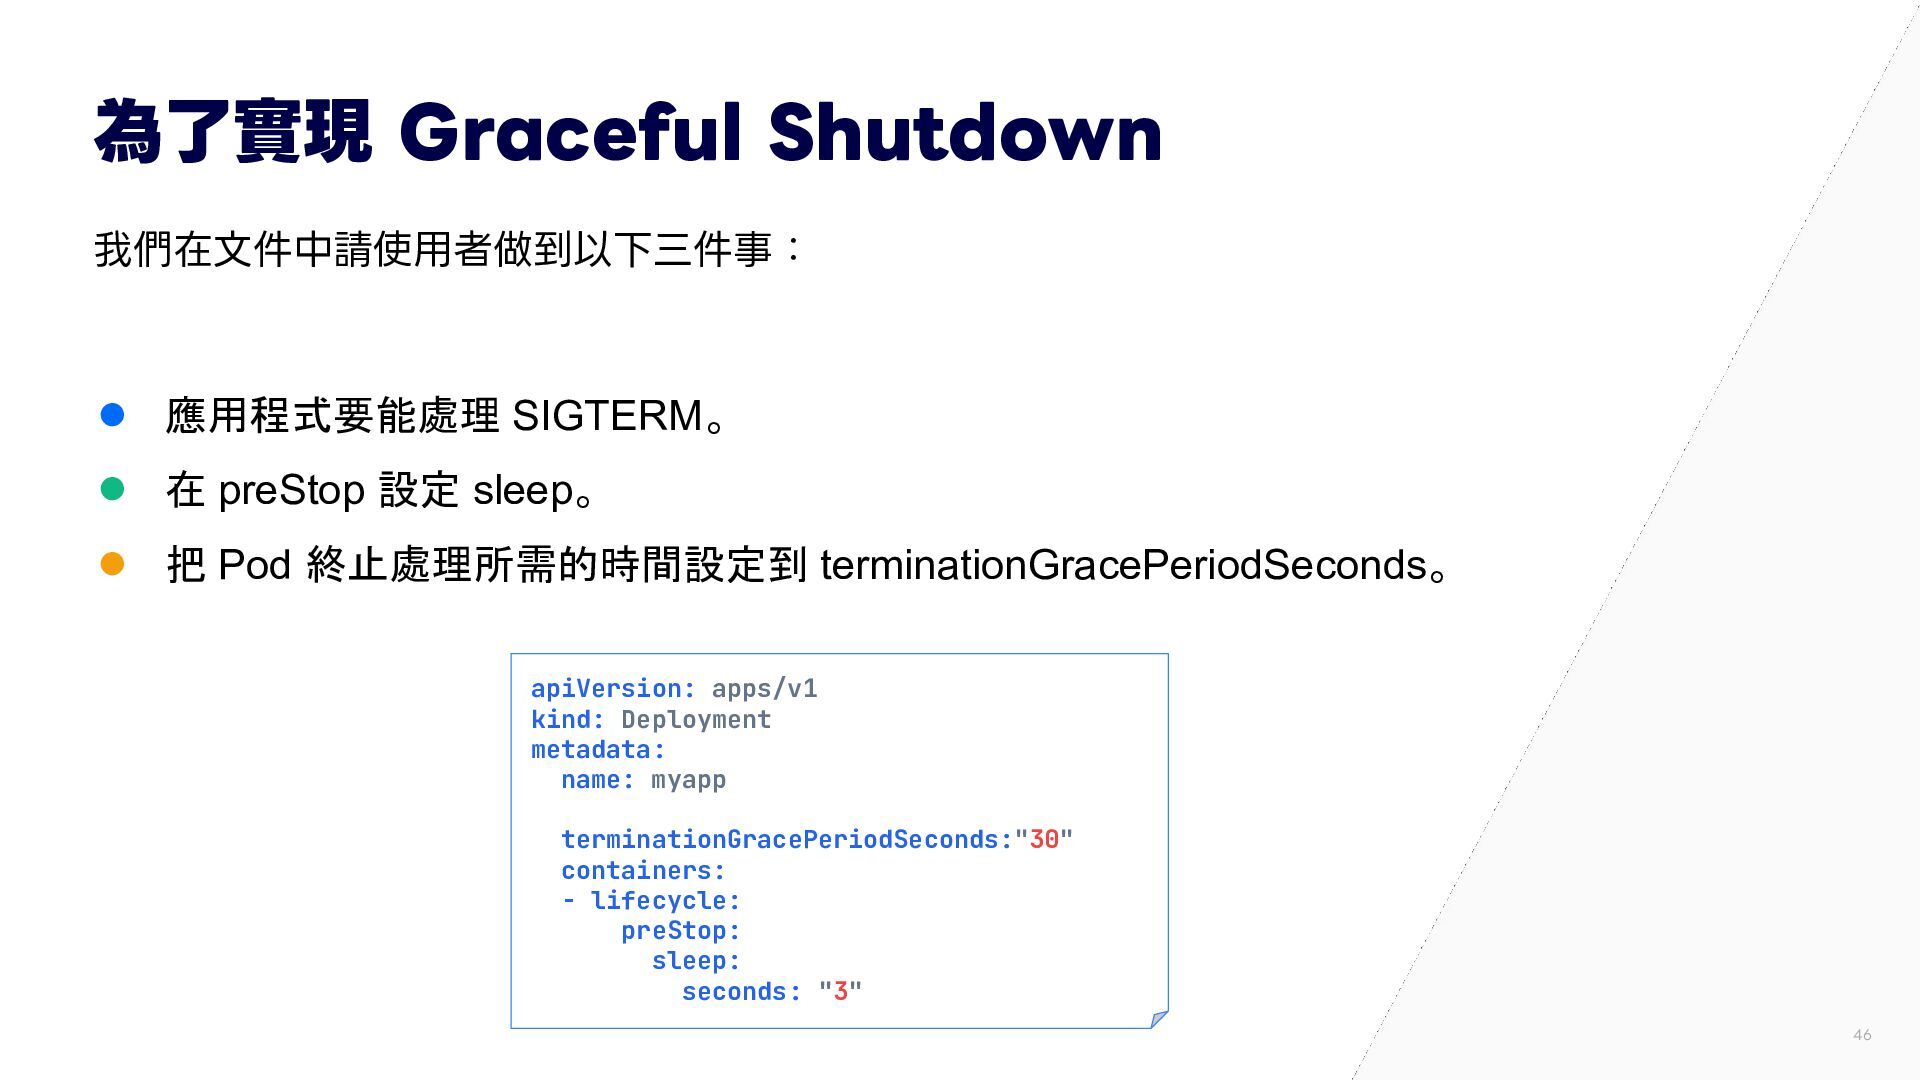
為了實現 Graceful Shutdown 我們在⽂件中請使⽤者做到以下三件事: • 應用程式要能處理 SIGTERM。 • 在 preStop
設定 sleep。 • 把 Pod 終止處理所需的時間設定到 terminationGracePeriodSeconds。 apiVersion: apps/v1 kind: Deployment metadata: name: myapp terminationGracePeriodSeconds:"30" containers: - lifecycle: preStop: sleep: seconds: "3" 46
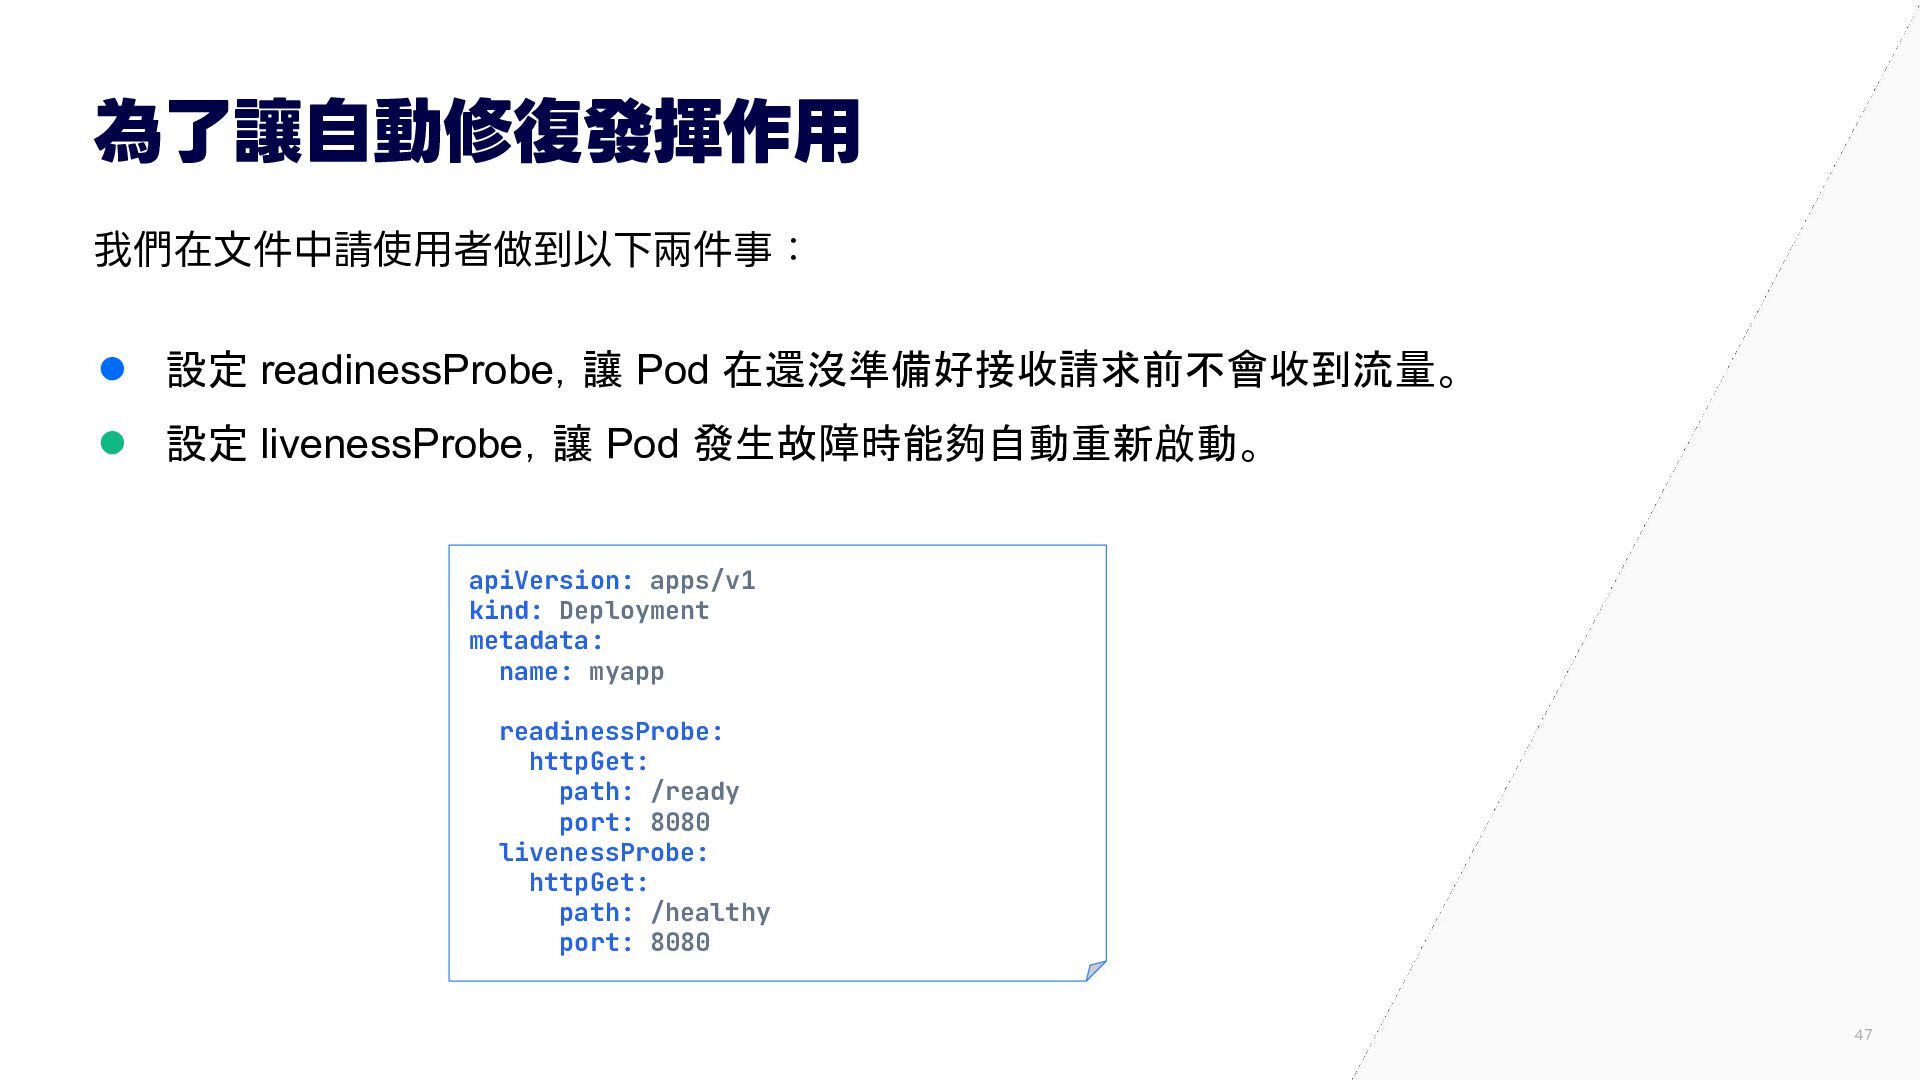
為了讓⾃動修復發揮作⽤ 我們在⽂件中請使⽤者做到以下兩件事: • 設定 readinessProbe,讓 Pod 在還沒準備好接收請求前不會收到流量。 • 設定 livenessProbe,讓
Pod 發生故障時能夠自動重新啟動。 apiVersion: apps/v1 kind: Deployment metadata: name: myapp readinessProbe: httpGet: path: /ready port: 8080 livenessProbe: httpGet: path: /healthy port: 8080 47
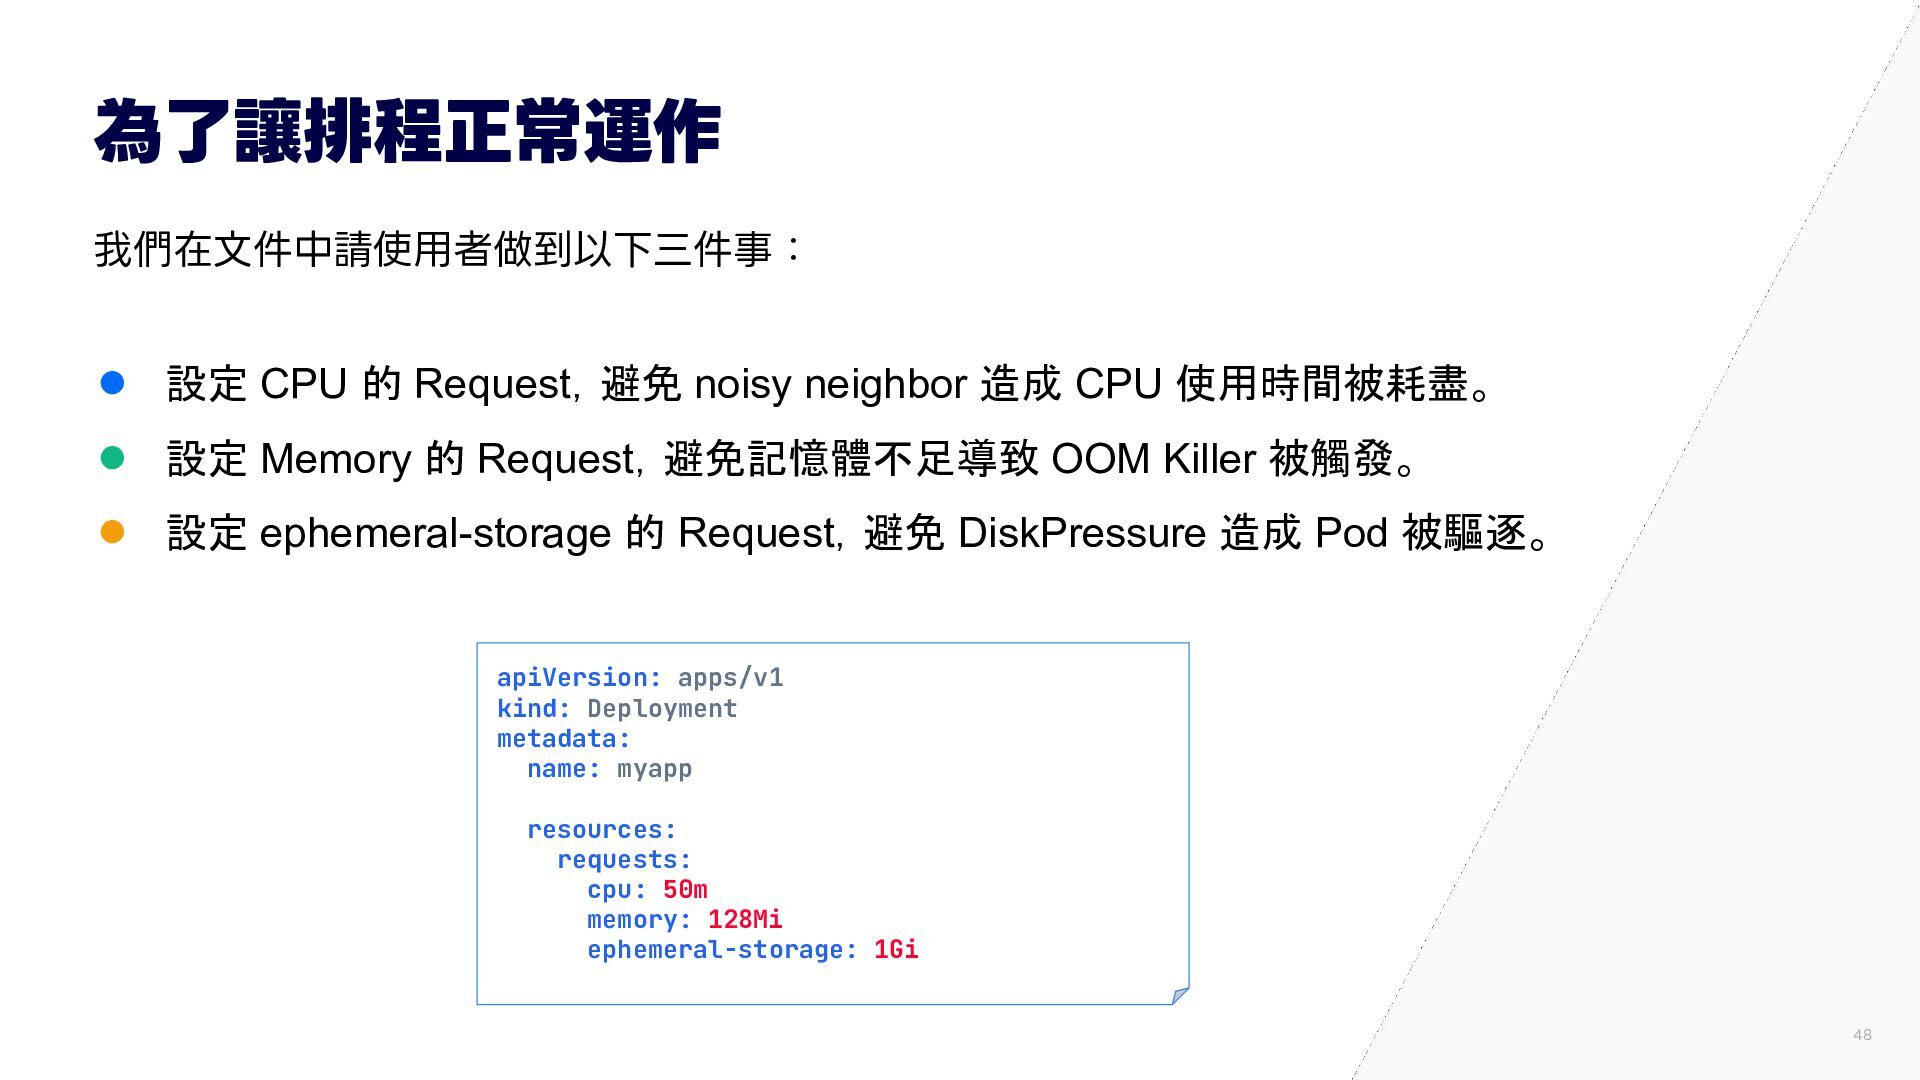
為了讓排程正常運作 我們在⽂件中請使⽤者做到以下三件事: • 設定 CPU 的 Request,避免 noisy neighbor 造成
CPU 使用時間被耗盡。 • 設定 Memory 的 Request,避免記憶體不足導致 OOM Killer 被觸發。 • 設定 ephemeral-storage 的 Request,避免 DiskPressure 造成 Pod 被驅逐。 apiVersion: apps/v1 kind: Deployment metadata: name: myapp resources: requests: cpu: 50m memory: 128Mi ephemeral-storage: 1Gi 48
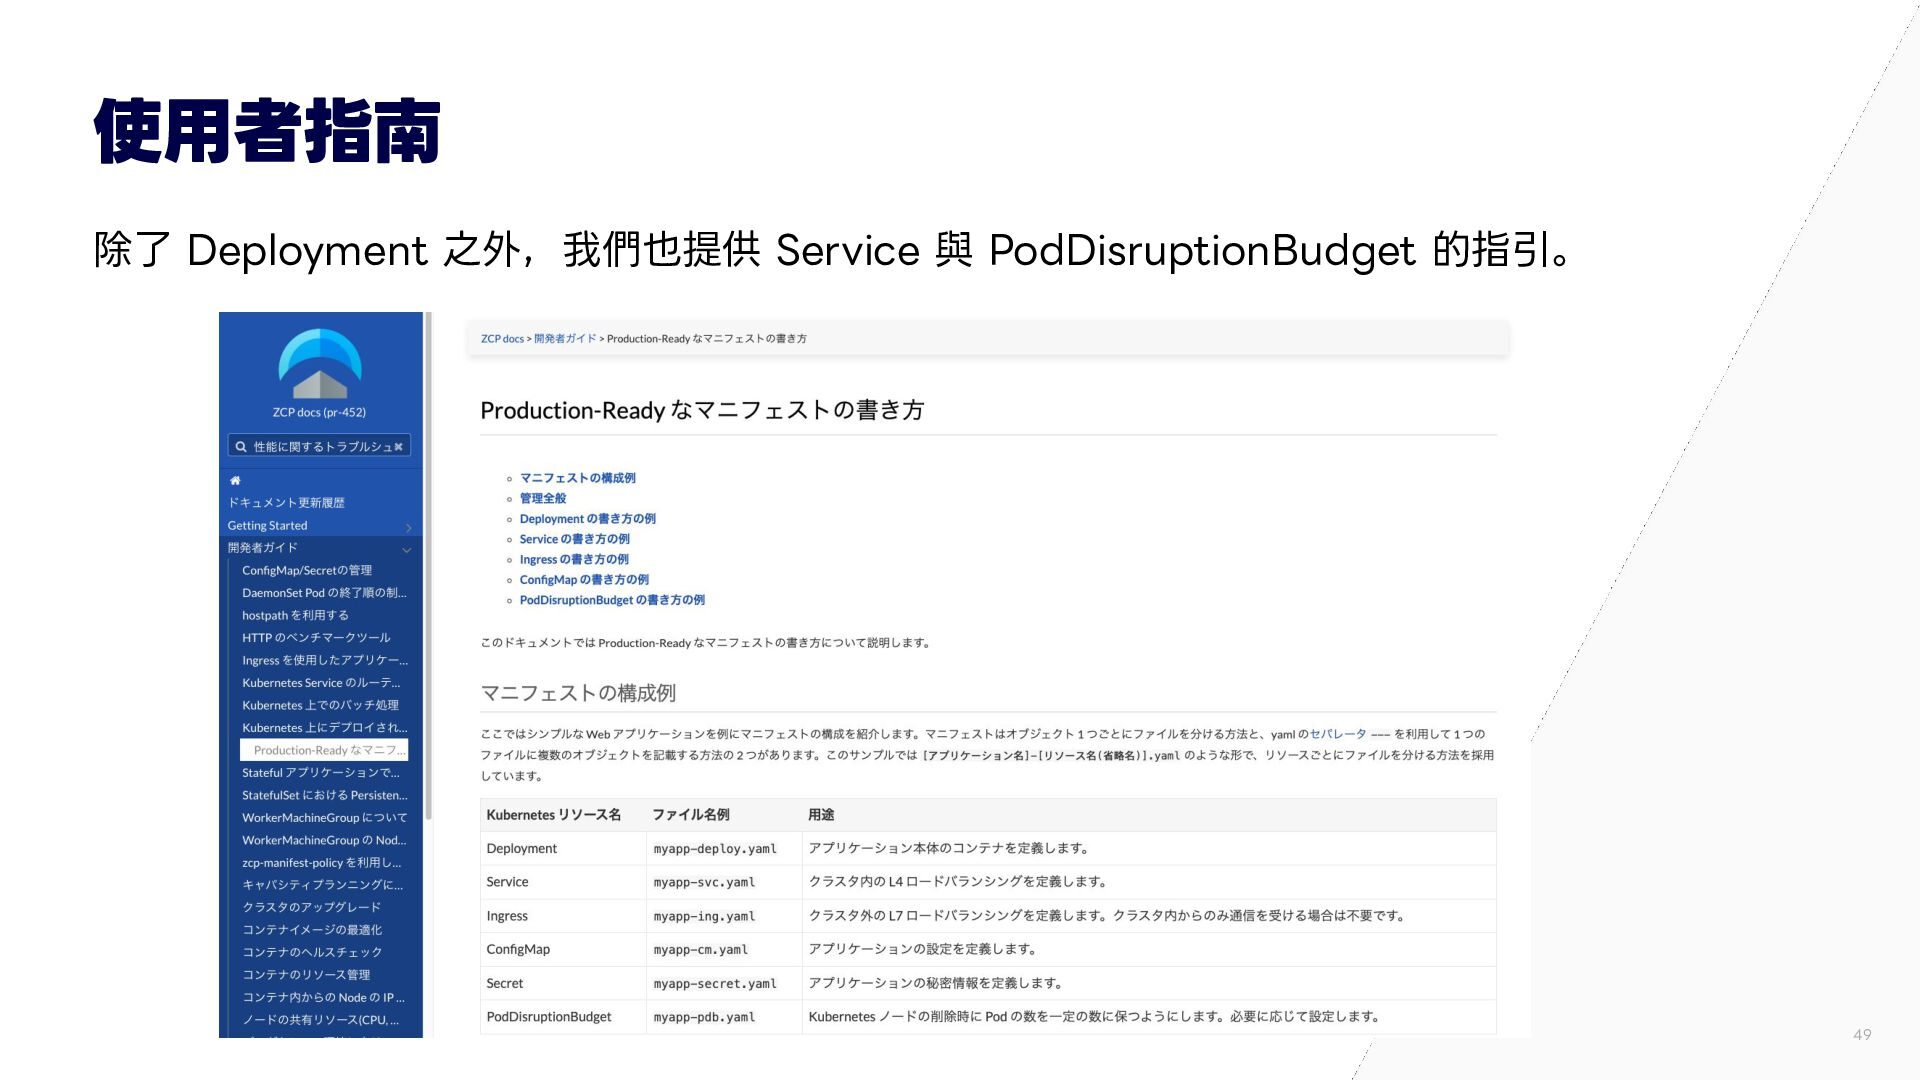
使⽤者指南 除了 Deployment 之外,我們也提供 Service 與 PodDisruptionBudget 的指引。 49
總結 50
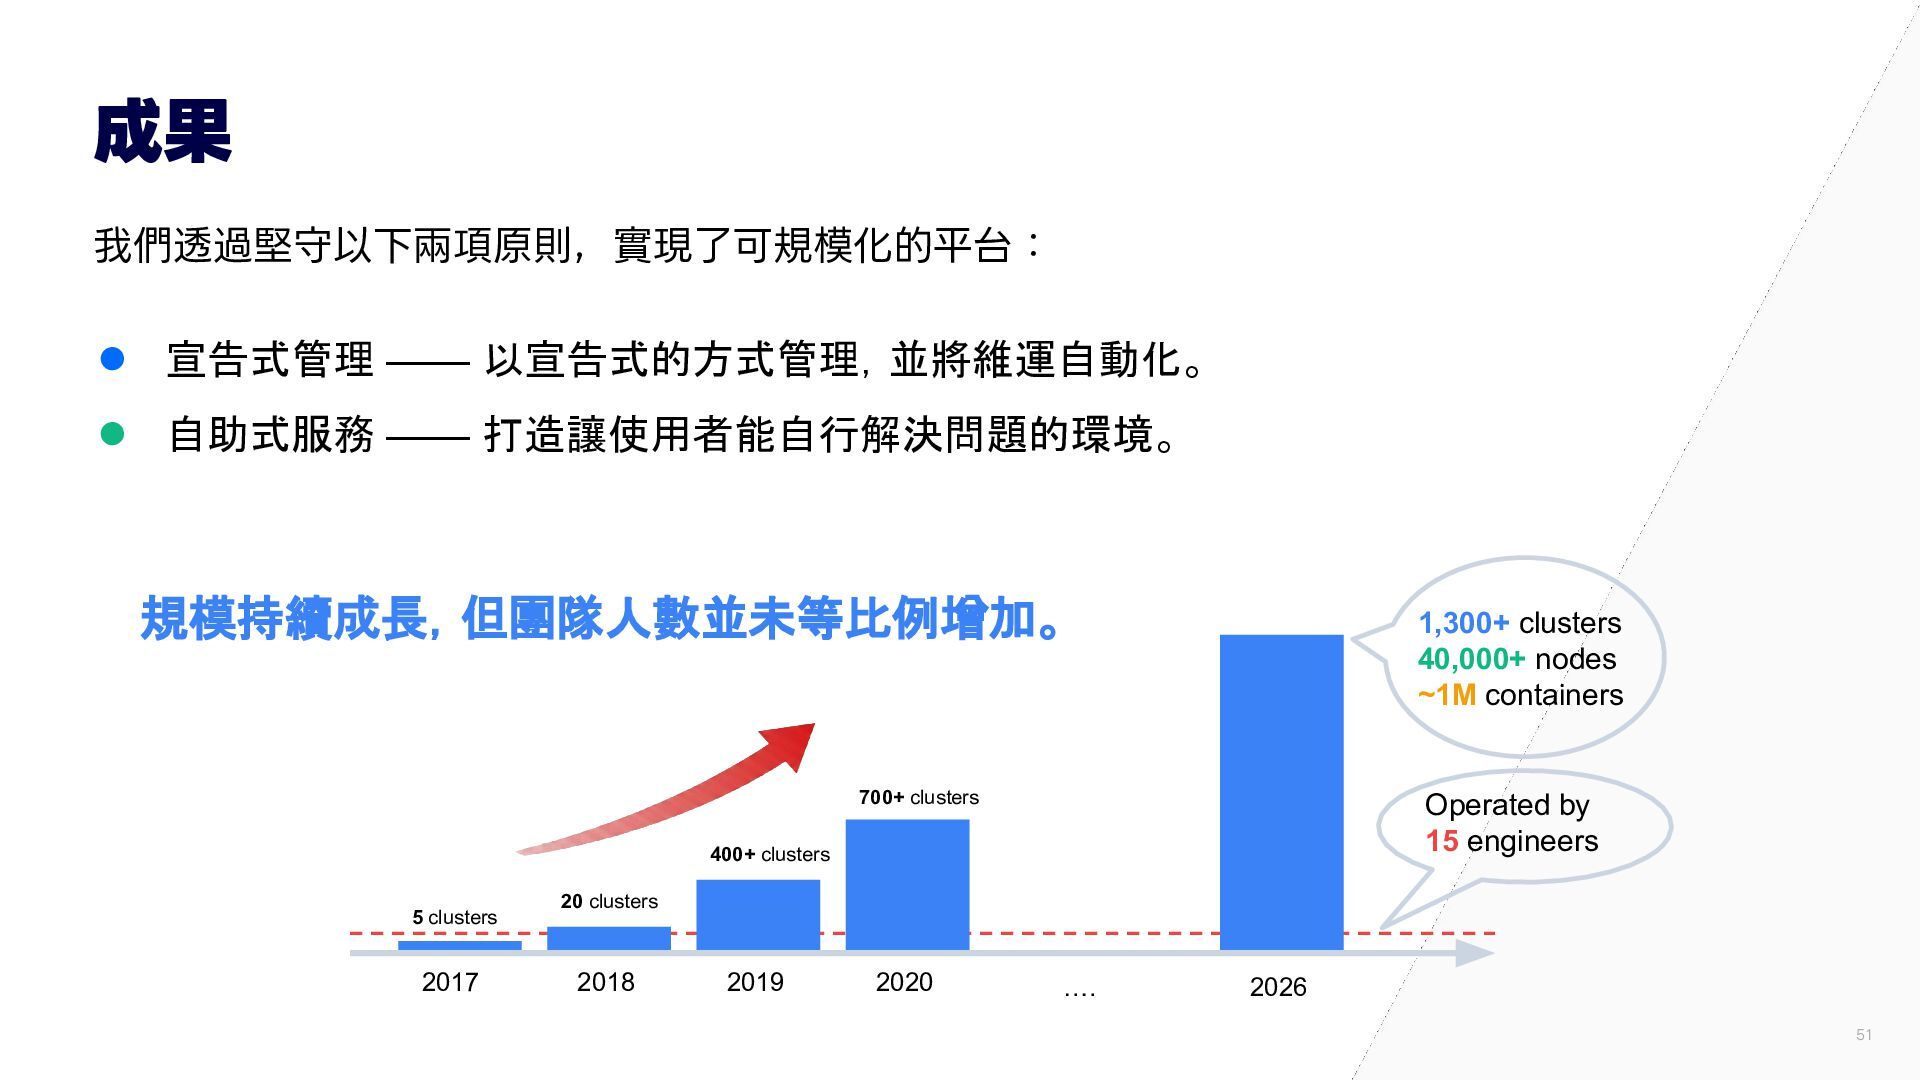
成果 我們透過堅守以下兩項原則,實現了可規模化的平台: • 宣告式管理 —— 以宣告式的方式管理,並將維運自動化。 • 自助式服務 —— 打造讓使用者能自行解決問題的環境。
規模持續成長,但團隊人數並未等比例增加。 1,300+ clusters 40,000+ nodes ~1M containers 700+ clusters Operated by 15 engineers 400+ clusters 5 clusters 2017 20 clusters 2018 2019 2020 …. 2026 51
最後 感謝您聽完這場演講。 有任何問題都歡迎直接來找我聊聊。 如果能透過 Google 翻譯 的 中日 文翻譯功能交流,我會很開心。 52
More Decks by yosshi_
See All by yosshi_
From 5 to 1,300+ Clusters: Declarative Scaling for Private Kubernetes
yosshi_
1
110
Scaling In Kubernetes Safely on On-Prem KaaS Across 1,300+ Clusters and 40,000+ Nodes
yosshi_
1
200
Getting Started with Kubernetes Observability
yosshi_
8
2.9k
PromQL_Compatibility_Testing_Recap
yosshi_
1
1.2k
プロダクト誕生の背景から学ぶ PrometheusとGrafana Loki
yosshi_
11
3.9k
これから学ぶKubernetesのReconciliation Loop
yosshi_
16
5.5k
伝統的なエンプラ企業で取り組むインフラの設計書のモダナイゼーション.pdf
yosshi_
14
6.6k
KubeCon2019_NA_Recap__NATS_.pdf
yosshi_
0
240
“Running Apache Samza on Kubernetes” Recap : KubeCon2019@NA
yosshi_
3
1.3k
Other Decks in Technology
See All in Technology
少ない人手 限られた予算 それでも守る 消せない・見つける・戻れる オールハザード型BCP on AWS / 20261107 Mitsutoshi Matsuo
shift_evolve
PRO
0
370
マネジメントされる側の仕事は「文句」を言うこと
riyaamemiya
2
420
E2E Test というハーネス — AI時代の自動テスト民主化
daishukojima
1
370
Claude Codeで新規事業を伸ばせるか? Zennの試行錯誤の記録
wadayusuke
2
160
仕様と現実の間で落とし所を探るリモートMCPの認証・認可 — Sansanの認証基盤における課題と実践
sansantech
PRO
2
280
うちなーぐちが認識できるなら、秋田弁もいけるはず!? Amazon Transcribe方言チューニング検証
ryouto715
1
170
セキュリティ専任チームなしで攻撃を先回りするSREが実践したSIEM on Amazon OpenSearch Service
cscengineer
PRO
1
860
異夢同船〜異なる夢でも同じ船でなんとかする〜
fortegp05
0
150
Active Directory と Entra ID のむむむな関係
murachiakira
PRO
4
1.8k
AI対話型分析を作成し、リリースするまでの話 / The Road to Release: Buiding AI Conversational Analytics
yappli_developers
0
100
GCASアップデート(202607-202610)
techniczna
1
330
Kiro Crew の Bot (続く役目を任せる窓口) | 目指せ Kiro マスター 12
inariku
PRO
2
380
Featured
See All Featured
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
280
Agile Leadership in an Agile Organization
kimpetersen
PRO
0
310
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
23k
Discover your Explorer Soul
emna__ayadi
2
1.3k
Marketing to machines
jonoalderson
1
6k
Large-scale JavaScript Application Architecture
addyosmani
516
110k
Navigating Algorithm Shifts & AI Overviews - #SMXNext
aleyda
1
1.7k
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
610
Abbi's Birthday
coloredviolet
5
11k
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
So, you think you're a good person
axbom
PRO
2
2.3k


 yosshi_
 shift_evolve
 riyaamemiya
 daishukojima
 wadayusuke
 sansantech
 ryouto715
 cscengineer
 fortegp05
 murachiakira
 yappli_developers
 techniczna
 inariku
 stuffmc
 kimpetersen
 smashingmag
 emna__ayadi
 jonoalderson
 addyosmani
 aleyda
 sstephenson
 baasie
 coloredviolet
 axbom