Share
Embed
Vision Language Modelと自動運転AIの最前線_20250730
Vision Language Modelと自動運転AIの最前線
VLMは視覚と言語を統合学習した生成AIで、物理世界の状況把握を支え、自動運転やロボティクスなどの応用の要となりつつあります。このランチョンセミナーでは、VLMの学習、現実世界へのアクションとの融合、世界モデルを含む自動運転に関連した最新研究をわかりやすく紹介します。
2025/7/30 12:25~ のスポンサーセッションの投影資料です
https://cvim.ipsj.or.jp/MIRU2025/sponsor-events.html
Yu Yamaguchi
July 30, 2025
Transcript
44 slides
-
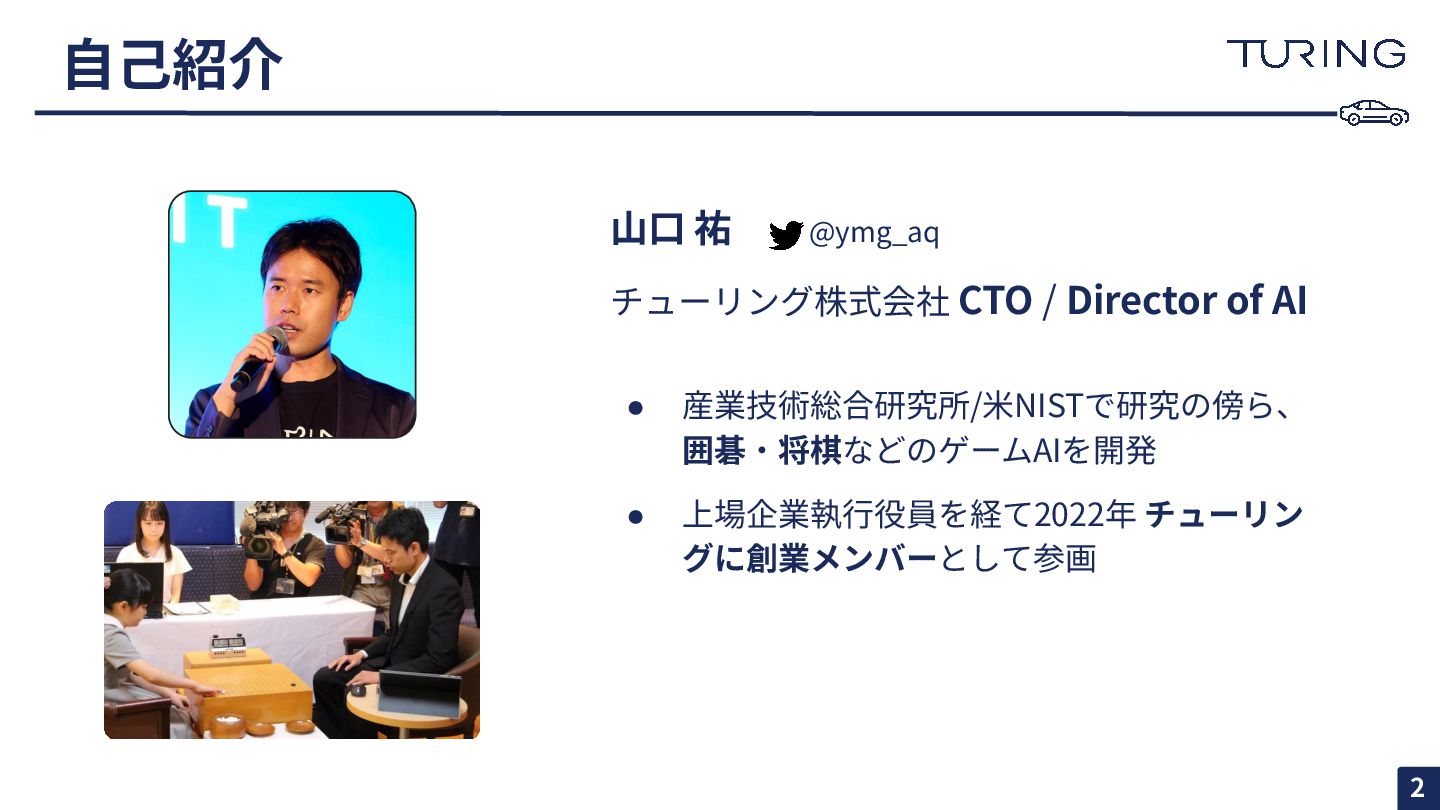
⾃⼰紹介 ⼭⼝ 祐 @ymg_aq チューリング株式会社 CTO / Director of AI
• 産業技術総合研究所/⽶NISTで研究の傍ら、 囲碁‧将棋などのゲームAIを開発 • 上場企業執⾏役員を経て2022年 チューリン グに創業メンバーとして参画 2 -
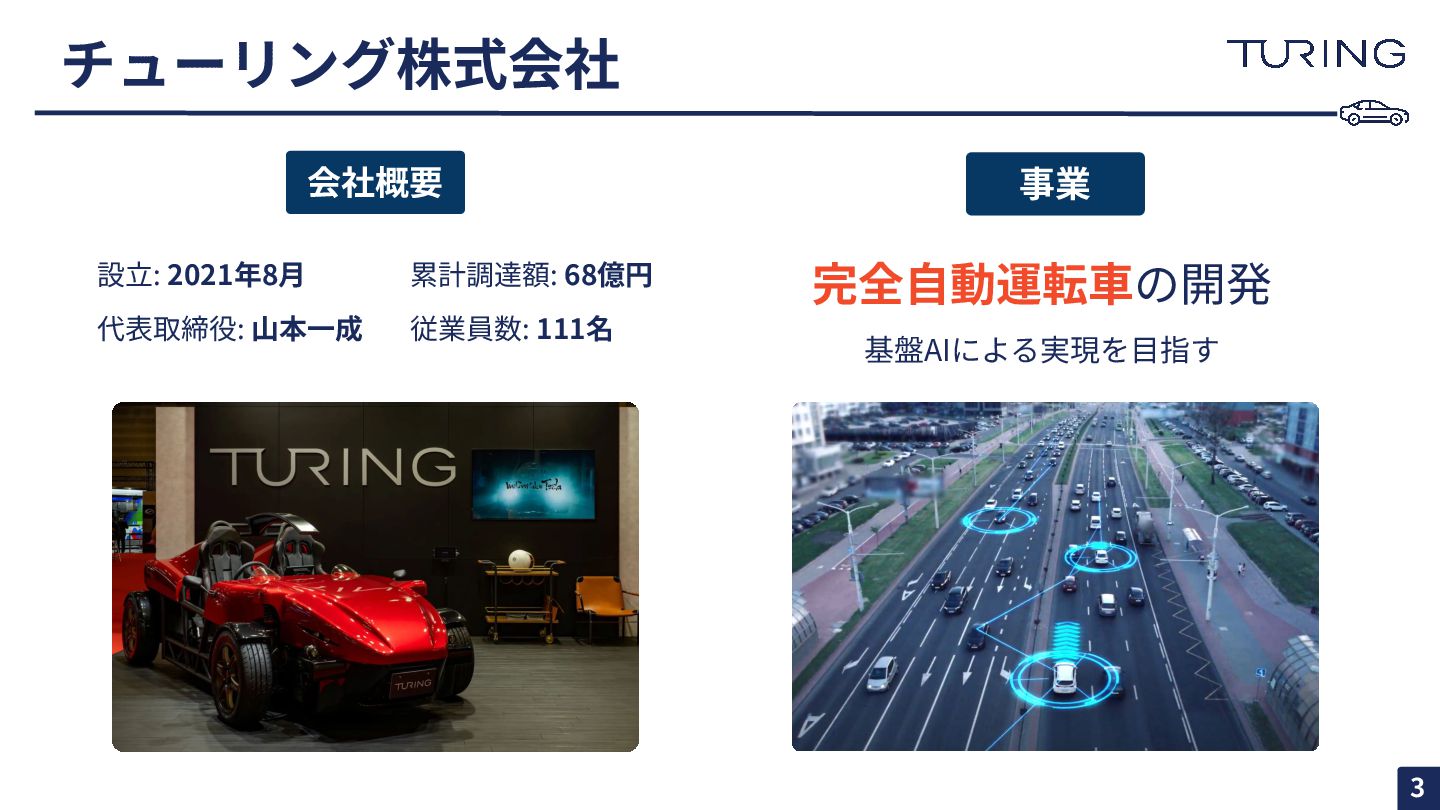
チューリング株式会社 累計調達額: 68億円 従業員数: 111名 会社概要 事業 完全⾃動運転⾞の開発 基盤AIによる実現を⽬指す 設⽴:
2021年8⽉ 代表取締役: ⼭本⼀成 3 -
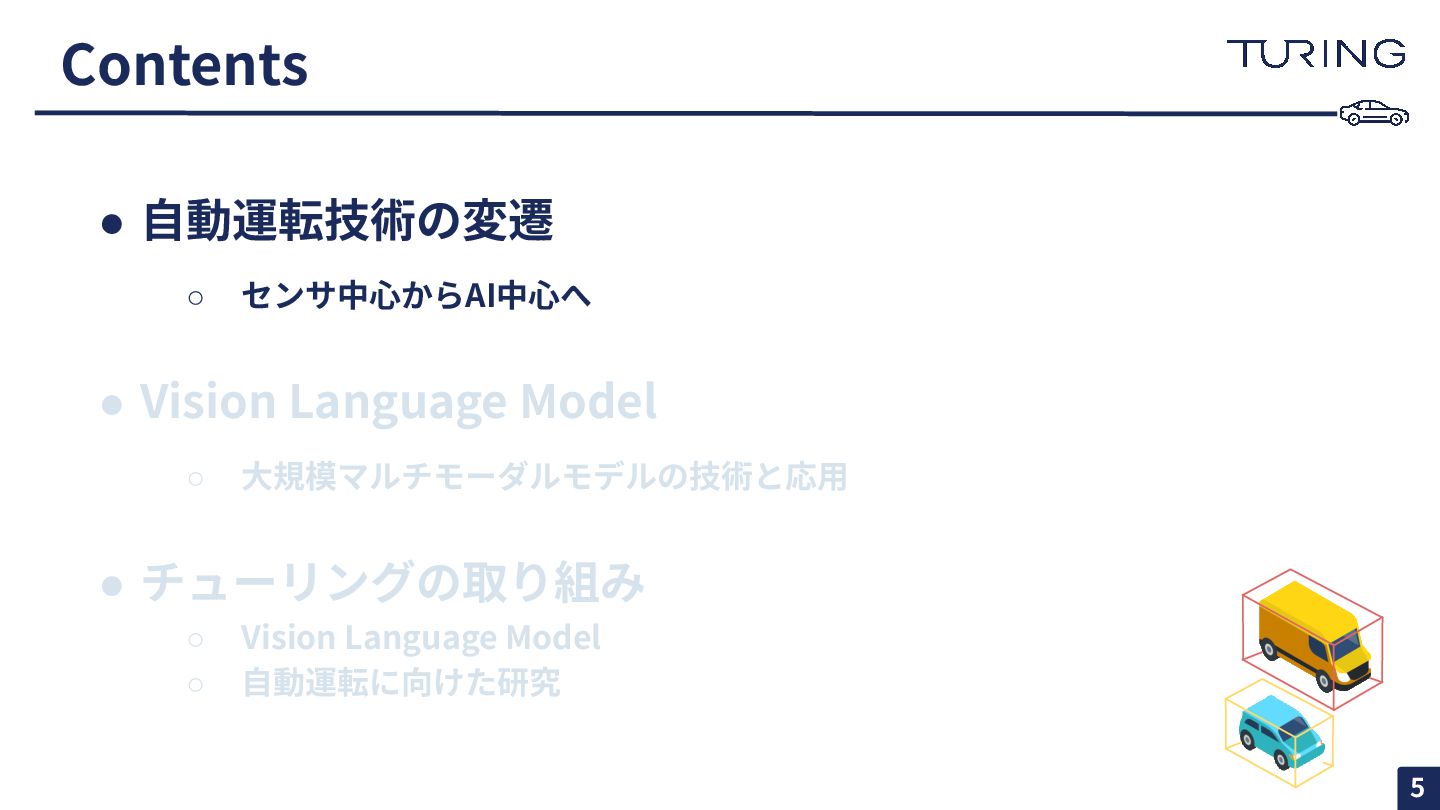
Contents • ⾃動運転技術の変遷 ◦ センサ中⼼からAI中⼼へ • Vision Language Model ◦
⼤規模マルチモーダルモデルの技術と応⽤ • チューリングの取り組み ◦ Vision Language Model ◦ ⾃動運転に向けた研究 4 -
Contents • ⾃動運転技術の変遷 ◦ センサ中⼼からAI中⼼へ • Vision Language Model ◦
⼤規模マルチモーダルモデルの技術と応⽤ • チューリングの取り組み ◦ Vision Language Model ◦ ⾃動運転に向けた研究 5 -
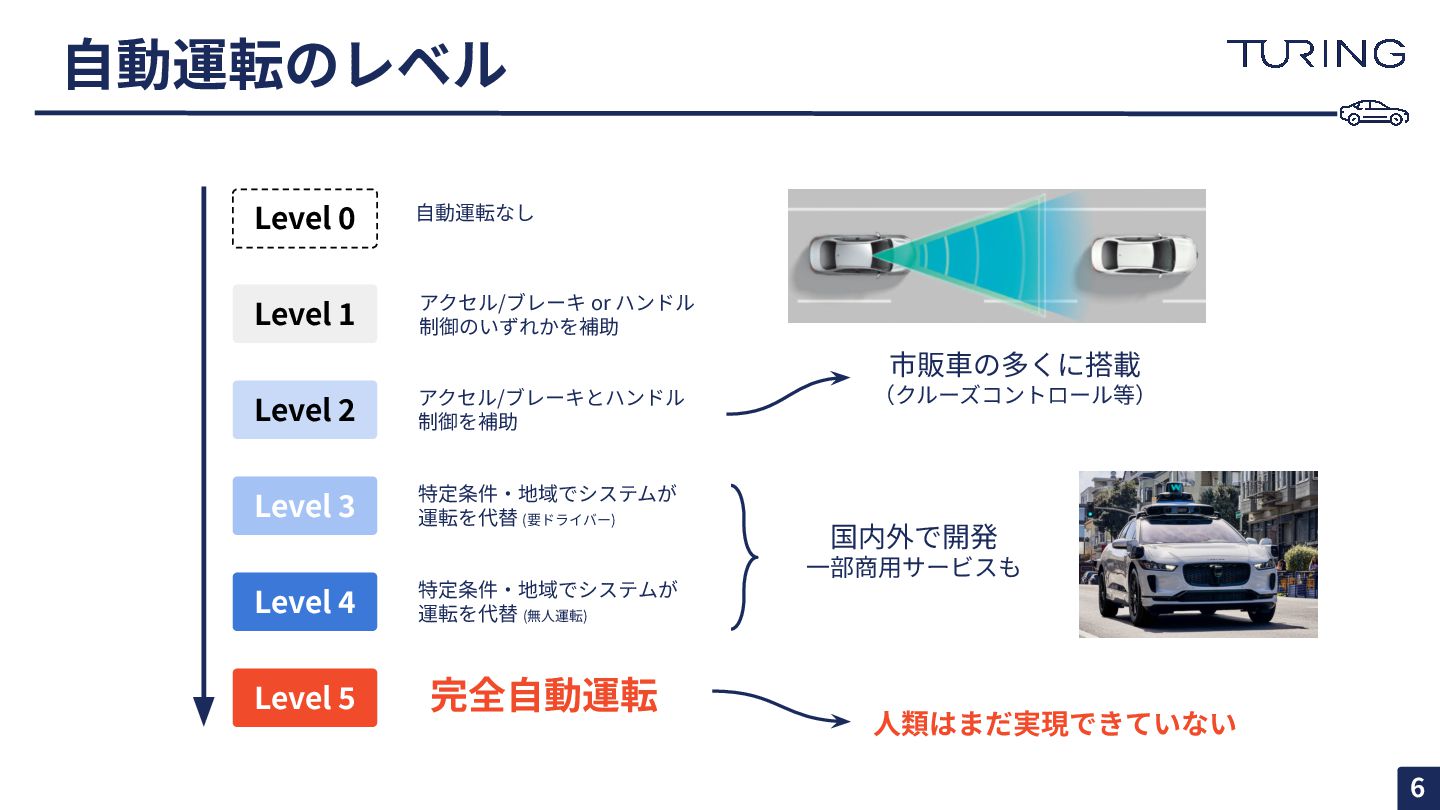
⾃動運転のレベル Level 0 Level 1 Level 2 Level 3 Level
4 Level 5 ⾃動運転なし アクセル/ブレーキ or ハンドル 制御のいずれかを補助 アクセル/ブレーキとハンドル 制御を補助 特定条件‧地域でシステムが 運転を代替 (要ドライバー) 特定条件‧地域でシステムが 運転を代替 (無⼈運転) 完全⾃動運転 市販⾞の多くに搭載 (クルーズコントロール等) 国内外で開発 ⼀部商⽤サービスも ⼈類はまだ実現できていない 6 -
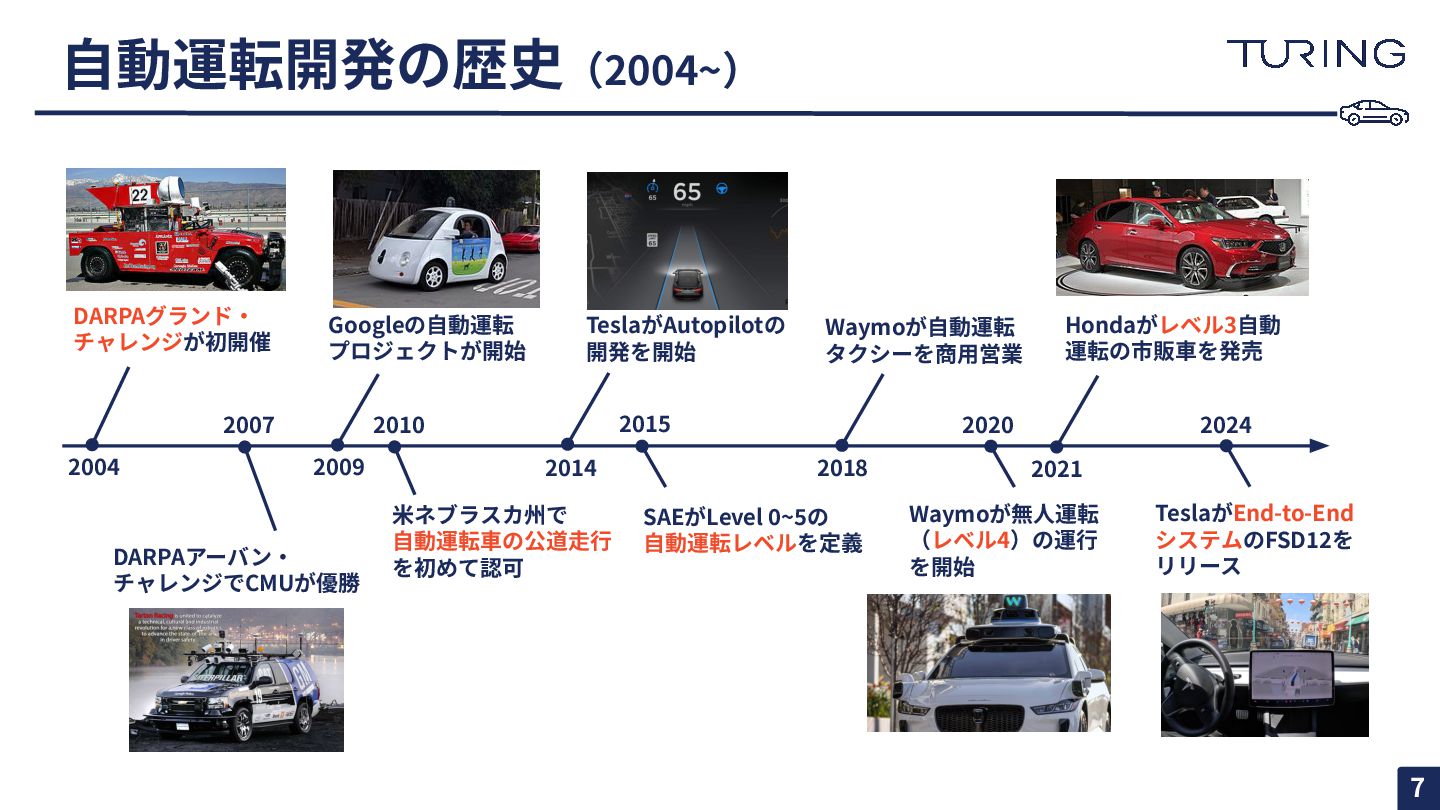
⾃動運転開発の歴史(2004~) 2004 DARPAグランド‧ チャレンジが初開催 2007 DARPAアーバン‧ チャレンジでCMUが優勝 2009 Googleの⾃動運転 プロジェクトが開始
2010 ⽶ネブラスカ州で ⾃動運転⾞の公道⾛⾏ を初めて認可 2014 TeslaがAutopilotの 開発を開始 2015 SAEがLevel 0~5の ⾃動運転レベルを定義 2018 Waymoが⾃動運転 タクシーを商⽤営業 2020 Hondaがレベル3⾃動 運転の市販⾞を発売 2024 2021 TeslaがEnd-to-End システムのFSD12を リリース Waymoが無⼈運転 (レベル4)の運⾏ を開始 7 -
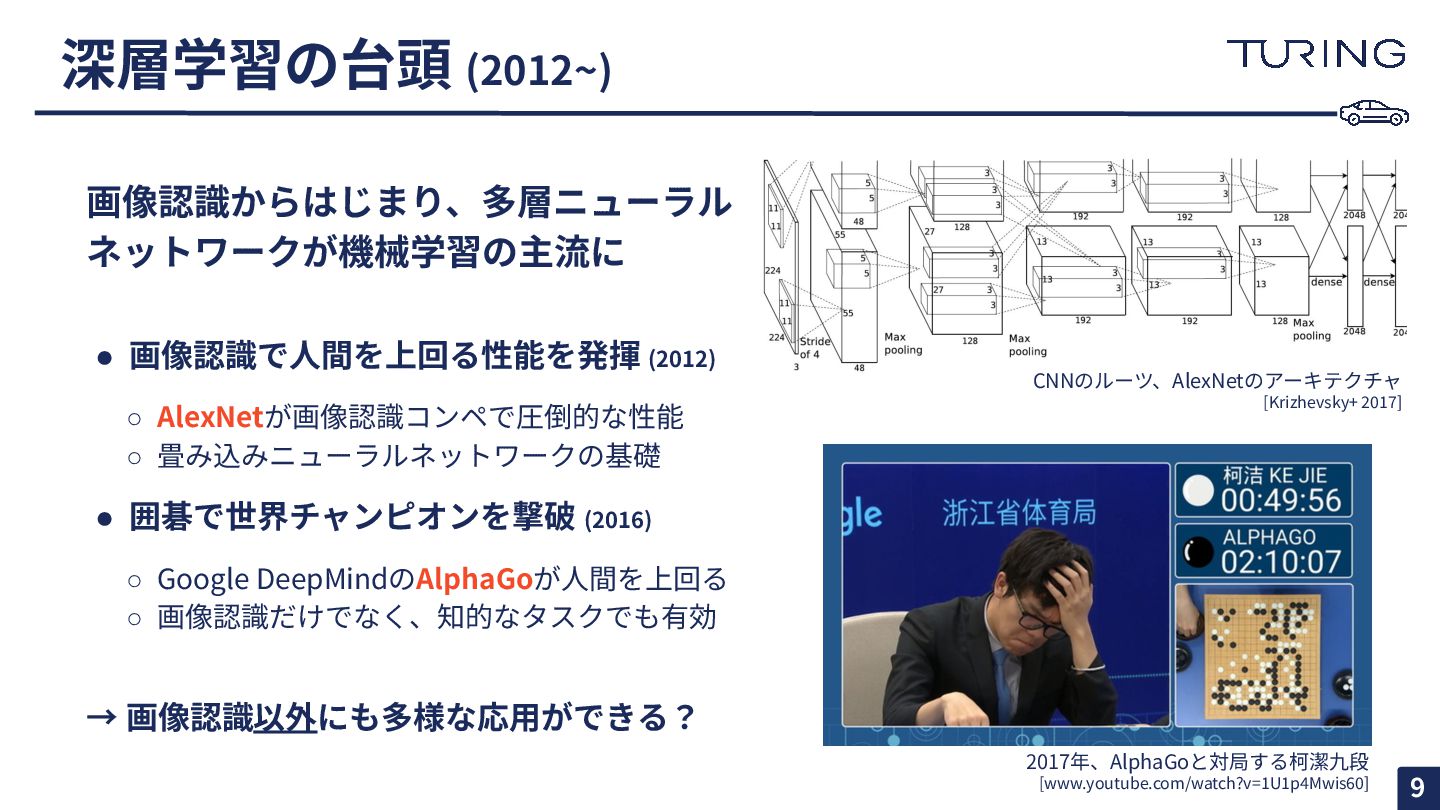
深層学習の台頭 (2012~) 画像認識からはじまり、多層ニューラル ネットワークが機械学習の主流に • 画像認識で⼈間を上回る性能を発揮 (2012) ◦ AlexNetが画像認識コンペで圧倒的な性能 ◦
畳み込みニューラルネットワークの基礎 • 囲碁で世界チャンピオンを撃破 (2016) ◦ Google DeepMindのAlphaGoが⼈間を上回る ◦ 画像認識だけでなく、知的なタスクでも有効 → 画像認識以外にも多様な応⽤ができる? 2017年、AlphaGoと対局する柯潔九段 [www.youtube.com/watch?v=1U1p4Mwis60] CNNのルーツ、AlexNetのアーキテクチャ [Krizhevsky+ 2017] 9 -
UniAD [Hu+ 2023] カメラのみから車の制御までを End-to-Endで学習するフレームワーク。 PerceptionやPredictionで個別の機能やマルチタスクにするのではなく、各モジュー ルを同時に最適化する。CVPR2023 Best Paperに選出。 11
Hu, Yihan, et al. “Planning‑oriented Autonomous Driving.” In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2023. -
Contents • ⾃動運転技術の変遷 ◦ センサ中⼼からAI中⼼へ • Vision Language Model ◦
⼤規模マルチモーダルモデルの技術と応⽤ • チューリングの取り組み ◦ Vision Language Model ◦ ⾃動運転に向けた研究 13 -
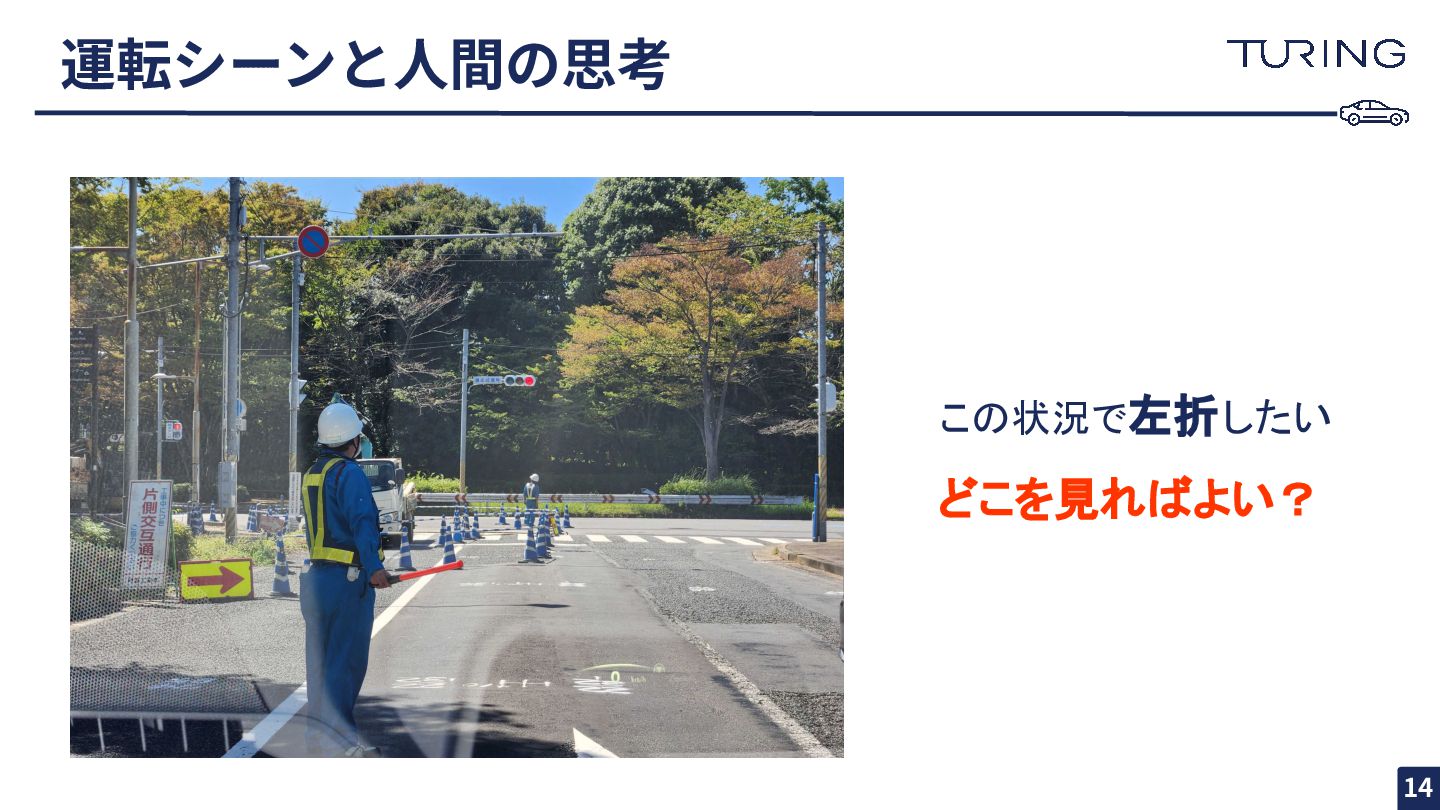
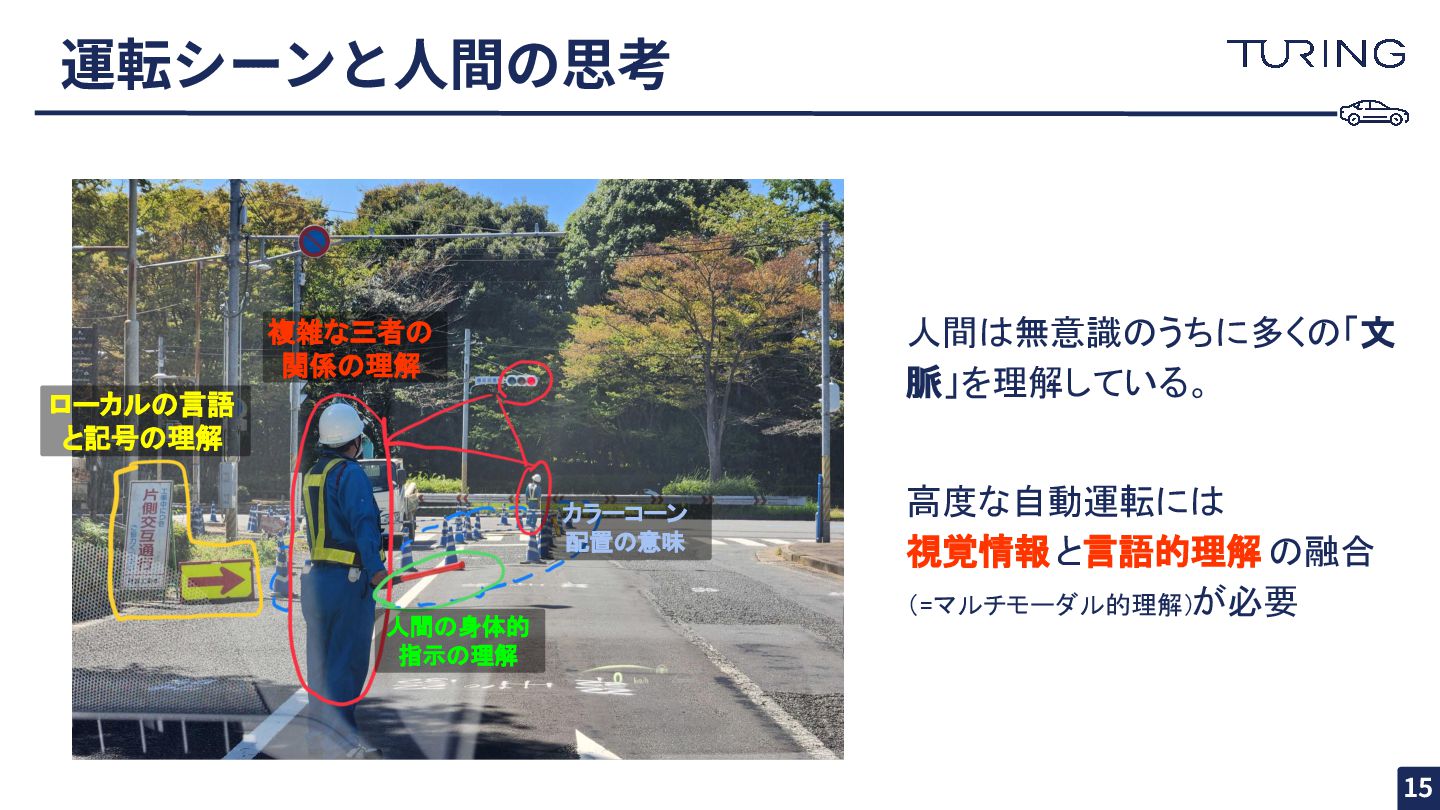
運転シーンと⼈間の思考 ローカルの言語 と記号の理解 複雑な三者の 関係の理解 カラーコーン 配置の意味 人間の身体的 指示の理解 人間は無意識のうちに多くの「文
脈」を理解している。 高度な自動運転には 視覚情報と言語的理解 の融合 (=マルチモーダル的理解)が必要 15 -
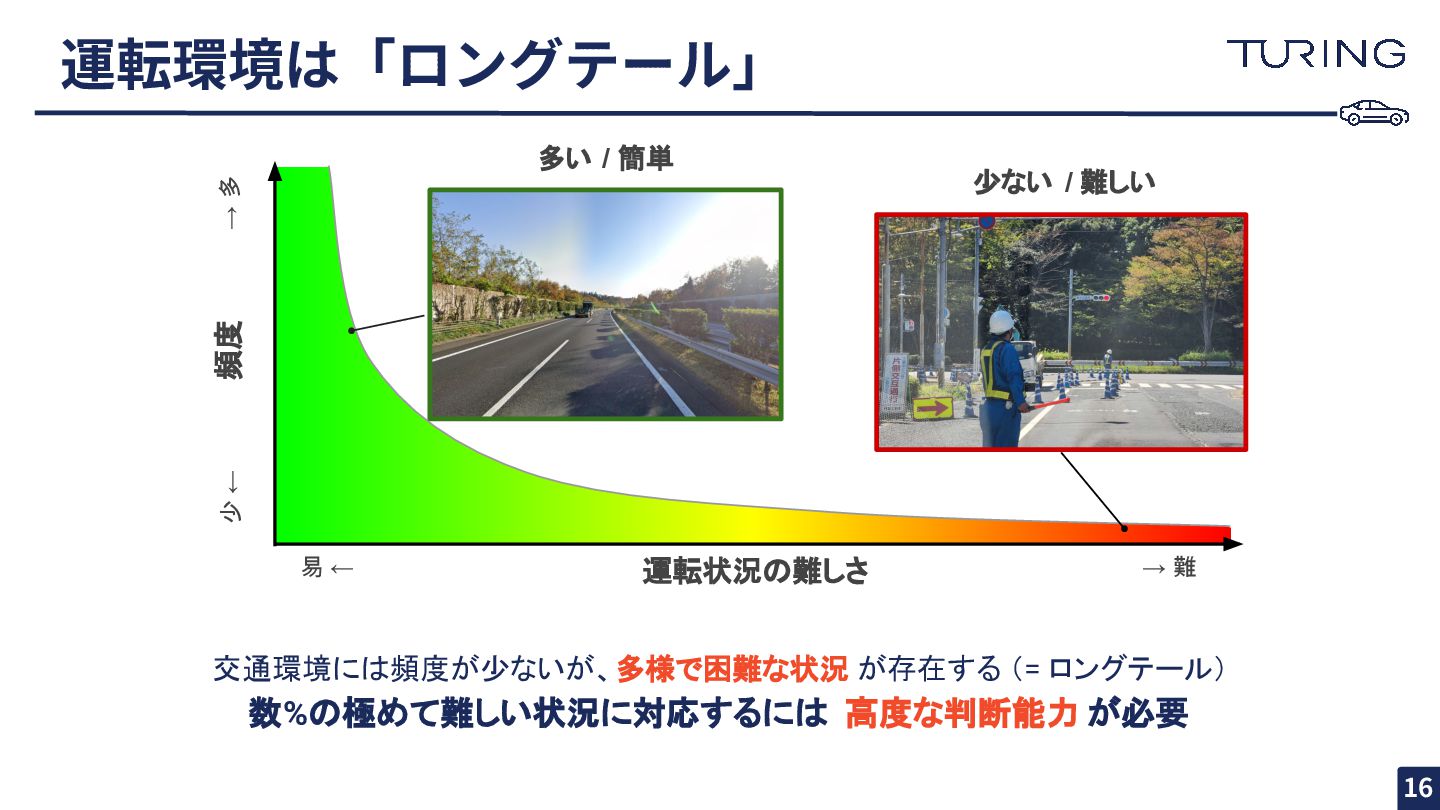
運転環境は「ロングテール」 運転状況の難しさ 頻度 少 ← → 難 易 ← →
多 多い / 簡単 少ない / 難しい 交通環境には頻度が少ないが、多様で困難な状況 が存在する (= ロングテール) 数%の極めて難しい状況に対応するには 高度な判断能力 が必要 16 -
第3世代の⾃動運転タスク (2023~) 深層学習ベースの自動運転の学習データは、大規模生成 AIをターゲットとした 自然言語による状況理解 に移行しつつある [Li+ 2024] 第1世代 (CNN,
2012~) 第2世代 (Transformer, 2019~) 第3世代 (LLM, 2023~) • 前方カメラ • LiDAR • 複数カメラ • LiDAR • Radar • HDマップ • 周囲カメラ • 言語による質問 /応答 DriveLM [Sima+ 2023] nuScenes [Caesar+ 2019] KITTI [Geiger+ 2012] 17 -
Flamingo [Alayac+ 2022] 画像‧動画とテキストが⾃由に混在した シーケンスをそのまま⼊⼒でき、 few-shotだけで多様なマルチモーダル課題 に適応 • Image encoder
+ LLM ◦ CLIP と Chinchilla [Hoffmann+ 2022] をベース ◦ Gated Cross-Attention を追加‧プロジェクターと して学習 ◦ 画像と映像をPerceiver [Jaegle+ 2021] 形式を⽤いて 効率的に固定⻑トークンに変換. 20 Alayrac, Jean‑Baptiste, et al. “Flamingo: a Visual Language Model for Few‑Shot Learning .” arXiv preprint arXiv:2204.14198 (2022). -
LLaVA [Liu+ 2023] ⾼品質の指⽰チューニングデータを画像- ⾔語タスクに適⽤することで⾼い性能を 達成 • 指⽰チューニングデータ ◦ COCO
dataset を GPT-4 を使い詳細なアノテー ションを付与、Q&Aも作成. 21 Liu, Haotian, et al. “Visual Instruction Tuning.” arXiv preprint arXiv:2304.08485 (2023). -
インターリーブされた画像-テキストの⽣成が可能 画像‧テキストが混在したデータに対して、⼀貫した理解が可能 Chameleon [C Team+ 2024] Team, Chameleon. "Chameleon: Mixed-modal
early-fusion foundation models." arXiv preprint arXiv:2405.09818 (2024). 22 -
LingoQA [Marcu+ 2023] 質疑応答フレームワークを使ったVLMによる交通環境における理解と意思決定 Marcu, Ana-Maria, et al. "Lingoqa: Video
question answering for autonomous driving." arXiv preprint arXiv:2312.14115 (2023) 23 -
RT-2 [Brohan+ 2023] 事前学習されたVLMをロボットアームのアクションデータでFT Zitkovich, Brianna, et al. "Rt-2: Vision-language-action
models transfer web knowledge to robotic control." CoRL 2023. Vision-Language-Action (VLA) モデルの概念を提唱. 24 -
Contents • ⾃動運転技術の変遷 ◦ センサ中⼼からAI中⼼へ • Vision Language Model ◦
⼤規模マルチモーダルモデルの技術と応⽤ • チューリングの取り組み ◦ Vision Language Model ◦ ⾃動運転に向けた研究 28 -
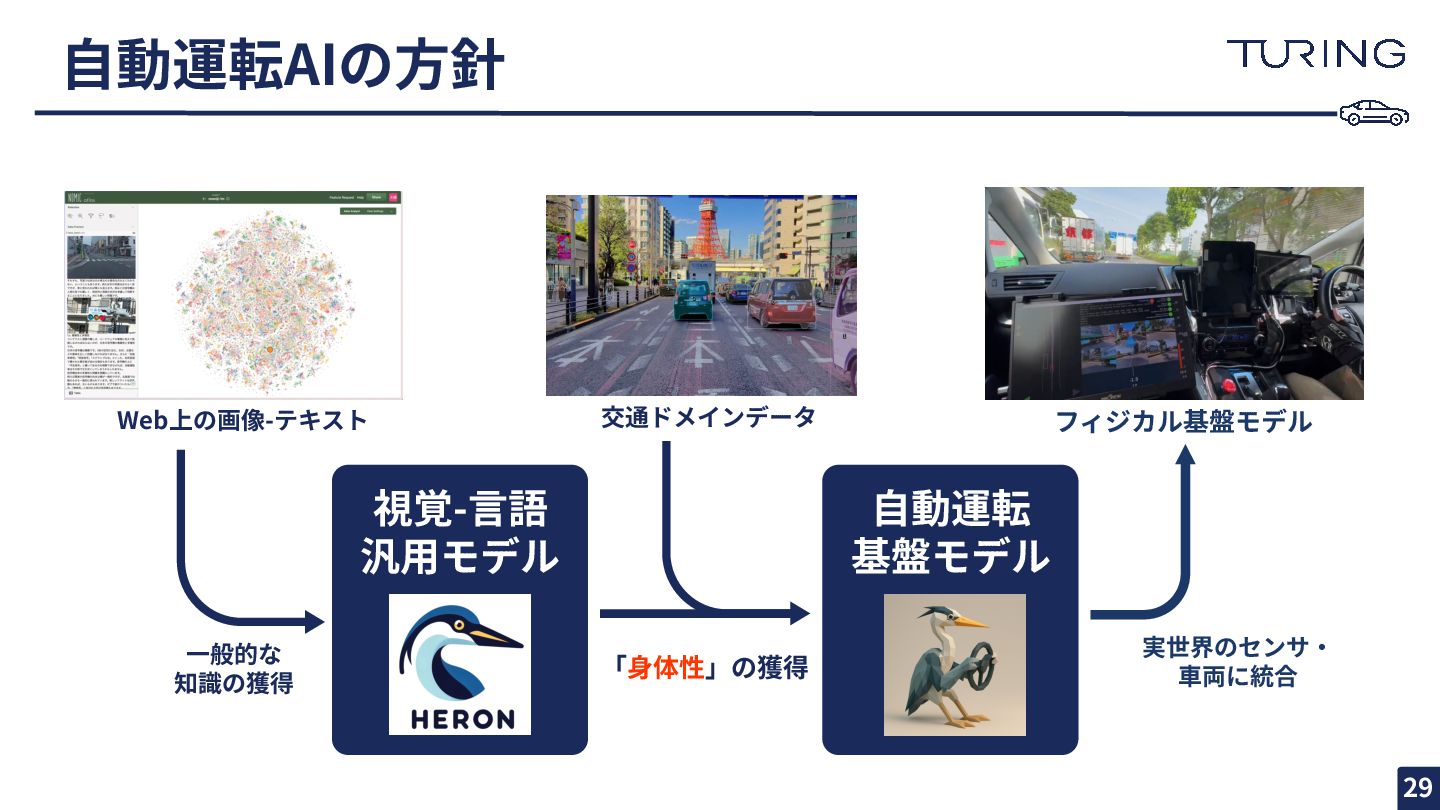
⾃動運転AIの⽅針 Web上の画像-テキスト 視覚-⾔語 汎⽤モデル ⼀般的な 知識の獲得 ⾃動運転 基盤モデル 「⾝体性」の獲得 交通ドメインデータ
フィジカル基盤モデル 実世界のセンサ‧ ⾞両に統合 29 -
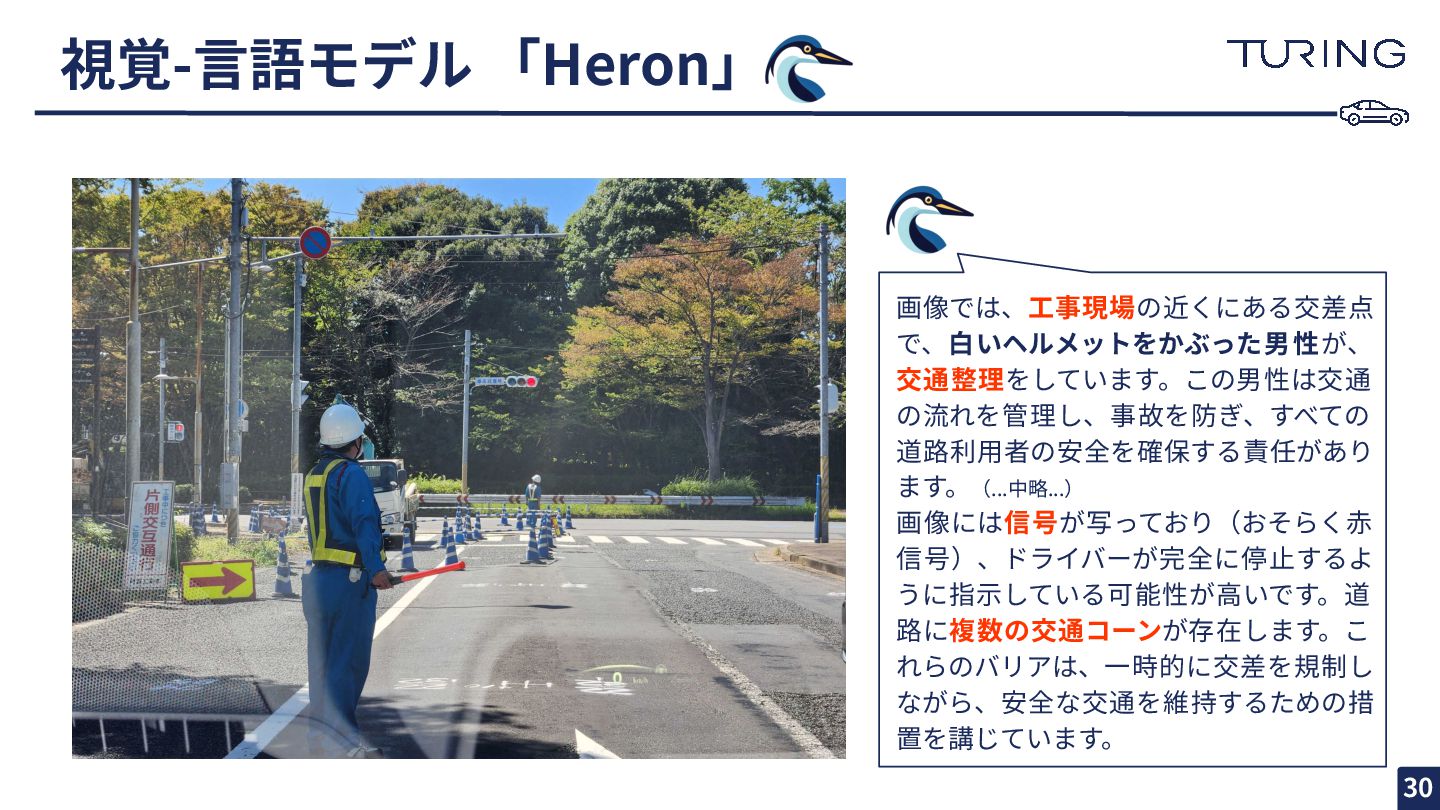
視覚-⾔語モデル 「Heron」 画像では、⼯事現場の近くにある交差点 で、⽩いヘルメットをかぶった男性が、 交通整理をしています。この男性は交通 の流れを管理し、事故を防ぎ、すべての 道路利⽤者の安全を確保する責任があり ます。(...中略...) 画像には信号が写っており(おそらく⾚ 信号)、ドライバーが完全に停⽌するよ
うに指⽰している可能性が⾼いです。道 路に複数の交通コーンが存在します。こ れらのバリアは、⼀時的に交差を規制し ながら、安全な交通を維持するための措 置を講じています。 30 -
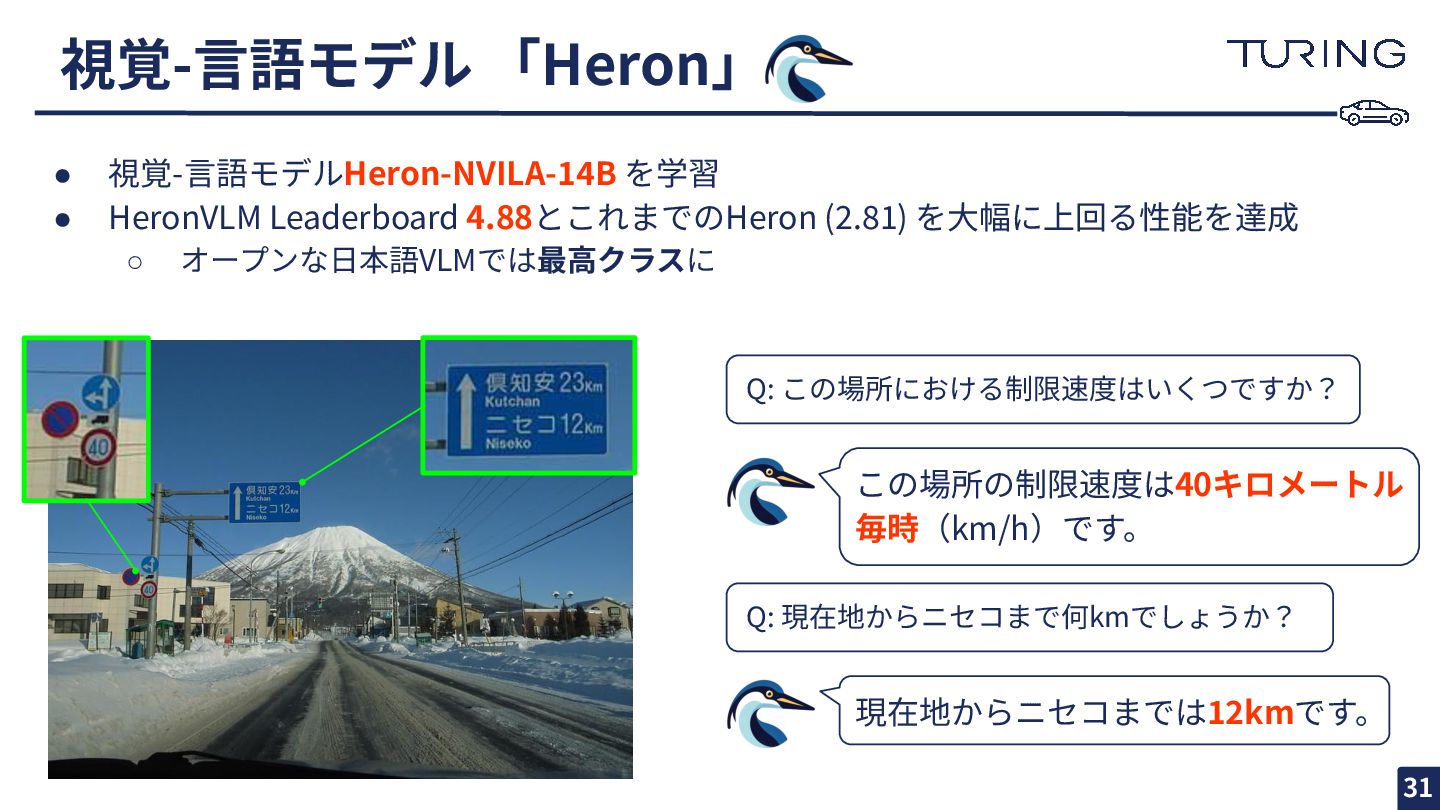
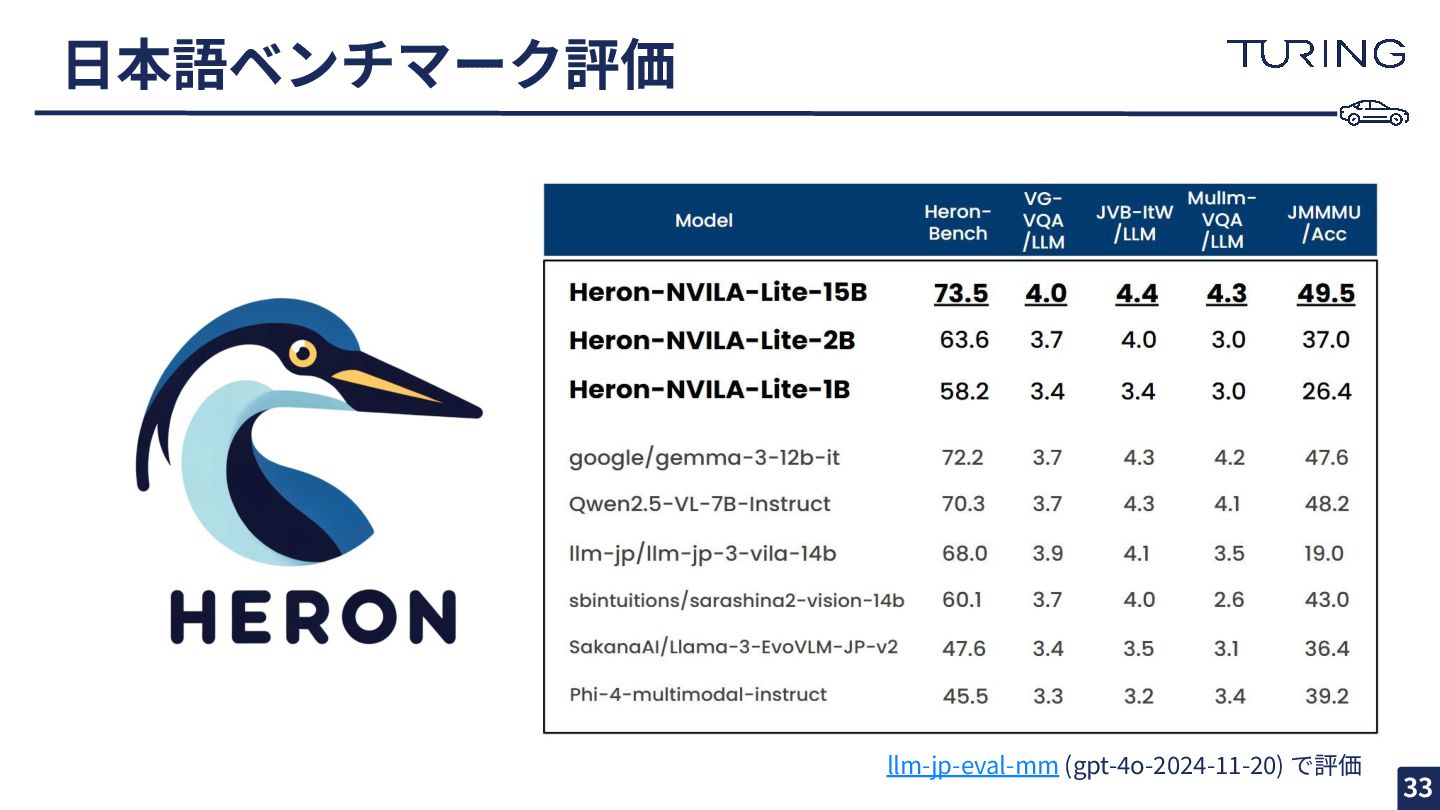
31 • 視覚-⾔語モデルHeron-NVILA-14B を学習 • HeronVLM Leaderboard 4.88とこれまでのHeron (2.81) を⼤幅に上回る性能を達成
◦ オープンな⽇本語VLMでは最⾼クラスに この場所の制限速度は40キロメートル 毎時(km/h)です。 Q: この場所における制限速度はいくつですか? 現在地からニセコまでは12kmです。 Q: 現在地からニセコまで何kmでしょうか? 視覚-⾔語モデル 「Heron」 -
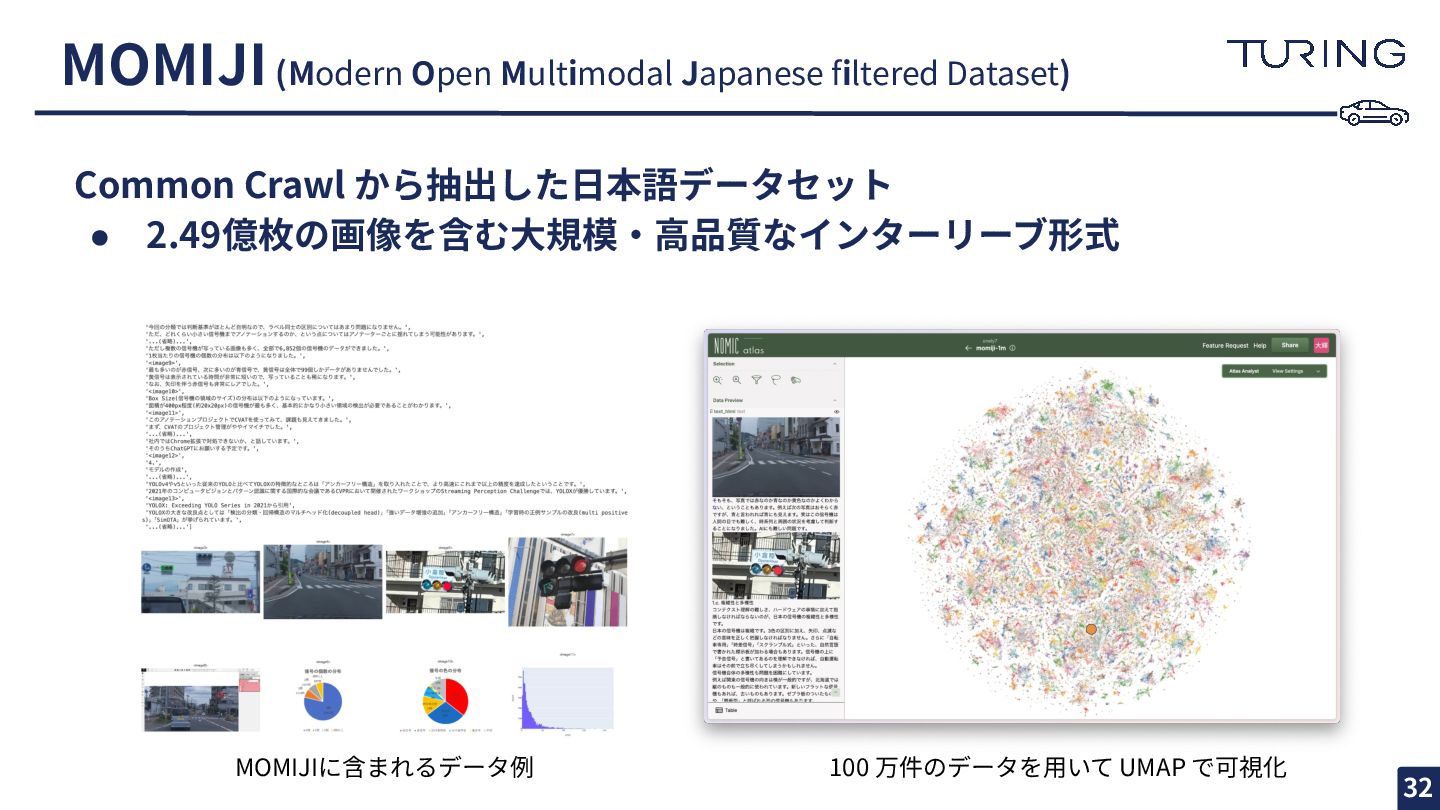
MOMIJI (Modern Open Multimodal Japanese filtered Dataset) Common Crawl から抽出した⽇本語データセット
• 2.49億枚の画像を含む⼤規模‧⾼品質なインターリーブ形式 100 万件のデータを⽤いて UMAP で可視化 MOMIJIに含まれるデータ例 32 -
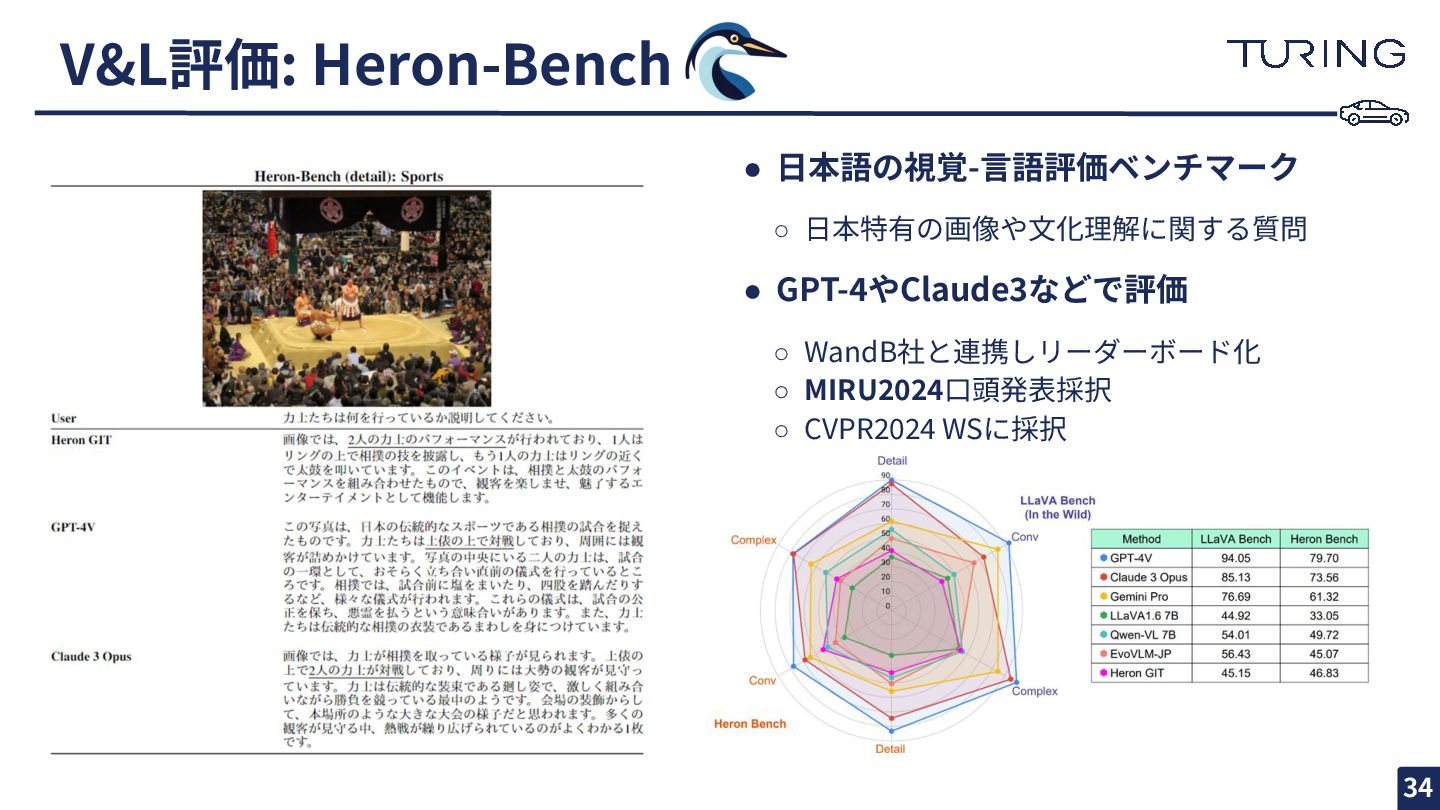
V&L評価: Heron-Bench • ⽇本語の視覚-⾔語評価ベンチマーク ◦ ⽇本特有の画像や⽂化理解に関する質問 • GPT-4やClaude3などで評価 ◦ WandB社と連携しリーダーボード化
◦ MIRU2024⼝頭発表採択 ◦ CVPR2024 WSに採択 34 -
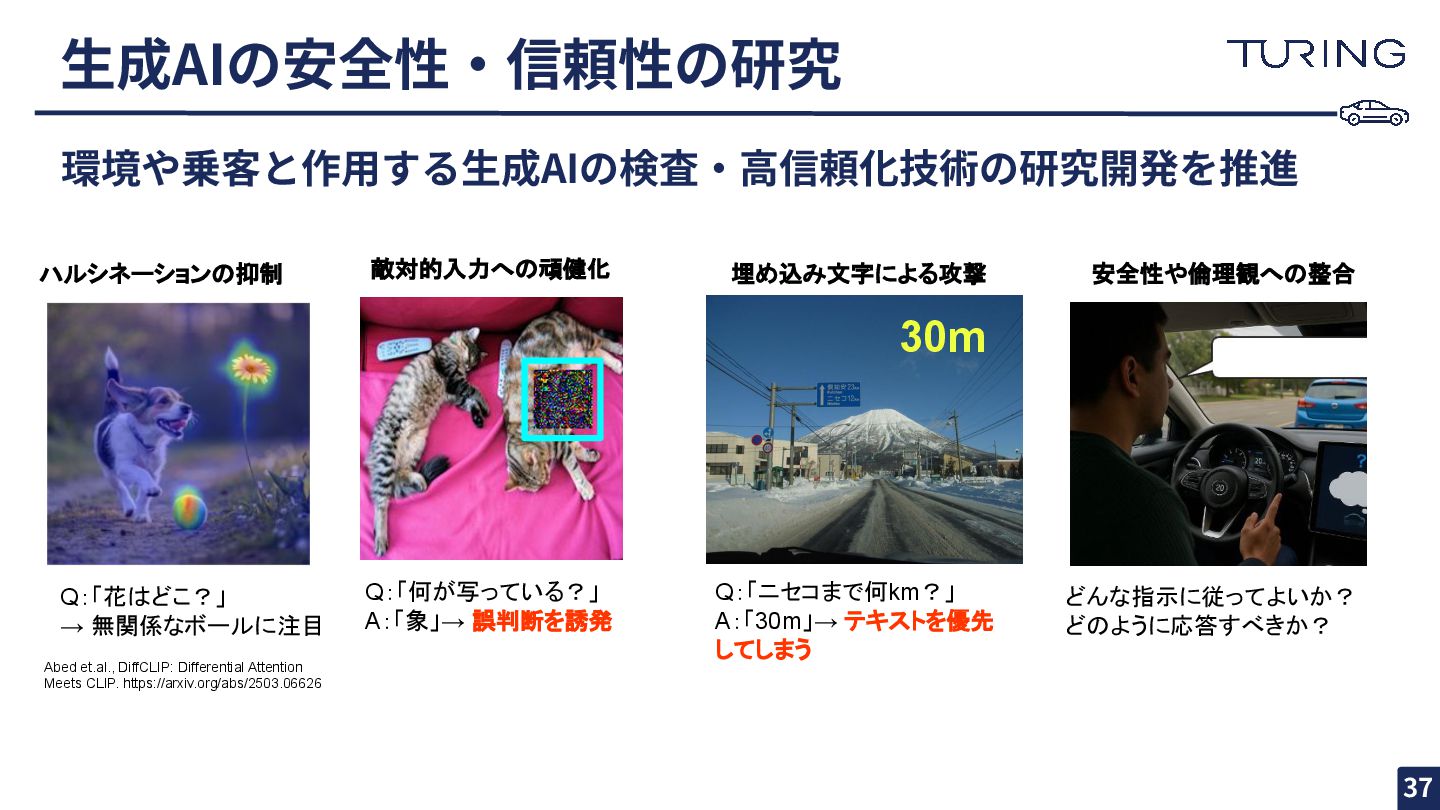
⽣成AIの安全性‧信頼性の研究 環境や乗客と作⽤する⽣成AIの検査‧⾼信頼化技術の研究開発を推進 ハルシネーションの抑制 敵対的入力への頑健化 Q:「花はどこ?」 → 無関係なボールに注目 Q:「何が写っている?」 A:「象」→ 誤判断を誘発
安全性や倫理観への整合 どんな指示に従ってよいか? どのように応答すべきか? Abed et.al., DiffCLIP: Differential Attention Meets CLIP. https://arxiv.org/abs/2503.06626 37 30m Q:「ニセコまで何km?」 A:「30m」→ テキストを優先 してしまう 埋め込み文字による攻撃 -
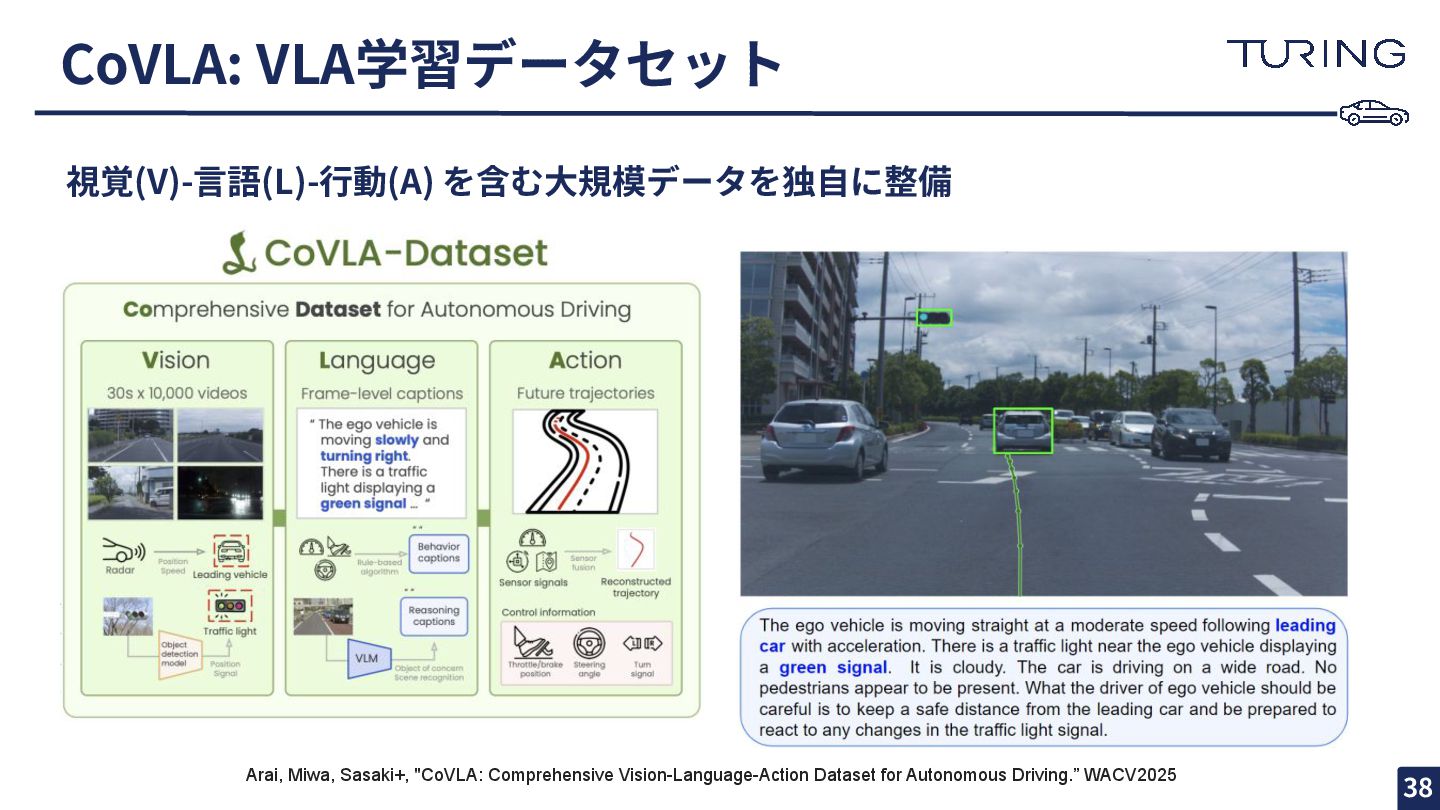
CoVLA: VLA学習データセット 視覚(V)-⾔語(L)-⾏動(A) を含む⼤規模データを独⾃に整備 Arai, Miwa, Sasaki+, "CoVLA: Comprehensive Vision-Language-Action
Dataset for Autonomous Driving.” WACV2025 38 -
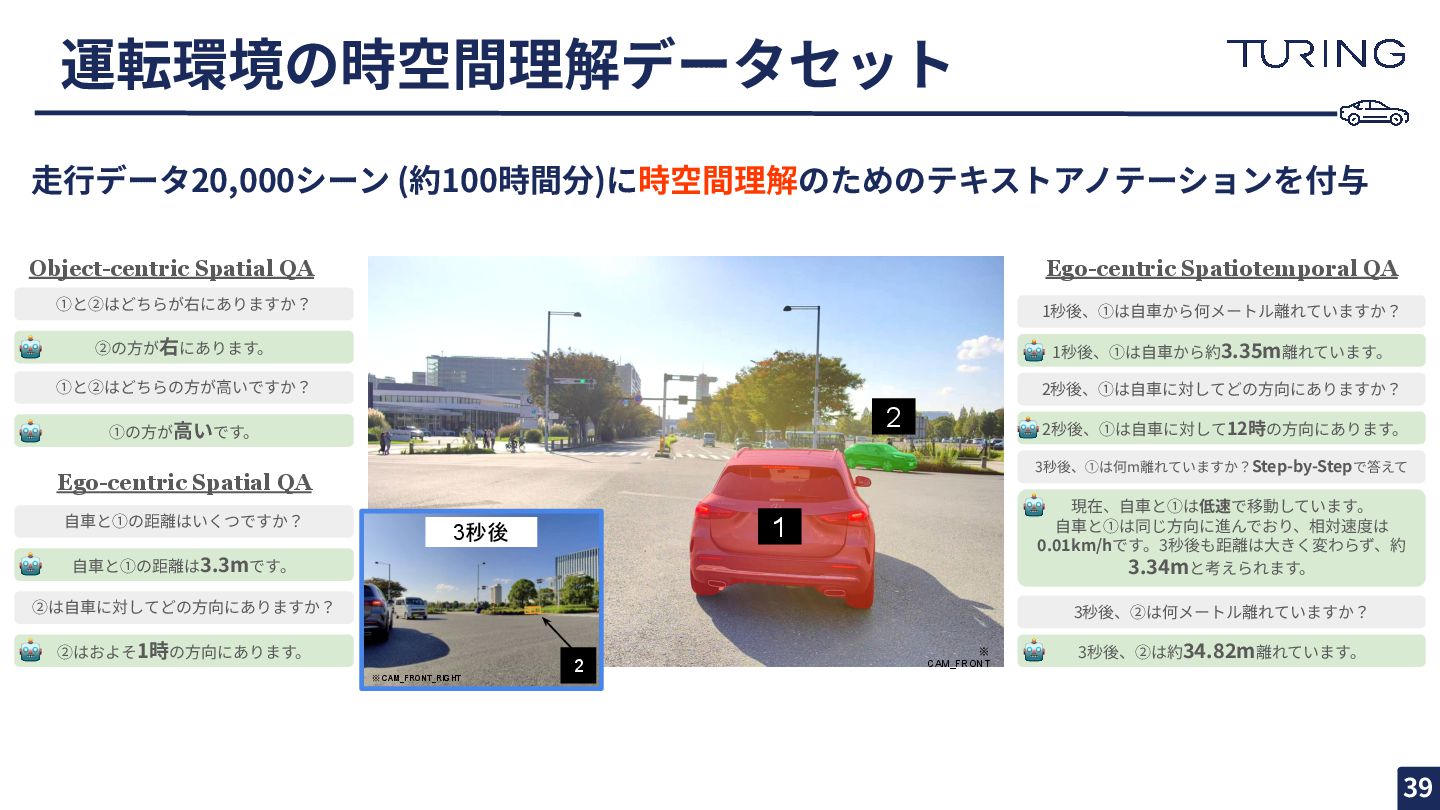
Object-centric Spatial QA Ego-centric Spatial QA Ego-centric Spatiotemporal QA ⾃⾞と①の距離はいくつですか?
⾃⾞と①の距離は3.3mです。 1秒後、①は⾃⾞から何メートル離れていますか? 1秒後、①は⾃⾞から約3.35m離れています。 ②は⾃⾞に対してどの⽅向にありますか? ②はおよそ1時の⽅向にあります。 2秒後、①は⾃⾞に対してどの⽅向にありますか? 2秒後、①は⾃⾞に対して12時の⽅向にあります。 3秒後、②は何メートル離れていますか? 3秒後、②は約34.82m離れています。 3秒後、①は何m離れていますか?Step-by-Stepで答えて 現在、⾃⾞と①は低速で移動しています。 ⾃⾞と①は同じ⽅向に進んでおり、相対速度は 0.01km/hです。3秒後も距離は⼤きく変わらず、約 3.34mと考えられます。 1 2 ①と②はどちらが右にありますか? ②の⽅が右にあります。 ①と②はどちらの⽅が⾼いですか? ①の⽅が⾼いです。 2 3秒後 ※ CAM_FRONT_RIGHT ※ CAM_FRONT ⾛⾏データ20,000シーン (約100時間分)に時空間理解のためのテキストアノテーションを付与 運転環境の時空間理解データセット 39