Intro to Theano and Lasagne for Deep Learning
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
Intro to Theano and Lasagne for Deep Learning
An Introduction to the Theano and Lasagne libraries for Deep Learning. Accompanying material for the Deep Learning - Advanced Techniques tutorial at PyData London 2016, May 6th.

Britefury
May 03, 2016
Transcript
76 slides
-
An introduction to Theano and Lasagne PyData London 2016 G.
French Kings College London & University of East Anglia Image montages from http://www.image-net.org -
Neural network software comes in two flavours: Neural network toolkits
Expression compilers -
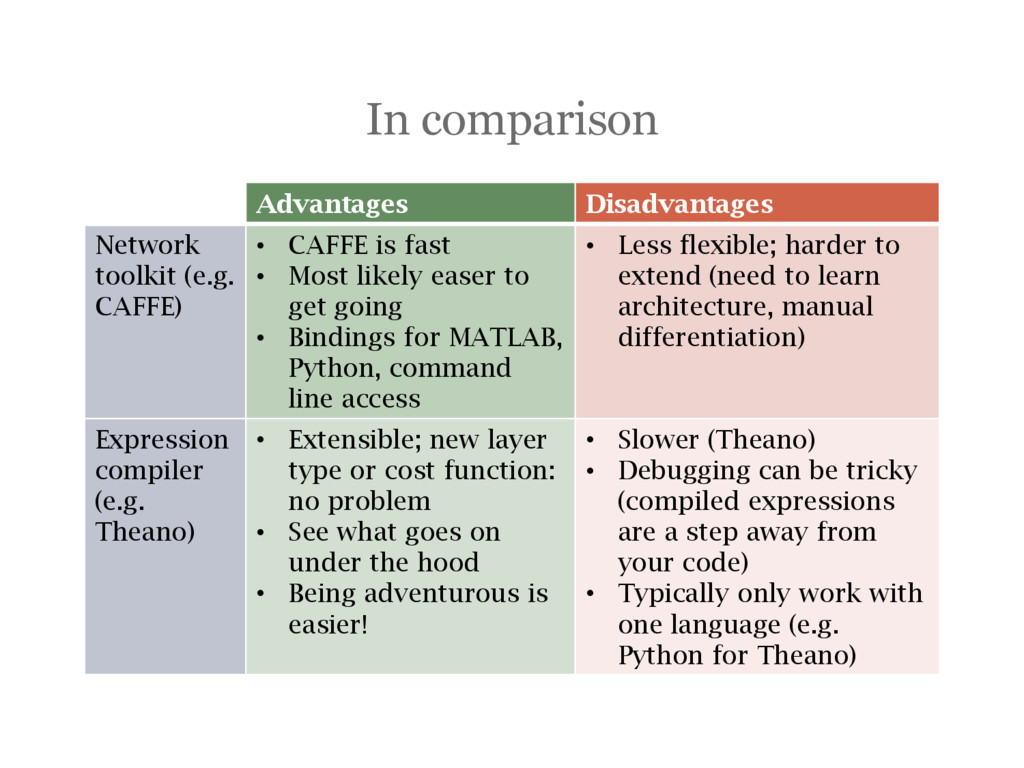
In comparison Advantages Disadvantages Network toolkit (e.g. CAFFE) • CAFFE
is fast • Most likely easer to get going • Bindings for MATLAB, Python, command line access • Less flexible; harder to extend (need to learn architecture, manual differentiation) Expression compiler (e.g. Theano) • Extensible; new layer type or cost function: no problem • See what goes on under the hood • Being adventurous is easier! • Slower (Theano) • Debugging can be tricky (compiled expressions are a step away from your code) • Typically only work with one language (e.g. Python for Theano) -
Write numpy style expressions Compiles to either C (CPU) or
CUDA (nVidia GPU) -
Theano basics Accompanying Jupyter Notebook can be found on Github:
[http://github.com/Britefury/deep-learning- tutorial-pydata2016/blob/master/INTRO 01 - Theano basics.ipynb] -
Theano expressions objectives: • Create data using Numpy and load
it into Theano shared variables • Create a Theano expression representing matrix multiplication • Evaluate a the matrix multiplication expression to get the result -
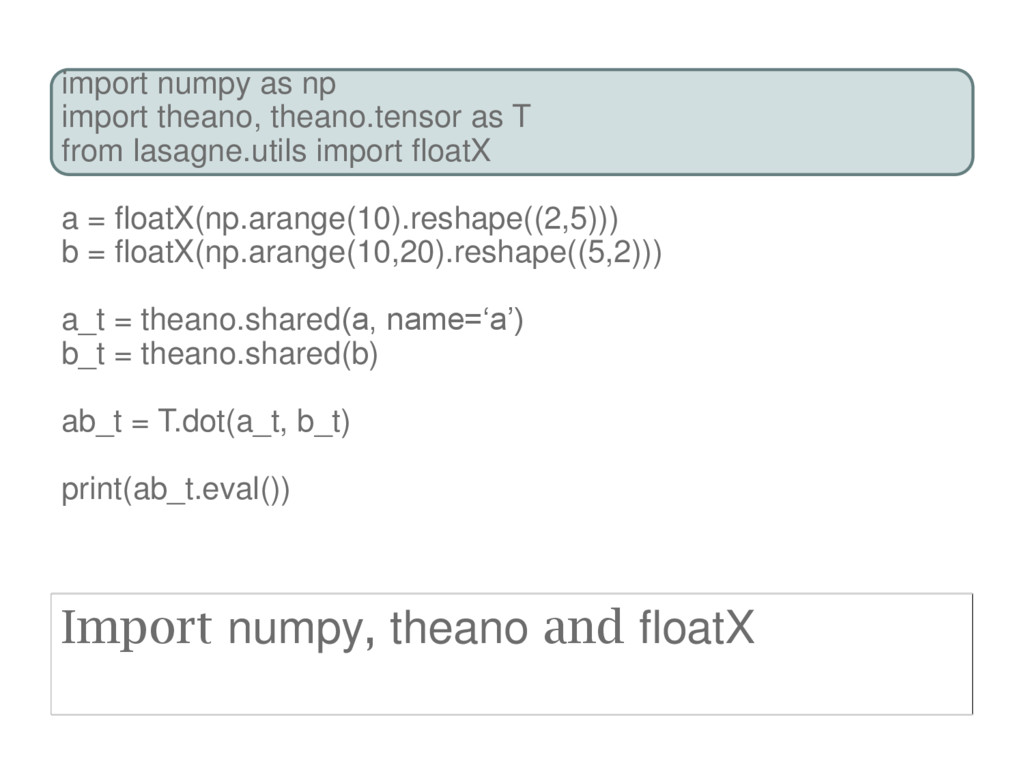
import numpy as np import theano, theano.tensor as T from
lasagne.utils import floatX a = floatX(np.arange(10).reshape((2,5))) b = floatX(np.arange(10,20).reshape((5,2))) a_t = theano.shared(a, name=‘a’) b_t = theano.shared(b) ab_t = T.dot(a_t, b_t) print(ab_t.eval()) Import numpy, theano and floatX -
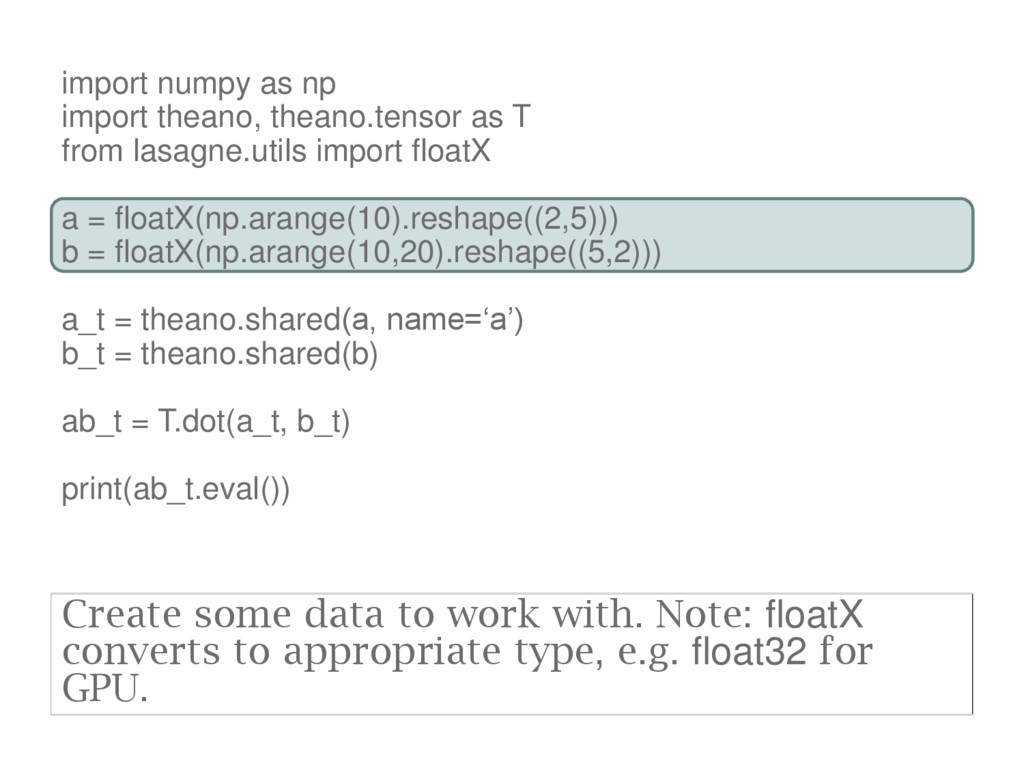
import numpy as np import theano, theano.tensor as T from
lasagne.utils import floatX a = floatX(np.arange(10).reshape((2,5))) b = floatX(np.arange(10,20).reshape((5,2))) a_t = theano.shared(a, name=‘a’) b_t = theano.shared(b) ab_t = T.dot(a_t, b_t) print(ab_t.eval()) Create some data to work with. Note: floatX converts to appropriate type, e.g. float32 for GPU. -
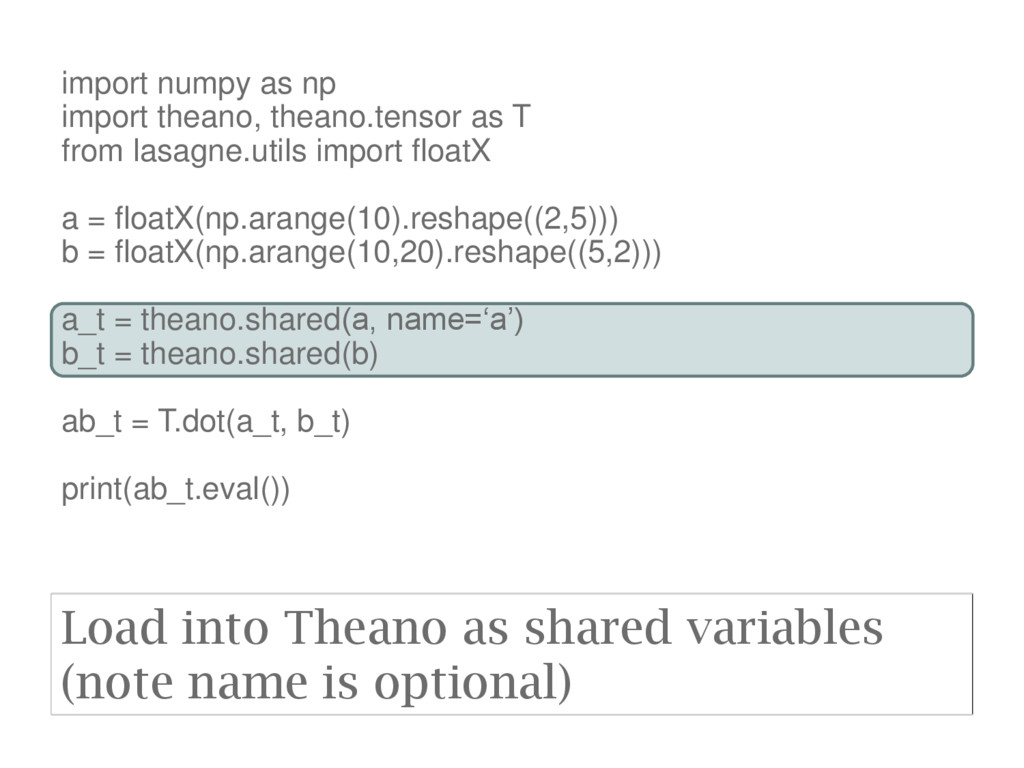
import numpy as np import theano, theano.tensor as T from
lasagne.utils import floatX a = floatX(np.arange(10).reshape((2,5))) b = floatX(np.arange(10,20).reshape((5,2))) a_t = theano.shared(a, name=‘a’) b_t = theano.shared(b) ab_t = T.dot(a_t, b_t) print(ab_t.eval()) Load into Theano as shared variables (note name is optional) -
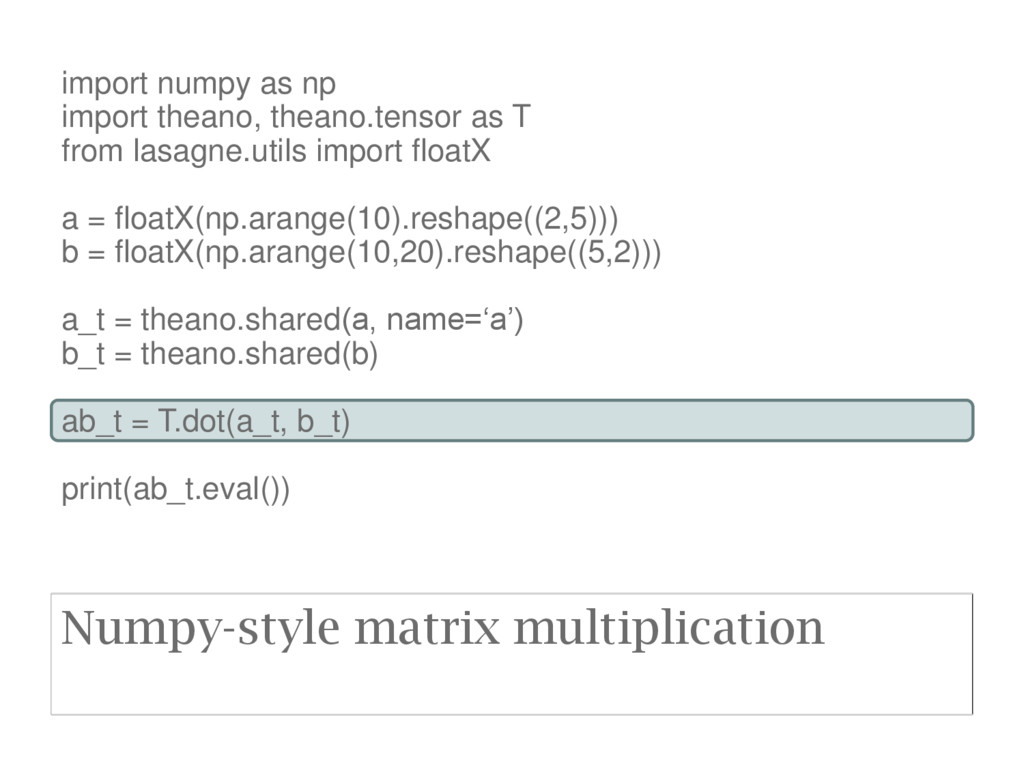
import numpy as np import theano, theano.tensor as T from
lasagne.utils import floatX a = floatX(np.arange(10).reshape((2,5))) b = floatX(np.arange(10,20).reshape((5,2))) a_t = theano.shared(a, name=‘a’) b_t = theano.shared(b) ab_t = T.dot(a_t, b_t) print(ab_t.eval()) Numpy-style matrix multiplication -
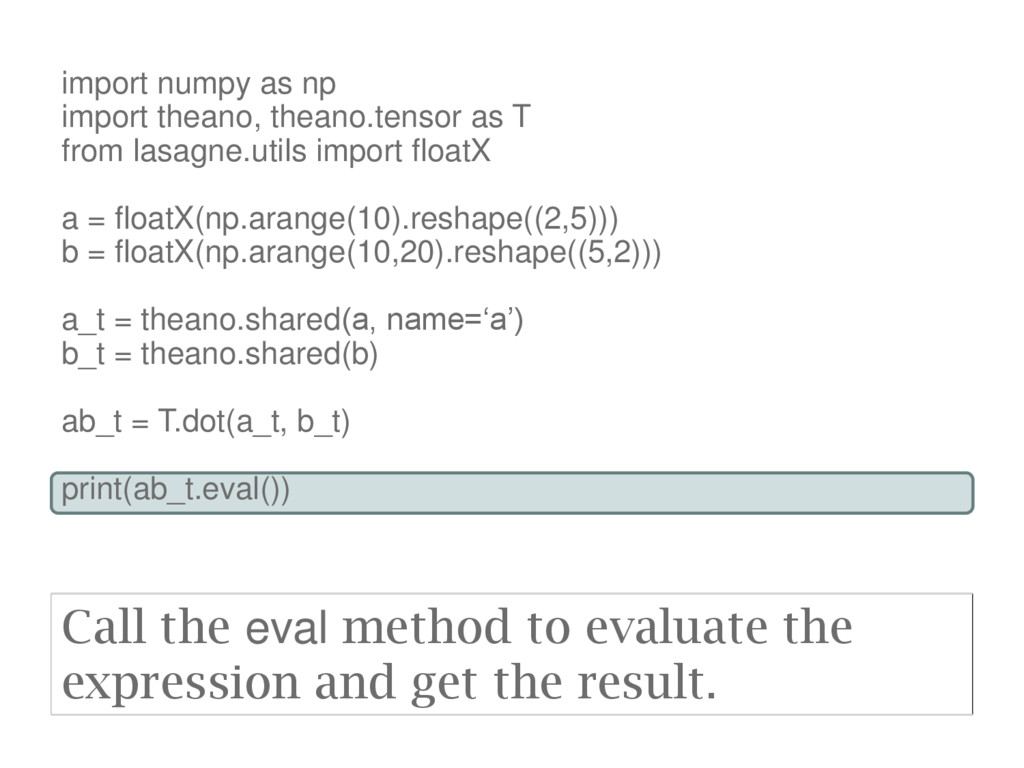
import numpy as np import theano, theano.tensor as T from
lasagne.utils import floatX a = floatX(np.arange(10).reshape((2,5))) b = floatX(np.arange(10,20).reshape((5,2))) a_t = theano.shared(a, name=‘a’) b_t = theano.shared(b) ab_t = T.dot(a_t, b_t) print(ab_t.eval()) Call the eval method to evaluate the expression and get the result. -
Modify shared variables • Create a random number generator •
Set the contents of the Theano shared variables to randomly generated matrices • Show how the existing matrix multiplication expression can be evaluated to get the new result -
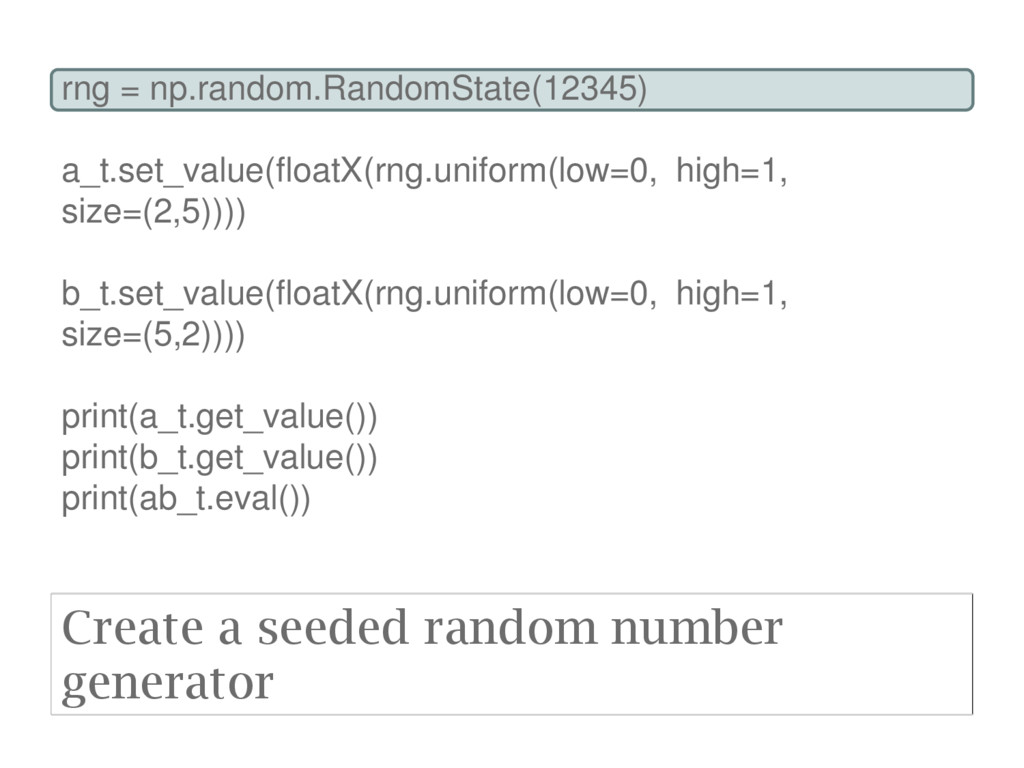
rng = np.random.RandomState(12345) a_t.set_value(floatX(rng.uniform(low=0, high=1, size=(2,5)))) b_t.set_value(floatX(rng.uniform(low=0, high=1, size=(5,2)))) print(a_t.get_value())
print(b_t.get_value()) print(ab_t.eval()) Create a seeded random number generator -
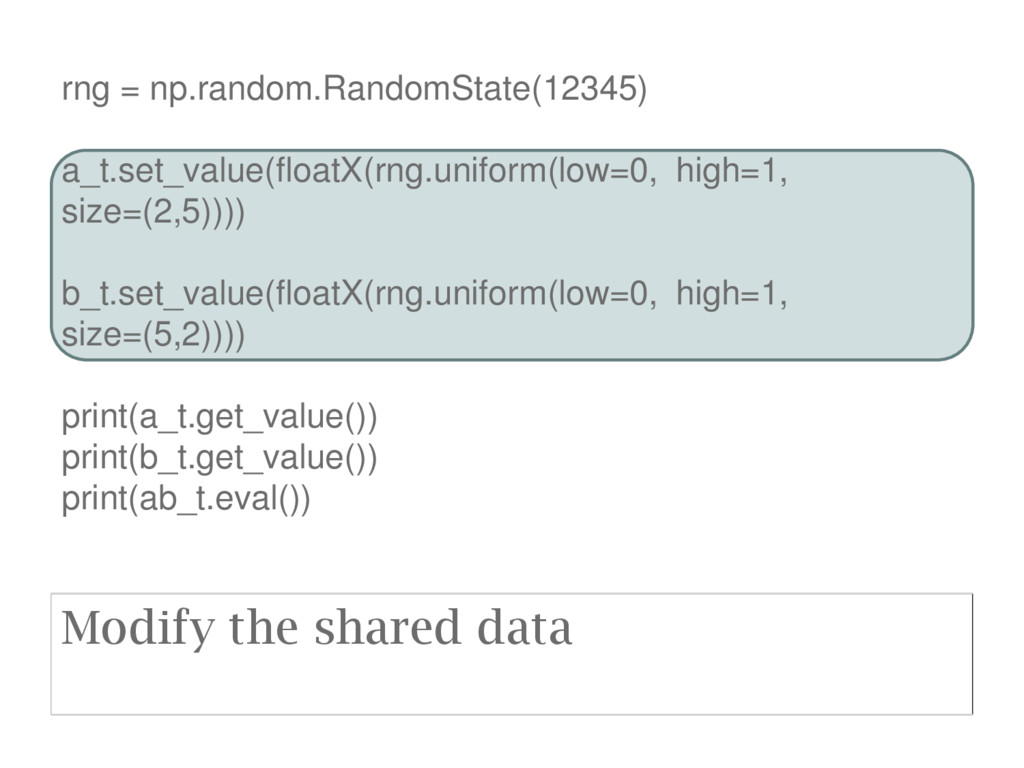
rng = np.random.RandomState(12345) a_t.set_value(floatX(rng.uniform(low=0, high=1, size=(2,5)))) b_t.set_value(floatX(rng.uniform(low=0, high=1, size=(5,2)))) print(a_t.get_value())
print(b_t.get_value()) print(ab_t.eval()) Modify the shared data -
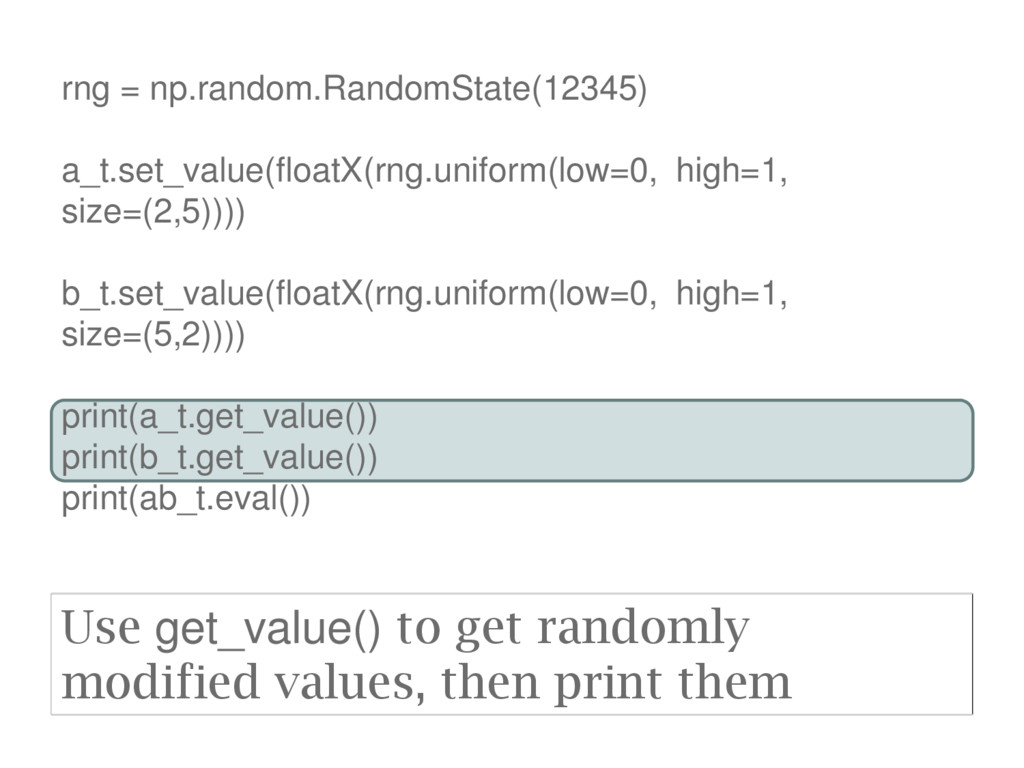
rng = np.random.RandomState(12345) a_t.set_value(floatX(rng.uniform(low=0, high=1, size=(2,5)))) b_t.set_value(floatX(rng.uniform(low=0, high=1, size=(5,2)))) print(a_t.get_value())
print(b_t.get_value()) print(ab_t.eval()) Use get_value() to get randomly modified values, then print them -
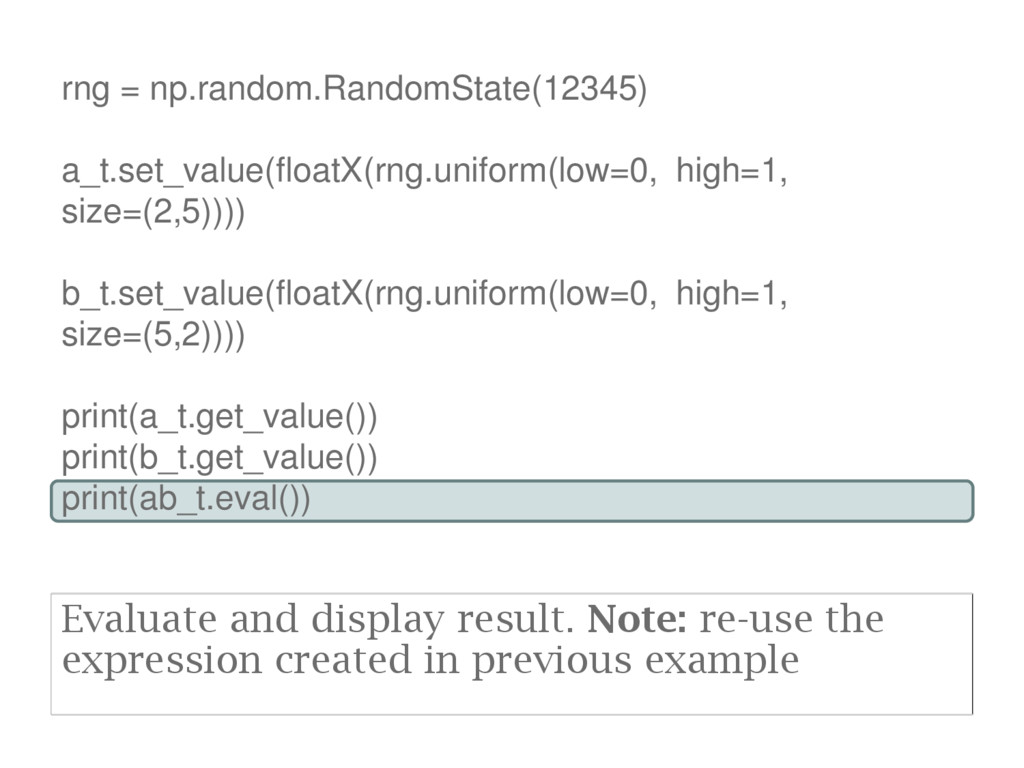
rng = np.random.RandomState(12345) a_t.set_value(floatX(rng.uniform(low=0, high=1, size=(2,5)))) b_t.set_value(floatX(rng.uniform(low=0, high=1, size=(5,2)))) print(a_t.get_value())
print(b_t.get_value()) print(ab_t.eval()) Evaluate and display result. Note: re-use the expression created in previous example -
Variables and functions • Theano variables act as placeholders; expressions
that will take a value passed as an argument to a Theano function • Theano functions act just like Python functions; you specify the arguments and the expression whose result should be returned. -
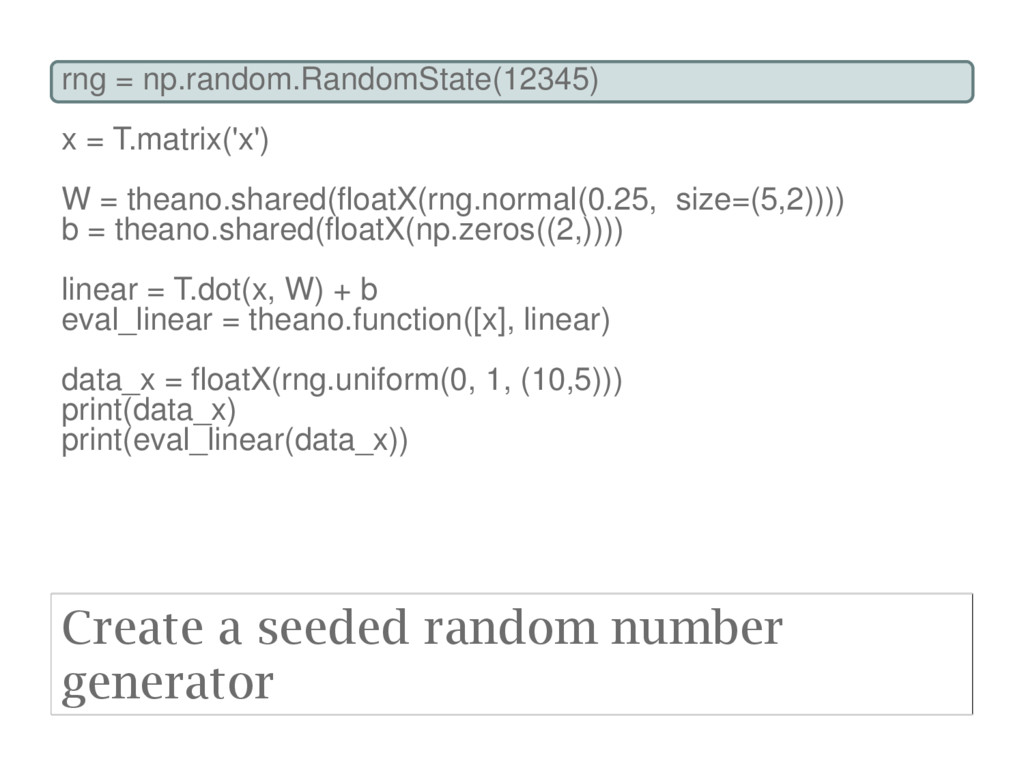
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Create a seeded random number generator -
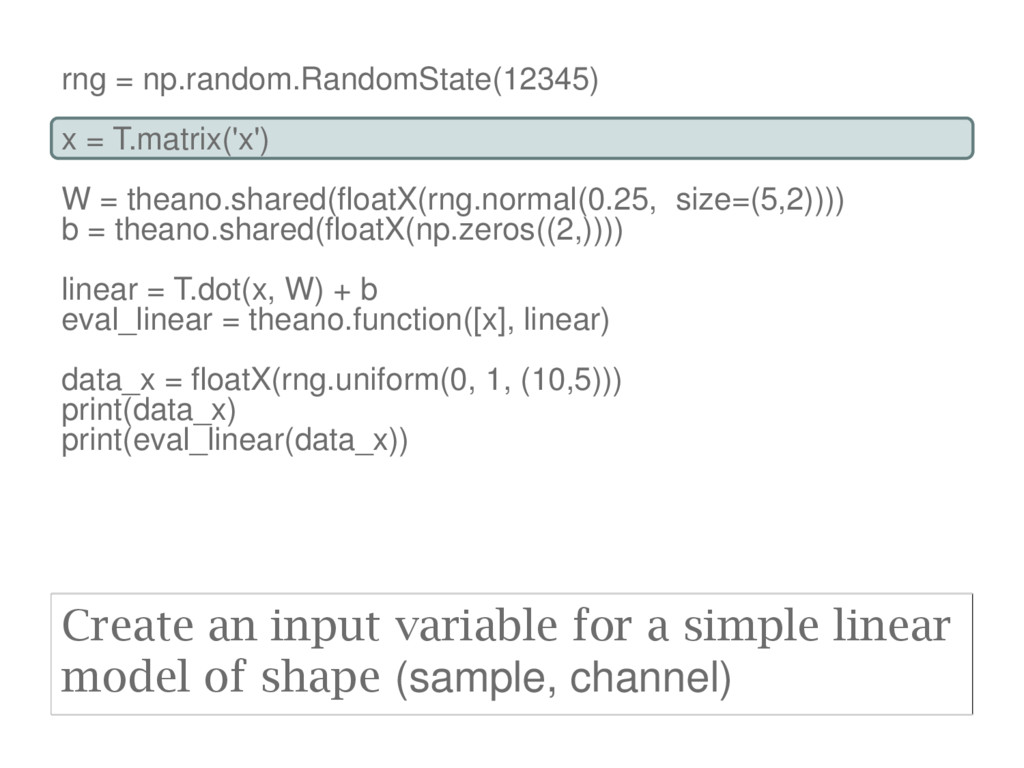
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Create an input variable for a simple linear model of shape (sample, channel) -
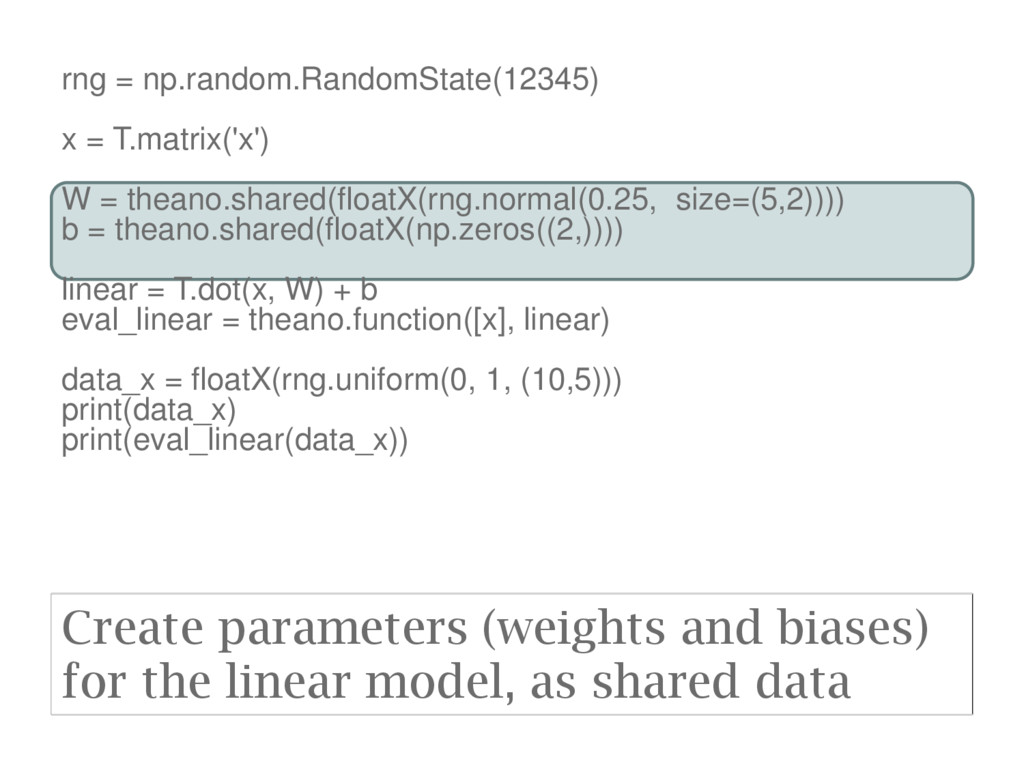
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Create parameters (weights and biases) for the linear model, as shared data -
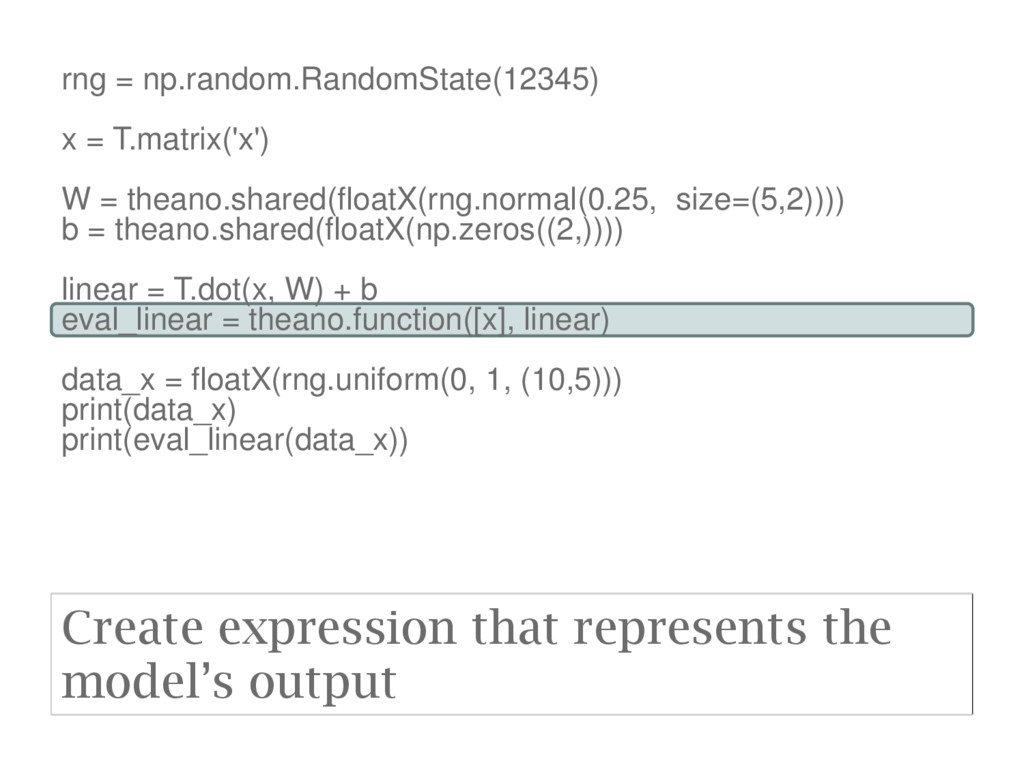
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Create expression that represents the model’s output -
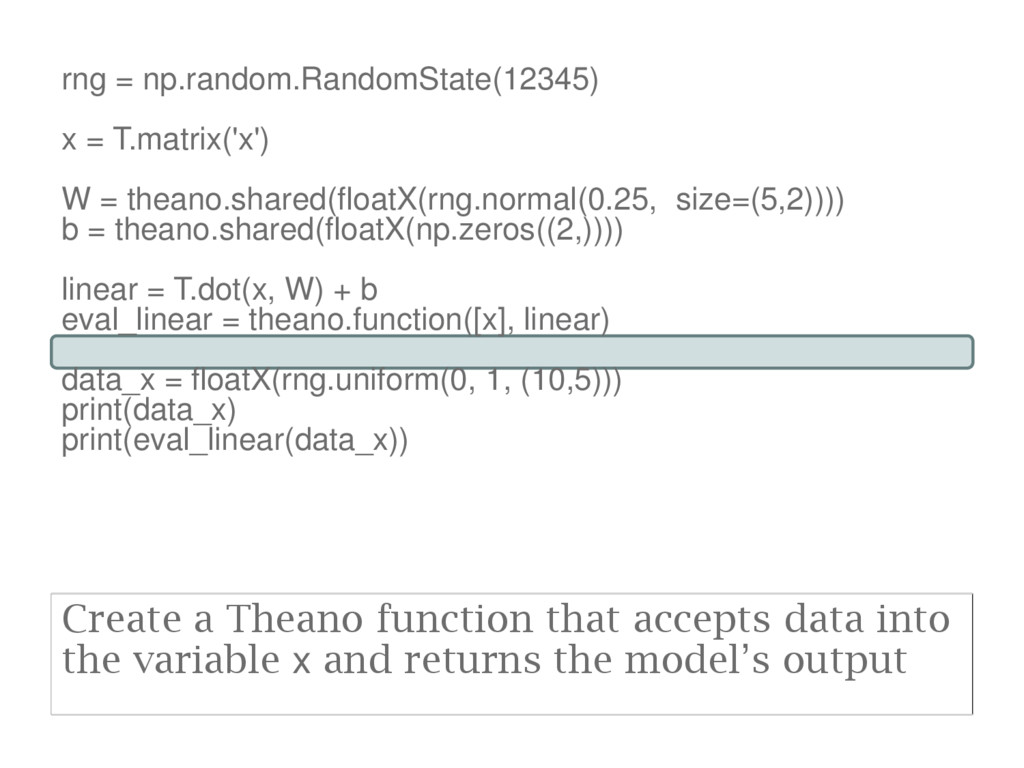
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Create a Theano function that accepts data into the variable x and returns the model’s output -
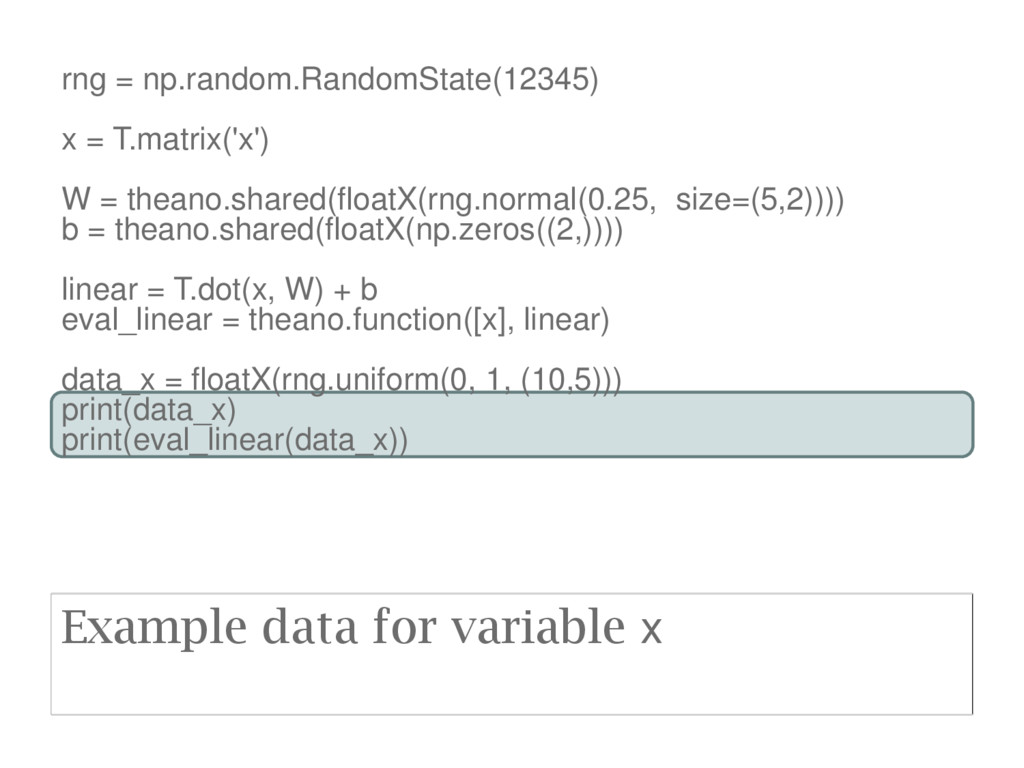
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Example data for variable x -
rng = np.random.RandomState(12345) x = T.matrix('x') W = theano.shared(floatX(rng.normal(0.25, size=(5,2))))
b = theano.shared(floatX(np.zeros((2,)))) linear = T.dot(x, W) + b eval_linear = theano.function([x], linear) data_x = floatX(rng.uniform(0, 1, (10,5))) print(data_x) print(eval_linear(data_x)) Evaluate model by calling the eval_linear function that was created by Theano -
Gradient and updates • theano.grad() generates an expression representing the
gradient of a scalar w.r.t. another value (scalar/vector/matrix/tensor). No need to work out expression for derivative by hand. -
Gradient and updates • Updates given to a Theano function
allow the function to update the values of shared variables. -
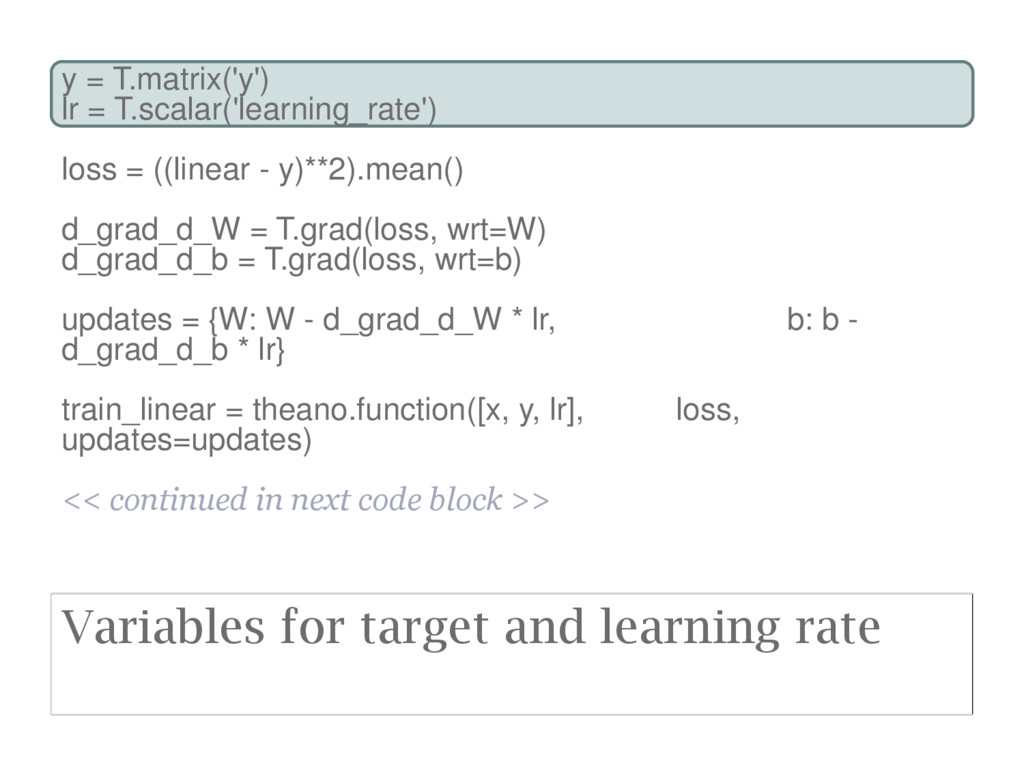
y = T.matrix('y') lr = T.scalar('learning_rate') loss = ((linear -
y)**2).mean() d_grad_d_W = T.grad(loss, wrt=W) d_grad_d_b = T.grad(loss, wrt=b) updates = {W: W - d_grad_d_W * lr, b: b - d_grad_d_b * lr} train_linear = theano.function([x, y, lr], loss, updates=updates) << continued in next code block >> Variables for target and learning rate -
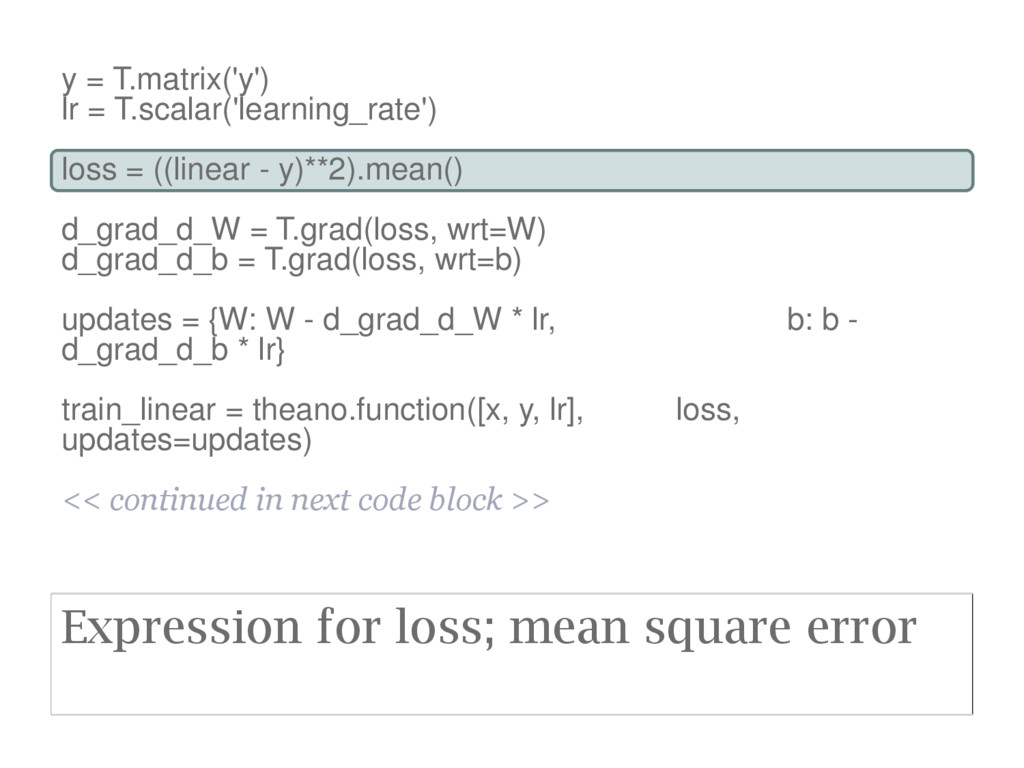
y = T.matrix('y') lr = T.scalar('learning_rate') loss = ((linear -
y)**2).mean() d_grad_d_W = T.grad(loss, wrt=W) d_grad_d_b = T.grad(loss, wrt=b) updates = {W: W - d_grad_d_W * lr, b: b - d_grad_d_b * lr} train_linear = theano.function([x, y, lr], loss, updates=updates) << continued in next code block >> Expression for loss; mean square error -
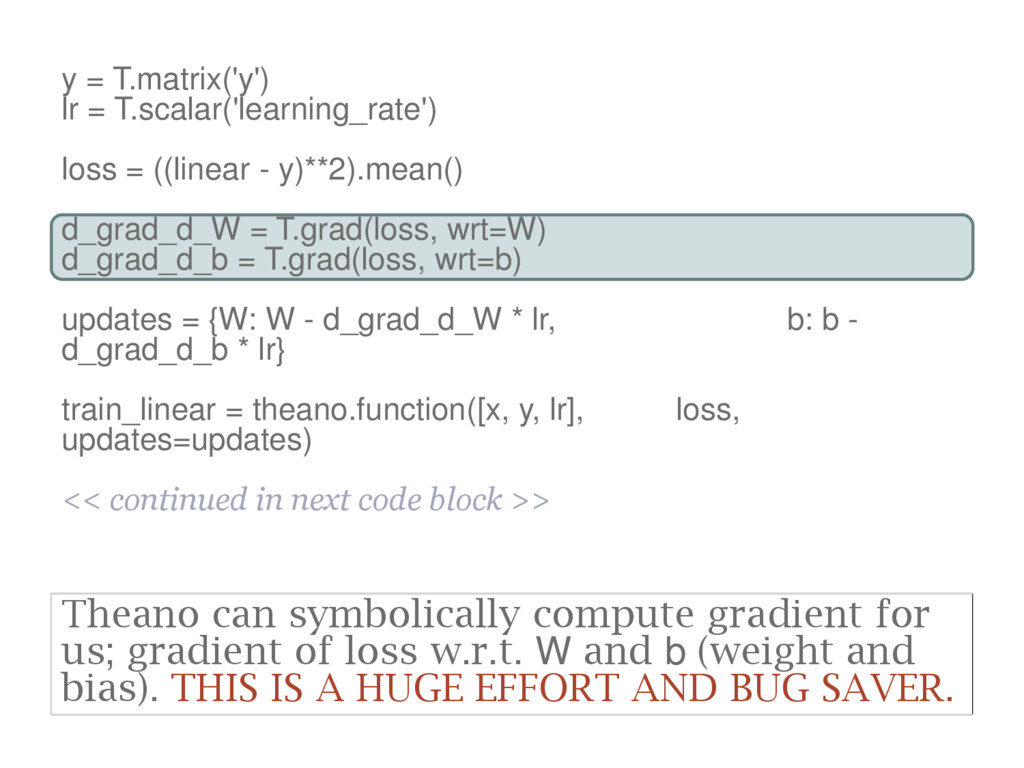
y = T.matrix('y') lr = T.scalar('learning_rate') loss = ((linear -
y)**2).mean() d_grad_d_W = T.grad(loss, wrt=W) d_grad_d_b = T.grad(loss, wrt=b) updates = {W: W - d_grad_d_W * lr, b: b - d_grad_d_b * lr} train_linear = theano.function([x, y, lr], loss, updates=updates) << continued in next code block >> Theano can symbolically compute gradient for us; gradient of loss w.r.t. W and b (weight and bias). THIS IS A HUGE EFFORT AND BUG SAVER. -
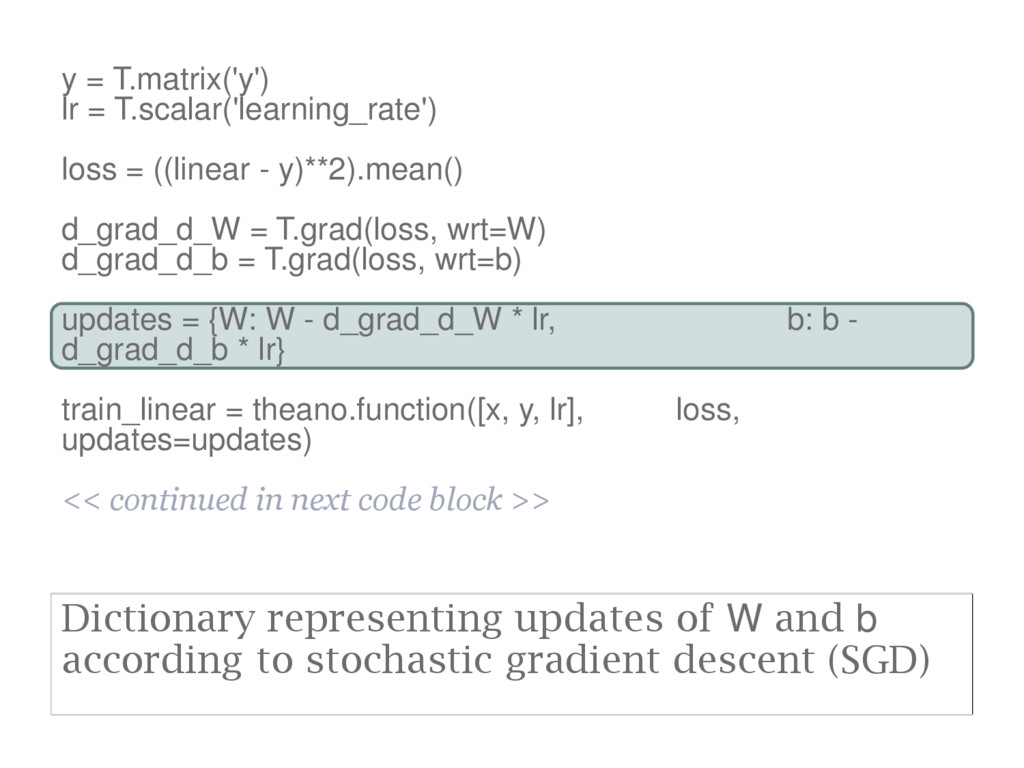
y = T.matrix('y') lr = T.scalar('learning_rate') loss = ((linear -
y)**2).mean() d_grad_d_W = T.grad(loss, wrt=W) d_grad_d_b = T.grad(loss, wrt=b) updates = {W: W - d_grad_d_W * lr, b: b - d_grad_d_b * lr} train_linear = theano.function([x, y, lr], loss, updates=updates) << continued in next code block >> Dictionary representing updates of W and b according to stochastic gradient descent (SGD) -
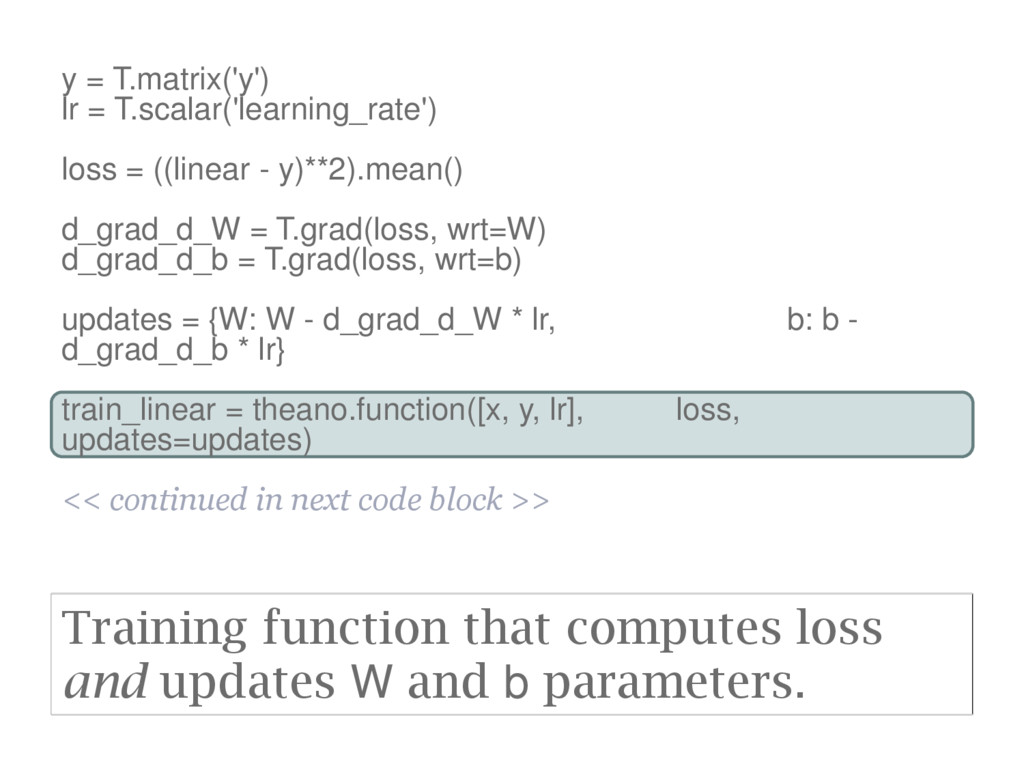
y = T.matrix('y') lr = T.scalar('learning_rate') loss = ((linear -
y)**2).mean() d_grad_d_W = T.grad(loss, wrt=W) d_grad_d_b = T.grad(loss, wrt=b) updates = {W: W - d_grad_d_W * lr, b: b - d_grad_d_b * lr} train_linear = theano.function([x, y, lr], loss, updates=updates) << continued in next code block >> Training function that computes loss and updates W and b parameters. -
train_linear = theano.function([x, y, lr], loss, updates=updates) << continued from
previous code block >> data_y = floatX(rng.uniform(0, 1, (10,2))) for i in xrange(1000): l = train_linear(data_x, data_y, 0.01) print(eval_linear(data_x)) Example data for target variable y. -
train_linear = theano.function([x, y, lr], loss, updates=updates) << continued from
previous code block >> data_y = floatX(rng.uniform(0, 1, (10,2))) for i in xrange(1000): l = train_linear(data_x, data_y, 0.01) print(eval_linear(data_x)) SGD training iterations; will evaluate loss and update parameters to minimise it. -
train_linear = theano.function([x, y, lr], loss, updates=updates) << continued from
previous code block >> data_y = floatX(rng.uniform(0, 1, (10,2))) for i in xrange(1000): l = train_linear(data_x, data_y, 0.01) print(eval_linear(data_x)) Evaluate model -
Provides API for: constructing layers of a network getting Theano
expressions representing output, loss, etc. -
Lasagne is quite a thin layer on top of Theano,
so understanding Theano is helpful On the plus side, implementing custom layers, loss functions, etc is quite doable. -
Lasagne basics Accompanying Jupyter Notebook can be found on Github:
[http://github.com/Britefury/deep-learning- tutorial-pydata2016/blob/master/INTRO 02 - Lasagne basics.ipynb] -
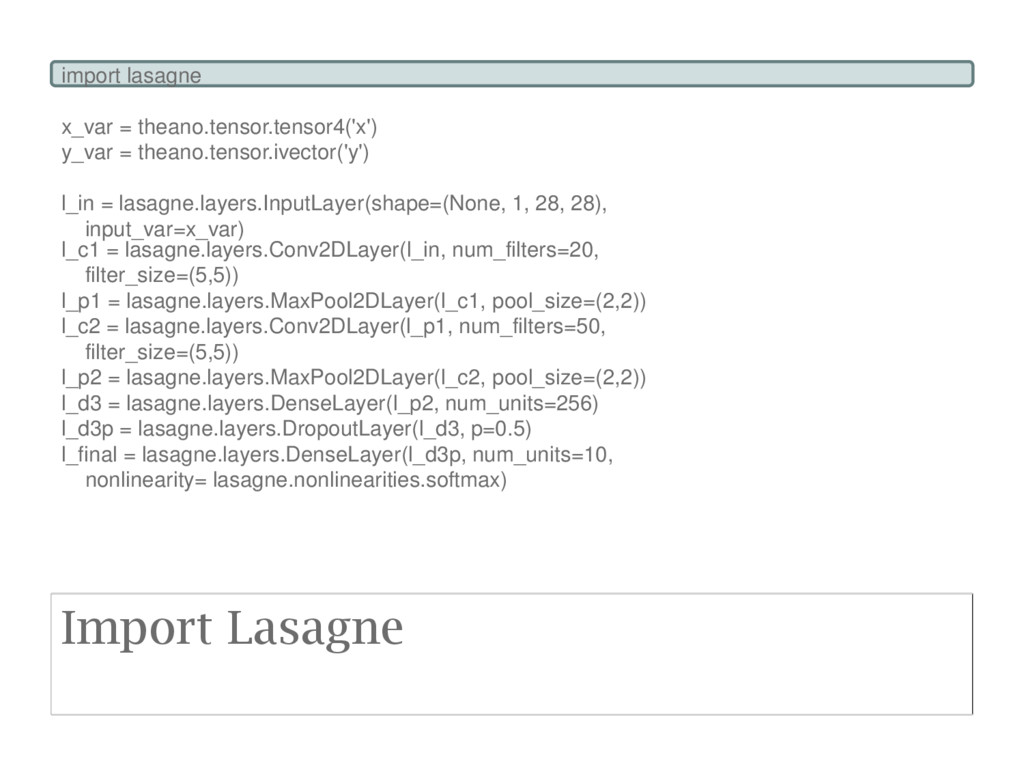
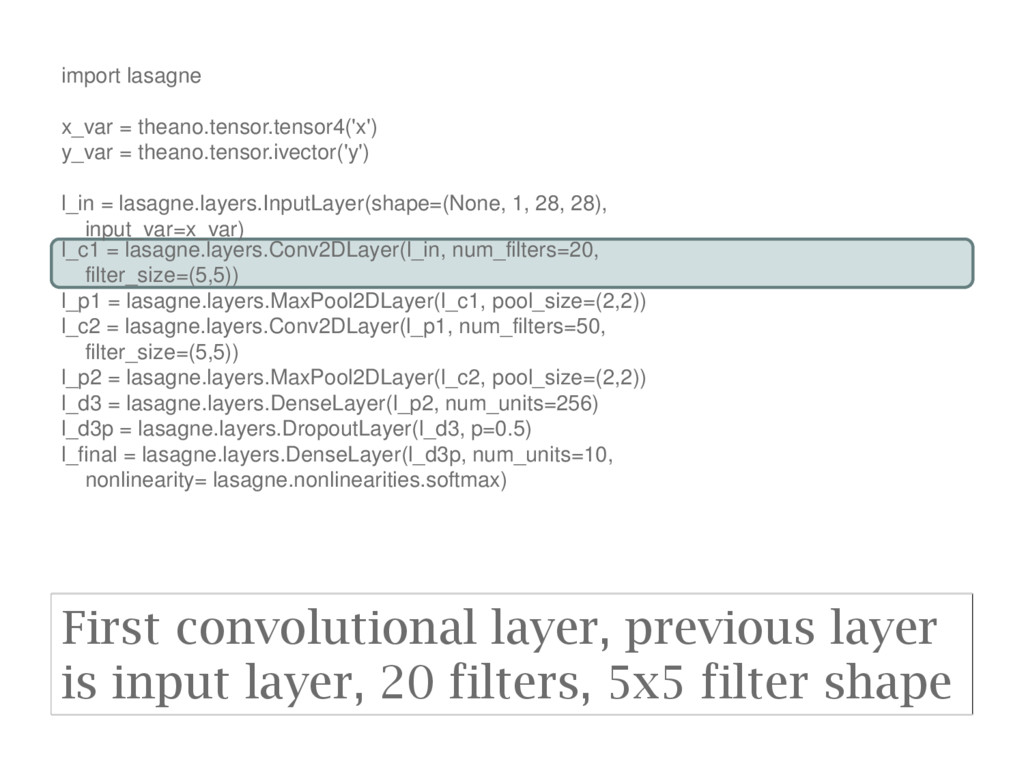
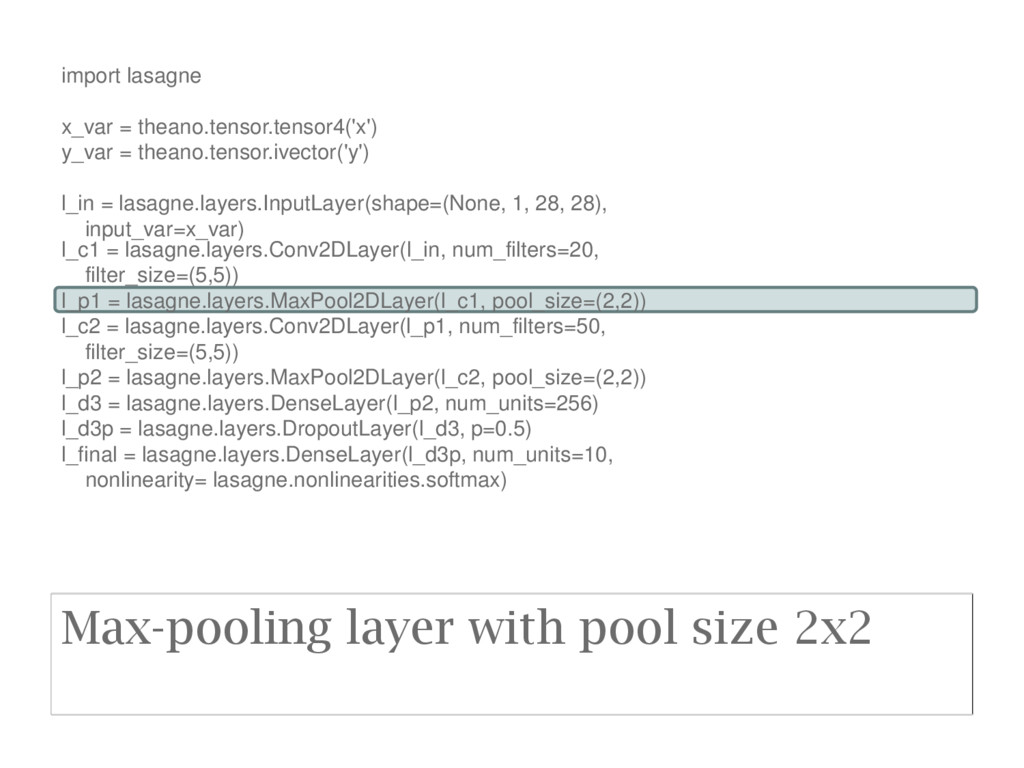
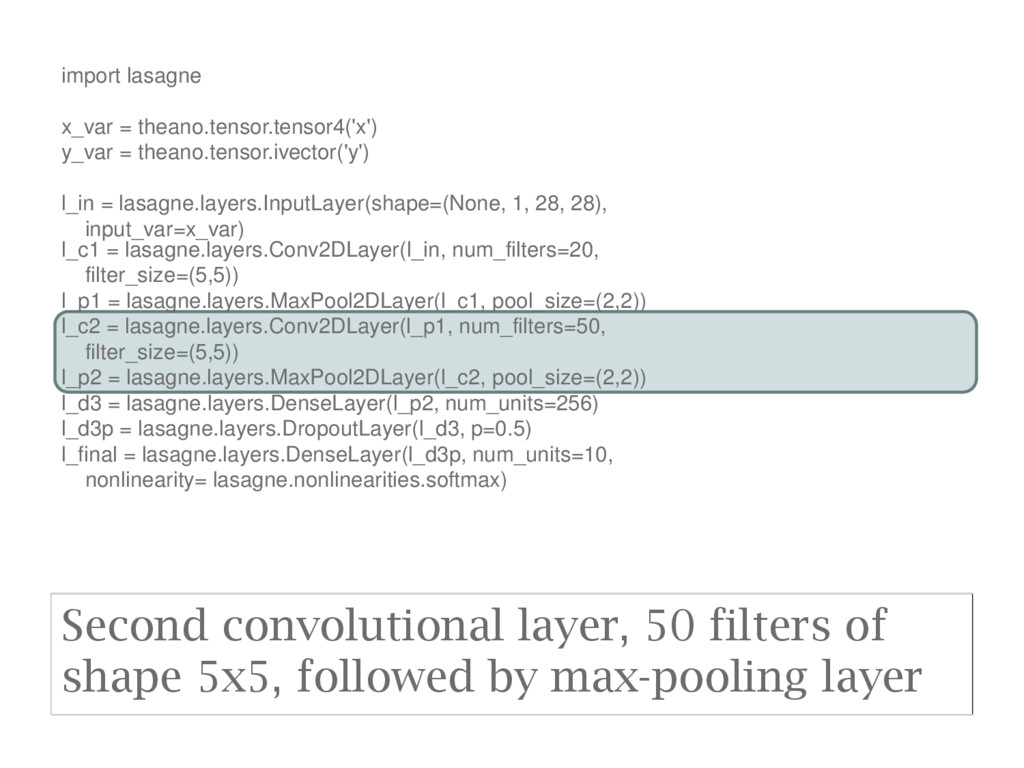
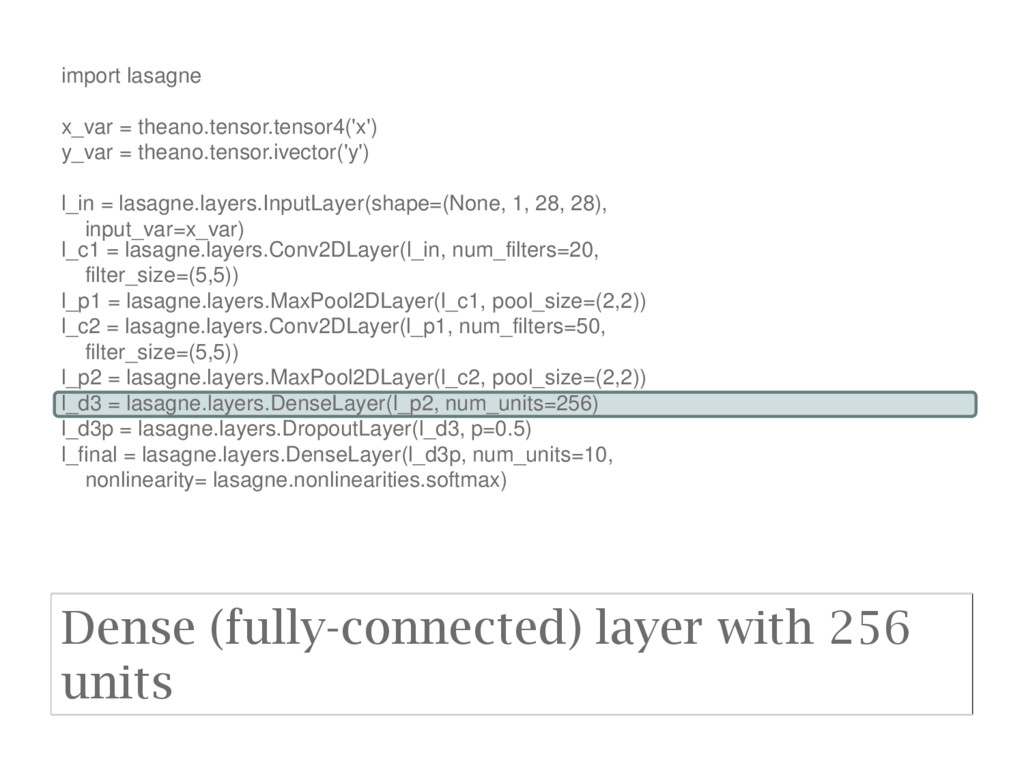
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Import Lasagne -
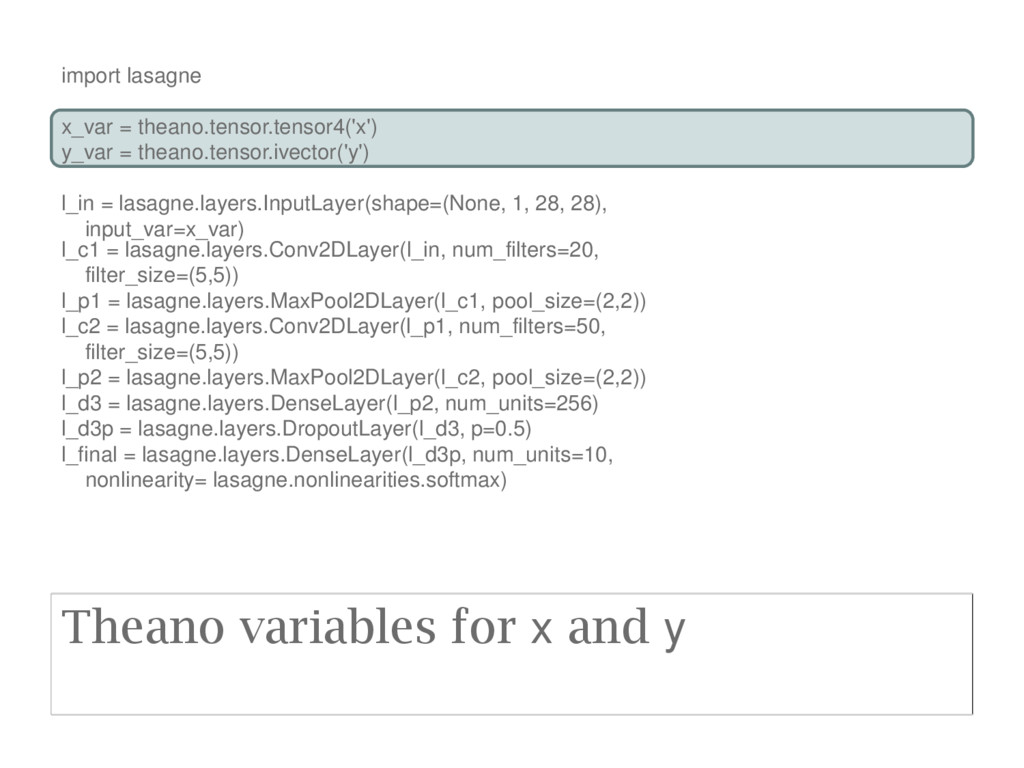
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Theano variables for x and y -
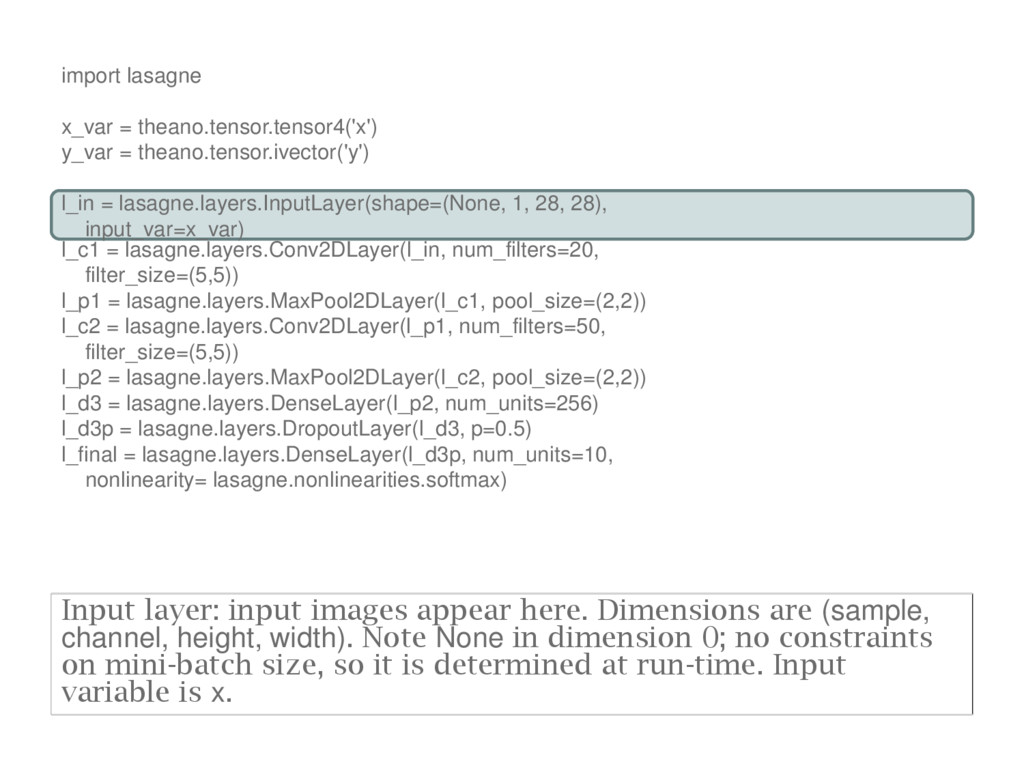
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Input layer: input images appear here. Dimensions are (sample, channel, height, width). Note None in dimension 0; no constraints on mini-batch size, so it is determined at run-time. Input variable is x. -
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) First convolutional layer, previous layer is input layer, 20 filters, 5x5 filter shape -
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Max-pooling layer with pool size 2x2 -
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Second convolutional layer, 50 filters of shape 5x5, followed by max-pooling layer -
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
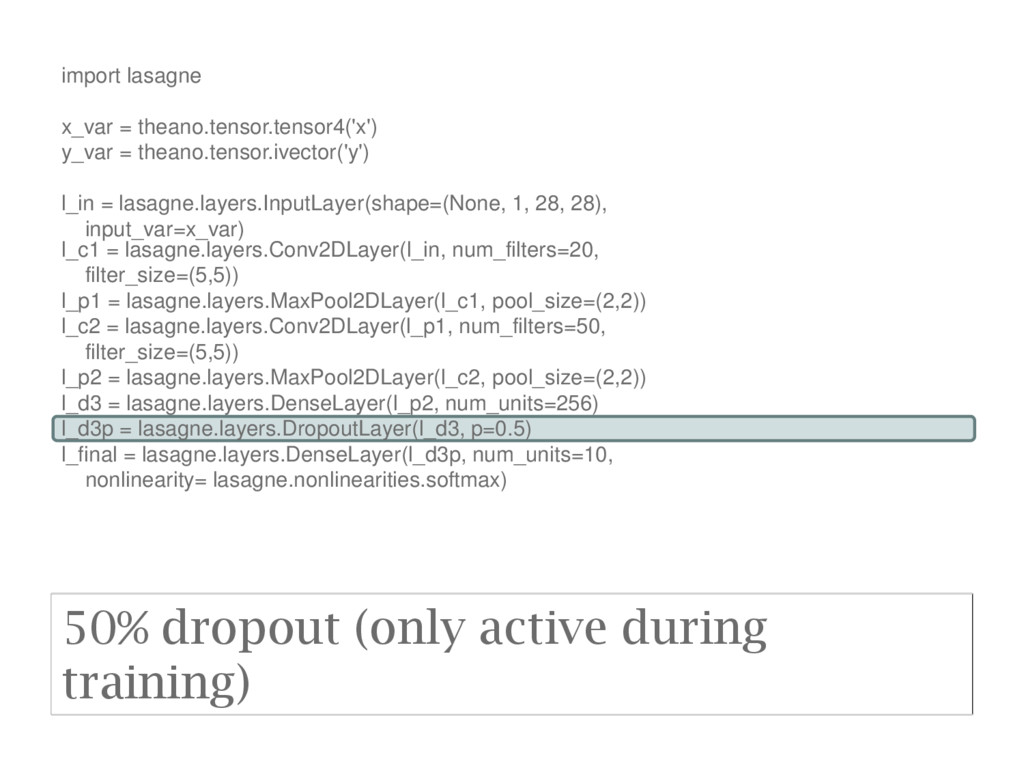
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Dense (fully-connected) layer with 256 units -
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) 50% dropout (only active during training) -
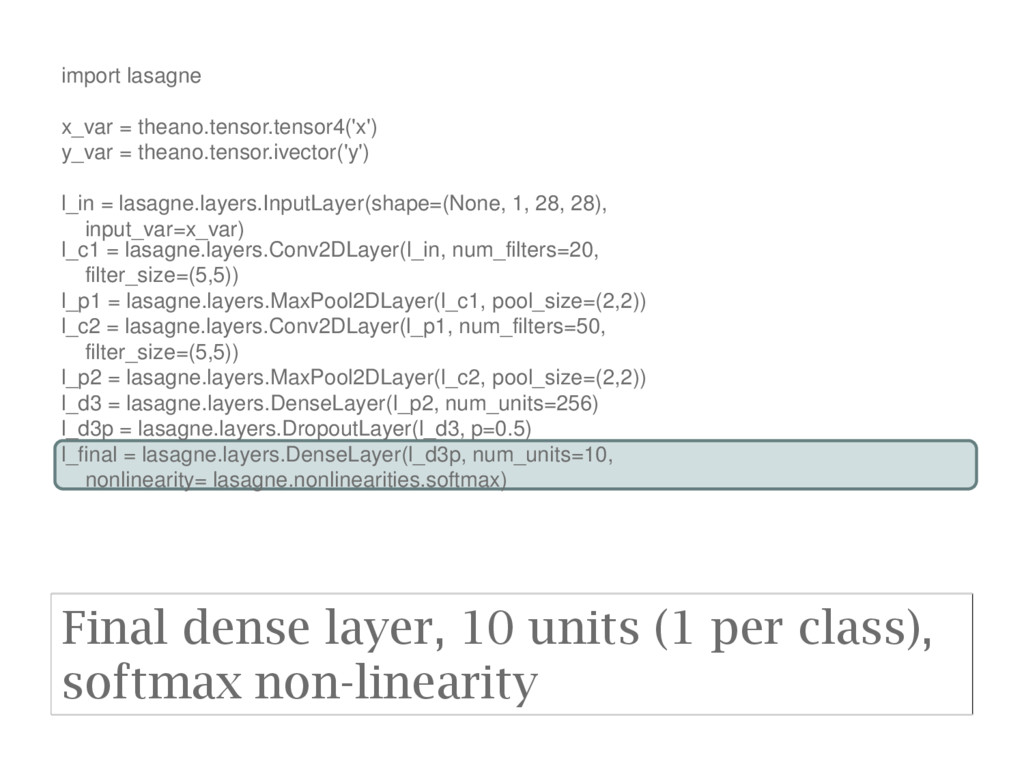
import lasagne x_var = theano.tensor.tensor4('x') y_var = theano.tensor.ivector('y') l_in =
lasagne.layers.InputLayer(shape=(None, 1, 28, 28), input_var=x_var) l_c1 = lasagne.layers.Conv2DLayer(l_in, num_filters=20, filter_size=(5,5)) l_p1 = lasagne.layers.MaxPool2DLayer(l_c1, pool_size=(2,2)) l_c2 = lasagne.layers.Conv2DLayer(l_p1, num_filters=50, filter_size=(5,5)) l_p2 = lasagne.layers.MaxPool2DLayer(l_c2, pool_size=(2,2)) l_d3 = lasagne.layers.DenseLayer(l_p2, num_units=256) l_d3p = lasagne.layers.DropoutLayer(l_d3, p=0.5) l_final = lasagne.layers.DenseLayer(l_d3p, num_units=10, nonlinearity= lasagne.nonlinearities.softmax) Final dense layer, 10 units (1 per class), softmax non-linearity -
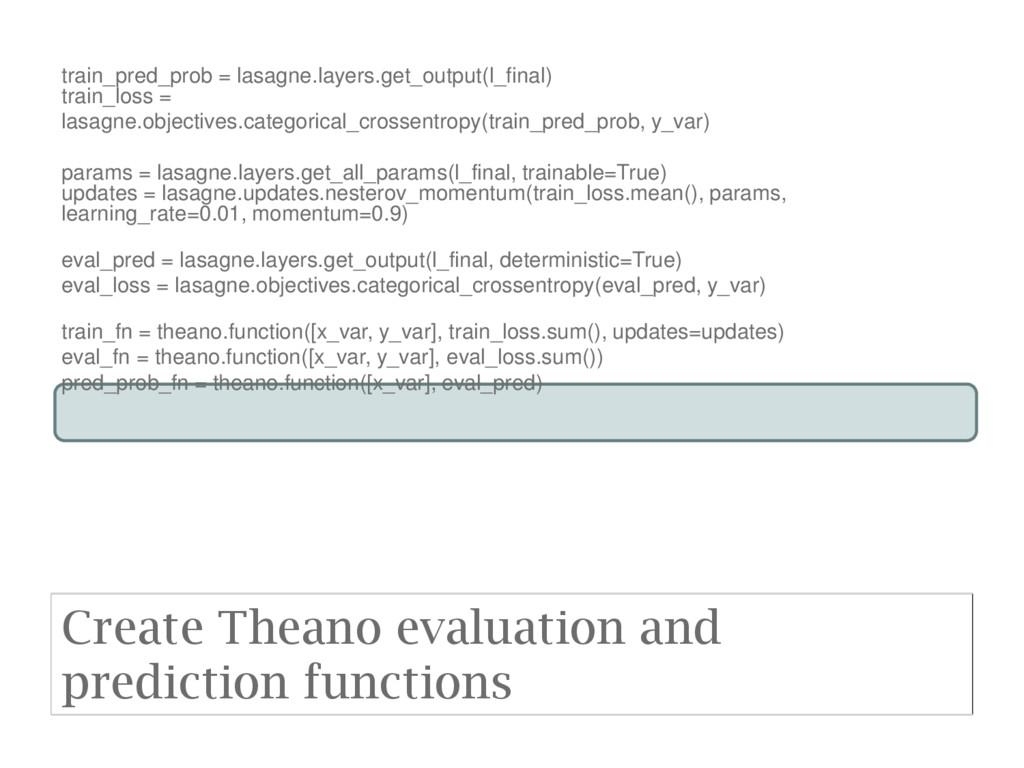
Modified LeNet for MNIST • Get Theano expression for predicted
output • Define loss expression • Get trainable parameters of network • Generate updates for training network acccording to Nesterov Momentum update rule • Create Theano functions for training and prediction -
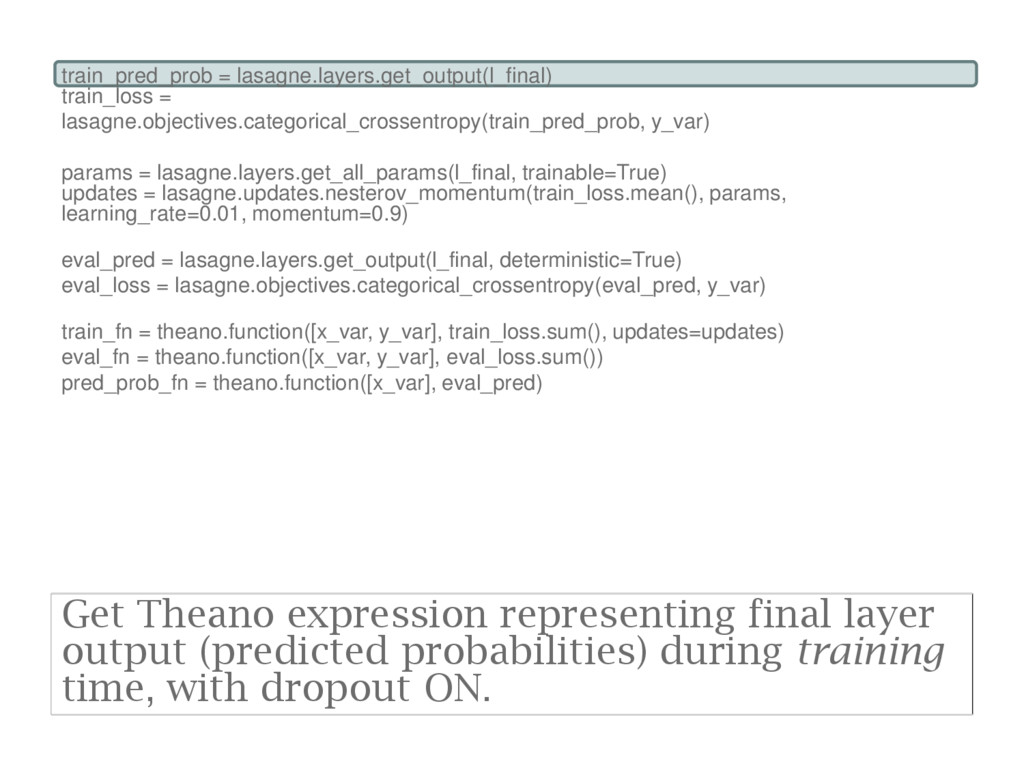
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Get Theano expression representing final layer output (predicted probabilities) during training time, with dropout ON. -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
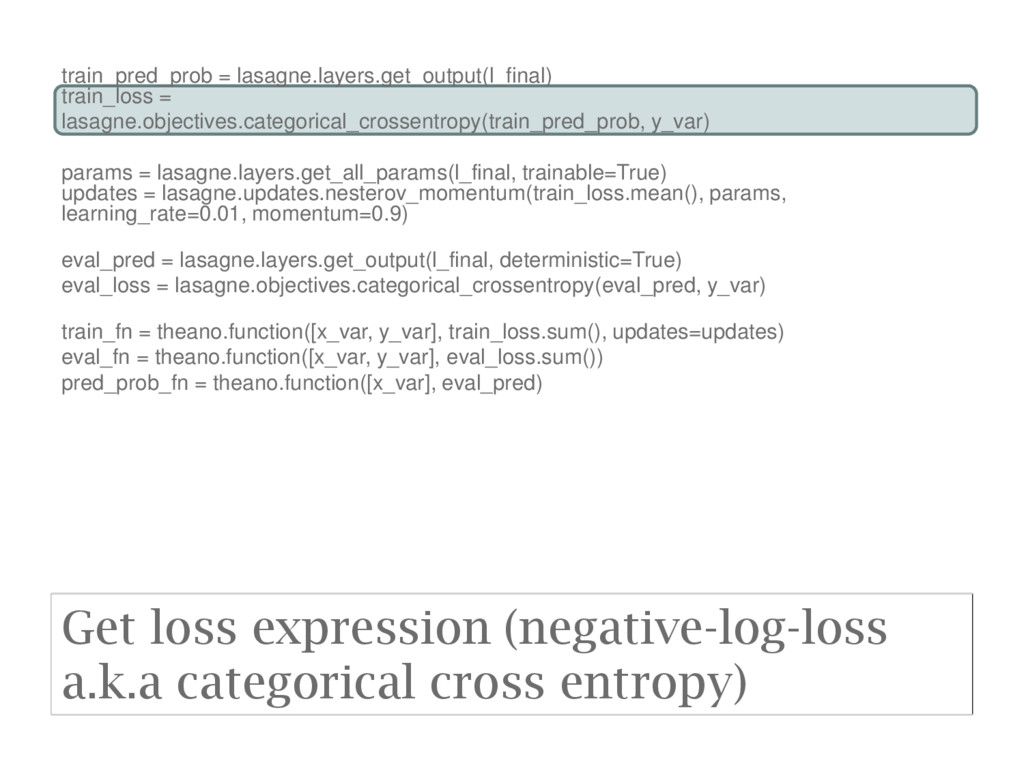
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Get loss expression (negative-log-loss a.k.a categorical cross entropy) -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
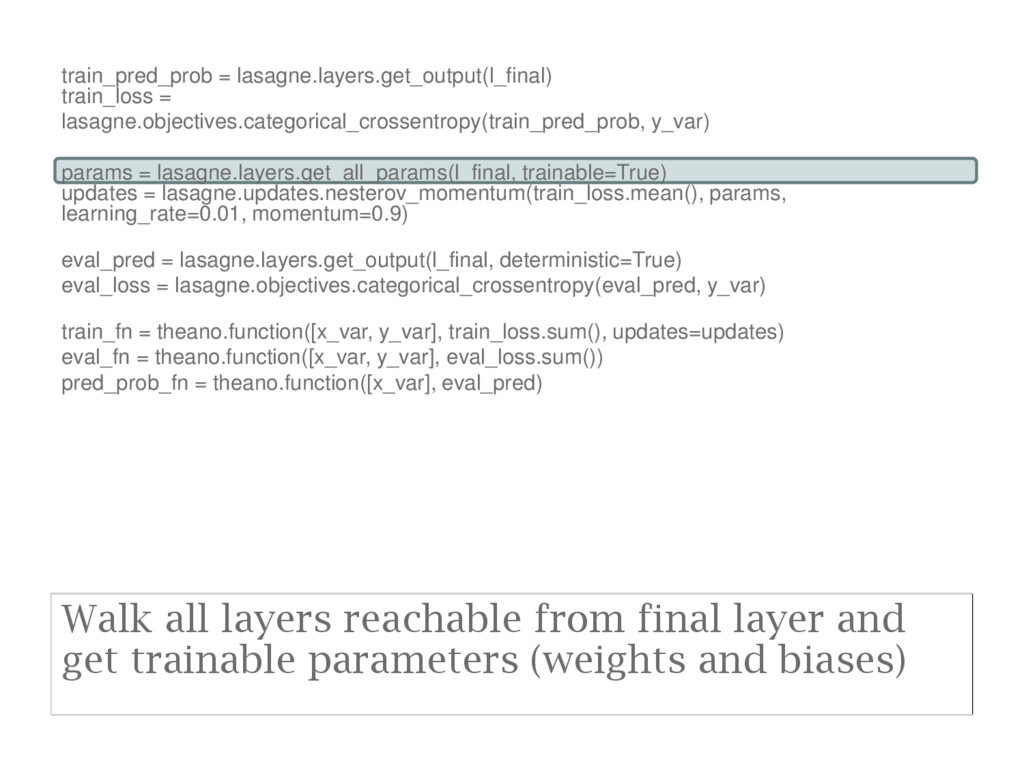
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Walk all layers reachable from final layer and get trainable parameters (weights and biases) -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
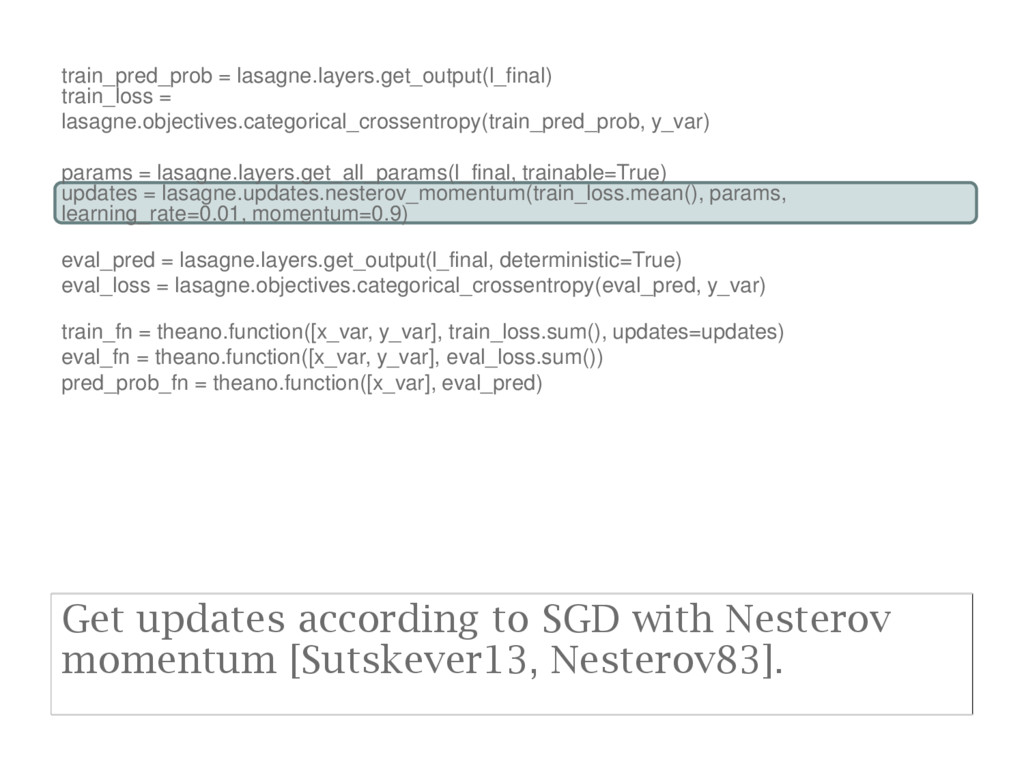
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Get updates according to SGD with Nesterov momentum [Sutskever13, Nesterov83]. -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Get expression for final layer output (predicted probabilities) during evaluation time, with dropout OFF (deterministic=True results in a Theano expression that excludes stochastic processes e.g. dropout). Then get evaluation loss. -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
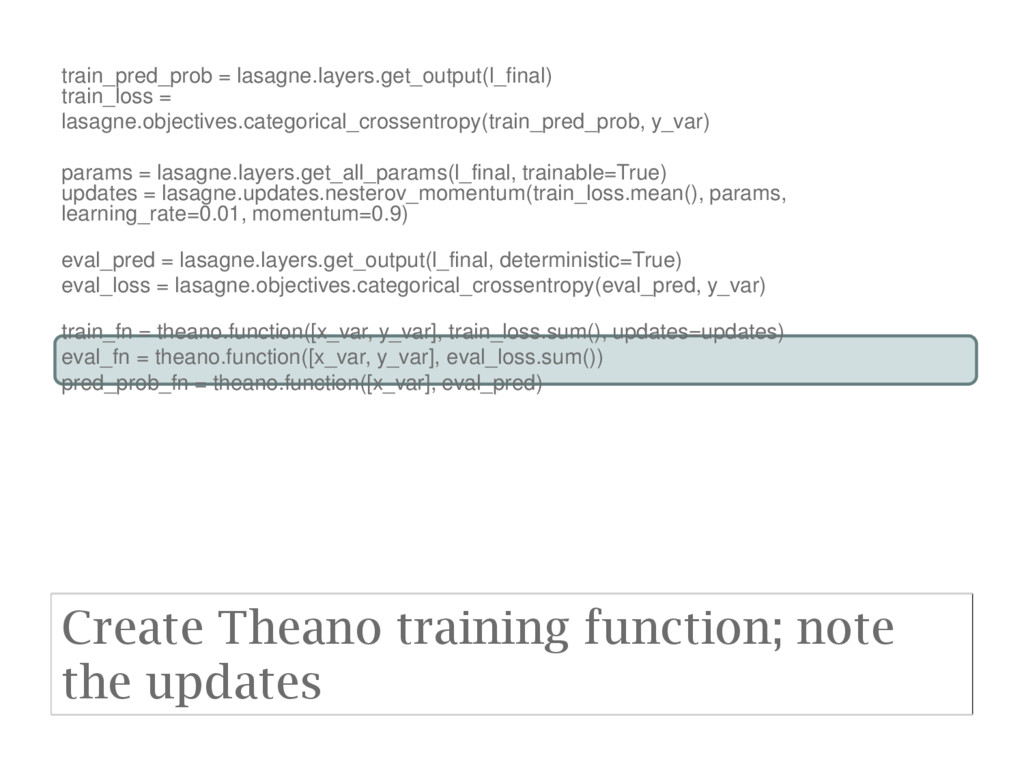
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Create Theano training function; note the updates -
train_pred_prob = lasagne.layers.get_output(l_final) train_loss = lasagne.objectives.categorical_crossentropy(train_pred_prob, y_var) params = lasagne.layers.get_all_params(l_final,
trainable=True) updates = lasagne.updates.nesterov_momentum(train_loss.mean(), params, learning_rate=0.01, momentum=0.9) eval_pred = lasagne.layers.get_output(l_final, deterministic=True) eval_loss = lasagne.objectives.categorical_crossentropy(eval_pred, y_var) train_fn = theano.function([x_var, y_var], train_loss.sum(), updates=updates) eval_fn = theano.function([x_var, y_var], eval_loss.sum()) pred_prob_fn = theano.function([x_var], eval_pred) Create Theano evaluation and prediction functions -
Modified LeNet for MNIST • Load the dataset using the
Fuel library • Draw samples from dataset in random order – hence shuffling – to build minibatches • Train the network -
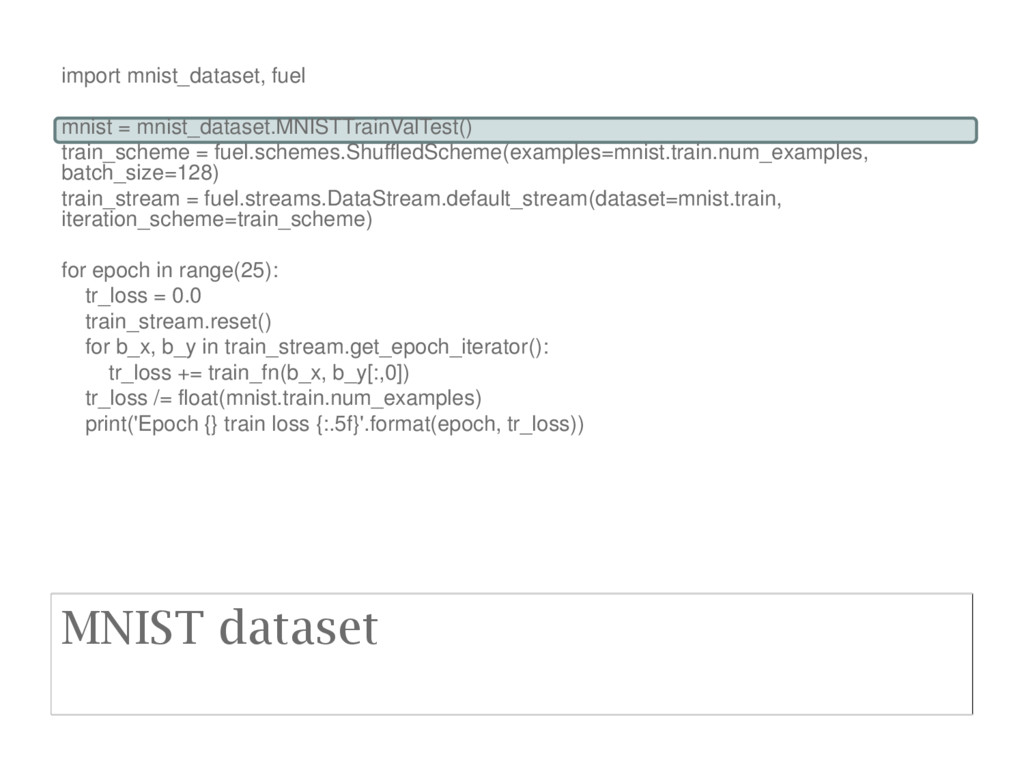
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) MNIST dataset -
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
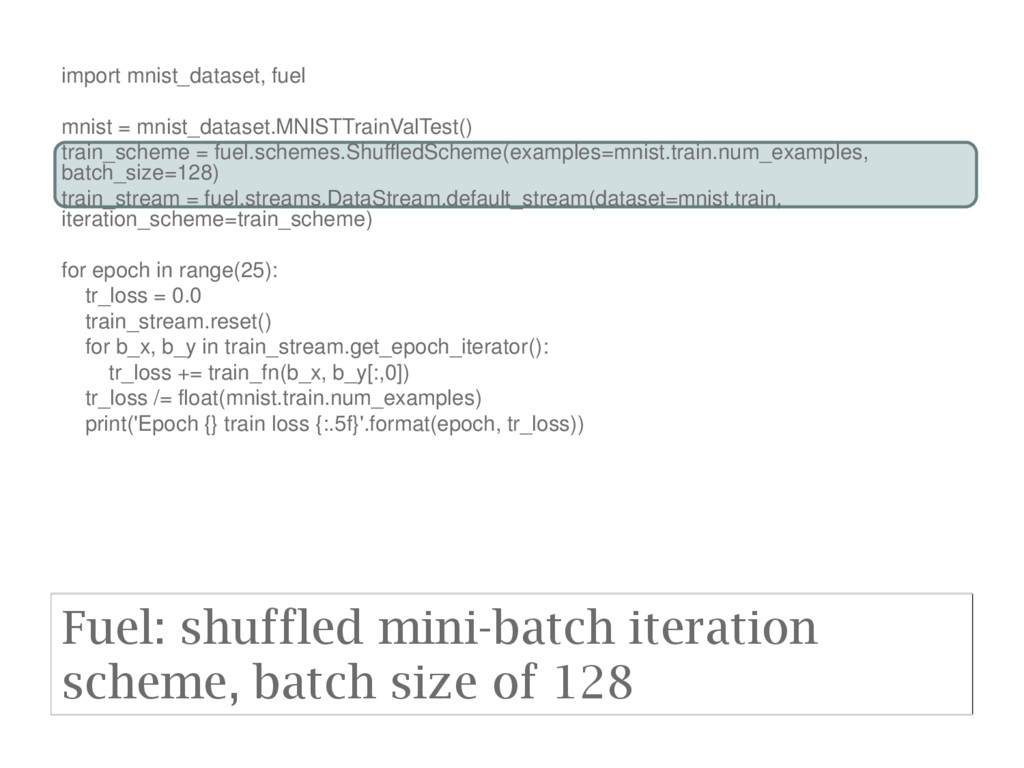
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) Fuel: shuffled mini-batch iteration scheme, batch size of 128 -
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
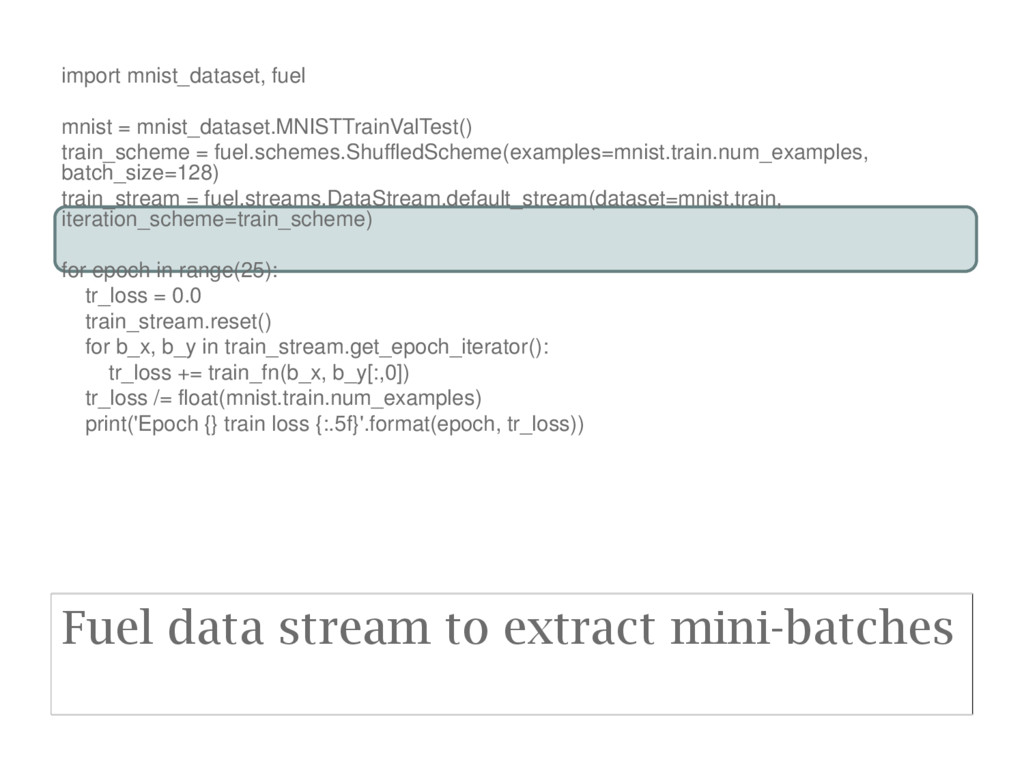
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) Fuel data stream to extract mini-batches -
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
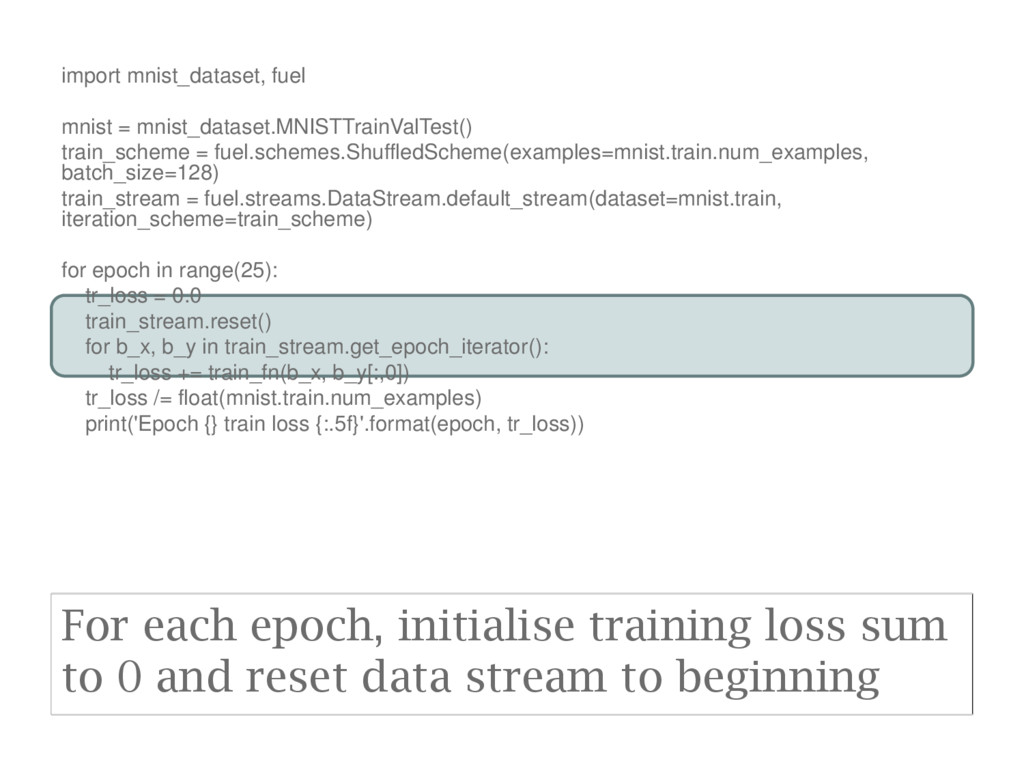
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) For each epoch, initialise training loss sum to 0 and reset data stream to beginning -
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
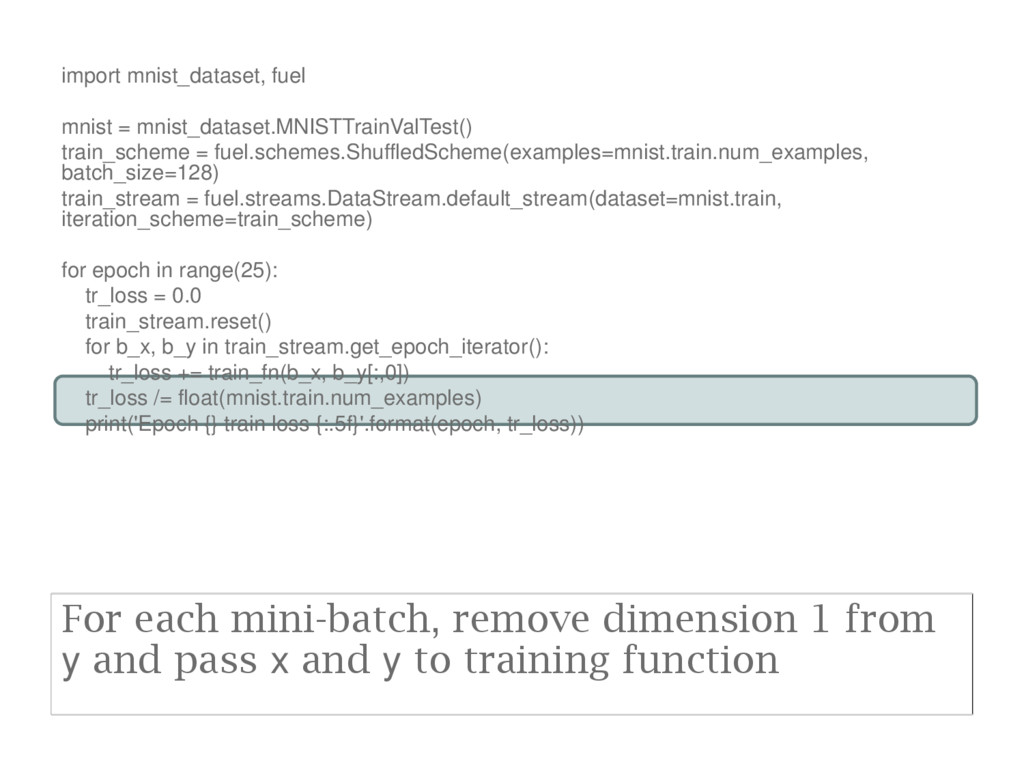
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) For each mini-batch, remove dimension 1 from y and pass x and y to training function -
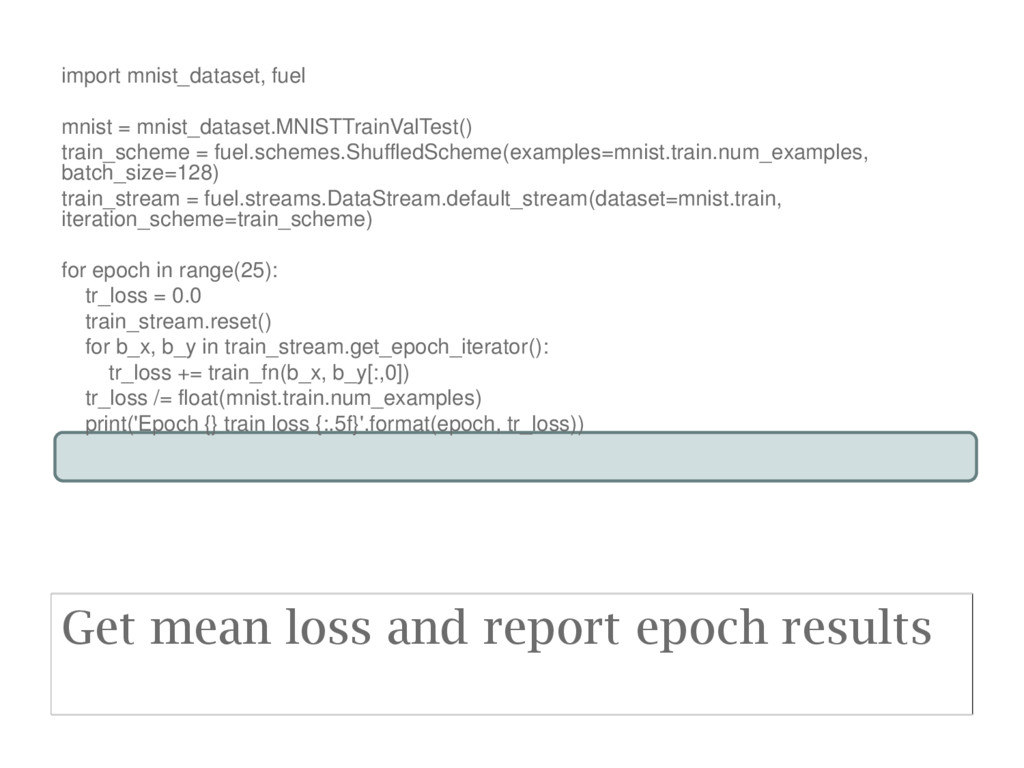
import mnist_dataset, fuel mnist = mnist_dataset.MNISTTrainValTest() train_scheme = fuel.schemes.ShuffledScheme(examples=mnist.train.num_examples, batch_size=128)
train_stream = fuel.streams.DataStream.default_stream(dataset=mnist.train, iteration_scheme=train_scheme) for epoch in range(25): tr_loss = 0.0 train_stream.reset() for b_x, b_y in train_stream.get_epoch_iterator(): tr_loss += train_fn(b_x, b_y[:,0]) tr_loss /= float(mnist.train.num_examples) print('Epoch {} train loss {:.5f}'.format(epoch, tr_loss)) Get mean loss and report epoch results
 britefury
 pvcresin
 ostk0069
 dayeon
 minodriven
 sodainc
 slobodan
 kazuki1023
 steliosf
 yukikurage
 kumaiu
 ooga04
 l2hyunwoo
 oripsolob
 jcasabona
 khoart
 62gerente
 kimpetersen
 chikuwait
 addyosmani
 portentint
 kneath
 marcoroth
 soysaucechin