Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
DynamoDB_Scan_vs_Query__検証で見えた境界線__-_Slidev.pdf
Search
hasuto sasaki
February 23, 2026
78
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
DynamoDB_Scan_vs_Query__検証で見えた境界線__-_Slidev.pdf
hasuto sasaki
February 23, 2026
Transcript
40 slides
DynamoDB Scan vs Query 検証で見えた境界線 @HasutoSasaki
Hasuto (Sasaki Hasuto ) Server-side Engineer 筋トレ アニメ 低レイヤー Golang
Neovim GitHub @vt23358 2023.04 - SES 企業 Web サイト・Web アプリ開発 Vue.js / Nuxt.js + Lambda / DynamoDB 2026.01 - classmethod Web アプリ開発 TypeScript / React + Lambda / DynamoDB
自分の手で検証する 自分の手で得た経験は 自分だけの武器 になる
今日持ち帰ってほしいこと 技術的な知見 Scan と Query の性能差を数値で理解する それ以上に大事なこと 自分の手で検証する姿勢
今日持ち帰ってほしいこと 技術的な知見 Scan と Query の性能差を数値で理解する それ以上に大事なこと 自分の手で検証する姿勢 この2 つを軸に、DynamoDB
の Scan と Query を検証した結果をお話しします
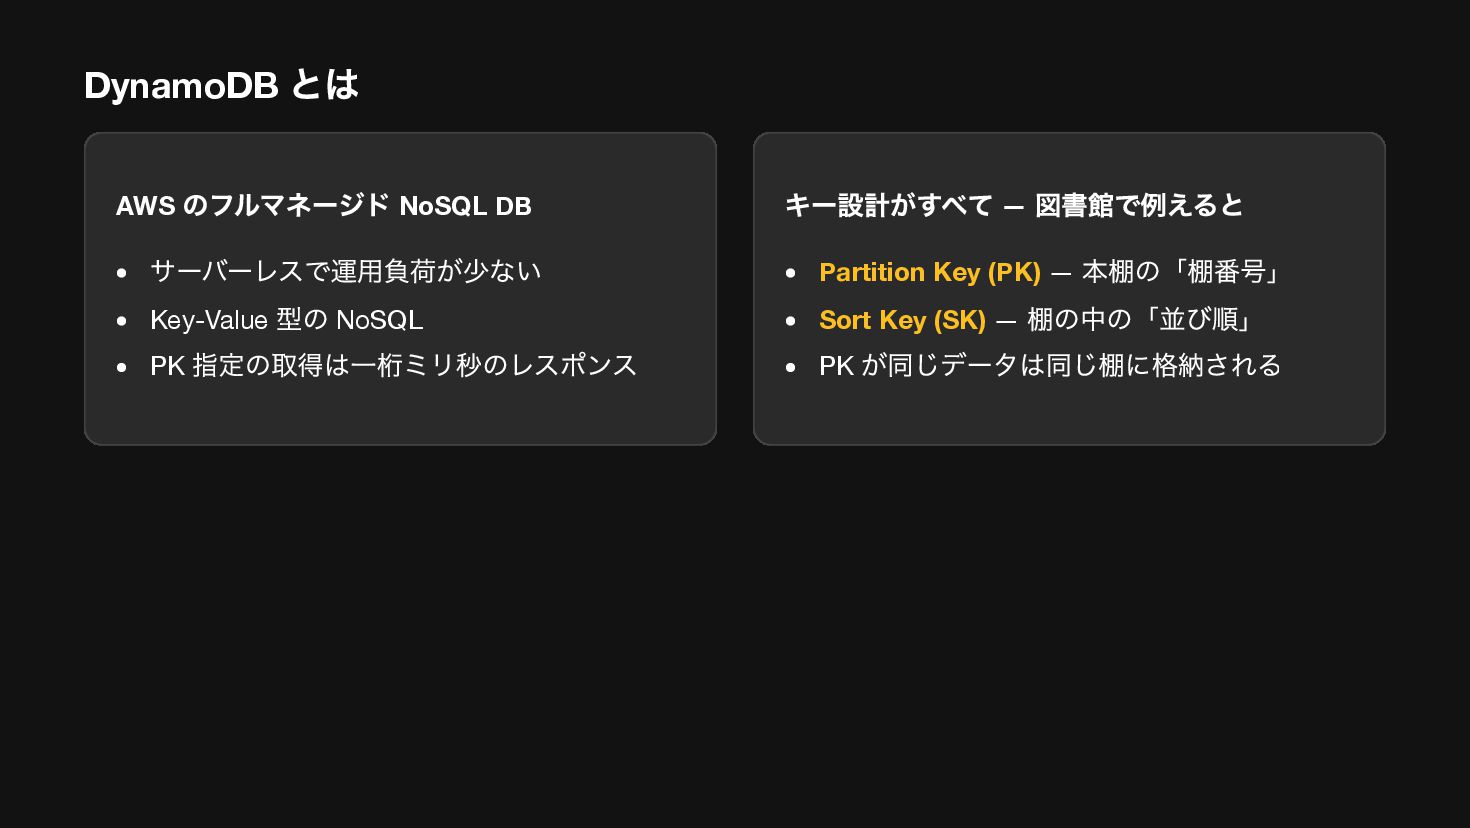
DynamoDB とは AWS のフルマネージド NoSQL DB サーバーレスで運用負荷が少ない Key-Value 型の NoSQL
PK 指定の取得は一桁ミリ秒のレスポンス キー設計がすべて — 図書館で例えると Partition Key (PK) — 本棚の「棚番号」 Sort Key (SK) — 棚の中の「並び順」 PK が同じデータは同じ棚に格納される
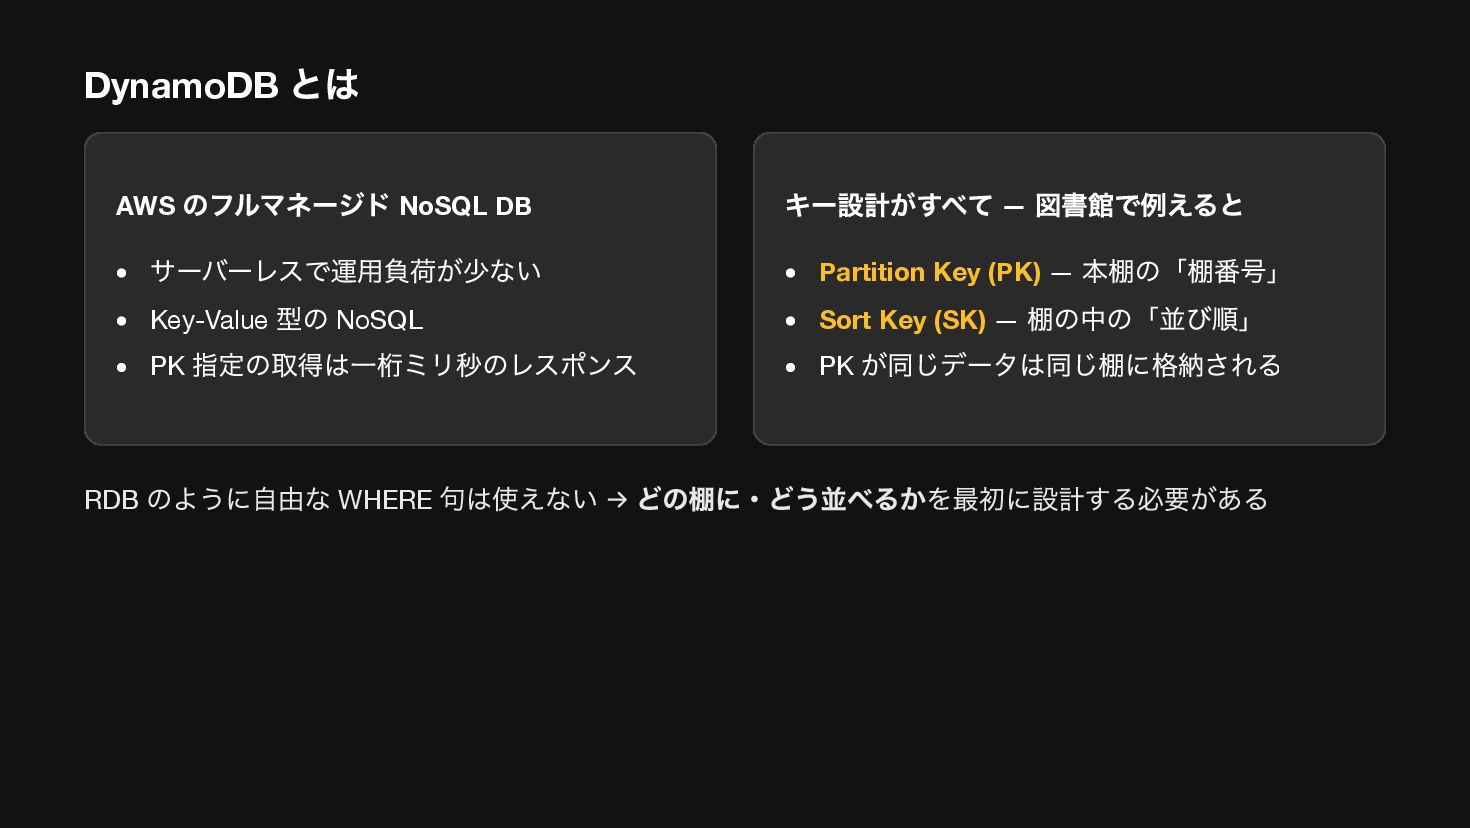
DynamoDB とは AWS のフルマネージド NoSQL DB サーバーレスで運用負荷が少ない Key-Value 型の NoSQL
PK 指定の取得は一桁ミリ秒のレスポンス キー設計がすべて — 図書館で例えると Partition Key (PK) — 本棚の「棚番号」 Sort Key (SK) — 棚の中の「並び順」 PK が同じデータは同じ棚に格納される RDB のように自由な WHERE 句は使えない → どの棚に・どう並べるかを最初に設計する必要がある
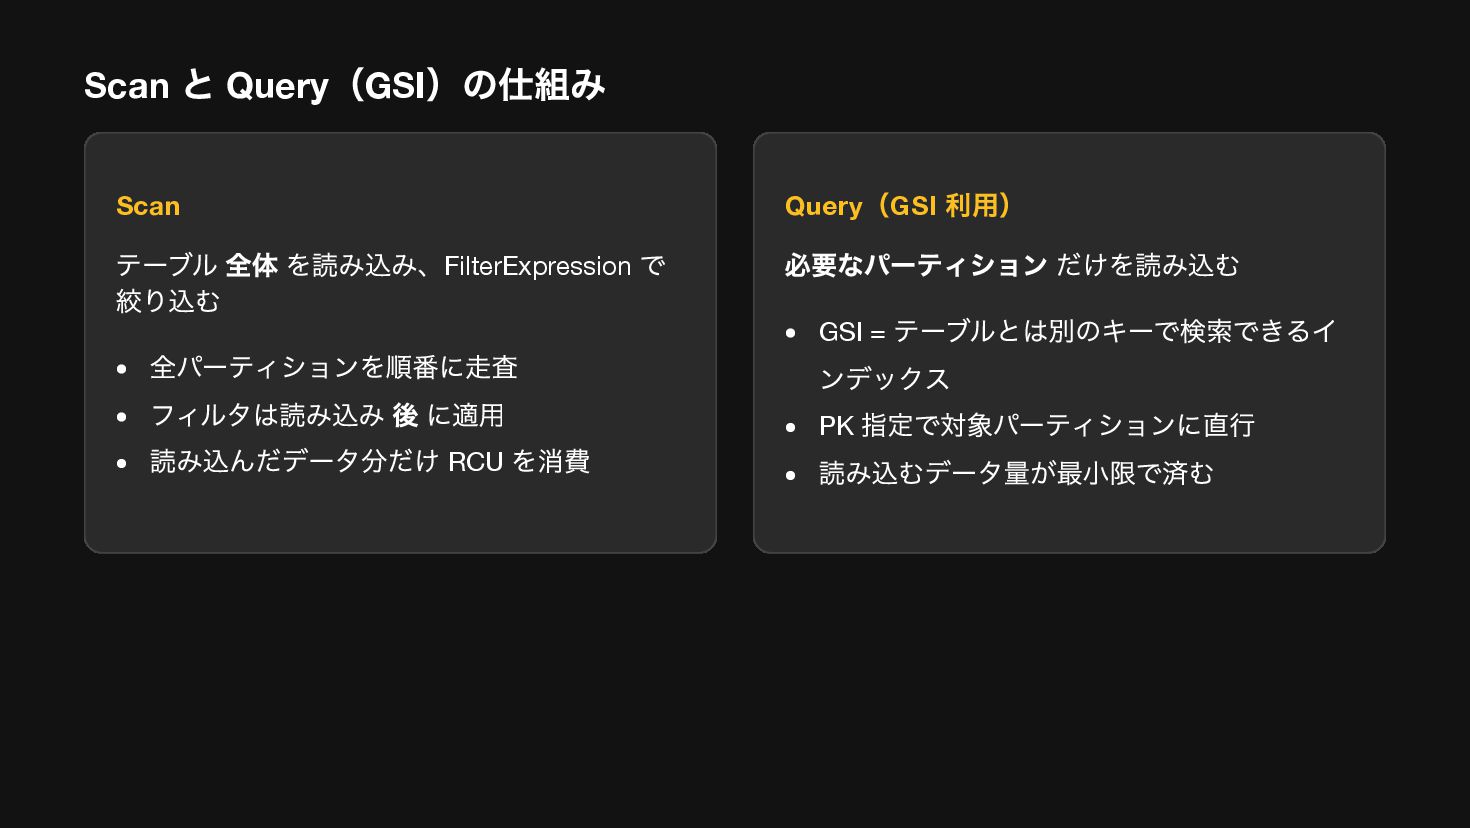
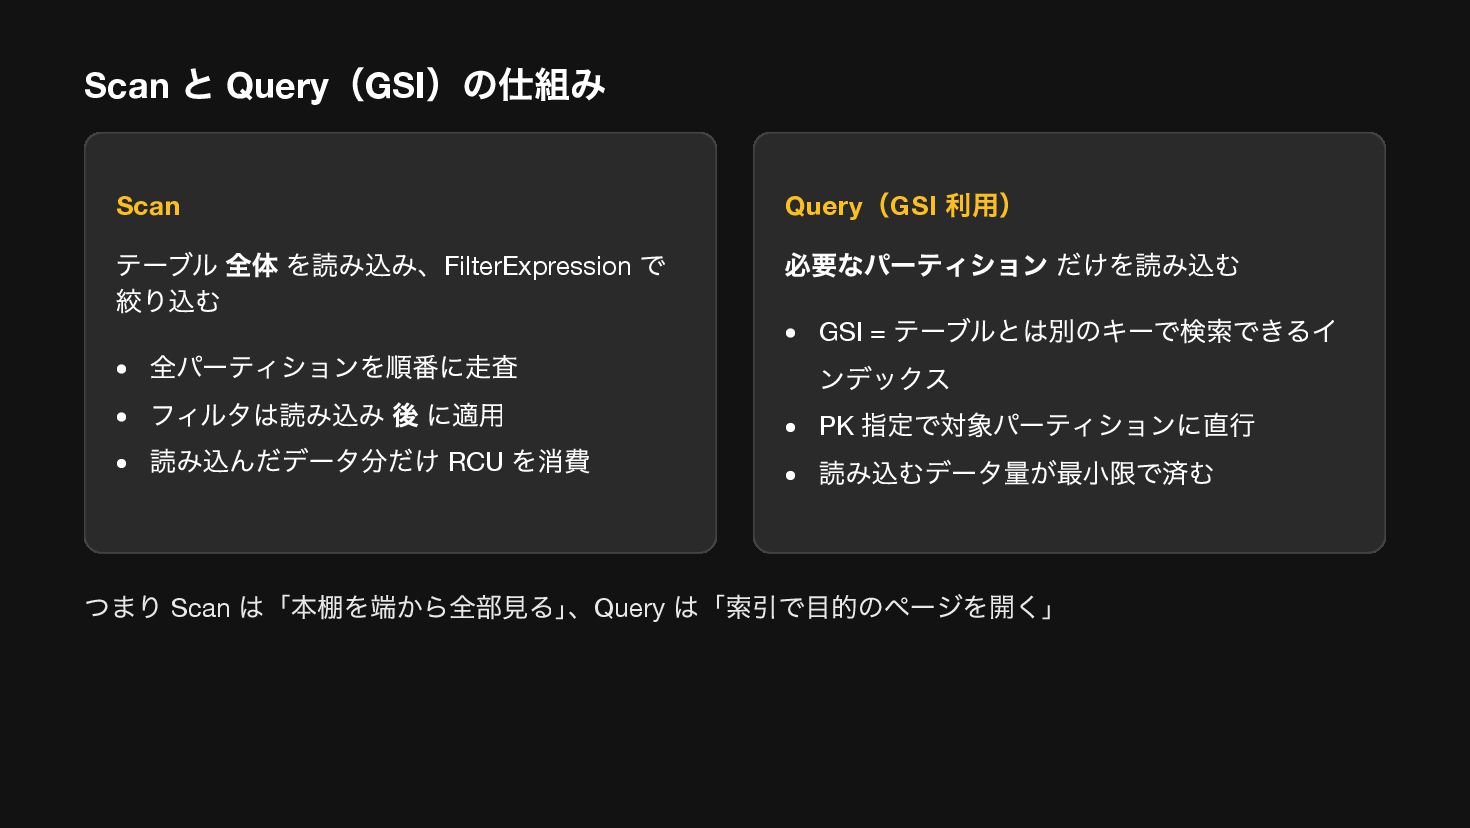
Scan と Query (GSI )の仕組み Scan テーブル 全体 を読み込み、FilterExpression で
絞り込む 全パーティションを順番に走査 フィルタは読み込み 後 に適用 読み込んだデータ分だけ RCU を消費 Query (GSI 利用) 必要なパーティション だけを読み込む GSI = テーブルとは別のキーで検索できるイ ンデックス PK 指定で対象パーティションに直行 読み込むデータ量が最小限で済む
Scan と Query (GSI )の仕組み Scan テーブル 全体 を読み込み、FilterExpression で
絞り込む 全パーティションを順番に走査 フィルタは読み込み 後 に適用 読み込んだデータ分だけ RCU を消費 Query (GSI 利用) 必要なパーティション だけを読み込む GSI = テーブルとは別のキーで検索できるイ ンデックス PK 指定で対象パーティションに直行 読み込むデータ量が最小限で済む つまり Scan は「本棚を端から全部見る」 、Query は「索引で目的のページを開く」
では本題に入ります。
"Scan は避けるべき"
よく聞く話 Scan は全データを読み込むから遅い GSI を使ってコストを抑えるべき RCU の消費量に大きな差が出る
よく聞く話 Scan は全データを読み込むから遅い GSI を使ってコストを抑えるべき RCU の消費量に大きな差が出る … でも、実際どれくらい差が出るの?
設計で自信が持てなかった 知っていたこと Scan はテーブル全体を読む GSI を使えば効率的にクエリできる RCU コストに差が出る わからなかったこと 数百件でも差は出るの?
何件から実用上問題になる? レコードサイズの影響は?
設計で自信が持てなかった 知っていたこと Scan はテーブル全体を読む GSI を使えば効率的にクエリできる RCU コストに差が出る わからなかったこと 数百件でも差は出るの?
何件から実用上問題になる? レコードサイズの影響は? 「聞いた話」ではなく「検証した事実」で判断したい
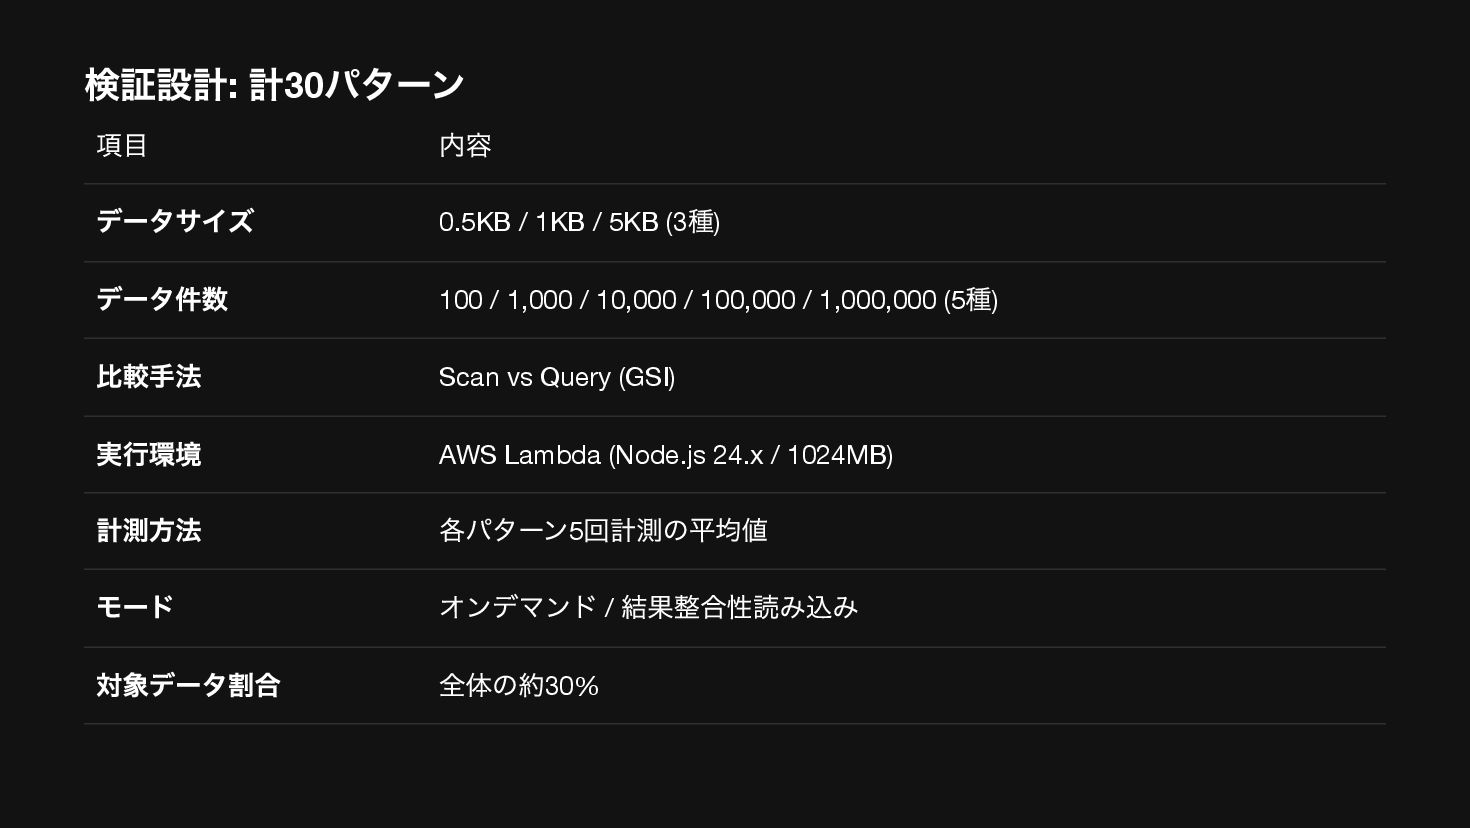
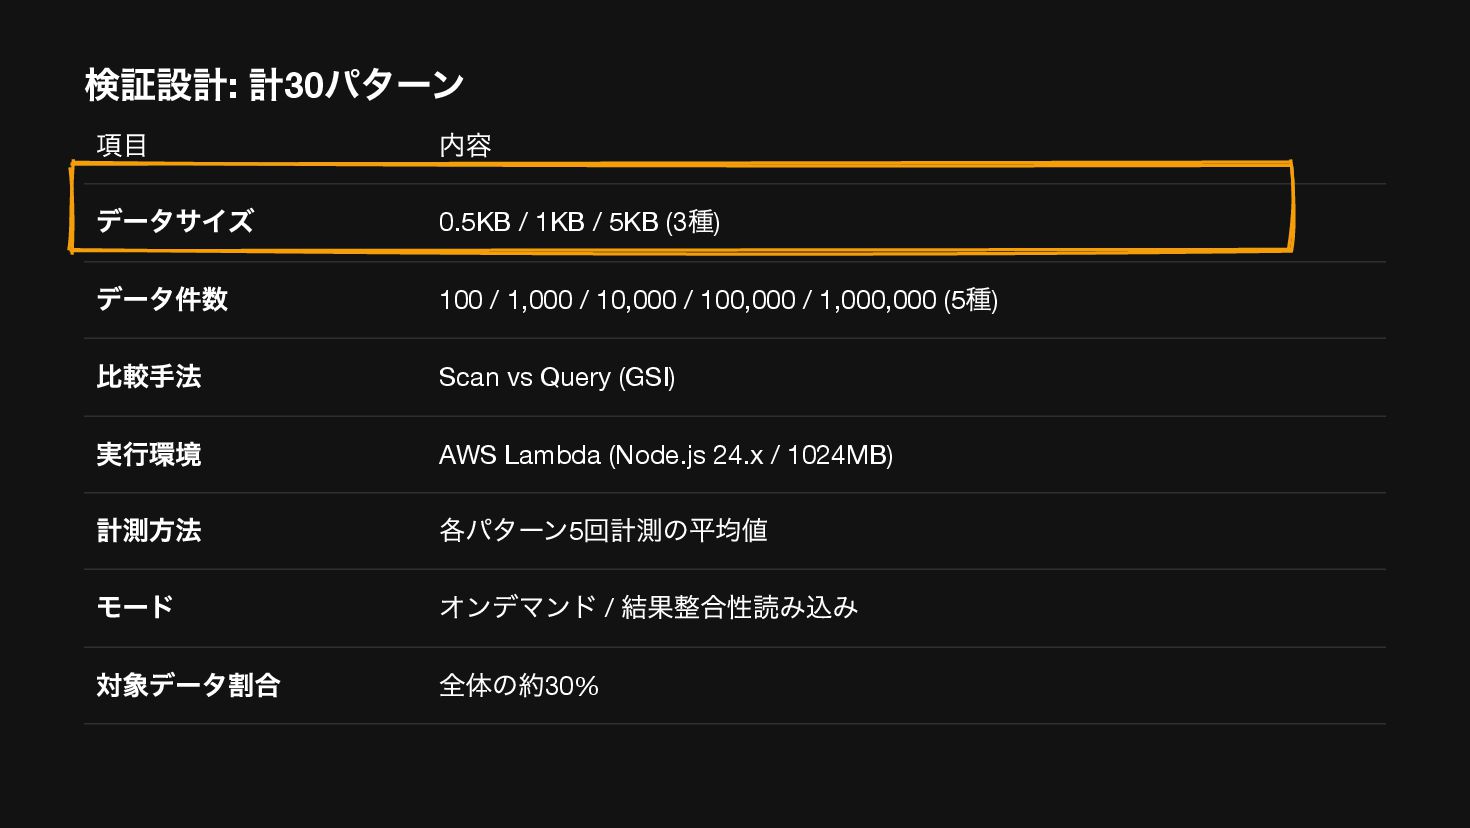
検証設計: 計30 パターン 項目 内容 データサイズ 0.5KB / 1KB /
5KB (3 種) データ件数 100 / 1,000 / 10,000 / 100,000 / 1,000,000 (5 種) 比較手法 Scan vs Query (GSI) 実行環境 AWS Lambda (Node.js 24.x / 1024MB) 計測方法 各パターン5 回計測の平均値 モード オンデマンド / 結果整合性読み込み 対象データ割合 全体の約30%
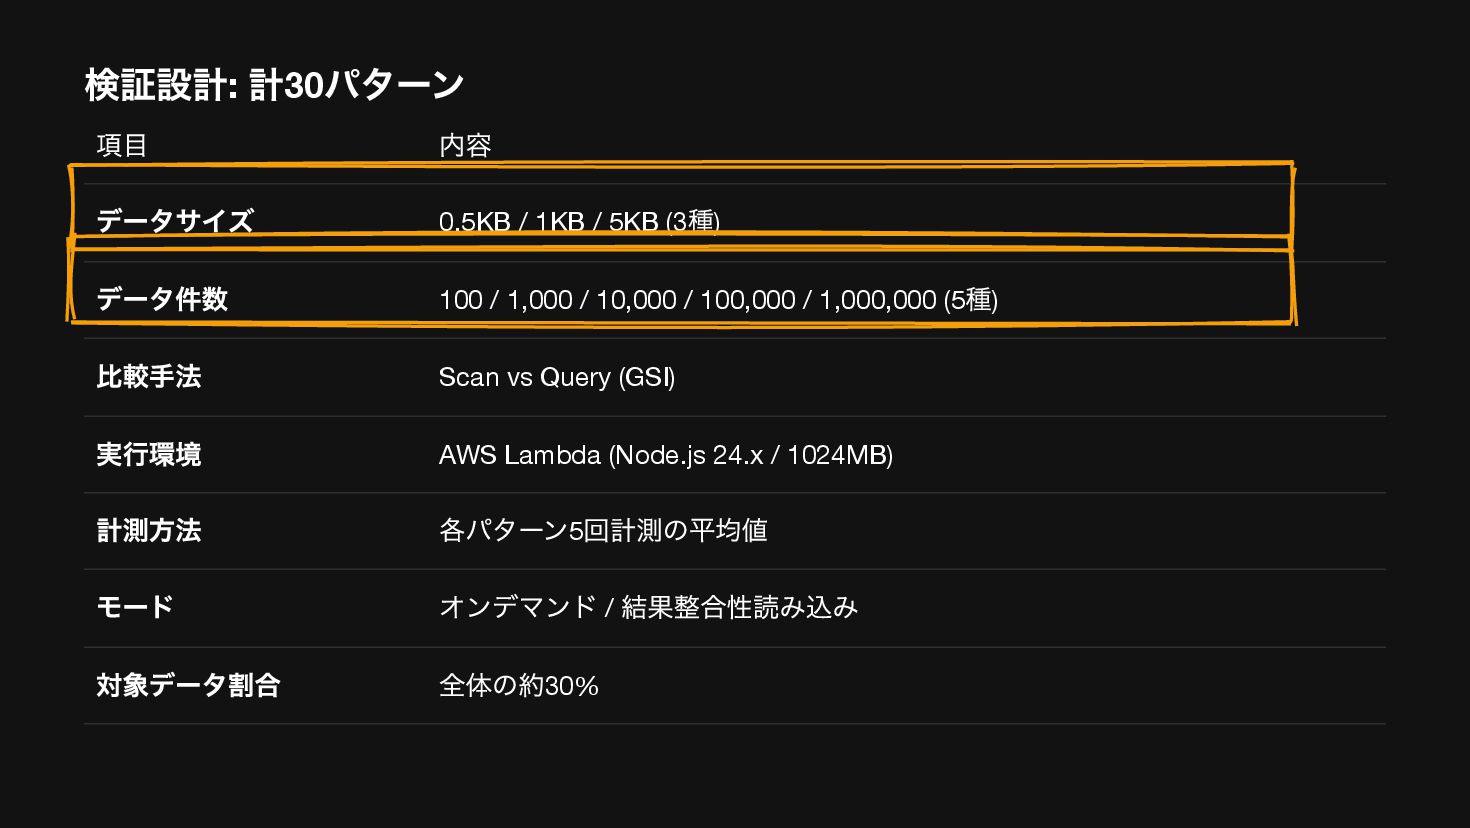
検証設計: 計30 パターン 項目 内容 データサイズ 0.5KB / 1KB /
5KB (3 種) データ件数 100 / 1,000 / 10,000 / 100,000 / 1,000,000 (5 種) 比較手法 Scan vs Query (GSI) 実行環境 AWS Lambda (Node.js 24.x / 1024MB) 計測方法 各パターン5 回計測の平均値 モード オンデマンド / 結果整合性読み込み 対象データ割合 全体の約30%
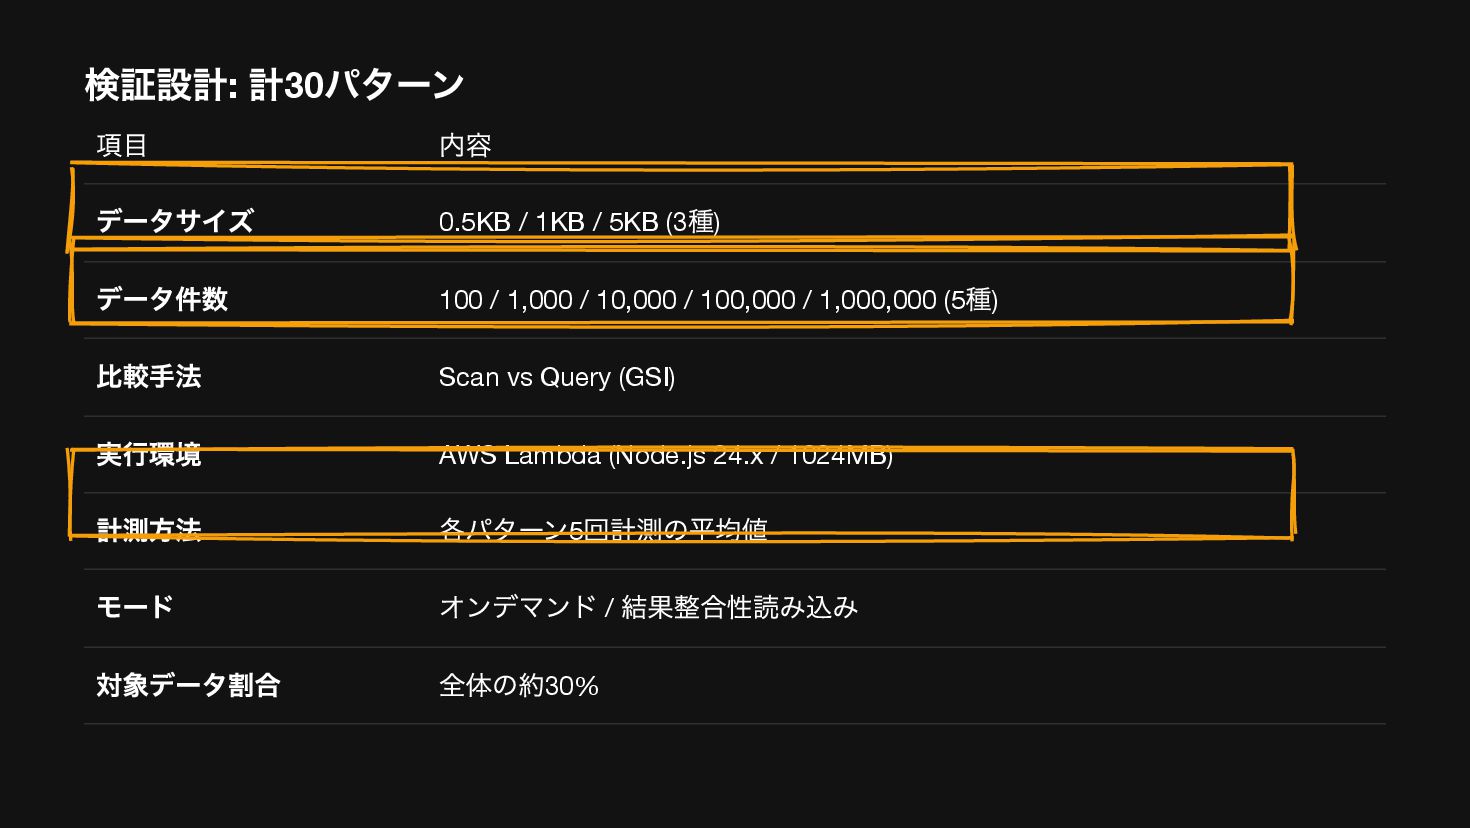
検証設計: 計30 パターン 項目 内容 データサイズ 0.5KB / 1KB /
5KB (3 種) データ件数 100 / 1,000 / 10,000 / 100,000 / 1,000,000 (5 種) 比較手法 Scan vs Query (GSI) 実行環境 AWS Lambda (Node.js 24.x / 1024MB) 計測方法 各パターン5 回計測の平均値 モード オンデマンド / 結果整合性読み込み 対象データ割合 全体の約30%
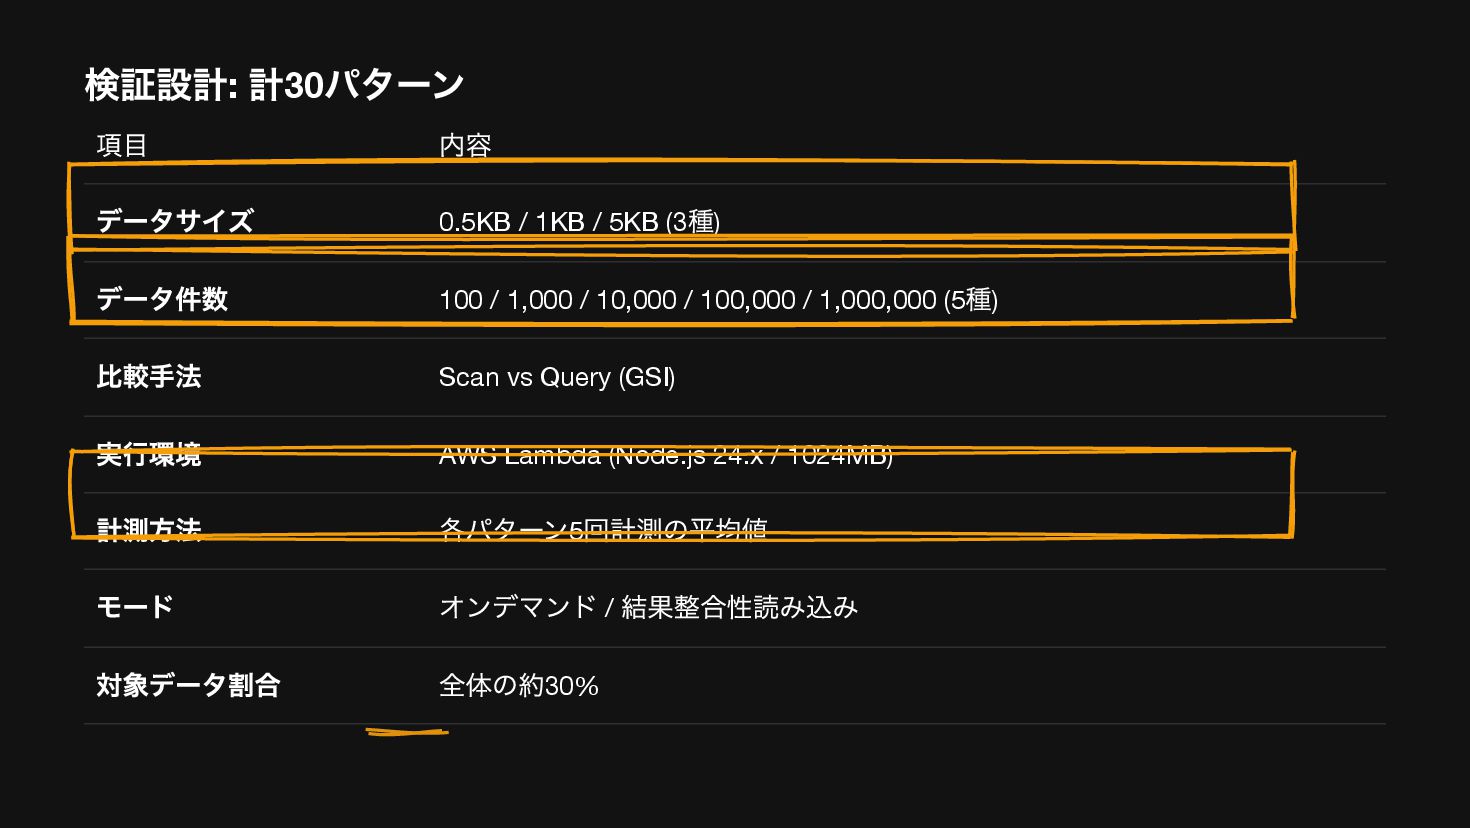
検証設計: 計30 パターン 項目 内容 データサイズ 0.5KB / 1KB /
5KB (3 種) データ件数 100 / 1,000 / 10,000 / 100,000 / 1,000,000 (5 種) 比較手法 Scan vs Query (GSI) 実行環境 AWS Lambda (Node.js 24.x / 1024MB) 計測方法 各パターン5 回計測の平均値 モード オンデマンド / 結果整合性読み込み 対象データ割合 全体の約30%
検証設計: 計30 パターン 項目 内容 データサイズ 0.5KB / 1KB /
5KB (3 種) データ件数 100 / 1,000 / 10,000 / 100,000 / 1,000,000 (5 種) 比較手法 Scan vs Query (GSI) 実行環境 AWS Lambda (Node.js 24.x / 1024MB) 計測方法 各パターン5 回計測の平均値 モード オンデマンド / 結果整合性読み込み 対象データ割合 全体の約30%
検証結果を見ていきましょう。
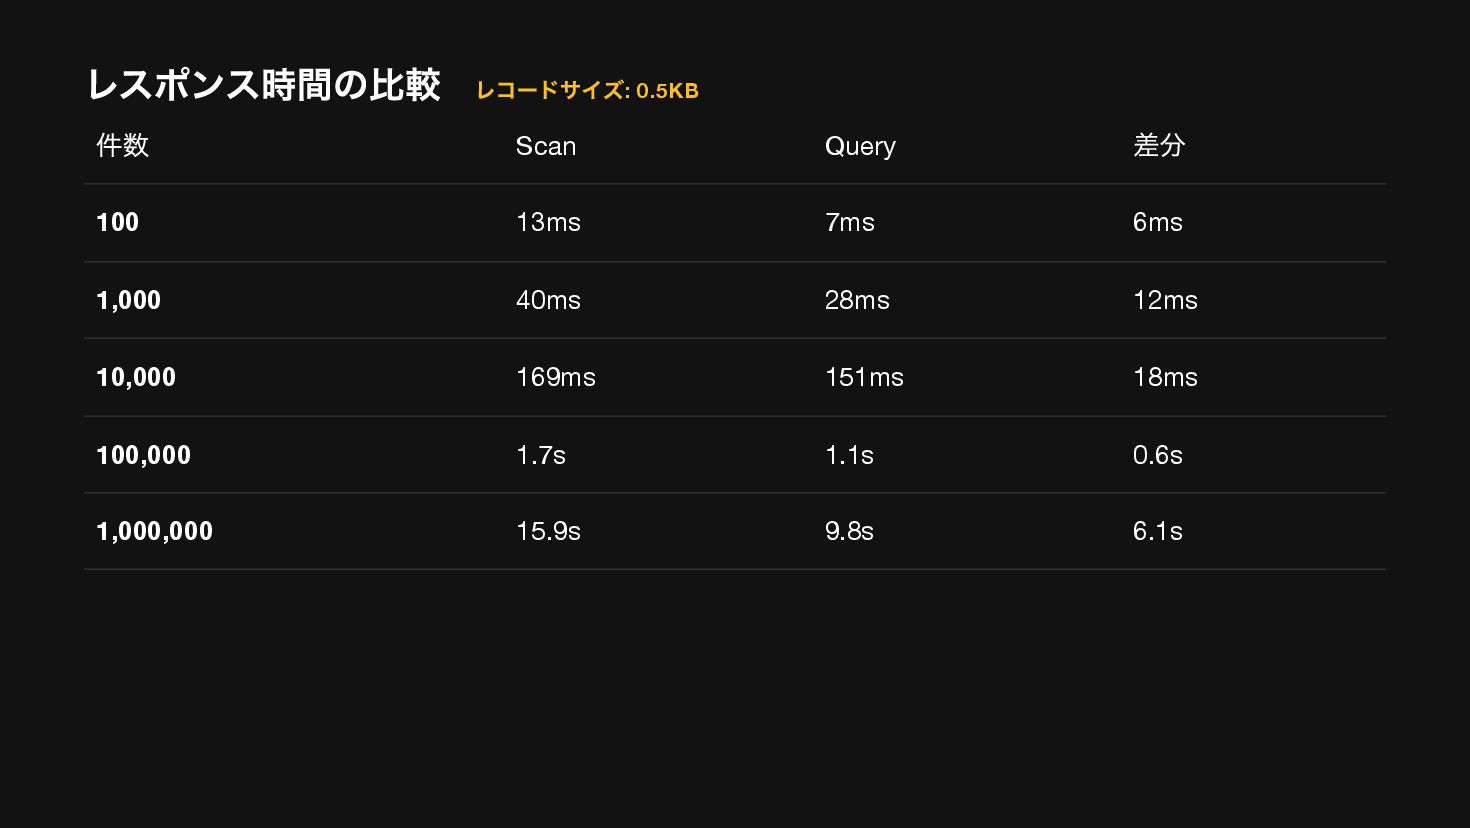
レスポンス時間の比較 レコードサイズ: 0.5KB 件数 Scan Query 差分 100 13ms 7ms
6ms 1,000 40ms 28ms 12ms 10,000 169ms 151ms 18ms 100,000 1.7s 1.1s 0.6s 1,000,000 15.9s 9.8s 6.1s
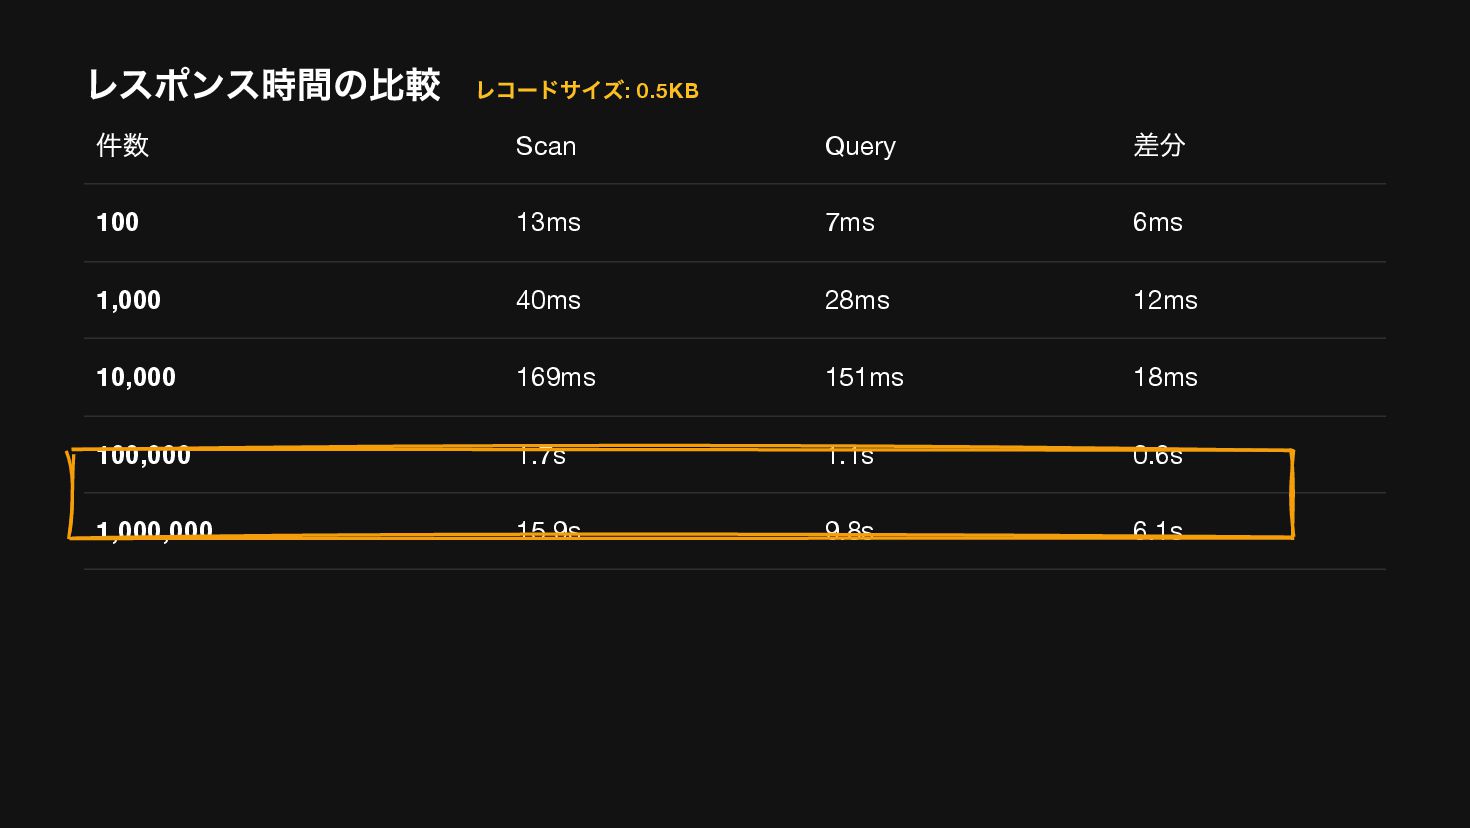
レスポンス時間の比較 レコードサイズ: 0.5KB 件数 Scan Query 差分 100 13ms 7ms
6ms 1,000 40ms 28ms 12ms 10,000 169ms 151ms 18ms 100,000 1.7s 1.1s 0.6s 1,000,000 15.9s 9.8s 6.1s
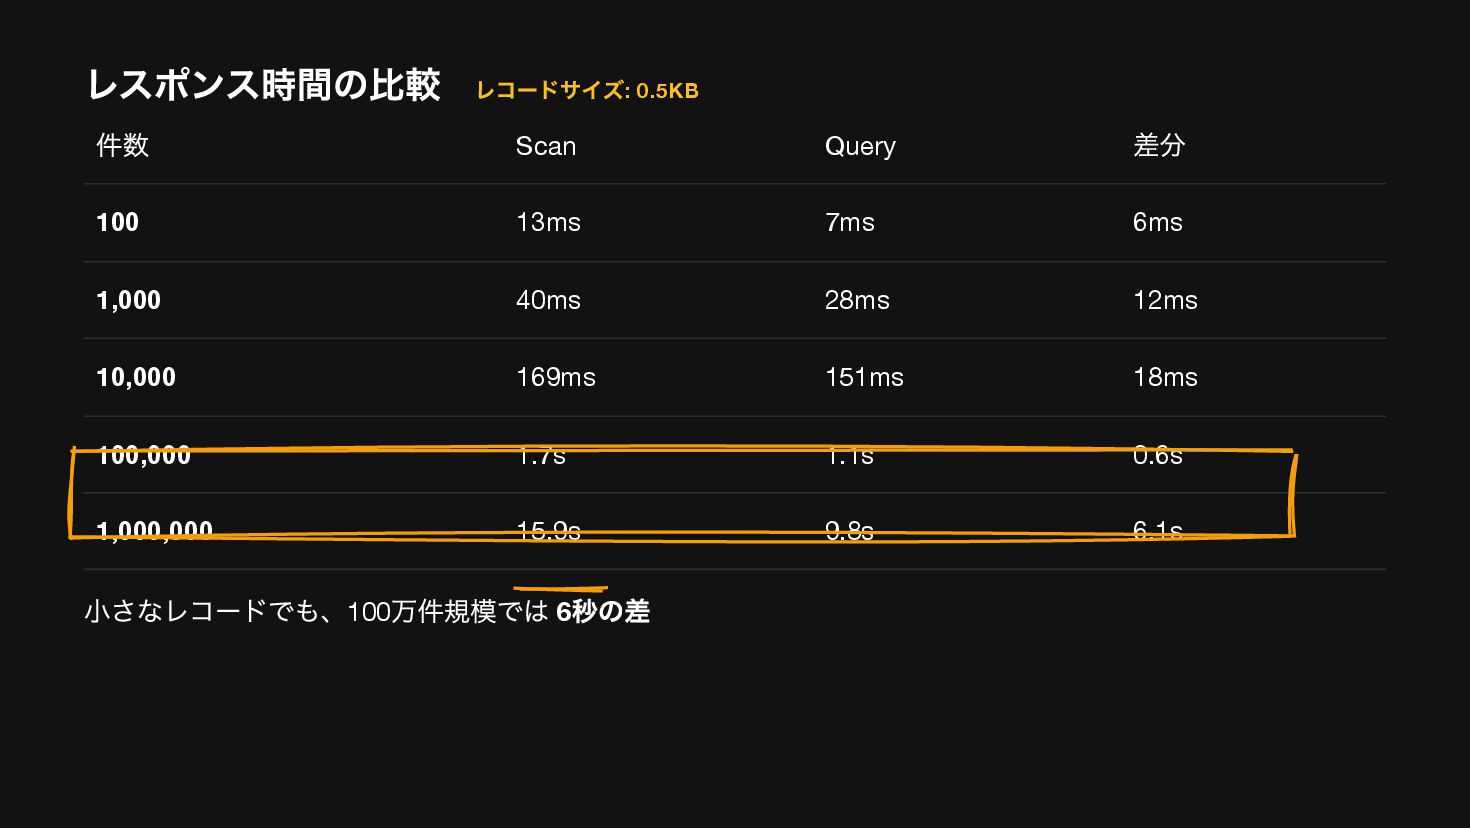
レスポンス時間の比較 レコードサイズ: 0.5KB 件数 Scan Query 差分 100 13ms 7ms
6ms 1,000 40ms 28ms 12ms 10,000 169ms 151ms 18ms 100,000 1.7s 1.1s 0.6s 1,000,000 15.9s 9.8s 6.1s 小さなレコードでも、100 万件規模では 6 秒の差
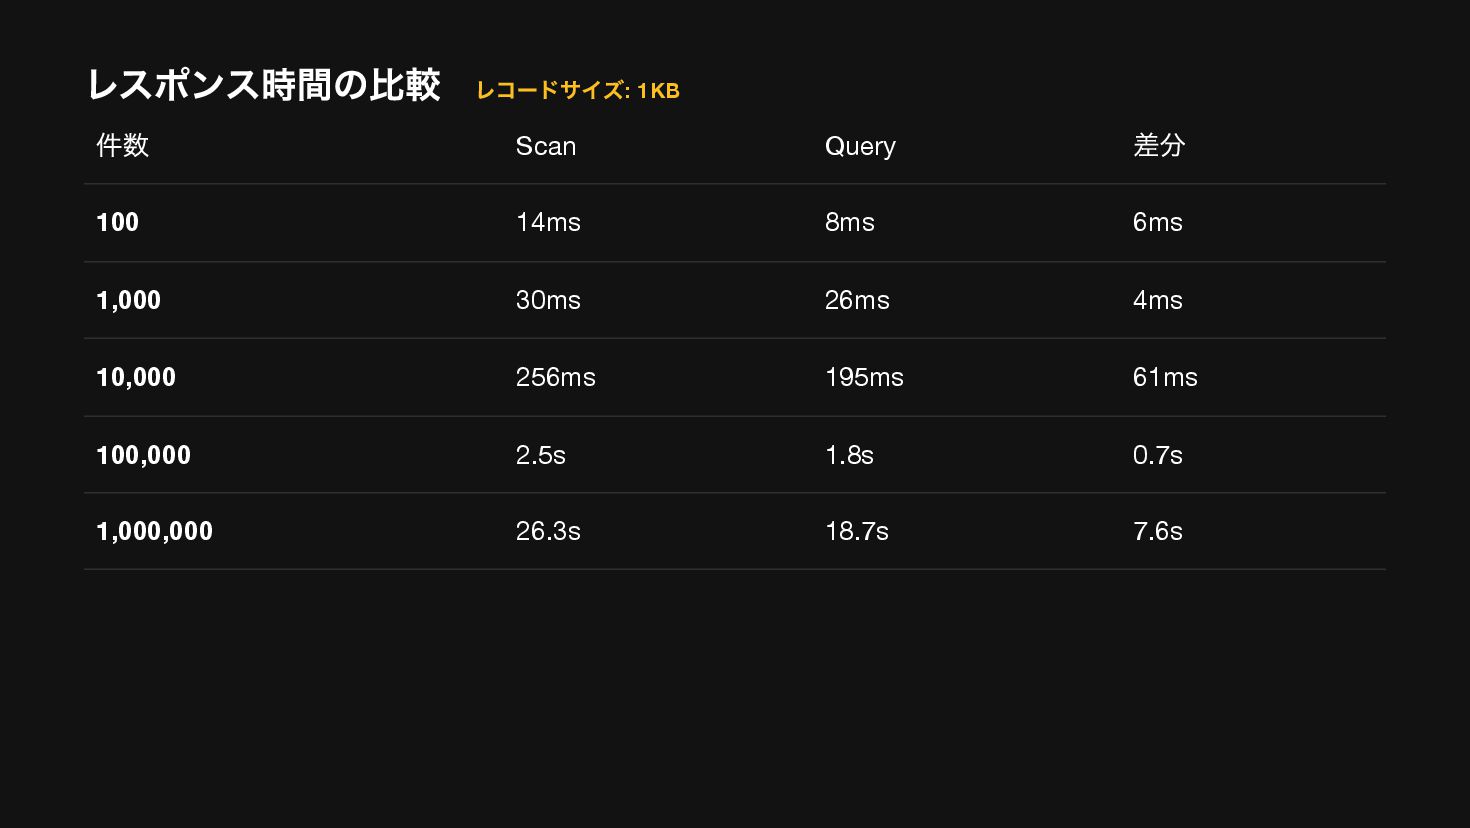
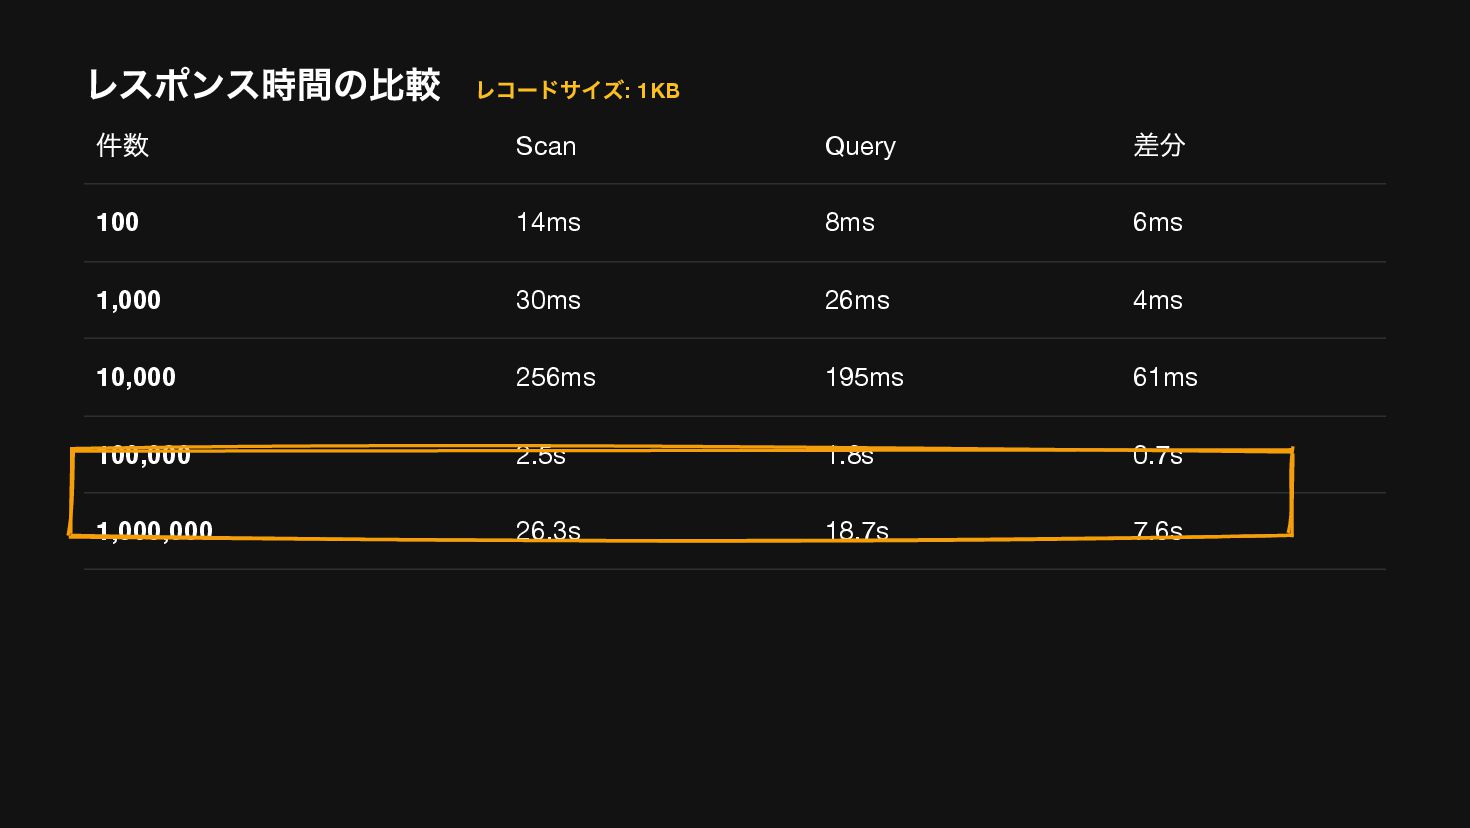
レスポンス時間の比較 レコードサイズ: 1KB 件数 Scan Query 差分 100 14ms 8ms
6ms 1,000 30ms 26ms 4ms 10,000 256ms 195ms 61ms 100,000 2.5s 1.8s 0.7s 1,000,000 26.3s 18.7s 7.6s
レスポンス時間の比較 レコードサイズ: 1KB 件数 Scan Query 差分 100 14ms 8ms
6ms 1,000 30ms 26ms 4ms 10,000 256ms 195ms 61ms 100,000 2.5s 1.8s 0.7s 1,000,000 26.3s 18.7s 7.6s
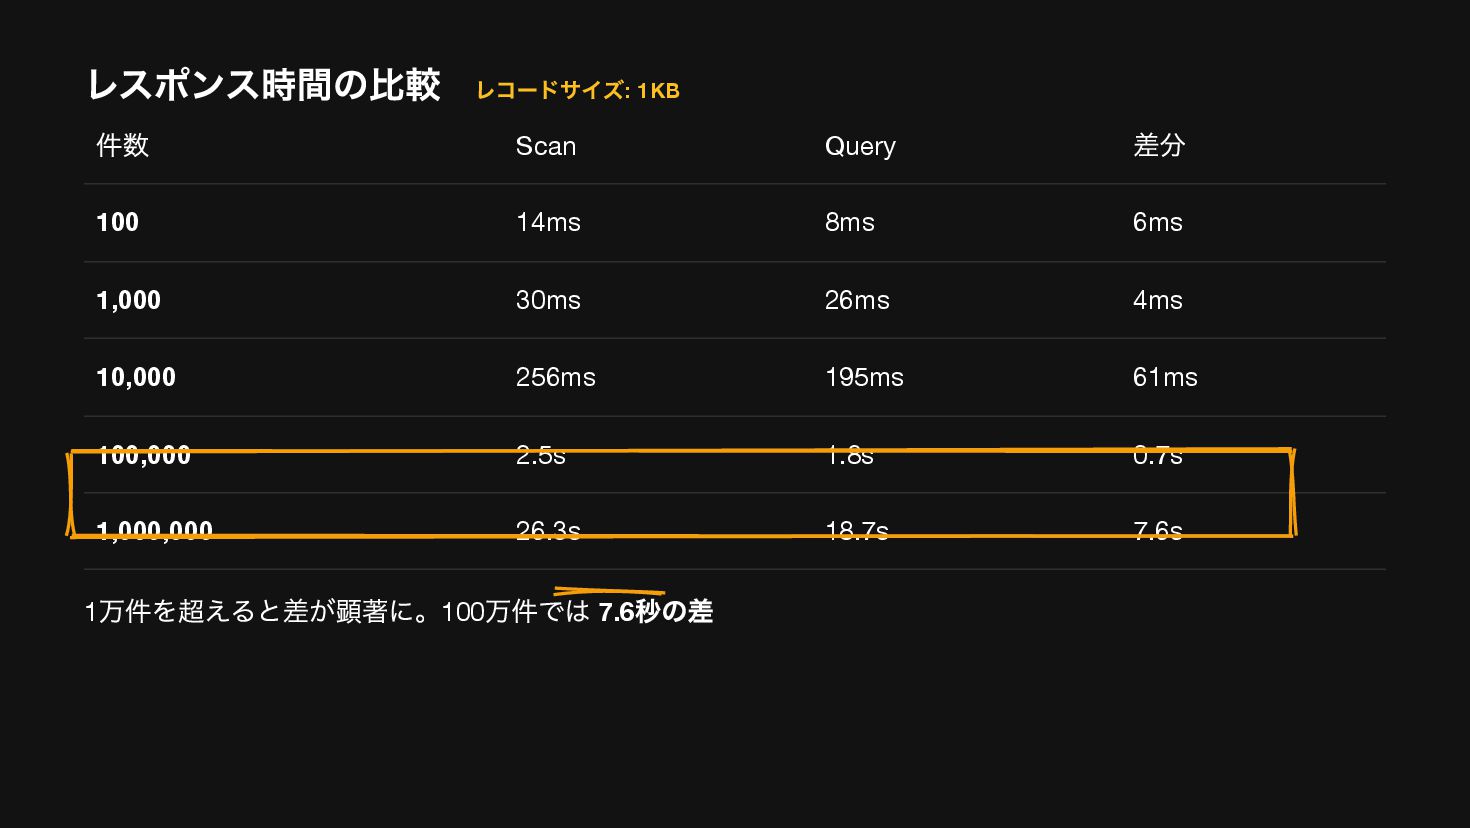
レスポンス時間の比較 レコードサイズ: 1KB 件数 Scan Query 差分 100 14ms 8ms
6ms 1,000 30ms 26ms 4ms 10,000 256ms 195ms 61ms 100,000 2.5s 1.8s 0.7s 1,000,000 26.3s 18.7s 7.6s 1 万件を超えると差が顕著に。100 万件では 7.6 秒の差
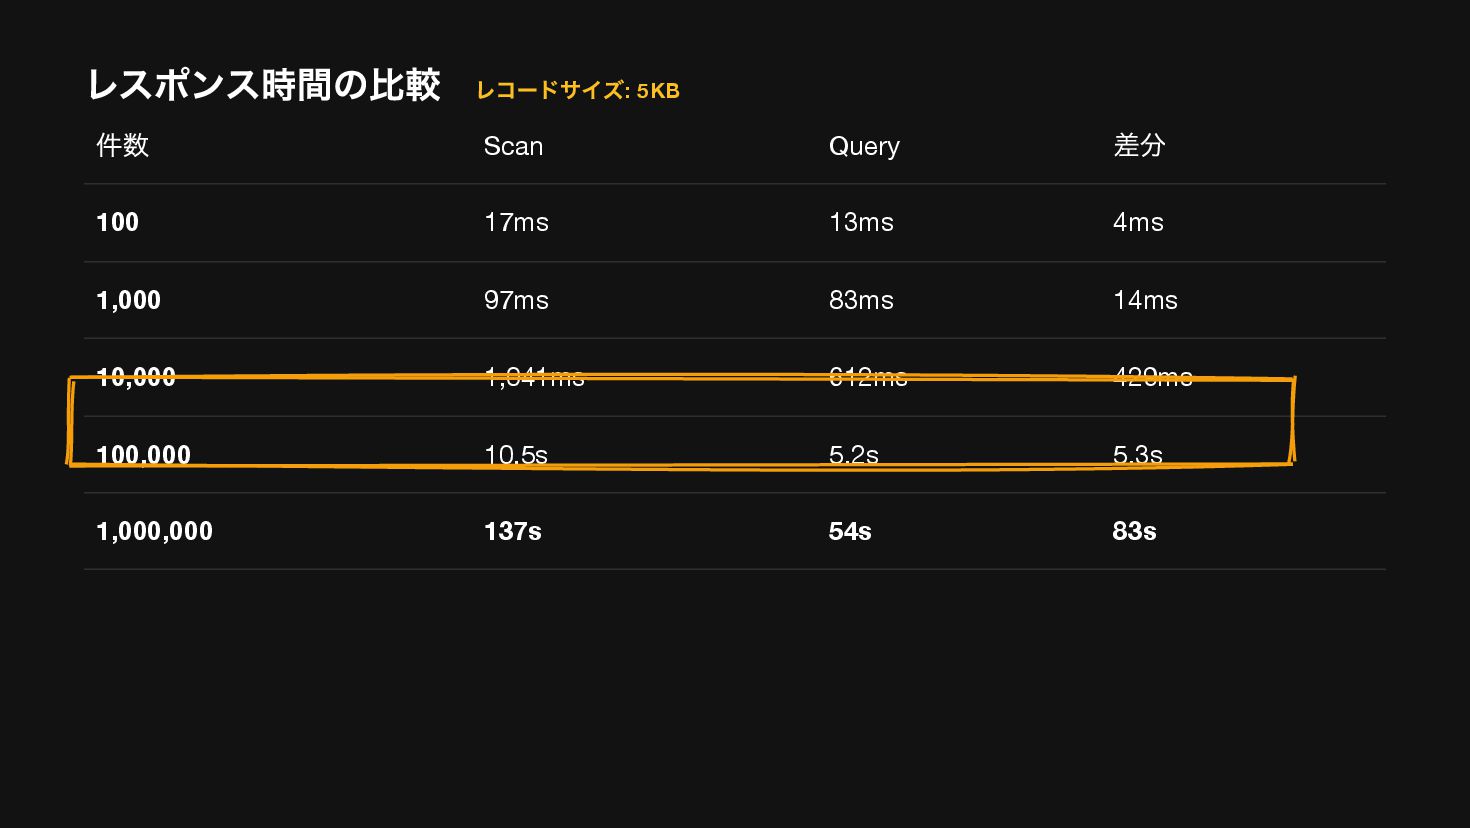
レスポンス時間の比較 レコードサイズ: 5KB 件数 Scan Query 差分 100 17ms 13ms
4ms 1,000 97ms 83ms 14ms 10,000 1,041ms 612ms 429ms 100,000 10.5s 5.2s 5.3s 1,000,000 137s 54s 83s
レスポンス時間の比較 レコードサイズ: 5KB 件数 Scan Query 差分 100 17ms 13ms
4ms 1,000 97ms 83ms 14ms 10,000 1,041ms 612ms 429ms 100,000 10.5s 5.2s 5.3s 1,000,000 137s 54s 83s
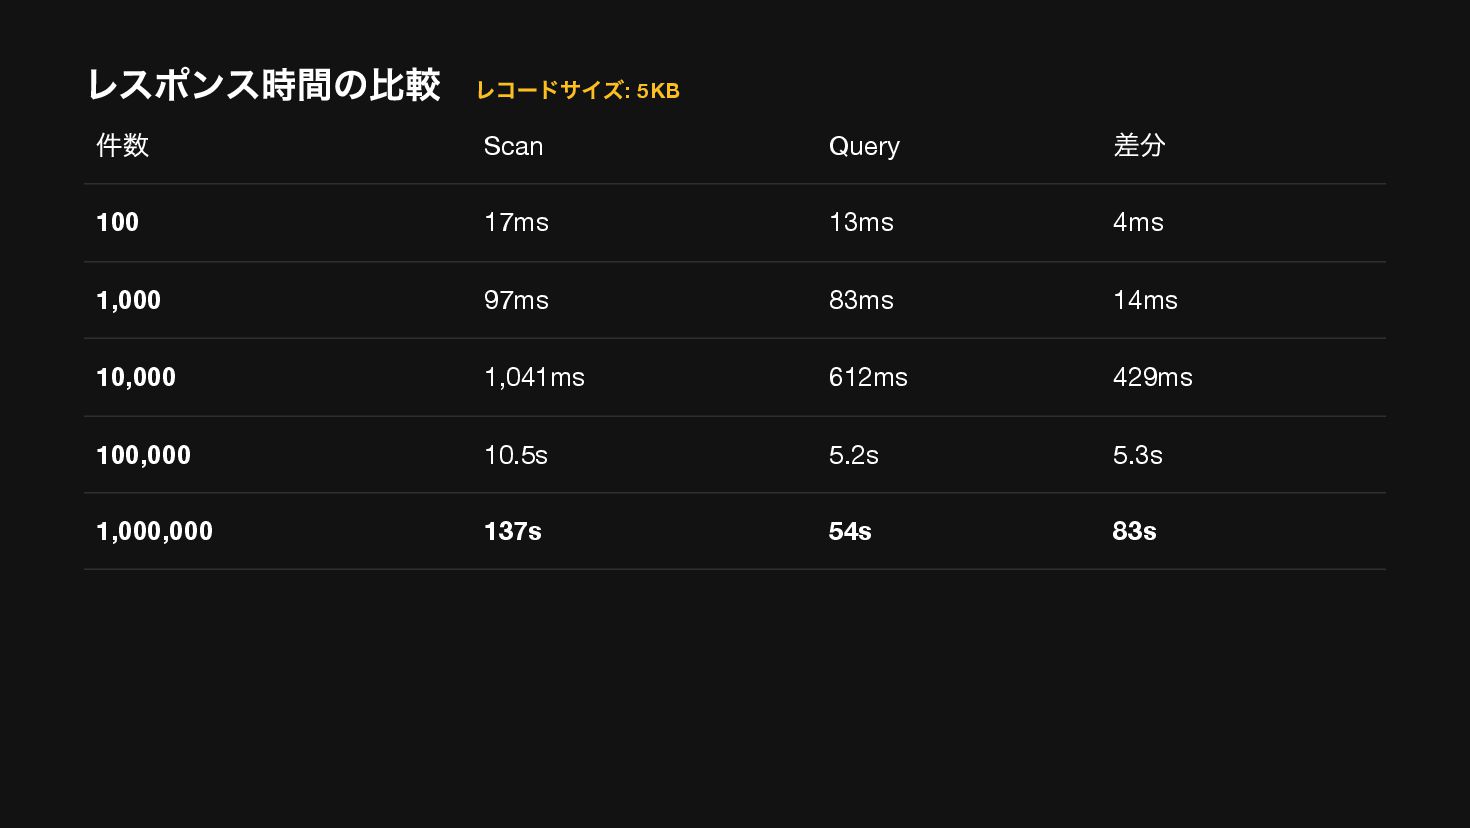
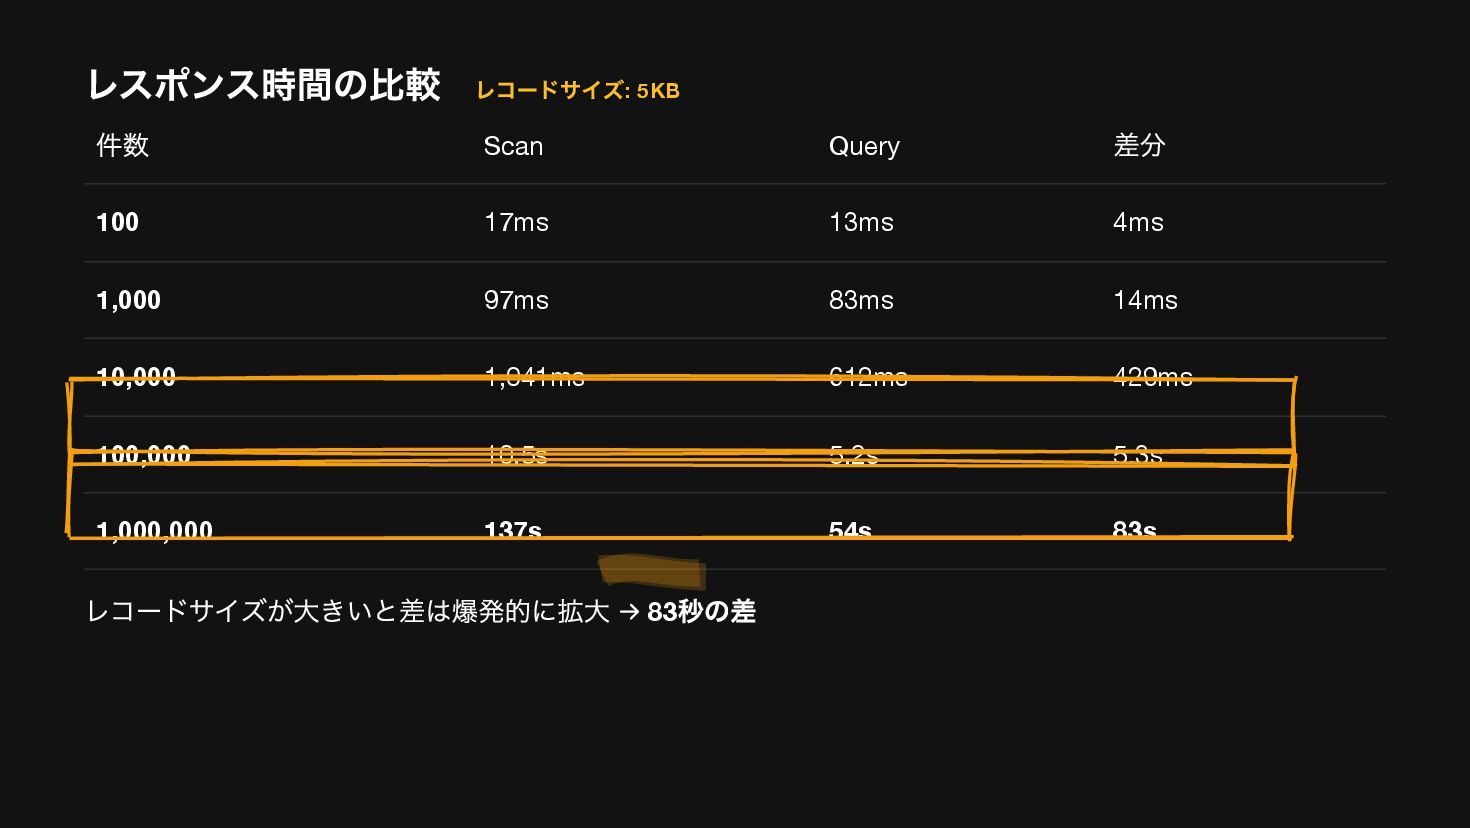
レスポンス時間の比較 レコードサイズ: 5KB 件数 Scan Query 差分 100 17ms 13ms
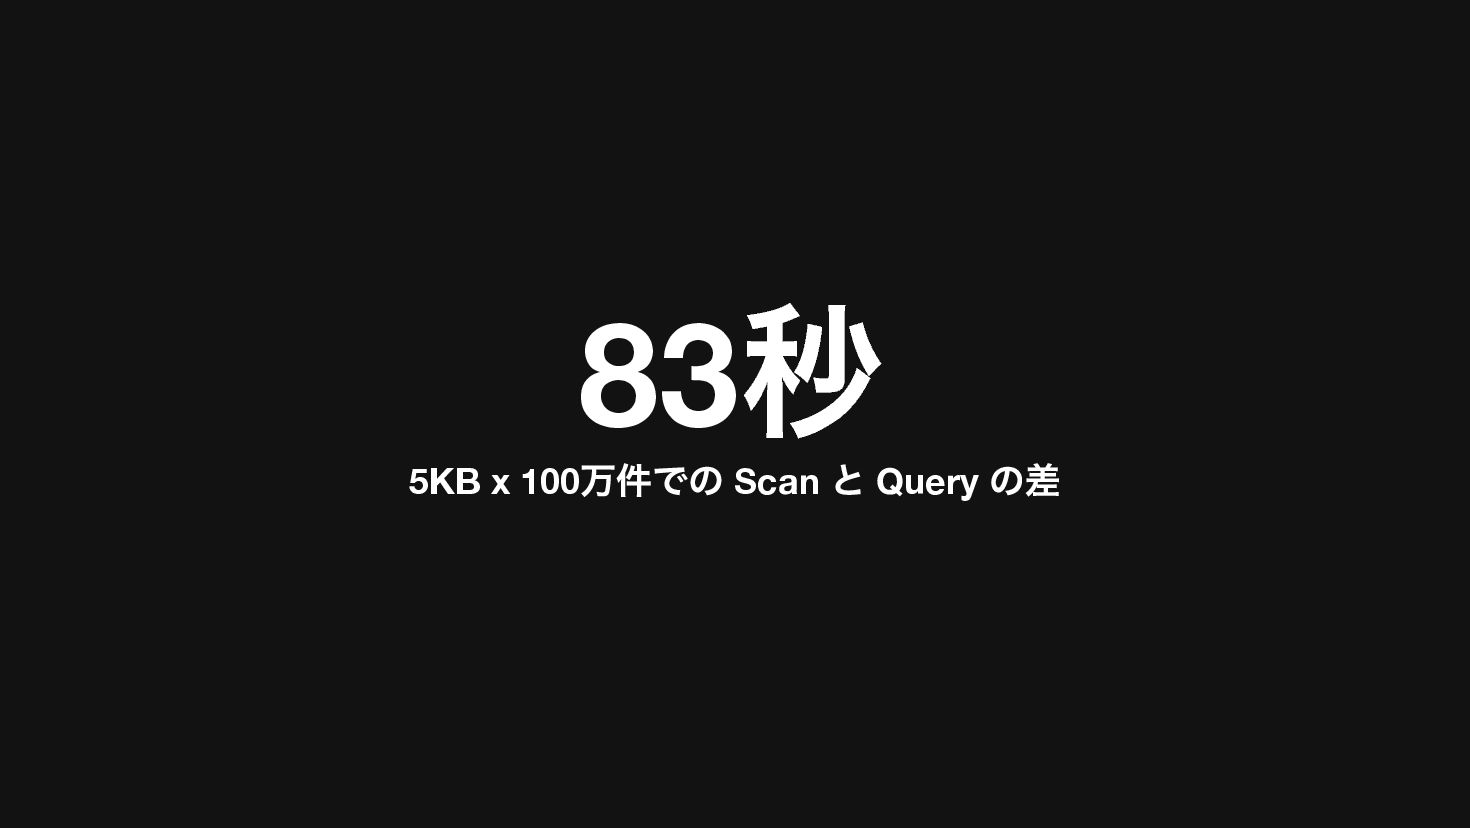
4ms 1,000 97ms 83ms 14ms 10,000 1,041ms 612ms 429ms 100,000 10.5s 5.2s 5.3s 1,000,000 137s 54s 83s レコードサイズが大きいと差は爆発的に拡大 → 83 秒の差
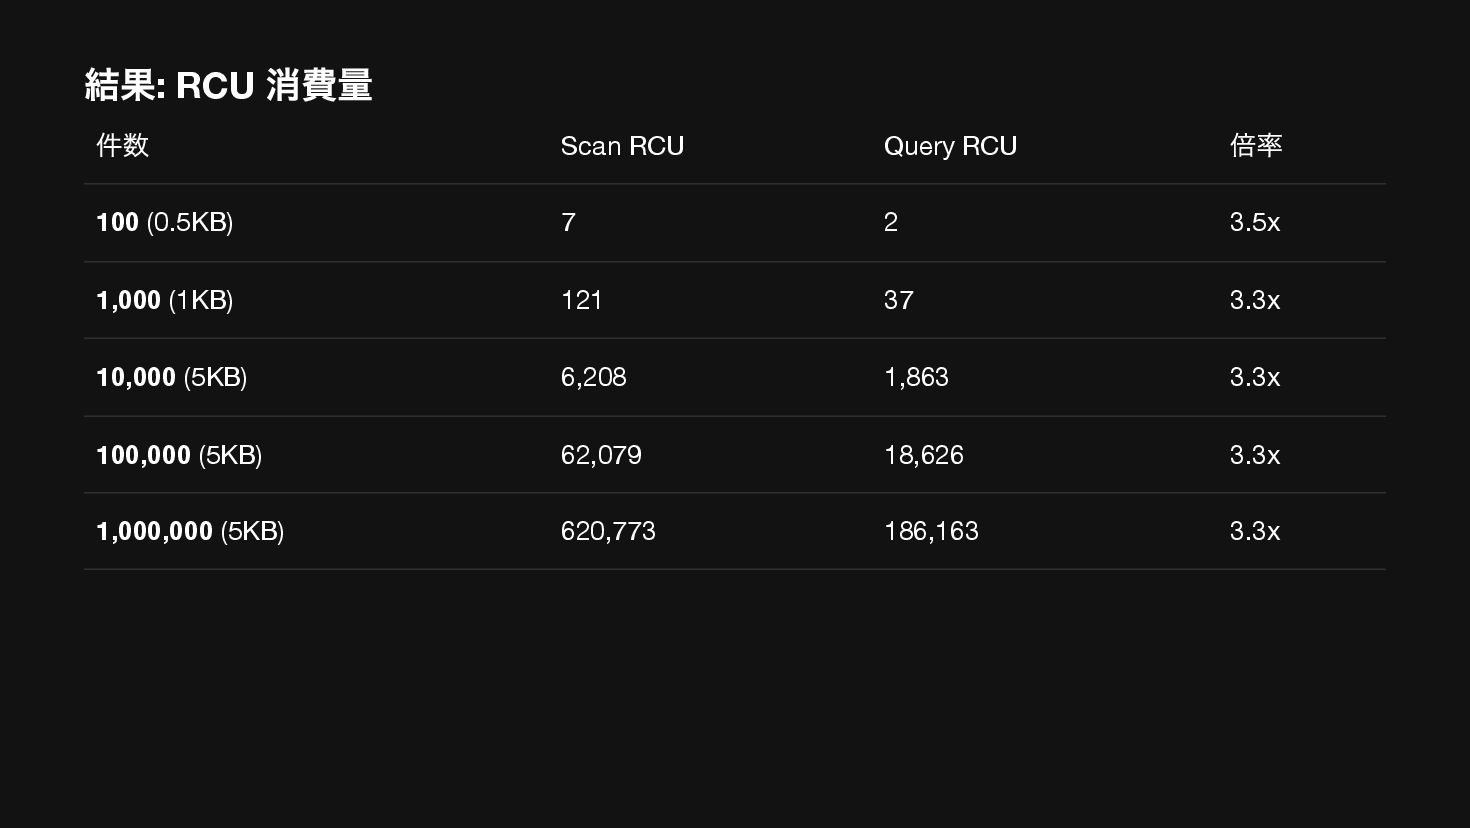
結果: RCU 消費量 件数 Scan RCU Query RCU 倍率 100
(0.5KB) 7 2 3.5x 1,000 (1KB) 121 37 3.3x 10,000 (5KB) 6,208 1,863 3.3x 100,000 (5KB) 62,079 18,626 3.3x 1,000,000 (5KB) 620,773 186,163 3.3x
結果: RCU 消費量 件数 Scan RCU Query RCU 倍率 100
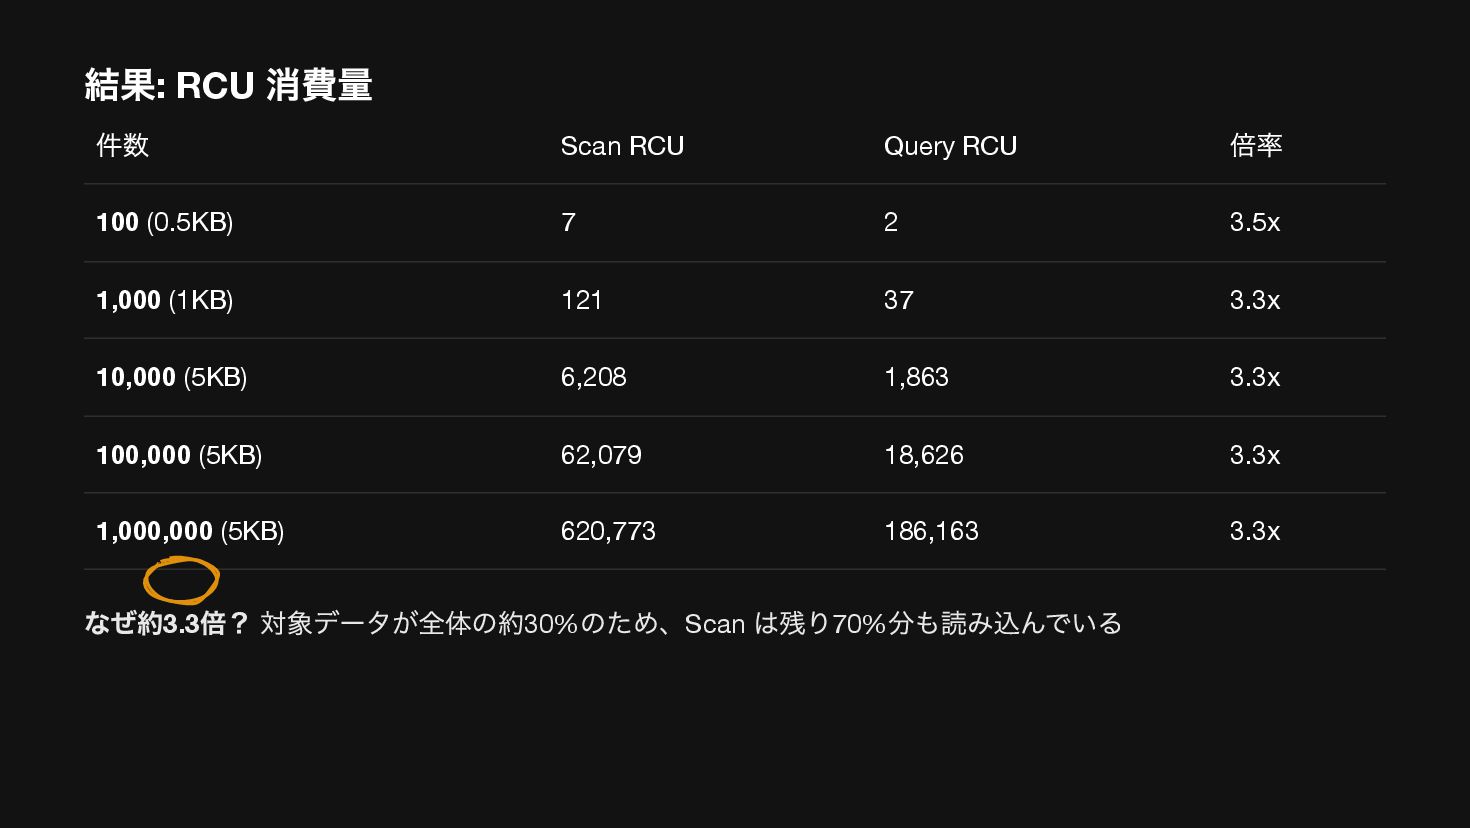
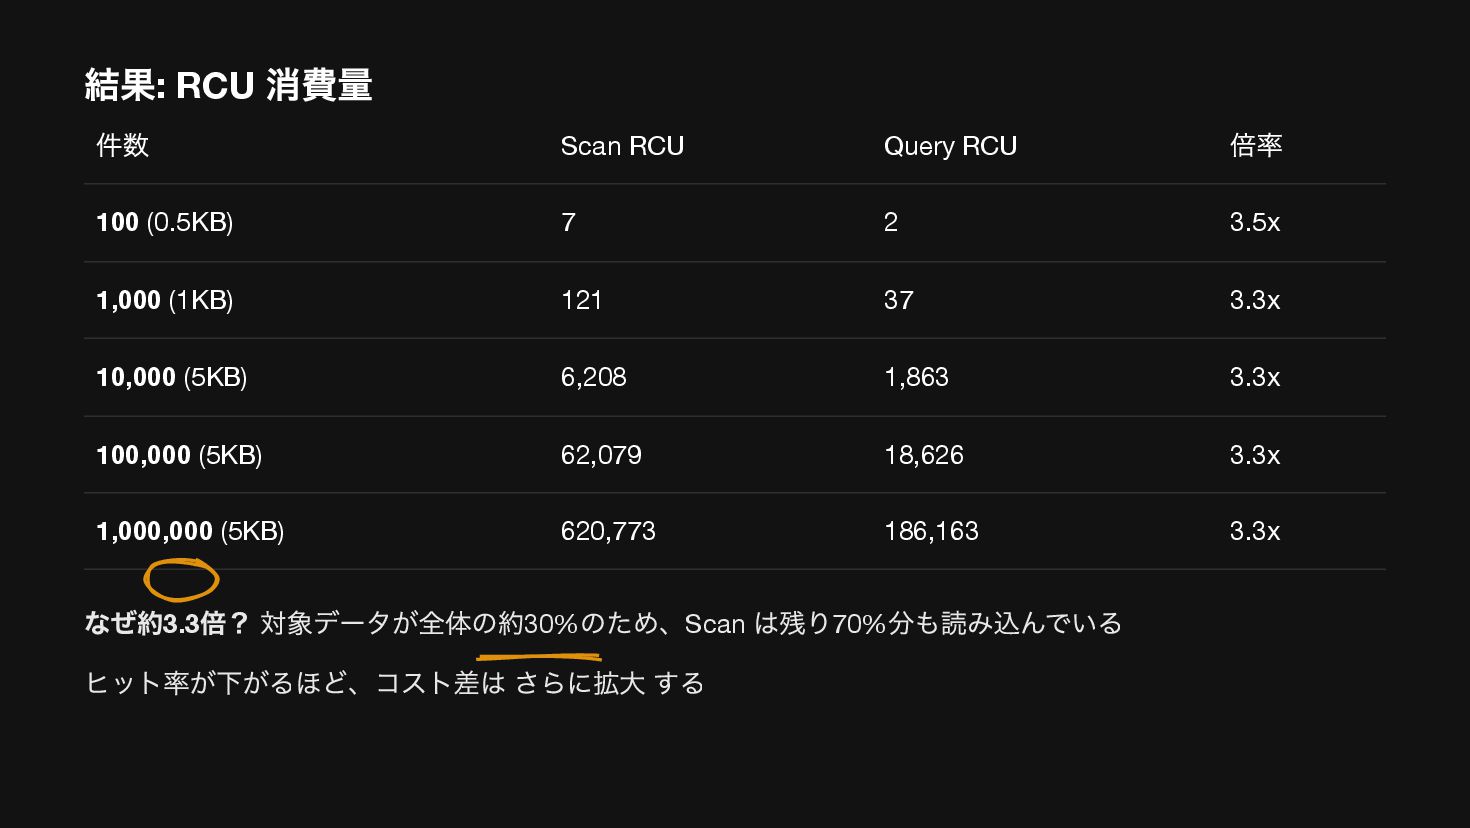
(0.5KB) 7 2 3.5x 1,000 (1KB) 121 37 3.3x 10,000 (5KB) 6,208 1,863 3.3x 100,000 (5KB) 62,079 18,626 3.3x 1,000,000 (5KB) 620,773 186,163 3.3x なぜ約3.3 倍? 対象データが全体の約30% のため、Scan は残り70% 分も読み込んでいる
結果: RCU 消費量 件数 Scan RCU Query RCU 倍率 100
(0.5KB) 7 2 3.5x 1,000 (1KB) 121 37 3.3x 10,000 (5KB) 6,208 1,863 3.3x 100,000 (5KB) 62,079 18,626 3.3x 1,000,000 (5KB) 620,773 186,163 3.3x なぜ約3.3 倍? 対象データが全体の約30% のため、Scan は残り70% 分も読み込んでいる ヒット率が下がるほど、コスト差は さらに拡大 する
83 秒 5KB x 100 万件での Scan と Query の差
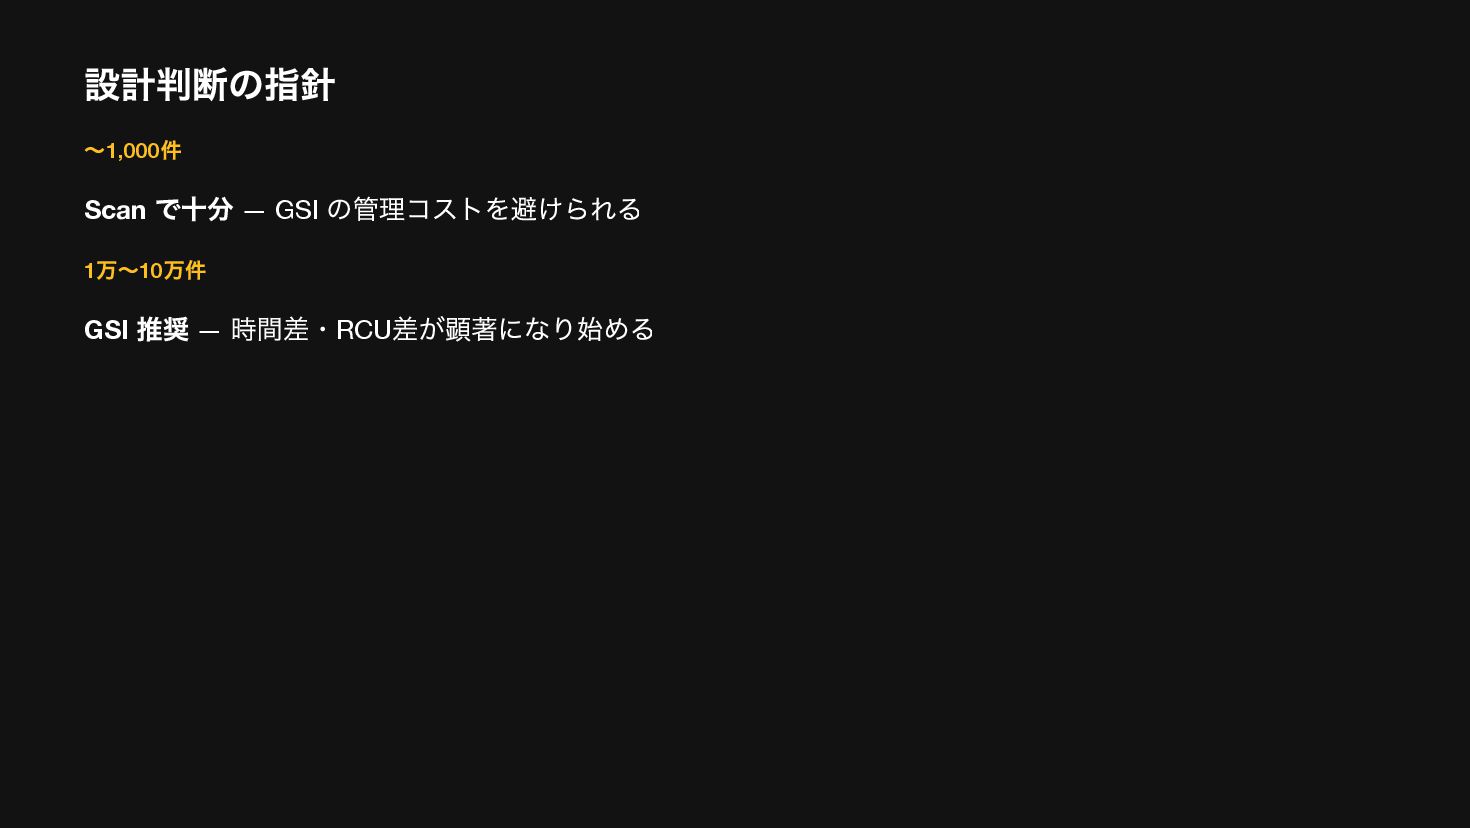
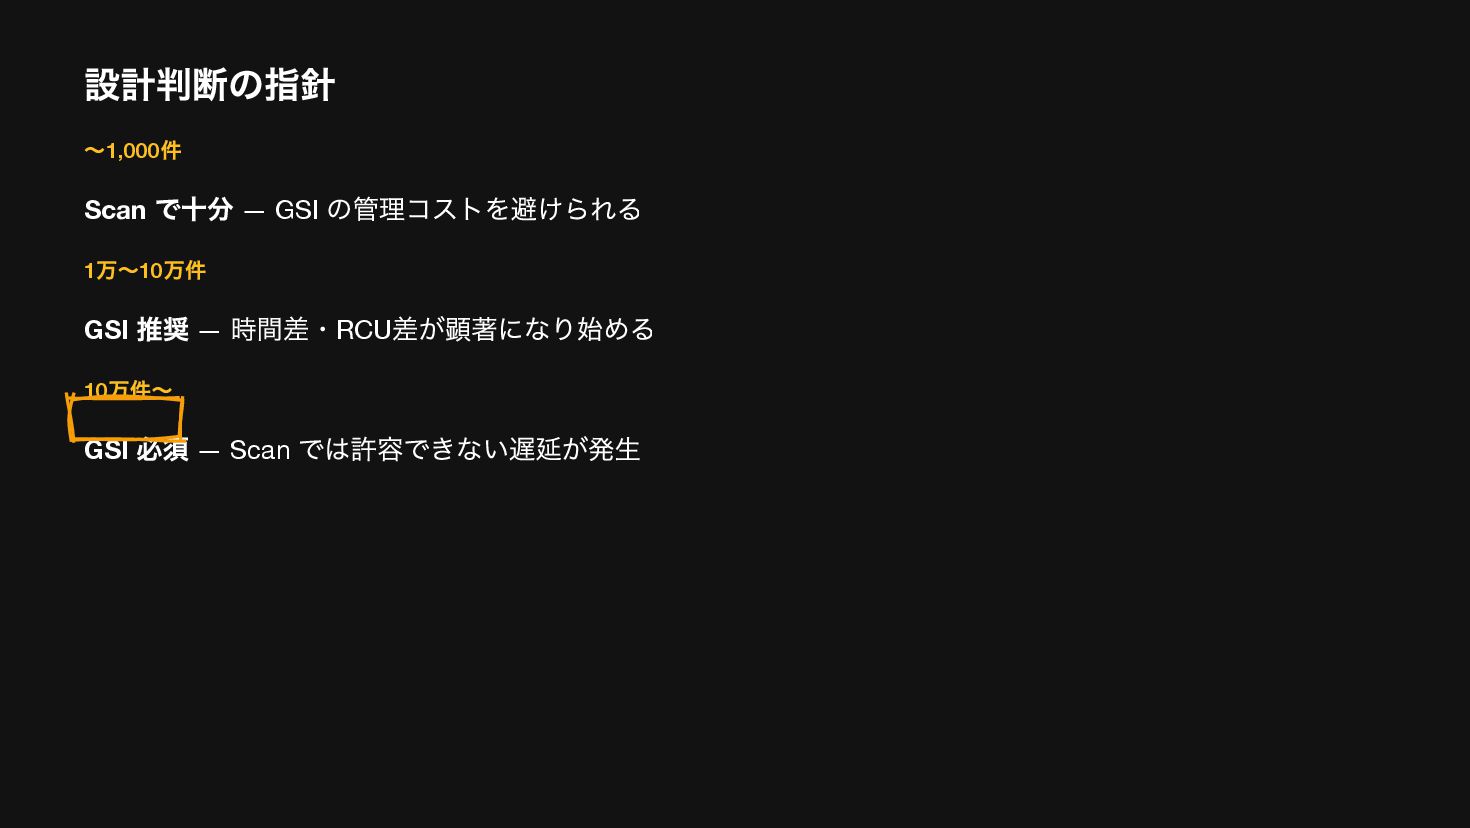
設計判断の指針
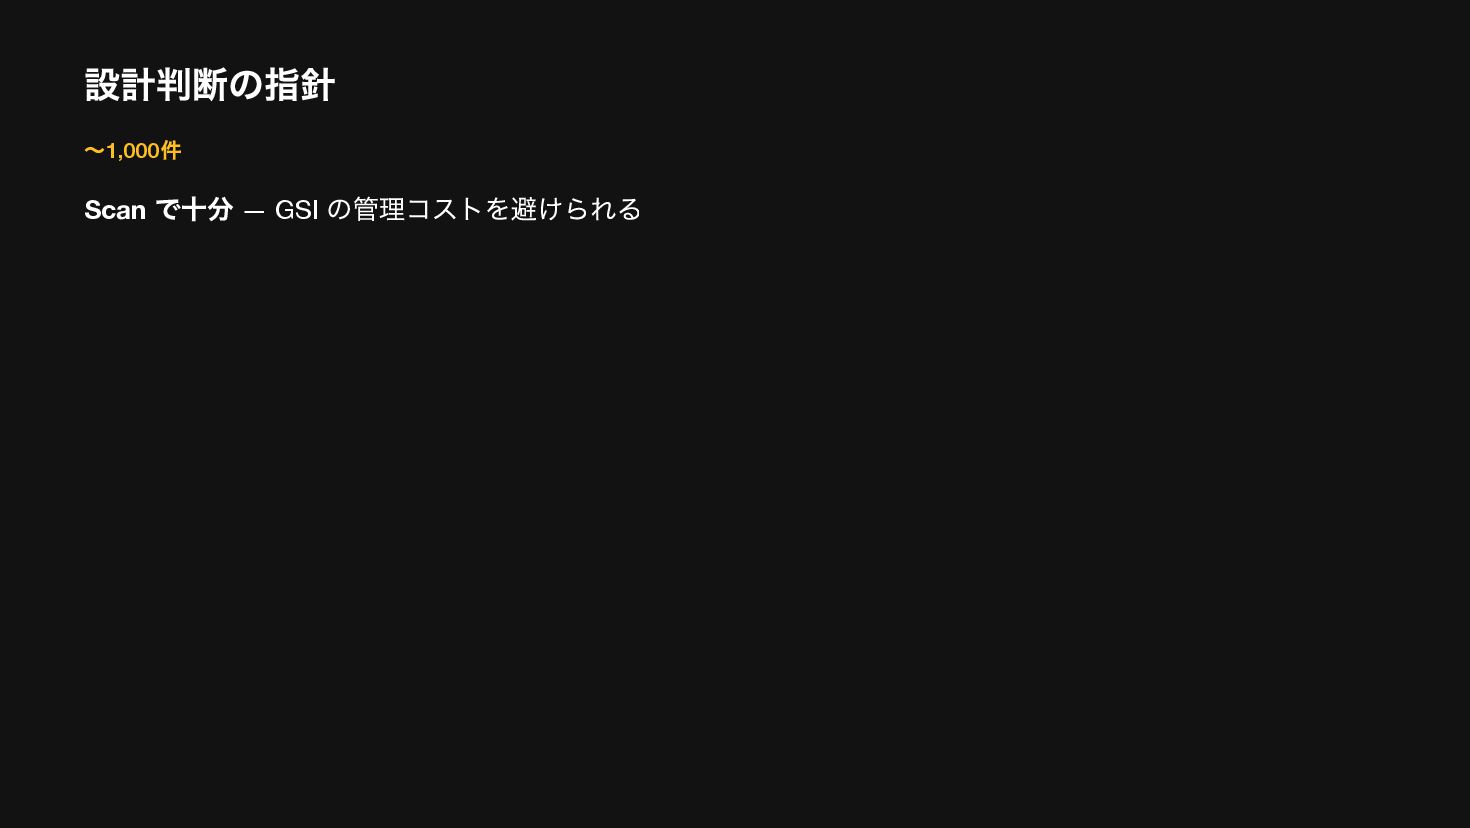
設計判断の指針 〜1,000 件 Scan で十分 — GSI の管理コストを避けられる
設計判断の指針 〜1,000 件 Scan で十分 — GSI の管理コストを避けられる 1 万〜10
万件 GSI 推奨 — 時間差・RCU 差が顕著になり始める
設計判断の指針 〜1,000 件 Scan で十分 — GSI の管理コストを避けられる 1 万〜10
万件 GSI 推奨 — 時間差・RCU 差が顕著になり始める 10 万件〜 GSI 必須 — Scan では許容できない遅延が発生
自分の手で検証する
ありがとうございました 詳細記事: DynamoDB Scan vs Query ベンチマーク検証 検証コード: github.com/HasutoSasaki/dynamodb-scan-vs-query-benchmark
More Decks by hasuto sasaki
See All by hasuto sasaki
あなたの await、OS まで届いてる? strace で覗く JavaScript の非同期
hasutosasaki
1
2.3k
筋トレ哲学_押し付け_トレーナーを作ってみた
hasutosasaki
0
520
AI Agent、思ってたのと違った
hasutosasaki
0
350
Featured
See All Featured
Why Our Code Smells
bkeepers
PRO
340
58k
Designing for Performance
lara
612
70k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.2k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
2
3.8k
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
470
Mind Mapping
helmedeiros
1
440
Information Architects: The Missing Link in Design Systems
soysaucechin
1
1.3k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
How to build a perfect <img>
jonoalderson
1
6.2k
Building Experiences: Design Systems, User Experience, and Full Site Editing
marktimemedia
1
660
Automating Front-end Workflow
addyosmani
1370
210k
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k


 hasutosasaki
 bkeepers
 lara
 aleyda
 uxyall
 marketingsoph
 helmedeiros
 soysaucechin
 aarron
 jonoalderson
 marktimemedia
 addyosmani
 eileencodes