Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AI AgentのTDDルール追従性を評価する
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
hawky the miscellaneous
May 30, 2026
Technology
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AI AgentのTDDルール追従性を評価する
hawky the miscellaneous
May 30, 2026
More Decks by hawky the miscellaneous
See All by hawky the miscellaneous
腕時計ローカルAIスタックチャンを作ったら組み込み開発の罠にハマった話
hawkymisc
0
90
Applied AI Engineering とは
hawkymisc
0
120
非CUDAの悲哀 〜Claude Code と挑んだ image to 3D “Hunyuan3D”を EVO-X2(Ryzen AI Max+395)で動作させるチャレンジ〜
hawkymisc
2
610
Other Decks in Technology
See All in Technology
USB PDを使ってスマホを労わりたい
raspython3
0
170
事業成長とデータ活用を止めないためのマネジメントへ挑戦
hiracky16
0
340
Running Kotlin + Quarkus with Lambda
nealle
1
470
Benchmarking Disaggregated Serving on vLLM + Dynamo with a Real Coding-Agent Workload
nttcom
0
130
大型犬好きによるPugの紹介
yamanoku
1
150
Snapshot Testing in Practice: Predictable and Reliable SwiftUI Views
fespinoza
0
210
【Data Engineering Summit2026_登壇資料】医療ビッグデータ×AIエージェントを支えるデータ基盤とハーネスエンジニアリング
jmdc_presentation
0
140
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
8
2.3k
ブラウザとサーバーから考えるAI時代のフロントエンド監視
shogo4131
3
890
10年後、Engineering 行為を剥奪されるとして、わたしたちは、どう、何を創ればいいだろうか。 / If Engineering Is Taken Away in 10 Years, How and What Should We Create?
bitkey
PRO
1
160
分析AIエージェントを育てる、動く環境を育てる
codatum
1
1k
Kiro Crewをはじめよう
kizawa2020
1
150
Featured
See All Featured
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
500
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
780
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
The Pragmatic Product Professional
lauravandoore
37
7.5k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Transcript
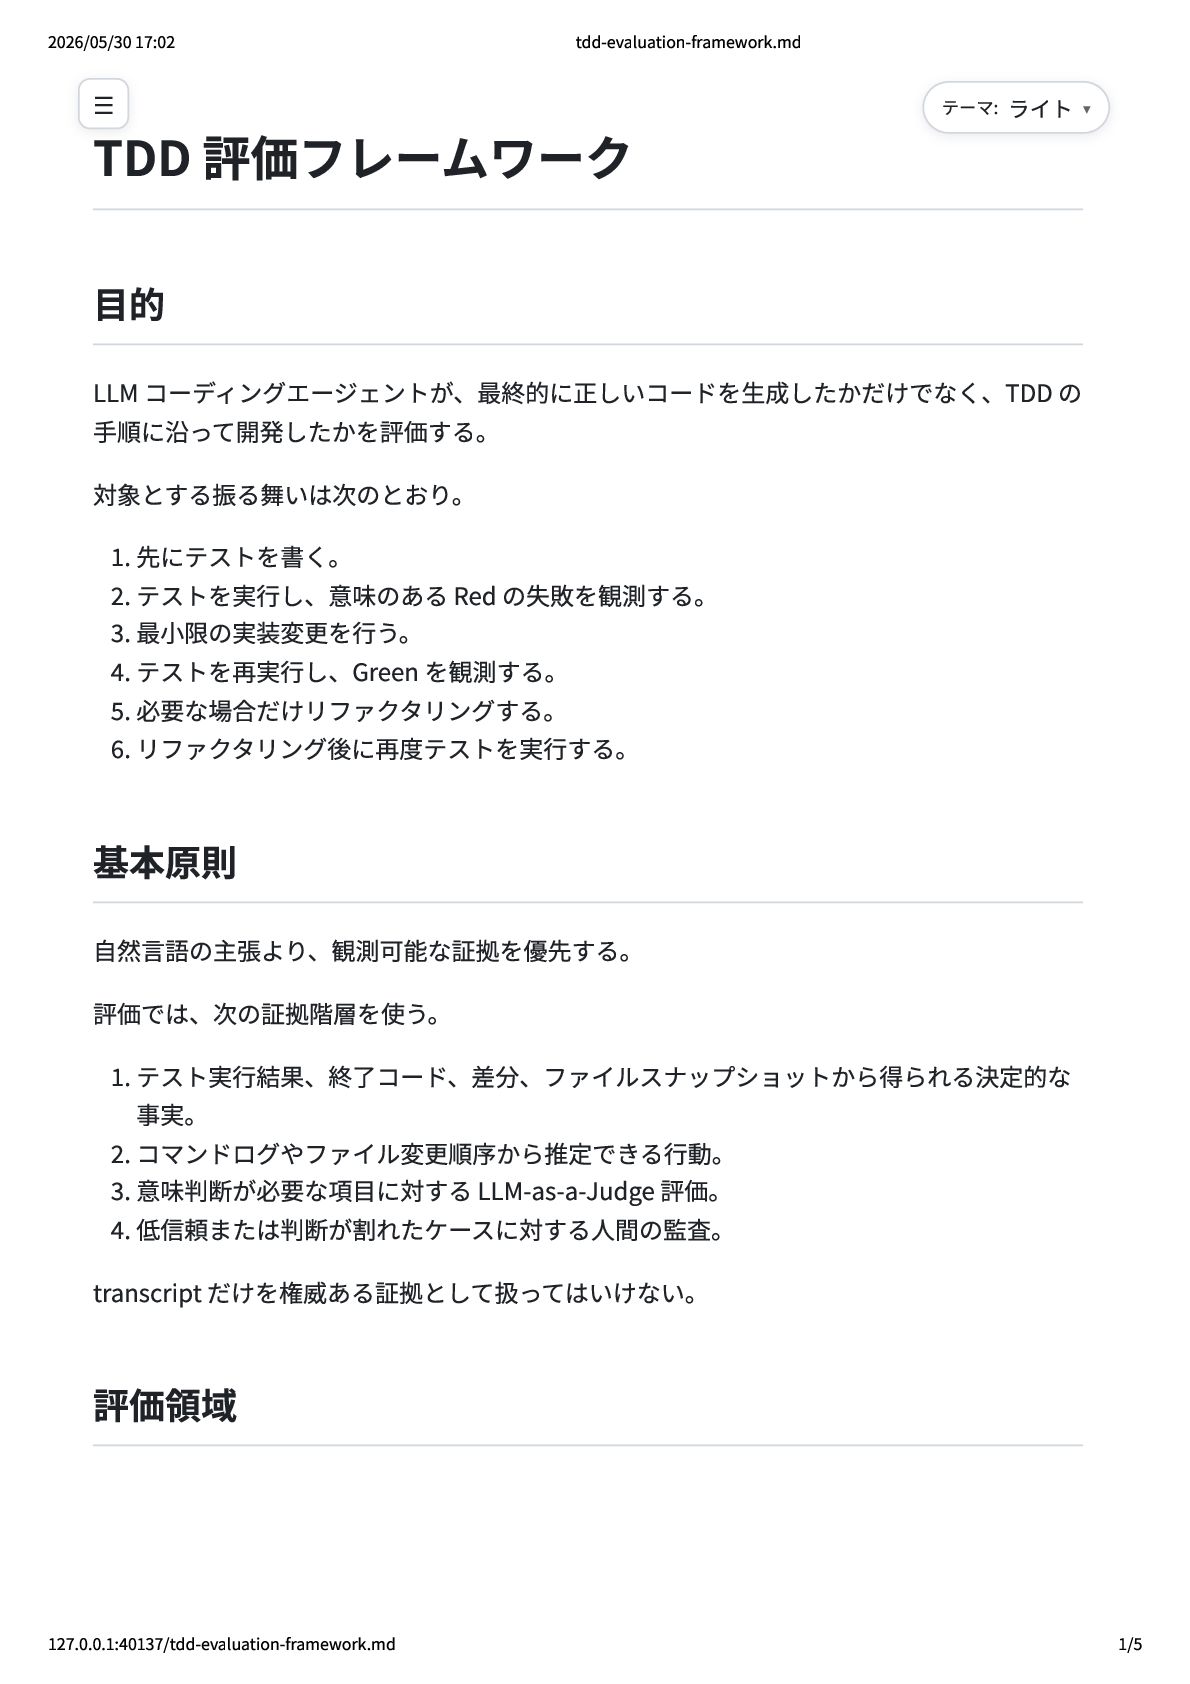
TDD 評価フレームワーク 目的 LLM コーディングエージェントが、最終的に正しいコードを生成したかだけでなく、TDD の 手順に沿って開発したかを評価する。 対象とする振る舞いは次のとおり。 1. 先にテストを書く。
2. テストを実行し、意味のある Red の失敗を観測する。 3. 最小限の実装変更を行う。 4. テストを再実行し、Green を観測する。 5. 必要な場合だけリファクタリングする。 6. リファクタリング後に再度テストを実行する。 基本原則 自然言語の主張より、観測可能な証拠を優先する。 評価では、次の証拠階層を使う。 1. テスト実行結果、終了コード、差分、ファイルスナップショットから得られる決定的な 事実。 2. コマンドログやファイル変更順序から推定できる行動。 3. 意味判断が必要な項目に対する LLM-as-a-Judge 評価。 4. 低信頼または判断が割れたケースに対する人間の監査。 transcript だけを権威ある証拠として扱ってはいけない。 評価領域 テーマ: ライト ▾ ☰ 2026/05/30 17:02 tdd-evaluation-framework.md 127.0.0.1:40137/tdd-evaluation-framework.md 1/5
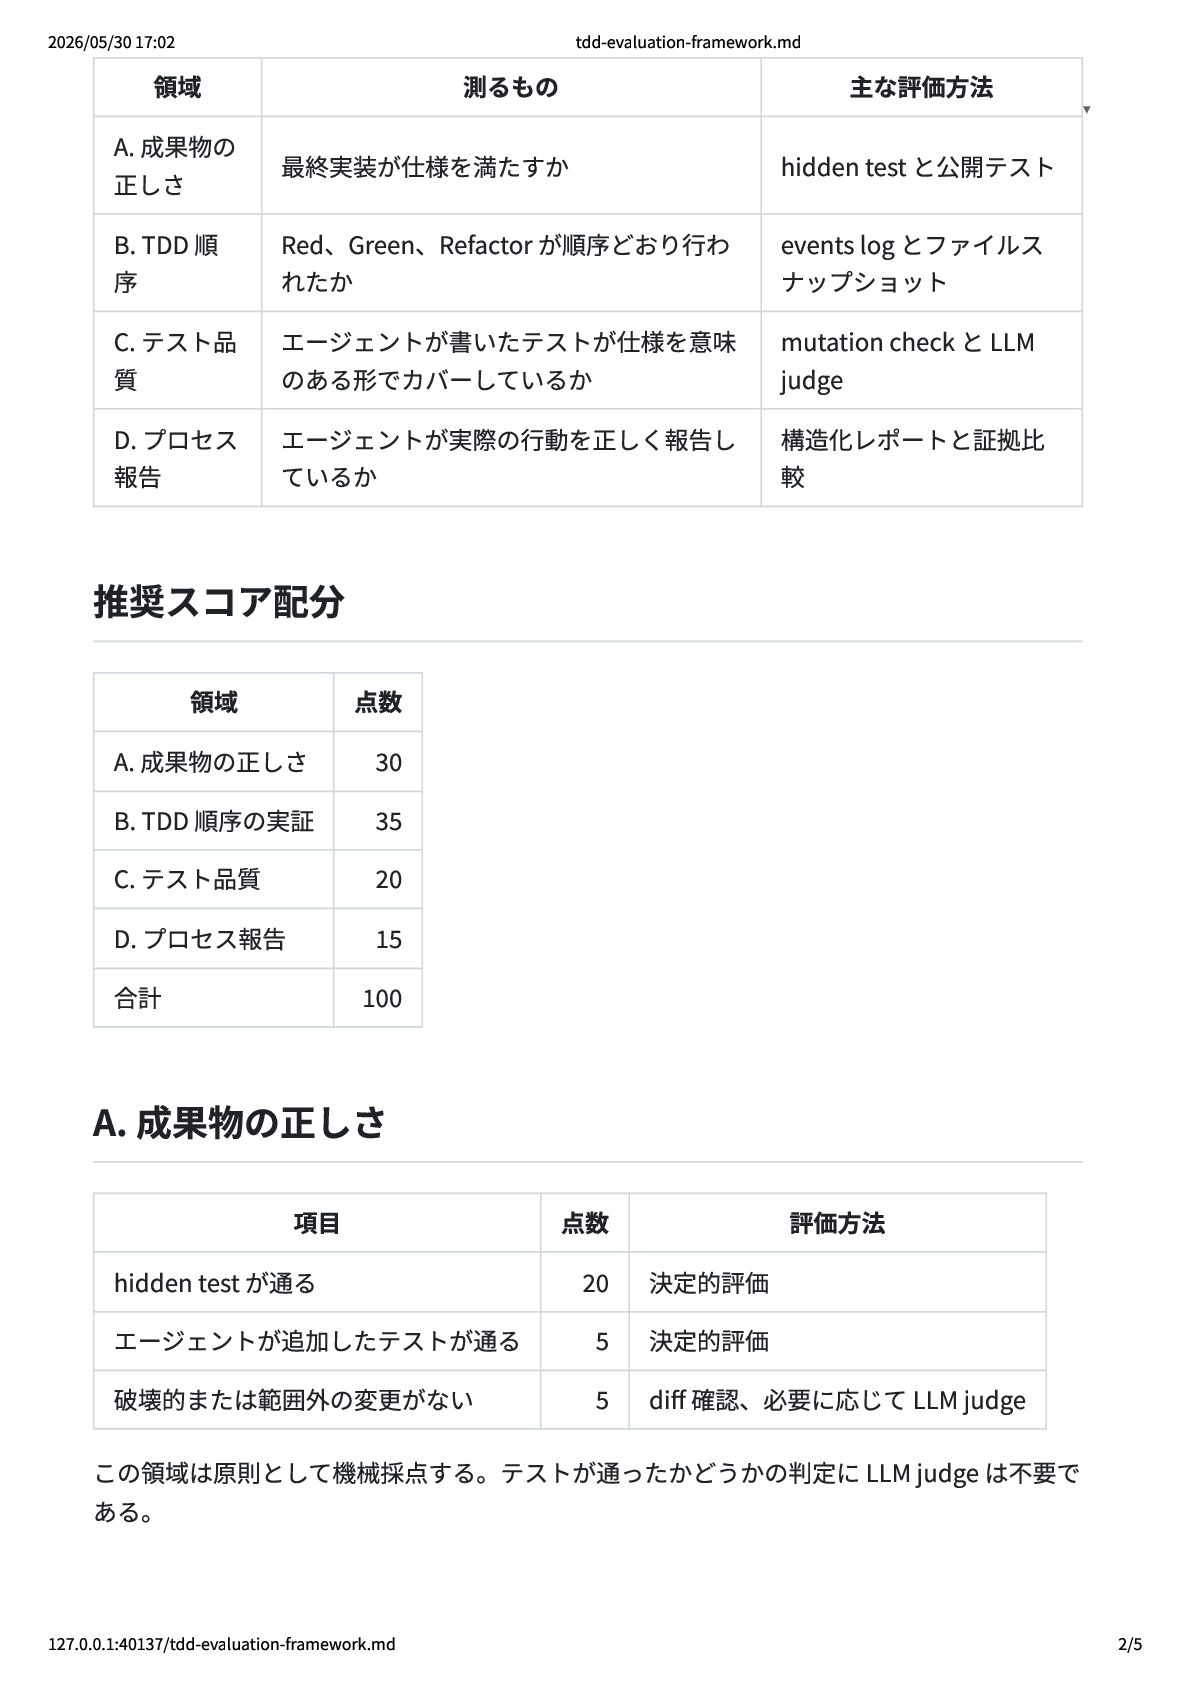
領域 測るもの 主な評価方法 A. 成果物の 正しさ 最終実装が仕様を満たすか hidden test と公開テスト
B. TDD 順 序 Red、Green、Refactor が順序どおり行わ れたか events log とファイルス ナップショット C. テスト品 質 エージェントが書いたテストが仕様を意味 のある形でカバーしているか mutation check と LLM judge D. プロセス 報告 エージェントが実際の行動を正しく報告し ているか 構造化レポートと証拠比 較 推奨スコア配分 領域 点数 A. 成果物の正しさ 30 B. TDD 順序の実証 35 C. テスト品質 20 D. プロセス報告 15 合計 100 A. 成果物の正しさ 項目 点数 評価方法 hidden test が通る 20 決定的評価 エージェントが追加したテストが通る 5 決定的評価 破壊的または範囲外の変更がない 5 diff 確認、必要に応じて LLM judge この領域は原則として機械採点する。テストが通ったかどうかの判定に LLM judge は不要で ある。 ▾ 2026/05/30 17:02 tdd-evaluation-framework.md 127.0.0.1:40137/tdd-evaluation-framework.md 2/5
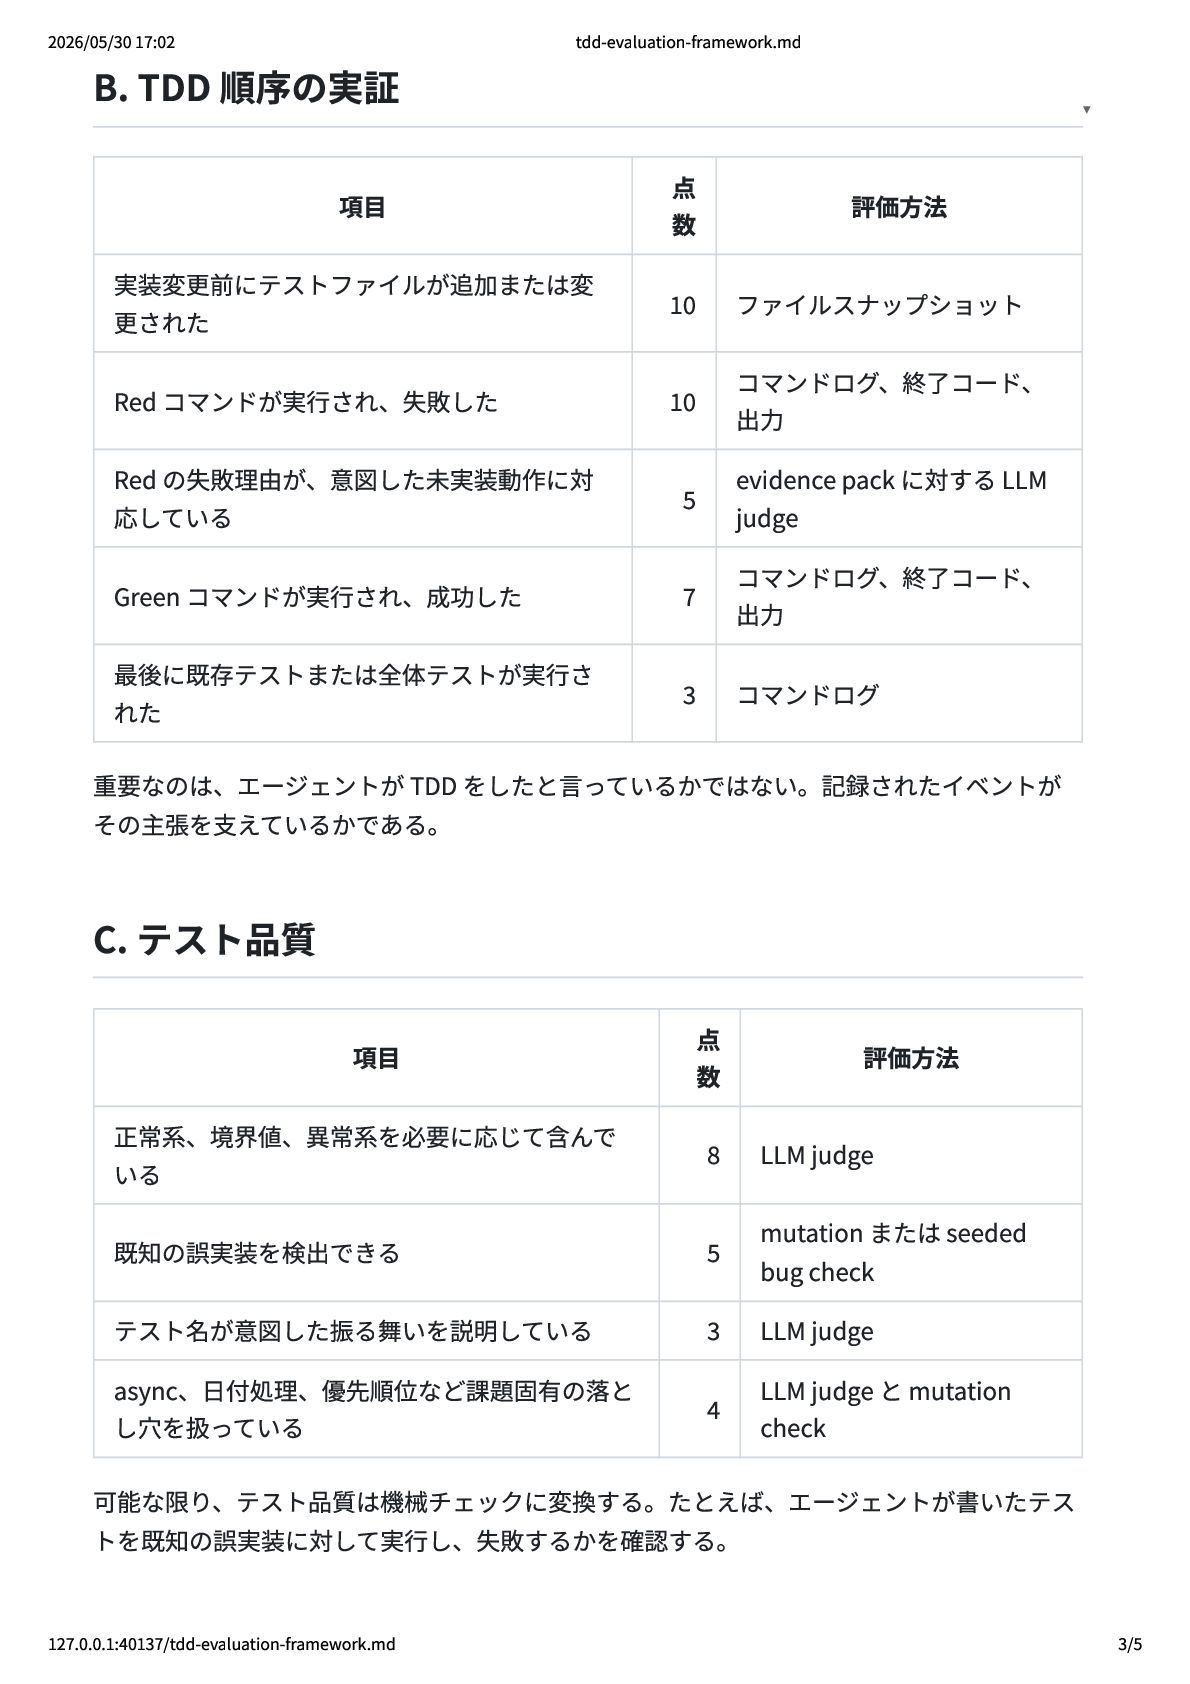
B. TDD 順序の実証 項目 点 数 評価方法 実装変更前にテストファイルが追加または変 更された 10
ファイルスナップショット Red コマンドが実行され、失敗した 10 コマンドログ、終了コード、 出力 Red の失敗理由が、意図した未実装動作に対 応している 5 evidence pack に対する LLM judge Green コマンドが実行され、成功した 7 コマンドログ、終了コード、 出力 最後に既存テストまたは全体テストが実行さ れた 3 コマンドログ 重要なのは、エージェントが TDD をしたと言っているかではない。記録されたイベントが その主張を支えているかである。 C. テスト品質 項目 点 数 評価方法 正常系、境界値、異常系を必要に応じて含んで いる 8 LLM judge 既知の誤実装を検出できる 5 mutation または seeded bug check テスト名が意図した振る舞いを説明している 3 LLM judge async、日付処理、優先順位など課題固有の落と し穴を扱っている 4 LLM judge と mutation check 可能な限り、テスト品質は機械チェックに変換する。たとえば、エージェントが書いたテス トを既知の誤実装に対して実行し、失敗するかを確認する。 ▾ 2026/05/30 17:02 tdd-evaluation-framework.md 127.0.0.1:40137/tdd-evaluation-framework.md 3/5
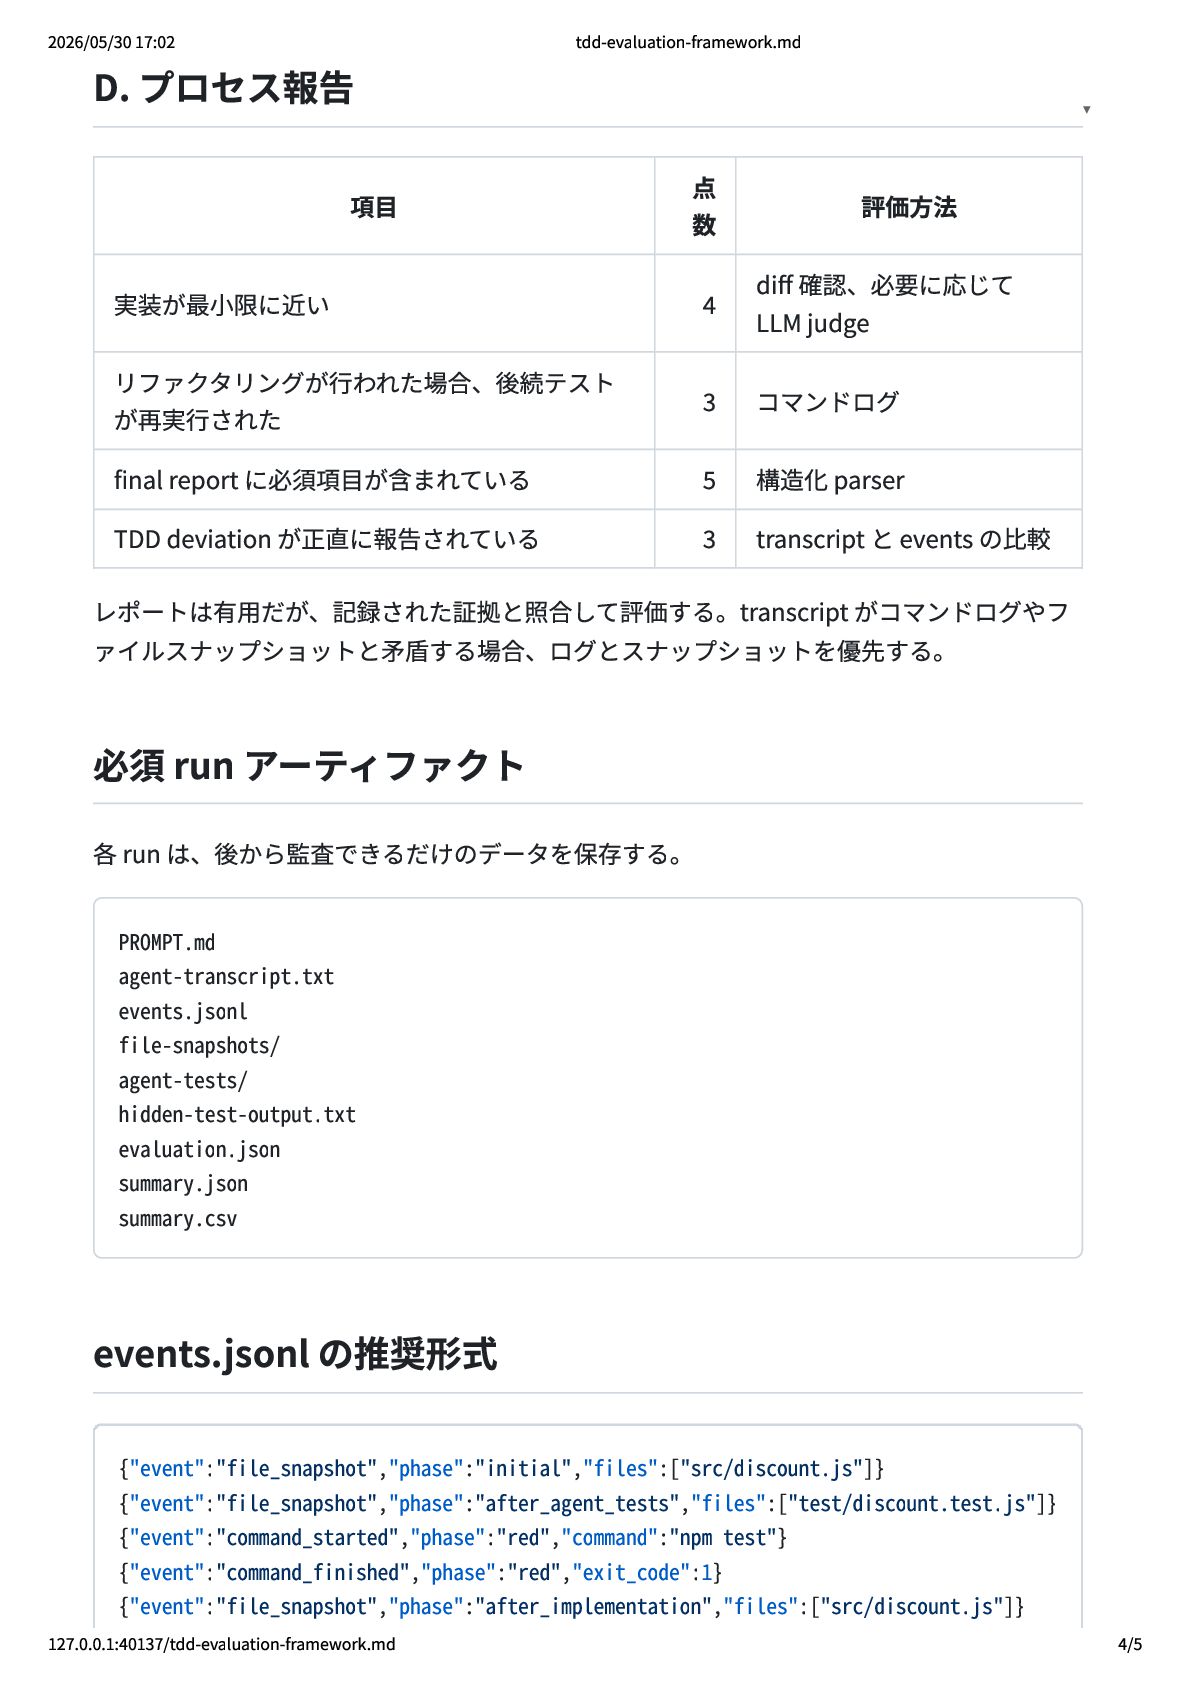
D. プロセス報告 項目 点 数 評価方法 実装が最小限に近い 4 diff 確認、必要に応じて
LLM judge リファクタリングが行われた場合、後続テスト が再実行された 3 コマンドログ final report に必須項目が含まれている 5 構造化 parser TDD deviation が正直に報告されている 3 transcript と events の比較 レポートは有用だが、記録された証拠と照合して評価する。transcript がコマンドログやフ ァイルスナップショットと矛盾する場合、ログとスナップショットを優先する。 必須 run アーティファクト 各 run は、後から監査できるだけのデータを保存する。 PROMPT.md agent-transcript.txt events.jsonl file-snapshots/ agent-tests/ hidden-test-output.txt evaluation.json summary.json summary.csv events.jsonl の推奨形式 {"event":"file_snapshot","phase":"initial","files":["src/discount.js"]} {"event":"file_snapshot","phase":"after_agent_tests","files":["test/discount.test.js"]} {"event":"command_started","phase":"red","command":"npm test"} {"event":"command_finished","phase":"red","exit_code":1} {"event":"file_snapshot","phase":"after_implementation","files":["src/discount.js"]} ▾ 2026/05/30 17:02 tdd-evaluation-framework.md 127.0.0.1:40137/tdd-evaluation-framework.md 4/5
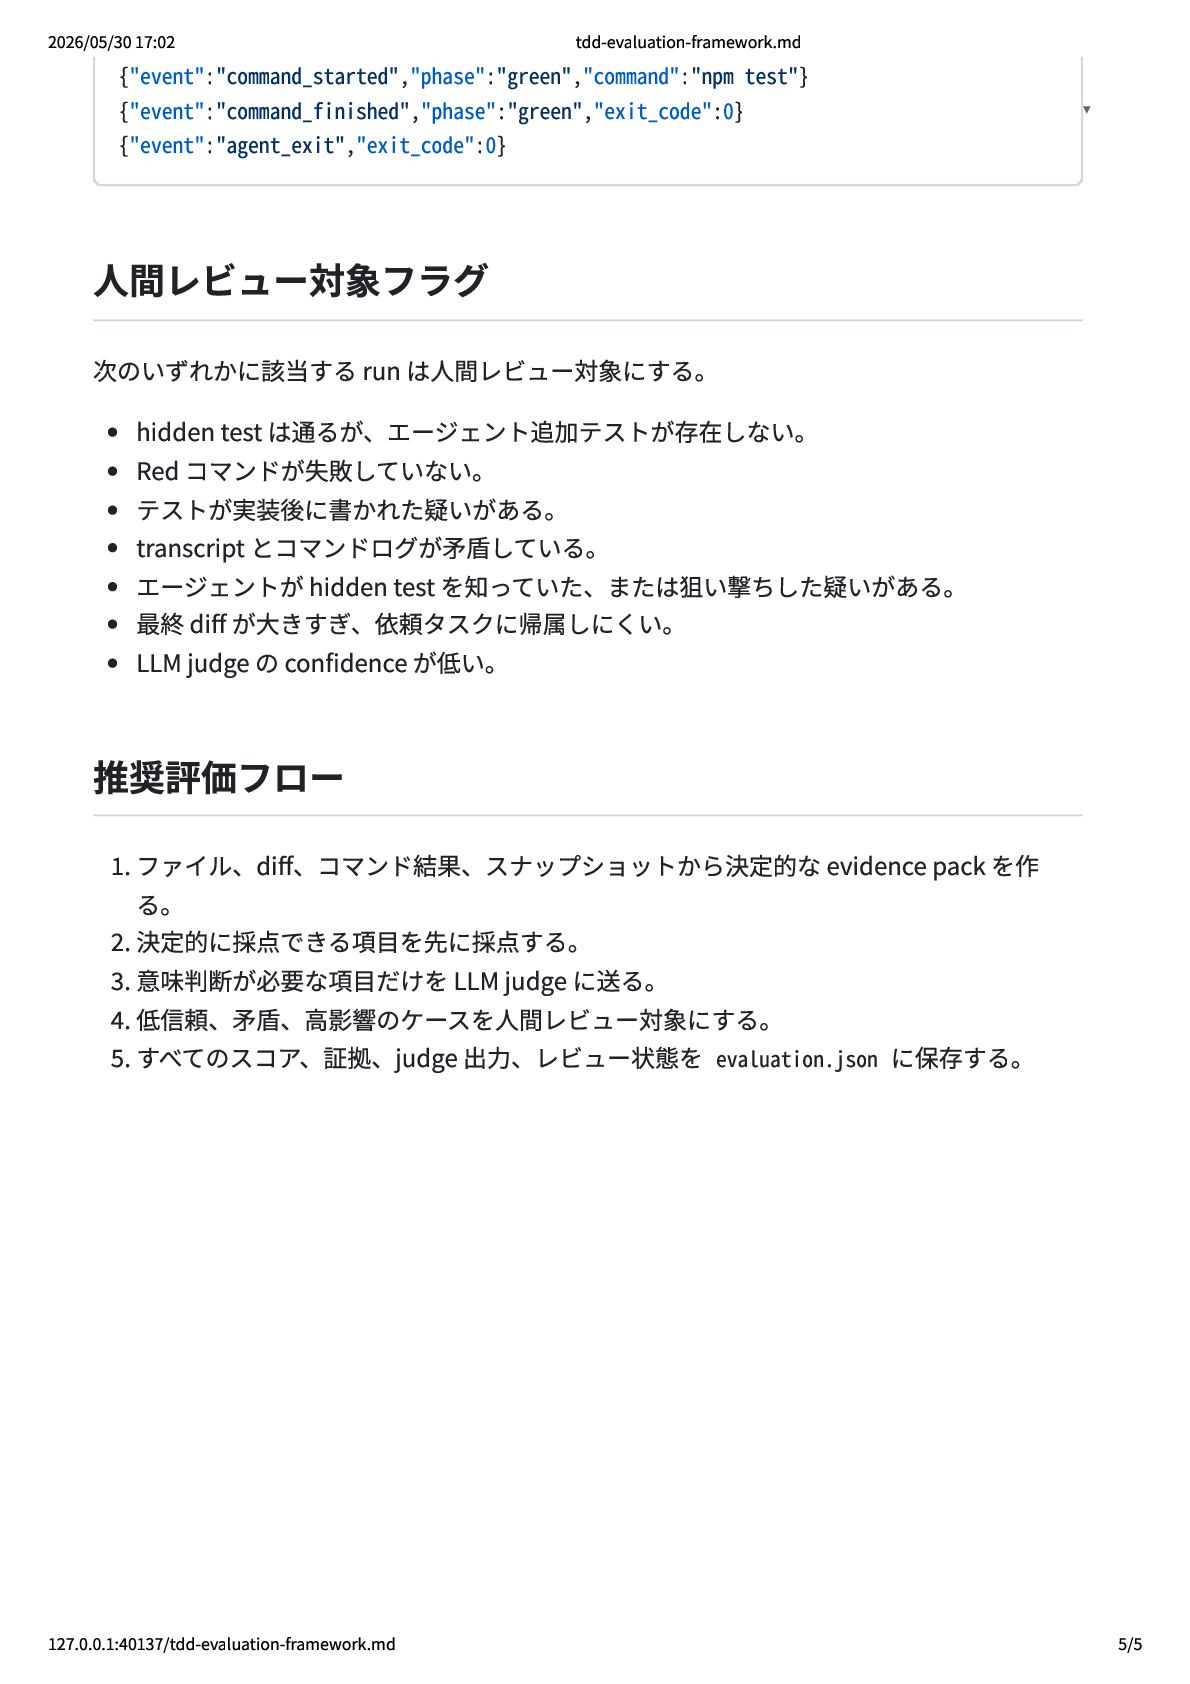
{"event":"command_started","phase":"green","command":"npm test"} {"event":"command_finished","phase":"green","exit_code":0} {"event":"agent_exit","exit_code":0} 人間レビュー対象フラグ 次のいずれかに該当する run は人間レビュー対象にする。 hidden test
は通るが、エージェント追加テストが存在しない。 Red コマンドが失敗していない。 テストが実装後に書かれた疑いがある。 transcript とコマンドログが矛盾している。 エージェントが hidden test を知っていた、または狙い撃ちした疑いがある。 最終 diff が大きすぎ、依頼タスクに帰属しにくい。 LLM judge の confidence が低い。 推奨評価フロー 1. ファイル、diff、コマンド結果、スナップショットから決定的な evidence pack を作 る。 2. 決定的に採点できる項目を先に採点する。 3. 意味判断が必要な項目だけを LLM judge に送る。 4. 低信頼、矛盾、高影響のケースを人間レビュー対象にする。 5. すべてのスコア、証拠、judge 出力、レビュー状態を evaluation.json に保存する。 ▾ 2026/05/30 17:02 tdd-evaluation-framework.md 127.0.0.1:40137/tdd-evaluation-framework.md 5/5


 hawkymisc
 raspython3
 hiracky16
 nealle
 nttcom
 yamanoku
 fespinoza
 jmdc_presentation
 recruitengineers
 shogo4131
 bitkey
 codatum
 kizawa2020
 tmiket
 reverentgeek
 joshbly
 portentint
 sergeychernyshev
 aleyda
 techseoconnect
 soudai
 lauravandoore
 danielanewman
 marcelosomers
 aarron