Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
超⼩型・多⾔語検索モデル Bekko Embedding
Search
Yuichi Tateno
November 01, 2026
Technology
97
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
超⼩型・多⾔語検索モデル Bekko Embedding
https://search-tech.connpass.com/event/404880/
での発表資料です
Yuichi Tateno
November 01, 2026
More Decks by Yuichi Tateno
See All by Yuichi Tateno
HAKARI-Bench - 実運用視点での情報検索モデル評価ベンチマーク
hotchpotch
1
850
OpenProvence - クエリに関連しない文章削除モデル日本語版の作成と公開
hotchpotch
2
2k
Ask! NIKKEI RAG検索技術の深層
hotchpotch
22
14k
react-navigation について
hotchpotch
3
2.3k
ユーザのために技術をどう活かすか
hotchpotch
27
21k
GlitchKit
hotchpotch
1
3.5k
クラウドを使った ユーザ向けサービス開発の面白さ
hotchpotch
3
1.4k
pull request を利用した開発ワークフロー
hotchpotch
141
53k
料理を支える技術2012
hotchpotch
10
11k
Other Decks in Technology
See All in Technology
Devin プロモコードの受け取りと適用(2026.10.27)
kinopeee
1
860
Building Audio Plugin Ecosystem for Android in 2026
atsushieno
2
140
20261031_IoTLT_vol140_kitazaki_v1.pdf
kitazaki
0
170
[re:Invent2026事前勉強会(有志開催)]続きは、ラスベガスの廊下で / continue-in-the-vegas-hallway
sh_fk2
0
510
アクセラレーターで実現するServiceNow活用の高速化 / ServiceNow World Forum 2026
visional_engineering_and_design
0
130
Claude Codeから見る、エンジニアの世界の変容とその先
oikon48
8
5.4k
reInvent2026stby LT00 "Change your life!"
shinichirokawano
1
570
セキュリティ専任チームなしで攻撃を先回りするSREが実践したSIEM on Amazon OpenSearch Service
cscengineer
PRO
0
110
Maestro MCPとClaude Code Skillsによる自律的なE2Eテスト支援
asmz
0
410
増え続けるプロダクトの品質をどう担保するか。ProductSpecとTypeScriptによる取り組み
joere
3
380
試験勉強はGrokBotでやれ
maigo999
0
110
企画からFlutter実装まで、1つの機能を一貫して開発したプロセスと成果物
khiroyuki1003
1
150
Featured
See All Featured
Building AI with AI
inesmontani
PRO
1
1.4k
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
560
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
830
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.2k
Exploring the Power of Turbo Streams & Action Cable | RailsConf2023
kevinliebholz
37
6.7k
Color Theory Basics | Prateek | Gurzu
gurzu
1
510
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
320
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
WCS-LA-2024
lcolladotor
0
970
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
590
Transcript
超小型・多言語検索モデル Bekko Embedding 舘野 祐一 / @hotchpotch / id:secondlife Search
Engineering Tech Talk 2026 Autumn ・ 2026/10/29
で、誰?
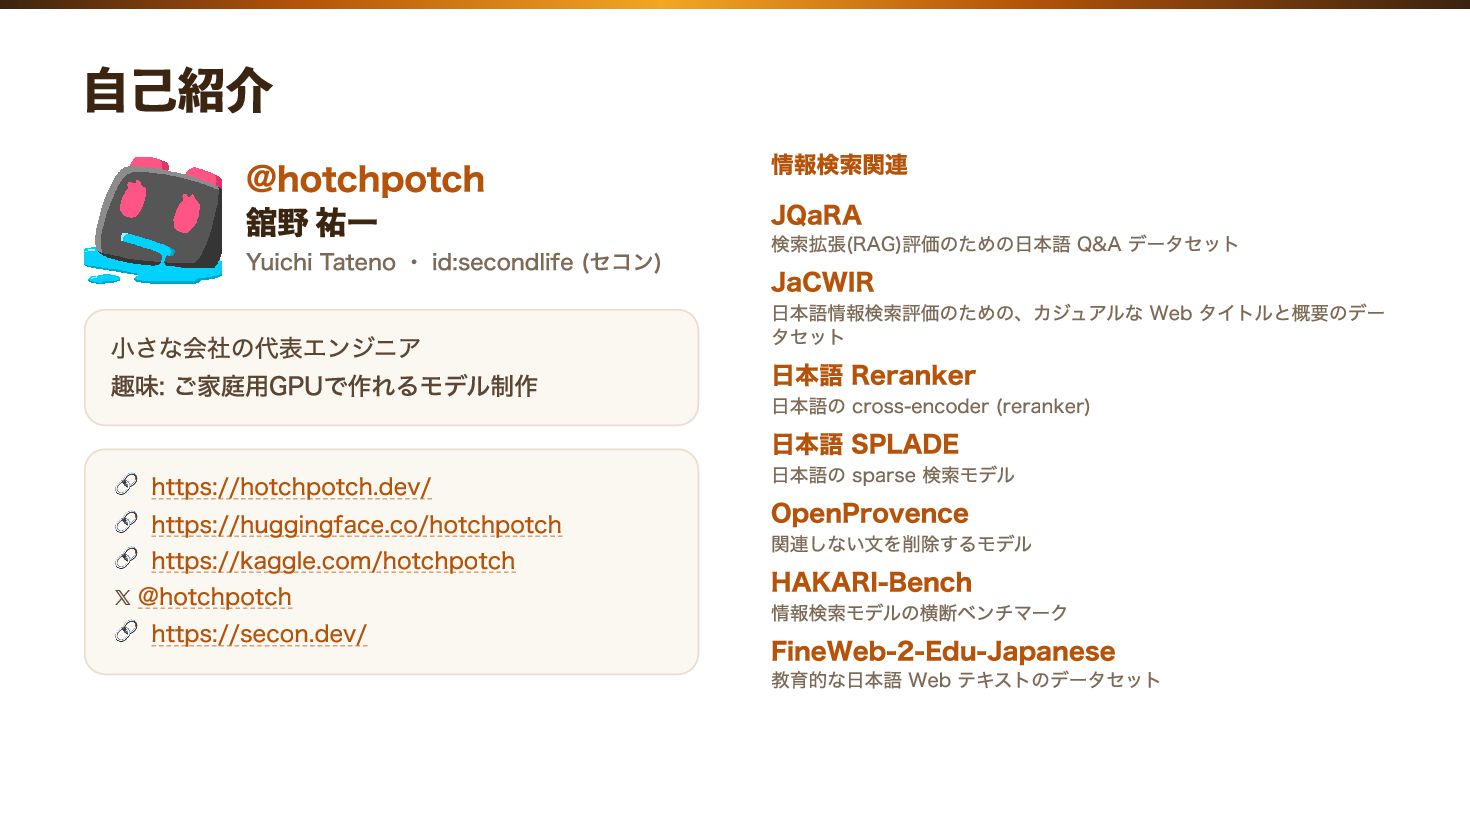
自己紹介 @hotchpotch 舘野 祐一 Yuichi Tateno ・ id:secondlife (セコン) 小さな会社の代表エンジニア
趣味: ご家庭用GPUで作れるモデル制作 🔗 https://hotchpotch.dev/ 🔗 https://huggingface.co/hotchpotch 🔗 https://kaggle.com/hotchpotch 𝕏 @hotchpotch 🔗 https://secon.dev/ 情報検索関連 JQaRA 検索拡張(RAG)評価のための日本語 Q&A データセット JaCWIR 日本語情報検索評価のための、カジュアルな Web タイトルと概要のデー タセット 日本語 Reranker 日本語の cross-encoder (reranker) 日本語 SPLADE 日本語の sparse 検索モデル OpenProvence 関連しない文を削除するモデル HAKARI-Bench 情報検索モデルの横断ベンチマーク FineWeb-2-Edu-Japanese 教育的な日本語 Web テキストのデータセット
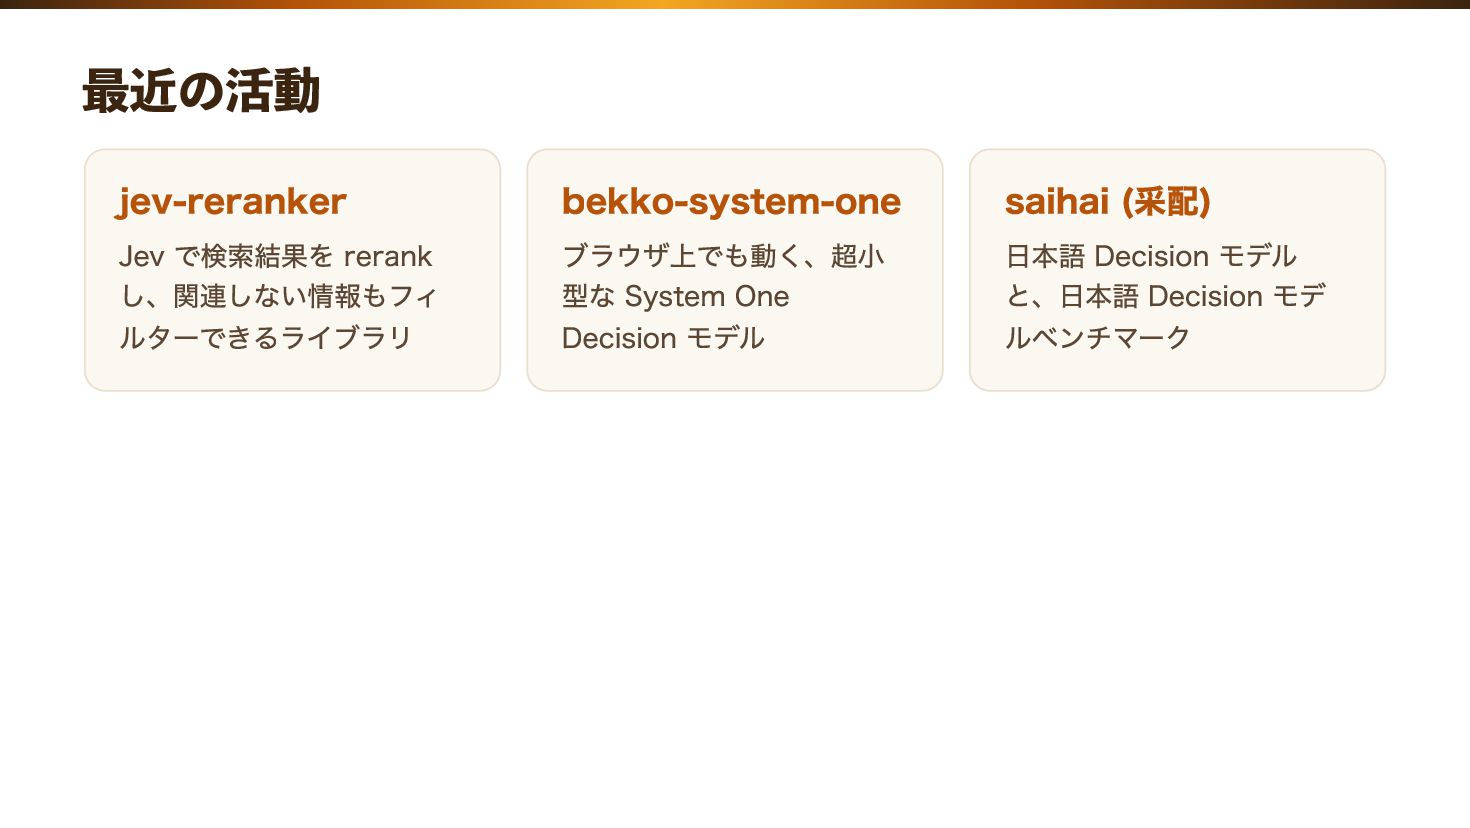
最近の活動 jev-reranker Jev で検索結果を rerank し、関連しない情報もフィ ルターできるライブラリ bekko-system-one ブラウザ上でも動く、超小 型な
System One Decision モデル saihai (采配) 日本語 Decision モデル と、日本語 Decision モデ ルベンチマーク
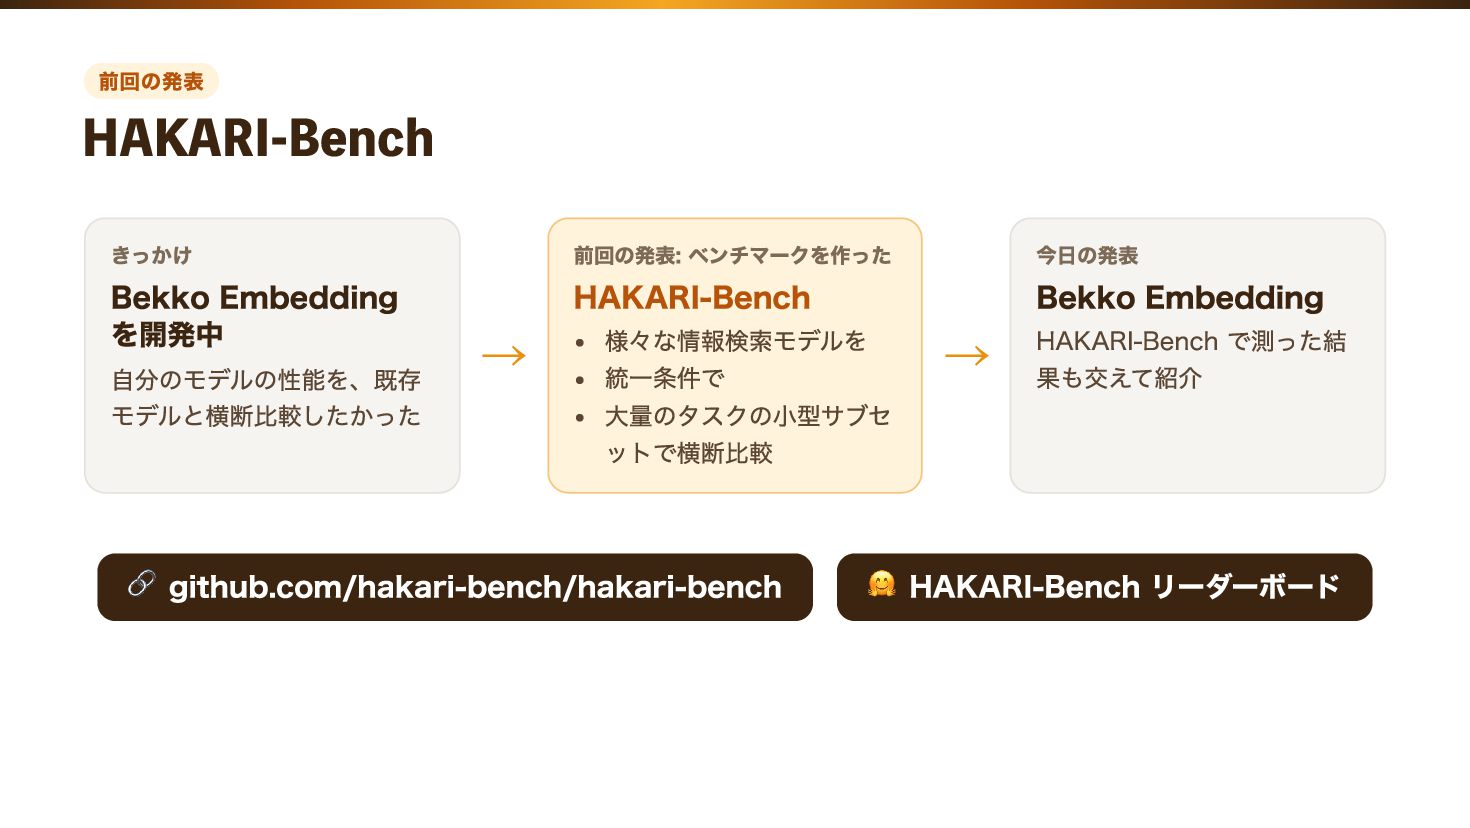
前回の発表 HAKARI-Bench きっかけ Bekko Embedding を開発中 自分のモデルの性能を、既存 → モデルと横断比較したかった 前回の発表:
ベンチマークを作った HAKARI-Bench 様々な情報検索モデルを 統一条件で 大量のタスクの小型サブセ ットで横断比較 🔗 github.com/hakari-bench/hakari-bench 今日の発表 Bekko Embedding で測った結 → HAKARI-Bench 果も交えて紹介 🤗 HAKARI-Bench リーダーボード
今日のお話 Bekko Embedding 超小型・多言語の検索モデル
DEMO まずはデモ 🌏 bekko-embedding-web ブラウザだけで動く サーバー不要 多言語ベクトル検索 huggingface.co/spaces/hotchpotch/bekko-embedding-web
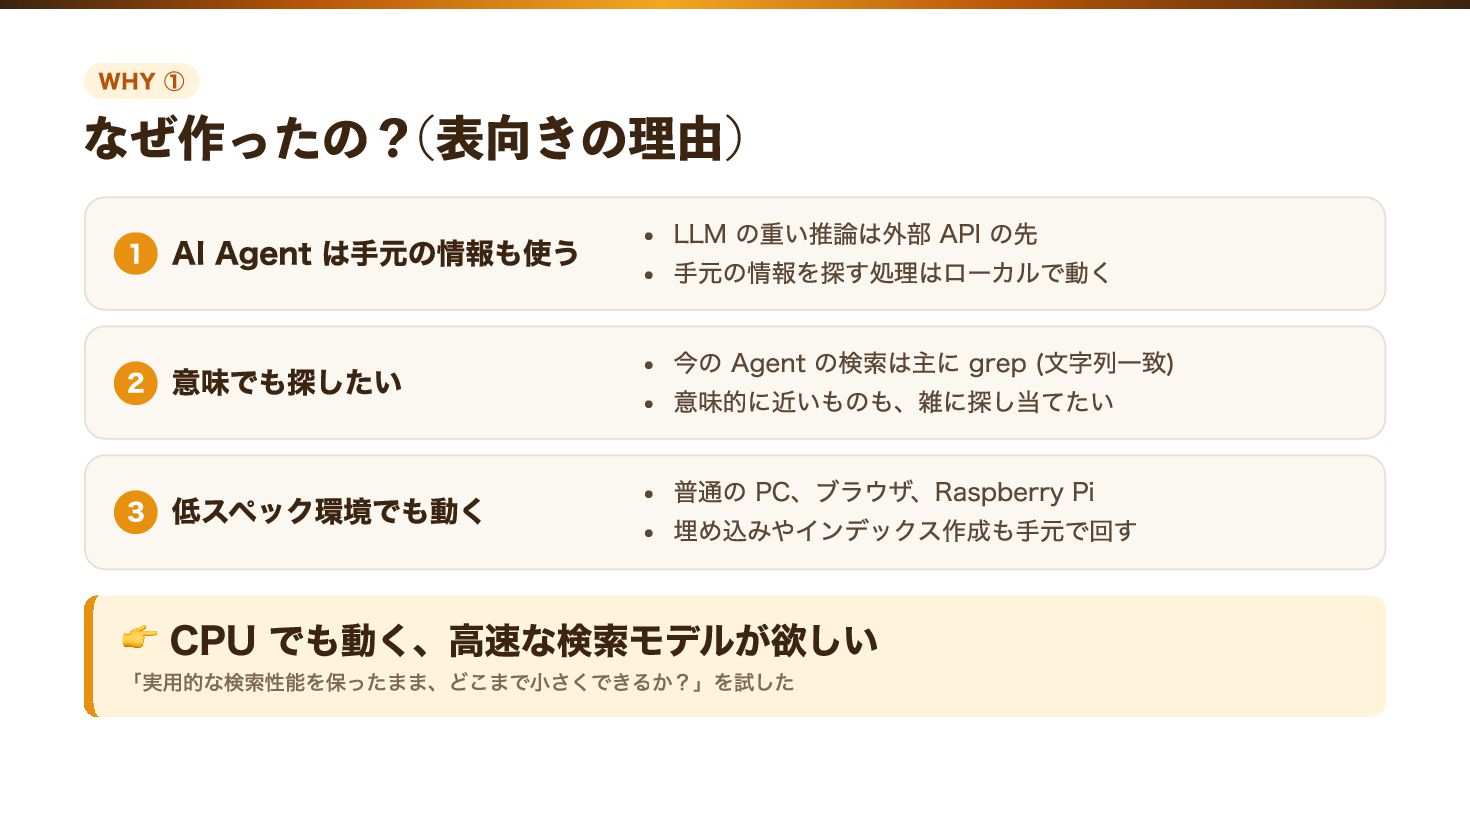
WHY ① なぜ作ったの?(表向きの理由) 1 AI Agent は手元の情報も使う LLM の重い推論は外部 API
の先 手元の情報を探す処理はローカルで動く 2 意味でも探したい 今の Agent の検索は主に grep (文字列一致) 意味的に近いものも、雑に探し当てたい 3 低スペック環境でも動く 普通の PC、ブラウザ、Raspberry Pi 埋め込みやインデックス作成も手元で回す 👉 CPU でも動く、高速な検索モデルが欲しい 「実用的な検索性能を保ったまま、どこまで小さくできるか?」を試した
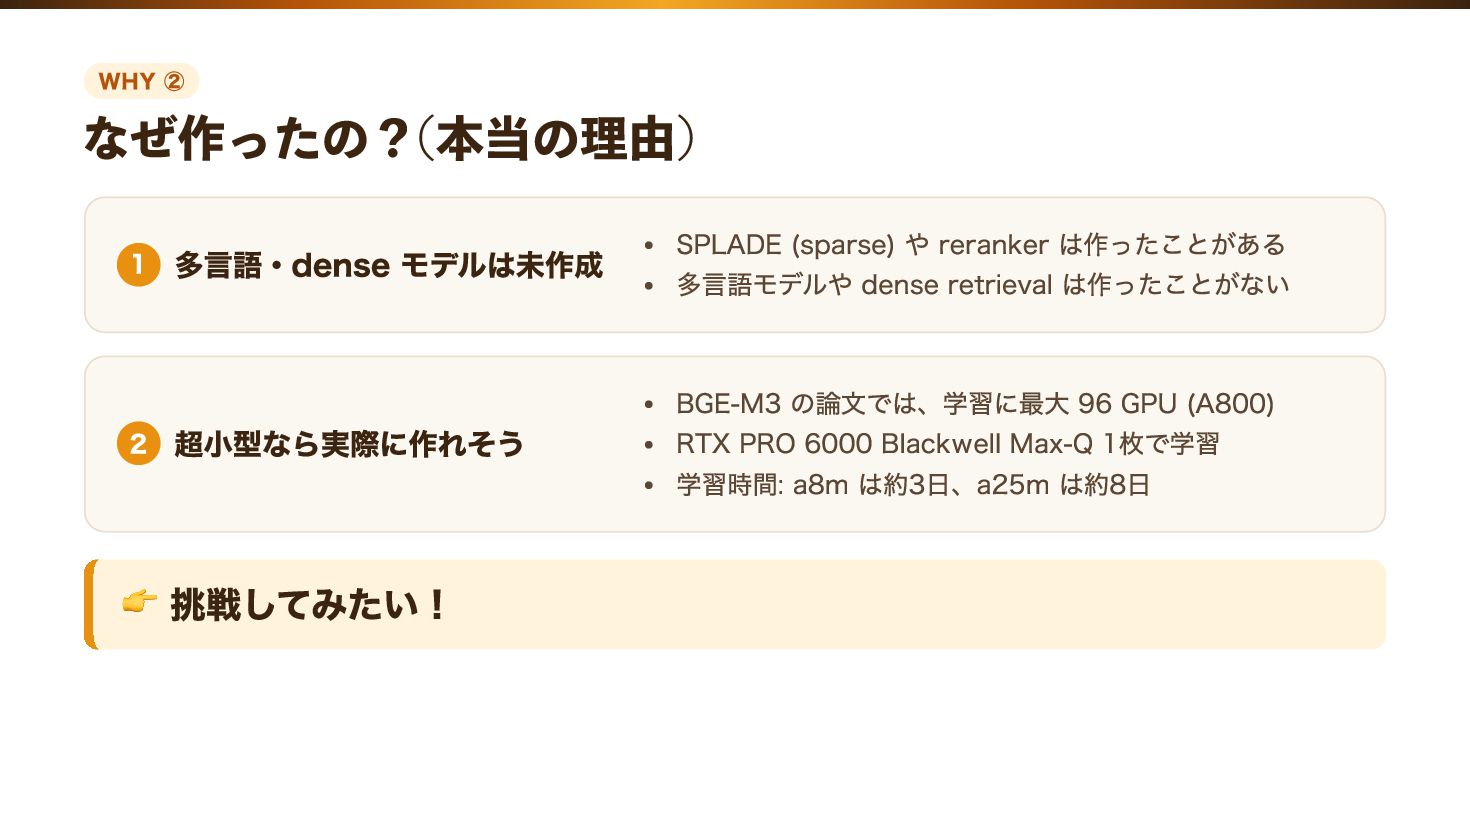
WHY ② なぜ作ったの?(本当の理由) 1 多言語・dense モデルは未作成 SPLADE (sparse) や reranker
は作ったことがある 多言語モデルや dense retrieval は作ったことがない 2 超小型なら実際に作れそう BGE-M3 の論文では、学習に最大 96 GPU (A800) RTX PRO 6000 Blackwell Max-Q 1枚で学習 学習時間: a8m は約3日、a25m は約8日 👉 挑戦してみたい!
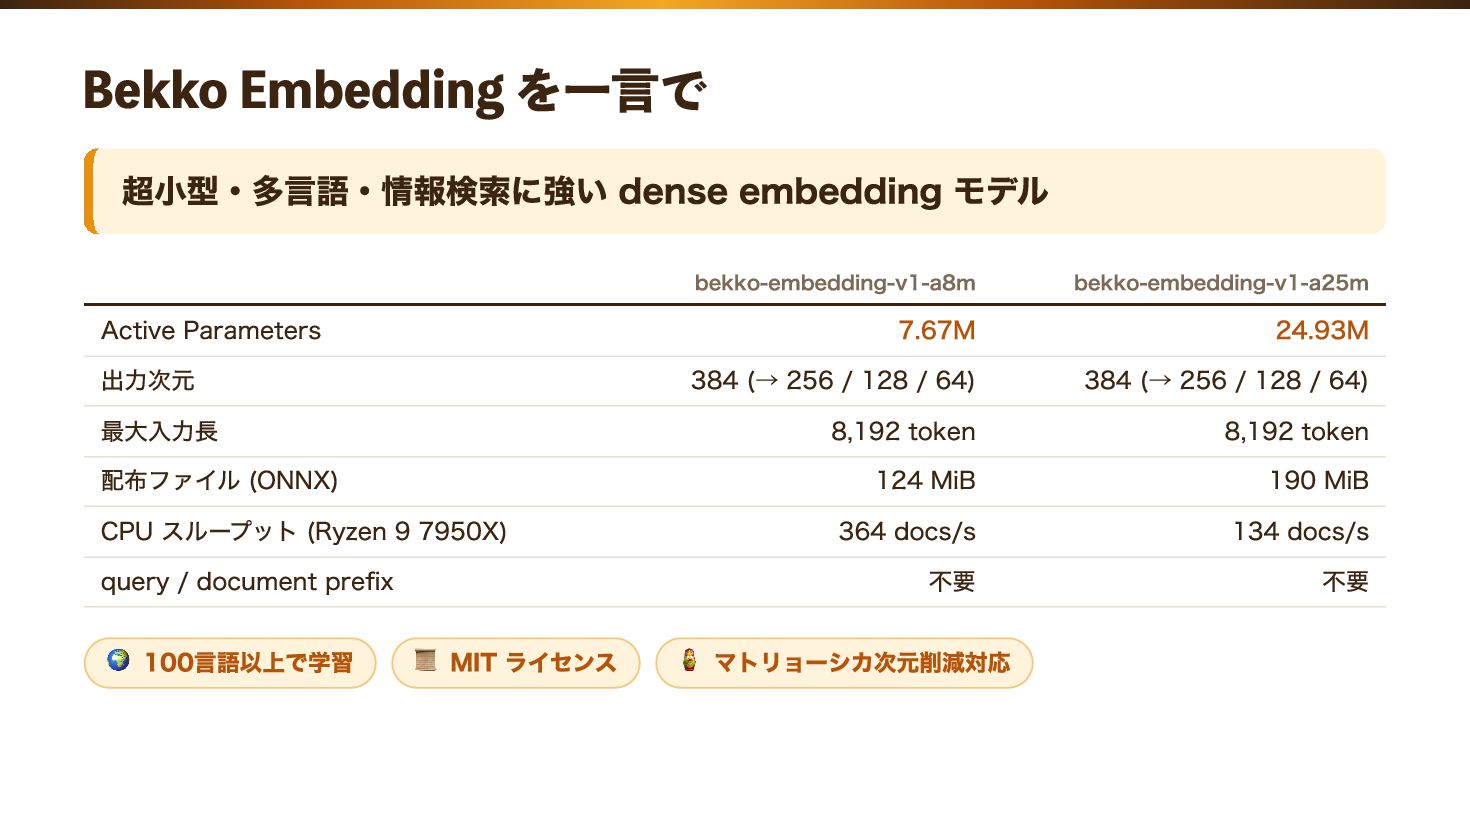
Bekko Embedding を一言で 超小型・多言語・情報検索に強い dense embedding モデル bekko-embedding-v1-a8m Active Parameters
出力次元 最大入力長 配布ファイル (ONNX) CPU スループット (Ryzen 9 7950X) query / document prefix 7.67M 384 (→ 256 / 128 / 64) 8,192 token 124 MiB 364 docs/s 不要 🌍 100言語以上で学習 🪆 マトリョーシカ次元削減対応 📜 MIT ライセンス bekko-embedding-v1-a25m 24.93M 384 (→ 256 / 128 / 64) 8,192 token 190 MiB 134 docs/s 不要
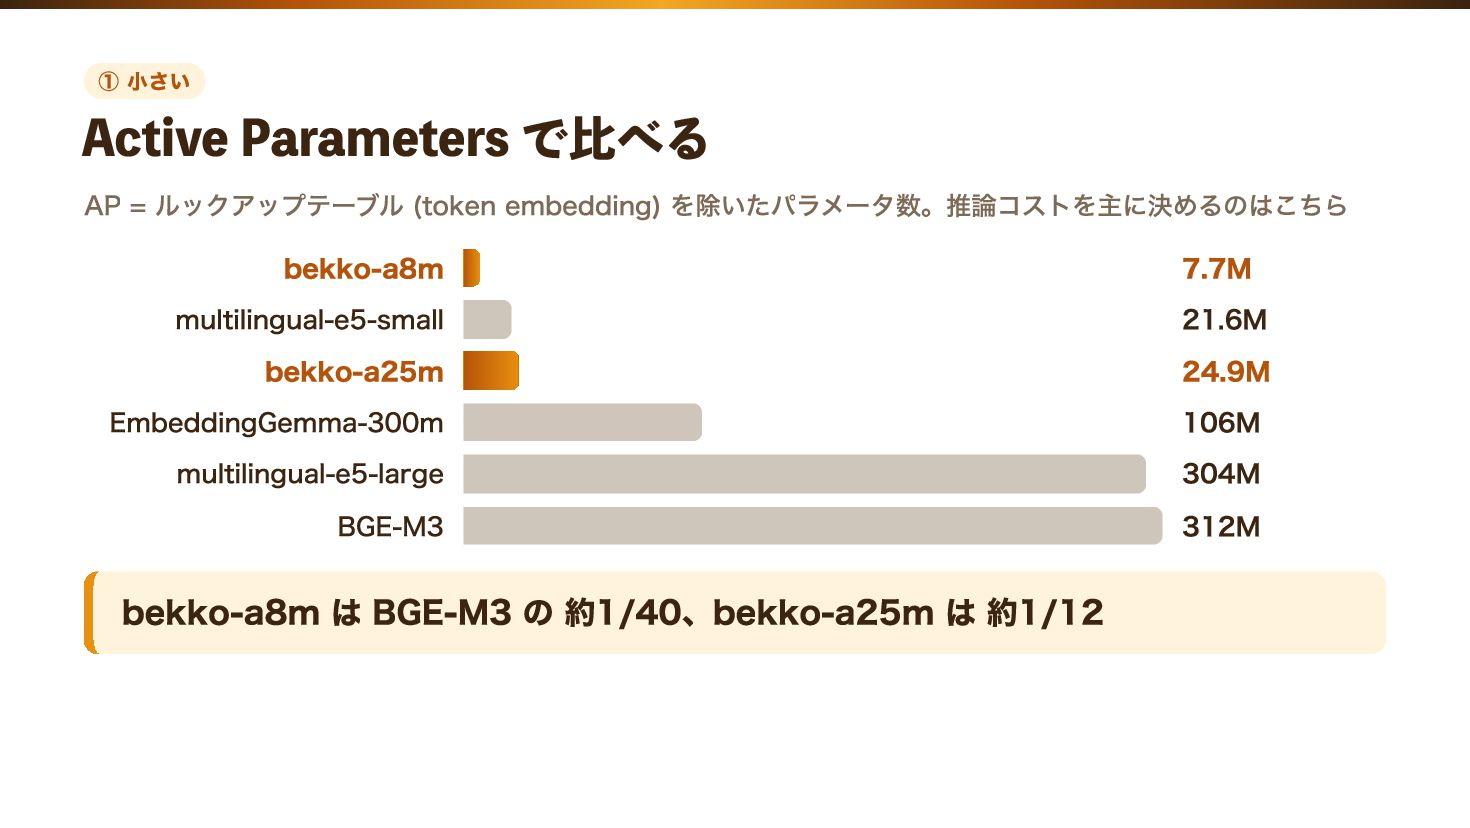
① 小さい Active Parameters で比べる AP = ルックアップテーブル (token embedding)
を除いたパラメータ数。推論コストを主に決めるのはこちら bekko-a8m 7.7M multilingual-e5-small 21.6M bekko-a25m 24.9M EmbeddingGemma-300m 106M multilingual-e5-large 304M BGE-M3 312M bekko-a8m は BGE-M3 の 約1/40、bekko-a25m は 約1/12
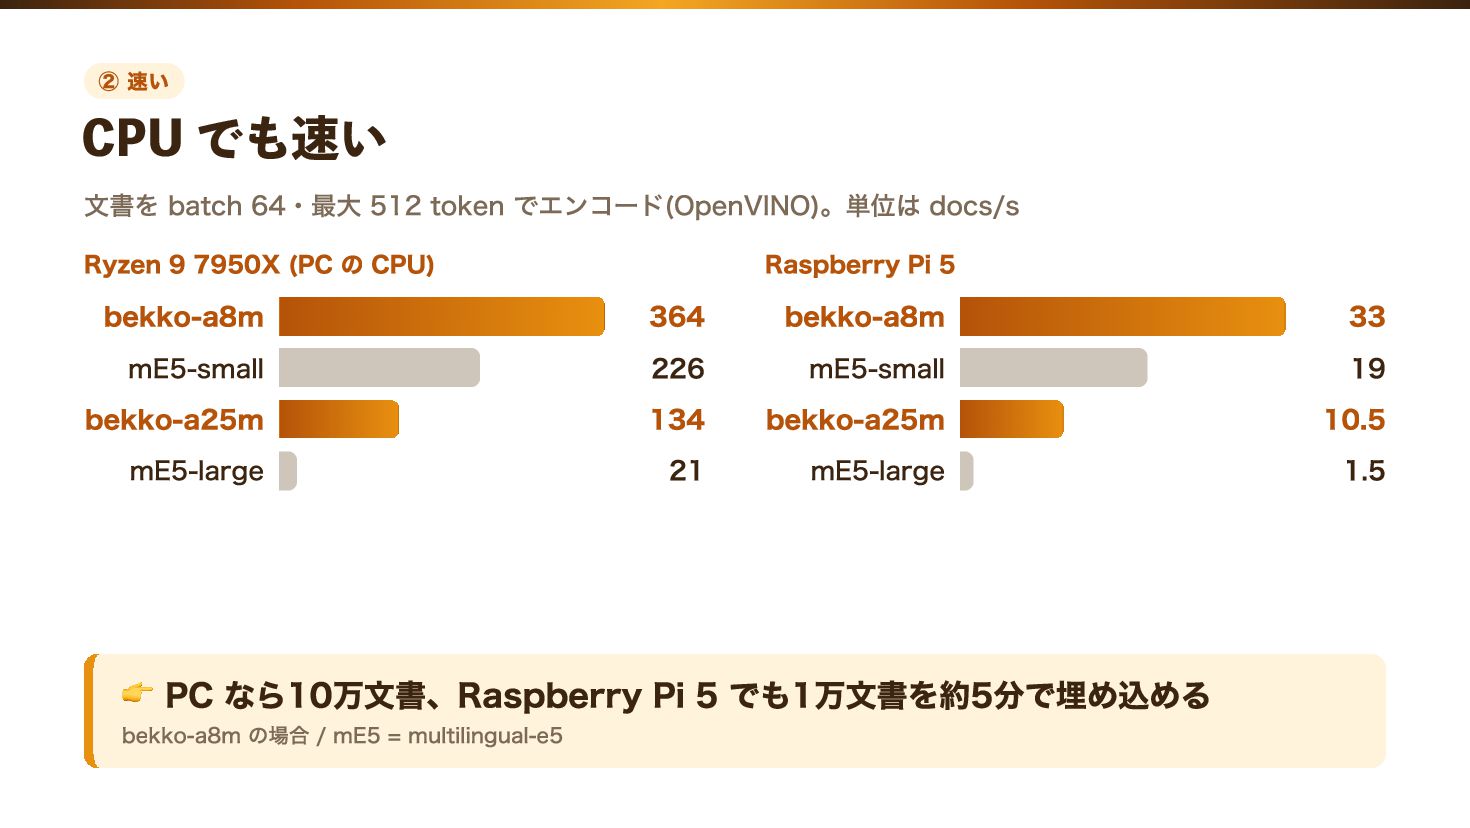
② 速い CPU でも速い 文書を batch 64・最大 512 token でエンコード(OpenVINO)。単位は
docs/s Ryzen 9 7950X (PC の CPU) bekko-a8m mE5-small bekko-a25m mE5-large 364 226 134 21 Raspberry Pi 5 bekko-a8m mE5-small bekko-a25m mE5-large 👉 PC なら10万文書、Raspberry Pi 5 でも1万文書を約5分で埋め込める bekko-a8m の場合 / mE5 = multilingual-e5 33 19 10.5 1.5
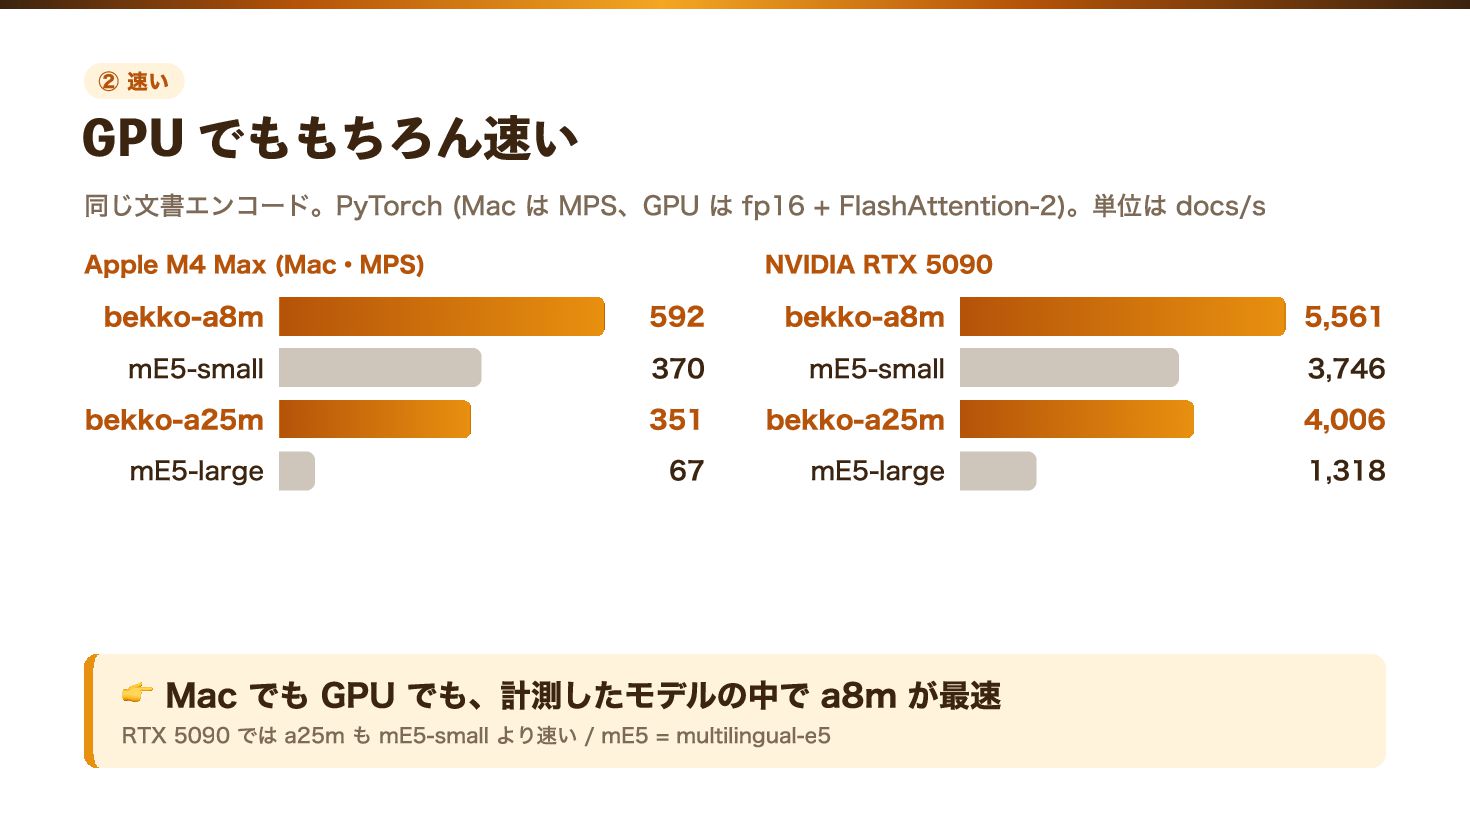
② 速い GPU でももちろん速い 同じ文書エンコード。PyTorch (Mac は MPS、GPU は fp16
+ FlashAttention-2)。単位は docs/s Apple M4 Max (Mac・MPS) bekko-a8m mE5-small bekko-a25m mE5-large 592 370 351 67 NVIDIA RTX 5090 bekko-a8m mE5-small bekko-a25m mE5-large 👉 Mac でも GPU でも、計測したモデルの中で a8m が最速 RTX 5090 では a25m も mE5-small より速い / mE5 = multilingual-e5 5,561 3,746 4,006 1,318
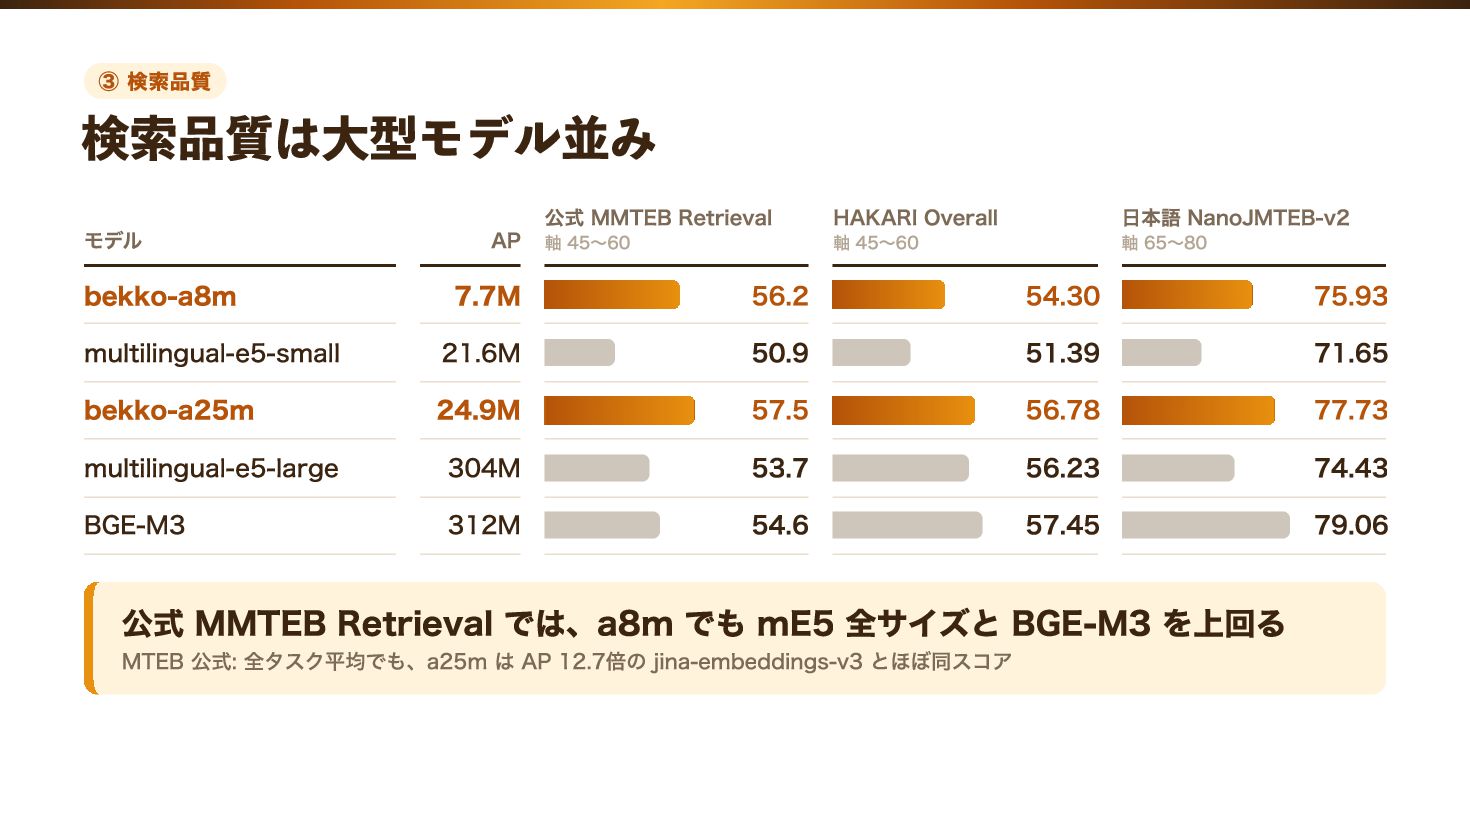
③ 検索品質 検索品質は大型モデル並み モデル bekko-a8m multilingual-e5-small bekko-a25m multilingual-e5-large BGE-M3 公式
MMTEB Retrieval AP 軸 45〜60 7.7M 21.6M 24.9M 304M 312M 56.2 50.9 57.5 53.7 54.6 HAKARI Overall 軸 45〜60 日本語 NanoJMTEB-v2 54.30 51.39 56.78 56.23 57.45 軸 65〜80 公式 MMTEB Retrieval では、a8m でも mE5 全サイズと BGE-M3 を上回る MTEB 公式: 全タスク平均でも、a25m は AP 12.7倍の jina-embeddings-v3 とほぼ同スコア 75.93 71.65 77.73 74.43 79.06
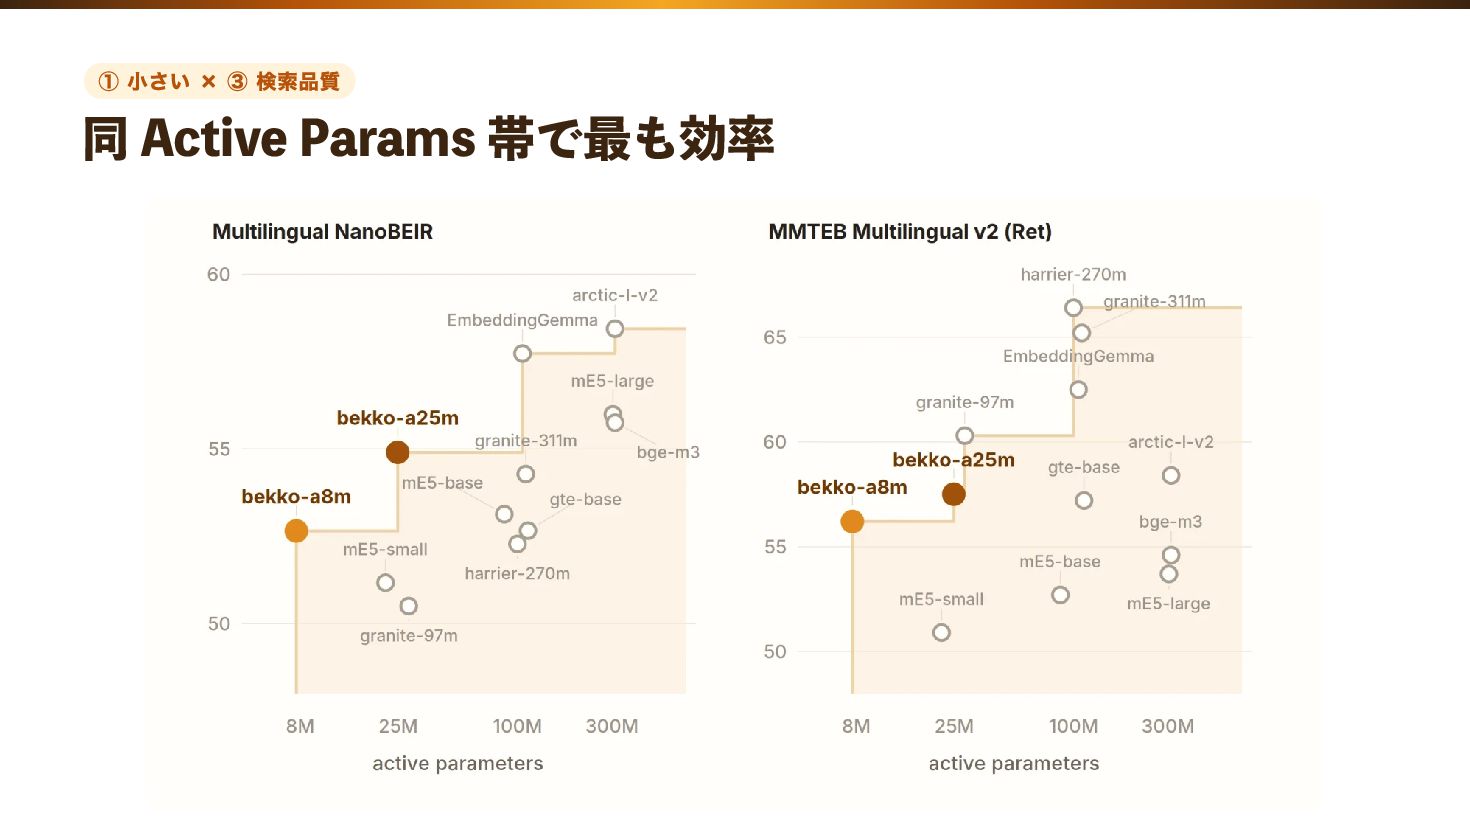
① 小さい × ③ 検索品質 同 Active Params 帯で最も効率
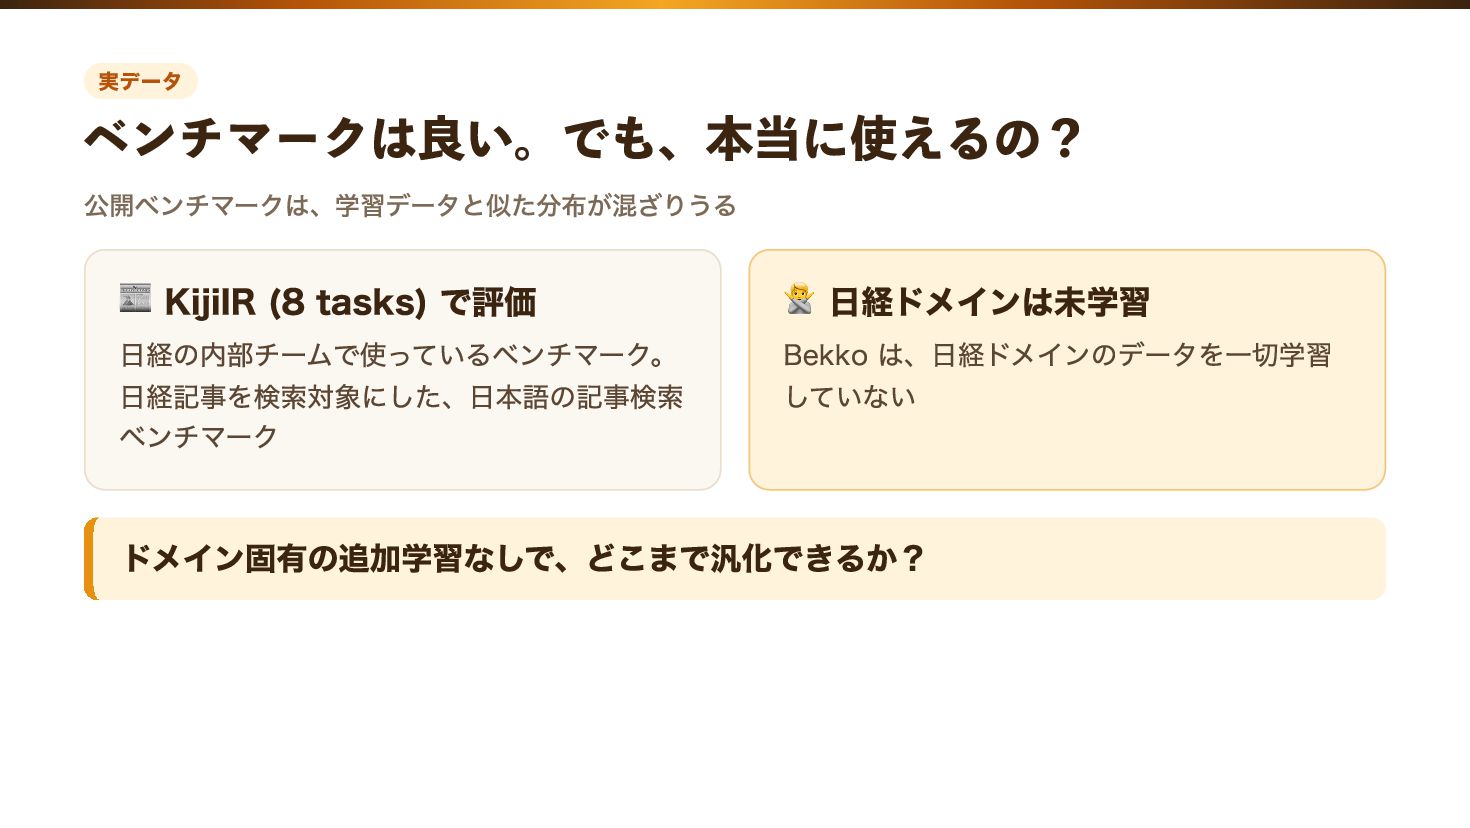
実データ ベンチマークは良い。でも、本当に使えるの? 公開ベンチマークは、学習データと似た分布が混ざりうる 📰 KijiIR (8 tasks) で評価 日経の内部チームで使っているベンチマーク。 日経記事を検索対象にした、日本語の記事検索
ベンチマーク 🙅 日経ドメインは未学習 Bekko は、日経ドメインのデータを一切学習 していない ドメイン固有の追加学習なしで、どこまで汎化できるか?
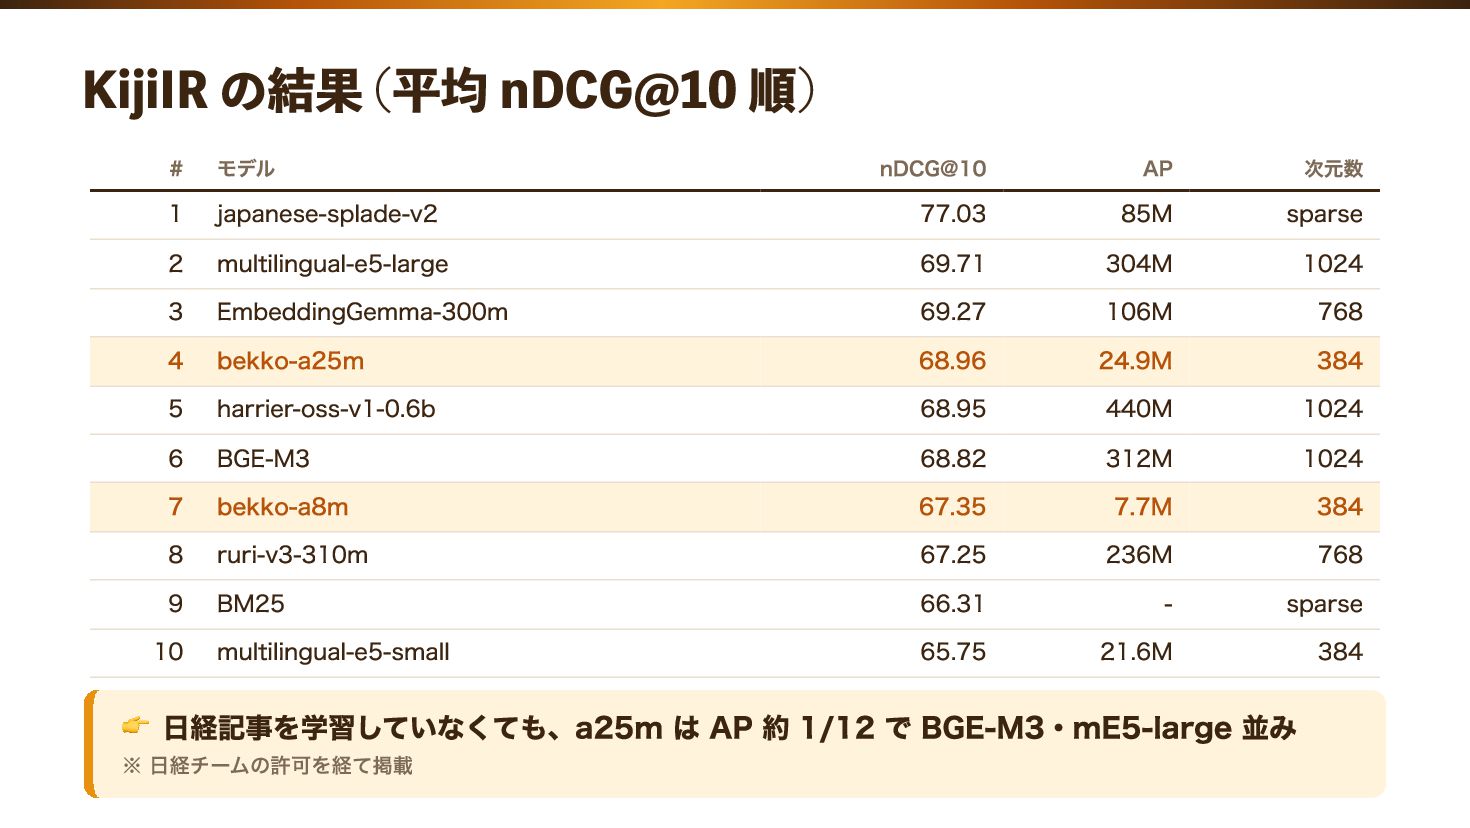
KijiIR の結果 (平均 nDCG@10 順) # モデル 1 2 3
4 5 6 7 8 9 10 japanese-splade-v2 multilingual-e5-large EmbeddingGemma-300m bekko-a25m harrier-oss-v1-0.6b BGE-M3 bekko-a8m ruri-v3-310m BM25 multilingual-e5-small nDCG@10 77.03 69.71 69.27 68.96 68.95 68.82 67.35 67.25 66.31 65.75 AP 85M 304M 106M 24.9M 440M 312M 7.7M 236M 21.6M sparse 1024 768 384 1024 1024 384 768 sparse 384 👉 日経記事を学習していなくても、a25m は AP 約 1/12 で BGE-M3・mE5-large 並み ※ 日経チームの許可を経て掲載 次元数
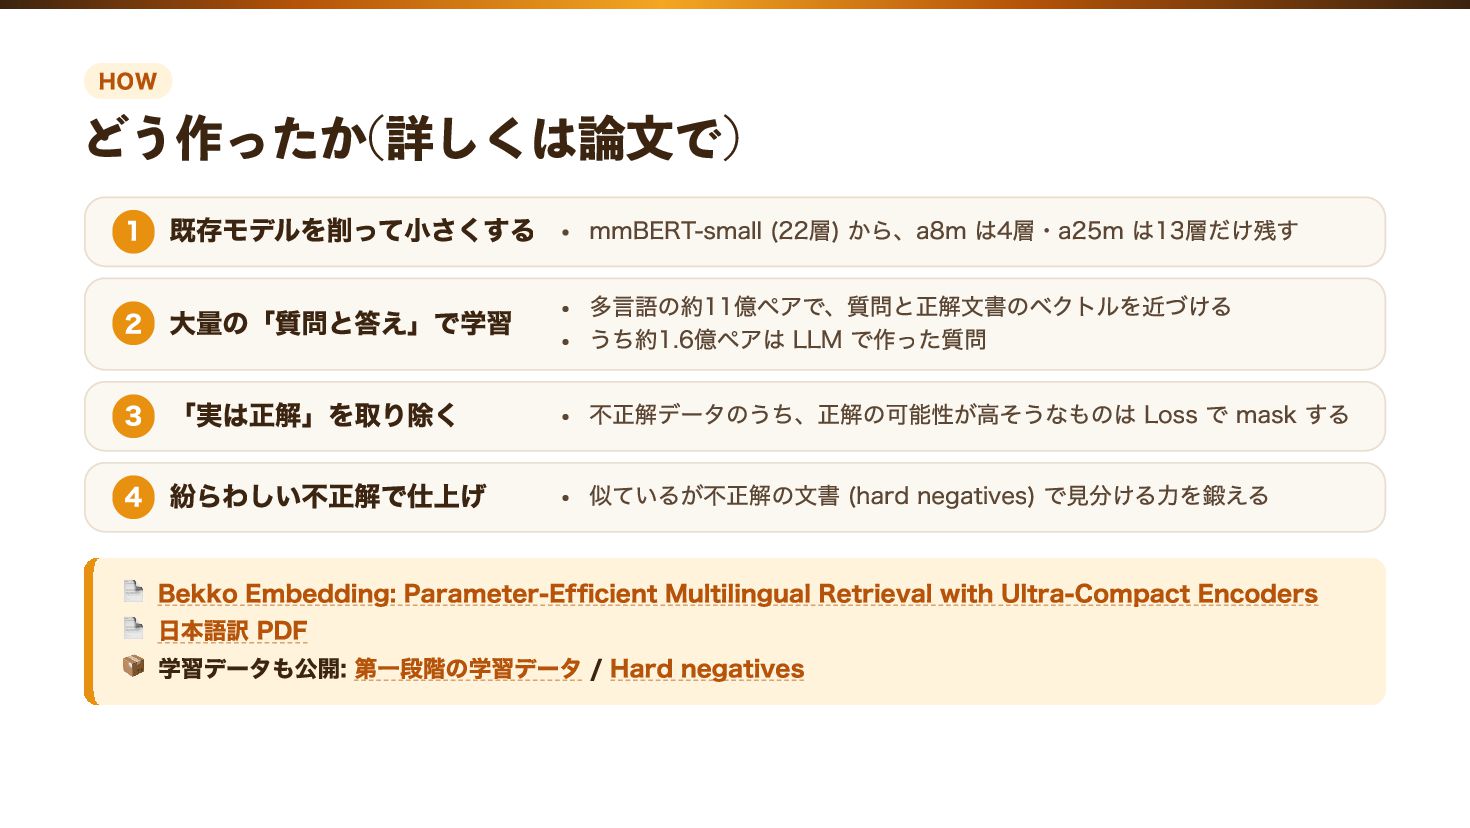
HOW どう作ったか(詳しくは論文で) 1 既存モデルを削って小さくする mmBERT-small (22層) から、a8m は4層・a25m は13層だけ残す 2
大量の「質問と答え」で学習 多言語の約11億ペアで、質問と正解文書のベクトルを近づける うち約1.6億ペアは LLM で作った質問 3 「実は正解」を取り除く 不正解データのうち、正解の可能性が高そうなものは Loss で mask する 4 紛らわしい不正解で仕上げ 似ているが不正解の文書 (hard negatives) で見分ける力を鍛える 📄 Bekko Embedding: Parameter-Efficient Multilingual Retrieval with Ultra-Compact Encoders 📄 日本語訳 PDF 📦 学習データも公開: 第一段階の学習データ / Hard negatives
もうひとつの Bekko さらに超高速な Static Embedding 版 bekko-static-embedding-v1 🤗 hotchpotch/bekko-static-embedding-v1 📝
紹介記事: secon.dev/entry/2026/10/24/100000-bekko-static-embedding/
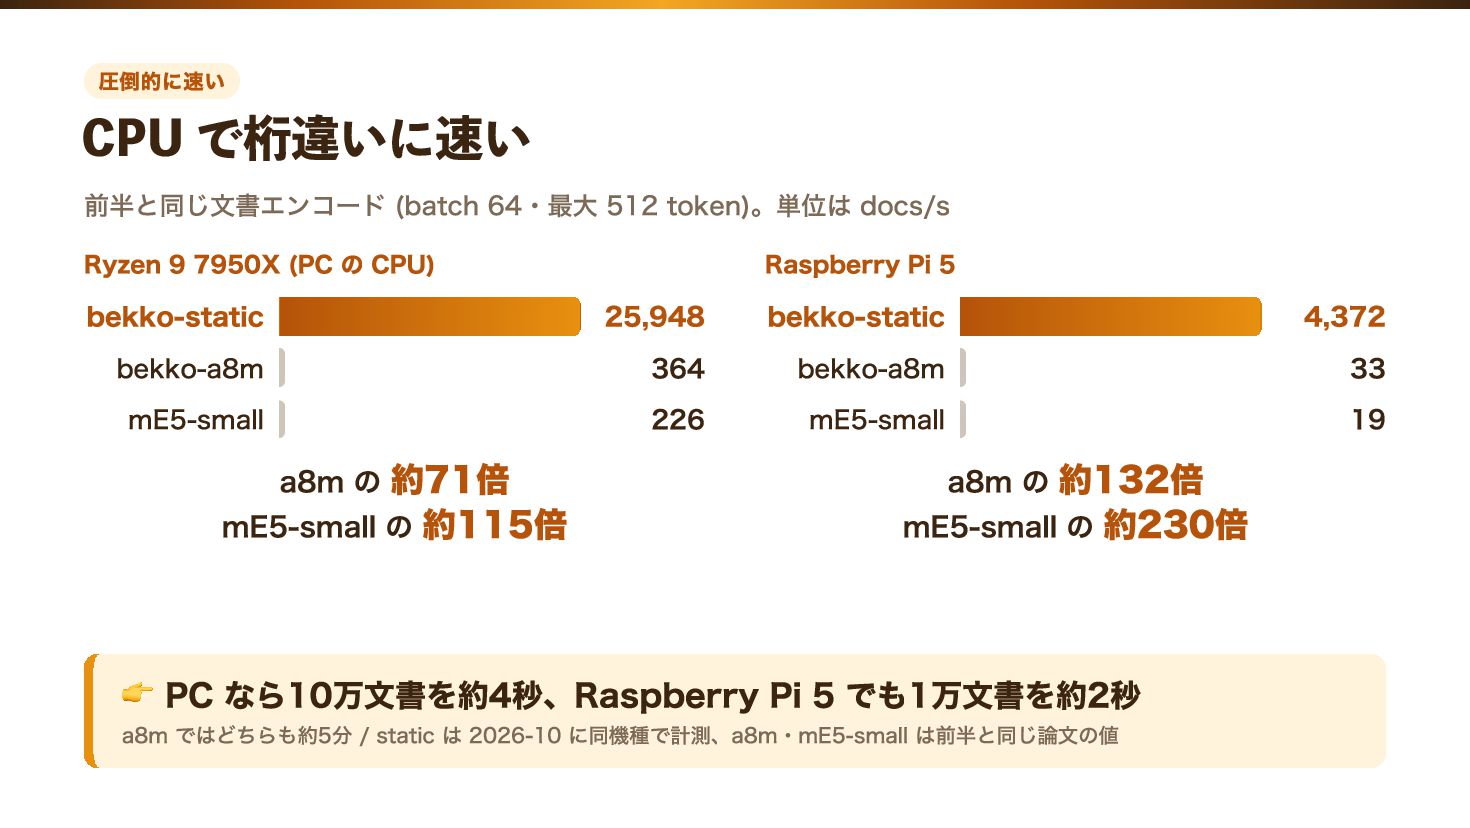
圧倒的に速い CPU で桁違いに速い 前半と同じ文書エンコード (batch 64・最大 512 token)。単位は docs/s Ryzen
9 7950X (PC の CPU) bekko-static bekko-a8m mE5-small a8m の 約71倍 mE5-small の 約115倍 25,948 364 226 Raspberry Pi 5 bekko-static bekko-a8m mE5-small a8m の 約132倍 mE5-small の 約230倍 👉 PC なら10万文書を約4秒、Raspberry Pi 5 でも1万文書を約2秒 a8m ではどちらも約5分 / static は 2026-10 に同機種で計測、a8m・mE5-small は前半と同じ論文の値 4,372 33 19
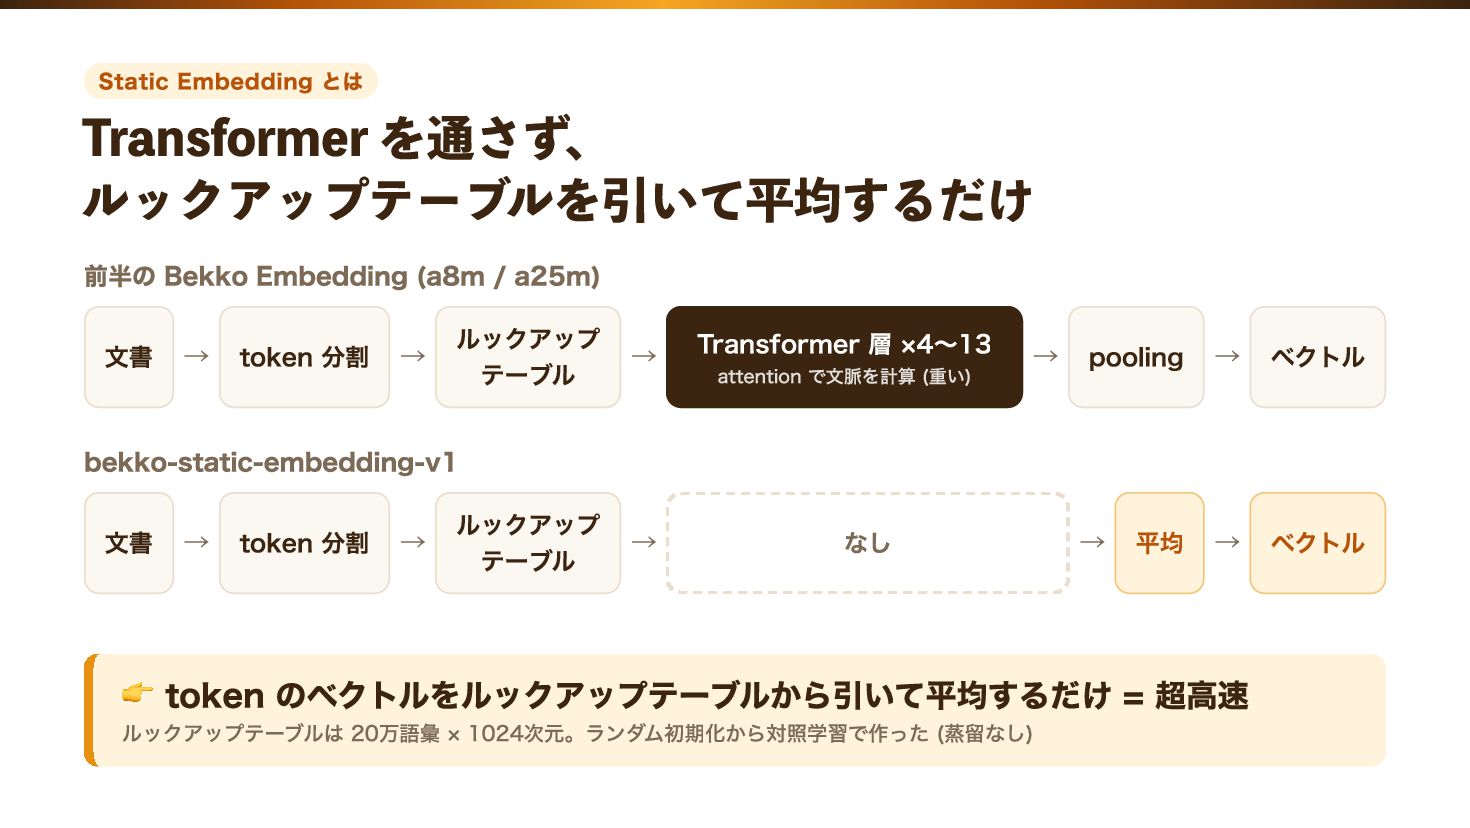
Static Embedding とは Transformer を通さず、 ルックアップテーブルを引いて平均するだけ 前半の Bekko Embedding (a8m
/ a25m) Transformer 層 ×4〜13 文書 → token 分割 → ルックアップ テーブル → attention で文脈を計算 (重い) → pooling → ベクトル bekko-static-embedding-v1 文書 → token 分割 → ルックアップ テーブル → なし → 平均 → ベクトル 👉 token のベクトルをルックアップテーブルから引いて平均するだけ = 超高速 ルックアップテーブルは 20万語彙 × 1024次元。ランダム初期化から対照学習で作った (蒸留なし)
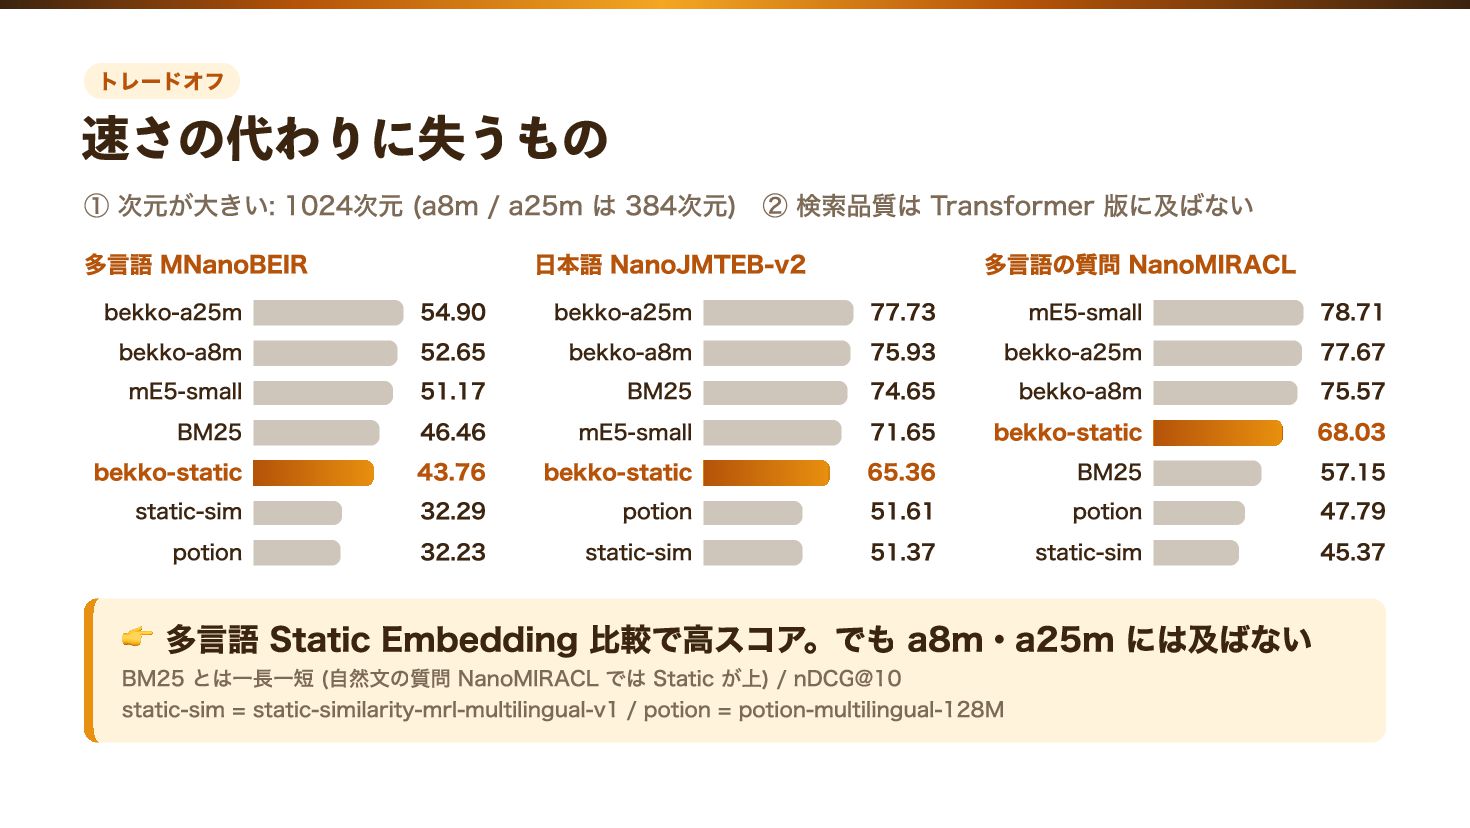
トレードオフ 速さの代わりに失うもの ① 次元が大きい: 1024次元 (a8m / a25m は 384次元)
② 検索品質は Transformer 版に及ばない 多言語 MNanoBEIR bekko-a25m bekko-a8m mE5-small BM25 bekko-static static-sim potion 54.90 52.65 51.17 46.46 43.76 32.29 32.23 日本語 NanoJMTEB-v2 bekko-a25m bekko-a8m BM25 mE5-small bekko-static potion static-sim 77.73 75.93 74.65 71.65 65.36 51.61 51.37 多言語の質問 NanoMIRACL mE5-small bekko-a25m bekko-a8m bekko-static BM25 potion static-sim 👉 多言語 Static Embedding 比較で高スコア。でも a8m・a25m には及ばない BM25 とは一長一短 (自然文の質問 NanoMIRACL では Static が上) / nDCG@10 static-sim = static-similarity-mrl-multilingual-v1 / potion = potion-multilingual-128M 78.71 77.67 75.57 68.03 57.15 47.79 45.37
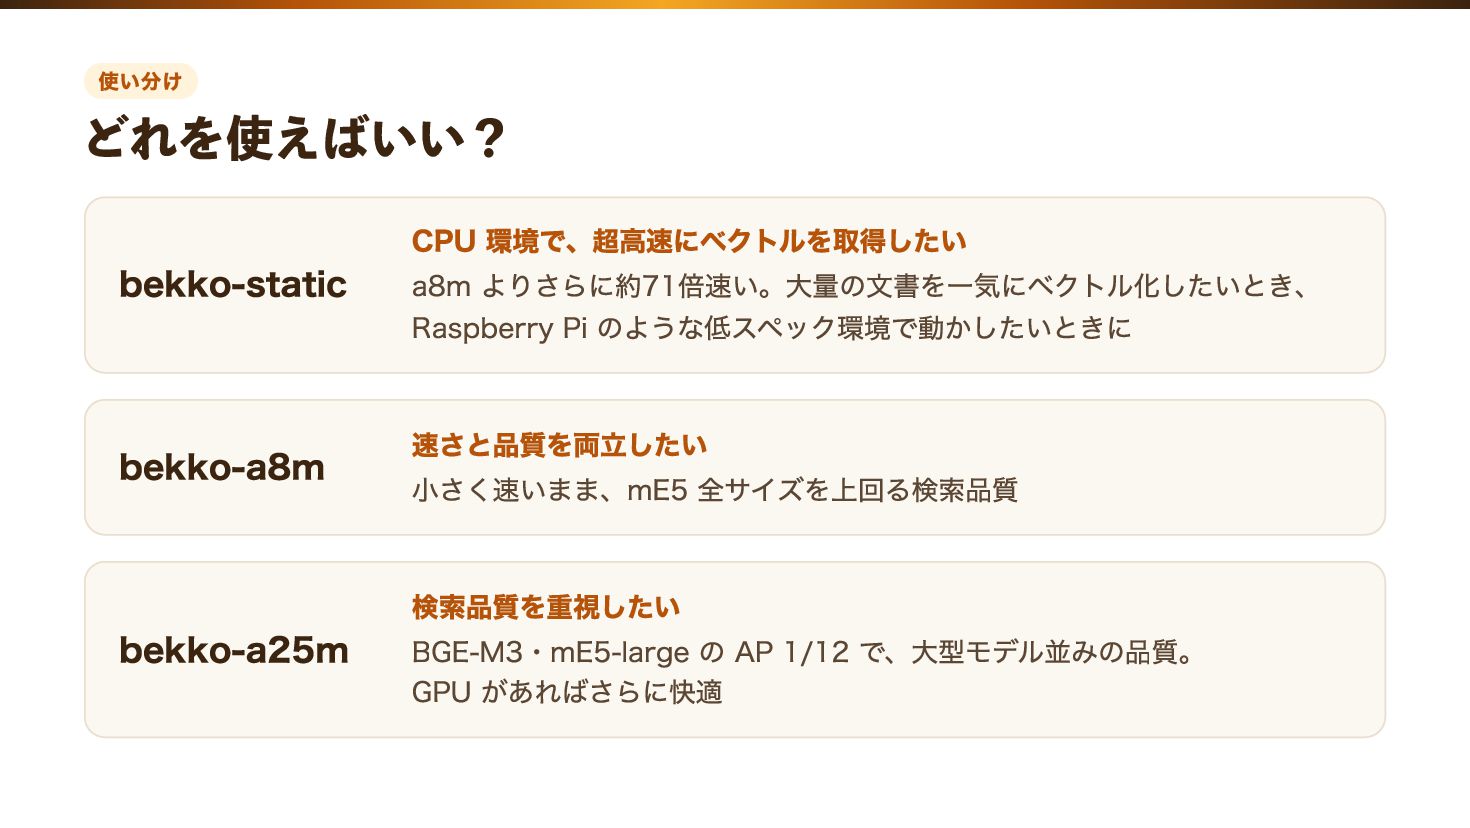
使い分け どれを使えばいい? bekko-static CPU 環境で、超高速にベクトルを取得したい a8m よりさらに約71倍速い。大量の文書を一気にベクトル化したいとき、 Raspberry Pi のような低スペック環境で動かしたいときに
bekko-a8m 速さと品質を両立したい 小さく速いまま、mE5 全サイズを上回る検索品質 bekko-a25m 検索品質を重視したい BGE-M3・mE5-large の AP 1/12 で、大型モデル並みの品質。 GPU があればさらに快適
🪶 小さい ⚡ 速い 🎯 検索品質良好 📰 実データでも良好 高速に・CPU で・ブラウザで、埋め込みベクトルを作りたい用途に是非!
気に入ったら、Hugging Face で like をもらえると励みにな ります! 🤗 bekko-a8m 🤗 bekko-a25m
🤗 bekko-static 📝 紹介記事: 超小型な多言語ベクトル検索モデル Bekko Embedding を公開 / Static 版 📄 論文 (arXiv) / 日本語訳 PDF


 hotchpotch
 kinopeee
 atsushieno
 kitazaki
 sh_fk2
 visional_engineering_and_design
 oikon48
 shinichirokawano
 cscengineer
 asmz
 joere
 maigo999
 khiroyuki1003
 inesmontani
 cassininazir
 honzajavorek
 bermonpainter
 honnibal
 kevinliebholz
 gurzu
 joshbly
 stephenakadiri
 scottboms
 lcolladotor
 pwiseman