Share
Embed

Transcript
79 slides
-
Table of contents 1. 仮説集合の複雑度 1.1 2.1 VC 次元 1.2
2.2 ラデマッハ複雑度 1.3 2.3 一様大数の法則 1.4 補足: カバリングナンバー 1 -
導入 本スライドは [4] の第 2 章のまとめである. ▶ 仮説空間の複雑さの指標: VC 次元,
ラデマッハ複雑度 • 時間があればカバリングナンバーも抑えたい(ちょっとだけ入 れた) ▶ 一様大数の法則による汎化誤差の上界評価 がメイントピック 2 -
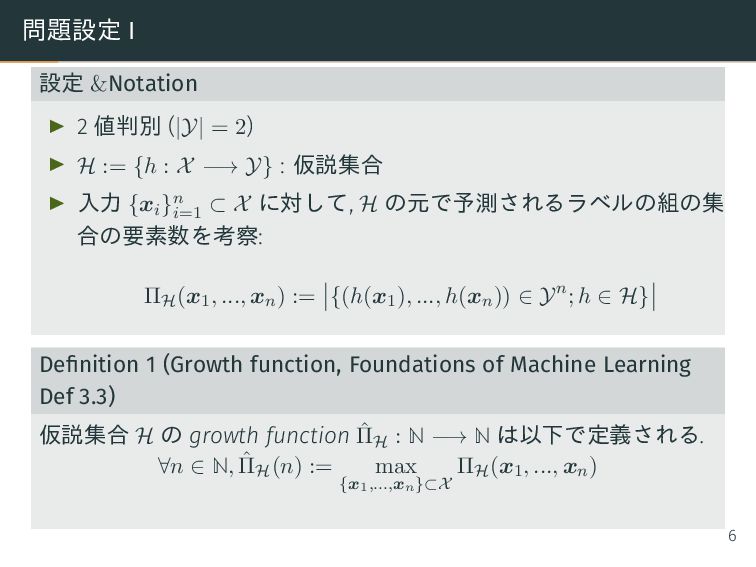
問題設定 I 設定 &Notation ▶ 2 値判別 (|Y| = 2)
▶ H := {h : X −→ Y} : 仮説集合 ▶ 入力 {xi}n i=1 ⊂ X に対して, H の元で予測されるラベルの組の集 合の要素数を考察: ΠH(x1, ..., xn) := {(h(x1), ..., h(xn)) ∈ Yn; h ∈ H} Definition 1 (Growth function, Foundations of Machine Learning Def 3.3) 仮説集合 H の growth function ˆ ΠH : N −→ N は以下で定義される. ∀n ∈ N, ˆ ΠH(n) := max {x1,...,xn}⊂X ΠH(x1, ..., xn) 6 -
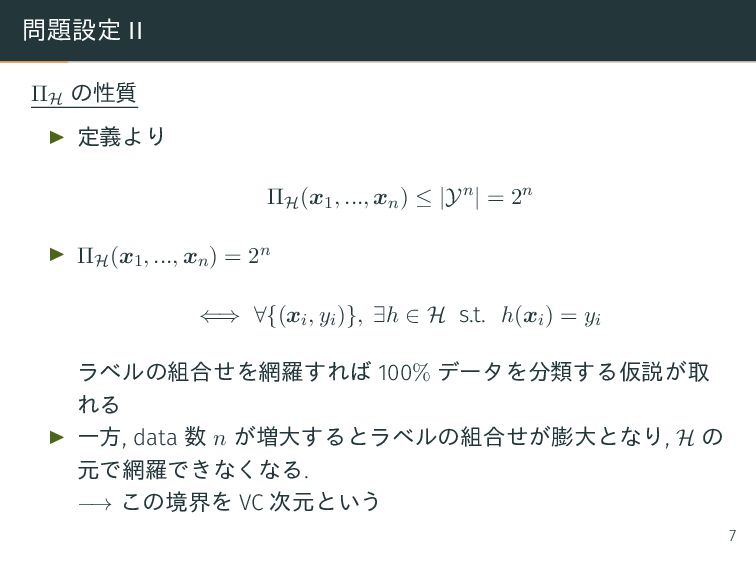
問題設定 II ΠH の性質 ▶ 定義より ΠH(x1, ..., xn) ≤
|Yn| = 2n ▶ ΠH(x1, ..., xn) = 2n ⇐⇒ ∀{(xi, yi)}, ∃h ∈ H s.t. h(xi) = yi ラベルの組合せを網羅すれば 100% データを分類する仮説が取 れる ▶ 一方, data 数 n が増大するとラベルの組合せが膨大となり, H の 元で網羅できなくなる. −→ この境界を VC 次元という 7 -
VC 次元 Definition 2 (VC 次元) 仮説空間 H の VC
次元は以下で定義される V Cdim(H) := max{n ∈ N; ˆ ΠH(n) = 2n} ▶ 仮説空間 H の元でラベルの組合せを網羅できる最大の data 数 が VC 次元 ▶ ∀n ∈ N, ∃x1, ..., xn ∈ X s.t. ΠH(x1, ..., xn) = 2n のとき, V Cdim(H) = ∞ と定義 ▶ 仮説集合がどんなラベル付にも対応できる → ノイズにも fitting する cf re-thinking generalization 論文 [ICLR2017]? 8 -
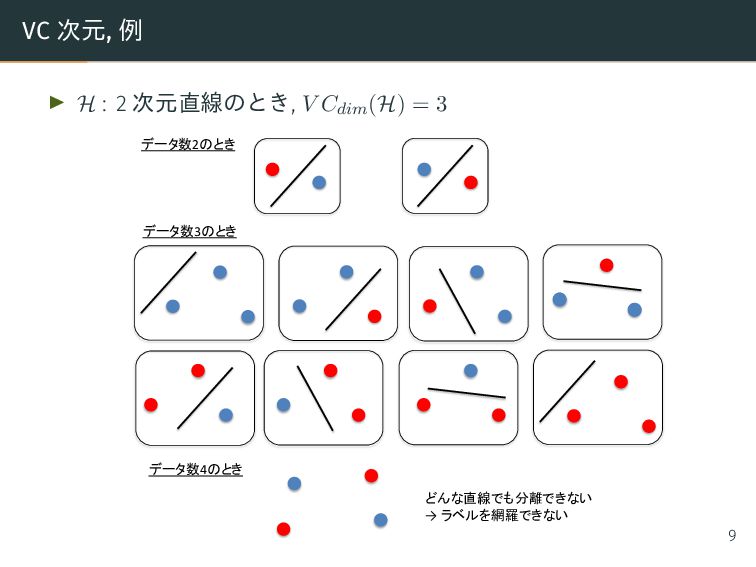
VC 次元, 例 ▶ H : 2 次元直線のとき, V Cdim(H)
= 3 データ数2のとき データ数3のとき データ数4のとき どんな直線でも分離できない → ラベルを網羅できない 9 -
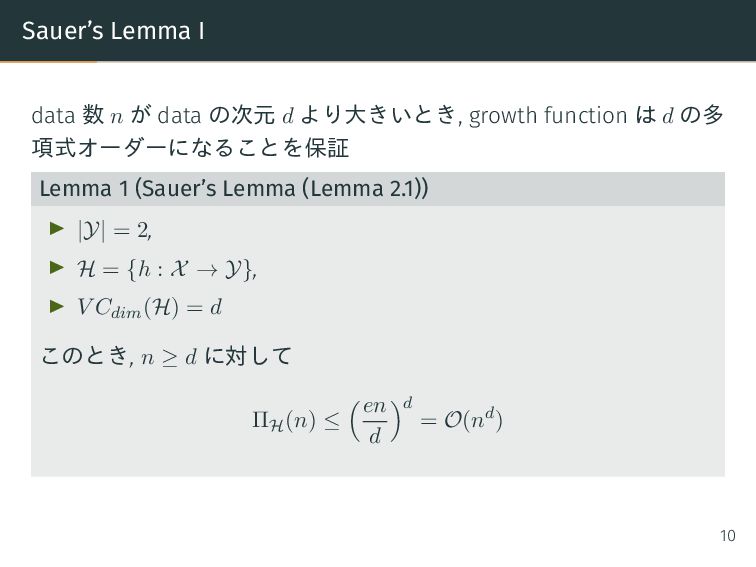
Sauer’s Lemma I data 数 n が data の次元 d
より大きいとき, growth function は d の多 項式オーダーになることを保証 Lemma 1 (Sauer’s Lemma (Lemma 2.1)) ▶ |Y| = 2, ▶ H = {h : X → Y}, ▶ V Cdim(H) = d このとき, n ≥ d に対して ΠH(n) ≤ en d d = O(nd) 10 -
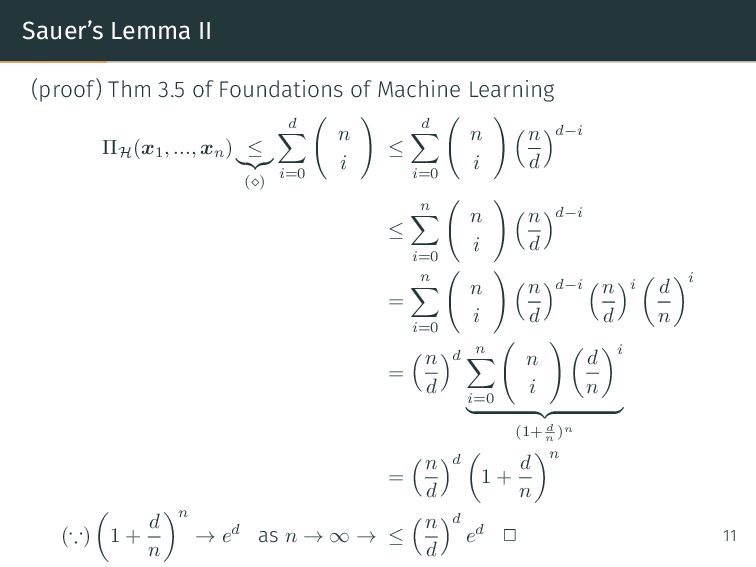
Sauer’s Lemma II (proof) Thm 3.5 of Foundations of Machine
Learning ΠH (x1 , ..., xn ) ≤ (⋄) d i=0 n i ≤ d i=0 n i n d d−i ≤ n i=0 n i n d d−i = n i=0 n i n d d−i n d i d n i = n d d n i=0 n i d n i (1+ d n )n = n d d 1 + d n n (∵) 1 + d n n → ed as n → ∞ → ≤ n d d ed 2 11 -
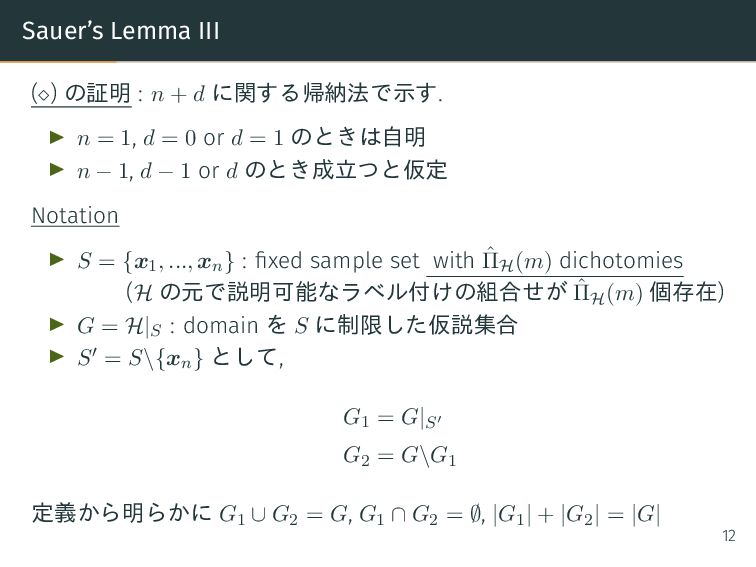
Sauer’s Lemma III ( ) の証明 : n + d
に関する帰納法で示す. ▶ n = 1, d = 0 or d = 1 のときは自明 ▶ n − 1, d − 1 or d のとき成立つと仮定 Notation ▶ S = {x1, ..., xn} : fixed sample set with ˆ ΠH(m) dichotomies (H の元で説明可能なラベル付けの組合せが ˆ ΠH(m) 個存在) ▶ G = H|S : domain を S に制限した仮説集合 ▶ S′ = S\{xn} として, G1 = G|S′ G2 = G\G1 定義から明らかに G1 ∪ G2 = G, G1 ∩ G2 = ∅, |G1| + |G2| = |G| 12 -
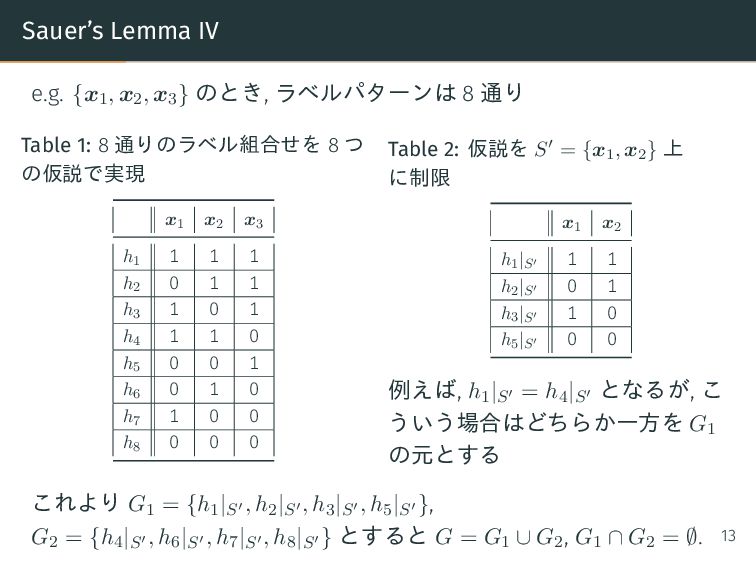
Sauer’s Lemma IV e.g. {x1, x2, x3} のとき, ラベルパターンは 8
通り Table 1: 8 通りのラベル組合せを 8 つ の仮説で実現 x1 x2 x3 h1 1 1 1 h2 0 1 1 h3 1 0 1 h4 1 1 0 h5 0 0 1 h6 0 1 0 h7 1 0 0 h8 0 0 0 Table 2: 仮説を S′ = {x1 , x2 } 上 に制限 x1 x2 h1|S′ 1 1 h2|S′ 0 1 h3|S′ 1 0 h5|S′ 0 0 例えば, h1|S′ = h4|S′ となるが, こ ういう場合はどちらか一方を G1 の元とする これより G1 = {h1|S′ , h2|S′ , h3|S′ , h5|S′ }, G2 = {h4|S′ , h6|S′ , h7|S′ , h8|S′ } とすると G = G1 ∪ G2 , G1 ∩ G2 = ∅. 13 -
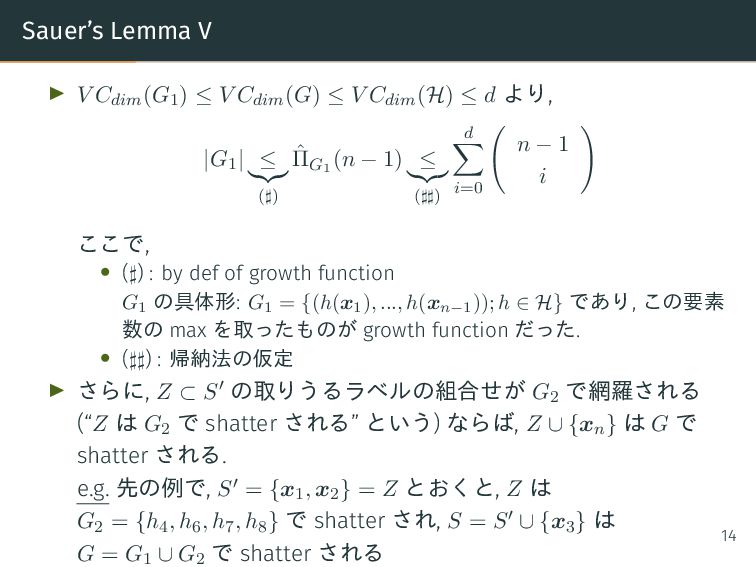
Sauer’s Lemma V ▶ V Cdim(G1) ≤ V Cdim(G) ≤
V Cdim(H) ≤ d より, |G1| ≤ (♯) ˆ ΠG1 (n − 1) ≤ (♯♯) d i=0 n − 1 i ここで, • (♯) : by def of growth function G1 の具体形: G1 = {(h(x1 ), ..., h(xn−1 )); h ∈ H} であり, この要素 数の max を取ったものが growth function だった. • (♯♯) : 帰納法の仮定 ▶ さらに, Z ⊂ S′ の取りうるラベルの組合せが G2 で網羅される (“Z は G2 で shatter される” という) ならば, Z ∪ {xn} は G で shatter される. e.g. 先の例で, S′ = {x1, x2} = Z とおくと, Z は G2 = {h4, h6, h7, h8} で shatter され, S = S′ ∪ {x3} は G = G1 ∪ G2 で shatter される 14 -
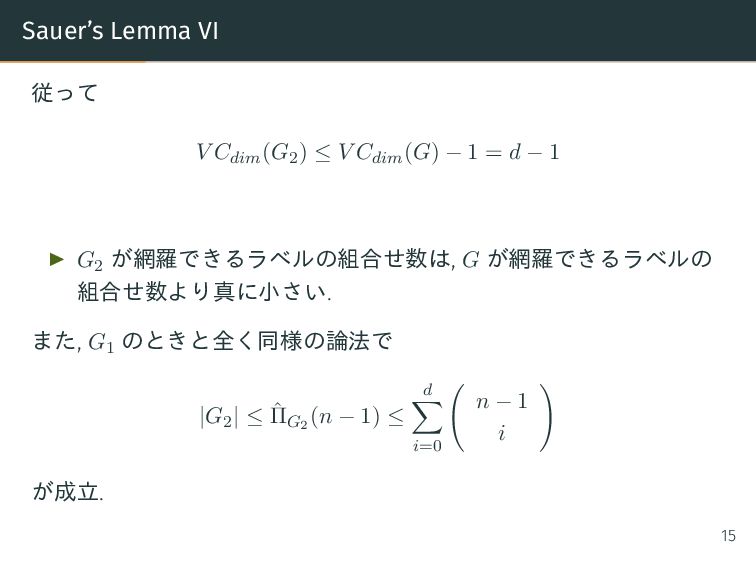
Sauer’s Lemma VI 従って V Cdim(G2) ≤ V Cdim(G) −
1 = d − 1 ▶ G2 が網羅できるラベルの組合せ数は, G が網羅できるラベルの 組合せ数より真に小さい. また, G1 のときと全く同様の論法で |G2| ≤ ˆ ΠG2 (n − 1) ≤ d i=0 n − 1 i が成立. 15 -
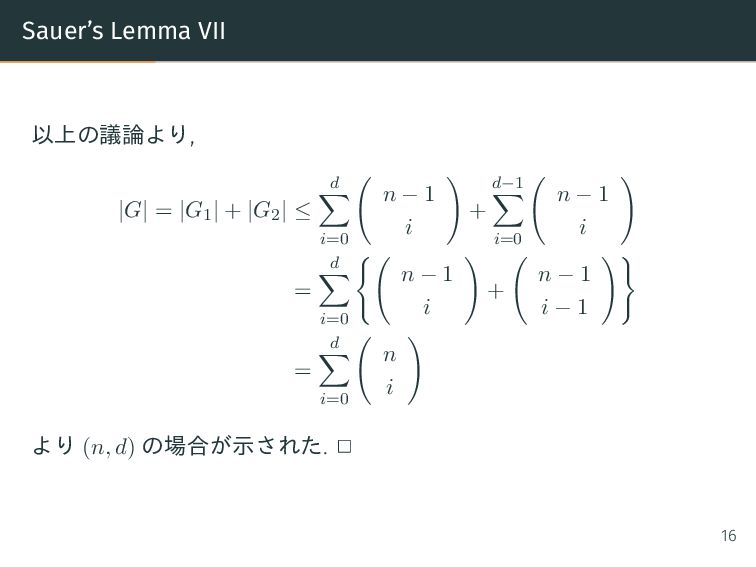
Sauer’s Lemma VII 以上の議論より, |G| = |G1| + |G2| ≤
d i=0 n − 1 i + d−1 i=0 n − 1 i = d i=0 n − 1 i + n − 1 i − 1 = d i=0 n i より (n, d) の場合が示された. 2 16 -
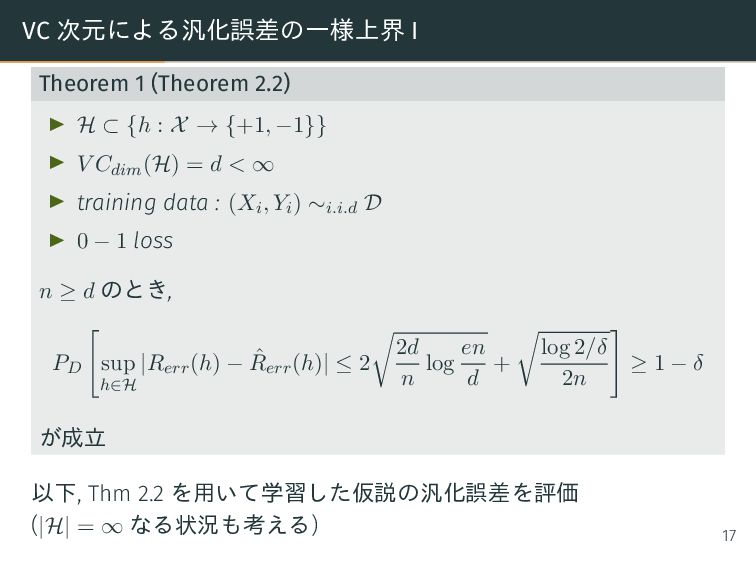
VC 次元による汎化誤差の一様上界 I Theorem 1 (Theorem 2.2) ▶ H ⊂
{h : X → {+1, −1}} ▶ V Cdim(H) = d < ∞ ▶ training data : (Xi, Yi) ∼i.i.d D ▶ 0 − 1 loss n ≥ d のとき, PD sup h∈H |Rerr(h) − ˆ Rerr(h)| ≤ 2 2d n log en d + log 2/δ 2n ≥ 1 − δ が成立 以下, Thm 2.2 を用いて学習した仮説の汎化誤差を評価 (|H| = ∞ なる状況も考える) 17 -
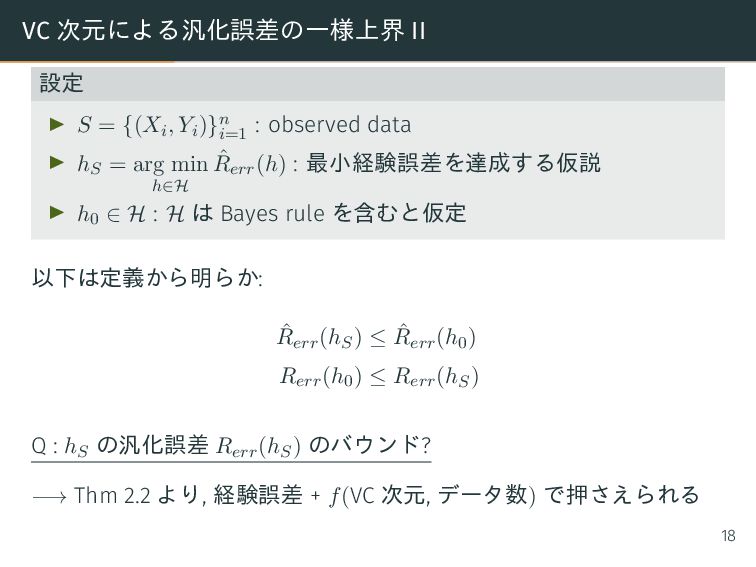
VC 次元による汎化誤差の一様上界 II 設定 ▶ S = {(Xi, Yi)}n i=1
: observed data ▶ hS = arg min h∈H ˆ Rerr(h) : 最小経験誤差を達成する仮説 ▶ h0 ∈ H : H は Bayes rule を含むと仮定 以下は定義から明らか: ˆ Rerr(hS) ≤ ˆ Rerr(h0) Rerr(h0) ≤ Rerr(hS) Q : hS の汎化誤差 Rerr(hS) のバウンド? −→ Thm 2.2 より, 経験誤差 + f(VC 次元, データ数) で押さえられる 18 -
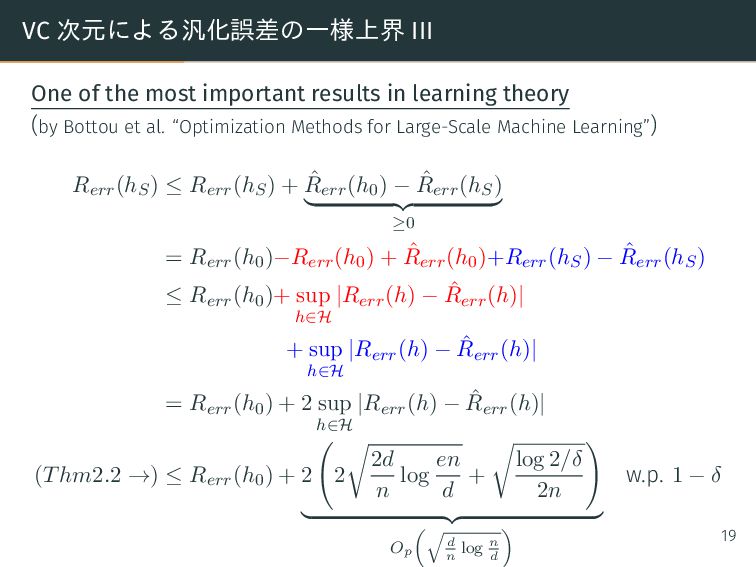
VC 次元による汎化誤差の一様上界 III One of the most important results in
learning theory (by Bottou et al. “Optimization Methods for Large-Scale Machine Learning”) Rerr(hS) ≤ Rerr(hS) + ˆ Rerr(h0) − ˆ Rerr(hS) ≥0 = Rerr(h0)−Rerr(h0) + ˆ Rerr(h0)+Rerr(hS) − ˆ Rerr(hS) ≤ Rerr(h0)+ sup h∈H |Rerr(h) − ˆ Rerr(h)| + sup h∈H |Rerr(h) − ˆ Rerr(h)| = Rerr(h0) + 2 sup h∈H |Rerr(h) − ˆ Rerr(h)| (Thm2.2 →) ≤ Rerr(h0) + 2 2 2d n log en d + log 2/δ 2n Op (√ d n log n d ) w.p. 1 − δ 19 -
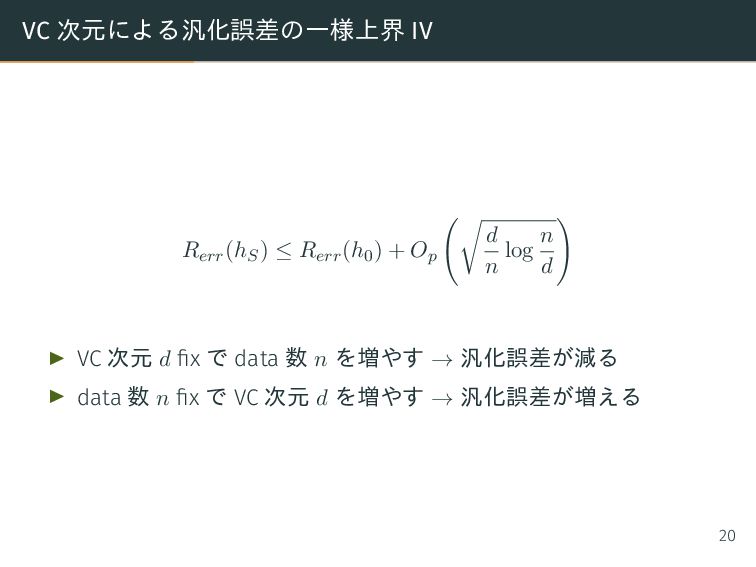
VC 次元による汎化誤差の一様上界 IV Rerr(hS) ≤ Rerr(h0) + Op d n
log n d ▶ VC 次元 d fix で data 数 n を増やす → 汎化誤差が減る ▶ data 数 n fix で VC 次元 d を増やす → 汎化誤差が増える 20 -
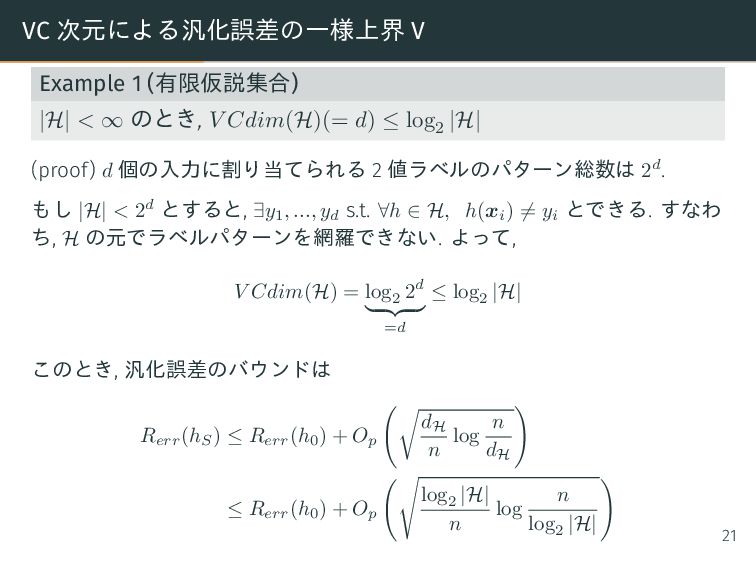
VC 次元による汎化誤差の一様上界 V Example 1 (有限仮説集合) |H| < ∞ のとき,
V Cdim(H)(= d) ≤ log2 |H| (proof) d 個の入力に割り当てられる 2 値ラベルのパターン総数は 2d. もし |H| < 2d とすると, ∃y1 , ..., yd s.t. ∀h ∈ H, h(xi ) = yi とできる. すなわ ち, H の元でラベルパターンを網羅できない. よって, V Cdim(H) = log2 2d =d ≤ log2 |H| このとき, 汎化誤差のバウンドは Rerr (hS ) ≤ Rerr (h0 ) + Op dH n log n dH ≤ Rerr (h0 ) + Op log2 |H| n log n log2 |H| 21 -
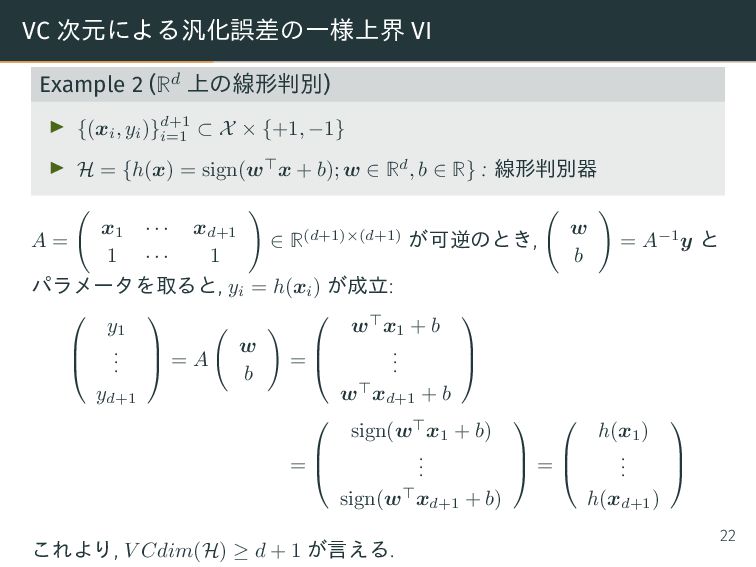
VC 次元による汎化誤差の一様上界 VI Example 2 (Rd 上の線形判別) ▶ {(xi ,
yi )}d+1 i=1 ⊂ X × {+1, −1} ▶ H = {h(x) = sign(w⊤x + b); w ∈ Rd, b ∈ R} : 線形判別器 A = x1 · · · xd+1 1 · · · 1 ∈ R(d+1)×(d+1) が可逆のとき, w b = A−1y と パラメータを取ると, yi = h(xi ) が成立: y1 . . . yd+1 = A w b = w⊤x1 + b . . . w⊤xd+1 + b = sign(w⊤x1 + b) . . . sign(w⊤xd+1 + b) = h(x1 ) . . . h(xd+1 ) これより, V Cdim(H) ≥ d + 1 が言える. 22 -
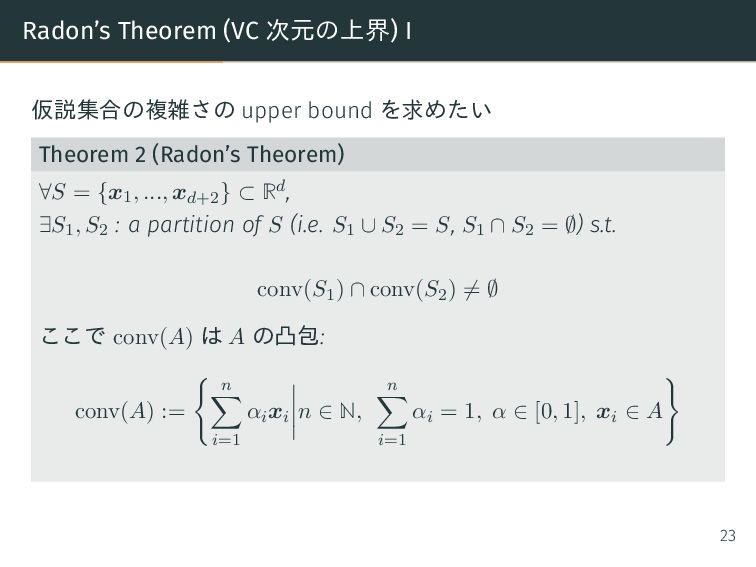
Radon’s Theorem (VC 次元の上界) I 仮説集合の複雑さの upper bound を求めたい Theorem
2 (Radon’s Theorem) ∀S = {x1, ..., xd+2} ⊂ Rd, ∃S1, S2 : a partition of S (i.e. S1 ∪ S2 = S, S1 ∩ S2 = ∅) s.t. conv(S1) ∩ conv(S2) = ∅ ここで conv(A) は A の凸包: conv(A) := n i=1 αixi n ∈ N, n i=1 αi = 1, α ∈ [0, 1], xi ∈ A 23 -
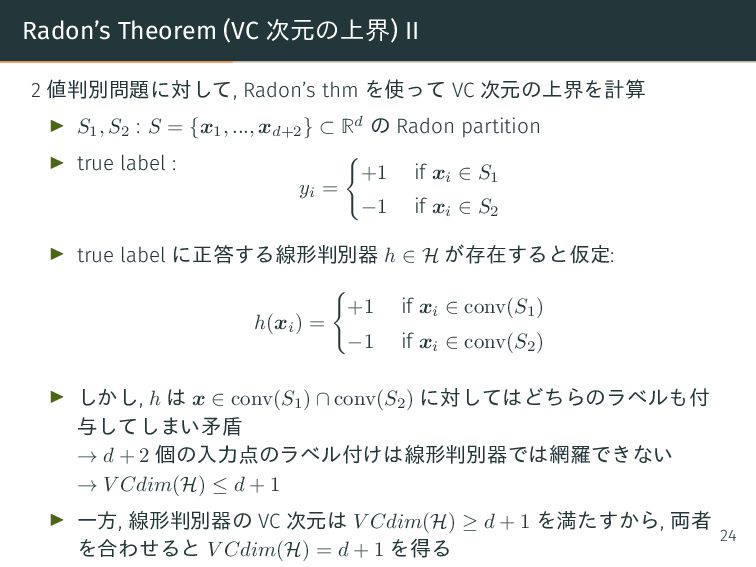
Radon’s Theorem (VC 次元の上界) II 2 値判別問題に対して, Radon’s thm を使って
VC 次元の上界を計算 ▶ S1 , S2 : S = {x1 , ..., xd+2 } ⊂ Rd の Radon partition ▶ true label : yi = +1 if xi ∈ S1 −1 if xi ∈ S2 ▶ true label に正答する線形判別器 h ∈ H が存在すると仮定: h(xi ) = +1 if xi ∈ conv(S1 ) −1 if xi ∈ conv(S2 ) ▶ しかし, h は x ∈ conv(S1 ) ∩ conv(S2 ) に対してはどちらのラベルも付 与してしまい矛盾 → d + 2 個の入力点のラベル付けは線形判別器では網羅できない → V Cdim(H) ≤ d + 1 ▶ 一方, 線形判別器の VC 次元は V Cdim(H) ≥ d + 1 を満たすから, 両者 を合わせると V Cdim(H) = d + 1 を得る 24 -
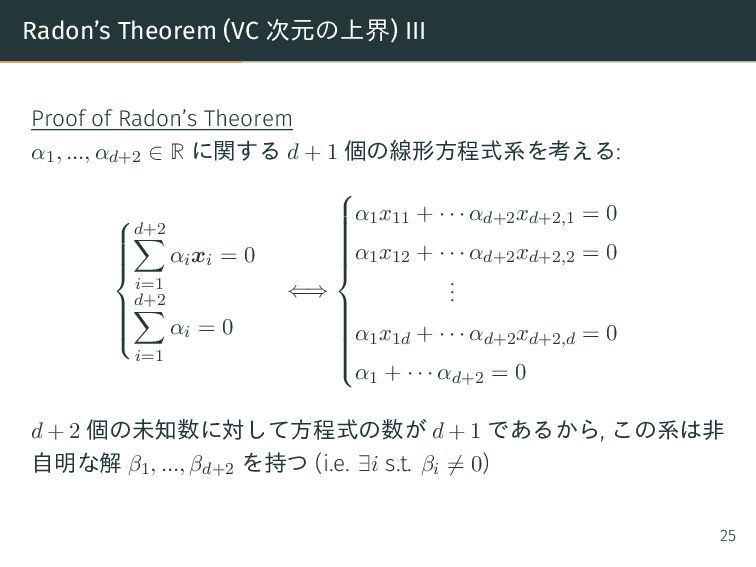
Radon’s Theorem (VC 次元の上界) III Proof of Radon’s Theorem α1,
..., αd+2 ∈ R に関する d + 1 個の線形方程式系を考える: d+2 i=1 αixi = 0 d+2 i=1 αi = 0 ⇐⇒ α1x11 + · · · αd+2xd+2,1 = 0 α1x12 + · · · αd+2xd+2,2 = 0 . . . α1x1d + · · · αd+2xd+2,d = 0 α1 + · · · αd+2 = 0 d + 2 個の未知数に対して方程式の数が d + 1 であるから, この系は非 自明な解 β1, ..., βd+2 を持つ (i.e. ∃i s.t. βi = 0) 25 -
Radon’s Theorem (VC 次元の上界) IV 集合 I1 , I2 をそれぞれ
I1 = {i ∈ [d + 2] | βi > 0} I2 = {i ∈ [d + 2] | βi ≤ 0} と定めると, d+2 i=1 βi = 0 かつ β の非自明性から, I1 = ∅, I2 = ∅ であり, S1 , S2 を S1 = {xi ∈ S | i ∈ I1} S2 = {xi ∈ S | i ∈ I2} ととると, これらは S の Radon partition をなす (i.e. S1 ∪ S2 = S, S1 ∩ S2 = ∅) 26 -
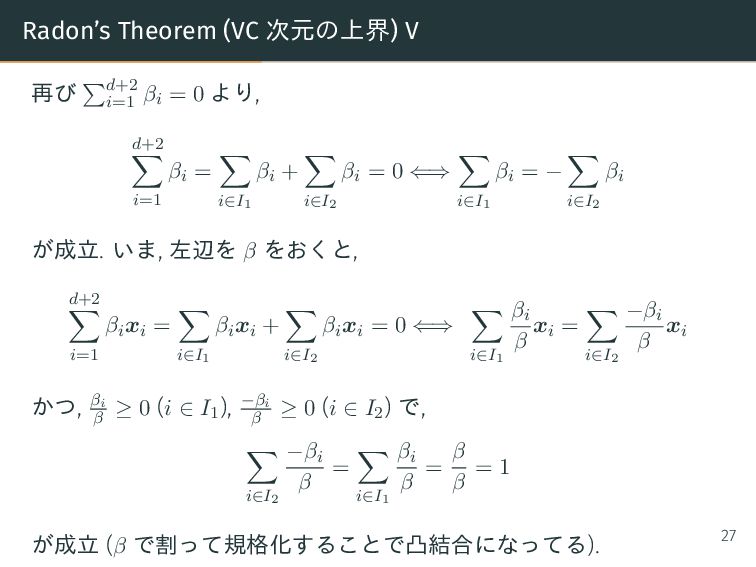
Radon’s Theorem (VC 次元の上界) V 再び d+2 i=1 βi =
0 より, d+2 i=1 βi = i∈I1 βi + i∈I2 βi = 0 ⇐⇒ i∈I1 βi = − i∈I2 βi が成立. いま, 左辺を β をおくと, d+2 i=1 βixi = i∈I1 βixi + i∈I2 βixi = 0 ⇐⇒ i∈I1 βi β xi = i∈I2 −βi β xi かつ, βi β ≥ 0 (i ∈ I1 ), −βi β ≥ 0 (i ∈ I2 ) で, i∈I2 −βi β = i∈I1 βi β = β β = 1 が成立 (β で割って規格化することで凸結合になってる). 27 -
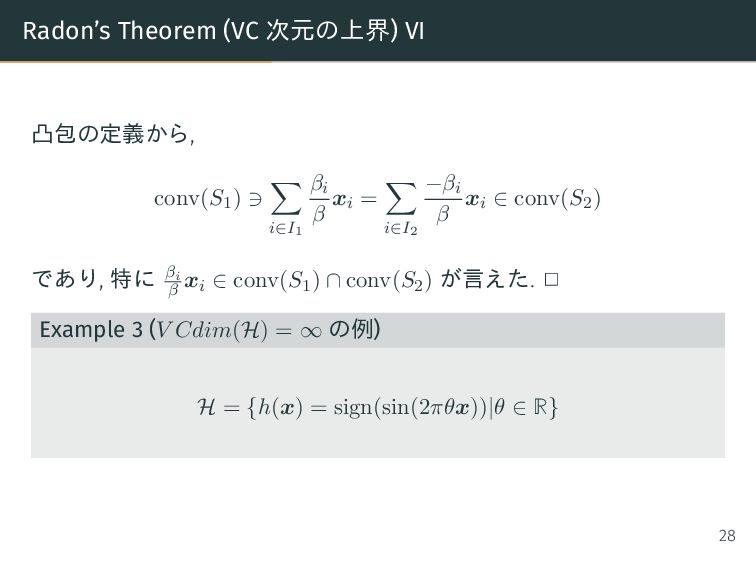
Radon’s Theorem (VC 次元の上界) VI 凸包の定義から, conv(S1) i∈I1 βi β
xi = i∈I2 −βi β xi ∈ conv(S2) であり, 特に βi β xi ∈ conv(S1) ∩ conv(S2) が言えた. 2 Example 3 (V Cdim(H) = ∞ の例) H = {h(x) = sign(sin(2πθx))|θ ∈ R} 28 -
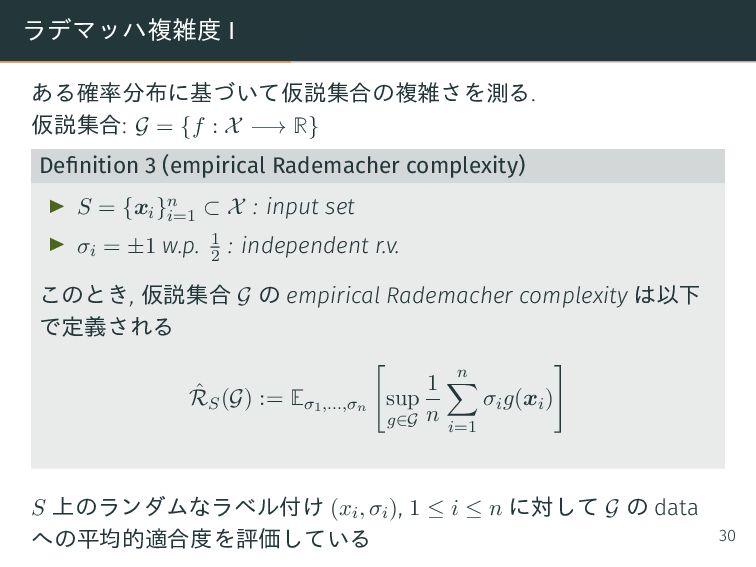
ラデマッハ複雑度 I ある確率分布に基づいて仮説集合の複雑さを測る. 仮説集合: G = {f : X −→
R} Definition 3 (empirical Rademacher complexity) ▶ S = {xi}n i=1 ⊂ X : input set ▶ σi = ±1 w.p. 1 2 : independent r.v. このとき, 仮説集合 G の empirical Rademacher complexity は以下 で定義される ˆ RS(G) := Eσ1,...,σn sup g∈G 1 n n i=1 σig(xi) S 上のランダムなラベル付け (xi, σi), 1 ≤ i ≤ n に対して G の data への平均的適合度を評価している 30 -
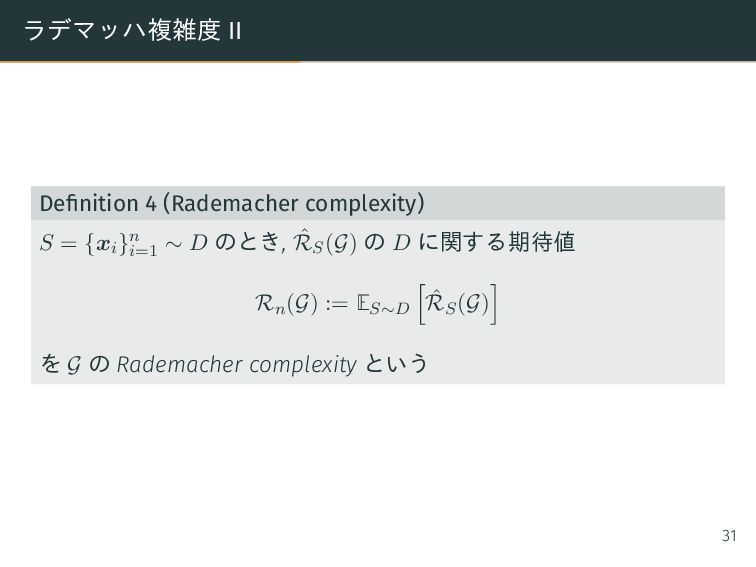
ラデマッハ複雑度 II Definition 4 (Rademacher complexity) S = {xi}n i=1
∼ D のとき, ˆ RS(G) の D に関する期待値 Rn(G) := ES∼D ˆ RS(G) を G の Rademacher complexity という 31 -
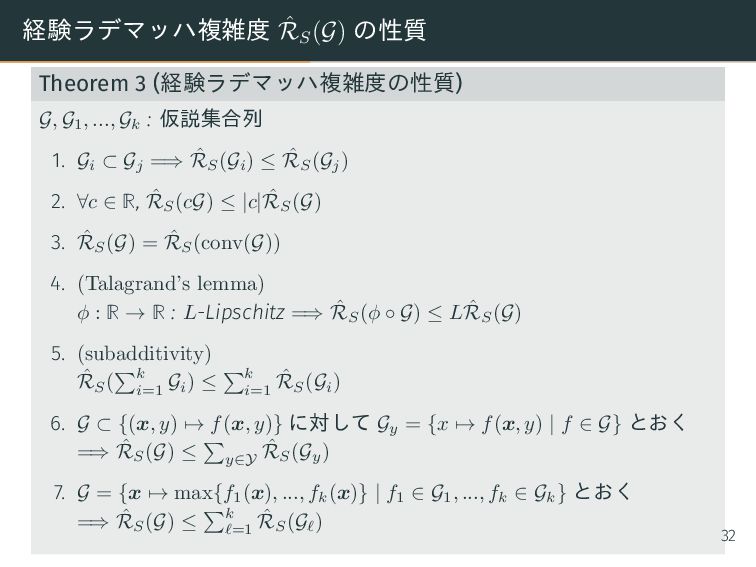
経験ラデマッハ複雑度 ˆ RS (G) の性質 Theorem 3 (経験ラデマッハ複雑度の性質) G, G1
, ..., Gk : 仮説集合列 1. Gi ⊂ Gj =⇒ ˆ RS (Gi ) ≤ ˆ RS (Gj ) 2. ∀c ∈ R, ˆ RS (cG) ≤ |c| ˆ RS (G) 3. ˆ RS (G) = ˆ RS (conv(G)) 4. (Talagrand’s lemma) ϕ : R → R : L-Lipschitz =⇒ ˆ RS (ϕ ◦ G) ≤ L ˆ RS (G) 5. (subadditivity) ˆ RS ( k i=1 Gi ) ≤ k i=1 ˆ RS (Gi ) 6. G ⊂ {(x, y) → f(x, y)} に対して Gy = {x → f(x, y) | f ∈ G} とおく =⇒ ˆ RS (G) ≤ y∈Y ˆ RS (Gy ) 7. G = {x → max{f1 (x), ..., fk (x)} | f1 ∈ G1 , ..., fk ∈ Gk } とおく =⇒ ˆ RS (G) ≤ k ℓ=1 ˆ RS (Gℓ ) 32 -
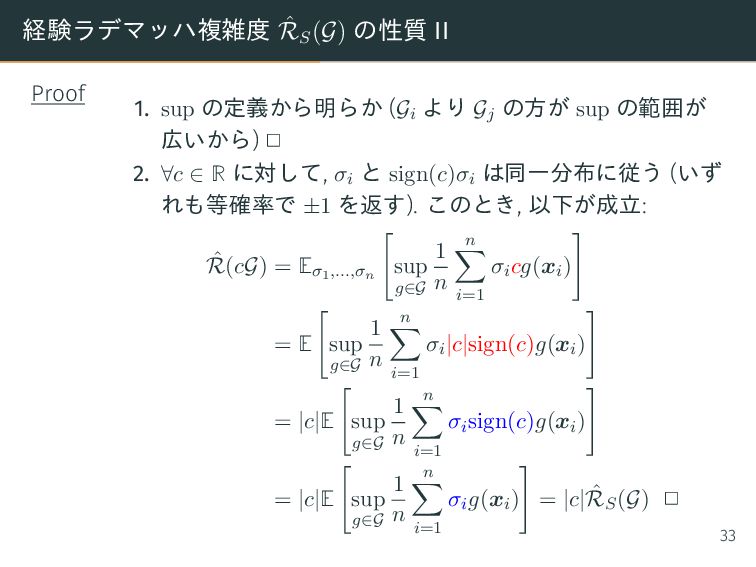
経験ラデマッハ複雑度 ˆ RS (G) の性質 II Proof 1. sup の定義から明らか
(Gi より Gj の方が sup の範囲が 広いから) 2 2. ∀c ∈ R に対して, σi と sign(c)σi は同一分布に従う (いず れも等確率で ±1 を返す). このとき, 以下が成立: ˆ R(cG) = Eσ1,...,σn sup g∈G 1 n n i=1 σicg(xi) = E sup g∈G 1 n n i=1 σi|c|sign(c)g(xi) = |c|E sup g∈G 1 n n i=1 σisign(c)g(xi) = |c|E sup g∈G 1 n n i=1 σig(xi) = |c| ˆ RS(G) 2 33 -
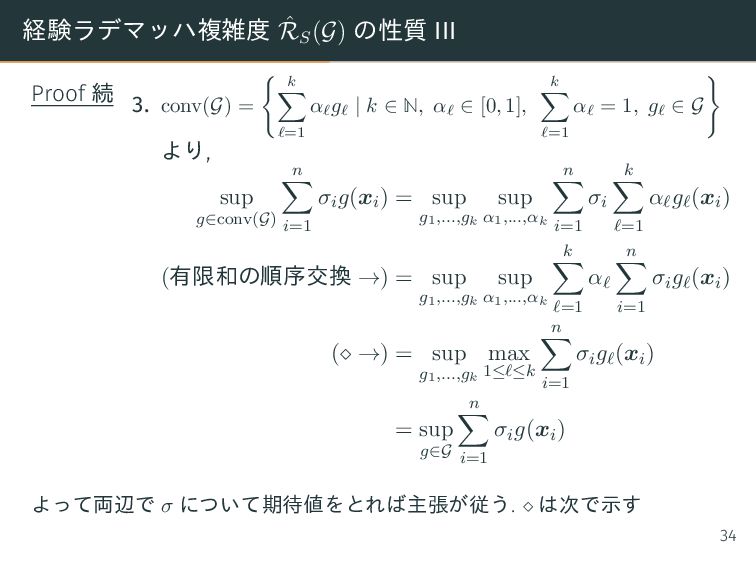
経験ラデマッハ複雑度 ˆ RS (G) の性質 III Proof 続 3. conv(G)
= k ℓ=1 αℓ gℓ | k ∈ N, αℓ ∈ [0, 1], k ℓ=1 αℓ = 1, gℓ ∈ G より, sup g∈conv(G) n i=1 σig(xi) = sup g1,...,gk sup α1,...,αk n i=1 σi k ℓ=1 αℓgℓ(xi) (有限和の順序交換 →) = sup g1,...,gk sup α1,...,αk k ℓ=1 αℓ n i=1 σigℓ(xi) ( →) = sup g1,...,gk max 1≤ℓ≤k n i=1 σigℓ(xi) = sup g∈G n i=1 σig(xi) よって両辺で σ について期待値をとれば主張が従う. は次で示す 34 -
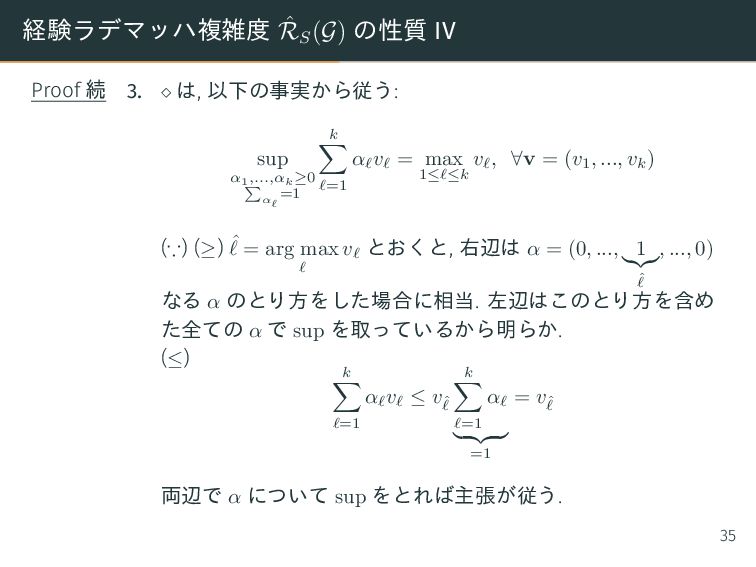
経験ラデマッハ複雑度 ˆ RS (G) の性質 IV Proof 続 3. は,
以下の事実から従う: sup α1,...,αk≥0 ∑ αℓ =1 k ℓ=1 αℓ vℓ = max 1≤ℓ≤k vℓ , ∀v = (v1 , ..., vk ) (∵) (≥) ˆ ℓ = arg max ℓ vℓ とおくと, 右辺は α = (0, ..., 1 ˆ ℓ , ..., 0) なる α のとり方をした場合に相当. 左辺はこのとり方を含め た全ての α で sup を取っているから明らか. (≤) k ℓ=1 αℓ vℓ ≤ vˆ ℓ k ℓ=1 αℓ =1 = vˆ ℓ 両辺で α について sup をとれば主張が従う. 35 -
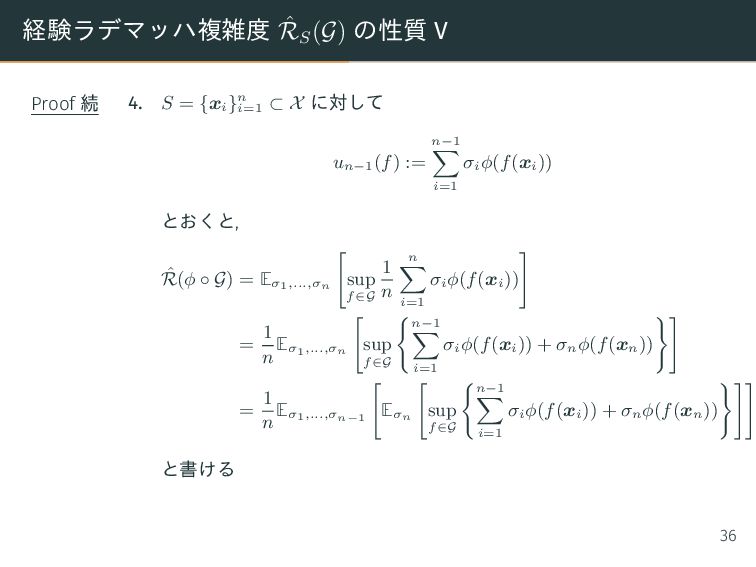
経験ラデマッハ複雑度 ˆ RS (G) の性質 V Proof 続 4. S
= {xi }n i=1 ⊂ X に対して un−1 (f) := n−1 ∑ i=1 σi ϕ(f(xi )) とおくと, ˆ R(ϕ ◦ G) = Eσ1,...,σn [ sup f∈G 1 n n ∑ i=1 σi ϕ(f(xi )) ] = 1 n Eσ1,...,σn [ sup f∈G { n−1 ∑ i=1 σi ϕ(f(xi )) + σn ϕ(f(xn )) }] = 1 n Eσ1,...,σn−1 [ Eσn [ sup f∈G { n−1 ∑ i=1 σi ϕ(f(xi )) + σn ϕ(f(xn )) }]] と書ける 36 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 VI Proof 続 4. sup
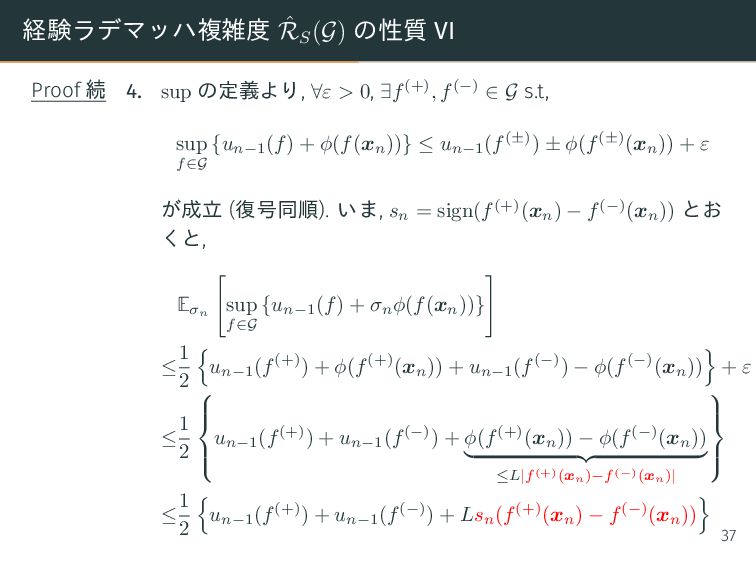
の定義より, ∀ε > 0, ∃f(+), f(−) ∈ G s.t, sup f∈G {un−1 (f) + ϕ(f(xn ))} ≤ un−1 (f(±)) ± ϕ(f(±)(xn )) + ε が成立 (復号同順). いま, sn = sign(f(+)(xn ) − f(−)(xn )) とお くと, Eσn sup f∈G {un−1 (f) + σn ϕ(f(xn ))} ≤ 1 2 un−1 (f(+)) + ϕ(f(+)(xn )) + un−1 (f(−)) − ϕ(f(−)(xn )) + ε ≤ 1 2 un−1 (f(+)) + un−1 (f(−)) + ϕ(f(+)(xn )) − ϕ(f(−)(xn )) ≤L|f(+)(xn)−f(−)(xn)| ≤ 1 2 un−1 (f(+)) + un−1 (f(−)) + Lsn (f(+)(xn ) − f(−)(xn )) 37 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 VII Proof 続 4. 1
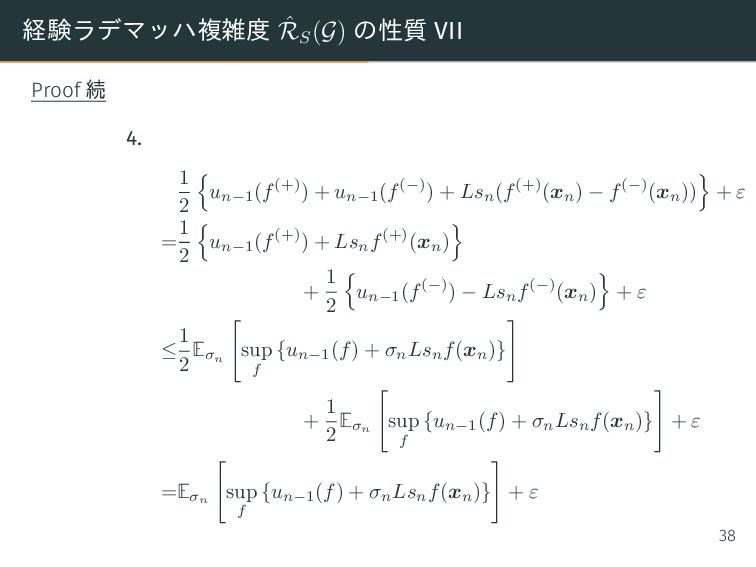
2 un−1 (f(+)) + un−1 (f(−)) + Lsn (f(+)(xn ) − f(−)(xn )) + ε = 1 2 un−1 (f(+)) + Lsn f(+)(xn ) + 1 2 un−1 (f(−)) − Lsn f(−)(xn ) + ε ≤ 1 2 Eσn sup f {un−1 (f) + σn Lsn f(xn )} + 1 2 Eσn sup f {un−1 (f) + σn Lsn f(xn )} + ε =Eσn sup f {un−1 (f) + σn Lsn f(xn )} + ε 38 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 VIII Proof 続 4. 上記の不等式が
∀ε > 0 で成立つから, ε 0 とすると, Eσn sup f∈G {un−1 (f) + σn ϕ(f(xn ))} ≤ Eσn sup f {un−1 (f) + σn Lf(xn )} が成立 (σn と σn sn が同一の分布を定めることを使う). 次に, n − 1 番目に注目して un−2 (f) = n−2 i=1 σi ϕ(f(xi )) + σn Lf(xn ) とおき, 同様の議論で Eσn−1,σn sup f∈G {un−2 (f) + σn−1 ϕ(f(xn−1 ))} ≤Eσn−1,σn sup f {un−2 (f) + σn−1 Lf(xn−1 )} を得る. 39 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 IX Proof 続 4. 以上の手続きを
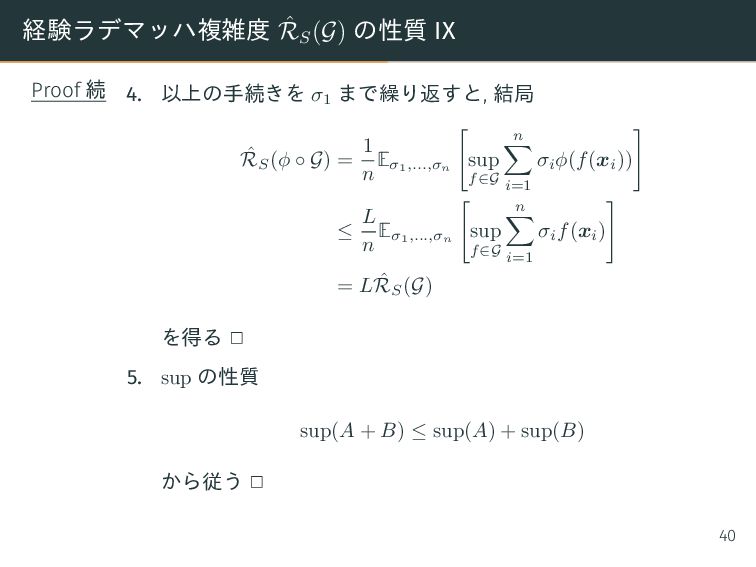
σ1 まで繰り返すと, 結局 ˆ RS (ϕ ◦ G) = 1 n Eσ1,...,σn sup f∈G n i=1 σi ϕ(f(xi )) ≤ L n Eσ1,...,σn sup f∈G n i=1 σi f(xi ) = L ˆ RS (G) を得る 2 5. sup の性質 sup(A + B) ≤ sup(A) + sup(B) から従う 2 40 -
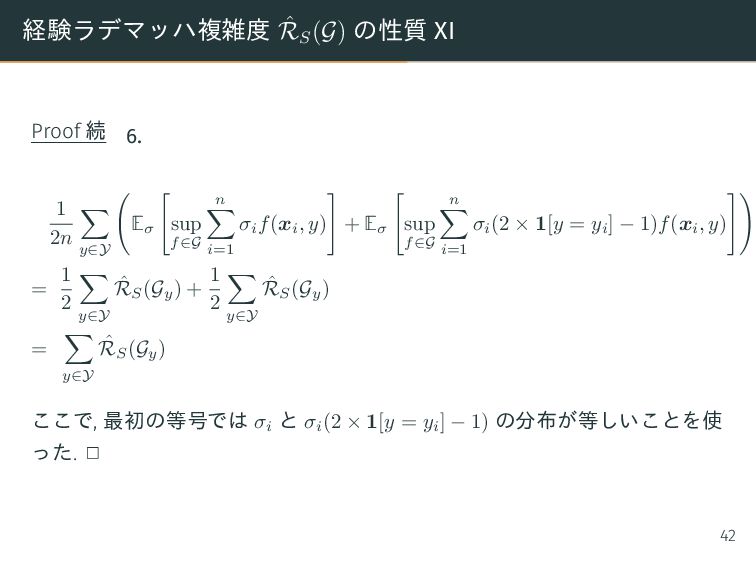
経験ラデマッハ複雑度 ˆ RS (G) の性質 X Proof 続 6. S
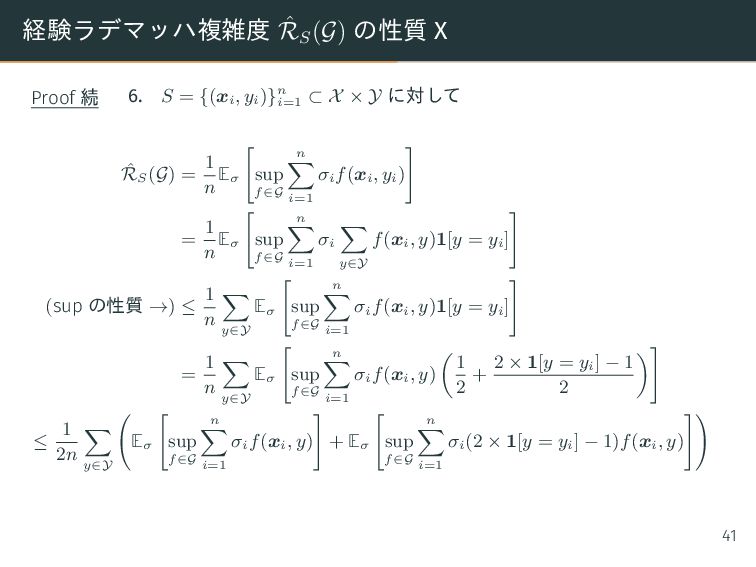
= {(xi , yi )}n i=1 ⊂ X × Y に対して ˆ RS (G) = 1 n Eσ [ sup f∈G n ∑ i=1 σi f(xi , yi ) ] = 1 n Eσ [ sup f∈G n ∑ i=1 σi ∑ y∈Y f(xi , y)1[y = yi ] ] (sup の性質 →) ≤ 1 n ∑ y∈Y Eσ [ sup f∈G n ∑ i=1 σi f(xi , y)1[y = yi ] ] = 1 n ∑ y∈Y Eσ [ sup f∈G n ∑ i=1 σi f(xi , y) ( 1 2 + 2 × 1[y = yi ] − 1 2 )] ≤ 1 2n ∑ y∈Y ( Eσ [ sup f∈G n ∑ i=1 σi f(xi , y) ] + Eσ [ sup f∈G n ∑ i=1 σi (2 × 1[y = yi ] − 1)f(xi , y) ]) 41 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 XI Proof 続 6. 1
2n y∈Y Eσ sup f∈G n i=1 σi f(xi , y) + Eσ sup f∈G n i=1 σi (2 × 1[y = yi ] − 1)f(xi , y) = 1 2 y∈Y ˆ RS (Gy ) + 1 2 y∈Y ˆ RS (Gy ) = y∈Y ˆ RS (Gy ) ここで, 最初の等号では σi と σi (2 × 1[y = yi ] − 1) の分布が等しいことを使 った. 2 42 -
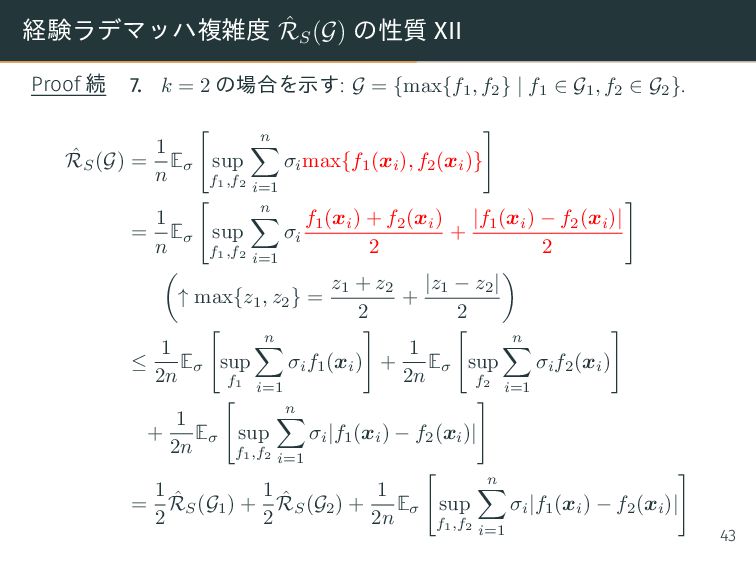
経験ラデマッハ複雑度 ˆ RS (G) の性質 XII Proof 続 7. k
= 2 の場合を示す: G = {max{f1 , f2 } | f1 ∈ G1 , f2 ∈ G2 }. ˆ RS (G) = 1 n Eσ sup f1,f2 n i=1 σi max{f1 (xi ), f2 (xi )} = 1 n Eσ sup f1,f2 n i=1 σi f1 (xi ) + f2 (xi ) 2 + |f1 (xi ) − f2 (xi )| 2 ↑ max{z1 , z2 } = z1 + z2 2 + |z1 − z2 | 2 ≤ 1 2n Eσ sup f1 n i=1 σi f1 (xi ) + 1 2n Eσ sup f2 n i=1 σi f2 (xi ) + 1 2n Eσ sup f1,f2 n i=1 σi |f1 (xi ) − f2 (xi )| = 1 2 ˆ RS (G1 ) + 1 2 ˆ RS (G2 ) + 1 2n Eσ sup f1,f2 n i=1 σi |f1 (xi ) − f2 (xi )| 43 -
経験ラデマッハ複雑度 ˆ RS (G) の性質 XIII Proof 続 7. 1
2 ˆ RS (G1 ) + 1 2 ˆ RS (G2 ) + 1 2n Eσ sup f1,f2 n i=1 σi |f1 (xi ) − f2 (xi )| | · | は 1-Lipschitz 連続なので, 本定理の 4 より, 1 2n Eσ sup f1,f2 n i=1 σi |f1 (xi ) − f2 (xi )| ≤ 1 2n Eσ sup f1,f2 n i=1 σi (f1 (xi ) − f2 (xi )) ≤ 1 2 ˆ RS (G1 ) + 1 2 ˆ RS (G2 ) 結局, ˆ RS (G) ≤ 1 2 ˆ RS (G1 ) + 1 2 ˆ RS (G2 ) + 1 2 ˆ RS (G1 ) + 1 2 ˆ RS (G2 ) = ˆ RS (G1 ) + ˆ RS (G2 ) k ≥ 3 の場合は以上を帰納的に繰り返す 2 44 -
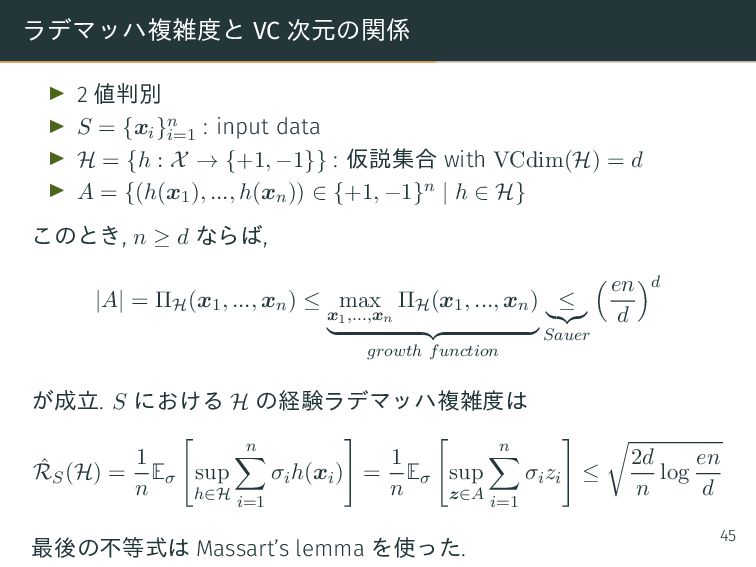
ラデマッハ複雑度と VC 次元の関係 ▶ 2 値判別 ▶ S = {xi}n
i=1 : input data ▶ H = {h : X → {+1, −1}} : 仮説集合 with VCdim(H) = d ▶ A = {(h(x1), ..., h(xn)) ∈ {+1, −1}n | h ∈ H} このとき, n ≥ d ならば, |A| = ΠH(x1, ..., xn) ≤ max x1,...,xn ΠH(x1, ..., xn) growth function ≤ Sauer en d d が成立. S における H の経験ラデマッハ複雑度は ˆ RS(H) = 1 n Eσ sup h∈H n i=1 σih(xi) = 1 n Eσ sup z∈A n i=1 σizi ≤ 2d n log en d 最後の不等式は Massart’s lemma を使った. 45 -
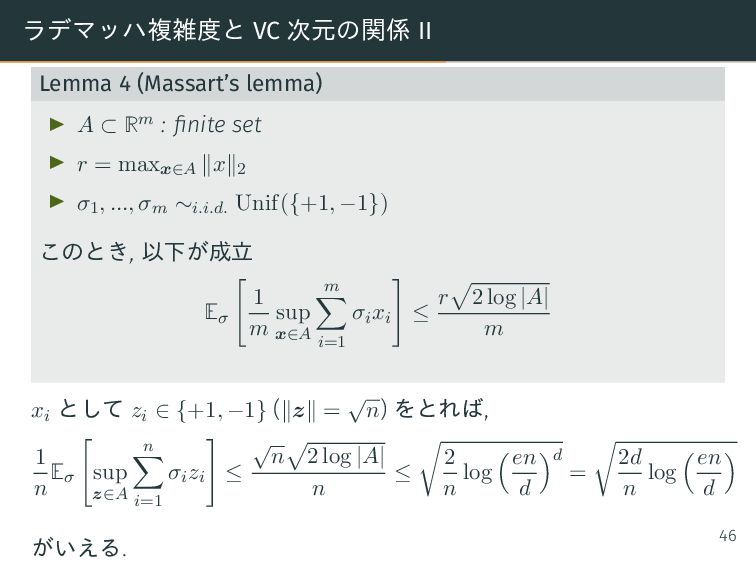
ラデマッハ複雑度と VC 次元の関係 II Lemma 4 (Massart’s lemma) ▶ A
⊂ Rm : finite set ▶ r = maxx∈A x 2 ▶ σ1, ..., σm ∼i.i.d. Unif({+1, −1}) このとき, 以下が成立 Eσ 1 m sup x∈A m i=1 σixi ≤ r 2 log |A| m xi として zi ∈ {+1, −1} ( z = √ n) をとれば, 1 n Eσ sup z∈A n i=1 σizi ≤ √ n 2 log |A| n ≤ 2 n log en d d = 2d n log en d がいえる. 46 -
ラデマッハ複雑度と VC 次元の関係 III Proof of Massart’s Lemma ∀t >
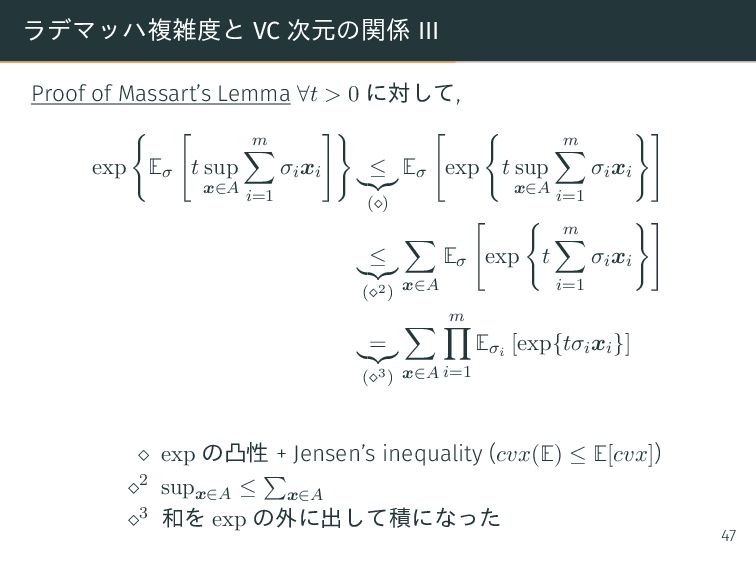
0 に対して, exp Eσ t sup x∈A m i=1 σixi ≤ (⋄) Eσ exp t sup x∈A m i=1 σixi ≤ (⋄2) x∈A Eσ exp t m i=1 σixi = (⋄3) x∈A m i=1 Eσi [exp{tσixi}] exp の凸性 + Jensen’s inequality (cvx(E) ≤ E[cvx]) 2 supx∈A ≤ x∈A 3 和を exp の外に出して積になった 47 -
ラデマッハ複雑度と VC 次元の関係 IV Proof of Massart’s Lemma さらに, Hoeffding’s
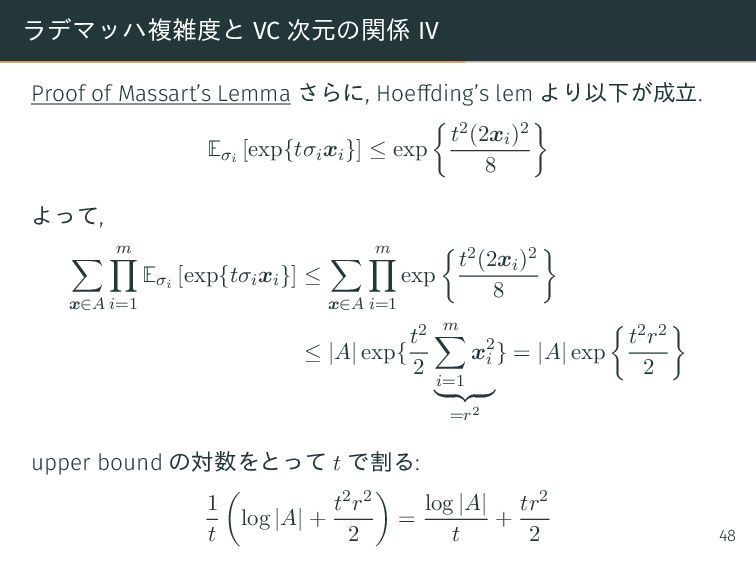
lem より以下が成立. Eσi [exp{tσixi}] ≤ exp t2(2xi)2 8 よって, x∈A m i=1 Eσi [exp{tσixi}] ≤ x∈A m i=1 exp t2(2xi)2 8 ≤ |A| exp{ t2 2 m i=1 x2 i =r2 } = |A| exp t2r2 2 upper bound の対数をとって t で割る: 1 t log |A| + t2r2 2 = log |A| t + tr2 2 48 -
ラデマッハ複雑度と VC 次元の関係 V Proof of Massart’s Lemma 最小化した上界を用いて, 以下を得る
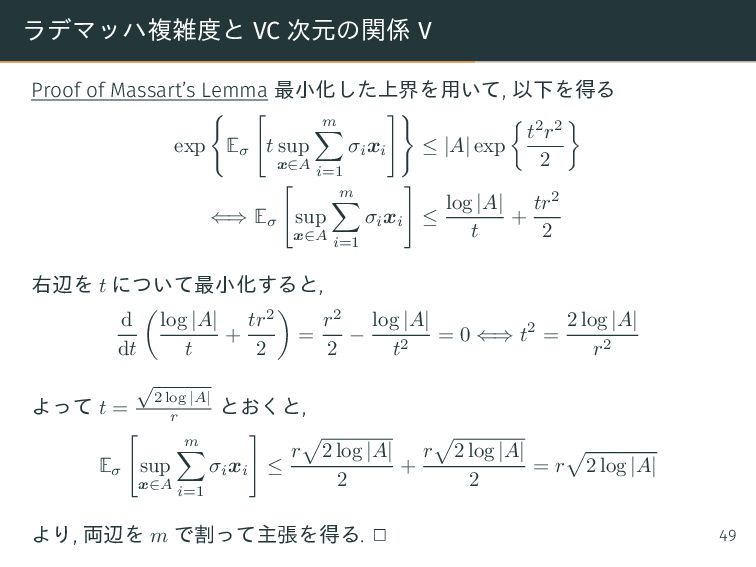
exp Eσ t sup x∈A m i=1 σi xi ≤ |A| exp t2r2 2 ⇐⇒ Eσ sup x∈A m i=1 σi xi ≤ log |A| t + tr2 2 右辺を t について最小化すると, d dt log |A| t + tr2 2 = r2 2 − log |A| t2 = 0 ⇐⇒ t2 = 2 log |A| r2 よって t = √ 2 log |A| r とおくと, Eσ sup x∈A m i=1 σi xi ≤ r 2 log |A| 2 + r 2 log |A| 2 = r 2 log |A| より, 両辺を m で割って主張を得る. 2 49 -
経験ラデマッハ複雑度の例 I : 有限集合 ▶ G = {g1 , ...,
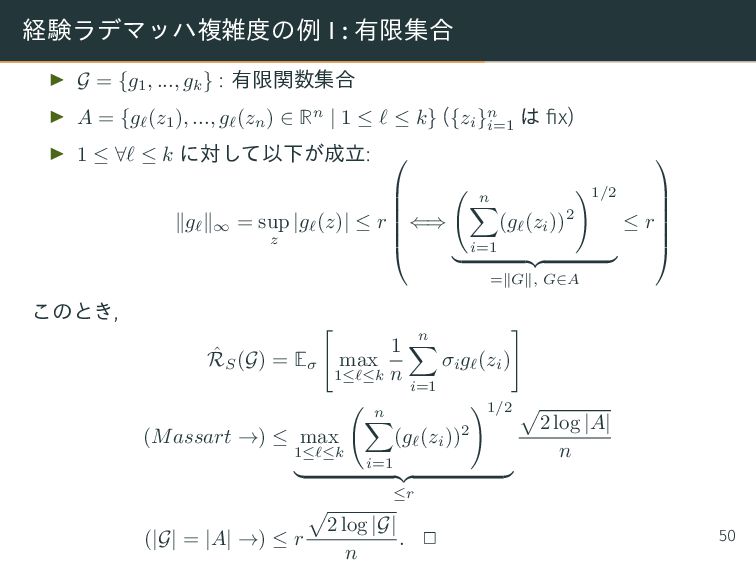
gk } : 有限関数集合 ▶ A = {gℓ (z1 ), ..., gℓ (zn ) ∈ Rn | 1 ≤ ℓ ≤ k} ({zi }n i=1 は fix) ▶ 1 ≤ ∀ℓ ≤ k に対して以下が成立: gℓ ∞ = sup z |gℓ (z)| ≤ r ⇐⇒ n i=1 (gℓ (zi ))2 1/2 =∥G∥, G∈A ≤ r このとき, ˆ RS (G) = Eσ max 1≤ℓ≤k 1 n n i=1 σi gℓ (zi ) (Massart →) ≤ max 1≤ℓ≤k n i=1 (gℓ (zi ))2 1/2 ≤r 2 log |A| n (|G| = |A| →) ≤ r 2 log |G| n . 2 50 -
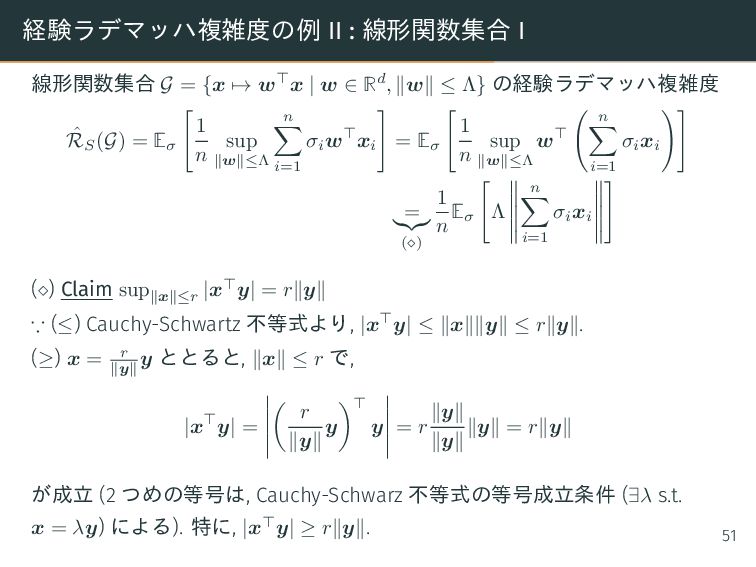
経験ラデマッハ複雑度の例 II : 線形関数集合 I 線形関数集合 G = {x →
w⊤x | w ∈ Rd, w ≤ Λ} の経験ラデマッハ複雑度 ˆ RS (G) = Eσ 1 n sup ∥w∥≤Λ n i=1 σi w⊤xi = Eσ 1 n sup ∥w∥≤Λ w⊤ n i=1 σi xi = (⋄) 1 n Eσ Λ n i=1 σi xi ( ) Claim sup∥x∥≤r |x⊤y| = r y ∵ (≤) Cauchy-Schwartz 不等式より, |x⊤y| ≤ x y ≤ r y . (≥) x = r ∥y∥ y ととると, x ≤ r で, |x⊤y| = r y y ⊤ y = r y y y = r y が成立 (2 つめの等号は, Cauchy-Schwarz 不等式の等号成立条件 (∃λ s.t. x = λy) による). 特に, |x⊤y| ≥ r y . 51 -
経験ラデマッハ複雑度の例 II : 線形関数集合 II 1 n Eσ Λ n
i=1 σi xi = 1 n Eσ Λ n i=1 σi xi 2 1/2 ≤ (⋄) Λ n Eσ n i=1 σi xi 2 1/2 = ⋄2 Λ n n i=1 xi 2 1/2 ( ) concave function √ · に対する Jensen 不等式 (E[ √ ·] ≤ E[·]) による. ( 2) n = 2 のとき (n ≥ 3 のときも同様にクロスタームが消える), E[ σ1 x1 + σ2 x2 ] = E[ σ1 x1 2 + σ2 x2 2 + σ1 σ2 x⊤ 1 x2 ] = E[ σ2 1 =1 x1 2 + σ2 2 =1 x2 2 + σ1 σ2 x⊤ 1 x2 ] = x1 2 + x2 2 + E[σ1 σ2 x⊤ 1 x2 ] (σ の独立性 →) = x1 2 + x2 2 + E[σ1 ] =0 E[σ2 ] =0 x⊤ 1 x2 = x1 2 + x2 2 52 -
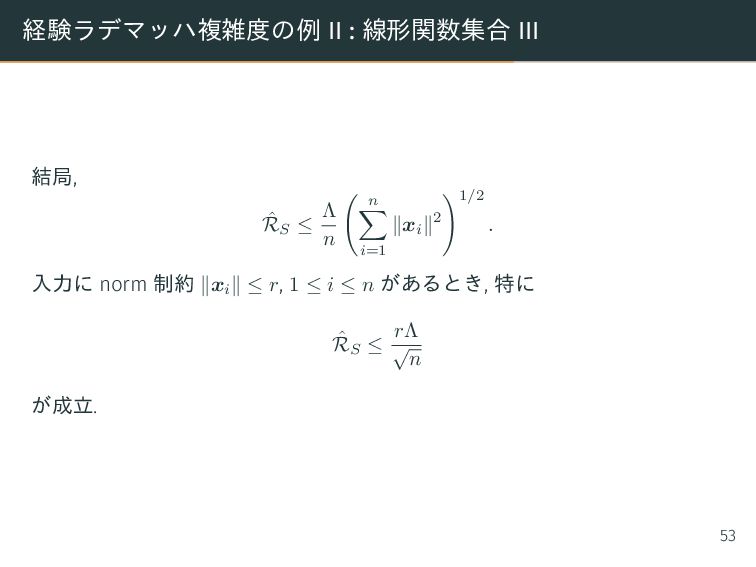
経験ラデマッハ複雑度の例 II : 線形関数集合 III 結局, ˆ RS ≤ Λ
n n i=1 xi 2 1/2 . 入力に norm 制約 xi ≤ r, 1 ≤ i ≤ n があるとき, 特に ˆ RS ≤ rΛ √ n が成立. 53 -
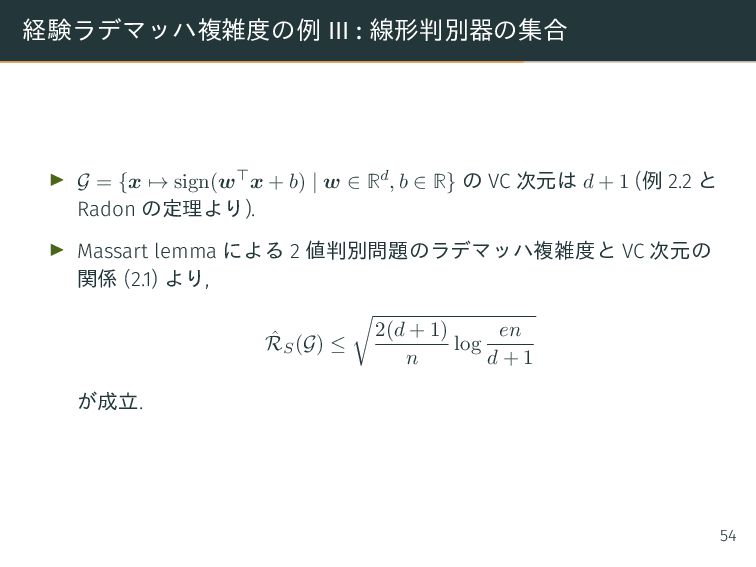
経験ラデマッハ複雑度の例 III : 線形判別器の集合 ▶ G = {x → sign(w⊤x
+ b) | w ∈ Rd, b ∈ R} の VC 次元は d + 1 (例 2.2 と Radon の定理より). ▶ Massart lemma による 2 値判別問題のラデマッハ複雑度と VC 次元の 関係 (2.1) より, ˆ RS (G) ≤ 2(d + 1) n log en d + 1 が成立. 54 -
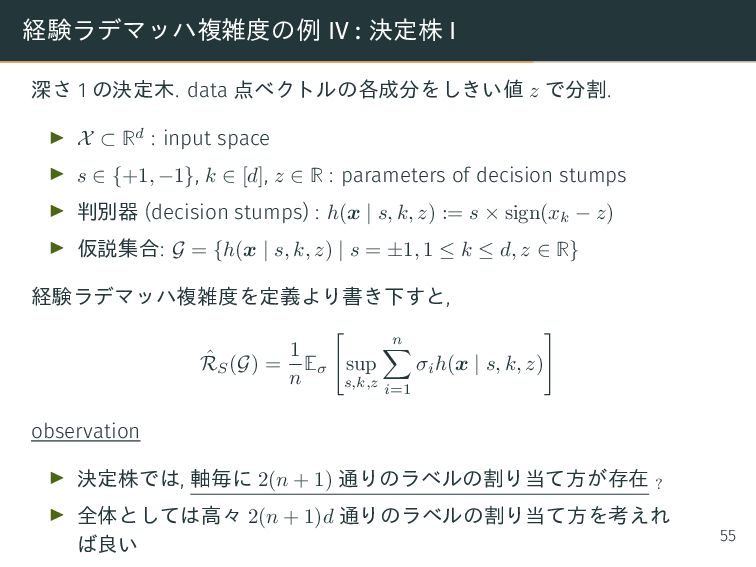
経験ラデマッハ複雑度の例 IV : 決定株 I 深さ 1 の決定木. data 点ベクトルの各成分をしきい値
z で分割. ▶ X ⊂ Rd : input space ▶ s ∈ {+1, −1}, k ∈ [d], z ∈ R : parameters of decision stumps ▶ 判別器 (decision stumps) : h(x | s, k, z) := s × sign(xk − z) ▶ 仮説集合: G = {h(x | s, k, z) | s = ±1, 1 ≤ k ≤ d, z ∈ R} 経験ラデマッハ複雑度を定義より書き下すと, ˆ RS (G) = 1 n Eσ sup s,k,z n i=1 σi h(x | s, k, z) observation ▶ 決定株では, 軸毎に 2(n + 1) 通りのラベルの割り当て方が存在 ? ▶ 全体としては高々 2(n + 1)d 通りのラベルの割り当て方を考えれ ば良い 55 -
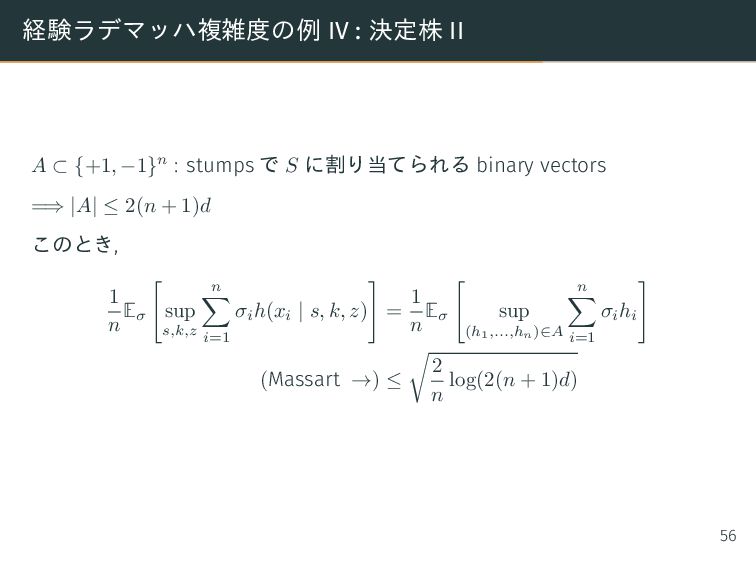
経験ラデマッハ複雑度の例 IV : 決定株 II A ⊂ {+1, −1}n :
stumps で S に割り当てられる binary vectors =⇒ |A| ≤ 2(n + 1)d このとき, 1 n Eσ sup s,k,z n i=1 σi h(xi | s, k, z) = 1 n Eσ sup (h1,...,hn)∈A n i=1 σi hi (Massart →) ≤ 2 n log(2(n + 1)d) 56 -
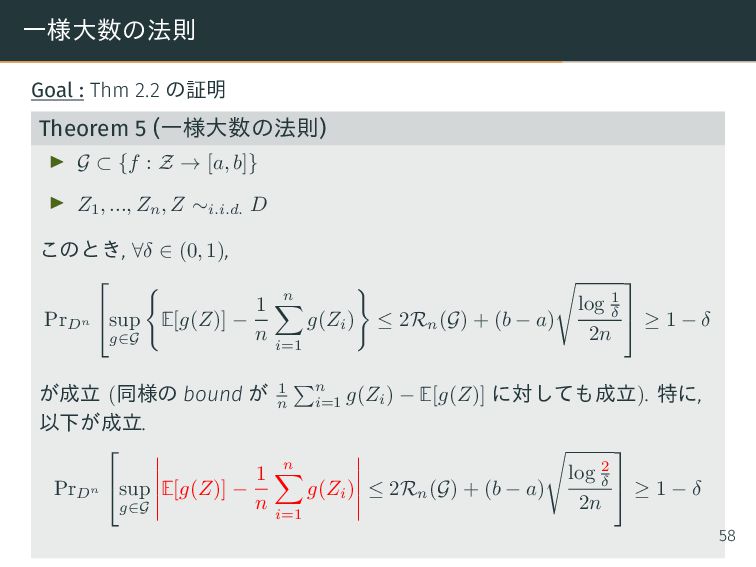
一様大数の法則 Goal : Thm 2.2 の証明 Theorem 5 (一様大数の法則) ▶
G ⊂ {f : Z → [a, b]} ▶ Z1 , ..., Zn , Z ∼i.i.d. D このとき, ∀δ ∈ (0, 1), PrDn sup g∈G E[g(Z)] − 1 n n i=1 g(Zi ) ≤ 2Rn (G) + (b − a) log 1 δ 2n ≥ 1 − δ が成立 (同様の bound が 1 n n i=1 g(Zi ) − E[g(Z)] に対しても成立). 特に, 以下が成立. PrDn sup g∈G E[g(Z)] − 1 n n i=1 g(Zi ) ≤ 2Rn (G) + (b − a) log 2 δ 2n ≥ 1 − δ 58 -
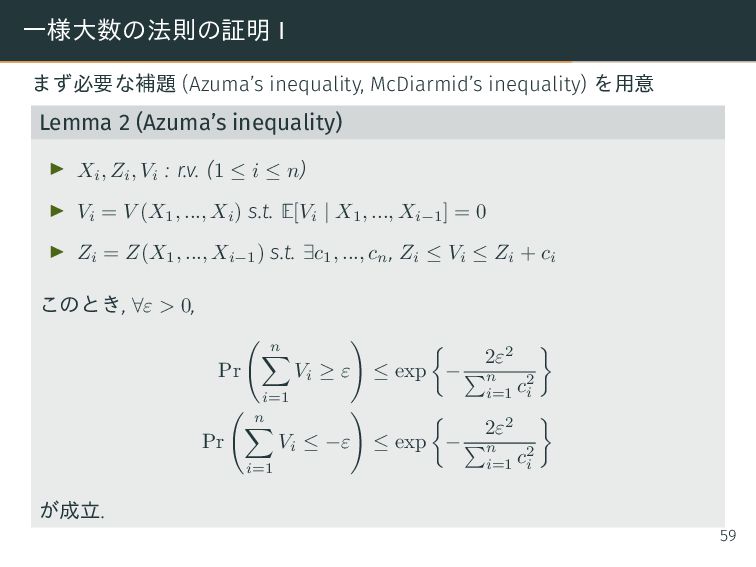
一様大数の法則の証明 I まず必要な補題 (Azuma’s inequality, McDiarmid’s inequality) を用意 Lemma 2
(Azuma’s inequality) ▶ Xi , Zi , Vi : r.v. (1 ≤ i ≤ n) ▶ Vi = V (X1 , ..., Xi ) s.t. E[Vi | X1 , ..., Xi−1 ] = 0 ▶ Zi = Z(X1 , ..., Xi−1 ) s.t. ∃c1 , ..., cn , Zi ≤ Vi ≤ Zi + ci このとき, ∀ε > 0, Pr n i=1 Vi ≥ ε ≤ exp − 2ε2 n i=1 c2 i Pr n i=1 Vi ≤ −ε ≤ exp − 2ε2 n i=1 c2 i が成立. 59 -
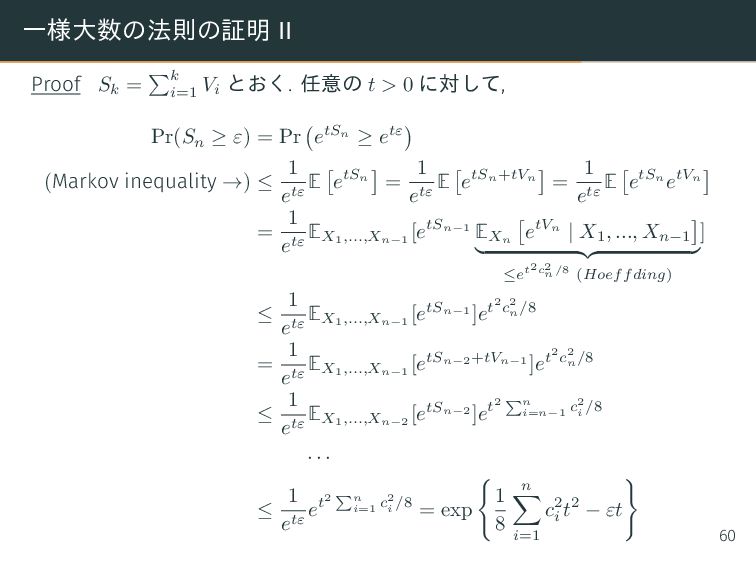
一様大数の法則の証明 II Proof Sk = k i=1 Vi とおく. 任意の
t > 0 に対して, Pr(Sn ≥ ε) = Pr etSn ≥ etε (Markov inequality →) ≤ 1 etε E etSn = 1 etε E etSn+tVn = 1 etε E etSn etVn = 1 etε EX1,...,Xn−1 [etSn−1 EXn etVn | X1 , ..., Xn−1 ≤et2c2 n/8 (Hoeffding) ] ≤ 1 etε EX1,...,Xn−1 [etSn−1 ]et2c2 n /8 = 1 etε EX1,...,Xn−1 [etSn−2+tVn−1 ]et2c2 n /8 ≤ 1 etε EX1,...,Xn−2 [etSn−2 ]et2 ∑ n i=n−1 c2 i /8 · · · ≤ 1 etε et2 ∑ n i=1 c2 i /8 = exp 1 8 n i=1 c2 i t2 − εt 60 -
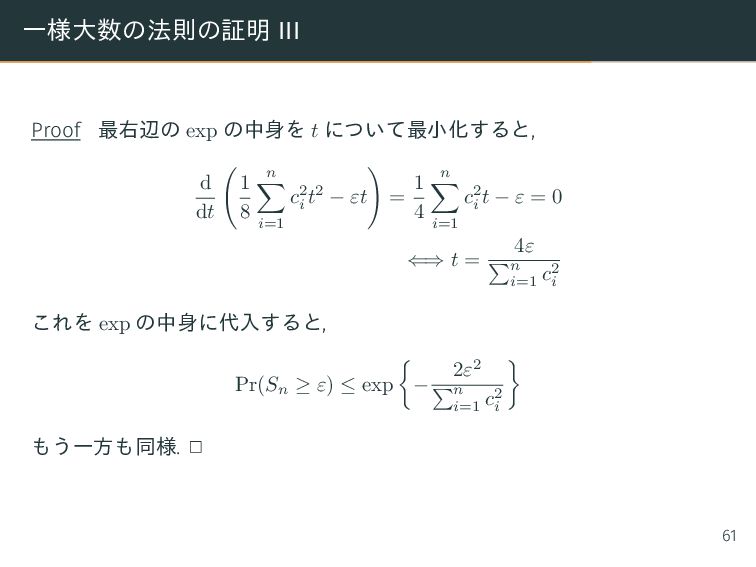
一様大数の法則の証明 III Proof 最右辺の exp の中身を t について最小化すると, d dt
1 8 n i=1 c2 i t2 − εt = 1 4 n i=1 c2 i t − ε = 0 ⇐⇒ t = 4ε n i=1 c2 i これを exp の中身に代入すると, Pr(Sn ≥ ε) ≤ exp − 2ε2 n i=1 c2 i もう一方も同様. 2 61 -
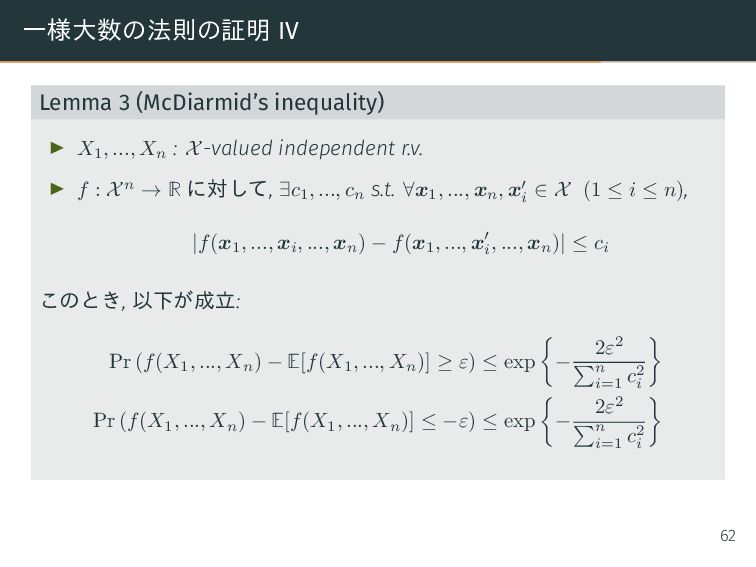
一様大数の法則の証明 IV Lemma 3 (McDiarmid’s inequality) ▶ X1 , ...,
Xn : X-valued independent r.v. ▶ f : Xn → R に対して, ∃c1 , ..., cn s.t. ∀x1 , ..., xn , x′ i ∈ X (1 ≤ i ≤ n), |f(x1 , ..., xi , ..., xn ) − f(x1 , ..., x′ i , ..., xn )| ≤ ci このとき, 以下が成立: Pr (f(X1 , ..., Xn ) − E[f(X1 , ..., Xn )] ≥ ε) ≤ exp − 2ε2 n i=1 c2 i Pr (f(X1 , ..., Xn ) − E[f(X1 , ..., Xn )] ≤ −ε) ≤ exp − 2ε2 n i=1 c2 i 62 -
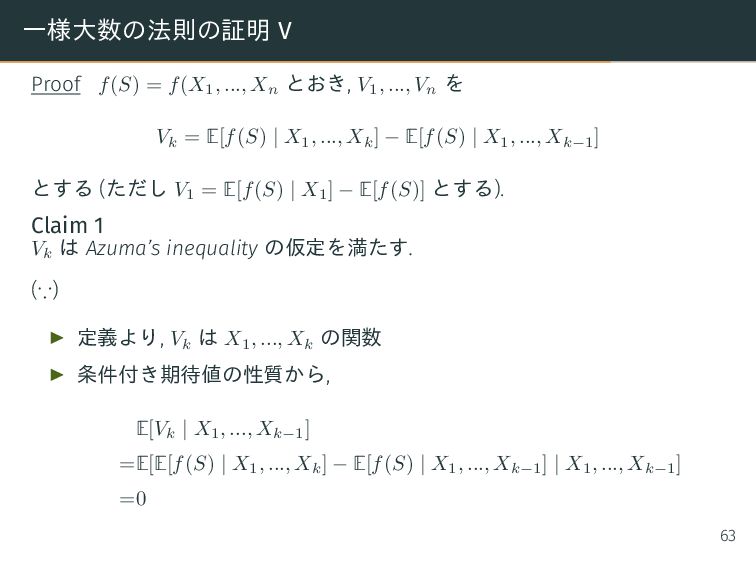
一様大数の法則の証明 V Proof f(S) = f(X1 , ..., Xn とおき,
V1 , ..., Vn を Vk = E[f(S) | X1 , ..., Xk ] − E[f(S) | X1 , ..., Xk−1 ] とする (ただし V1 = E[f(S) | X1 ] − E[f(S)] とする). Claim 1 Vk は Azuma’s inequality の仮定を満たす. (∵) ▶ 定義より, Vk は X1 , ..., Xk の関数 ▶ 条件付き期待値の性質から, E[Vk | X1 , ..., Xk−1 ] =E[E[f(S) | X1 , ..., Xk ] − E[f(S) | X1 , ..., Xk−1 ] | X1 , ..., Xk−1 ] =0 63 -
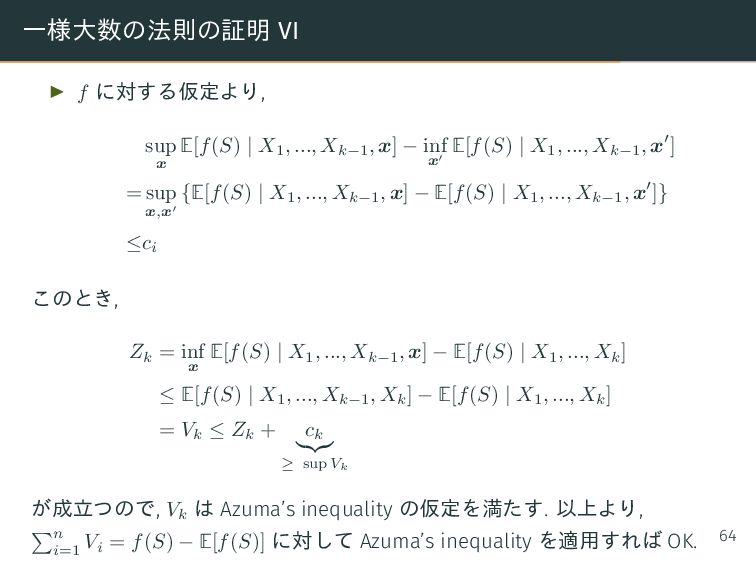
一様大数の法則の証明 VI ▶ f に対する仮定より, sup x E[f(S) | X1
, ..., Xk−1 , x] − inf x′ E[f(S) | X1 , ..., Xk−1 , x′] = sup x,x′ {E[f(S) | X1 , ..., Xk−1 , x] − E[f(S) | X1 , ..., Xk−1 , x′]} ≤ci このとき, Zk = inf x E[f(S) | X1 , ..., Xk−1 , x] − E[f(S) | X1 , ..., Xk ] ≤ E[f(S) | X1 , ..., Xk−1 , Xk ] − E[f(S) | X1 , ..., Xk ] = Vk ≤ Zk + ck ≥ sup Vk が成立つので, Vk は Azuma’s inequality の仮定を満たす. 以上より, n i=1 Vi = f(S) − E[f(S)] に対して Azuma’s inequality を適用すれば OK. 64 -
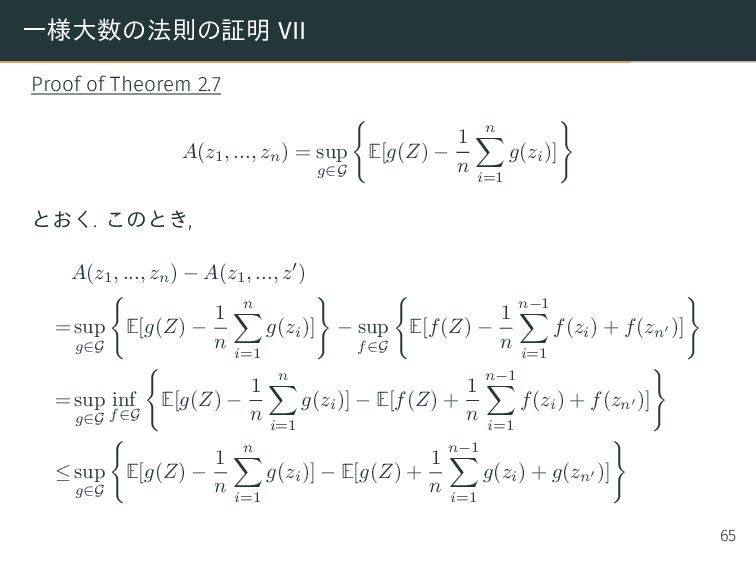
一様大数の法則の証明 VII Proof of Theorem 2.7 A(z1 , ..., zn
) = sup g∈G E[g(Z) − 1 n n i=1 g(zi )] とおく. このとき, A(z1 , ..., zn ) − A(z1 , ..., z′) = sup g∈G E[g(Z) − 1 n n i=1 g(zi )] − sup f∈G E[f(Z) − 1 n n−1 i=1 f(zi ) + f(zn′ )] = sup g∈G inf f∈G E[g(Z) − 1 n n i=1 g(zi )] − E[f(Z) + 1 n n−1 i=1 f(zi ) + f(zn′ )] ≤ sup g∈G E[g(Z) − 1 n n i=1 g(zi )] − E[g(Z) + 1 n n−1 i=1 g(zi ) + g(zn′ )] 65 -
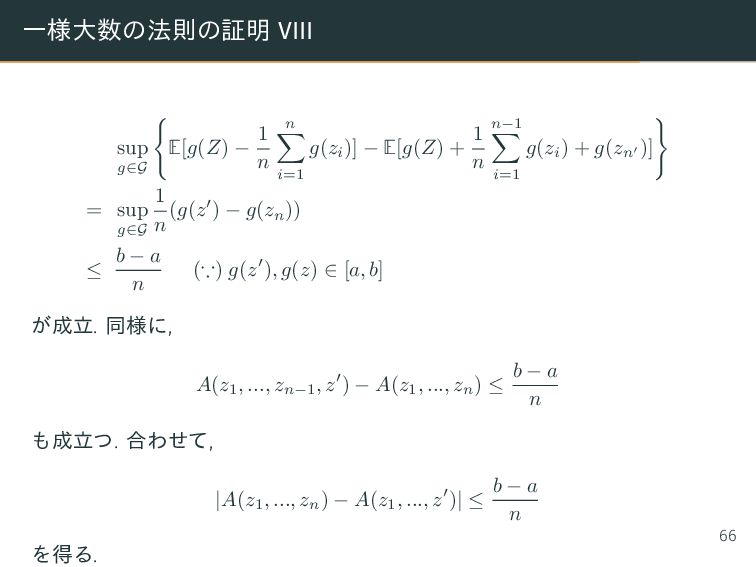
一様大数の法則の証明 VIII sup g∈G E[g(Z) − 1 n n i=1
g(zi )] − E[g(Z) + 1 n n−1 i=1 g(zi ) + g(zn′ )] = sup g∈G 1 n (g(z′) − g(zn )) ≤ b − a n (∵) g(z′), g(z) ∈ [a, b] が成立. 同様に, A(z1 , ..., zn−1 , z′) − A(z1 , ..., zn ) ≤ b − a n も成立つ. 合わせて, |A(z1 , ..., zn ) − A(z1 , ..., z′)| ≤ b − a n を得る. 66 -
一様大数の法則の証明 IX McDiarmid’s inequality より, ε > 0 に対して Pr
(A(Z1 , ..., Zn ) − E[A(Z1 , ..., Zn )] ≤ ε) ≥ 1 − exp − 2ε2 n × (b−a)2 n2 が成立するので, 特に δ = exp − 2ε2 1 n (b−a)2 とおくと, log δ = − 2nε2 (b − a)2 ⇐⇒ ε2 = (b − a)2 × log 1 δ 2n ∵ ε = (b − a) log 1 δ 2n となるので, Pr A(Z1 , ..., Zn ) − E[A(Z1 , ..., Zn )] ≤ (b − a) log 1 δ 2n ≥ 1 − δ 67 -
一様大数の法則の証明 X 次に, E[A(Z1 , ..., Zn )] を評価する. Z1
, ..., Zn , Z′ 1 , ..., Z′ n ∼i.i.d. PZ とすると, 以下が成立. A(Z1 , ..., Zn ) (標本平均の不偏性 →) = sup g∈G EZ′ 1 ,...,Z′ n 1 n n i=1 g(Z′ i ) − 1 n n i=1 g(Zi ) (和の sup≤sup の和 →) ≤ EZ′ 1 ,...,Z′ n sup g∈G 1 n n i=1 (g(Z′ i ) − g(Zi )) Fact 6 1. g(Z′ i ) − g(Zi ) と g(Zi ) − g(Z′ i ) は同一分布に従う (対称性) 2. σi = +1 w.p. 1 2 −1 w.p. 1 2 とすると, σi (g(Z′ i ) − g(Zi )) と g(Z′ i ) − g(Zi ) は同一 分布に従う 68 -
一様大数の法則の証明 XI Fact より, Eσ,Z [A(Z1 , ..., Zn )]
≤ Eσ EZ′ 1 ,...,Z′ n sup g∈G 1 n n i=1 σi (g(Z′ i ) − g(Zi )) ≤ EZ′ Eσ sup 1 n σi g(Z′ i ) =Rn(G) + EZ Eσ sup 1 n σi g(Zi ) =Rn(G) = 2Rn (G) これを (2.5) 式に代入すると, 確率 1 − δ で以下が成立. sup g∈G EZ [g(Z)] − 1 n n i=1 g(Zi ) − E[A(Z1 , ..., Zn )] ≤ (b − a) log 1 δ 2n ⇐⇒ sup g∈G EZ [g(Z)] − 1 n n i=1 g(Zi ) ≤ 2Rn (G) + (b − a) log 1 δ 2n 2 69 -
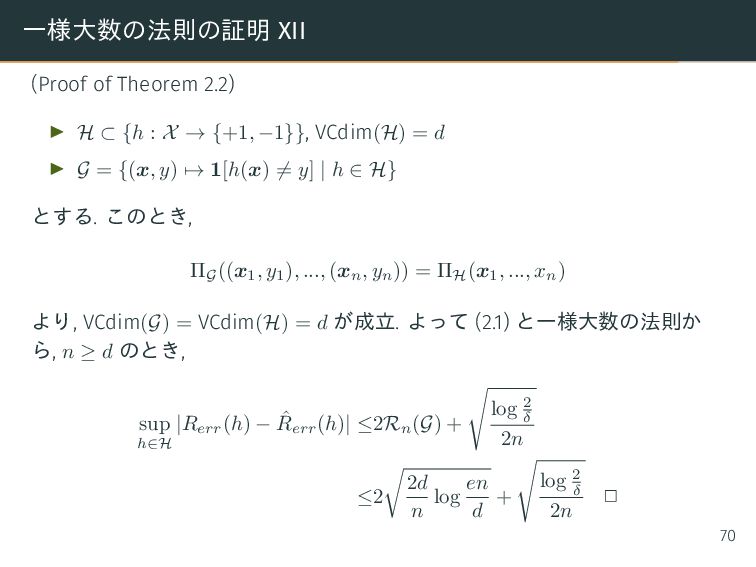
一様大数の法則の証明 XII (Proof of Theorem 2.2) ▶ H ⊂ {h
: X → {+1, −1}}, VCdim(H) = d ▶ G = {(x, y) → 1[h(x) = y] | h ∈ H} とする. このとき, ΠG ((x1 , y1 ), ..., (xn , yn )) = ΠH (x1 , ..., xn ) より, VCdim(G) = VCdim(H) = d が成立. よって (2.1) と一様大数の法則か ら, n ≥ d のとき, sup h∈H |Rerr (h) − ˆ Rerr (h)| ≤2Rn (G) + log 2 δ 2n ≤2 2d n log en d + log 2 δ 2n 2 70 -
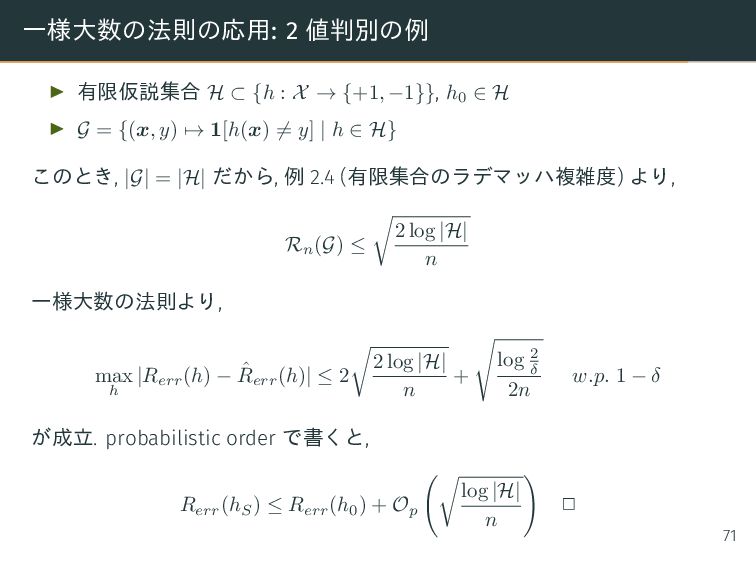
一様大数の法則の応用: 2 値判別の例 ▶ 有限仮説集合 H ⊂ {h : X
→ {+1, −1}}, h0 ∈ H ▶ G = {(x, y) → 1[h(x) = y] | h ∈ H} このとき, |G| = |H| だから, 例 2.4 (有限集合のラデマッハ複雑度) より, Rn (G) ≤ 2 log |H| n 一様大数の法則より, max h |Rerr (h) − ˆ Rerr (h)| ≤ 2 2 log |H| n + log 2 δ 2n w.p. 1 − δ が成立. probabilistic order で書くと, Rerr (hS ) ≤ Rerr (h0 ) + Op log |H| n 2 71 -
カバリングナンバー ラデマッハ複雑度を上から bound する量 Definition 5 (ε-cover) x1:n = {xi}n
i=1 を点集合, V ⊂ Rn とする. 任意の f ∈ H に対して, v ∈ V が存在して, 1 n n i=1 |vi − f(xi)|p 1/p ≤ ε を満たすとき, V を H の p-次 ε-cover と呼ぶ Definition 6 (covering number) H の p-次 covering number は以下で定義される Np(ε, H, n) = sup x1:n min{|V | | V : H の x1:n 上の p-次 ε-cover} 73 -
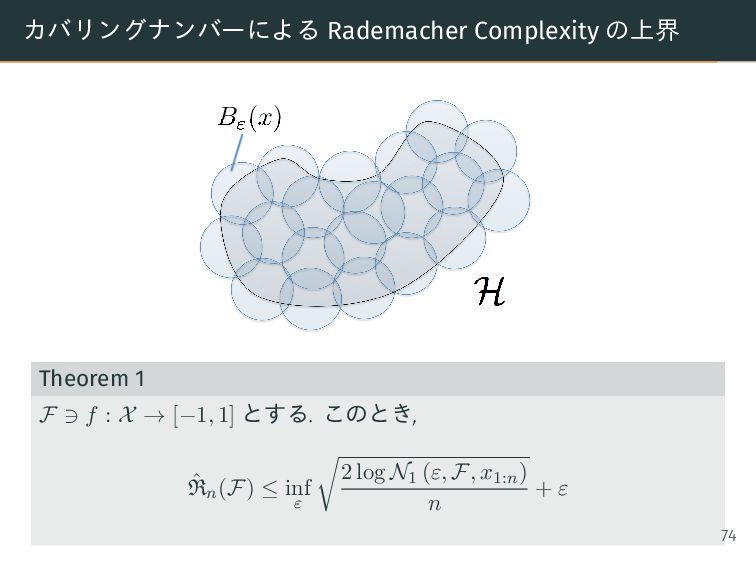
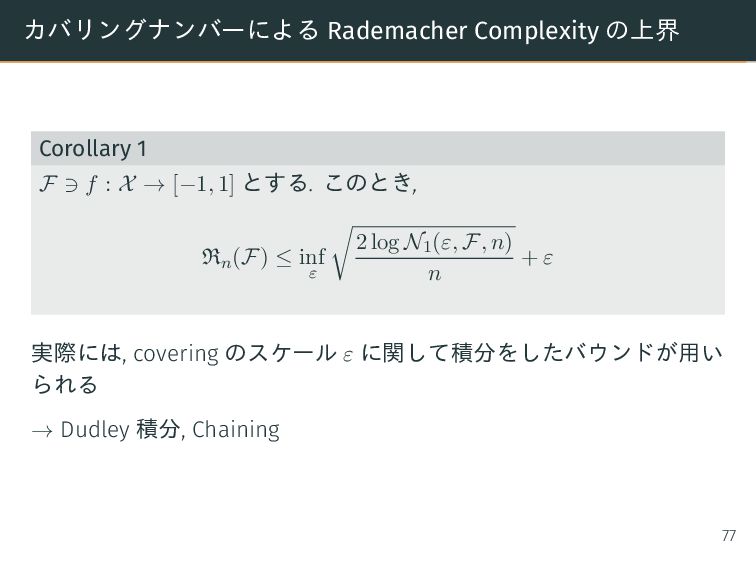
カバリングナンバーによる Rademacher Complexity の上界 H Bε (x) Theorem 1 F
f : X → [−1, 1] とする. このとき, ˆ Rn(F) ≤ inf ε 2 log N1 (ε, F, x1:n) n + ε 74 -
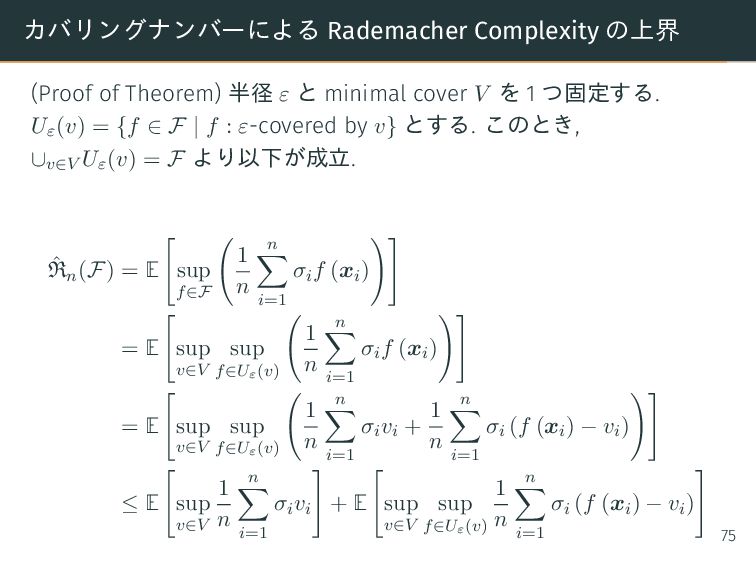
カバリングナンバーによる Rademacher Complexity の上界 (Proof of Theorem) 半径 ε と
minimal cover V を 1 つ固定する. Uε(v) = {f ∈ F | f : ε-covered by v} とする. このとき, ∪v∈V Uε(v) = F より以下が成立. ˆ Rn(F) = E sup f∈F 1 n n i=1 σif (xi) = E sup v∈V sup f∈Uε(v) 1 n n i=1 σif (xi) = E sup v∈V sup f∈Uε(v) 1 n n i=1 σivi + 1 n n i=1 σi (f (xi) − vi) ≤ E sup v∈V 1 n n i=1 σivi + E sup v∈V sup f∈Uε(v) 1 n n i=1 σi (f (xi) − vi) 75 -
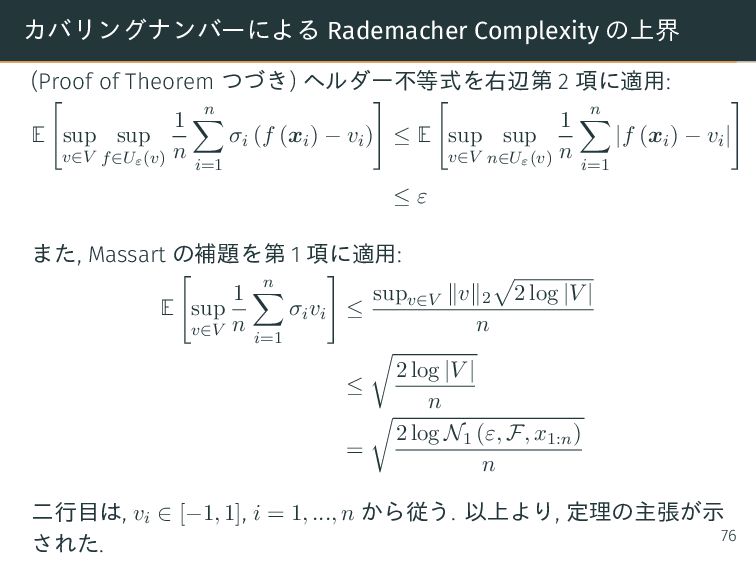
カバリングナンバーによる Rademacher Complexity の上界 (Proof of Theorem つづき) ヘルダー不等式を右辺第 2
項に適用: E sup v∈V sup f∈Uε(v) 1 n n i=1 σi (f (xi) − vi) ≤ E sup v∈V sup n∈Uε(v) 1 n n i=1 |f (xi) − vi| ≤ ε また, Massart の補題を第 1 項に適用: E sup v∈V 1 n n i=1 σivi ≤ supv∈V v 2 2 log |V | n ≤ 2 log |V | n = 2 log N1 (ε, F, x1:n) n 二行目は, vi ∈ [−1, 1], i = 1, ..., n から従う. 以上より, 定理の主張が示 された. 76 -
カバリングナンバーによる Rademacher Complexity の上界 Corollary 1 F f : X
→ [−1, 1] とする. このとき, Rn(F) ≤ inf ε 2 log N1(ε, F, n) n + ε 実際には, covering のスケール ε に関して積分をしたバウンドが用い られる → Dudley 積分, Chaining 77 -
References [1] Olivier Bousquet, Stéphane Boucheron, and Gábor Lugosi. Introduction
to statistical learning theory. In Advanced lectures on machine learning, pages 169–207. Springer, 2004. [2] Mehryar Mohri, Afshin Rostamizadeh, and Ameet Talwalkar. Foundations of machine learning. MIT press, 2012. [3] Shai Shalev-Shwartz and Shai Ben-David. Understanding machine learning: From theory to algorithms. Cambridge university press, 2014. [4] 金森敬文. 統計的学習理論 (機械学習プロフェッショナルシリーズ). 講談社, 2015. 78
 kmatsui
 amarelo_n24
 kmotohas
 tnir
 rist
 say_no_w
 daishukojima
 masasuzu
 shotashiratori
 bulbulpaul
 masspeaks
 yama3133
 kota2and3kan
 tammyeverts
 stephaniewalter
 addyosmani
 csswizardry
 szymonslowik
 baasie
 aleyda
 eitanlees
 jonoalderson
 tmiket