Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
深層学習の基礎と導入
Search
kmotohas
March 13, 2019
Technology
160
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
深層学習の基礎と導入
for 実践者向けディープラーニング勉強会 第一回
2019-03-13
https://dl4-practitioners.connpass.com/event/122794/
kmotohas
March 13, 2019
More Decks by kmotohas
See All by kmotohas
AWS の最新生成 AI 開発基盤サービス Amazon Bedrock AgentCore ご紹介
kmotohas
0
65
OpenAI gpt-oss ファインチューニング入門
kmotohas
3
3.6k
SageMaker Dive Deep Workshop 動かして理解する SageMaker Training Job の仕組み
kmotohas
0
130
AWS re:Invent直前! 2021年のアップデートを振り返ろう AI/MLサービス編
kmotohas
0
1k
論文解説 150 Successful Machine Learning Models: 6 Lessons Learned at Booking.com
kmotohas
0
1.4k
konduit-servingとSpring Cloud Data Flowを用いたMLアプリケーション開発
kmotohas
0
710
Deep Learningによる画像認識の基礎・CNNの仕組み
kmotohas
0
1.2k
詳説Deep LearningとDL4JとMLOps入門
kmotohas
0
770
オートエンコーダーと異常検知入門
kmotohas
1
1.9k
Other Decks in Technology
See All in Technology
AI駆動開発、viviONの1年 ── うまくいったこと・いかなかったこと
vivion
0
270
freeeらしさをAIとともに作る / Creating the freee Experience with AI
ymrl
0
220
メルペイ 会計システム概要と歴史
mewuto
0
200
あなたの知らないAmazon VPC Route Server/Amazon VPC Route Server you don't know about
masakiokuda
2
240
パッチ更新でterraform initが落ちた日
grimoh
1
100
ブラウザとサーバーから考えるAI時代のフロントエンド監視
shogo4131
2
590
Lambda MicroVMsが分からなすぎたので使い所を1から考えてみた
tsukuboshi
2
440
SREでアラート疲れを 解決しよう!
kairim0
1
220
ファミコンでPHPを動かす / PHP on the Famicom side b
tomzoh
0
140
私の推しは「聞いてから進む」AIです -AI-DLCに一人でアプリを作らせた話
yama3133
1
180
自作バイナリを動かす「入口」8選
puhitaku
1
1.2k
オンラインゲームのシステム全体像 - コロプラ 2026年度 新卒研修
colopl
0
990
Featured
See All Featured
jQuery: Nuts, Bolts and Bling
dougneiner
66
8.6k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Designing for humans not robots
tammielis
254
26k
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
510
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
300
Crafting Experiences
bethany
1
380
A Modern Web Designer's Workflow
chriscoyier
699
190k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
The Anti-SEO Checklist Checklist. Pubcon Cyber Week
ryanjones
0
260
GitHub's CSS Performance
jonrohan
1033
470k
Transcript
深層学習の基礎と導⼊ 1
| アジェンダ 19:00 〜 19:05 opening 19:05 〜 19:30 機械学習と深層学習の導⼊
19:30 〜 19:45 walkthrough ニューラルネットワークの内部構造 19:45 〜 20:00 breakout ニューラルネットワーク数理モデル 20:00 〜 20:30 訓練⼿法の解説とCNN/RNNの概要 20:30 〜 20:45 walkthrough ニューラルネットワークの訓練 20:45 〜 20:55 breakout 誤差逆伝播法 20:55 〜 21:00 closing 2
機械学習と深層学習の導⼊ 3
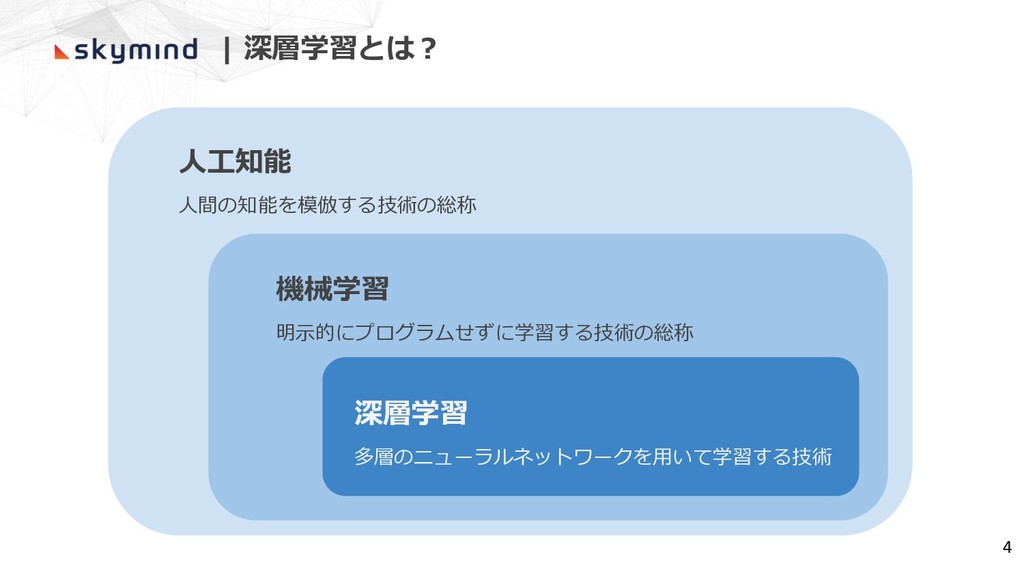
| 深層学習とは︖ 4 ⼈⼯知能 ⼈間の知能を模倣する技術の総称 機械学習 明⽰的にプログラムせずに学習する技術の総称 深層学習 多層のニューラルネットワークを⽤いて学習する技術
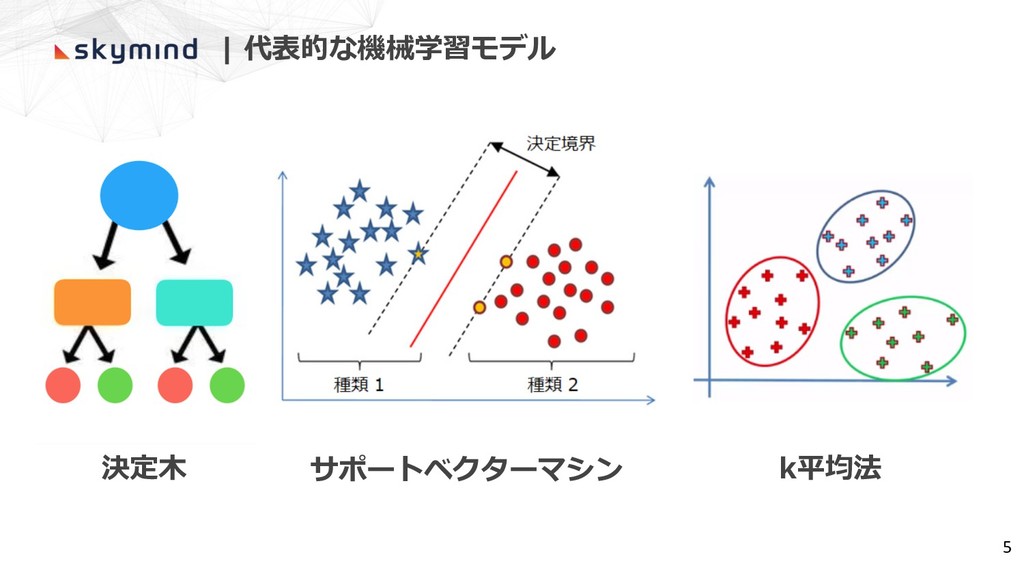
| 代表的な機械学習モデル 決定⽊ サポートベクターマシン k平均法 5
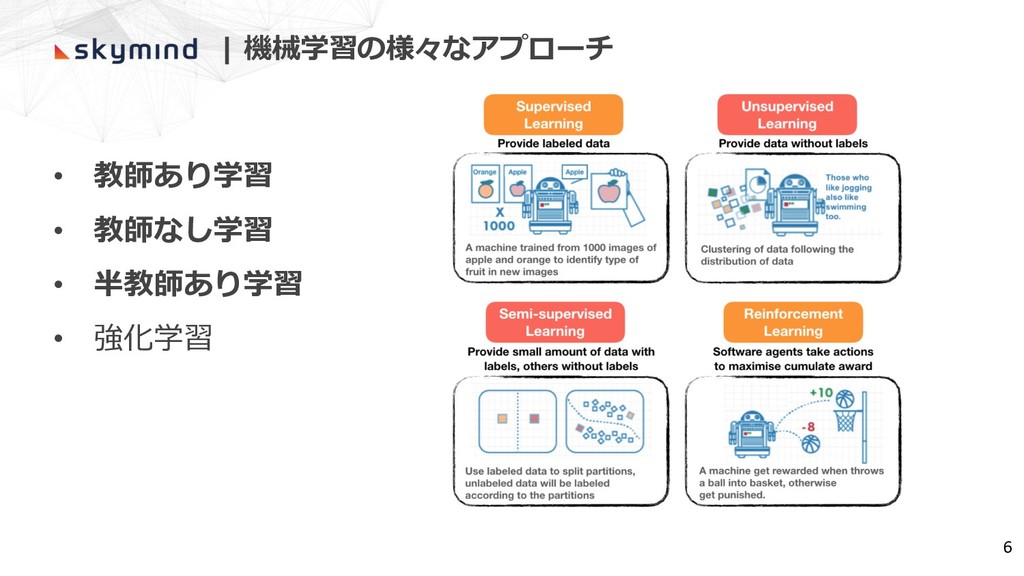
| 機械学習の様々なアプローチ • 教師あり学習 • 教師なし学習 • 半教師あり学習 • 強化学習
6
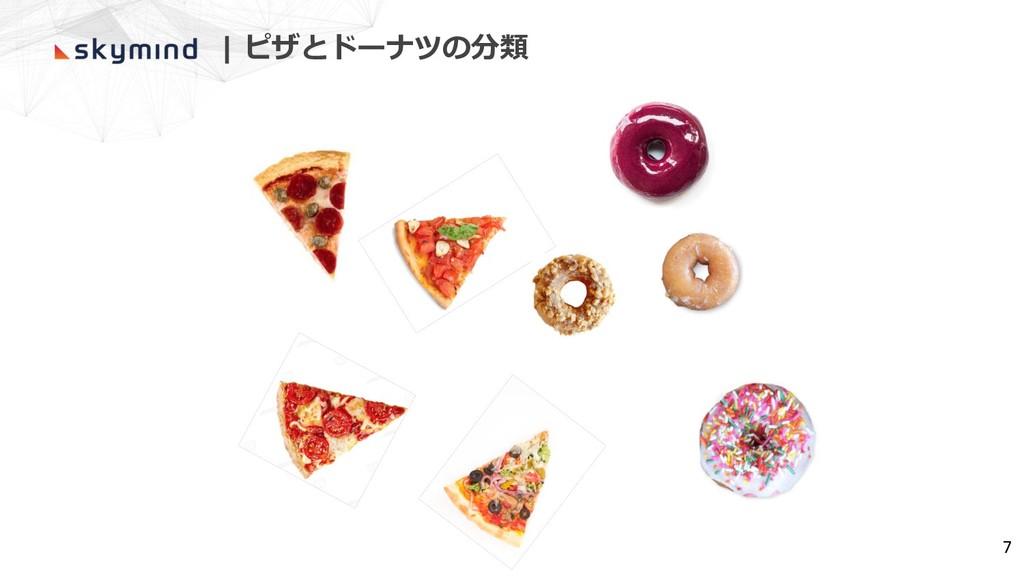
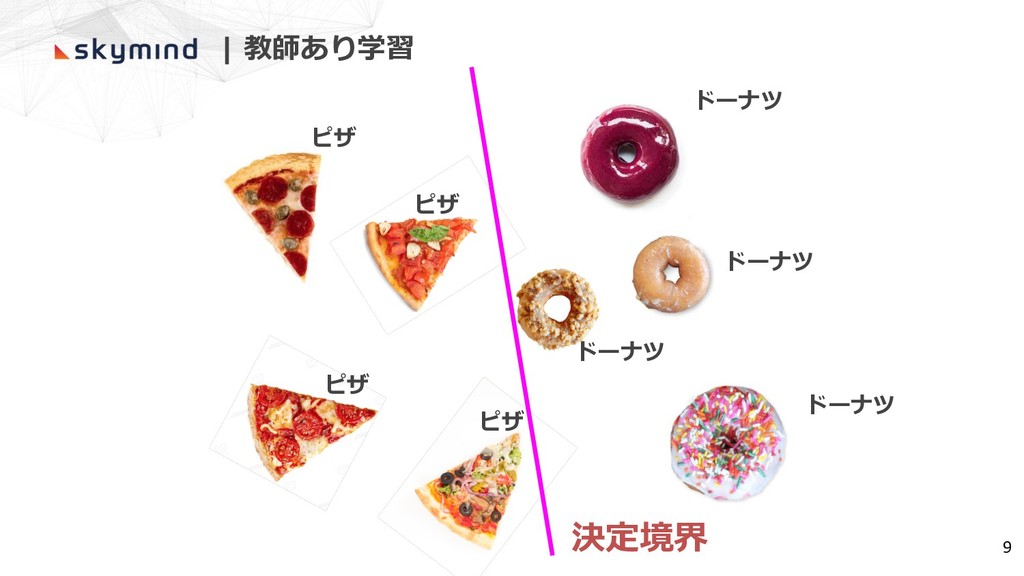
| ピザとドーナツの分類 7
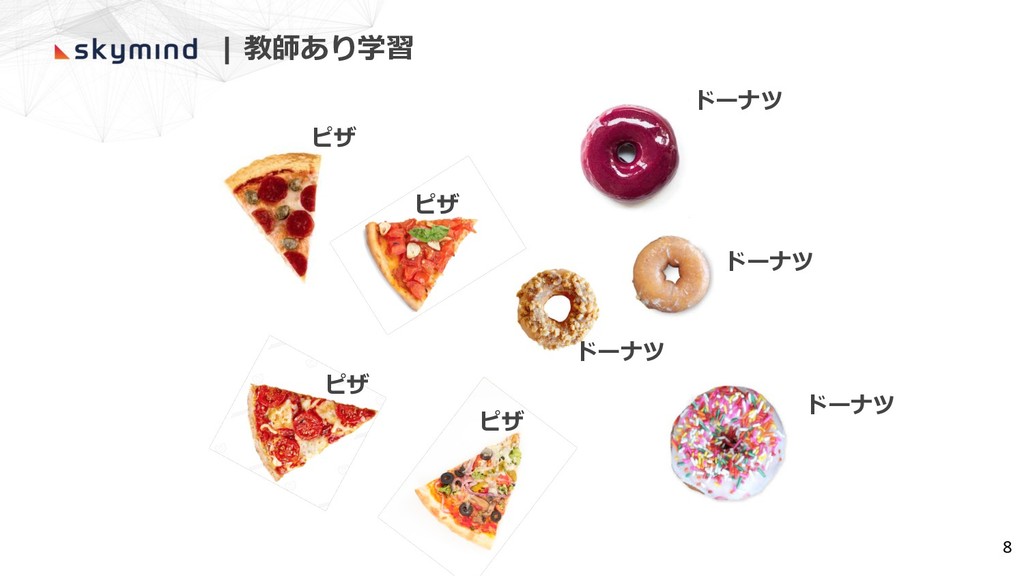
ピザ ピザ ピザ ピザ ドーナツ ドーナツ ドーナツ ドーナツ | 教師あり学習
8
ピザ ピザ ピザ ピザ ドーナツ ドーナツ ドーナツ ドーナツ 9 |
教師あり学習 決定境界
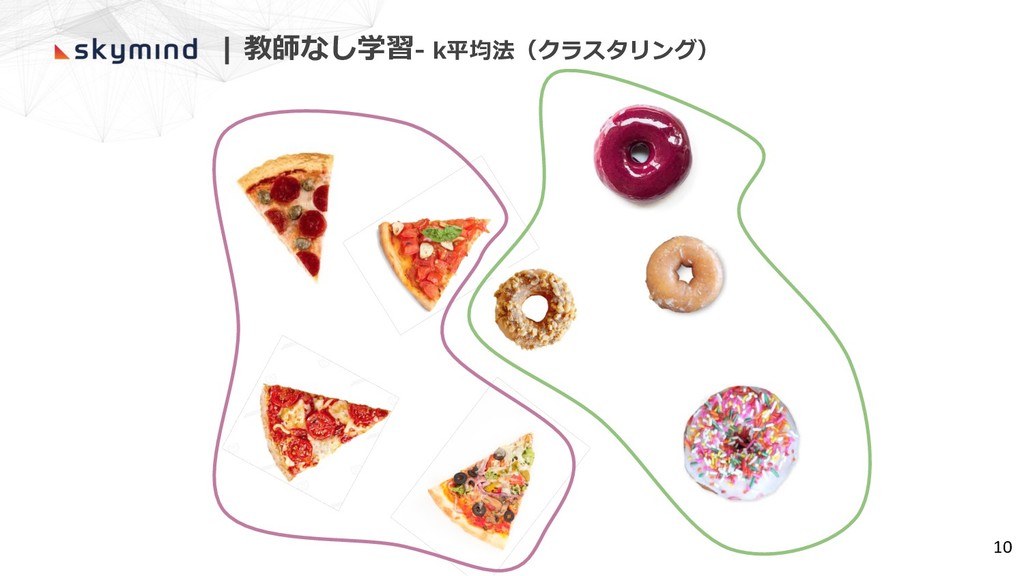
| 教師なし学習- k平均法(クラスタリング) 10
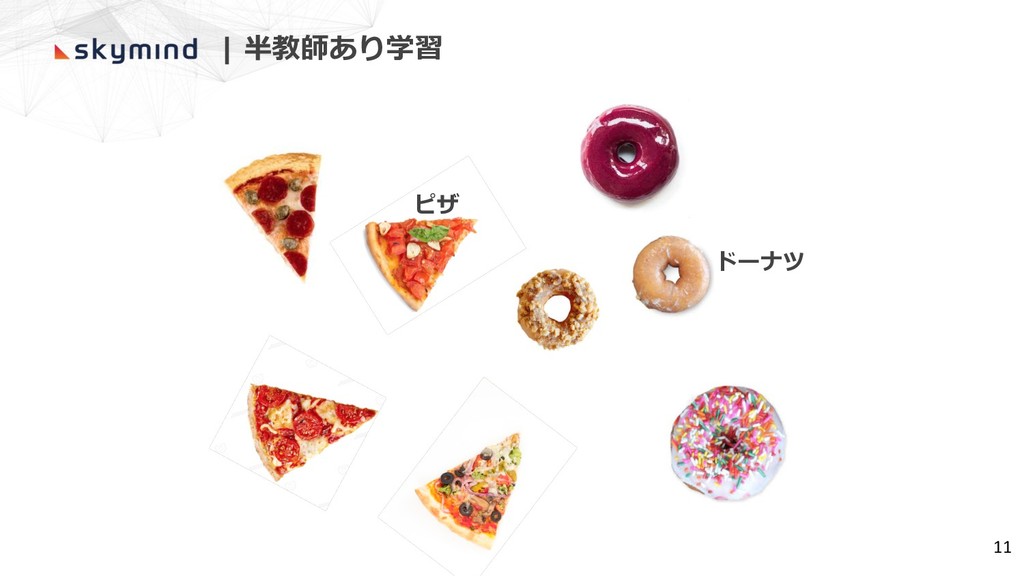
ピザ ドーナツ 11 | 半教師あり学習
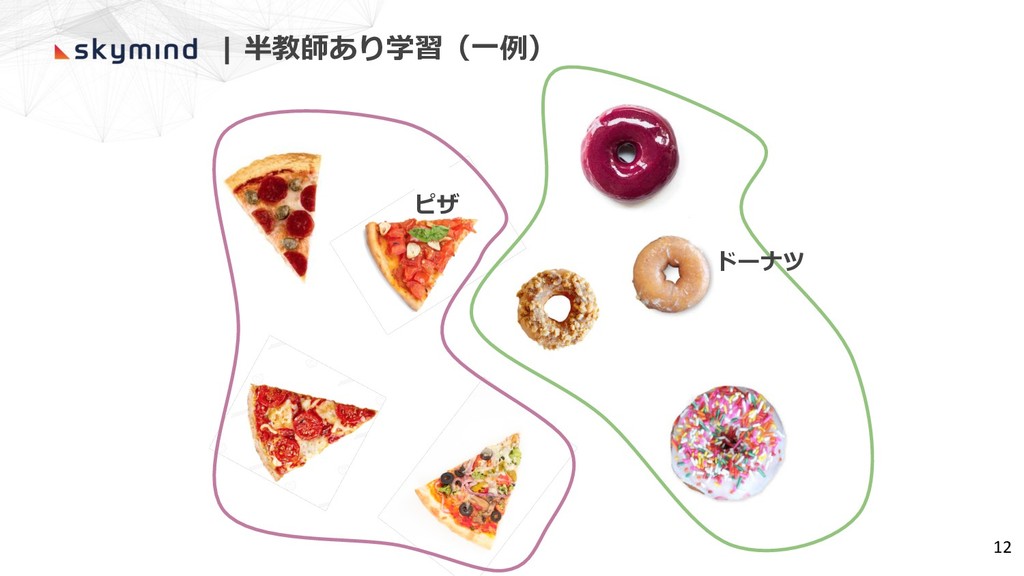
ドーナツ ピザ 12 | 半教師あり学習(⼀例)
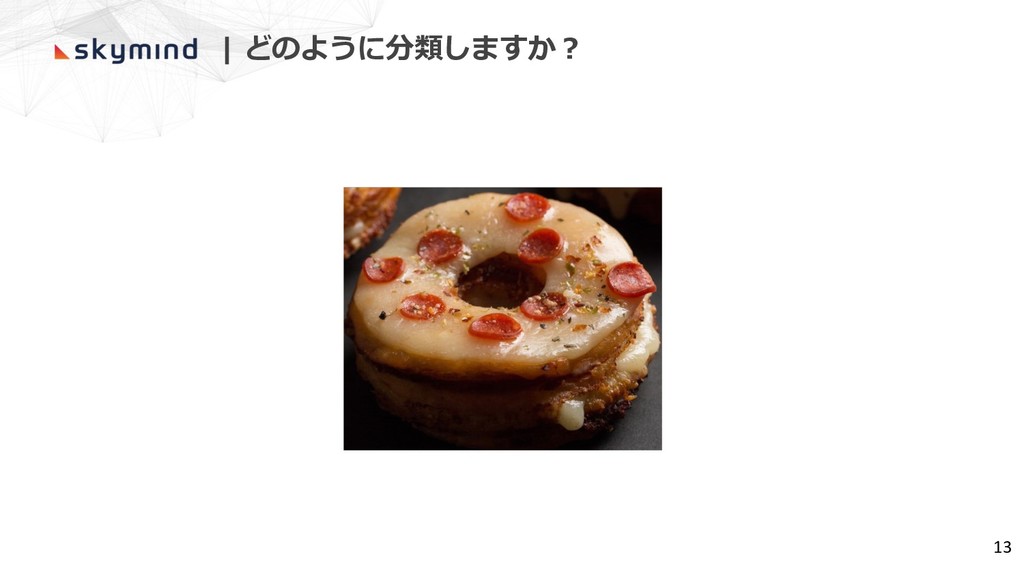
| どのように分類しますか︖ 13
| 深層学習 • 多層のニューラルネットワークによる機械学習⼿法 • 深層学習は幅広い領域で成功を収めている ◦ 画像認識 ◦ ⾃動運転
◦ ⾳声認識 ◦ ⾃然⾔語処理 ◦ 機械翻訳 ◦ 創薬 ◦ 顧客関係管理(CRM) ◦ レコメンドシステム ◦ ... 14
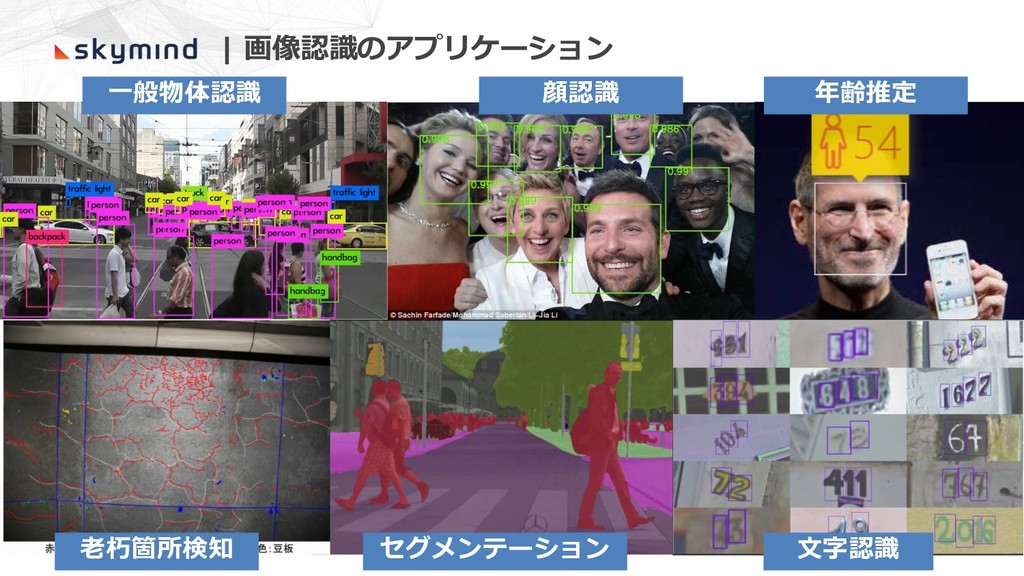
| 画像認識のアプリケーション 15 ⼀般物体認識 顔認識 年齢推定 ⽼朽箇所検知 セグメンテーション ⽂字認識
| 現在︓深層学習ブームの背景 ビッグデータ インターネットの成⻑により膨⼤なデータが⽣み出されています ムーアの法則、 GPU CPU/GPUの計算能⼒の成⻑によりビッグデータを処理できるように 応⽤範囲の拡⼤ IoT、スマートフォン、クラウドコンピューティング 開発ソフトウェアの整備
DeepLearning4J(DL4J)、Tensorflow、Keras、Chainer、PyTorch など 16
| ハードウェア要件 深層学習は計算コストが⾼い 妥当な時間内にモデルをトレーニングするために必要なハードウェア は、ユースケースによって異なる 最⼩要件 • NVIDIA GTX 1060
以上 • 16GB RAM • SSD(not HDD) 17
| ハードウェア要件 ⼤規模モデルの場合は、はるかに⾼いスペックが必要 • NVIDIA Titan XP 以上 • 32GB
RAM • SSD(not HDD) 18
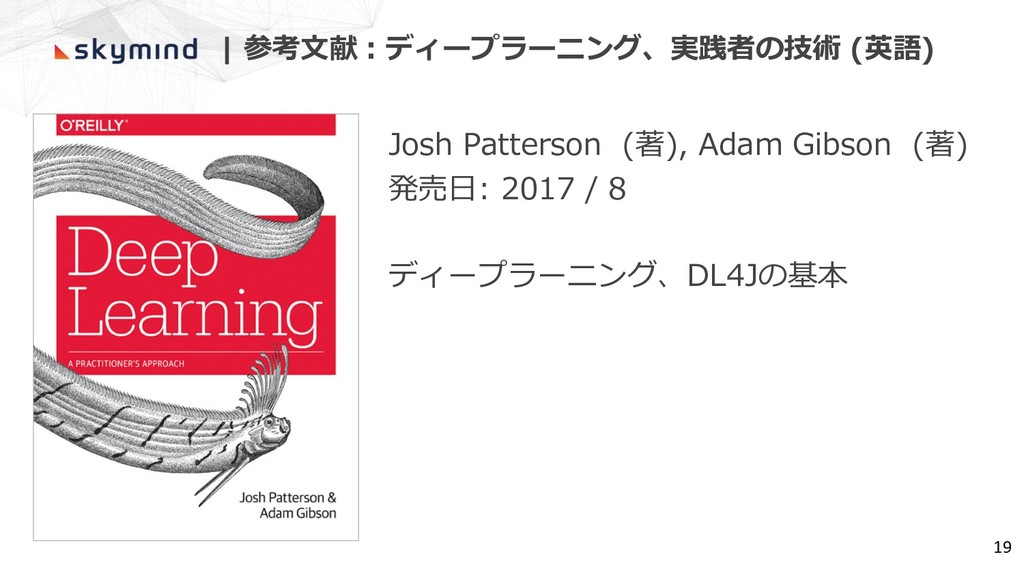
| 参考⽂献︓ディープラーニング、実践者の技術 (英語) Josh Patterson (著), Adam Gibson (著) 発売⽇:
2017 / 8 ディープラーニング、DL4Jの基本 19
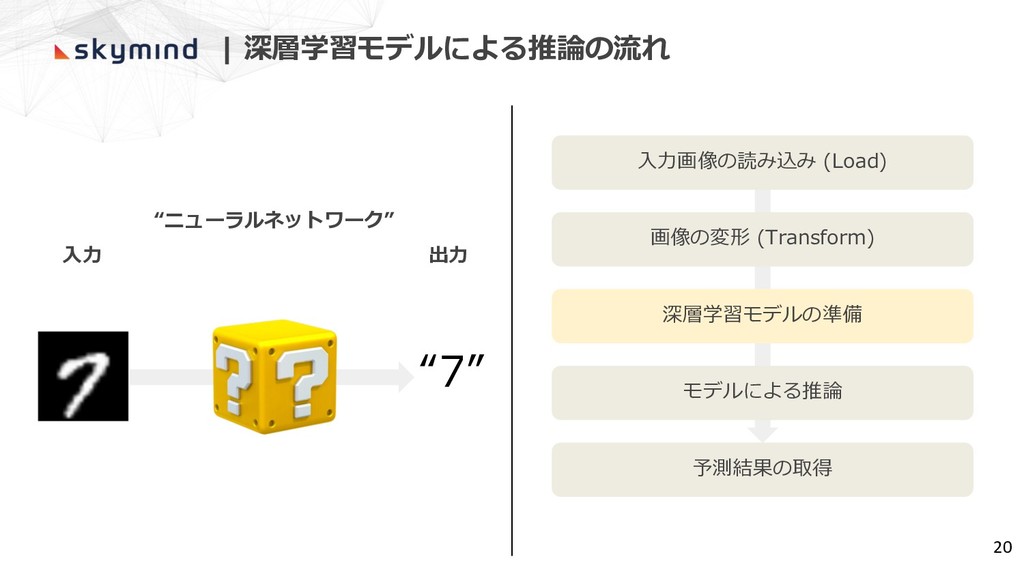
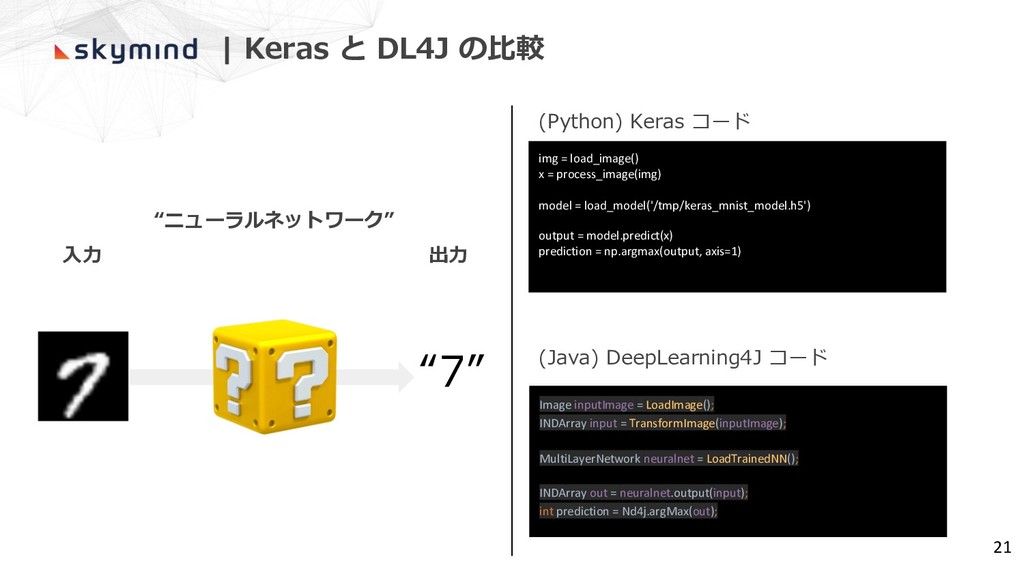
| 深層学習モデルによる推論の流れ ⼊⼒ 出⼒ “ニューラルネットワーク” “7” 20 ⼊⼒画像の読み込み (Load) 画像の変形
(Transform) 深層学習モデルの準備 モデルによる推論 予測結果の取得
| Keras と DL4J の⽐較 Image inputImage = LoadImage(); INDArray
input = TransformImage(inputImage); MultiLayerNetwork neuralnet = LoadTrainedNN(); INDArray out = neuralnet.output(input); int prediction = Nd4j.argMax(out); (Java) DeepLearning4J コード (Python) Keras コード img = load_image() x = process_image(img) model = load_model('/tmp/keras_mnist_model.h5') output = model.predict(x) prediction = np.argmax(output, axis=1) 21 ⼊⼒ 出⼒ “ニューラルネットワーク” “7”
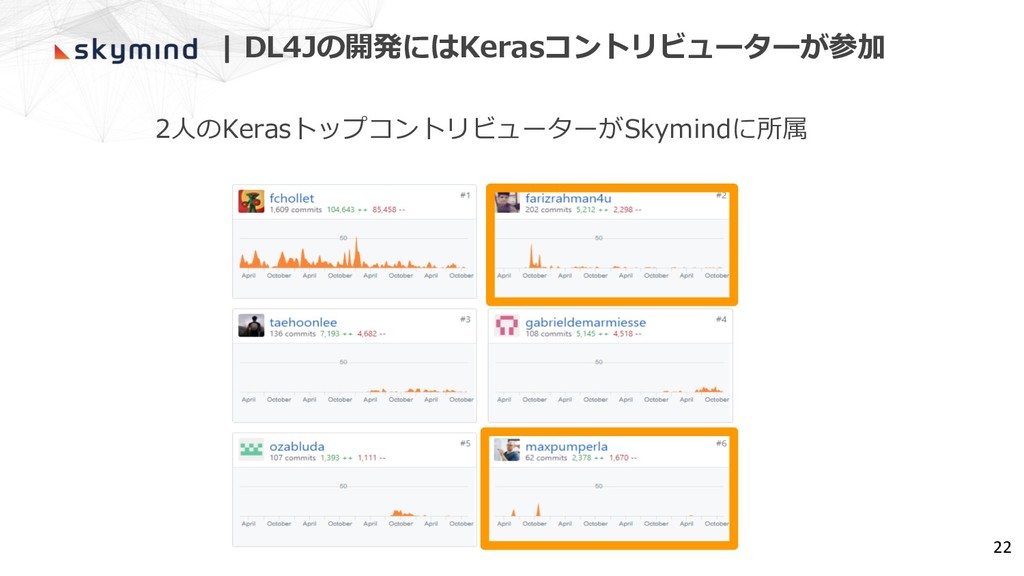
| DL4Jの開発にはKerasコントリビューターが参加 2⼈のKerasトップコントリビューターがSkymindに所属 22
Walkthrough ニューラルネットの内部構造 23
Breakout session 1 ニューラルネットワーク数理モデル 24
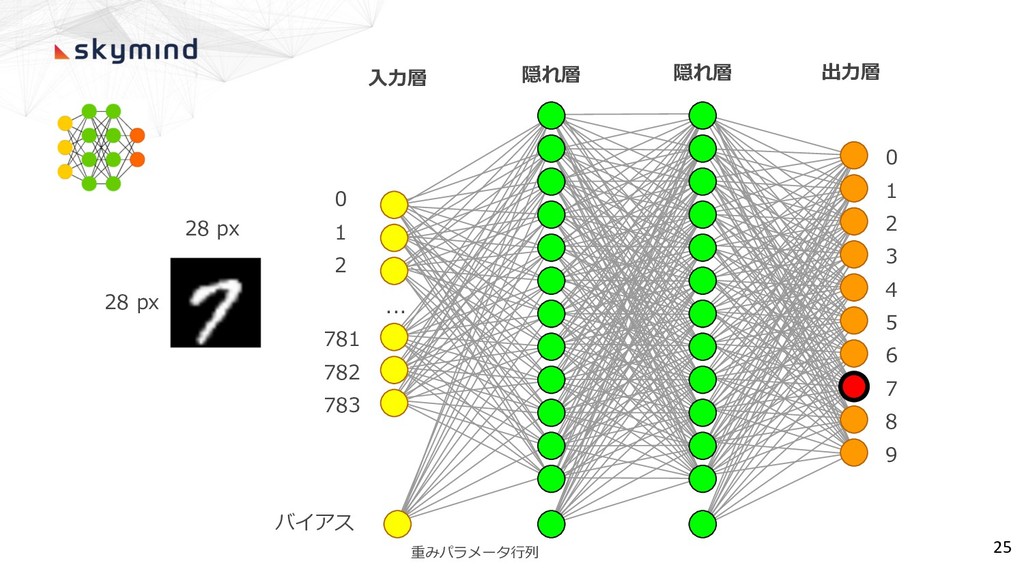
0 1 2 ... 781 782 783 0 1 2
3 4 5 6 7 8 9 28 px 28 px バイアス ⼊⼒層 隠れ層 出⼒層 重みパラメータ⾏列 25 隠れ層
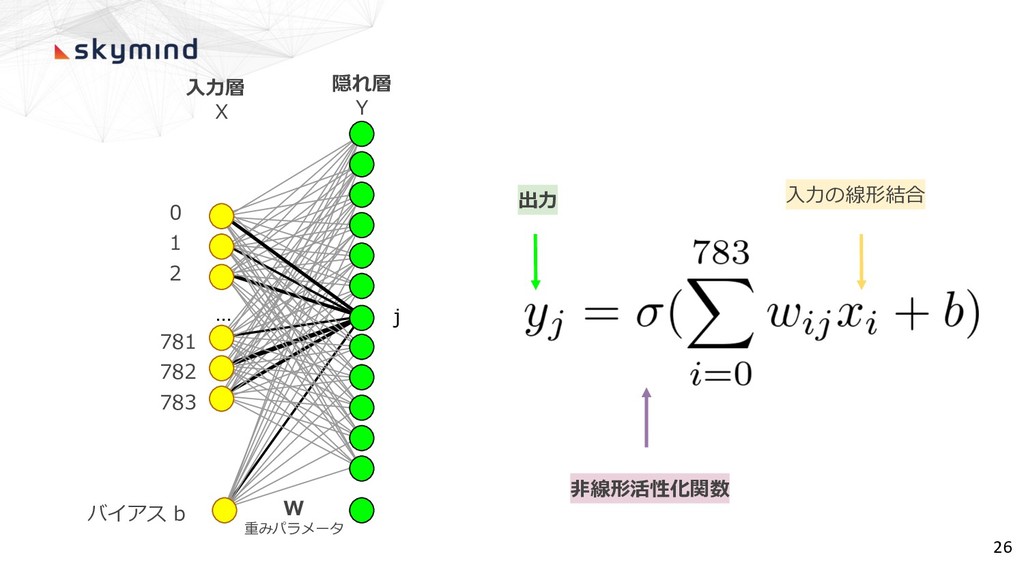
0 1 2 ... 781 782 783 バイアス b ⼊⼒層
X 隠れ層 Y j W 重みパラメータ 出⼒ ⼊⼒の線形結合 ⾮線形活性化関数 26
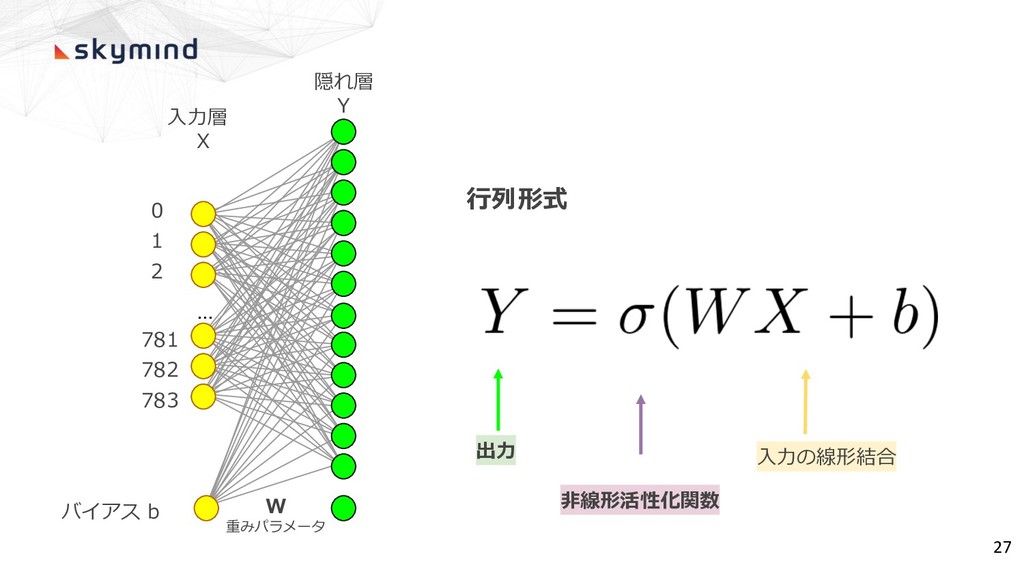
0 1 2 ... 781 782 783 バイアス b ⼊⼒層
X 隠れ層 Y W 重みパラメータ ⾏列形式 出⼒ ⼊⼒の線形結合 ⾮線形活性化関数 27
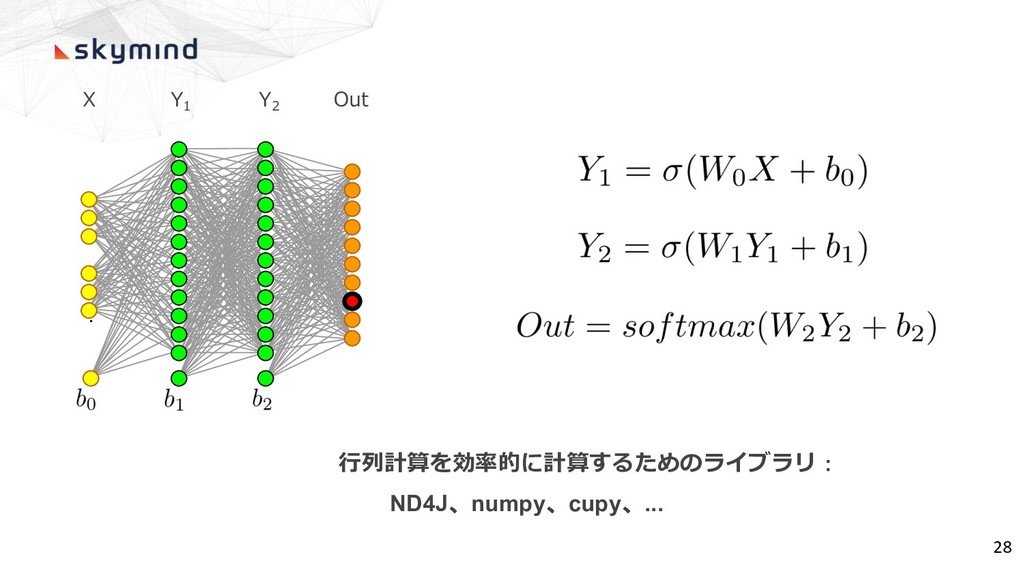
. . . X Y1 Y2 Out ⾏列計算を効率的に計算するためのライブラリ: ND4J、numpy、cupy、... 28
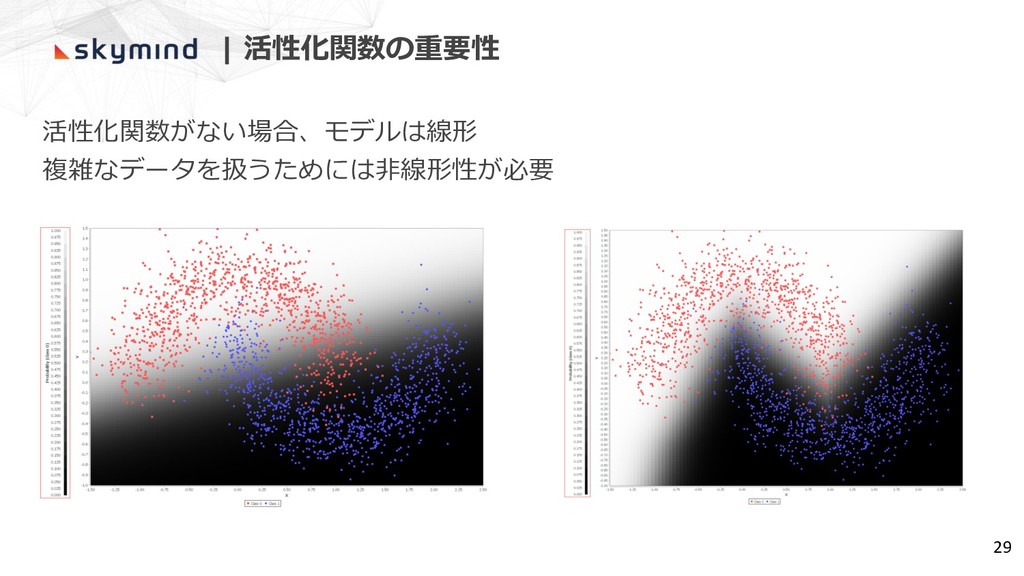
| 活性化関数の重要性 活性化関数がない場合、モデルは線形 複雑なデータを扱うためには⾮線形性が必要 29
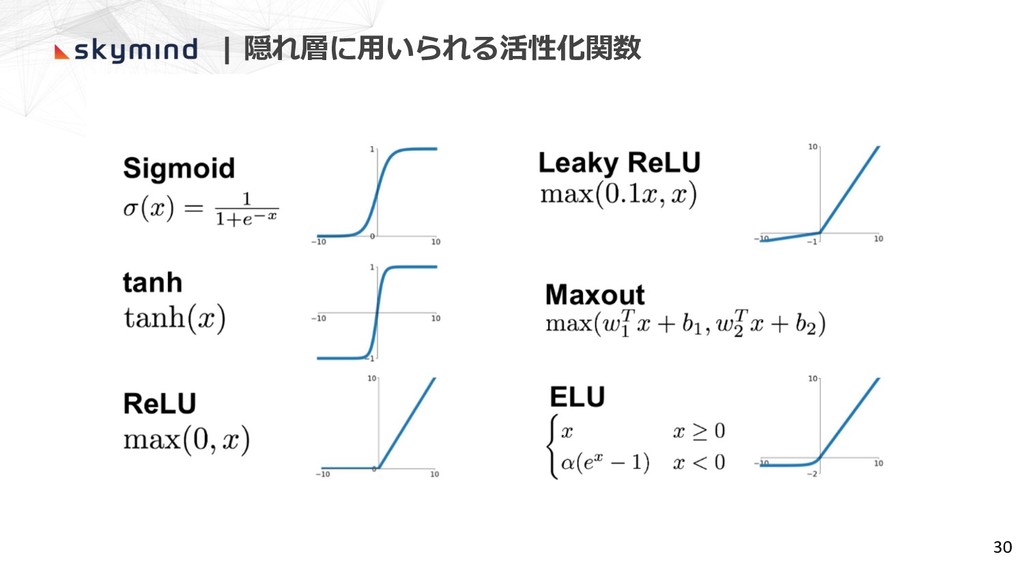
| 隠れ層に⽤いられる活性化関数 30
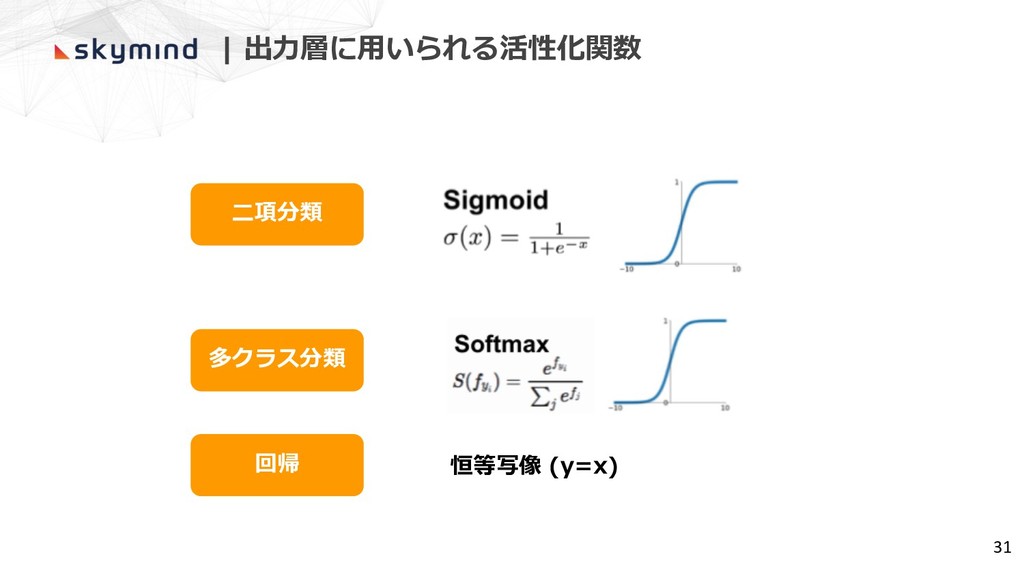
| 出⼒層に⽤いられる活性化関数 ⼆項分類 多クラス分類 31 回帰 恒等写像 (y=x)
ニューラルネットワーク訓練⼿法の解説 32
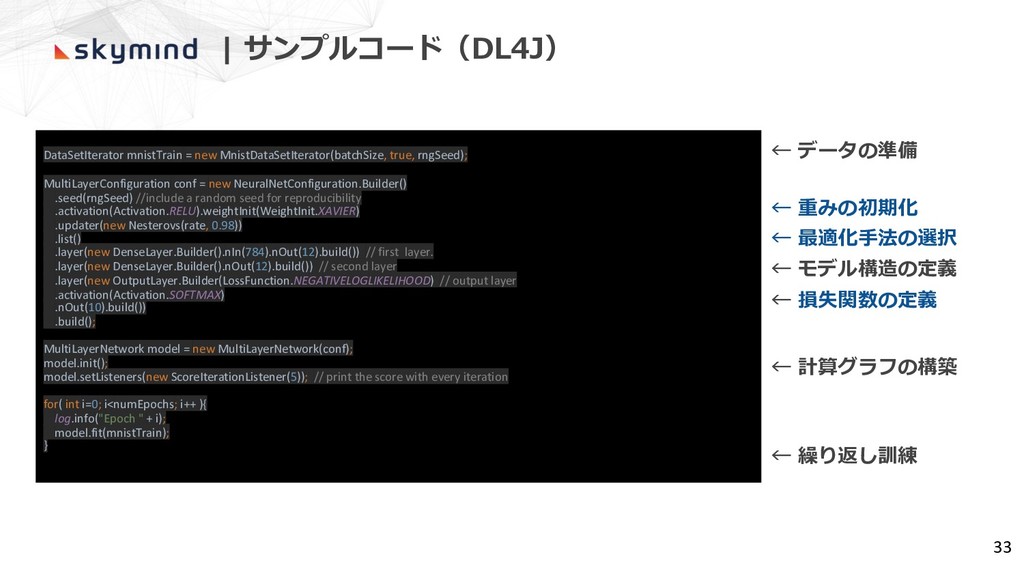
| サンプルコード(DL4J) DataSetIterator mnistTrain = new MnistDataSetIterator(batchSize, true, rngSeed); MultiLayerConfiguration
conf = new NeuralNetConfiguration.Builder() .seed(rngSeed) //include a random seed for reproducibility .activation(Activation.RELU).weightInit(WeightInit.XAVIER) .updater(new Nesterovs(rate, 0.98)) .list() .layer(new DenseLayer.Builder().nIn(784).nOut(12).build()) // first layer. .layer(new DenseLayer.Builder().nOut(12).build()) // second layer .layer(new OutputLayer.Builder(LossFunction.NEGATIVELOGLIKELIHOOD) // output layer .activation(Activation.SOFTMAX) .nOut(10).build()) .build(); MultiLayerNetwork model = new MultiLayerNetwork(conf); model.init(); model.setListeners(new ScoreIterationListener(5)); // print the score with every iteration for( int i=0; i<numEpochs; i++ ){ log.info("Epoch " + i); model.fit(mnistTrain); } 33 ← データの準備 ← モデル構造の定義 ← 重みの初期化 ← 最適化⼿法の選択 ← 損失関数の定義 ← 計算グラフの構築 ← 繰り返し訓練
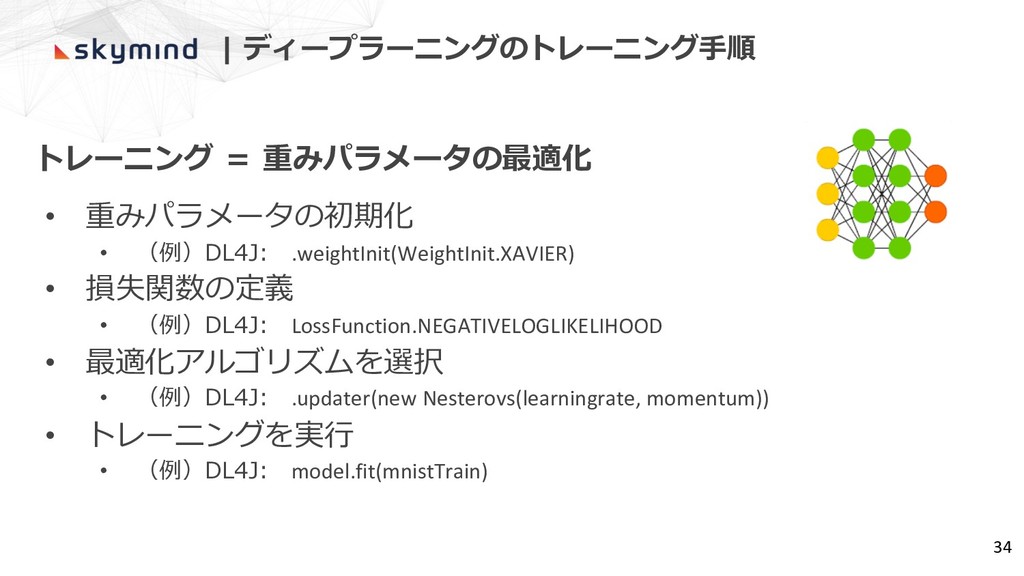
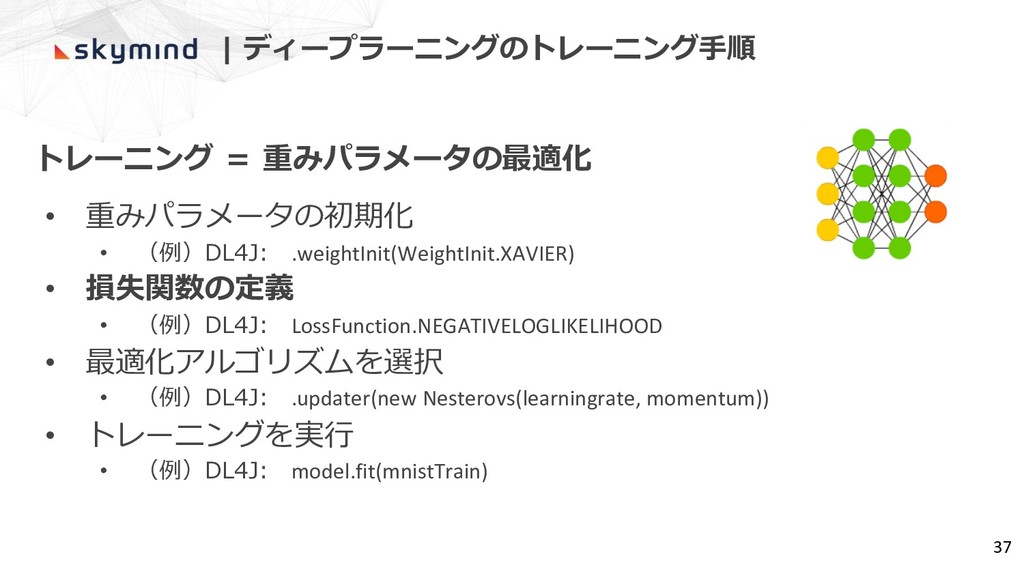
| ディープラーニングのトレーニング⼿順 34 トレーニング = 重みパラメータの最適化 • 重みパラメータの初期化 • (例)DL4J:
.weightInit(WeightInit.XAVIER) • 損失関数の定義 • (例)DL4J: LossFunction.NEGATIVELOGLIKELIHOOD • 最適化アルゴリズムを選択 • (例)DL4J: .updater(new Nesterovs(learningrate, momentum)) • トレーニングを実⾏ • (例)DL4J: model.fit(mnistTrain)
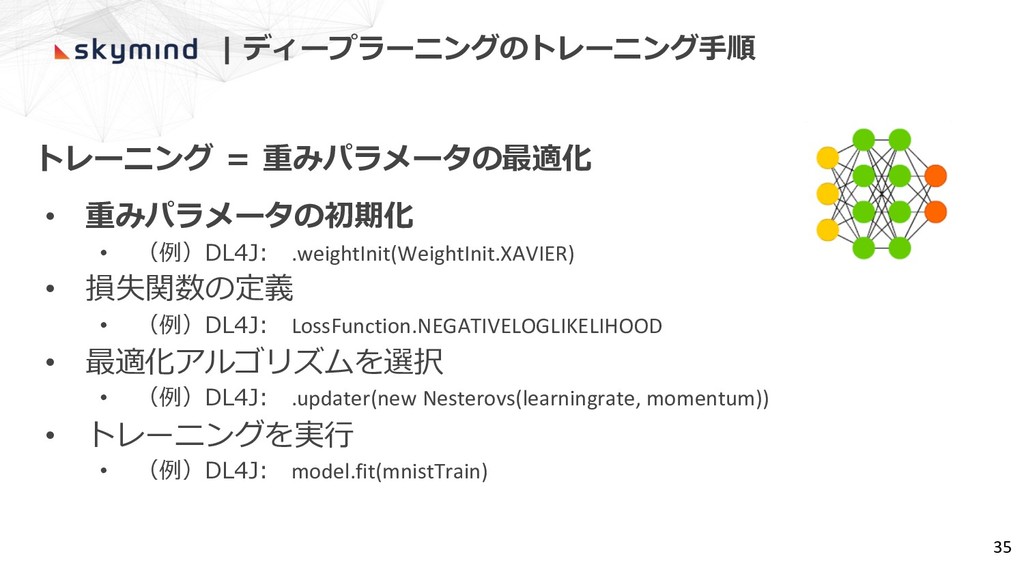
35 | ディープラーニングのトレーニング⼿順 トレーニング = 重みパラメータの最適化 • 重みパラメータの初期化 • (例)DL4J:
.weightInit(WeightInit.XAVIER) • 損失関数の定義 • (例)DL4J: LossFunction.NEGATIVELOGLIKELIHOOD • 最適化アルゴリズムを選択 • (例)DL4J: .updater(new Nesterovs(learningrate, momentum)) • トレーニングを実⾏ • (例)DL4J: model.fit(mnistTrain)
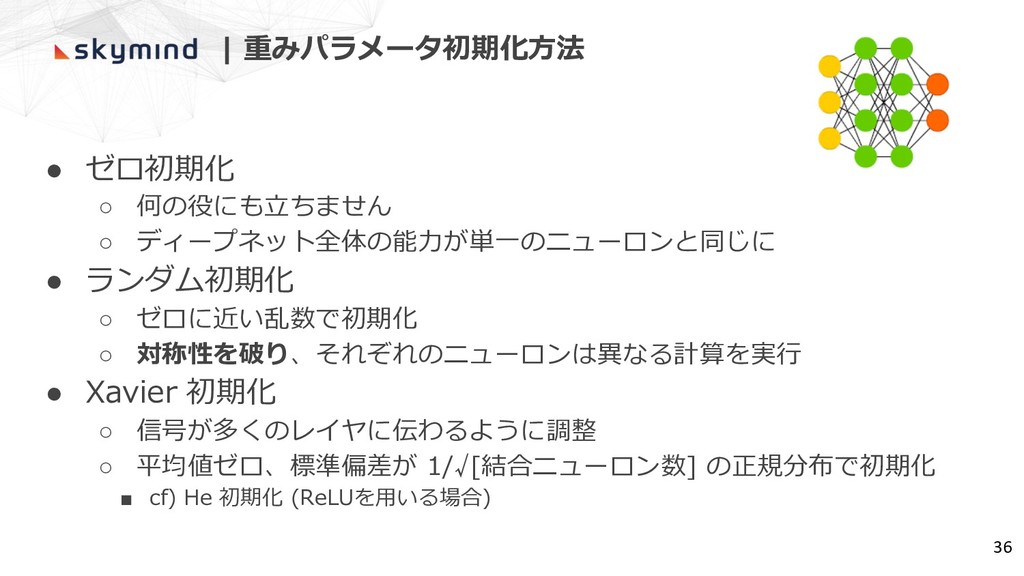
| 重みパラメータ初期化⽅法 • ゼロ初期化 ◦ 何の役にも⽴ちません ◦ ディープネット全体の能⼒が単⼀のニューロンと同じに • ランダム初期化
◦ ゼロに近い乱数で初期化 ◦ 対称性を破り、それぞれのニューロンは異なる計算を実⾏ • Xavier 初期化 ◦ 信号が多くのレイヤに伝わるように調整 ◦ 平均値ゼロ、標準偏差が 1/√[結合ニューロン数] の正規分布で初期化 ▪ cf) He 初期化 (ReLUを⽤いる場合) 36
37 | ディープラーニングのトレーニング⼿順 トレーニング = 重みパラメータの最適化 • 重みパラメータの初期化 • (例)DL4J:
.weightInit(WeightInit.XAVIER) • 損失関数の定義 • (例)DL4J: LossFunction.NEGATIVELOGLIKELIHOOD • 最適化アルゴリズムを選択 • (例)DL4J: .updater(new Nesterovs(learningrate, momentum)) • トレーニングを実⾏ • (例)DL4J: model.fit(mnistTrain)
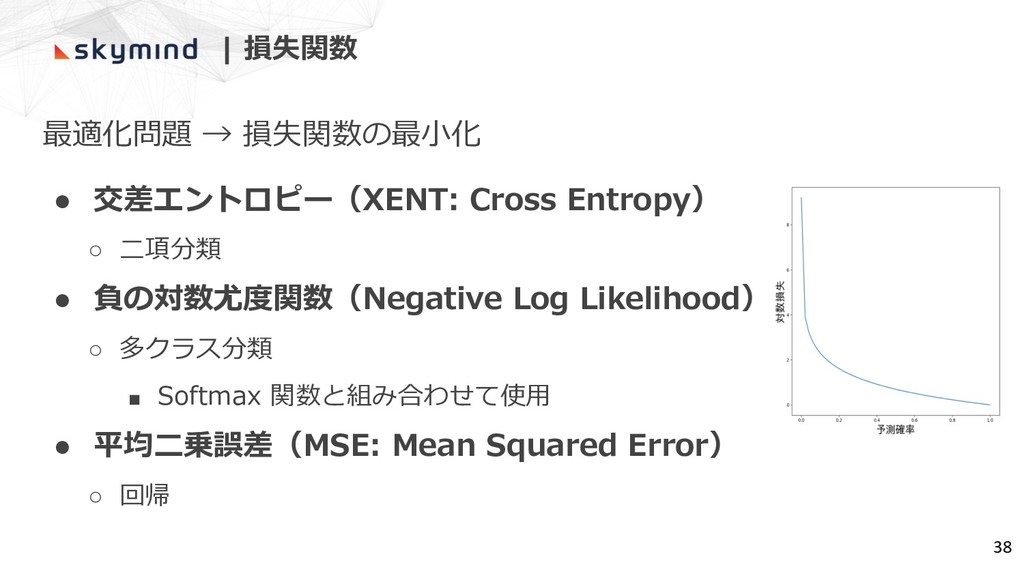
| 損失関数 最適化問題 → 損失関数の最⼩化 • 交差エントロピー(XENT: Cross Entropy) ◦
⼆項分類 • 負の対数尤度関数(Negative Log Likelihood) ◦ 多クラス分類 ▪ Softmax 関数と組み合わせて使⽤ • 平均⼆乗誤差(MSE: Mean Squared Error) ◦ 回帰 38
| 交差エントロピー 39
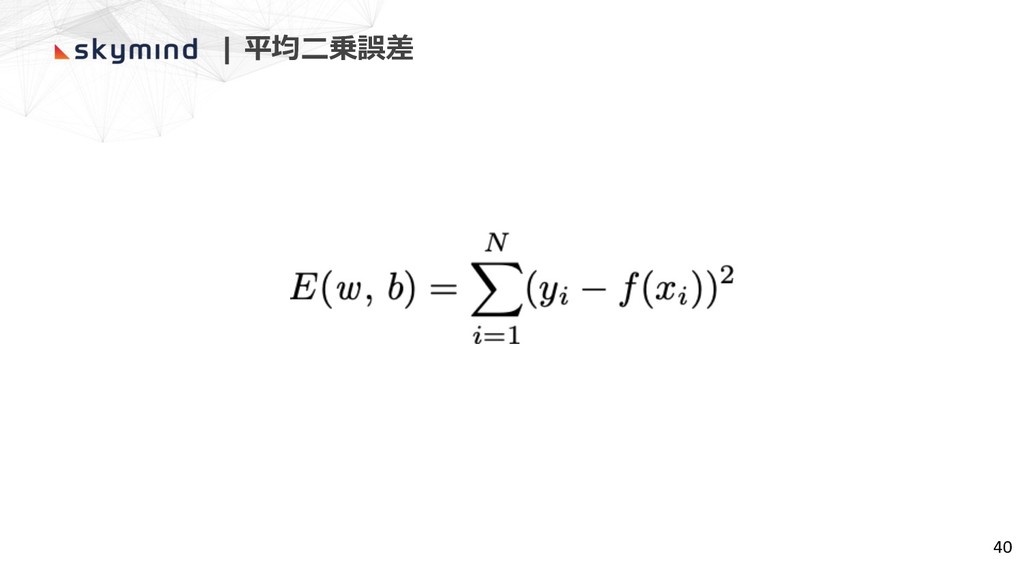
| 平均⼆乗誤差 40
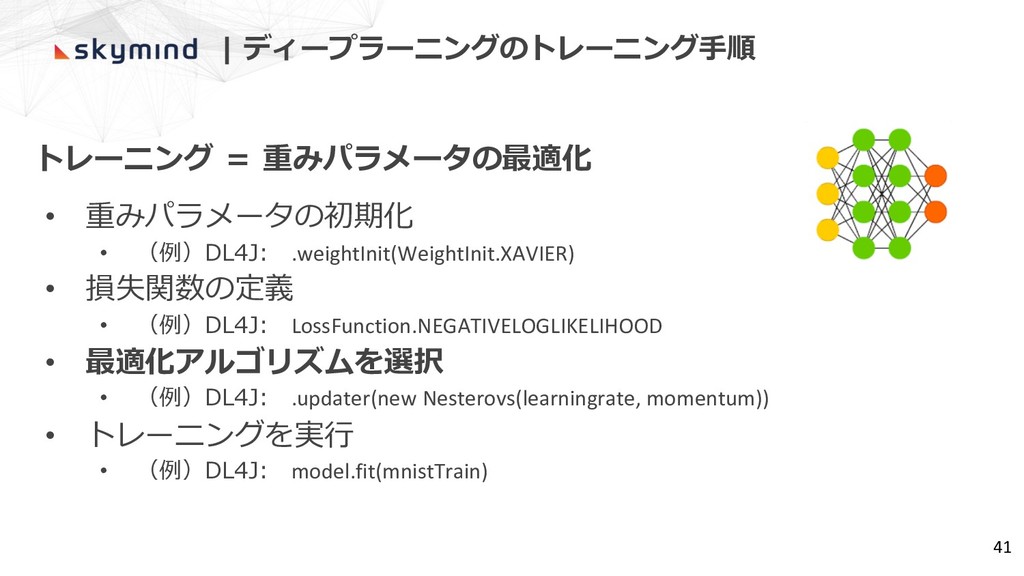
41 | ディープラーニングのトレーニング⼿順 トレーニング = 重みパラメータの最適化 • 重みパラメータの初期化 • (例)DL4J:
.weightInit(WeightInit.XAVIER) • 損失関数の定義 • (例)DL4J: LossFunction.NEGATIVELOGLIKELIHOOD • 最適化アルゴリズムを選択 • (例)DL4J: .updater(new Nesterovs(learningrate, momentum)) • トレーニングを実⾏ • (例)DL4J: model.fit(mnistTrain)
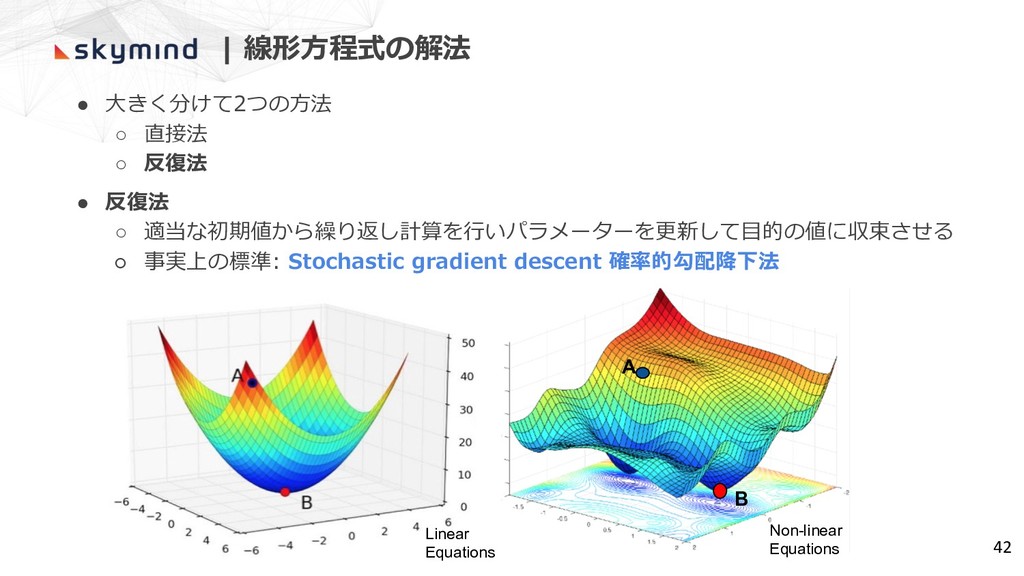
• ⼤きく分けて2つの⽅法 ◦ 直接法 ◦ 反復法 • 反復法 ◦ 適当な初期値から繰り返し計算を⾏いパラメーターを更新して⽬的の値に収束させる
◦ 事実上の標準: Stochastic gradient descent 確率的勾配降下法 B A | 線形⽅程式の解法 Non-linear Equations Linear Equations 42
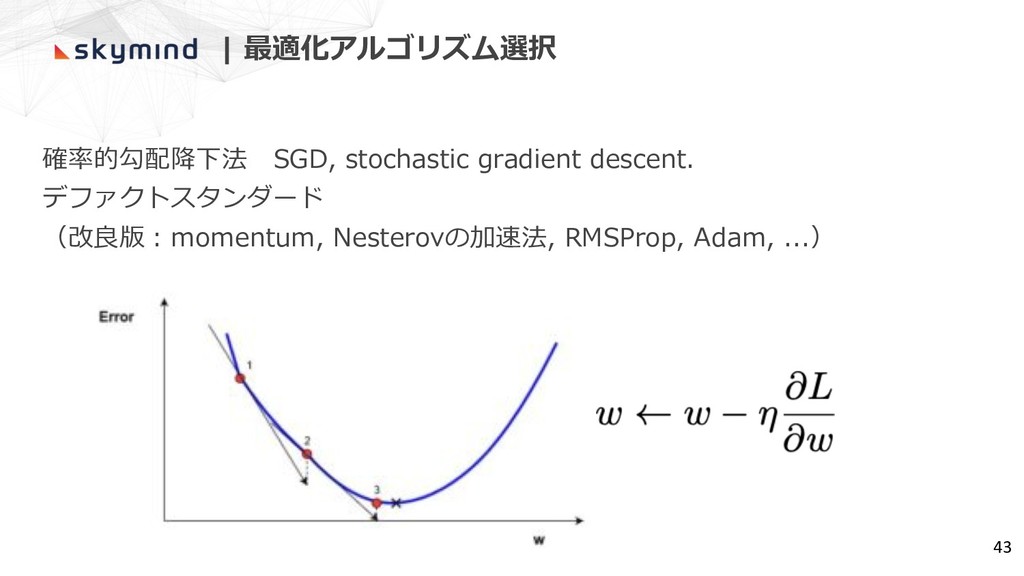
| 最適化アルゴリズム選択 確率的勾配降下法 SGD, stochastic gradient descent. デファクトスタンダード (改良版︓momentum, Nesterovの加速法,
RMSProp, Adam, ...) 43
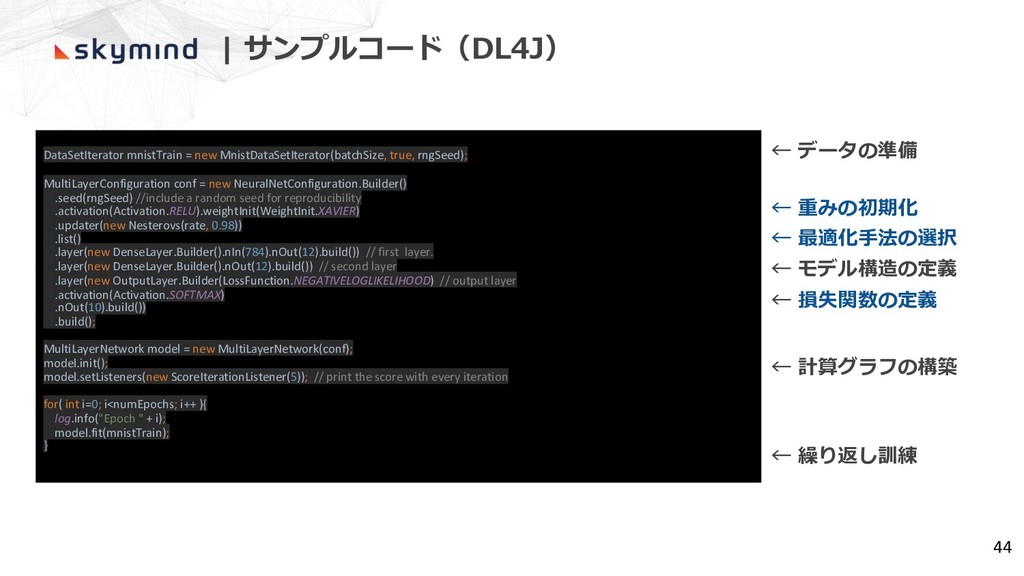
| サンプルコード(DL4J) DataSetIterator mnistTrain = new MnistDataSetIterator(batchSize, true, rngSeed); MultiLayerConfiguration
conf = new NeuralNetConfiguration.Builder() .seed(rngSeed) //include a random seed for reproducibility .activation(Activation.RELU).weightInit(WeightInit.XAVIER) .updater(new Nesterovs(rate, 0.98)) .list() .layer(new DenseLayer.Builder().nIn(784).nOut(12).build()) // first layer. .layer(new DenseLayer.Builder().nOut(12).build()) // second layer .layer(new OutputLayer.Builder(LossFunction.NEGATIVELOGLIKELIHOOD) // output layer .activation(Activation.SOFTMAX) .nOut(10).build()) .build(); MultiLayerNetwork model = new MultiLayerNetwork(conf); model.init(); model.setListeners(new ScoreIterationListener(5)); // print the score with every iteration for( int i=0; i<numEpochs; i++ ){ log.info("Epoch " + i); model.fit(mnistTrain); } 44 ← データの準備 ← モデル構造の定義 ← 重みの初期化 ← 最適化⼿法の選択 ← 損失関数の定義 ← 計算グラフの構築 ← 繰り返し訓練
| トレーニング: 決定境界 # Keras example X, y = datasets.make_moons(n_samples=1000,
noise=0.2) model = Sequential() model.add(Dense(units=20, activation=relu, input_dim=2)) model.add(Dense(units=1, activation=sigmoid)) model.compile(loss=losses.binary_crossentropy, optimizer=optimizers.SGD(lr=0.01, momentum=0.9, nesterov=True)) model.fit(X[:500], y[:500], verbose=0, epochs=2000, shuffle=True) plot_decision_boundary(X, y, model, cmap='RdBu') 45
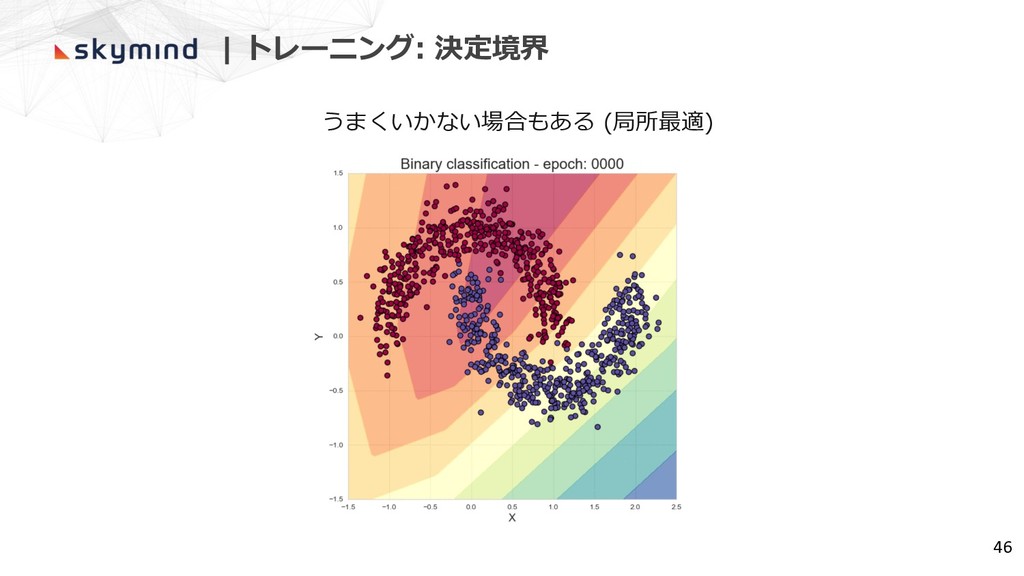
| トレーニング: 決定境界 46 うまくいかない場合もある (局所最適)
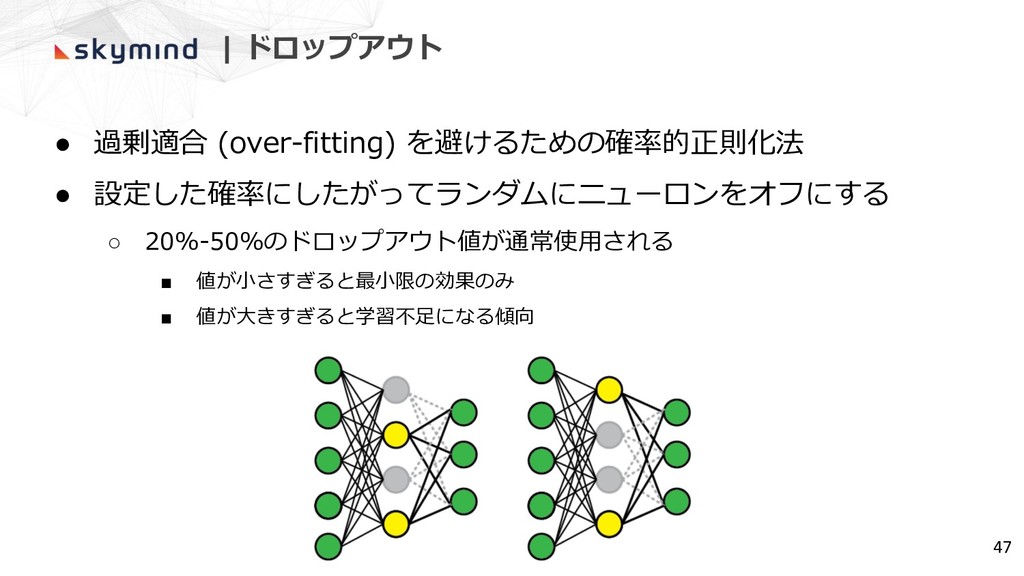
| ドロップアウト • 過剰適合 (over-fitting) を避けるための確率的正則化法 • 設定した確率にしたがってランダムにニューロンをオフにする ◦ 20%-50%のドロップアウト値が通常使⽤される
▪ 値が⼩さすぎると最⼩限の効果のみ ▪ 値が⼤きすぎると学習不⾜になる傾向 47
モデルの評価指標 48
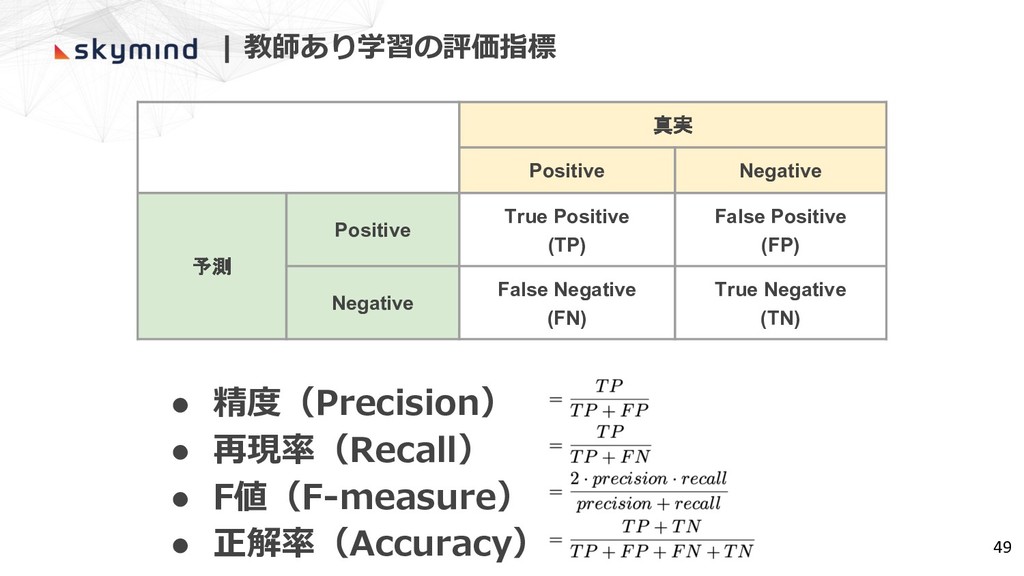
| 教師あり学習の評価指標 真実 Positive Negative 予測 Positive True Positive (TP)
False Positive (FP) Negative False Negative (FN) True Negative (TN) 49 • 精度(Precision) • 再現率(Recall) • F値(F-measure) • 正解率(Accuracy)
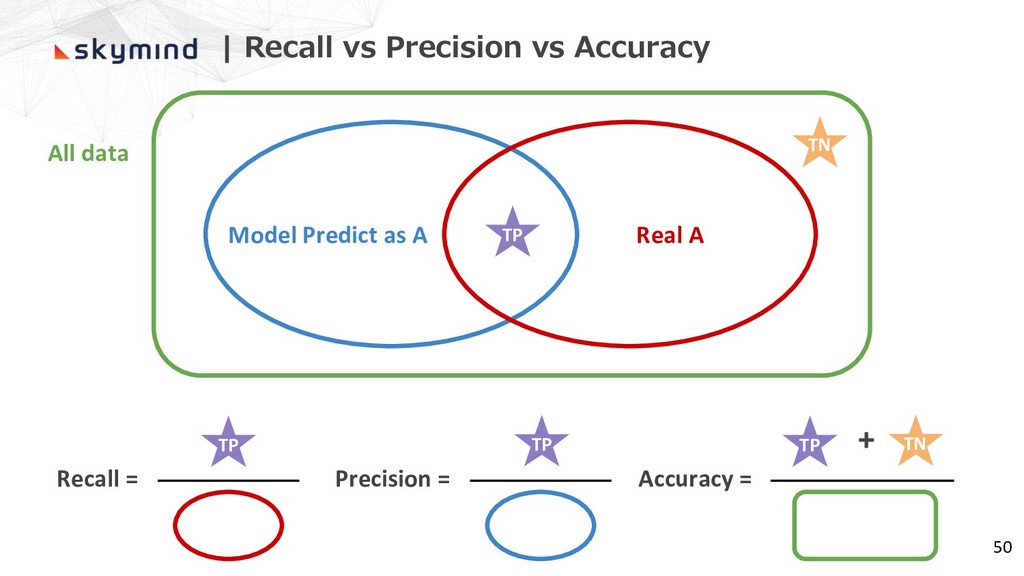
| Recall vs Precision vs Accuracy 50 Model Predict as
A Real A All data Recall = Precision = Accuracy = + ★ TP ★ TN ★ TP ★ TP ★ TP ★ TN
Walkthrough ニューラルネットワークの訓練 51
畳み込みニューラルネットワーク リカレントニューラルネットワーク 52
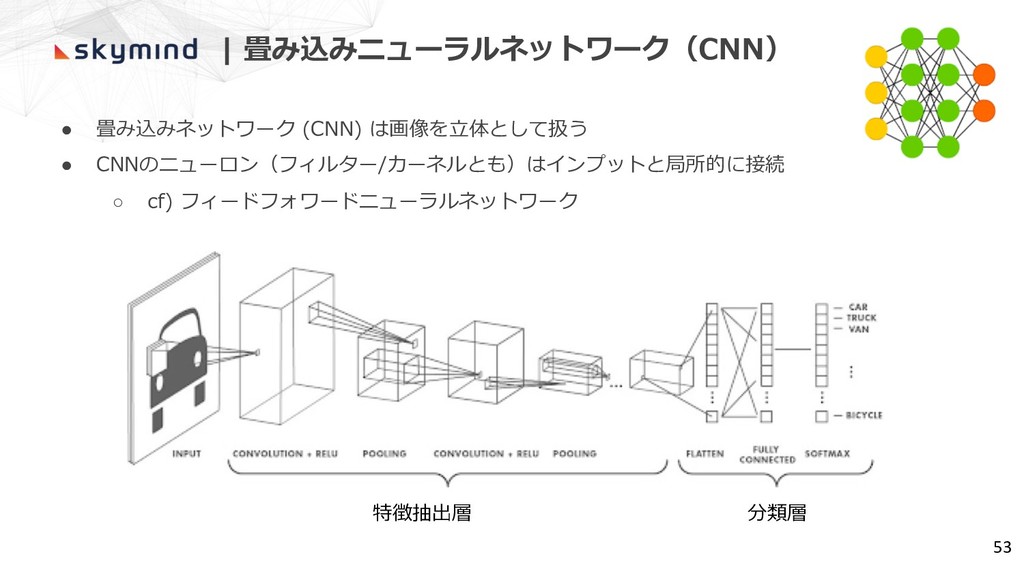
| 畳み込みニューラルネットワーク(CNN) • 畳み込みネットワーク (CNN) は画像を⽴体として扱う • CNNのニューロン(フィルター/カーネルとも)はインプットと局所的に接続 ◦ cf)
フィードフォワードニューラルネットワーク 53 分類層 特徴抽出層
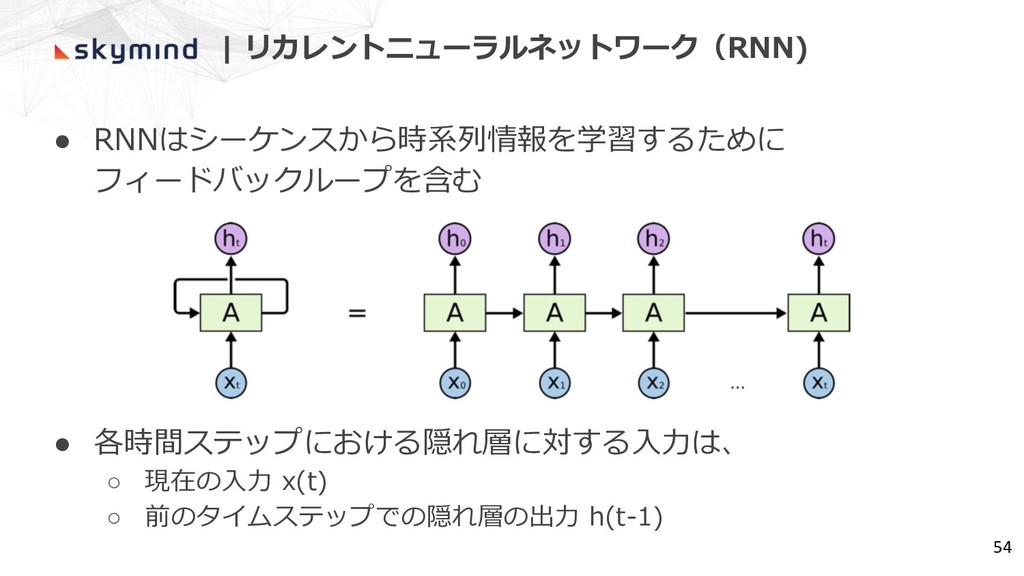
| リカレントニューラルネットワーク(RNN) • RNNはシーケンスから時系列情報を学習するために フィードバックループを含む • 各時間ステップにおける隠れ層に対する⼊⼒は、 ◦ 現在の⼊⼒ x(t)
◦ 前のタイムステップでの隠れ層の出⼒ h(t-1) 54
| まとめ • ⼈⼯知能 ⊃ 機械学習 ⊃ 深層学習 • Deeplearning4J
と Keras の関係 • ニューラルネットワークによる出⼒の計算⽅法 ◦ 活性化機能の重要性 • ディープラーニングのトレーニング ◦ 重みパラメータの初期化 ◦ 損失関数 ◦ 最適化アルゴリズム • モデルの評価指標 • CNN/RNNの概要 55
Breakout session 2 誤差逆伝播法 56
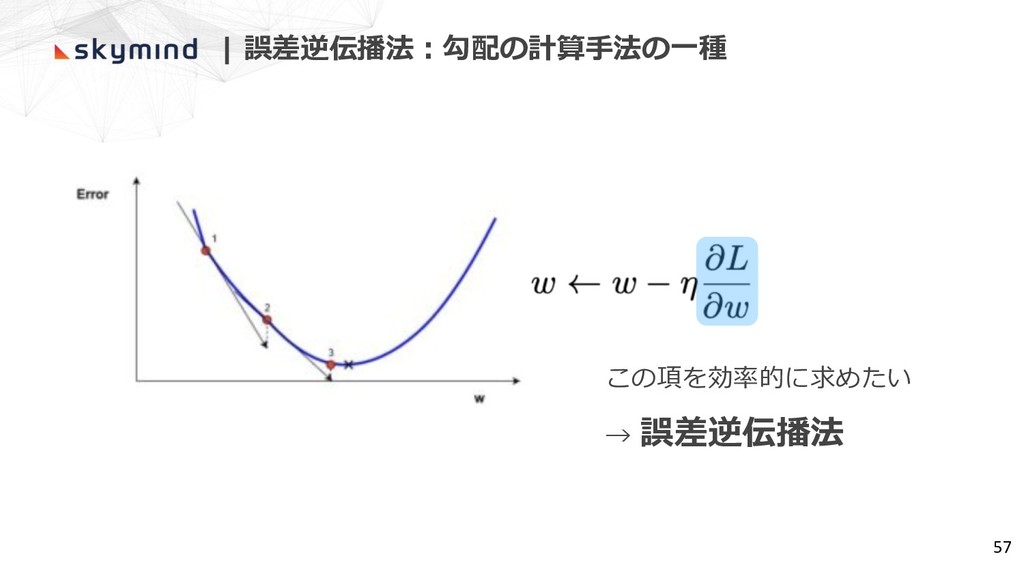
| 誤差逆伝播法︓勾配の計算⼿法の⼀種 57 この項を効率的に求めたい → 誤差逆伝播法
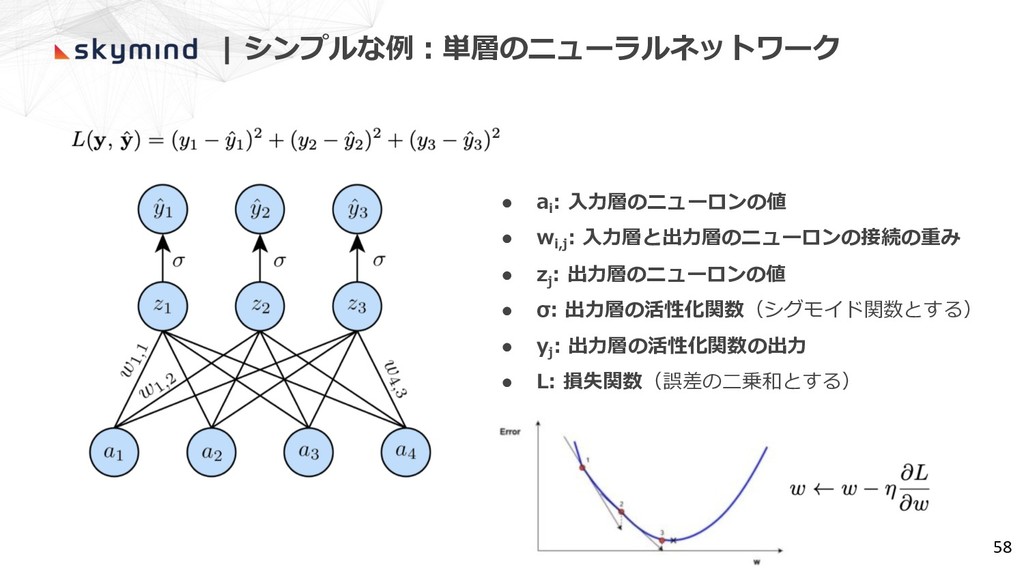
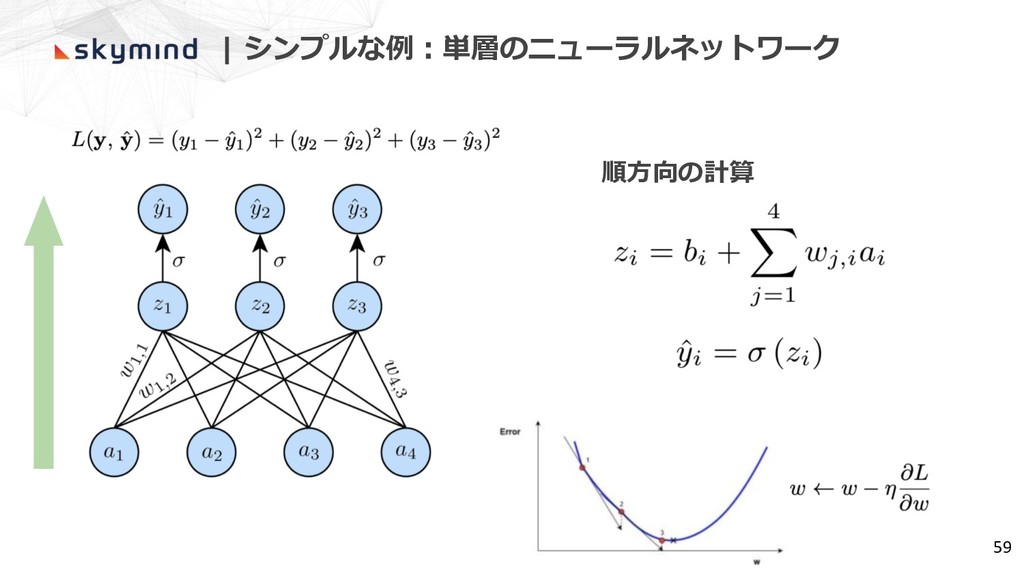
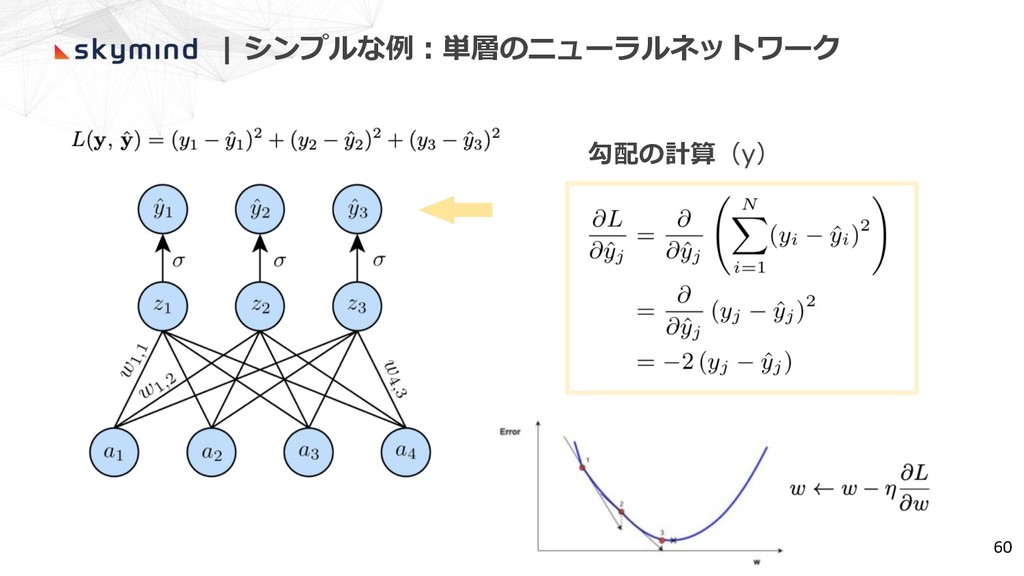
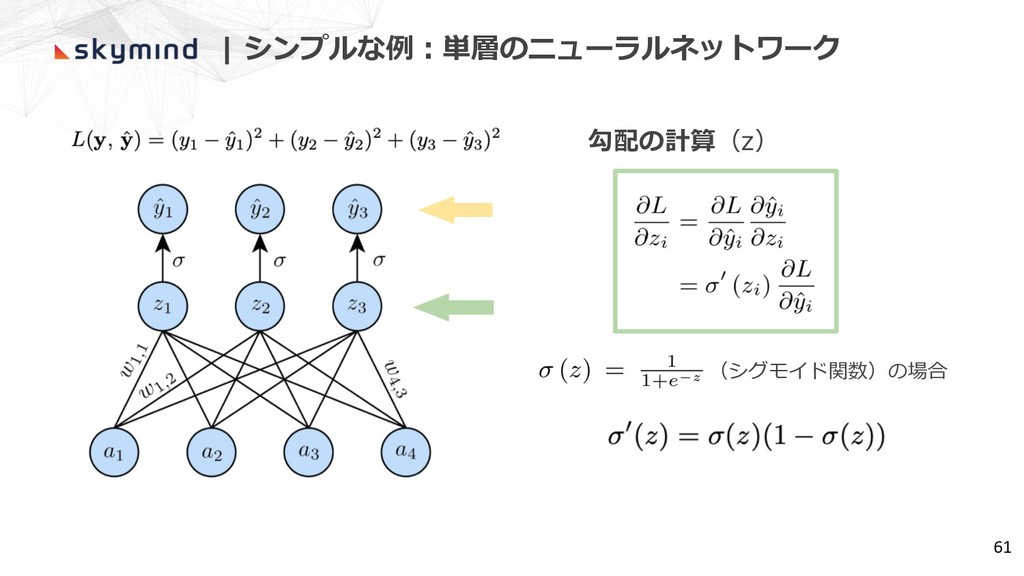
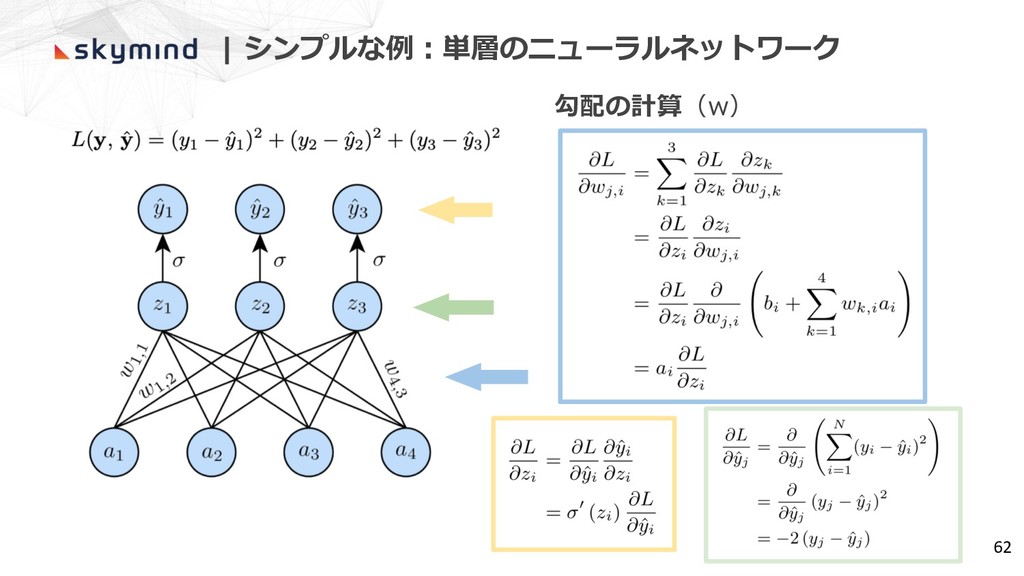
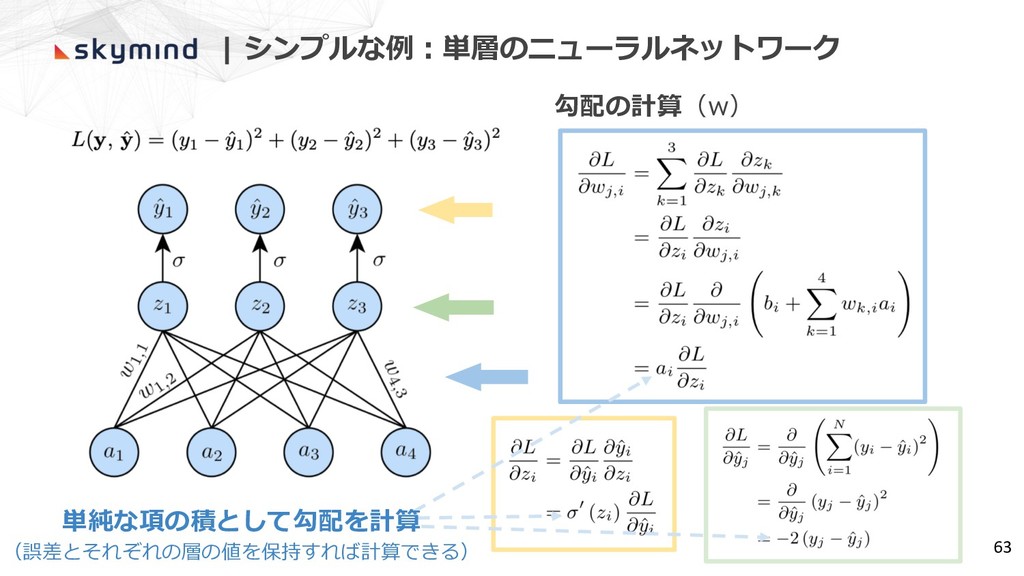
| シンプルな例︓単層のニューラルネットワーク 58 • ai : ⼊⼒層のニューロンの値 • wi,j :
⼊⼒層と出⼒層のニューロンの接続の重み • zj : 出⼒層のニューロンの値 • σ: 出⼒層の活性化関数(シグモイド関数とする) • yj : 出⼒層の活性化関数の出⼒ • L: 損失関数(誤差の⼆乗和とする)
| シンプルな例︓単層のニューラルネットワーク 59 順⽅向の計算
| シンプルな例︓単層のニューラルネットワーク 60 勾配の計算(y)
| シンプルな例︓単層のニューラルネットワーク 61 勾配の計算(z) (シグモイド関数)の場合
| シンプルな例︓単層のニューラルネットワーク 62 勾配の計算(w)
| シンプルな例︓単層のニューラルネットワーク 63 単純な項の積として勾配を計算 (誤差とそれぞれの層の値を保持すれば計算できる) 勾配の計算(w)


 kmotohas
 vivion
 ymrl
 mewuto
 masakiokuda
 grimoh
 shogo4131
 tsukuboshi
 kairim0
 tomzoh
 yama3133
 puhitaku
 colopl
 dougneiner
 bermonpainter
 tammielis
 lemiorhan
 ks91
 sarafernandez
 bethany
 chriscoyier
 reverentgeek
 aleyda
 ryanjones
 jonrohan