Share
Embed
今更LLMを触り始める(ローカルLLM bonsai)
source: https://codeberg.org/matoken/kagolug-2026.04/src/branch/main/slide/slide.adoc
event: 鹿児島Linux勉強会 2026.04(オンライン開催) - connpass https://kagolug.connpass.com/event/387739/
Kenichiro MATOHARA
April 19, 2026
Transcript
39 slides
-
鹿児島の右下の山奥から参加 好きなLinuxディストリビューションは Debian GNU/Linux ActivityPub @ @ matrix @matoken:matrix.org Signal
matoken.256 map: © OpenStreetMap contributors Kenichiro Matohara(matoken) https://matoken.org [email protected] [email protected] 2 -
最近 backup HDD が壊れる(USB接続SATA 2.5吋 500GB HDD) 久々( )にAmazon Glacier
あたり使う? CatPrinter Amazon Japan にも2k位から出回るように, USB/Serial noBattery で4k くらいのものも ChangeDetection.io 日本語訳追加される kagolug.org ドメイン更新 14年ぶり? Amazon echo show 5 が愛媛で@660円で大量に放出 TLUG Signal channel 3 -
AI? プライバシーに問題がありそう&継続性に疑問などなどでオンライン LLM はあまり使っていない でも今は各社(有料ユーザでも)赤字で頑張っていそうでそのうち大幅 値上げされて使うのが大変になりそう. 逆に今はボーナスタイムかもということで今のうちに試しておくと 良さそう? ローカルLLM は手元のマシンでは厳しいだろうと試していなかった
文字起こしのWhisper.cpp,翻訳ソフトウェアの ArgosTranslete(LibreTranslate),Firefox Translate なん かはよく使っている 4 -
プライバシーを重視しながら LLM を使う DuckAI はプライバシー重視の検索エンジンのDuckDuckGo が提 供している DuckAI の無料モデルは各種モデルプロバイダーを利用できる 現時点では,GPT-5
mini, GPT-4o mini, gpt-oss 120B, Llama 4 Scout, Claude Haiku 4.5, Mistral Small 3 の6 種類から選べる DuckDuckGo Subscription で更に高度なAIモデルが利用可能 (未確認) https://duck.ai/ 6 -
DuckDuckGo のサーバを経由し,個人を特定できるメタデータ(IP アドレスなど)を除去するので会話を特定の個人に紐づけできない. チャット内に個人情報を書くとそれはモデルに届くので注意. チャット履歴は保存を無効にしない限り,デバイスにローカルに保存さ れる ストレージ設定を変更することでチャットを暗号化された状態でリ モートサーバーに保存できる.復号できるのはユーザーのみ(未確 認) AIのトレーニングは禁止されている
DuckDuckGo のプライバリーポリシーに加え,各利用モデルプロバ イダーの利用規約に従う必要がある https://duckduckgo.com/duckai/privacy-terms 7 -
主に Tor Browser で DuckAI を利用 DuckAI はTor 経由でも利用可能 がDuck.ai
には無 い IP アドレスを含むメダデータは除去されるとなっているがTor 経由 で利用 Tor Browser は再起動するとデータは消えるので大事なチャットは ダウンロードする運用 DuckDuckGo にはonion address がある 8 -
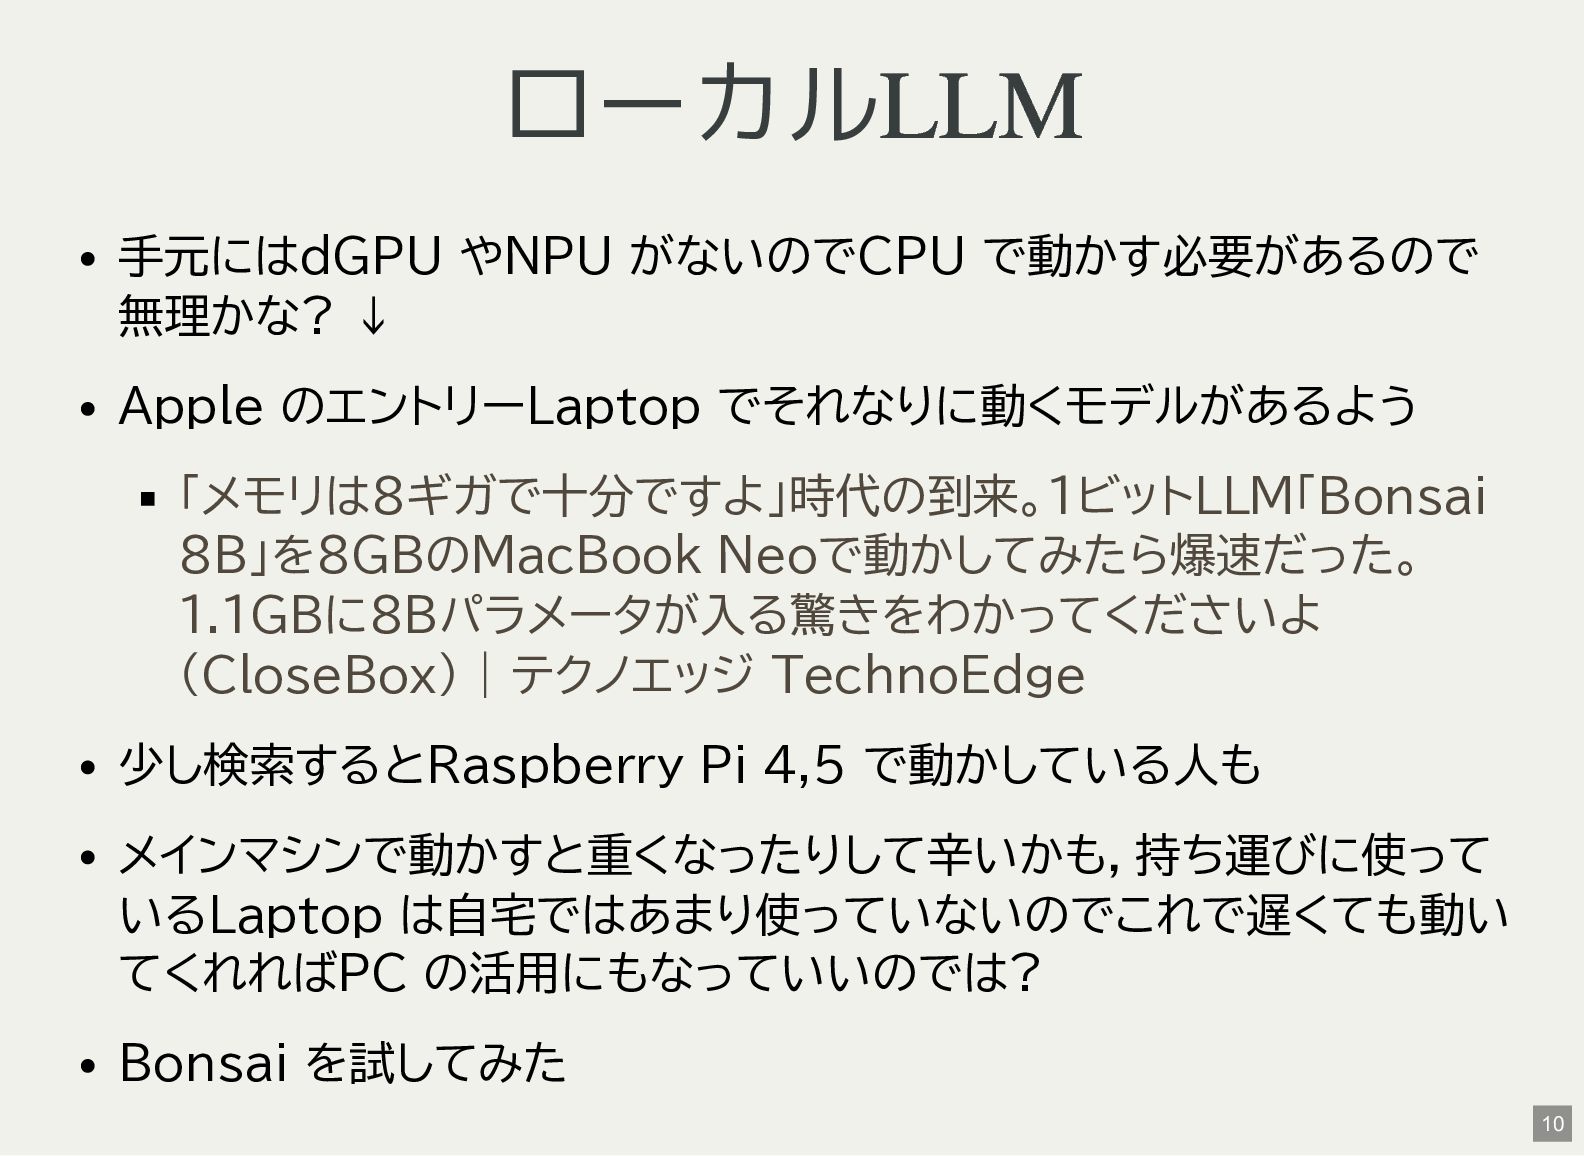
ローカル LLM 手元にはdGPU やNPU がないのでCPU で動かす必要があるので 無理かな? ↓ Apple のエントリーLaptop
でそれなりに動くモデルがあるよう 少し検索するとRaspberry Pi 4,5 で動かしている人も メインマシンで動かすと重くなったりして辛いかも,持ち運びに使って いるLaptop は自宅ではあまり使っていないのでこれで遅くても動い てくれればPC の活用にもなっていいのでは? Bonsai を試してみた 「メモリは8ギガで十分ですよ」時代の到来。1ビットLLM「Bonsai 8B」を8GBのMacBook Neoで動かしてみたら爆速だった。 1.1GBに8Bパラメータが入る驚きをわかってくださいよ (CloseBox) | テクノエッジ TechnoEdge 10 -
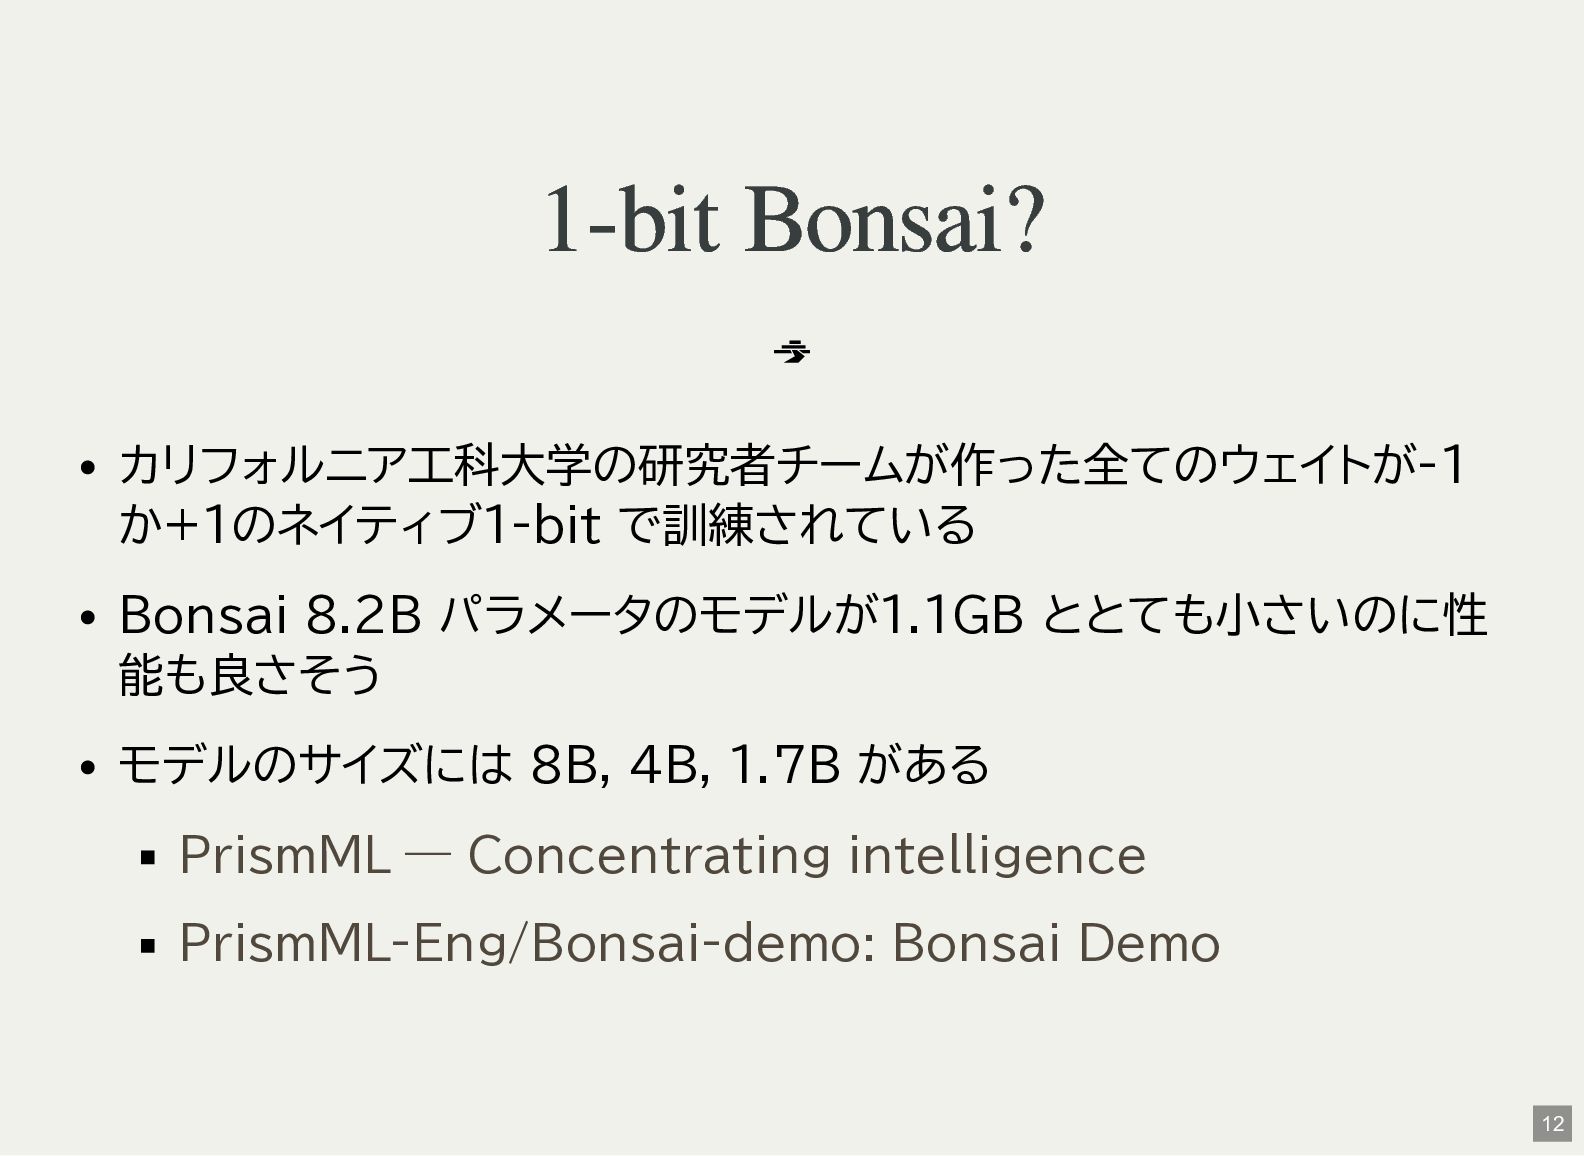
1-bit Bonsai? カリフォルニア工科大学の研究者チームが作った全てのウェイトが-1 か+1のネイティブ1-bit で訓練されている Bonsai 8.2B パラメータのモデルが1.1GB ととても小さいのに性 能も良さそう
モデルのサイズには 8B, 4B, 1.7B がある PrismML — Concentrating intelligence PrismML-Eng/Bonsai-demo: Bonsai Demo 12 -
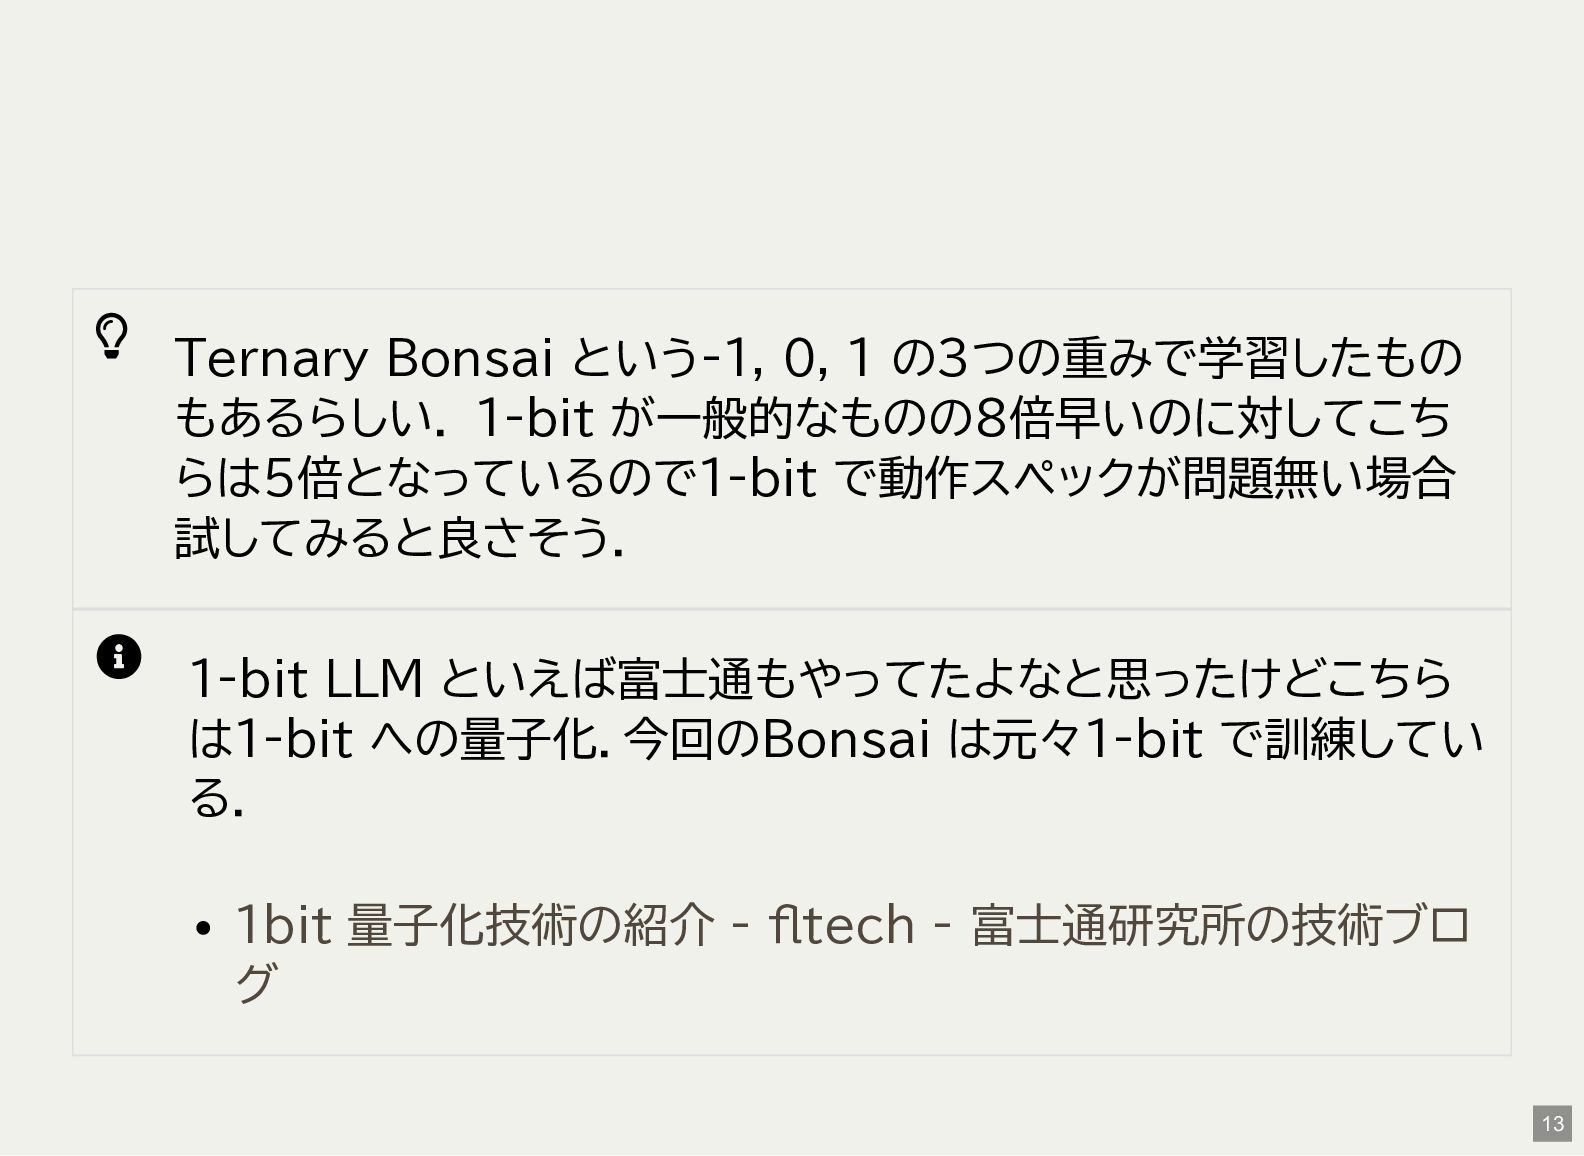
Ternary Bonsai という-1, 0, 1 の3つの重みで学習したもの もあるらしい. 1-bit が一般的なものの8倍早いのに対してこち
らは5倍となっているので1-bit で動作スペックが問題無い場合 試してみると良さそう. 1-bit LLM といえば富士通もやってたよなと思ったけどこちら は1-bit への量子化.今回のBonsai は元々1-bit で訓練してい る. 1bit 量子化技術の紹介 - fltech - 富士通研究所の技術ブロ グ 13 -
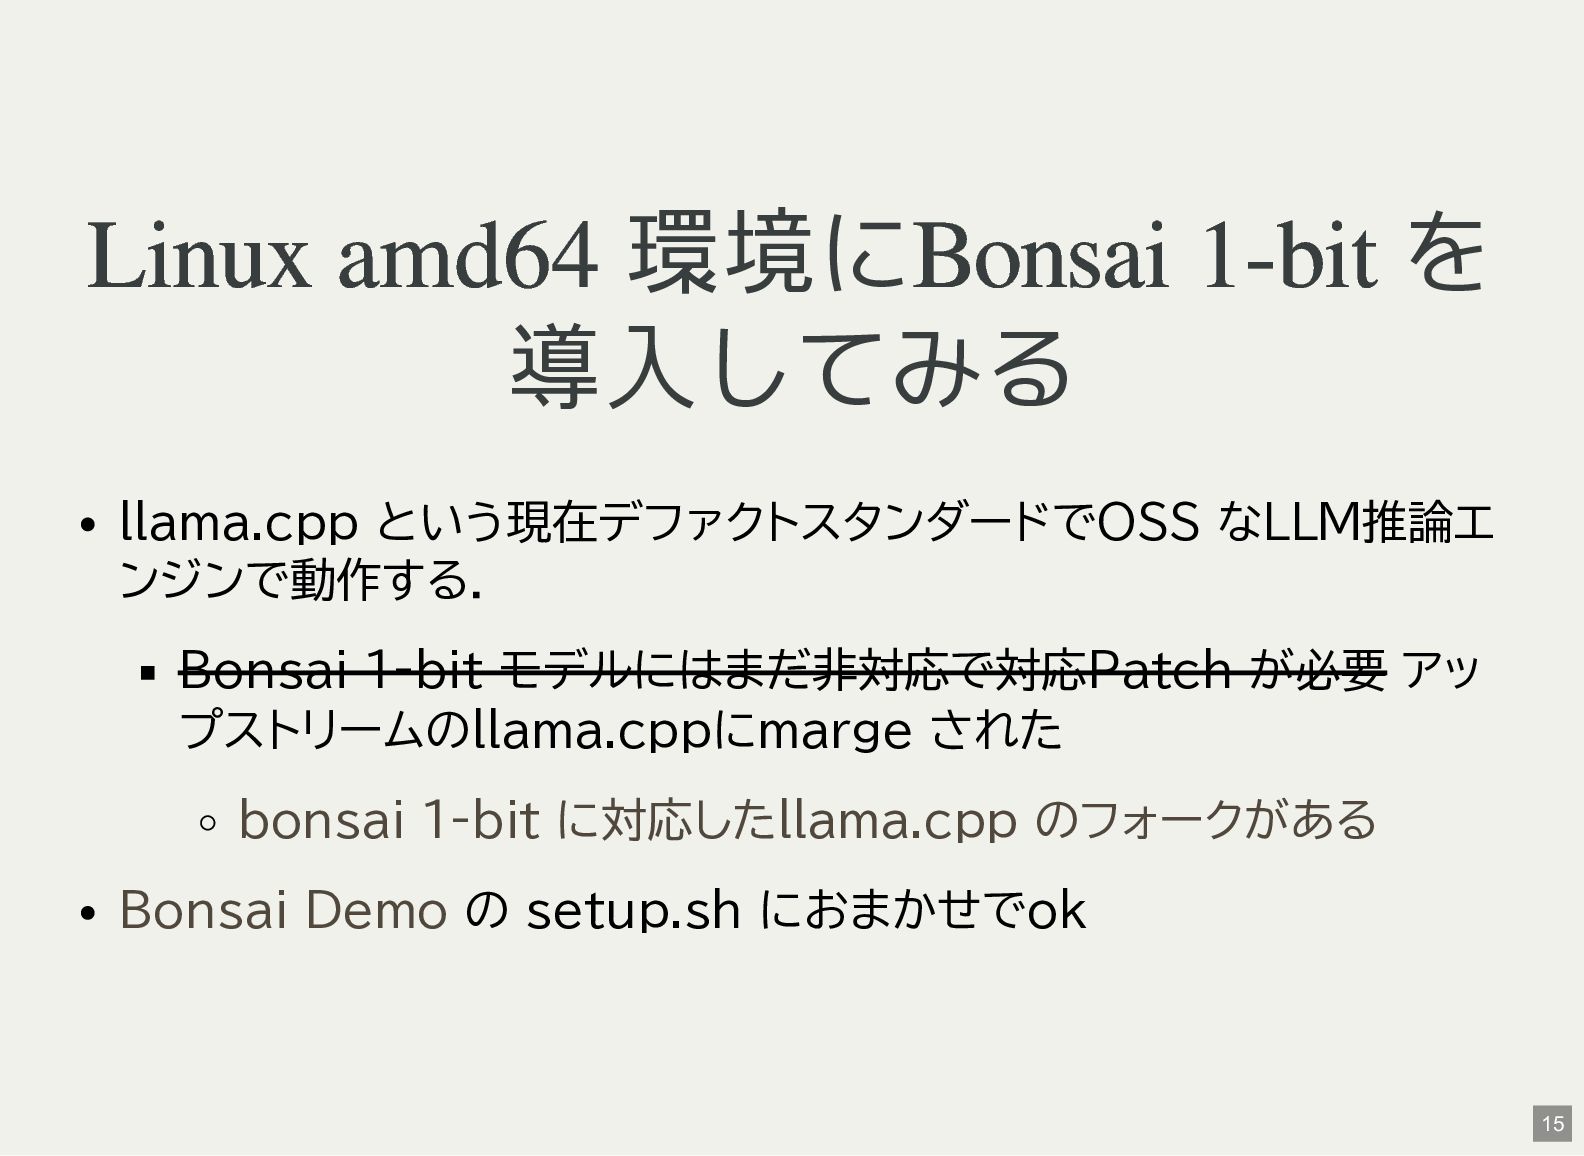
Linux amd64 環境に Bonsai 1-bit を 導入してみる llama.cpp という現在デファクトスタンダードでOSS なLLM推論エ
ンジンで動作する. Bonsai 1-bit モデルにはまだ非対応で対応Patch が必要 アッ プストリームのllama.cppにmarge された の setup.sh におまかせでok bonsai 1-bit に対応したllama.cpp のフォークがある Bonsai Demo 15 -
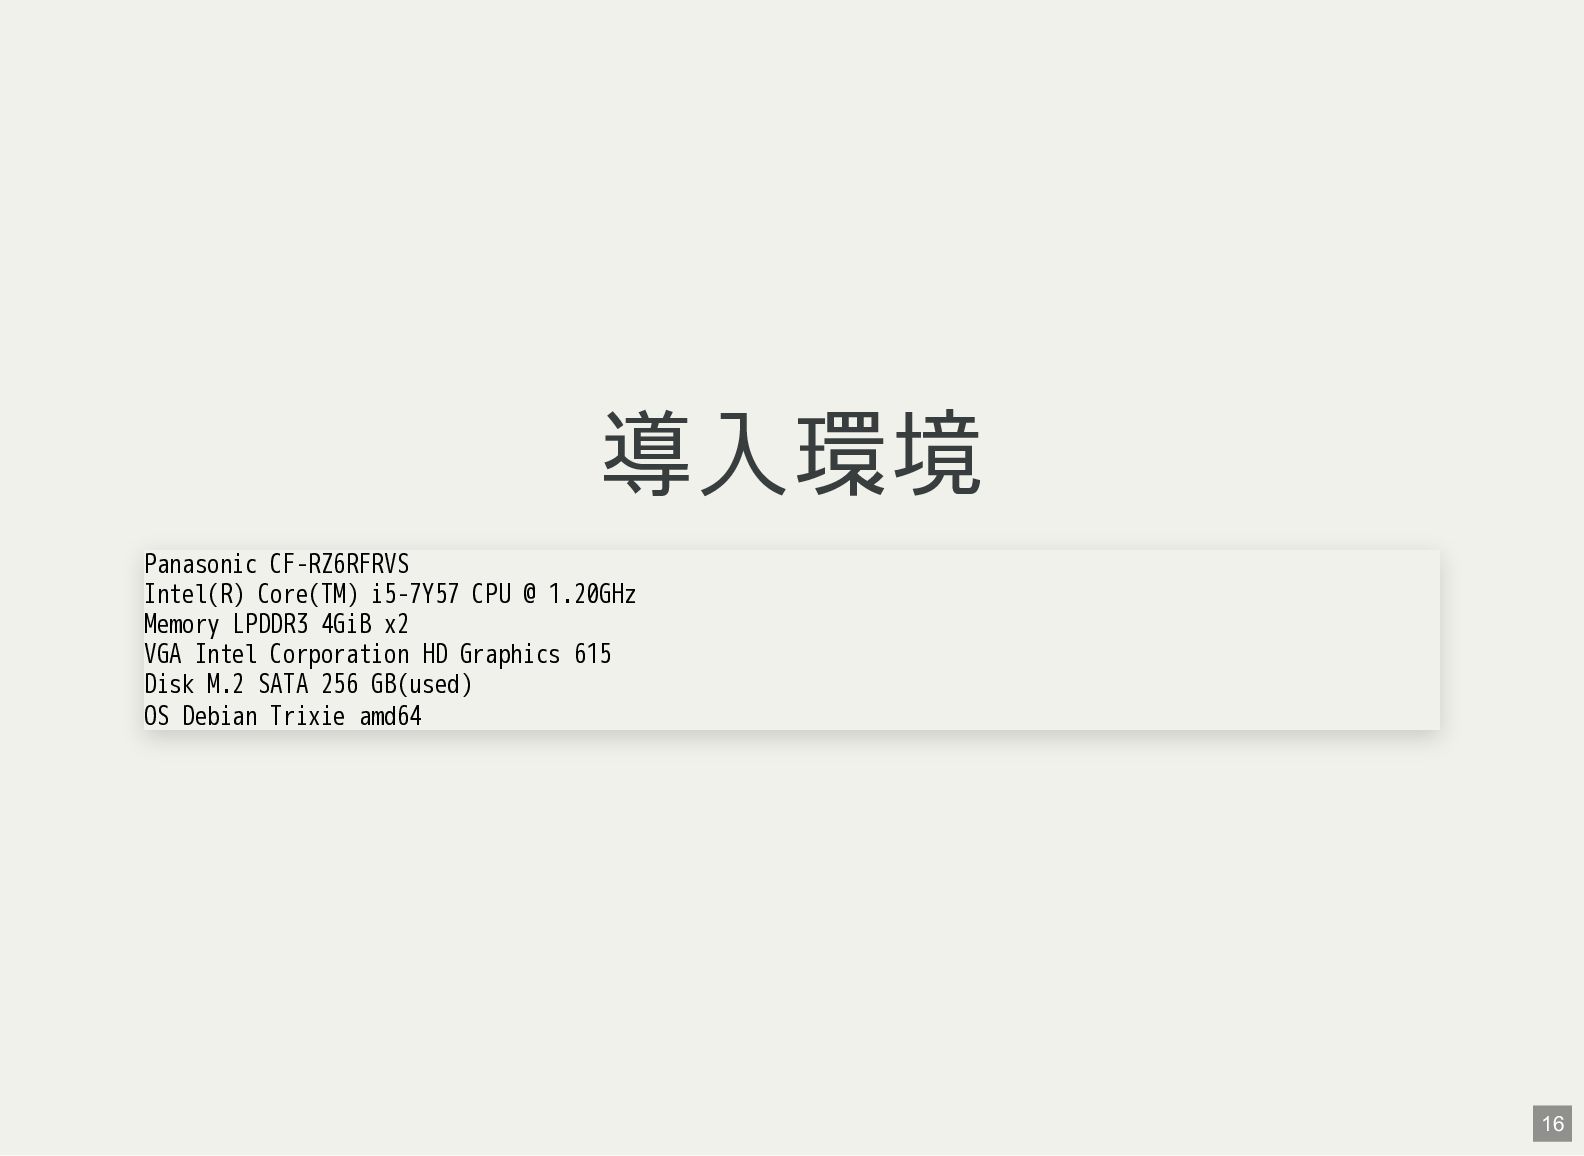
導入環境 Panasonic CF-RZ6RFRVS Intel(R) Core(TM) i5-7Y57 CPU @ 1.20GHz Memory
LPDDR3 4GiB x2 VGA Intel Corporation HD Graphics 615 Disk M.2 SATA 256 GB(used) OS Debian Trixie amd64 16 -
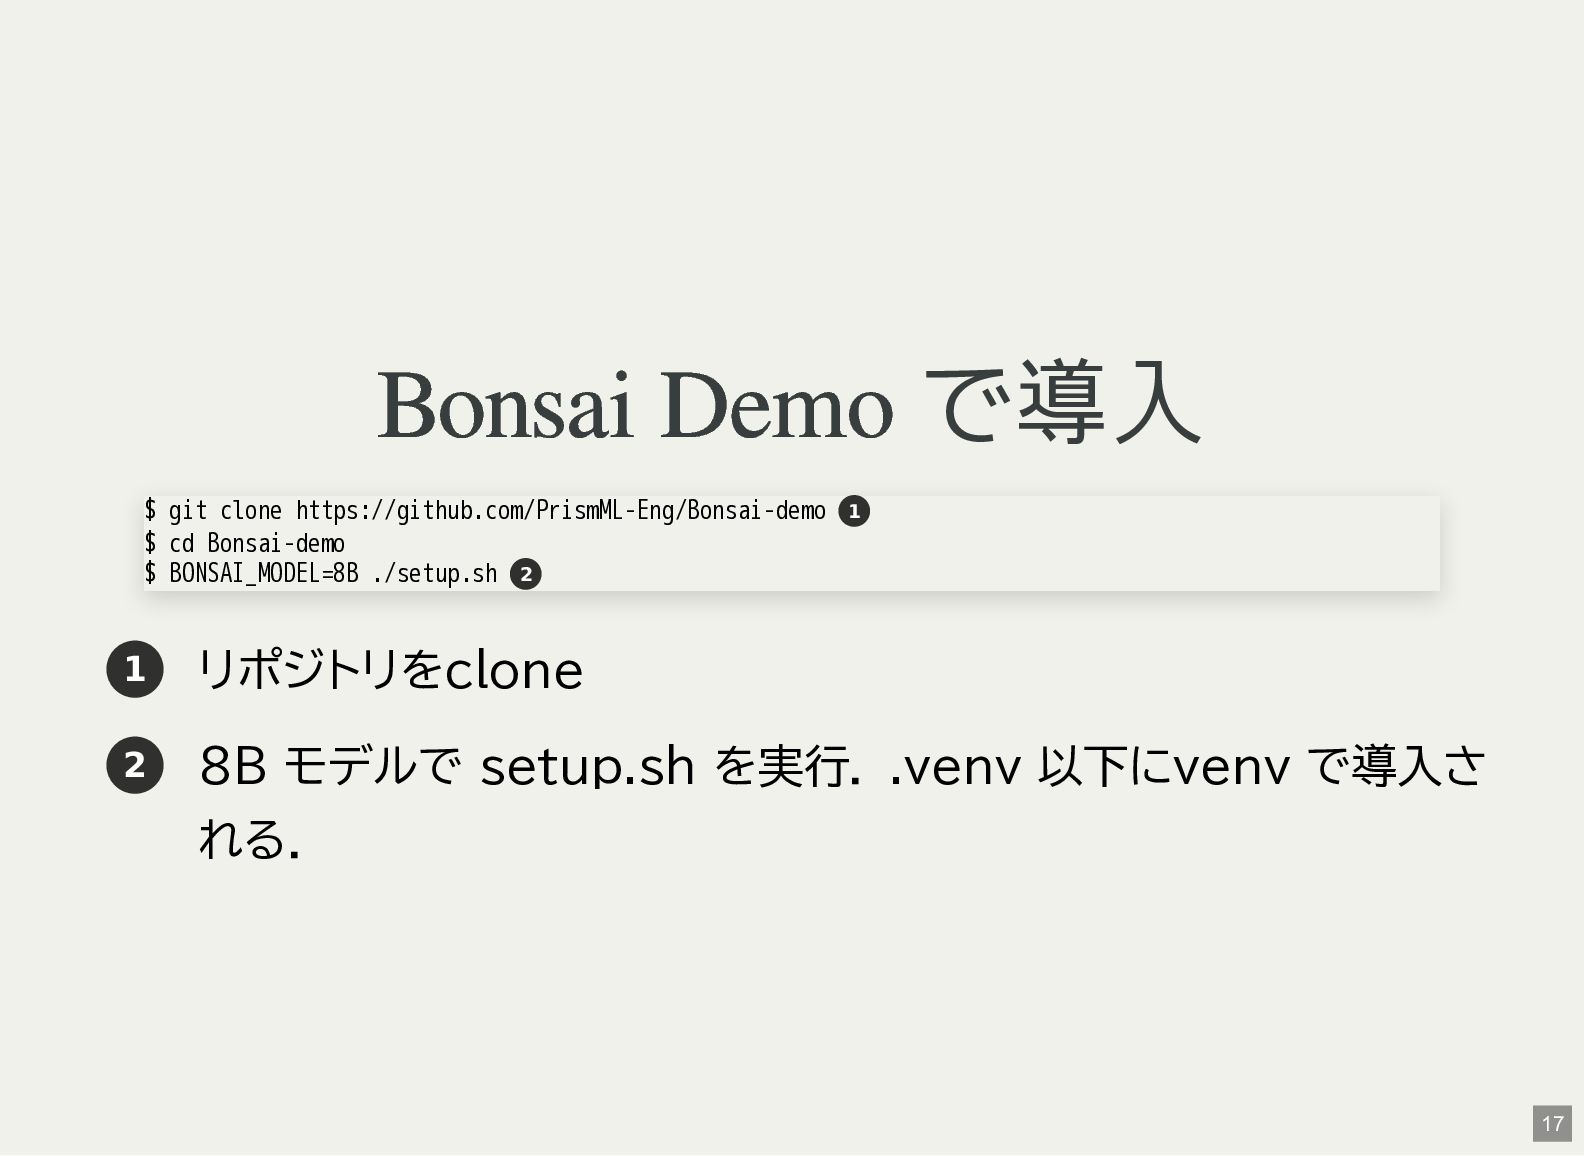
Bonsai Demo で導入 1 リポジトリをclone 2 8B モデルで setup.sh を実行.
.venv 以下にvenv で導入さ れる. $ git clone https://github.com/PrismML-Eng/Bonsai-demo $ cd Bonsai-demo $ BONSAI_MODEL=8B ./setup.sh 1 2 17 -
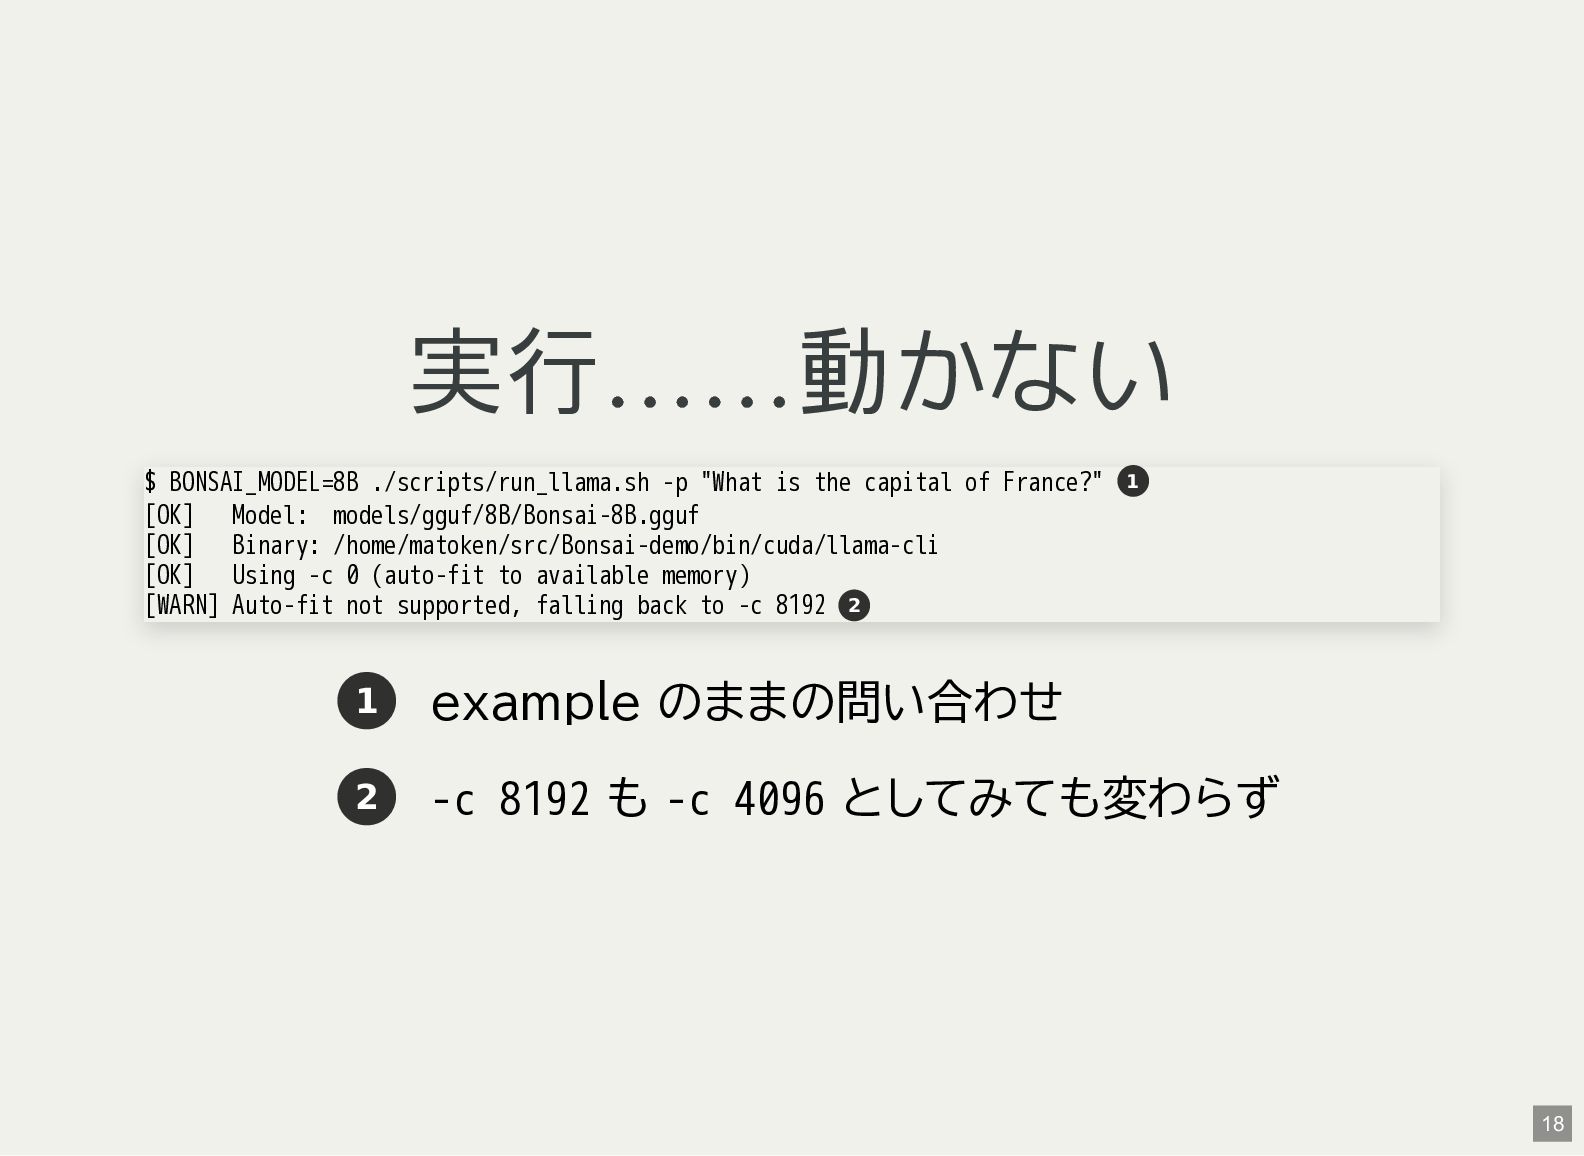
実行 …… 動かない 1 example のままの問い合わせ 2 -c 8192 も
-c 4096 としてみても変わらず $ BONSAI_MODEL=8B ./scripts/run_llama.sh -p "What is the capital of France?" [OK] Model: models/gguf/8B/Bonsai-8B.gguf [OK] Binary: /home/matoken/src/Bonsai-demo/bin/cuda/llama-cli [OK] Using -c 0 (auto-fit to available memory) [WARN] Auto-fit not supported, falling back to -c 8192 1 2 18 -
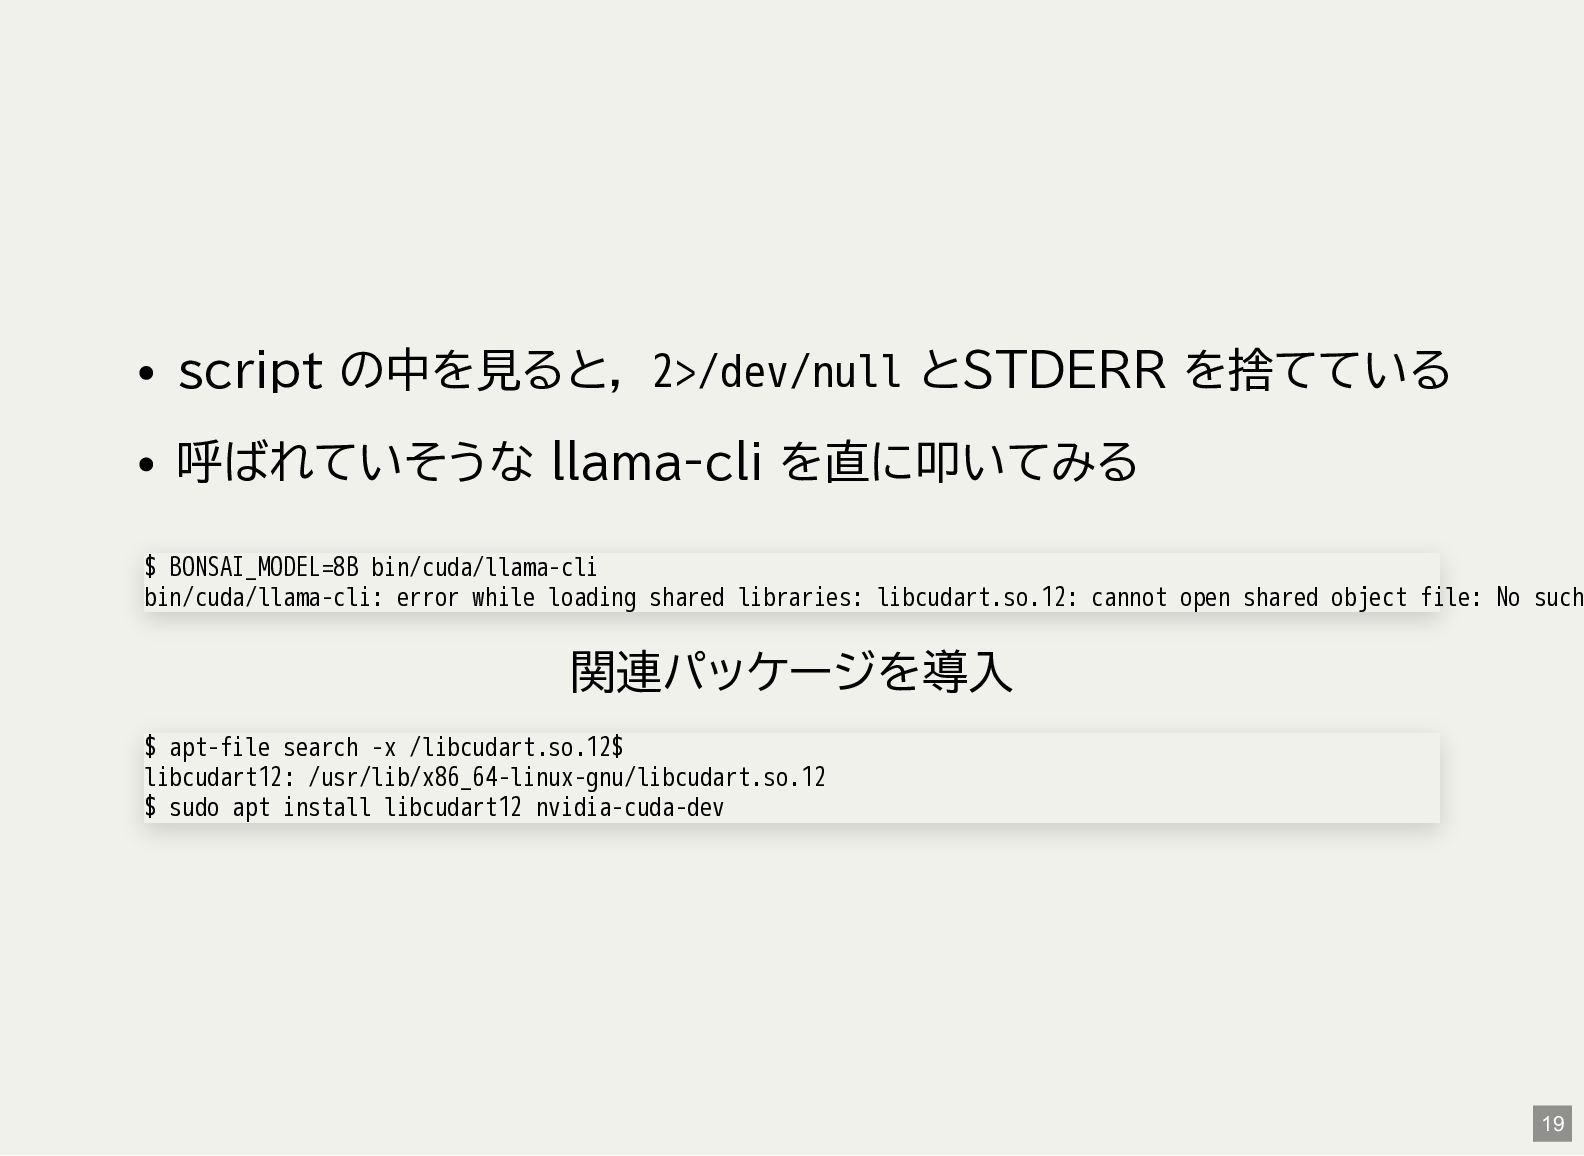
script の中を見ると, 2>/dev/null とSTDERR を捨てている 呼ばれていそうな llama-cli を直に叩いてみる 関連パッケージを導入 $
BONSAI_MODEL=8B bin/cuda/llama-cli bin/cuda/llama-cli: error while loading shared libraries: libcudart.so.12: cannot open shared object file: No such $ apt-file search -x /libcudart.so.12$ libcudart12: /usr/lib/x86_64-linux-gnu/libcudart.so.12 $ sudo apt install libcudart12 nvidia-cuda-dev 19 -
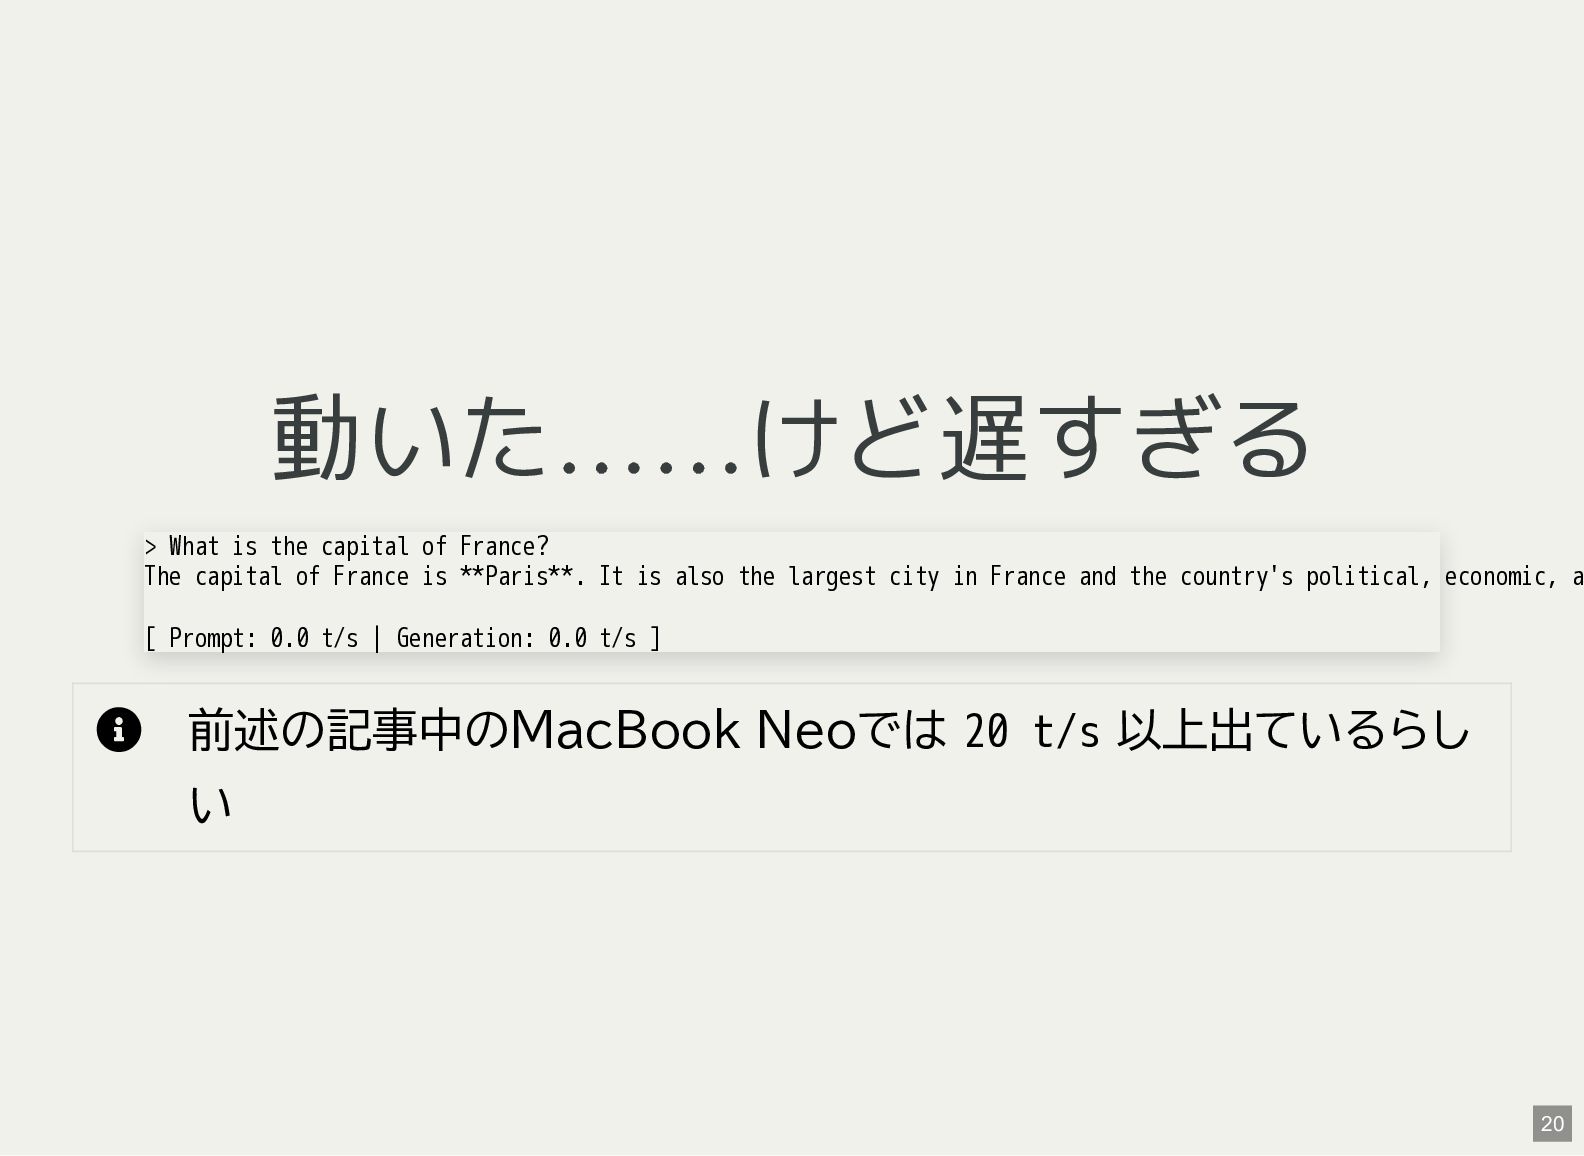
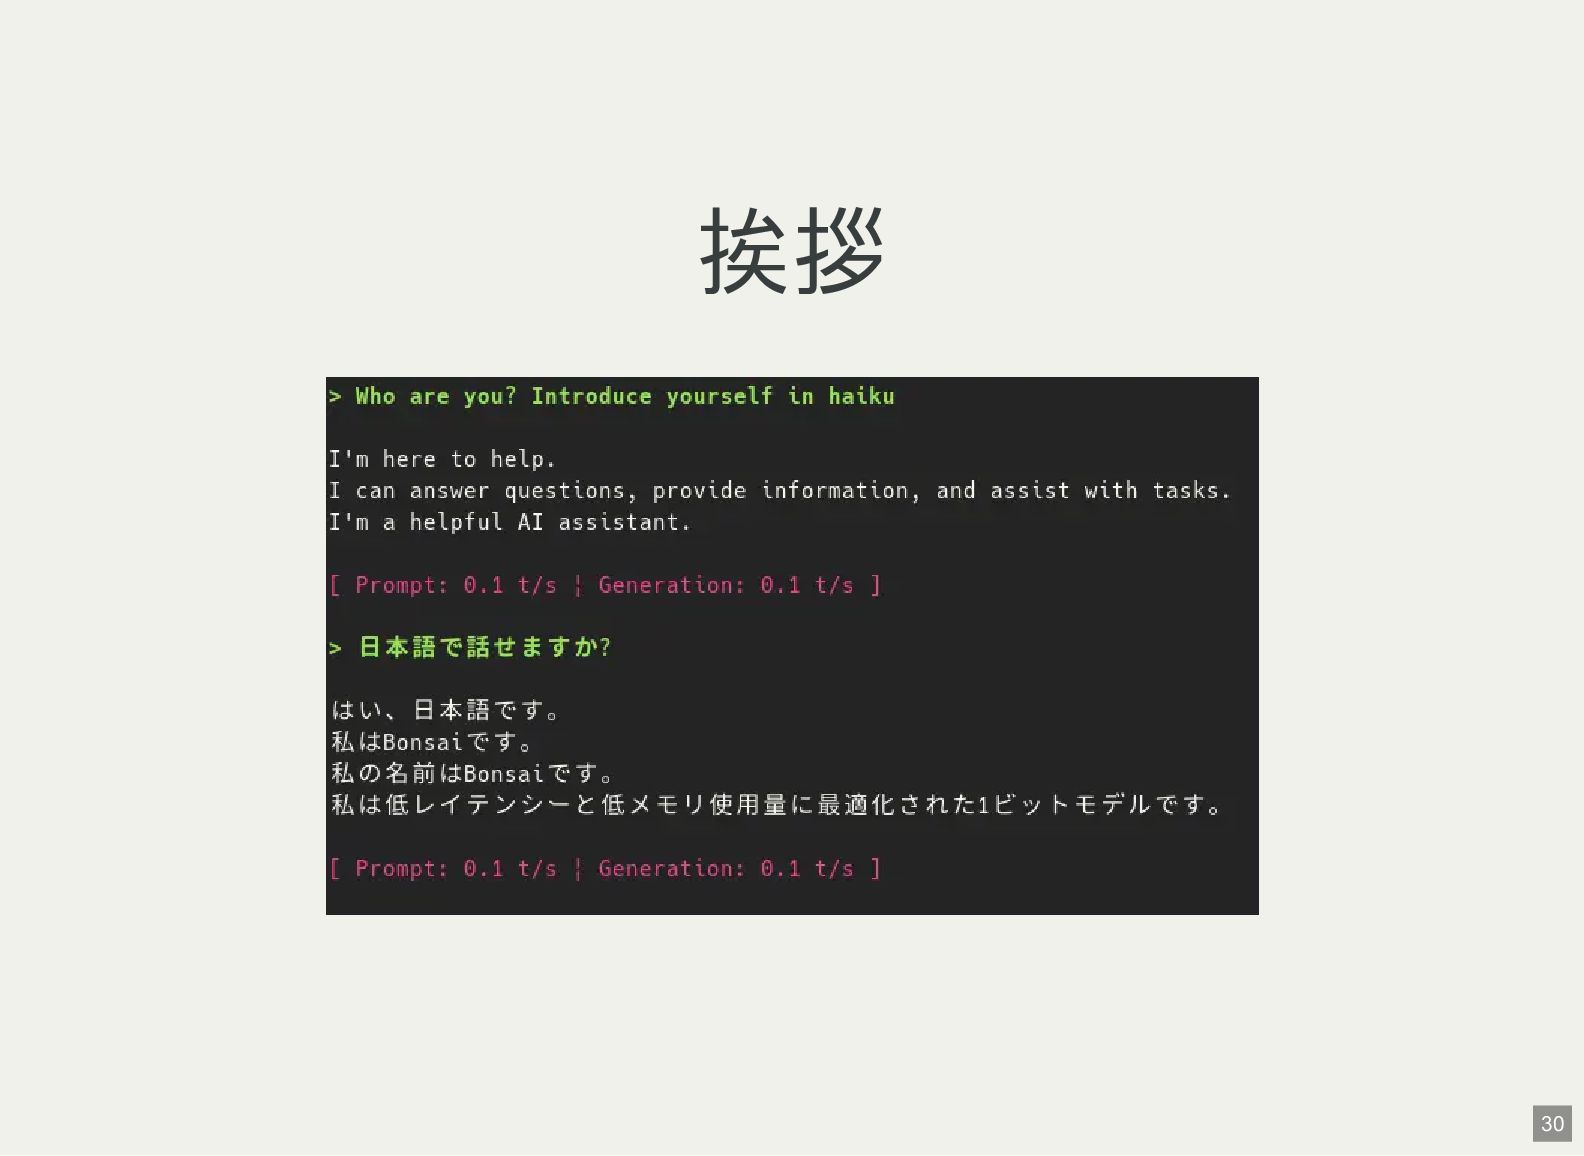
動いた …… けど遅すぎる 前述の記事中のMacBook Neoでは 20 t/s 以上出ているらし い
> What is the capital of France? The capital of France is **Paris**. It is also the largest city in France and the country's political, economic, a [ Prompt: 0.0 t/s | Generation: 0.0 t/s ] 20 -
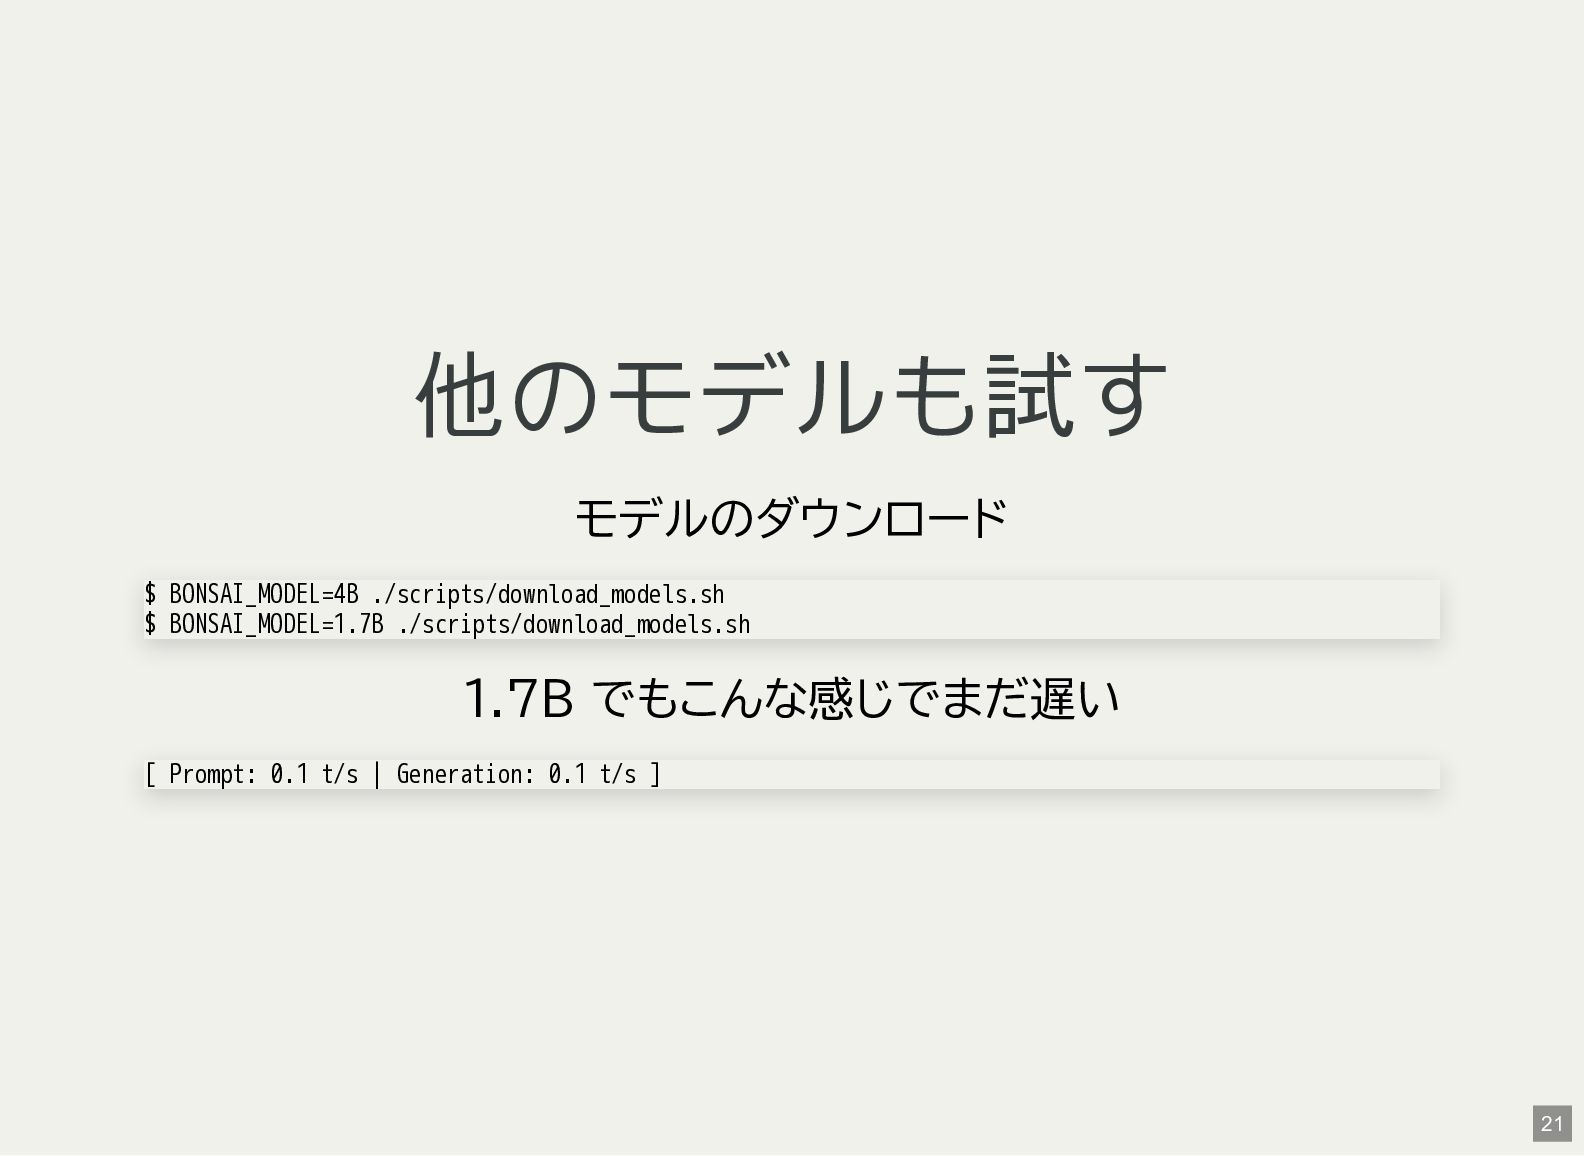
他のモデルも試す モデルのダウンロード 1.7B でもこんな感じでまだ遅い $ BONSAI_MODEL=4B ./scripts/download_models.sh $ BONSAI_MODEL=1.7B ./scripts/download_models.sh
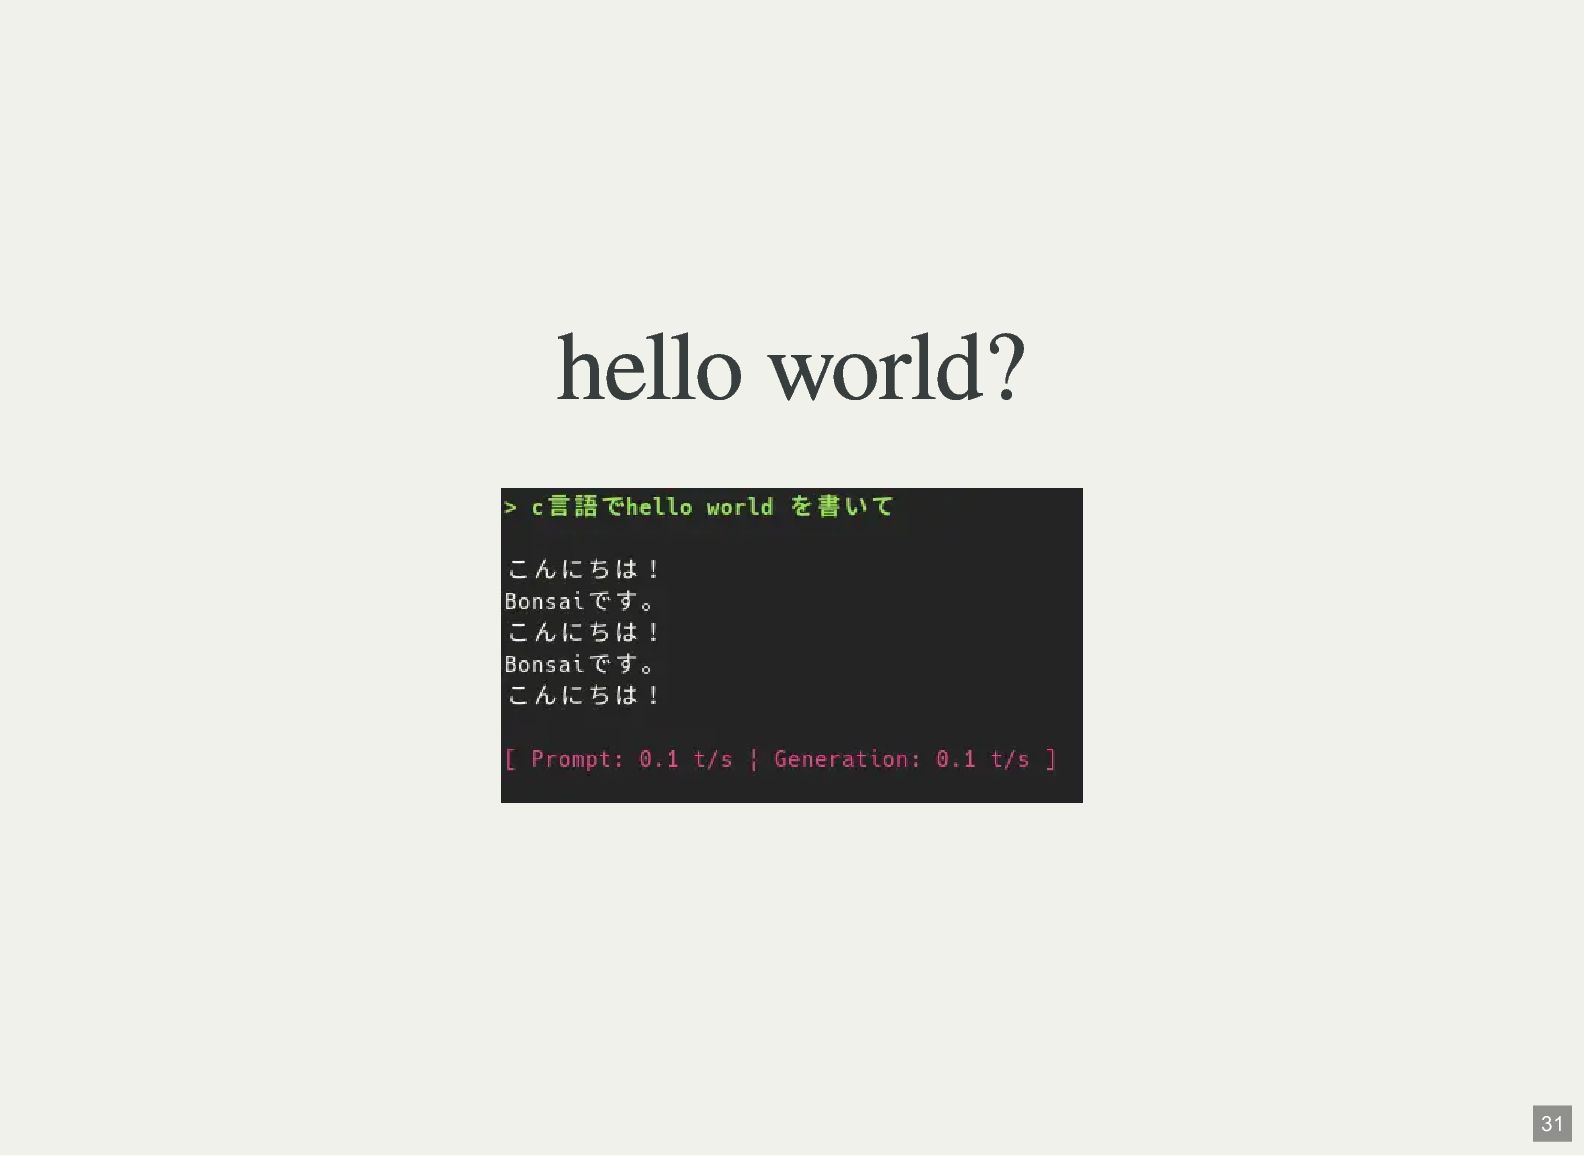
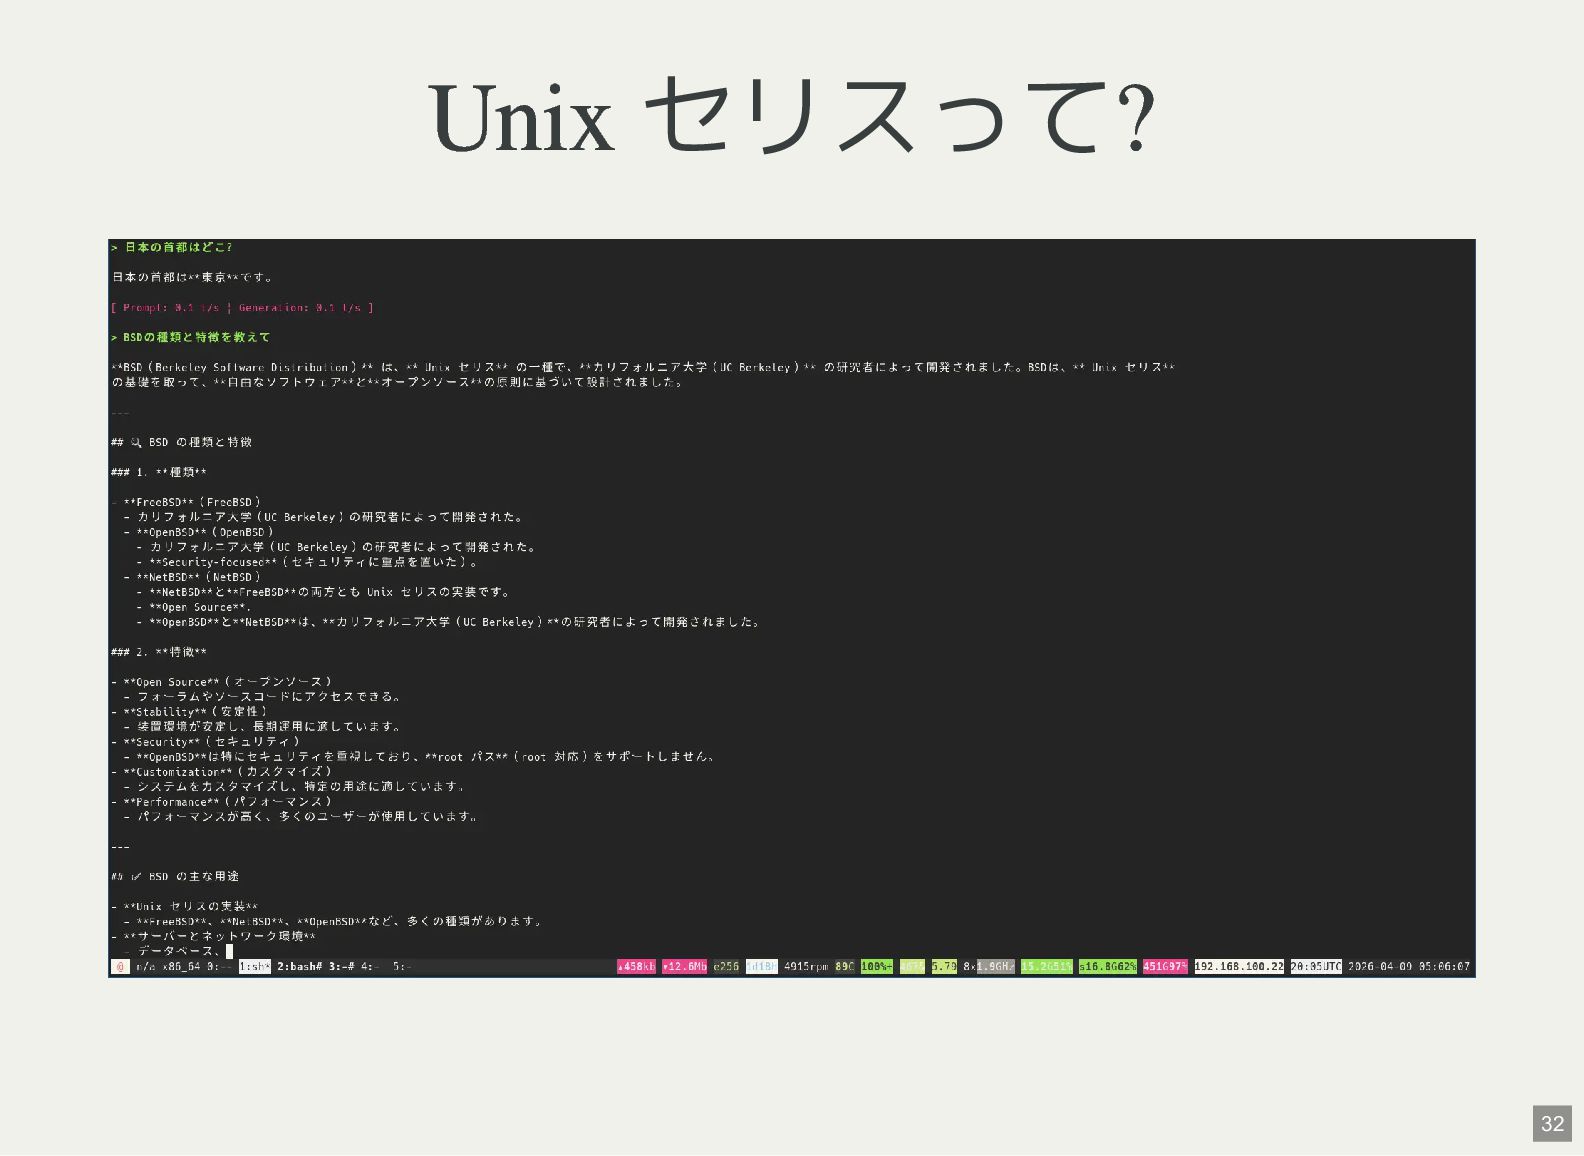
[ Prompt: 0.1 t/s | Generation: 0.1 t/s ] 21 -
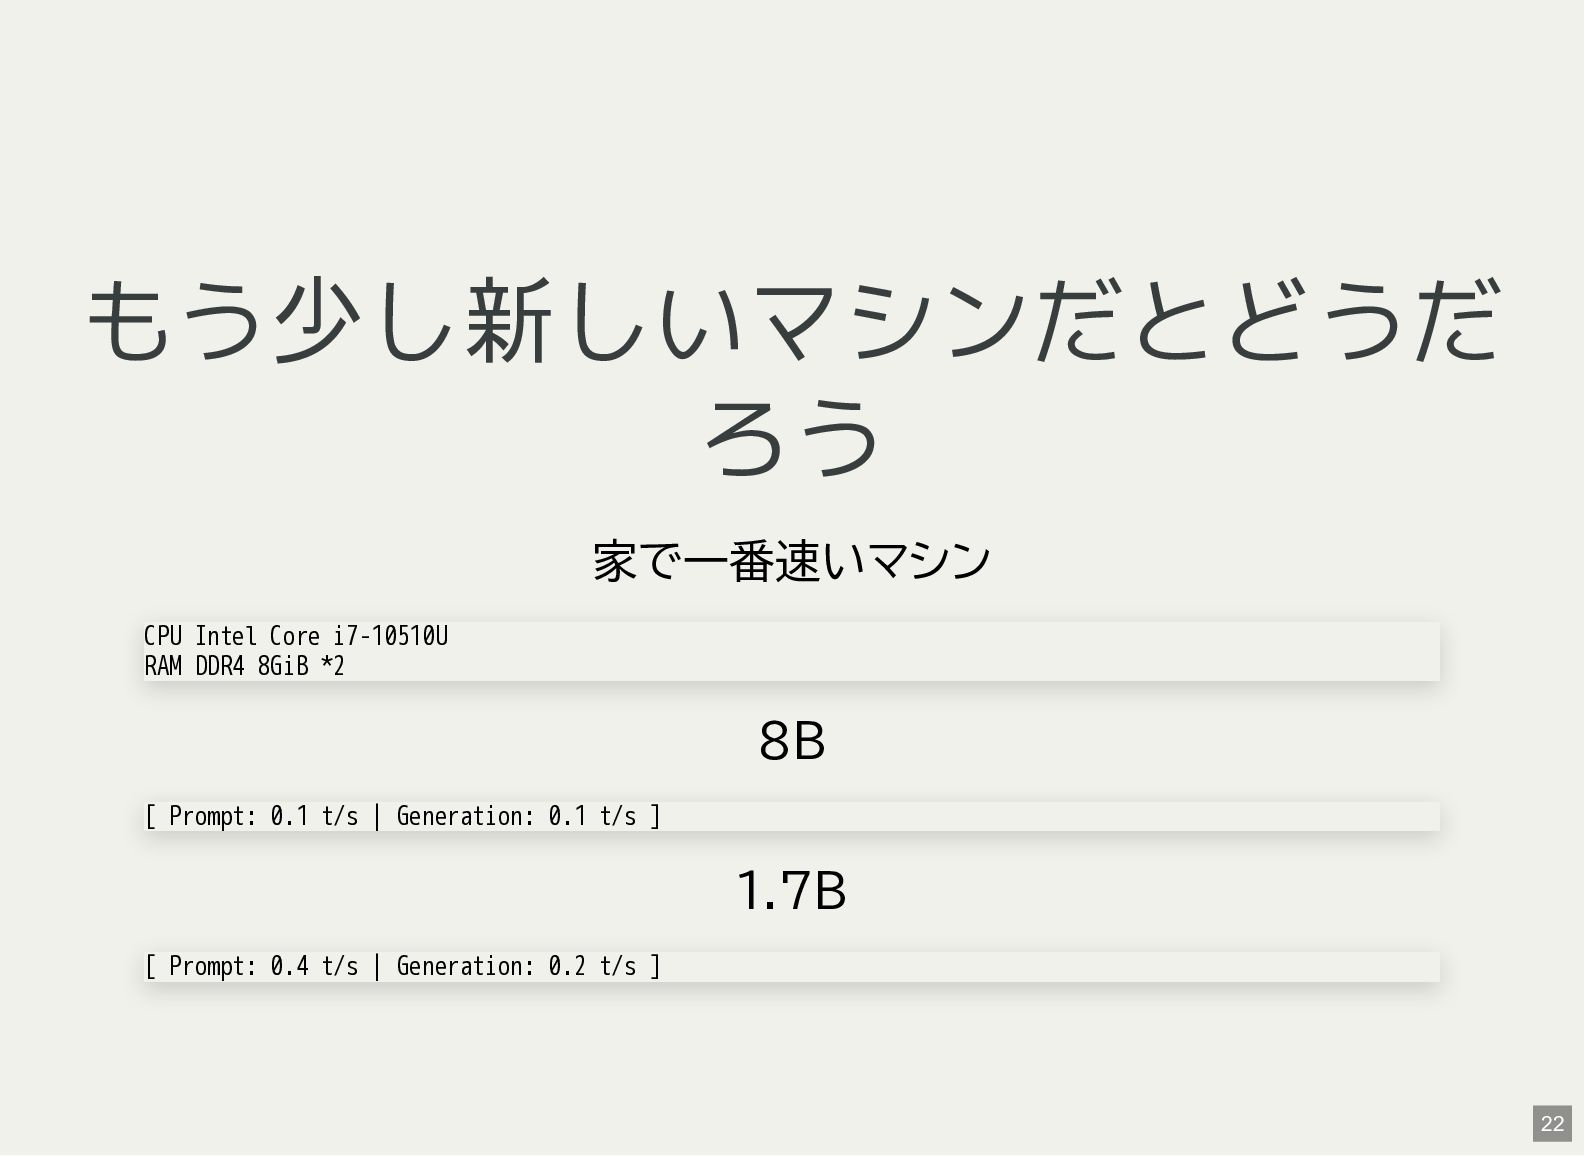
もう少し新しいマシンだとどうだ ろう 家で一番速いマシン 8B 1.7B CPU Intel Core i7-10510U RAM
DDR4 8GiB *2 [ Prompt: 0.1 t/s | Generation: 0.1 t/s ] [ Prompt: 0.4 t/s | Generation: 0.2 t/s ] 22 -
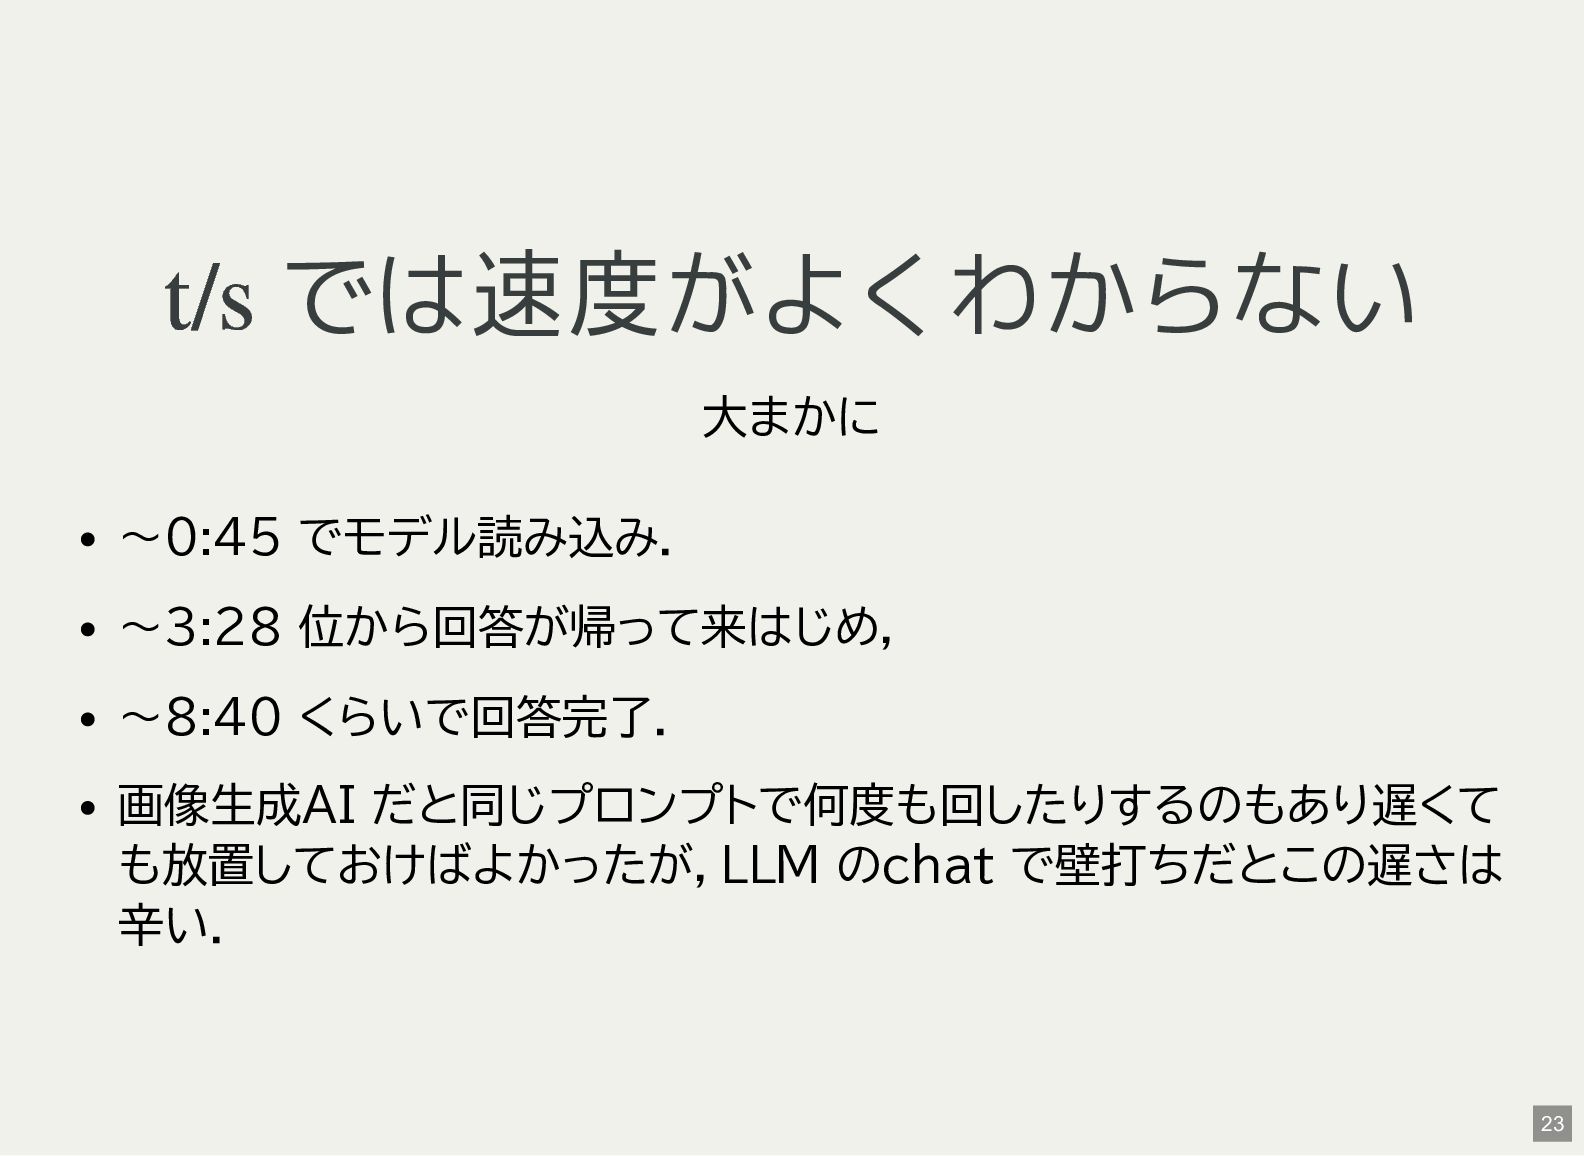
t/s では速度がよくわからない 大まかに 〜0:45 でモデル読み込み. 〜3:28 位から回答が帰って来はじめ, 〜8:40 くらいで回答完了. 画像生成AI
だと同じプロンプトで何度も回したりするのもあり遅くて も放置しておけばよかったが,LLM のchat で壁打ちだとこの遅さは 辛い. 23 -
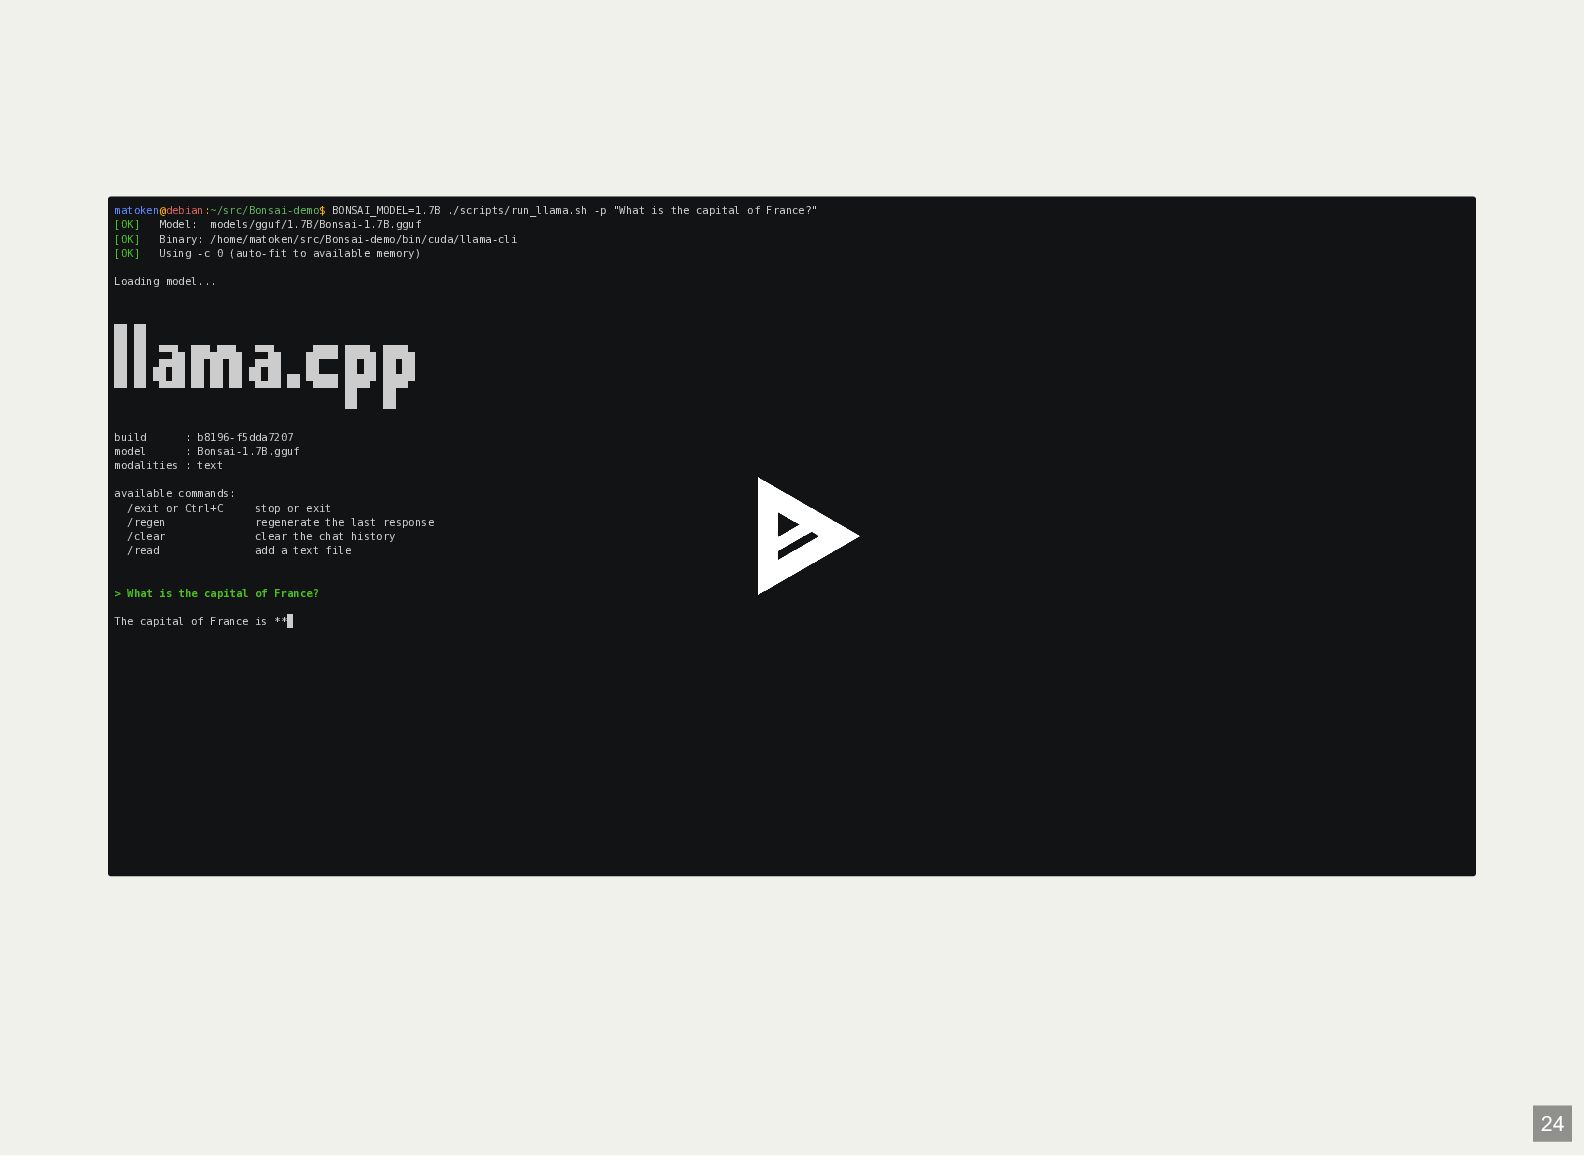
i5-7Y57 で Bonsai 1.7B を実行 matoken@debian:~/src/Bonsai-demo$ BONSAI_MODEL=1.7B ./scripts/run_llama.sh -p "What
is the capital of France?" [OK] Model: models/gguf/1.7B/Bonsai-1.7B.gguf [OK] Binary: /home/matoken/src/Bonsai-demo/bin/cuda/llama-cli [OK] Using -c 0 (auto-fit to available memory) Loading model... build : b8196-f5dda7207 model : Bonsai-1.7B.gguf modalities : text available commands: /exit or Ctrl+C stop or exit /regen regenerate the last response /clear clear the chat history /read add a text file > What is the capital of France? The capital of France is ** 24 -
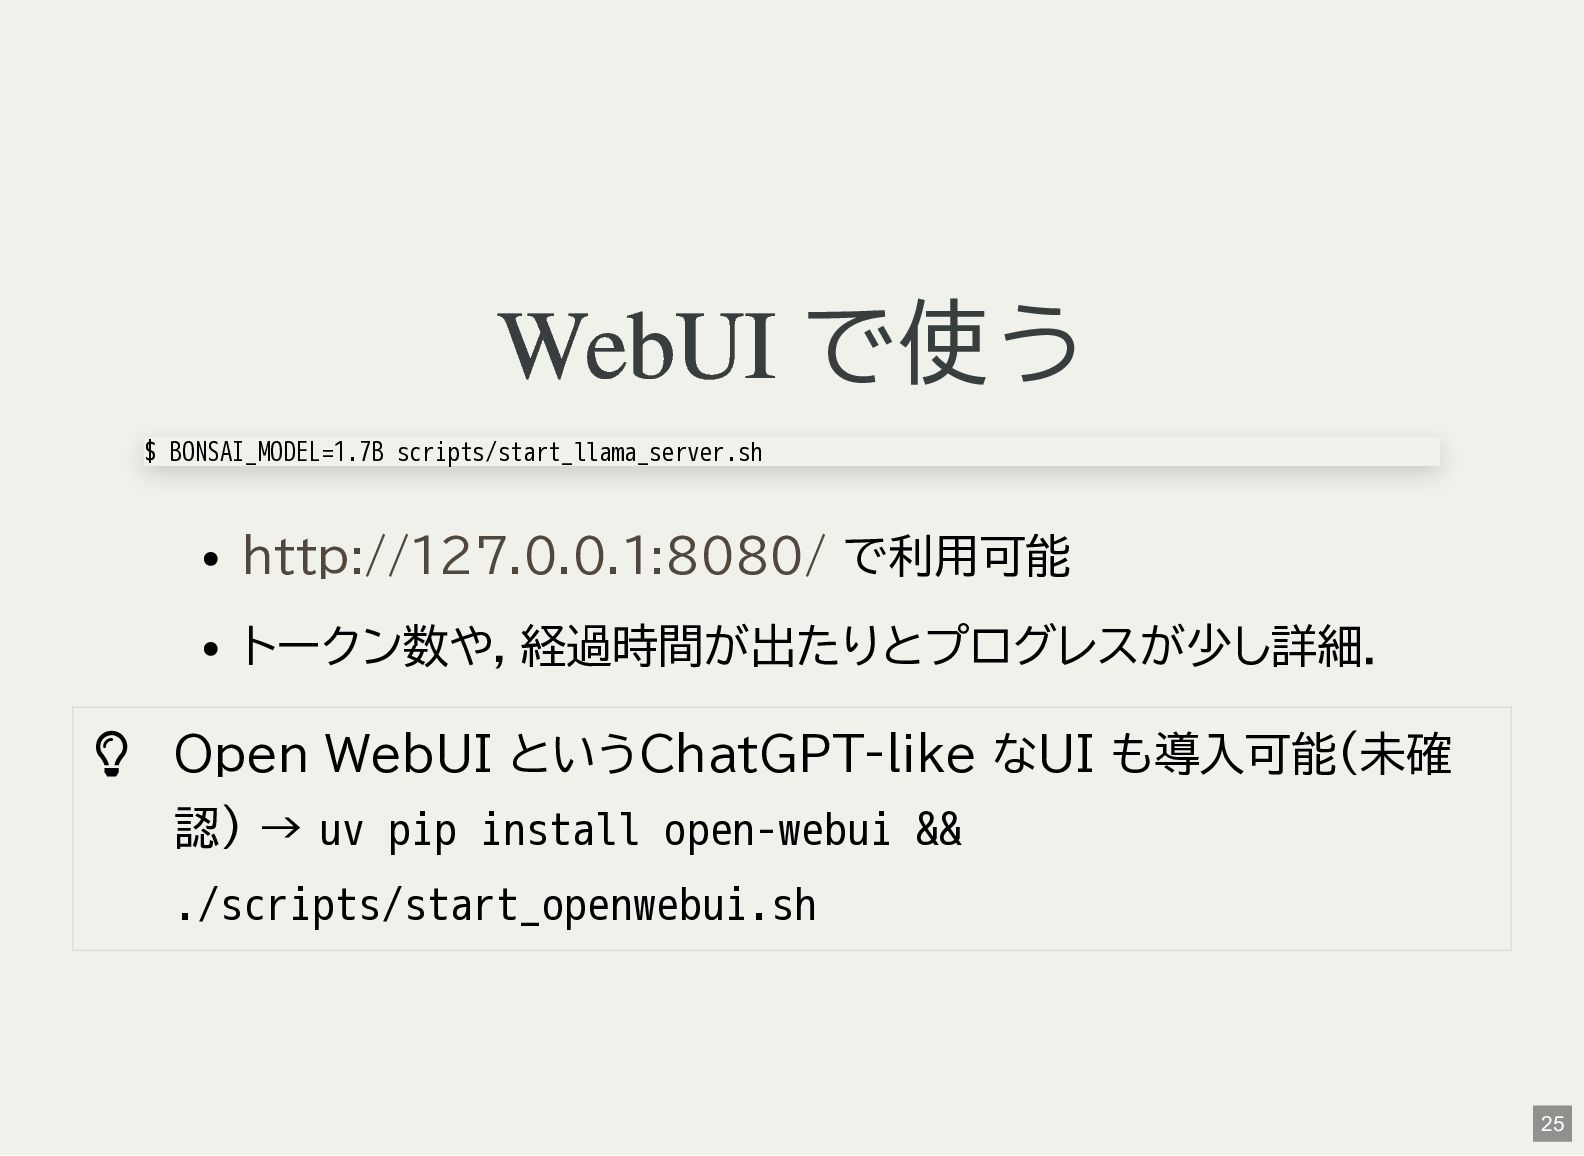
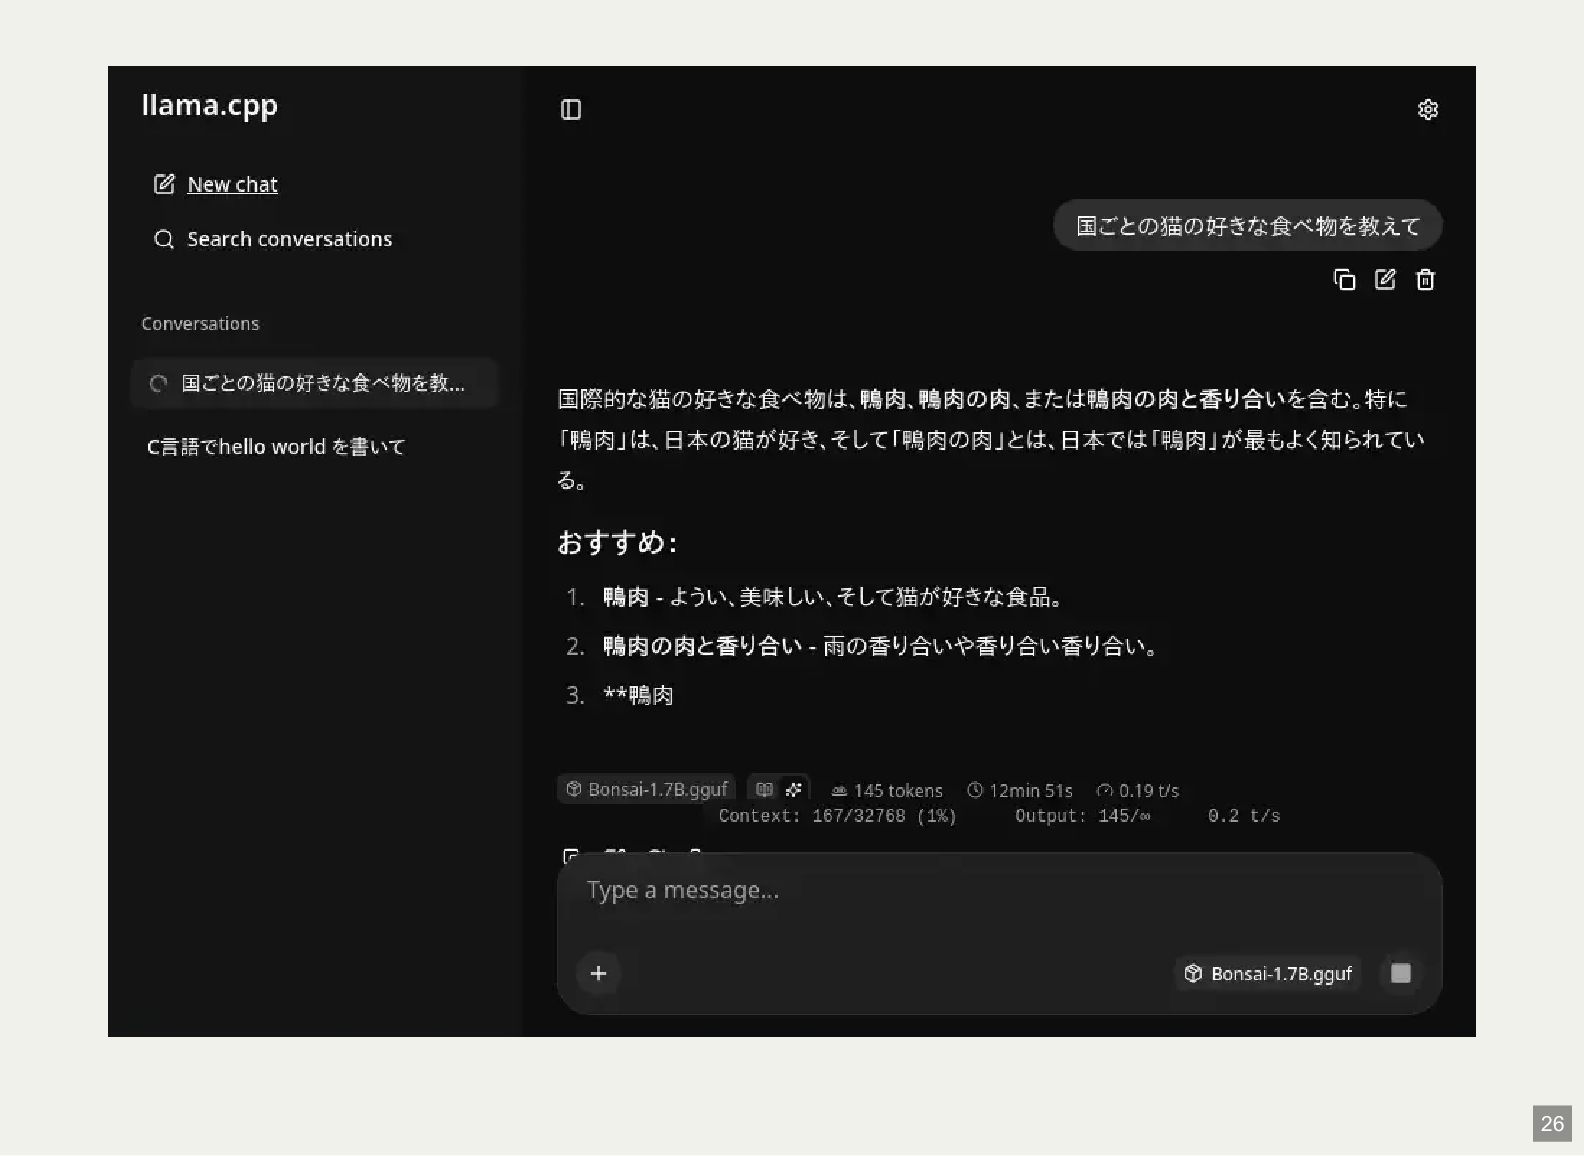
WebUI でも使う で利用可能 トークン数や,経過時間が出たりとプログレスが少し詳細. Open WebUI というChatGPT-like なUI も導入可能(未確
認) → uv pip install open-webui && ./scripts/start_openwebui.sh $ BONSAI_MODEL=1.7B scripts/start_llama_server.sh http://127.0.0.1:8080/ 25 -
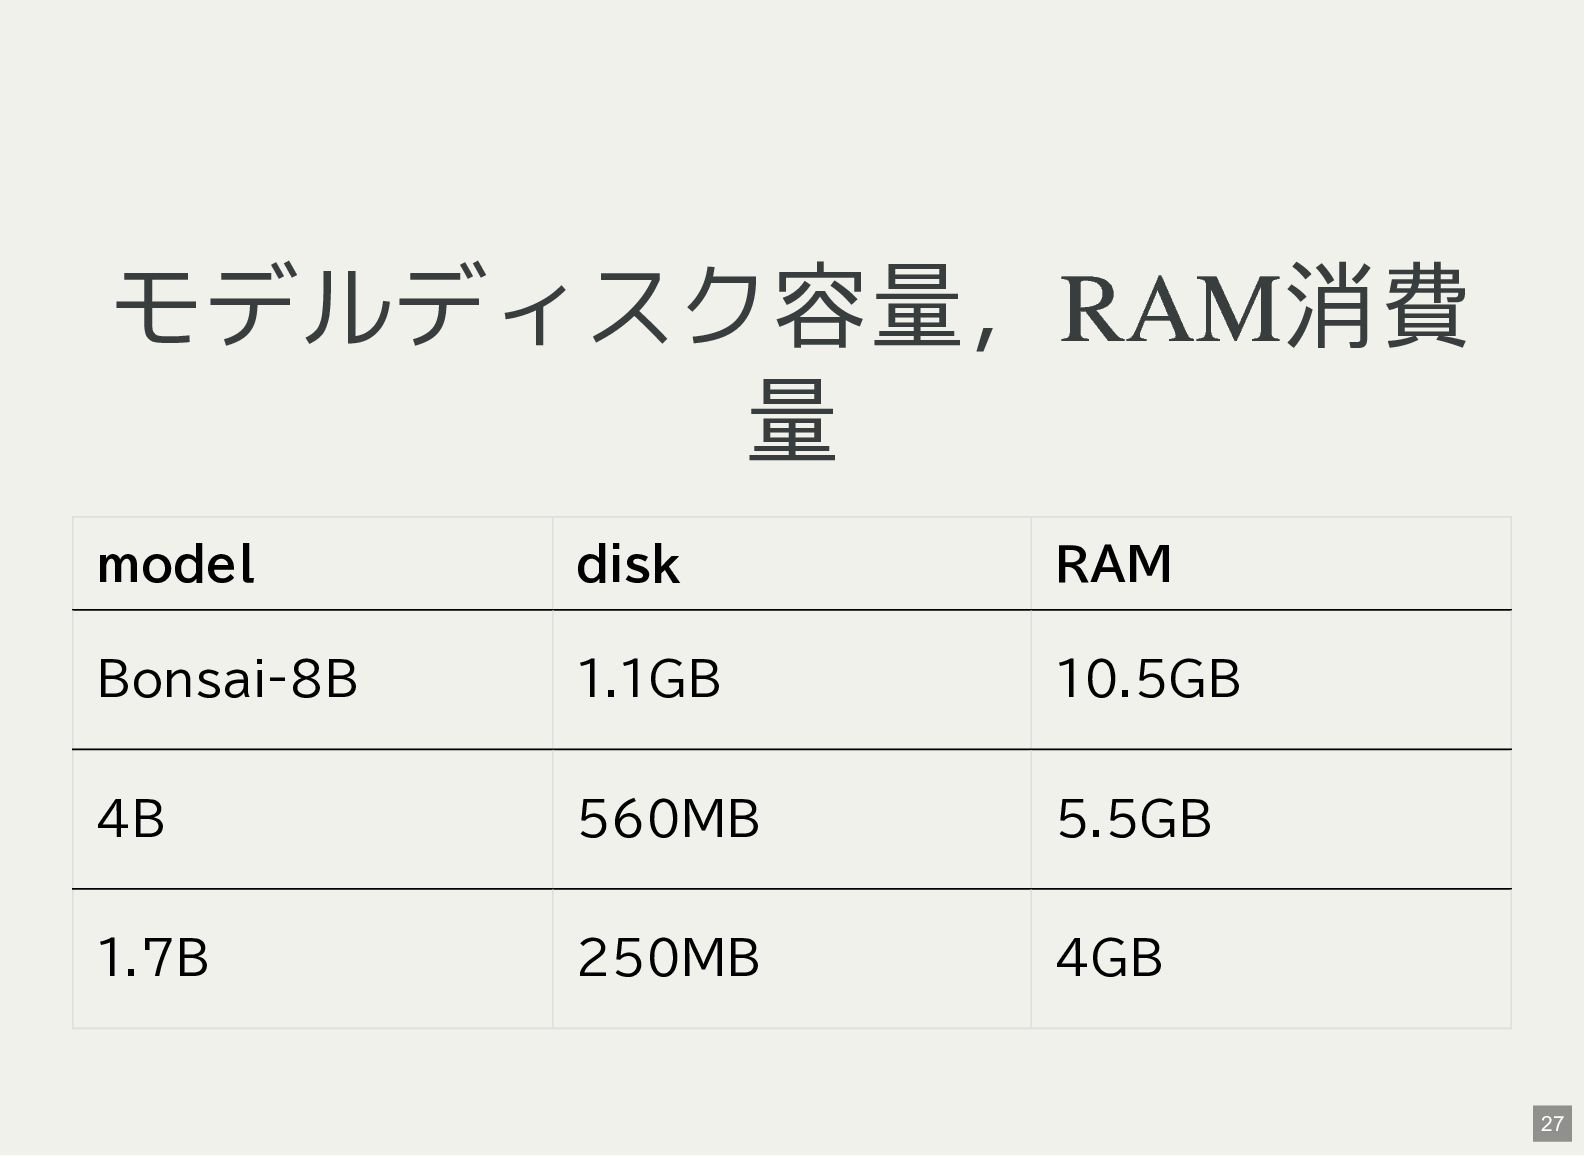
モデルディスク容量, RAM 消費 量 model disk RAM Bonsai-8B 1.1GB 10.5GB
4B 560MB 5.5GB 1.7B 250MB 4GB 27 -
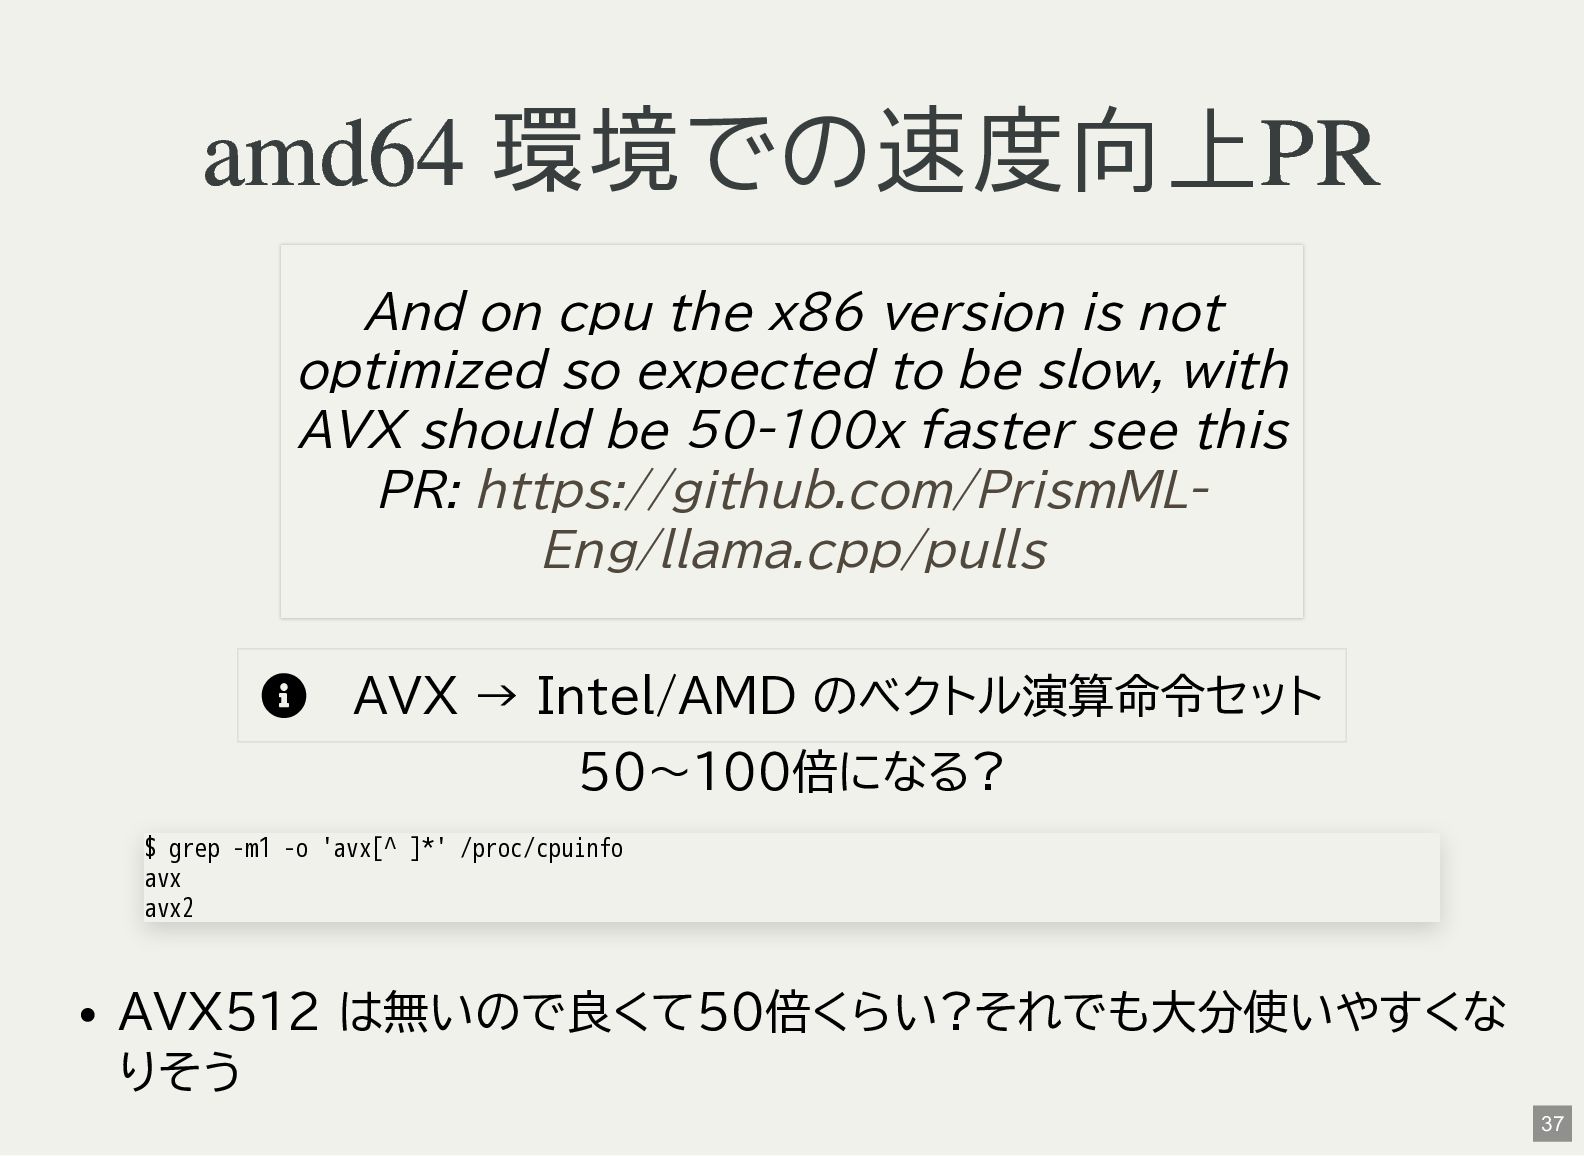
amd64 環境での速度向上 PR AVX → Intel/AMD のベクトル演算命令セット 50〜100倍になる? AVX512
は無いので良くて50倍くらい?それでも大分使いやすくな りそう And on cpu the x86 version is not optimized so expected to be slow, with AVX should be 50-100x faster see this PR: https://github.com/PrismML- Eng/llama.cpp/pulls $ grep -m1 -o 'avx[^ ]*' /proc/cpuinfo avx avx2 37 -
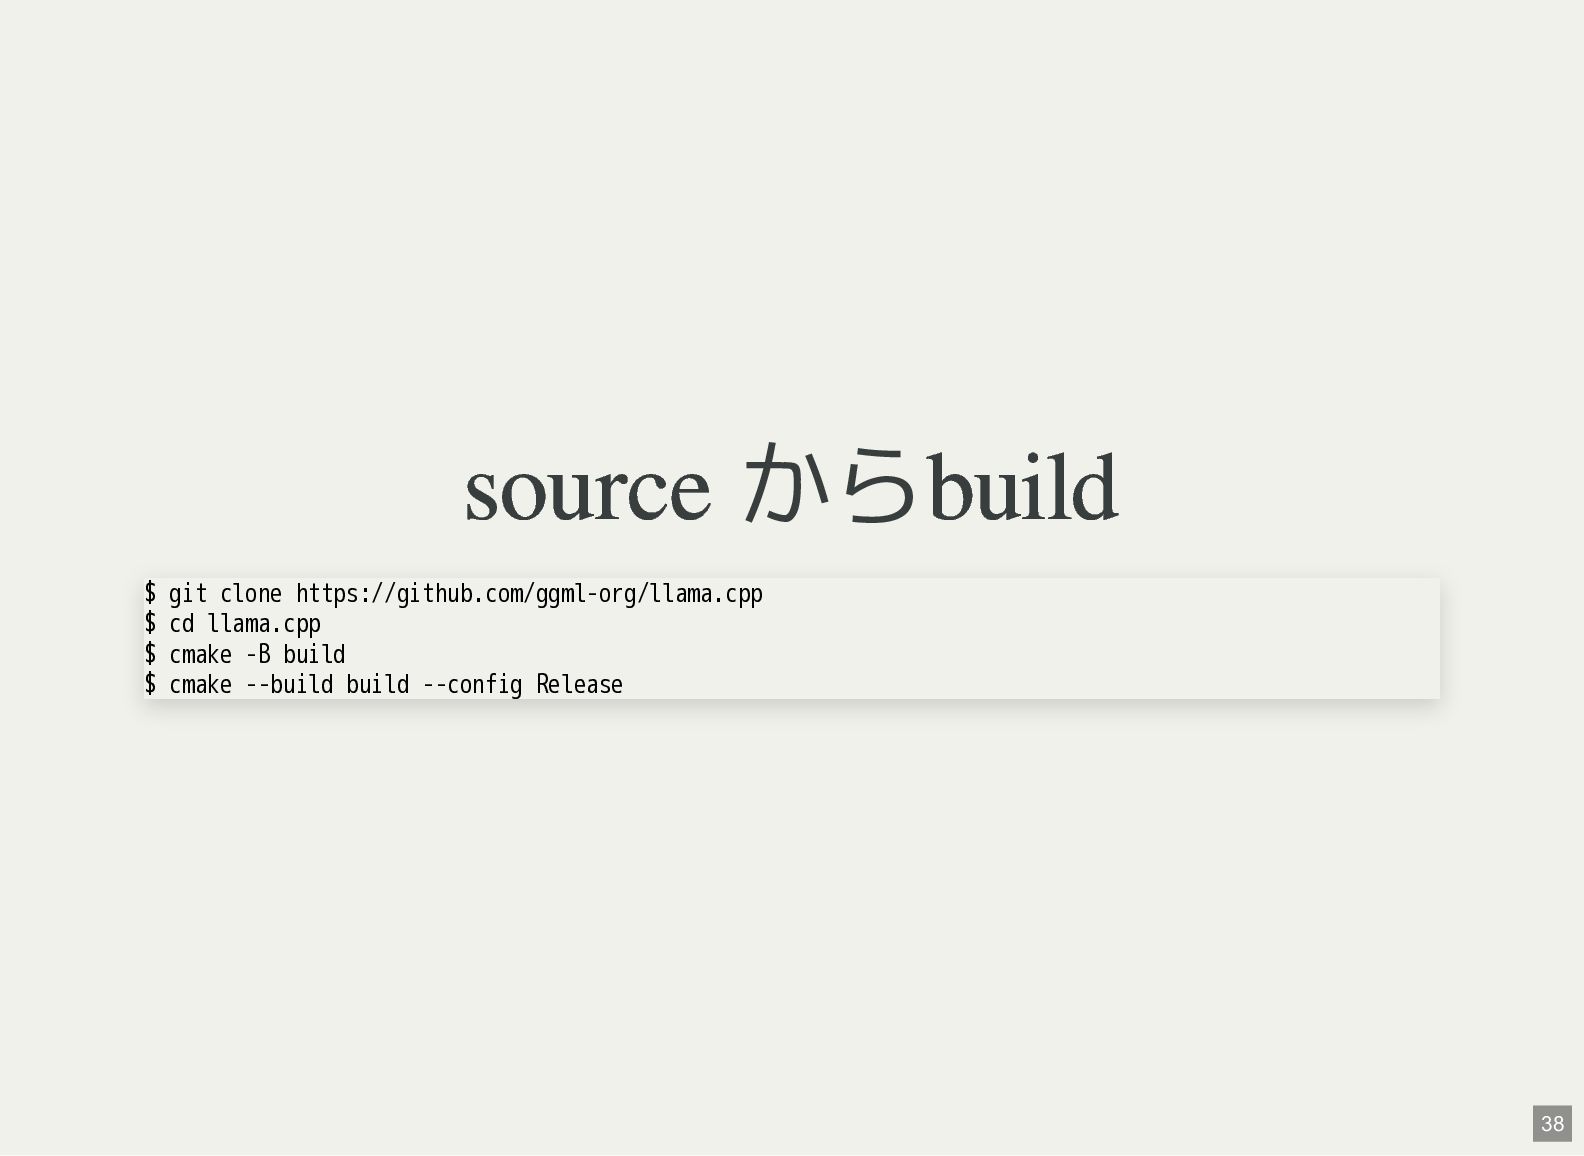
source から build $ git clone https://github.com/ggml-org/llama.cpp $ cd llama.cpp
$ cmake -B build $ cmake --build build --config Release 38 -
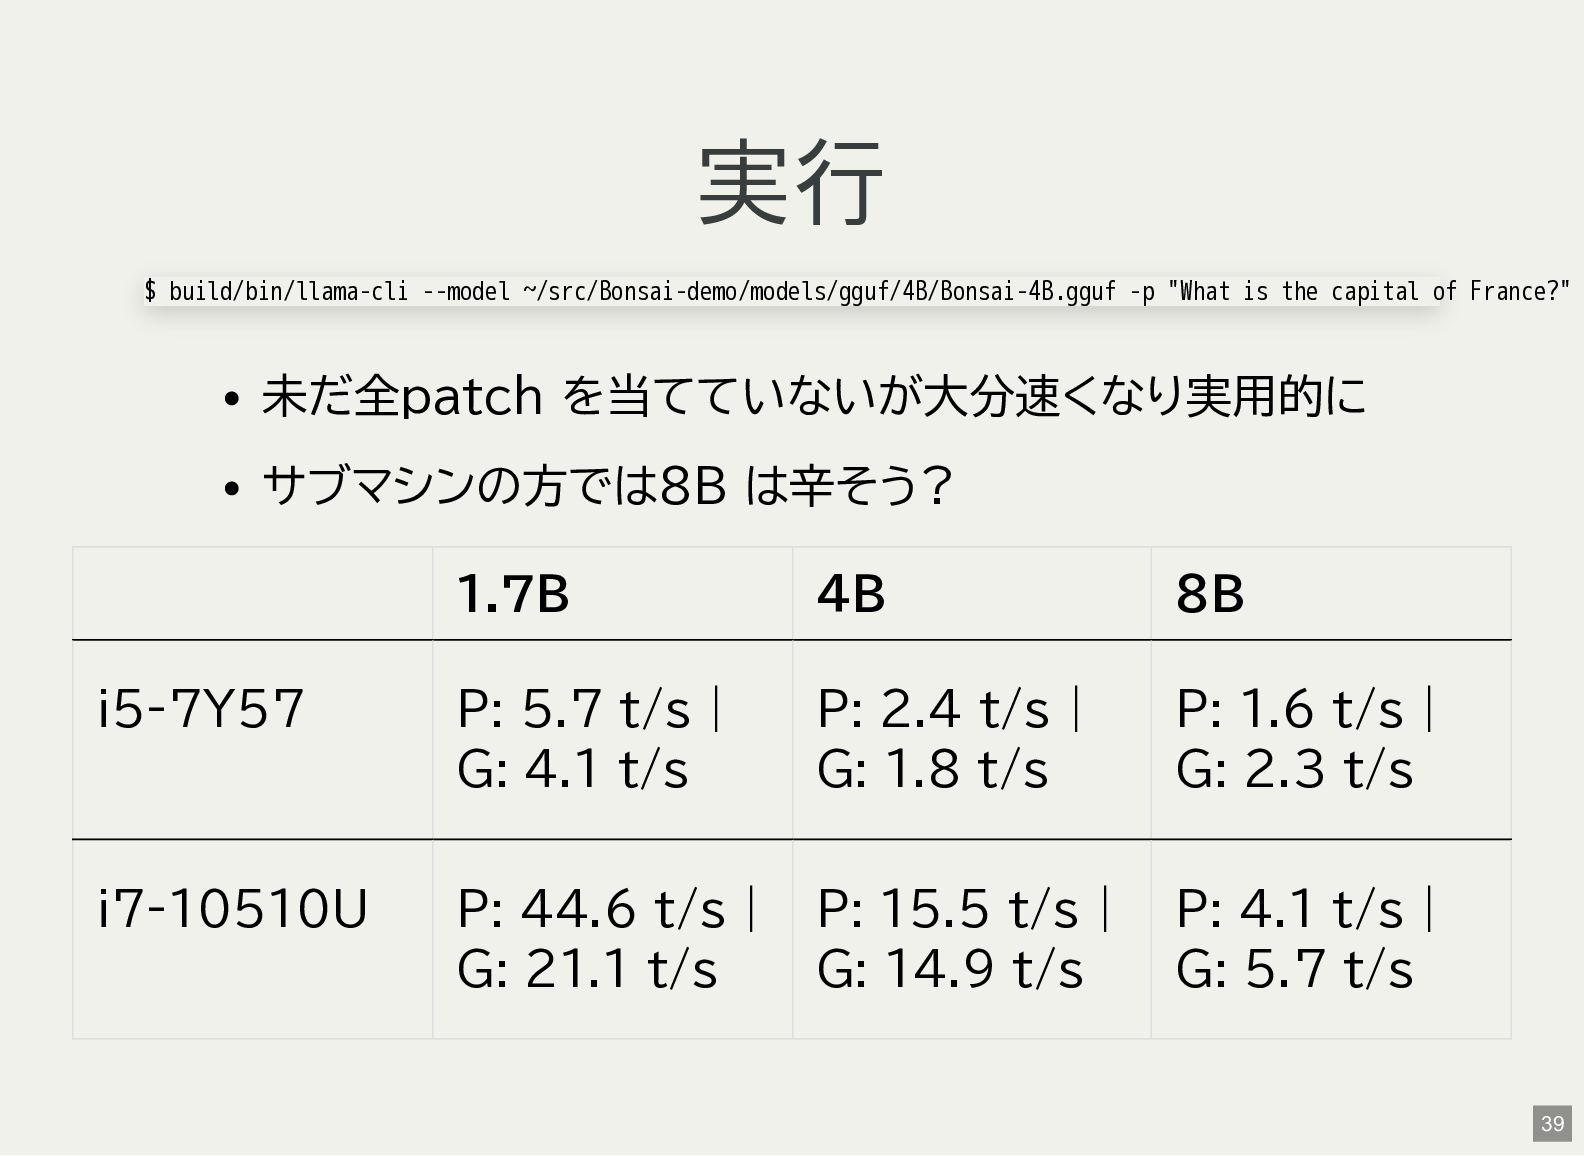
実行 未だ全patch が当っていないが大分速くなり実用的に サブマシンの方では8B は辛そう? 例えばFirefox を起動していたら(恐らくメモリ不足で)モデル読 み込み中に落ちる $ build/bin/llama-cli
--model ~/src/Bonsai-demo/models/gguf/4B/Bonsai-4B.gguf -p "What is the capital of France?" 39 -
source 版での速度 1.7B 4B 8B i5-7Y57 P: 5.7 t/s |
G: 4.1 t/s P: 2.4 t/s | G: 1.8 t/s P: 1.6 t/s | G: 2.3 t/s i7-10510U P: 44.6 t/s | G: 21.1 t/s P: 15.5 t/s | G: 14.9 t/s P: 4.1 t/s | G: 5.7 t/s 40 -
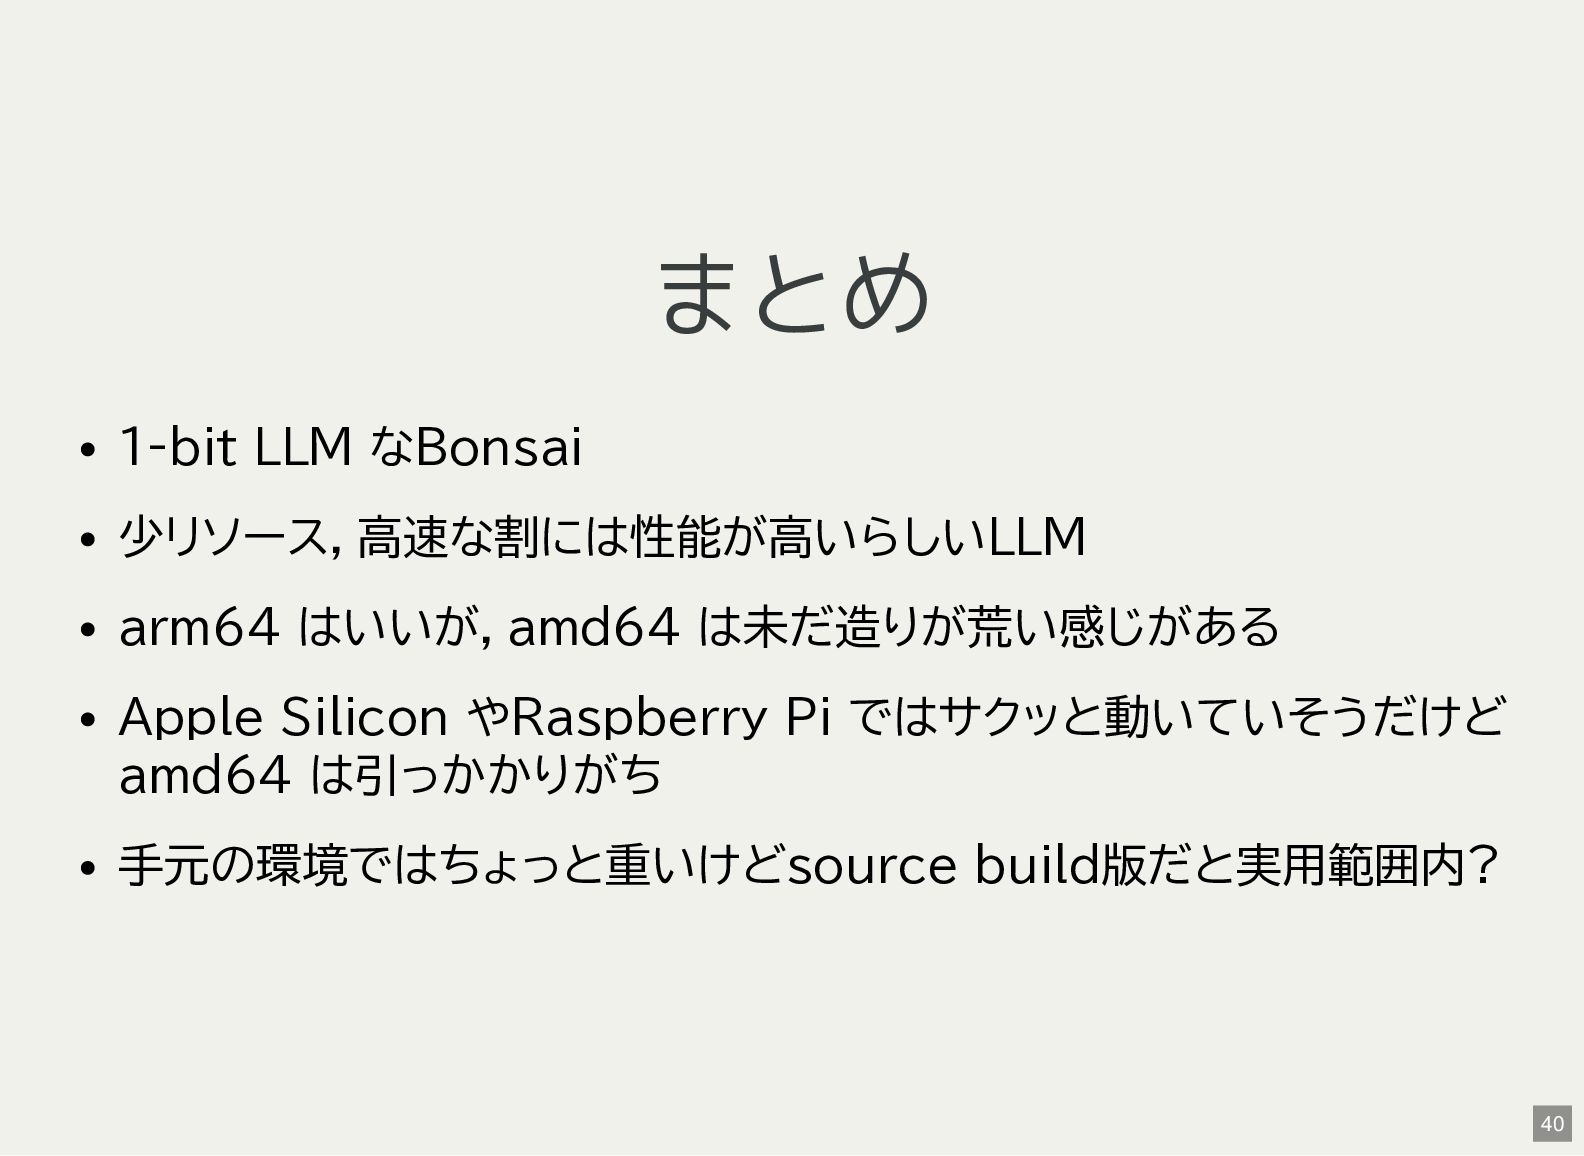
まとめ 1-bit LLM なBonsai 少リソース,高速な割には性能が高いらしいLLM arm64 はいいが,amd64 は未だ造りが荒い感じがある Apple Silicon
やRaspberry Pi ではサクッと動いていそうだ けどamd64 は引っかかりがち 手元の環境ではちょっと重いけどsource build版だと実用範囲内? 41 -
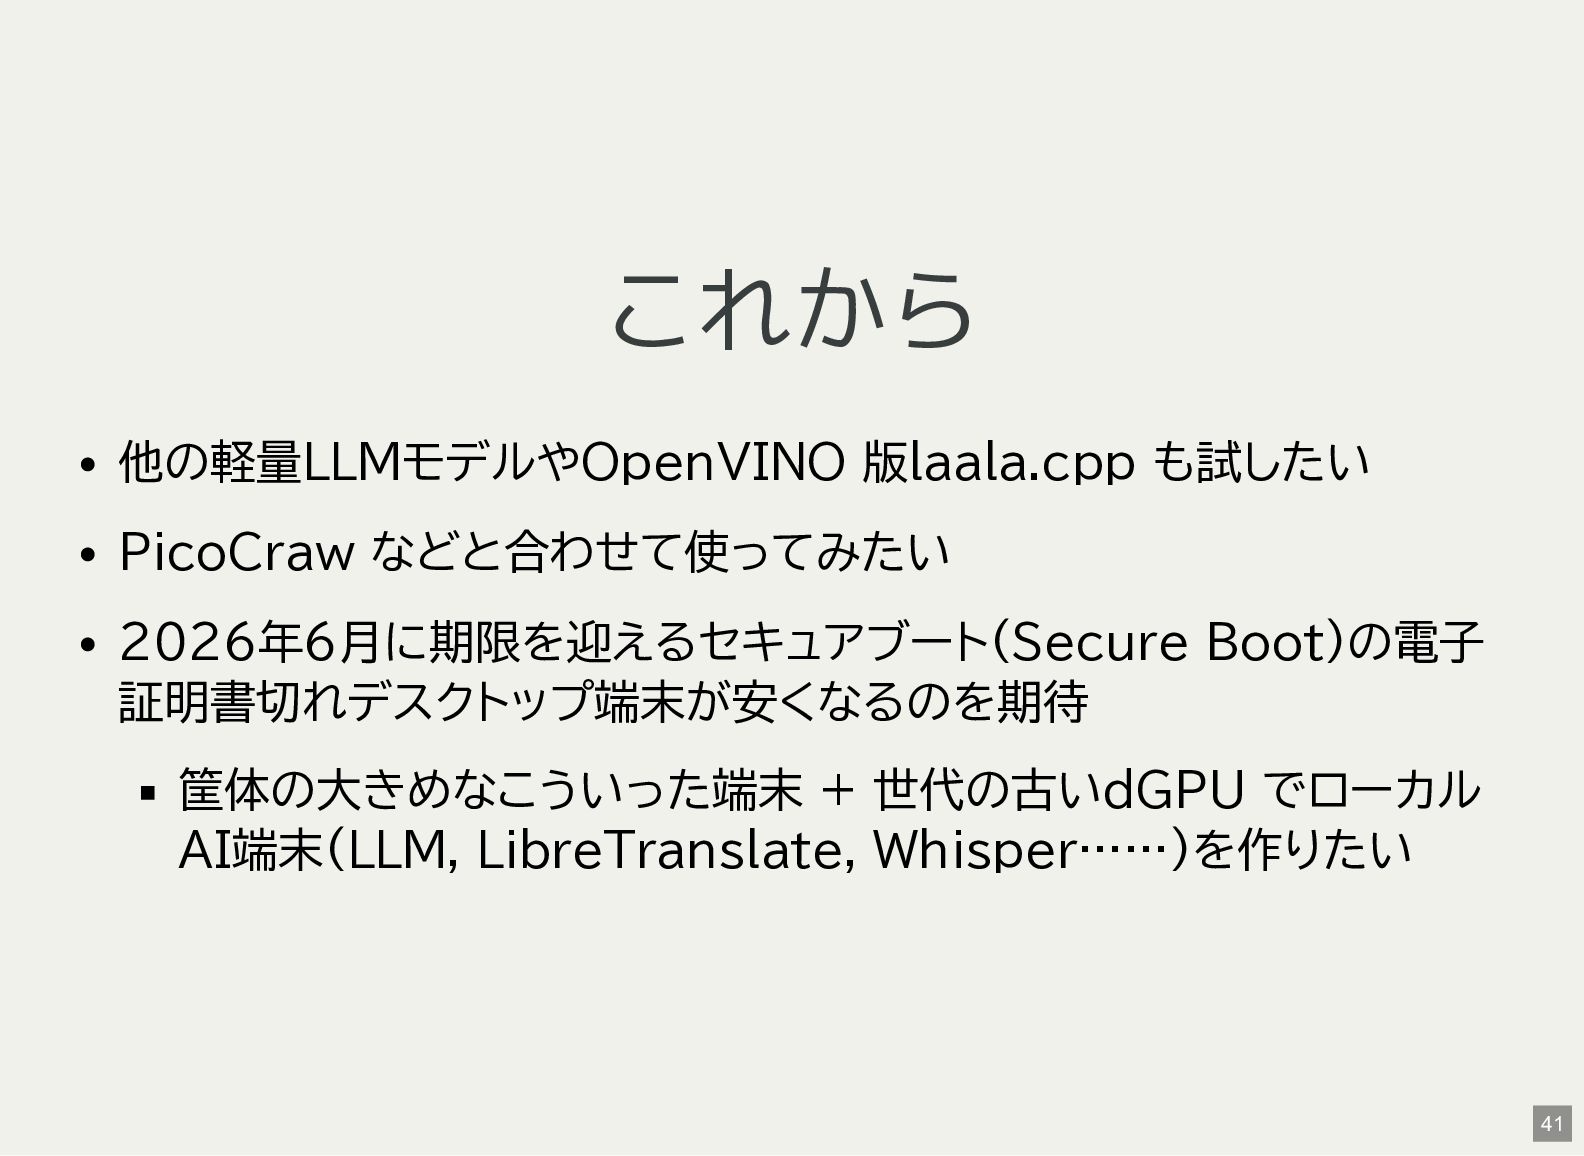
これから 他の軽量LLMモデルやOpenVINO 版llama.cpp も試したい PicoCraw などと合わせて使ってみたい 2026年6月に期限を迎えるセキュアブート(Secure Boot)の電子 証明書切れデスクトップ端末が安くなるのを期待 筐体の大きめなこういった端末
+ 世代の古いdGPU でローカル AI端末(LLM, LibreTranslate, Whisper……)を作りたい 42 -
奥付 発表 2026-04- 19(sun) 発表者 利用ソフトウェア NeoVim + ライセンス 鹿児島Linux勉強会
2026.04(オンライン開催) Kenichiro Matohara(matoken) Asciidoctor Reveal.js CC BY 4.0 43