Share
Embed
トークンをケチるな、設計しろ:GitHub Copilotを賢く使うコンテキスト戦略
GitHub Copilotを使うほど、課題は「どう質問するか」から「何をAIに読ませるか」へ移ります。本セッションでは、MCP、Skills、AGENTS .md、DESIGN.mdがどのタイミングで読み込まれ、レスポンスでトークンが増えるのかを整理します。自動化による速度向上だけでなく、レビュー有無・設計品質・コストのバランスを取るための判断軸を紹介します。
Ochtum
June 25, 2026
Transcript
51 slides
-
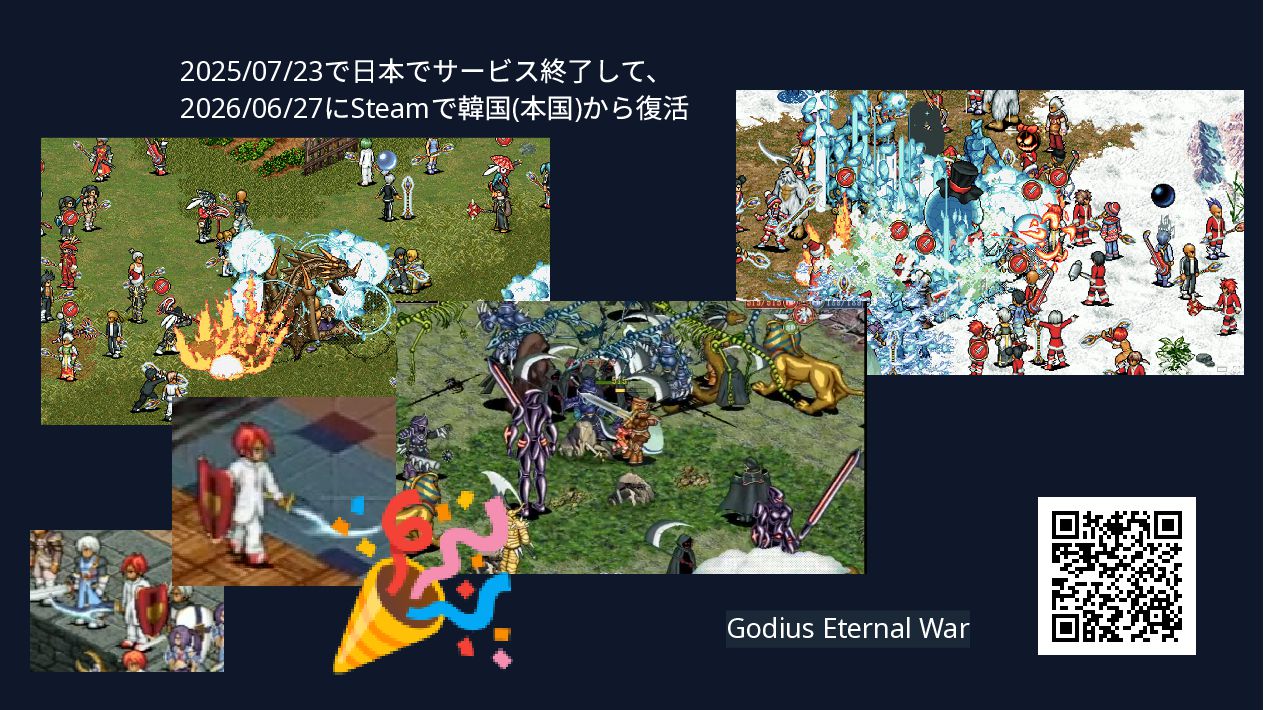
Godius Eternal War 2025/07/23 で 日本で サービス終了して、 2026/06/27 に Steam
で 韓国( 本国) から 復活 🎉 -
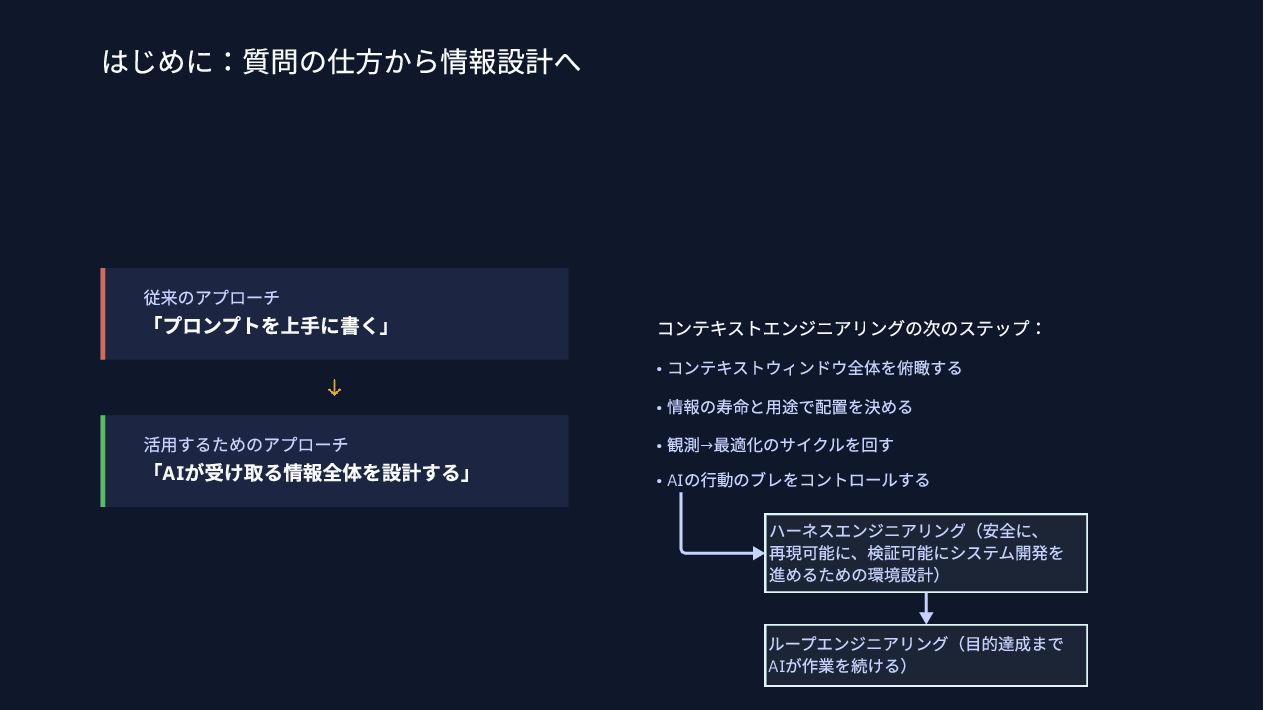
はじめに:質問の仕方から情報設計へ 従来のアプローチ 「プロンプトを上手に書く」 活用する ための アプローチ 「AI が受け取る情報全体を設計する」 コンテキストエンジニアリングの 次の
ステップ: • コンテキストウィンドウ全体を俯瞰する • 情報の寿命と用途で配置を決める • 観測→ 最適化のサイクルを回す • AI の 行動の ブレを コントロールする ハーネスエンジニアリング (安全に、 再現可能に、 検証可能に システム開発を 進める ための 環境設計) ループエンジニアリング (目的達成まで AI が 作業を 続ける) -
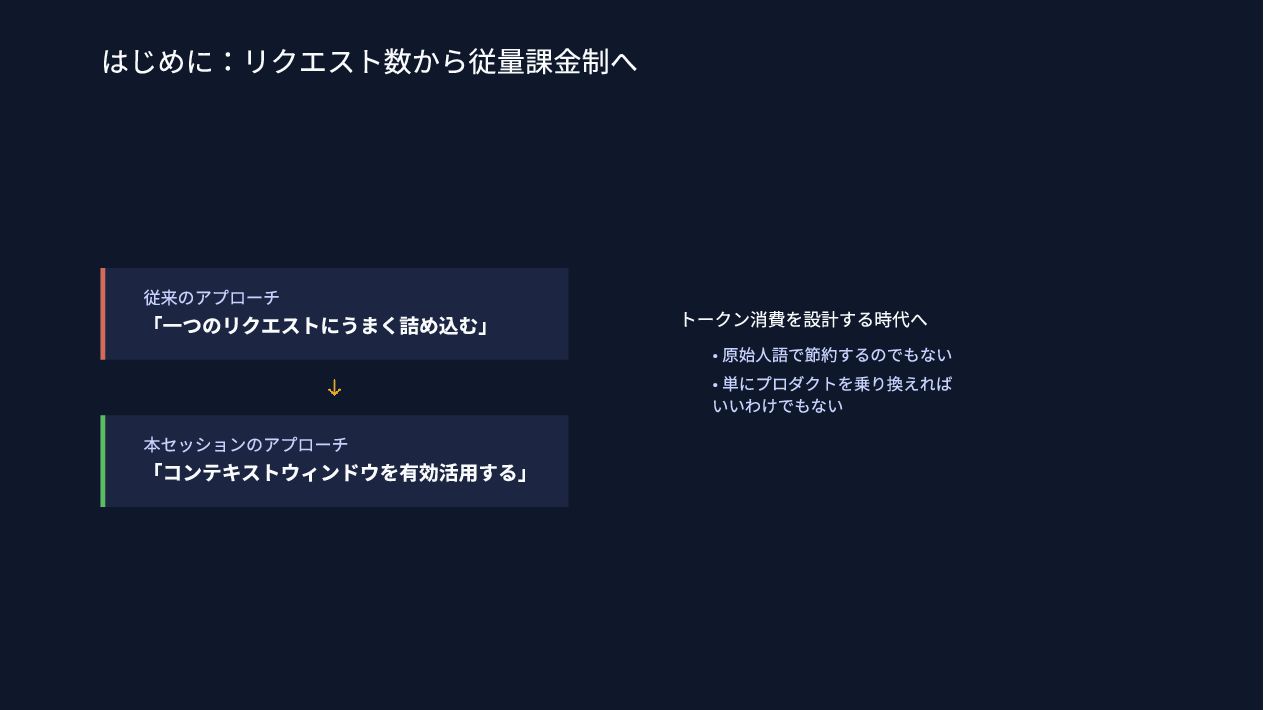
はじめに :リクエスト数から 従量課金制へ 従来のアプローチ 「一つの リクエストに うまく 詰め込む」 本セッションの アプローチ
「コンテキストウィンドウを 有効活用する」 トークン消費を 設計する 時代へ • 原始人語で 節約するのでもない • 単に プロダクトを 乗り換えれば いいわけでもない -
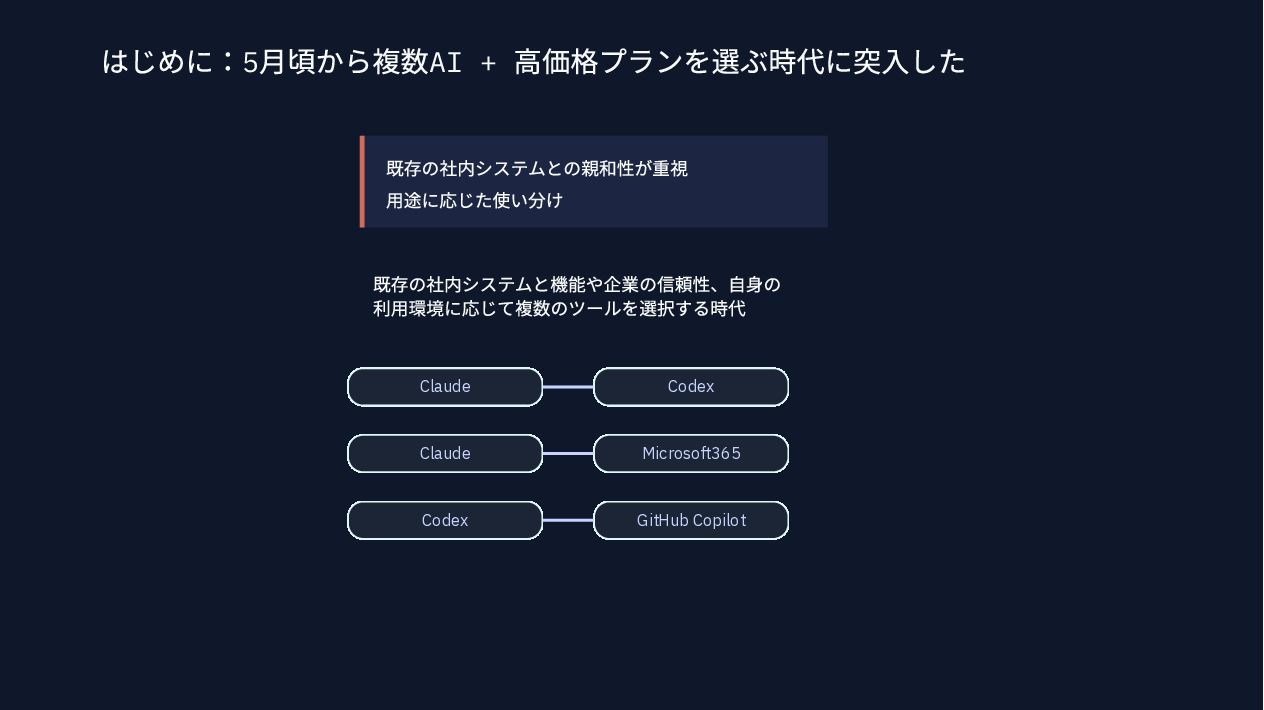
はじめに :5 月頃から 複数AI + 高価格プランを 選ぶ 時代に 突入した 既存の
社内システムと 機能や 企業の 信頼性、 自身の 利用環境に 応じて 複数の ツールを 選択する 時代 既存の 社内システムとの 親和性が 重視 用途に 応じた 使い分け Claude Codex Claude Microsoft365 Codex GitHub Copilot -
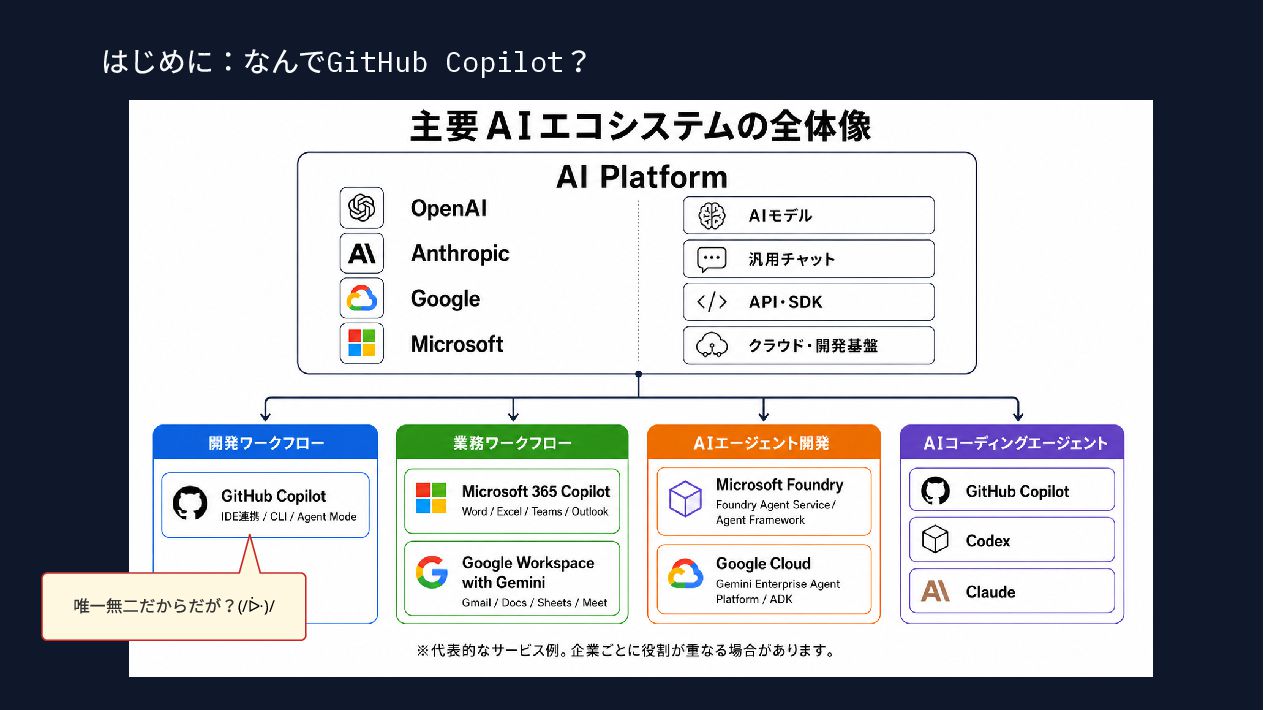
はじめに :GitHub Copilot + 何か で 選ぶべきでしょ 開発会社/ 部
署が GitHub Copilot 選ばない 理由なくね? ╭( ・ㅂ・)و -
// KEY MESSAGE トークンを「節約」するのではなく 「適正に設計」する 必要な情報を必要な形で、必要なタイミングで届ける。それがコンテキスト設計。 GitHub Copilot の 料金体系が
変わった ことで 困っている 人へ 捧ぐ \(^O^) / -
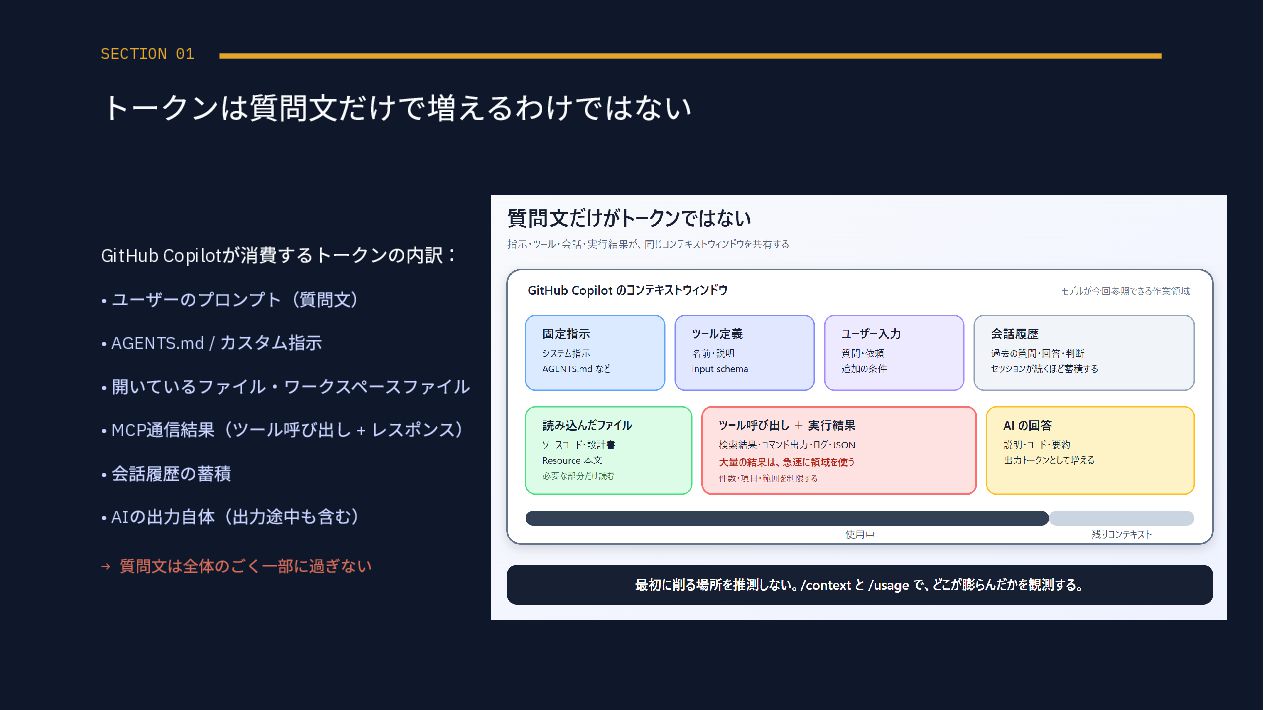
SECTION 01 トークンは質問文だけで増えるわけではない GitHub Copilot が消費するトークンの内訳: • ユーザーのプロンプト(質問文) • AGENTS.md
/ カスタム指示 • 開いているファイル・ワークスペースファイル • MCP 通信結果(ツール呼び出し + レスポンス) • 会話履歴の蓄積 • AI の出力自体(出力途中も含む) → 質問文は全体のごく一部に過ぎない -
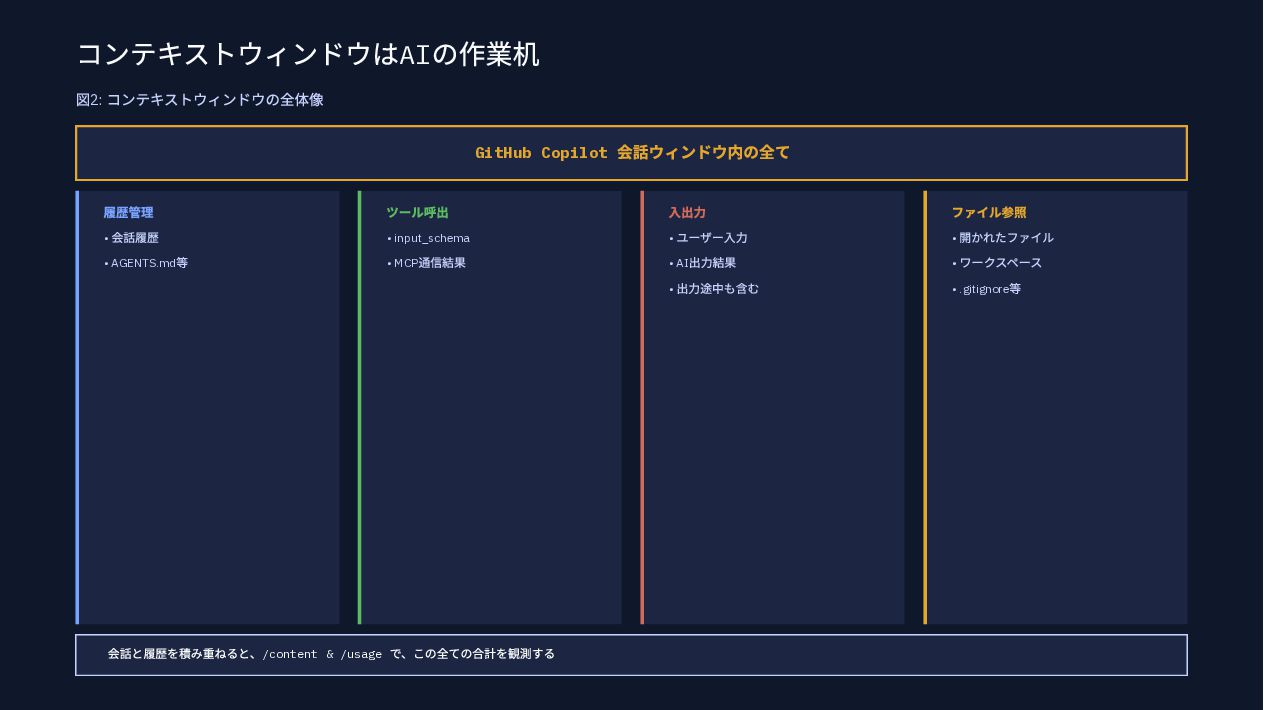
コンテキストウィンドウはAI の作業机 図2: コンテキストウィンドウの全体像 GitHub Copilot 会話ウィンドウ内の全て 履歴管理 • 会話履歴
• AGENTS.md 等 ツール呼出 • input_schema • MCP 通信結果 入出力 • ユーザー入力 • AI 出力結果 • 出力途中も含む ファイル参照 • 開かれたファイル • ワークスペース • .gitignore 等 会話と履歴を積み重ねると、/content & /usage で、この全ての合計を観測する -
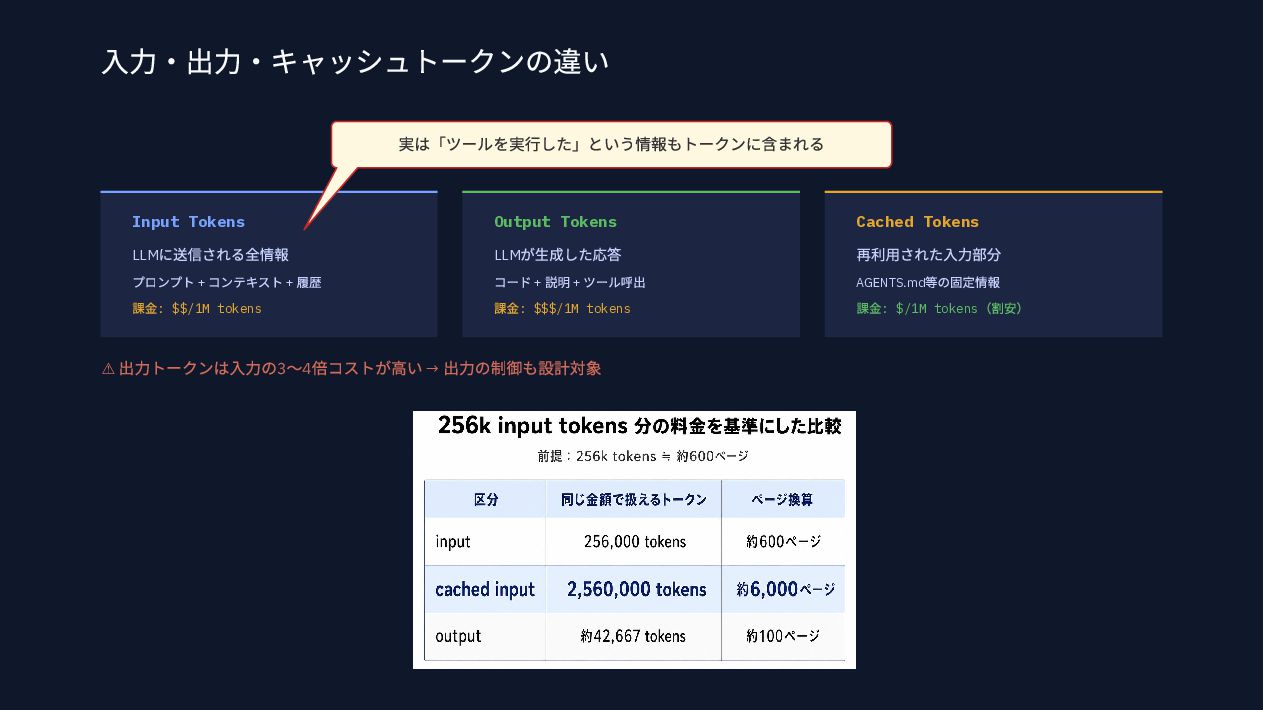
入力・出力・キャッシュトークンの違い Input Tokens LLM に送信される全情報 プロンプト + コンテキスト + 履歴
課金: $$/1M tokens Output Tokens LLM が生成した応答 コード + 説明 + ツール呼出 課金: $$$/1M tokens Cached Tokens 再利用された入力部分 AGENTS.md 等の固定情報 課金: $/1M tokens (割安) ⚠ 出力トークンは入力の3 〜4 倍コストが高い → 出力の制御も設計対象 実は 「ツールを 実行した」と いう 情報も トークンに 含まれる -
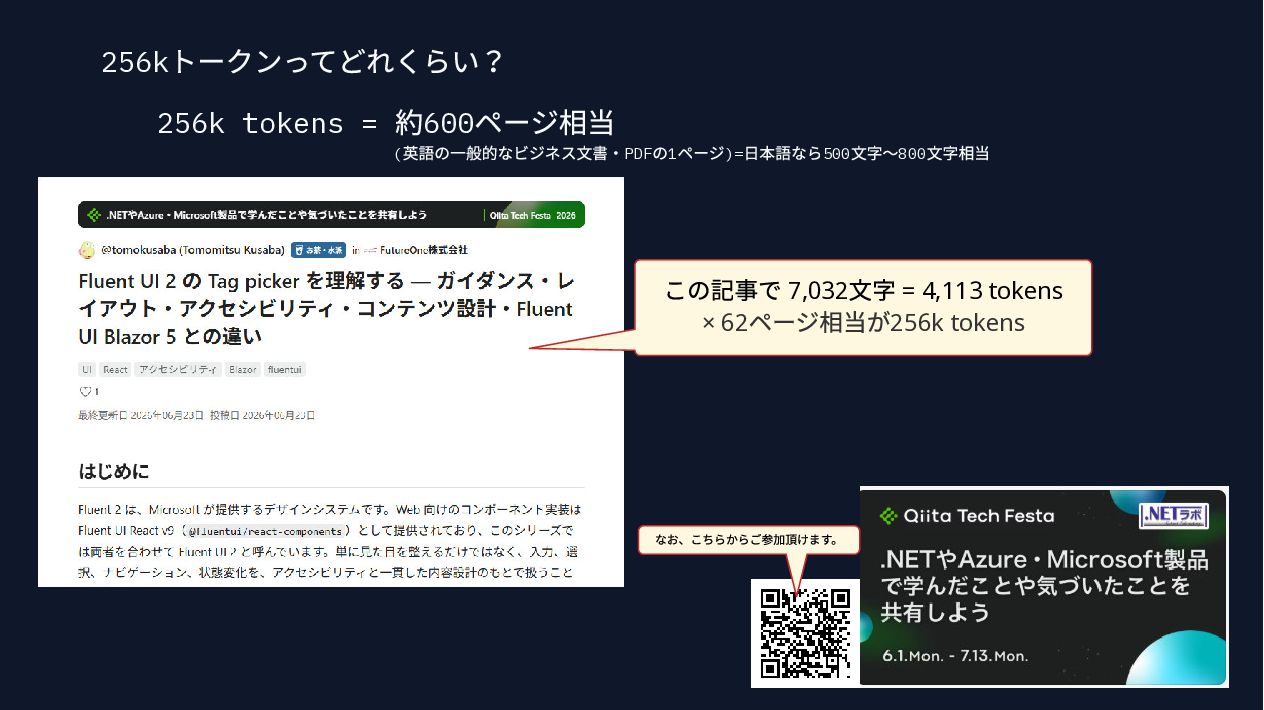
256k トークンって どれくらい? 256k tokens = 約600 ページ 相当 (
英語の 一般的な ビジネス文書・PDF の 1 ページ)= 日本語なら 500 文字~800 文字相当 この 記事で 7,032 文字 = 4,113 tokens × 62 ページ 相当が 256k tokens な お、 こちらから ご参加頂けます。 -
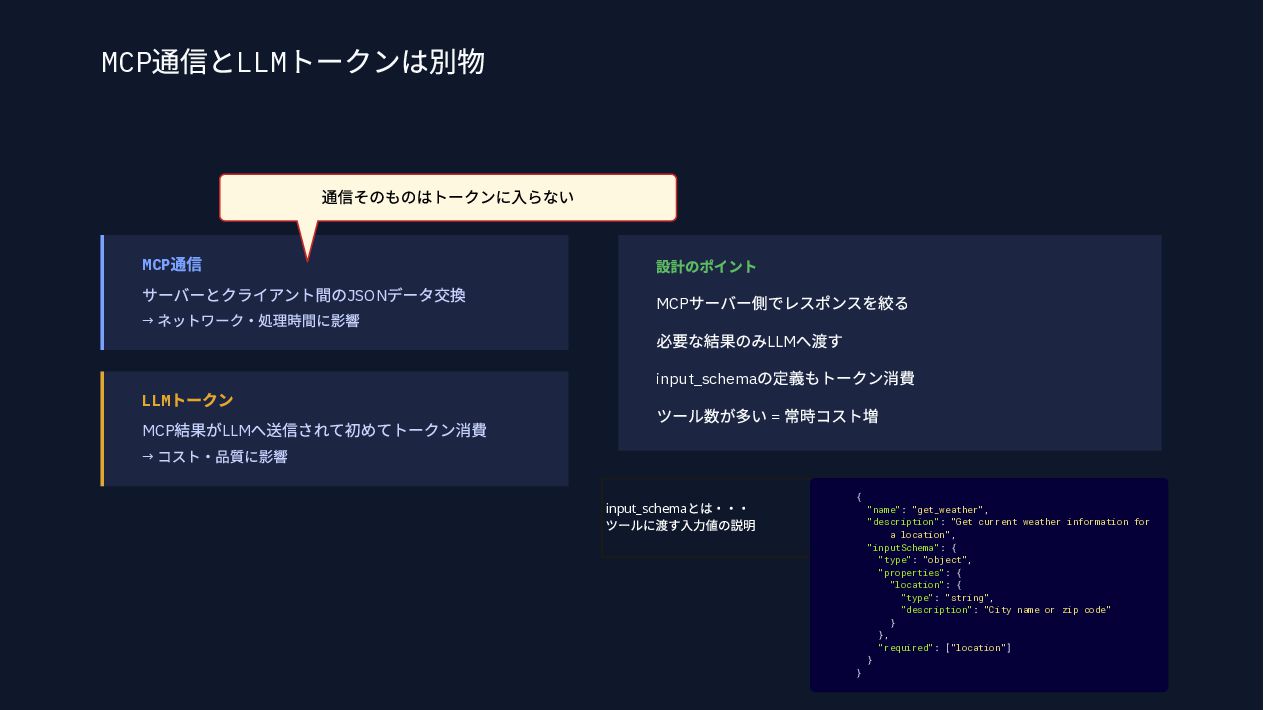
MCP 通信とLLM トークンは別物 MCP 通信 サーバーとクライアント間のJSON データ交換 → ネットワーク・処理時間に影響 LLM
トークン MCP 結果がLLM へ送信されて初めてトークン消費 → コスト・品質に影響 設計のポイント MCP サーバー側でレスポンスを絞る 必要な結果のみLLM へ渡す input_schema の定義もトークン消費 ツール数が多い = 常時コスト増 input_schema とは・・・ ツールに 渡す入力値の 説明 { "name": "get_weather", "description": "Get current weather information for a location", "inputSchema": { "type": "object", "properties": { "location": { "type": "string", "description": "City name or zip code" } }, "required": ["location"] } } 通信 その ものは トークンに 入らない -
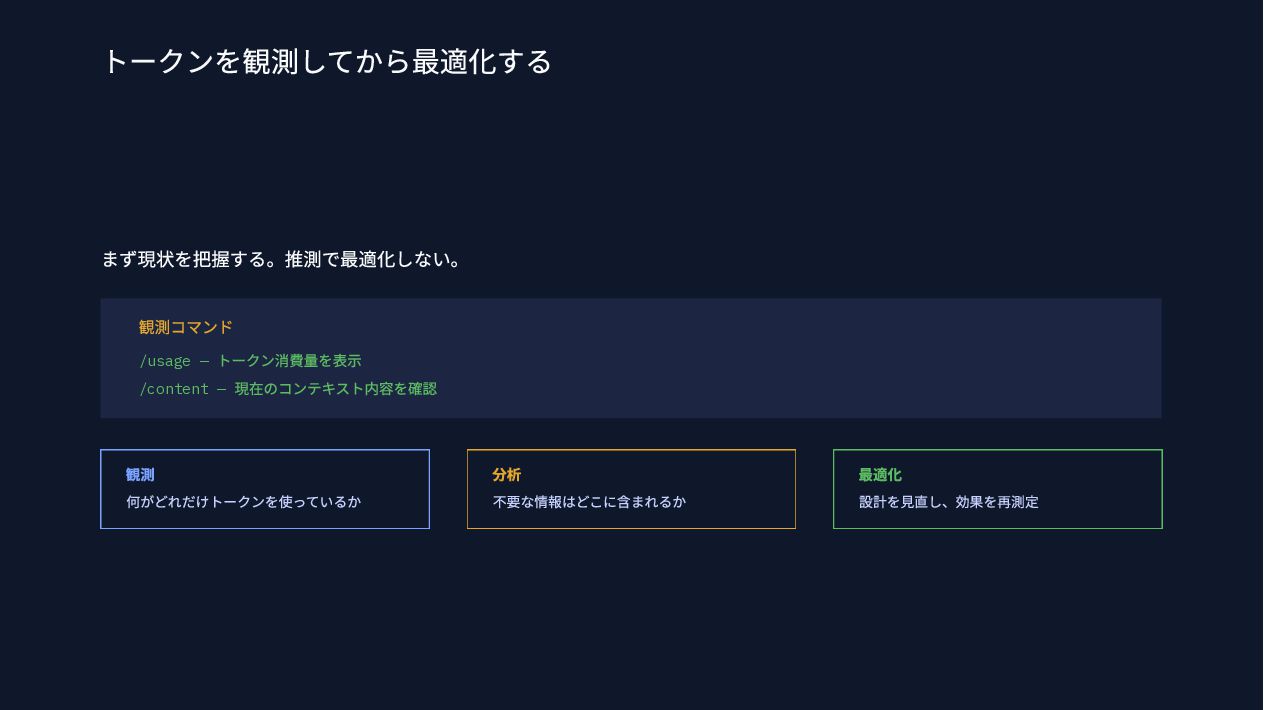
トークンを 観測してから 最適化する まず現状を把握する。推測で最適化しない。 観測コマンド /usage — トークン消費量を表示 /content —
現在のコンテキスト内容を確認 観測 何がどれだけトークンを使っているか 分析 不要な情報はどこに含まれるか 最適化 設計を見直し、効果を再測定 -
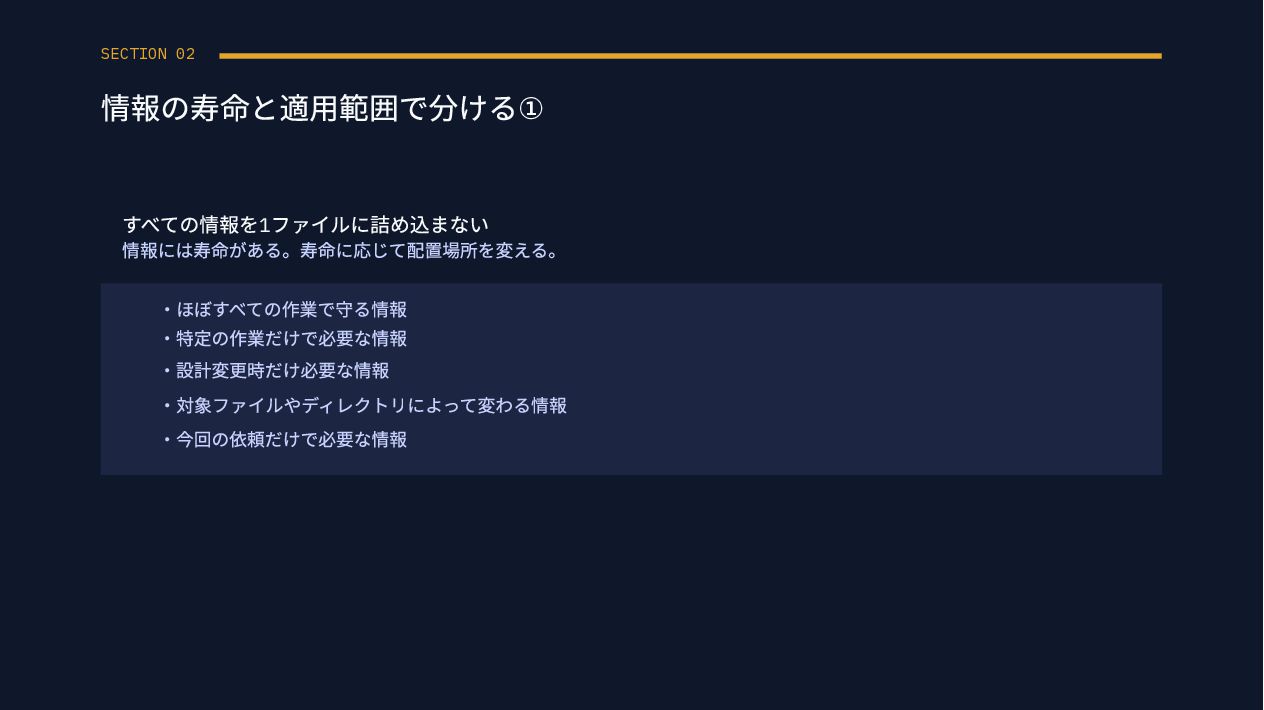
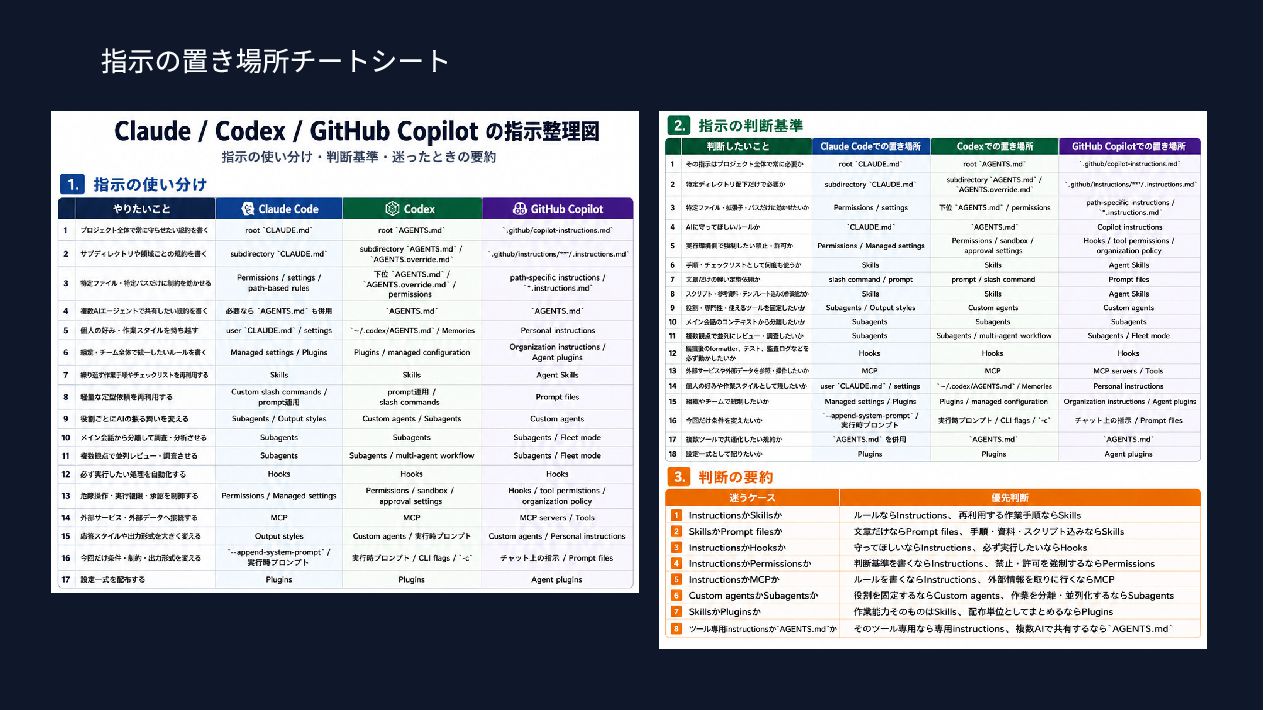
SECTION 02 情報の 寿命と 適用範囲で 分ける ① すべての情報を1 ファイルに詰め込まない 情報には寿命がある。寿命に応じて配置場所を変える。
・ ほぼ すべての 作業で 守る 情報 ・ 特定の 作業だけで 必要な 情報 ・設計変更時だけ必要な 情報 ・対象ファイルや ディレクトリに よって 変わる 情報 ・ 今回の 依頼だけで 必要な 情報 -
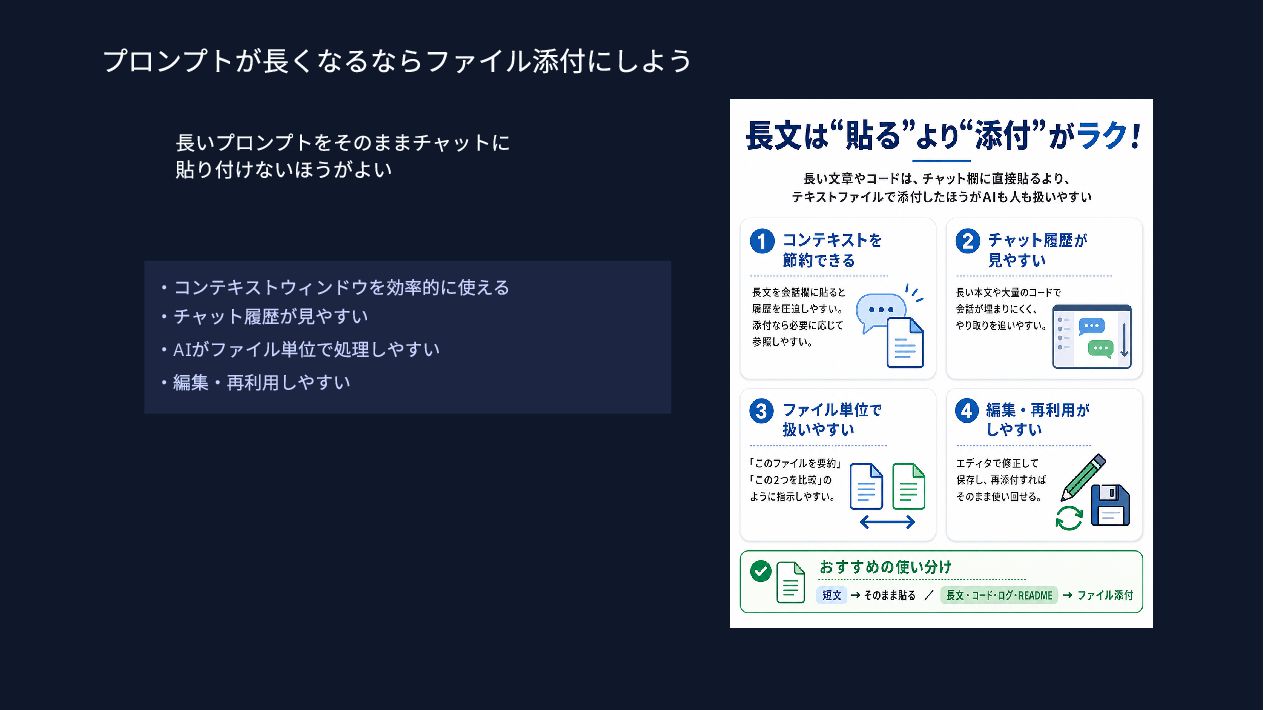
プロンプトが 長くなるなら ファイル添付にしよう 長い プロンプトを そのまま チャットに 貼り付けない ほうが よい
・コンテキストウィンドウを 効率的に 使える ・チャット履歴が 見やすい ・AI が ファイル単位で 処理しやすい ・編集・再利用しやすい -
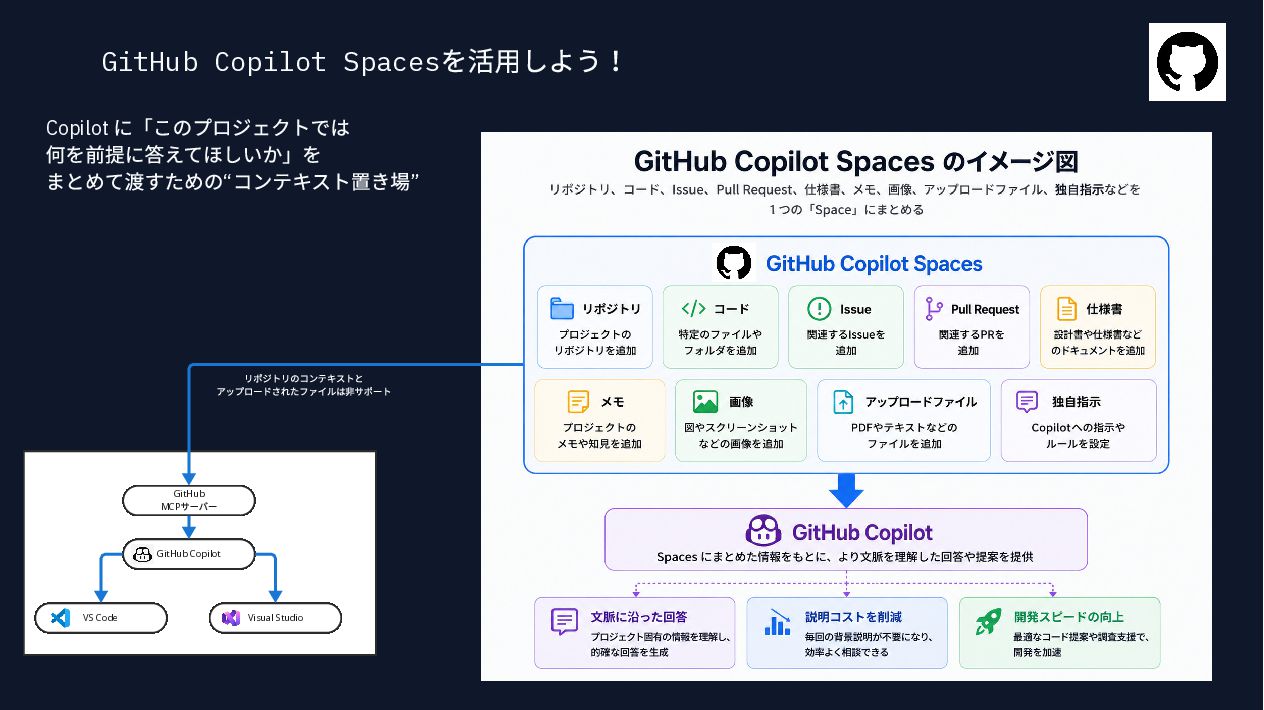
GitHub Copilot Spaces を活用しよう! Copilot に 「この プロジェクトでは 何を 前提に
答えて ほしいか」を まとめて 渡すための “ コンテキスト置き場” GitHub MCP サーバー VS Code Visual Studio GitHub Copilot リポジトリの コンテキストと アップロードされた ファイルは 非サポート -
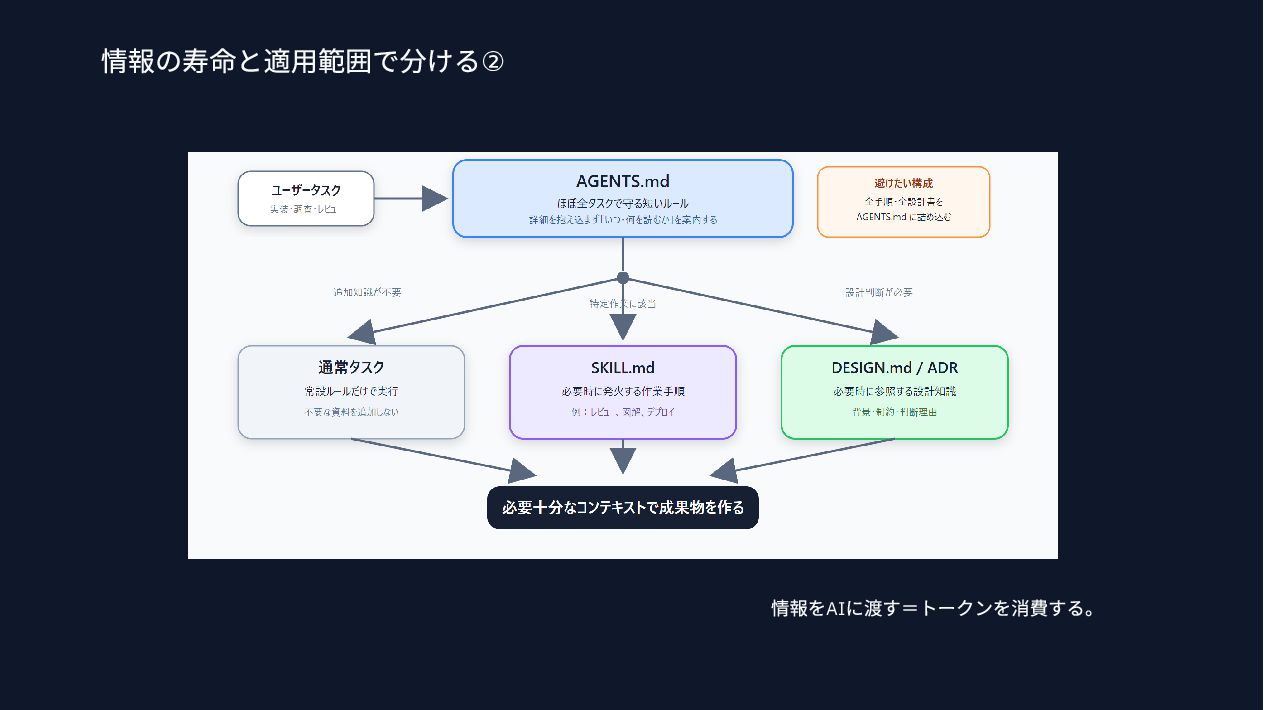
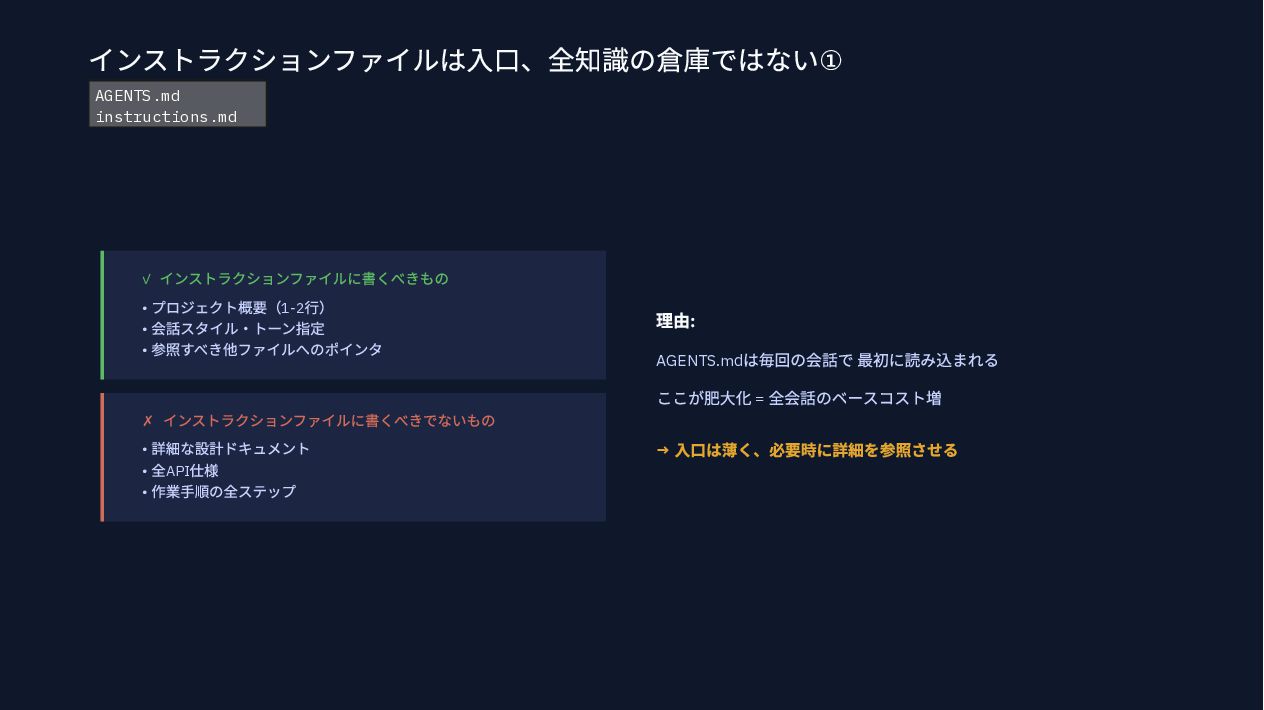
AGENTS.md ✓ インストラクションファイルに 書くべきもの • プロジェクト概要(1-2 行) • 会話スタイル・トーン指定 •
参照すべき他ファイルへのポインタ ✗ インストラクションファイルに 書くべきでない もの • 詳細な設計ドキュメント • 全API 仕様 • 作業手順の全ステップ 理由: AGENTS.md は毎回の会話で 最初に読み込まれる ここが肥大化 = 全会話のベースコスト増 → 入口は薄く、必要時に詳細を参照させる インストラクションファイルは 入口、 全知識の 倉庫ではない ① instructions.md -
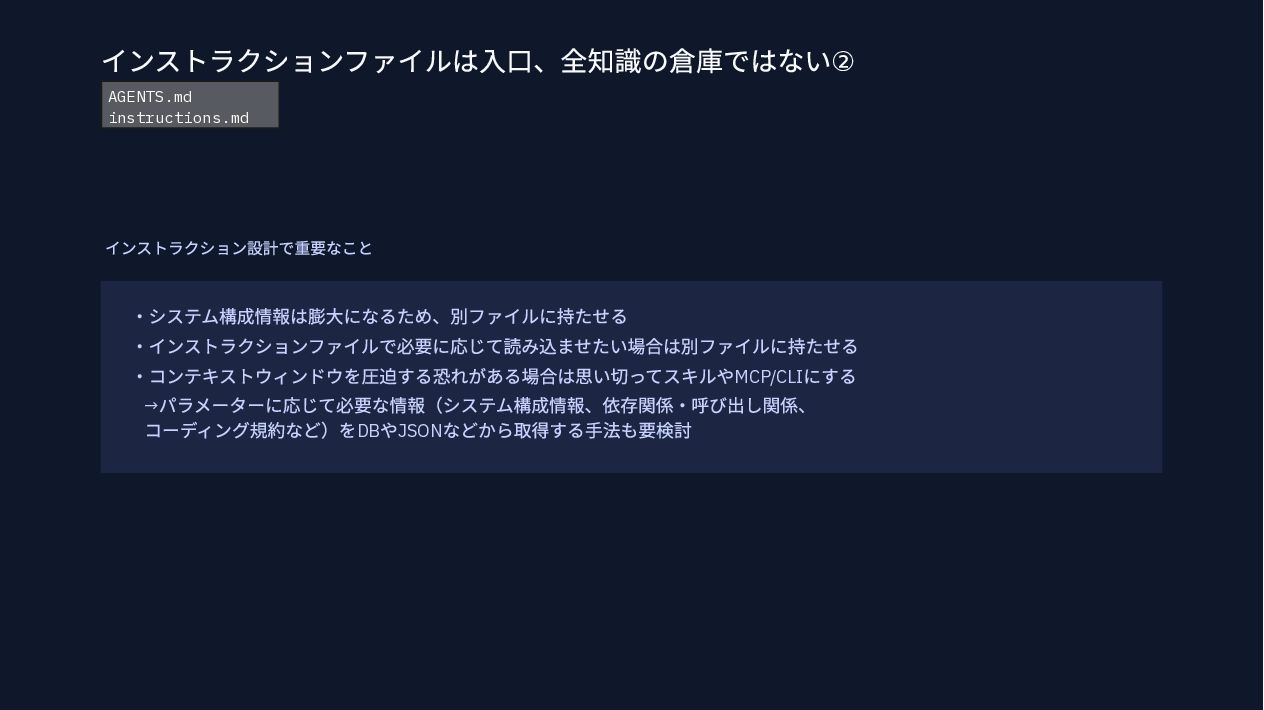
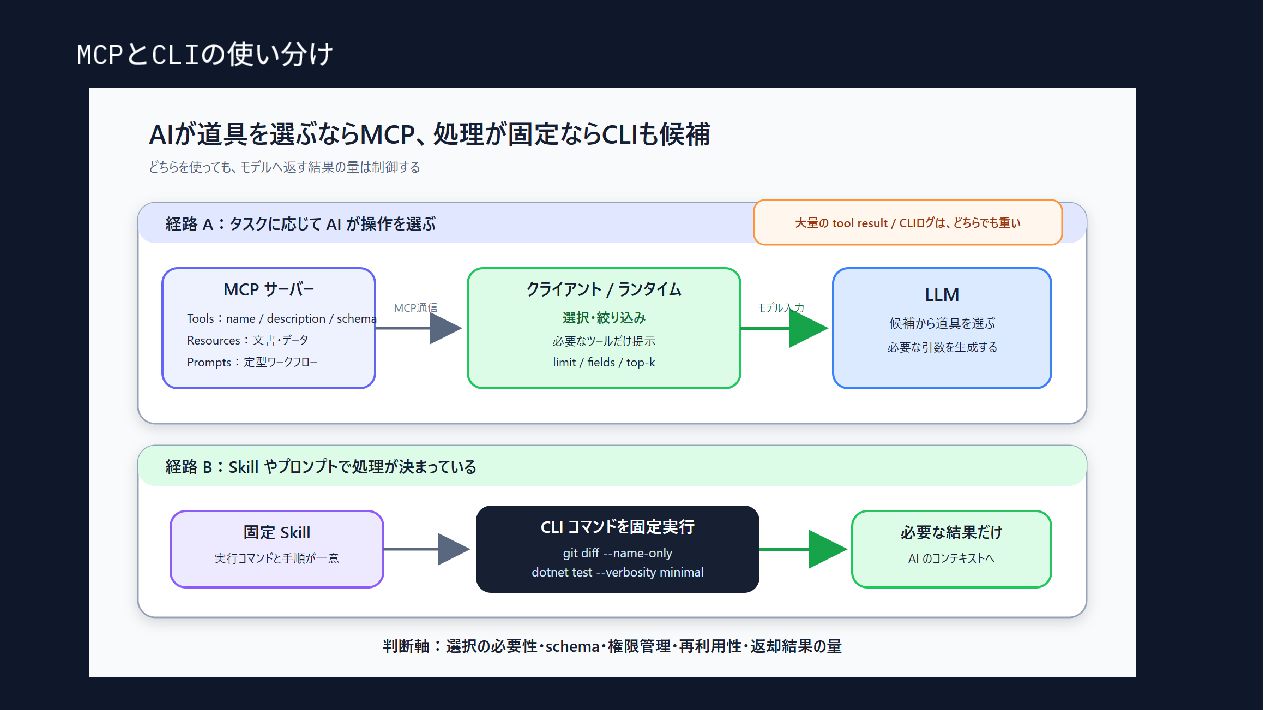
インストラクションファイルは 入口、 全知識の 倉庫ではない ② インストラクション設計で 重要な こと ・システム構成情報は 膨大に
なる ため、 別ファイルに 持たせる ・インストラクションファイルで 必要に 応じて 読み込ませたい 場合は 別ファイルに 持たせる ・コンテキストウィンドウを 圧迫する 恐れが ある 場合は 思い切って スキルや MCP/CLI に する → パラメーターに 応じて 必要な 情報 (システム構成情報、 依存関係・ 呼び出し関係、 コーディング規約など)を DB や JSON などから 取得する 手法も 要検討 AGENTS.md instructions.md -
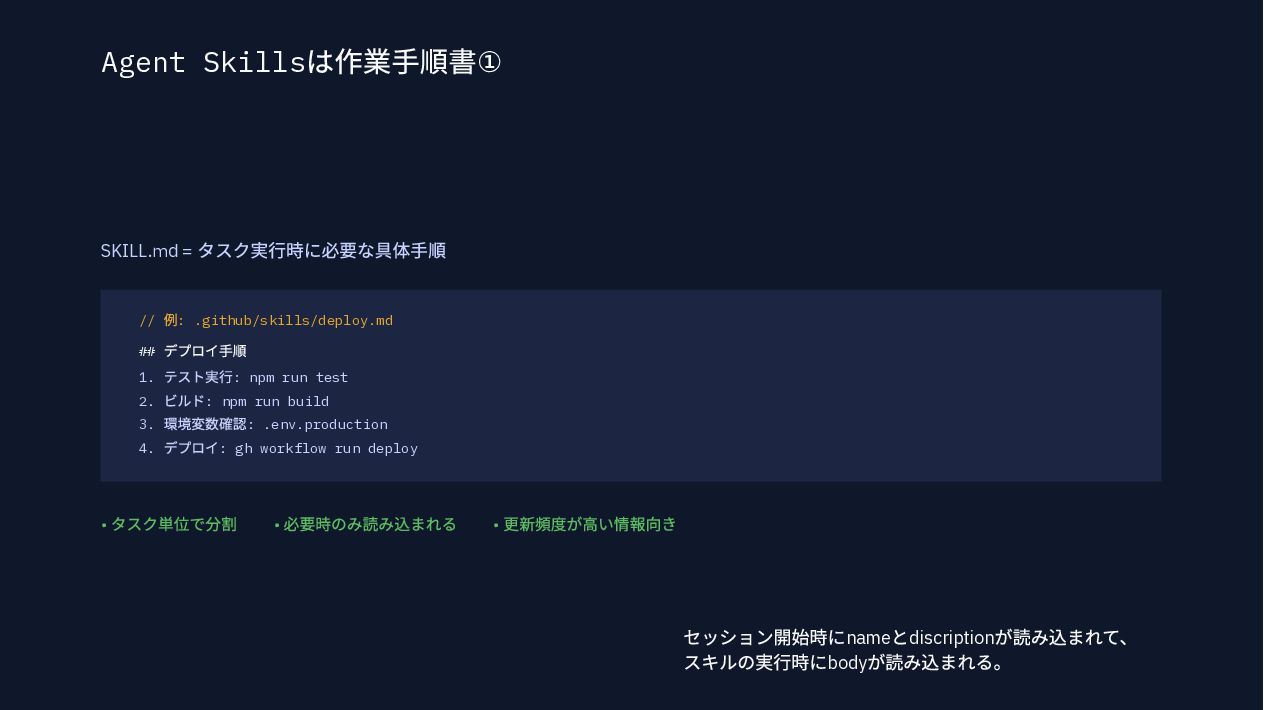
Agent Skills は作業手順書 ① SKILL.md = タスク実行時に必要な具体手順 // 例: .github/skills/deploy.md
## デプロイ手順 1. テスト実行: npm run test 2. ビルド: npm run build 3. 環境変数確認: .env.production 4. デプロイ: gh workflow run deploy • タスク単位で分割 • 必要時のみ読み込まれる • 更新頻度が高い情報向き セッション開始時に name と discription が 読み込まれて、 スキルの 実行時に body が 読み込まれる。 -
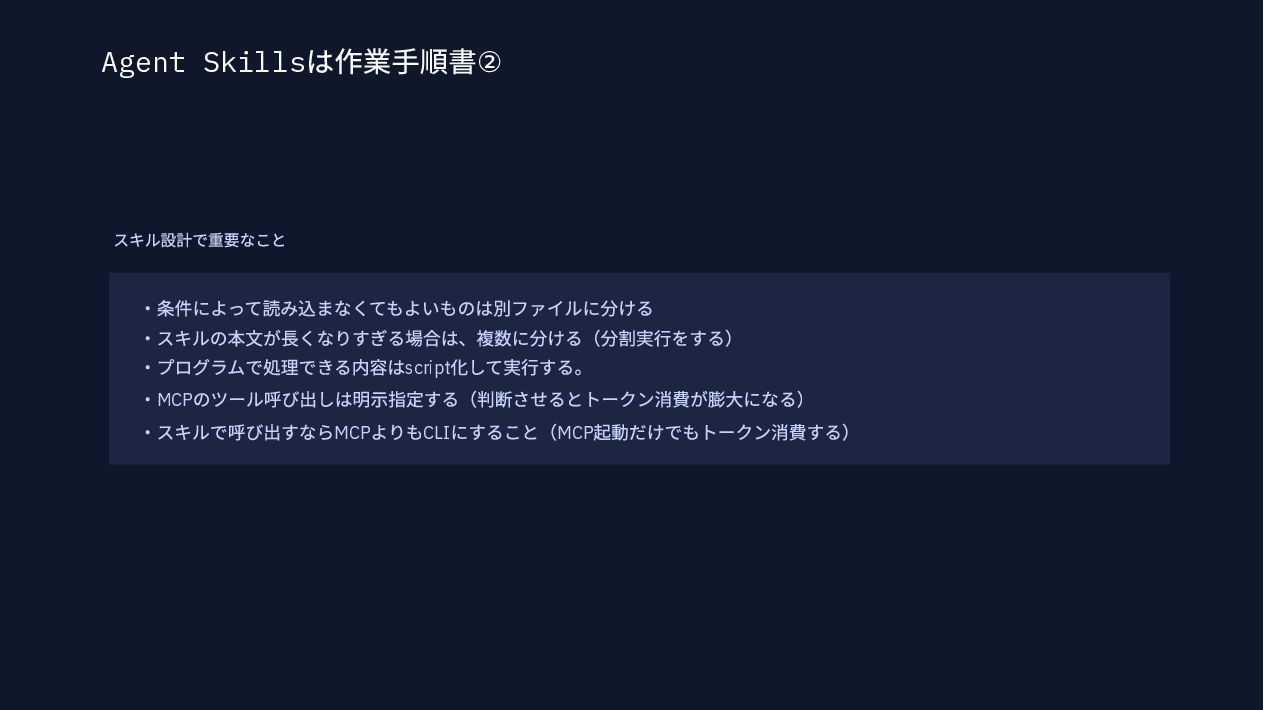
Agent Skills は作業手順書 ② スキル設計で 重要な こと ・条件に よって 読み込まなくても
よい ものは 別ファイルに 分ける ・スキルの 本文が 長くなりすぎる 場合は、 複数に 分ける (分割実行を する) ・プログラムで 処理できる 内容は script 化して 実行する。 ・MCP の ツール呼び出しは 明示指定する (判断させると トークン消費が 膨大に なる) ・スキルで 呼び出すなら MCP よりも CLI に する こと (MCP 起動だけでも トークン消費する) -
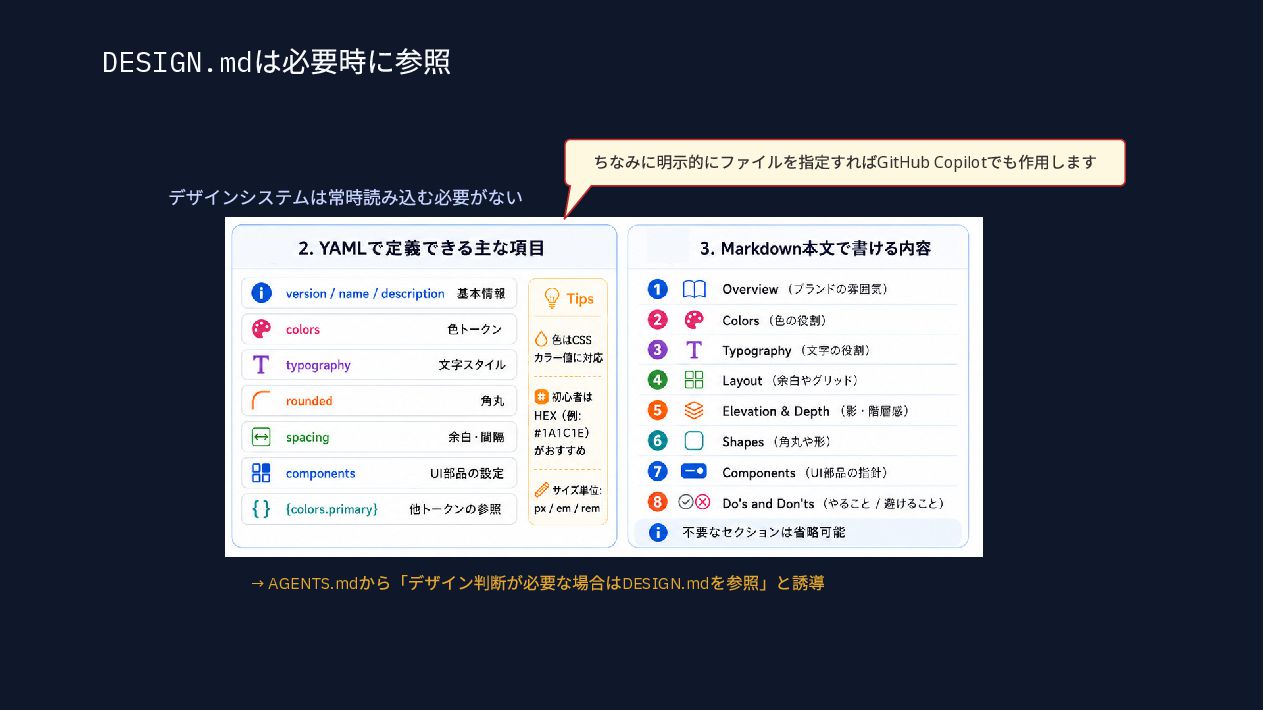
DESIGN.md は必要時に参照 デザインシステムは 常時読み込む必要が ない → AGENTS.md から 「デザイン判断が 必要な
場合は DESIGN.md を 参照」と 誘導 ちなみに 明示的に ファイルを 指定すれば GitHub Copilot でも 作用します -
SECTION 03 MCP は定義と実行結果を設計する MCP ツールは便利。でもトークンコストを意識していますか? MCP がトークンに影響する3 つの経路: 定義
input_schema が毎回送信される 呼び出し ツール呼び出しのJSON 結果 レスポンス全体がコンテキストへ -
MCP で重くなる三つの場所 1. ツール定義の肥大化 ツール数 × input_schema = 常時消費 20
ツール登録 → 数千トークンが常時占有 2. レスポンスの無制限返却 DB 全件取得 → 巨大JSON LLM にとって処理不能な量 3. 不要なメタデータ タイムスタンプ、ID 、内部フラグ等 LLM の判断に不要な情報 ⚠ MCP の「便利さ」がトークンを圧迫するパターンに注意 -
MCP サーバー側で結果を制御 サーバー側の設計で、LLM に渡る情報量を制御する // MCP Resource 設計の工夫 ✓ ページネーション:
limit / offset パラメータ ✓ フィールド選択: fields パラメータで返却項目を絞る ✓ サマリー返却: 詳細ではなく要約を返す ✓ エラー情報の簡潔化: スタックトレースを除外 → 「必要な結果のみLLM へ送信」がMCP 設計の原則 -
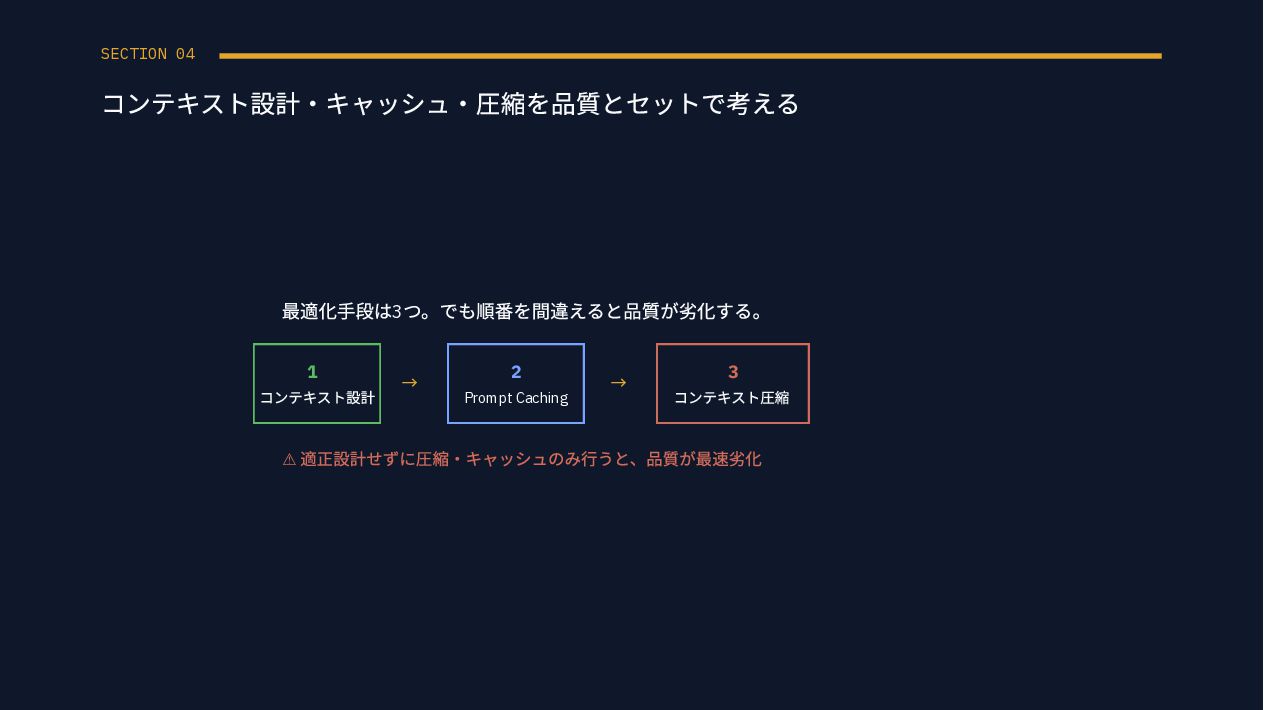
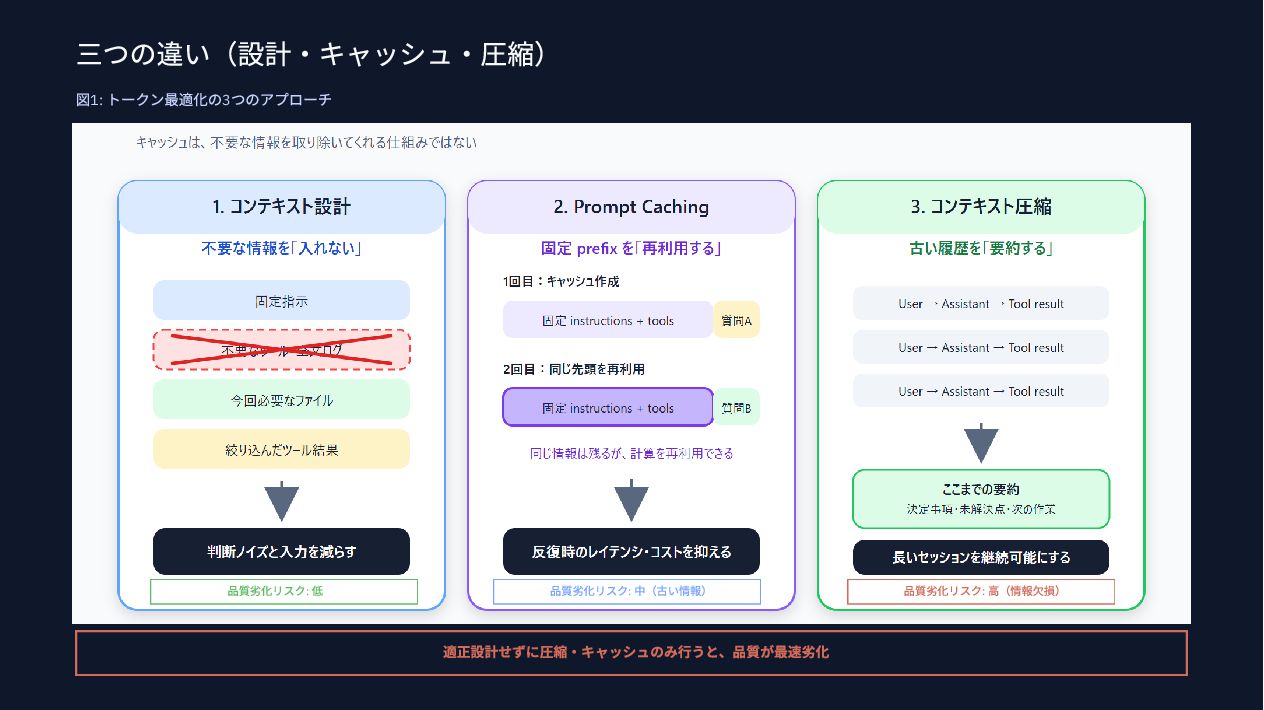
SECTION 04 コンテキスト設計・キャッシュ・圧縮を 品質と セットで 考える 最適化手段は3 つ。でも順番を間違えると品質が劣化する。 1 コンテキスト設計
→ 2 Prompt Caching → 3 コンテキスト圧縮 ⚠ 適正設計せずに圧縮・キャッシュのみ行うと、品質が最速劣化 -
コンテキスト設計は 不要な 情報を 入れない 実行する タイミングで 不要な 情報は 最初から 入れないようにしましょう
・ 使わない ツールを 提示しない ・対象外の 設計書を 読まない ・検索結果を 上位20 件に 制限する ・ログ全文ではなく エラー周辺を 返す ・ 一覧取得と 詳細取得を 分ける これは 入力トークンを 減らすだけでなく、 AI の 判断ノイズを 減らします。 -
Prompt Caching を 活用する なら 「固定文」は できるだけ前に 書く [system] あなたは〜
[tools] tool1: ... tool2: ... [messages] user: ... assistant: ... tool_result: ... キャッシュ発火 バイト列と して 完全一致していれば キャッシュが 効く 前回 ABCDEFG | HIJK ABCDEFG | LMNO 今回 が 一致してれば キャッシュヒット ABCDEFG 👉 セッション継続中は、 いままでの 文脈を 引き継いで 次の 指示を 受け入れる ため、 指示を 出すたびに コンテキストサイズは 増えていく。 その ため、 意識せずとも 意外と キャッシュは 効く。 LLM に 送られる 最終イメージ -
コンテキスト圧縮は 長い 履歴を 要約してしまう コンテキスト圧縮は、 長くなった 会話履歴を 短い 要約へ 置き換える
考え方です。 これに より、 古い 会話を すべて 保持しなくても、 重要な 判断を 引き継げます。 ただし、 要約時に 細かな 情報が 失われる 可能性が あります。 後から 必要に なる 原文は、 ファイルや 外部 記録へ 残しておく方が 安全です。 -
状況に 応じて セッション継続を やめよう [system] あなたは〜 [tools] tool1: ... tool2:
... [messages] user: ... assistant: ... tool_result: ... [system] あなたは〜 [tools] tool1: ... tool2: ... [messages] user: ... assistant: ... tool_result: ... ~~ 長く 継続する ほど、 最初の 指示が いい 加減に なってくる。 セッションを 継続し続ける たびに コンテキストを 圧迫して、 やる ことに ブレが 起きやすくなる。 -
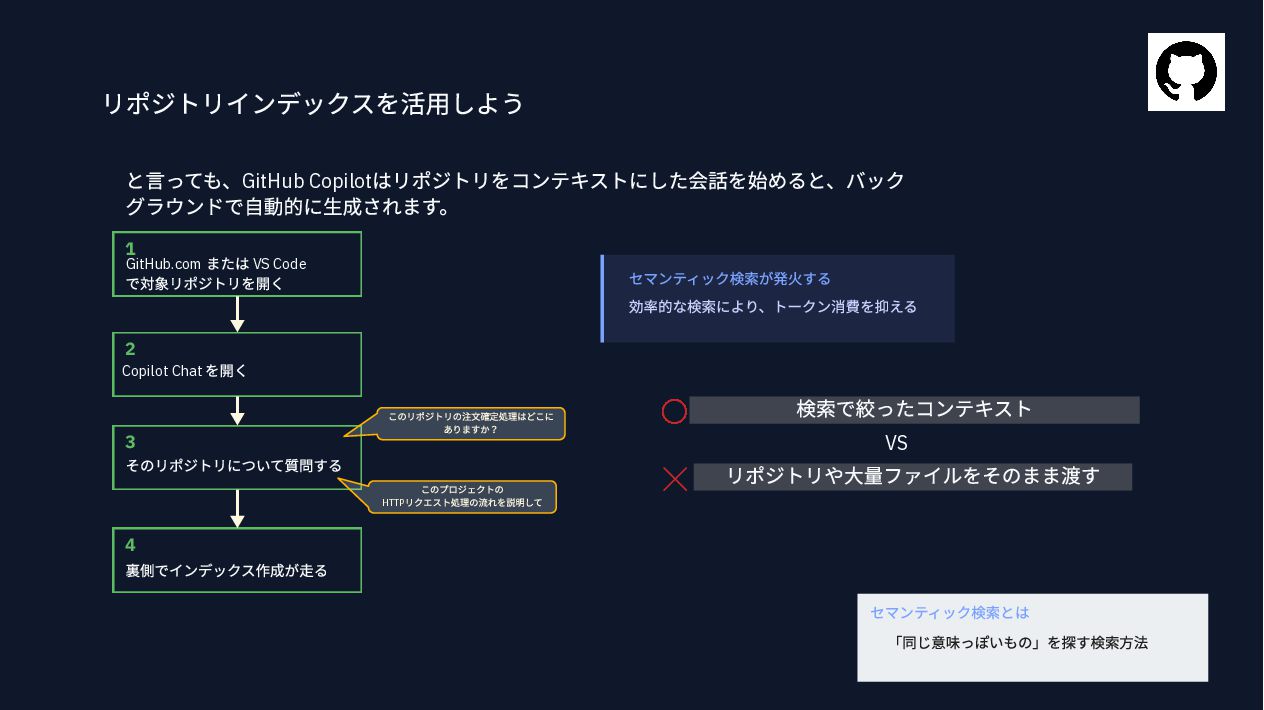
リポジトリインデックスを 活用しよう と 言っても、 GitHub Copilot は リポジトリを コンテキストに した
会話を 始めると、 バック グラウンドで 自動的に 生成されます。 1 GitHub.com または VS Code で対象リポジトリを開く 2 Copilot Chat を開く 3 そのリポジトリに ついて 質問する 4 裏側で インデックス作成が 走る この リポジトリの 注文確定処理は どこに ありますか? 検索で 絞った コンテキスト リポジトリや 大量ファイルを そのまま 渡す セマンティック検索が 発火する 効率的な 検索に より、 トークン消費を 抑える VS セマンティック検索とは 「同じ 意味っぽい もの」を 探す検索方 法 この プロジェクトの HTTP リクエスト処理の 流れを 説明して -
三つの違い(設計・キャッシュ・圧縮) 図1: トークン最適化の3 つのアプローチ コンテキスト設計 不要情報は「入れない」 設計で対応 Prompt Caching 繰り返し使う情報を「再利用」
キャッシュで対応 コンテキスト圧縮 必要情報を「圧縮」 AI 圧縮で対応 適正設計せずに圧縮・キャッシュのみ行うと、品質が最速劣化 品質劣化リスク: 低 品質劣化リスク: 中(古い情報) 品質劣化リスク: 高(情報欠損) -
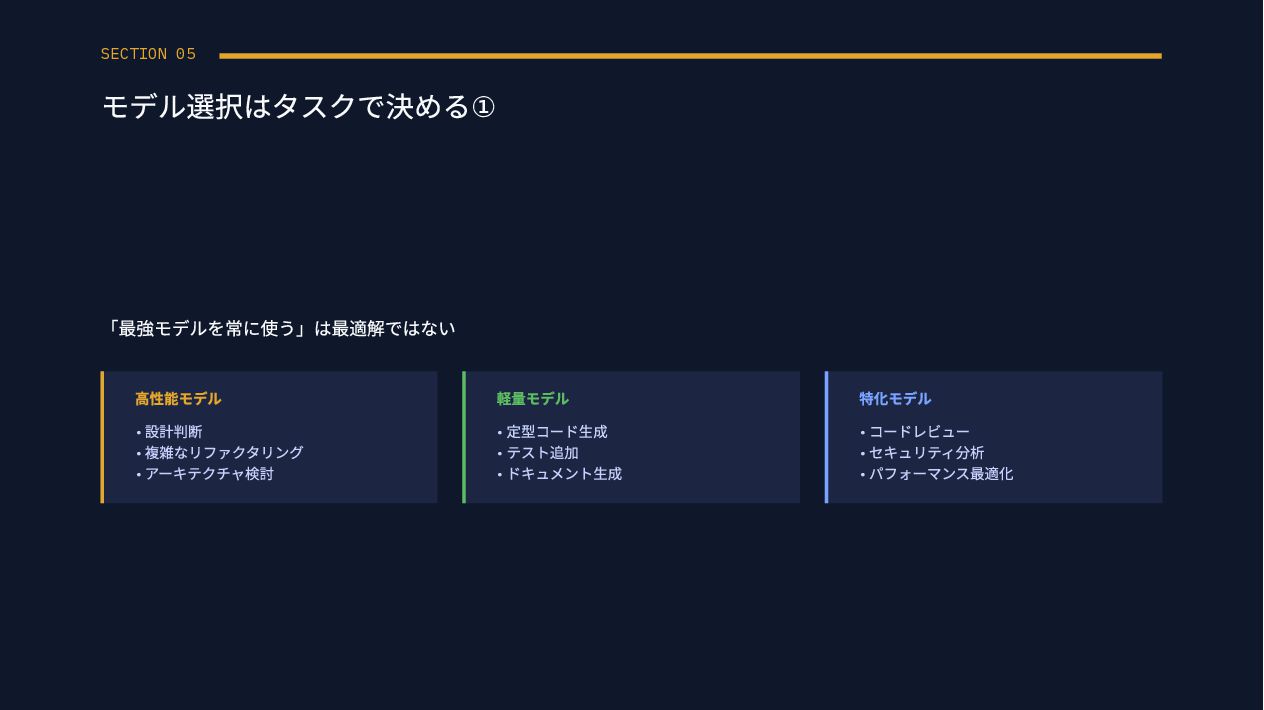
SECTION 05 モデル選択は タスクで 決める ① 「最強モデルを常に使う」は最適解ではない 高性能モデル • 設計判断
• 複雑なリファクタリング • アーキテクチャ検討 軽量モデル • 定型コード生成 • テスト追加 • ドキュメント生成 特化モデル • コードレビュー • セキュリティ分析 • パフォーマンス最適化 -
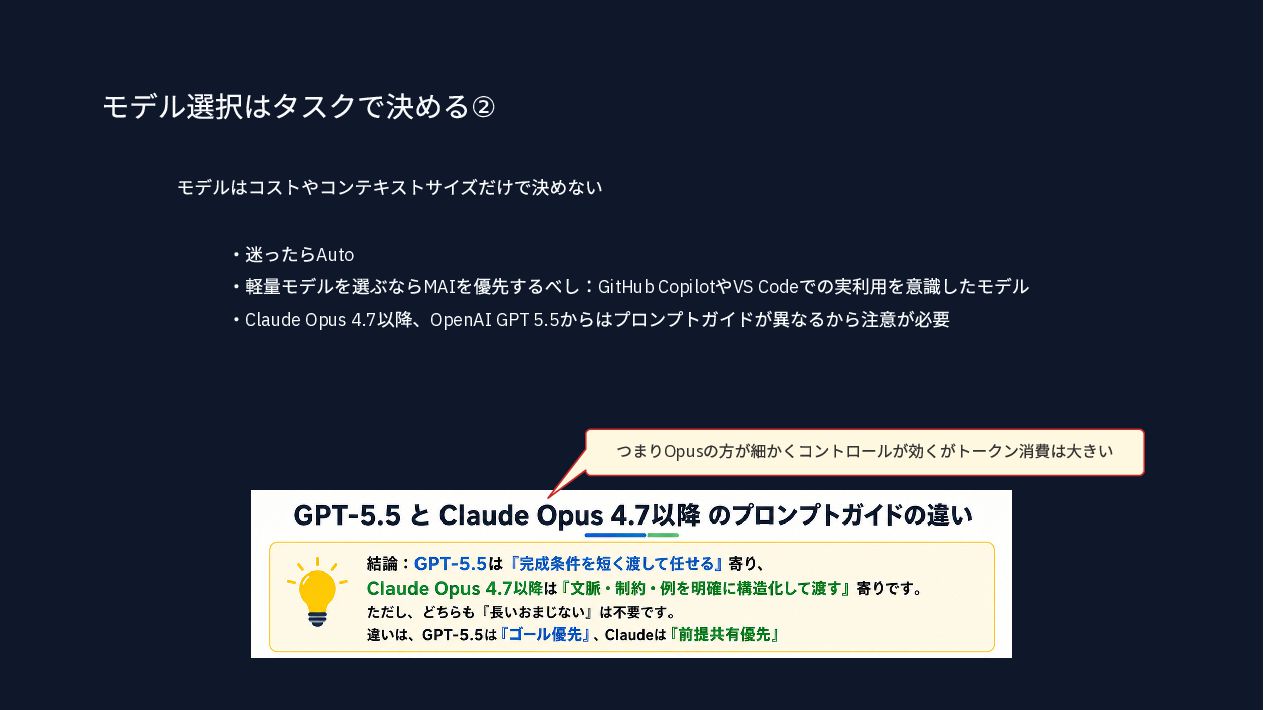
モデル選択は タスクで 決める ② モデルは コストや コンテキストサイズだけで 決めない ・迷ったら Auto
・軽量モデルを 選ぶなら MAI を 優先するべし:GitHub Copilot や VS Code での 実利用を 意識した モデル ・Claude Opus 4.7 以降、 OpenAI GPT 5.5 からは プロンプトガイドが 異なるから 注意が 必要 つまり Opus の 方が 細かく コントロールが 効くが トークン消費は 大きい -
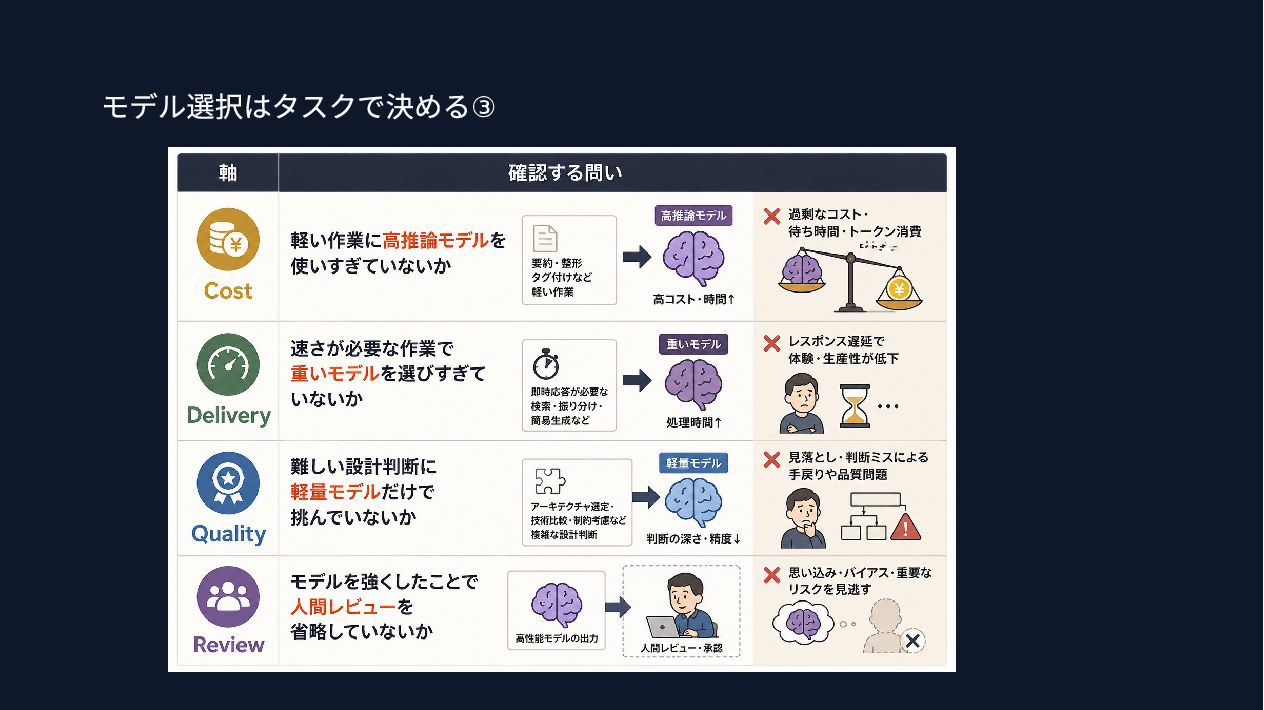
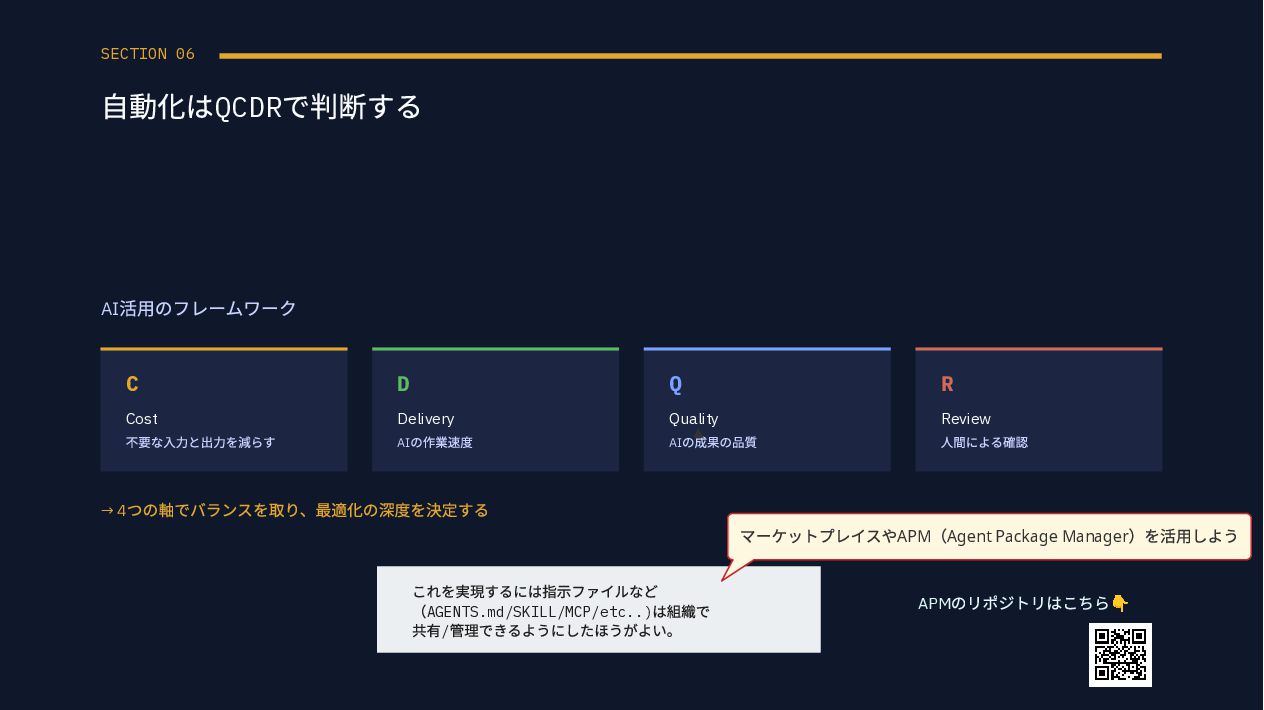
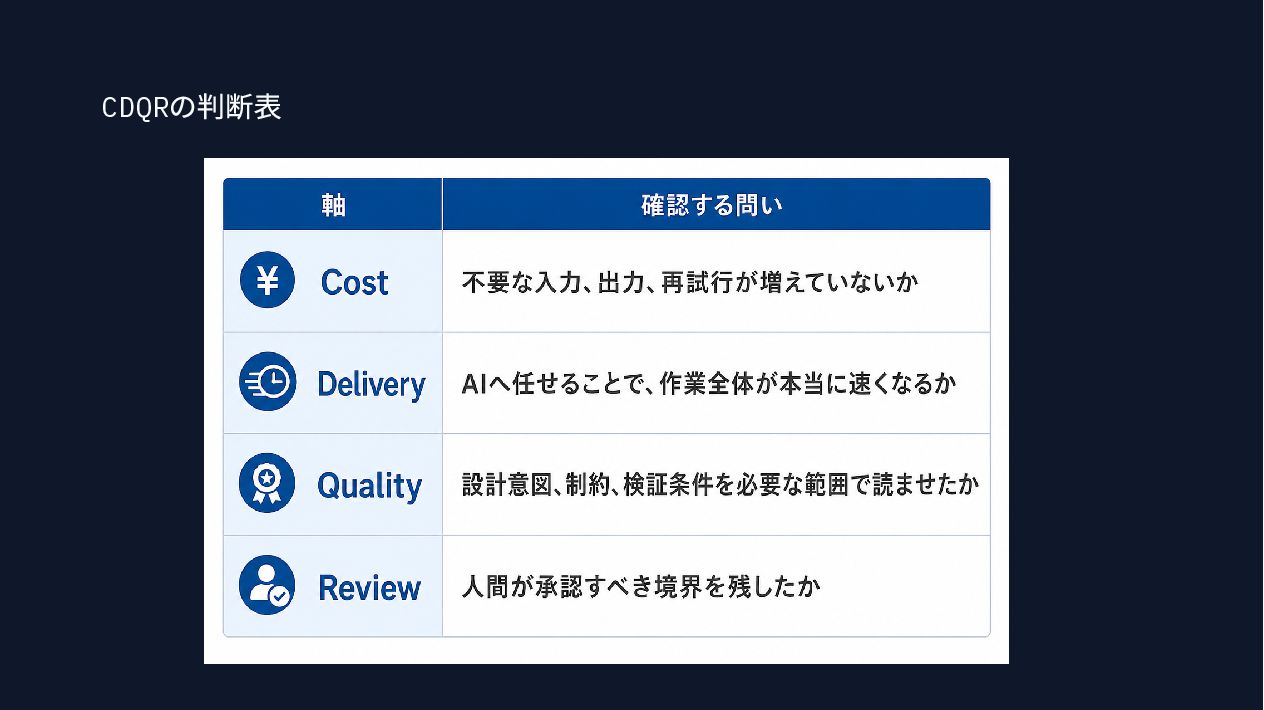
SECTION 06 自動化は QCDR で 判断する AI 活用の フレームワーク C
Cost 不要な 入力と 出力を 減らす D Delivery AI の 作業速度 Q Quality AI の 成果の 品質 R Review 人間に よる 確認 → 4 つの軸でバランスを取り、最適化の深度を決定する これを 実現するには 指示ファイルなど (AGENTS.md/SKILL/MCP/etc..) は 組織で 共有/ 管理できるように した ほうが よい。 マーケットプレイスや APM (Agent Package Manager )を 活用しよう APM の リポジトリは こちら👇 -
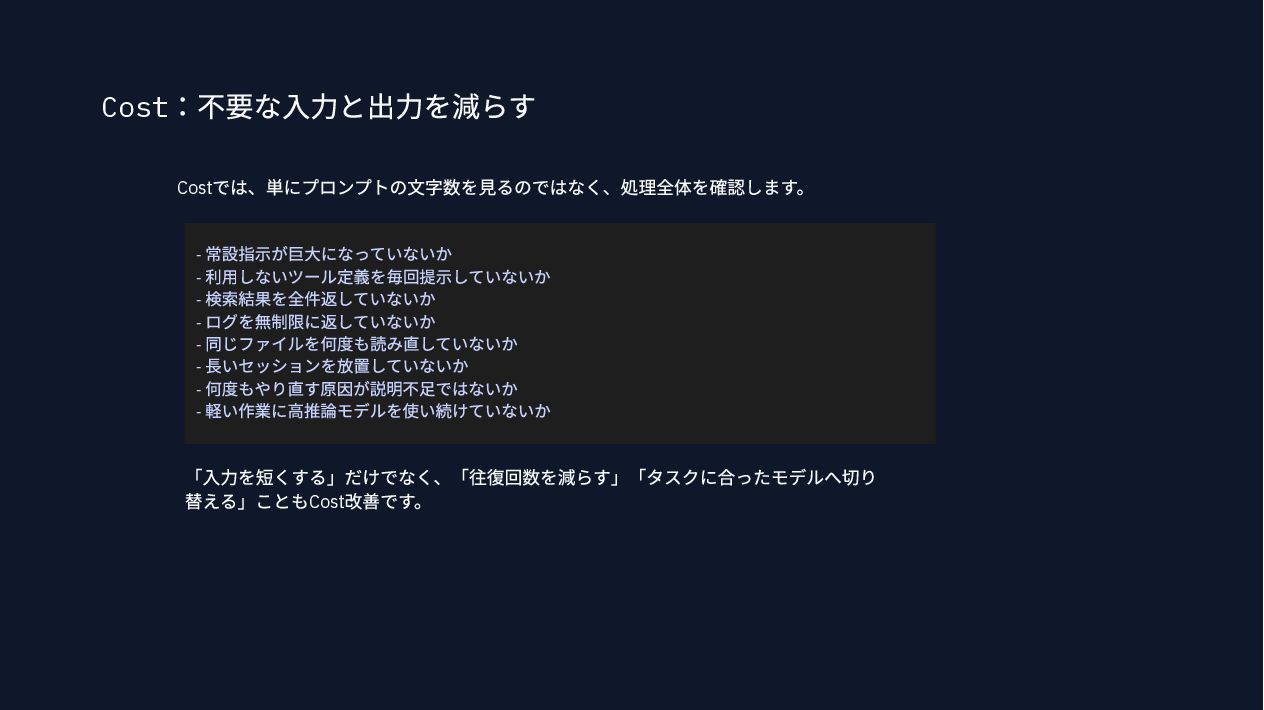
Cost :不要な 入力と 出力を 減らす Cost では、 単に プロンプトの 文字数を
見るのではなく、 処理全体を 確認します。 - 常設指示が 巨大に なっていないか - 利用しない ツール定義を 毎回 提示していないか - 検索結果を 全件返していないか - ログを 無制限に 返していないか - 同じ ファイルを 何度も 読み直していないか - 長い セッションを 放置していないか - 何度も やり直す原因が 説明不足ではないか - 軽い 作業に 高推論モデルを 使い続けていないか 「入力を 短く する」だけでなく、 「往復回数を 減らす」 「タスクに 合った モデルへ 切り 替える」ことも Cost 改善です。 -
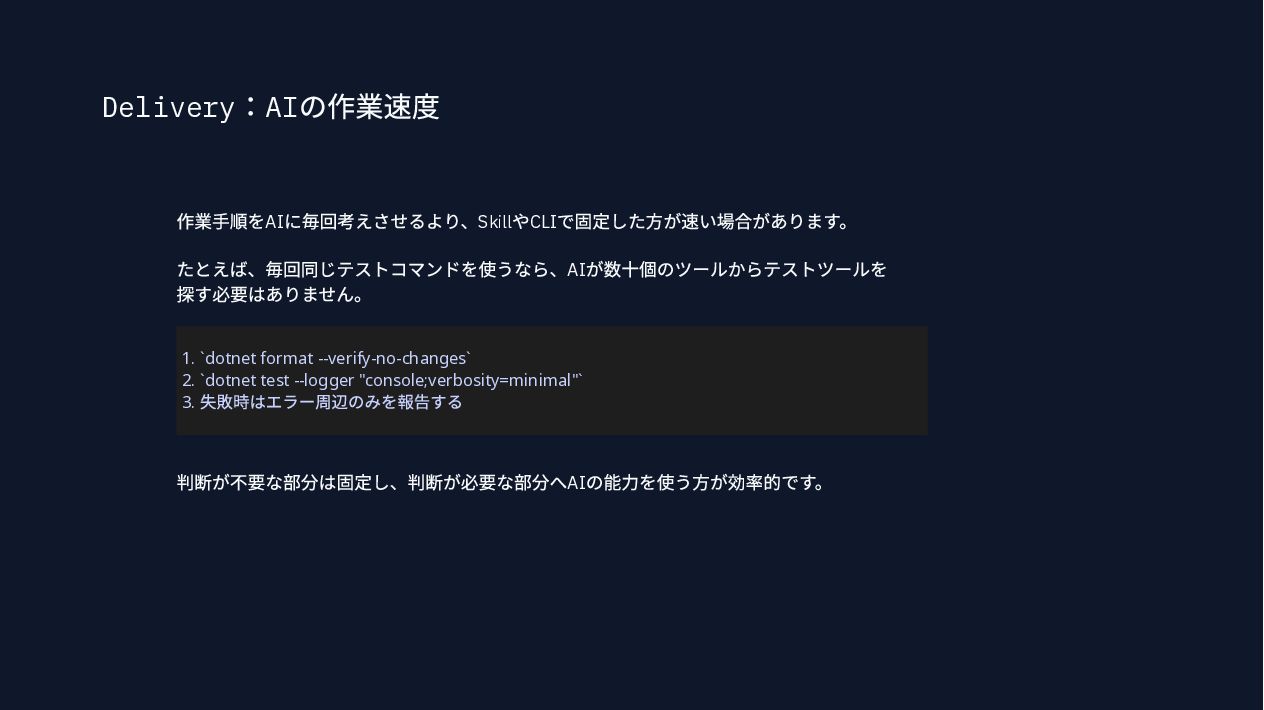
Delivery :AI の作業速度 作業手順を AI に 毎回 考えさせるより、 Skill や
CLI で 固定した方が 速い 場合が あります。 た とえば、 毎回 同じ テストコマンドを 使うなら、 AI が 数十個の ツールから テストツールを 探す必要は ありません。 1. `dotnet format -- verify- no- changes` 2. `dotnet test -- logger "console;verbosity=minimal"` 3. 失敗時はエラー周辺のみを報告する 判断が 不要な 部分は 固定し、 判断が 必要な 部分へ AI の 能力を 使う方が 効率的です。 -
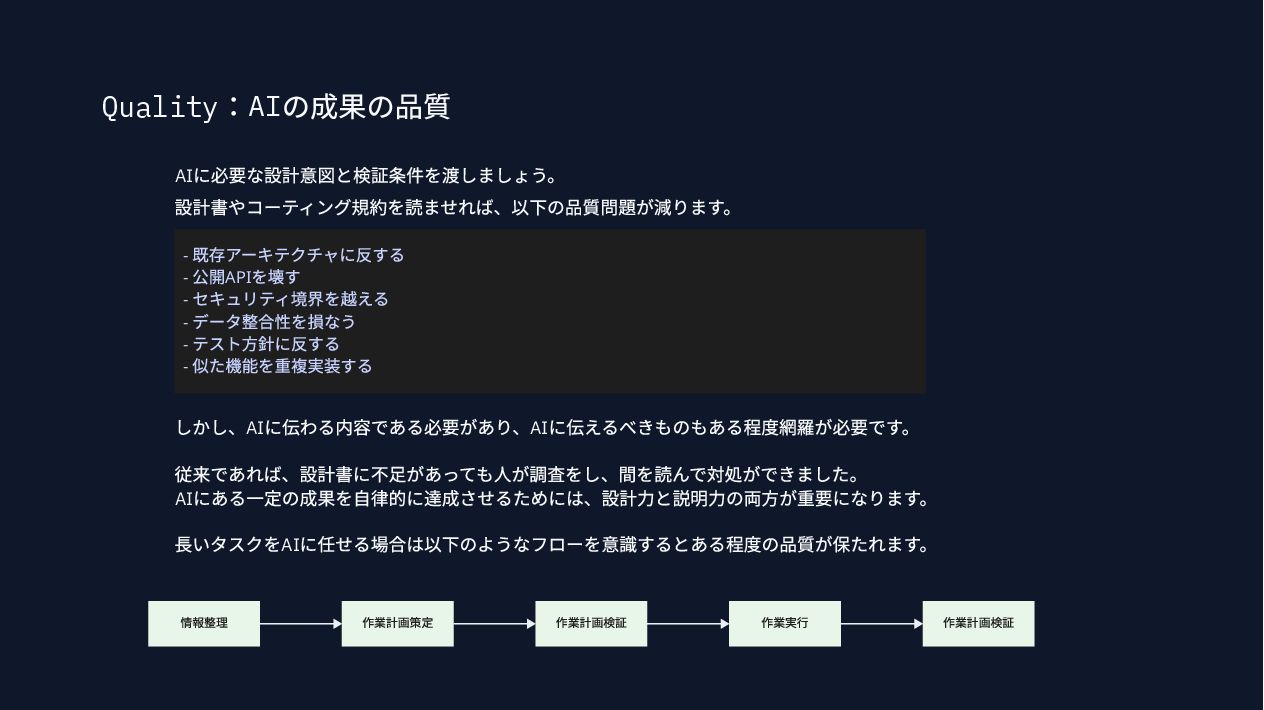
Quality :AI の 成果の 品質 設計書や コーティング規約を 読ませれば、 以下の 品質問題が
減ります。 - 既存アーキテクチャに 反する - 公開API を 壊す - セキュリティ境界を 越える - データ 整合性を 損なう - テスト方 針に 反する - 似た 機能を 重複実装する しかし、 AI に 伝わる 内容である 必要が あり、 AI に 伝えるべきものも ある 程度網羅が 必要です。 従来で あれば、 設計書に 不足が あっても 人が 調査を し、 間を 読んで 対処が できました。 AI に ある 一定の 成果を 自律的に 達成させる ためには、 設計力と 説明力の 両方が 重要に なります。 長いタスクを AI に 任せる 場合は 以下のような フローを 意識すると ある 程度の 品質が 保たれます。 AI に 必要な 設計意図と 検証条件を 渡しましょう。 作業 計画 策定 作業 計 画 検証 作業 実行 情報 整理 作業 計 画 検証 -
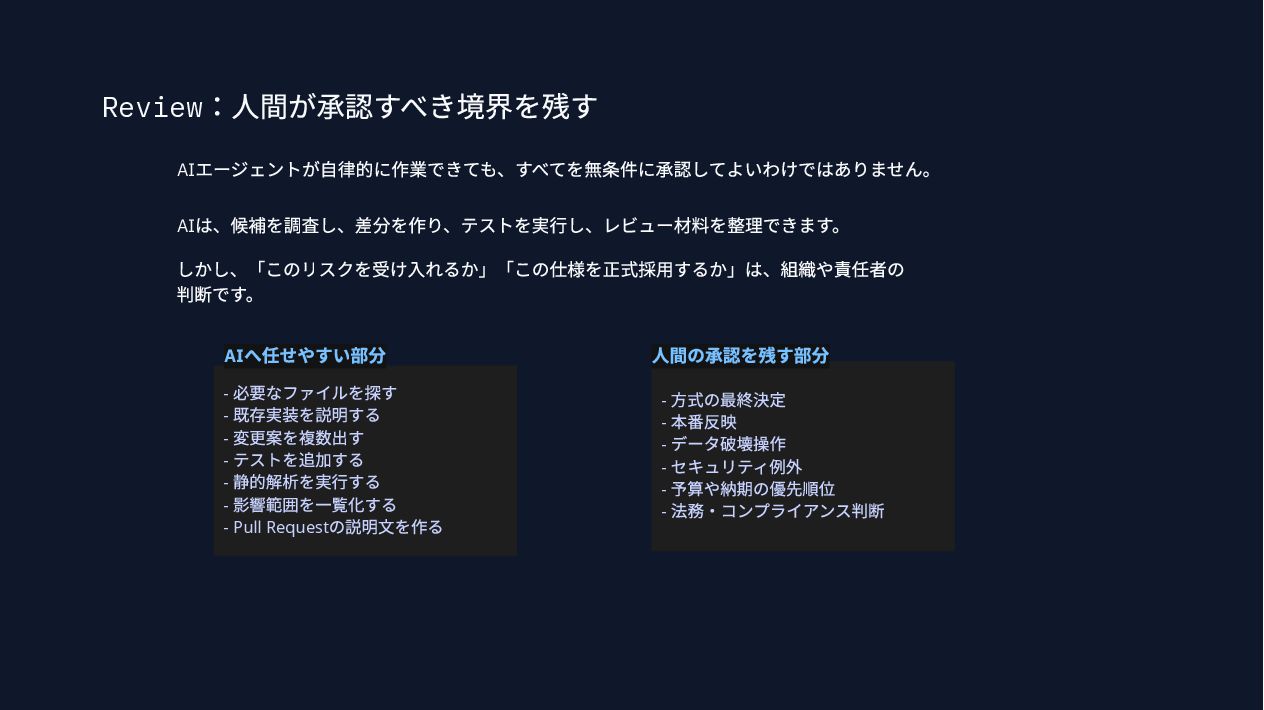
Review :人間が 承認すべき境界を 残す AI エージェントが 自律的に 作業できても、 すべてを 無条件に
承認して よいわけでは ありません。 AI は、 候補を 調査し、 差分を 作り、 テストを 実行し、 レビュー材料を 整理できます。 しかし、 「この リスクを 受け入れるか」 「この 仕様を 正式採用するか」は、 組織や 責任者の 判断です。 - 必要な ファイルを 探す - 既存実装を 説明する - 変更案を 複数出す - テストを 追加する - 静的解析を 実行する - 影響範囲を 一覧化する - Pull Request の 説明文を 作る - 方 式の 最終決定 - 本番反映 - データ破壊操作 - セキュリティ例外 - 予算や 納期の 優先順位 - 法務・コンプライアンス判断 AI へ 任せやすい 部 分 人間の 承認を 残す部 分 -
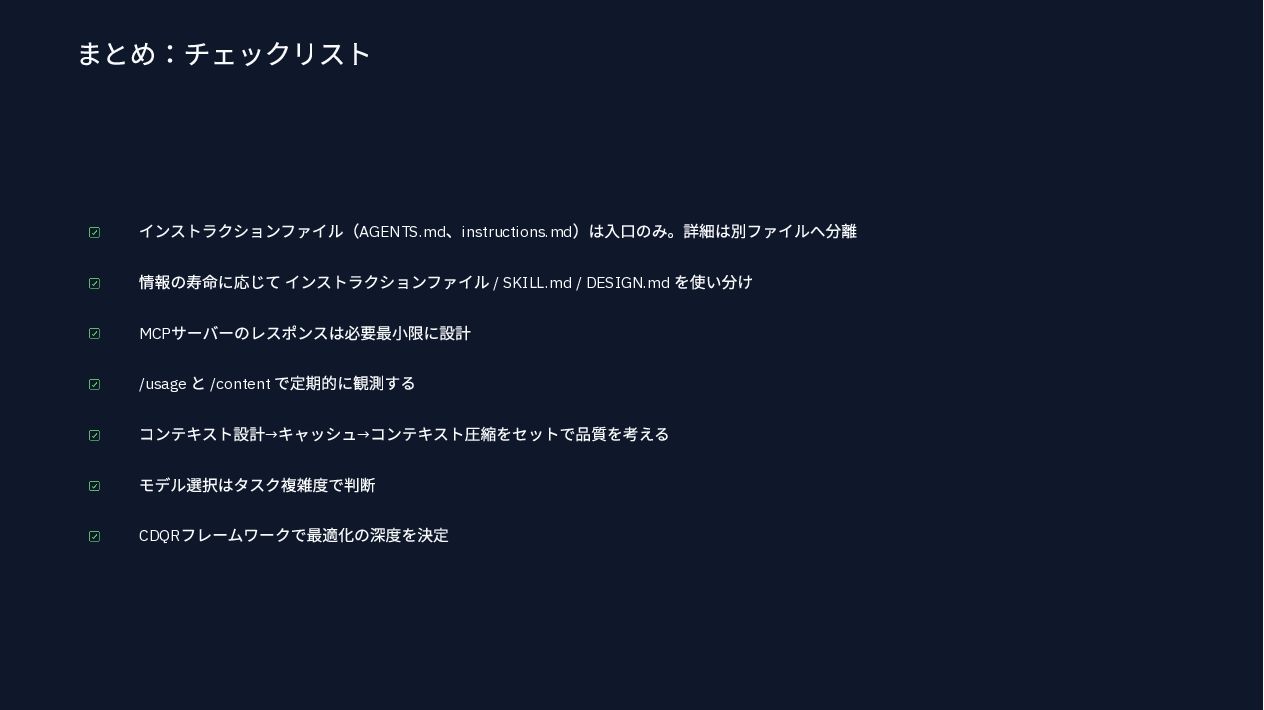
まとめ:チェックリスト インストラクションファイル (AGENTS.md 、 instructions.md )は 入口のみ。 詳細は 別ファイルへ 分離
情報の 寿命に 応じて インストラクションファイル / SKILL.md / DESIGN.md を 使い分け MCP サーバーのレスポンスは必要最小限に設計 /usage と /content で定期的に観測する コンテキスト設計→ キャッシュ→ コンテキスト圧縮を セットで 品質を 考える モデル選択はタスク複雑度で判断 CDQR フレームワークで 最適化の 深度を 決定