Share
Embed
Elasticsearch
Presentation held at the JavaLand Conference in Brühl, Germany, on March 25, 2014.
Patrick Peschlow
March 25, 2014
Transcript
63 slides
-
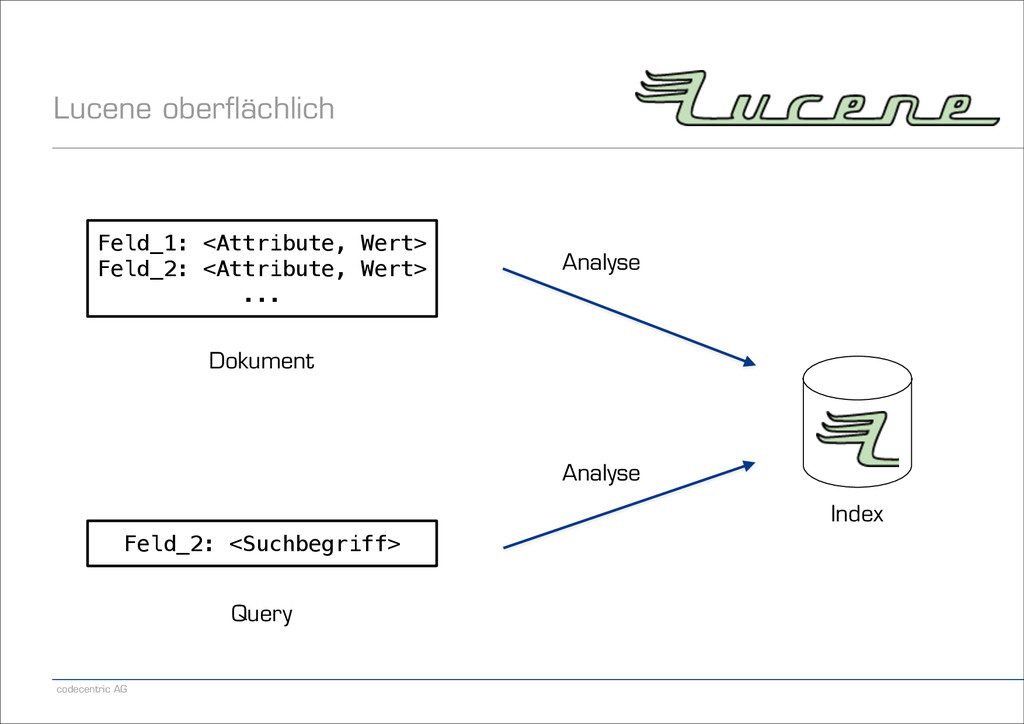
codecentric AG Lucene oberflächlich Feld_1: <Attribute, Wert> Feld_2: <Attribute, Wert>
... Dokument Analyse Index Feld_2: <Suchbegriff> Query Analyse -
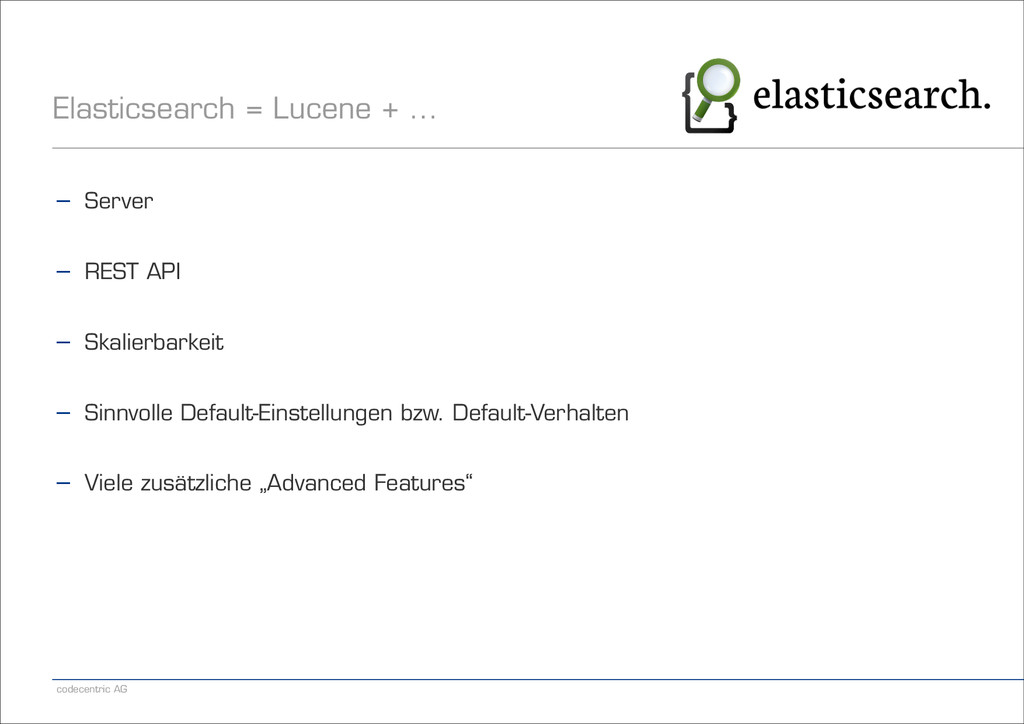
codecentric AG Elasticsearch = Lucene + … − Server !
− REST API ! − Skalierbarkeit ! − Sinnvolle Default-Einstellungen bzw. Default-Verhalten ! − Viele zusätzliche „Advanced Features“ -
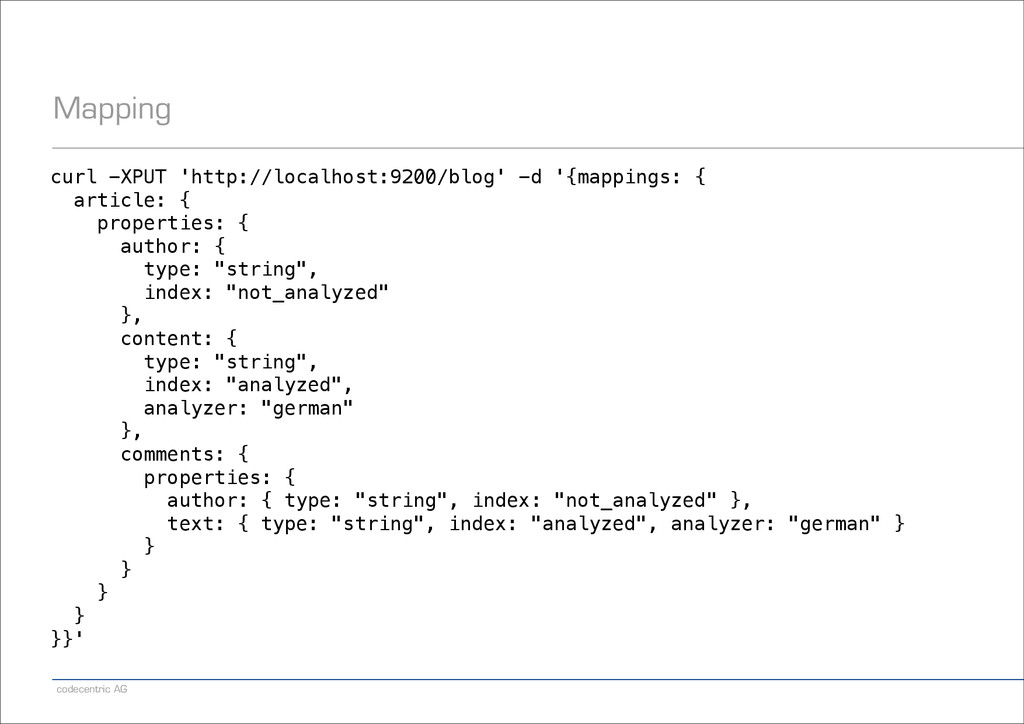
codecentric AG Mapping curl -XPUT 'http://localhost:9200/blog' -d '{mappings: { article:
{ properties: { author: { type: "string", index: "not_analyzed" }, content: { type: "string", index: "analyzed", analyzer: "german" }, comments: { properties: { author: { type: "string", index: "not_analyzed" }, text: { type: "string", index: "analyzed", analyzer: "german" } } } } } }}' -
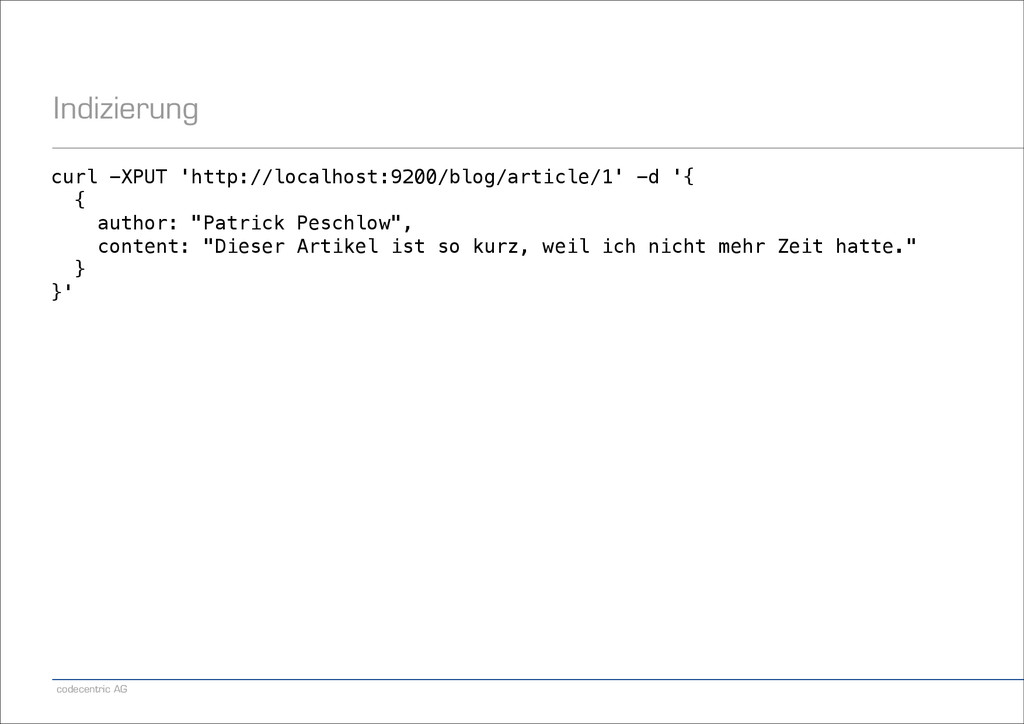
codecentric AG Indizierung curl -XPUT 'http://localhost:9200/blog/article/1' -d '{ { author:
"Patrick Peschlow", content: "Dieser Artikel ist so kurz, weil ich nicht mehr Zeit hatte." } }' -
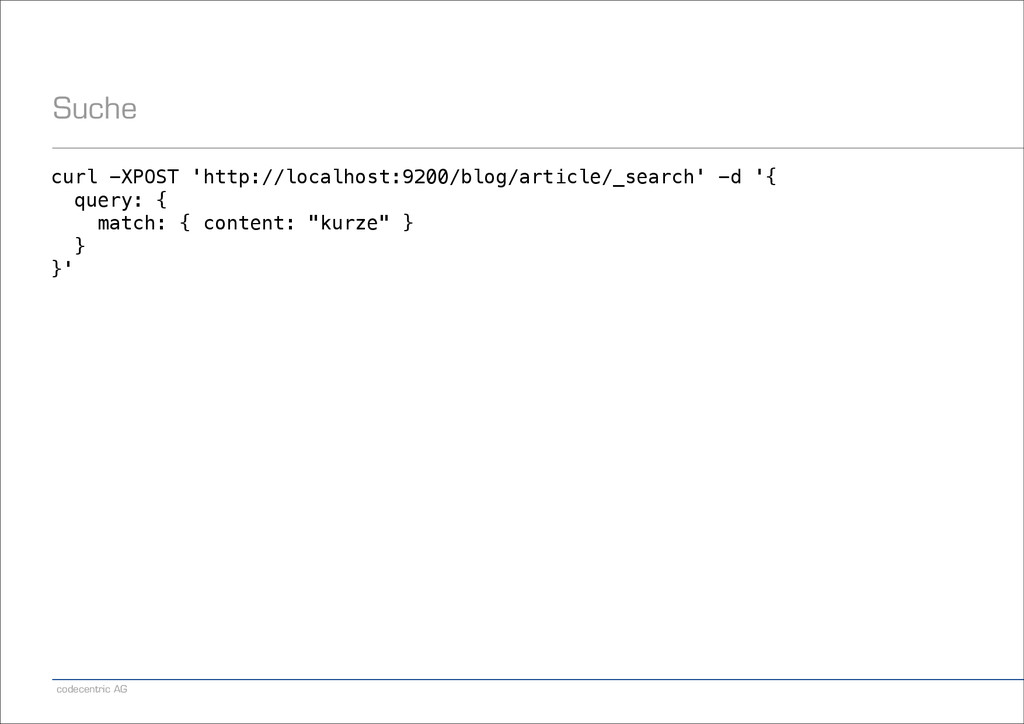
codecentric AG Suche curl -XPOST 'http://localhost:9200/blog/article/_search' -d '{ query: {
match: { content: "kurze" } } }' -
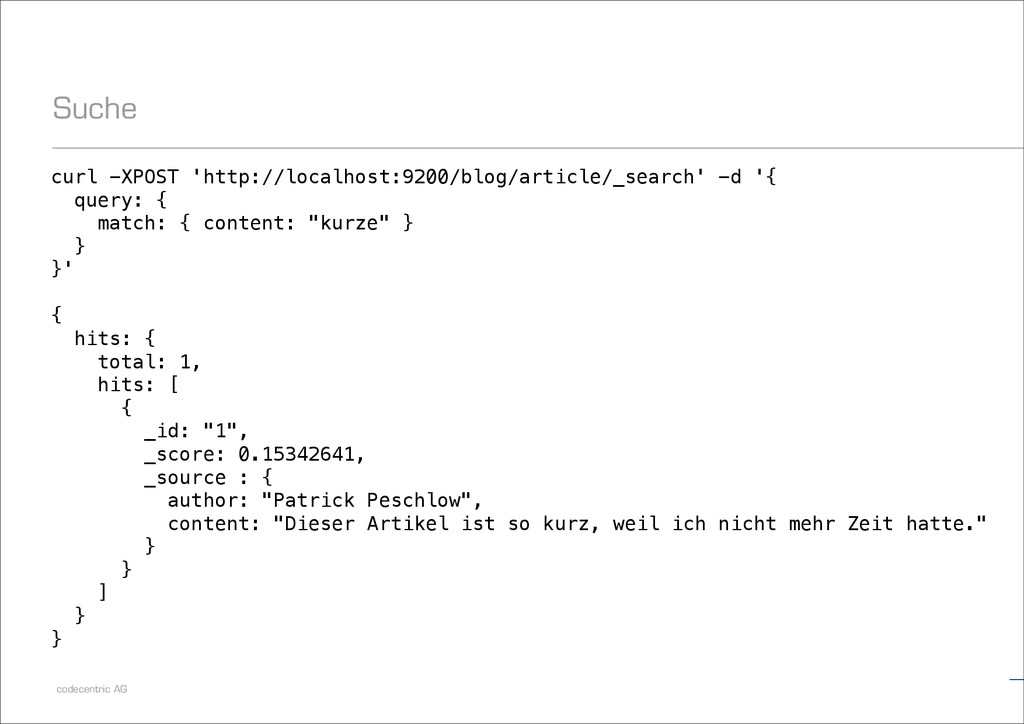
codecentric AG Suche curl -XPOST 'http://localhost:9200/blog/article/_search' -d '{ query: {
match: { content: "kurze" } } }' ! { hits: { total: 1, hits: [ { _id: "1", _score: 0.15342641, _source : { author: "Patrick Peschlow", content: "Dieser Artikel ist so kurz, weil ich nicht mehr Zeit hatte." } } ] } } -
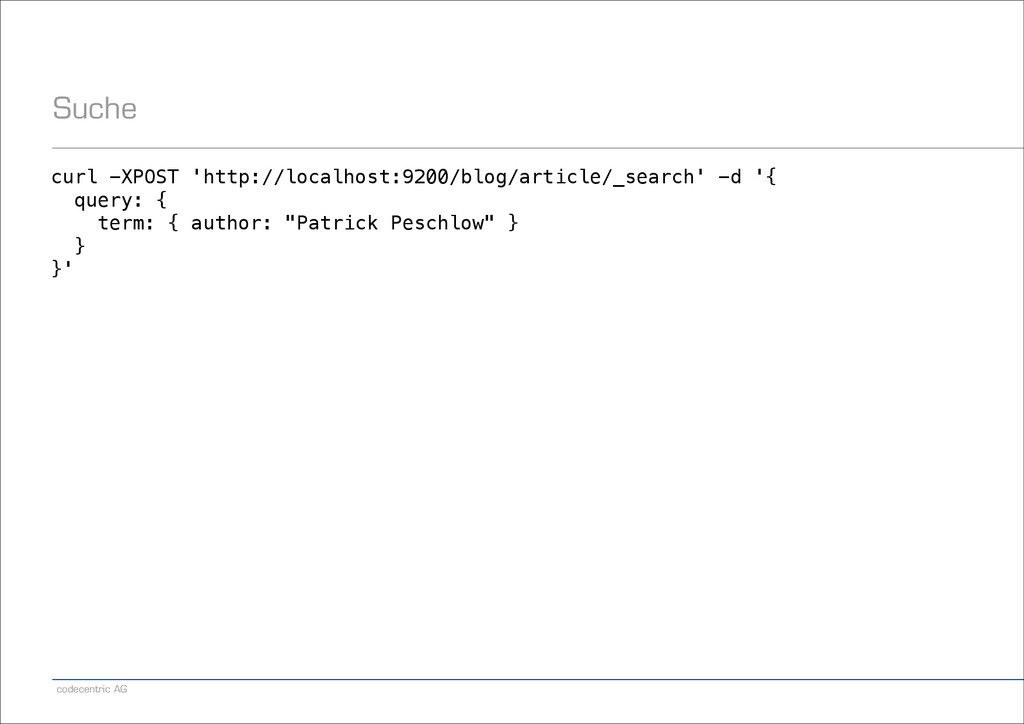
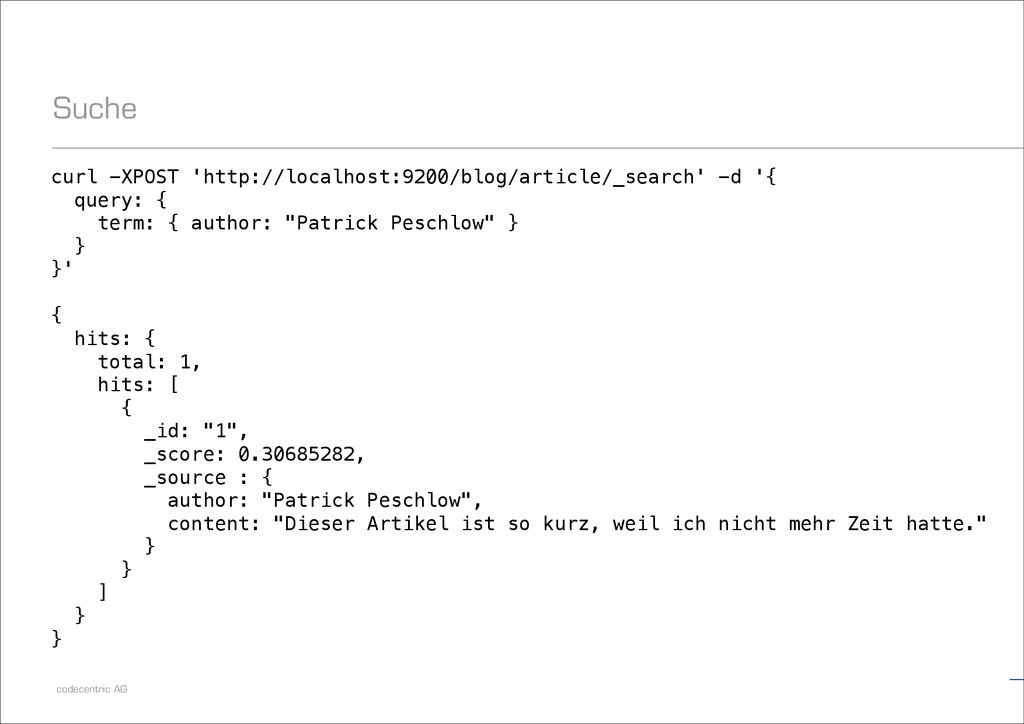
codecentric AG Suche curl -XPOST 'http://localhost:9200/blog/article/_search' -d '{ query: {
term: { author: "Patrick Peschlow" } } }' -
codecentric AG Suche curl -XPOST 'http://localhost:9200/blog/article/_search' -d '{ query: {
term: { author: "Patrick Peschlow" } } }' ! { hits: { total: 1, hits: [ { _id: "1", _score: 0.30685282, _source : { author: "Patrick Peschlow", content: "Dieser Artikel ist so kurz, weil ich nicht mehr Zeit hatte." } } ] } } -
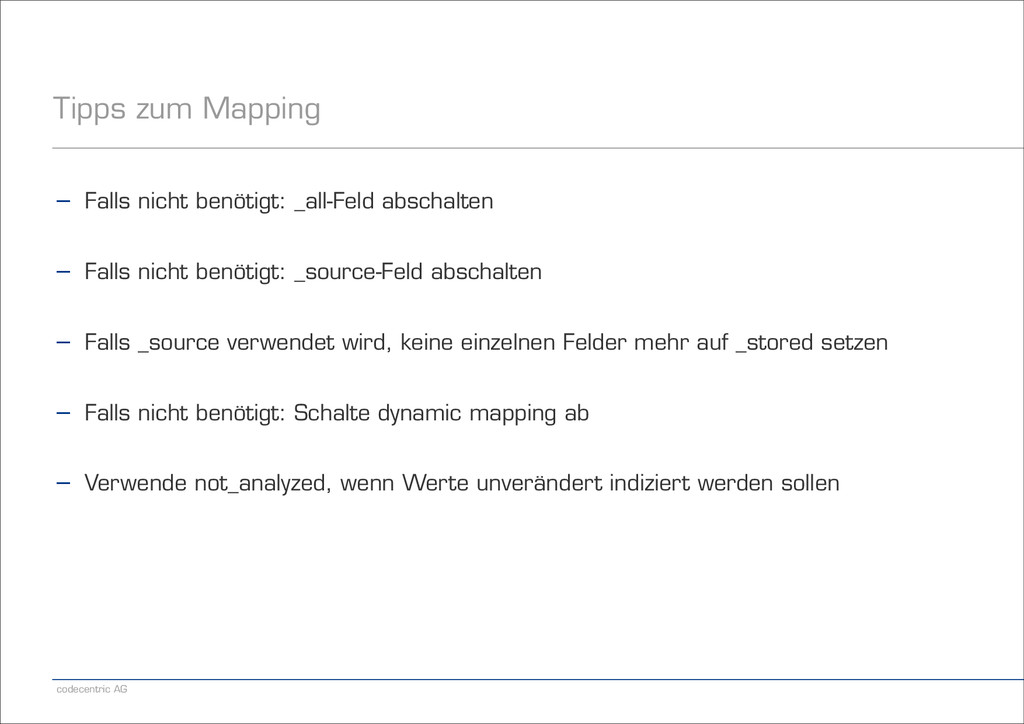
codecentric AG Tipps zum Mapping − Falls nicht benötigt: _all-Feld
abschalten ! − Falls nicht benötigt: _source-Feld abschalten ! − Falls _source verwendet wird, keine einzelnen Felder mehr auf _stored setzen ! − Falls nicht benötigt: Schalte dynamic mapping ab ! − Verwende not_analyzed, wenn Werte unverändert indiziert werden sollen -
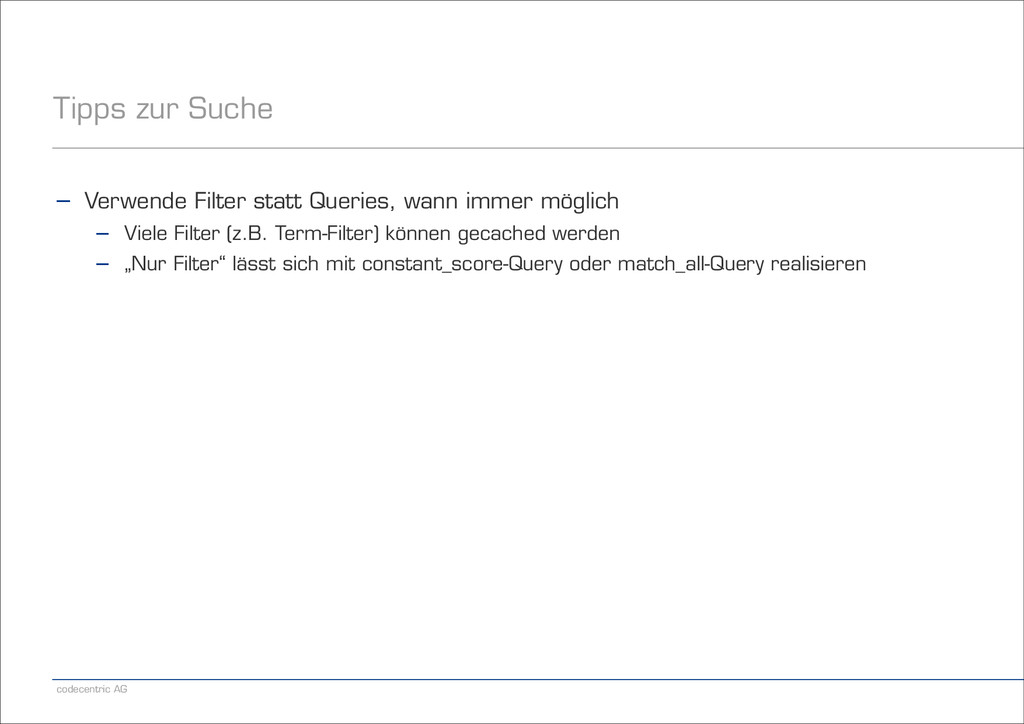
codecentric AG Tipps zur Suche − Verwende Filter statt Queries,
wann immer möglich − Viele Filter (z.B. Term-Filter) können gecached werden − „Nur Filter“ lässt sich mit constant_score-Query oder match_all-Query realisieren -
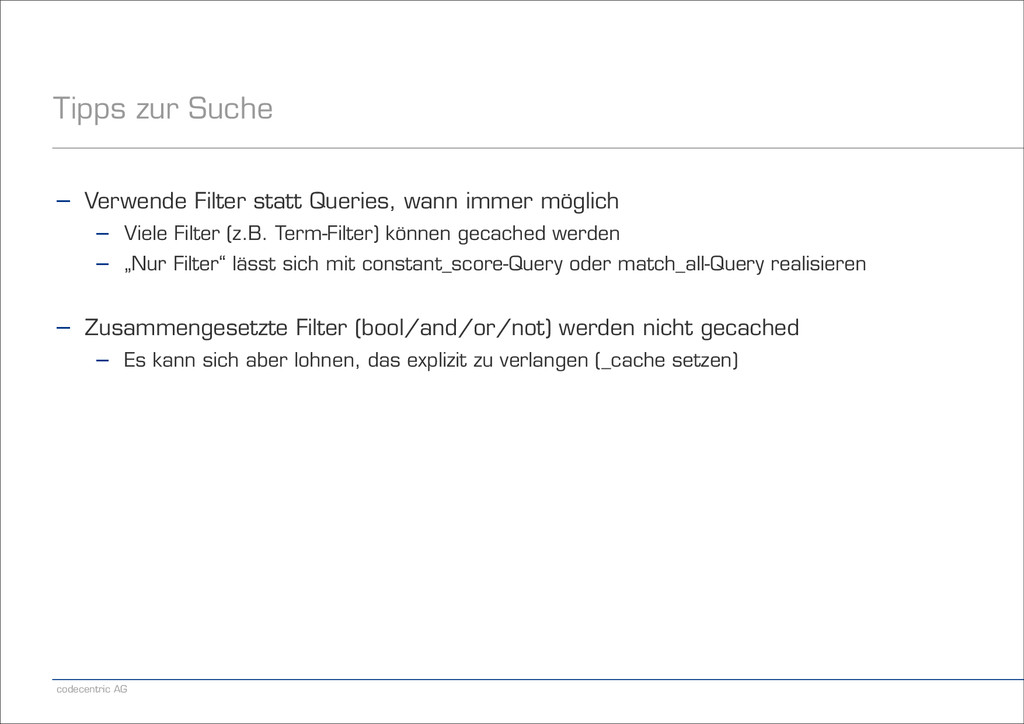
codecentric AG Tipps zur Suche − Verwende Filter statt Queries,
wann immer möglich − Viele Filter (z.B. Term-Filter) können gecached werden − „Nur Filter“ lässt sich mit constant_score-Query oder match_all-Query realisieren ! − Zusammengesetzte Filter (bool/and/or/not) werden nicht gecached − Es kann sich aber lohnen, das explizit zu verlangen (_cache setzen) -
codecentric AG Tipps zur Suche − Verwende Filter statt Queries,
wann immer möglich − Viele Filter (z.B. Term-Filter) können gecached werden − „Nur Filter“ lässt sich mit constant_score-Query oder match_all-Query realisieren ! − Zusammengesetzte Filter (bool/and/or/not) werden nicht gecached − Es kann sich aber lohnen, das explizit zu verlangen (_cache setzen) ! − Bevorzuge bool-Filter vor and/or/not, wenn sie Cached-Filter kombinieren − Denn and/or/not benutzen den Cache nicht (aber: andere Vorteile) -
codecentric AG Tipps zur Suche − Verwende Filter statt Queries,
wann immer möglich − Viele Filter (z.B. Term-Filter) können gecached werden − „Nur Filter“ lässt sich mit constant_score-Query oder match_all-Query realisieren ! − Zusammengesetzte Filter (bool/and/or/not) werden nicht gecached − Es kann sich aber lohnen, das explizit zu verlangen (_cache setzen) ! − Bevorzuge bool-Filter vor and/or/not, wenn sie Cached-Filter kombinieren − Denn and/or/not benutzen den Cache nicht (aber: andere Vorteile) ! − Es gibt verschiedene Möglichkeiten, Filter anzuwenden − Je nachdem findet die Ausführung vor oder nach dem Query statt − Beeinflusst den Scope von Facetten im selben Request − Meistens ist „filtered query“ das, was man benötigt -
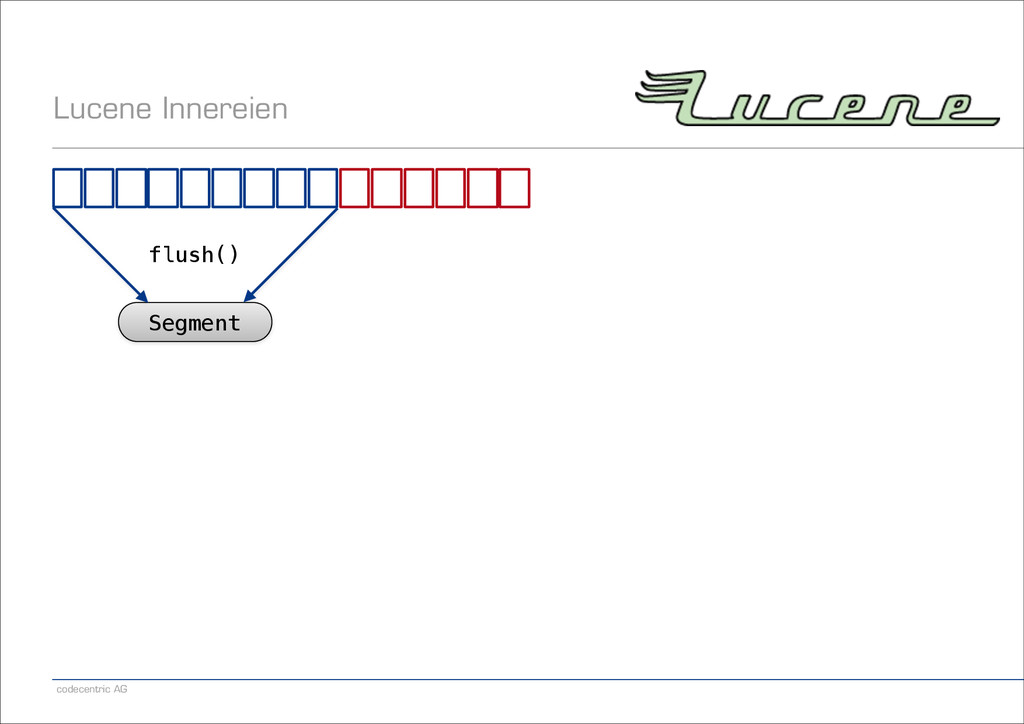
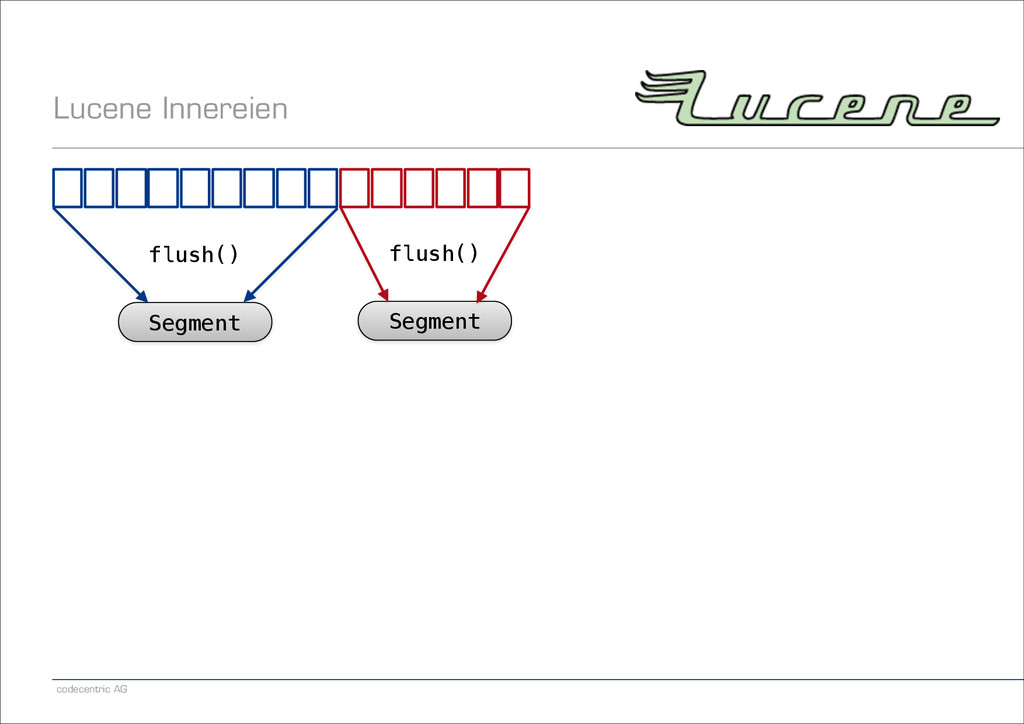
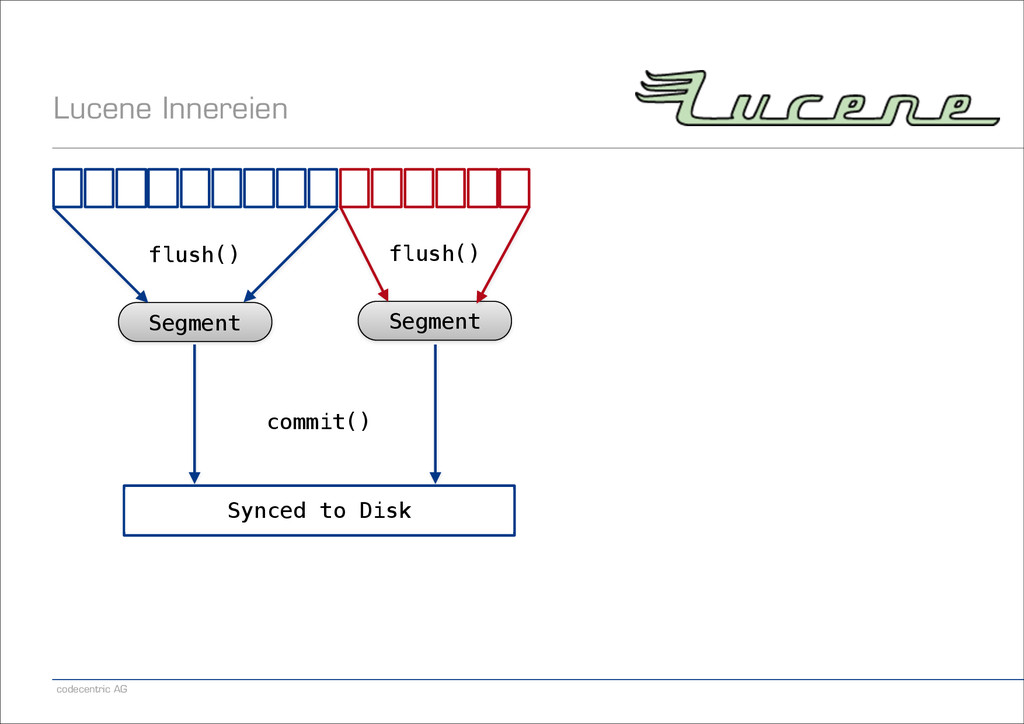
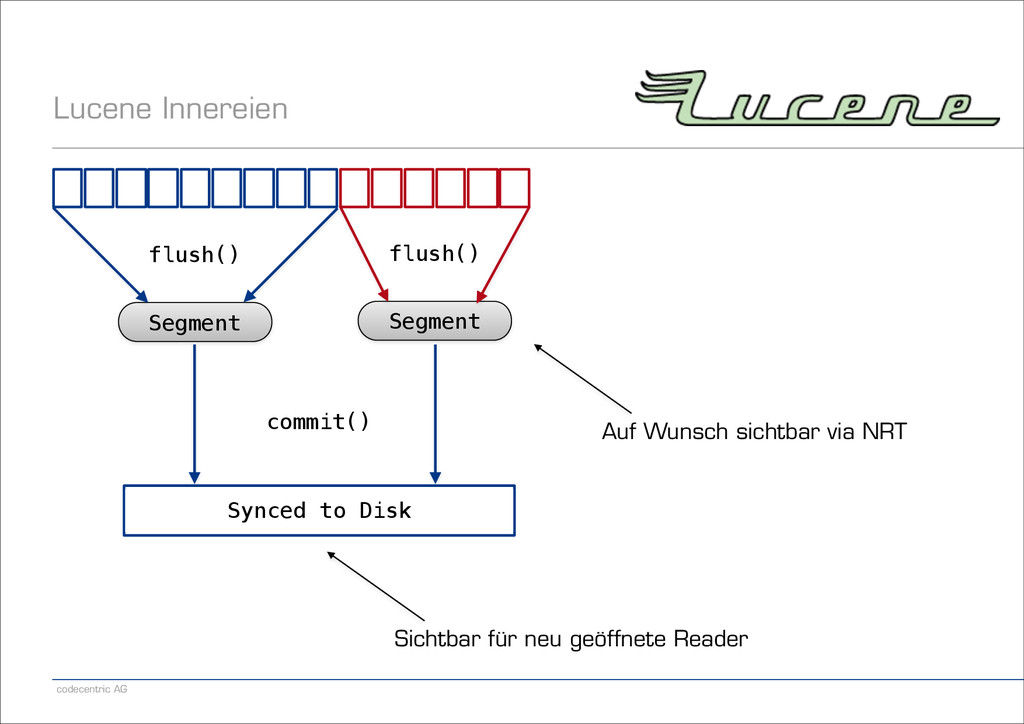
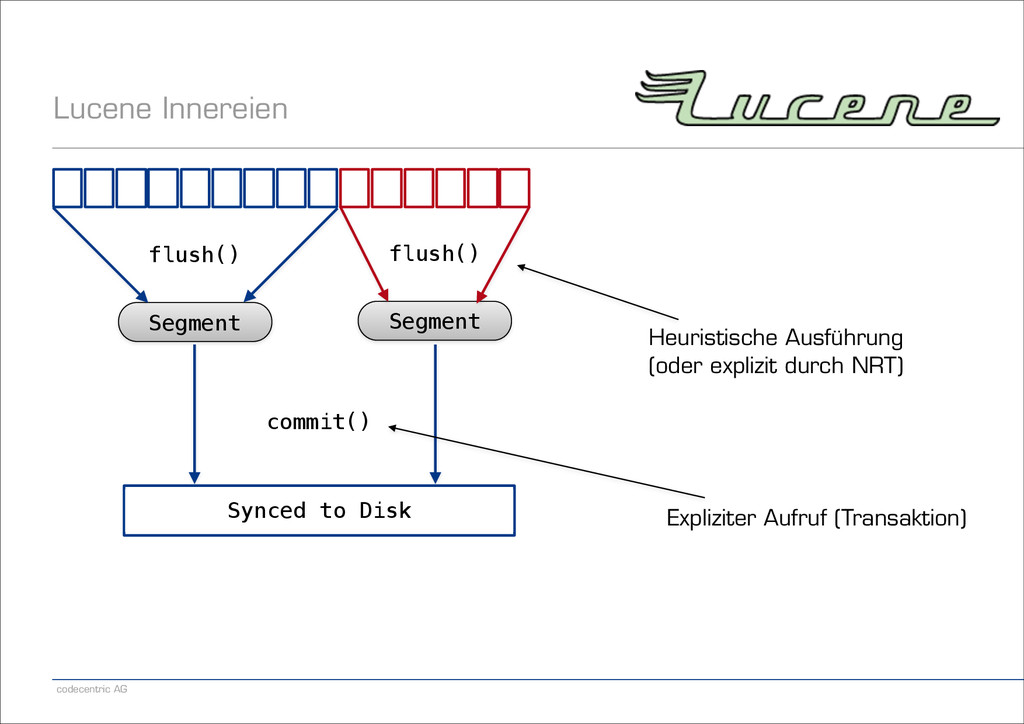
codecentric AG Lucene Innereien Sichtbar für neu geöffnete Reader Segment
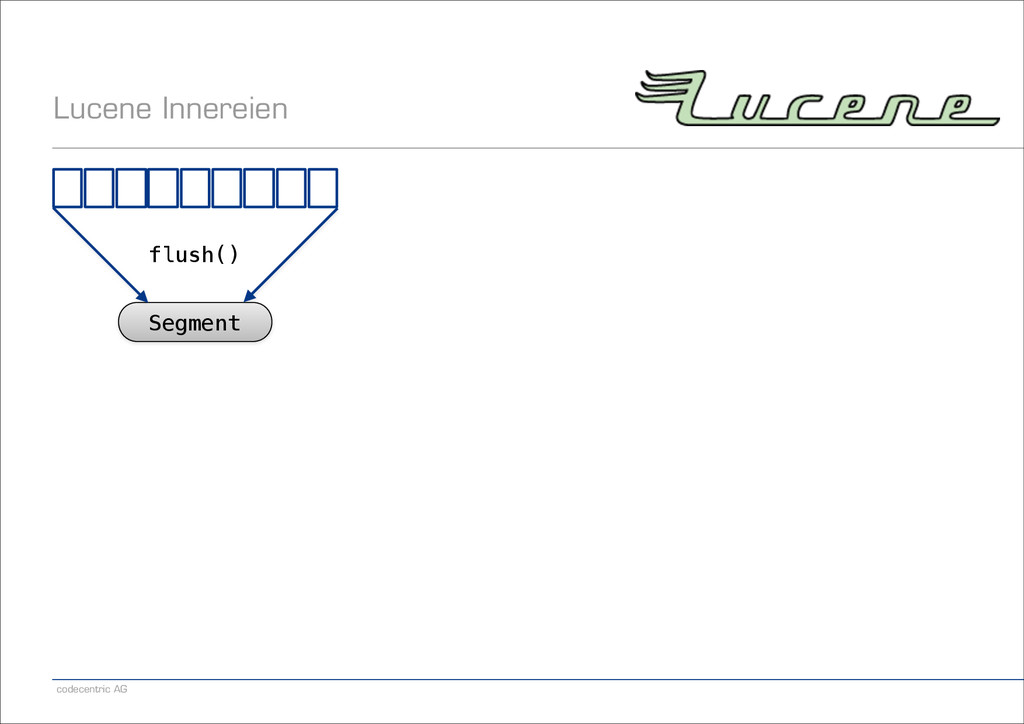
flush() Segment flush() commit() Synced to Disk Auf Wunsch sichtbar via NRT -
codecentric AG Lucene Innereien Segment flush() Segment flush() commit() Synced
to Disk Heuristische Ausführung (oder explizit durch NRT) Expliziter Aufruf (Transaktion) -
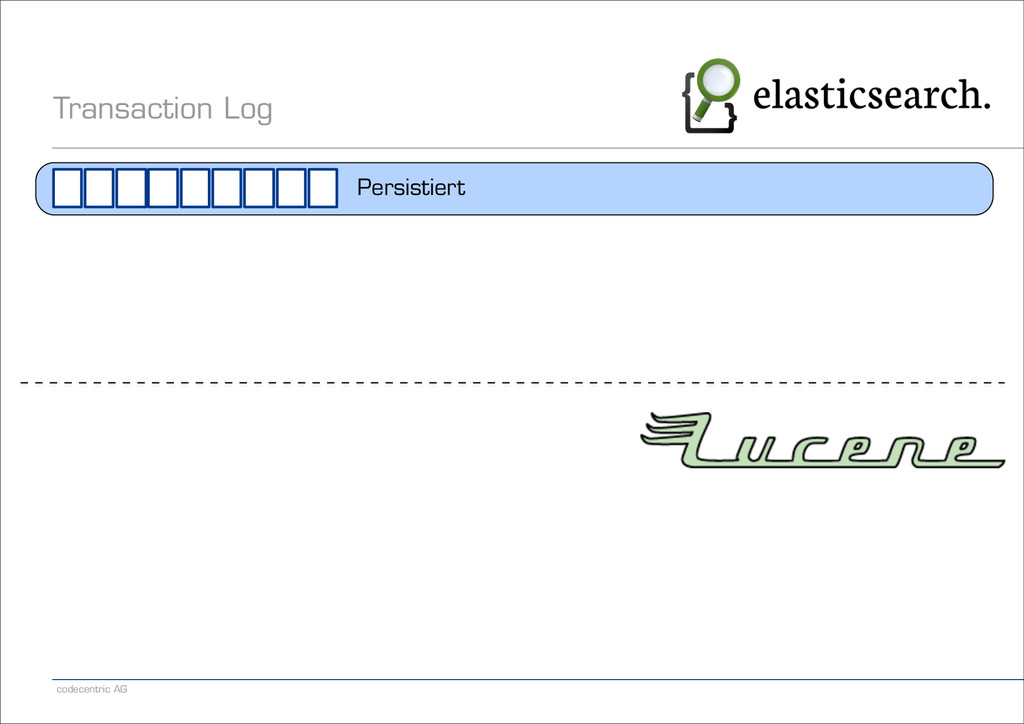
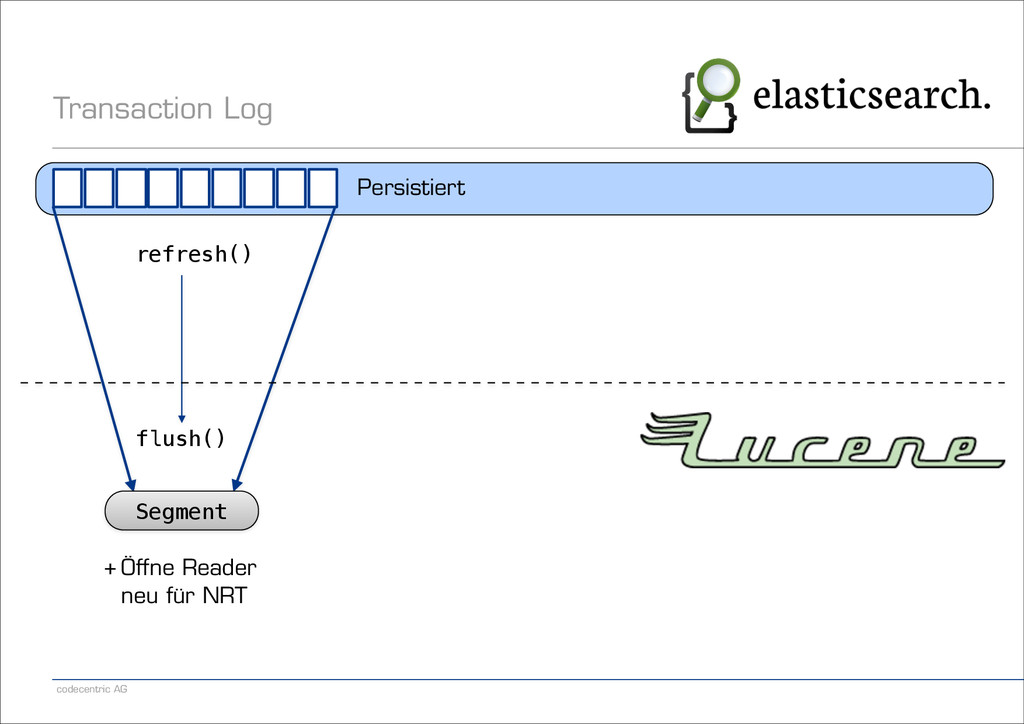
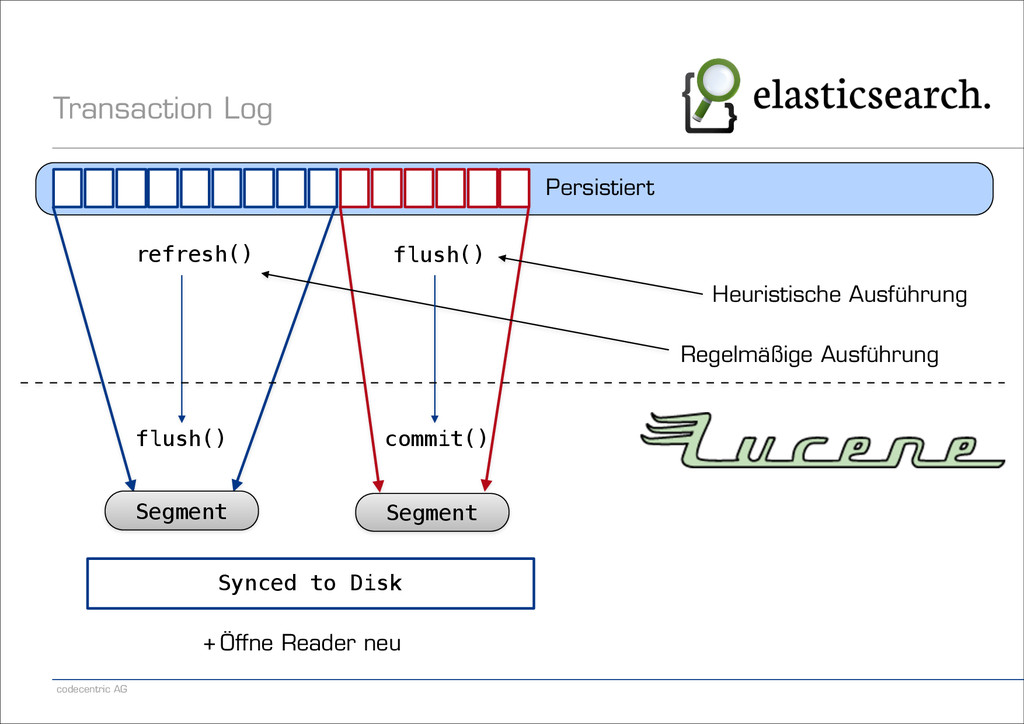
codecentric AG Transaction Log Persistiert + Öffne Reader neu für
NRT refresh() Segment flush() -
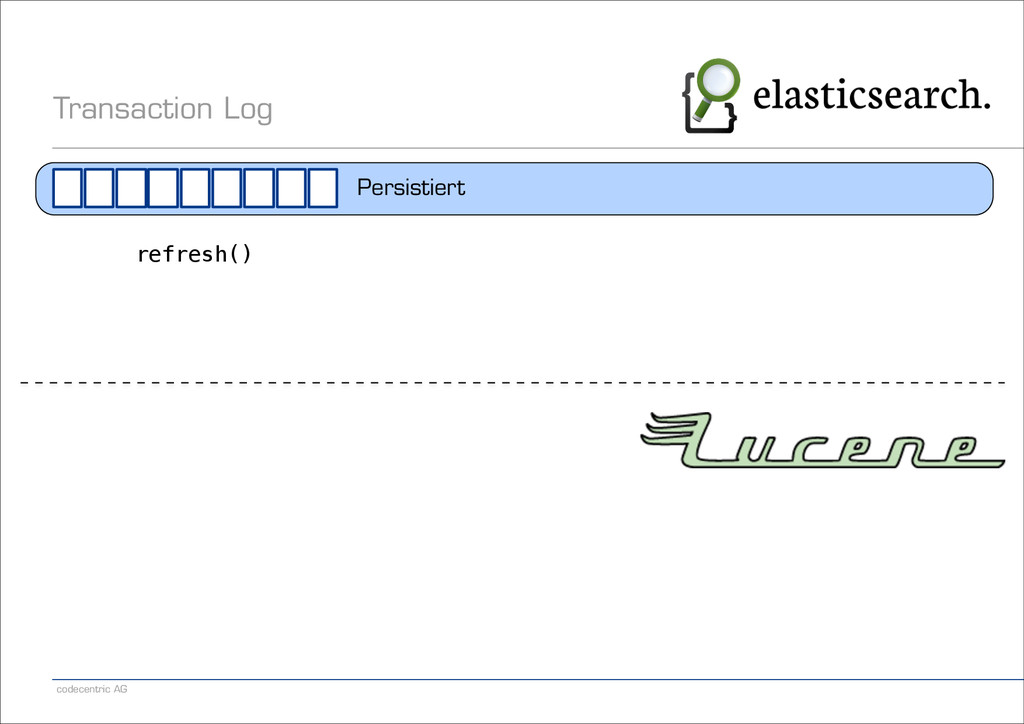
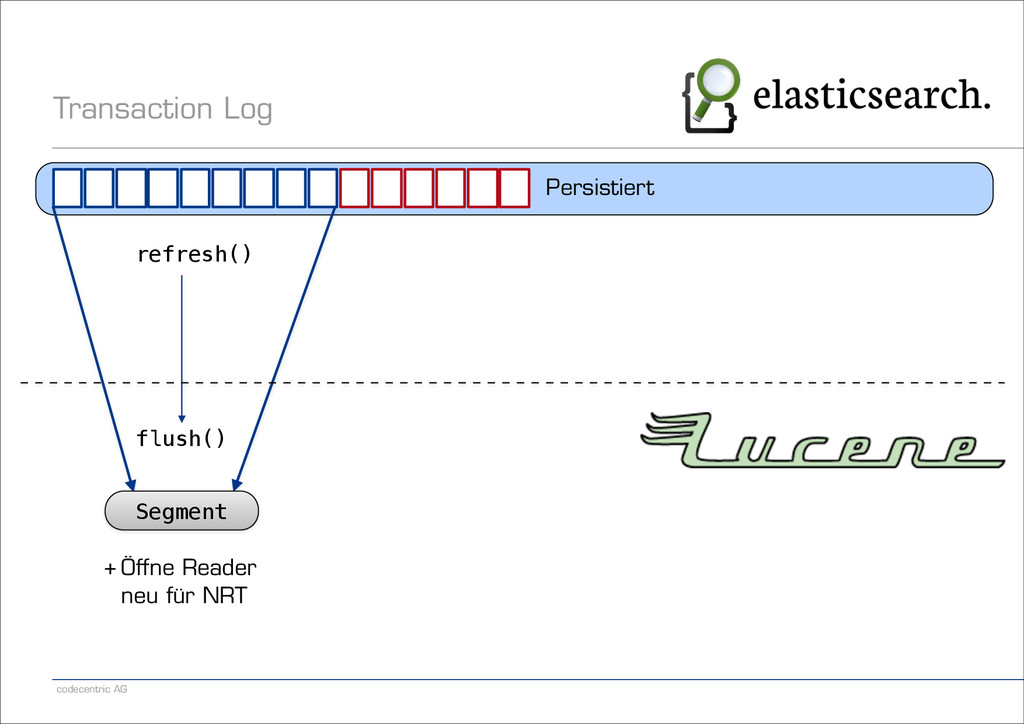
codecentric AG Transaction Log Persistiert + Öffne Reader neu für
NRT refresh() Segment flush() -
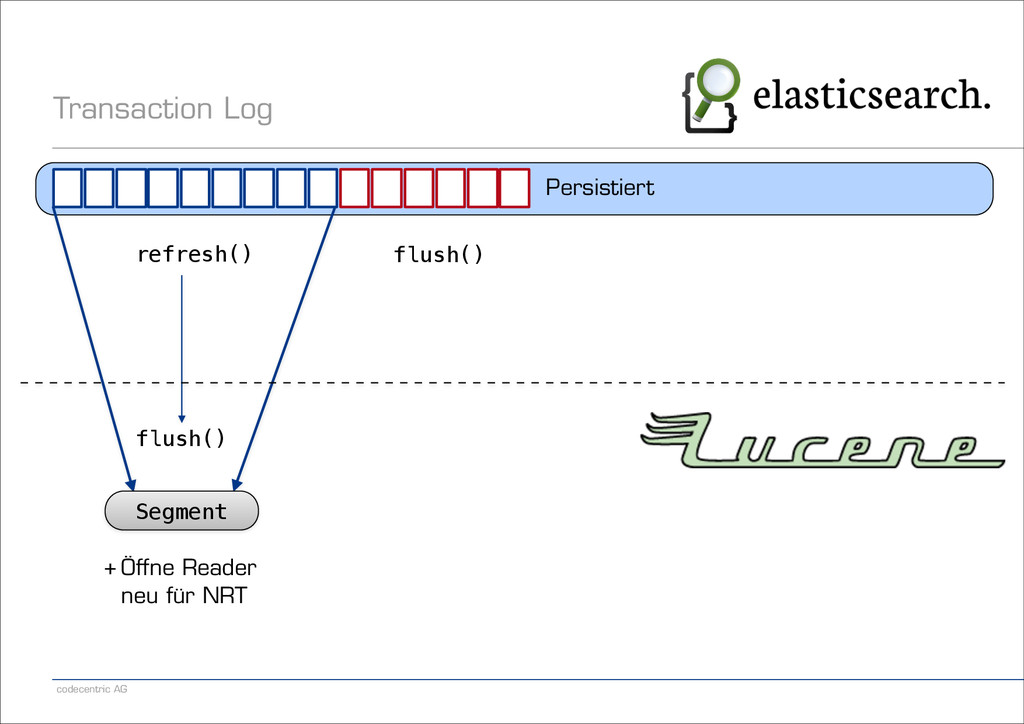
codecentric AG Transaction Log flush() Persistiert + Öffne Reader neu
für NRT refresh() Segment flush() -
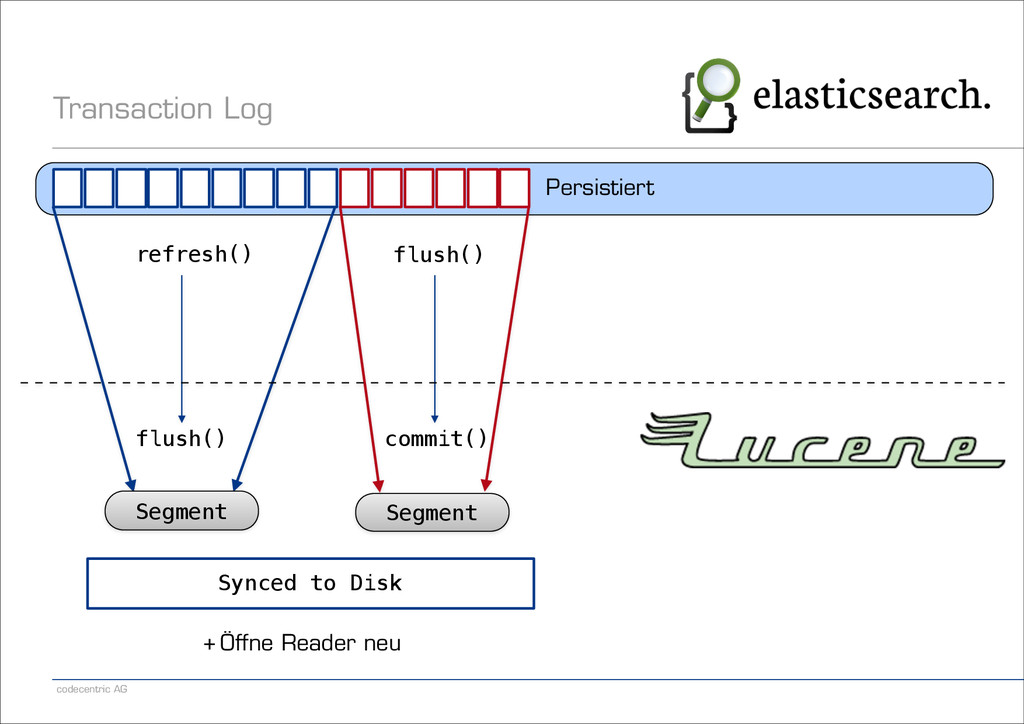
codecentric AG Transaction Log Segment flush() Synced to Disk Persistiert
refresh() Segment flush() commit() + Öffne Reader neu -
codecentric AG Transaction Log Segment flush() Persistiert refresh() Segment flush()
Heuristische Ausführung Regelmäßige Ausführung commit() Synced to Disk + Öffne Reader neu -
codecentric AG Transaction Log Alle Dokumente persistiert und suchbar: Transaction
Log kann geleert werden -
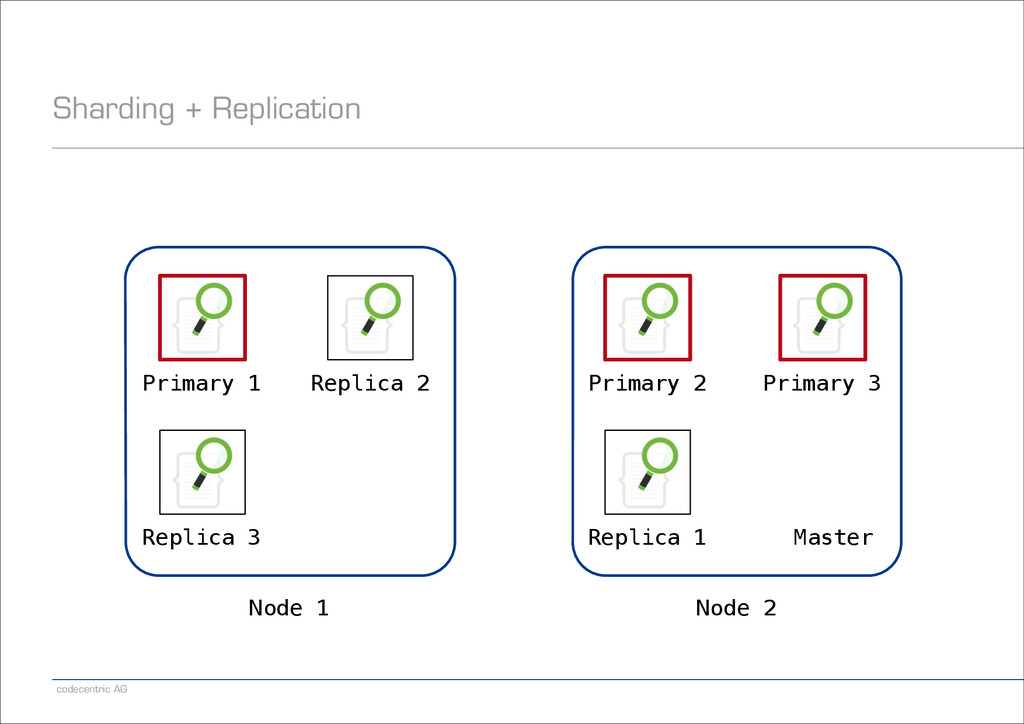
codecentric AG Sharding + Replication Node 1 Node 2 Primary
1 Primary 2 Primary 3 Replica 2 Replica 3 Replica 1 Master -
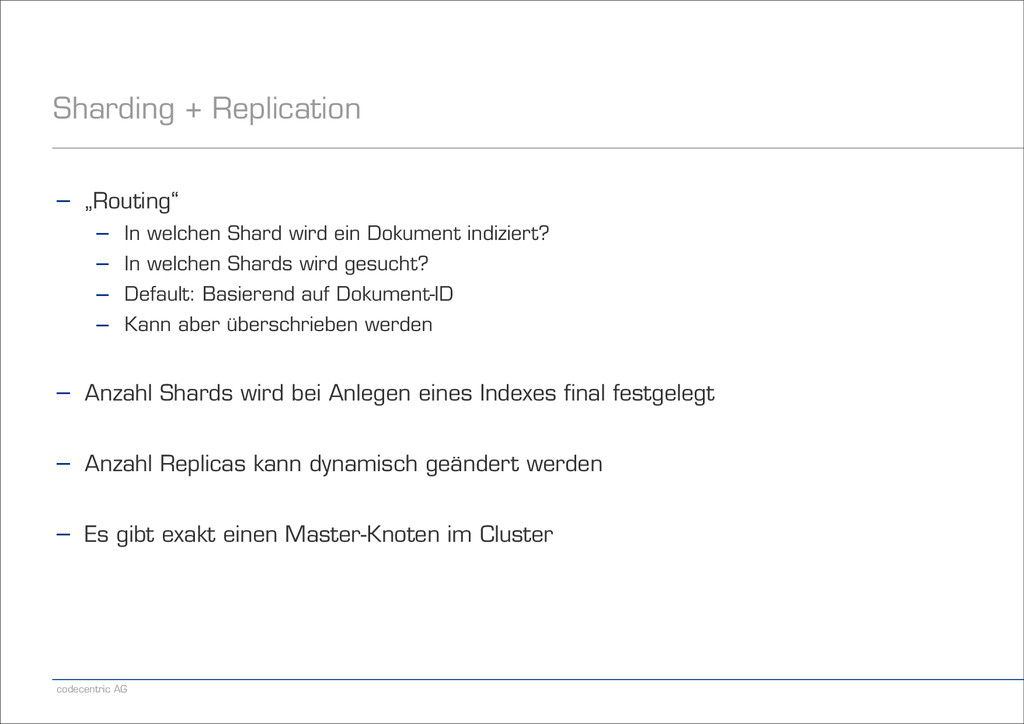
codecentric AG Sharding + Replication − „Routing“ − In welchen
Shard wird ein Dokument indiziert? − In welchen Shards wird gesucht? − Default: Basierend auf Dokument-ID − Kann aber überschrieben werden ! − Anzahl Shards wird bei Anlegen eines Indexes final festgelegt ! − Anzahl Replicas kann dynamisch geändert werden ! − Es gibt exakt einen Master-Knoten im Cluster -
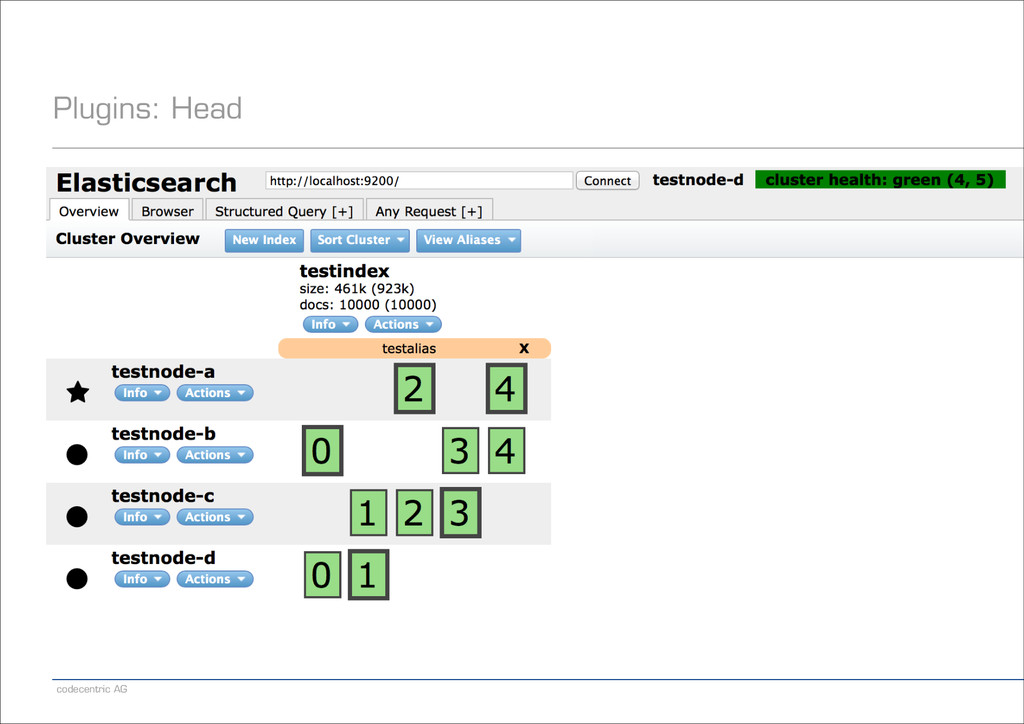
codecentric AG Cluster-Status − „Shard-Status“ − rot = Primary Shard
ist nicht angelegt − gelb = Primary Shard ist angelegt, aber nicht alle verlangten Replicas − grün = Alle Shards sind angelegt ! − „Index-Status“ = Schlechtester Status aller Shards des Indexes ! − „Cluster-Status“ = Schlechtester Status aller Indexe des Clusters ! − „Wait Until“: Möglichkeit, auf den gewünschten Status zu warten ! − Beachte: Auch bei Cluster-Status Rot funktioniert noch so einiges! -
codecentric AG Tipps zum Cluster − Cluster-Zugang absichern − Eindeutiger
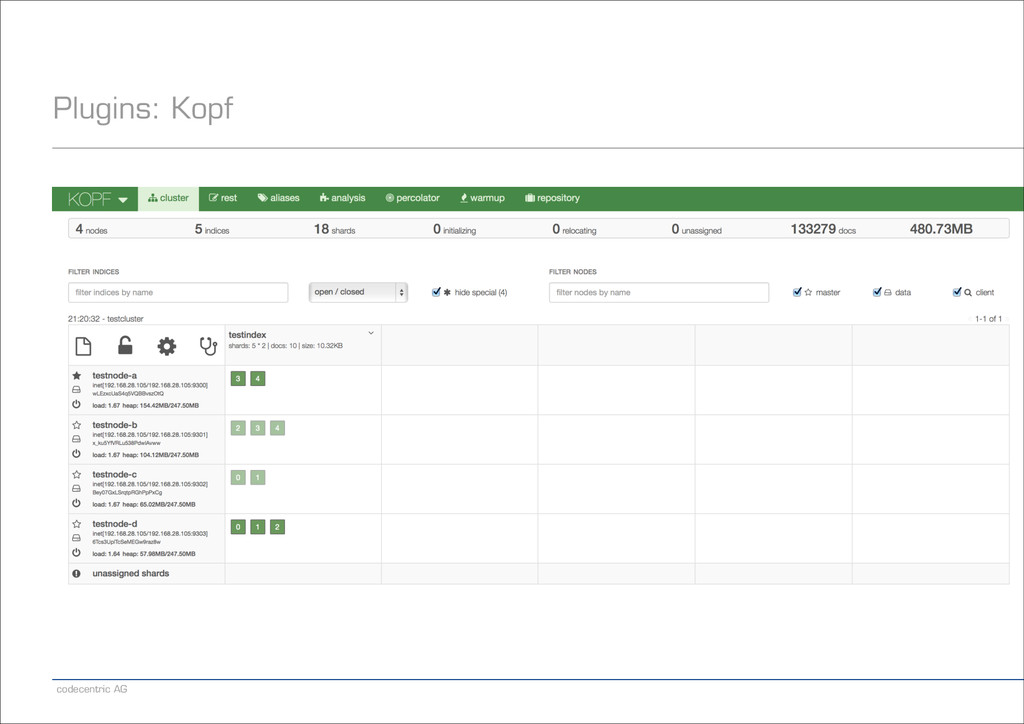
Cluster-Name − Unicast- vs. Multicast-Discovery ! − Allocation Awareness − Praktisch beliebige Regeln, damit Shards nur auf bestimmten Knoten angelegt werden − Indizes können ebenfalls Einschränkungen definieren ! − Knoten können verschiedene Fähigkeiten haben − „master“, „data“, „client“ − Ermöglicht Architektur mit Aggregator-Knoten ! − Gefährlicher Default: minimum_master_nodes = 1 -
codecentric AG Konsistenz-Parameter bei Indizierung − „consistency“ − Werte: all,
quorum, one − Default: quorum − Wie viele Shards müssen da sein, damit die Operation zulässig ist? ! − „replication=async“ − Kehrt bereits nach Indizierung auf dem Primary Shard zurück − Default: Vollständige Replikation wird abgewartet -
codecentric AG Konsistenz-Parameter bei Suche − „preference“ − Legt fest,
auf welchem Shard die Suche ausgeführt werden darf − Werte: Lokal, nur Primary, nur bestimmte Shards, nur bestimmte Nodes, etc. − Außerdem: Beliebiger String möglich, z.B. für einheitliche Sicht pro User − Default: Round-Robin -
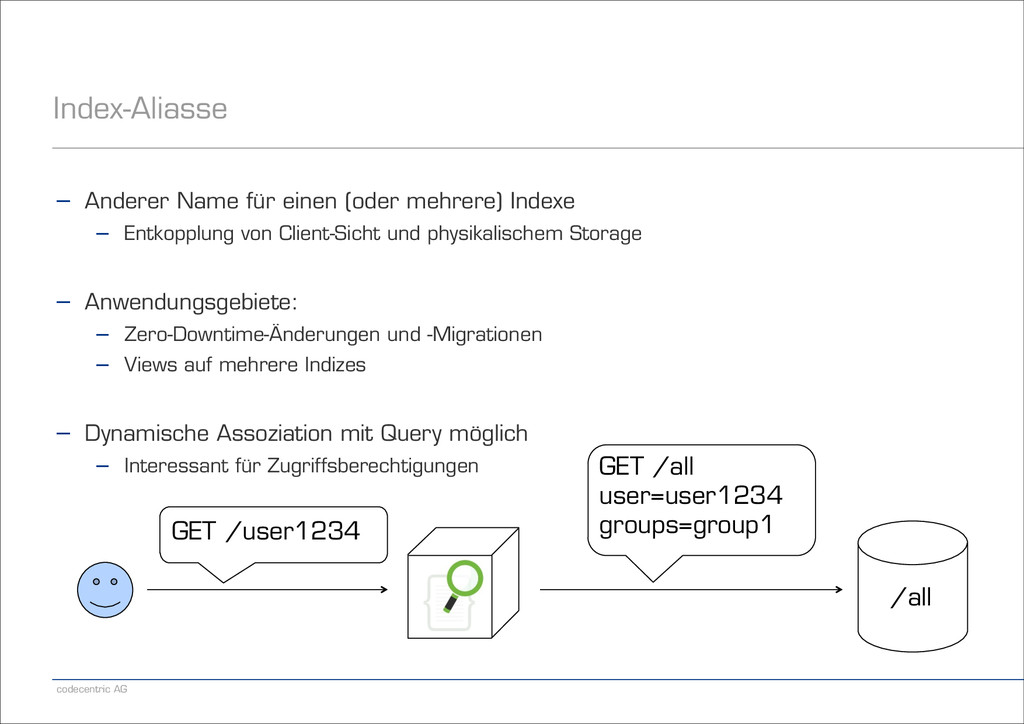
codecentric AG Index-Aliasse − Anderer Name für einen (oder mehrere)
Indexe − Entkopplung von Client-Sicht und physikalischem Storage ! − Anwendungsgebiete: − Zero-Downtime-Änderungen und -Migrationen − Views auf mehrere Indizes -
codecentric AG Index-Aliasse − Anderer Name für einen (oder mehrere)
Indexe − Entkopplung von Client-Sicht und physikalischem Storage ! − Anwendungsgebiete: − Zero-Downtime-Änderungen und -Migrationen − Views auf mehrere Indizes ! − Dynamische Assoziation mit Query möglich − Interessant für Zugriffsberechtigungen GET /user1234 GET /all user=user1234 groups=group1 /all -
codecentric AG Tipps zur Skalierung − Anzahl Shards sollte basierend
auf Schätzungen/Berechnungen gewählt werden − Eine leichte Überallokation ist in Ordnung − Andererseits nicht zu viel, denn Shards benötigen Ressourcen ! − Wenn die Datenmenge doch größer wird, helfen Aliasse − Einen weiteren, identischen Index anlegen − Neue Dokumente nur dem neuen Index hinzufügen − Ein Alias definieren, so dass in beiden Indexen gemeinsam gesucht wird − Ideal: Direkt von Beginn an mit Aliassen arbeiten ! − Merke: − Suche in einem Index mit 50 Shards = Suche in 50 Indexen mit jeweils einem Shard − Denn in beiden Fällen werden 50 Lucene-Indexe durchsucht -
codecentric AG Relationen curl -XPUT 'http://localhost:9200/blog/article/1' -d '{ { author:
"Patrick Peschlow", content: "Dieser Artikel ist so kurz, weil ich nicht mehr Zeit hatte.“, comments: [ {author: "Lukas Pustina", text: "Schade."}, {author: "Daniel Schneller", text: "Wie zu erwarten war."} ] } }' -
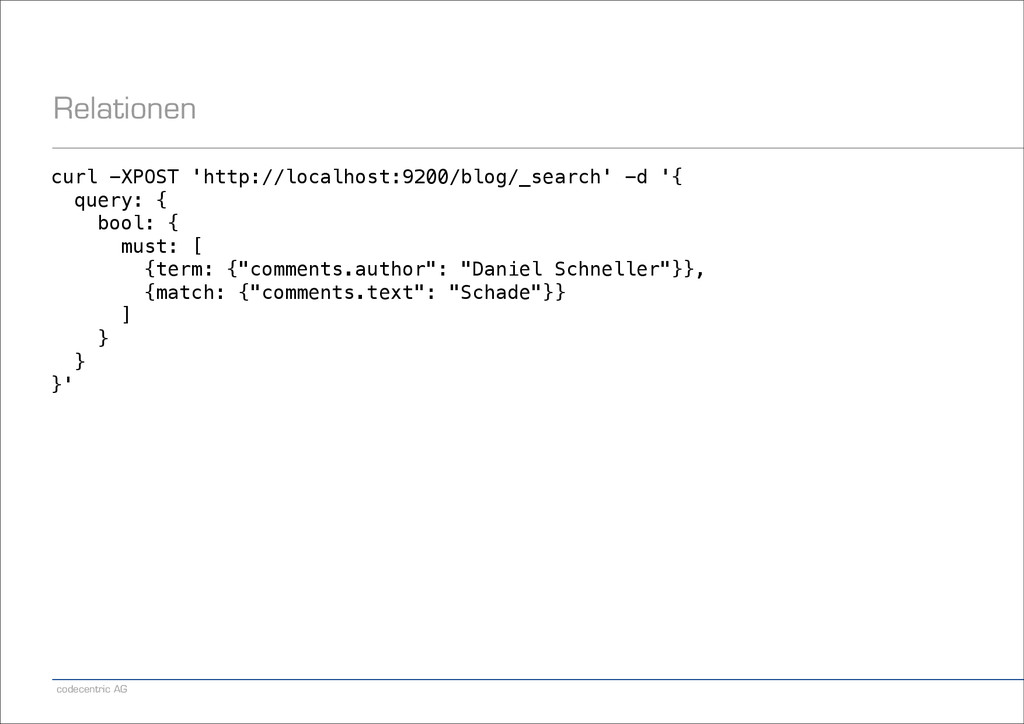
codecentric AG Relationen curl -XPOST 'http://localhost:9200/blog/_search' -d '{ query: {
bool: { must: [ {term: {"comments.author": "Daniel Schneller"}}, {match: {"comments.text": "Schade"}} ] } } }' -
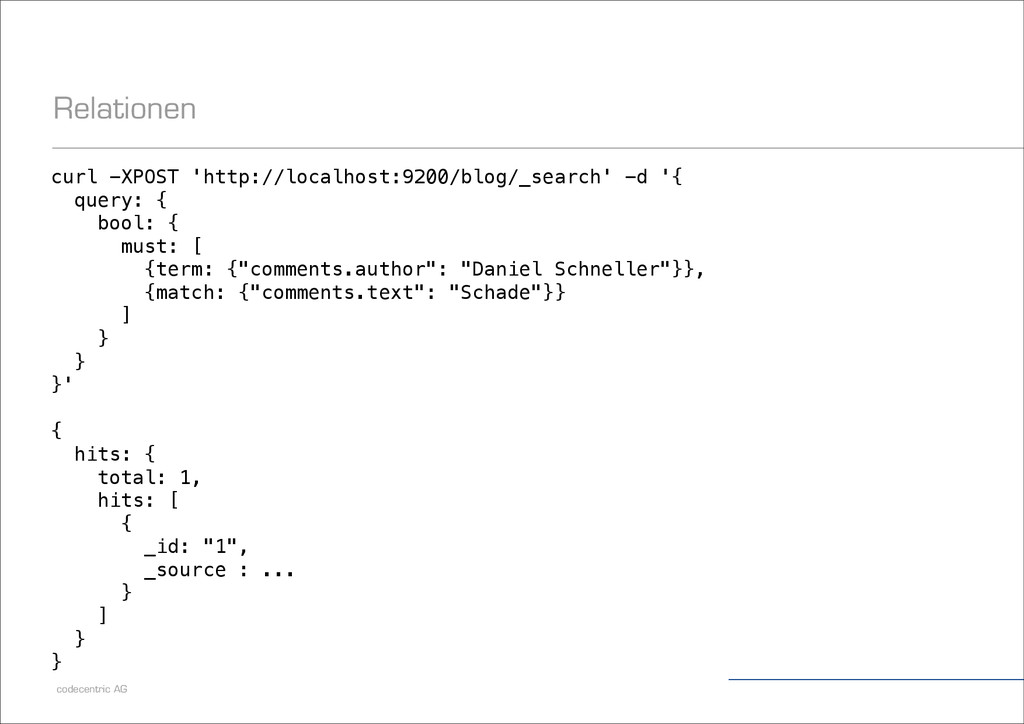
codecentric AG Relationen curl -XPOST 'http://localhost:9200/blog/_search' -d '{ query: {
bool: { must: [ {term: {"comments.author": "Daniel Schneller"}}, {match: {"comments.text": "Schade"}} ] } } }' ! { hits: { total: 1, hits: [ { _id: "1", _source : ... } ] } } -
codecentric AG Relationen − Dokumentstruktur von Lucene ist flach !
− Das gilt auch für verschachtelte JSON-Objekte bei Elasticsearch ! − Zwei Lösungen − Nested Objects − Parent/Child Mapping -
codecentric AG Percolator − Speichere Queries, um später zu prüfen
ob Dokumente matchen − Ermöglicht Suchaufträge ! − Zusätzlicher .percolate-Type im selben Index wie die eigentlichen Dokumente ! − Einschränkung: − Ab Elasticsearch 1.0 ist kein kombiniertes „Index and percolate“ mehr möglich − Es bleibt: Percolate von bereits indizierten Dokumenten − Oder: Direktes Percolate ohne Indizierung − Grund: Verteilte Implementierung des Percolators -
codecentric AG Beachtenswerte Features in Elasticsearch 1.0 − Snapshot/Restore !
− Aggregations ! − Federated Search ! − Circuit Breaker -
codecentric AG Fragen? Dr. rer. nat. Patrick Peschlow codecentric AG
Merscheider Straße 1 42699 Solingen tel +49 (0) 212.23 36 28 54 fax +49 (0) 212.23 36 28 79 [email protected] www.codecentric.de -
codecentric AG Tipps zu Produktion − Allgemeine Performance-Empfehlungen beachten −
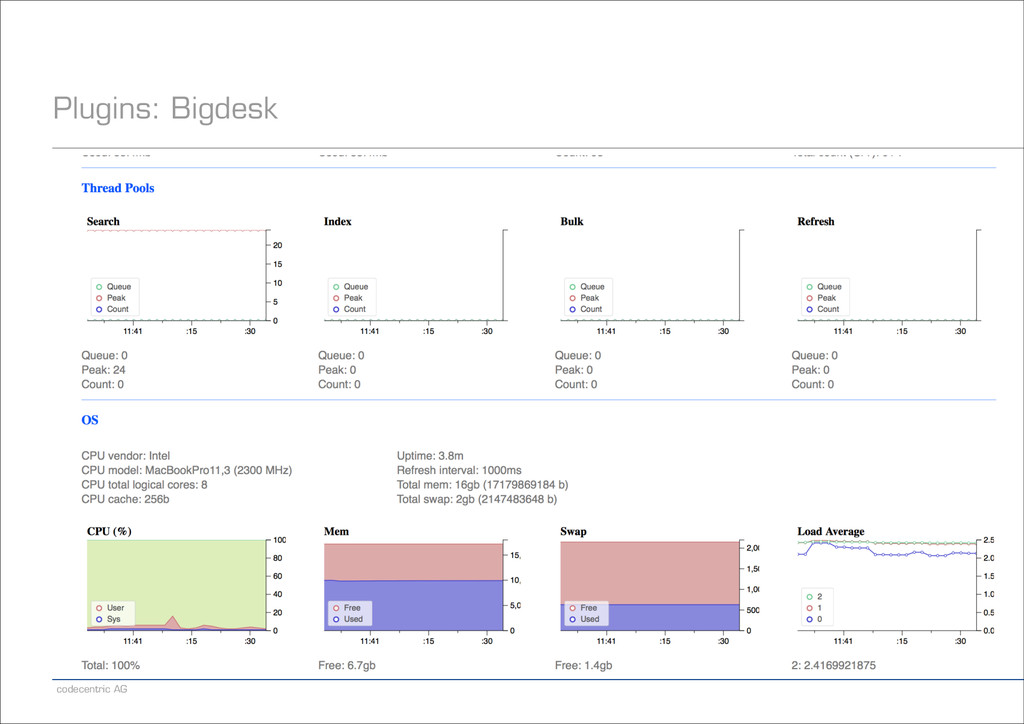
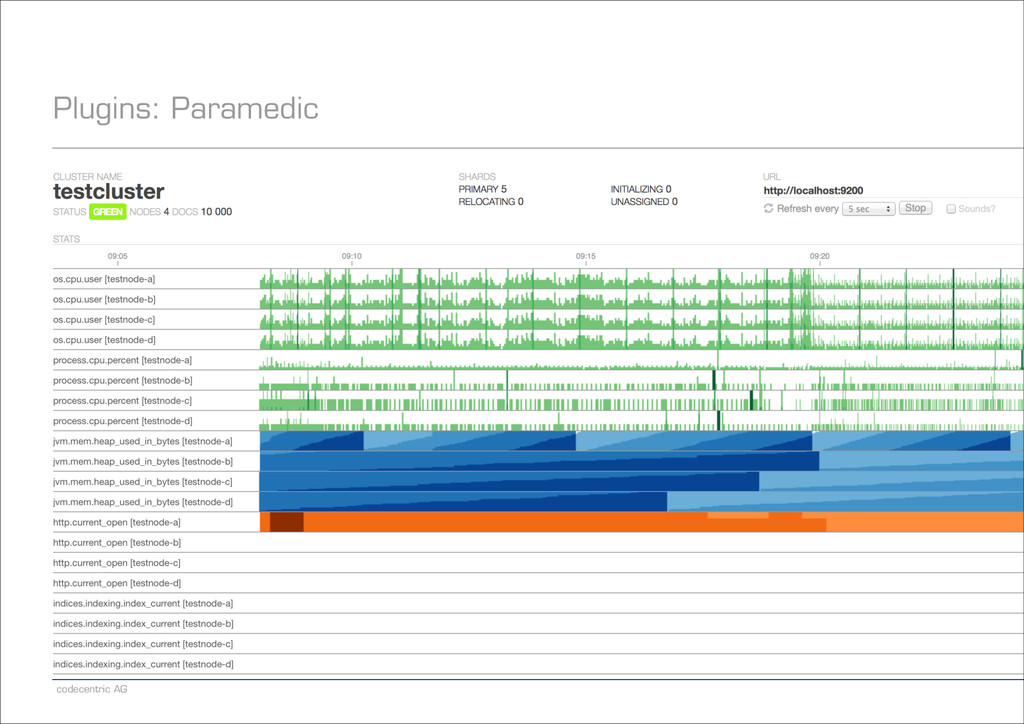
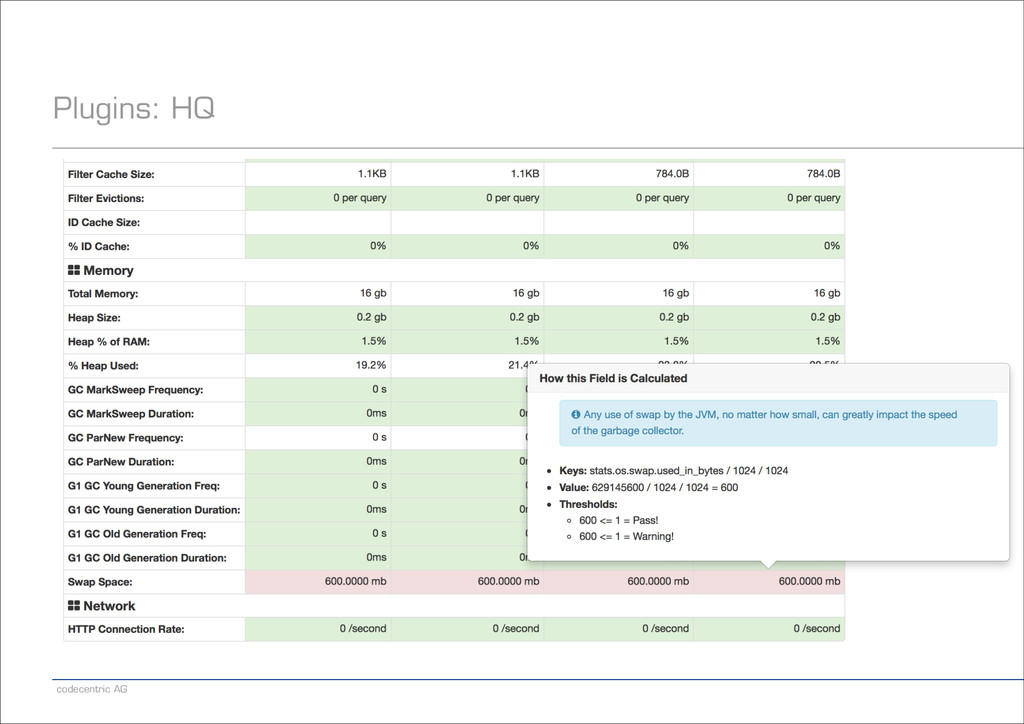
Geeignete Heap-Größe − Swapping vermeiden − Hinreichend großes FD-Limit − Nicht zu schwache Hardware (mindestens „medium“, besser „large“) − SSDs ! − Features wie Doc Values verwenden ! − Threadpool-Größen prüfen und ggf. ändern ! − Monitoring − API stellt sehr viele Informationen bereit -
codecentric AG Update API − Zwei Möglichkeiten − Partial Document
− Script ! − Achtung − Auch feingranulare Updates bedeuten intern „Löschen + Hinzufügen“ − Updates benötigen _source − Partial Document Update von inneren Objekten ist ein Merge, alles sonst ein Replace − Partial Document und Script können nicht miteinander kombiniert werden