Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
20261113_JAWS_Osaka
Search
Takuya Yonezawa
November 13, 2026
Technology
140
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
20261113_JAWS_Osaka
Takuya Yonezawa
November 13, 2026
Transcript
14 slides
JAWS-UG大阪 あなたの推しサービス教えて!LT回 DynamoDB Takuya Yonezawa 2026.11.23 © 2026 Japan Digital
Design, Inc. 1
プロフィール 公私ともシステム開発にはDynamoDBを多用 最近はバックエンド(FastAPI)らへんが中心 実家は米農家。今年は3.5㌧収穫しました 採用活動もやってますので是非お声掛けください 証券系→銀行系 と 金融×IT なキャリアを歩んでいます (証券外務員一種)
米澤 拓也 Software Engineer Community Builder (Serverless) 2023~ Technology & Development Div. and Corporate Culture室 takuya_y0ne © 2026 Japan Digital Design, Inc. 2
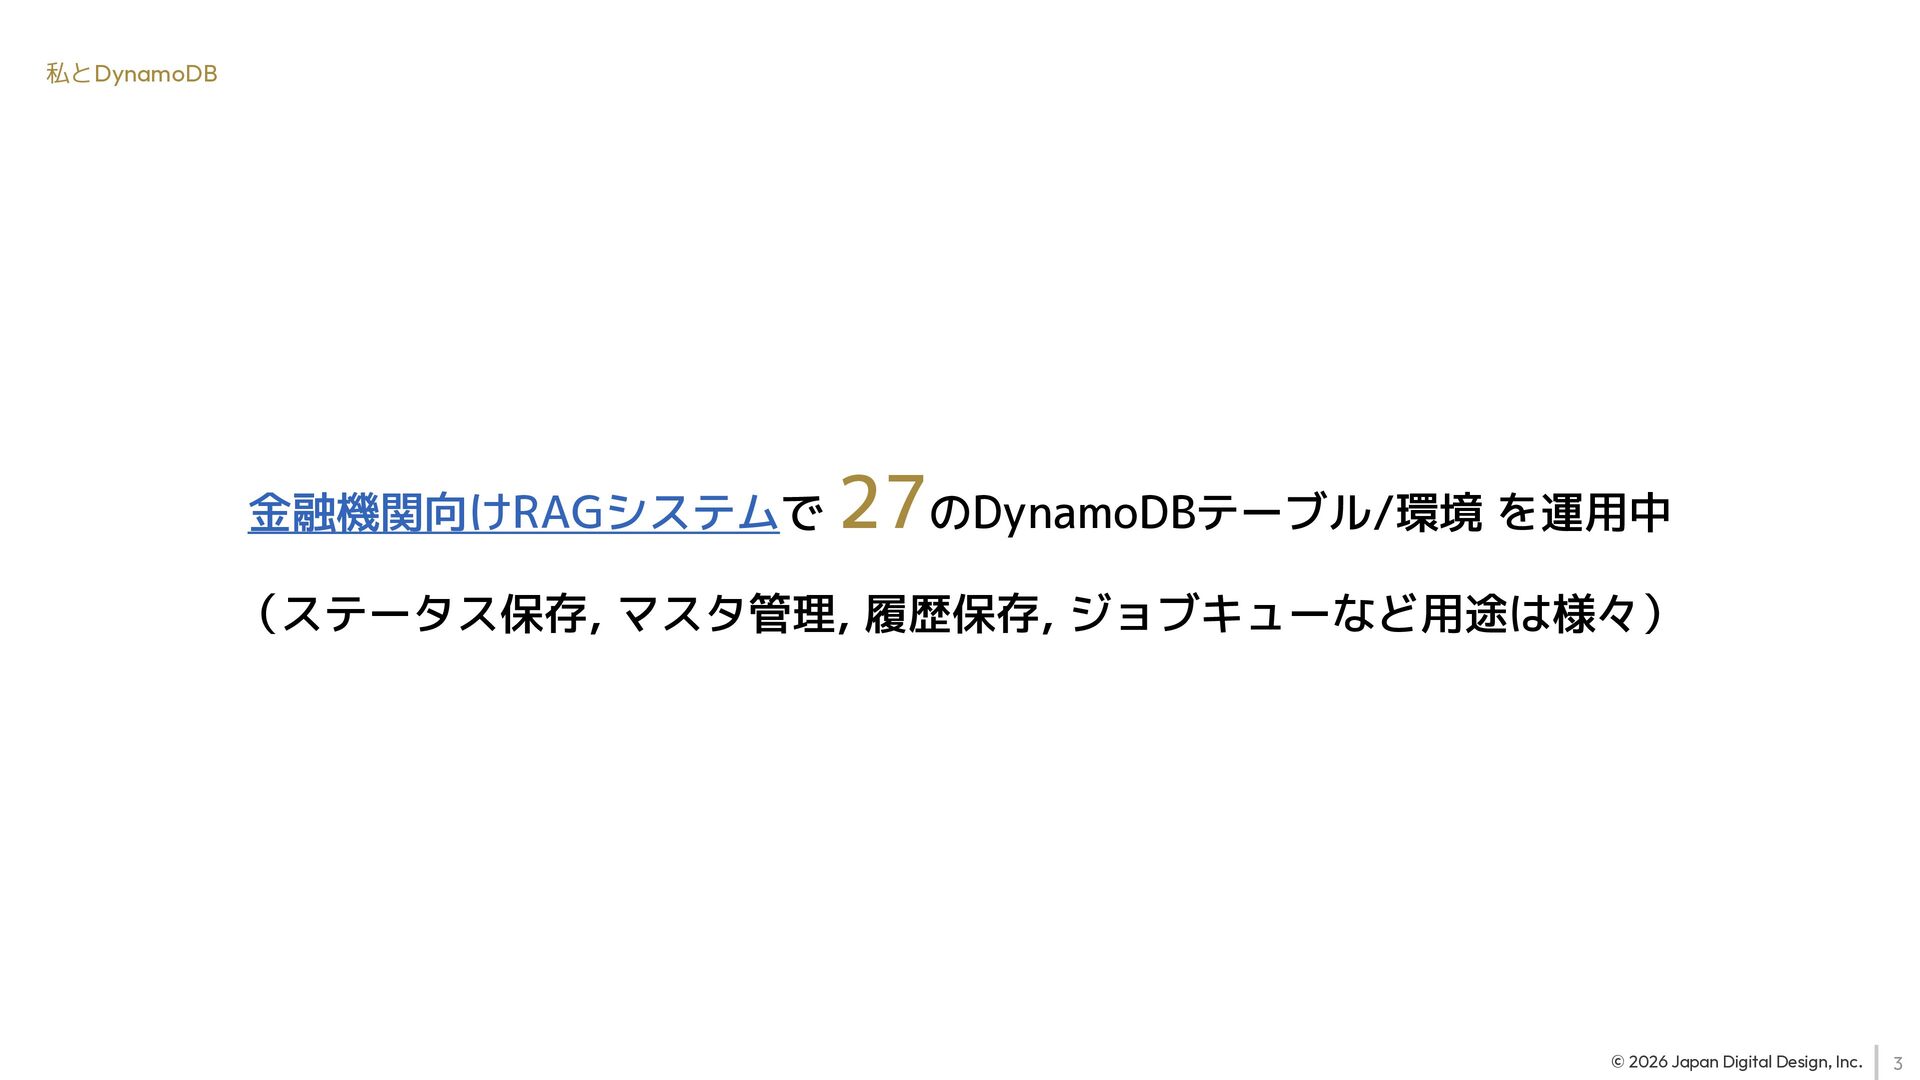
私とDynamoDB 金融機関向けRAGシステムで 27のDynamoDBテーブル/環境 を運用中 (ステータス保存, マスタ管理, 履歴保存, ジョブキューなど用途は様々) © 2026
Japan Digital Design, Inc. 3
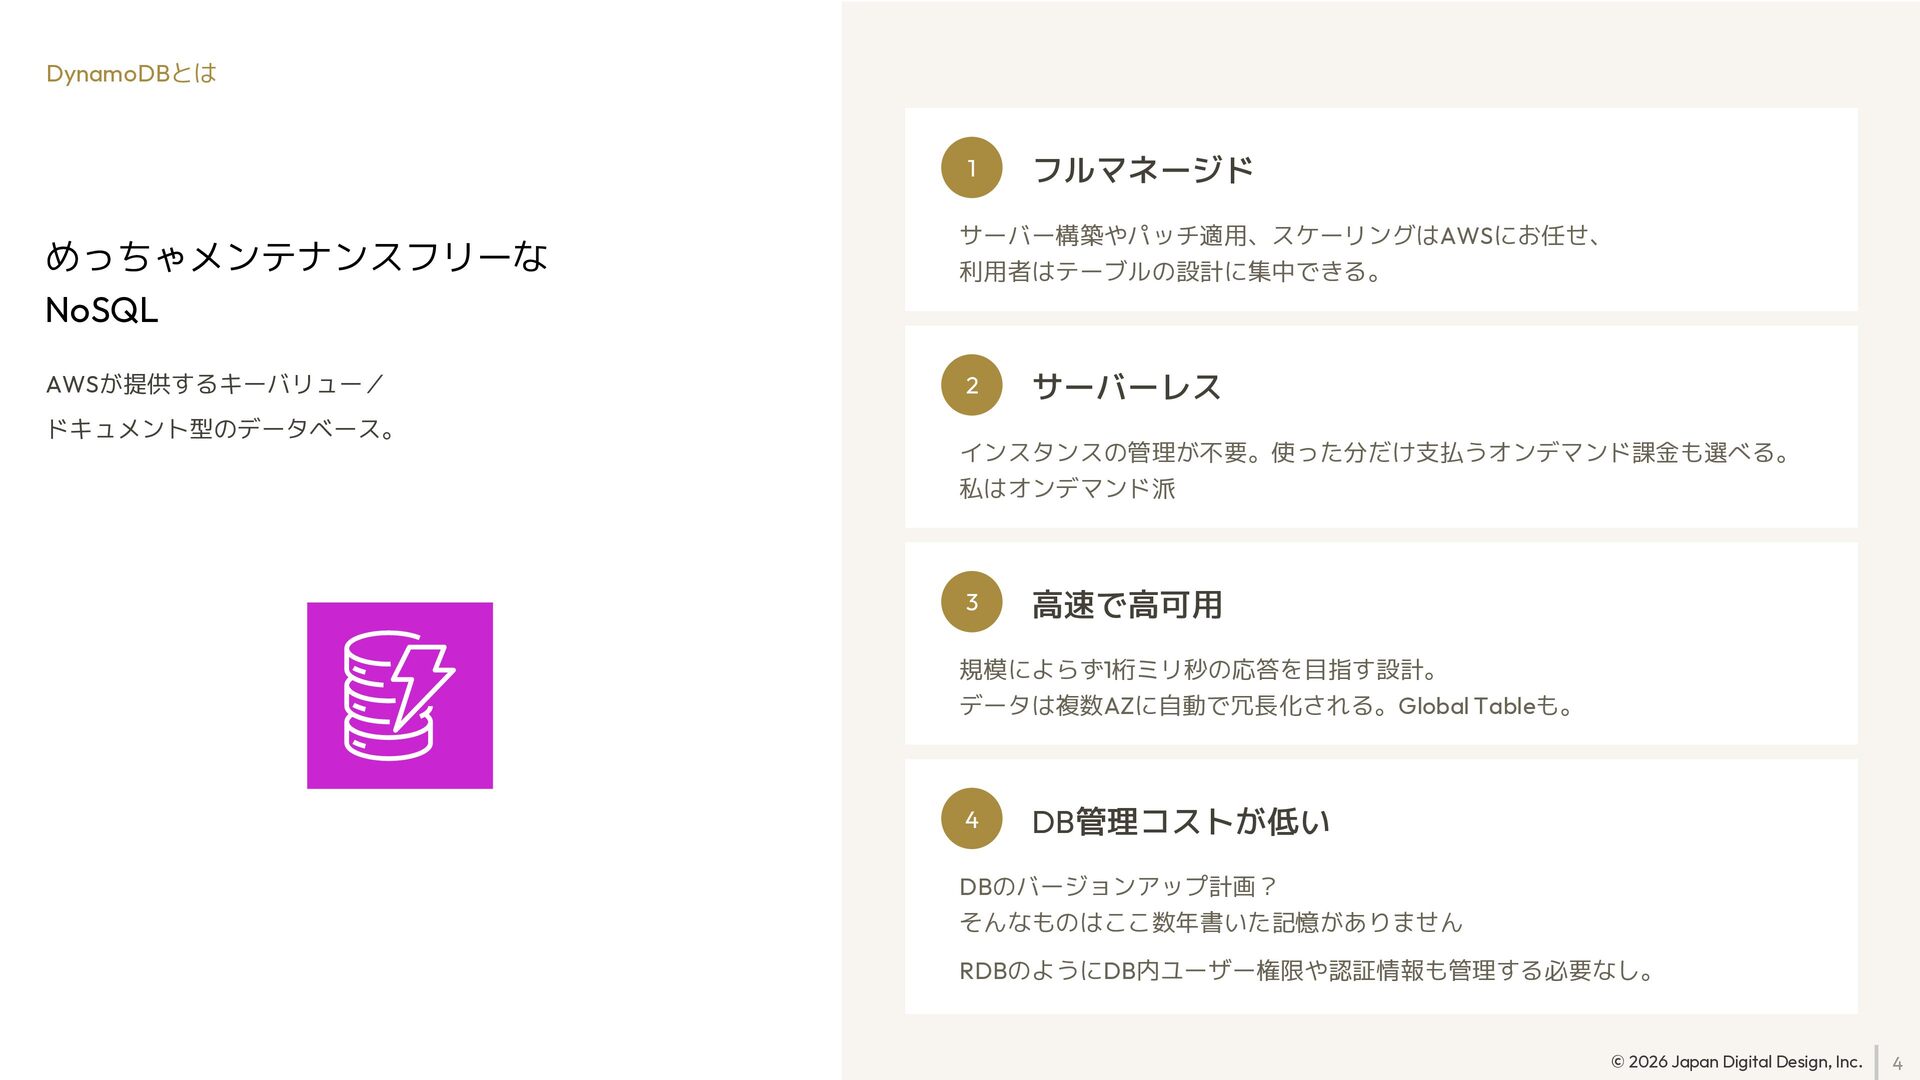
DynamoDBとは 1 めっちゃメンテナンスフリーな NoSQL AWSが提供するキーバリュー/ ドキュメント型のデータベース。 フルマネージド サーバー構築やパッチ適用、スケーリングはAWSにお任せ、 利用者はテーブルの設計に集中できる。 2
サーバーレス インスタンスの管理が不要。使った分だけ支払うオンデマンド課金も選べる。 私はオンデマンド派 3 高速で高可用 規模によらず1桁ミリ秒の応答を目指す設計。 データは複数AZに自動で冗長化される。Global Tableも。 4 DB管理コストが低い DBのバージョンアップ計画? そんなものはここ数年書いた記憶がありません RDBのようにDB内ユーザー権限や認証情報も管理する必要なし。 © 2026 Japan Digital Design, Inc. 4
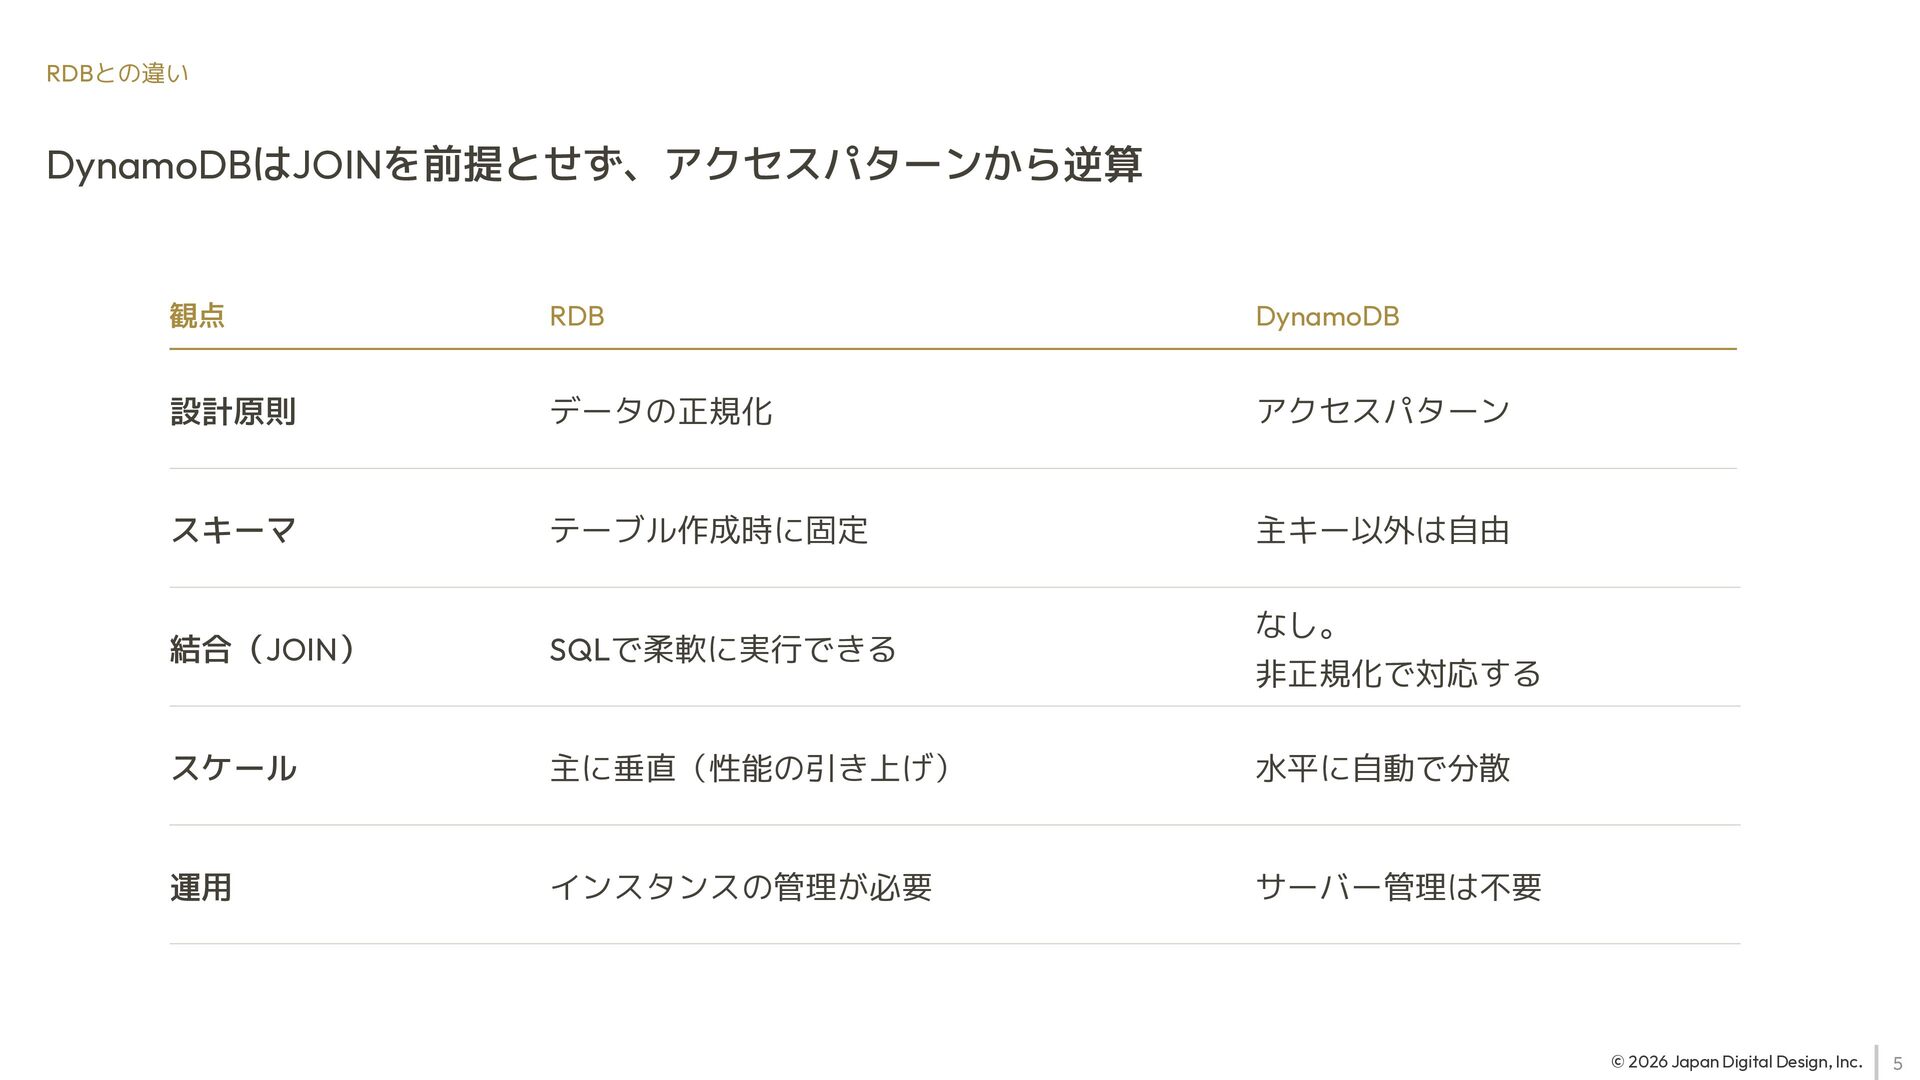
RDBとの違い DynamoDBはJOINを前提とせず、アクセスパターンから逆算 観点 RDB DynamoDB 設計原則 データの正規化 アクセスパターン スキーマ テーブル作成時に固定
主キー以外は自由 なし。 結合(JOIN) SQLで柔軟に実行できる スケール 主に垂直(性能の引き上げ) 水平に自動で分散 運用 インスタンスの管理が必要 サーバー管理は不要 非正規化で対応する © 2026 Japan Digital Design, Inc. 5
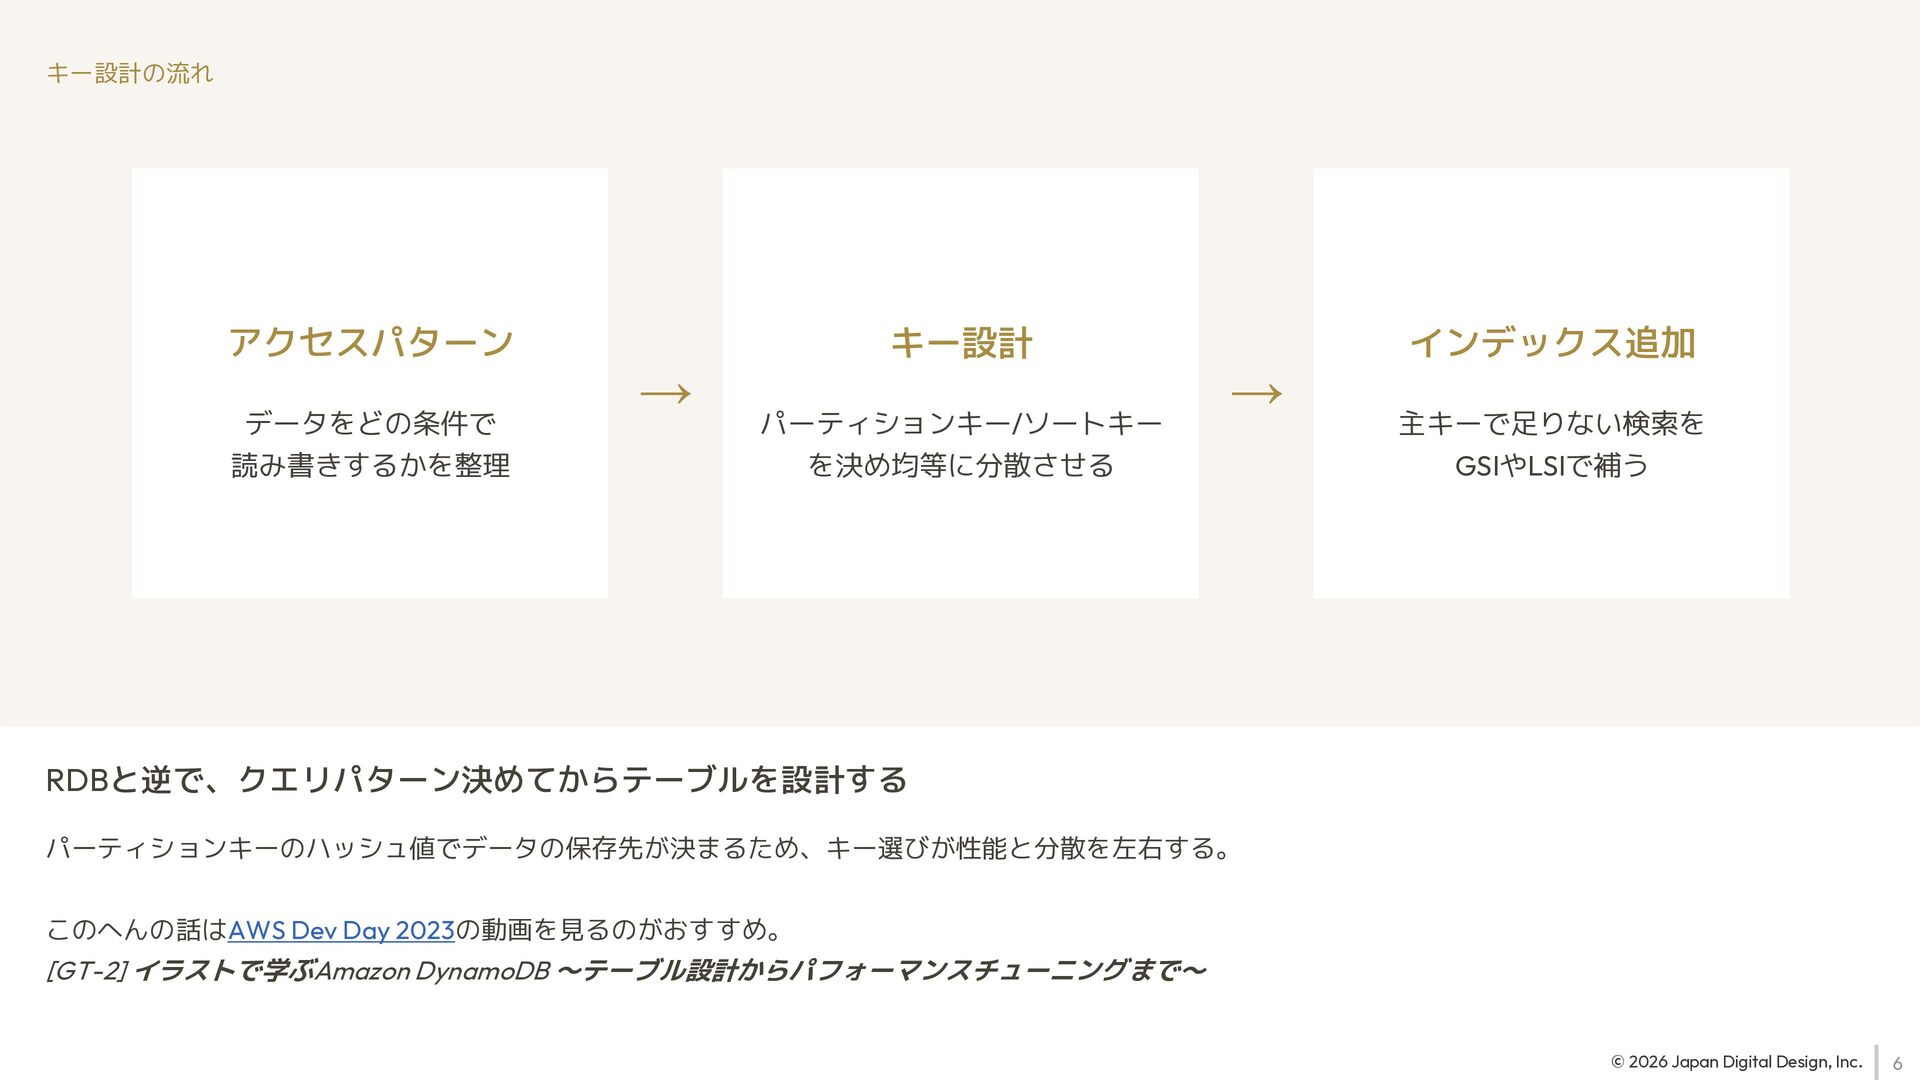
キー設計の流れ アクセスパターン データをどの条件で 読み書きするかを整理 → キー設計 パーティションキー/ソートキー を決め均等に分散させる → インデックス追加
主キーで足りない検索を GSIやLSIで補う RDBと逆で、クエリパターン決めてからテーブルを設計する パーティションキーのハッシュ値でデータの保存先が決まるため、キー選びが性能と分散を左右する。 このへんの話はAWS Dev Day 2023の動画を見るのがおすすめ。 [GT-2] イラストで学ぶAmazon DynamoDB ~テーブル設計からパフォーマンスチューニングまで~ © 2026 Japan Digital Design, Inc. 6
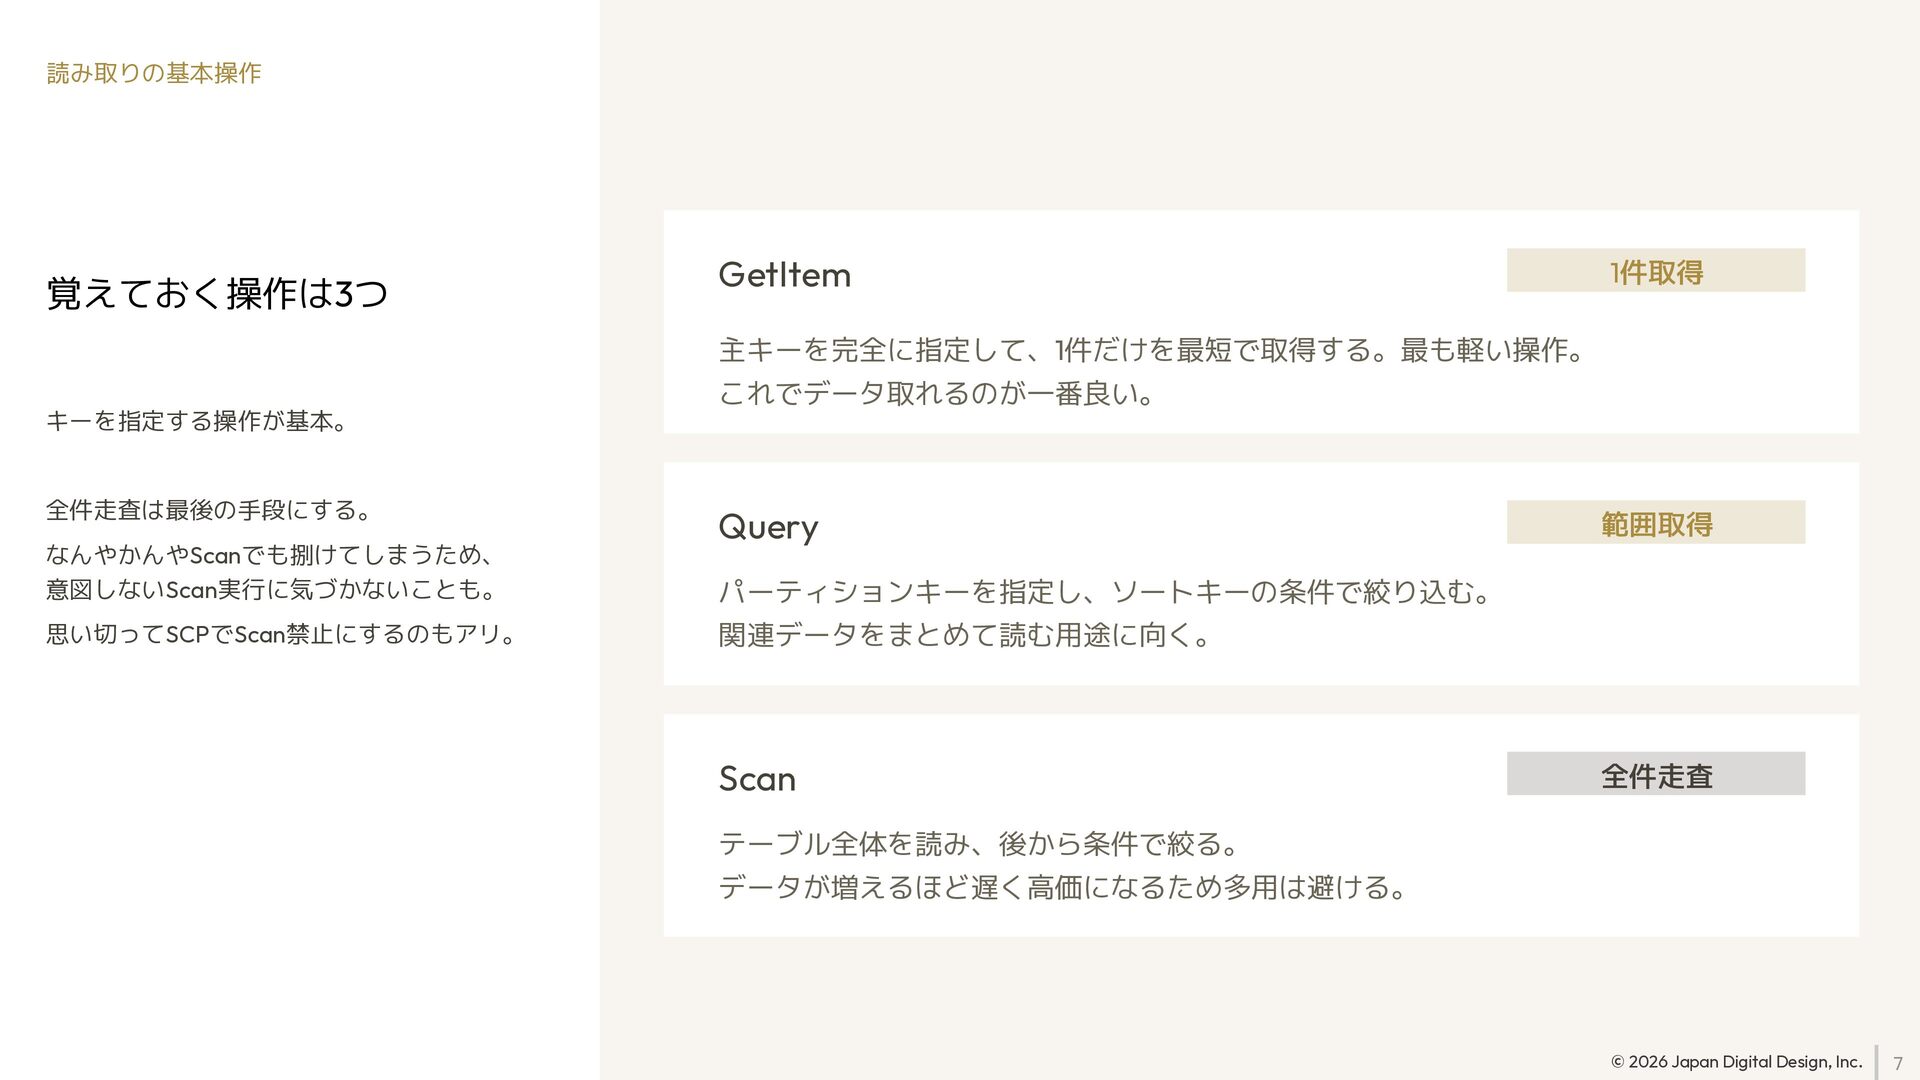
読み取りの基本操作 覚えておく操作は3つ GetItem 1件取得 主キーを完全に指定して、1件だけを最短で取得する。最も軽い操作。 キーを指定する操作が基本。 全件走査は最後の手段にする。 なんやかんやScanでも捌けてしまうため、 意図しないScan実行に気づかないことも。 思い切ってSCPでScan禁止にするのもアリ。
これでデータ取れるのが一番良い。 Query 範囲取得 パーティションキーを指定し、ソートキーの条件で絞り込む。 関連データをまとめて読む用途に向く。 Scan 全件走査 テーブル全体を読み、後から条件で絞る。 データが増えるほど遅く高価になるため多用は避ける。 © 2026 Japan Digital Design, Inc. 7
DynamoDBを良い感じに使うTips © 2026 Japan Digital Design, Inc. 8
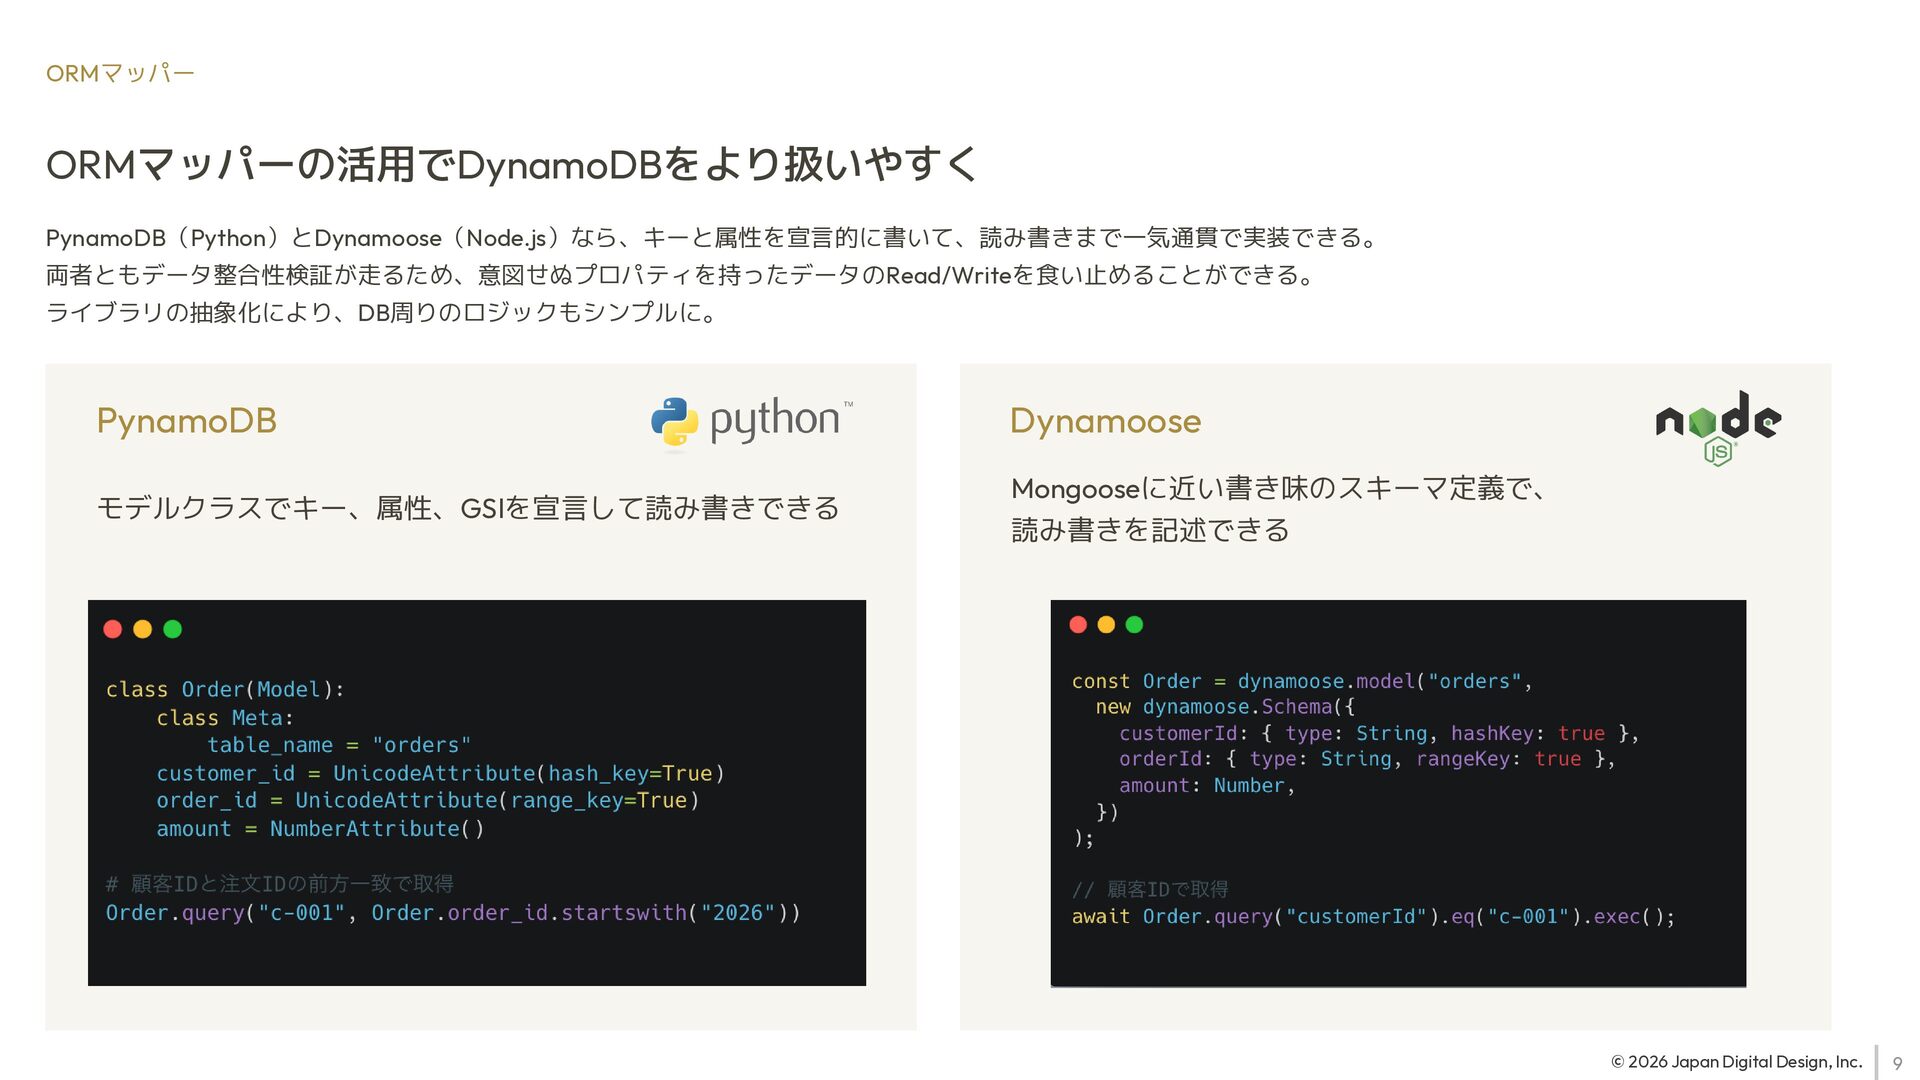
ORMマッパー ORMマッパーの活用でDynamoDBをより扱いやすく PynamoDB(Python)とDynamoose(Node.js)なら、キーと属性を宣言的に書いて、読み書きまで一気通貫で実装できる。 両者ともデータ整合性検証が走るため、意図せぬプロパティを持ったデータのRead/Writeを食い止めることができる。 ライブラリの抽象化により、DB周りのロジックもシンプルに。 PynamoDB Dynamoose モデルクラスでキー、属性、GSIを宣言して読み書きできる Mongooseに近い書き味のスキーマ定義で、 読み書きを記述できる
© 2026 Japan Digital Design, Inc. 9
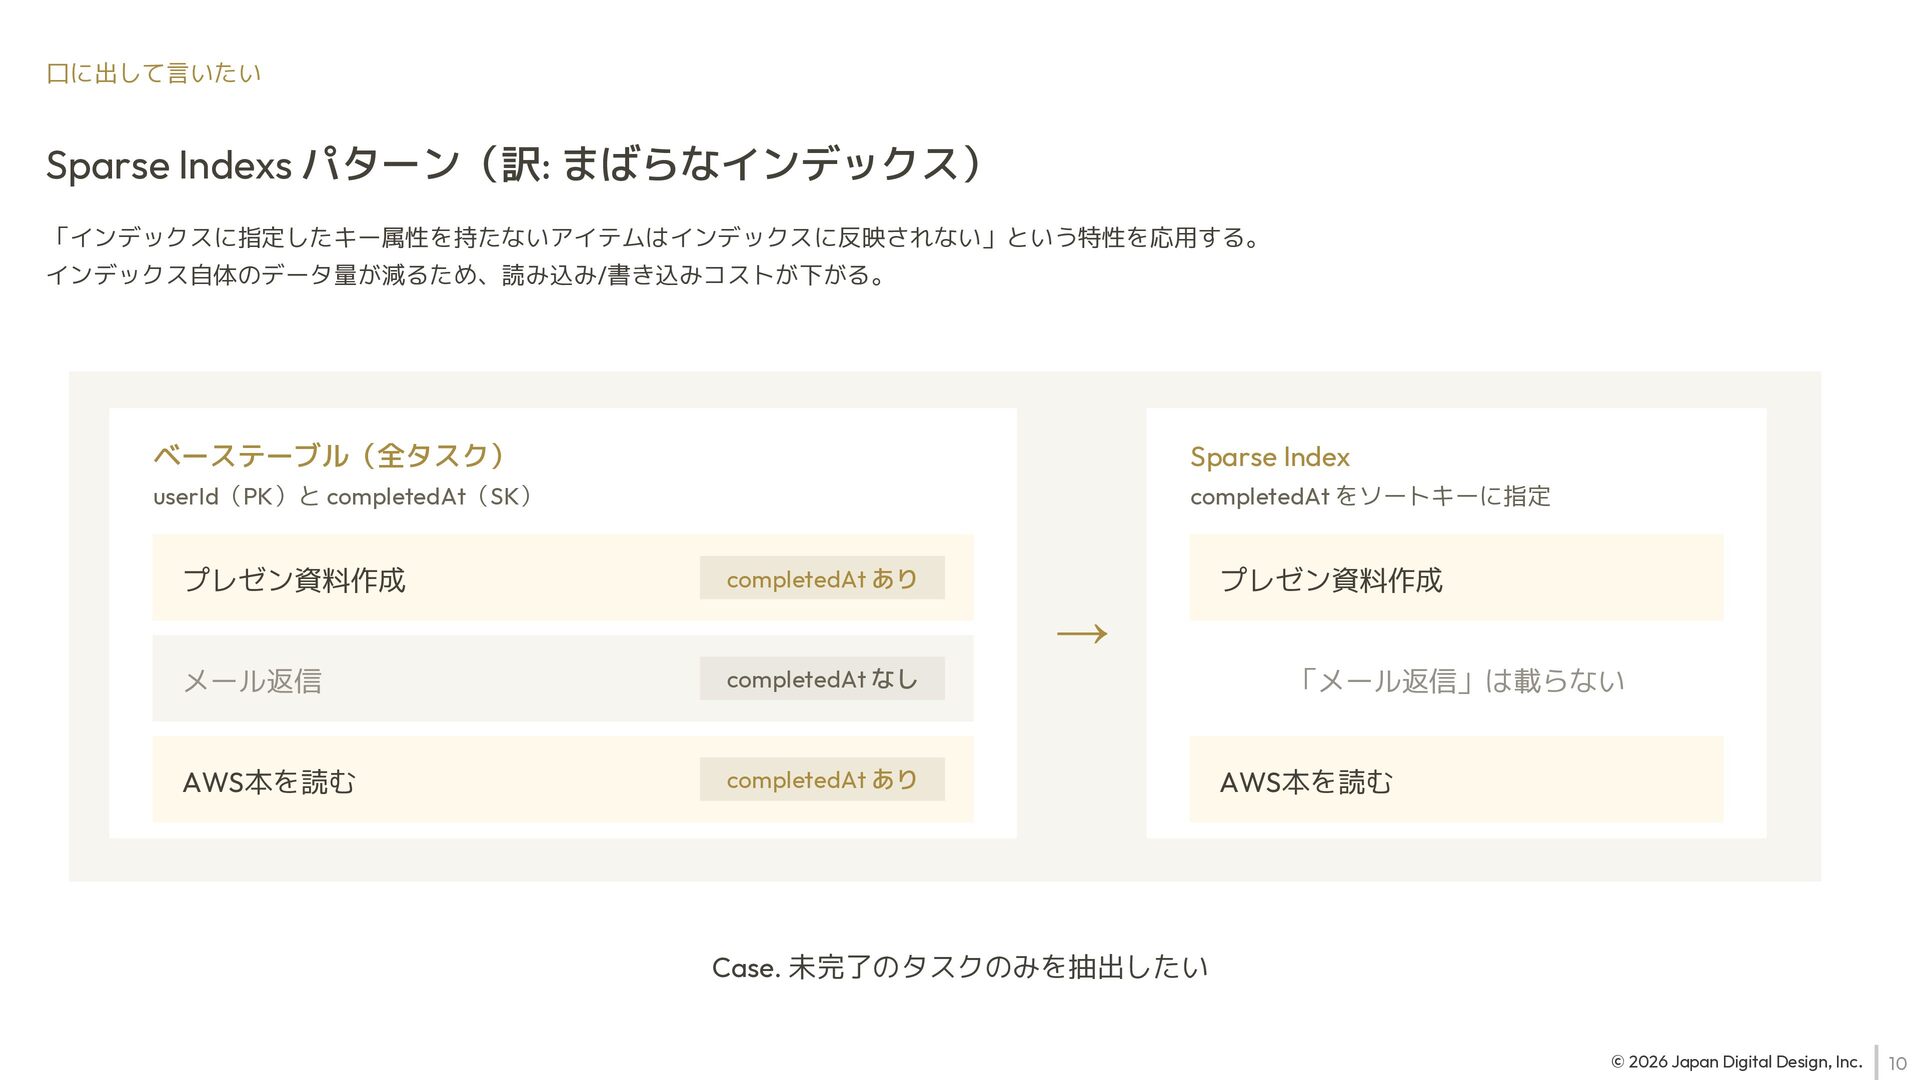
口に出して言いたい Sparse Indexs パターン(訳: まばらなインデックス) 「インデックスに指定したキー属性を持たないアイテムはインデックスに反映されない」という特性を応用する。 インデックス自体のデータ量が減るため、読み込み/書き込みコストが下がる。 ベーステーブル(全タスク) Sparse Index
userId(PK)と completedAt(SK) completedAt をソートキーに指定 プレゼン資料作成 プレゼン資料作成 completedAt あり → メール返信 completedAt なし AWS本を読む completedAt あり 「メール返信」は載らない AWS本を読む Case. 未完了のタスクのみを抽出したい © 2026 Japan Digital Design, Inc. 10
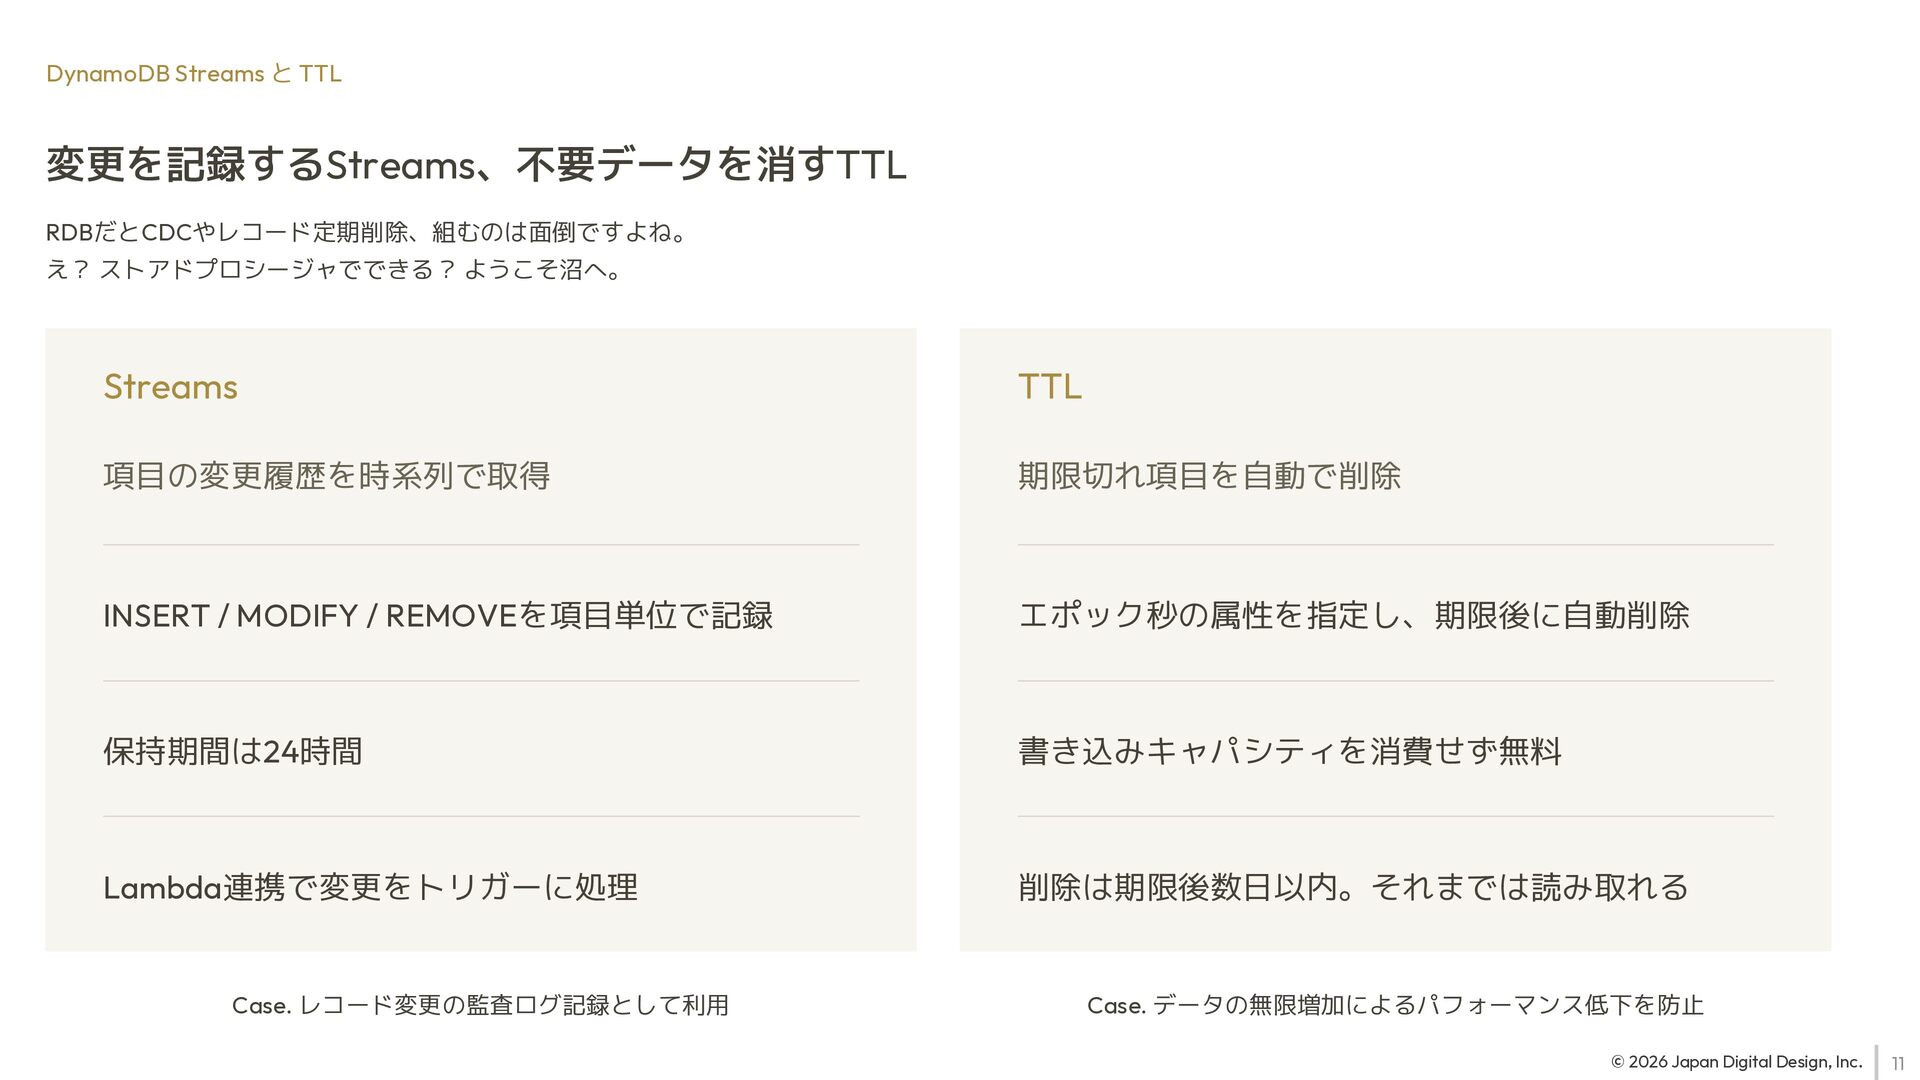
DynamoDB Streams と TTL 変更を記録するStreams、不要データを消すTTL RDBだとCDCやレコード定期削除、組むのは面倒ですよね。 え? ストアドプロシージャでできる? ようこそ沼へ。 Streams
TTL 項目の変更履歴を時系列で取得 期限切れ項目を自動で削除 INSERT / MODIFY / REMOVEを項目単位で記録 エポック秒の属性を指定し、期限後に自動削除 保持期間は24時間 書き込みキャパシティを消費せず無料 Lambda連携で変更をトリガーに処理 削除は期限後数日以内。それまでは読み取れる Case. レコード変更の監査ログ記録として利用 Case. データの無限増加によるパフォーマンス低下を防止 © 2026 Japan Digital Design, Inc. 11
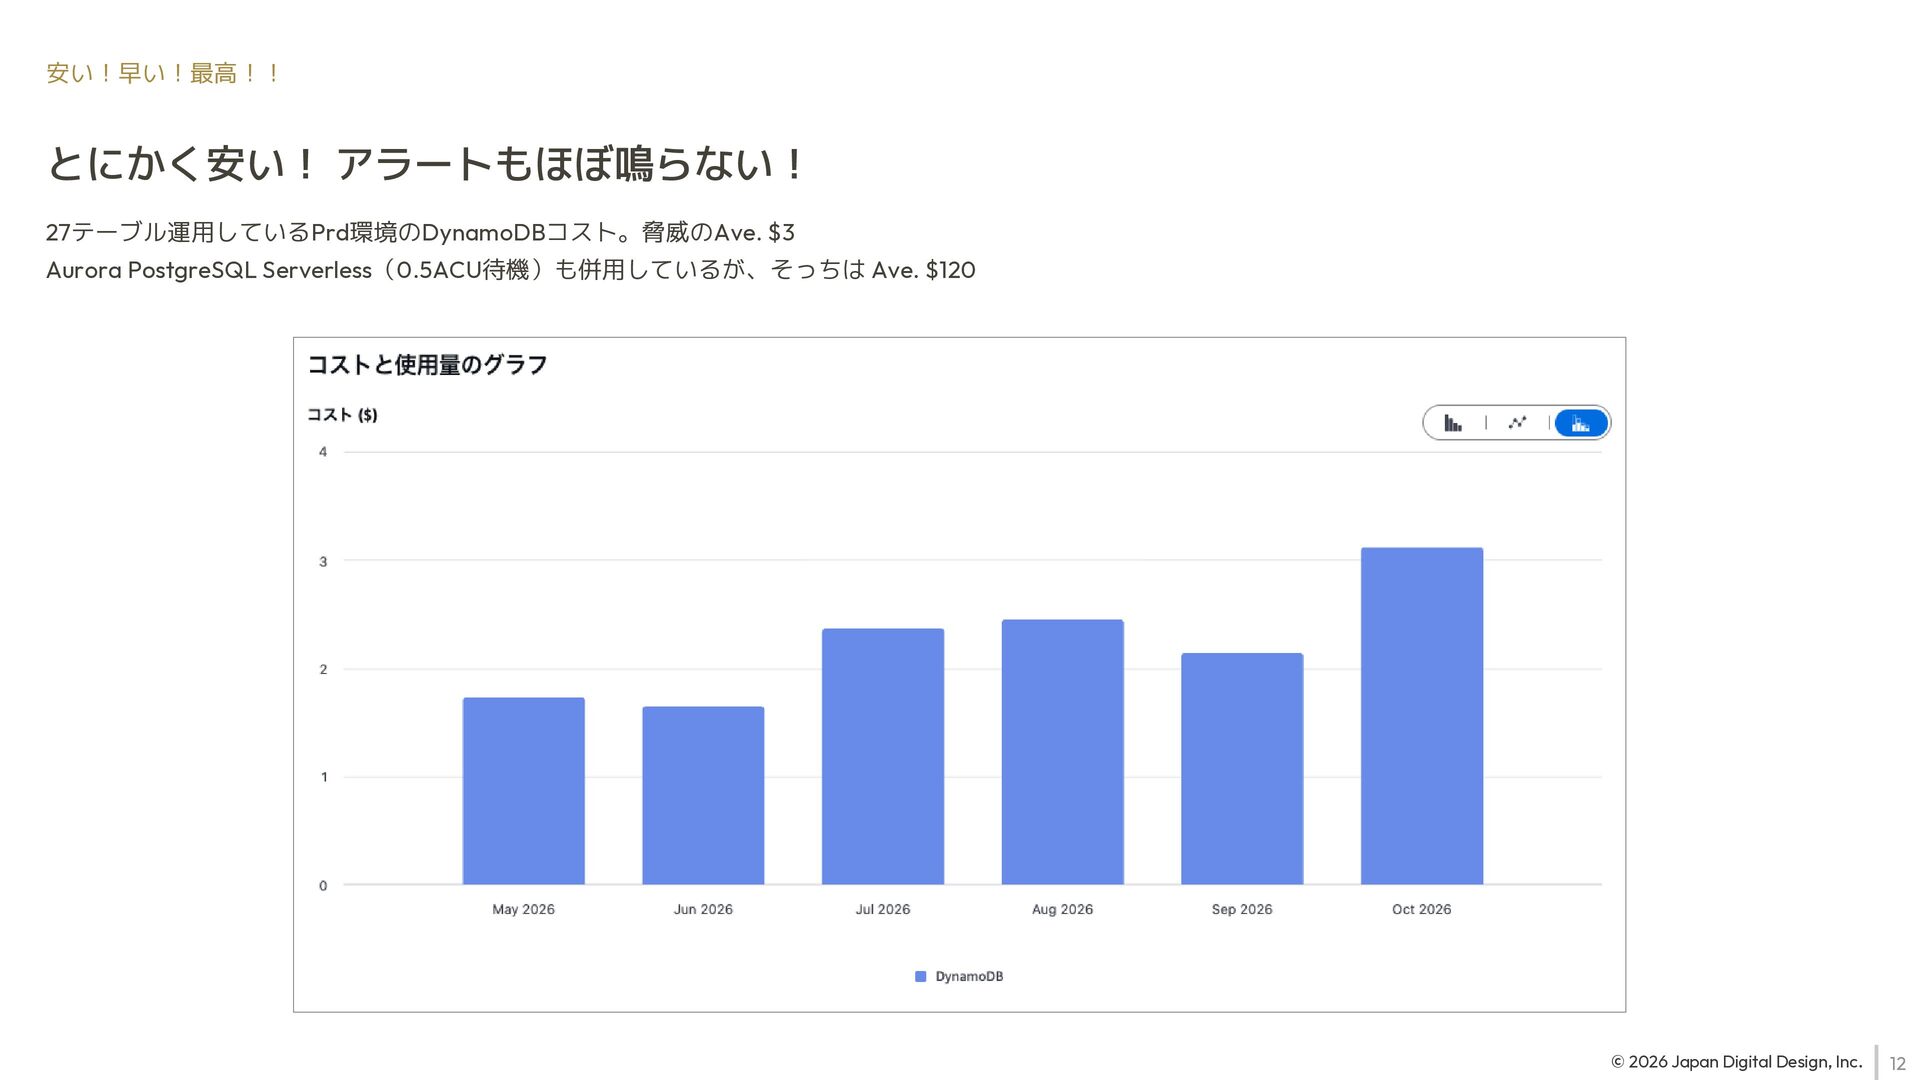
安い!早い!最高!! とにかく安い! アラートもほぼ鳴らない! 27テーブル運用しているPrd環境のDynamoDBコスト。脅威のAve. $3 Aurora PostgreSQL Serverless(0.5ACU待機)も併用しているが、そっちは Ave. $120
© 2026 Japan Digital Design, Inc. 12
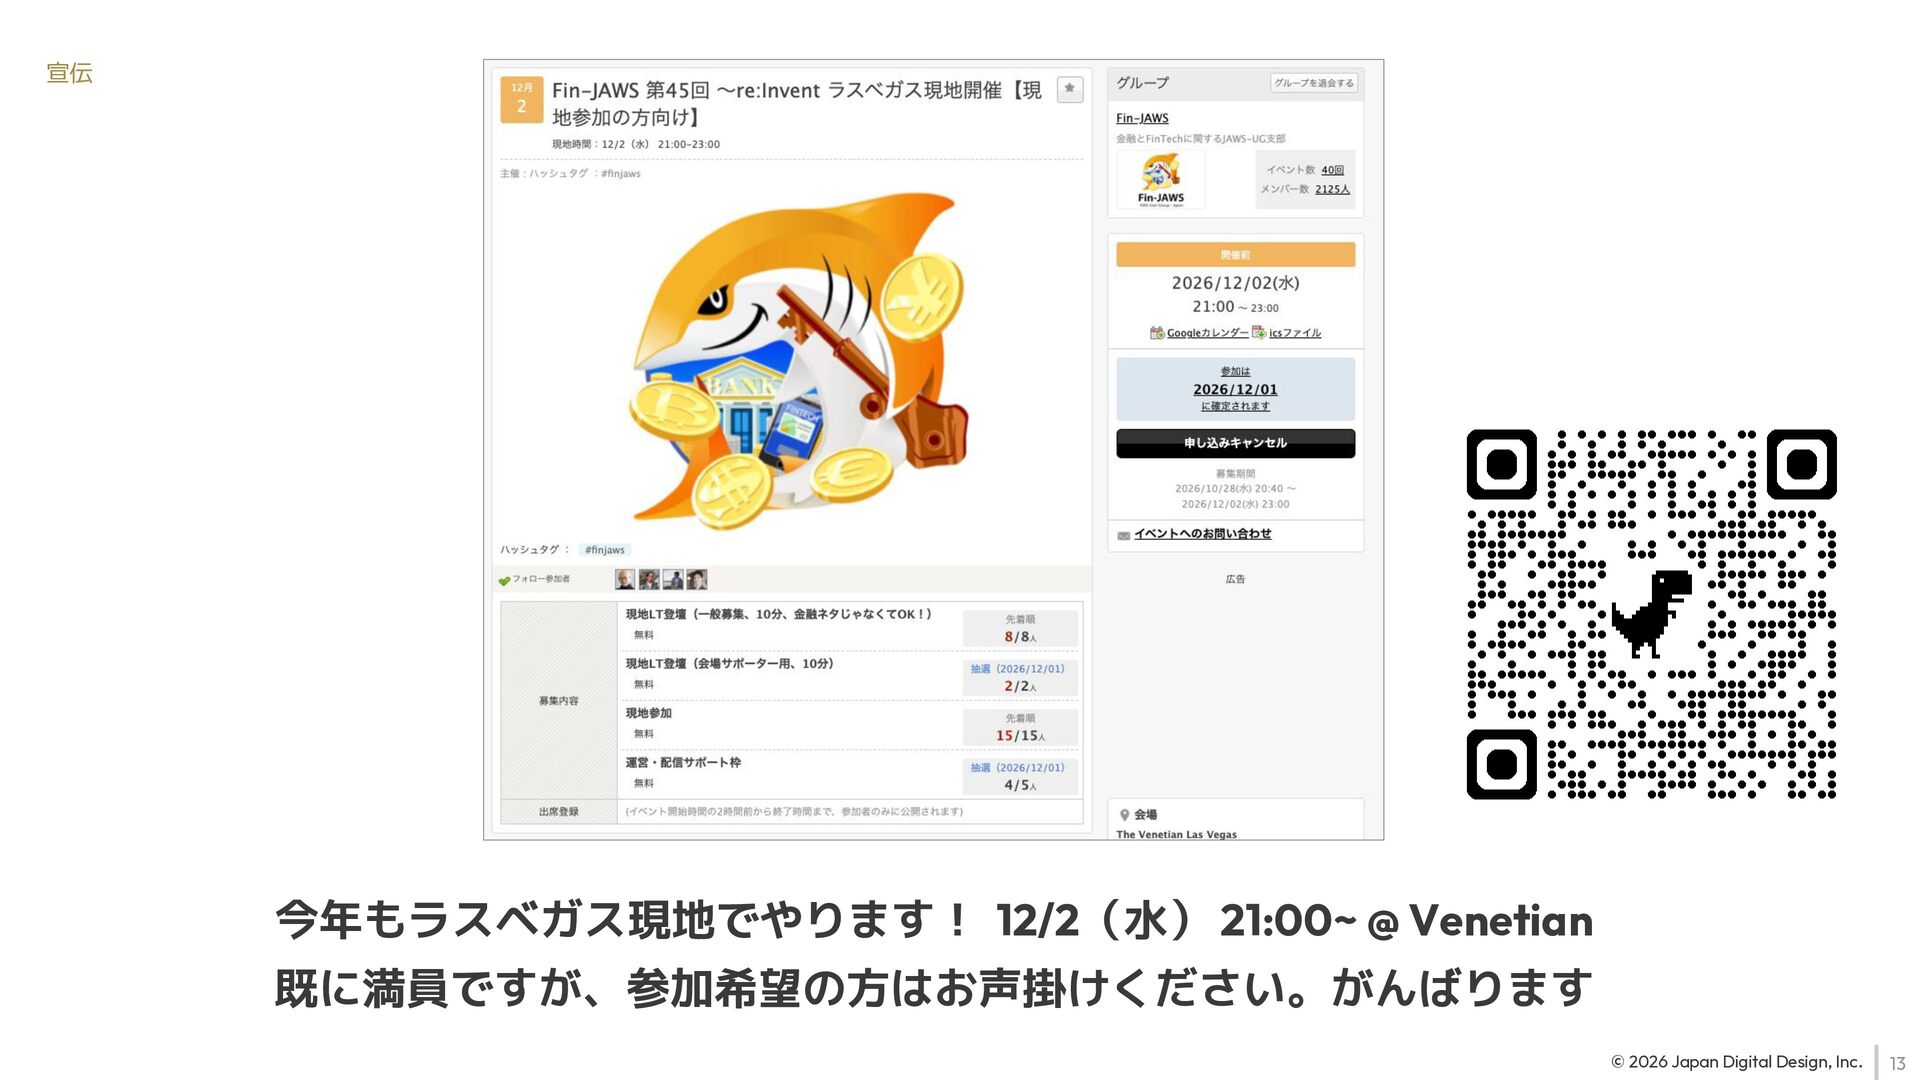
宣伝 今年もラスベガス現地でやります! 12/2(水) 21:00~ @ Venetian 既に満員ですが、参加希望の方はお声掛けください。がんばります © 2026 Japan
Digital Design, Inc. 13
Thank you. © 2026 Japan Digital Design, Inc. 14
More Decks by Takuya Yonezawa
See All by Takuya Yonezawa
20260516_SecJAWS_Days
takuyay0ne
5
1.1k
20260422_Midosuji_Tech
takuyay0ne
2
150
脱 雰囲気実装! AgentCoreを良い感じに WEBアプリケーションに組み込むために
takuyay0ne
3
740
20260228_JAWS_Beginner_Kansai
takuyay0ne
5
800
20260204_Midosuji_Tech
takuyay0ne
1
270
20260129_CB_Kansai
takuyay0ne
1
420
20260126_JAWS_Osaka
takuyay0ne
1
85
こんな時代だからこそ! 想定しておきたい アクセスキー漏洩後のムーブ
takuyay0ne
4
860
セキュリティは全員参加!_JAWSのイベントサイトで脅威モデリングを学んでみよう!
takuyay0ne
0
250
Other Decks in Technology
See All in Technology
狙われているAPIの脆弱性!今こそ手をつけるべき根本的な対策とは?
nagix
0
120
AIが会計業務の伴走者に。 マネーフォワード クラウド会計MCPサーバーで実現するAI前提の新しい業務プロセス
nobitabashi
0
110
AWS基盤改善を支える 私たちの理念と行動指針
kentosuzuki
0
200
AWS構成から考えるWebセキュリティ ― WordPressの構築経験から考える公開範囲と更新運用【JAWS FESTA 2026 in AKITA】
cscengineer
PRO
2
420
これからのデータエンジニアの役割について考える / Rethinking the Role of Data Engineers in the AI Era
okiyuki99
0
440
あの日、見つかっていなかったらどうなっていたか
kazzpapa3
2
140
【Oracle AI SPOTLIGHT ウェビナー】【特別開催:日本語で解説!】Oracle AI World 2026 最新情報フィードバック
oracle4engineer
PRO
1
200
Claude Codeで作ったアプリを安全に公開する/Built with Claude Japan 2026
yoshidashingo
0
230
Ebitengine製iOSアプリ公開ボタンを押す会
eiei114
0
120
高品質と高スピードを支える品質のシフトレフトのアプローチ
goyoki
2
520
Kiro CLI 入門 (ターミナルと CI で使う) | 目指せ Kiro マスター 03
inariku
PRO
2
140
Frontier Teams — Amazon は AI で「開発のやり方」をどう変えたのか
kmotohas
0
220
Featured
See All Featured
個人開発の失敗を避けるイケてる考え方 / tips for indie hackers
panda_program
123
22k
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
Paper Plane
katiecoart
PRO
6
55k
Into the Great Unknown - MozCon
thekraken
41
2.8k
Mind Mapping
helmedeiros
1
440
Exploring anti-patterns in Rails
aemeredith
4
560
Making the Leap to Tech Lead
cromwellryan
135
10k
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
460
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.6k
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
610


 takuyay0ne
 nagix
 nobitabashi
 kentosuzuki
 cscengineer
 okiyuki99
 kazzpapa3
 oracle4engineer
 yoshidashingo
 eiei114
 goyoki
 inariku
 kmotohas
 panda_program
 aleyda
 mongodb
 tanoku
 katiecoart
 thekraken
 helmedeiros
 aemeredith
 cromwellryan
 akademiya2063
 inesmontani
 techseoconnect