Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
OpenSearchで実現する ホットペッパーグルメの検索基盤
Search
Recruit
PRO
November 18, 2026
Technology
19
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
OpenSearchで実現する ホットペッパーグルメの検索基盤
2026/10/21に、OpenSearch Tokyo Meetup #2で発表した蜂須賀の資料になります。
Recruit
PRO
November 18, 2026
Transcript
40 slides
OpenSearchで実現する ホットペッパーグルメの検索基盤 株式会社リクルート 蜂須賀 笙太 2026/10/21 © Recruit Co., Ltd.
All Rights Reserved
Profile 所属 データ推進室 旅⾏‧飲⾷‧ビューティー‧IDP‧SaaSデータエンジ ニアリング部 データエンジニアリング1グループ 『ホットペッパーグルメ』の検索基盤を担当 経歴 蜂須賀 笙太
2025-2026 『ホットペッパーグルメ』の検索基盤開発に従事 Hachisuka Shota 2 © Recruit Co., Ltd. All Rights Reserved
Agenda 1. ホットペッパーグルメと「席押さえ」 2. 地図検索機能 3. ニアリアルタイムでのデータ連携 3 © Recruit
Co., Ltd. All Rights Reserved
Agenda1 ホットペッパーグルメと「席押さえ」 © Recruit Co., Ltd. All Rights Reserved
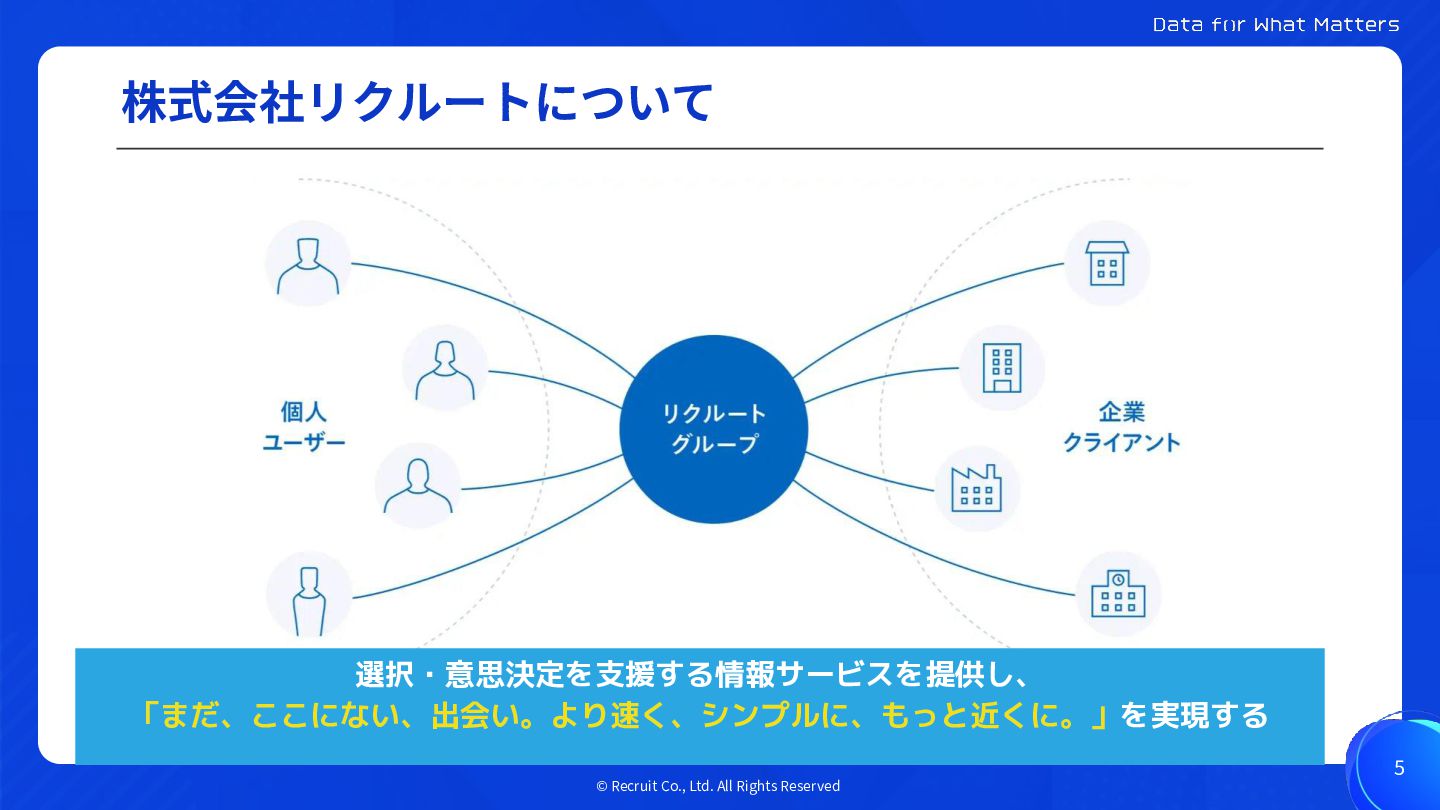
株式会社リクルートについて 選択・意思決定を支援する情報サービスを提供し、 「まだ、ここにない、出会い。より速く、シンプルに、もっと近くに。」を実現する 5 © Recruit Co., Ltd. All Rights
Reserved
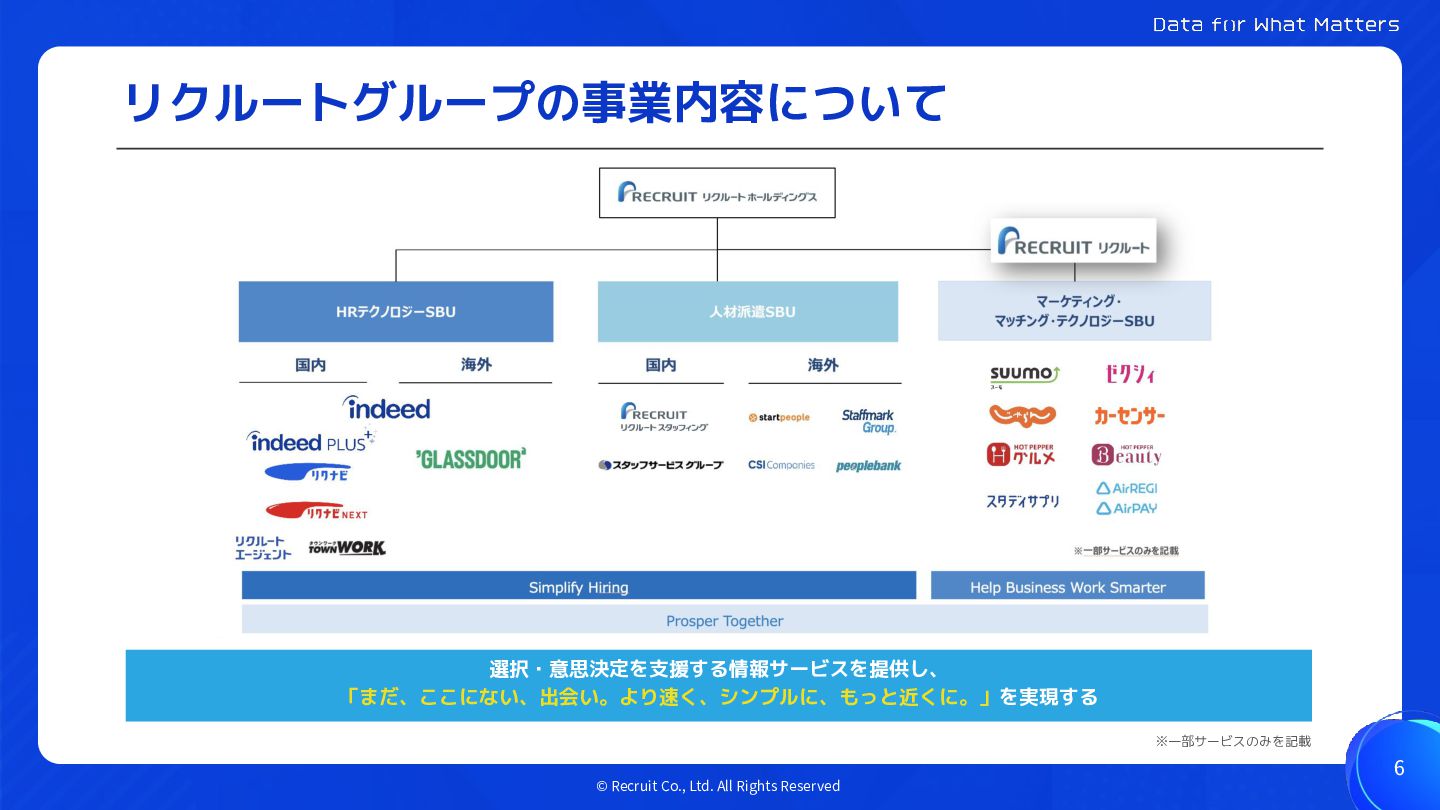
リクルートグループの事業内容について 選択・意思決定を支援する情報サービスを提供し、 「まだ、ここにない、出会い。より速く、シンプルに、もっと近くに。」を実現する ※一部サービスのみを記載 6 © Recruit Co., Ltd. All
Rights Reserved
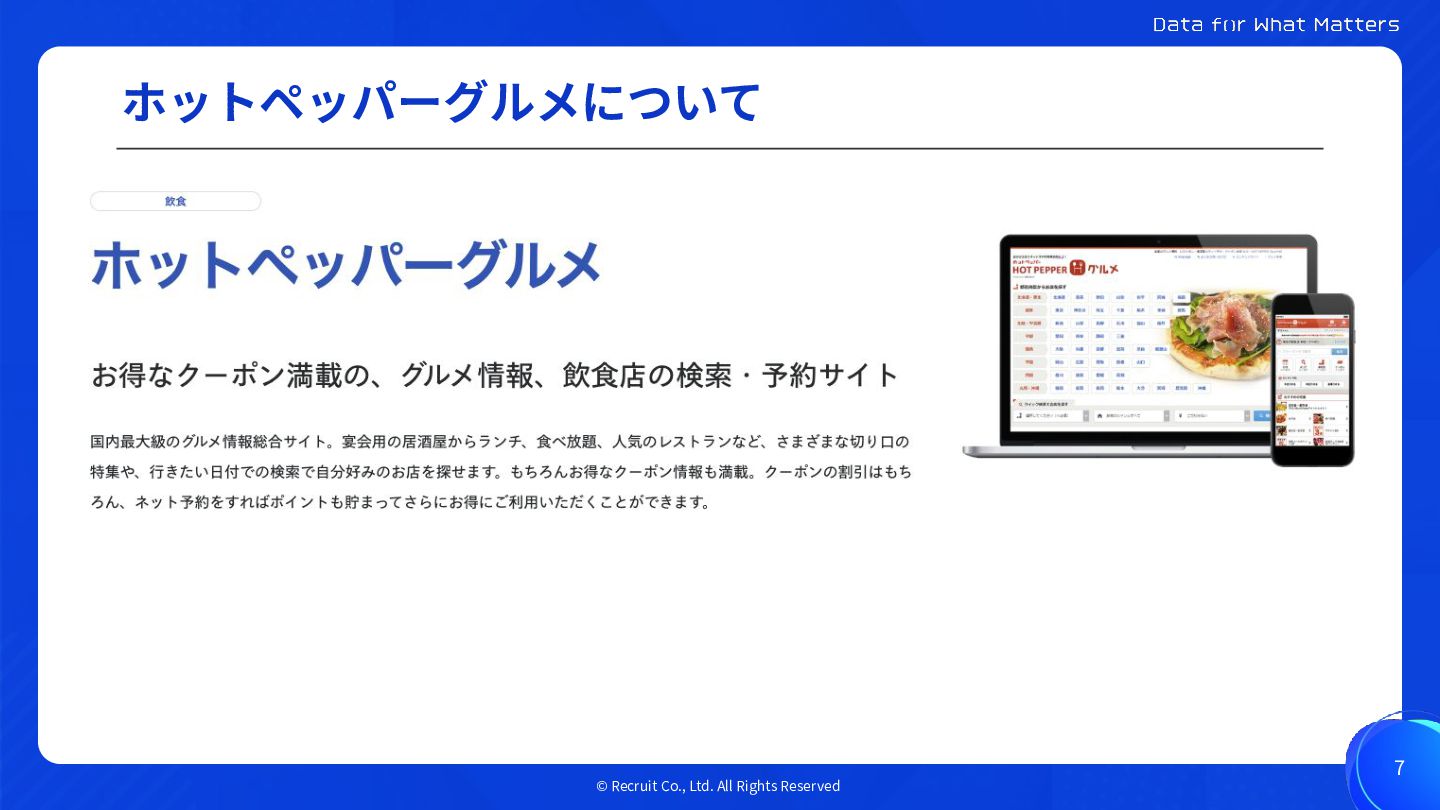
ホットペッパーグルメについて 7 © Recruit Co., Ltd. All Rights Reserved
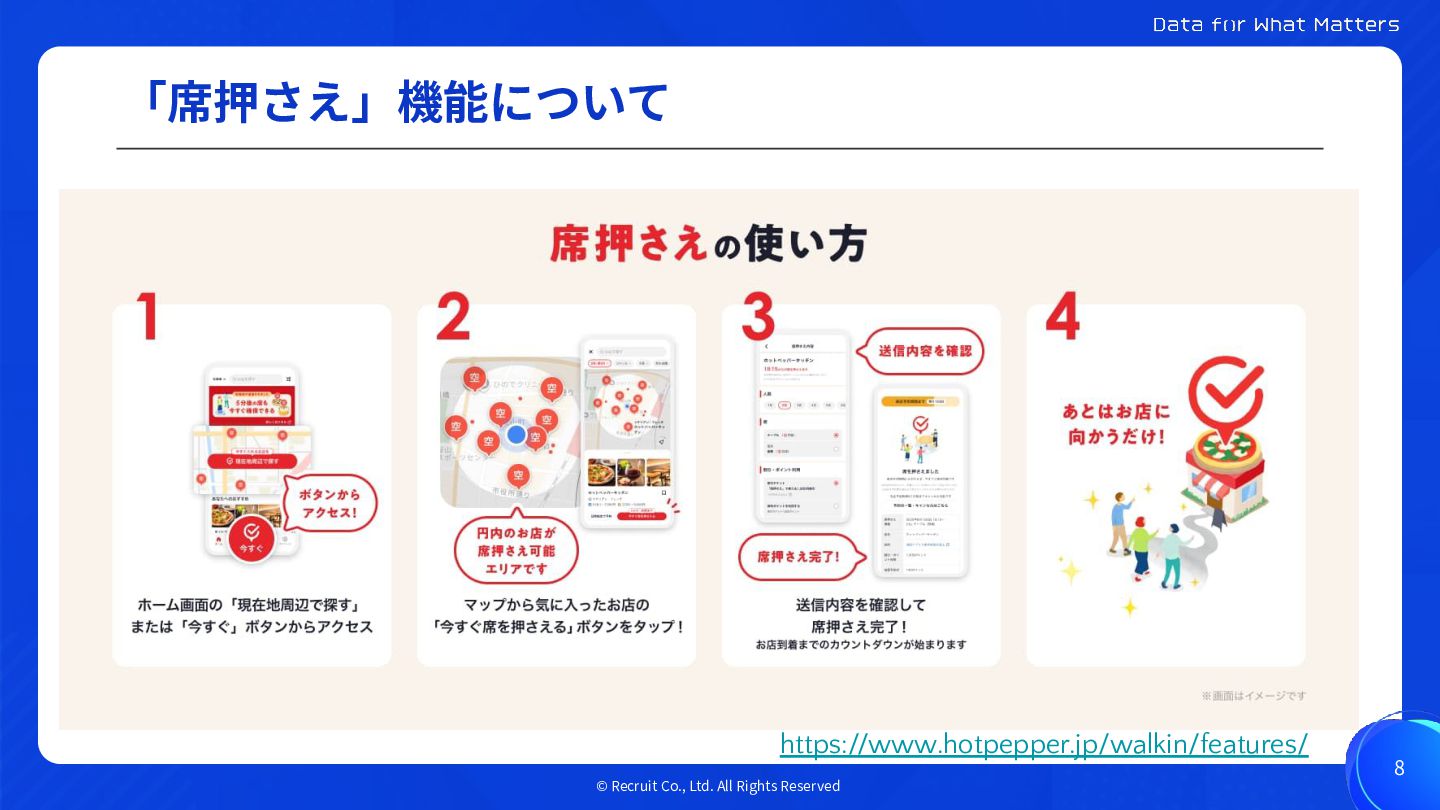
「席押さえ」機能について https://www.hotpepper.jp/walkin/features/ © Recruit Co., Ltd. All Rights Reserved 8
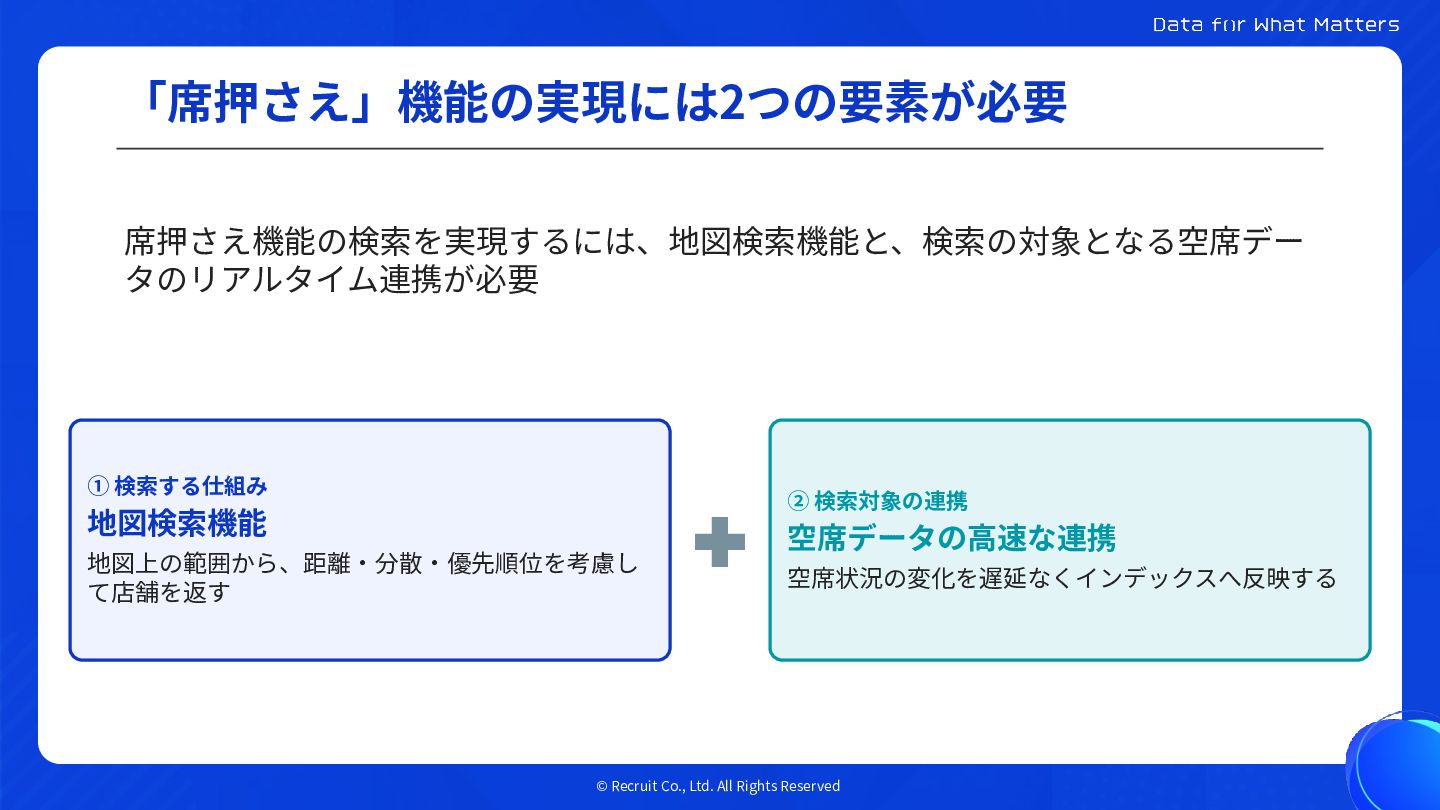
「席押さえ」機能の実現には2つの要素が必要 席押さえ機能の検索を実現するには、地図検索機能と、検索の対象となる空席デー タのリアルタイム連携が必要 ① 検索する仕組み ② 検索対象の連携 地図検索機能 地図上の範囲から、距離‧分散‧優先順位を考慮し て店舗を返す
空席データの⾼速な連携 空席状況の変化を遅延なくインデックスへ反映する © Recruit Co., Ltd. All Rights Reserved
Agenda2 地図検索機能 © Recruit Co., Ltd. All Rights Reserved
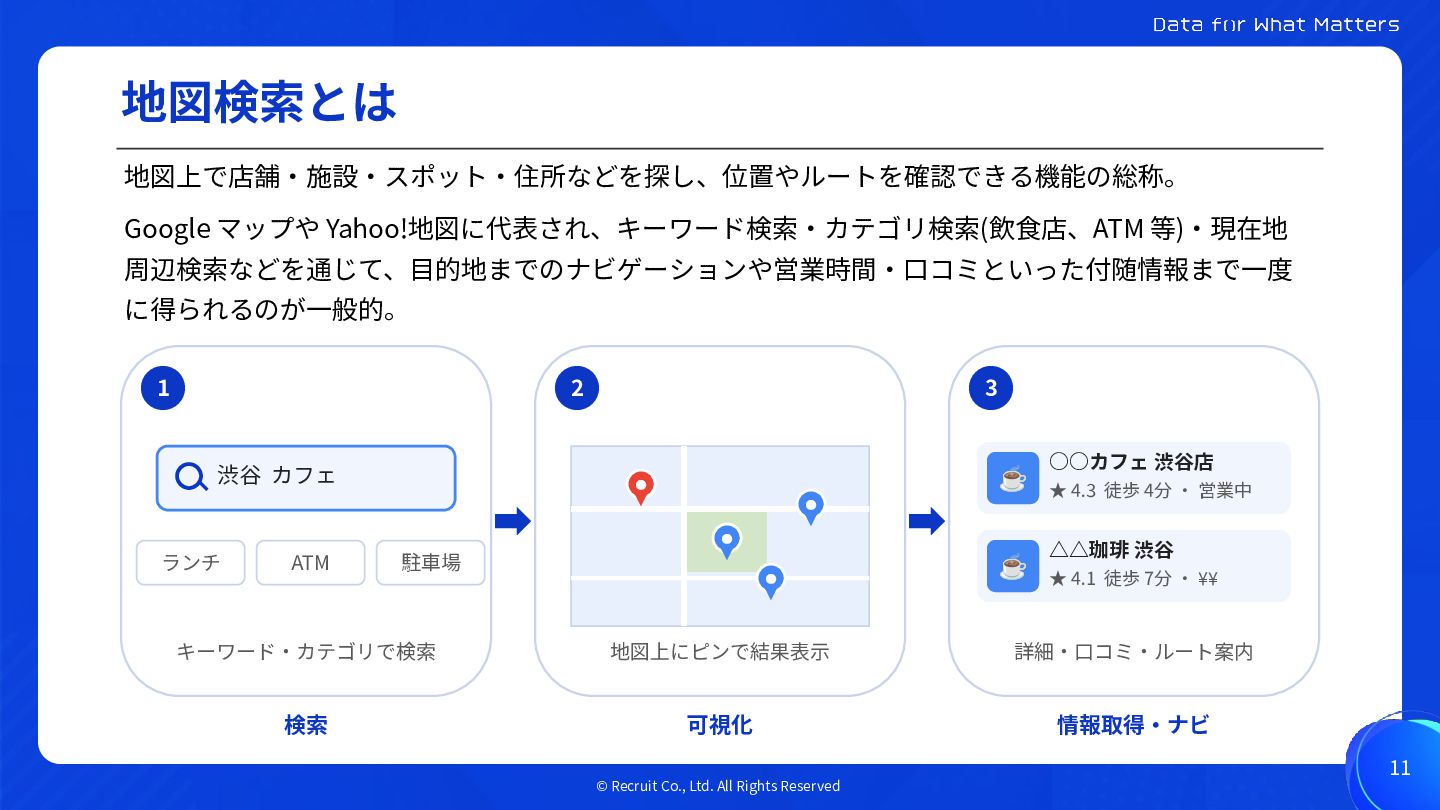
地図検索とは 地図上で店舗‧施設‧スポット‧住所などを探し、位置やルートを確認できる機能の総称。 Google マップや Yahoo!地図に代表され、キーワード検索‧カテゴリ検索(飲⾷店、ATM 等)‧現在地 周辺検索などを通じて、⽬的地までのナビゲーションや営業時間‧⼝コミといった付随情報まで⼀度 に得られるのが⼀般的。 1 2
3 渋⾕ カフェ ランチ ATM ☕ 駐⾞場 ☕ ◦◦カフェ 渋⾕店 ★ 4.3 徒歩 4分 ‧ 営業中 △△珈琲 渋⾕ ★ 4.1 徒歩 7分 ‧ ¥¥ キーワード‧カテゴリで検索 地図上にピンで結果表⽰ 詳細‧⼝コミ‧ルート案内 検索 可視化 情報取得‧ナビ 11 © Recruit Co., Ltd. All Rights Reserved
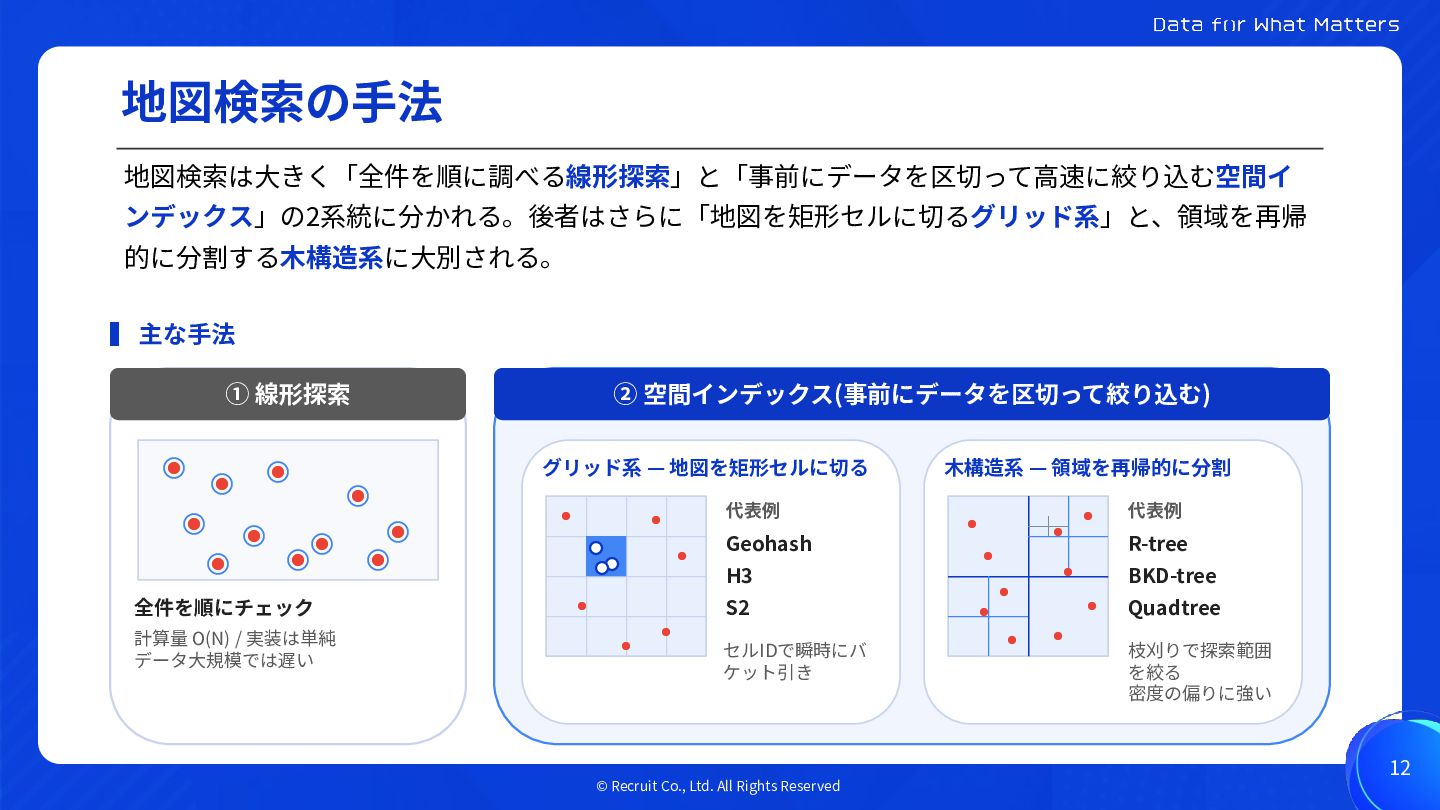
地図検索の⼿法 地図検索は⼤きく「全件を順に調べる線形探索」と「事前にデータを区切って⾼速に絞り込む空間イ ンデックス」の2系統に分かれる。後者はさらに「地図を矩形セルに切るグリッド系」と、領域を再帰 的に分割する⽊構造系に⼤別される。 ▍ 主な⼿法 ① 線形探索 ② 空間インデックス(事前にデータを区切って絞り込む)
グリッド系 — 地図を矩形セルに切る 全件を順にチェック 計算量 O(N) / 実装は単純 データ⼤規模では遅い ⽊構造系 — 領域を再帰的に分割 代表例 代表例 Geohash R-tree H3 BKD-tree S2 Quadtree セルIDで瞬時にバ ケット引き 枝刈りで探索範囲 を絞る 密度の偏りに強い 12 © Recruit Co., Ltd. All Rights Reserved
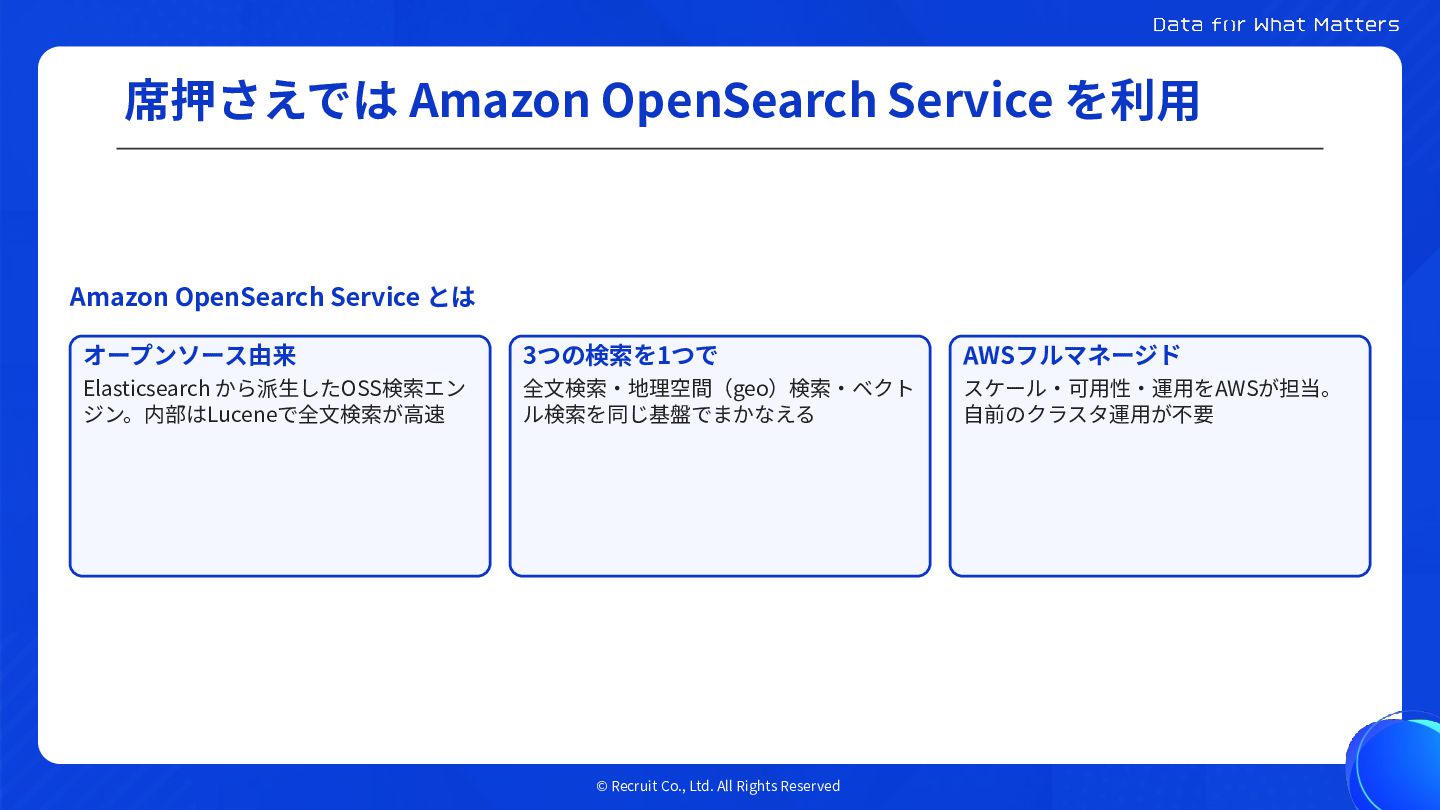
席押さえでは Amazon OpenSearch Service を利⽤ Amazon OpenSearch Service とは オープンソース由来
3つの検索を1つで AWSフルマネージド Elasticsearch から派⽣したOSS検索エン ジン。内部はLuceneで全⽂検索が⾼速 全⽂検索‧地理空間(geo)検索‧ベクト ル検索を同じ基盤でまかなえる スケール‧可⽤性‧運⽤をAWSが担当。 ⾃前のクラスタ運⽤が不要 © Recruit Co., Ltd. All Rights Reserved
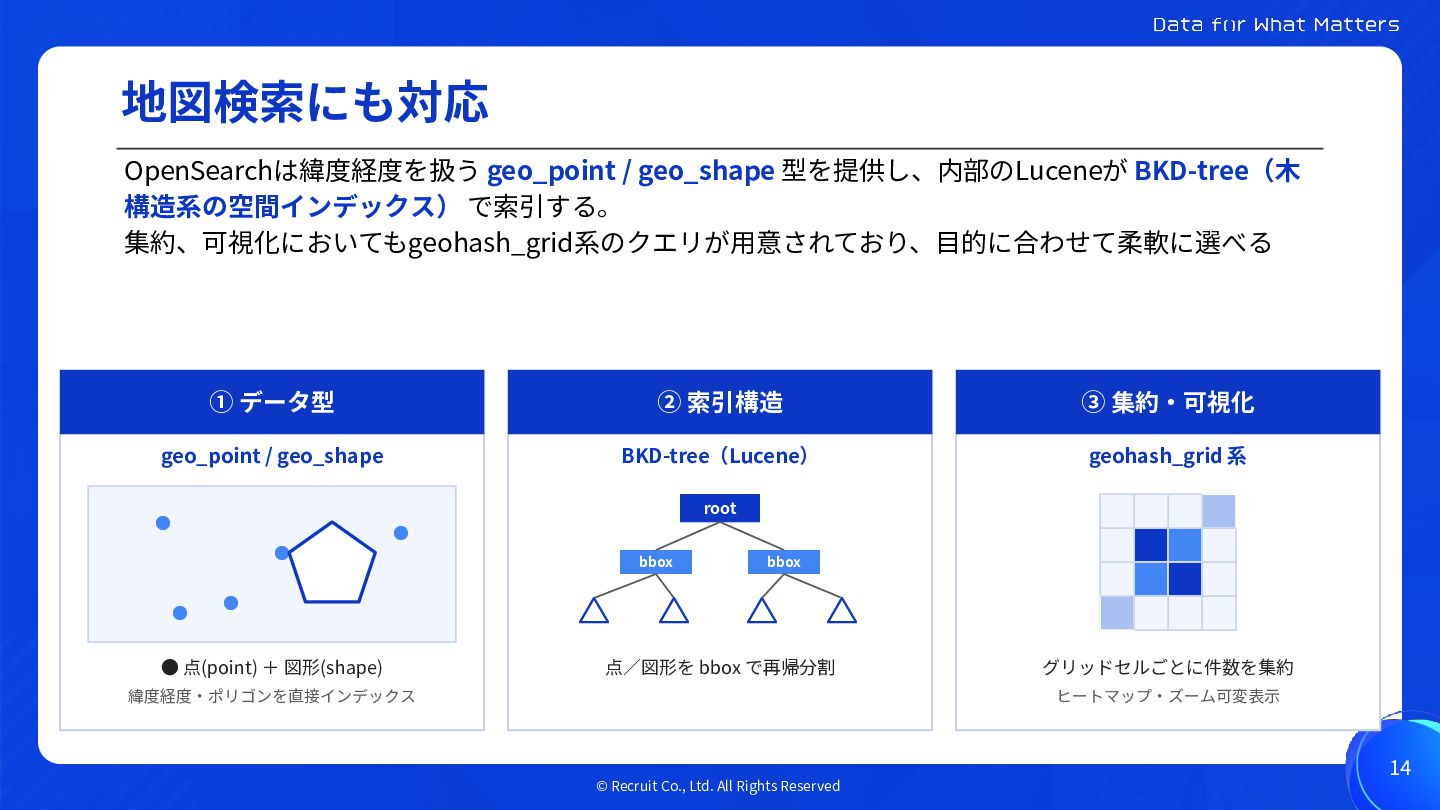
地図検索にも対応 OpenSearchは緯度経度を扱う geo_point / geo_shape 型を提供し、内部のLuceneが BKD-tree(⽊ 構造系の空間インデックス) で索引する。 集約、可視化においてもgeohash_grid系のクエリが⽤意されており、⽬的に合わせて柔軟に選べる
① データ型 ② 索引構造 ③ 集約‧可視化 geo_point / geo_shape BKD-tree(Lucene) geohash_grid 系 root bbox • 点(point) + 図形(shape) bbox 点∕図形を bbox で再帰分割 緯度経度‧ポリゴンを直接インデックス グリッドセルごとに件数を集約 ヒートマップ‧ズーム可変表⽰ 14 © Recruit Co., Ltd. All Rights Reserved
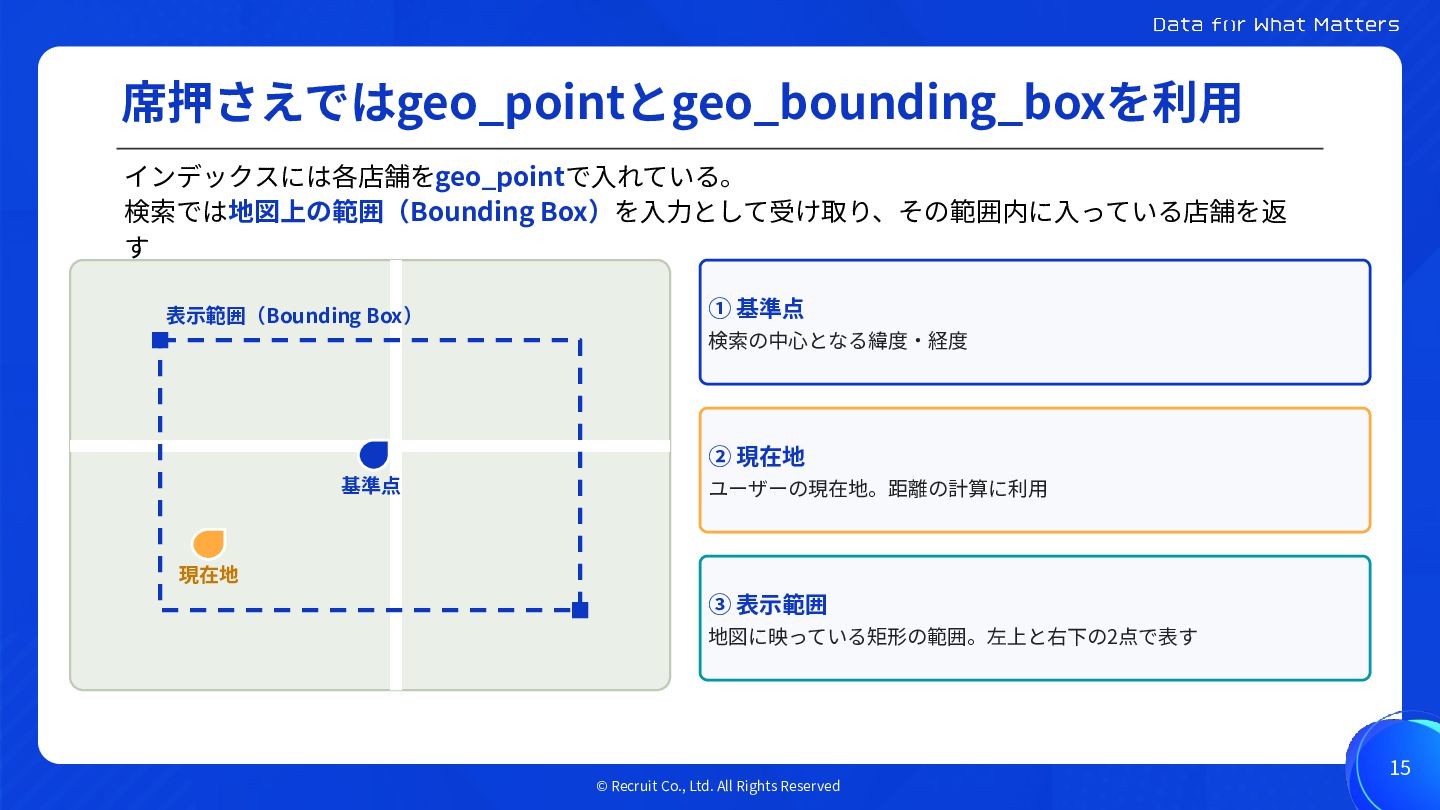
席押さえではgeo_pointとgeo_bounding_boxを利⽤ インデックスには各店舗をgeo_pointで⼊れている。 検索では地図上の範囲(Bounding Box)を⼊⼒として受け取り、その範囲内に⼊っている店舗を返 す 表⽰範囲(Bounding Box) ① 基準点 検索の中⼼となる緯度‧経度
② 現在地 基準点 ユーザーの現在地。距離の計算に利⽤ 現在地 ③ 表⽰範囲 地図に映っている矩形の範囲。左上と右下の2点で表す 15 © Recruit Co., Ltd. All Rights Reserved
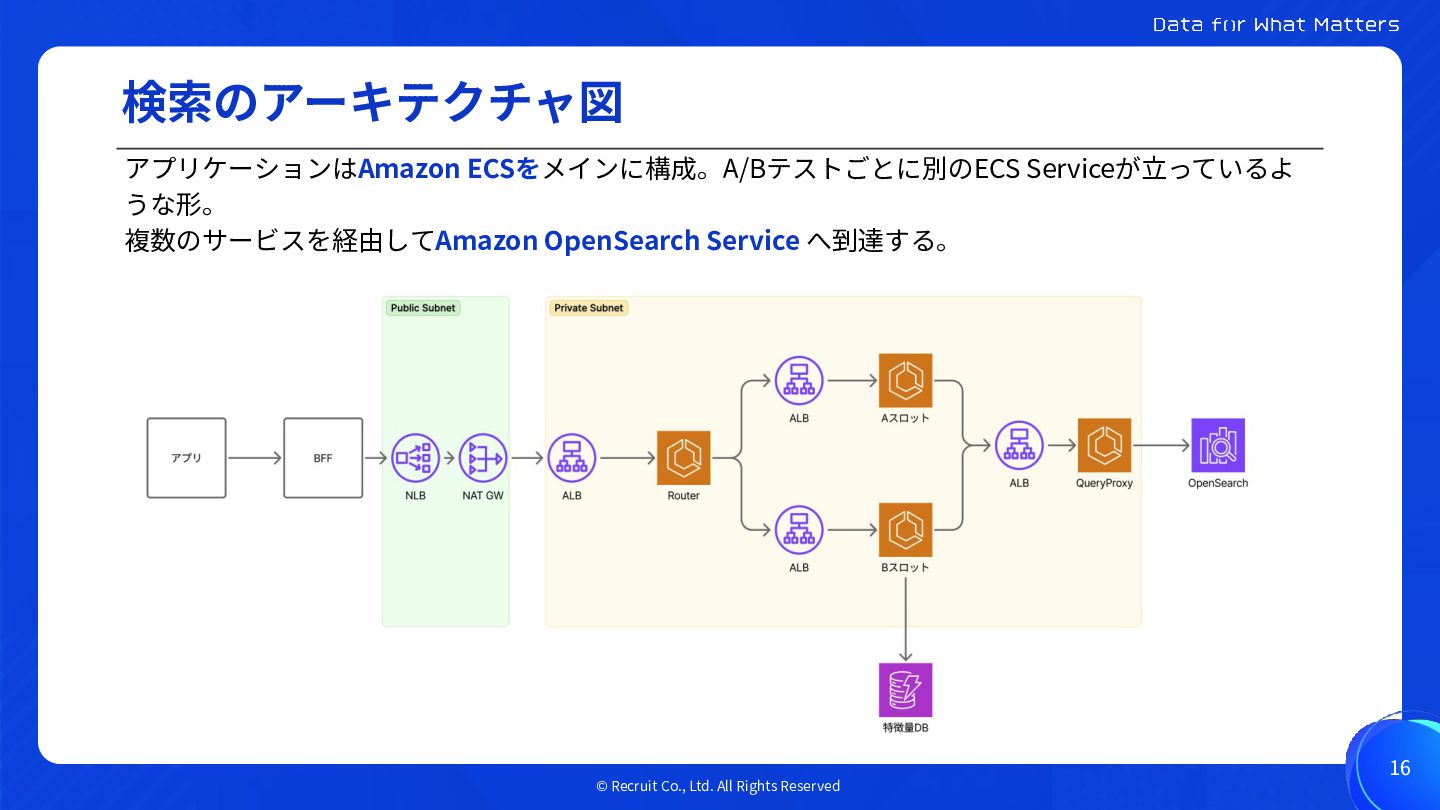
検索のアーキテクチャ図 アプリケーションはAmazon ECSをメインに構成。A/Bテストごとに別のECS Serviceが⽴っているよ うな形。 複数のサービスを経由してAmazon OpenSearch Service へ到達する。 16
© Recruit Co., Ltd. All Rights Reserved
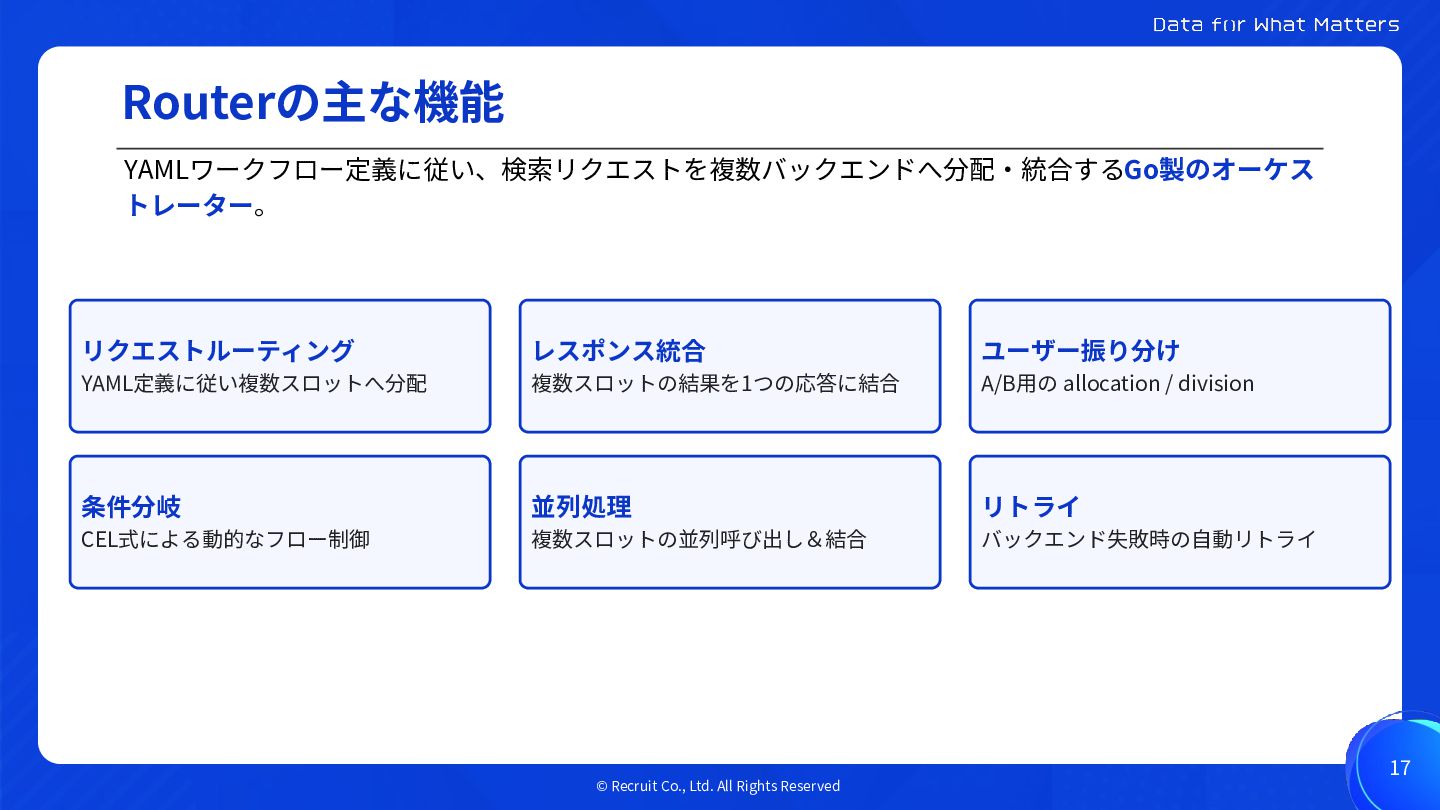
Routerの主な機能 YAMLワークフロー定義に従い、検索リクエストを複数バックエンドへ分配‧統合するGo製のオーケス トレーター。 リクエストルーティング レスポンス統合 ユーザー振り分け YAML定義に従い複数スロットへ分配 複数スロットの結果を1つの応答に結合 A/B⽤の allocation
/ division 条件分岐 並列処理 リトライ CEL式による動的なフロー制御 複数スロットの並列呼び出し&結合 バックエンド失敗時の⾃動リトライ 17 © Recruit Co., Ltd. All Rights Reserved
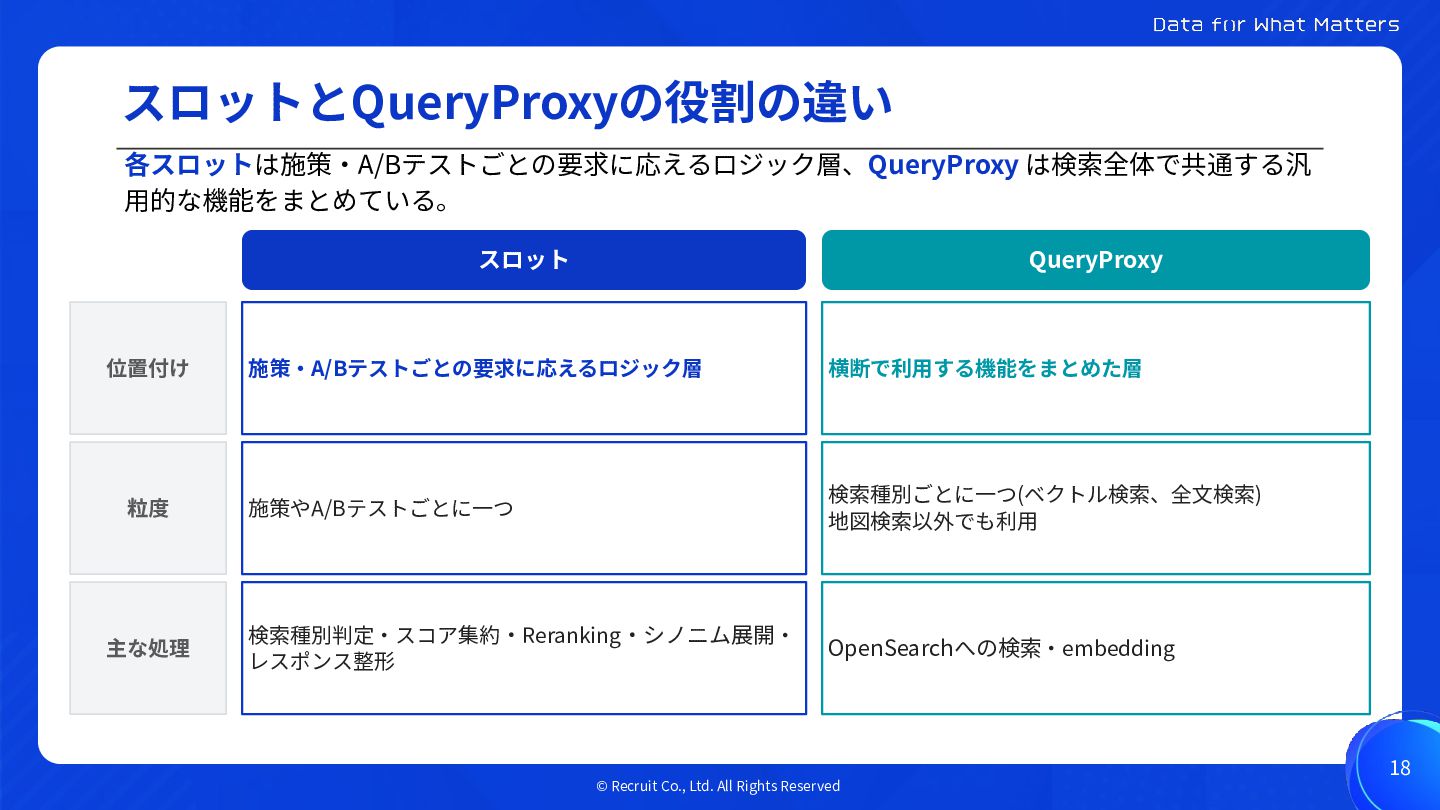
スロットとQueryProxyの役割の違い 各スロットは施策‧A/Bテストごとの要求に応えるロジック層、QueryProxy は検索全体で共通する汎 ⽤的な機能をまとめている。 スロット 位置付け 粒度 主な処理 QueryProxy 施策‧A/Bテストごとの要求に応えるロジック層
横断で利⽤する機能をまとめた層 施策やA/Bテストごとに⼀つ 検索種別ごとに⼀つ(ベクトル検索、全⽂検索) 地図検索以外でも利⽤ 検索種別判定‧スコア集約‧Reranking‧シノニム展開‧ レスポンス整形 OpenSearchへの検索‧embedding 18 © Recruit Co., Ltd. All Rights Reserved
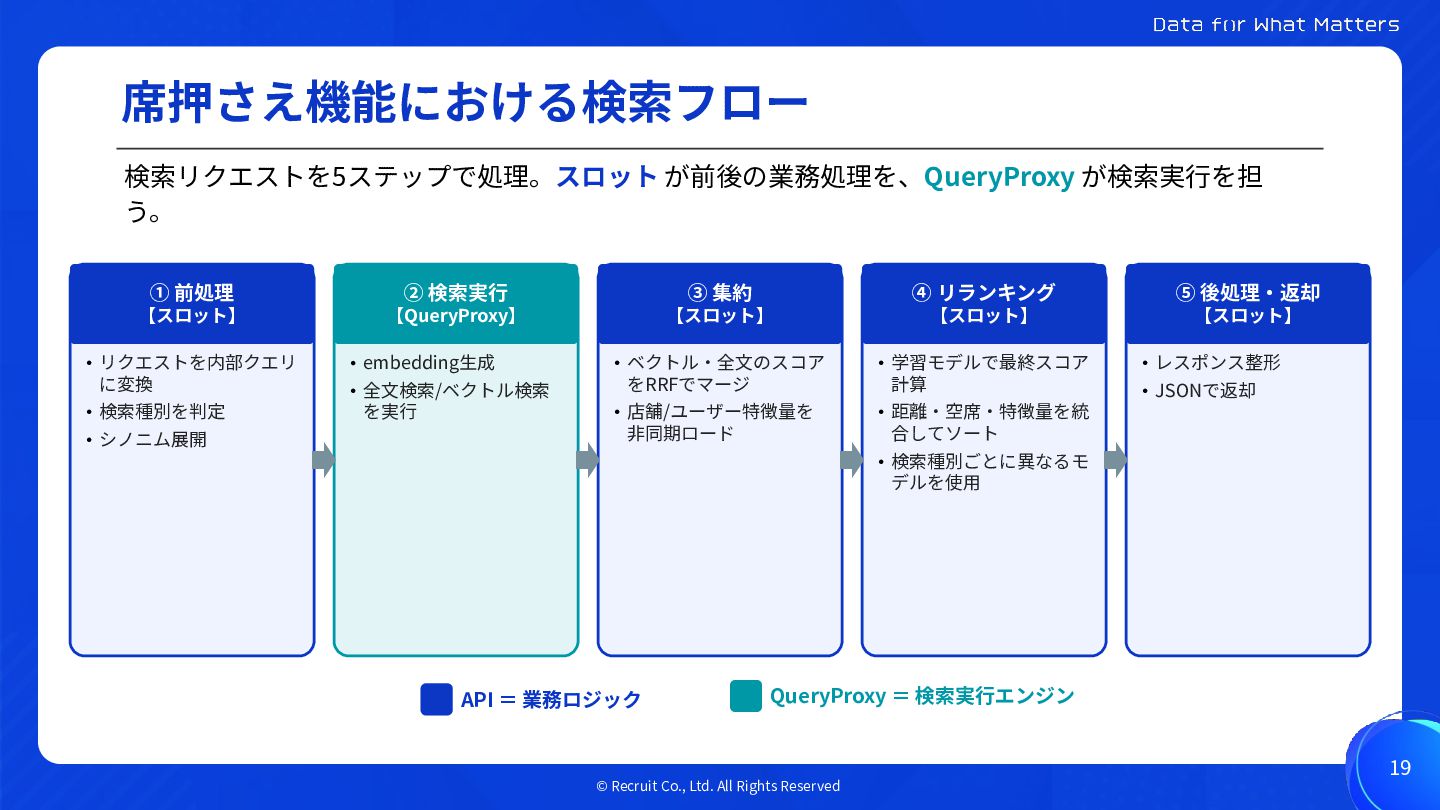
席押さえ機能における検索フロー 検索リクエストを5ステップで処理。スロット が前後の業務処理を、QueryProxy が検索実⾏を担 う。 ① 前処理 ② 検索実⾏ ③
集約 ④ リランキング ⑤ 後処理‧返却 【スロット】 【QueryProxy】 【スロット】 【スロット】 【スロット】 • ベクトル‧全⽂のスコア をRRFでマージ • 学習モデルで最終スコア 計算 • 店舗/ユーザー特徴量を ⾮同期ロード • 距離‧空席‧特徴量を統 合してソート • リクエストを内部クエリ に変換 • 検索種別を判定 • シノニム展開 • embedding⽣成 • 全⽂検索/ベクトル検索 を実⾏ • レスポンス整形 • JSONで返却 • 検索種別ごとに異なるモ デルを使⽤ API = 業務ロジック QueryProxy = 検索実⾏エンジン 19 © Recruit Co., Ltd. All Rights Reserved
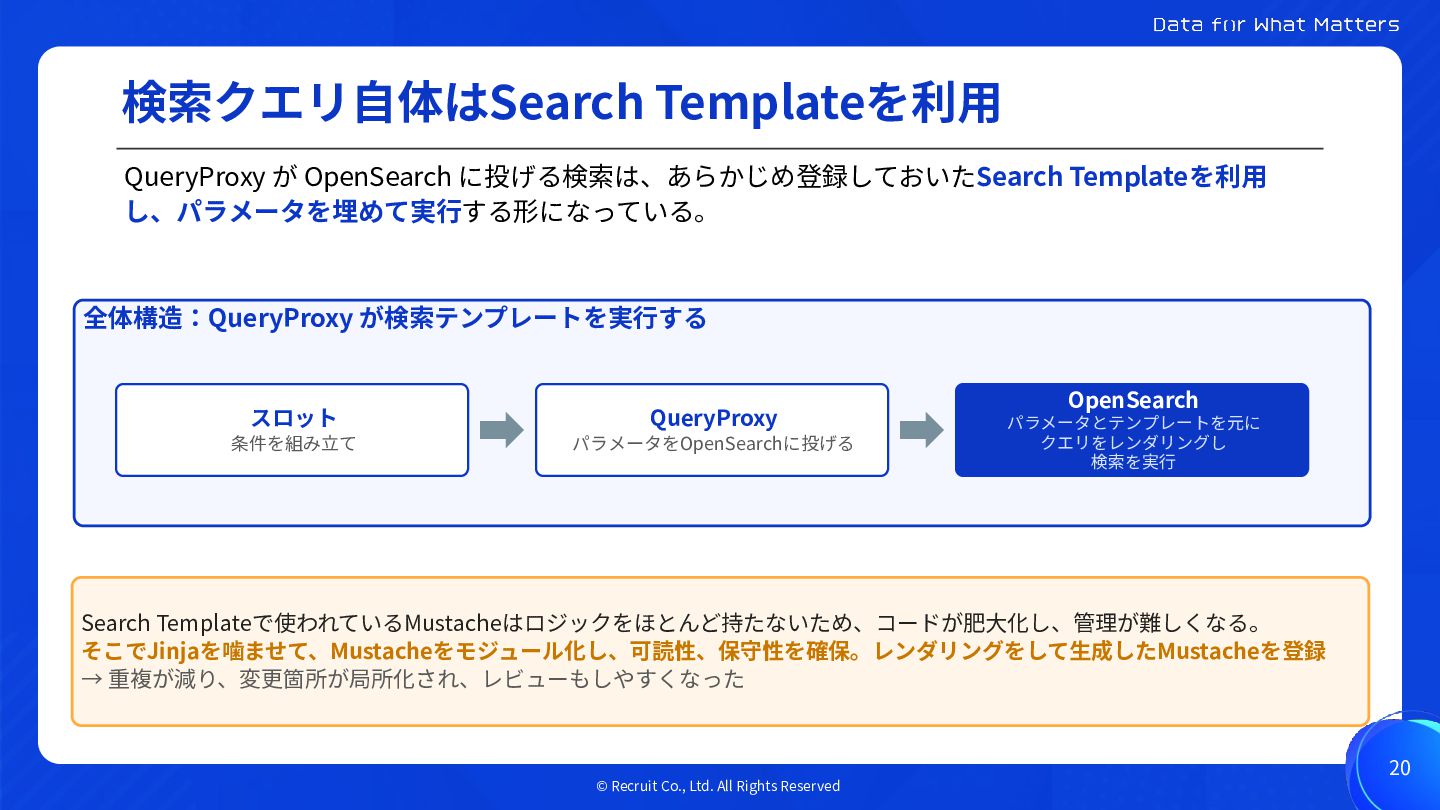
検索クエリ⾃体はSearch Templateを利⽤ QueryProxy が OpenSearch に投げる検索は、あらかじめ登録しておいたSearch Templateを利⽤ し、パラメータを埋めて実⾏する形になっている。 全体構造:QueryProxy が検索テンプレートを実⾏する
スロット QueryProxy 条件を組み⽴て パラメータをOpenSearchに投げる OpenSearch パラメータとテンプレートを元に クエリをレンダリングし 検索を実⾏ Search Templateで使われているMustacheはロジックをほとんど持たないため、コードが肥⼤化し、管理が難しくなる。 そこでJinjaを噛ませて、Mustacheをモジュール化し、可読性、保守性を確保。レンダリングをして⽣成したMustacheを登録 → 重複が減り、変更箇所が局所化され、レビューもしやすくなった 20 © Recruit Co., Ltd. All Rights Reserved
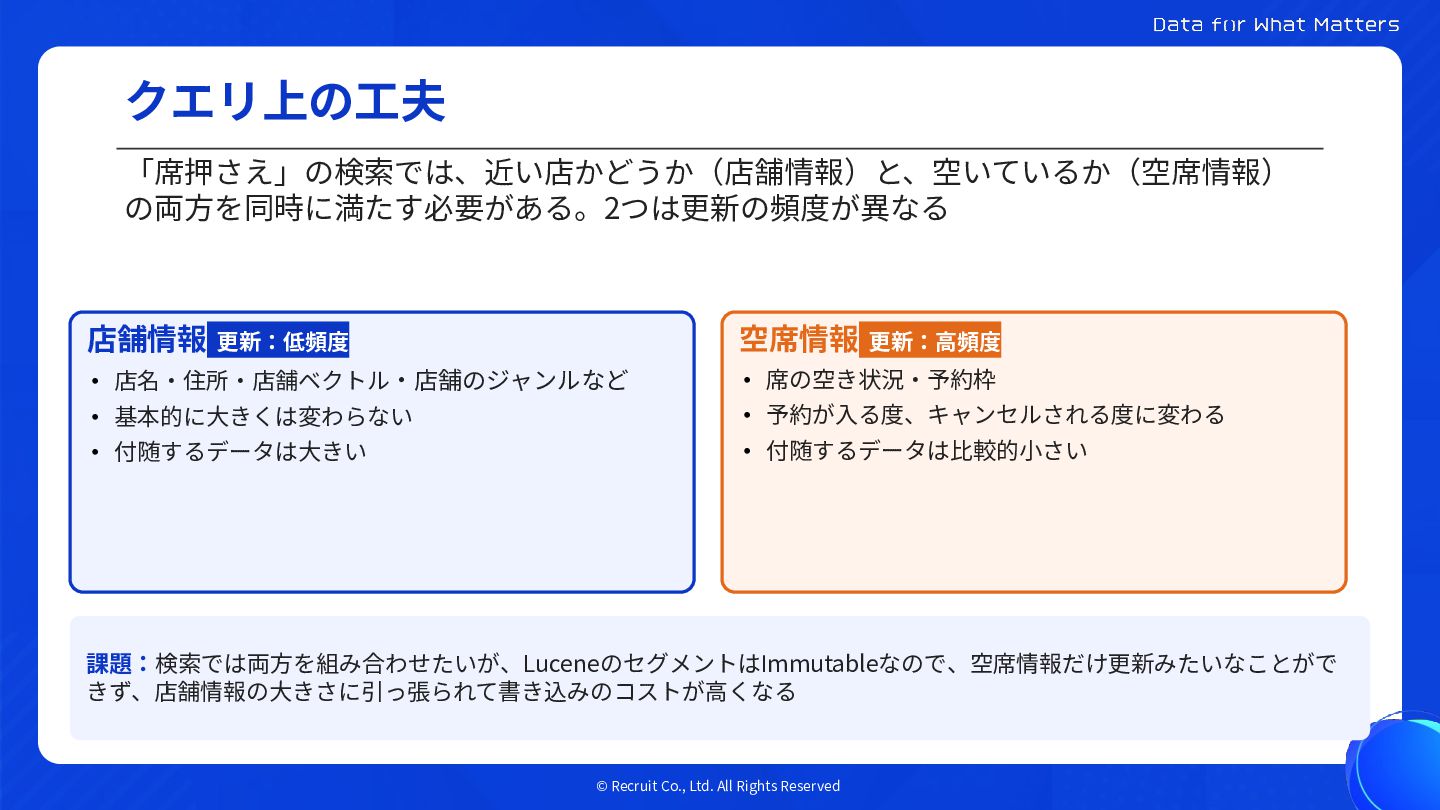
クエリ上の⼯夫 「席押さえ」の検索では、近い店かどうか(店舗情報)と、空いているか(空席情報) の両⽅を同時に満たす必要がある。2つは更新の頻度が異なる 店舗情報 更新:低頻度 空席情報 更新:⾼頻度 • 店名‧住所‧店舗ベクトル‧店舗のジャンルなど •
席の空き状況‧予約枠 • 基本的に⼤きくは変わらない • 予約が⼊る度、キャンセルされる度に変わる • 付随するデータは⼤きい • 付随するデータは⽐較的⼩さい 課題:検索では両⽅を組み合わせたいが、LuceneのセグメントはImmutableなので、空席情報だけ更新みたいなことがで きず、店舗情報の⼤きさに引っ張られて書き込みのコストが⾼くなる © Recruit Co., Ltd. All Rights Reserved
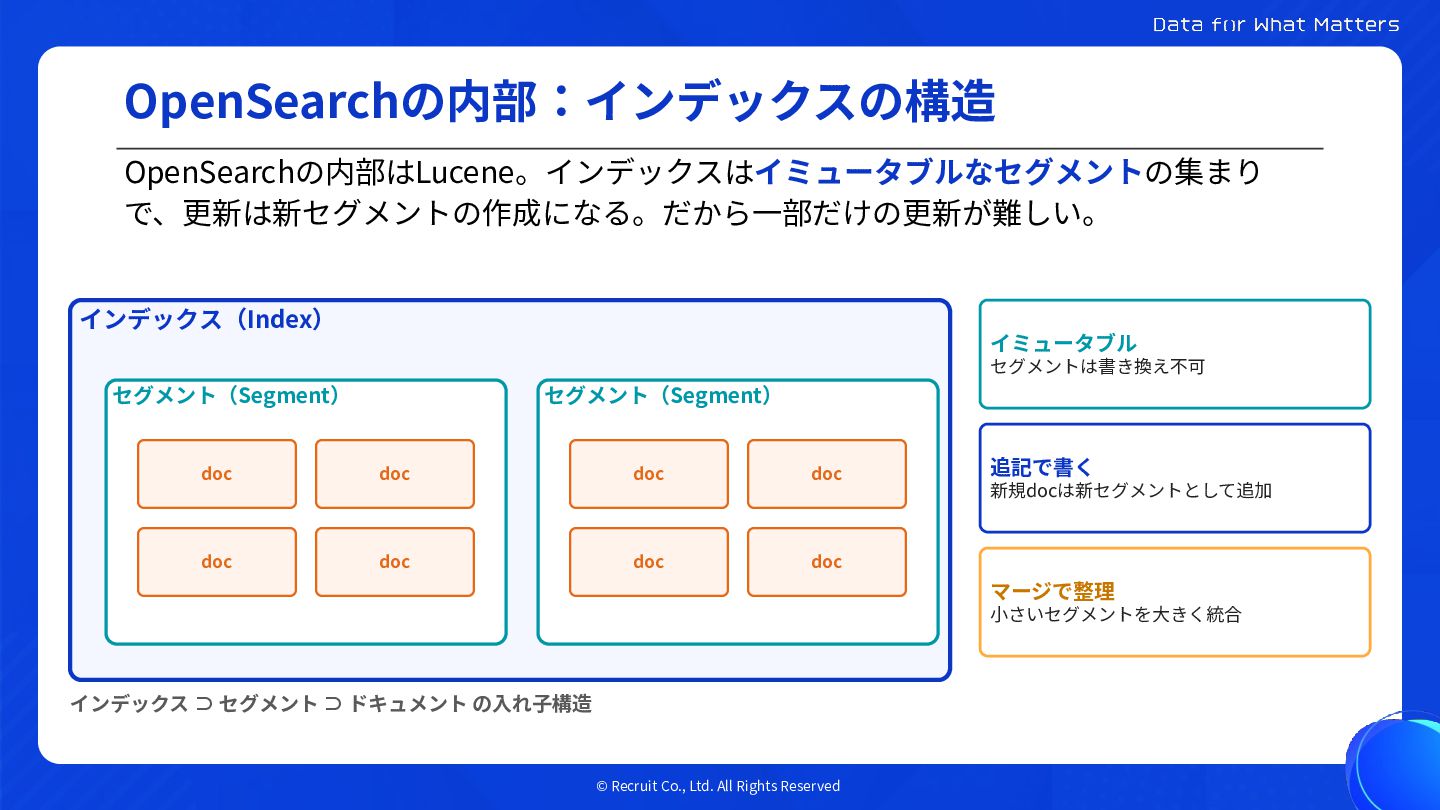
OpenSearchの内部:インデックスの構造 OpenSearchの内部はLucene。インデックスはイミュータブルなセグメントの集まり で、更新は新セグメントの作成になる。だから⼀部だけの更新が難しい。 インデックス(Index) イミュータブル セグメントは書き換え不可 セグメント(Segment) セグメント(Segment) doc doc
doc doc doc doc doc doc 追記で書く 新規docは新セグメントとして追加 マージで整理 ⼩さいセグメントを⼤きく統合 インデックス ⊃ セグメント ⊃ ドキュメント の⼊れ⼦構造 © Recruit Co., Ltd. All Rights Reserved
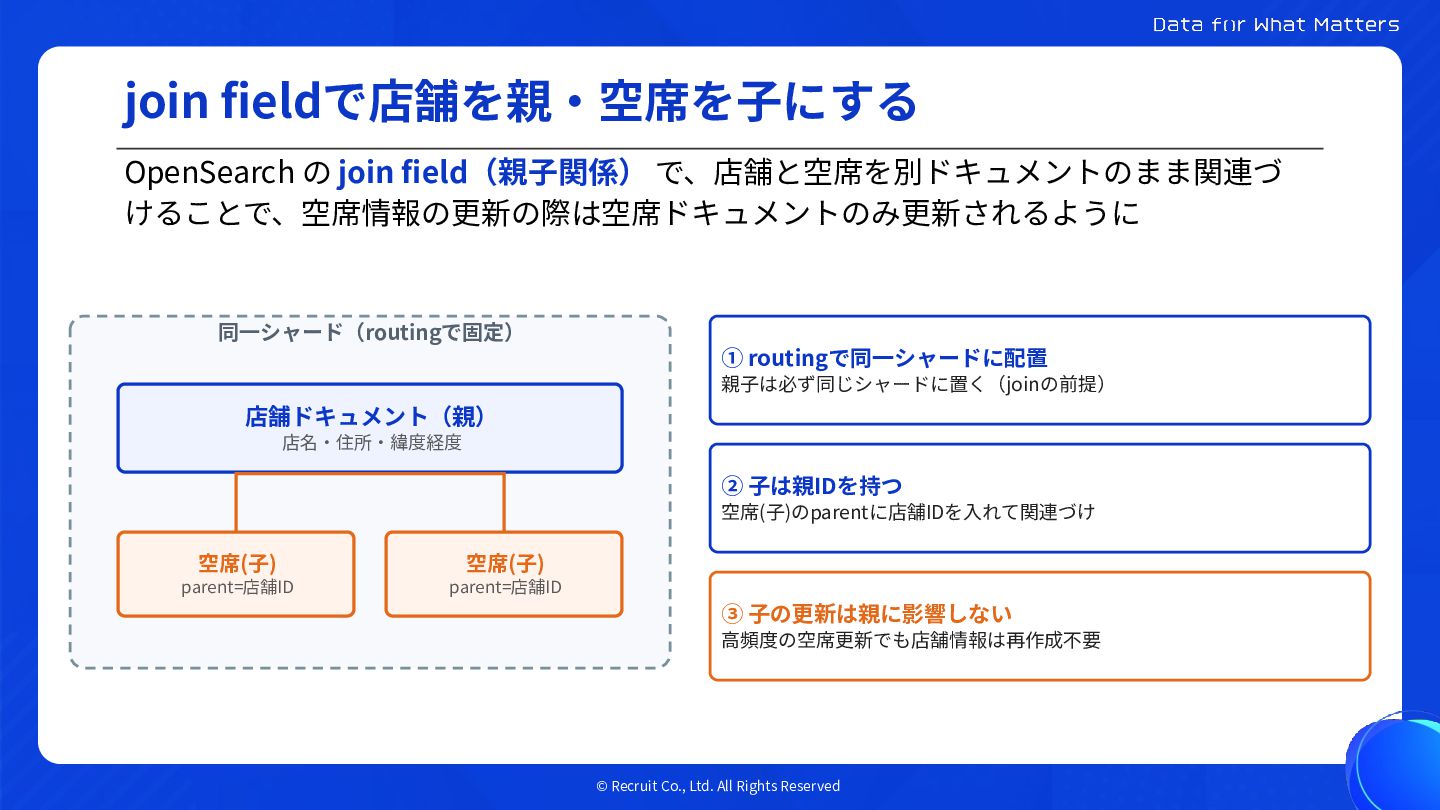
join fieldで店舗を親‧空席を⼦にする OpenSearch の join field(親⼦関係) で、店舗と空席を別ドキュメントのまま関連づ けることで、空席情報の更新の際は空席ドキュメントのみ更新されるように 同⼀シャード(routingで固定) ①
routingで同⼀シャードに配置 親⼦は必ず同じシャードに置く(joinの前提) 店舗ドキュメント(親) 店名‧住所‧緯度経度 ② ⼦は親IDを持つ 空席(⼦)のparentに店舗IDを⼊れて関連づけ 空席(⼦) 空席(⼦) parent=店舗ID parent=店舗ID ③ ⼦の更新は親に影響しない ⾼頻度の空席更新でも店舗情報は再作成不要 © Recruit Co., Ltd. All Rights Reserved
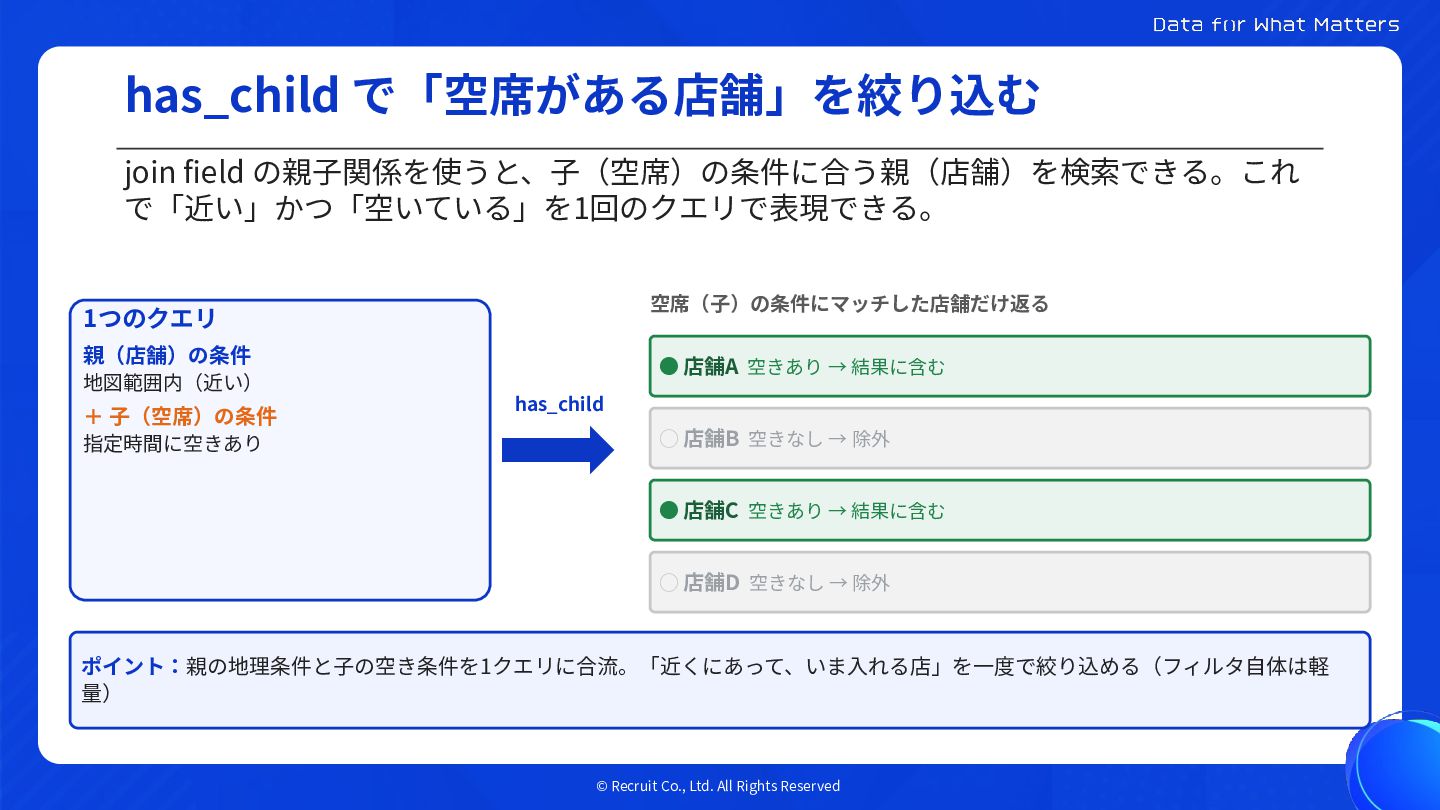
has_child で「空席がある店舗」を絞り込む join field の親⼦関係を使うと、⼦(空席)の条件に合う親(店舗)を検索できる。これ で「近い」かつ「空いている」を1回のクエリで表現できる。 空席(⼦)の条件にマッチした店舗だけ返る 1つのクエリ 親(店舗)の条件 地図範囲内(近い)
+ ⼦(空席)の条件 指定時間に空きあり • 店舗A 空きあり → 結果に含む has_child ◦ 店舗B 空きなし → 除外 • 店舗C 空きあり → 結果に含む ◦ 店舗D 空きなし → 除外 ポイント:親の地理条件と⼦の空き条件を1クエリに合流。「近くにあって、いま⼊れる店」を⼀度で絞り込める(フィルタ⾃体は軽 量) © Recruit Co., Ltd. All Rights Reserved
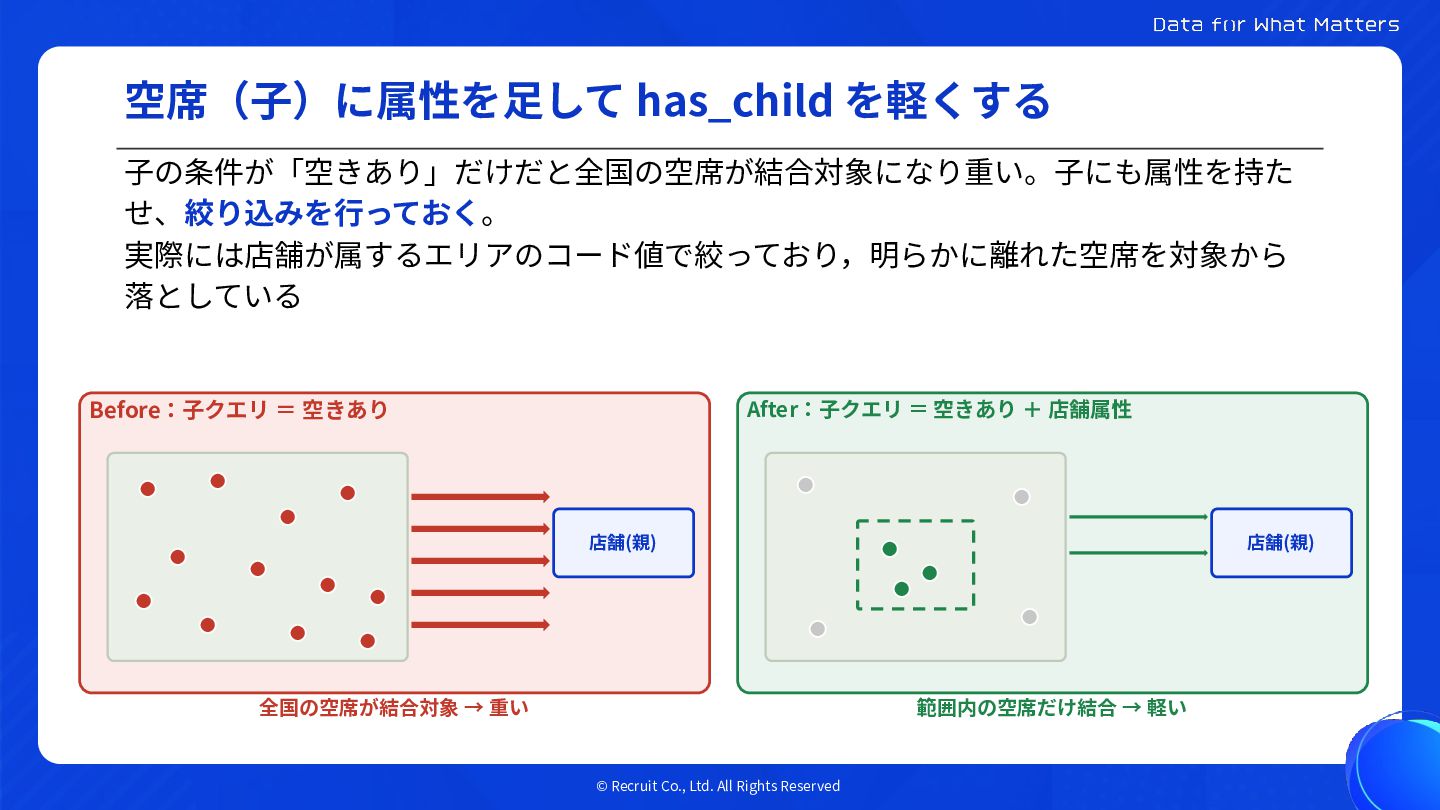
空席(⼦)に属性を⾜して has_child を軽くする ⼦の条件が「空きあり」だけだと全国の空席が結合対象になり重い。⼦にも属性を持た せ、絞り込みを⾏っておく。 実際には店舗が属するエリアのコード値で絞っており,明らかに離れた空席を対象から 落としている After:⼦クエリ = 空きあり
+ 店舗属性 Before:⼦クエリ = 空きあり 店舗(親) 全国の空席が結合対象 → 重い 店舗(親) 範囲内の空席だけ結合 → 軽い © Recruit Co., Ltd. All Rights Reserved
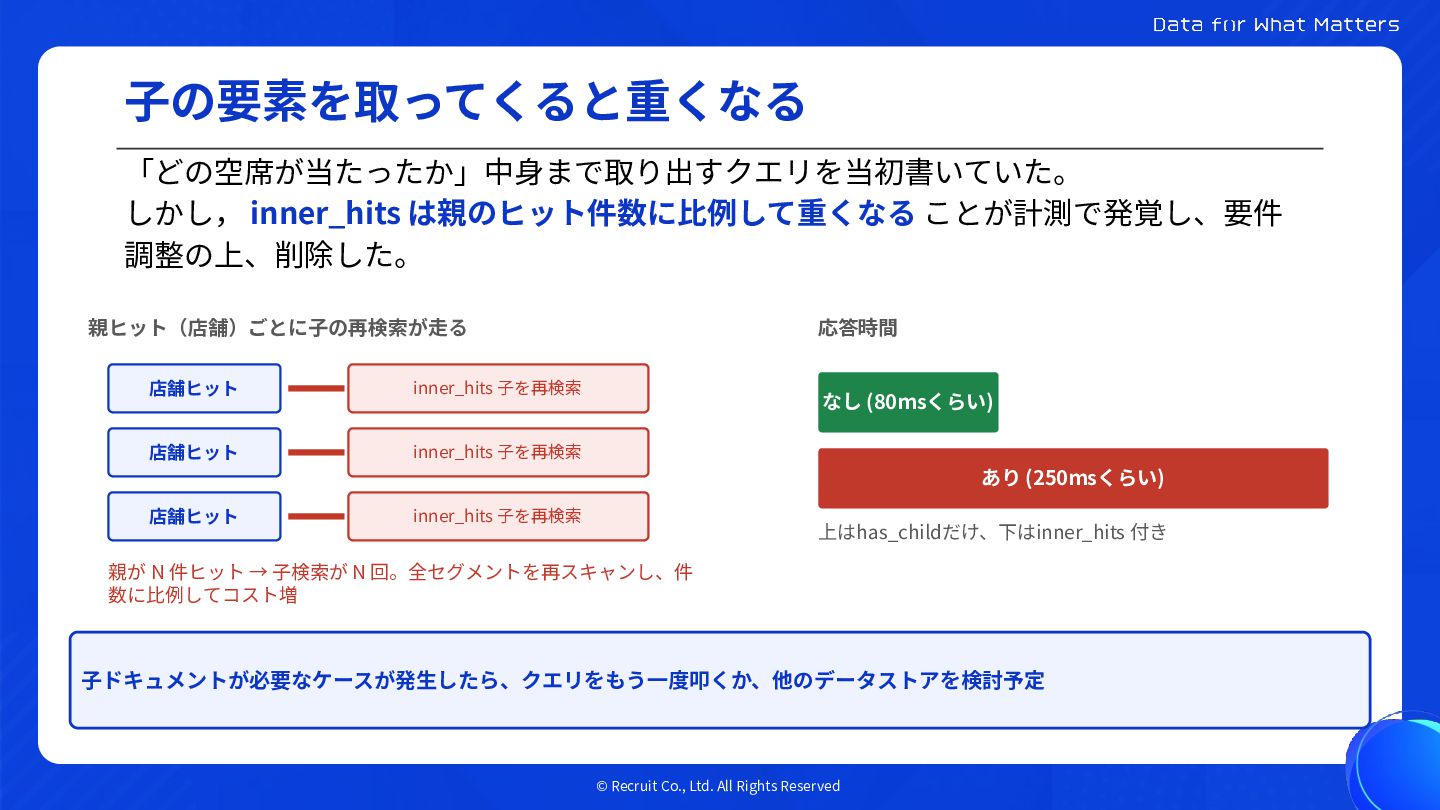
⼦の要素を取ってくると重くなる 「どの空席が当たったか」中⾝まで取り出すクエリを当初書いていた。 しかし, inner_hits は親のヒット件数に⽐例して重くなる ことが計測で発覚し、要件 調整の上、削除した。 親ヒット(店舗)ごとに⼦の再検索が⾛る 店舗ヒット inner_hits
⼦を再検索 店舗ヒット inner_hits ⼦を再検索 応答時間 なし (80msくらい) あり (250msくらい) 店舗ヒット inner_hits ⼦を再検索 上はhas_childだけ、下はinner_hits 付き 親が N 件ヒット → ⼦検索が N 回。全セグメントを再スキャンし、件 数に⽐例してコスト増 ⼦ドキュメントが必要なケースが発⽣したら、クエリをもう⼀度叩くか、他のデータストアを検討予定 © Recruit Co., Ltd. All Rights Reserved
Agenda3 ニアリアルタイムでのデータ連携 © Recruit Co., Ltd. All Rights Reserved
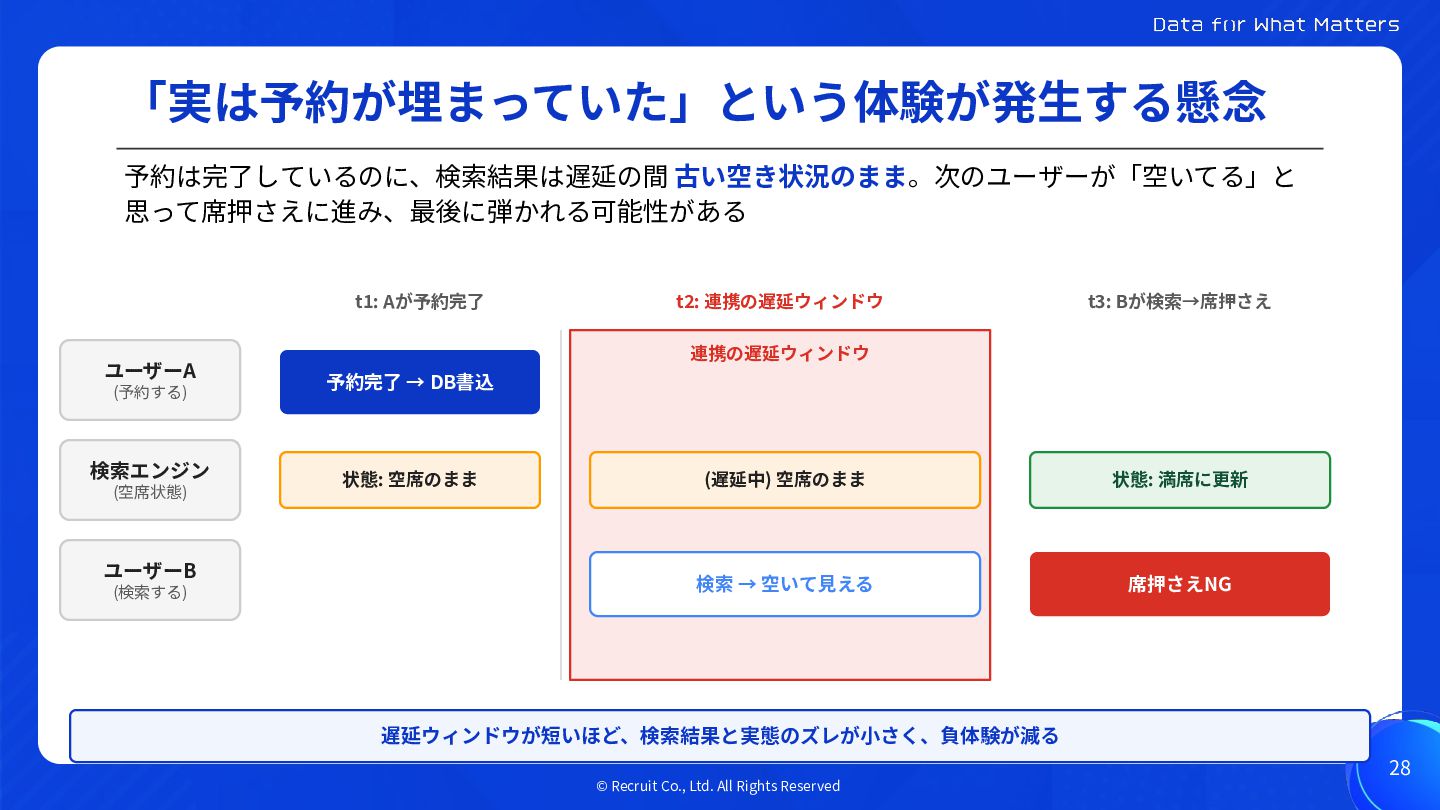
「実は予約が埋まっていた」という体験が発⽣する懸念 予約は完了しているのに、検索結果は遅延の間 古い空き状況のまま。次のユーザーが「空いてる」と 思って席押さえに進み、最後に弾かれる可能性がある t1: Aが予約完了 ユーザーA (予約する) 検索エンジン (空席状態)
ユーザーB (検索する) t2: 連携の遅延ウィンドウ t3: Bが検索→席押さえ 連携の遅延ウィンドウ 予約完了 → DB書込 状態: 空席のまま (遅延中) 空席のまま 状態: 満席に更新 検索 → 空いて⾒える 席押さえNG 遅延ウィンドウが短いほど、検索結果と実態のズレが⼩さく、負体験が減る 28 © Recruit Co., Ltd. All Rights Reserved
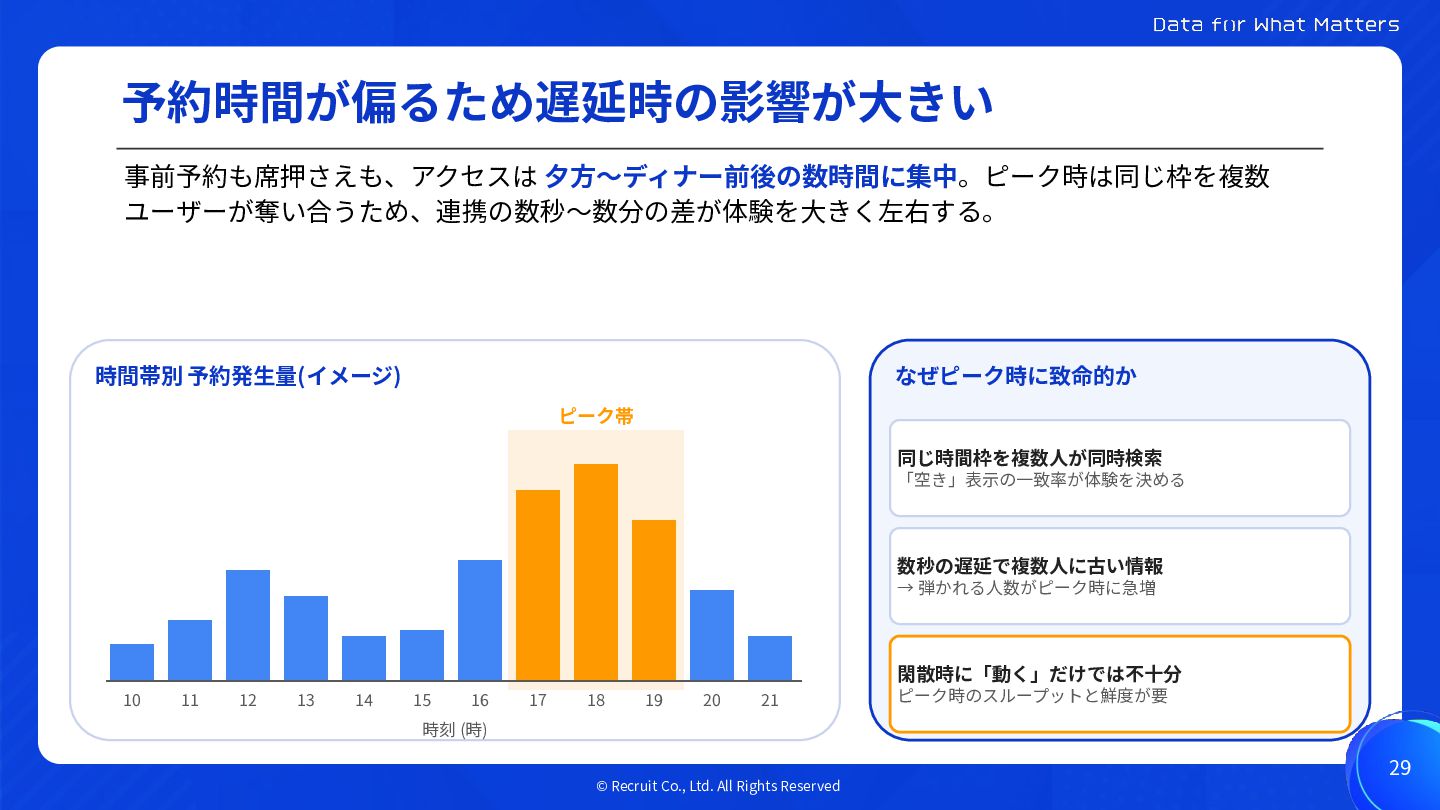
予約時間が偏るため遅延時の影響が⼤きい 事前予約も席押さえも、アクセスは ⼣⽅〜ディナー前後の数時間に集中。ピーク時は同じ枠を複数 ユーザーが奪い合うため、連携の数秒〜数分の差が体験を⼤きく左右する。 時間帯別 予約発⽣量(イメージ) なぜピーク時に致命的か ピーク帯 同じ時間枠を複数⼈が同時検索 「空き」表⽰の⼀致率が体験を決める
数秒の遅延で複数⼈に古い情報 → 弾かれる⼈数がピーク時に急増 閑散時に「動く」だけでは不⼗分 10 11 12 13 14 15 16 17 18 19 20 21 ピーク時のスループットと鮮度が要 時刻 (時) 29 © Recruit Co., Ltd. All Rights Reserved
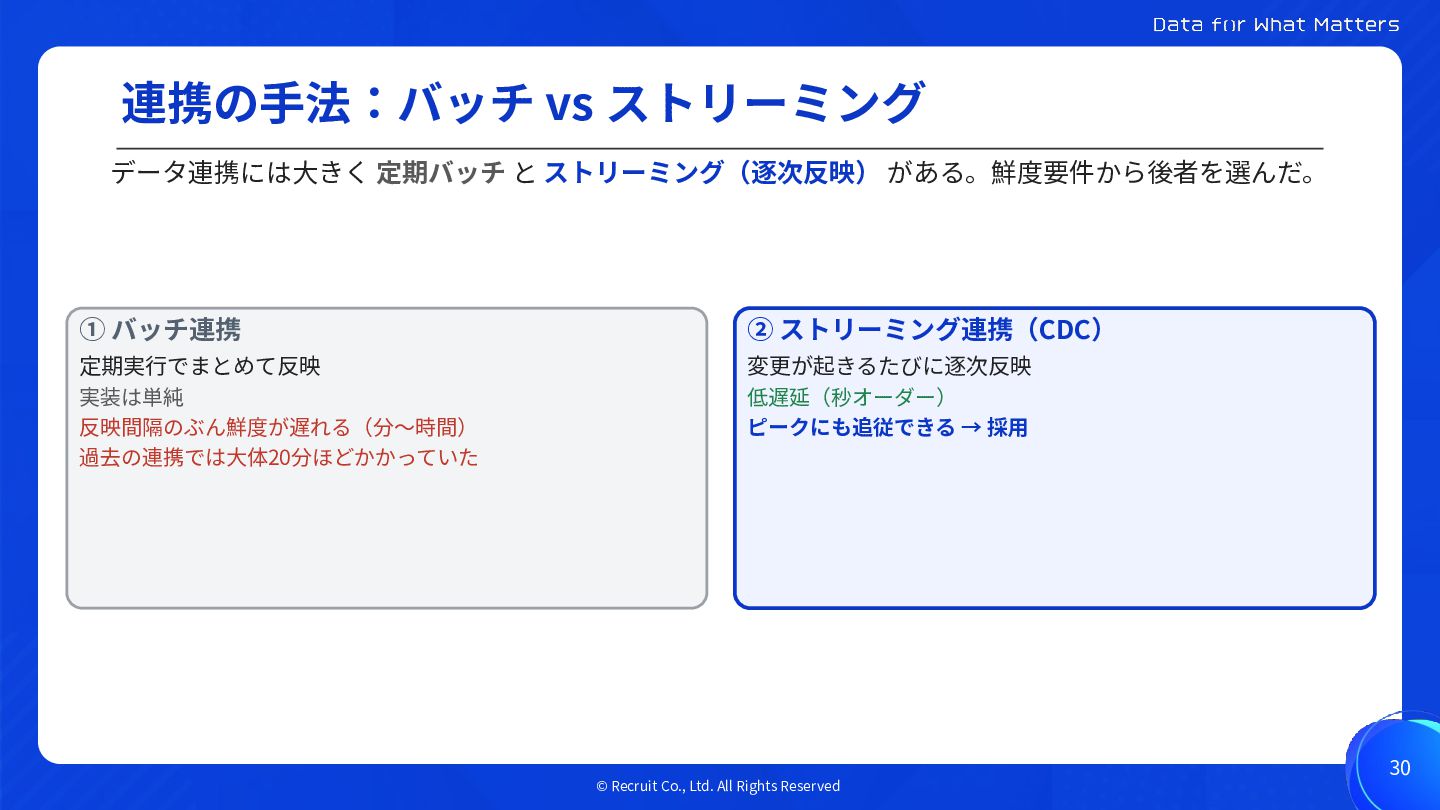
連携の⼿法:バッチ vs ストリーミング データ連携には⼤きく 定期バッチ と ストリーミング(逐次反映) がある。鮮度要件から後者を選んだ。 ① バッチ連携
② ストリーミング連携(CDC) 定期実⾏でまとめて反映 実装は単純 反映間隔のぶん鮮度が遅れる(分〜時間) 過去の連携では⼤体20分ほどかかっていた 変更が起きるたびに逐次反映 低遅延(秒オーダー) ピークにも追従できる → 採⽤ 30 © Recruit Co., Ltd. All Rights Reserved
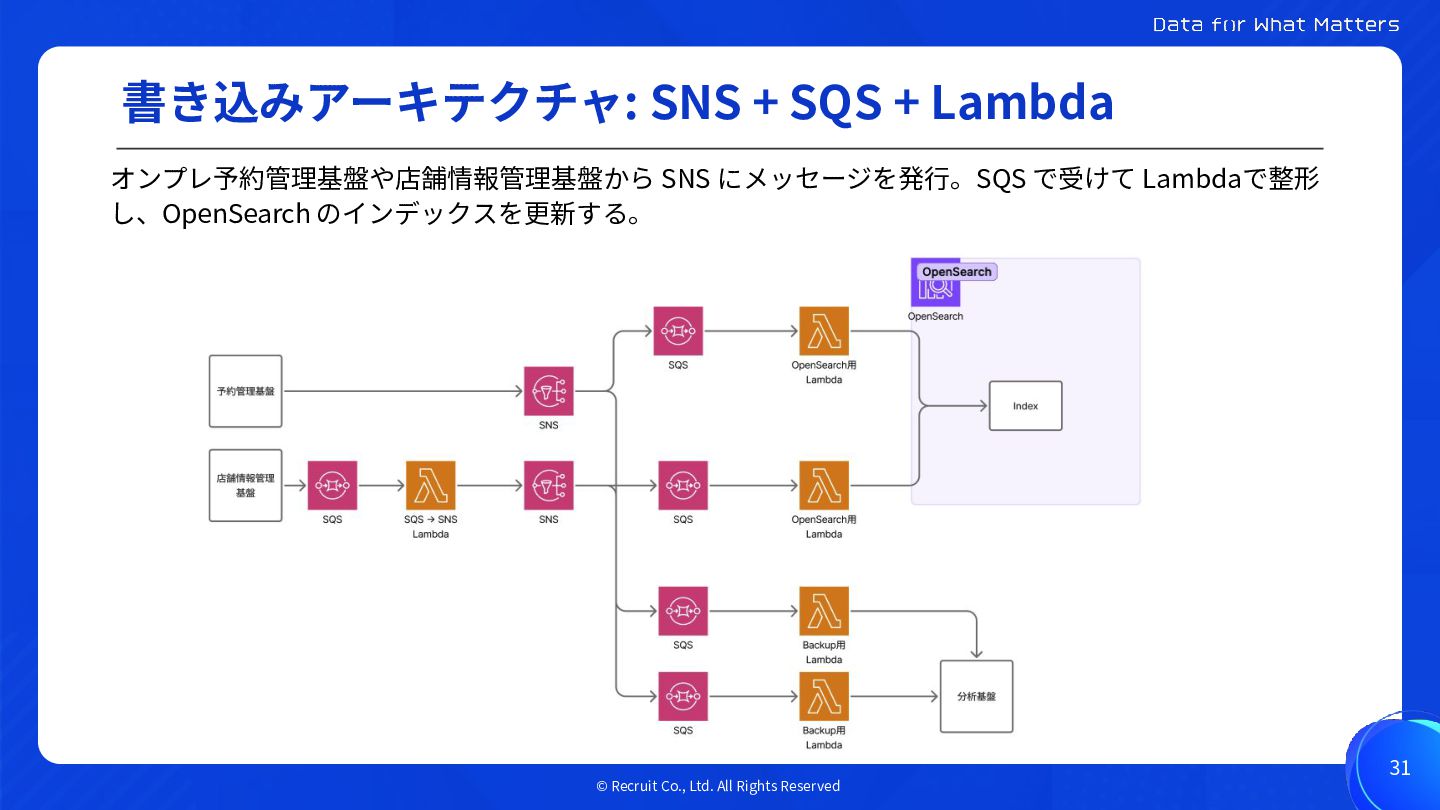
書き込みアーキテクチャ: SNS + SQS + Lambda オンプレ予約管理基盤や店舗情報管理基盤から SNS にメッセージを発⾏。SQS で受けて
Lambdaで整形 し、OpenSearch のインデックスを更新する。 31 © Recruit Co., Ltd. All Rights Reserved
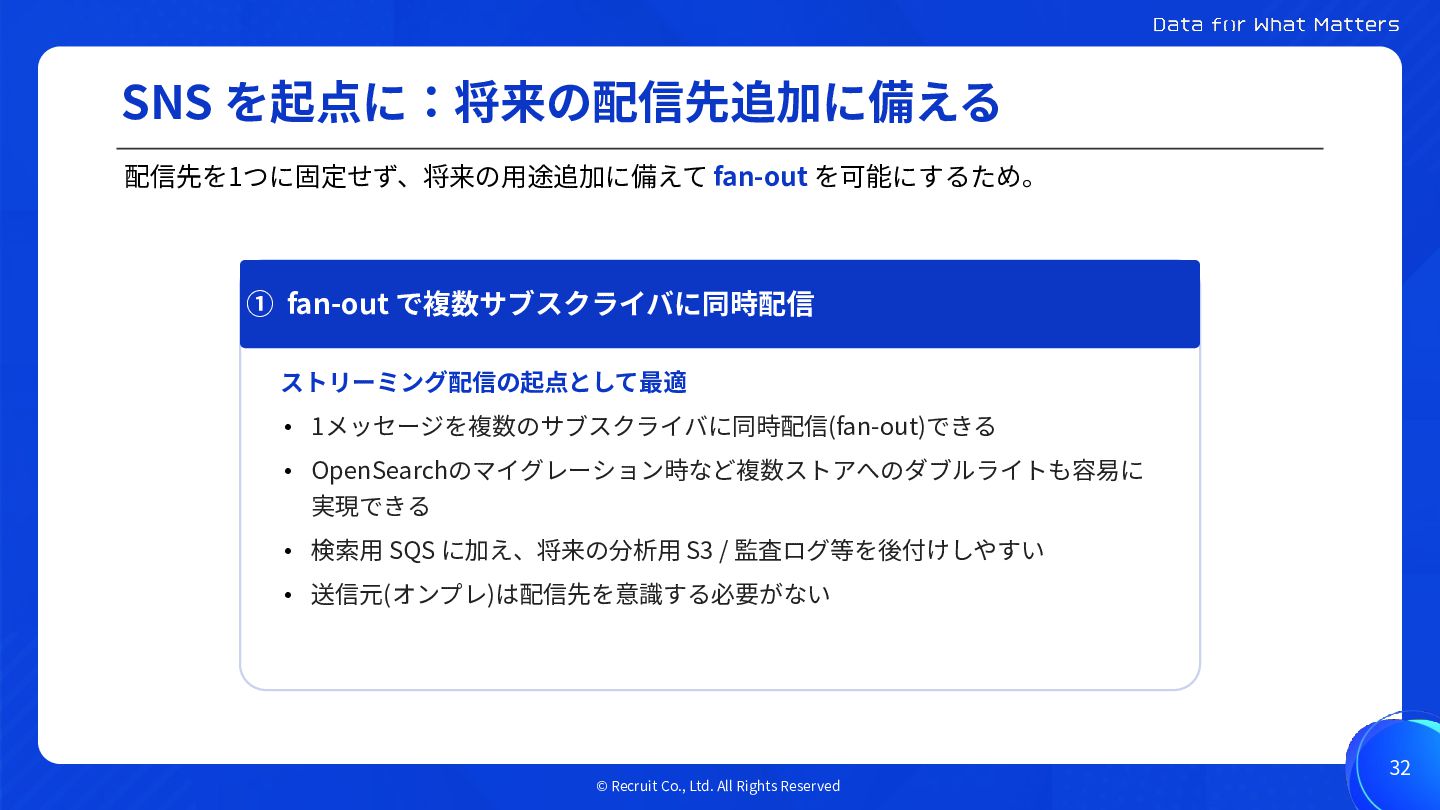
SNS を起点に:将来の配信先追加に備える 配信先を1つに固定せず、将来の⽤途追加に備えて fan-out を可能にするため。 ① fan-out で複数サブスクライバに同時配信 ストリーミング配信の起点として最適 •
1メッセージを複数のサブスクライバに同時配信(fan-out)できる • OpenSearchのマイグレーション時など複数ストアへのダブルライトも容易に 実現できる • 検索⽤ SQS に加え、将来の分析⽤ S3 / 監査ログ等を後付けしやすい • 送信元(オンプレ)は配信先を意識する必要がない 32 © Recruit Co., Ltd. All Rights Reserved
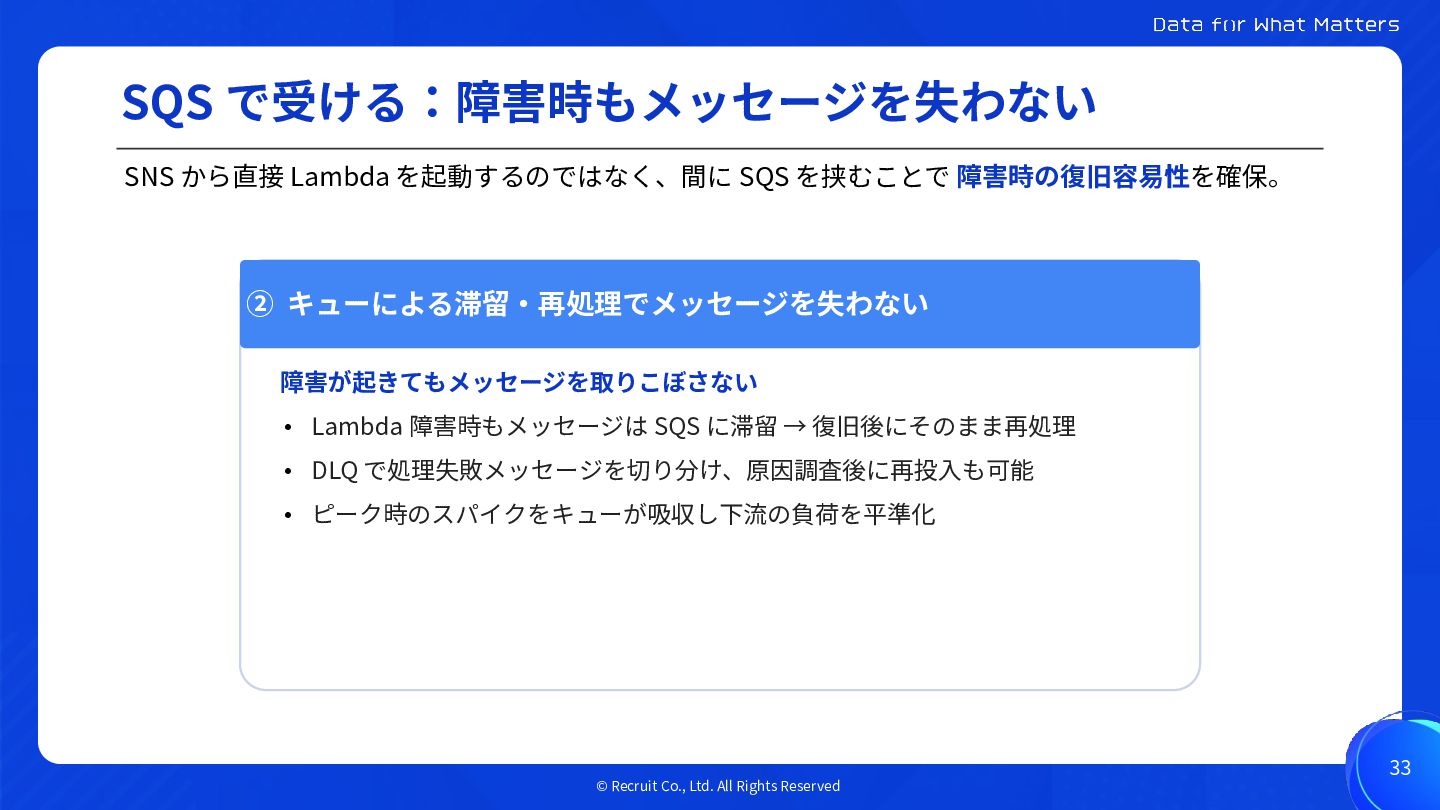
SQS で受ける:障害時もメッセージを失わない SNS から直接 Lambda を起動するのではなく、間に SQS を挟むことで 障害時の復旧容易性を確保。 ②
キューによる滞留‧再処理でメッセージを失わない 障害が起きてもメッセージを取りこぼさない • Lambda 障害時もメッセージは SQS に滞留 → 復旧後にそのまま再処理 • DLQ で処理失敗メッセージを切り分け、原因調査後に再投⼊も可能 • ピーク時のスパイクをキューが吸収し下流の負荷を平準化 33 © Recruit Co., Ltd. All Rights Reserved
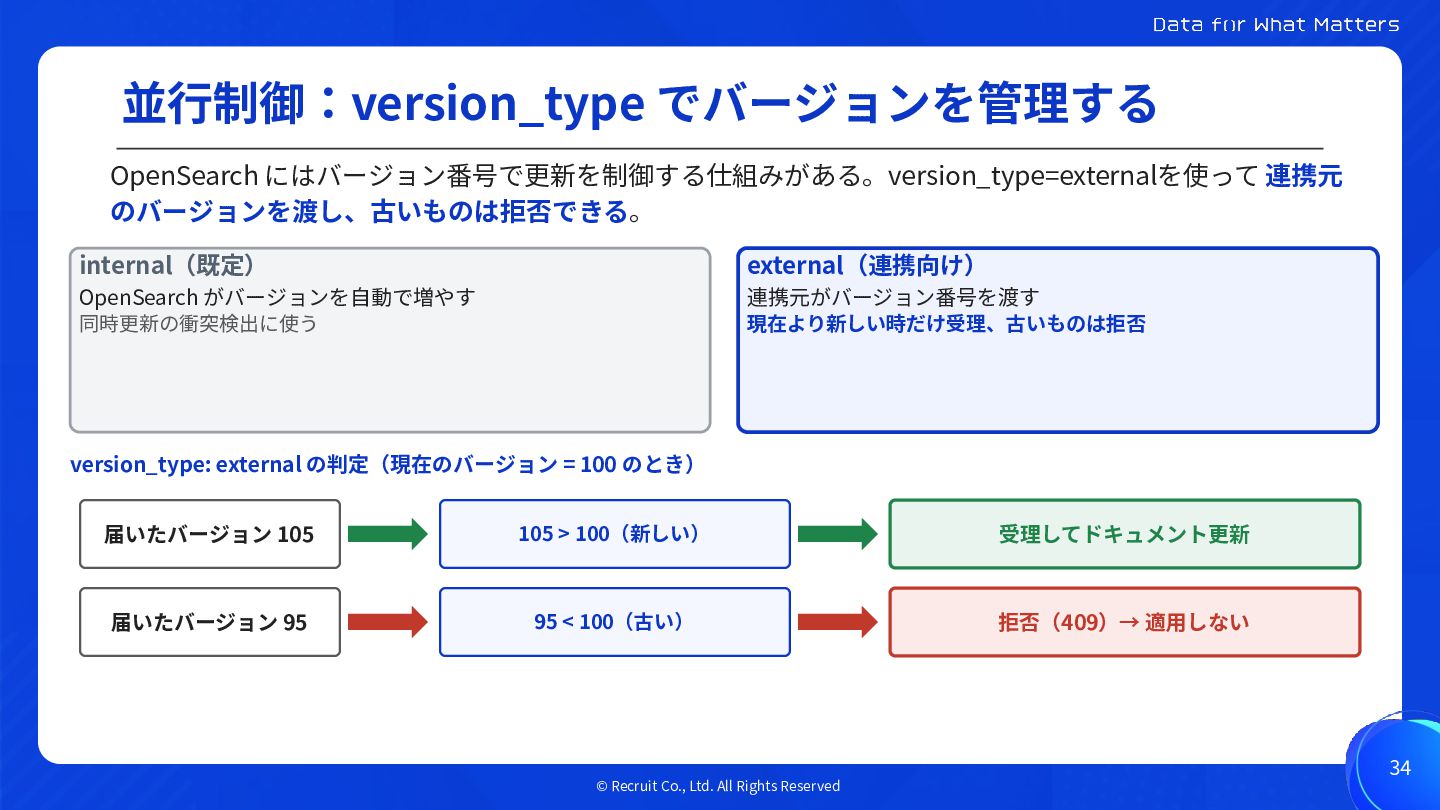
並⾏制御:version_type でバージョンを管理する OpenSearch にはバージョン番号で更新を制御する仕組みがある。version_type=externalを使って 連携元 のバージョンを渡し、古いものは拒否できる。 internal(既定) external(連携向け) OpenSearch がバージョンを⾃動で増やす
同時更新の衝突検出に使う 連携元がバージョン番号を渡す 現在より新しい時だけ受理、古いものは拒否 version_type: external の判定(現在のバージョン = 100 のとき) 届いたバージョン 105 105 > 100(新しい) 受理してドキュメント更新 届いたバージョン 95 95 < 100(古い) 拒否(409)→ 適⽤しない 34 © Recruit Co., Ltd. All Rights Reserved
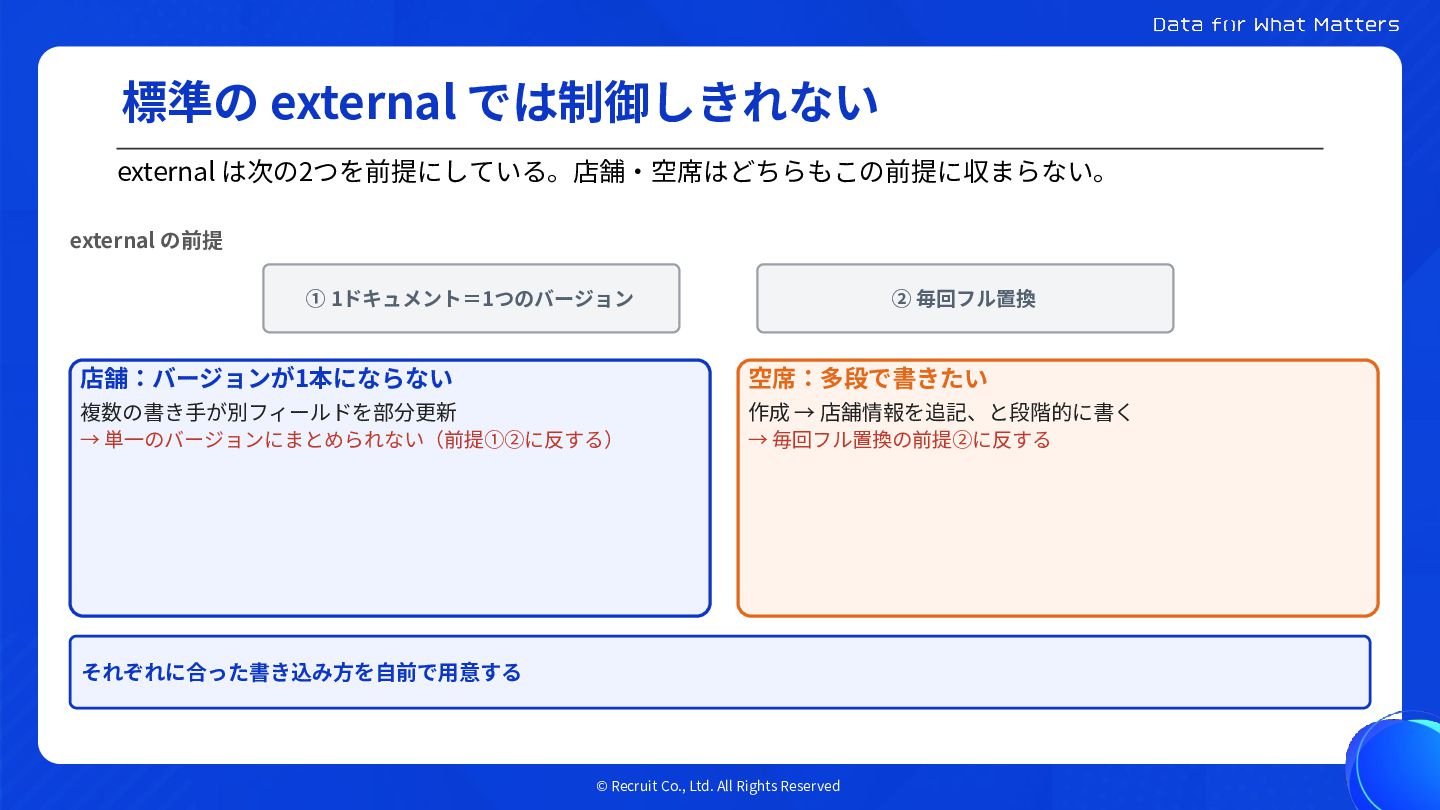
標準の external では制御しきれない external は次の2つを前提にしている。店舗‧空席はどちらもこの前提に収まらない。 external の前提 ① 1ドキュメント=1つのバージョン ②
毎回フル置換 店舗:バージョンが1本にならない 空席:多段で書きたい 複数の書き⼿が別フィールドを部分更新 → 単⼀のバージョンにまとめられない(前提①②に反する) 作成 → 店舗情報を追記、と段階的に書く → 毎回フル置換の前提②に反する それぞれに合った書き込み⽅を⾃前で⽤意する © Recruit Co., Ltd. All Rights Reserved
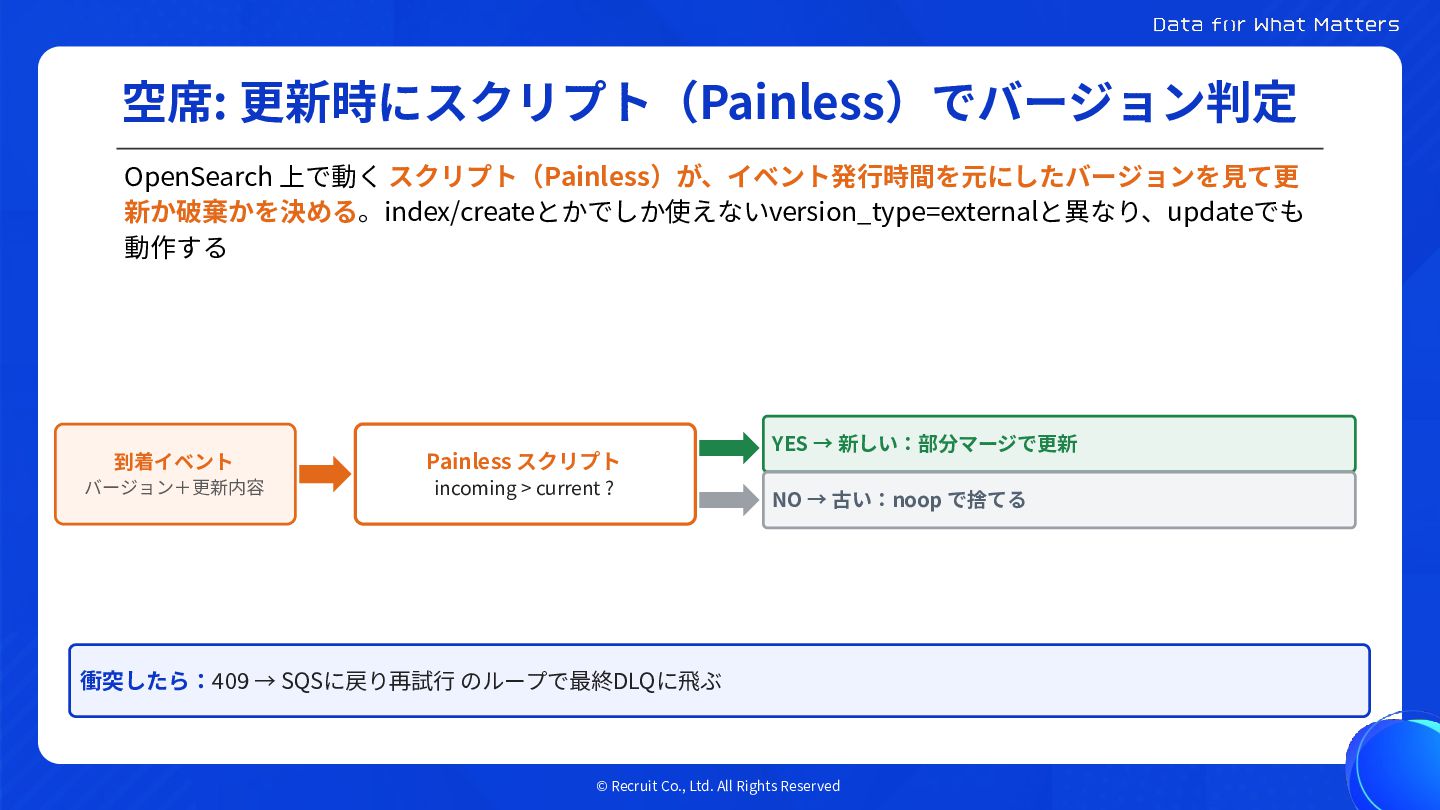
空席: 更新時にスクリプト(Painless)でバージョン判定 OpenSearch 上で動く スクリプト(Painless)が、イベント発⾏時間を元にしたバージョンを⾒て更 新か破棄かを決める。index/createとかでしか使えないversion_type=externalと異なり、updateでも 動作する 到着イベント Painless スクリプト
バージョン+更新内容 incoming > current ? YES → 新しい:部分マージで更新 NO → 古い:noop で捨てる 衝突したら:409 → SQSに戻り再試⾏ のループで最終DLQに⾶ぶ © Recruit Co., Ltd. All Rights Reserved
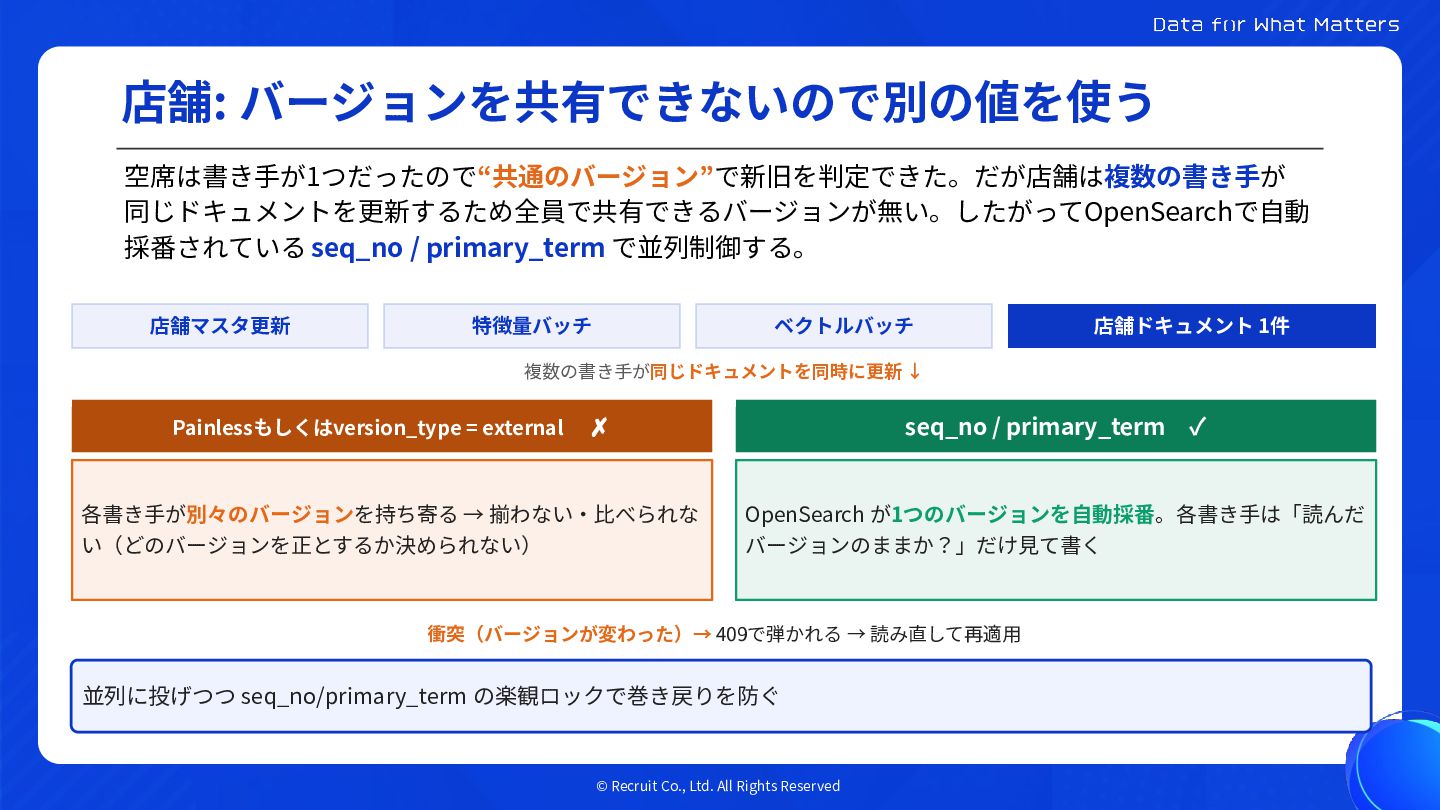
店舗: バージョンを共有できないので別の値を使う 空席は書き⼿が1つだったので“共通のバージョン”で新旧を判定できた。だが店舗は複数の書き⼿が 同じドキュメントを更新するため全員で共有できるバージョンが無い。したがってOpenSearchで⾃動 採番されている seq_no / primary_term で並列制御する。 店舗マスタ更新
特徴量バッチ ベクトルバッチ 店舗ドキュメント 1件 複数の書き⼿が同じドキュメントを同時に更新 ↓ Painlessもしくはversion_type = external ✗ 各書き⼿が別々のバージョンを持ち寄る → 揃わない‧⽐べられな い(どのバージョンを正とするか決められない) seq_no / primary_term ✓ OpenSearch が1つのバージョンを⾃動採番。各書き⼿は「読んだ バージョンのままか?」だけ⾒て書く 衝突(バージョンが変わった)→ 409で弾かれる → 読み直して再適⽤ 並列に投げつつ seq_no/primary_term の楽観ロックで巻き戻りを防ぐ © Recruit Co., Ltd. All Rights Reserved
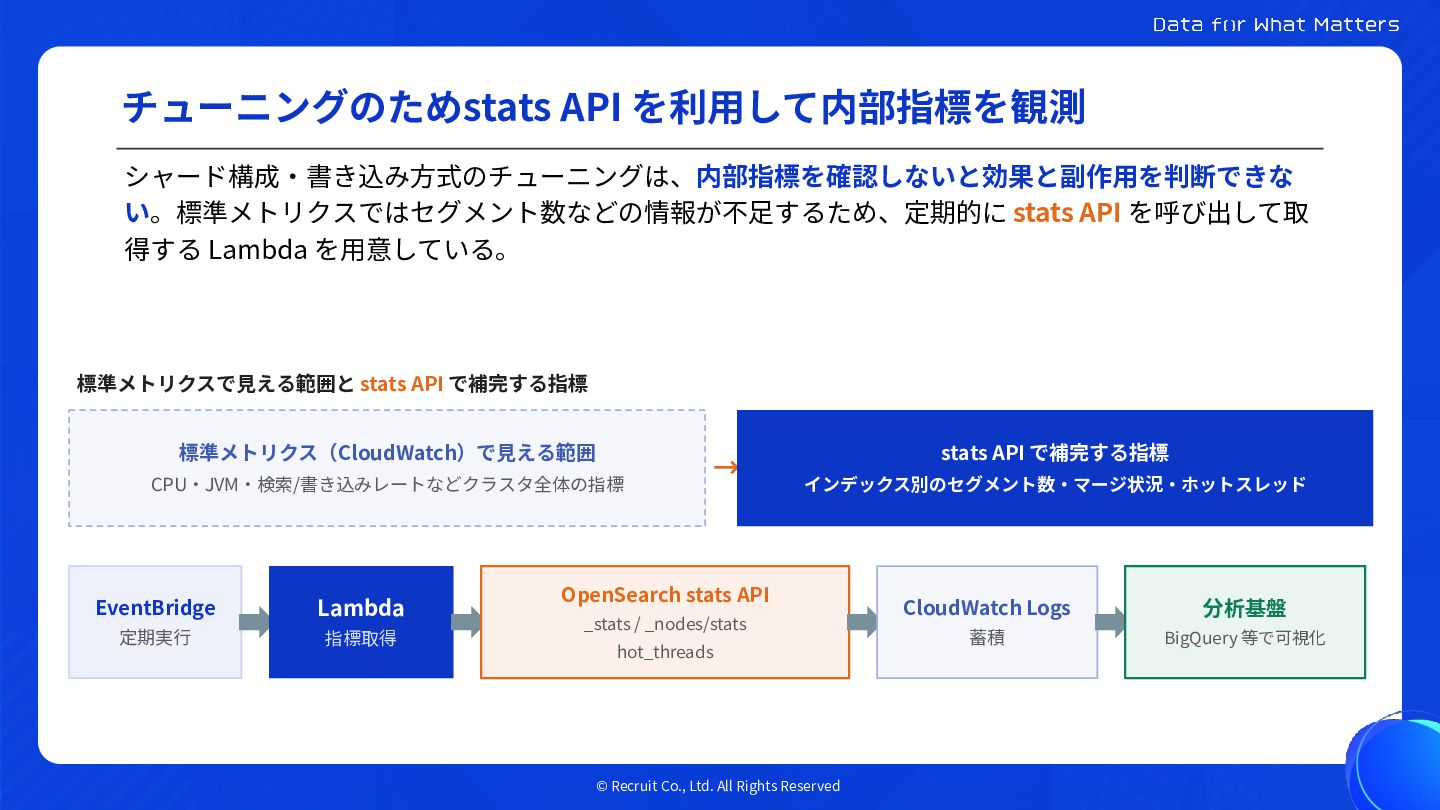
チューニングのためstats API を利⽤して内部指標を観測 シャード構成‧書き込み⽅式のチューニングは、内部指標を確認しないと効果と副作⽤を判断できな い。標準メトリクスではセグメント数などの情報が不⾜するため、定期的に stats API を呼び出して取 得する Lambda
を⽤意している。 標準メトリクスで⾒える範囲と stats API で補完する指標 標準メトリクス(CloudWatch)で⾒える範囲 CPU‧JVM‧検索/書き込みレートなどクラスタ全体の指標 EventBridge Lambda 定期実⾏ 指標取得 → stats API で補完する指標 インデックス別のセグメント数‧マージ状況‧ホットスレッド OpenSearch stats API _stats / _nodes/stats hot_threads © Recruit Co., Ltd. All Rights Reserved CloudWatch Logs 分析基盤 蓄積 BigQuery 等で可視化
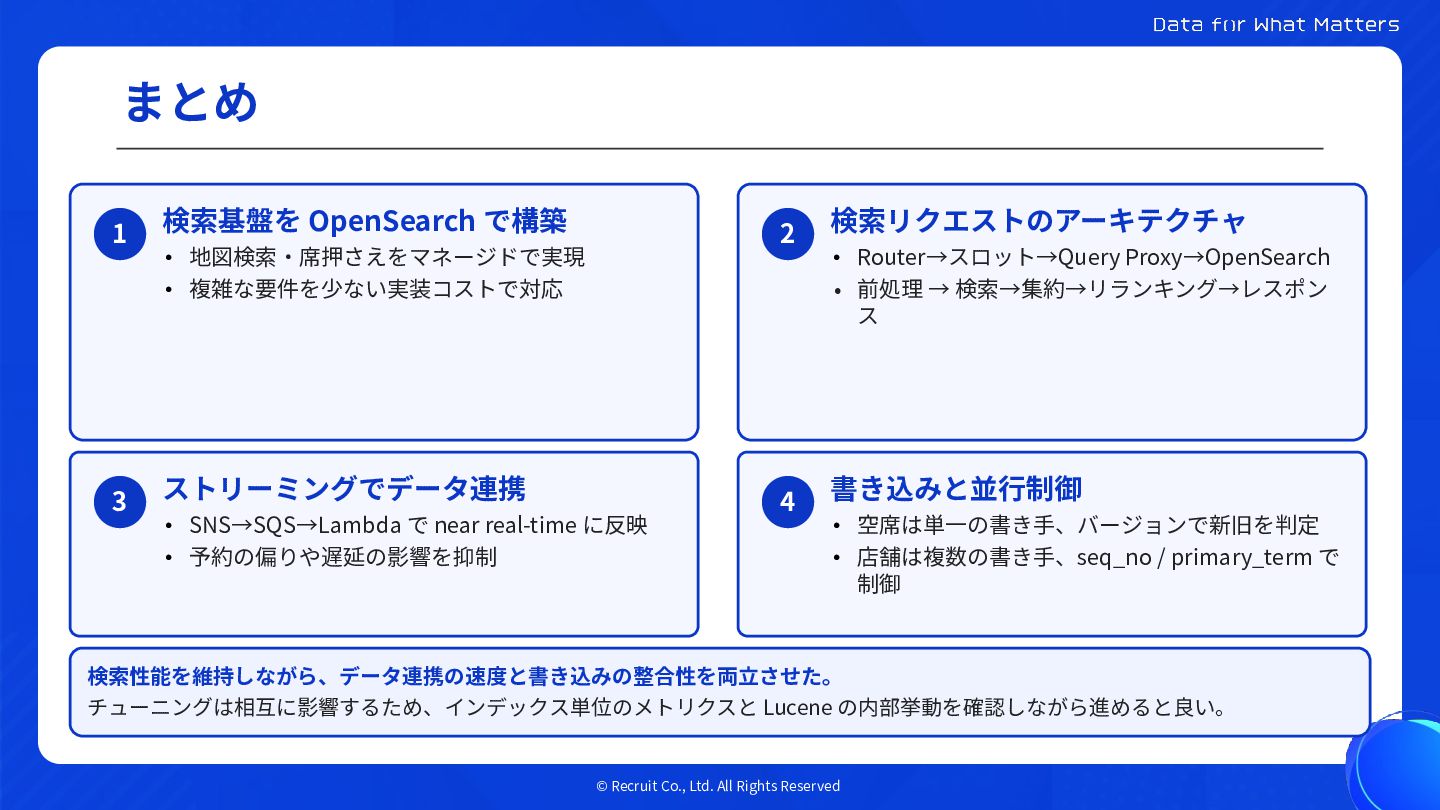
まとめ 1 検索基盤を OpenSearch で構築 3 ストリーミングでデータ連携 • 地図検索‧席押さえをマネージドで実現 •
複雑な要件を少ない実装コストで対応 • SNS→SQS→Lambda で near real-time に反映 • 予約の偏りや遅延の影響を抑制 2 検索リクエストのアーキテクチャ 4 書き込みと並⾏制御 • Router→スロット→Query Proxy→OpenSearch • 前処理 → 検索→集約→リランキング→レスポン ス • 空席は単⼀の書き⼿、バージョンで新旧を判定 • 店舗は複数の書き⼿、seq_no / primary_term で 制御 検索性能を維持しながら、データ連携の速度と書き込みの整合性を両⽴させた。 チューニングは相互に影響するため、インデックス単位のメトリクスと Lucene の内部挙動を確認しながら進めると良い。 © Recruit Co., Ltd. All Rights Reserved
© Recruit Co., Ltd. All Rights Reserved
More Decks by Recruit
See All by Recruit
局所最適は悪ではない。壊れているのは指標です。量と質を同時に見る先行指標の設計
recruitengineers
PRO
3
1.7k
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
9
3k
大規模フロントエンド開発におけるmonorepoという選択肢
recruitengineers
PRO
2
140
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
360
Google Cloud Next Tokyo 26登壇時のスクリプト
recruitengineers
PRO
0
390
つくって納得、つかって実感! 大規模言語モデルことはじめ ver2.0
recruitengineers
PRO
6
3.2k
ブラウザ研修 2026
recruitengineers
PRO
8
2.3k
事業価値と Engineering 2026年度版
recruitengineers
PRO
60
32k
トヨタ⽣産⽅式(TPS)⼊⾨
recruitengineers
PRO
3
1.6k
Other Decks in Technology
See All in Technology
文書画像からの情報抽出を行うエージェントを、軌跡の正解データ無しで作れるか
sansantech
PRO
2
200
[NW-JAWS DAY]「うちのAWS、インターネット出られないんで」― AWS外の自社サービスをPrivateLinkでシュッと公開する方法
ykimi
3
850
個人ASを取得して、自宅Kubernetes上のVMをグローバルIPで公開した話
munenick
0
190
AWS Emulator を評価する: 手元で動く AWS の API の仕組み、始め方、確かめ方
inariku
PRO
2
760
gem install とrequire のむこうがわ
ydah
0
210
速くなるほど、深く考える AI時代のQAに学ぶ
kobayashiyorimitsu
0
260
マネージャーをエスパーにしない マネジメントされる側から始める、働きやすい現場づくり
comi190327
1
780
Sonnetだけで業務はまわる?
kintotechdev
1
150
Context parameters で作る!はじめての型クラス
kworkdev
PRO
1
150
ラクスル会社紹介資料|エンジニア向け / RAKSUL Introduction for Engineers
raksulrecruiting
0
130
エンタープライズ事業未経験のデータ屋、 AI時代にN回撃沈する.pdf
ryoskdara_
0
150
Biohub - Cell Tracking During Development 5th place solution
rist
0
170
Featured
See All Featured
Rebuilding a faster, lazier Slack
samanthasiow
85
9.8k
Evolving SEO for Evolving Search Engines
ryanjones
0
360
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
600
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
The Invisible Side of Design
smashingmag
301
52k
GitHub's CSS Performance
jonrohan
1033
470k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
1
300
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
6
940
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
48k
BBQ
matthewcrist
90
10k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.6k
Embracing the Ebb and Flow
colly
88
5.2k


 recruitengineers
 sansantech
 ykimi
 munenick
 inariku
 ydah
 kobayashiyorimitsu
 comi190327
 kintotechdev
 kworkdev
 raksulrecruiting
 ryoskdara_
 rist
 samanthasiow
 ryanjones
 samtorres
 joshbly
 smashingmag
 jonrohan
 marketingsoph
 marcoroth
 rkaga
 matthewcrist
 inesmontani
 colly