大規模言語モデル (LLM) 入門
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed
大規模言語モデル (LLM) 入門
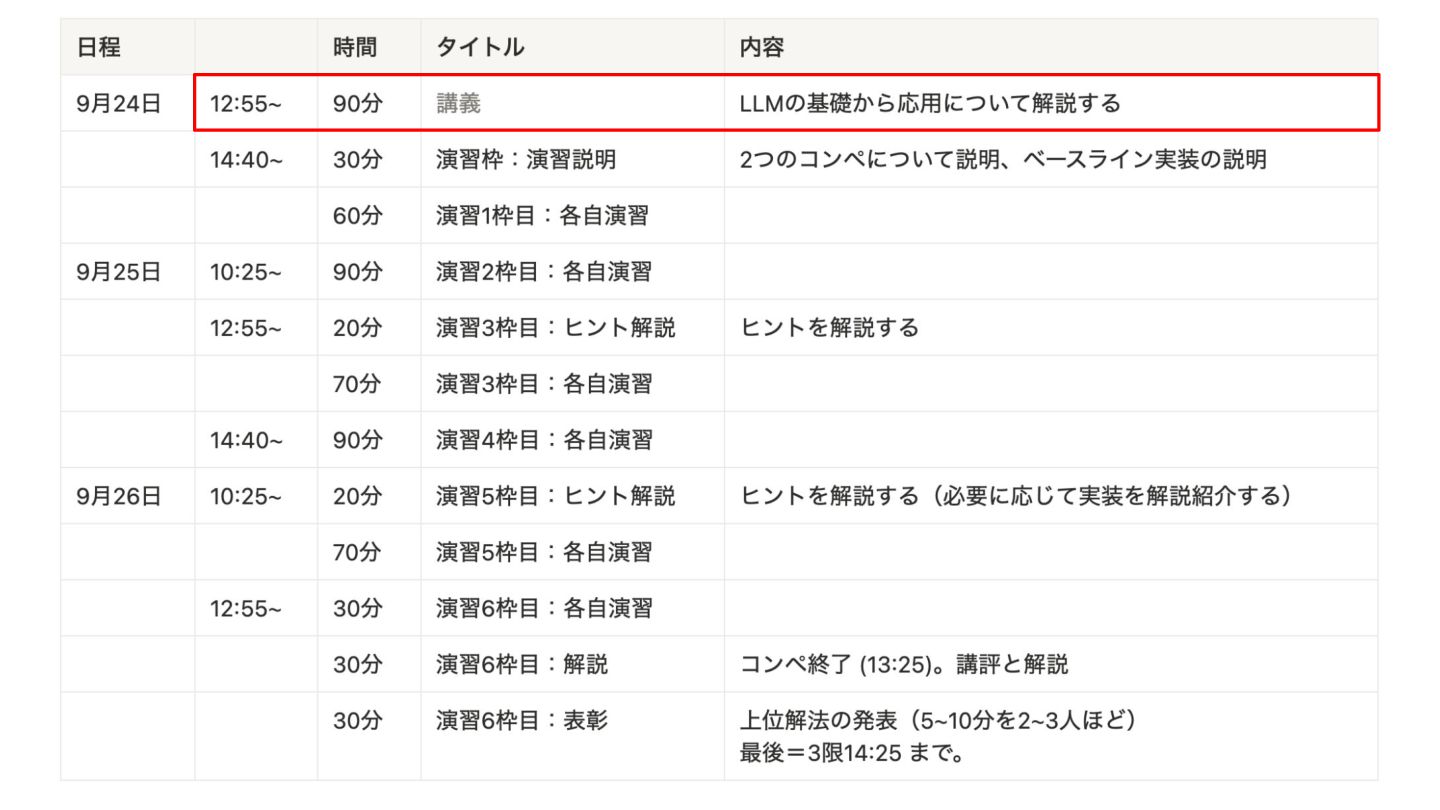
2025年9月24日~26日にかけて、熊本大学にて講義を行いました。
その時に使用したスライド資料です。
作成者:小嵜 耕平

Rist Inc.
October 16, 2025
Transcript
61 slides
-
Agenda • 導入 (5m) • LLMの基礎 (15m) • プロンプトエンジニアリング (40m)
• LLM研究の最近の動向 (20m) • 質疑応答 (10m) -
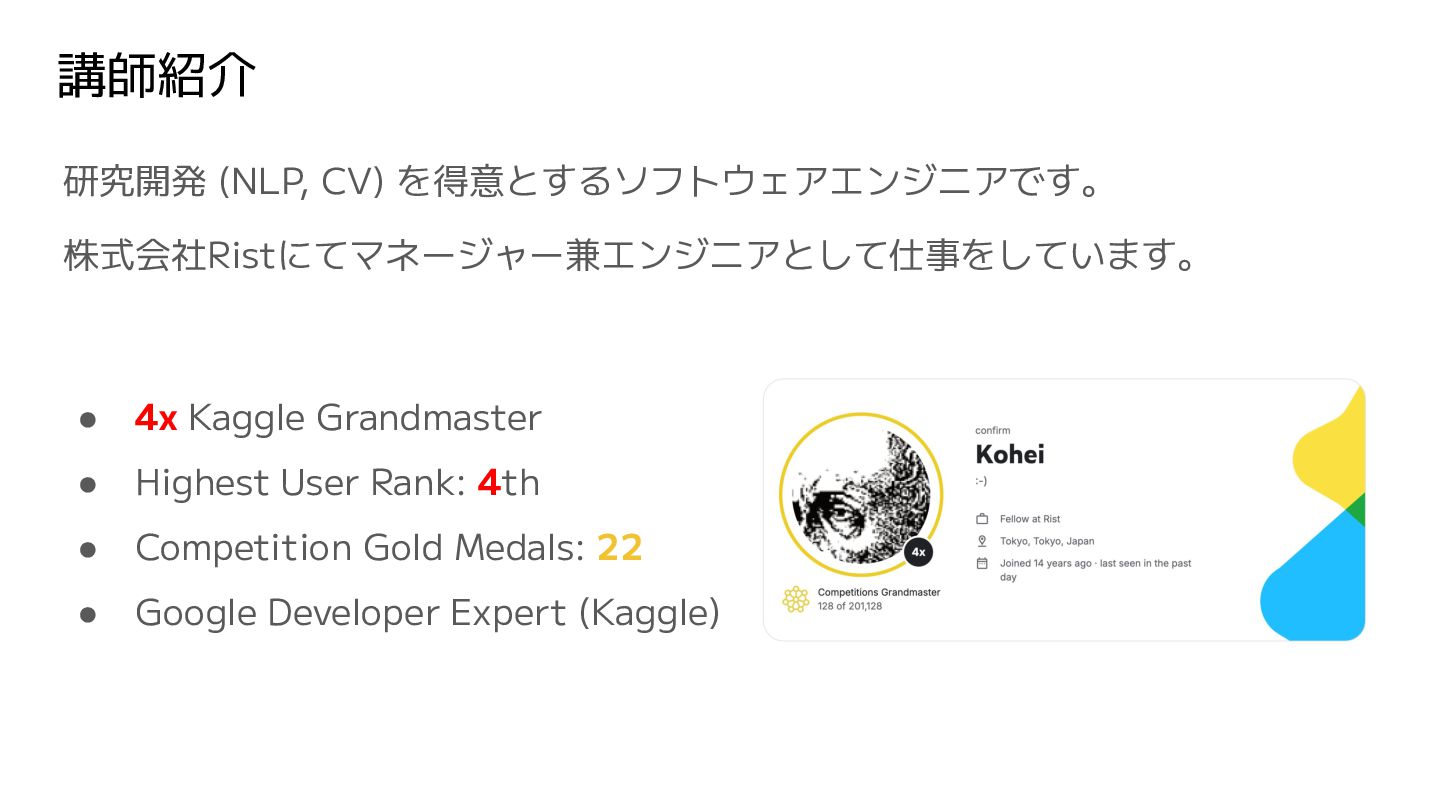
講師紹介 研究開発 (NLP, CV) を得意とするソフトウェアエンジニアです。 株式会社Ristにてマネージャー兼エンジニアとして仕事をしています。 • 4x Kaggle Grandmaster
• Highest User Rank: 4th • Competition Gold Medals: 22 • Google Developer Expert (Kaggle) -
Agenda • 導入 (5m) ◦ 大規模言語モデル (LLM) の代表例 ◦ 言語モデル(次の単語を予測するモデル)
• LLMの基礎 (15m) • プロンプトエンジニアリング (40m) • LLM研究の最近の動向 (20m) • 質疑応答 (10m) -
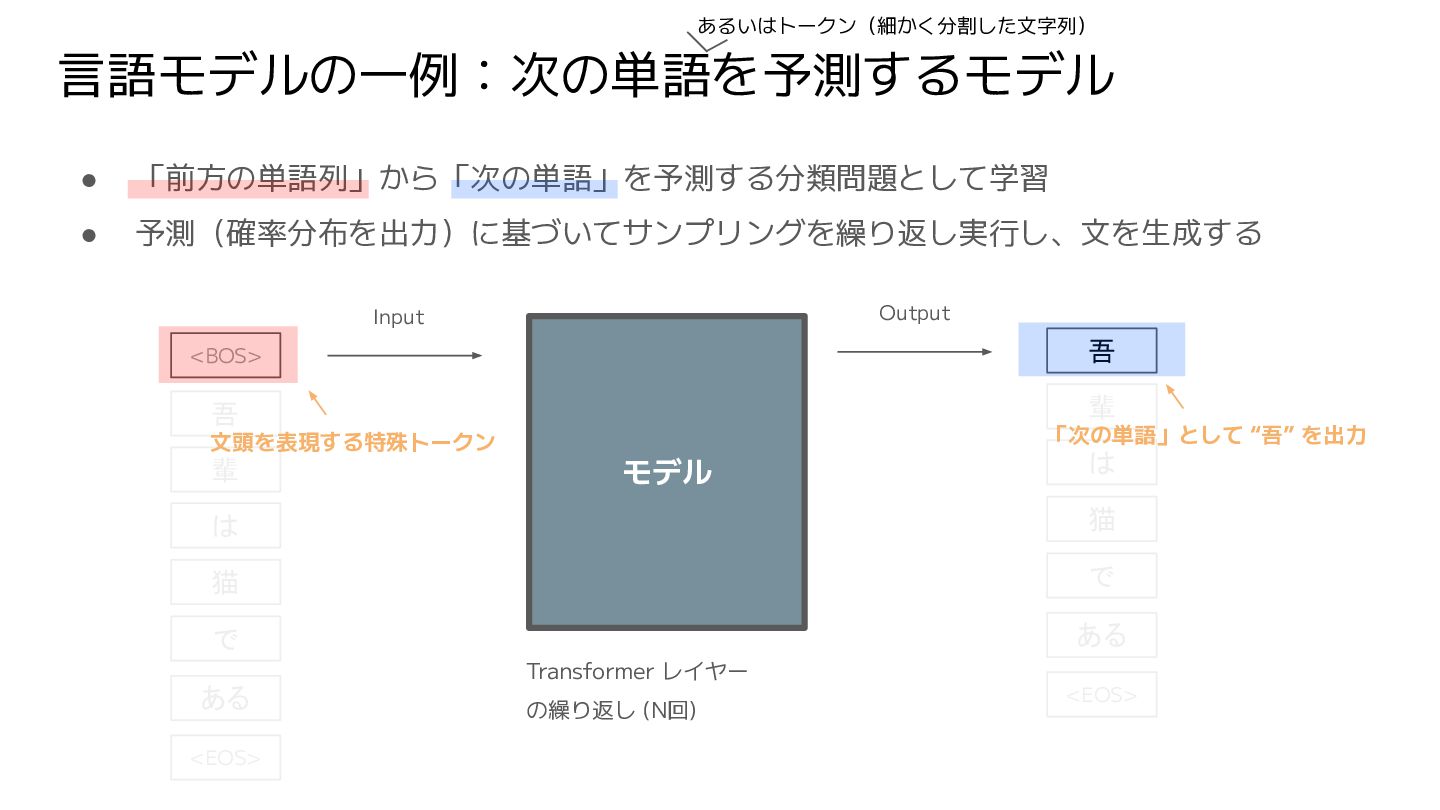
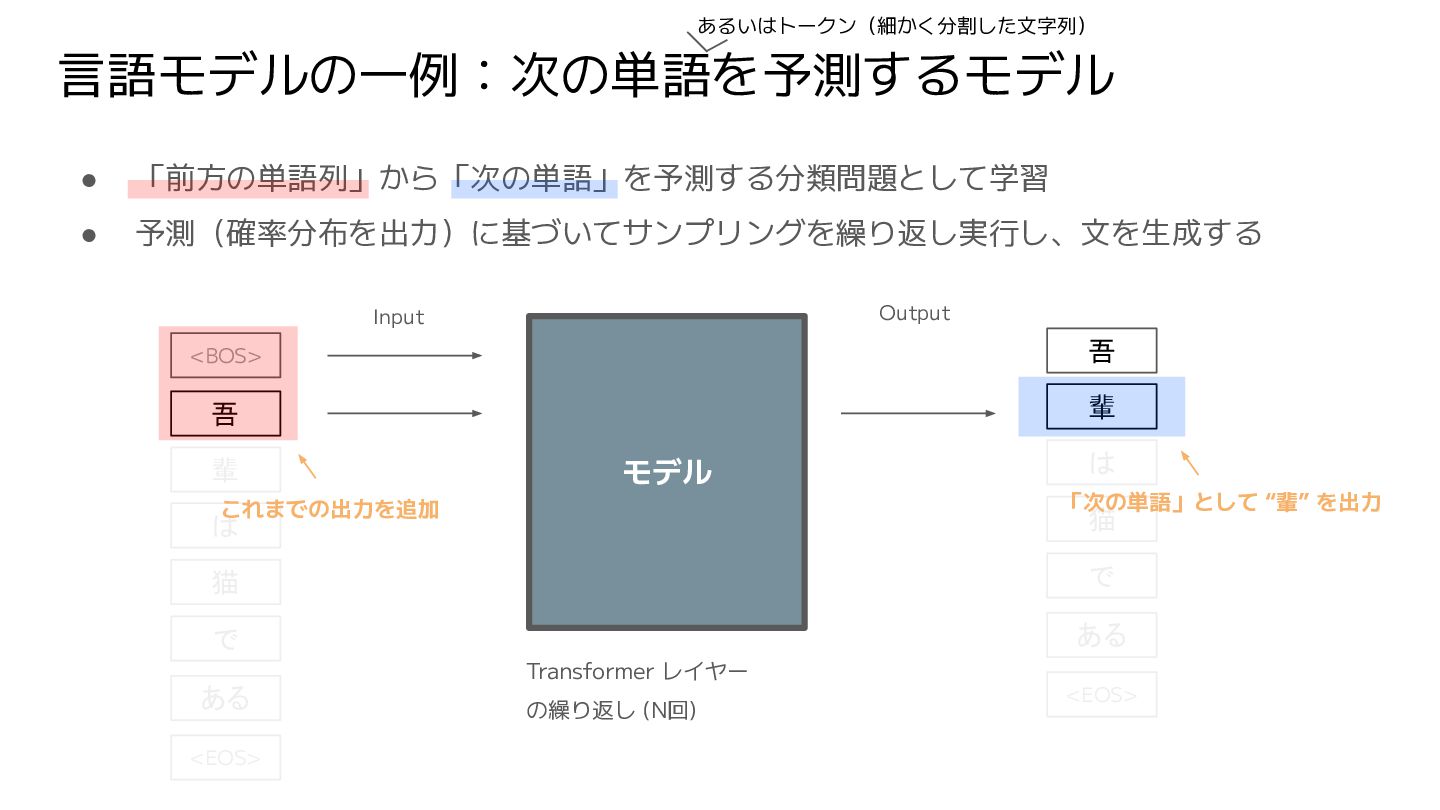
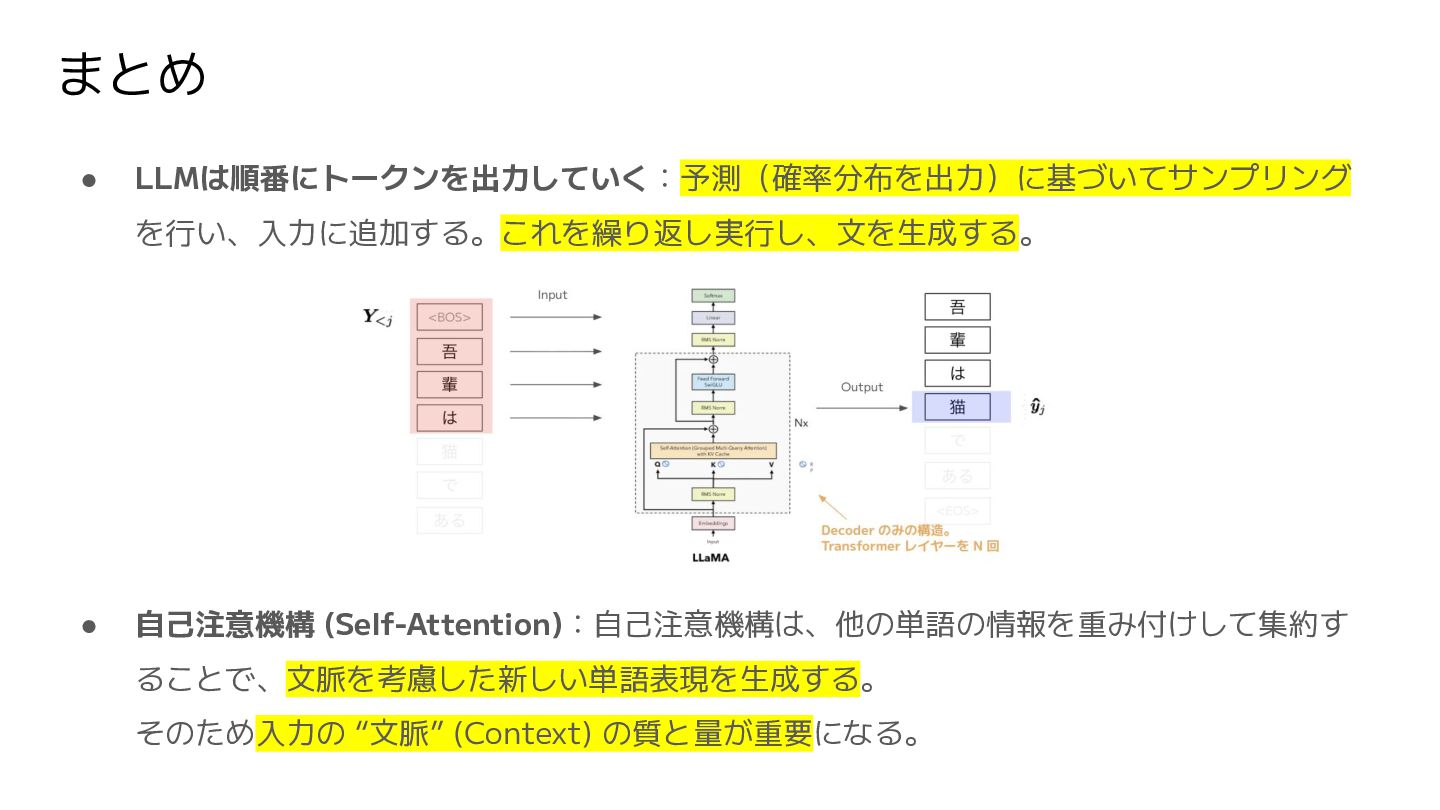
言語モデルの一例:次の単語を予測するモデル • 「前方の単語列」から「次の単語」を予測する分類問題として学習 • 予測(確率分布を出力)に基づいてサンプリングを繰り返し実行し、文を生成する モデル 吾 Input 輩 は
猫 で ある <BOS> <EOS> Output 吾 輩 は 猫 で ある <EOS> Transformer レイヤー の繰り返し (N回) 文頭を表現する特殊トークン 「次の単語」として “吾” を出力 あるいはトークン(細かく分割した文字列) -
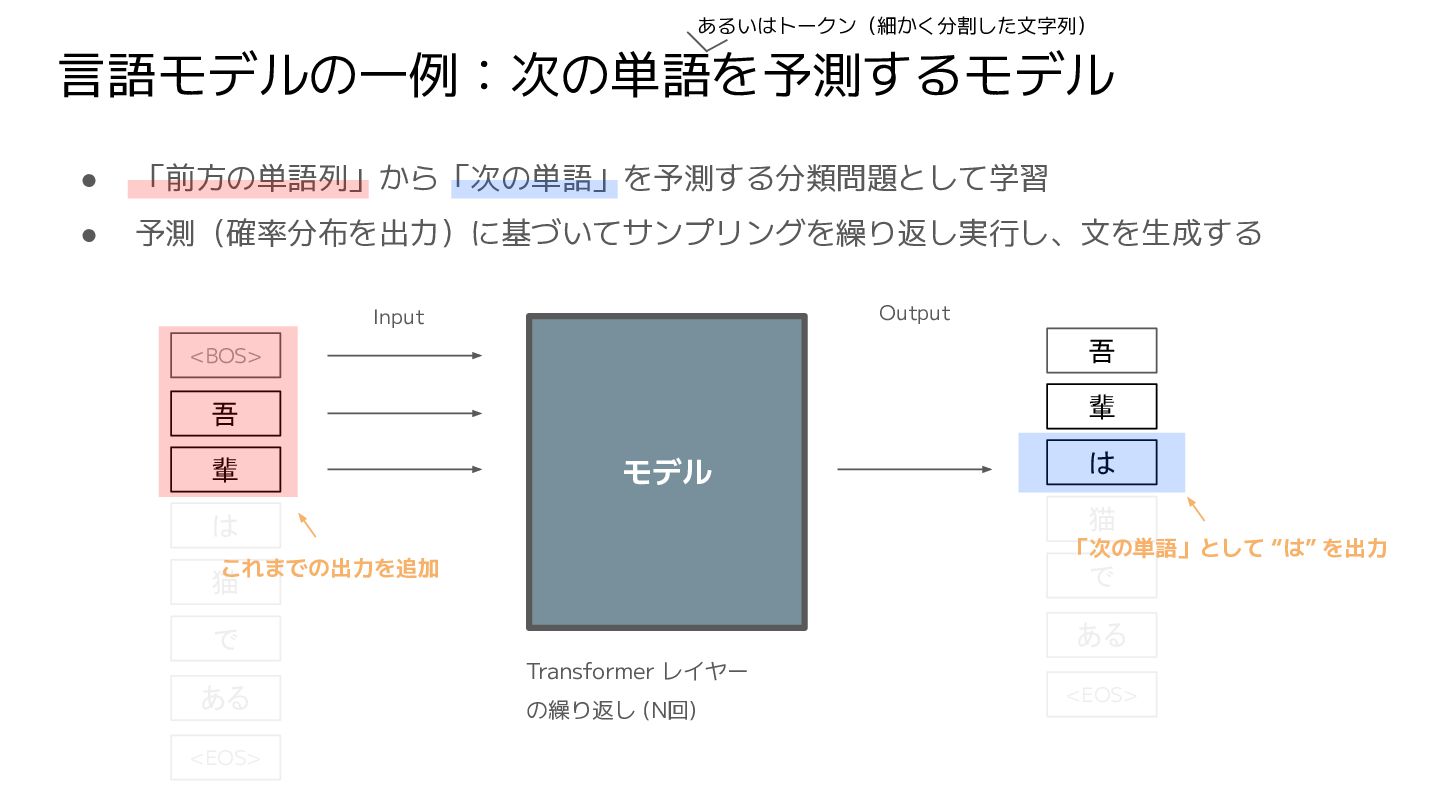
言語モデルの一例:次の単語を予測するモデル • 「前方の単語列」から「次の単語」を予測する分類問題として学習 • 予測(確率分布を出力)に基づいてサンプリングを繰り返し実行し、文を生成する モデル 吾 Input 輩 は
猫 で ある <BOS> <EOS> Output 吾 輩 は 猫 で ある <EOS> Transformer レイヤー の繰り返し (N回) これまでの出力を追加 「次の単語」として “輩” を出力 あるいはトークン(細かく分割した文字列) -
言語モデルの一例:次の単語を予測するモデル • 「前方の単語列」から「次の単語」を予測する分類問題として学習 • 予測(確率分布を出力)に基づいてサンプリングを繰り返し実行し、文を生成する モデル 吾 Input 輩 は
猫 で ある <BOS> <EOS> Output 吾 輩 は 猫 で ある <EOS> Transformer レイヤー の繰り返し (N回) これまでの出力を追加 「次の単語」として “は” を出力 あるいはトークン(細かく分割した文字列) -
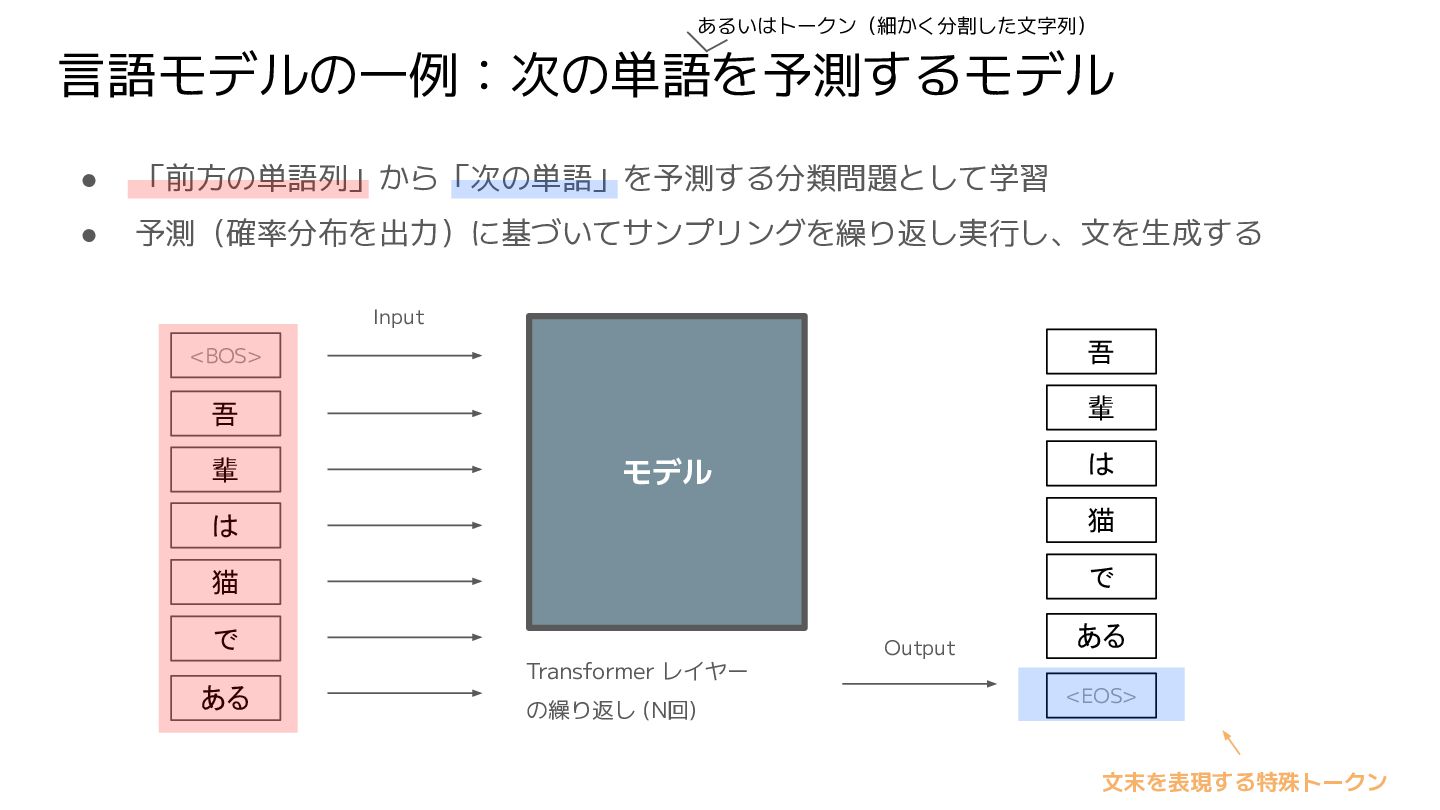
<BOS> 言語モデルの一例:次の単語を予測するモデル • 「前方の単語列」から「次の単語」を予測する分類問題として学習 • 予測(確率分布を出力)に基づいてサンプリングを繰り返し実行し、文を生成する モデル 吾 Input 輩
は 猫 で ある Output 吾 輩 は 猫 で ある <EOS> Transformer レイヤー の繰り返し (N回) 文末を表現する特殊トークン あるいはトークン(細かく分割した文字列) -
Agenda • 導入 (5m) • LLMの基礎 (25m) ◦ Transformers の全体像
◦ トークン埋め込み ◦ 注意機構 ◦ エンコーダー・デコーダー構造 ◦ Autoregressive Models • プロンプトエンジニアリング (30m) • LLM研究の最近の動向 (20m) • 質疑応答 (10m) -
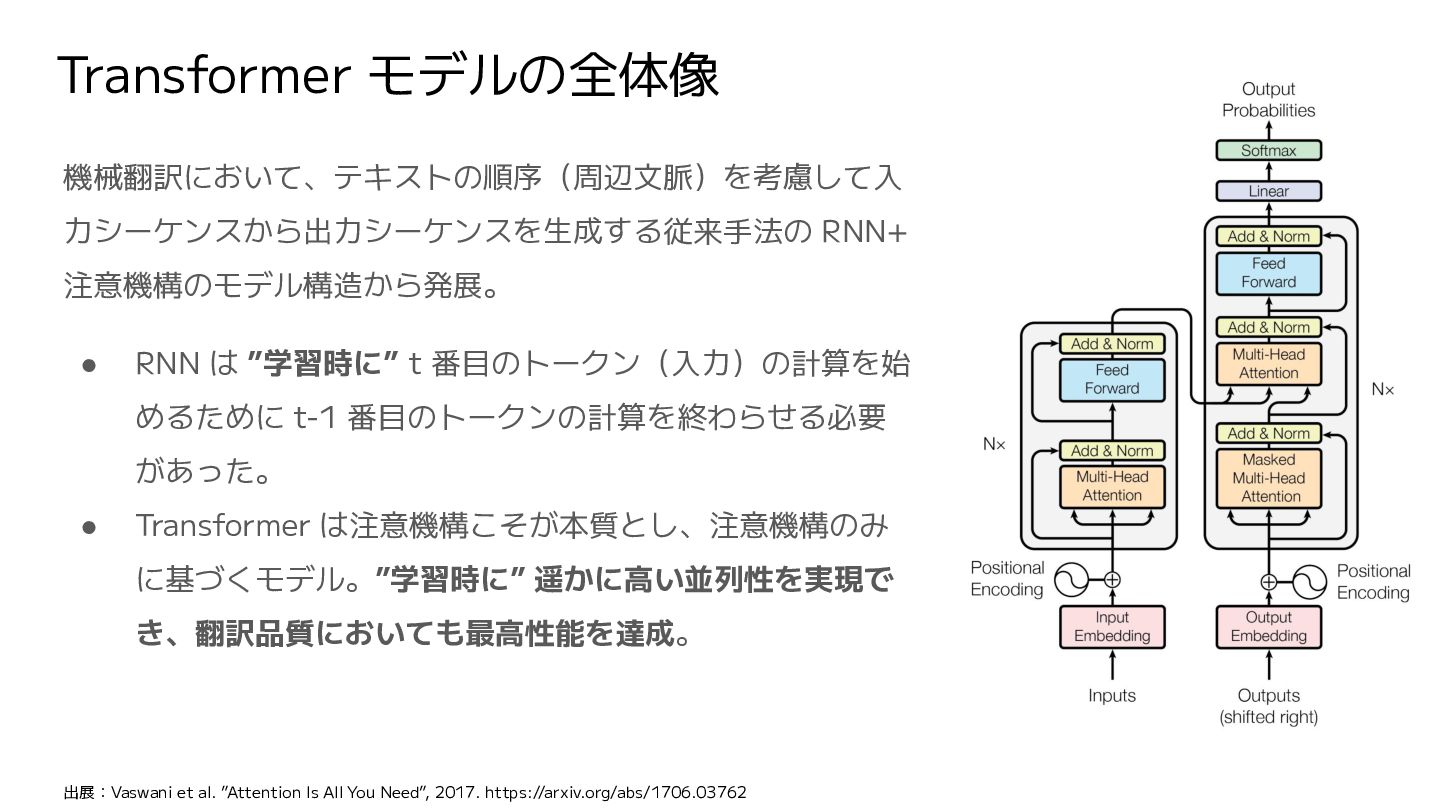
Transformer モデルの全体像 機械翻訳において、テキストの順序(周辺文脈)を考慮して入 力シーケンスから出力シーケンスを生成する従来手法の RNN+ 注意機構のモデル構造から発展。 • RNN は ”学習時に”
t 番目のトークン(入力)の計算を始 めるために t-1 番目のトークンの計算を終わらせる必要 があった。 • Transformer は注意機構こそが本質とし、注意機構のみ に基づくモデル。”学習時に” 遥かに高い並列性を実現で き、翻訳品質においても最高性能を達成。 出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
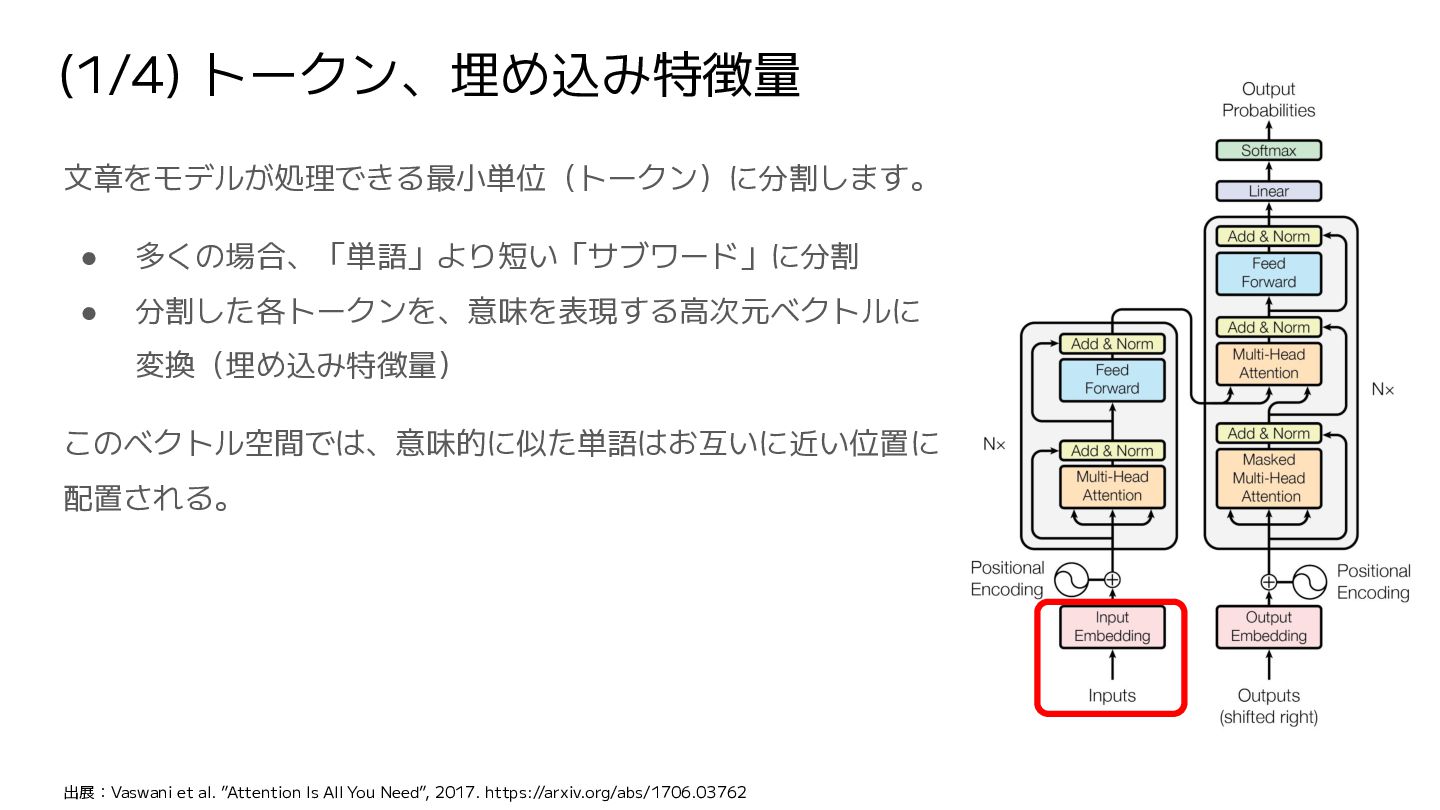
(1/4) トークン、埋め込み特徴量 文章をモデルが処理できる最小単位(トークン)に分割します。 • 多くの場合、「単語」より短い「サブワード」に分割 • 分割した各トークンを、意味を表現する高次元ベクトルに 変換(埋め込み特徴量) このベクトル空間では、意味的に似た単語はお互いに近い位置に 配置される。
出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
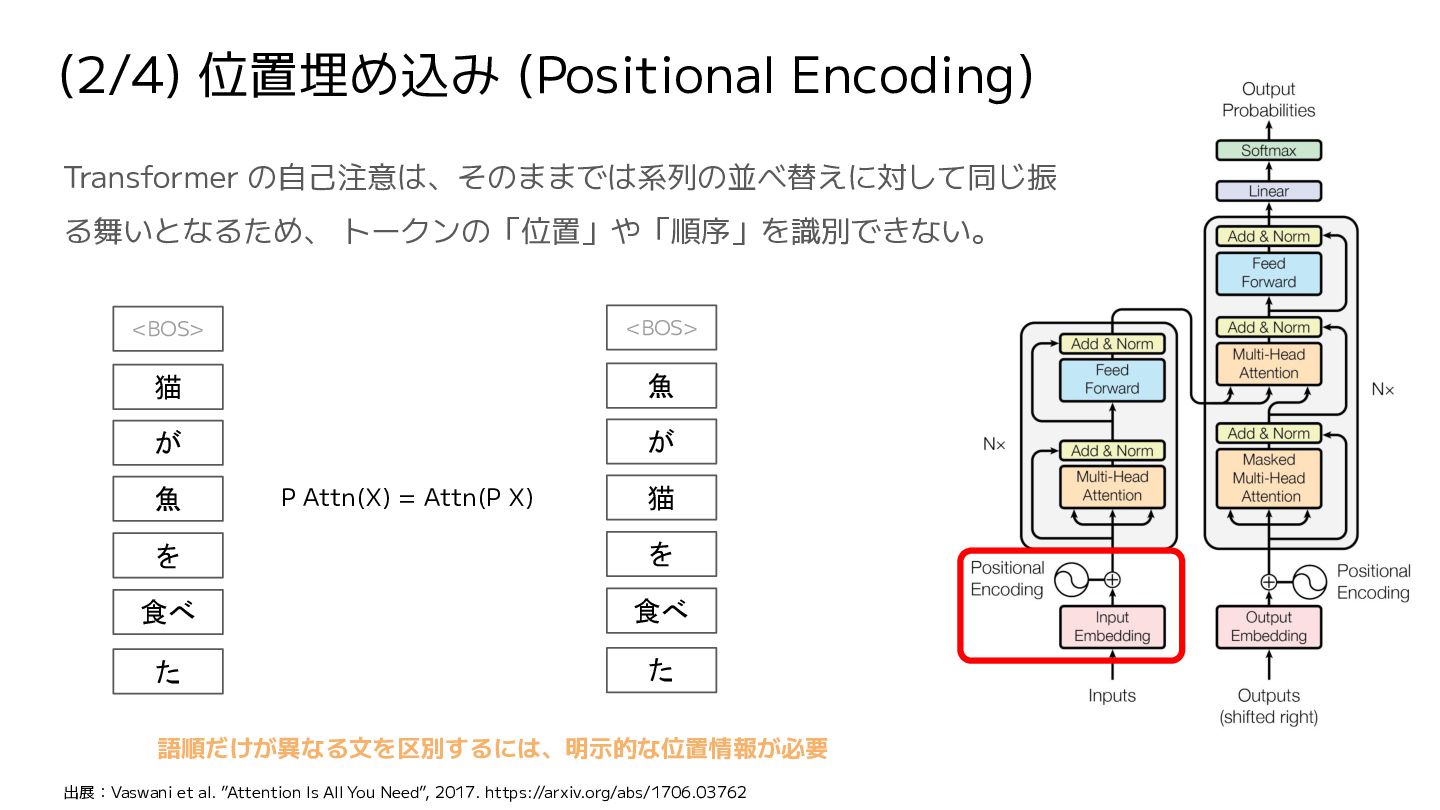
(2/4) 位置埋め込み (Positional Encoding) Transformer の自己注意は、そのままでは系列の並べ替えに対して同じ振 る舞いとなるため、 トークンの「位置」や「順序」を識別できない。 P Attn(X)
= Attn(P X) 語順だけが異なる文を区別するには、明示的な位置情報が必要 <BOS> 猫 が 魚 を 食べ た <BOS> 魚 が 猫 を 食べ た 出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
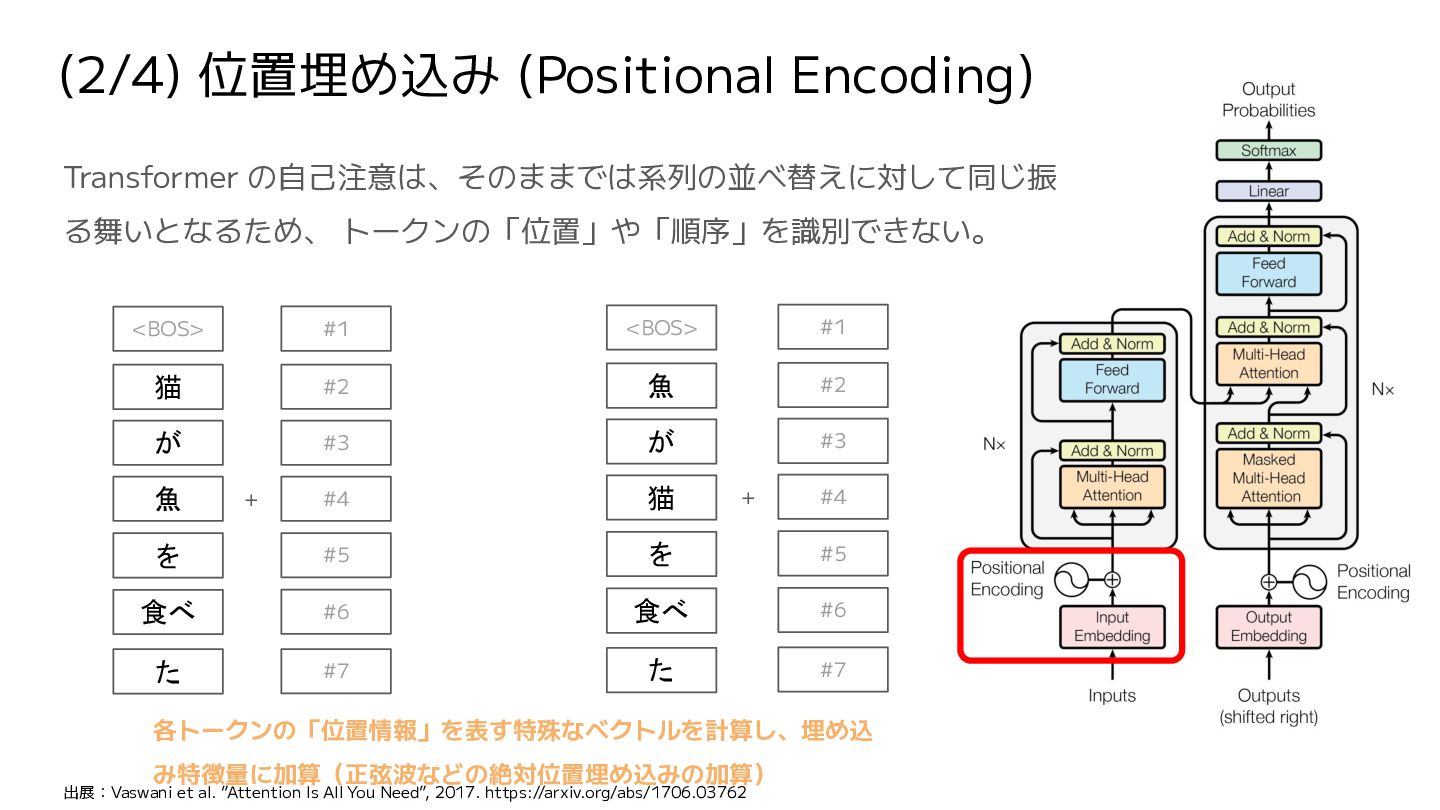
(2/4) 位置埋め込み (Positional Encoding) Transformer の自己注意は、そのままでは系列の並べ替えに対して同じ振 る舞いとなるため、 トークンの「位置」や「順序」を識別できない。 <BOS> 猫
が 魚 を 食べ た <BOS> 魚 が 猫 を 食べ た 各トークンの「位置情報」を表す特殊なベクトルを計算し、埋め込 み特徴量に加算(正弦波などの絶対位置埋め込みの加算) #1 #2 #3 #4 #5 #6 #7 + #1 #2 #3 #4 #5 #6 #7 + 出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
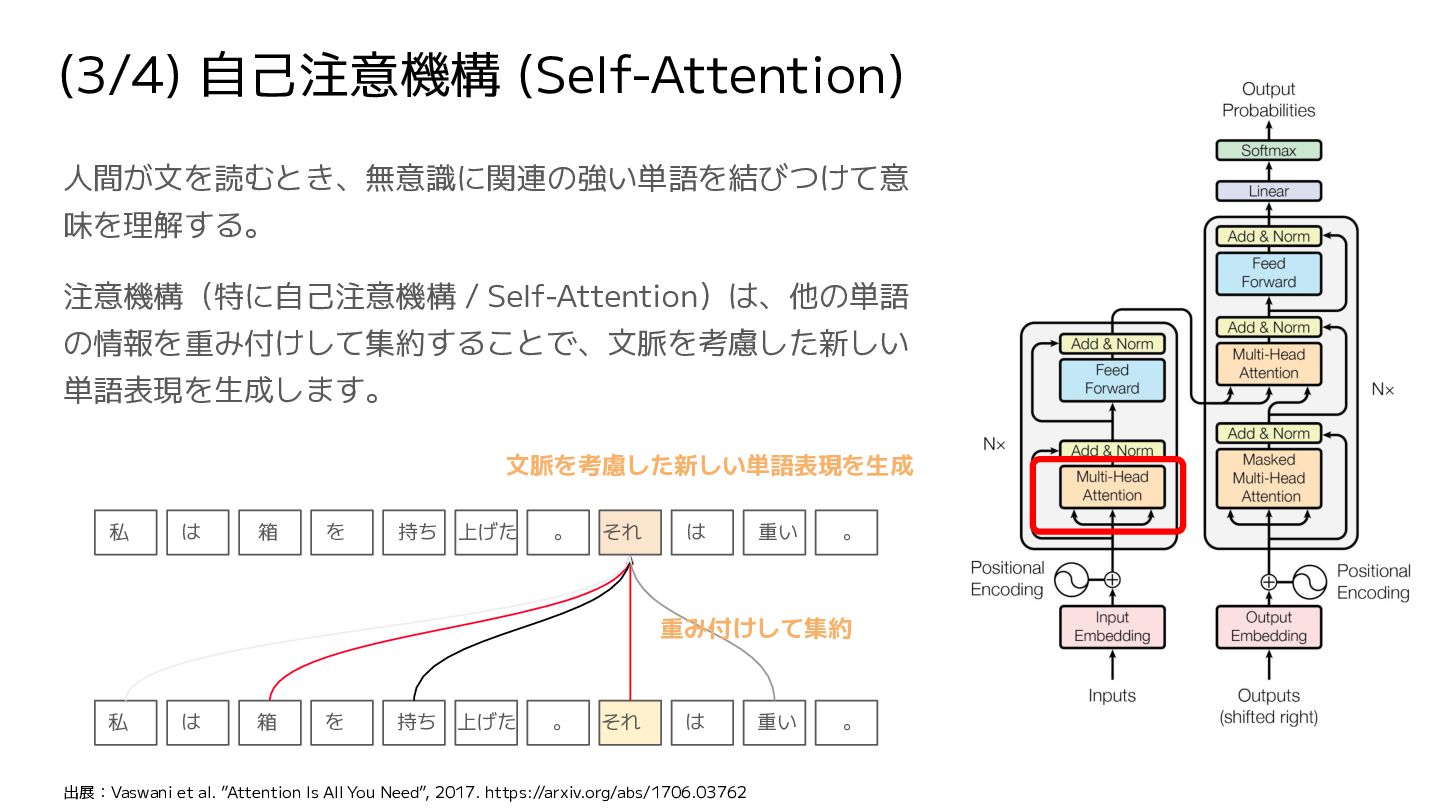
(3/4) 自己注意機構 (Self-Attention) 人間が文を読むとき、無意識に関連の強い単語を結びつけて意 味を理解する。 注意機構(特に自己注意機構 / Self-Attention)は、他の単語 の情報を重み付けして集約することで、文脈を考慮した新しい 単語表現を生成します。
私 は 箱 を 持ち 上げた 。 それ は 重い 。 文脈を考慮した新しい単語表現を生成 重み付けして集約 私 は 箱 を 持ち 上げた 。 それ は 重い 。 出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
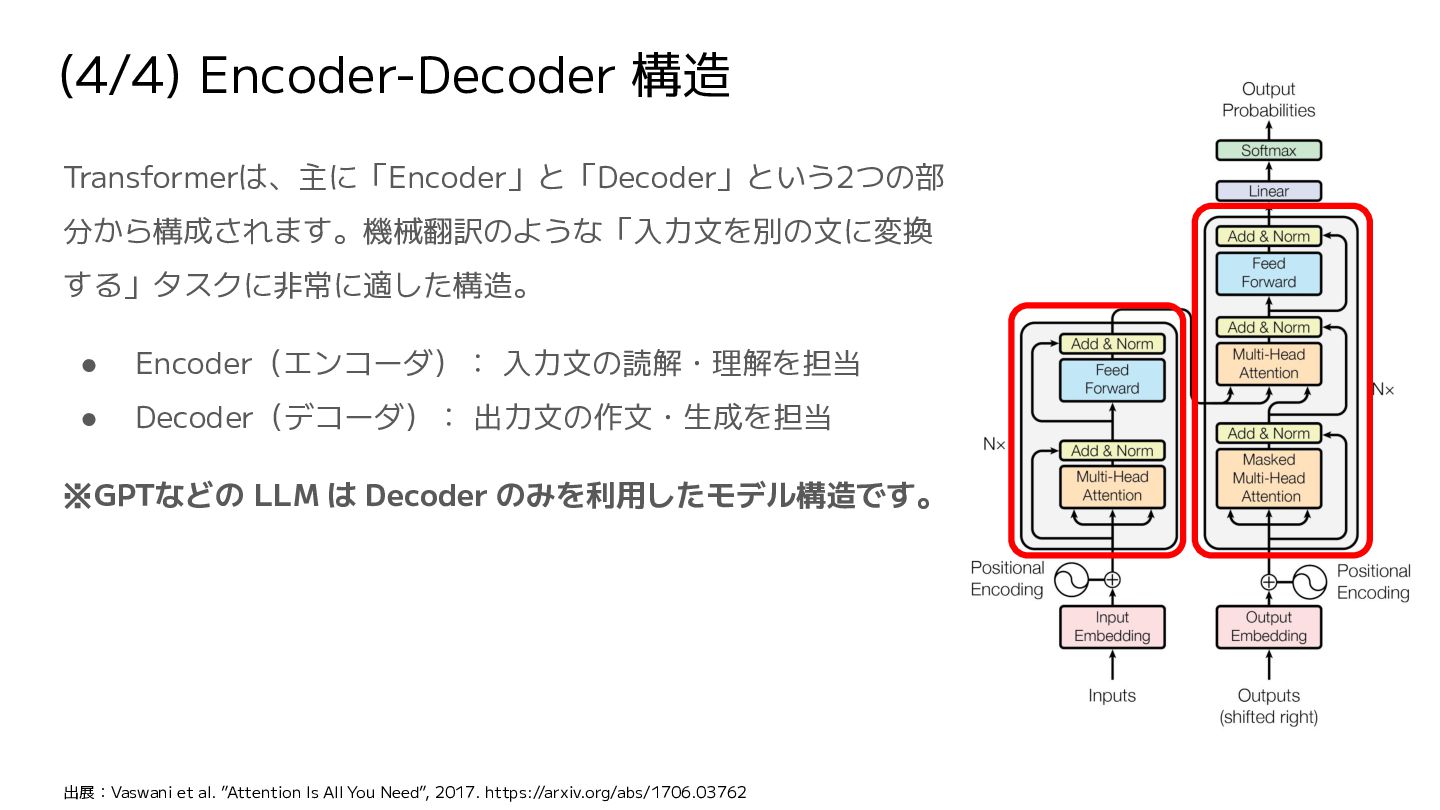
(4/4) Encoder-Decoder 構造 Transformerは、主に「Encoder」と「Decoder」という2つの部 分から構成されます。機械翻訳のような「入力文を別の文に変換 する」タスクに非常に適した構造。 • Encoder(エンコーダ): 入力文の読解・理解を担当 •
Decoder(デコーダ): 出力文の作文・生成を担当 ※GPTなどの LLM は Decoder のみを利用したモデル構造です。 出展:Vaswani et al. ”Attention Is All You Need”, 2017. https://arxiv.org/abs/1706.03762 -
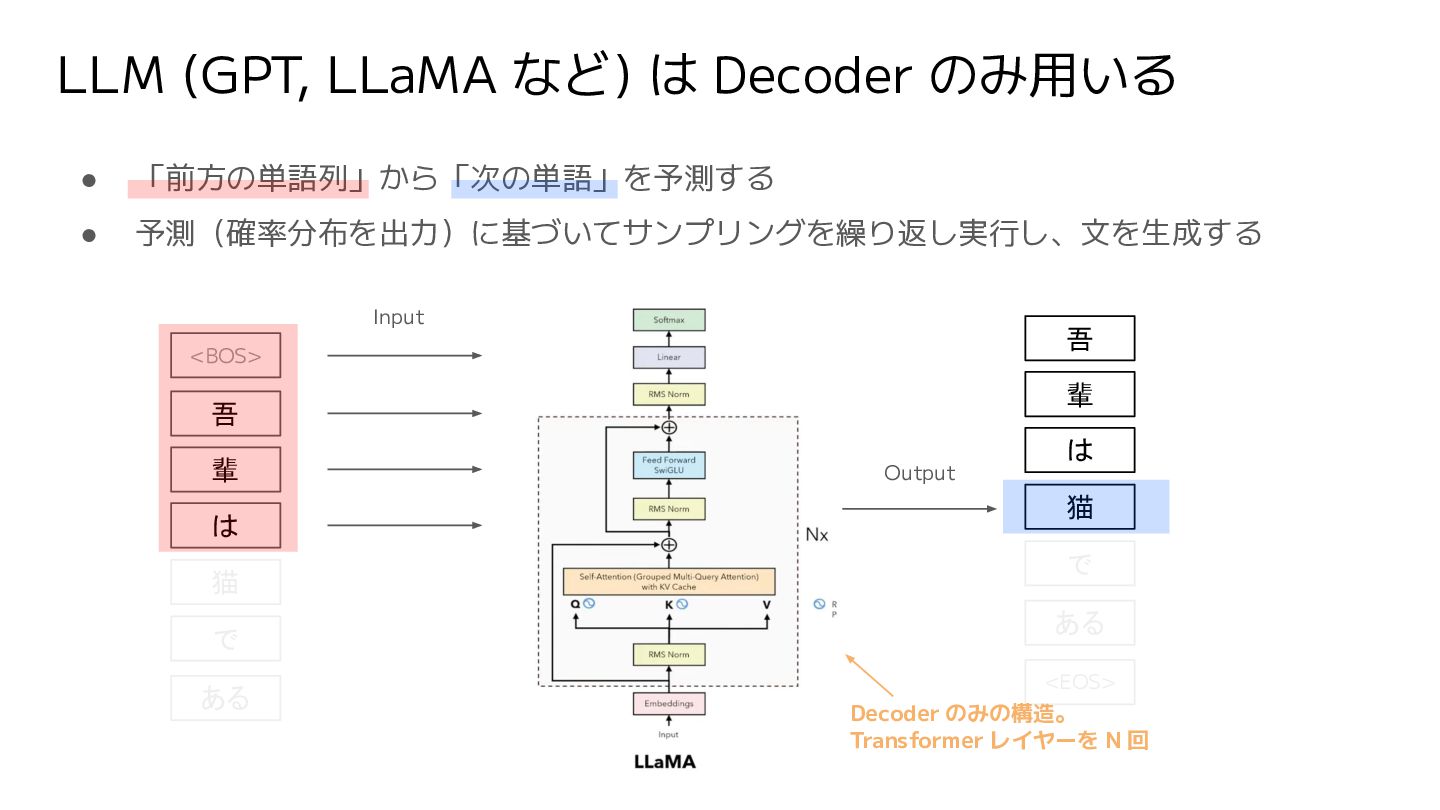
<BOS> LLM (GPT, LLaMA など) は Decoder のみ用いる • 「前方の単語列」から「次の単語」を予測する
• 予測(確率分布を出力)に基づいてサンプリングを繰り返し実行し、文を生成する 吾 Input 輩 は 猫 で ある Output 吾 輩 は 猫 で ある <EOS> Decoder のみの構造。 Transformer レイヤーを N 回 -
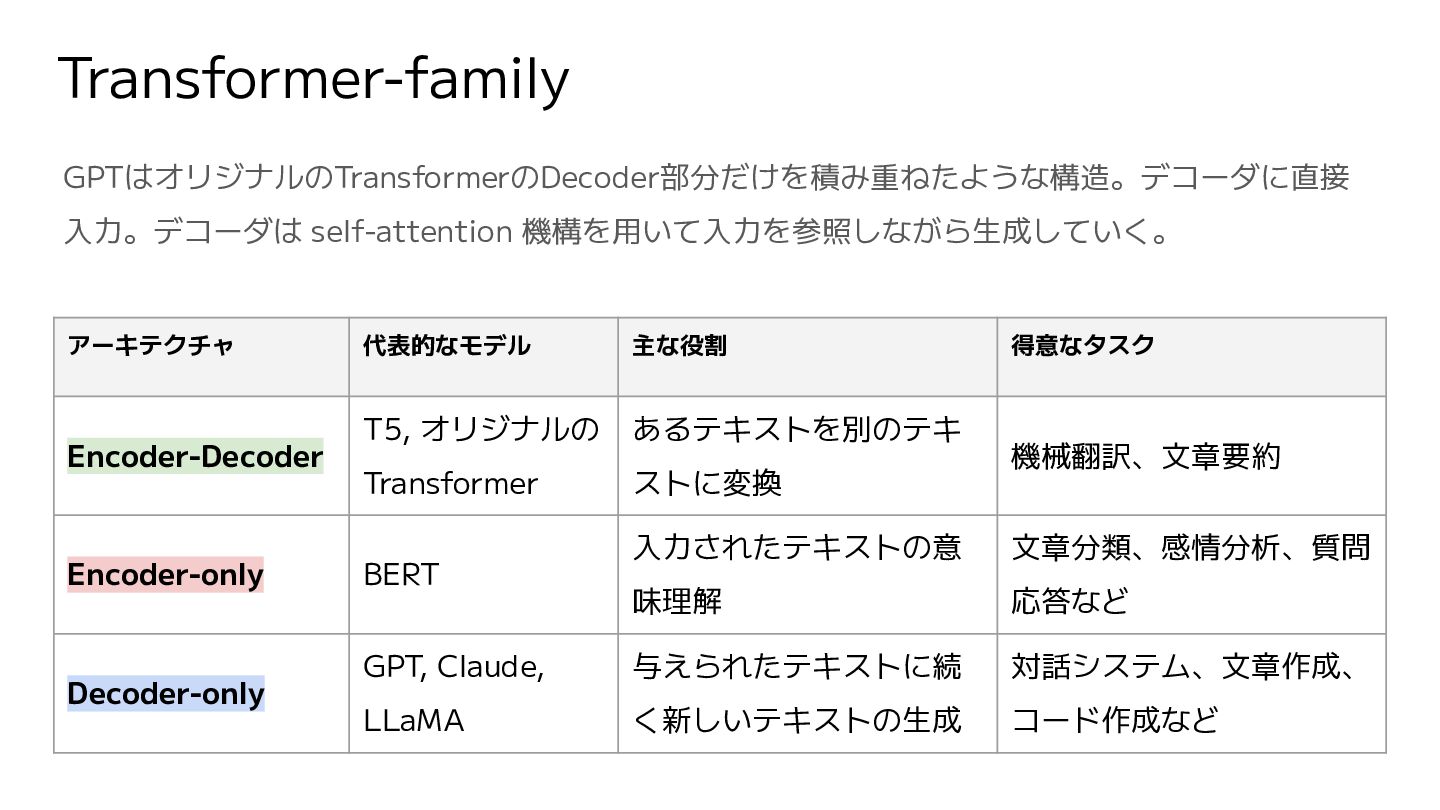
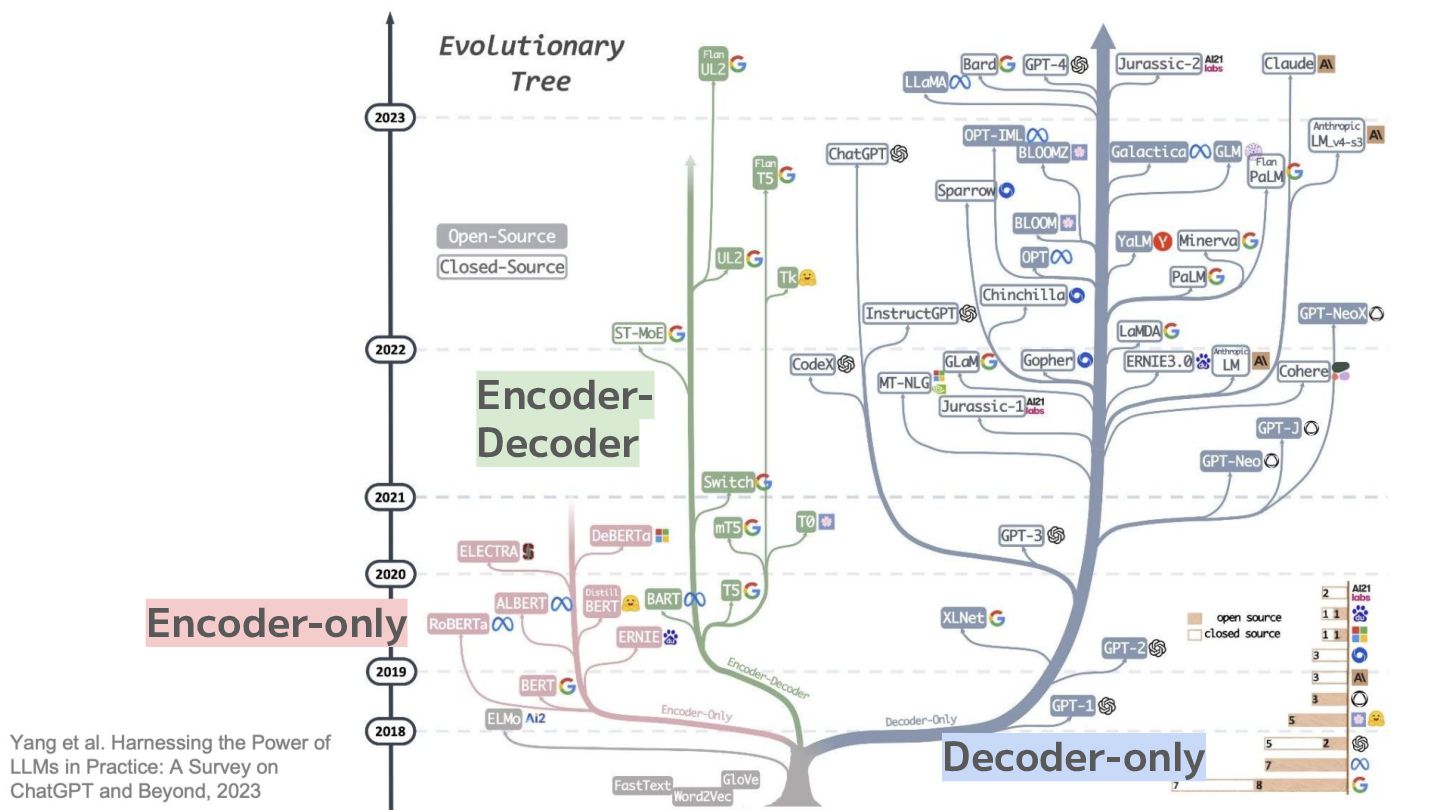
Transformer-family GPTはオリジナルのTransformerのDecoder部分だけを積み重ねたような構造。デコーダに直接 入力。デコーダは self-attention 機構を用いて入力を参照しながら生成していく。 アーキテクチャ 代表的なモデル 主な役割 得意なタスク Encoder-Decoder
T5, オリジナルの Transformer あるテキストを別のテキ ストに変換 機械翻訳、文章要約 Encoder-only BERT 入力されたテキストの意 味理解 文章分類、感情分析、質問 応答など Decoder-only GPT, Claude, LLaMA 与えられたテキストに続 く新しいテキストの生成 対話システム、文章作成、 コード作成など -
Agenda • 導入 (5m) • LLMの基礎 (15m) • プロンプトエンジニアリング (40m)
◦ LLMの出力設定 ◦ サンプリングの制御 ◦ 例を与える(One-shot, Few-shot) ◦ プロンプト手法(CoT, Step-Back) ◦ コンテキストエンジニアリング • LLM研究の最近の動向 (20m) • 質疑応答 (10m) -
Prompt Engineering LLMをガイドして正確な出力が生成させる。質の高いプロンプトを設計する技術 やそのプロセスのことを、プロンプトエンジニアリングと呼ぶ • プロンプト:応答や予測を生成させるために “モデルに与えられる入力” • LLMが適切なトークンを予測するように仕向ける •
テキストの要約、情報抽出、質疑応答、テキスト分類、言語やコードの翻 訳、コード生成、コードのドキュメント作成や推論など、様々な種類の理解 ・生成タスクを達成するために工夫して使用する 引用元:"5-Day Gen AI Intensive Course with Google", https://www.kaggle.com/learn-guide/5-day-genai -
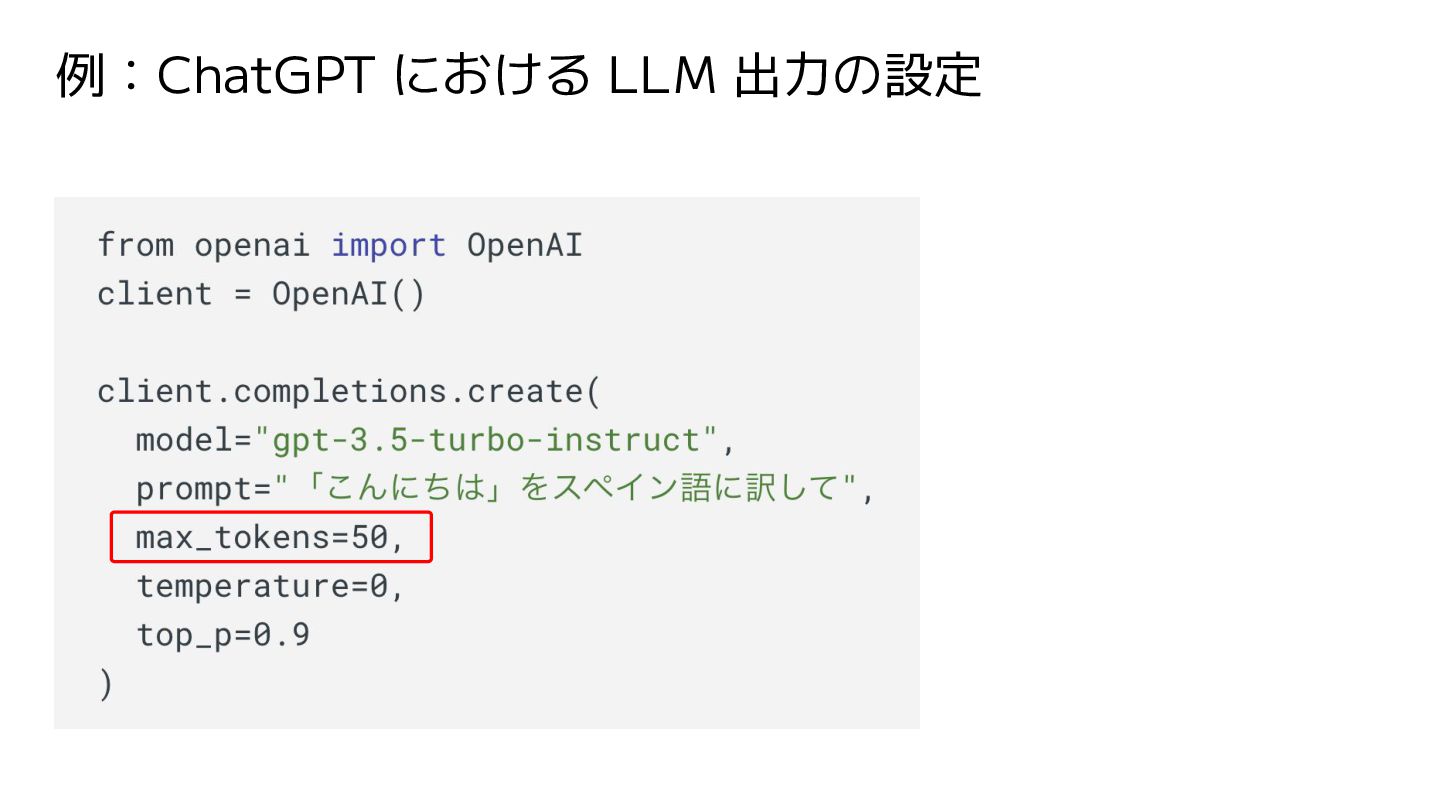
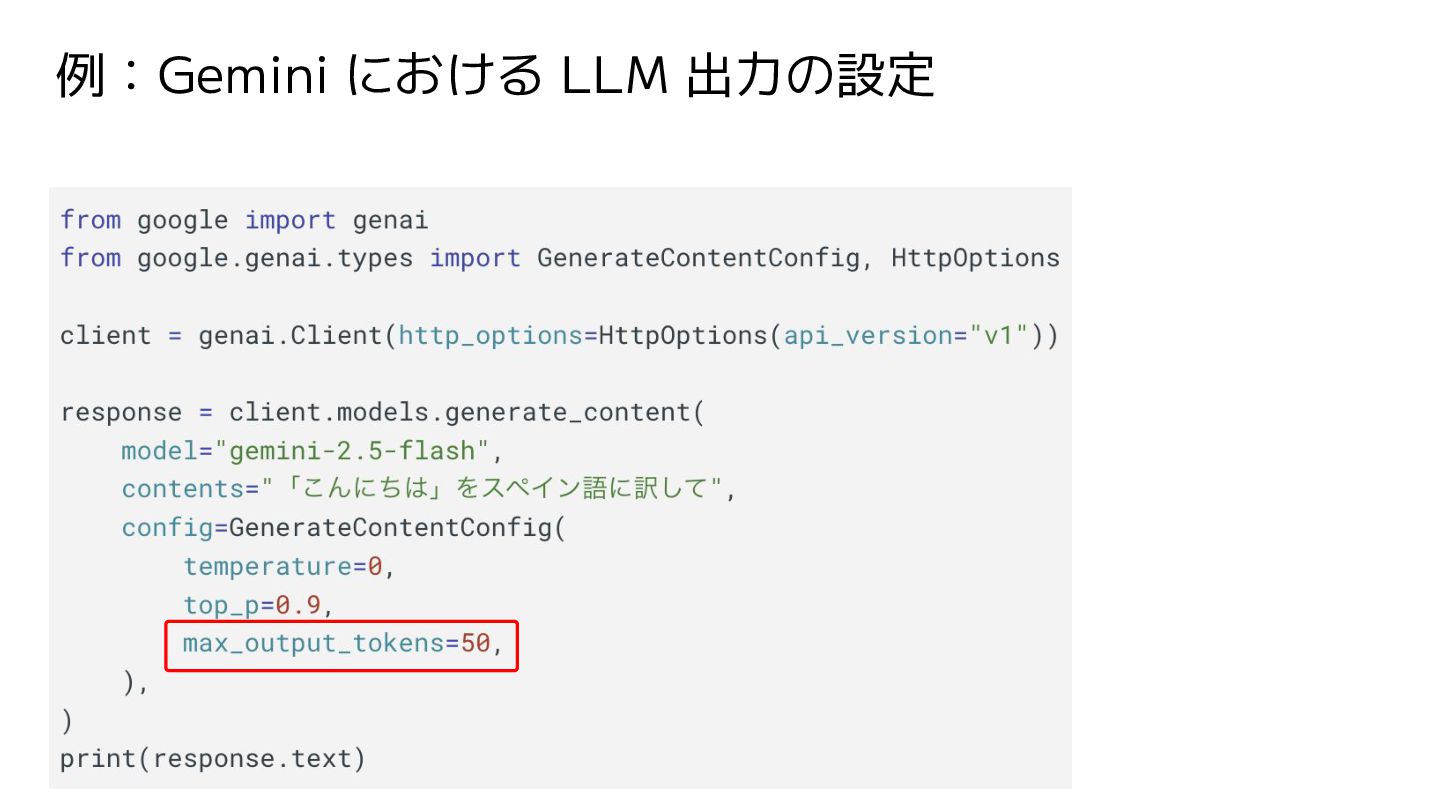
LLMの出力設定 多くの LLM 実装では、LLM の出力を制御するための様々な設定オプションが備 わっている 効果的なプロンプトエンジニアリングのためには、タスクに合わせてこれらの設 定を最適に設定することが求められる 重要な設定項目として、以下について紹介: •
出力長 (Output Length) • サンプリング制御 (Sampling Control) -
LLMの出力設定:出力長 (Output Length) 重要な設定項目である「応答で生成するトークン数」 • 多くのトークンを生成するためには、多くのLLMの計算量が必要。エネル ギー消費量の増加、応答時間の遅延の可能性、コスト上昇に繋がる • 必要な出力長に設定してコスト上昇を抑止する よくある誤解:LLMの出力長を短くしても、LLMが生成する出力の文体やテ
キストが簡潔になるわけではない。単に、上限に達した時点でLLMがそれ以 上のトークンの予測を停止するだけ。 → もし短い簡潔な出力が必要な場合は、プロンプト側でも工夫が必要 -
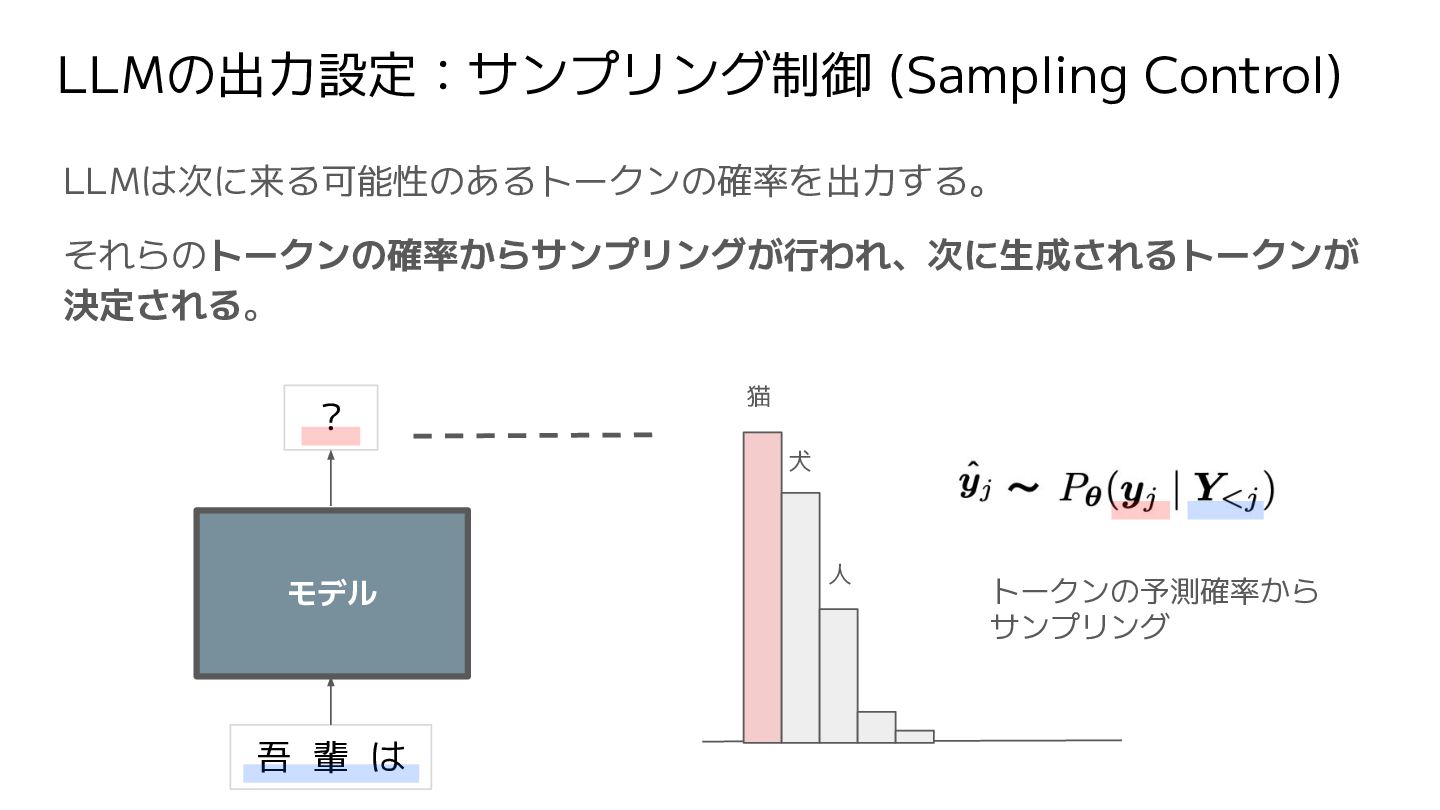
LLMの出力設定:サンプリング制御 (Sampling Control) LLMは次に来る可能性のあるトークンの確率を出力する。 それらのトークンの確率からサンプリングが行われ、次に生成されるトークンが 決定される。 吾 輩 は ?
猫 犬 人 トークンの予測確率から サンプリング モデル -
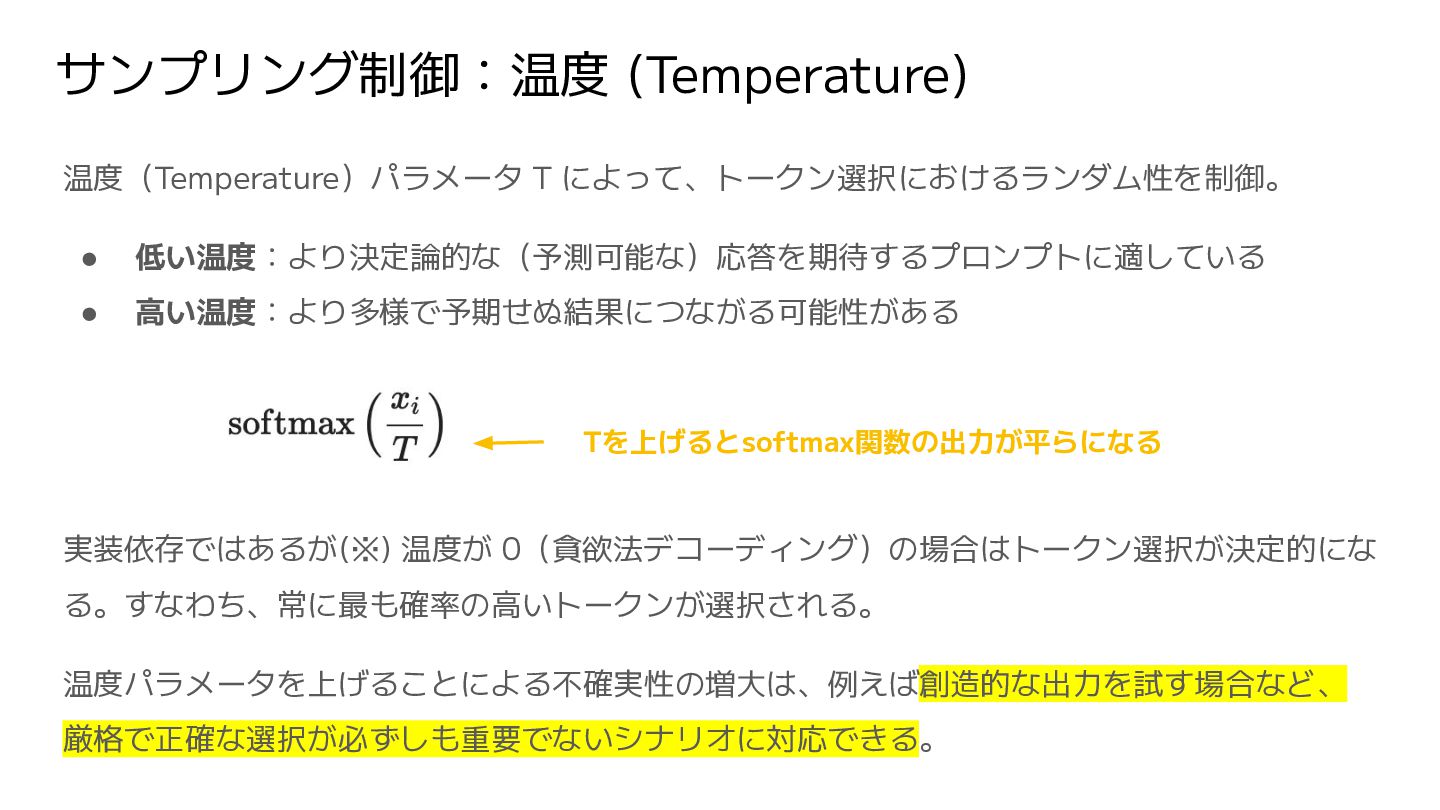
サンプリング制御:温度 (Temperature) 温度(Temperature)パラメータ T によって、トークン選択におけるランダム性を制御。 • 低い温度:より決定論的な(予測可能な)応答を期待するプロンプトに適している • 高い温度:より多様で予期せぬ結果につながる可能性がある 実装依存ではあるが(※)
温度が 0(貪欲法デコーディング)の場合はトークン選択が決定的にな る。すなわち、常に最も確率の高いトークンが選択される。 温度パラメータを上げることによる不確実性の増大は、例えば創造的な出力を試す場合など、 厳格で正確な選択が必ずしも重要でないシナリオに対応できる。 Tを上げるとsoftmax関数の出力が平らになる -
サンプリング制御:Top-P と Top-K (nucleus sampling) Top-P と Top-K は、LLMで使われる2つのサンプリング設定で、次に予測されるトークンを、予 測確率が高い“上位のトークン群に限定する”ためのもの。温度パラメータと同様に、これらのサ
ンプリング設定は、生成されるテキストのランダム性と多様性を制御する。 • Top-Pサンプリング:累積確率が特定の値(P)を超えない範囲で、上位のトークンを選択 します。Pの値の範囲は0(貪欲法デコーディング)から1(LLMの語彙に含まれる全トーク ン)まで。 • Top-Kサンプリング:モデルが予測した確率分布から、最も可能性の高い上位K個のトーク ンを選択します。Top-Kを高くするほど、モデルの出力はより創造的で多様になり、低くす るほど、より限定的で事実に基づいた出力になります。Top-Kを1に設定するのは、貪欲法 デコーディングと同じ。 -
サンプリング制御:Top-P と Top-K (nucleus sampling) Top-P と Top-K は、LLMで使われる2つのサンプリング設定で、次に予測されるトークンを、予 測確率が高い“上位のトークン群に限定する”ためのもの。温度パラメータと同様に、これらのサ
ンプリング設定は、生成されるテキストのランダム性と多様性を制御する。 • Top-Pサンプリング:累積確率が特定の値(P)を超えない範囲で、上位のトークンを選択 します。Pの値の範囲は0(貪欲法デコーディング)から1(LLMの語彙に含まれる全トーク ン)まで。 • Top-Kサンプリング:モデルが予測した確率分布から、最も可能性の高い上位K個のトーク ンを選択します。Top-Kを高くするほど、モデルの出力はより創造的で多様になり、低くす るほど、より限定的で事実に基づいた出力になります。Top-Kを1に設定するのは、貪欲法 デコーディングと同じ。 -
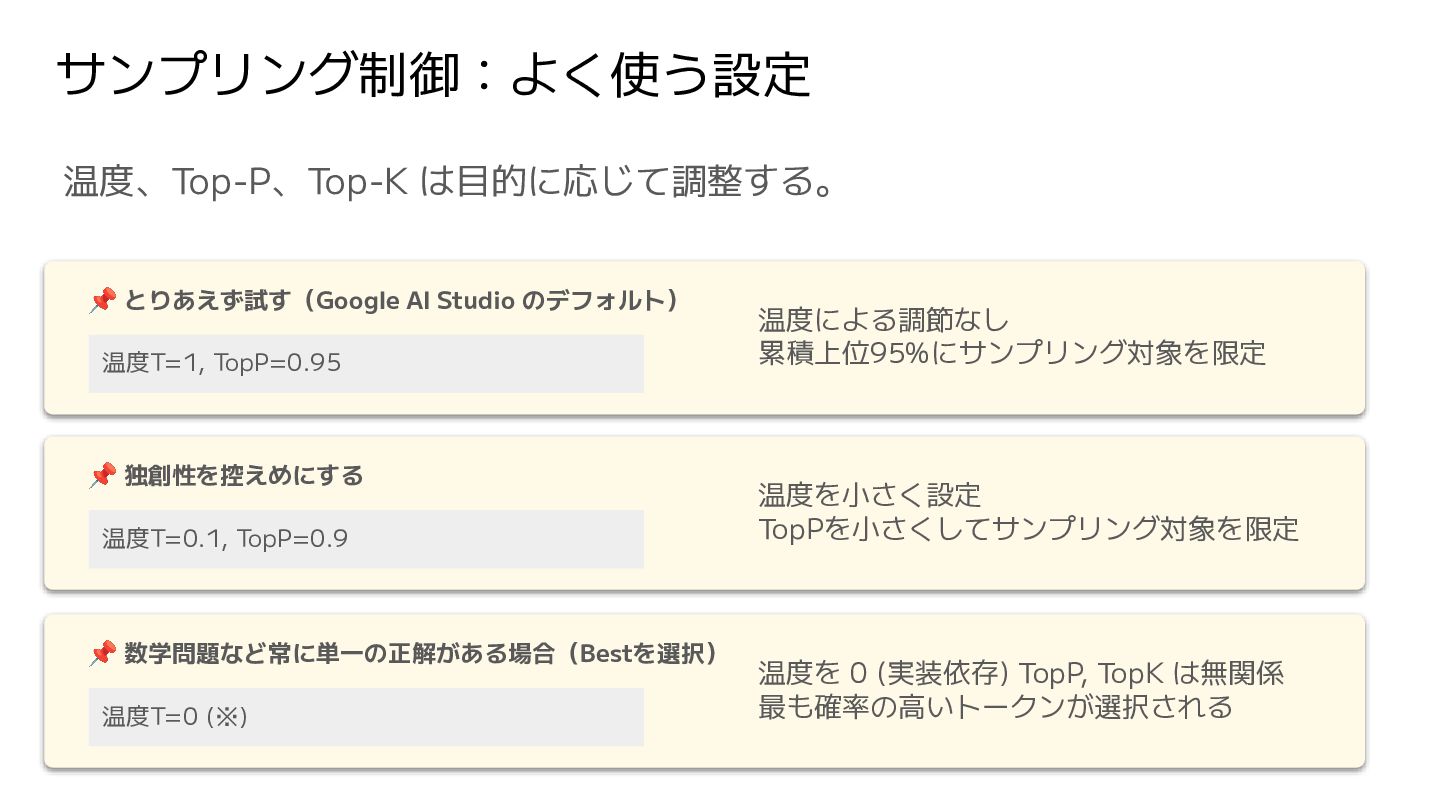
サンプリング制御:よく使う設定 温度、Top-P、Top-K は目的に応じて調整する。 📌 とりあえず試す(Google AI Studio のデフォルト) 温度T=1, TopP=0.95
温度による調節なし 累積上位95%にサンプリング対象を限定 📌 独創性を控えめにする 温度T=0.1, TopP=0.9 温度を小さく設定 TopPを小さくしてサンプリング対象を限定 📌 数学問題など常に単一の正解がある場合(Bestを選択) 温度T=0 (※) 温度を 0 (実装依存) TopP, TopK は無関係 最も確率の高いトークンが選択される -
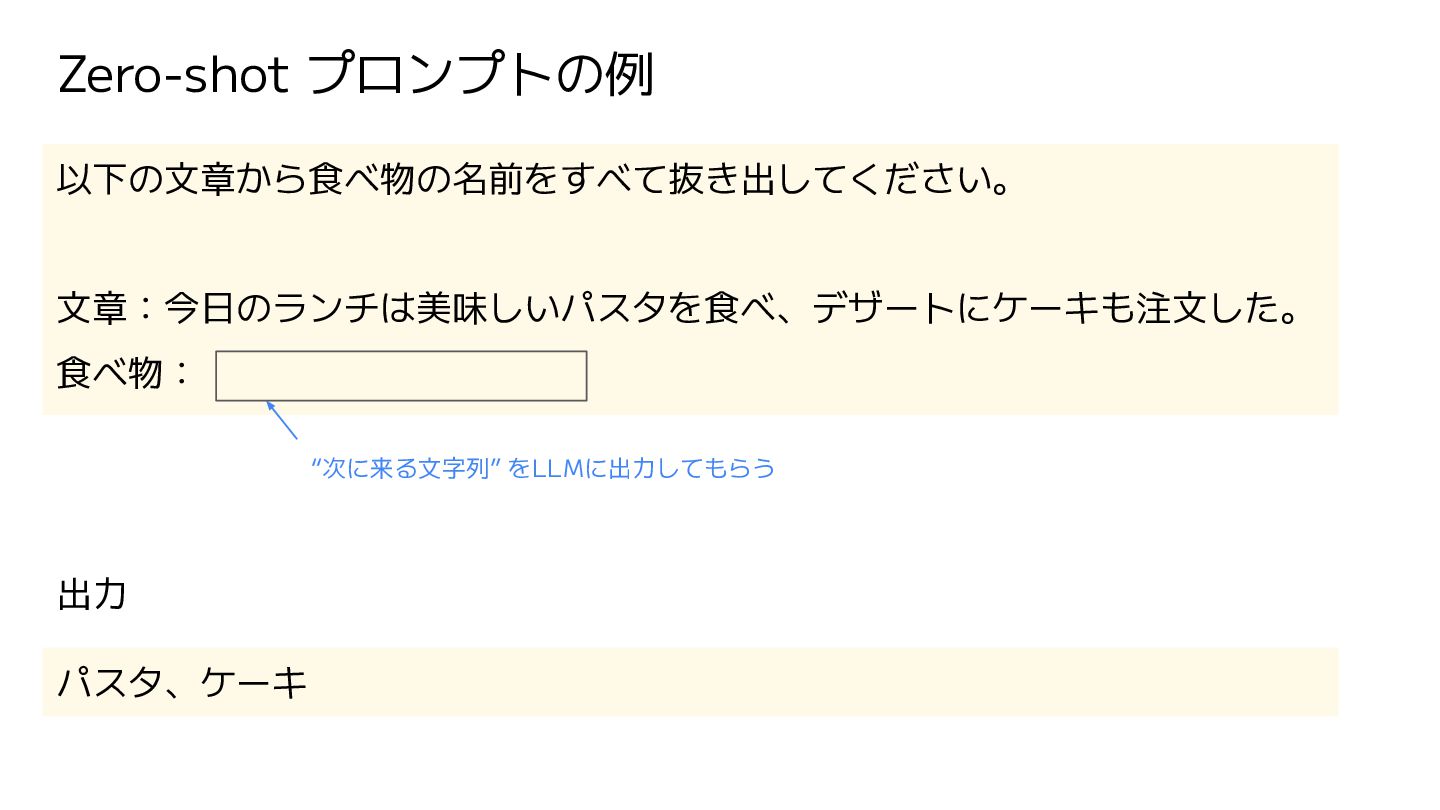
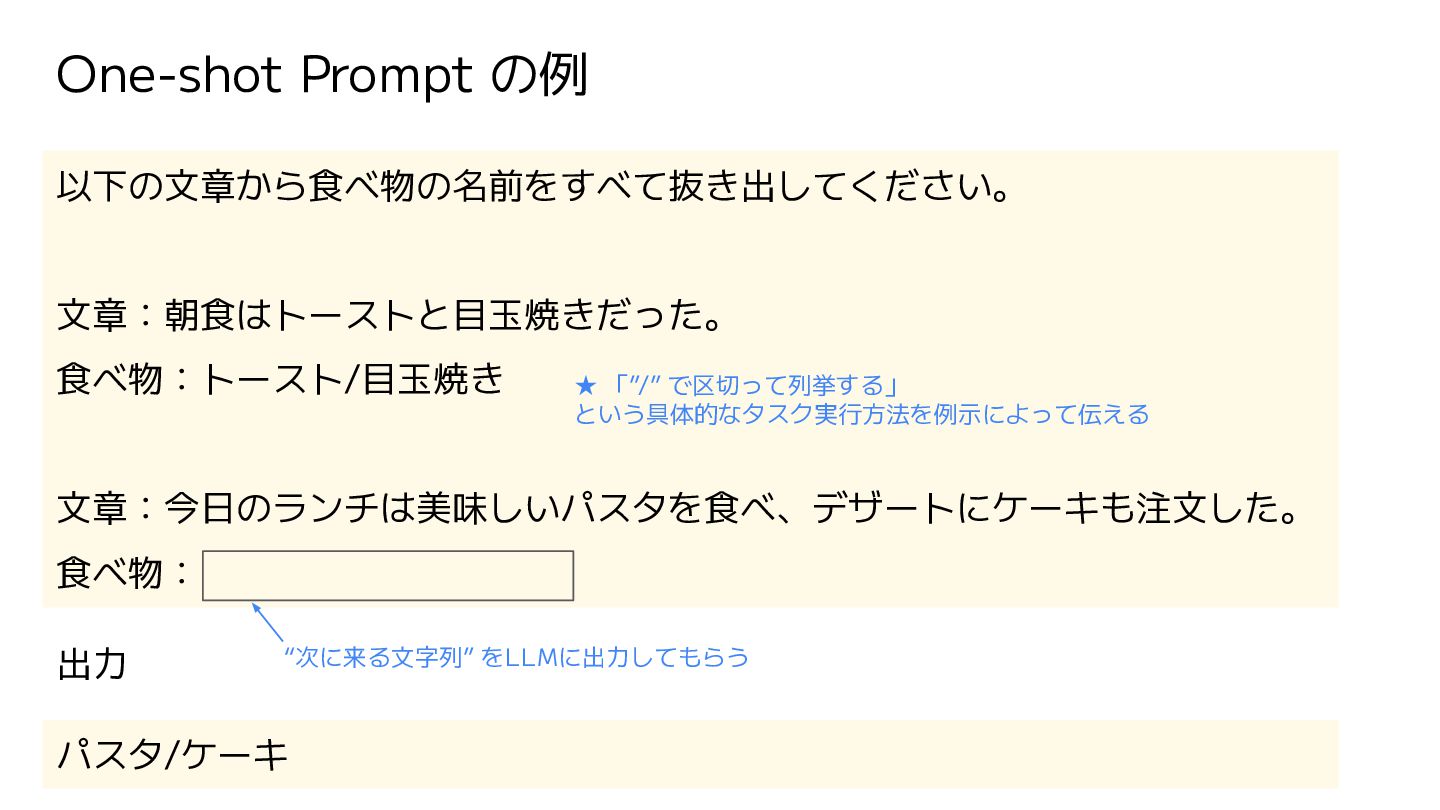
以下の文章から食べ物の名前をすべて抜き出してください。 文章:朝食はトーストと目玉焼きだった。 食べ物:トースト/目玉焼き 文章:今日のランチは美味しいパスタを食べ、デザートにケーキも注文した。 食べ物: 出力 パスタ/ケーキ “次に来る文字列” をLLMに出力してもらう ★
「”/” で区切って列挙する」 という具体的なタスク実行方法を例示によって伝える One-shot Prompt の例 -
Few-shot Prompting において何個の例示が必要か? フューショットプロンプティングに必要な例の数は、タスクの複雑さ、例の質、 使用している生成AI(gen AI)モデルの能力など、いくつかの要因によって異な る。 一般的な経験則として、フューショットプロンプティングには少なくとも3〜5つ の例を使用するべき。 より複雑なタスクには、より多くの例が必要になる。多くの例を追加することは
コストにも影響し、性能とコストのトレードオフの関係になることが多い。モデ ルの入力長の制限により、より少ない例しか使えない場合もある。 -
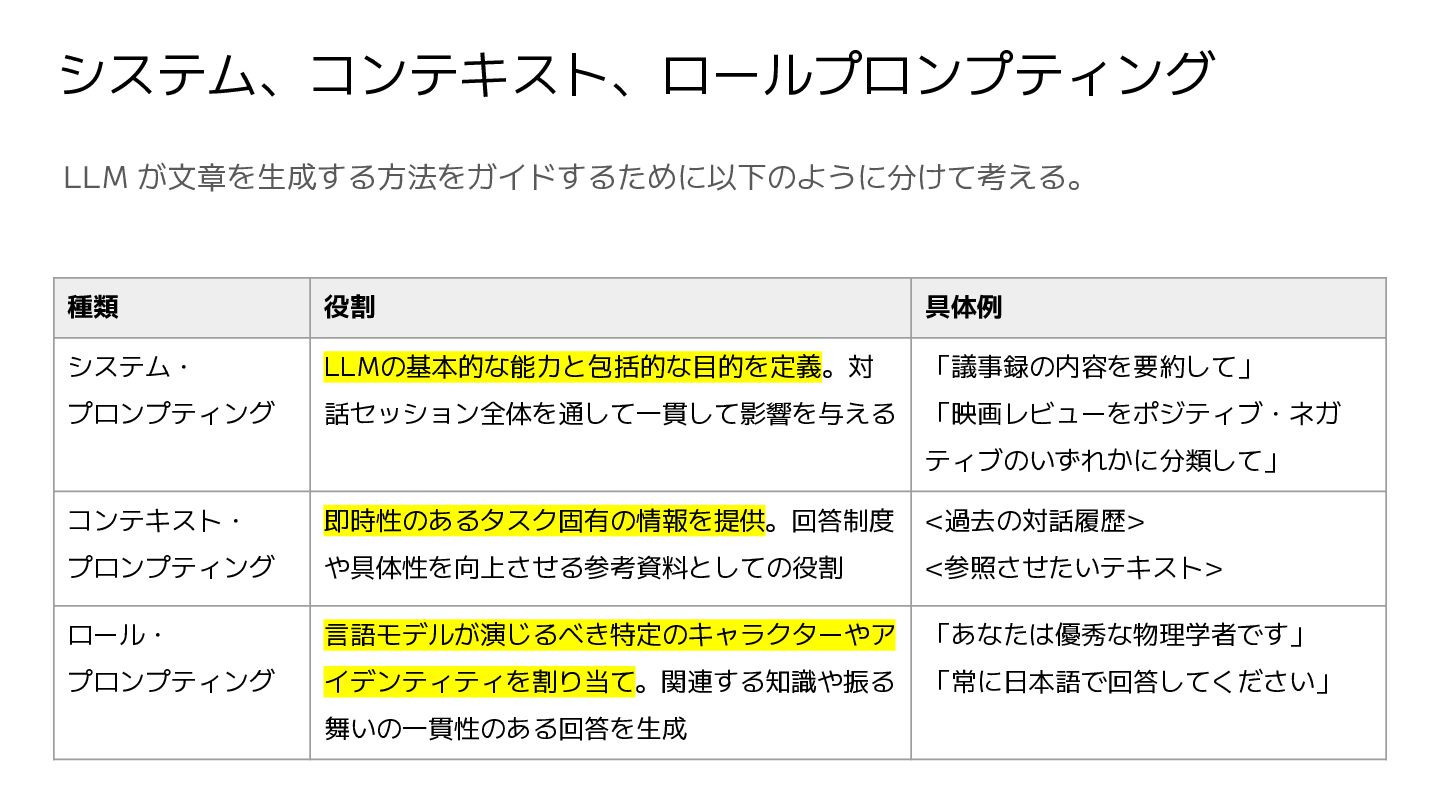
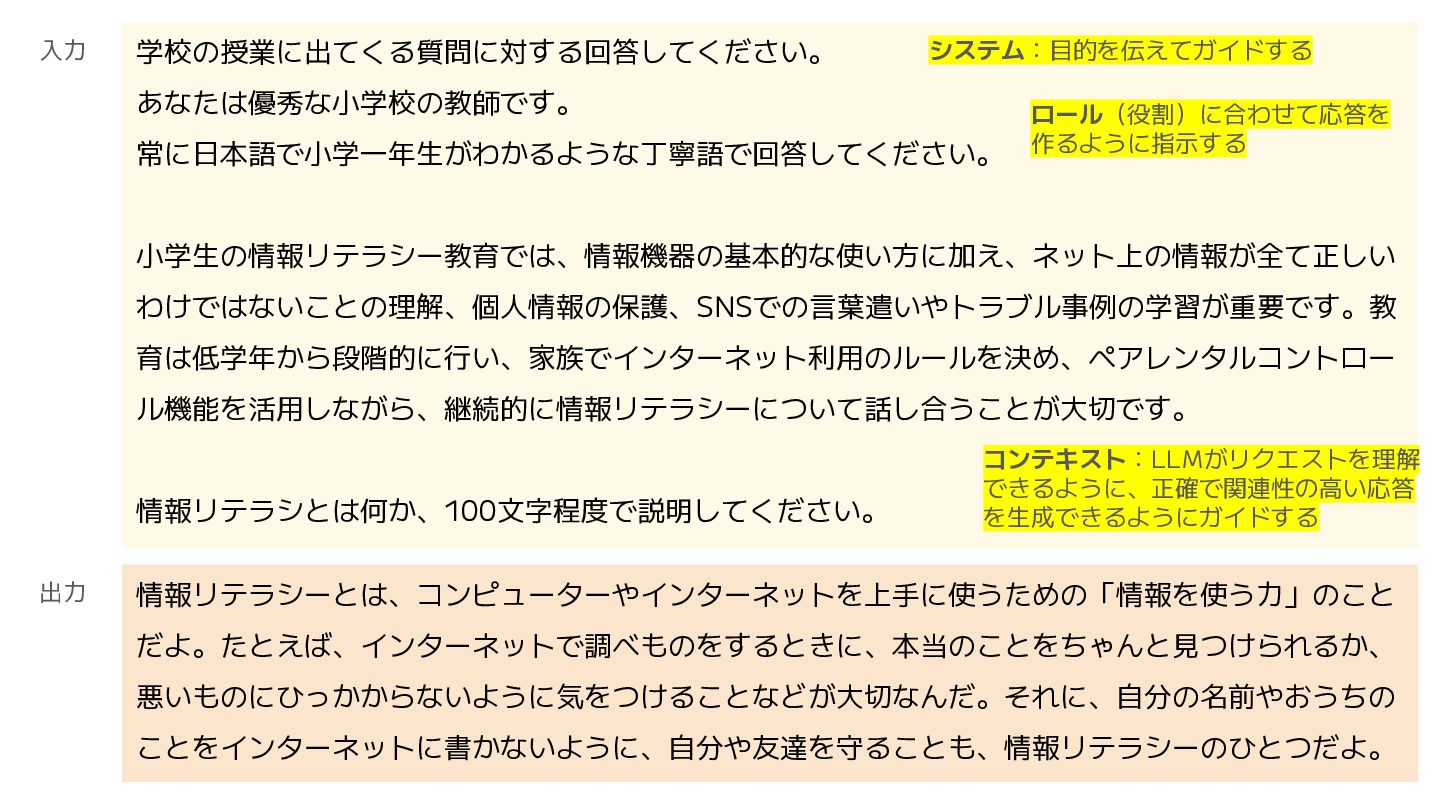
システム、コンテキスト、ロールプロンプティング LLM が文章を生成する方法をガイドするために以下のように分けて考える。 種類 役割 具体例 システム・ プロンプティング LLMの基本的な能力と包括的な目的を定義。対 話セッション全体を通して一貫して影響を与える
「議事録の内容を要約して」 「映画レビューをポジティブ・ネガ ティブのいずれかに分類して」 コンテキスト・ プロンプティング 即時性のあるタスク固有の情報を提供。回答制度 や具体性を向上させる参考資料としての役割 <過去の対話履歴> <参照させたいテキスト> ロール・ プロンプティング 言語モデルが演じるべき特定のキャラクターやア イデンティティを割り当て。関連する知識や振る 舞いの一貫性のある回答を生成 「あなたは優秀な物理学者です」 「常に日本語で回答してください」 -
学校の授業に出てくる質問に対する回答してください。 あなたは優秀な小学校の教師です。 常に日本語で小学一年生がわかるような丁寧語で回答してください。 小学生の情報リテラシー教育では、情報機器の基本的な使い方に加え、ネット上の情報が全て正しい わけではないことの理解、個人情報の保護、SNSでの言葉遣いやトラブル事例の学習が重要です。教 育は低学年から段階的に行い、家族でインターネット利用のルールを決め、ペアレンタルコントロー ル機能を活用しながら、継続的に情報リテラシーについて話し合うことが大切です。 情報リテラシとは何か、100文字程度で説明してください。 情報リテラシーとは、コンピューターやインターネットを上手に使うための「情報を使う力」のこと だよ。たとえば、インターネットで調べものをするときに、本当のことをちゃんと見つけられるか、
悪いものにひっかからないように気をつけることなどが大切なんだ。それに、自分の名前やおうちの ことをインターネットに書かないように、自分や友達を守ることも、情報リテラシーのひとつだよ。 入力 出力 システム:目的を伝えてガイドする ロール(役割)に合わせて応答を 作るように指示する コンテキスト:LLMがリクエストを理解 できるように、正確で関連性の高い応答 を生成できるようにガイドする -
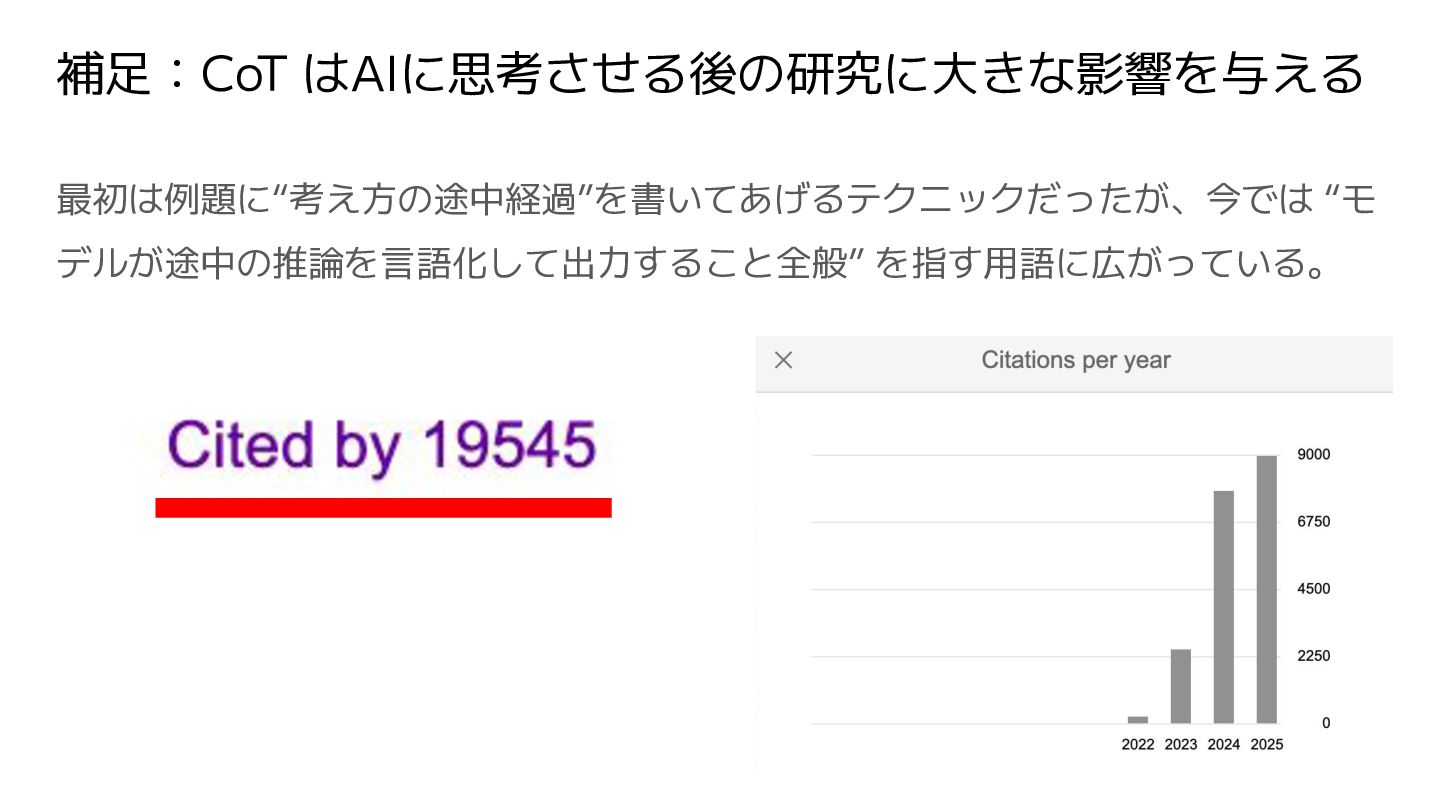
Chain of Thought (CoT) [Wei+ ‘22]:思考の連鎖 中間的な推論ステップを例示することで、LLM が推論ステップを生成できるよう にガイドする [Wei+
‘22] “Chain-of-thought prompting elicits reasoning in large language models”, NeurIPS’22 https://arxiv.org/abs/2201.11903 ロジャーはテニスボールを5個持っていま す。彼はさらにテニスボールの缶を2つ買 います。それぞれの缶にはテニスボール が3個入っています。 彼は今、テニスボールをいくつ持ってい ますか? ロジャーは 5 個のボールから始めまし た。3 個ずつ入った缶 2 つで、6 個のテ ニス ボールになります。5 + 6 = 11。 答えは 11 です。 推論ステップを One-shot で例示。 出力が推論ステップを生成して 正しく正解を出力するようになる。 -
Step-Back Prompting [Zheng+ ‘24]:一歩引く CoT は中間の推論ステップでの正確性が低いことで失敗する場合がある。“一歩引く” ことで LLM は特定の問題解決を試みる前に、関連する背景知識や推論プロセスを活性化させる手法。 Step1(抽象):LLM
に当面の特定タスクに関連する一般的な質問を検討させる Step2(思考):その一般的な質問への回答を、特定のタスクのための後続のプロンプトに追加 出展:Zheng et al., "Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models", https://arxiv.org/abs/2310.06117 -
Step-Back Prompting [Zheng+ ‘24]:一歩引く 例:エステラ・レオポルドは1954年8月から11月の間にどの学校に通っていたか? Chain-of-Thought の場合。 推論ステップでの正確性が低い例 ※「UCBで1950年に修士」と「1955年博士」は どちらも正しいが、博士は別大学の
Yale が正解 出展:Zheng et al., "Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models", https://arxiv.org/abs/2310.06117 -
Step-Back Prompting [Zheng+ ‘24]:一歩引く 一歩引いた質問:「エステラ・レオポルド」の学歴は何ですか? 質問の回答を得て、最初の質問に追加 例:エステラ・レオポルドは1954年8月から11月の間にどの学校に通っていたか? 出展:Zheng et al.,
"Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models", https://arxiv.org/abs/2310.06117 -
まとめ • LLMの出力長:出力長を短くしても、LLMが生成する出力の文体やテキストが簡潔になるわ けではありません。単に、上限に達した時点でLLMがそれ以上のトークンの予測を停止する だけです • サンプリング制御:目的に応じてサンプリング制御のパラメータを決定する。独創性を抑え たい場合は温度を下げたり Top-P を小さくする。独創性が必要ない場合は温度を
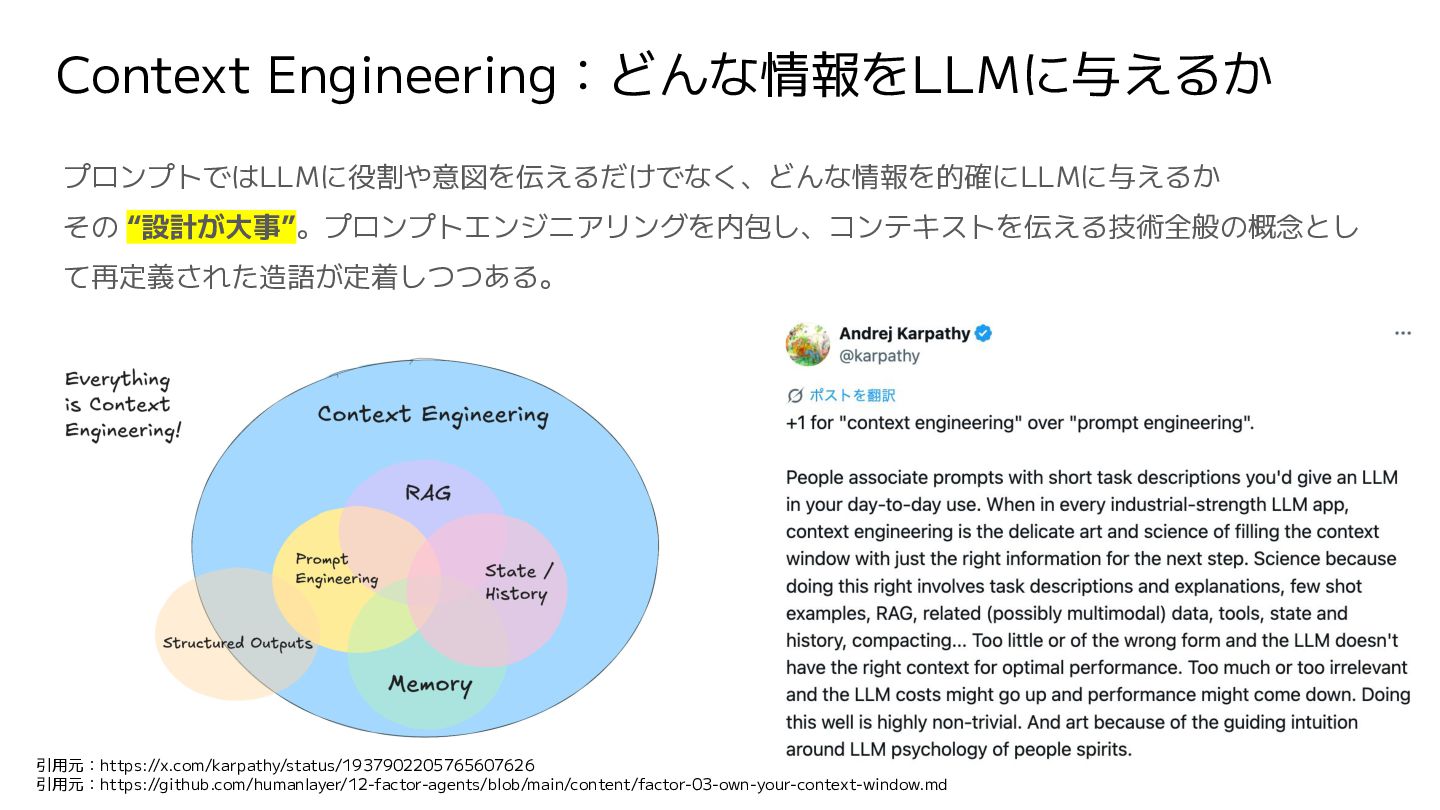
0 にす る。 • CoT:複雑なタスクを解く場合、LLM が推論ステップを生成できるようにガイドする • Step-Back:一歩引いた質問をすることで、推論プロセスを活性化させる • プロンプトではLLMに役割や意図を伝えるだけでなく、どんな情報を的確にLLMに与えるか その “設計が大事” -
Agenda • 導入 (5m) • LLMの基礎 (15m) • プロンプトエンジニアリング (40m)
• LLM研究の最近の動向 (20m) ◦ 推論時スケーリング ◦ GRPO (効率的な事後学習アルゴリズム) ◦ 推論時の自己改善のアプローチ ◦ 進化論的アプローチによるアルゴリズム探索 • 質疑応答 (10m) -
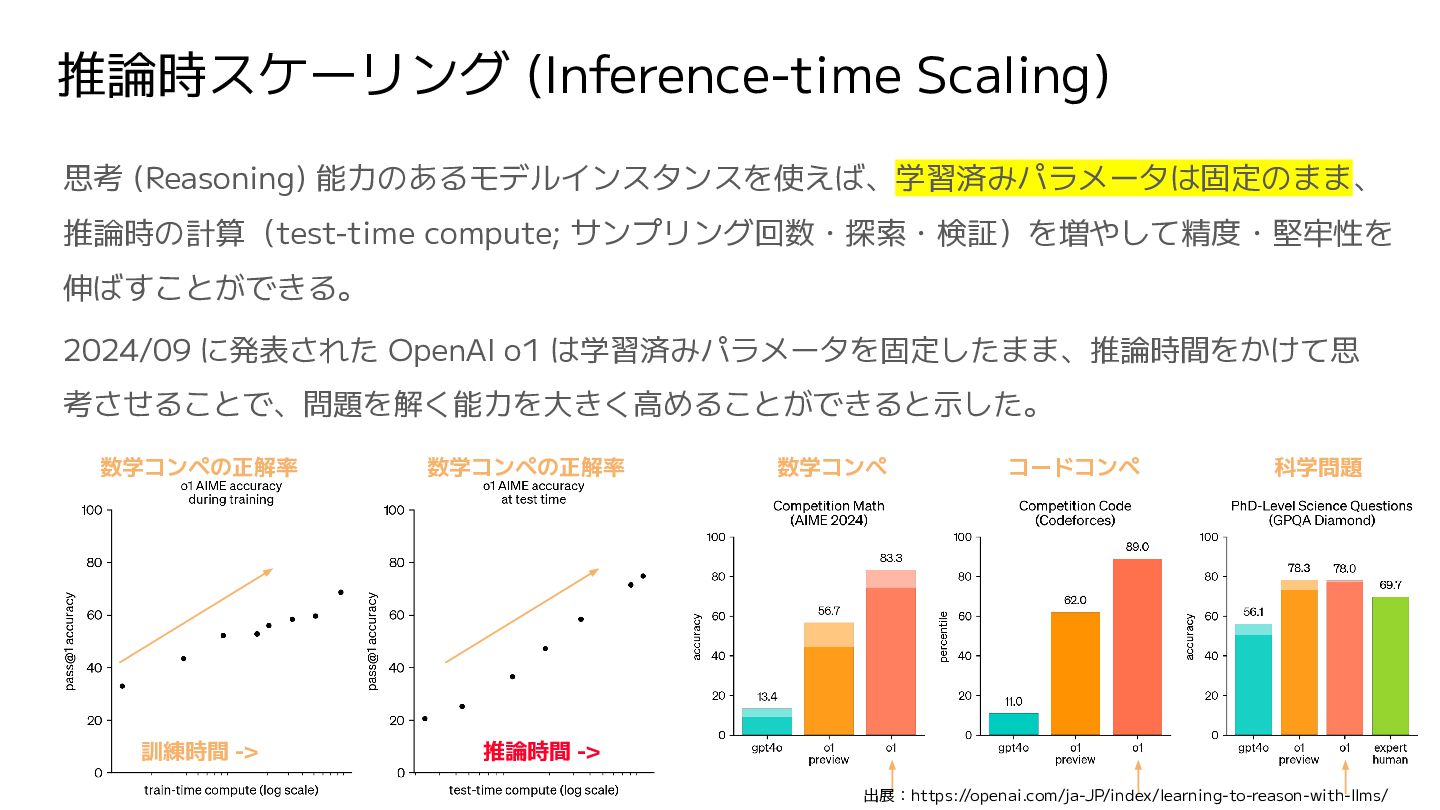
推論時スケーリング (Inference-time Scaling) 思考 (Reasoning) 能力のあるモデルインスタンスを使えば、学習済みパラメータは固定のまま、 推論時の計算(test-time compute; サンプリング回数・探索・検証)を増やして精度・堅牢性を 伸ばすことができる。
2024/09 に発表された OpenAI o1 は学習済みパラメータを固定したまま、推論時間をかけて思 考させることで、問題を解く能力を大きく高めることができると示した。 推論時間 -> 訓練時間 -> 数学コンペ コードコンペ 科学問題 数学コンペの正解率 数学コンペの正解率 出展:https://openai.com/ja-JP/index/learning-to-reason-with-llms/ -
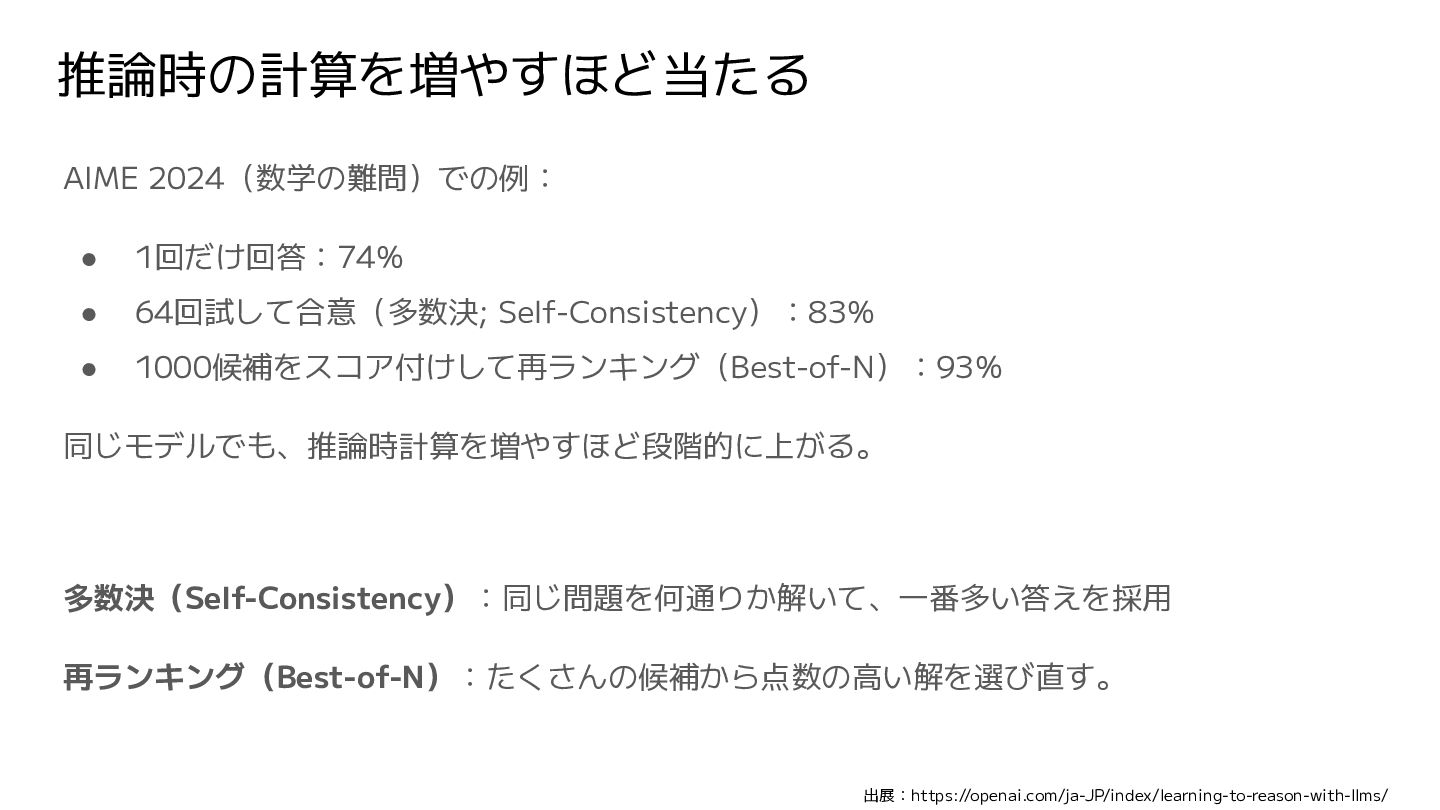
推論時の計算を増やすほど当たる AIME 2024(数学の難問)での例: • 1回だけ回答:74% • 64回試して合意(多数決; Self-Consistency):83% • 1000候補をスコア付けして再ランキング(Best-of-N):93%
同じモデルでも、推論時計算を増やすほど段階的に上がる。 多数決(Self-Consistency):同じ問題を何通りか解いて、一番多い答えを採用 再ランキング(Best-of-N):たくさんの候補から点数の高い解を選び直す。 出展:https://openai.com/ja-JP/index/learning-to-reason-with-llms/ -
難しい問題にだけ余分に計算を配る [Snell+ ‘25] すべての問題に同じだけ “Best-of-N” を計算するのではなく、難しい問題にだけ余分に計算時 間を分配すると効率が良い。 Snell et al,
“Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters”, ICLR ‘25 https://arxiv.org/abs/2408.03314 易しい問題:順次見直し (Seq. Revisions) が効果的 普通の問題:多数決 (Self-Consistency)・再ランキ ング (Best-of-N) 難しい問題:並列サンプリング + 過程を採点できる 検証器(Process Reward Model)を使った探索の 比重を上げる -
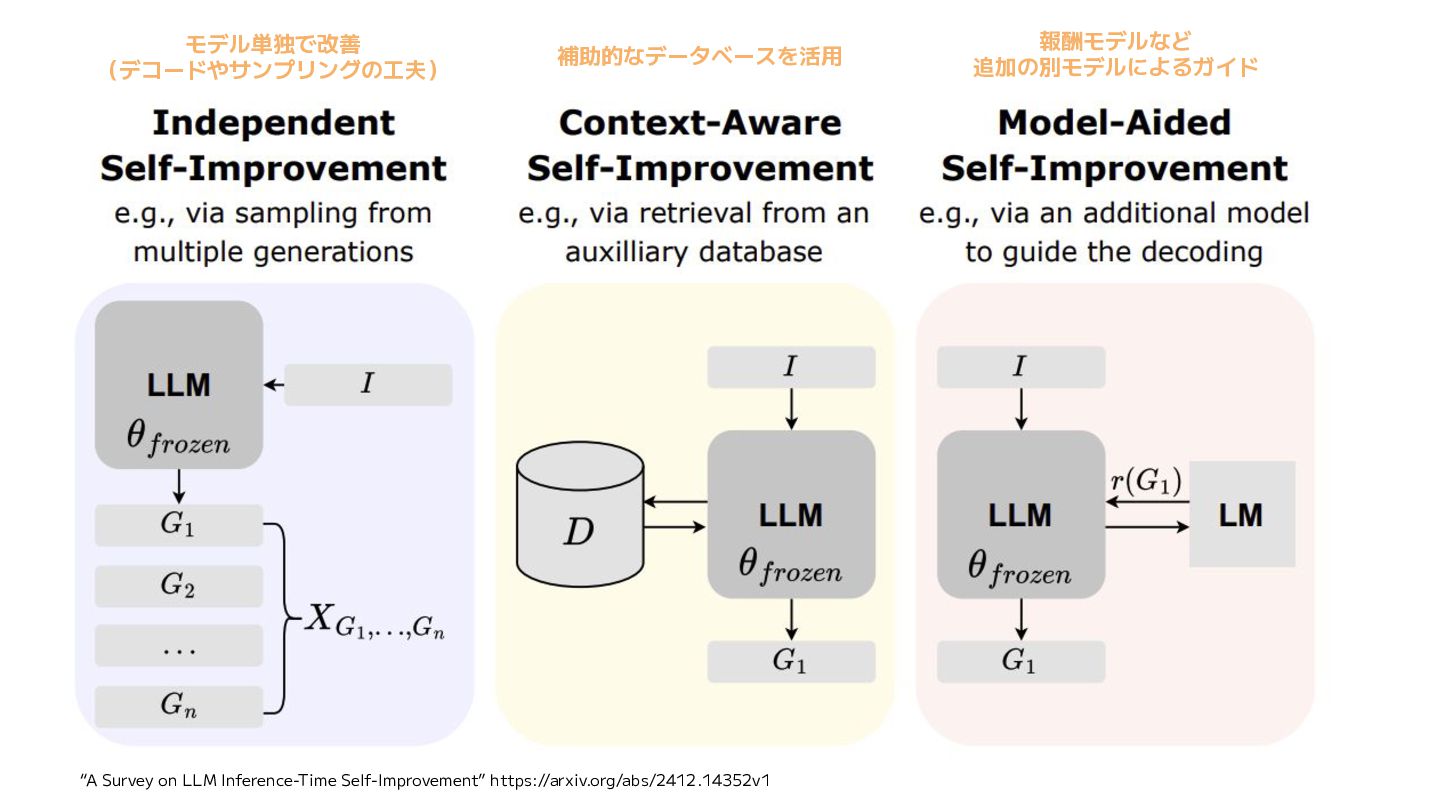
モデル単独で改善 (デコードやサンプリングの工夫) 補助的なデータベースを活用 報酬モデルなど 追加の別モデルによるガイド “A Survey on LLM Inference-Time
Self-Improvement” https://arxiv.org/abs/2412.14352v1 -
(2024/09) 推論時スケーリングの現象を生み出すことができる学習方法について は、技術詳細は明らかにされていないが「CoT + 強化学習」と紹介されていた。 (2025/01) 推論時スケーリングの現象を生み出すことができる、 計算効率の良い学習方法が DeepSeek-R1 の論文で示された。※
※要素技術の GRPO 自体は 2024/02 の DeepSeekMath で示されているが、 それらの集大成として多様なタスクで評価して蒸留モデルも全部含めて公開され注目を集めた。 deepseek については 2024/04 の DeepSeek-V2 リリースの低価格&高性能な API サービスにより 中国のAI市場で価格破壊を引き起こし話題になっていた -
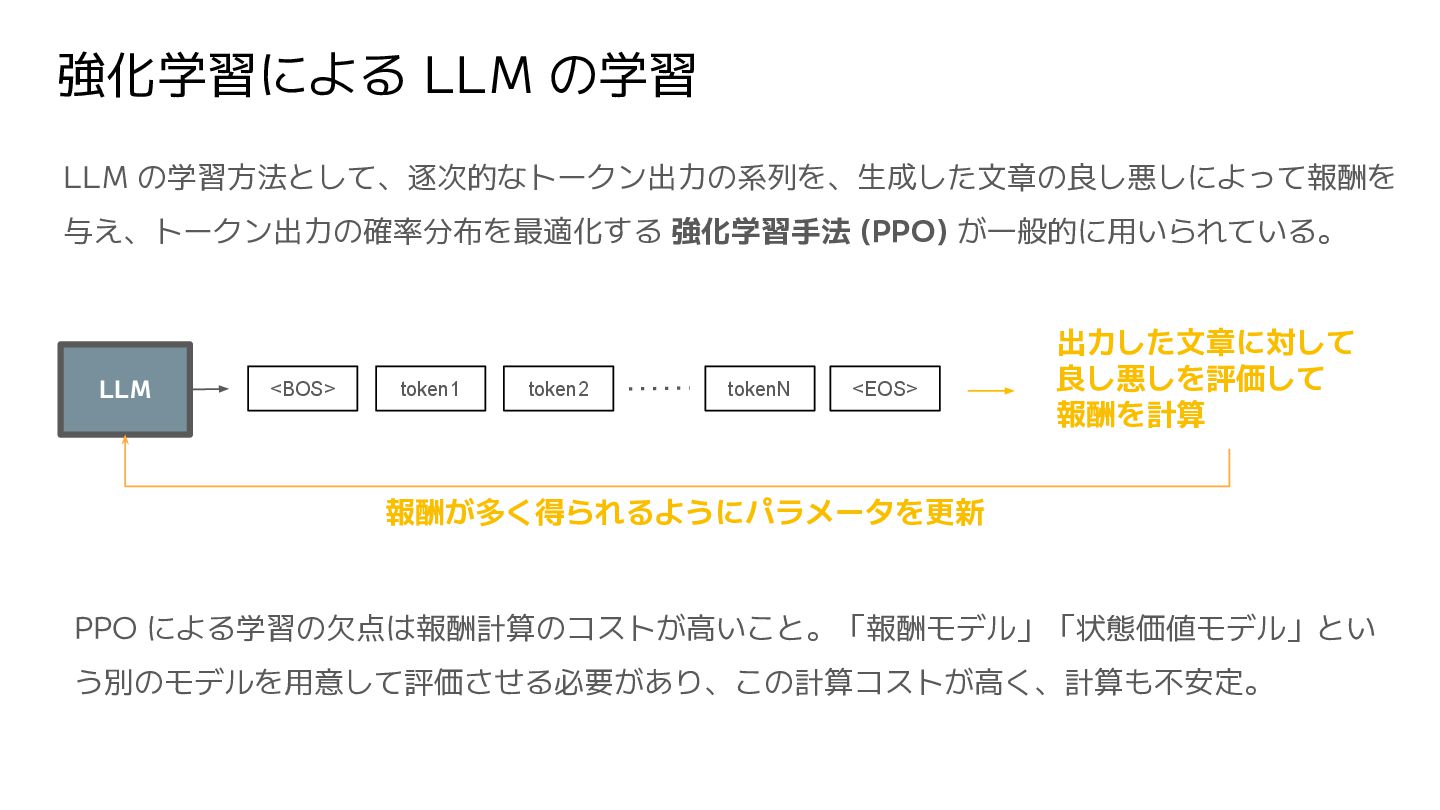
強化学習による LLM の学習 LLM の学習方法として、逐次的なトークン出力の系列を、生成した文章の良し悪しによって報酬を 与え、トークン出力の確率分布を最適化する 強化学習手法 (PPO) が一般的に用いられている。 <BOS>
token1 token2 tokenN <EOS> 出力した文章に対して 良し悪しを評価して 報酬を計算 PPO による学習の欠点は報酬計算のコストが高いこと。「報酬モデル」「状態価値モデル」とい う別のモデルを用意して評価させる必要があり、この計算コストが高く、計算も不安定。 LLM 報酬が多く得られるようにパラメータを更新 -
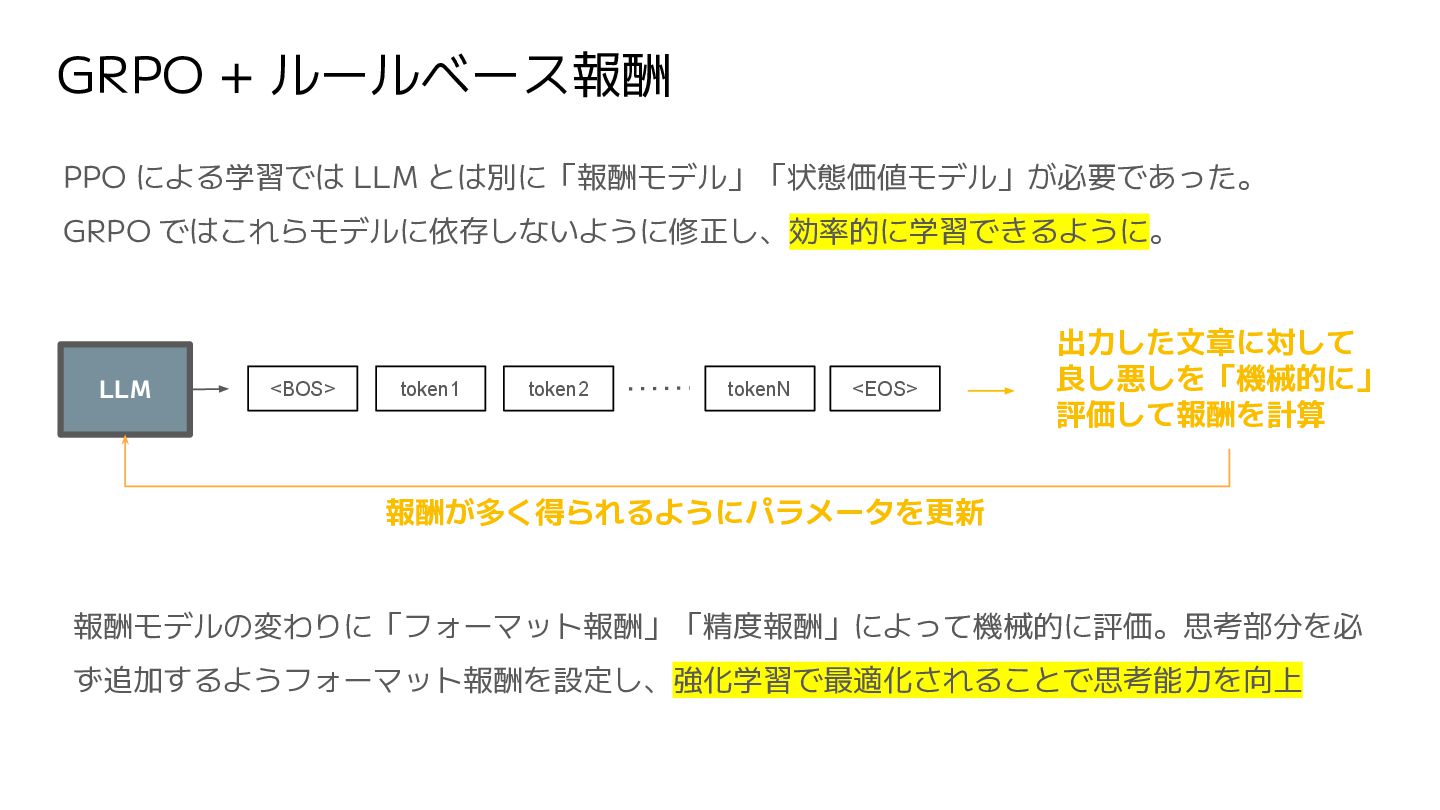
GRPO + ルールベース報酬 PPO による学習では LLM とは別に「報酬モデル」「状態価値モデル」が必要であった。 GRPO ではこれらモデルに依存しないように修正し、効率的に学習できるように。 報酬モデルの変わりに「フォーマット報酬」「精度報酬」によって機械的に評価。思考部分を必
ず追加するようフォーマット報酬を設定し、強化学習で最適化されることで思考能力を向上 <BOS> token1 token2 tokenN <EOS> 出力した文章に対して 良し悪しを「機械的に」 評価して報酬を計算 LLM 報酬が多く得られるようにパラメータを更新 -
AlphaEvolve [Novikov+ ‘25]:進化的コーディングエージェント 大規模言語モデル(LLM)を創造的な核として利用し、進化的計算を組み合わせたコーディング エージェント。科学的およびアルゴリズム的な発見を行う 行列乗算アルゴリズムなどのアルゴリズム設計からGoogleのインフラストラクチャの最適化ま で、広範な領域でSOTAを塗り替える結果を示した。 どのコードから改善していくかの取捨選択 で進化的計算のアイディアを取り入れる アルゴリズムの創造をLLMに頼る
Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery”, https://arxiv.org/abs/2506.13131 -
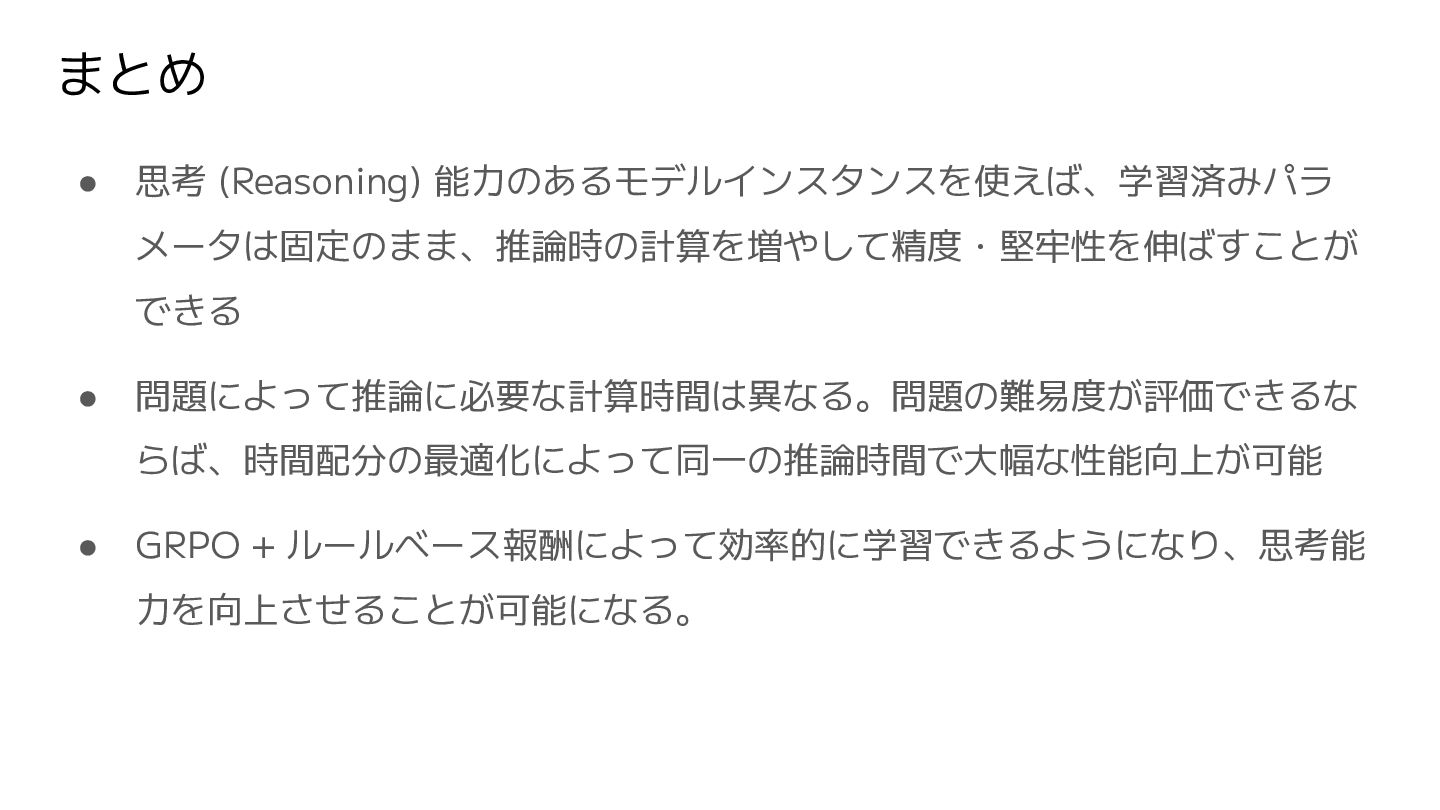
まとめ • 思考 (Reasoning) 能力のあるモデルインスタンスを使えば、学習済みパラ メータは固定のまま、推論時の計算を増やして精度・堅牢性を伸ばすことが できる • 問題によって推論に必要な計算時間は異なる。問題の難易度が評価できるな らば、時間配分の最適化によって同一の推論時間で大幅な性能向上が可能
• GRPO + ルールベース報酬によって効率的に学習できるようになり、思考能 力を向上させることが可能になる。
 rist
 codingconduct
 aki_iinuma
 bermonpainter
 lara
 notwaldorf
 gr2m
 garrettdimon
 tammyeverts
 reverentgeek
 bcantrill