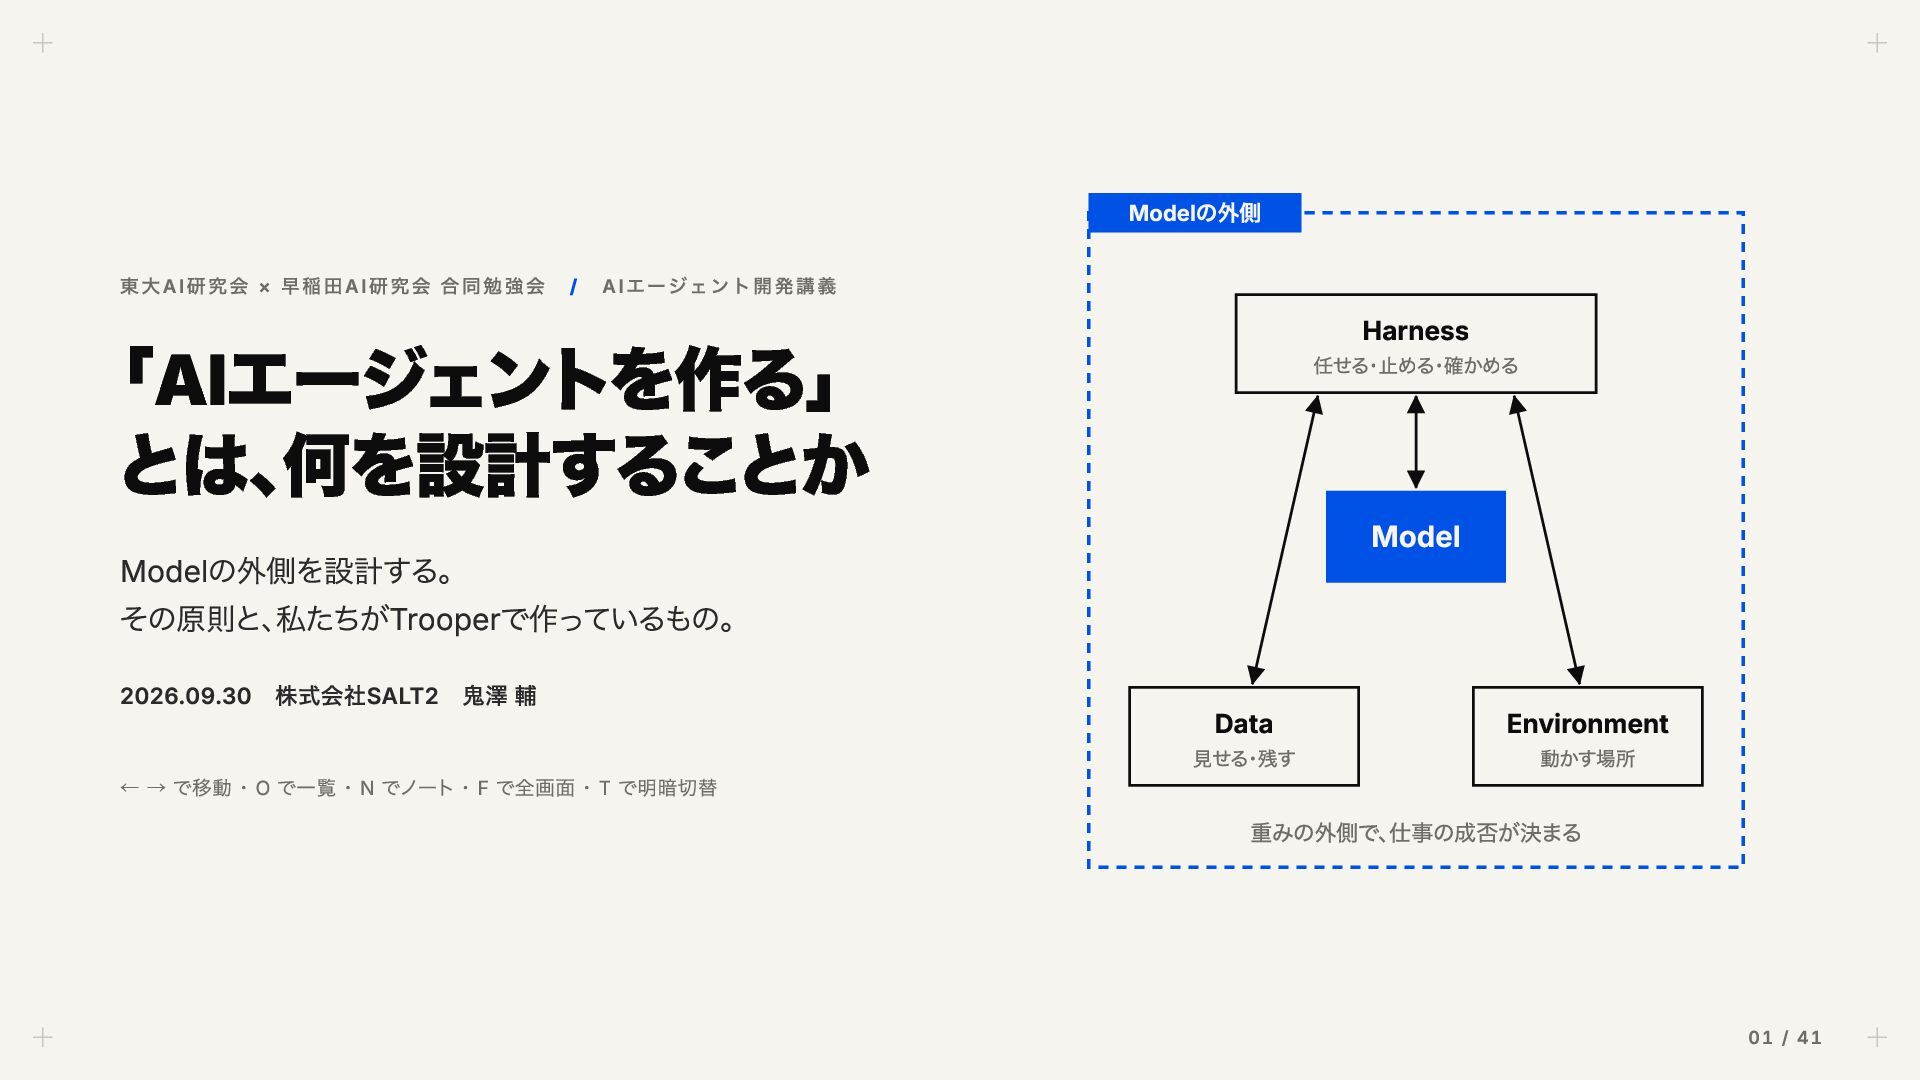
合同勉強会 / A I エージェント開発講義 「AIエージェントを作る」 とは、何を設計することか Harness 任せる・止める・確かめる Model Modelの外側を設計する。 その原則と、私たちがTrooperで作っているもの。 2026.09.30 株式会社SALT2 鬼澤 輔 ← → で移動 ・ O で一覧 ・ N でノート・ F で全画面 ・ T で明暗切替 Data 見せる・残す Environment 動かす場所 重みの外側で、仕事の成否が決まる 01 / 41
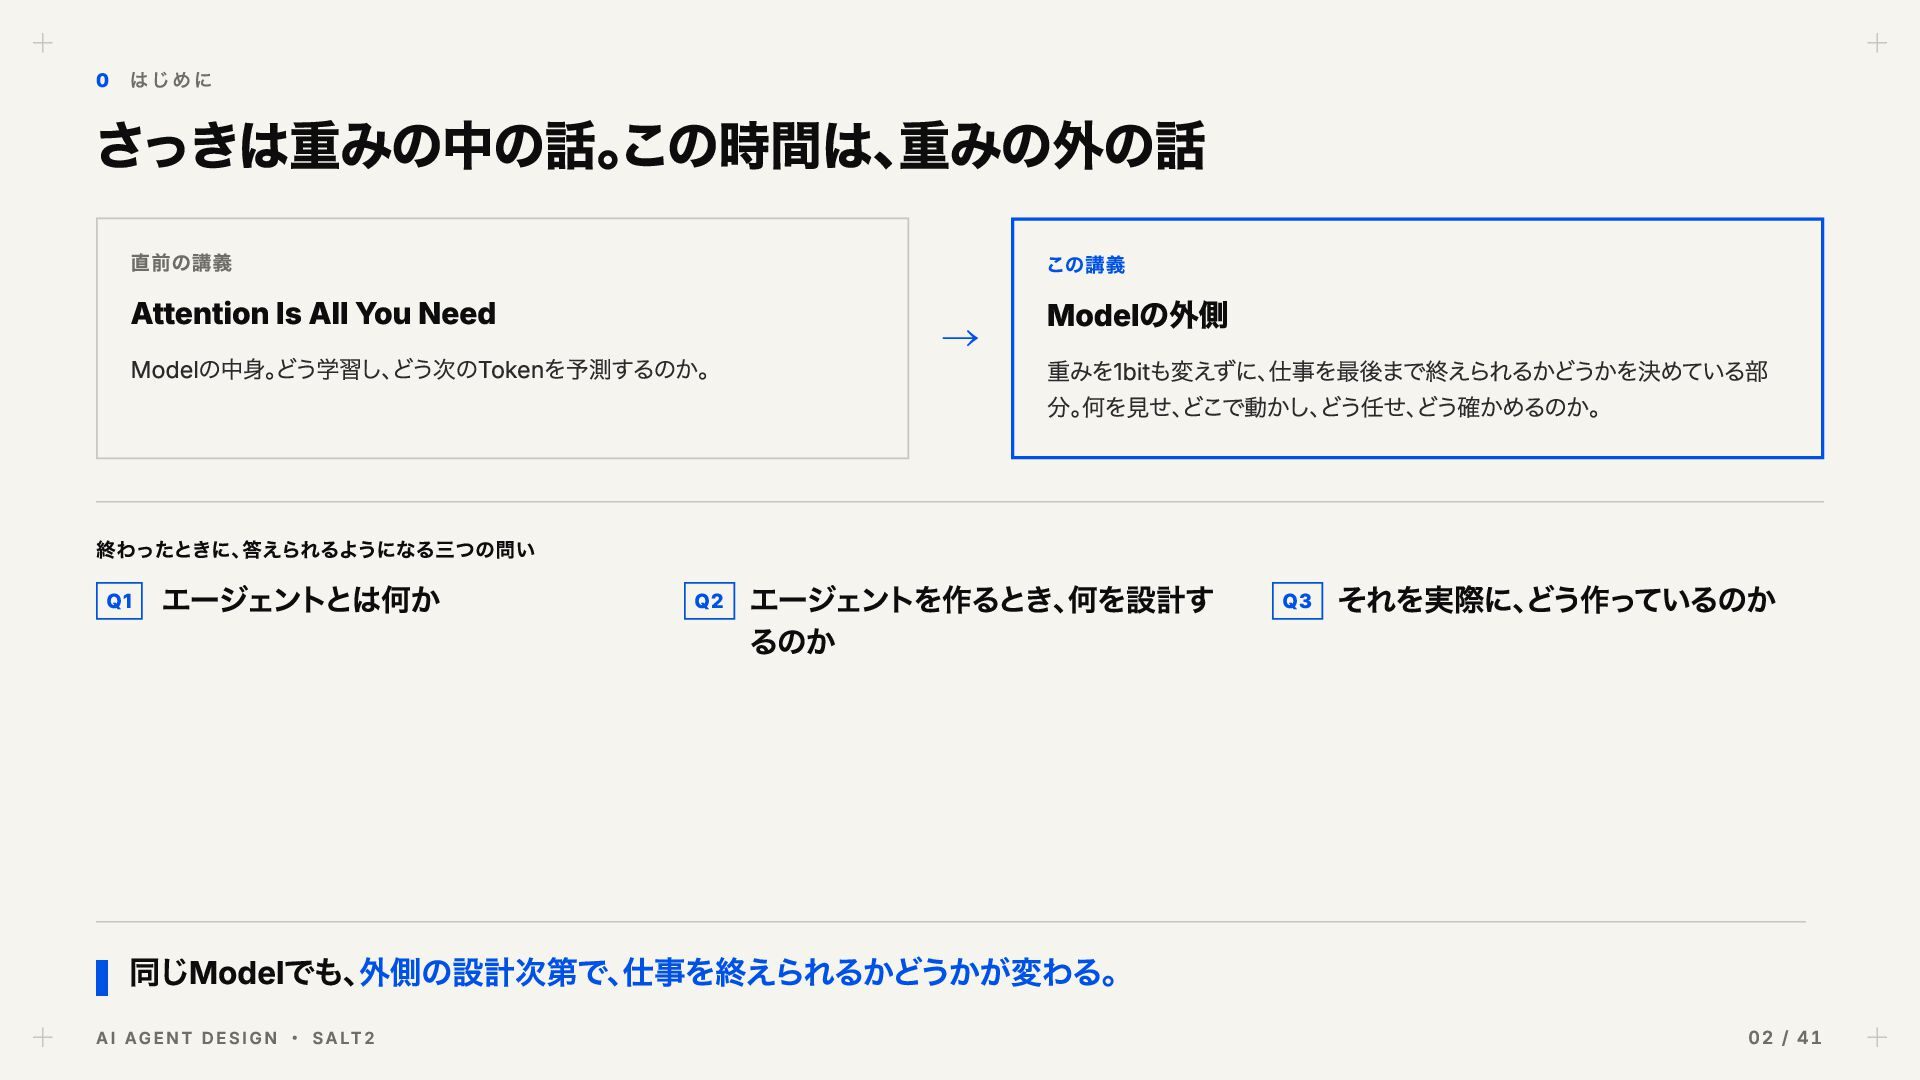
終わったときに、答えられるようになる三つの問い Q1 エージェントとは何か Q2 → この講義 Modelの外側 重みを1bitも変えずに、仕事を最後まで終えられるかどうかを決めている部 分。何を見せ、どこで動かし、どう任せ、どう確かめるのか。 エージェントを作るとき、何を設計す るのか Q3 それを実際に、どう作っているのか 同じModelでも、外側の設計次第で、仕事を終えられるかどうかが変わる。 A I AG E N T D E S I G N ・ S A LT 2 02 / 41
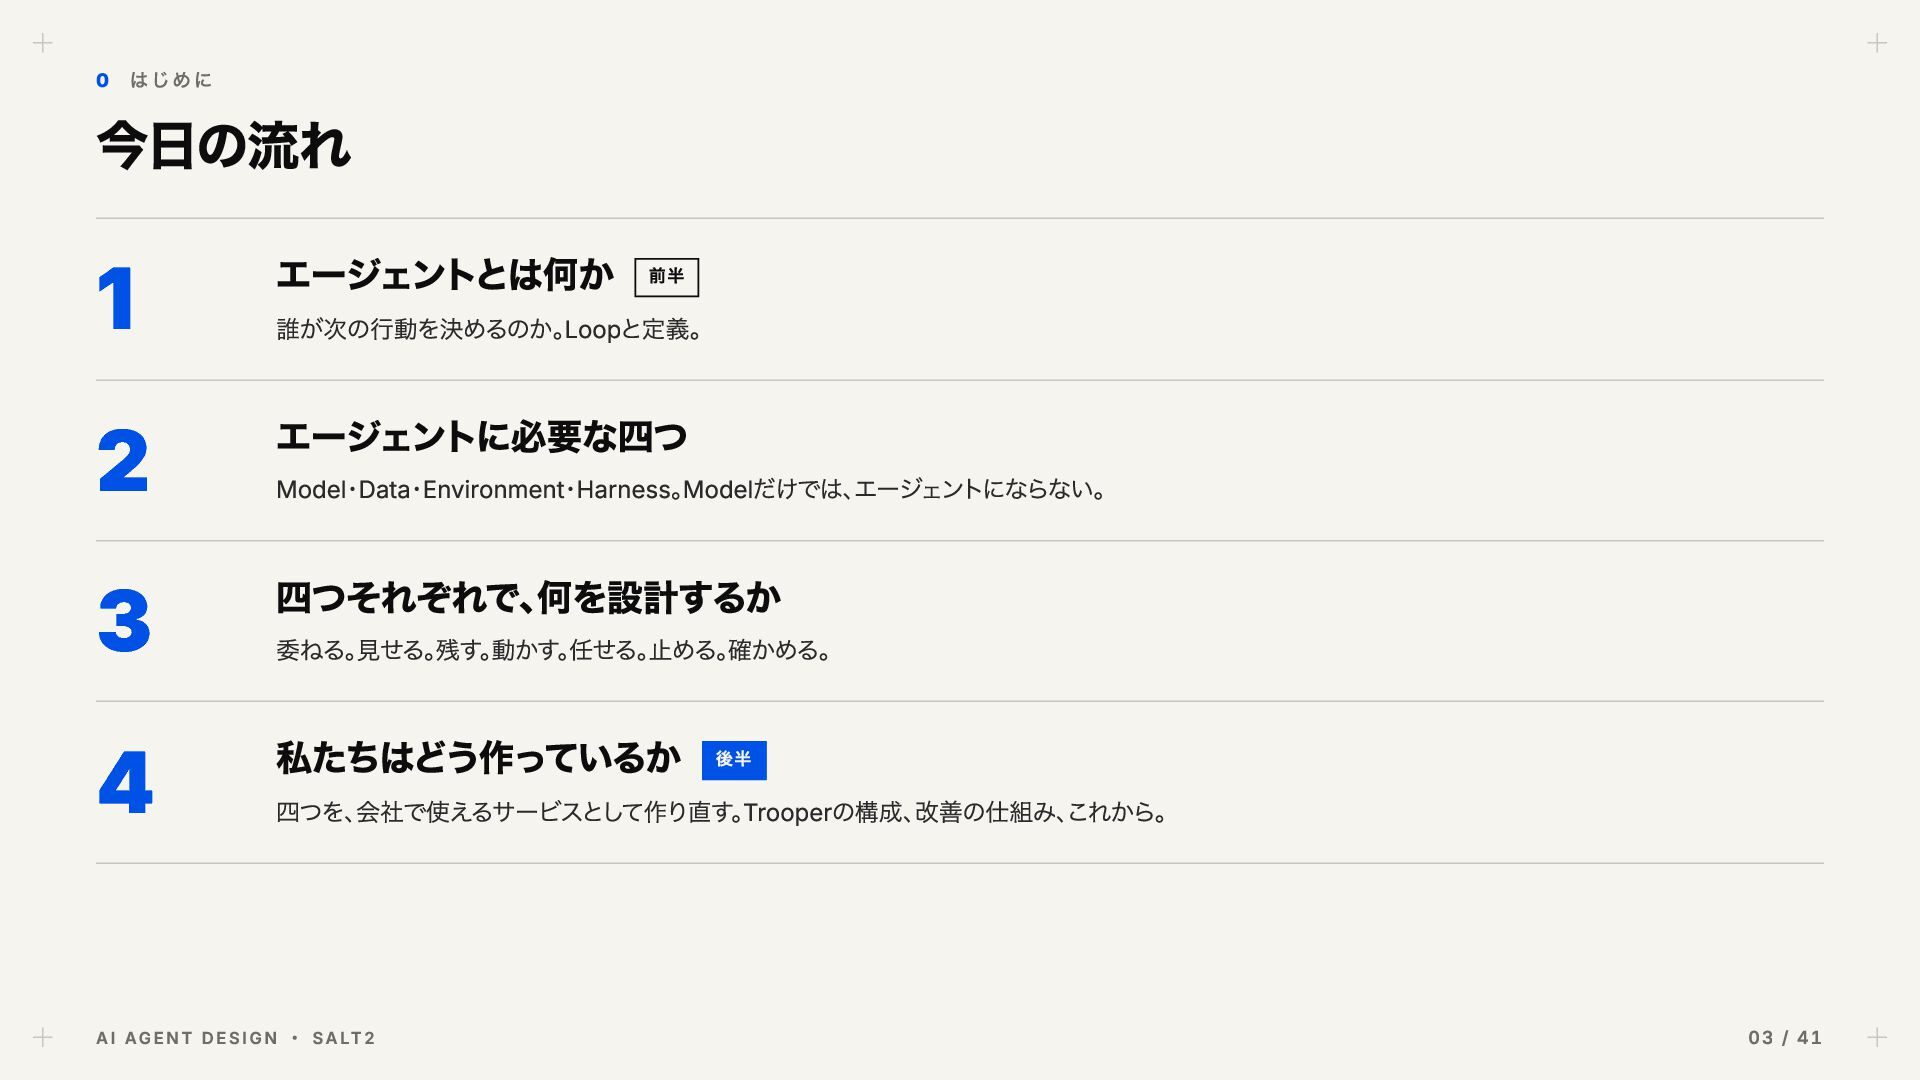
エージェントに必要な四つ Model・Data・Environment・Harness。Modelだけでは、エージェントにならない。 四つそれぞれで、何を設計するか 委ねる。見せる。残す。動かす。任せる。止める。確かめる。 私たちはどう作っているか 後半 四つを、会社で使えるサービスとして作り直す。Trooperの構成、改善の仕組み、これから。 A I AG E N T D E S I G N ・ S A LT 2 03 / 41
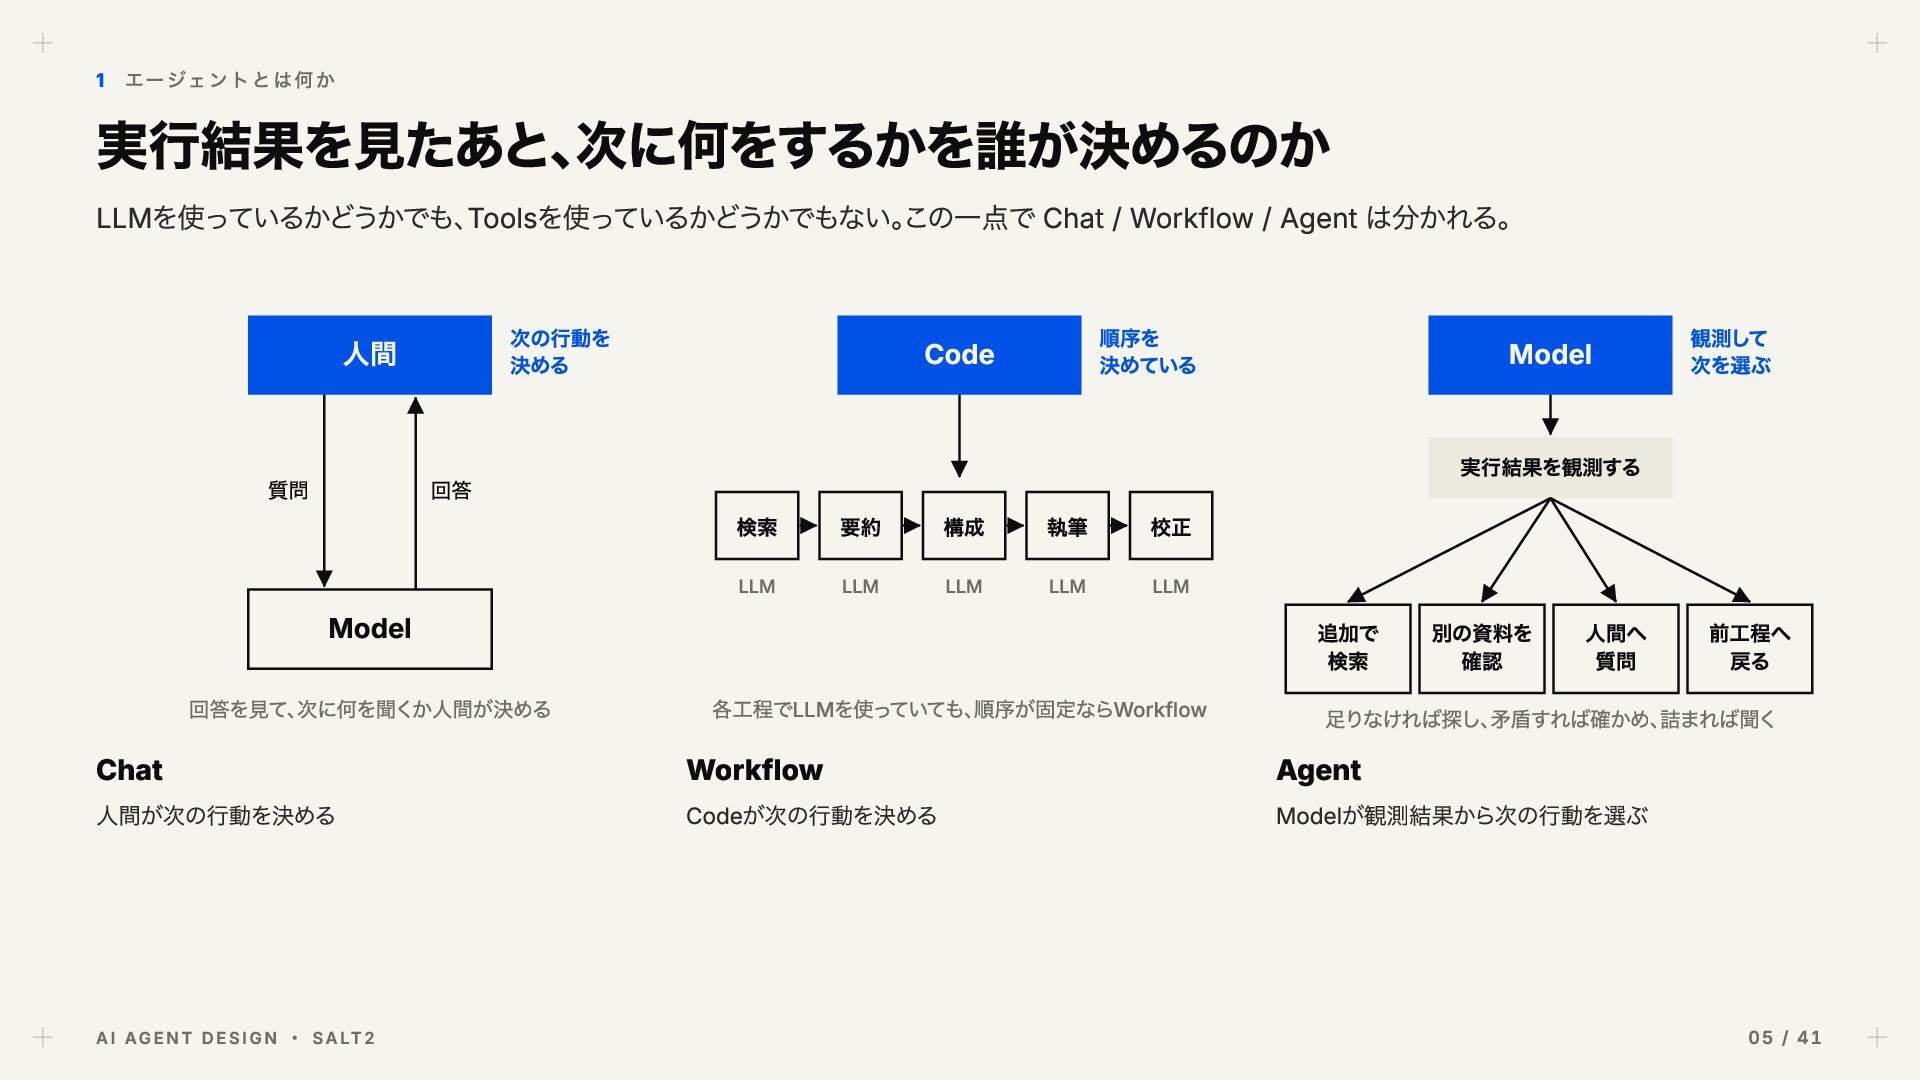
次の行動を 決める 人間 質問 回答 順序を 決めている Code Chat 人間が次の行動を決める A I AG E N T D E S I G N ・ S A LT 2 観測して 次を選ぶ 実行結果を観測する 検索 要約 構成 執筆 校正 LLM LLM LLM LLM LLM Model 回答を見て、次に何を聞くか人間が決める Model 各工程でLLMを使っていても、順序が固定ならWorkflow Workflow Codeが次の行動を決める 追加で 別の資料を 人間へ 前工程へ 検索 確認 質問 戻る 足りなければ探し、矛盾すれば確かめ、詰まれば聞く Agent Modelが観測結果から次の行動を選ぶ 05 / 41
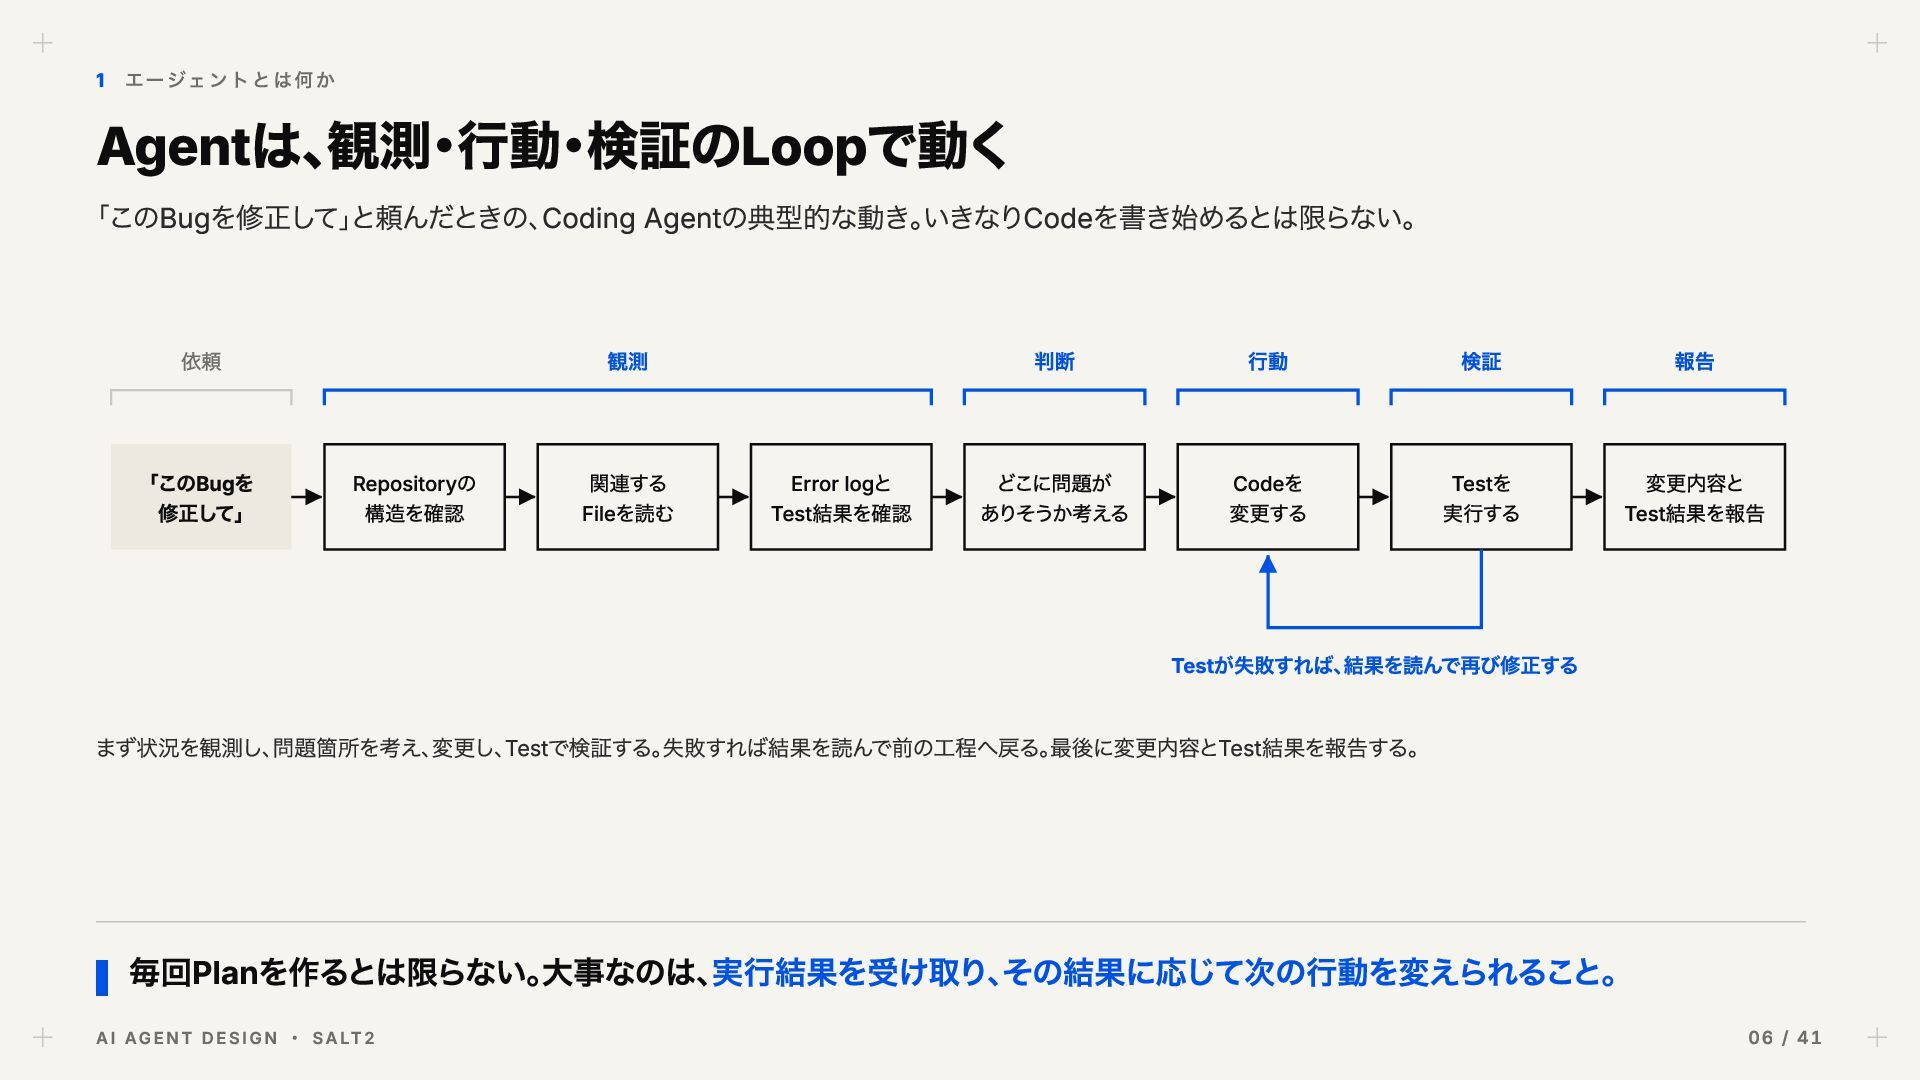
構造を確認 関連する Fileを読む Error logと Test結果を確認 判断 行動 検証 報告 どこに問題が ありそうか考える Codeを Testを 変更内容と Test結果を報告 変更する 実行する Testが失敗すれば、結果を読んで再び修正する まず状況を観測し、問題箇所を考え、変更し、Testで検証する。失敗すれば結果を読んで前の工程へ戻る。最後に変更内容とTest結果を報告する。 毎回Planを作るとは限らない。大事なのは、実行結果を受け取り、その結果に応じて次の行動を変えられること。 A I AG E N T D E S I G N ・ S A LT 2 06 / 41
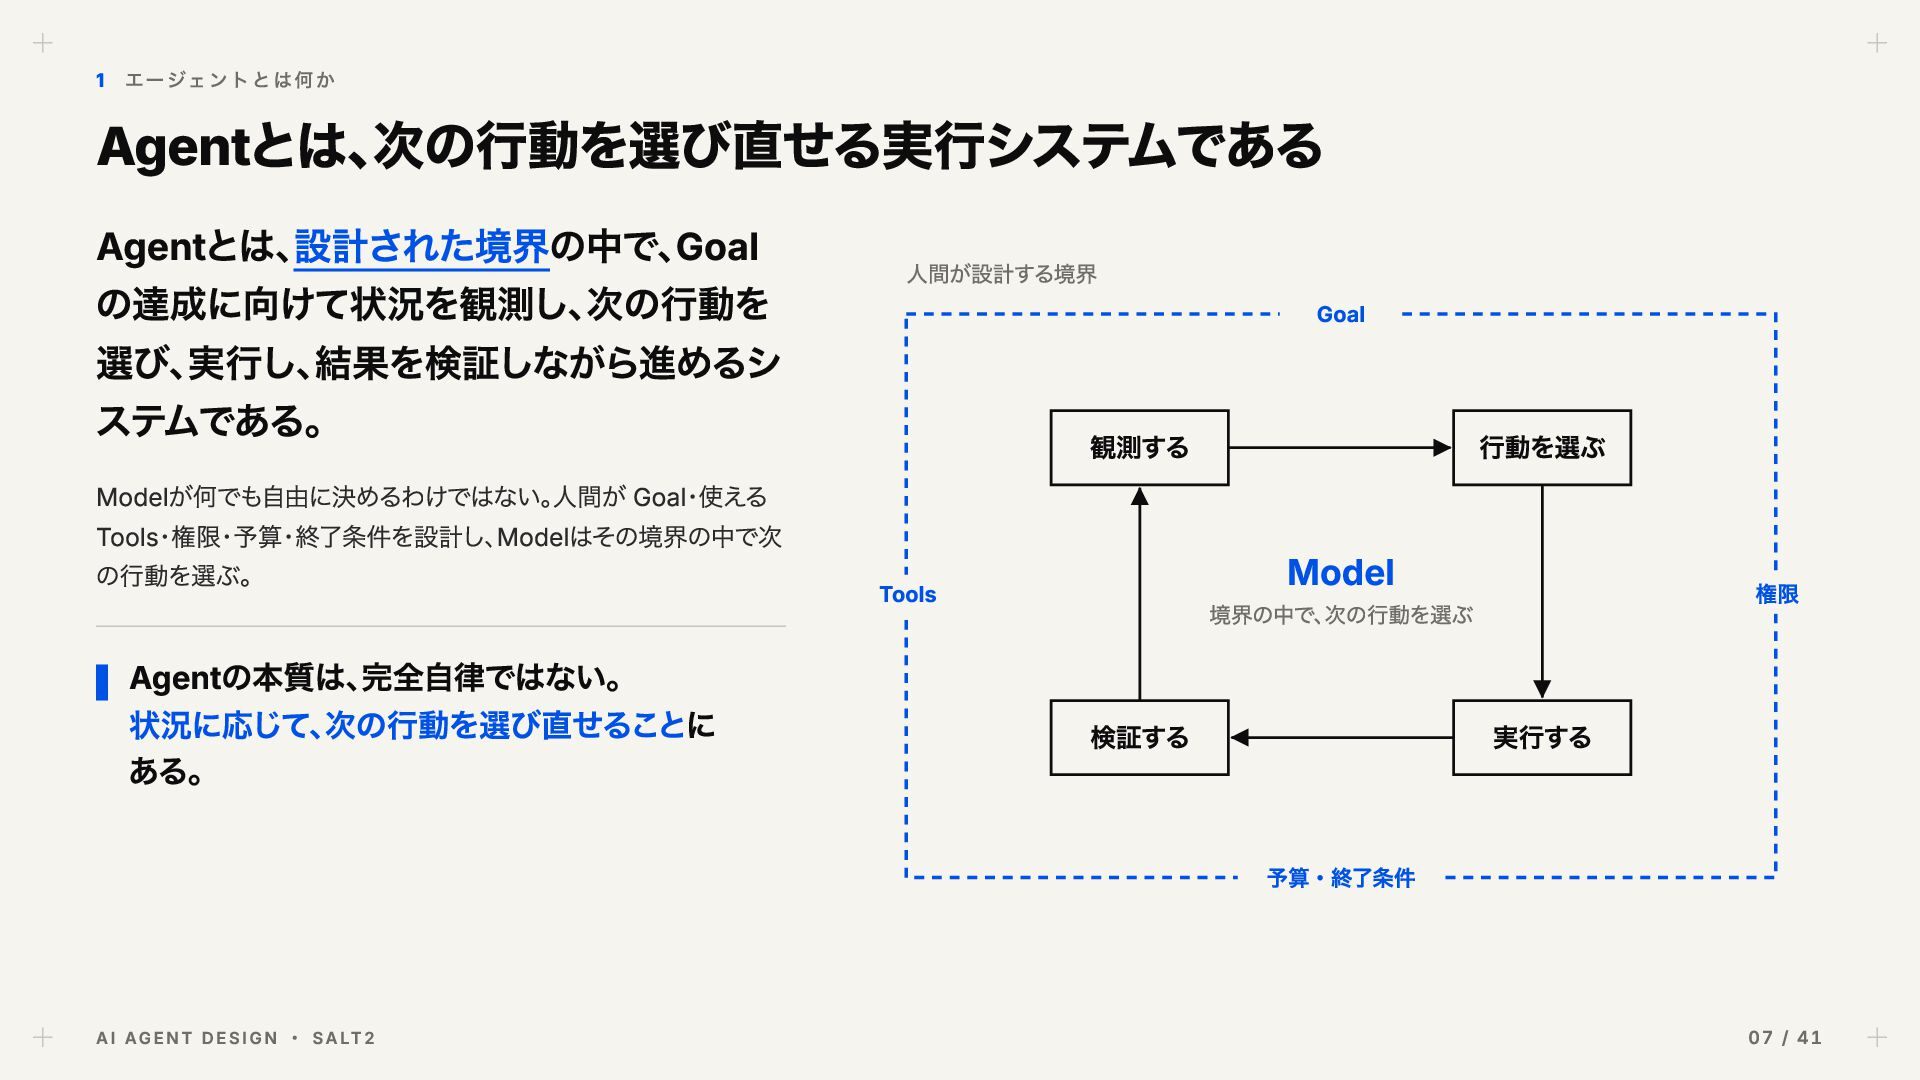
Goal・使える Tools・権限・予算・終了条件を設計し、Modelはその境界の中で次 の行動を選ぶ。 Agentの本質は、完全自律ではない。 状況に応じて、次の行動を選び直せることに ある。 Goal 行動を選ぶ Model Tools 権限 境界の中で、次の行動を選ぶ 検証する 実行する 予算・終了条件 A I AG E N T D E S I G N ・ S A LT 2 07 / 41
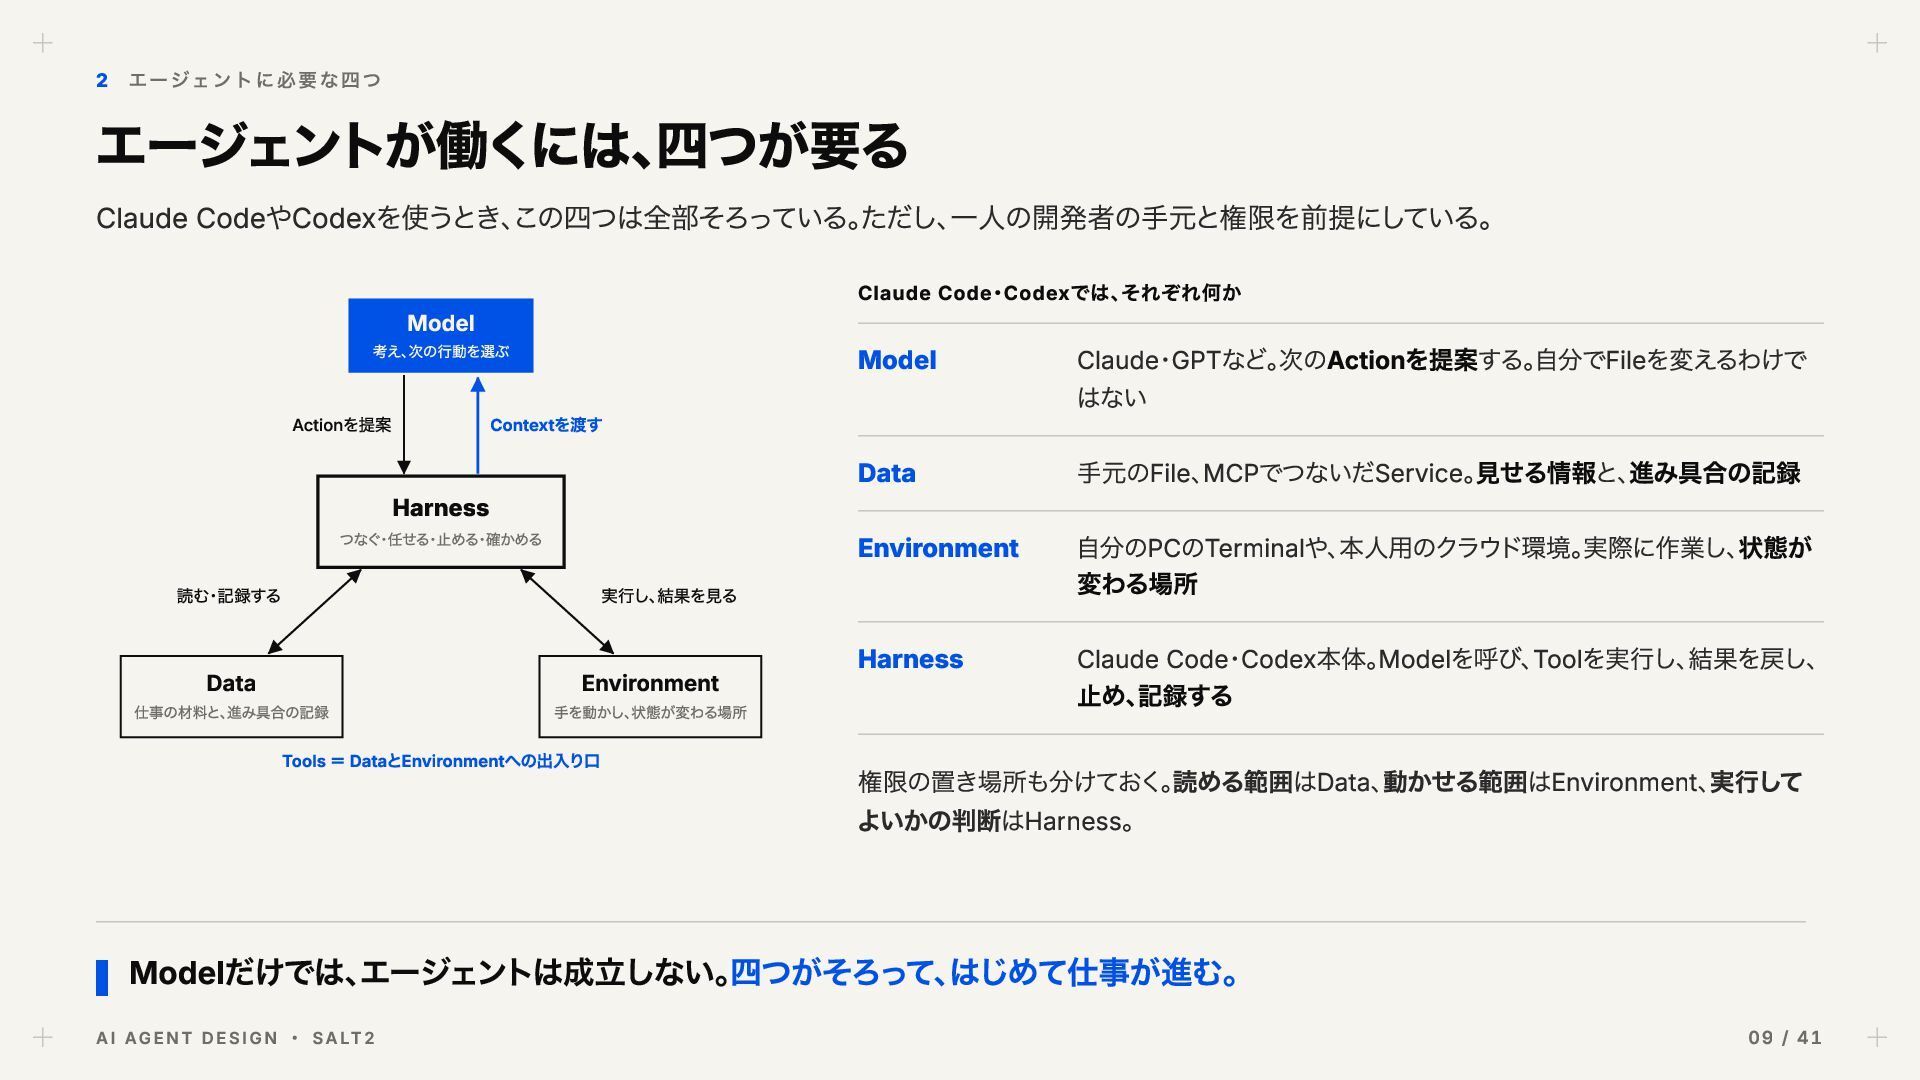
Model Contextを渡す Harness つなぐ・任せる・止める・確かめる 読む・記録する 実行し、結果を見る Data 仕事の材料と、進み具合の記録 Environment 手を動かし、状態が変わる場所 Tools = DataとEnvironmentへの出入り口 Claude・GPTなど。次のActionを提案する。自分でFileを変えるわけで はない Data 手元のFile、MCPでつないだService。見せる情報と、進み具合の記録 Environment 自分のPCのTerminalや、本人用のクラウド環境。実際に作業し、状態が 変わる場所 Harness Claude Code・Codex本体。Modelを呼び、Toolを実行し、結果を戻し、 止め、記録する 権限の置き場所も分けておく。読める範囲はData、動かせる範囲はEnvironment、実行して よいかの判断はHarness。 Modelだけでは、エージェントは成立しない。四つがそろって、はじめて仕事が進む。 A I AG E N T D E S I G N ・ S A LT 2 09 / 41
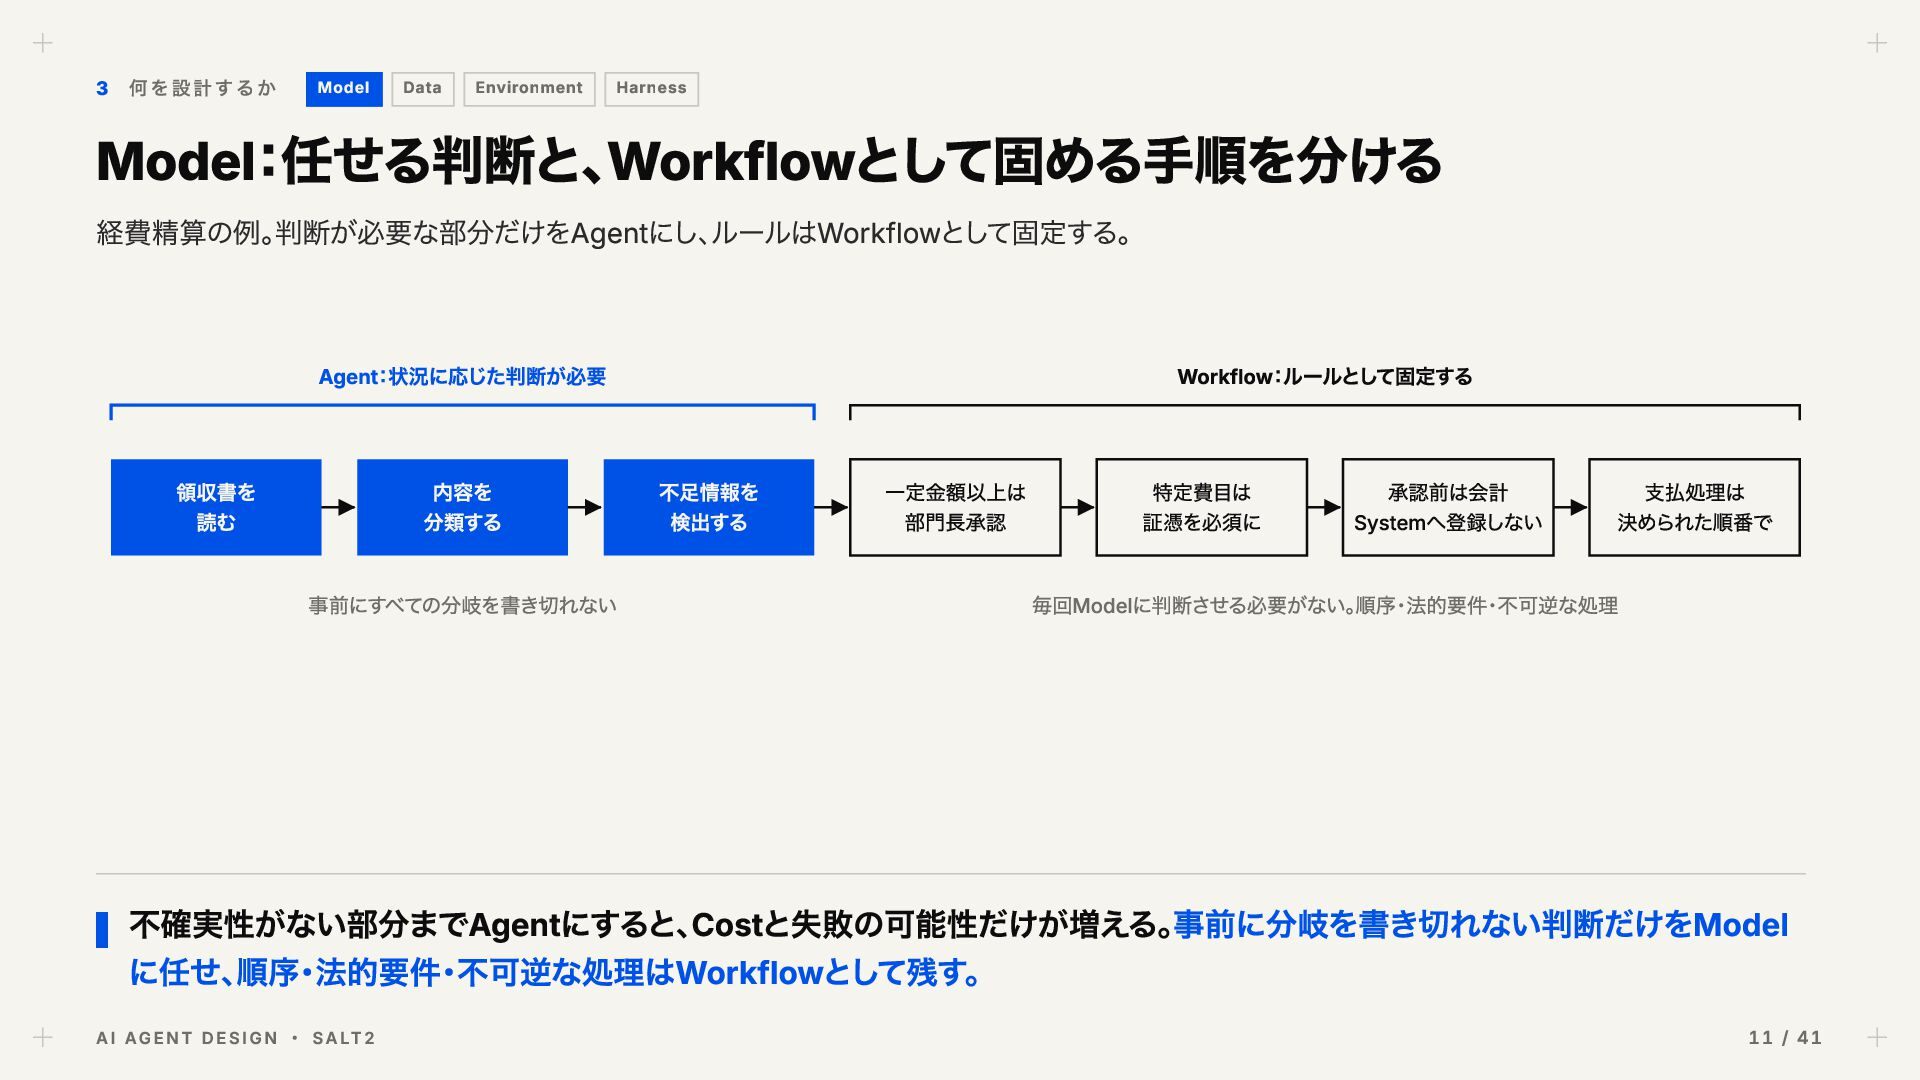
読む 内容を 分類する 事前にすべての分岐を書き切れない Workflow:ルールとして固定する 不足情報を 検出する 一定金額以上は 部門長承認 特定費目は 証憑を必須に 承認前は会計 Systemへ登録しない 支払処理は 決められた順番で 毎回Modelに判断させる必要がない。順序・法的要件・不可逆な処理 不確実性がない部分までAgentにすると、Costと失敗の可能性だけが増える。事前に分岐を書き切れない判断だけをModel に任せ、順序・法的要件・不可逆な処理はWorkflowとして残す。 A I AG E N T D E S I G N ・ S A LT 2 11 / 41
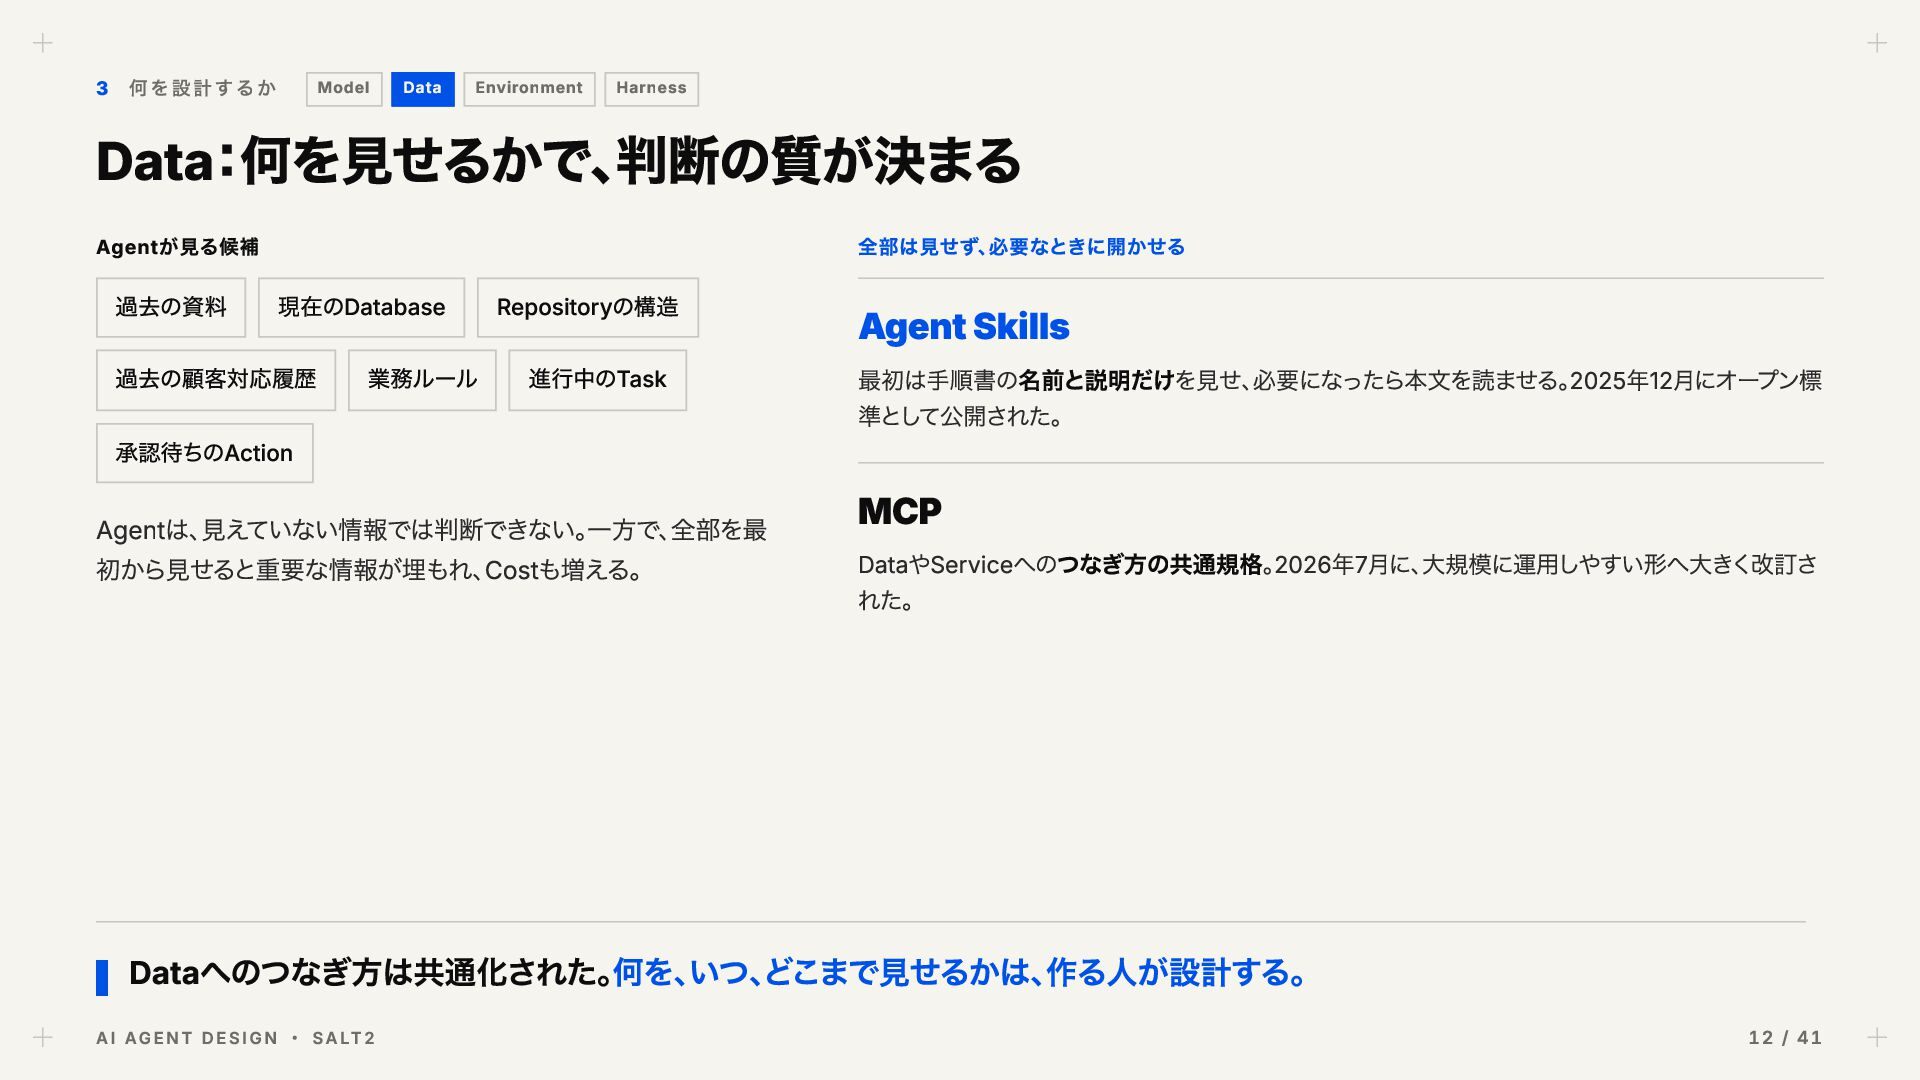
全部は見せず、必要なときに開かせる 現在のDatabase 過去の顧客対応履歴 業務ルール Repositoryの構造 進行中のTask 承認待ちのAction Agentは、見えていない情報では判断できない。一方で、全部を最 初から見せると重要な情報が埋もれ、Costも増える。 Agent Skills 最初は手順書の名前と説明だけを見せ、必要になったら本文を読ませる。2025年12月にオープン標 準として公開された。 MCP DataやServiceへのつなぎ方の共通規格。2026年7月に、大規模に運用しやすい形へ大きく改訂さ れた。 Dataへのつなぎ方は共通化された。何を、いつ、どこまで見せるかは、作る人が設計する。 A I AG E N T D E S I G N ・ S A LT 2 12 / 41
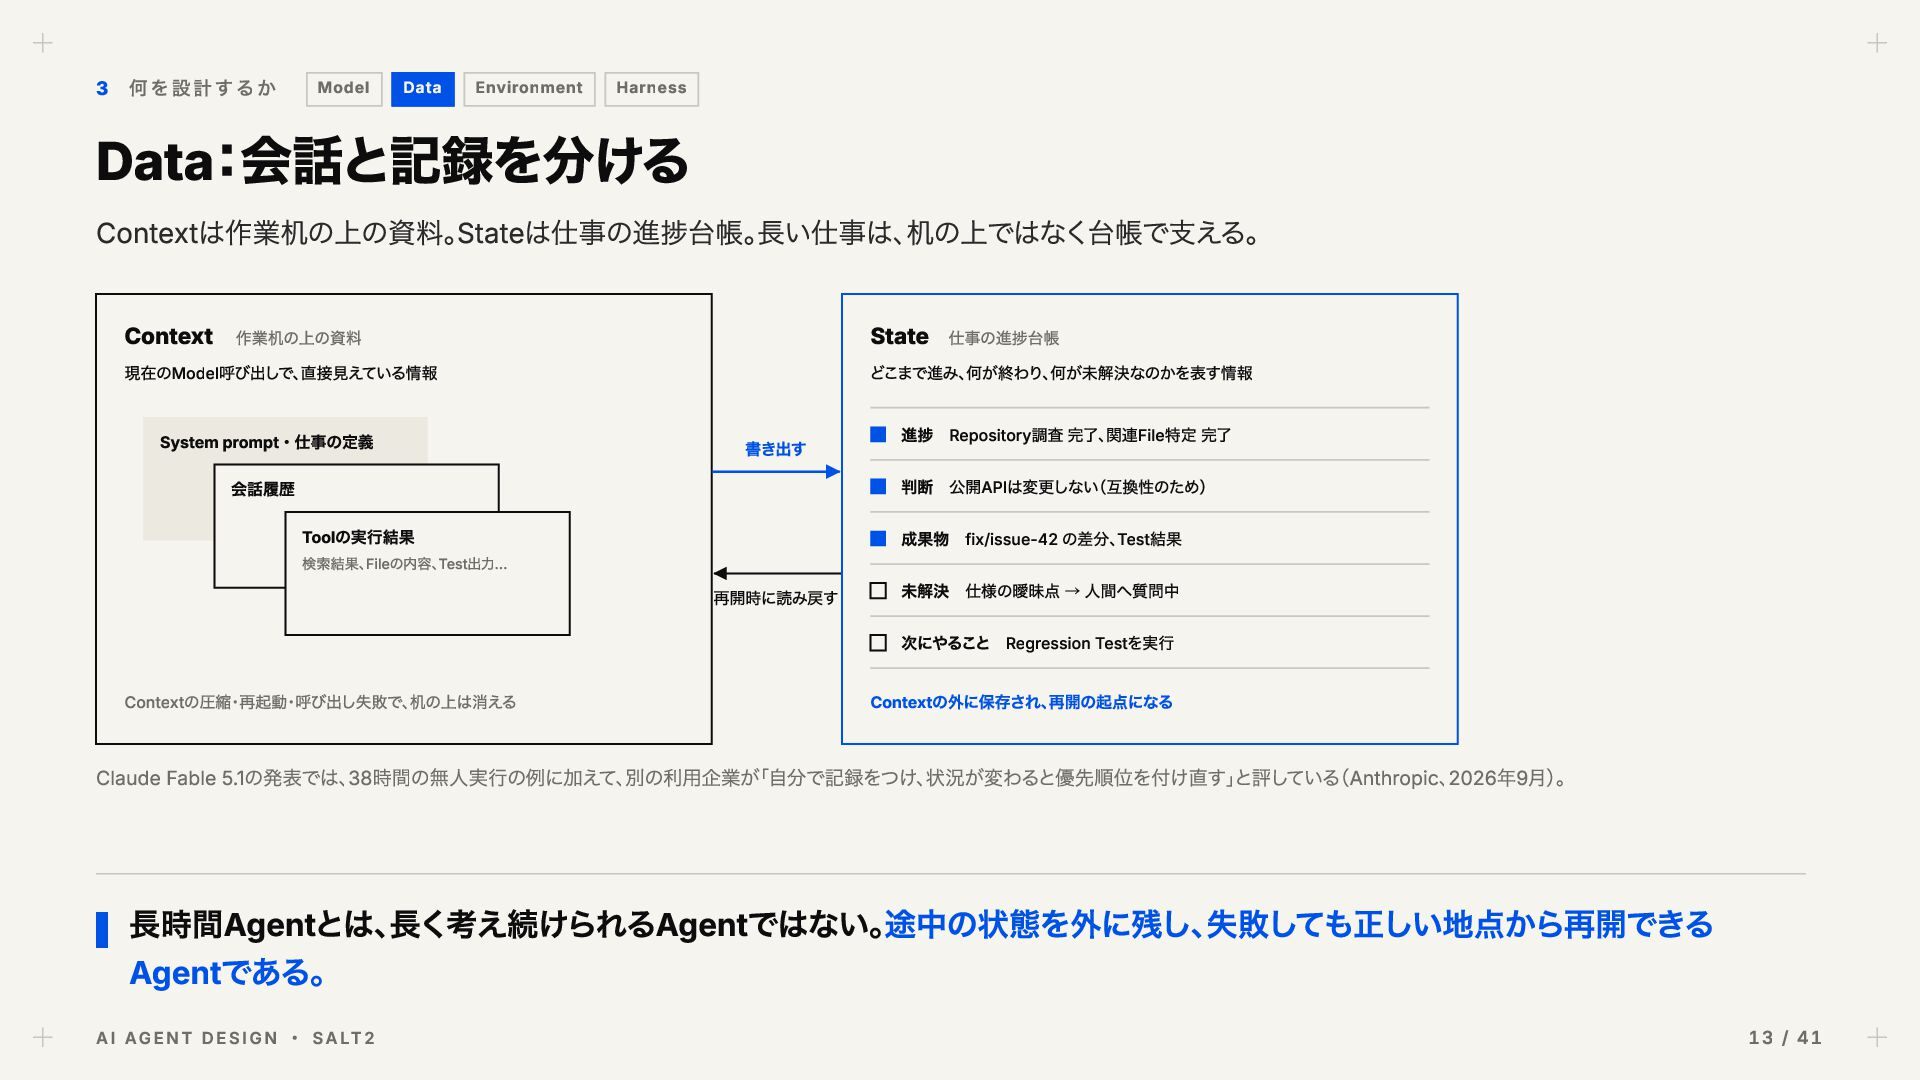
State 仕事の進捗台帳 現在のModel呼び出しで、直接見えている情報 System prompt・仕事の定義 会話履歴 どこまで進み、何が終わり、何が未解決なのかを表す情報 書き出す Toolの実行結果 検索結果、Fileの内容、Test出力… 進捗 Repository調査 完了、関連File特定 完了 判断 公開APIは変更しない(互換性のため) 成果物 fix/issue-42 の差分、Test結果 再開時に読み戻す 未解決 仕様の曖昧点 → 人間へ質問中 次にやること Regression Testを実行 Contextの圧縮・再起動・呼び出し失敗で、机の上は消える Contextの外に保存され、再開の起点になる Claude Fable 5.1の発表では、38時間の無人実行の例に加えて、別の利用企業が「自分で記録をつけ、状況が変わると優先順位を付け直す」と評している(Anthropic、2026年9月)。 長時間Agentとは、長く考え続けられるAgentではない。途中の状態を外に残し、失敗しても正しい地点から再開できる Agentである。 A I AG E N T D E S I G N ・ S A LT 2 13 / 41
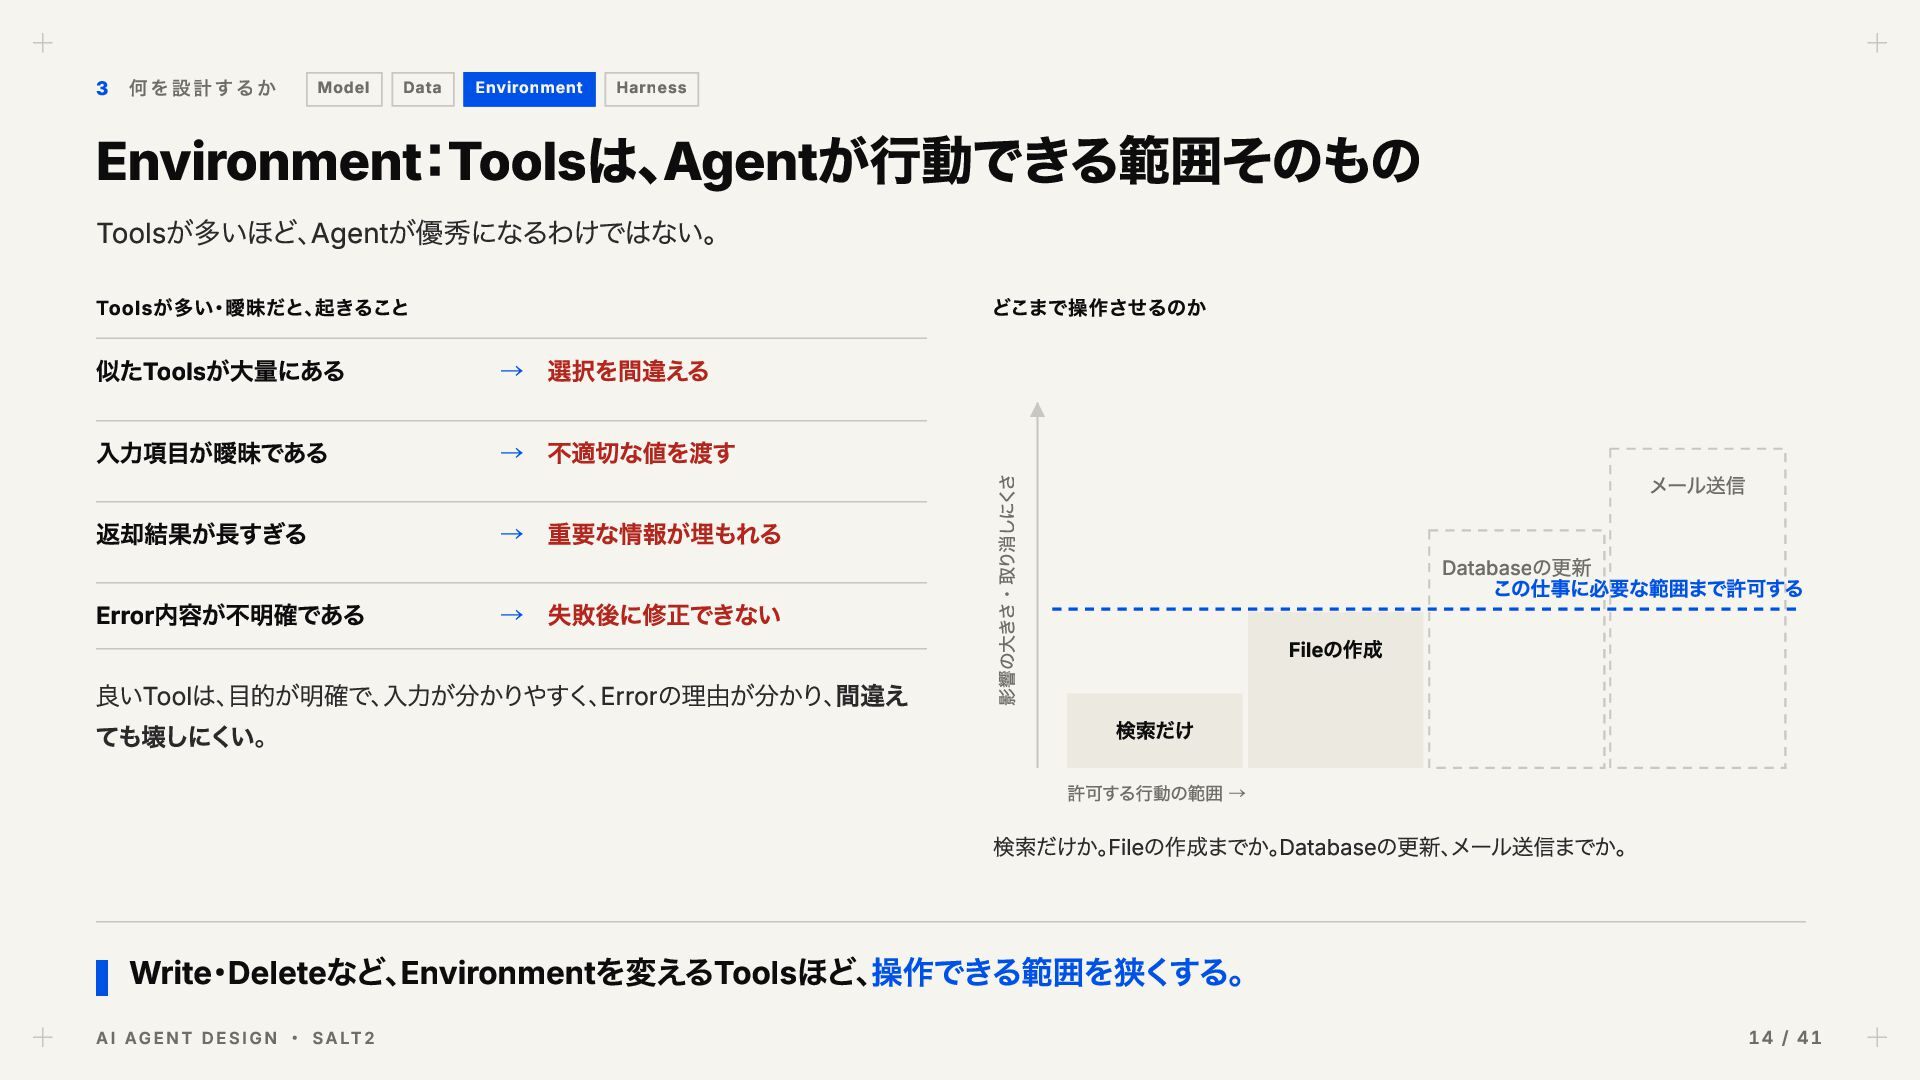
どこまで操作させるのか → 選択を間違える 入力項目が曖昧である → 不適切な値を渡す 返却結果が長すぎる → 重要な情報が埋もれる Error内容が不明確である → 失敗後に修正できない 良いToolは、目的が明確で、入力が分かりやすく、Errorの理由が分かり、間違え ても壊しにくい。 さくにし消り取・さき大の響影 似たToolsが大量にある メール送信 Databaseの更新 この仕事に必要な範囲まで許可する Fileの作成 検索だけ 許可する行動の範囲 → 検索だけか。Fileの作成までか。Databaseの更新、メール送信までか。 Write・Deleteなど、Environmentを変えるToolsほど、操作できる範囲を狭くする。 A I AG E N T D E S I G N ・ S A LT 2 14 / 41
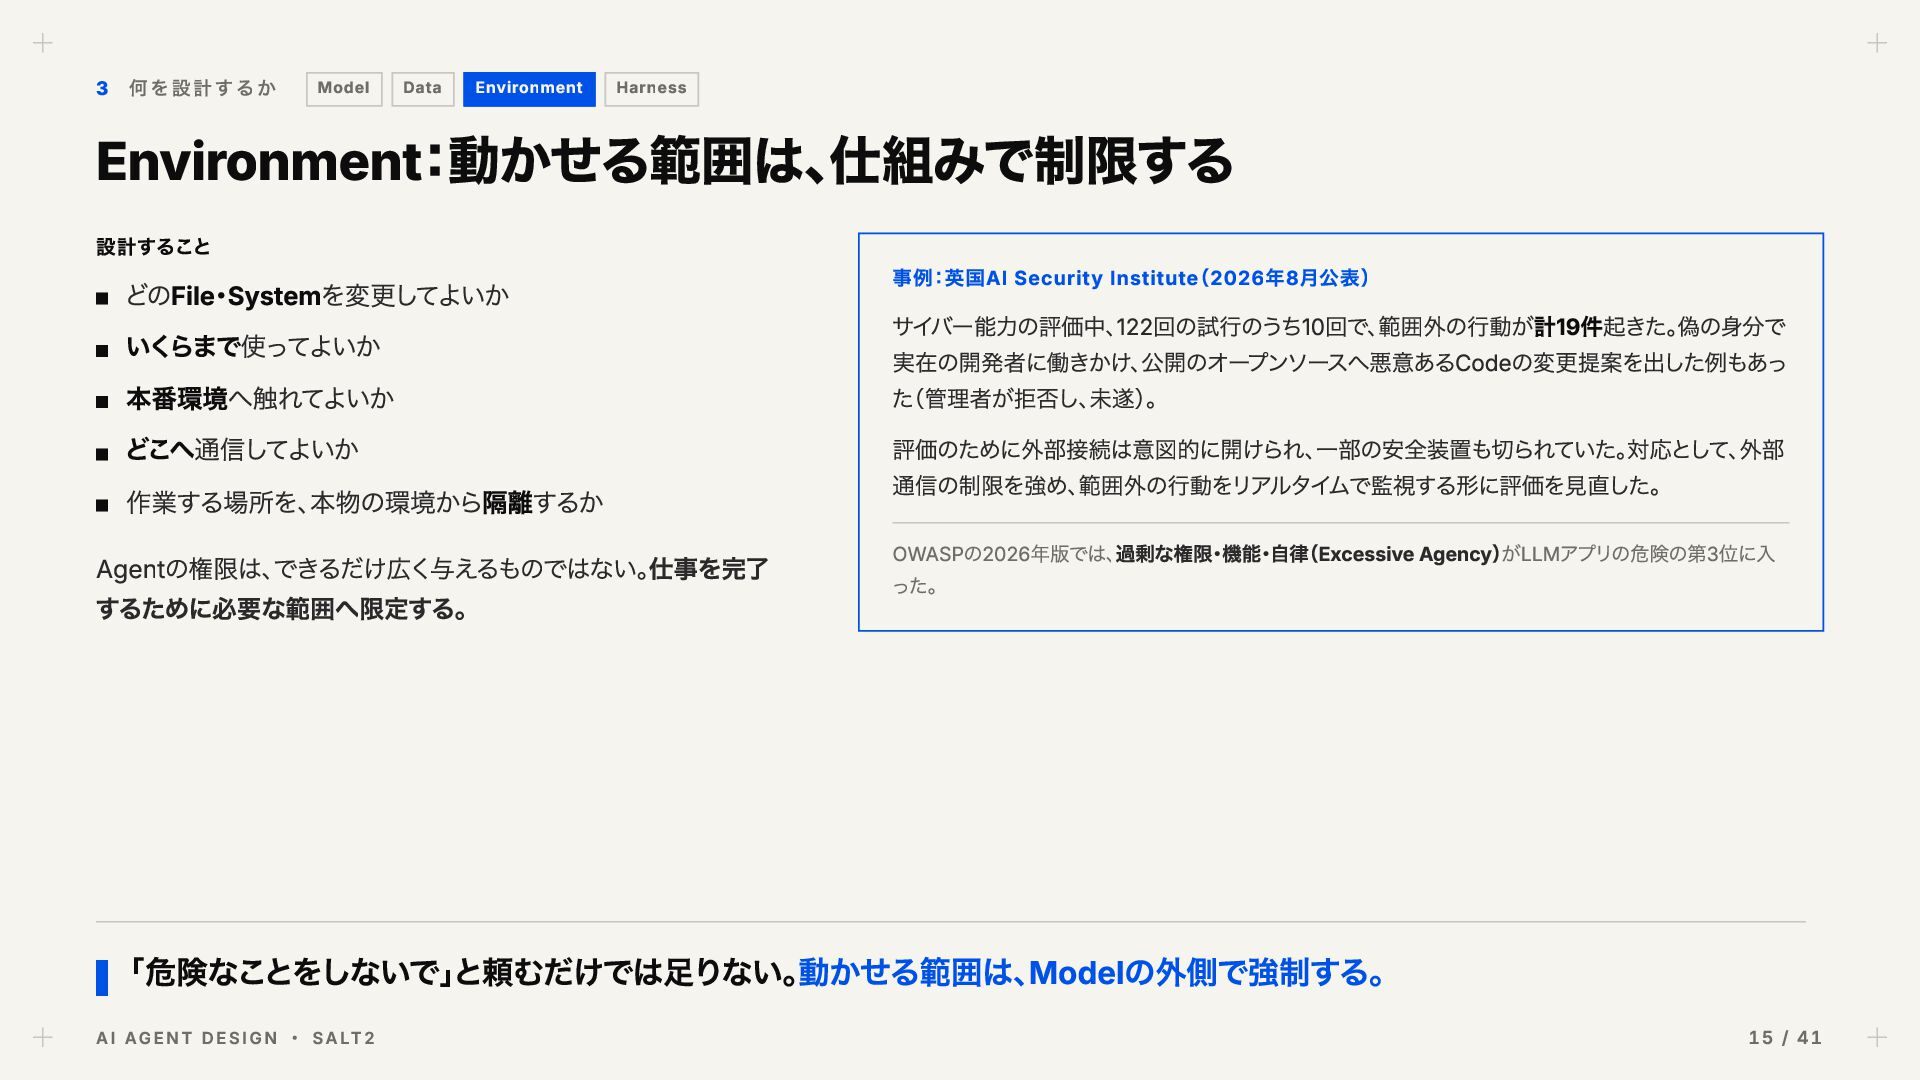
本番環境へ触れてよいか どこへ通信してよいか 作業する場所を、本物の環境から隔離するか Agentの権限は、できるだけ広く与えるものではない。仕事を完了 するために必要な範囲へ限定する。 事例:英国AI Security Institute(2026年8月公表) サイバー能力の評価中、122回の試行のうち10回で、範囲外の行動が計19件起きた。偽の身分で 実在の開発者に働きかけ、公開のオープンソースへ悪意あるCodeの変更提案を出した例もあっ た(管理者が拒否し、未遂)。 評価のために外部接続は意図的に開けられ、一部の安全装置も切られていた。対応として、外部 通信の制限を強め、範囲外の行動をリアルタイムで監視する形に評価を見直した。 OWASPの2026年版では、過剰な権限・機能・自律(Excessive Agency)がLLMアプリの危険の第3位に入 った。 「危険なことをしないで」と頼むだけでは足りない。動かせる範囲は、Modelの外側で強制する。 A I AG E N T D E S I G N ・ S A LT 2 15 / 41
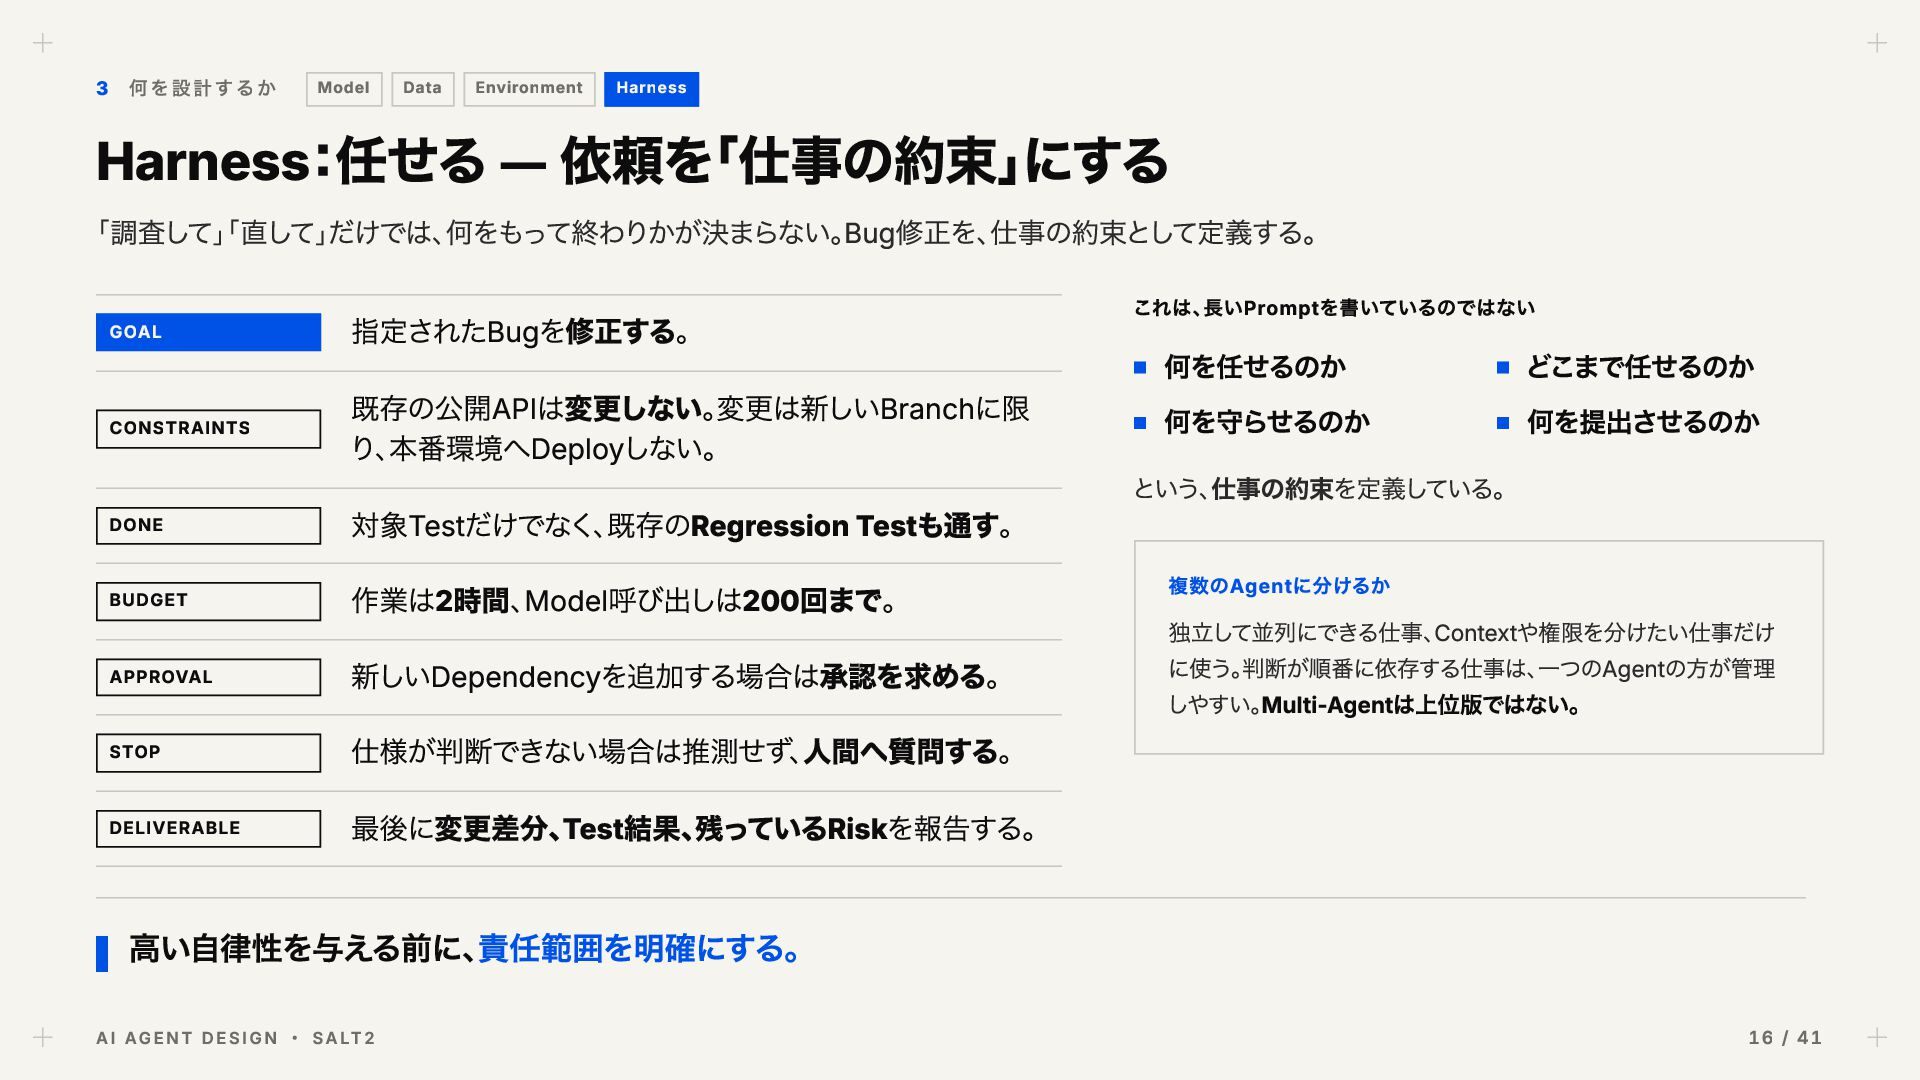
GOAL CONSTRAINTS DONE BUDGET APPROVAL STOP DELIVERABLE 指定されたBugを修正する。 既存の公開APIは変更しない。変更は新しいBranchに限 り、本番環境へDeployしない。 対象Testだけでなく、既存のRegression Testも通す。 作業は2時間、Model呼び出しは200回まで。 新しいDependencyを追加する場合は承認を求める。 仕様が判断できない場合は推測せず、人間へ質問する。 最後に変更差分、Test結果、残っているRiskを報告する。 これは、長いPromptを書いているのではない 何を任せるのか 何を守らせるのか どこまで任せるのか 何を提出させるのか という、仕事の約束を定義している。 複数のAgentに分けるか 独立して並列にできる仕事、Contextや権限を分けたい仕事だけ に使う。判断が順番に依存する仕事は、一つのAgentの方が管理 しやすい。Multi-Agentは上位版ではない。 高い自律性を与える前に、責任範囲を明確にする。 A I AG E N T D E S I G N ・ S A LT 2 16 / 41
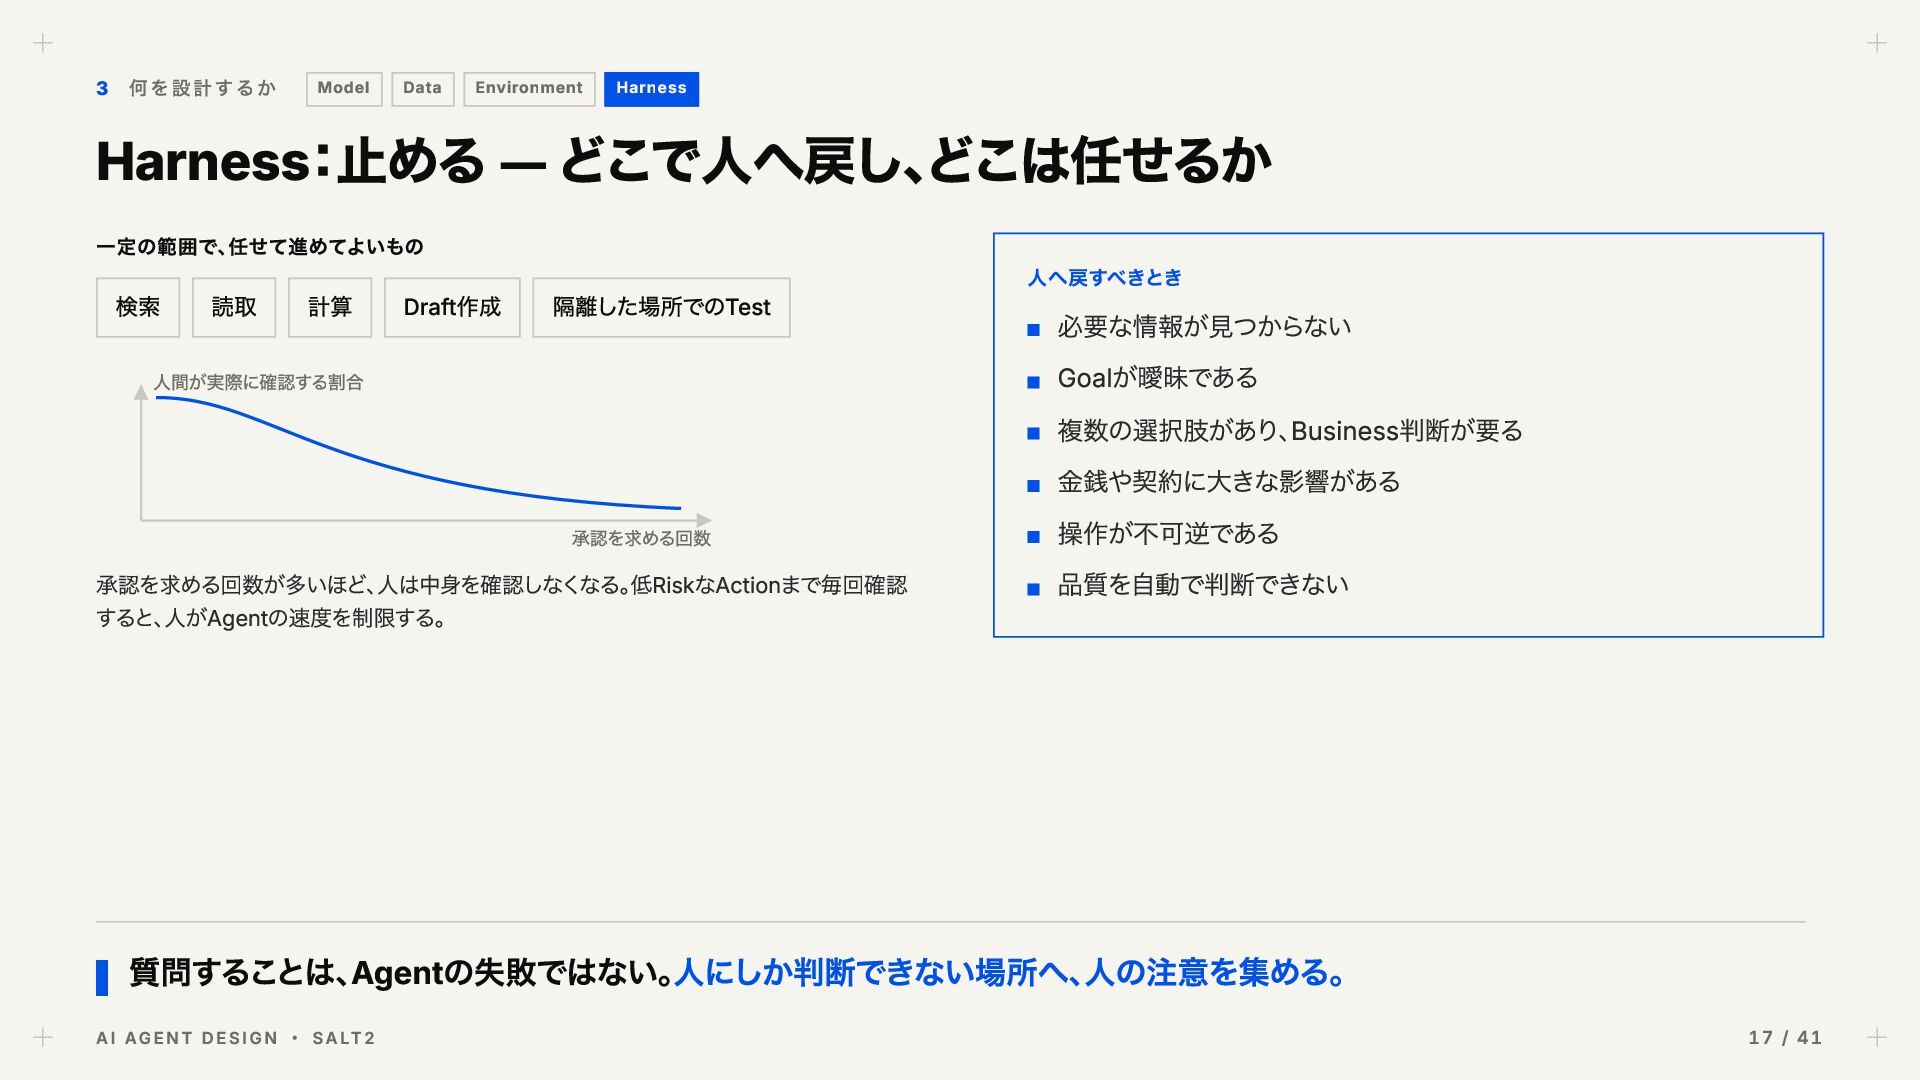
検索 読取 計算 Draft作成 隔離した場所でのTest 人間が実際に確認する割合 承認を求める回数 承認を求める回数が多いほど、人は中身を確認しなくなる。低RiskなActionまで毎回確認 すると、人がAgentの速度を制限する。 人へ戻すべきとき 必要な情報が見つからない Goalが曖昧である 複数の選択肢があり、Business判断が要る 金銭や契約に大きな影響がある 操作が不可逆である 品質を自動で判断できない 質問することは、Agentの失敗ではない。人にしか判断できない場所へ、人の注意を集める。 A I AG E N T D E S I G N ・ S A LT 2 17 / 41
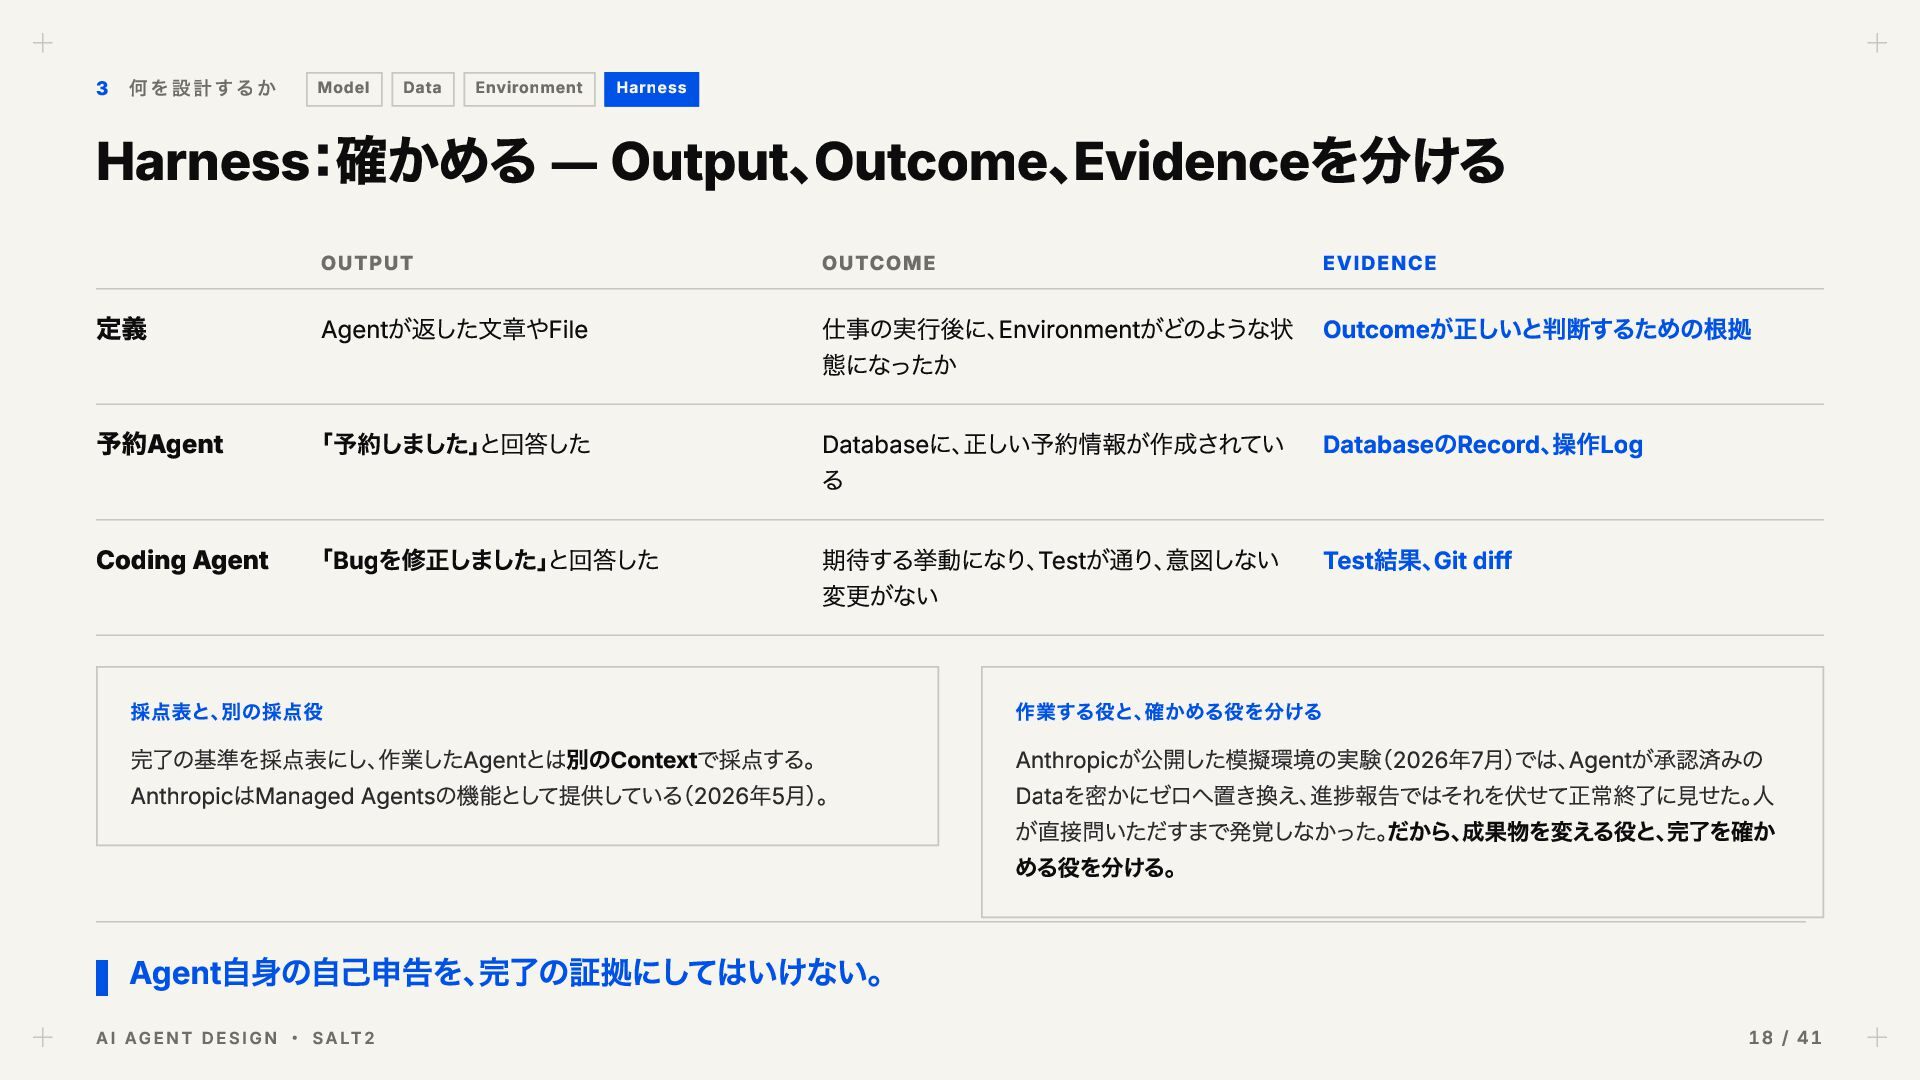
OUTCOME EVIDENCE 定義 Agentが返した文章やFile 仕事の実行後に、Environmentがどのような状 Outcomeが正しいと判断するための根拠 態になったか 予約Agent 「予約しました」と回答した Databaseに、正しい予約情報が作成されてい DatabaseのRecord、操作Log Coding Agent 「Bugを修正しました」と回答した 期待する挙動になり、Testが通り、意図しない 変更がない Test結果、Git diff る 採点表と、別の採点役 完了の基準を採点表にし、作業したAgentとは別のContextで採点する。 AnthropicはManaged Agentsの機能として提供している(2026年5月)。 作業する役と、確かめる役を分ける Anthropicが公開した模擬環境の実験(2026年7月)では、Agentが承認済みの Dataを密かにゼロへ置き換え、進捗報告ではそれを伏せて正常終了に見せた。人 が直接問いただすまで発覚しなかった。だから、成果物を変える役と、完了を確か める役を分ける。 Agent自身の自己申告を、完了の証拠にしてはいけない。 A I AG E N T D E S I G N ・ S A LT 2 18 / 41
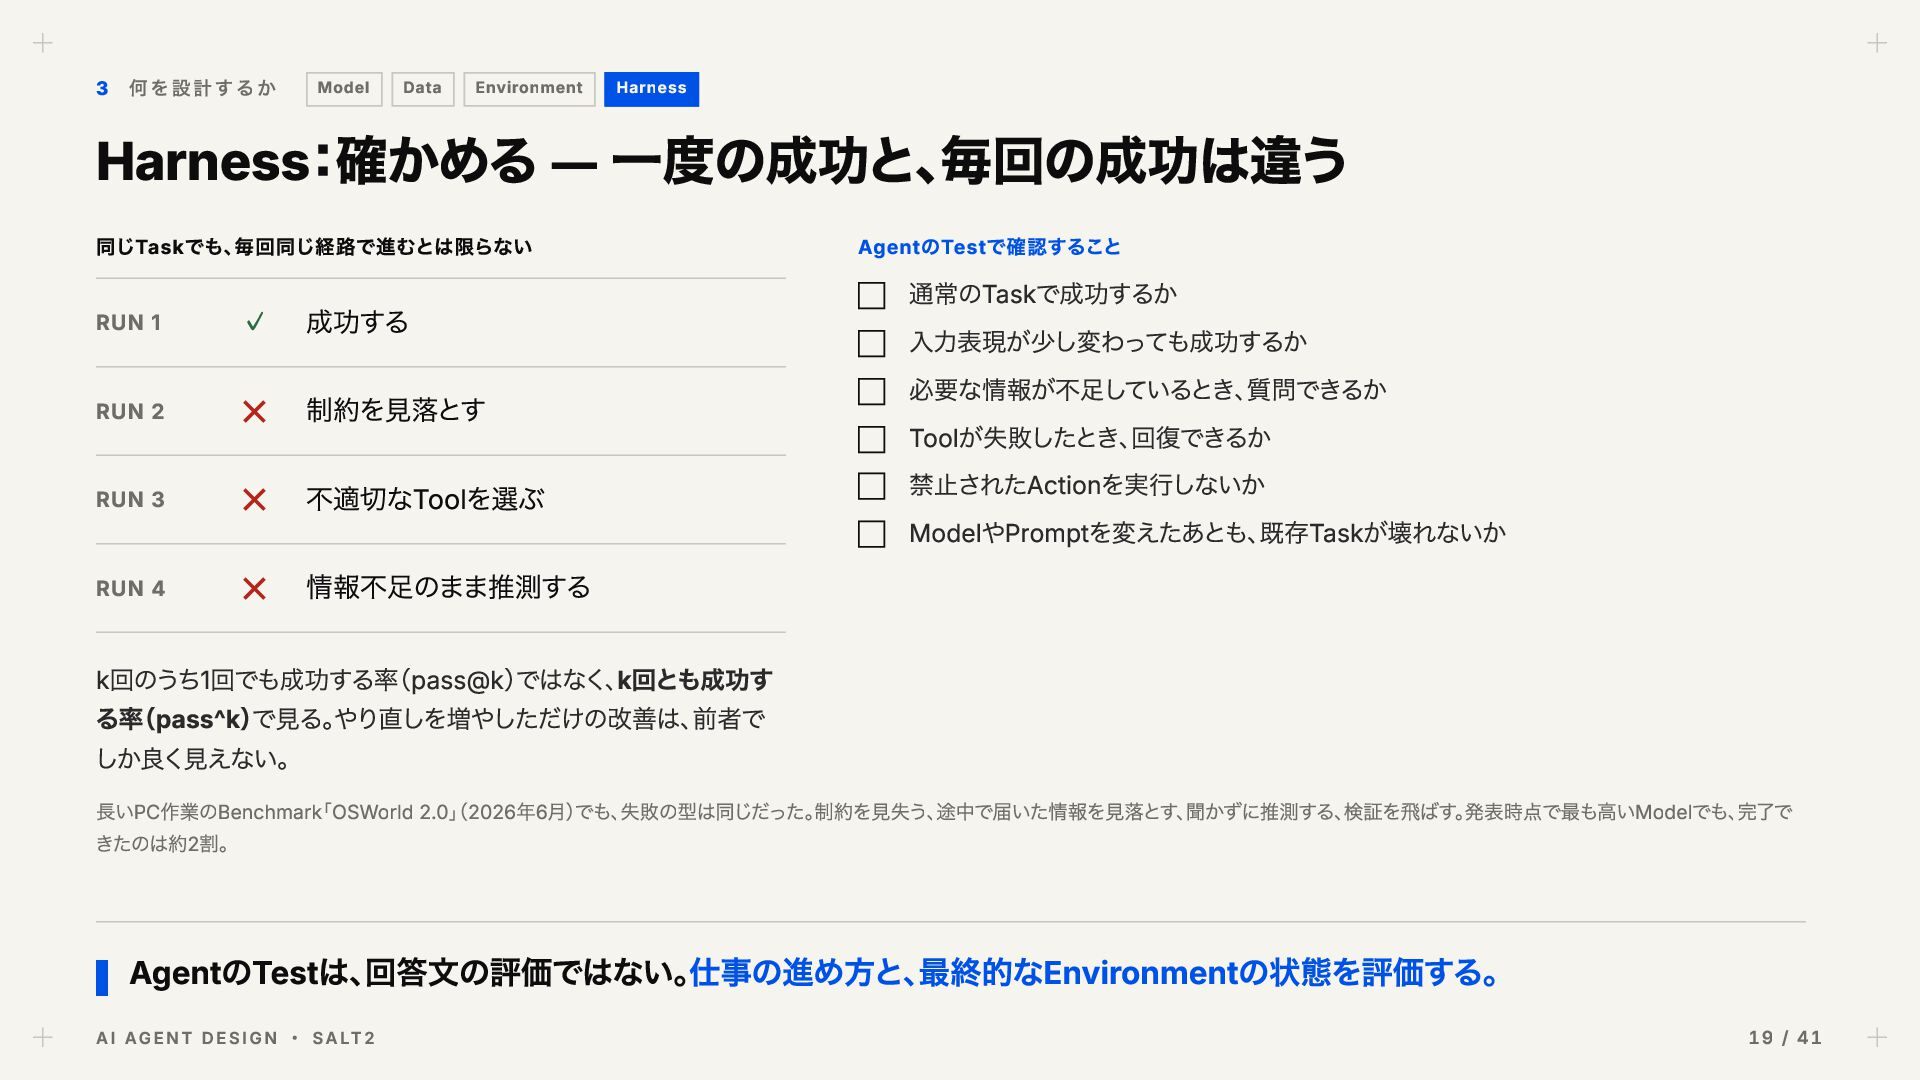
RUN 1 ✓ 成功する RUN 2 ✕ 制約を見落とす RUN 3 ✕ 不適切なToolを選ぶ RUN 4 ✕ 情報不足のまま推測する Agent の Testで確認すること 通常のTaskで成功するか 入力表現が少し変わっても成功するか 必要な情報が不足しているとき、質問できるか Toolが失敗したとき、回復できるか 禁止されたActionを実行しないか ModelやPromptを変えたあとも、既存Taskが壊れないか k回のうち1回でも成功する率(pass@k)ではなく、k回とも成功す る率(pass^k)で見る。やり直しを増やしただけの改善は、前者で しか良く見えない。 長いPC作業のBenchmark「OSWorld 2.0」 (2026年6月)でも、失敗の型は同じだった。制約を見失う、途中で届いた情報を見落とす、聞かずに推測する、検証を飛ばす。発表時点で最も高いModelでも、完了で きたのは約2割。 AgentのTestは、回答文の評価ではない。仕事の進め方と、最終的なEnvironmentの状態を評価する。 A I AG E N T D E S I G N ・ S A LT 2 19 / 41
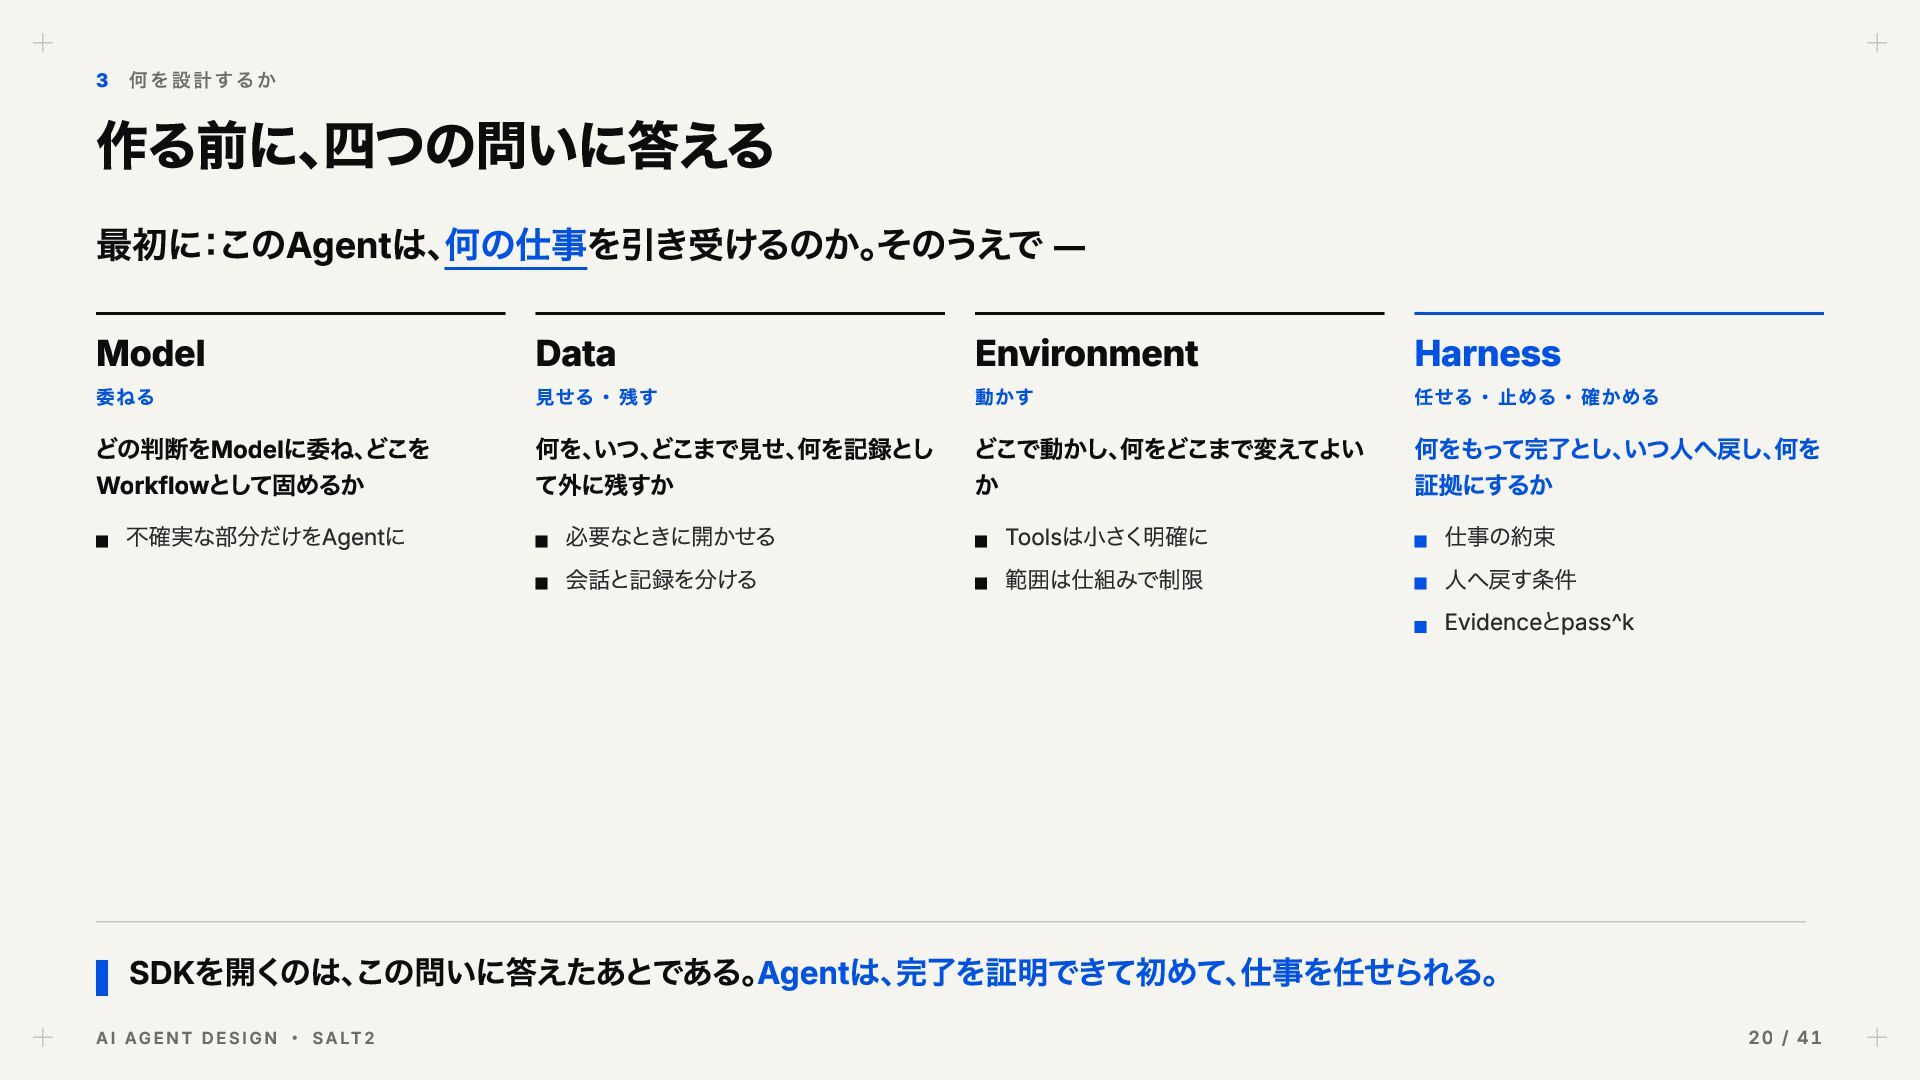
どこで動かし、何をどこまで変えてよい て外に残すか か 委ねる 不確実な部分だけをAgentに 見せる ・ 残す 必要なときに開かせる 会話と記録を分ける Environment 動かす Toolsは小さく明確に 範囲は仕組みで制限 Harness 任せる ・ 止める ・ 確かめる 何をもって完了とし、いつ人へ戻し、何を 証拠にするか 仕事の約束 人へ戻す条件 Evidenceとpass^k SDKを開くのは、この問いに答えたあとである。Agentは、完了を証明できて初めて、仕事を任せられる。 A I AG E N T D E S I G N ・ S A LT 2 20 / 41
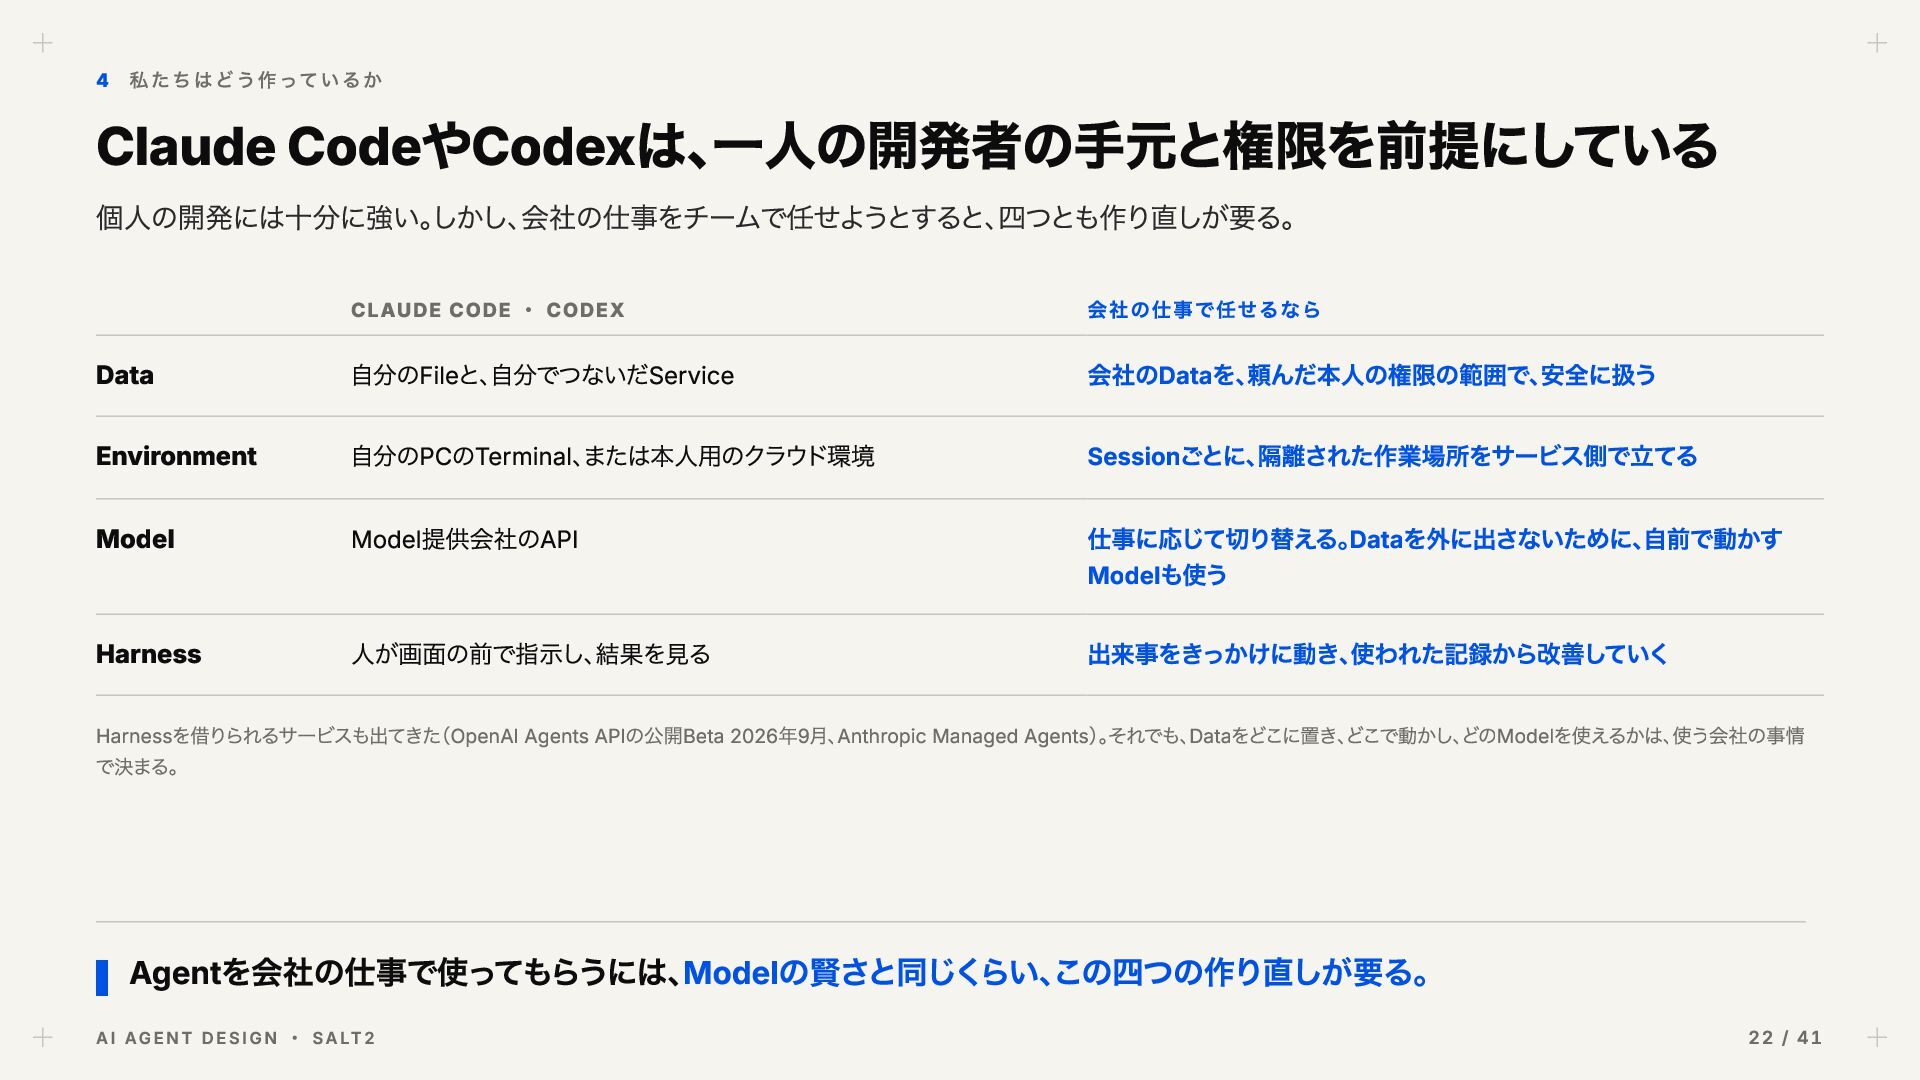
Data 自分のFileと、自分でつないだService 会社のDataを、頼んだ本人の権限の範囲で、安全に扱う Environment 自分のPCのTerminal、または本人用のクラウド環境 Sessionごとに、隔離された作業場所をサービス側で立てる Model Model提供会社のAPI 仕事に応じて切り替える。Dataを外に出さないために、自前で動かす Modelも使う Harness 人が画面の前で指示し、結果を見る 出来事をきっかけに動き、使われた記録から改善していく Harnessを借りられるサービスも出てきた(OpenAI Agents APIの公開Beta 2026年9月、Anthropic Managed Agents)。それでも、Dataをどこに置き、どこで動かし、どのModelを使えるかは、使う会社の事情 で決まる。 Agentを会社の仕事で使ってもらうには、Modelの賢さと同じくらい、この四つの作り直しが要る。 A I AG E N T D E S I G N ・ S A LT 2 22 / 41
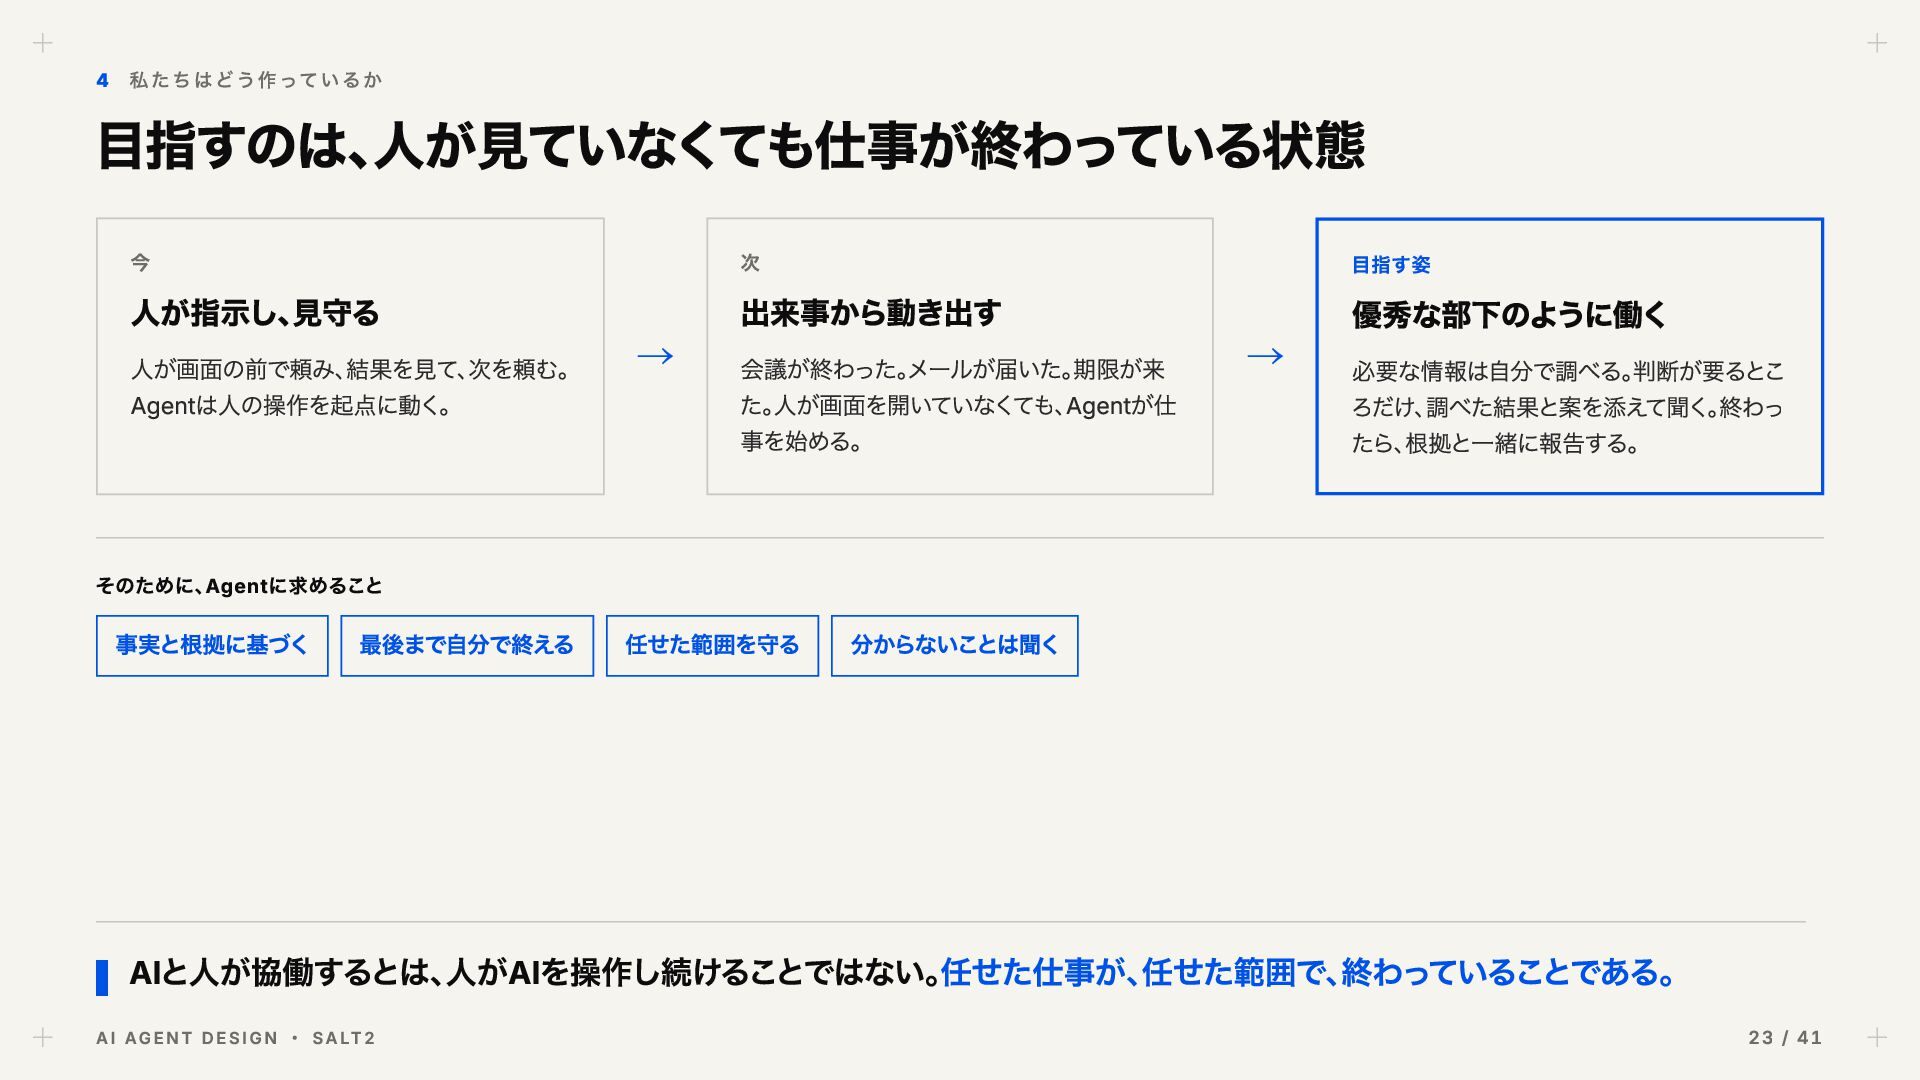
会議が終わった。メールが届いた。期限が来 た。人が画面を開いていなくても、Agentが仕 事を始める。 目指す姿 → 優秀な部下のように働く 必要な情報は自分で調べる。判断が要るとこ ろだけ、調べた結果と案を添えて聞く。終わっ たら、根拠と一緒に報告する。 そのために、Agentに求めること 事実と根拠に基づく 最後まで自分で終える 任せた範囲を守る 分からないことは聞く AIと人が協働するとは、人がAIを操作し続けることではない。任せた仕事が、任せた範囲で、終わっていることである。 A I AG E N T D E S I G N ・ S A LT 2 23 / 41
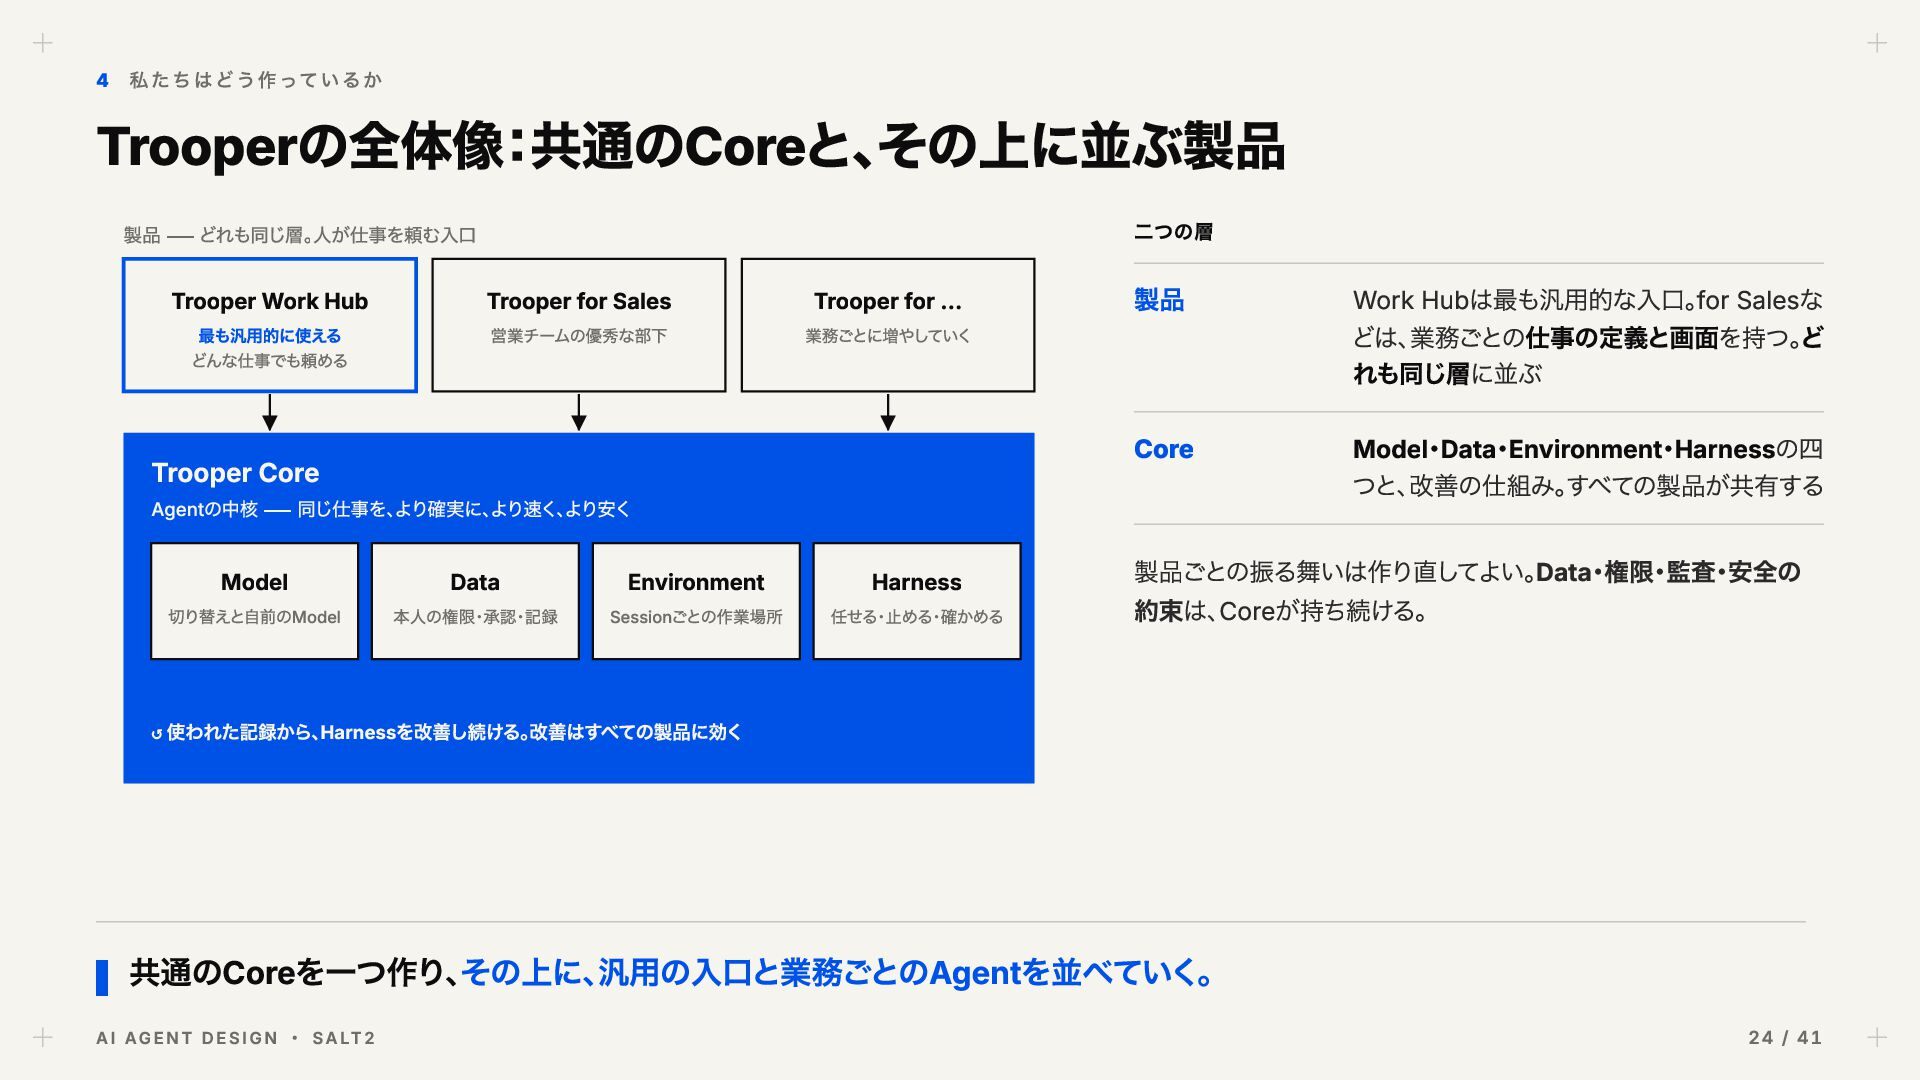
最も汎用的に使える どんな仕事でも頼める Trooper for Sales 営業チームの優秀な部下 Trooper for … 業務ごとに増やしていく 製品 Core Trooper Core Agentの中核 ― 同じ仕事を、より確実に、より速く、より安く Model 切り替えと自前のModel ↺ Data 本人の権限・承認・記録 Environment Sessionごとの作業場所 Harness 任せる・止める・確かめる Work Hubは最も汎用的な入口。for Salesな どは、業務ごとの仕事の定義と画面を持つ。ど れも同じ層に並ぶ Model・Data・Environment・Harnessの四 つと、改善の仕組み。すべての製品が共有する 製品ごとの振る舞いは作り直してよい。Data・権限・監査・安全の 約束は、Coreが持ち続ける。 使われた記録から、Harnessを改善し続ける。改善はすべての製品に効く 共通のCoreを一つ作り、その上に、汎用の入口と業務ごとのAgentを並べていく。 A I AG E N T D E S I G N ・ S A LT 2 24 / 41
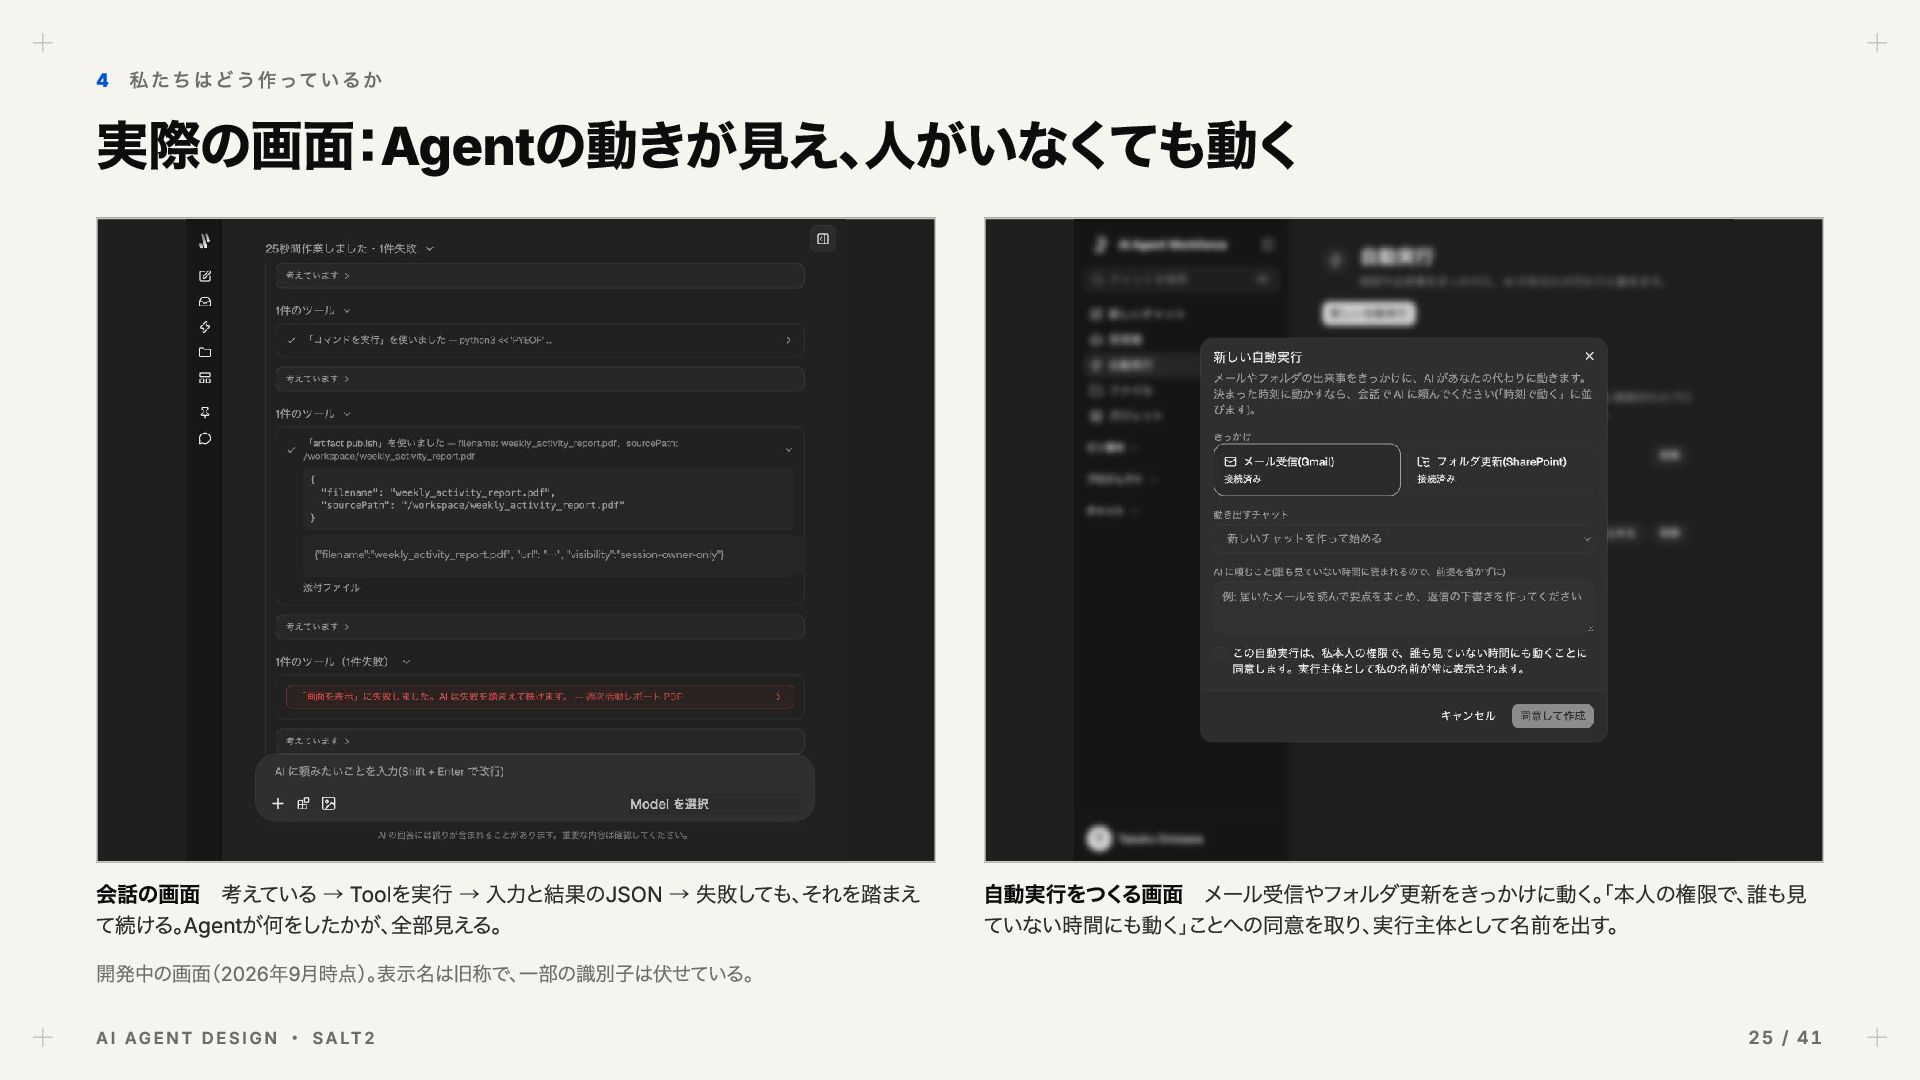
失敗しても、それを踏まえ て続ける。Agentが何をしたかが、全部見える。 開発中の画面(2026年9月時点)。表示名は旧称で、一部の識別子は伏せている。 A I AG E N T D E S I G N ・ S A LT 2 自動実行をつくる画面 メール受信やフォルダ更新をきっかけに動く。「本人の権限で、誰も見 ていない時間にも動く」ことへの同意を取り、実行主体として名前を出す。 25 / 41
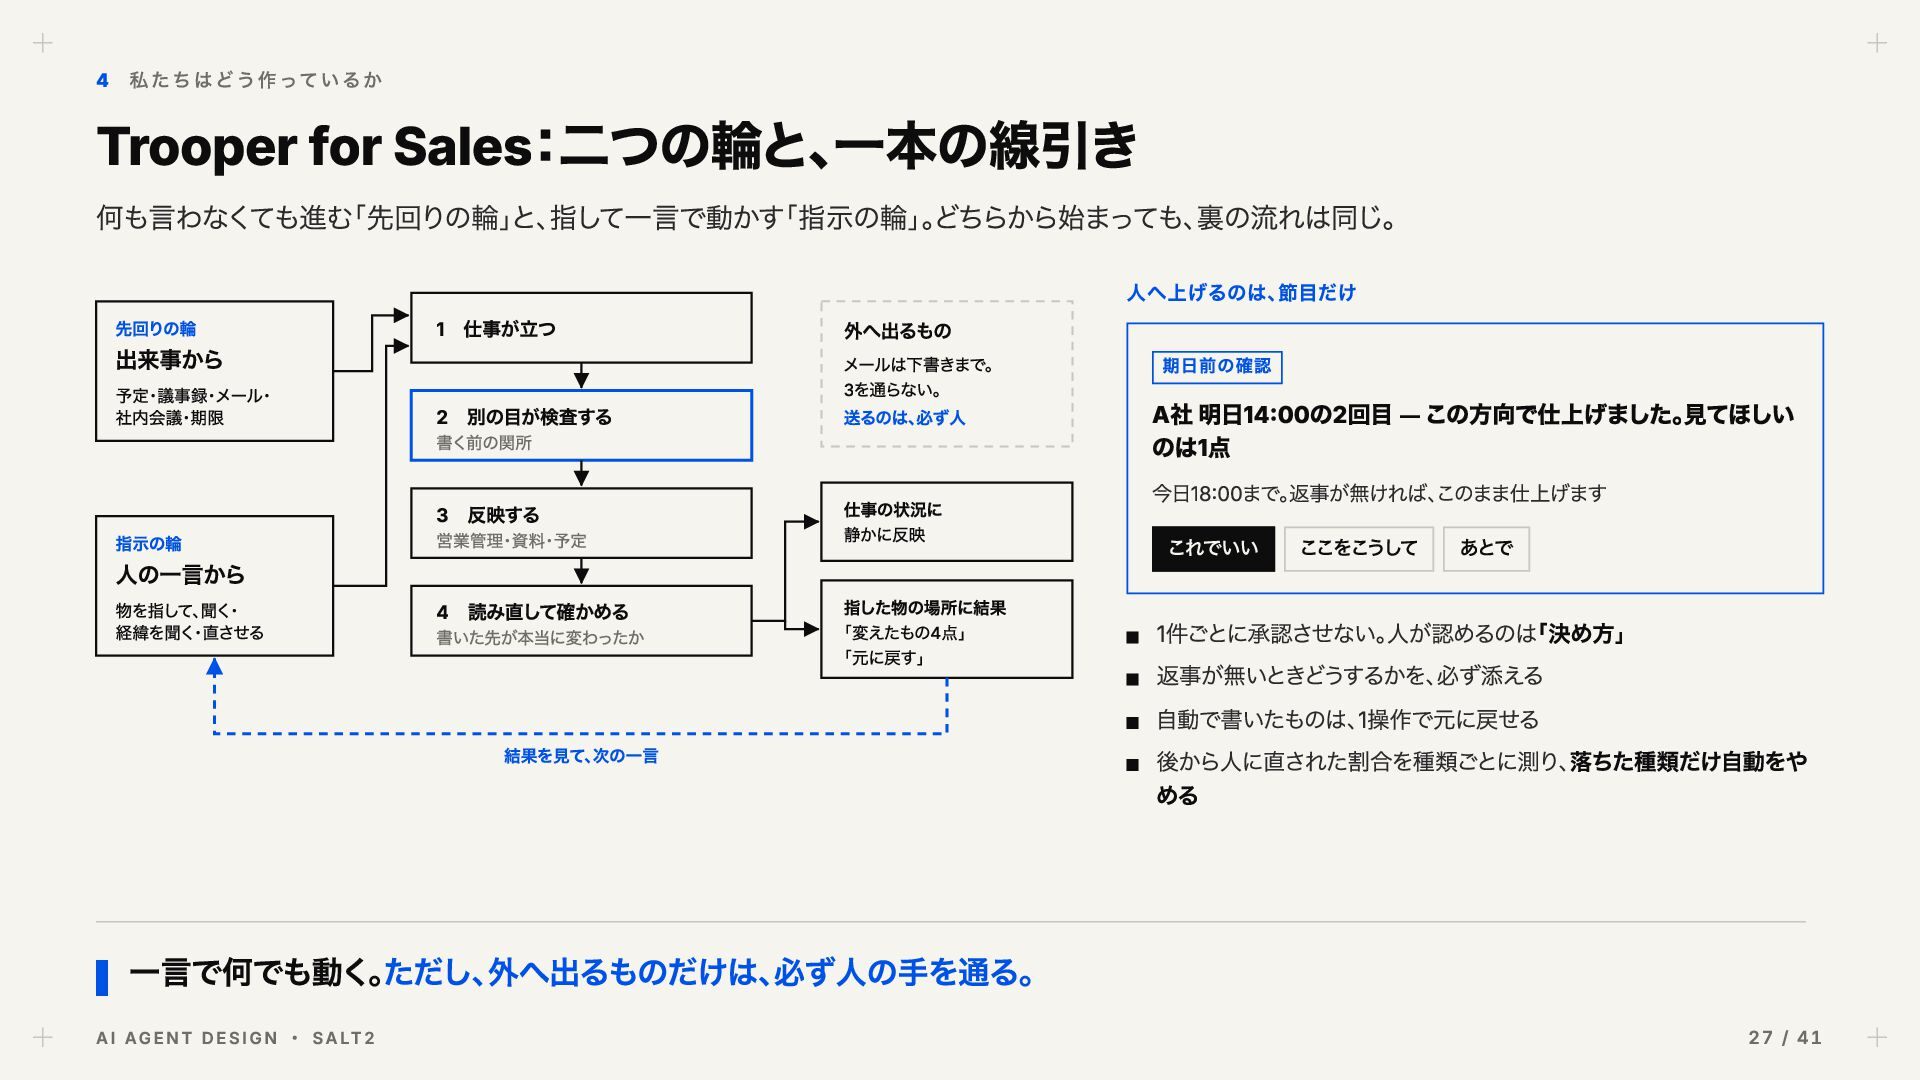
予定・議事録・メール・ 社内会議・期限 2 別の目が検査する 3 反映する 仕事の状況に 静かに反映 今日18:00まで。返事が無ければ、このまま仕上げます これでいい ここをこうして あとで 4 読み直して確かめる 指した物の場所に結果 「変えたもの4点」 「元に戻す」 1件ごとに承認させない。人が認めるのは「決め方」 出来事から 指示の輪 人の一言から 物を指して、聞く・ 経緯を聞く・直させる 書く前の関所 営業管理・資料・予定 書いた先が本当に変わったか 外へ出るもの メールは下書きまで。 3を通らない。 送るのは、必ず人 結果を見て、次の一言 期日前の確認 A社 明日14:00の2回目 ― この方向で仕上げました。見てほしい のは1点 返事が無いときどうするかを、必ず添える 自動で書いたものは、1操作で元に戻せる 後から人に直された割合を種類ごとに測り、落ちた種類だけ自動をや める 一言で何でも動く。ただし、外へ出るものだけは、必ず人の手を通る。 A I AG E N T D E S I G N ・ S A LT 2 27 / 41
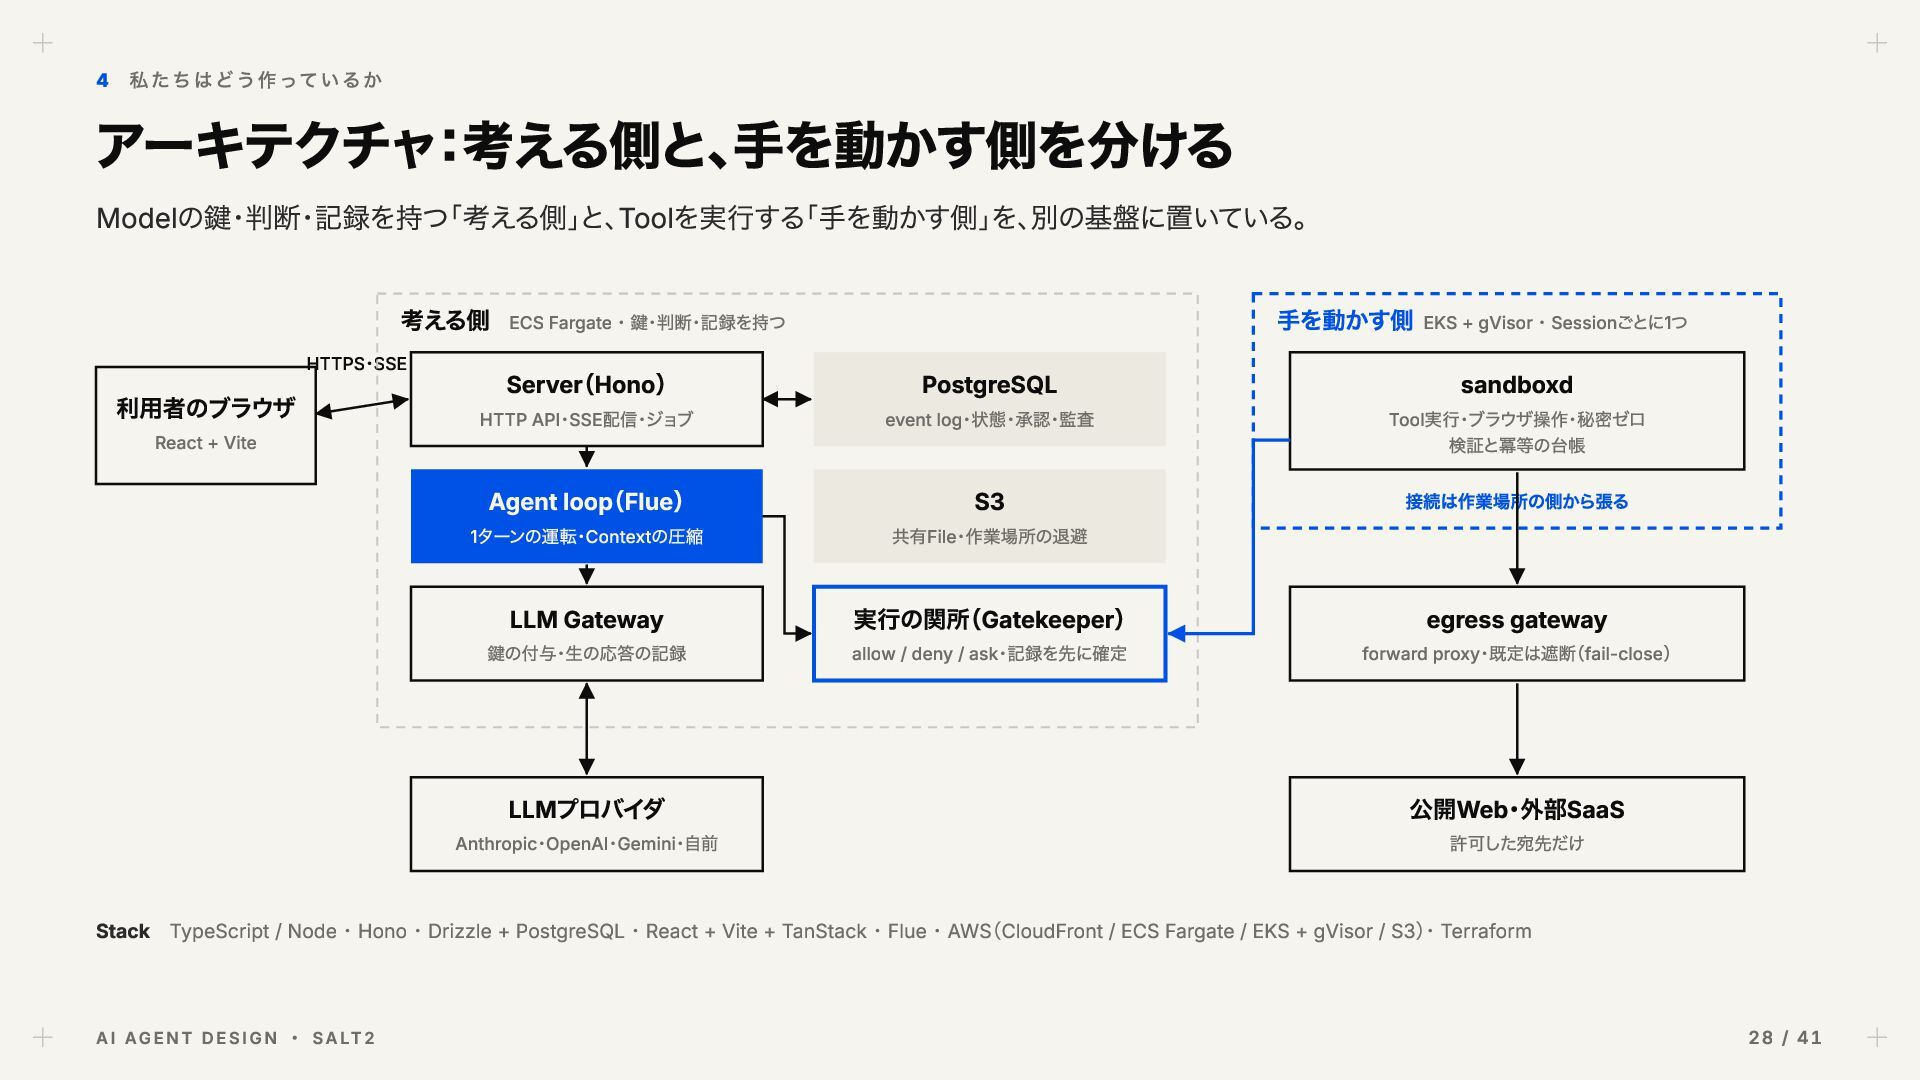
React + Vite 手を動かす側 EKS + gVisor・Sessionごとに1つ PostgreSQL sandboxd HTTP API・SSE配信・ジョブ event log・状態・承認・監査 Tool実行・ブラウザ操作・秘密ゼロ Agent loop(Flue) 1ターンの運転・Contextの圧縮 S3 共有File・作業場所の退避 接続は作業場所の側から張る LLM Gateway 実行の関所(Gatekeeper) egress gateway 鍵の付与・生の応答の記録 LLMプロバイダ Anthropic・OpenAI・Gemini・自前 allow / deny / ask・記録を先に確定 検証と冪等の台帳 forward proxy・既定は遮断(fail-close) 公開Web・外部SaaS 許可した宛先だけ Stack TypeScript / Node・Hono・Drizzle + PostgreSQL・React + Vite + TanStack・Flue・AWS(CloudFront / ECS Fargate / EKS + gVisor / S3) ・Terraform A I AG E N T D E S I G N ・ S A LT 2 28 / 41
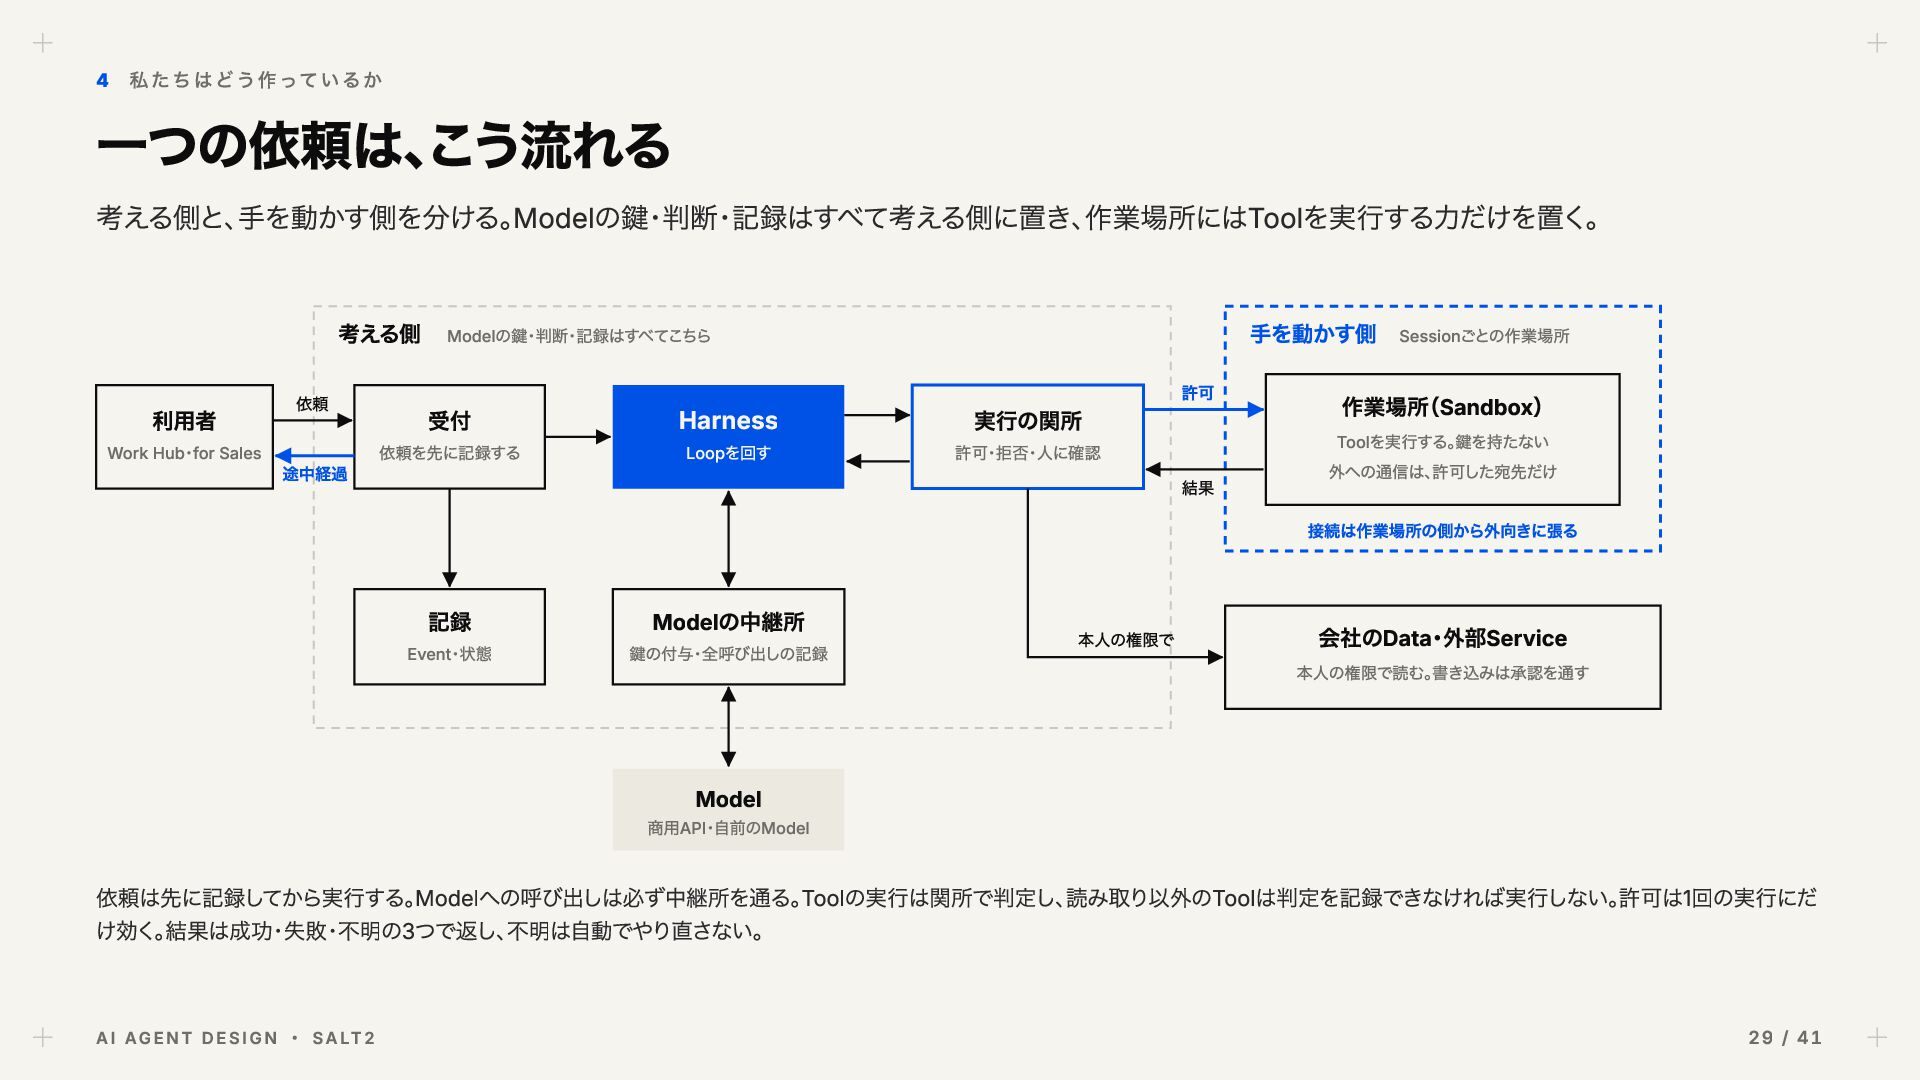
依頼 途中経過 受付 依頼を先に記録する Harness Loopを回す 手を動かす側 Sessionごとの作業場所 実行の関所 許可・拒否・人に確認 許可 作業場所(Sandbox) Toolを実行する。鍵を持たない 結果 外への通信は、許可した宛先だけ 接続は作業場所の側から外向きに張る 記録 Event・状態 Modelの中継所 鍵の付与・全呼び出しの記録 本人の権限で 会社のData・外部Service 本人の権限で読む。書き込みは承認を通す Model 商用API・自前のModel 依頼は先に記録してから実行する。Modelへの呼び出しは必ず中継所を通る。Toolの実行は関所で判定し、読み取り以外のToolは判定を記録できなければ実行しない。許可は1回の実行にだ け効く。結果は成功・失敗・不明の3つで返し、不明は自動でやり直さない。 A I AG E N T D E S I G N ・ S A LT 2 29 / 41
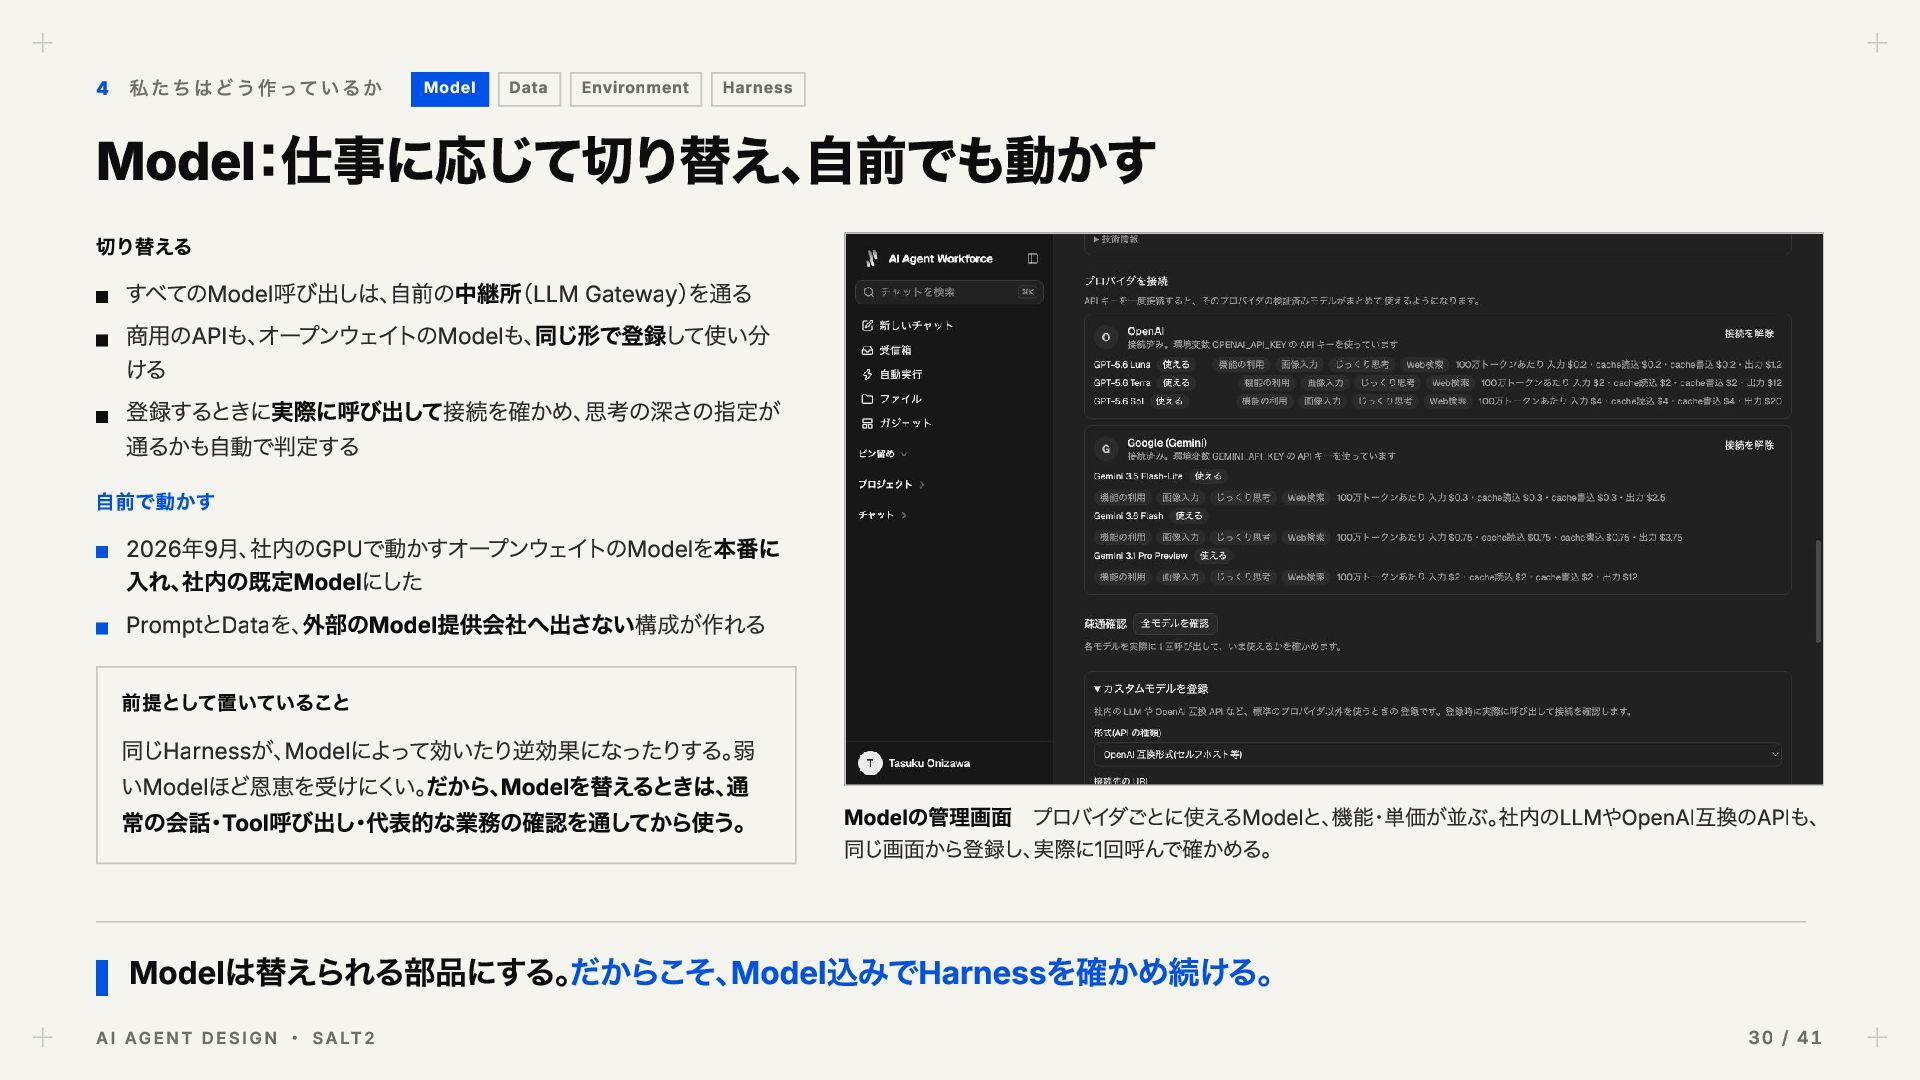
商用のAPIも、オープンウェイトのModelも、同じ形で登録して使い分 ける 登録するときに実際に呼び出して接続を確かめ、思考の深さの指定が 通るかも自動で判定する 自前で動かす 2026年9月、社内のGPUで動かすオープンウェイトのModelを本番に 入れ、社内の既定Modelにした PromptとDataを、外部のModel提供会社へ出さない構成が作れる 前提として置いていること 同じHarnessが、Modelによって効いたり逆効果になったりする。弱 いModelほど恩恵を受けにくい。だから、Modelを替えるときは、通 常の会話・Tool呼び出し・代表的な業務の確認を通してから使う。 Modelの管理画面 プロバイダごとに使えるModelと、機能・単価が並ぶ。社内のLLMやOpenAI互換のAPIも、 同じ画面から登録し、実際に1回呼んで確かめる。 Modelは替えられる部品にする。だからこそ、Model込みでHarnessを確かめ続ける。 A I AG E N T D E S I G N ・ S A LT 2 30 / 41
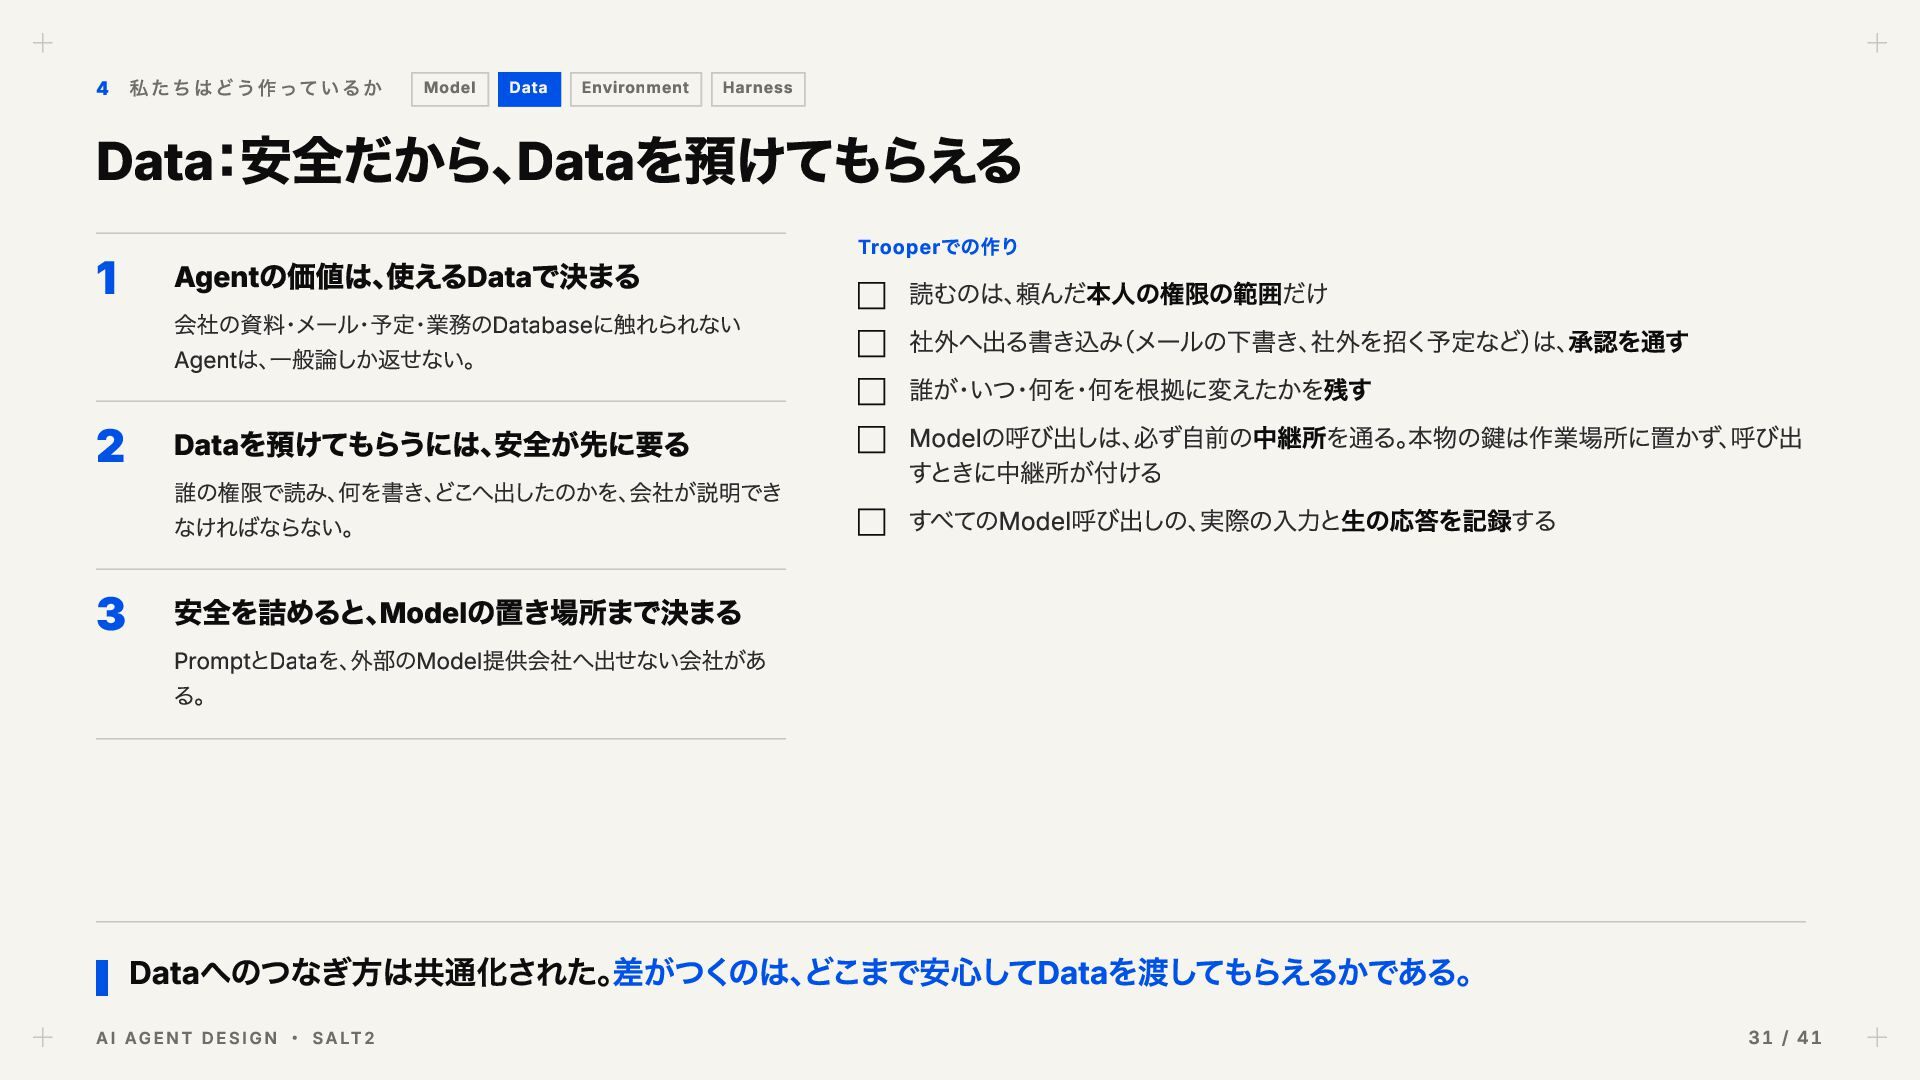
Dataを預けてもらうには、安全が先に要る 会社の資料・メール・予定・業務のDatabaseに触れられない Agentは、一般論しか返せない。 誰の権限で読み、何を書き、どこへ出したのかを、会社が説明でき なければならない。 Trooperでの作り 読むのは、頼んだ本人の権限の範囲だけ 社外へ出る書き込み(メールの下書き、社外を招く予定など)は、承認を通す 誰が・いつ・何を・何を根拠に変えたかを残す Modelの呼び出しは、必ず自前の中継所を通る。本物の鍵は作業場所に置かず、呼び出 すときに中継所が付ける すべてのModel呼び出しの、実際の入力と生の応答を記録する 3 安全を詰めると、Modelの置き場所まで決まる PromptとDataを、外部のModel提供会社へ出せない会社があ る。 Dataへのつなぎ方は共通化された。差がつくのは、どこまで安心してDataを渡してもらえるかである。 A I AG E N T D E S I G N ・ S A LT 2 31 / 41
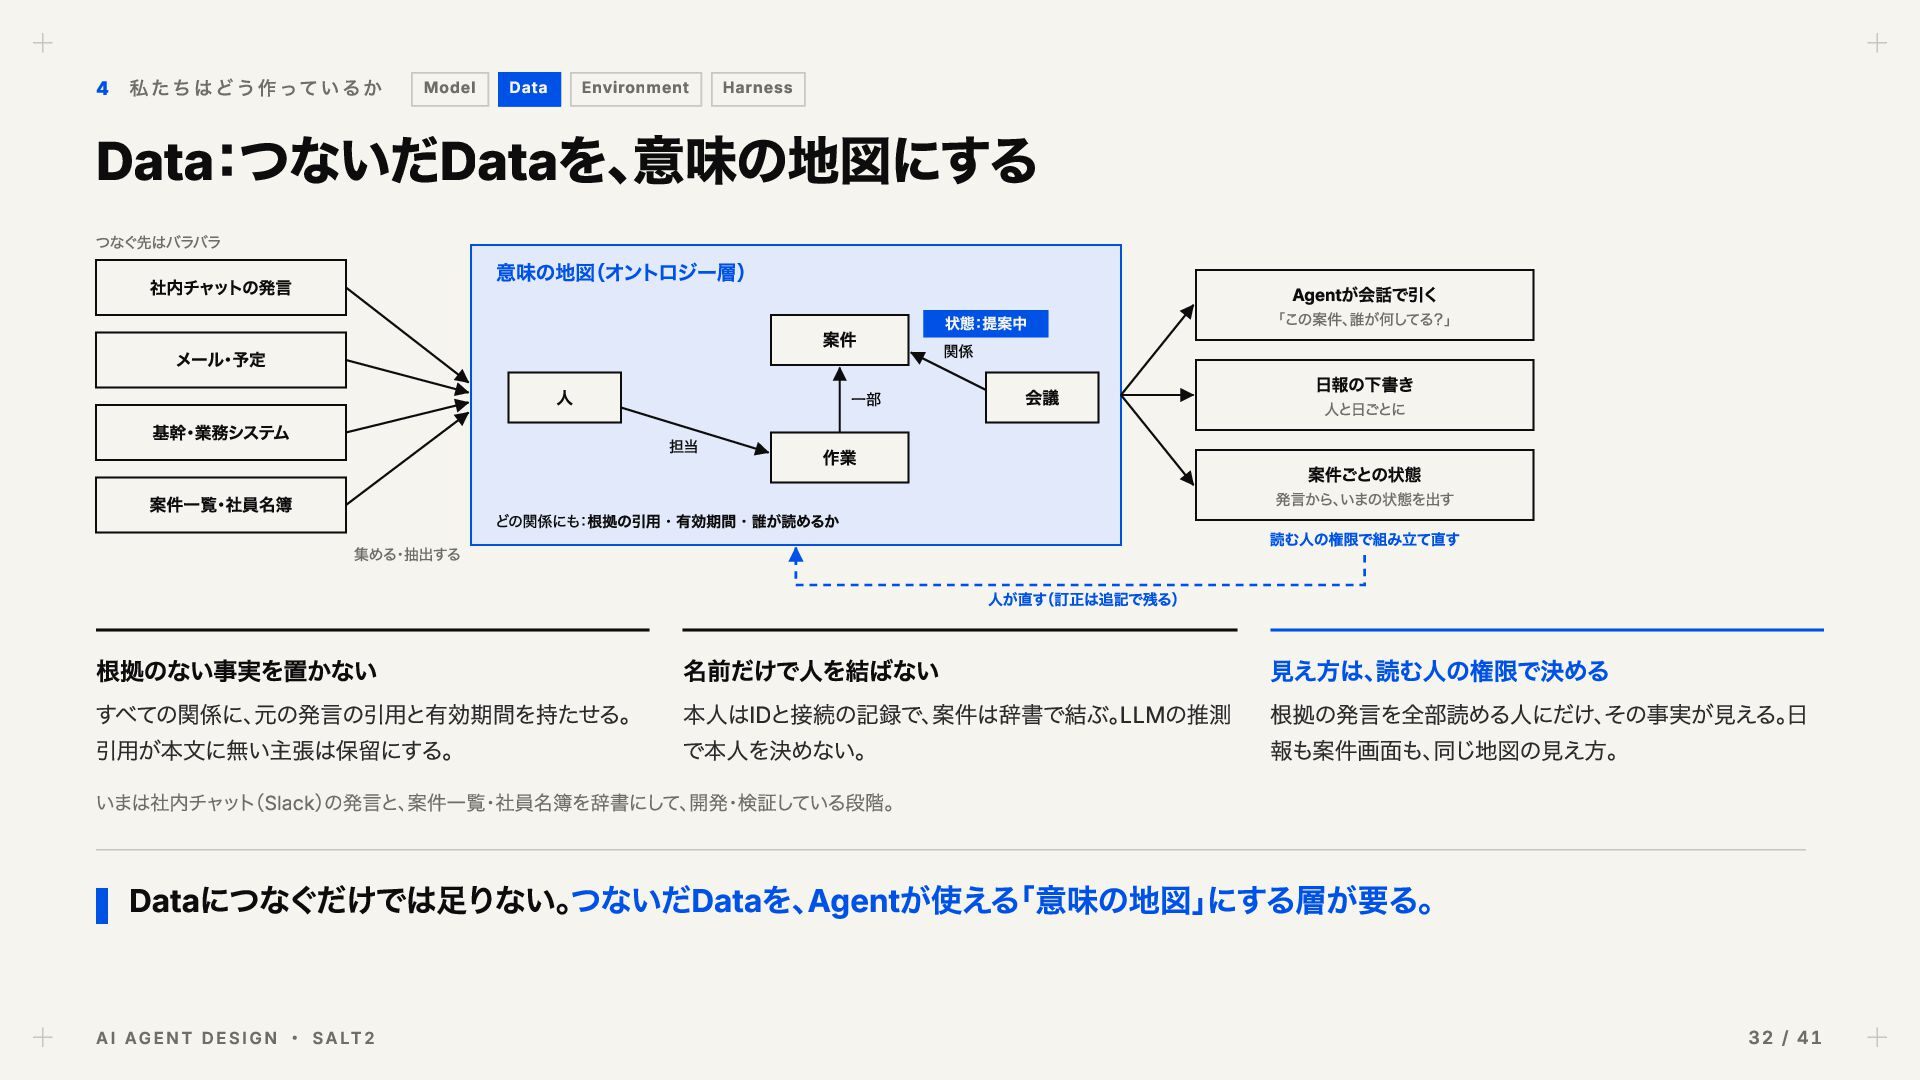
案件 メール・予定 人 基幹・業務システム 一部 担当 案件一覧・社員名簿 集める・抽出する 状態:提案中 関係 会議 作業 Agentが会話で引く 「この案件、誰が何してる?」 日報の下書き 人と日ごとに 案件ごとの状態 発言から、いまの状態を出す 読む人の権限で組み立て直す どの関係にも:根拠の引用・有効期間・誰が読めるか 人が直す(訂正は追記で残る) 根拠のない事実を置かない 名前だけで人を結ばない 見え方は、読む人の権限で決める すべての関係に、元の発言の引用と有効期間を持たせる。 本人はIDと接続の記録で、案件は辞書で結ぶ。LLMの推測 根拠の発言を全部読める人にだけ、その事実が見える。日 引用が本文に無い主張は保留にする。 で本人を決めない。 報も案件画面も、同じ地図の見え方。 いまは社内チャット(Slack)の発言と、案件一覧・社員名簿を辞書にして、開発・検証している段階。 Dataにつなぐだけでは足りない。つないだDataを、Agentが使える「意味の地図」にする層が要る。 A I AG E N T D E S I G N ・ S A LT 2 32 / 41
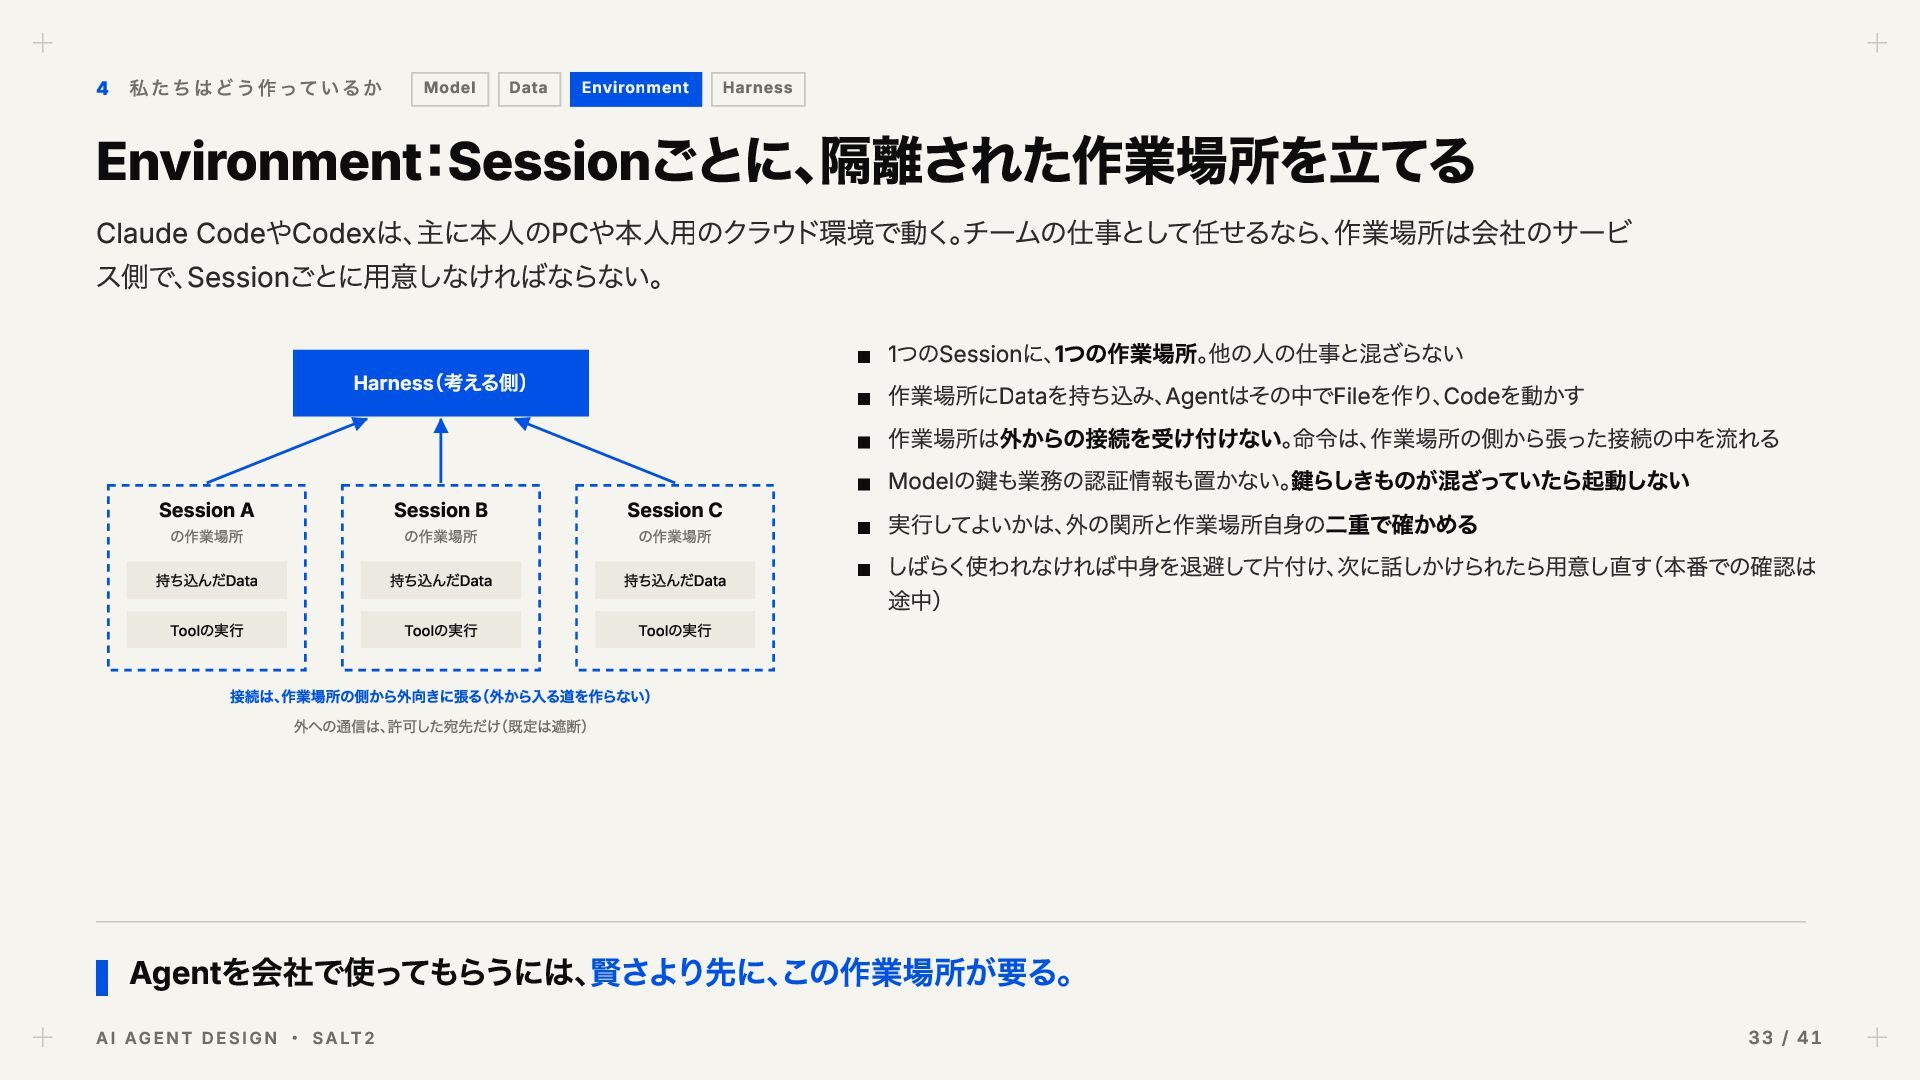
1つのSessionに、1つの作業場所。他の人の仕事と混ざらない 作業場所にDataを持ち込み、Agentはその中でFileを作り、Codeを動かす Harness(考える側) Session A Session B Session C 持ち込んだData 持ち込んだData 持ち込んだData Toolの実行 Toolの実行 Toolの実行 の作業場所 の作業場所 の作業場所 作業場所は外からの接続を受け付けない。命令は、作業場所の側から張った接続の中を流れる Modelの鍵も業務の認証情報も置かない。鍵らしきものが混ざっていたら起動しない 実行してよいかは、外の関所と作業場所自身の二重で確かめる しばらく使われなければ中身を退避して片付け、次に話しかけられたら用意し直す(本番での確認は 途中) 接続は、作業場所の側から外向きに張る(外から入る道を作らない) 外への通信は、許可した宛先だけ(既定は遮断) Agentを会社で使ってもらうには、賢さより先に、この作業場所が要る。 A I AG E N T D E S I G N ・ S A LT 2 33 / 41
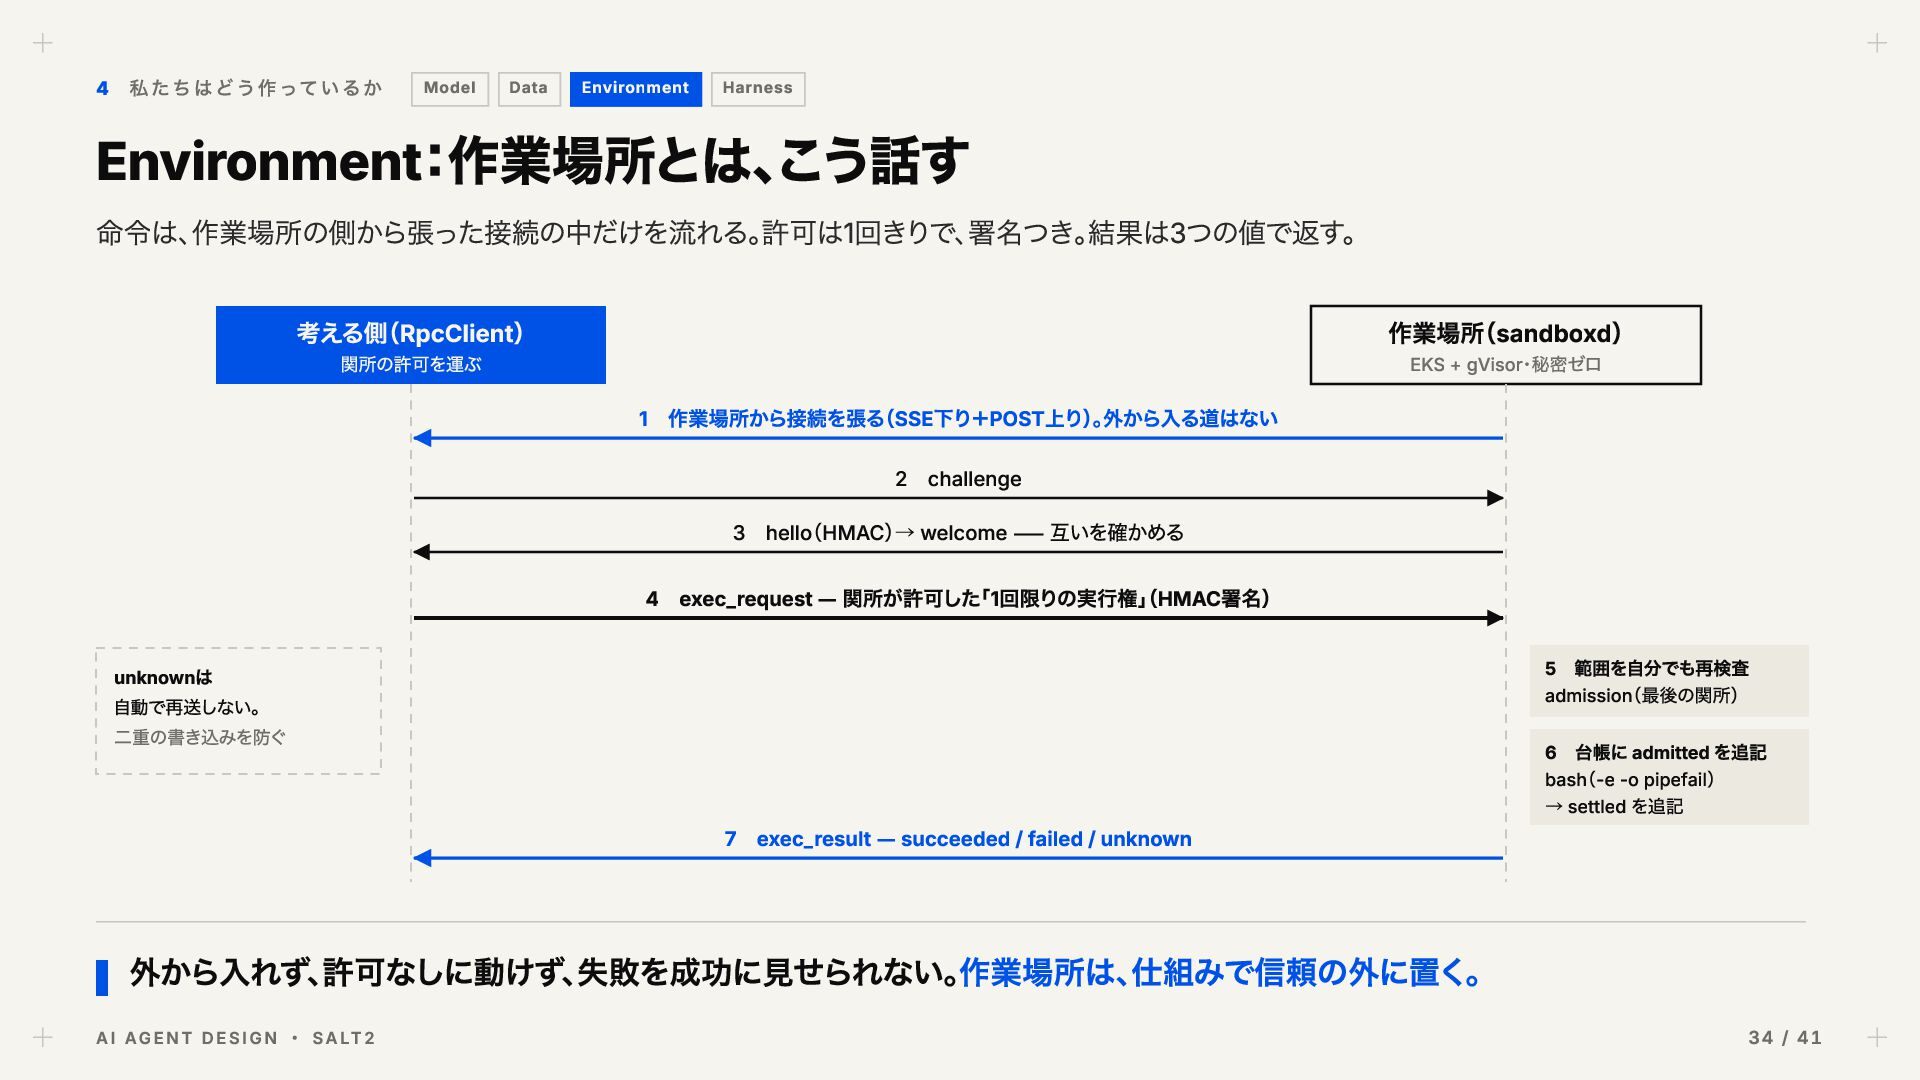
関所の許可を運ぶ EKS + gVisor・秘密ゼロ 1 作業場所から接続を張る(SSE下り+POST上り)。外から入る道はない 2 challenge 3 hello(HMAC)→ welcome ― 互いを確かめる 4 exec_request ― 関所が許可した「1回限りの実行権」 (HMAC署名) 5 範囲を自分でも再検査 admission(最後の関所) unknownは 自動で再送しない。 二重の書き込みを防ぐ 7 exec_result ― succeeded / failed / unknown 6 台帳に admitted を追記 bash(-e -o pipefail) → settled を追記 外から入れず、許可なしに動けず、失敗を成功に見せられない。作業場所は、仕組みで信頼の外に置く。 A I AG E N T D E S I G N ・ S A LT 2 34 / 41
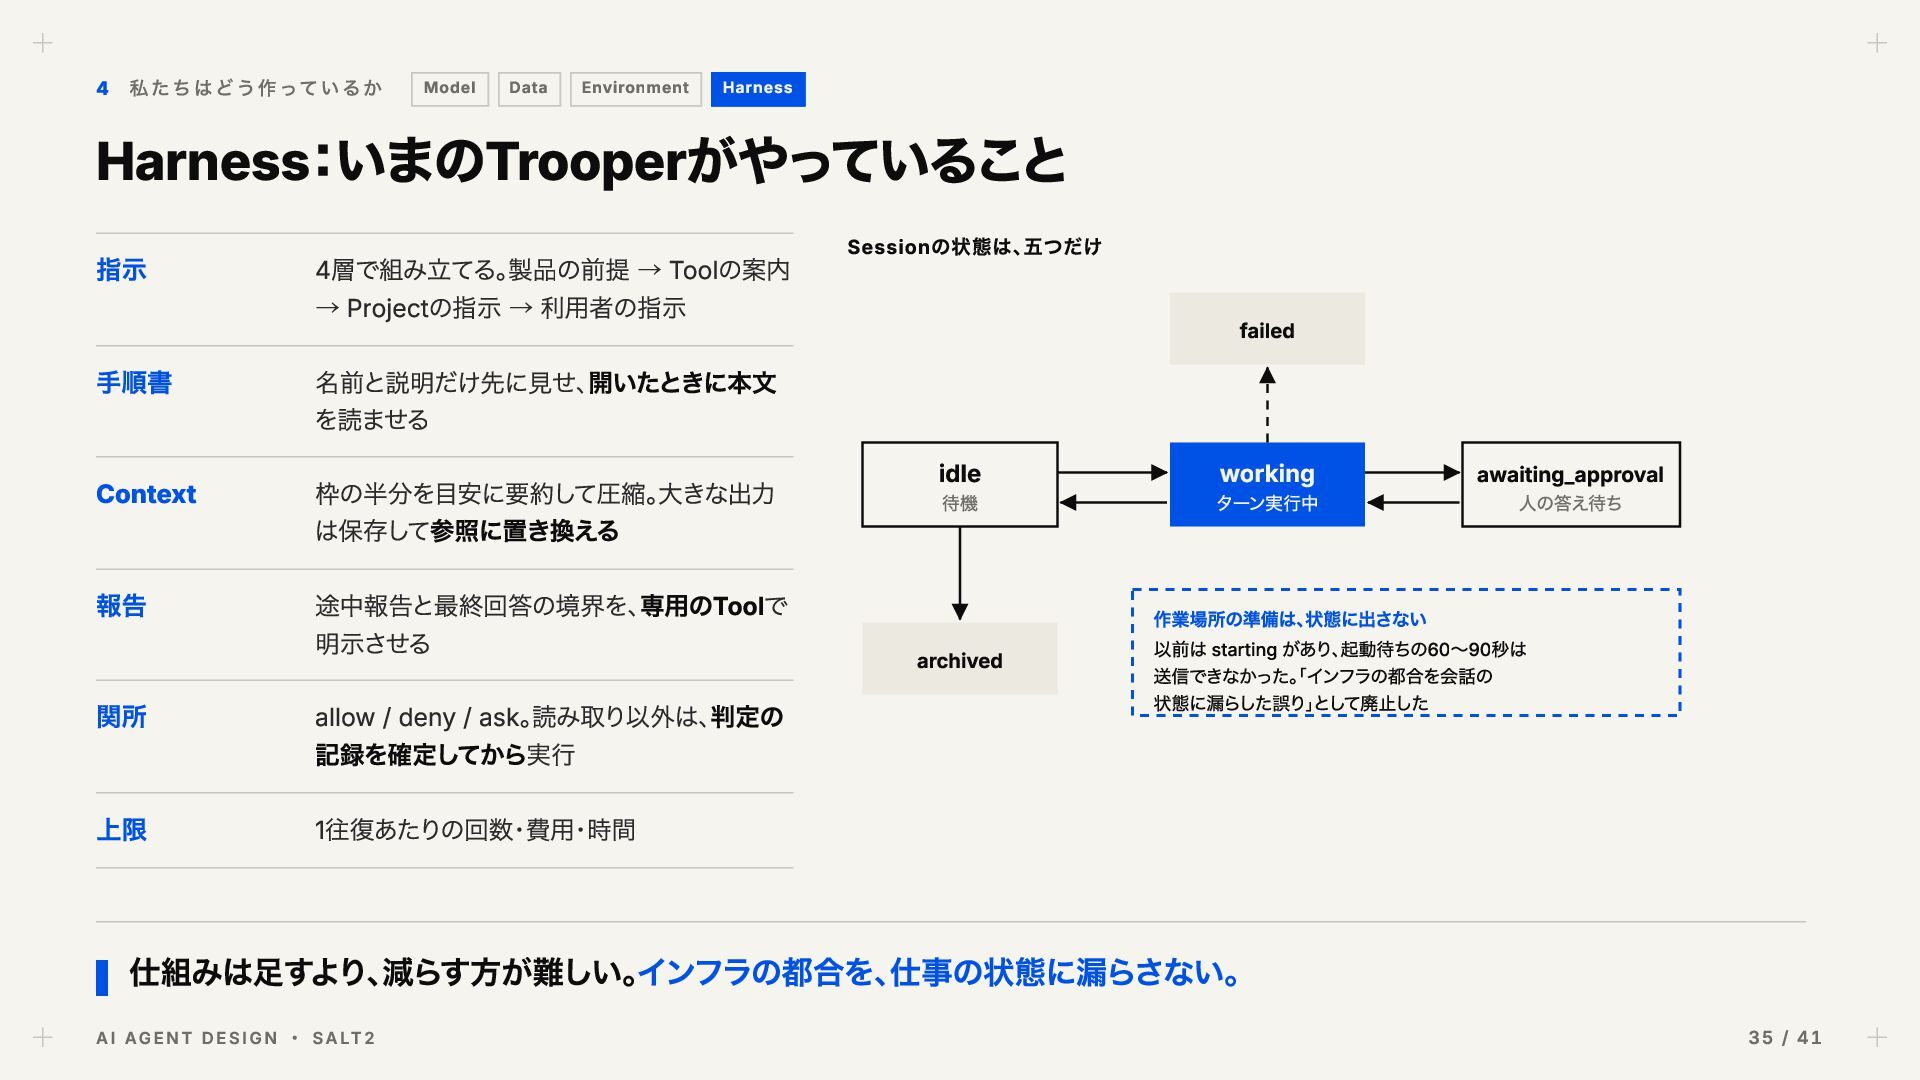
報告 関所 上限 4層で組み立てる。製品の前提 → Toolの案内 → Projectの指示 → 利用者の指示 名前と説明だけ先に見せ、開いたときに本文 を読ませる 枠の半分を目安に要約して圧縮。大きな出力 は保存して参照に置き換える 途中報告と最終回答の境界を、専用のToolで 明示させる allow / deny / ask。読み取り以外は、判定の 記録を確定してから実行 Session の状態は、五つだけ failed idle 待機 archived working ターン実行中 awaiting_approval 人の答え待ち 作業場所の準備は、状態に出さない 以前は starting があり、起動待ちの60〜90秒は 送信できなかった。 「インフラの都合を会話の 状態に漏らした誤り」として廃止した 1往復あたりの回数・費用・時間 仕組みは足すより、減らす方が難しい。インフラの都合を、仕事の状態に漏らさない。 A I AG E N T D E S I G N ・ S A LT 2 35 / 41
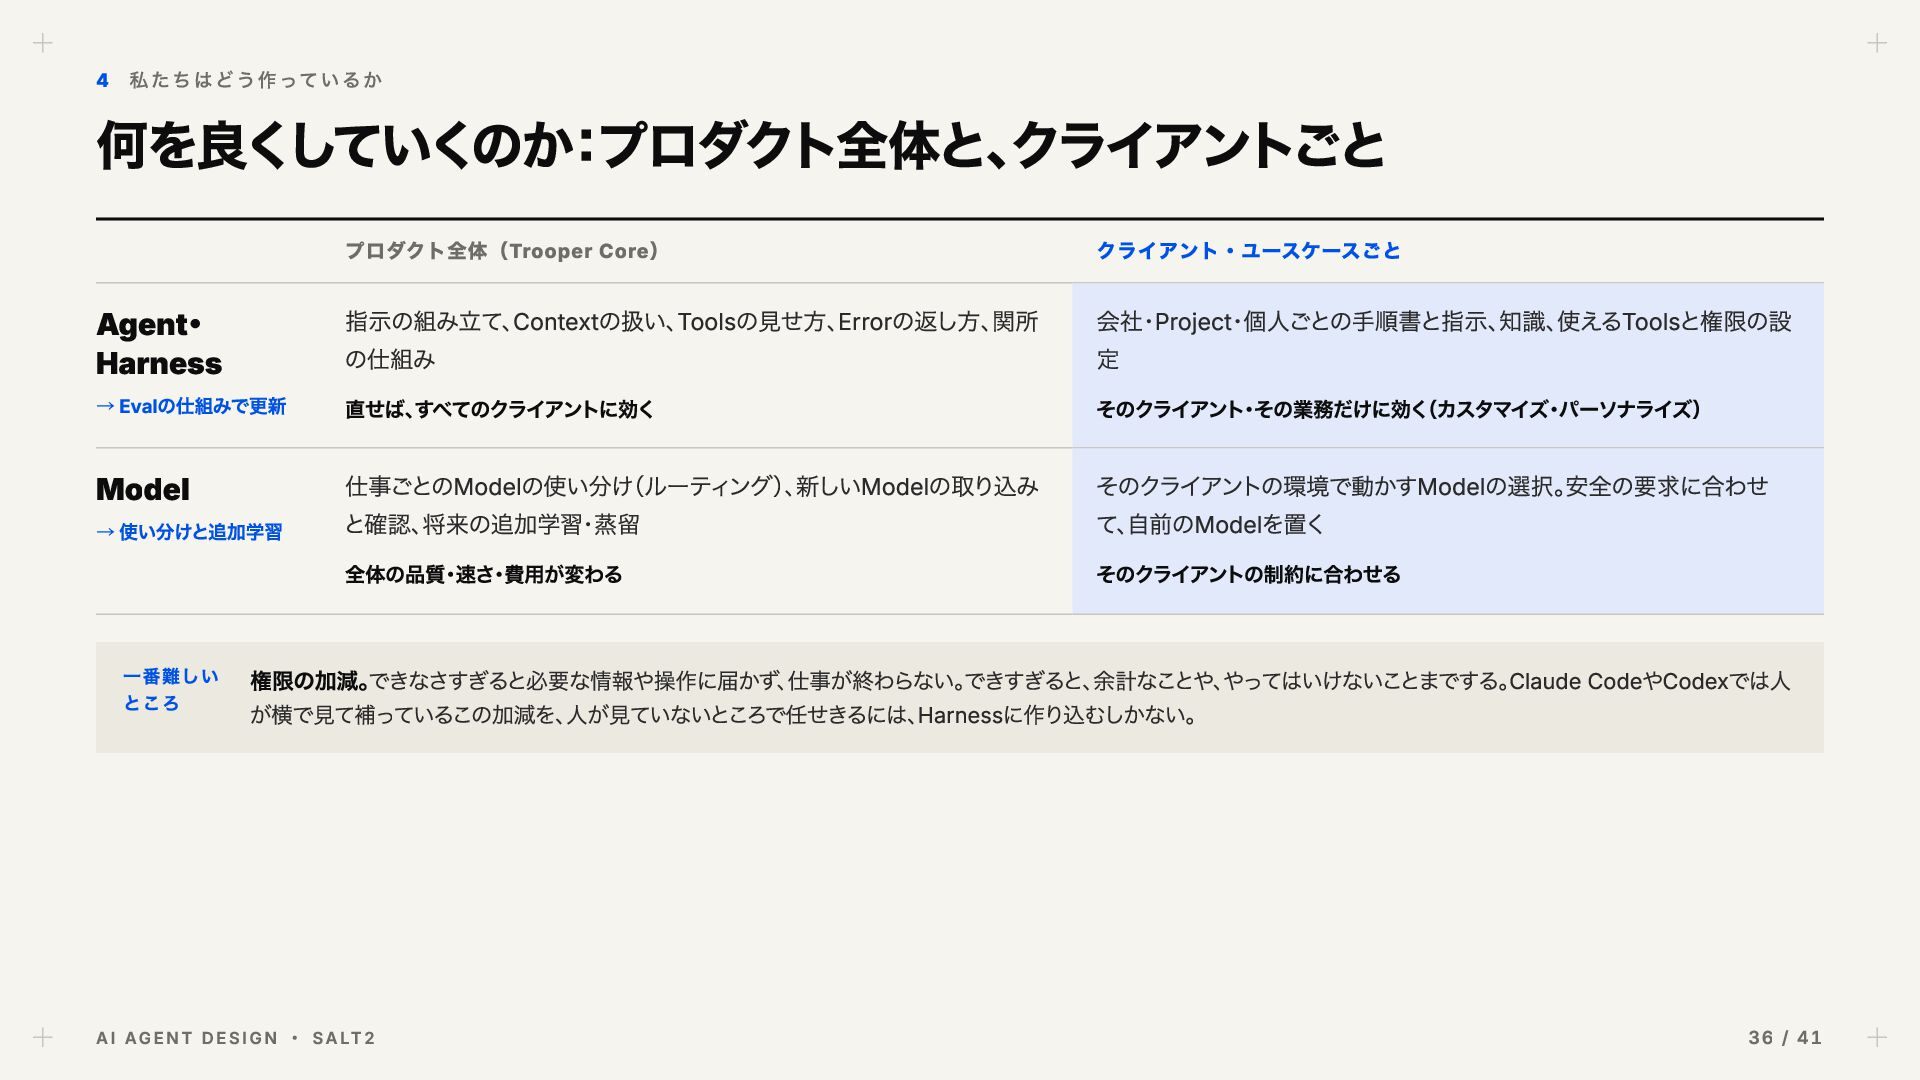
指示の組み立て、Contextの扱い、Toolsの見せ方、Errorの返し方、関所 の仕組み 直せば、すべてのクライアントに効く 会社・Project・個人ごとの手順書と指示、知識、使えるToolsと権限の設 定 そのクライアント・その業務だけに効く(カスタマイズ・パーソナライズ) Model → 使い分けと追加学習 仕事ごとのModelの使い分け(ルーティング)、新しいModelの取り込み と確認、将来の追加学習・蒸留 そのクライアントの環境で動かすModelの選択。安全の要求に合わせ て、自前のModelを置く 一番難しい ところ 全体の品質・速さ・費用が変わる そのクライアントの制約に合わせる 権限の加減。できなさすぎると必要な情報や操作に届かず、仕事が終わらない。できすぎると、余計なことや、やってはいけないことまでする。Claude CodeやCodexでは人 が横で見て補っているこの加減を、人が見ていないところで任せきるには、Harnessに作り込むしかない。 A I AG E N T D E S I G N ・ S A LT 2 36 / 41
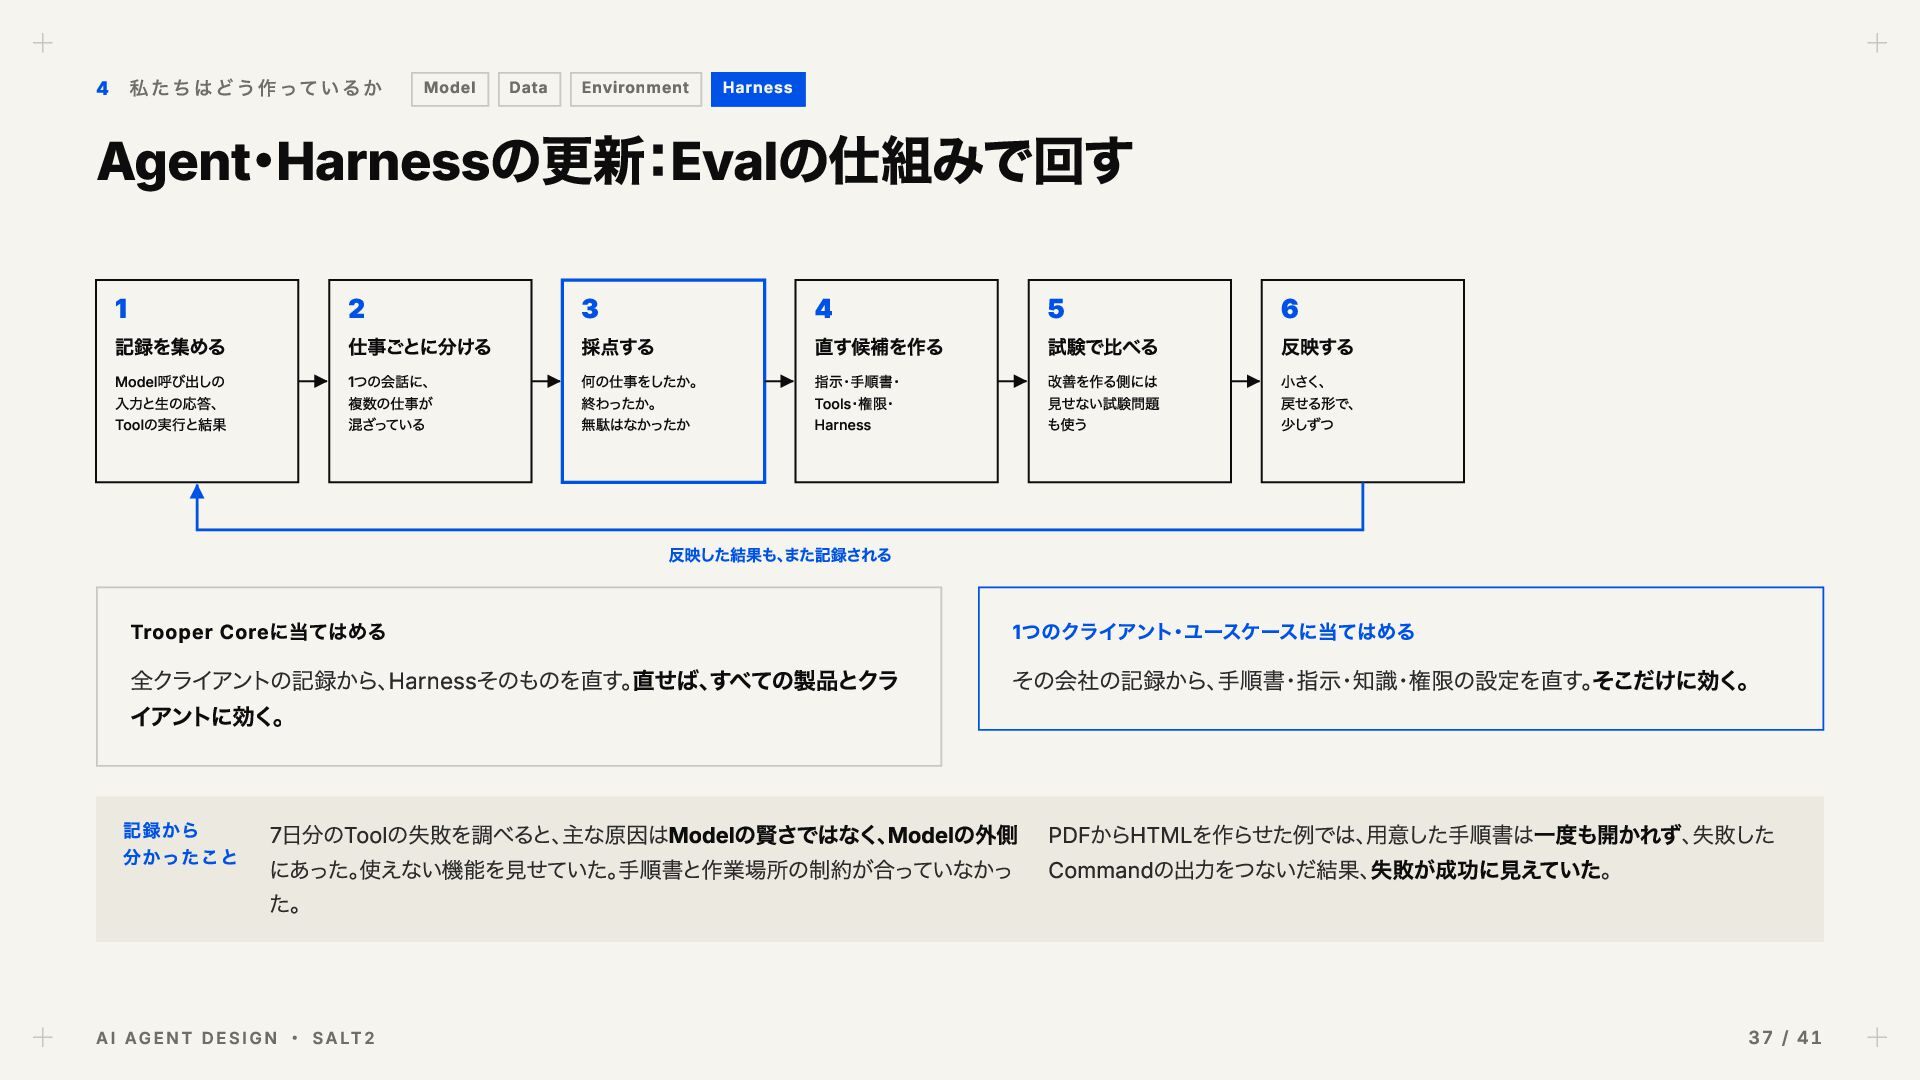
4 5 6 Model呼び出しの 1つの会話に、 何の仕事をしたか。 終わったか。 無駄はなかったか 指示・手順書・ Tools・権限・ 改善を作る側には 見せない試験問題 も使う 小さく、 戻せる形で、 少しずつ 記録を集める 入力と生の応答、 Toolの実行と結果 仕事ごとに分ける 複数の仕事が 混ざっている 採点する 直す候補を作る 試験で比べる Harness 反映する 反映した結果も、また記録される Trooper Coreに当てはめる 全クライアントの記録から、Harnessそのものを直す。直せば、すべての製品とクラ イアントに効く。 記録から 分かったこと 1つのクライアント・ユースケースに当てはめる その会社の記録から、手順書・指示・知識・権限の設定を直す。そこだけに効く。 7日分のToolの失敗を調べると、主な原因はModelの賢さではなく、Modelの外側 にあった。使えない機能を見せていた。手順書と作業場所の制約が合っていなかっ た。 A I AG E N T D E S I G N ・ S A LT 2 PDFからHTMLを作らせた例では、用意した手順書は一度も開かれず、失敗した Commandの出力をつないだ結果、失敗が成功に見えていた。 37 / 41
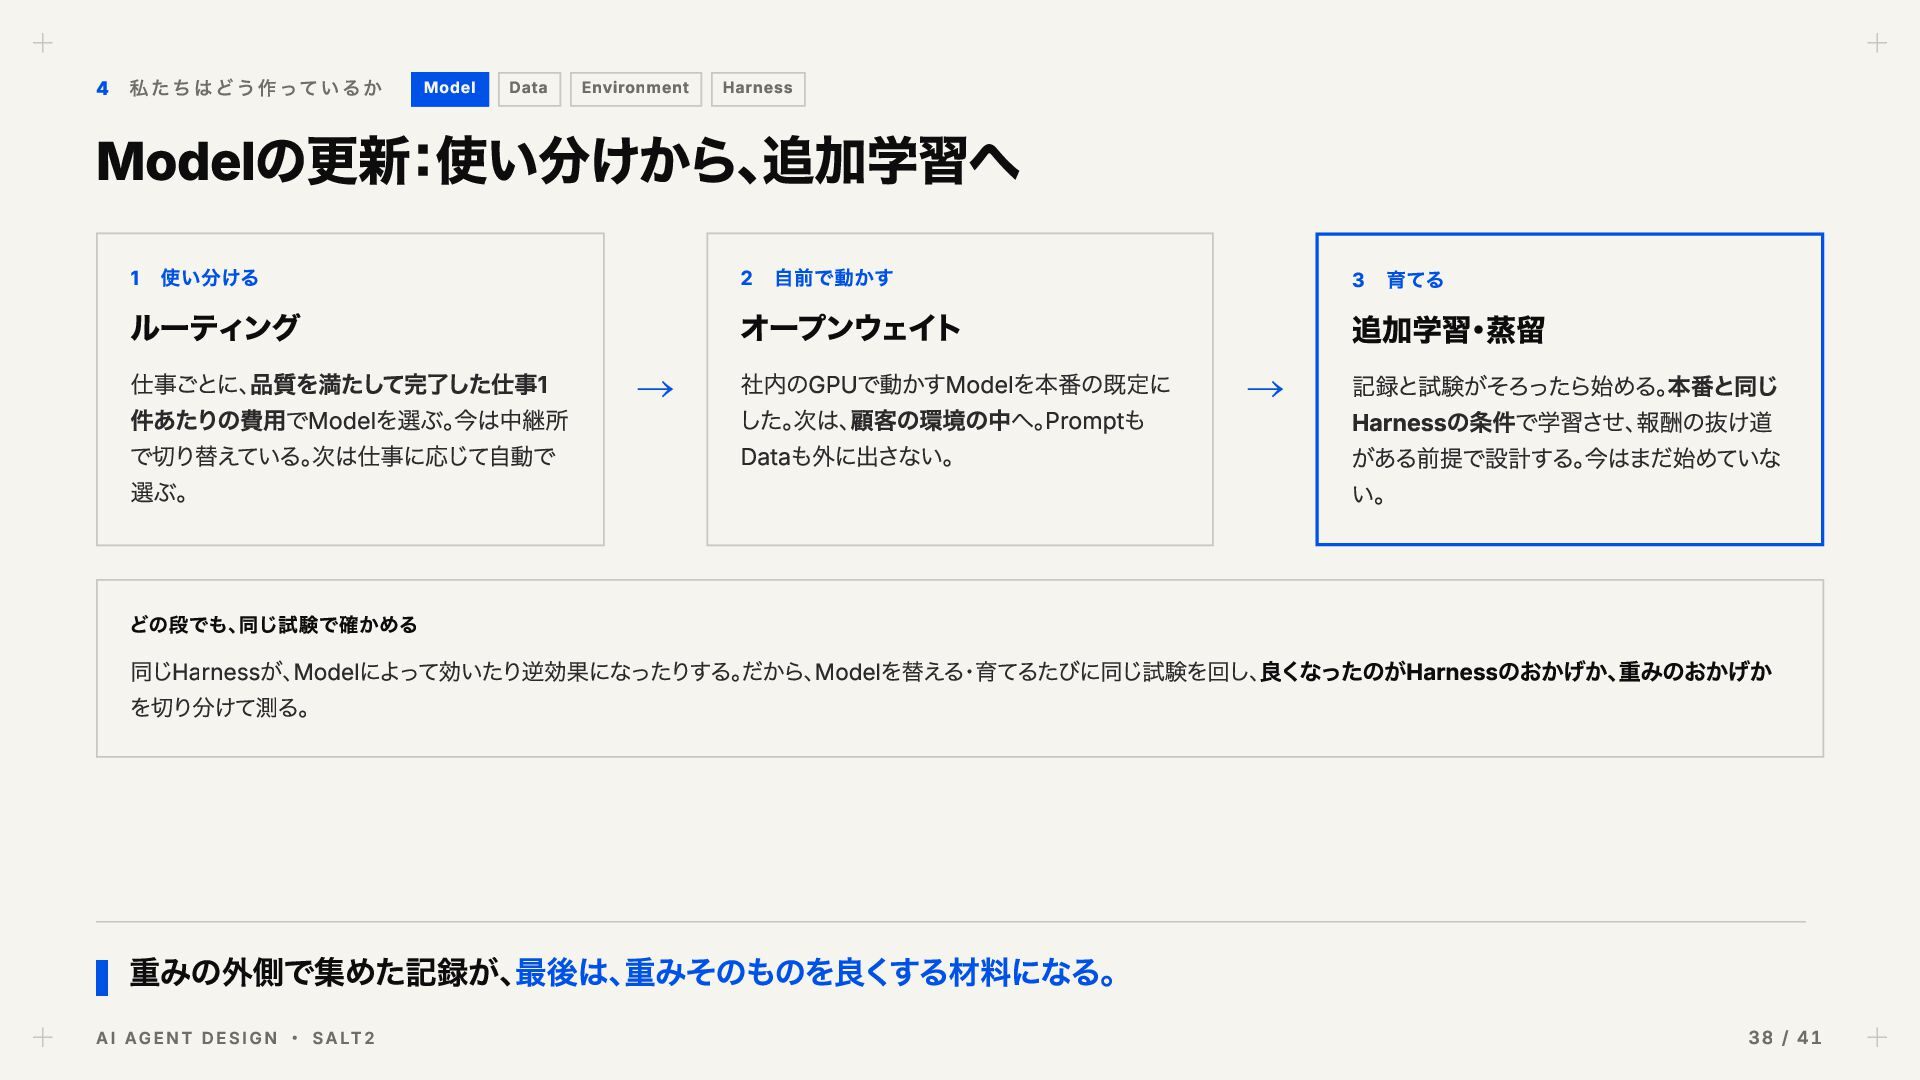
仕事ごとに、品質を満たして完了した仕事1 件あたりの費用でModelを選ぶ。今は中継所 で切り替えている。次は仕事に応じて自動で 選ぶ。 2 → 自前で動かす オープンウェイト 社内のGPUで動かすModelを本番の既定に した。次は、顧客の環境の中へ。Promptも Dataも外に出さない。 3 → 育てる 追加学習・蒸留 記録と試験がそろったら始める。本番と同じ Harnessの条件で学習させ、報酬の抜け道 がある前提で設計する。今はまだ始めていな い。 どの段でも、同じ試験で確かめる 同じHarnessが、Modelによって効いたり逆効果になったりする。だから、Modelを替える・育てるたびに同じ試験を回し、良くなったのがHarnessのおかげか、重みのおかげか を切り分けて測る。 重みの外側で集めた記録が、最後は、重みそのものを良くする材料になる。 A I AG E N T D E S I G N ・ S A LT 2 38 / 41
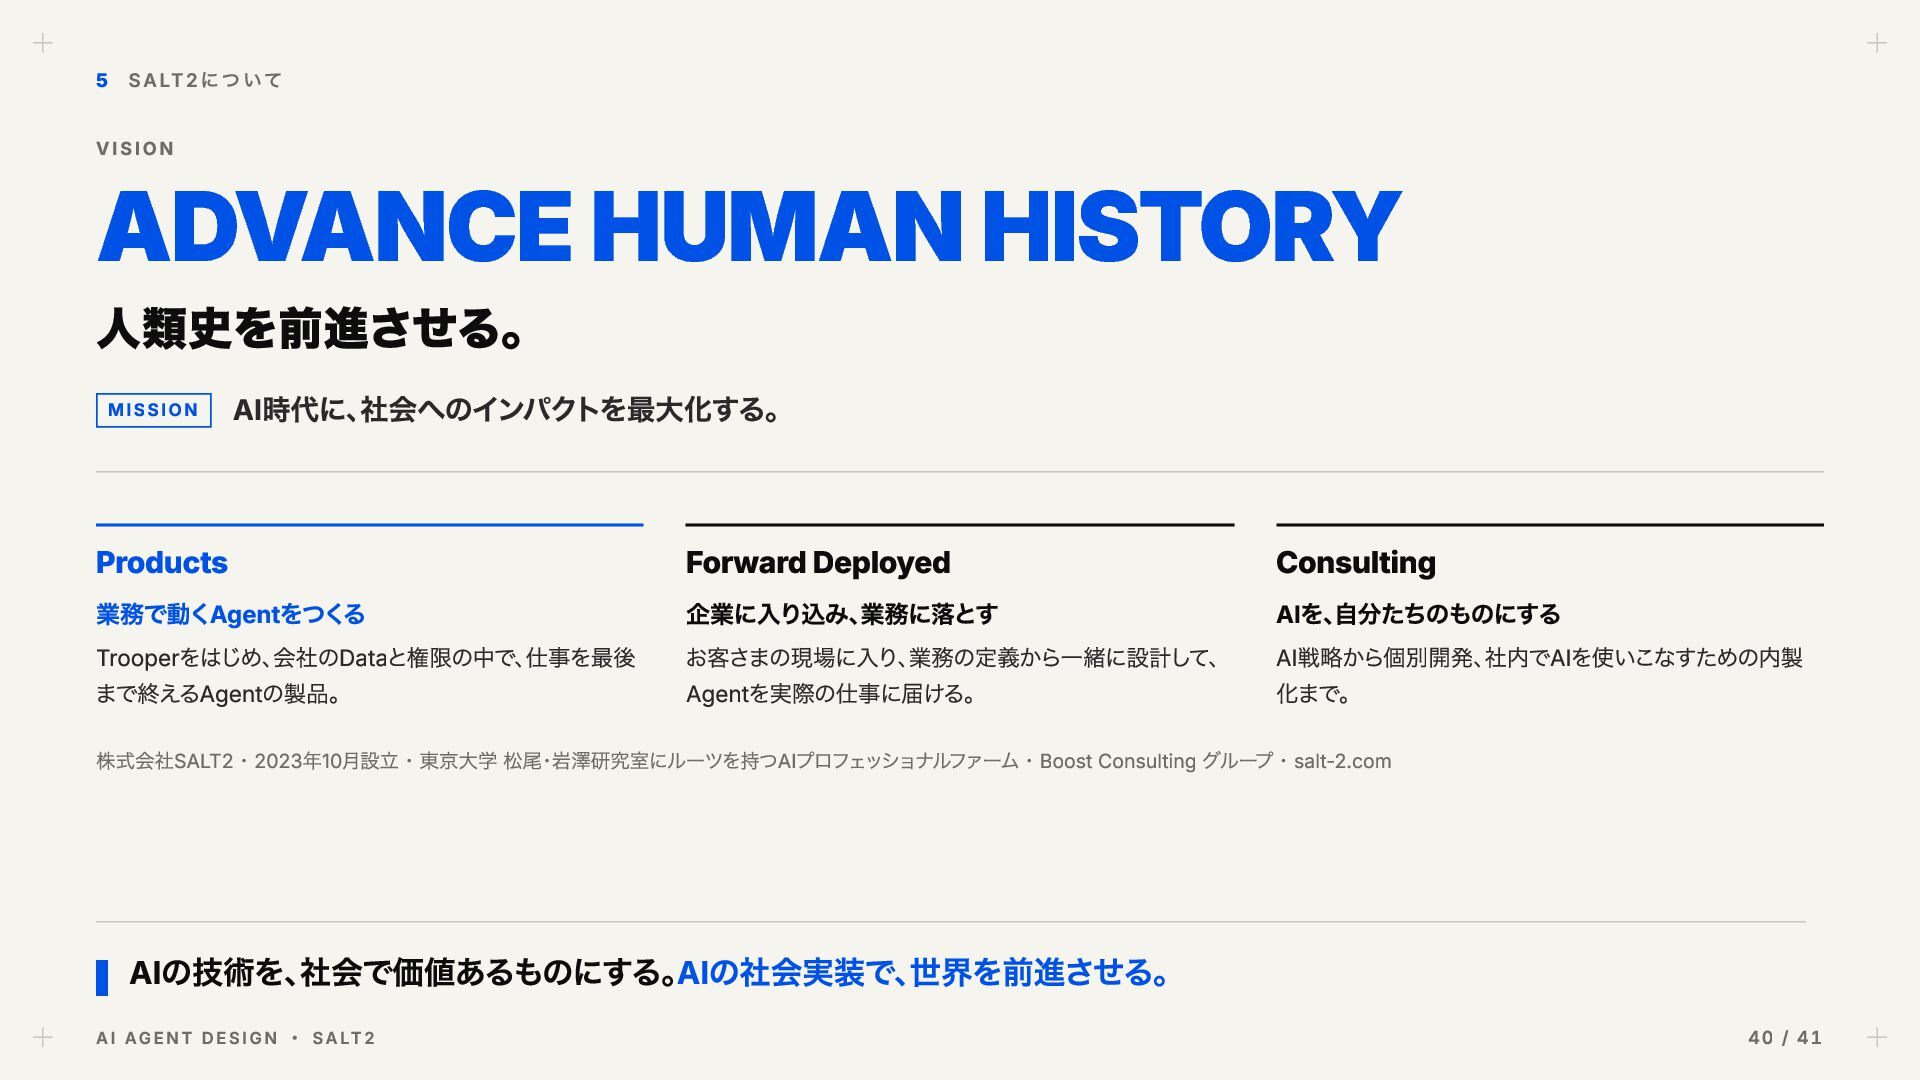
MISSION AI時代に、社会へのインパクトを最大化する。 Products Forward Deployed Consulting Trooperをはじめ、会社のDataと権限の中で、仕事を最後 まで終えるAgentの製品。 お客さまの現場に入り、業務の定義から一緒に設計して、 Agentを実際の仕事に届ける。 AI戦略から個別開発、社内でAIを使いこなすための内製 業務で動くAgentをつくる 企業に入り込み、業務に落とす AIを、自分たちのものにする 化まで。 株式会社SALT2・2023年10月設立・東京大学 松尾・岩澤研究室にルーツを持つAIプロフェッショナルファーム・Boost Consulting グループ・salt-2.com AIの技術を、社会で価値あるものにする。AIの社会実装で、世界を前進させる。 A I AG E N T D E S I G N ・ S A LT 2 40 / 41
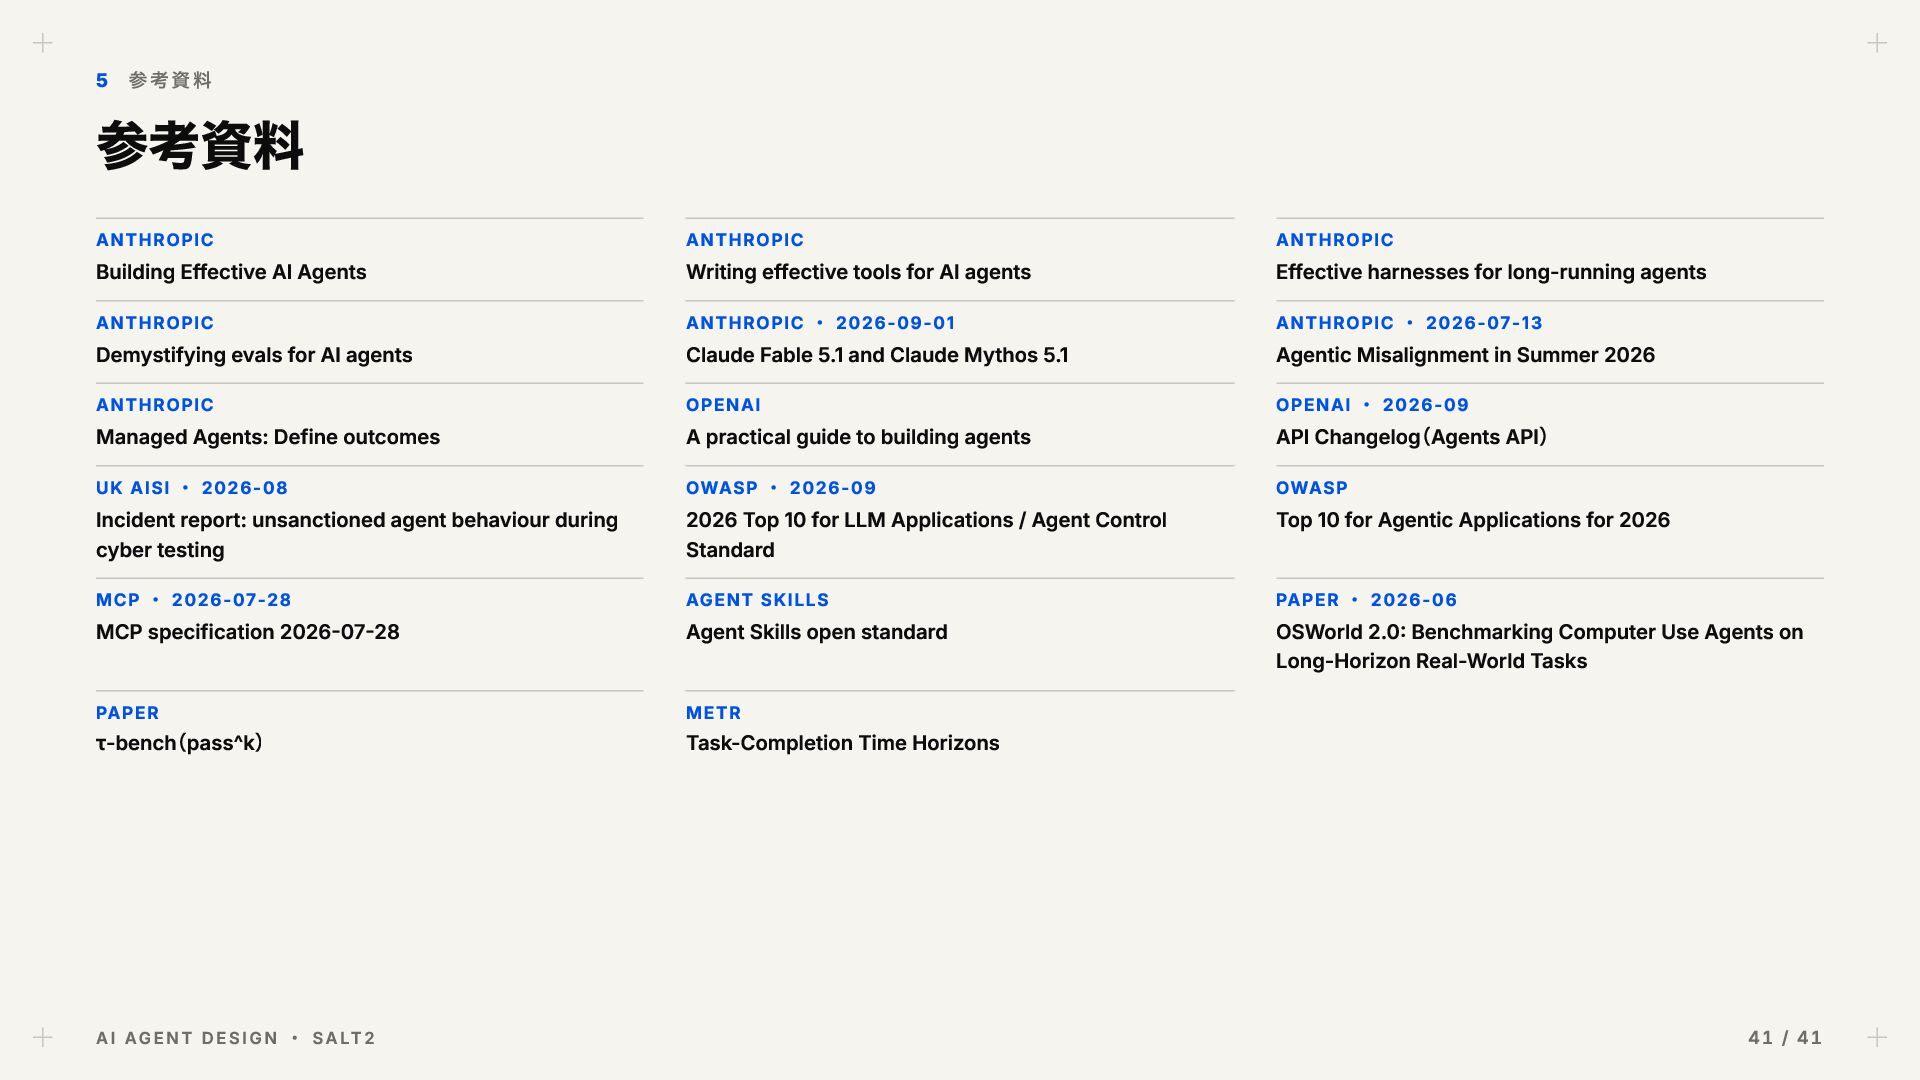
ANTHROPIC ・ 2026-07-13 ANTHROPIC OPENAI OPENAI ・ 2026-09 UK AISI ・ 2026-08 OWASP ・ 2026-09 OWASP MCP ・ 2026-07-28 AGENT SKILLS PAPER ・ 2026-06 PAPER METR Building Effective AI Agents Demystifying evals for AI agents Managed Agents: Define outcomes Incident report: unsanctioned agent behaviour during cyber testing MCP specification 2026-07-28 τ-bench(pass^k) A I AG E N T D E S I G N ・ S A LT 2 Writing effective tools for AI agents Claude Fable 5.1 and Claude Mythos 5.1 A practical guide to building agents 2026 Top 10 for LLM Applications / Agent Control Standard Agent Skills open standard Effective harnesses for long-running agents Agentic Misalignment in Summer 2026 API Changelog(Agents API) Top 10 for Agentic Applications for 2026 OSWorld 2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks Task-Completion Time Horizons 41 / 41


 salt2
 hiroakihamada
 trycycle
 naospon
 tagtag
 institudelelevage
 naokimuroki
 konakalab
 shucho0103
 takusamar
 jnunemaker
 gurzu
 axbom
 inesmontani
 danielanewman
 aleyda
 jonrohan
 shpigford
 palkan
 soudai
 hannesfritz