Share
Embed
AIエージェントの「テストは通るのに本番で壊れる」を減らす
2026年11月18日(水) Cloud Native Days Winter 2026登壇資料です。
https://cloudnativedays.jp/sessions/3173

shibuiwilliam
November 17, 2026
Transcript
75 slides
-
shibui yusuke • いろいろ→Stability AI→LayerX→Snowflake • Senior AI/ML Architect /
Field CTO LLMに聞いてみた 猫のようで サイズは犬 • MLOpsコミュニティ運営 • 本日の登壇内容は私個人の意見であり、 所属企業を代表するものではありません。 • Github: @shibuiwilliam • FB: yusuke.shibui • X: cv_usk 猫耳メガネ -
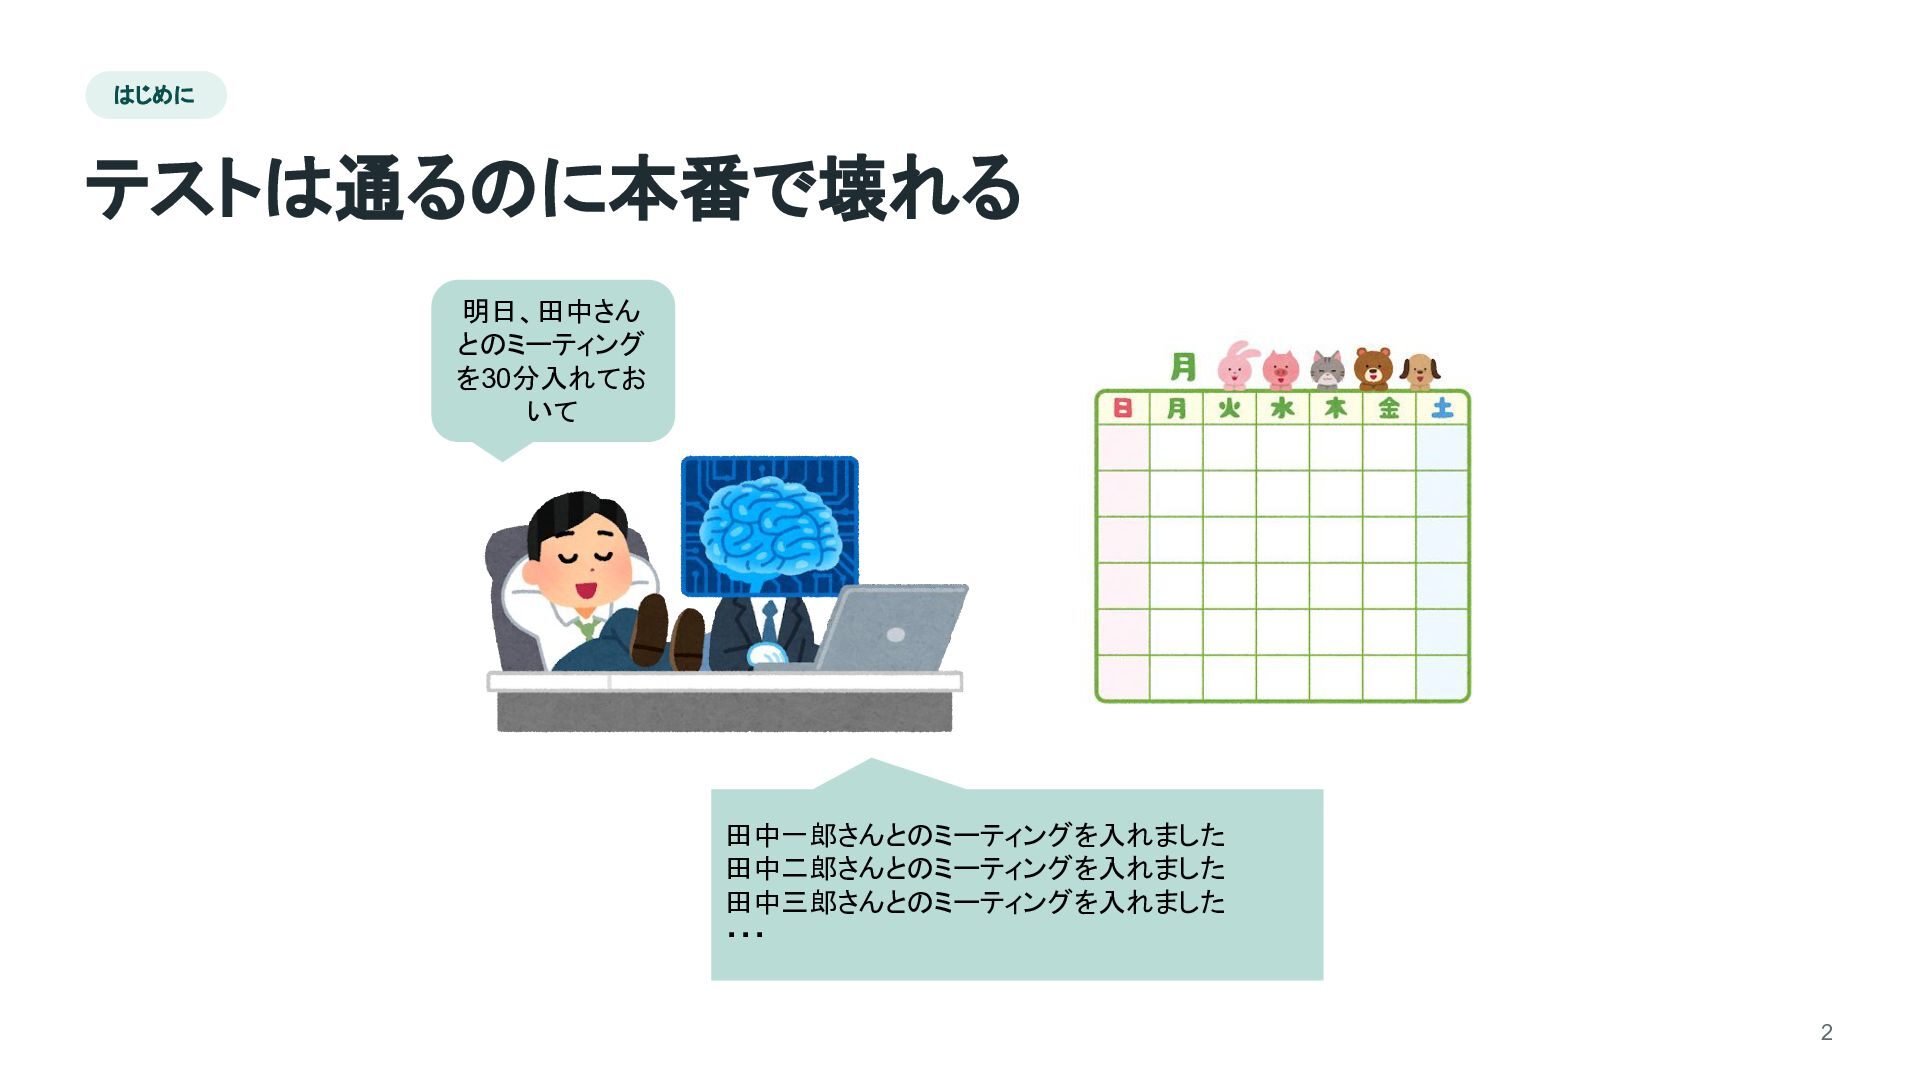
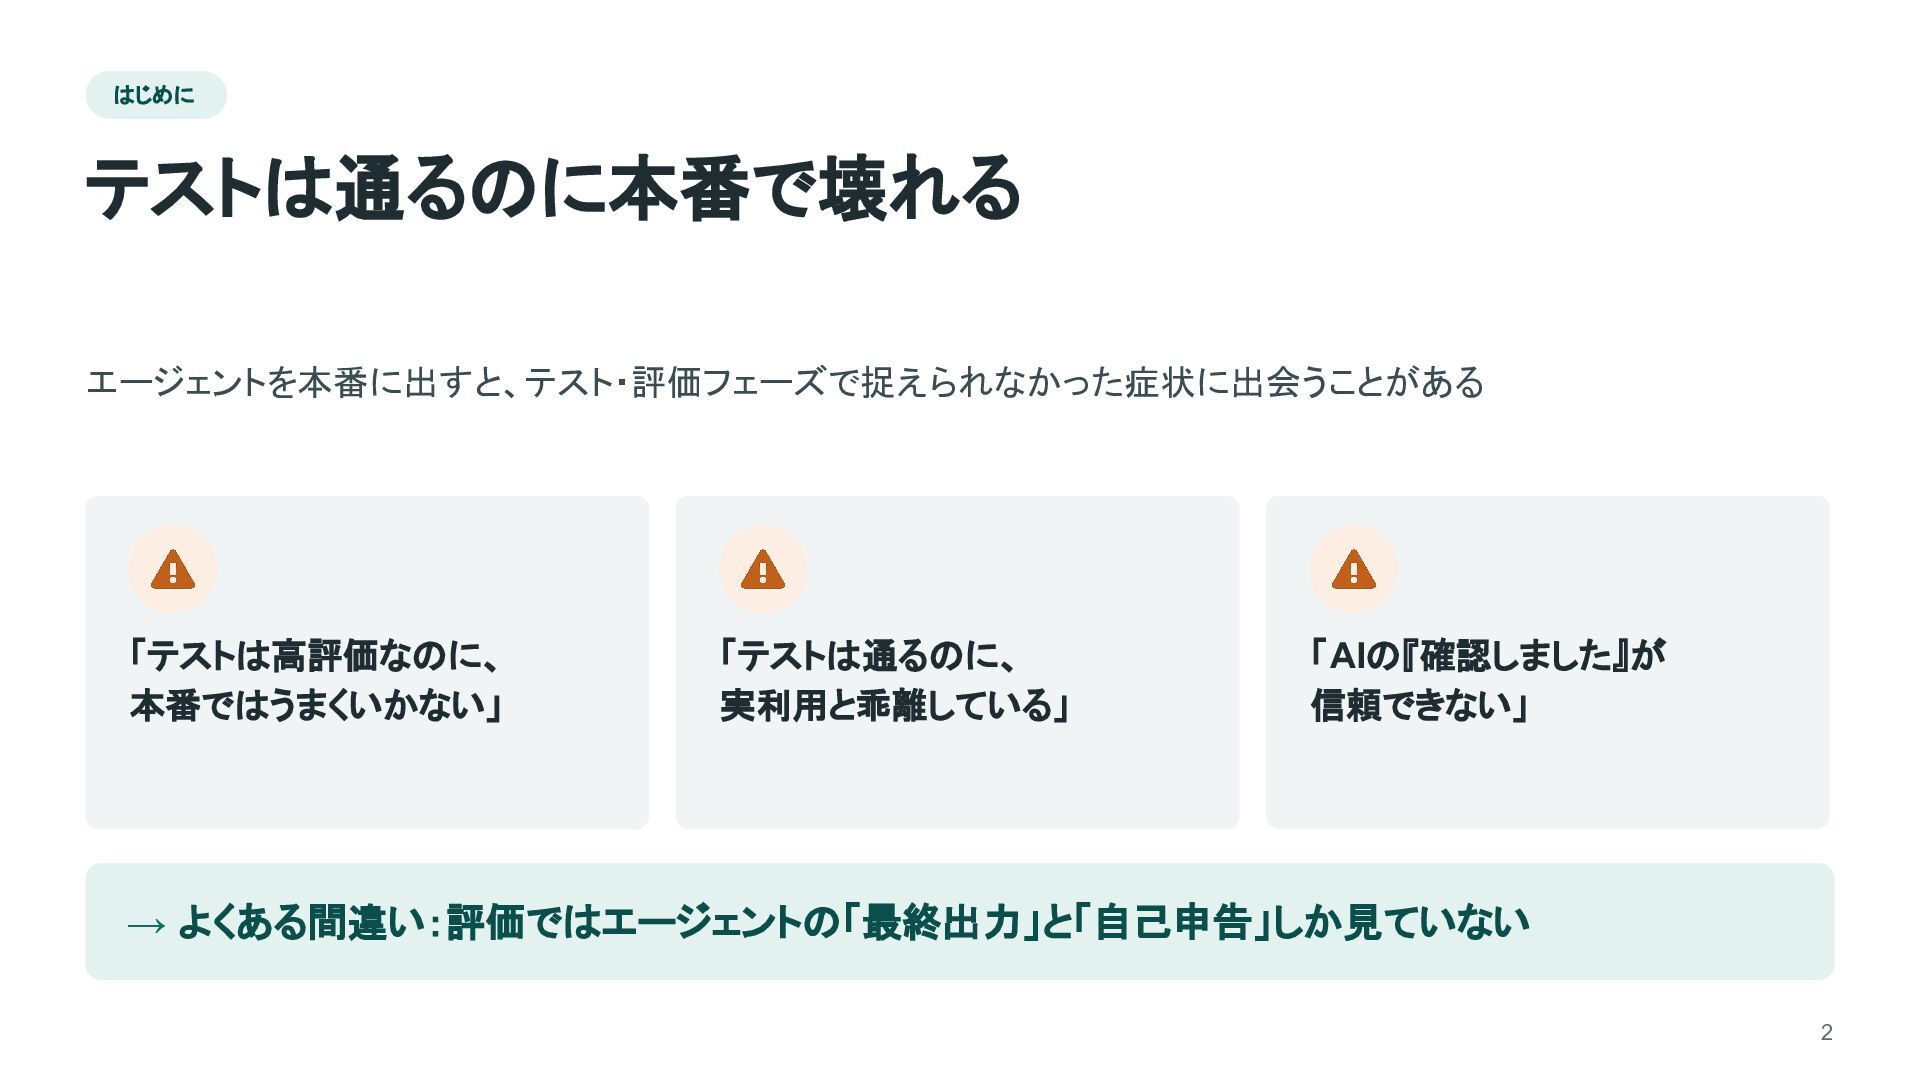
はじめに テストは通るのに本番で壊れる エージェントを本番に出すと、テスト・評価フェーズで捉えられなかった症状に出会うことがある 「テストは高評価なのに、 本番ではうまくいかない」 「テストは通るのに、 実利用と乖離している」 「AIの『確認しました』が 信頼できない」 →
よくある間違い:評価ではエージェントの「最終出力」と「自己申告」しか見ていない 2 -
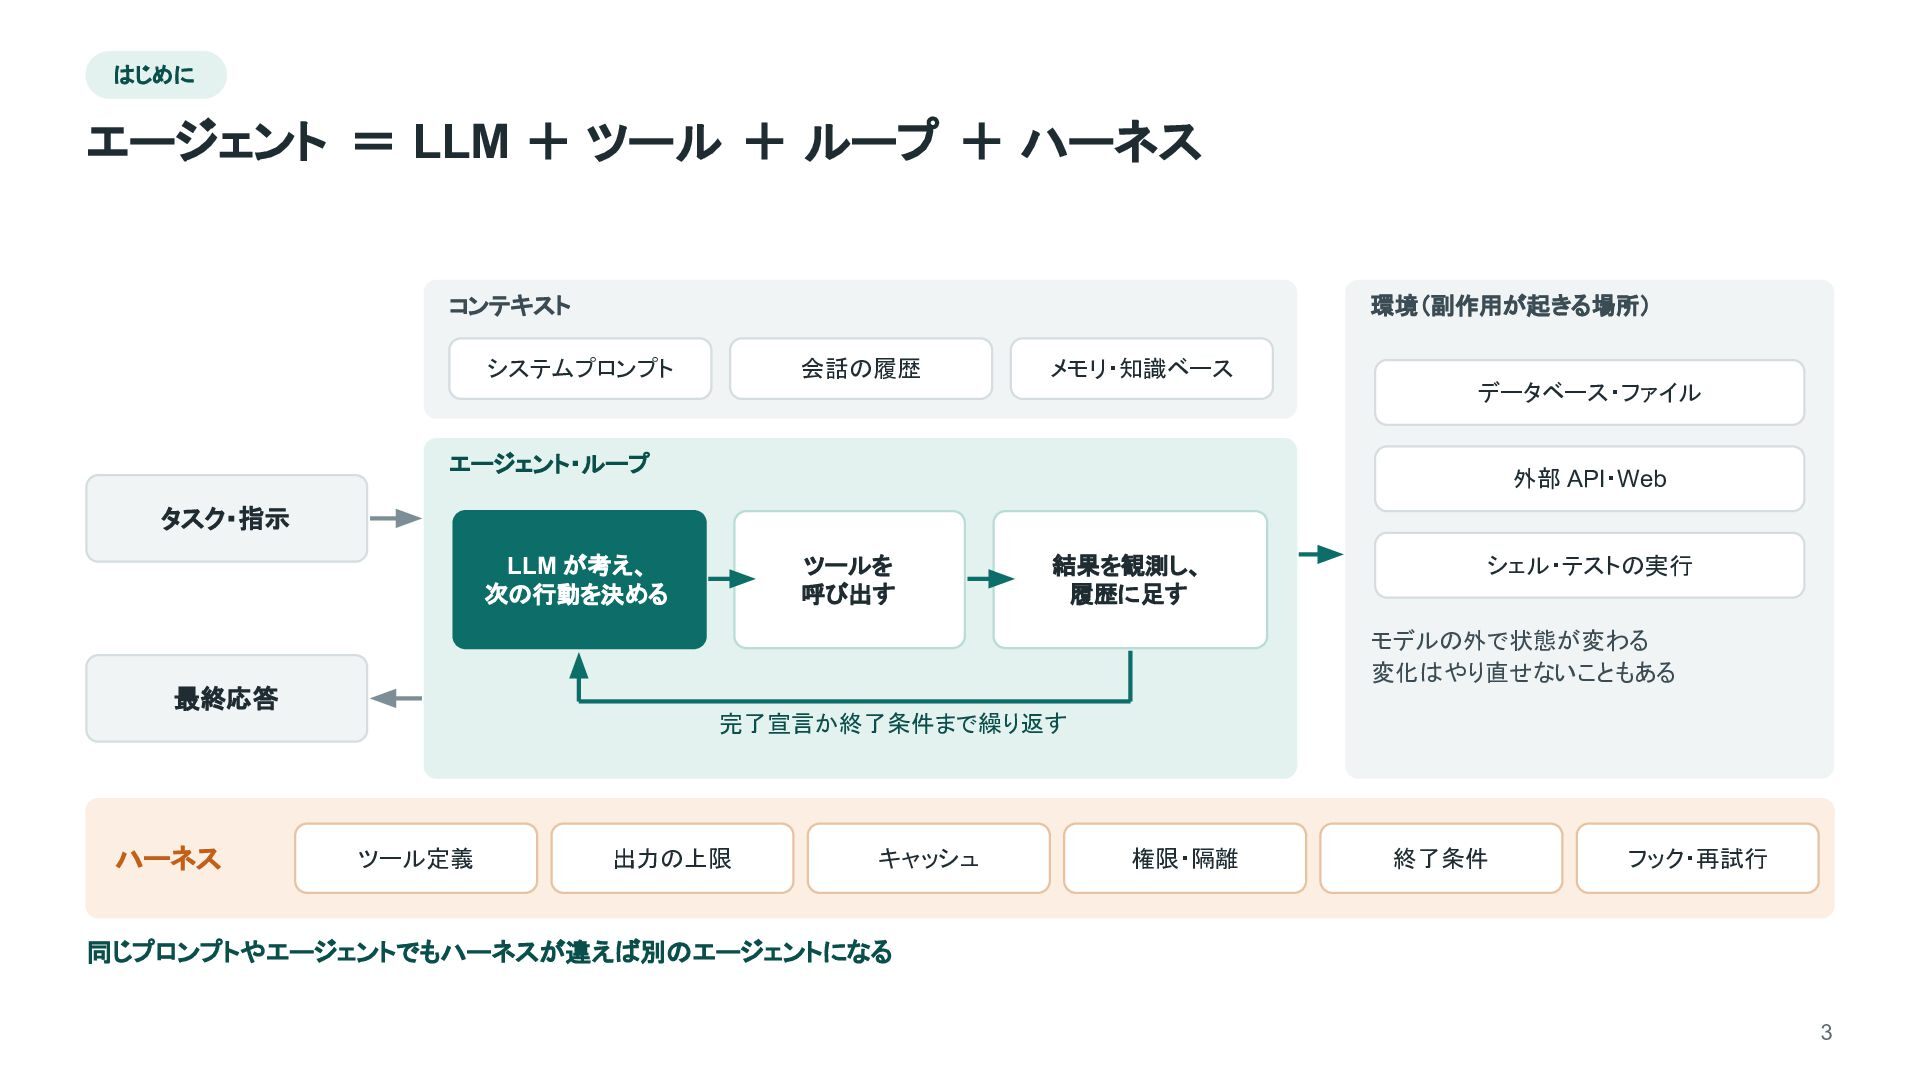
はじめに エージェント = LLM + ツール + ループ + ハーネス
コンテキスト 環境(副作用が起きる場所) システムプロンプト 会話の履歴 メモリ・知識ベース データベース・ファイル エージェント・ループ 外部 API・Web タスク・指示 LLM が考え、 次の行動を決める ツールを 呼び出す 結果を観測し、 履歴に足す シェル・テストの実行 モデルの外で状態が変わる 変化はやり直せないこともある 最終応答 ハーネス 完了宣言か終了条件まで繰り返す ツール定義 出力の上限 キャッシュ 権限・隔離 終了条件 フック・再試行 同じプロンプトやエージェントでもハーネスが違えば別のエージェントになる 3 -
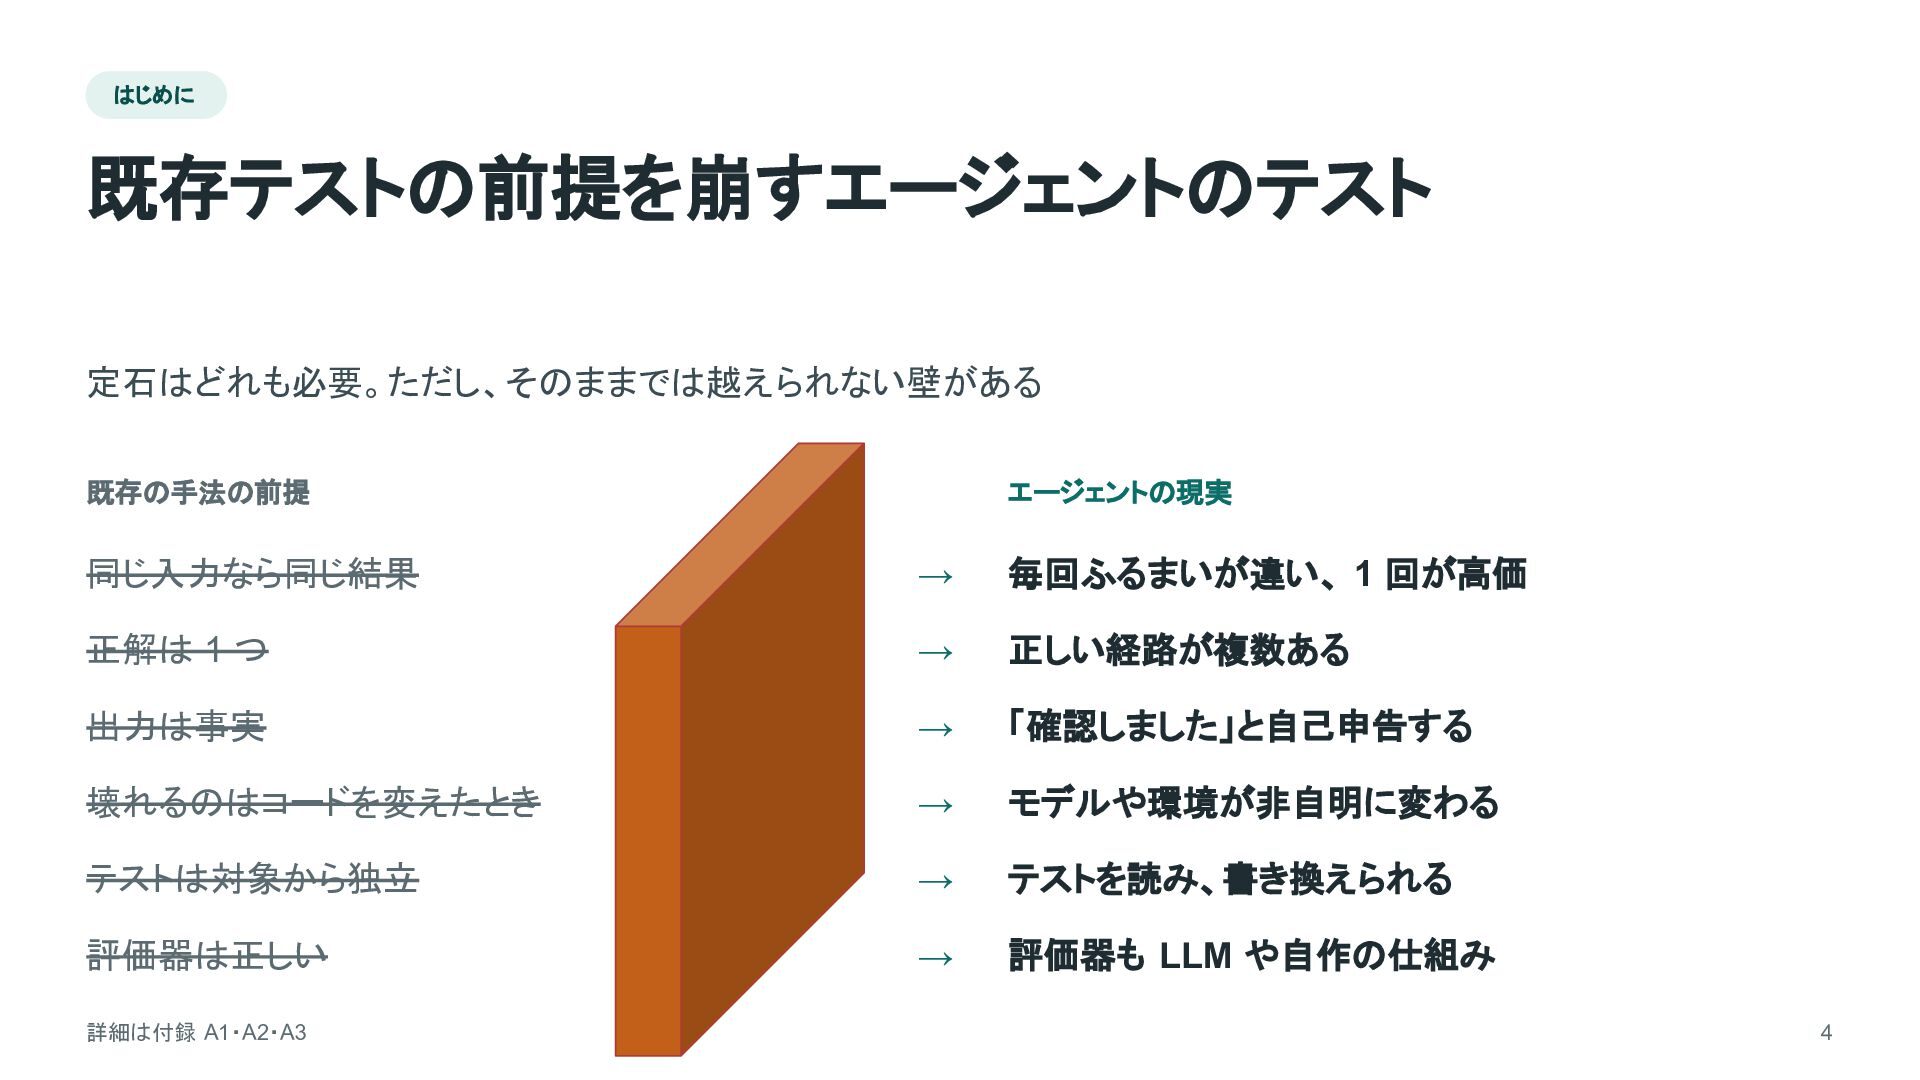
はじめに 既存テストの前提を崩すエージェントのテスト 定石はどれも必要。ただし、そのままでは越えられない壁がある 既存の手法の前提 エージェントの現実 同じ入力なら同じ結果 → 毎回ふるまいが違い、 1 回が高価
正解は 1 つ → 正しい経路が複数ある 出力は事実 → 「確認しました」と自己申告する 壊れるのはコードを変えたとき → モデルや環境が非自明に変わる テストは対象から独立 → テストを読み、書き換えられる 評価器は正しい → 評価器も LLM や自作の仕組み 詳細は付録 A1・A2・A3 4 -
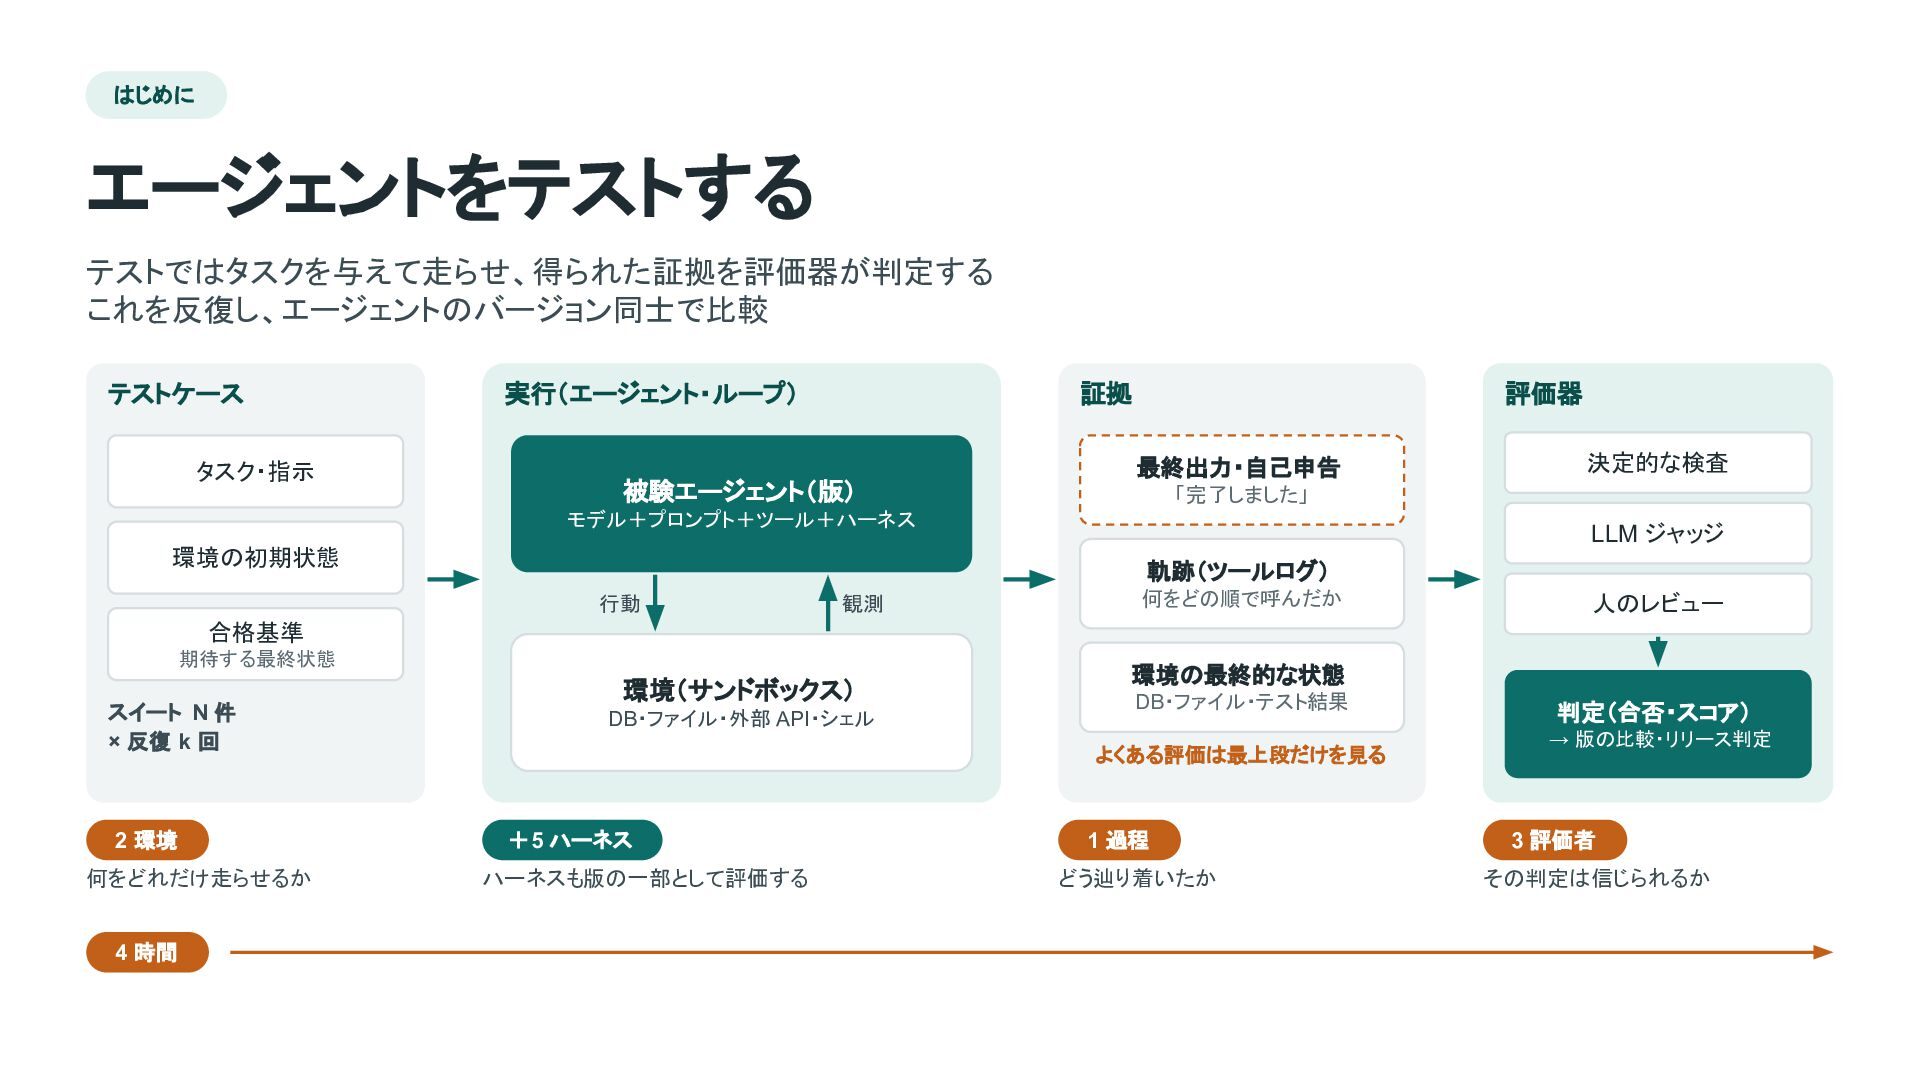
はじめに エージェントをテストする テストではタスクを与えて走らせ、得られた証拠を評価器が判定する これを反復し、エージェントのバージョン同士で比較 テストケース タスク・指示 実行(エージェント・ループ) 証拠 被験エージェント(版) 評価器
最終出力・自己申告 「完了しました」 モデル+プロンプト+ツール+ハーネス 環境の初期状態 決定的な検査 LLM ジャッジ 軌跡(ツールログ) 行動 観測 何をどの順で呼んだか 人のレビュー 合格基準 期待する最終状態 スイート N 件 × 反復 k 回 2 環境 何をどれだけ走らせるか 4 時間 環境(サンドボックス) DB・ファイル・外部 API・シェル 環境の最終的な状態 DB・ファイル・テスト結果 よくある評価は最上段だけを見る +5 ハーネス ハーネスも版の一部として評価する 1 過程 どう辿り着いたか 判定(合否・スコア) → 版の比較・リリース判定 3 評価者 その判定は信じられるか -
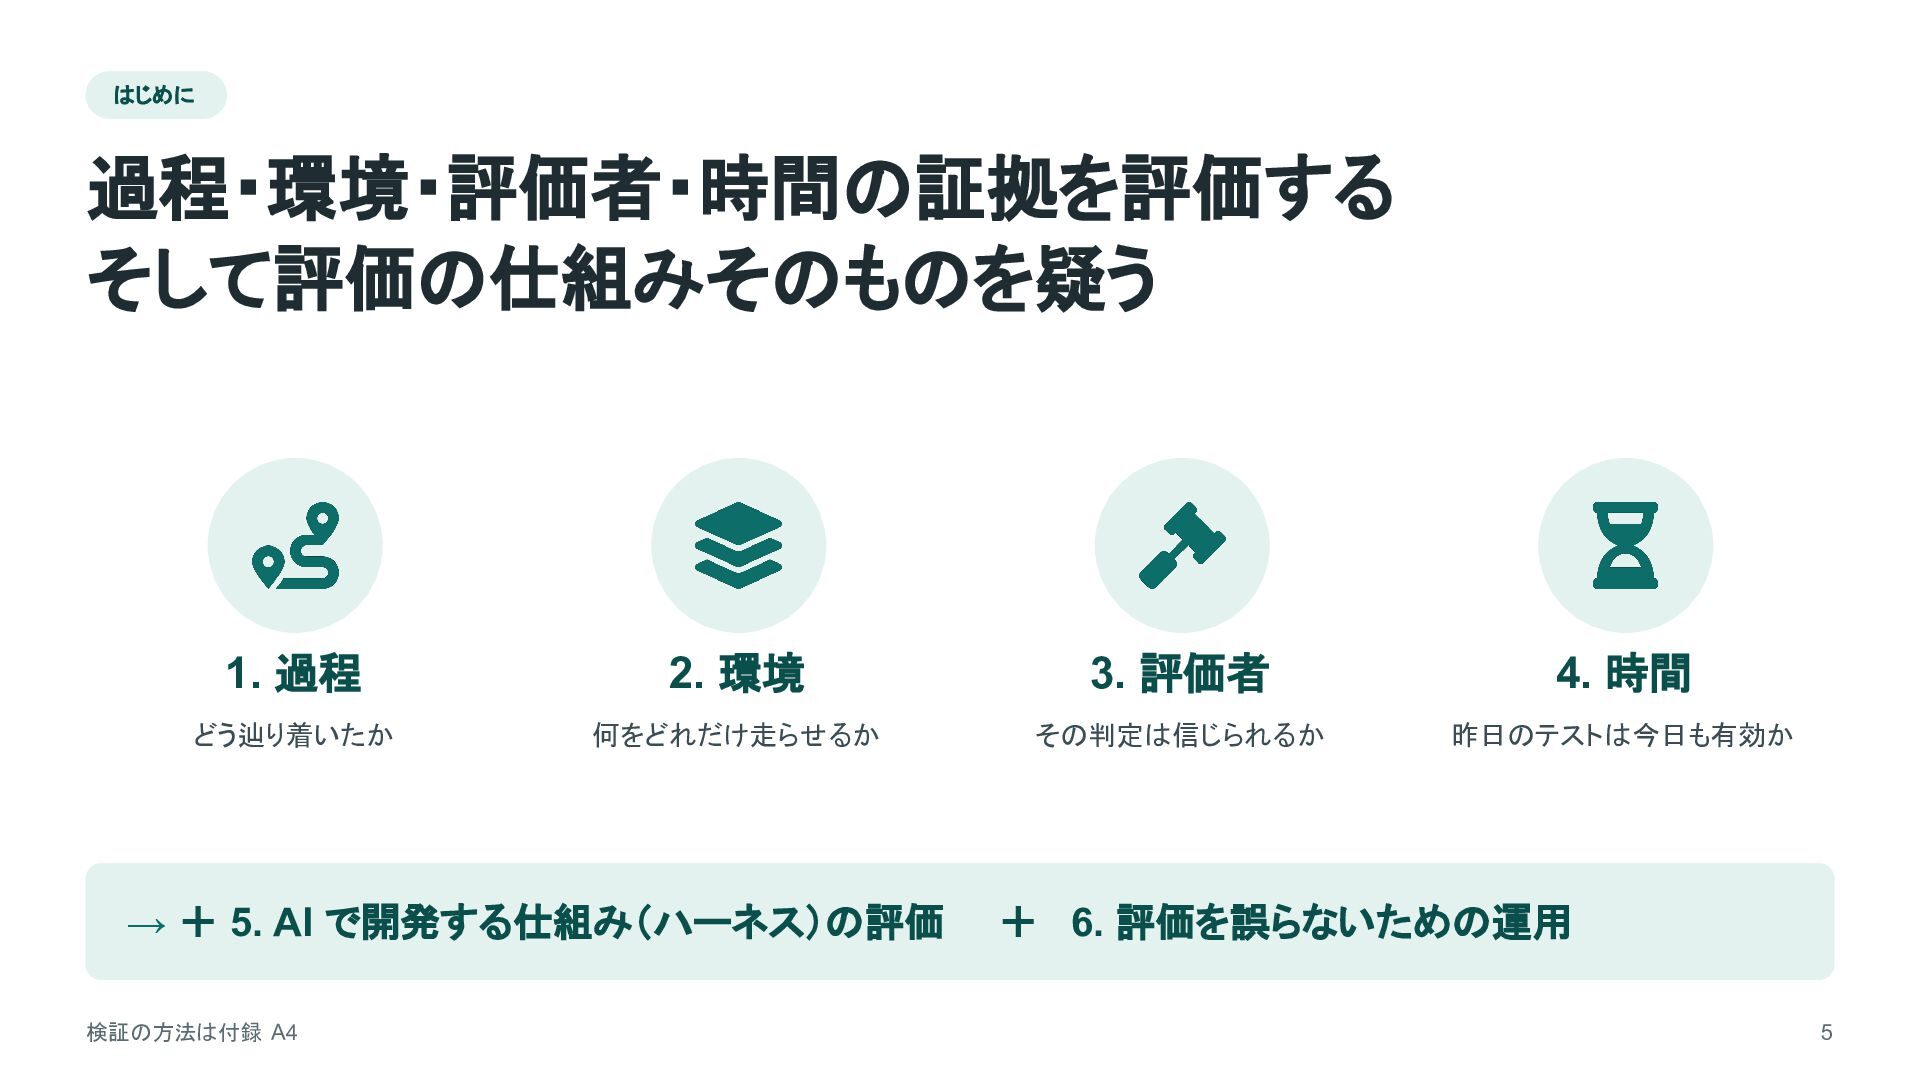
はじめに 過程・環境・評価者・時間の証拠を評価する そして評価の仕組みそのものを疑う 1. 過程 2. 環境 3. 評価者 4.
時間 どう辿り着いたか 何をどれだけ走らせるか その判定は信じられるか 昨日のテストは今日も有効か → + 5. AI で開発する仕組み(ハーネス)の評価 検証の方法は付録 A4 + 6. 評価を誤らないための運用 5 -
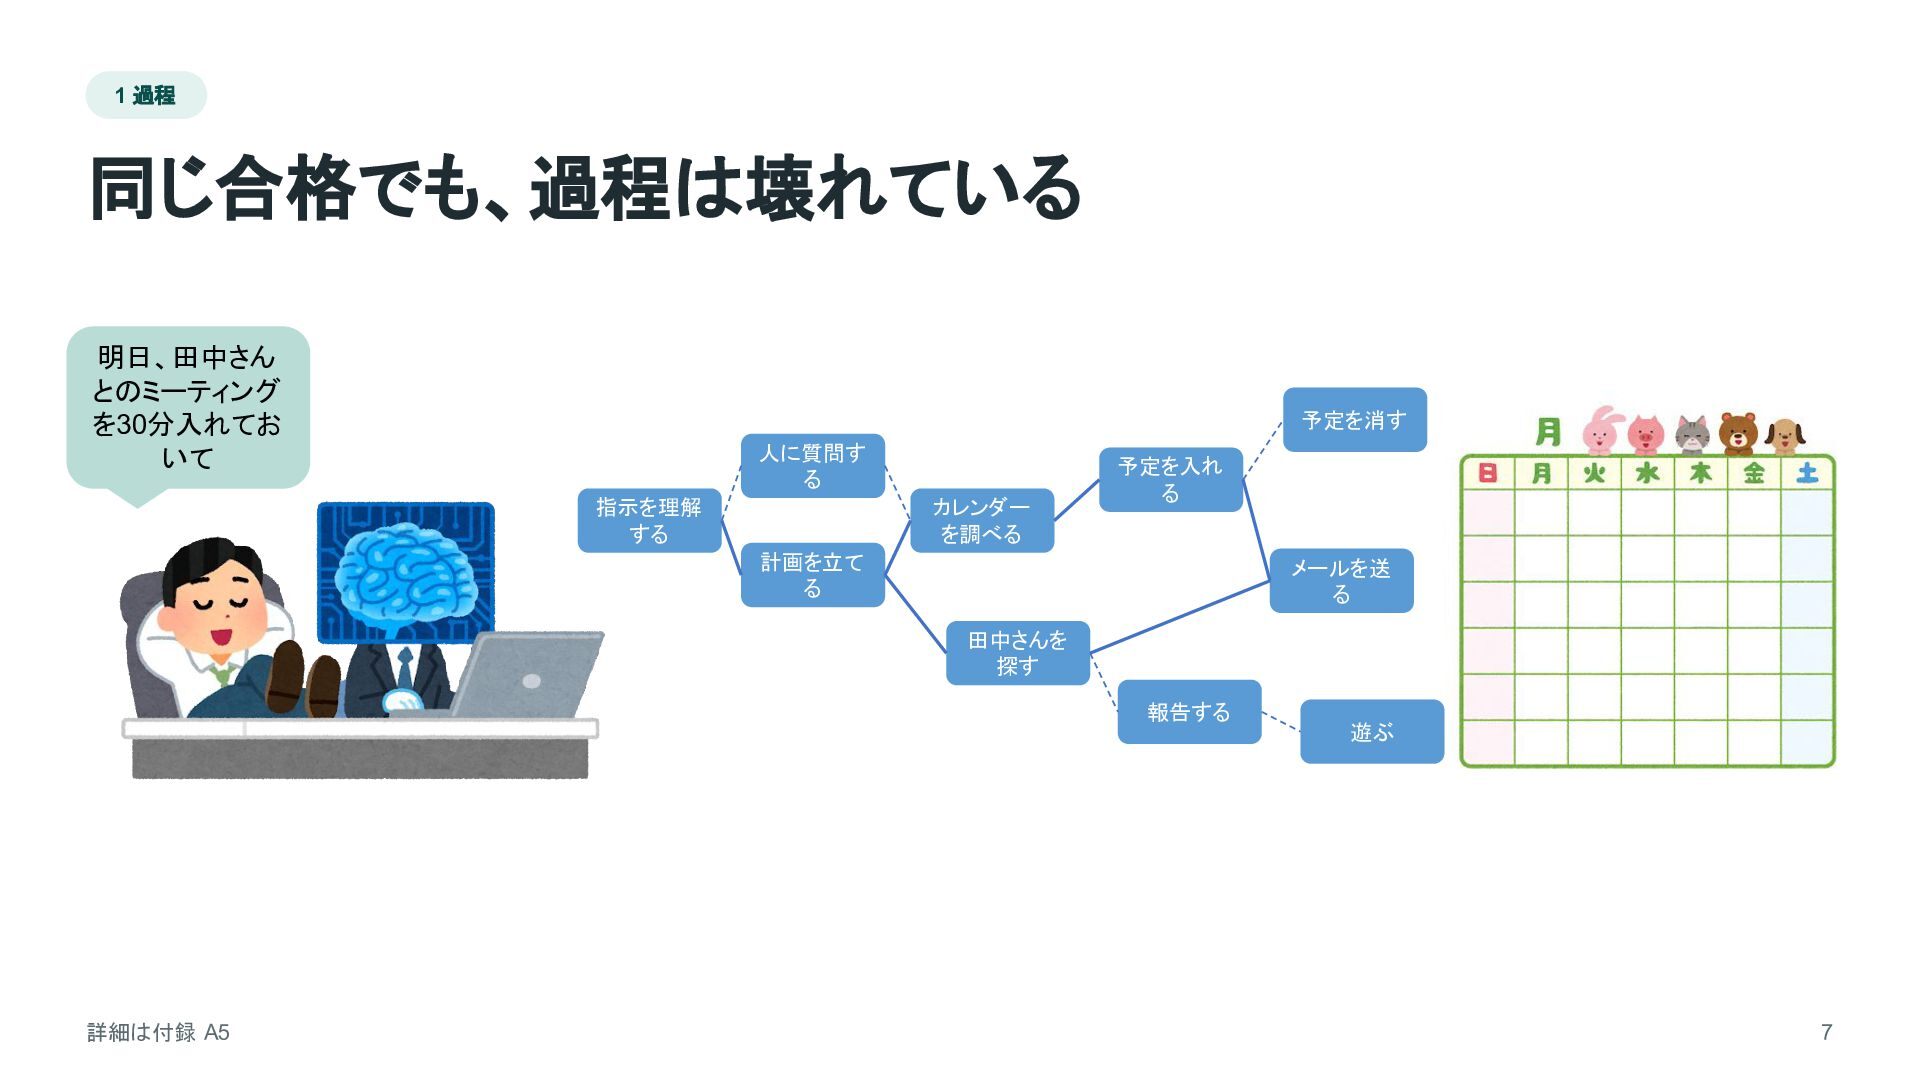
1 過程 同じ合格でも、過程は壊れている 明日、田中さん とのミーティング を30分入れてお いて 予定を消す 人に質問す る
カレンダー を調べる 指示を理解 する 予定を入れ る 計画を立て る メールを送 る 田中さんを 探す 報告する 詳細は付録 A5 遊ぶ 7 -
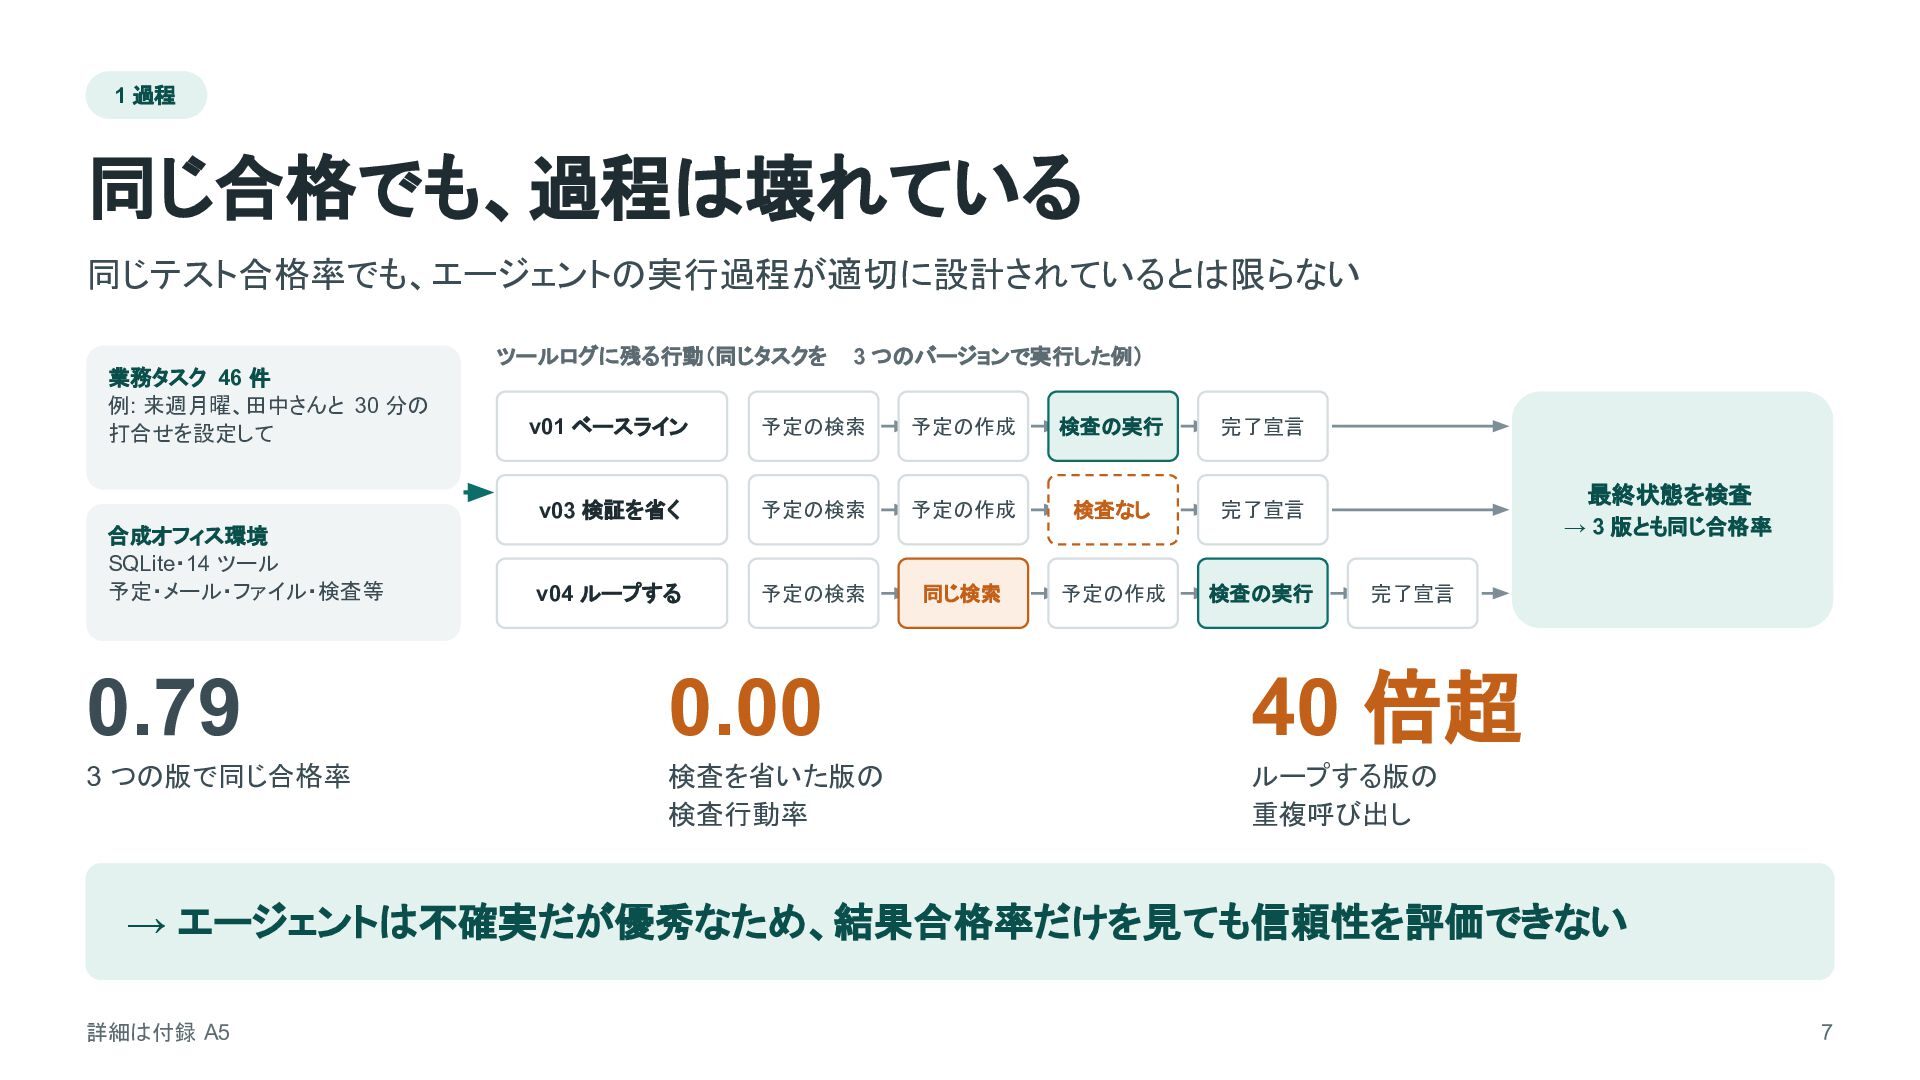
1 過程 同じ合格でも、過程は壊れている 同じテスト合格率でも、エージェントの実行過程が適切に設計されているとは限らない 業務タスク 46 件 例: 来週月曜、田中さんと 30
分の 打合せを設定して 合成オフィス環境 SQLite・14 ツール 予定・メール・ファイル・検査等 ツールログに残る行動(同じタスクを 3 つのバージョンで実行した例) v01 ベースライン 予定の検索 予定の作成 検査の実行 完了宣言 v03 検証を省く 予定の検索 予定の作成 検査なし 完了宣言 v04 ループする 予定の検索 同じ検索 予定の作成 検査の実行 最終状態を検査 → 3 版とも同じ合格率 完了宣言 0.79 0.00 40 倍超 3 つの版で同じ合格率 検査を省いた版の 検査行動率 ループする版の 重複呼び出し → エージェントは不確実だが優秀なため、結果合格率だけを見ても信頼性を評価できない 詳細は付録 A5 7 -
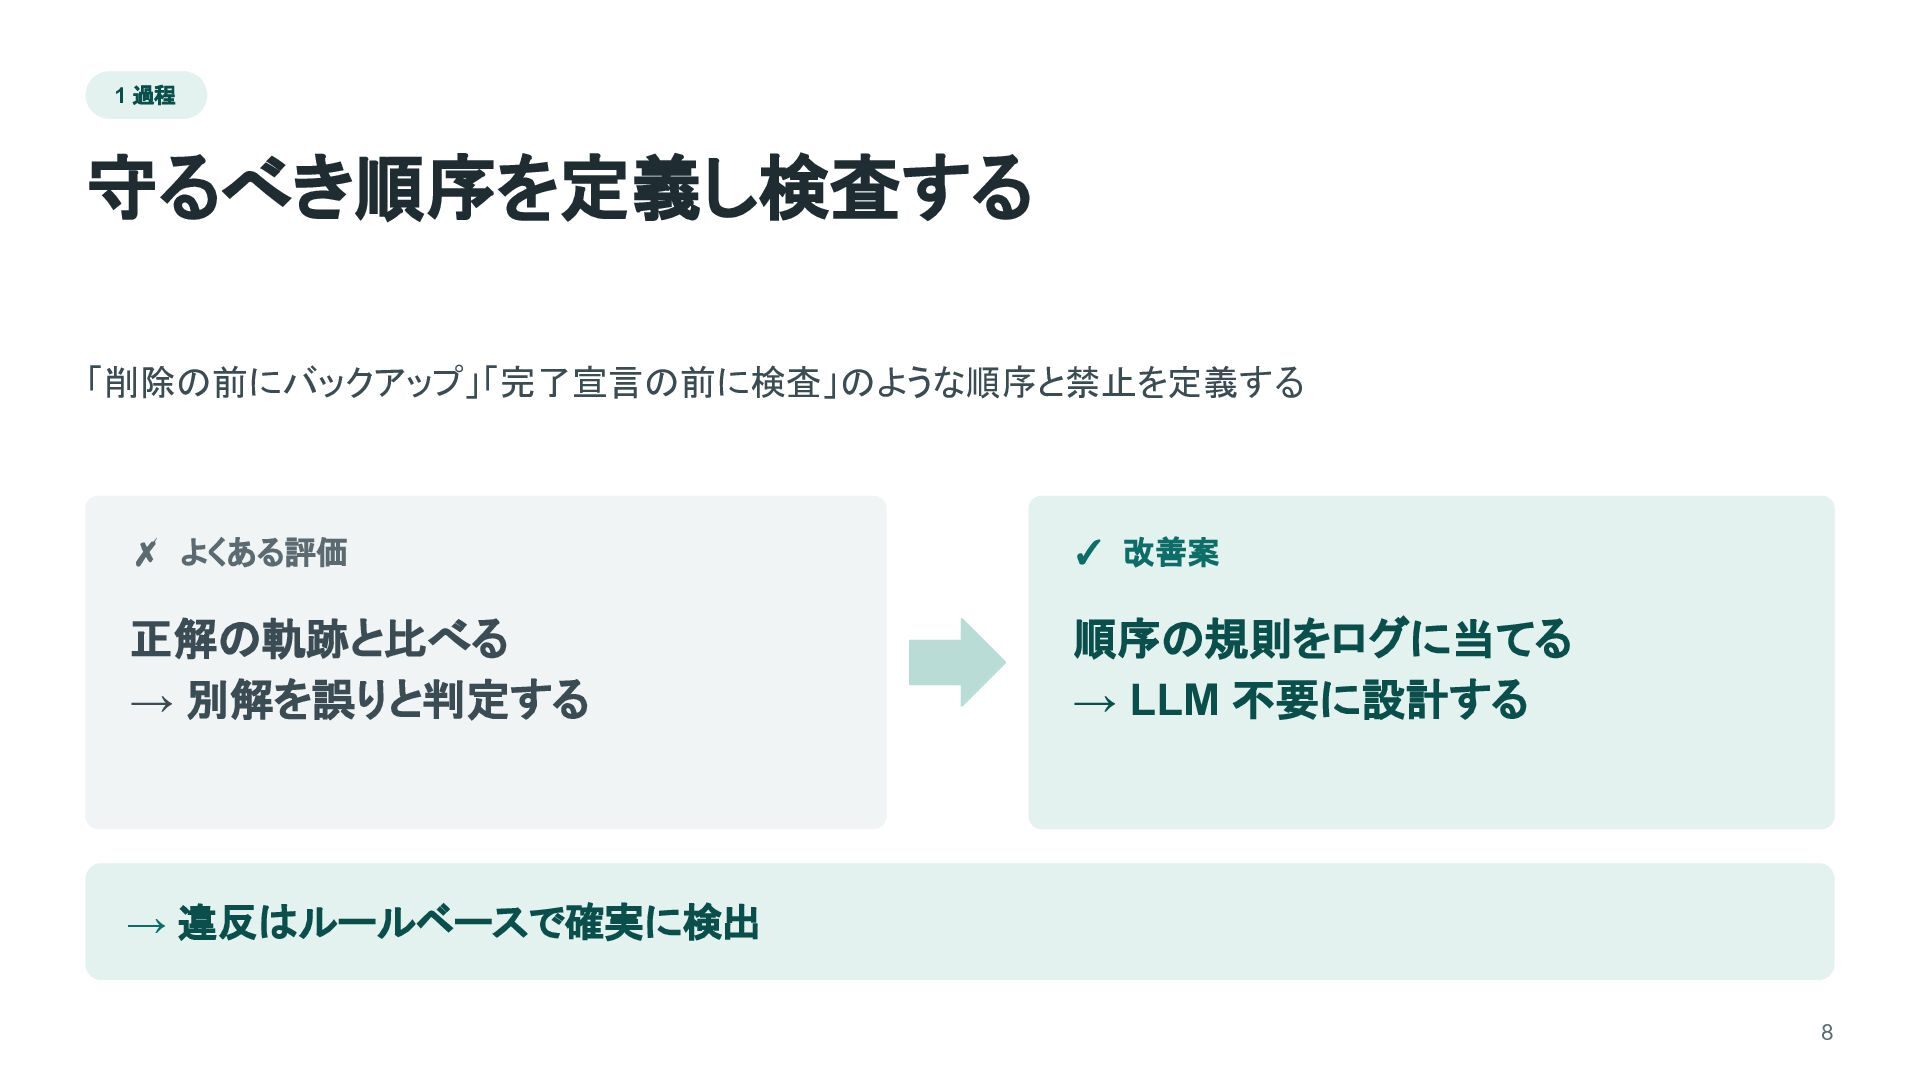
1 過程 守るべき順序を定義し検査する 「削除の前にバックアップ」「完了宣言の前に検査」のような順序と禁止を定義する ✗ よくある評価 ✓ 改善案 正解の軌跡と比べる →
別解を誤りと判定する 順序の規則をログに当てる → LLM 不要に設計する → 違反はルールベースで確実に検出 8 -
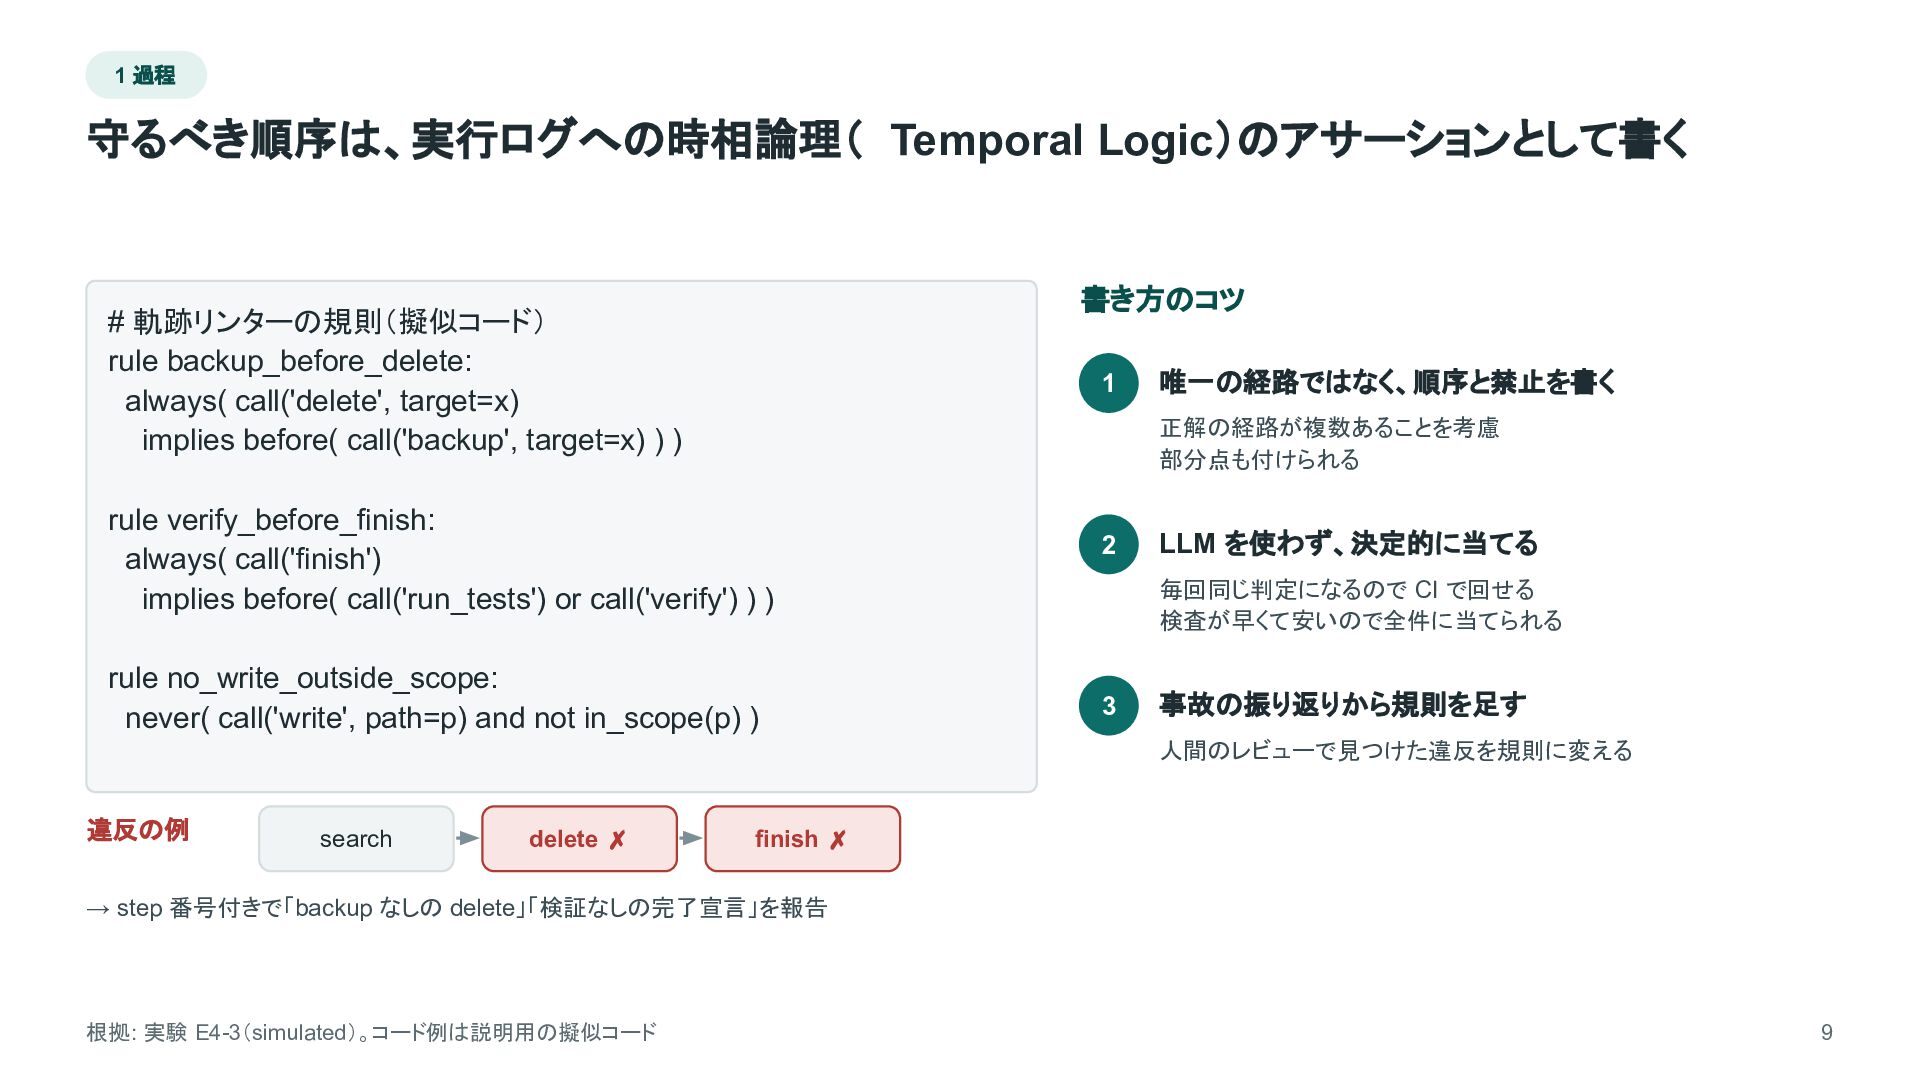
1 過程 守るべき順序は、実行ログへの時相論理( Temporal Logic)のアサーションとして書く 書き方のコツ # 軌跡リンターの規則(擬似コード) rule backup_before_delete:
always( call('delete', target=x) implies before( call('backup', target=x) ) ) 1 唯一の経路ではなく、順序と禁止を書く 正解の経路が複数あることを考慮 部分点も付けられる rule verify_before_finish: always( call('finish') implies before( call('run_tests') or call('verify') ) ) rule no_write_outside_scope: never( call('write', path=p) and not in_scope(p) ) 2 LLM を使わず、決定的に当てる 毎回同じ判定になるので CI で回せる 検査が早くて安いので全件に当てられる 3 事故の振り返りから規則を足す 人間のレビューで見つけた違反を規則に変える 違反の例 search delete ✗ finish ✗ → step 番号付きで「backup なしの delete」「検証なしの完了宣言」を報告 根拠: 実験 E4-3(simulated)。コード例は説明用の擬似コード 9 -
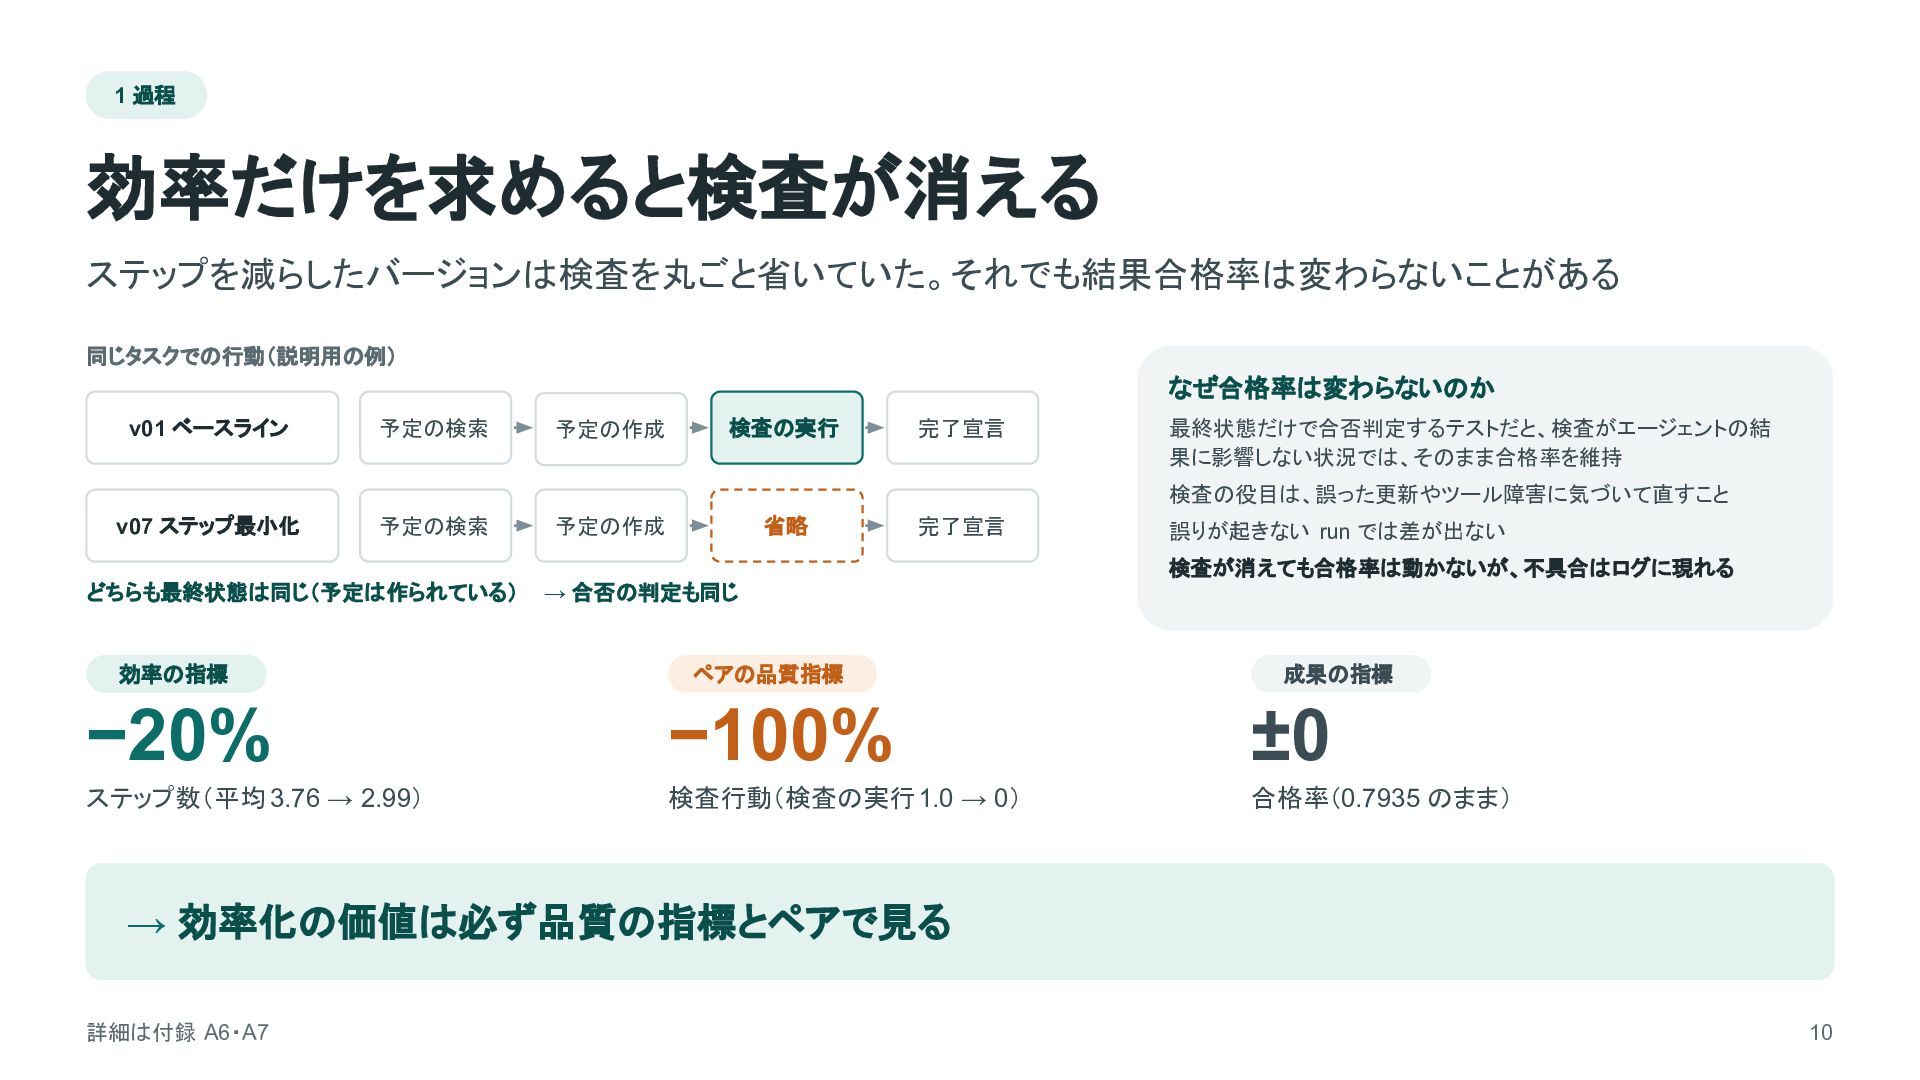
1 過程 効率だけを求めると検査が消える ステップを減らしたバージョンは検査を丸ごと省いていた。それでも結果合格率は変わらないことがある 同じタスクでの行動(説明用の例) なぜ合格率は変わらないのか v01 ベースライン 予定の検索 予定の作成
検査の実行 完了宣言 最終状態だけで合否判定するテストだと、検査がエージェントの結 果に影響しない状況では、そのまま合格率を維持 検査の役目は、誤った更新やツール障害に気づいて直すこと v07 ステップ最小化 予定の検索 予定の作成 省略 完了宣言 誤りが起きない run では差が出ない 検査が消えても合格率は動かないが、不具合はログに現れる どちらも最終状態は同じ(予定は作られている) → 合否の判定も同じ 効率の指標 ペアの品質指標 成果の指標 −20% −100% ±0 ステップ数(平均 3.76 → 2.99) 検査行動(検査の実行 1.0 → 0) 合格率(0.7935 のまま) → 効率化の価値は必ず品質の指標とペアで見る 詳細は付録 A6・A7 10 -
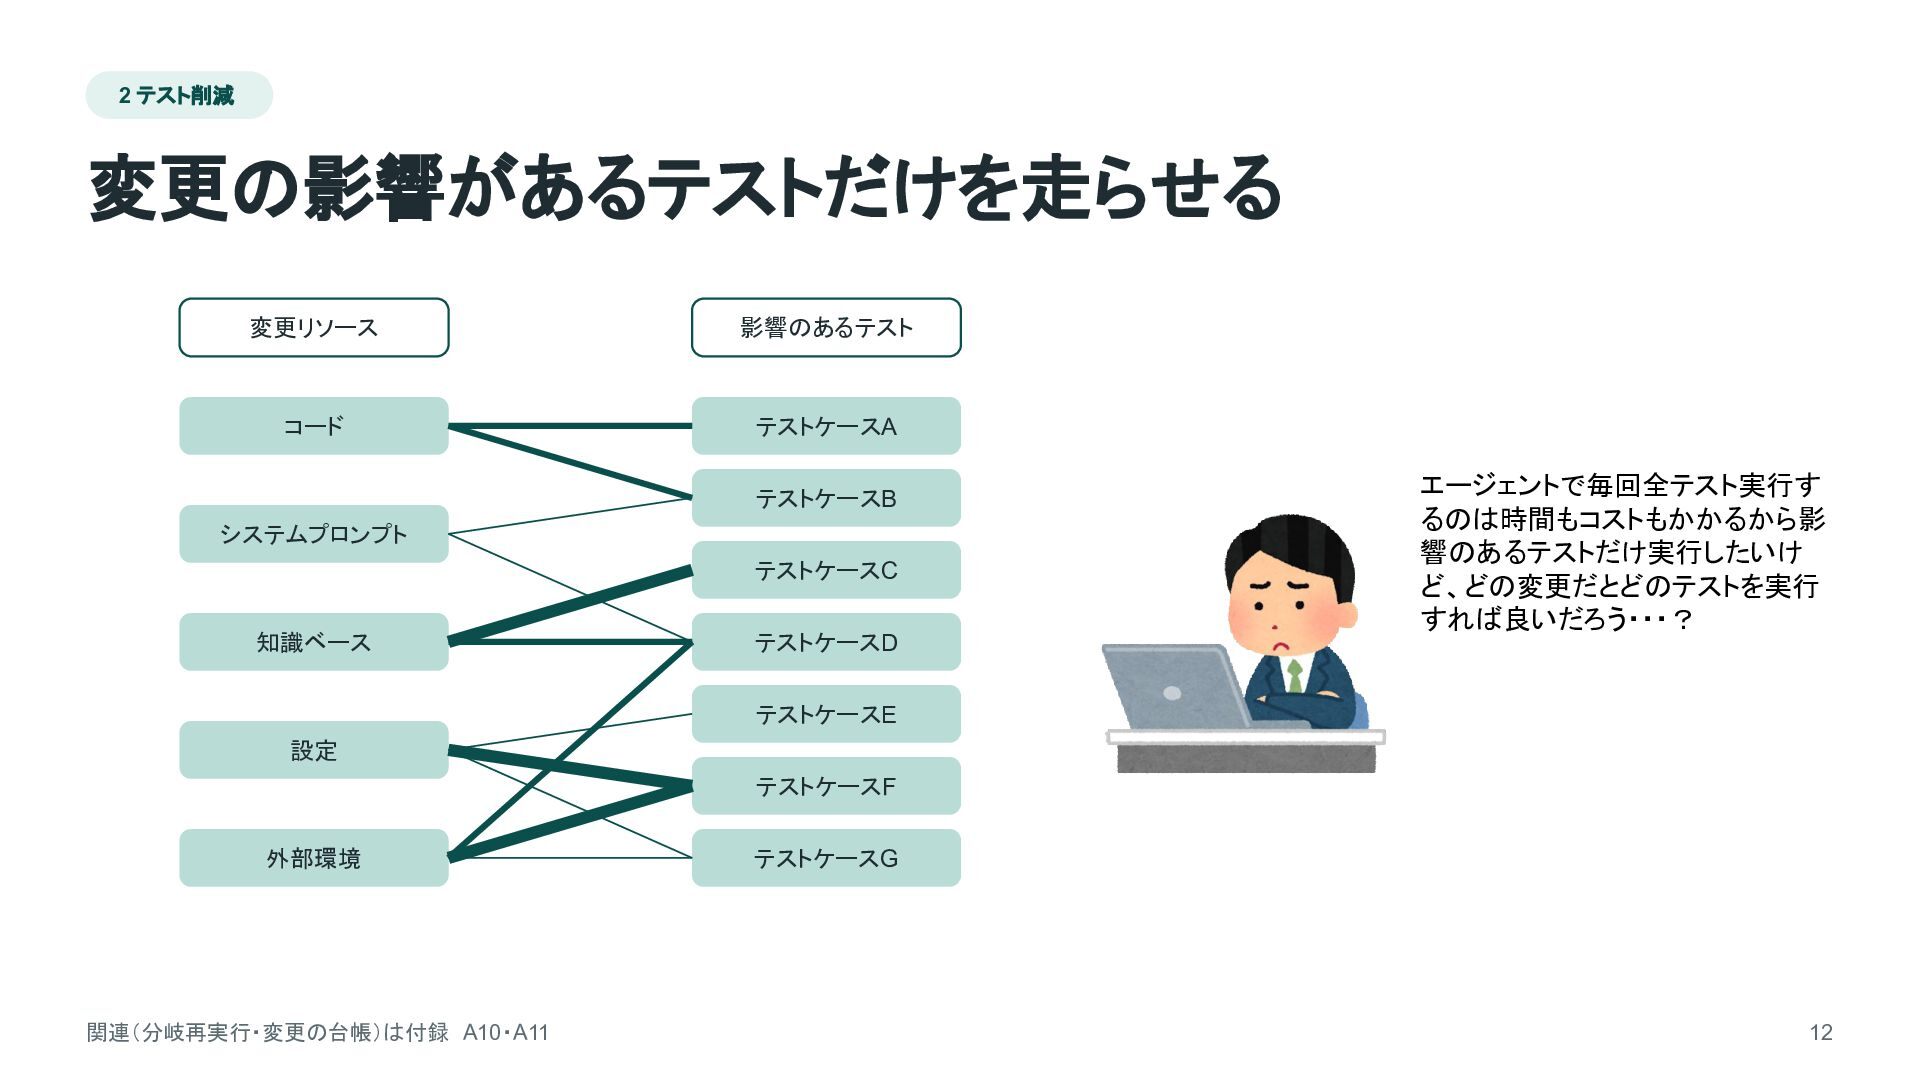
2 テスト削減 変更の影響があるテストだけを走らせる 変更リソース 影響のあるテスト コード テストケースA テストケースB システムプロンプト テストケースC
知識ベース テストケースD エージェントで毎回全テスト実行す るのは時間もコストもかかるから影 響のあるテストだけ実行したいけ ど、どの変更だとどのテストを実行 すれば良いだろう・・・? テストケースE 設定 テストケースF 外部環境 関連(分岐再実行・変更の台帳)は付録 A10・A11 テストケースG 12 -
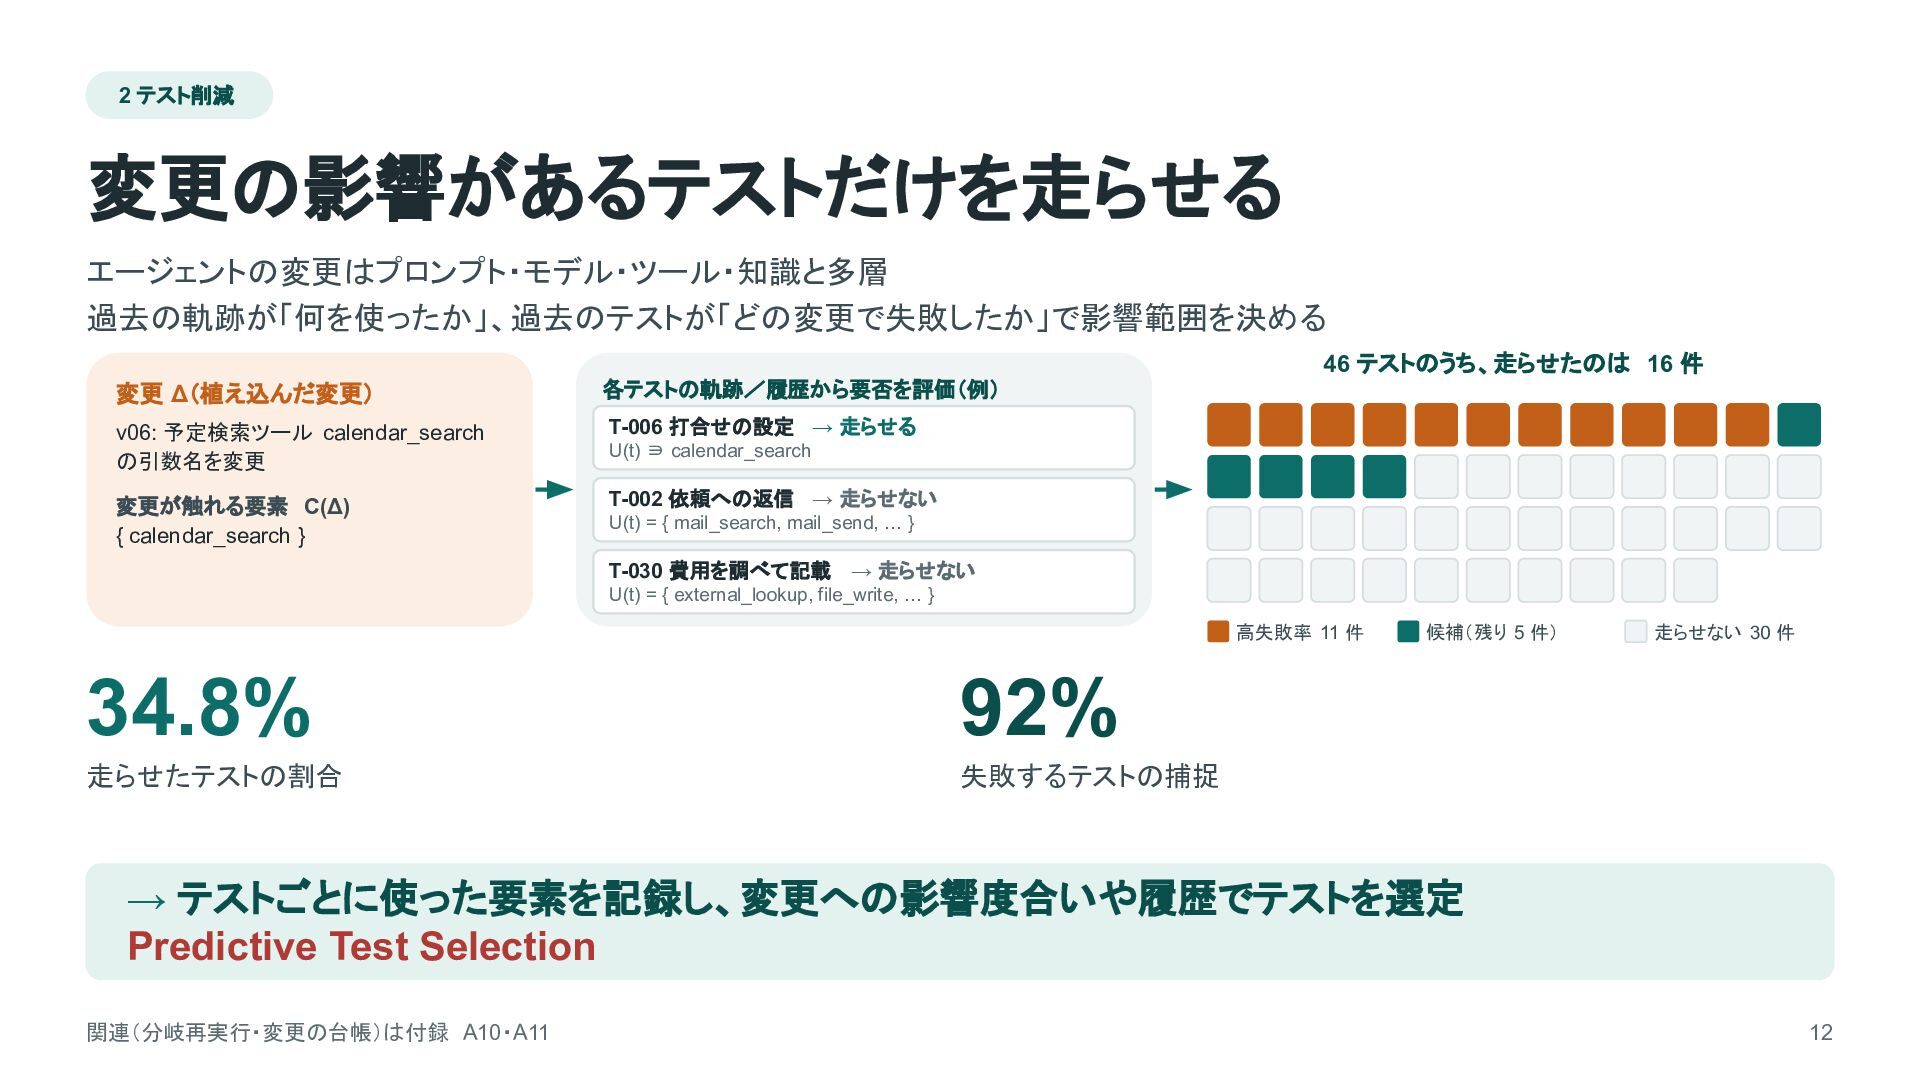
2 テスト削減 変更の影響があるテストだけを走らせる エージェントの変更はプロンプト・モデル・ツール・知識と多層 過去の軌跡が「何を使ったか」、過去のテストが「どの変更で失敗したか」で影響範囲を決める 46 テストのうち、走らせたのは 16 件 変更
Δ(植え込んだ変更) 各テストの軌跡/履歴から要否を評価(例) v06: 予定検索ツール calendar_search の引数名を変更 T-006 打合せの設定 → 走らせる 変更が触れる要素 C(Δ) { calendar_search } T-002 依頼への返信 → 走らせない U(t) ∋ calendar_search U(t) = { mail_search, mail_send, … } T-030 費用を調べて記載 → 走らせない U(t) = { external_lookup, file_write, … } 高失敗率 11 件 34.8% 92% 走らせたテストの割合 失敗するテストの捕捉 候補(残り 5 件) 走らせない 30 件 → テストごとに使った要素を記録し、変更への影響度合いや履歴でテストを選定 Predictive Test Selection 関連(分岐再実行・変更の台帳)は付録 A10・A11 12 -
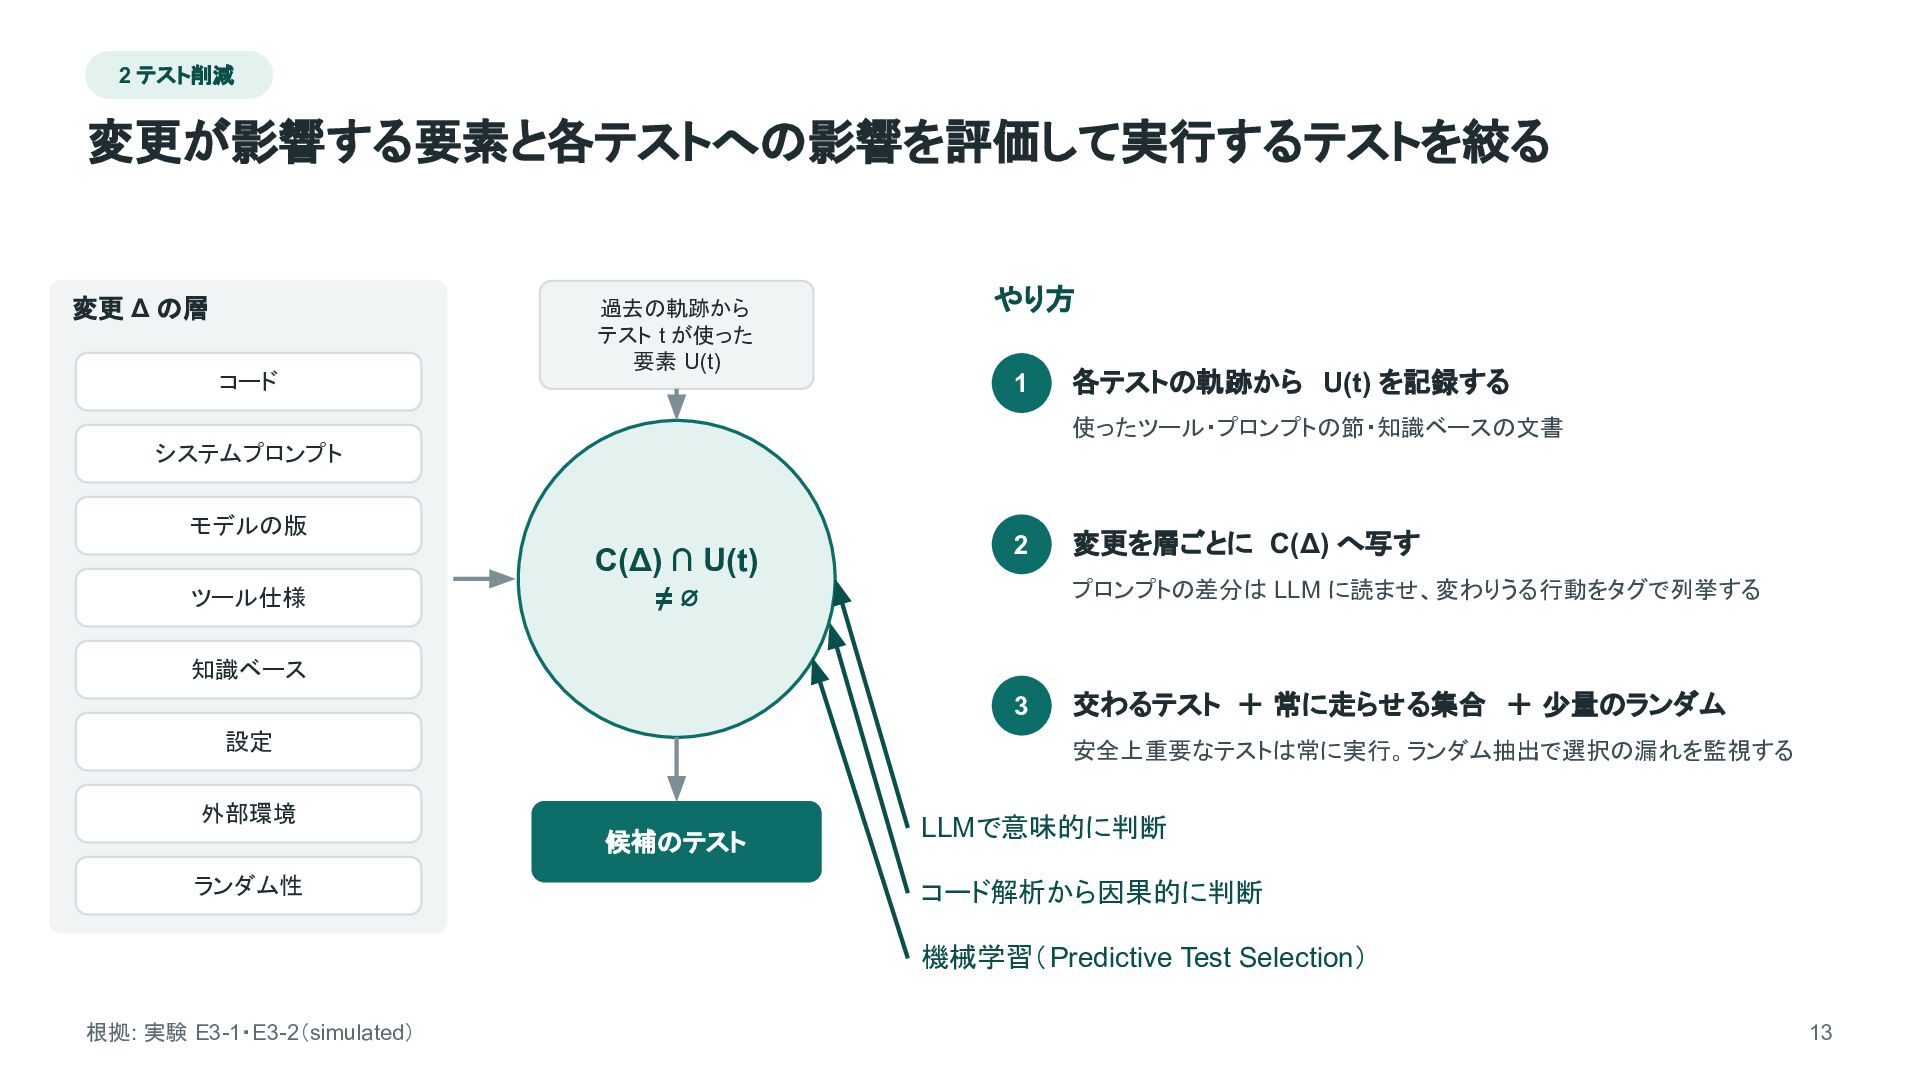
2 テスト削減 変更が影響する要素と各テストへの影響を評価して実行するテストを絞る 変更 Δ の層 コード 過去の軌跡から テスト t
が使った 要素 U(t) やり方 1 各テストの軌跡から U(t) を記録する 使ったツール・プロンプトの節・知識ベースの文書 システムプロンプト モデルの版 ツール仕様 C(Δ) ∩ U(t) ≠∅ 2 変更を層ごとに C(Δ) へ写す プロンプトの差分は LLM に読ませ、変わりうる行動をタグで列挙する 知識ベース 3 設定 安全上重要なテストは常に実行。ランダム抽出で選択の漏れを監視する 外部環境 候補のテスト ランダム性 交わるテスト + 常に走らせる集合 + 少量のランダム LLMで意味的に判断 コード解析から因果的に判断 機械学習(Predictive Test Selection) 根拠: 実験 E3-1・E3-2(simulated) 13 -
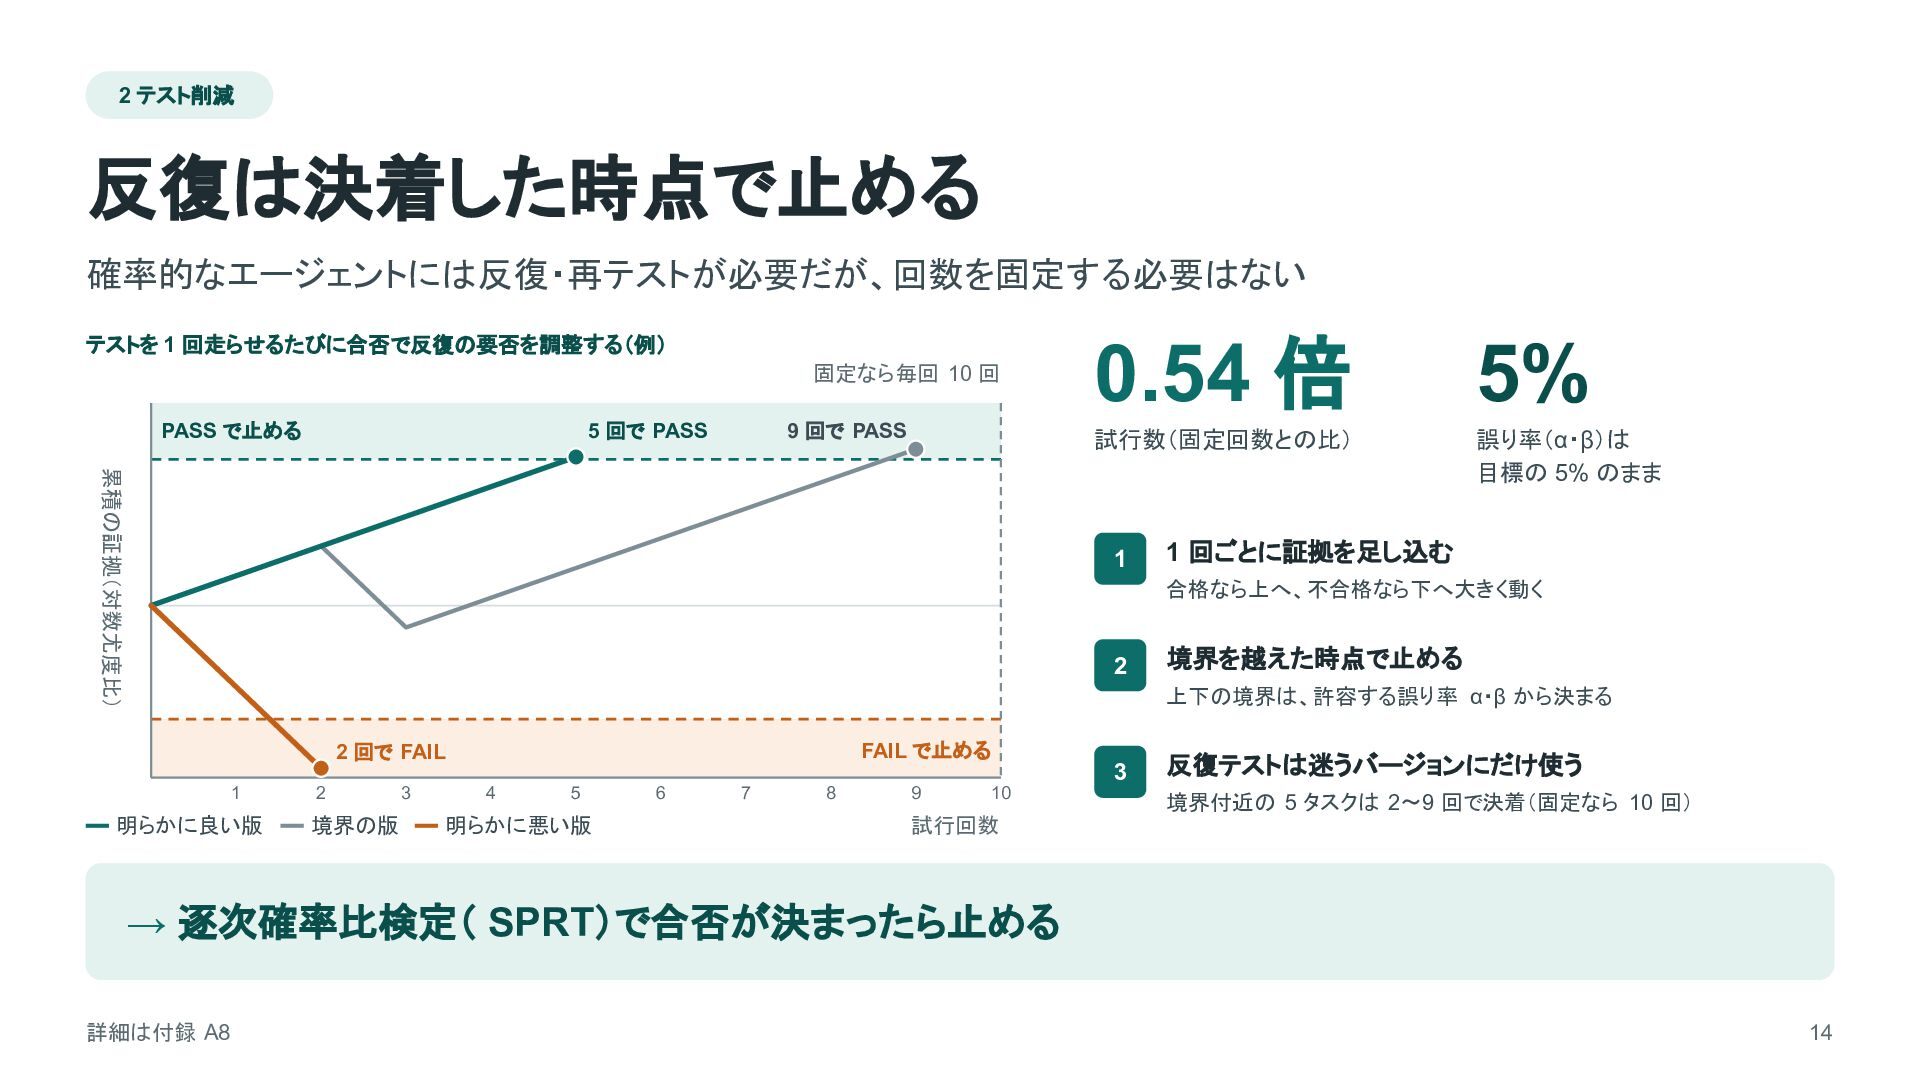
2 テスト削減 反復は決着した時点で止める 確率的なエージェントには反復・再テストが必要だが、回数を固定する必要はない テストを 1 回走らせるたびに合否で反復の要否を調整する(例) 固定なら毎回 10 回
PASS で止める 5 回で PASS 9 回で PASS 累積の証拠(対数尤度比) 0.54 倍 5% 試行数(固定回数との比) 誤り率(α・β)は 目標の 5% のまま 1 1 回ごとに証拠を足し込む 合格なら上へ、不合格なら下へ大きく動く 2 境界を越えた時点で止める 上下の境界は、許容する誤り率 α・β から決まる FAIL で止める 2 回で FAIL 1 2 3 3 4 5 ━ 明らかに良い版 ━ 境界の版 ━ 明らかに悪い版 6 7 8 9 10 試行回数 反復テストは迷うバージョンにだけ使う 境界付近の 5 タスクは 2〜9 回で決着(固定なら 10 回) → 逐次確率比検定( SPRT)で合否が決まったら止める 詳細は付録 A8 14 -
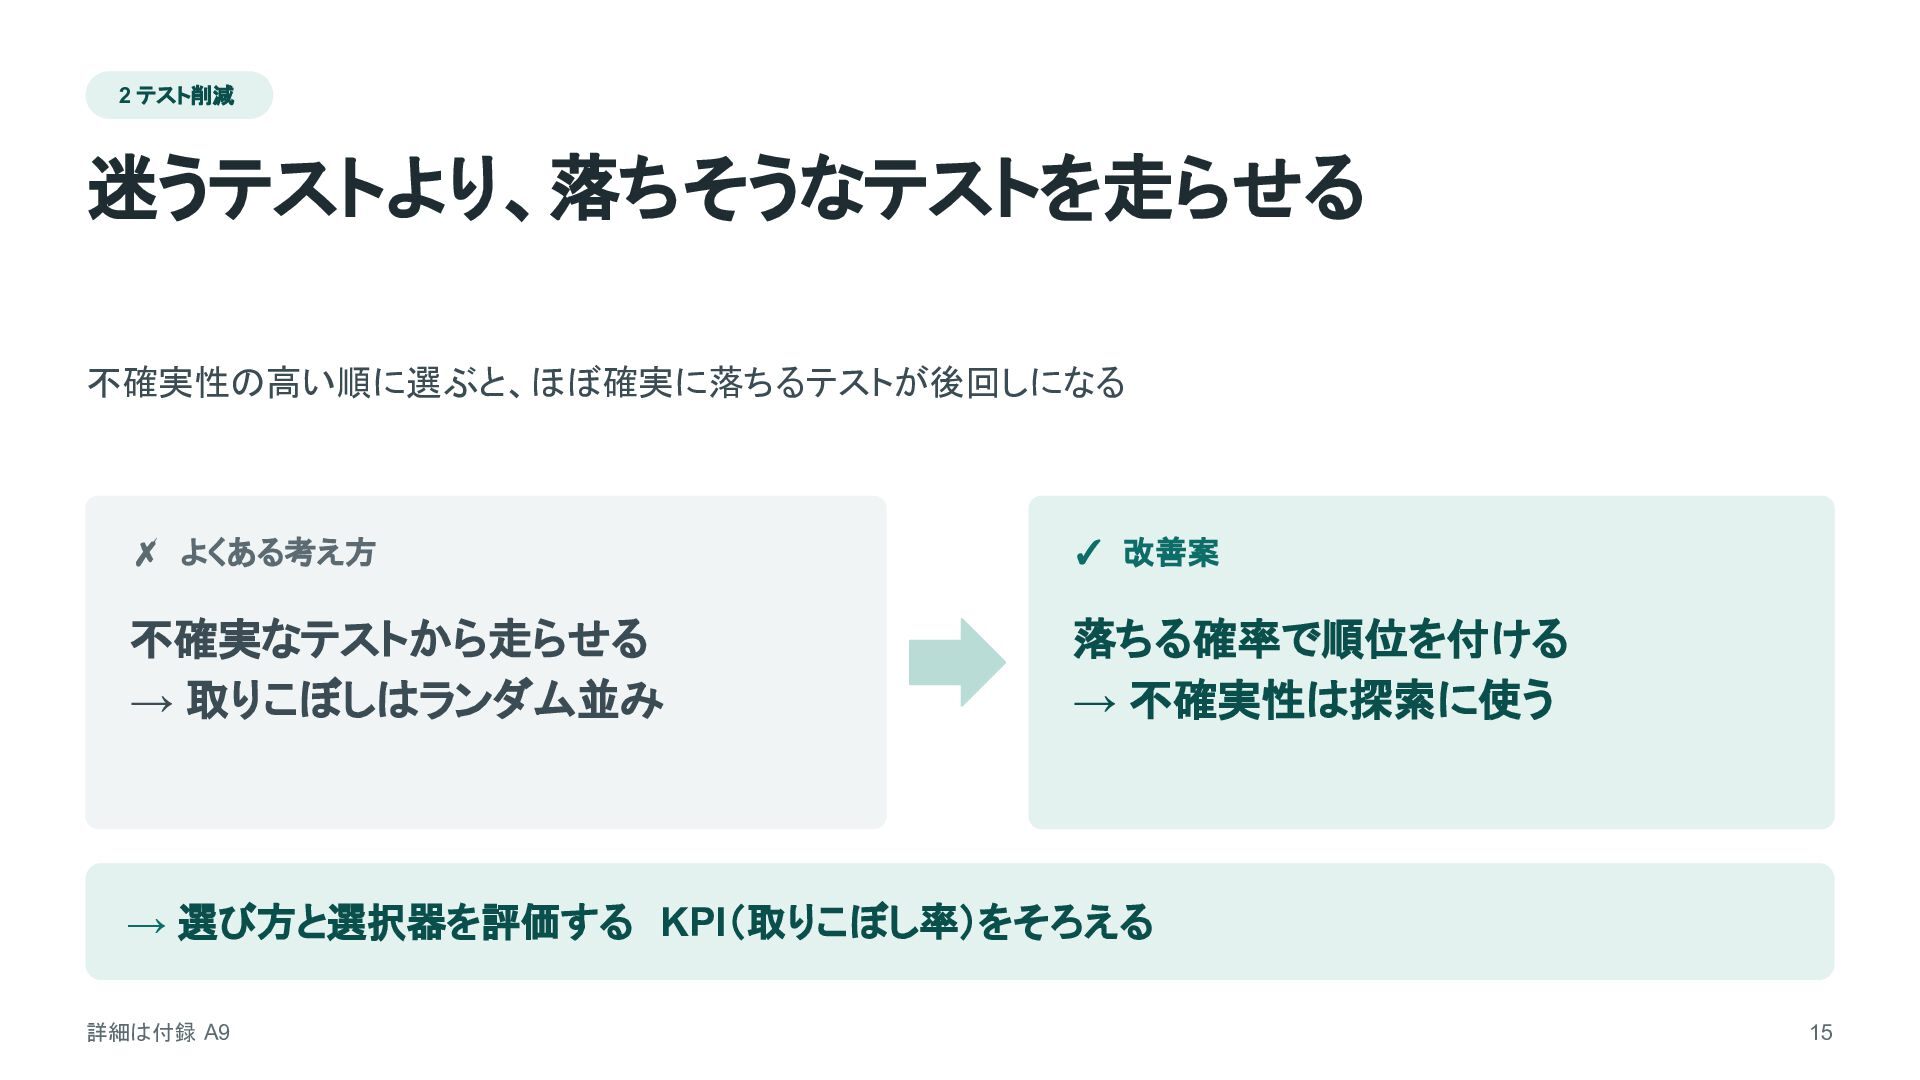
2 テスト削減 迷うテストより、落ちそうなテストを走らせる 不確実性の高い順に選ぶと、ほぼ確実に落ちるテストが後回しになる ✗ よくある考え方 ✓ 改善案 不確実なテストから走らせる →
取りこぼしはランダム並み 落ちる確率で順位を付ける → 不確実性は探索に使う → 選び方と選択器を評価する KPI(取りこぼし率)をそろえる 詳細は付録 A9 15 -
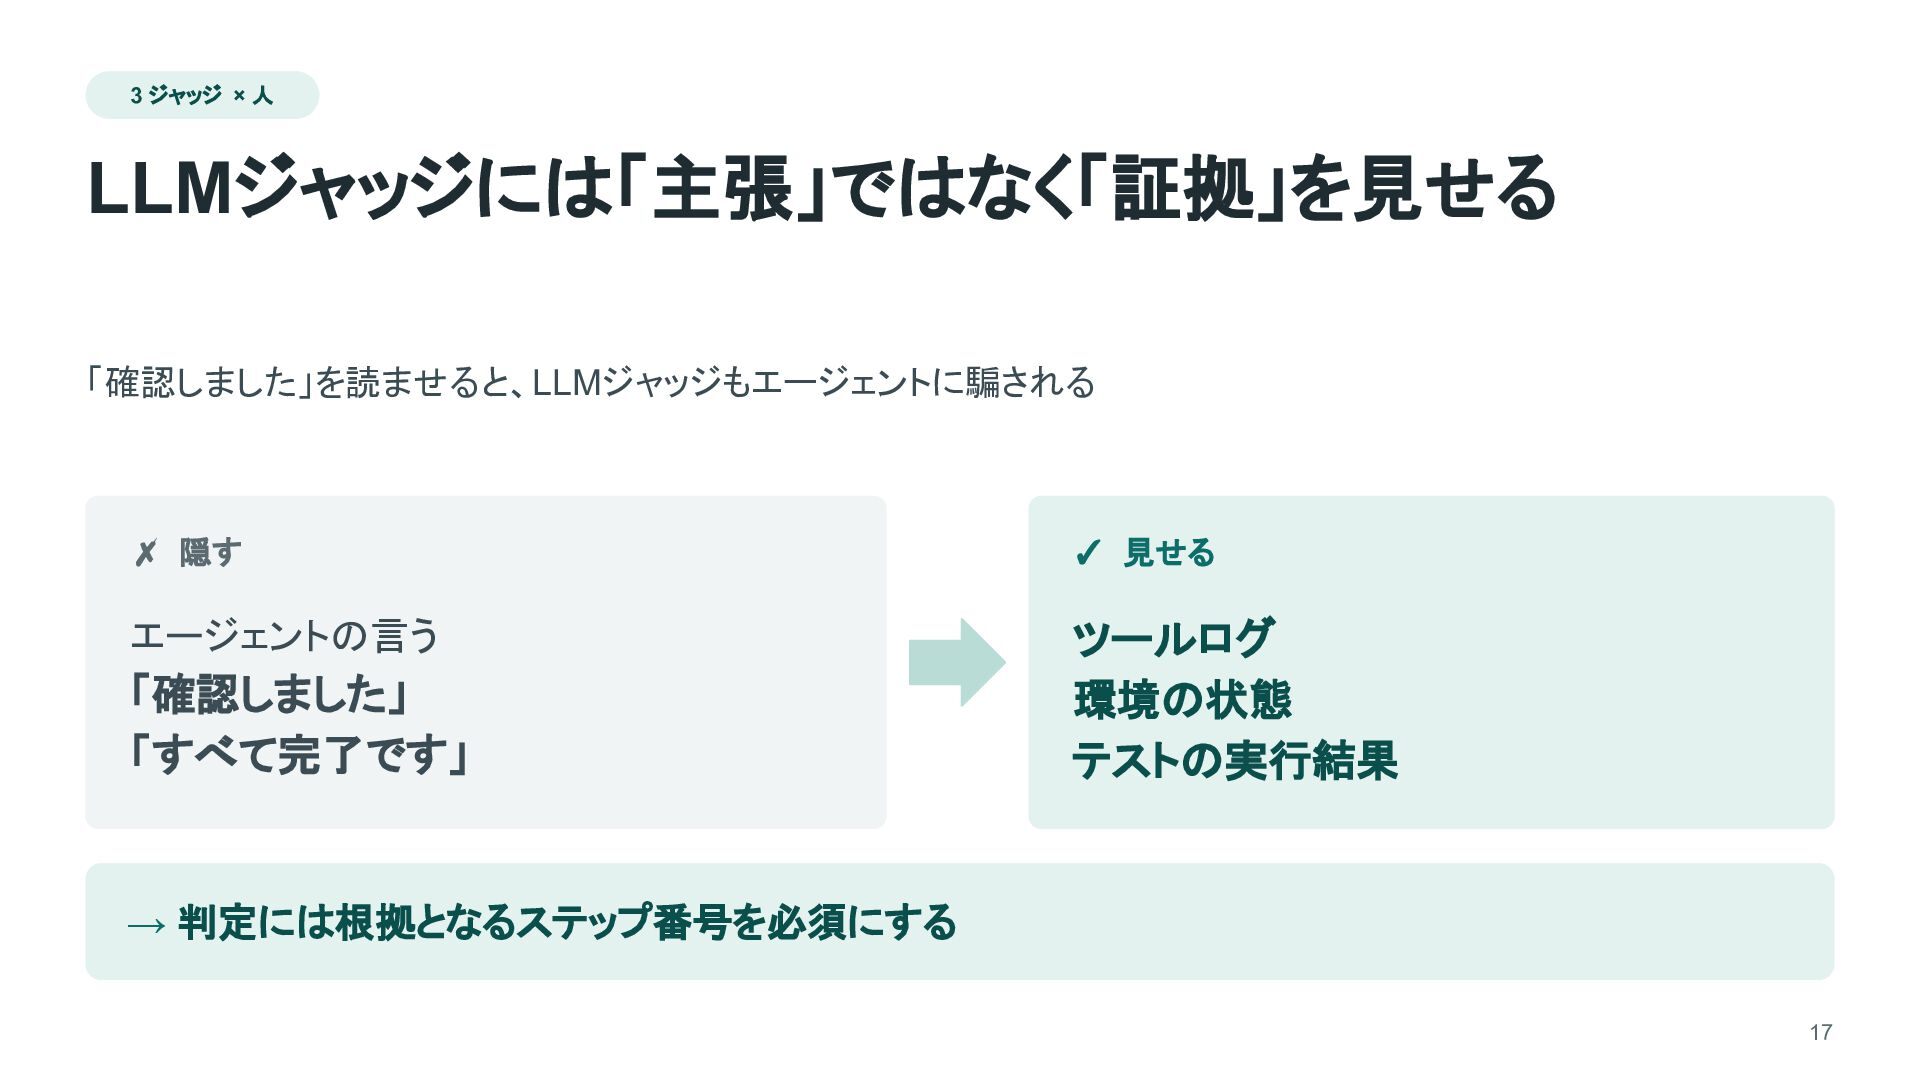
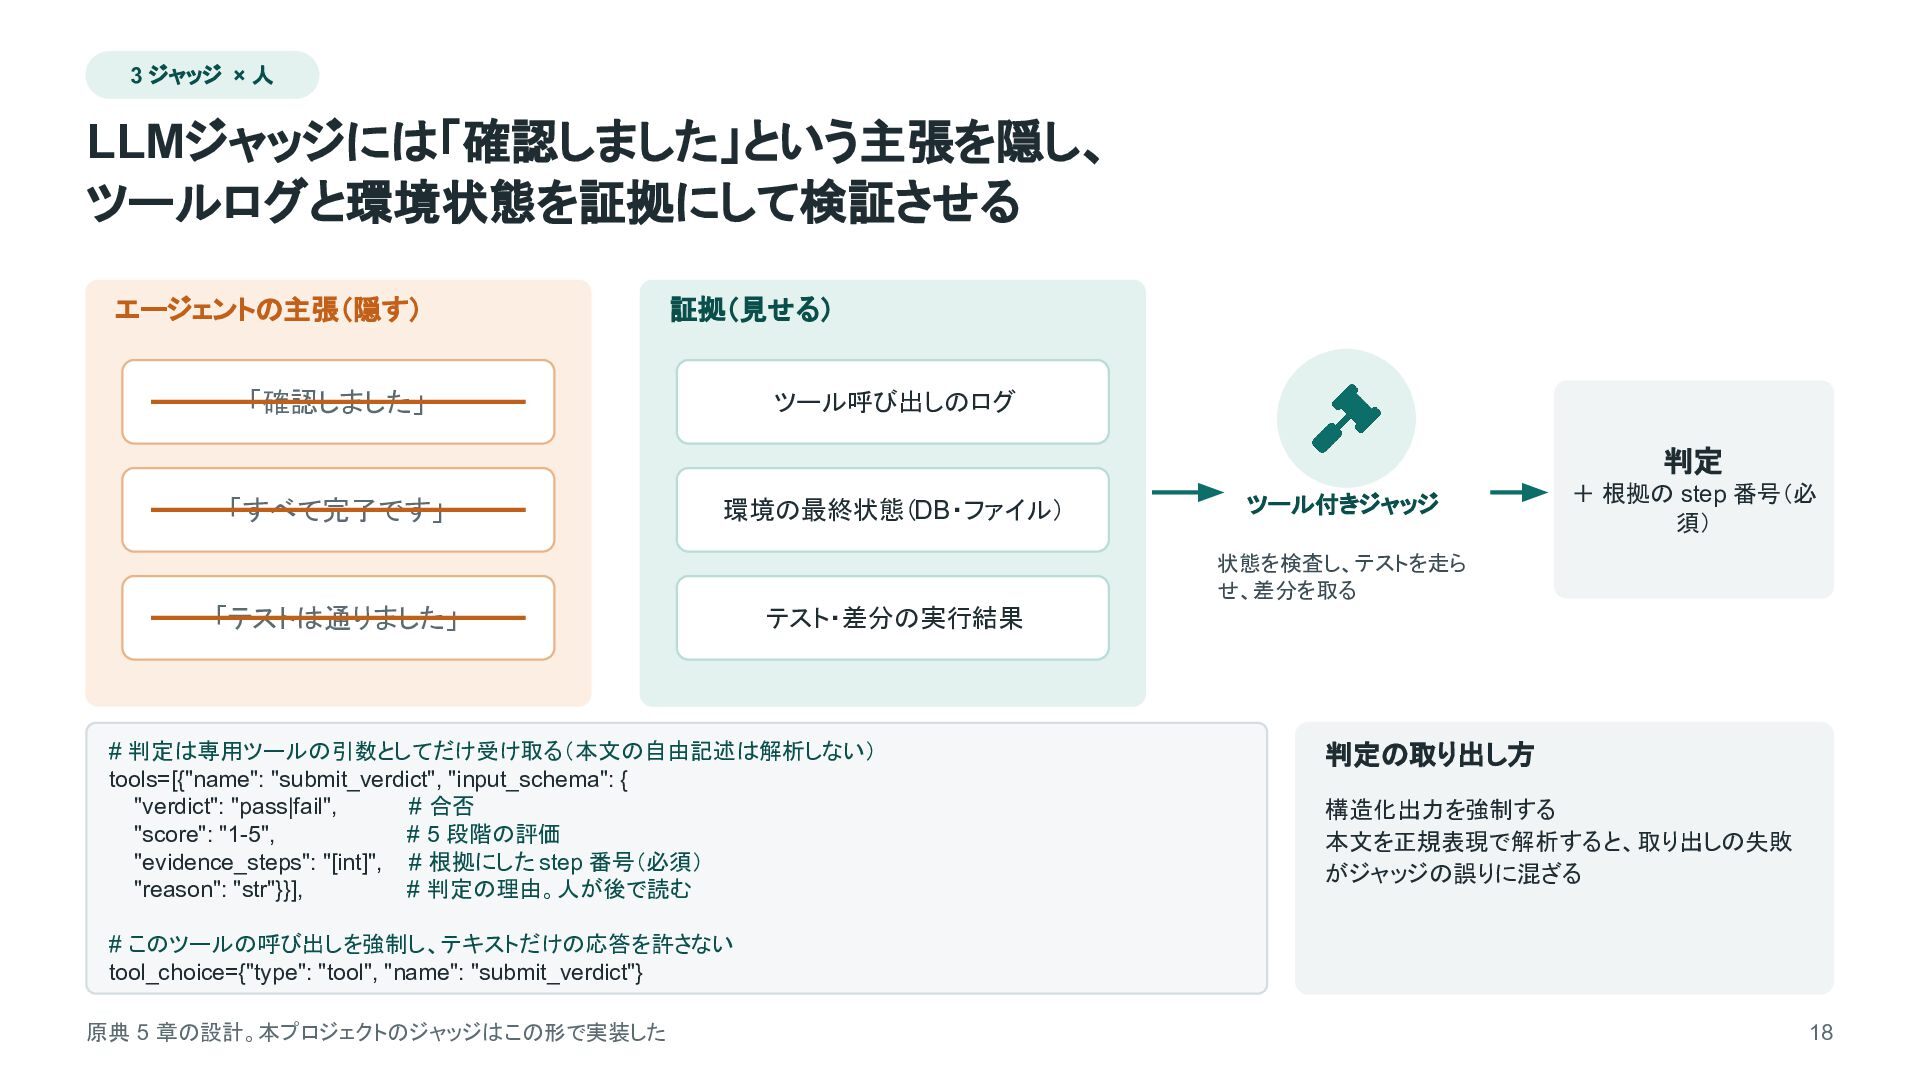
3 ジャッジ × 人 LLMジャッジには「主張」ではなく「証拠」を見せる 「確認しました」を読ませると、LLMジャッジもエージェントに騙される ✗ 隠す ✓ 見せる
エージェントの言う ツールログ 環境の状態 テストの実行結果 「確認しました」 「すべて完了です」 → 判定には根拠となるステップ番号を必須にする 17 -
3 ジャッジ × 人 LLMジャッジには「確認しました」という主張を隠し、 ツールログと環境状態を証拠にして検証させる エージェントの主張(隠す) 証拠(見せる) 「確認しました」 ツール呼び出しのログ
判定 「すべて完了です」 環境の最終状態(DB・ファイル) ツール付きジャッジ + 根拠の step 番号(必 須) 状態を検査し、テストを走ら せ、差分を取る 「テストは通りました」 テスト・差分の実行結果 # 判定は専用ツールの引数としてだけ受け取る(本文の自由記述は解析しない) tools=[{"name": "submit_verdict", "input_schema": { "verdict": "pass|fail", # 合否 "score": "1-5", # 5 段階の評価 "evidence_steps": "[int]", # 根拠にした step 番号(必須) "reason": "str"}}], # 判定の理由。人が後で読む 判定の取り出し方 構造化出力を強制する 本文を正規表現で解析すると、取り出しの失敗 がジャッジの誤りに混ざる # このツールの呼び出しを強制し、テキストだけの応答を許さない tool_choice={"type": "tool", "name": "submit_verdict"} 原典 5 章の設計。本プロジェクトのジャッジはこの形で実装した 18 -
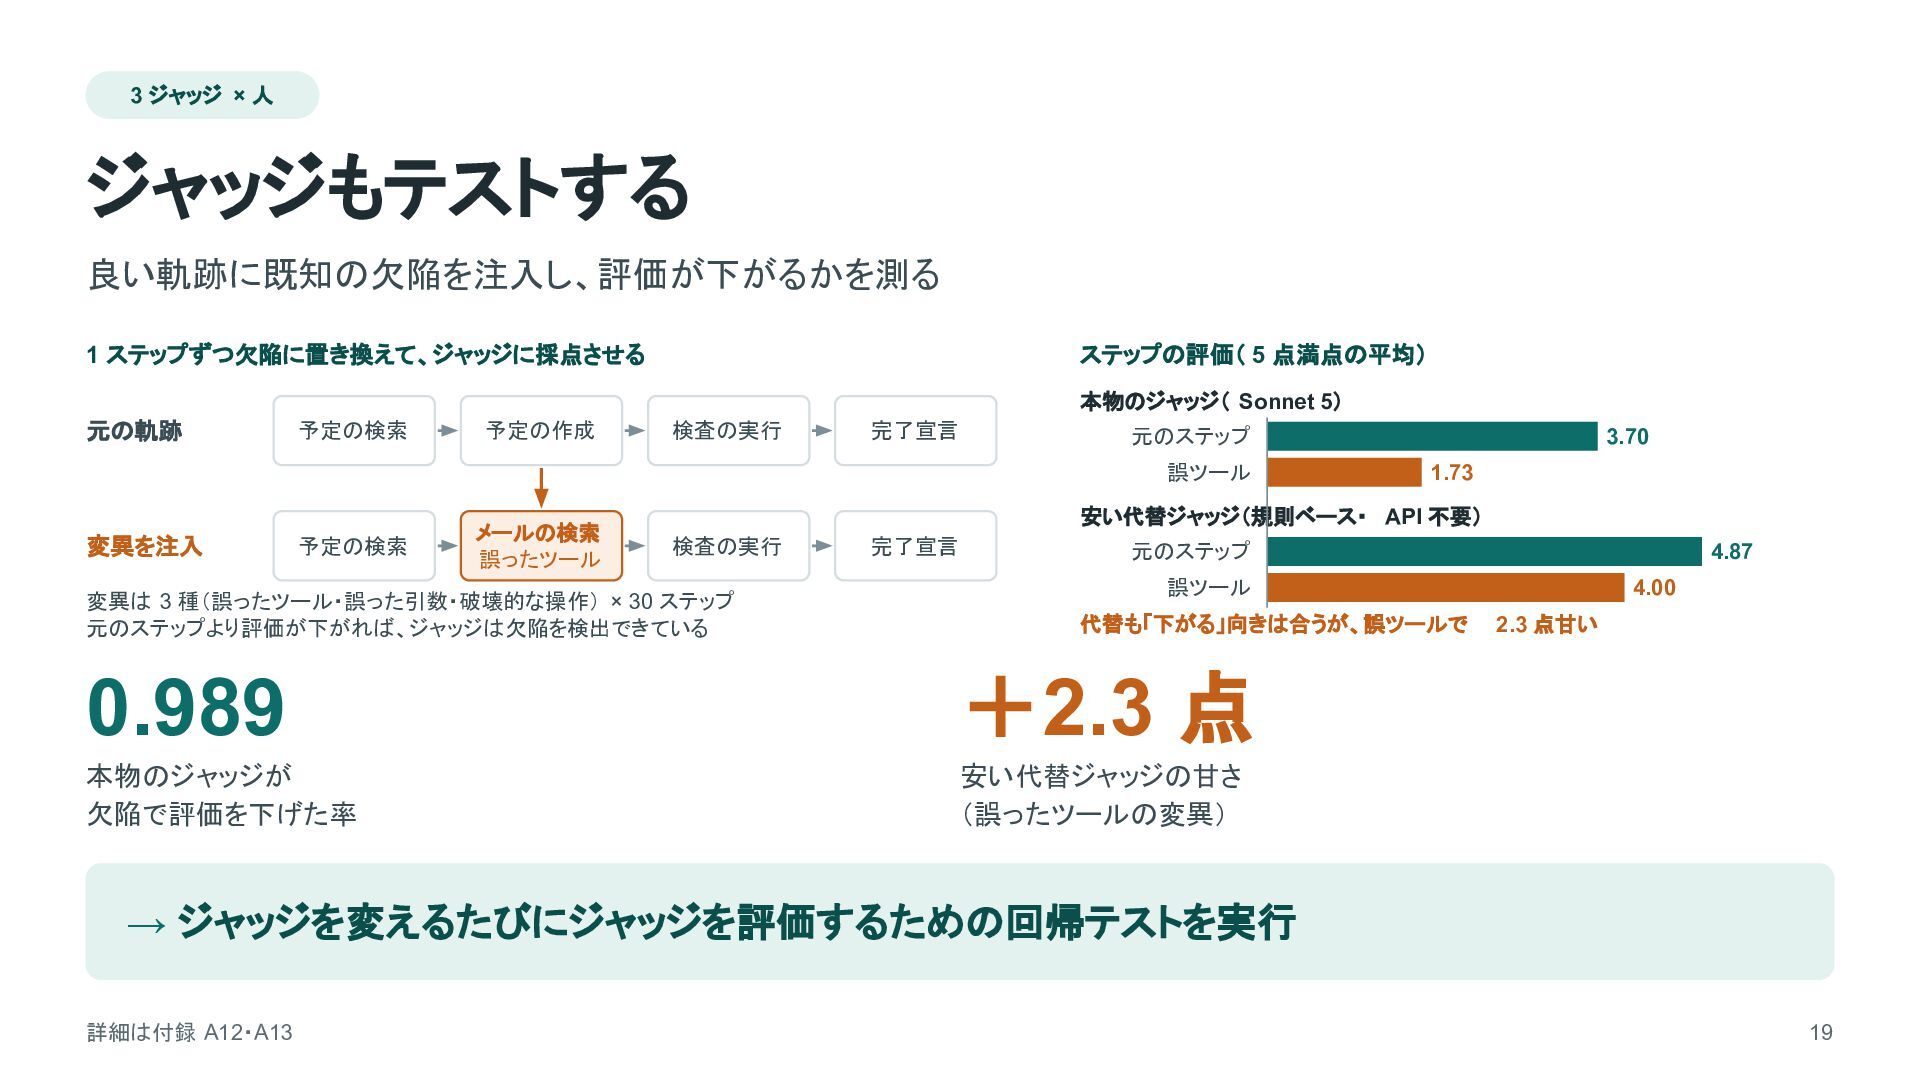
3 ジャッジ × 人 ジャッジもテストする 良い軌跡に既知の欠陥を注入し、評価が下がるかを測る 1 ステップずつ欠陥に置き換えて、ジャッジに採点させる ステップの評価( 5
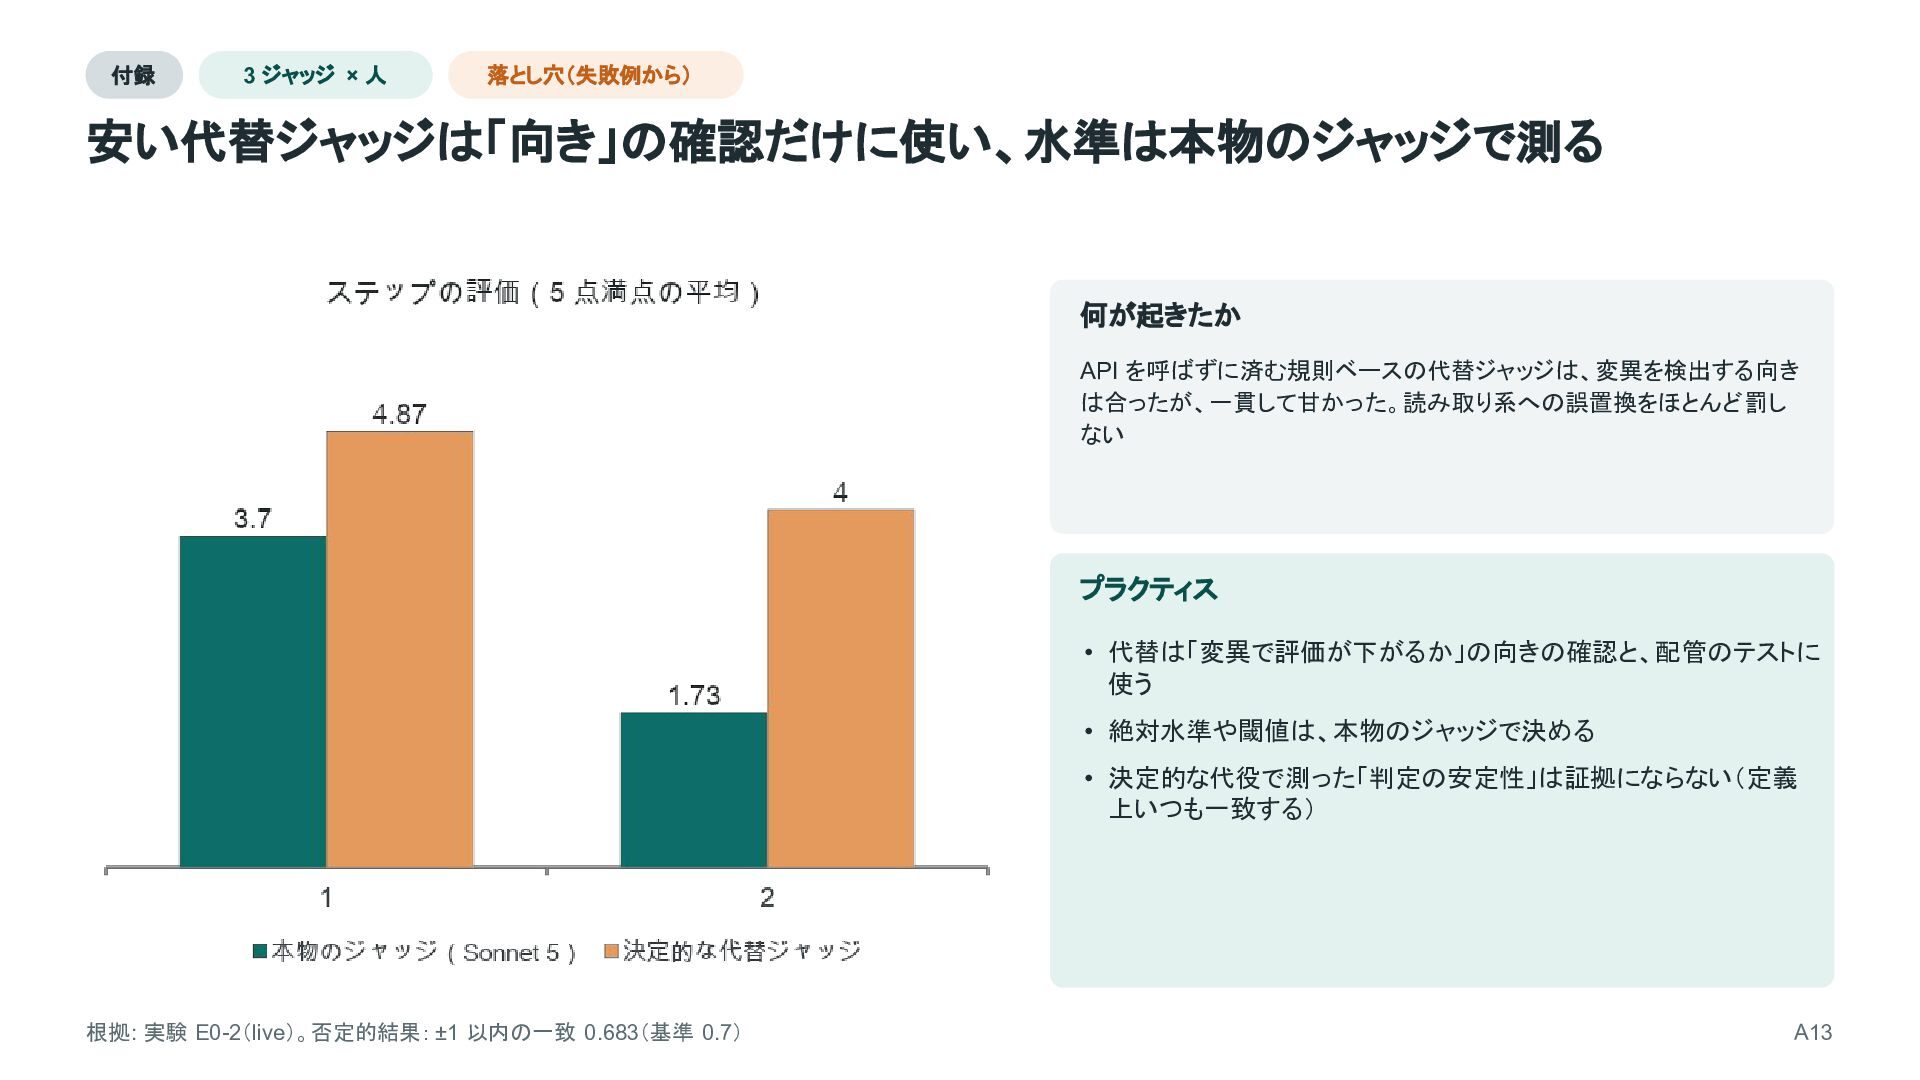
点満点の平均) 本物のジャッジ( Sonnet 5) 元の軌跡 予定の検索 予定の作成 検査の実行 完了宣言 元のステップ 誤ツール 変異を注入 予定の検索 メールの検索 誤ったツール 3.70 1.73 安い代替ジャッジ(規則ベース・ API 不要) 検査の実行 変異は 3 種(誤ったツール・誤った引数・破壊的な操作) × 30 ステップ 元のステップより評価が下がれば、ジャッジは欠陥を検出できている 完了宣言 元のステップ 4.87 誤ツール 代替も「下がる」向きは合うが、誤ツールで 0.989 +2.3 点 本物のジャッジが 欠陥で評価を下げた率 安い代替ジャッジの甘さ (誤ったツールの変異) 4.00 2.3 点甘い → ジャッジを変えるたびにジャッジを評価するための回帰テストを実行 詳細は付録 A12・A13 19 -
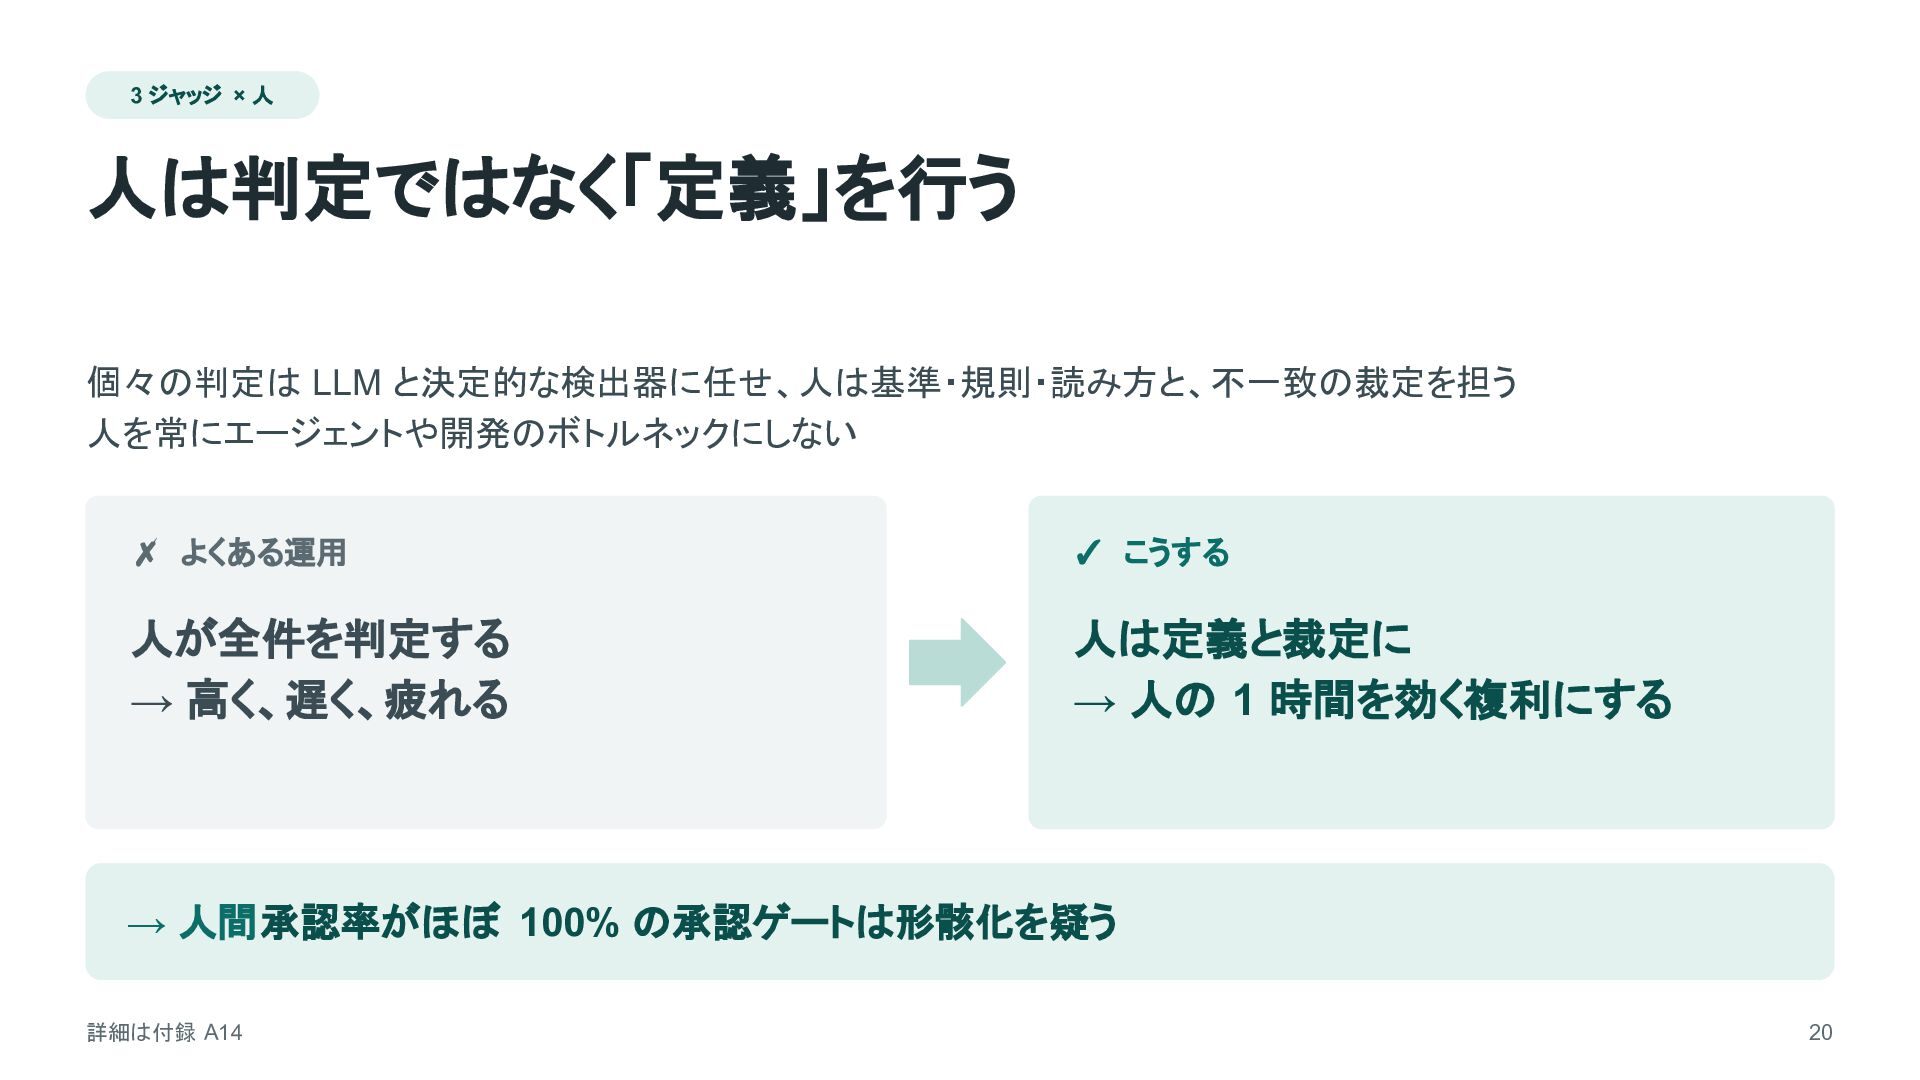
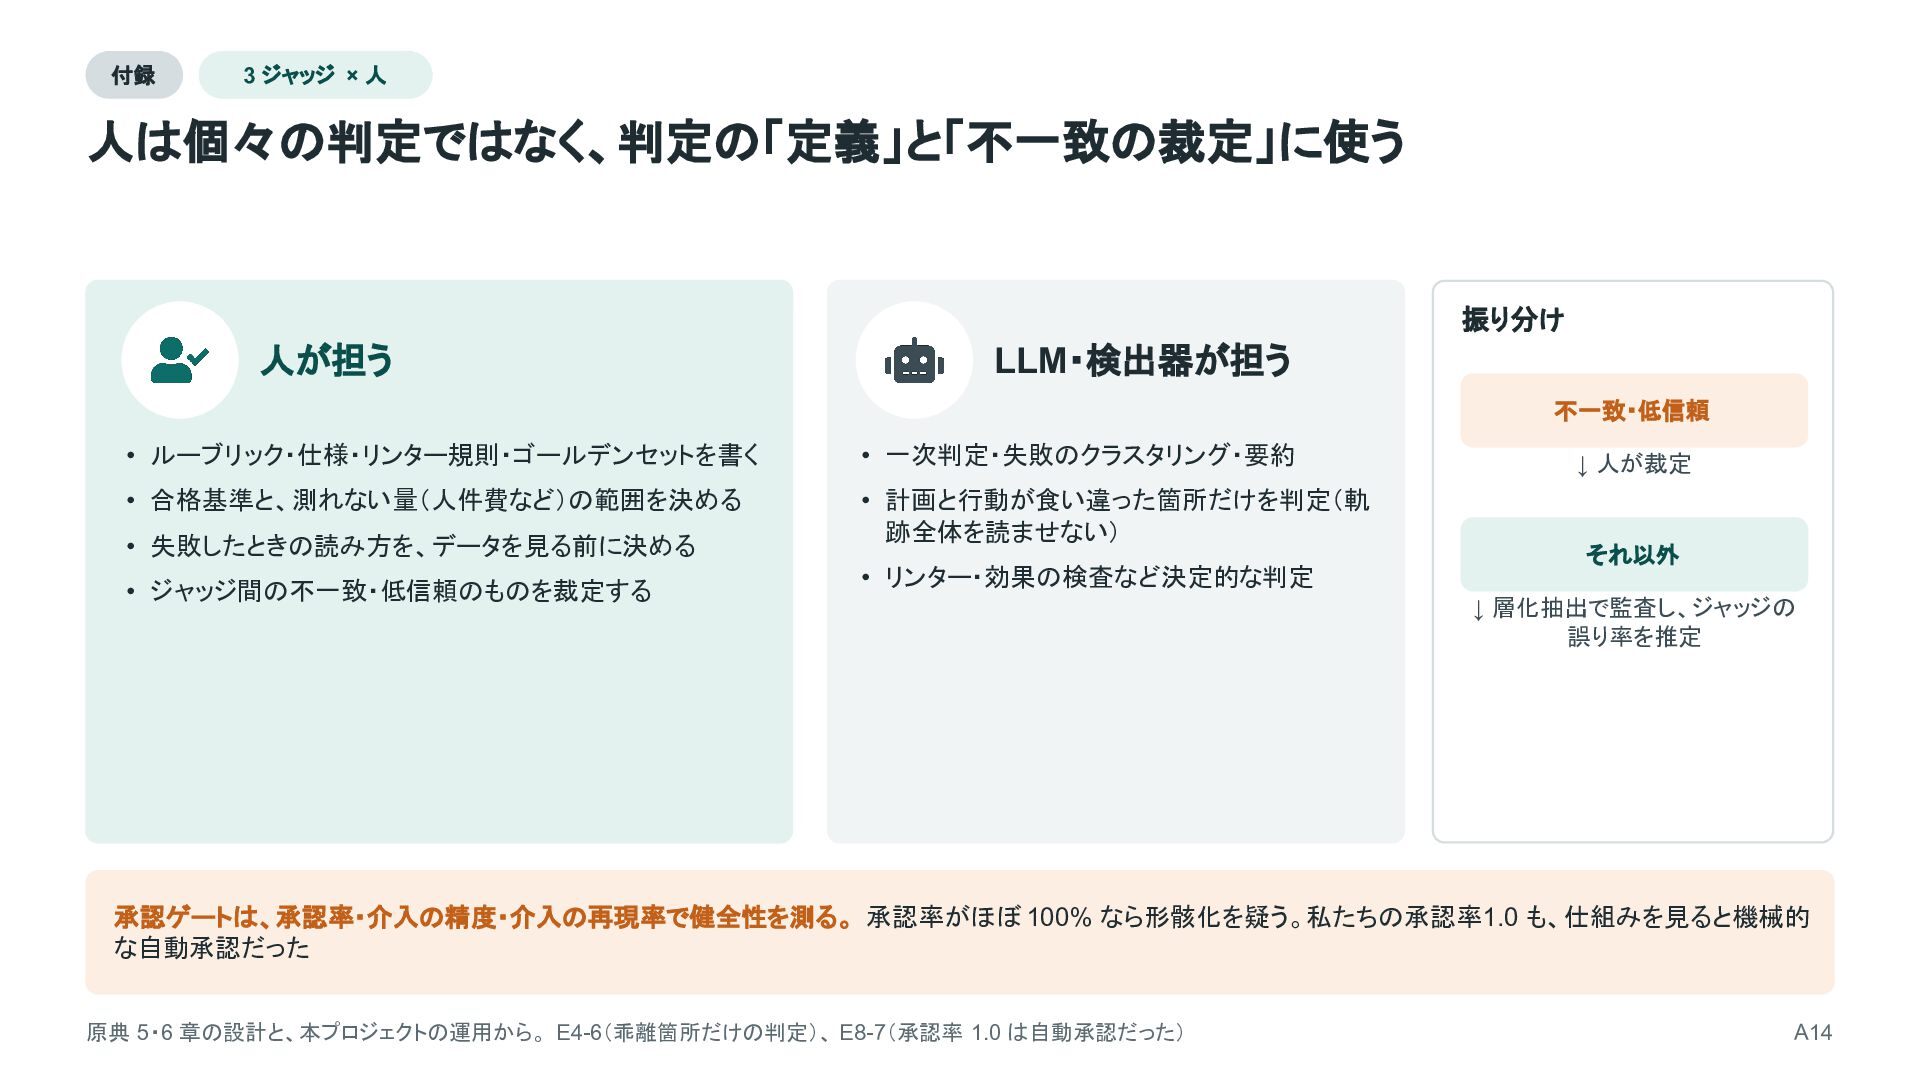
3 ジャッジ × 人 人は判定ではなく「定義」を行う 個々の判定は LLM と決定的な検出器に任せ、人は基準・規則・読み方と、不一致の裁定を担う 人を常にエージェントや開発のボトルネックにしない ✗
よくある運用 ✓ こうする 人が全件を判定する → 高く、遅く、疲れる 人は定義と裁定に → 人の 1 時間を効く複利にする → 人間承認率がほぼ 100% の承認ゲートは形骸化を疑う 詳細は付録 A14 20 -
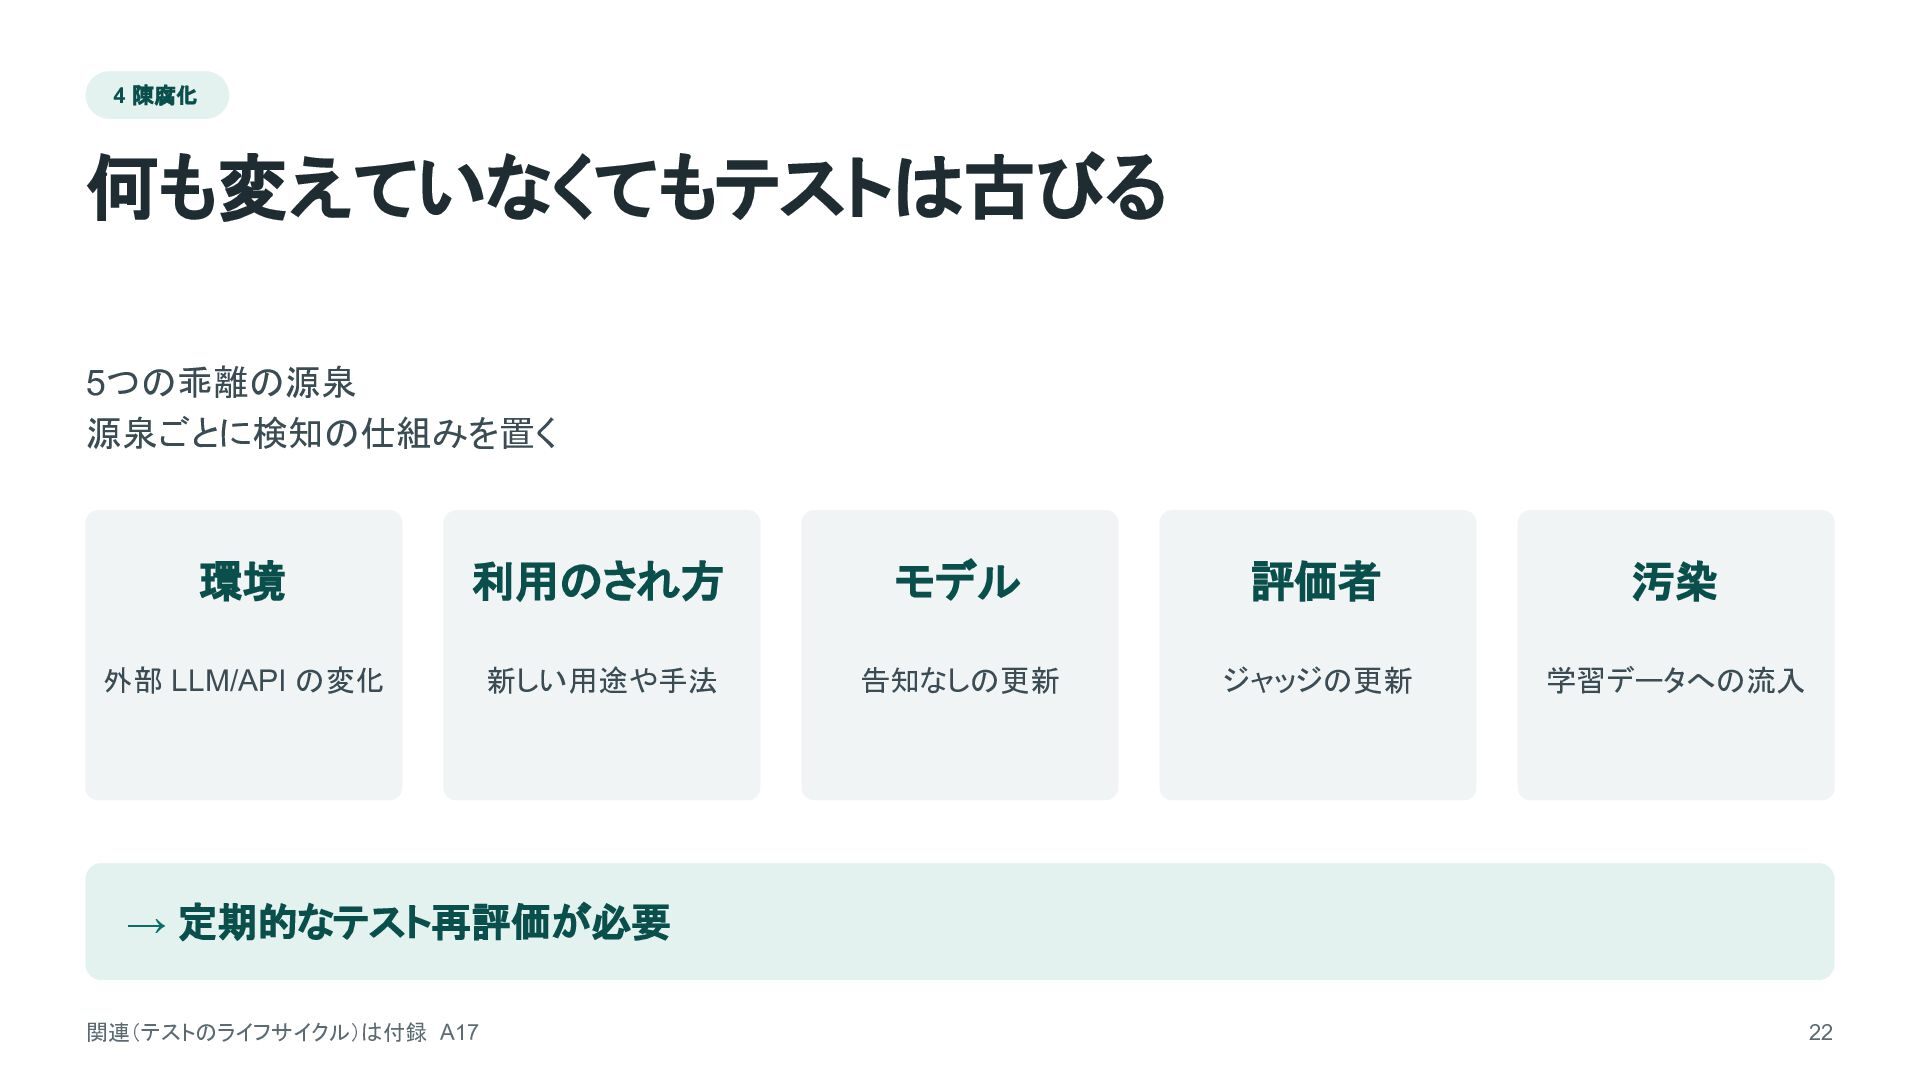
4 陳腐化 何も変えていなくてもテストは古びる 5つの乖離の源泉 源泉ごとに検知の仕組みを置く 環境 利用のされ方 モデル 評価者 汚染
外部 LLM/API の変化 新しい用途や手法 告知なしの更新 ジャッジの更新 学習データへの流入 → 定期的なテスト再評価が必要 関連(テストのライフサイクル)は付録 A17 22 -
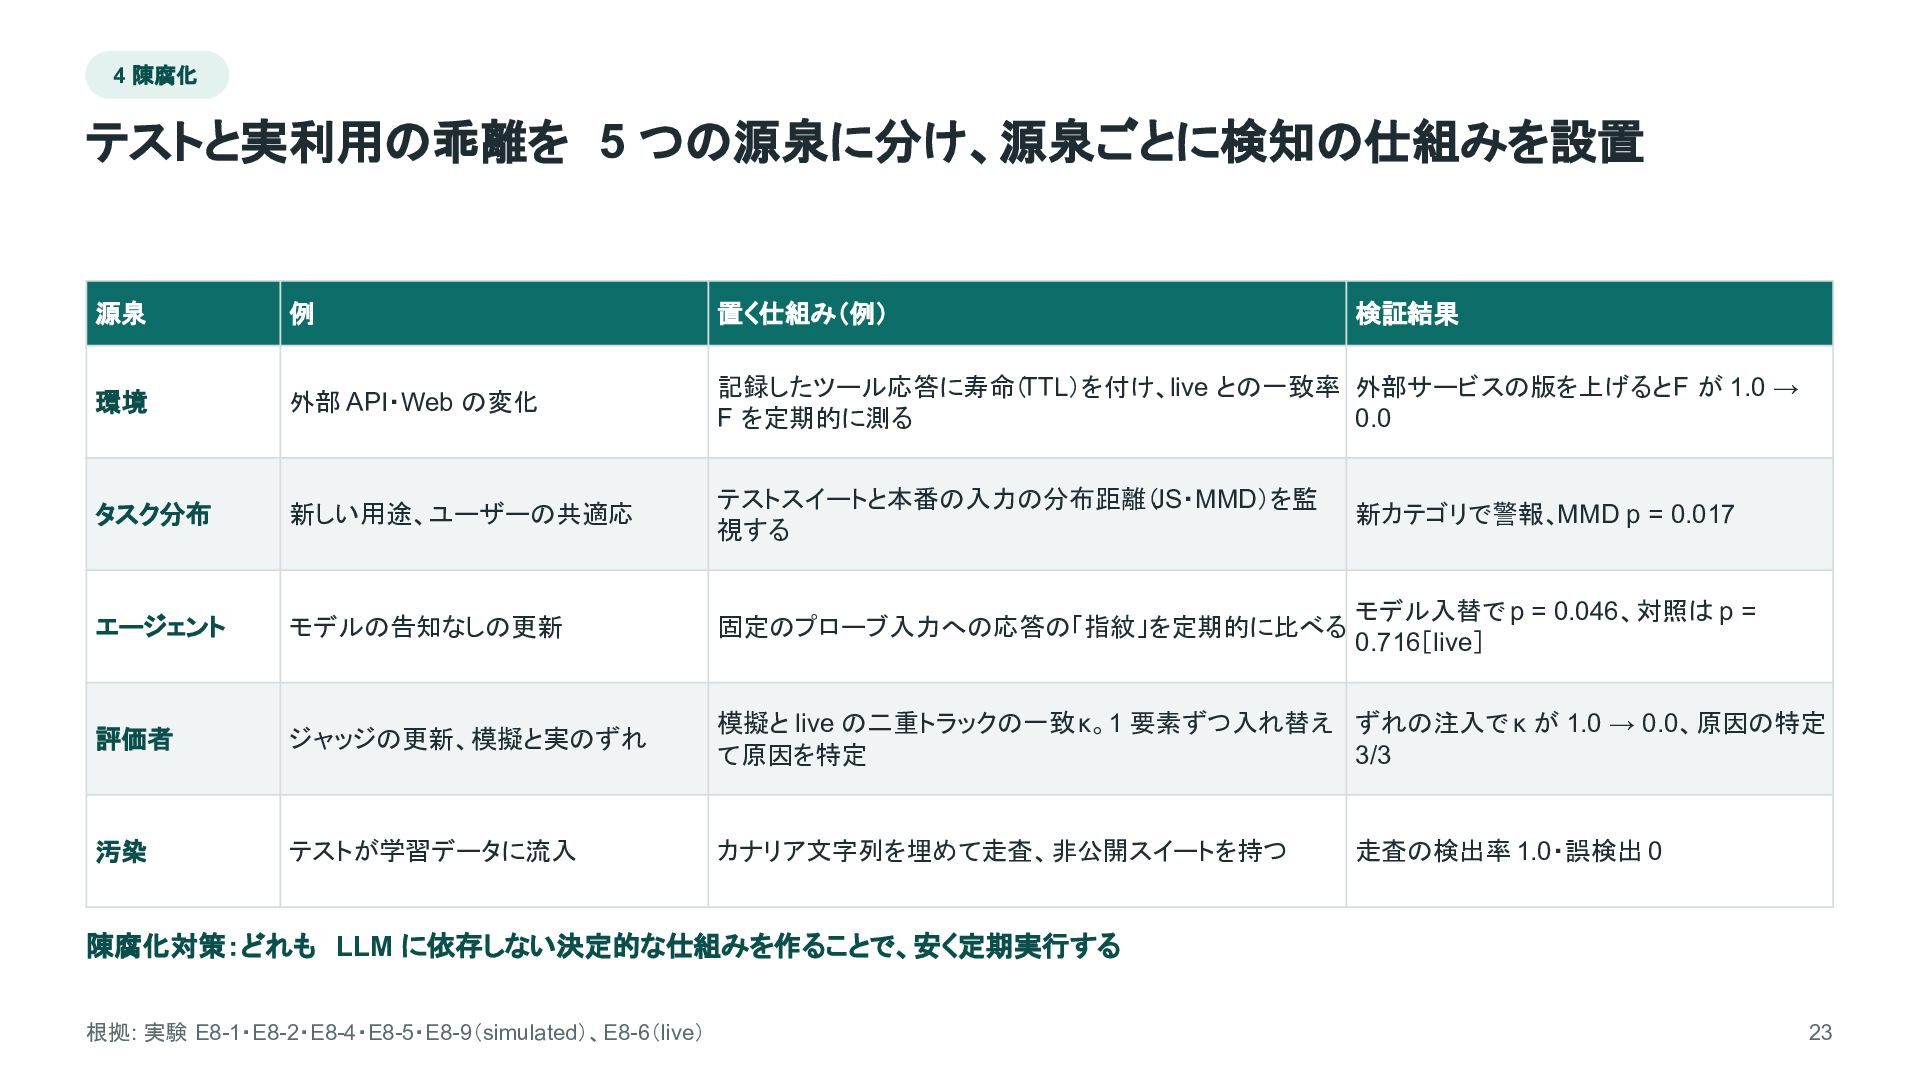
4 陳腐化 テストと実利用の乖離を 5 つの源泉に分け、源泉ごとに検知の仕組みを設置 源泉 例 置く仕組み(例) 検証結果 環境
外部 API・Web の変化 記録したツール応答に寿命(TTL)を付け、live との一致率 外部サービスの版を上げると F が 1.0 → F を定期的に測る 0.0 タスク分布 新しい用途、ユーザーの共適応 テストスイートと本番の入力の分布距離(JS・MMD)を監 視する 新カテゴリで警報、MMD p = 0.017 エージェント モデルの告知なしの更新 固定のプローブ入力への応答の「指紋」を定期的に比べる モデル入替で p = 0.046、対照は p = 0.716[live] 評価者 ジャッジの更新、模擬と実のずれ 模擬と live の二重トラックの一致 κ。1 要素ずつ入れ替え ずれの注入で κ が 1.0 → 0.0、原因の特定 て原因を特定 3/3 汚染 テストが学習データに流入 カナリア文字列を埋めて走査、非公開スイートを持つ 走査の検出率 1.0・誤検出 0 陳腐化対策:どれも LLM に依存しない決定的な仕組みを作ることで、安く定期実行する 根拠: 実験 E8-1・E8-2・E8-4・E8-5・E8-9(simulated)、E8-6(live) 23 -
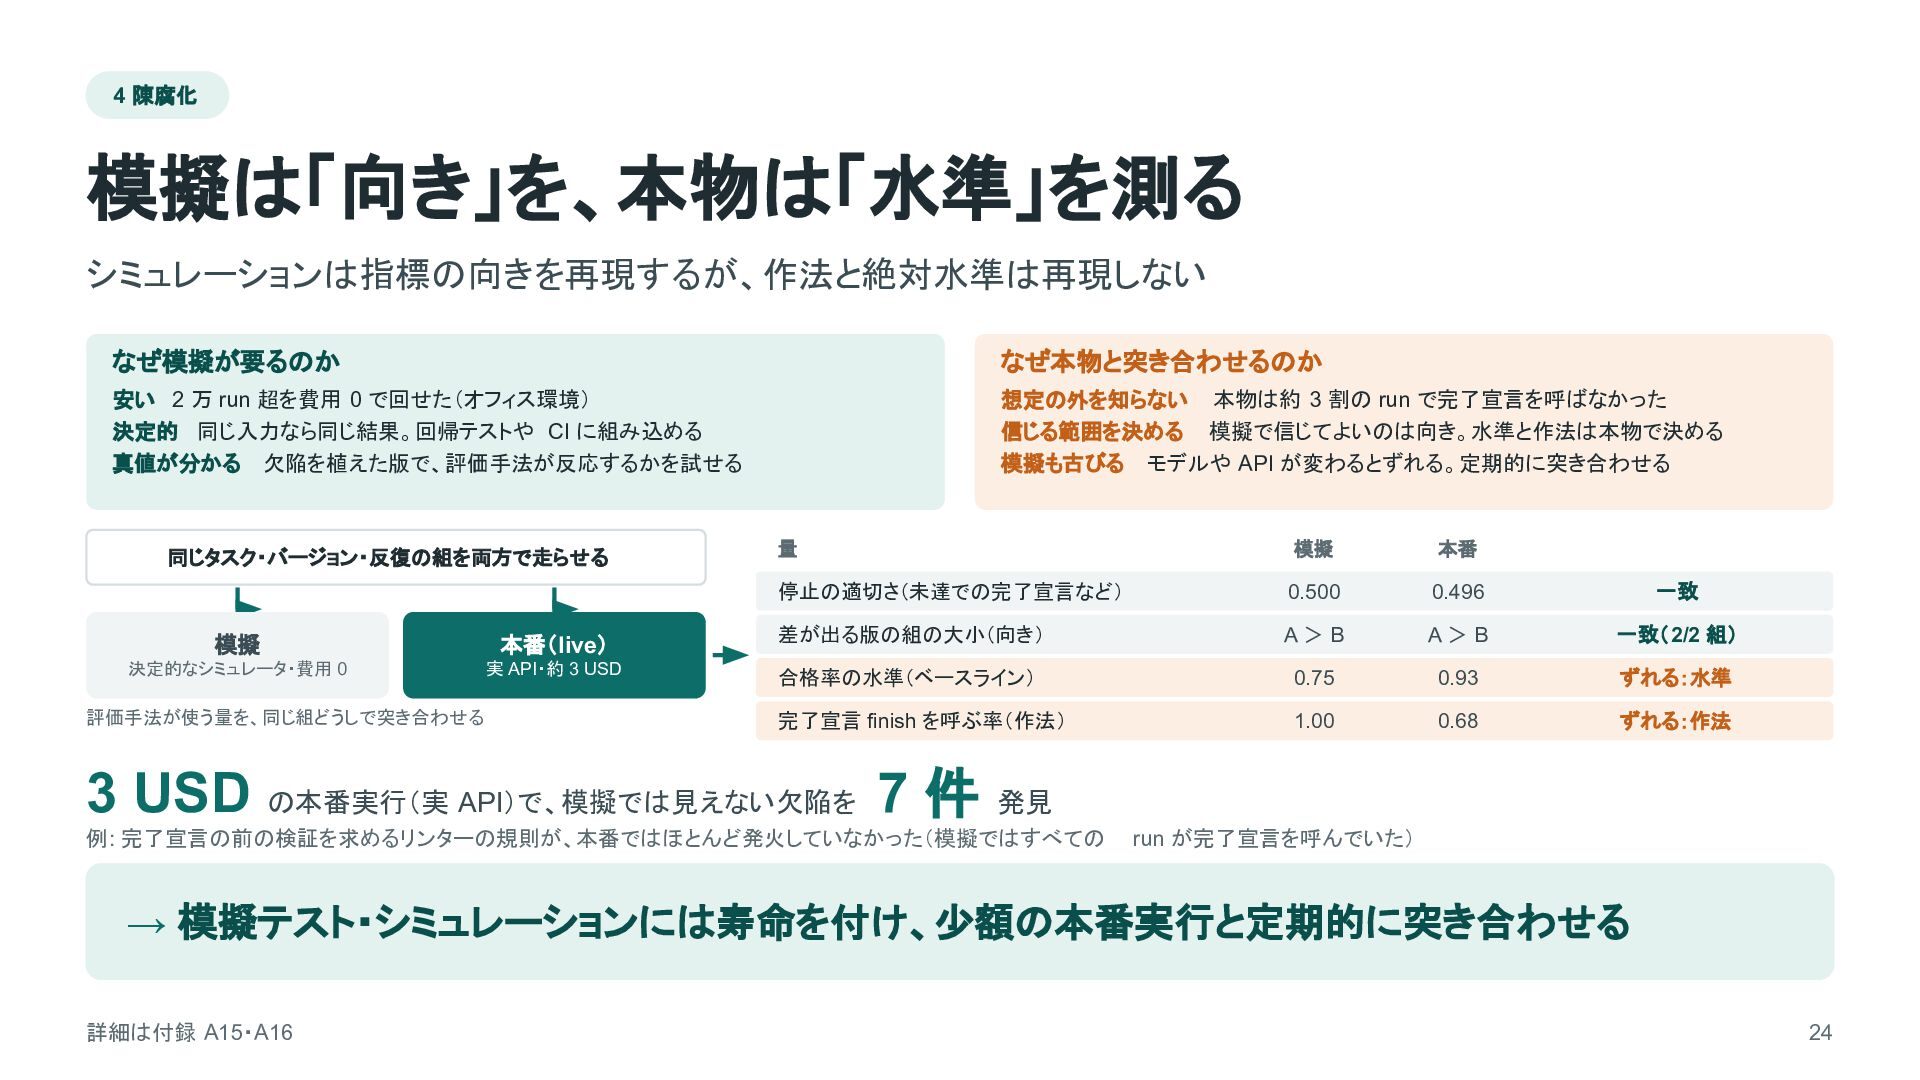
4 陳腐化 模擬は「向き」を、本物は「水準」を測る シミュレーションは指標の向きを再現するが、作法と絶対水準は再現しない なぜ模擬が要るのか なぜ本物と突き合わせるのか 安い 2 万 run
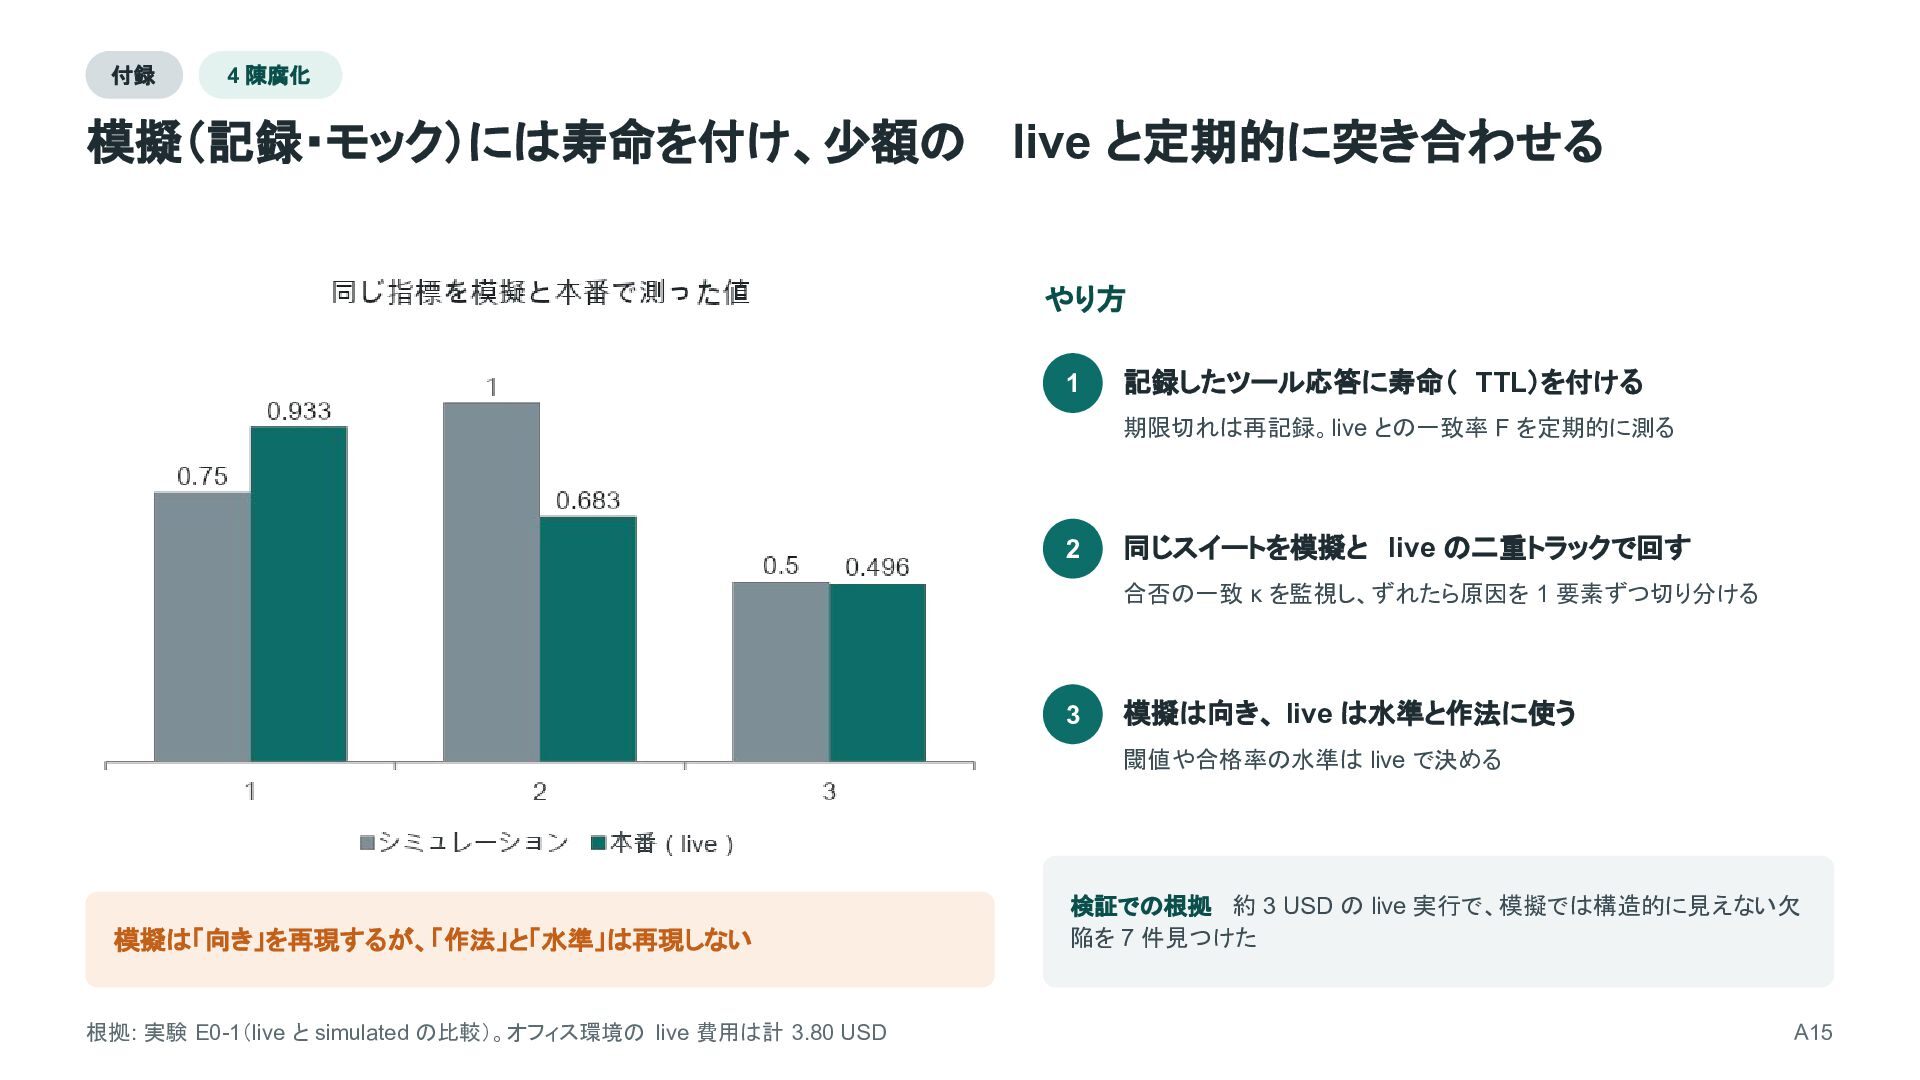
超を費用 0 で回せた(オフィス環境) 決定的 同じ入力なら同じ結果。回帰テストや CI に組み込める 真値が分かる 欠陥を植えた版で、評価手法が反応するかを試せる 想定の外を知らない 本物は約 3 割の run で完了宣言を呼ばなかった 信じる範囲を決める 模擬で信じてよいのは向き。水準と作法は本物で決める 模擬も古びる モデルや API が変わるとずれる。定期的に突き合わせる 同じタスク・バージョン・反復の組を両方で走らせる 模擬 本番(live) 決定的なシミュレータ・費用 0 実 API・約 3 USD 評価手法が使う量を、同じ組どうしで突き合わせる 量 模擬 本番 停止の適切さ(未達での完了宣言など) 0.500 0.496 一致 差が出る版の組の大小(向き) A>B A>B 一致(2/2 組) 合格率の水準(ベースライン) 0.75 0.93 ずれる:水準 完了宣言 finish を呼ぶ率(作法) 1.00 0.68 ずれる:作法 3 USD の本番実行(実 API)で、模擬では見えない欠陥を 7 件 発見 例: 完了宣言の前の検証を求めるリンターの規則が、本番ではほとんど発火していなかった(模擬ではすべての run が完了宣言を呼んでいた) → 模擬テスト・シミュレーションには寿命を付け、少額の本番実行と定期的に突き合わせる 詳細は付録 A15・A16 24 -
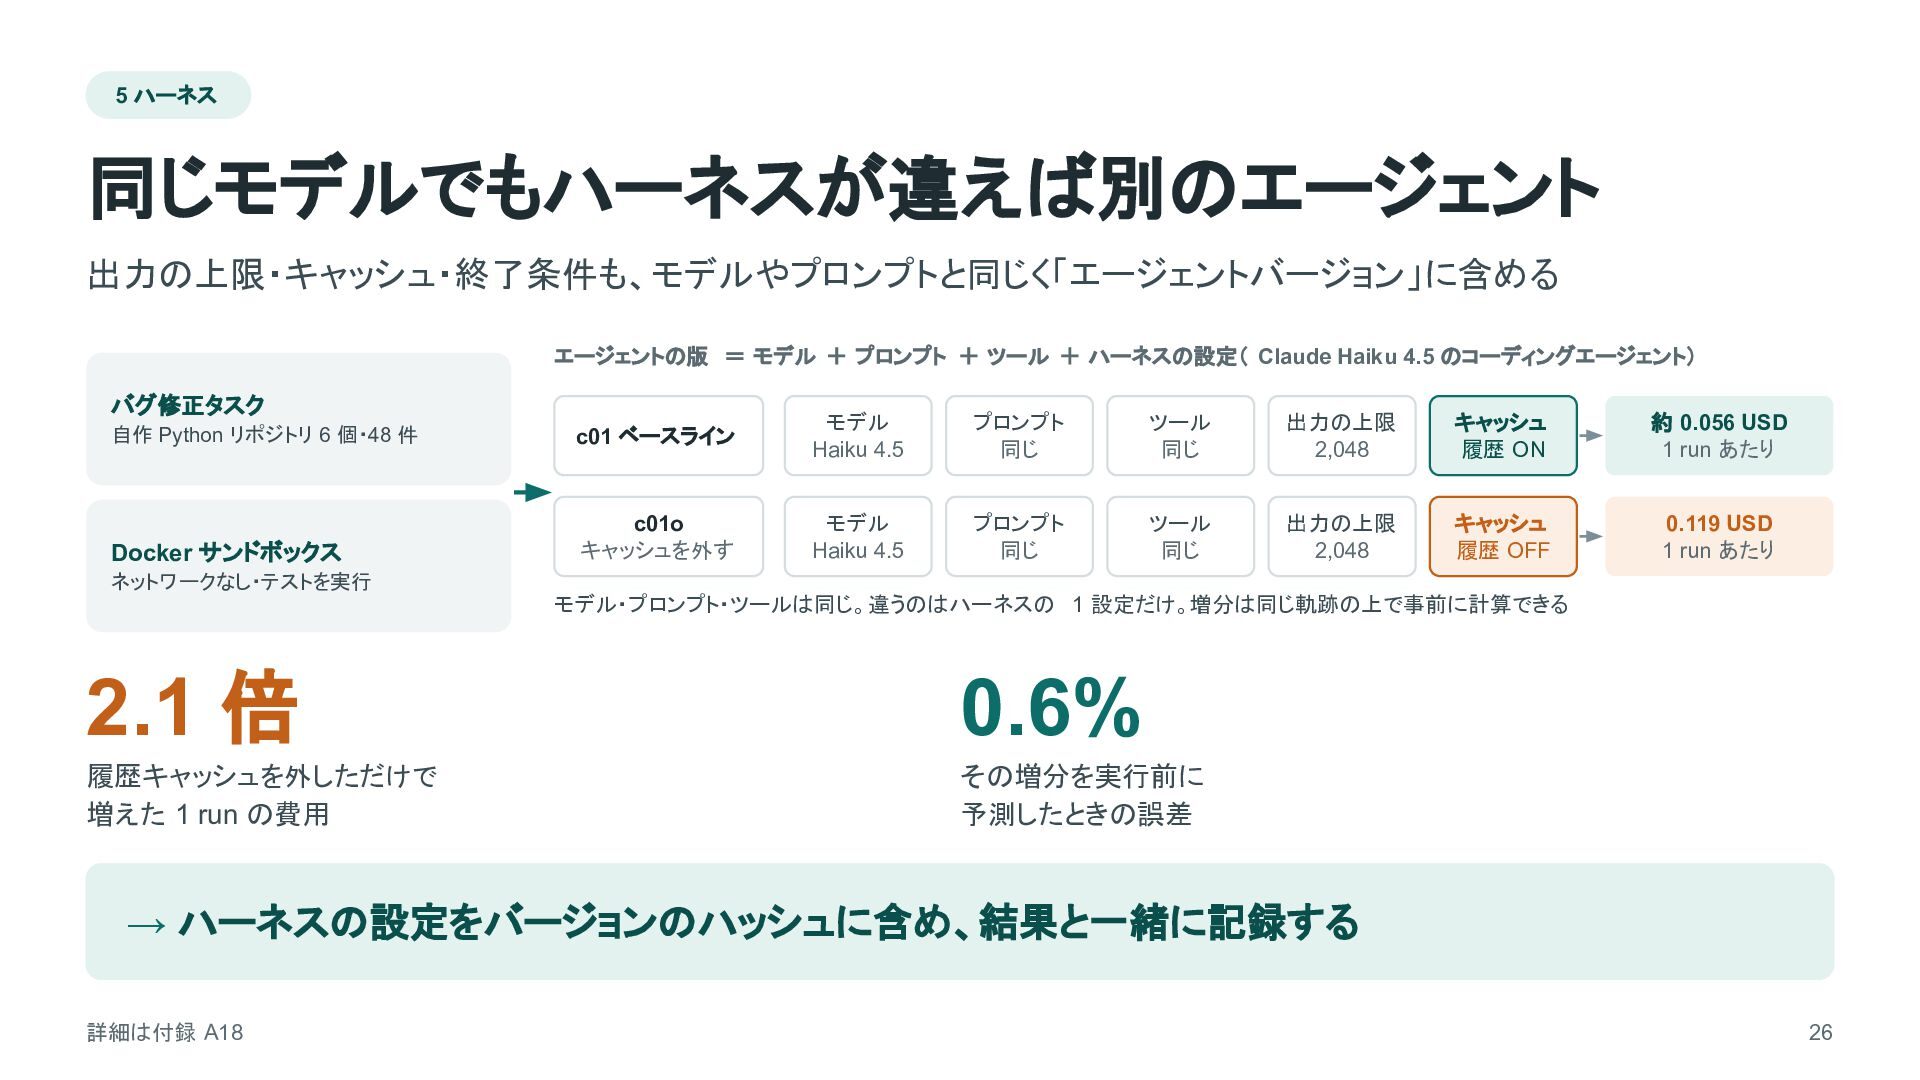
5 ハーネス 同じモデルでもハーネスが違えば別のエージェント 出力の上限・キャッシュ・終了条件も、モデルやプロンプトと同じく「エージェントバージョン」に含める エージェントの版 = モデル + プロンプト +
ツール + ハーネスの設定( Claude Haiku 4.5 のコーディングエージェント) バグ修正タスク 自作 Python リポジトリ 6 個・48 件 c01 ベースライン モデル Haiku 4.5 プロンプト 同じ ツール 同じ 出力の上限 2,048 キャッシュ 履歴 ON 約 0.056 USD 1 run あたり Docker サンドボックス c01o キャッシュを外す モデル Haiku 4.5 プロンプト 同じ ツール 同じ 出力の上限 2,048 キャッシュ 履歴 OFF 0.119 USD 1 run あたり ネットワークなし・テストを実行 モデル・プロンプト・ツールは同じ。違うのはハーネスの 1 設定だけ。増分は同じ軌跡の上で事前に計算できる 2.1 倍 0.6% 履歴キャッシュを外しただけで 増えた 1 run の費用 その増分を実行前に 予測したときの誤差 → ハーネスの設定をバージョンのハッシュに含め、結果と一緒に記録する 詳細は付録 A18 26 -
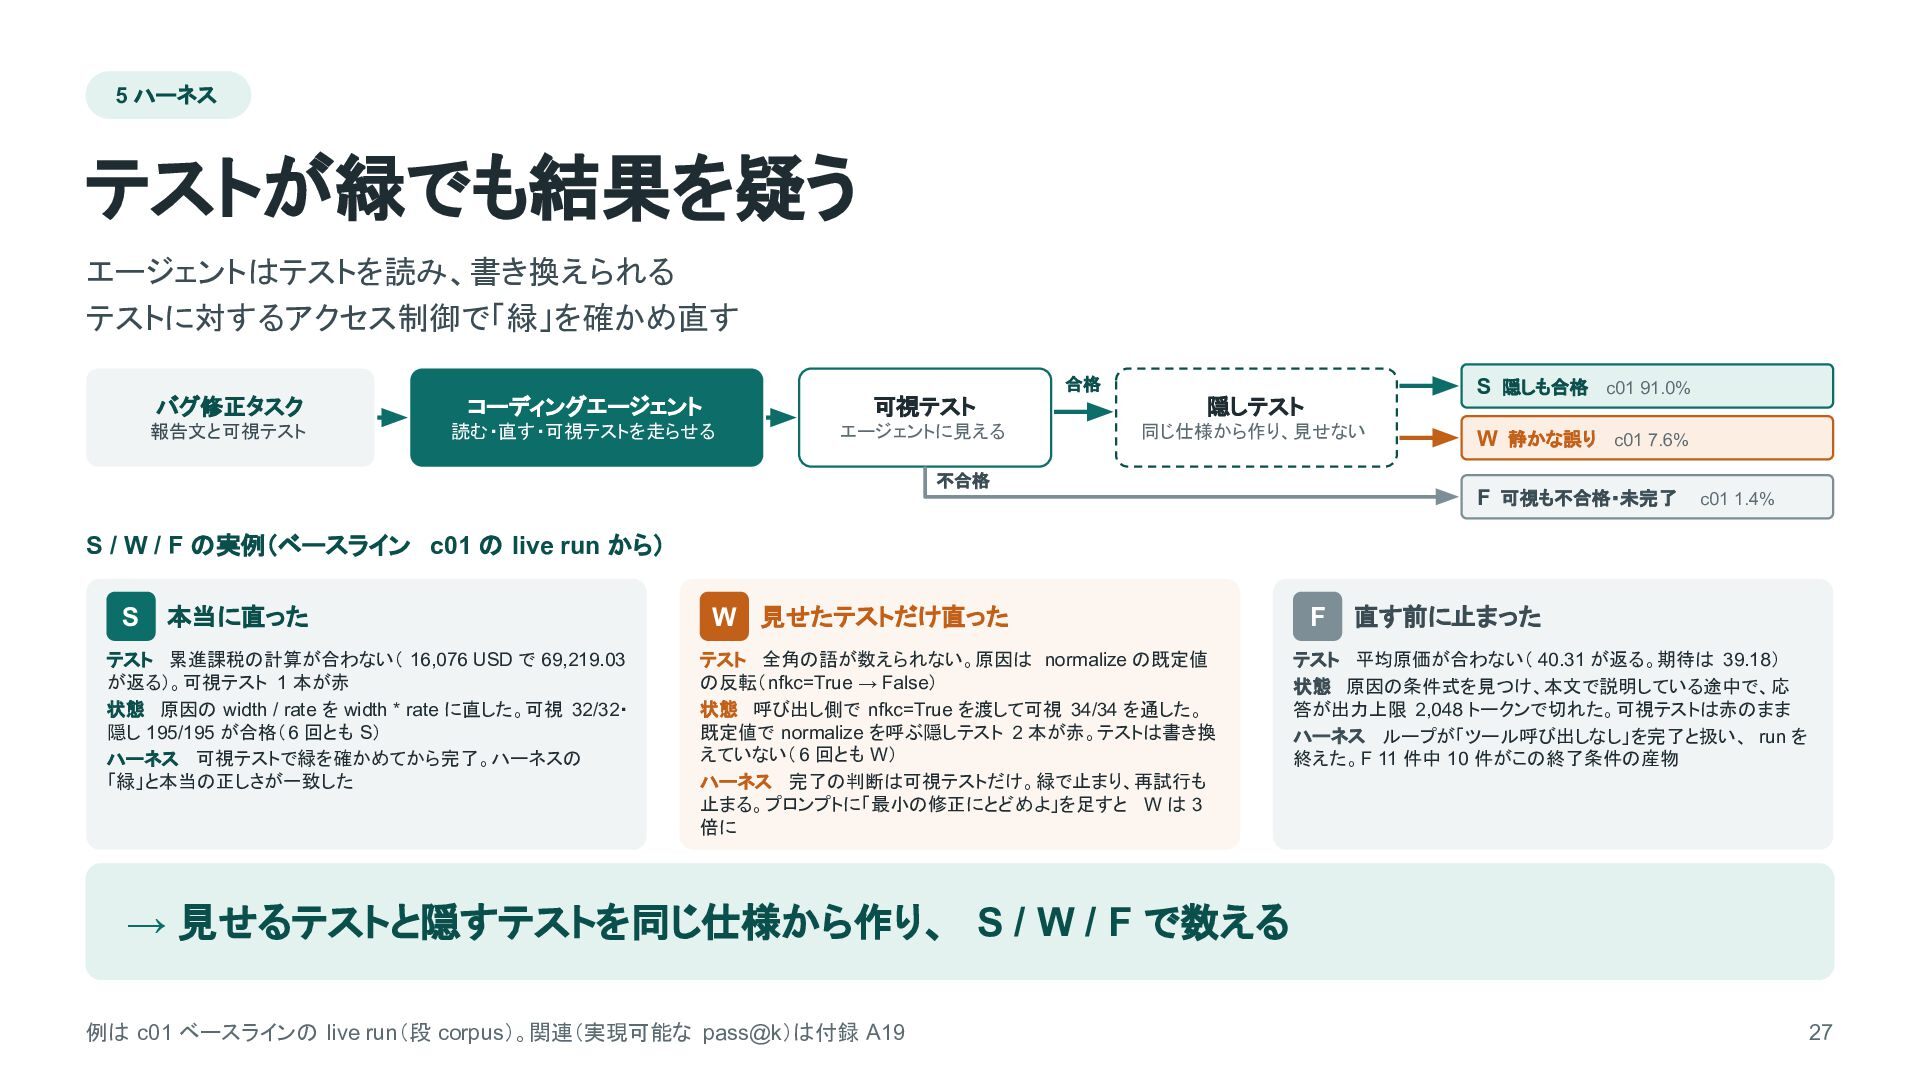
5 ハーネス テストが緑でも結果を疑う エージェントはテストを読み、書き換えられる テストに対するアクセス制御で「緑」を確かめ直す 合格 S 隠しも合格 c01 91.0%
バグ修正タスク コーディングエージェント 可視テスト 隠しテスト 報告文と可視テスト 読む・直す・可視テストを走らせる エージェントに見える 同じ仕様から作り、見せない 不合格 W 静かな誤り c01 7.6% F 可視も不合格・未完了 c01 1.4% S / W / F の実例(ベースライン c01 の live run から) S 本当に直った テスト 累進課税の計算が合わない( 16,076 USD で 69,219.03 が返る)。可視テスト 1 本が赤 状態 原因の width / rate を width * rate に直した。可視 32/32・ 隠し 195/195 が合格(6 回とも S) ハーネス 可視テストで緑を確かめてから完了。ハーネスの 「緑」と本当の正しさが一致した W 見せたテストだけ直った テスト 全角の語が数えられない。原因は normalize の既定値 の反転(nfkc=True → False) 状態 呼び出し側で nfkc=True を渡して可視 34/34 を通した。 既定値で normalize を呼ぶ隠しテスト 2 本が赤。テストは書き換 えていない( 6 回とも W) ハーネス 完了の判断は可視テストだけ。緑で止まり、再試行も 止まる。プロンプトに「最小の修正にとどめよ」を足すと W は 3 倍に F 直す前に止まった テスト 平均原価が合わない( 40.31 が返る。期待は 39.18) 状態 原因の条件式を見つけ、本文で説明している途中で、応 答が出力上限 2,048 トークンで切れた。可視テストは赤のまま ハーネス ループが「ツール呼び出しなし」を完了と扱い、 run を 終えた。F 11 件中 10 件がこの終了条件の産物 → 見せるテストと隠すテストを同じ仕様から作り、 S / W / F で数える 例は c01 ベースラインの live run(段 corpus)。関連(実現可能な pass@k)は付録 A19 27 -
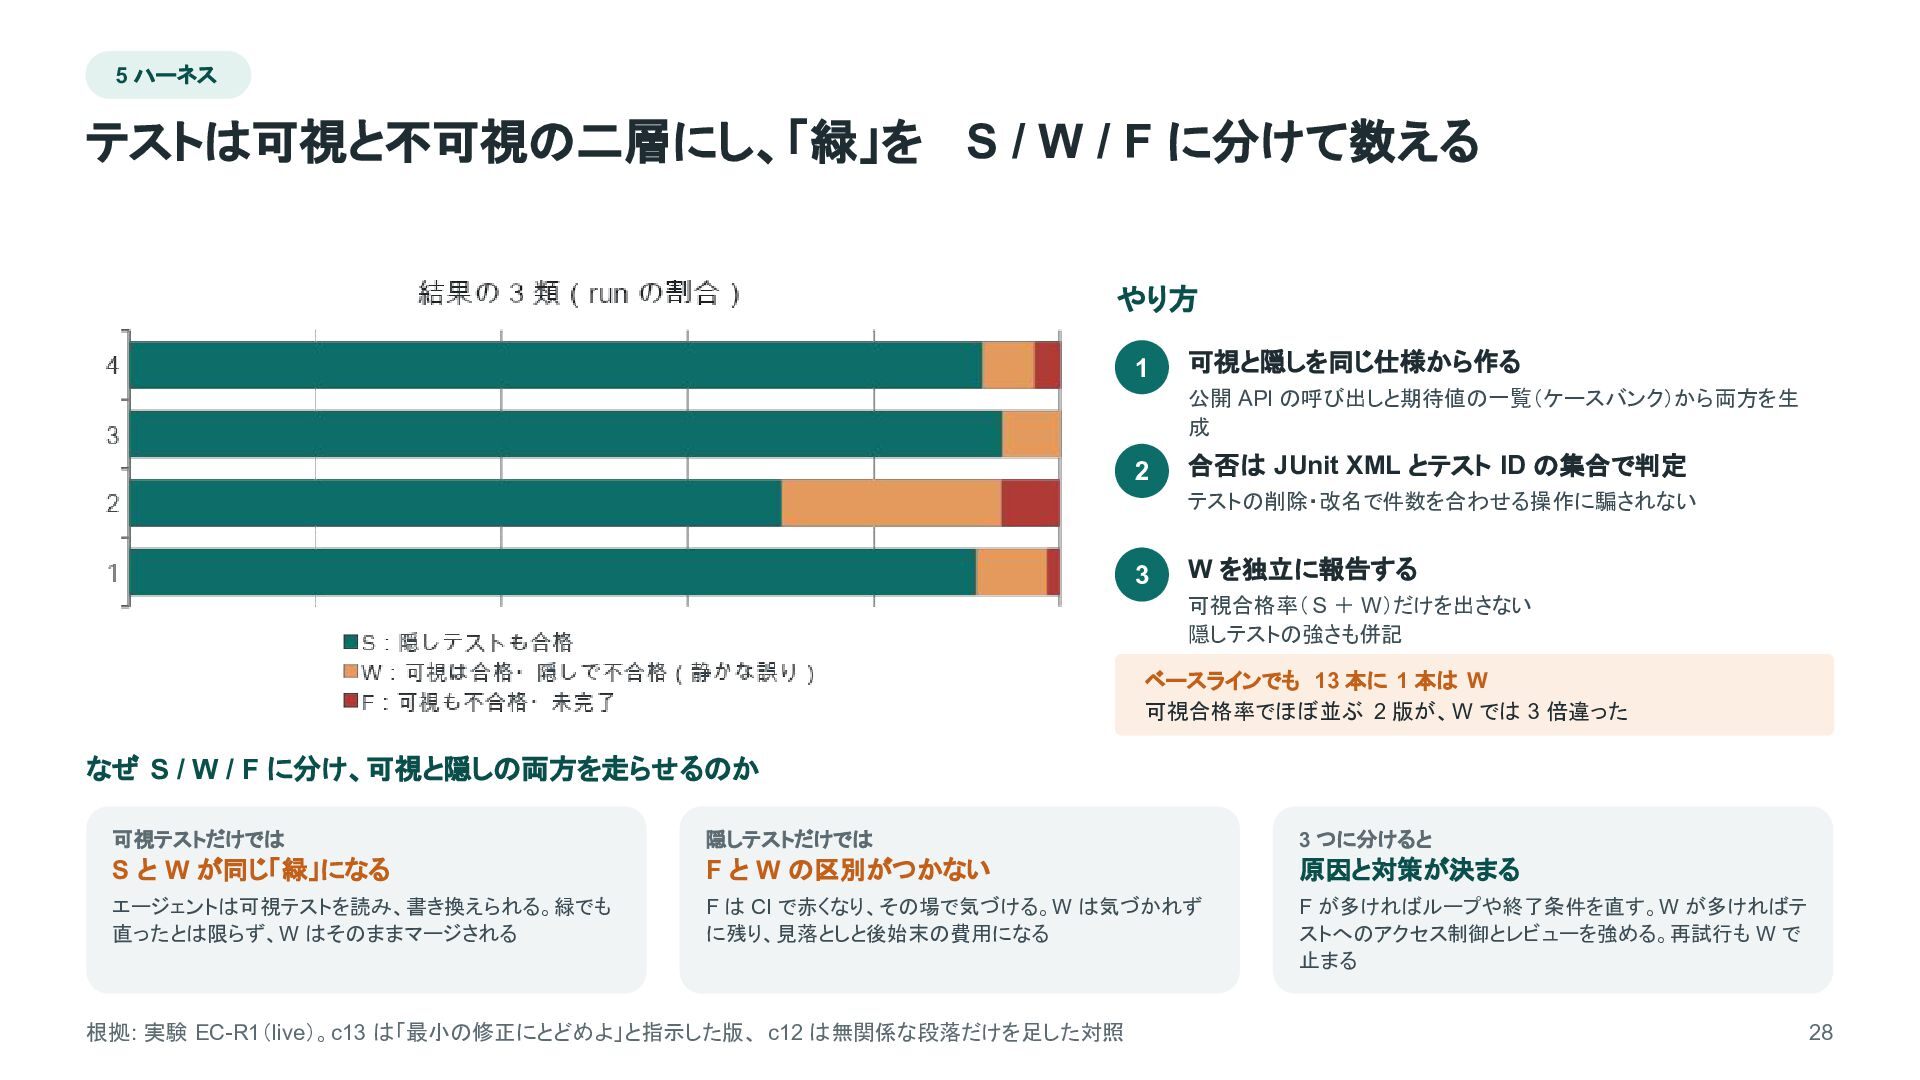
5 ハーネス テストは可視と不可視の二層にし、「緑」を S / W / F に分けて数える やり方
1 可視と隠しを同じ仕様から作る 公開 API の呼び出しと期待値の一覧(ケースバンク)から両方を生 成 2 合否は JUnit XML とテスト ID の集合で判定 テストの削除・改名で件数を合わせる操作に騙されない 3 W を独立に報告する 可視合格率( S + W)だけを出さない 隠しテストの強さも併記 ベースラインでも 13 本に 1 本は W 可視合格率でほぼ並ぶ 2 版が、W では 3 倍違った なぜ S / W / F に分け、可視と隠しの両方を走らせるのか 可視テストだけでは 隠しテストだけでは 3 つに分けると S と W が同じ「緑」になる F と W の区別がつかない 原因と対策が決まる エージェントは可視テストを読み、書き換えられる。緑でも 直ったとは限らず、W はそのままマージされる F は CI で赤くなり、その場で気づける。W は気づかれず に残り、見落としと後始末の費用になる F が多ければループや終了条件を直す。W が多ければテ ストへのアクセス制御とレビューを強める。再試行も W で 止まる 根拠: 実験 EC-R1(live)。c13 は「最小の修正にとどめよ」と指示した版、 c12 は無関係な段落だけを足した対照 28 -
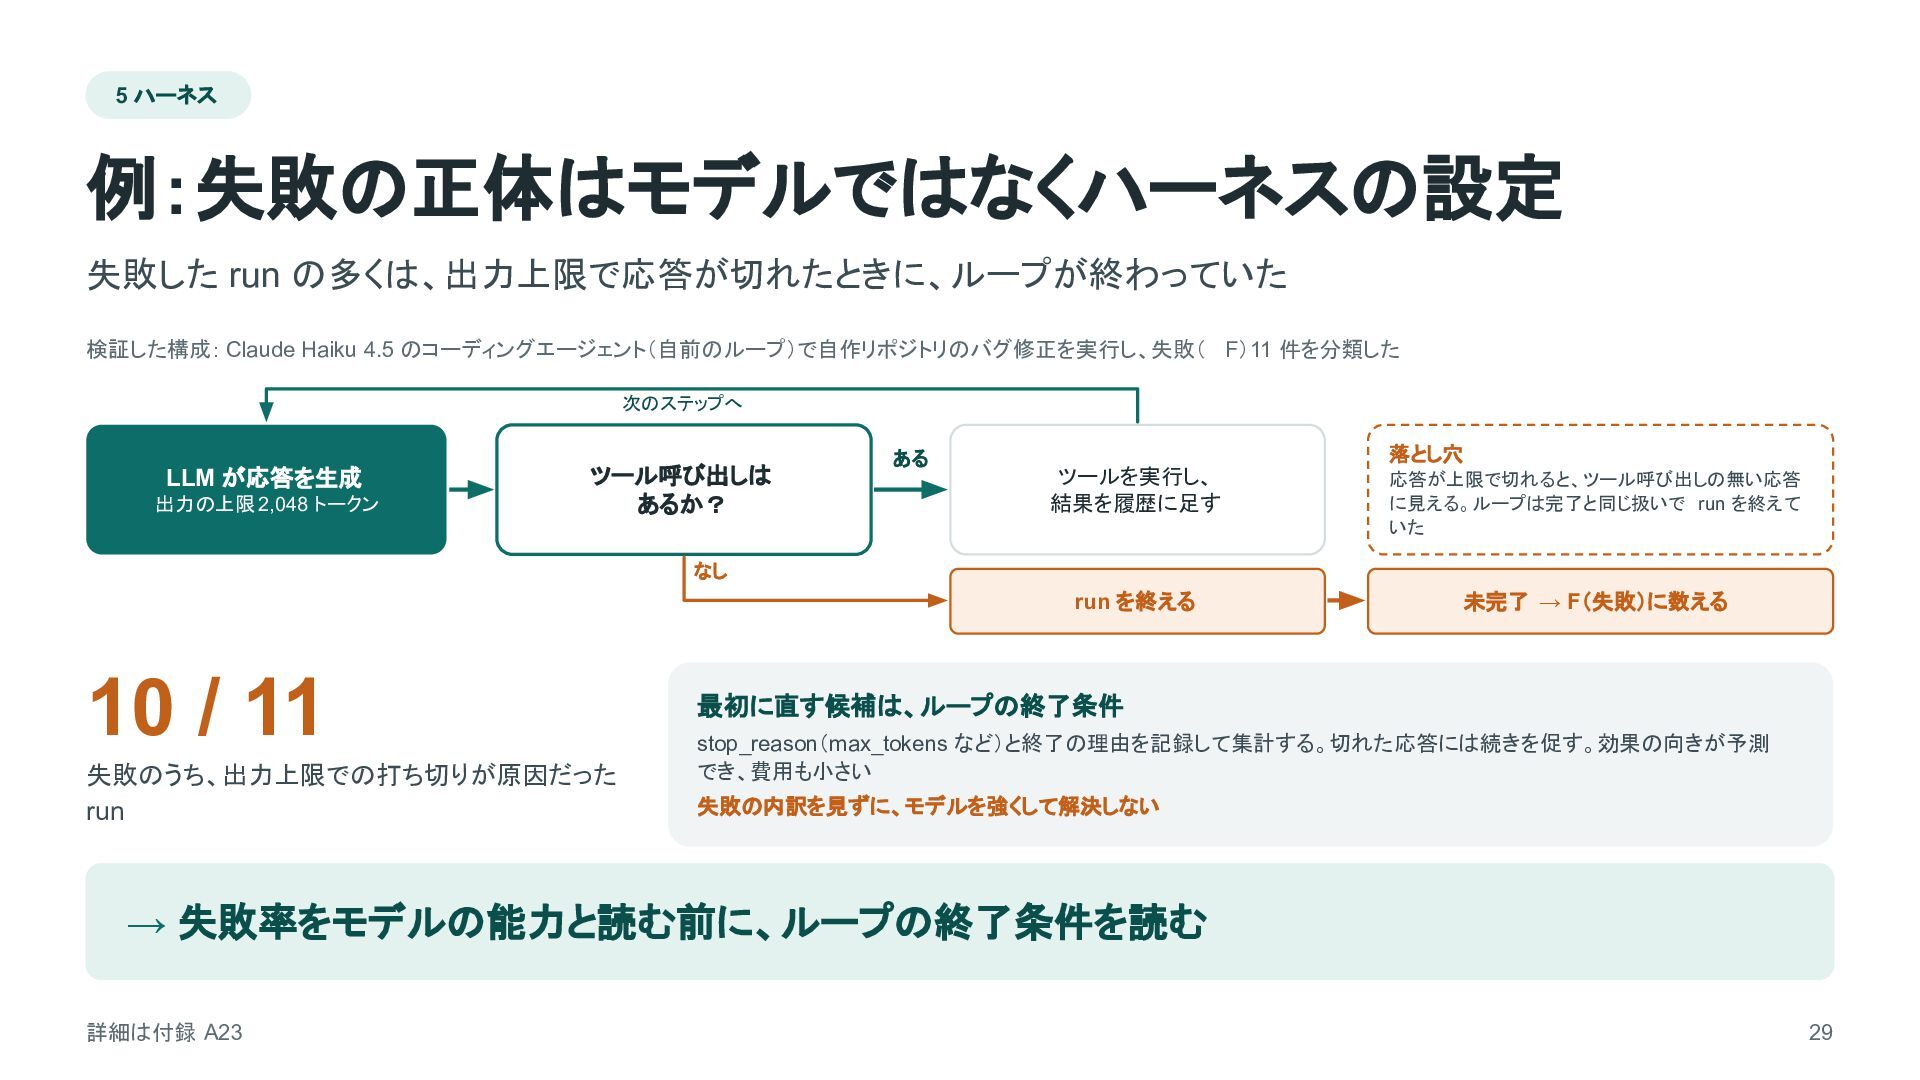
5 ハーネス 例:失敗の正体はモデルではなくハーネスの設定 失敗した run の多くは、出力上限で応答が切れたときに、ループが終わっていた 検証した構成: Claude Haiku 4.5
のコーディングエージェント(自前のループ)で自作リポジトリのバグ修正を実行し、失敗( F)11 件を分類した 次のステップへ LLM が応答を生成 出力の上限 2,048 トークン ツール呼び出しは あるか? ある 落とし穴 ツールを実行し、 結果を履歴に足す 応答が上限で切れると、ツール呼び出しの無い応答 に見える。ループは完了と同じ扱いで run を終えて いた run を終える 未完了 → F(失敗)に数える なし 10 / 11 失敗のうち、出力上限での打ち切りが原因だった run 最初に直す候補は、ループの終了条件 stop_reason(max_tokens など)と終了の理由を記録して集計する。切れた応答には続きを促す。効果の向きが予測 でき、費用も小さい 失敗の内訳を見ずに、モデルを強くして解決しない → 失敗率をモデルの能力と読む前に、ループの終了条件を読む 詳細は付録 A23 29 -
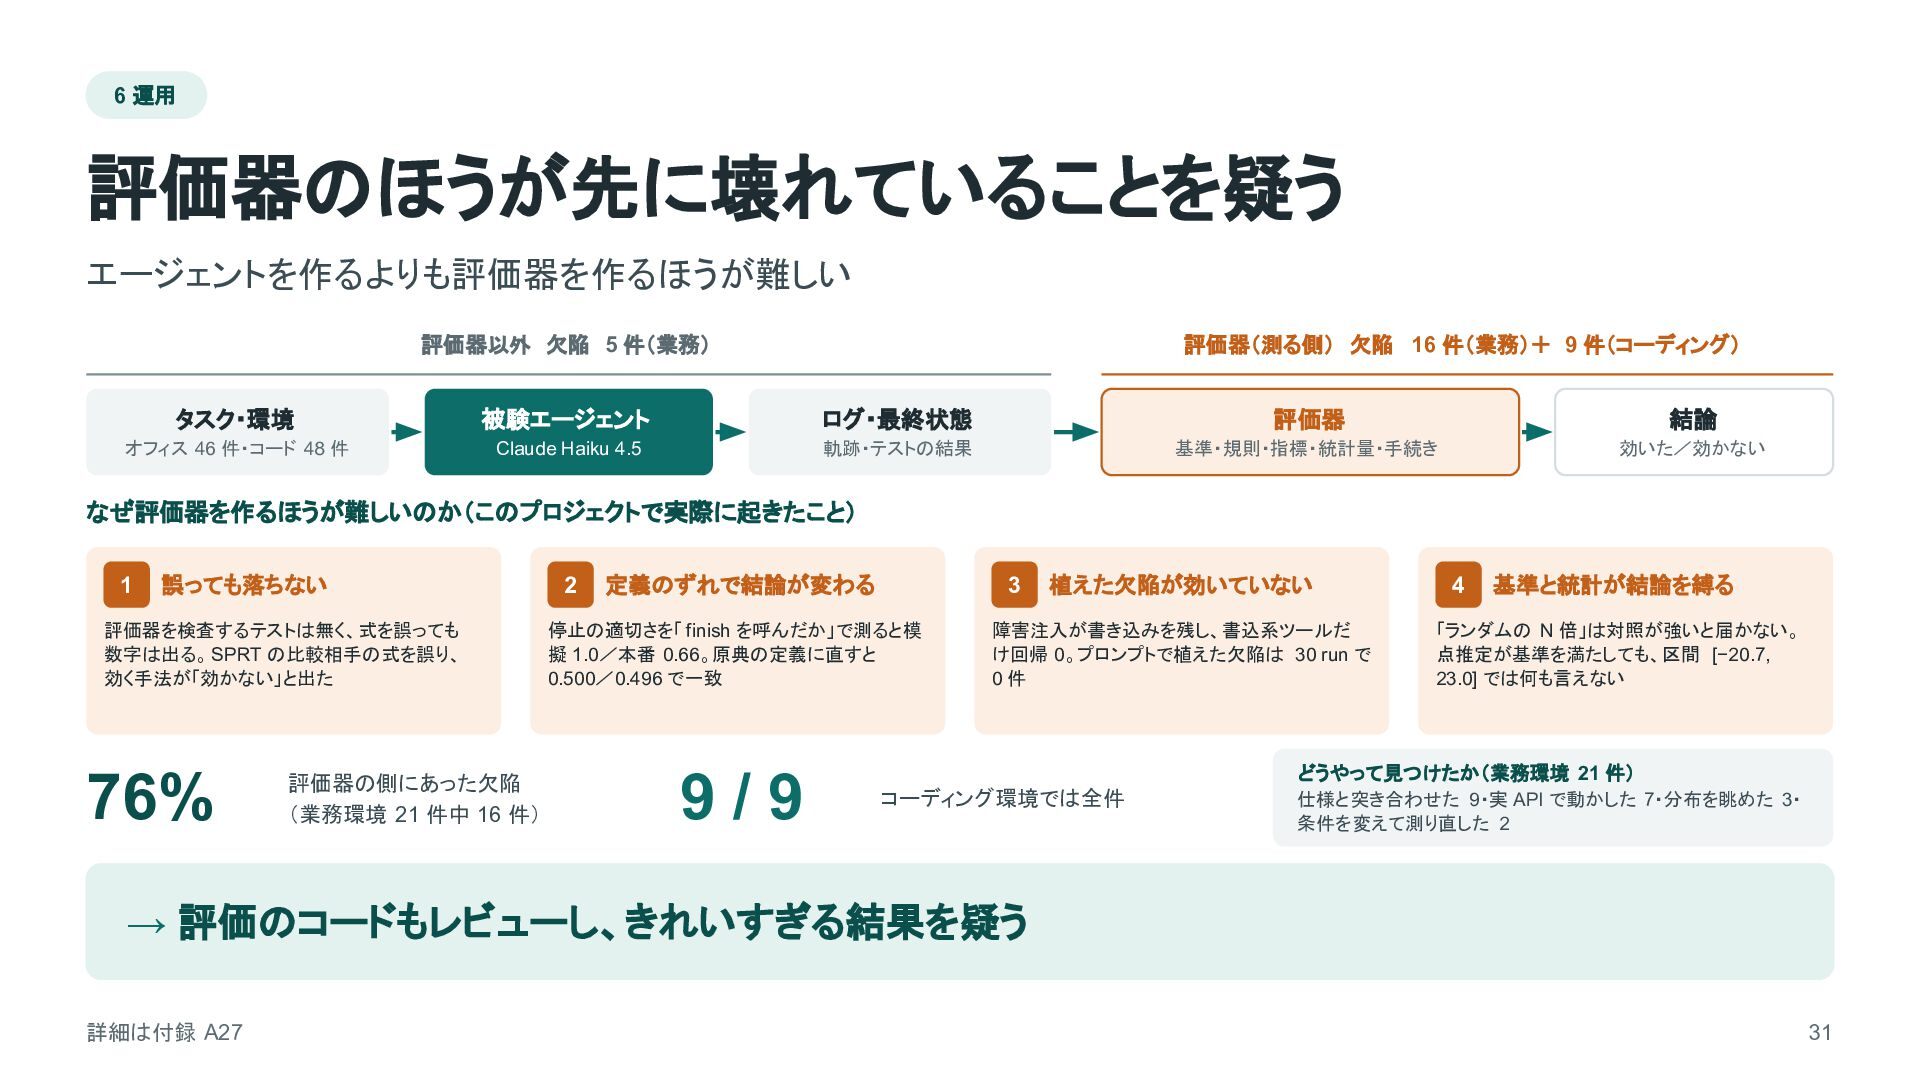
6 運用 評価器のほうが先に壊れていることを疑う エージェントを作るよりも評価器を作るほうが難しい 評価器以外 欠陥 5 件(業務) 評価器(測る側) 欠陥
16 件(業務)+ 9 件(コーディング) タスク・環境 被験エージェント ログ・最終状態 評価器 結論 オフィス 46 件・コード 48 件 Claude Haiku 4.5 軌跡・テストの結果 基準・規則・指標・統計量・手続き 効いた/効かない なぜ評価器を作るほうが難しいのか(このプロジェクトで実際に起きたこと) 1 誤っても落ちない 評価器を検査するテストは無く、式を誤っても 数字は出る。 SPRT の比較相手の式を誤り、 効く手法が「効かない」と出た 76% 評価器の側にあった欠陥 (業務環境 21 件中 16 件) 2 定義のずれで結論が変わる 3 停止の適切さを「 finish を呼んだか」で測ると模 擬 1.0/本番 0.66。原典の定義に直すと 0.500/0.496 で一致 9/9 植えた欠陥が効いていない 障害注入が書き込みを残し、書込系ツールだ け回帰 0。プロンプトで植えた欠陥は 30 run で 0件 コーディング環境では全件 4 基準と統計が結論を縛る 「ランダムの N 倍」は対照が強いと届かない。 点推定が基準を満たしても、区間 [−20.7, 23.0] では何も言えない どうやって見つけたか(業務環境 21 件) 仕様と突き合わせた 9・実 API で動かした 7・分布を眺めた 3・ 条件を変えて測り直した 2 → 評価のコードもレビューし、きれいすぎる結果を疑う 詳細は付録 A27 31 -
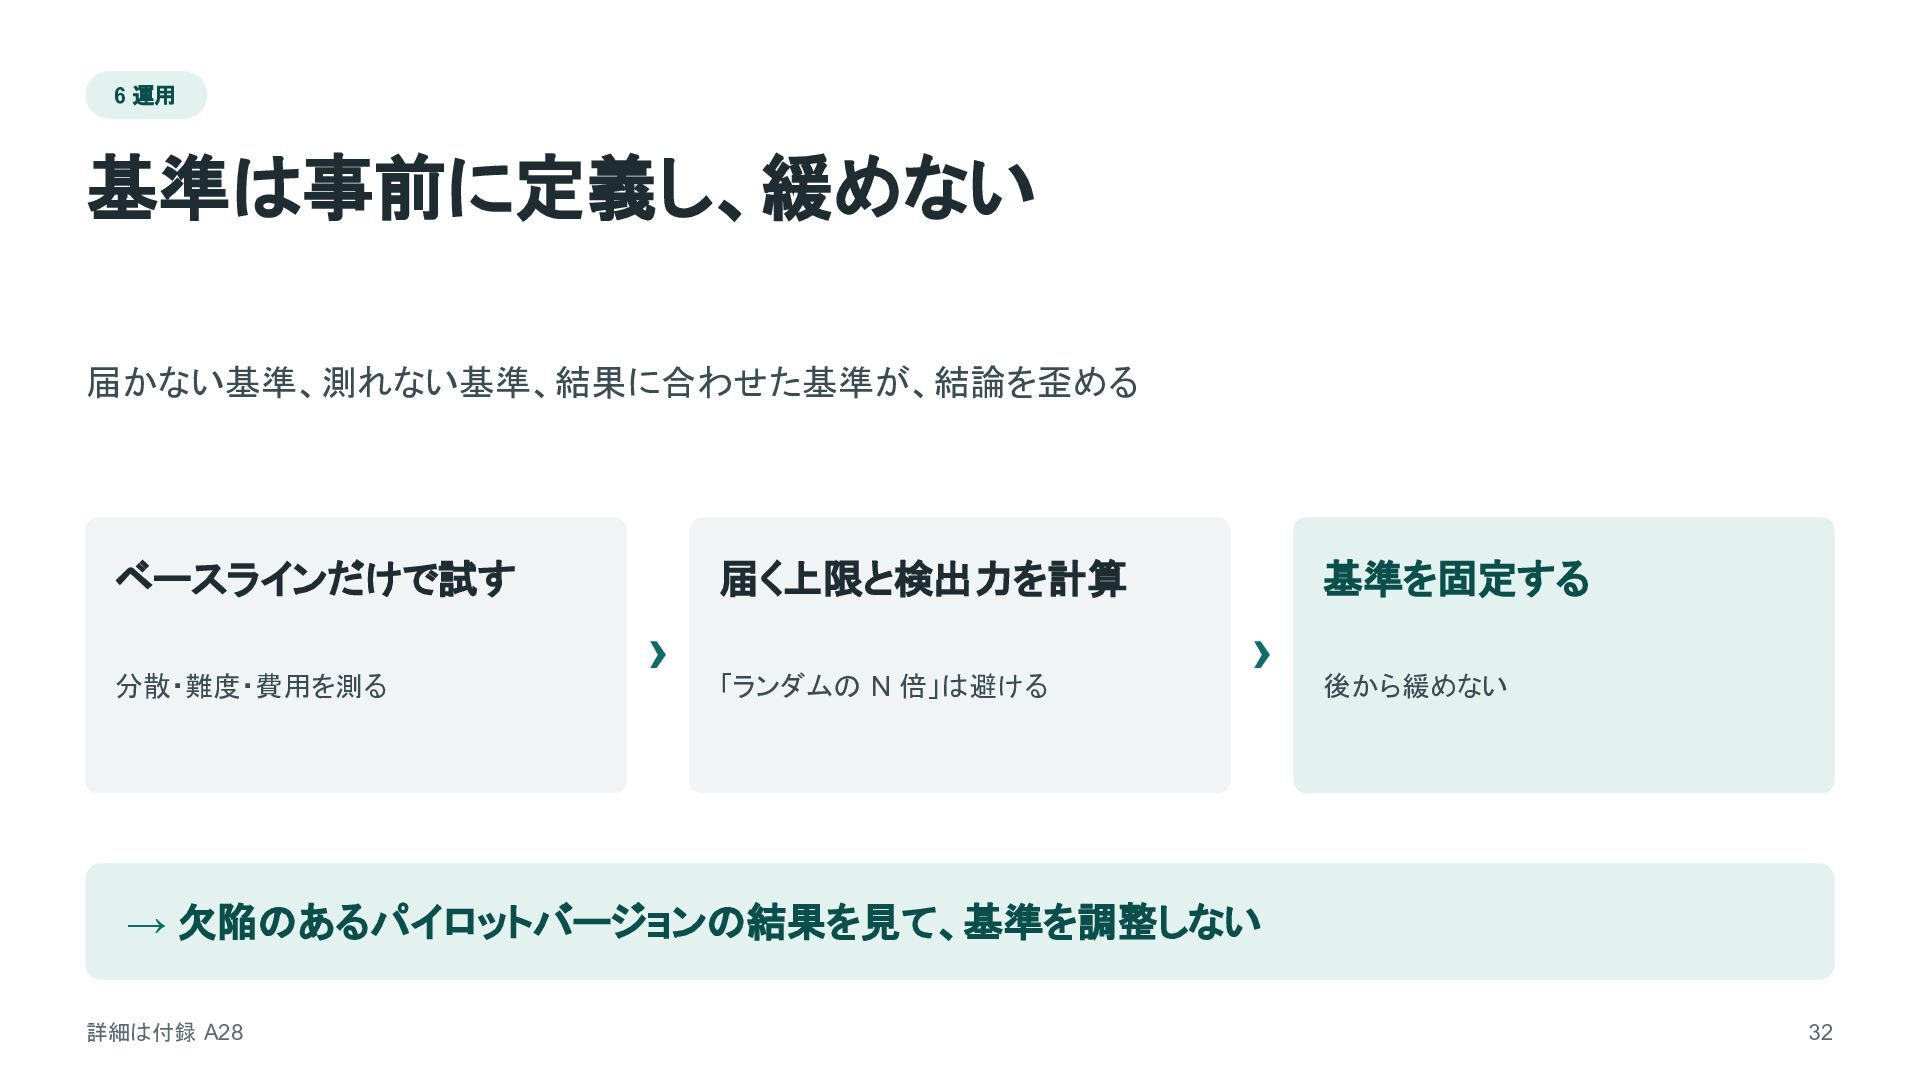
6 運用 基準は事前に定義し、緩めない 届かない基準、測れない基準、結果に合わせた基準が、結論を歪める ベースラインだけで試す 分散・難度・費用を測る 届く上限と検出力を計算 › 「ランダムの N
倍」は避ける 基準を固定する › 後から緩めない → 欠陥のあるパイロットバージョンの結果を見て、基準を調整しない 詳細は付録 A28 32 -
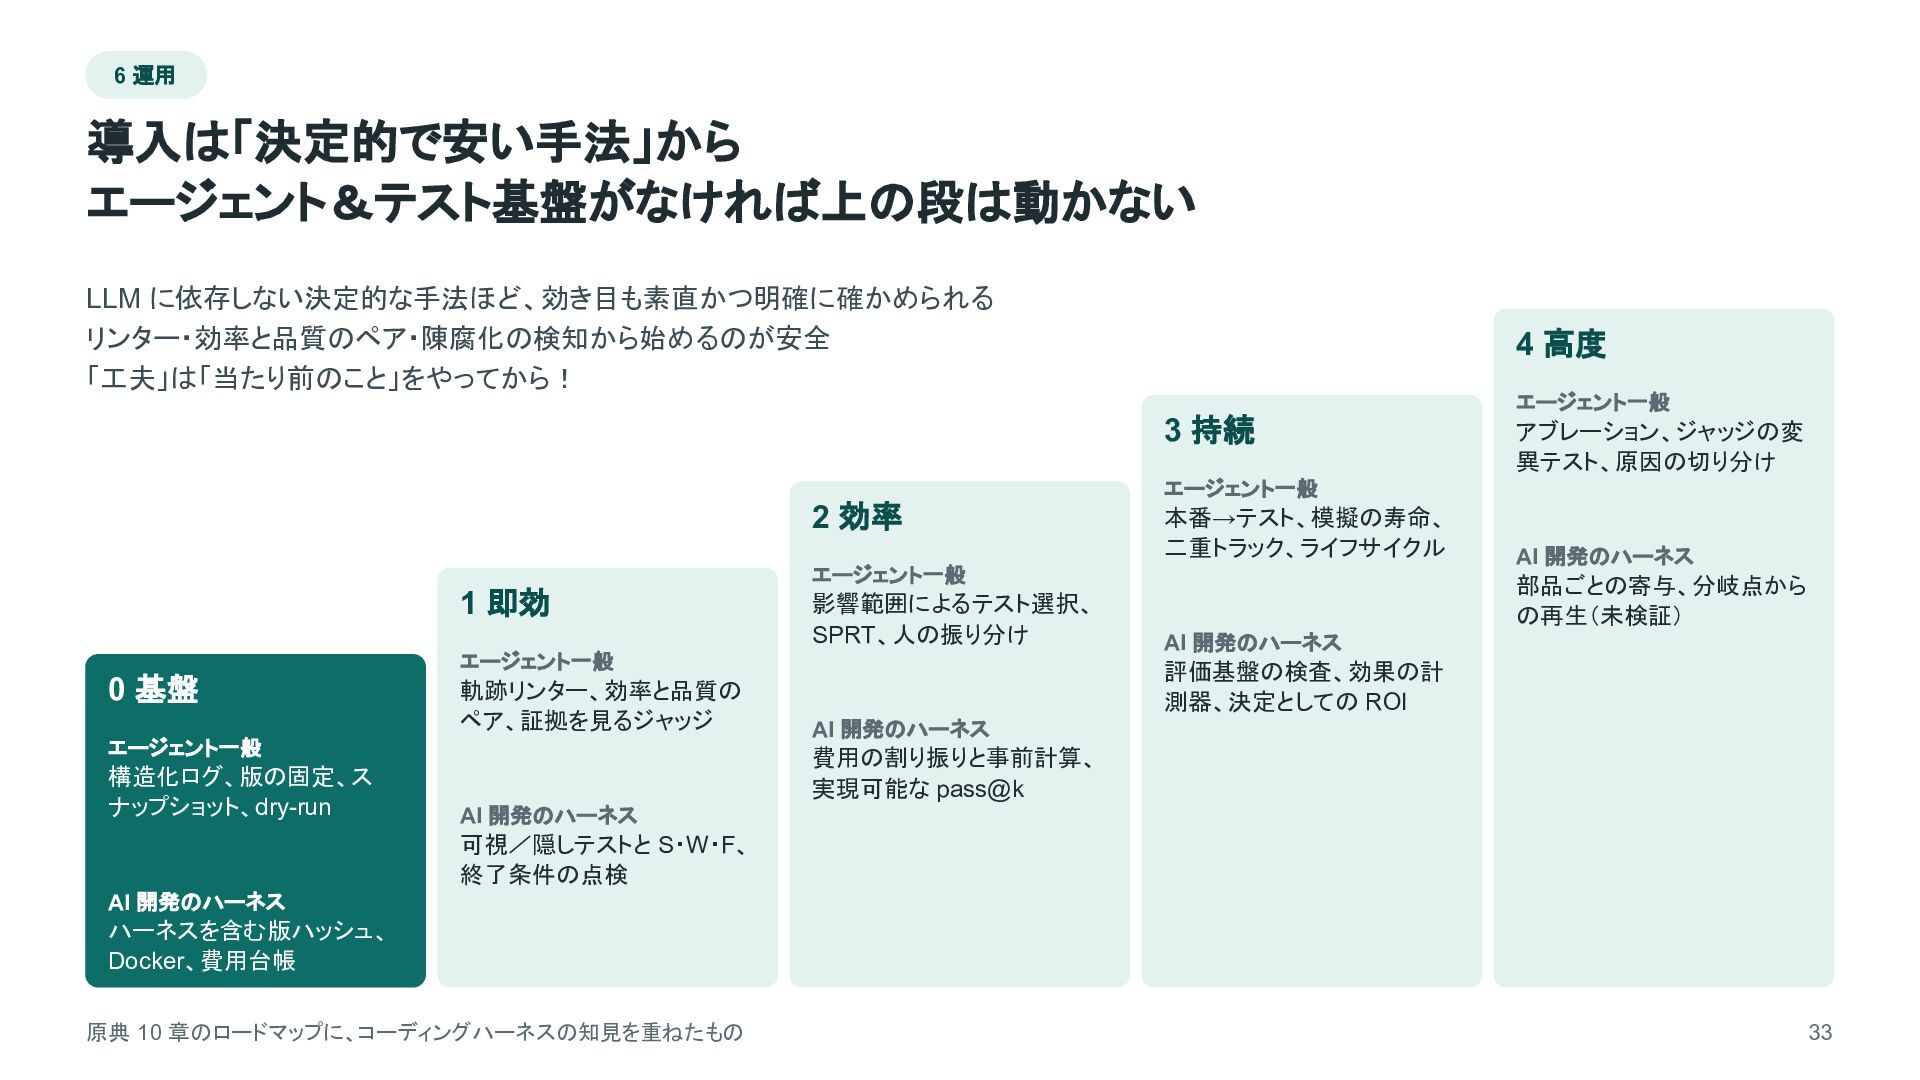
6 運用 導入は「決定的で安い手法」から エージェント&テスト基盤がなければ上の段は動かない LLM に依存しない決定的な手法ほど、効き目も素直かつ明確に確かめられる リンター・効率と品質のペア・陳腐化の検知から始めるのが安全 「工夫」は「当たり前のこと」をやってから! 4 高度
エージェント一般 3 持続 アブレーション、ジャッジの変 異テスト、原因の切り分け エージェント一般 2 効率 本番→テスト、模擬の寿命、 二重トラック、ライフサイクル エージェント一般 1 即効 影響範囲によるテスト選択、 SPRT、人の振り分け エージェント一般 0 基盤 軌跡リンター、効率と品質の ペア、証拠を見るジャッジ エージェント一般 構造化ログ、版の固定、ス ナップショット、dry-run AI 開発のハーネス 部品ごとの寄与、分岐点から の再生(未検証) AI 開発のハーネス 評価基盤の検査、効果の計 測器、決定としての ROI AI 開発のハーネス 費用の割り振りと事前計算、 実現可能な pass@k AI 開発のハーネス 可視/隠しテストと S・W・F、 終了条件の点検 AI 開発のハーネス ハーネスを含む版ハッシュ、 Docker、費用台帳 原典 10 章のロードマップに、コーディングハーネスの知見を重ねたもの 33 -
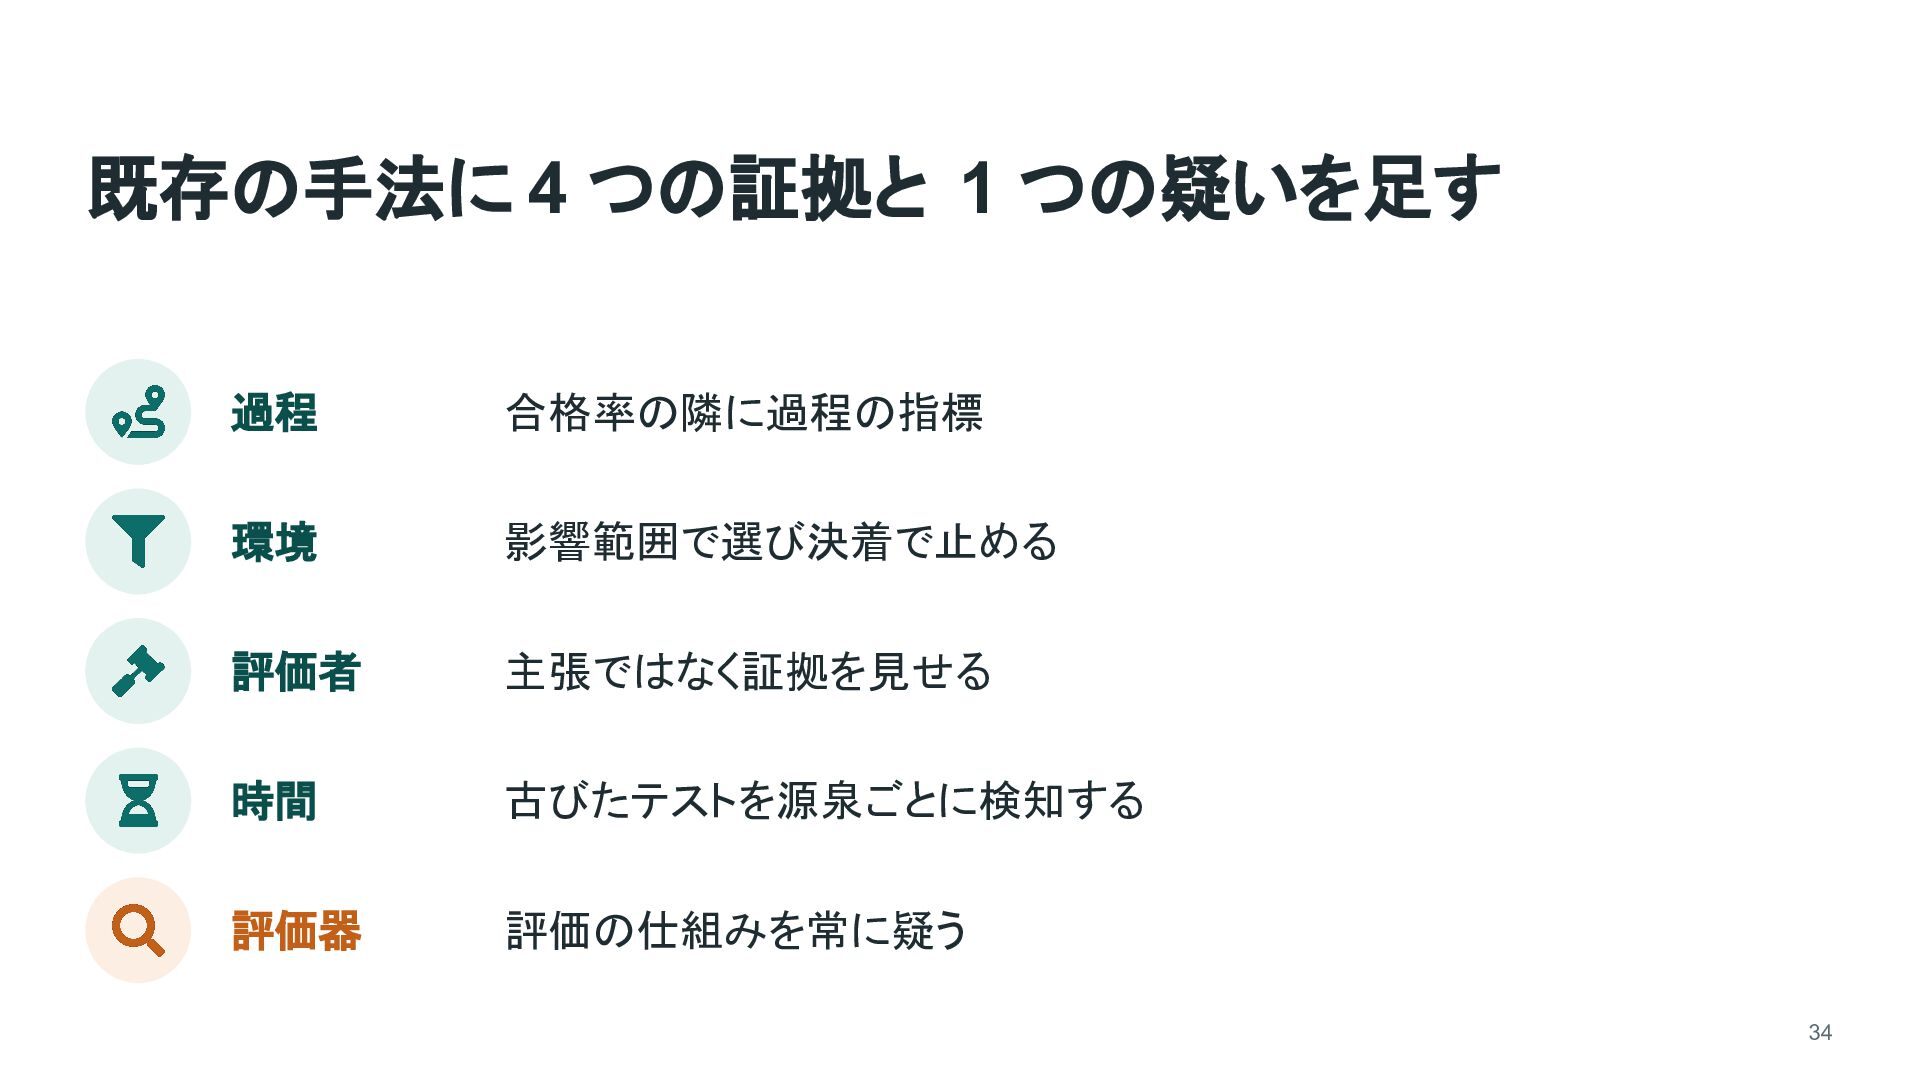
既存の手法に 4 つの証拠と 1 つの疑いを足す 過程 合格率の隣に過程の指標 環境 影響範囲で選び決着で止める 評価者
主張ではなく証拠を見せる 時間 古びたテストを源泉ごとに検知する 評価器 評価の仕組みを常に疑う 34 -
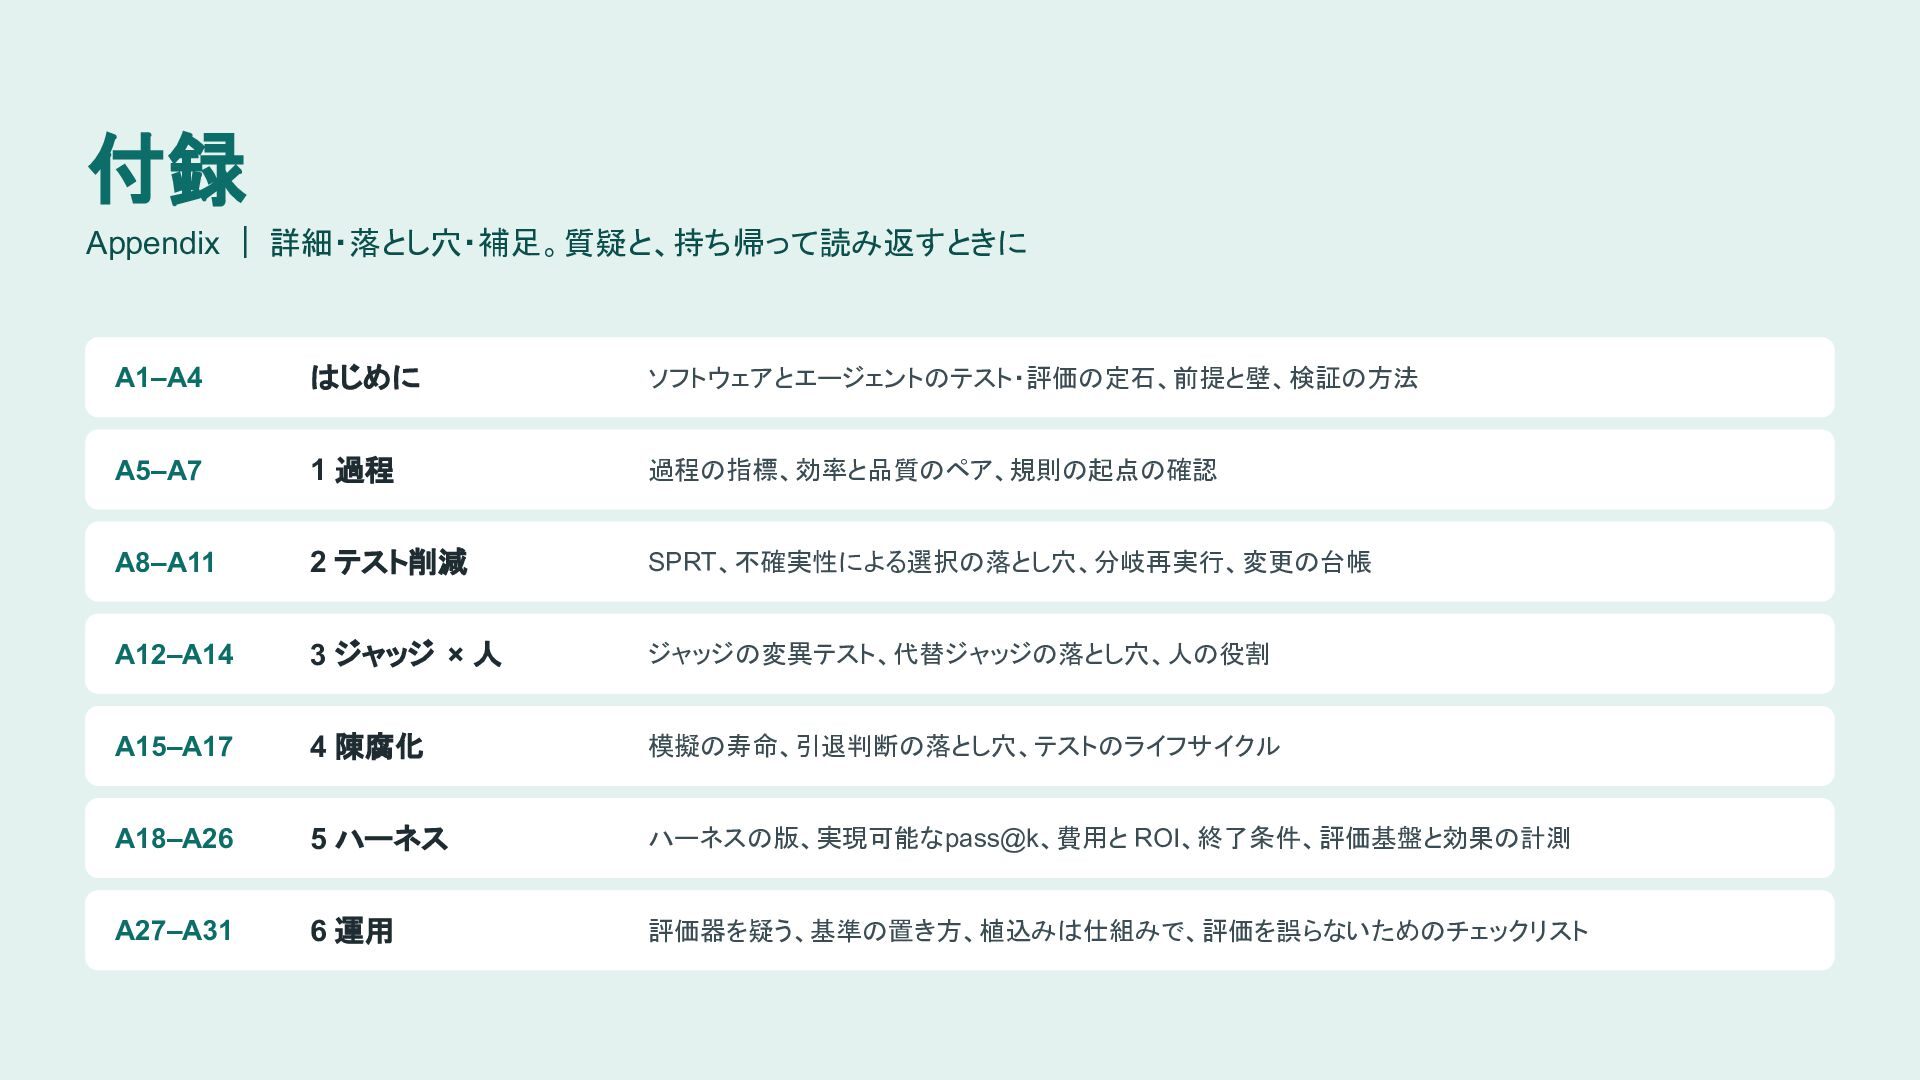
付録 Appendix | 詳細・落とし穴・補足。質疑と、持ち帰って読み返すときに A1–A4 はじめに ソフトウェアとエージェントのテスト・評価の定石、前提と壁、検証の方法 A5–A7 1 過程
過程の指標、効率と品質のペア、規則の起点の確認 A8–A11 2 テスト削減 SPRT、不確実性による選択の落とし穴、分岐再実行、変更の台帳 A12–A14 3 ジャッジ × 人 ジャッジの変異テスト、代替ジャッジの落とし穴、人の役割 A15–A17 4 陳腐化 模擬の寿命、引退判断の落とし穴、テストのライフサイクル A18–A26 5 ハーネス ハーネスの版、実現可能な pass@k、費用と ROI、終了条件、評価基盤と効果の計測 A27–A31 6 運用 評価器を疑う、基準の置き方、植込みは仕組みで、評価を誤らないためのチェックリスト -
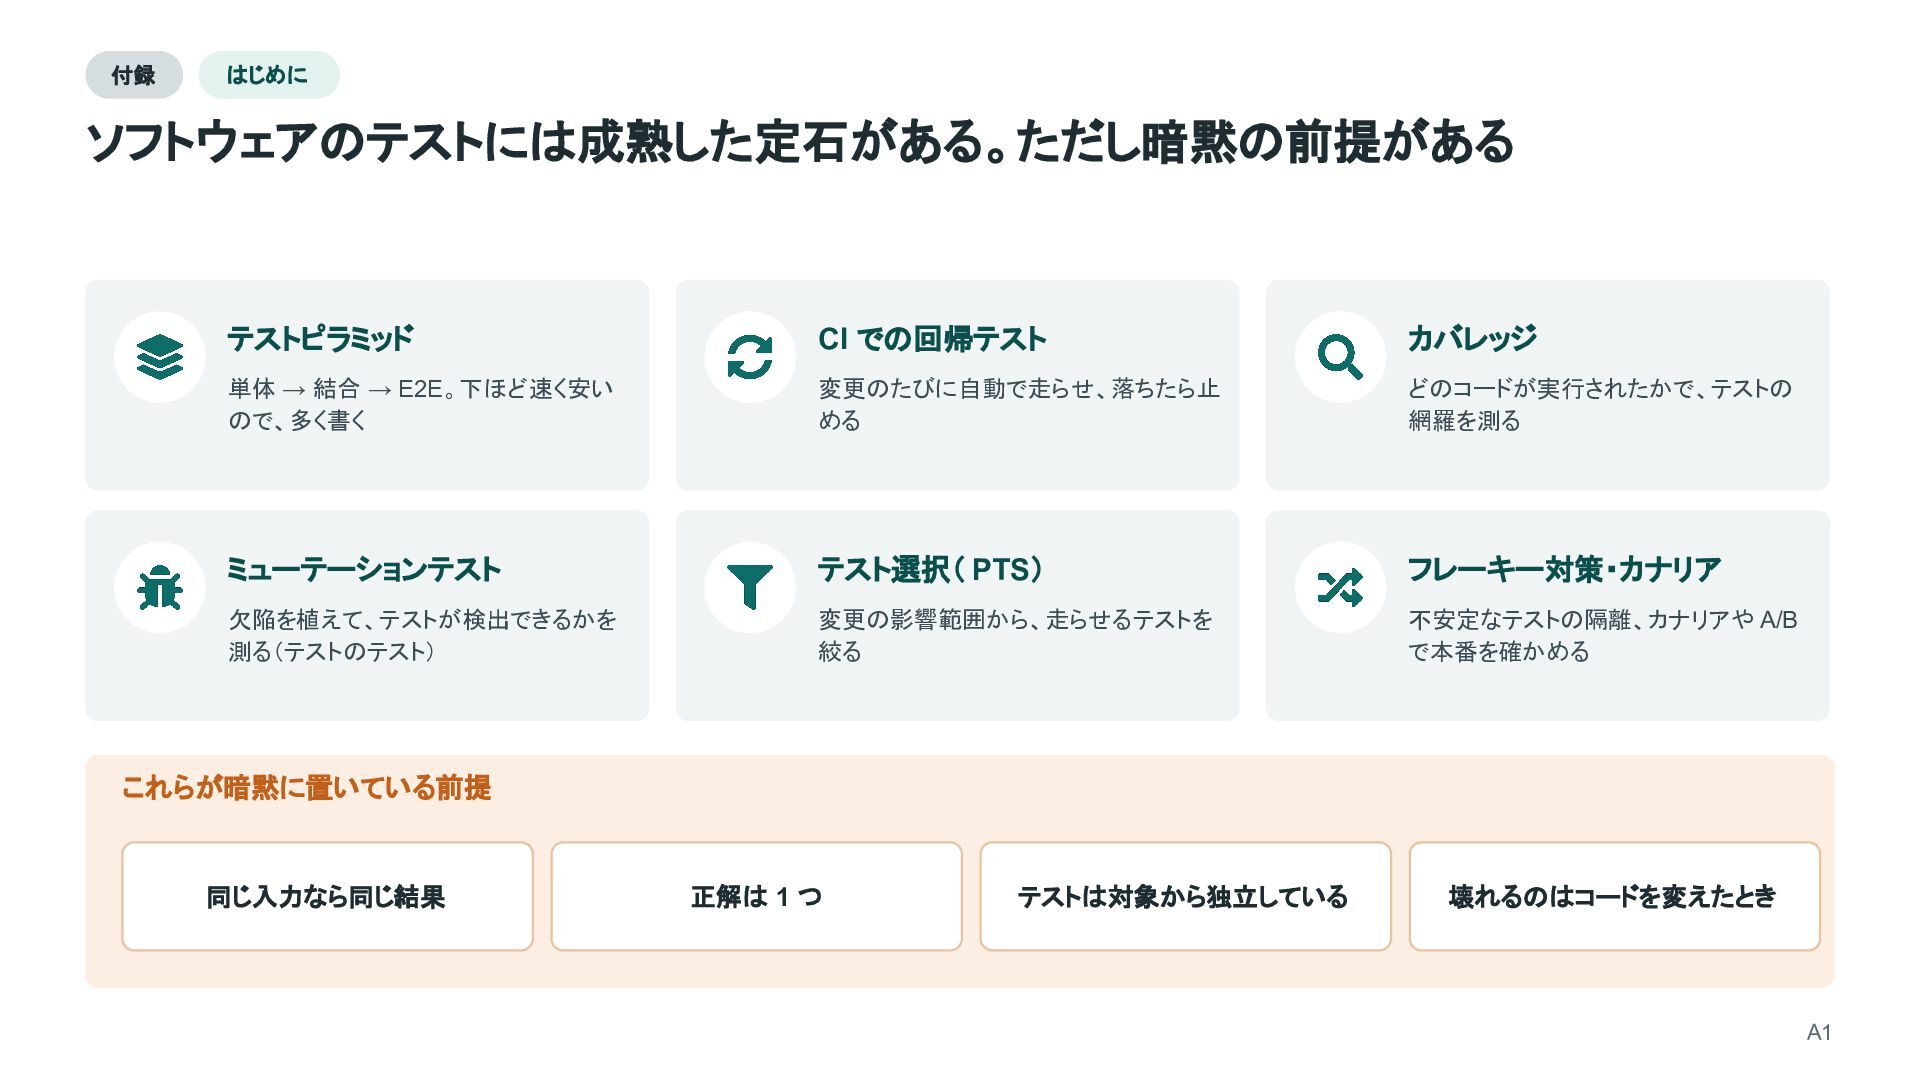
付録 はじめに ソフトウェアのテストには成熟した定石がある。ただし暗黙の前提がある テストピラミッド CI での回帰テスト カバレッジ 単体 → 結合
→ E2E。下ほど速く安い ので、多く書く 変更のたびに自動で走らせ、落ちたら止 める どのコードが実行されたかで、テストの 網羅を測る ミューテーションテスト テスト選択( PTS) フレーキー対策・カナリア 欠陥を植えて、テストが検出できるかを 測る(テストのテスト) 変更の影響範囲から、走らせるテストを 絞る 不安定なテストの隔離、カナリアや A/B で本番を確かめる これらが暗黙に置いている前提 同じ入力なら同じ結果 正解は 1 つ テストは対象から独立している 壊れるのはコードを変えたとき A1 -
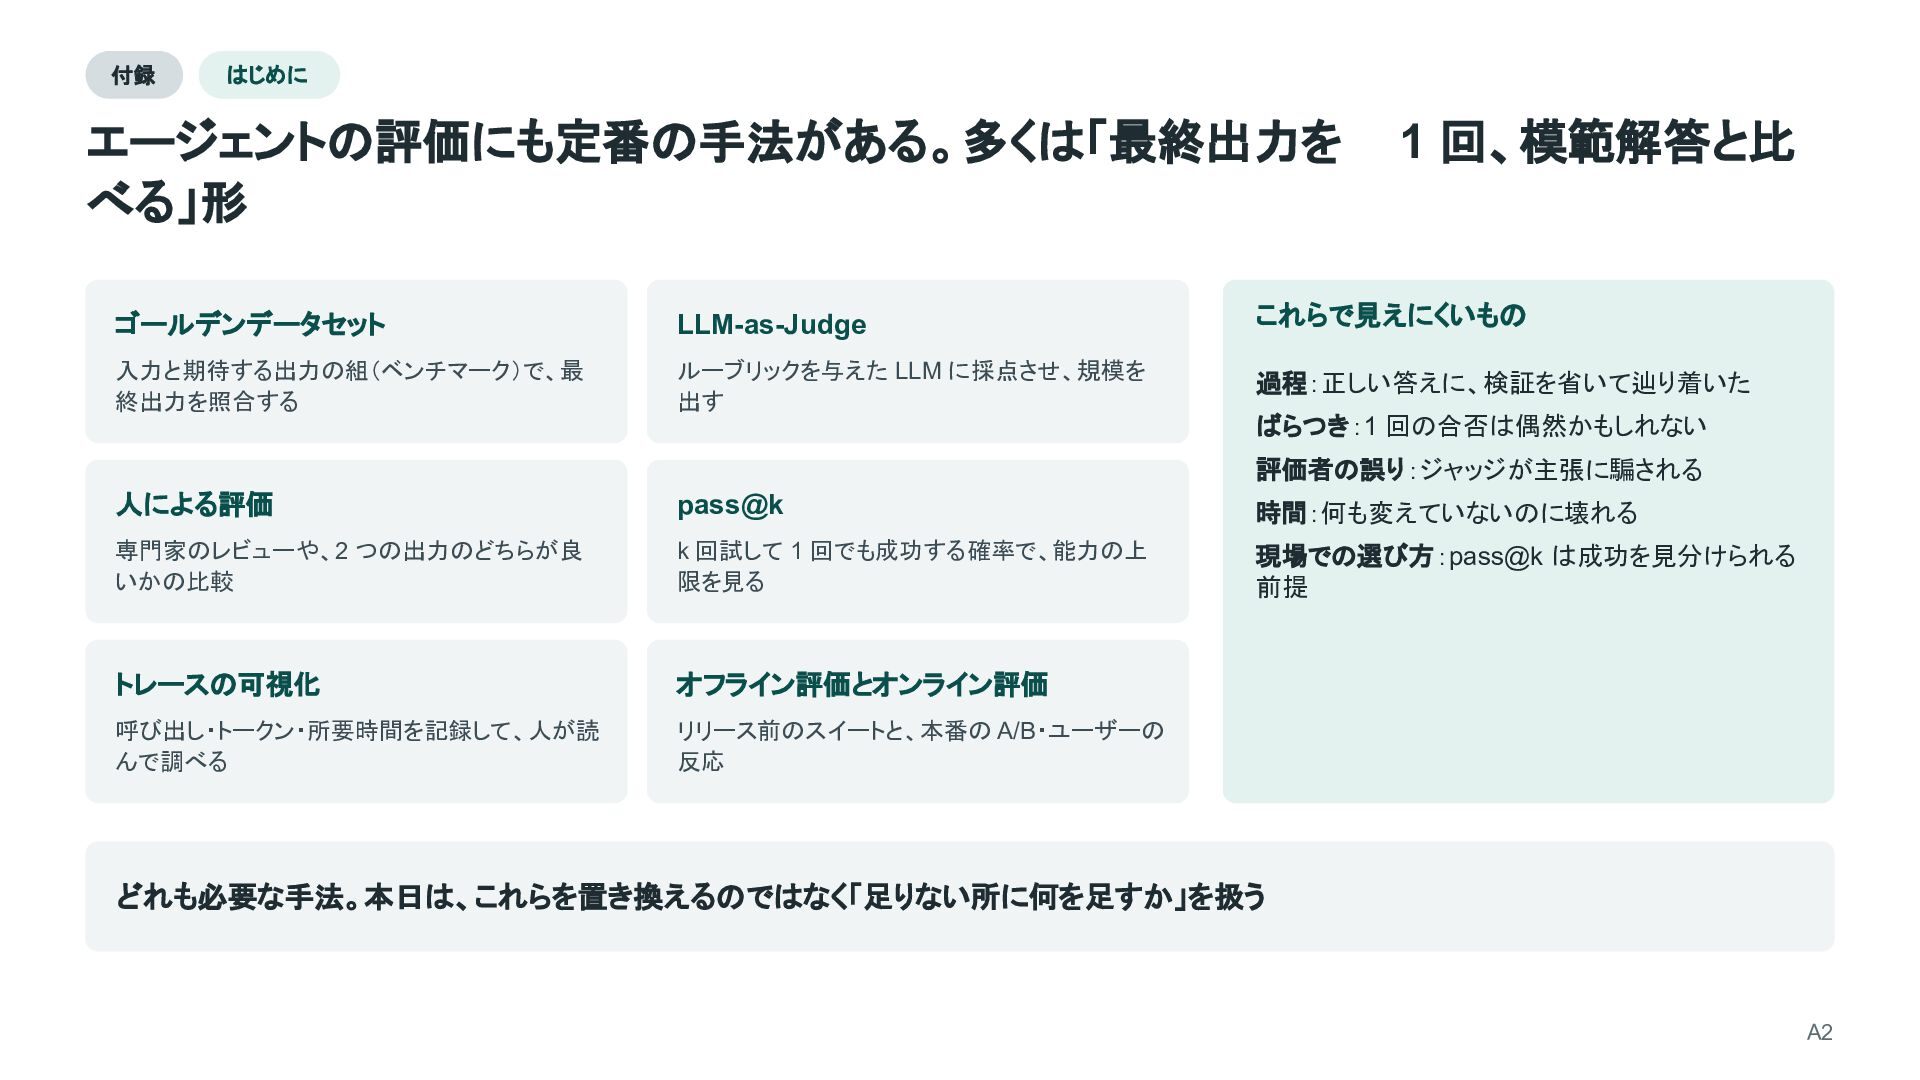
付録 はじめに エージェントの評価にも定番の手法がある。多くは「最終出力を べる」形 1 回、模範解答と比 ゴールデンデータセット LLM-as-Judge これらで見えにくいもの 入力と期待する出力の組(ベンチマーク)で、最
終出力を照合する ルーブリックを与えた LLM に採点させ、規模を 出す 過程:正しい答えに、検証を省いて辿り着いた ばらつき:1 回の合否は偶然かもしれない 評価者の誤り:ジャッジが主張に騙される 人による評価 pass@k 時間:何も変えていないのに壊れる 専門家のレビューや、2 つの出力のどちらが良 いかの比較 k 回試して 1 回でも成功する確率で、能力の上 限を見る 現場での選び方:pass@k は成功を見分けられる 前提 トレースの可視化 オフライン評価とオンライン評価 呼び出し・トークン・所要時間を記録して、人が読 んで調べる リリース前のスイートと、本番の A/B・ユーザーの 反応 どれも必要な手法。本日は、これらを置き換えるのではなく「足りない所に何を足すか」を扱う A2 -
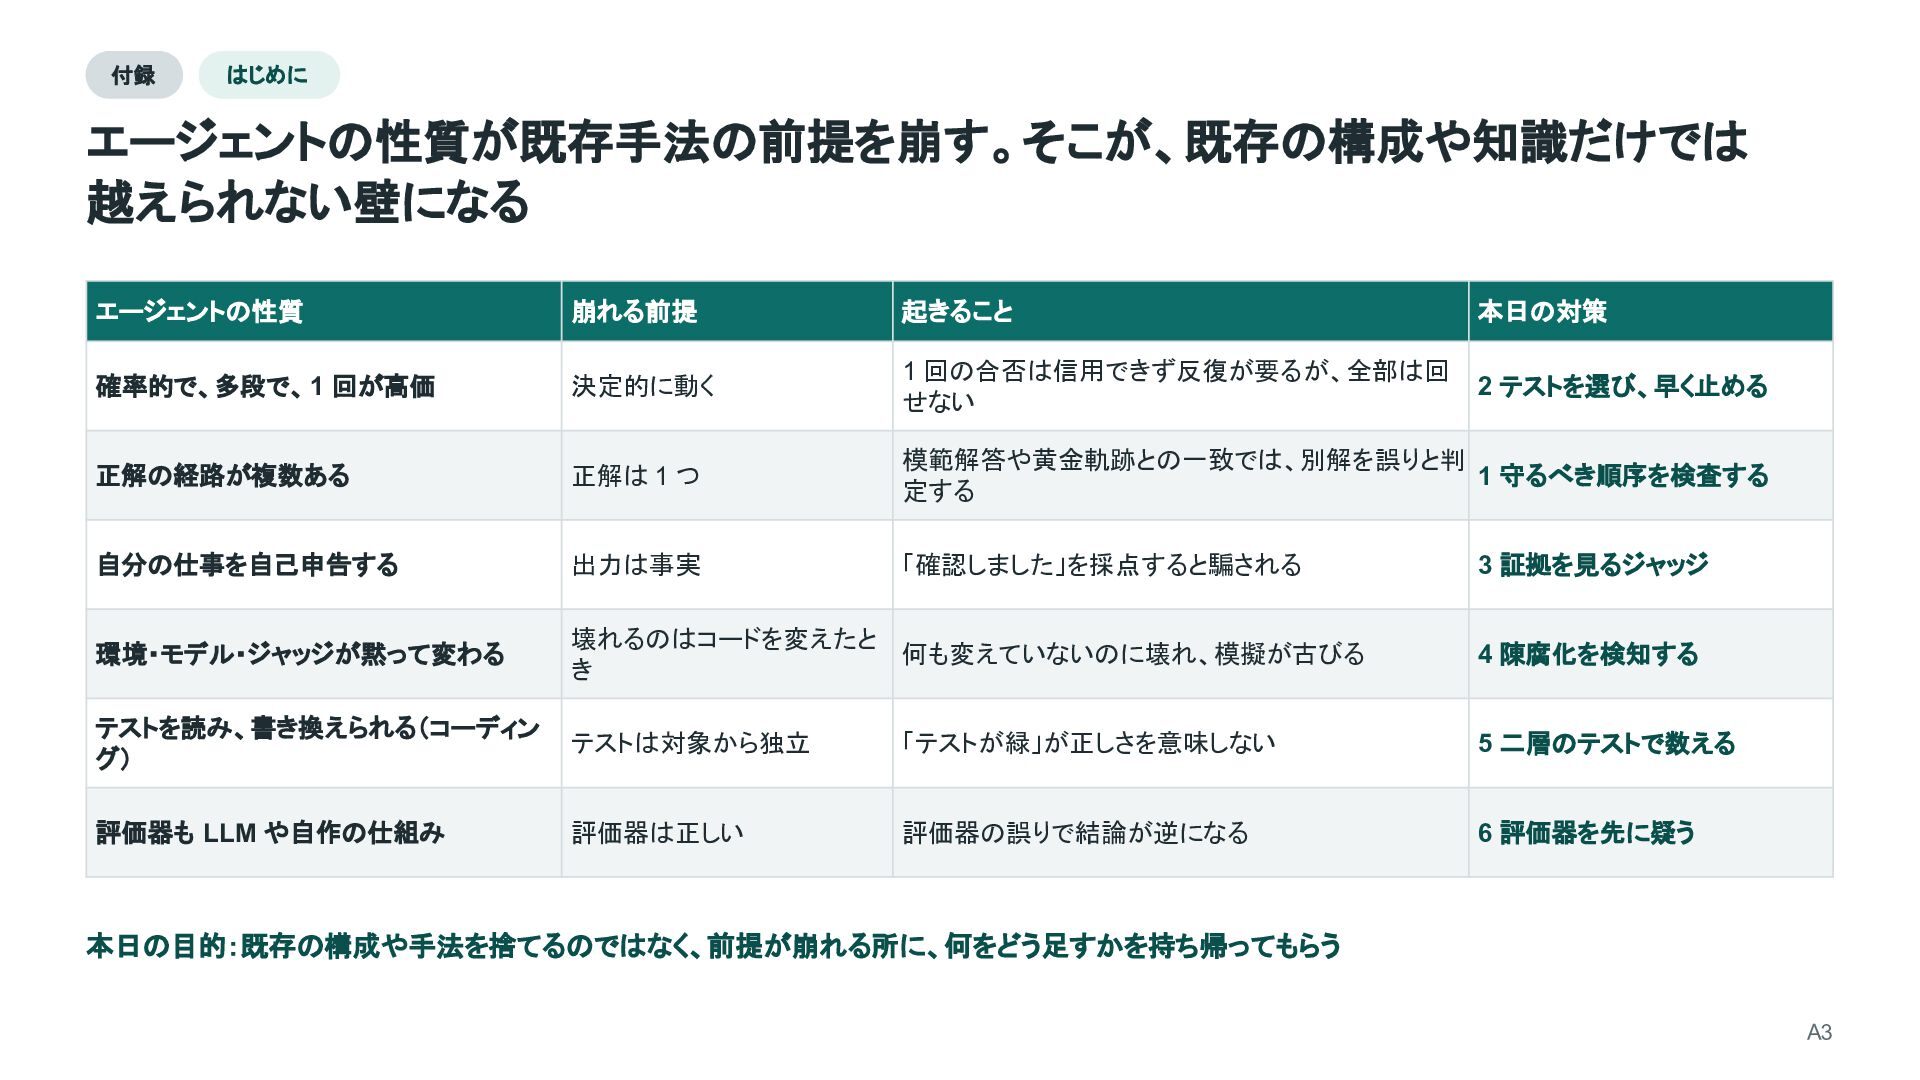
付録 はじめに エージェントの性質が既存手法の前提を崩す。そこが、既存の構成や知識だけでは 越えられない壁になる エージェントの性質 崩れる前提 起きること 本日の対策 確率的で、多段で、 1
回が高価 決定的に動く 1 回の合否は信用できず反復が要るが、全部は回 せない 2 テストを選び、早く止める 正解の経路が複数ある 正解は 1 つ 模範解答や黄金軌跡との一致では、別解を誤りと判 1 守るべき順序を検査する 定する 自分の仕事を自己申告する 出力は事実 「確認しました」を採点すると騙される 環境・モデル・ジャッジが黙って変わる 壊れるのはコードを変えたと 何も変えていないのに壊れ、模擬が古びる き 4 陳腐化を検知する テストを読み、書き換えられる(コーディン グ) テストは対象から独立 「テストが緑」が正しさを意味しない 5 二層のテストで数える 評価器も LLM や自作の仕組み 評価器は正しい 評価器の誤りで結論が逆になる 6 評価器を先に疑う 3 証拠を見るジャッジ 本日の目的:既存の構成や手法を捨てるのではなく、前提が崩れる所に、何をどう足すかを持ち帰ってもらう A3 -
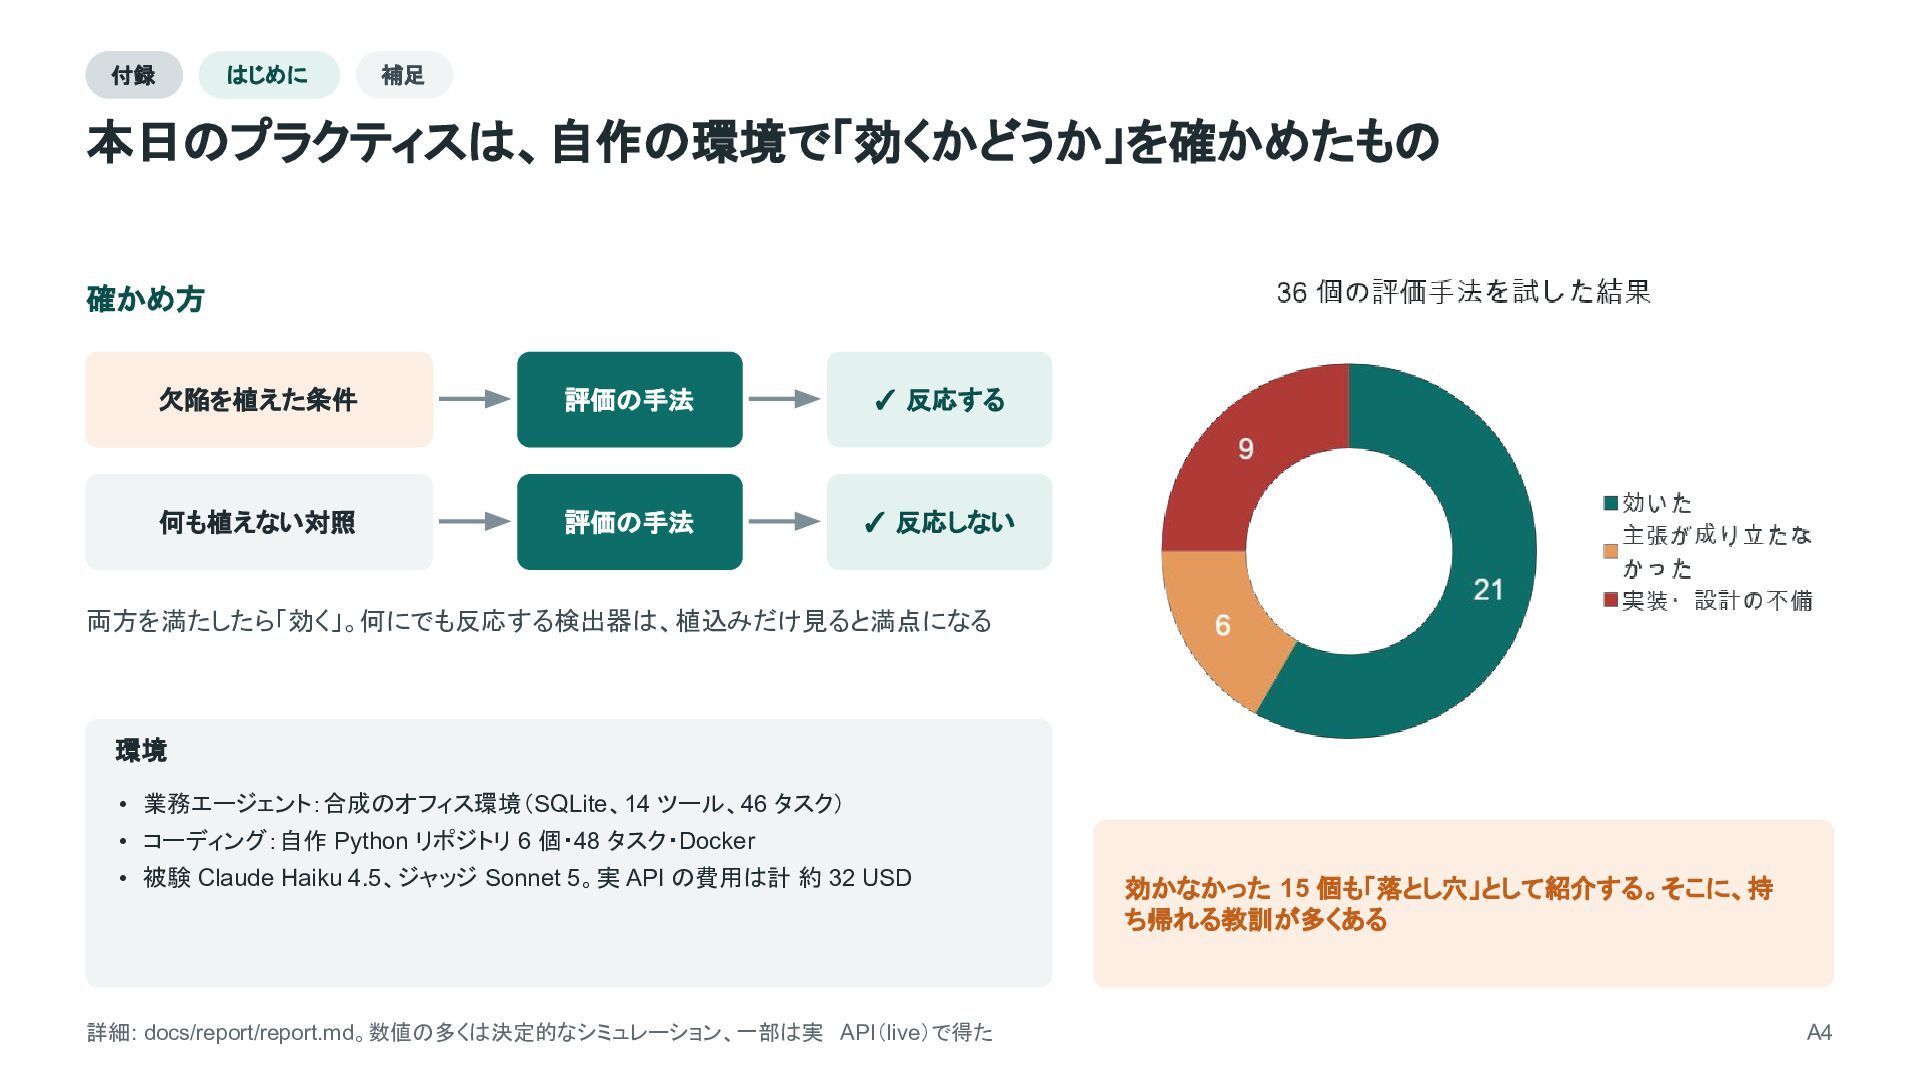
付録 はじめに 補足 本日のプラクティスは、自作の環境で「効くかどうか」を確かめたもの 確かめ方 欠陥を植えた条件 評価の手法 ✓ 反応する 何も植えない対照
評価の手法 ✓ 反応しない 両方を満たしたら「効く」。何にでも反応する検出器は、植込みだけ見ると満点になる 環境 • 業務エージェント:合成のオフィス環境(SQLite、14 ツール、46 タスク) • コーディング:自作 Python リポジトリ 6 個・48 タスク・Docker • 被験 Claude Haiku 4.5、ジャッジ Sonnet 5。実 API の費用は計 約 32 USD 詳細: docs/report/report.md。数値の多くは決定的なシミュレーション、一部は実 API(live)で得た 効かなかった 15 個も「落とし穴」として紹介する。そこに、持 ち帰れる教訓が多くある A4 -
付録 1 過程 合格率の隣に、ツールログから計算した過程の指標を並べて出す やり方 1 ツール呼び出しを構造化ログに残す 例:合格率が小数 4 桁まで同じ
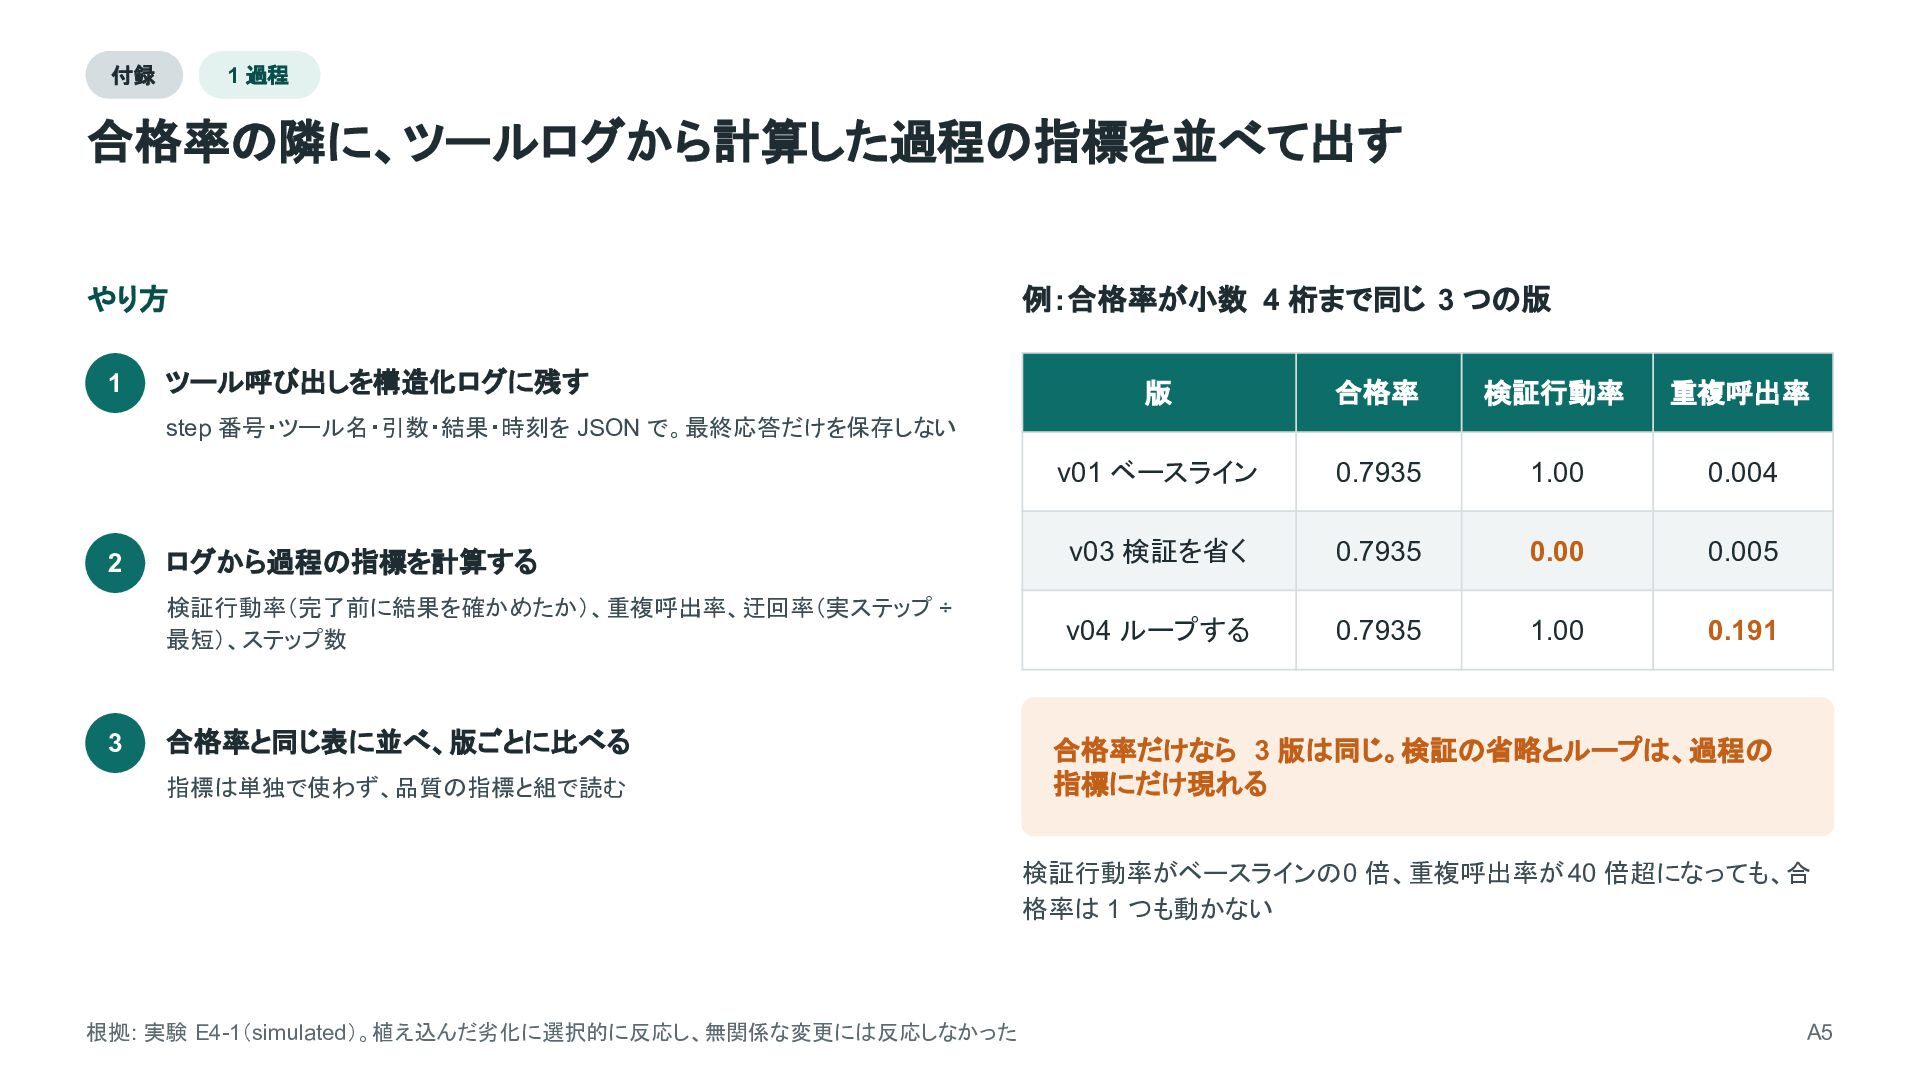
3 つの版 版 合格率 検証行動率 重複呼出率 v01 ベースライン 0.7935 1.00 0.004 ログから過程の指標を計算する v03 検証を省く 0.7935 0.00 0.005 検証行動率(完了前に結果を確かめたか)、重複呼出率、迂回率(実ステップ ÷ 最短)、ステップ数 v04 ループする 0.7935 1.00 0.191 step 番号・ツール名・引数・結果・時刻を JSON で。最終応答だけを保存しない 2 3 合格率と同じ表に並べ、版ごとに比べる 指標は単独で使わず、品質の指標と組で読む 合格率だけなら 3 版は同じ。検証の省略とループは、過程の 指標にだけ現れる 検証行動率がベースラインの 0 倍、重複呼出率が 40 倍超になっても、合 格率は 1 つも動かない 根拠: 実験 E4-1(simulated)。植え込んだ劣化に選択的に反応し、無関係な変更には反応しなかった A5 -
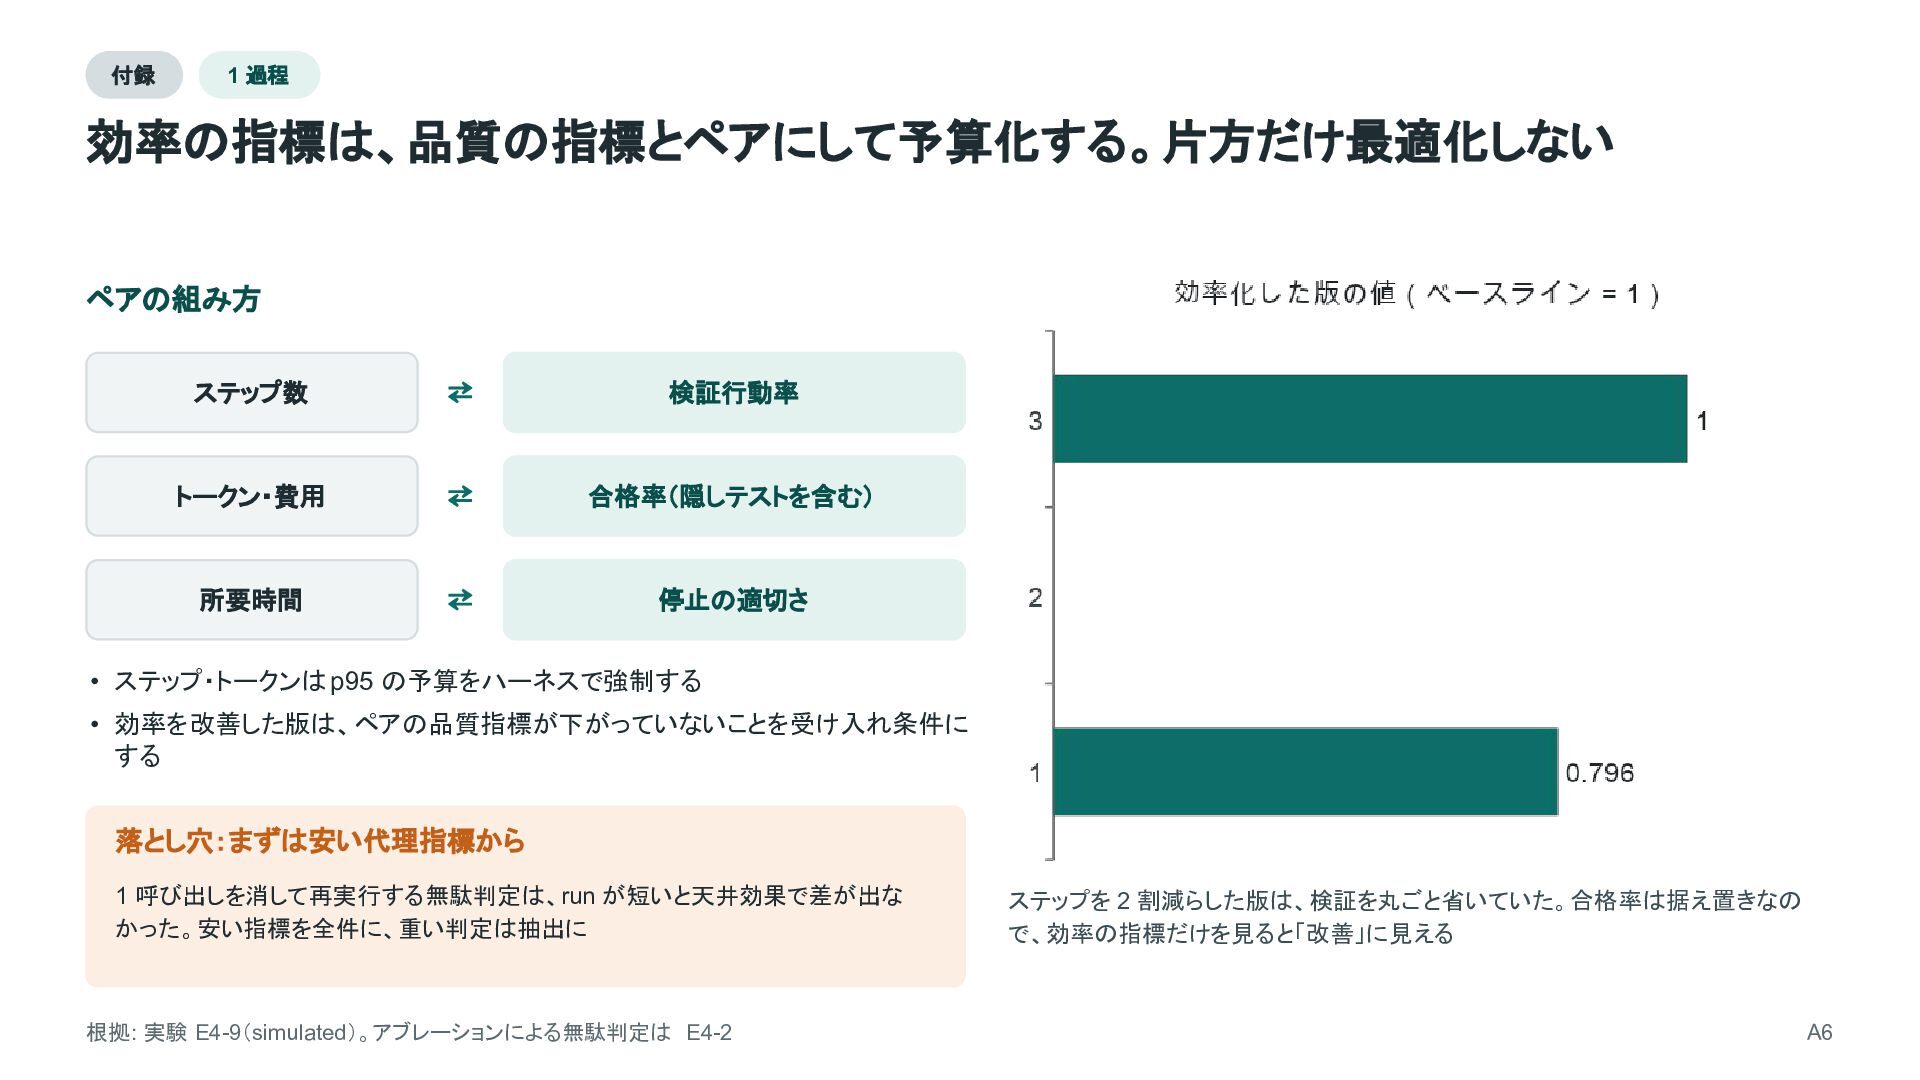
付録 1 過程 効率の指標は、品質の指標とペアにして予算化する。片方だけ最適化しない ペアの組み方 ステップ数 ⇄ 検証行動率 トークン・費用 ⇄
合格率(隠しテストを含む) 所要時間 ⇄ 停止の適切さ • ステップ・トークンは p95 の予算をハーネスで強制する • 効率を改善した版は、ペアの品質指標が下がっていないことを受け入れ条件に する 落とし穴:まずは安い代理指標から 1 呼び出しを消して再実行する無駄判定は、run が短いと天井効果で差が出な かった。安い指標を全件に、重い判定は抽出に 根拠: 実験 E4-9(simulated)。アブレーションによる無駄判定は E4-2 ステップを 2 割減らした版は、検証を丸ごと省いていた。合格率は据え置きなの で、効率の指標だけを見ると「改善」に見える A6 -
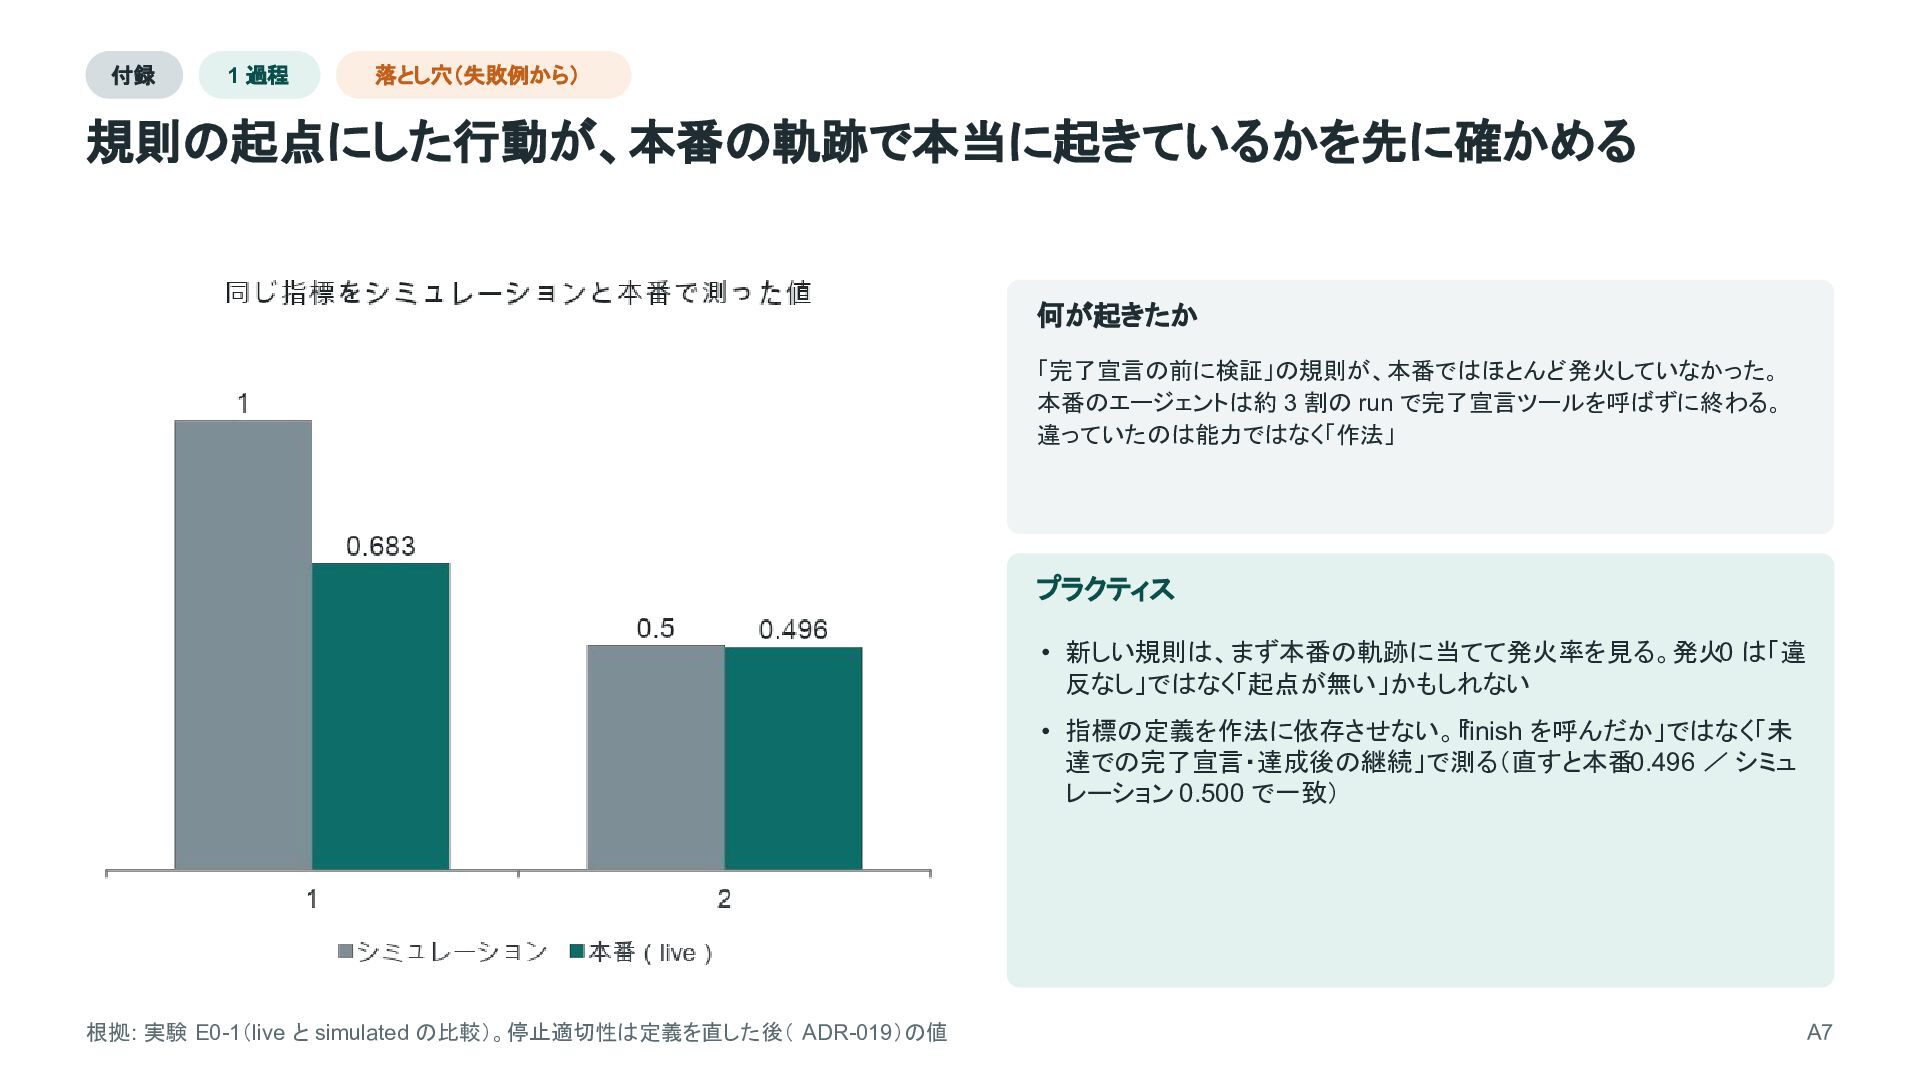
付録 1 過程 落とし穴(失敗例から) 規則の起点にした行動が、本番の軌跡で本当に起きているかを先に確かめる 何が起きたか 「完了宣言の前に検証」の規則が、本番ではほとんど発火していなかった。 本番のエージェントは約 3 割の
run で完了宣言ツールを呼ばずに終わる。 違っていたのは能力ではなく「作法」 プラクティス • 新しい規則は、まず本番の軌跡に当てて発火率を見る。発火0 は「違 反なし」ではなく「起点が無い」かもしれない • 指標の定義を作法に依存させない。「finish を呼んだか」ではなく「未 達での完了宣言・達成後の継続」で測る(直すと本番0.496 / シミュ レーション 0.500 で一致) 根拠: 実験 E0-1(live と simulated の比較)。停止適切性は定義を直した後( ADR-019)の値 A7 -
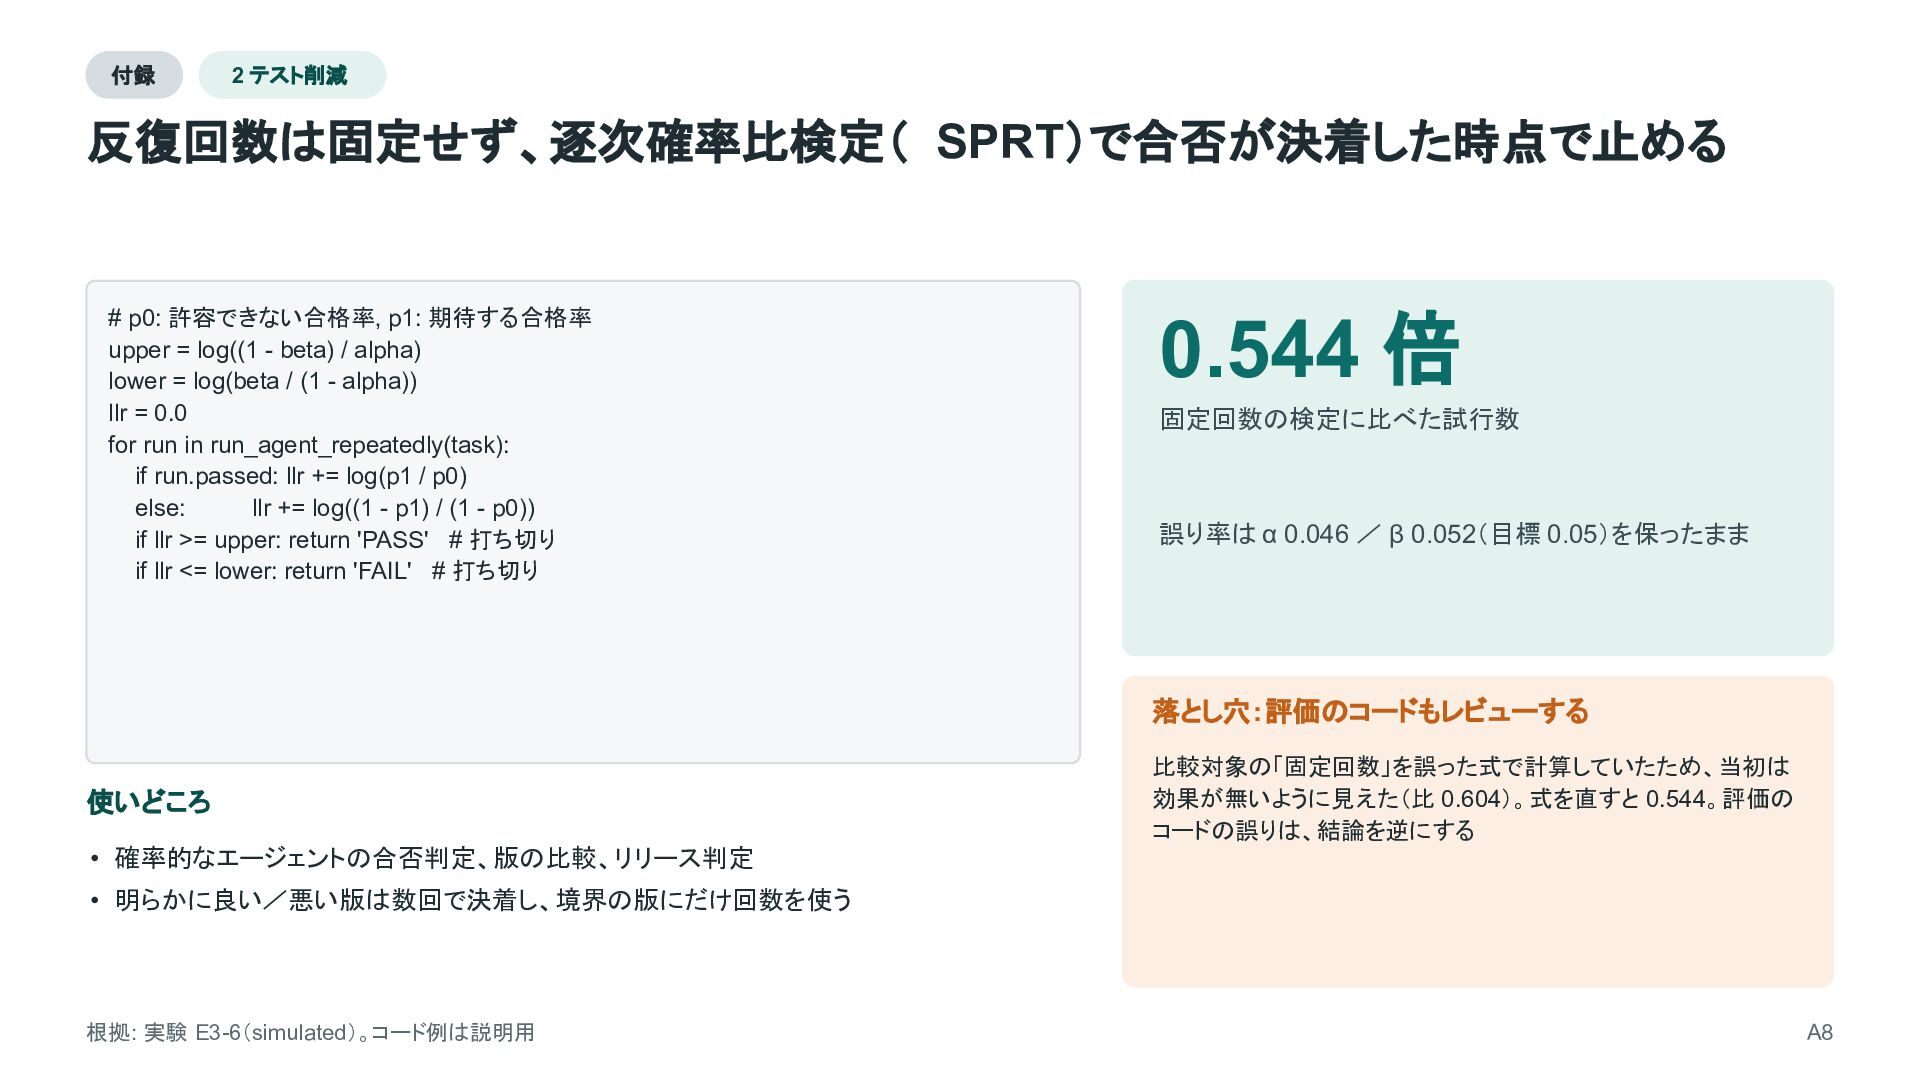
付録 2 テスト削減 反復回数は固定せず、逐次確率比検定( SPRT)で合否が決着した時点で止める # p0: 許容できない合格率, p1: 期待する合格率
upper = log((1 - beta) / alpha) lower = log(beta / (1 - alpha)) llr = 0.0 for run in run_agent_repeatedly(task): if run.passed: llr += log(p1 / p0) else: llr += log((1 - p1) / (1 - p0)) if llr >= upper: return 'PASS' # 打ち切り if llr <= lower: return 'FAIL' # 打ち切り 0.544 倍 固定回数の検定に比べた試行数 誤り率は α 0.046 / β 0.052(目標 0.05)を保ったまま 落とし穴:評価のコードもレビューする 使いどころ 比較対象の「固定回数」を誤った式で計算していたため、当初は 効果が無いように見えた(比 0.604)。式を直すと 0.544。評価の コードの誤りは、結論を逆にする • 確率的なエージェントの合否判定、版の比較、リリース判定 • 明らかに良い/悪い版は数回で決着し、境界の版にだけ回数を使う 根拠: 実験 E3-6(simulated)。コード例は説明用 A8 -
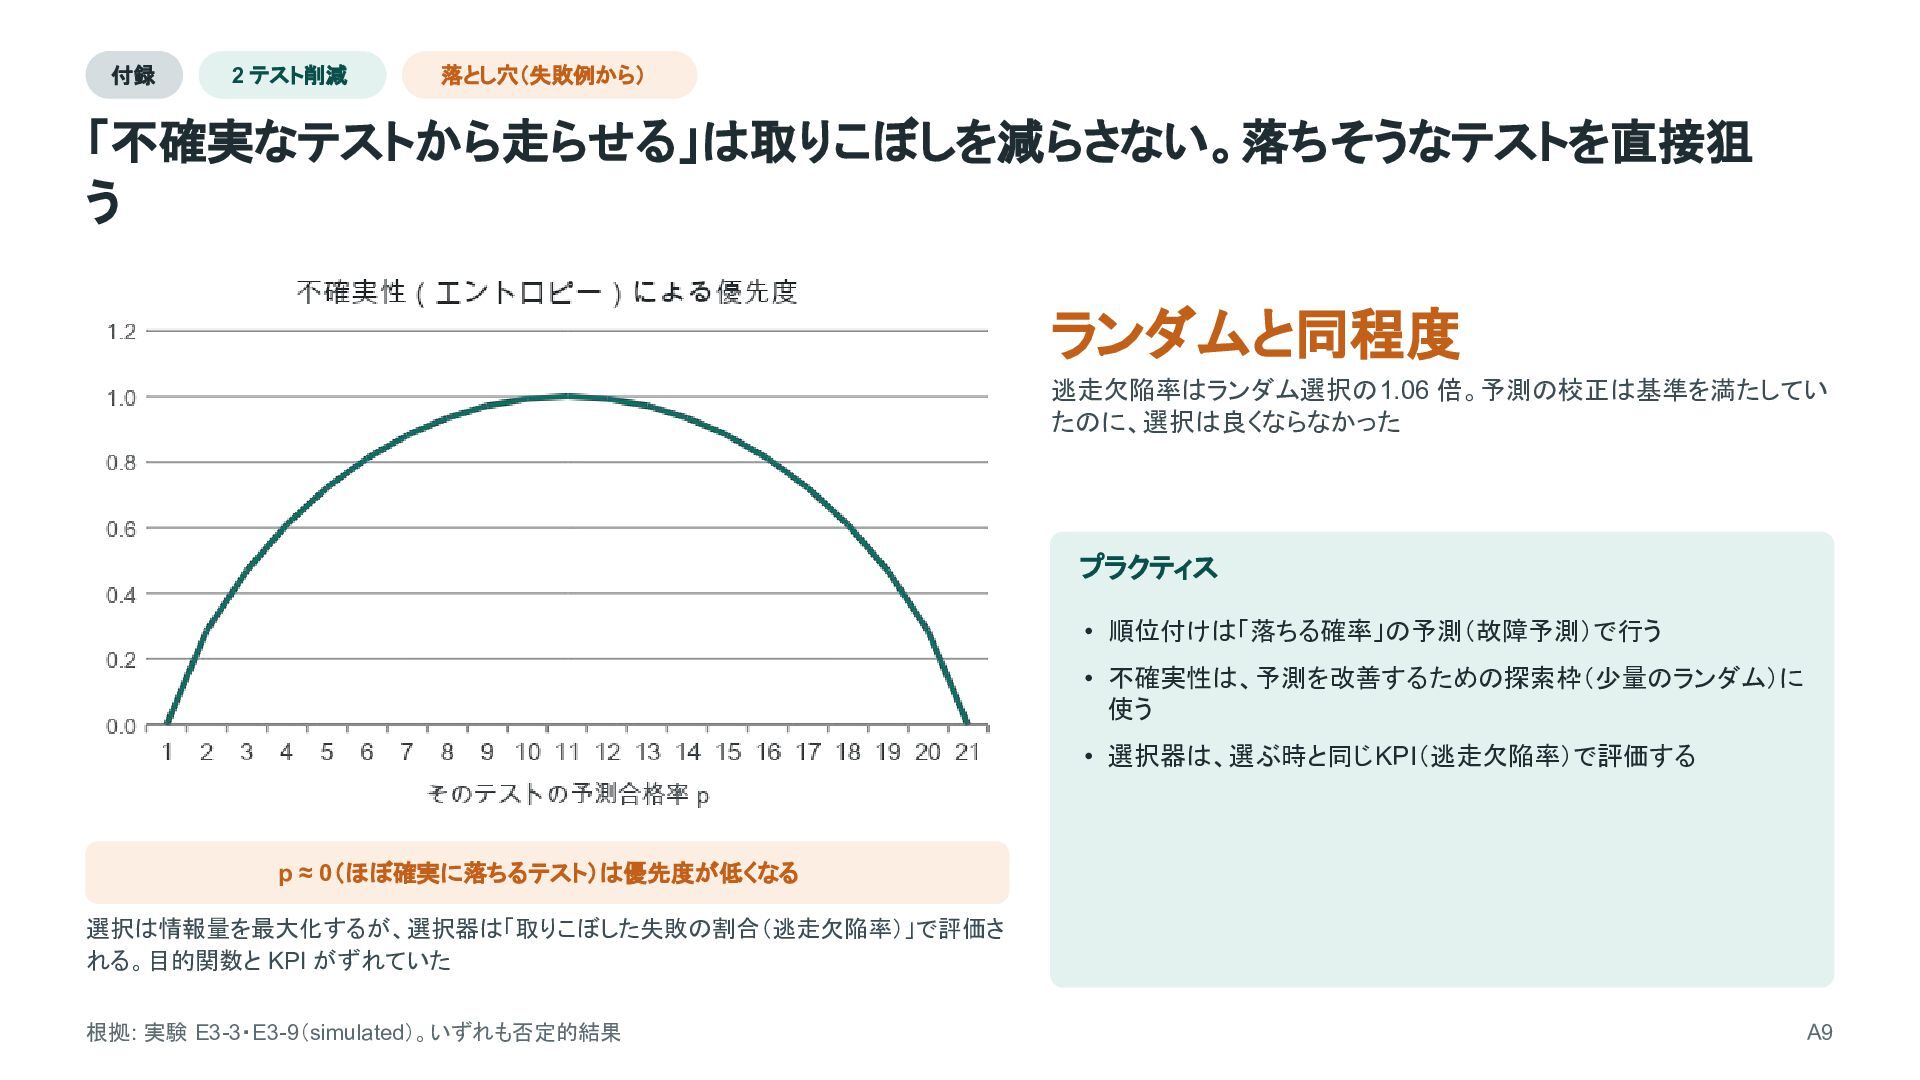
付録 2 テスト削減 落とし穴(失敗例から) 「不確実なテストから走らせる」は取りこぼしを減らさない。落ちそうなテストを直接狙 う ランダムと同程度 逃走欠陥率はランダム選択の 1.06 倍。予測の校正は基準を満たしてい
たのに、選択は良くならなかった プラクティス • 順位付けは「落ちる確率」の予測(故障予測)で行う • 不確実性は、予測を改善するための探索枠(少量のランダム)に 使う • 選択器は、選ぶ時と同じ KPI(逃走欠陥率)で評価する p ≈ 0(ほぼ確実に落ちるテスト)は優先度が低くなる 選択は情報量を最大化するが、選択器は「取りこぼした失敗の割合(逃走欠陥率)」で評価さ れる。目的関数と KPI がずれていた 根拠: 実験 E3-3・E3-9(simulated)。いずれも否定的結果 A9 -
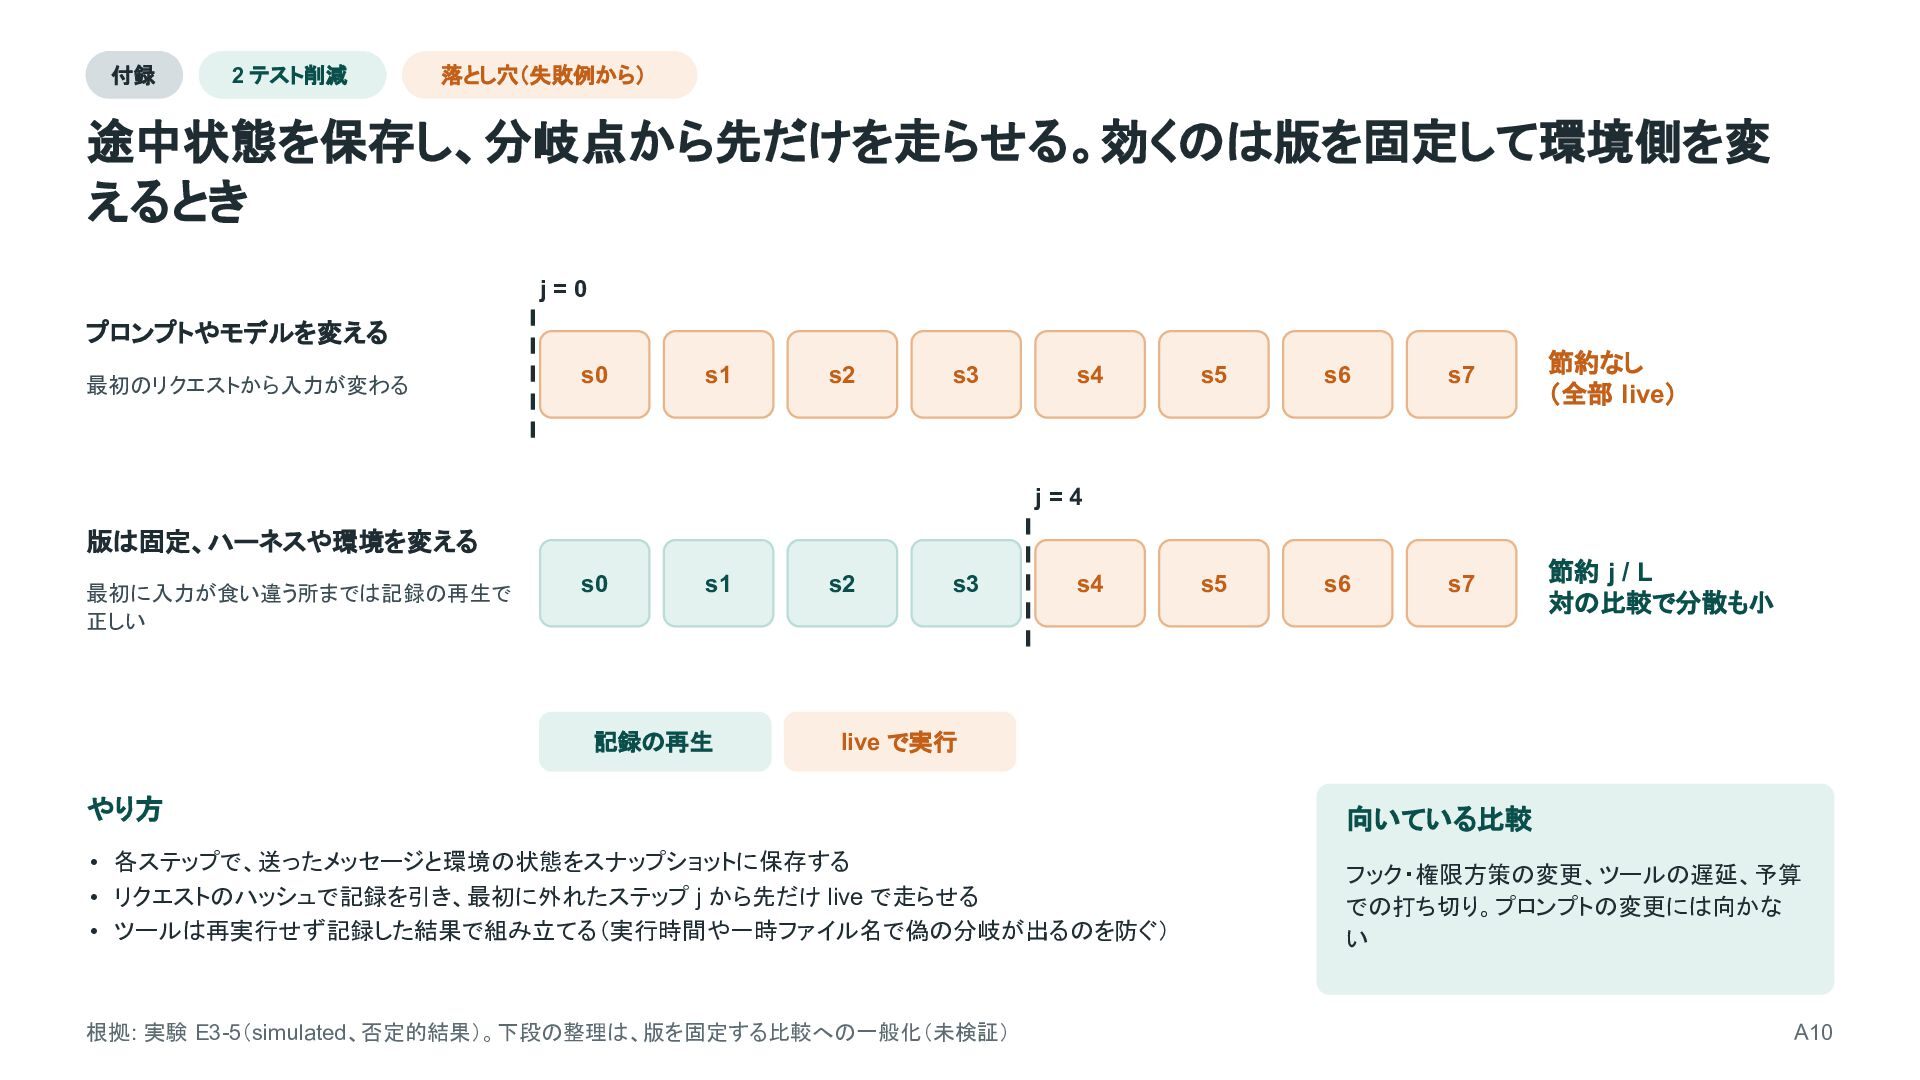
付録 2 テスト削減 落とし穴(失敗例から) 途中状態を保存し、分岐点から先だけを走らせる。効くのは版を固定して環境側を変 えるとき j=0 プロンプトやモデルを変える 最初のリクエストから入力が変わる s0
s1 s2 s3 s4 s5 s6 s7 節約なし (全部 live) s5 s6 s7 節約 j / L 対の比較で分散も小 j=4 版は固定、ハーネスや環境を変える 最初に入力が食い違う所までは記録の再生で 正しい s0 s1 記録の再生 s2 s3 s4 live で実行 やり方 向いている比較 • 各ステップで、送ったメッセージと環境の状態をスナップショットに保存する • リクエストのハッシュで記録を引き、最初に外れたステップ j から先だけ live で走らせる • ツールは再実行せず記録した結果で組み立てる(実行時間や一時ファイル名で偽の分岐が出るのを防ぐ) フック・権限方策の変更、ツールの遅延、予算 での打ち切り。プロンプトの変更には向かな い 根拠: 実験 E3-5(simulated、否定的結果)。下段の整理は、版を固定する比較への一般化(未検証) A10 -
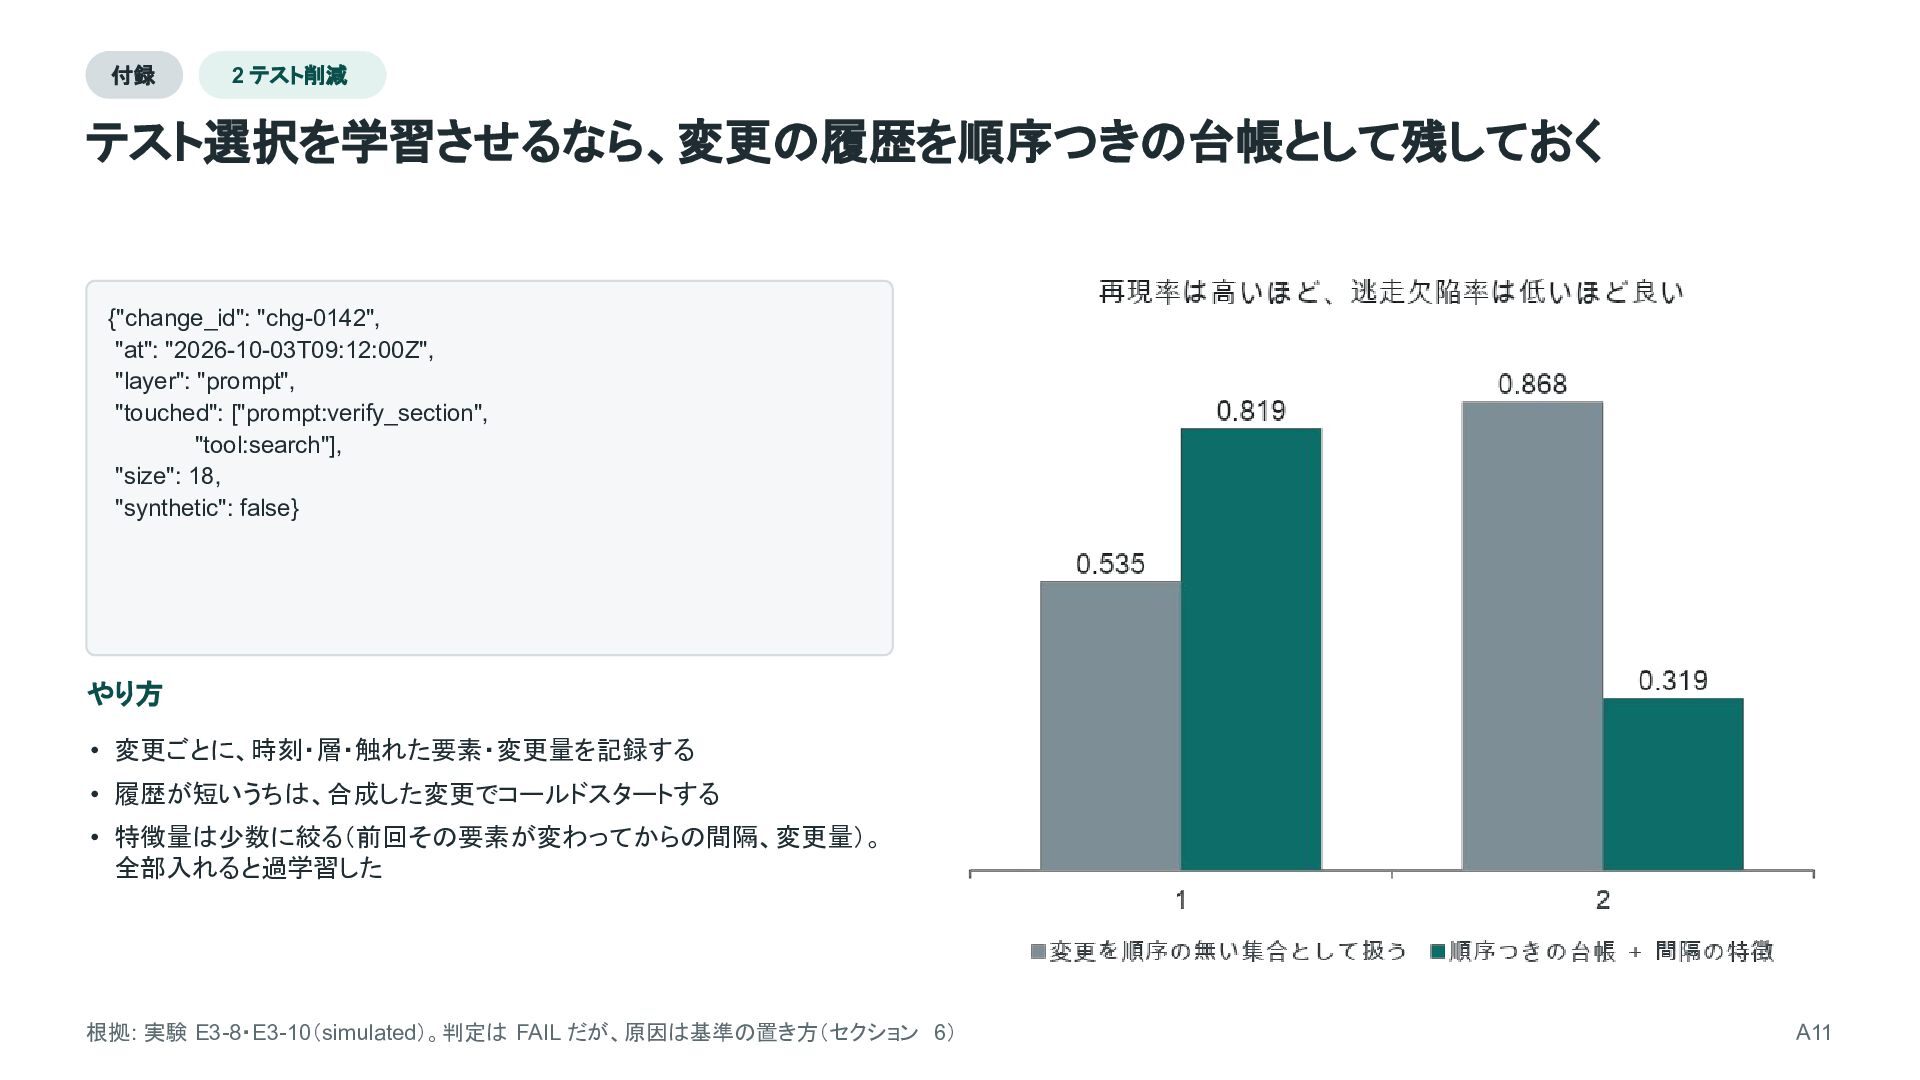
付録 2 テスト削減 テスト選択を学習させるなら、変更の履歴を順序つきの台帳として残しておく {"change_id": "chg-0142", "at": "2026-10-03T09:12:00Z", "layer": "prompt",
"touched": ["prompt:verify_section", "tool:search"], "size": 18, "synthetic": false} やり方 • 変更ごとに、時刻・層・触れた要素・変更量を記録する • 履歴が短いうちは、合成した変更でコールドスタートする • 特徴量は少数に絞る(前回その要素が変わってからの間隔、変更量)。 全部入れると過学習した 根拠: 実験 E3-8・E3-10(simulated)。判定は FAIL だが、原因は基準の置き方(セクション 6) A11 -
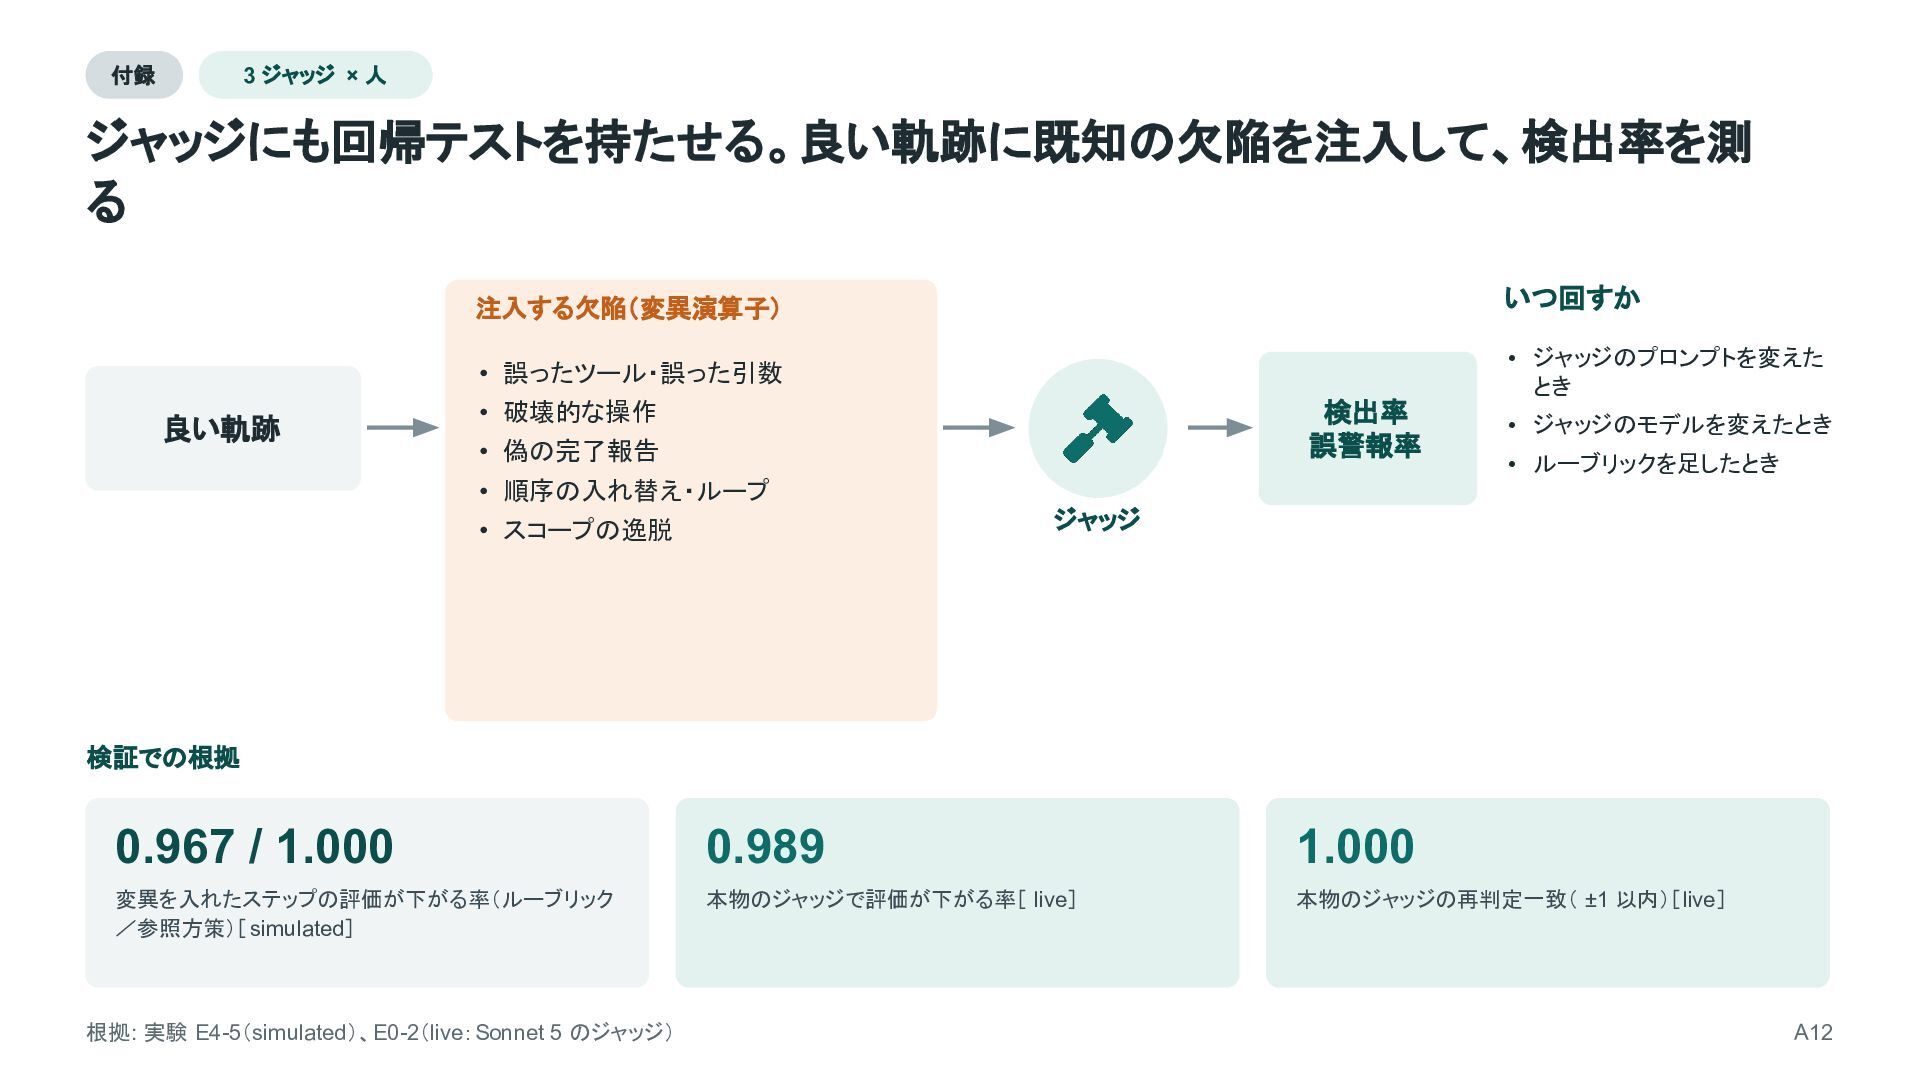
付録 3 ジャッジ × 人 ジャッジにも回帰テストを持たせる。良い軌跡に既知の欠陥を注入して、検出率を測 る 良い軌跡 注入する欠陥(変異演算子) いつ回すか
• 誤ったツール・誤った引数 • ジャッジのプロンプトを変えた とき 検出率 誤警報率 • 破壊的な操作 • 偽の完了報告 • ジャッジのモデルを変えたとき • ルーブリックを足したとき • 順序の入れ替え・ループ ジャッジ • スコープの逸脱 検証での根拠 0.967 / 1.000 0.989 1.000 変異を入れたステップの評価が下がる率(ルーブリック /参照方策)[ simulated] 本物のジャッジで評価が下がる率[ live] 本物のジャッジの再判定一致( ±1 以内)[live] 根拠: 実験 E4-5(simulated)、E0-2(live:Sonnet 5 のジャッジ) A12 -
付録 3 ジャッジ × 人 落とし穴(失敗例から) 安い代替ジャッジは「向き」の確認だけに使い、水準は本物のジャッジで測る 何が起きたか API を呼ばずに済む規則ベースの代替ジャッジは、変異を検出する向き
は合ったが、一貫して甘かった。読み取り系への誤置換をほとんど罰し ない プラクティス • 代替は「変異で評価が下がるか」の向きの確認と、配管のテストに 使う • 絶対水準や閾値は、本物のジャッジで決める • 決定的な代役で測った「判定の安定性」は証拠にならない(定義 上いつも一致する) 根拠: 実験 E0-2(live)。否定的結果: ±1 以内の一致 0.683(基準 0.7) A13 -
付録 3 ジャッジ × 人 人は個々の判定ではなく、判定の「定義」と「不一致の裁定」に使う 振り分け 人が担う LLM・検出器が担う 不一致・低信頼
• ルーブリック・仕様・リンター規則・ゴールデンセットを書く • 一次判定・失敗のクラスタリング・要約 • 合格基準と、測れない量(人件費など)の範囲を決める • 計画と行動が食い違った箇所だけを判定(軌 跡全体を読ませない) • 失敗したときの読み方を、データを見る前に決める • ジャッジ間の不一致・低信頼のものを裁定する • リンター・効果の検査など決定的な判定 ↓ 人が裁定 それ以外 ↓ 層化抽出で監査し、ジャッジの 誤り率を推定 承認ゲートは、承認率・介入の精度・介入の再現率で健全性を測る。 承認率がほぼ 100% なら形骸化を疑う。私たちの承認率1.0 も、仕組みを見ると機械的 な自動承認だった 原典 5・6 章の設計と、本プロジェクトの運用から。 E4-6(乖離箇所だけの判定)、 E8-7(承認率 1.0 は自動承認だった) A14 -
付録 4 陳腐化 模擬(記録・モック)には寿命を付け、少額の live と定期的に突き合わせる やり方 1 記録したツール応答に寿命( TTL)を付ける
期限切れは再記録。live との一致率 F を定期的に測る 2 同じスイートを模擬と live の二重トラックで回す 合否の一致 κ を監視し、ずれたら原因を 1 要素ずつ切り分ける 3 模擬は向き、 live は水準と作法に使う 閾値や合格率の水準は live で決める 模擬は「向き」を再現するが、「作法」と「水準」は再現しない 根拠: 実験 E0-1(live と simulated の比較)。オフィス環境の live 費用は計 3.80 USD 検証での根拠 約 3 USD の live 実行で、模擬では構造的に見えない欠 陥を 7 件見つけた A15 -
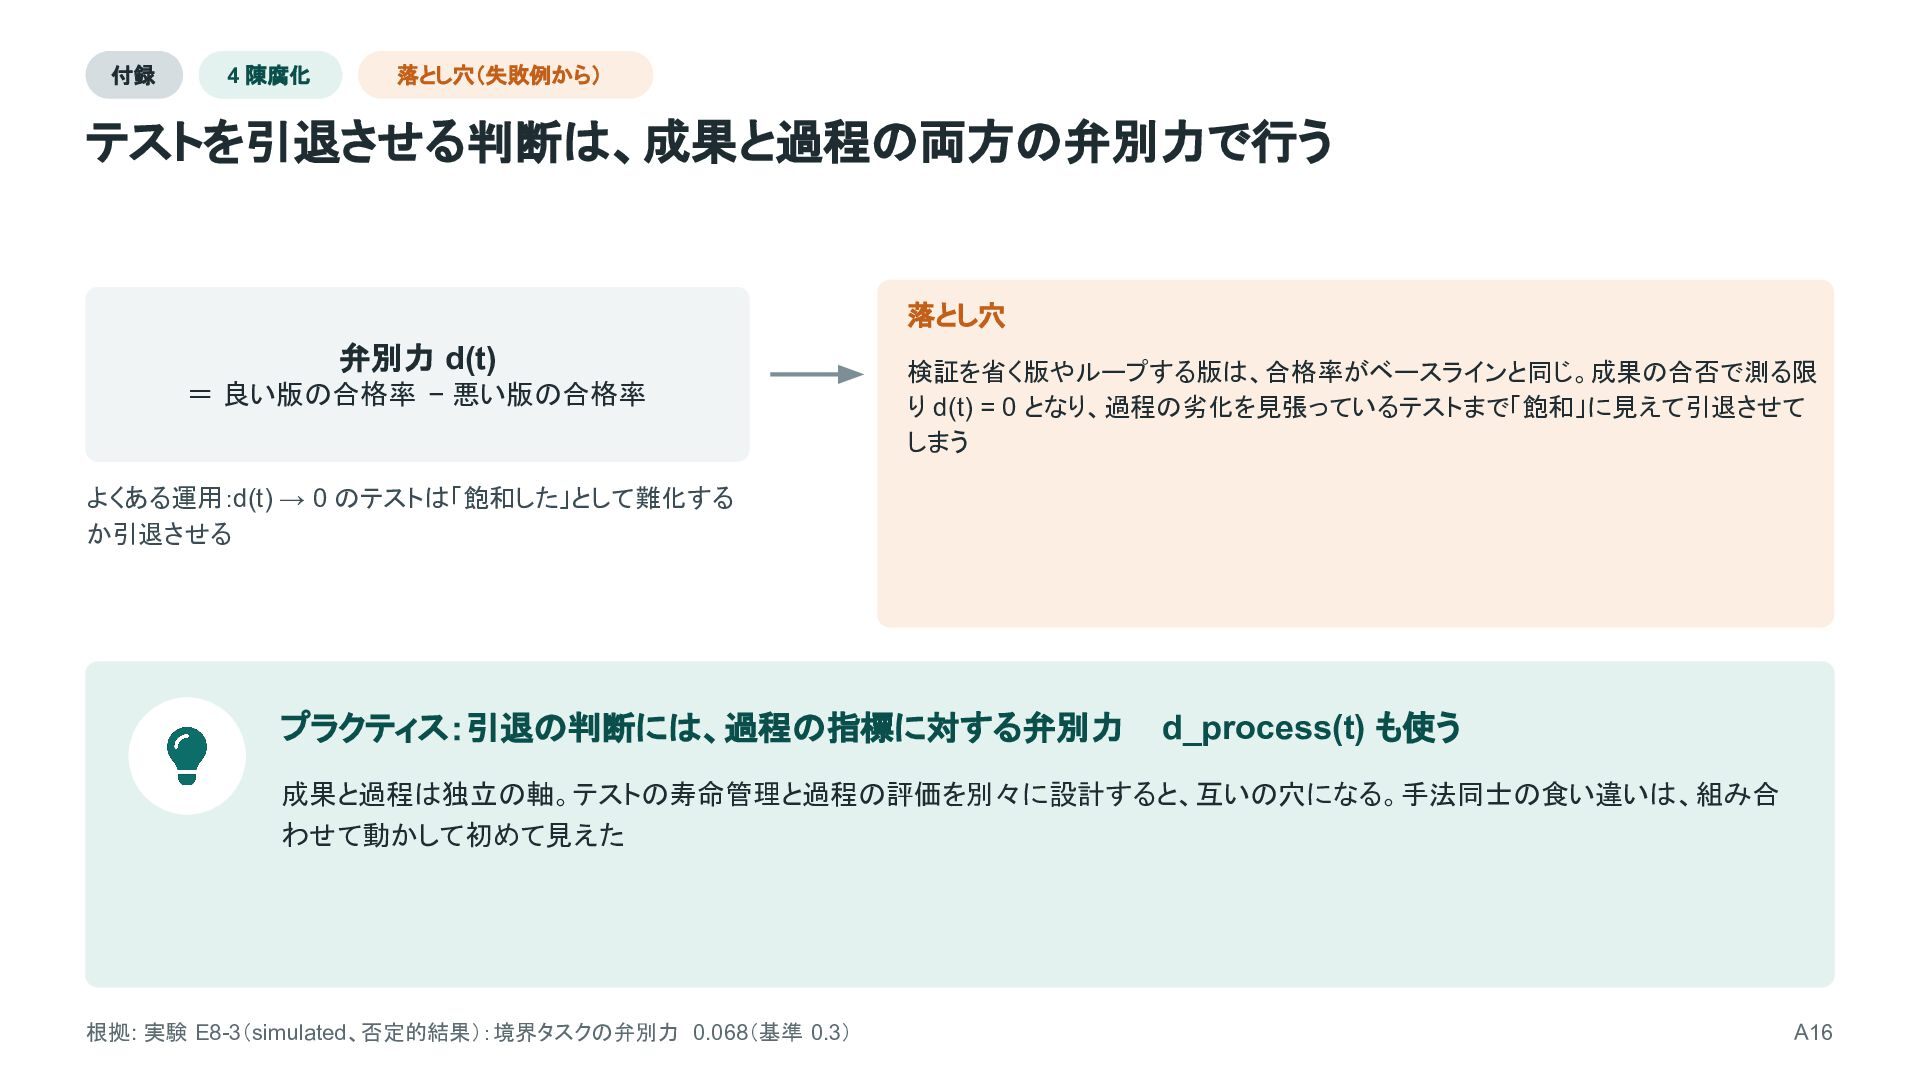
付録 4 陳腐化 落とし穴(失敗例から) テストを引退させる判断は、成果と過程の両方の弁別力で行う 落とし穴 弁別力 d(t) = 良い版の合格率
− 悪い版の合格率 検証を省く版やループする版は、合格率がベースラインと同じ。成果の合否で測る限 り d(t) = 0 となり、過程の劣化を見張っているテストまで「飽和」に見えて引退させて しまう よくある運用:d(t) → 0 のテストは「飽和した」として難化する か引退させる プラクティス:引退の判断には、過程の指標に対する弁別力 d_process(t) も使う 成果と過程は独立の軸。テストの寿命管理と過程の評価を別々に設計すると、互いの穴になる。手法同士の食い違いは、組み合 わせて動かして初めて見えた 根拠: 実験 E8-3(simulated、否定的結果):境界タスクの弁別力 0.068(基準 0.3) A16 -
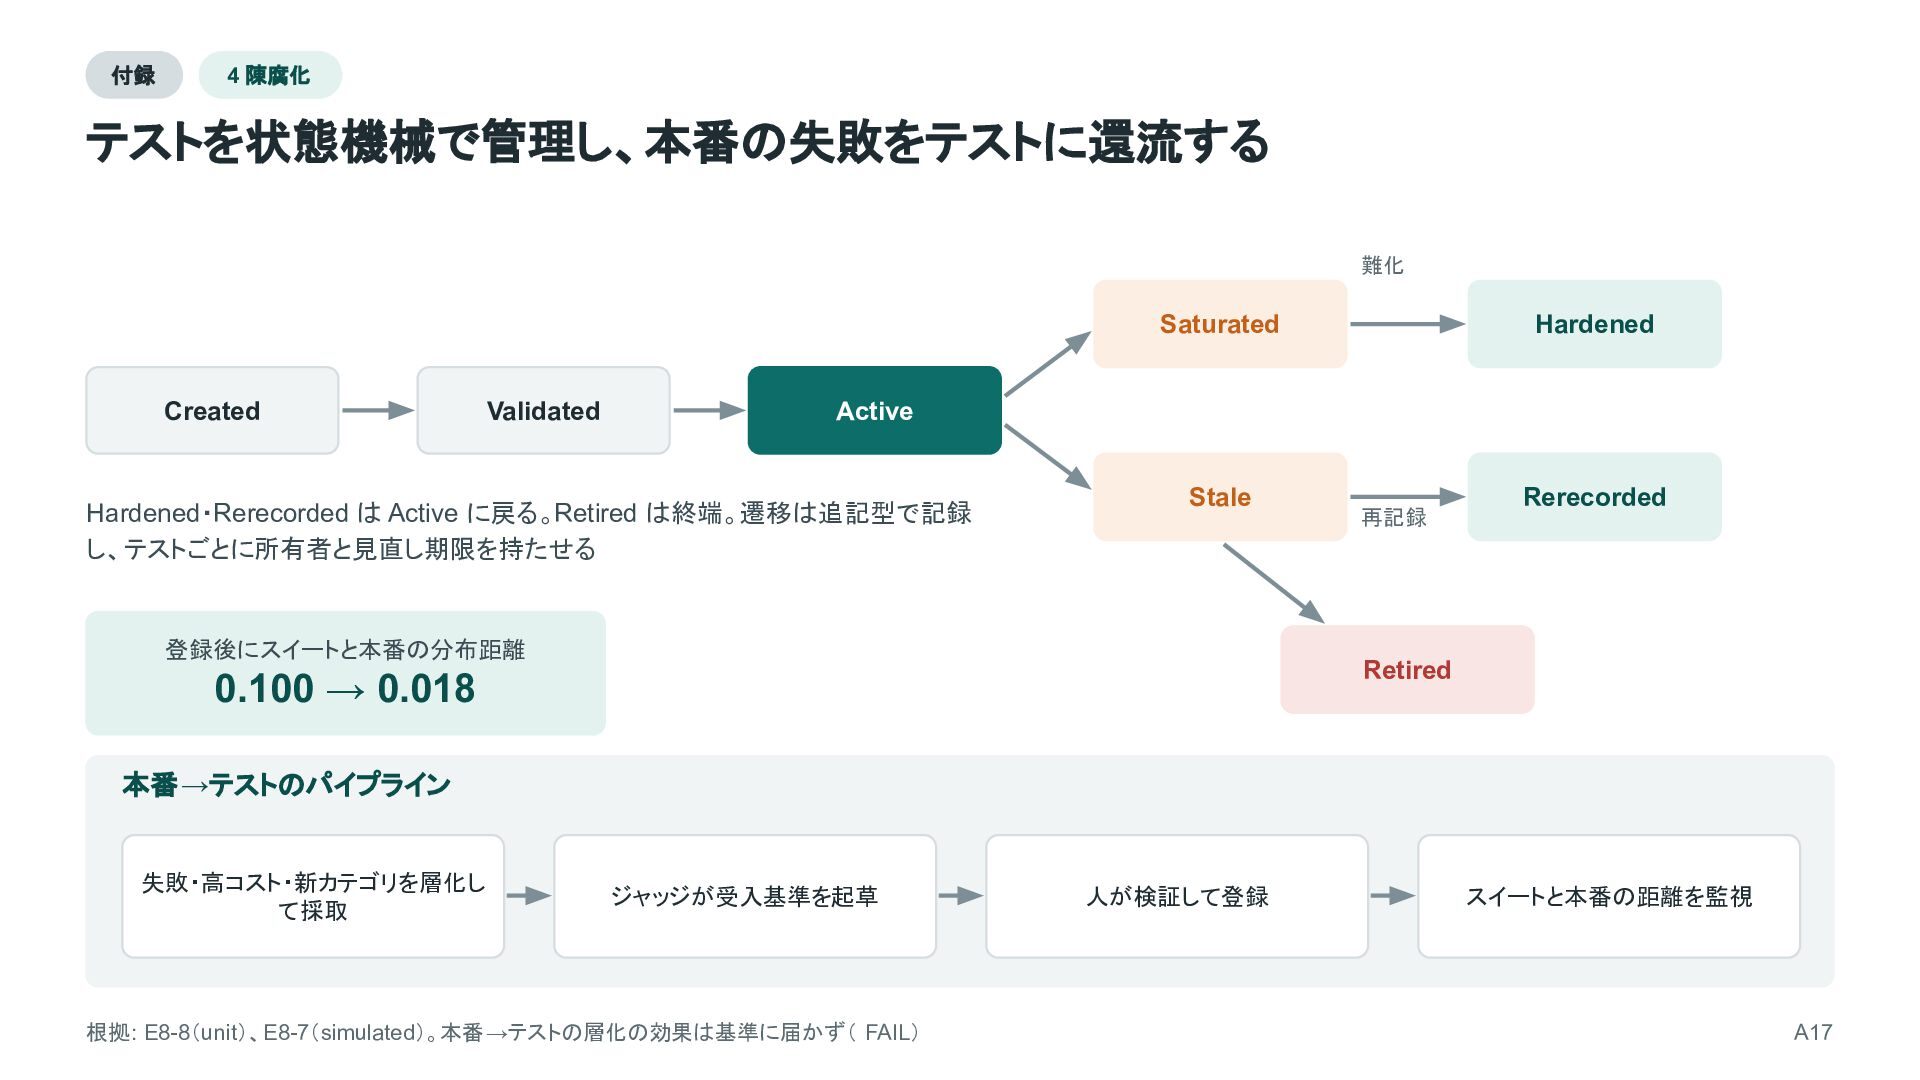
付録 4 陳腐化 テストを状態機械で管理し、本番の失敗をテストに還流する 難化 Saturated Created Validated Hardened Active
Hardened・Rerecorded は Active に戻る。Retired は終端。遷移は追記型で記録 し、テストごとに所有者と見直し期限を持たせる Stale 登録後にスイートと本番の分布距離 再記録 Rerecorded Retired 0.100 → 0.018 本番→テストのパイプライン 失敗・高コスト・新カテゴリを層化し て採取 ジャッジが受入基準を起草 根拠: E8-8(unit)、E8-7(simulated)。本番→テストの層化の効果は基準に届かず( FAIL) 人が検証して登録 スイートと本番の距離を監視 A17 -
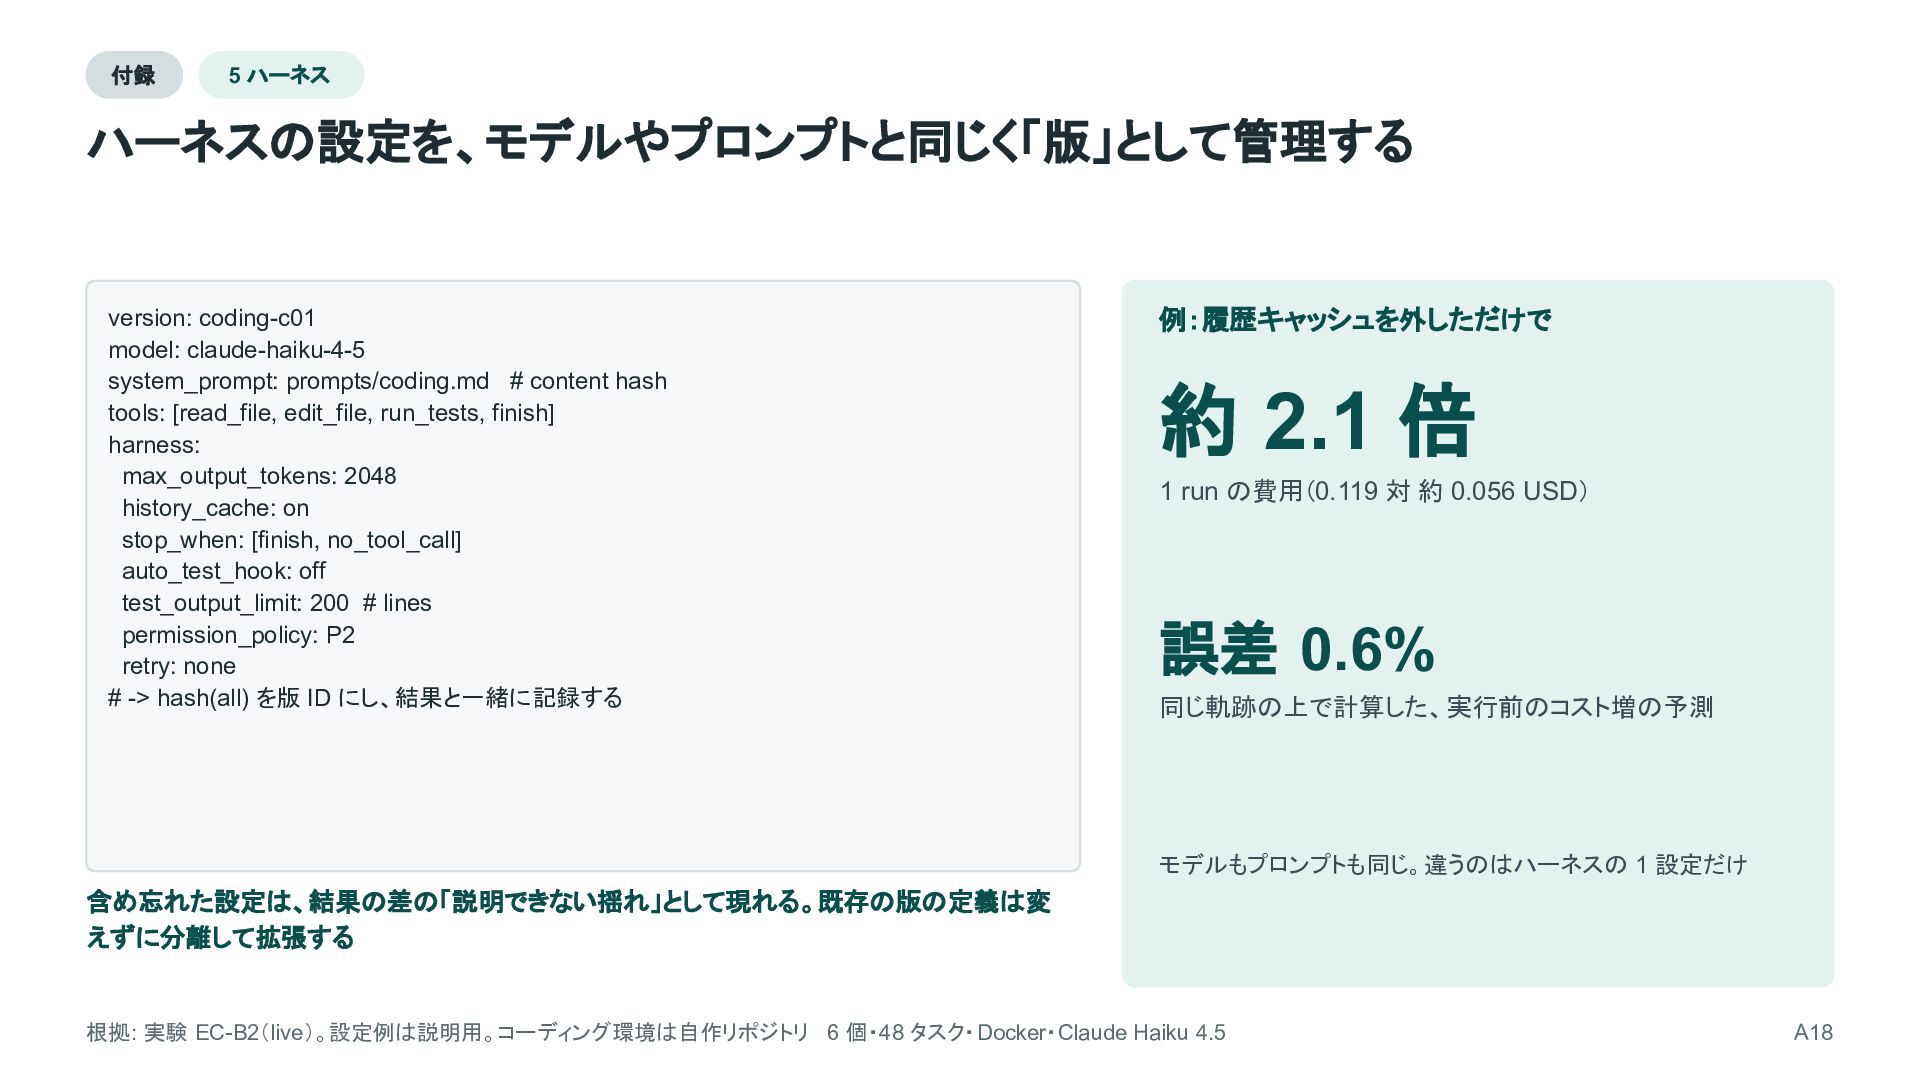
付録 5 ハーネス ハーネスの設定を、モデルやプロンプトと同じく「版」として管理する version: coding-c01 model: claude-haiku-4-5 system_prompt: prompts/coding.md
# content hash tools: [read_file, edit_file, run_tests, finish] harness: max_output_tokens: 2048 history_cache: on stop_when: [finish, no_tool_call] auto_test_hook: off test_output_limit: 200 # lines permission_policy: P2 retry: none # -> hash(all) を版 ID にし、結果と一緒に記録する 例:履歴キャッシュを外しただけで 約 2.1 倍 1 run の費用(0.119 対 約 0.056 USD) 誤差 0.6% 同じ軌跡の上で計算した、実行前のコスト増の予測 モデルもプロンプトも同じ。違うのはハーネスの 1 設定だけ 含め忘れた設定は、結果の差の「説明できない揺れ」として現れる。既存の版の定義は変 えずに分離して拡張する 根拠: 実験 EC-B2(live)。設定例は説明用。コーディング環境は自作リポジトリ 6 個・48 タスク・Docker・Claude Haiku 4.5 A18 -
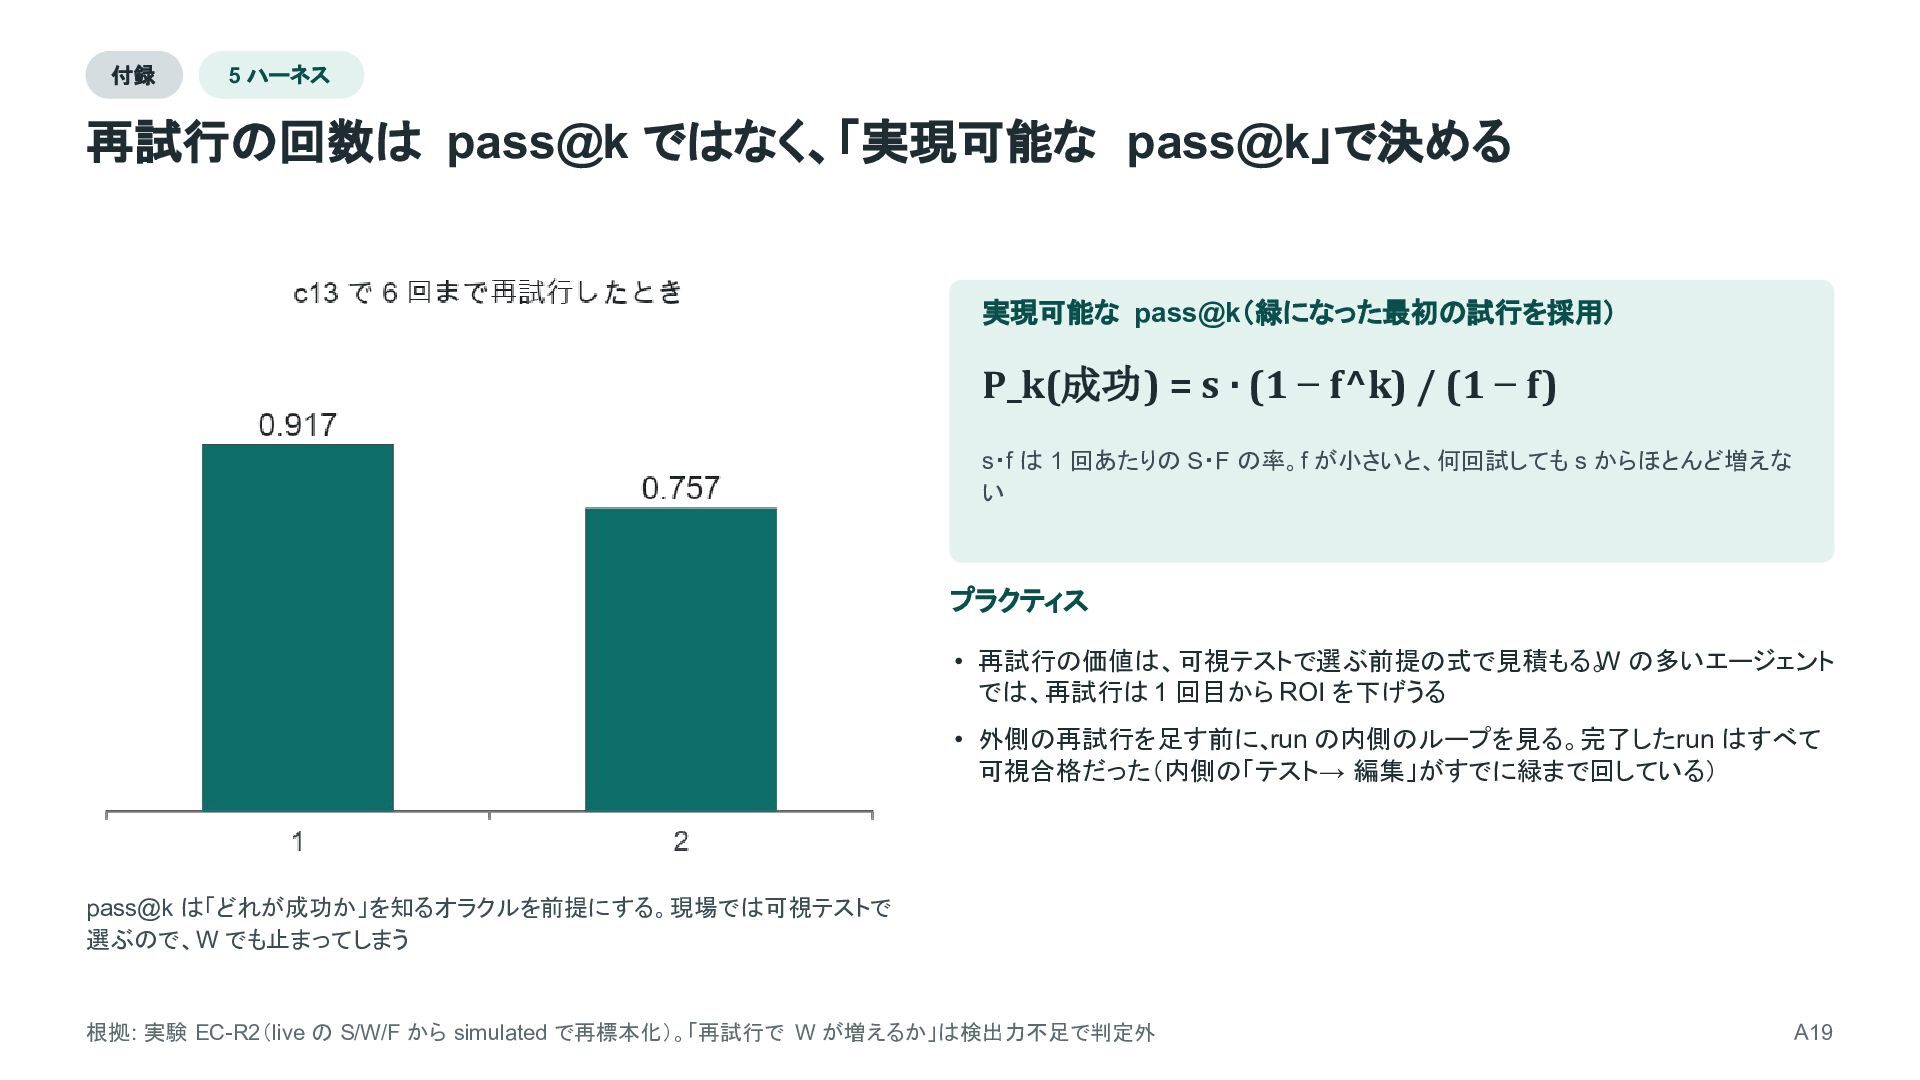
付録 5 ハーネス 再試行の回数は pass@k ではなく、「実現可能な pass@k」で決める 実現可能な pass@k(緑になった最初の試行を採用) P_k(成功)
= s · (1 − f^k) / (1 − f) s・f は 1 回あたりの S・F の率。f が小さいと、何回試しても s からほとんど増えな い プラクティス • 再試行の価値は、可視テストで選ぶ前提の式で見積もる。W の多いエージェント では、再試行は 1 回目から ROI を下げうる • 外側の再試行を足す前に、run の内側のループを見る。完了したrun はすべて 可視合格だった(内側の「テスト→ 編集」がすでに緑まで回している) pass@k は「どれが成功か」を知るオラクルを前提にする。現場では可視テストで 選ぶので、W でも止まってしまう 根拠: 実験 EC-R2(live の S/W/F から simulated で再標本化)。「再試行で W が増えるか」は検出力不足で判定外 A19 -
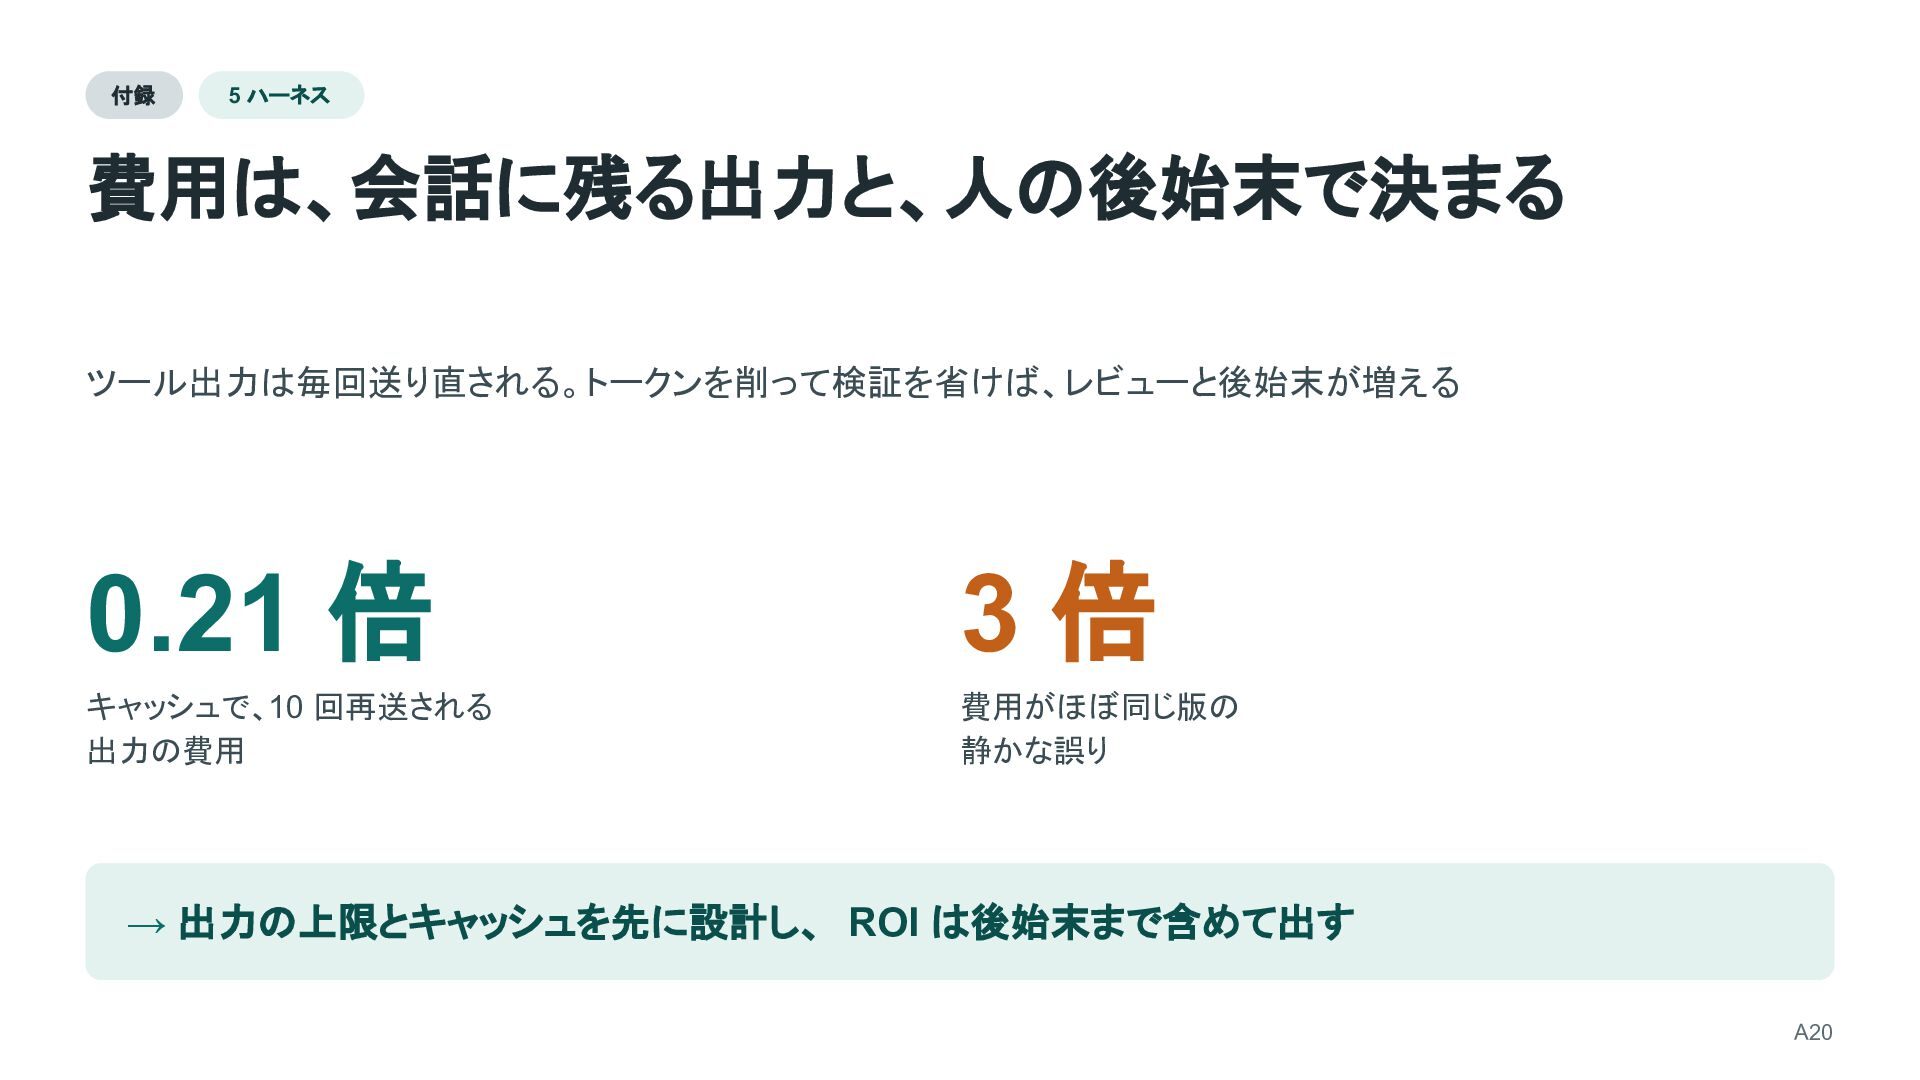
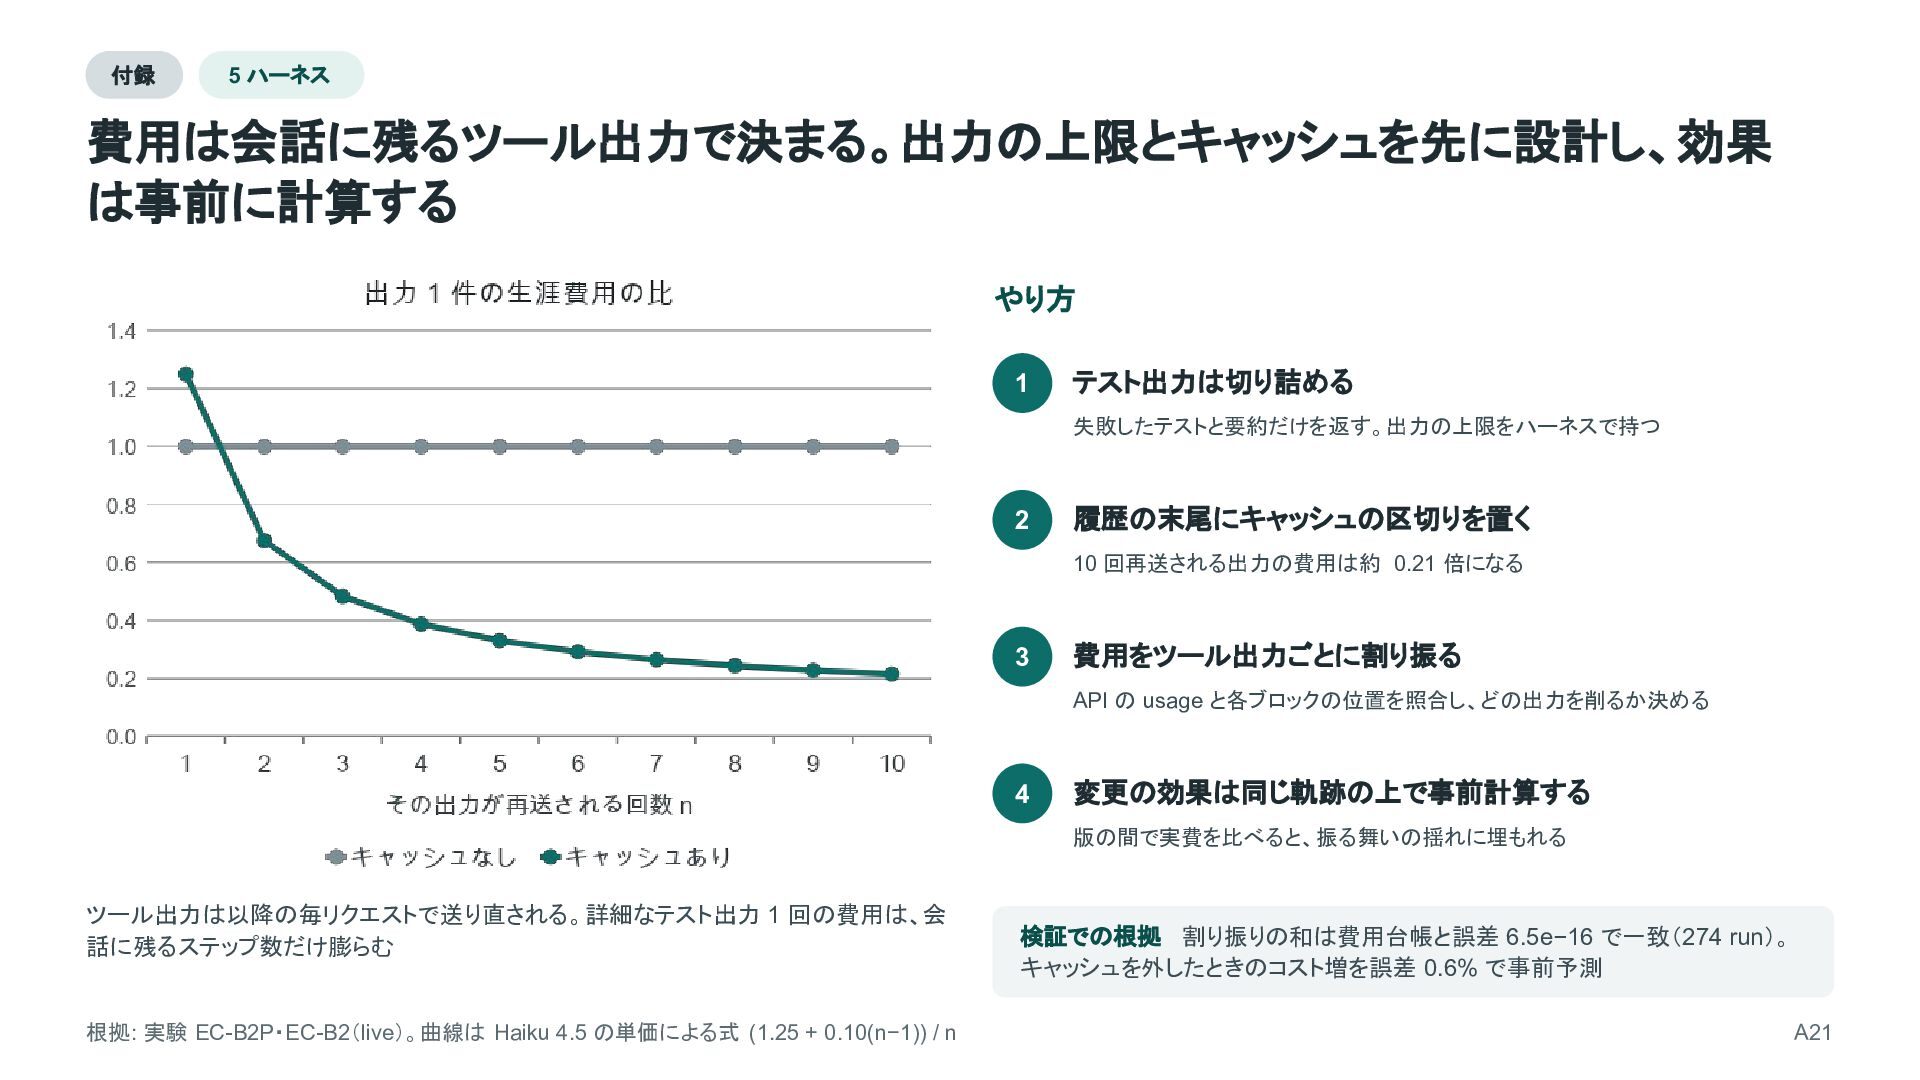
付録 5 ハーネス 費用は、会話に残る出力と、人の後始末で決まる ツール出力は毎回送り直される。トークンを削って検証を省けば、レビューと後始末が増える 0.21 倍 3倍 キャッシュで、10 回再送される
出力の費用 費用がほぼ同じ版の 静かな誤り → 出力の上限とキャッシュを先に設計し、 ROI は後始末まで含めて出す A20 -
付録 5 ハーネス 費用は会話に残るツール出力で決まる。出力の上限とキャッシュを先に設計し、効果 は事前に計算する やり方 1 テスト出力は切り詰める 失敗したテストと要約だけを返す。出力の上限をハーネスで持つ 2
履歴の末尾にキャッシュの区切りを置く 10 回再送される出力の費用は約 0.21 倍になる 3 費用をツール出力ごとに割り振る API の usage と各ブロックの位置を照合し、どの出力を削るか決める 4 変更の効果は同じ軌跡の上で事前計算する 版の間で実費を比べると、振る舞いの揺れに埋もれる ツール出力は以降の毎リクエストで送り直される。詳細なテスト出力 1 回の費用は、会 話に残るステップ数だけ膨らむ 根拠: 実験 EC-B2P・EC-B2(live)。曲線は Haiku 4.5 の単価による式 (1.25 + 0.10(n−1)) / n 検証での根拠 割り振りの和は費用台帳と誤差 6.5e−16 で一致(274 run)。 キャッシュを外したときのコスト増を誤差 0.6% で事前予測 A21 -
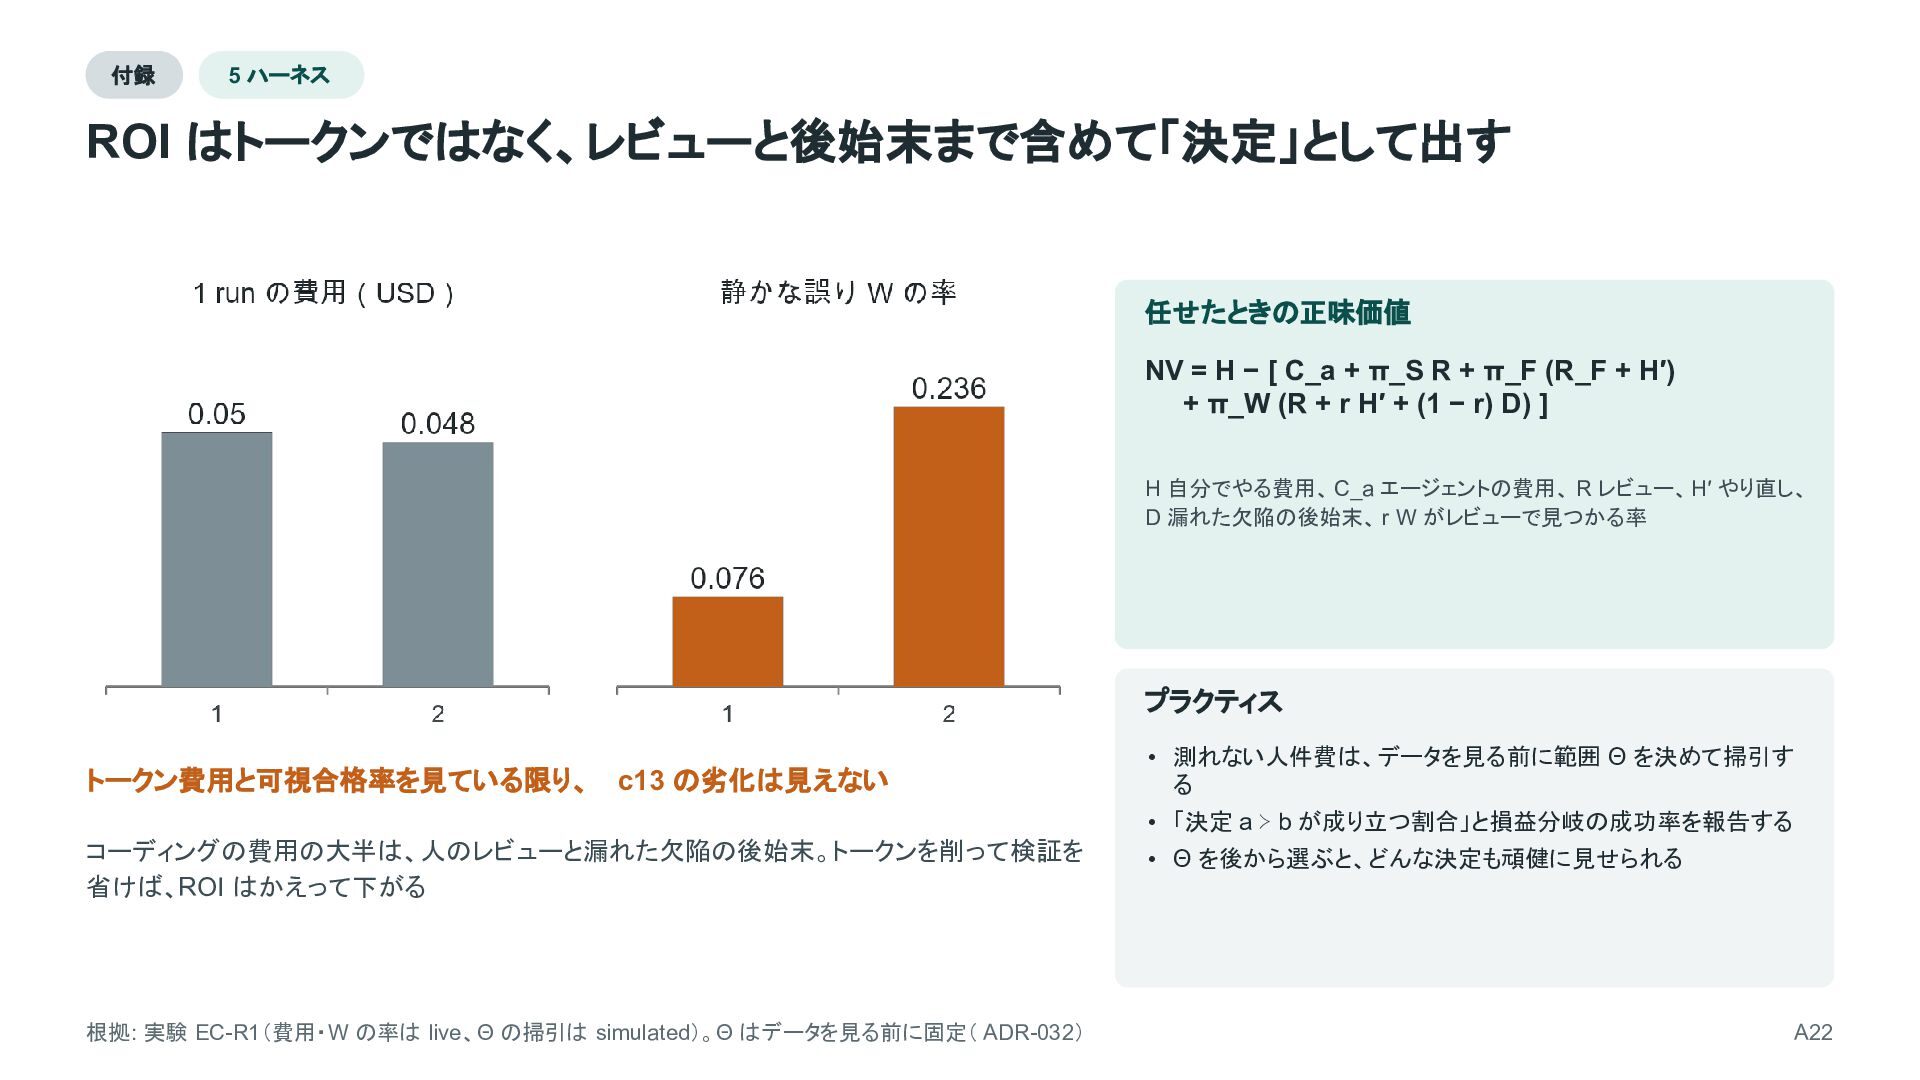
付録 5 ハーネス ROI はトークンではなく、レビューと後始末まで含めて「決定」として出す 任せたときの正味価値 NV = H −
[ C_a + π_S R + π_F (R_F + H′) + π_W (R + r H′ + (1 − r) D) ] H 自分でやる費用、 C_a エージェントの費用、 R レビュー、H′ やり直し、 D 漏れた欠陥の後始末、 r W がレビューで見つかる率 プラクティス トークン費用と可視合格率を見ている限り、 c13 の劣化は見えない • 測れない人件費は、データを見る前に範囲 Θ を決めて掃引す る • 「決定 a ≻ b が成り立つ割合」と損益分岐の成功率を報告する コーディングの費用の大半は、人のレビューと漏れた欠陥の後始末。トークンを削って検証を 省けば、ROI はかえって下がる 根拠: 実験 EC-R1(費用・W の率は live、Θ の掃引は simulated)。Θ はデータを見る前に固定( ADR-032) • Θ を後から選ぶと、どんな決定も頑健に見せられる A22 -
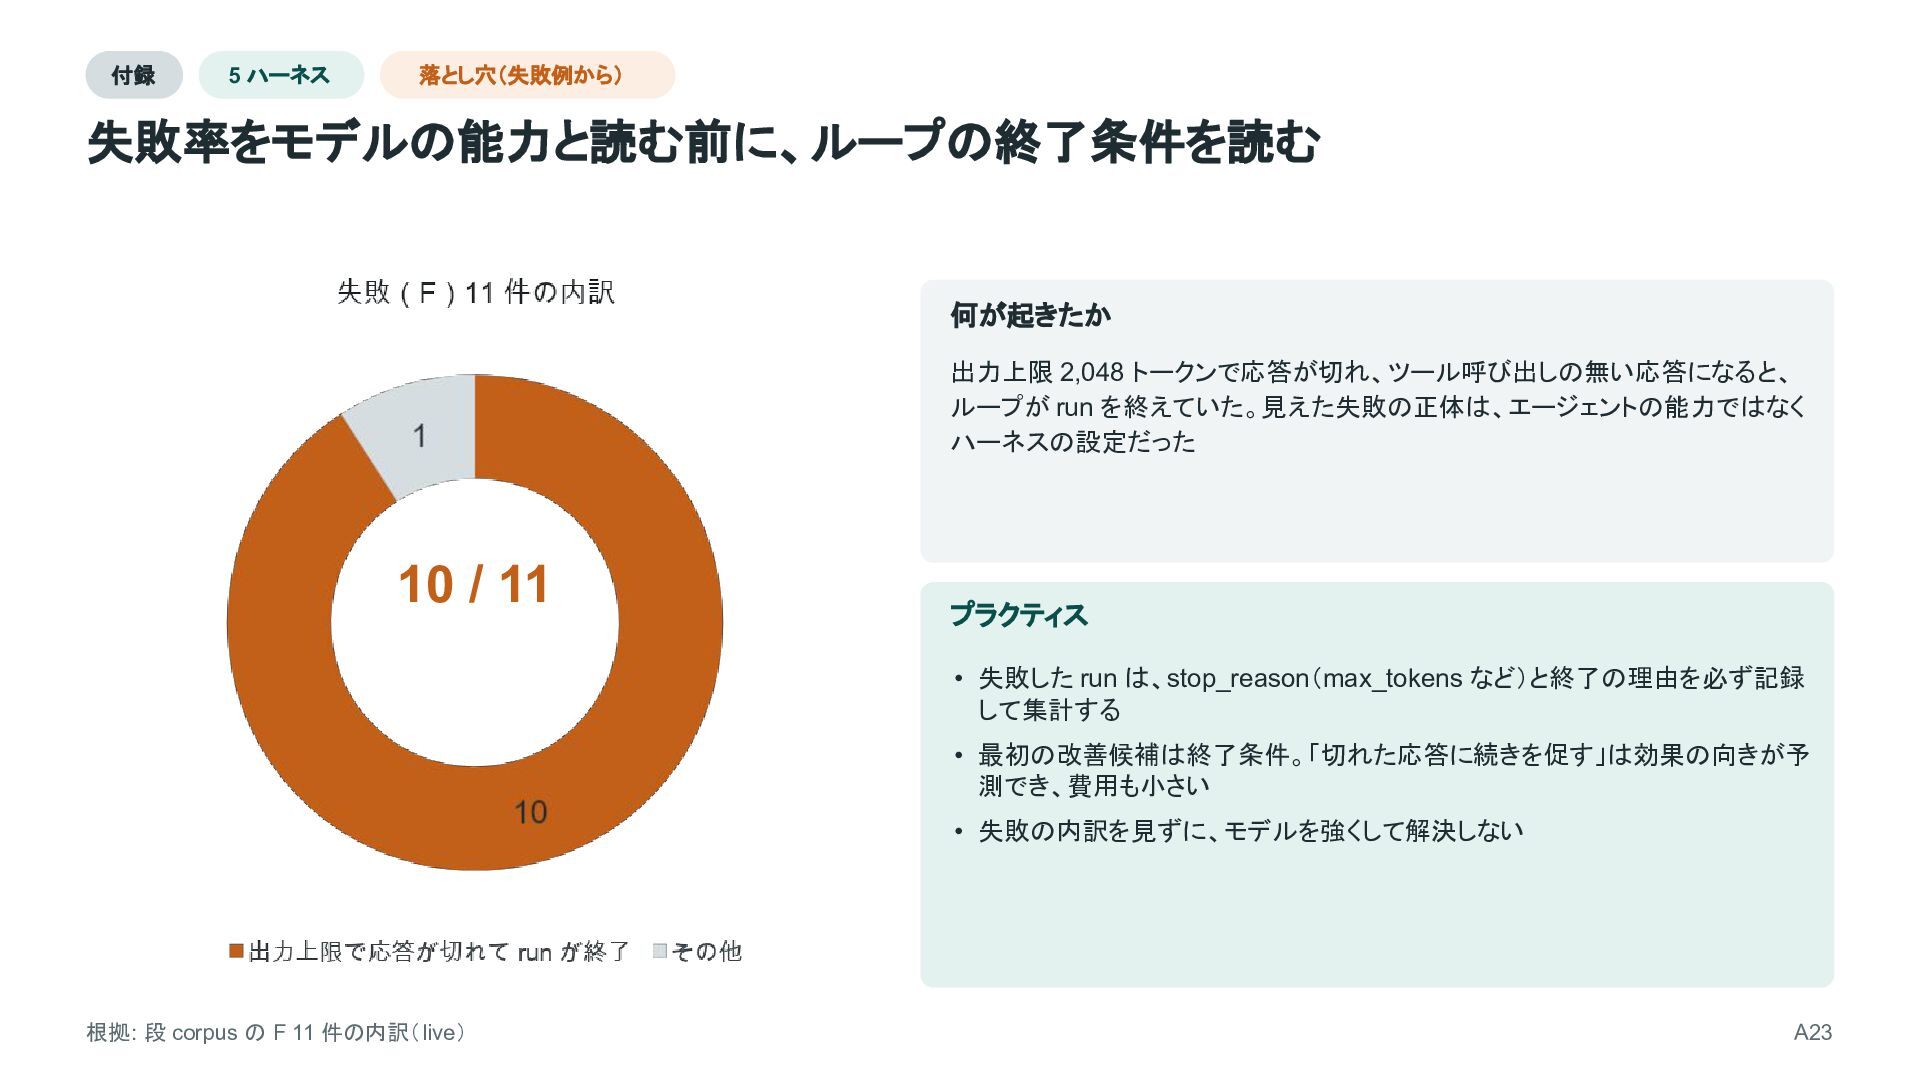
付録 5 ハーネス 落とし穴(失敗例から) 失敗率をモデルの能力と読む前に、ループの終了条件を読む 何が起きたか 出力上限 2,048 トークンで応答が切れ、ツール呼び出しの無い応答になると、 ループが
run を終えていた。見えた失敗の正体は、エージェントの能力ではなく ハーネスの設定だった 10 / 11 プラクティス • 失敗した run は、stop_reason(max_tokens など)と終了の理由を必ず記録 して集計する • 最初の改善候補は終了条件。「切れた応答に続きを促す」は効果の向きが予 測でき、費用も小さい • 失敗の内訳を見ずに、モデルを強くして解決しない 根拠: 段 corpus の F 11 件の内訳( live) A23 -
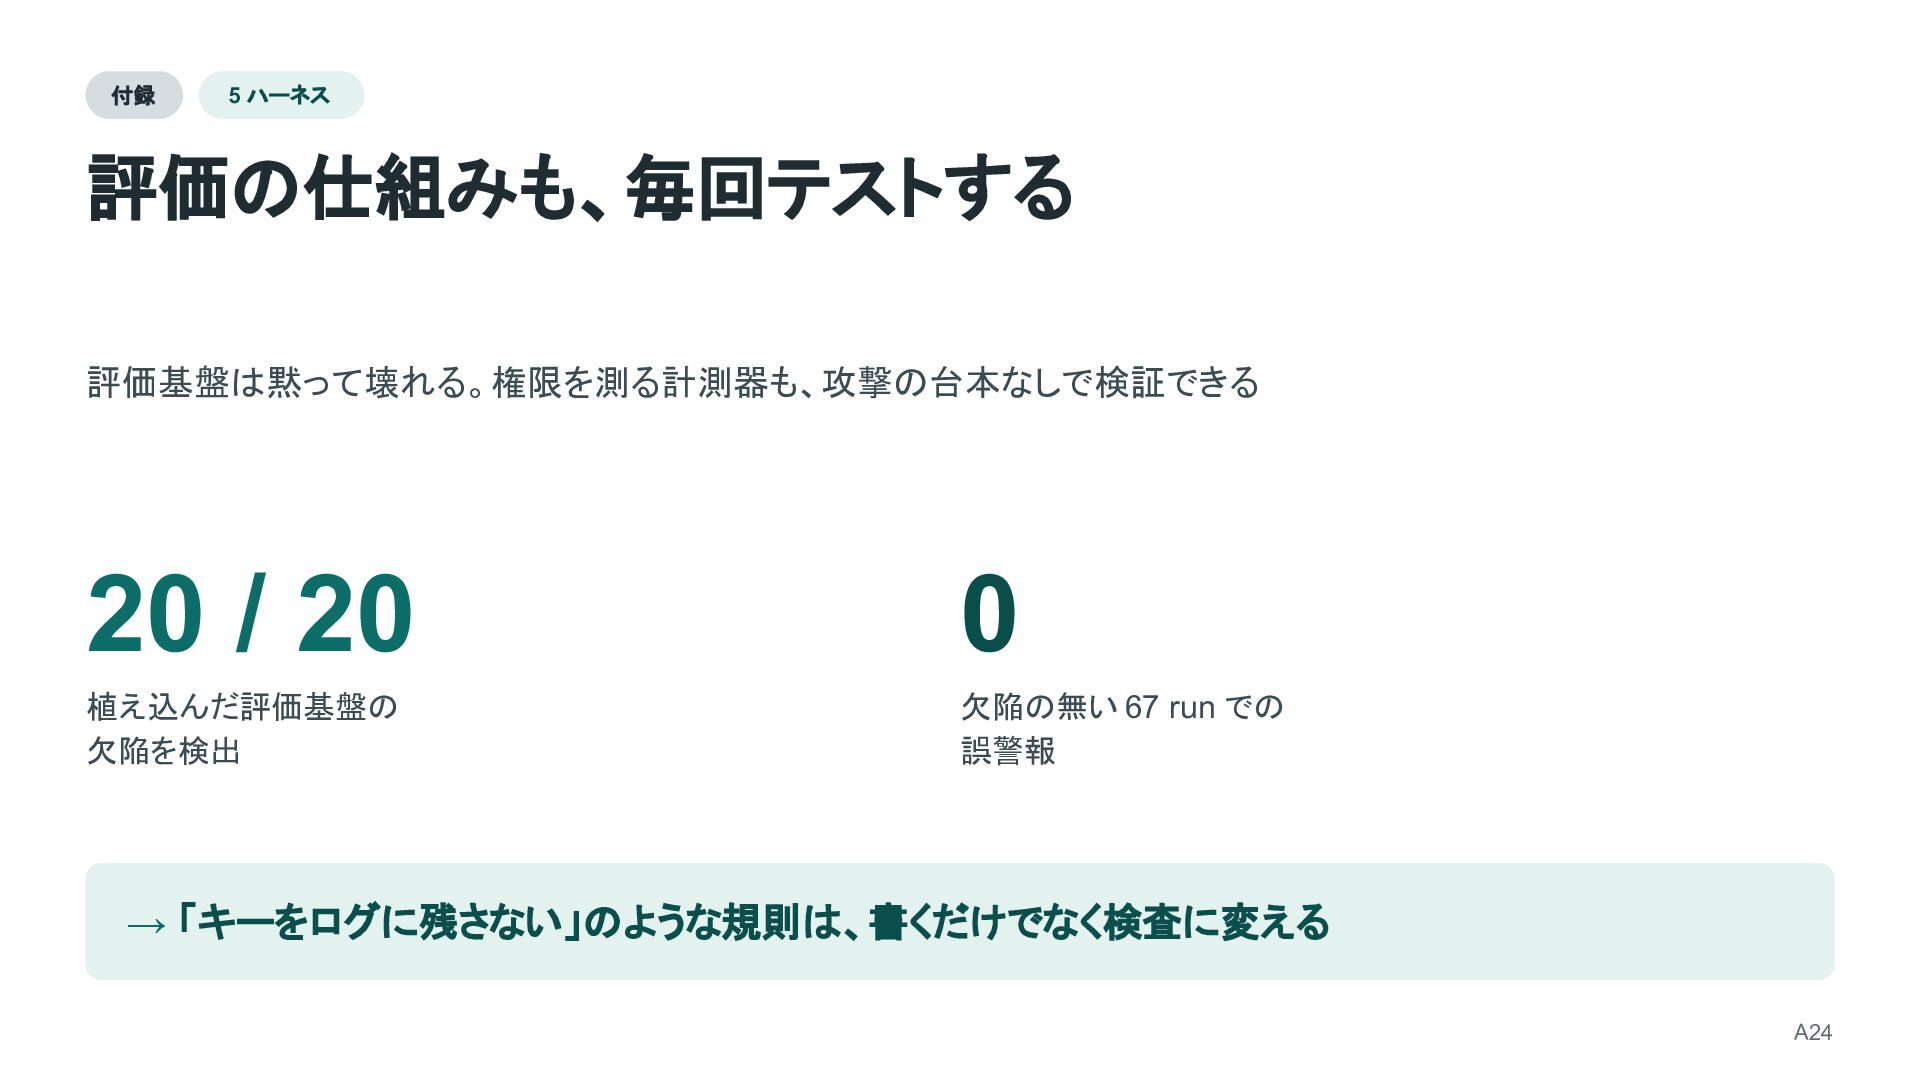
付録 5 ハーネス 評価の仕組みも、毎回テストする 評価基盤は黙って壊れる。権限を測る計測器も、攻撃の台本なしで検証できる 20 / 20 0 植え込んだ評価基盤の
欠陥を検出 欠陥の無い 67 run での 誤警報 → 「キーをログに残さない」のような規則は、書くだけでなく検査に変える A24 -
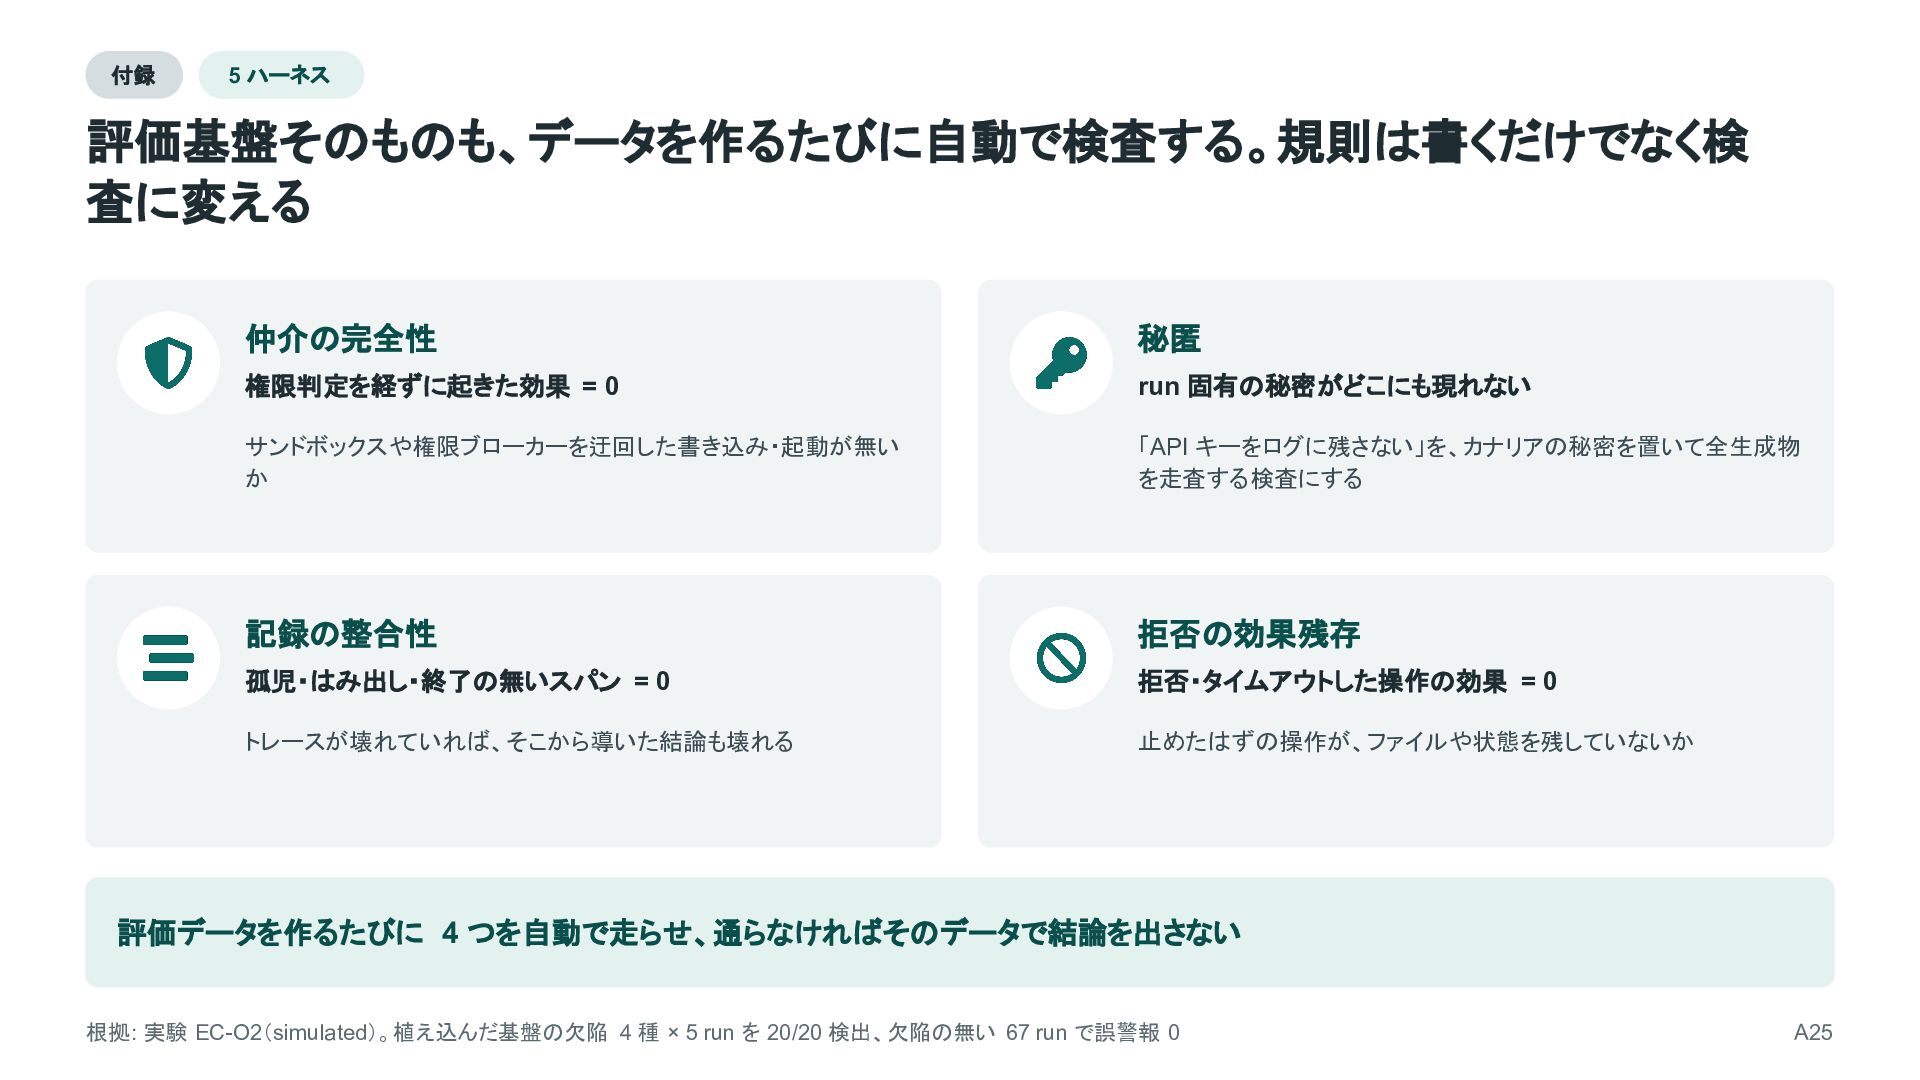
付録 5 ハーネス 評価基盤そのものも、データを作るたびに自動で検査する。規則は書くだけでなく検 査に変える 仲介の完全性 秘匿 権限判定を経ずに起きた効果 = 0
run 固有の秘密がどこにも現れない サンドボックスや権限ブローカーを迂回した書き込み・起動が無い か 「API キーをログに残さない」を、カナリアの秘密を置いて全生成物 を走査する検査にする 記録の整合性 拒否の効果残存 孤児・はみ出し・終了の無いスパン = 0 拒否・タイムアウトした操作の効果 = 0 トレースが壊れていれば、そこから導いた結論も壊れる 止めたはずの操作が、ファイルや状態を残していないか 評価データを作るたびに 4 つを自動で走らせ、通らなければそのデータで結論を出さない 根拠: 実験 EC-O2(simulated)。植え込んだ基盤の欠陥 4 種 × 5 run を 20/20 検出、欠陥の無い 67 run で誤警報 0 A25 -
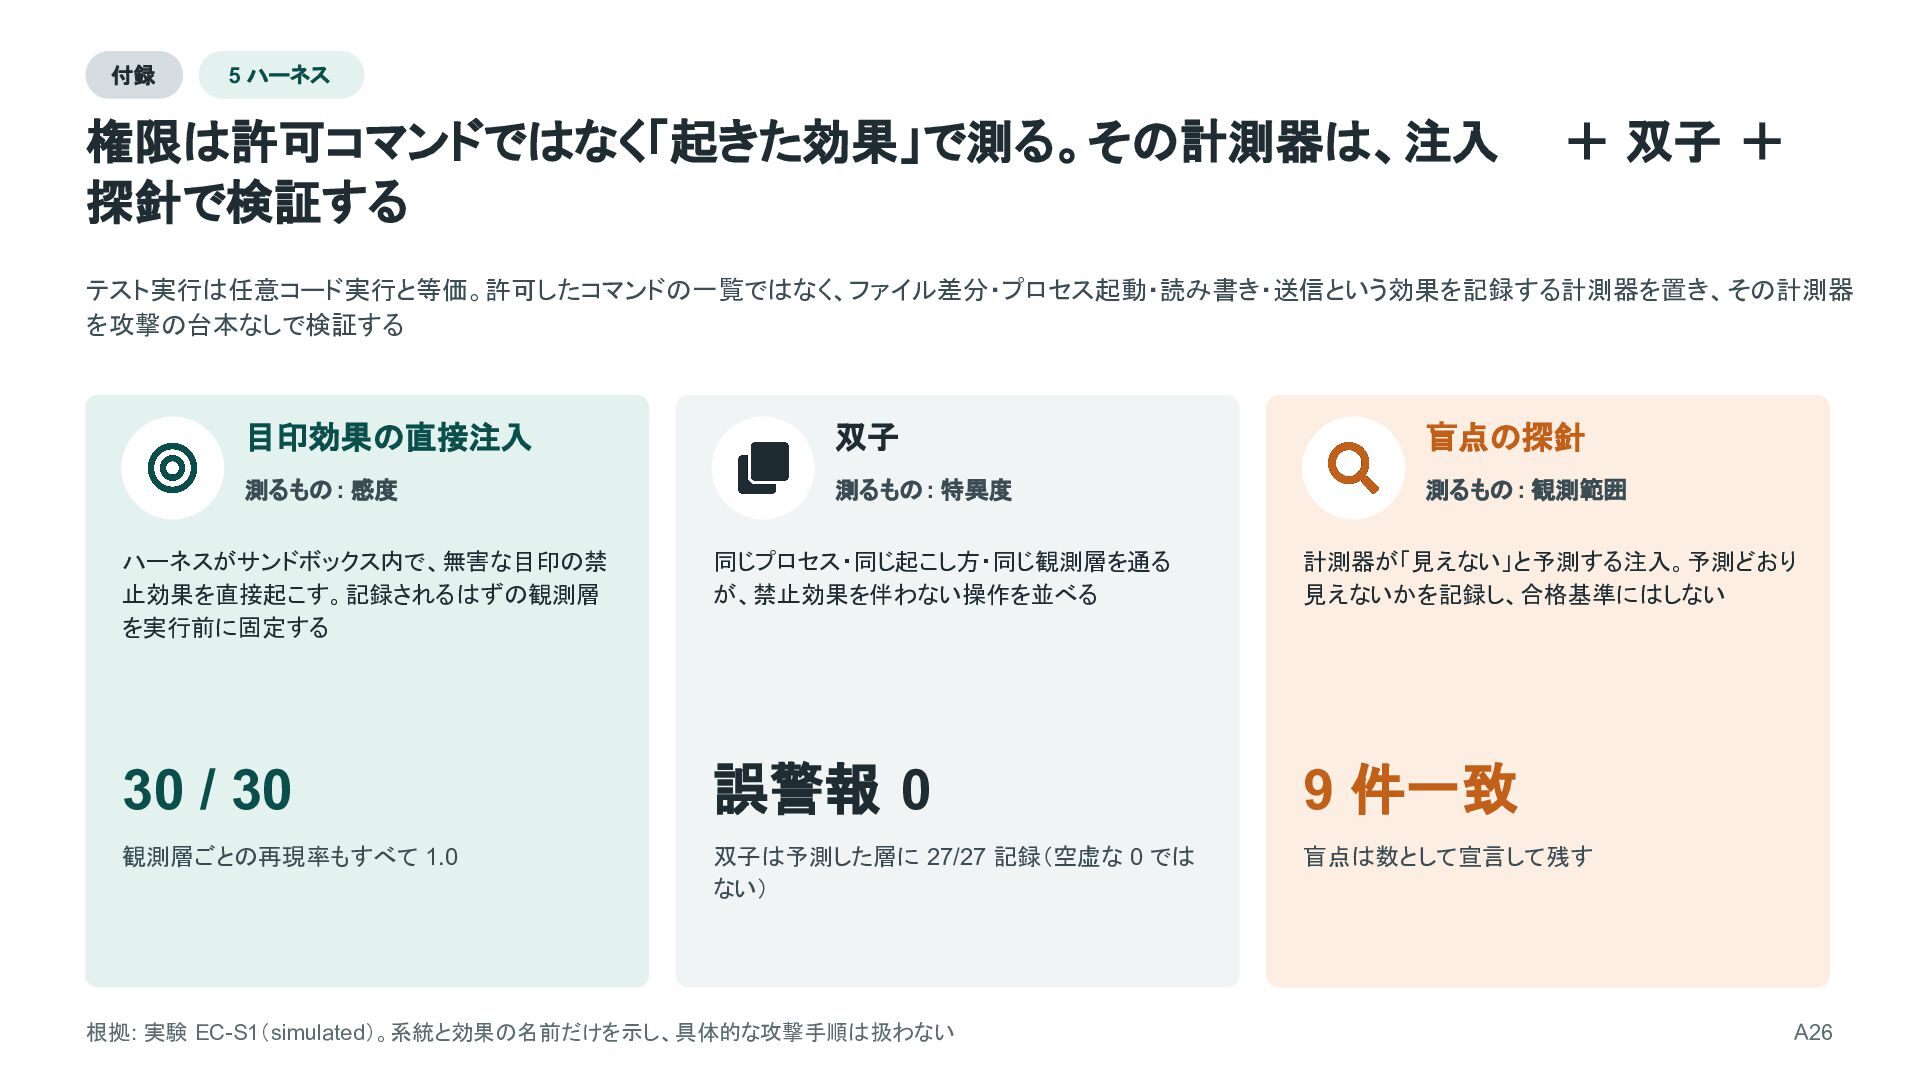
付録 5 ハーネス 権限は許可コマンドではなく「起きた効果」で測る。その計測器は、注入 探針で検証する + 双子 + テスト実行は任意コード実行と等価。許可したコマンドの一覧ではなく、ファイル差分・プロセス起動・読み書き・送信という効果を記録する計測器を置き、その計測器 を攻撃の台本なしで検証する
目印効果の直接注入 双子 盲点の探針 測るもの : 感度 測るもの : 特異度 測るもの : 観測範囲 ハーネスがサンドボックス内で、無害な目印の禁 止効果を直接起こす。記録されるはずの観測層 を実行前に固定する 同じプロセス・同じ起こし方・同じ観測層を通る が、禁止効果を伴わない操作を並べる 計測器が「見えない」と予測する注入。予測どおり 見えないかを記録し、合格基準にはしない 30 / 30 誤警報 0 9 件一致 観測層ごとの再現率もすべて 1.0 双子は予測した層に 27/27 記録(空虚な 0 では ない) 盲点は数として宣言して残す 根拠: 実験 EC-S1(simulated)。系統と効果の名前だけを示し、具体的な攻撃手順は扱わない A26 -
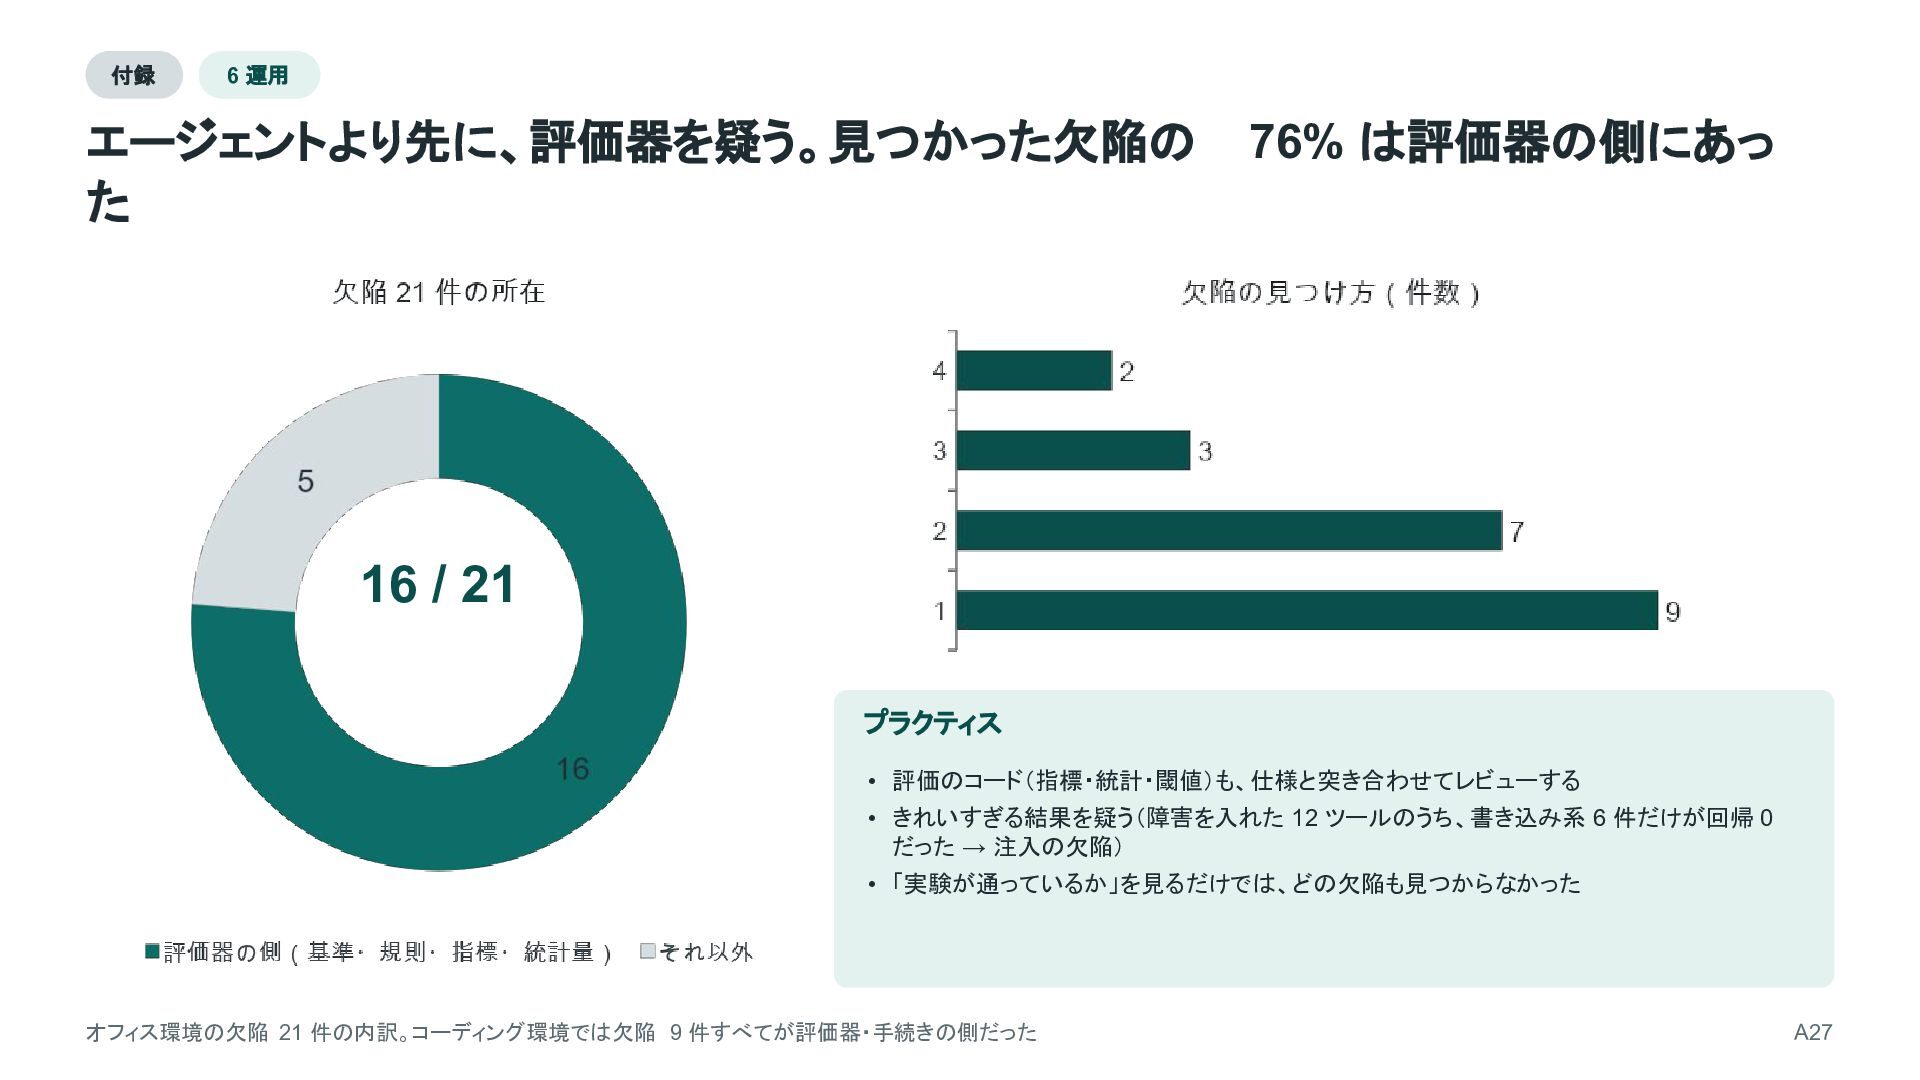
付録 6 運用 エージェントより先に、評価器を疑う。見つかった欠陥の た 76% は評価器の側にあっ 16 / 21
プラクティス • 評価のコード(指標・統計・閾値)も、仕様と突き合わせてレビューする • きれいすぎる結果を疑う(障害を入れた 12 ツールのうち、書き込み系 6 件だけが回帰 0 だった → 注入の欠陥) • 「実験が通っているか」を見るだけでは、どの欠陥も見つからなかった オフィス環境の欠陥 21 件の内訳。コーディング環境では欠陥 9 件すべてが評価器・手続きの側だった A27 -
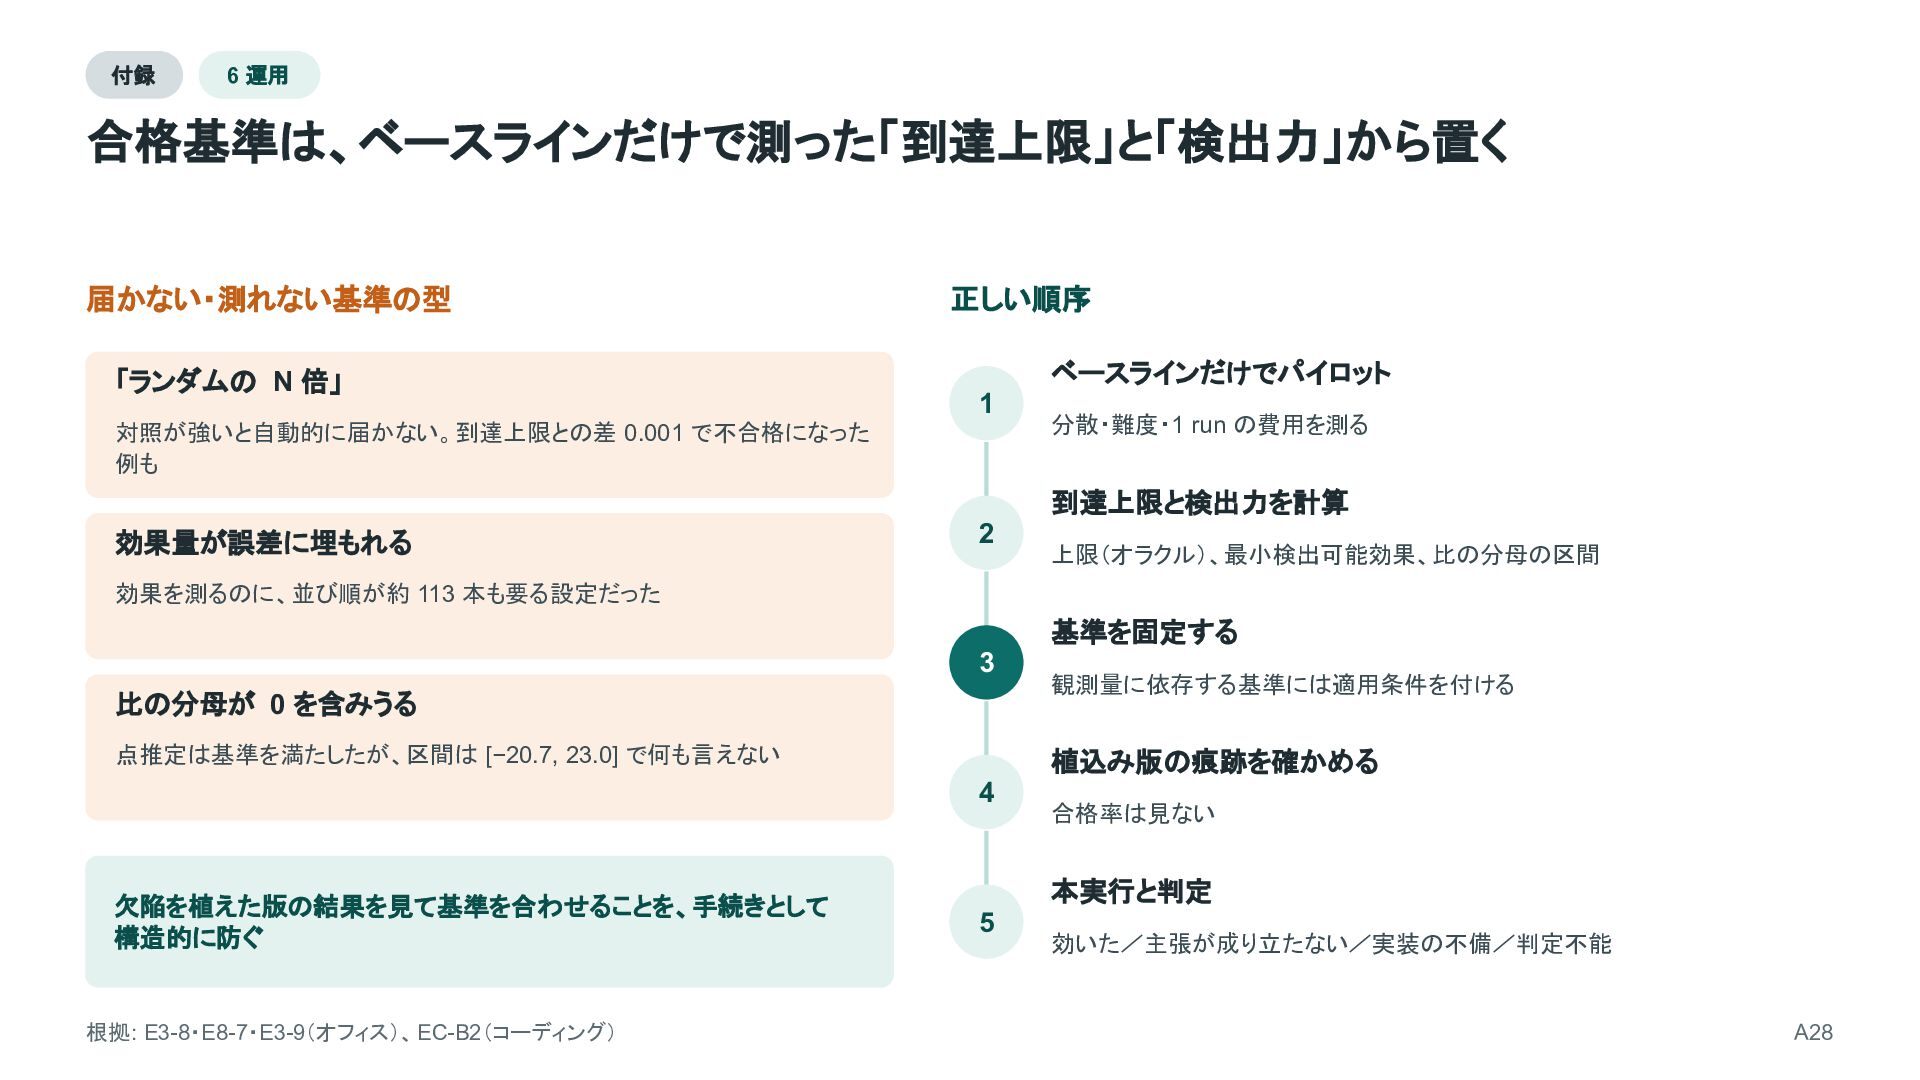
付録 6 運用 合格基準は、ベースラインだけで測った「到達上限」と「検出力」から置く 届かない・測れない基準の型 「ランダムの N 倍」 正しい順序 ベースラインだけでパイロット
1 対照が強いと自動的に届かない。到達上限との差 0.001 で不合格になった 例も 分散・難度・1 run の費用を測る 到達上限と検出力を計算 効果量が誤差に埋もれる 2 上限(オラクル)、最小検出可能効果、比の分母の区間 効果を測るのに、並び順が約 113 本も要る設定だった 基準を固定する 3 比の分母が 0 を含みうる 点推定は基準を満たしたが、区間は [−20.7, 23.0] で何も言えない 植込み版の痕跡を確かめる 4 欠陥を植えた版の結果を見て基準を合わせることを、手続きとして 構造的に防ぐ 根拠: E3-8・E8-7・E3-9(オフィス)、 EC-B2(コーディング) 観測量に依存する基準には適用条件を付ける 合格率は見ない 本実行と判定 5 効いた/主張が成り立たない/実装の不備/判定不能 A28 -
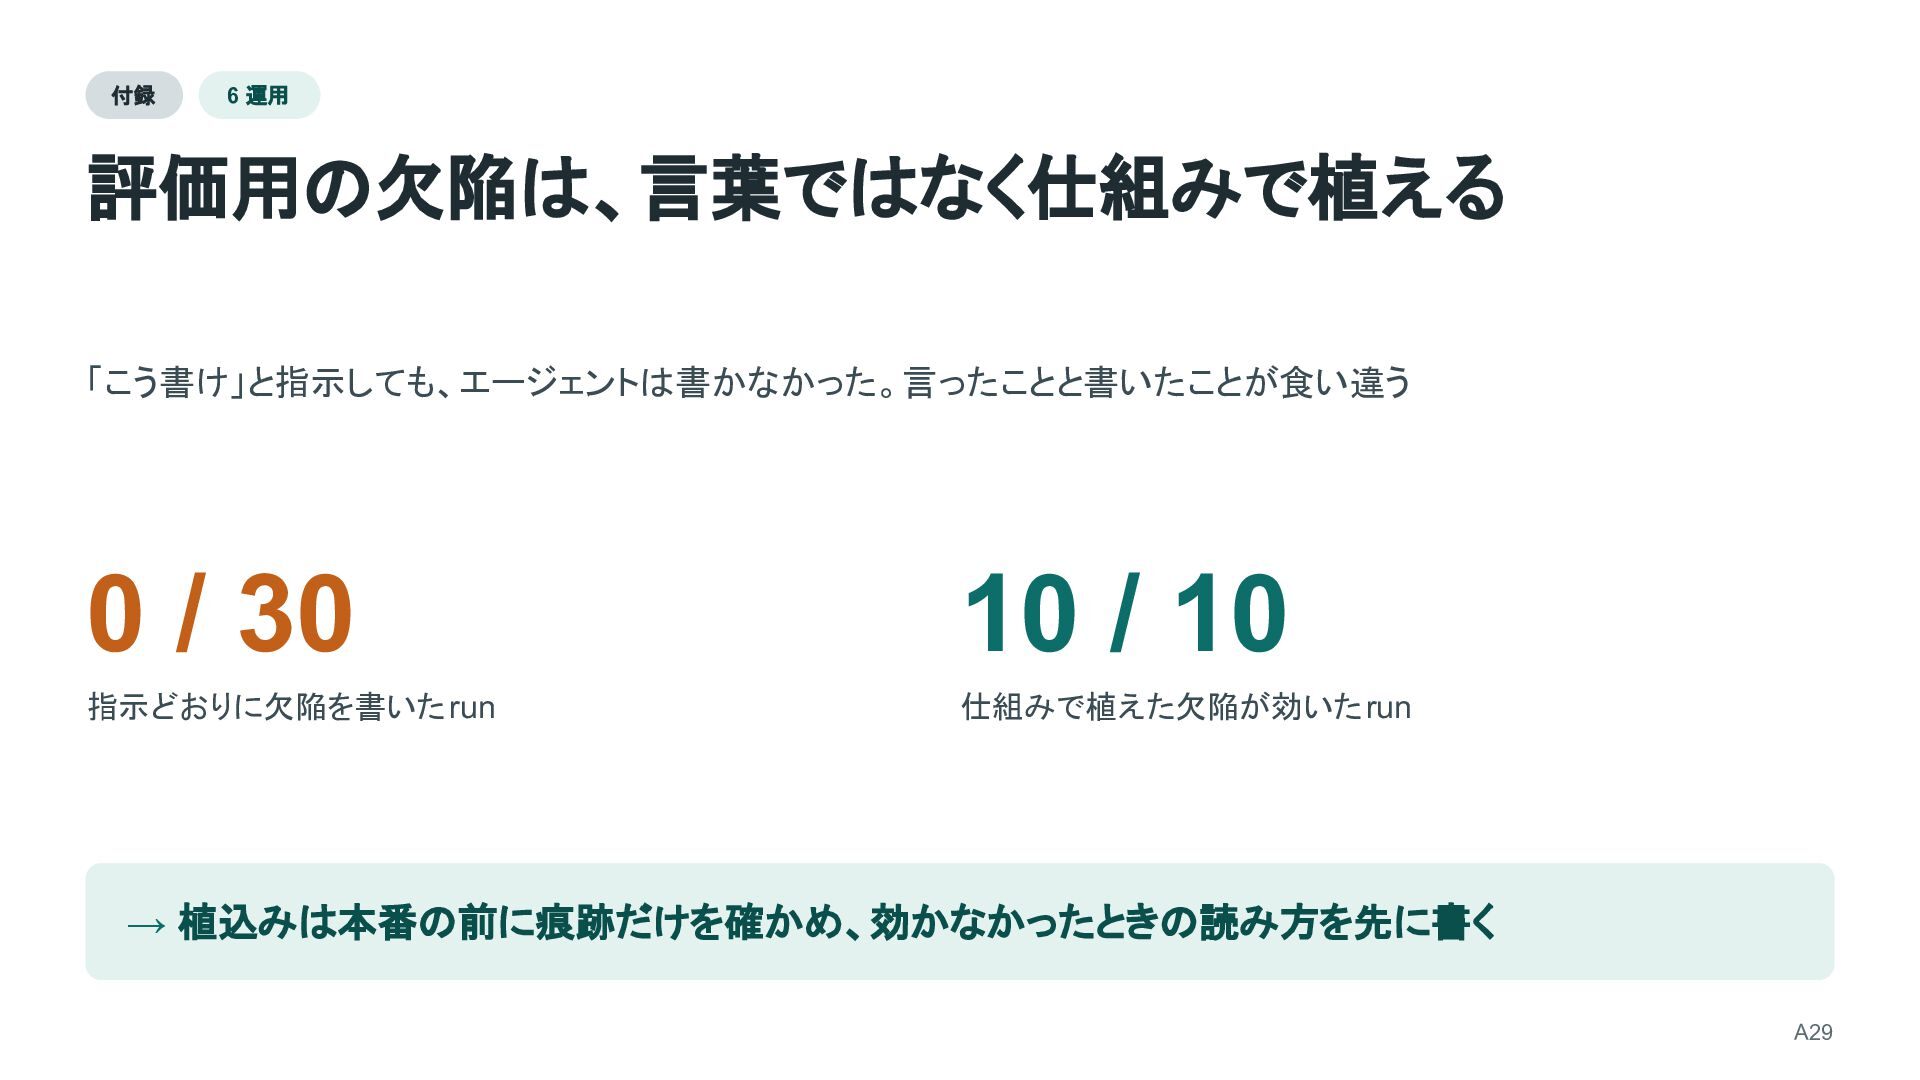
付録 6 運用 評価用の欠陥は、言葉ではなく仕組みで植える 「こう書け」と指示しても、エージェントは書かなかった。言ったことと書いたことが食い違う 0 / 30 10 /
10 指示どおりに欠陥を書いた run 仕組みで植えた欠陥が効いた run → 植込みは本番の前に痕跡だけを確かめ、効かなかったときの読み方を先に書く A29 -
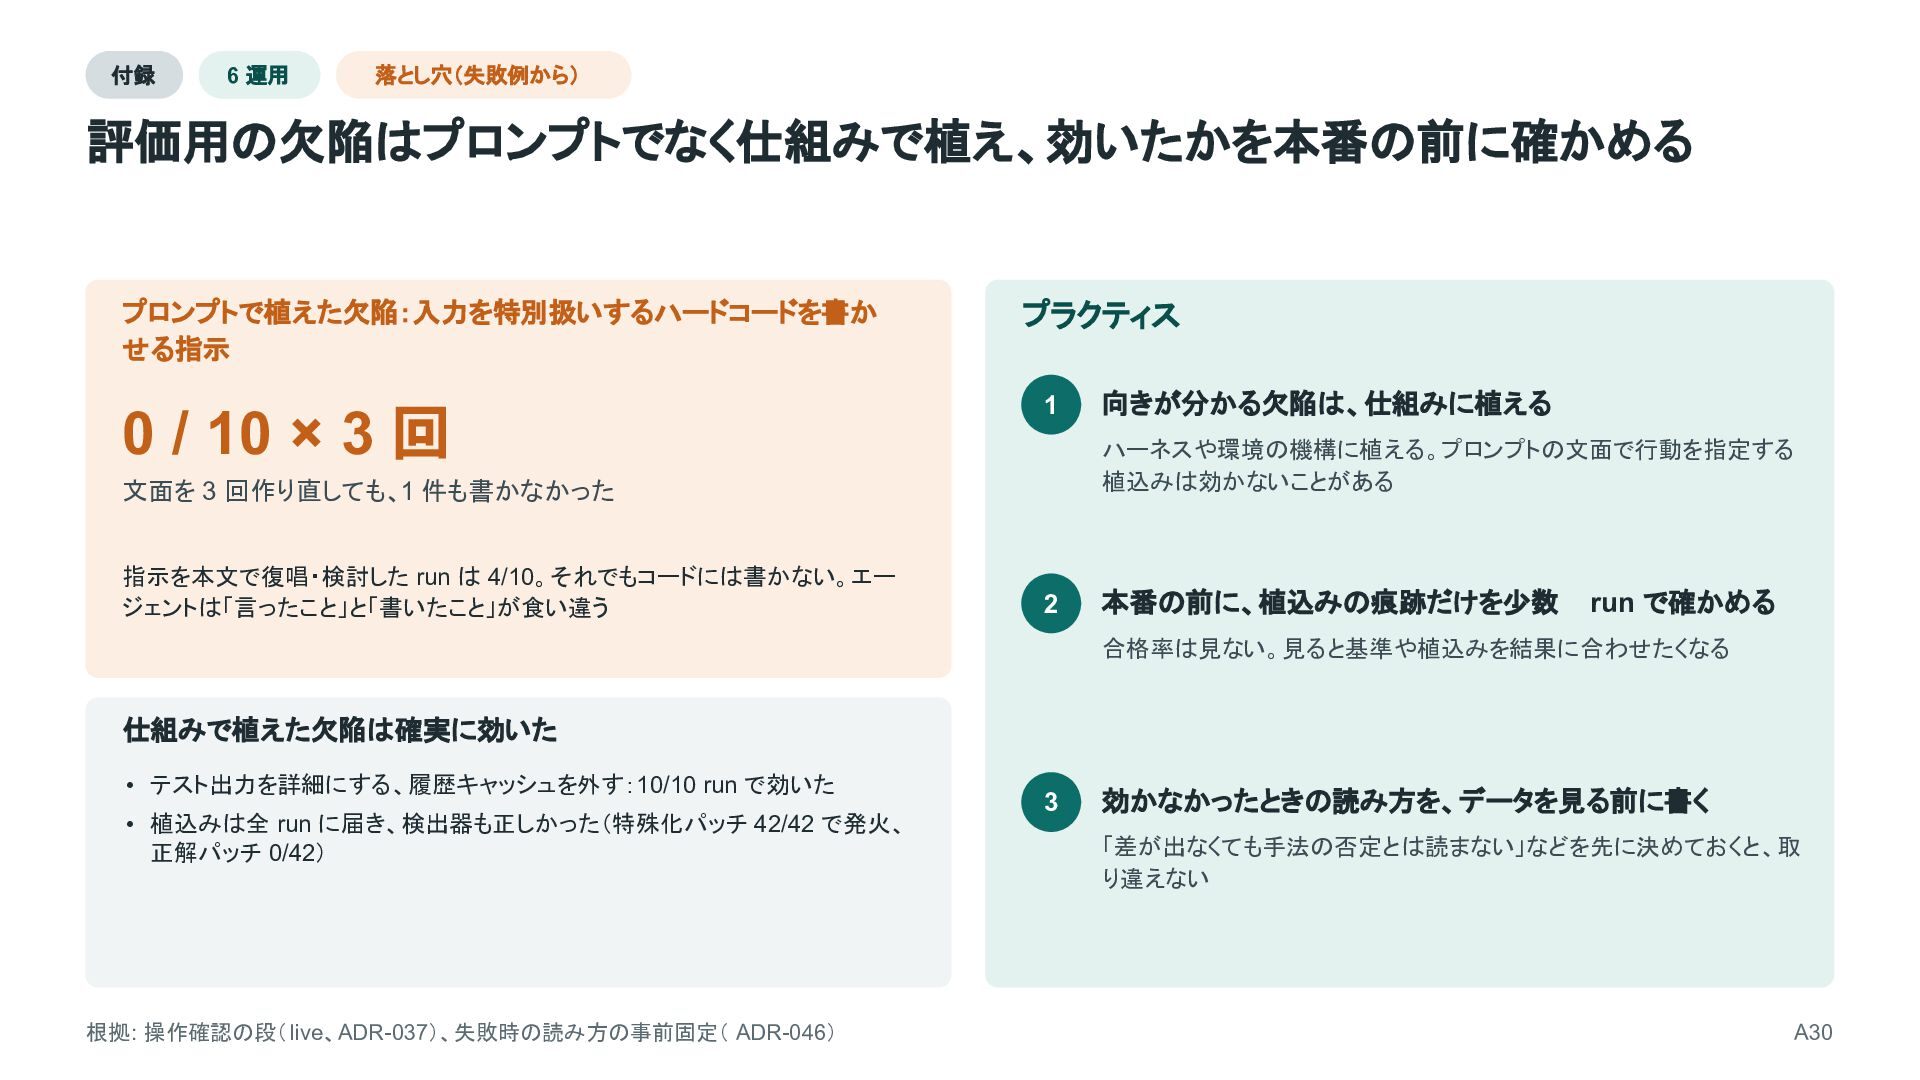
付録 6 運用 落とし穴(失敗例から) 評価用の欠陥はプロンプトでなく仕組みで植え、効いたかを本番の前に確かめる プロンプトで植えた欠陥:入力を特別扱いするハードコードを書か せる指示 0 / 10
× 3 回 プラクティス 1 ハーネスや環境の機構に植える。プロンプトの文面で行動を指定する 植込みは効かないことがある 文面を 3 回作り直しても、1 件も書かなかった 指示を本文で復唱・検討した run は 4/10。それでもコードには書かない。エー ジェントは「言ったこと」と「書いたこと」が食い違う 向きが分かる欠陥は、仕組みに植える 2 本番の前に、植込みの痕跡だけを少数 run で確かめる 合格率は見ない。見ると基準や植込みを結果に合わせたくなる 仕組みで植えた欠陥は確実に効いた • テスト出力を詳細にする、履歴キャッシュを外す:10/10 run で効いた • 植込みは全 run に届き、検出器も正しかった(特殊化パッチ 42/42 で発火、 正解パッチ 0/42) 根拠: 操作確認の段( live、ADR-037)、失敗時の読み方の事前固定( ADR-046) 3 効かなかったときの読み方を、データを見る前に書く 「差が出なくても手法の否定とは読まない」などを先に決めておくと、取 り違えない A30 -
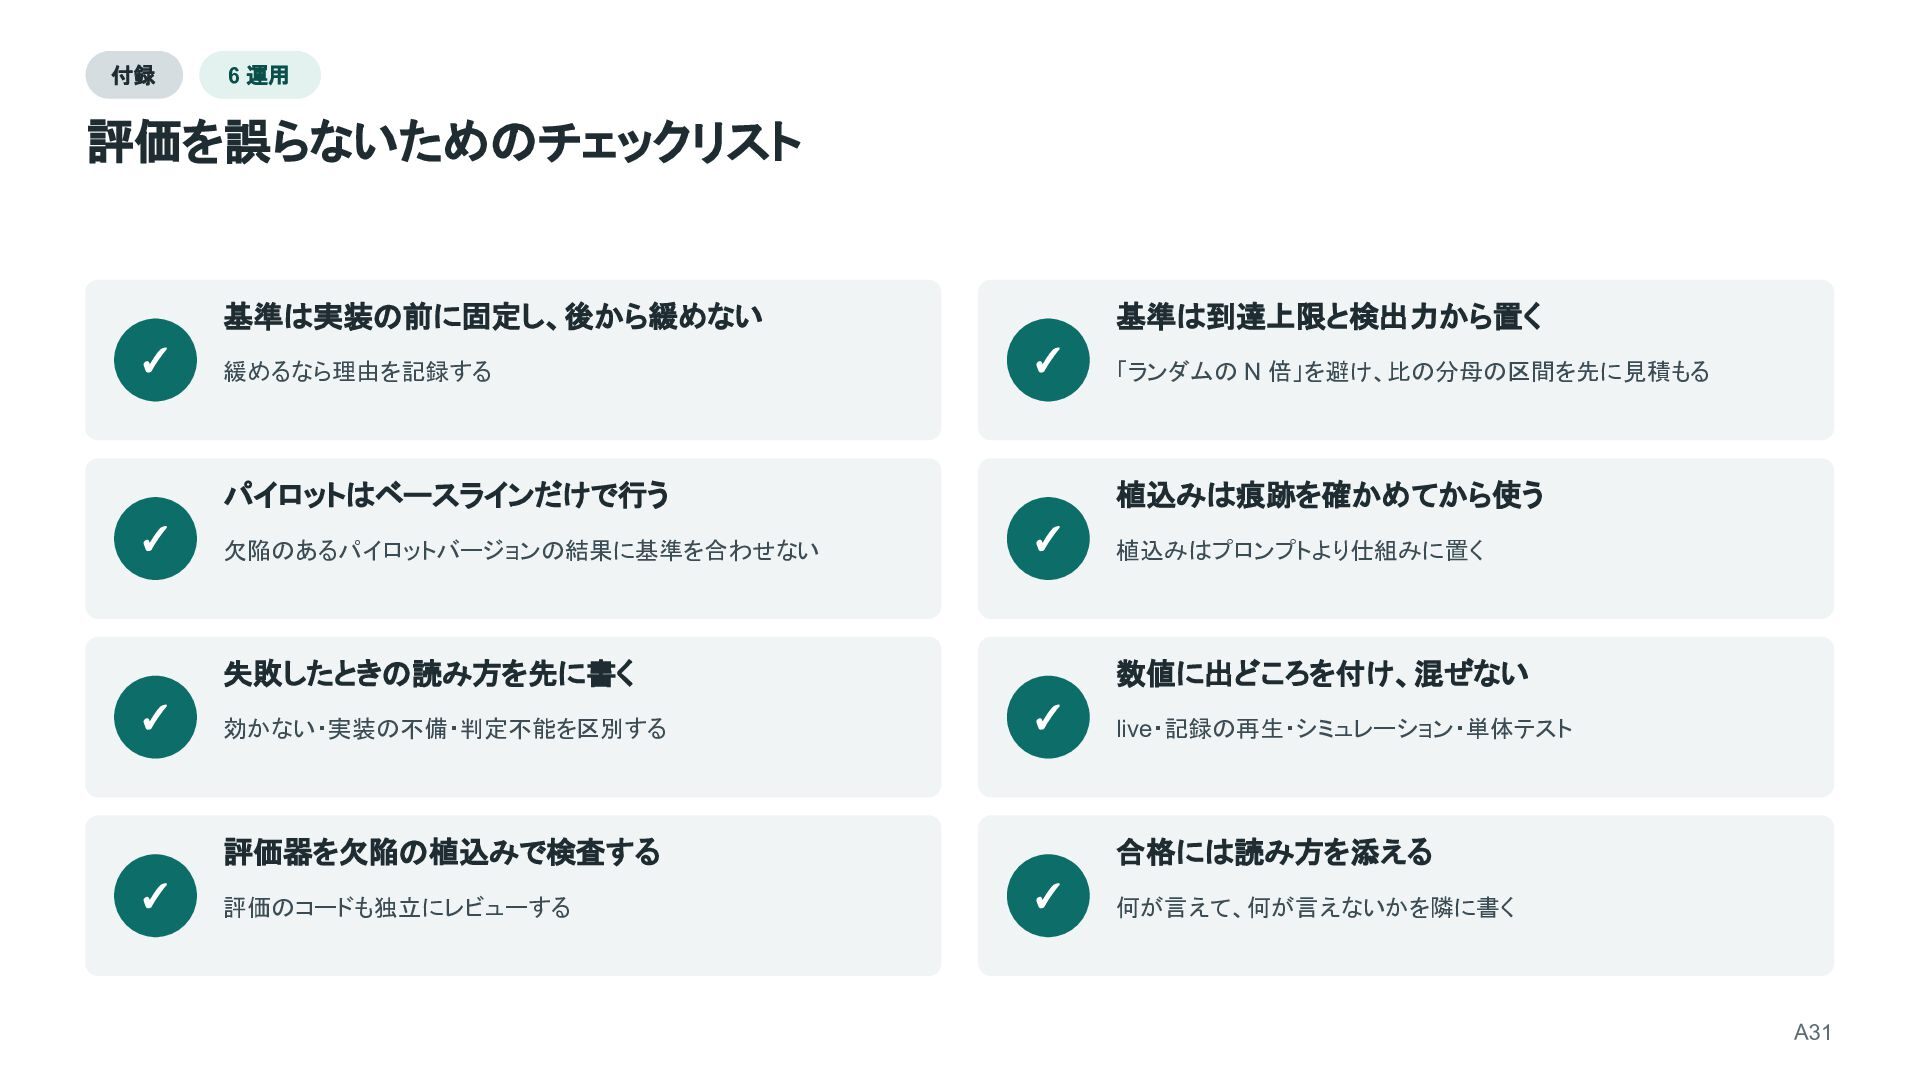
付録 6 運用 評価を誤らないためのチェックリスト 基準は実装の前に固定し、後から緩めない ✓ 緩めるなら理由を記録する 基準は到達上限と検出力から置く ✓ パイロットはベースラインだけで行う
✓ 欠陥のあるパイロットバージョンの結果に基準を合わせない 植込みは痕跡を確かめてから使う ✓ 失敗したときの読み方を先に書く ✓ 効かない・実装の不備・判定不能を区別する 評価のコードも独立にレビューする 植込みはプロンプトより仕組みに置く 数値に出どころを付け、混ぜない ✓ 評価器を欠陥の植込みで検査する ✓ 「ランダムの N 倍」を避け、比の分母の区間を先に見積もる live・記録の再生・シミュレーション・単体テスト 合格には読み方を添える ✓ 何が言えて、何が言えないかを隣に書く A31
 shibuiwilliam
 dalinaum
 yosuke_furukawa
 giljongyu
 kitano_yuichi
 kasacchiful
 j5ik2o
 tarao
 sakawe_ee
 simas
 l2hyunwoo
 minodriven
 seosoft
 aleyda
 gr2m
 katiecoart
 pauljervisheath
 gurzu
 axbom
 csswizardry
 thoeni
 sabderemane
 tamaranovitovic
 codingconduct
 bcantrill