Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
2025-06-20_人とAIの_合意領域_に基づく_信頼性スコアモデリング___レビ...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
matsui-dmm
June 25, 2025
1.6k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
2025-06-20_人とAIの_合意領域_に基づく_信頼性スコアモデリング___レビュー自動承認と信頼構築_HAZ__.pdf
matsui-dmm
June 25, 2025
Transcript
38 slides
© DMM © DMM CONFIDENTIAL 人とAIの「合意領域」に基づく 信頼性スコアモデリング ― Modeling Trust
Scores Based on Human-AI Agreement Zone (HAZ)― 「AIに任せる範囲」を明確化 レビュー審査の自動化を実現した「先駆的な研究」 1
© DMM 2 • 所属: DMM.com PF 第1開発部 • 業務:
商品レビューのプロダクト開発 • 役職: チームリーダー ー 自己紹介 ー AI研究は初めてですが、長年の現場経験から 10ヶ月で自動化、14ヶ月で論文化できました。 その成果をお伝えできることを嬉しく思います。
© DMM Agenda 1. 背景と課題 2. 生成AIの導入 3. 精度改善の取り組み 4.
自動化基準の策定 5. 自動化の成果 6. 未来の展望と提言 3
© DMM 1章. 背景と課題 4 4
© DMM 研究背景:AIにどこまで任せるのか? • 国内外の企業が、AIの役割を「支援型」(=サポート)にとどめている ◦ 例:開発支援、要約、推薦など • 「AI主導」で重要な判断を任せ、自動化する構造に至りにくい状況 ◦
例: ChatBotの誤回答により顧客に損害(Cursor、Air Canada社が提訴) 5
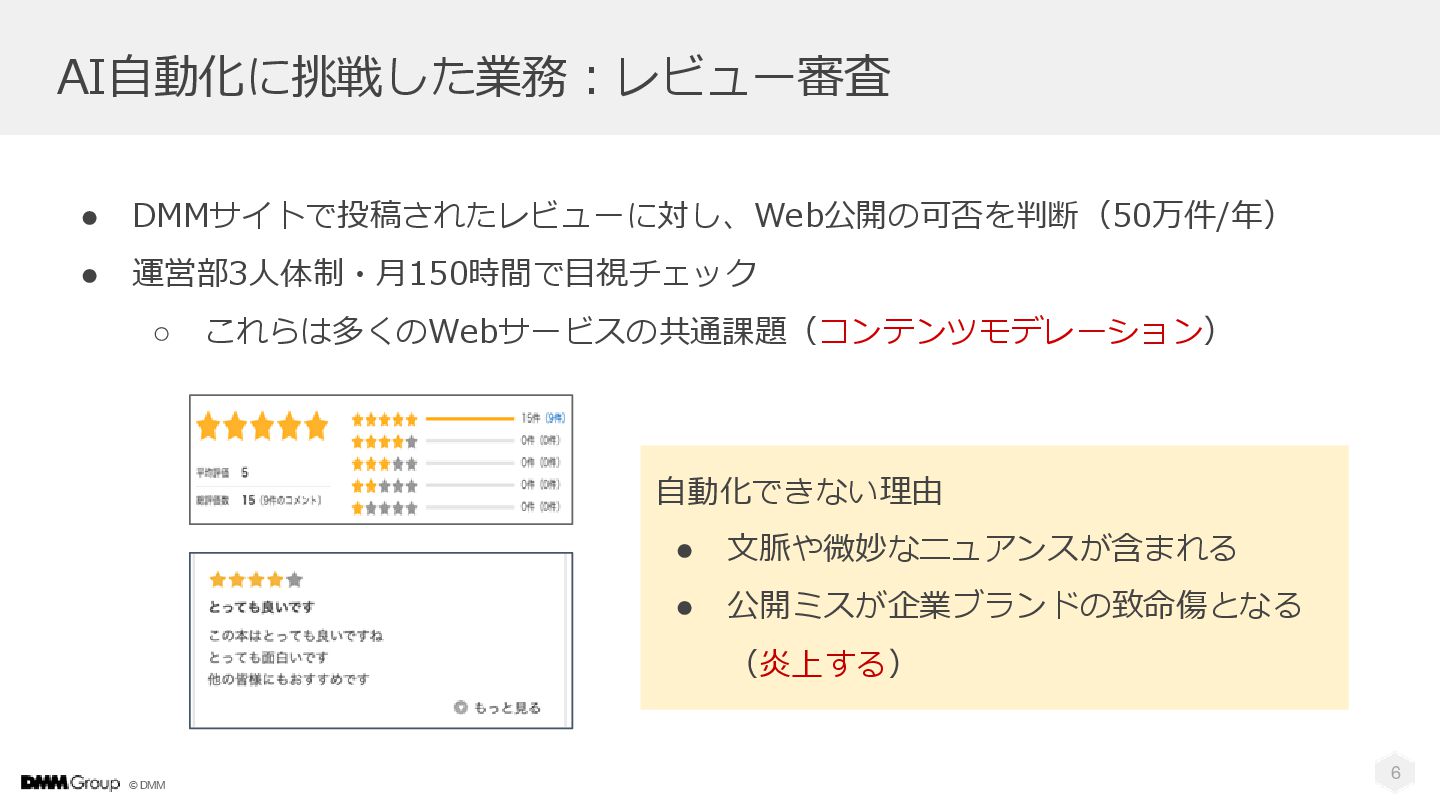
© DMM 6 • DMMサイトで投稿されたレビューに対し、Web公開の可否を判断(50万件/年) • 運営部3人体制・月150時間で目視チェック ◦ これらは多くのWebサービスの共通課題(コンテンツモデレーション) AI自動化に挑戦した業務:レビュー審査
自動化できない理由 • 文脈や微妙なニュアンスが含まれる • 公開ミスが企業ブランドの致命傷となる (炎上する)
© DMM 研究目的 • 本研究では 「AIにどこまで任せることができるか」という課題に対して 「レビュー審査業務のAI自動化」の事例を通じ、解決策を提示する 7
© DMM 2章. 生成AIの導入 8
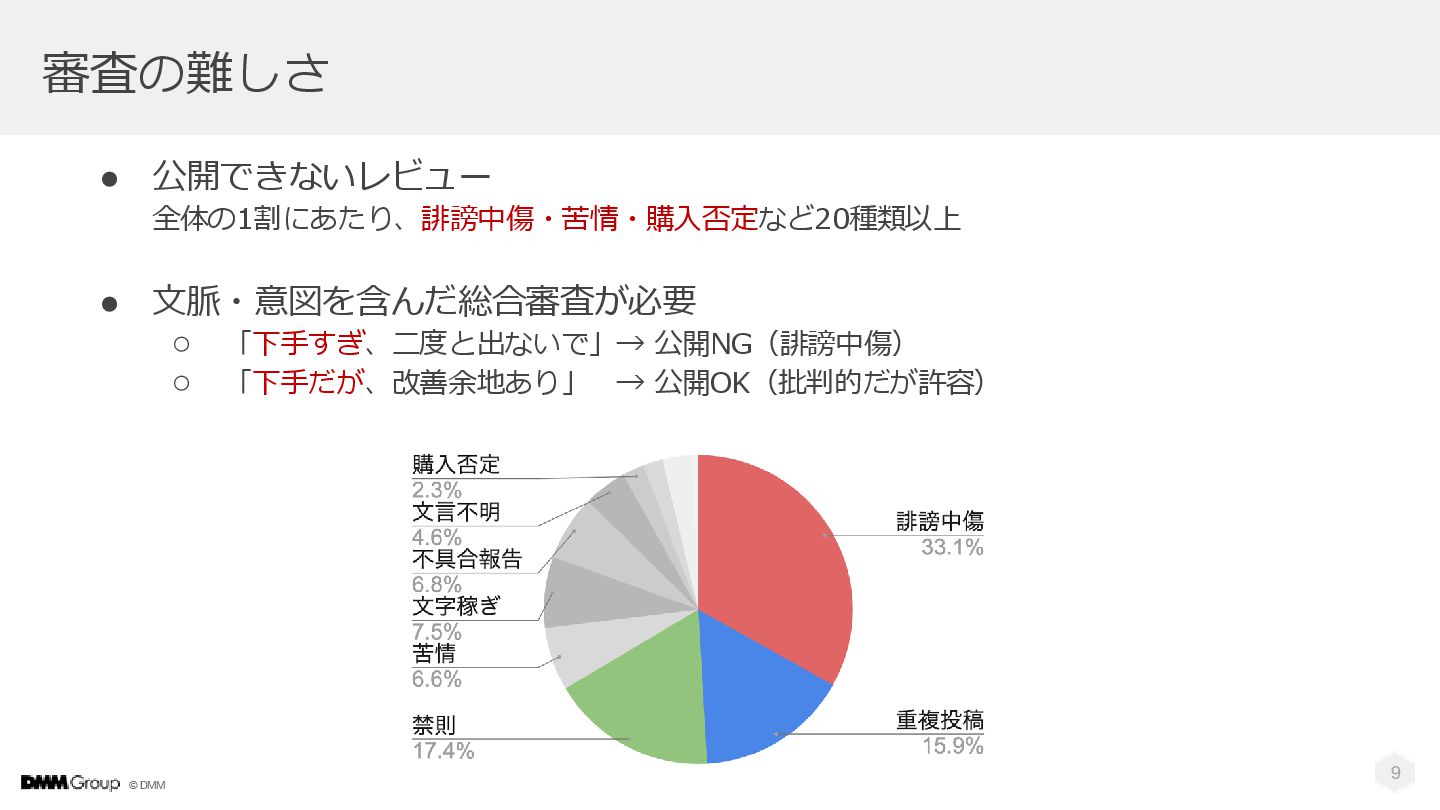
© DMM 9 • 公開できないレビュー 全体の1割にあたり、誹謗中傷・苦情・購入否定など20種類以上 • 文脈・意図を含んだ総合審査が必要 ◦ 「下手すぎ、二度と出ないで」→
公開NG(誹謗中傷) ◦ 「下手だが、改善余地あり」 → 公開OK(批判的だが許容) 審査の難しさ
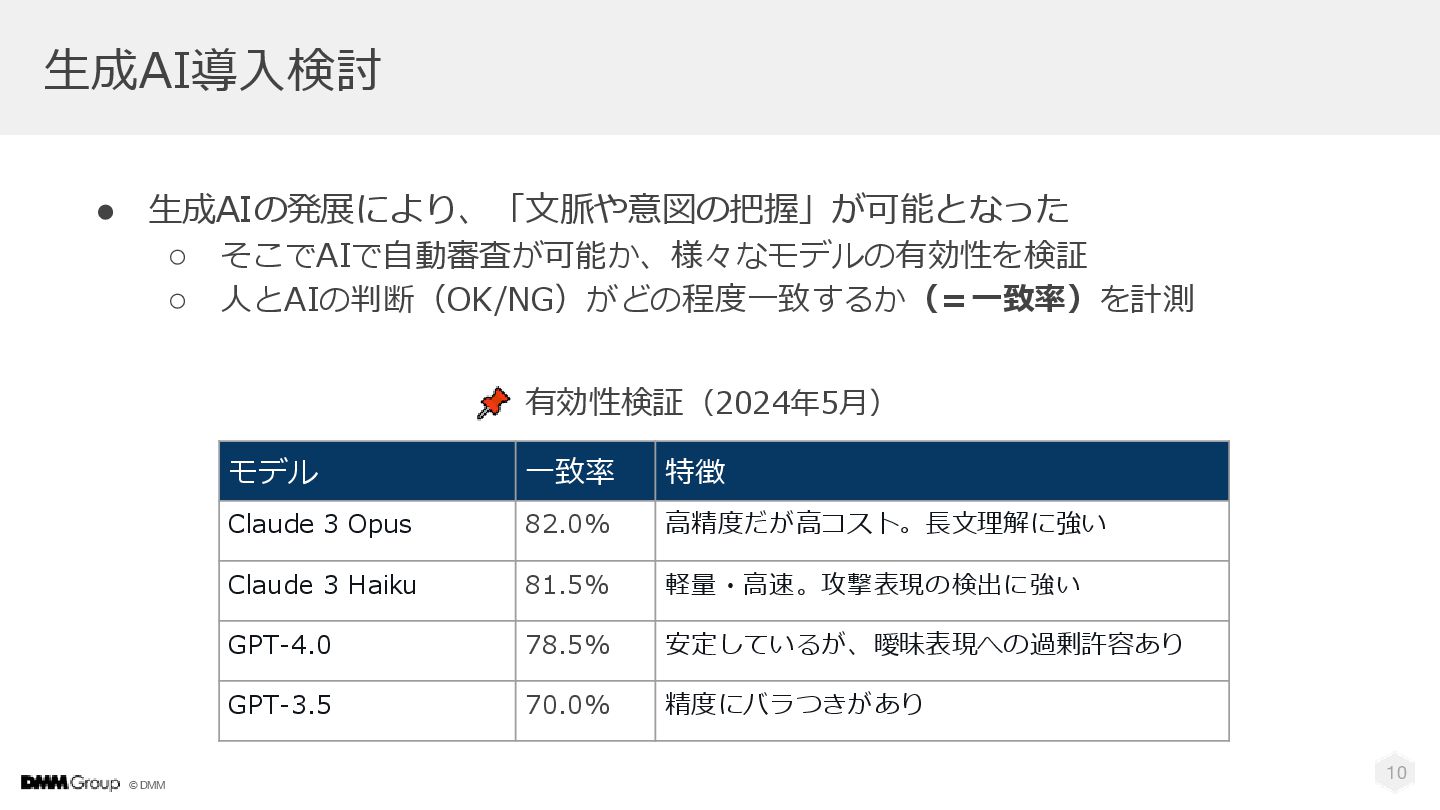
© DMM 10 生成AI導入検討 • 生成AIの発展により、「文脈や意図の把握」が可能となった ◦ そこでAIで自動審査が可能か、様々なモデルの有効性を検証 ◦ 人とAIの判断(OK/NG)がどの程度一致するか(=一致率)を計測
モデル 一致率 特徴 Claude 3 Opus 82.0% 高精度だが高コスト。長文理解に強い Claude 3 Haiku 81.5% 軽量・高速。攻撃表現の検出に強い GPT-4.0 78.5% 安定しているが、曖昧表現への過剰許容あり GPT-3.5 70.0% 精度にバラつきがあり 有効性検証(2024年5月)
© DMM 11 生成AI導入の検討結果 • ある程度の有効性を確認できたが、70〜80%では自動化に不十分 ◦ 特に文脈依存の高い複雑な判断は、ハルシネーションも発生しやすい • 次章では、まずAIの審査構造そのものを見直し、精度改善を行う
© DMM 3章. 精度改善の取り組み 12
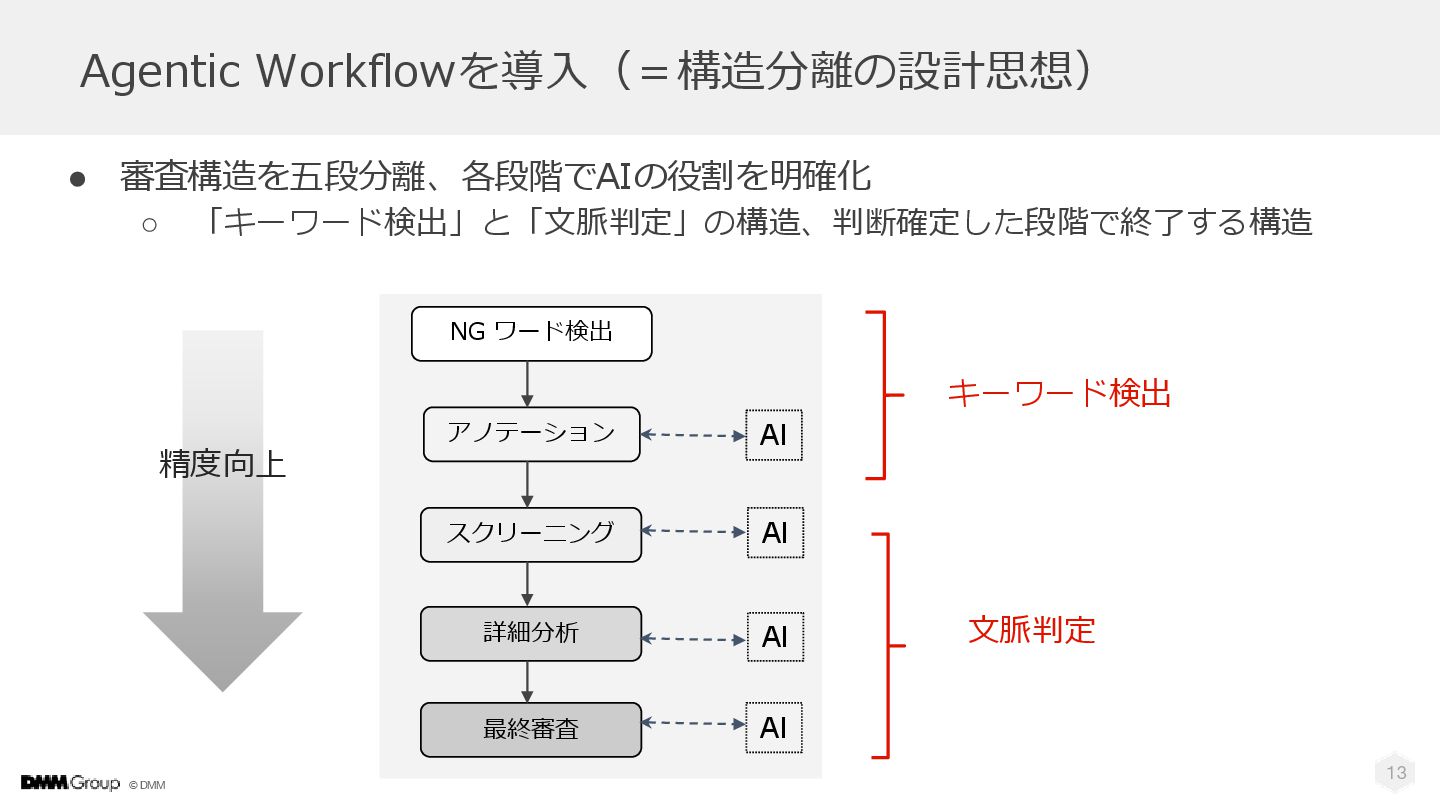
© DMM 13 Agentic Workflowを導入(=構造分離の設計思想) • 審査構造を五段分離、各段階でAIの役割を明確化 ◦ 「キーワード検出」と「文脈判定」の構造、判断確定した段階で終了する構造 NG
ワード検出 最終審査 詳細分析 アノテーション スクリーニング キーワード検出 文脈判定 精度向上 AI AI AI AI
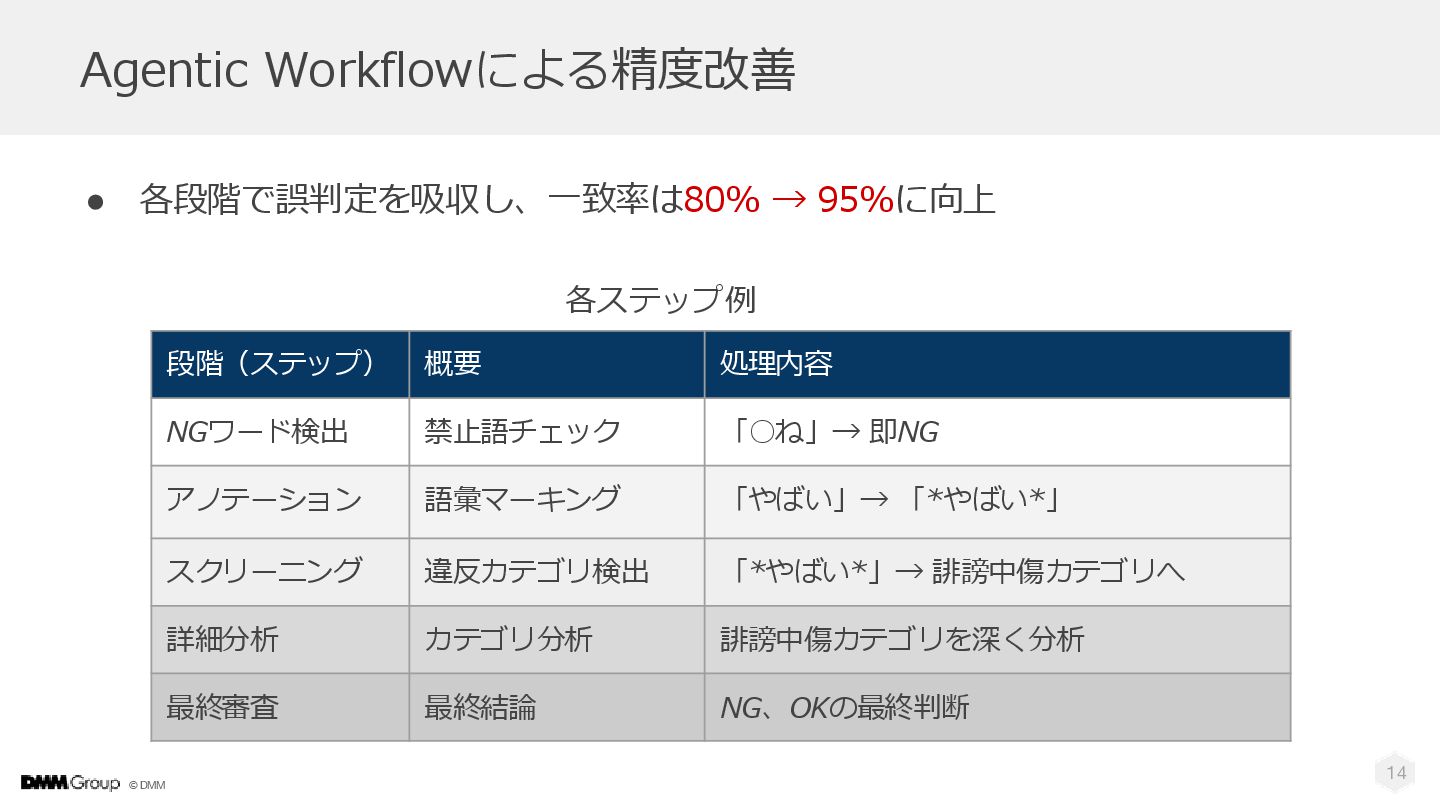
© DMM 14 Agentic Workflowによる精度改善 • 各段階で誤判定を吸収し、一致率は80% → 95%に向上 段階(ステップ)
概要 処理内容 NGワード検出 禁止語チェック 「◦ね」→ 即NG アノテーション 語彙マーキング 「やばい」→ 「*やばい*」 スクリーニング 違反カテゴリ検出 「*やばい*」→ 誹謗中傷カテゴリへ 詳細分析 カテゴリ分析 誹謗中傷カテゴリを深く分析 最終審査 最終結論 NG、OKの最終判断 各ステップ例
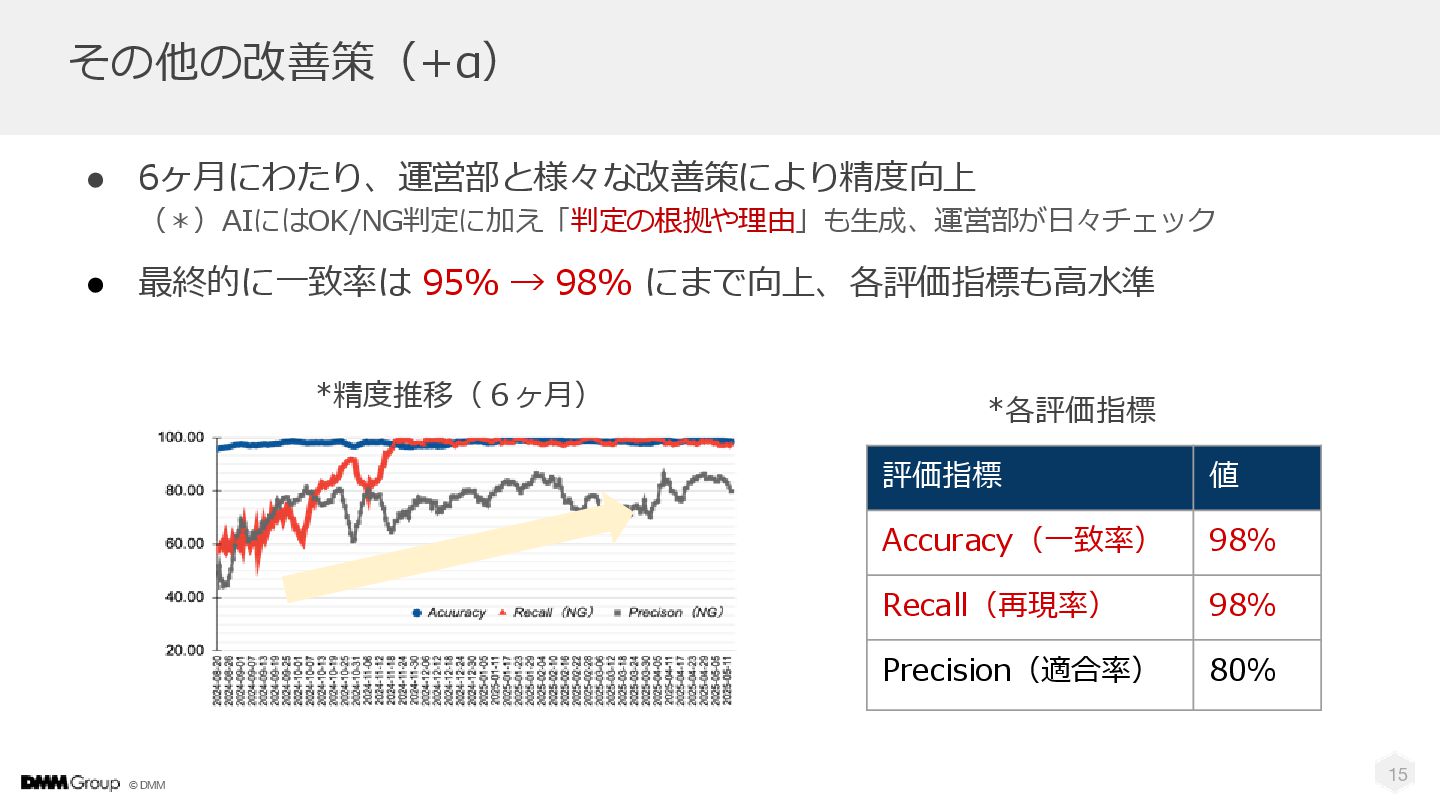
© DMM その他の改善策(+α) • 6ヶ月にわたり、運営部と様々な改善策により精度向上 (*)AIにはOK/NG判定に加え「判定の根拠や理由」も生成、運営部が日々チェック • 最終的に一致率は 95% →
98% にまで向上、各評価指標も高水準 15 評価指標 値 Accuracy(一致率) 98% Recall(再現率) 98% Precision(適合率) 80% *各評価指標 *精度推移(6ヶ月)
© DMM 16 * 「AIにまかせてよい範囲」はどこか? • 残る 1〜2% の判断差異が自動化の障壁となった ◦
判断のばらつきに「自動化が可能か判断できない」状態が残された • そこで精度改善に加え「自動化の対象範囲」を決める必要が生じた
© DMM 4章.自動化基準の策定 「ここからは、本研究の核心」 「信頼スコアとHAZ」 17
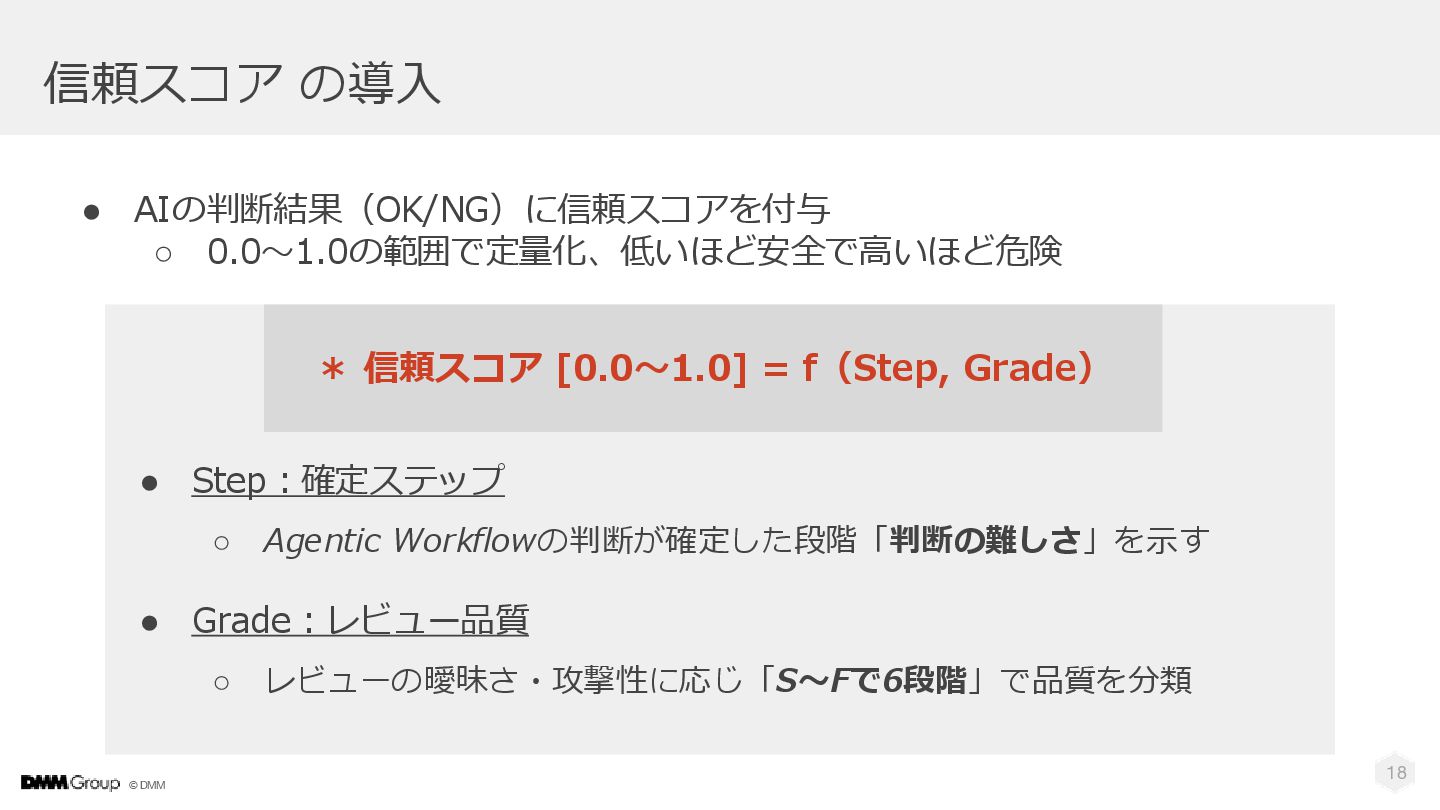
© DMM 信頼スコア の導入 • AIの判断結果(OK/NG)に信頼スコアを付与 ◦ 0.0〜1.0の範囲で定量化、低いほど安全で高いほど危険 18 •
Step:確定ステップ ◦ Agentic Workflowの判断が確定した段階「判断の難しさ」を示す • Grade:レビュー品質 ◦ レビューの曖昧さ・攻撃性に応じ「S〜Fで6段階」で品質を分類 * 信頼スコア [0.0〜1.0] = f(Step, Grade)
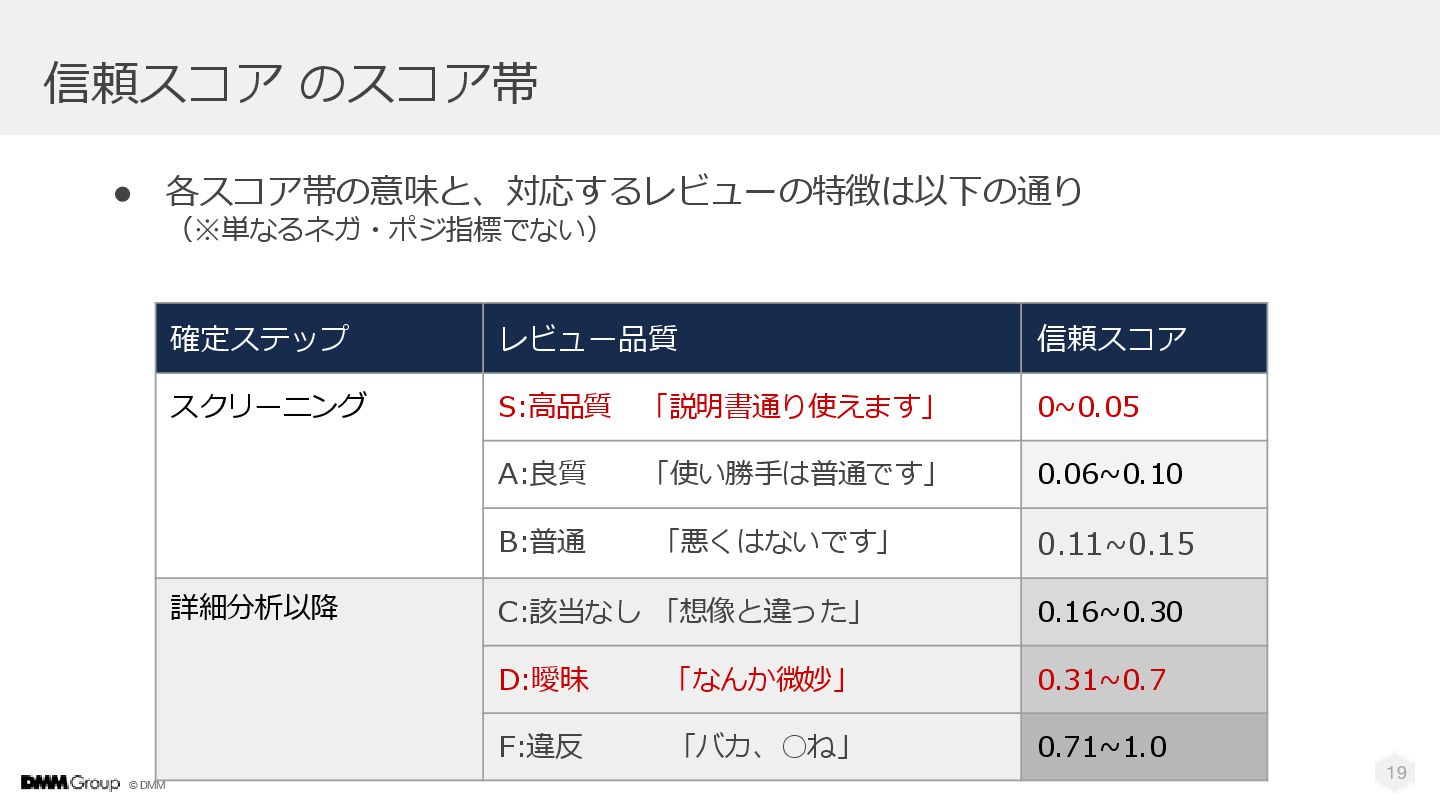
© DMM 信頼スコア のスコア帯 確定ステップ レビュー品質 信頼スコア スクリーニング S:高品質 「説明書通り使えます」
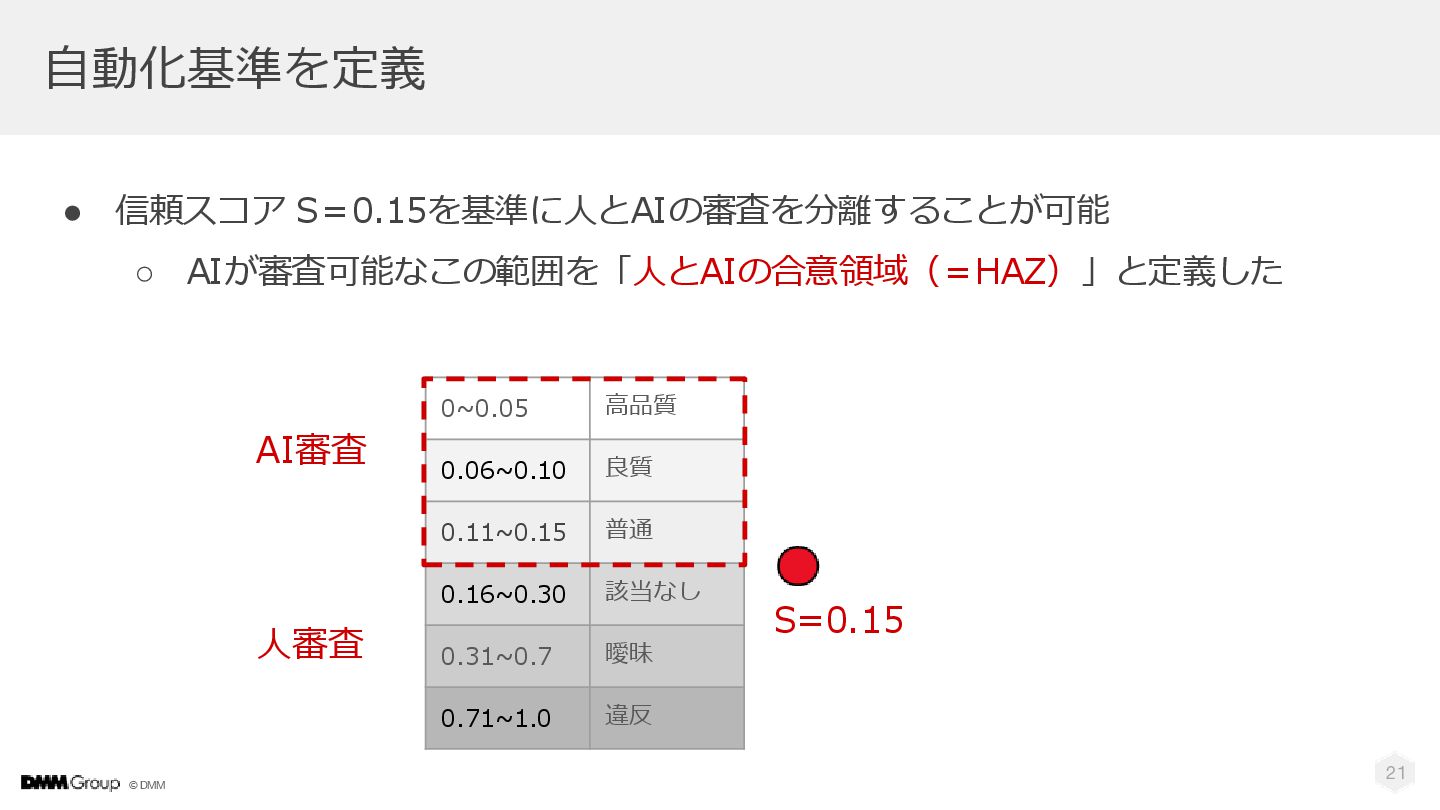
0~0.05 A:良質 「使い勝手は普通です」 0.06~0.10 B:普通 「悪くはないです」 0.11~0.15 詳細分析以降 C:該当なし 「想像と違った」 0.16~0.30 D:曖昧 「なんか微妙」 0.31~0.7 F:違反 「バカ、◦ね」 0.71~1.0 19 • 各スコア帯の意味と、対応するレビューの特徴は以下の通り (※単なるネガ・ポジ指標でない)
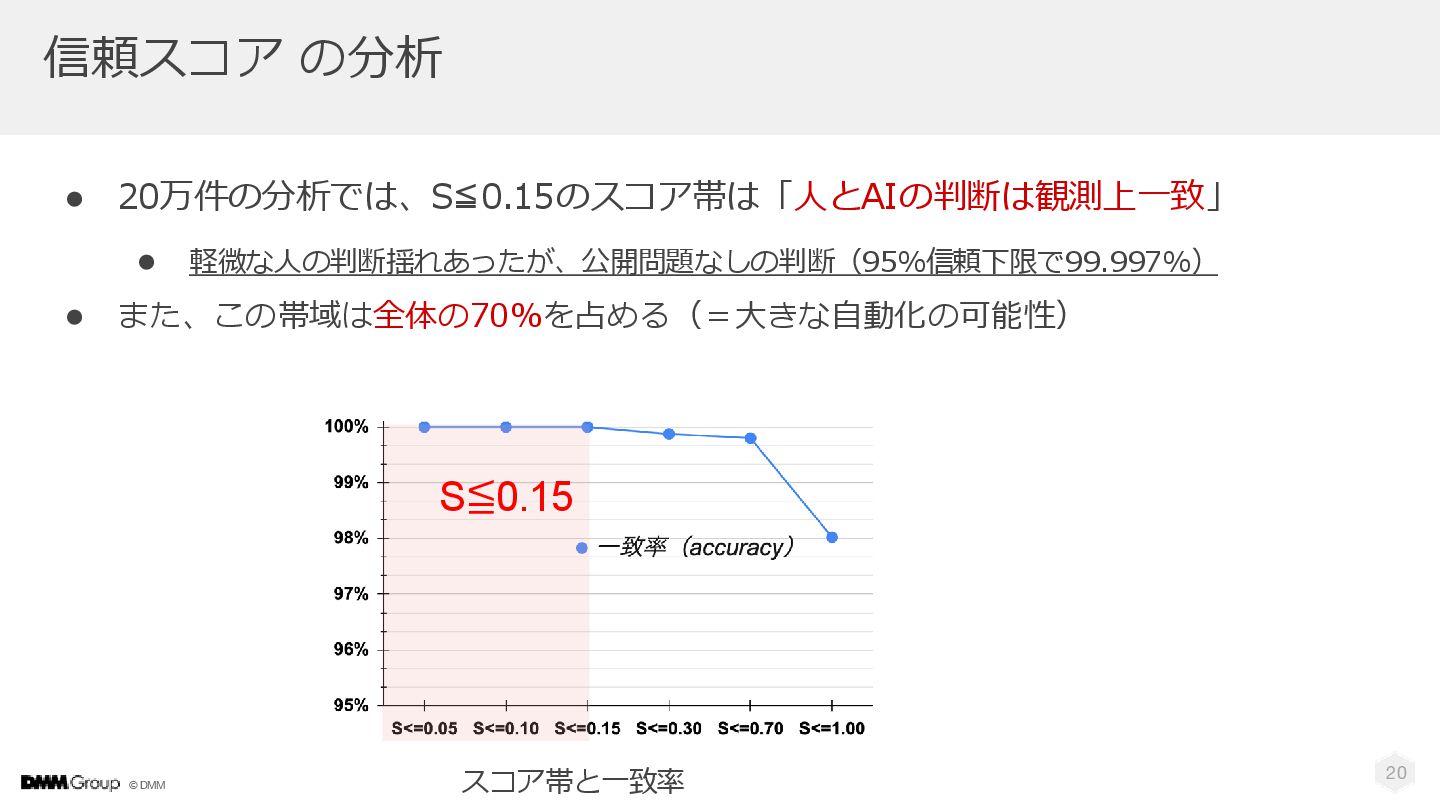
© DMM 信頼スコア の分析 • 20万件の分析では、S≦0.15のスコア帯は「人とAIの判断は観測上一致」 • 軽微な人の判断揺れあったが、公開問題なしの判断(95%信頼下限で99.997%) • また、この帯域は全体の70%を占める(=大きな自動化の可能性)
20 S≦0.15 スコア帯と一致率
© DMM 0~0.05 高品質 0.06~0.10 良質 0.11~0.15 普通 0.16~0.30 該当なし
0.31~0.7 曖昧 0.71~1.0 違反 自動化基準を定義 • 信頼スコア S=0.15を基準に人とAIの審査を分離することが可能 ◦ AIが審査可能なこの範囲を「人とAIの合意領域(=HAZ)」と定義した 21 人審査 S=0.15 AI審査
© DMM HAZ:Human-AI Agreement Zone 私が提唱した概念 人とAIが合意した範囲において AIによる自動化が可能なフレームワーク 22
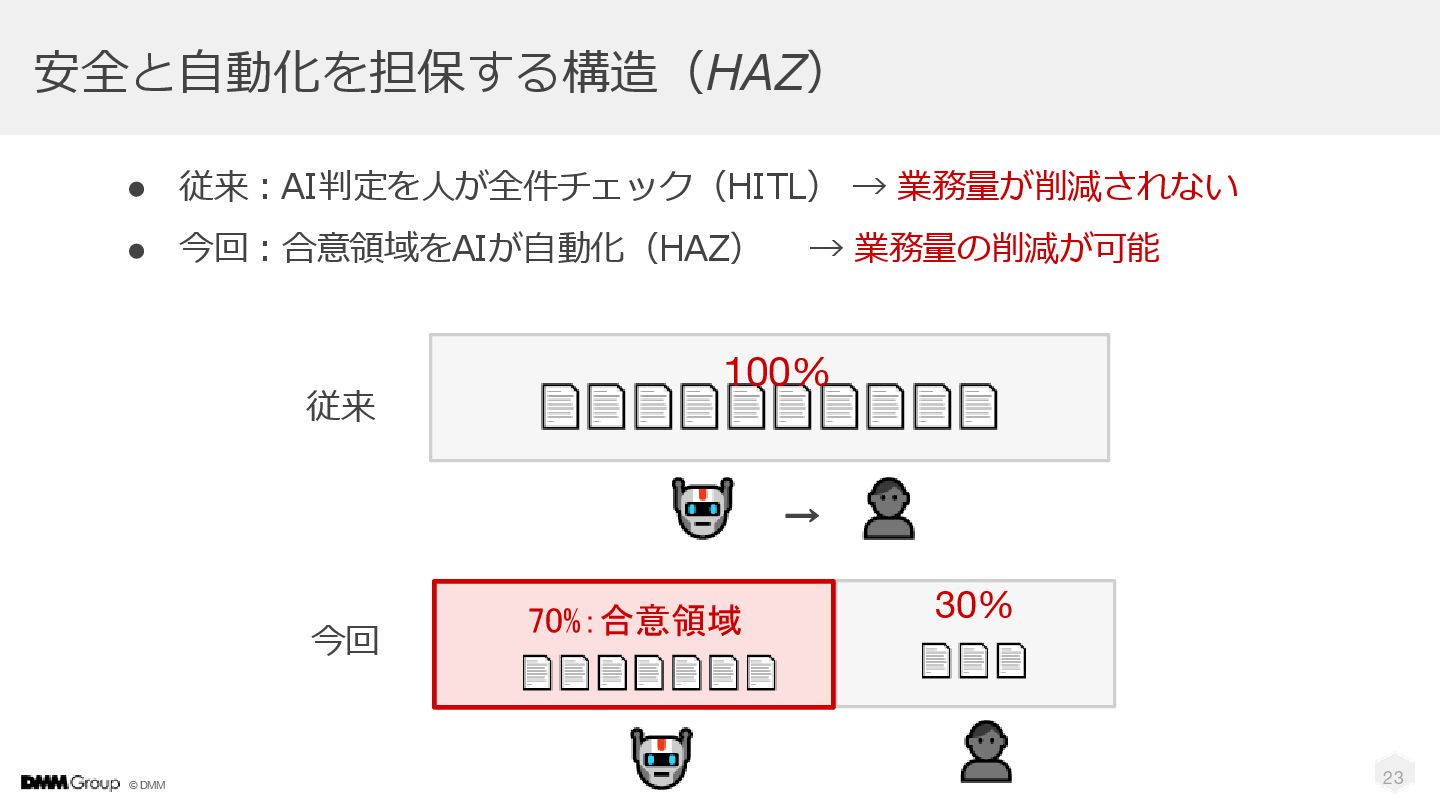
© DMM 安全と自動化を担保する構造(HAZ) • 従来:AI判定を人が全件チェック(HITL) → 業務量が削減されない • 今回:合意領域をAIが自動化(HAZ) →
業務量の削減が可能 23 従来 今回 70%:合意領域 30% 100% →
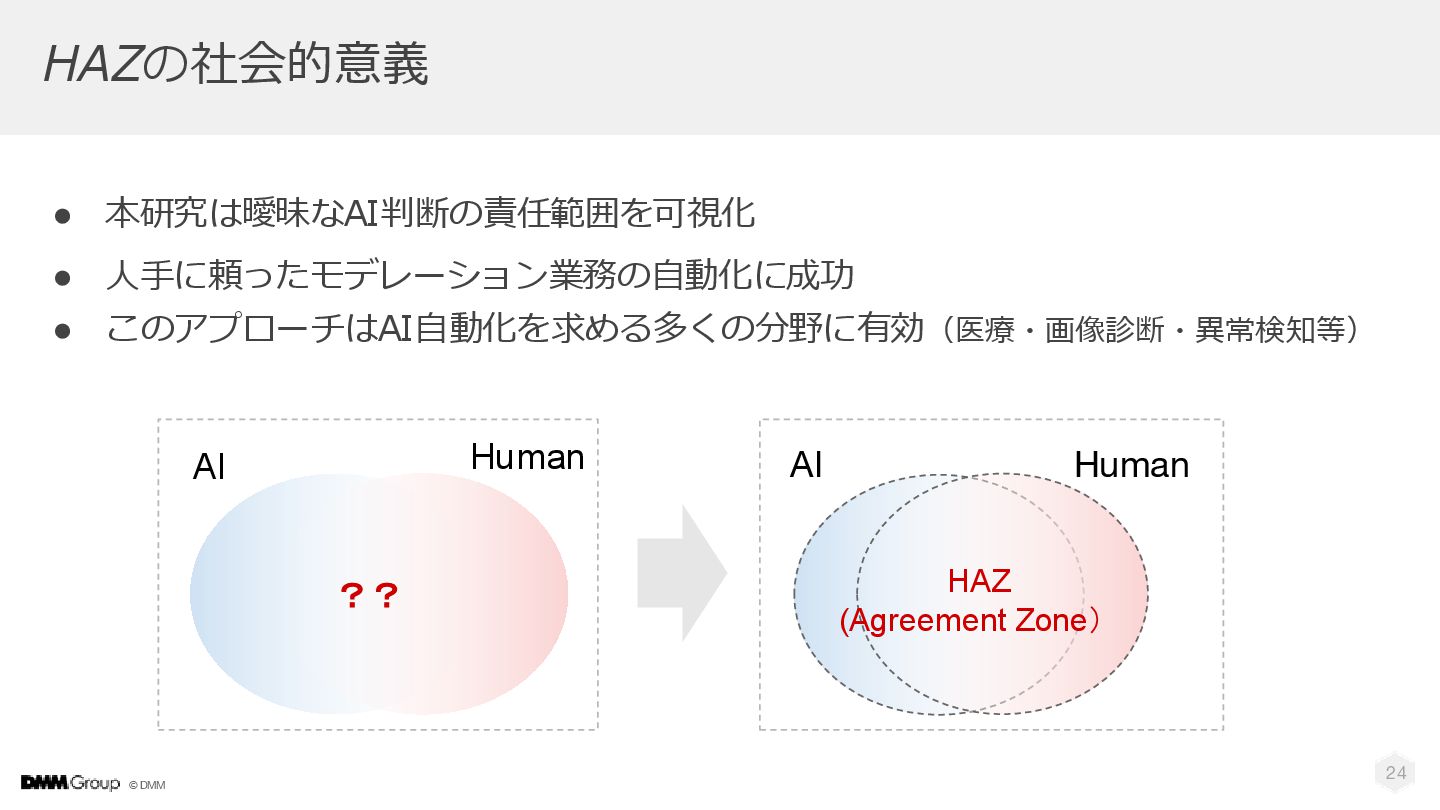
© DMM HAZの社会的意義 • 本研究は曖昧なAI判断の責任範囲を可視化 • 人手に頼ったモデレーション業務の自動化に成功 • このアプローチはAI自動化を求める多くの分野に有効(医療・画像診断・異常検知等) 24
AI Human HAZ (Agreement Zone) AI Human ??
© DMM HAZは、提案にとどまらず 現場を大きく変えました 次は、その変化の実態をお見せします 25
© DMM 5章. 自動化の成果 26
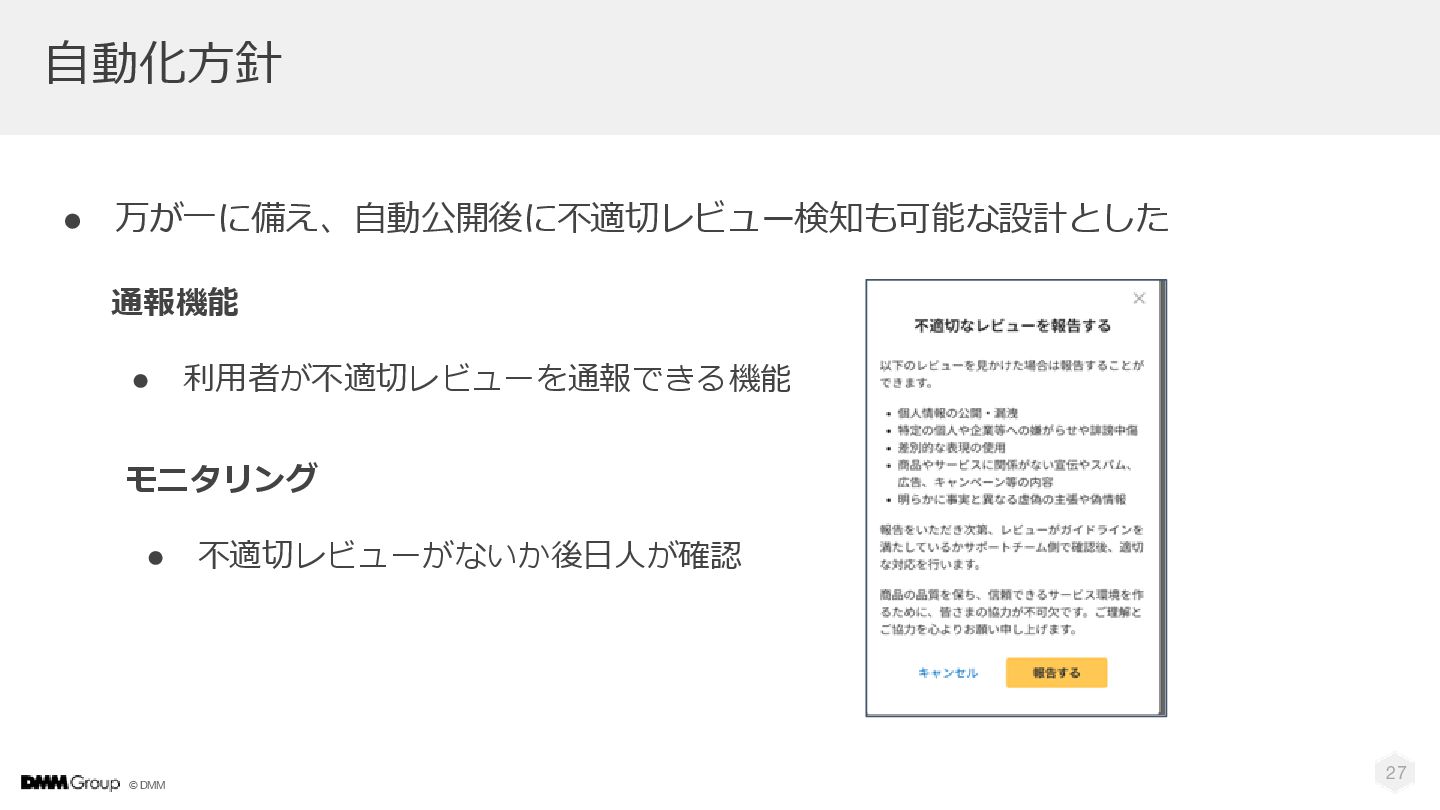
© DMM 自動化方針 • 万が一に備え、自動公開後に不適切レビュー検知も可能な設計とした 27 通報機能 • 利用者が不適切レビューを通報できる機能 モニタリング
• 不適切レビューがないか後日人が確認
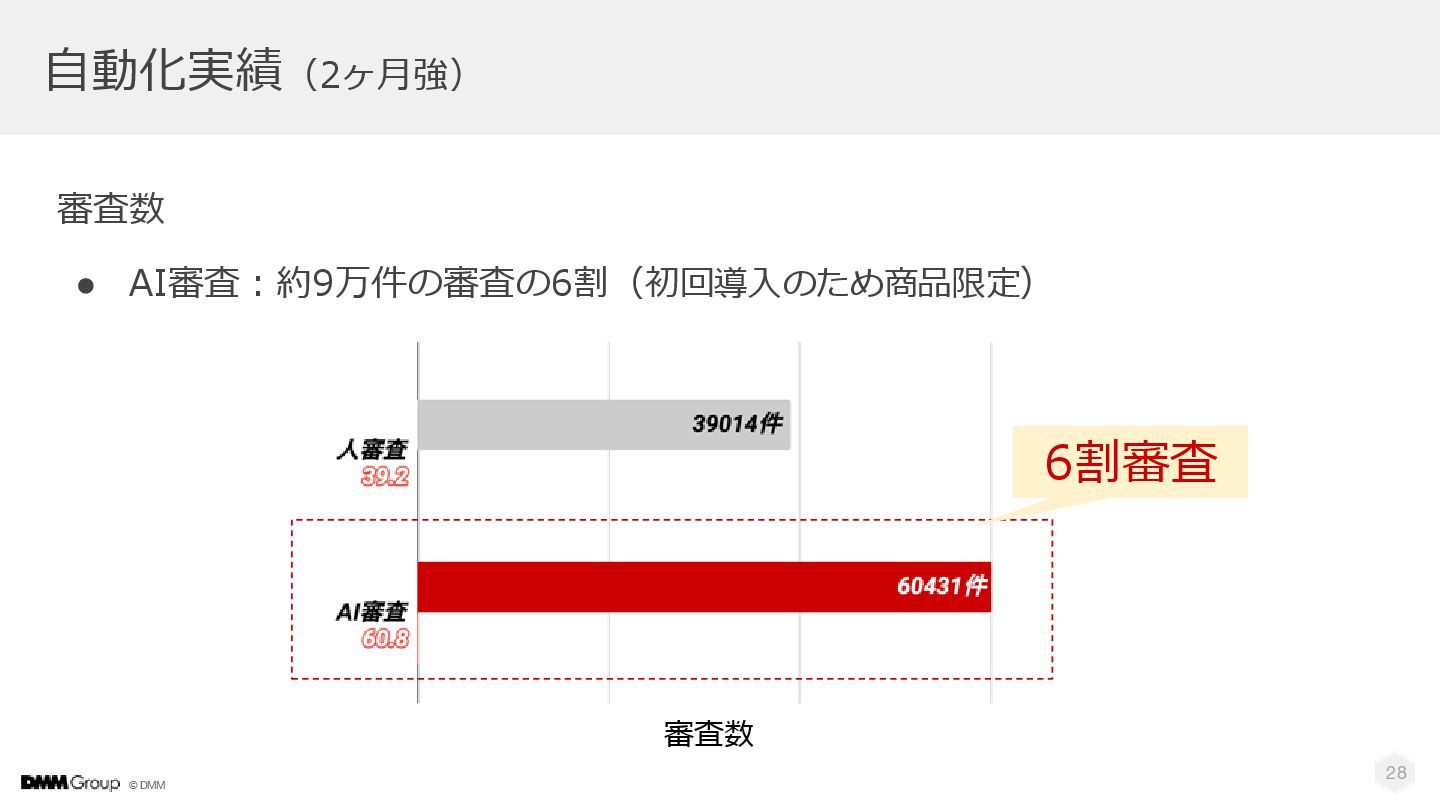
© DMM 28 自動化実績(2ヶ月強) 審査数 • AI審査:約9万件の審査の6割(初回導入のため商品限定) 6割審査 審査数
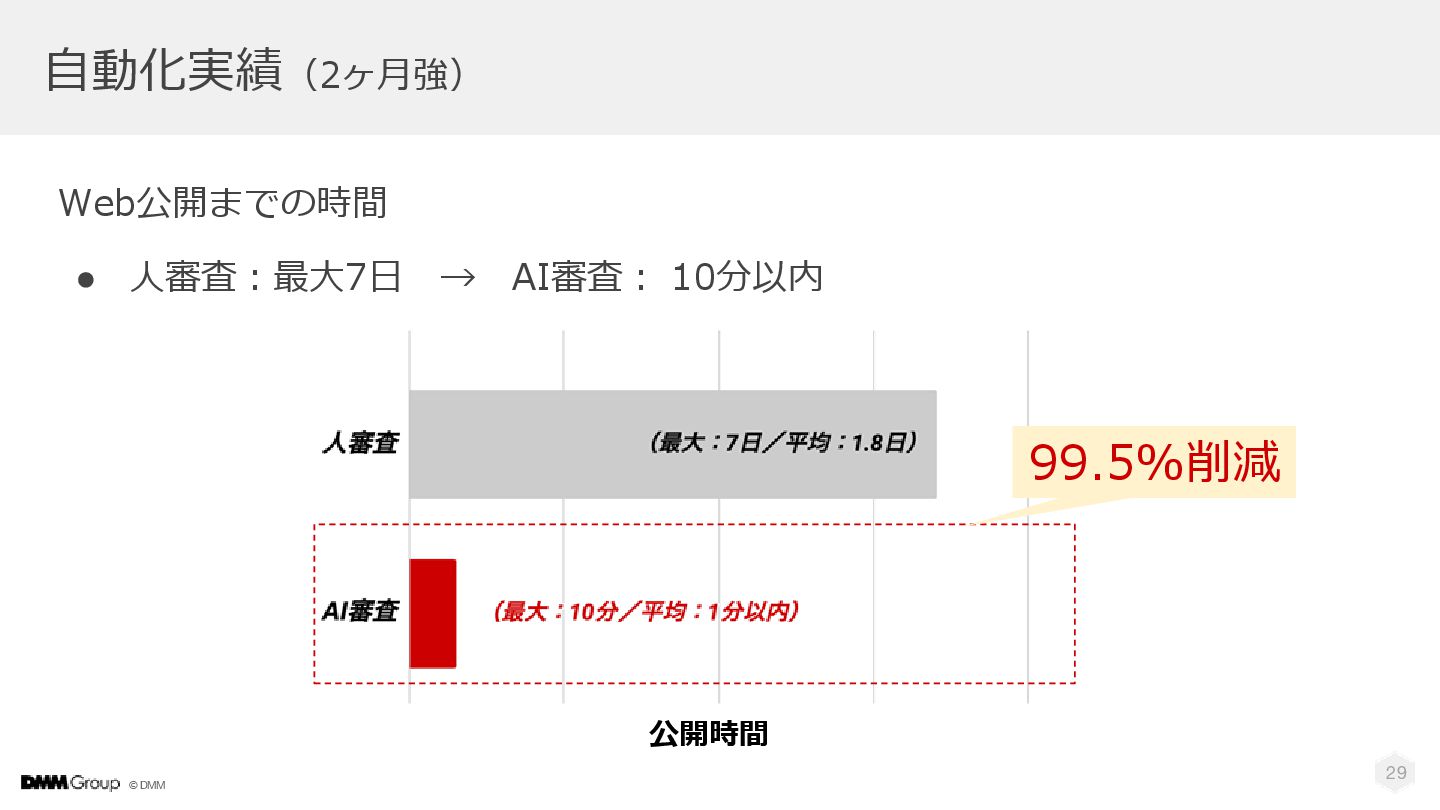
© DMM 29 自動化実績(2ヶ月強) Web公開までの時間 • 人審査:最大7日 → AI審査: 10分以内
99.5%削減 公開時間
© DMM 社内の声の変遷 30 • 導入検討:「AI自動化など絶対に無理、責任取れない」 ↓ • 検証期間:「精度は高いが実運用が心配」→ HAZ適用
↓ • 運用開始:「無理と思ったが、実現がすごい!クレームもゼロ!」
© DMM 自動化の成果 • 「モデレーション業務の自動化」を実現し、業務を劇的に改善 自動化成功の鍵 • AIに「任せる範囲を明確化」したこと こうした取り組みを通じ、「人とAIが協調」 責任分離する新たな社会構造を実現した
まとめ 31
© DMM 6章. 未来の展望と提言 32
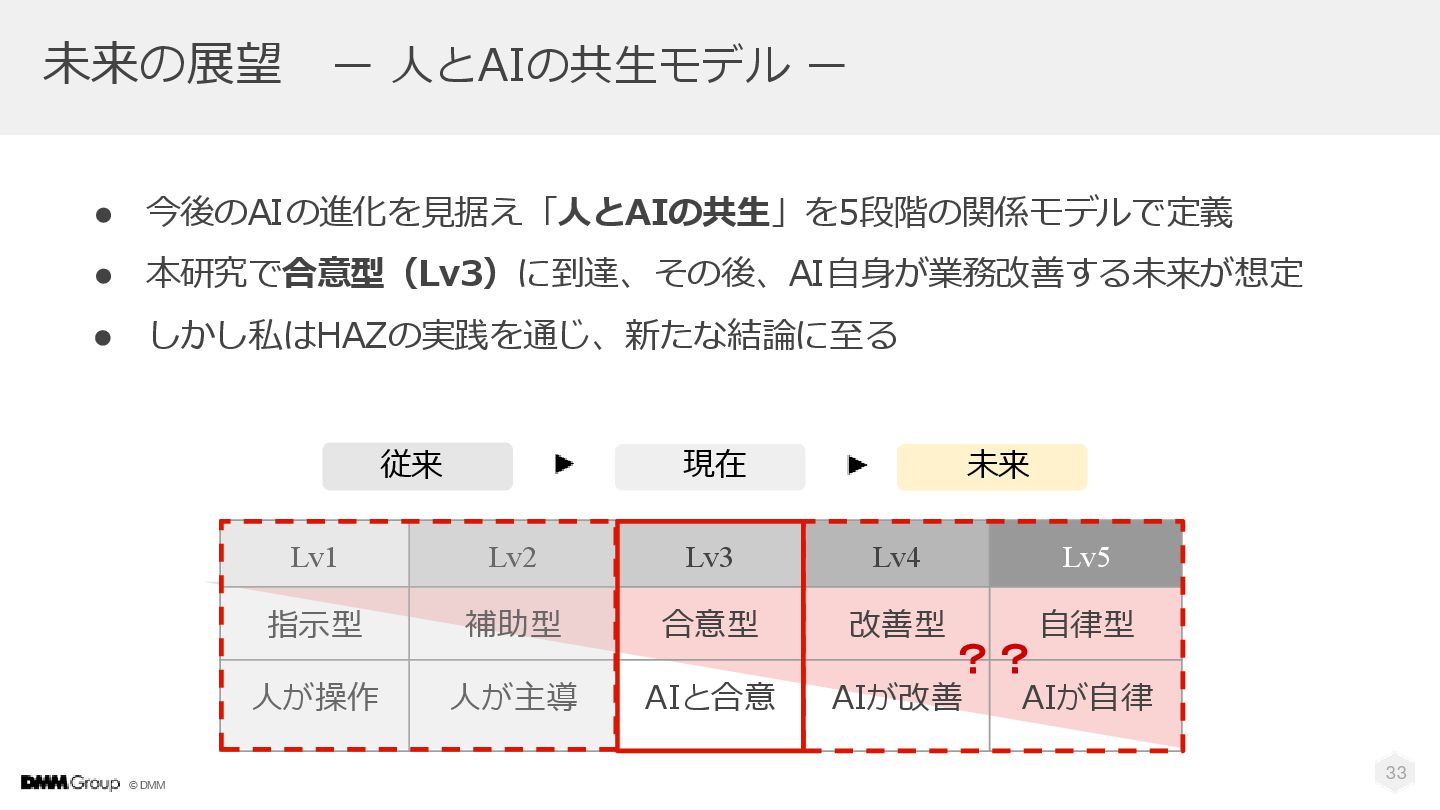
© DMM 未来の展望 ー 人とAIの共生モデル ー 33 • 今後のAIの進化を見据え「人とAIの共生」を5段階の関係モデルで定義 •
本研究で合意型(Lv3)に到達、その後、AI自身が業務改善する未来が想定 • しかし私はHAZの実践を通じ、新たな結論に至る Lv1 Lv2 Lv3 Lv4 Lv5 指示型 補助型 合意型 改善型 自律型 人が操作 人が主導 AIと合意 AIが改善 AIが自律 現在 未来 従来 ??
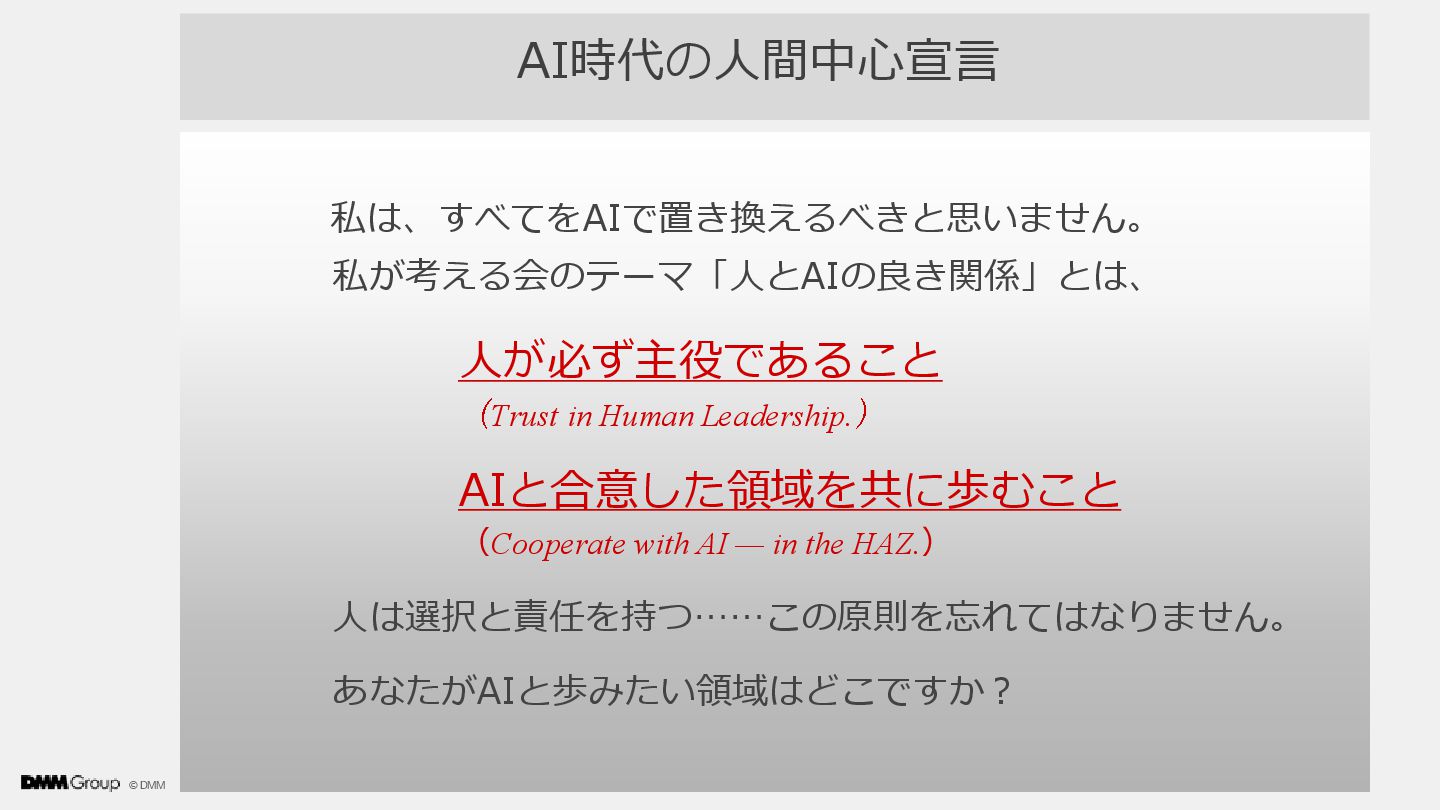
© DMM AI時代の人間中心宣言 私は、すべてをAIで置き換えるべきと思いません。 私が考える会のテーマ「人とAIの良き関係」とは、 人が必ず主役であること Trust in Human Leadership.
AIと合意した領域を共に歩むこと (Cooperate with AI — in the HAZ.) 人は選択と責任を持つ……この原則を忘れてはなりません。 あなたがAIと歩みたい領域はどこですか?
© DMM 35 まだまだ研究は道半ばですが ひとつの指針になれば幸いです ご清聴ありがとうございました。
© DMM APPENDIX 36
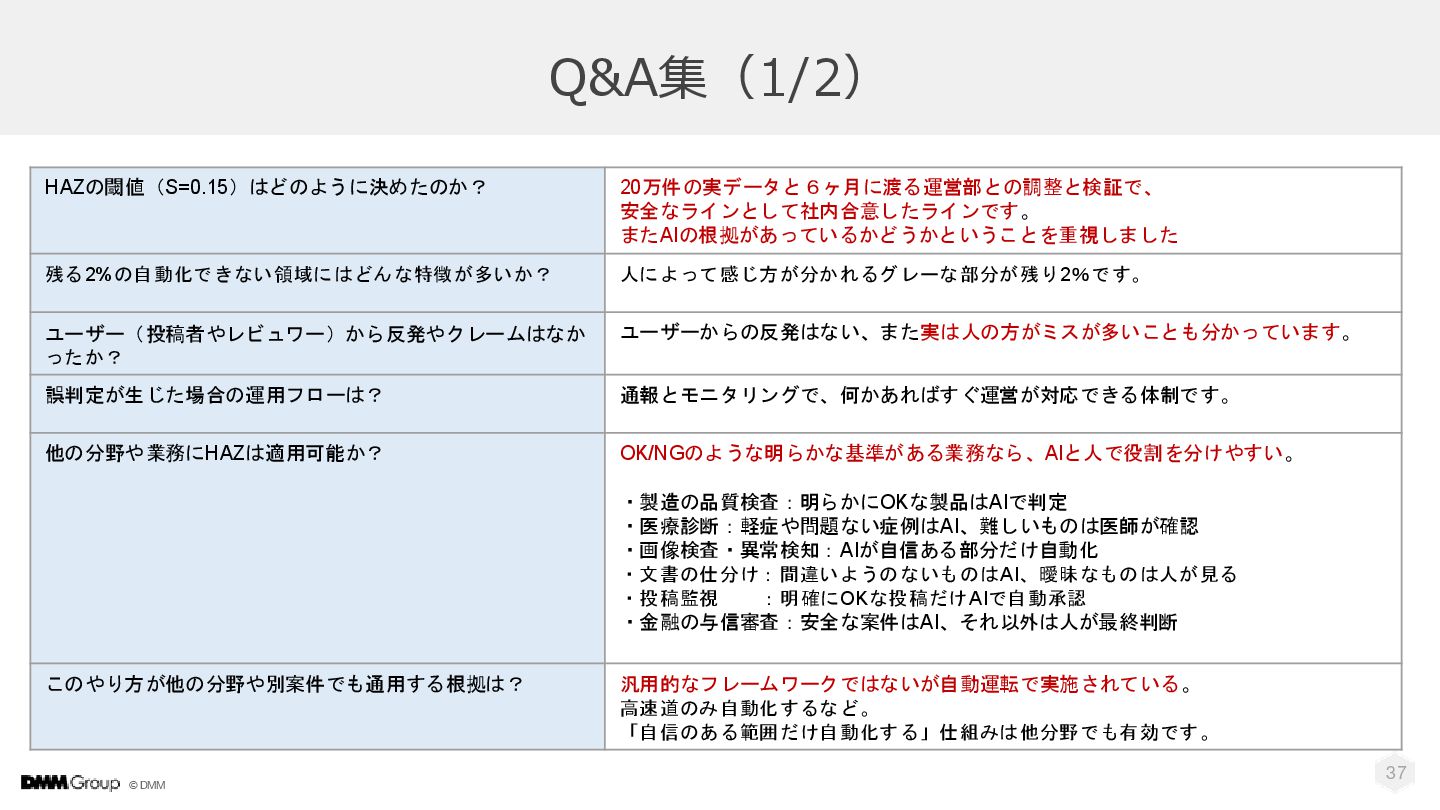
© DMM Q&A集(1/2) 37 HAZの閾値(S=0.15)はどのように決めたのか? 20万件の実データと6ヶ月に渡る運営部との調整と検証で、 安全なラインとして社内合意したラインです。 またAIの根拠があっているかどうかということを重視しました 残る2%の自動化できない領域にはどんな特徴が多いか? 人によって感じ方が分かれるグレーな部分が残り2%です。
ユーザー(投稿者やレビュワー)から反発やクレームはなか ったか? ユーザーからの反発はない、また実は人の方がミスが多いことも分かっています。 誤判定が生じた場合の運用フローは? 通報とモニタリングで、何かあればすぐ運営が対応できる体制です。 他の分野や業務にHAZは適用可能か? OK/NGのような明らかな基準がある業務なら、AIと人で役割を分けやすい。 ・製造の品質検査:明らかにOKな製品はAIで判定 ・医療診断:軽症や問題ない症例はAI、難しいものは医師が確認 ・画像検査・異常検知:AIが自信ある部分だけ自動化 ・文書の仕分け:間違いようのないものはAI、曖昧なものは人が見る ・投稿監視 :明確にOKな投稿だけAIで自動承認 ・金融の与信審査:安全な案件はAI、それ以外は人が最終判断 このやり方が他の分野や別案件でも通用する根拠は? 汎用的なフレームワークではないが自動運転で実施されている。 高速道のみ自動化するなど。 「自信のある範囲だけ自動化する」仕組みは他分野でも有効です。
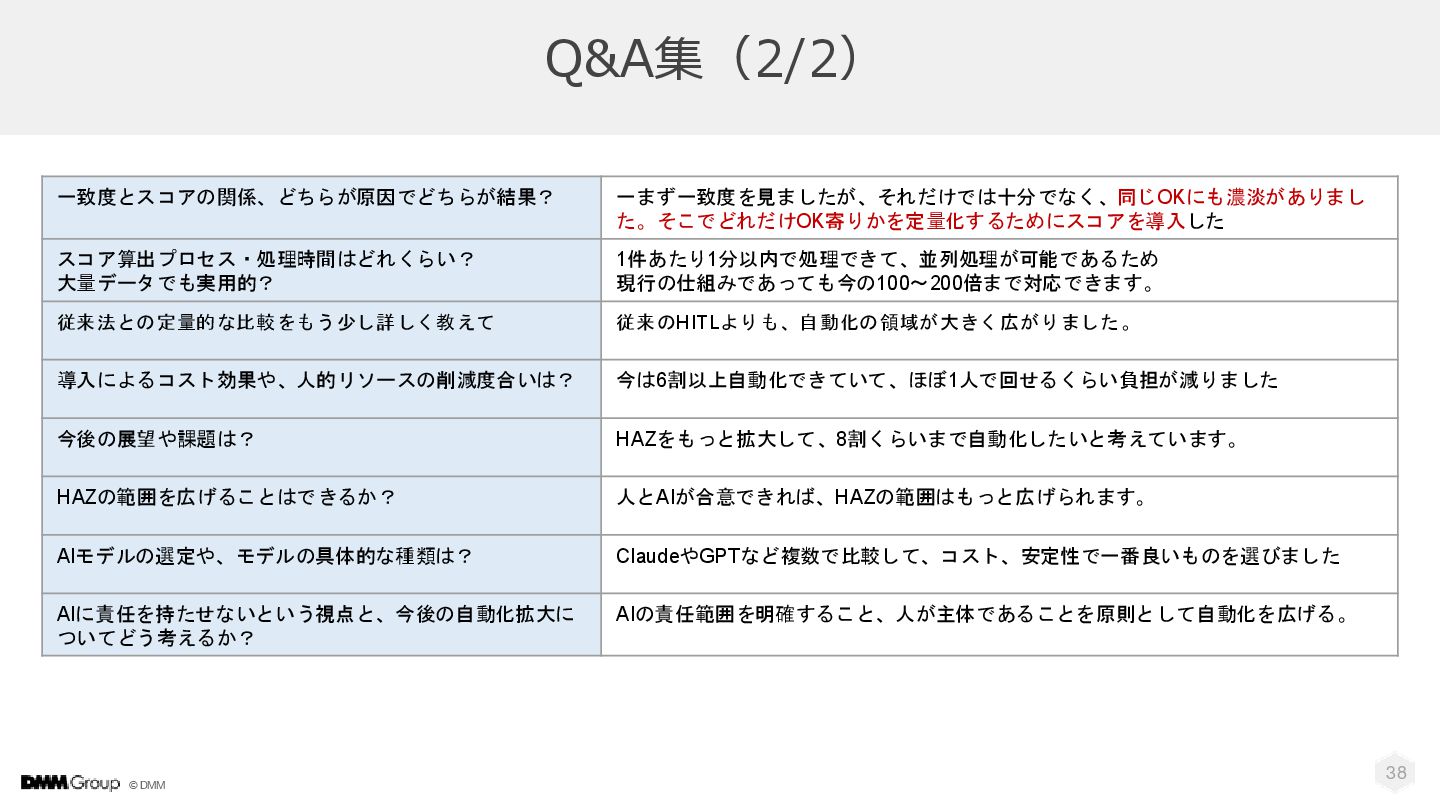
© DMM Q&A集(2/2) 38 一致度とスコアの関係、どちらが原因でどちらが結果? 一まず一致度を見ましたが、それだけでは十分でなく、同じOKにも濃淡がありまし た。そこでどれだけOK寄りかを定量化するためにスコアを導入した スコア算出プロセス・処理時間はどれくらい? 大量データでも実用的? 1件あたり1分以内で処理できて、並列処理が可能であるため
現行の仕組みであっても今の100〜200倍まで対応できます。 従来法との定量的な比較をもう少し詳しく教えて 従来のHITLよりも、自動化の領域が大きく広がりました。 導入によるコスト効果や、人的リソースの削減度合いは? 今は6割以上自動化できていて、ほぼ1人で回せるくらい負担が減りました 今後の展望や課題は? HAZをもっと拡大して、8割くらいまで自動化したいと考えています。 HAZの範囲を広げることはできるか? 人とAIが合意できれば、HAZの範囲はもっと広げられます。 AIモデルの選定や、モデルの具体的な種類は? ClaudeやGPTなど複数で比較して、コスト、安定性で一番良いものを選びました AIに責任を持たせないという視点と、今後の自動化拡大に ついてどう考えるか? AIの責任範囲を明確すること、人が主体であることを原則として自動化を広げる。
More Decks by matsui-dmm
See All by matsui-dmm
AI駆動開発で仕様はどこまで書くべきか? ― 人とAIの責務境界から考える開発プロセスの実践
takahiromatsui
1
430
AI駆動開発における人とAIの責務境界モデルの提案 ― 境界仕様に基づくBSDDの実践 ―
takahiromatsui
0
79
BSDD_Human-AI_Responsibility_Separation.pdf
takahiromatsui
0
170
2026-06-24_人とAIの責務分離に基づく開発プロセスの提案.pdf
takahiromatsui
0
1.9k
20250513_人とAIの共生とHAZの構築_DMMの4000万人基盤の_商品レビューをAI自動承認するまで.pdf
takahiromatsui
0
270
20250326_生成AIによる_レビュー承認システムの実現.pdf
takahiromatsui
22
8.8k
生成AIによるレビュー承認自動化___導入後14日間のレポート_.pdf
takahiromatsui
0
880
レビュー承認業務のAI自動化の紹介.pdf
takahiromatsui
0
190
AWS_Re_Invent_2024_参加レポート.pdf
takahiromatsui
0
720
Featured
See All Featured
Thoughts on Productivity
jonyablonski
76
5.5k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.4k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
2
520
Primal Persuasion: How to Engage the Brain for Learning That Lasts
tmiket
0
520
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3.1k
GitHub's CSS Performance
jonrohan
1033
470k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
680
Documentation Writing (for coders)
carmenintech
77
5.6k
GraphQLとの向き合い方2022年版
quramy
50
15k
Believing is Seeing
oripsolob
1
280


 takahiromatsui
 jonyablonski
 aleyda
 axbom
 tmiket
 eileencodes
 bluesmoon
 jonrohan
 keavy
 reverentgeek
 carmenintech
 quramy
 oripsolob