Share
Embed

Transcript
82 slides
-
材料科学特許文書からの 固有表現認識 Named Entity Recognition from Materials Science Patent Documents
酒井 敏彦 / 九州大学大学院 システム情報科学府 情報知能工学専攻 2026/8/24 学位論文公聴会 -
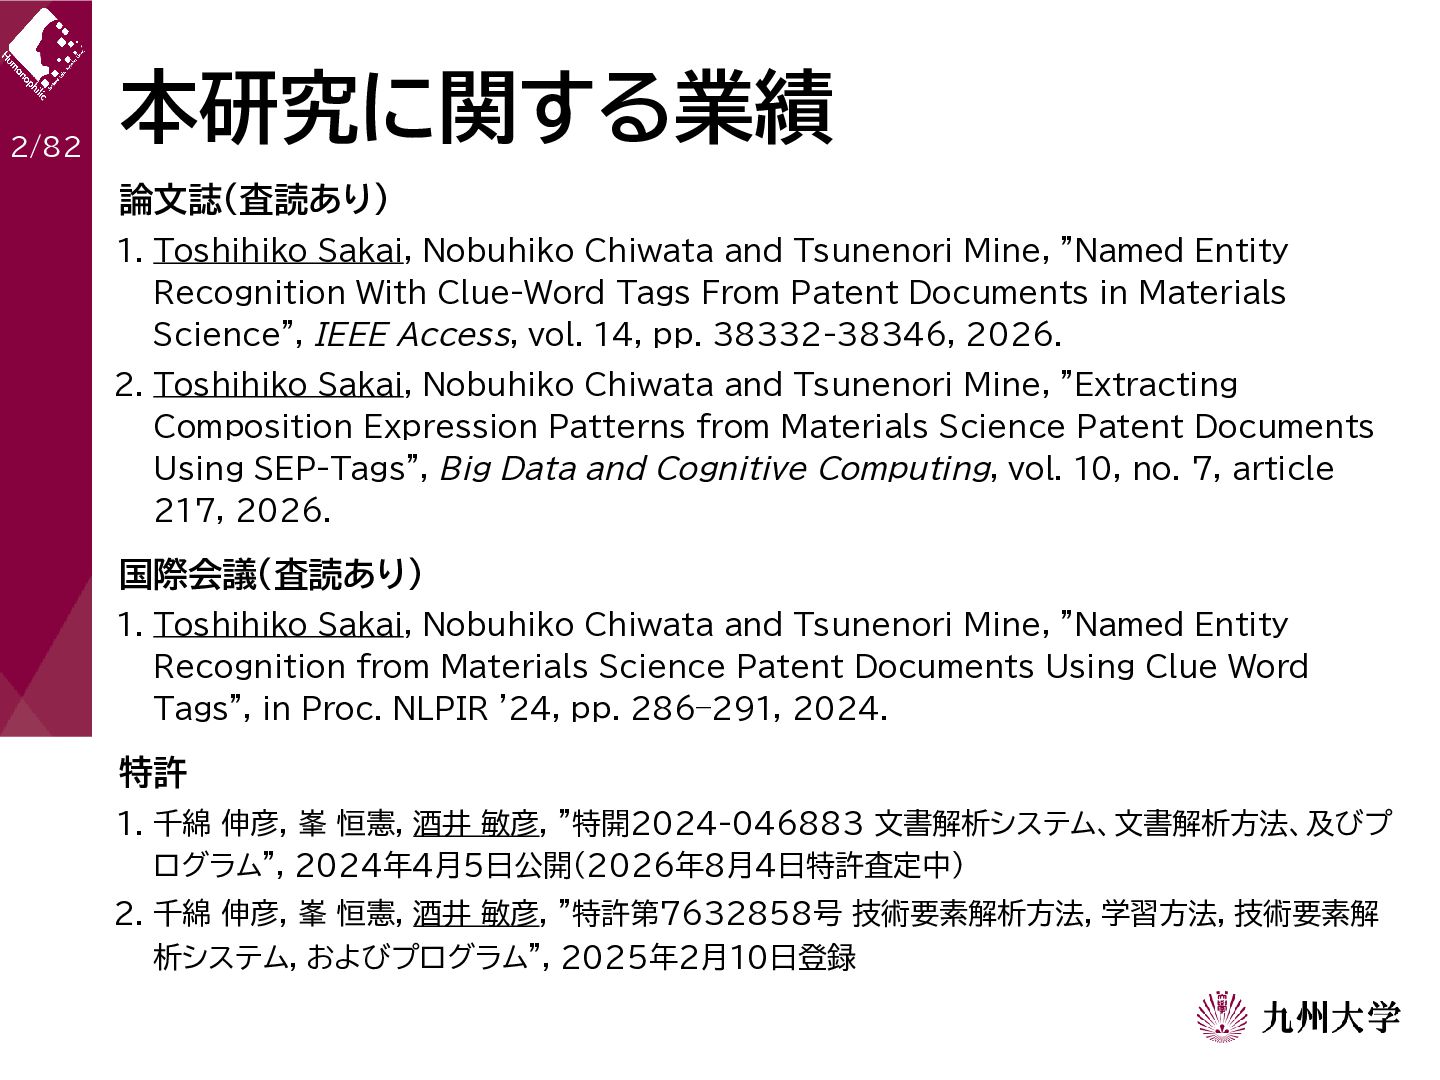
2/82 本研究に関する業績 論文誌(査読あり) 1. Toshihiko Sakai, Nobuhiko Chiwata and Tsunenori
Mine, "Named Entity Recognition With Clue-Word Tags From Patent Documents in Materials Science", IEEE Access, vol. 14, pp. 38332-38346, 2026. 2. Toshihiko Sakai, Nobuhiko Chiwata and Tsunenori Mine, "Extracting Composition Expression Patterns from Materials Science Patent Documents Using SEP-Tags", Big Data and Cognitive Computing, vol. 10, no. 7, article 217, 2026. 国際会議(査読あり) 1. Toshihiko Sakai, Nobuhiko Chiwata and Tsunenori Mine, "Named Entity Recognition from Materials Science Patent Documents Using Clue Word Tags", in Proc. NLPIR '24, pp. 286–291, 2024. 特許 1. 千綿 伸彦, 峯 恒憲, 酒井 敏彦, "特開2024-046883 文書解析システム、文書解析方法、及びプ ログラム", 2024年4月5日公開(2026年8月4日特許査定中) 2. 千綿 伸彦, 峯 恒憲, 酒井 敏彦, "特許第7632858号 技術要素解析方法,学習方法,技術要素解 析システム,およびプログラム", 2025年2月10日登録 -
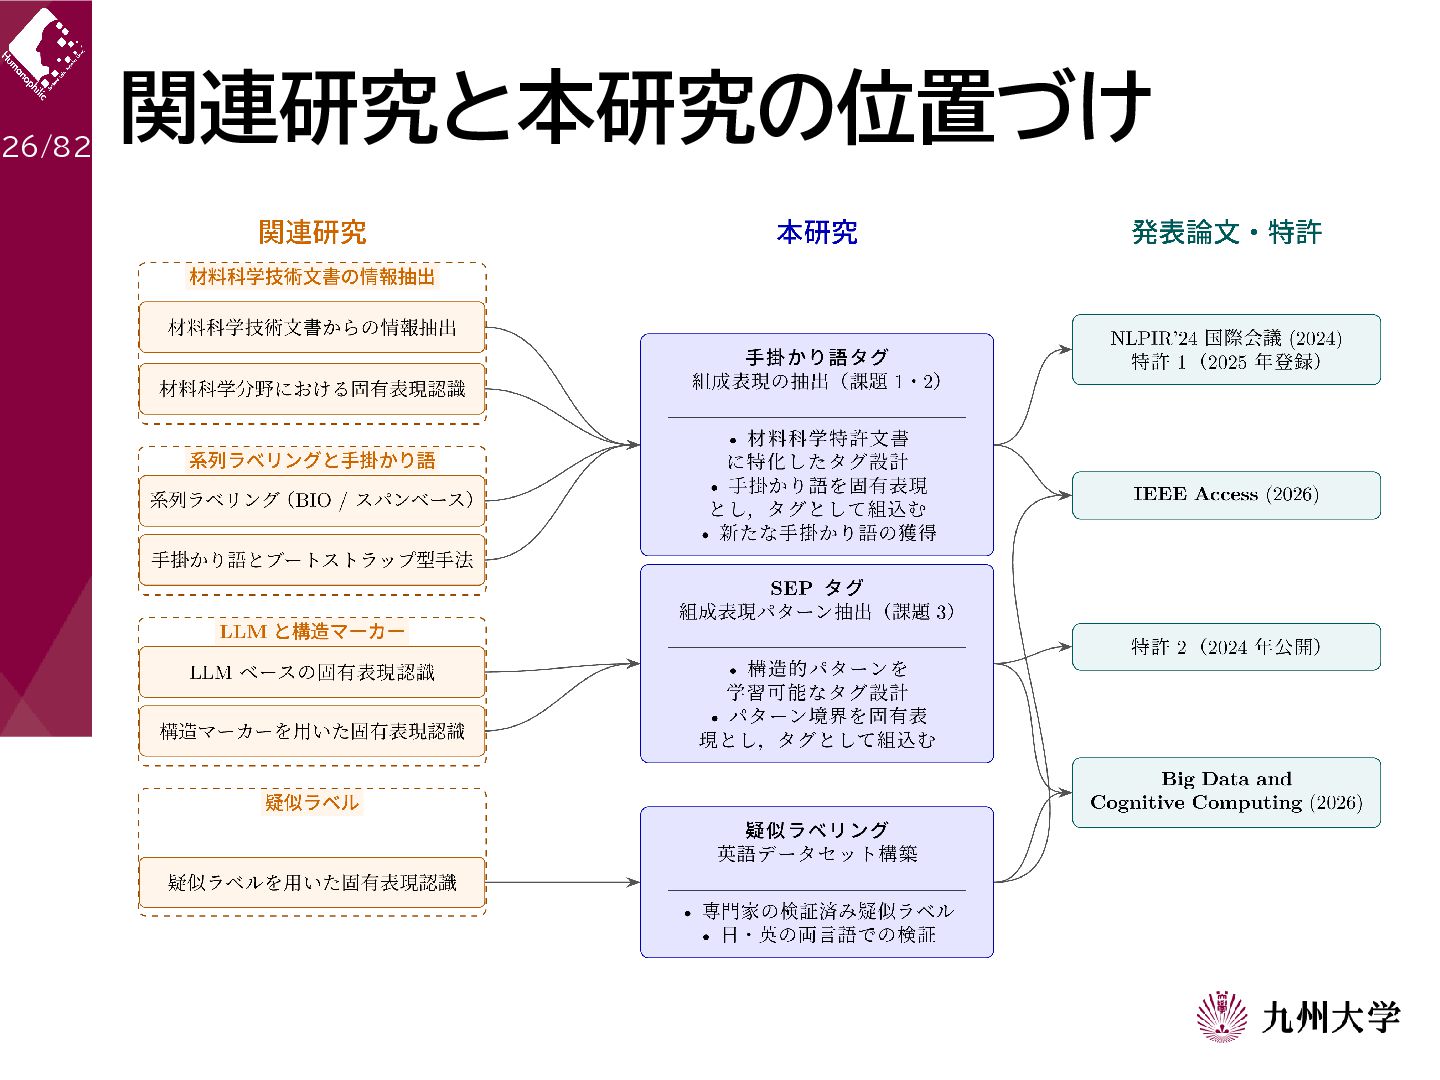
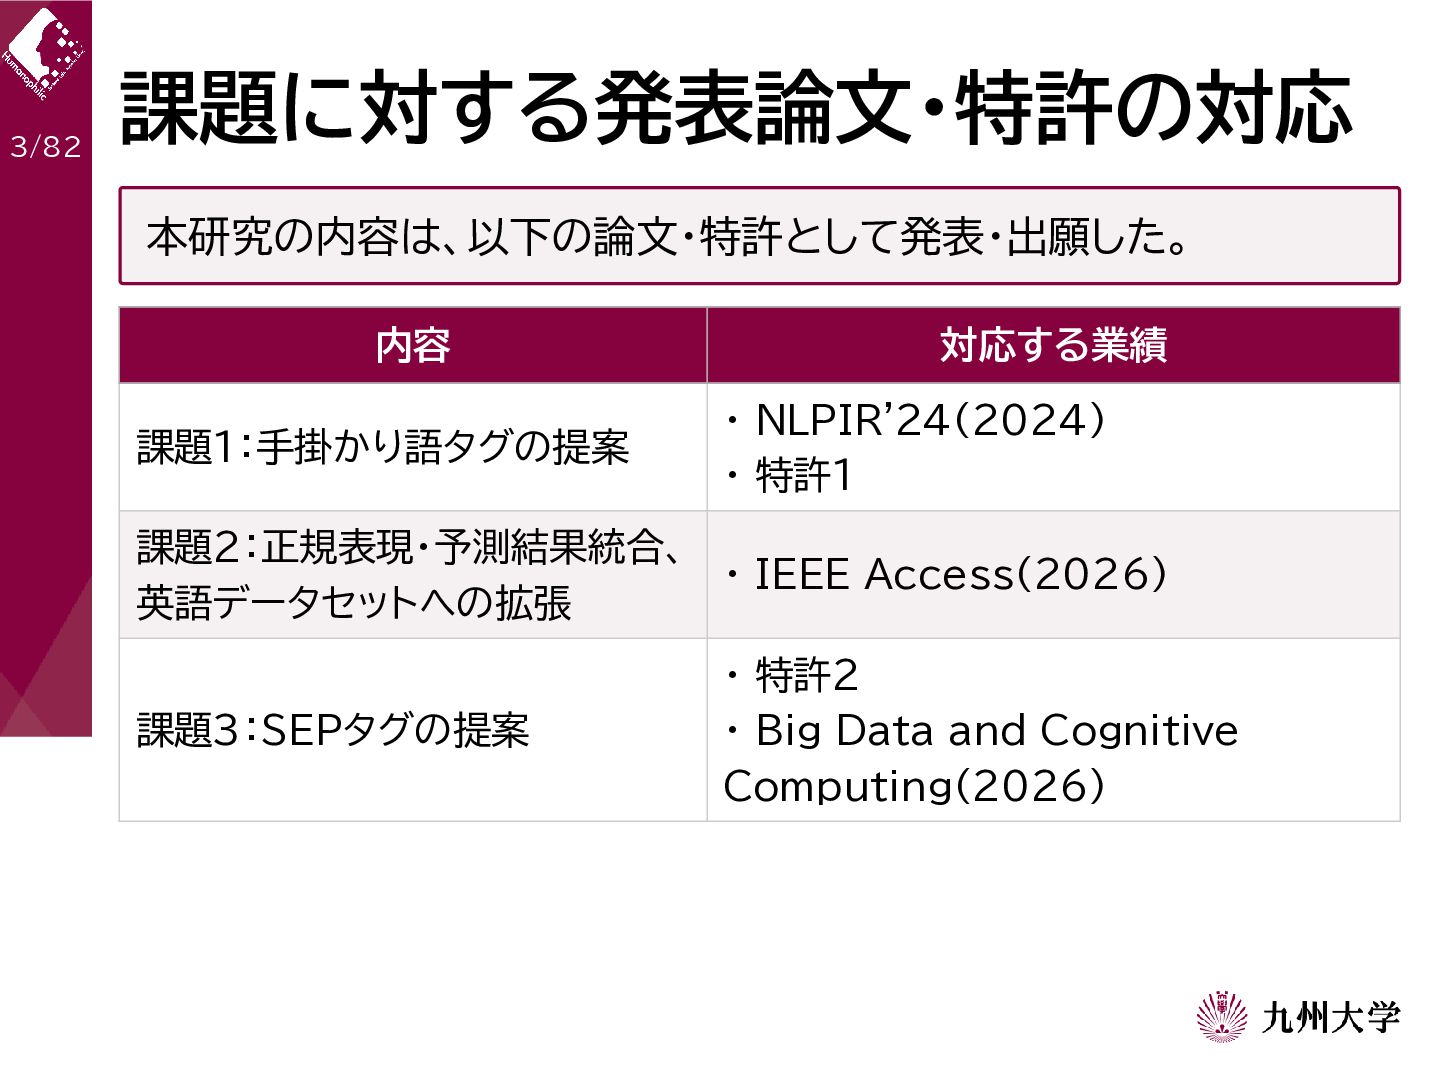
3/82 課題に対する発表論文・特許の対応 本研究の内容は、以下の論文・特許として発表・出願した。 内容 課題1:手掛かり語タグの提案 対応する業績 ・ NLPIR'24(2024) ・ 特許1
課題2:正規表現・予測結果統合、 ・ IEEE Access(2026) 英語データセットへの拡張 課題3:SEPタグの提案 ・ 特許2 ・ Big Data and Cognitive Computing(2026) -
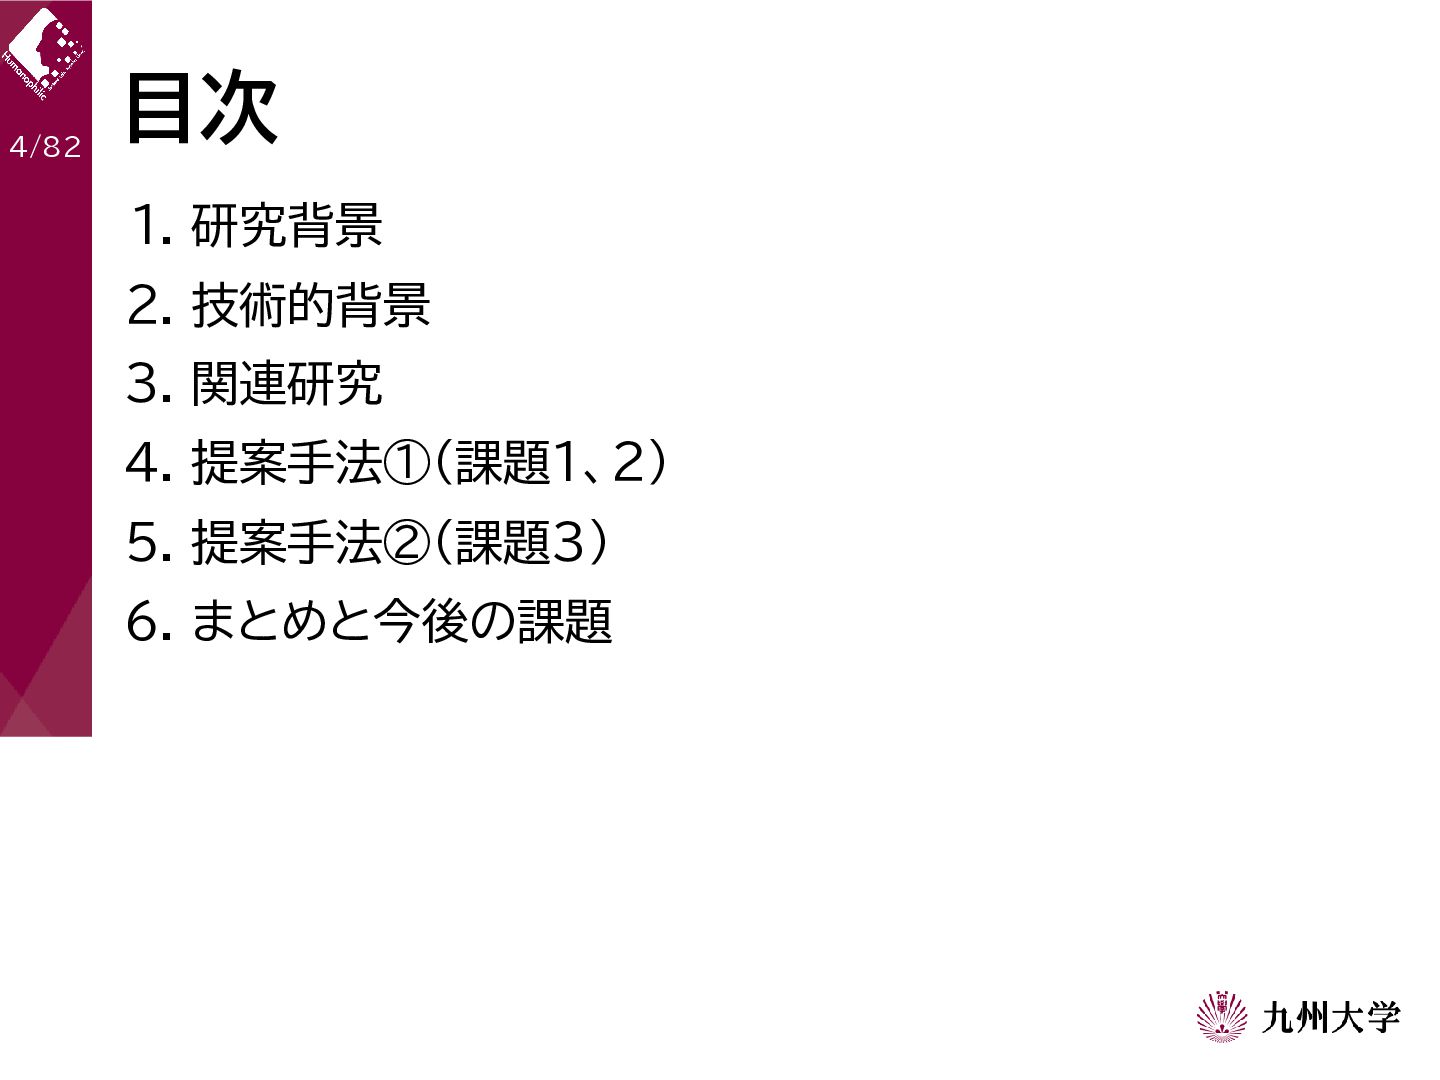
4/82 目次 1. 研究背景 2. 技術的背景 3. 関連研究 4. 提案手法①(課題1、2)
5. 提案手法②(課題3) 6. まとめと今後の課題 -
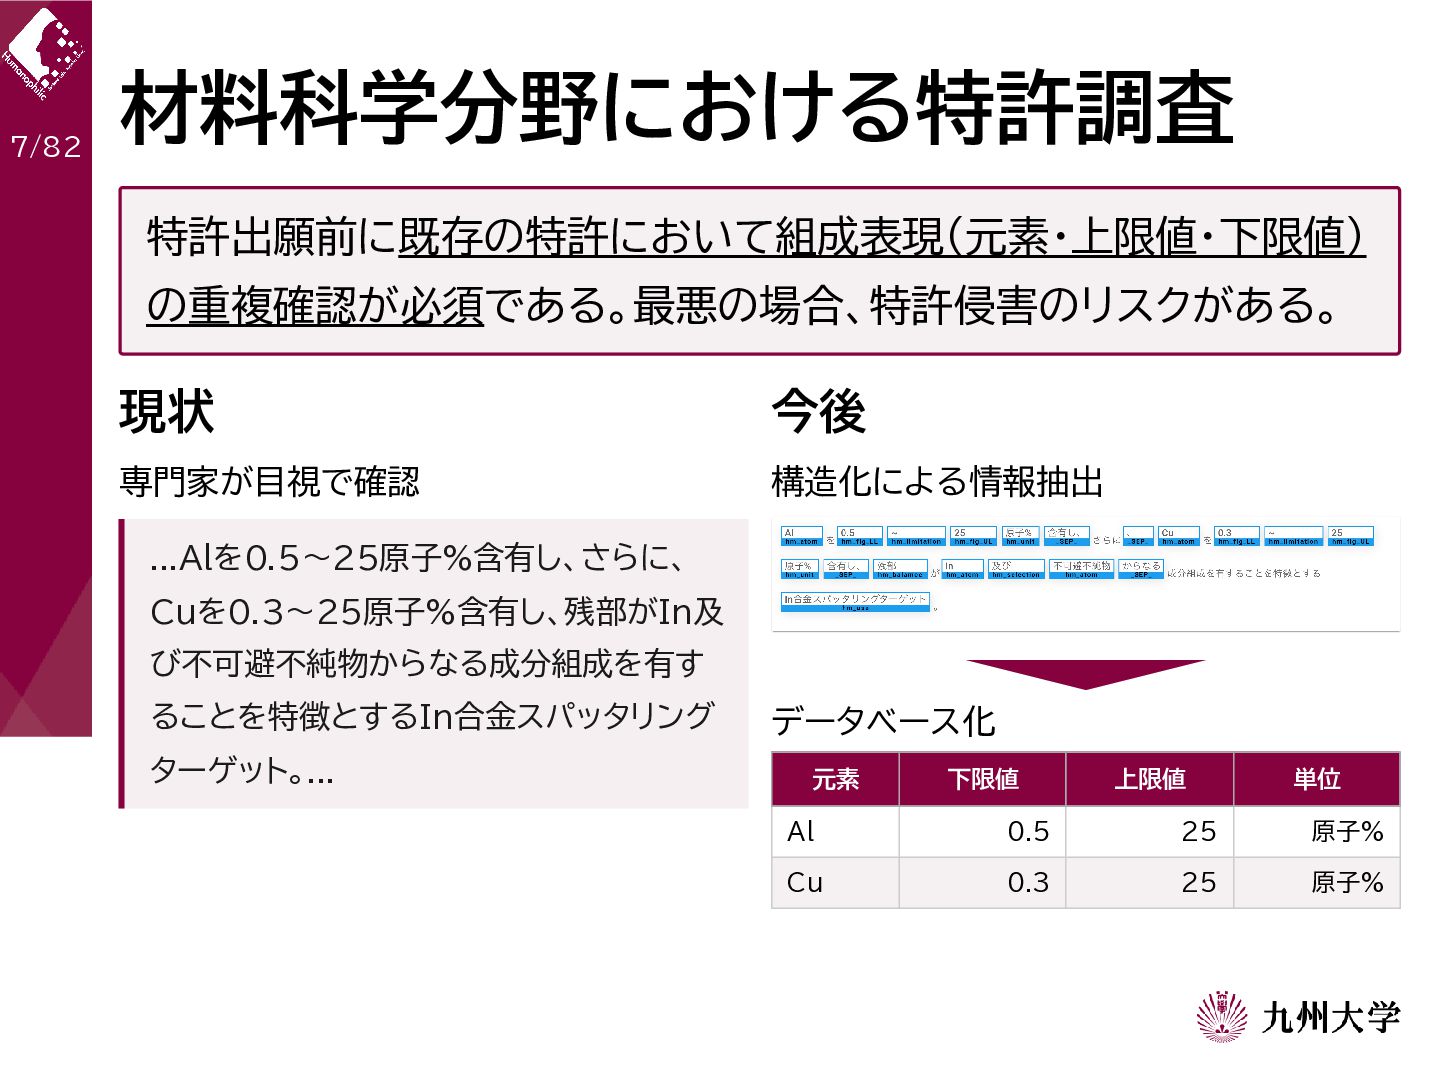
7/82 材料科学分野における特許調査 特許出願前に既存の特許において組成表現(元素・上限値・下限値) の重複確認が必須である。最悪の場合、特許侵害のリスクがある。 現状 今後 専門家が目視で確認 構造化による情報抽出 ...Alを0.5〜25原子%含有し、さらに、 Cuを0.3〜25原子%含有し、残部がIn及
び不可避不純物からなる成分組成を有す ることを特徴とするIn合金スパッタリング ターゲット。... データベース化 元素 下限値 上限値 単位 Al 0.5 25 原子% Cu 0.3 25 原子% -
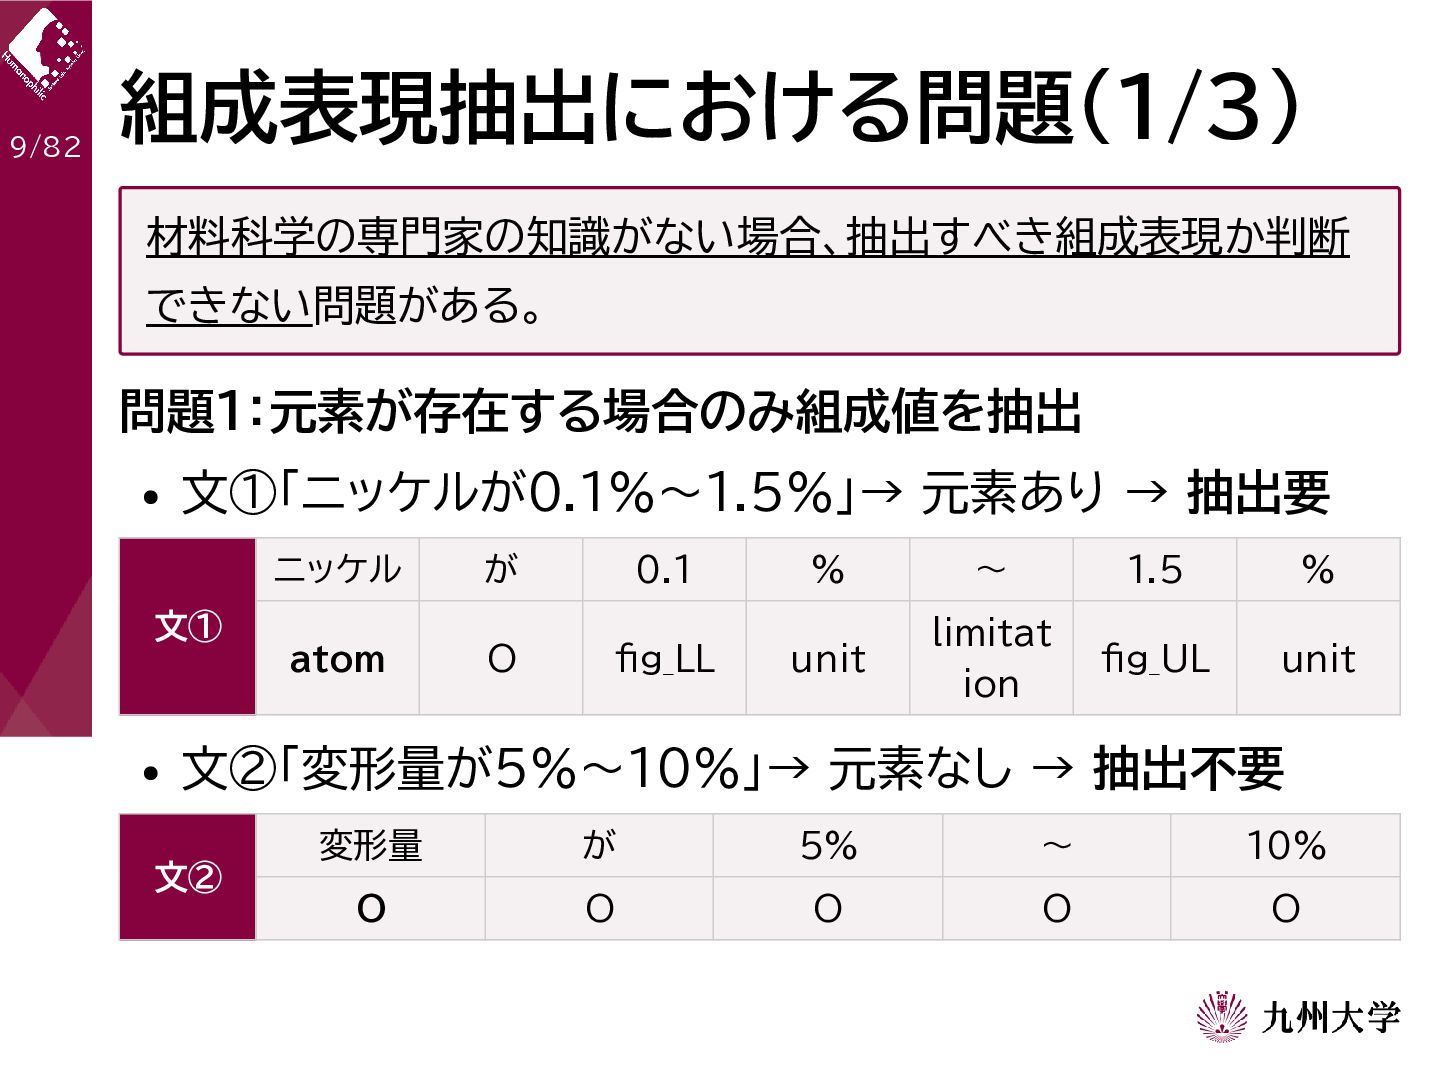
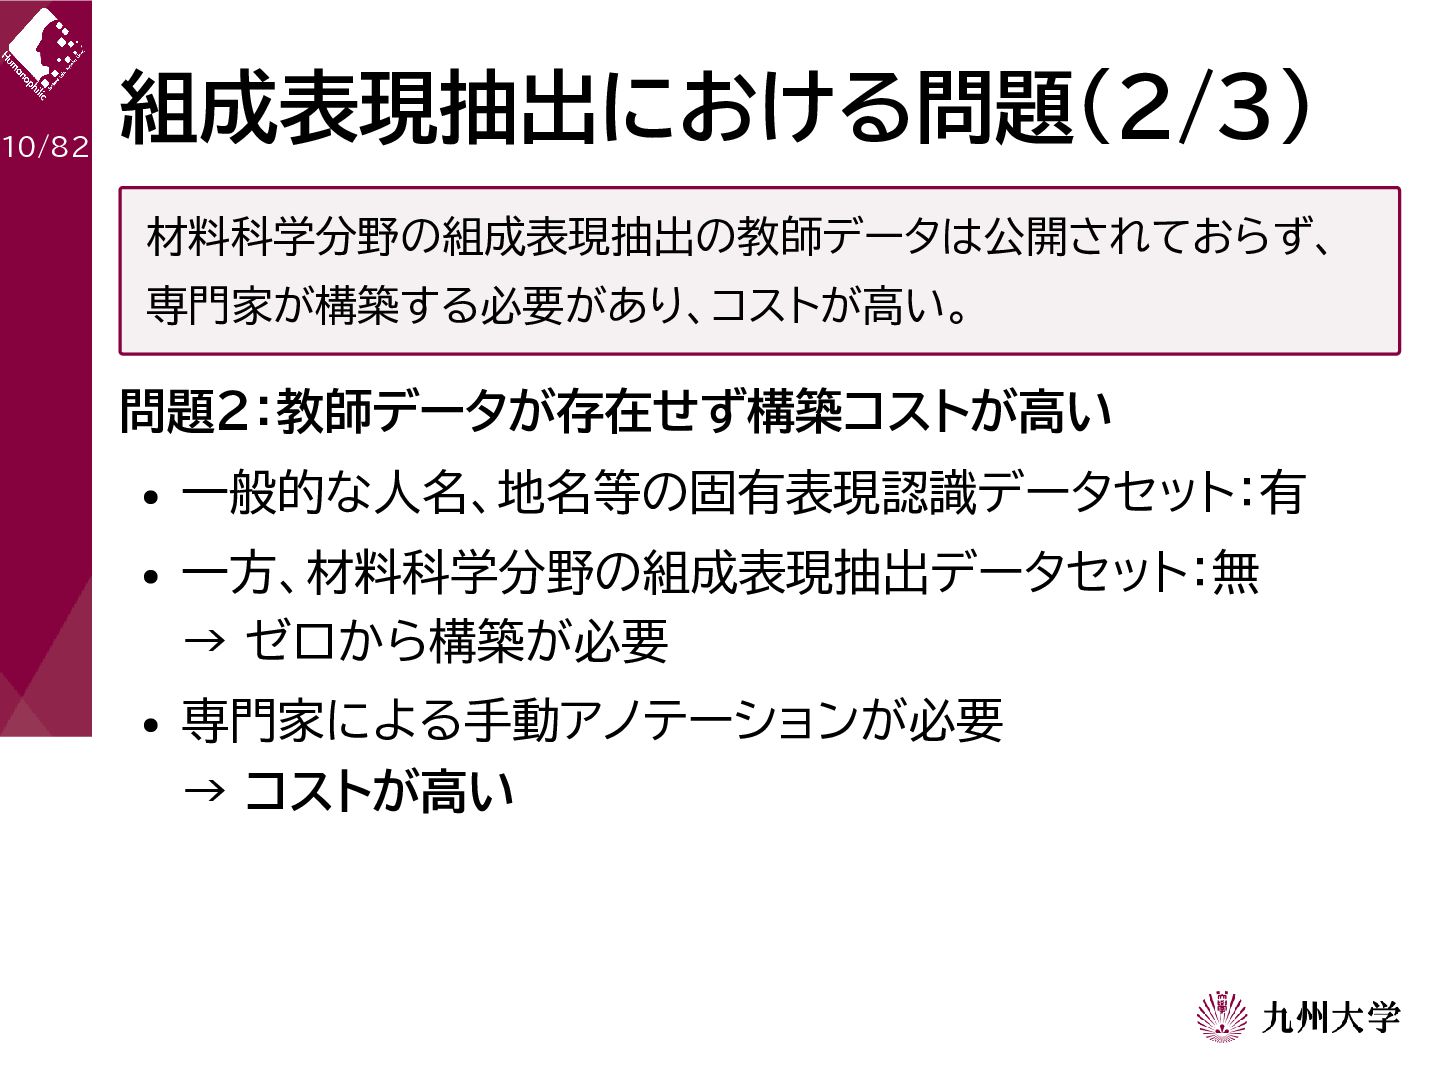
9/82 組成表現抽出における問題(1/3) 材料科学の専門家の知識がない場合、抽出すべき組成表現か判断 できない問題がある。 問題1:元素が存在する場合のみ組成値を抽出 文①「ニッケルが0.1%〜1.5%」→ 元素あり → 抽出要 文①
ニッケル が 0.1 % 〜 1.5 % atom O fig_LL unit limitat ion fig_UL unit 文②「変形量が5%〜10%」→ 元素なし → 抽出不要 文② 変形量 が 5% 〜 10% O O O O O -
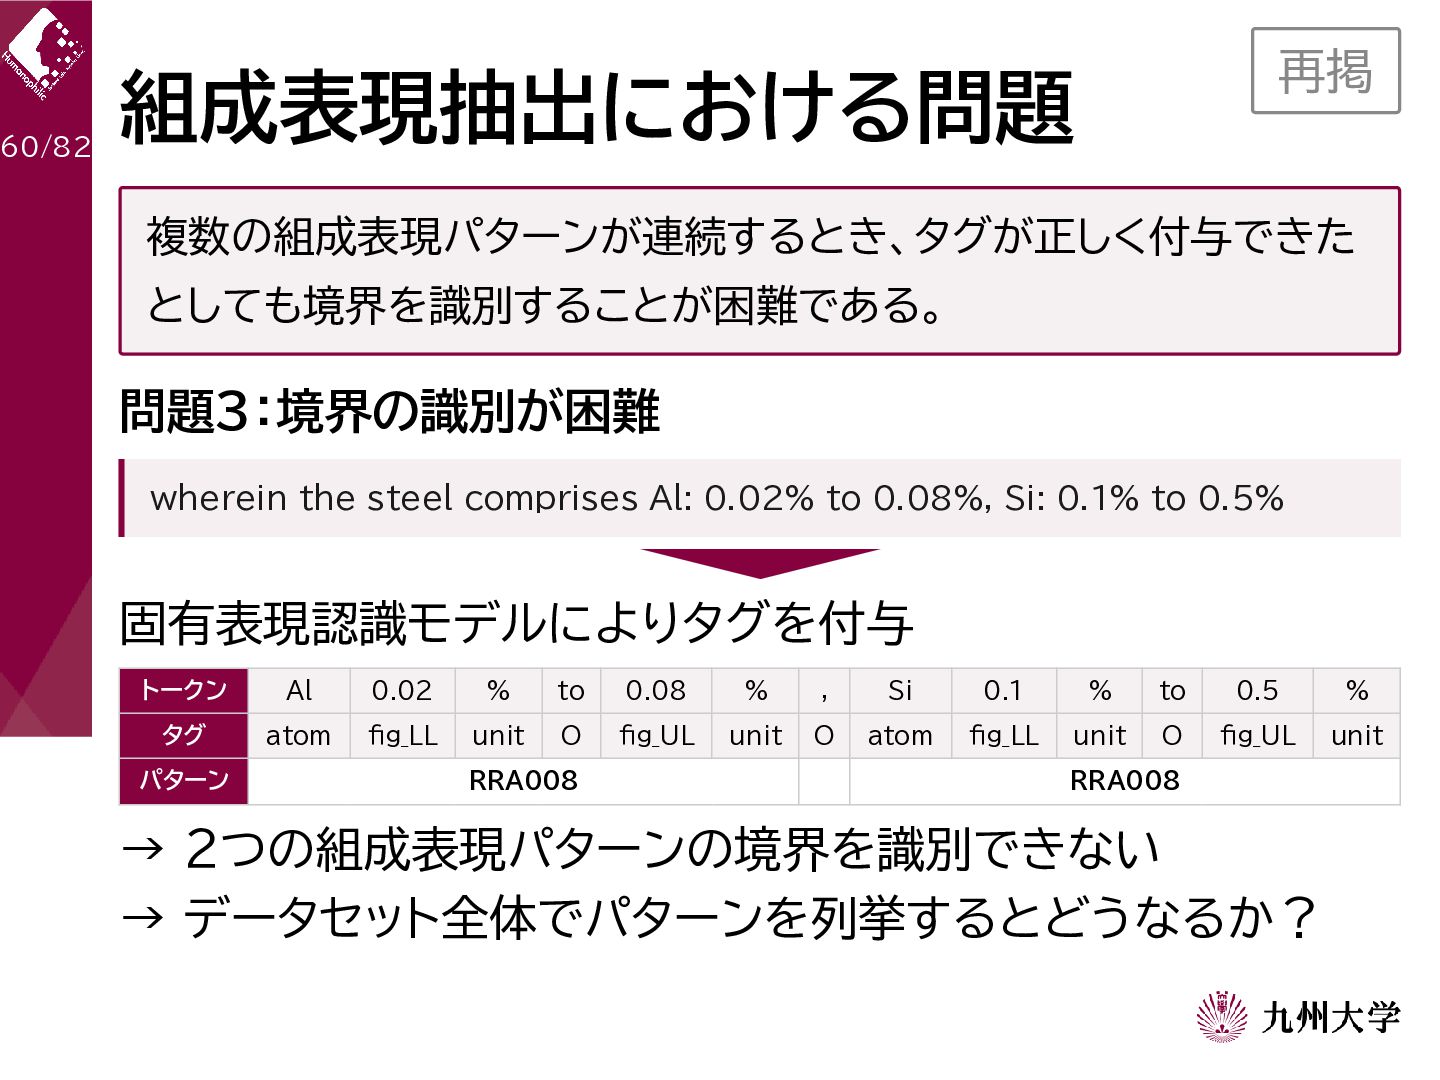
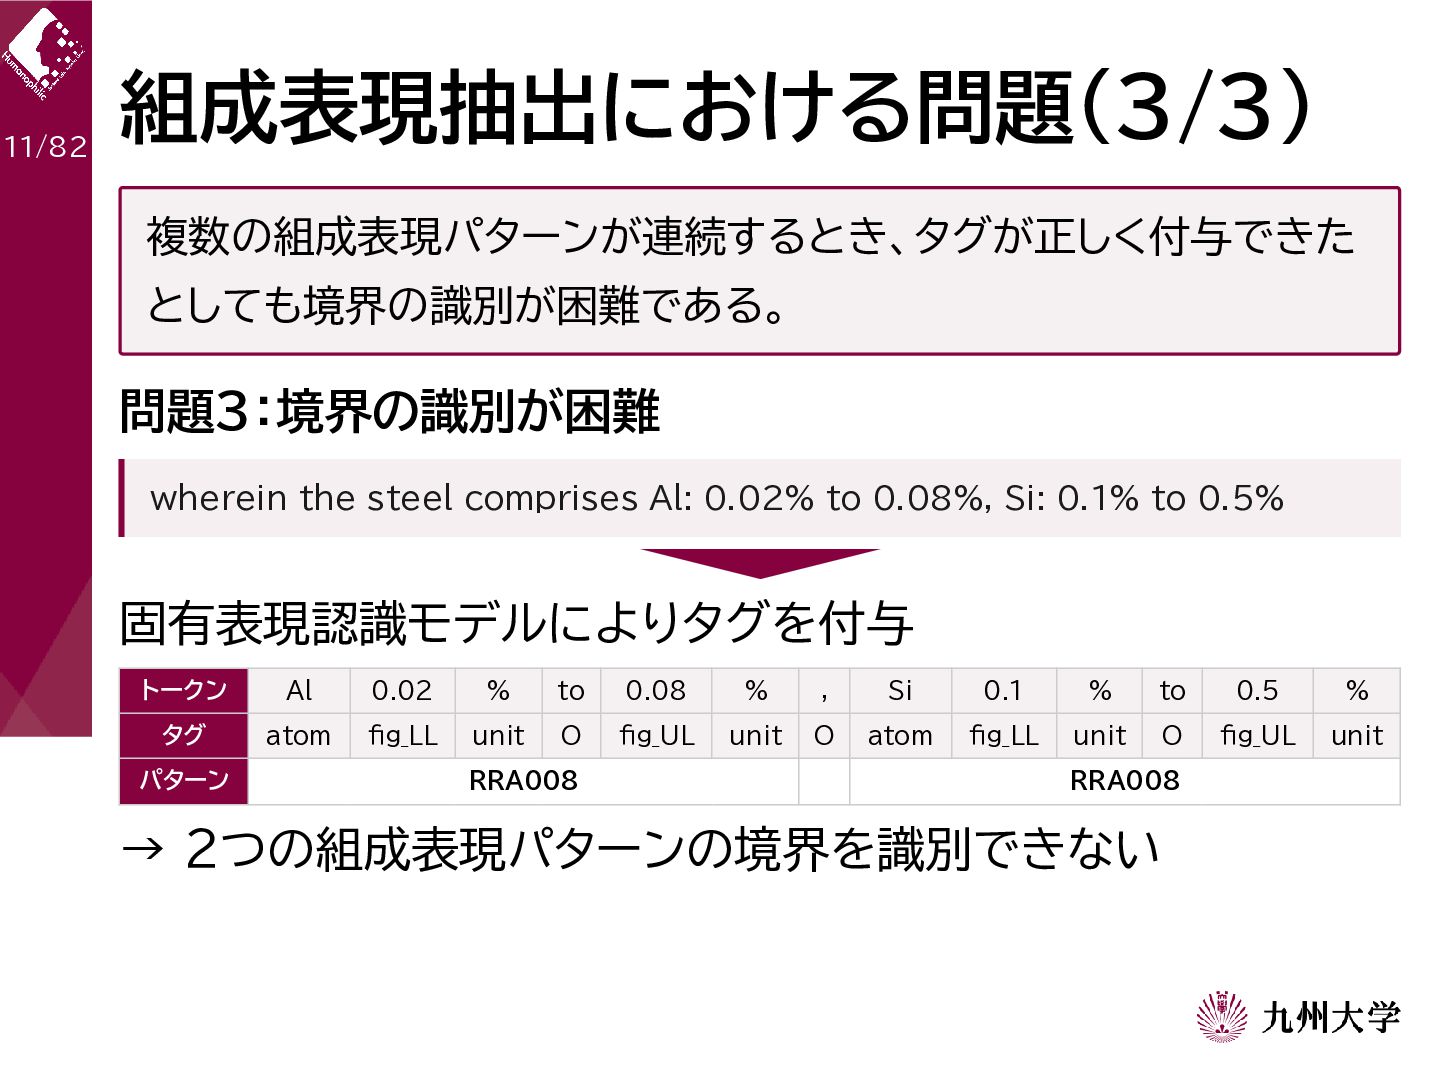
11/82 組成表現抽出における問題(3/3) 複数の組成表現パターンが連続するとき、タグが正しく付与できた としても境界の識別が困難である。 問題3:境界の識別が困難 wherein the steel comprises Al:
0.02% to 0.08%, Si: 0.1% to 0.5% 固有表現認識モデルによりタグを付与 トークン Al 0.02 % to 0.08 % , Si 0.1 % to 0.5 % タグ atom fig_LL unit O fig_UL unit O atom fig_LL unit O fig_UL unit パターン RRA008 RRA008 → 2つの組成表現パターンの境界を識別できない -
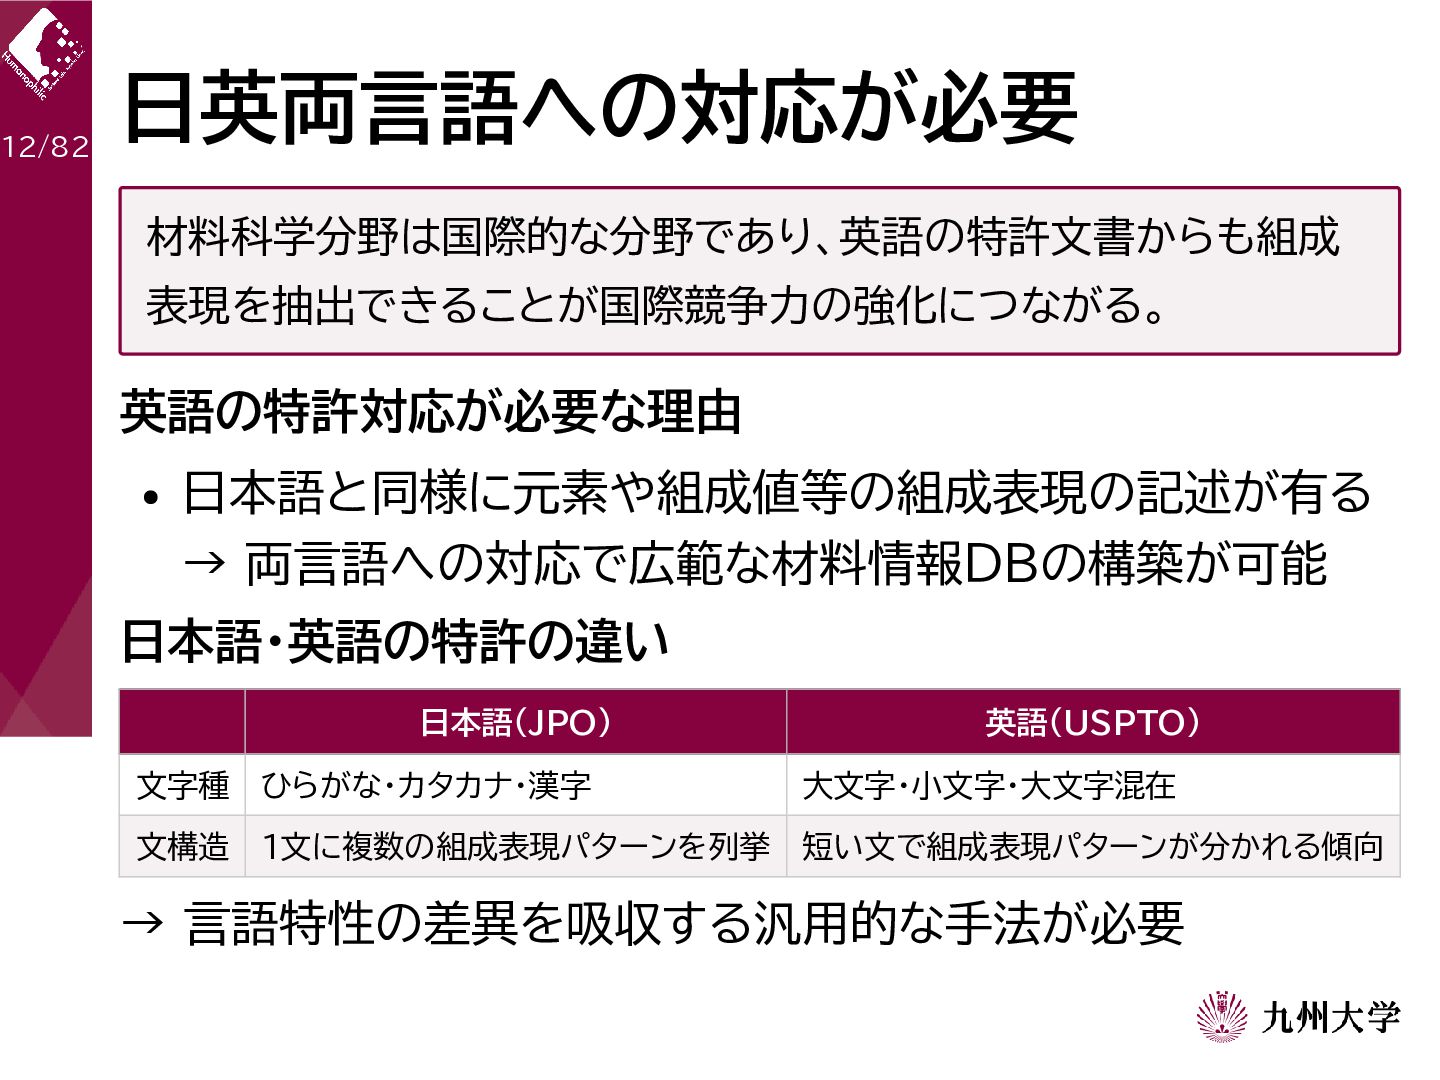
12/82 日英両言語への対応が必要 材料科学分野は国際的な分野であり、英語の特許文書からも組成 表現を抽出できることが国際競争力の強化につながる。 英語の特許対応が必要な理由 日本語と同様に元素や組成値等の組成表現の記述が有る → 両言語への対応で広範な材料情報DBの構築が可能 日本語・英語の特許の違い 日本語(JPO)
英語(USPTO) 文字種 ひらがな・カタカナ・漢字 大文字・小文字・大文字混在 文構造 1文に複数の組成表現パターンを列挙 短い文で組成表現パターンが分かれる傾向 → 言語特性の差異を吸収する汎用的な手法が必要 -
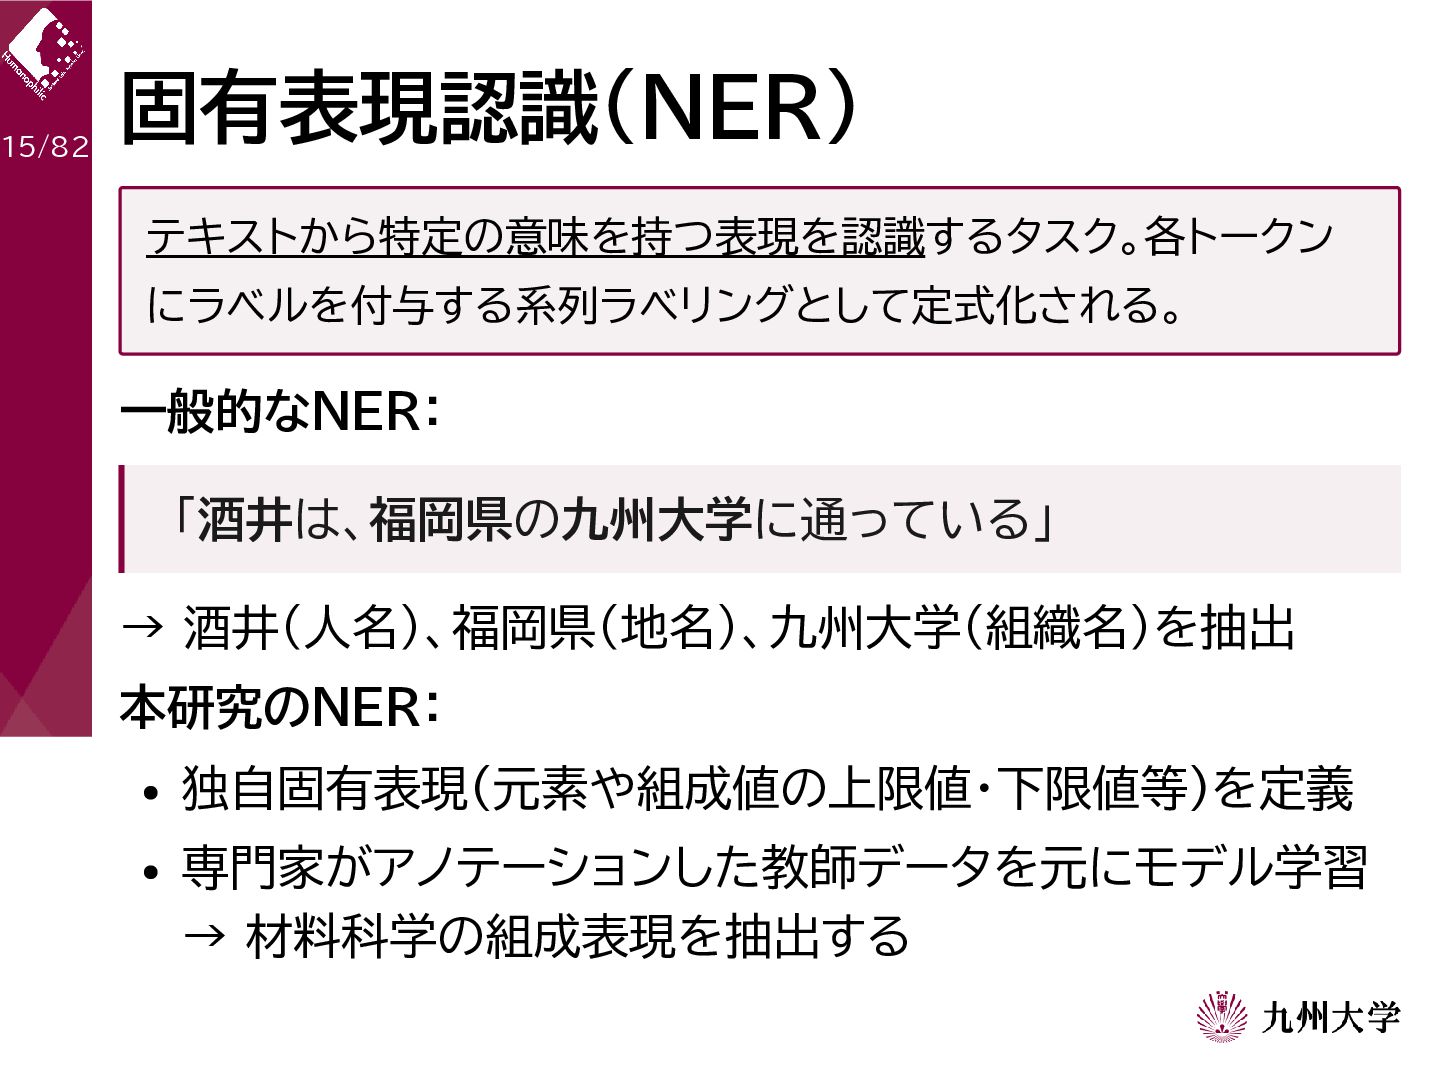
15/82 固有表現認識(NER) テキストから特定の意味を持つ表現を認識するタスク。各トークン にラベルを付与する系列ラベリングとして定式化される。 一般的なNER: 「酒井は、福岡県の九州大学に通っている」 → 酒井(人名)、福岡県(地名)、九州大学(組織名)を抽出 本研究のNER: 独自固有表現(元素や組成値の上限値・下限値等)を定義
専門家がアノテーションした教師データを元にモデル学習 → 材料科学の組成表現を抽出する -
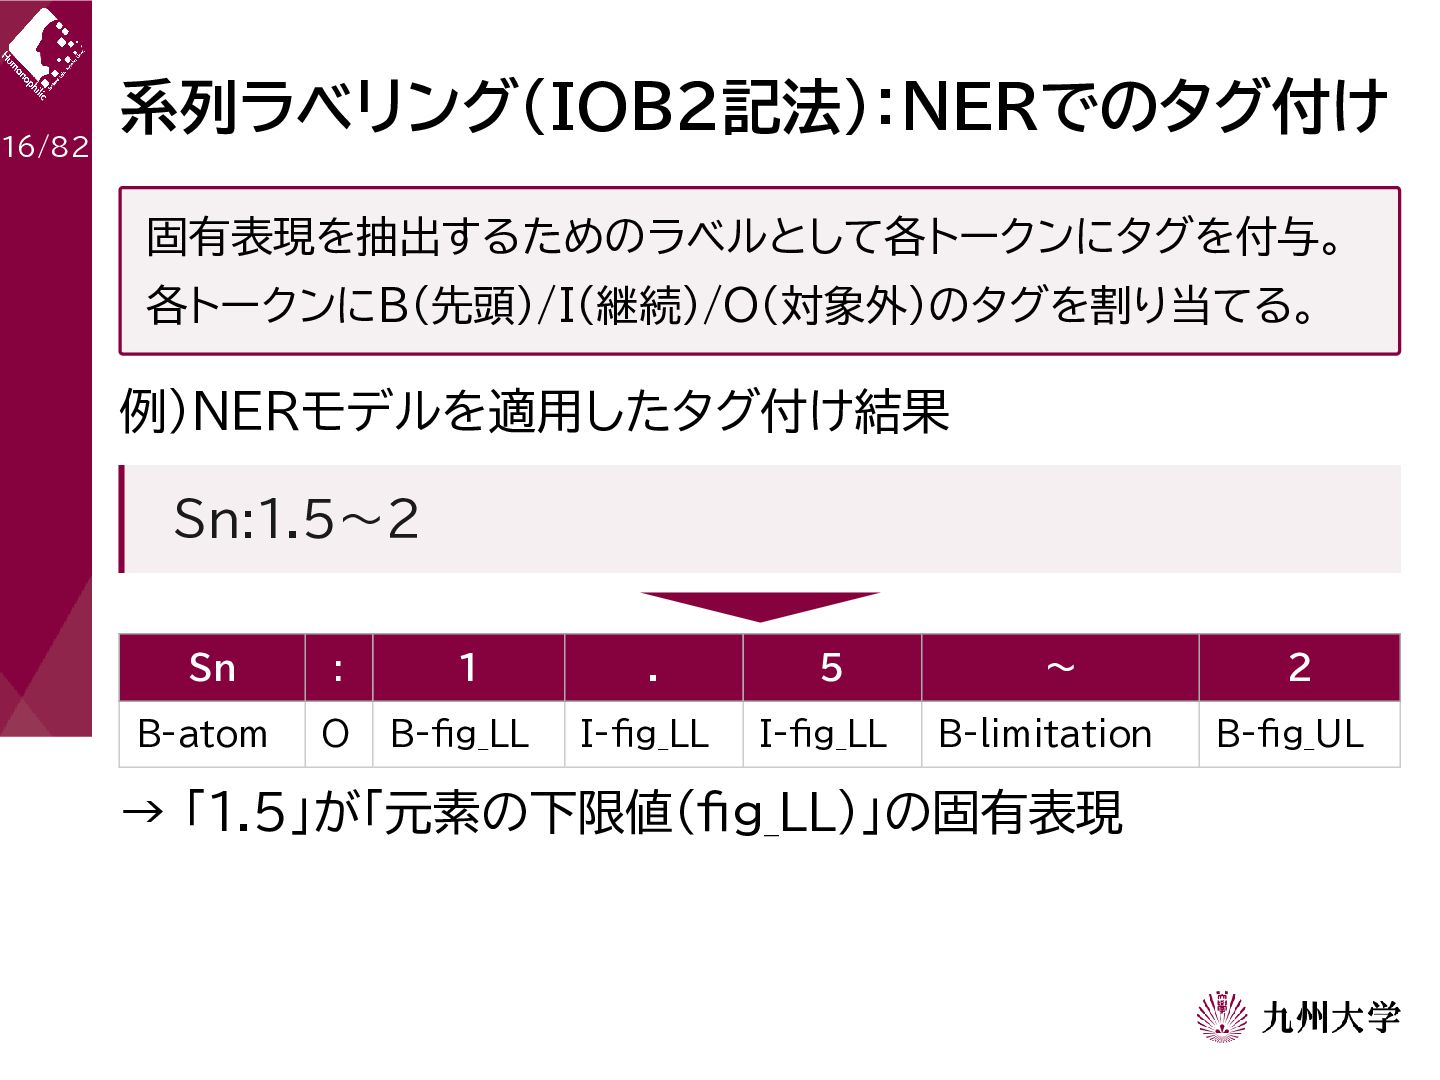
16/82 系列ラベリング(IOB2記法):NERでのタグ付け 固有表現を抽出するためのラベルとして各トークンにタグを付与。 各トークンにB(先頭)/I(継続)/O(対象外)のタグを割り当てる。 例)NERモデルを適用したタグ付け結果 Sn:1.5〜2 Sn : 1 .
5 〜 2 B-atom O B-fig_LL I-fig_LL I-fig_LL B-limitation B-fig_UL → 「1.5」が「元素の下限値(fig_LL)」の固有表現 -
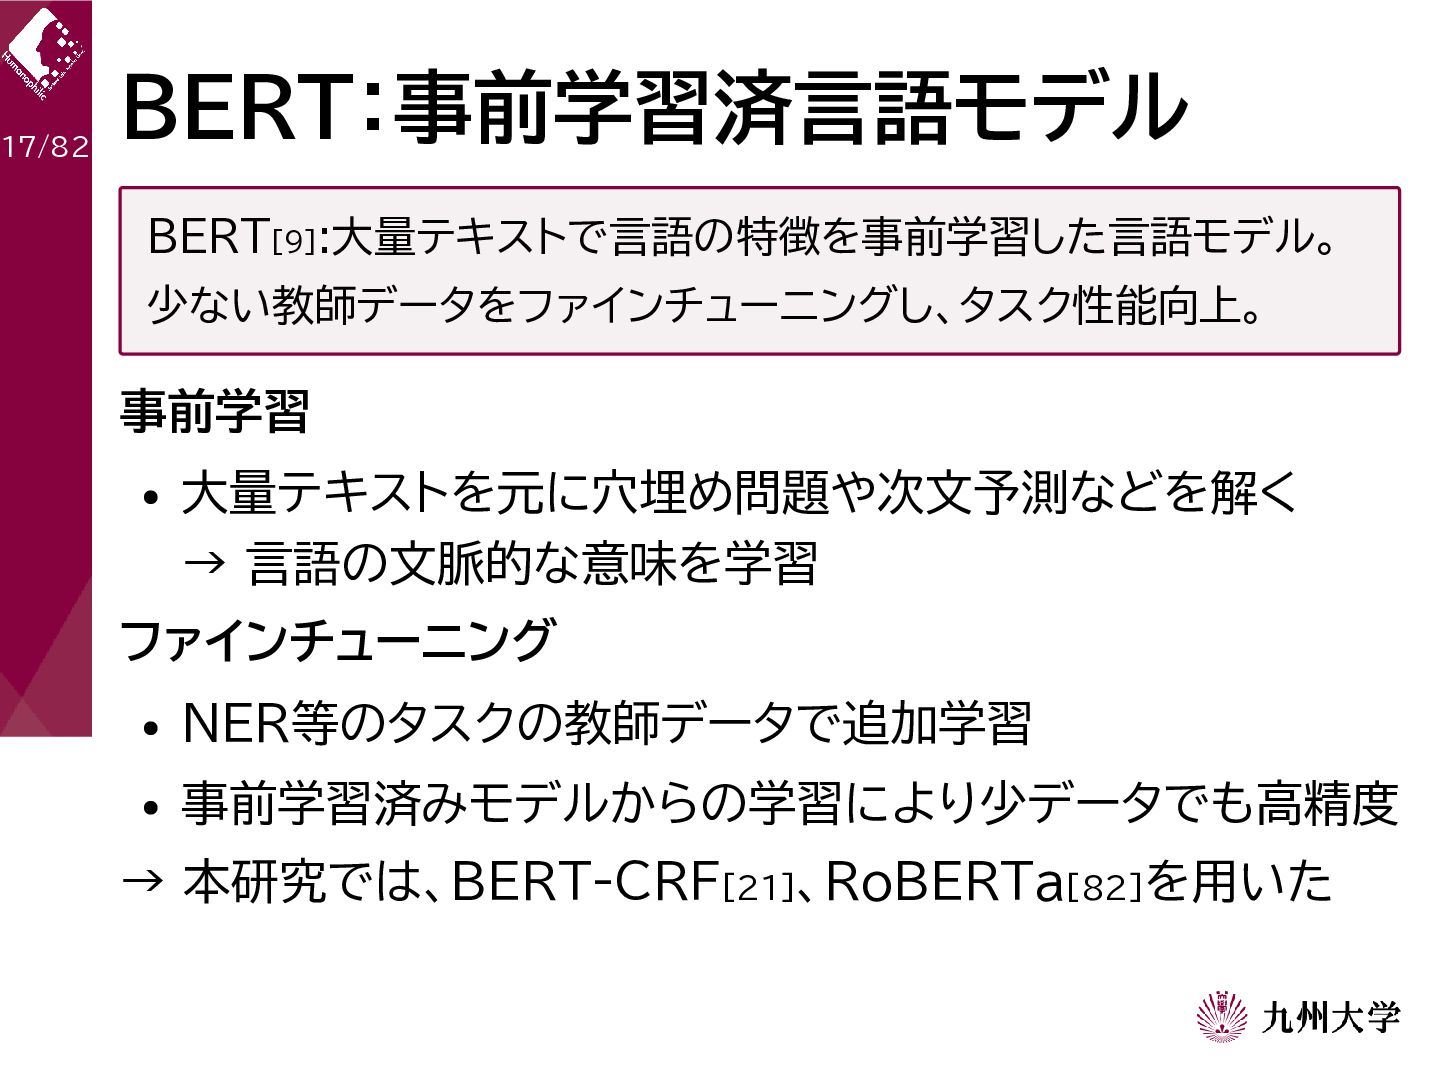
17/82 BERT:事前学習済言語モデル BERT[9]:大量テキストで言語の特徴を事前学習した言語モデル。 少ない教師データをファインチューニングし、タスク性能向上。 事前学習 大量テキストを元に穴埋め問題や次文予測などを解く → 言語の文脈的な意味を学習 ファインチューニング NER等のタスクの教師データで追加学習
事前学習済みモデルからの学習により少データでも高精度 → 本研究では、BERT-CRF[21]、RoBERTa[82]を用いた -
18/82 条件付き確率場(CRF) 素性とタグ間の遷移パターンを同時に学習し、系列全体として整合 性の高いラベル列を出力するモデル。 系列ラベリングにおける問題 通常の分類モデルは各トークンを独立に予測 → 前後の文脈を無視したラベル列が生成される可能性 CRFの特徴 前後のトークン・品詞・文字種などの素性、および、タグ間
の遷移確率を同時に学習→ラベル列全体の整合性を保つ → どのような素性を設計するかが精度向上の鍵となる -
20/82 材料科学分野の情報抽出研究 材料科学分野NERの研究は進展してきたが、既存研究は個々の固 有表現の認識に絞られている。 研究 手法 対象 Westonら[4](2019) LSTM 無機材料論文の固有表現抽出
Kimら[33](2017) ルールベース 特許文書の組成関連固有表現 Guptaら[12](2022) MatSciBERT 材料科学特化の事前学習モデル Trewarthaら[34](2022) MatBERT 材料科学特化の事前学習モデル Huangら[28](2024) 機械読解 NERを質問応答タスクに再定義 いずれも個々の固有表現の認識が対象 → 複数の固有表現をまとめて「組成表現パターン」として抽出 する手法はない -
21/82 手掛かり語の研究 従来のブートストラップ型手法は手掛かり語の手動定義や、共起す る表現を繰り返し獲得する必要があり、計算コストがかかる。 ブートストラップ型手法[31,43,44,45,46] 手掛かり語を辞書として手動定義、手掛かり語と共起する 表現を繰り返し獲得 問題①:手掛かり語の手動定義が必要 問題②:計算コストがかかる →
本研究の手掛かり語タグはNERの予測だけで 手掛かり語も同時獲得できる点に新規性がある -
22/82 LLMの研究 材料科学分野のNERでは、LLMよりも教師あり学習モデル(BERT 系)が性能を上回ることが複数の研究で示されている。 材料科学分野のNERでLLMを用いた研究 関連研究 結論(認識性能で比較) Huら[48](2024) ChatGPT <
BioClinicalBERT Foppianoら[36](2024) GPT-4 < BERT Potuら[37](2025) LLM < MatSciBERT/DeBERTa LLMの課題:ハルシネーション、再現性[50]、語句言い換えに よる精度低下[36] → 本研究:教師あり学習モデル(BERT/CRF)を採用 -
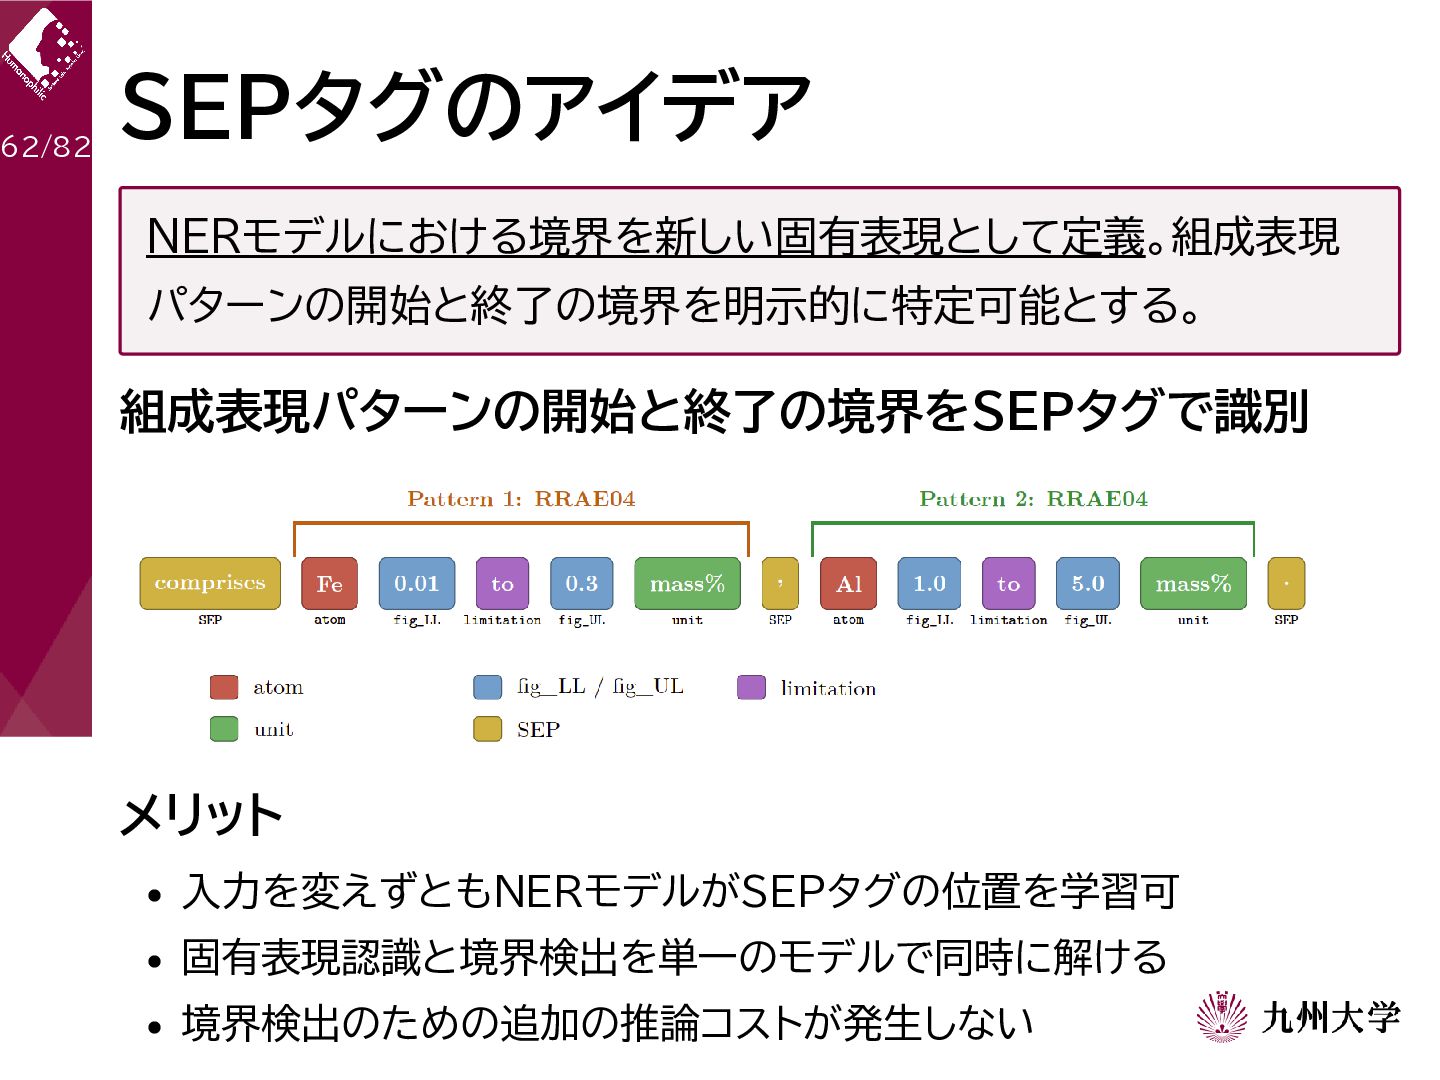
23/82 構造マーカーの研究 先行研究の境界マーカー[55][56]はいずれも入力列を変更するが、 SEPタグはラベル空間のみに符号化する。 構造マーカー(先行研究) Livioら[56](2019) [E1]…[/E1] を入力に挿入 → 区間の情報を認識
SEPタグ(本研究) 入力列は変更しない ラベル空間のみに境界情報 を符号化 -
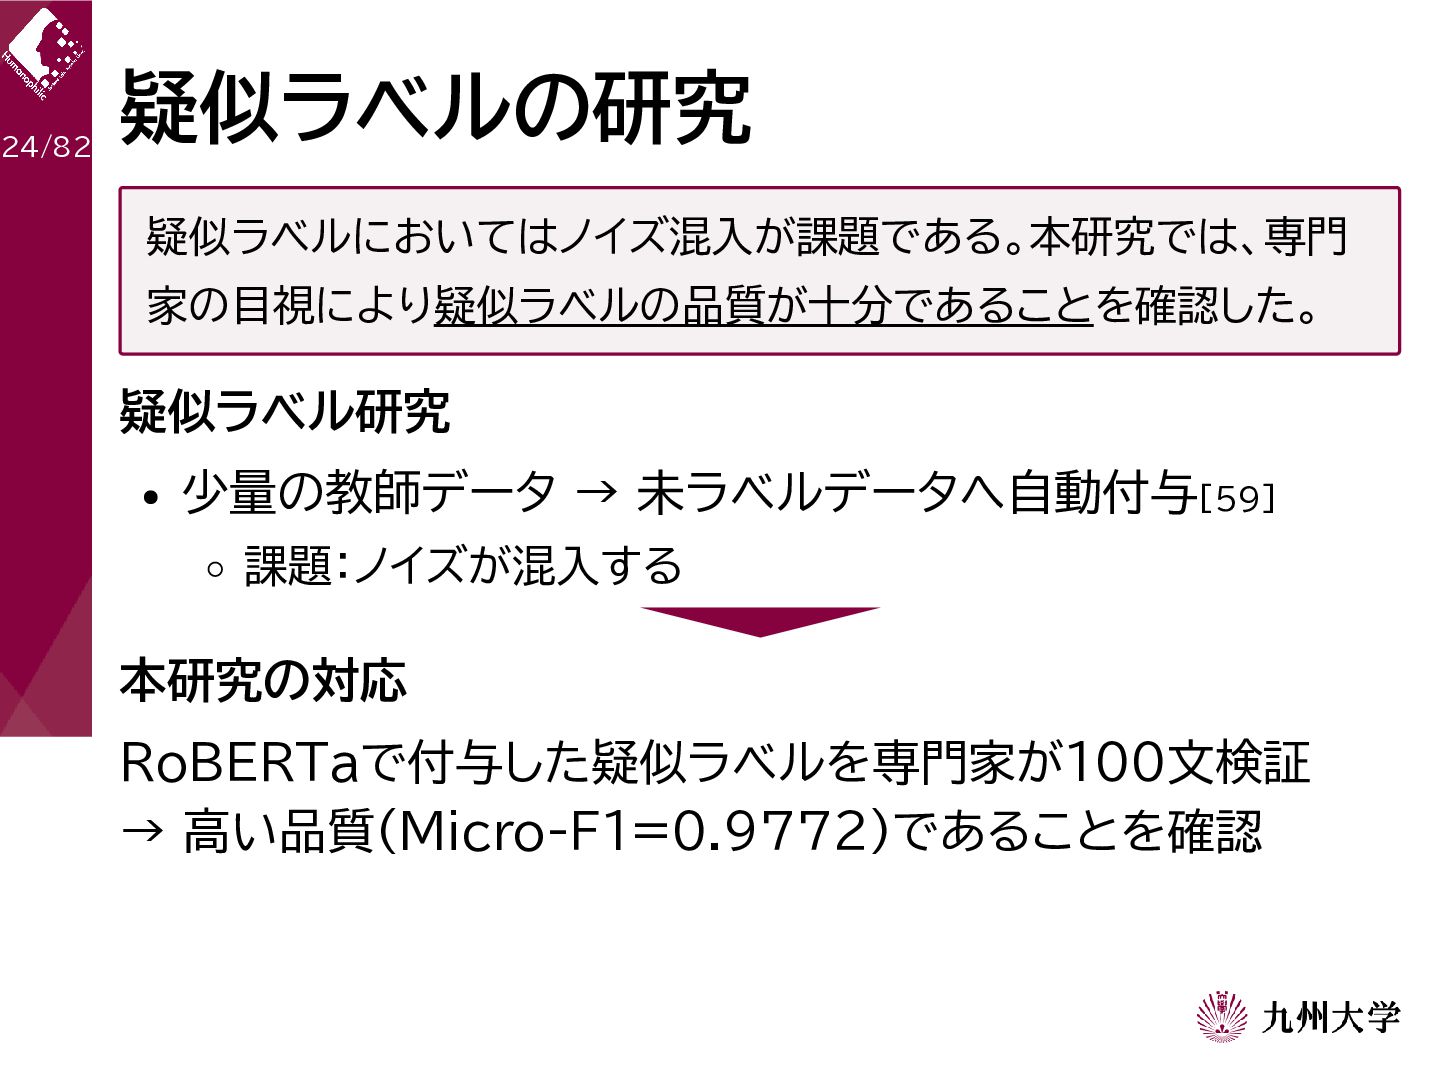
24/82 疑似ラベルの研究 疑似ラベルにおいてはノイズ混入が課題である。本研究では、専門 家の目視により疑似ラベルの品質が十分であることを確認した。 疑似ラベル研究 少量の教師データ → 未ラベルデータへ自動付与[59] 課題:ノイズが混入する 本研究の対応
RoBERTaで付与した疑似ラベルを専門家が100文検証 → 高い品質(Micro-F1=0.9772)であることを確認 -
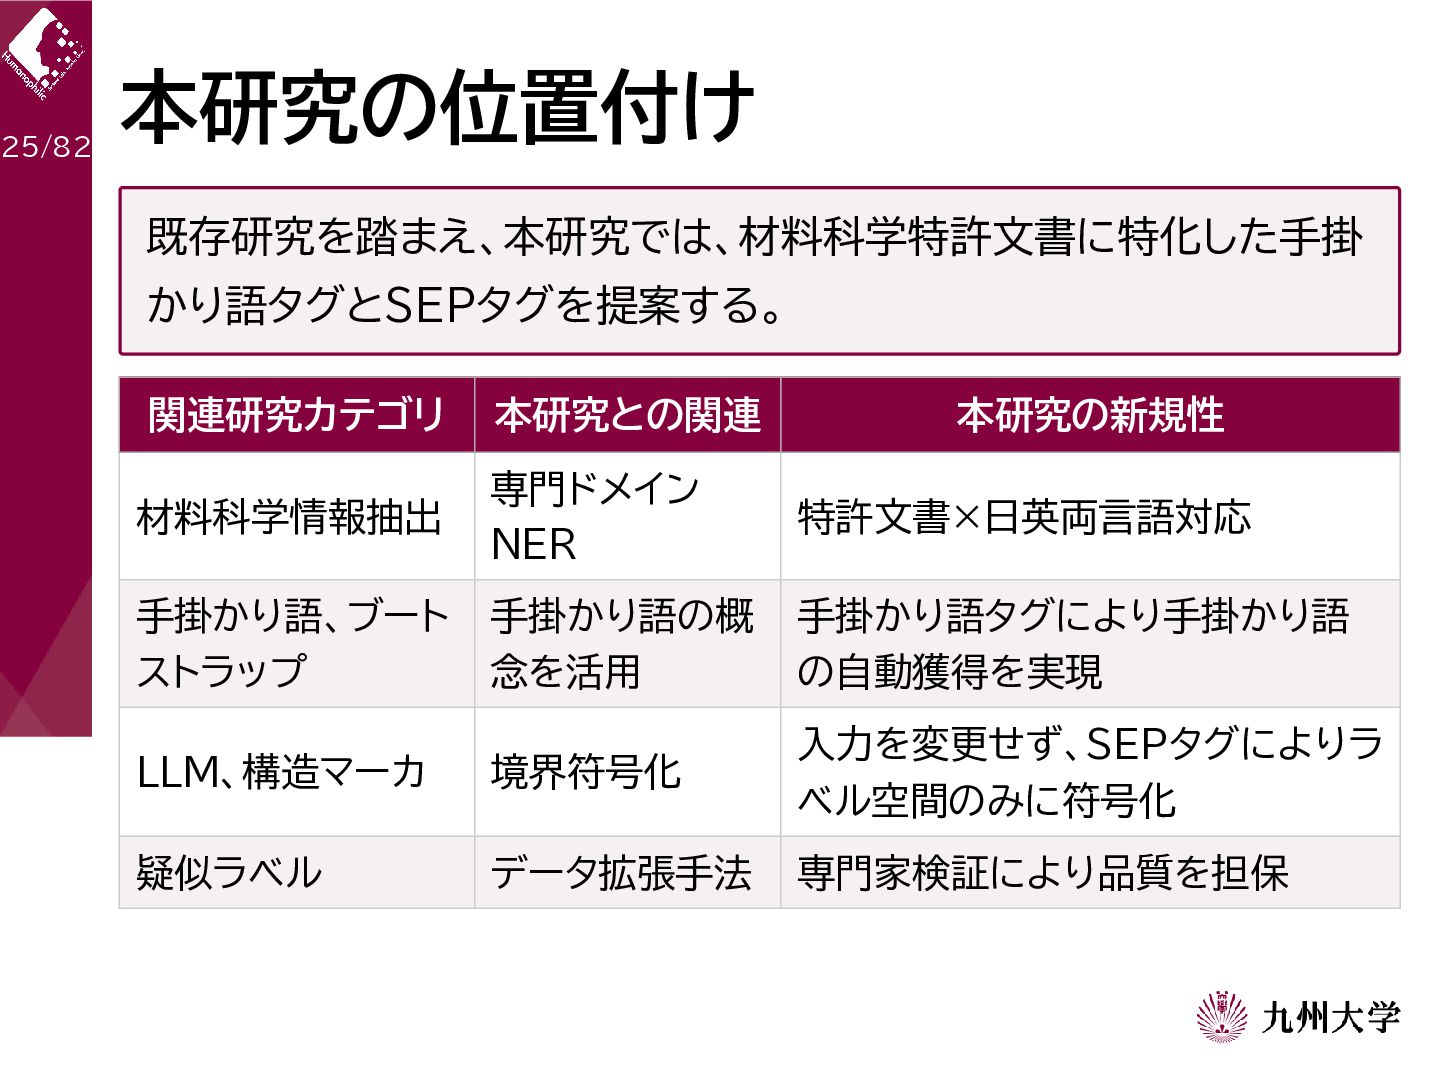
25/82 本研究の位置付け 既存研究を踏まえ、本研究では、材料科学特許文書に特化した手掛 かり語タグとSEPタグを提案する。 関連研究カテゴリ 本研究との関連 本研究の新規性 材料科学情報抽出 専門ドメイン NER
特許文書×日英両言語対応 手掛かり語、ブート ストラップ 手掛かり語の概 念を活用 手掛かり語タグにより手掛かり語 の自動獲得を実現 LLM、構造マーカ 境界符号化 入力を変更せず、SEPタグによりラ ベル空間のみに符号化 疑似ラベル データ拡張手法 専門家検証により品質を担保 -
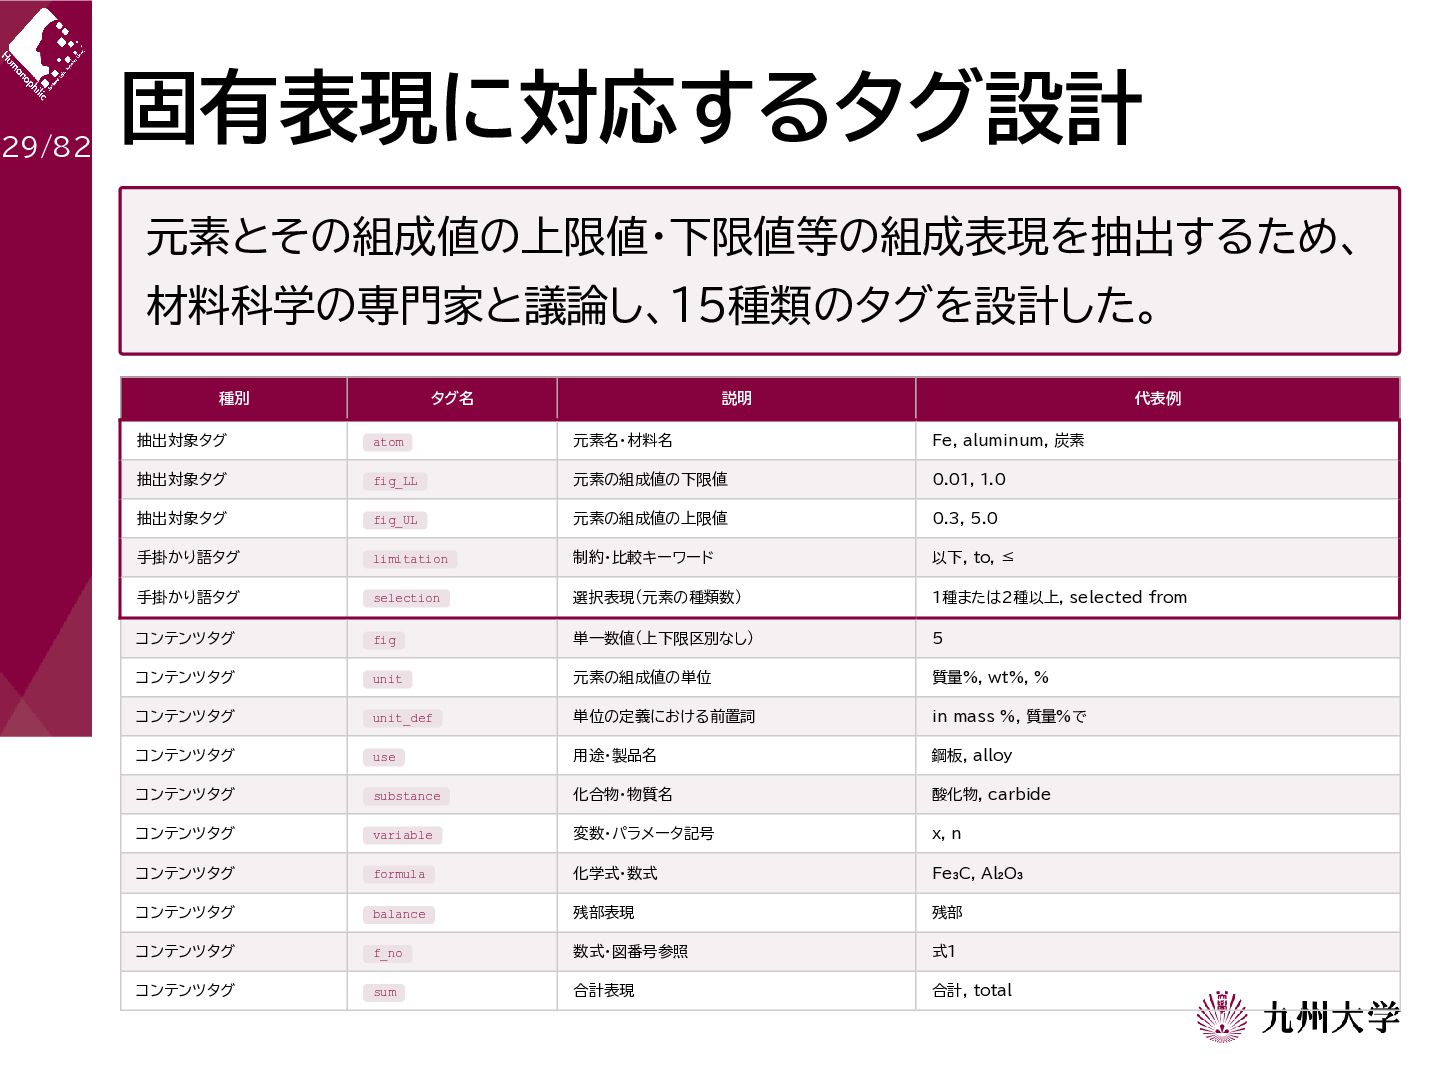
29/82 固有表現に対応するタグ設計 元素とその組成値の上限値・下限値等の組成表現を抽出するため、 材料科学の専門家と議論し、15種類のタグを設計した。 種別 タグ名 説明 代表例 抽出対象タグ atom
元素名・材料名 Fe, aluminum, 炭素 抽出対象タグ fig_LL 元素の組成値の下限値 0.01, 1.0 抽出対象タグ fig_UL 元素の組成値の上限値 0.3, 5.0 手掛かり語タグ limitation 制約・比較キーワード 以下, to, ≤ 手掛かり語タグ selection 選択表現(元素の種類数) 1種または2種以上, selected from コンテンツタグ fig 単一数値(上下限区別なし) 5 コンテンツタグ unit 元素の組成値の単位 質量%, wt%, % コンテンツタグ unit_def 単位の定義における前置詞 in mass %, 質量%で コンテンツタグ use 用途・製品名 鋼板, alloy コンテンツタグ substance 化合物・物質名 酸化物, carbide コンテンツタグ variable 変数・パラメータ記号 x, n コンテンツタグ formula 化学式・数式 Fe C, Al O コンテンツタグ balance 残部表現 残部 コンテンツタグ f_no 数式・図番号参照 式1 コンテンツタグ sum 合計表現 合計, total ₃ ₂ ₃ -
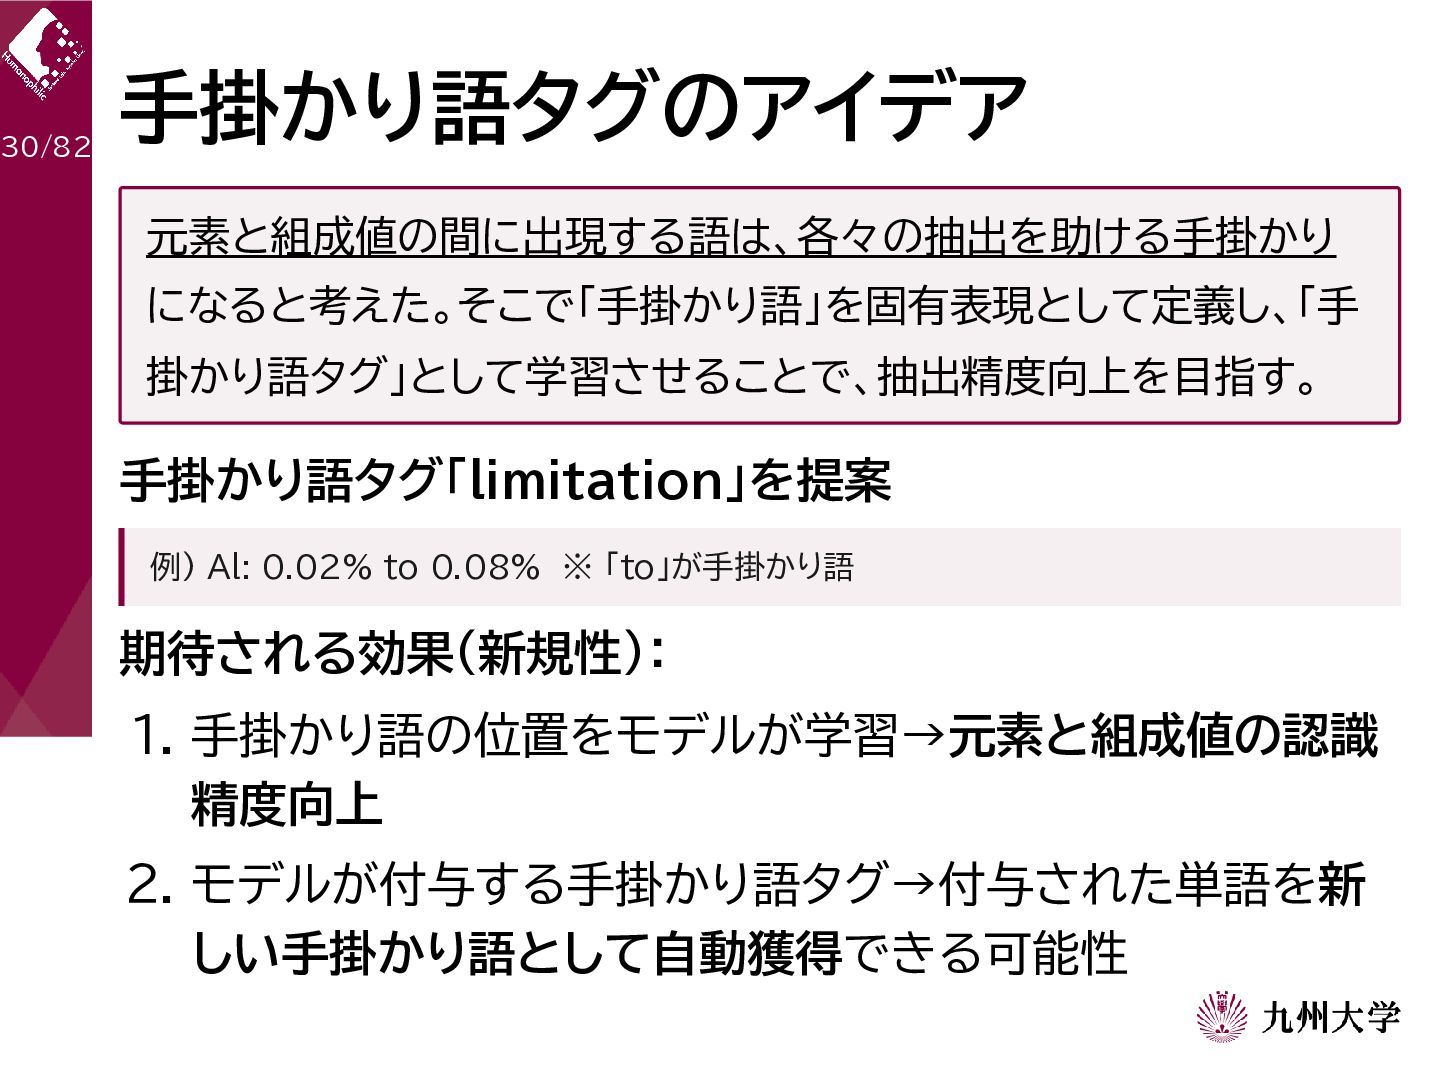
30/82 手掛かり語タグのアイデア 元素と組成値の間に出現する語は、各々の抽出を助ける手掛かり になると考えた。そこで「手掛かり語」を固有表現として定義し、「手 掛かり語タグ」として学習させることで、抽出精度向上を目指す。 手掛かり語タグ「limitation」を提案 例) Al: 0.02% to
0.08% ※ 「to」が手掛かり語 期待される効果(新規性): 1. 手掛かり語の位置をモデルが学習→元素と組成値の認識 精度向上 2. モデルが付与する手掛かり語タグ→付与された単語を新 しい手掛かり語として自動獲得できる可能性 -
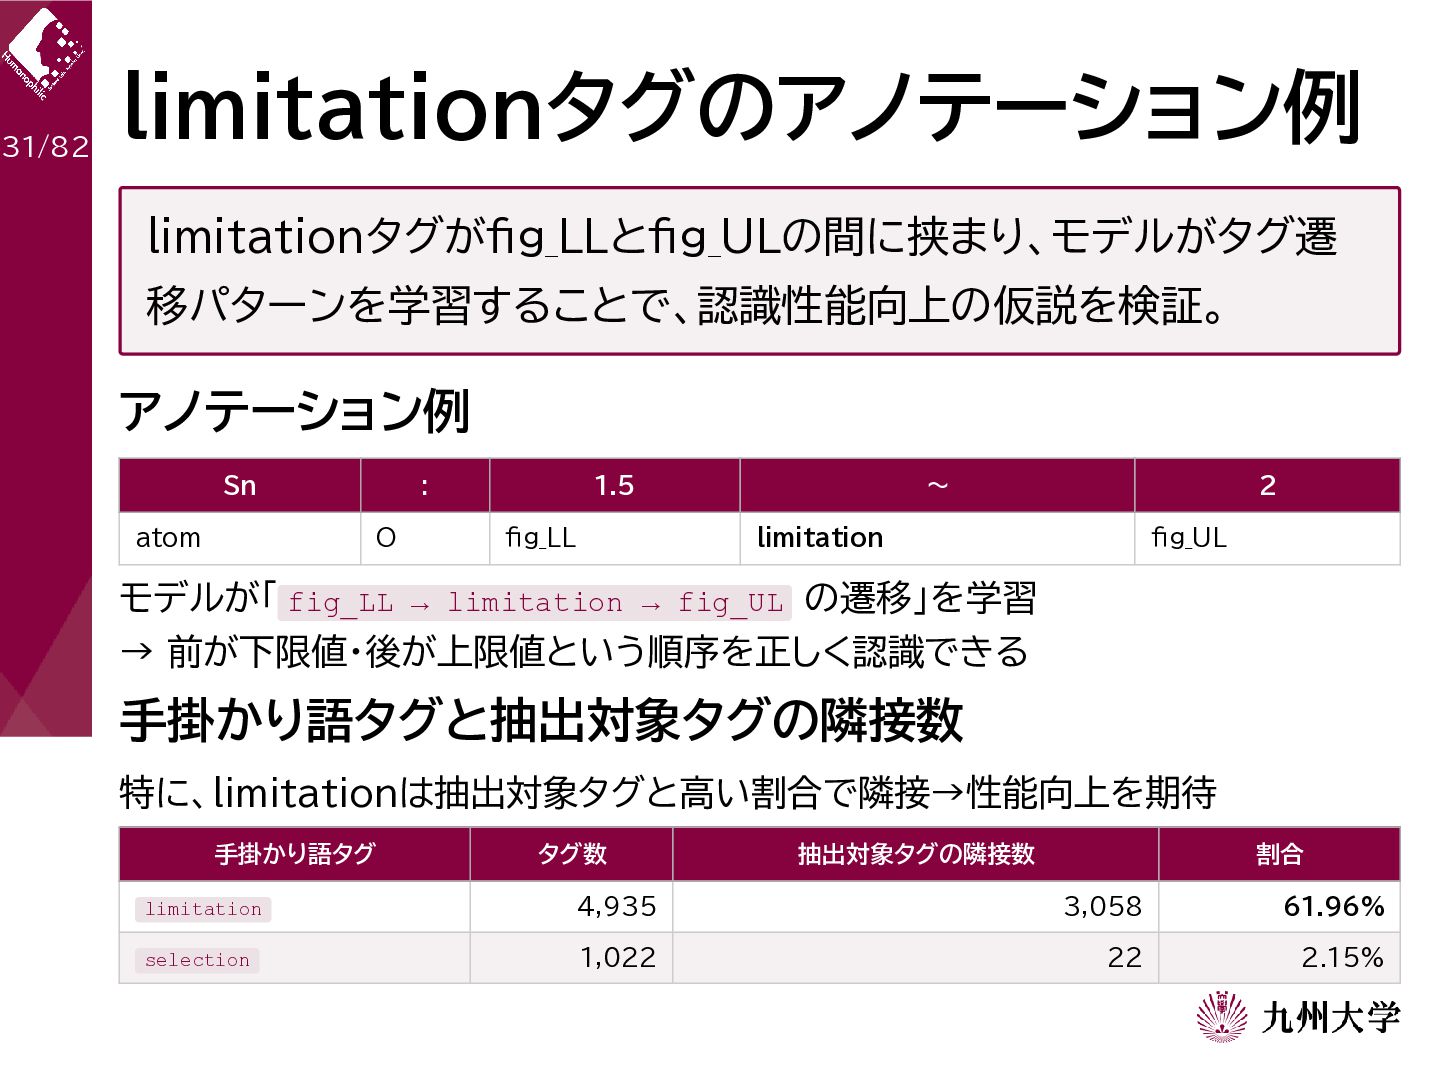
31/82 limitationタグのアノテーション例 limitationタグがfig_LLとfig_ULの間に挟まり、モデルがタグ遷 移パターンを学習することで、認識性能向上の仮説を検証。 アノテーション例 Sn atom : O 1.5
fig_LL 〜 2 limitation fig_UL モデルが「 fig_LL → limitation → fig_UL の遷移」を学習 → 前が下限値・後が上限値という順序を正しく認識できる 手掛かり語タグと抽出対象タグの隣接数 特に、limitationは抽出対象タグと高い割合で隣接→性能向上を期待 手掛かり語タグ タグ数 抽出対象タグの隣接数 割合 limitation 4,935 3,058 61.96% selection 1,022 22 2.15% -
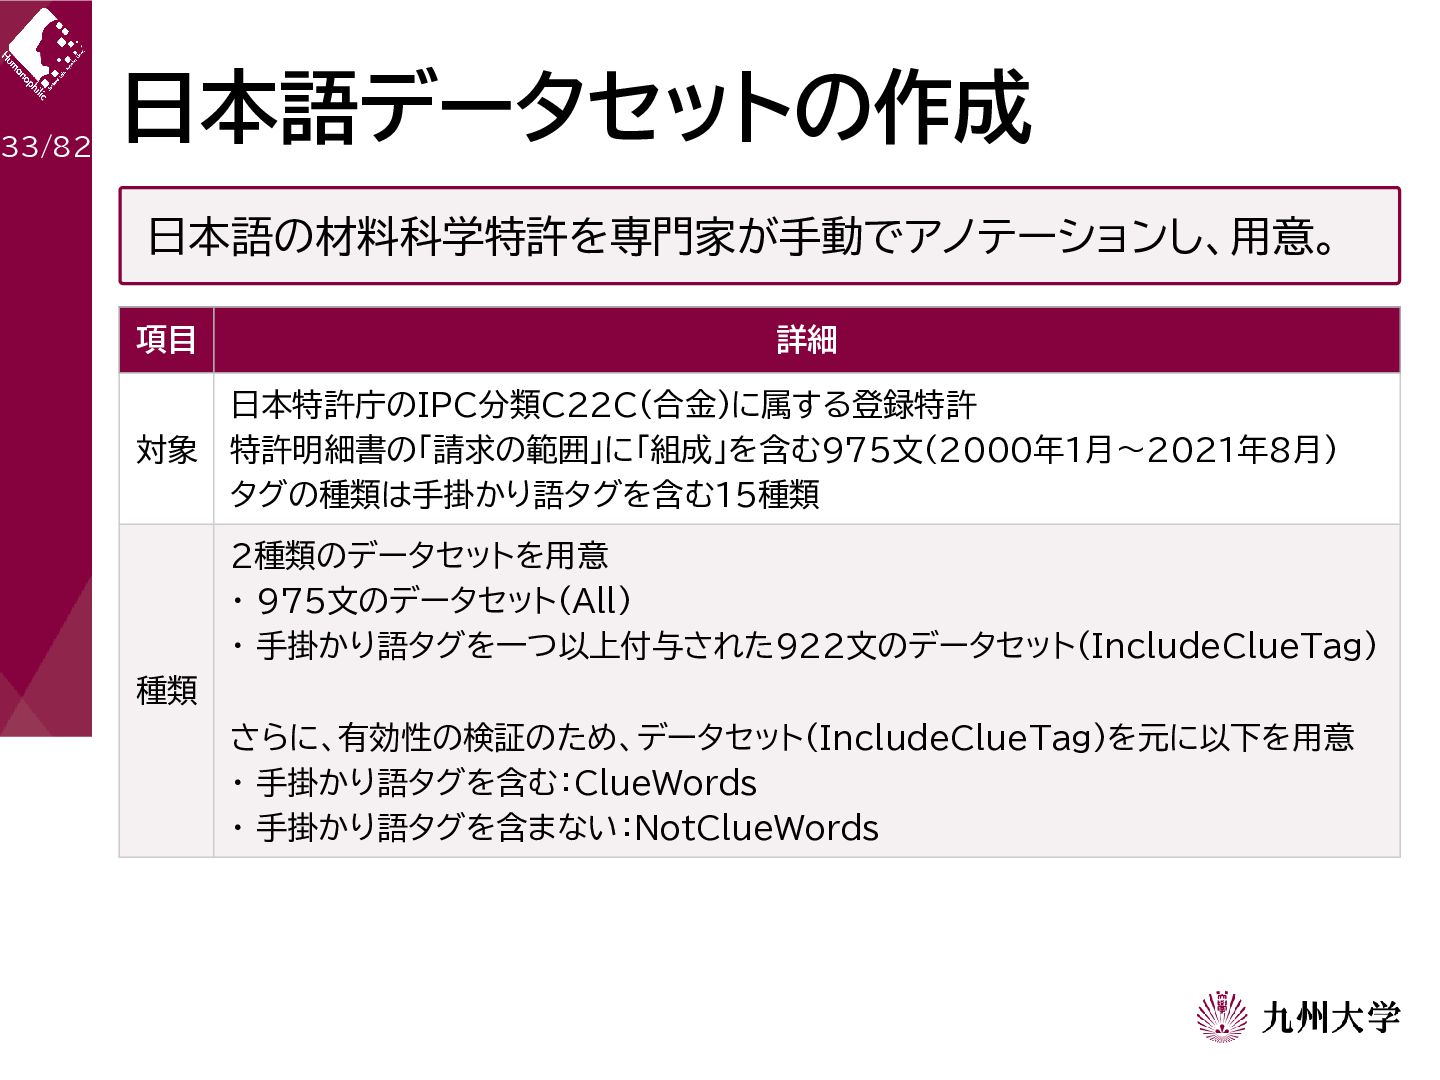
33/82 日本語データセットの作成 日本語の材料科学特許を専門家が手動でアノテーションし、用意。 項目 対象 詳細 日本特許庁のIPC分類C22C(合金)に属する登録特許 特許明細書の「請求の範囲」に「組成」を含む975文(2000年1月〜2021年8月) タグの種類は手掛かり語タグを含む15種類 2種類のデータセットを用意
・ 975文のデータセット(All) ・ 手掛かり語タグを一つ以上付与された922文のデータセット(IncludeClueTag) 種類 さらに、有効性の検証のため、データセット(IncludeClueTag)を元に以下を用意 ・ 手掛かり語タグを含む:ClueWords ・ 手掛かり語タグを含まない:NotClueWords -
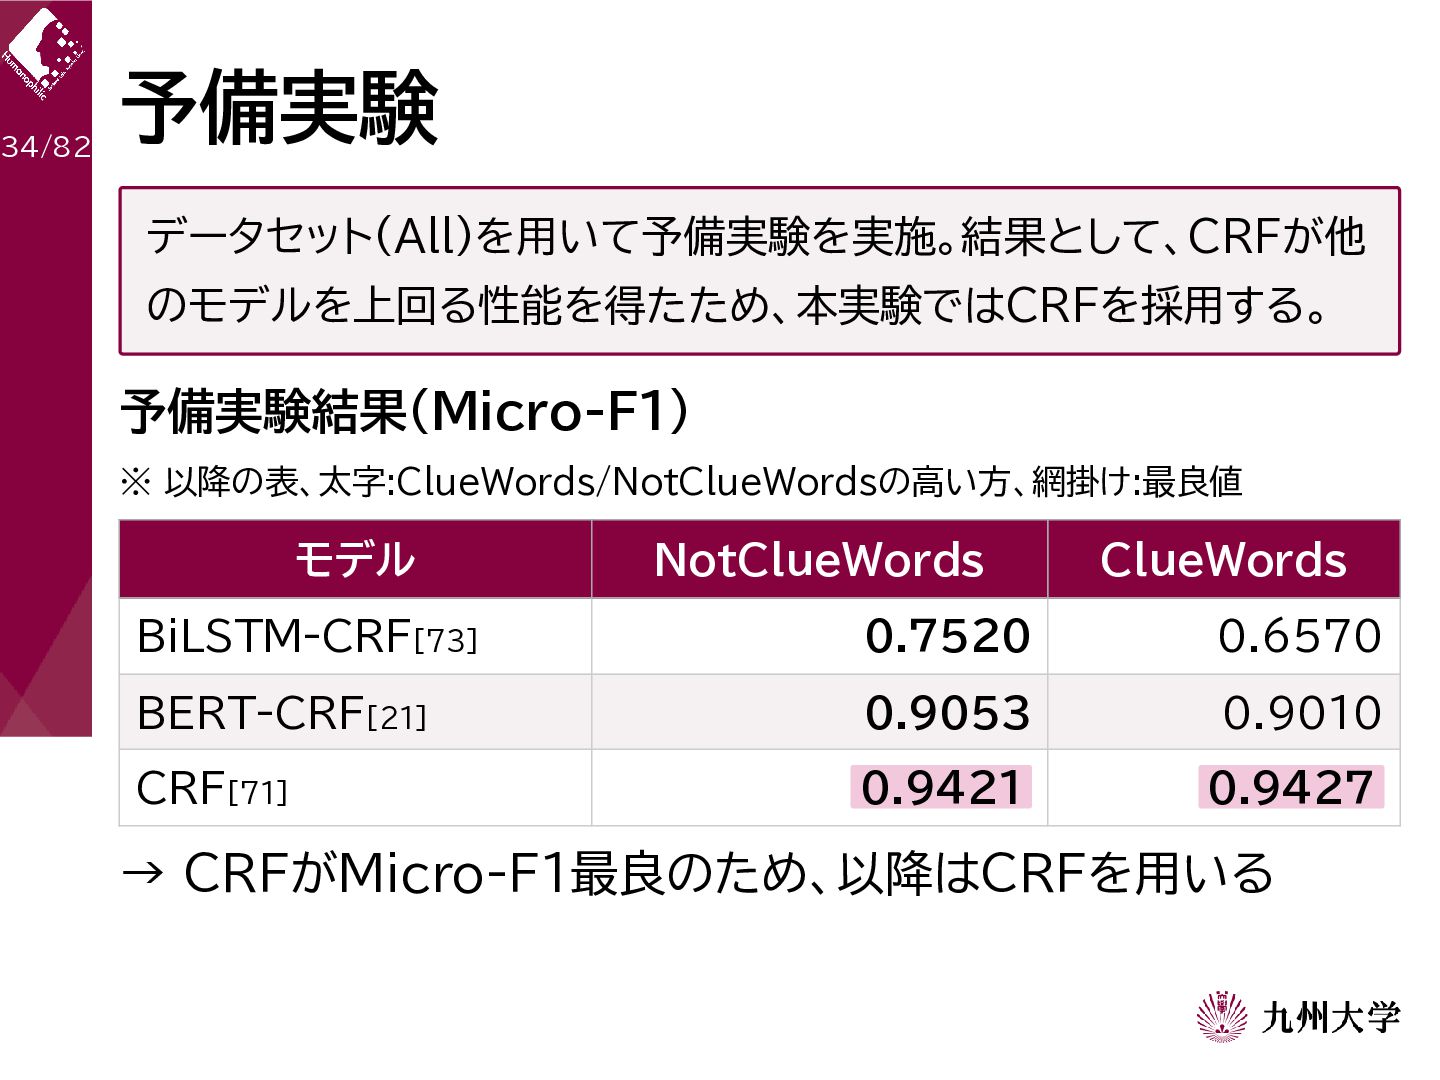
34/82 予備実験 データセット(All)を用いて予備実験を実施。結果として、CRFが他 のモデルを上回る性能を得たため、本実験ではCRFを採用する。 予備実験結果(Micro-F1) ※ 以降の表、太字:ClueWords/NotClueWordsの高い方、網掛け:最良値 モデル NotClueWords ClueWords
BiLSTM-CRF[73] 0.7520 0.6570 BERT-CRF[21] 0.9053 0.9010 CRF[71] 0.9421 0.9427 → CRFがMicro-F1最良のため、以降はCRFを用いる -
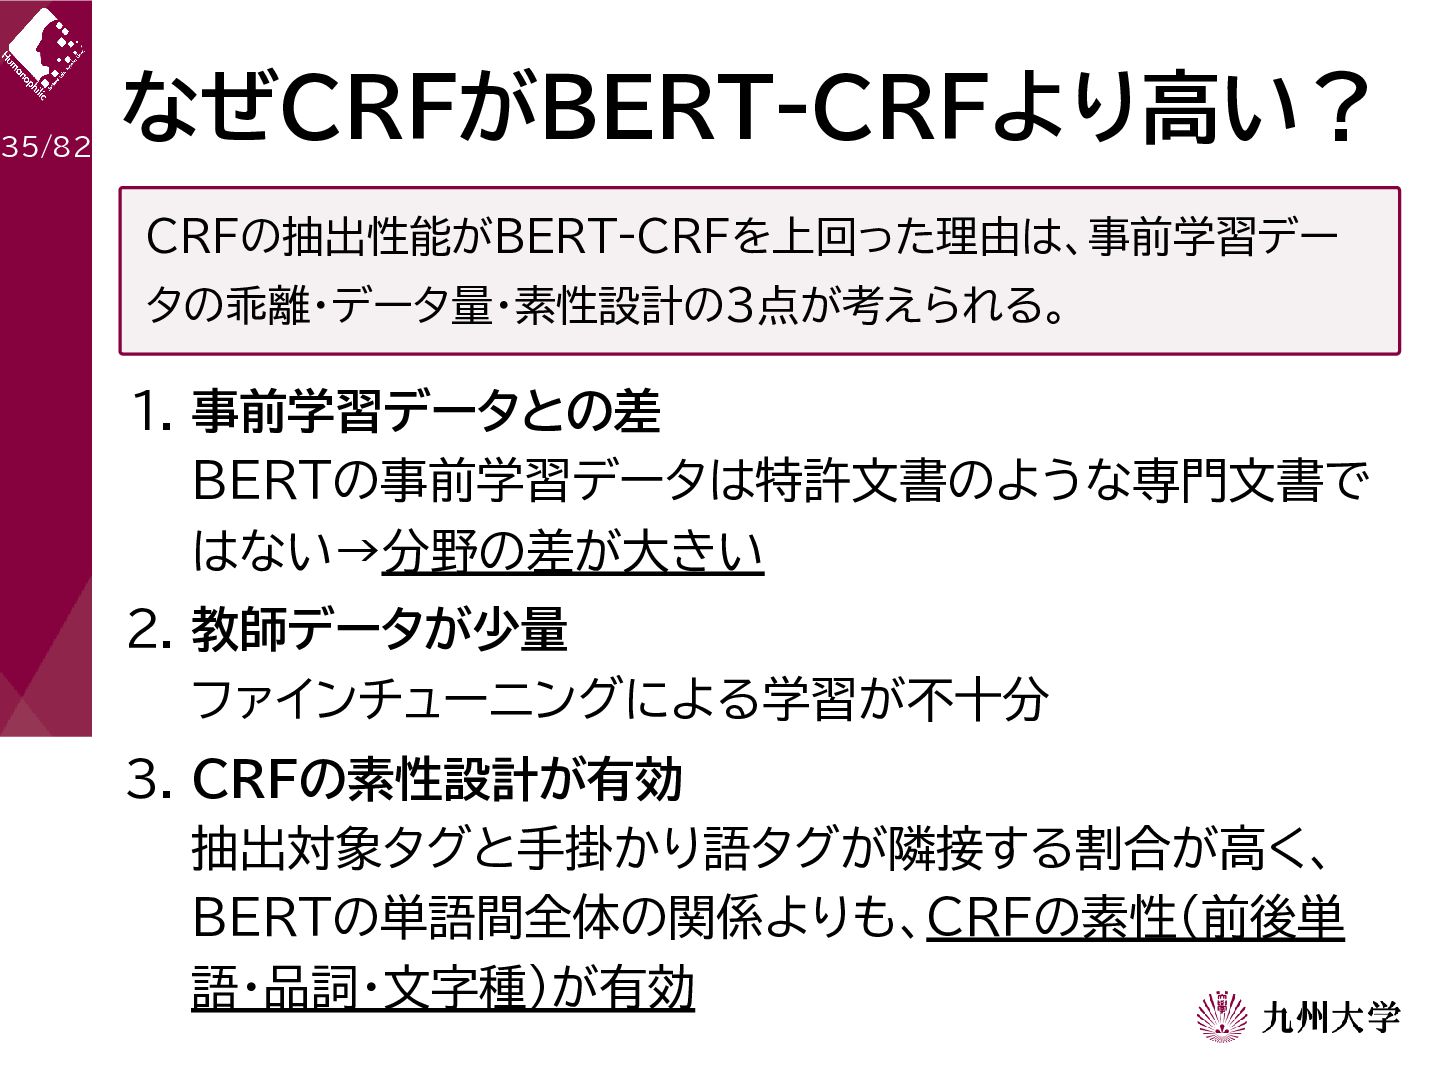
35/82 なぜCRFがBERT-CRFより高い? CRFの抽出性能がBERT-CRFを上回った理由は、事前学習デー タの乖離・データ量・素性設計の3点が考えられる。 1. 事前学習データとの差 BERTの事前学習データは特許文書のような専門文書で はない→分野の差が大きい 2. 教師データが少量
ファインチューニングによる学習が不十分 3. CRFの素性設計が有効 抽出対象タグと手掛かり語タグが隣接する割合が高く、 BERTの単語間全体の関係よりも、CRFの素性(前後単 語・品詞・文字種)が有効 -
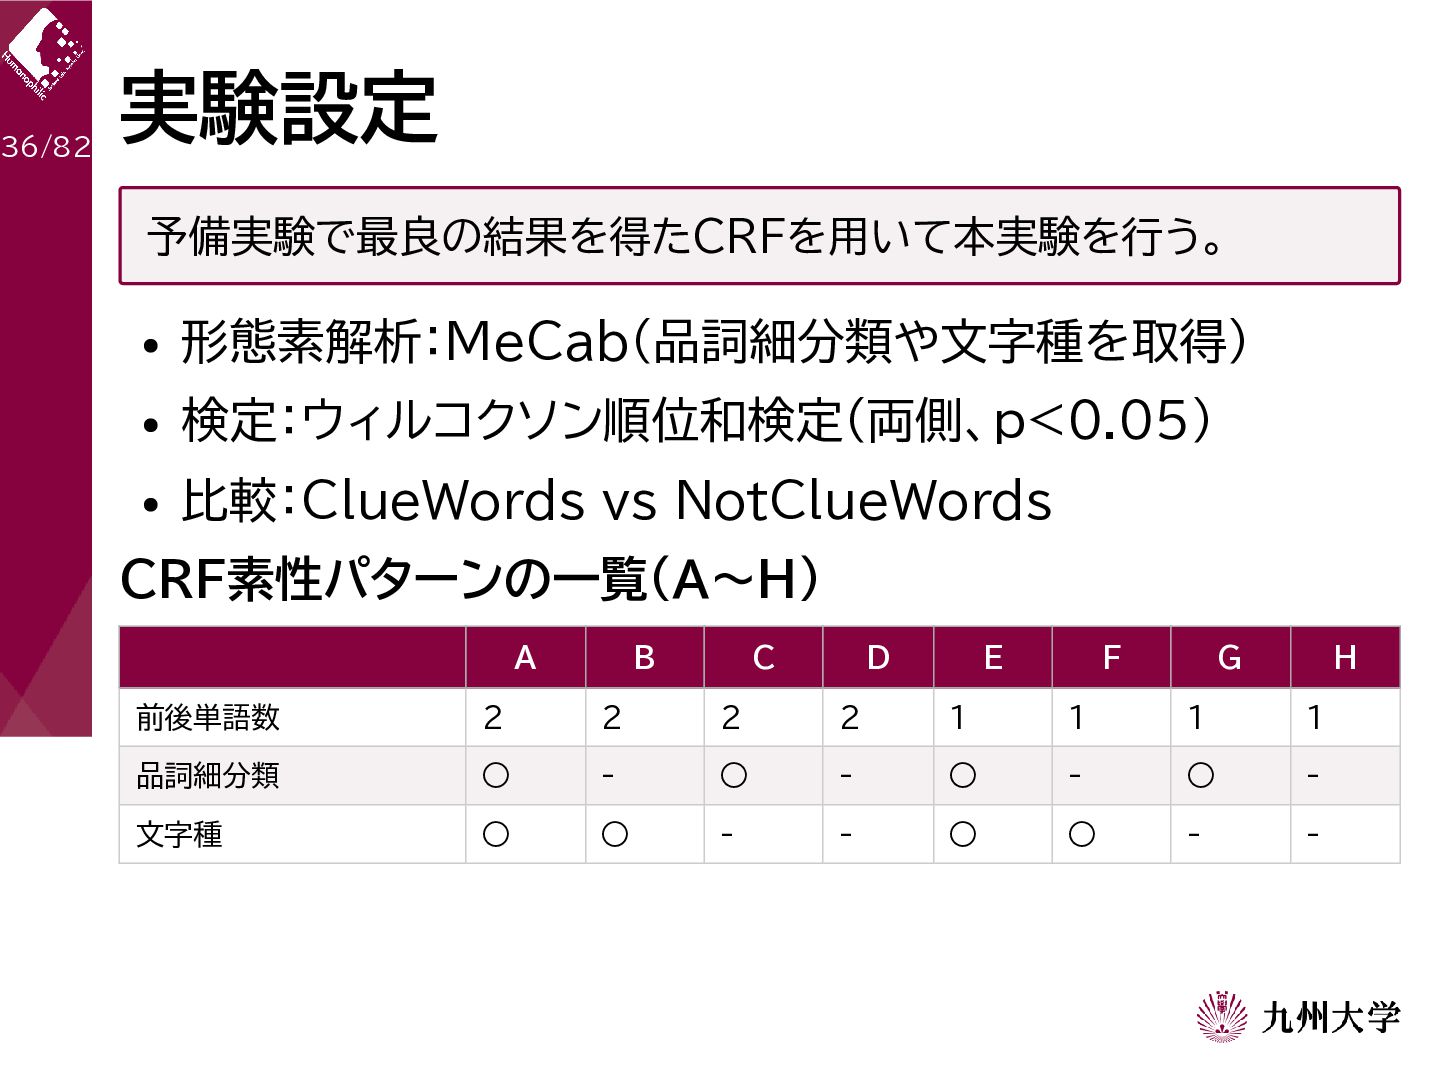
36/82 実験設定 予備実験で最良の結果を得たCRFを用いて本実験を行う。 形態素解析:MeCab(品詞細分類や文字種を取得) 検定:ウィルコクソン順位和検定(両側、p<0.05) 比較:ClueWords vs NotClueWords CRF素性パターンの一覧(A〜H) A
B C D E F G H 前後単語数 2 2 2 2 1 1 1 1 品詞細分類 ◦ - ◦ - ◦ - ◦ - 文字種 ◦ ◦ - - ◦ ◦ - - -
37/82 手掛かり語タグに関するRQ 再掲 手掛かり語タグはクラス数の増加を伴い、他タグへの悪影響の懸念 がある。そこで3つのリサーチクエスチョンを設定し、検証する。 RQ1) 手掛かり語タグにより抽出対象タグの付与性能は 低下するか RQ2) 手掛かり語タグが影響を与える可能性のあるタグ
およびその性質はどのようなものか RQ3) 手掛かり語タグのラベリングにより有益な手掛かり 語が獲得できるか -
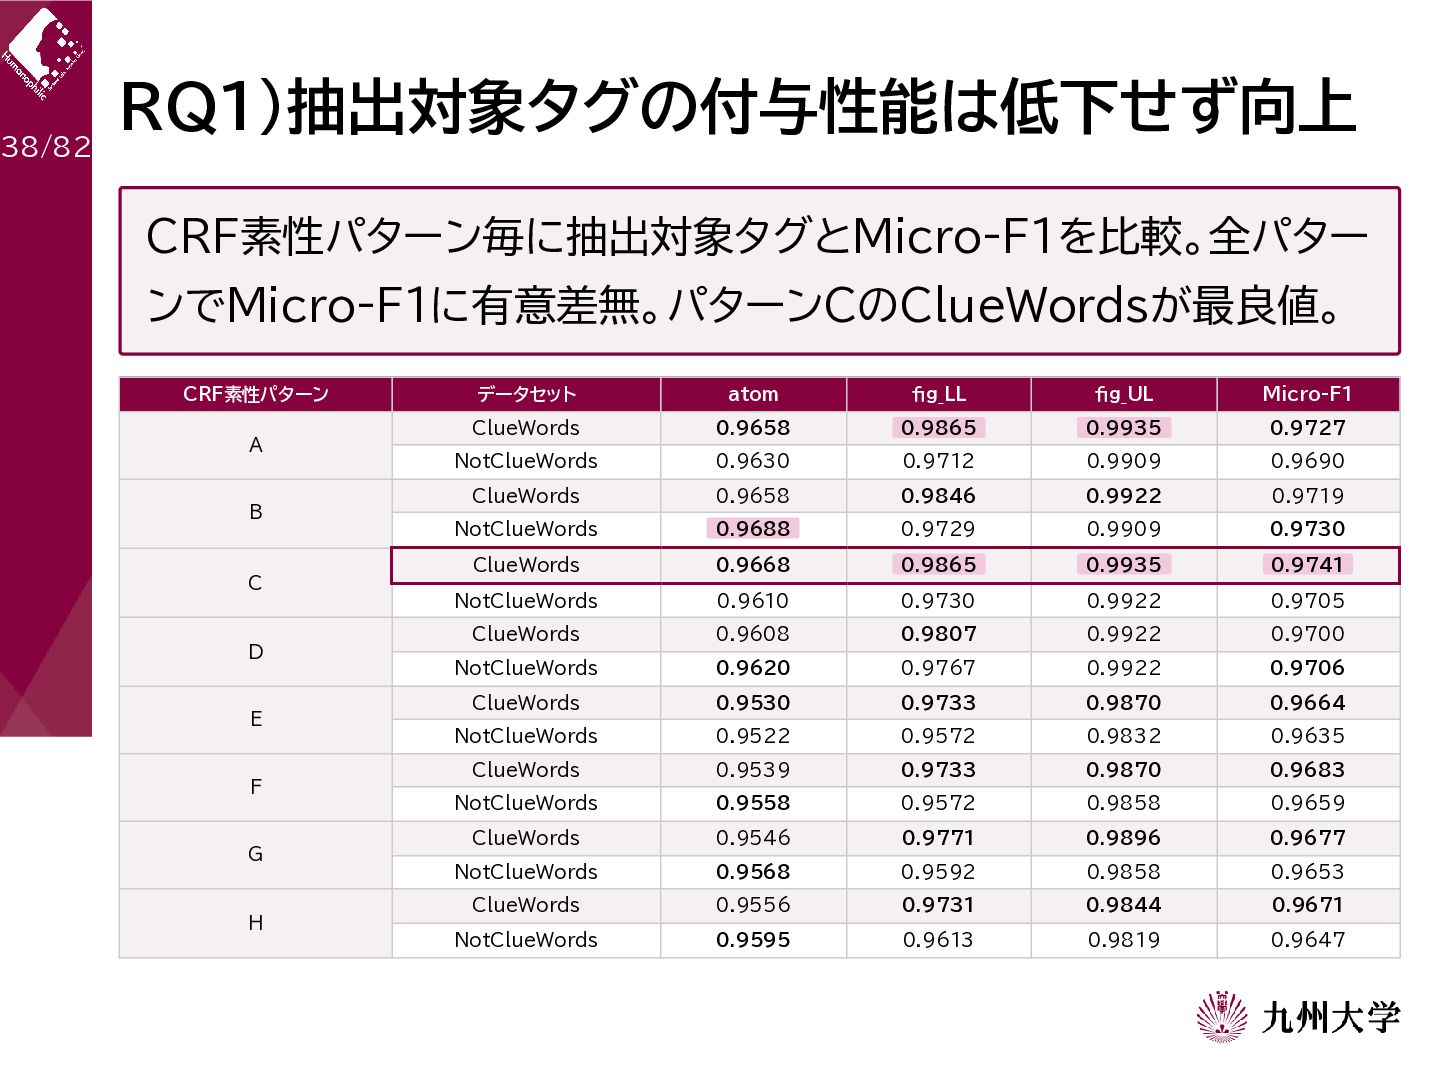
38/82 RQ1)抽出対象タグの付与性能は低下せず向上 CRF素性パターン毎に抽出対象タグとMicro-F1を比較。全パター ンでMicro-F1に有意差無。パターンCのClueWordsが最良値。 CRF素性パターン A B C D E
F G H データセット atom fig_LL fig_UL Micro-F1 ClueWords 0.9658 0.9865 0.9935 0.9727 NotClueWords 0.9630 0.9712 0.9909 0.9690 ClueWords 0.9658 0.9846 0.9922 0.9719 NotClueWords 0.9688 0.9729 0.9909 0.9730 ClueWords 0.9668 0.9865 0.9935 0.9741 NotClueWords 0.9610 0.9730 0.9922 0.9705 ClueWords 0.9608 0.9807 0.9922 0.9700 NotClueWords 0.9620 0.9767 0.9922 0.9706 ClueWords 0.9530 0.9733 0.9870 0.9664 NotClueWords 0.9522 0.9572 0.9832 0.9635 ClueWords 0.9539 0.9733 0.9870 0.9683 NotClueWords 0.9558 0.9572 0.9858 0.9659 ClueWords 0.9546 0.9771 0.9896 0.9677 NotClueWords 0.9568 0.9592 0.9858 0.9653 ClueWords 0.9556 0.9731 0.9844 0.9671 NotClueWords 0.9595 0.9613 0.9819 0.9647 -
39/82 手掛かり語タグに関するRQ 再掲 手掛かり語タグはクラス数の増加を伴い、他タグへの悪影響の懸念 がある。そこで3つのリサーチクエスチョンを設定し、検証する。 RQ1) 手掛かり語タグにより抽出対象タグの付与性能は 低下するか RQ2) 手掛かり語タグが影響を与える可能性のあるタグ
およびその性質はどのようなものか RQ3) 手掛かり語タグのラベリングにより有益な手掛かり 語が獲得できるか -
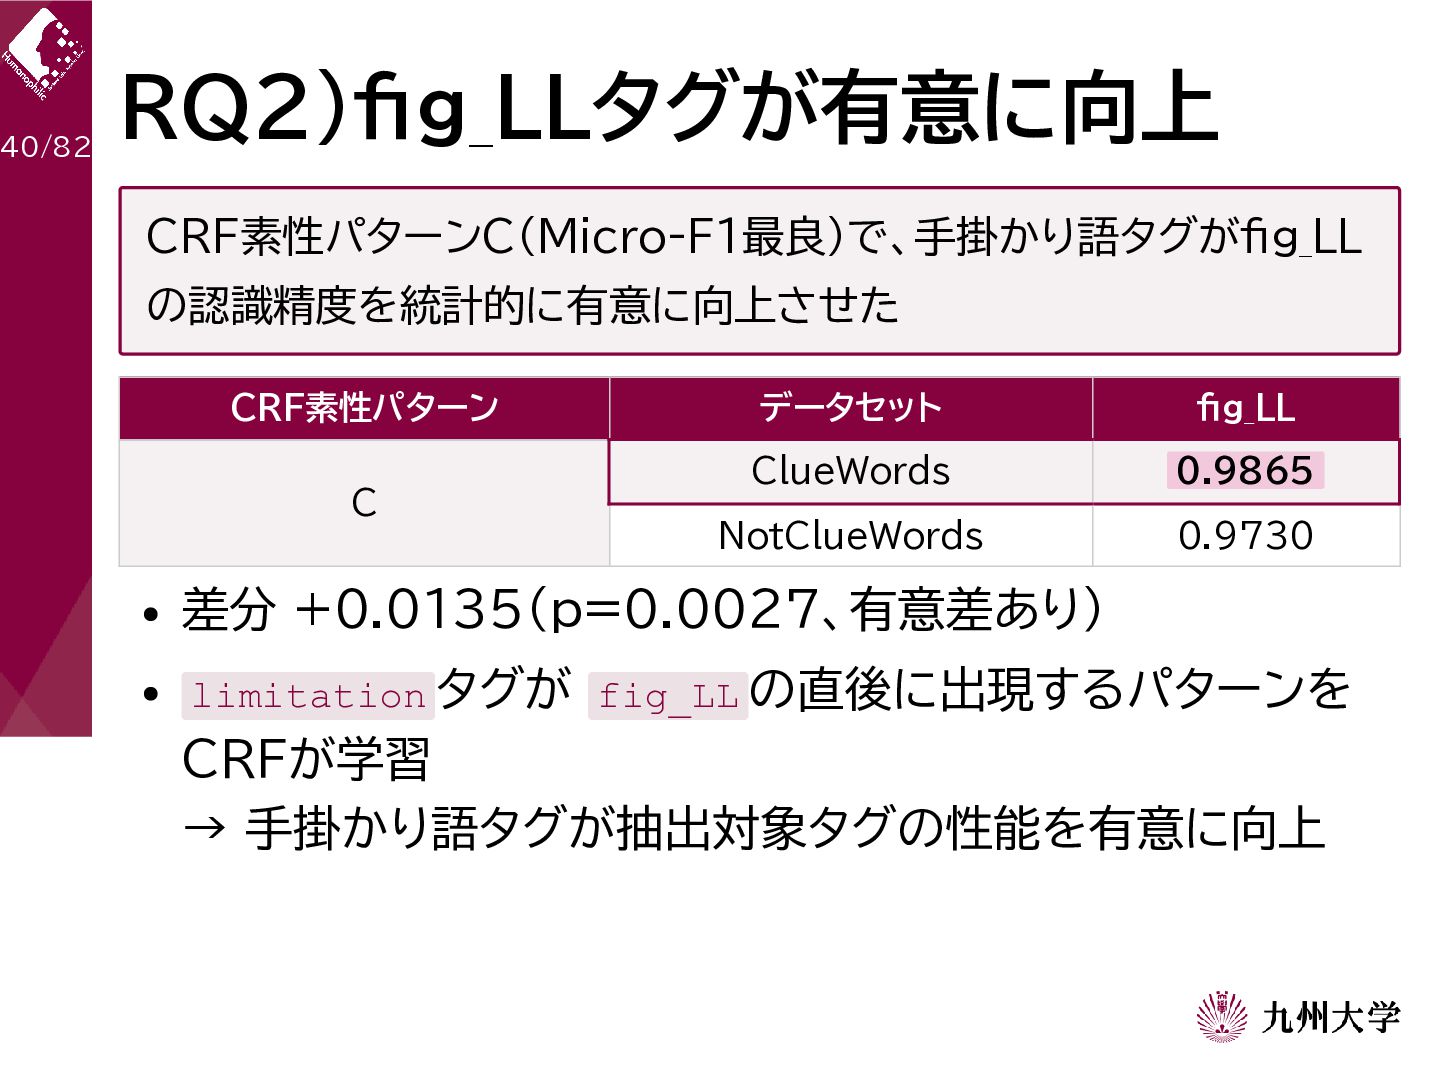
40/82 RQ2)fig_LLタグが有意に向上 CRF素性パターンC(Micro-F1最良)で、手掛かり語タグがfig_LL の認識精度を統計的に有意に向上させた CRF素性パターン C データセット fig_LL ClueWords 0.9865
NotClueWords 0.9730 差分 +0.0135(p=0.0027、有意差あり) limitation タグが fig_LL の直後に出現するパターンを CRFが学習 → 手掛かり語タグが抽出対象タグの性能を有意に向上 -
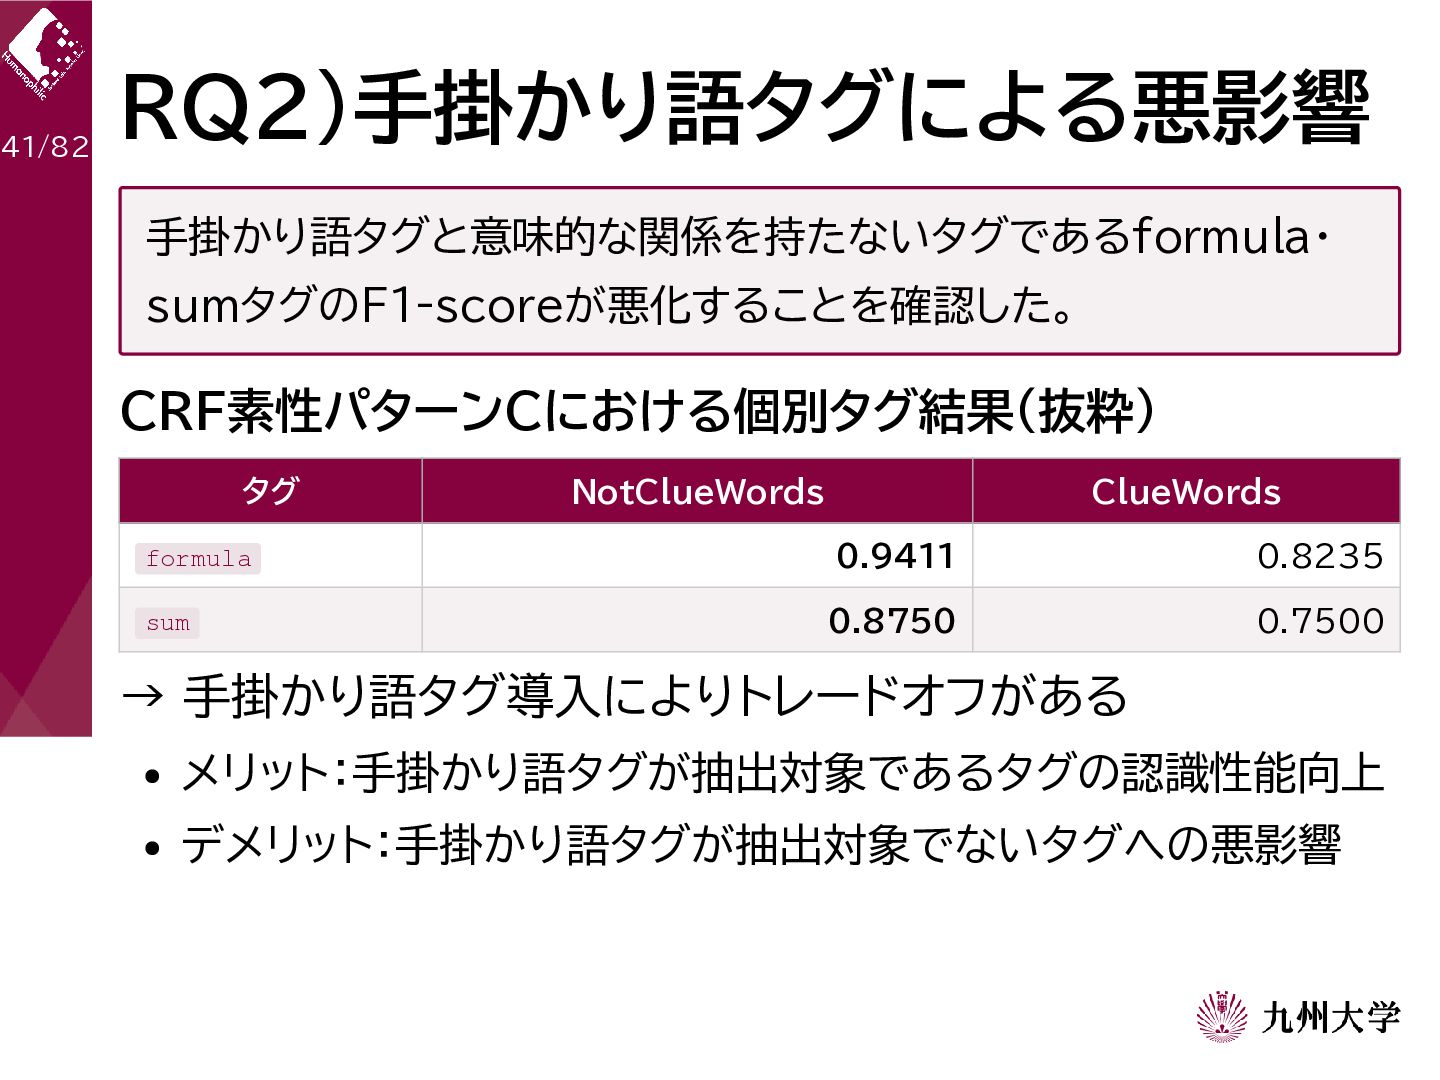
41/82 RQ2)手掛かり語タグによる悪影響 手掛かり語タグと意味的な関係を持たないタグであるformula・ sumタグのF1-scoreが悪化することを確認した。 CRF素性パターンCにおける個別タグ結果(抜粋) タグ NotClueWords ClueWords formula 0.9411
0.8235 sum 0.8750 0.7500 → 手掛かり語タグ導入によりトレードオフがある メリット:手掛かり語タグが抽出対象であるタグの認識性能向上 デメリット:手掛かり語タグが抽出対象でないタグへの悪影響 -
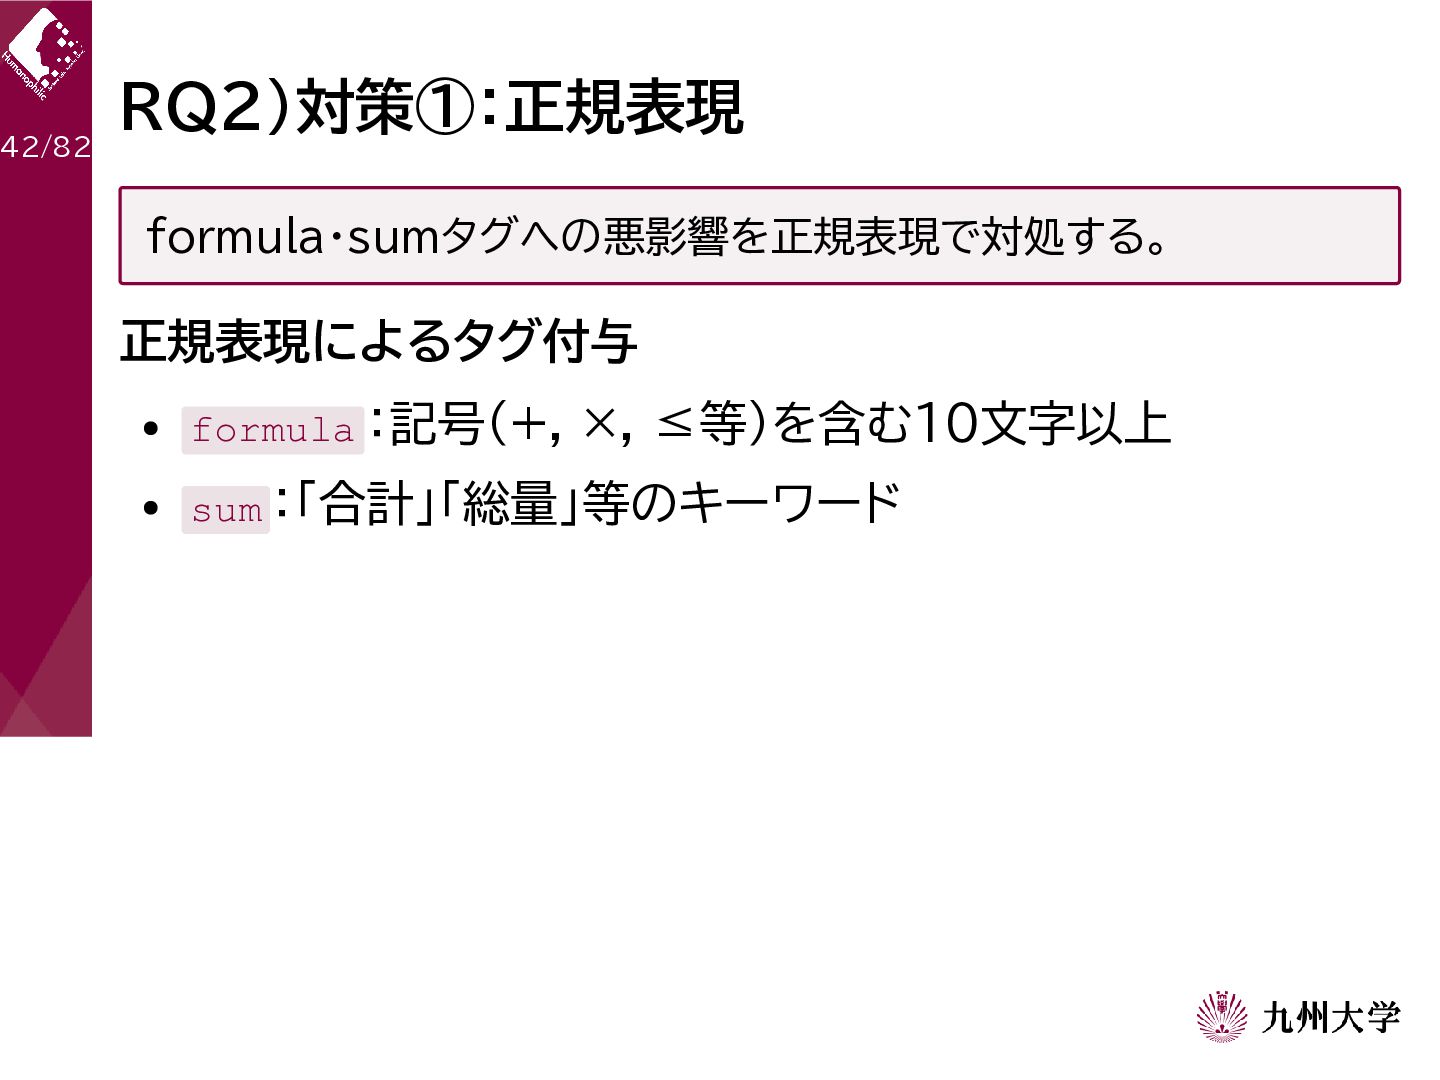
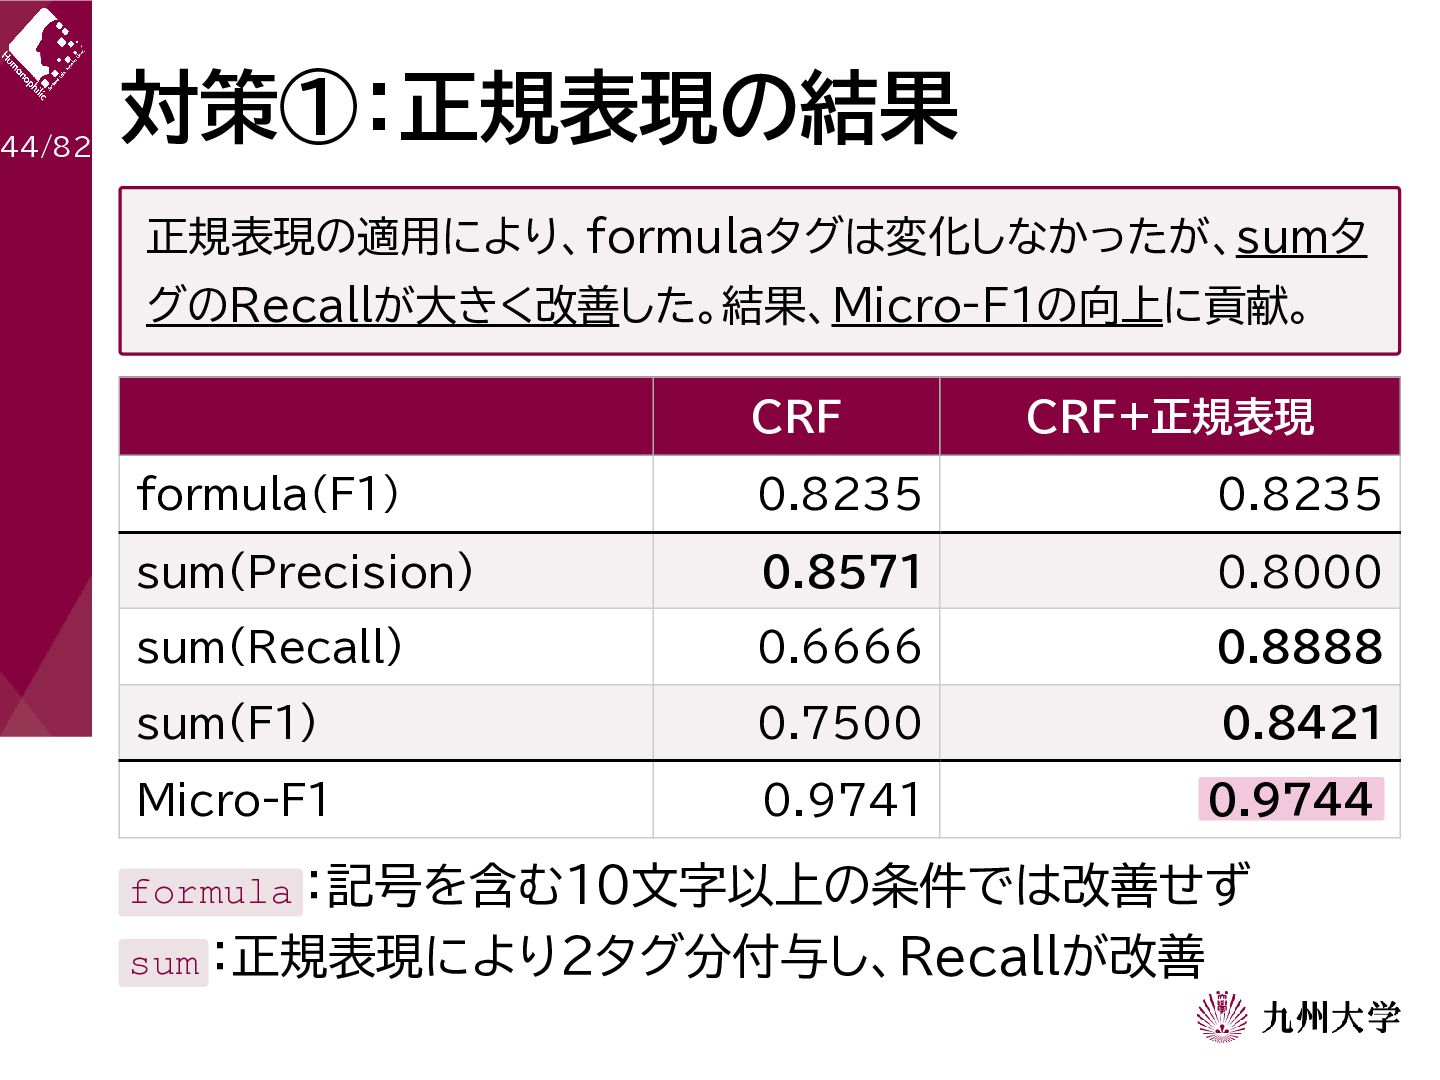
44/82 対策①:正規表現の結果 正規表現の適用により、formulaタグは変化しなかったが、sumタ グのRecallが大きく改善した。結果、Micro-F1の向上に貢献。 CRF CRF+正規表現 formula(F1) 0.8235 0.8235 sum(Precision)
0.8571 0.8000 sum(Recall) 0.6666 0.8888 sum(F1) 0.7500 0.8421 Micro-F1 0.9741 0.9744 formula :記号を含む10文字以上の条件では改善せず sum :正規表現により2タグ分付与し、Recallが改善 -
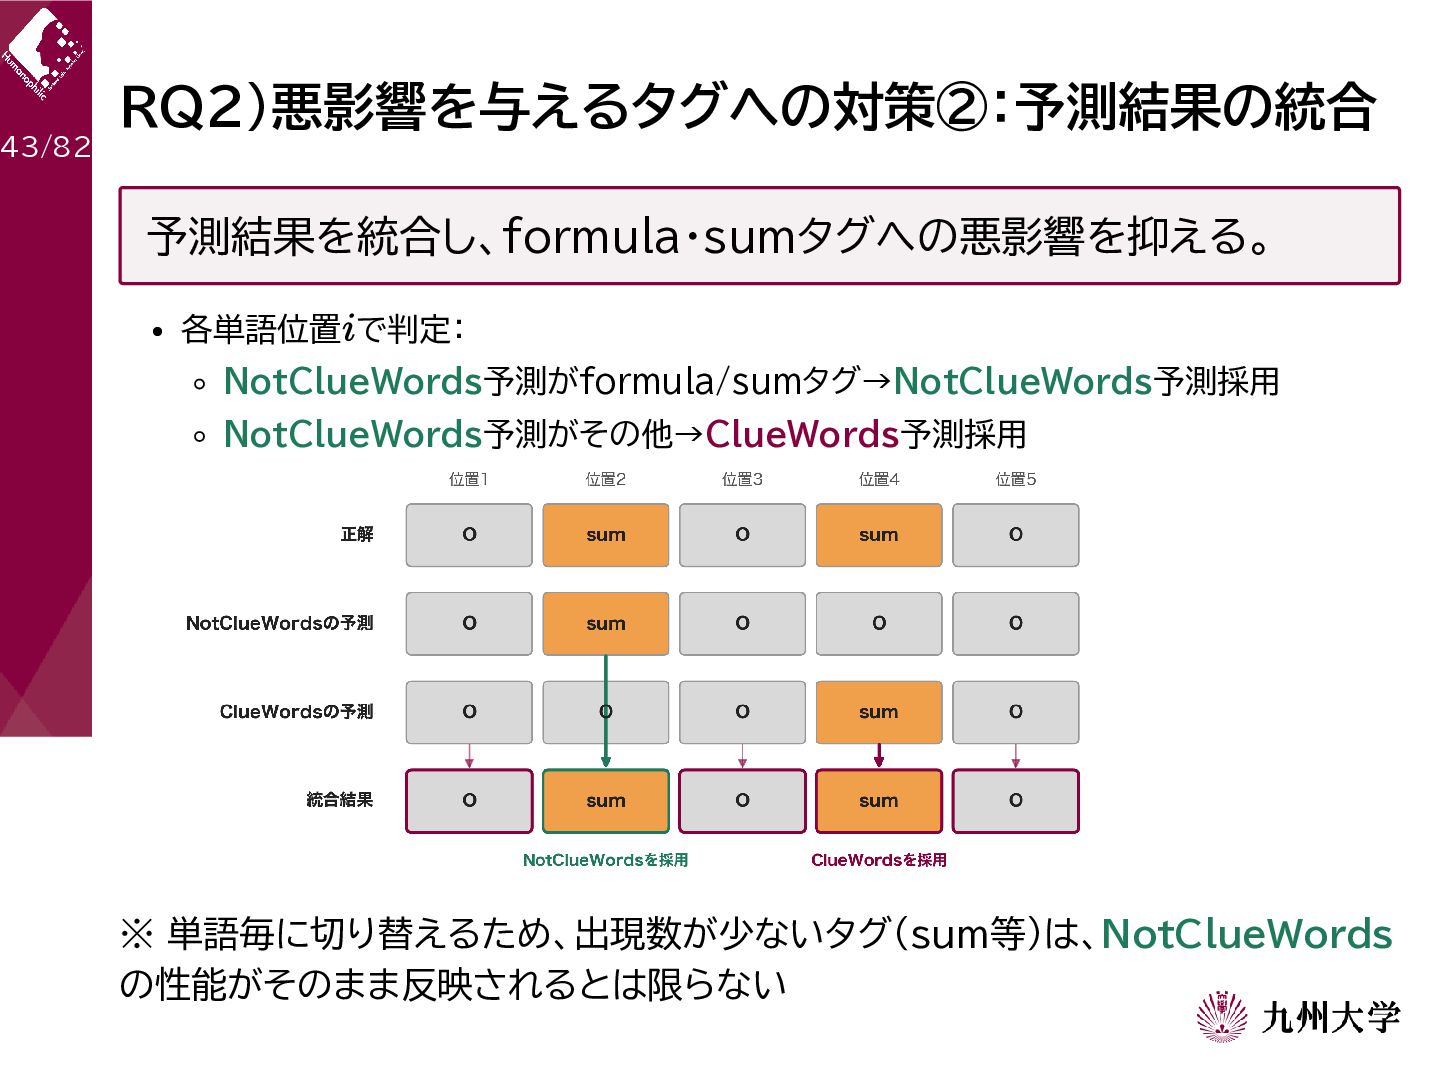
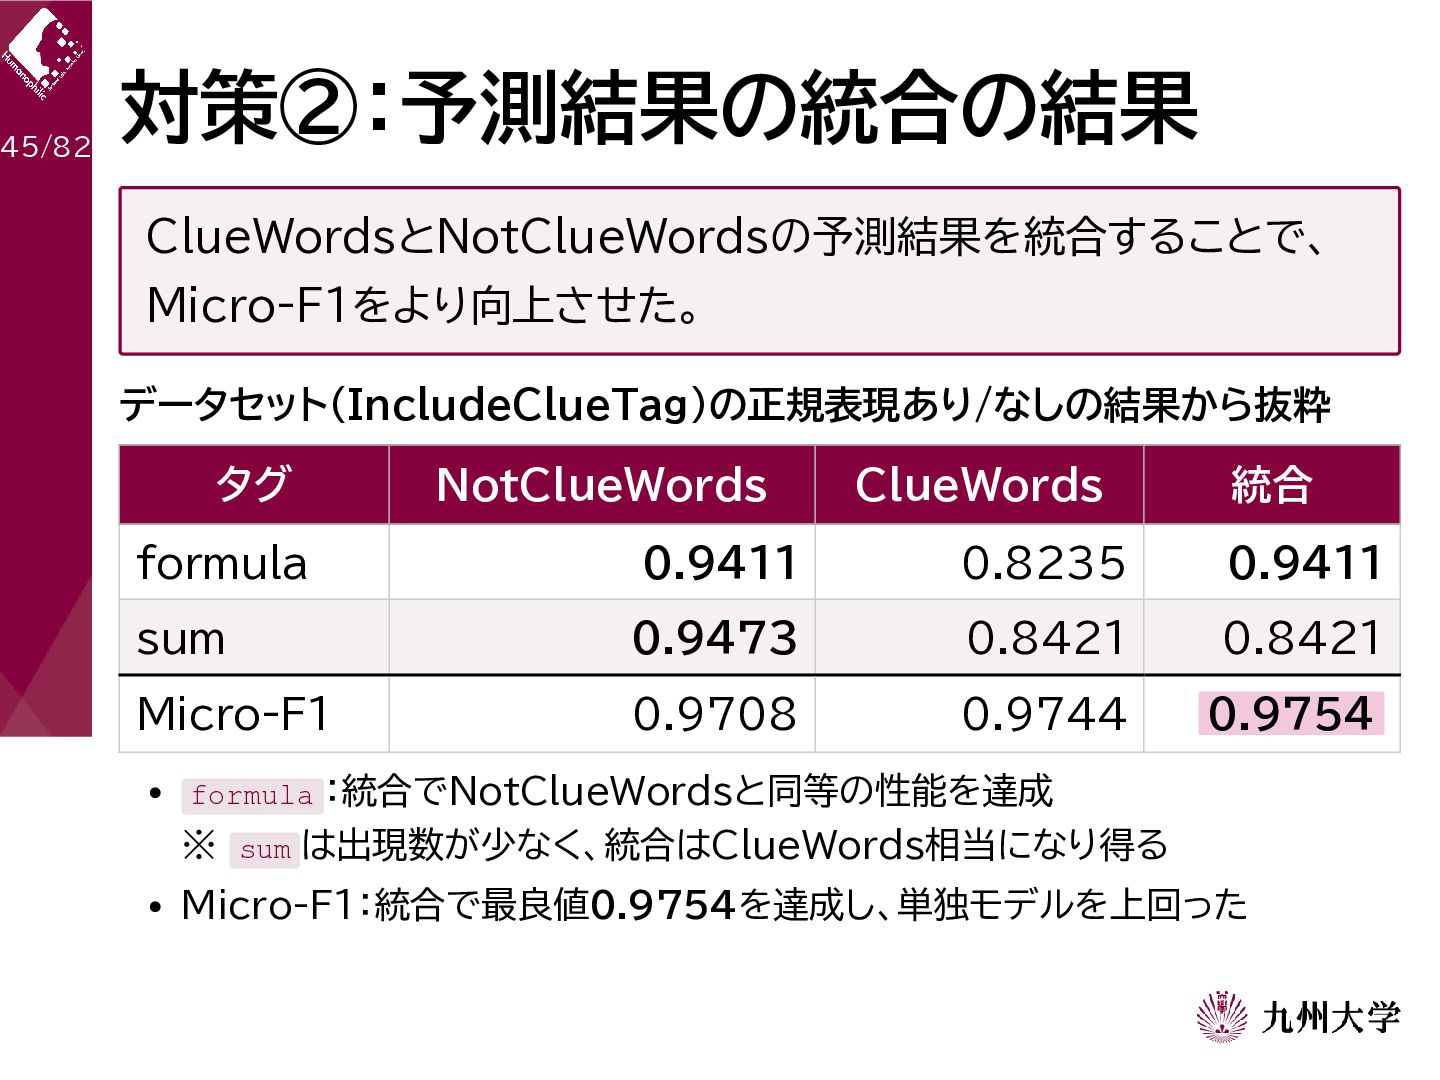
45/82 対策②:予測結果の統合の結果 ClueWordsとNotClueWordsの予測結果を統合することで、 Micro-F1をより向上させた。 データセット(IncludeClueTag)の正規表現あり/なしの結果から抜粋 タグ NotClueWords ClueWords 統合 formula
0.9411 0.8235 0.9411 sum 0.9473 0.8421 0.8421 Micro-F1 0.9708 0.9744 0.9754 formula :統合でNotClueWordsと同等の性能を達成 ※ sum は出現数が少なく、統合はClueWords相当になり得る Micro-F1:統合で最良値0.9754を達成し、単独モデルを上回った -
46/82 手掛かり語タグに関するRQ 再掲 手掛かり語タグはクラス数の増加を伴い、他タグへの悪影響の懸念 がある。そこで3つのリサーチクエスチョンを設定し、検証する。 RQ1) 手掛かり語タグにより抽出対象タグの付与性能は 低下するか RQ2) 手掛かり語タグが影響を与える可能性のあるタグ
およびその性質はどのようなものか RQ3) 手掛かり語タグのラベリングにより有益な手掛か り語が獲得できるか -
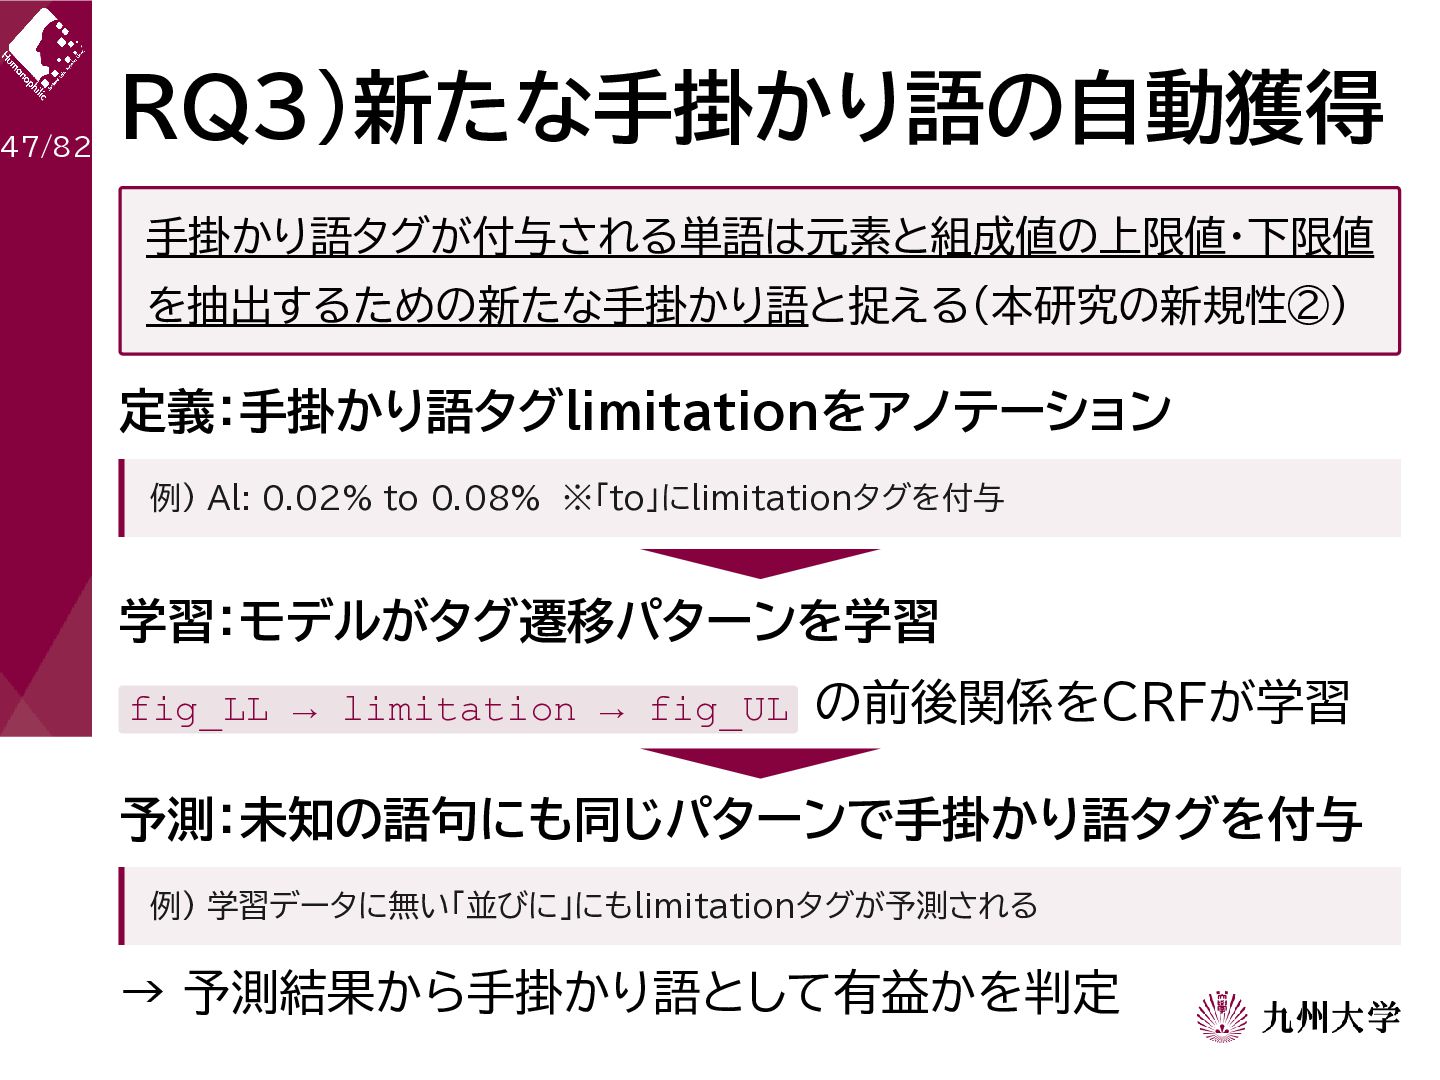
47/82 RQ3)新たな手掛かり語の自動獲得 手掛かり語タグが付与される単語は元素と組成値の上限値・下限値 を抽出するための新たな手掛かり語と捉える(本研究の新規性②) 定義:手掛かり語タグlimitationをアノテーション 例) Al: 0.02% to 0.08%
※「to」にlimitationタグを付与 学習:モデルがタグ遷移パターンを学習 fig_LL → limitation → fig_UL の前後関係をCRFが学習 予測:未知の語句にも同じパターンで手掛かり語タグを付与 例) 学習データに無い「並びに」にもlimitationタグが予測される → 予測結果から手掛かり語として有益かを判定 -
48/82 手掛かり語タグに関するRQ 再掲 手掛かり語タグはクラス数の増加を伴い、他タグへの悪影響の懸念 がある。そこで3つのリサーチクエスチョンを設定し、検証する。 RQ1) 手掛かり語タグにより抽出対象タグの付与性能は 低下するか RQ2) 手掛かり語タグが影響を与える可能性のあるタグ
およびその性質はどのようなものか RQ3) 手掛かり語タグのラベリングにより有益な手掛か り語が獲得できるか -
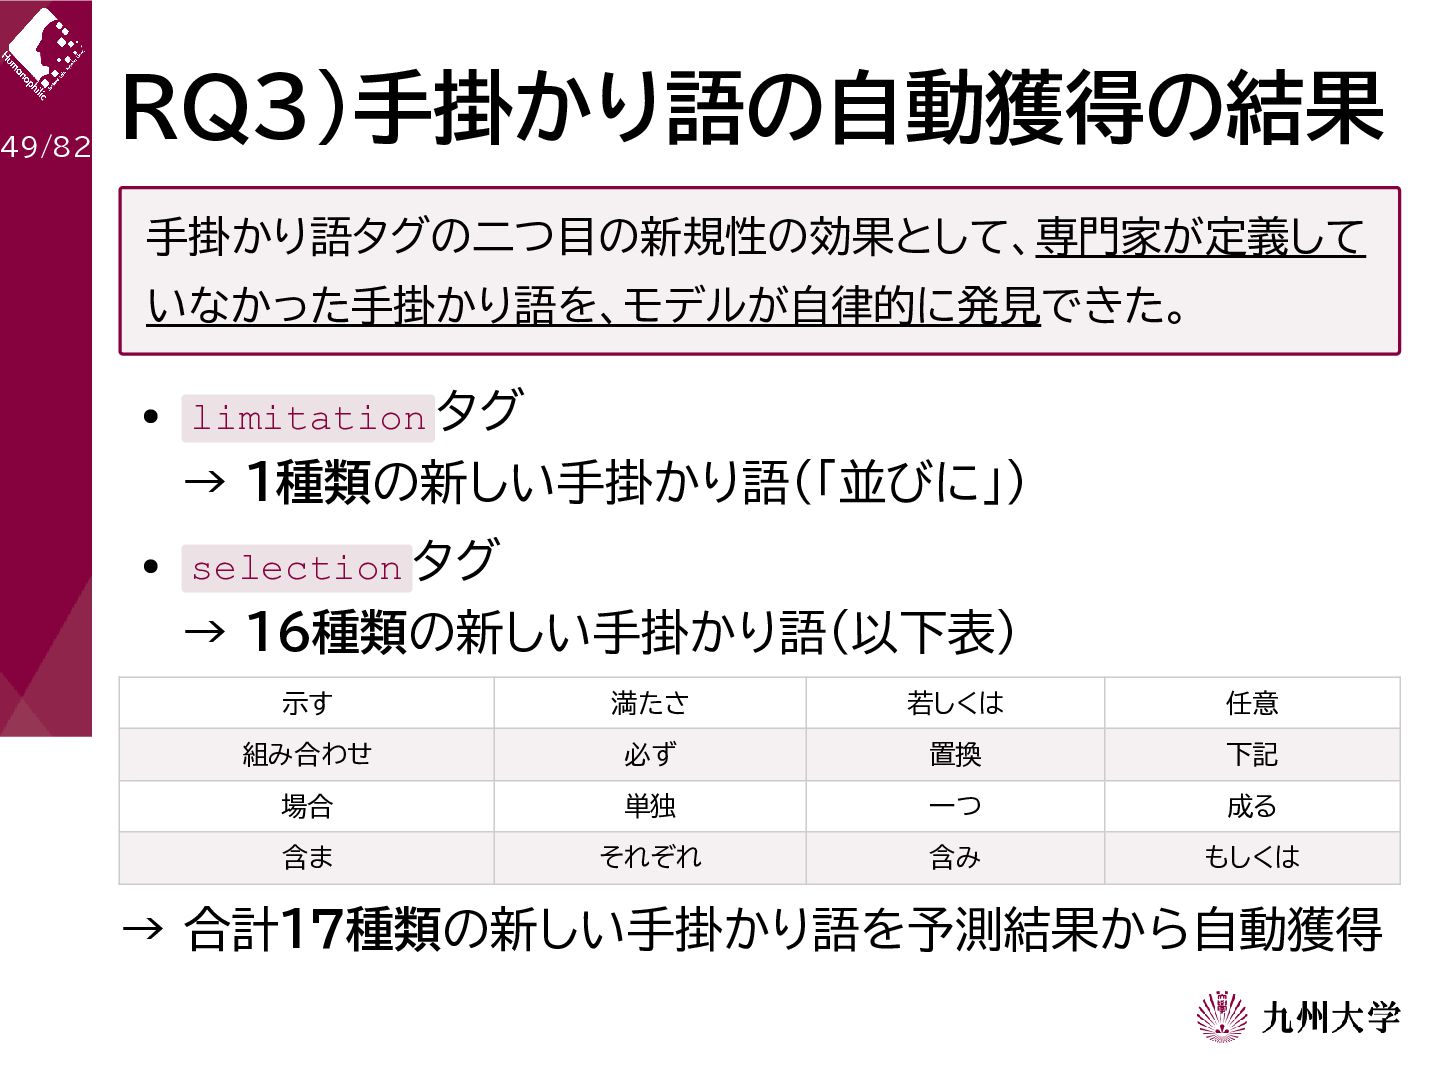
49/82 RQ3)手掛かり語の自動獲得の結果 手掛かり語タグの二つ目の新規性の効果として、専門家が定義して いなかった手掛かり語を、モデルが自律的に発見できた。 limitation タグ → 1種類の新しい手掛かり語(「並びに」) selection タグ
→ 16種類の新しい手掛かり語(以下表) 示す 満たさ 若しくは 任意 組み合わせ 必ず 置換 下記 場合 単独 一つ 成る 含ま それぞれ 含み もしくは → 合計17種類の新しい手掛かり語を予測結果から自動獲得 -
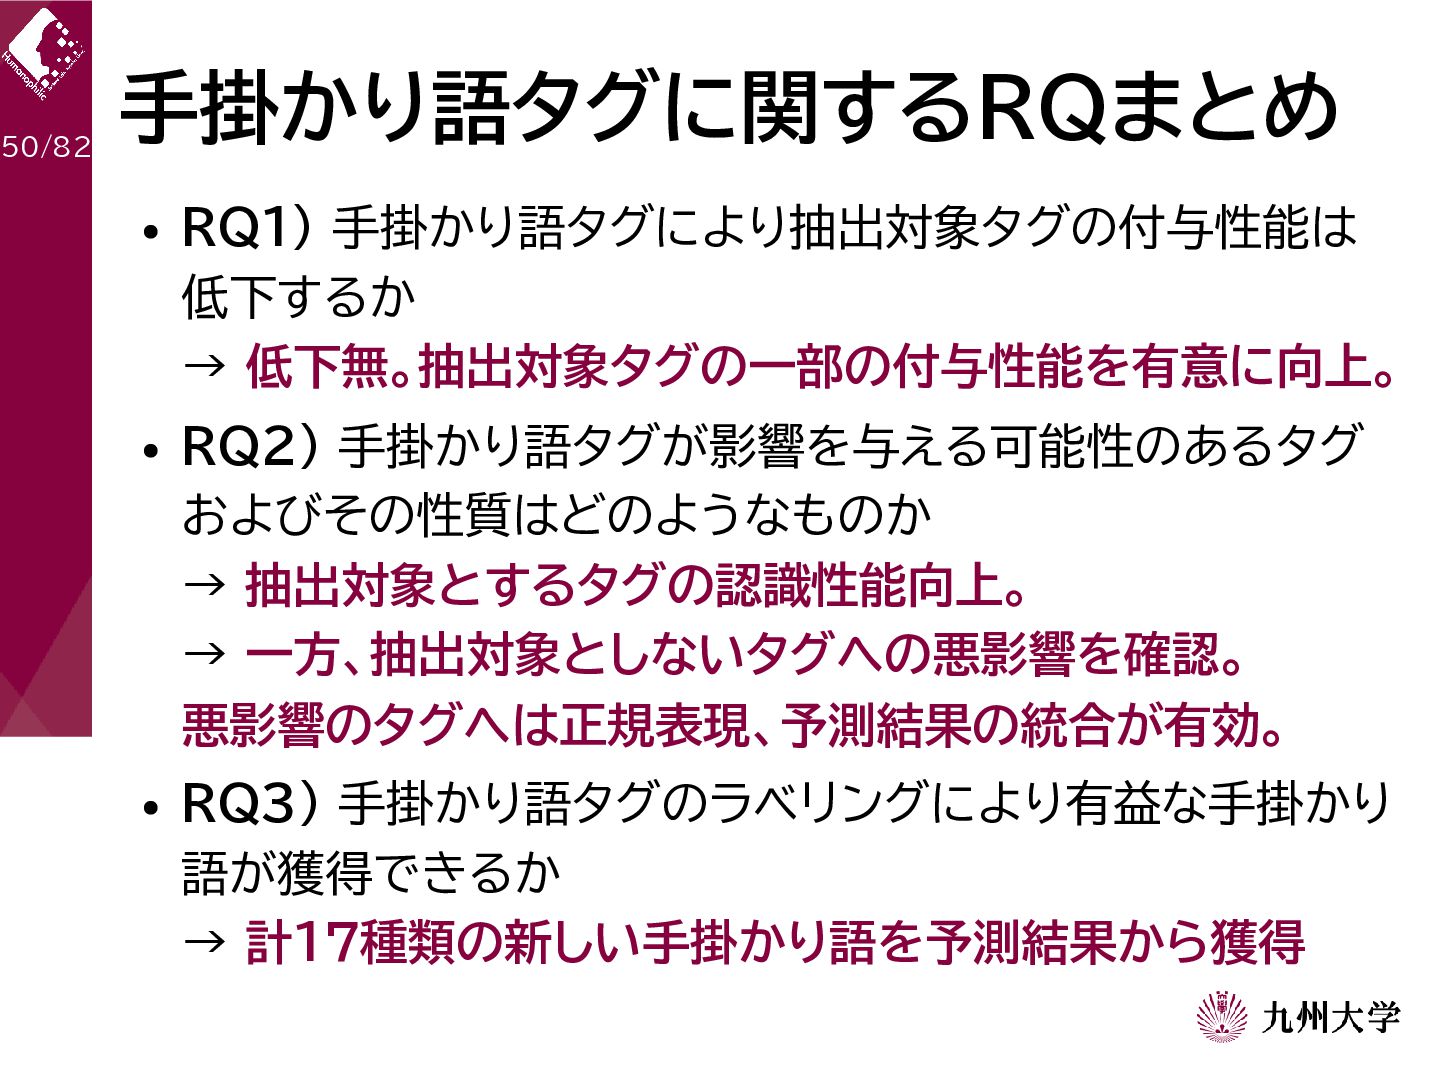
50/82 手掛かり語タグに関するRQまとめ RQ1) 手掛かり語タグにより抽出対象タグの付与性能は 低下するか → 低下無。抽出対象タグの一部の付与性能を有意に向上。 RQ2) 手掛かり語タグが影響を与える可能性のあるタグ およびその性質はどのようなものか
→ 抽出対象とするタグの認識性能向上。 → 一方、抽出対象としないタグへの悪影響を確認。 悪影響のタグへは正規表現、予測結果の統合が有効。 RQ3) 手掛かり語タグのラベリングにより有益な手掛かり 語が獲得できるか → 計17種類の新しい手掛かり語を予測結果から獲得 -
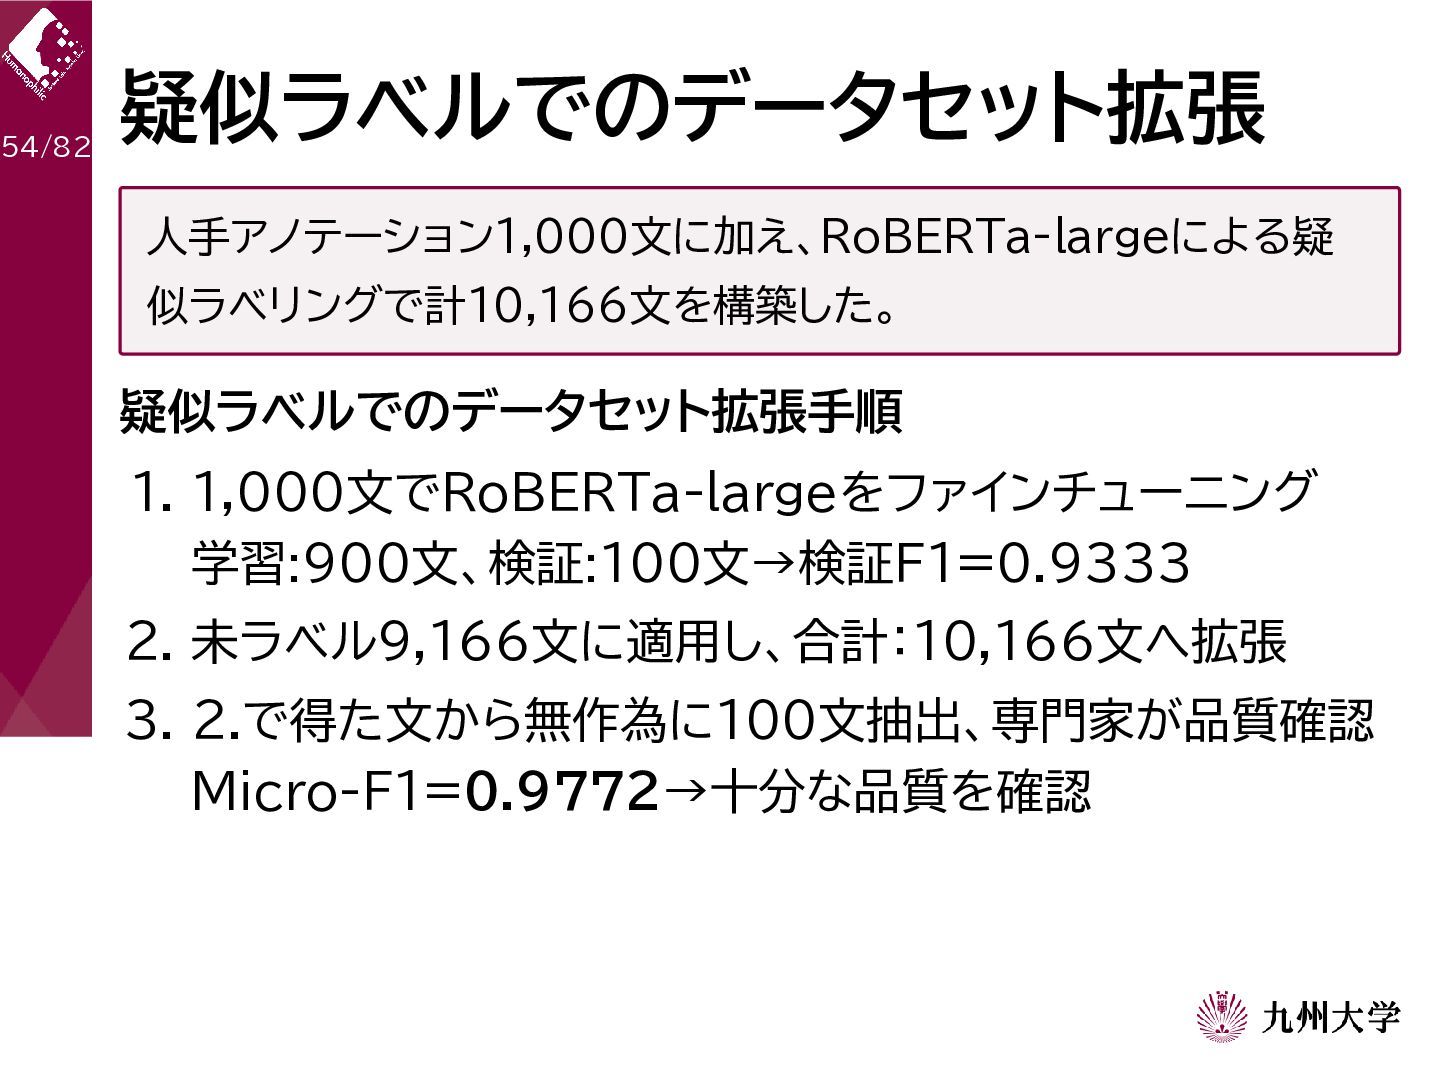
54/82 疑似ラベルでのデータセット拡張 人手アノテーション1,000文に加え、RoBERTa-largeによる疑 似ラベリングで計10,166文を構築した。 疑似ラベルでのデータセット拡張手順 1. 1,000文でRoBERTa-largeをファインチューニング 学習:900文、検証:100文→検証F1=0.9333 2. 未ラベル9,166文に適用し、合計:10,166文へ拡張
3. 2.で得た文から無作為に100文抽出、専門家が品質確認 Micro-F1=0.9772→十分な品質を確認 -
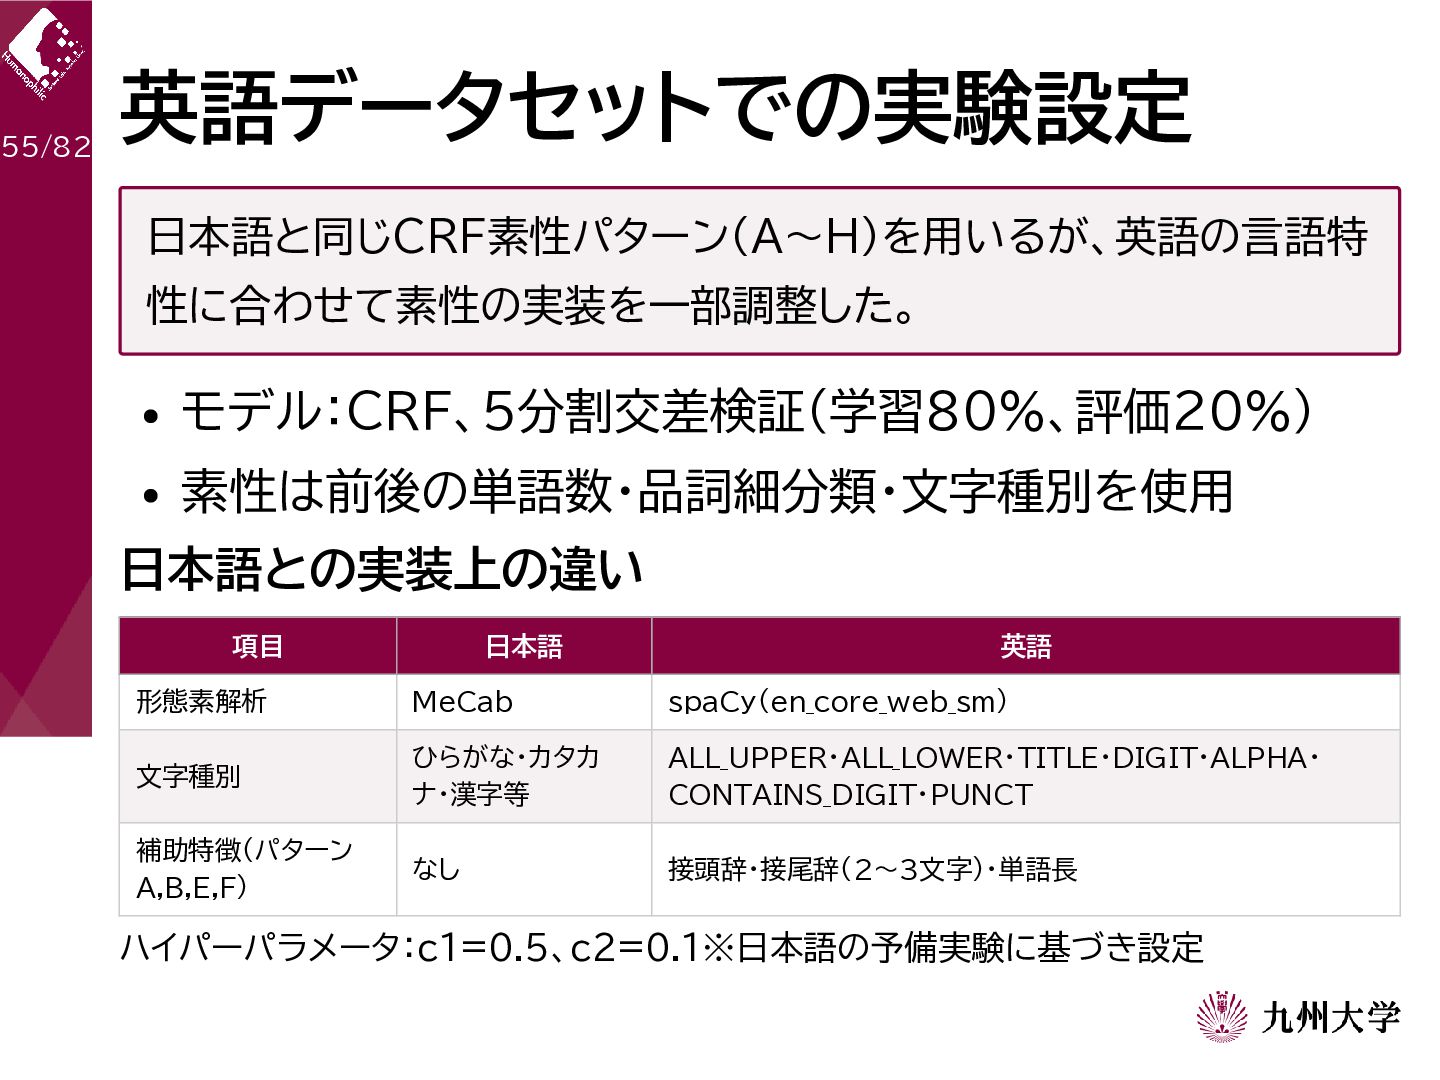
55/82 英語データセットでの実験設定 日本語と同じCRF素性パターン(A〜H)を用いるが、英語の言語特 性に合わせて素性の実装を一部調整した。 モデル:CRF、5分割交差検証(学習80%、評価20%) 素性は前後の単語数・品詞細分類・文字種別を使用 日本語との実装上の違い 項目 日本語 英語
形態素解析 MeCab spaCy(en_core_web_sm) 文字種別 ひらがな・カタカ ナ・漢字等 ALL_UPPER・ALL_LOWER・TITLE・DIGIT・ALPHA・ CONTAINS_DIGIT・PUNCT 補助特徴(パターン A,B,E,F) なし 接頭辞・接尾辞(2〜3文字)・単語長 ハイパーパラメータ:c1=0.5、c2=0.1※日本語の予備実験に基づき設定 -
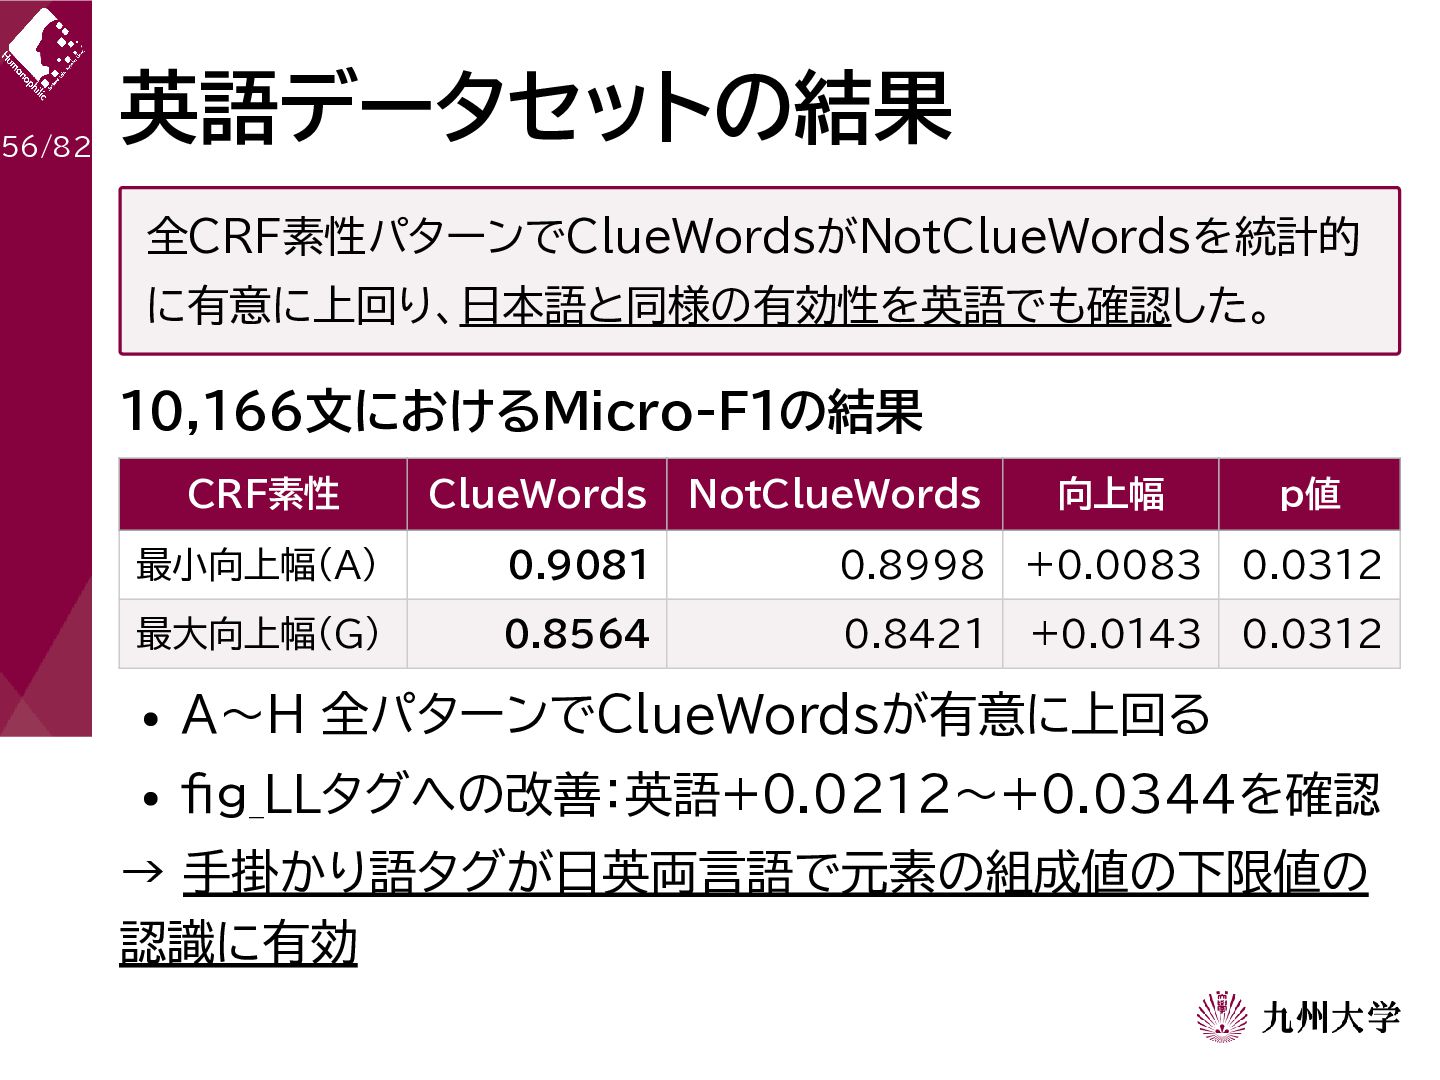
56/82 英語データセットの結果 全CRF素性パターンでClueWordsがNotClueWordsを統計的 に有意に上回り、日本語と同様の有効性を英語でも確認した。 10,166文におけるMicro-F1の結果 CRF素性 ClueWords NotClueWords 向上幅 p値
最小向上幅(A) 0.9081 0.8998 +0.0083 0.0312 最大向上幅(G) 0.8564 0.8421 +0.0143 0.0312 A〜H 全パターンでClueWordsが有意に上回る fig_LLタグへの改善:英語+0.0212〜+0.0344を確認 → 手掛かり語タグが日英両言語で元素の組成値の下限値の 認識に有効 -
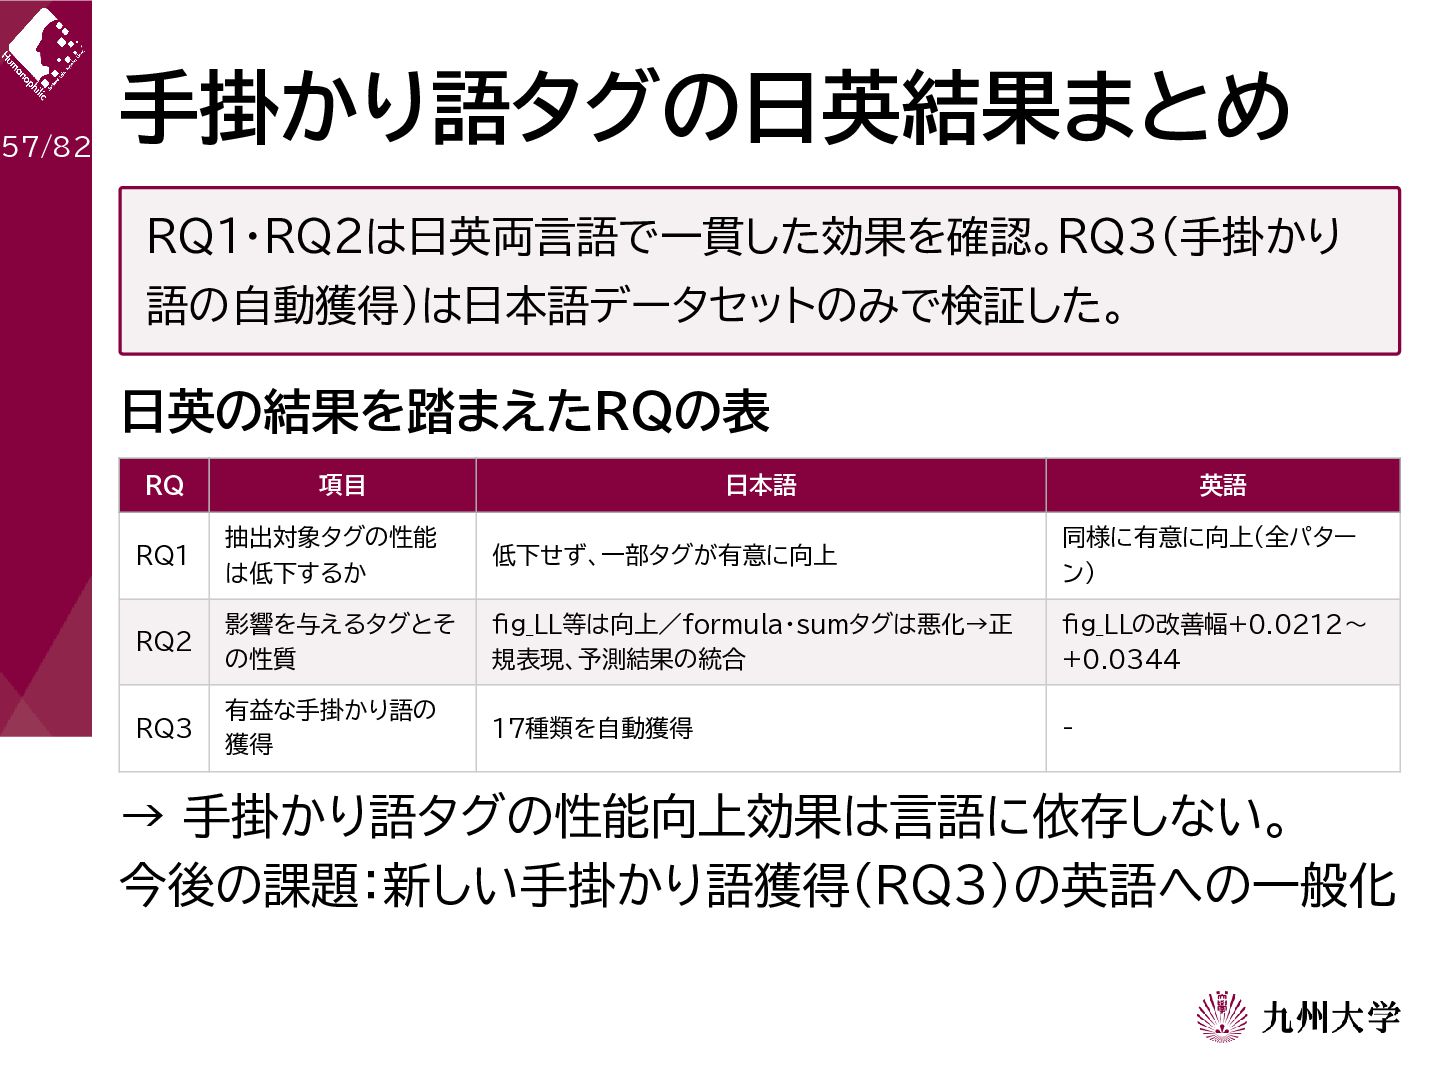
57/82 手掛かり語タグの日英結果まとめ RQ1・RQ2は日英両言語で一貫した効果を確認。RQ3(手掛かり 語の自動獲得)は日本語データセットのみで検証した。 日英の結果を踏まえたRQの表 RQ 項目 日本語 英語 RQ1
抽出対象タグの性能 は低下するか 低下せず、一部タグが有意に向上 同様に有意に向上(全パター ン) RQ2 影響を与えるタグとそ の性質 fig_LL等は向上/formula・sumタグは悪化→正 規表現、予測結果の統合 fig_LLの改善幅+0.0212〜 +0.0344 RQ3 有益な手掛かり語の 獲得 17種類を自動獲得 - → 手掛かり語タグの性能向上効果は言語に依存しない。 今後の課題:新しい手掛かり語獲得(RQ3)の英語への一般化 -
60/82 再掲 組成表現抽出における問題 複数の組成表現パターンが連続するとき、タグが正しく付与できた としても境界を識別することが困難である。 問題3:境界の識別が困難 wherein the steel comprises
Al: 0.02% to 0.08%, Si: 0.1% to 0.5% 固有表現認識モデルによりタグを付与 トークン Al 0.02 % to 0.08 % , Si 0.1 % to 0.5 % タグ atom fig_LL unit O fig_UL unit O atom fig_LL unit O fig_UL unit パターン RRA008 RRA008 → 2つの組成表現パターンの境界を識別できない → データセット全体でパターンを列挙するとどうなるか? -
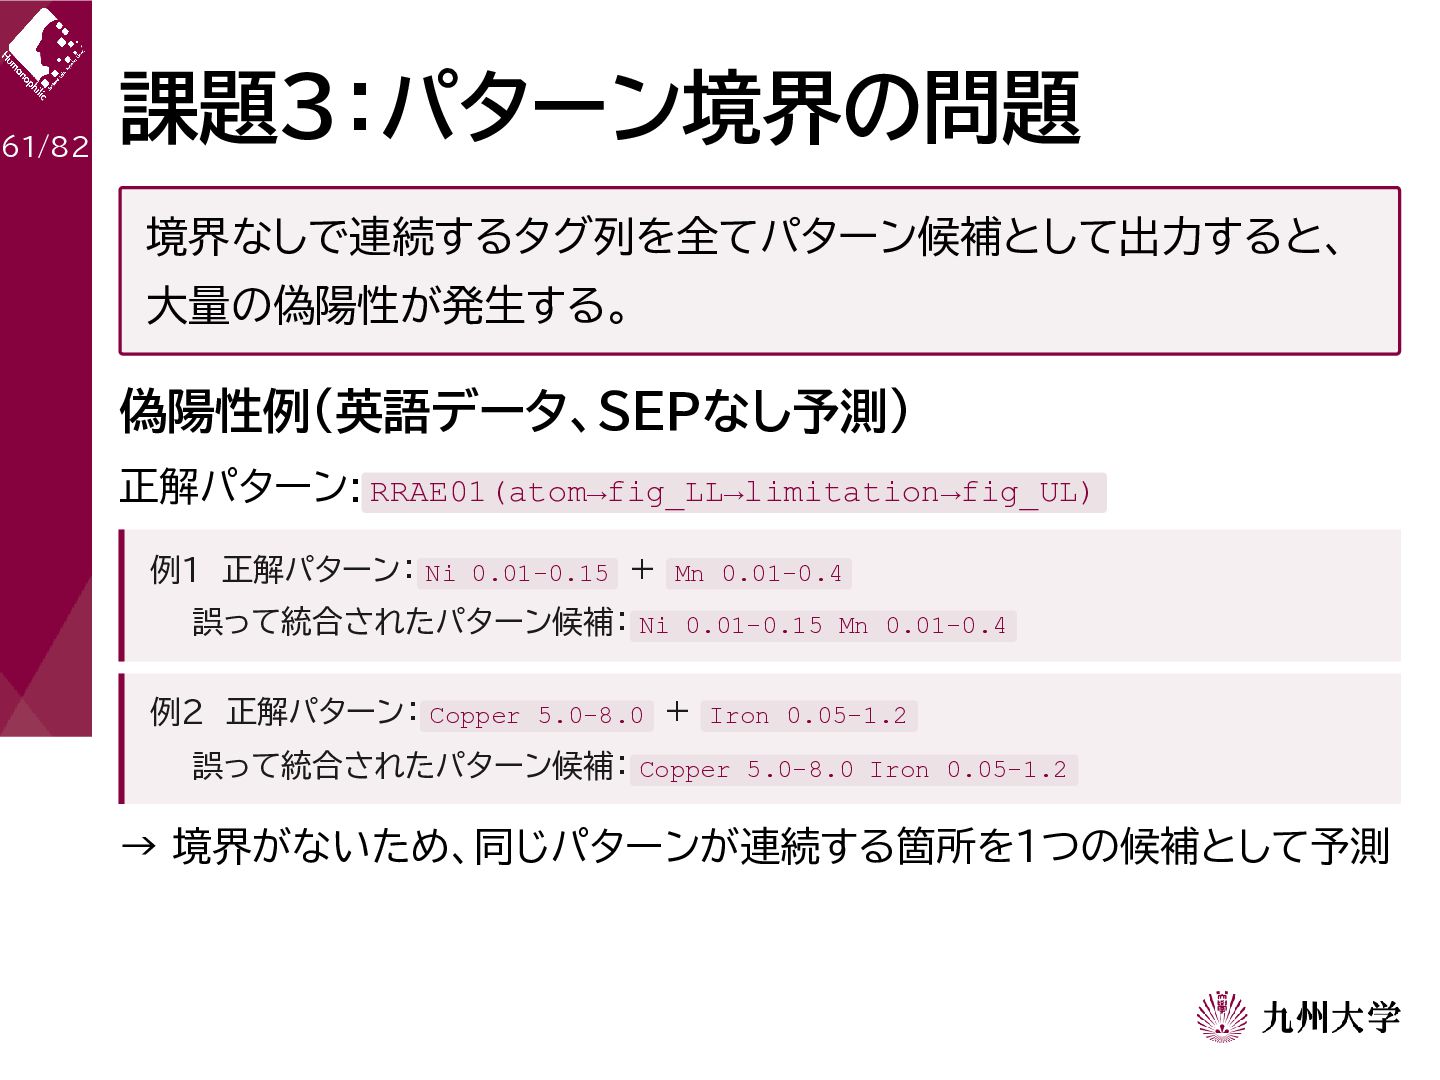
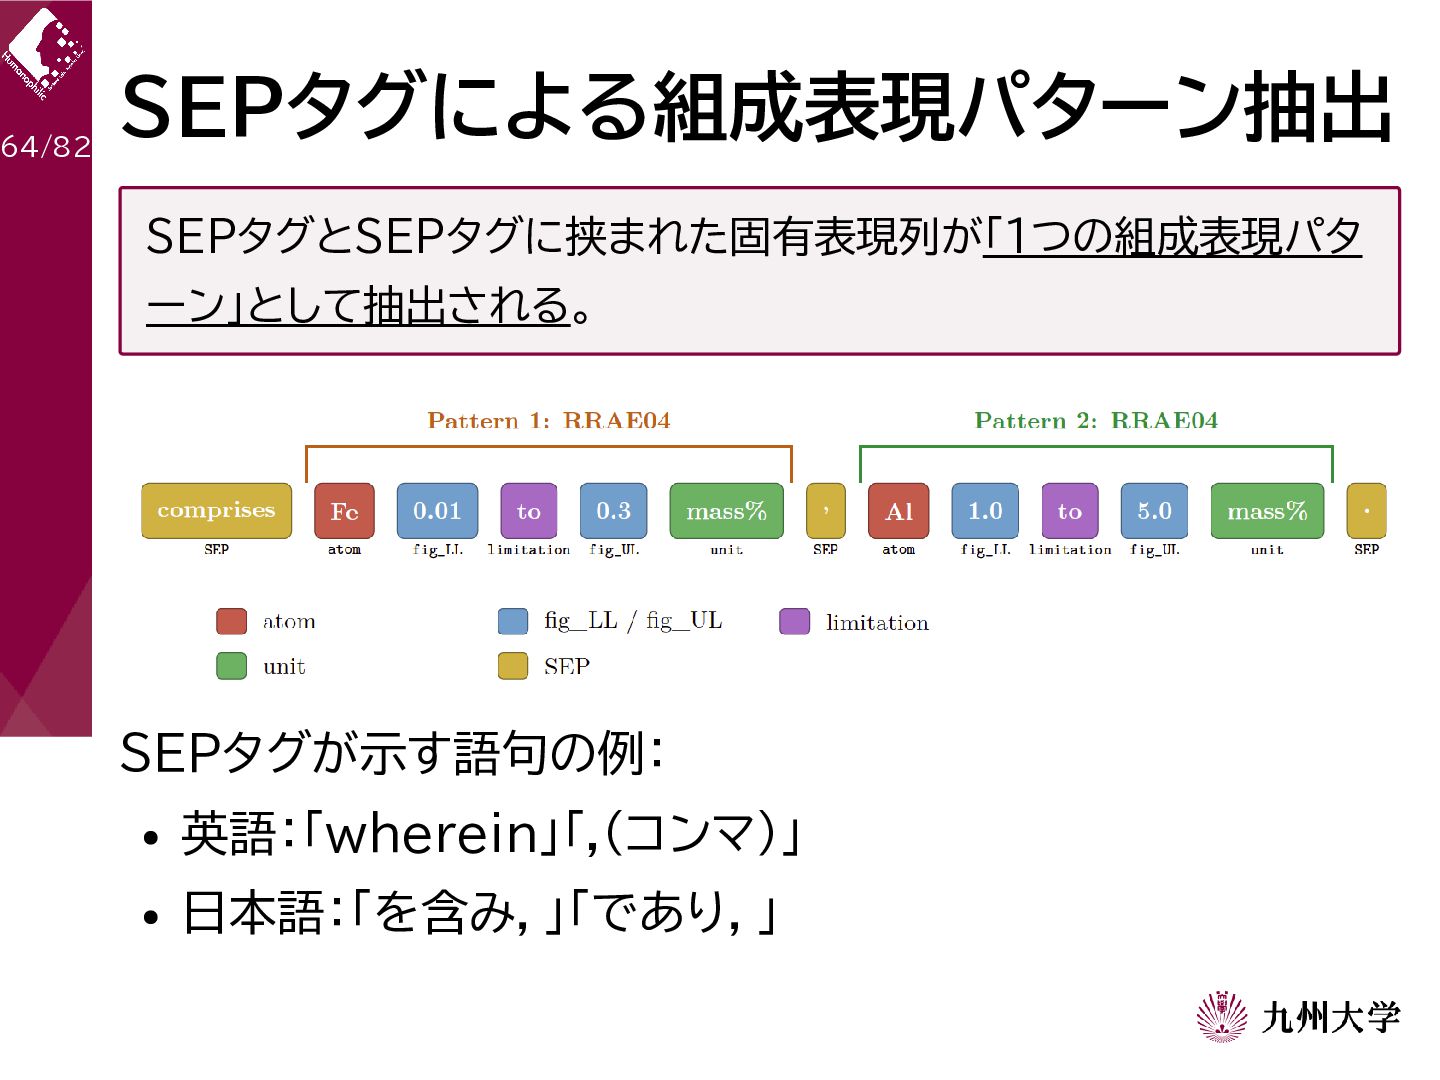
61/82 課題3:パターン境界の問題 境界なしで連続するタグ列を全てパターン候補として出力すると、 大量の偽陽性が発生する。 偽陽性例(英語データ、SEPなし予測) 正解パターン: RRAE01(atom→fig_LL→limitation→fig_UL) 例1 正解パターン: Ni
0.01-0.15 + Mn 0.01-0.4 誤って統合されたパターン候補: Ni 0.01-0.15 Mn 0.01-0.4 例2 正解パターン: Copper 5.0-8.0 + Iron 0.05-1.2 誤って統合されたパターン候補: Copper 5.0-8.0 Iron 0.05-1.2 → 境界がないため、同じパターンが連続する箇所を1つの候補として予測 -
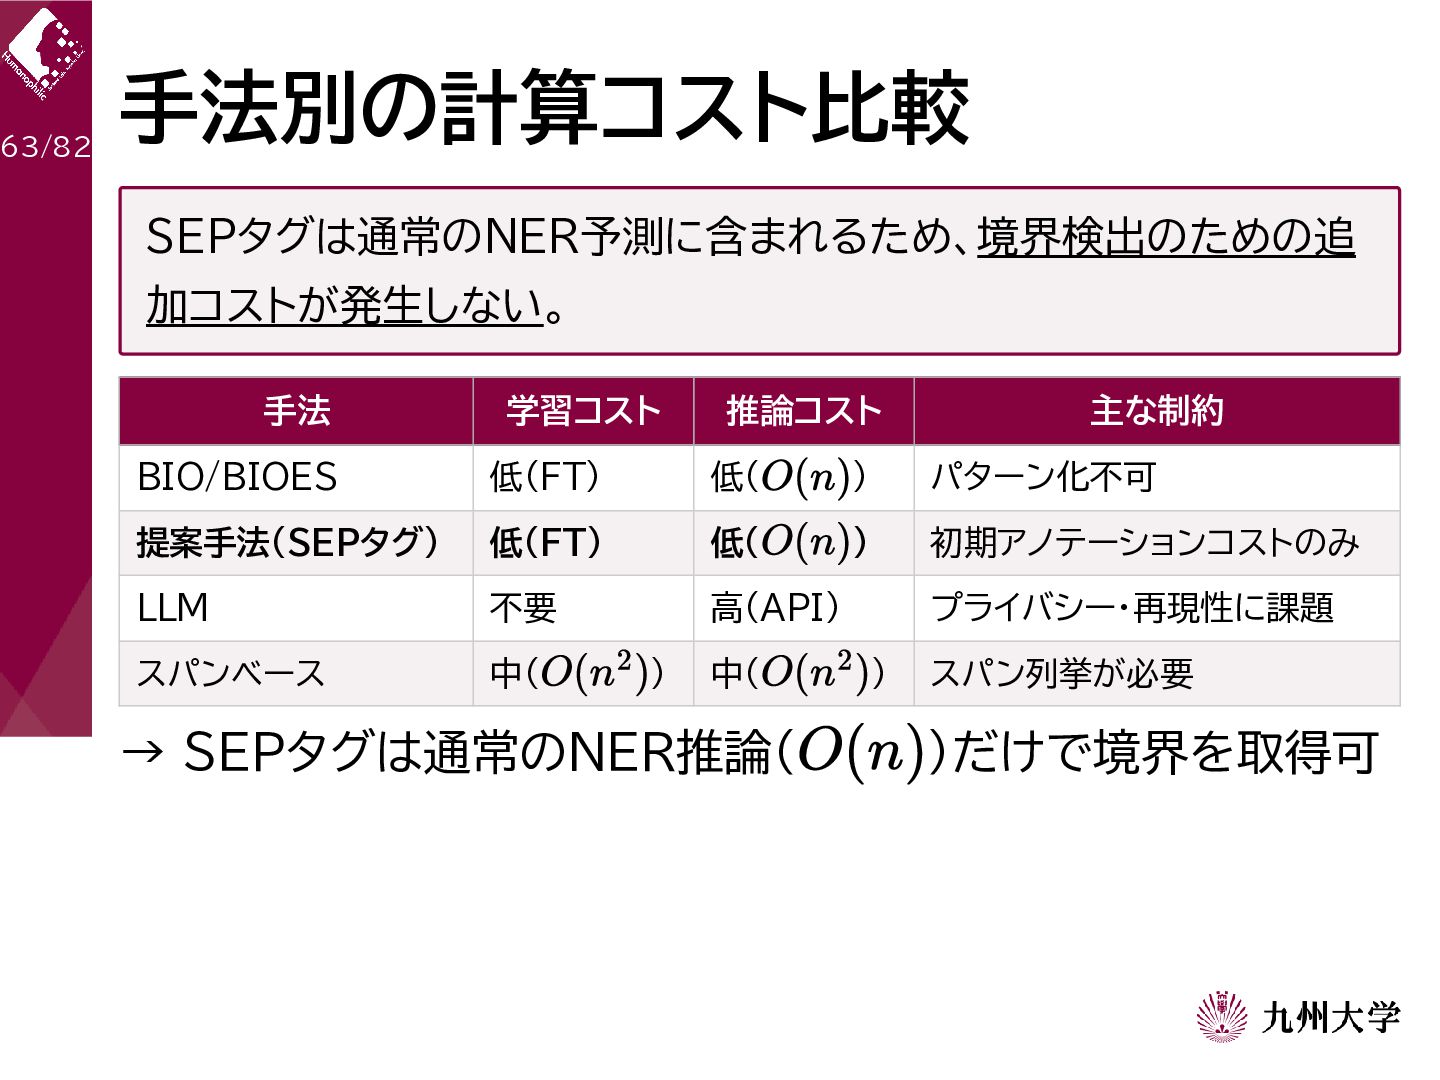
63/82 手法別の計算コスト比較 SEPタグは通常のNER予測に含まれるため、境界検出のための追 加コストが発生しない。 手法 学習コスト 推論コスト BIO/BIOES 低(FT) 低(
) パターン化不可 提案手法(SEPタグ) 低(FT) 低( ) 初期アノテーションコストのみ LLM 不要 高(API) スパンベース 中( ) 中( → SEPタグは通常のNER推論( 主な制約 プライバシー・再現性に課題 ) スパン列挙が必要 )だけで境界を取得可 -
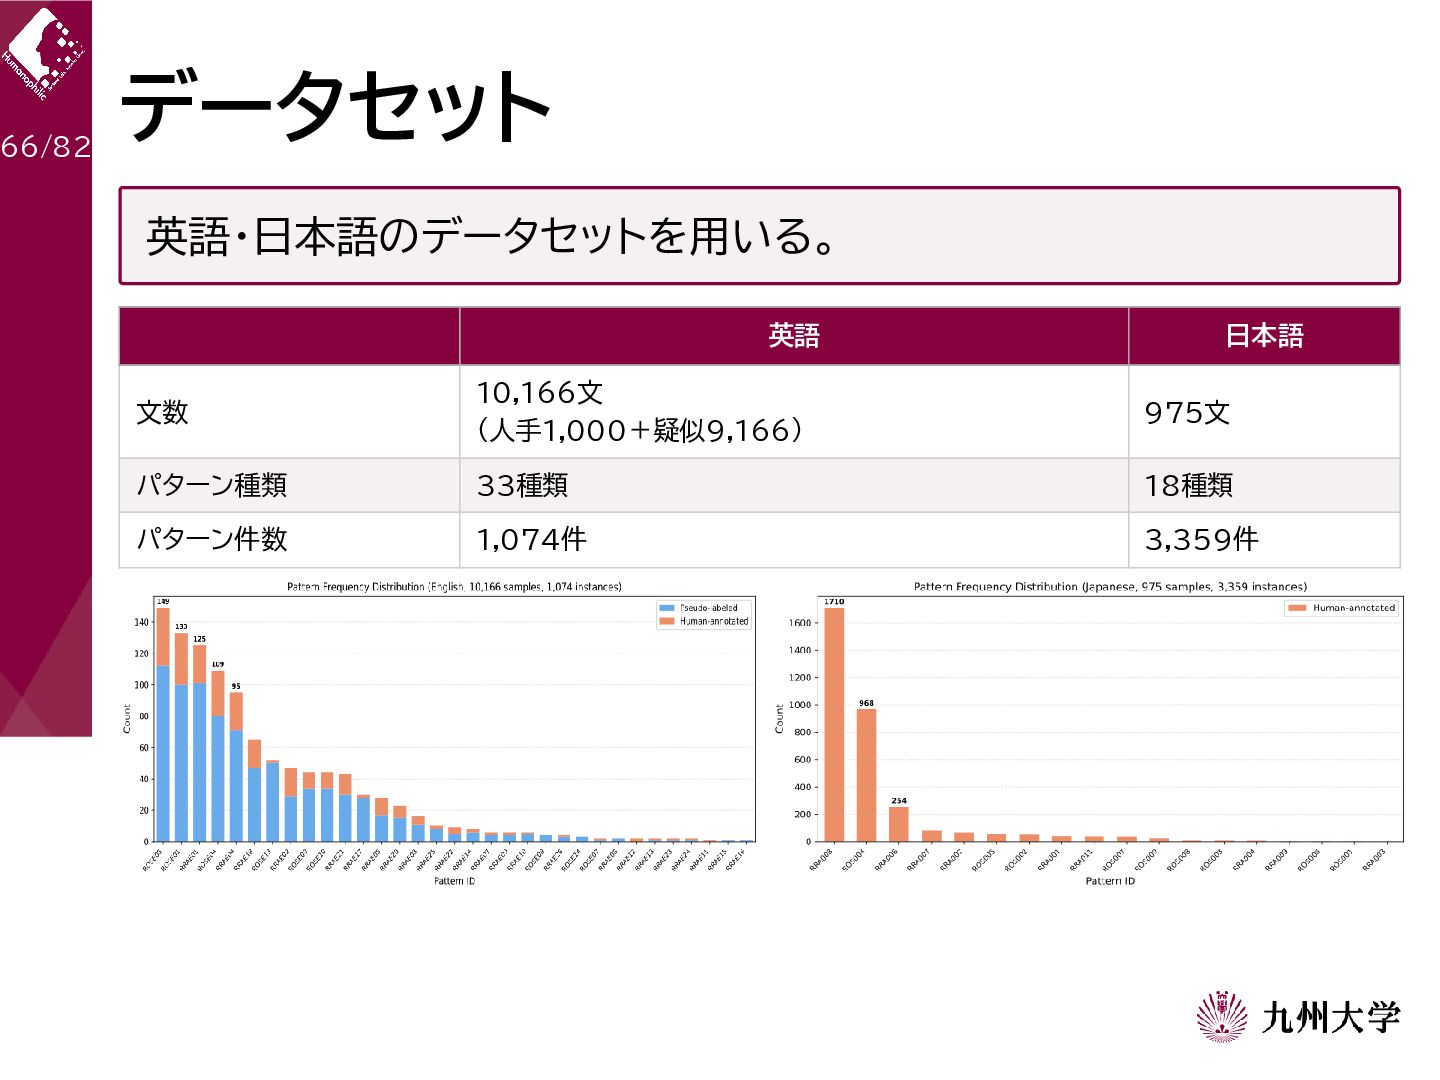
66/82 データセット 英語・日本語のデータセットを用いる。 英語 日本語 文数 10,166文 (人手1,000+疑似9,166) 975文 パターン種類
33種類 18種類 パターン件数 1,074件 3,359件 -
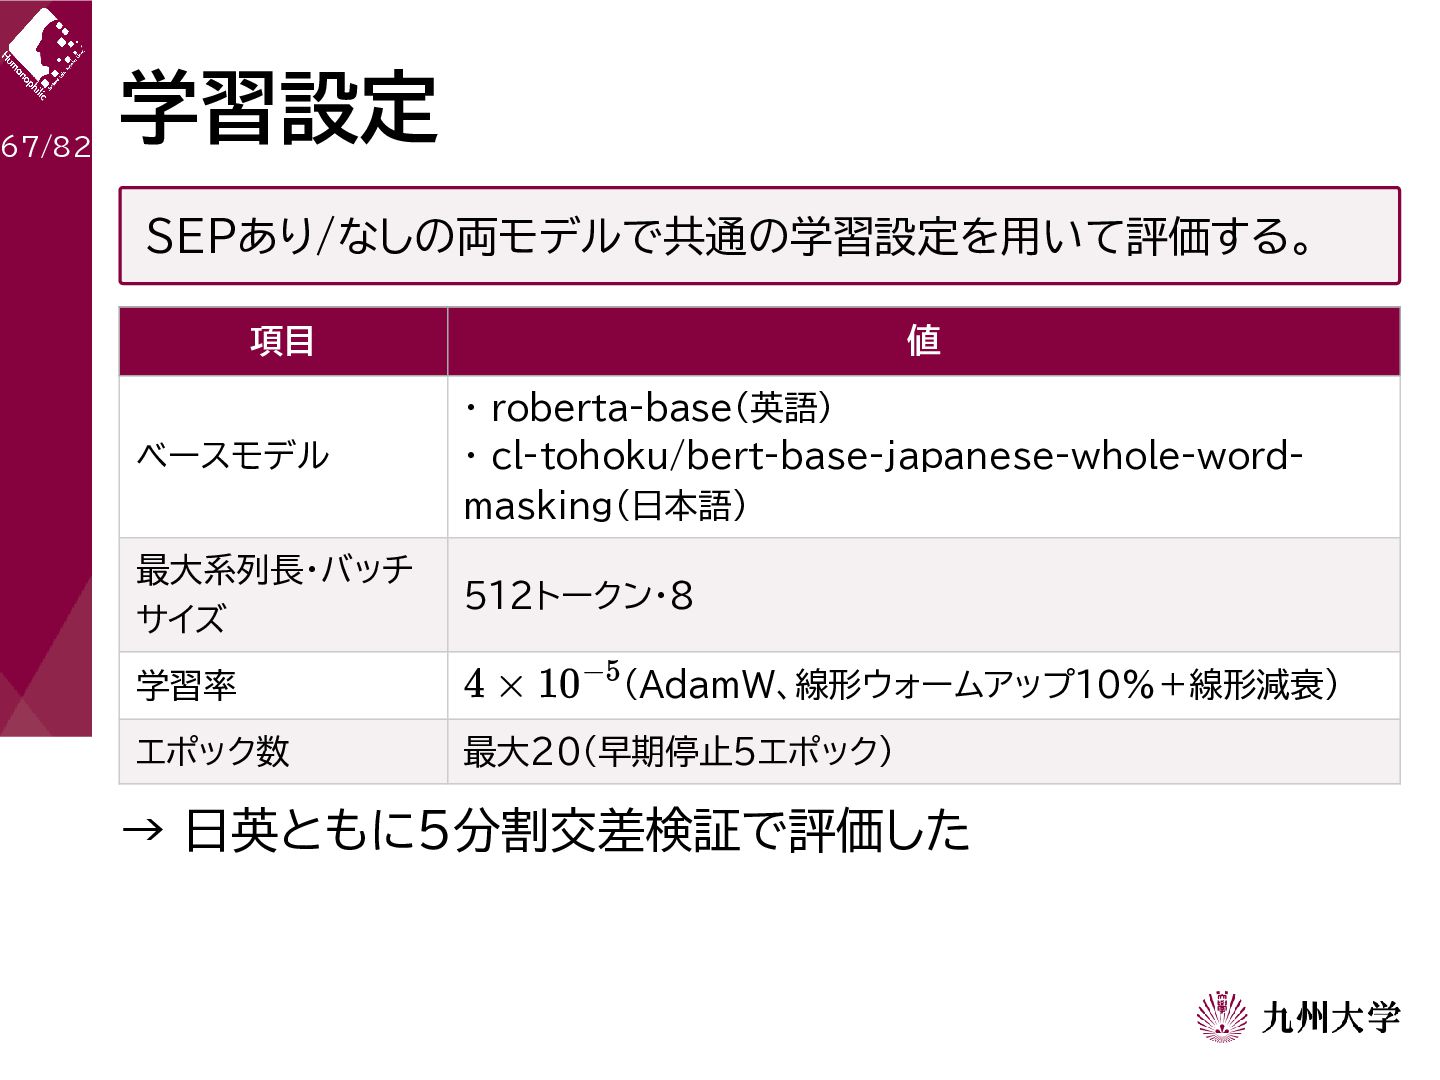
67/82 学習設定 SEPあり/なしの両モデルで共通の学習設定を用いて評価する。 項目 値 ベースモデル ・ roberta-base(英語) ・ cl-tohoku/bert-base-japanese-whole-wordmasking(日本語)
最大系列長・バッチ サイズ 512トークン・8 学習率 エポック数 (AdamW、線形ウォームアップ10%+線形減衰) 最大20(早期停止5エポック) → 日英ともに5分割交差検証で評価した -
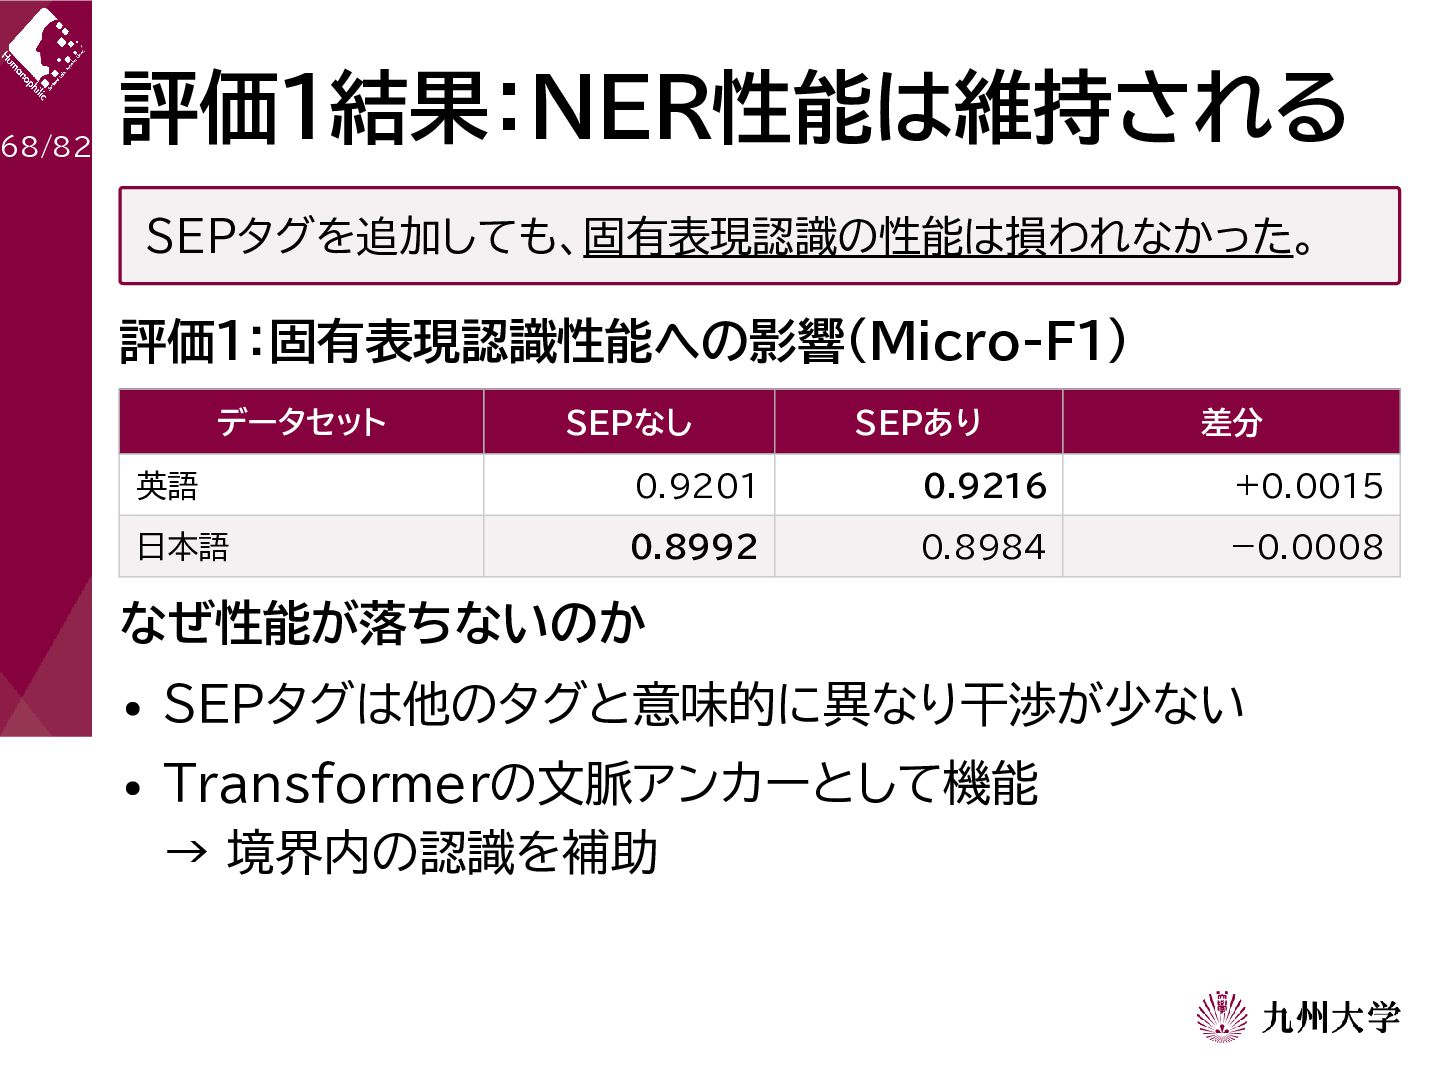
68/82 評価1結果:NER性能は維持される SEPタグを追加しても、固有表現認識の性能は損われなかった。 評価1:固有表現認識性能への影響(Micro-F1) データセット SEPなし SEPあり 差分 英語 0.9201
0.9216 +0.0015 日本語 0.8992 0.8984 −0.0008 なぜ性能が落ちないのか SEPタグは他のタグと意味的に異なり干渉が少ない Transformerの文脈アンカーとして機能 → 境界内の認識を補助 -
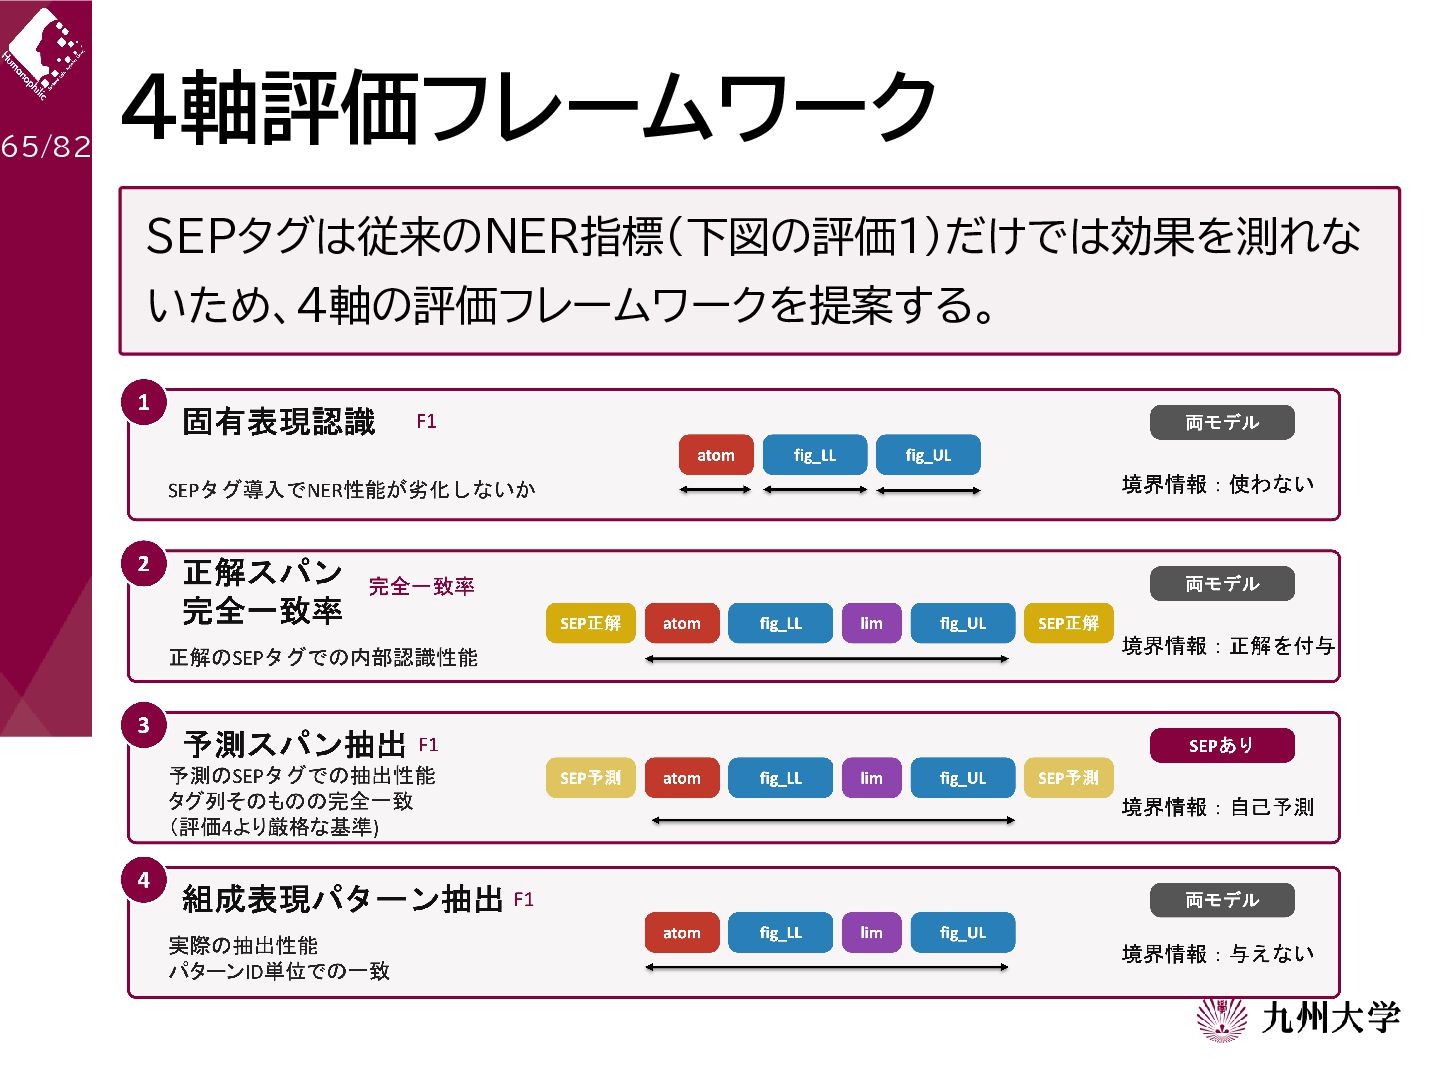
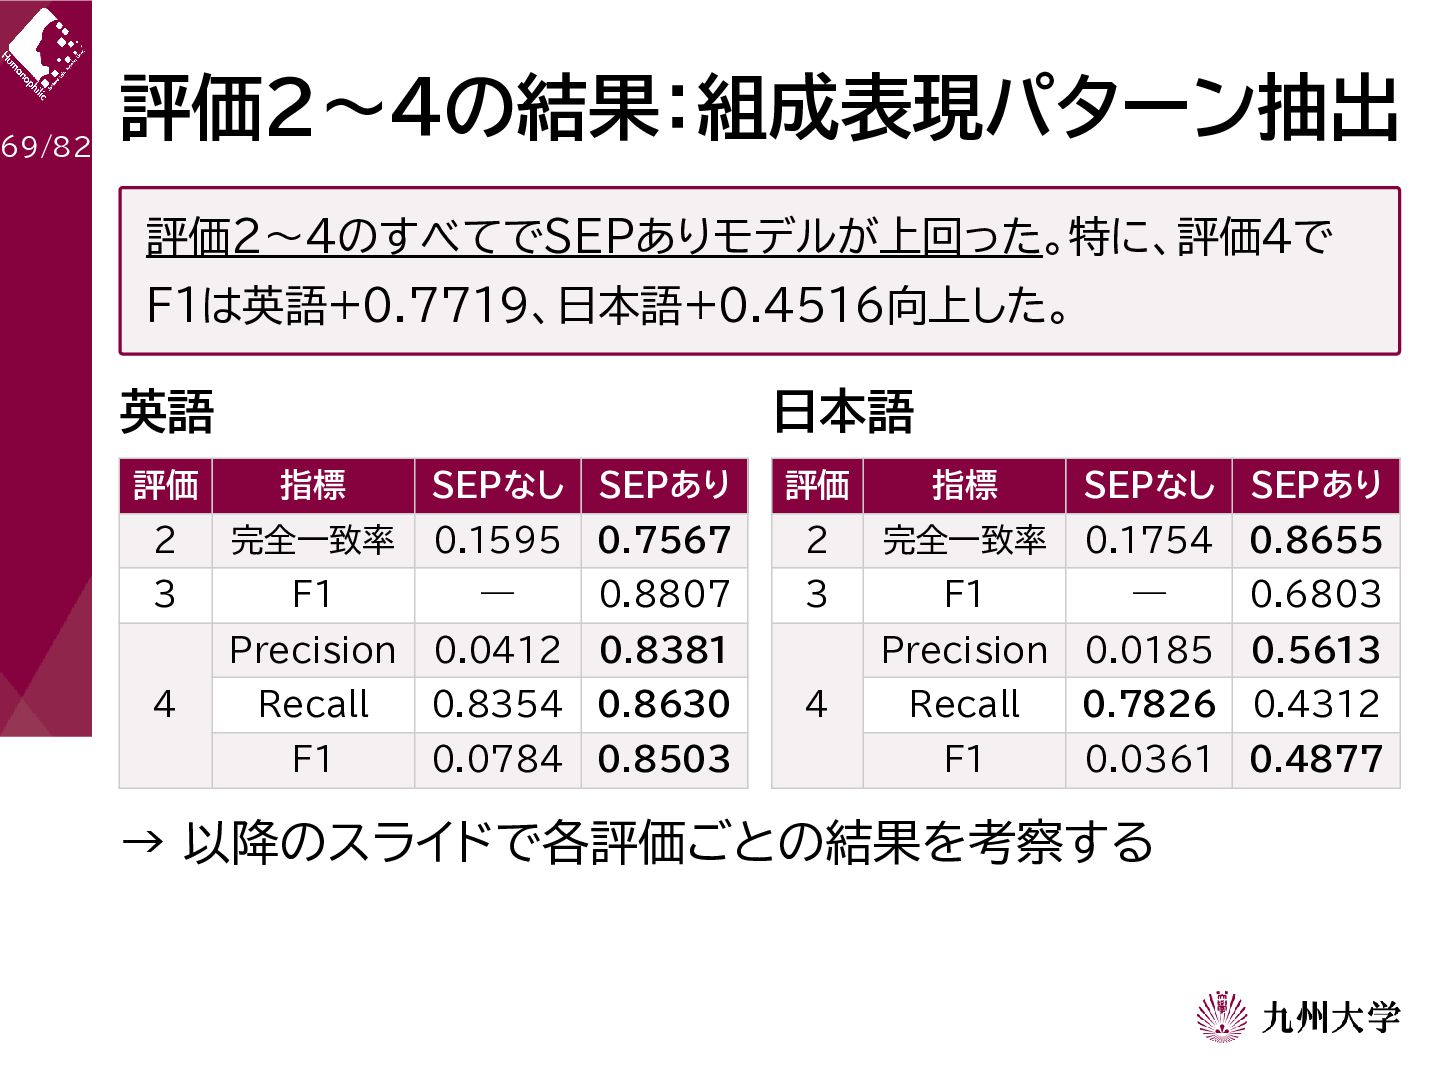
69/82 評価2〜4の結果:組成表現パターン抽出 評価2〜4のすべてでSEPありモデルが上回った。特に、評価4で F1は英語+0.7719、日本語+0.4516向上した。 英語 日本語 評価 指標 SEPなし SEPあり
評価 指標 SEPなし SEPあり 2 完全一致率 0.1595 0.7567 2 完全一致率 0.1754 0.8655 3 F1 — 0.8807 3 F1 — 0.6803 Precision 0.0412 0.8381 Precision 0.0185 0.5613 Recall 0.7826 0.4312 F1 0.0361 0.4877 4 Recall 0.8354 0.8630 F1 0.0784 0.8503 4 → 以降のスライドで各評価ごとの結果を考察する -
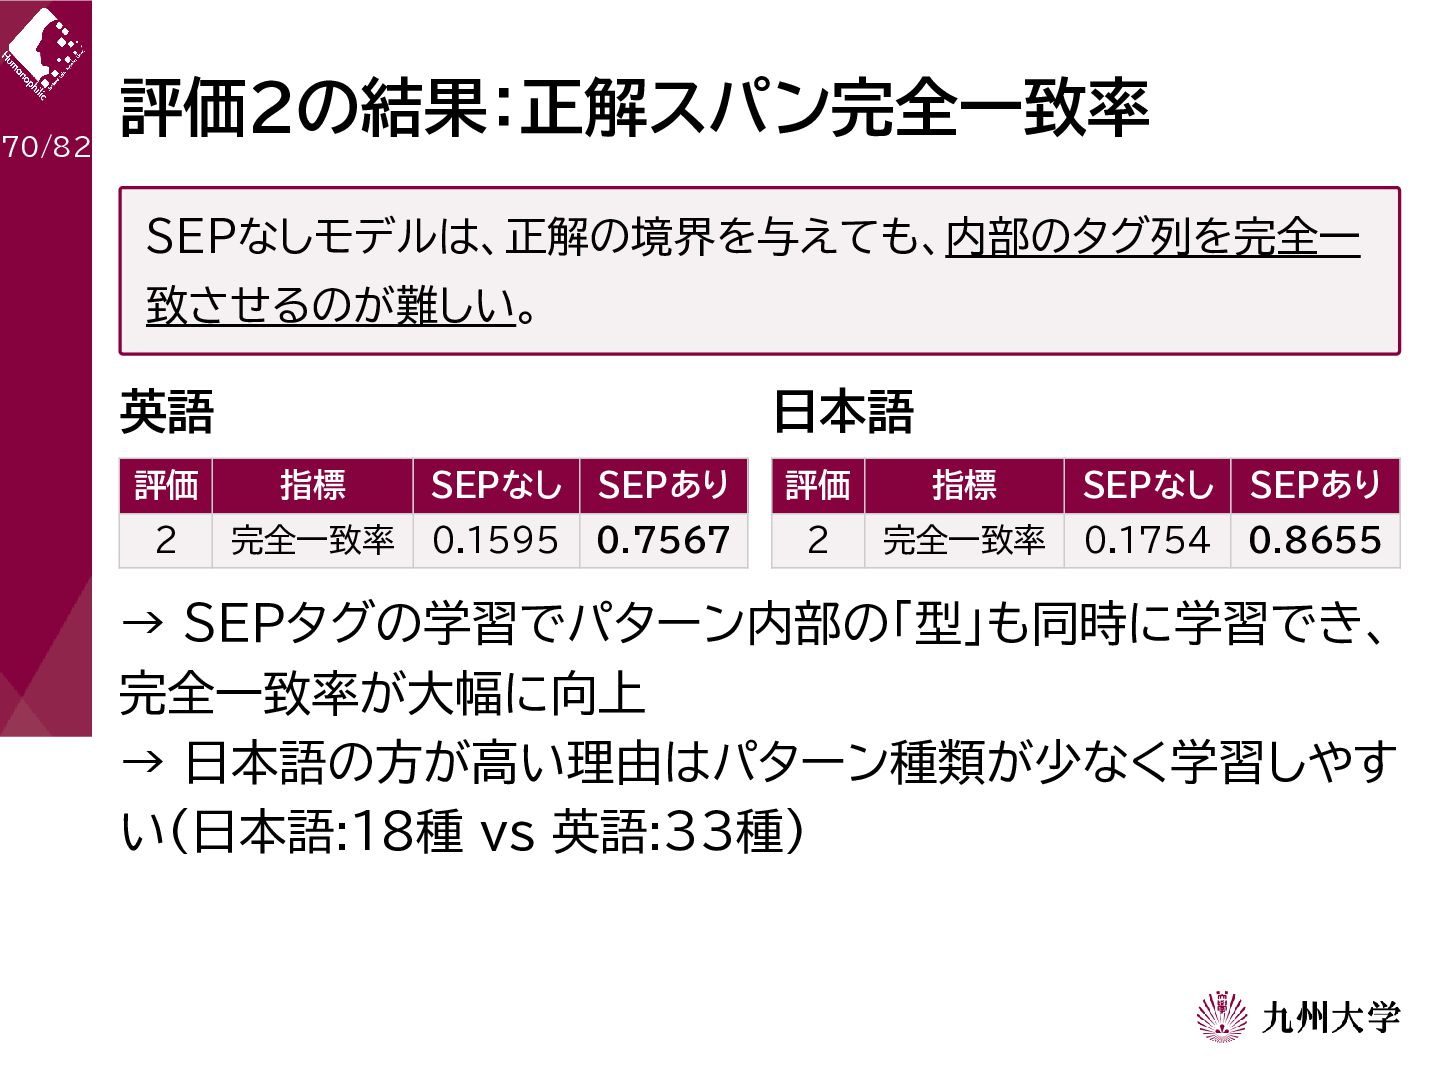
70/82 評価2の結果:正解スパン完全一致率 SEPなしモデルは、正解の境界を与えても、内部のタグ列を完全一 致させるのが難しい。 英語 日本語 評価 指標 SEPなし SEPあり
評価 指標 SEPなし SEPあり 2 完全一致率 0.1595 0.7567 2 完全一致率 0.1754 0.8655 → SEPタグの学習でパターン内部の「型」も同時に学習でき、 完全一致率が大幅に向上 → 日本語の方が高い理由はパターン種類が少なく学習しやす い(日本語:18種 vs 英語:33種) -
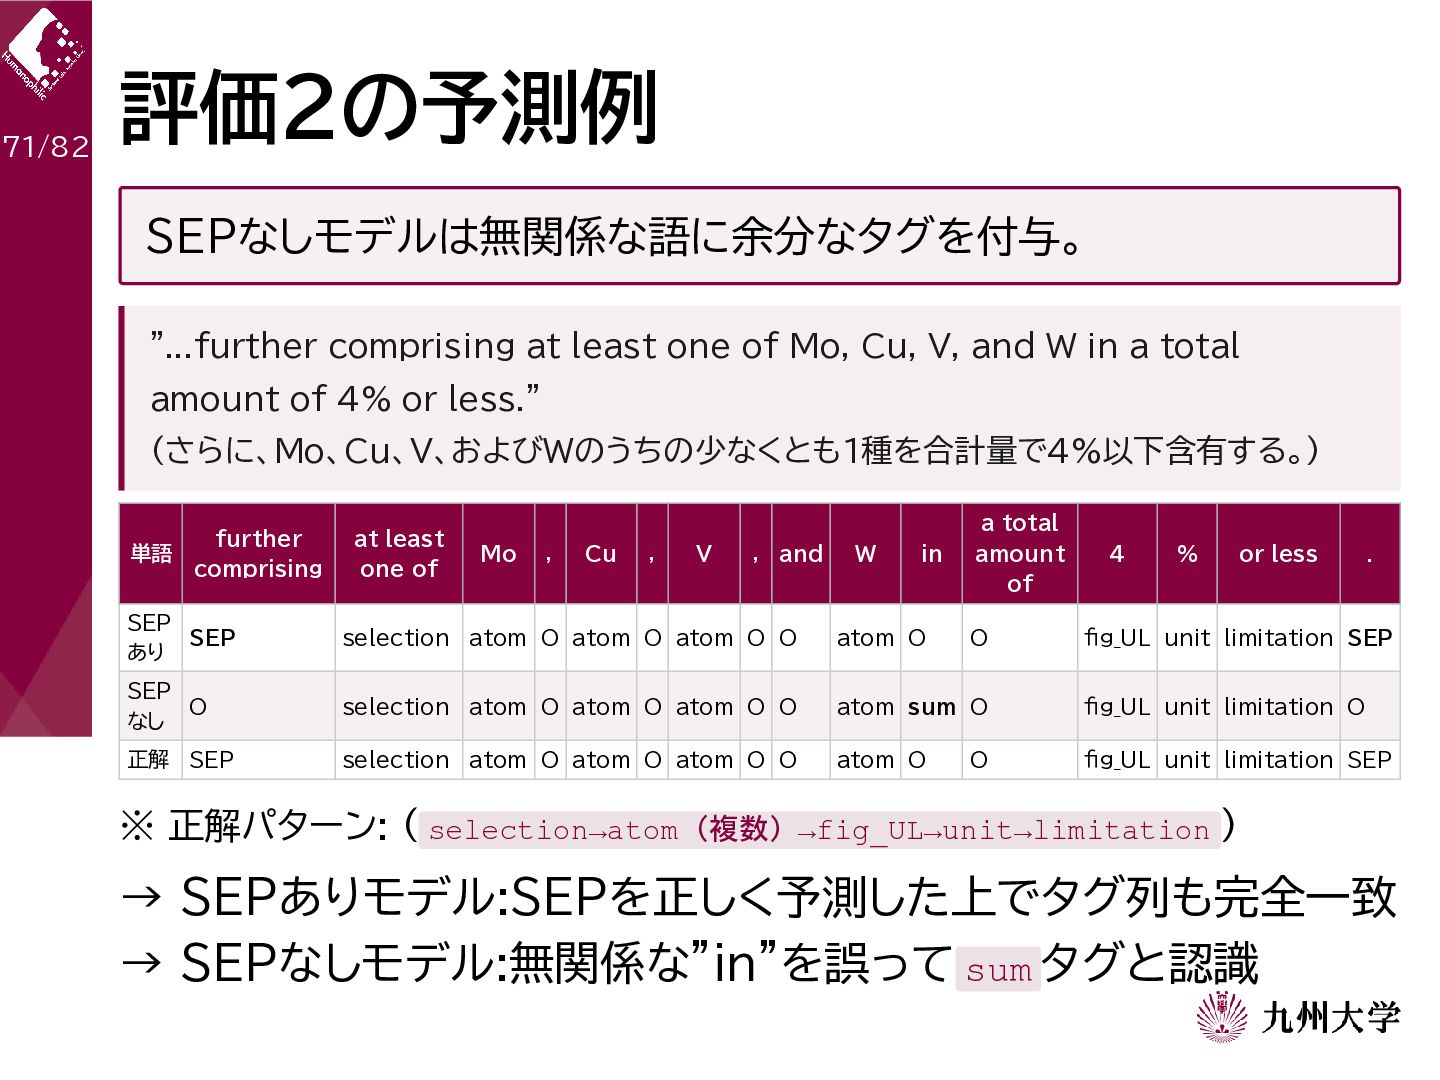
71/82 評価2の予測例 SEPなしモデルは無関係な語に余分なタグを付与。 "...further comprising at least one of Mo,
Cu, V, and W in a total amount of 4% or less." (さらに、Mo、Cu、V、およびWのうちの少なくとも1種を合計量で4%以下含有する。) 単語 further comprising at least one of Mo , Cu , V , and W in a total amount of 4 % or less . SEP SEP あり selection atom O atom O atom O O atom O SEP O なし selection atom O atom O atom O O atom sum O fig_UL unit limitation O 正解 SEP selection atom O atom O atom O O atom O fig_UL unit limitation SEP O O fig_UL unit limitation SEP ※ 正解パターン: ( selection→atom(複数)→fig_UL→unit→limitation ) → SEPありモデル:SEPを正しく予測した上でタグ列も完全一致 → SEPなしモデル:無関係な"in"を誤って sum タグと認識 -
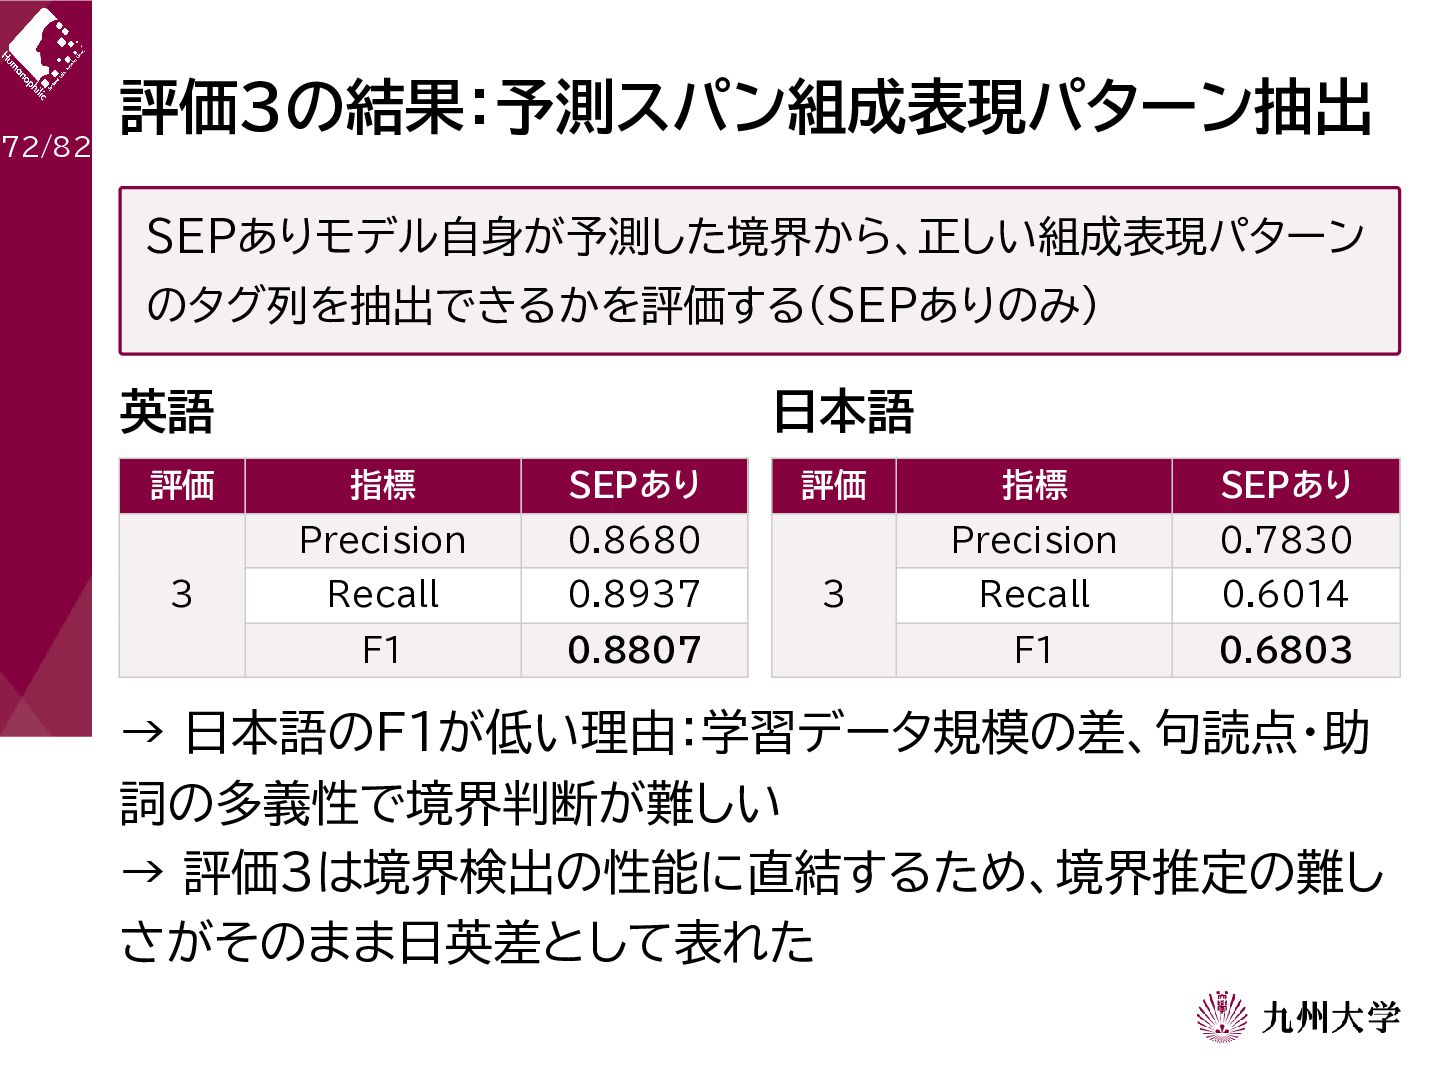
72/82 評価3の結果:予測スパン組成表現パターン抽出 SEPありモデル自身が予測した境界から、正しい組成表現パターン のタグ列を抽出できるかを評価する(SEPありのみ) 英語 評価 3 日本語 指標 SEPあり
Precision 0.8680 Recall 0.8937 F1 0.8807 評価 3 指標 SEPあり Precision 0.7830 Recall 0.6014 F1 0.6803 → 日本語のF1が低い理由:学習データ規模の差、句読点・助 詞の多義性で境界判断が難しい → 評価3は境界検出の性能に直結するため、境界推定の難し さがそのまま日英差として表れた -
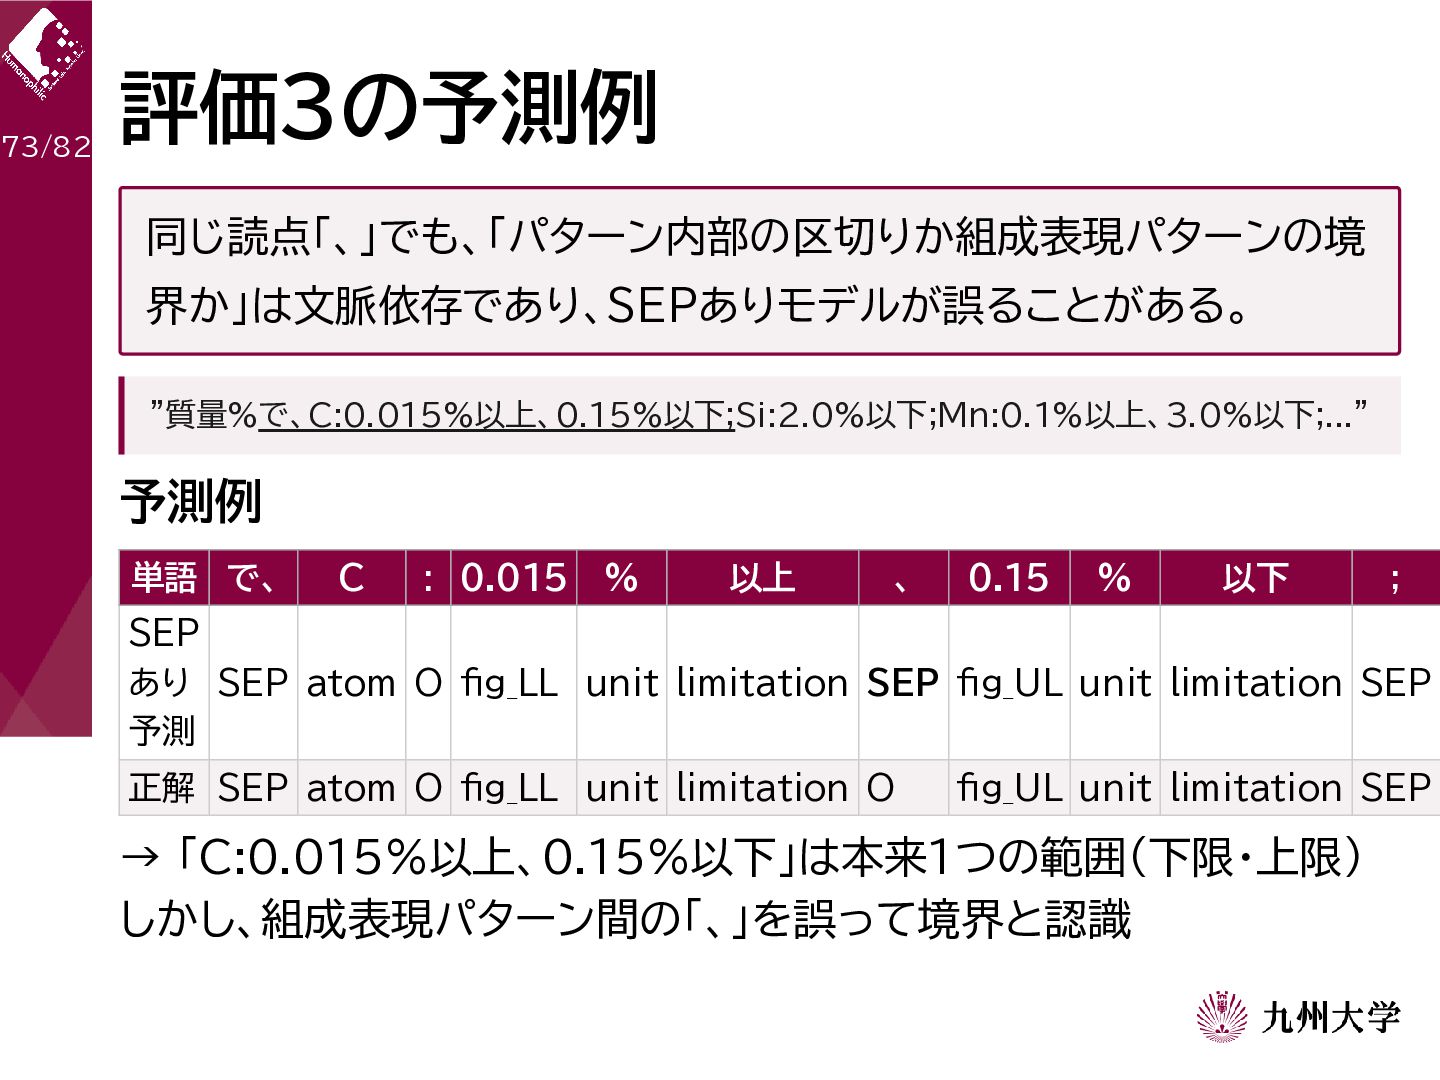
73/82 評価3の予測例 同じ読点「、」でも、「パターン内部の区切りか組成表現パターンの境 界か」は文脈依存であり、SEPありモデルが誤ることがある。 "質量%で、C:0.015%以上、0.15%以下;Si:2.0%以下;Mn:0.1%以上、3.0%以下;..." 予測例 単語 で、 C :
0.015 % 以上 、 0.15 % 以下 ; SEP あり SEP atom O fig_LL unit limitation SEP fig_UL unit limitation SEP 予測 正解 SEP atom O fig_LL unit limitation O fig_UL unit limitation SEP → 「C:0.015%以上、0.15%以下」は本来1つの範囲(下限・上限) しかし、組成表現パターン間の「、」を誤って境界と認識 -
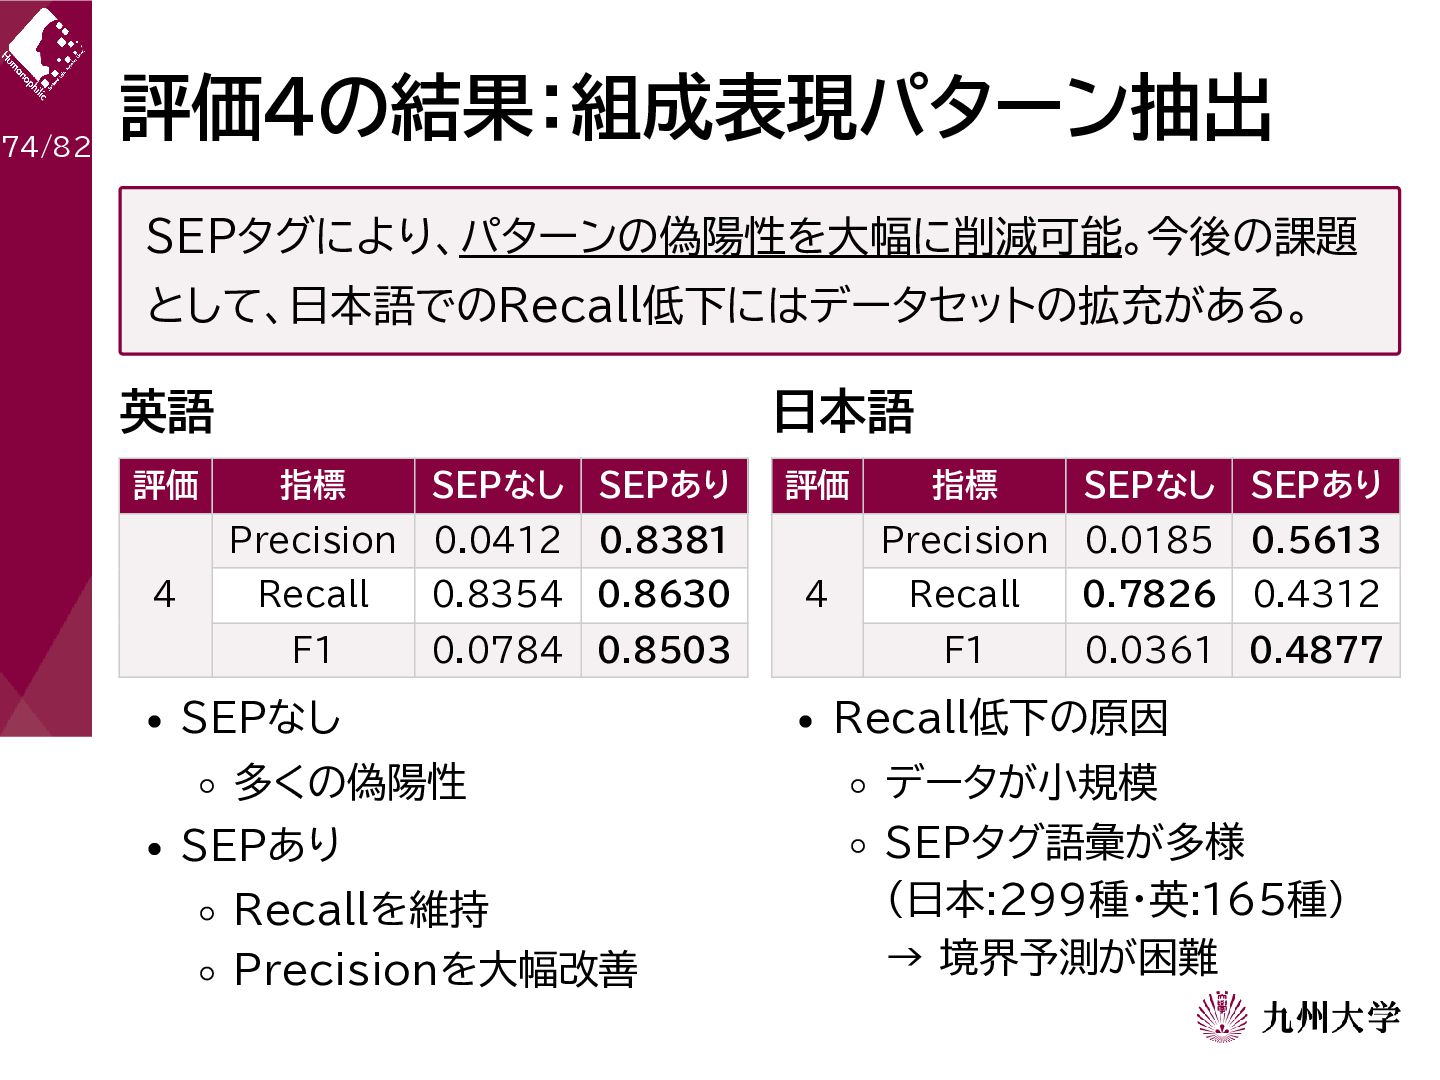
74/82 評価4の結果:組成表現パターン抽出 SEPタグにより、パターンの偽陽性を大幅に削減可能。今後の課題 として、日本語でのRecall低下にはデータセットの拡充がある。 英語 評価 4 日本語 指標 SEPなし
SEPあり Precision 0.0412 0.8381 Recall 0.8354 0.8630 F1 0.0784 0.8503 SEPなし 多くの偽陽性 SEPあり Recallを維持 Precisionを大幅改善 評価 4 指標 SEPなし SEPあり Precision 0.0185 0.5613 Recall 0.7826 0.4312 F1 0.0361 0.4877 Recall低下の原因 データが小規模 SEPタグ語彙が多様 (日本:299種・英:165種) → 境界予測が困難 -
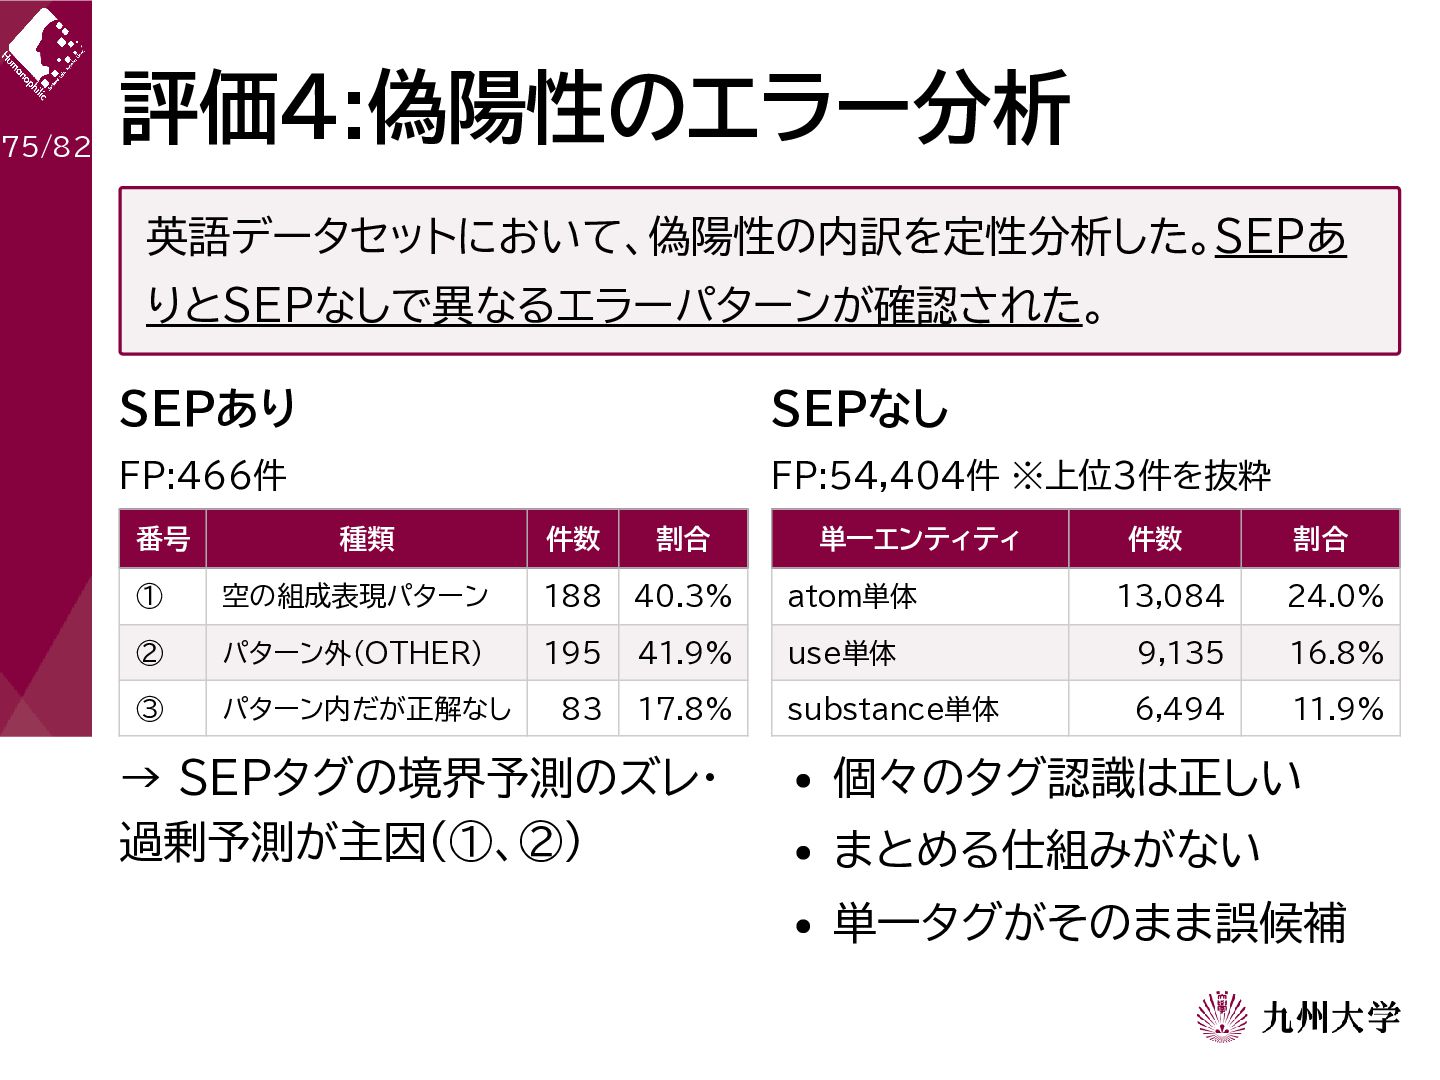
75/82 評価4:偽陽性のエラー分析 英語データセットにおいて、偽陽性の内訳を定性分析した。SEPあ りとSEPなしで異なるエラーパターンが確認された。 SEPあり SEPなし FP:466件 FP:54,404件 ※上位3件を抜粋 番号
種類 件数 割合 ① 空の組成表現パターン 188 40.3% ② パターン外(OTHER) 195 ③ パターン内だが正解なし 83 件数 割合 atom単体 13,084 24.0% 41.9% use単体 9,135 16.8% 17.8% substance単体 6,494 11.9% → SEPタグの境界予測のズレ・ 過剰予測が主因(①、②) 単一エンティティ 個々のタグ認識は正しい まとめる仕組みがない 単一タグがそのまま誤候補 -
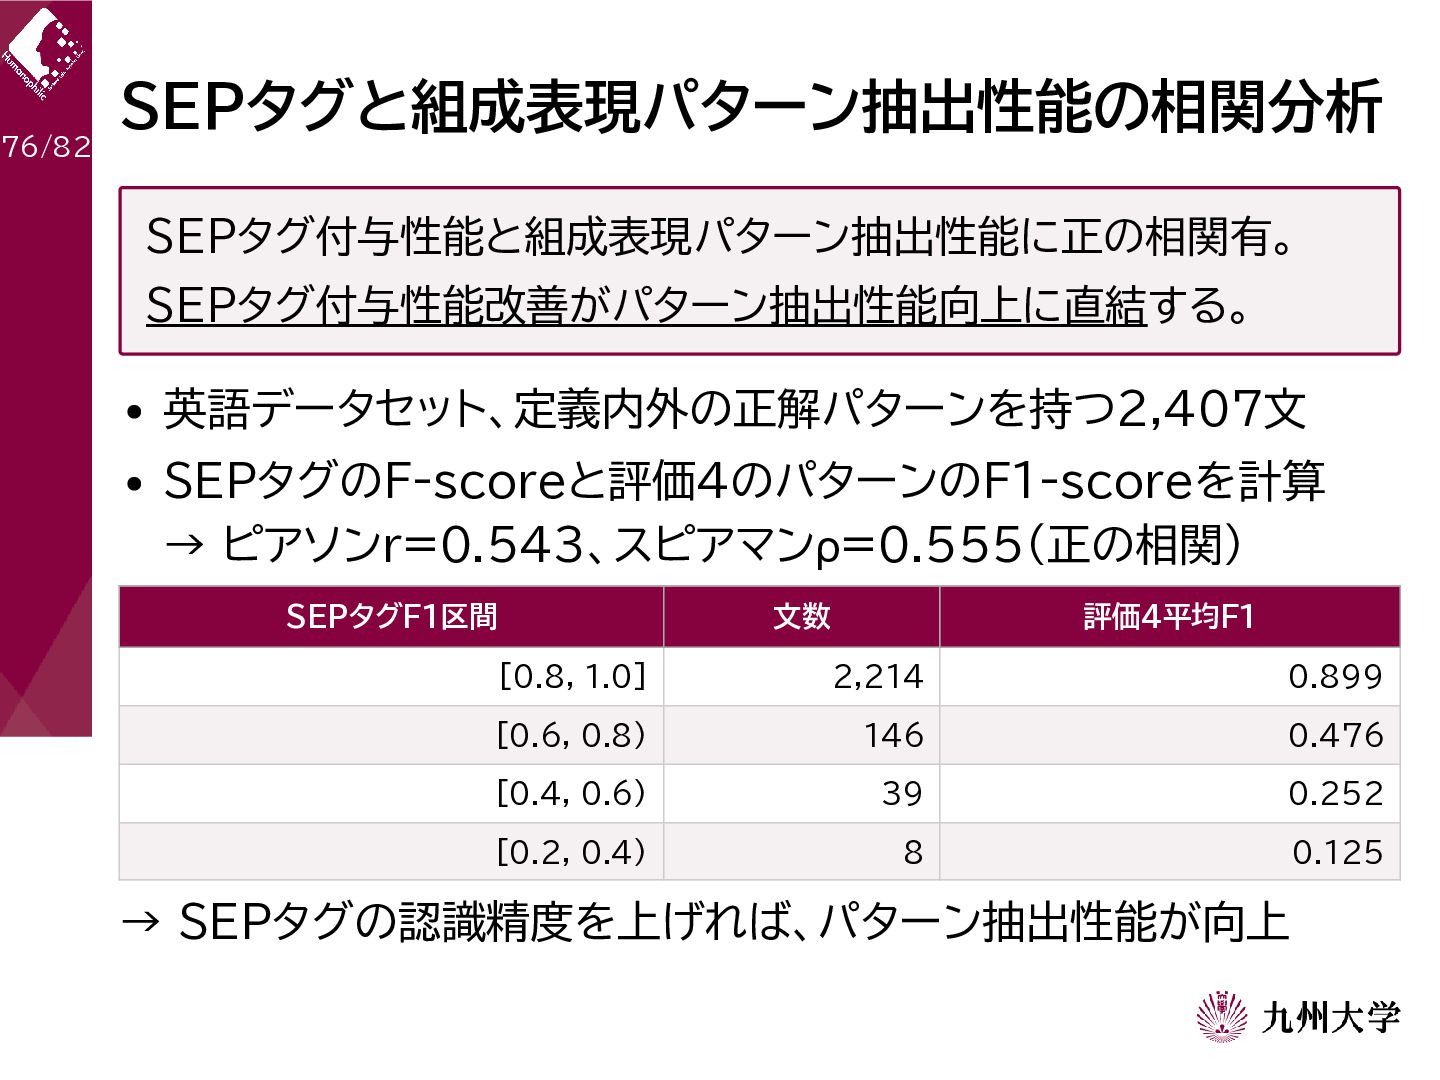
SEPタグと組成表現パターン抽出性能の相関分析 76/82 SEPタグ付与性能と組成表現パターン抽出性能に正の相関有。 SEPタグ付与性能改善がパターン抽出性能向上に直結する。 英語データセット、定義内外の正解パターンを持つ2,407文 SEPタグのF-scoreと評価4のパターンのF1-scoreを計算 → ピアソンr=0.543、スピアマンρ=0.555(正の相関) SEPタグF1区間 文数
評価4平均F1 [0.8, 1.0] 2,214 0.899 [0.6, 0.8) 146 0.476 [0.4, 0.6) 39 0.252 [0.2, 0.4) 8 0.125 → SEPタグの認識精度を上げれば、パターン抽出性能が向上 -
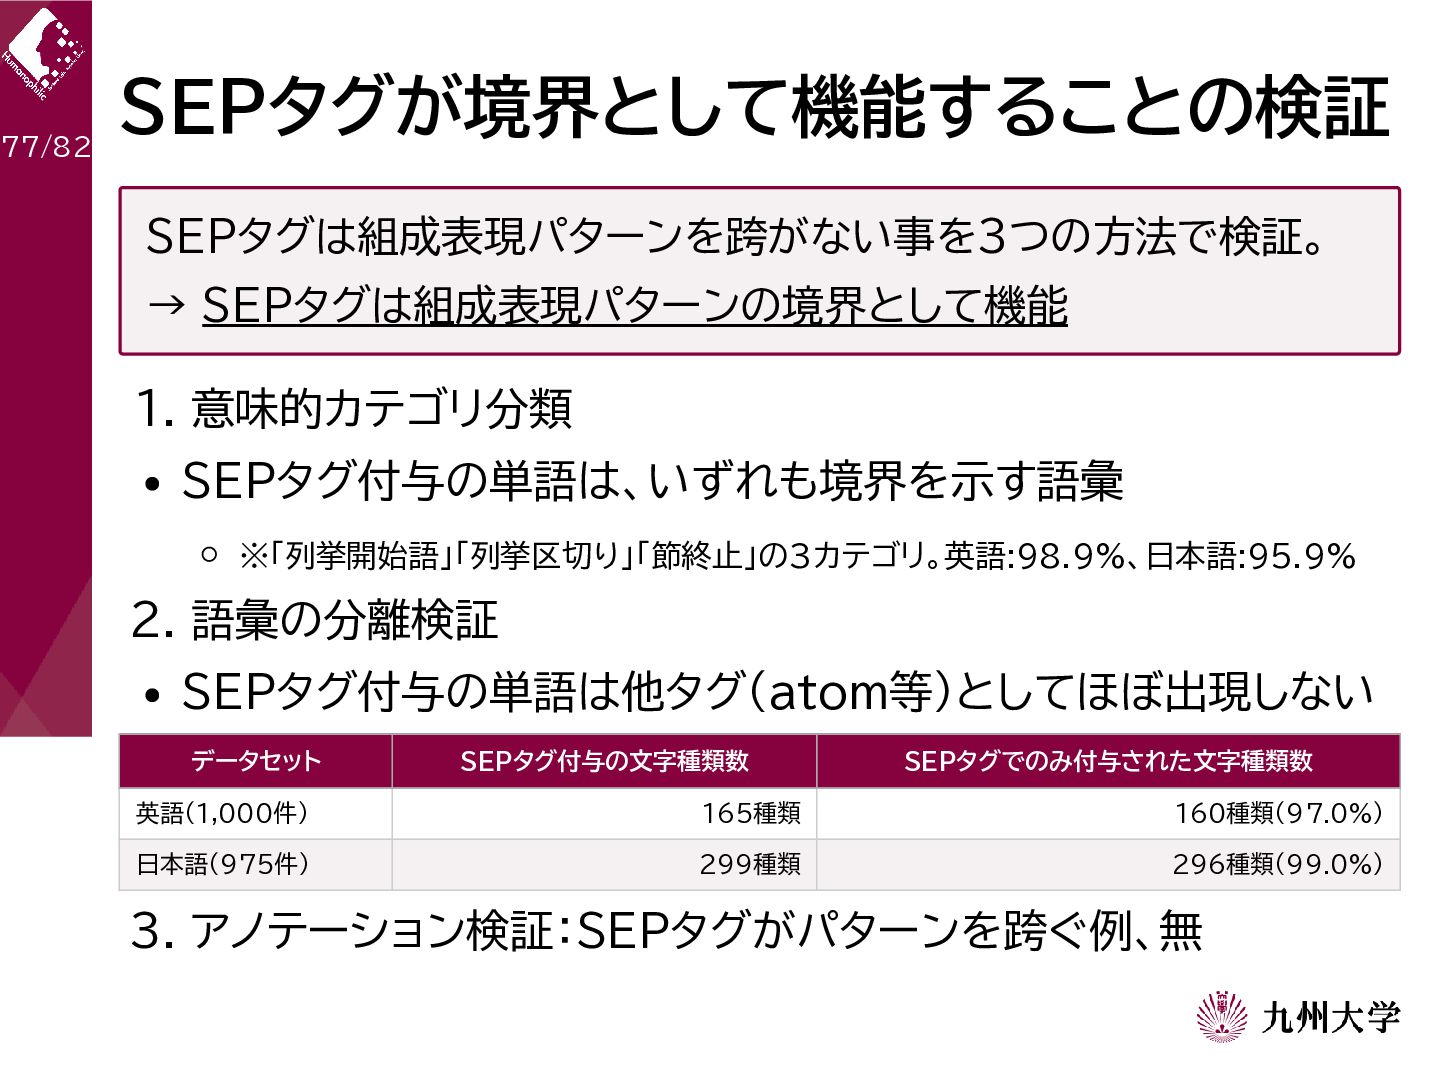
77/82 SEPタグが境界として機能することの検証 SEPタグは組成表現パターンを跨がない事を3つの方法で検証。 → SEPタグは組成表現パターンの境界として機能 1. 意味的カテゴリ分類 SEPタグ付与の単語は、いずれも境界を示す語彙 ※「列挙開始語」「列挙区切り」「節終止」の3カテゴリ。英語:98.9%、日本語:95.9% 2.
語彙の分離検証 SEPタグ付与の単語は他タグ(atom等)としてほぼ出現しない データセット SEPタグ付与の文字種類数 SEPタグでのみ付与された文字種類数 英語(1,000件) 165種類 160種類(97.0%) 日本語(975件) 299種類 296種類(99.0%) 3. アノテーション検証:SEPタグがパターンを跨ぐ例、無 -
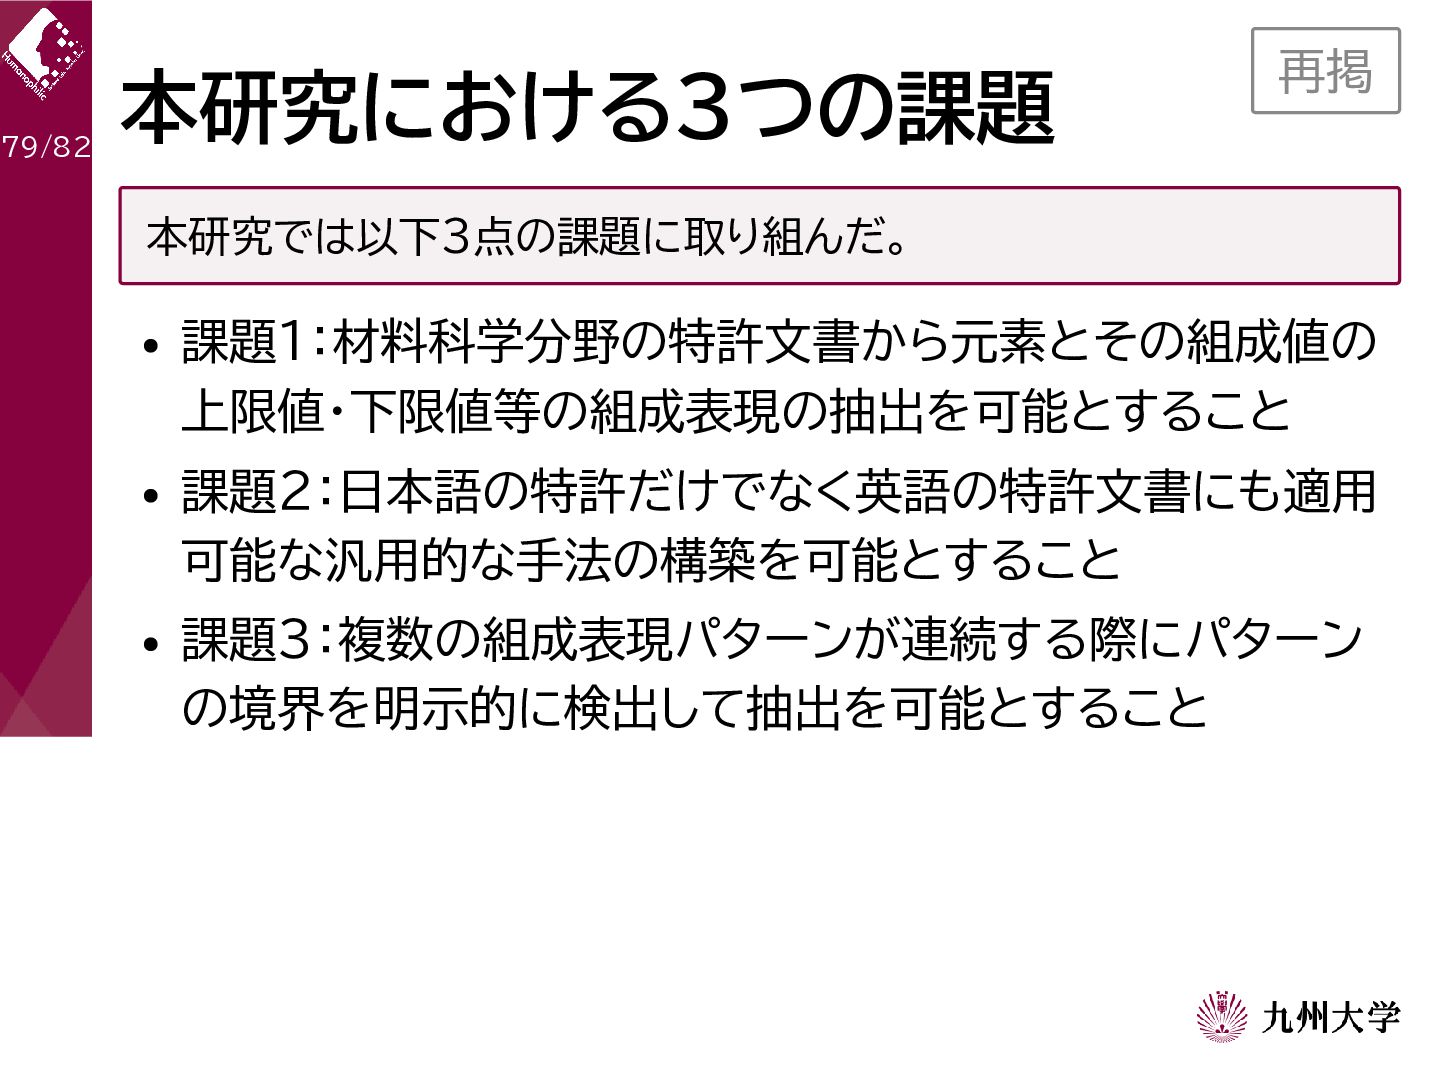
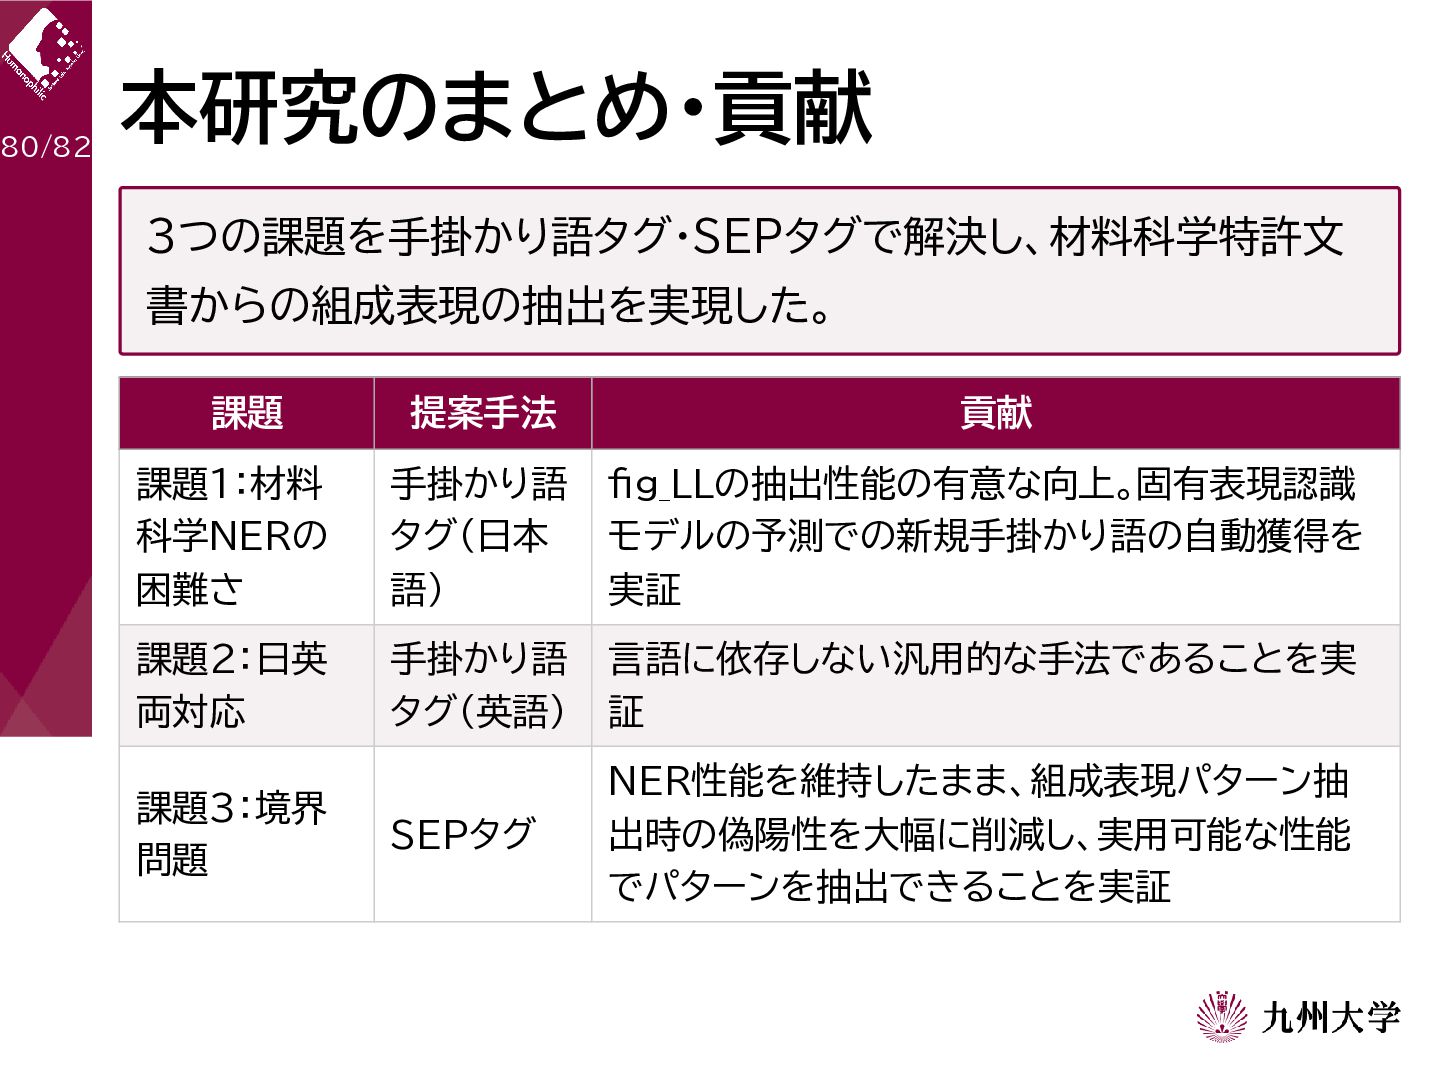
80/82 本研究のまとめ・貢献 3つの課題を手掛かり語タグ・SEPタグで解決し、材料科学特許文 書からの組成表現の抽出を実現した。 課題 提案手法 貢献 課題1:材料 科学NERの 困難さ
手掛かり語 タグ(日本 語) fig_LLの抽出性能の有意な向上。固有表現認識 モデルの予測での新規手掛かり語の自動獲得を 実証 課題2:日英 両対応 手掛かり語 タグ(英語) 言語に依存しない汎用的な手法であることを実 証 SEPタグ NER性能を維持したまま、組成表現パターン抽 出時の偽陽性を大幅に削減し、実用可能な性能 でパターンを抽出できることを実証 課題3:境界 問題 -
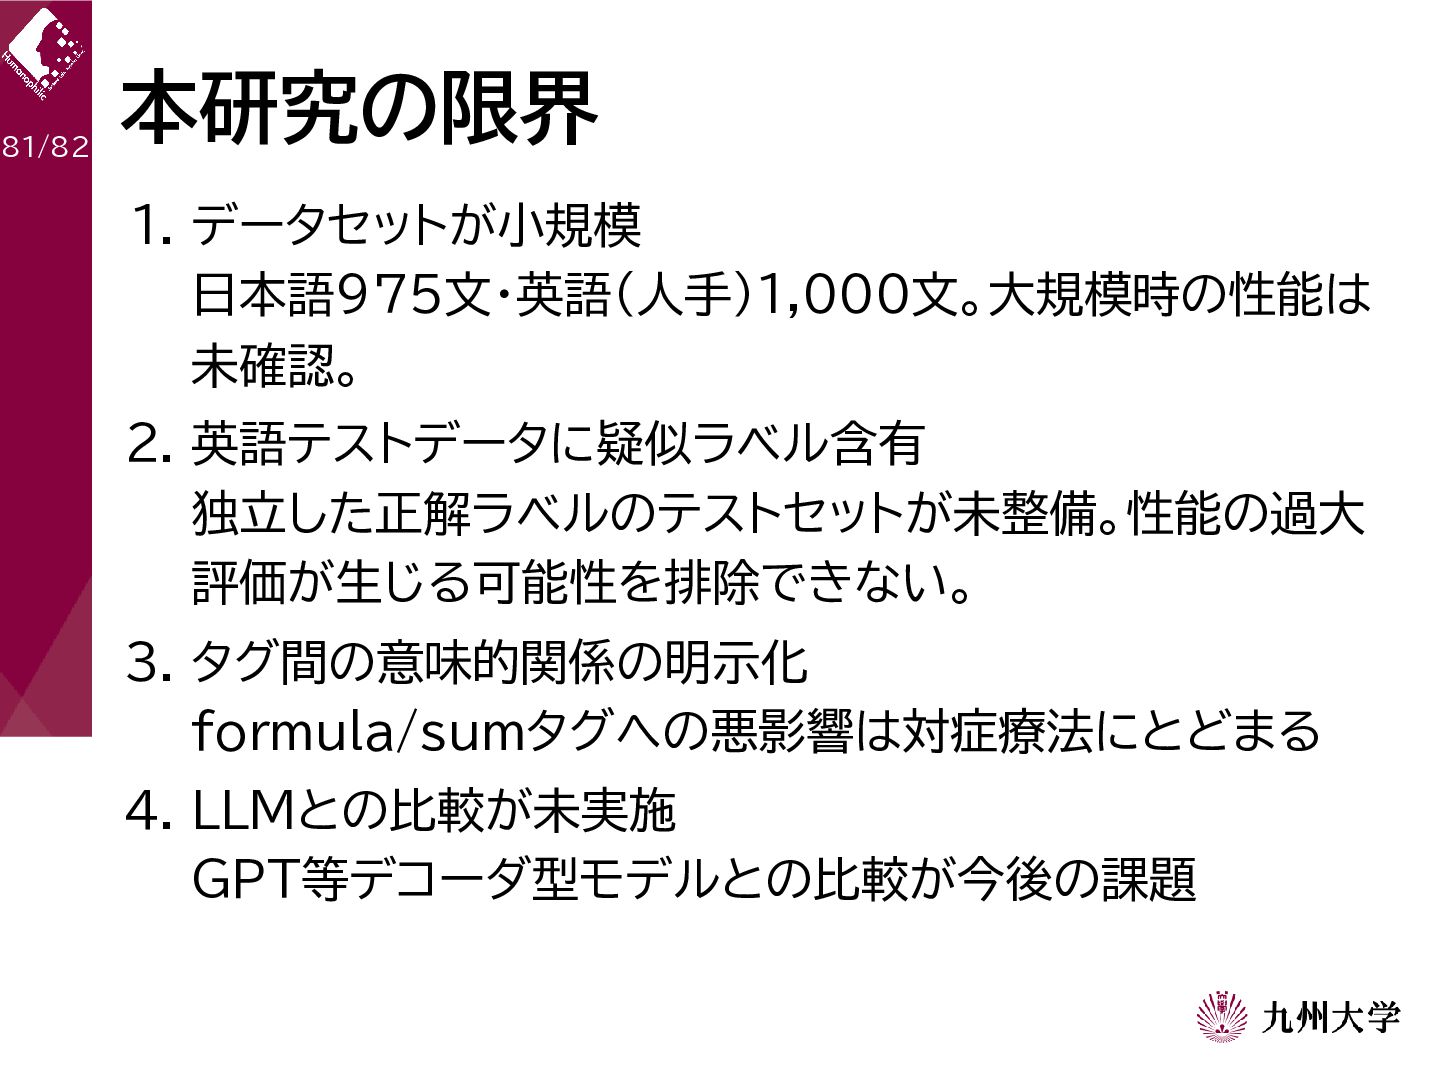
81/82 本研究の限界 1. データセットが小規模 日本語975文・英語(人手)1,000文。大規模時の性能は 未確認。 2. 英語テストデータに疑似ラベル含有 独立した正解ラベルのテストセットが未整備。性能の過大 評価が生じる可能性を排除できない。
3. タグ間の意味的関係の明示化 formula/sumタグへの悪影響は対症療法にとどまる 4. LLMとの比較が未実施 GPT等デコーダ型モデルとの比較が今後の課題 -
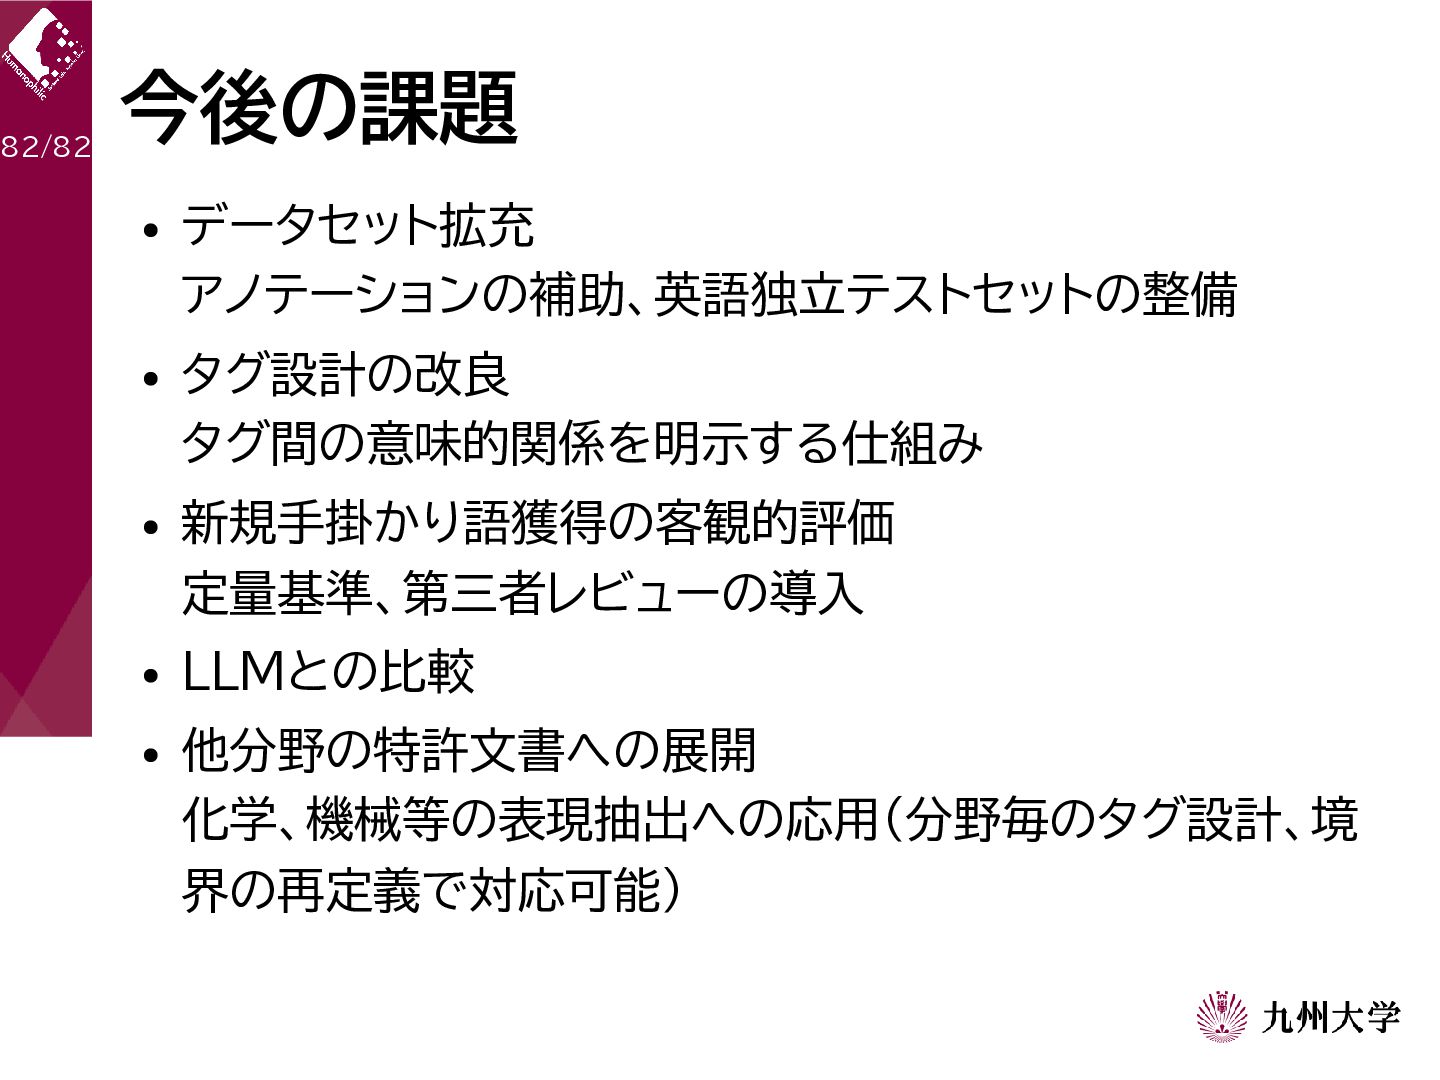
82/82 今後の課題 データセット拡充 アノテーションの補助、英語独立テストセットの整備 タグ設計の改良 タグ間の意味的関係を明示する仕組み 新規手掛かり語獲得の客観的評価 定量基準、第三者レビューの導入 LLMとの比較 他分野の特許文書への展開
化学、機械等の表現抽出への応用(分野毎のタグ設計、境 界の再定義で対応可能)
 tossy
 raygrieselhuber
 samanthasiow
 sonatard
 panda_program
 inesmontani
 baasie
 jmmastey
 maltzj
 codingconduct
 akademiya2063
 hatefulcrawdad
 bluesmoon
 LSTM 無機材料論文の固有表現抽出](https://files.speakerdeck.com/presentations/58b4be217e2c4e7994b9e8d36d59114f/slide_19.jpg)
 ChatGPT <](https://files.speakerdeck.com/presentations/58b4be217e2c4e7994b9e8d36d59114f/slide_21.jpg)
 [E1]…[/E1] を入力に挿入 → 区間の情報を認識](https://files.speakerdeck.com/presentations/58b4be217e2c4e7994b9e8d36d59114f/slide_22.jpg)