Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AIエージェントの自己改善をどう設計するか / How to Design Self-Impr...

Avatar for 223 223
September 15, 2026

AIエージェントの自己改善をどう設計するか / How to Design Self-Improvement for AI Agents

AIエージェントに改善を繰り返させても、プロンプトの加筆や出力の整形に留まり、最初の設計を見直せずに停滞することがあります。
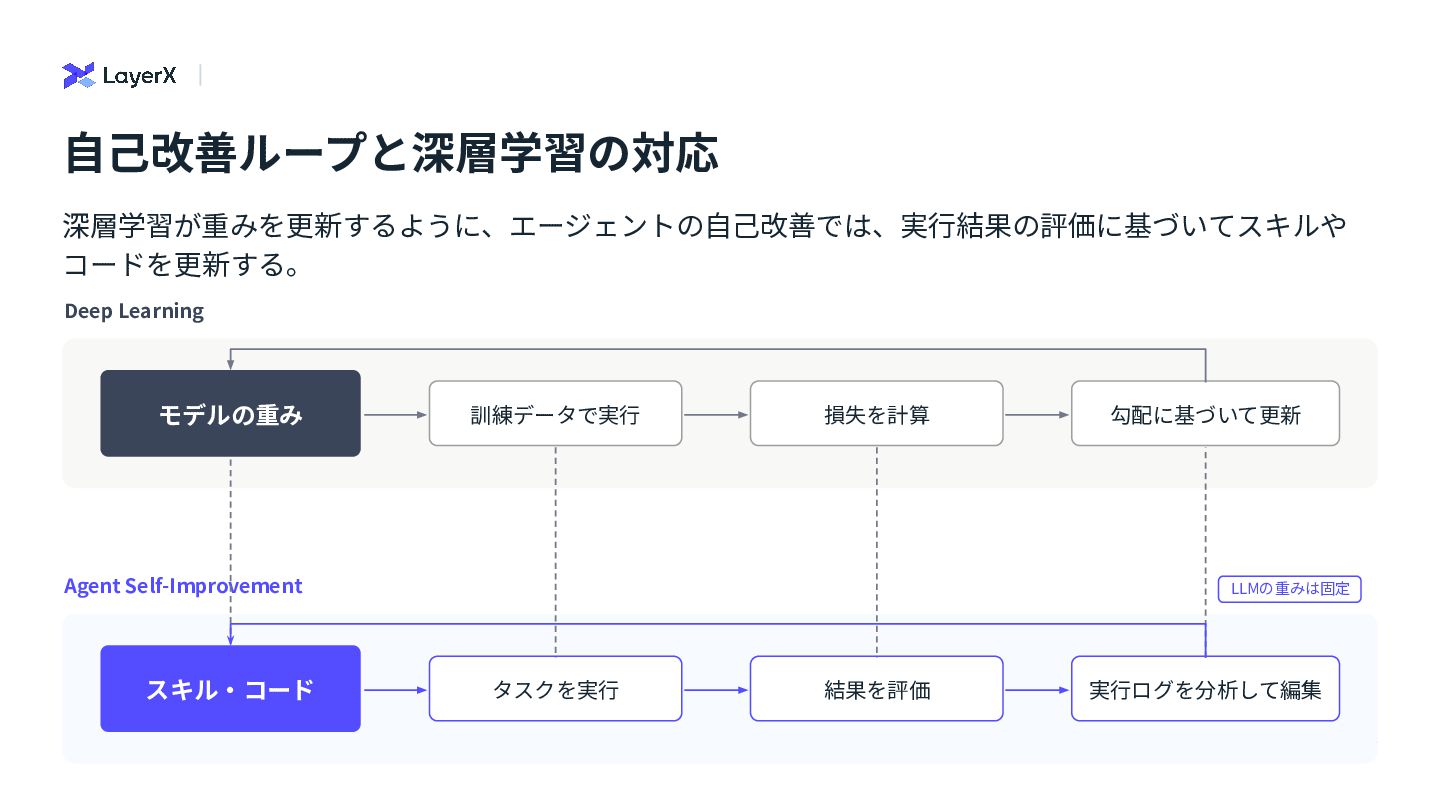
本資料では、業務AIワークフローの構築・改善で経験した課題と関連研究をもとに、自己改善を支えるハーネスの設計を解説します。深層学習の訓練ループとの対応を手がかりに、Training Data・Optimizer・Search Strategy・Evaluationの4つの観点を整理し、「何を業務上の正解とするか」を定める評価設計の重要性を考えます。

関連ブログ:
- https://zenn.dev/layerx/articles/b36ceffe6b5e20
- https://zenn.dev/layerx/articles/9f25ec86a31730

Avatar for 223

223

September 15, 2026

Other Decks in Technology

Transcript

  1. ⾃⼰紹介 ⾃⼰紹介 • 堤⼤貴(つつみ だいき) • LayerX Ai Workforce事業部FDE部エンジニア •

    これまで ◦ 学⽣の頃にNLP領域でMLE(機械学習エンジニア) ◦ 新卒でMLEとして、株式会社ELYZAに⼊社 ◦ ⼈材‧⾦融領域の⼤⼿企業におけるLLMの社会実装を リード • 現在 ◦ ◦ © LayerX Inc. LayerXでForward Deployed Engineer エンタープライズ向けAIエージェントの開発を担当 2
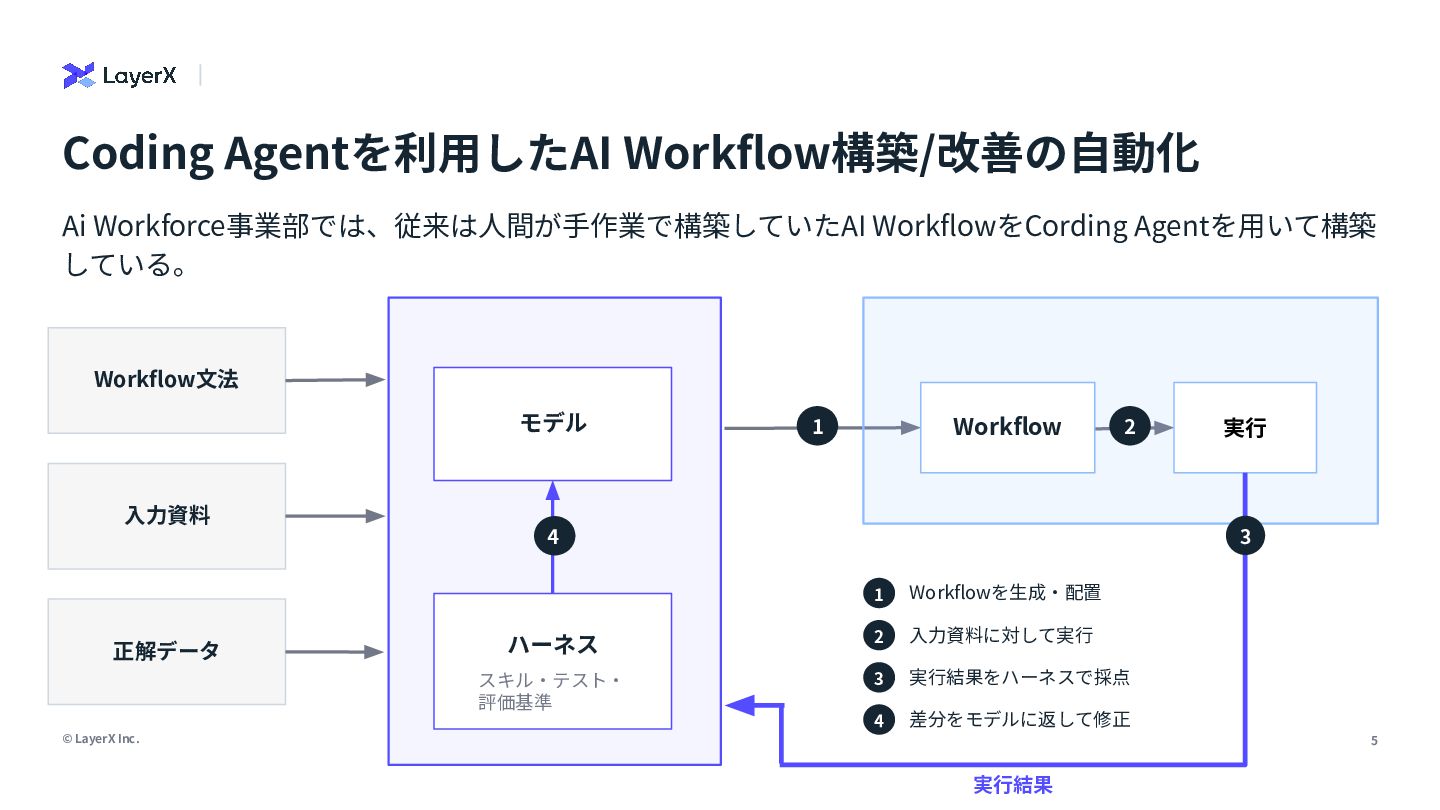
  2. Coding Agentを利⽤したAI Workflow構築/改善の⾃動化 Ai Workforce事業部では、従来は⼈間が⼿作業で構築していたAI WorkflowをCording Agentを⽤いて構築 している。 Workflow⽂法 モデル

    Workflow 1 2 実⾏ ⼊⼒資料 4 正解データ 3 1 Workflowを⽣成‧配置 ハーネス 2 ⼊⼒資料に対して実⾏ スキル‧テスト‧ 評価基準 3 実⾏結果をハーネスで採点 4 差分をモデルに返して修正 © LayerX Inc. 5 実⾏結果
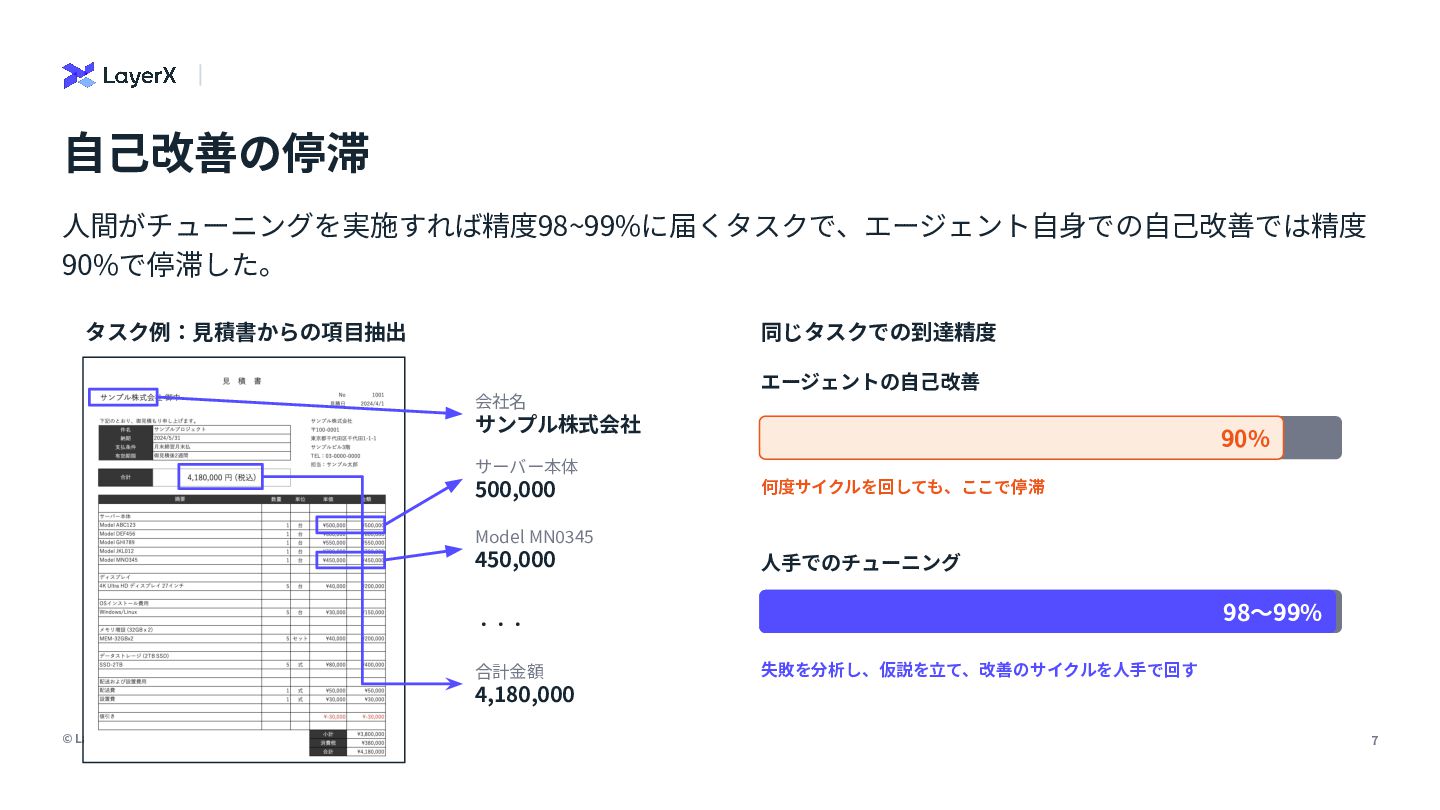
  3. ⾃⼰改善の停滞 ⼈間がチューニングを実施すれば精度98~99%に届くタスクで、エージェント⾃⾝での⾃⼰改善では精度 90%で停滞した。 タスク例:⾒積書からの項⽬抽出 同じタスクでの到達精度 エージェントの⾃⼰改善 会社名 サンプル株式会社 90% サーバー本体

    500,000 何度サイクルを回しても、ここで停滞 Model MN0345 450,000 ⼈⼿でのチューニング 98〜99% ‧‧‧ 合計⾦額 失敗を分析し、仮説を⽴て、改善のサイクルを⼈⼿で回す 4,180,000 © LayerX Inc. 7
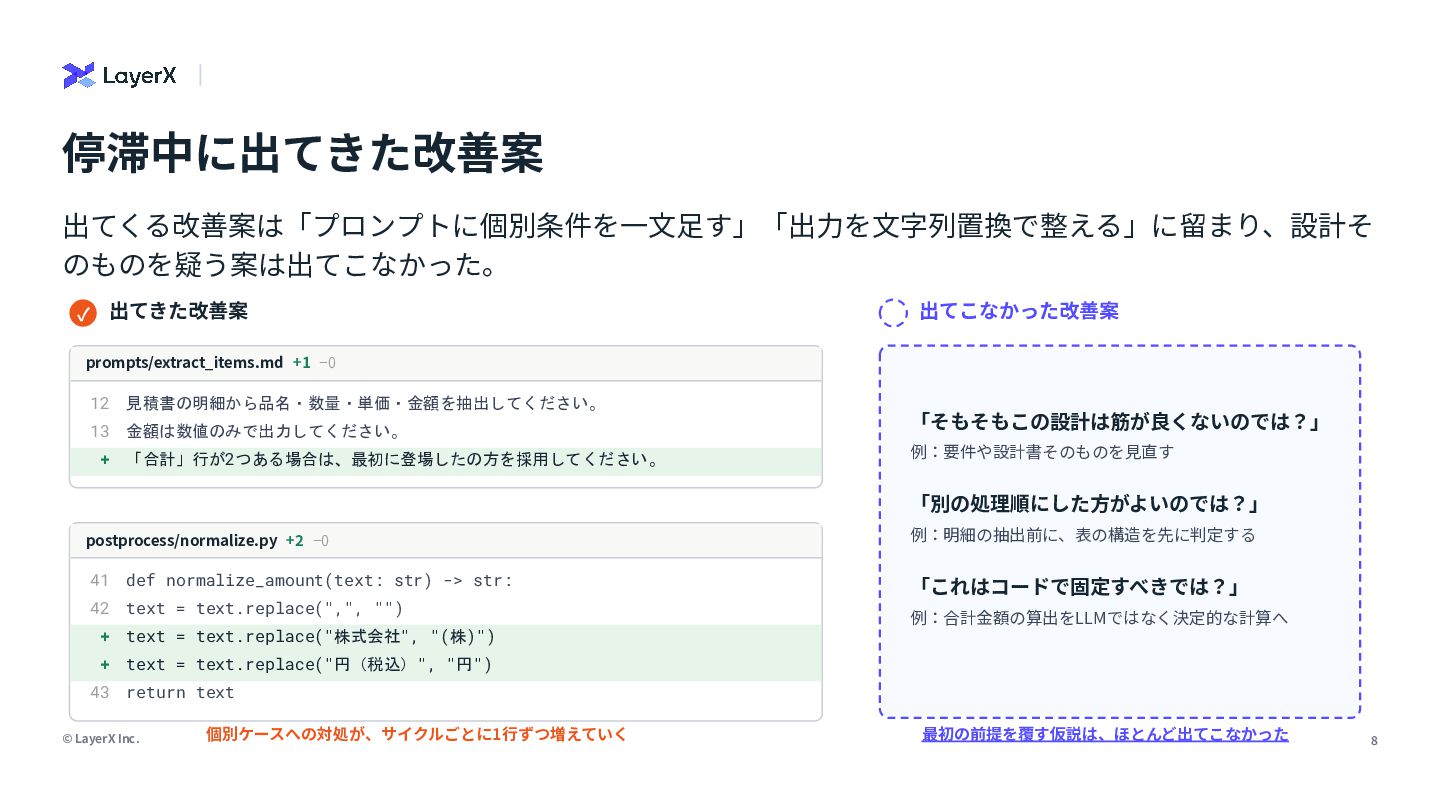
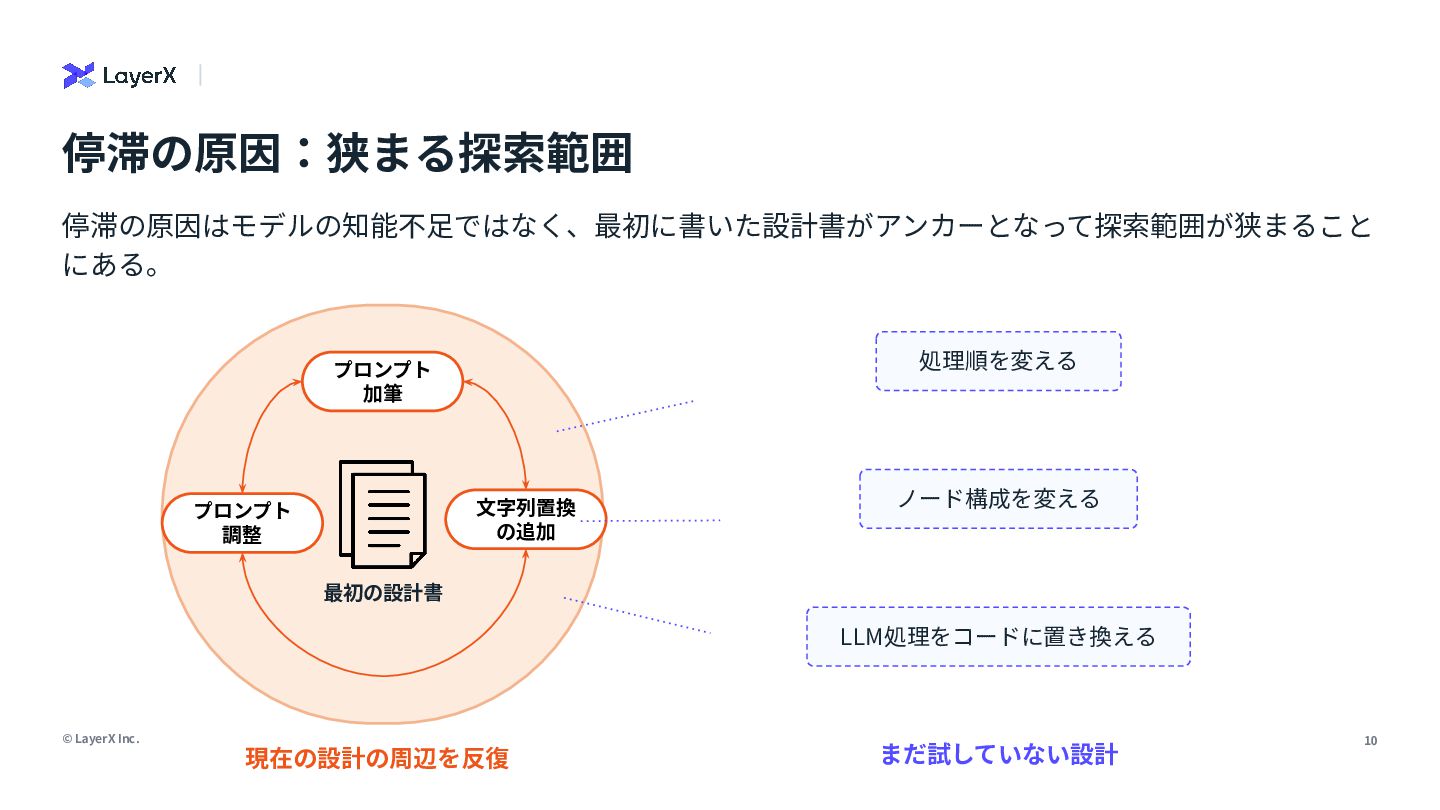
  4. 停滞中に出てきた改善案 出てくる改善案は「プロンプトに個別条件を⼀⽂⾜す」「出⼒を⽂字列置換で整える」に留まり、設計そ のものを疑う案は出てこなかった。 ✓ 出てきた改善案 出てこなかった改善案 prompts/extract_items.md +1 −0 12

    見積書の明細から品名・数量・単価・金額を抽出してください。 13 金額は数値のみで出力してください。 + 「合計」行が2つある場合は、最初に登場したの方を採用してください。 「そもそもこの設計は筋が良くないのでは?」 例:要件や設計書そのものを⾒直す 「別の処理順にした⽅がよいのでは?」 postprocess/normalize.py +2 −0 例:明細の抽出前に、表の構造を先に判定する 41 def normalize_amount(text: str) -> str: 「これはコードで固定すべきでは?」 42 text = text.replace(",", "") 例:合計⾦額の算出をLLMではなく決定的な計算へ + text = text.replace("株式会社", "(株)") + text = text.replace("円(税込)", "円") 43 return text © LayerX Inc. 個別ケースへの対処が、サイクルごとに1⾏ずつ増えていく 最初の前提を覆す仮説は、ほとんど出てこなかった 8
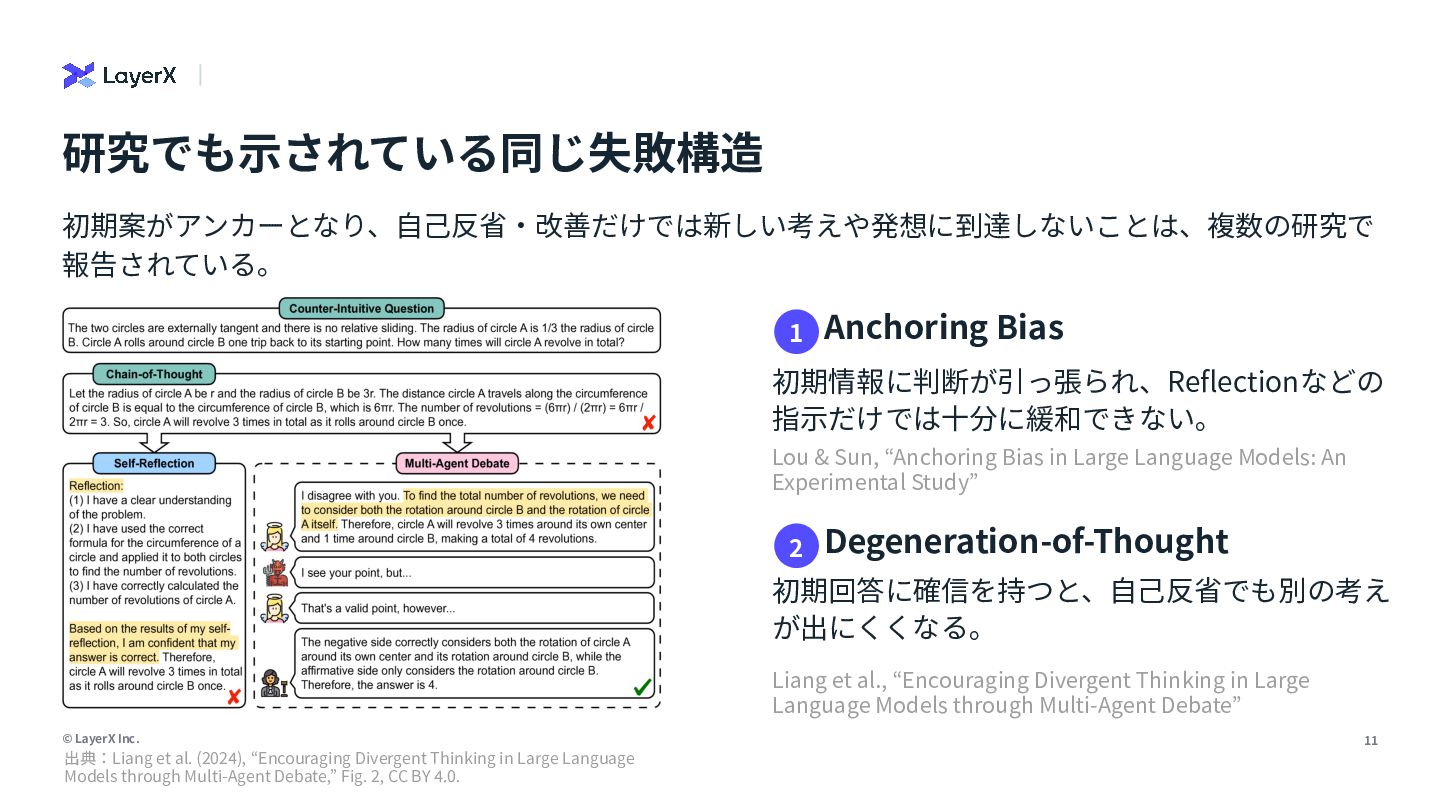
  5. 研究でも⽰されている同じ失敗構造 初期案がアンカーとなり、⾃⼰反省‧改善だけでは新しい考えや発想に到達しないことは、複数の研究で 報告されている。 1 Anchoring Bias 初期情報に判断が引っ張られ、Reflectionなどの 指⽰だけでは⼗分に緩和できない。 Lou &

    Sun, “Anchoring Bias in Large Language Models: An Experimental Study” 2 Degeneration-of-Thought 初期回答に確信を持つと、⾃⼰反省でも別の考え が出にくくなる。 Liang et al., “Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate” © LayerX Inc. 出典:Liang et al. (2024), “Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate,” Fig. 2, CC BY 4.0. 11
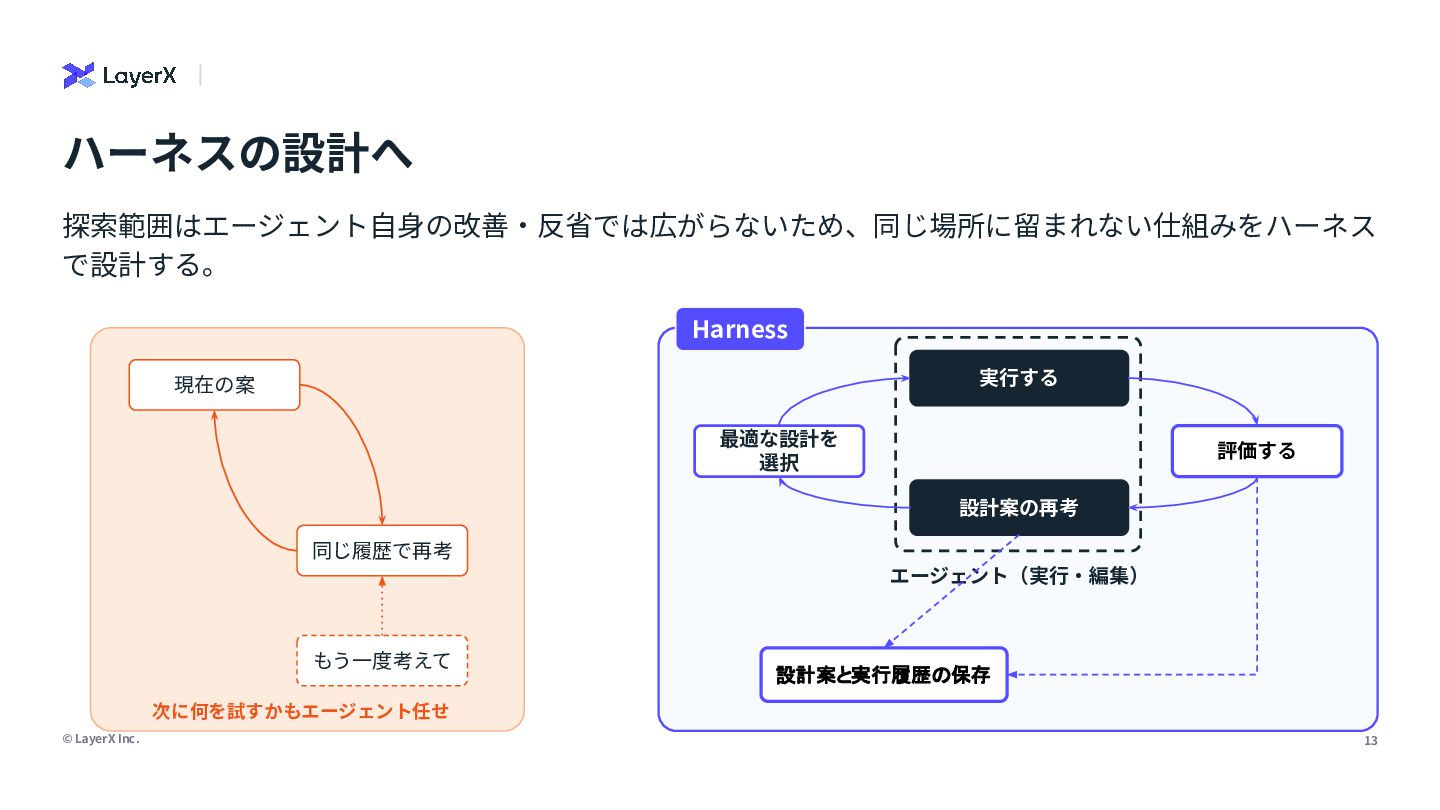
  6. ハーネスの設計へ 探索範囲はエージェント⾃⾝の改善‧反省では広がらないため、同じ場所に留まれない仕組みをハーネス で設計する。 Harness 実⾏する 現在の案 最適な設計を 選択 評価する 設計案の再考

    同じ履歴で再考 エージェント(実⾏‧編集) もう⼀度考えて 設計案と実行履歴の保存 次に何を試すかもエージェント任せ © LayerX Inc. 13
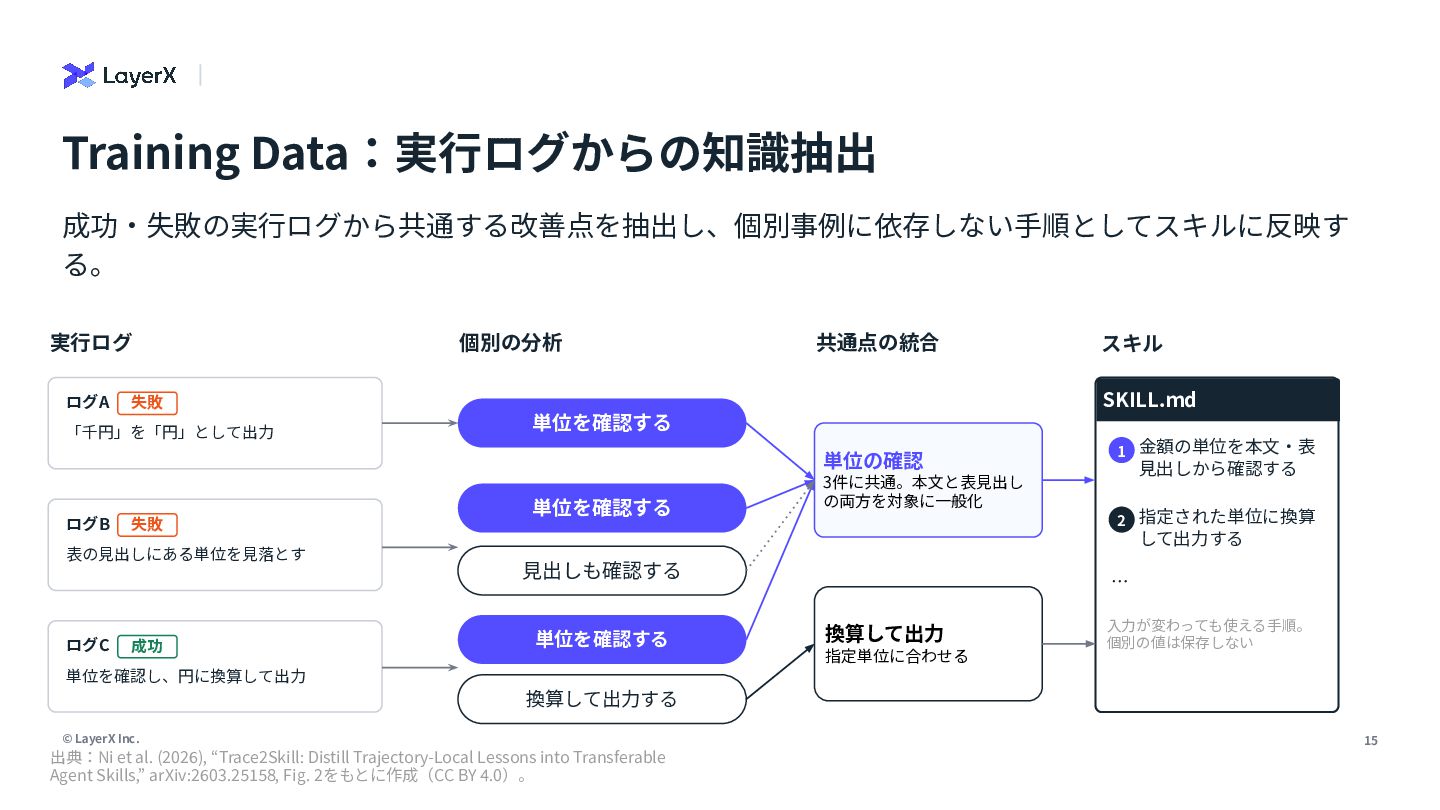
  7. Training Data:実⾏ログからの知識抽出 成功‧失敗の実⾏ログから共通する改善点を抽出し、個別事例に依存しない⼿順としてスキルに反映す る。 実⾏ログ ログA 個別の分析 共通点の統合 SKILL.md 失敗

    「千円」を「円」として出⼒ 単位を確認する 単位の確認 ログB 失敗 表の⾒出しにある単位を⾒落とす ログC 成功 スキル 単位を確認する ⾦額の単位を本⽂‧表 ⾒出しから確認する 2 指定された単位に換算 して出⼒する 3件に共通。本⽂と表⾒出し の両⽅を対象に⼀般化 ⾒出しも確認する 単位を確認する 1 … 換算して出⼒ 指定単位に合わせる ⼊⼒が変わっても使える⼿順。 個別の値は保存しない 単位を確認し、円に換算して出⼒ 換算して出⼒する © LayerX Inc. 出典:Ni et al. (2026), “Trace2Skill: Distill Trajectory-Local Lessons into Transferable Agent Skills,” arXiv:2603.25158, Fig. 2をもとに作成(CC BY 4.0)。 15
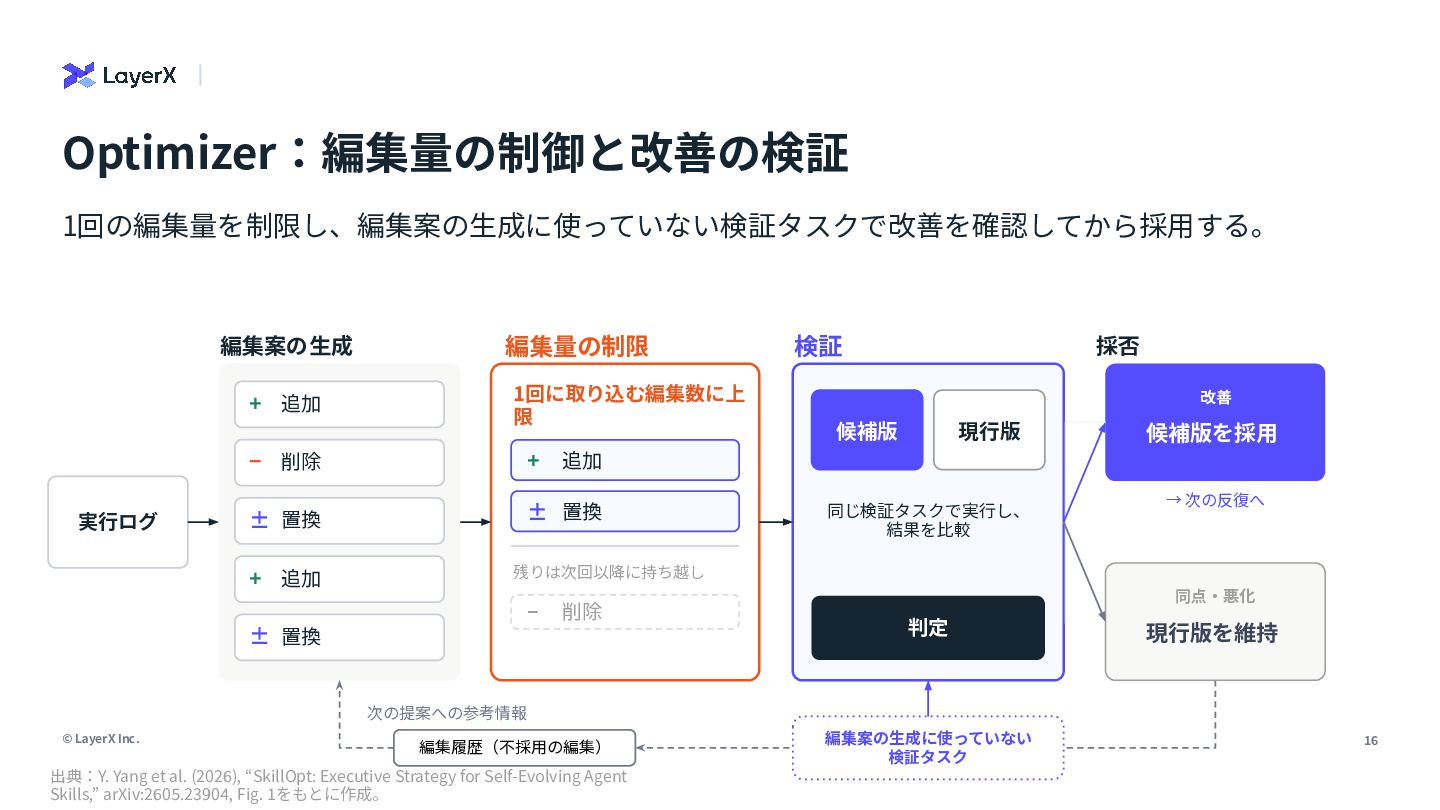
  8. Optimizer:編集量の制御と改善の検証 1回の編集量を制限し、編集案の⽣成に使っていない検証タスクで改善を確認してから採⽤する。 編集案の⽣成 + 追加 実⾏ログ 編集量の制限 1回に取り込む編集数に上 限 −

    削除 + ± 置換 ± 置換 + 追加 検証 採否 改善 候補版 現⾏版 候補版を採⽤ 追加 同じ検証タスクで実⾏し、 結果を⽐較 → 次の反復へ 残りは次回以降に持ち越し − 削除 ± 置換 同点‧悪化 判定 現⾏版を維持 次の提案への参考情報 © LayerX Inc. 編集履歴(不採⽤の編集) 出典:Y. Yang et al. (2026), “SkillOpt: Executive Strategy for Self-Evolving Agent Skills,” arXiv:2605.23904, Fig. 1をもとに作成。 編集案の⽣成に使っていない 検証タスク 16
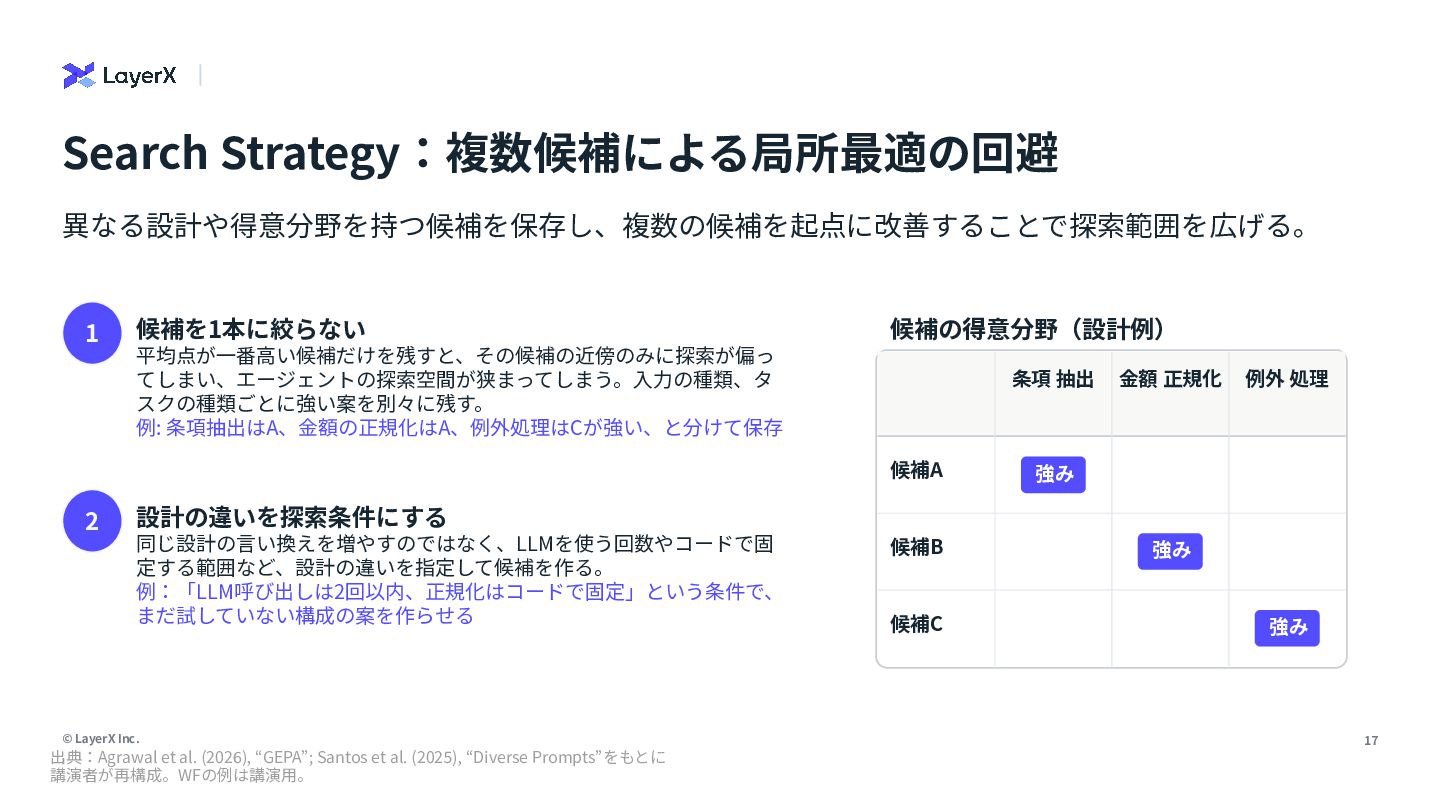
  9. Search Strategy:複数候補による局所最適の回避 異なる設計や得意分野を持つ候補を保存し、複数の候補を起点に改善することで探索範囲を広げる。 1 候補を1本に絞らない 候補の得意分野(設計例) 平均点が⼀番⾼い候補だけを残すと、その候補の近傍のみに探索が偏っ てしまい、エージェントの探索空間が狭まってしまう。⼊⼒の種類、タ スクの種類ごとに強い案を別々に残す。 例:

    条項抽出はA、⾦額の正規化はA、例外処理はCが強い、と分けて保存 条項 抽出 候補A 2 ⾦額 正規化 例外 処理 強み 設計の違いを探索条件にする 同じ設計の⾔い換えを増やすのではなく、LLMを使う回数やコードで固 定する範囲など、設計の違いを指定して候補を作る。 例:「LLM呼び出しは2回以内、正規化はコードで固定」という条件で、 まだ試していない構成の案を作らせる © LayerX Inc. 出典:Agrawal et al. (2026), “GEPA”; Santos et al. (2025), “Diverse Prompts”をもとに 講演者が再構成。WFの例は講演⽤。 候補B 候補C 強み 強み 17
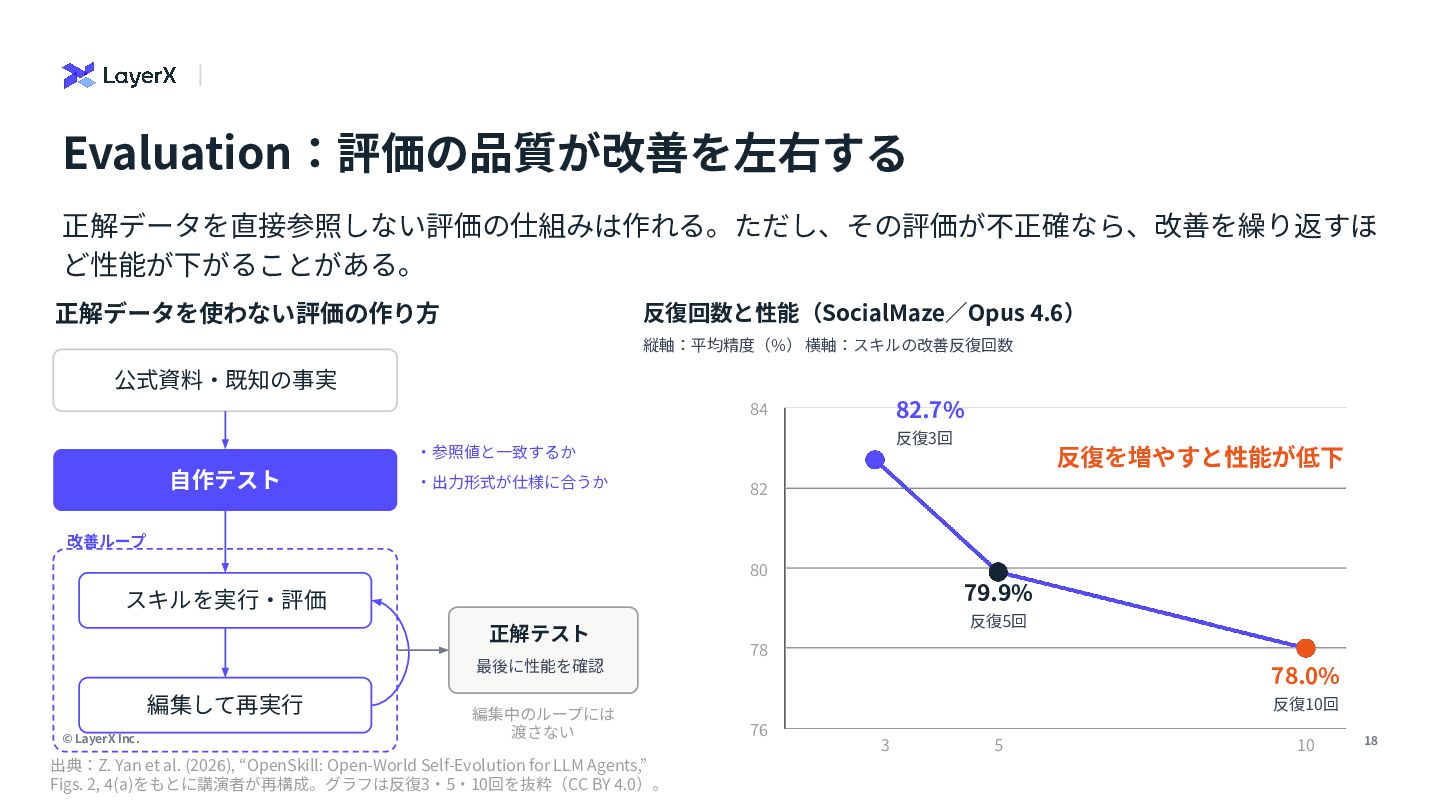
  10. Evaluation:評価の品質が改善を左右する 正解データを直接参照しない評価の仕組みは作れる。ただし、その評価が不正確なら、改善を繰り返すほ ど性能が下がることがある。 反復回数と性能(SocialMaze∕Opus 4.6) 正解データを使わない評価の作り⽅ 縦軸:平均精度(%) 横軸:スキルの改善反復回数 公式資料‧既知の事実 82.7%

    84 反復3回 ‧参照値と⼀致するか ⾃作テスト ‧出⼒形式が仕様に合うか 反復を増やすと性能が低下 82 改善ループ 80 79.9% スキルを実⾏‧評価 正解テスト 反復5回 78 最後に性能を確認 編集して再実⾏ © LayerX Inc. 編集中のループには 渡さない 出典:Z. Yan et al. (2026), “OpenSkill: Open-World Self-Evolution for LLM Agents,” Figs. 2, 4(a)をもとに講演者が再構成。グラフは反復3‧5‧10回を抜粋(CC BY 4.0)。 78.0% 反復10回 76 3 5 10 18
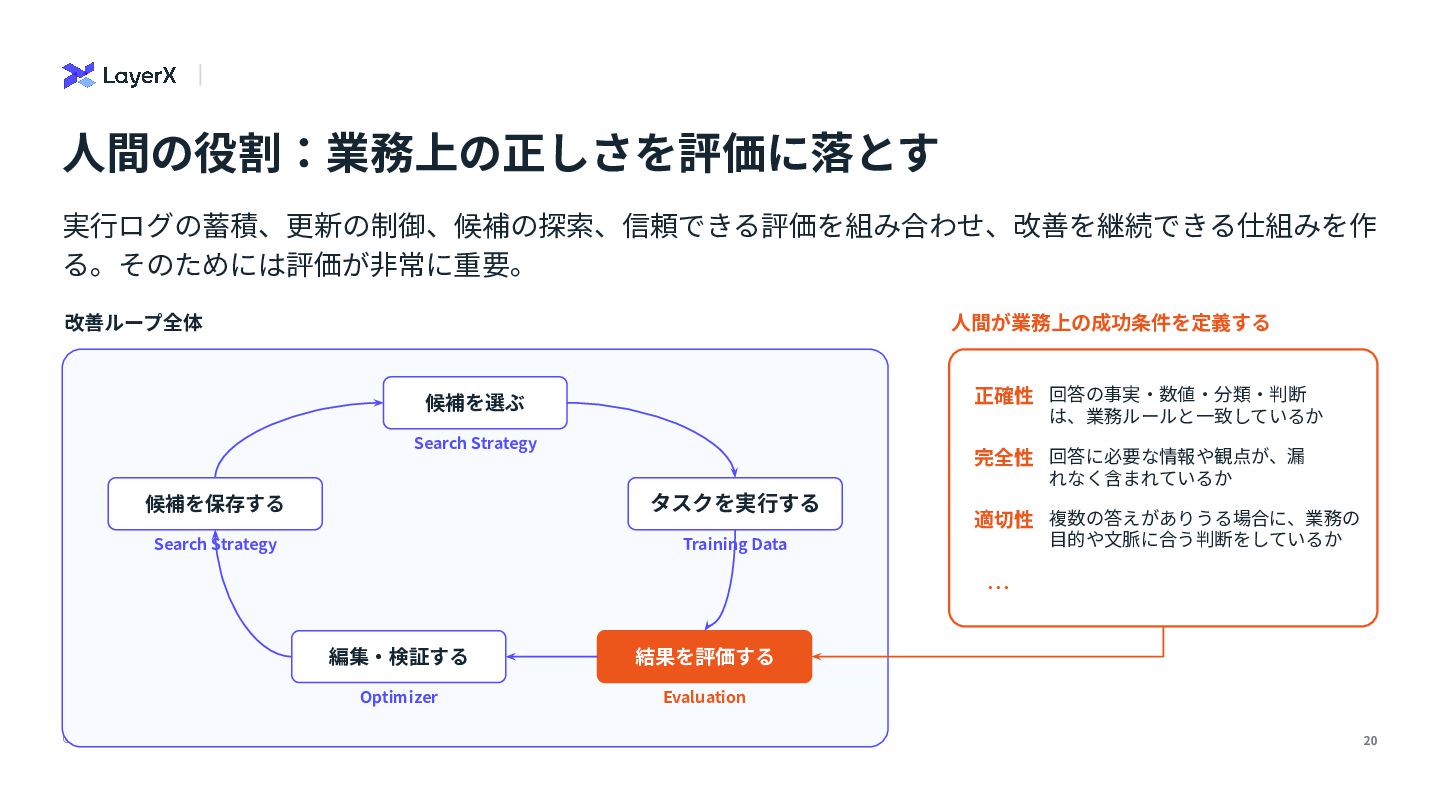
  11. ⼈間の役割:業務上の正しさを評価に落とす 実⾏ログの蓄積、更新の制御、候補の探索、信頼できる評価を組み合わせ、改善を継続できる仕組みを作 る。そのためには評価が⾮常に重要。 改善ループ全体 ⼈間が業務上の成功条件を定義する 正確性 回答の事実‧数値‧分類‧判断 候補を選ぶ は、業務ルールと⼀致しているか Search

    Strategy 完全性 回答に必要な情報や観点が、漏 れなく含まれているか 候補を保存する タスクを実⾏する Search Strategy Training Data 適切性 複数の答えがありうる場合に、業務の ⽬的や⽂脈に合う判断をしているか … © LayerX Inc. 編集‧検証する 結果を評価する Optimizer Evaluation 20
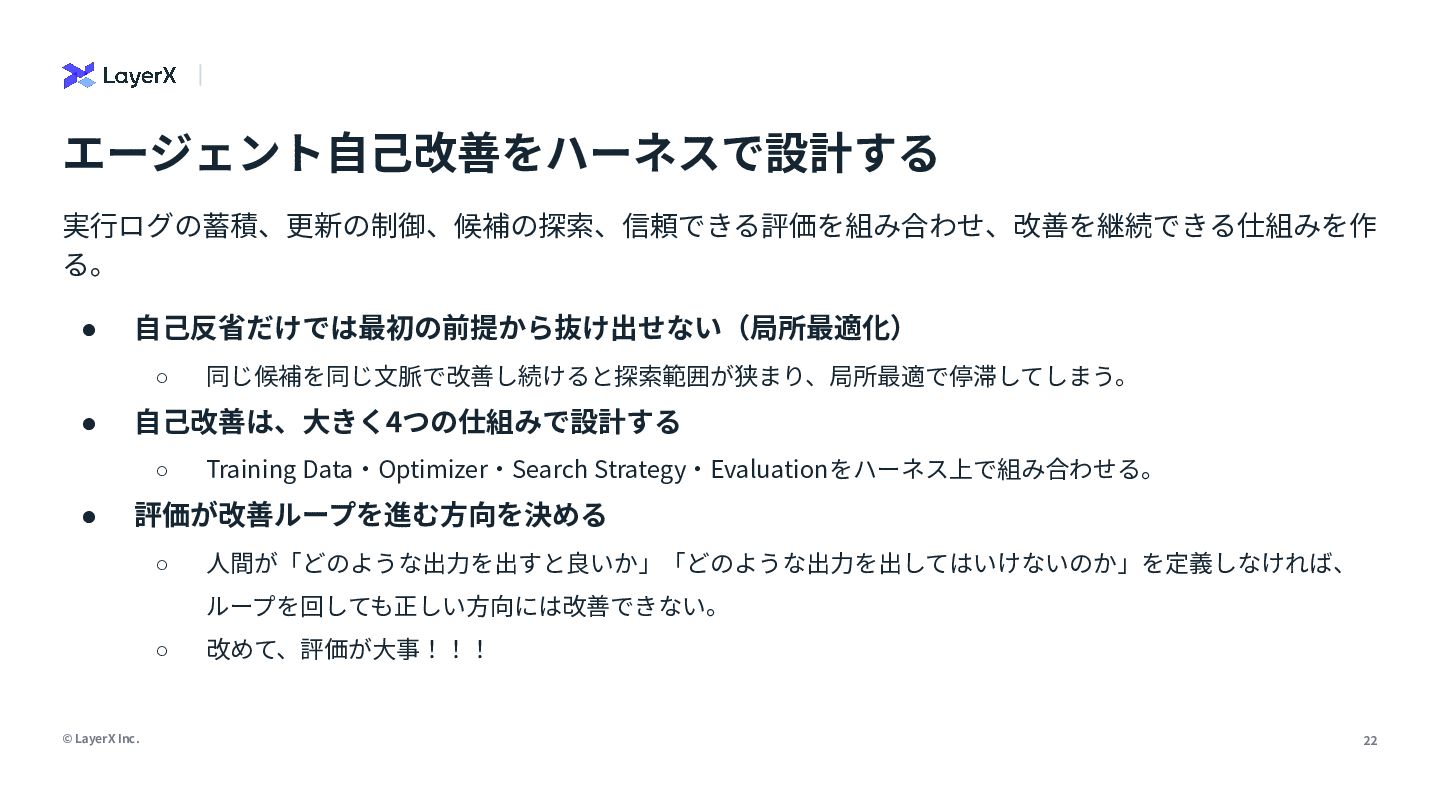
  12. エージェント⾃⼰改善をハーネスで設計する 実⾏ログの蓄積、更新の制御、候補の探索、信頼できる評価を組み合わせ、改善を継続できる仕組みを作 る。 • ⾃⼰反省だけでは最初の前提から抜け出せない(局所最適化) ◦ • ⾃⼰改善は、⼤きく4つの仕組みで設計する ◦ •

    同じ候補を同じ⽂脈で改善し続けると探索範囲が狭まり、局所最適で停滞してしまう。 Training Data‧Optimizer‧Search Strategy‧Evaluationをハーネス上で組み合わせる。 評価が改善ループを進む⽅向を決める ◦ ⼈間が「どのような出⼒を出すと良いか」「どのような出⼒を出してはいけないのか」を定義しなければ、 ループを回しても正しい⽅向には改善できない。 ◦ © LayerX Inc. 改めて、評価が⼤事!!! 22