Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Apache Iceberg が拓く AI 時代のオープンレイクハウス

Apache Iceberg が拓く AI 時代のオープンレイクハウス

Apache Iceberg が AI 時代のオープンレイクハウスを支える仕組みを解説します。テーブル管理の基本から Iceberg V3 の機能、V4 で議論中のメタデータ改善、Delta Lake との共通化の動向まで紹介します。

Avatar for Tomohiro Tanaka

Tomohiro Tanaka

September 28, 2026

More Decks by Tomohiro Tanaka

Other Decks in Technology

Transcript

  1. Tomohiro Tanaka Senior Forward Deployed Engineer at Databricks • Contributing

    to the Apache Iceberg OSS • Co-authored “実践 Apache Iceberg” • Co-organizing Apache Iceberg Japan Meetup ©2026 Databricks, Inc. — All rights reserved 2
  2. Agenda Iceberg が求められる背景 Lakehouse を支える Iceberg の役割と仕組み Iceberg table format

    の AI 時代への対応 Iceberg format version 4 - 更なる Iceberg の進化 ©2026 Databricks, Inc. — All rights reserved
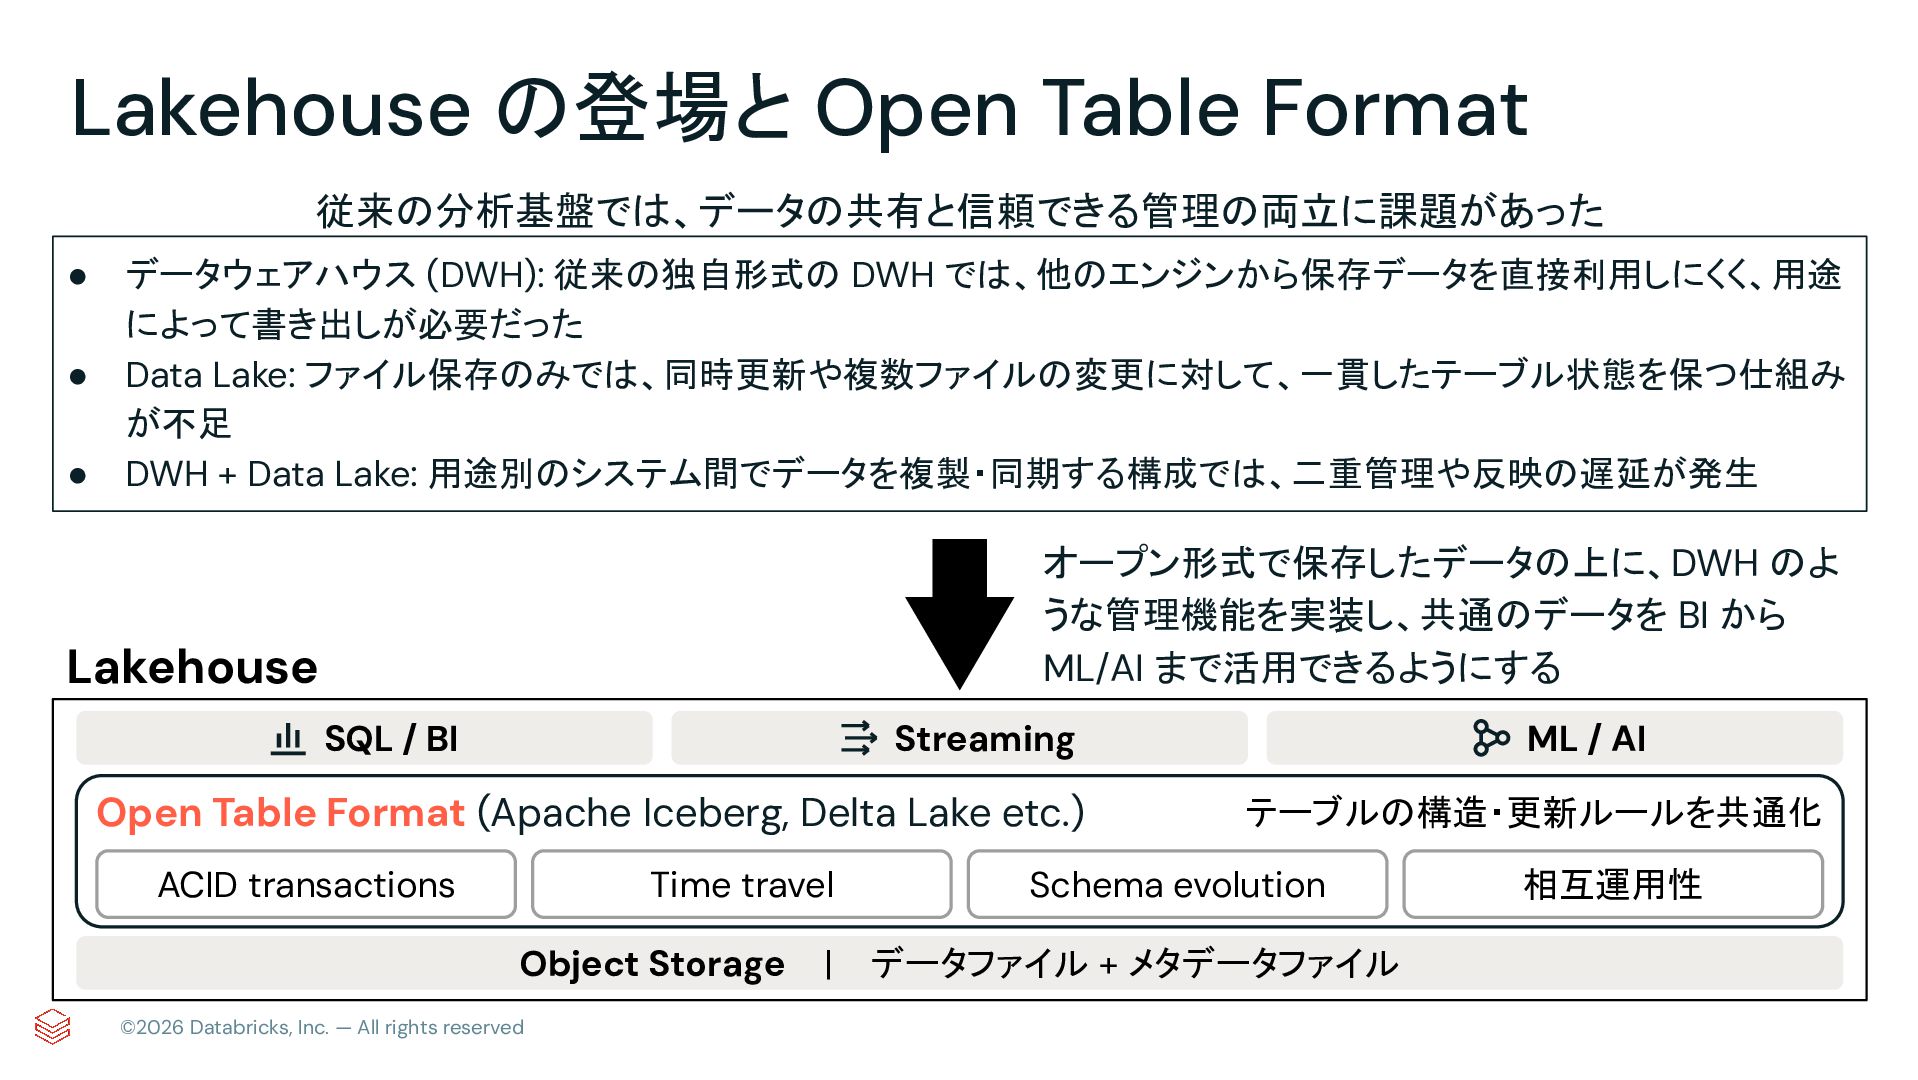
  3. Lakehouse の登場と Open Table Format 従来の分析基盤では、データの共有と信頼できる管理の両立に課題があった • • • データウェアハウス

    (DWH): 従来の独自形式の DWH では、他のエンジンから保存データを直接利用しにくく、用途 によって書き出しが必要だった Data Lake: ファイル保存のみでは、同時更新や複数ファイルの変更に対して、一貫したテーブル状態を保つ仕組み が不足 DWH + Data Lake: 用途別のシステム間でデータを複製・同期する構成では、二重管理や反映の遅延が発生 オープン形式で保存したデータの上に、DWH のよ うな管理機能を実装し、共通のデータを BI から ML/AI まで活用できるようにする Lakehouse SQL / BI Streaming Open Table Format (Apache Iceberg, Delta Lake etc.) ACID transactions Time travel Object Storage ©2026 Databricks, Inc. — All rights reserved | ML / AI テーブルの構造・更新ルールを共通化 Schema evolution データファイル + メタデータファイル 相互運用性
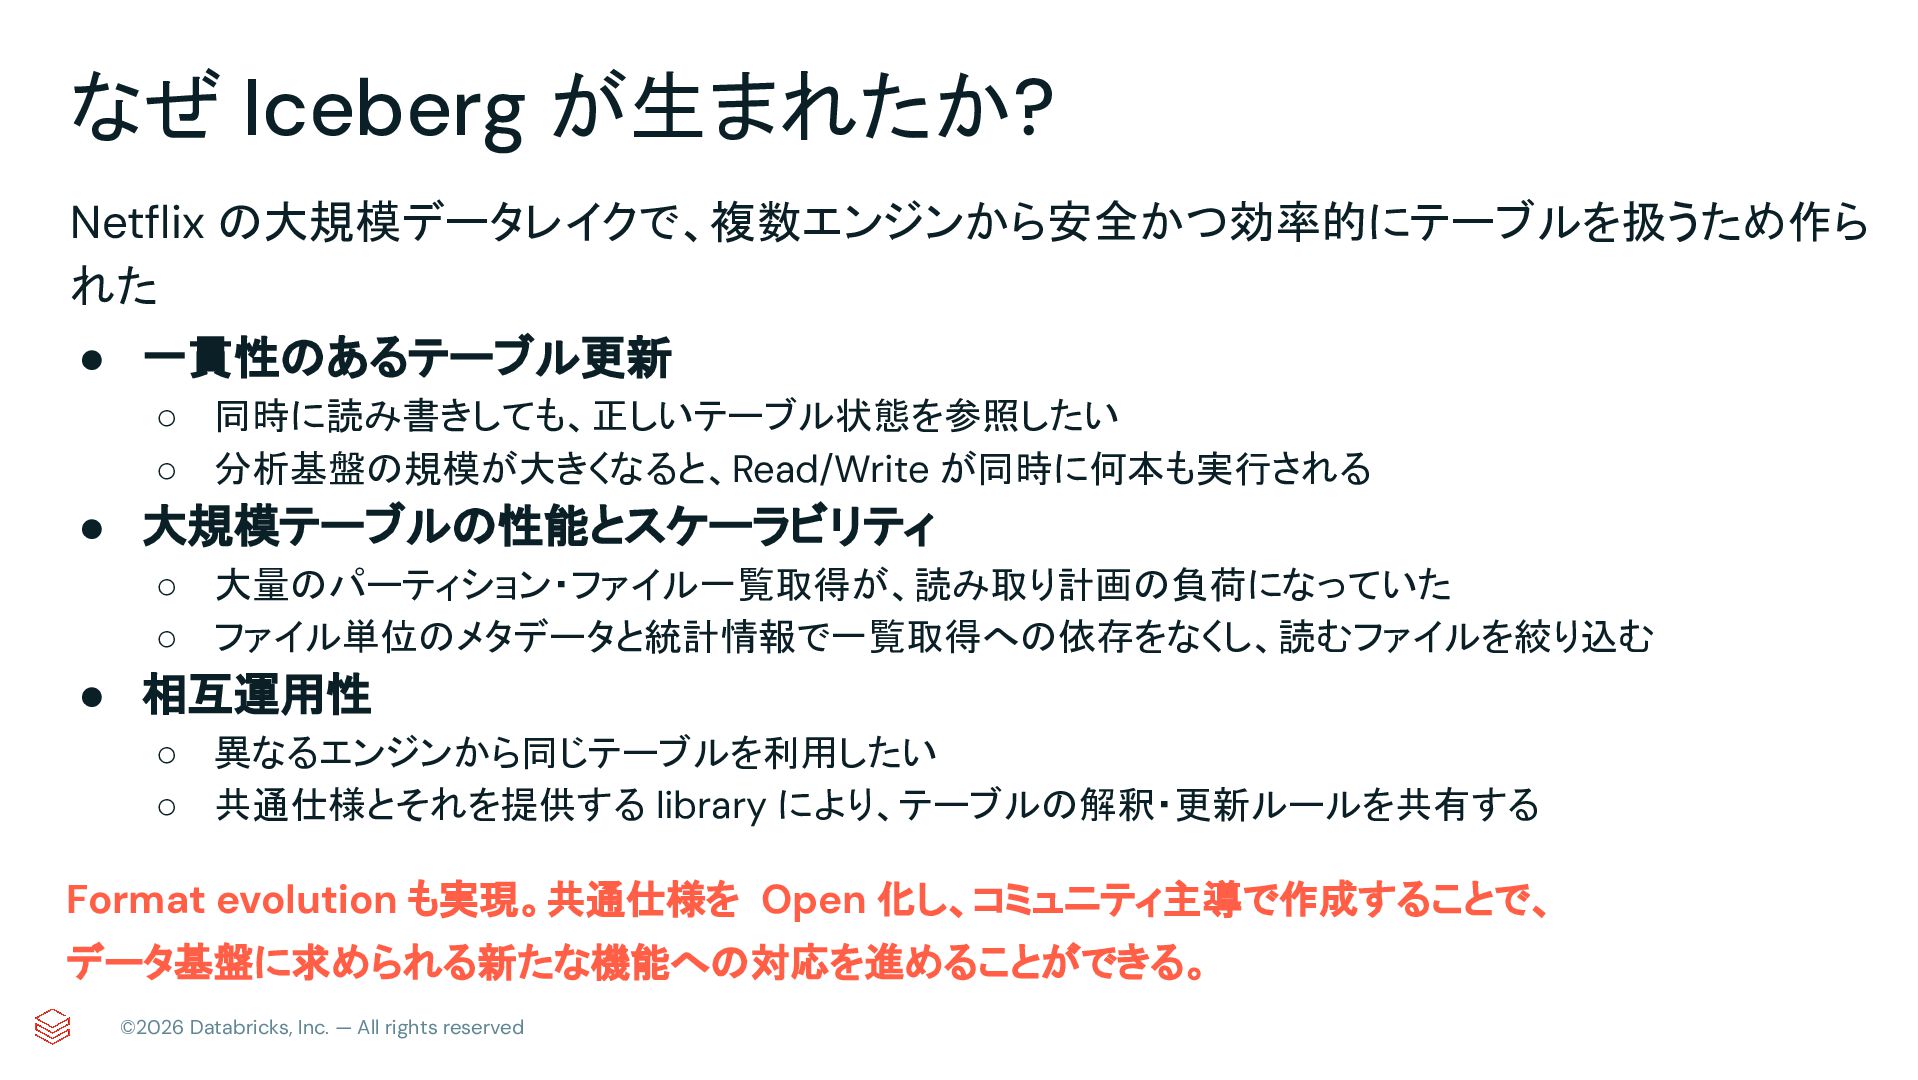
  4. なぜ Iceberg が生まれたか? Netflix の大規模データレイクで、複数エンジンから安全かつ効率的にテーブルを扱うため作ら れた • 一貫性のあるテーブル更新 ◦ 同時に読み書きしても、正しいテーブル状態を参照したい

    ◦ 分析基盤の規模が大きくなると、Read/Write が同時に何本も実行される • 大規模テーブルの性能とスケーラビリティ ◦ 大量のパーティション・ファイル一覧取得が、読み取り計画の負荷になっていた ◦ ファイル単位のメタデータと統計情報で一覧取得への依存をなくし、読むファイルを絞り込む • 相互運用性 ◦ 異なるエンジンから同じテーブルを利用したい ◦ 共通仕様とそれを提供する library により、テーブルの解釈・更新ルールを共有する Format evolution も実現。共通仕様を Open 化し、コミュニティ主導で作成することで、 データ基盤に求められる新たな機能への対応を進めることができる。 ©2026 Databricks, Inc. — All rights reserved
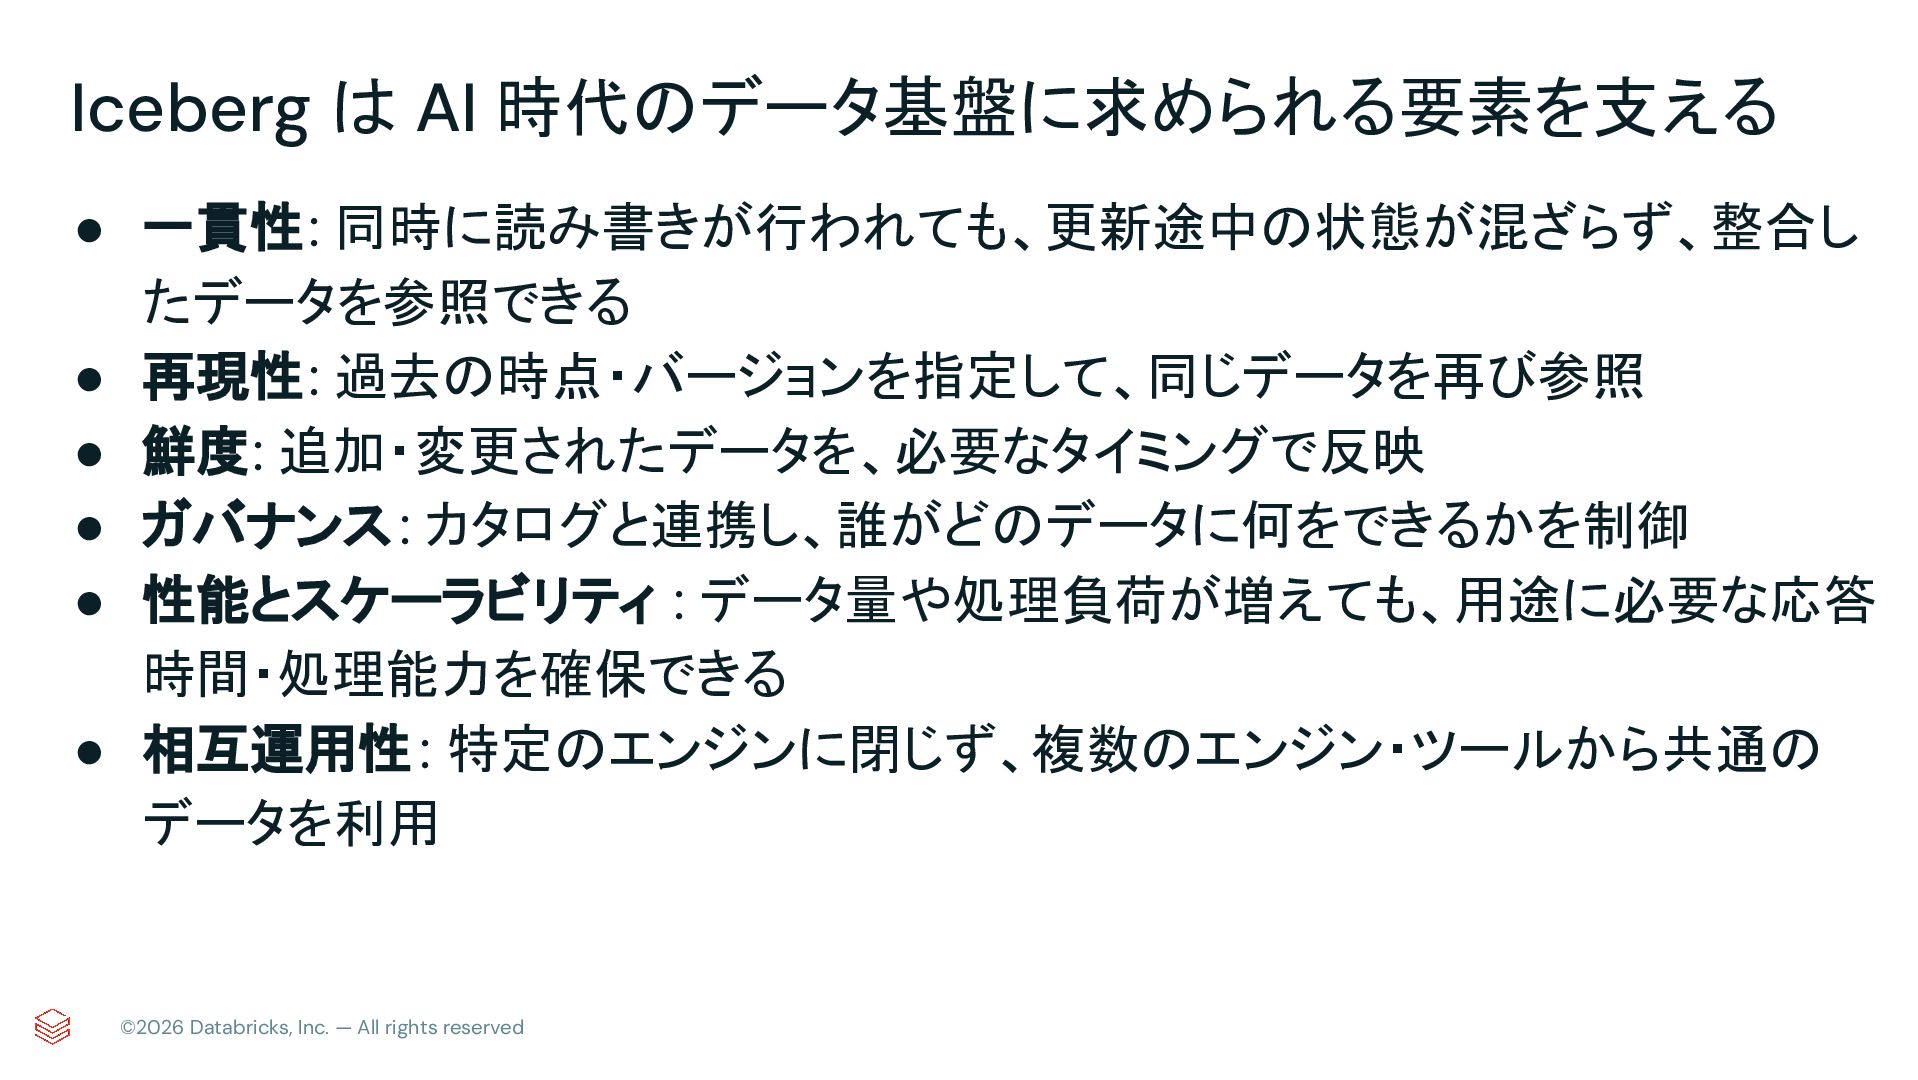
  5. Iceberg は AI 時代のデータ基盤に求められる要素を支える • 一貫性: 同時に読み書きが行われても、更新途中の状態が混ざらず、整合し たデータを参照できる • 再現性:

    過去の時点・バージョンを指定して、同じデータを再び参照 • 鮮度: 追加・変更されたデータを、必要なタイミングで反映 • ガバナンス : カタログと連携し、誰がどのデータに何をできるかを制御 • 性能とスケーラビリティ : データ量や処理負荷が増えても、用途に必要な応答 時間・処理能力を確保できる • 相互運用性 : 特定のエンジンに閉じず、複数のエンジン・ツールから共通の データを利用 ©2026 Databricks, Inc. — All rights reserved
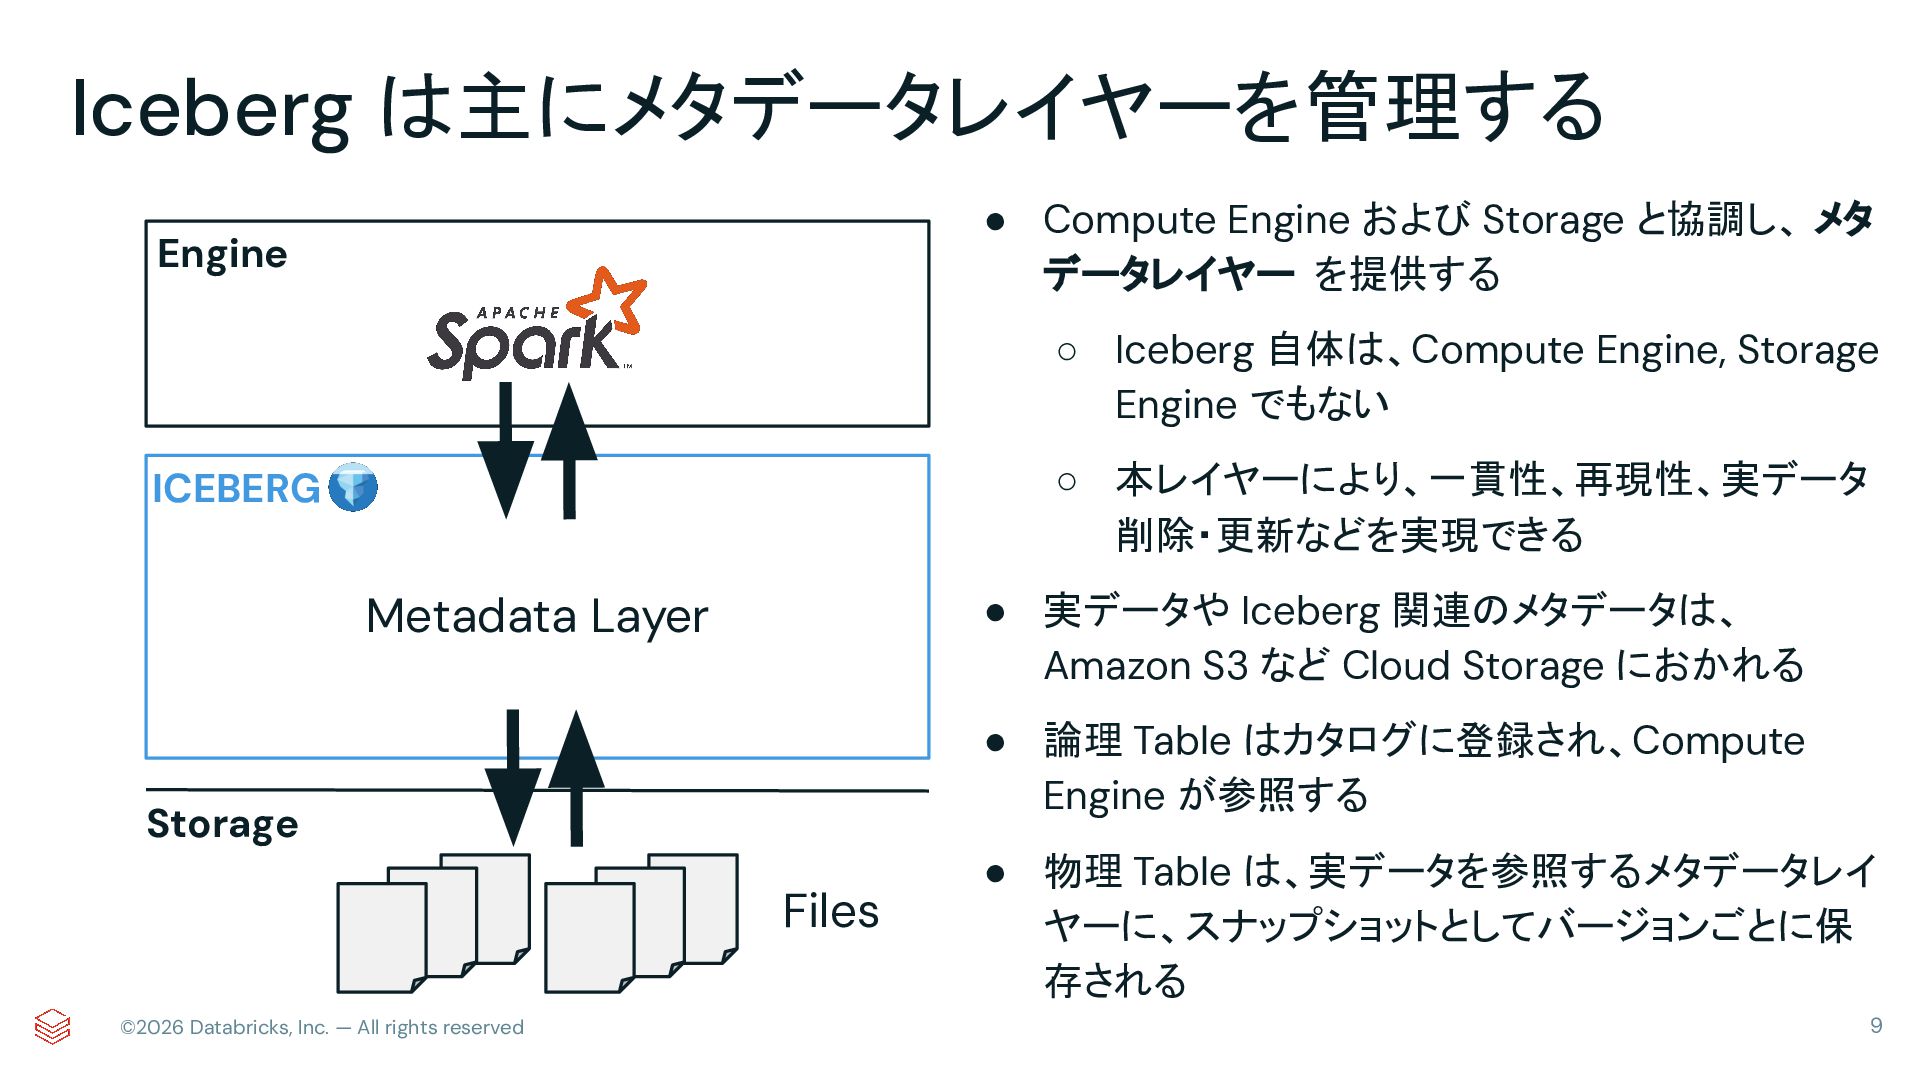
  6. Iceberg は主にメタデータレイヤーを管理する • Compute Engine および Storage と協調し、 メタ データレイヤー

    を提供する Engine ◦ Iceberg 自体は、Compute Engine, Storage Engine でもない ◦ 本レイヤーにより、一貫性、再現性、実データ 削除・更新などを実現できる ICEBERG Metadata Layer • 実データや Iceberg 関連のメタデータは、 Amazon S3 など Cloud Storage におかれる • 論理 Table はカタログに登録され、Compute Engine が参照する Storage Files ©2026 Databricks, Inc. — All rights reserved • 物理 Table は、実データを参照するメタデータレイ ヤーに、スナップショットとしてバージョンごとに保 存される 9
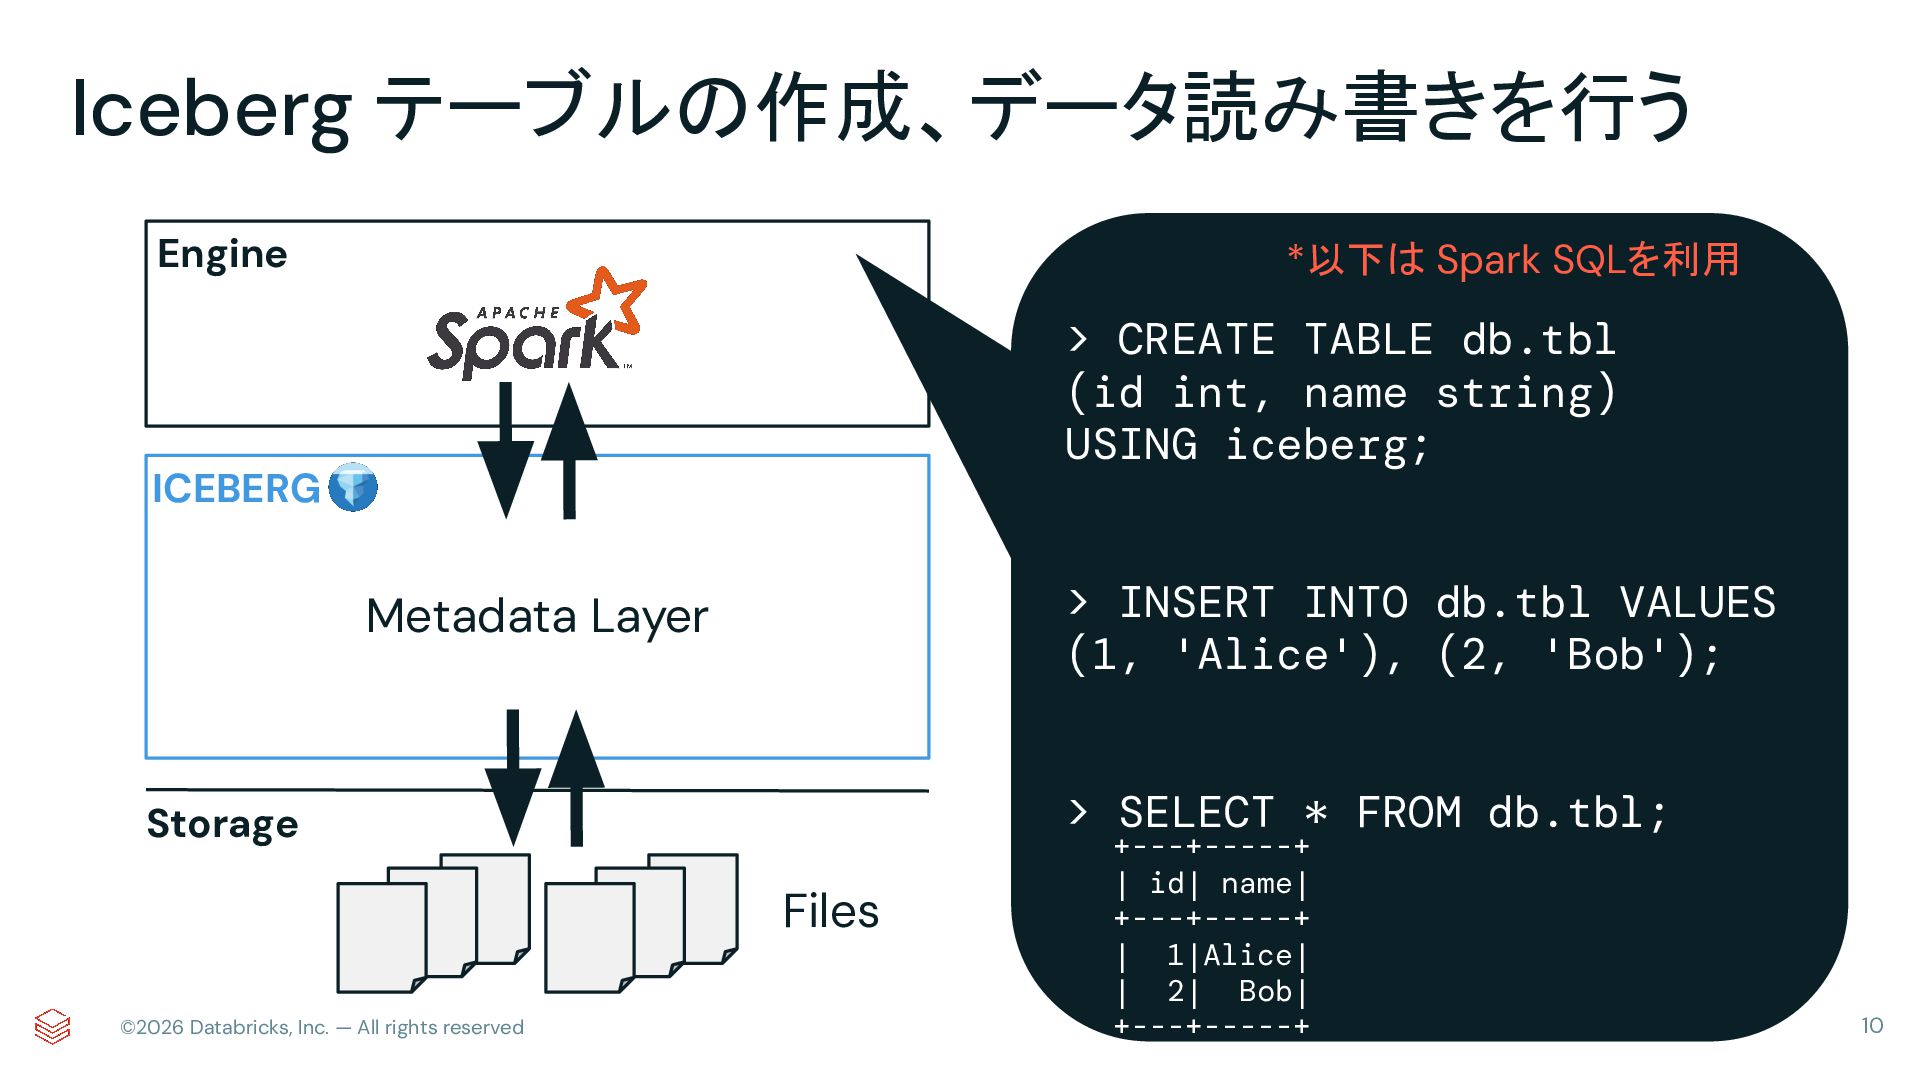
  7. Iceberg テーブルの作成、データ読み書きを行う Engine *以下は Spark SQLを利用 > CREATE TABLE db.tbl

    (id int, name string) USING iceberg; ICEBERG > INSERT INTO db.tbl VALUES (1, 'Alice'), (2, 'Bob'); Metadata Layer > SELECT * FROM db.tbl; Storage Files ©2026 Databricks, Inc. — All rights reserved +---+-----+ | id| name| +---+-----+ | 1|Alice| | 2| Bob| +---+-----+ 10
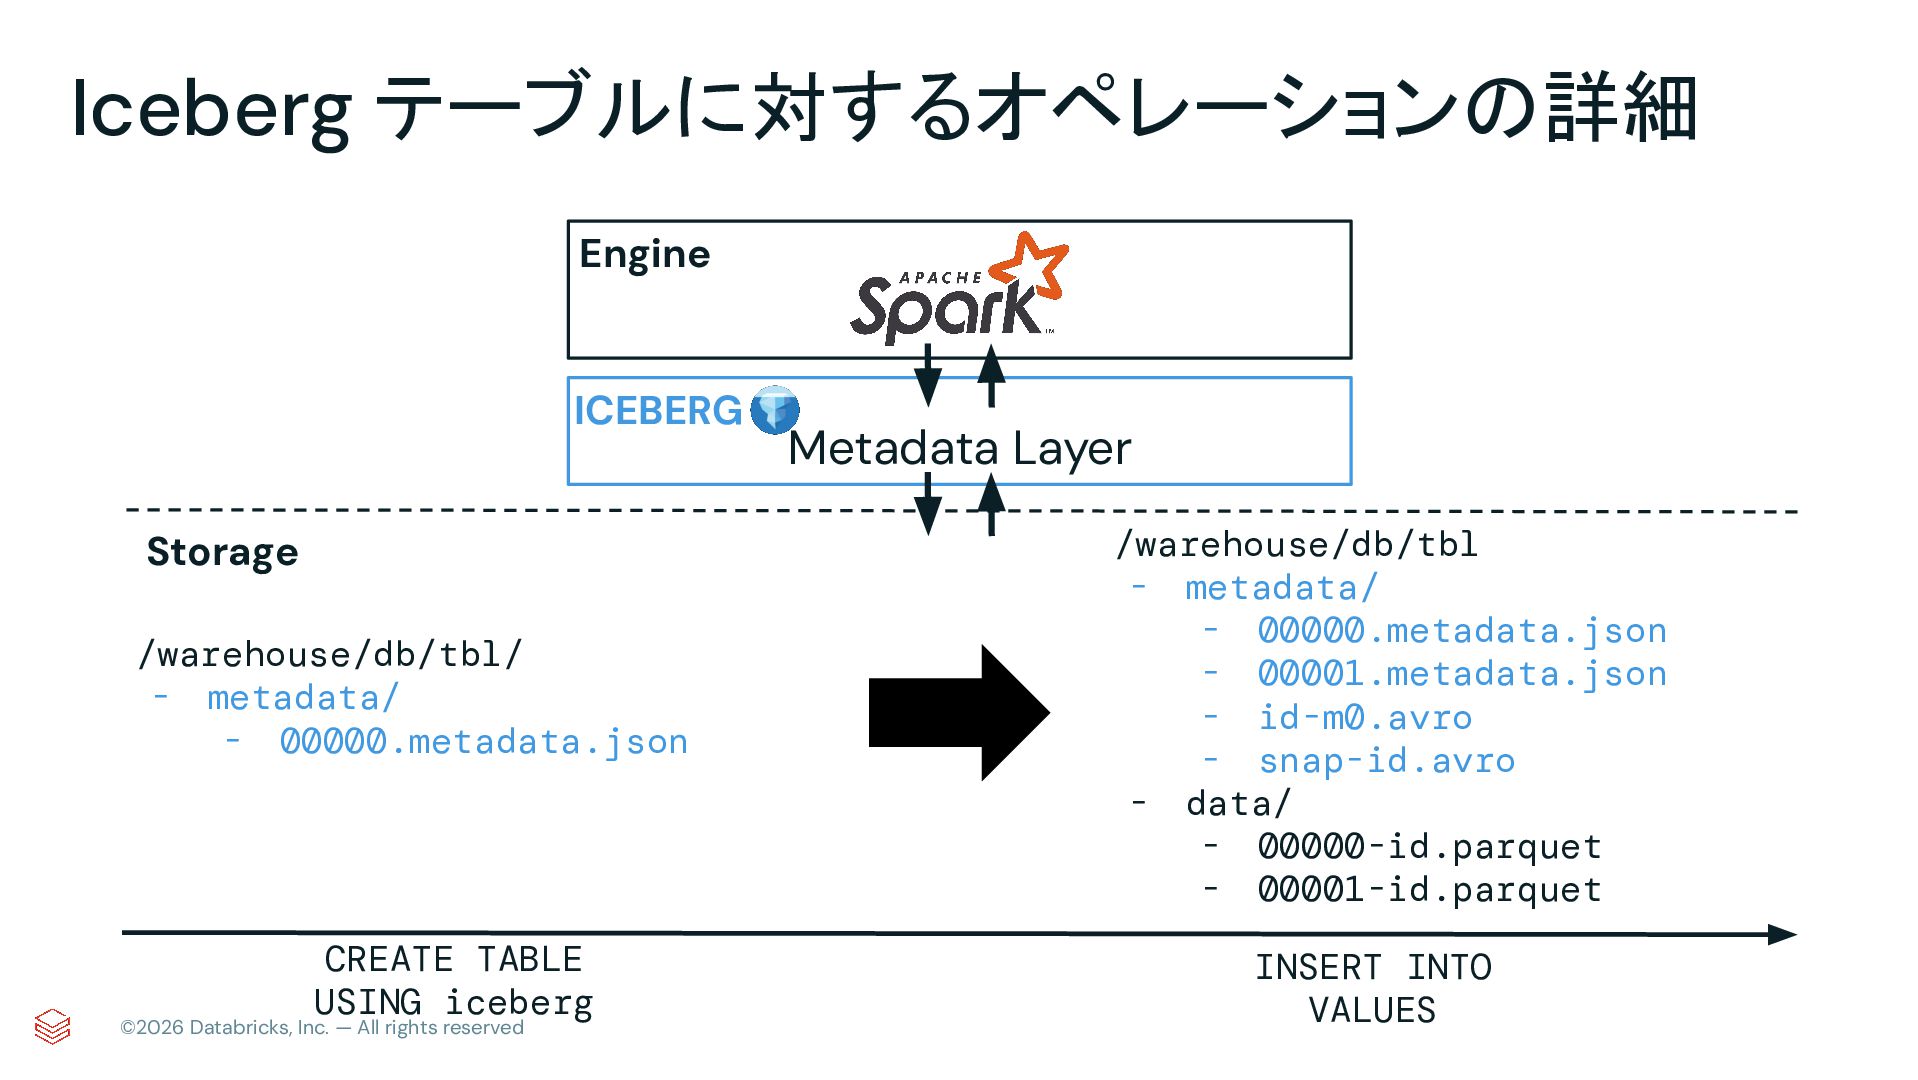
  8. Iceberg テーブルに対するオペレーションの詳細 Engine ICEBERG Storage /warehouse/db/tbl/ - metadata/ - 00000.metadata.json

    CREATE TABLE USING iceberg ©2026 Databricks, Inc. — All rights reserved Metadata Layer /warehouse/db/tbl - metadata/ - 00000.metadata.json - 00001.metadata.json - id-m0.avro - snap-id.avro - data/ - 00000-id.parquet - 00001-id.parquet INSERT INTO VALUES
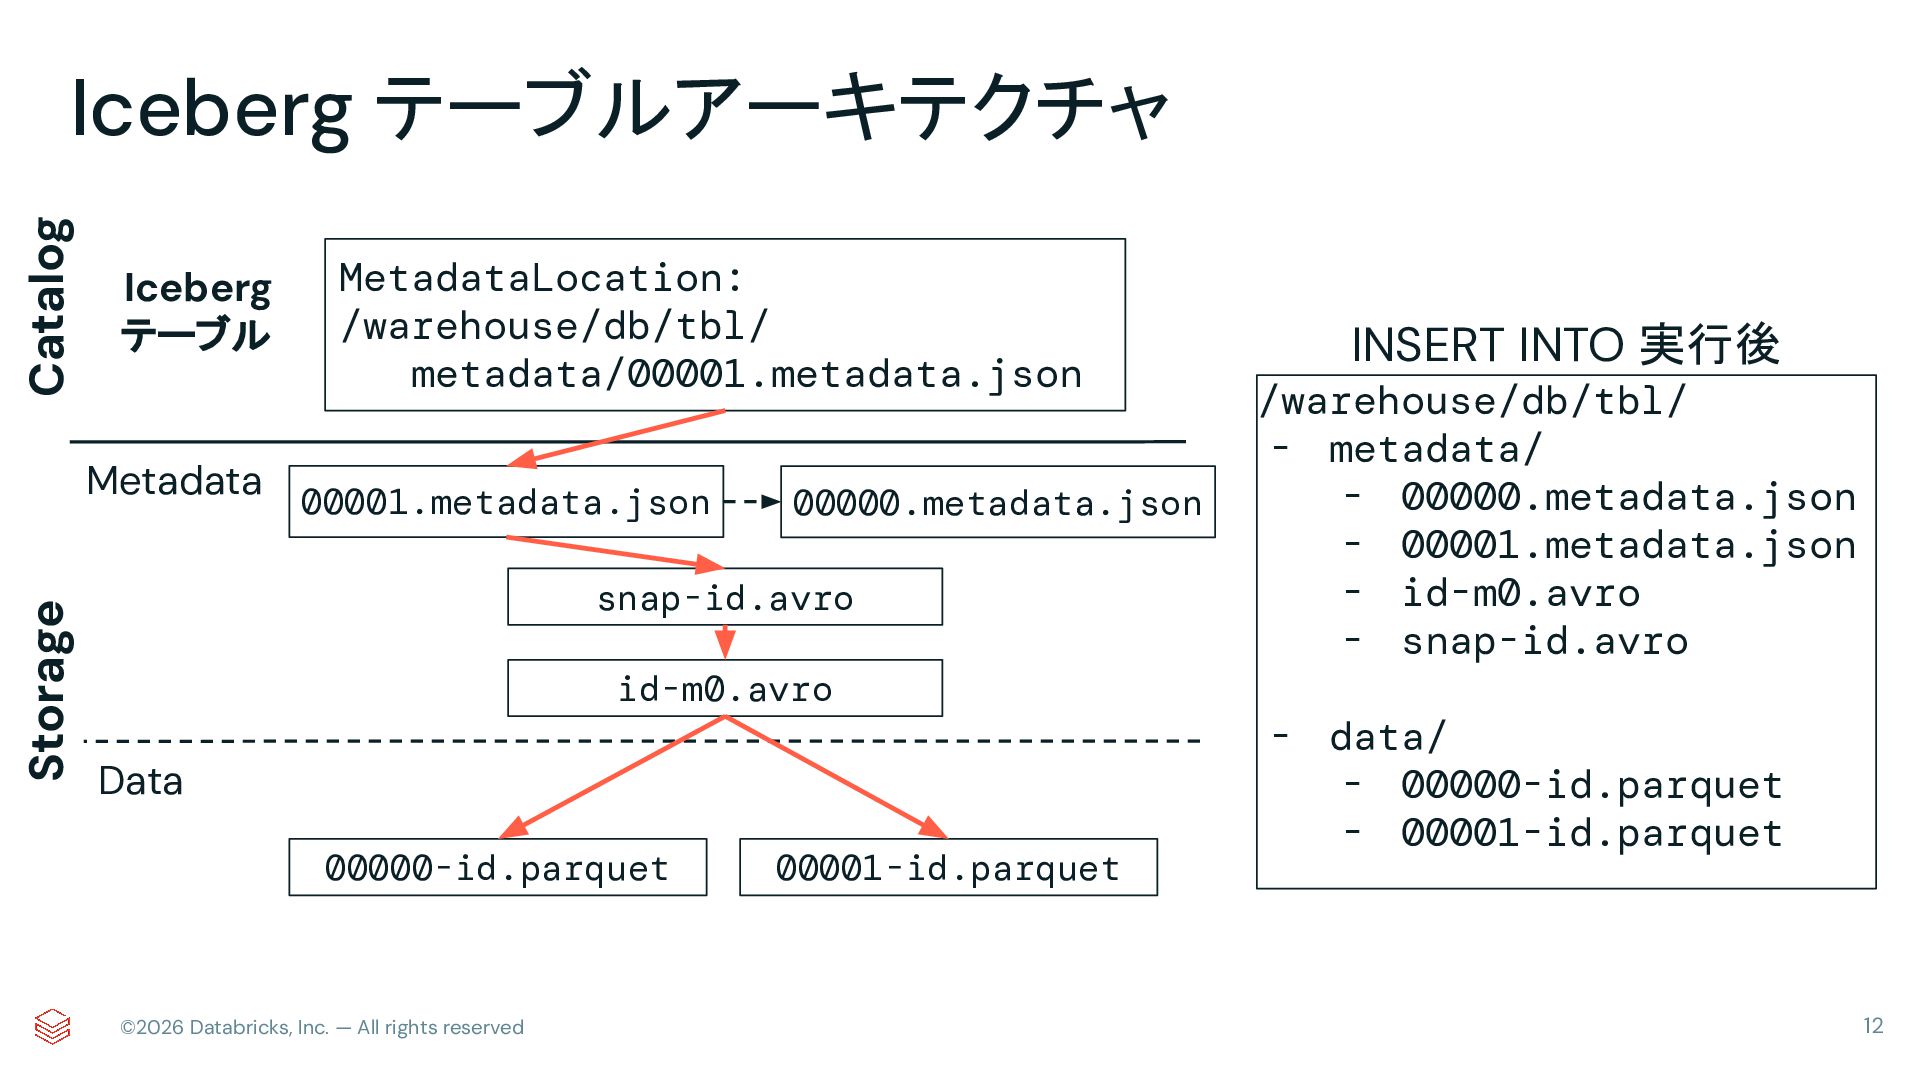
  9. Catalog Iceberg テーブルアーキテクチャ Iceberg テーブル Storage Metadata MetadataLocation: /warehouse/db/tbl/ metadata/00001.metadata.json

    00001.metadata.json 00000.metadata.json snap-id.avro id-m0.avro Data 00000-id.parquet ©2026 Databricks, Inc. — All rights reserved 00001-id.parquet INSERT INTO 実行後 /warehouse/db/tbl/ - metadata/ - 00000.metadata.json - 00001.metadata.json - id-m0.avro - snap-id.avro - data/ - 00000-id.parquet - 00001-id.parquet 12
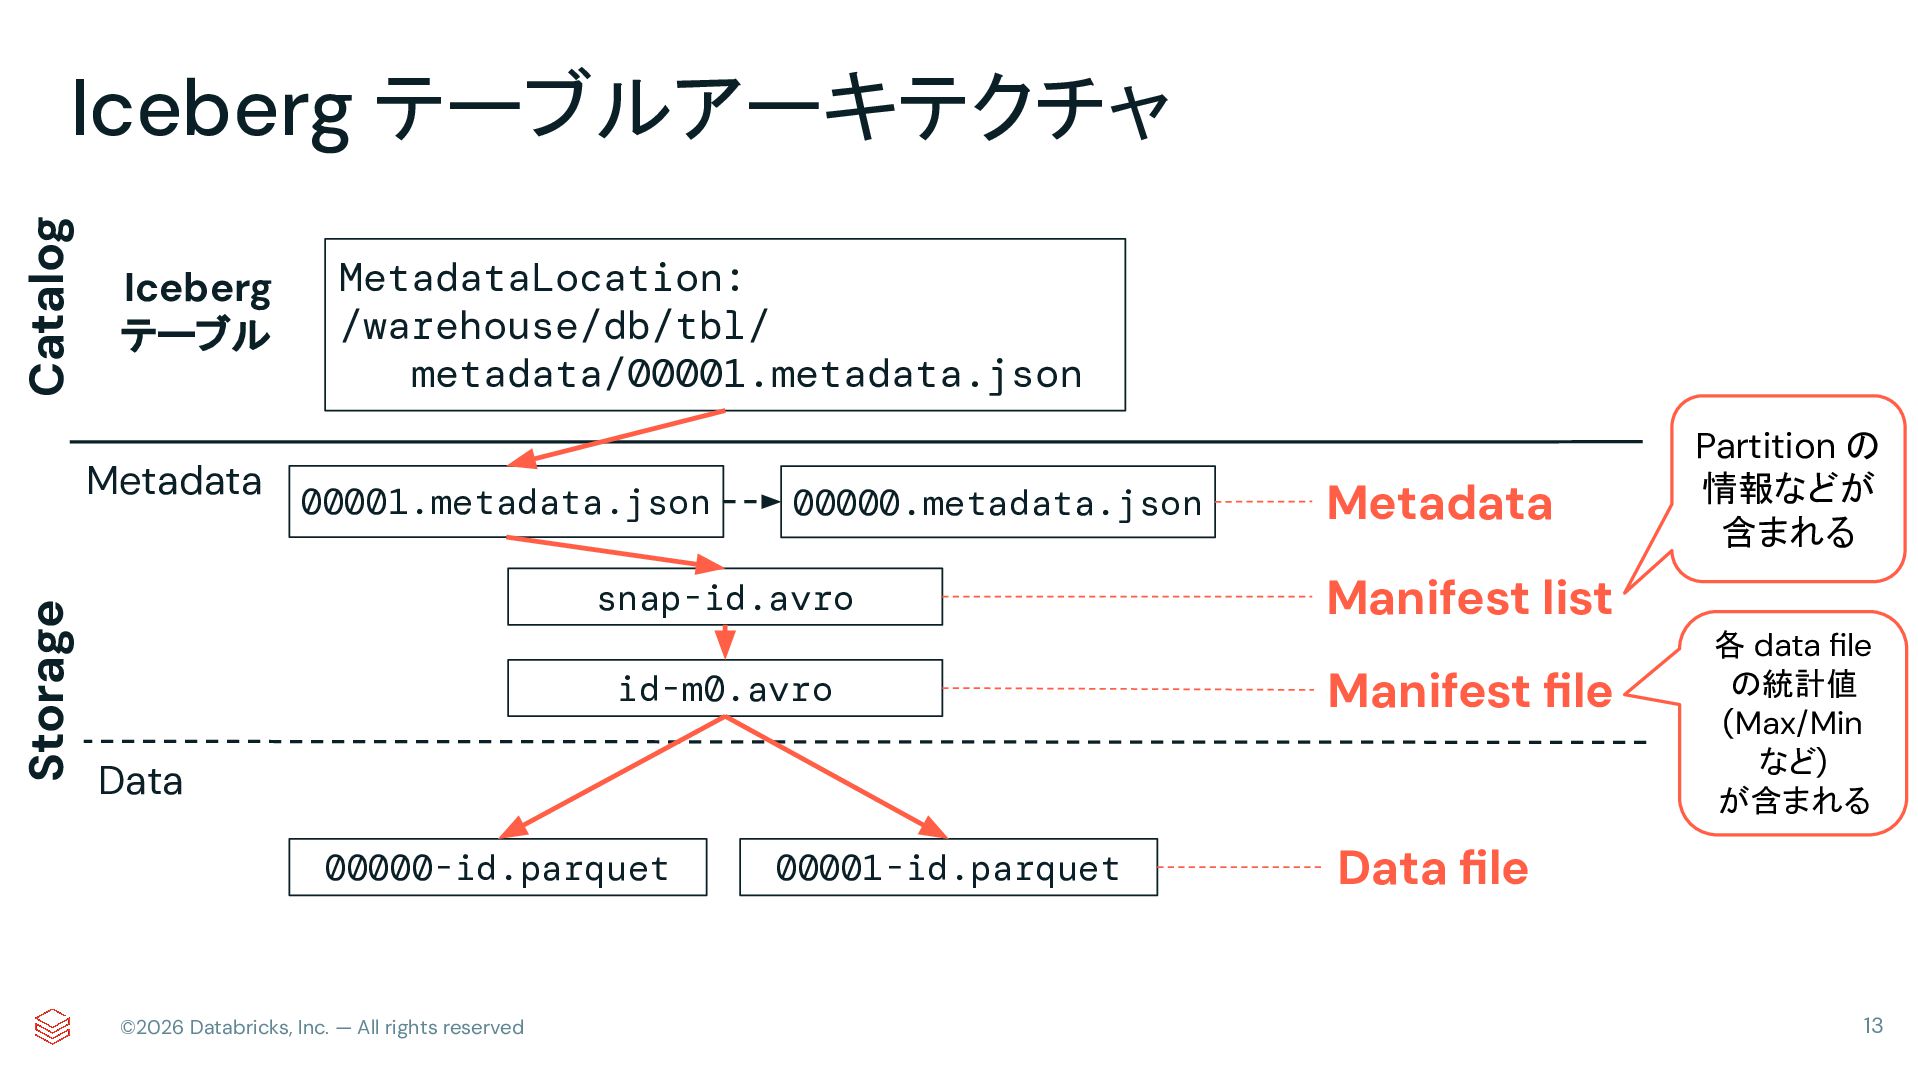
  10. Catalog Iceberg テーブルアーキテクチャ Iceberg テーブル Storage Metadata MetadataLocation: /warehouse/db/tbl/ metadata/00001.metadata.json

    00001.metadata.json 00000.metadata.json snap-id.avro id-m0.avro Metadata Manifest list Manifest file Data 00000-id.parquet ©2026 Databricks, Inc. — All rights reserved 00001-id.parquet Partition の 情報などが 含まれる 各 data file の統計値 (Max/Min など) が含まれる Data file 13
  11. Read (5) Return a result Metadata Iceberg table MetadataLocation •

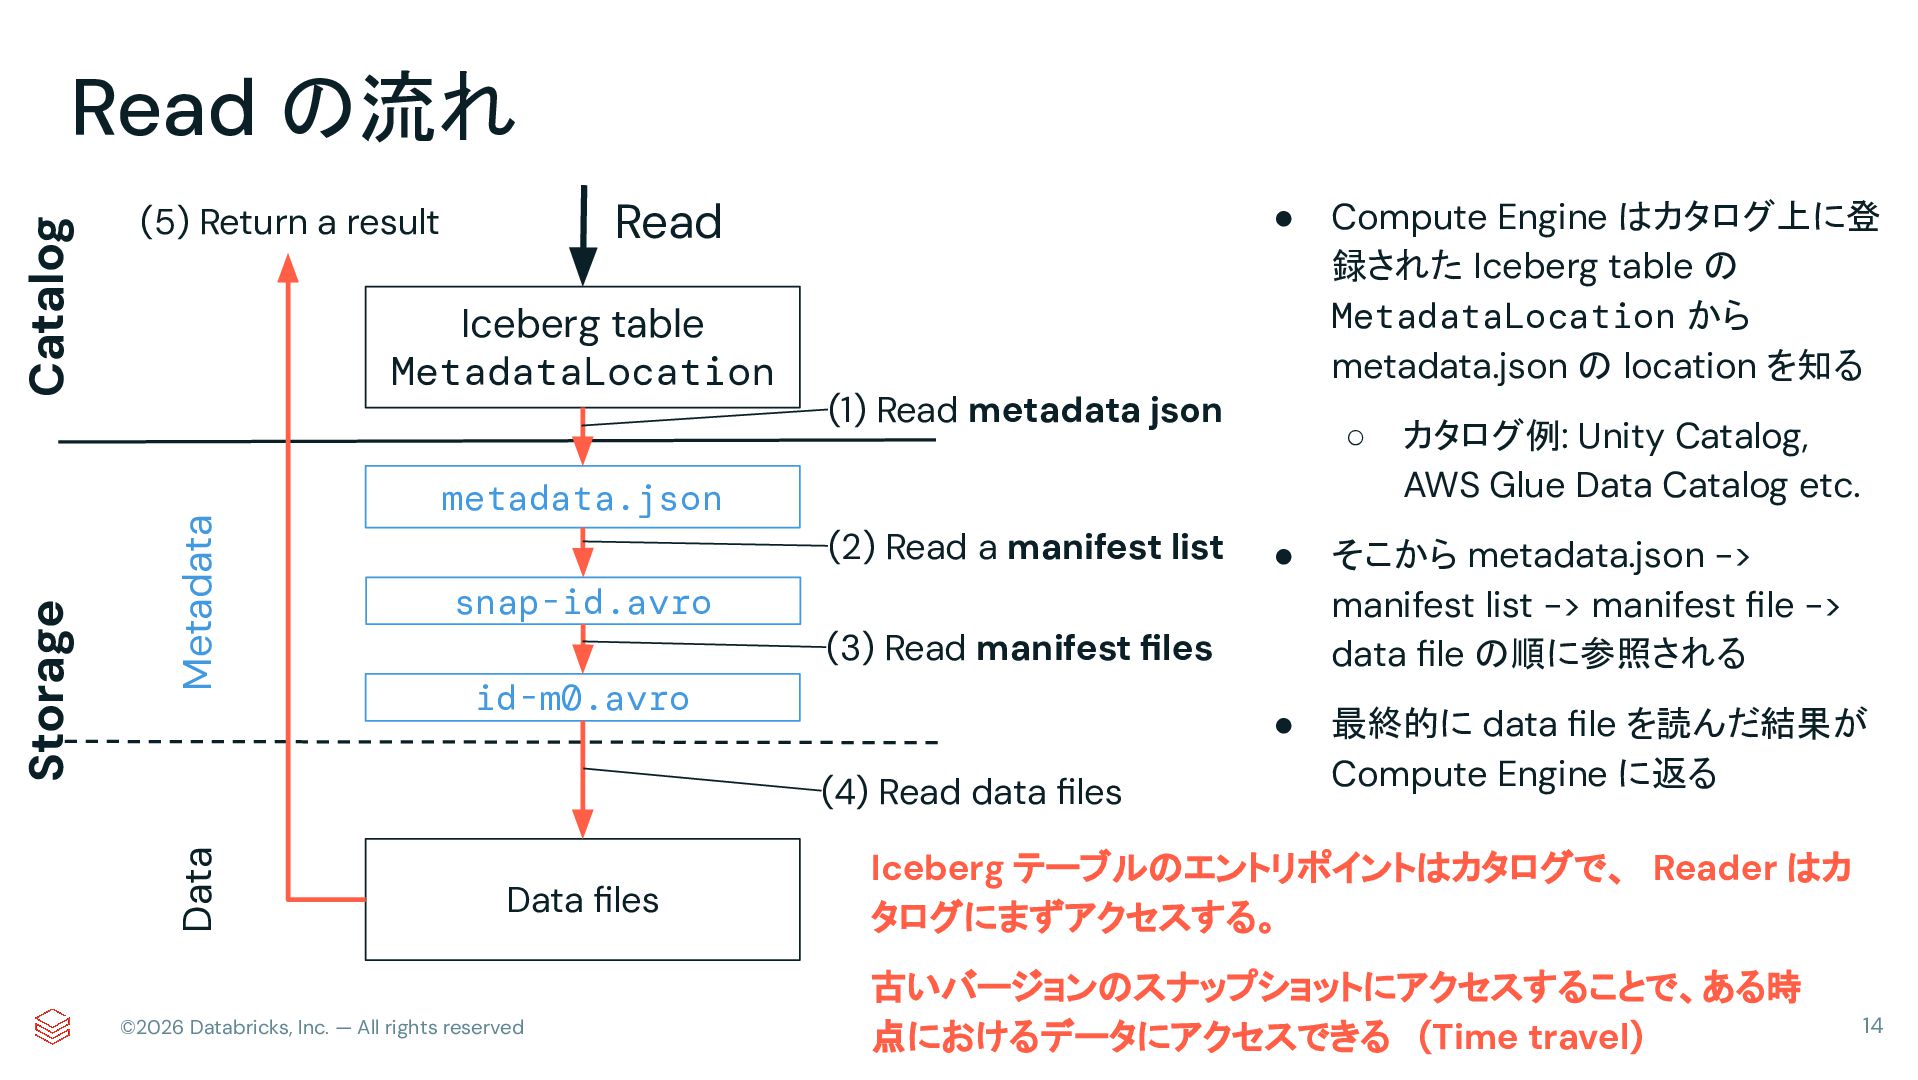
    (1) Read metadata json (2) Read a manifest list snap-id.avro Data files ©2026 Databricks, Inc. — All rights reserved カタログ例: Unity Catalog, AWS Glue Data Catalog etc. • そこから metadata.json -> manifest list -> manifest file -> data file の順に参照される • 最終的に data file を読んだ結果が Compute Engine に返る (3) Read manifest files id-m0.avro Compute Engine はカタログ上に登 録された Iceberg table の MetadataLocation から metadata.json の location を知る ◦ metadata.json (4) Read data files Data Storage Catalog Read の流れ Iceberg テーブルのエントリポイントはカタログで、 Reader はカ タログにまずアクセスする。 古いバージョンのスナップショットにアクセスすることで、ある時 点におけるデータにアクセスできる (Time travel) 14
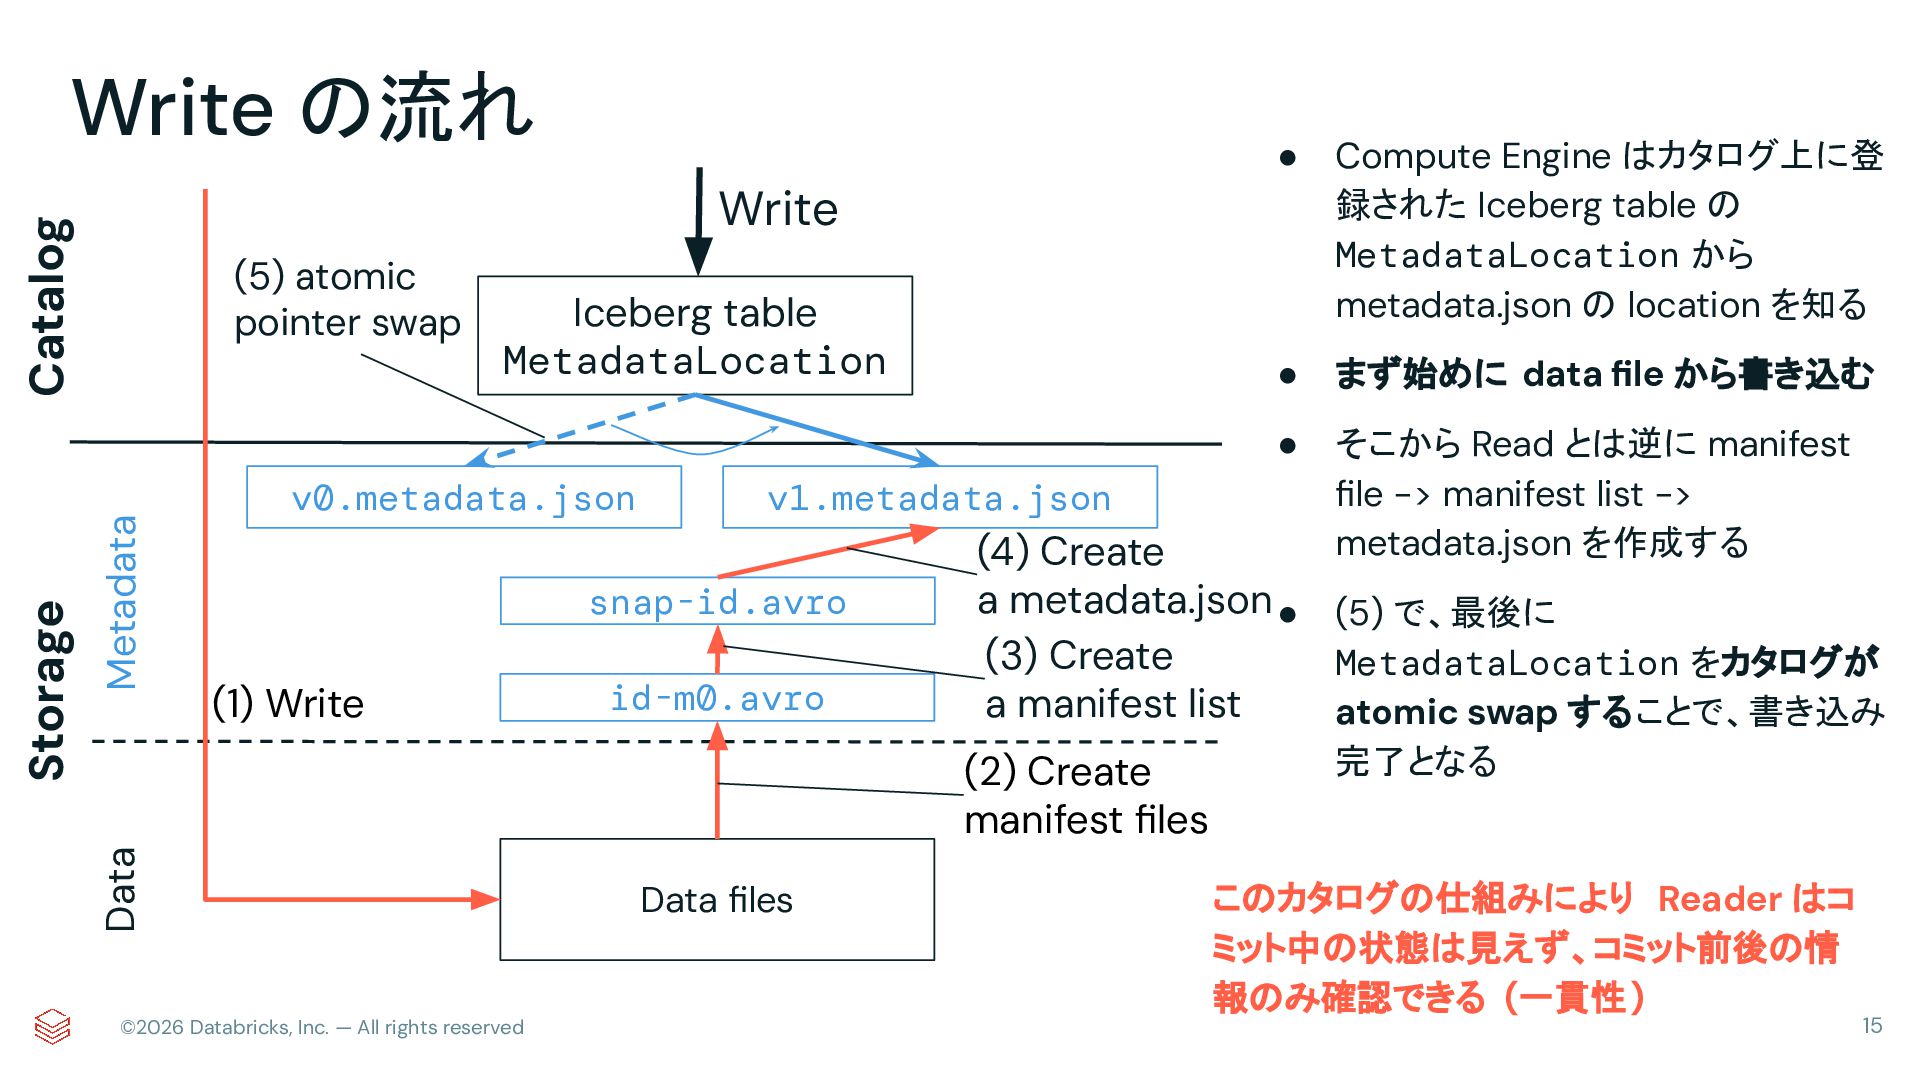
  12. Write の流れ Compute Engine はカタログ上に登 録された Iceberg table の MetadataLocation

    から metadata.json の location を知る • まず始めに data file から書き込む • そこから Read とは逆に manifest file -> manifest list -> metadata.json を作成する Write Catalog Metadata (5) atomic pointer swap Iceberg table MetadataLocation v0.metadata.json v1.metadata.json snap-id.avro (1) Write id-m0.avro (4) Create a metadata.json • (5) で、最後に (3) Create MetadataLocation をカタログが a manifest list atomic swap することで、書き込み (2) Create manifest files Data Storage • ©2026 Databricks, Inc. — All rights reserved Data files 完了となる このカタログの仕組みにより Reader はコ ミット中の状態は見えず、コミット前後の情 報のみ確認できる (一貫性) 15
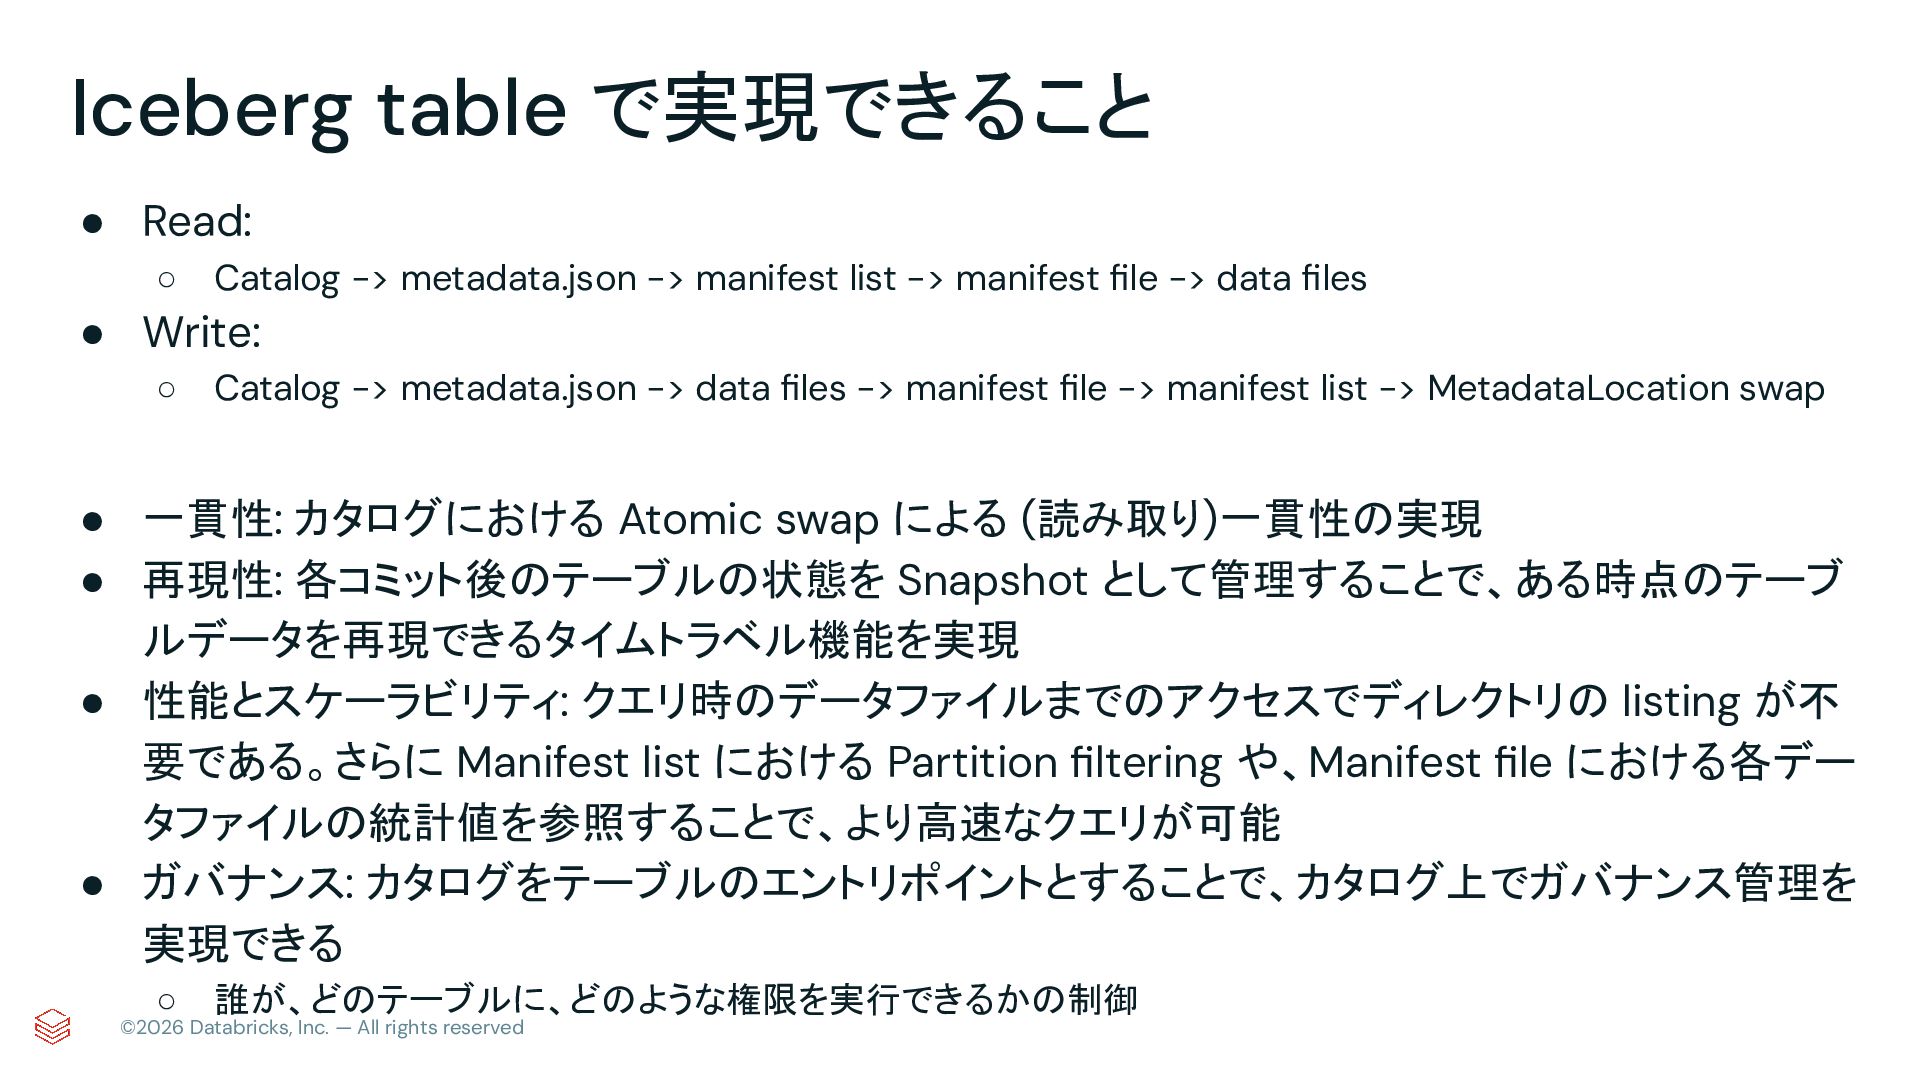
  13. Iceberg table で実現できること • Read: ◦ Catalog -> metadata.json ->

    manifest list -> manifest file -> data files • Write: ◦ Catalog -> metadata.json -> data files -> manifest file -> manifest list -> MetadataLocation swap • 一貫性: カタログにおける Atomic swap による (読み取り)一貫性の実現 • 再現性: 各コミット後のテーブルの状態を Snapshot として管理することで、ある時点のテーブ ルデータを再現できるタイムトラベル機能を実現 • 性能とスケーラビリティ: クエリ時のデータファイルまでのアクセスでディレクトリの listing が不 要である。さらに Manifest list における Partition filtering や、Manifest file における各デー タファイルの統計値を参照することで、より高速なクエリが可能 • ガバナンス: カタログをテーブルのエントリポイントとすることで、カタログ上でガバナンス管理を 実現できる ◦ 誰が、どのテーブルに、どのような権限を実行できるかの制御 ©2026 Databricks, Inc. — All rights reserved
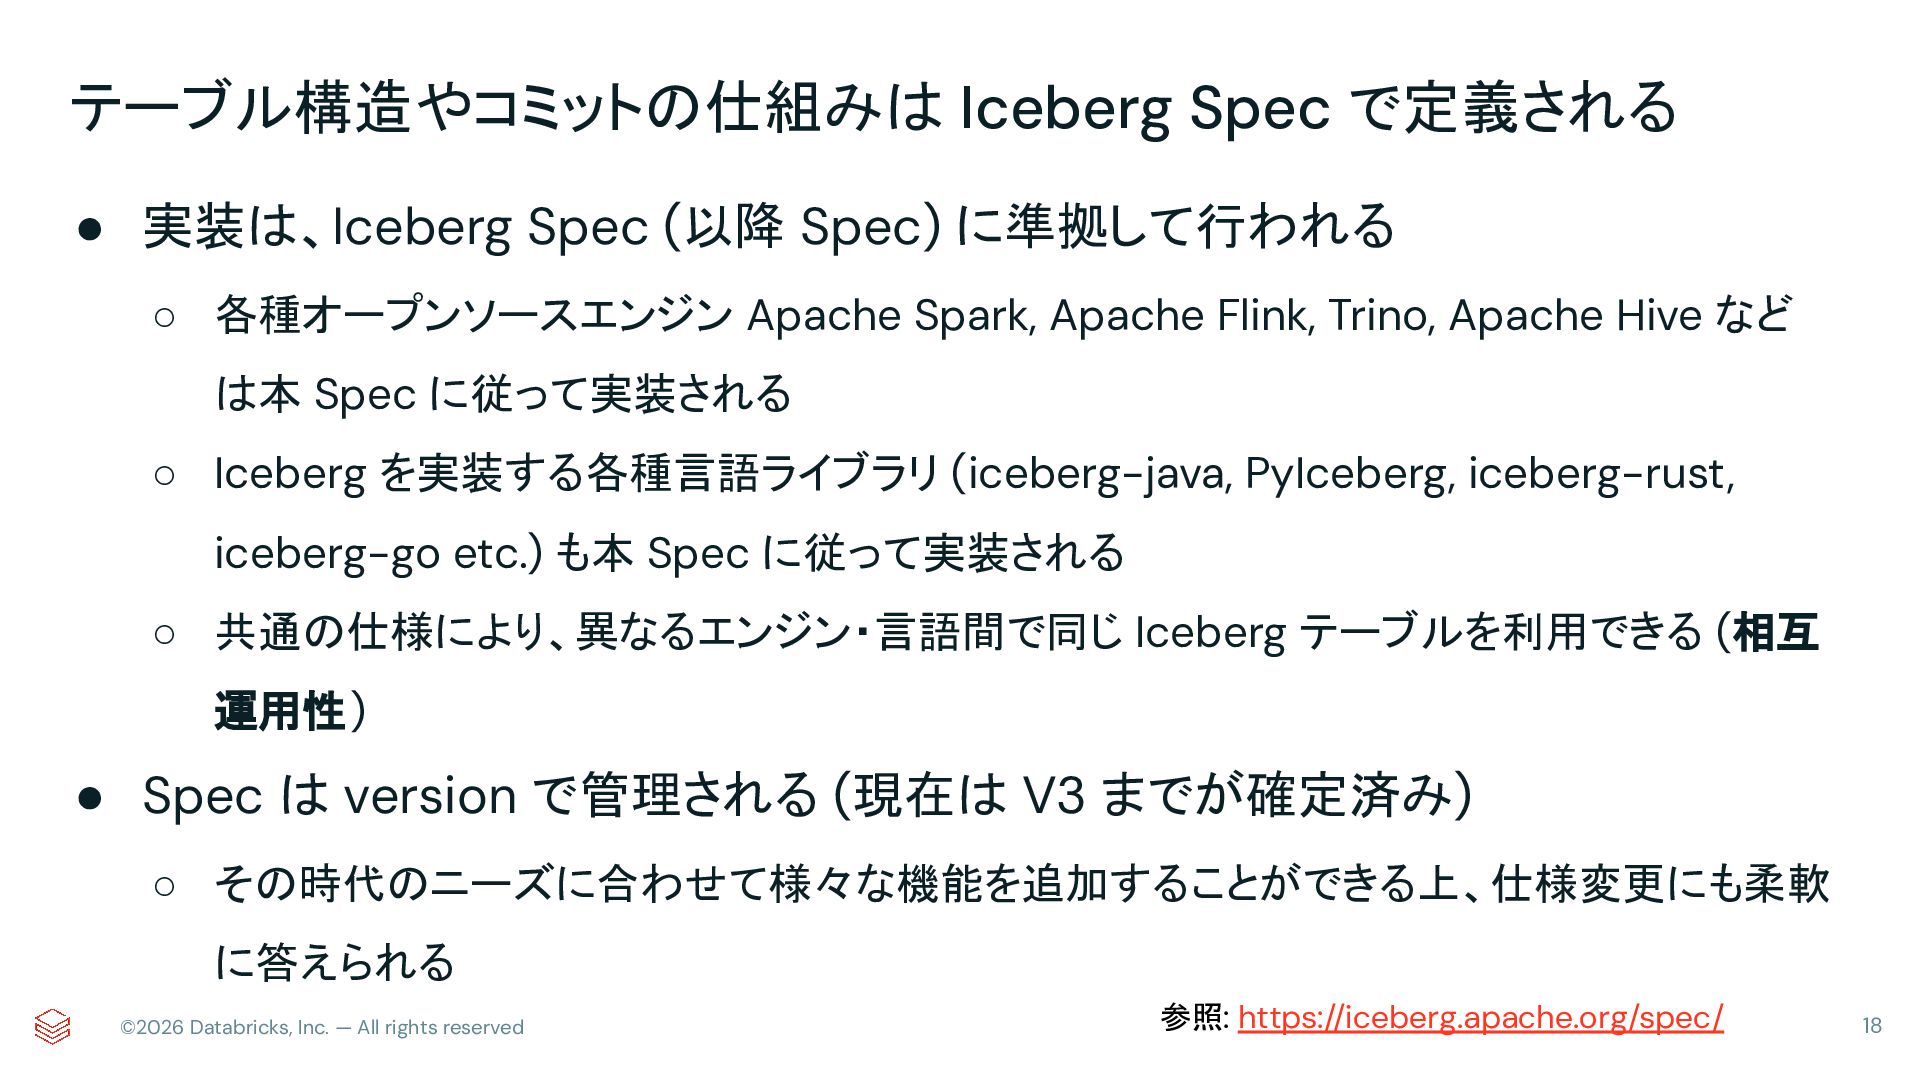
  14. テーブル構造やコミットの仕組みは Iceberg Spec で定義される • 実装は、Iceberg Spec (以降 Spec) に準拠して行われる

    ◦ 各種オープンソースエンジン Apache Spark, Apache Flink, Trino, Apache Hive など は本 Spec に従って実装される ◦ Iceberg を実装する各種言語ライブラリ (iceberg-java, PyIceberg, iceberg-rust, iceberg-go etc.) も本 Spec に従って実装される ◦ 共通の仕様により、異なるエンジン・言語間で同じ Iceberg テーブルを利用できる (相互 運用性) • Spec は version で管理される (現在は V3 までが確定済み) ◦ その時代のニーズに合わせて様々な機能を追加することができる上、仕様変更にも柔軟 に答えられる ©2026 Databricks, Inc. — All rights reserved 参照: https://iceberg.apache.org/spec/ 18
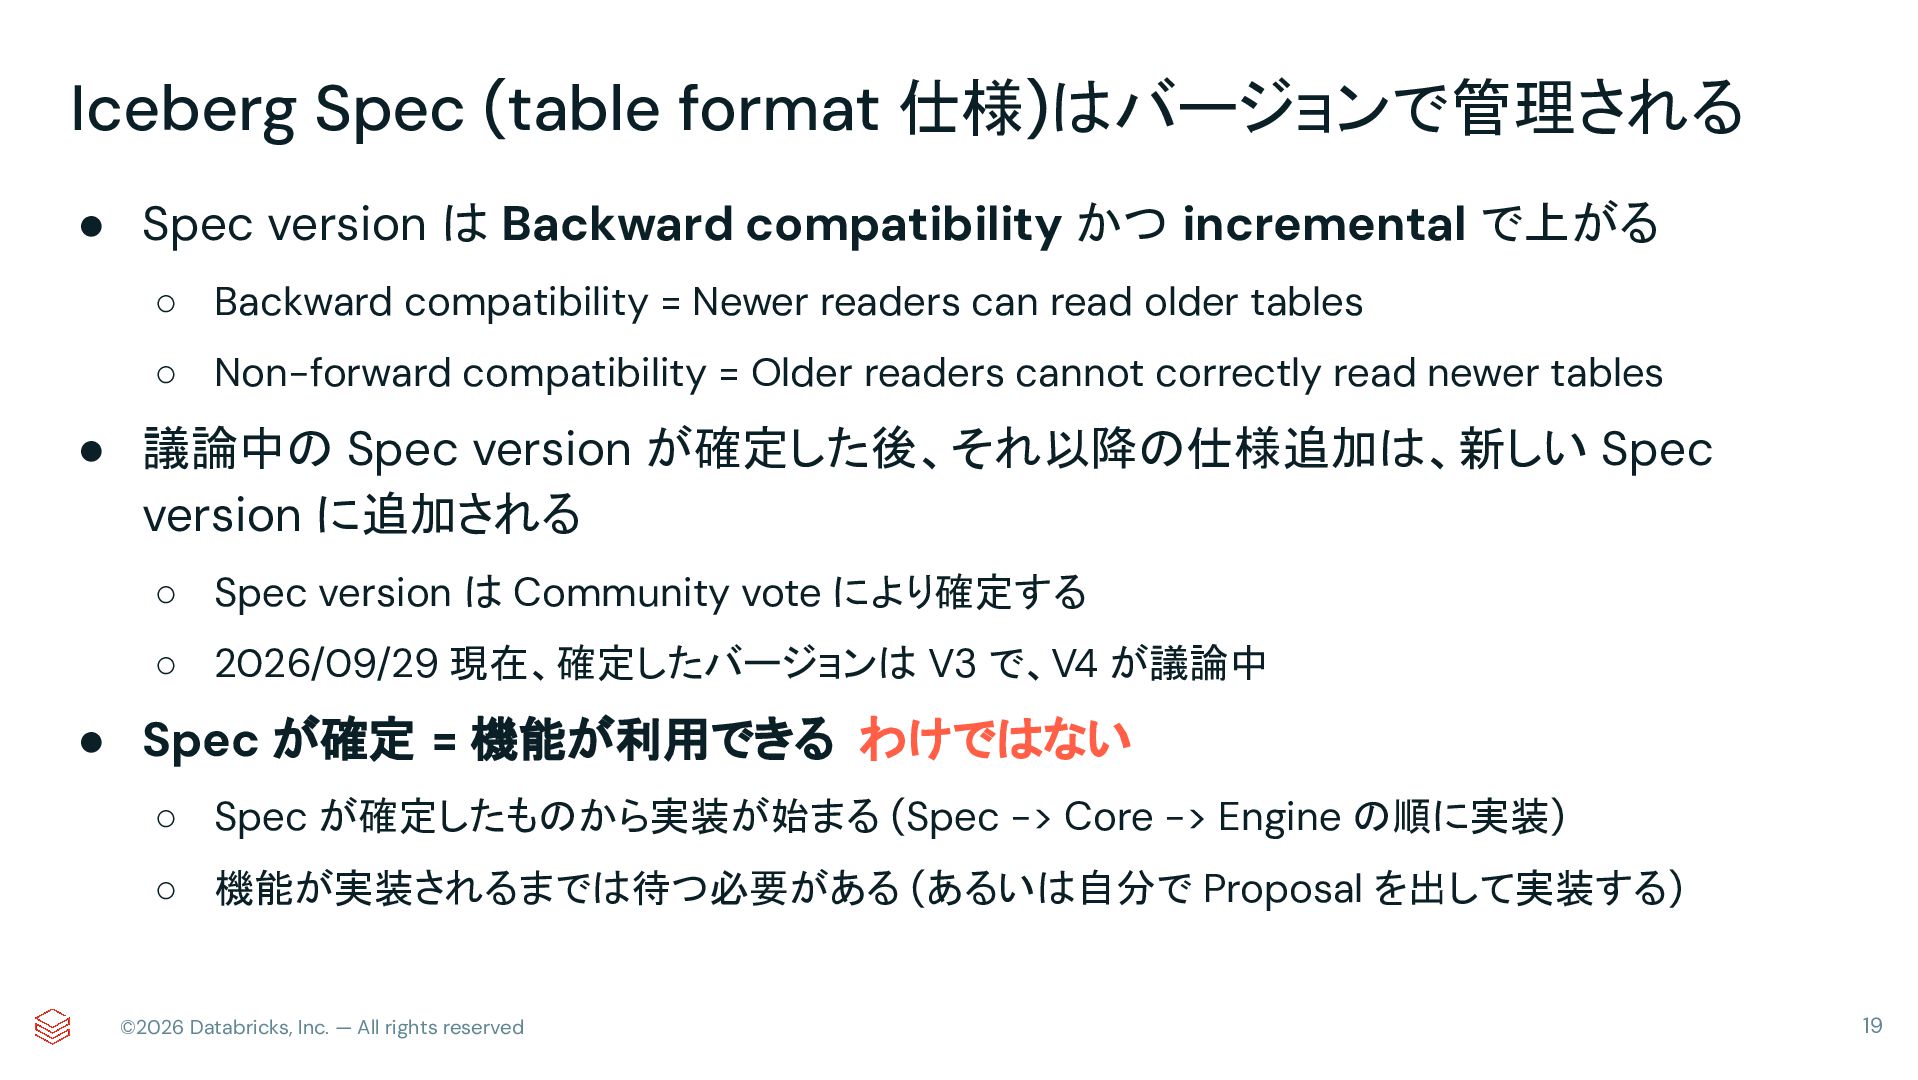
  15. Iceberg Spec (table format 仕様)はバージョンで管理される • Spec version は Backward

    compatibility かつ incremental で上がる ◦ Backward compatibility = Newer readers can read older tables ◦ Non-forward compatibility = Older readers cannot correctly read newer tables • 議論中の Spec version が確定した後、それ以降の仕様追加は、新しい Spec version に追加される ◦ Spec version は Community vote により確定する ◦ 2026/09/29 現在、確定したバージョンは V3 で、V4 が議論中 • Spec が確定 = 機能が利用できる わけではない ◦ Spec が確定したものから実装が始まる (Spec -> Core -> Engine の順に実装) ◦ 機能が実装されるまでは待つ必要がある (あるいは自分で Proposal を出して実装する) ©2026 Databricks, Inc. — All rights reserved 19
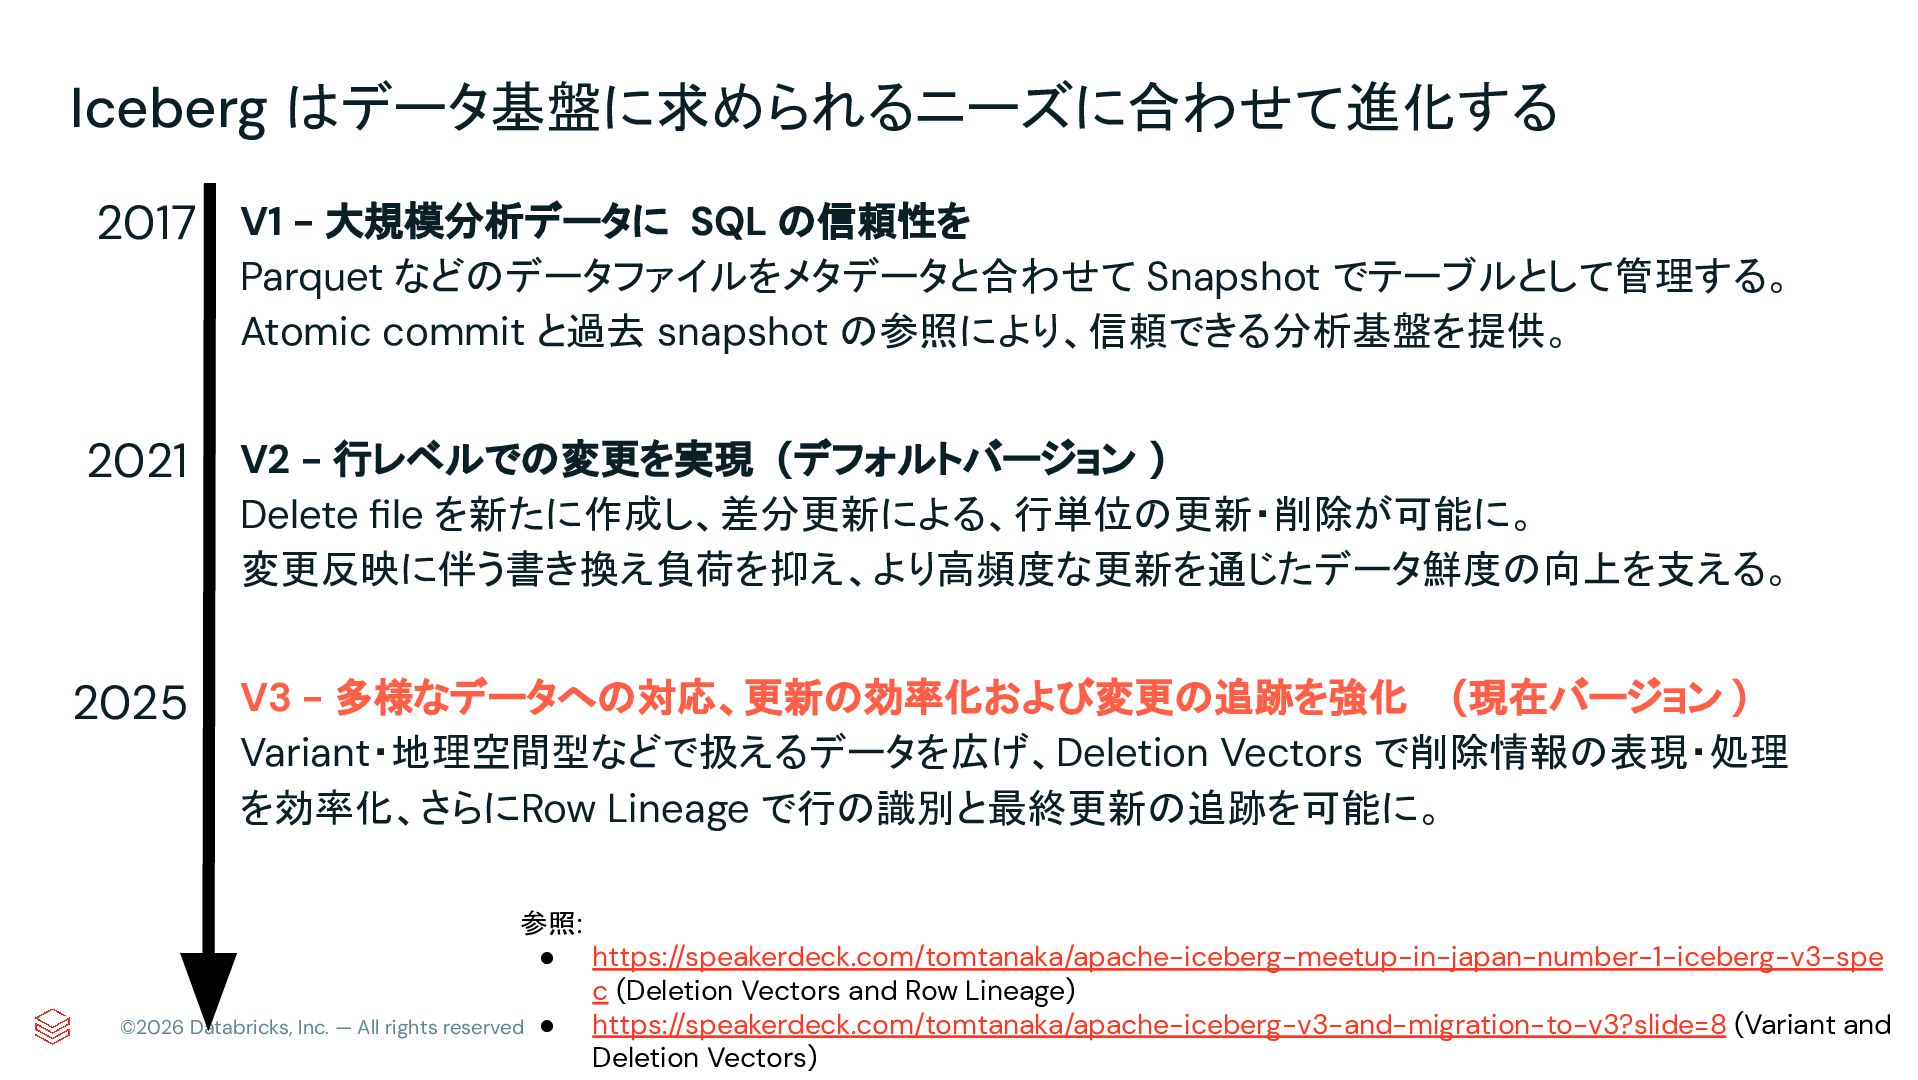
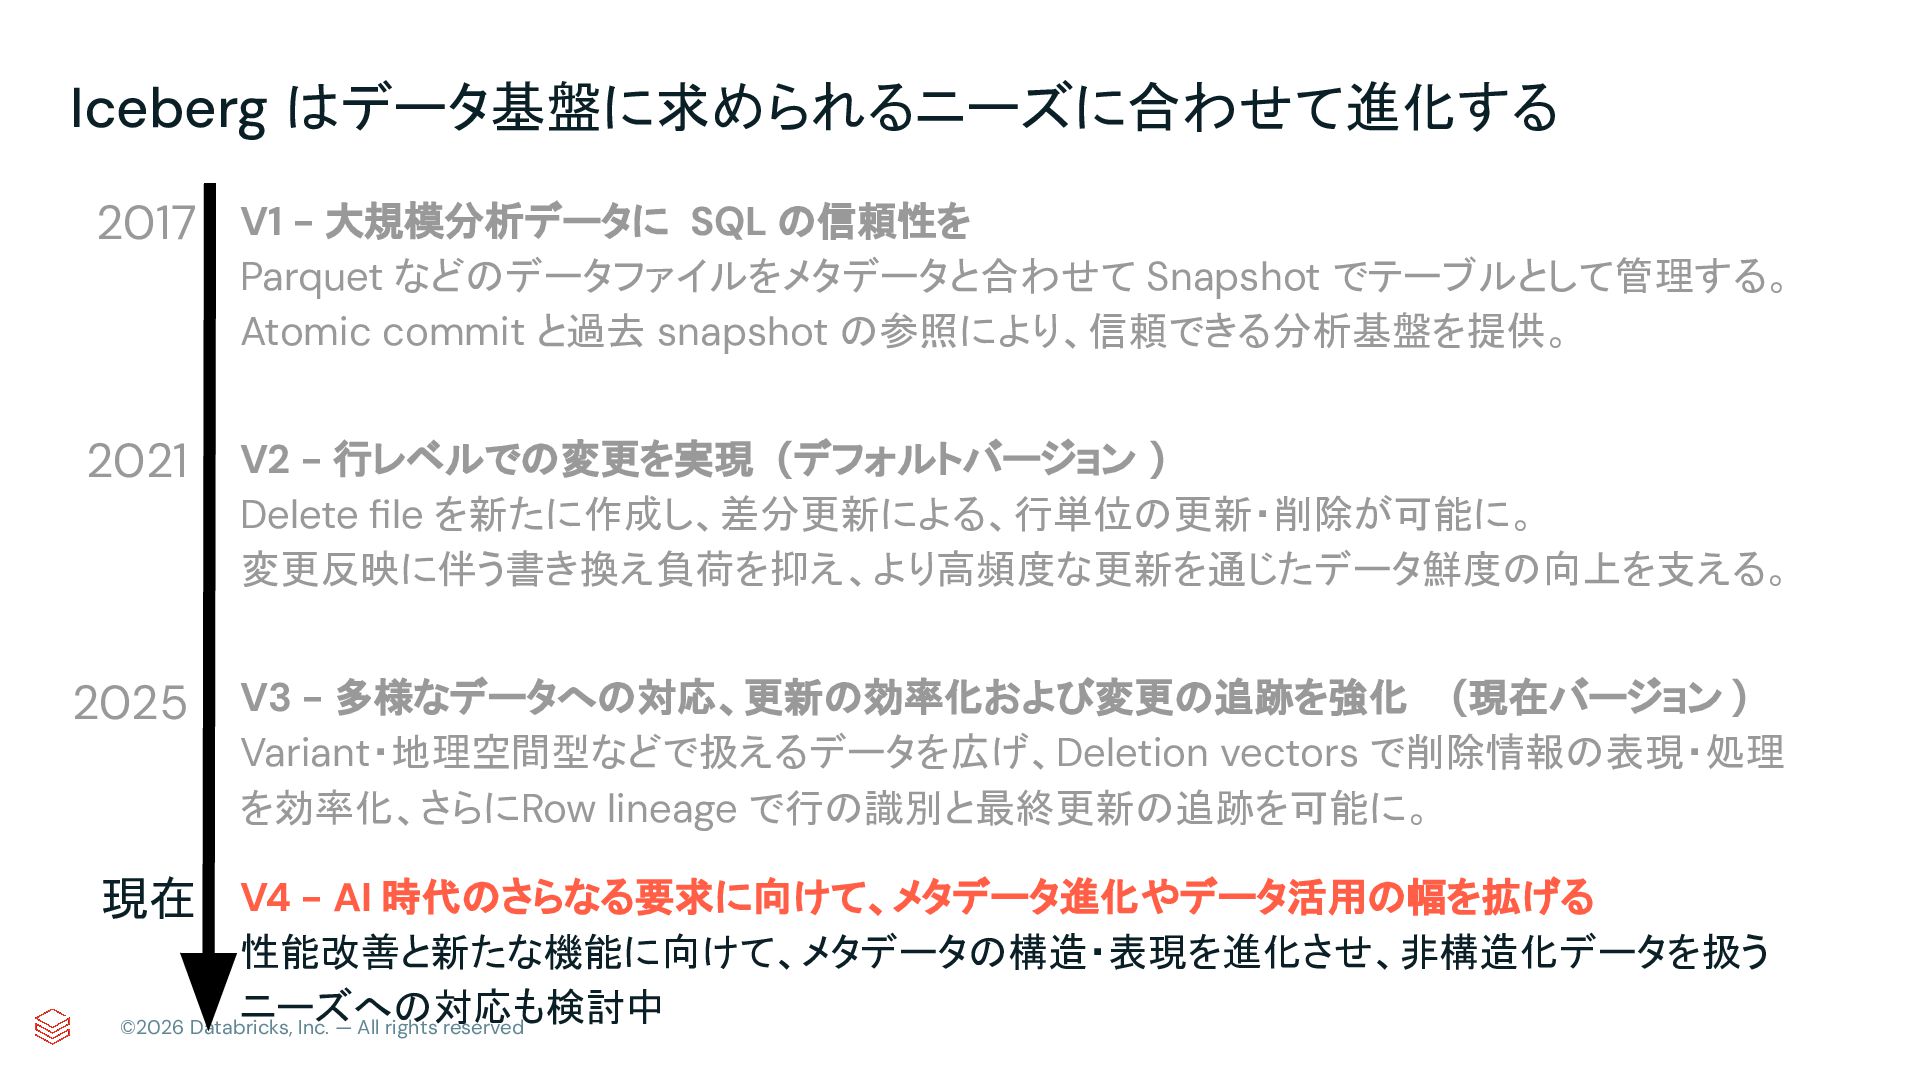
  16. Iceberg はデータ基盤に求められるニーズに合わせて進化する 2017 V1 - 大規模分析データに SQL の信頼性を Parquet などのデータファイルをメタデータと合わせて

    Snapshot でテーブルとして管理する。 Atomic commit と過去 snapshot の参照により、信頼できる分析基盤を提供。 2021 V2 - 行レベルでの変更を実現 (デフォルトバージョン ) Delete file を新たに作成し、差分更新による、行単位の更新・削除が可能に。 変更反映に伴う書き換え負荷を抑え、より高頻度な更新を通じたデータ鮮度の向上を支える。 2025 V3 - 多様なデータへの対応、更新の効率化および変更の追跡を強化 (現在バージョン ) Variant・地理空間型などで扱えるデータを広げ、Deletion Vectors で削除情報の表現・処理 を効率化、さらにRow Lineage で行の識別と最終更新の追跡を可能に。 参照: • https://speakerdeck.com/tomtanaka/apache-iceberg-meetup-in-japan-number-1-iceberg-v3-spe c (Deletion Vectors and Row Lineage) https://speakerdeck.com/tomtanaka/apache-iceberg-v3-and-migration-to-v3?slide=8 (Variant and ©2026 Databricks, Inc. — All rights reserved • Deletion Vectors)
  17. Iceberg はデータ基盤に求められるニーズに合わせて進化する 2017 V1 - 大規模分析データに SQL の信頼性を Parquet などのデータファイルをメタデータと合わせて

    Snapshot でテーブルとして管理する。 Atomic commit と過去 snapshot の参照により、信頼できる分析基盤を提供。 2021 V2 - 行レベルでの変更を実現 (デフォルトバージョン ) Delete file を新たに作成し、差分更新による、行単位の更新・削除が可能に。 変更反映に伴う書き換え負荷を抑え、より高頻度な更新を通じたデータ鮮度の向上を支える。 2025 V3 - 多様なデータへの対応、更新の効率化および変更の追跡を強化 (現在バージョン ) Variant・地理空間型などで扱えるデータを広げ、Deletion vectors で削除情報の表現・処理 を効率化、さらにRow lineage で行の識別と最終更新の追跡を可能に。 現在 V4 - AI 時代のさらなる要求に向けて、メタデータ進化やデータ活用の幅を拡げる 性能改善と新たな機能に向けて、メタデータの構造・表現を進化させ、非構造化データを扱う ニーズへの対応も検討中 ©2026 Databricks, Inc. — All rights reserved
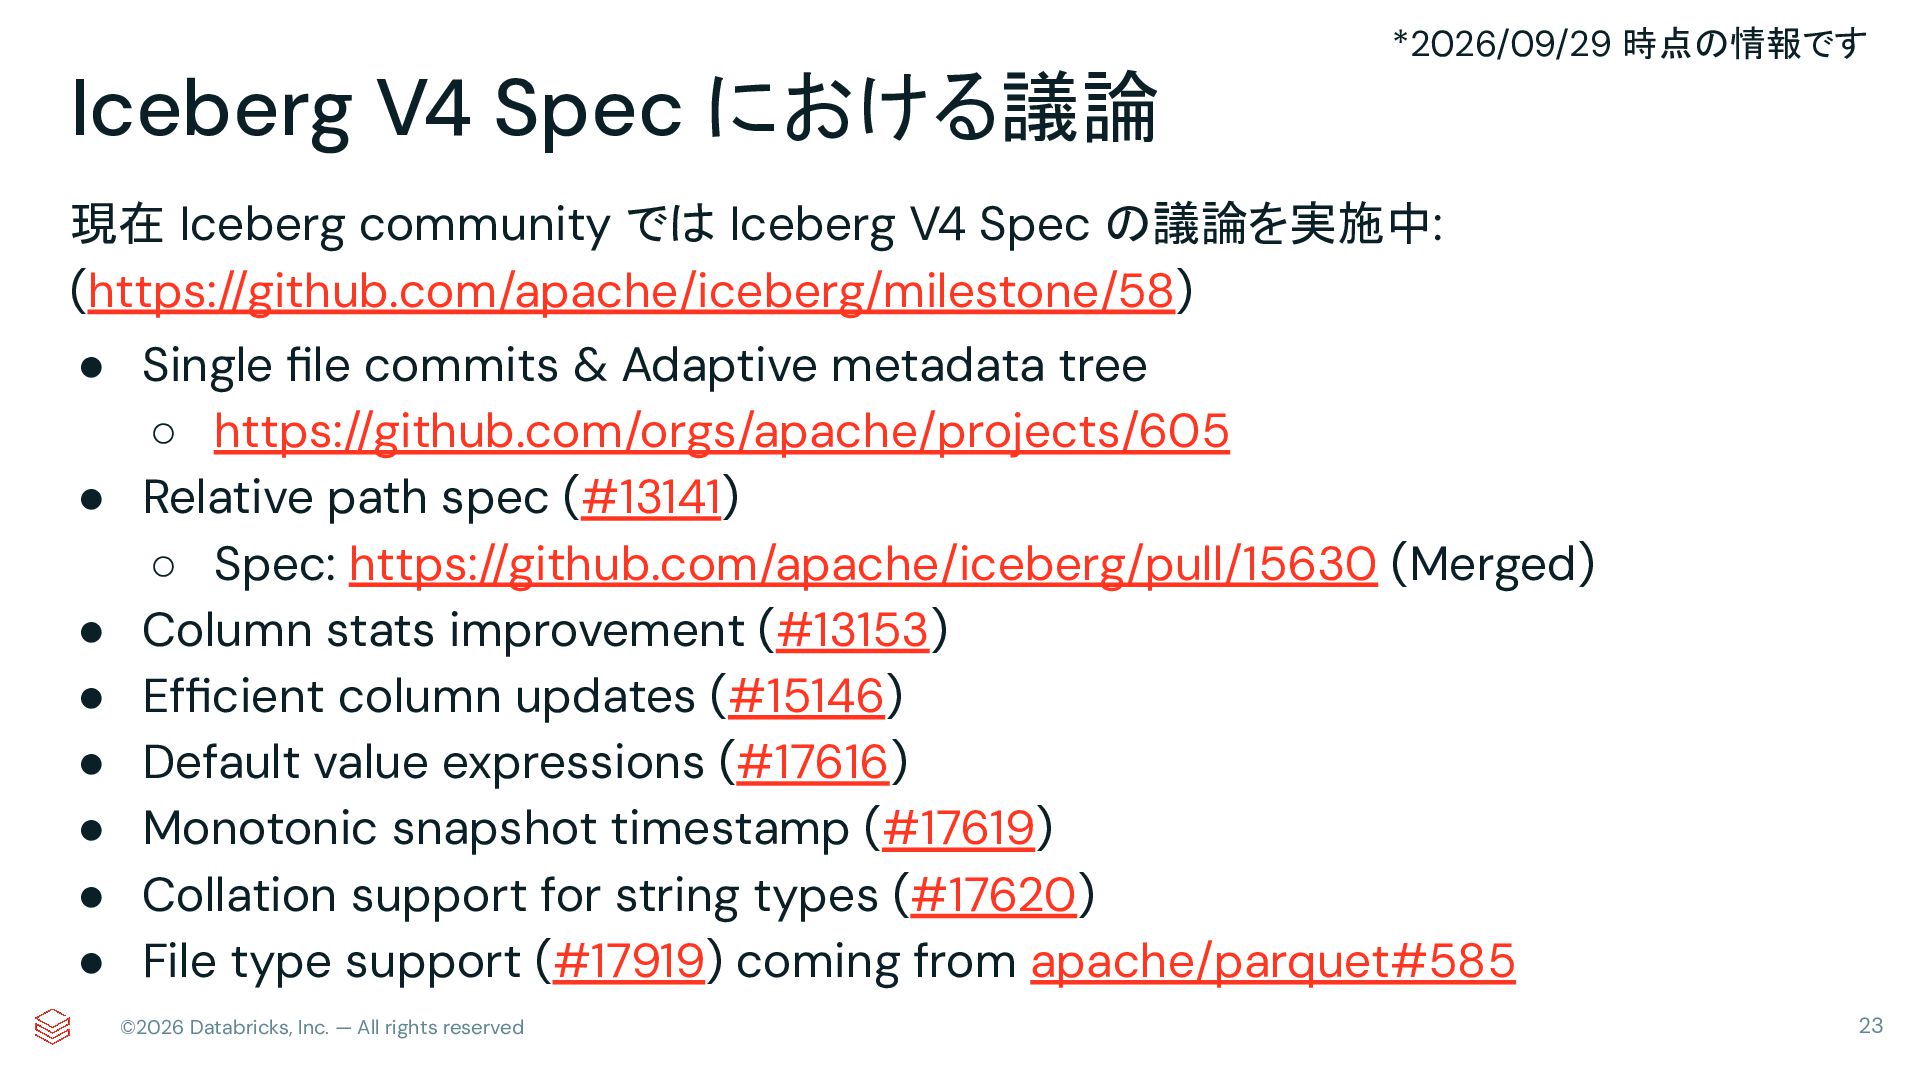
  18. Iceberg V4 Spec における議論 *2026/09/29 時点の情報です 現在 Iceberg community では

    Iceberg V4 Spec の議論を実施中: (https://github.com/apache/iceberg/milestone/58) • Single file commits & Adaptive metadata tree ◦ https://github.com/orgs/apache/projects/605 • Relative path spec (#13141) ◦ Spec: https://github.com/apache/iceberg/pull/15630 (Merged) • Column stats improvement (#13153) • Efficient column updates (#15146) • Default value expressions (#17616) • Monotonic snapshot timestamp (#17619) • Collation support for string types (#17620) • File type support (#17919) coming from apache/parquet#585 ©2026 Databricks, Inc. — All rights reserved 23
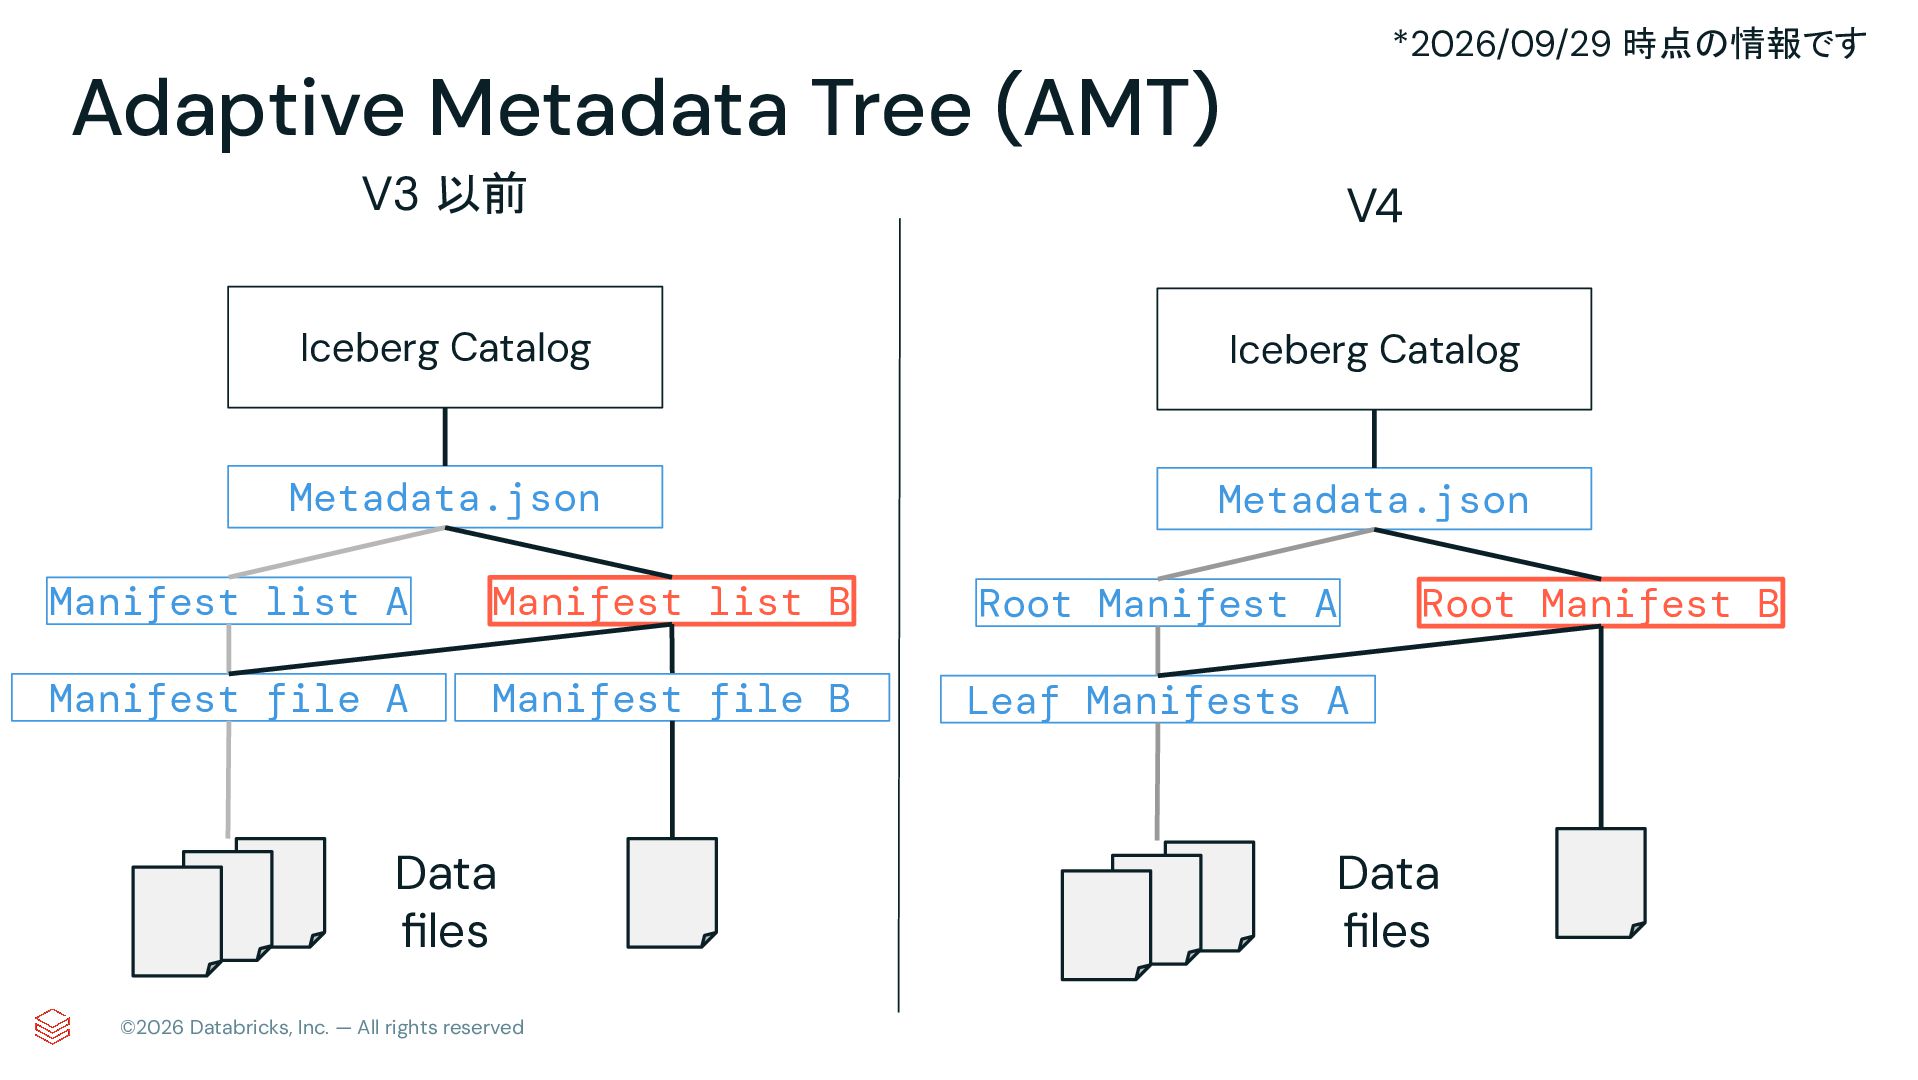
  19. *2026/09/29 時点の情報です Adaptive Metadata Tree (AMT) V3 以前 V4 Iceberg

    Catalog Iceberg Catalog Metadata.json Metadata.json Manifest list A Manifest list B Root Manifest A Manifest file A Manifest file B Leaf Manifests A Data files ©2026 Databricks, Inc. — All rights reserved Root Manifest B Data files
  20. Adaptive Metadata Tree (AMT) *2026/09/29 時点の情報です V4 では、Commit の度に書くメタデータを減らすため、メタデータの構造を刷新する •

    V3 までの課題: コミットごとに manifest, manifest list, metadata.json の最低 3 ファイルを順 に書く ◦ 小さな書き込みほど、メタデータ作成時間が占める割合が大きくなる ◦ 1 ファイルの削除でも、そのファイルを含む manifest 全体を書き換える • Adaptive Metadata Tree: Root Manifest と Leaf Manifest の最大 2 階層で、規模に応じ て形を変える • Single File Commit: manifest list を廃止し、スナップショットごとに Root Manifest を 1 つ置 く ◦ Root Manifest にデータファイルを直接記録でき、小さなコミットは Root Manifest 1 ファイルで済む ◦ metadata.json は V4 でも残り、Catalog (特に REST Catalog)側で扱う方向で議論中 • Spec PR (#16025) は承認済みだが、未マージで、Java 実装も進行中 参照: 設計ドキュメント (s.apache.org/iceberg-single-file-commit), Spec PR (apache/iceberg#16025) ©2026 Databricks, Inc. — All rights reserved
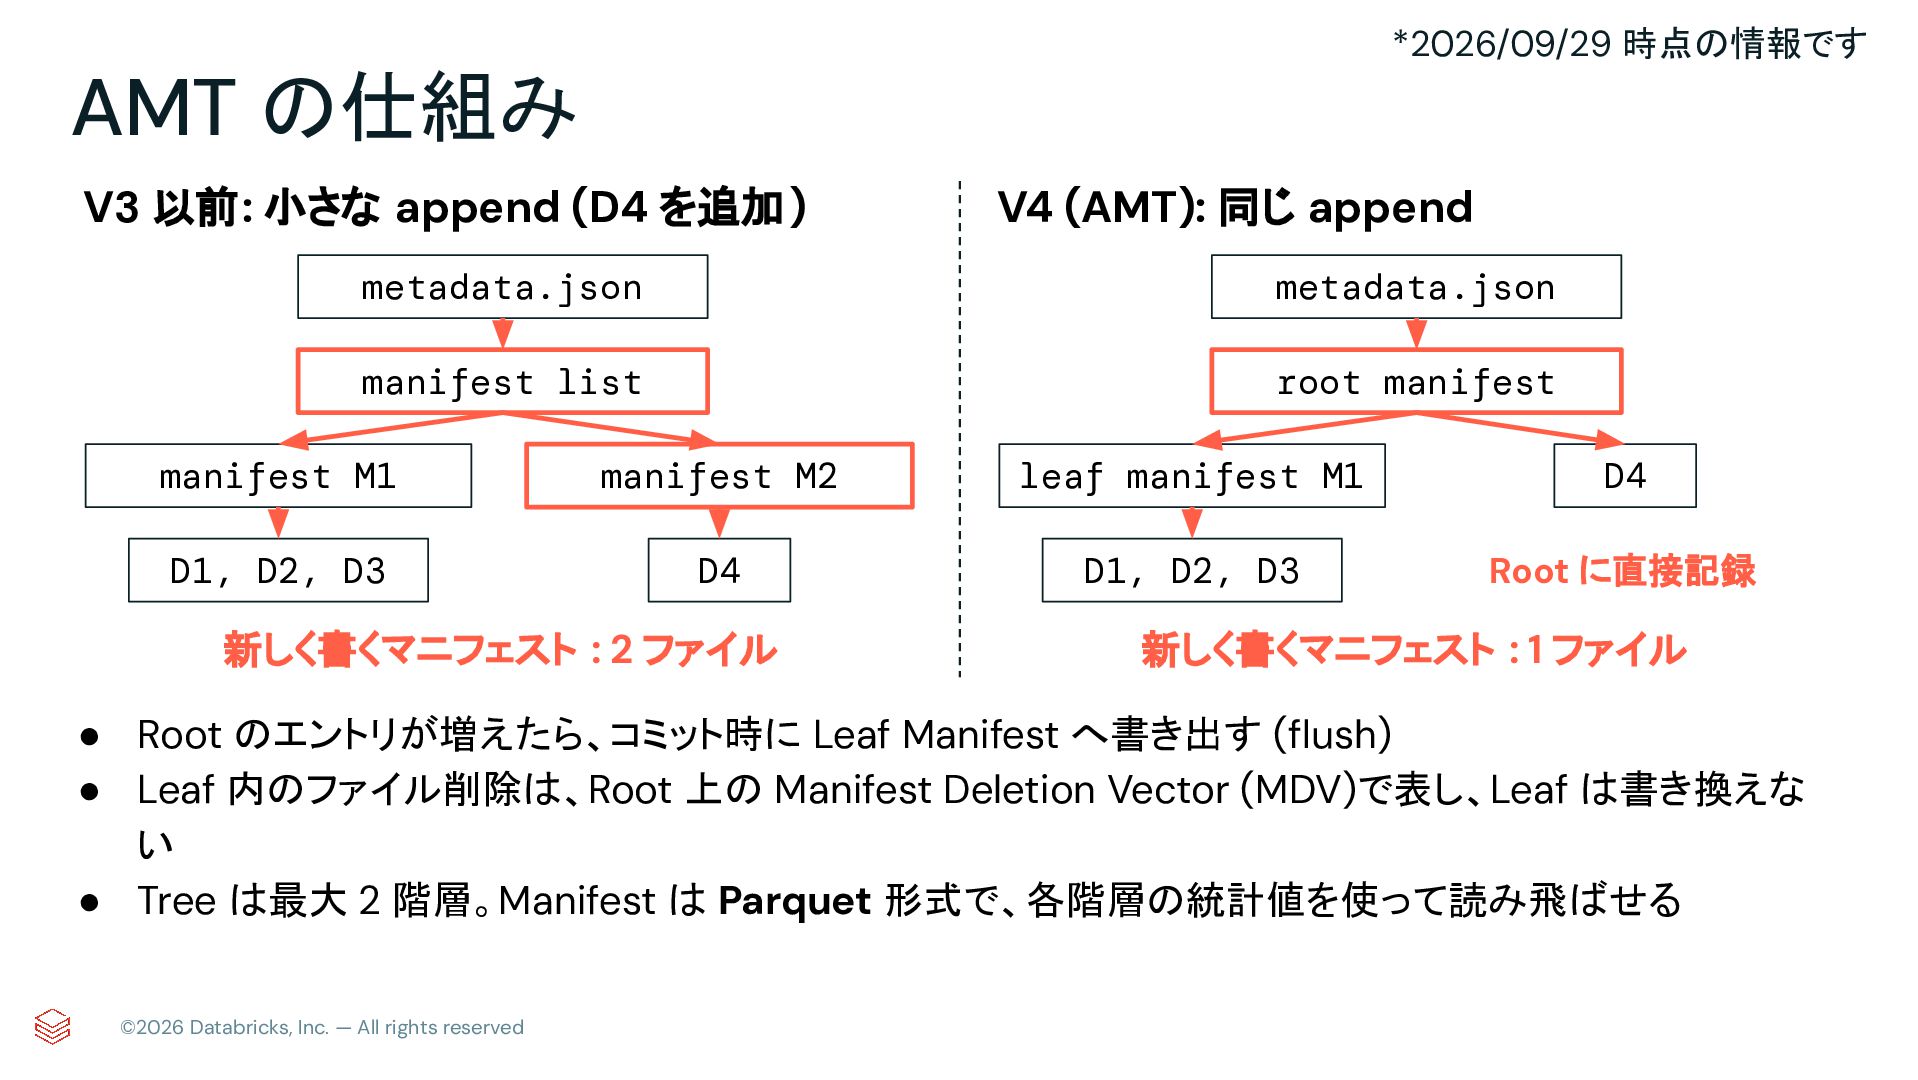
  21. *2026/09/29 時点の情報です AMT の仕組み V3 以前: 小さな append (D4 を追加)

    V4 (AMT): 同じ append metadata.json metadata.json manifest list root manifest manifest M1 manifest M2 leaf manifest M1 D4 D1, D2, D3 D4 D1, D2, D3 Root に直接記録 新しく書くマニフェスト : 2 ファイル 新しく書くマニフェスト : 1 ファイル • Root のエントリが増えたら、コミット時に Leaf Manifest へ書き出す (flush) • Leaf 内のファイル削除は、Root 上の Manifest Deletion Vector (MDV)で表し、Leaf は書き換えな い • Tree は最大 2 階層。Manifest は Parquet 形式で、各階層の統計値を使って読み飛ばせる ©2026 Databricks, Inc. — All rights reserved
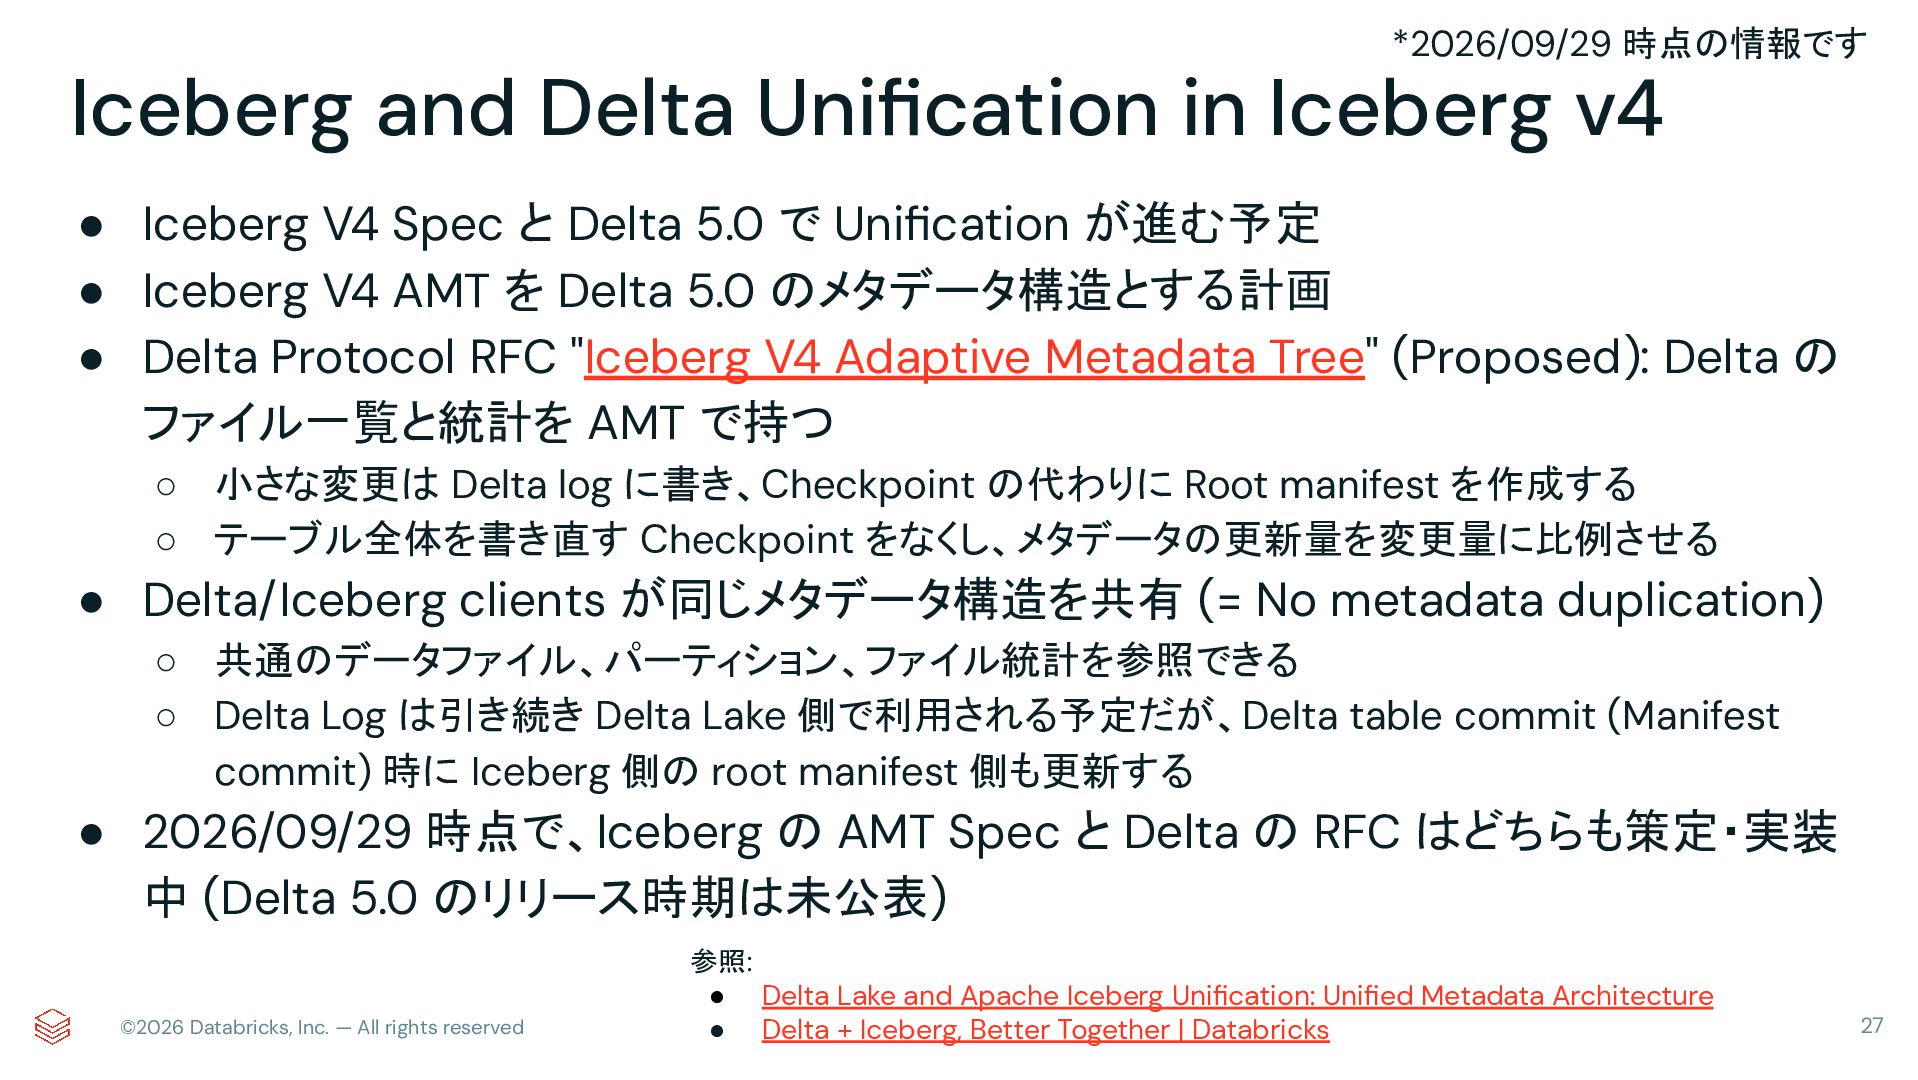
  22. *2026/09/29 時点の情報です Iceberg and Delta Unification in Iceberg v4 •

    Iceberg V4 Spec と Delta 5.0 で Unification が進む予定 • Iceberg V4 AMT を Delta 5.0 のメタデータ構造とする計画 • Delta Protocol RFC "Iceberg V4 Adaptive Metadata Tree" (Proposed): Delta の ファイル一覧と統計を AMT で持つ ◦ 小さな変更は Delta log に書き、Checkpoint の代わりに Root manifest を作成する ◦ テーブル全体を書き直す Checkpoint をなくし、メタデータの更新量を変更量に比例させる • Delta/Iceberg clients が同じメタデータ構造を共有 (= No metadata duplication) ◦ 共通のデータファイル、パーティション、ファイル統計を参照できる ◦ Delta Log は引き続き Delta Lake 側で利用される予定だが、Delta table commit (Manifest commit) 時に Iceberg 側の root manifest 側も更新する • 2026/09/29 時点で、Iceberg の AMT Spec と Delta の RFC はどちらも策定・実装 中 (Delta 5.0 のリリース時期は未公表) ©2026 Databricks, Inc. — All rights reserved 参照: • Delta Lake and Apache Iceberg Unification: Unified Metadata Architecture • Delta + Iceberg, Better Together | Databricks 27
  23. Key takeaways • Iceberg は、ストレージ上のデータをテーブルとして管理するメタデータレイヤーで、 AI 時代の Lakehouse を支える •

    Catalog を起点にメタデータを階層で管理し、atomic swap で一貫性を保ち、 Snapshot でタイムトラベル、メタデータによる効率的な読み取りを実現する • Spec はコミュニティで策定・バージョン管理され、確定後に各エンジンへ実装される • 現行の V3 では、Variant などで扱えるデータを広げ、 Deletion Vectors と Row Lineage で更新の効率化と変更の追跡を強化した • V4 では、Single File Commit と Adaptive Metadata Tree により、 コミットごとに書くメタデータを減らす議論が進んでいる • Delta 5.0 でも AMT の採用が提案されており、Iceberg と Delta はデータに続いてメタデータ でも共通化に向かっている ©2026 Databricks, Inc. — All rights reserved 28