Share
Embed
XAI勉強会 第二回
AcademiX が開催した 第2回 XAI勉強会 資料
トピック:線形モデルの説明可能性
日時:2023/08/13
参考図書:実践XAI[説明可能なAI] 機械学習の予測を説明するためのPythonコーディング
AcademiX
August 15, 2023
Transcript
32 slides
-
参考文献 • 実践XAI[説明可能なAI] 機械学習の予測を説明するための Pythonコーディング • コード :https://github.com/Apress/Practical-Explainable-AI-Using- Python/tree/main •
データセット :https://github.com/Apress/Practical-Explainable-AI-Using- Python/blob/main/Datasets/automobile.csv ◦ スライドに引用記載のない図は全て上記から引用 -
目次 • 3章について ◦ 線形モデルとVIFとは何かを理解 ◦ 4つのライブラリの特徴と使用例を知る ▪ SHAP, LIME,
Skater, ELI5 ▪ 特にSHAPの原理を理解 ◦ ロジスティック回帰と4つのライブラリ • まとめ -
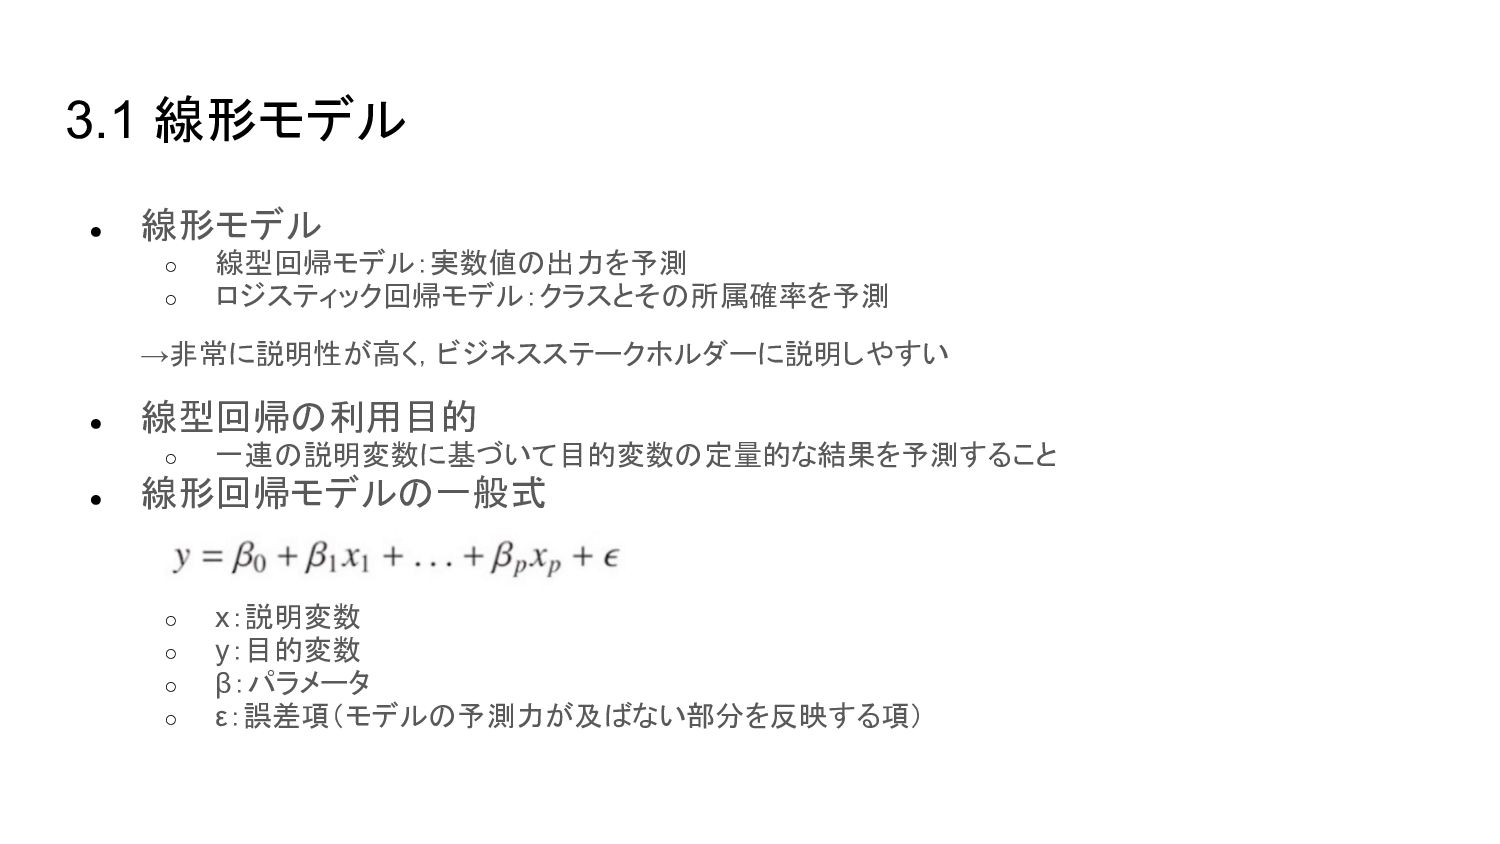
3.1 線形モデル • 線形モデル ◦ 線型回帰モデル:実数値の出力を予測 ◦ ロジスティック回帰モデル:クラスとその所属確率を予測 →非常に説明性が高く,ビジネスステークホルダーに説明しやすい •
線型回帰の利用目的 ◦ 一連の説明変数に基づいて目的変数の定量的な結果を予測すること • 線形回帰モデルの一般式 ◦ x:説明変数 ◦ y:目的変数 ◦ β:パラメータ ◦ ε:誤差項(モデルの予測力が及ばない部分を反映する項) -
今回利用するデータセット • 目的 ◦ 与えられた車の属性から車の価格を予測する線形回 帰モデルを作成 • データセット :https://github.com/Apress/Practical-Explainable-AI-Using- Python/blob/main/Datasets/automobile.csv
• サイズ:(6019, 11) データセットhttps://github.com/Apress/Practical-Explainable-AI-Using-Python/blob/main/Datasets/automobile.csv -
3.2 線形回帰(モデル作成) モデル • 多重線形回帰モデル データの前処理 • 外れ値・正規化の処理 • 訓練・検証データの分割
• one-hot エンコーディング(ダミー変数) ◦ 文字列を数値に変換 -
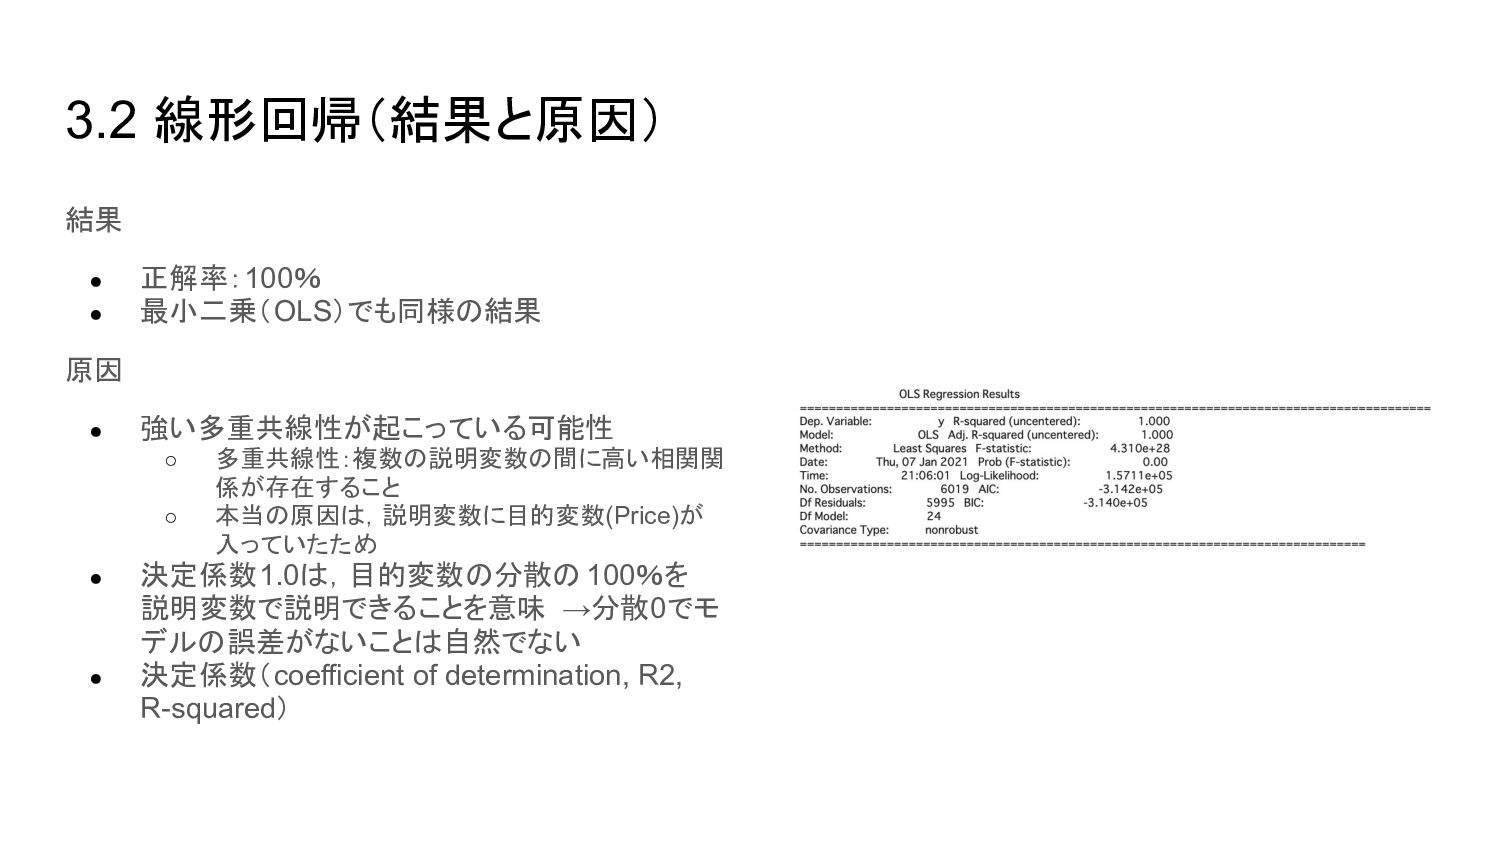
3.2 線形回帰(結果と原因) 結果 • 正解率:100% • 最小二乗(OLS)でも同様の結果 原因 • 強い多重共線性が起こっている可能性
◦ 多重共線性:複数の説明変数の間に高い相関関 係が存在すること ◦ 本当の原因は,説明変数に目的変数(Price)が 入っていたため • 決定係数1.0は,目的変数の分散の 100%を 説明変数で説明できることを意味 →分散0でモ デルの誤差がないことは自然でない • 決定係数(coefficient of determination, R2, R-squared) -
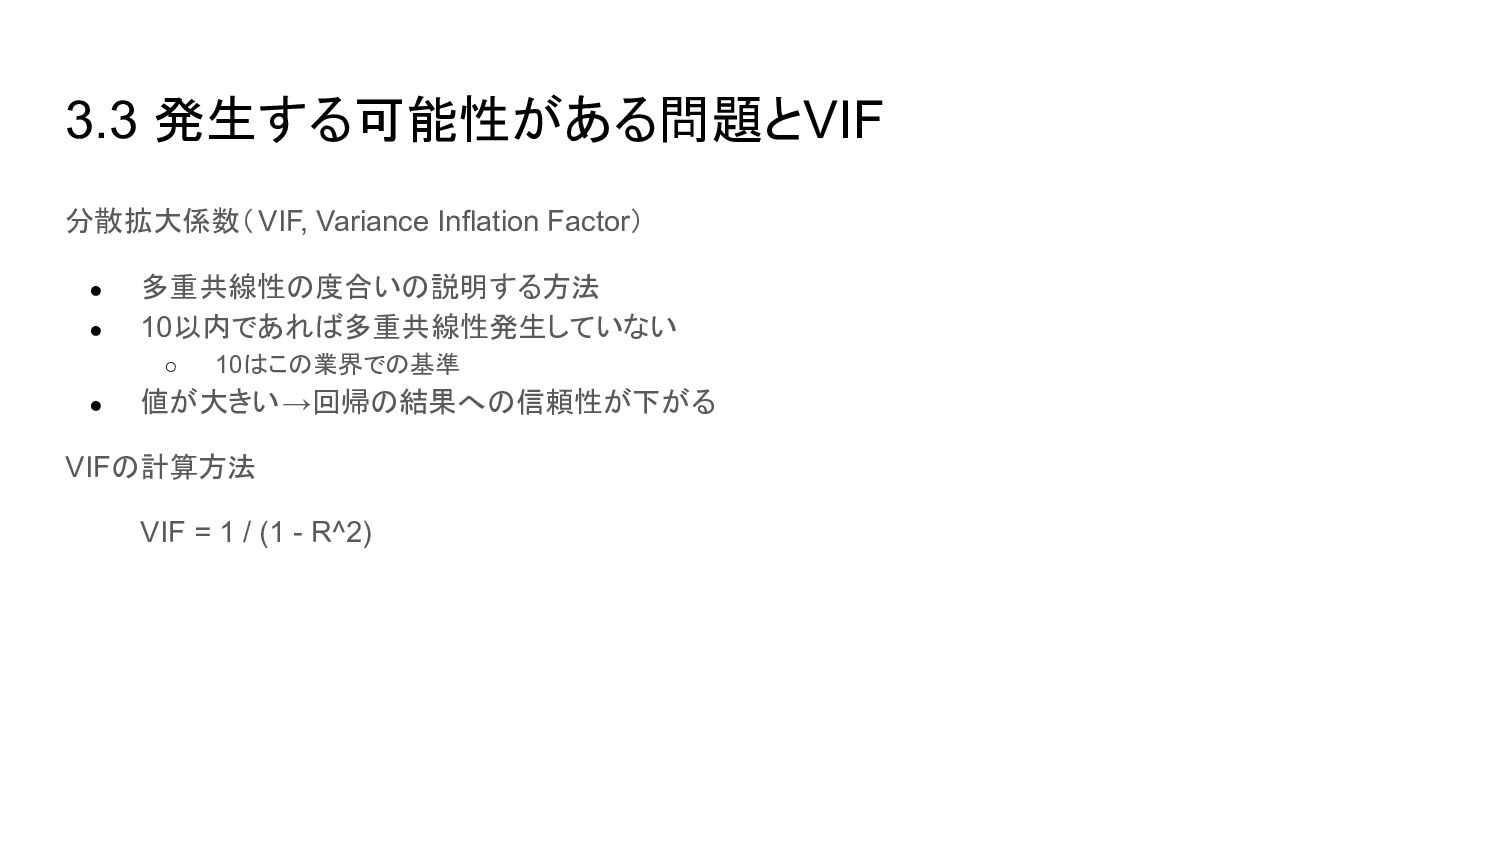
3.3 発生する可能性がある問題とVIF 分散拡大係数(VIF, Variance Inflation Factor) • 多重共線性の度合いの説明する方法 • 10以内であれば多重共線性発生していない
◦ 10はこの業界での基準 • 値が大きい→回帰の結果への信頼性が下がる VIFの計算方法 VIF = 1 / (1 - R^2) -
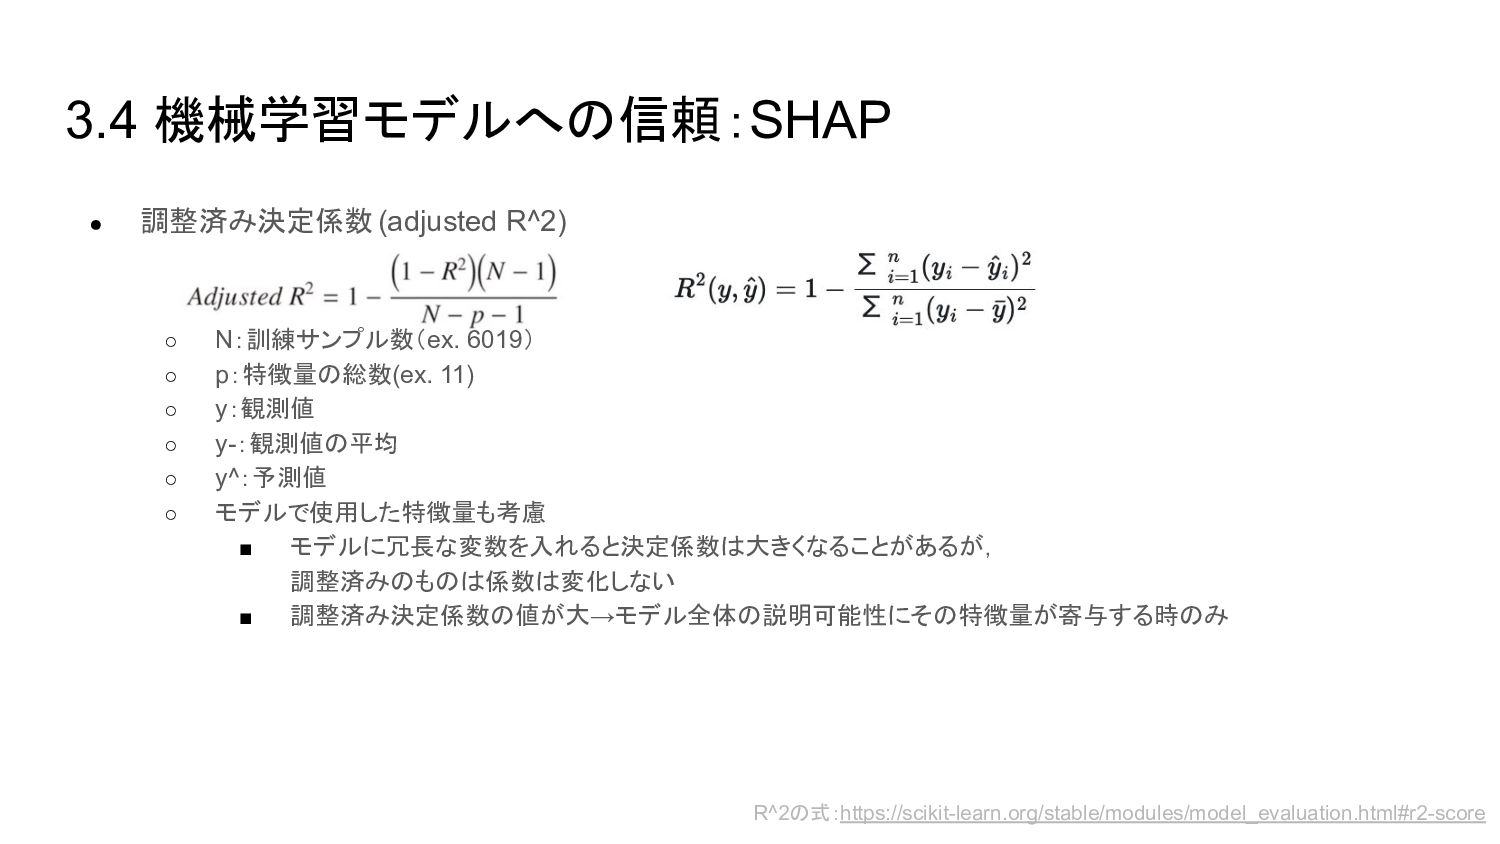
3.4 機械学習モデルへの信頼:SHAP • 調整済み決定係数(adjusted R^2) ◦ N:訓練サンプル数(ex. 6019) ◦ p:特徴量の総数(ex.
11) ◦ y:観測値 ◦ y-:観測値の平均 ◦ y^:予測値 ◦ モデルで使用した特徴量も考慮 ▪ モデルに冗長な変数を入れると決定係数は大きくなることがあるが, 調整済みのものは係数は変化しない ▪ 調整済み決定係数の値が大→モデル全体の説明可能性にその特徴量が寄与する時のみ R^2の式:https://scikit-learn.org/stable/modules/model_evaluation.html#r2-score -
各特徴量のシャープレイ値の計算式 • 各特徴量の貢献度を計算するにあたり, SHAP は全ての特徴量のサブセット ”S”で モデルを再訓練することを要求 • i: 個々の特徴量
• F:全ての特徴量からなるセット • S:特徴量セットFのサブセット • 任意の特徴量”i”で”i”を含むモデル1と含まない モデル2で予測の差分を計算 • ある特徴量がモデルに与える影響はモデルの 他の特徴量がどのように機能するかで決定 • あらゆる組合せのSで予測値の差分が 計算され,それらの平均値を求める • 考えられる全ての差分の加重平均値で特徴量 の重要度を求める -
SHAP値の具体例 • X軸:ある特徴量(Age)の値とその分布 • Y軸:目的変数Priceの値 • E[f(x)]:水平の点線はモデルの出力の 期待値(平均値) • E[Age]:Age特徴量の平均値
• E[f(x)]とE[Age]の交点:データ分布に関する PDPの中心 • 特徴量”i”のSHAP値:モデルの目的変数の値 (正解値)と特徴量の値 xiでのPDPとの差分 ◦ Age=10のSHAP値:赤の縦線の高さ -
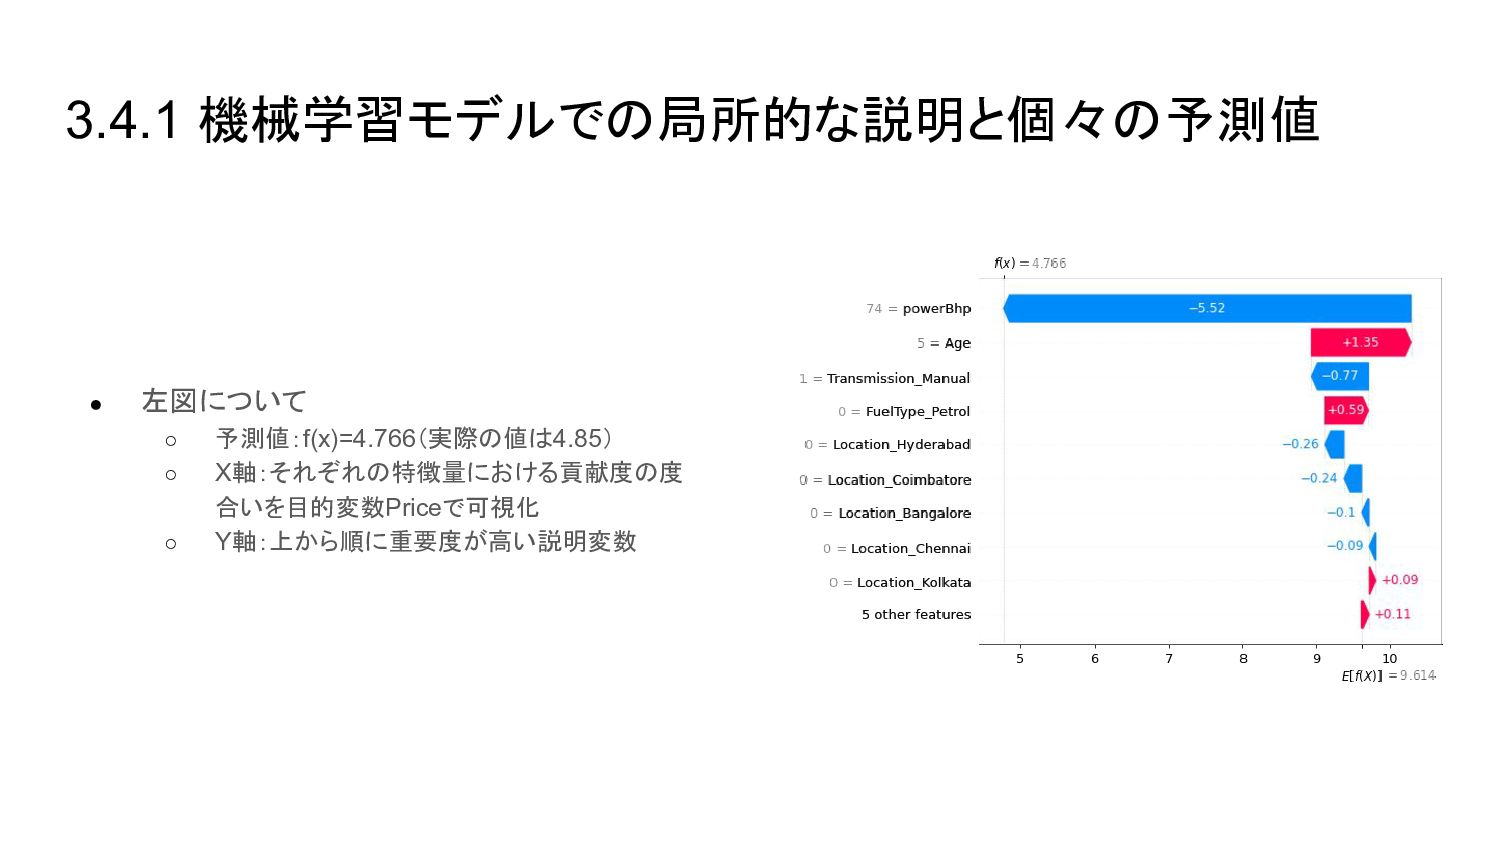
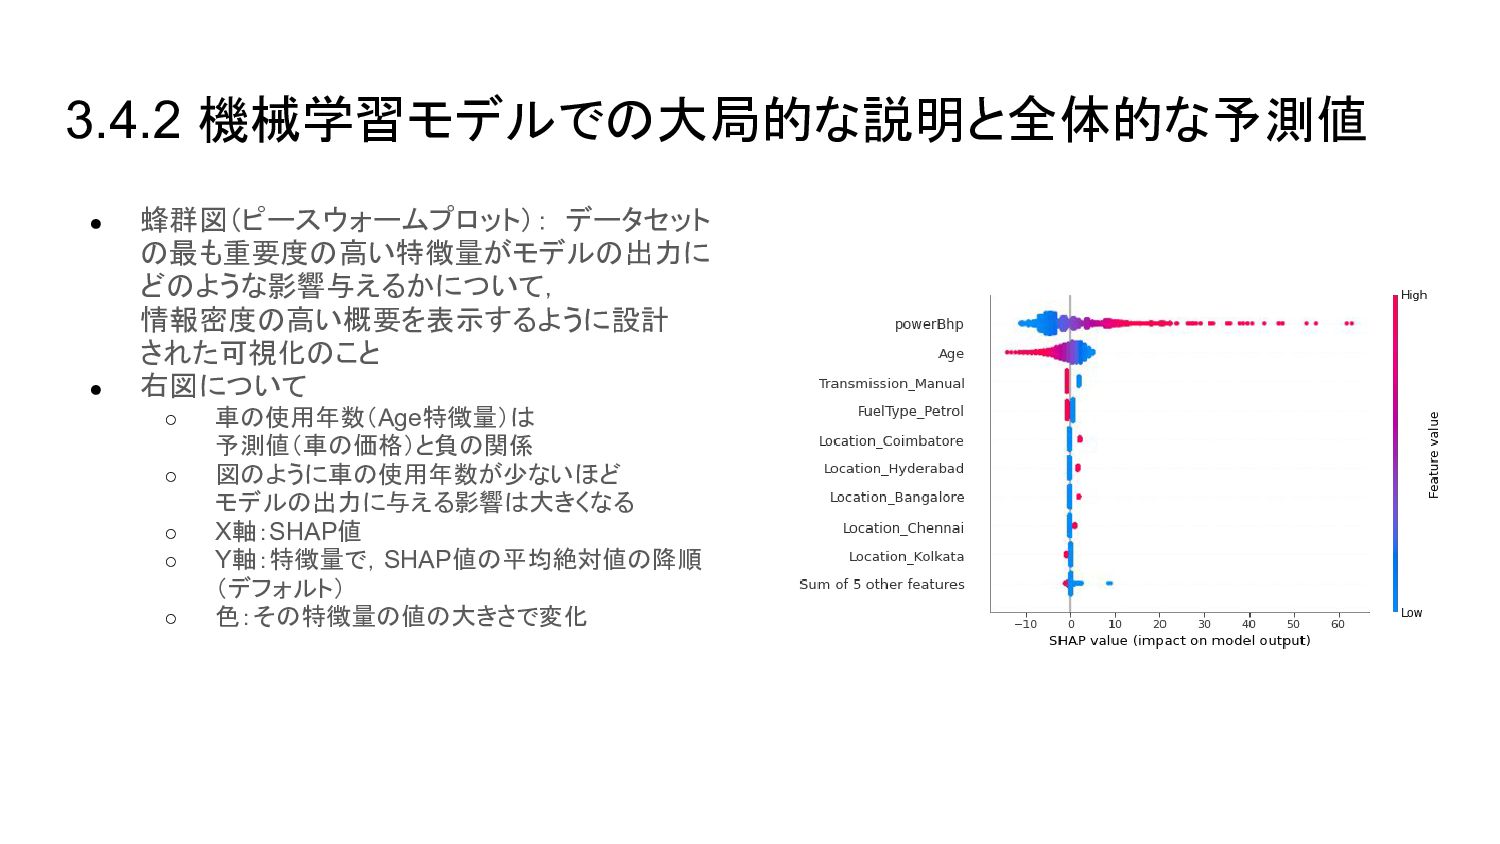
3.4.2 機械学習モデルでの大局的な説明と全体的な予測値 • 蜂群図(ピースウォームプロット): データセット の最も重要度の高い特徴量がモデルの出力に どのような影響与えるかについて, 情報密度の高い概要を表示するように設計 された可視化のこと •
右図について ◦ 車の使用年数(Age特徴量)は 予測値(車の価格)と負の関係 ◦ 図のように車の使用年数が少ないほど モデルの出力に与える影響は大きくなる ◦ X軸:SHAP値 ◦ Y軸:特徴量で,SHAP値の平均絶対値の降順 (デフォルト) ◦ 色:その特徴量の値の大きさで変化 -
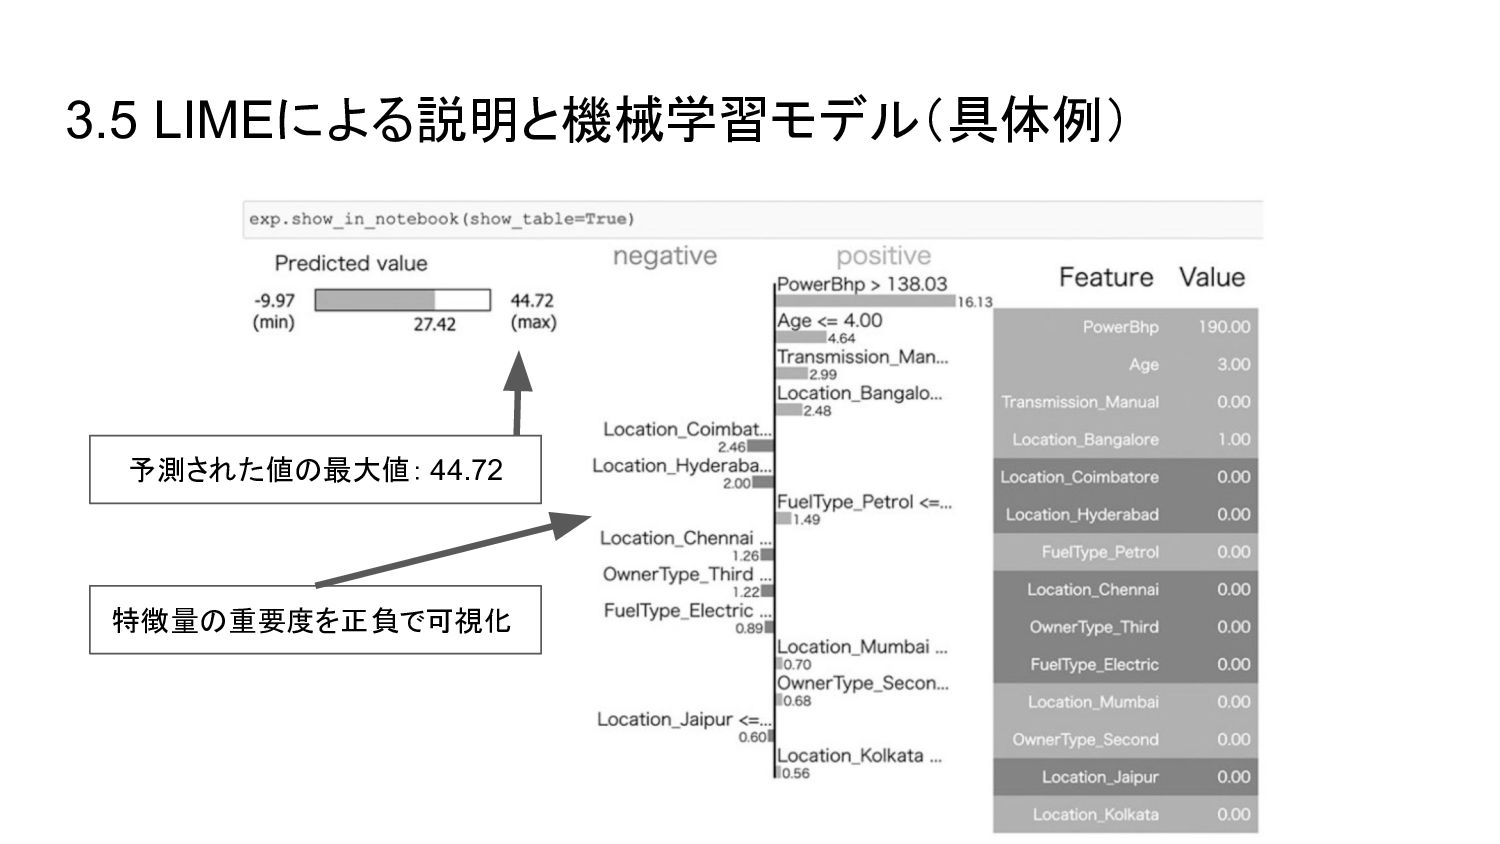
3.5 LIMEによる説明と機械学習モデル LIME(Local Interpretable Model-agnostic Explainations) • アルゴリズム: 特徴量の値を調整することでサンプルを1つだけ変更し 結果として出力にどのような影響を与えるのかを観測
• LIMEは予測値を説明するための説明器(Explainer)の役割 • 線形回帰や決定木に利用可能 • モデルに依存しない手法(model-agnostic) • 問題を局所化しモデルを大域的なレベルなく局所的なレベルで説明 -
3.5 LIMEによる説明と機械学習モデル(LIMEの式) LIMEにおける,忠実性と解釈可能性の関係式 • f:元の予測関数 • g:モデルの説明 • x:元の特徴量 •
πx:xの周りの局所性を定義する指標 • Ω:説明におけるモデルの複雑度の指標 LIMEの短所 • 近傍と近接の定義が不正確であること ◦ サンプリングでガウス分布を使うが様々な特徴量の 間の関係は考慮しない ◦ 目的変数と説明変数の間で線形でない場合は説明 が不正確となる • SubmodularPick:データセットのサンプルからn個の サンプルを持つサブセットを選択するもの ◦ 大量の出力を生成するため,解釈が難しい -
3.6 Skaterによる説明と機械学習モデル • Skater ◦ あらゆる形式のモデルの解釈性を可能にする オープンソースの統合フレームワークであり 実用性が高い ◦ ブラックボックスモデルの学習された構造を
グローバル(完全なデータセットに基づく推論)とローカル (個々の予測に関する推論)の両方で解明 するように設計 ◦ モデルの意思決定ポリシーを推論・デバックする 機能も提供 • Two-way PDP:2つの特徴量と目的変数を使って 生成した図 ◦ 右図は関連性を示したもので,因果関係として 解釈すべきでない ◦ 2つの合計の貢献度が高い(深緑) →低い(青) ◦ 深緑のほうがより大きな予測りを表す ◦ このPDPにはそれほど付加価値はない (重要な洞察が得られることもある) ◦ 信頼区間を出力可 -
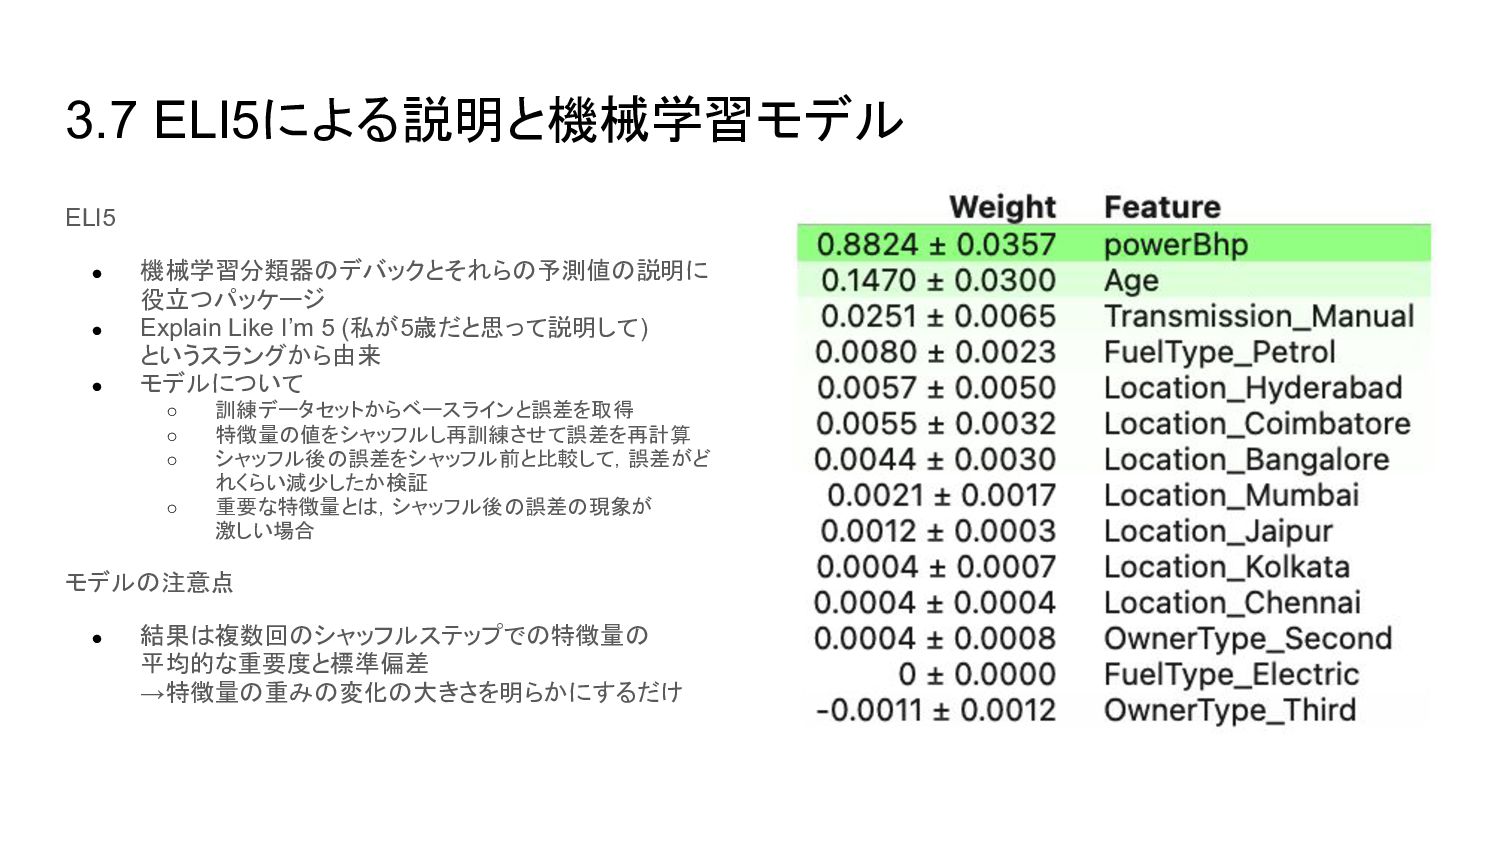
3.7 ELI5による説明と機械学習モデル ELI5 • 機械学習分類器のデバックとそれらの予測値の説明に 役立つパッケージ • Explain Like I’m
5 (私が5歳だと思って説明して) というスラングから由来 • モデルについて ◦ 訓練データセットからベースラインと誤差を取得 ◦ 特徴量の値をシャッフルし再訓練させて誤差を再計算 ◦ シャッフル後の誤差をシャッフル前と比較して,誤差がど れくらい減少したか検証 ◦ 重要な特徴量とは,シャッフル後の誤差の現象が 激しい場合 モデルの注意点 • 結果は複数回のシャッフルステップでの特徴量の 平均的な重要度と標準偏差 →特徴量の重みの変化の大きさを明らかにするだけ -
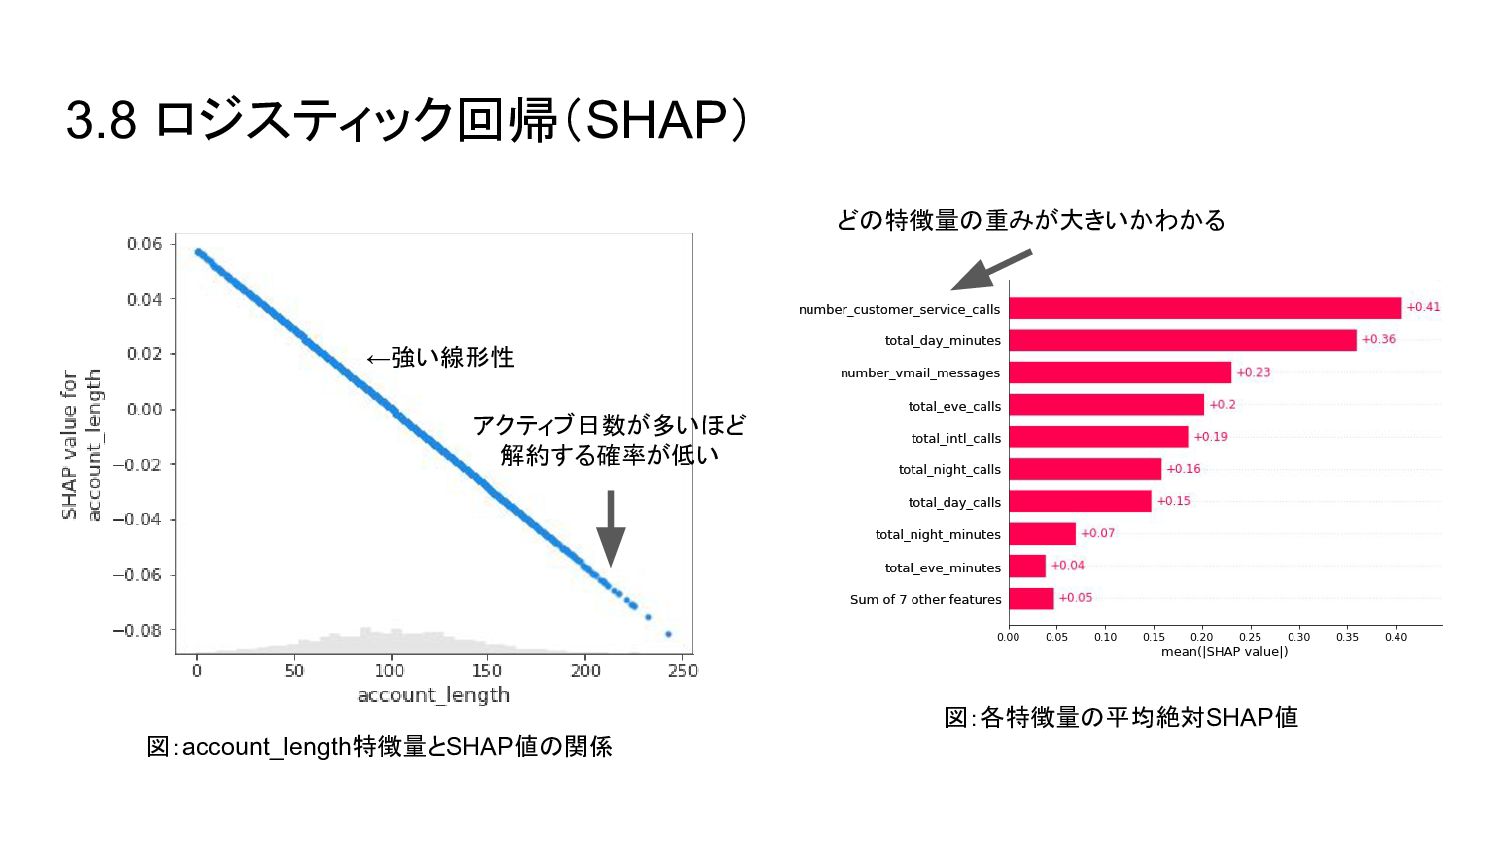
3.8 ロジスティック回帰(基礎) ロジスティック回帰モデル • 二値の入力からオッズ比という対数オッズを計算 • シグモイド関数 • 対数オッズ:事象Pが発生する確率としない確率の比率 ◦
右辺の加重和は確率値に変換 ◦ Ln:自然対数 -
3.8 ロジスティック回帰(データとモデル) 使用するデータ • ChurnData.csv:電気通信会社の解約予測用のデータセット ◦ 参考文献:https://github.com/Apress/Practical-Explainable-AI-Using-Python/blob/main/Datasets/ChurnData.csv ◦ (3333, 18)
モデル • 80%訓練データ・ダミー変数 • モデル:ロジスティック回帰 • 結果:train(0.853), test(0.856) 表:電気通信会社の解約予測用のデータセット -
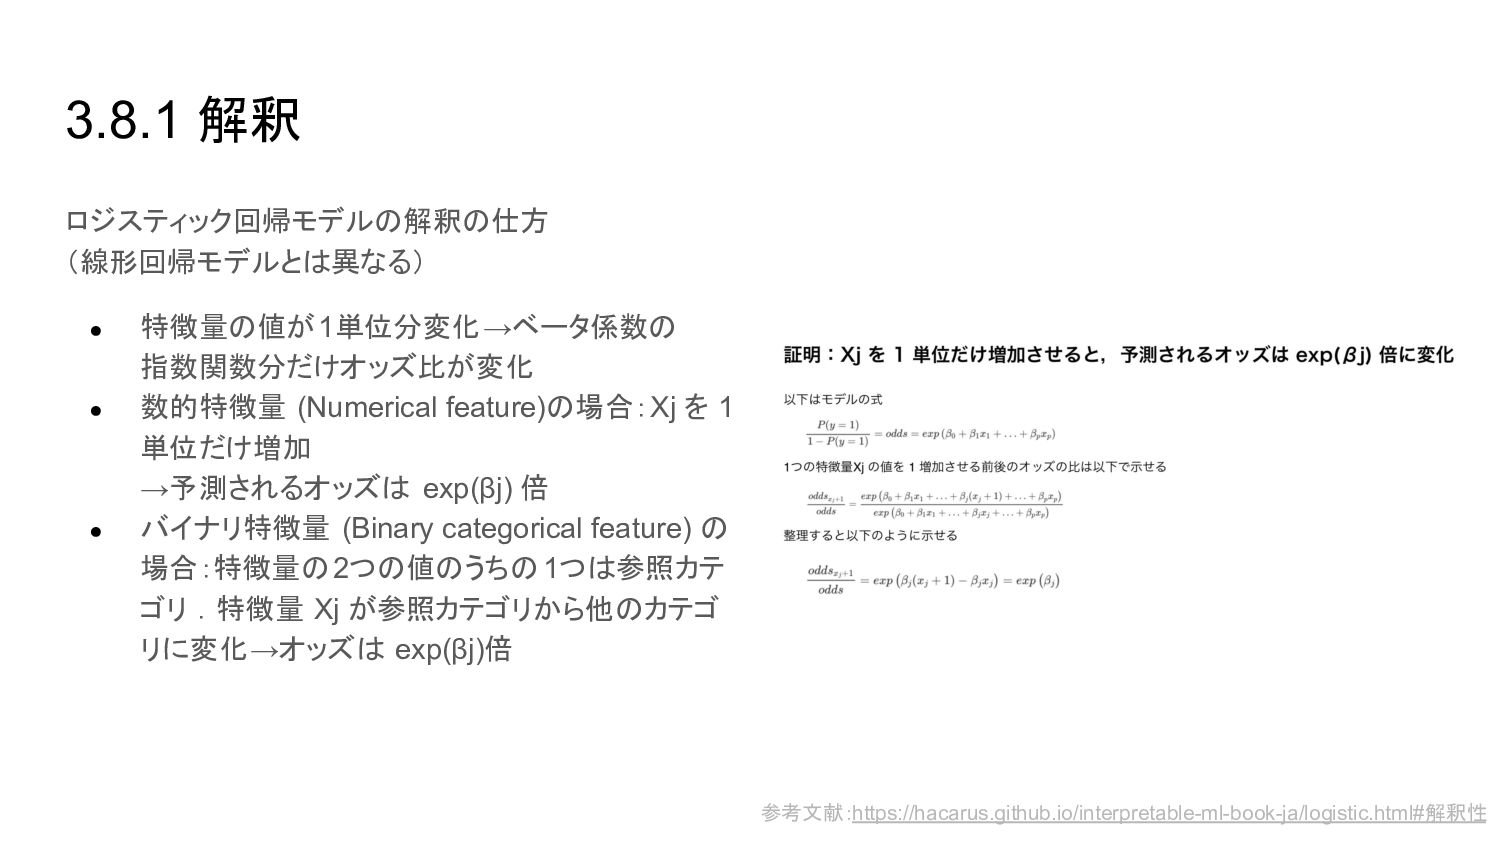
3.8.1 解釈 ロジスティック回帰モデルの解釈の仕方 (線形回帰モデルとは異なる) • 特徴量の値が1単位分変化→ベータ係数の 指数関数分だけオッズ比が変化 • 数的特徴量 (Numerical
feature)の場合:Xj を 1 単位だけ増加 →予測されるオッズは exp(βj) 倍 • バイナリ特徴量 (Binary categorical feature) の 場合:特徴量の2つの値のうちの1つは参照カテ ゴリ .特徴量 Xj が参照カテゴリから他のカテゴ リに変化→オッズは exp(βj)倍 参考文献:https://hacarus.github.io/interpretable-ml-book-ja/logistic.html#解釈性