Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
GPUのVRAMをRAMディスク化するアプリ「VRAMDISK」の紹介
Search
ActiveTK.
September 06, 2026
1.1k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
GPUのVRAMをRAMディスク化するアプリ「VRAMDISK」の紹介
ActiveTK.
September 06, 2026
More Decks by ActiveTK.
See All by ActiveTK.
内容証明郵便で♰画像♰を送ろう!!
activetk
1
270
Featured
See All Featured
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
410
Facilitating Awesome Meetings
lara
57
7.1k
コードの90%をAIが書く世界で何が待っているのか / What awaits us in a world where 90% of the code is written by AI
rkaga
63
46k
Raft: Consensus for Rubyists
vanstee
142
7.7k
We Are The Robots
honzajavorek
0
380
Believing is Seeing
oripsolob
1
220
Balancing Empowerment & Direction
lara
6
1.3k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
0
250
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Mobile First: as difficult as doing things right
swwweet
225
10k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
The Curious Case for Waylosing
cassininazir
1
520
Transcript
GPUのVRAMをRAMディスク化するアプリ 「VRAMDISK」の紹介 @ActiveTK5929 1
最近、自作PCで 困っていることがあります。 3
それは・・ 最近のメモリ代は高すぎる!! 皆さんは今、メモリを何GB積んでいますか? 4
一方、GPUのVRAMは空いている ・ メインメモリは常に取り合い - ブラウザ、IDE、VM、RAMディスク… 増設したいが高い ・ GPUにも VRAM というメモリが載っている(例:
RTX 4070 で 12GB) - ゲームや推論をしていない間は、ほぼ空いている - 内部帯域は 500GB/s 級(GDDR6X) ・ この空いている VRAM を RAMディスクとして使えないか? 5
前提①: RAMディスクとは ・ メインメモリ(RAM)の一部を切り出し、ドライブ(例: R:)としてマウントして使う仕組み ・ OSからは普通のディスクに見えるので、既存のアプリはそのまま読み書きできる ・ 特徴 -
速い:SSDの数倍〜十数倍の帯域、ランダムアクセスも極めて高速 - 揮発性:電源を切る/アンマウントすると中身は消える - 用途:一時ファイル、ビルドの中間生成物、ブラウザキャッシュ、動画編集の作業領域など ・ 問題点:使った分だけメインメモリが減る → メモリが高い今、贅沢な使い方 6
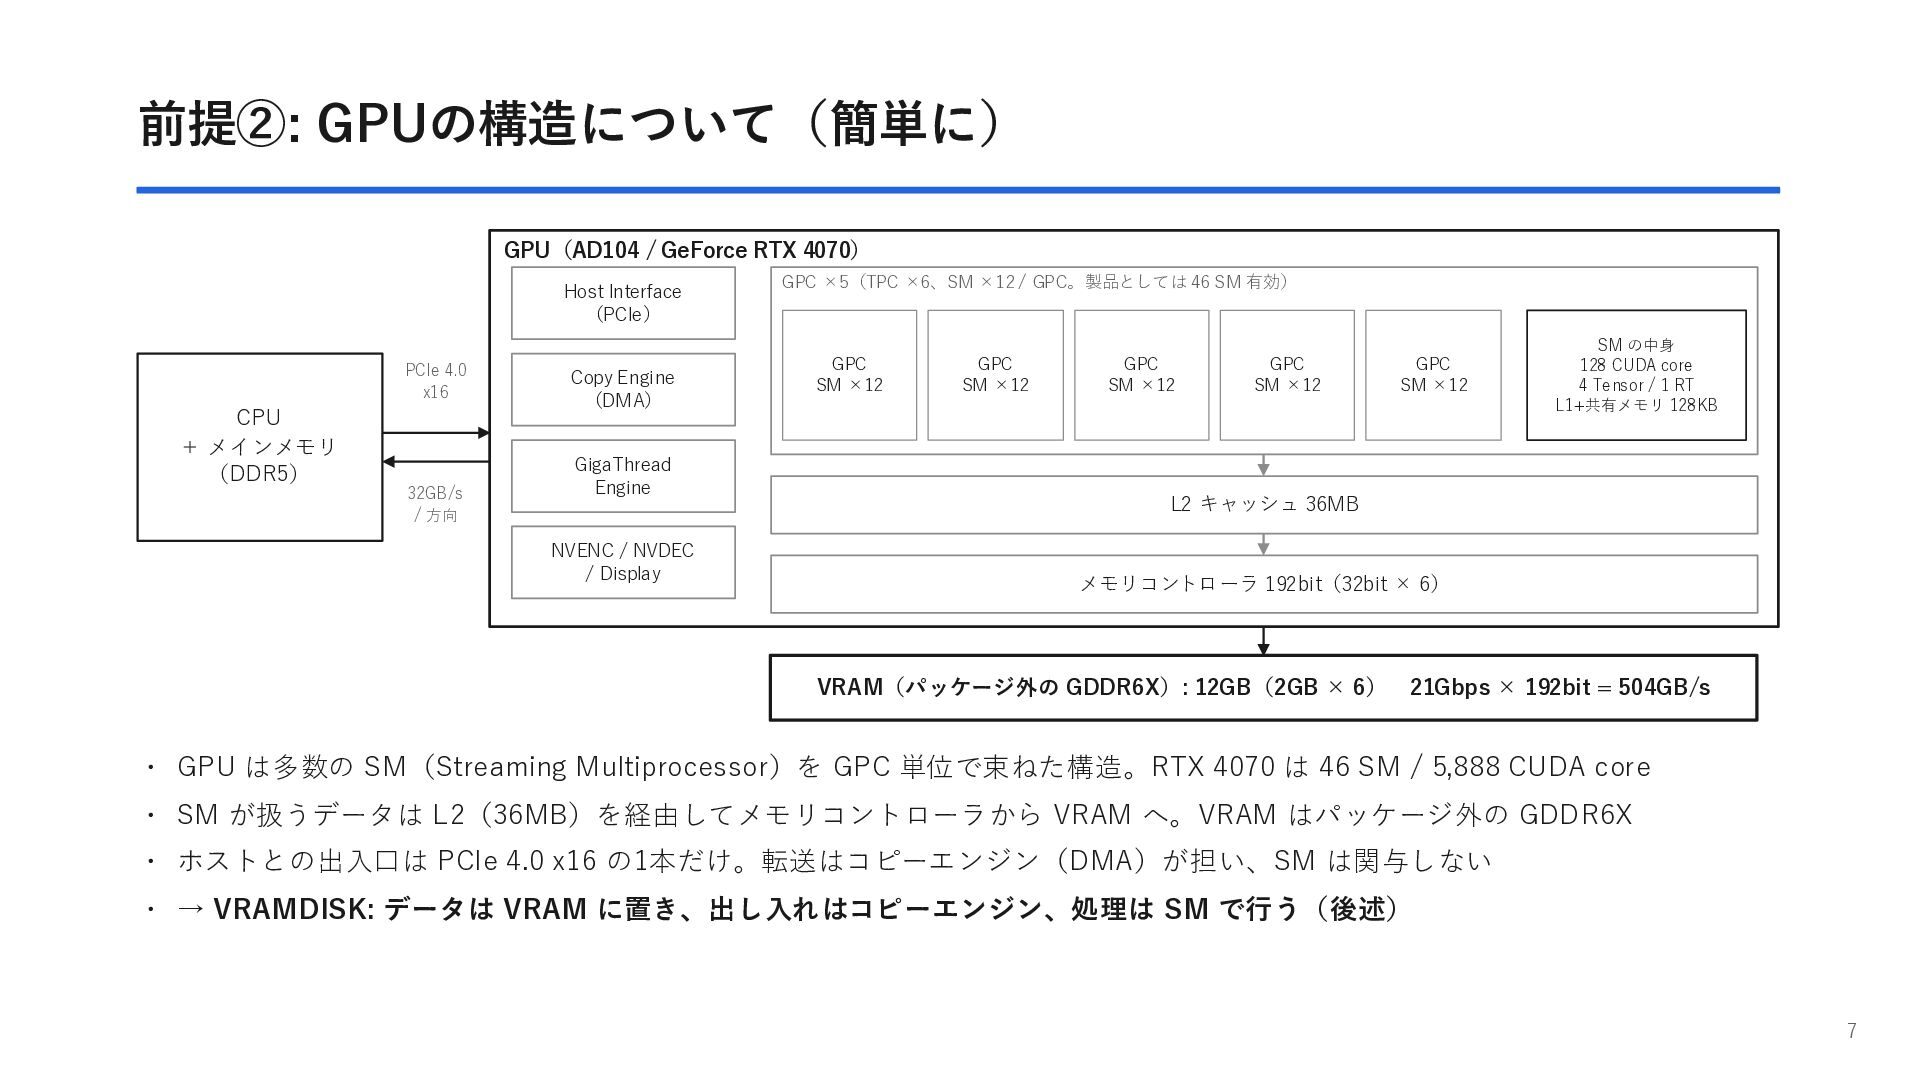
前提②: GPUの構造について(簡単に) GPU(AD104 / GeForce RTX 4070) Host Interface (PCIe)
PCIe 4.0 x16 CPU + メインメモリ (DDR5) 32GB/s / 方向 Copy Engine (DMA) GigaThread Engine NVENC / NVDEC / Display GPC ×5(TPC ×6、SM ×12 / GPC。製品としては 46 SM 有効) GPC SM ×12 GPC SM ×12 GPC SM ×12 GPC SM ×12 GPC SM ×12 SM の中身 128 CUDA core 4 Tensor / 1 RT L1+共有メモリ 128KB L2 キャッシュ 36MB メモリコントローラ 192bit(32bit × 6) VRAM(パッケージ外の GDDR6X): 12GB(2GB × 6) 21Gbps × 192bit = 504GB/s ・ GPU は多数の SM(Streaming Multiprocessor)を GPC 単位で束ねた構造。RTX 4070 は 46 SM / 5,888 CUDA core ・ SM が扱うデータは L2(36MB)を経由してメモリコントローラから VRAM へ。VRAM はパッケージ外の GDDR6X ・ ホストとの出入口は PCIe 4.0 x16 の1本だけ。転送はコピーエンジン(DMA)が担い、SM は関与しない ・ → VRAMDISK: データは VRAM に置き、出し入れはコピーエンジン、処理は SM で行う(後述) 7
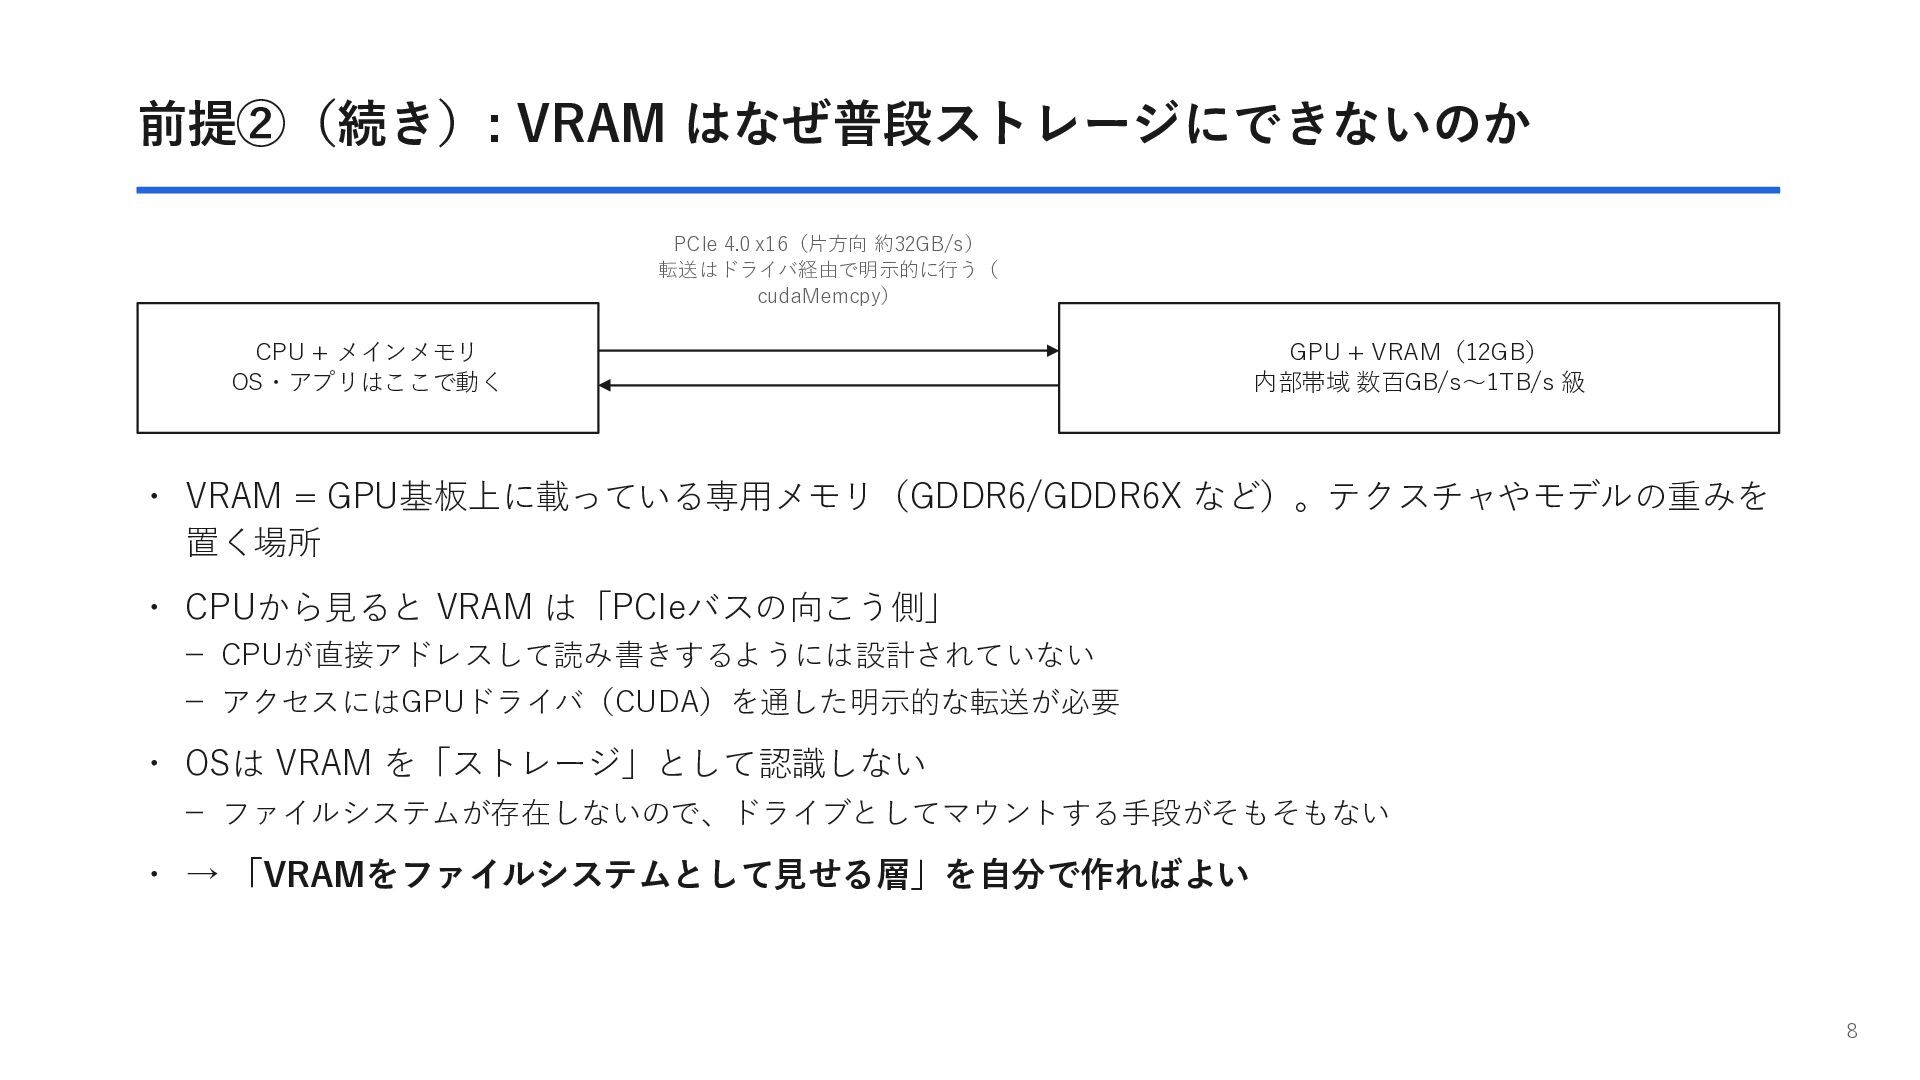
前提②(続き): VRAM はなぜ普段ストレージにできないのか PCIe 4.0 x16(片方向 約32GB/s) 転送はドライバ経由で明示的に行う( cudaMemcpy) CPU
+ メインメモリ OS・アプリはここで動く GPU + VRAM(12GB) 内部帯域 数百GB/s〜1TB/s 級 ・ VRAM = GPU基板上に載っている専用メモリ(GDDR6/GDDR6X など)。テクスチャやモデルの重みを 置く場所 ・ CPUから見ると VRAM は「PCIeバスの向こう側」 - CPUが直接アドレスして読み書きするようには設計されていない - アクセスにはGPUドライバ(CUDA)を通した明示的な転送が必要 ・ OSは VRAM を「ストレージ」として認識しない - ファイルシステムが存在しないので、ドライブとしてマウントする手段がそもそもない ・ → 「VRAMをファイルシステムとして見せる層」を自分で作ればよい 8
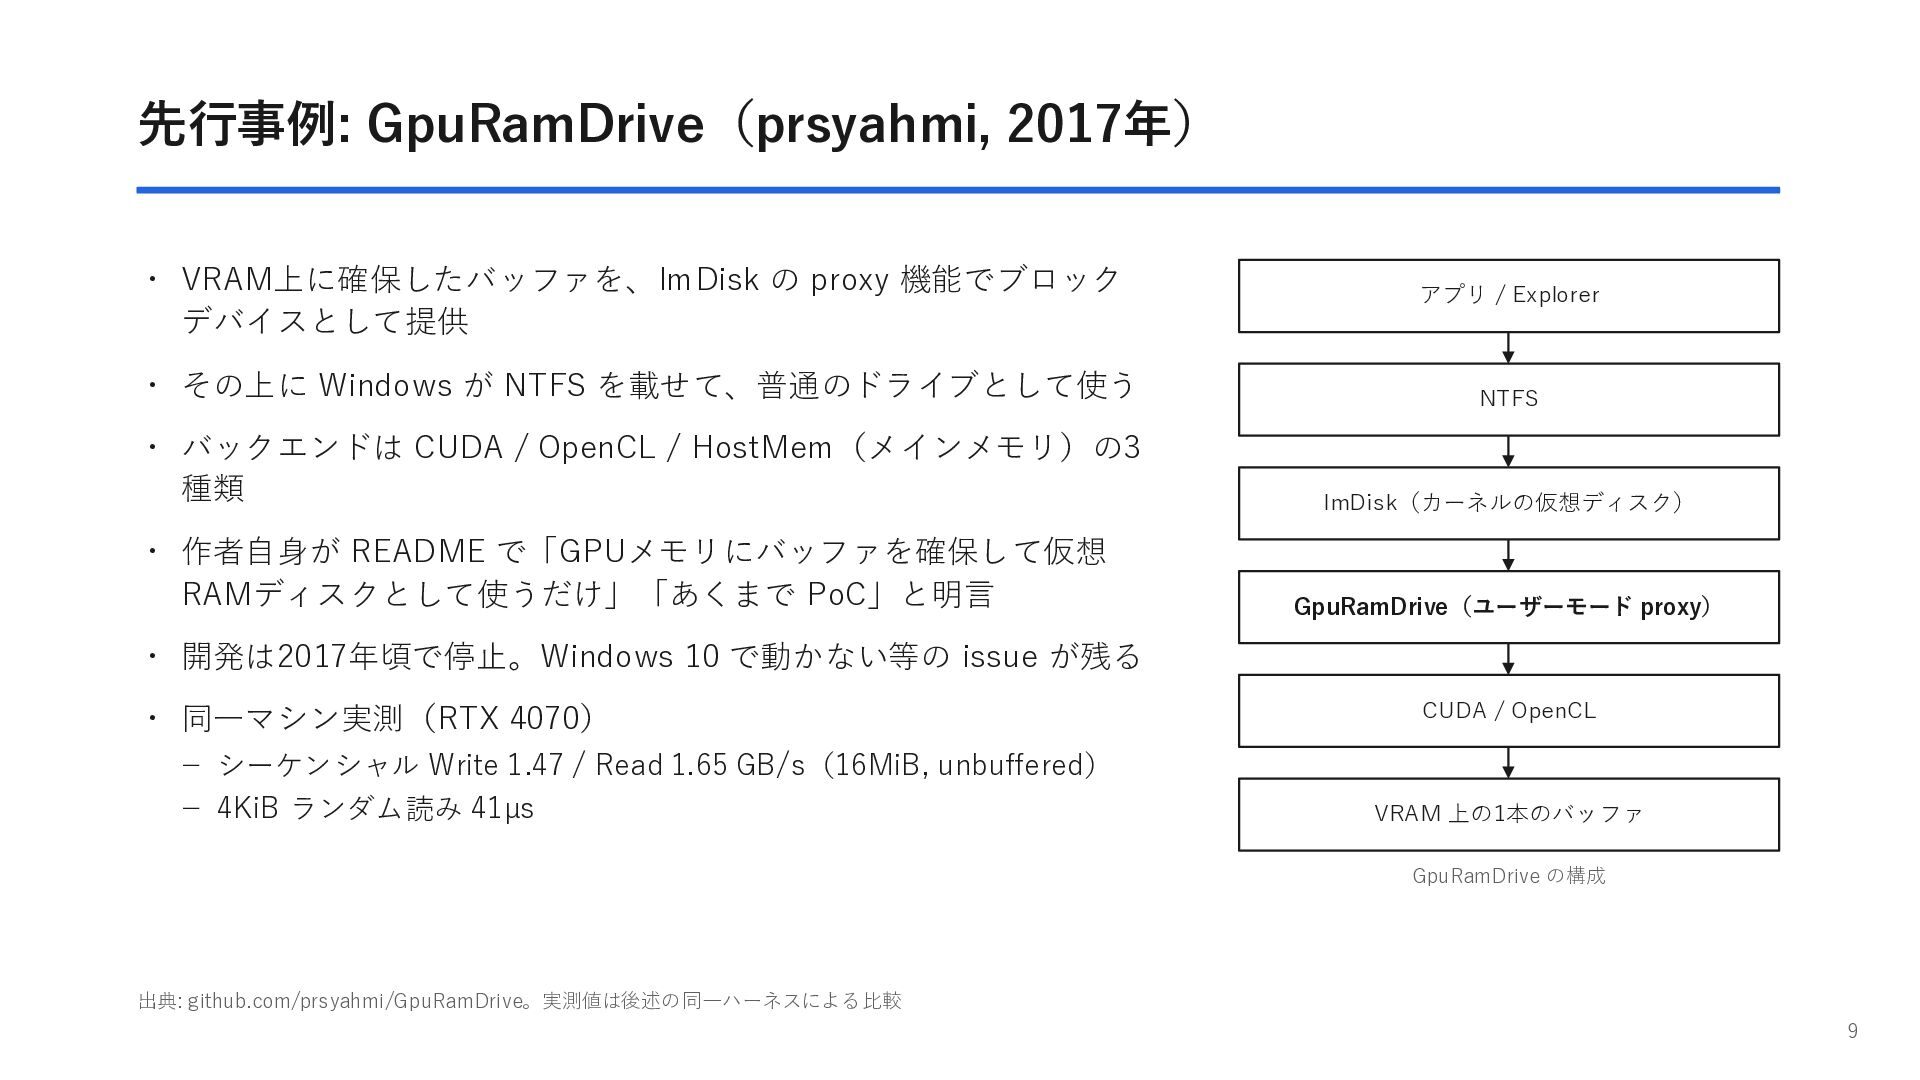
先行事例: GpuRamDrive(prsyahmi, 2017年) ・ VRAM上に確保したバッファを、ImDisk の proxy 機能でブロック デバイスとして提供 アプリ
/ Explorer ・ その上に Windows が NTFS を載せて、普通のドライブとして使う NTFS ・ バックエンドは CUDA / OpenCL / HostMem(メインメモリ)の3 種類 ImDisk(カーネルの仮想ディスク) ・ 作者自身が README で「GPUメモリにバッファを確保して仮想 RAMディスクとして使うだけ」「あくまで PoC」と明言 GpuRamDrive(ユーザーモード proxy) ・ 開発は2017年頃で停止。Windows 10 で動かない等の issue が残る ・ 同一マシン実測(RTX 4070) - シーケンシャル Write 1.47 / Read 1.65 GB/s(16MiB, unbuffered) - 4KiB ランダム読み 41µs CUDA / OpenCL VRAM 上の1本のバッファ GpuRamDrive の構成 出典: github.com/prsyahmi/GpuRamDrive。実測値は後述の同一ハーネスによる比較 9
GpuRamDrive の問題点 ・ VRAM を「ただのセクタの配列」としか見ていない - GPU でも DRAM でも
HDD でも同じコードで動く(実際 HostMem モードがある) - VRAM である必然性がゼロ ・ ファイルシステムは Windows(NTFS)任せ - どのセクタをいつ、どの単位で読み書きするかを制御できない - PCIe 転送が細切れになり、帯域を使い切れない(実測 1.4GB/s 前後) ・ GPU を一度も「計算」に使っていない - 置いたデータの検索・圧縮・ハッシュは GPU の得意技なのに、ただの置き場で終わっている ・ → VRAM を活かすなら、ファイルシステムそのものを自分で持つ必要がある 10
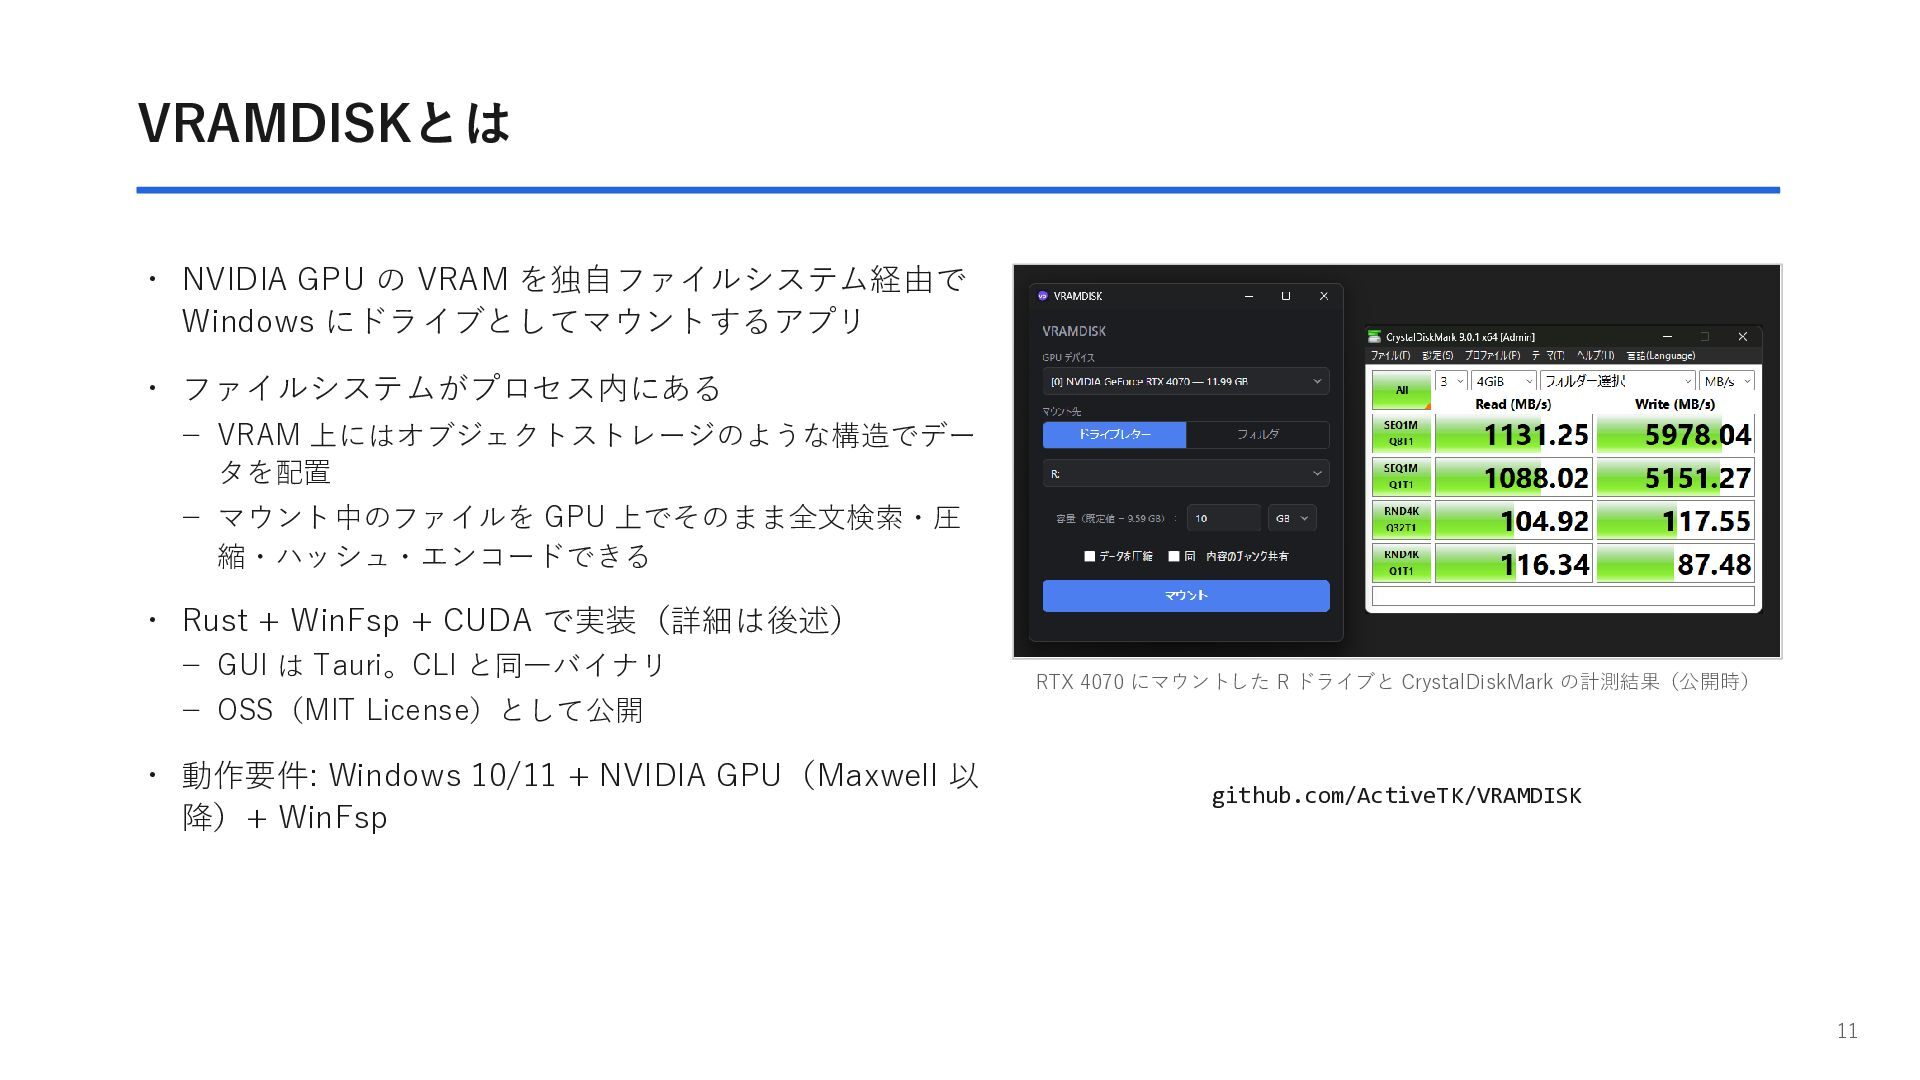
VRAMDISKとは ・ NVIDIA GPU の VRAM を独自ファイルシステム経由で Windows にドライブとしてマウントするアプリ ・
ファイルシステムがプロセス内にある - VRAM 上にはオブジェクトストレージのような構造でデー タを配置 - マウント中のファイルを GPU 上でそのまま全文検索・圧 縮・ハッシュ・エンコードできる ・ Rust + WinFsp + CUDA で実装(詳細は後述) - GUI は Tauri。CLI と同一バイナリ RTX 4070 にマウントした R ドライブと CrystalDiskMark の計測結果(公開時) - OSS(MIT License)として公開 ・ 動作要件: Windows 10/11 + NVIDIA GPU(Maxwell 以 降)+ WinFsp github.com/ActiveTK/VRAMDISK 11
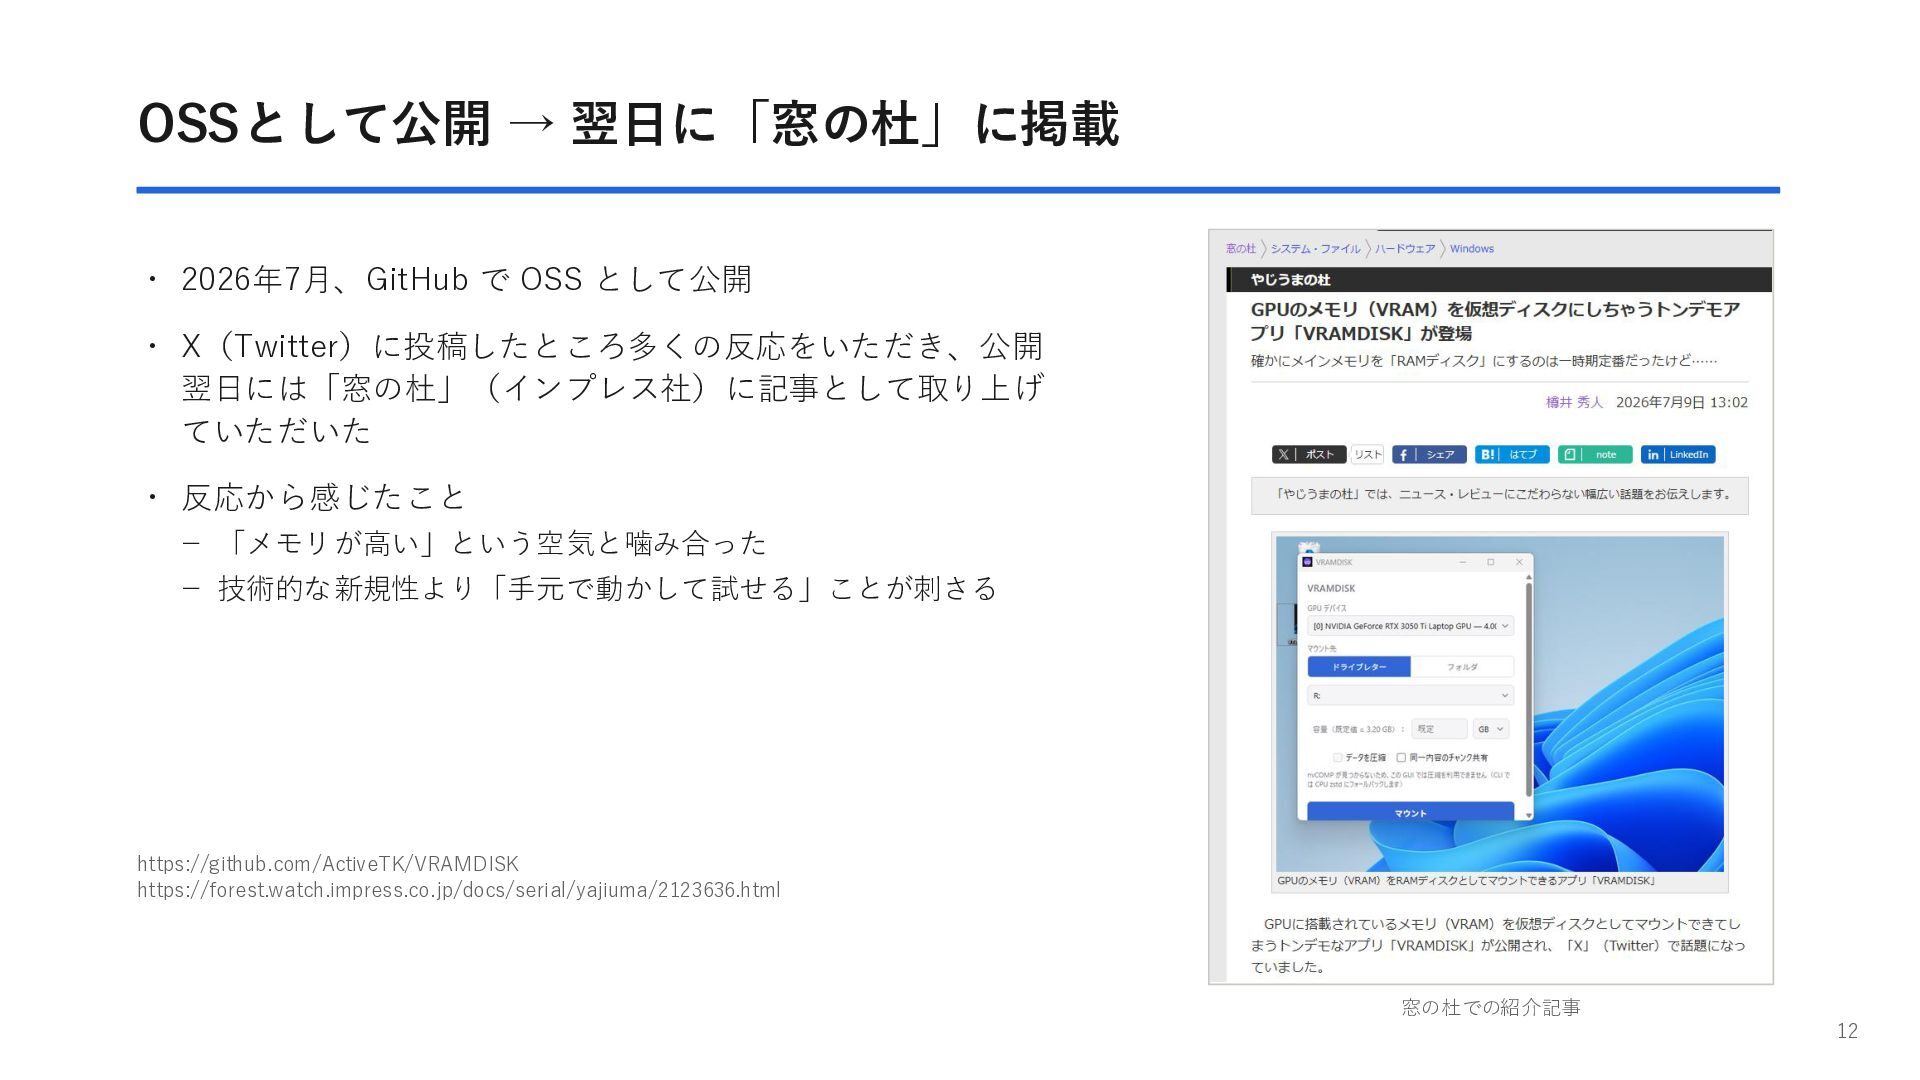
OSSとして公開 → 翌日に「窓の杜」に掲載 ・ 2026年7月、GitHub で OSS として公開 ・ X(Twitter)に投稿したところ多くの反応をいただき、公開
翌日には「窓の杜」(インプレス社)に記事として取り上げ ていただいた ・ 反応から感じたこと - 「メモリが高い」という空気と噛み合った - 技術的な新規性より「手元で動かして試せる」ことが刺さる https://github.com/ActiveTK/VRAMDISK https://forest.watch.impress.co.jp/docs/serial/yajiuma/2123636.html 窓の杜での紹介記事 12
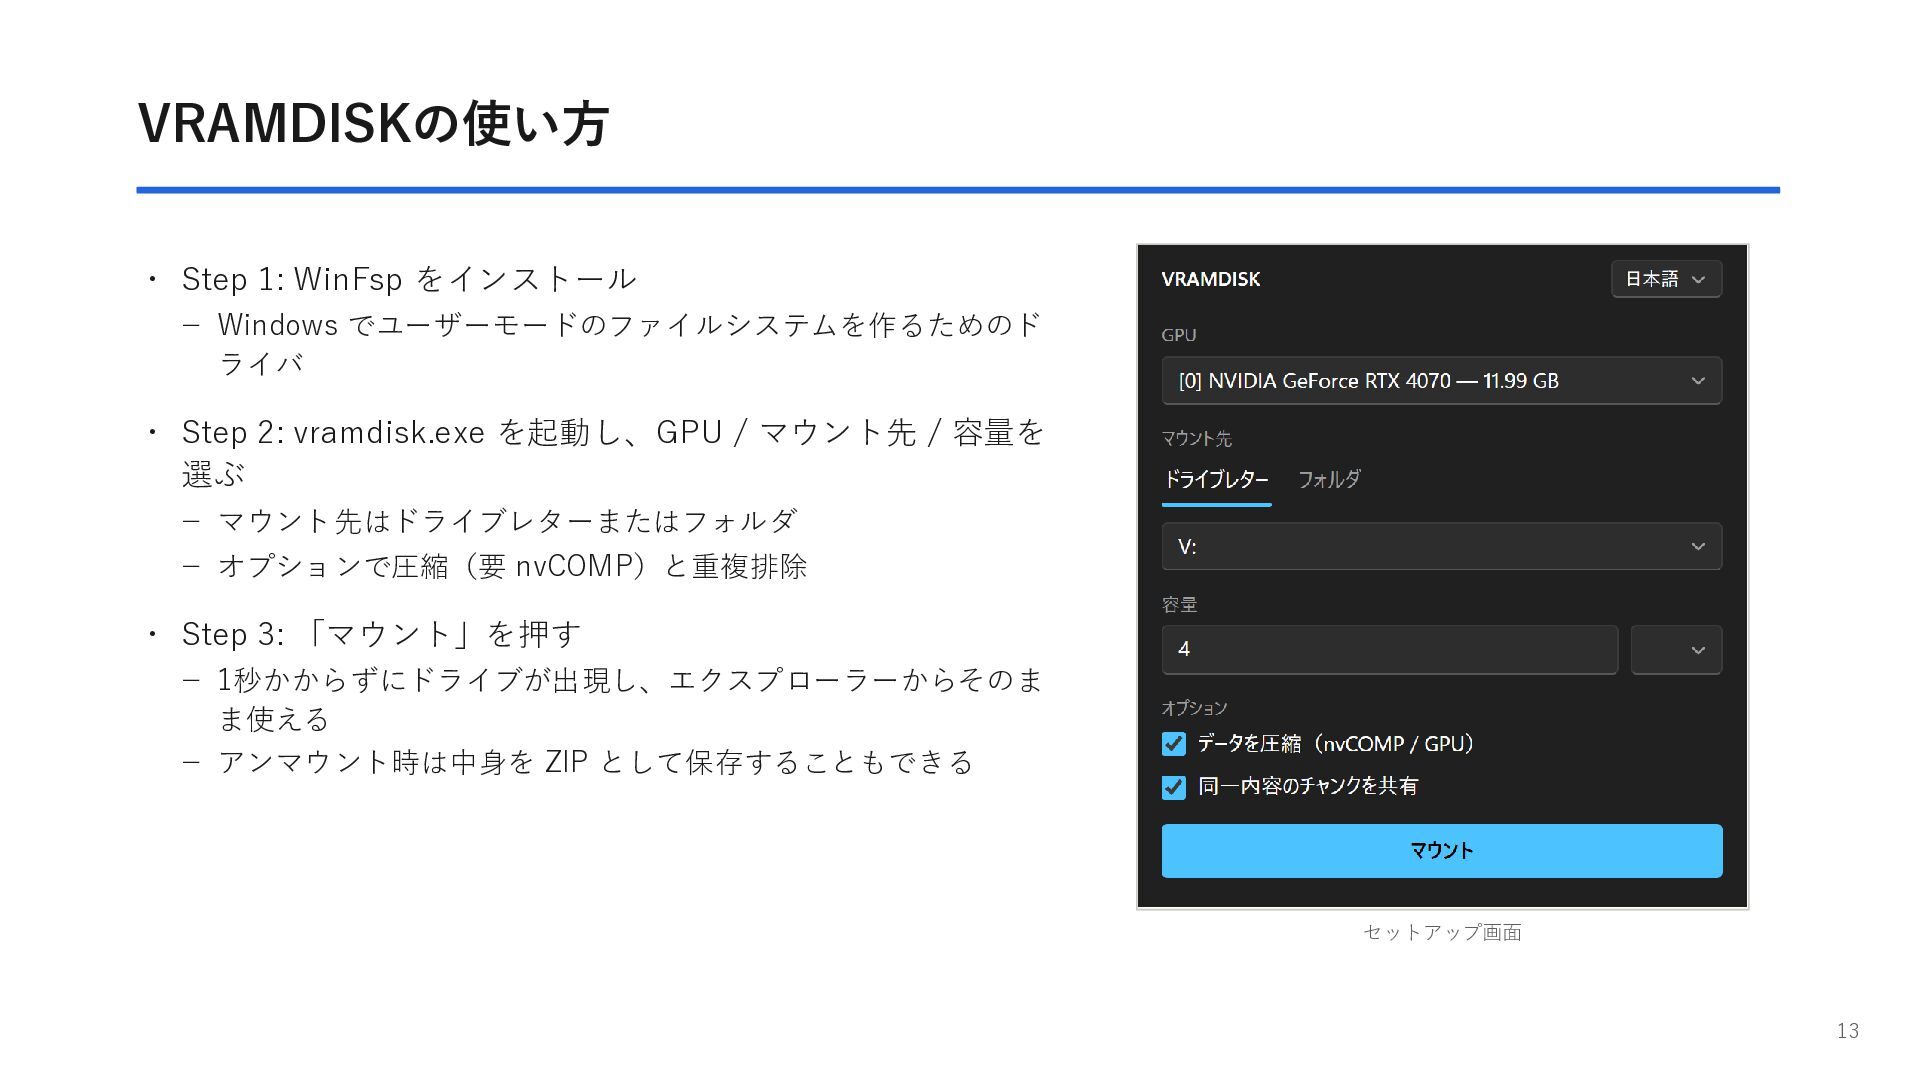
VRAMDISKの使い方 ・ Step 1: WinFsp をインストール - Windows でユーザーモードのファイルシステムを作るためのド ライバ
・ Step 2: vramdisk.exe を起動し、GPU / マウント先 / 容量を 選ぶ - マウント先はドライブレターまたはフォルダ - オプションで圧縮(要 nvCOMP)と重複排除 ・ Step 3: 「マウント」を押す - 1秒かからずにドライブが出現し、エクスプローラーからそのま ま使える - アンマウント時は中身を ZIP として保存することもできる セットアップ画面 13
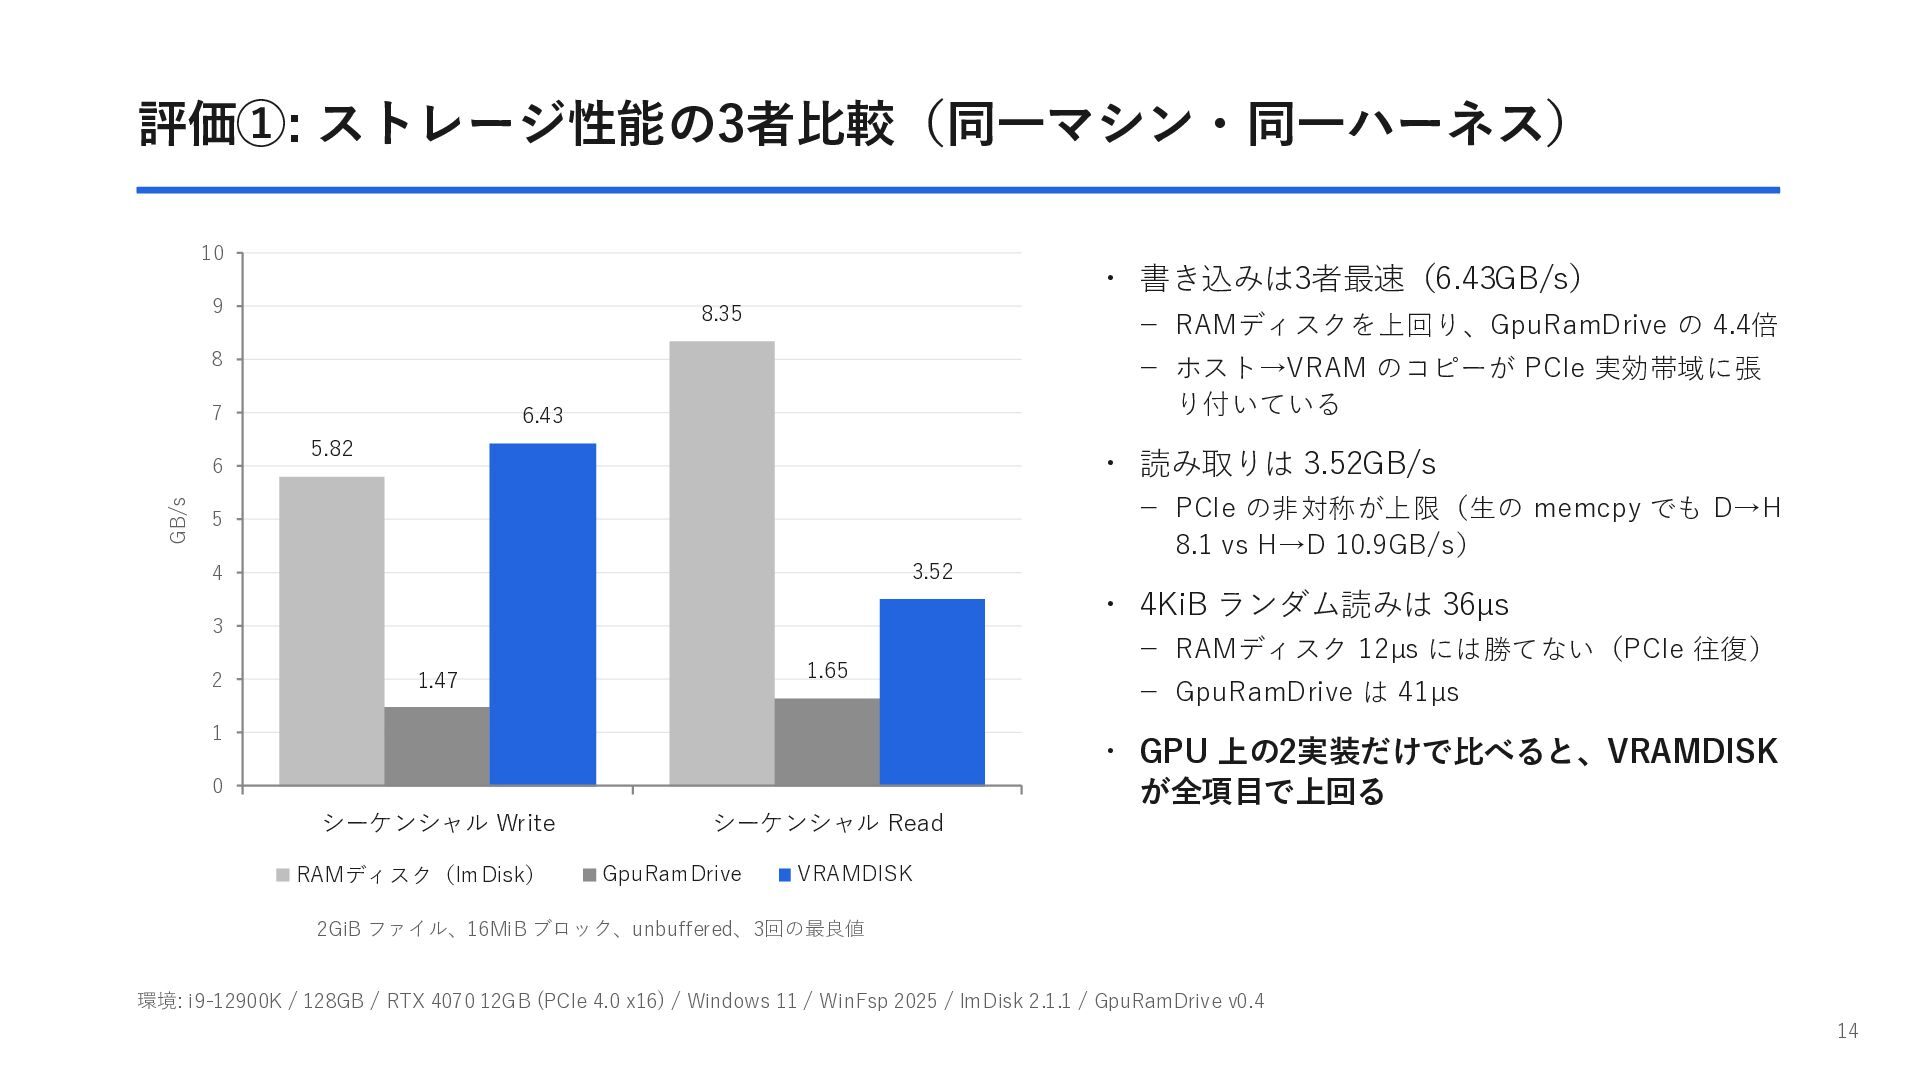
評価①: ストレージ性能の3者比較(同一マシン・同一ハーネス) 10 ・ 書き込みは3者最速(6.43GB/s) 9 8.35 - RAMディスクを上回り、GpuRamDrive の
4.4倍 8 7 GB/s 6 - ホスト→VRAM のコピーが PCIe 実効帯域に張 り付いている 6.43 5.82 ・ 読み取りは 3.52GB/s - PCIe の非対称が上限(生の memcpy でも D→H 8.1 vs H→D 10.9GB/s) 5 3.52 4 ・ 4KiB ランダム読みは 36µs 3 2 1.65 1.47 1 - RAMディスク 12µs には勝てない(PCIe 往復) - GpuRamDrive は 41µs ・ GPU 上の2実装だけで比べると、VRAMDISK が全項目で上回る 0 シーケンシャル Write RAMディスク(ImDisk) シーケンシャル Read GpuRamDrive VRAMDISK 2GiB ファイル、16MiB ブロック、unbuffered、3回の最良値 環境: i9-12900K / 128GB / RTX 4070 12GB (PCIe 4.0 x16) / Windows 11 / WinFsp 2025 / ImDisk 2.1.1 / GpuRamDrive v0.4 14
評価②: GPU 上でのデータ処理 ・ データがすでに VRAM にあるので、PCIe を通さず VRAM 帯域で処理
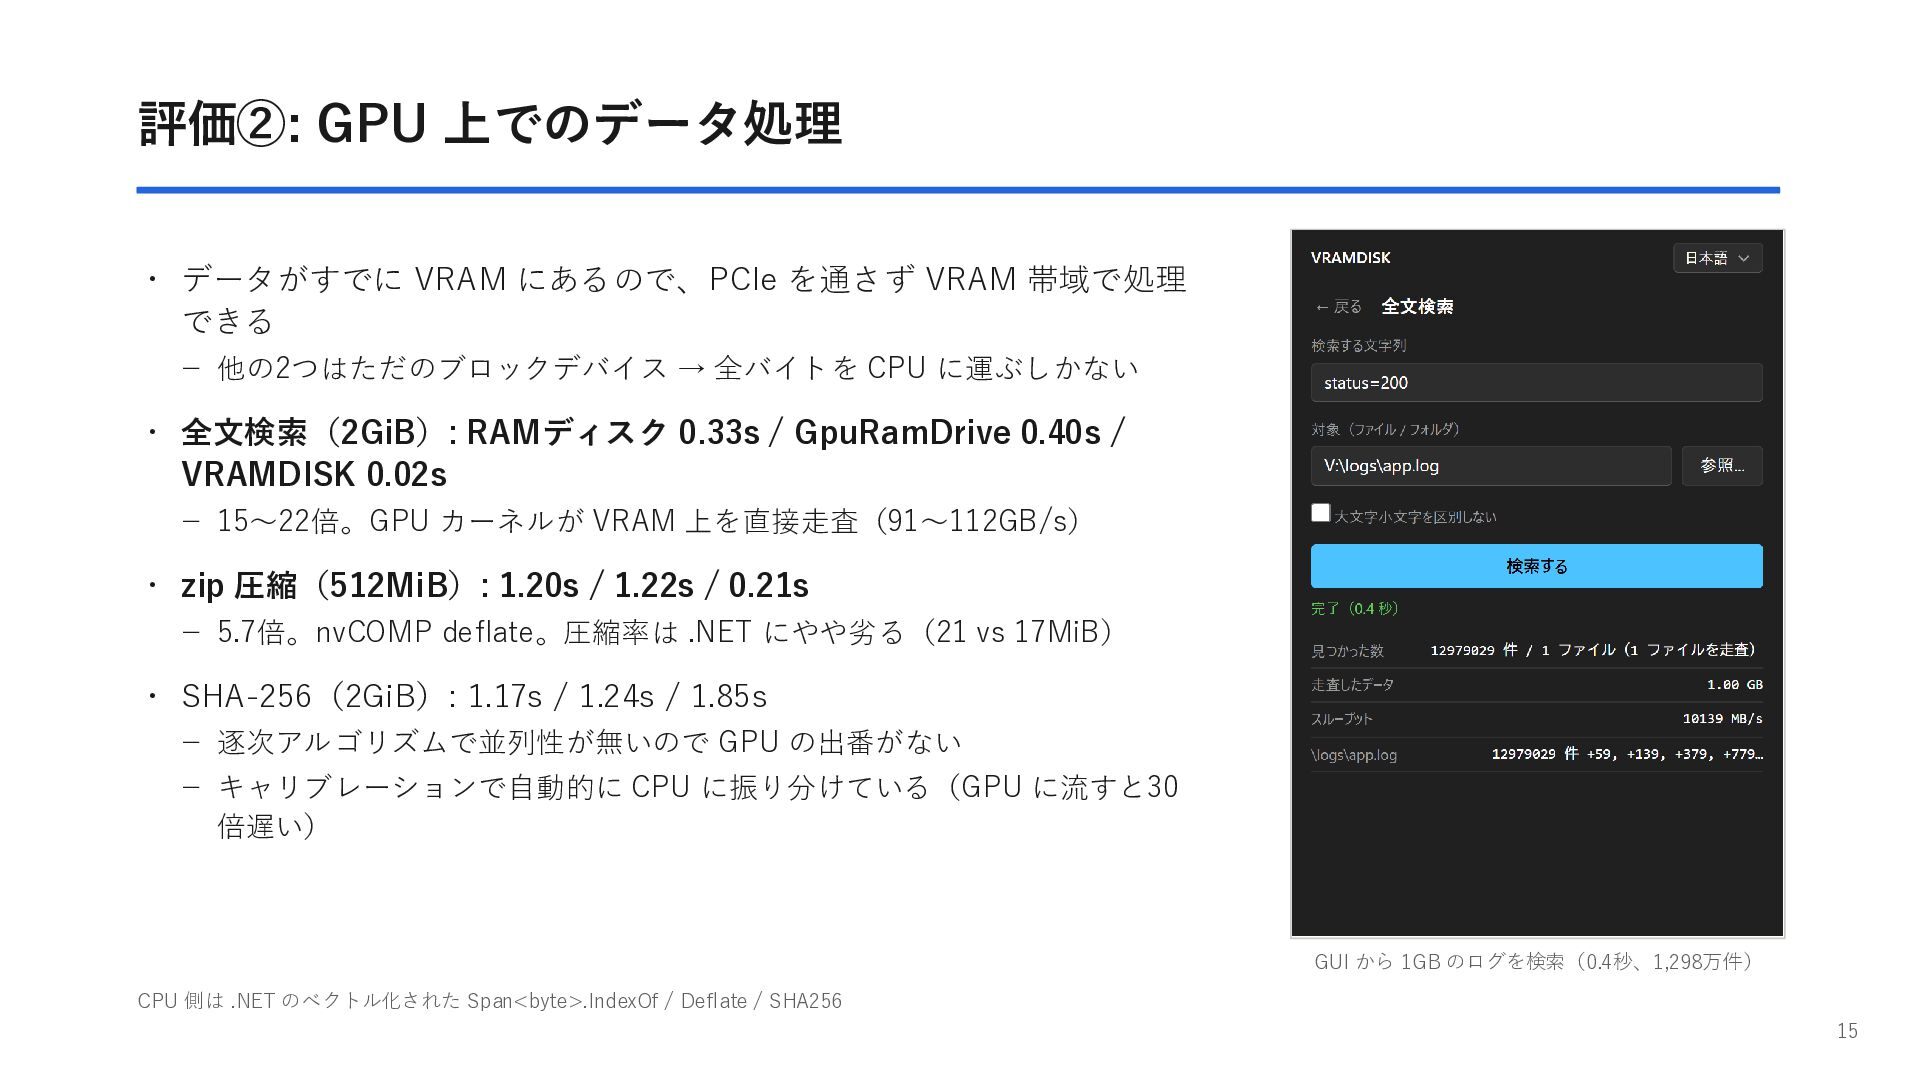
できる - 他の2つはただのブロックデバイス → 全バイトを CPU に運ぶしかない ・ 全文検索(2GiB): RAMディスク 0.33s / GpuRamDrive 0.40s / VRAMDISK 0.02s - 15〜22倍。GPU カーネルが VRAM 上を直接走査(91〜112GB/s) ・ zip 圧縮(512MiB): 1.20s / 1.22s / 0.21s - 5.7倍。nvCOMP deflate。圧縮率は .NET にやや劣る(21 vs 17MiB) ・ SHA-256(2GiB): 1.17s / 1.24s / 1.85s - 逐次アルゴリズムで並列性が無いので GPU の出番がない - キャリブレーションで自動的に CPU に振り分けている(GPU に流すと30 倍遅い) GUI から 1GB のログを検索(0.4秒、1,298万件) CPU 側は .NET のベクトル化された Span<byte>.IndexOf / Deflate / SHA256 15
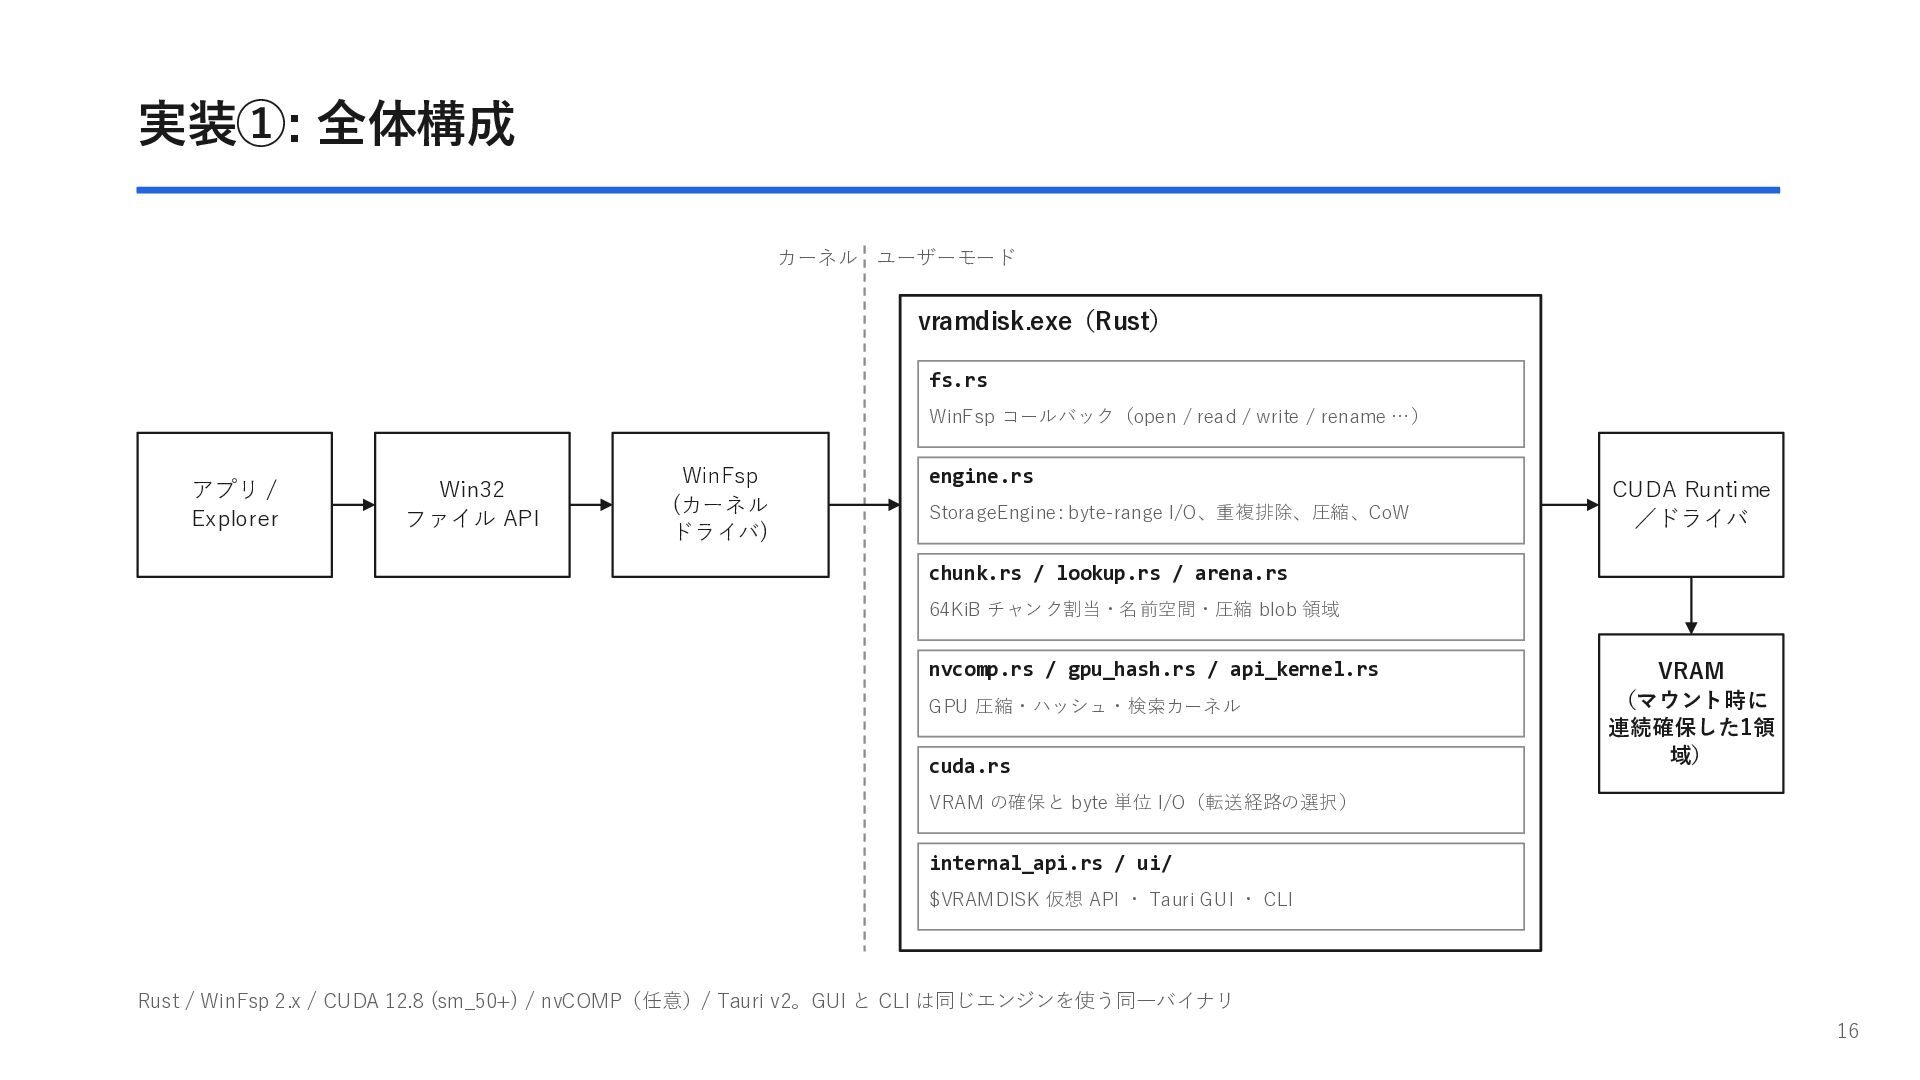
実装①: 全体構成 カーネル ユーザーモード vramdisk.exe(Rust) fs.rs WinFsp コールバック(open / read
/ write / rename …) アプリ / Explorer Win32 ファイル API WinFsp (カーネル ドライバ) engine.rs StorageEngine: byte-range I/O、重複排除、圧縮、CoW CUDA Runtime /ドライバ chunk.rs / lookup.rs / arena.rs 64KiB チャンク割当・名前空間・圧縮 blob 領域 nvcomp.rs / gpu_hash.rs / api_kernel.rs GPU 圧縮・ハッシュ・検索カーネル cuda.rs VRAM (マウント時に 連続確保した1領 域) VRAM の確保と byte 単位 I/O(転送経路の選択) internal_api.rs / ui/ $VRAMDISK 仮想 API ・ Tauri GUI ・ CLI Rust / WinFsp 2.x / CUDA 12.8 (sm_50+) / nvCOMP(任意)/ Tauri v2。GUI と CLI は同じエンジンを使う同一バイナリ 16
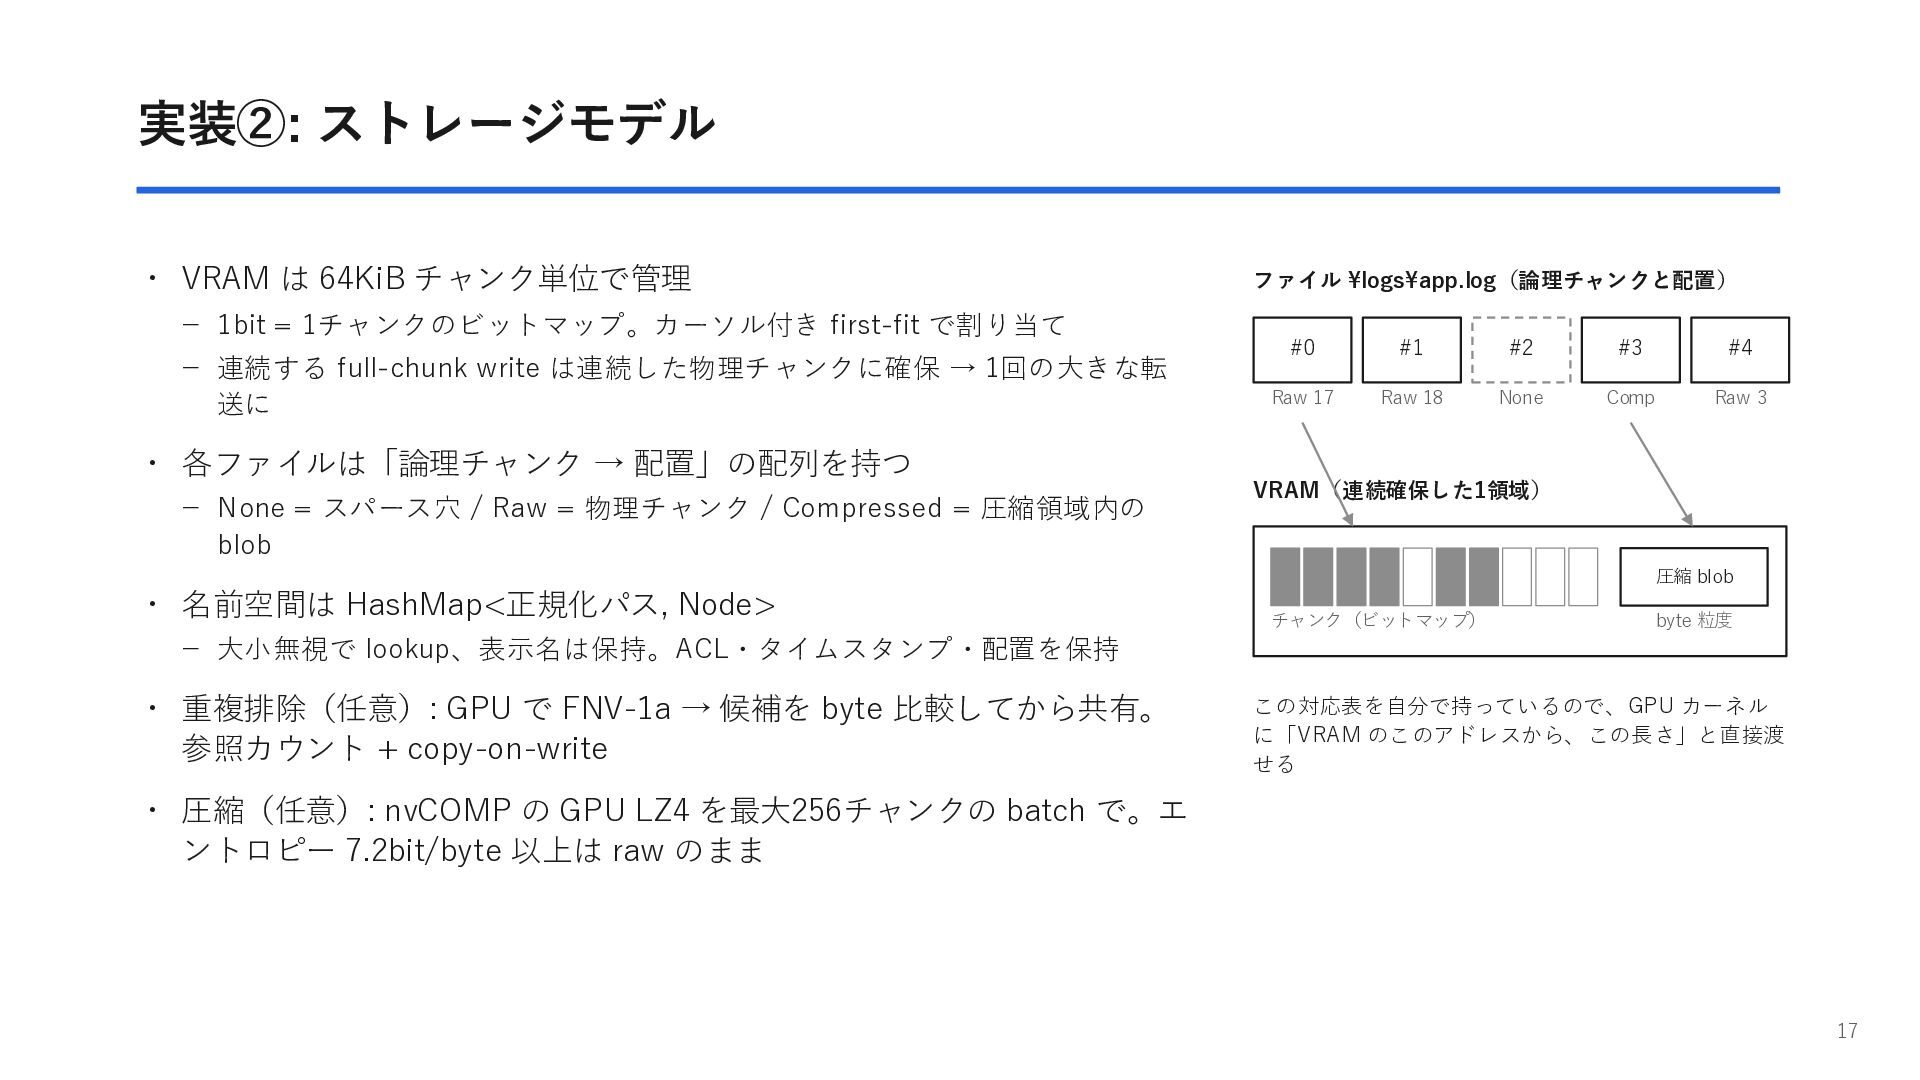
実装②: ストレージモデル ・ VRAM は 64KiB チャンク単位で管理 - 1bit =
1チャンクのビットマップ。カーソル付き first-fit で割り当て - 連続する full-chunk write は連続した物理チャンクに確保 → 1回の大きな転 送に ファイル \logs\app.log(論理チャンクと配置) #0 #1 #2 #3 #4 Raw 17 Raw 18 None Comp Raw 3 ・ 各ファイルは「論理チャンク → 配置」の配列を持つ - None = スパース穴 / Raw = 物理チャンク / Compressed = 圧縮領域内の blob VRAM(連続確保した1領域) 圧縮 blob ・ 名前空間は HashMap<正規化パス, Node> チャンク(ビットマップ) byte 粒度 - 大小無視で lookup、表示名は保持。ACL・タイムスタンプ・配置を保持 ・ 重複排除(任意): GPU で FNV-1a → 候補を byte 比較してから共有。 参照カウント + copy-on-write この対応表を自分で持っているので、GPU カーネル に「VRAM のこのアドレスから、この長さ」と直接渡 せる ・ 圧縮(任意): nvCOMP の GPU LZ4 を最大256チャンクの batch で。エ ントロピー 7.2bit/byte 以上は raw のまま 17
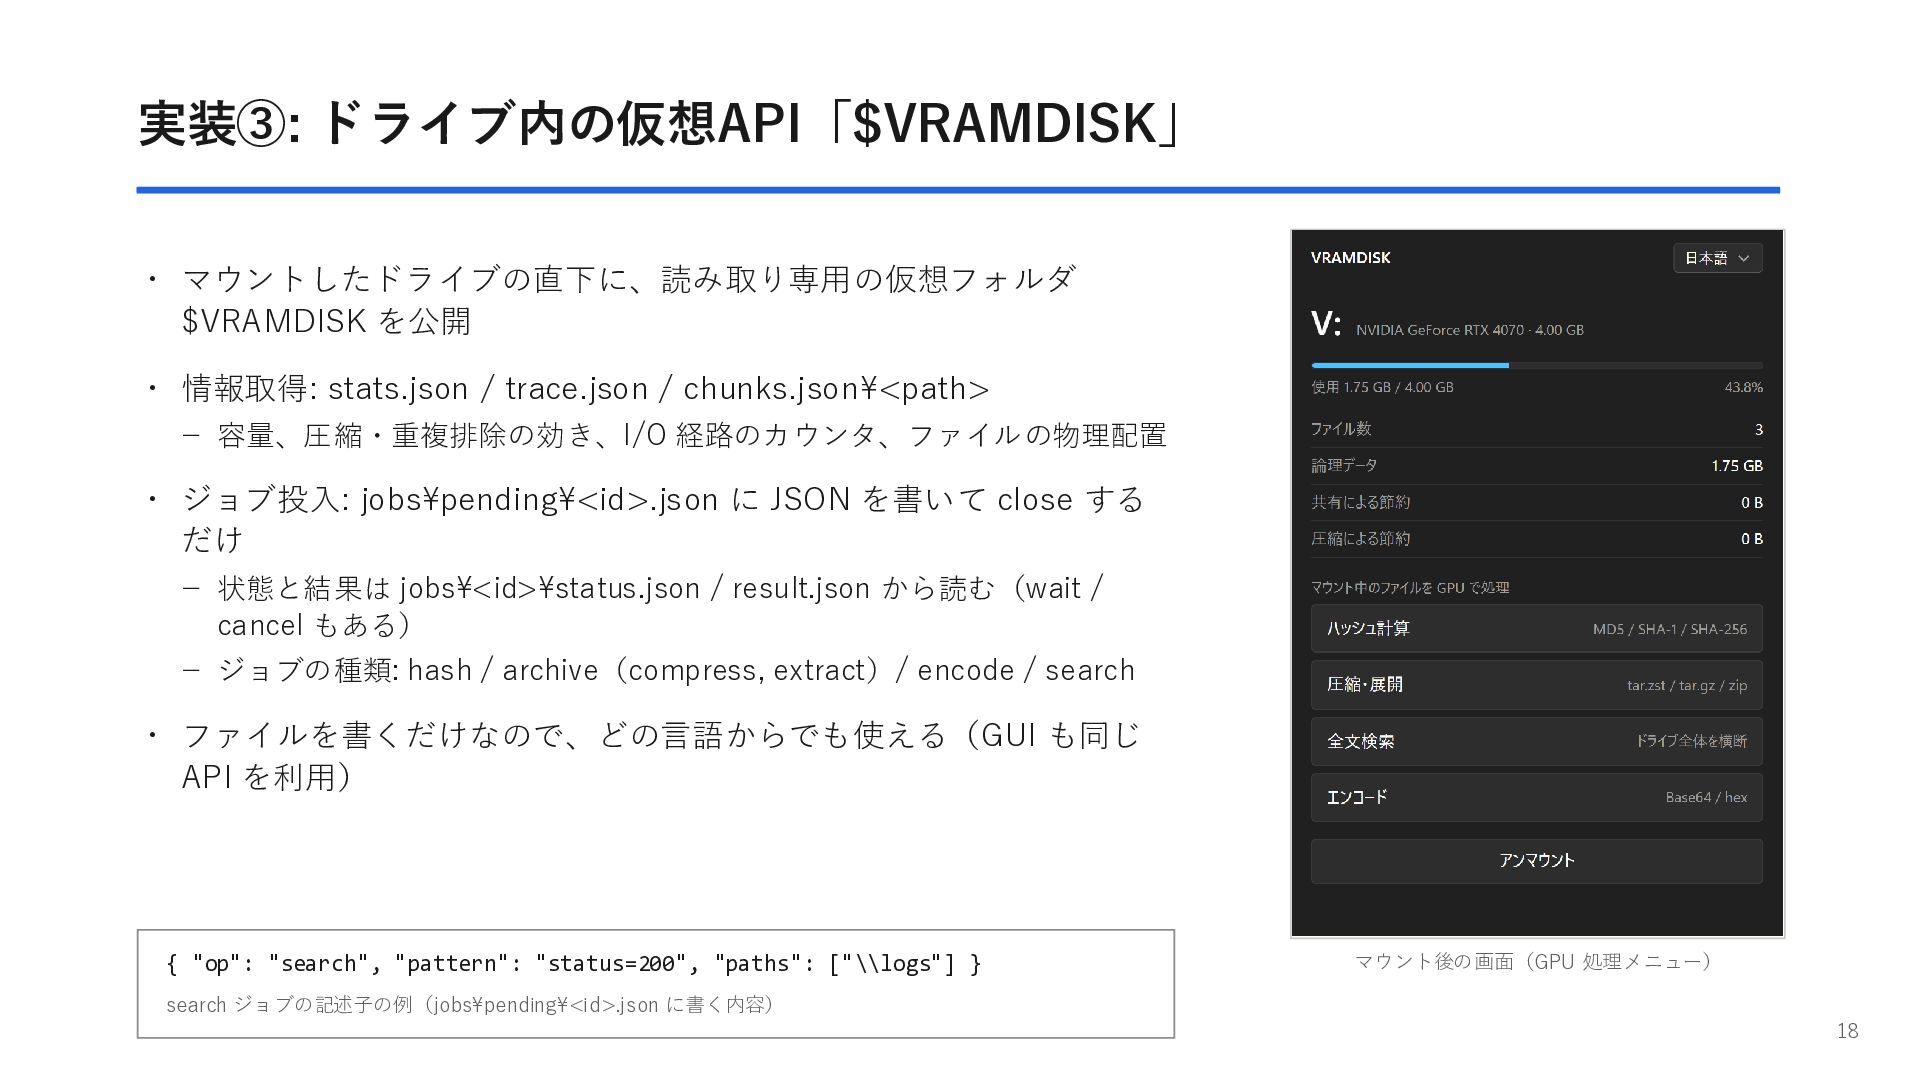
実装③: ドライブ内の仮想API「$VRAMDISK」 ・ マウントしたドライブの直下に、読み取り専用の仮想フォルダ $VRAMDISK を公開 ・ 情報取得: stats.json /
trace.json / chunks.json\<path> - 容量、圧縮・重複排除の効き、I/O 経路のカウンタ、ファイルの物理配置 ・ ジョブ投入: jobs\pending\<id>.json に JSON を書いて close する だけ - 状態と結果は jobs\<id>\status.json / result.json から読む(wait / cancel もある) - ジョブの種類: hash / archive(compress, extract)/ encode / search ・ ファイルを書くだけなので、どの言語からでも使える(GUI も同じ API を利用) { "op": "search", "pattern": "status=200", "paths": ["\\logs"] } マウント後の画面(GPU 処理メニュー) search ジョブの記述子の例(jobs\pending\<id>.json に書く内容) 18
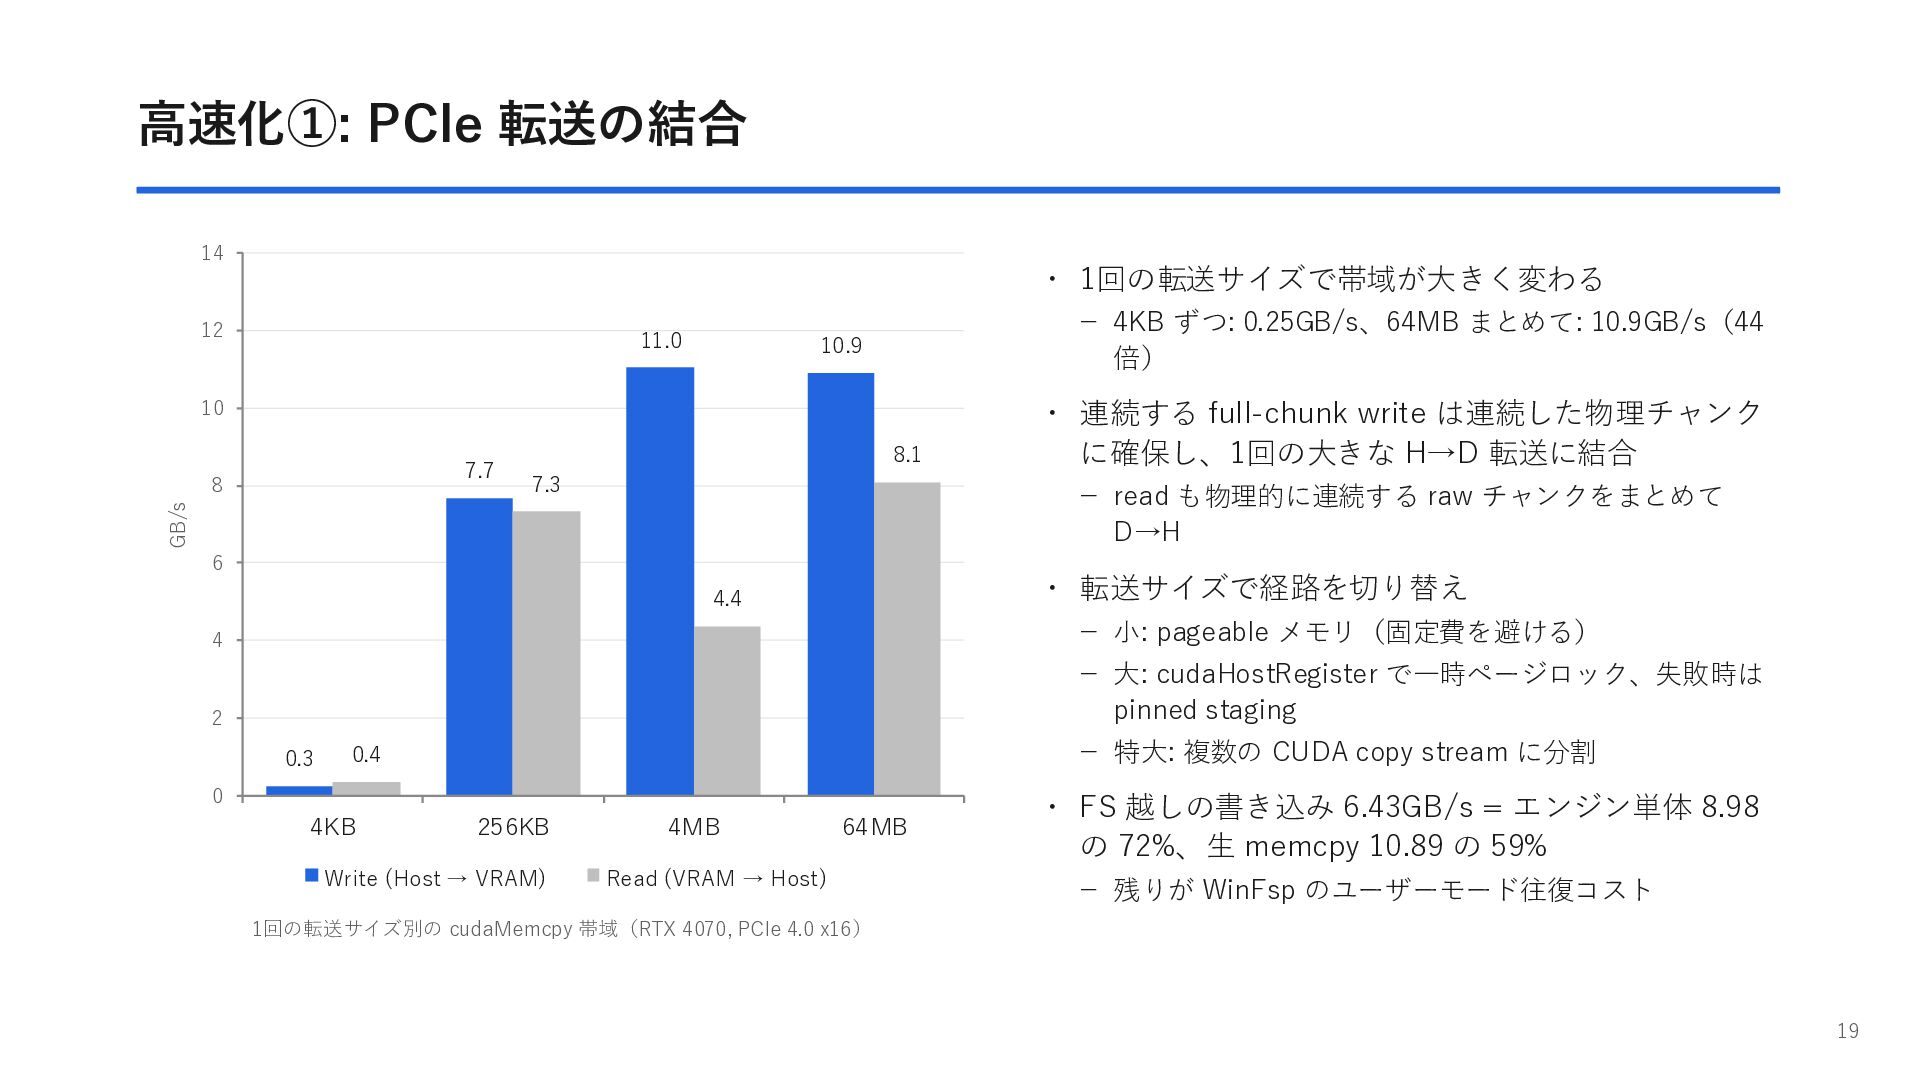
高速化①: PCIe 転送の結合 14 ・ 1回の転送サイズで帯域が大きく変わる 12 11.0 - 4KB
ずつ: 0.25GB/s、64MB まとめて: 10.9GB/s(44 倍) 10.9 10 7.7 7.3 - read も物理的に連続する raw チャンクをまとめて D→H GB/s 8 8.1 ・ 連続する full-chunk write は連続した物理チャンク に確保し、1回の大きな H→D 転送に結合 6 ・ 転送サイズで経路を切り替え 4.4 4 - 小: pageable メモリ(固定費を避ける) 2 - 大: cudaHostRegister で一時ページロック、失敗時は pinned staging 0.3 - 特大: 複数の CUDA copy stream に分割 0.4 0 4KB 256KB Write (Host → VRAM) 4MB 64MB Read (VRAM → Host) ・ FS 越しの書き込み 6.43GB/s = エンジン単体 8.98 の 72%、生 memcpy 10.89 の 59% - 残りが WinFsp のユーザーモード往復コスト 1回の転送サイズ別の cudaMemcpy 帯域(RTX 4070, PCIe 4.0 x16) 19
高速化②: WinFsp の往復とロック ・ WinFsp のコールバック1往復 ≈ 14µs。これを減らし、並行して走らせる ・ メタデータのキャッシュ
- dir_info / volume_info / security / stream_info のキャッシュが 0 だった → 5種すべて 1000ms に - security はパス解決のたびに問い合わされるので特に効く。代償は最大1秒の staleness ・ コールバックを大域直列化しない - エンジンを RwLock で保護。stat・ディレクトリ列挙・ACL・volume 情報は shared guard で並行 - raw チャンクだけの read も shared guard で並行。write と圧縮 read だけ exclusive ・ 長いジョブでボリュームを止めない - CPU hash は 32MiB 窓ごと、GPU hash は約0.1秒分の launch ごとにロックを取り直す ・ GPU カーネルの事前コンパイル - PTX は NVRTC で実行時コンパイル(約5秒)。マウント時に同期すると mount が 0.2 → 5.6秒 - プロセスに1回だけ、背景スレッドで先行コンパイル。mount は 0.23秒のまま 20
高速化③: GPU 処理 ・ 全文検索: 2.96 → 102.8GB/s - staging
コピーしてから走査 → 連続ランを in-place で走査(コピーが走査を一桁上回っていた): 88.9GB/s - 一致オフセットを毎 launch 64Ki 件転送・ソート → 呼び出し側が保持する件数だけに: 102.8GB/s - カーネルは1候補位置 = 1スレッド。pattern の先頭と末尾バイトで先に落とし、帯域律速にする ・ ボリューム内コピー(D→D): 4.2 → 176GB/s - コピー先を先に連続確保してから転送を結合(確保しないと 64KiB ごとの memcpy になる) ・ GPU ハッシュ(FNV-1a): 0.86 → 73.6GB/s - 1チャンクずつ launch → 256チャンク / launch の batch(1チャンク = 1 CUDA block) - host との転送は offset 配列と結果だけ。チャンク本体は VRAM に残る ・ SHA-256 / MD5 は逐次アルゴリズム → キャリブレーションで CPU に振り分け 21
補足: GPU ベンチマークの注意点 ・ 同じ検索が、3者比較のハーネス内では 20.3GB/s、単体計測では 103GB/s だった ・ 疑ったものを順に潰した
- チャンクの断片化 → chunks.json で確認、32,768 チャンクが常に1ラン - 上書きのブロックサイズ / 直前の書き込みとの競合 / VRAM の空き不足 → いずれも 10〜11ms で否定 ・ 連続検索の engine 時間: 95 → 90 → 90 → 34 → 11 → 11ms - 走査バイト数・物理ラン数・read_ops は全反復で同一。コード経路の差ではない ・ 原因: 検索の直前に nvidia-smi を呼ぶだけで減衰が消えた - ハーネスは直前の15分間コピーエンジンだけを使い SM を遊ばせていた → GPU が低クロックに落ちていた - 最初の数カーネルは 1/8 の速度で走る ・ GPU 処理のベンチは、時間を測らないウォームアップを入れてから測る - 修正後: 0.02s / 91〜112GB/s。初版の文書に書いた誤った説明も実測で訂正した 22
制約 ・ 揮発性: アンマウント/プロセス終了で消える - GUI はアンマウント前に ZIP 保存を提案するが、クラッシュや GPU
リセットには無力 ・ 環境限定: Windows 10/11 + NVIDIA GPU(Maxwell 以降)+ WinFsp - GPU 圧縮には nvCOMP が別途必要。AMD / Linux は非対応 ・ 読み取りが書き込みより遅い(FS 越しで Read 3.52 vs Write 6.43GB/s) - PCIe の非対称。読み中心の用途は RAM ディスクが有利 ・ 小ファイル・メタデータに弱い(create 1,774/s vs RAM ディスク 10,334/s) - 1操作ごとにユーザーモード往復。node_modules の置き場には向かない ・ 並列読みがスケールしない(8スレッドで 1.59GB/s、RAM ディスクは 8.64) - 読み手が同じ PCIe リンクを共有するため ・ VRAM をマウント時に全額確保。ゲーム・推論と取り合う - 逆に、置いたデータの分のホスト RAM は消費しない ほかに: マウント後最初の GPU ジョブだけ約5秒(NVRTC)。GUI 管理下で同時にマウントできるのは1つ 23
本当は GPUDirect Storage を使いたい! ・ GPUDirect Storage(GDS): ストレージと GPU メモリの間で直接
DMA する仕組み(cuFile API) - ホストメモリを経由せず、CPU の関与なしでデータが GPU に届く ・ VRAMDISK の律速は「Win32 のファイル API のバッファがホスト側にある」こと - どのアプリから読み書きしても、必ず PCIe を往復する(読み 3.5 / 書き 6.4 GB/s の壁) ・ GDS 相当の経路があれば - CUDA アプリが VRAMDISK 上のファイルを、自分の GPU バッファへ直接 read / write できる(D→D、PCIe を通らな い) - NVMe → VRAMDISK への大きなデータの取り込みも、ホストを経由せずに DMA できる ・ しかし Windows では使えない - GDS は Linux 専用。カーネルモジュール nvidia-fs.ko と対応ファイルシステム(ext4 / xfs + O_DIRECT、NVMe、 Lustre など)が前提 - 対象 GPU も Quadro / Data Center 系のみ。GeForce は対象外 - Windows の DirectStorage は目的が逆(ストレージ → 自アプリの GPU バッファ)で、VRAM を他のアプリに公開す る用途には使えない ・ → 現状の Windows / WinFsp 構成では PCIe 往復が上限。次のスライドで「もし D→D で完結したら」を測 ってみた 24
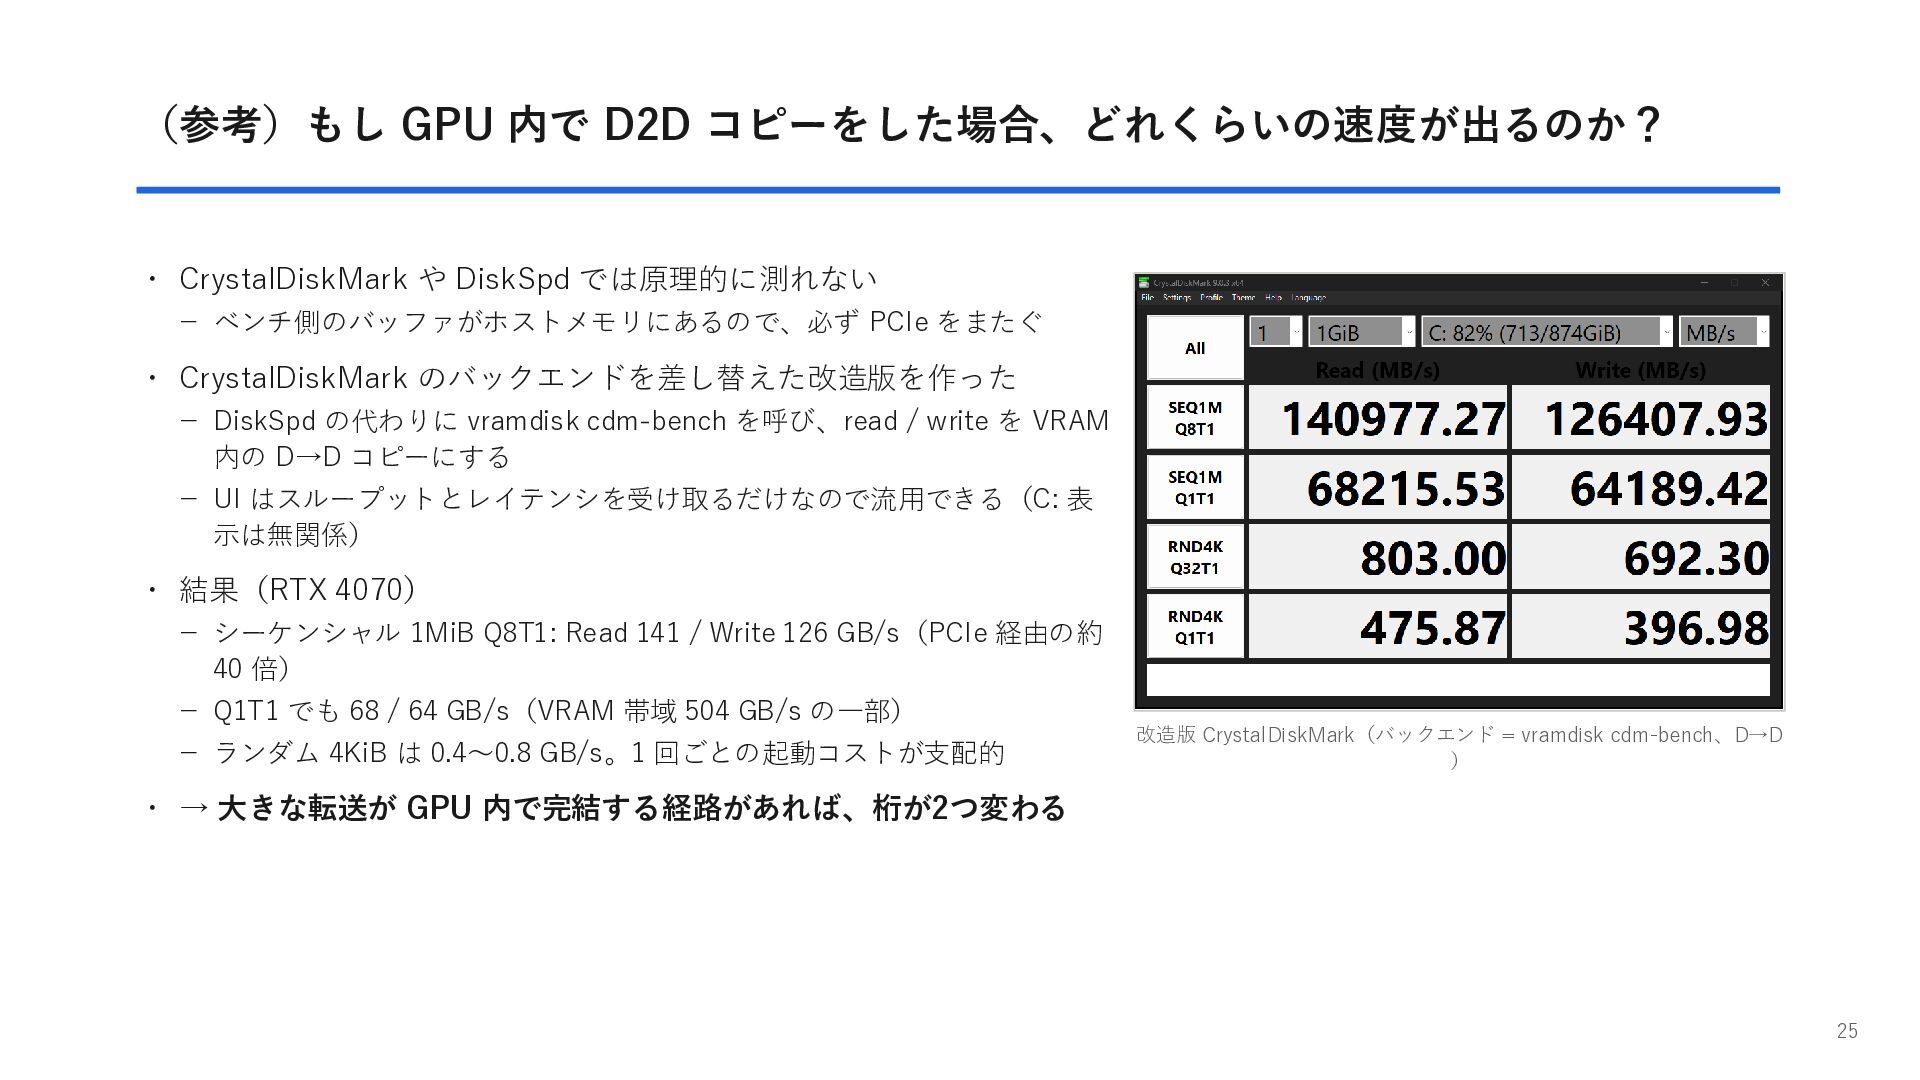
(参考)もし GPU 内で D2D コピーをした場合、どれくらいの速度が出るのか? ・ CrystalDiskMark や DiskSpd では原理的に測れない
- ベンチ側のバッファがホストメモリにあるので、必ず PCIe をまたぐ ・ CrystalDiskMark のバックエンドを差し替えた改造版を作った - DiskSpd の代わりに vramdisk cdm-bench を呼び、read / write を VRAM 内の D→D コピーにする - UI はスループットとレイテンシを受け取るだけなので流用できる(C: 表 示は無関係) ・ 結果(RTX 4070) - シーケンシャル 1MiB Q8T1: Read 141 / Write 126 GB/s(PCIe 経由の約 40 倍) - Q1T1 でも 68 / 64 GB/s(VRAM 帯域 504 GB/s の一部) - ランダム 4KiB は 0.4〜0.8 GB/s。1 回ごとの起動コストが支配的 改造版 CrystalDiskMark(バックエンド = vramdisk cdm-bench、D→D ) ・ → 大きな転送が GPU 内で完結する経路があれば、桁が2つ変わる 25
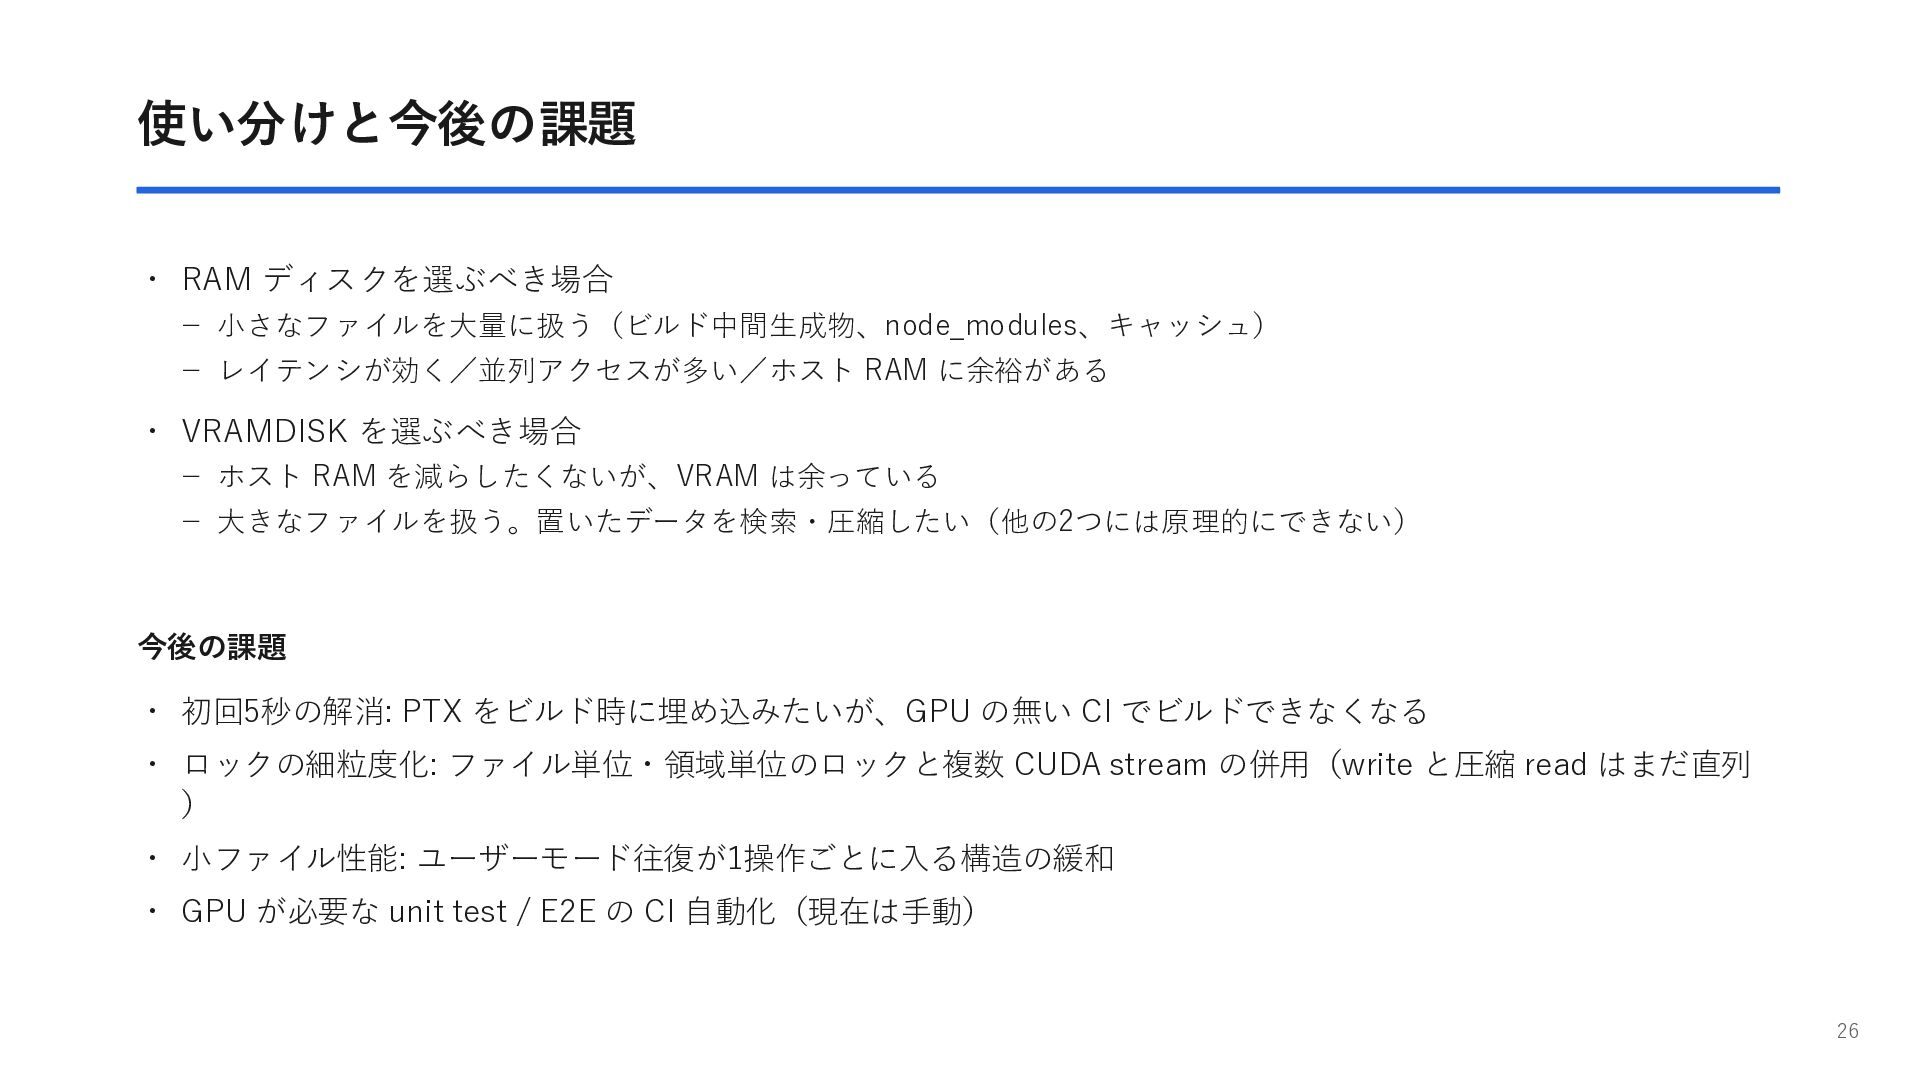
使い分けと今後の課題 ・ RAM ディスクを選ぶべき場合 - 小さなファイルを大量に扱う(ビルド中間生成物、node_modules、キャッシュ) - レイテンシが効く/並列アクセスが多い/ホスト RAM に余裕がある
・ VRAMDISK を選ぶべき場合 - ホスト RAM を減らしたくないが、VRAM は余っている - 大きなファイルを扱う。置いたデータを検索・圧縮したい(他の2つには原理的にできない) 今後の課題 ・ 初回5秒の解消: PTX をビルド時に埋め込みたいが、GPU の無い CI でビルドできなくなる ・ ロックの細粒度化: ファイル単位・領域単位のロックと複数 CUDA stream の併用(write と圧縮 read はまだ直列 ) ・ 小ファイル性能: ユーザーモード往復が1操作ごとに入る構造の緩和 ・ GPU が必要な unit test / E2E の CI 自動化(現在は手動) 26
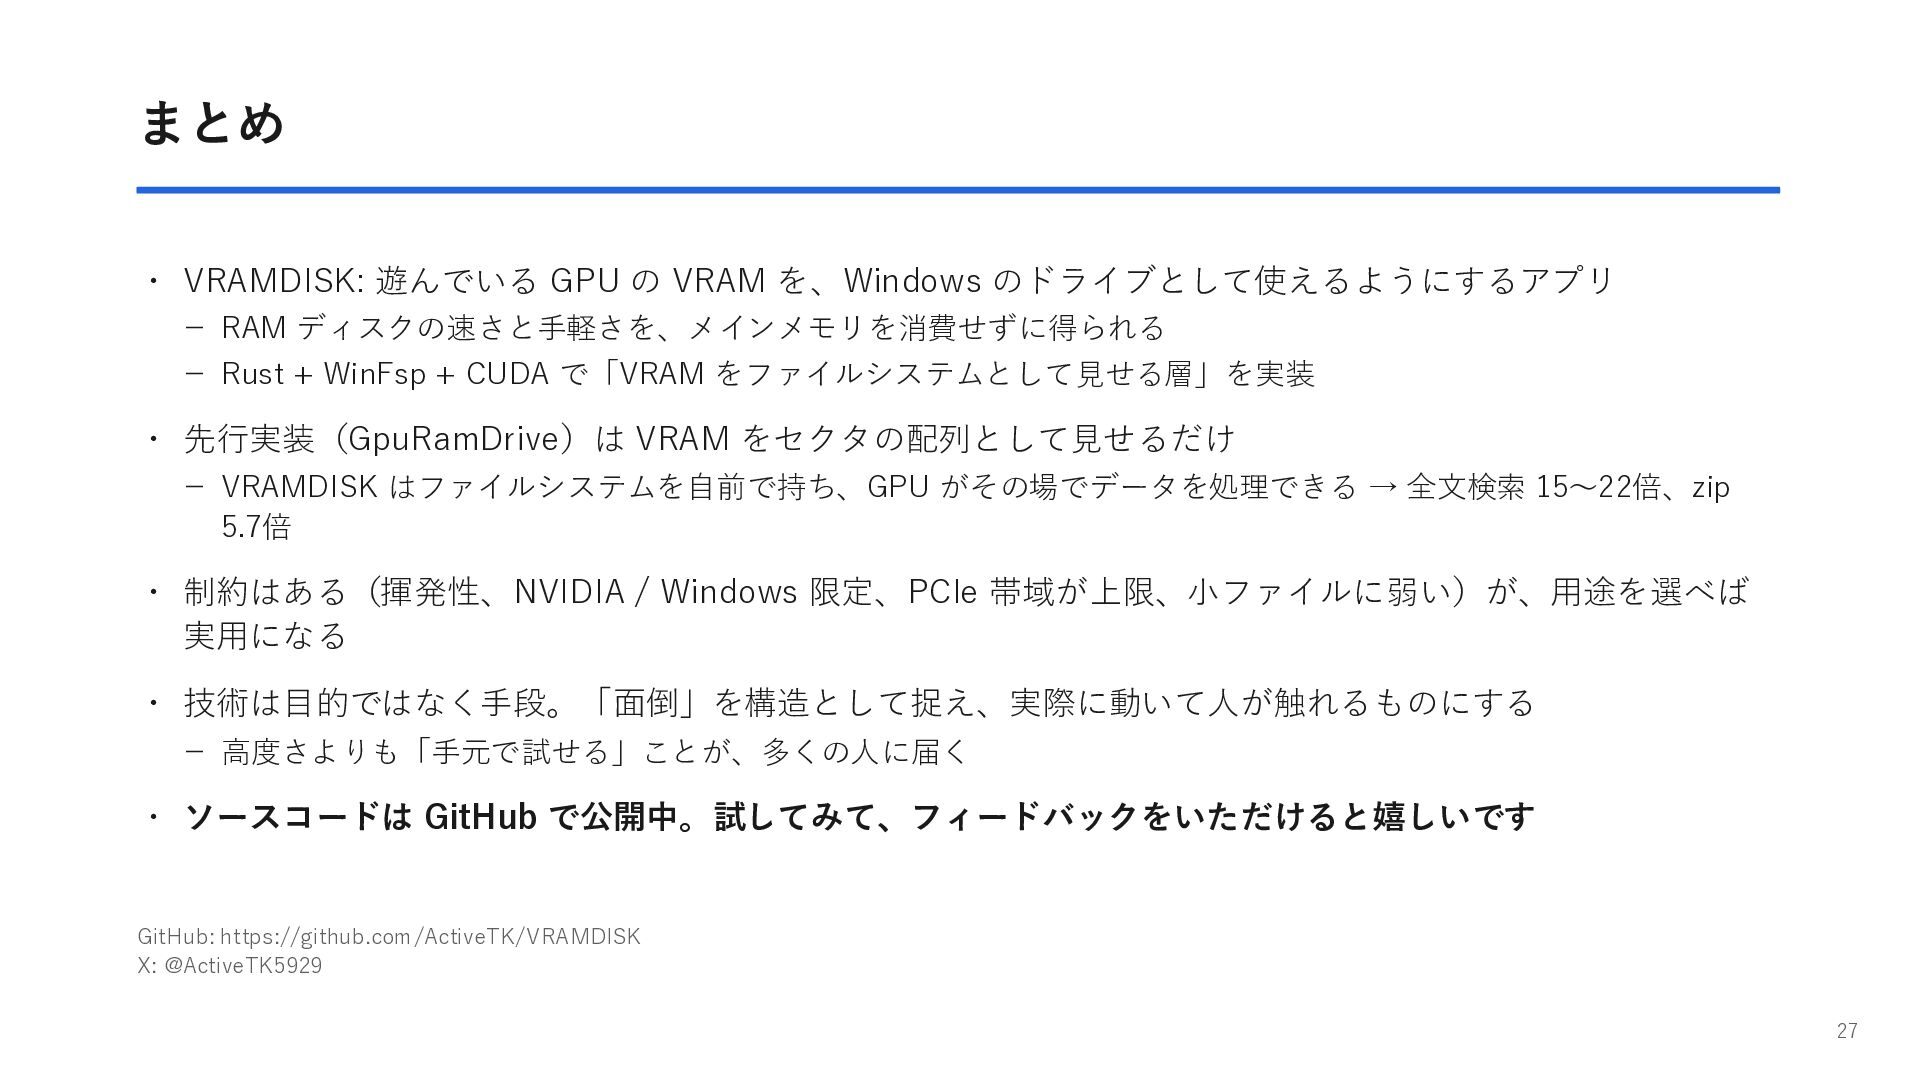
まとめ ・ VRAMDISK: 遊んでいる GPU の VRAM を、Windows のドライブとして使えるようにするアプリ -
RAM ディスクの速さと手軽さを、メインメモリを消費せずに得られる - Rust + WinFsp + CUDA で「VRAM をファイルシステムとして見せる層」を実装 ・ 先行実装(GpuRamDrive)は VRAM をセクタの配列として見せるだけ - VRAMDISK はファイルシステムを自前で持ち、GPU がその場でデータを処理できる → 全文検索 15〜22倍、zip 5.7倍 ・ 制約はある(揮発性、NVIDIA / Windows 限定、PCIe 帯域が上限、小ファイルに弱い)が、用途を選べば 実用になる ・ 技術は目的ではなく手段。「面倒」を構造として捉え、実際に動いて人が触れるものにする - 高度さよりも「手元で試せる」ことが、多くの人に届く ・ ソースコードは GitHub で公開中。試してみて、フィードバックをいただけると嬉しいです GitHub: https://github.com/ActiveTK/VRAMDISK X: @ActiveTK5929 27


 activetk
 uxyall
 lara
 rkaga
 vanstee
 honzajavorek
 oripsolob
 marketingsoph
 sugarenia
 swwweet
 davidcarrasco
 cassininazir