Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【AWS AIF対策】ML開発の流れと評価指標
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
赤神青空
PRO
September 24, 2026
Programming
16
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【AWS AIF対策】ML開発の流れと評価指標
赤神青空
PRO
September 24, 2026
More Decks by 赤神青空
See All by 赤神青空
【AWS AIF対策】生成AIの基本用語
akagami
PRO
0
11
【AWS AIF対策】AWSのAIサービスの使い分け
akagami
PRO
0
22
【AWS AIF対策】推論の種類とMLの使いどころ
akagami
PRO
0
23
【AWS AIF対策】AI・ML・生成AIの関係を整理する
akagami
PRO
0
19
【情報整理用】ハッカソンの是非論を整理する
akagami
PRO
0
28
【AWSのログ周りを整理する】第6回 選び方 ── 結局ど う決めるのか
akagami
PRO
0
22
【AWSのログ周りを整理する】第5回 調べる ── 貯めたログに問い合わせる
akagami
PRO
0
23
【AWSのログ周りを整理する】第4回 貯める ── コストの大半はここで 決まる
akagami
PRO
0
22
【AWSのログ周りを整理する】第3回 運ぶ ── 発生源と置き場のあいだ
akagami
PRO
0
21
Other Decks in Programming
See All in Programming
Security issues being discussed on Web Platforms
petamoriken
0
1.2k
手動確認はもう限界 〜XCUITestでCustom URL Schemeの遷移を起動種別ごとに自動テストする〜 / Testing Custom URL Schemes with XCUITest
otouto
0
330
AgentCore CLI で進化した AWS での AI エージェントの作り方 : 必要な機能を必要な時に
icoxfog417
PRO
3
370
thread_parallel_with_free-threaded_Python_and_NumPy.pdf
riku_sakamoto
0
350
iOS 27でニュースアプリはどう変わる!? 〜日経電子版の新機能対応と、開発事例から〜
lynnswap
1
12k
スマート反転とウェブアクセシビリティ
camiha
0
210
App Intentsのビルドプロセスを支える技術
kntkymt
0
430
動作中のプログラムの中身をリアルタイムに覗く / Realtime Debugger for CSharp with Roslyn
prota
1
1k
速習iPhone Duo対応
yuukiw00w
1
710
世界の中心で、AI(App Intents)をさけぶ ー App Intents中心設計の実践ガイド
touyou
0
650
ゲームコントローラやキーボードのファームウェアをSwiftで書く
kishikawakatsumi
1
250
市販E-Readerを乗っ取れ 〜Embedded Swiftで電子ペーパーガジェットを制御する〜
trickart
0
200
Featured
See All Featured
Fireside Chat
paigeccino
43
4k
The Curious Case for Waylosing
cassininazir
1
520
The Invisible Side of Design
smashingmag
301
52k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Deep Space Network (abreviated)
tonyrice
0
320
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Unsuck your backbone
ammeep
672
58k
BBQ
matthewcrist
89
10k
Paper Plane (Part 1)
katiecoart
PRO
2
11k
Practical Orchestrator
shlominoach
192
12k
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
Transcript
2026年9月 ML開発の流れと評価指標 AWS Certified AI Practitioner 対策 #4 赤神青空
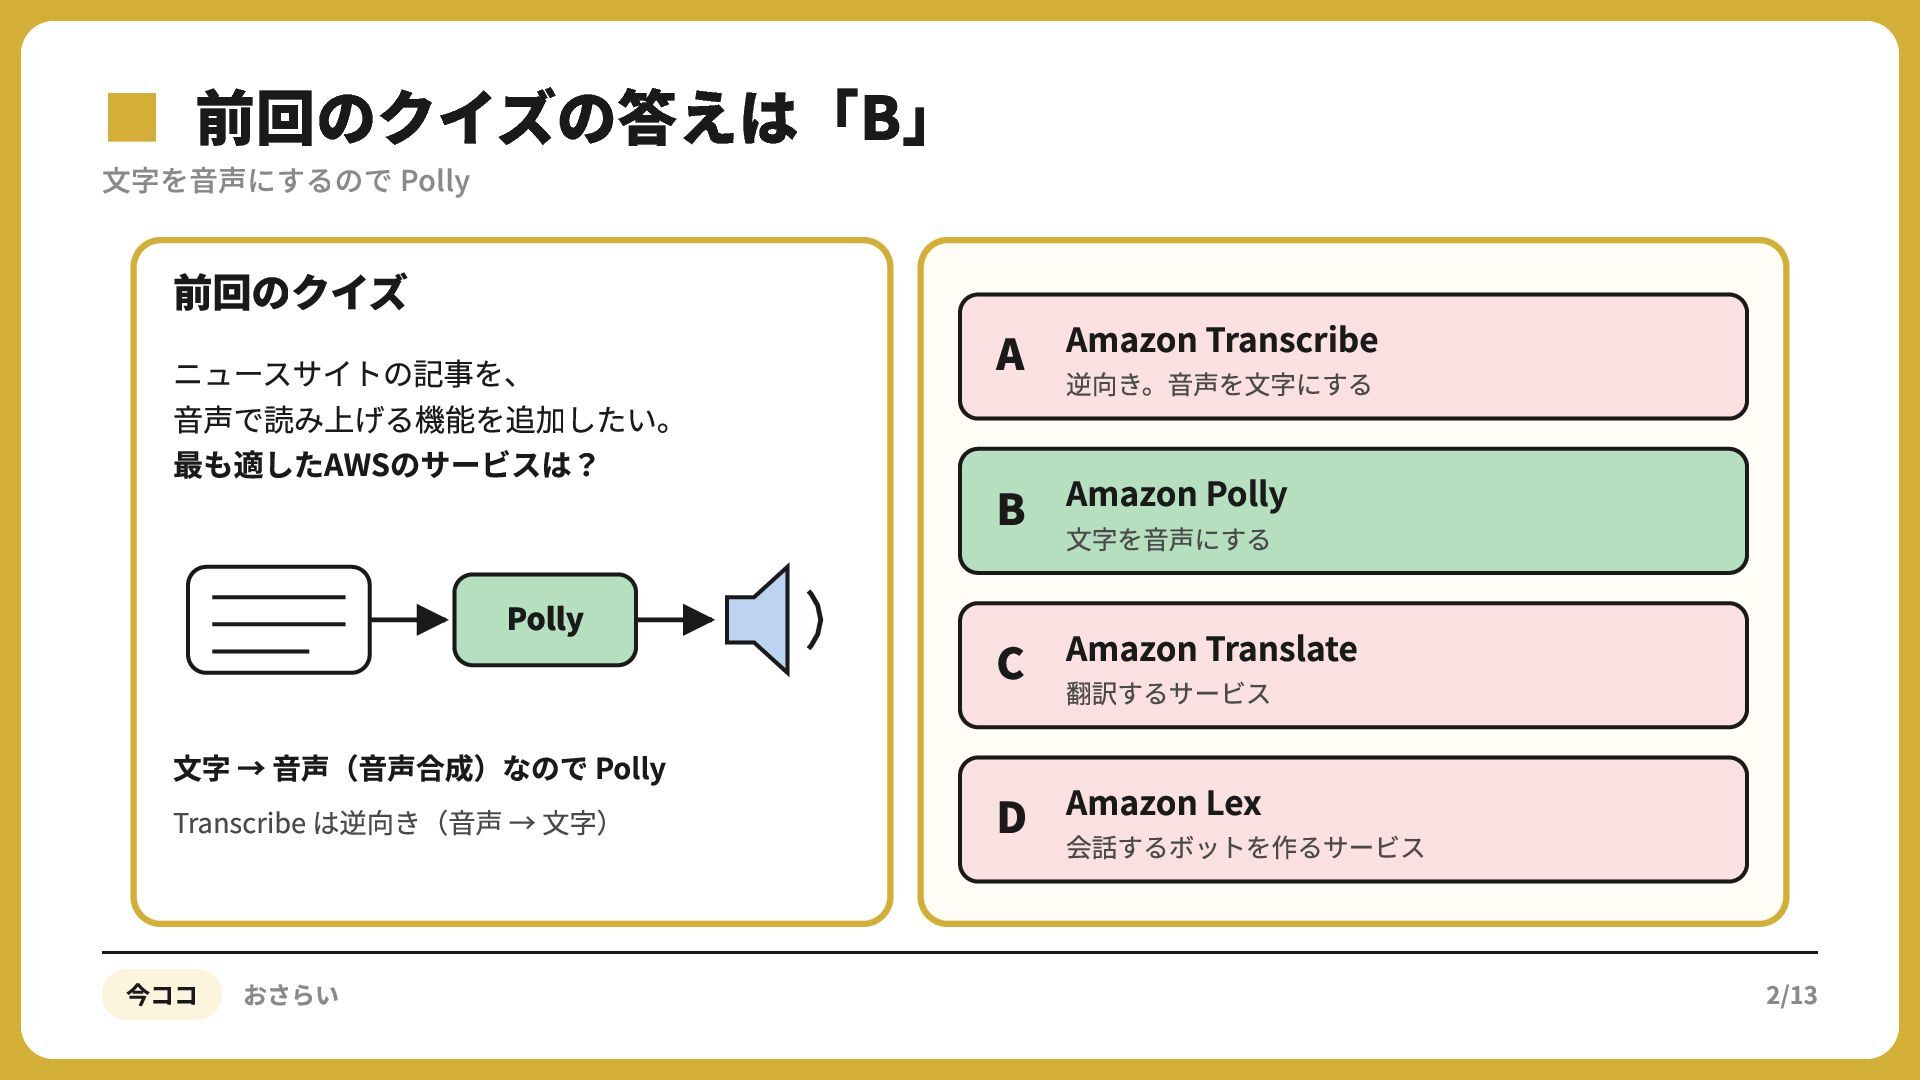
▪文字を音声にするので 前回のクイズの答えは「B」 Polly 前回のクイズ ニュースサイトの記事を、 ⾳声で読み上げる機能を追加したい。 最も適したAWSのサービスは? Polly ⽂字 →
⾳声(⾳声合成)なので Polly Transcribe は逆向き(⾳声 → ⽂字) 今ココ おさらい Transcribe A Amazon 逆向き。⾳声を⽂字にする Polly B Amazon ⽂字を⾳声にする Translate C Amazon 翻訳するサービス Lex D Amazon 会話するボットを作るサービス 2/13
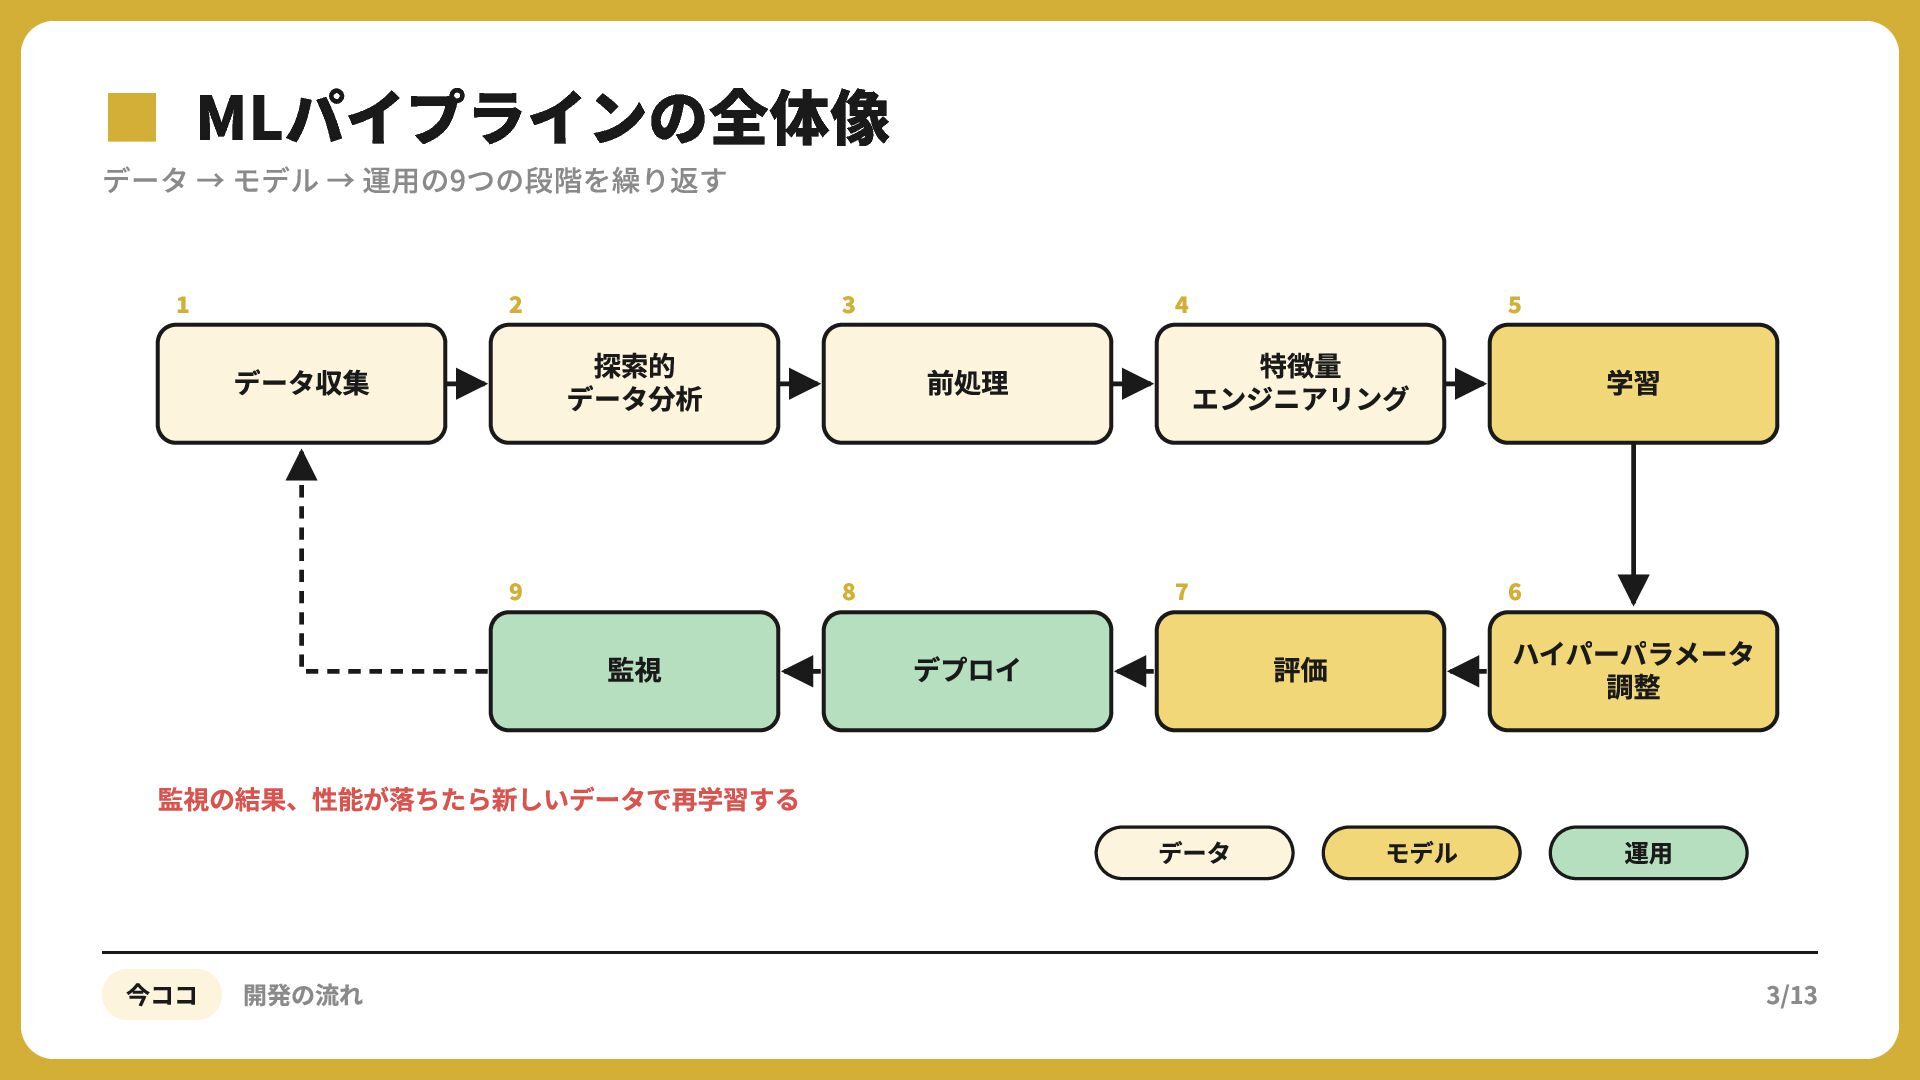
▪データ MLパイプラインの全体像 → モデル → 運用の9つの段階を繰り返す データ収集 探索的 データ分析 前処理
特徴量 エンジニアリング 学習 監視 デプロイ 評価 ハイパーパラメータ 調整 監視の結果、性能が落ちたら新しいデータで再学習する 今ココ 開発の流れ データ モデル 運⽤ 3/13
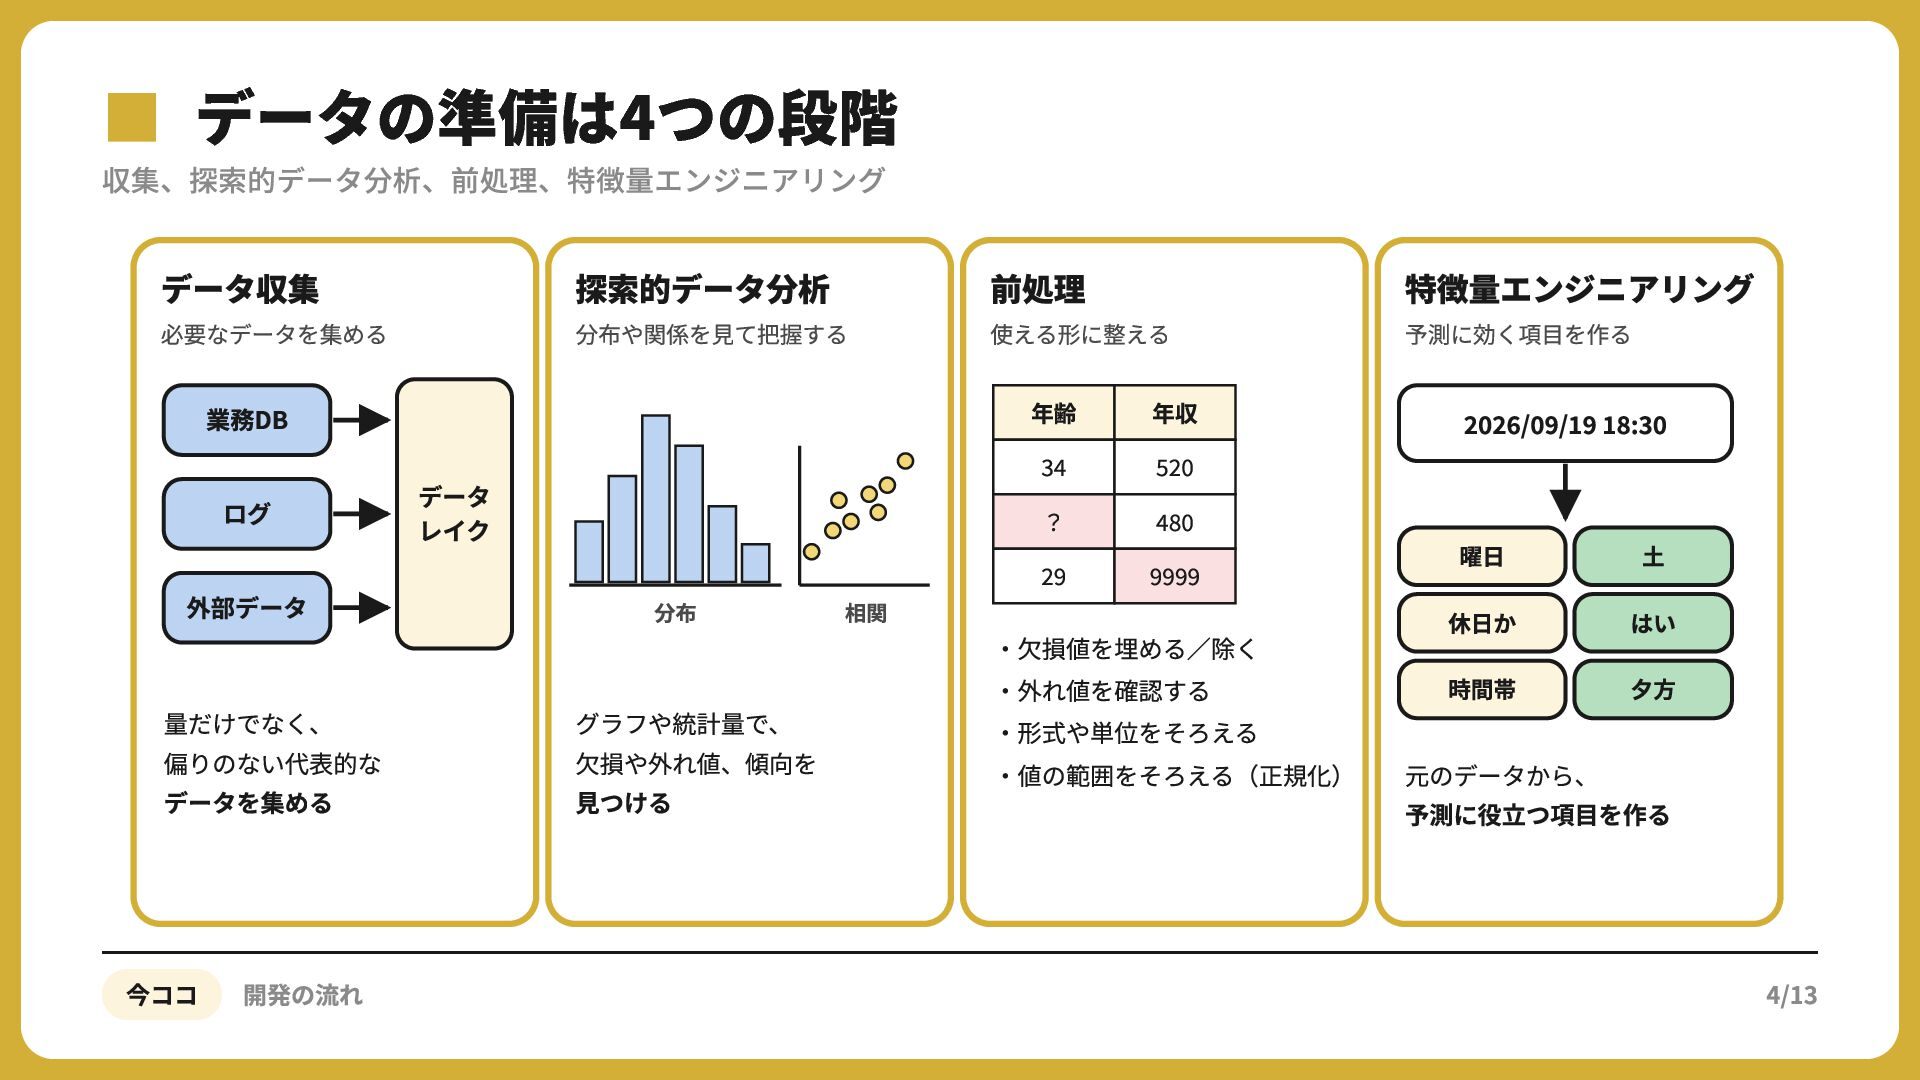
▪収集、探索的データ分析、前処理、特徴量エンジニアリング データの準備は4つの段階 データ収集 探索的データ分析 必要なデータを集める 分布や関係を⾒て把握する データ レイク 分布 量だけでなく、
偏りのない代表的な データを集める グラフや統計量で、 ⽋損や外れ値、傾向を ⾒つける 相関 特徴量エンジニアリング 予測に効く項⽬を作る 年収 ? 外部データ 今ココ 開発の流れ 使える形に整える 年齢 業務DB ログ 前処理 ‧⽋損値を埋める∕除く ‧外れ値を確認する ‧形式や単位をそろえる ‧値の範囲をそろえる(正規化) / / 曜⽇ 休⽇か 時間帯 : ⼟ はい ⼣⽅ 元のデータから、 予測に役⽴つ項⽬を作る 4/13
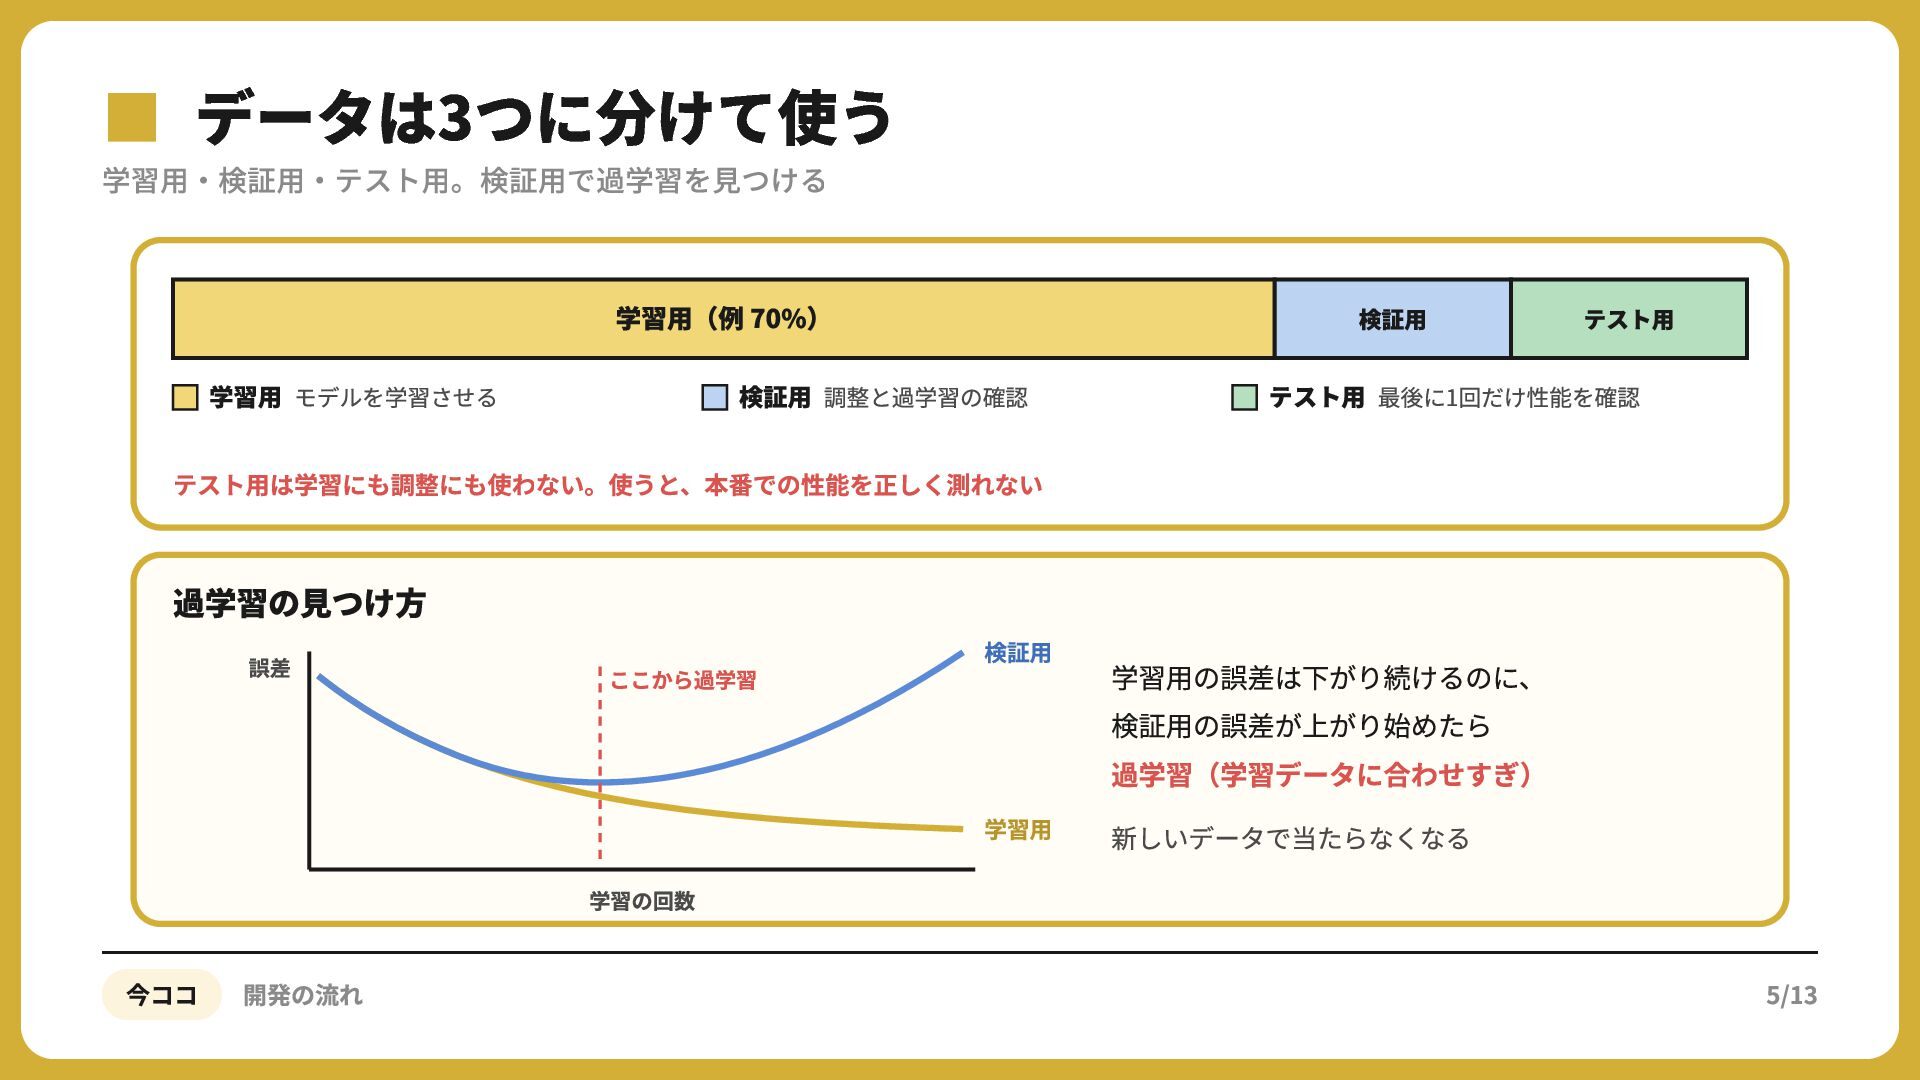
▪学習用・検証用・テスト用。検証用で過学習を見つける データは3つに分けて使う 学習⽤(例 70%) 学習⽤ モデルを学習させる 検証⽤ 検証⽤ 調整と過学習の確認 テスト⽤
テスト⽤ 最後に1回だけ性能を確認 テスト⽤は学習にも調整にも使わない。使うと、本番での性能を正しく測れない 過学習の⾒つけ⽅ 誤差 ここから過学習 検証⽤ 学習⽤ 学習⽤の誤差は下がり続けるのに、 検証⽤の誤差が上がり始めたら 過学習(学習データに合わせすぎ) 新しいデータで当たらなくなる 学習の回数 今ココ 開発の流れ 5/13
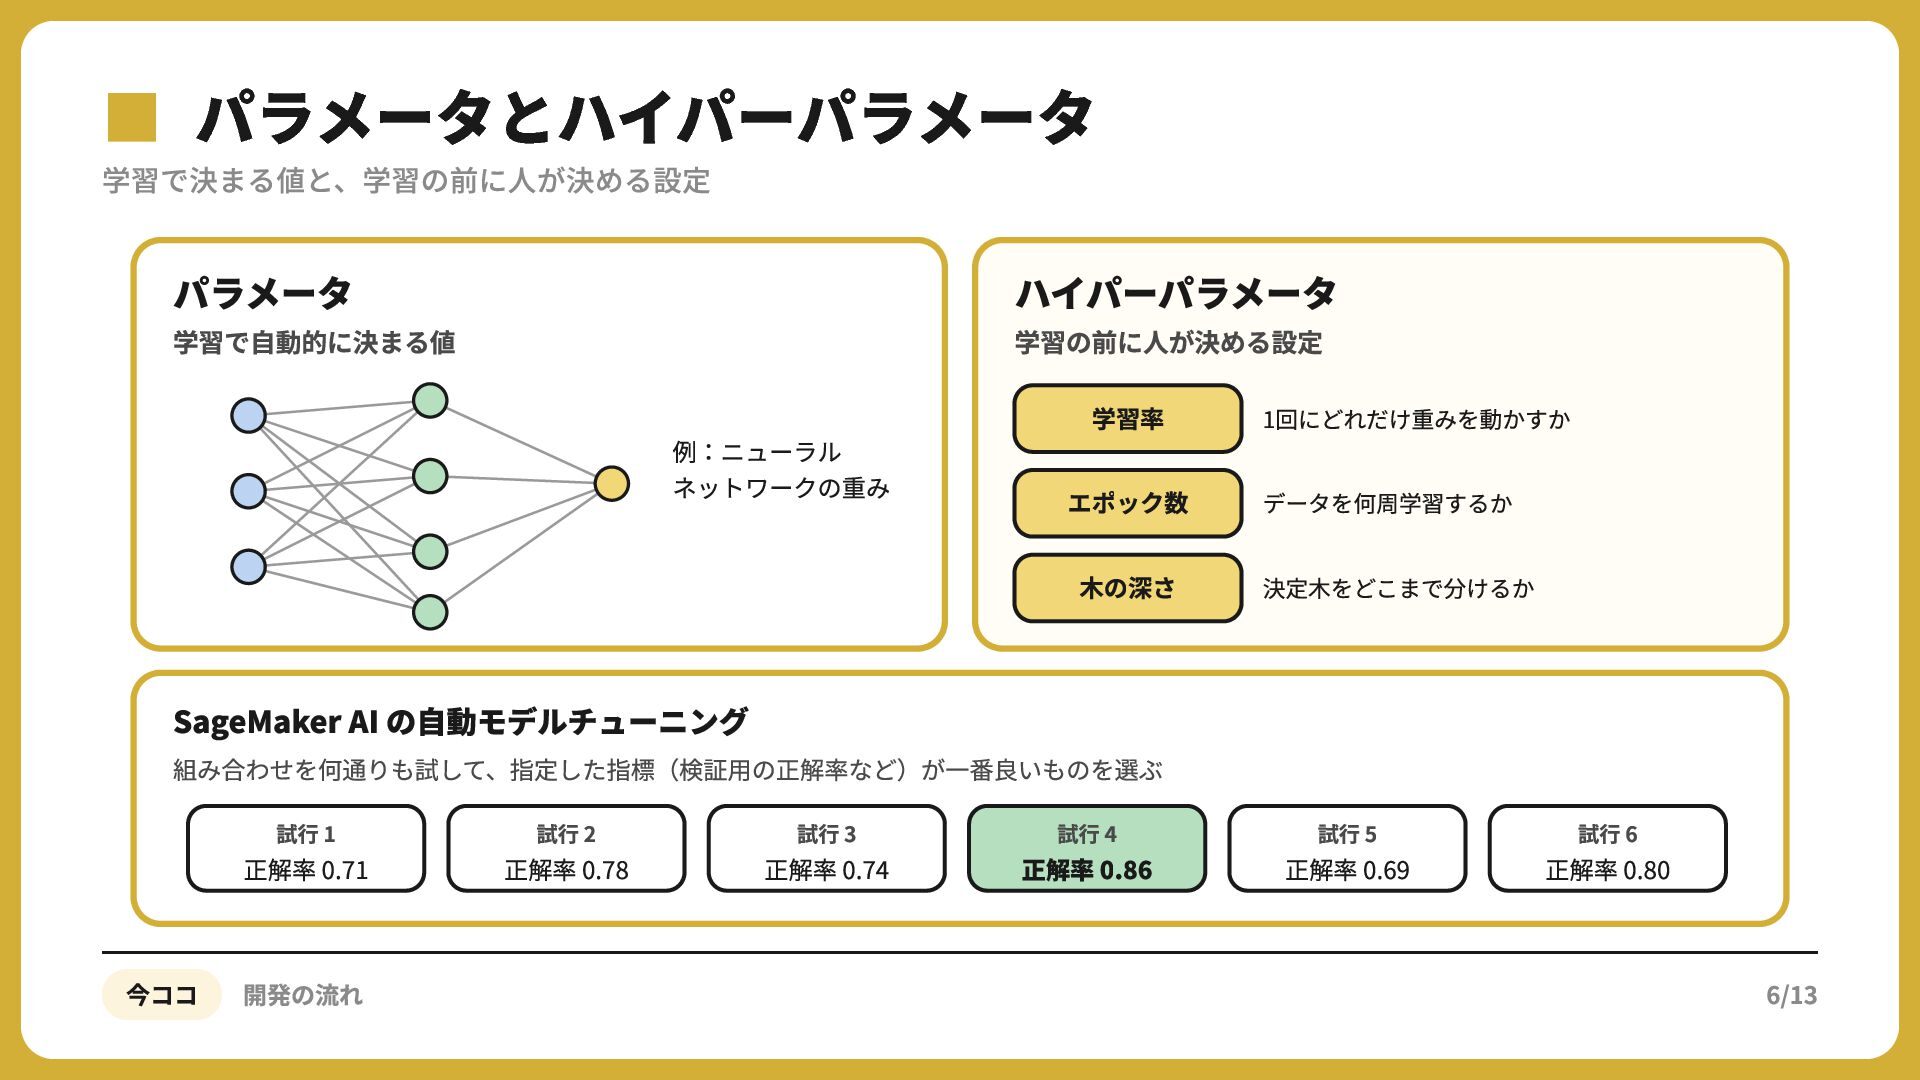
▪学習で決まる値と、学習の前に人が決める設定 パラメータとハイパーパラメータ パラメータ ハイパーパラメータ 学習で⾃動的に決まる値 学習の前に⼈が決める設定 例:ニューラル ネットワークの重み 学習率 1回にどれだけ重みを動かすか
エポック数 データを何周学習するか ⽊の深さ 決定⽊をどこまで分けるか SageMaker AI の⾃動モデルチューニング 組み合わせを何通りも試して、指定した指標(検証⽤の正解率など)が⼀番良いものを選ぶ 試⾏ 1 正解率 0.71 今ココ 開発の流れ 試⾏ 2 正解率 0.78 試⾏ 3 正解率 0.74 試⾏ 4 正解率 0.86 試⾏ 5 正解率 0.69 試⾏ 6 正解率 0.80 6/13
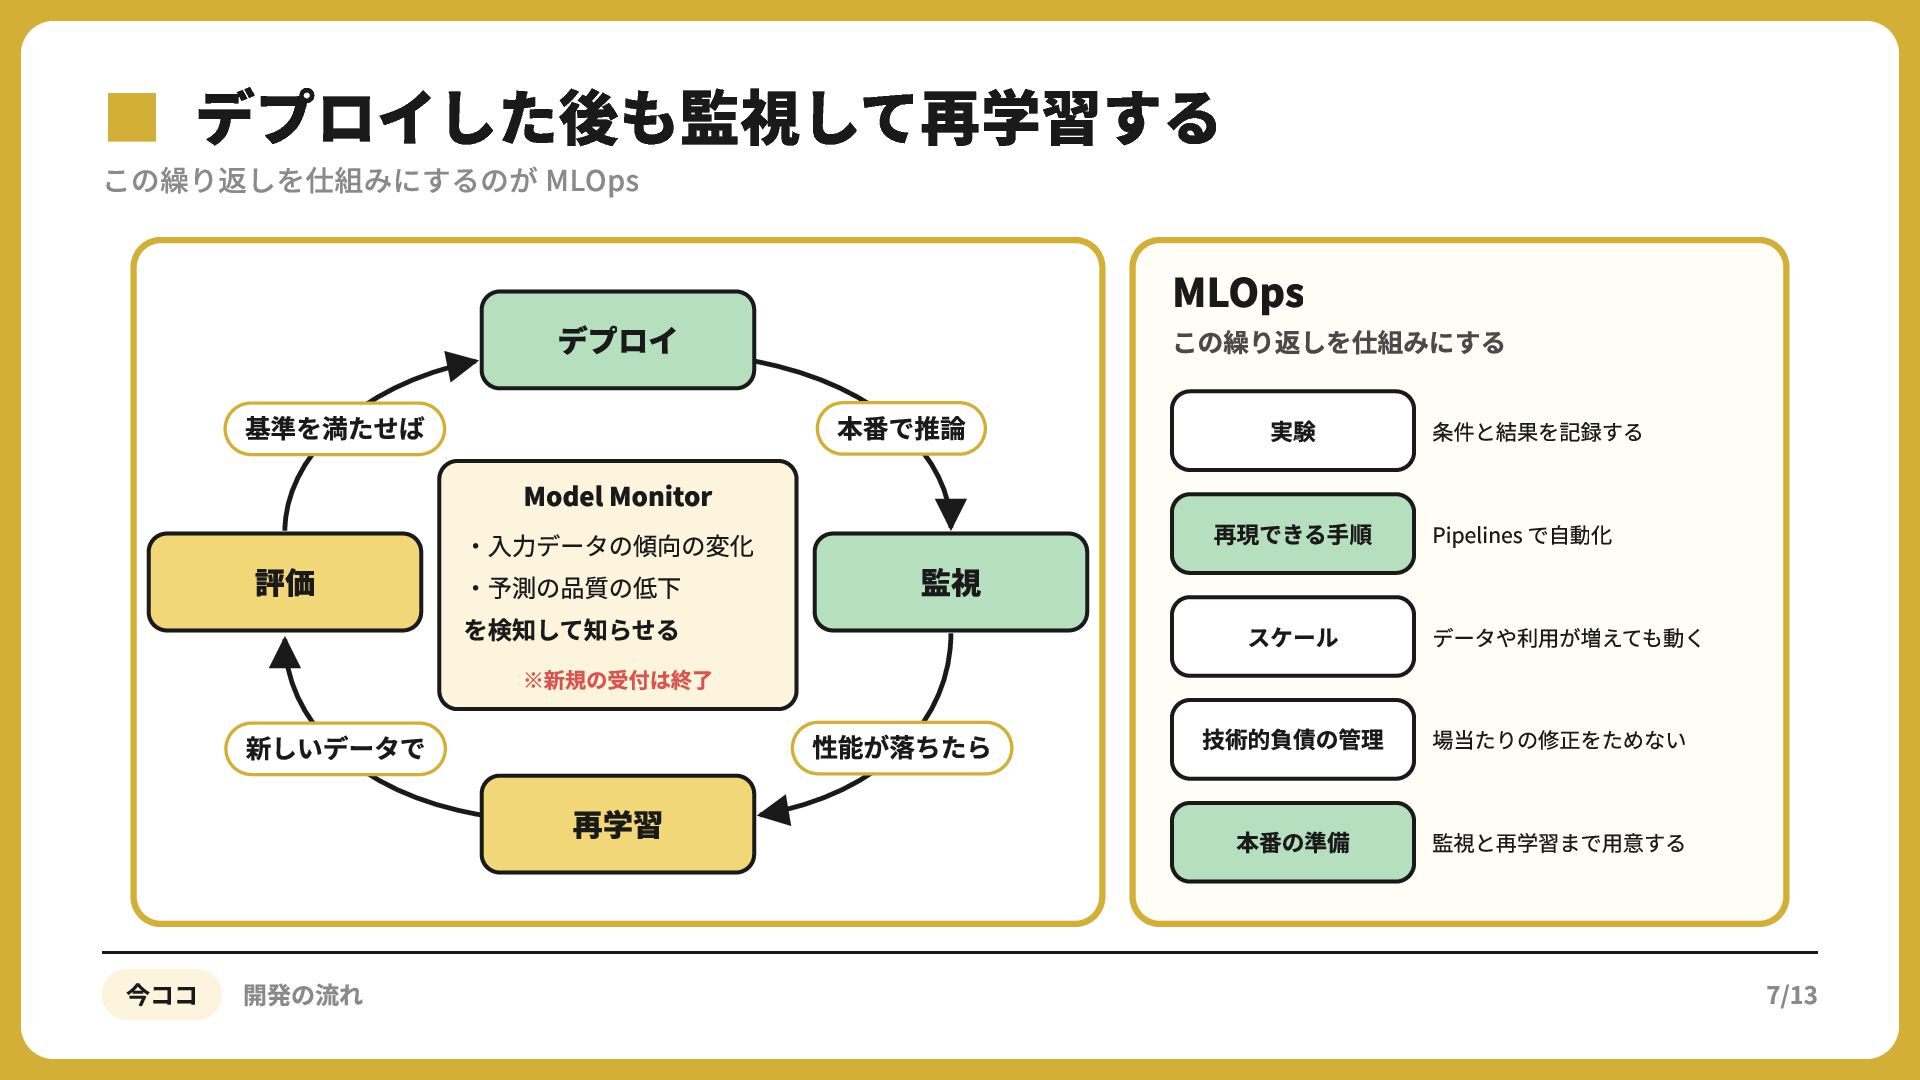
▪この繰り返しを仕組みにするのが デプロイした後も監視して再学習する MLOps MLOps デプロイ この繰り返しを仕組みにする 本番で推論 基準を満たせば Model Monitor
評価 ‧⼊⼒データの傾向の変化 ‧予測の品質の低下 を検知して知らせる 監視 ※新規の受付は終了 性能が落ちたら 新しいデータで 再学習 今ココ 開発の流れ 実験 条件と結果を記録する 再現できる⼿順 Pipelines で⾃動化 スケール データや利⽤が増えても動く 技術的負債の管理 場当たりの修正をためない 本番の準備 監視と再学習まで⽤意する 7/13
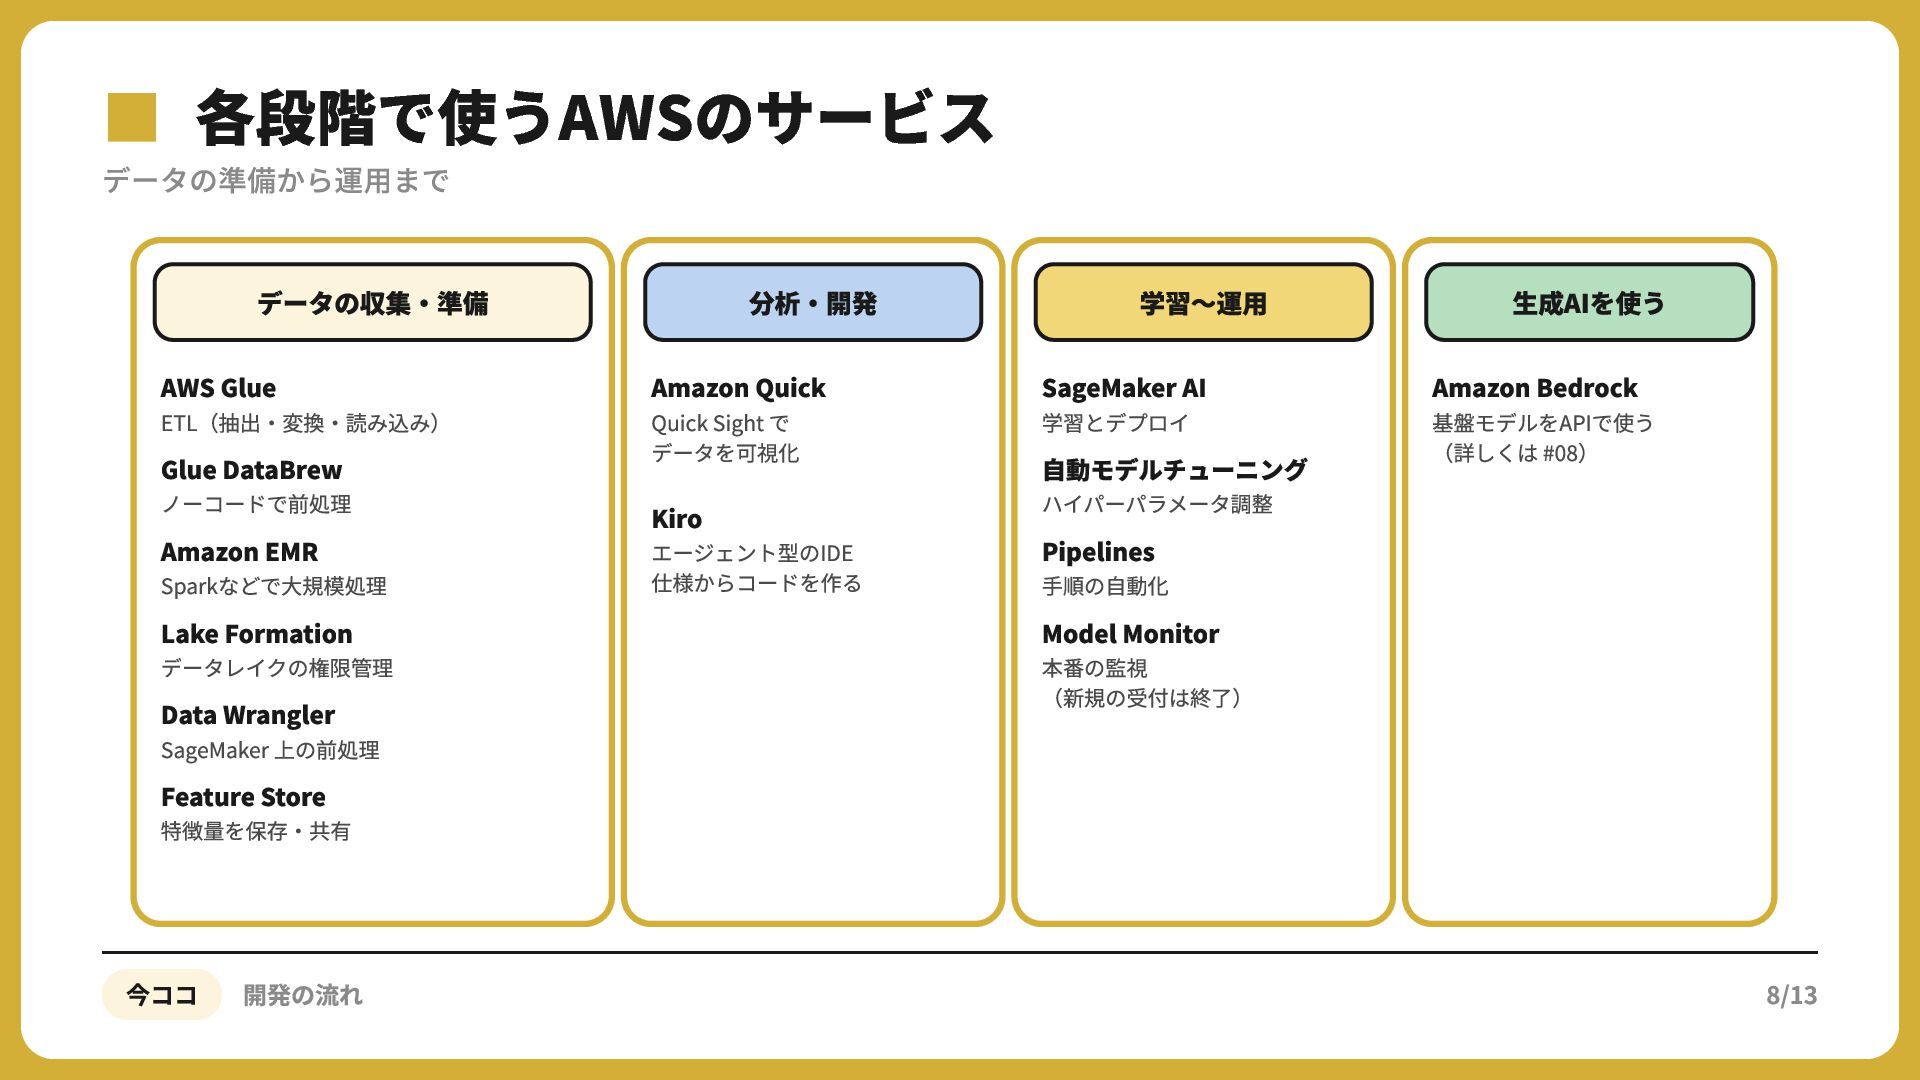
▪データの準備から運用まで 各段階で使うAWSのサービス データの収集‧準備 AWS Glue ETL(抽出‧変換‧読み込み) Glue DataBrew ノーコードで前処理 Amazon
EMR Sparkなどで⼤規模処理 Lake Formation データレイクの権限管理 Data Wrangler SageMaker 上の前処理 分析‧開発 Amazon Quick Quick Sight で データを可視化 Kiro エージェント型のIDE 仕様からコードを作る 学習〜運⽤ SageMaker AI 学習とデプロイ ⾃動モデルチューニング ハイパーパラメータ調整 ⽣成AIを使う Amazon Bedrock 基盤モデルをAPIで使う (詳しくは #08) Pipelines ⼿順の⾃動化 Model Monitor 本番の監視 (新規の受付は終了) Feature Store 特徴量を保存‧共有 今ココ 開発の流れ 8/13
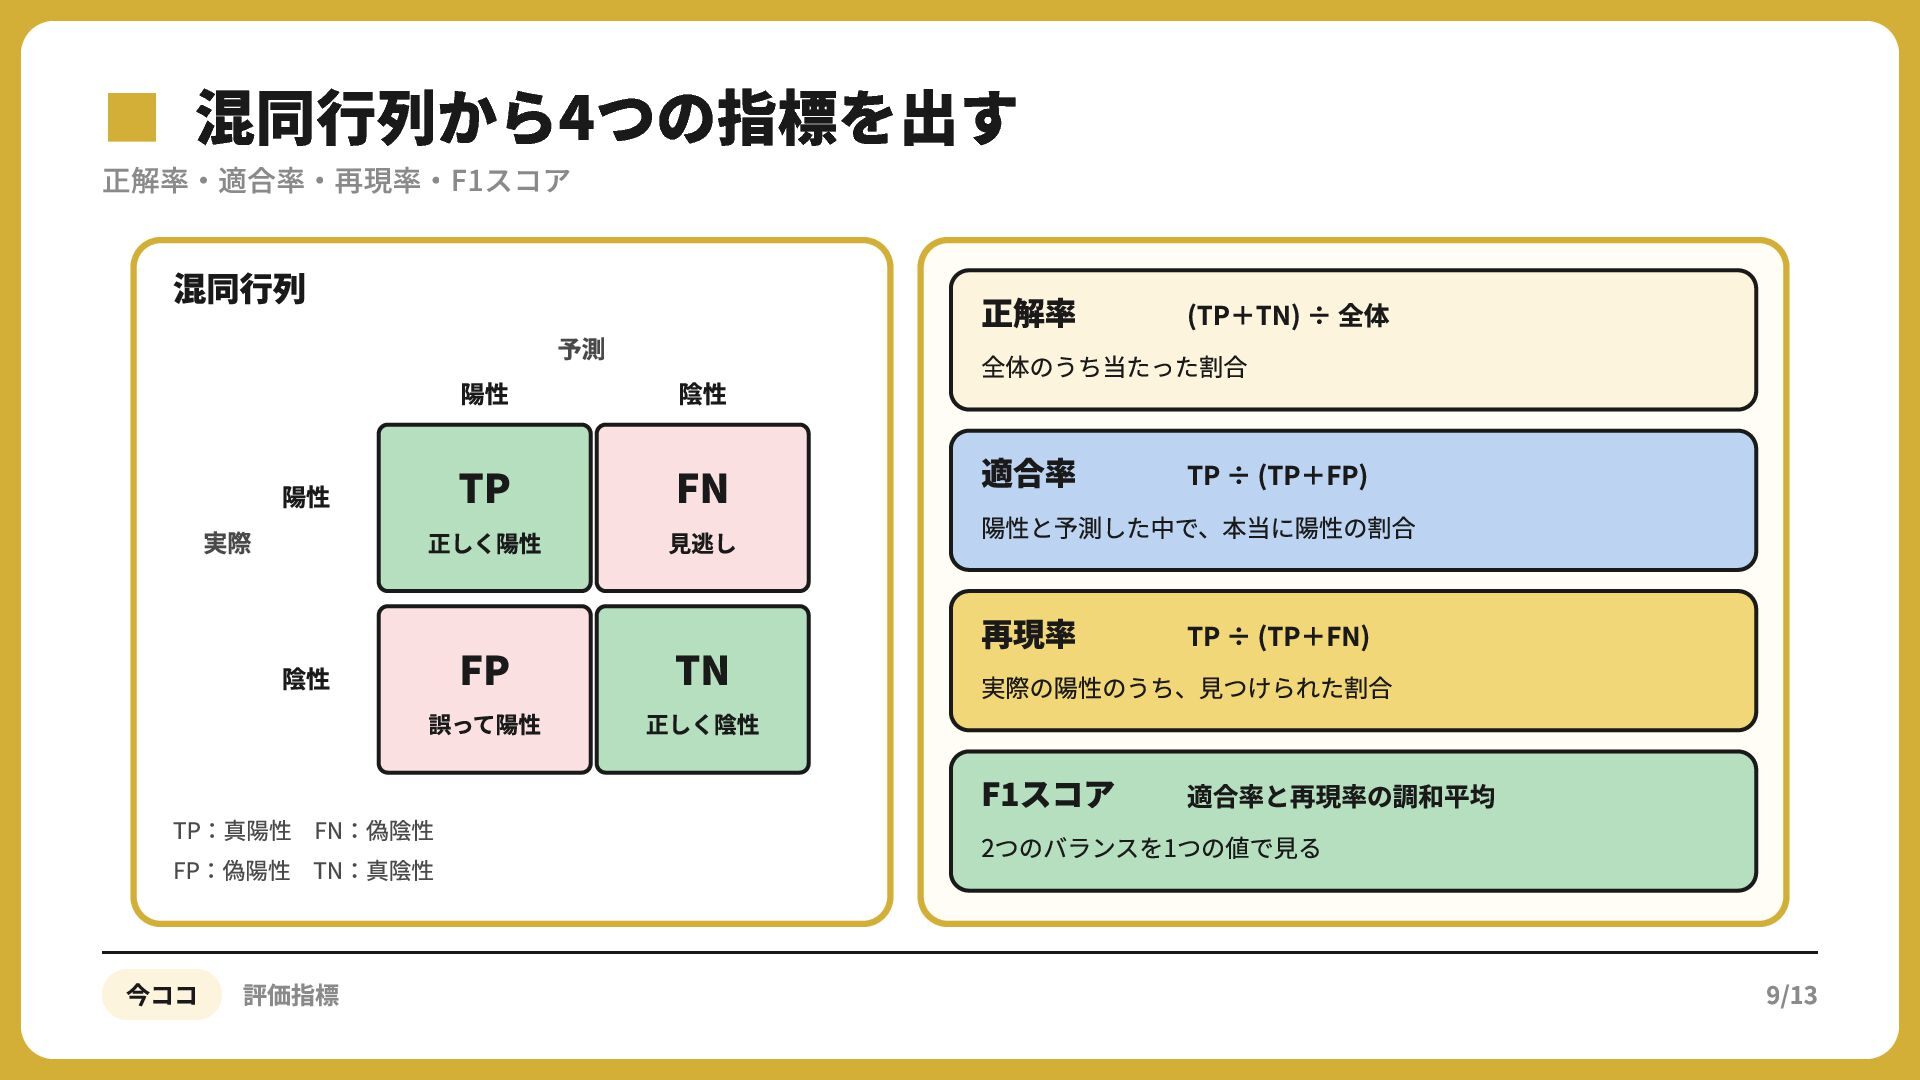
▪正解率・適合率・再現率・F1スコア 混同行列から4つの指標を出す 混同⾏列 陽性 実際 陽性 陰性 TP 正しく陽性 誤って陽性
TP:真陽性 FN:偽陰性 FP:偽陽性 TN:真陰性 今ココ 評価指標 FP 予測 正解率 (TP+TN) ÷ 全体 FN 適合率 TP ÷ (TP+FP) TN 再現率 TP ÷ (TP+FN) F スコア 適合率と再現率の調和平均 陰性 ⾒逃し 正しく陰性 全体のうち当たった割合 陽性と予測した中で、本当に陽性の割合 実際の陽性のうち、⾒つけられた割合 2つのバランスを1つの値で⾒る 9/13
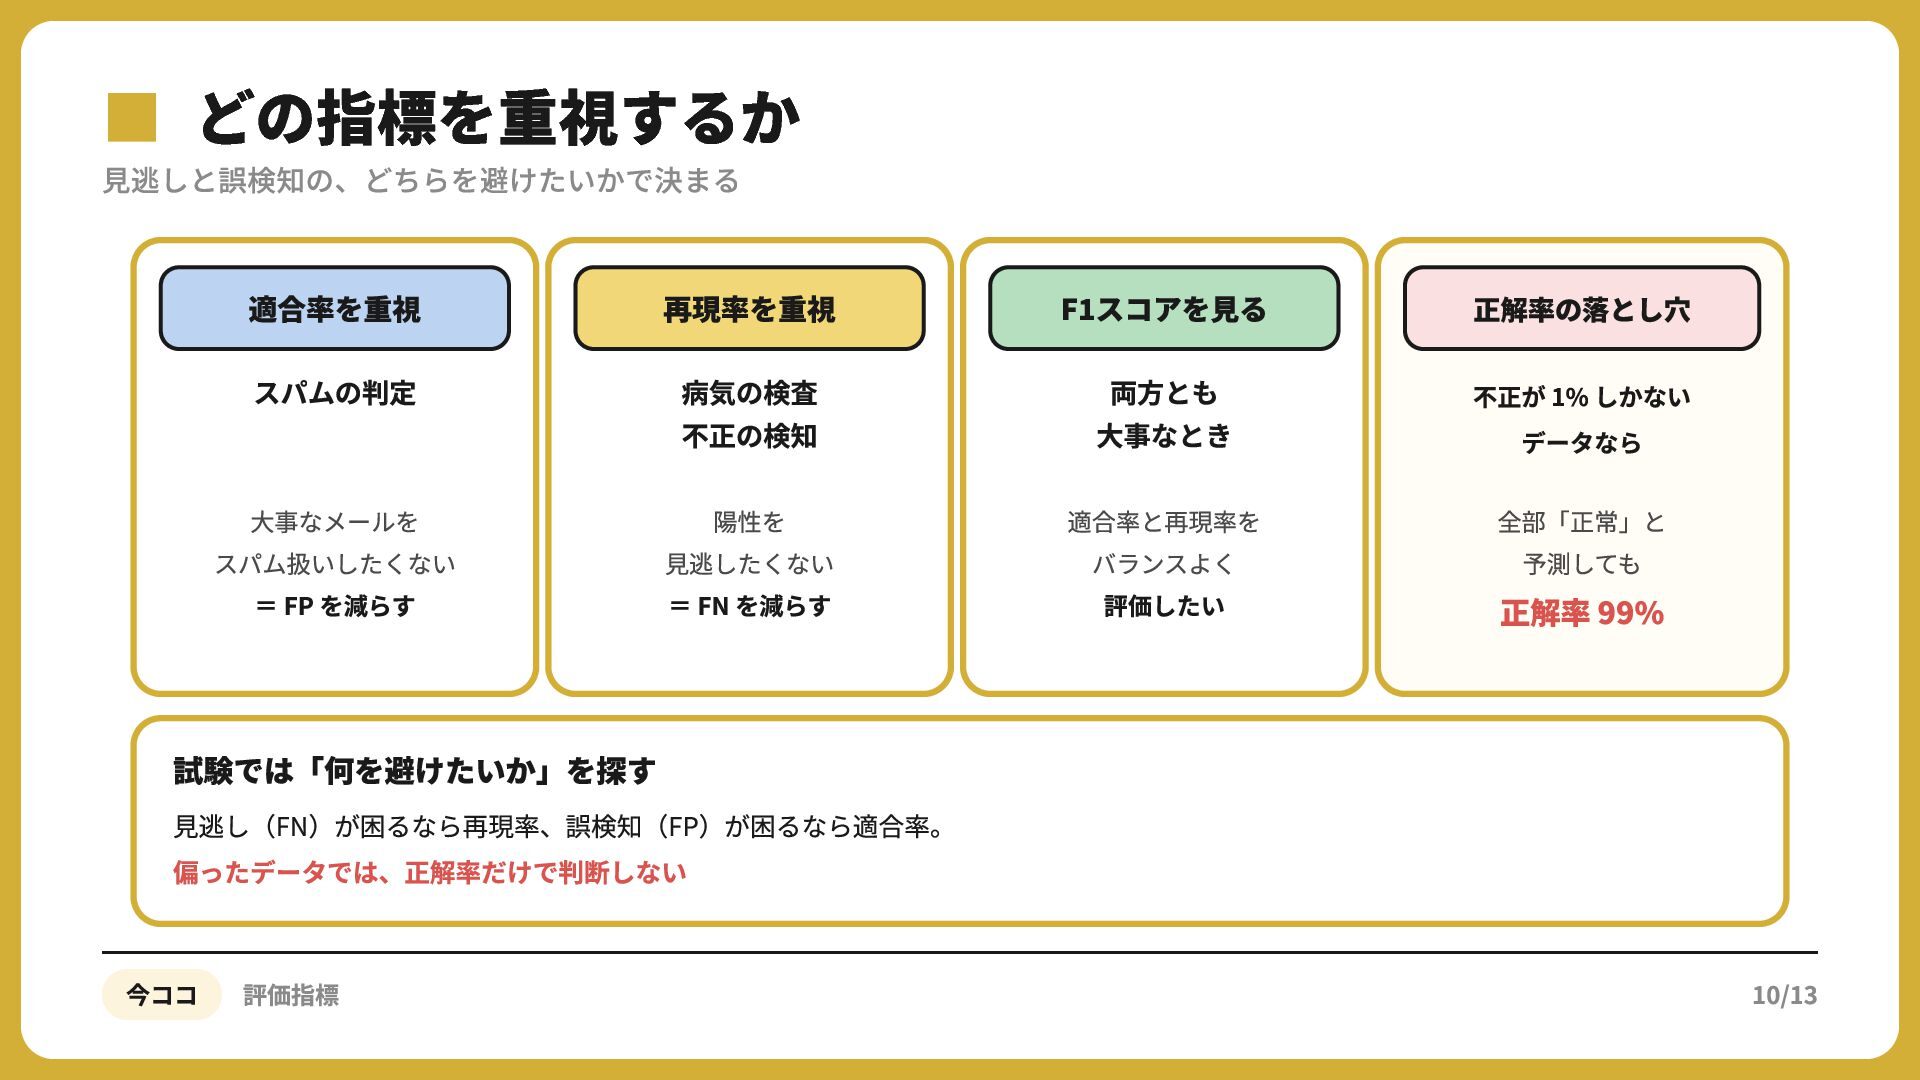
▪見逃しと誤検知の、どちらを避けたいかで決まる どの指標を重視するか 適合率を重視 再現率を重視 F スコアを⾒る 正解率の落とし⽳ スパムの判定 病気の検査 不正の検知
両⽅とも ⼤事なとき 不正が 1% しかない データなら ⼤事なメールを スパム扱いしたくない = FP を減らす 陽性を ⾒逃したくない = FN を減らす 適合率と再現率を バランスよく 評価したい 全部「正常」と 予測しても 正解率 99% 試験では「何を避けたいか」を探す ⾒逃し(FN)が困るなら再現率、誤検知(FP)が困るなら適合率。 偏ったデータでは、正解率だけで判断しない 今ココ 評価指標 10/13
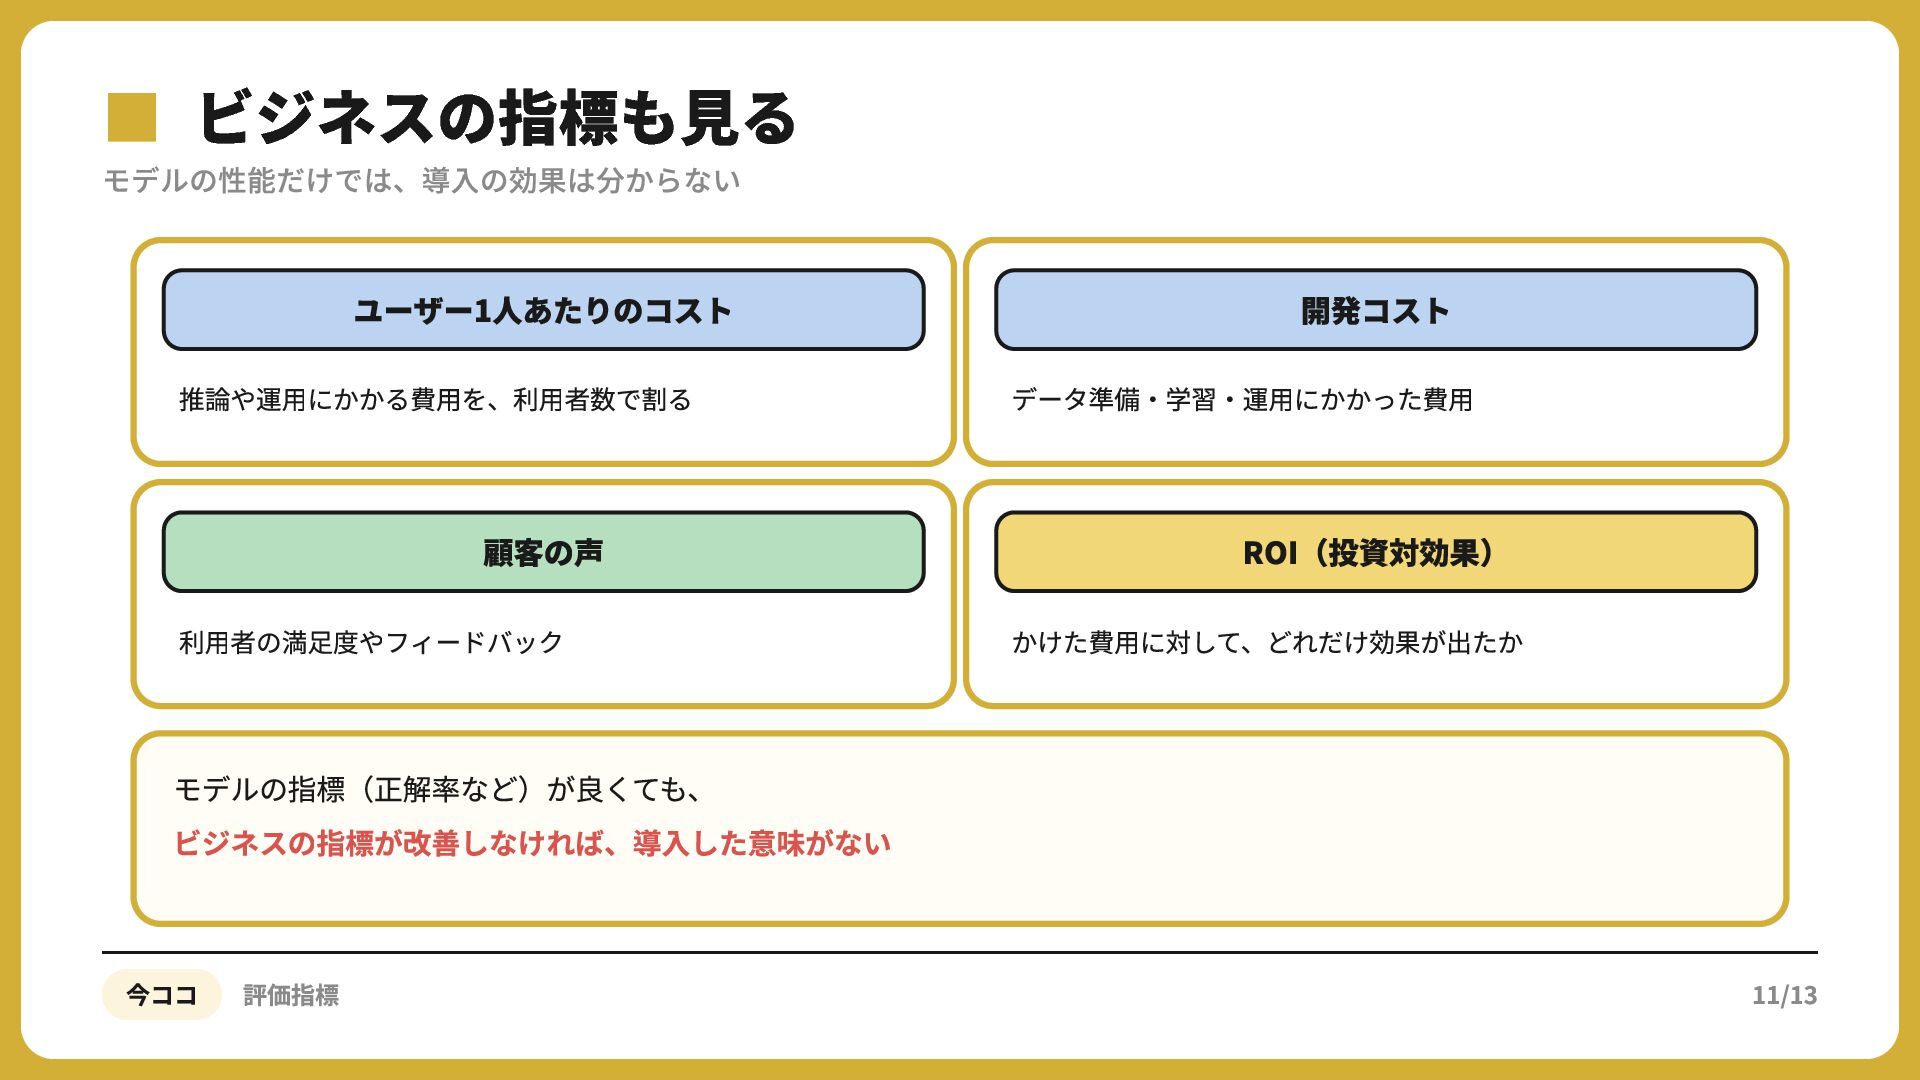
▪モデルの性能だけでは、導入の効果は分からない ビジネスの指標も見る ユーザー1⼈あたりのコスト 推論や運⽤にかかる費⽤を、利⽤者数で割る 顧客の声 利⽤者の満⾜度やフィードバック 開発コスト データ準備‧学習‧運⽤にかかった費⽤ ROI(投資対効果) かけた費⽤に対して、どれだけ効果が出たか
モデルの指標(正解率など)が良くても、 ビジネスの指標が改善しなければ、導⼊した意味がない 今ココ 評価指標 11/13
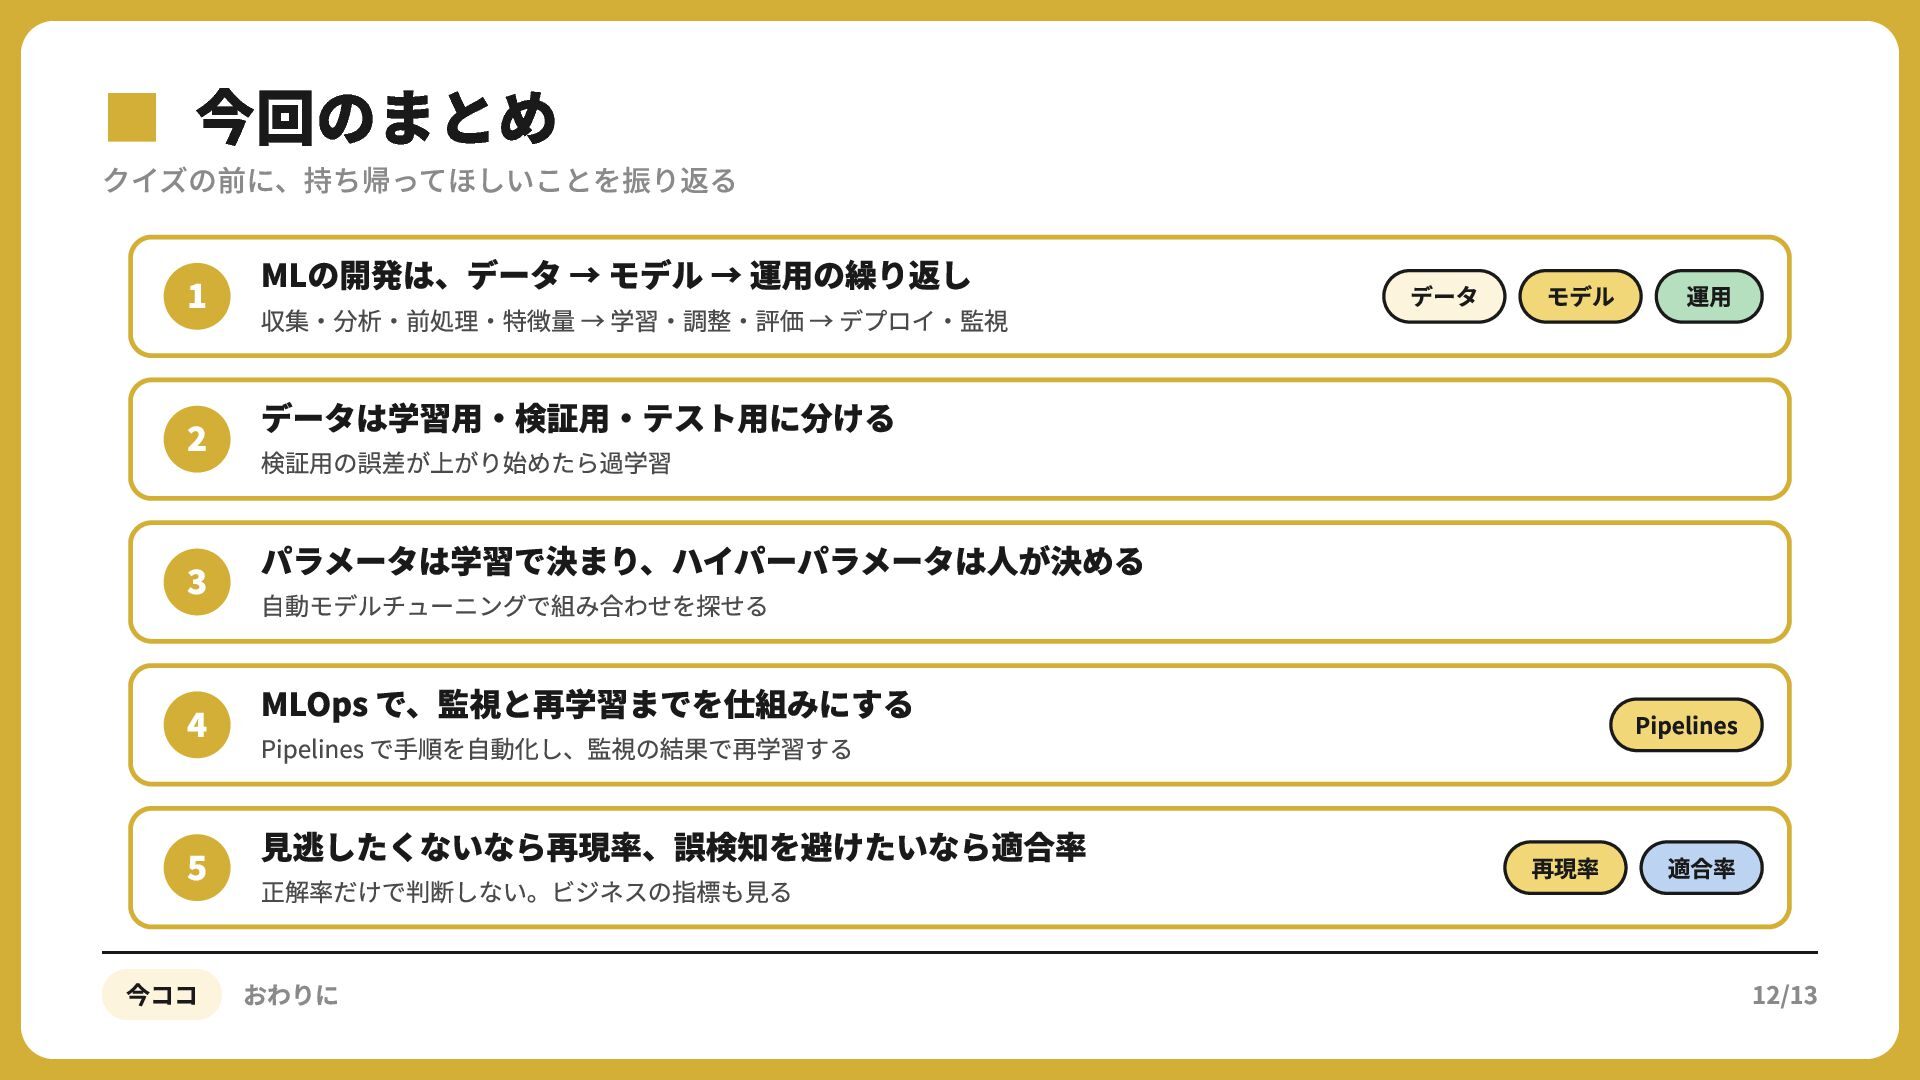
▪クイズの前に、持ち帰ってほしいことを振り返る 今回のまとめ MLの開発は、データ → モデル → 運⽤の繰り返し 収集‧分析‧前処理‧特徴量 → 学習‧調整‧評価
→ デプロイ‧監視 データ モデル 運⽤ データは学習⽤‧検証⽤‧テスト⽤に分ける 検証⽤の誤差が上がり始めたら過学習 パラメータは学習で決まり、ハイパーパラメータは⼈が決める ⾃動モデルチューニングで組み合わせを探せる MLOps で、監視と再学習までを仕組みにする Pipelines Pipelines で⼿順を⾃動化し、監視の結果で再学習する ⾒逃したくないなら再現率、誤検知を避けたいなら適合率 正解率だけで判断しない。ビジネスの指標も⾒る 今ココ おわりに 再現率 適合率 12/13
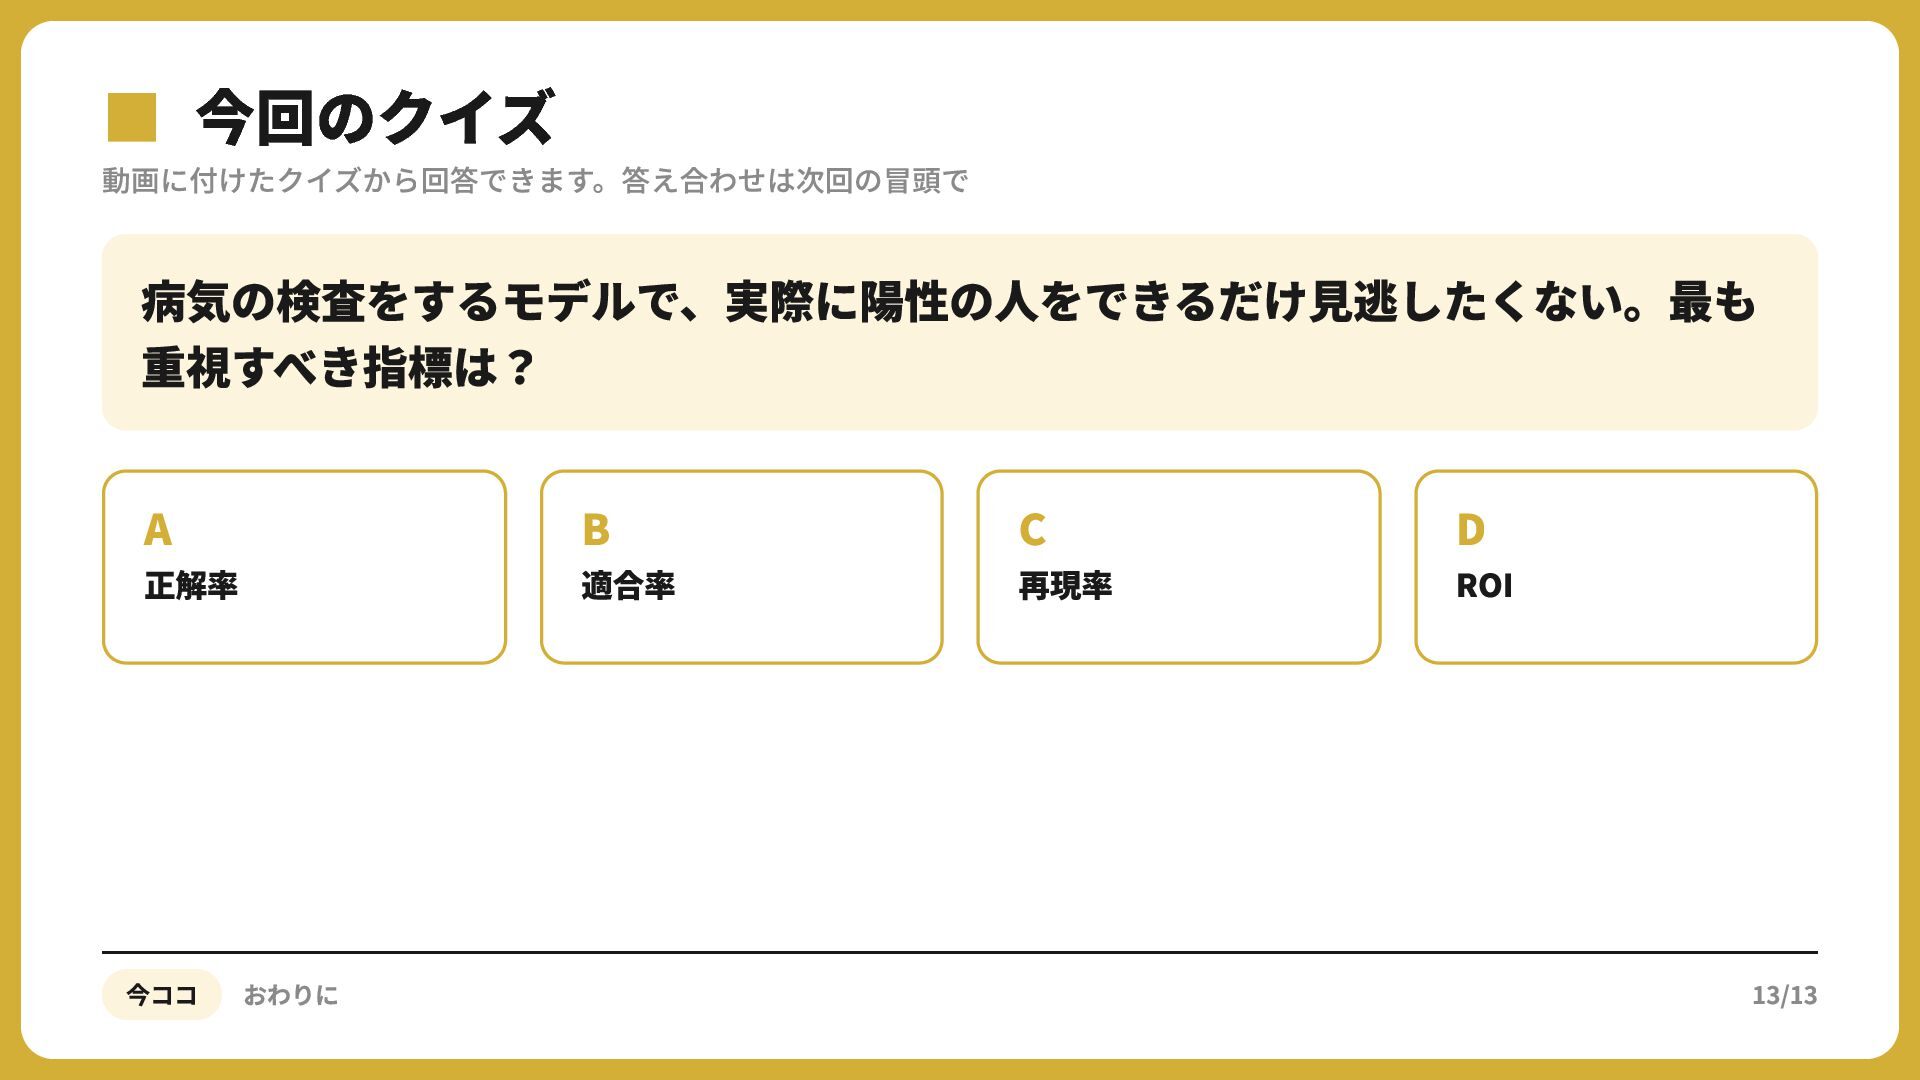
▪動画に付けたクイズから回答できます。答え合わせは次回の冒頭で 今回のクイズ 病気の検査をするモデルで、実際に陽性の人をできるだけ見逃したくない。最も 重視すべき指標は? A 正解率 今ココ おわりに B 適合率
C 再現率 D ROI 13/13

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 akagami
 petamoriken
 otouto
 icoxfog417
 riku_sakamoto
 lynnswap
 camiha
 kntkymt
 prota
 yuukiw00w
 touyou
 kishikawakatsumi
 trickart
 paigeccino
 cassininazir
 smashingmag
 lynnandtonic
 tonyrice
 samlambert
 ammeep
 matthewcrist
 katiecoart
 shlominoach
 tammyeverts
 inesmontani