Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【AWS AIF対策】生成AIの基本用語
Search
赤神青空
PRO
September 25, 2026
Video
Programming
11
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【AWS AIF対策】生成AIの基本用語
赤神青空
PRO
September 25, 2026
Video
More Decks by 赤神青空
See All by 赤神青空
【AWS AIF対策】ML開発の流れと評価指標
akagami
PRO
0
16
【AWS AIF対策】AWSのAIサービスの使い分け
akagami
PRO
0
22
【AWS AIF対策】推論の種類とMLの使いどころ
akagami
PRO
0
23
【AWS AIF対策】AI・ML・生成AIの関係を整理する
akagami
PRO
0
19
【情報整理用】ハッカソンの是非論を整理する
akagami
PRO
0
28
【AWSのログ周りを整理する】第6回 選び方 ── 結局ど う決めるのか
akagami
PRO
0
22
【AWSのログ周りを整理する】第5回 調べる ── 貯めたログに問い合わせる
akagami
PRO
0
23
【AWSのログ周りを整理する】第4回 貯める ── コストの大半はここで 決まる
akagami
PRO
0
22
【AWSのログ周りを整理する】第3回 運ぶ ── 発生源と置き場のあいだ
akagami
PRO
0
21
Other Decks in Programming
See All in Programming
Agents on Rails - Rails at Scale 2026
irinanazarova
0
180
フロントエンドUIフレームワークのこれまでとこれから
ssssota
5
2.9k
MVNOの申込からeSIM開通までをiOSアプリでつなぐ- 本人確認・MNP・通信事業者基盤をまたぐ実装
satotakeshi
0
460
iOSDC Japan 2026 - Swiftで作って学ぼう!データベース自作入門
kaseken
2
320
AGENTS.md Is Not Enough: Build Skills, Don't Download Them
lx_t
0
130
スマートフォンでモールス信号を送受信する 〜スマートフォンのLEDとカメラで作る光通信の設計と実装〜
atsuki_seo
0
170
仕様駆動開発による爆速プロダクト開発 / Bakusoku Spec Driven Development
kobakei
0
130
一人だけ、Kiroが静止する日
hideg
0
130
What We Talk About When We Talk About XP
m_seki
2
680
App Storeの外へ──日本のiOSサイドローディング入門 for iOSDC Japan 2026
yuukiw00w
0
240
AWS DevOps Agentで インシデント対応をAIに任せたい
honmarkhunt
7
3.1k
Apple Intelligence を用いた個人情報誤送信防止、及びユーザーリクエスト体験の改善について
yukiny
0
120
Featured
See All Featured
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
530
Become a Pro
speakerdeck
PRO
31
6.3k
Six Lessons from altMBA
skipperchong
29
4.5k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
Speed Design
sergeychernyshev
33
2.1k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
550
Leo the Paperboy
mayatellez
10
2.3k
The browser strikes back
jonoalderson
0
1.7k
The Spectacular Lies of Maps
axbom
PRO
1
1k
Utilizing Notion as your number one productivity tool
mfonobong
4
590
GraphQLとの向き合い方2022年版
quramy
50
15k
Transcript
2026年9月 生成AIの基本用語 AWS Certified AI Practitioner 対策 #5 赤神青空
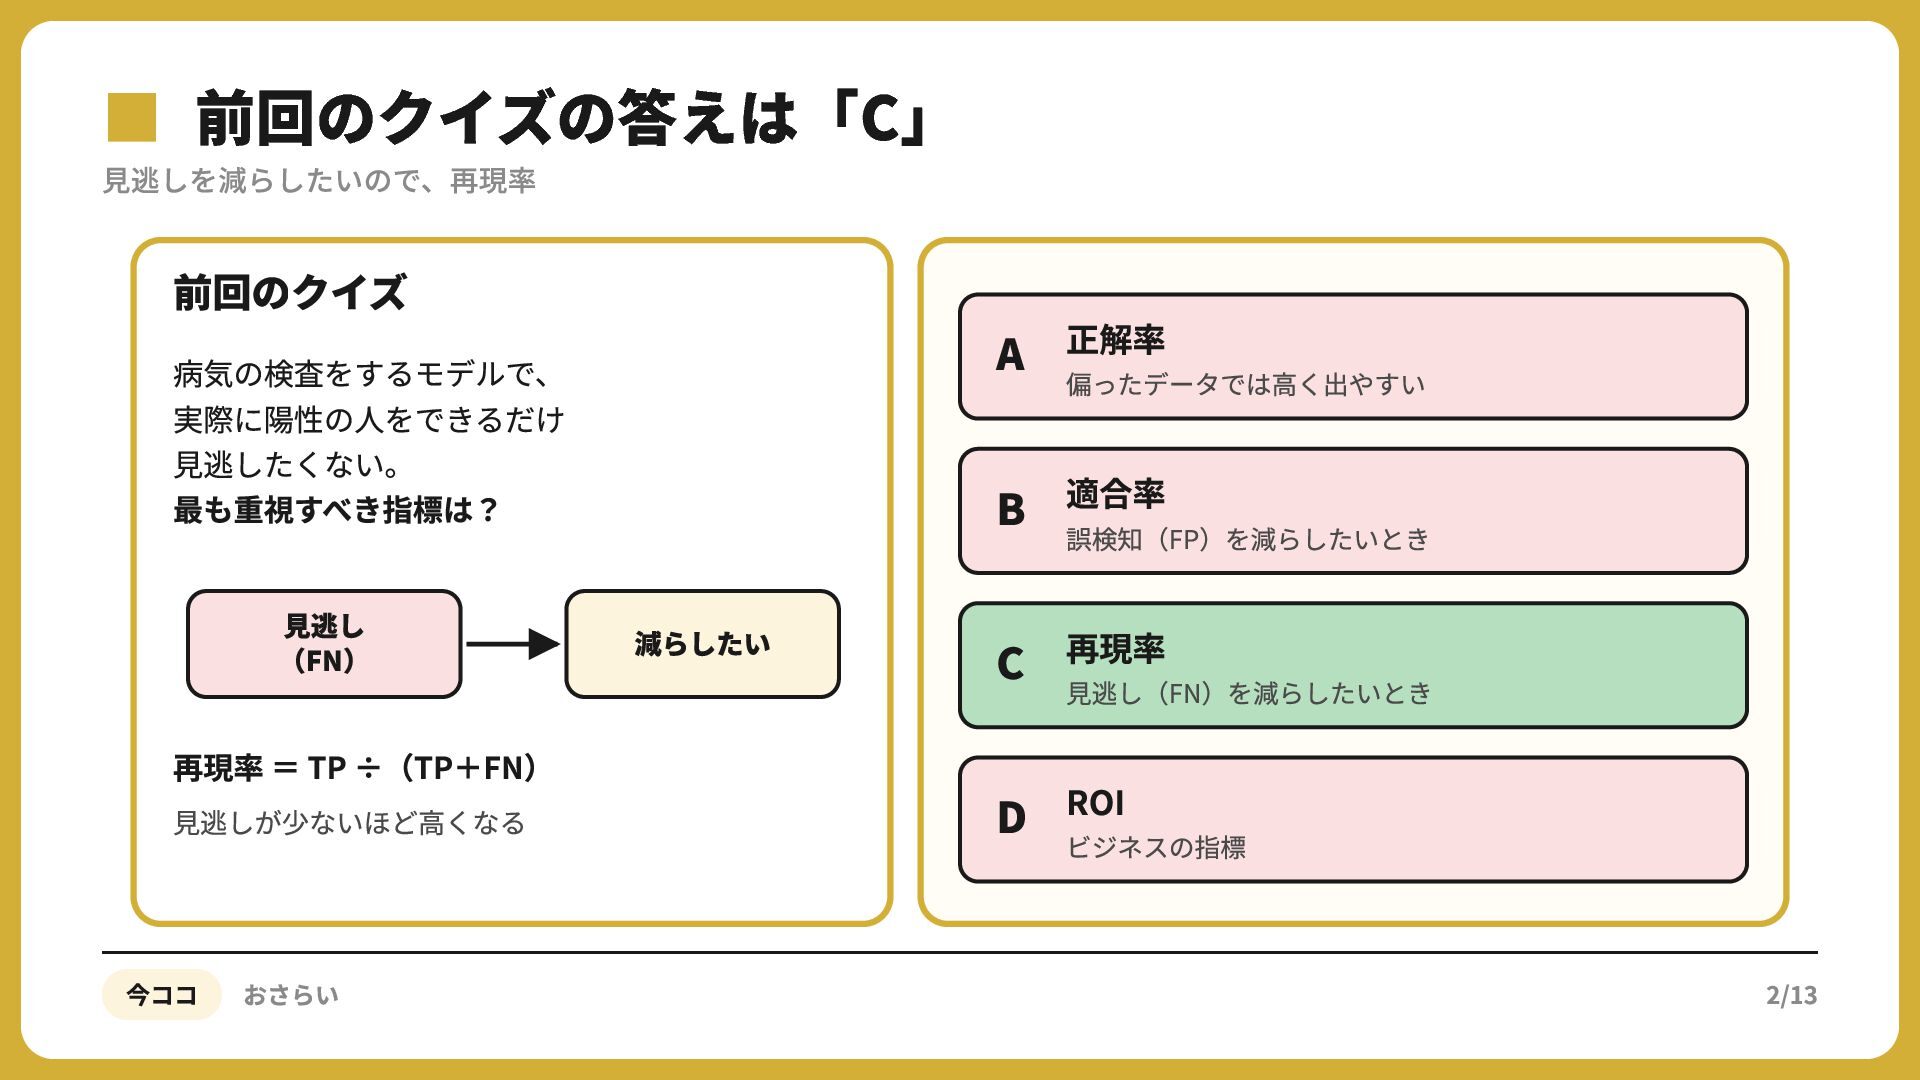
▪見逃しを減らしたいので、再現率 前回のクイズの答えは「C」 前回のクイズ A 正解率 偏ったデータでは⾼く出やすい 病気の検査をするモデルで、 実際に陽性の⼈をできるだけ ⾒逃したくない。 最も重視すべき指標は?
⾒逃し (FN) 再現率 = TP ÷(TP+FN) ⾒逃しが少ないほど⾼くなる 今ココ おさらい B 適合率 誤検知(FP)を減らしたいとき 減らしたい C 再現率 ⾒逃し(FN)を減らしたいとき D ROI ビジネスの指標 2/13
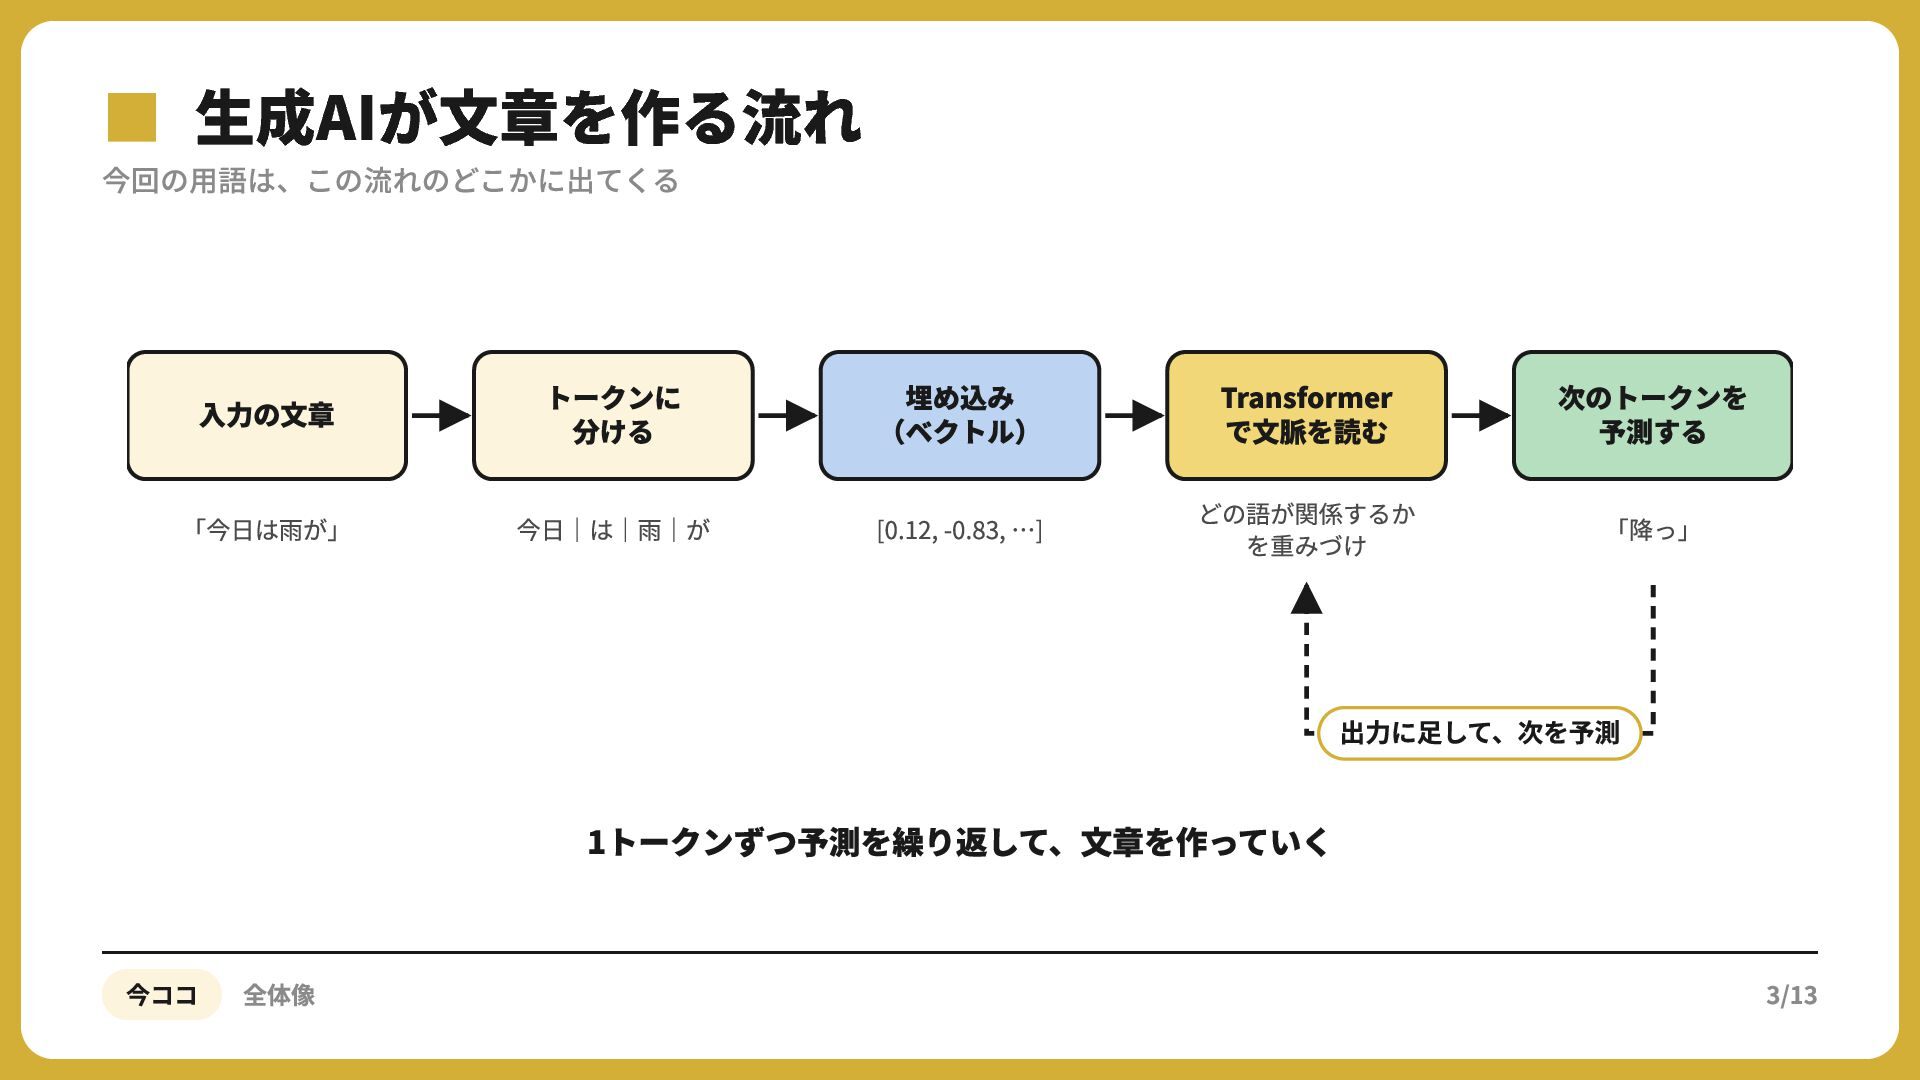
▪今回の用語は、この流れのどこかに出てくる 生成AIが文章を作る流れ ⼊⼒の⽂章 トークンに 分ける 埋め込み (ベクトル) Transformer で⽂脈を読む 次のトークンを
予測する 「今⽇は⾬が」 今⽇|は|⾬|が [0.12, -0.83, …] どの語が関係するか を重みづけ 「降っ」 出⼒に⾜して、次を予測 1トークンずつ予測を繰り返して、⽂章を作っていく 今ココ 全体像 3/13
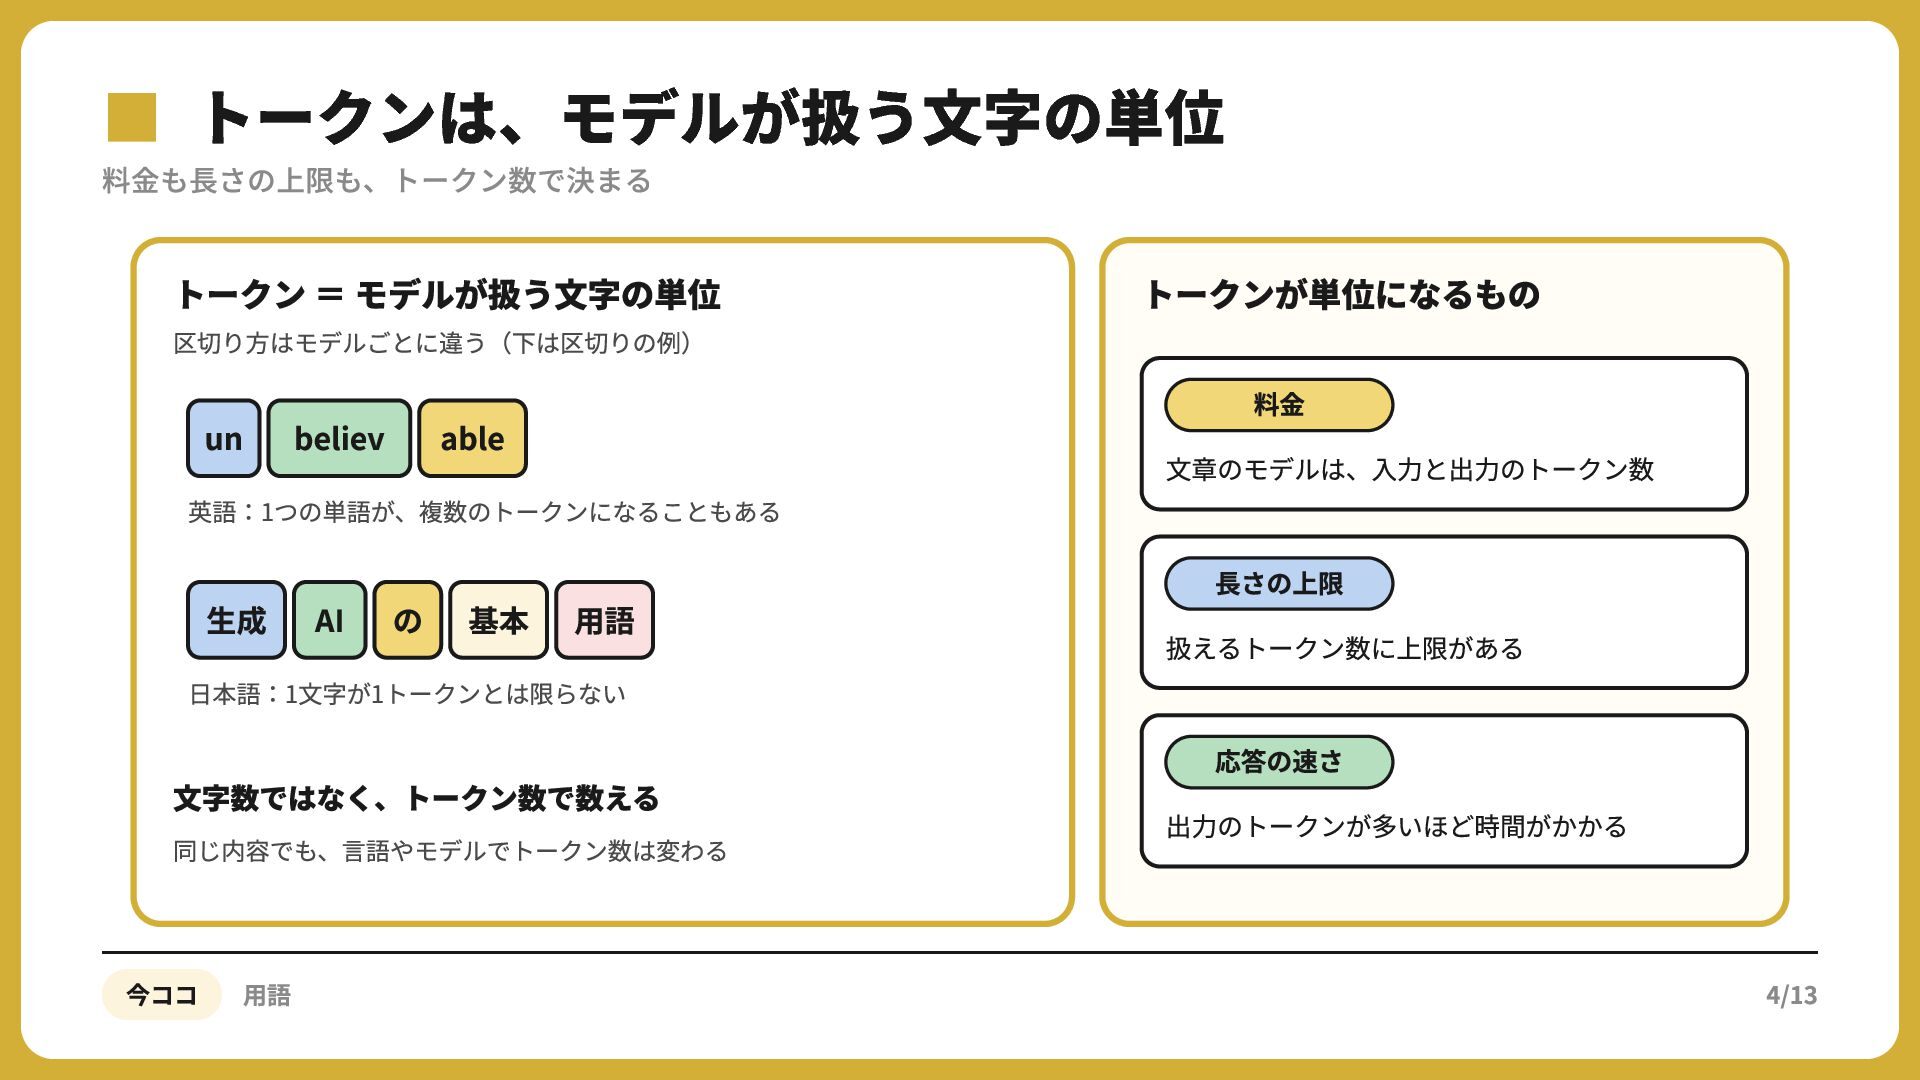
▪料金も長さの上限も、トークン数で決まる トークンは、モデルが扱う文字の単位 トークン = モデルが扱う⽂字の単位 トークンが単位になるもの un believ able 料⾦
⽂章のモデルは、⼊⼒と出⼒のトークン数 区切り⽅はモデルごとに違う(下は区切りの例) 英語:1つの単語が、複数のトークンになることもある ⽣成 AI の 基本 ⽤語 ⽇本語:1⽂字が1トークンとは限らない ⽂字数ではなく、トークン数で数える 同じ内容でも、⾔語やモデルでトークン数は変わる 今ココ 用語 ⻑さの上限 扱えるトークン数に上限がある 応答の速さ 出⼒のトークンが多いほど時間がかかる 4/13
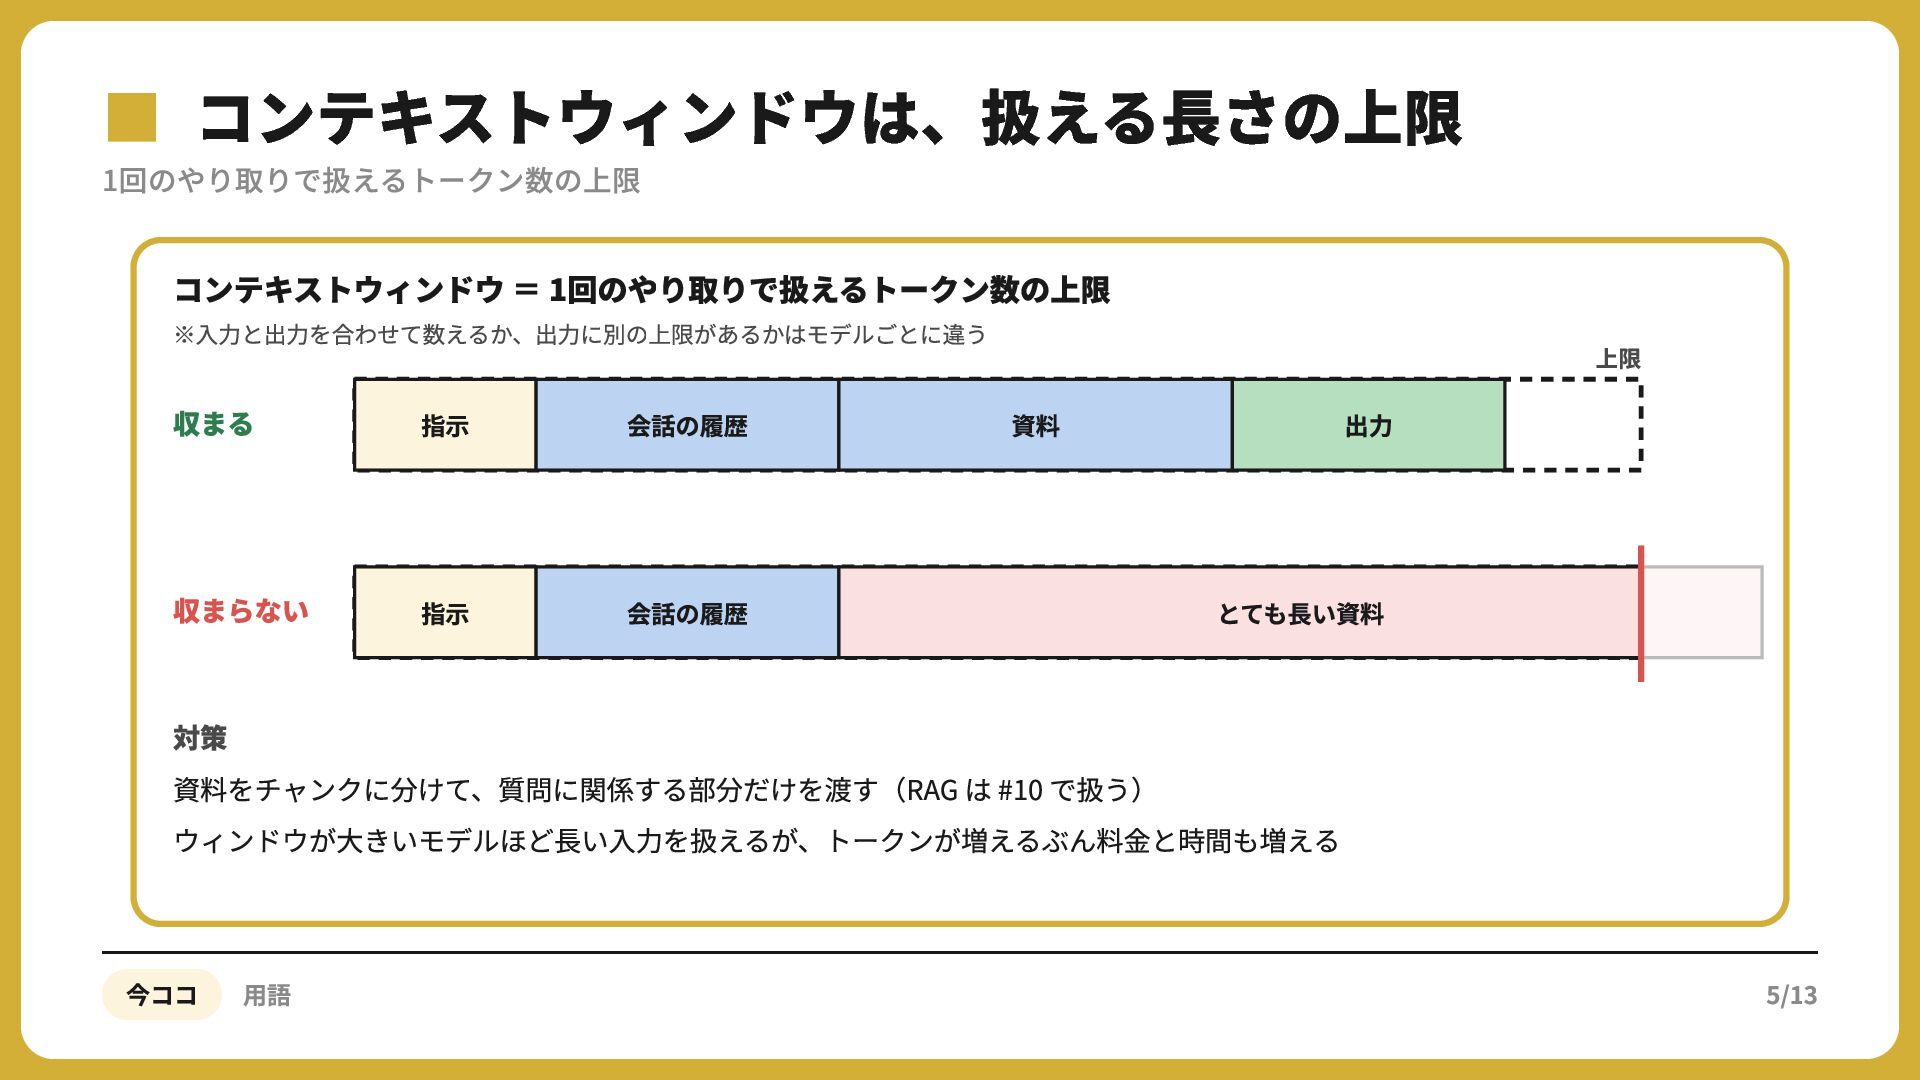
▪1回のやり取りで扱えるトークン数の上限 コンテキストウィンドウは、扱える長さの上限 コンテキストウィンドウ = 1回のやり取りで扱えるトークン数の上限 ※⼊⼒と出⼒を合わせて数えるか、出⼒に別の上限があるかはモデルごとに違う 収まる 指⽰ 会話の履歴 収まらない
指⽰ 会話の履歴 上限 資料 出⼒ とても⻑い資料 対策 資料をチャンクに分けて、質問に関係する部分だけを渡す(RAG は #10 で扱う) ウィンドウが⼤きいモデルほど⻑い⼊⼒を扱えるが、トークンが増えるぶん料⾦と時間も増える 今ココ 用語 5/13
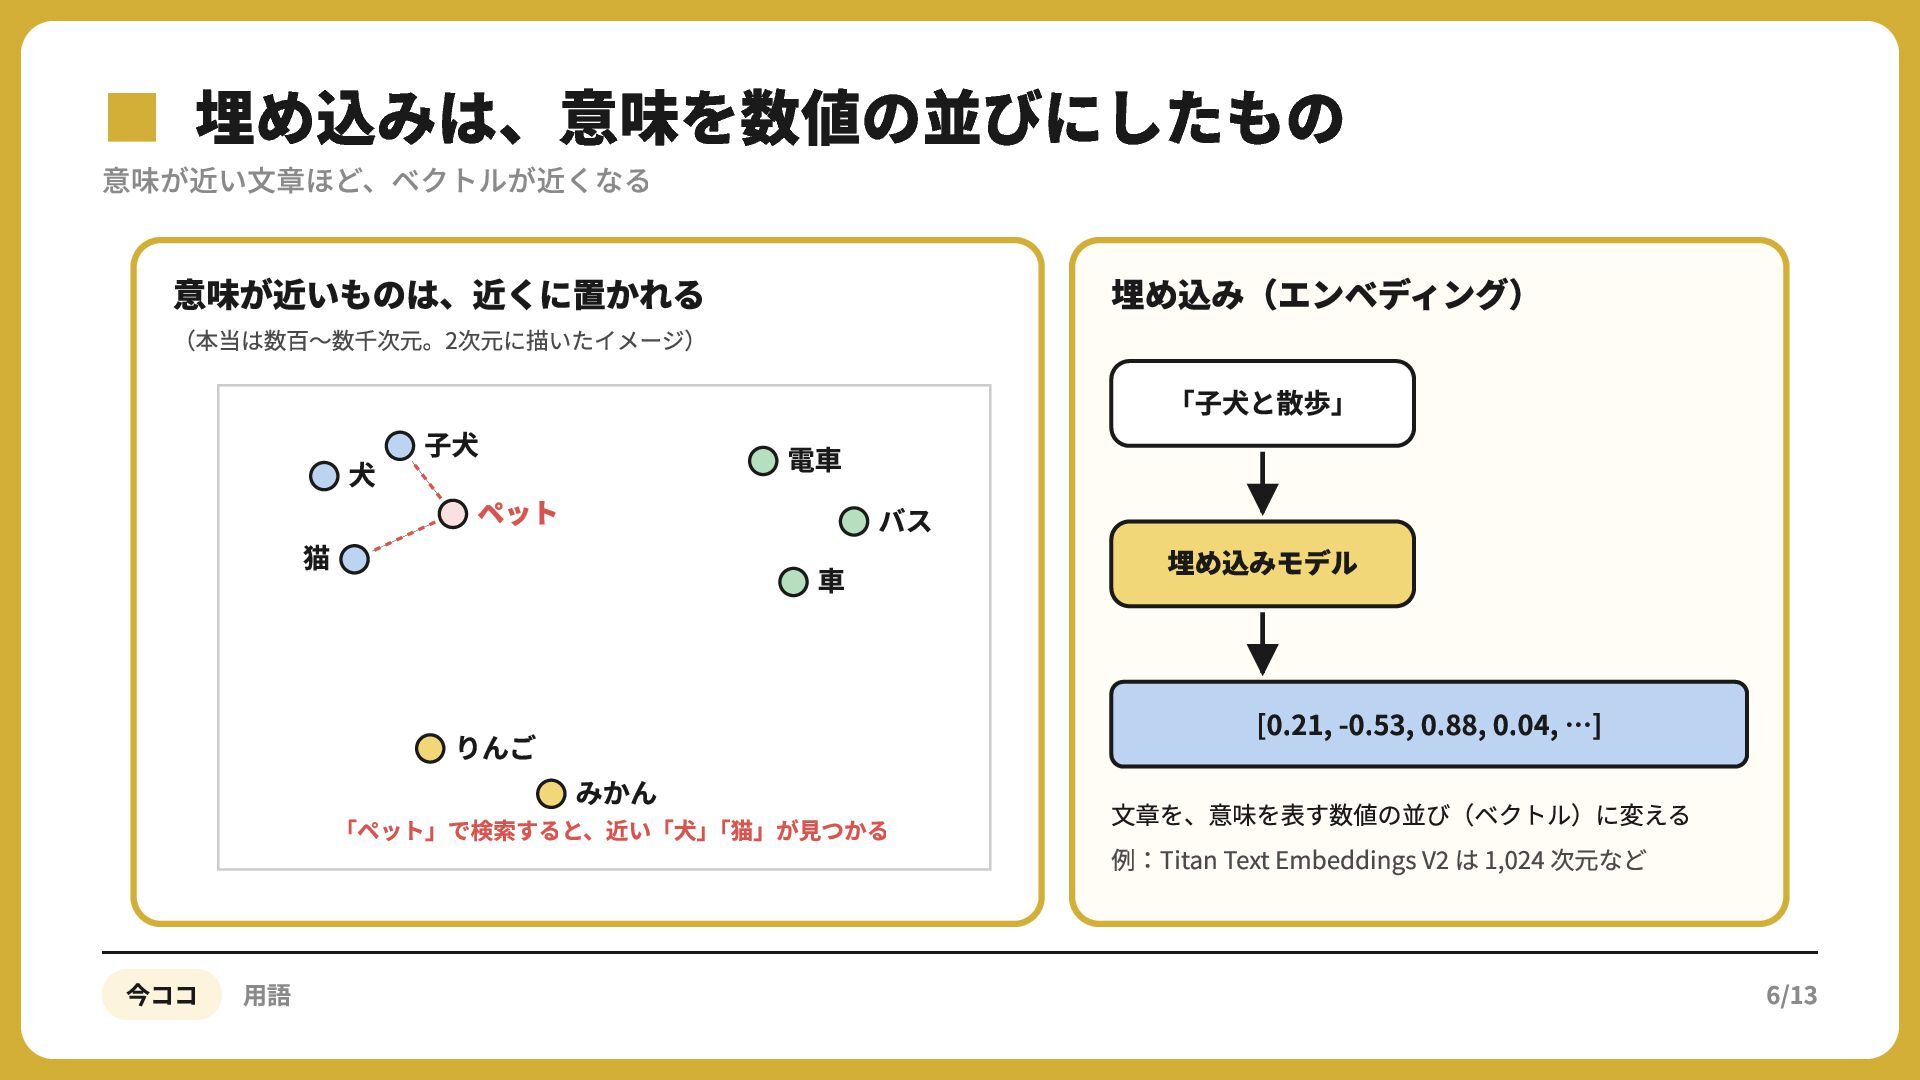
▪意味が近い文章ほど、ベクトルが近くなる 埋め込みは、意味を数値の並びにしたもの 意味が近いものは、近くに置かれる 埋め込み(エンベディング) (本当は数百〜数千次元。2次元に描いたイメージ) 猫 ⼦⽝ ⽝ ペット りんご
電⾞ ⾞ みかん 「⼦⽝と散歩」 バス 「ペット」で検索すると、近い「⽝」「猫」が⾒つかる 今ココ 用語 埋め込みモデル [0.21, -0.53, 0.88, 0.04, …] ⽂章を、意味を表す数値の並び(ベクトル)に変える 例:Titan Text Embeddings V は 1,024 次元など 6/13
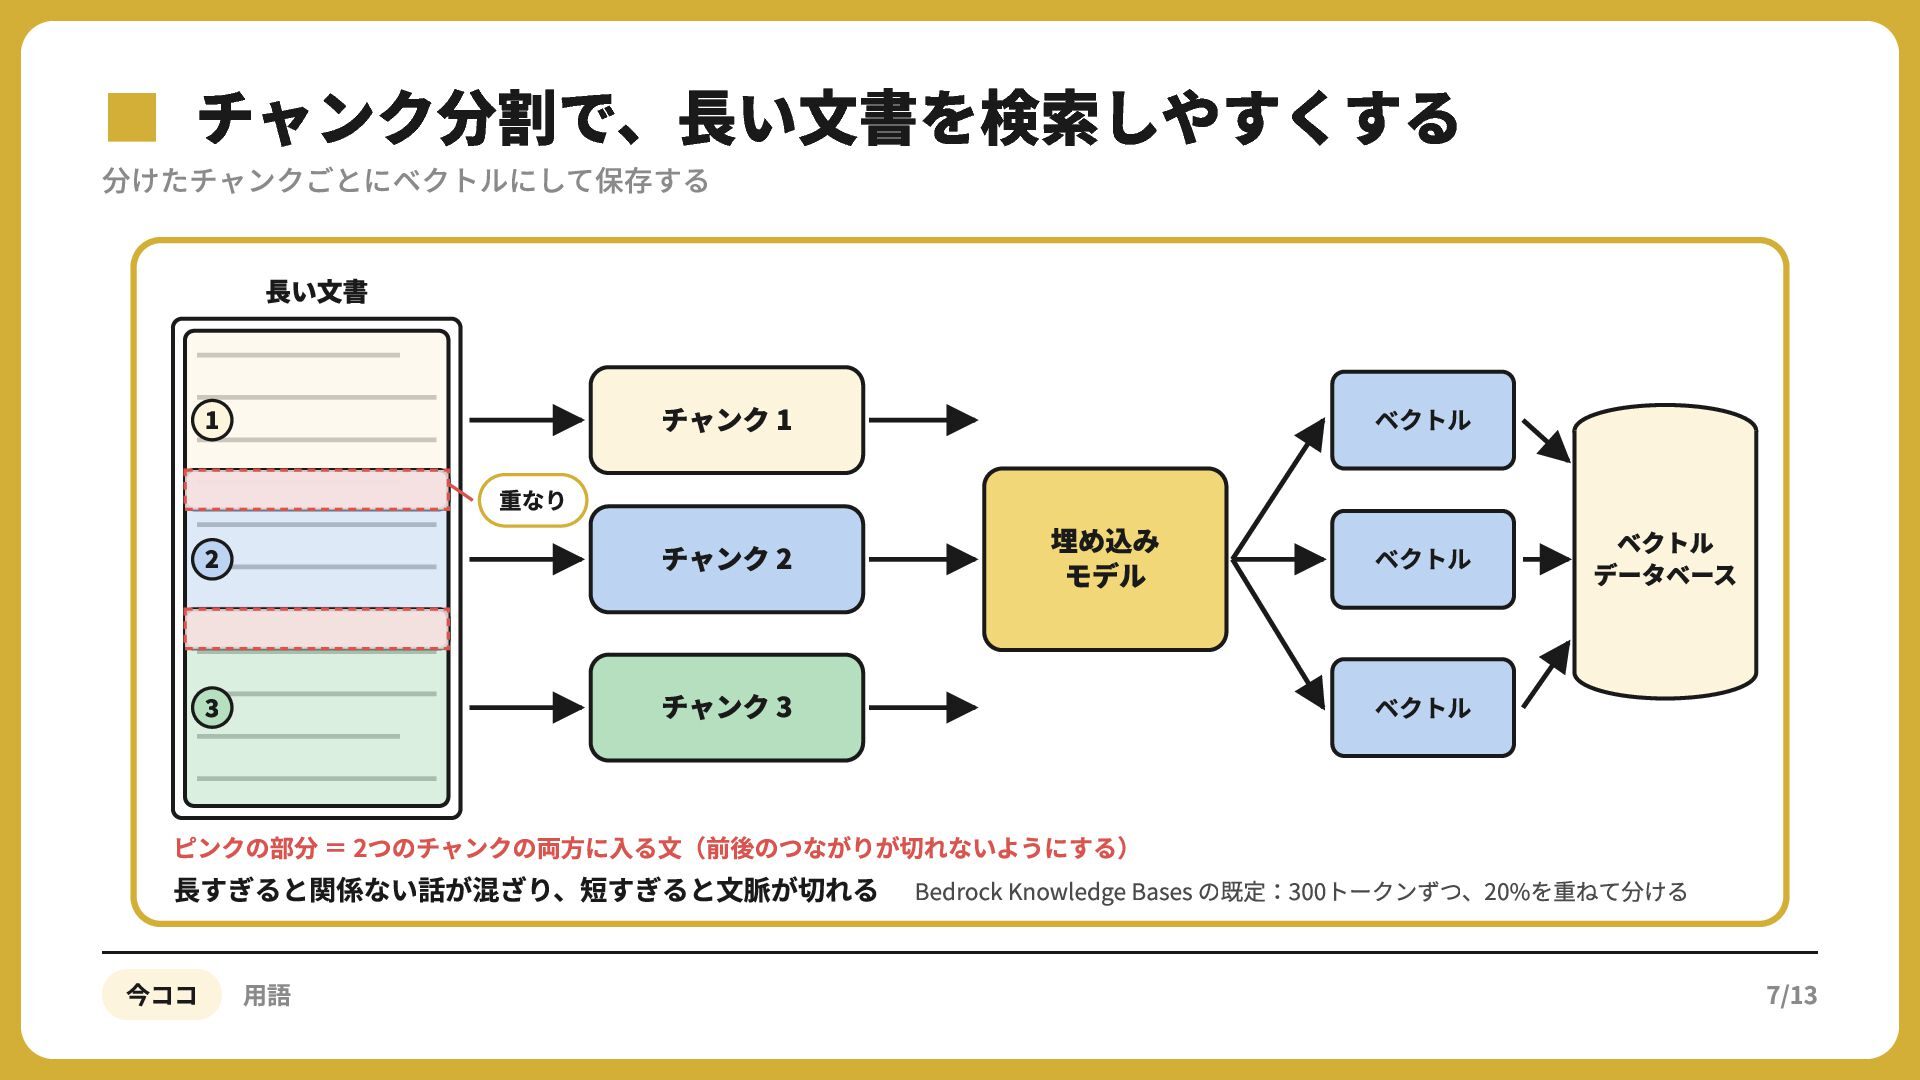
▪分けたチャンクごとにベクトルにして保存する チャンク分割で、長い文書を検索しやすくする ⻑い⽂書 チャンク 1 重なり チャンク 2 ベクトル 埋め込み
モデル チャンク 3 ベクトル ベクトル データベース ベクトル ピンクの部分 = 2つのチャンクの両⽅に⼊る⽂(前後のつながりが切れないようにする) ⻑すぎると関係ない話が混ざり、短すぎると⽂脈が切れる Bedrock Knowledge Bases の既定:300トークンずつ、20%を重ねて分ける 今ココ 用語 7/13
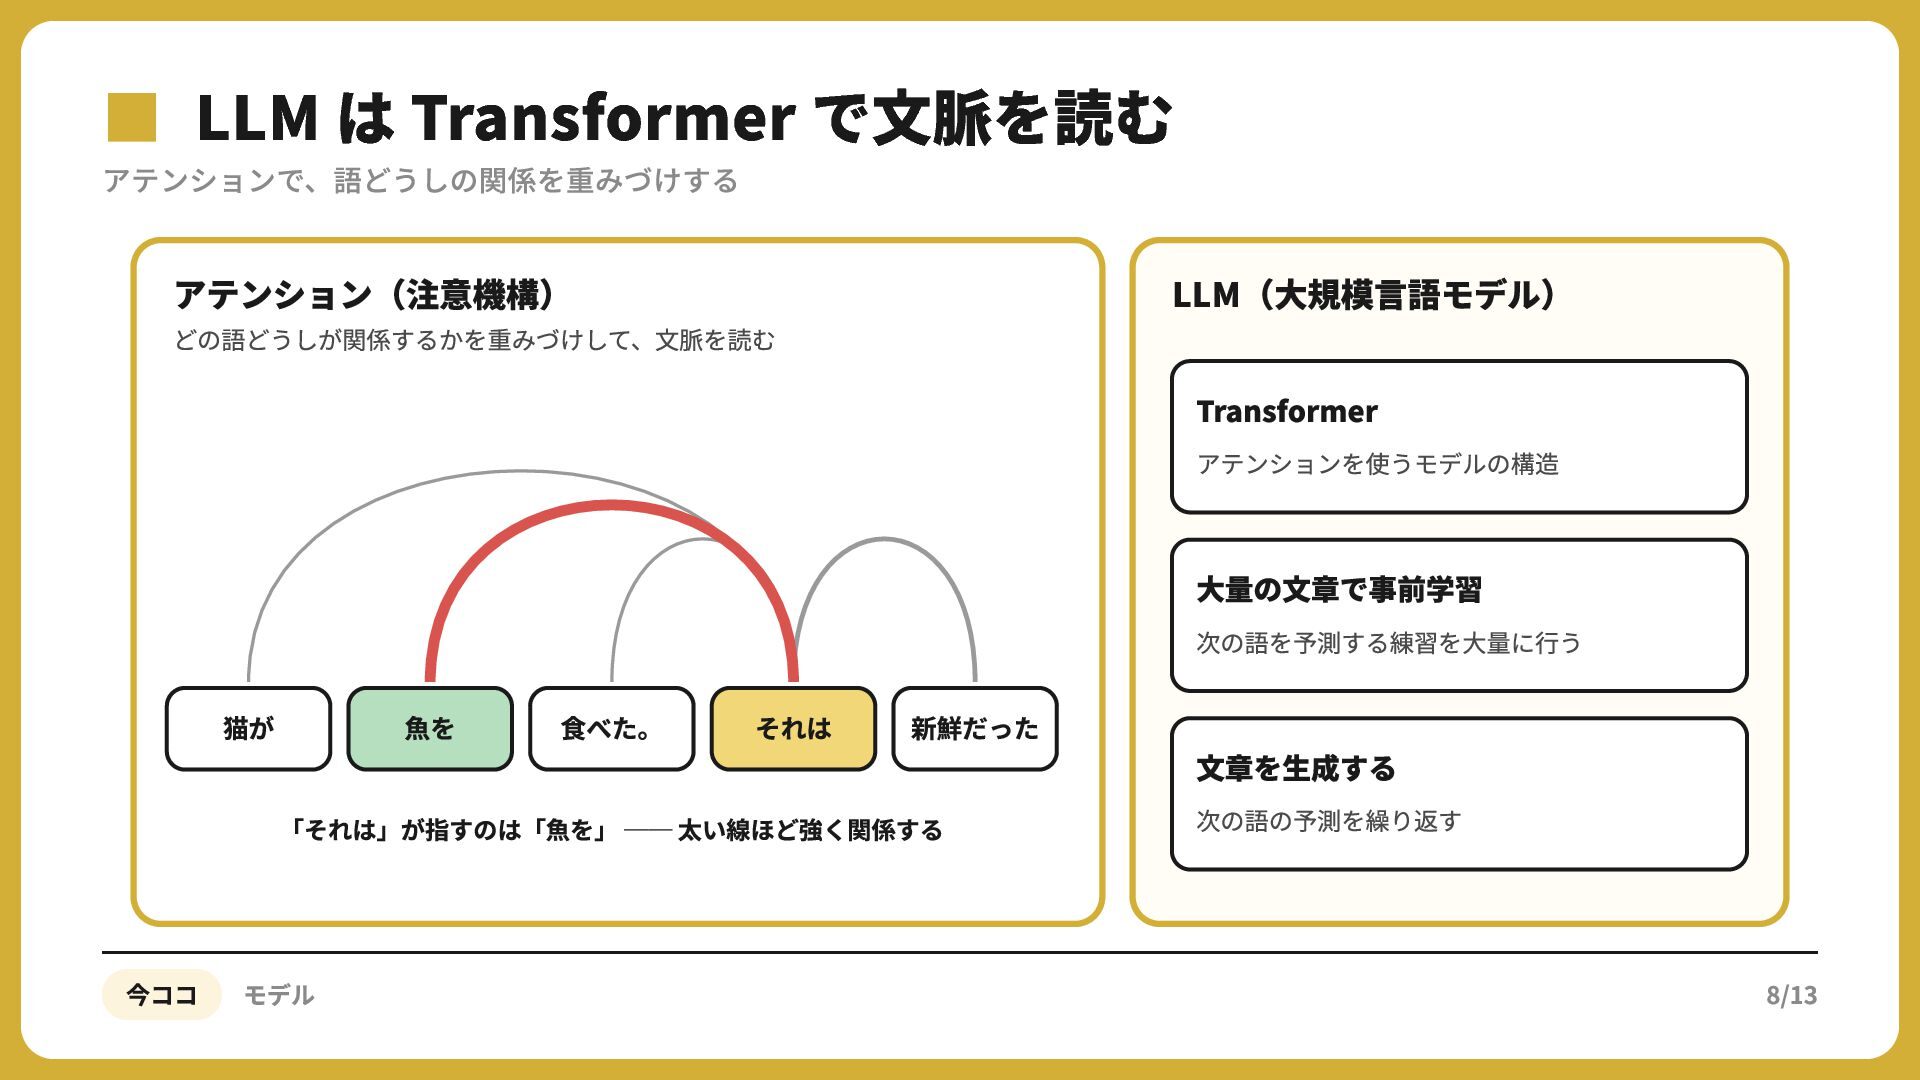
▪アテンションで、語どうしの関係を重みづけする LLM は Transformer で文脈を読む アテンション(注意機構) LLM(⼤規模⾔語モデル) どの語どうしが関係するかを重みづけして、⽂脈を読む Transformer アテンションを使うモデルの構造
⼤量の⽂章で事前学習 次の語を予測する練習を⼤量に⾏う 猫が ⿂を ⾷べた。 それは 新鮮だった 「それは」が指すのは「⿂を」 ── 太い線ほど強く関係する 今ココ モデル ⽂章を⽣成する 次の語の予測を繰り返す 8/13
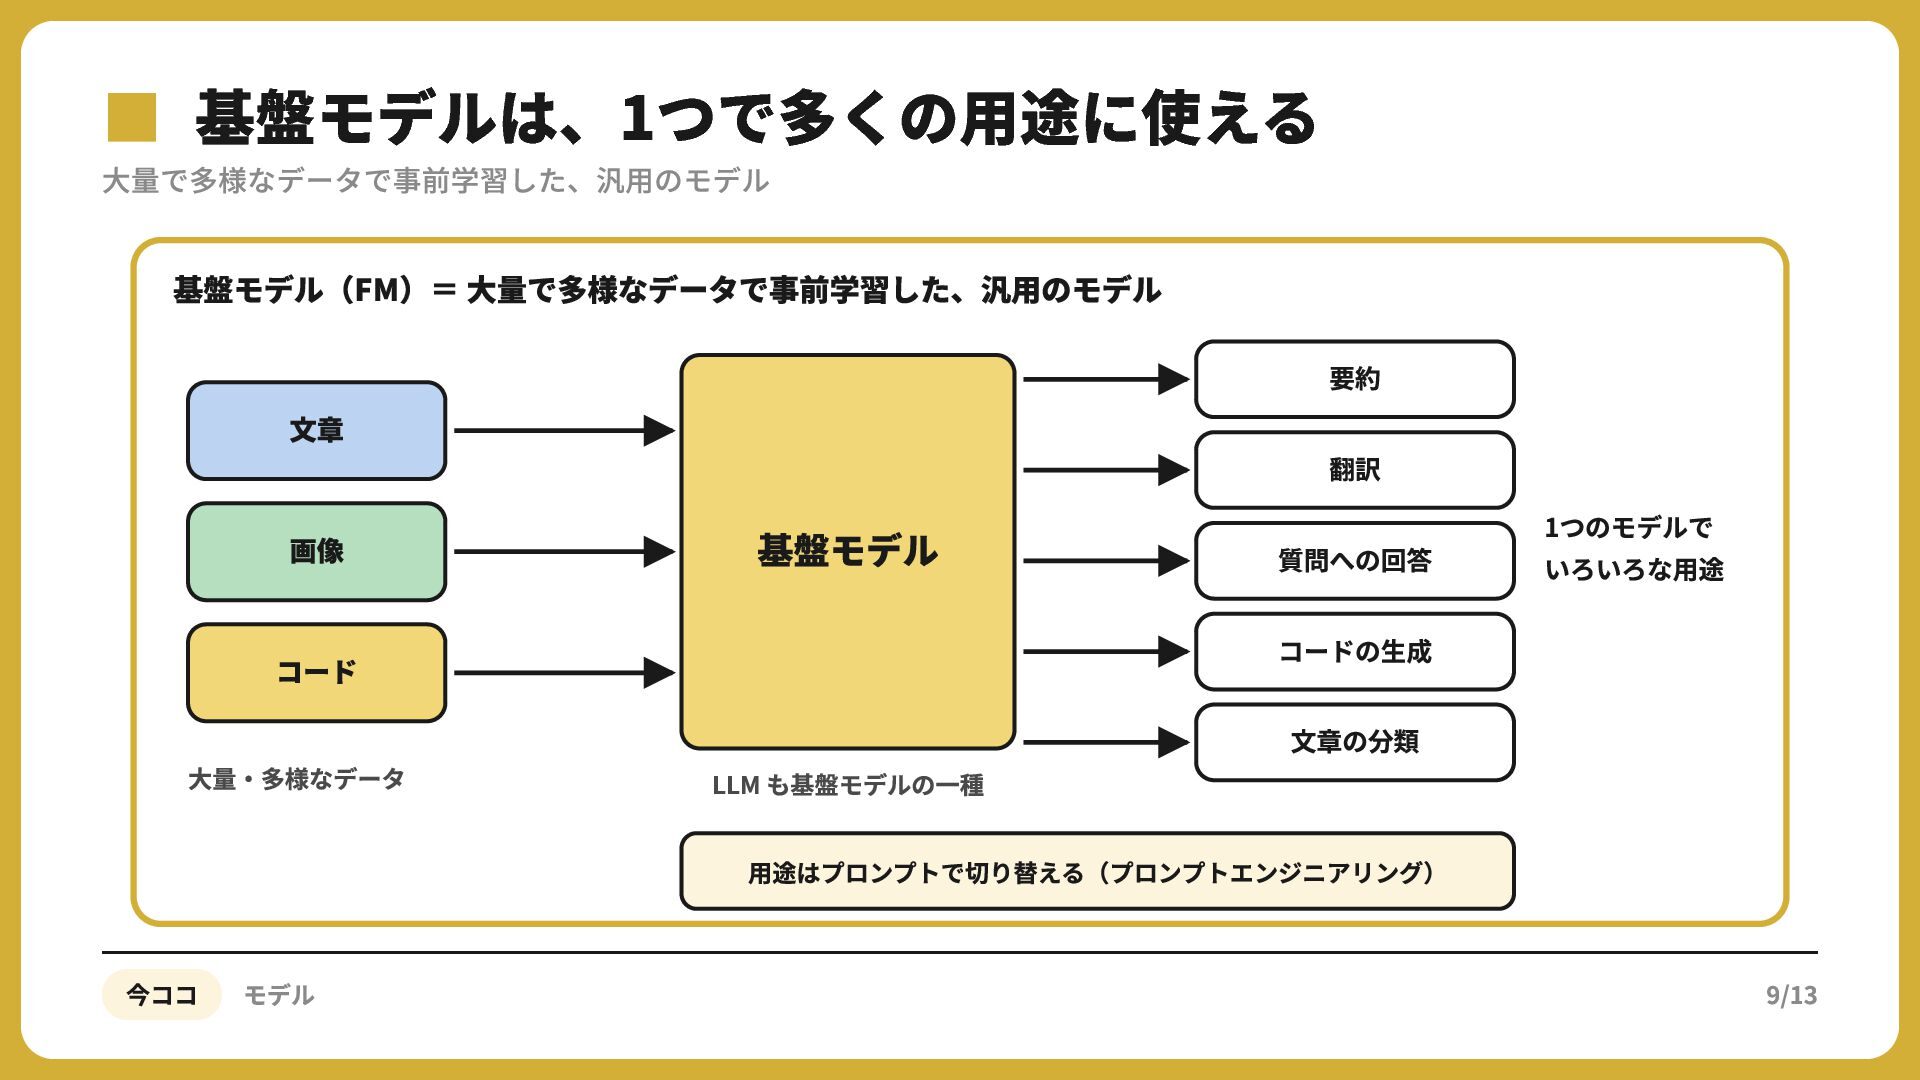
▪大量で多様なデータで事前学習した、汎用のモデル 基盤モデルは、1つで多くの用途に使える 基盤モデル(FM)= ⼤量で多様なデータで事前学習した、汎⽤のモデル 要約 ⽂章 画像 基盤モデル 質問への回答 1つのモデルで
いろいろな⽤途 コードの⽣成 コード ⼤量‧多様なデータ 翻訳 LLM も基盤モデルの⼀種 ⽂章の分類 ⽤途はプロンプトで切り替える(プロンプトエンジニアリング) 今ココ モデル 9/13
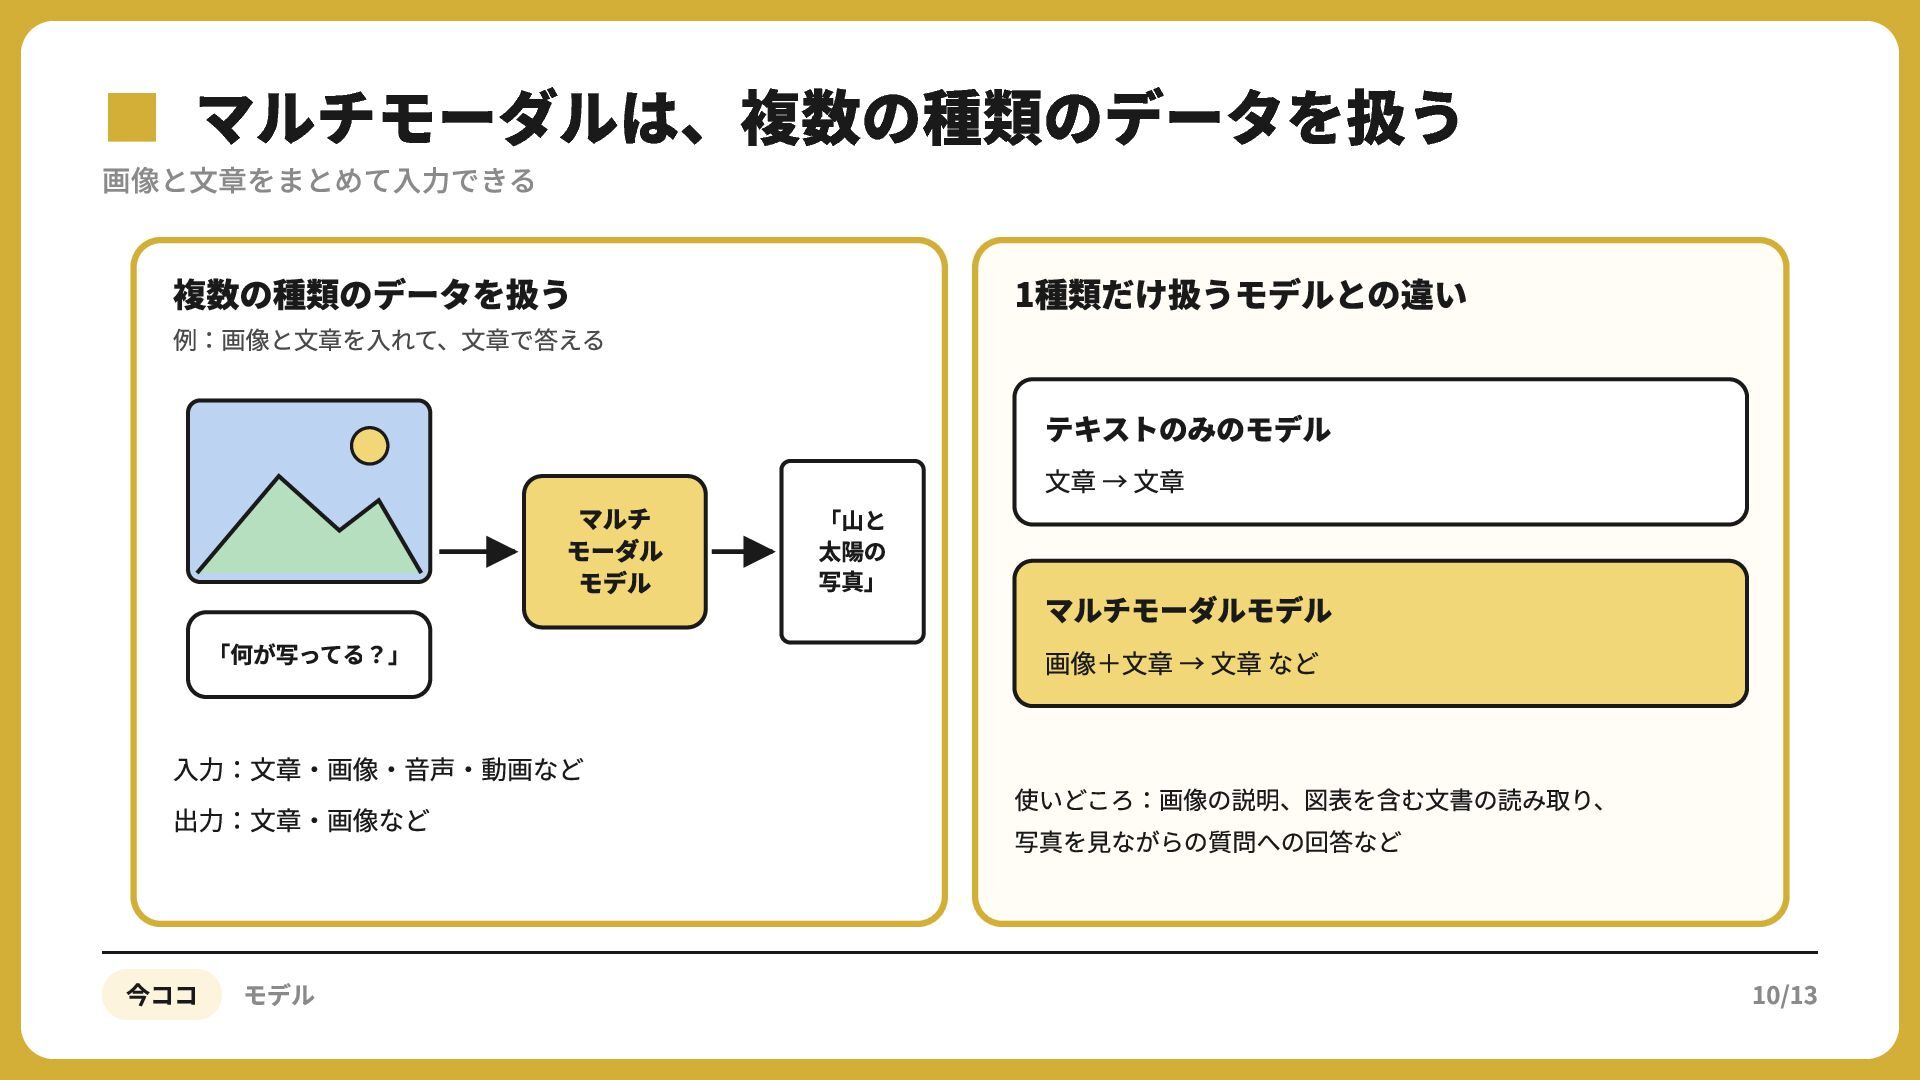
▪画像と文章をまとめて入力できる マルチモーダルは、複数の種類のデータを扱う 複数の種類のデータを扱う 1種類だけ扱うモデルとの違い 例:画像と⽂章を⼊れて、⽂章で答える テキストのみのモデル マルチ モーダル モデル 「何が写ってる?」
⼊⼒:⽂章‧画像‧⾳声‧動画など 出⼒:⽂章‧画像など 今ココ モデル 「⼭と 太陽の 写真」 ⽂章 → ⽂章 マルチモーダルモデル 画像+⽂章 → ⽂章 など 使いどころ:画像の説明、図表を含む⽂書の読み取り、 写真を⾒ながらの質問への回答など 10/13
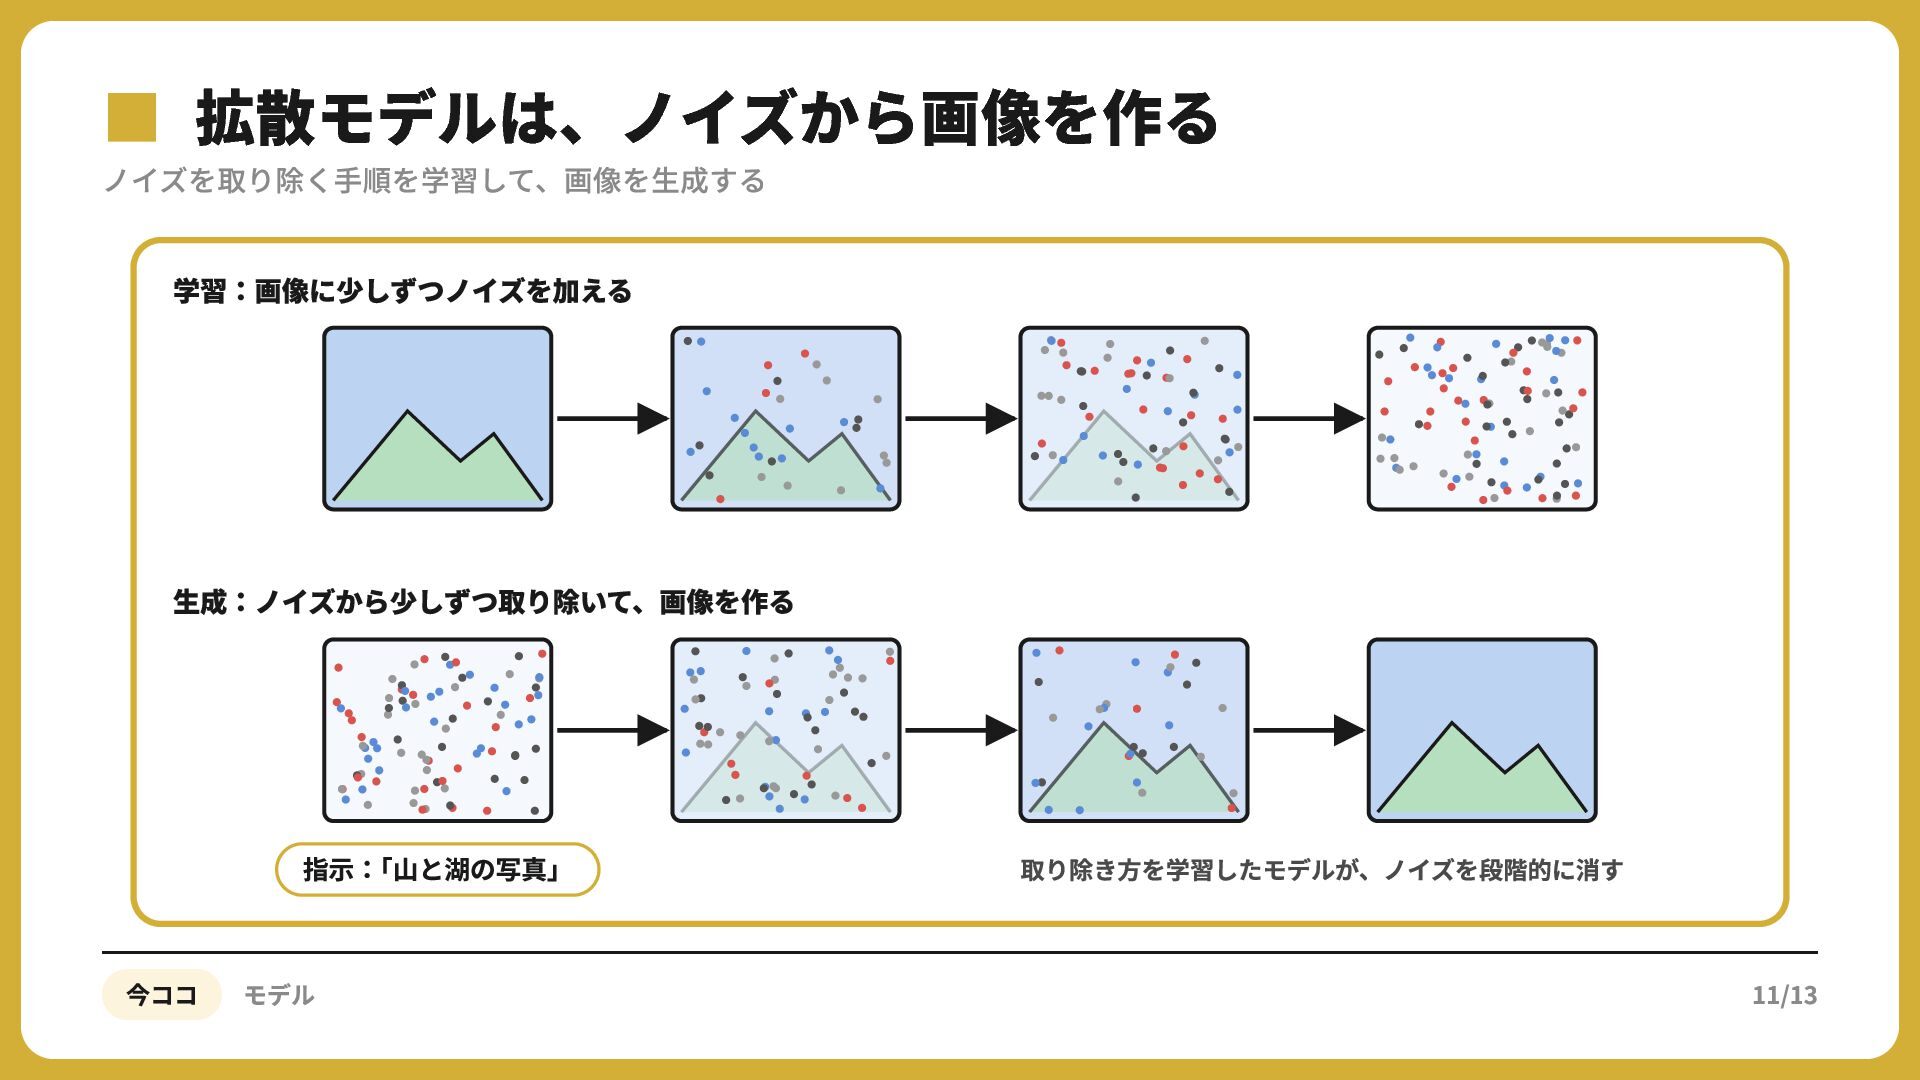
▪ノイズを取り除く手順を学習して、画像を生成する 拡散モデルは、ノイズから画像を作る 学習:画像に少しずつノイズを加える ⽣成:ノイズから少しずつ取り除いて、画像を作る 指⽰:「⼭と湖の写真」 今ココ モデル 取り除き⽅を学習したモデルが、ノイズを段階的に消す 11/13
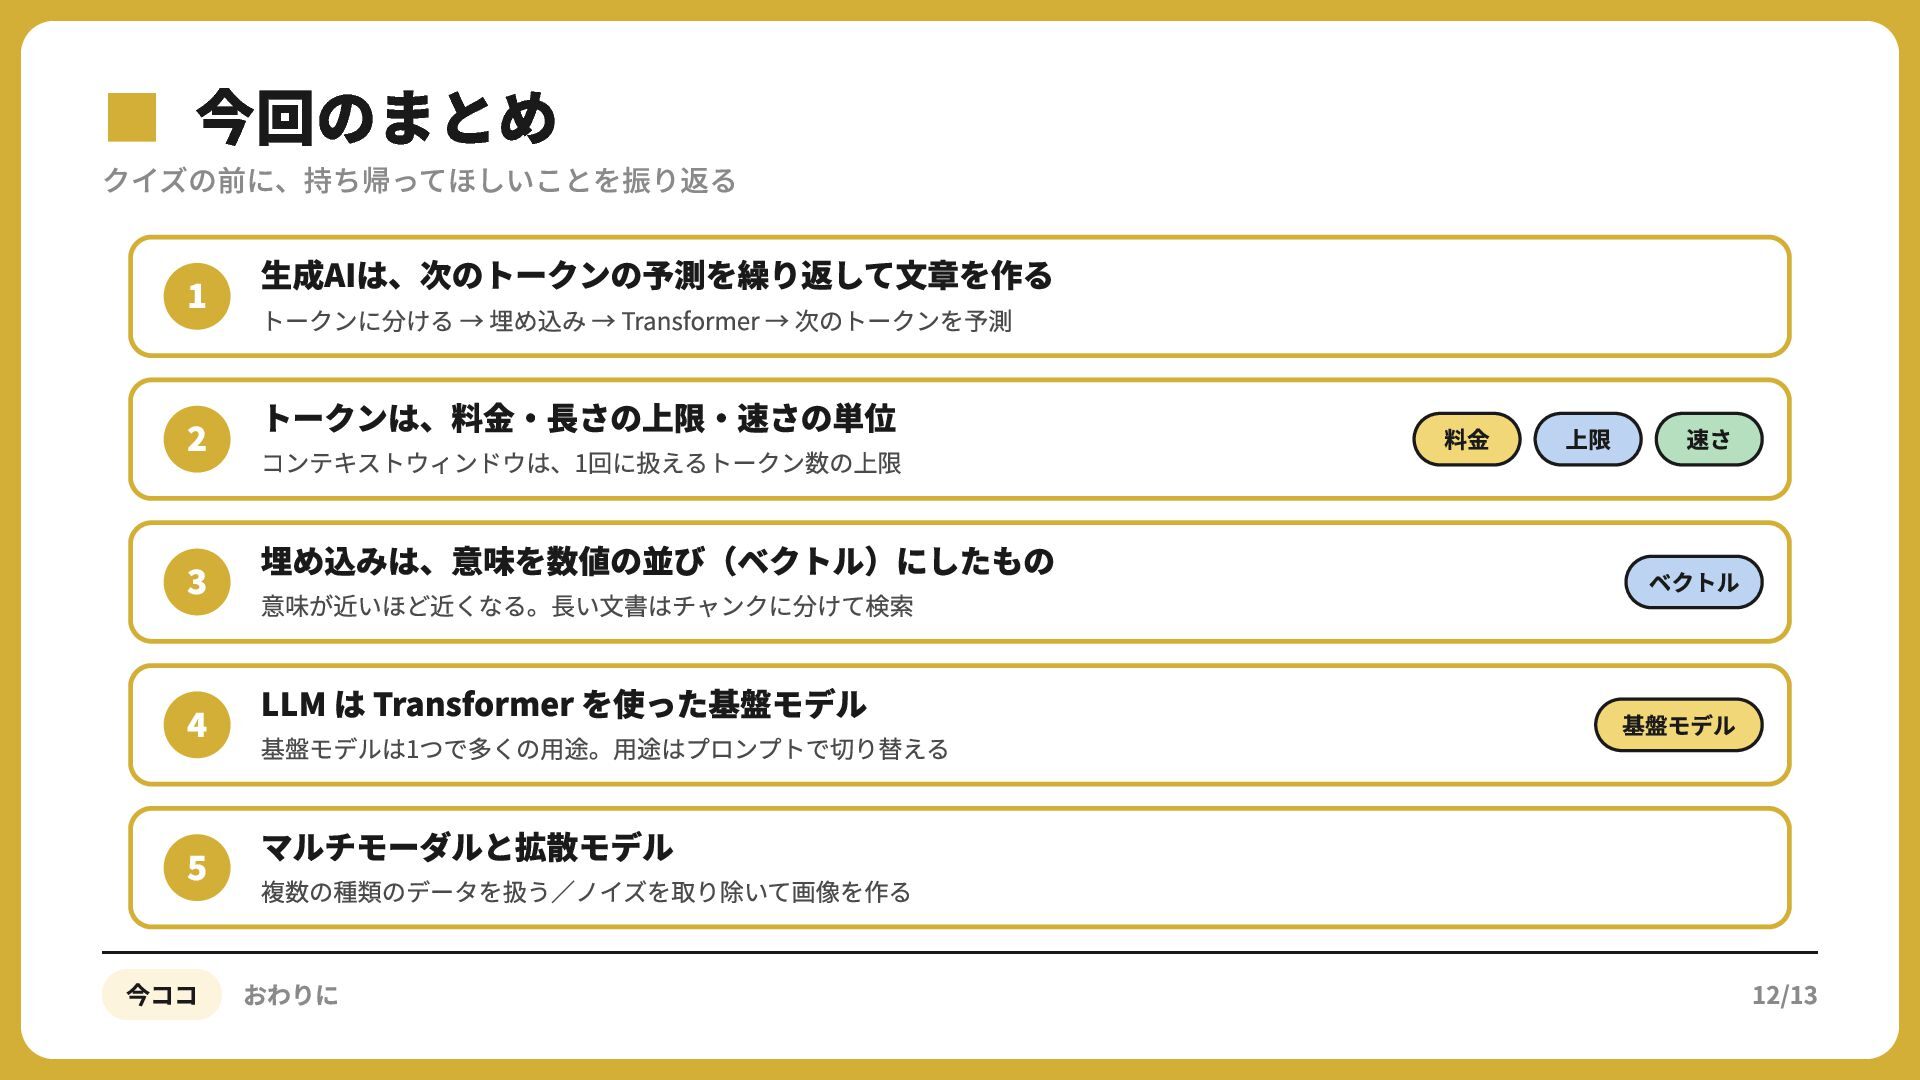
▪クイズの前に、持ち帰ってほしいことを振り返る 今回のまとめ ⽣成AIは、次のトークンの予測を繰り返して⽂章を作る トークンに分ける → 埋め込み → Transformer → 次のトークンを予測
トークンは、料⾦‧⻑さの上限‧速さの単位 コンテキストウィンドウは、1回に扱えるトークン数の上限 料⾦ 上限 速さ 埋め込みは、意味を数値の並び(ベクトル)にしたもの ベクトル LLM は Transformer を使った基盤モデル 基盤モデル 意味が近いほど近くなる。⻑い⽂書はチャンクに分けて検索 基盤モデルは1つで多くの⽤途。⽤途はプロンプトで切り替える マルチモーダルと拡散モデル 複数の種類のデータを扱う∕ノイズを取り除いて画像を作る 今ココ おわりに 12/13
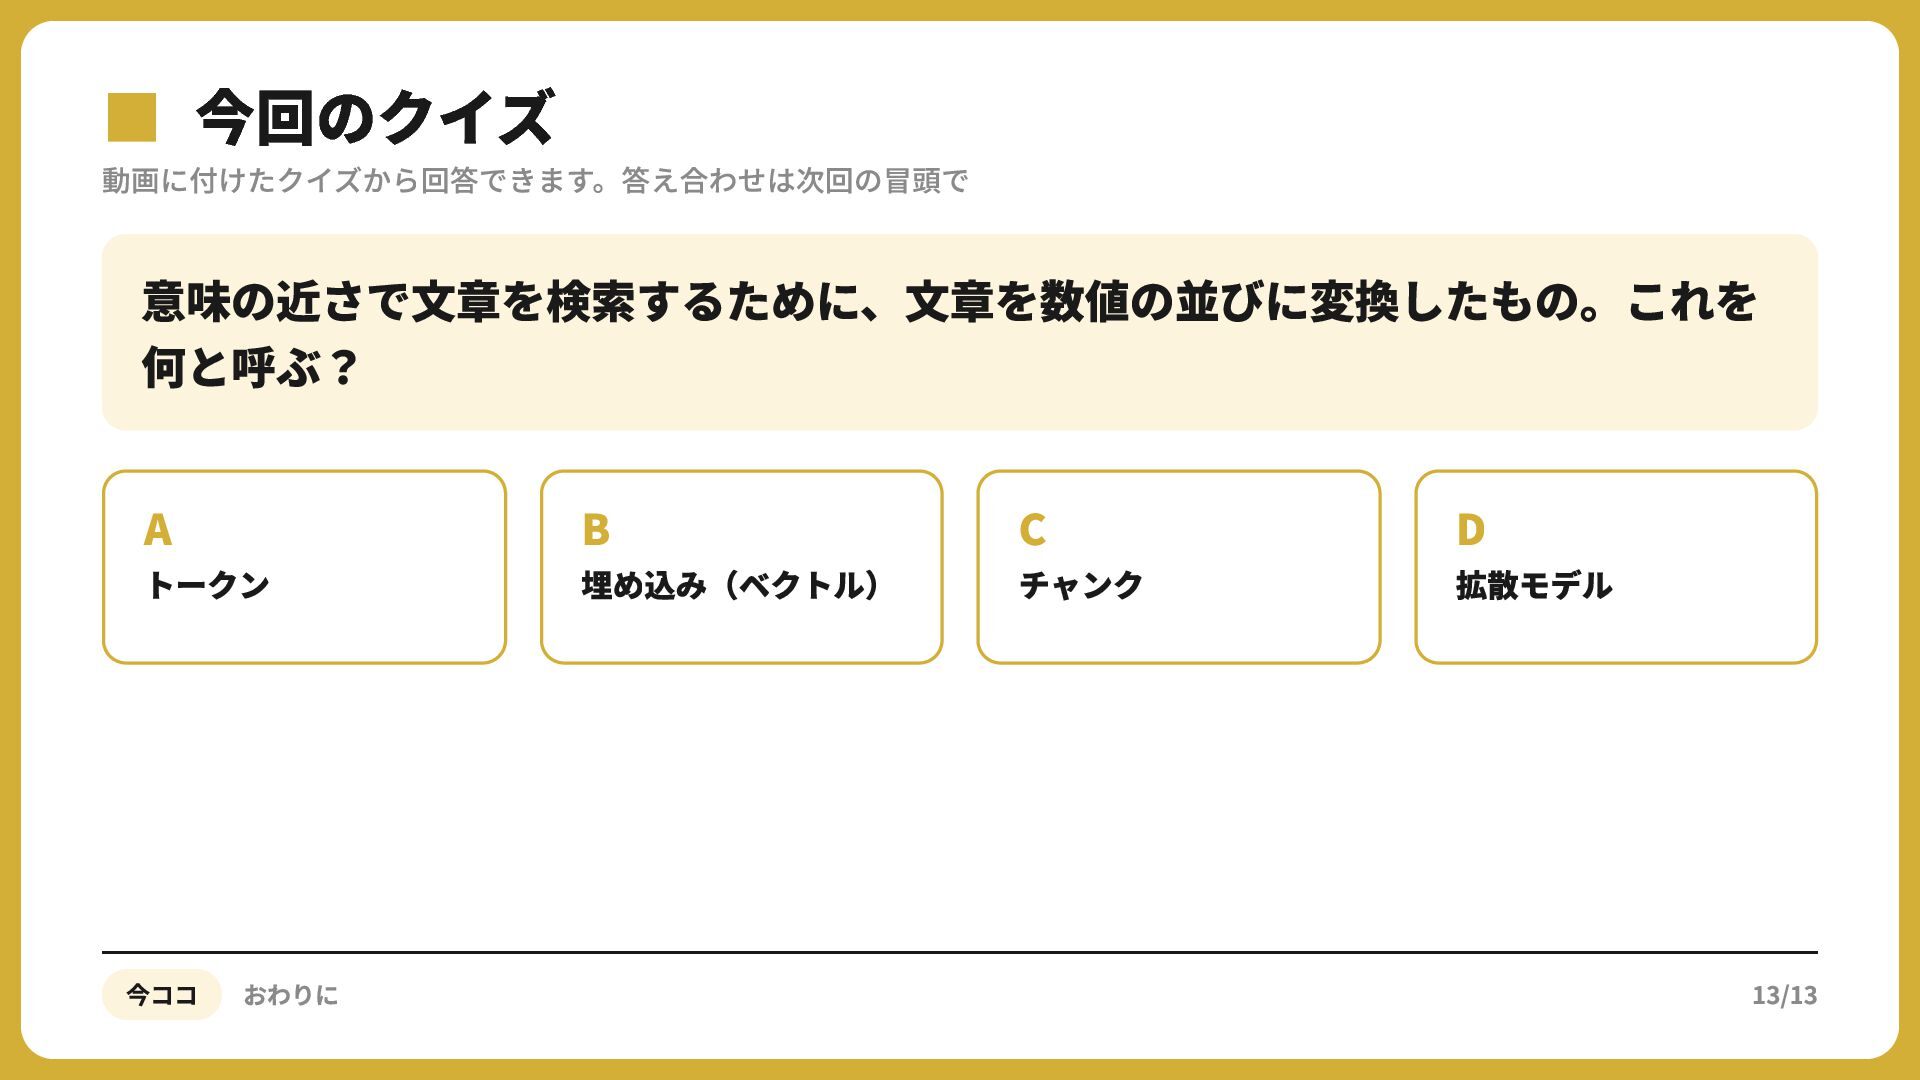
▪動画に付けたクイズから回答できます。答え合わせは次回の冒頭で 今回のクイズ 意味の近さで文章を検索するために、文章を数値の並びに変換したもの。これを 何と呼ぶ? A トークン 今ココ おわりに B 埋め込み(ベクトル)
C チャンク D 拡散モデル 13/13


 akagami
 irinanazarova
 ssssota
 satotakeshi
 kaseken
 lx_t
 atsuki_seo
 kobakei
 hideg
 m_seki
 yuukiw00w
 honmarkhunt
 yukiny
 aleyda
 pwiseman
 speakerdeck
 skipperchong
 rmw
 sergeychernyshev
 mfonobong
 mayatellez
 jonoalderson
 axbom
 quramy