Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
DBTS2026 盛り上がってますか!?Databricksが実現するAI時代のデータ基盤
Search
Akihiro Kuwano
November 06, 2026
Technology
100
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
DBTS2026 盛り上がってますか!?Databricksが実現するAI時代のデータ基盤
DB Tech Showcase 2026にて講演しましたスライドです
Akihiro Kuwano
November 06, 2026
More Decks by Akihiro Kuwano
See All by Akihiro Kuwano
あの手この手で今をときめけ!Databricks!
akuwano
1
1.3k
Lakeflow - Spark Declarative Pipelines って知ってますか?
akuwano
1
330
Text2SQLだよ全員集合!!!データエージェントのチューニング事始め!
akuwano
0
240
データ基盤からデータベースまで?広がるユースケースのDatabricksについて教えるよ!
akuwano
3
670
Databricksで完全履修!オールインワンレイクハウスは実在した!
akuwano
0
430
レイクハウスとはなんだったのか?
akuwano
18
5.2k
Delta Commit…の最近...
akuwano
2
370
貴方のツールボックスにねじこみたい!ドキュメントデータベースのススメ
akuwano
3
990
これから始めるNoSQL!AWSのNoSQLサービスを紹介します!
akuwano
1
530
Other Decks in Technology
See All in Technology
Maestro MCPとClaude Code Skillsによる自律的なE2Eテスト支援
asmz
0
420
bpf_arenaとstruct_opsを使うのが難しかった話
masu_mi
1
120
超⼩型・多⾔語検索モデル Bekko Embedding
hotchpotch
1
100
公共分野での生成AI活用
toru_kubota
1
150
AWS構成から考えるWebセキュリティ ― WordPressの構築経験から考える公開範囲と更新運用【JAWS FESTA 2026 in AKITA】
cscengineer
PRO
1
170
eBPF 簡介 2026 版
shunghsiyu
0
180
分析作業をどこまで任せるか自分で決められる AIネイティブBI『Golden Analytics』が 良さげな話 /golden-analytics-is-ai-native-bi
shinyaa31
0
120
これだけは抑えておきたい!後悔しない re:Invent の過ごし方 / AWS re:Invent 2026 prestudy
kinunori
2
710
レガシーコードに対する loop engineering的なAI開発プロセス導入について
kubell_hr
0
230
生き様としてのSRE
hokkai7go
1
170
[General] 개발자로 해외 기업에서 일하기
skydoves
1
300
Deep Data Security 機能解説
oracle4engineer
PRO
3
1k
Featured
See All Featured
The browser strikes back
jonoalderson
0
1.9k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.2k
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.7k
Self-Hosted WebAssembly Runtime for Runtime-Neutral Checkpoint/Restore in Edge–Cloud Continuum
chikuwait
0
920
Faster Mobile Websites
deanohume
310
32k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
290
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
400
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3.1k
Un-Boring Meetings
codingconduct
0
490
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
520
Transcript
盛り上がって ますか!? Databricksが実現する AI時代のデータ基盤 DB TECH SHOWCASE 2026 / COMMUNITY
SESSION / 2026-11-06 ROOM C ©2026 Databricks, Inc. — All rights reserved
プロダクト セーフ ハーバー ステートメント この情報は、データブリックスの一般的な製品の方向性を概説するために提供さ れるものであり、情報提供のみを目的 としています。データブリックスのサービス を購入するお客様は、現在利用可能なサービス、特徴、機能のみに依拠して購 入を決定してください。将来見通しに関する記述に記載されている未発表の機能 または特徴は、データブリックスの裁量で変更される可能性があり、計画通りま
たは全く提供されない可能性があります。 ©2026 Databricks, Inc. — All rights reserved
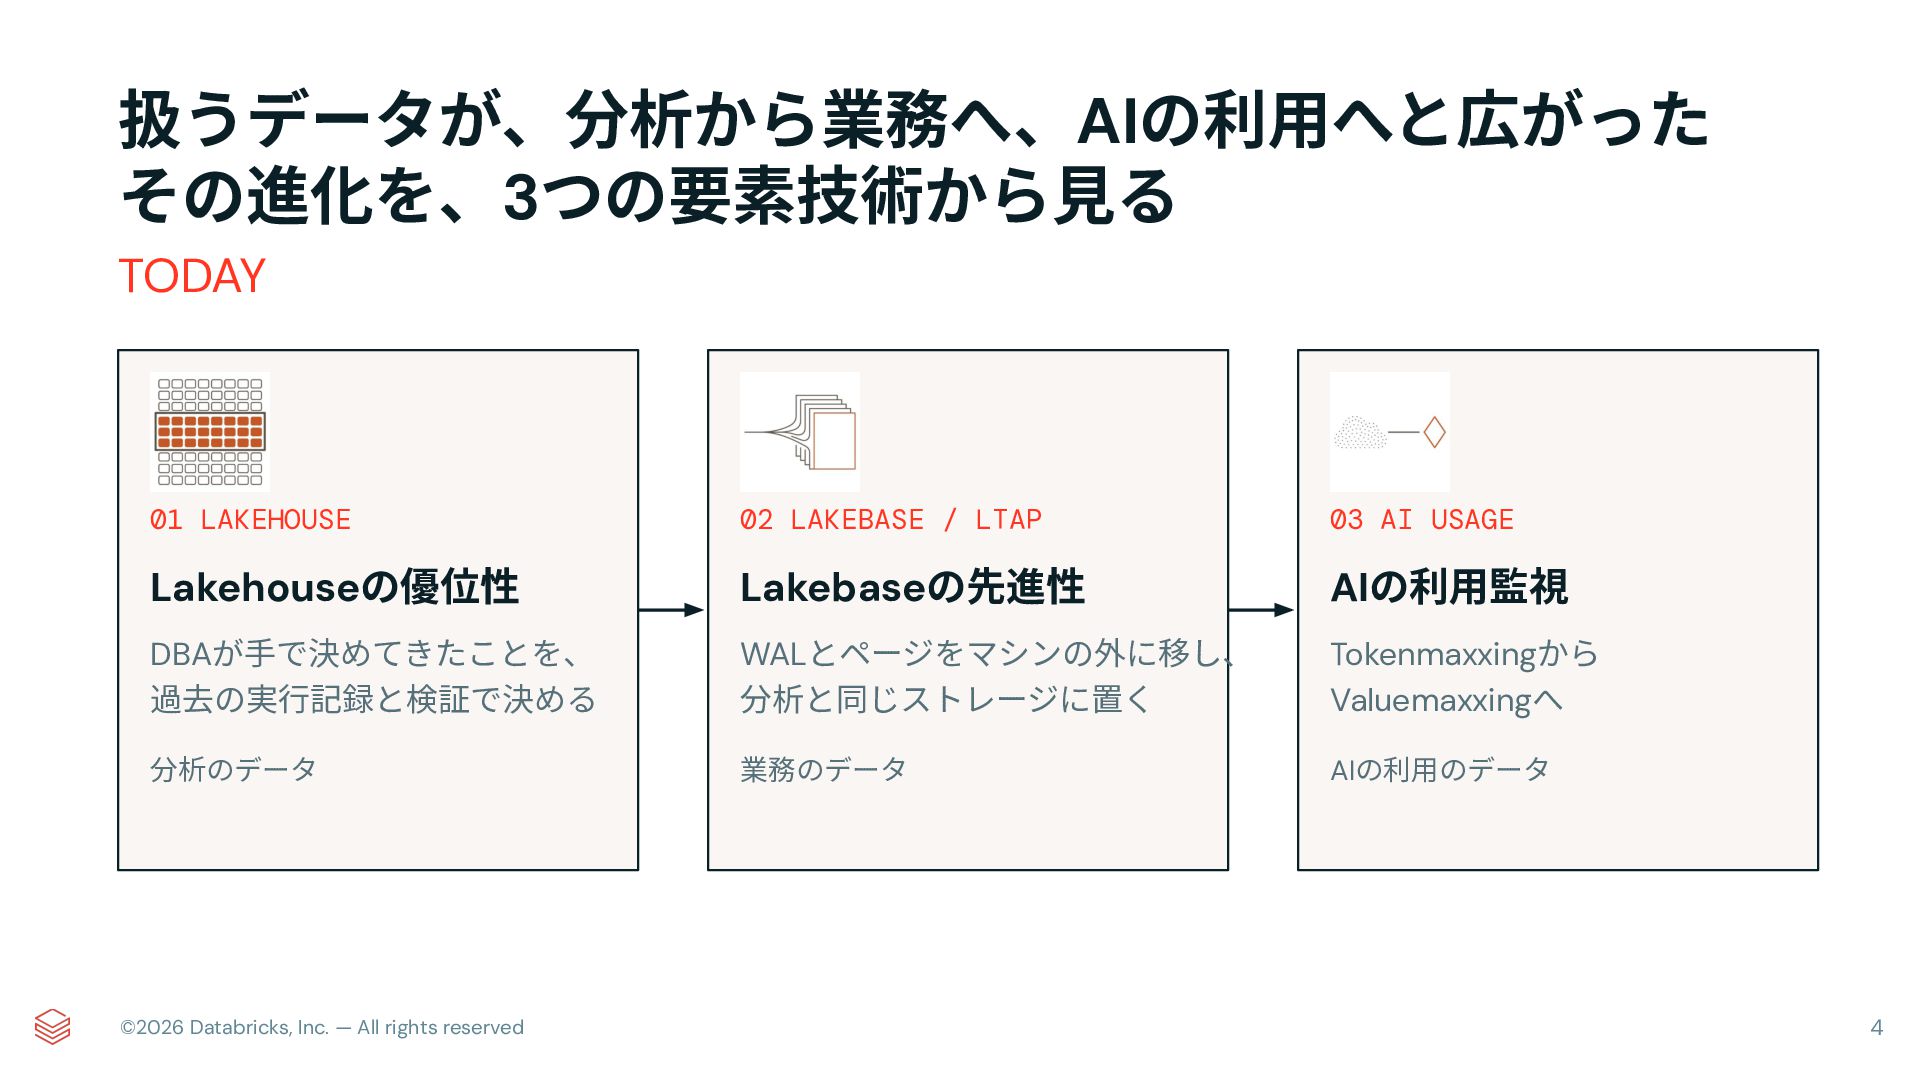
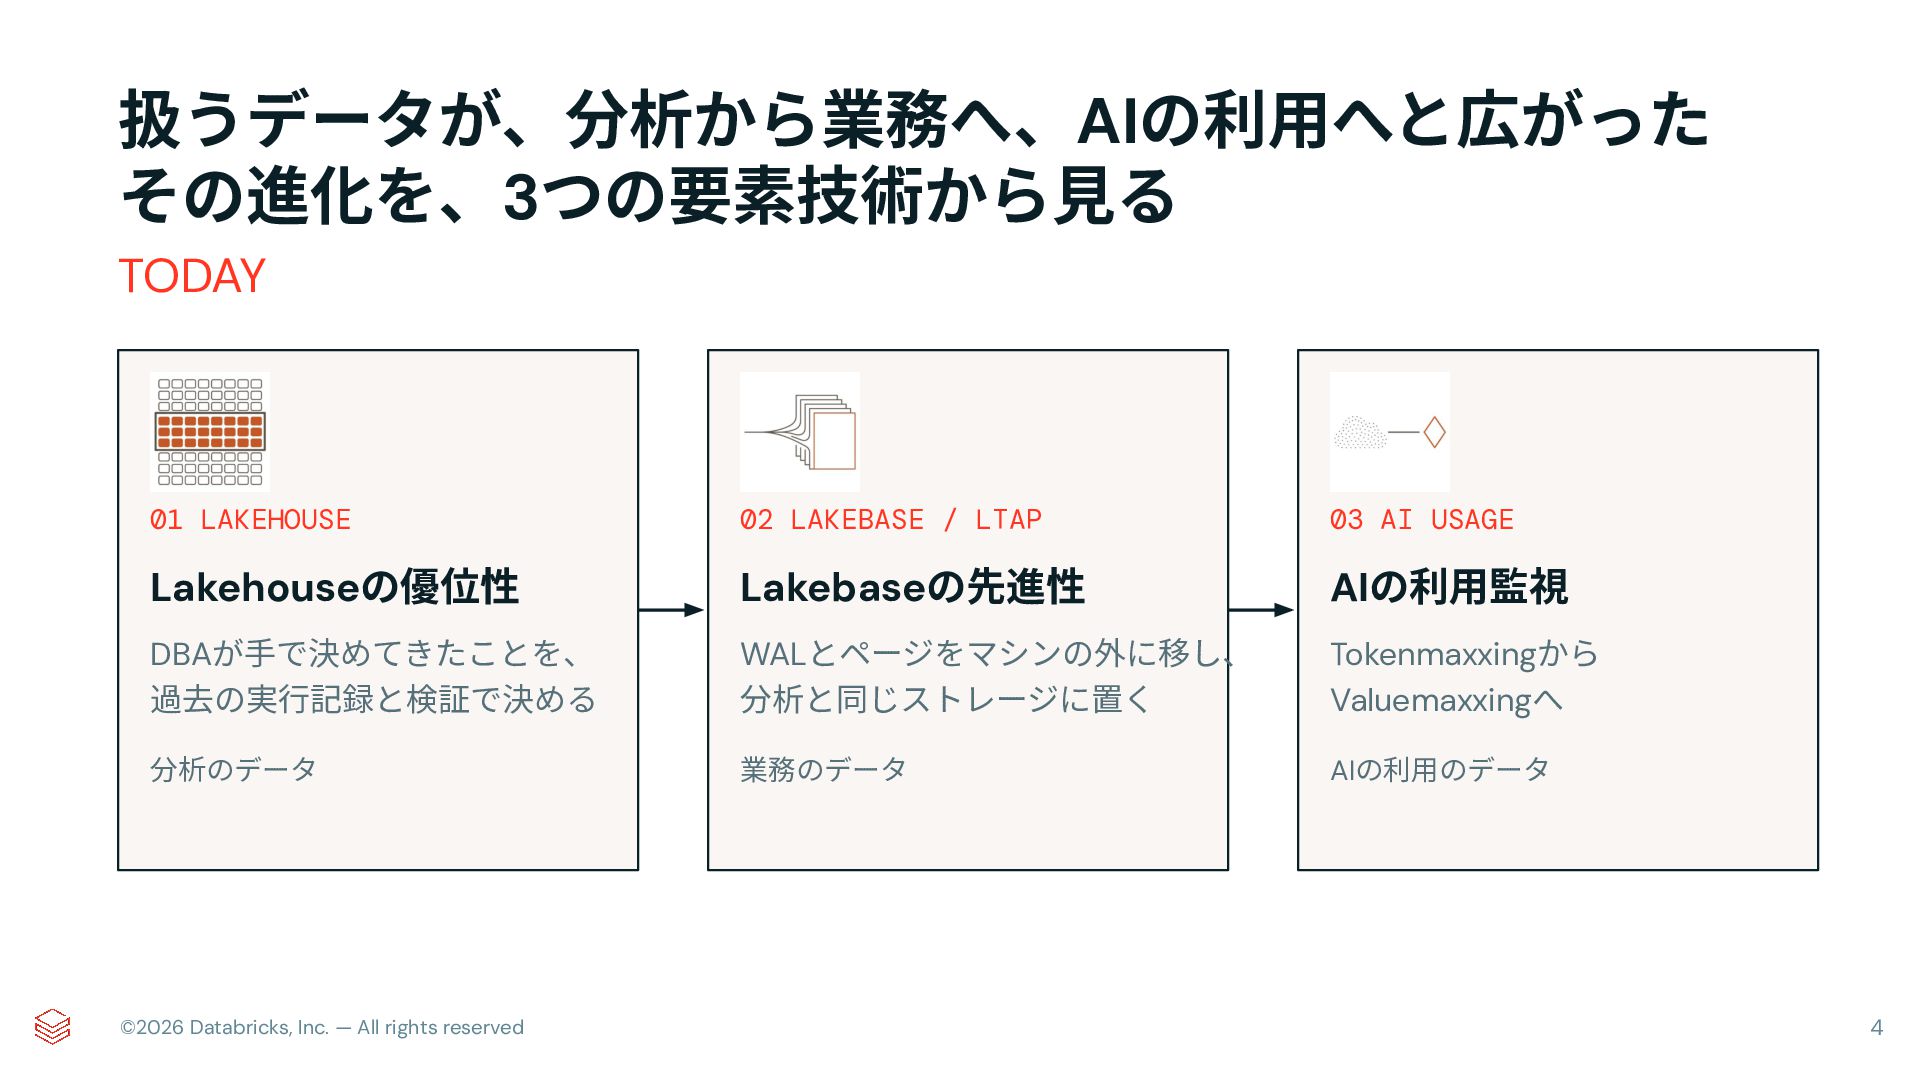
扱うデータが、分析から業務へ、AIの利⽤へと広がった その進化を、3つの要素技術から⾒る TODAY 01 LAKEHOUSE 02 LAKEBASE / LTAP 03
AI USAGE Lakehouseの優位性 Lakebaseの先進性 AIの利⽤監視 DBAが⼿で決めてきたことを、 過去の実⾏記録と検証で決める WALとページをマシンの外に移し、 分析と同じストレージに置く Tokenmaxxingから Valuemaxxingへ 分析のデータ 業務のデータ AIの利⽤のデータ ©2026 Databricks, Inc. — All rights reserved 4
Databricksは、データとAIを 1つの基盤で扱う 公式 · 会社概要 WHAT IS DATABRICKS 基本の構成 2013
分析 データ処理 機械学習 AI 創業 Apache Spark(分散処理)や Delta Lake(表の形式)の 最初の開発者たちが創業 ©2026 Databricks, Inc. — All rights reserved 同じ権限の仕組み(Unity Catalog) オブジェクトストレージ(開いた形式) 5
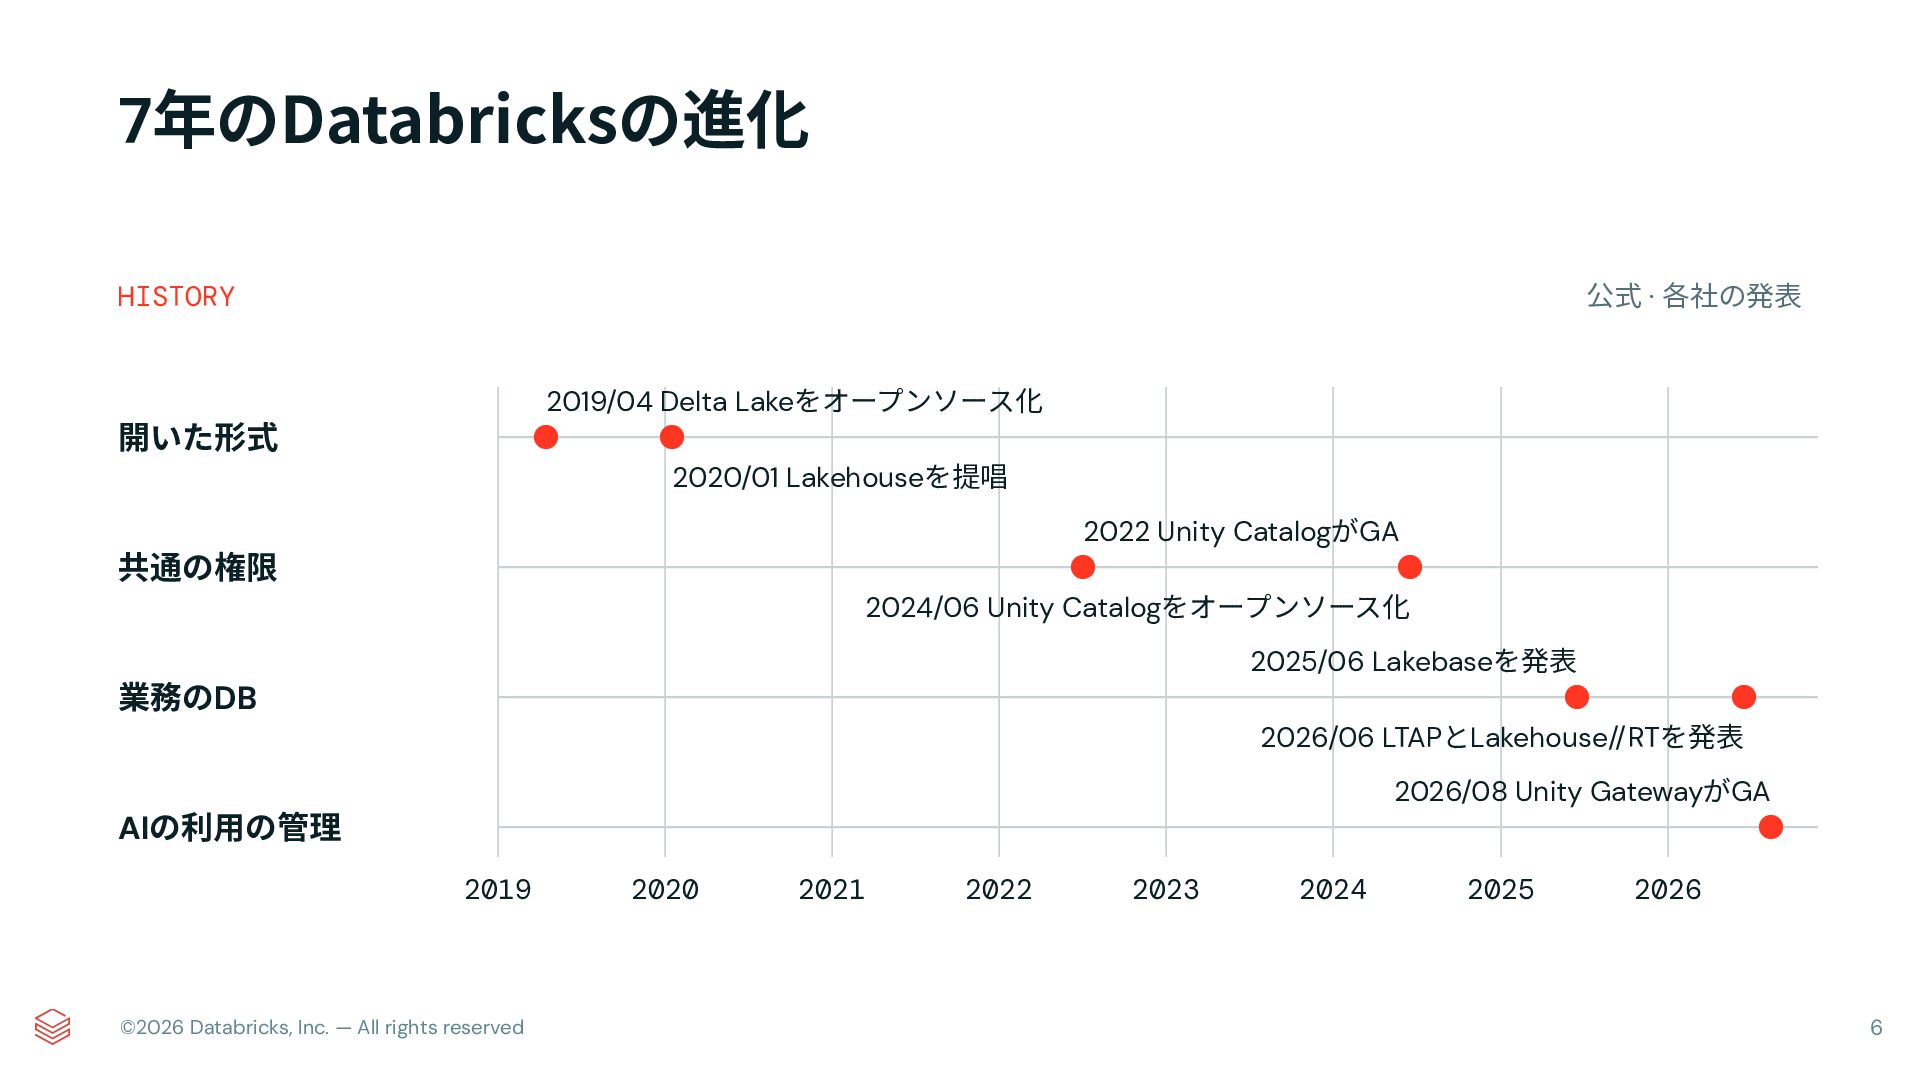
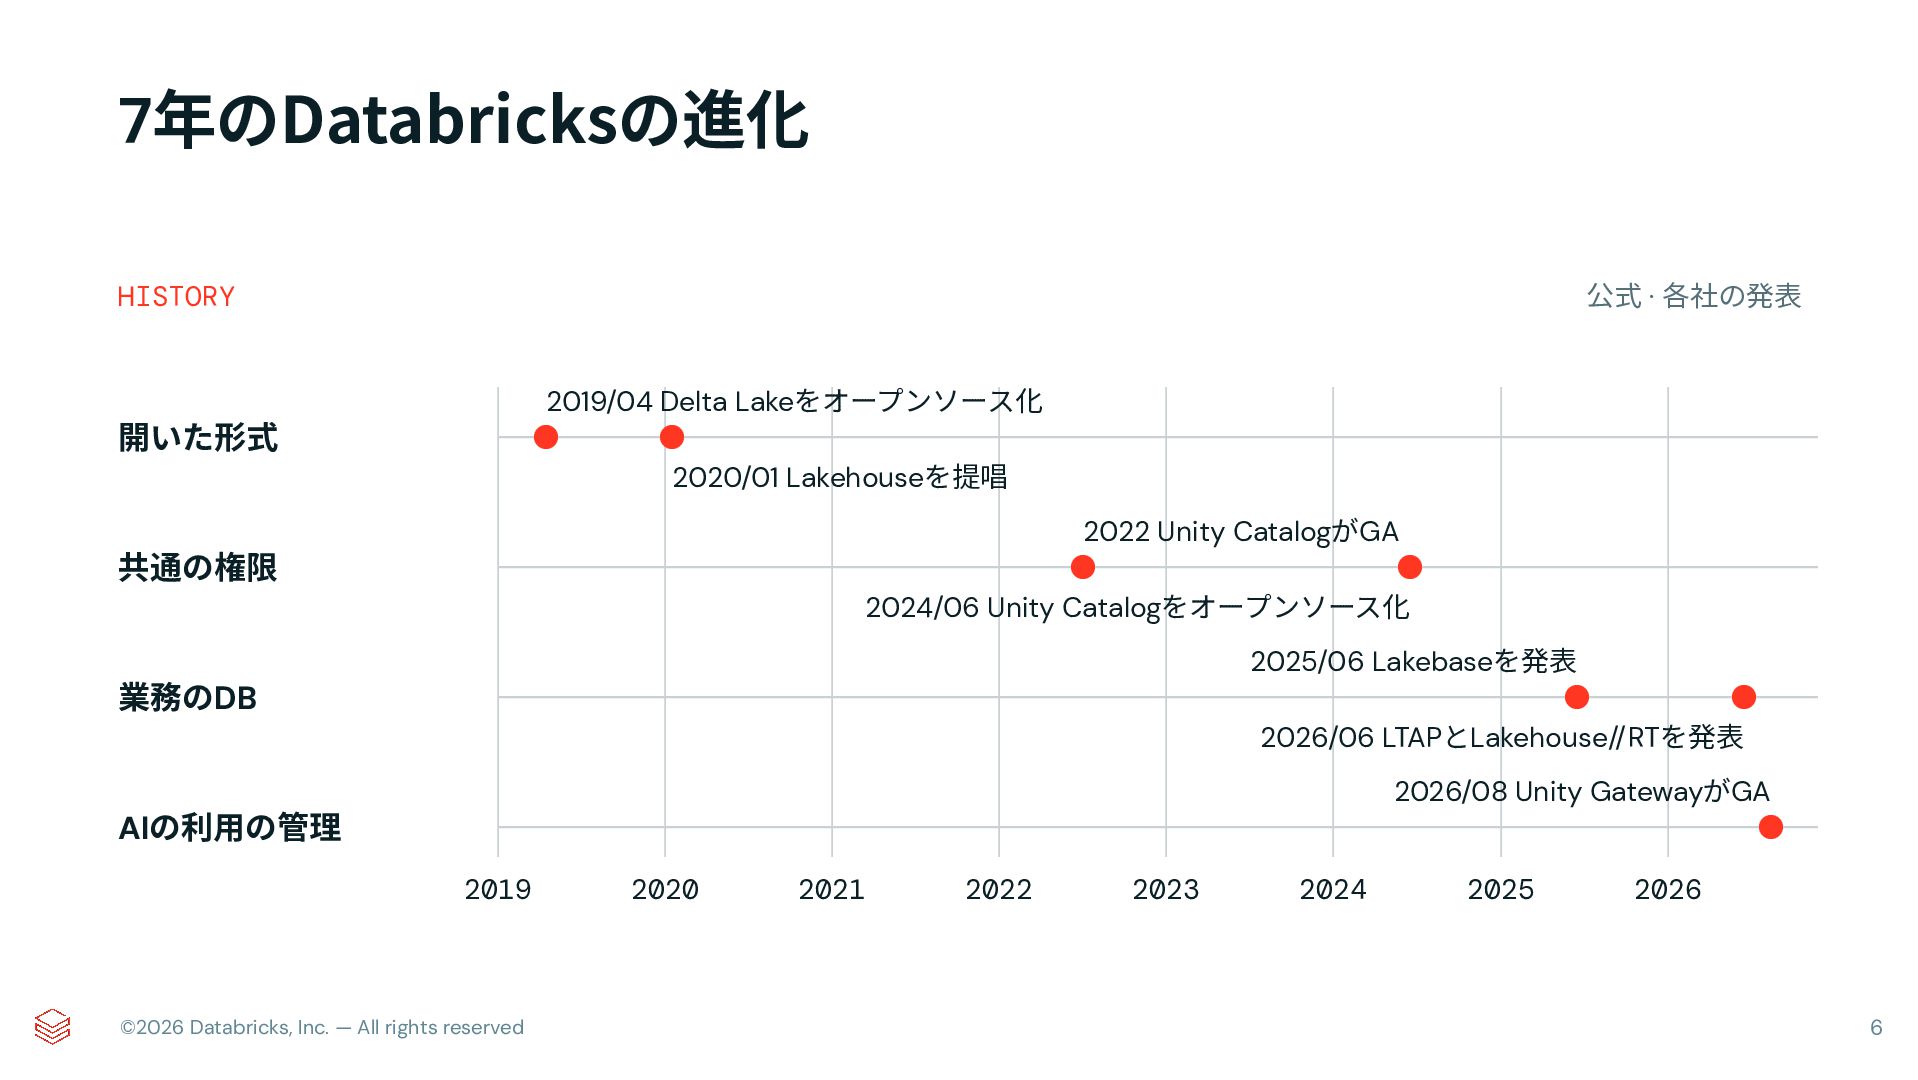
7年のDatabricksの進化 公式 · 各社の発表 HISTORY 2019/04 Delta Lakeをオープンソース化 開いた形式 2020/01
Lakehouseを提唱 2022 Unity CatalogがGA 共通の権限 2024/06 Unity Catalogをオープンソース化 2025/06 Lakebaseを発表 業務のDB 2026/06 LTAPとLakehouse//RTを発表 2026/08 Unity GatewayがGA AIの利⽤の管理 2019 ©2026 Databricks, Inc. — All rights reserved 2020 2021 2022 2023 2024 2025 2026 6
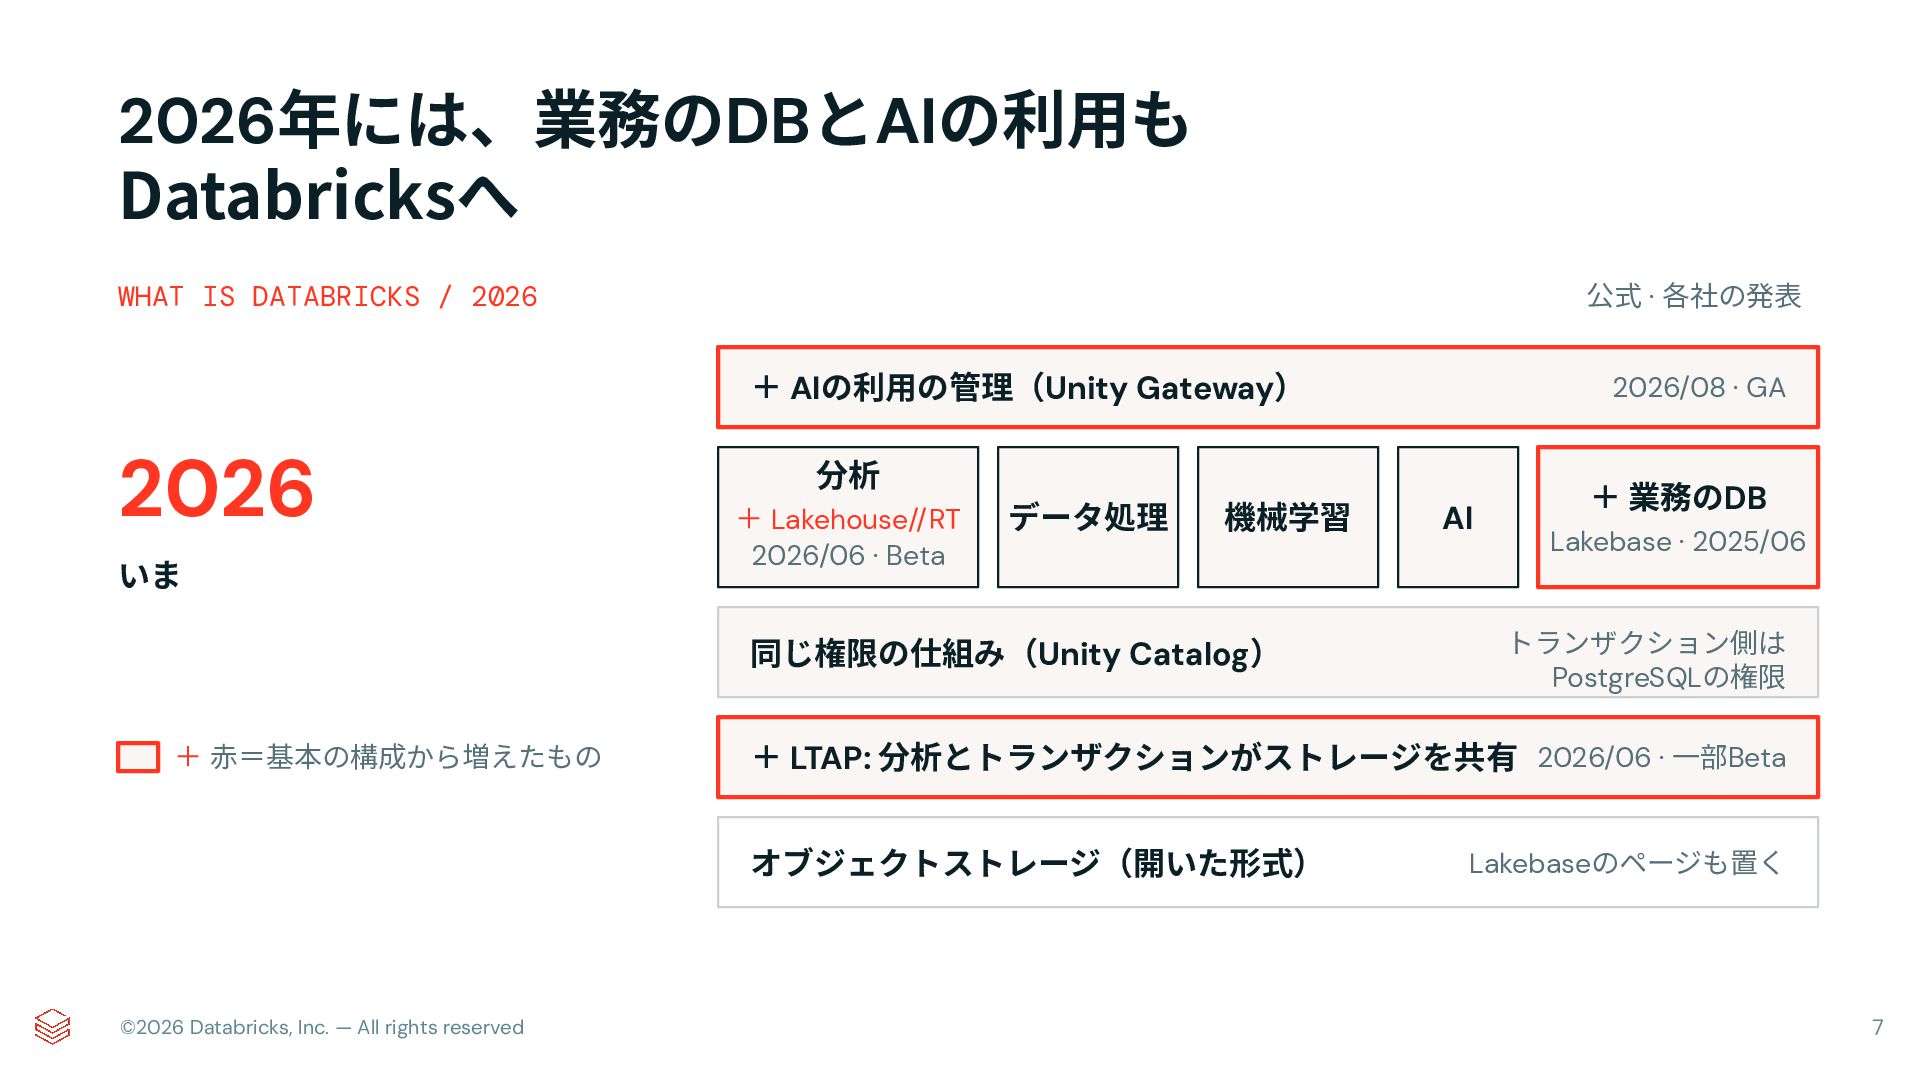
2026年には、業務のDBとAIの利⽤も Databricksへ 公式 · 各社の発表 WHAT IS DATABRICKS / 2026
+ AIの利⽤の管理(Unity Gateway) 2026 いま 分析 + Lakehouse//RT 2026/06 · Beta データ処理 機械学習 同じ権限の仕組み(Unity Catalog) + ⾚=基本の構成から増えたもの AI + 業務のDB Lakebase · 2025/06 トランザクション側は PostgreSQLの権限 + LTAP: 分析とトランザクションがストレージを共有 2026/06 · ⼀部Beta オブジェクトストレージ(開いた形式) ©2026 Databricks, Inc. — All rights reserved 2026/08 · GA Lakebaseのページも置く 7
今日はDatabricksの技術の源泉である 論文と、社内のドッグフーディング から! いくつかの紹介をしていきます ©2026 Databricks, Inc. — All rights
reserved
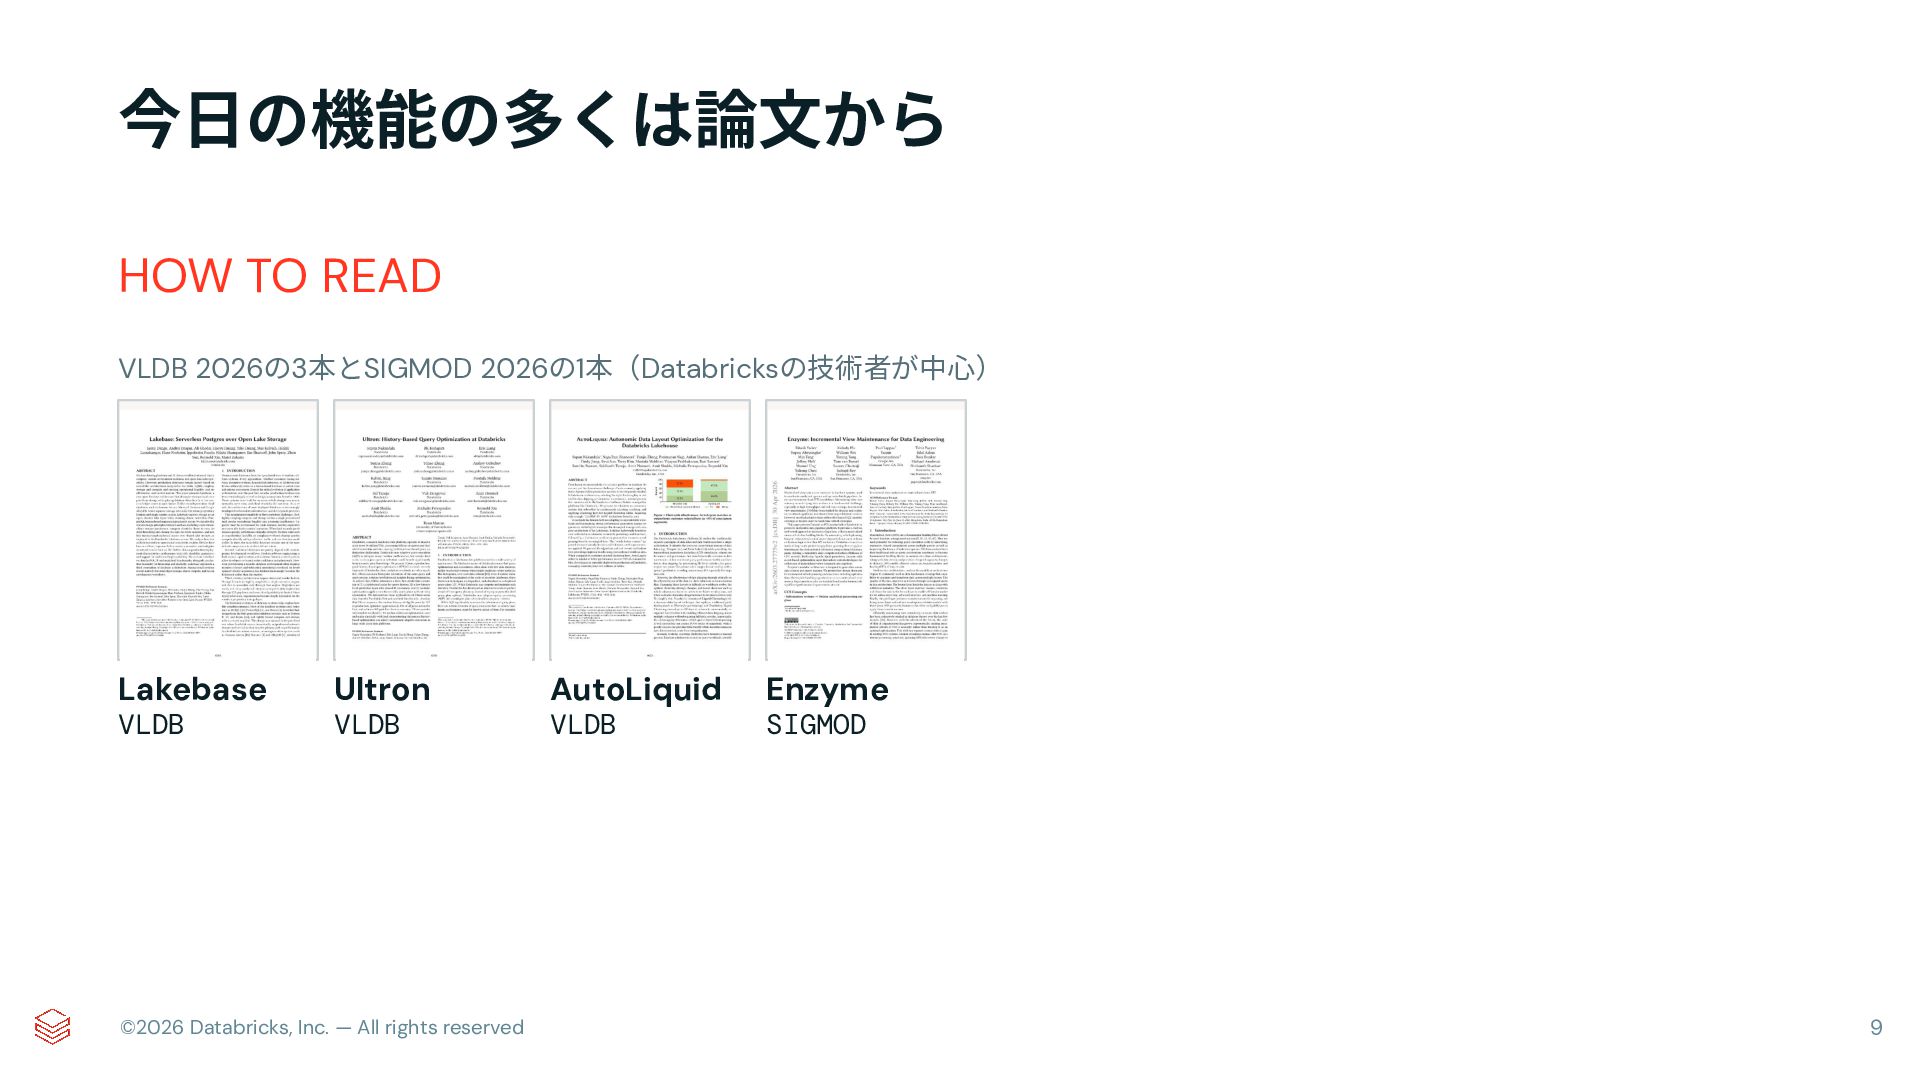
今⽇の機能の多くは論⽂から HOW TO READ VLDB 2026の3本とSIGMOD 2026の1本(Databricksの技術者が中⼼) Lakebase VLDB Ultron
VLDB ©2026 Databricks, Inc. — All rights reserved AutoLiquid VLDB Enzyme SIGMOD 9
01 分析のデータと Lakehouse ©2026 Databricks, Inc. — All rights reserved
10
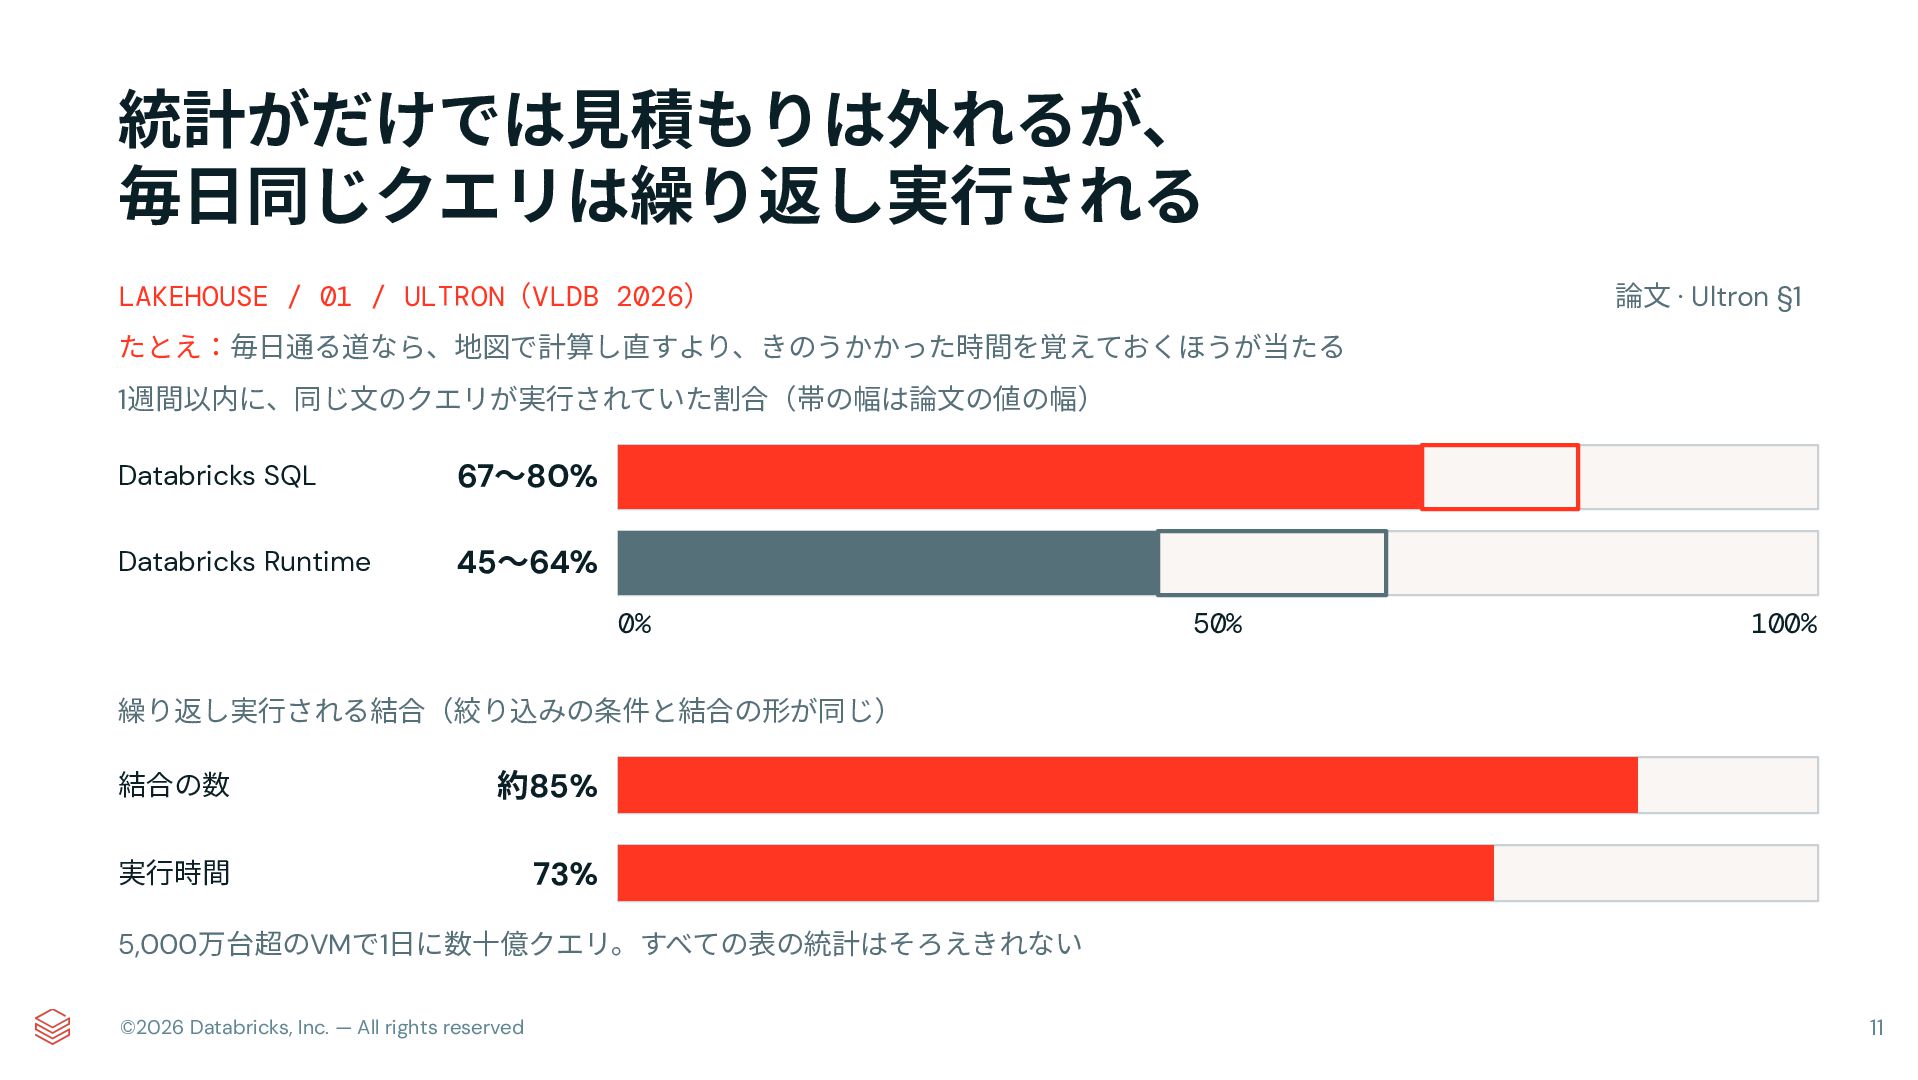
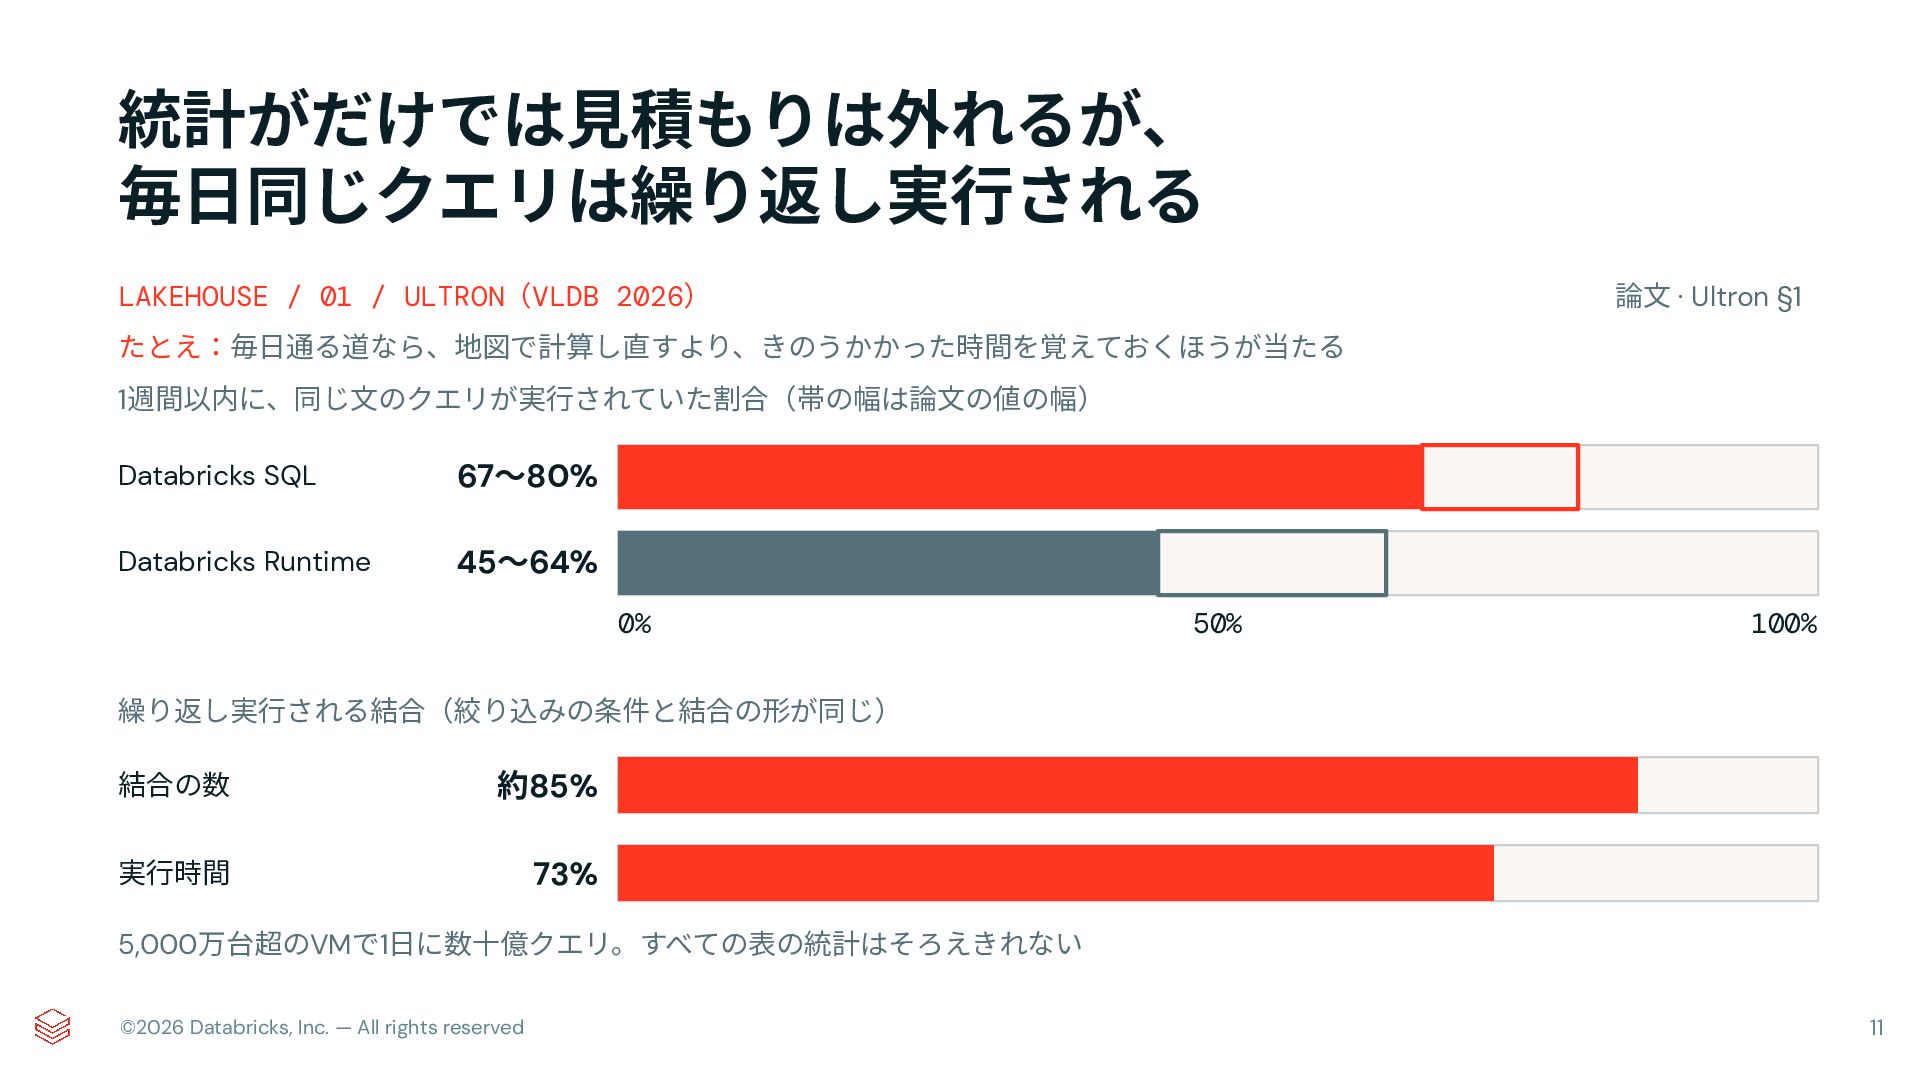
統計がだけでは⾒積もりは外れるが、 毎⽇同じクエリは繰り返し実⾏される 論⽂ · Ultron §1 LAKEHOUSE / 01 /
ULTRON(VLDB 2026) たとえ:毎⽇通る道なら、地図で計算し直すより、きのうかかった時間を覚えておくほうが当たる 1週間以内に、同じ⽂のクエリが実⾏されていた割合(帯の幅は論⽂の値の幅) Databricks SQL 67〜80% Databricks Runtime 45〜64% 0% 50% 100% 繰り返し実⾏される結合(絞り込みの条件と結合の形が同じ) 結合の数 約85% 実⾏時間 73% 5,000万台超のVMで1⽇に数⼗億クエリ。すべての表の統計はそろえきれない ©2026 Databricks, Inc. — All rights reserved 11
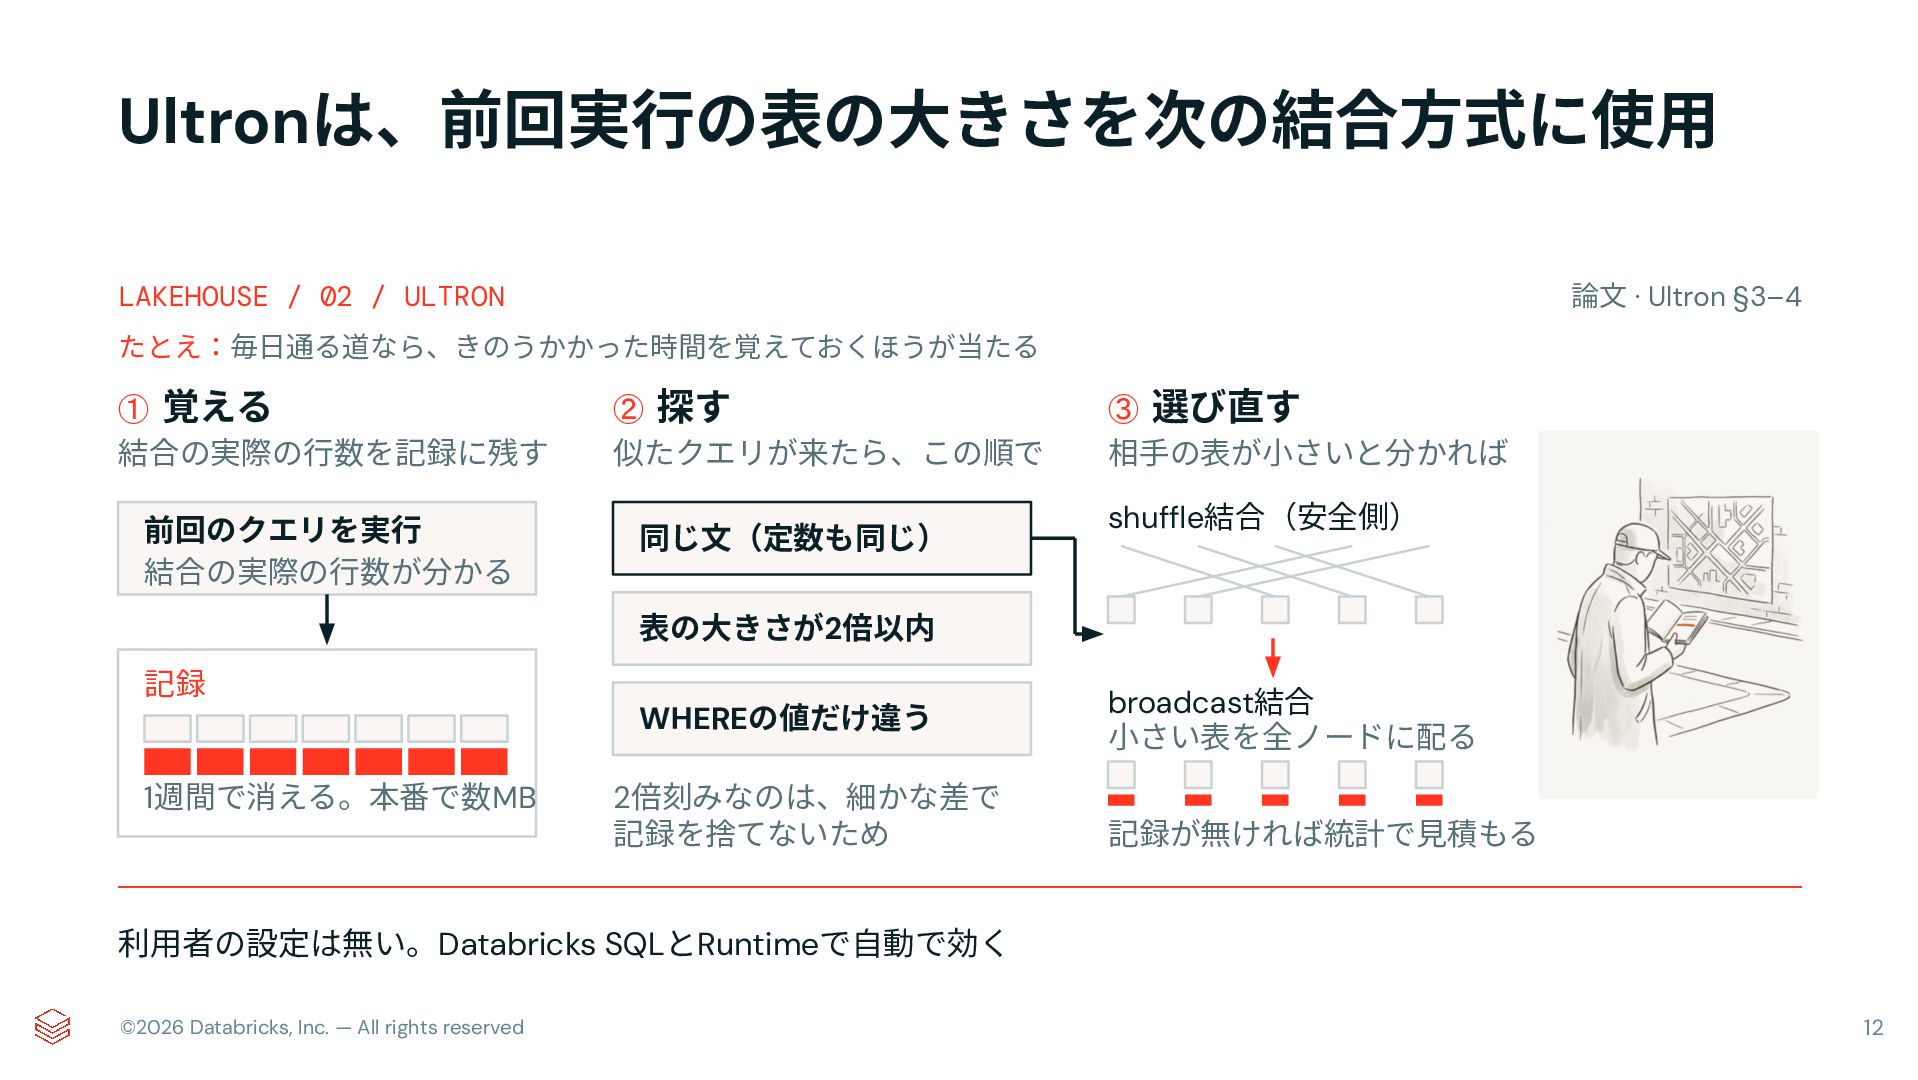
Ultronは、前回実⾏の表の⼤きさを次の結合⽅式に使⽤ 論⽂ · Ultron §3–4 LAKEHOUSE / 02 / ULTRON
たとえ:毎⽇通る道なら、きのうかかった時間を覚えておくほうが当たる ① 覚える 結合の実際の⾏数を記録に残す 前回のクエリを実⾏ 結合の実際の⾏数が分かる ② 探す 似たクエリが来たら、この順で 同じ⽂(定数も同じ) ③ 選び直す 相⼿の表が⼩さいと分かれば shuffle結合(安全側) 表の⼤きさが2倍以内 記録 1週間で消える。本番で数MB WHEREの値だけ違う 2倍刻みなのは、細かな差で 記録を捨てないため broadcast結合 ⼩さい表を全ノードに配る 記録が無ければ統計で⾒積もる 利⽤者の設定は無い。Databricks SQLとRuntimeで⾃動で効く ©2026 Databricks, Inc. — All rights reserved 12
対象の86%は⾼速化、14%は逆に、、、最悪で2.5倍 LAKEHOUSE / 03 / ULTRONの効果と代償 論⽂ · Ultron §5.1,
5.4 本番の2週間、Ultronを適⽤できたクエリのあり‧なしを組にして⽐べた 速くなる 86% 遅くなる 14% 中央値で25%短縮 最⼤2.5倍(値の偏った表をshuffleしたとき) 結合⽅式の判断の正解率(結合ごとに事後に判定) Ultron 96% 常にshuffle結合 56% 最適化の時間は中央値で+5%未満。表のスキーマが変わると、記録を全部捨てる ©2026 Databricks, Inc. — All rights reserved 13
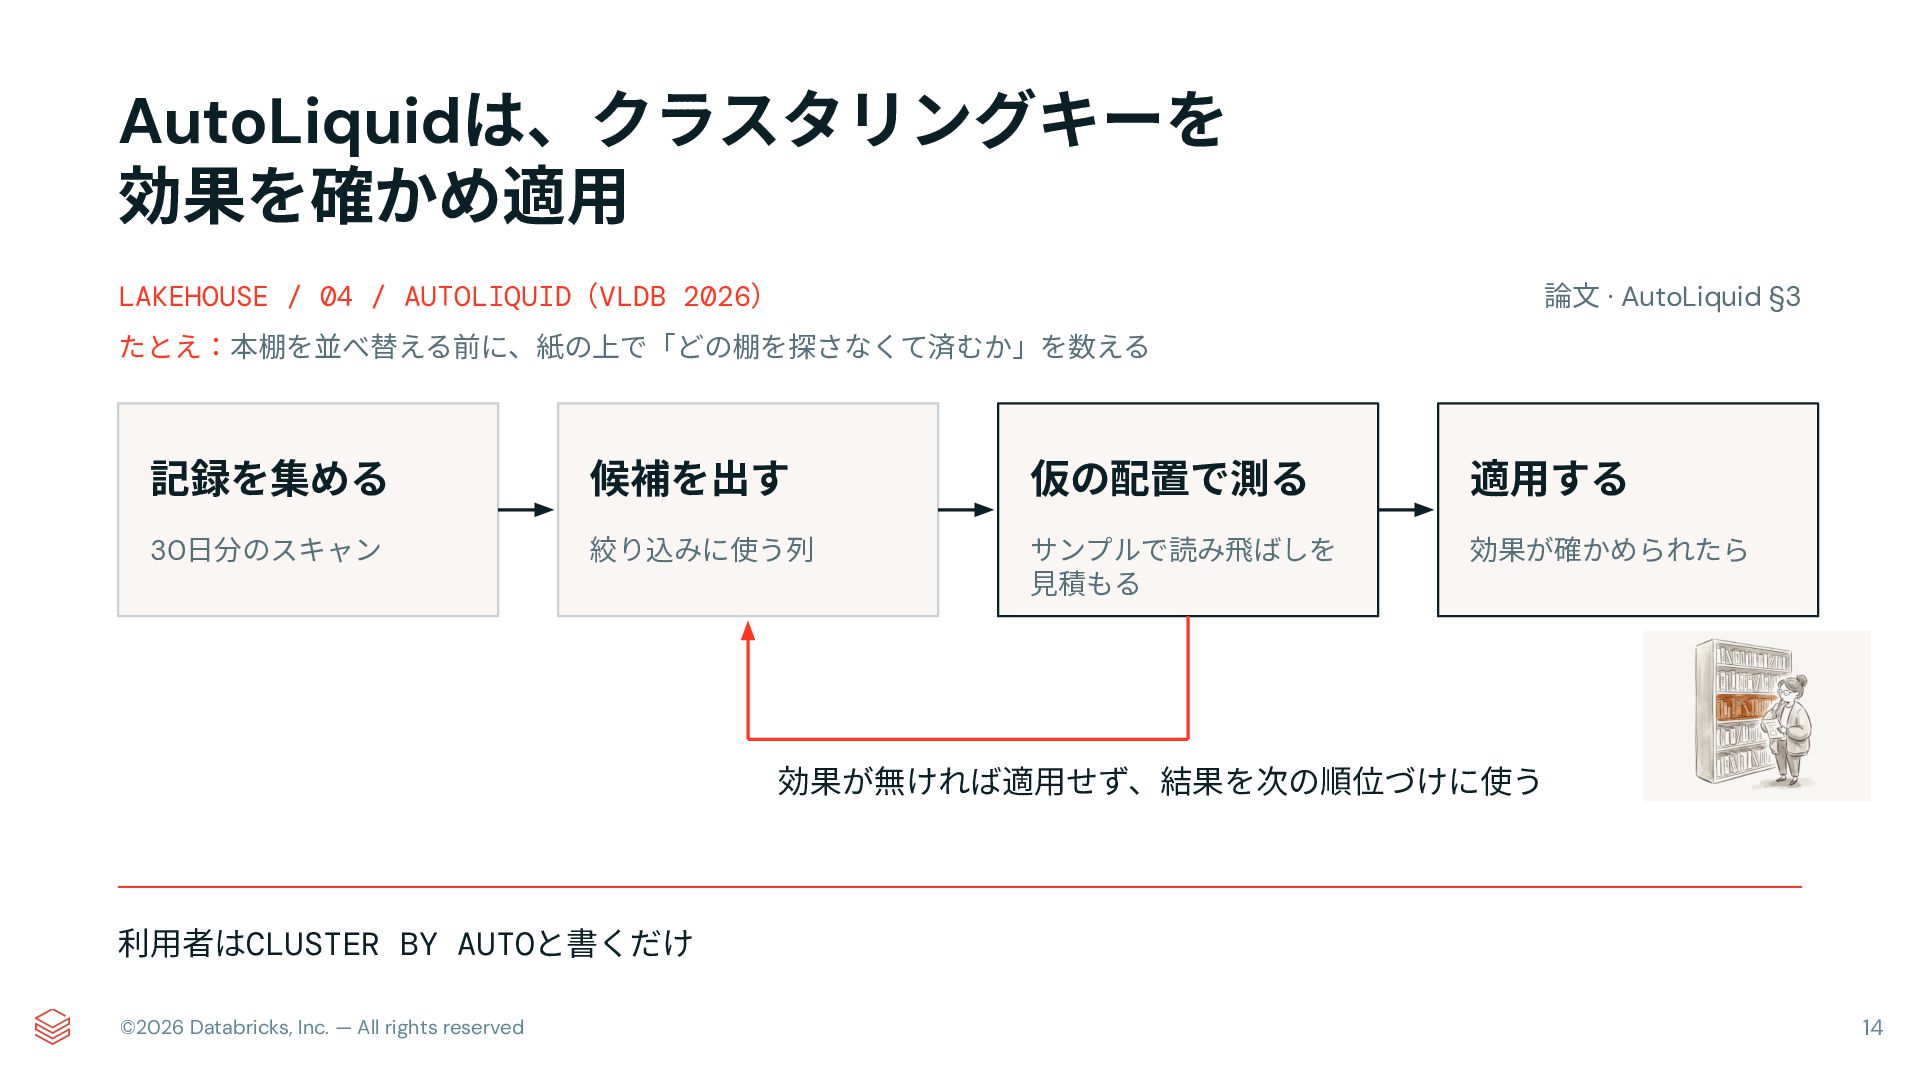
AutoLiquidは、クラスタリングキーを 効果を確かめ適⽤ 論⽂ · AutoLiquid §3 LAKEHOUSE / 04 /
AUTOLIQUID(VLDB 2026) たとえ:本棚を並べ替える前に、紙の上で「どの棚を探さなくて済むか」を数える 記録を集める 候補を出す 仮の配置で測る 適⽤する 30⽇分のスキャン 絞り込みに使う列 サンプルで読み⾶ばしを ⾒積もる 効果が確かめられたら 効果が無ければ適⽤せず、結果を次の順位づけに使う 利⽤者はCLUSTER BY AUTOと書くだけ ©2026 Databricks, Inc. — All rights reserved 14
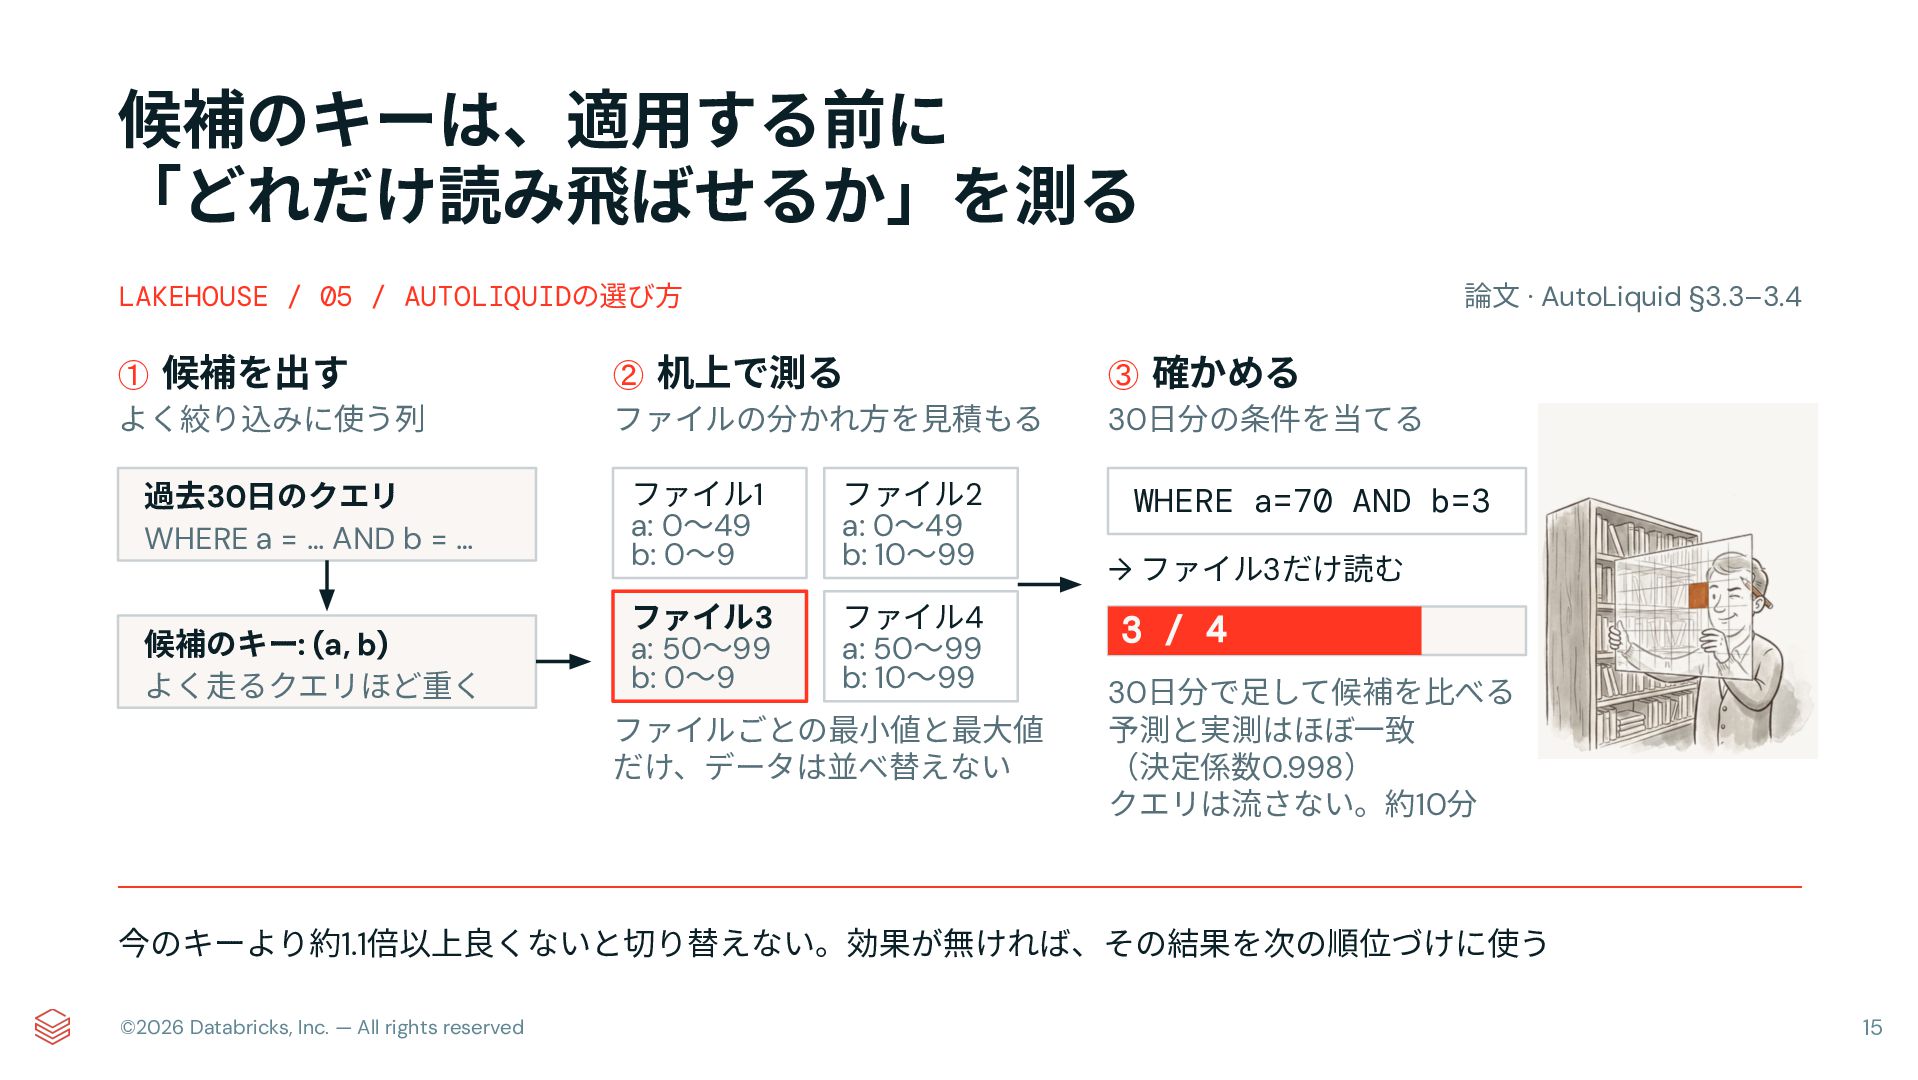
候補のキーは、適⽤する前に 「どれだけ読み⾶ばせるか」を測る 論⽂ · AutoLiquid §3.3–3.4 LAKEHOUSE / 05 /
AUTOLIQUIDの選び⽅ ① 候補を出す よく絞り込みに使う列 過去30⽇のクエリ WHERE a = … AND b = … 候補のキー: (a, b) よく⾛るクエリほど重く ② 机上で測る ファイルの分かれ⽅を⾒積もる ファイル1 a: 0〜49 b: 0〜9 ファイル2 a: 0〜49 b: 10〜99 ファイル3 a: 50〜99 b: 0〜9 ファイル4 a: 50〜99 b: 10〜99 ファイルごとの最⼩値と最⼤値 だけ、データは並べ替えない ③ 確かめる 30⽇分の条件を当てる WHERE a=70 AND b=3 → ファイル3だけ読む 3 / 4 30⽇分で⾜して候補を⽐べる 予測と実測はほぼ⼀致 (決定係数0.998) クエリは流さない。約10分 今のキーより約1.1倍以上良くないと切り替えない。効果が無ければ、その結果を次の順位づけに使う ©2026 Databricks, Inc. — All rights reserved 15
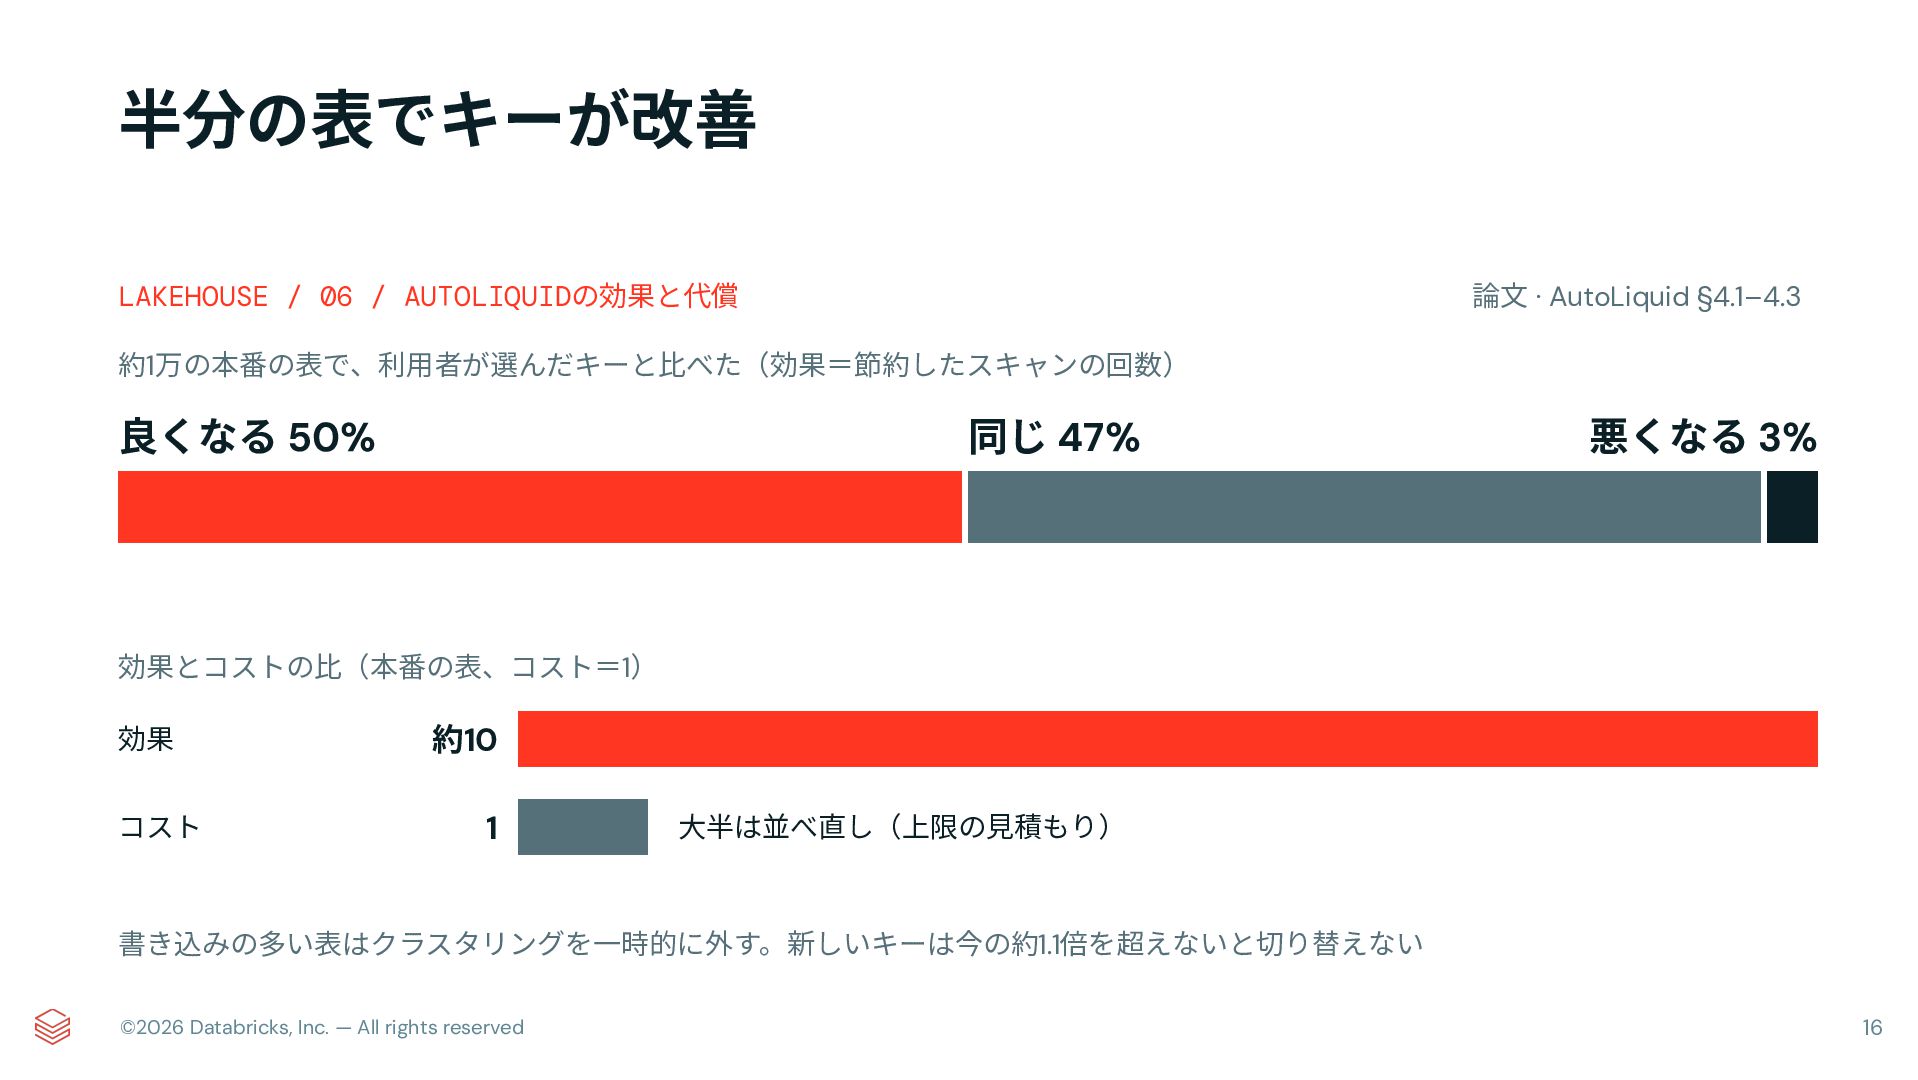
半分の表でキーが改善 論⽂ · AutoLiquid §4.1–4.3 LAKEHOUSE / 06 / AUTOLIQUIDの効果と代償
約1万の本番の表で、利⽤者が選んだキーと⽐べた(効果=節約したスキャンの回数) 良くなる 50% 同じ 47% 悪くなる 3% 効果とコストの⽐(本番の表、コスト=1) 効果 コスト 約10 1 ⼤半は並べ直し(上限の⾒積もり) 書き込みの多い表はクラスタリングを⼀時的に外す。新しいキーは今の約1.1倍を超えないと切り替えない ©2026 Databricks, Inc. — All rights reserved 16
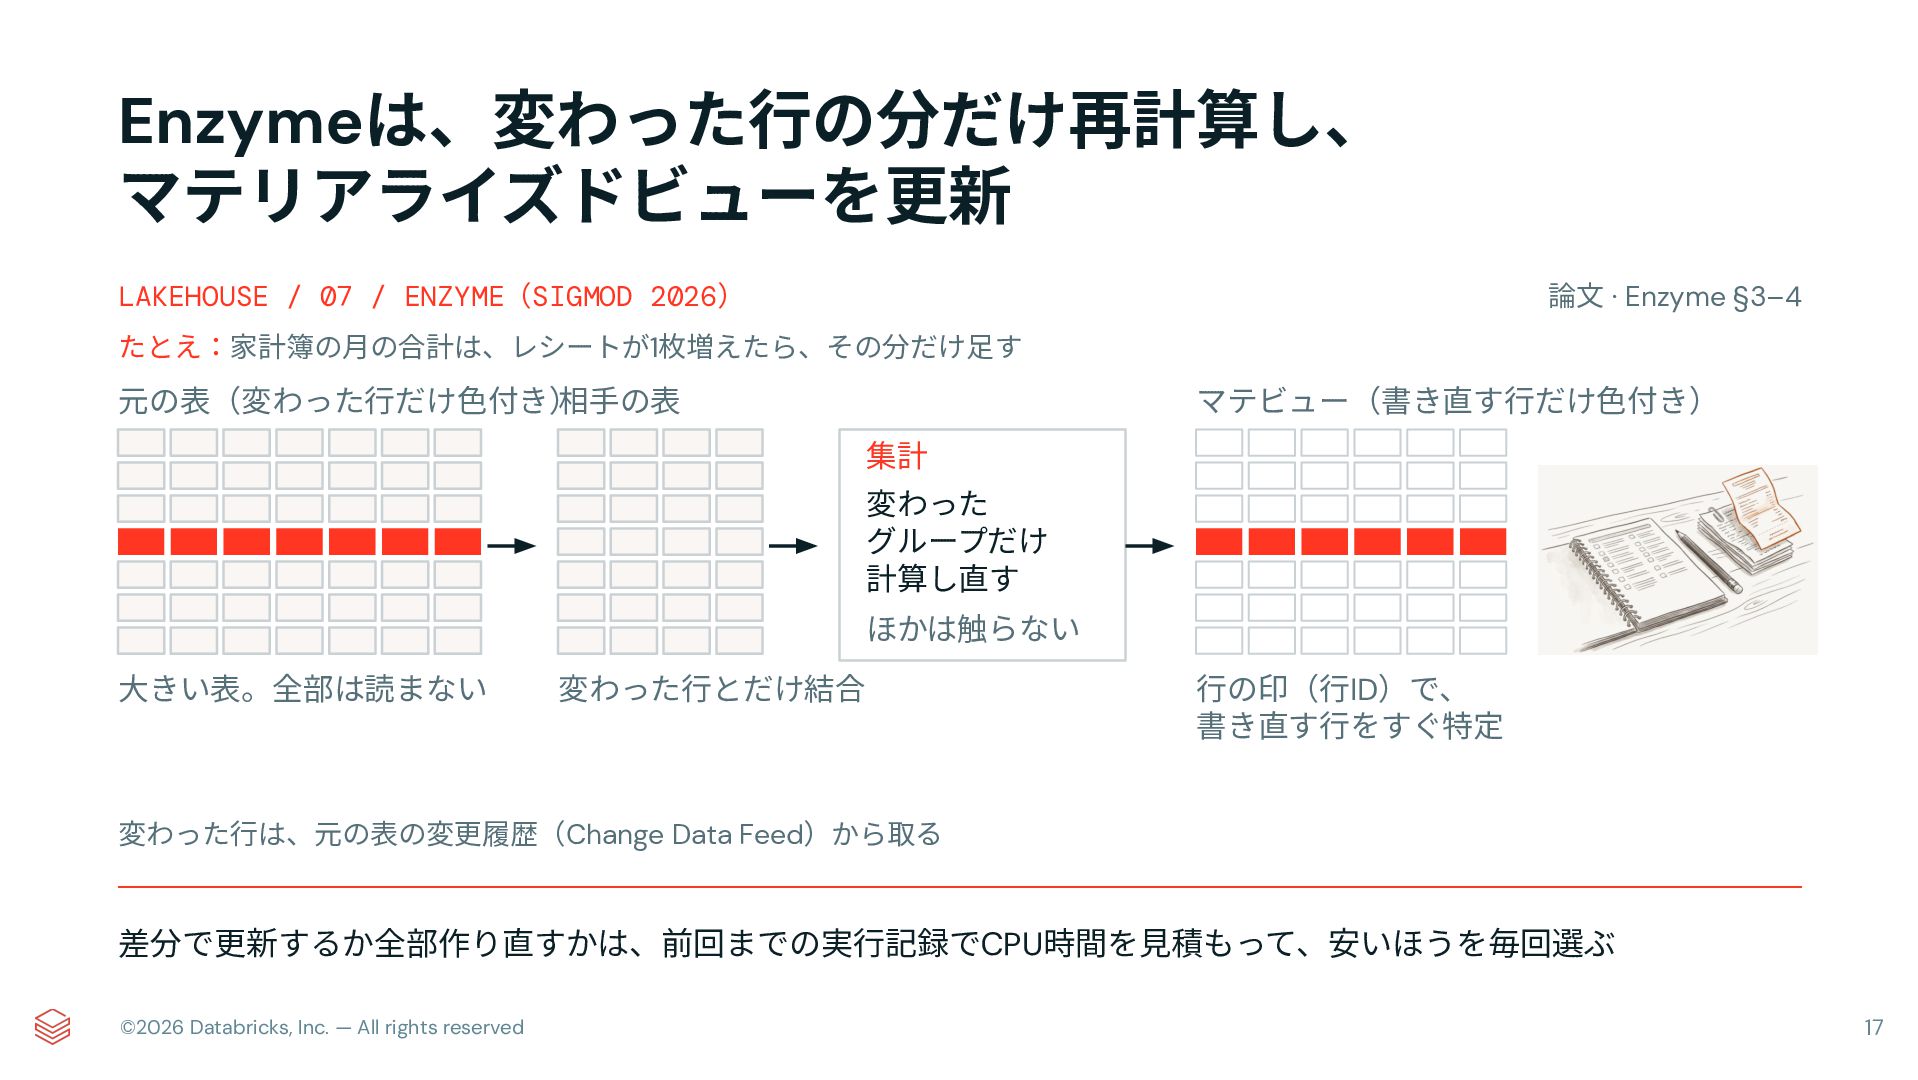
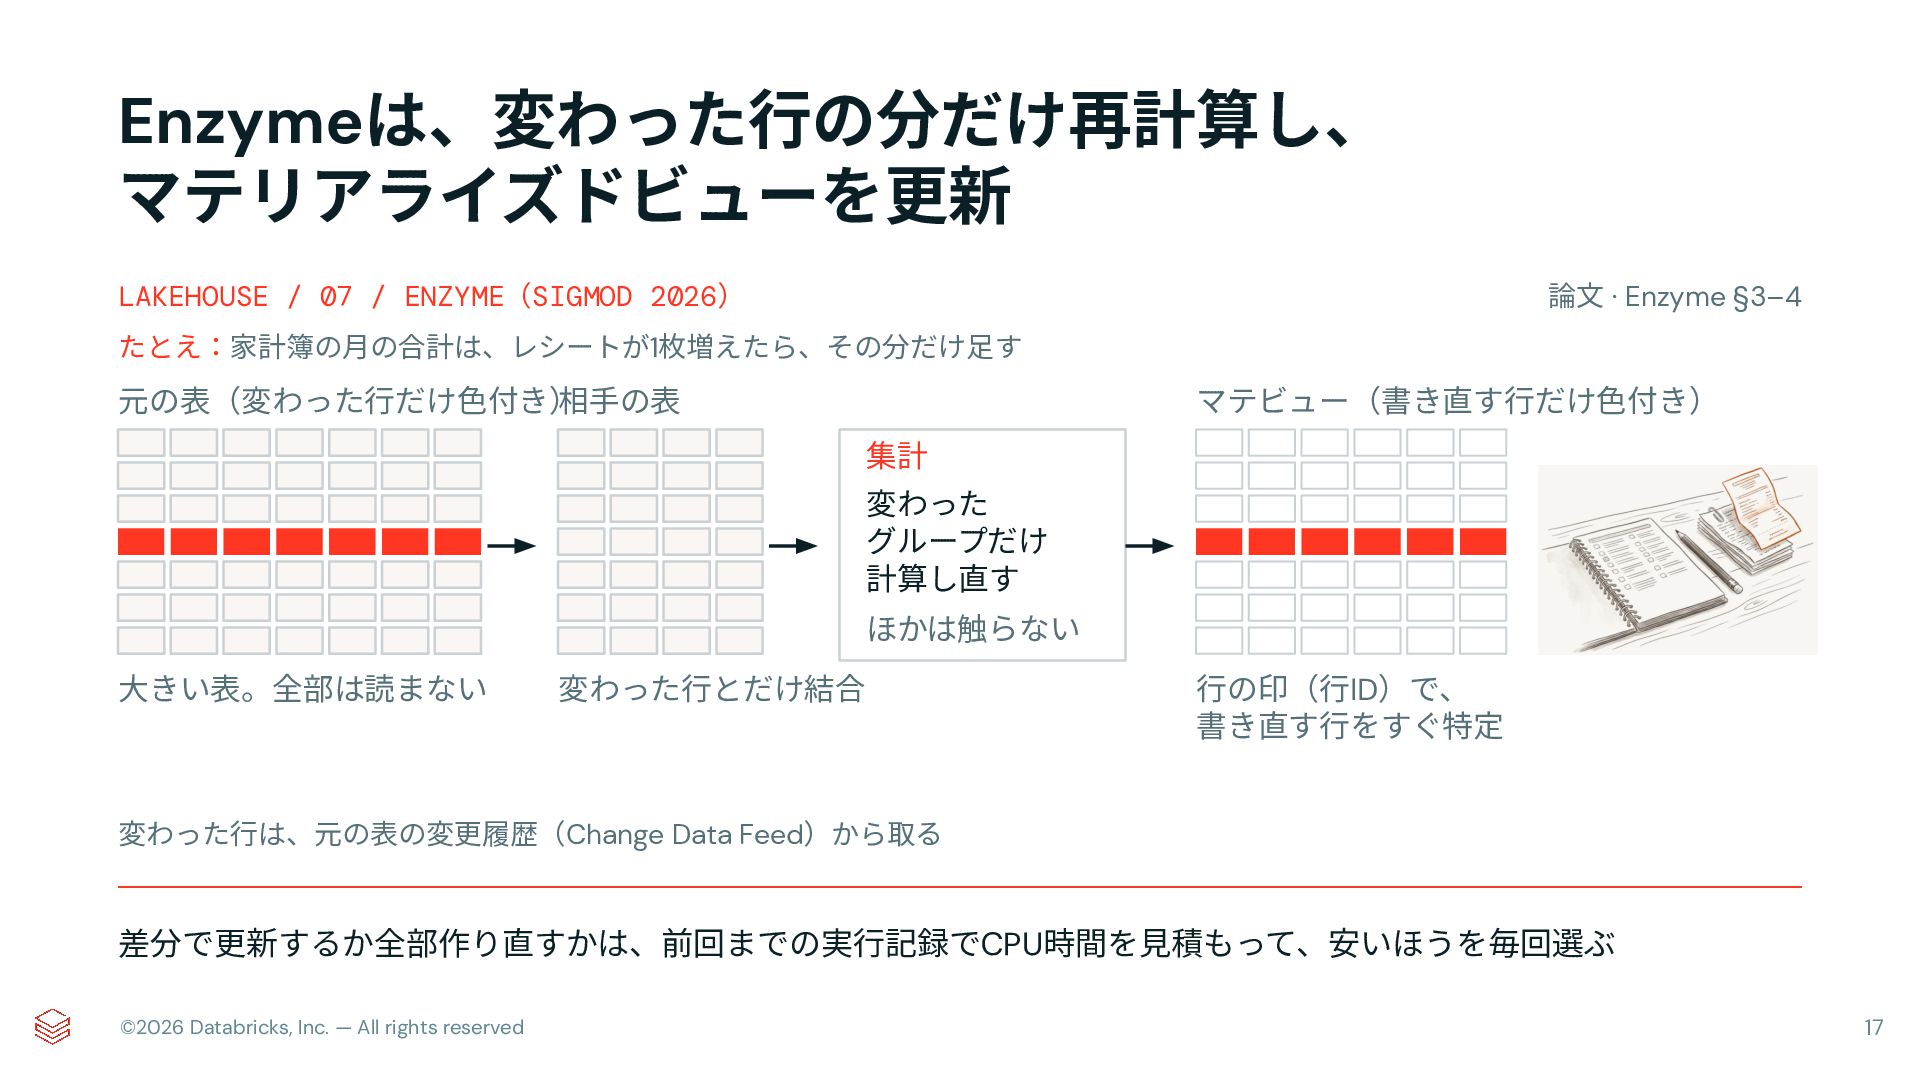
Enzymeは、変わった⾏の分だけ再計算し、 マテリアライズドビューを更新 論⽂ · Enzyme §3–4 LAKEHOUSE / 07 /
ENZYME(SIGMOD 2026) たとえ:家計簿の⽉の合計は、レシートが1枚増えたら、その分だけ⾜す 元の表(変わった⾏だけ⾊付き) 相⼿の表 マテビュー(書き直す⾏だけ⾊付き) 集計 変わった グループだけ 計算し直す ほかは触らない ⼤きい表。全部は読まない 変わった⾏とだけ結合 ⾏の印(⾏ID)で、 書き直す⾏をすぐ特定 変わった⾏は、元の表の変更履歴(Change Data Feed)から取る 差分で更新するか全部作り直すかは、前回までの実⾏記録でCPU時間を⾒積もって、安いほうを毎回選ぶ ©2026 Databricks, Inc. — All rights reserved 17
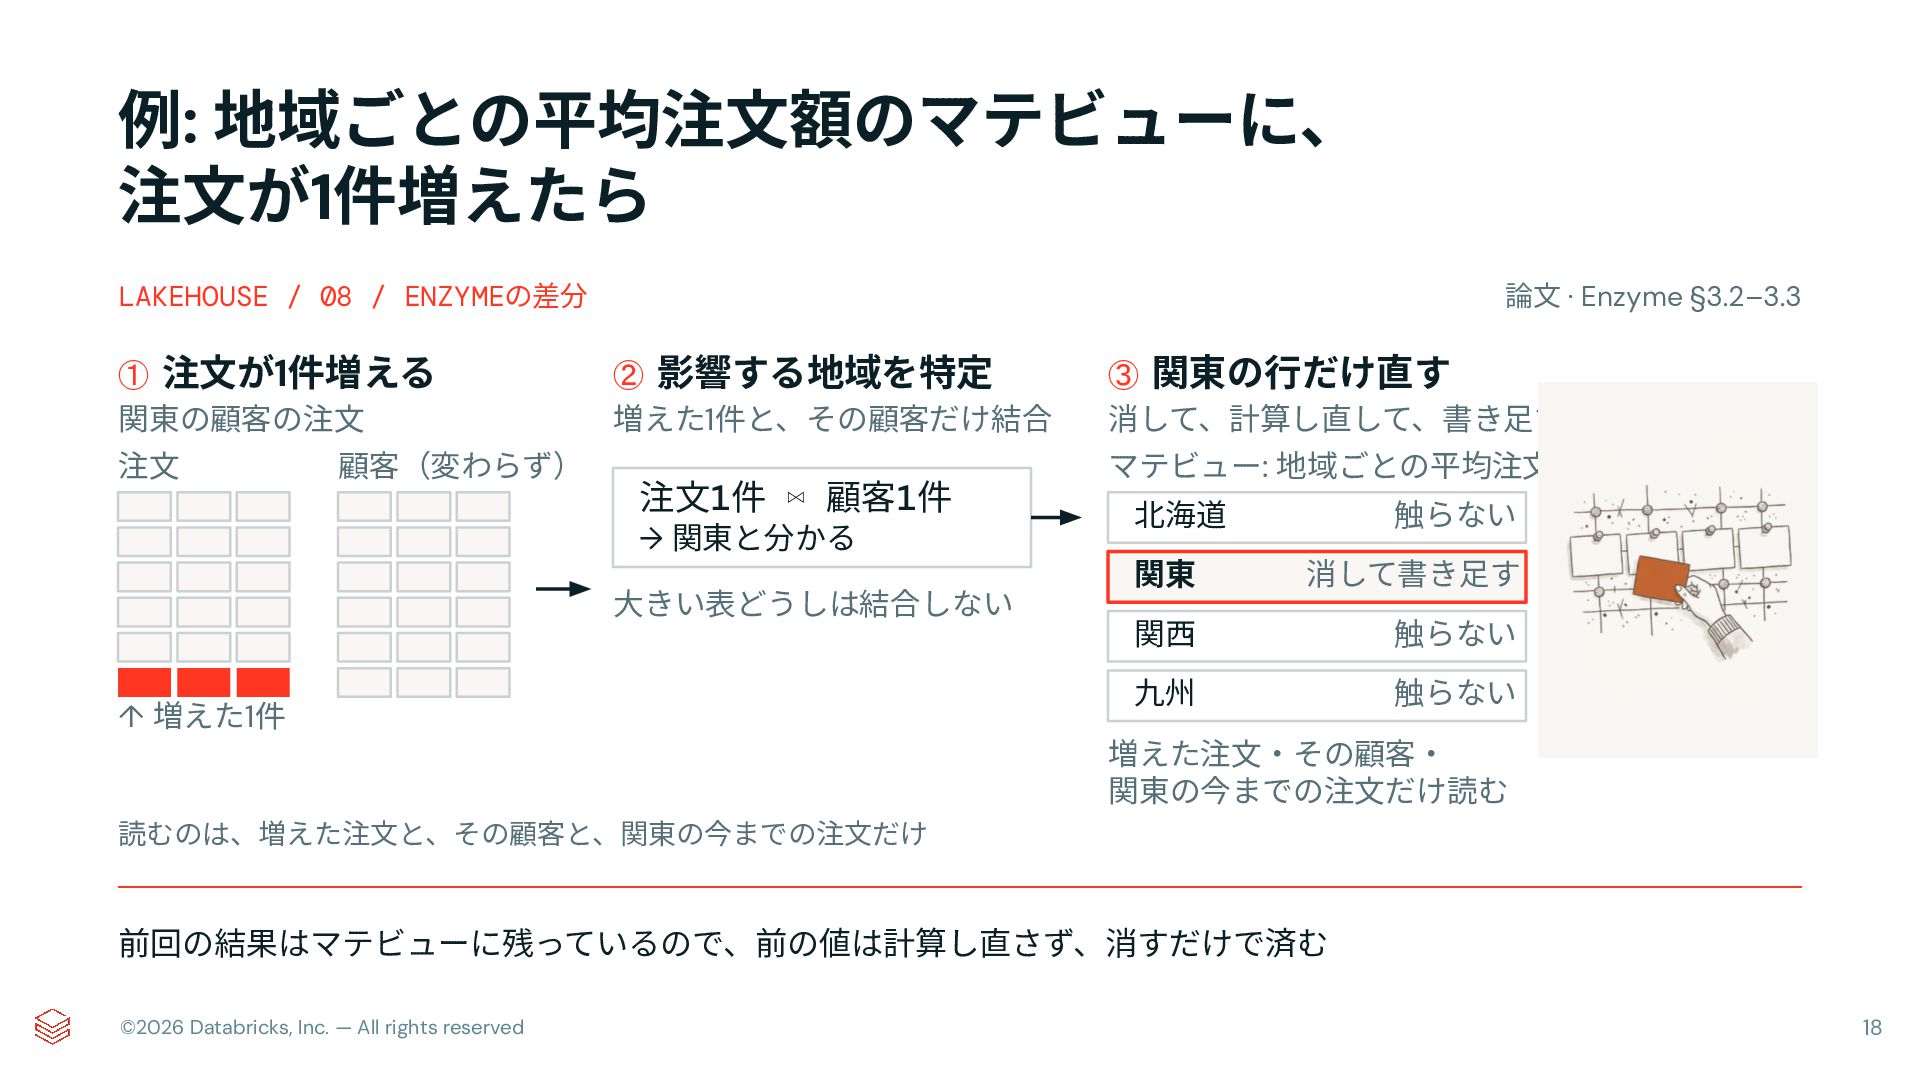
例: 地域ごとの平均注⽂額のマテビューに、 注⽂が1件増えたら 論⽂ · Enzyme §3.2–3.3 LAKEHOUSE / 08
/ ENZYMEの差分 ① 注⽂が1件増える 関東の顧客の注⽂ 注⽂ 顧客(変わらず) ② 影響する地域を特定 増えた1件と、その顧客だけ結合 注⽂1件 ⋈ 顧客1件 → 関東と分かる ⼤きい表どうしは結合しない ↑ 増えた1件 ③ 関東の⾏だけ直す 消して、計算し直して、書き⾜す マテビュー: 地域ごとの平均注⽂額 北海道 触らない 関東 消して書き⾜す 関⻄ 触らない 九州 触らない 増えた注⽂‧その顧客‧ 関東の今までの注⽂だけ読む 読むのは、増えた注⽂と、その顧客と、関東の今までの注⽂だけ 前回の結果はマテビューに残っているので、前の値は計算し直さず、消すだけで済む ©2026 Databricks, Inc. — All rights reserved 18
差分がいつも速いとは限らない、全再計算も 論⽂ · Enzyme §6.2 LAKEHOUSE / 09 / ENZYMEの代償
ベンチマークTPC-DIの8つの表で、差分更新と全再計算を⽐べた 差分更新で⼤きく速くなった 6 そうならなかった 2 Prospect: 全再計算のほうが速い。ほぼ全⾏が毎回書き換わる DimAccount: 速くなる幅が⼩さい。1分未満の軽い表 コストモデルの判断が最適 7 外した 1 定義の変化を⾒落とすと結果が誤り、変わったと誤判定するとペタバイト規模の全再計算になる 本番の数千のパイプラインで、1⽇あたり数⼗億CPU秒を減らした ©2026 Databricks, Inc. — All rights reserved 19
02 業務のデータと Lakebase‧LTAP ©2026 Databricks, Inc. — All rights reserved
20
RDBは、計算とWAL/データファイルを、同じマシンに保存 ブログ · Reynold Xin(2026-06) LAKEBASE / 01 / WHY
1台のマシン 物理複製 読み取りのレプリカ 計算(SQLの実⾏とキャッシュ) 物理複製 WAL データファイル 同じCPUとディスクを取り合う ⾼可⽤性のスタンバイ 分析のクエリ 同期レプリケーションや冗⻑なストレージで守れるが、計算ノードと複製の運⽤が結び付く ©2026 Databricks, Inc. — All rights reserved 21
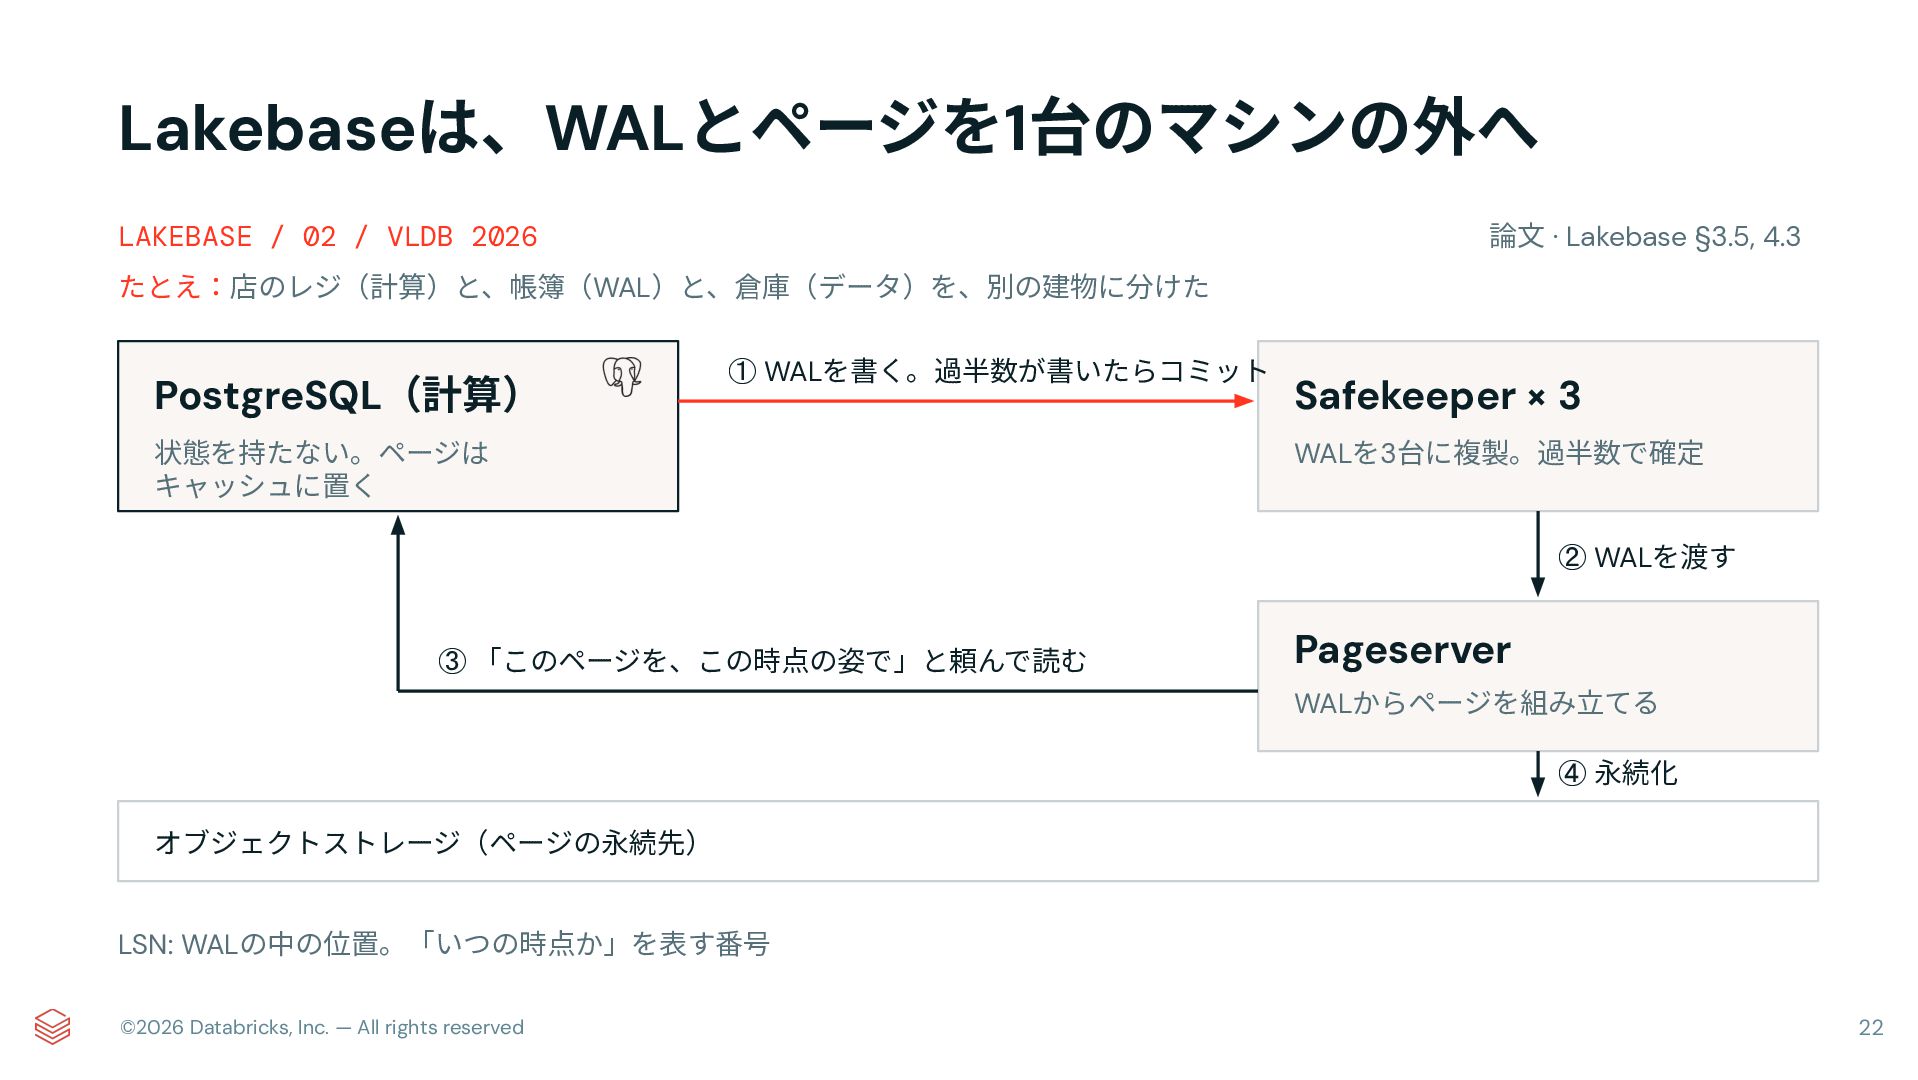
Lakebaseは、WALとページを1台のマシンの外へ 論⽂ · Lakebase §3.5, 4.3 LAKEBASE / 02 /
VLDB 2026 たとえ:店のレジ(計算)と、帳簿(WAL)と、倉庫(データ)を、別の建物に分けた PostgreSQL(計算) ① WALを書く。過半数が書いたらコミット 状態を持たない。ページは キャッシュに置く Safekeeper × 3 WALを3台に複製。過半数で確定 ② WALを渡す ③ 「このページを、この時点の姿で」と頼んで読む Pageserver WALからページを組み⽴てる ④ 永続化 オブジェクトストレージ(ページの永続先) LSN: WALの中の位置。「いつの時点か」を表す番号 ©2026 Databricks, Inc. — All rights reserved 22
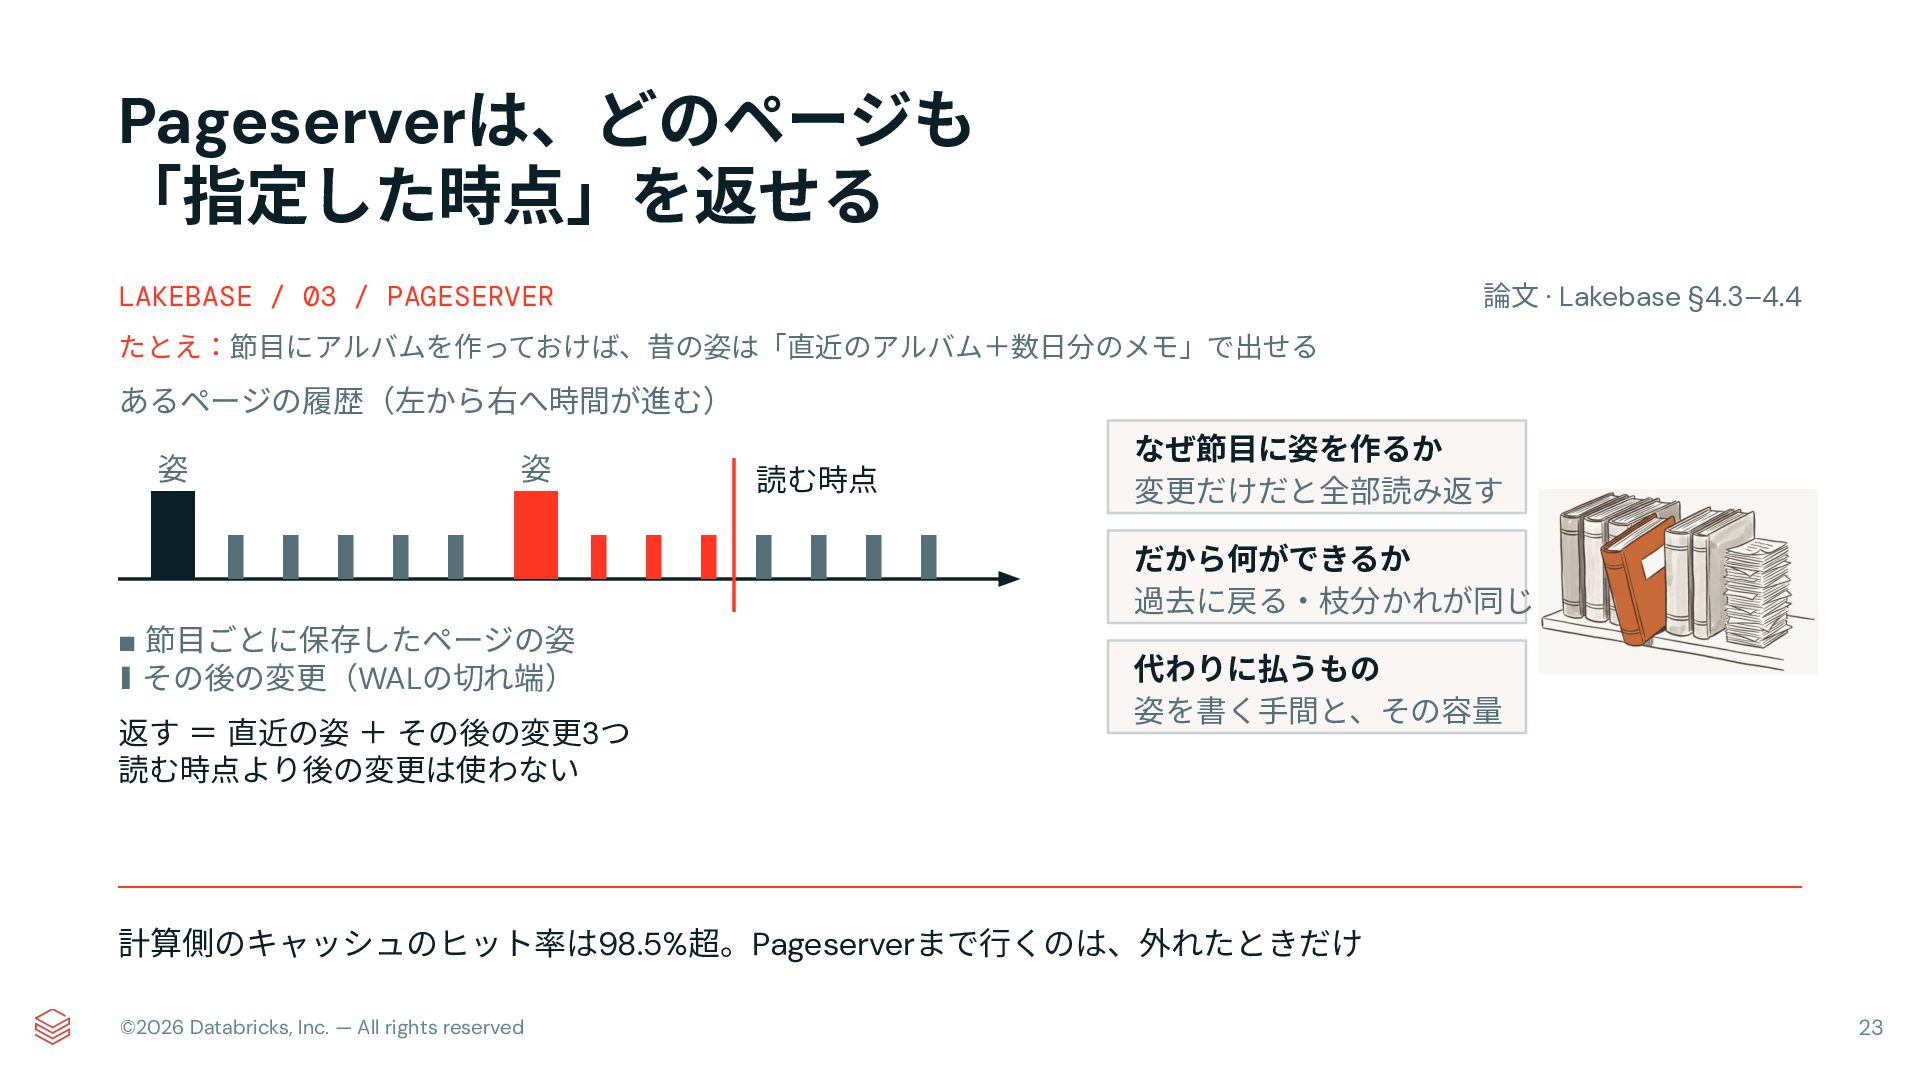
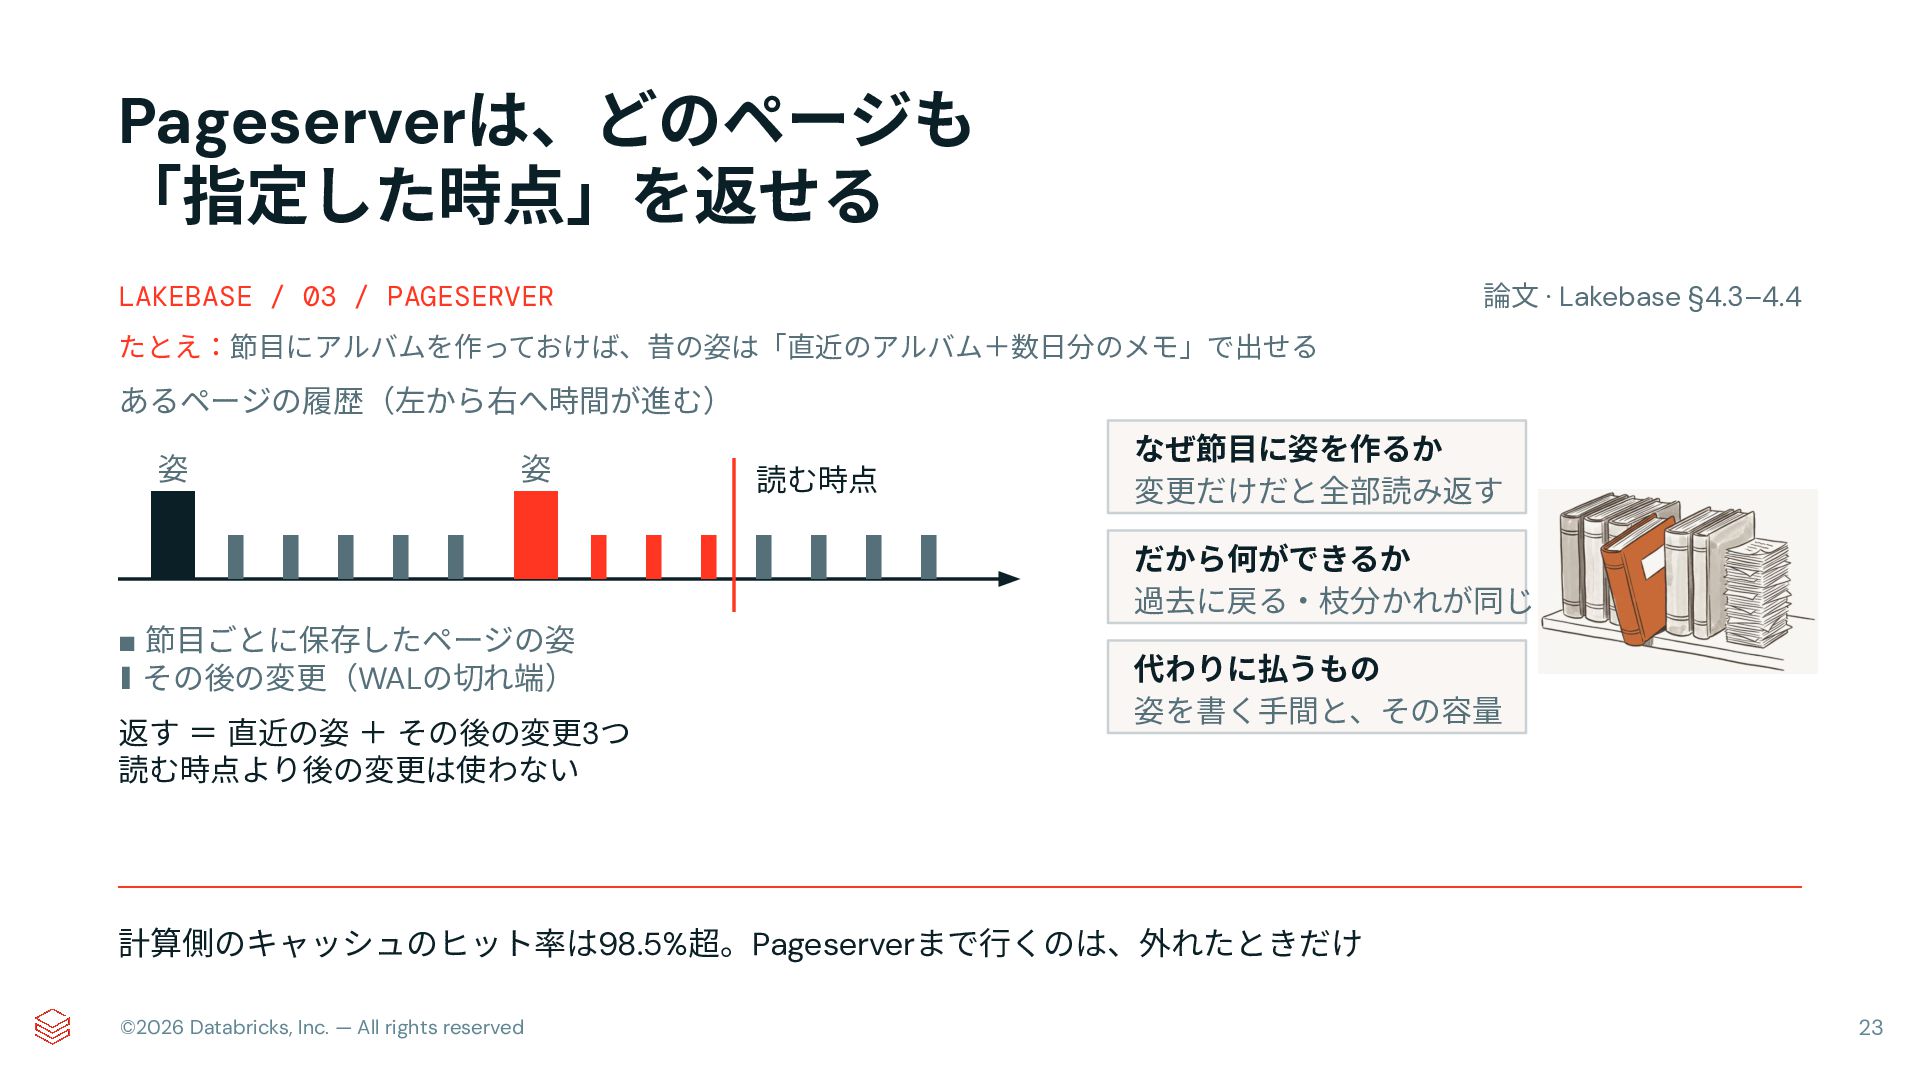
Pageserverは、どのページも 「指定した時点」を返せる 論⽂ · Lakebase §4.3–4.4 LAKEBASE / 03 /
PAGESERVER たとえ:節⽬にアルバムを作っておけば、昔の姿は「直近のアルバム+数⽇分のメモ」で出せる あるページの履歴(左から右へ時間が進む) 姿 姿 ▪ 節⽬ごとに保存したページの姿 ▮ その後の変更(WALの切れ端) 返す = 直近の姿 + その後の変更3つ 読む時点より後の変更は使わない 読む時点 なぜ節⽬に姿を作るか 変更だけだと全部読み返す だから何ができるか 過去に戻る‧枝分かれが同じ 代わりに払うもの 姿を書く⼿間と、その容量 計算側のキャッシュのヒット率は98.5%超。Pageserverまで⾏くのは、外れたときだけ ©2026 Databricks, Inc. — All rights reserved 23
ブランチもPITRも、データをコピーしない 「どの時点の親を⾒るか」を持つだけ 論⽂ · Lakebase §4.2, 7.1 LAKEBASE / 04
たとえ:本番のコピーを作るのに、「どの時点の親を⾒るか」の付箋を1枚貼るだけ 親(本番)のタイムライン。左から右へ時間が進む ブランチ: 付箋1枚(親のID+分けた時点) 作成は⼀瞬。データ量に関係ない PITR: 過去の時点から新しい枝を作る 「戻す」も「枝を作る」と同じ操作 起動はp95で500ms未満 起動済みの予備から取る 無いページは親から読む 分けた後の親の変更は⾒ない 開発‧試験に本番のコピー どれも、Pageserverが「指定した時点の姿」を返せるから成り⽴つ ©2026 Databricks, Inc. — All rights reserved 24
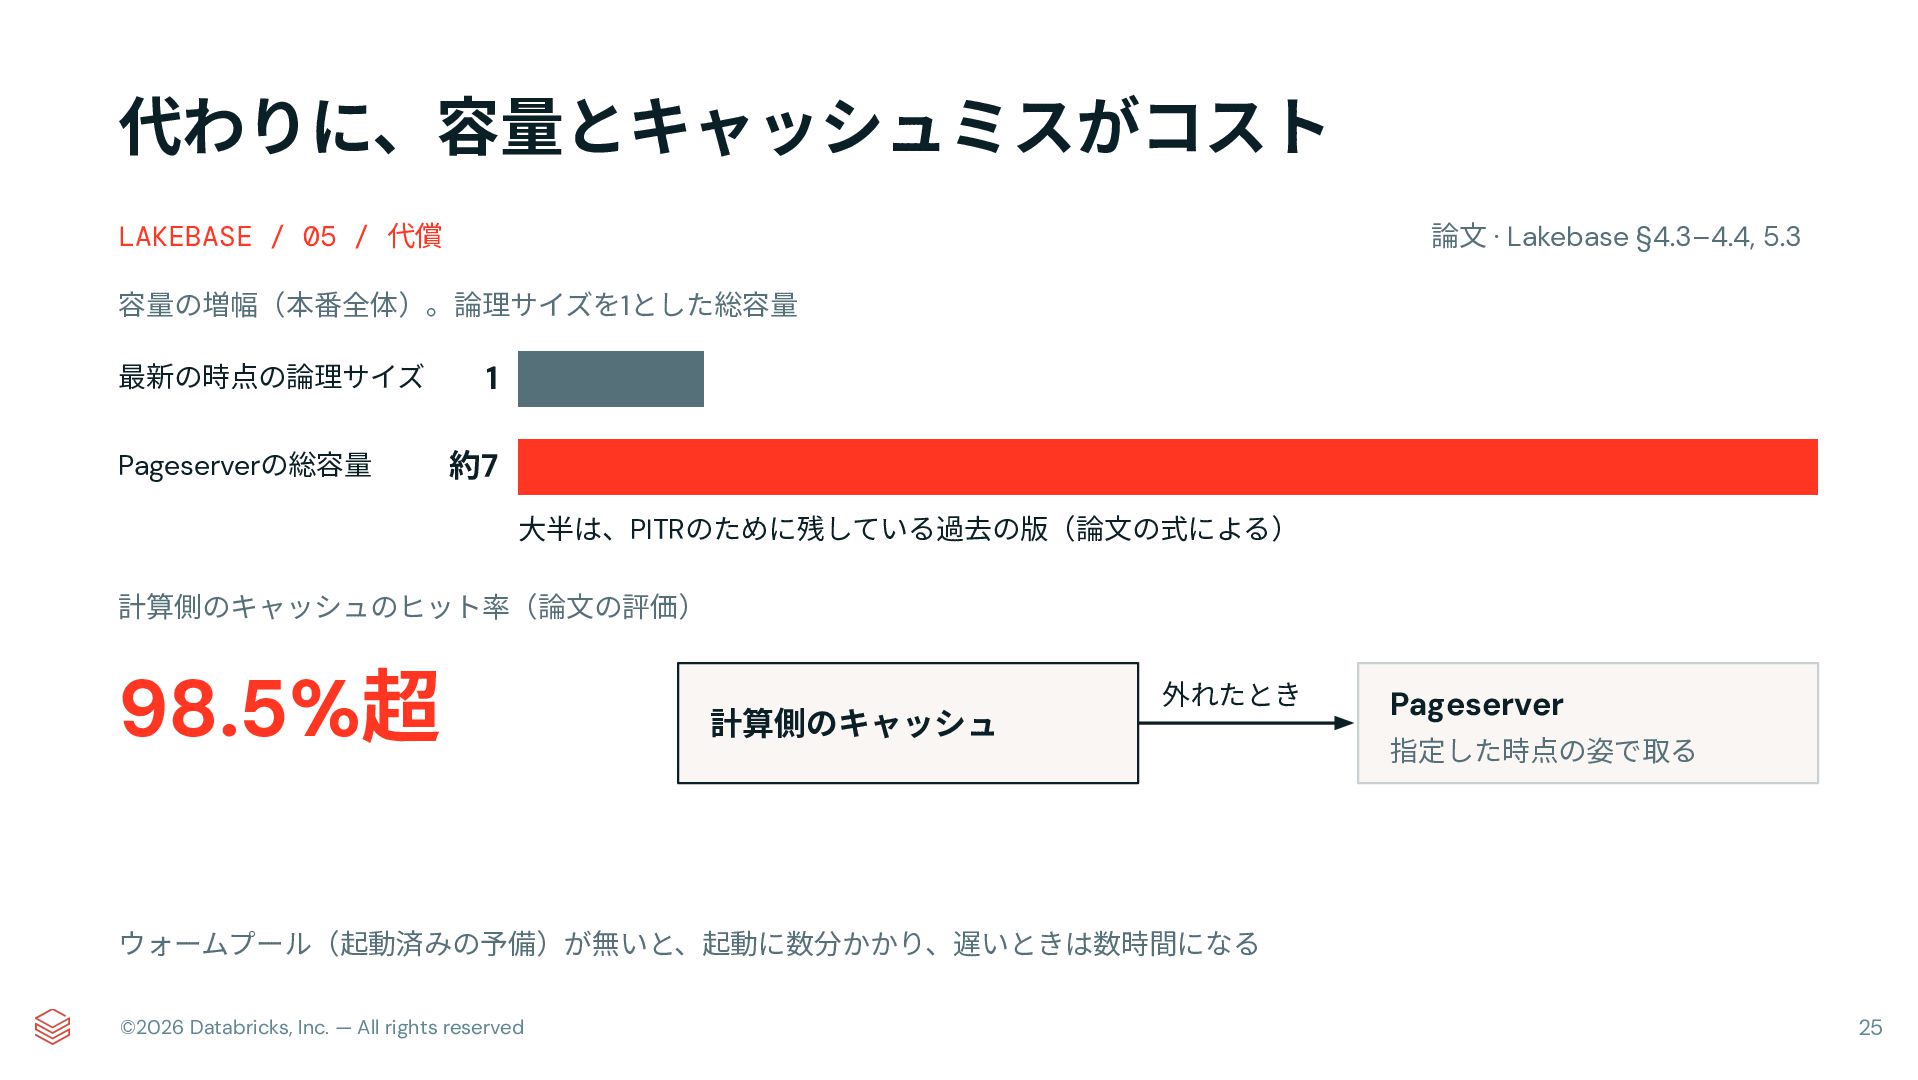
代わりに、容量とキャッシュミスがコスト LAKEBASE / 05 / 代償 論⽂ · Lakebase §4.3–4.4,
5.3 容量の増幅(本番全体)。論理サイズを1とした総容量 最新の時点の論理サイズ Pageserverの総容量 1 約7 ⼤半は、PITRのために残している過去の版(論⽂の式による) 計算側のキャッシュのヒット率(論⽂の評価) 98.5%超 計算側のキャッシュ 外れたとき Pageserver 指定した時点の姿で取る ウォームプール(起動済みの予備)が無いと、起動に数分かかり、遅いときは数時間になる ©2026 Databricks, Inc. — All rights reserved 25
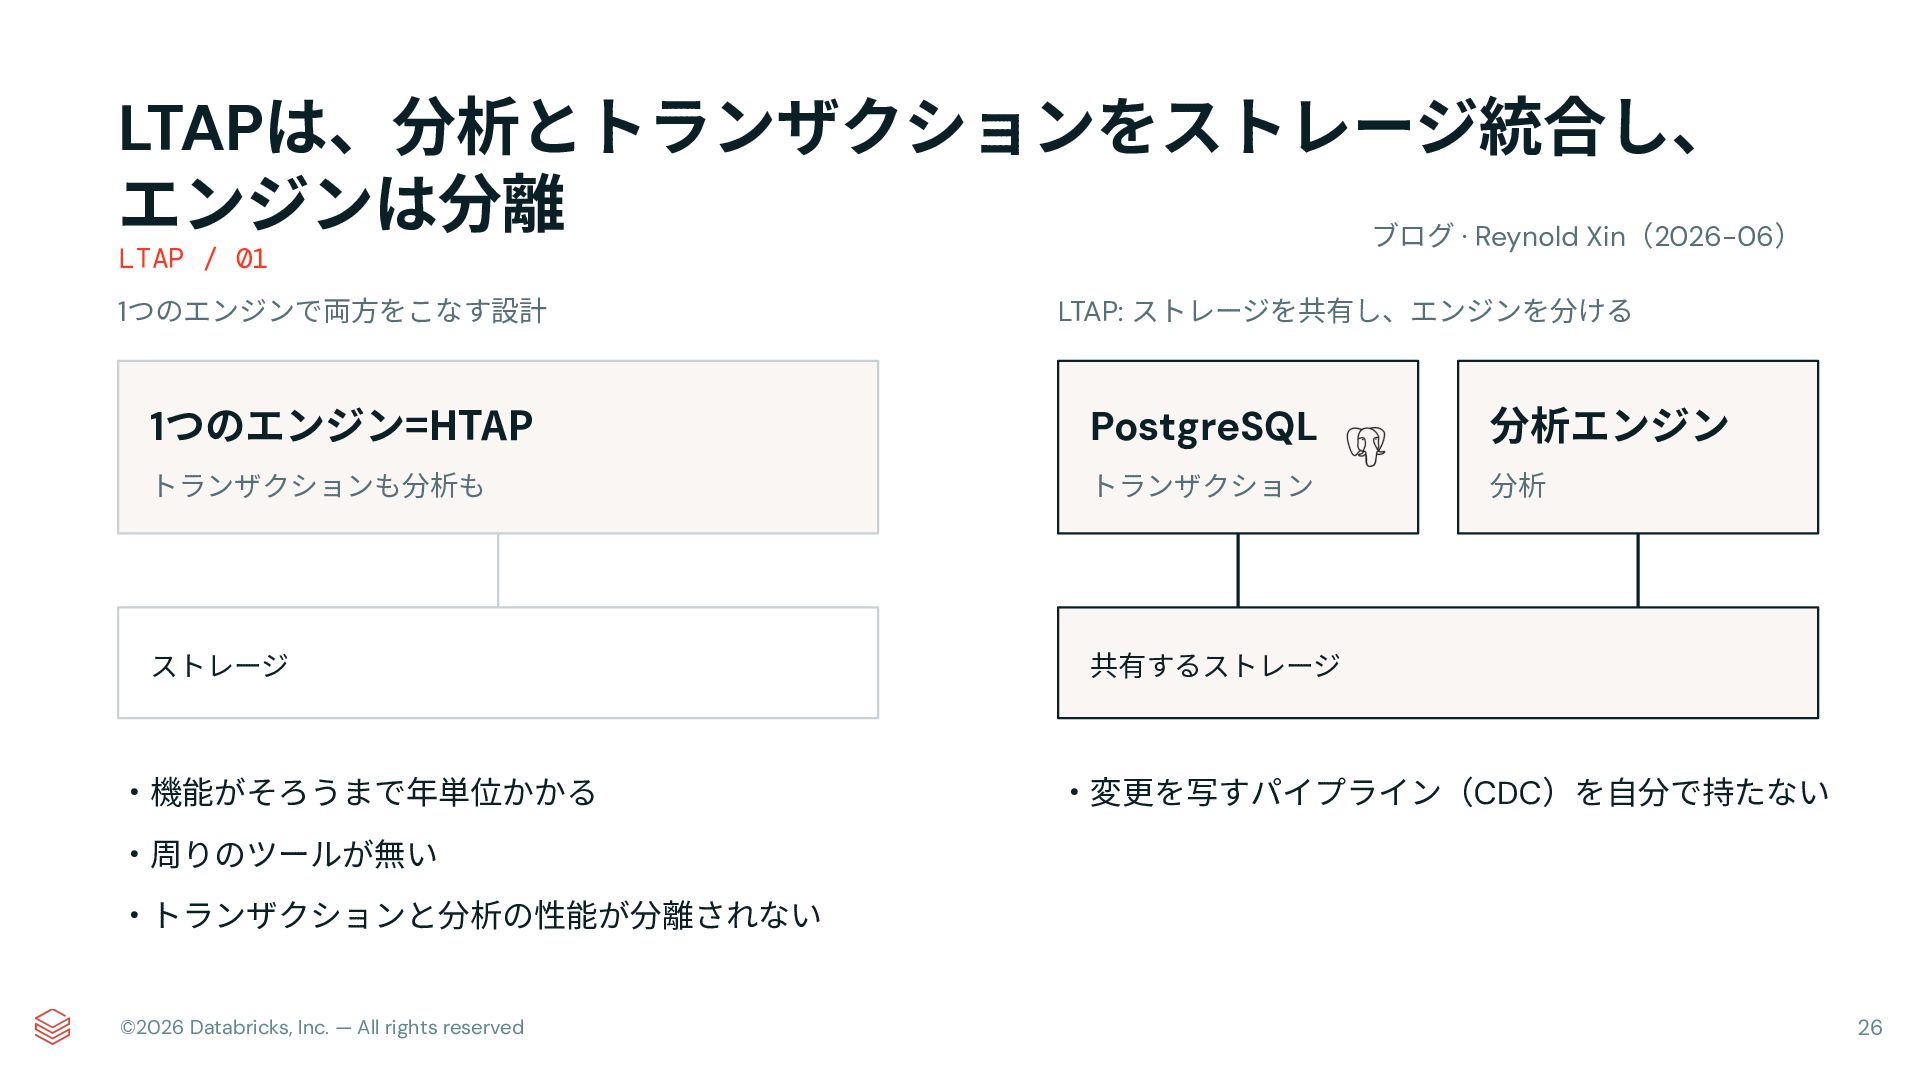
LTAPは、分析とトランザクションをストレージ統合し、 エンジンは分離 ブログ · Reynold Xin(2026-06) LTAP / 01 1つのエンジンで両⽅をこなす設計
LTAP: ストレージを共有し、エンジンを分ける 1つのエンジン=HTAP PostgreSQL 分析エンジン トランザクションも分析も トランザクション 分析 ストレージ 共有するストレージ ‧機能がそろうまで年単位かかる ‧変更を写すパイプライン(CDC)を⾃分で持たない ‧周りのツールが無い ‧トランザクションと分析の性能が分離されない ©2026 Databricks, Inc. — All rights reserved 26
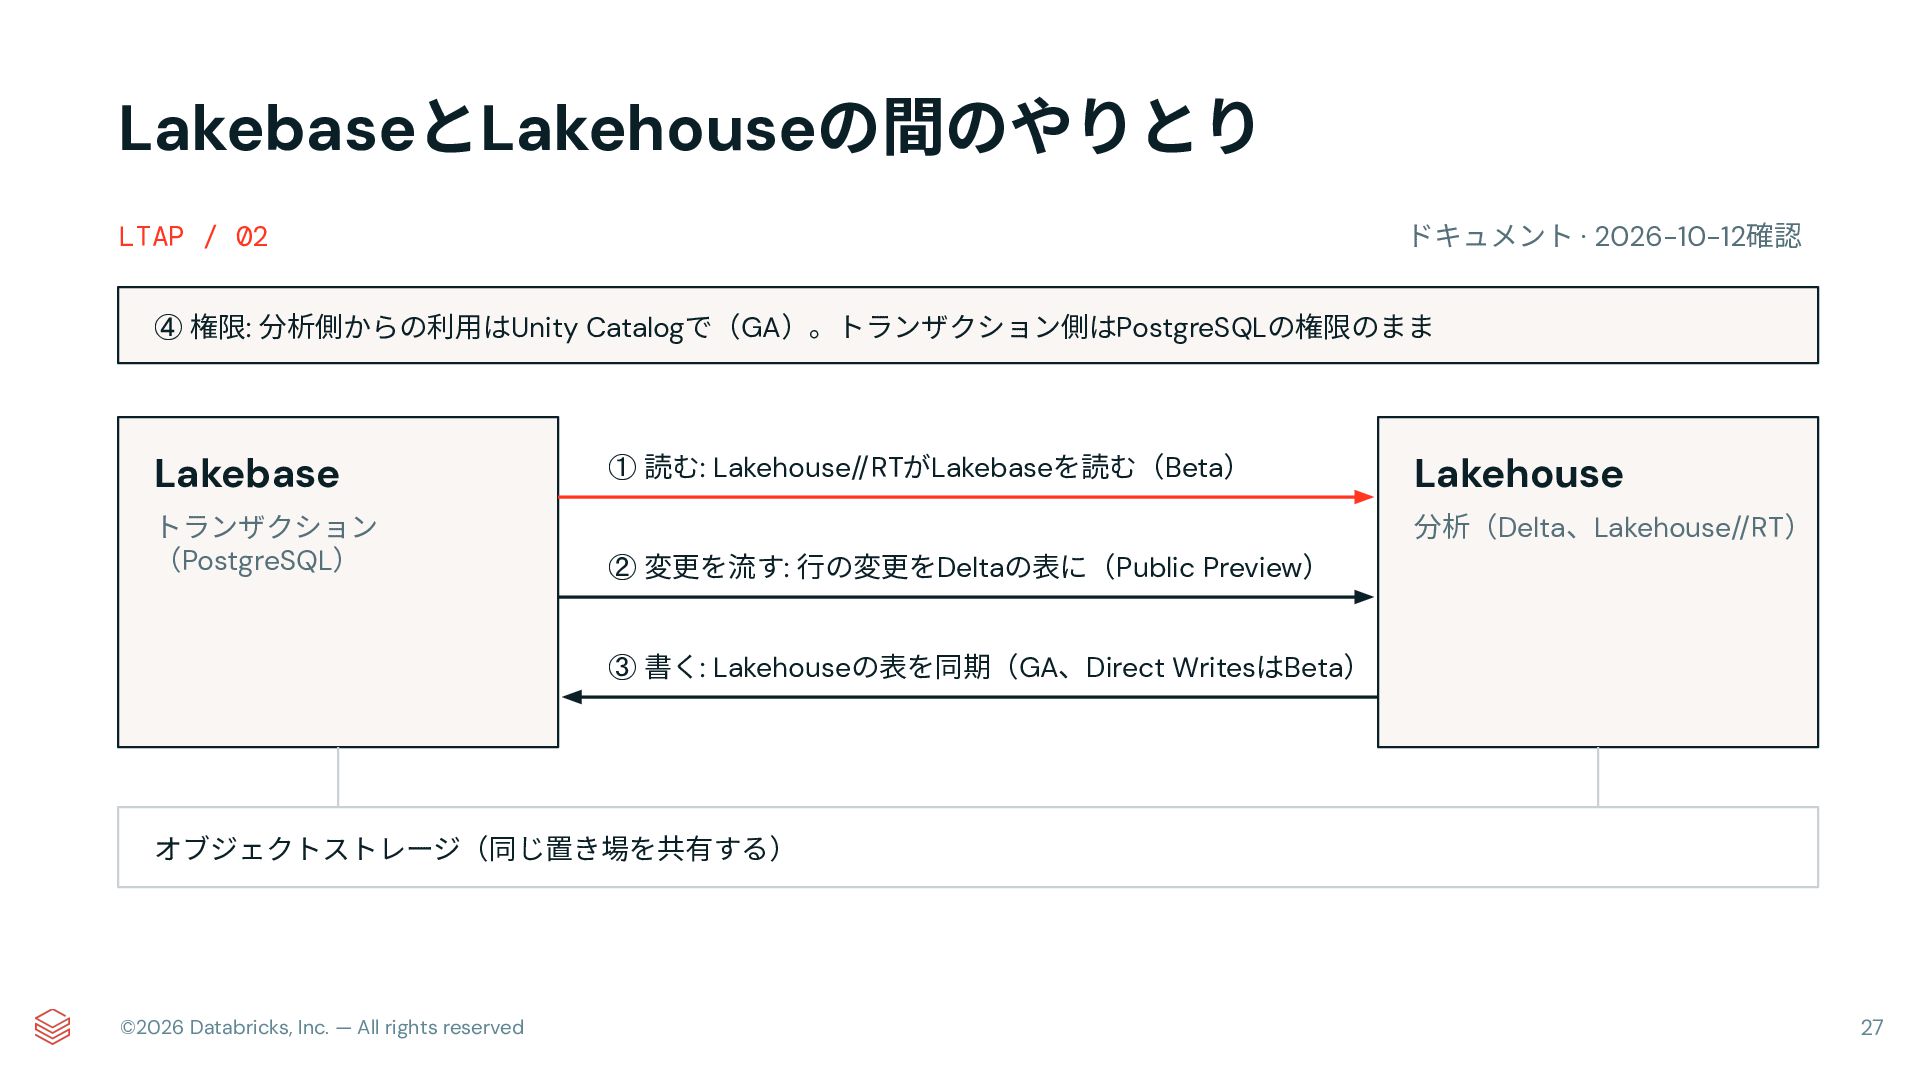
LakebaseとLakehouseの間のやりとり ドキュメント · 2026-10-12確認 LTAP / 02 ④ 権限: 分析側からの利⽤はUnity
Catalogで(GA)。トランザクション側はPostgreSQLの権限のまま Lakebase トランザクション (PostgreSQL) ① 読む: Lakehouse//RTがLakebaseを読む(Beta) ② 変更を流す: ⾏の変更をDeltaの表に(Public Preview) Lakehouse 分析(Delta、Lakehouse//RT) ③ 書く: Lakehouseの表を同期(GA、Direct WritesはBeta) オブジェクトストレージ(同じ置き場を共有する) ©2026 Databricks, Inc. — All rights reserved 27
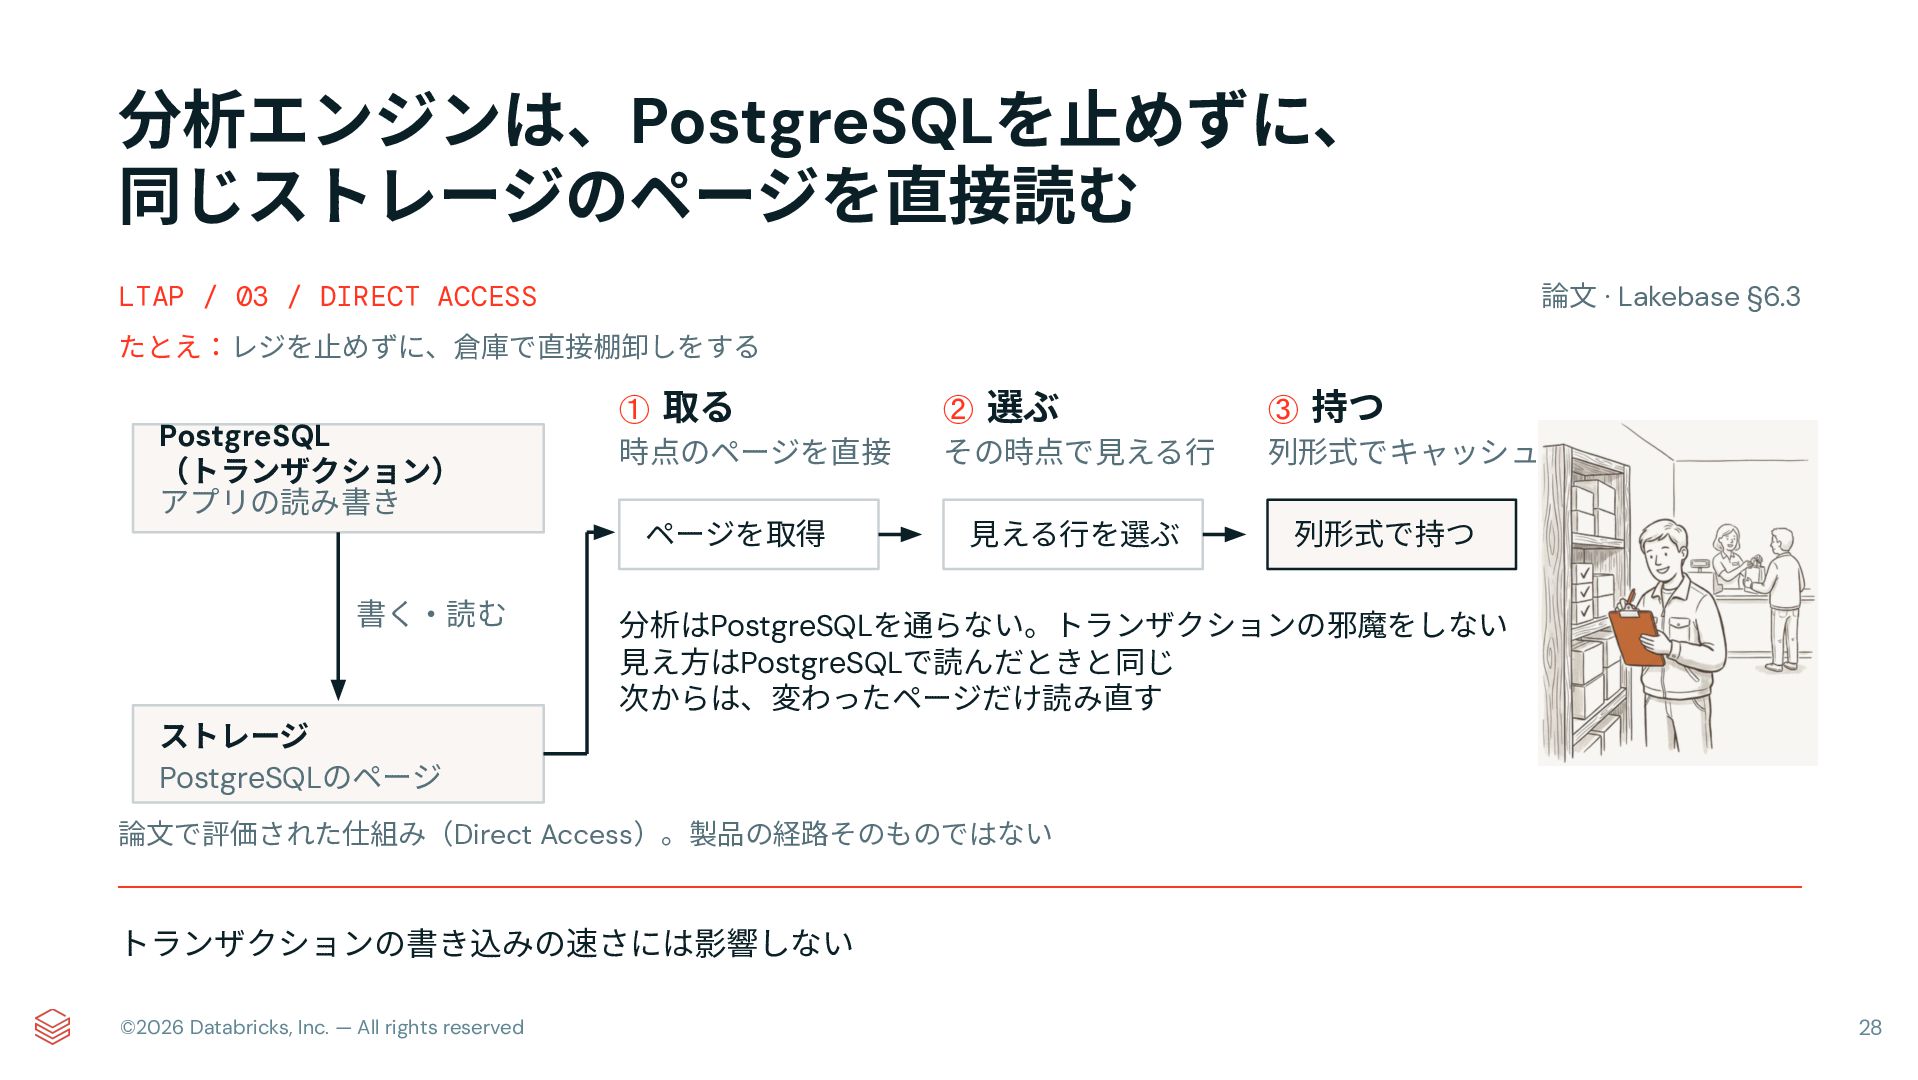
分析エンジンは、PostgreSQLを⽌めずに、 同じストレージのページを直接読む 論⽂ · Lakebase §6.3 LTAP / 03 /
DIRECT ACCESS たとえ:レジを⽌めずに、倉庫で直接棚卸しをする PostgreSQL (トランザクション) アプリの読み書き 書く‧読む ストレージ PostgreSQLのページ ① 取る 時点のページを直接 ② 選ぶ その時点で⾒える⾏ ③ 持つ 列形式でキャッシュ ページを取得 ⾒える⾏を選ぶ 列形式で持つ 分析はPostgreSQLを通らない。トランザクションの邪魔をしない ⾒え⽅はPostgreSQLで読んだときと同じ 次からは、変わったページだけ読み直す 論⽂で評価された仕組み(Direct Access)。製品の経路そのものではない トランザクションの書き込みの速さには影響しない ©2026 Databricks, Inc. — All rights reserved 28
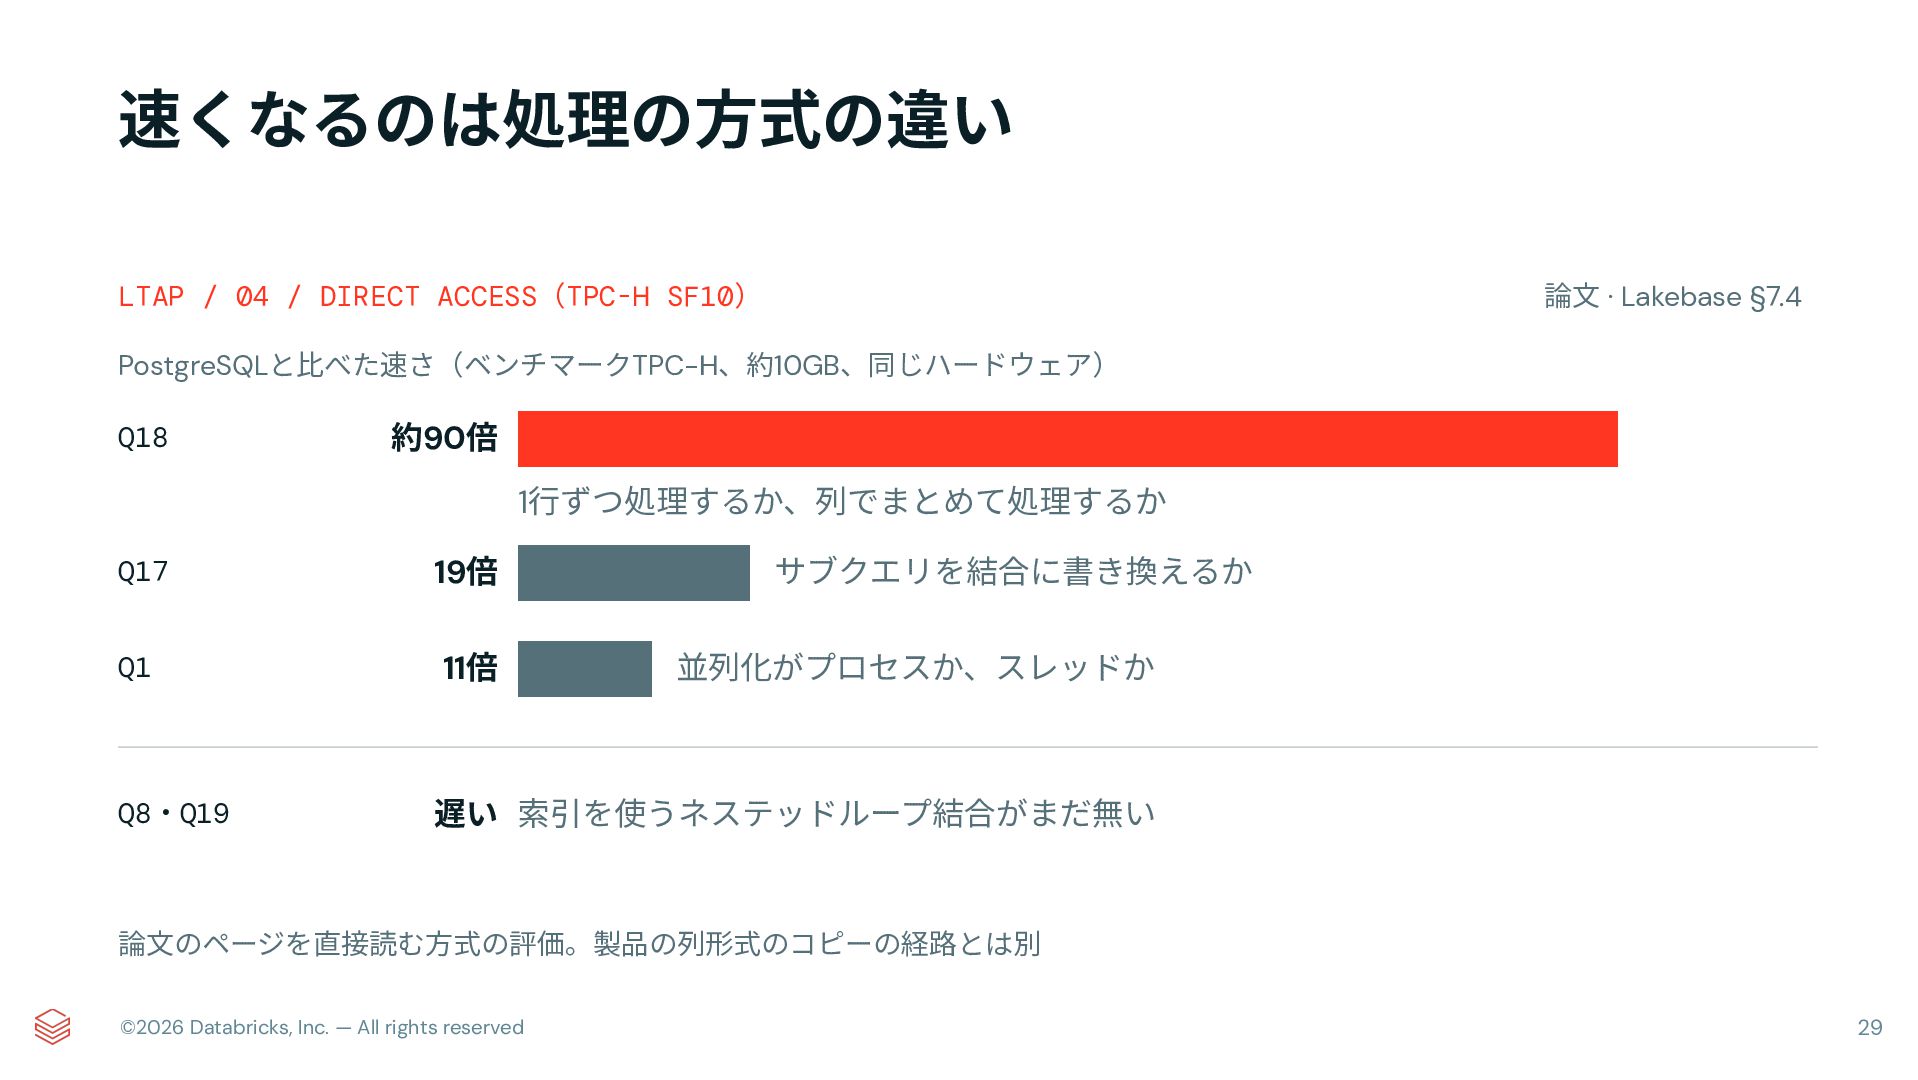
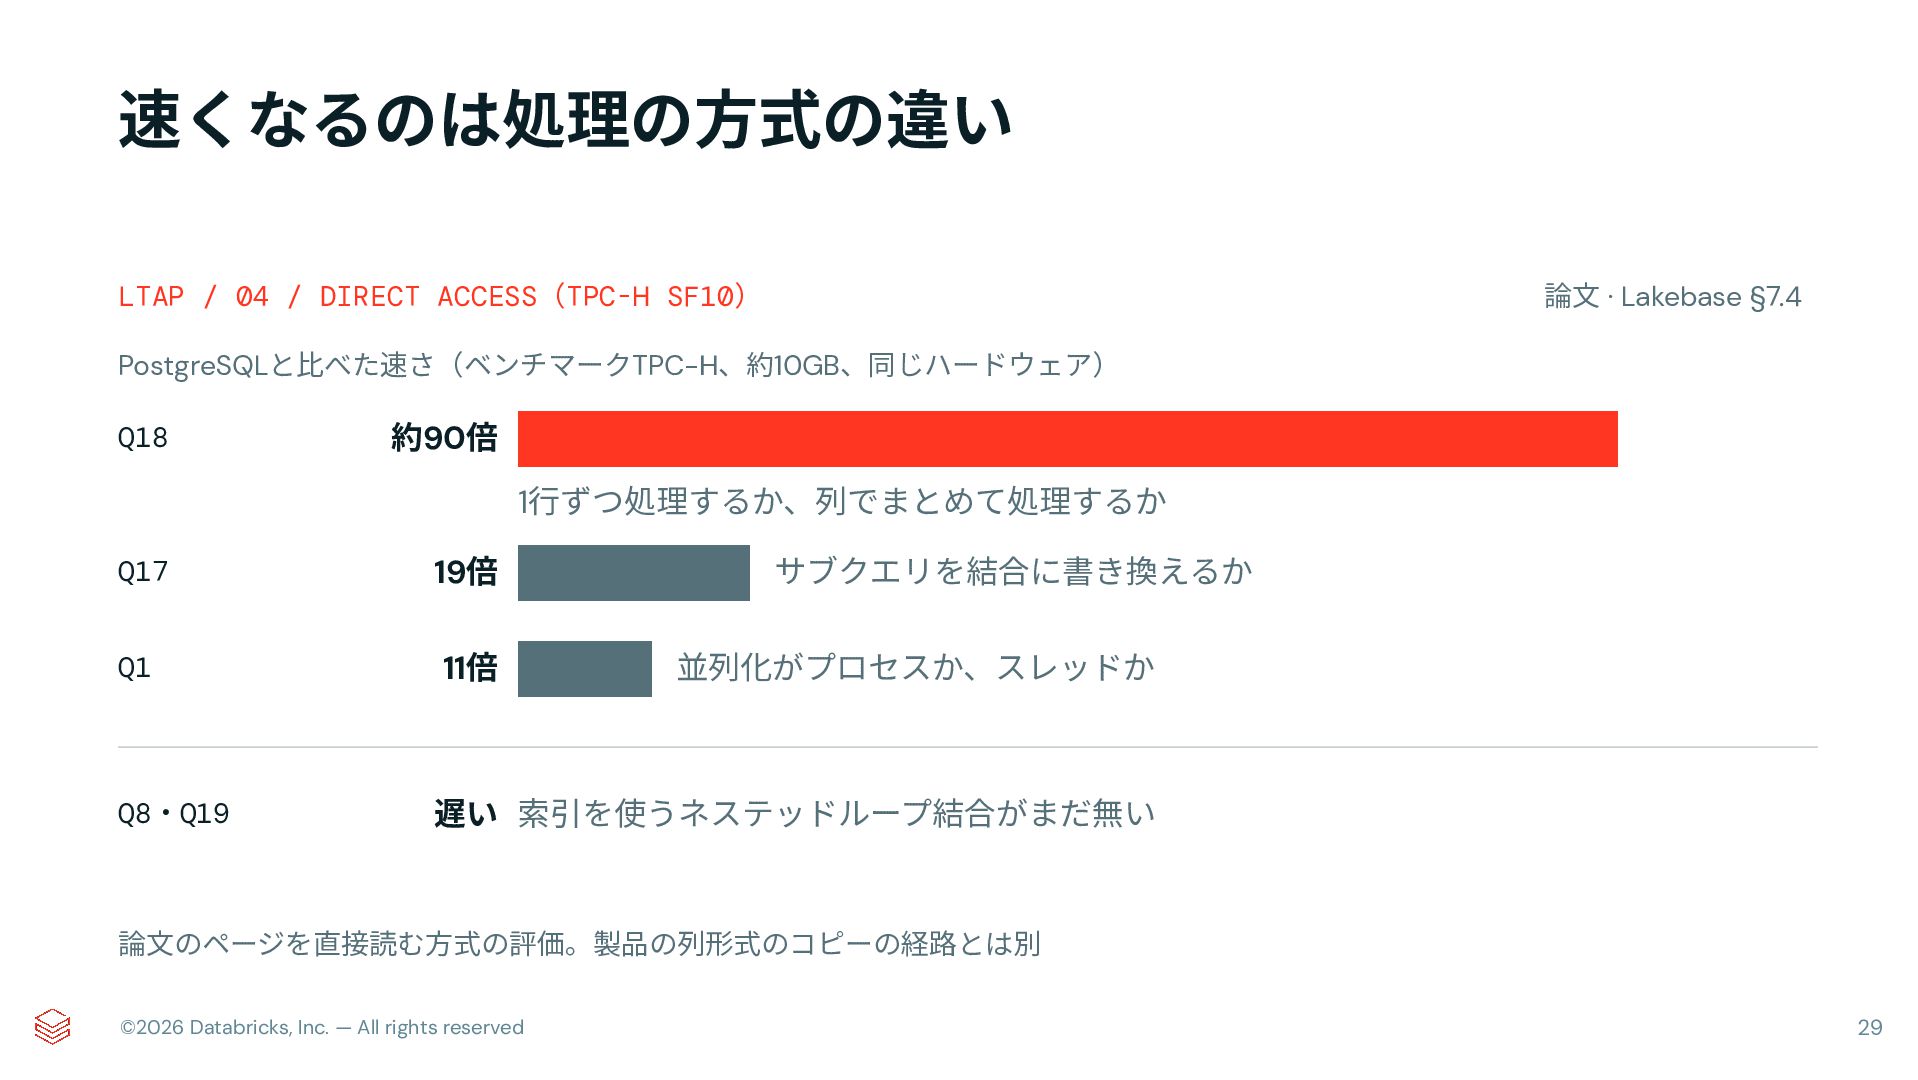
速くなるのは処理の⽅式の違い 論⽂ · Lakebase §7.4 LTAP / 04 / DIRECT
ACCESS(TPC-H SF10) PostgreSQLと⽐べた速さ(ベンチマークTPC-H、約10GB、同じハードウェア) Q18 約90倍 1⾏ずつ処理するか、列でまとめて処理するか サブクエリを結合に書き換えるか Q17 19倍 Q1 11倍 Q8‧Q19 遅い 索引を使うネステッドループ結合がまだ無い 並列化がプロセスか、スレッドか 論⽂のページを直接読む⽅式の評価。製品の列形式のコピーの経路とは別 ©2026 Databricks, Inc. — All rights reserved 29
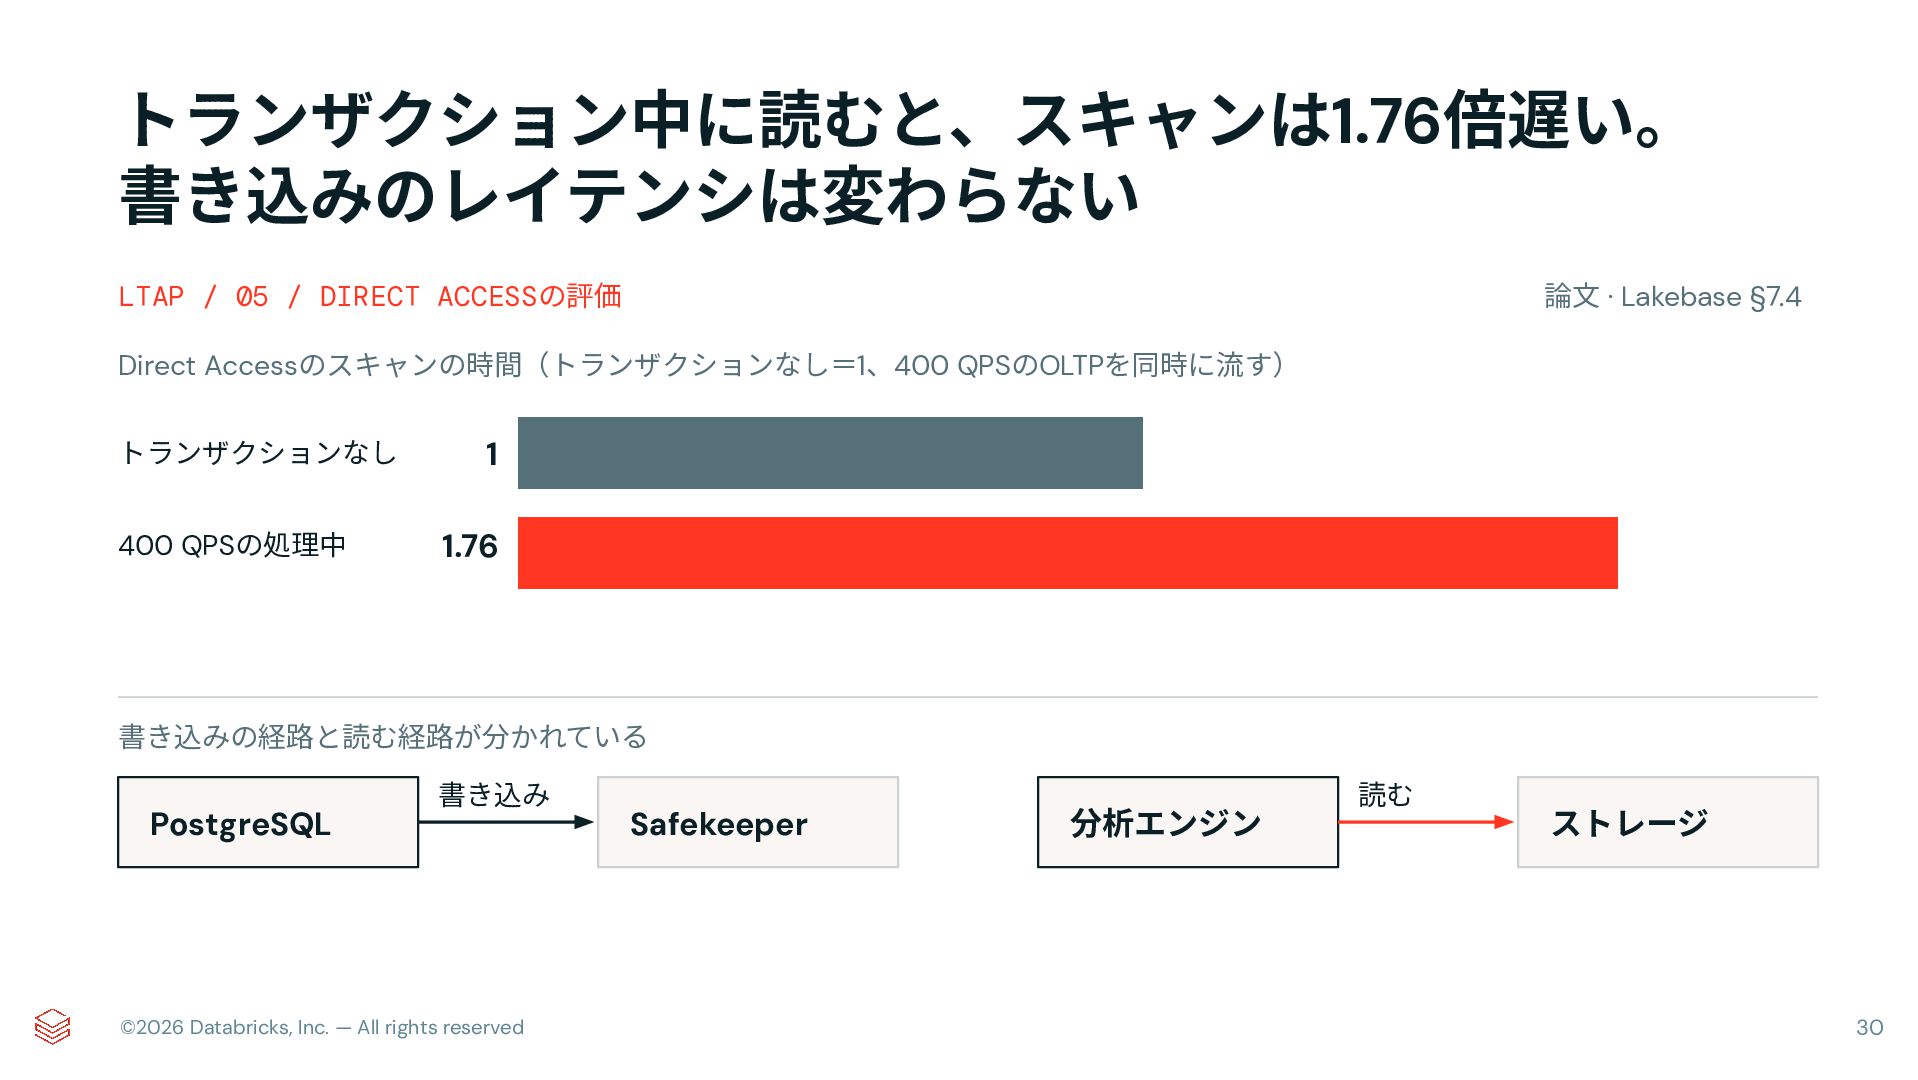
トランザクション中に読むと、スキャンは1.76倍遅い。 書き込みのレイテンシは変わらない 論⽂ · Lakebase §7.4 LTAP / 05 /
DIRECT ACCESSの評価 Direct Accessのスキャンの時間(トランザクションなし=1、400 QPSのOLTPを同時に流す) トランザクションなし 400 QPSの処理中 1 1.76 書き込みの経路と読む経路が分かれている PostgreSQL 書き込み ©2026 Databricks, Inc. — All rights reserved Safekeeper 分析エンジン 読む ストレージ 30
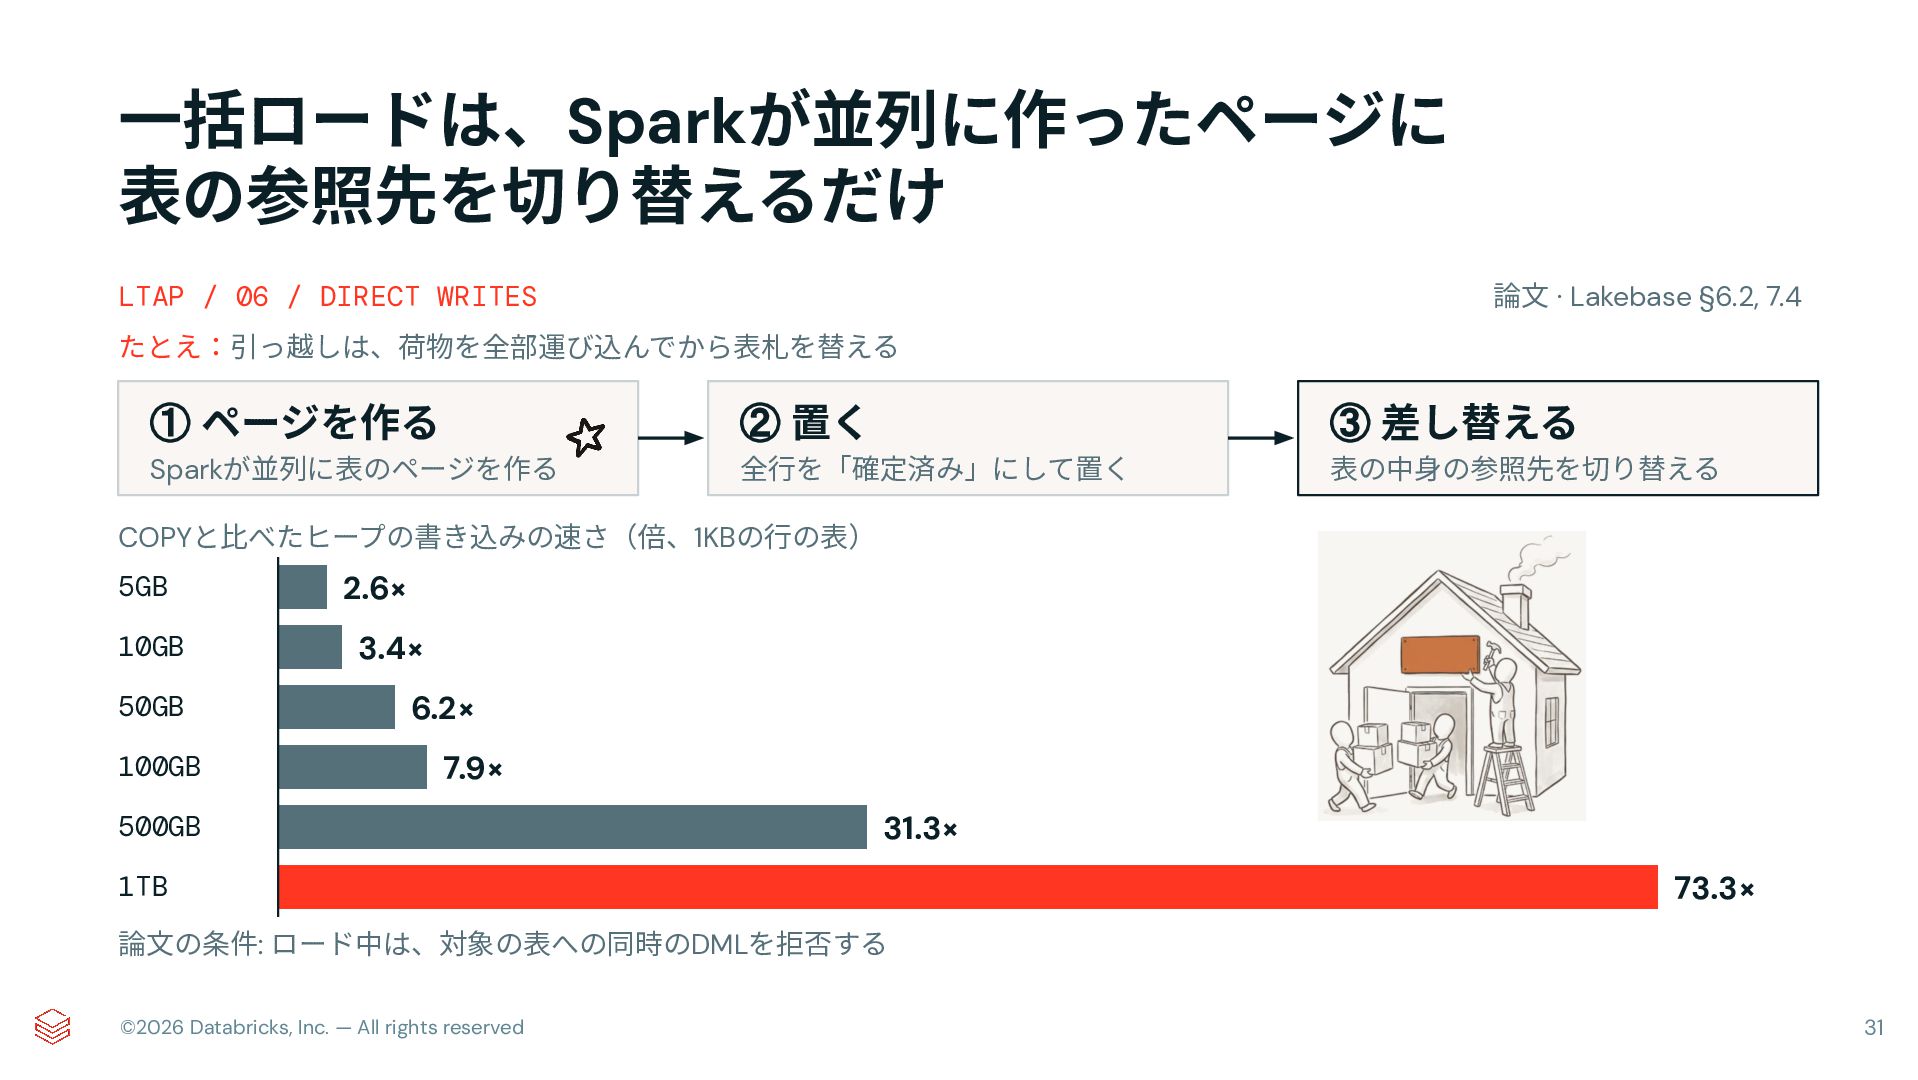
⼀括ロードは、Sparkが並列に作ったページに 表の参照先を切り替えるだけ 論⽂ · Lakebase §6.2, 7.4 LTAP / 06
/ DIRECT WRITES たとえ:引っ越しは、荷物を全部運び込んでから表札を替える ① ページを作る ② 置く Sparkが並列に表のページを作る 全⾏を「確定済み」にして置く ③ 差し替える 表の中⾝の参照先を切り替える COPYと⽐べたヒープの書き込みの速さ(倍、1KBの⾏の表) 5GB 2.6× 10GB 3.4× 50GB 100GB 6.2× 7.9× 500GB 31.3× 1TB 73.3× 論⽂の条件: ロード中は、対象の表への同時のDMLを拒否する ©2026 Databricks, Inc. — All rights reserved 31
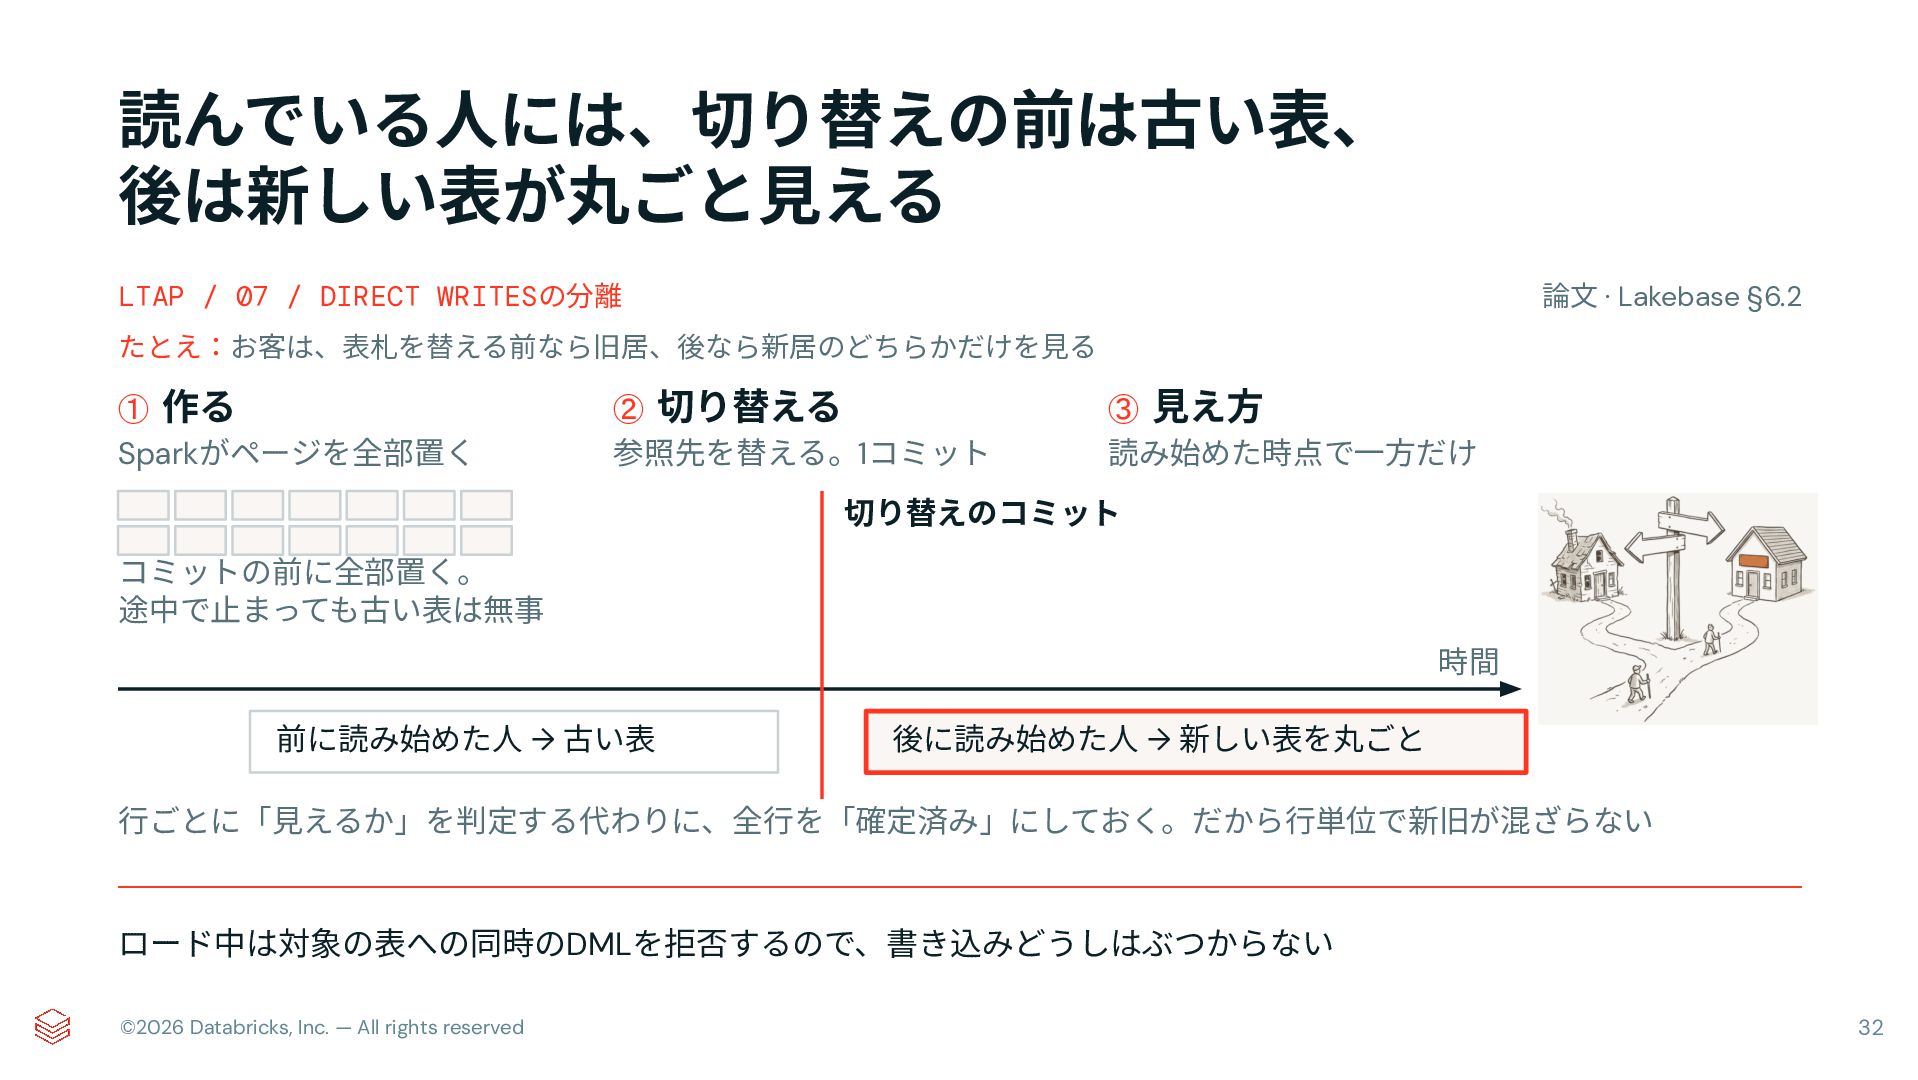
読んでいる⼈には、切り替えの前は古い表、 後は新しい表が丸ごと⾒える 論⽂ · Lakebase §6.2 LTAP / 07 /
DIRECT WRITESの分離 たとえ:お客は、表札を替える前なら旧居、後なら新居のどちらかだけを⾒る ① 作る Sparkがページを全部置く ② 切り替える 参照先を替える。1コミット ③ ⾒え⽅ 読み始めた時点で⼀⽅だけ 切り替えのコミット コミットの前に全部置く。 途中で⽌まっても古い表は無事 時間 前に読み始めた⼈ → 古い表 後に読み始めた⼈ → 新しい表を丸ごと ⾏ごとに「⾒えるか」を判定する代わりに、全⾏を「確定済み」にしておく。だから⾏単位で新旧が混ざらない ロード中は対象の表への同時のDMLを拒否するので、書き込みどうしはぶつからない ©2026 Databricks, Inc. — All rights reserved 32
03 AIの利⽤監視 ©2026 Databricks, Inc. — All rights reserved 33
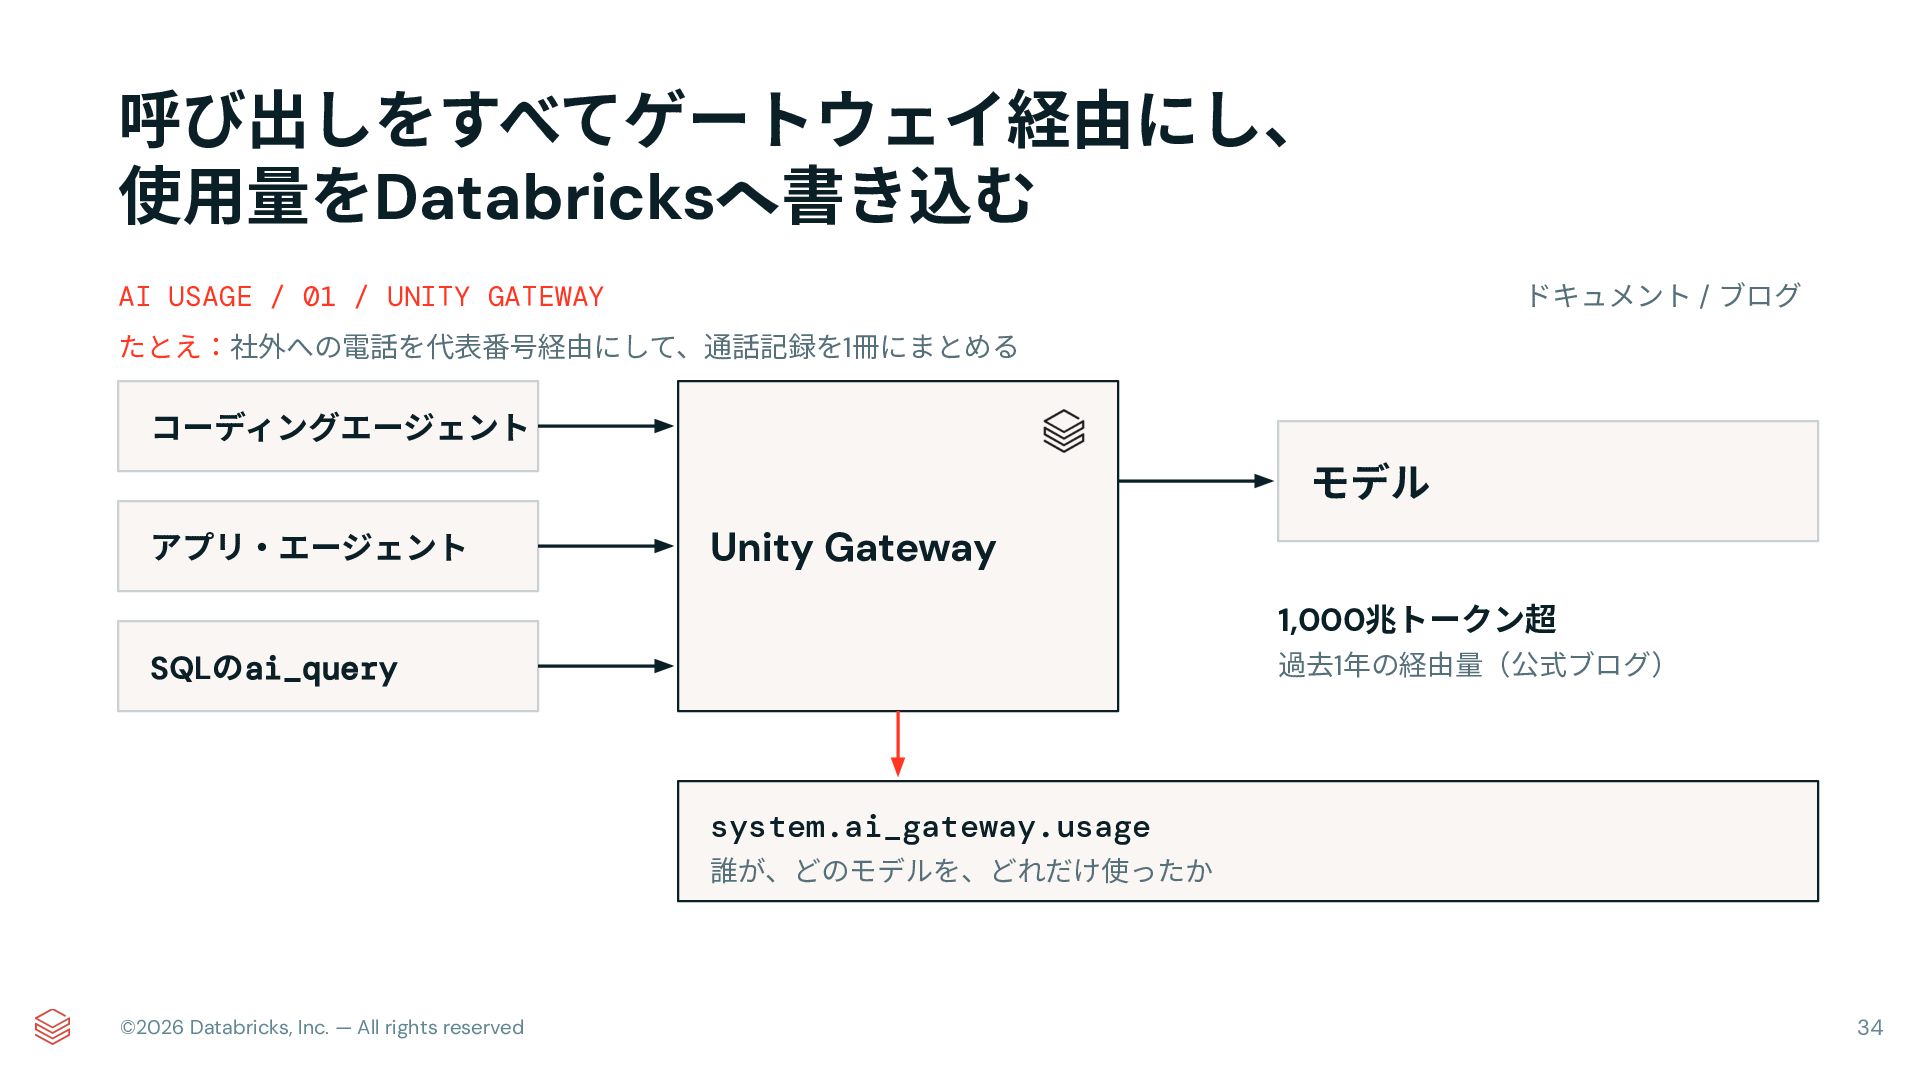
呼び出しをすべてゲートウェイ経由にし、 使⽤量をDatabricksへ書き込む ドキュメント / ブログ AI USAGE / 01 /
UNITY GATEWAY たとえ:社外への電話を代表番号経由にして、通話記録を1冊にまとめる コーディングエージェント モデル アプリ‧エージェント Unity Gateway 1,000兆トークン超 過去1年の経由量(公式ブログ) SQLのai_query system.ai_gateway.usage 誰が、どのモデルを、どれだけ使ったか ©2026 Databricks, Inc. — All rights reserved 34
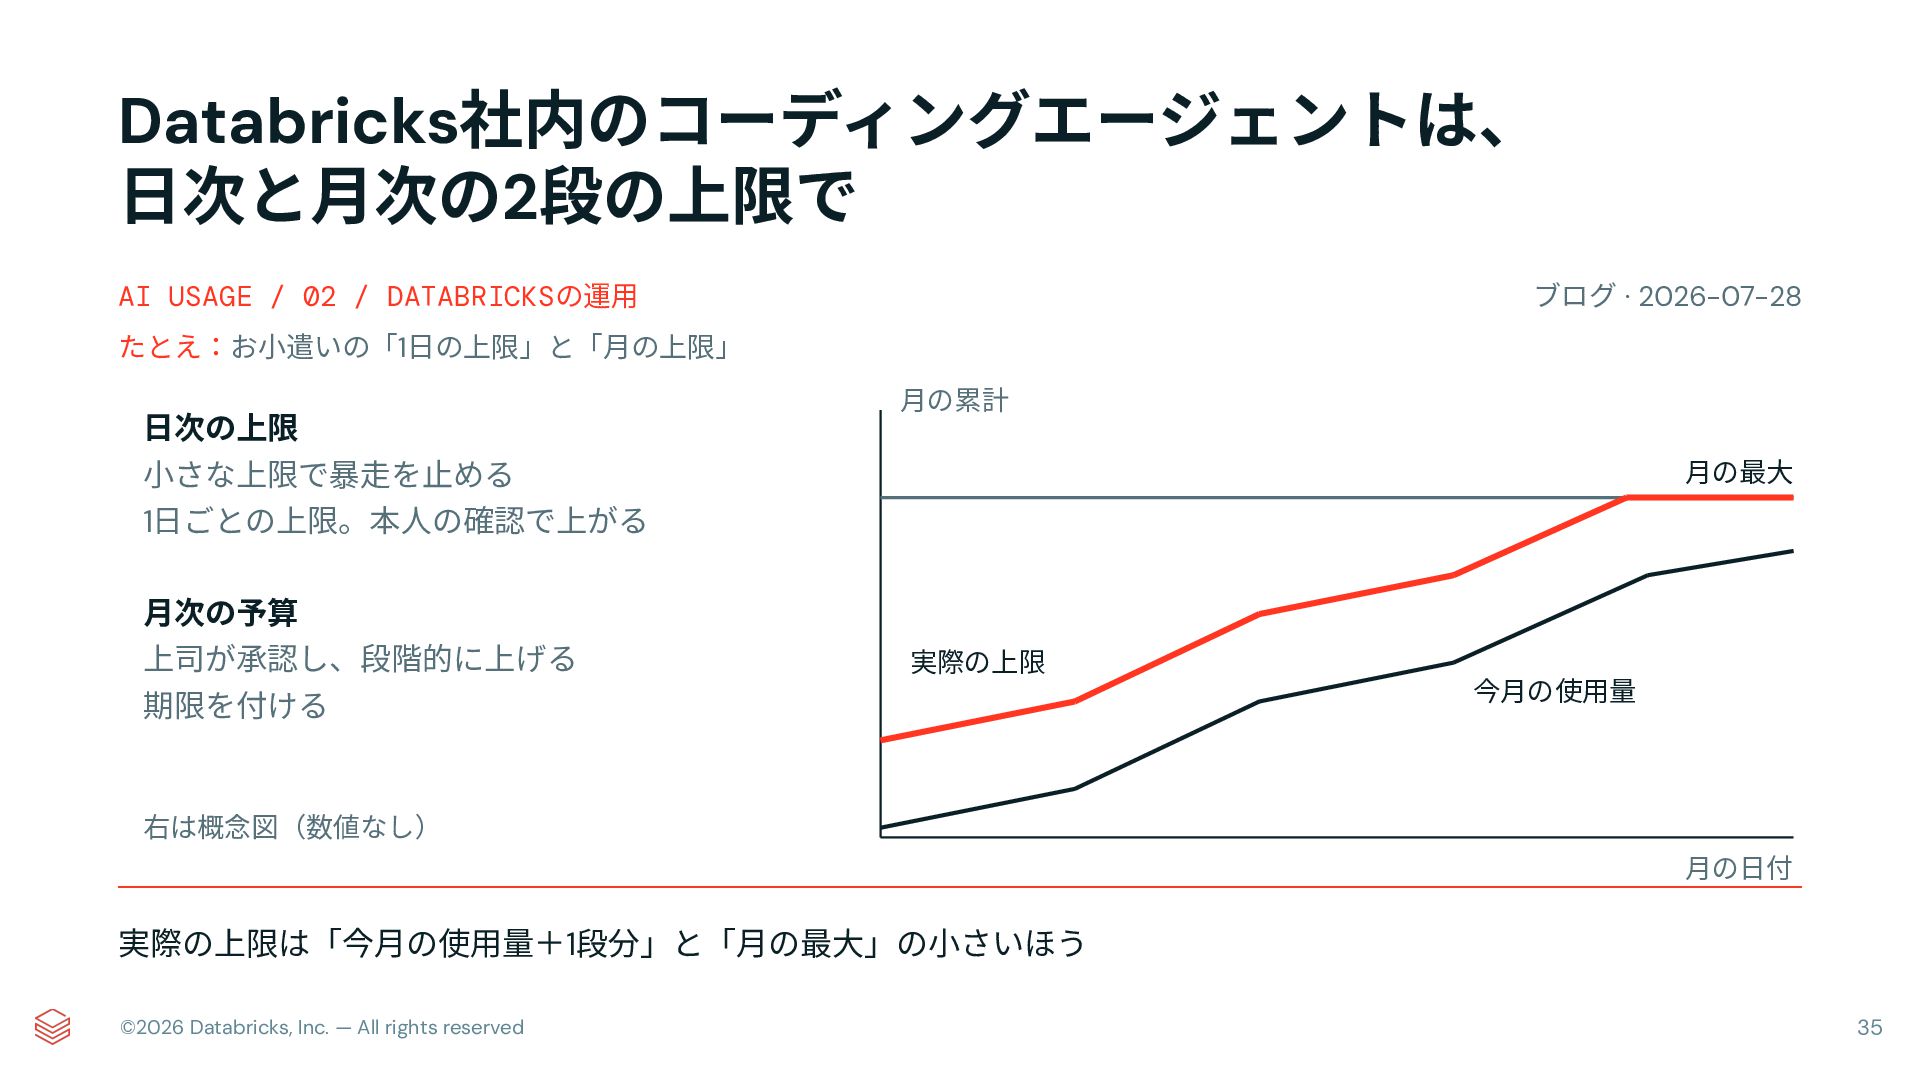
Databricks社内のコーディングエージェントは、 ⽇次と⽉次の2段の上限で ブログ · 2026-07-28 AI USAGE / 02 /
DATABRICKSの運⽤ たとえ:お⼩遣いの「1⽇の上限」と「⽉の上限」 ⽇次の上限 ⼩さな上限で暴⾛を⽌める 1⽇ごとの上限。本⼈の確認で上がる ⽉次の予算 上司が承認し、段階的に上げる 期限を付ける ⽉の累計 ⽉の最⼤ 実際の上限 今⽉の使⽤量 右は概念図(数値なし) ⽉の⽇付 実際の上限は「今⽉の使⽤量+1段分」と「⽉の最⼤」の⼩さいほう ©2026 Databricks, Inc. — All rights reserved 35
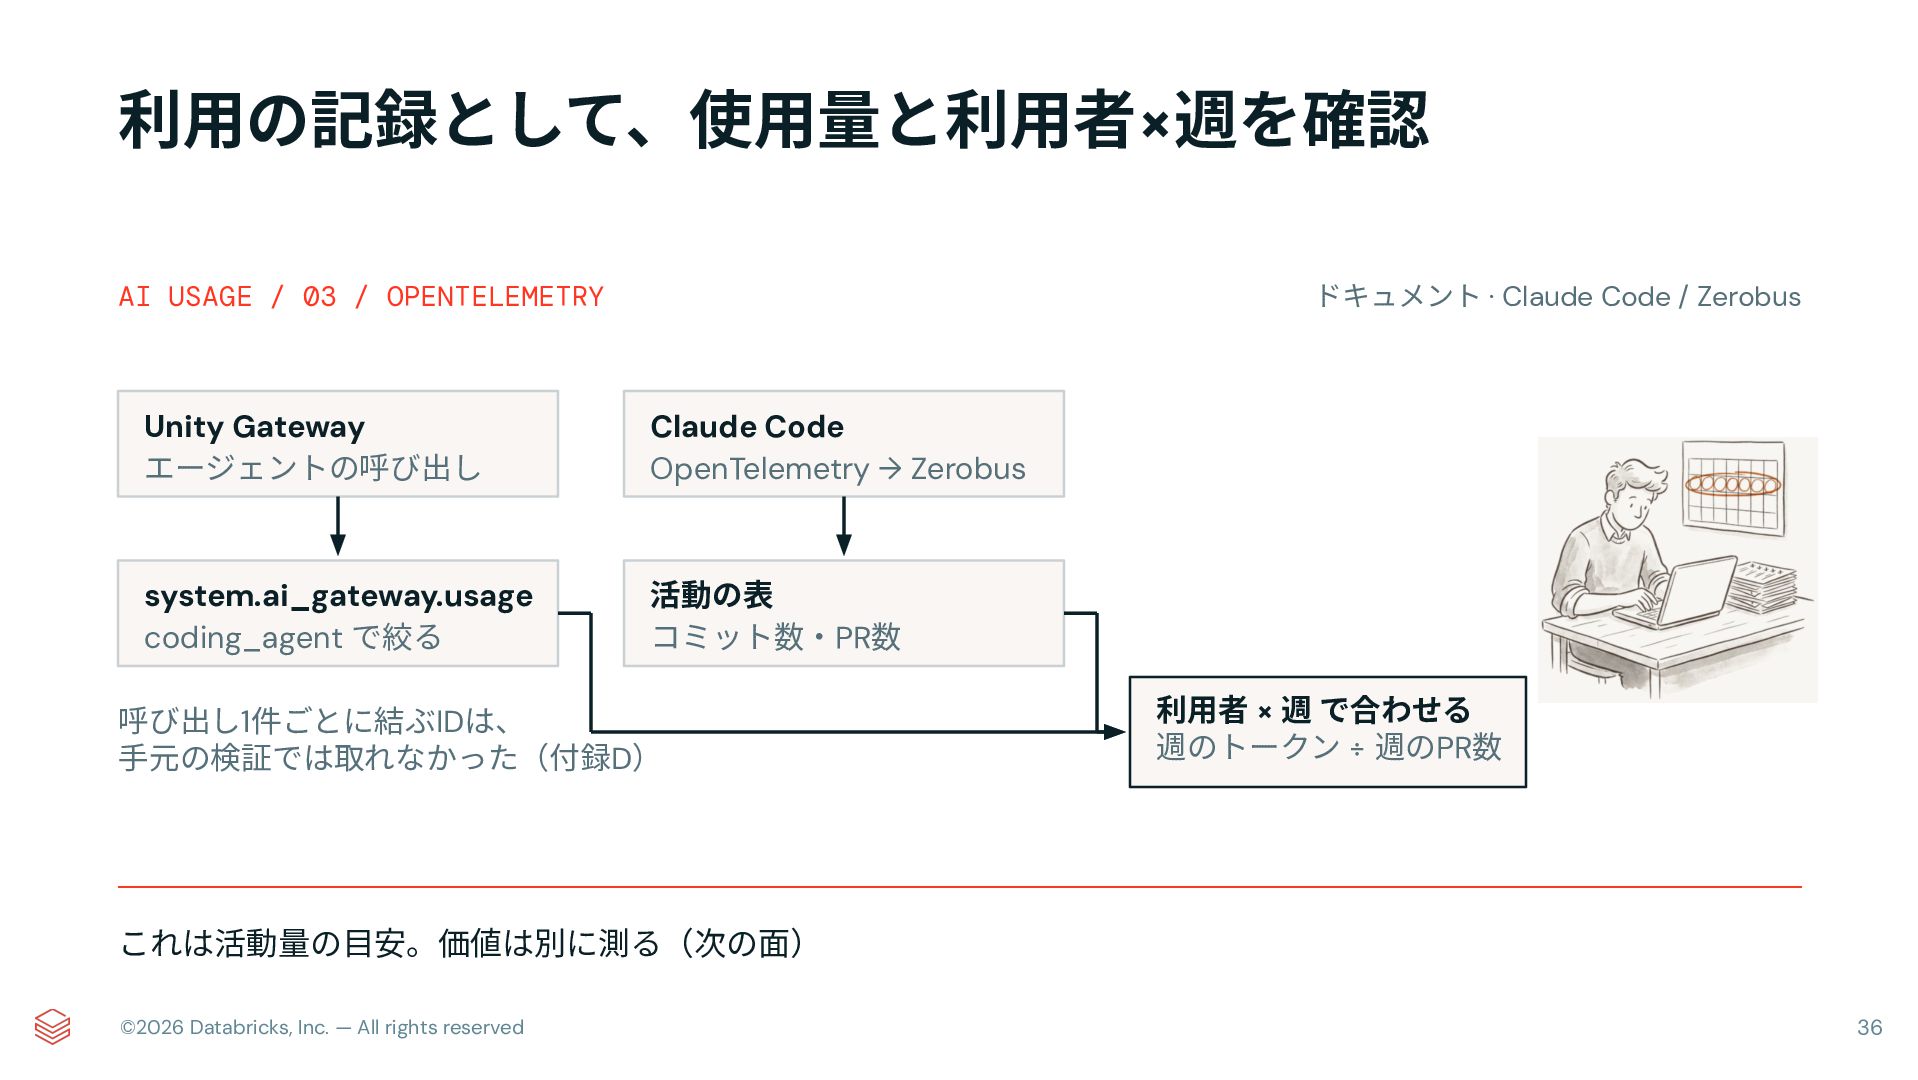
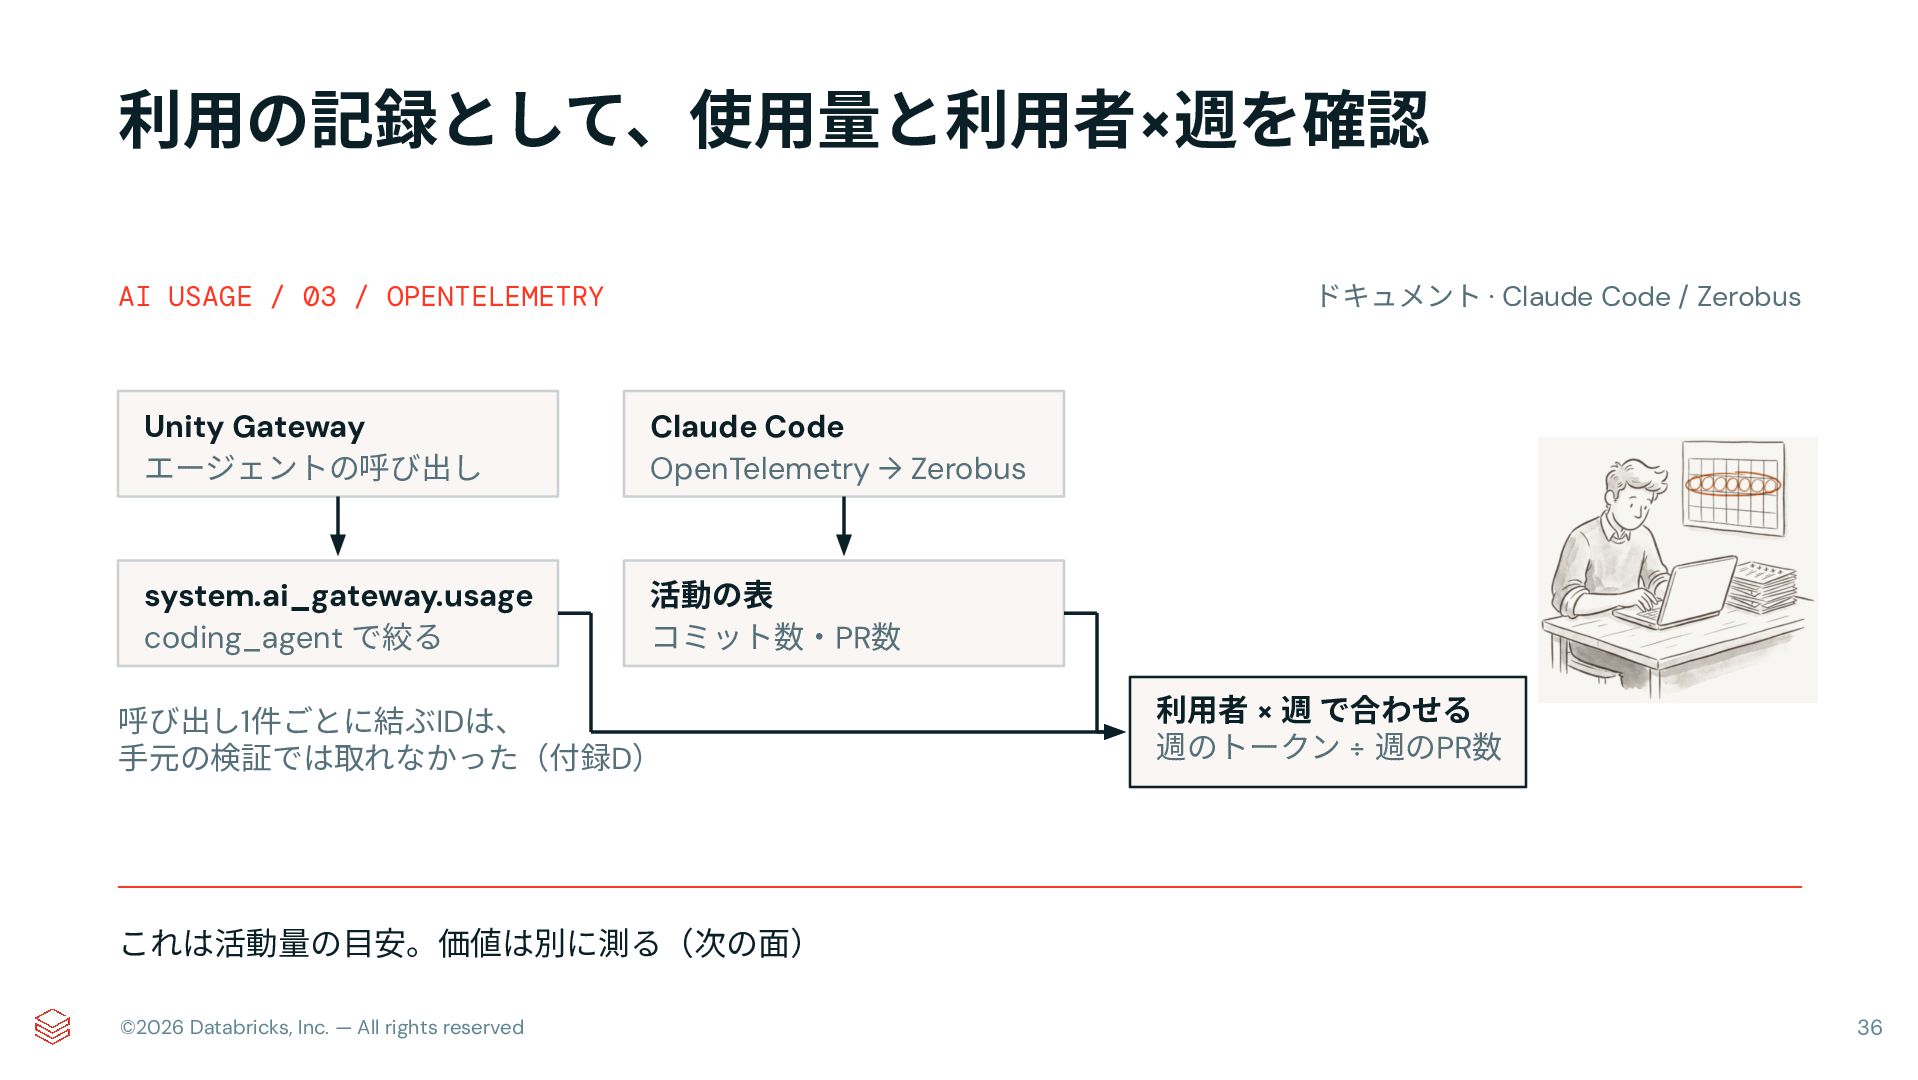
利⽤の記録として、使⽤量と利⽤者×週を確認 ドキュメント · Claude Code / Zerobus AI USAGE /
03 / OPENTELEMETRY Unity Gateway エージェントの呼び出し Claude Code OpenTelemetry → Zerobus system.ai_gateway.usage coding_agent で絞る 活動の表 コミット数‧PR数 呼び出し1件ごとに結ぶIDは、 ⼿元の検証では取れなかった(付録D) 利⽤者 × 週 で合わせる 週のトークン ÷ 週のPR数 これは活動量の⽬安。価値は別に測る(次の⾯) ©2026 Databricks, Inc. — All rights reserved 36
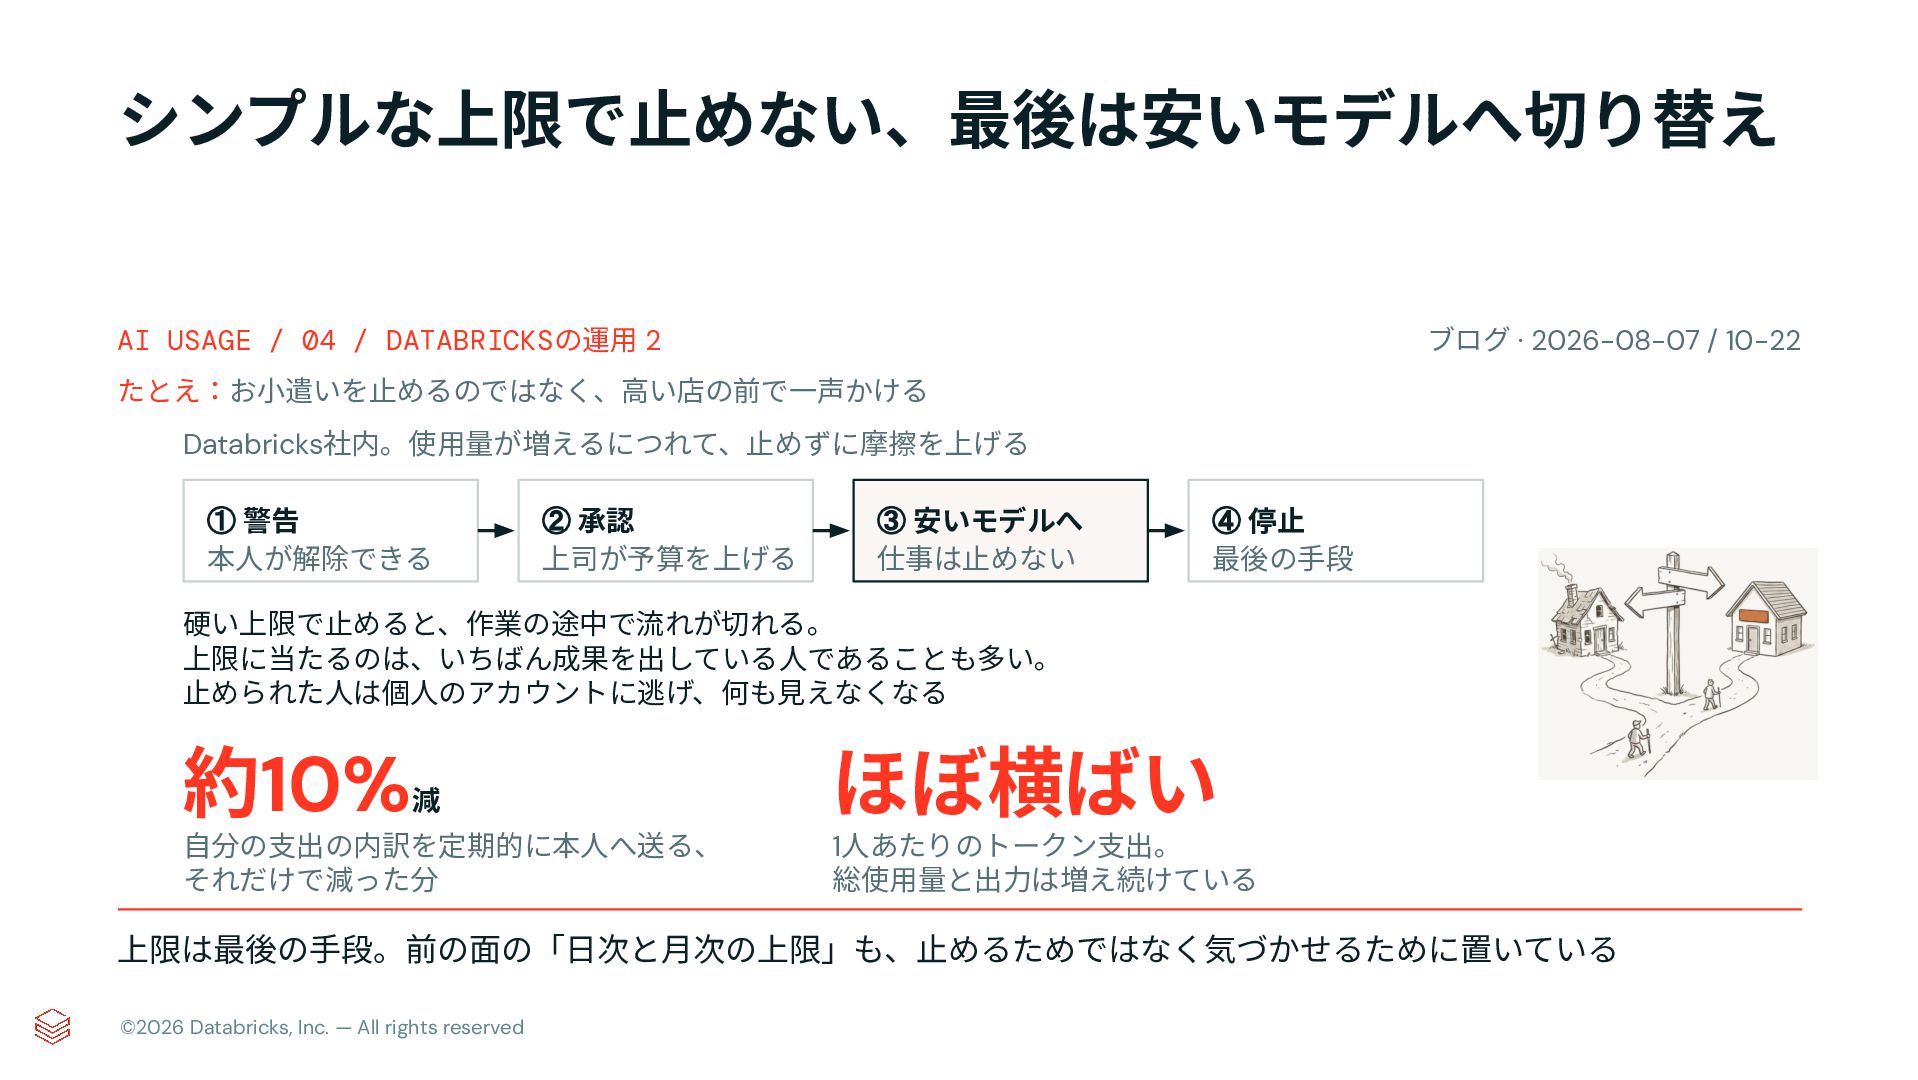
シンプルな上限で⽌めない、最後は安いモデルへ切り替え ブログ · 2026-08-07 / 10-22 AI USAGE / 04
/ DATABRICKSの運⽤ 2 たとえ:お⼩遣いを⽌めるのではなく、⾼い店の前で⼀声かける Databricks社内。使⽤量が増えるにつれて、⽌めずに摩擦を上げる ① 警告 本⼈が解除できる ② 承認 上司が予算を上げる ③ 安いモデルへ 仕事は⽌めない ④ 停⽌ 最後の⼿段 硬い上限で⽌めると、作業の途中で流れが切れる。 上限に当たるのは、いちばん成果を出している⼈であることも多い。 ⽌められた⼈は個⼈のアカウントに逃げ、何も⾒えなくなる 約10% 減 ⾃分の⽀出の内訳を定期的に本⼈へ送る、 それだけで減った分 ほぼ横ばい 1⼈あたりのトークン⽀出。 総使⽤量と出⼒は増え続けている 上限は最後の⼿段。前の⾯の「⽇次と⽉次の上限」も、⽌めるためではなく気づかせるために置いている ©2026 Databricks, Inc. — All rights reserved
費⽤を下げる4つの施策、合わせて最⼤90%減 ブログ · 2026-08-07 / 10-22 AI USAGE / 05
/ DATABRICKSの運⽤ 3 ① 効率の良い新モデルへ移す ゲートウェイの1か所で切り替え。開発者は何も変えない ② 課題に合うモデルへ振り分ける Smart Routing。簡単な課題は安いモデルへ 50%以上 30%以上 ③ 可視化と段階的な摩擦 前の⾯。⽀出の内訳を本⼈へ送る ④ トークンの無駄を減らす ハーネスの設定とキャッシュの調整 減 最⼤のレバー。週に数本出る新モデルを ⾃社のベンチで測り、良ければ移す 約10% 減 硬い上限ではなく、⾒せて気づかせる 減 課題あたりの費⽤。品質は いちばん⾼いモデルとほぼ同じ 約50% 減 ⽣成トークン。品質の低下は観測されず トークンの単価は課題あたりの費⽤の⽬安にならない。単価が1.7倍安いモデルが、トークンを多く使って課題 あたりでは⾼かった ©2026 Databricks, Inc. — All rights reserved
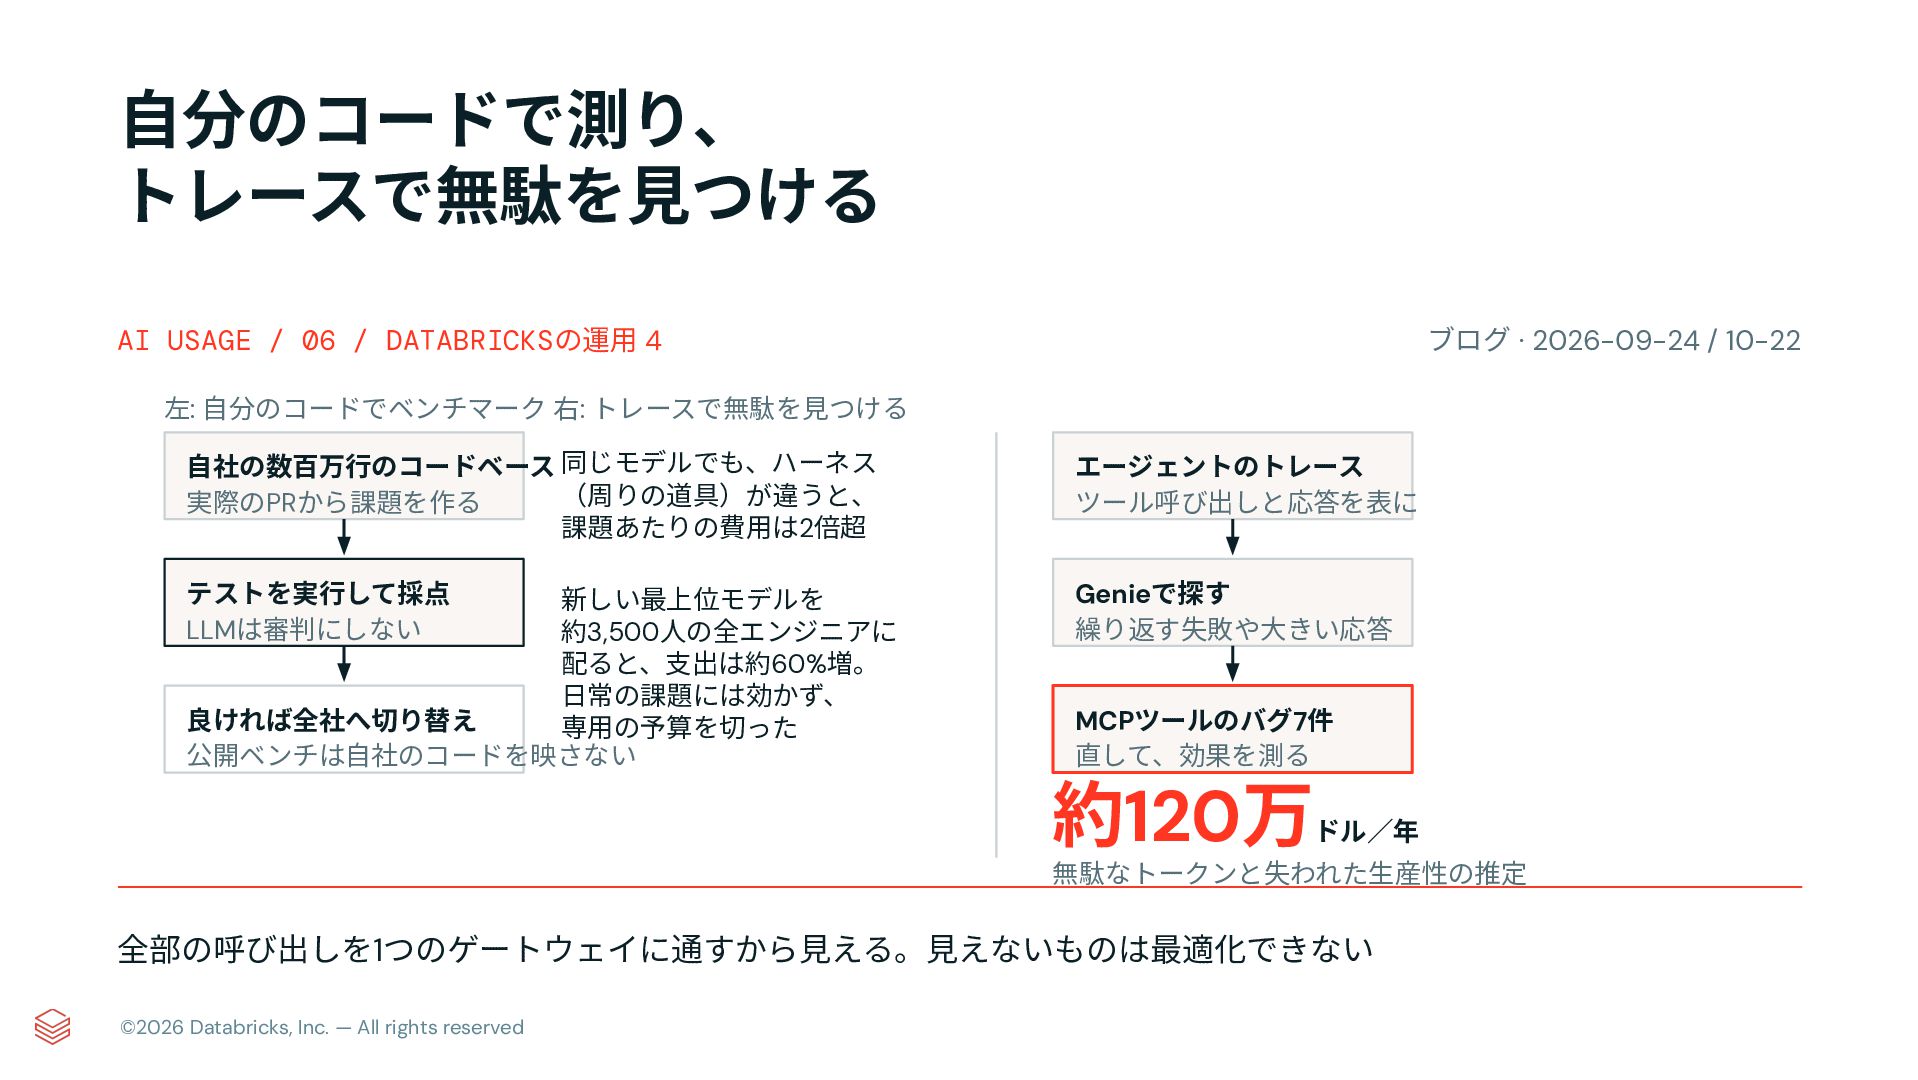
⾃分のコードで測り、 トレースで無駄を⾒つける ブログ · 2026-09-24 / 10-22 AI USAGE /
06 / DATABRICKSの運⽤ 4 左: ⾃分のコードでベンチマーク 右: トレースで無駄を⾒つける ⾃社の数百万⾏のコードベース 同じモデルでも、ハーネス (周りの道具)が違うと、 実際のPRから課題を作る 課題あたりの費⽤は2倍超 エージェントのトレース ツール呼び出しと応答を表に テストを実⾏して採点 LLMは審判にしない Genieで探す 繰り返す失敗や⼤きい応答 新しい最上位モデルを 約3,500⼈の全エンジニアに 配ると、⽀出は約60%増。 ⽇常の課題には効かず、 良ければ全社へ切り替え 専⽤の予算を切った 公開ベンチは⾃社のコードを映さない MCPツールのバグ7件 直して、効果を測る 約120万 ドル∕年 無駄なトークンと失われた⽣産性の推定 全部の呼び出しを1つのゲートウェイに通すから⾒える。⾒えないものは最適化できない ©2026 Databricks, Inc. — All rights reserved
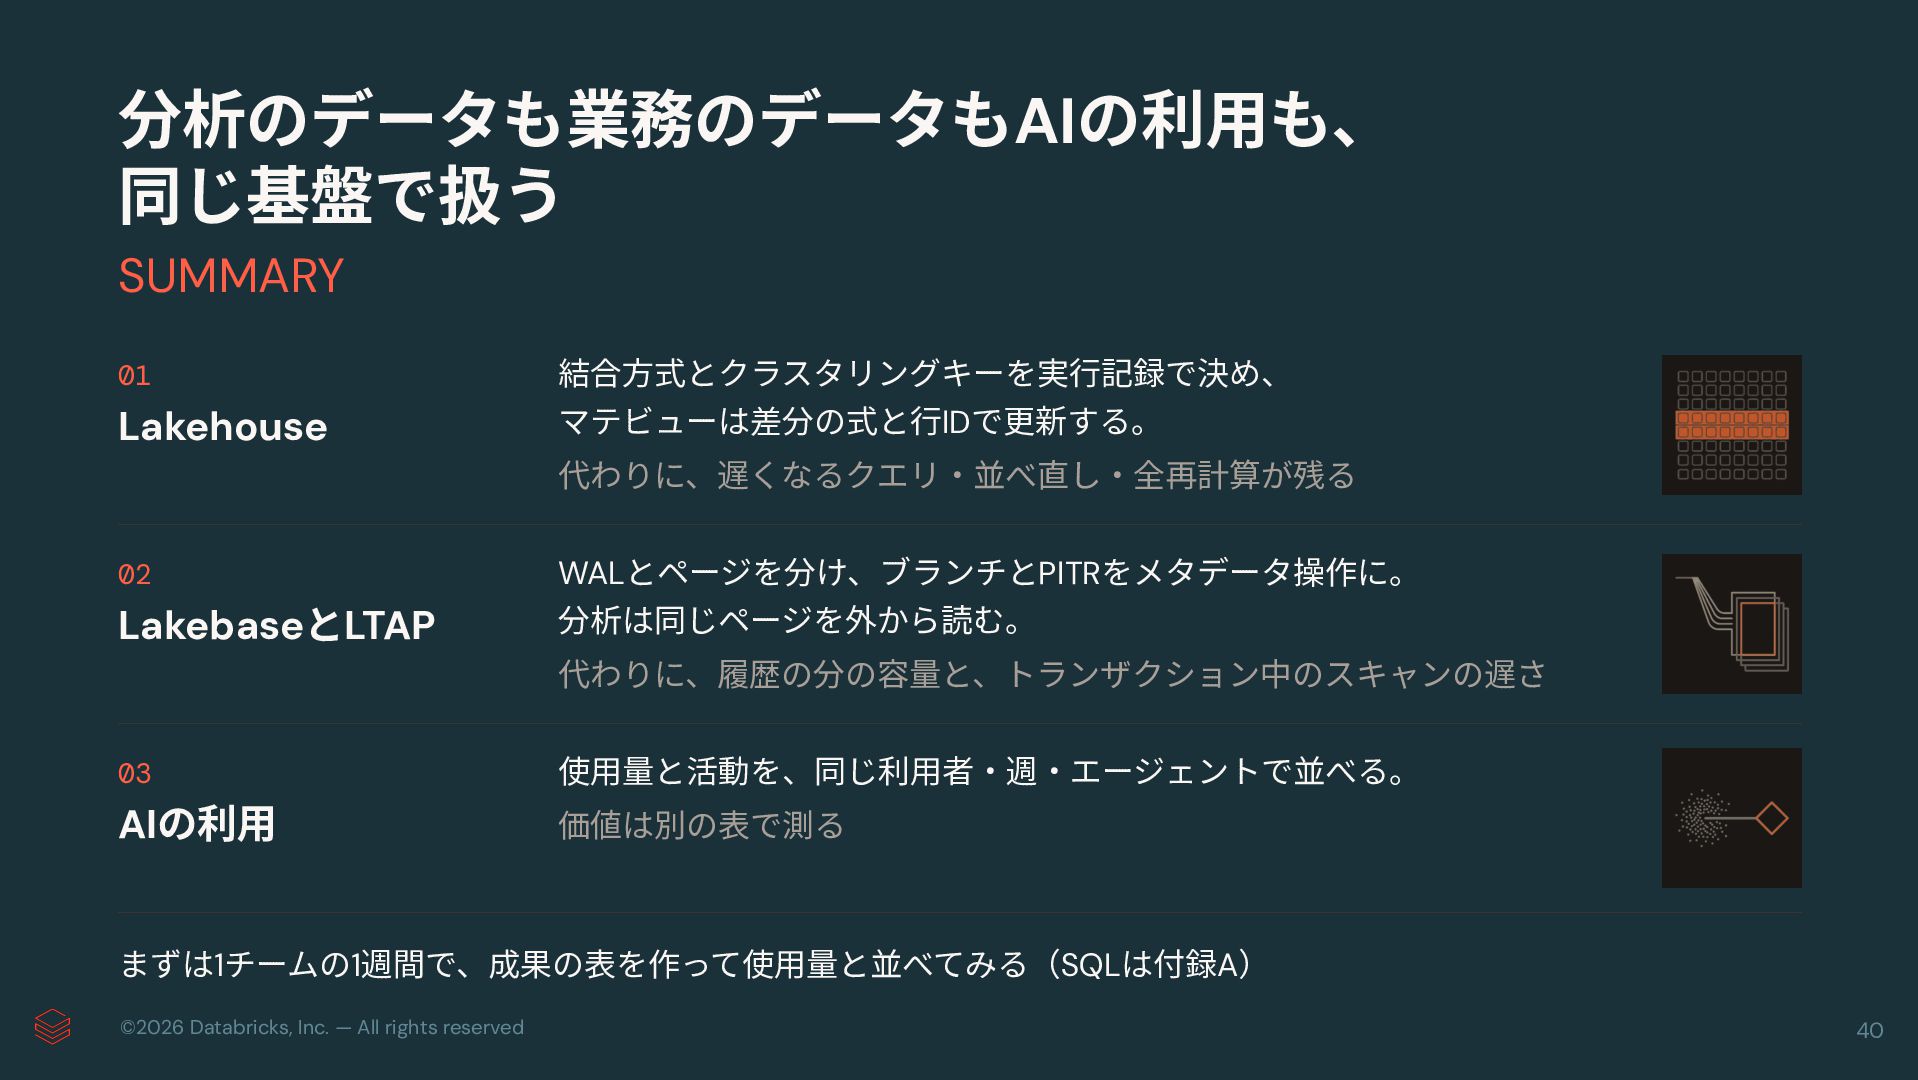
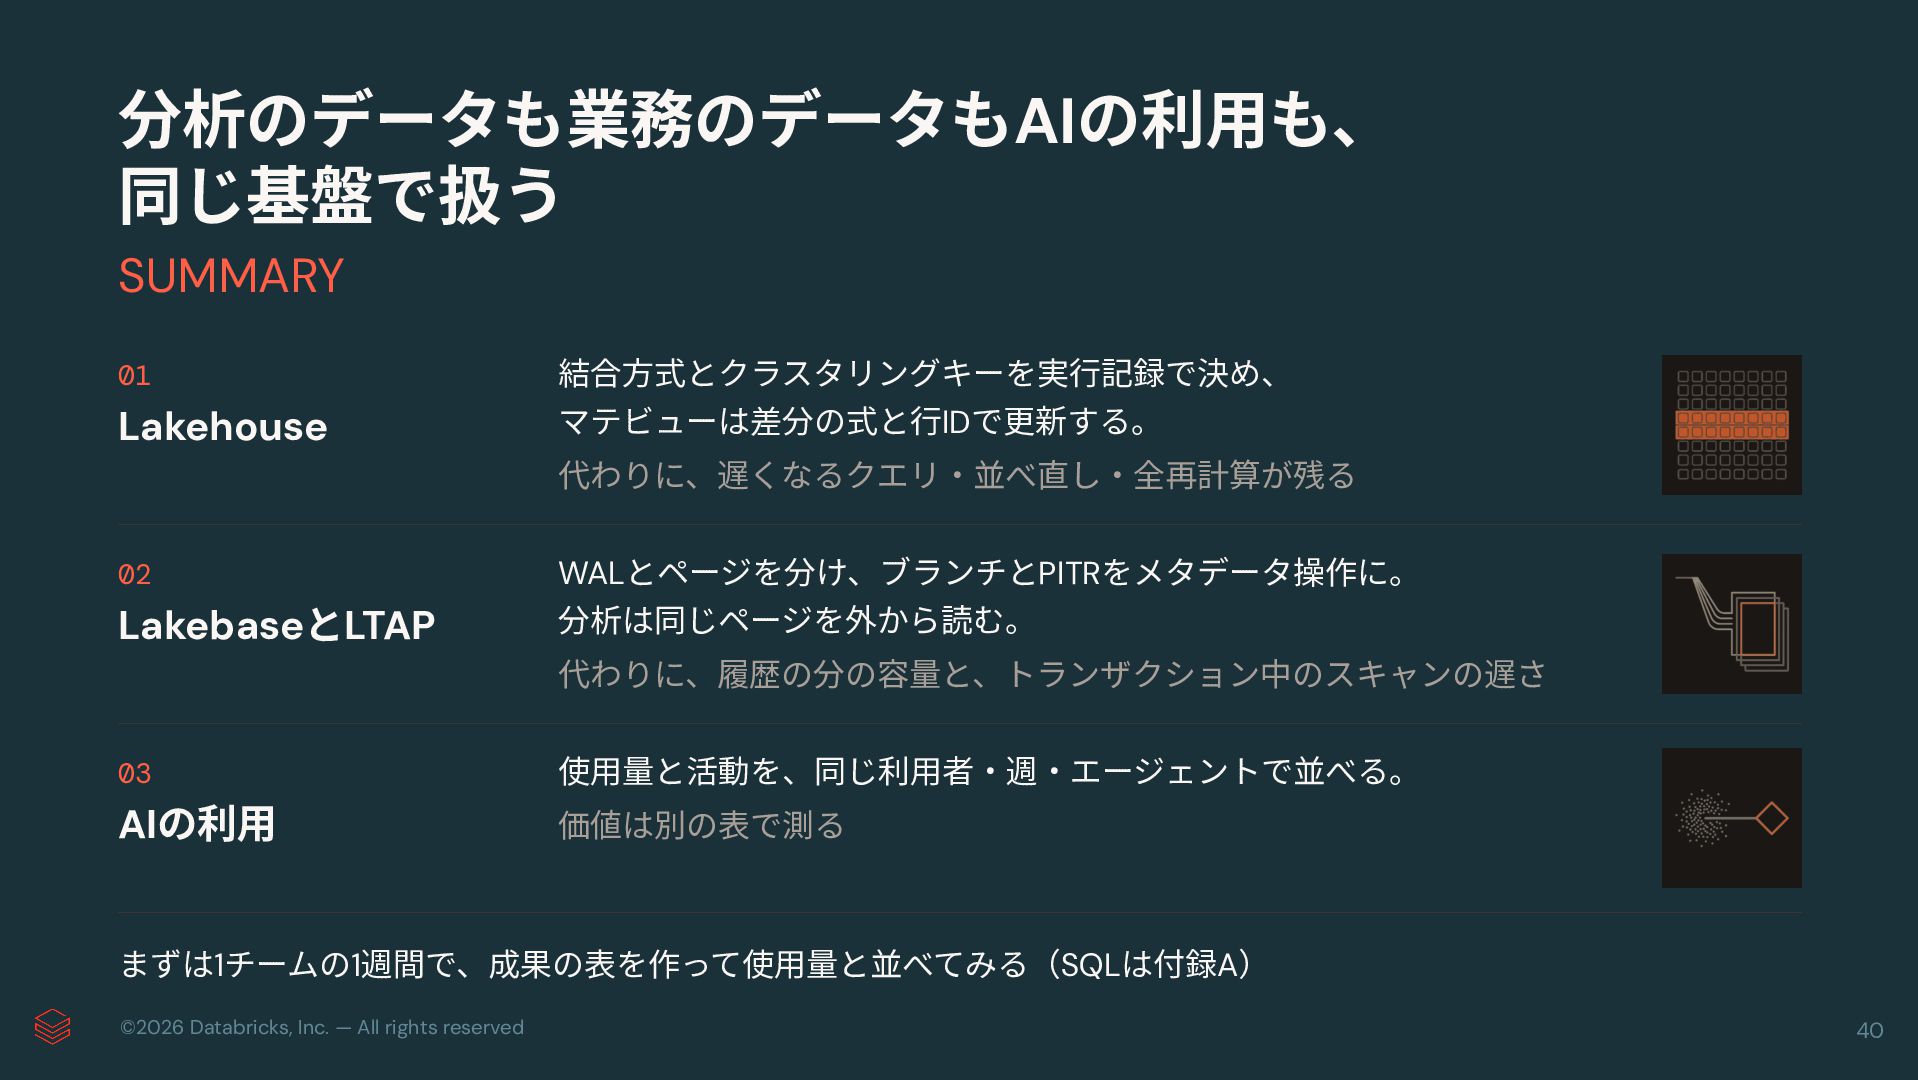
分析のデータも業務のデータもAIの利⽤も、 同じ基盤で扱う SUMMARY 01 結合⽅式とクラスタリングキーを実⾏記録で決め、 Lakehouse マテビューは差分の式と⾏IDで更新する。 02 WALとページを分け、ブランチとPITRをメタデータ操作に。 LakebaseとLTAP
分析は同じページを外から読む。 03 使⽤量と活動を、同じ利⽤者‧週‧エージェントで並べる。 AIの利⽤ 価値は別の表で測る 代わりに、遅くなるクエリ‧並べ直し‧全再計算が残る 代わりに、履歴の分の容量と、トランザクション中のスキャンの遅さ まずは1チームの1週間で、成果の表を作って使⽤量と並べてみる(SQLは付録A) ©2026 Databricks, Inc. — All rights reserved 40
数字の出典は、公開されている論⽂‧ブログ‧ ドキュメントと、⼿元の実測 REFERENCES PAPERS Lakebase、Ultron、AutoLiquid(PVLDB 19(12), 2026)、Enzyme(SIGMOD Companion '26) BLOGS
Databricksの公式ブログ(LTAP、Lakehouse//RT、Unity Gateway)と報道(ITPro) DOCS LTAP、synced tables、OpenTelemetryの取り込み、Claude Codeの監視 MEASURED ai_queryとClaude CodeのOpenTelemetry(2026年9⽉) LINKS vldb.org/pvldb/vol19(p4385‧p4358‧p4023)、arxiv.org/abs/2603.27775。ほかは配布PDFに TRY まず1チーム‧1週間ぶん成果の表を作り、使⽤量とチーム×週で並べる(SQLは付録A) ©2026 Databricks, Inc. — All rights reserved 41
今日はDatabricksの技術の源泉である 論文と、ドッグフーディングの紹介をしま した! このように Databricksの技術は進んで 行くことがおわかりになったのではない でしょうか? ©2026 Databricks, Inc.
— All rights reserved
ご興味ありましたら 是非Databricks触ってみてください! Free Editionもあるよ! ©2026 Databricks, Inc. — All rights
reserved
©2026 Databricks, Inc. — All rights reserved 44


 akuwano
 asmz
 masu_mi
 hotchpotch
 toru_kubota
 cscengineer
 shunghsiyu
 shinyaa31
 kinunori
 kubell_hr
 hokkai7go
 skydoves
 oracle4engineer
 jonoalderson
 aleyda
 irinanazarova
 chikuwait
 deanohume
 garrettdimon
 davidcarrasco
 greggifford
 geshan
 bcantrill
 codingconduct
 kimpetersen