Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Scaling your data infrastructure
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
barrachri
April 20, 2018
Technology
240
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Scaling your data infrastructure
Scaling your data infrastructure @ PyConNove
barrachri
April 20, 2018
More Decks by barrachri
See All by barrachri
Will Tech Save Us?
barrachri
0
130
How software can feed the World
barrachri
1
210
How to fight with yourself and win.
barrachri
0
360
Introduction to Statistics with Python
barrachri
0
470
EuroPython 2015 and the future
barrachri
2
140
Start with Flask
barrachri
3
210
Django & Docker
barrachri
6
1.1k
Other Decks in Technology
See All in Technology
AIにシークレットを見せない、WSL2で安全な開発環境
yazm
0
340
freeeにおける AI を用いた ブラウザ動作確認の自動化の取り組み
freee
PRO
0
140
古い指輪から広がった JAVA コミュニティ とのつながり
yamad
0
140
コンテナ運用におけるネットワーク・コンテナコストの削減方法/How to Reduce Network and Container Costs in Container Operations
masakiokuda
2
380
How to teach your AI Agent with Agent skills
linedevth
0
100
僕のハーネスを紹介します
watany
5
1.4k
LLM-as-a-Judgeは本当に信頼できるのか――評価器を評価する話
taka_aki
3
1k
CSS2026:OWS研究会・招待講演「世界観を、実装する」
atsush1_sada
2
220
日本語に強いオープンな大規模言語モデル「LLM-jp」
odashi
5
1.2k
こんにちは!SORACOM です & IoT とは【SORACOM UG 東北 in 八戸】
soracom
PRO
0
170
Active Record Connection Adaptersにおける長年の課題に再び取り組む
yahonda
0
410
From Developer Experience to Agentic Experience: The Next Evolution of APIs
benjagm
0
110
Featured
See All Featured
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
For a Future-Friendly Web
brad_frost
184
10k
Facilitating Awesome Meetings
lara
57
7.2k
Mind Mapping
helmedeiros
1
400
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
Fantastic passwords and where to find them - at NoRuKo
philnash
53
4k
Mobile First: as difficult as doing things right
swwweet
225
10k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
380
WCS-LA-2024
lcolladotor
0
900
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
1
280
Transcript
Scaling your data infrastructure C H R I S T
I A N B A R R A @ P Y C O N N O V E
THE AGENDA 2 3 START THE DATA SCIENCE WORKFLOW SCALING
IS NOT JUST A MATTER OF MACHINE WHEN THE SIZE OF YOUR DATA MATTERS 1
THE AGENDA 4 5 CONTAINERIZED DATA SCIENCE CASSINY: PUT ALL
THE THINGS TOGETHER END
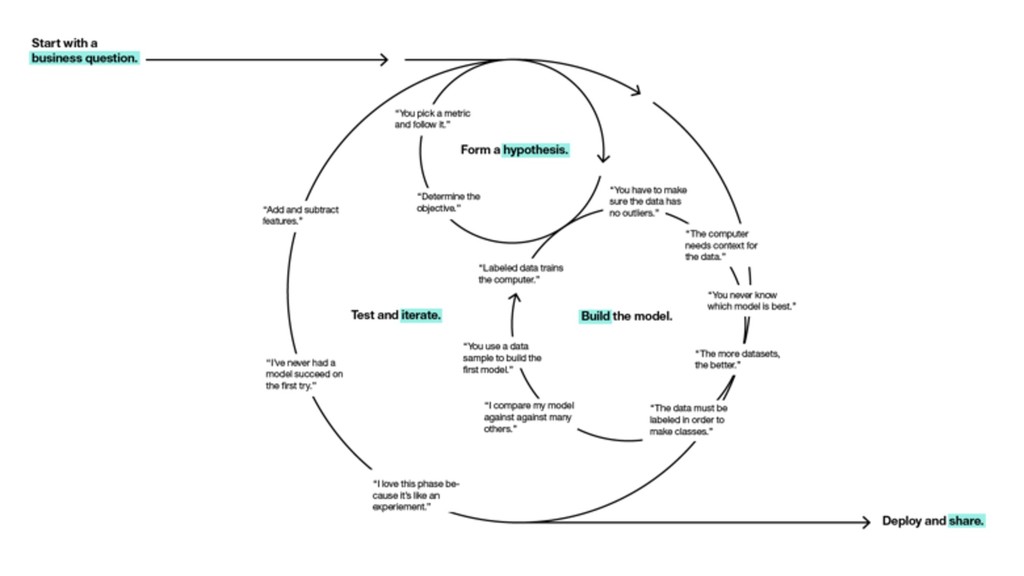
THE DATA SCIENCE WORKFLOW
HEXAGON PRESENTATION TEMPLATE
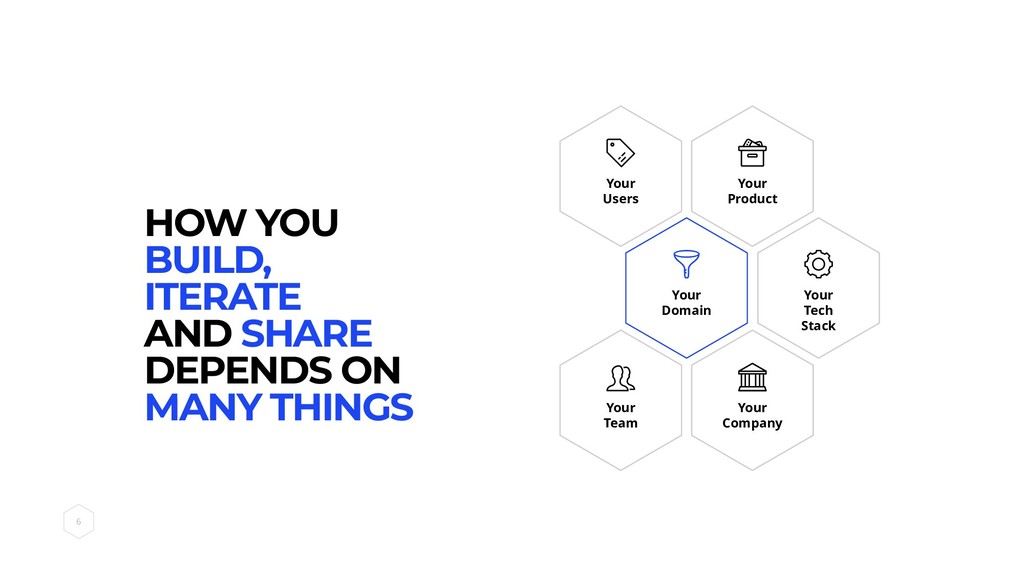
HOW YOU BUILD, ITERATE AND SHARE DEPENDS ON MANY THINGS
Your Users Your Product Your Team Your Company Your Tech Stack Your Domain
SCIKIT-LEARN DOCKER DATA SCIENCE TOOLBELT PANDAS JUPYTER RAY
SCALING IS NOT JUST A MATTER OF MACHINES
We all use it.
We really care about versioning. We have Untitled_1.ipynb, Untitled_2.ipynb and
Untitled_3.ipynb. HOMER SIMPSON C H I E F D A T A S C I E N T I S T D A T A B E E R I N C
Since JSON is a plain text format, they can be
version-controlled and shared with colleagues. E X I P Y T H O N N O T E B O O K D O C U M E N T A T I O N
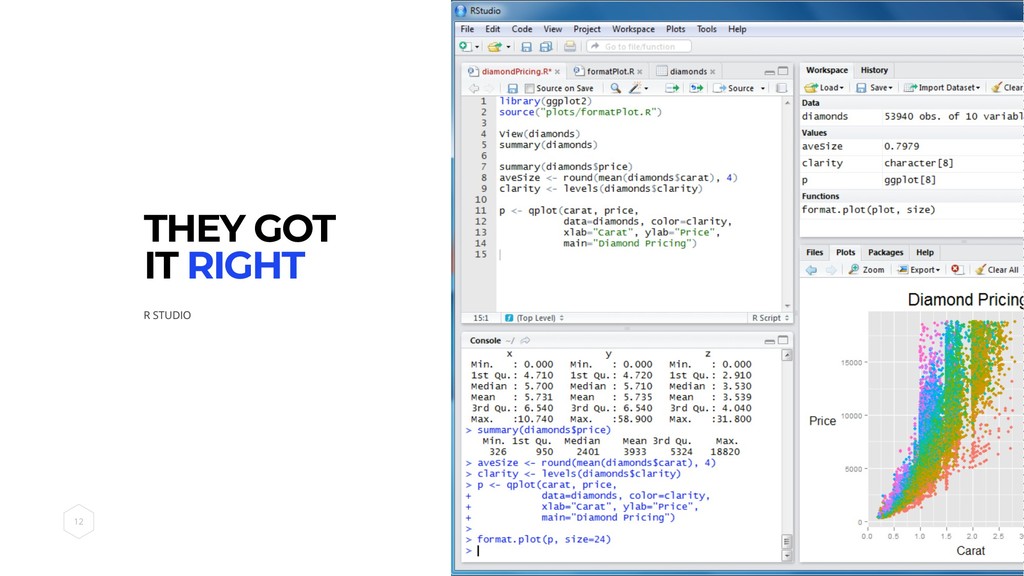
THEY GOT IT RIGHT
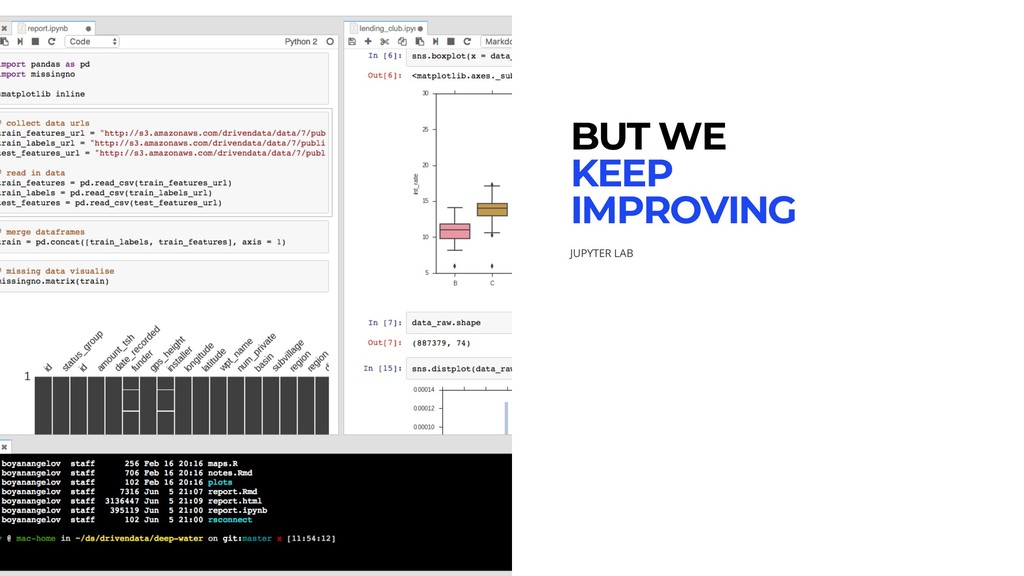
BUT WE KEEP IMPROVING
90% OF JUPITER IS MADE BY HYDROGEN
THE HARD THING ABOUT STORAGE
PARQUET P A R Q U E T + O
B J E C T S T O R A G E = YO U C A N Q U E R Y I T U S I N G S Q L PA N DA S H A S N AT I V E S U P P O R T F O R G E T A B O U T C S V
WHEN THE SIZE OF YOUR DATA MATTERS
IT’S TOO SLOW DOESN’T FIT IN YOUR RAM
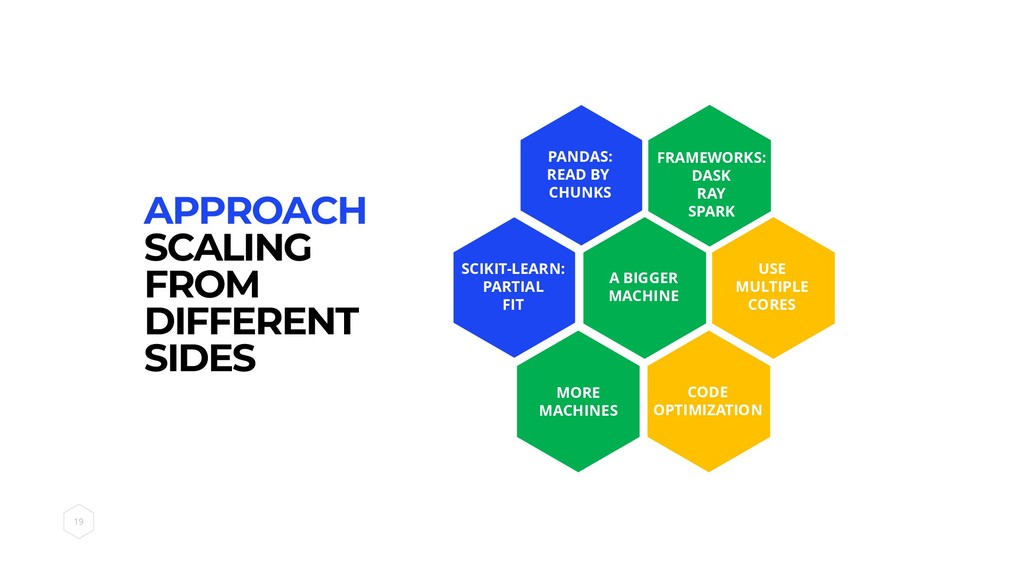
CODE OPTIMIZATION APPROACH SCALING FROM DIFFERENT SIDES A BIGGER MACHINE
USE MULTIPLE CORES MORE MACHINES FRAMEWORKS: DASK RAY SPARK PANDAS: READ BY CHUNKS SCIKIT-LEARN: PARTIAL FIT
chunks & partial_fit 1 M A C H I N
E
Multiple machines. n M A C H I N E
S
I don’t want to use Spark/JVM, what do you have
for me? H A P P Y P Y T H O N U S E R
WHAT IS RAY?
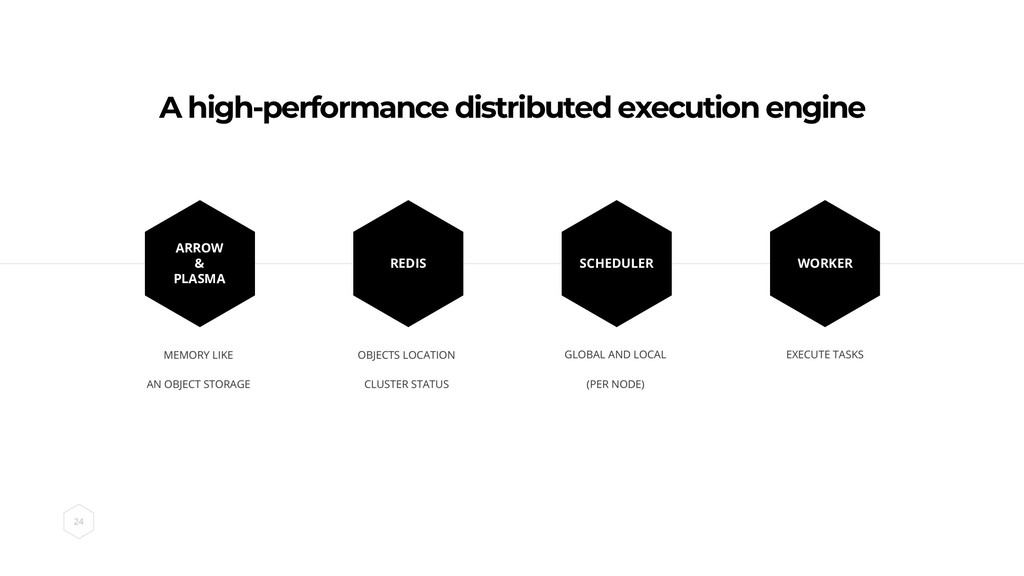
A high-performance distributed execution engine REDIS SCHEDULER WORKER ARROW &
PLASMA
Use pandas through ray to query parquet files in an
object storage. W O R K I N P R O G R E S S
CONTAINERIZED DATA SCIENCE
If you trained a model with scikit-learn 0.18.1, will the
same model work with 0.19.1? P R O B L E M # 1
How do you share your models? P R O B
L E M # 2
How do you put your models in production? P R
O B L E M # 3
Containerize everything. T H E A N S W E
R
1. It’s damn easy to move things around 2. You
get versioning for free 3. Stack agnostic 4. Move Docker images around T O R E C A P
CASSINY: PUT ALL THE THINGS TOGETHER
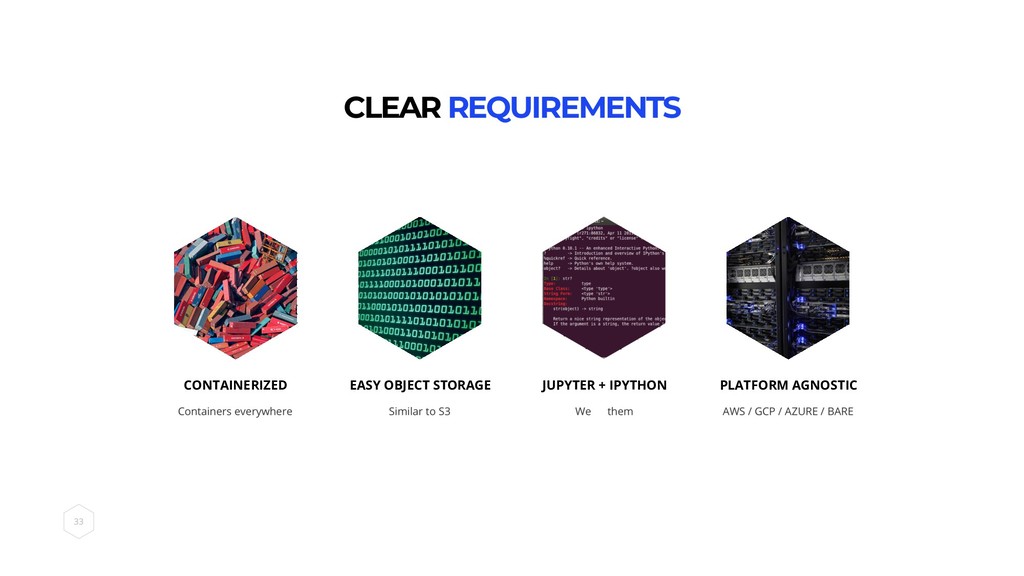
CLEAR REQUIREMENTS CONTAINERIZED EASY OBJECT STORAGE JUPYTER + IPYTHON PLATFORM
AGNOSTIC
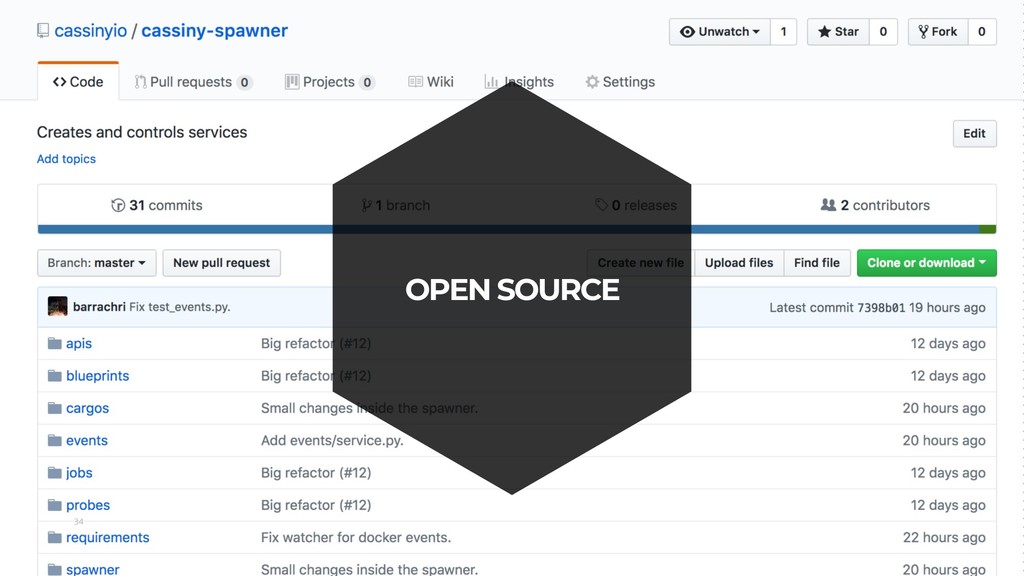
OPEN SOURCE
DEMO
TAKEAWAYS UNIFIED DATA WAREHOUSE KEEP YOUR CODE RUNNING ON ONE
MACHINE USE DOCKER TRY RAY BRING CI/CD TO YOUR DATASCIENCE WORKFLOW OBJECT STORAGE IS COOL DISTRIBUTED COMPUTING IS HARD I DIDN’T HAVE ANOTHER POINT
None


 barrachri
 yazm
 freee
 yamad
 masakiokuda
 linedevth
 watany
 taka_aki
 atsush1_sada
 odashi
 soracom
 yahonda
 benjagm
 caitiem20
 brad_frost
 lara
 helmedeiros
 addyosmani
 philnash
 swwweet
 jdejongh
 lcolladotor
 marktimemedia
 geshan
 marketingsoph