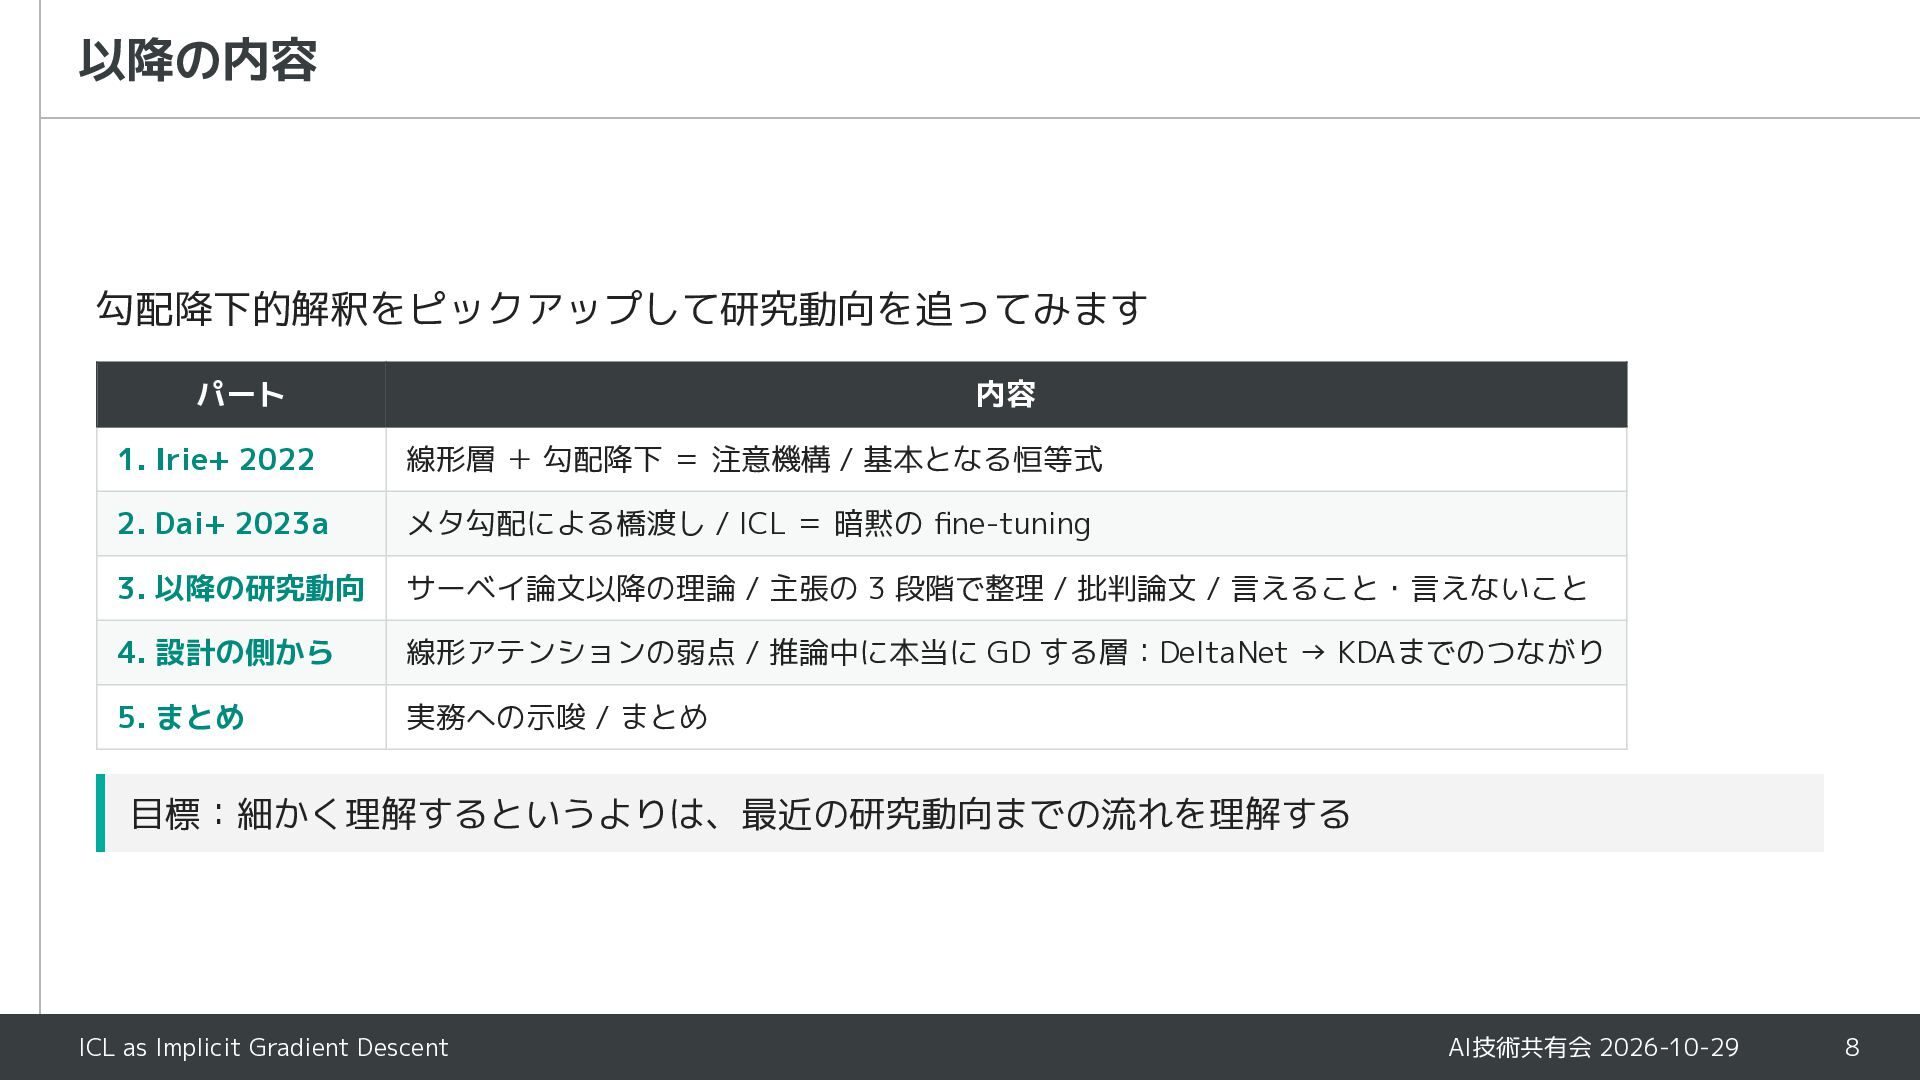
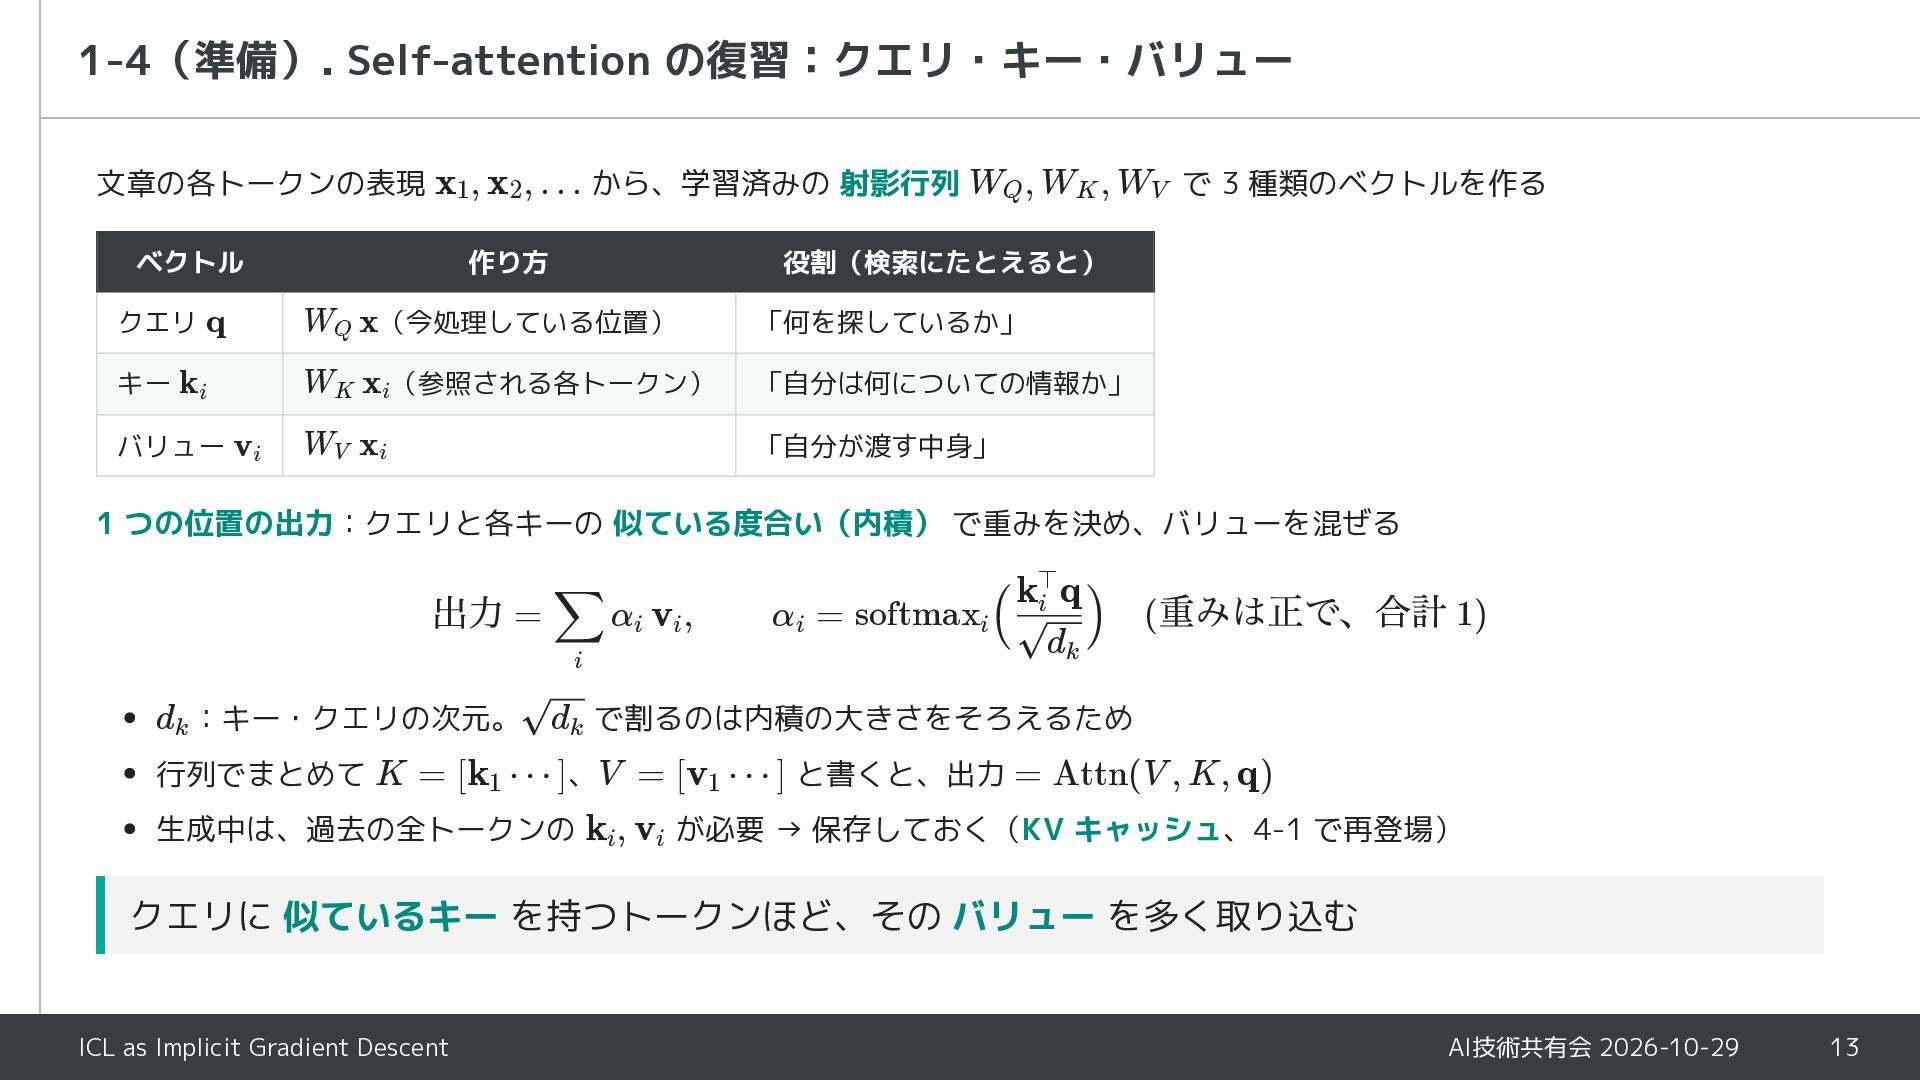
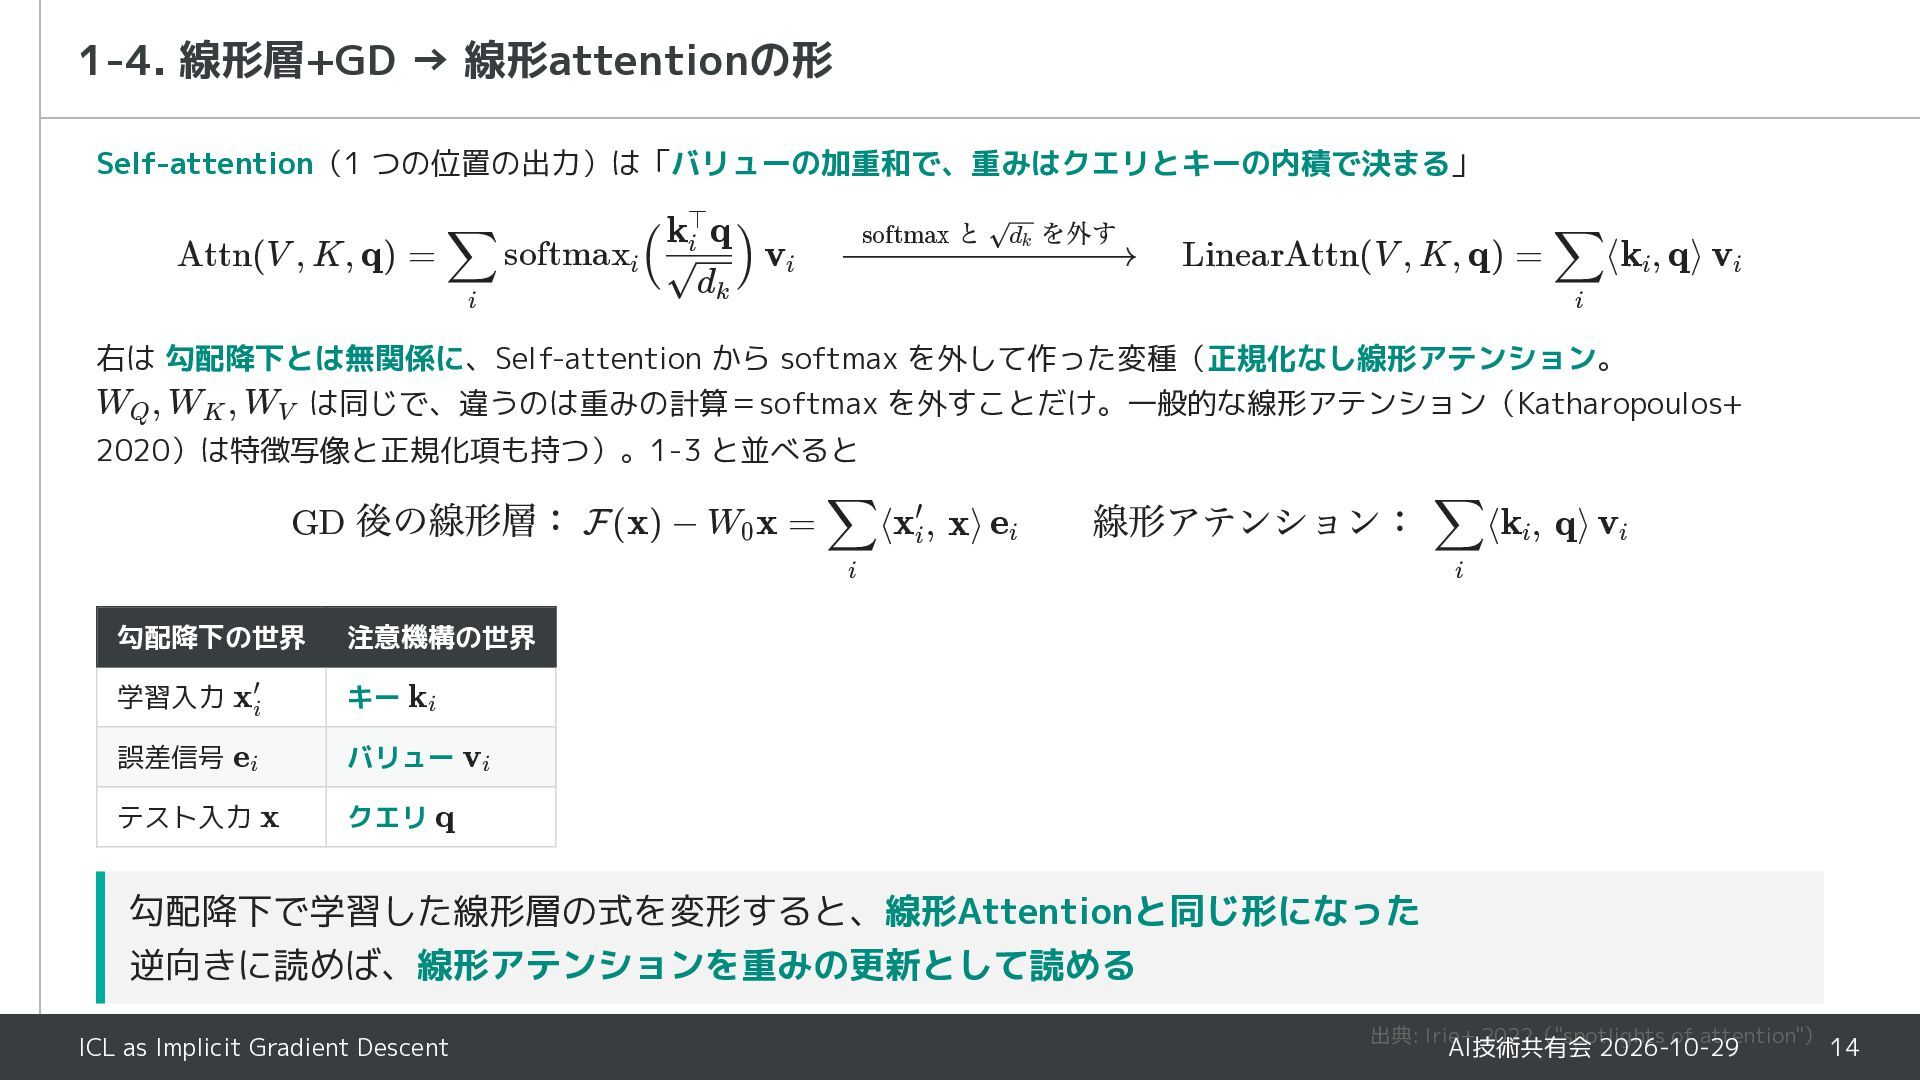
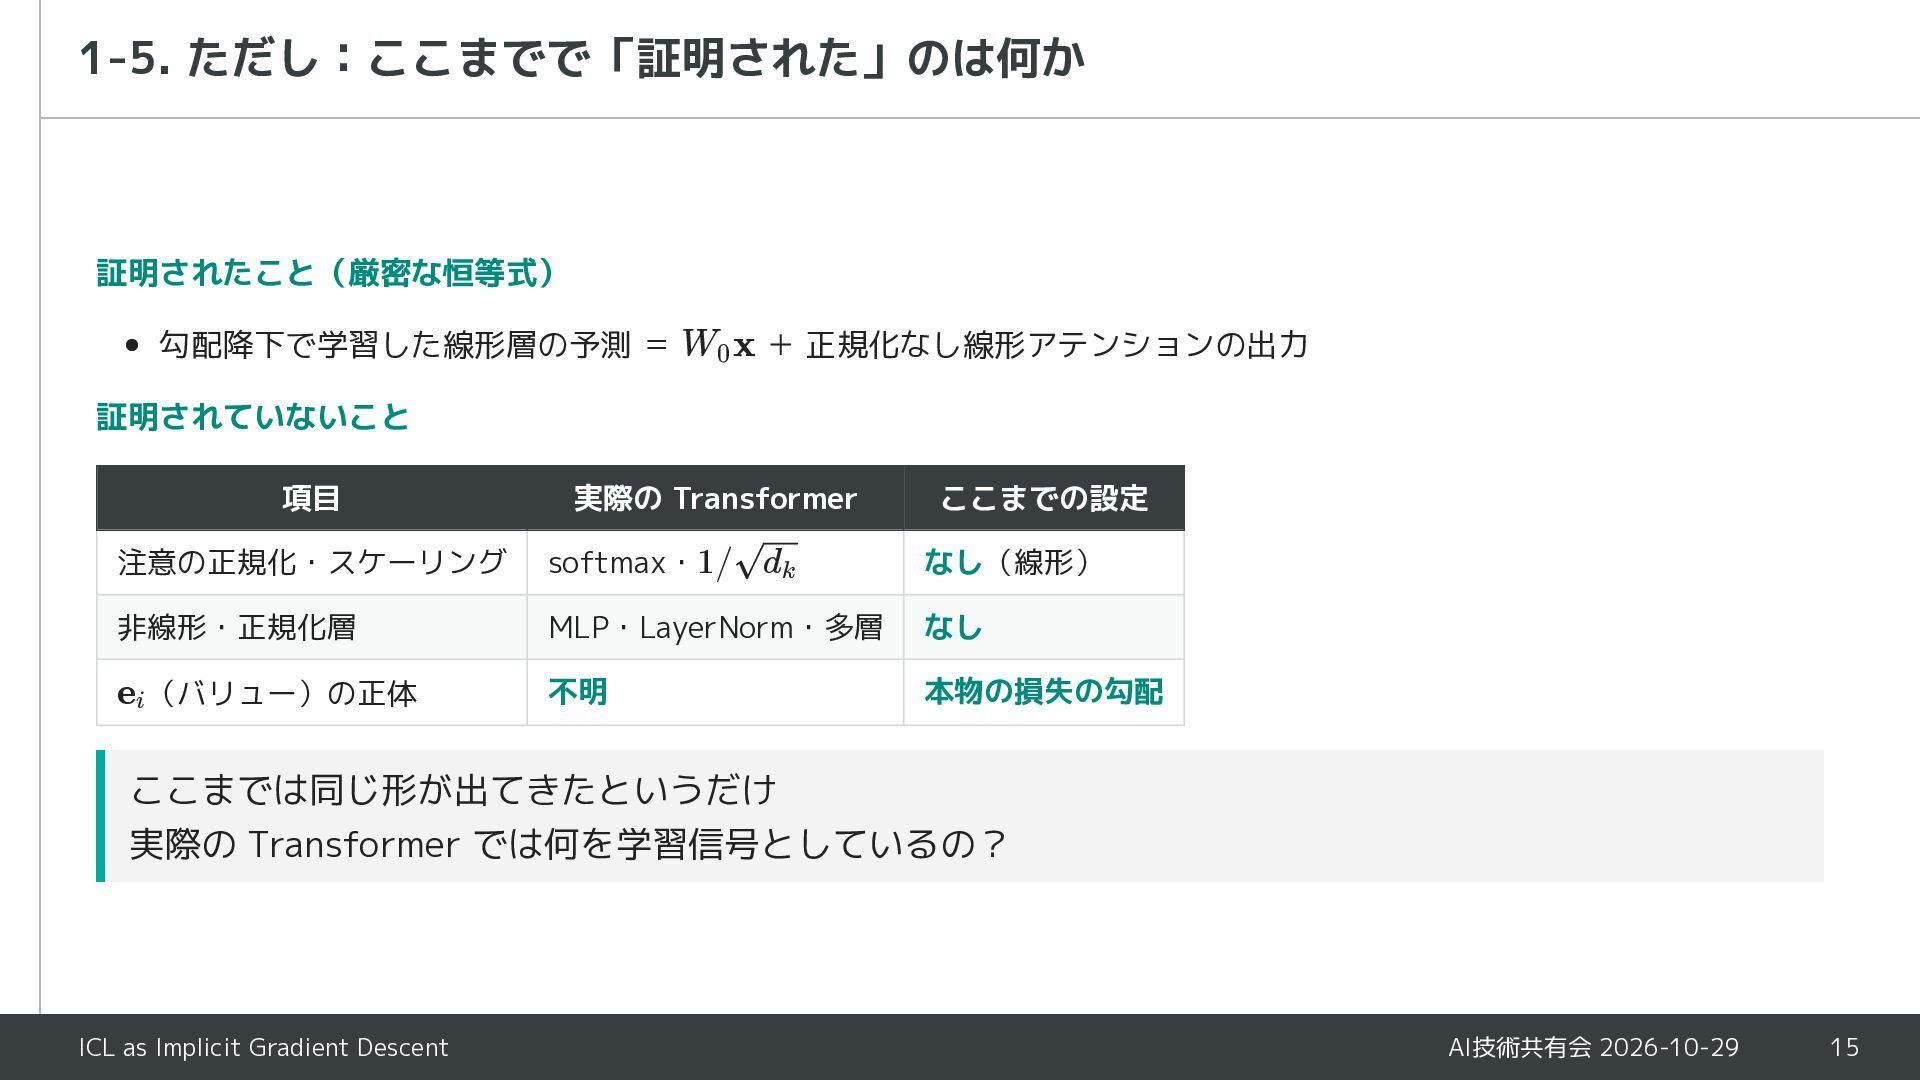
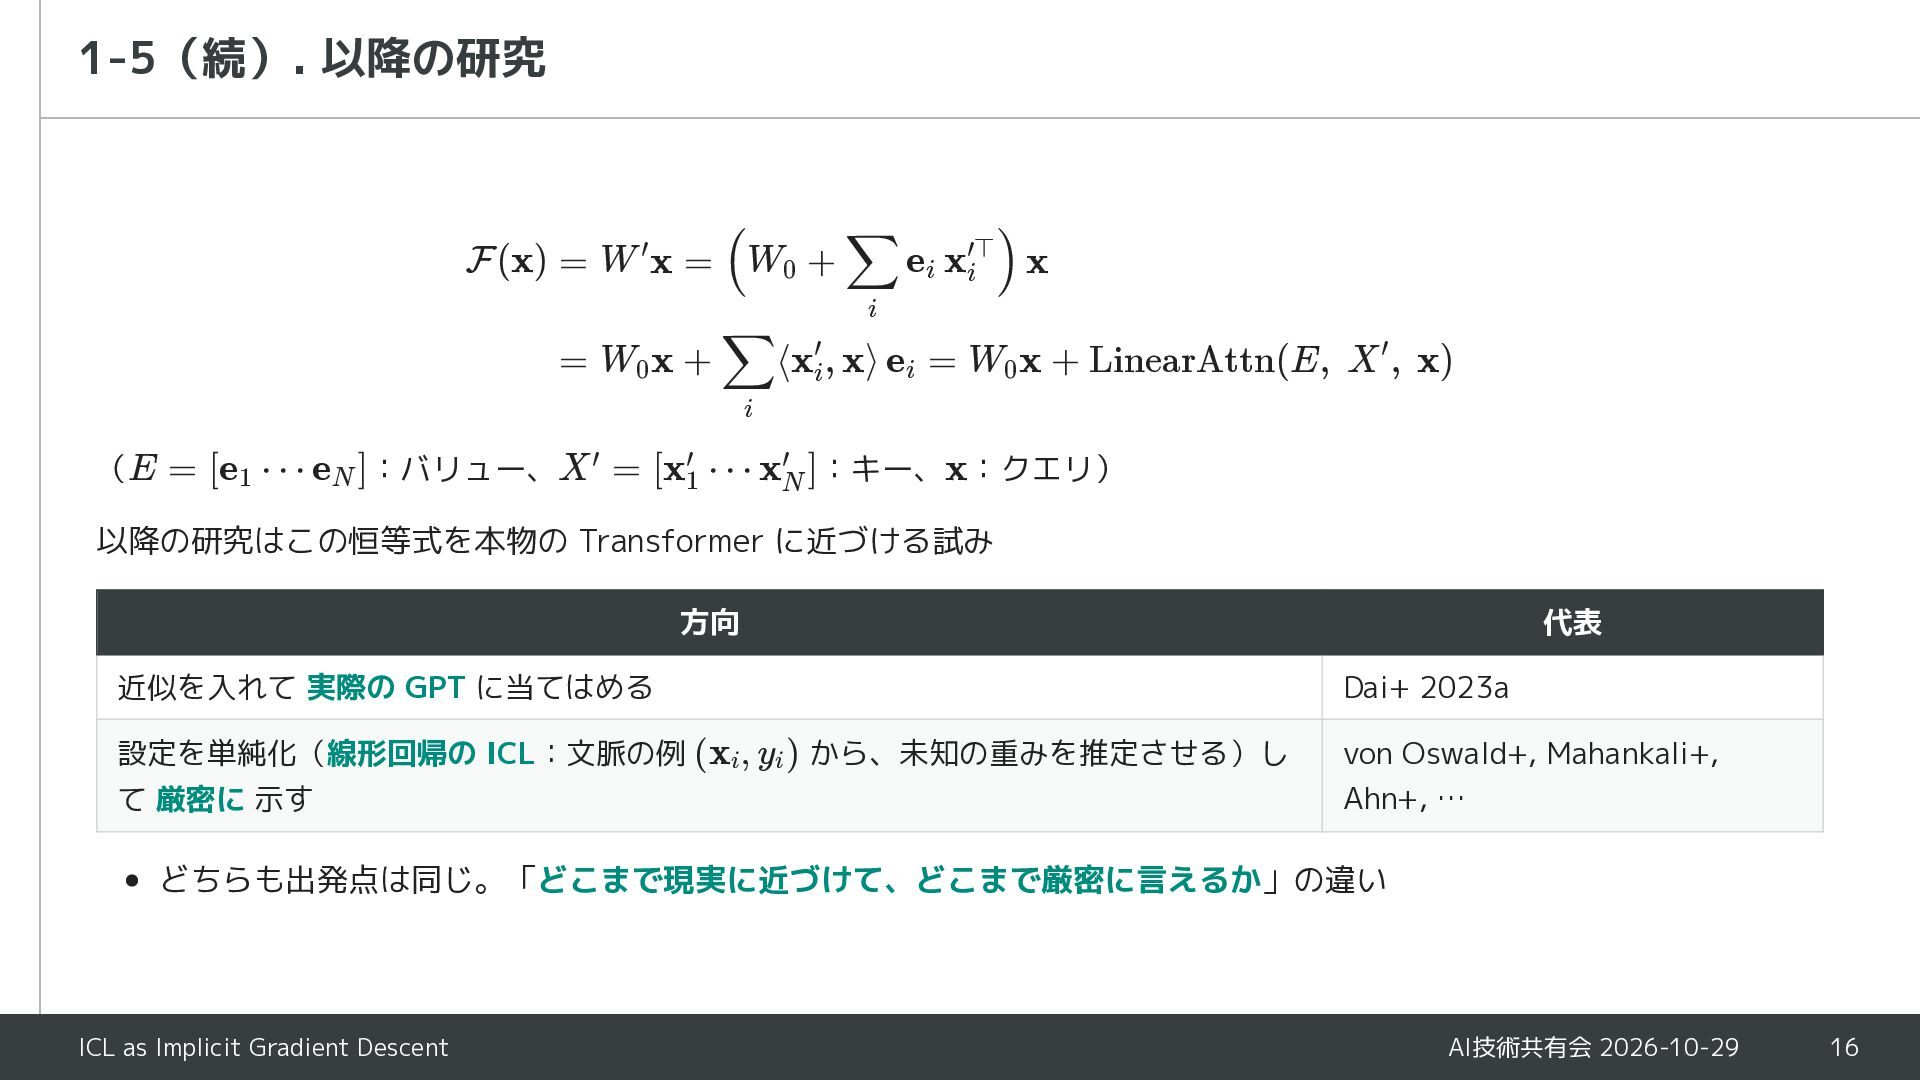
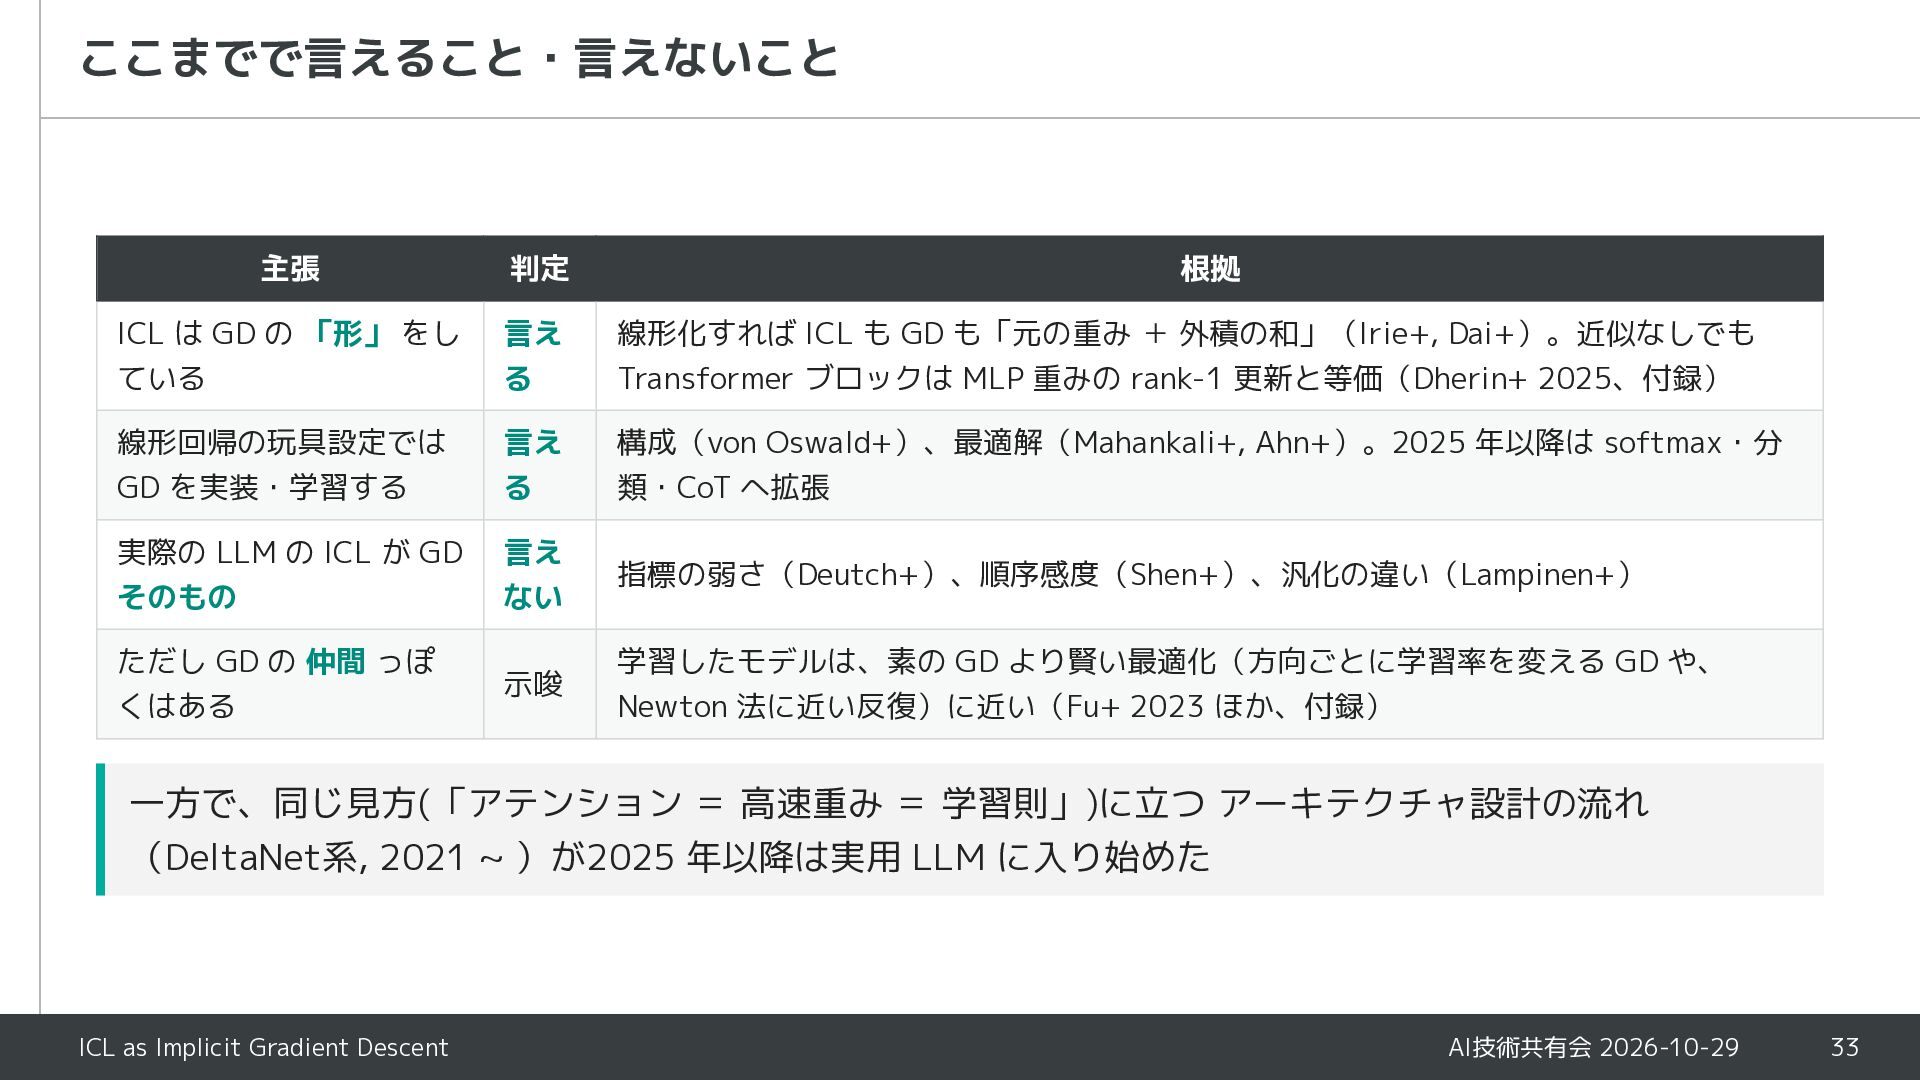
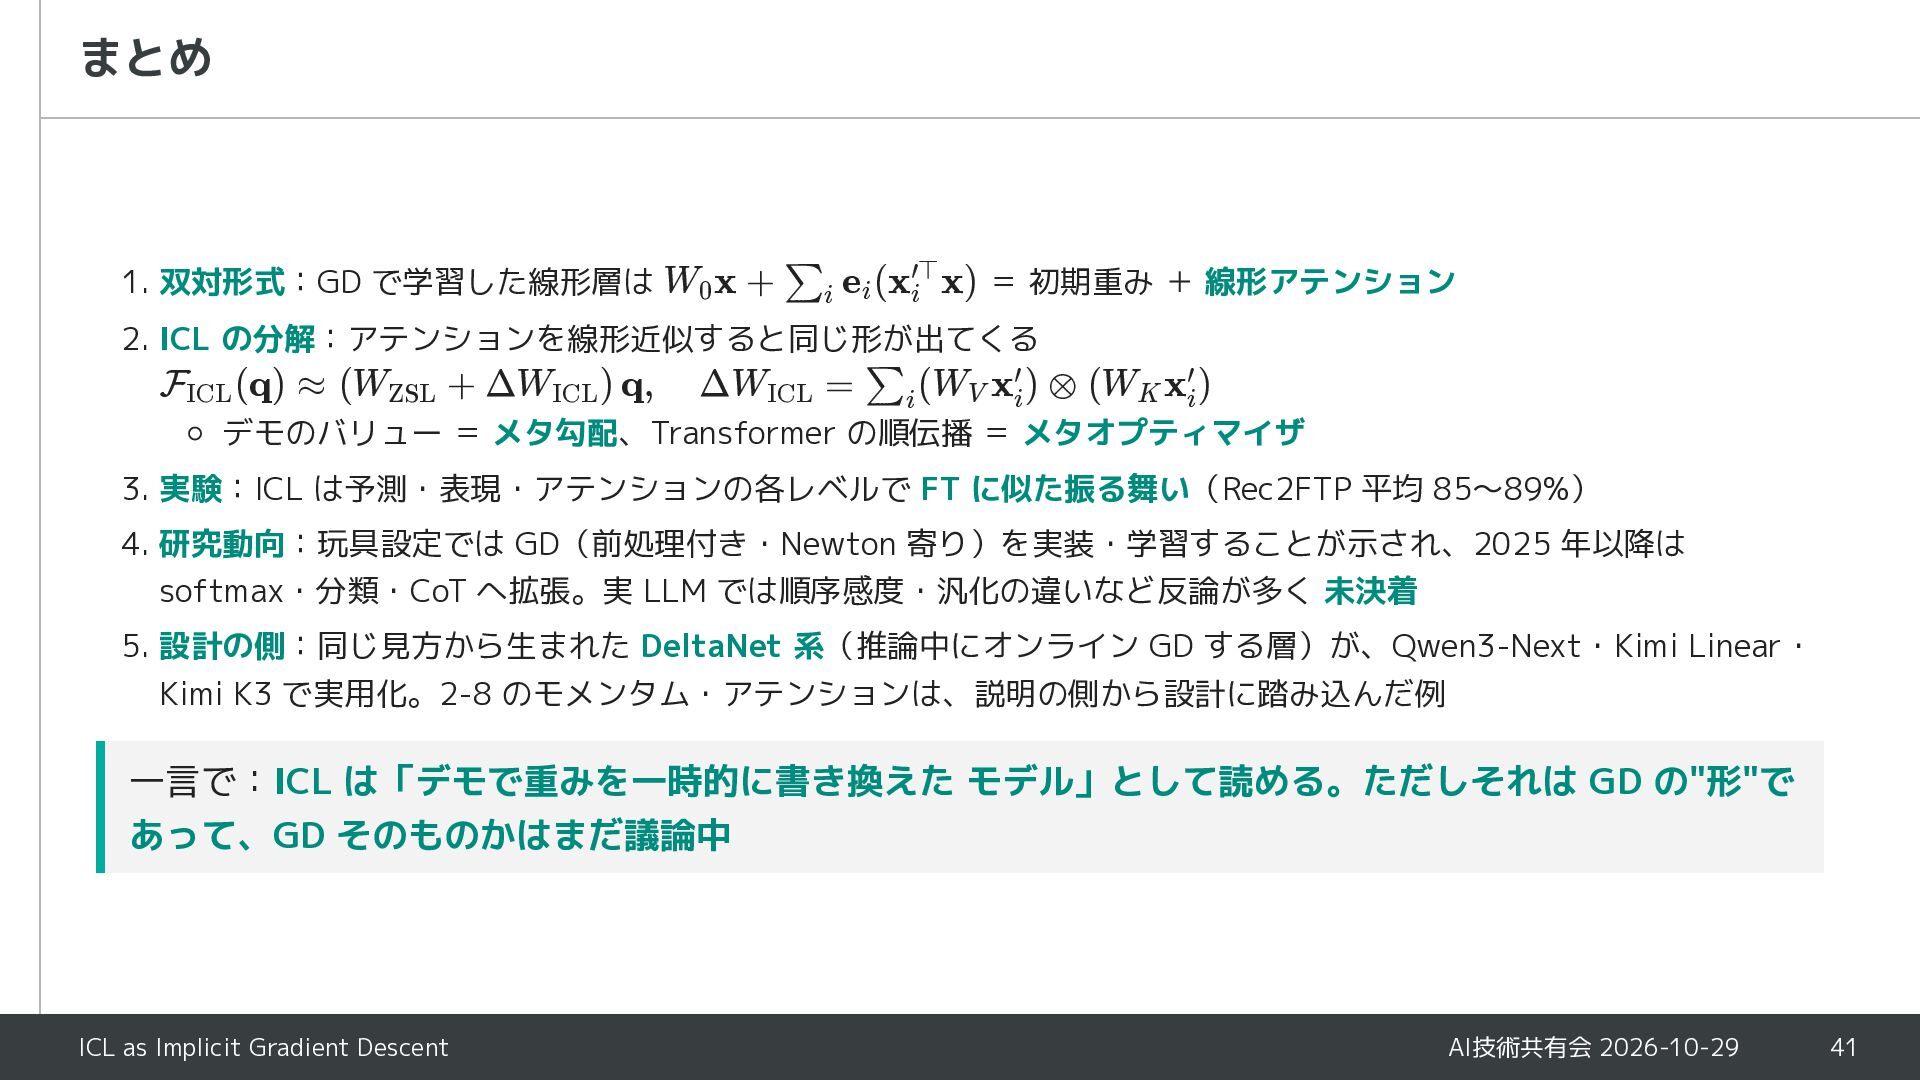
Neural Networks Revisited: Connecting Test Time Predictions to Training Patterns via Spotlights of Attention", Kazuki Irie et al., ICML2022 AI技術共有会 2026-10-29 9
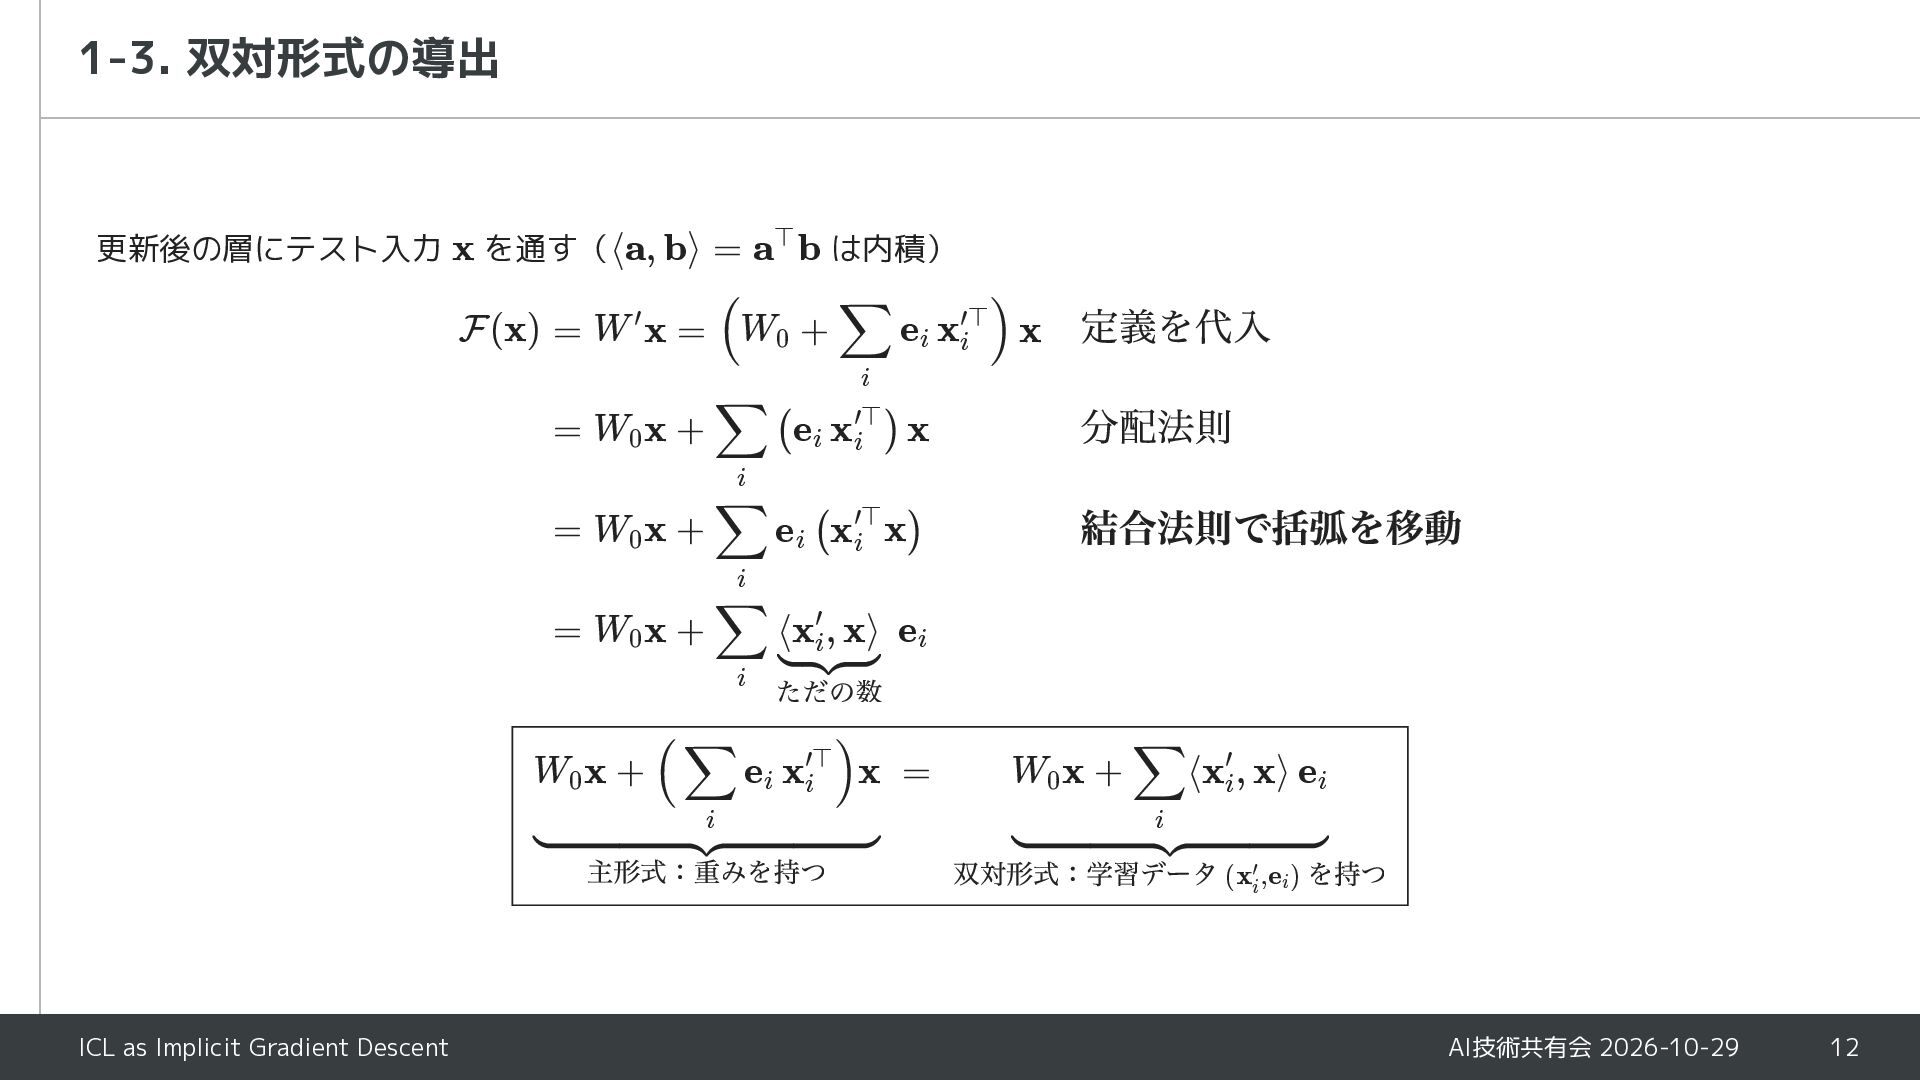
定義を代入 分配法則 結合法則で括弧を移動 F(x) = W ′ x = (W0 + ∑ ei x′⊤ i )x i = W0 x + ∑ (ei x′⊤ i )x i = W0 x + ∑ ei (x′⊤ i x) i = W0 x + ∑ ⟨x′i , x⟩ ei i ただの数 W0 x + ( ∑ ei x′⊤ i )x = W0 x + ∑⟨x′i , x⟩ ei 主形式:重みを持つ 双対形式:学習データ (x ,e ) を持つ i ICL as Implicit Gradient Descent i ′ i i AI技術共有会 2026-10-29 12
Can GPT Learn In-Context? Language Models Secretly Perform Gradient Descent as Meta-Optimizers", Damai Dai et al., 2023(Findings of ACL 2023) AI技術共有会 2026-10-29 17
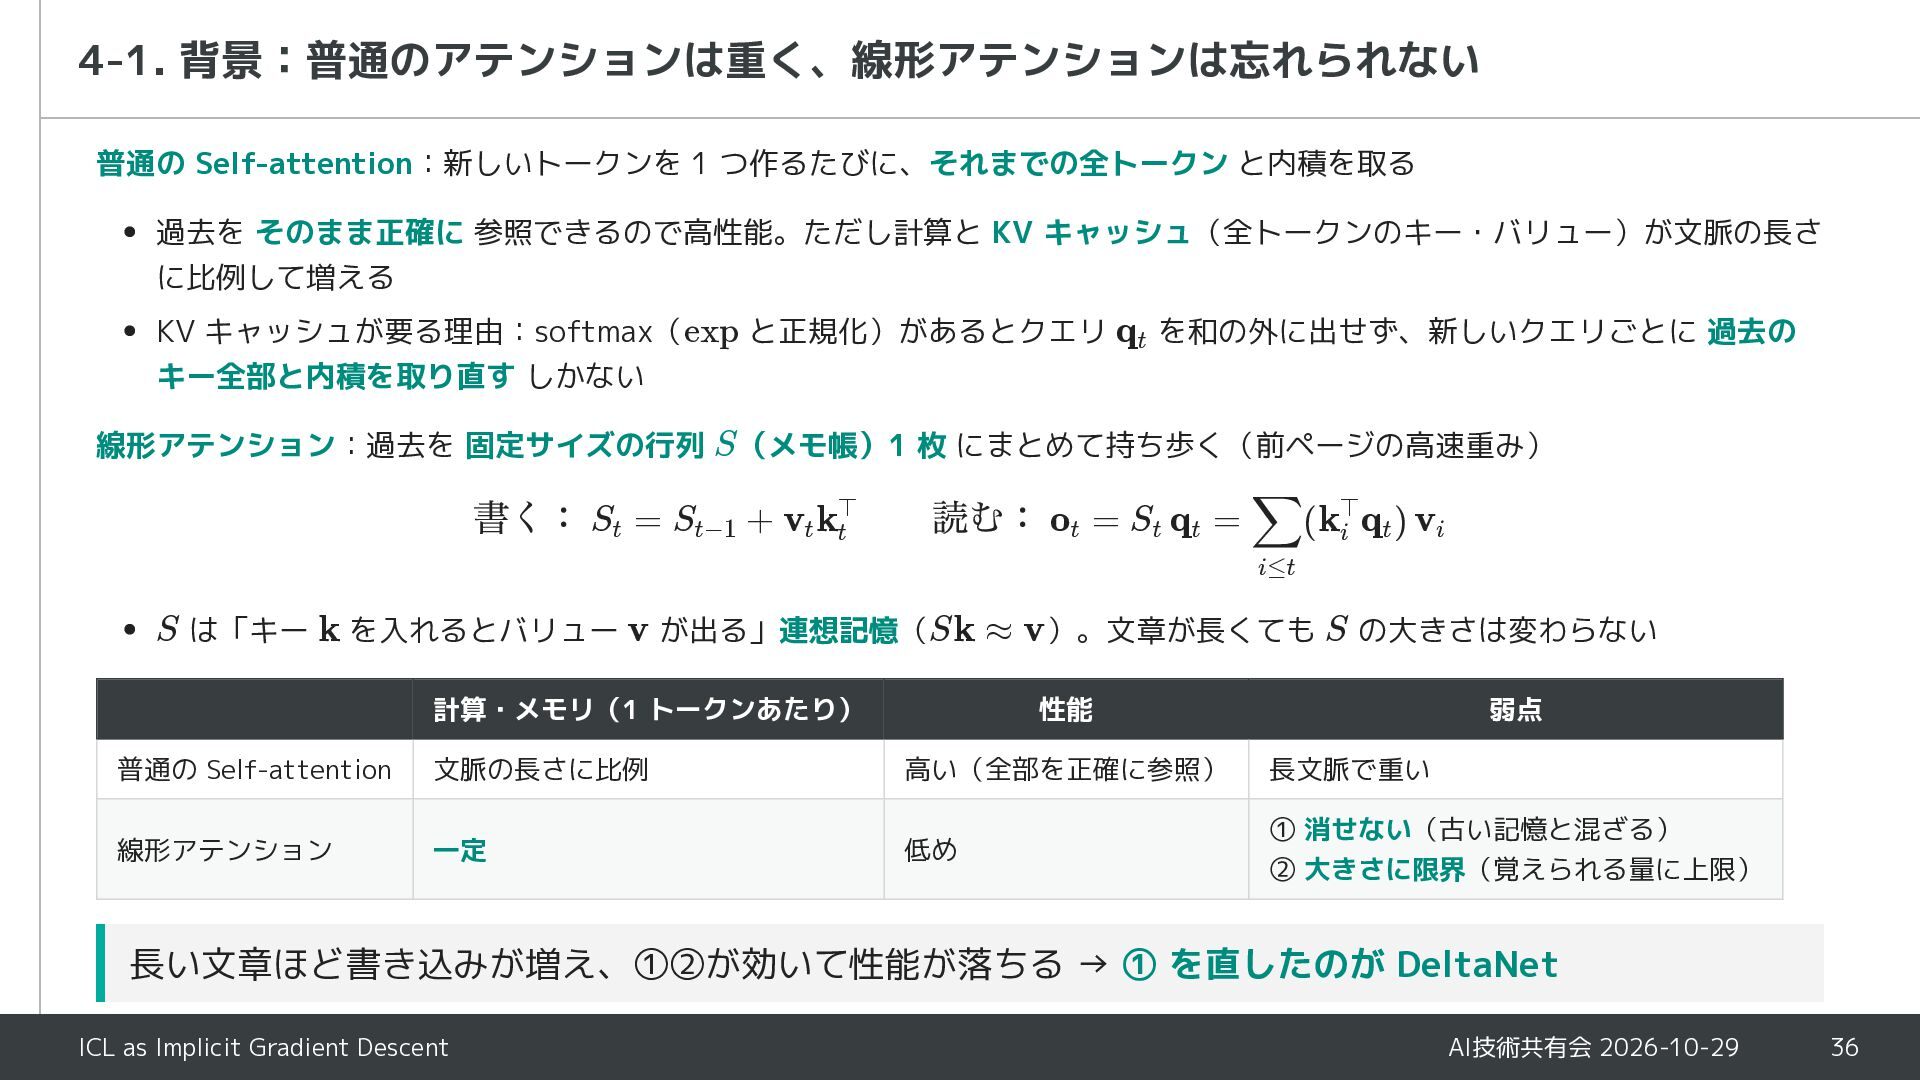
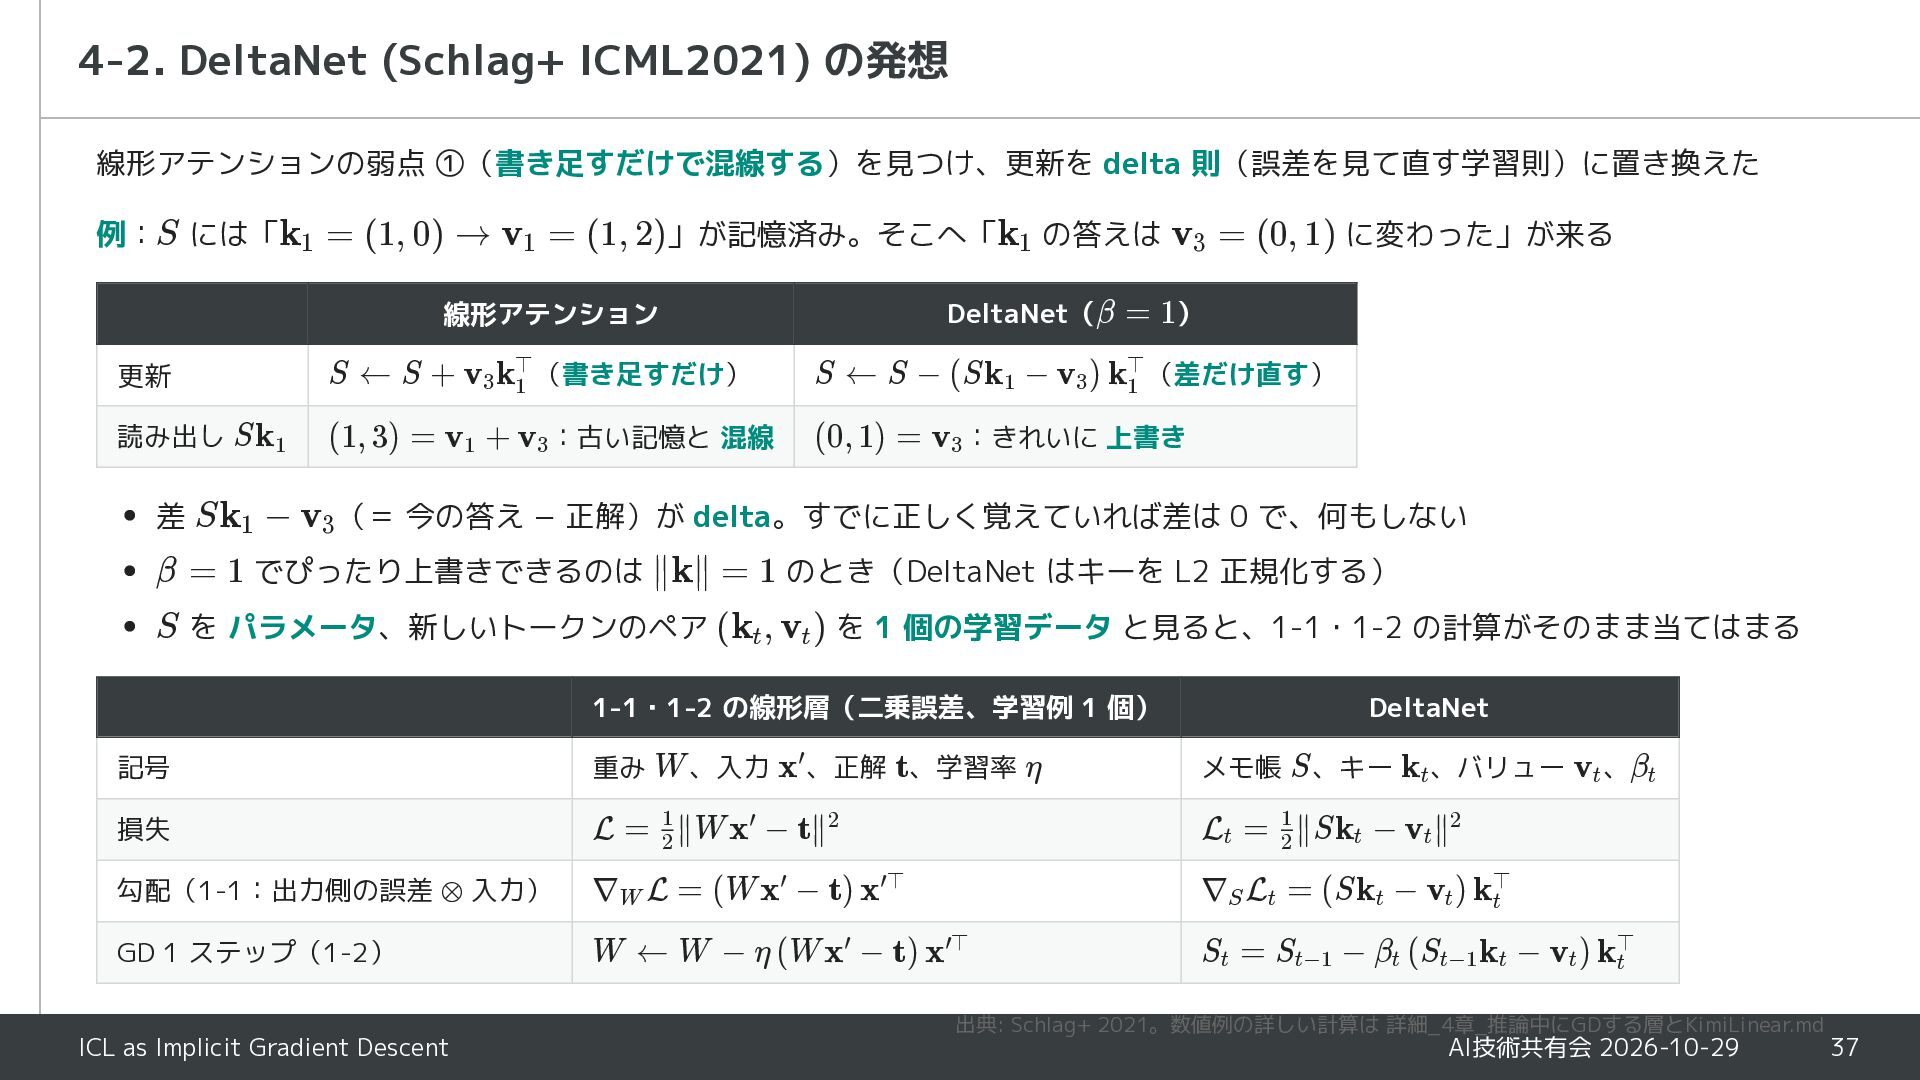
KV キャッシュ(全トークンのキー・バリュー)が文脈の長さ に比例して増える KV キャッシュが要る理由:softmax(exp と正規化)があるとクエリ qt を和の外に出せず、新しいクエリごとに 過去の キー全部と内積を取り直す しかない 線形アテンション:過去を 固定サイズの行列 S (メモ帳)1 枚 にまとめて持ち歩く(前ページの高速重み) 書く: S = S t ⊤ t−1 + vt kt 読む: o = S q = ∑(k q ) v t t t ⊤ i t i i≤t S は「キー k を入れるとバリュー v が出る」連想記憶(Sk ≈ v)。文章が長くても S の大きさは変わらない 計算・メモリ(1 トークンあたり) 性能 弱点 普通の Self-attention 文脈の長さに比例 高い(全部を正確に参照) 長文脈で重い 線形アテンション 一定 低め ① 消せない(古い記憶と混ざる) ② 大きさに限界(覚えられる量に上限) 長い文章ほど書き込みが増え、①②が効いて性能が落ちる → ① を直したのが DeltaNet ICL as Implicit Gradient Descent AI技術共有会 2026-10-29 36
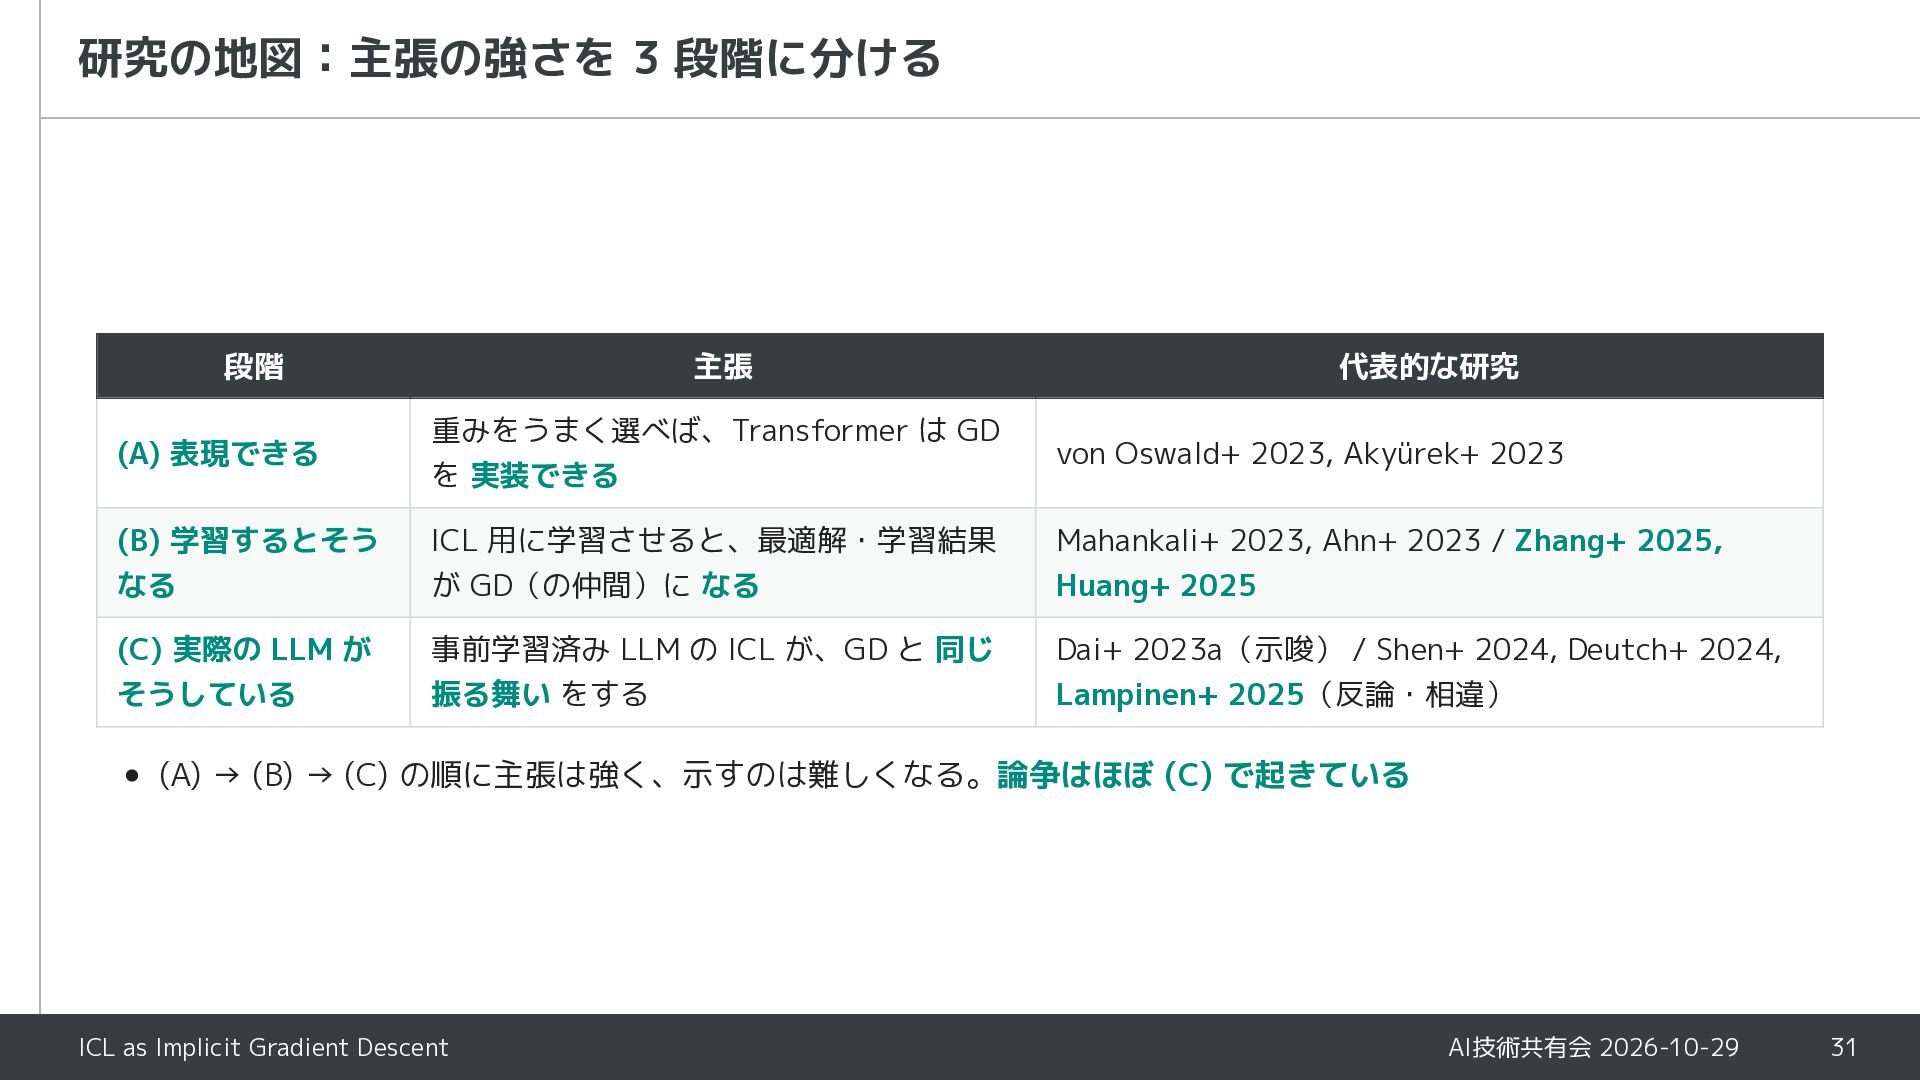
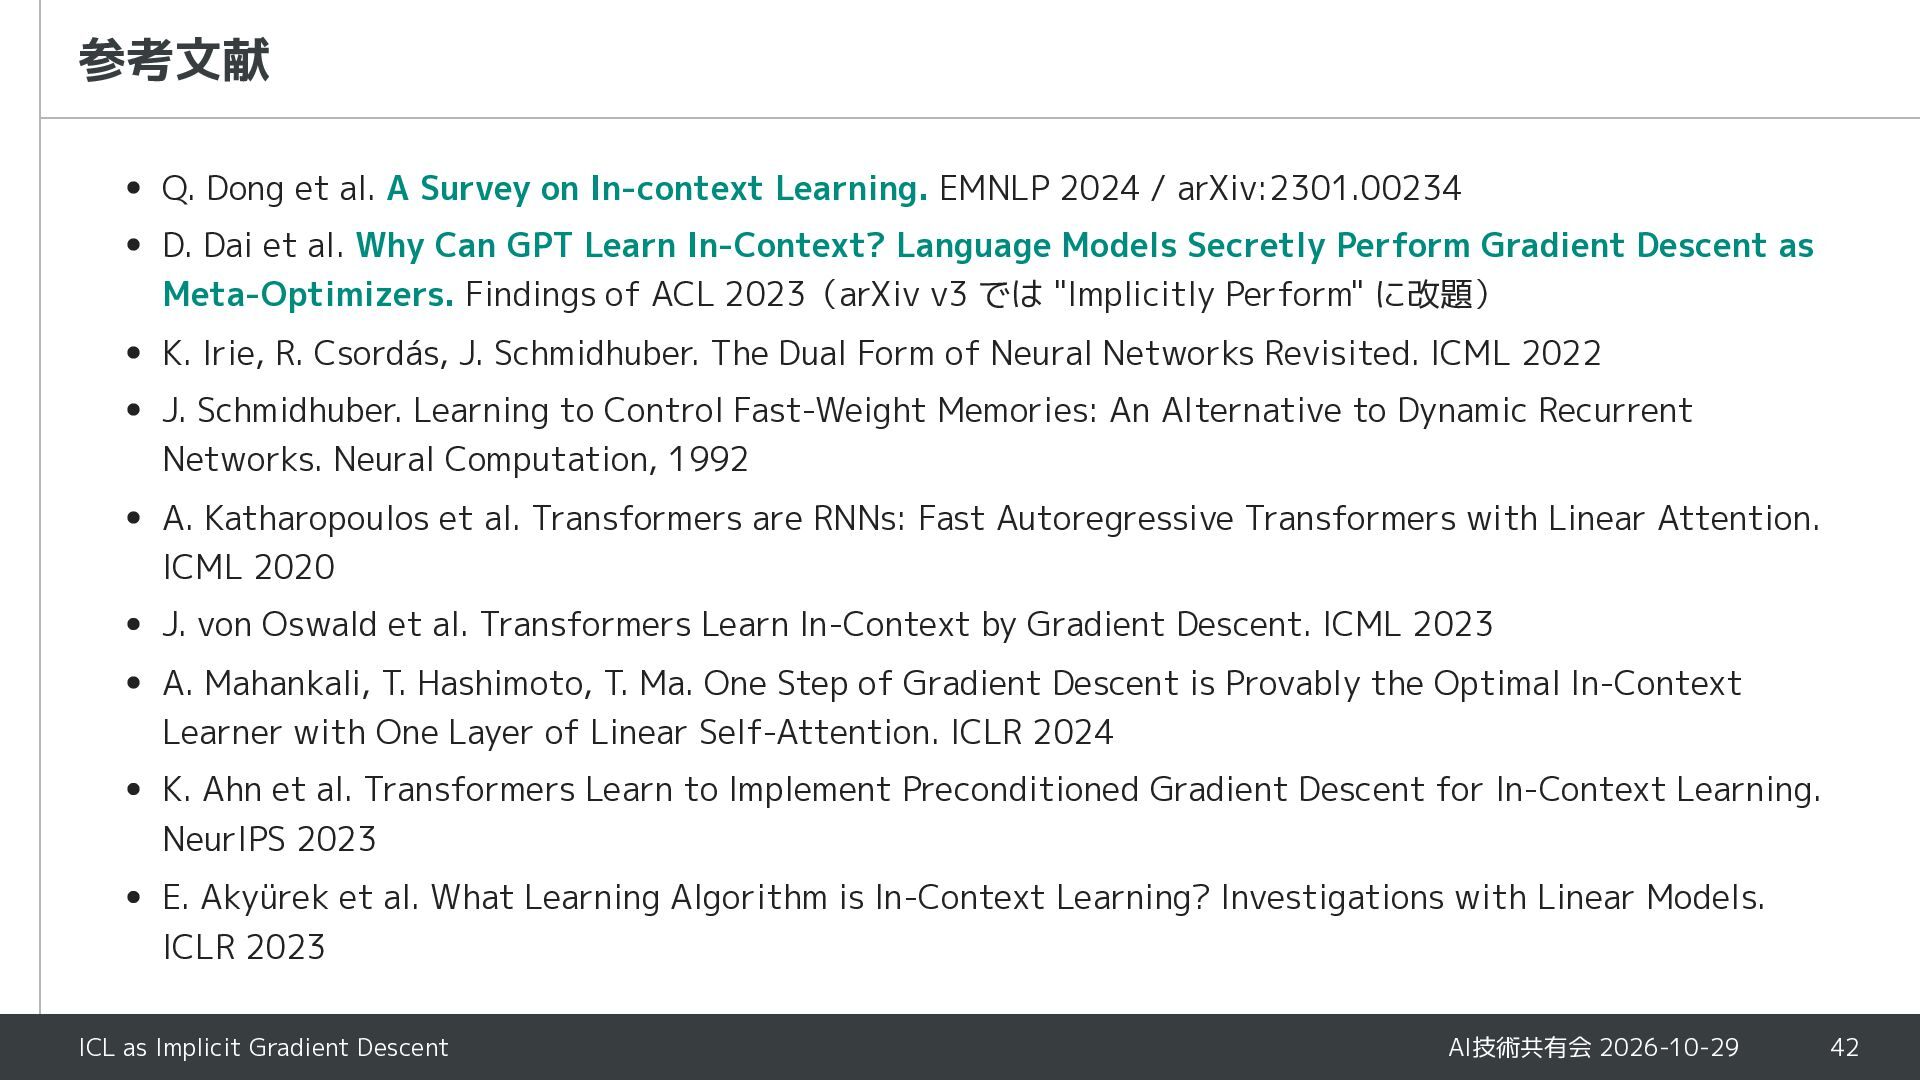
EMNLP 2024 / arXiv:2301.00234 D. Dai et al. Why Can GPT Learn In-Context? Language Models Secretly Perform Gradient Descent as Meta-Optimizers. Findings of ACL 2023(arXiv v3 では "Implicitly Perform" に改題) K. Irie, R. Csordás, J. Schmidhuber. The Dual Form of Neural Networks Revisited. ICML 2022 J. Schmidhuber. Learning to Control Fast-Weight Memories: An Alternative to Dynamic Recurrent Networks. Neural Computation, 1992 A. Katharopoulos et al. Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. ICML 2020 J. von Oswald et al. Transformers Learn In-Context by Gradient Descent. ICML 2023 A. Mahankali, T. Hashimoto, T. Ma. One Step of Gradient Descent is Provably the Optimal In-Context Learner with One Layer of Linear Self-Attention. ICLR 2024 K. Ahn et al. Transformers Learn to Implement Preconditioned Gradient Descent for In-Context Learning. NeurIPS 2023 E. Akyürek et al. What Learning Algorithm is In-Context Learning? Investigations with Linear Models. ICLR 2023 ICL as Implicit Gradient Descent AI技術共有会 2026-10-29 42
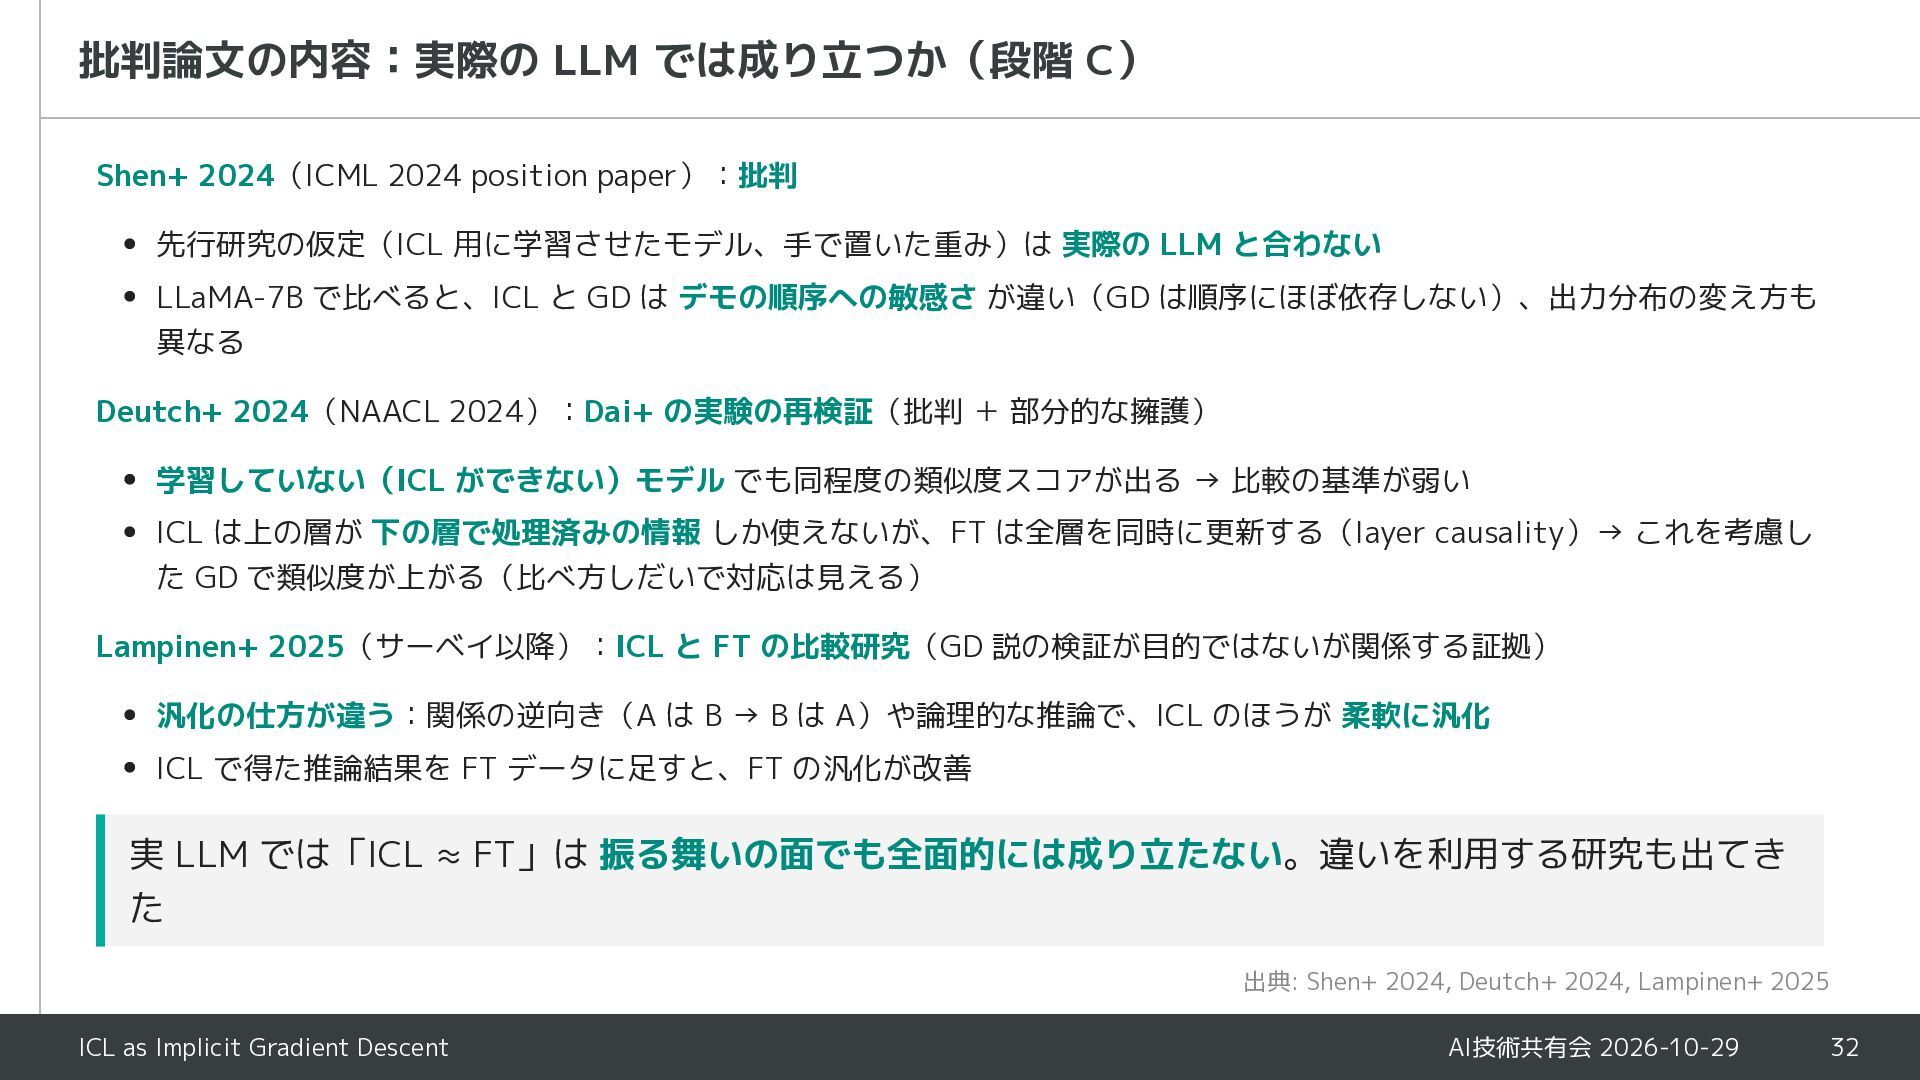
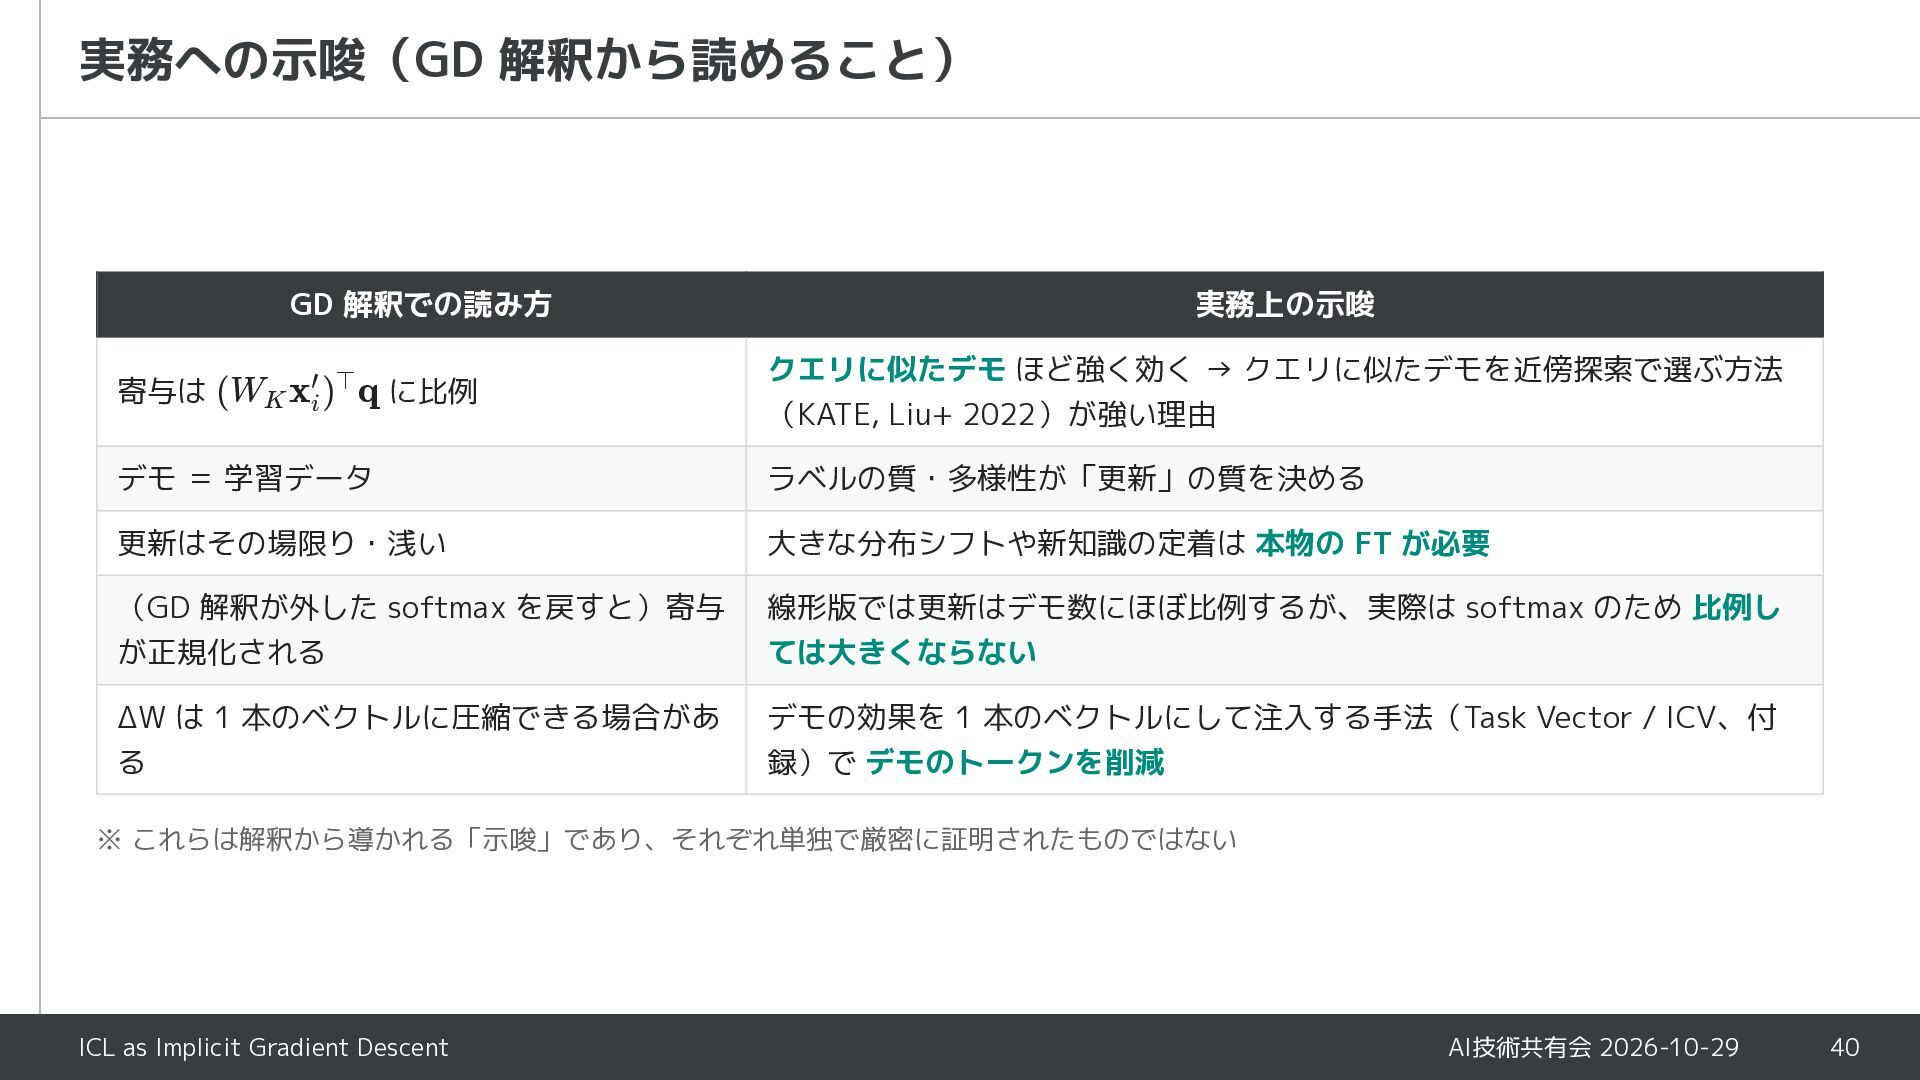
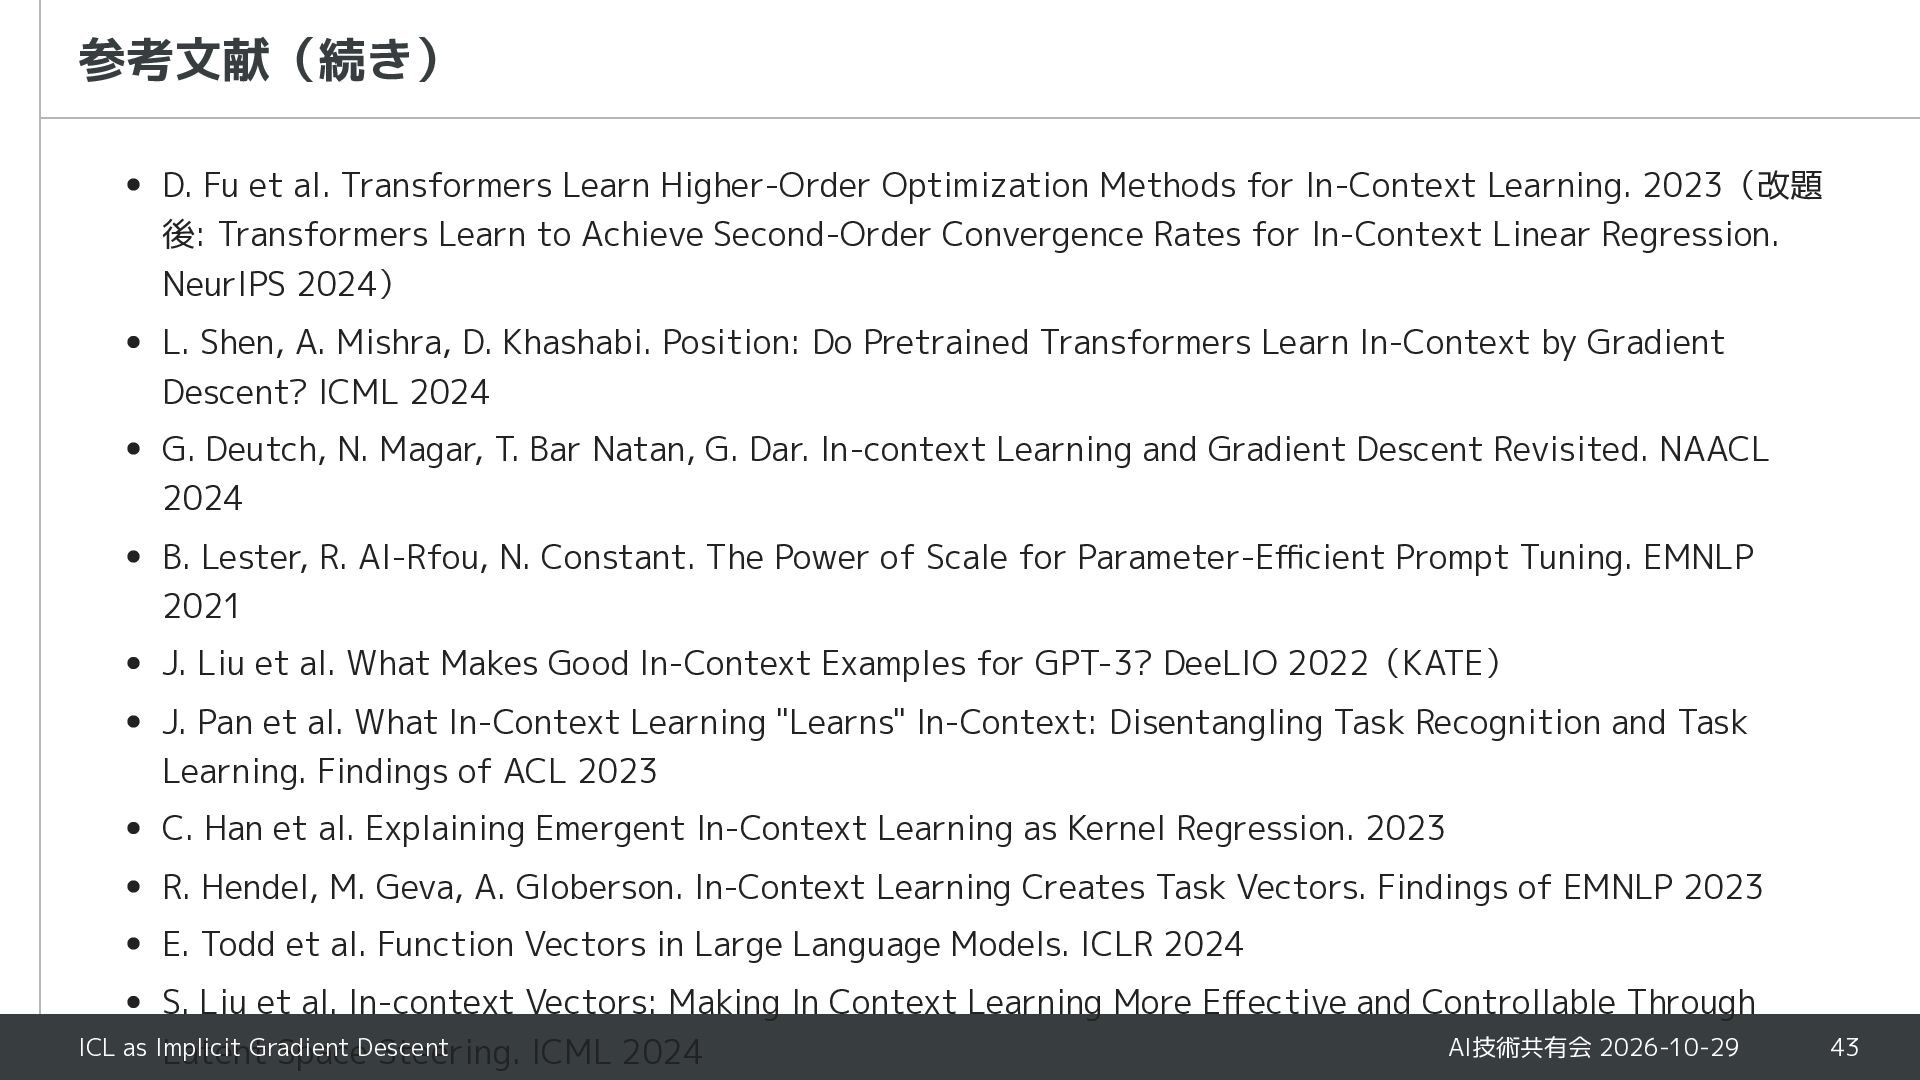
for In-Context Learning. 2023(改題 後: Transformers Learn to Achieve Second-Order Convergence Rates for In-Context Linear Regression. NeurIPS 2024) L. Shen, A. Mishra, D. Khashabi. Position: Do Pretrained Transformers Learn In-Context by Gradient Descent? ICML 2024 G. Deutch, N. Magar, T. Bar Natan, G. Dar. In-context Learning and Gradient Descent Revisited. NAACL 2024 B. Lester, R. Al-Rfou, N. Constant. The Power of Scale for Parameter-Efficient Prompt Tuning. EMNLP 2021 J. Liu et al. What Makes Good In-Context Examples for GPT-3? DeeLIO 2022(KATE) J. Pan et al. What In-Context Learning "Learns" In-Context: Disentangling Task Recognition and Task Learning. Findings of ACL 2023 C. Han et al. Explaining Emergent In-Context Learning as Kernel Regression. 2023 R. Hendel, M. Geva, A. Globerson. In-Context Learning Creates Task Vectors. Findings of EMNLP 2023 E. Todd et al. Function Vectors in Large Language Models. ICLR 2024 S. Liu et al. In-context Vectors: Making In Context Learning More Effective and Controllable Through ICL as Implicit Gradient AI技術共有会 2026-10-29 Latent SpaceDescent Steering. ICML 2024 43
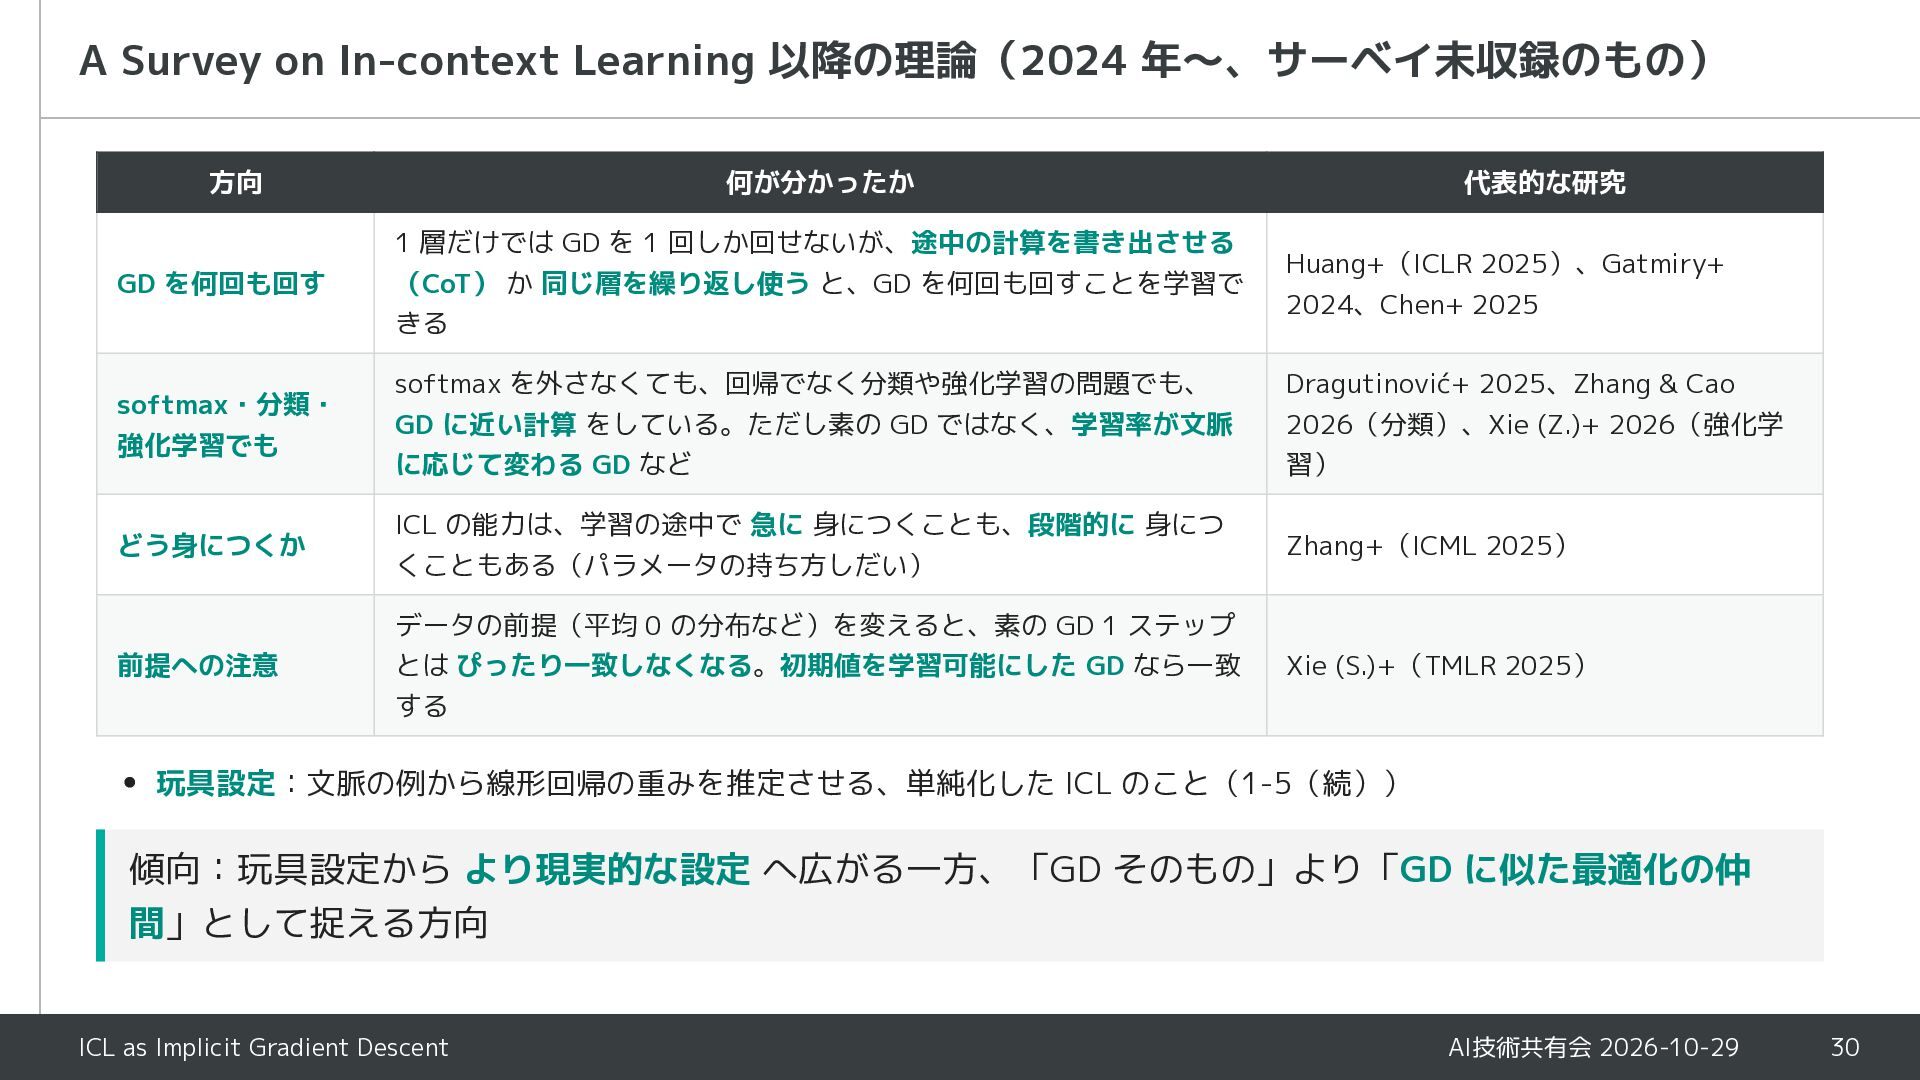
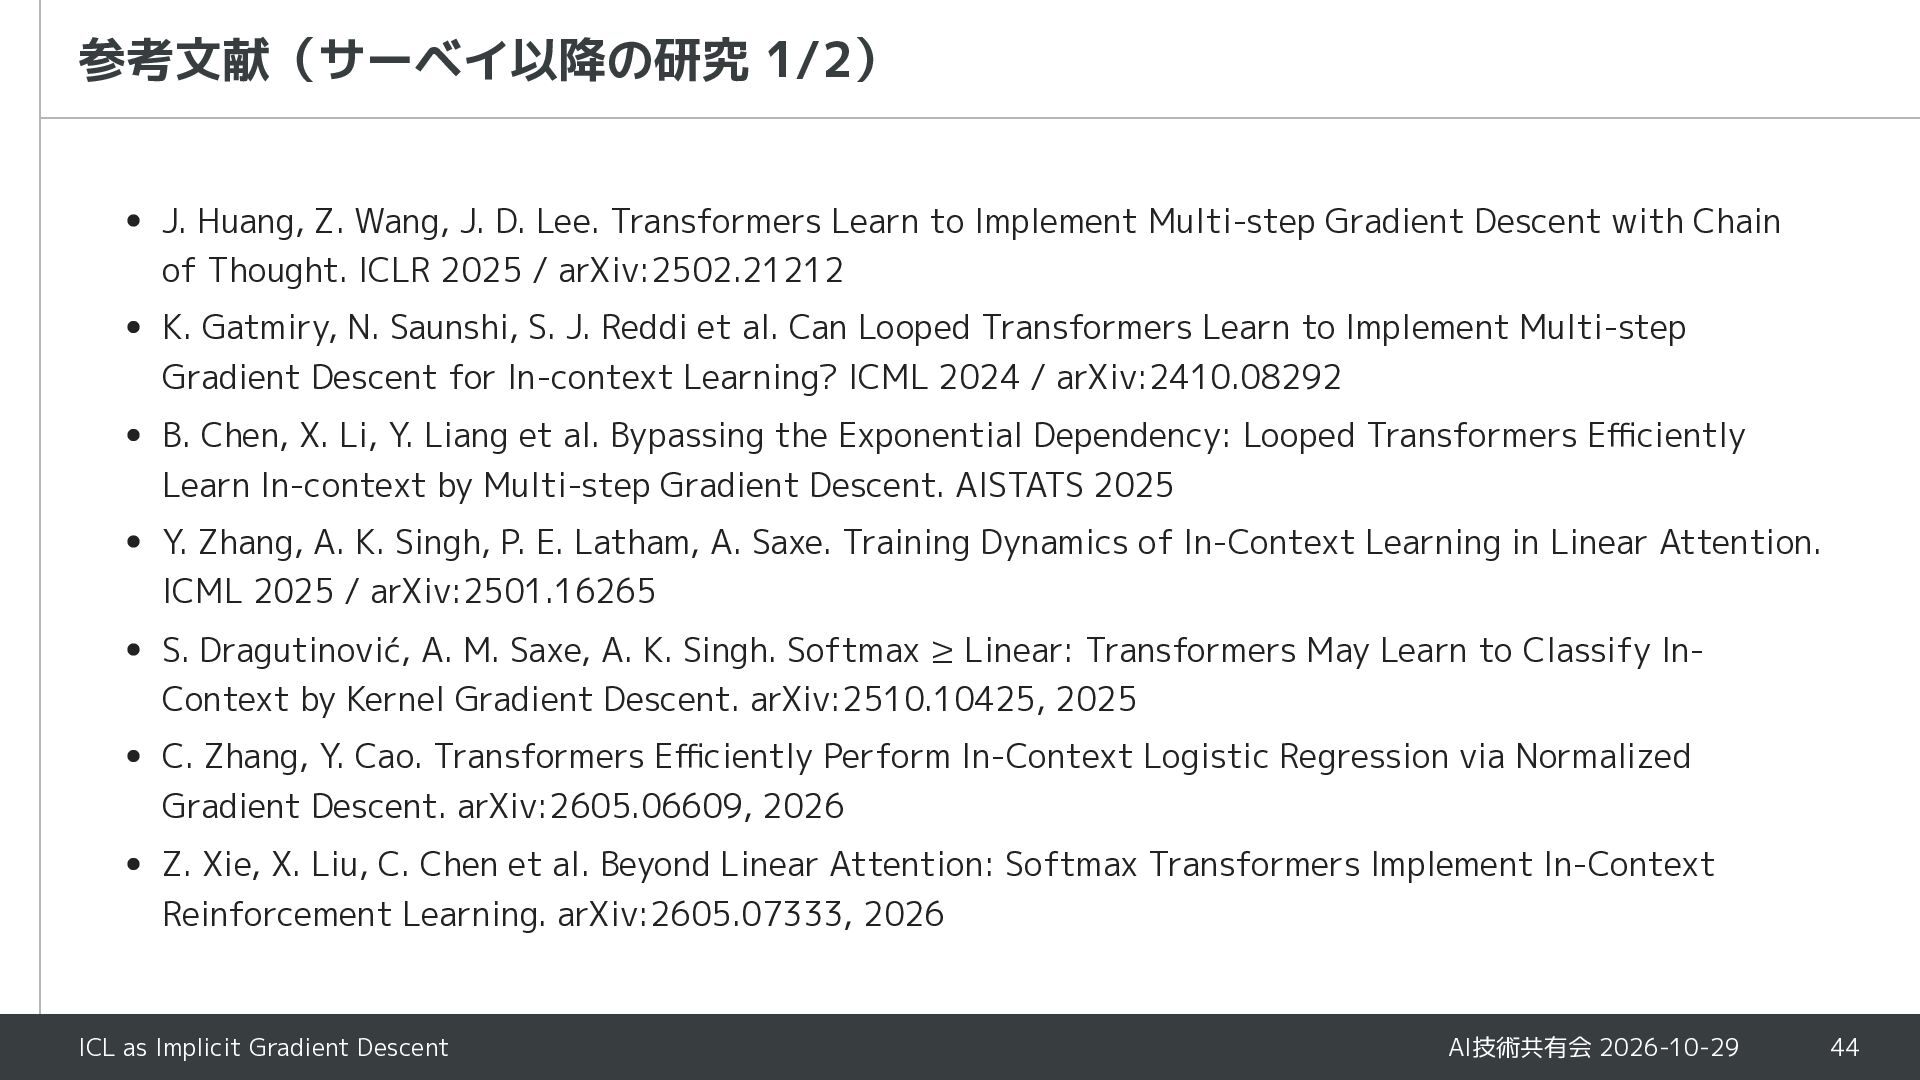
Learn to Implement Multi-step Gradient Descent with Chain of Thought. ICLR 2025 / arXiv:2502.21212 K. Gatmiry, N. Saunshi, S. J. Reddi et al. Can Looped Transformers Learn to Implement Multi-step Gradient Descent for In-context Learning? ICML 2024 / arXiv:2410.08292 B. Chen, X. Li, Y. Liang et al. Bypassing the Exponential Dependency: Looped Transformers Efficiently Learn In-context by Multi-step Gradient Descent. AISTATS 2025 Y. Zhang, A. K. Singh, P. E. Latham, A. Saxe. Training Dynamics of In-Context Learning in Linear Attention. ICML 2025 / arXiv:2501.16265 S. Dragutinović, A. M. Saxe, A. K. Singh. Softmax ≥ Linear: Transformers May Learn to Classify InContext by Kernel Gradient Descent. arXiv:2510.10425, 2025 C. Zhang, Y. Cao. Transformers Efficiently Perform In-Context Logistic Regression via Normalized Gradient Descent. arXiv:2605.06609, 2026 Z. Xie, X. Liu, C. Chen et al. Beyond Linear Attention: Softmax Transformers Implement In-Context Reinforcement Learning. arXiv:2605.07333, 2026 ICL as Implicit Gradient Descent AI技術共有会 2026-10-29 44
The Initialization Determines Whether In-Context Learning Is Gradient Descent. TMLR 2025 / arXiv:2512.04268 A. K. Lampinen et al. On the Generalization of Language Models from In-Context Learning and Finetuning: A Controlled Study. arXiv:2505.00661, 2025 B. Dherin, M. Munn, H. Mazzawi, M. Wunder, J. Gonzalvo. Learning without Training: The Implicit Dynamics of In-Context Learning. arXiv:2507.16003, 2025 K. A. Wang, J. Shi, E. B. Fox. Test-time Regression: A Unifying Framework for Designing Sequence Models with Associative Memory. JMLR 2026 / arXiv:2501.12352 J. Liu, S. Elflein, O. Litany et al. Test-Time Training with KV Binding Is Secretly Linear Attention. ICML 2026 / arXiv:2602.21204 ICL as Implicit Gradient Descent AI技術共有会 2026-10-29 45
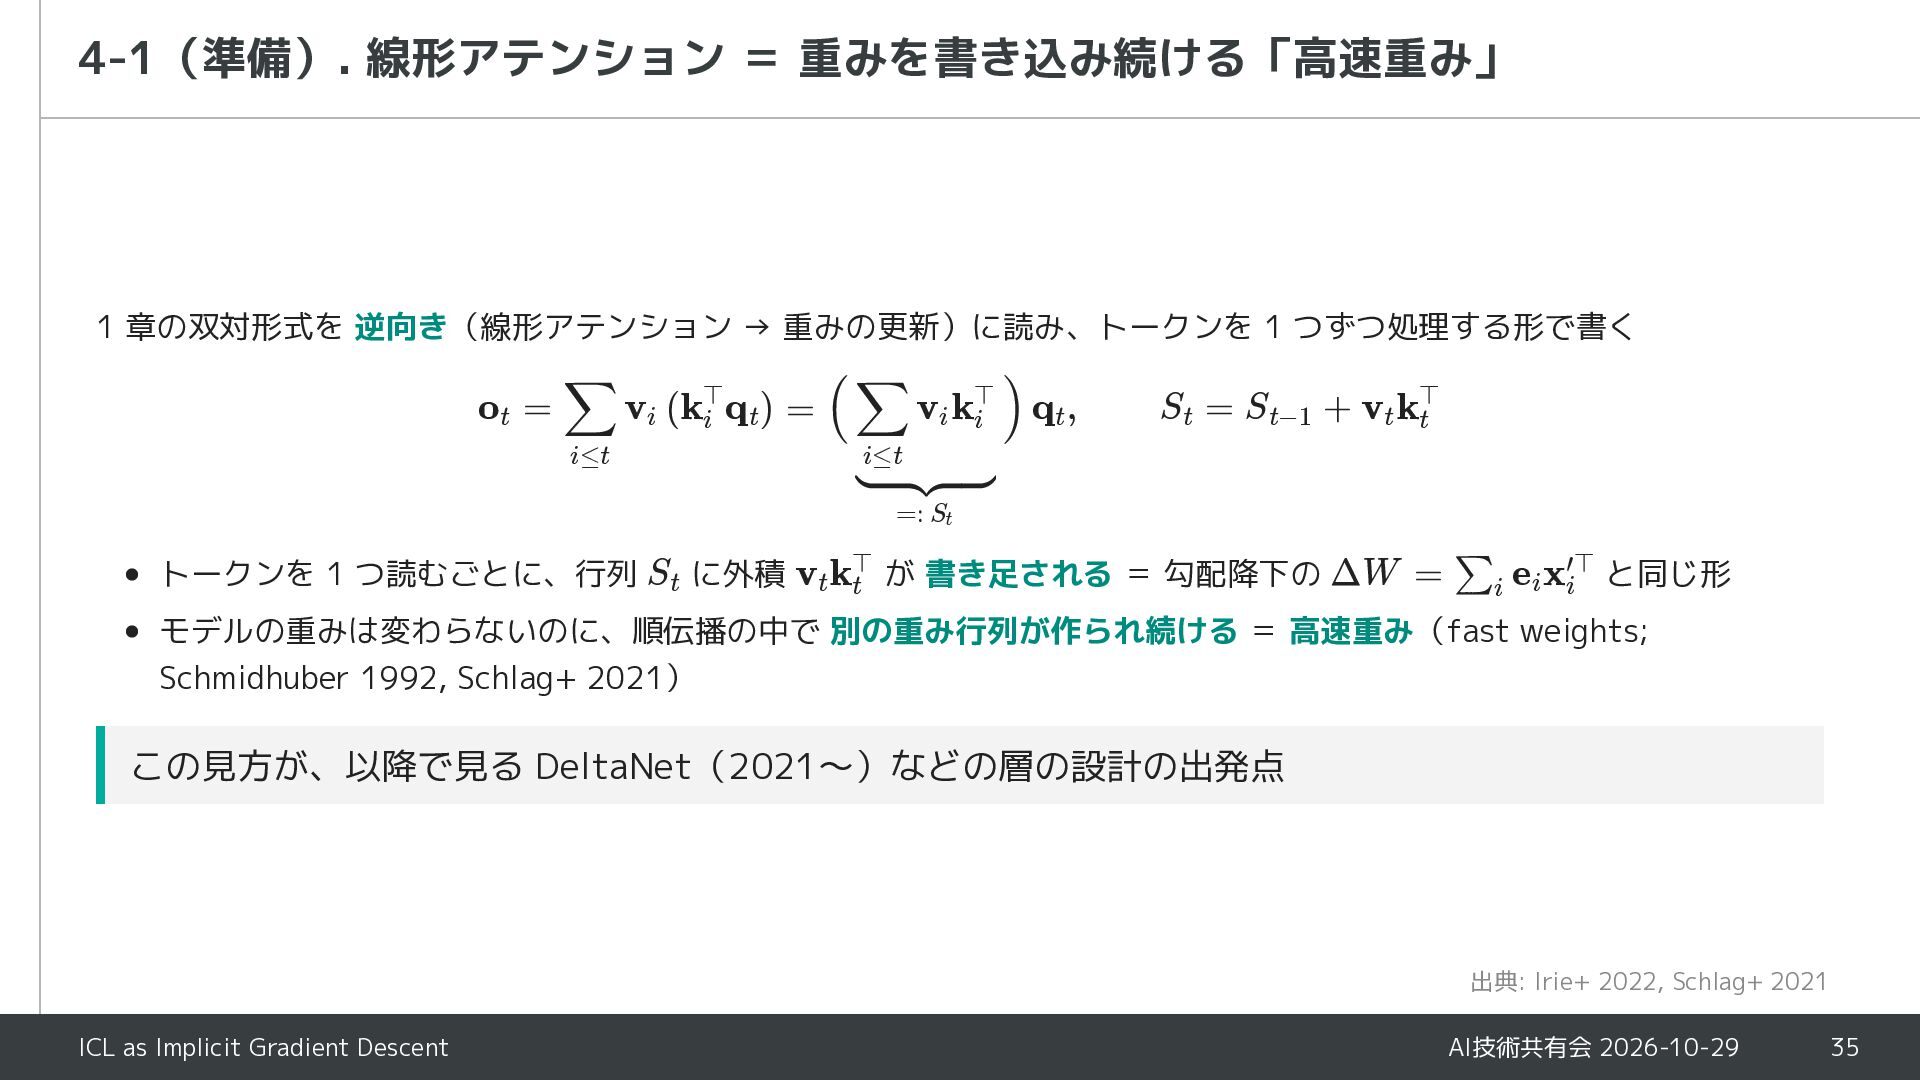
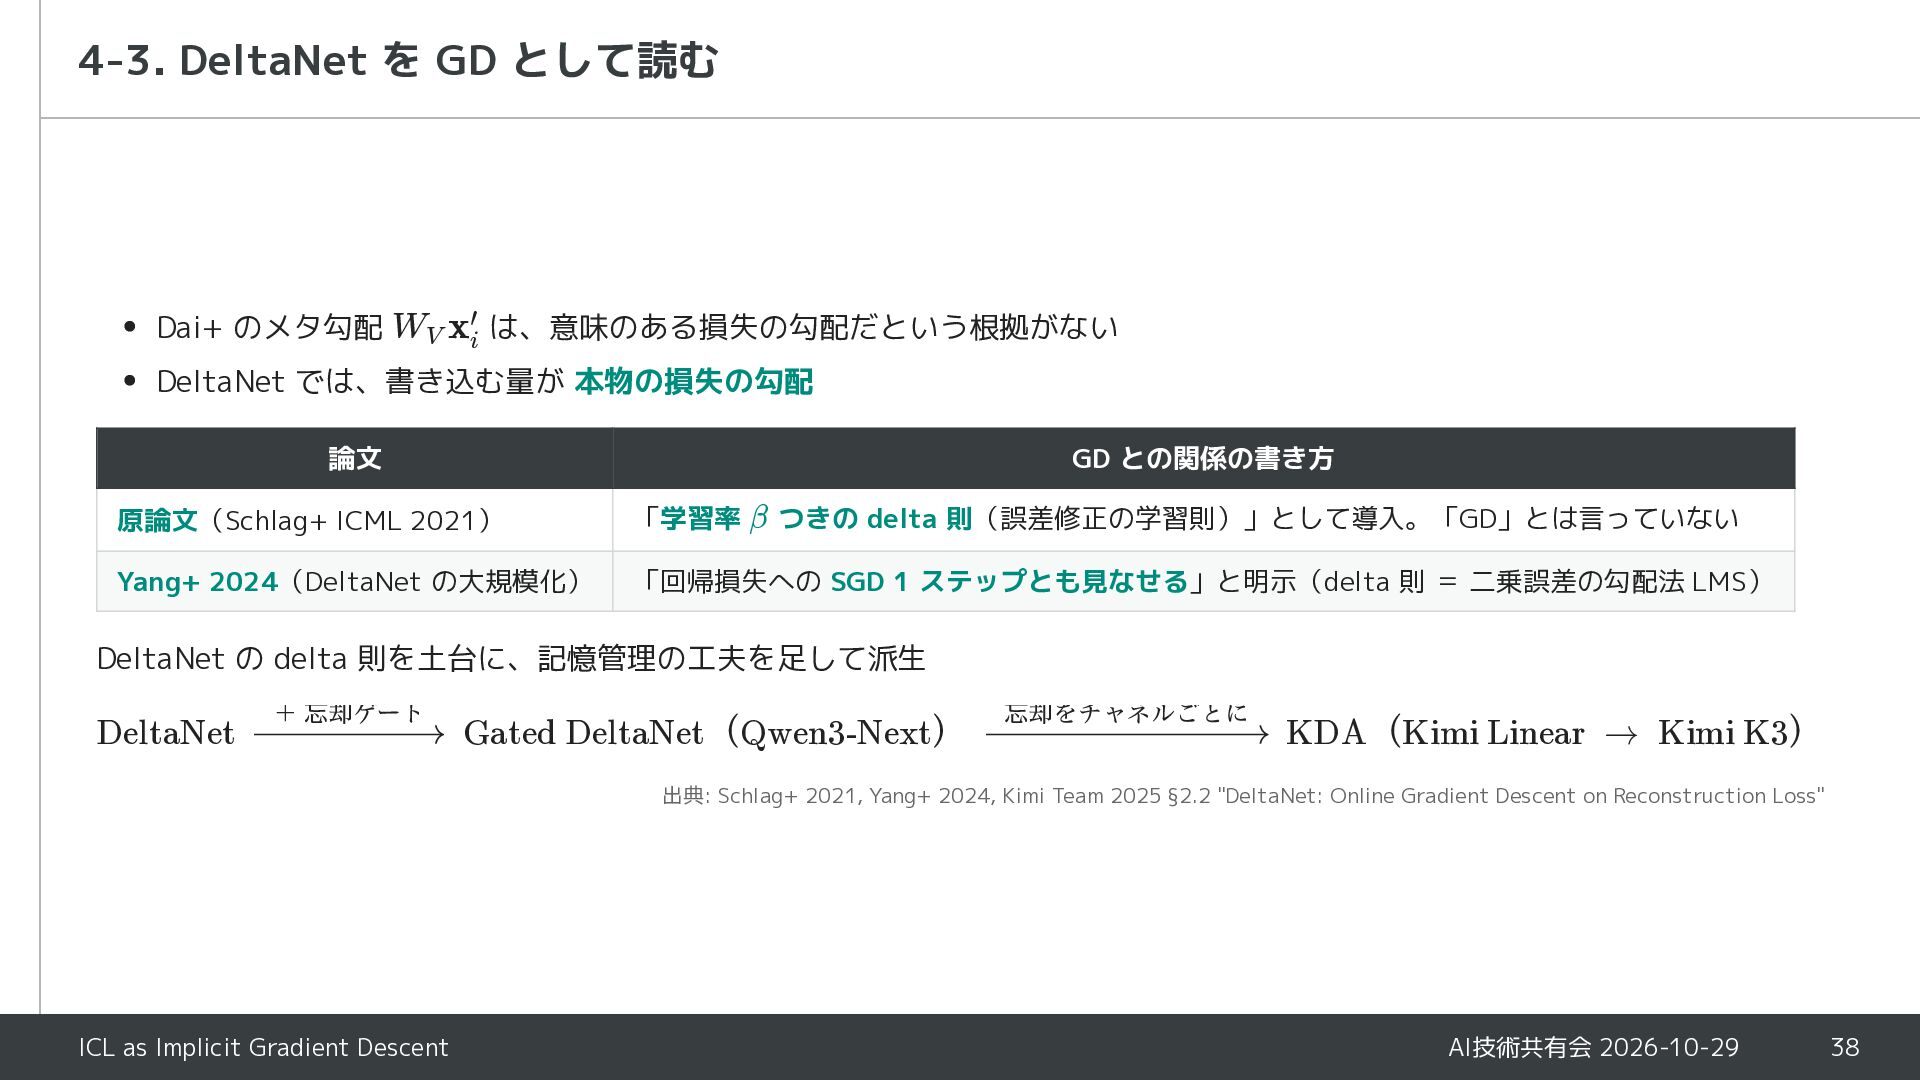
Transformers Are Secretly Fast Weight Programmers. ICML 2021 S. Yang, B. Wang, Y. Zhang, Y. Shen et al. Parallelizing Linear Transformers with the Delta Rule over Sequence Length. NeurIPS 2024 S. Yang, J. Kautz, A. Hatamizadeh. Gated Delta Networks: Improving Mamba2 with Delta Rule. ICLR 2025 / arXiv:2412.06464 Y. Sun et al. Learning to (Learn at Test Time): RNNs with Expressive Hidden States. arXiv:2407.04620, 2024 A. Behrouz, P. Zhong, V. Mirrokni. Titans: Learning to Memorize at Test Time. arXiv:2501.00663, 2025 C. Zhou, H. Li, Y. Liu et al. OSDN: Improving Delta Rule with Provable Online Preconditioning in Linear Attention. arXiv:2605.13473, 2026 J. von Oswald, N. Scherrer, S. Kobayashi et al. MesaNet: Sequence Modeling by Locally Optimal Test-Time Training. ICLR 2026 Kimi Team. Kimi Linear: An Expressive, Efficient Attention Architecture. arXiv:2510.26692, 2025 Kimi Team. Kimi K3: Open Frontier Intelligence. arXiv:2607.24653, 2026 Qwen Team. Qwen3-Next モデルカード, 2025 ICL as Implicit Gradient Descent AI技術共有会 2026-10-29 46


 sakusaku3939
 myohei
 akaboshinit
 kinunori
 cyberagentdevelopers
 hisuzuya
 yakumo
 minorun365
 rmetzger
 asmz
 yoshiiryo1
 akosma
 carmenintech
 chriscoyier
 jlugia
 tessaabrams
 codingconduct
 lara
 baasie
 nikkihalliwell
 danielanewman
 jeffersonlam
 tammyeverts
 marktimemedia