Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
30座EKS, 180次升級淬煉的EKS Upgrade Skill 的歷程
Search
Eric
September 14, 2026
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
30座EKS, 180次升級淬煉的EKS Upgrade Skill 的歷程
KubeSummit 2026 @ 2026-09-10
https://k8s.ithome.com.tw/2026/session/4910
Eric
September 14, 2026
More Decks by Eric
See All by Eric
用恐龍書剖析 AWS Legacy Infra 的效能瓶頸
eric8230
0
81
伸長自如的磁碟空間
eric8230
0
450
加速你的Ansible
eric8230
5
1.7k
Other Decks in Technology
See All in Technology
SQL文一行も書けない人事がCortexもろもろを使って人事業務を楽にしてみる
ponponmikankan
1
240
HRC_Frontend_Conference_Fukuoka_2026.pdf
ts020
0
680
現場で役立つ技術負債の効果的な返済方法
masuda220
PRO
6
1.7k
2026-09-10 【Snowflake World Tour Tokyo 2026】dbt Core と Snowflake で実現する多層的なデータガバナンス / Multi-Layered Data Governance Powered by dbt Core and Snowflake
civitaspo
0
390
あるけみー式LTスライド作成術
alchemy1115
1
210
2026-09-11 【Snowflake World Tour Tokyo 2026】Snowflakeを起点に、AI Agentが自律稼働し続ける未来へ / Driving AI Agents with Snowflake
civitaspo
0
390
2026_devsumi_ozono.pdf
o3
3
470
SREは、MCPとAutopilotをこう使え!
kazumax55
2
730
Claude Codeを「使うほど育つ」AI秘書にするノウハウ
minorun365
PRO
10
6.8k
Reactの設計論
uhyo
22
12k
Podは生きているのにGoだけが落ちる:GOGCとGOMEMLIMITで追うInvisible OOM Killの謎
tkc66buzz
1
710
データ_AIの事業の勝敗をわけるもの
nek0128
0
240
Featured
See All Featured
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
490
The untapped power of vector embeddings
frankvandijk
2
1.9k
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
Prompt Engineering for Job Search
mfonobong
0
450
Building the Perfect Custom Keyboard
takai
2
870
GitHub's CSS Performance
jonrohan
1033
470k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.6k
jQuery: Nuts, Bolts and Bling
dougneiner
66
8.6k
Producing Creativity
orderedlist
PRO
348
41k
Crafting Experiences
bethany
1
330
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.7k
Transcript
KUBE SUMMIT 2026 30座EKS 180次淬煉的 EKS Upgrade Skill 3ric &
Criz Chien 2026-09-10
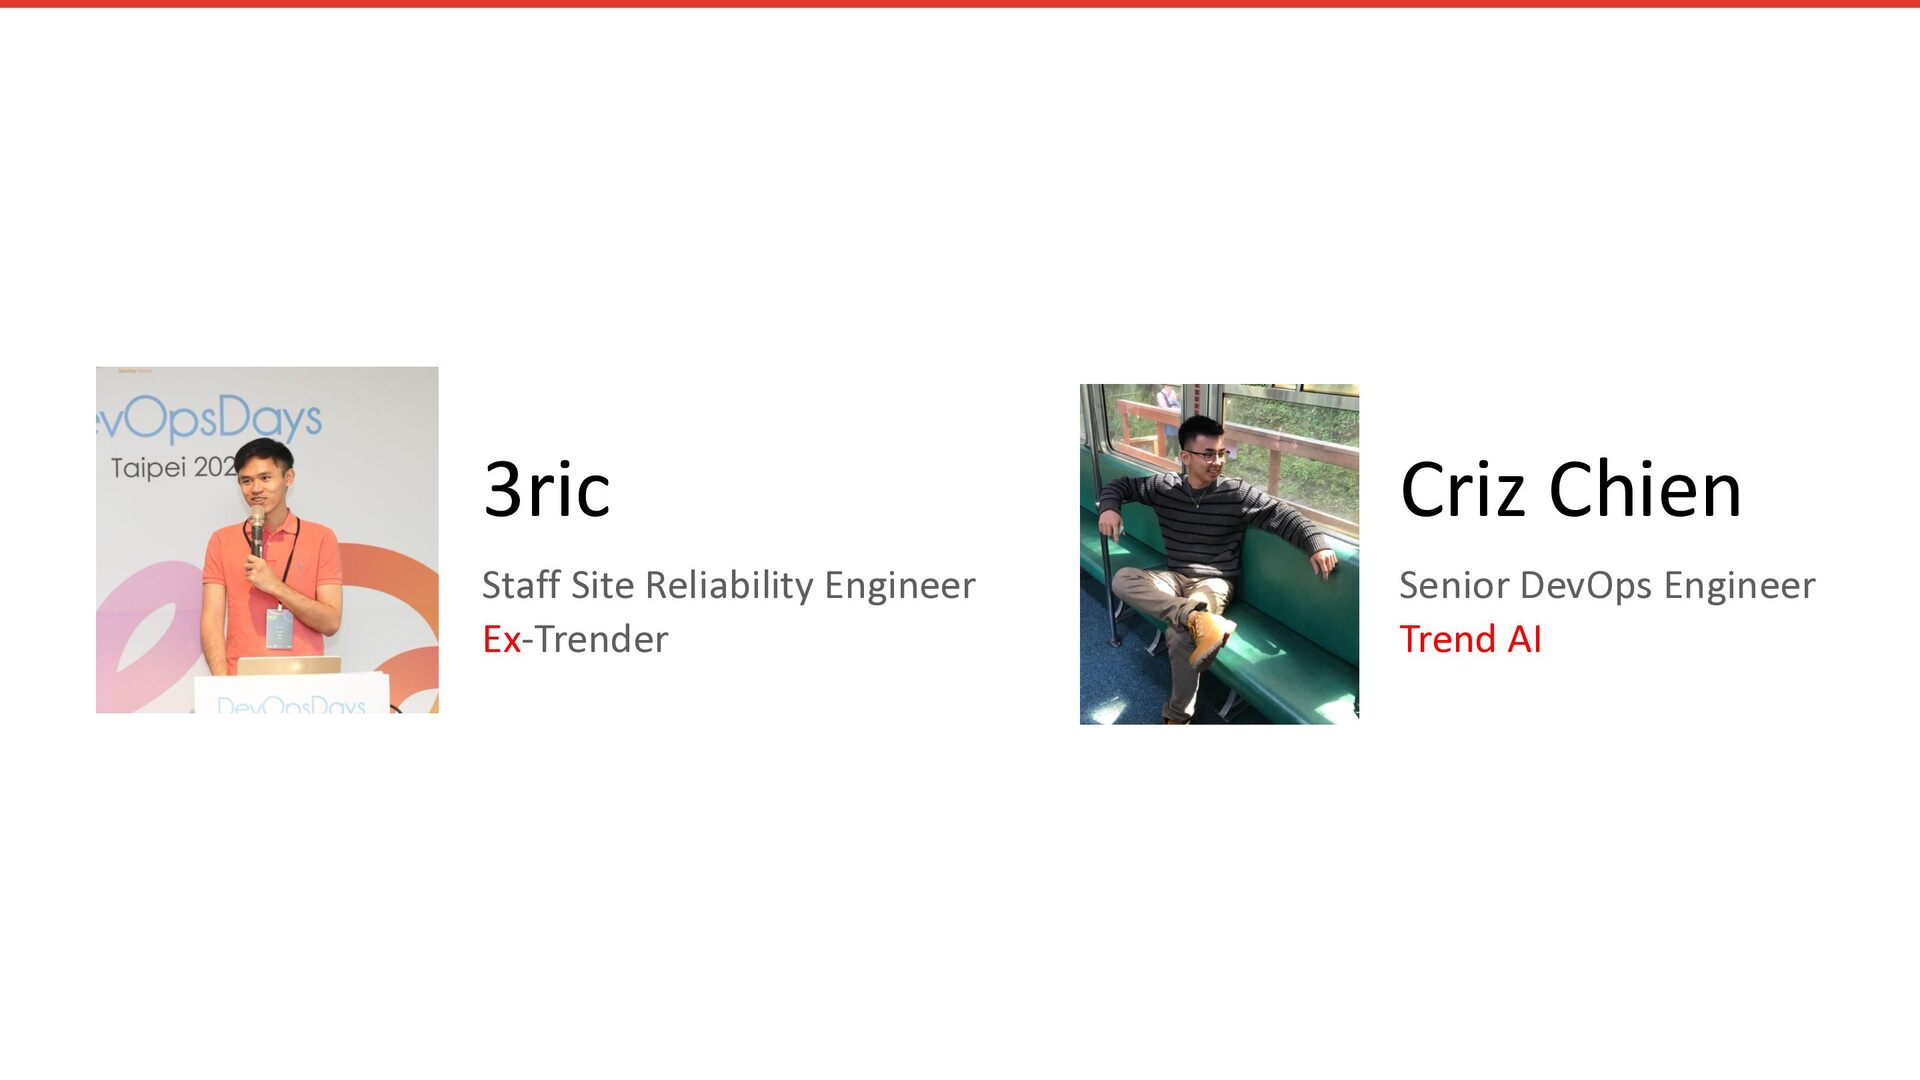
3ric Criz Chien Staff Site Reliability Engineer Ex-Trender Senior DevOps
Engineer Trend AI
01 當時的狀況與痛點 2025-12 → 2026-02
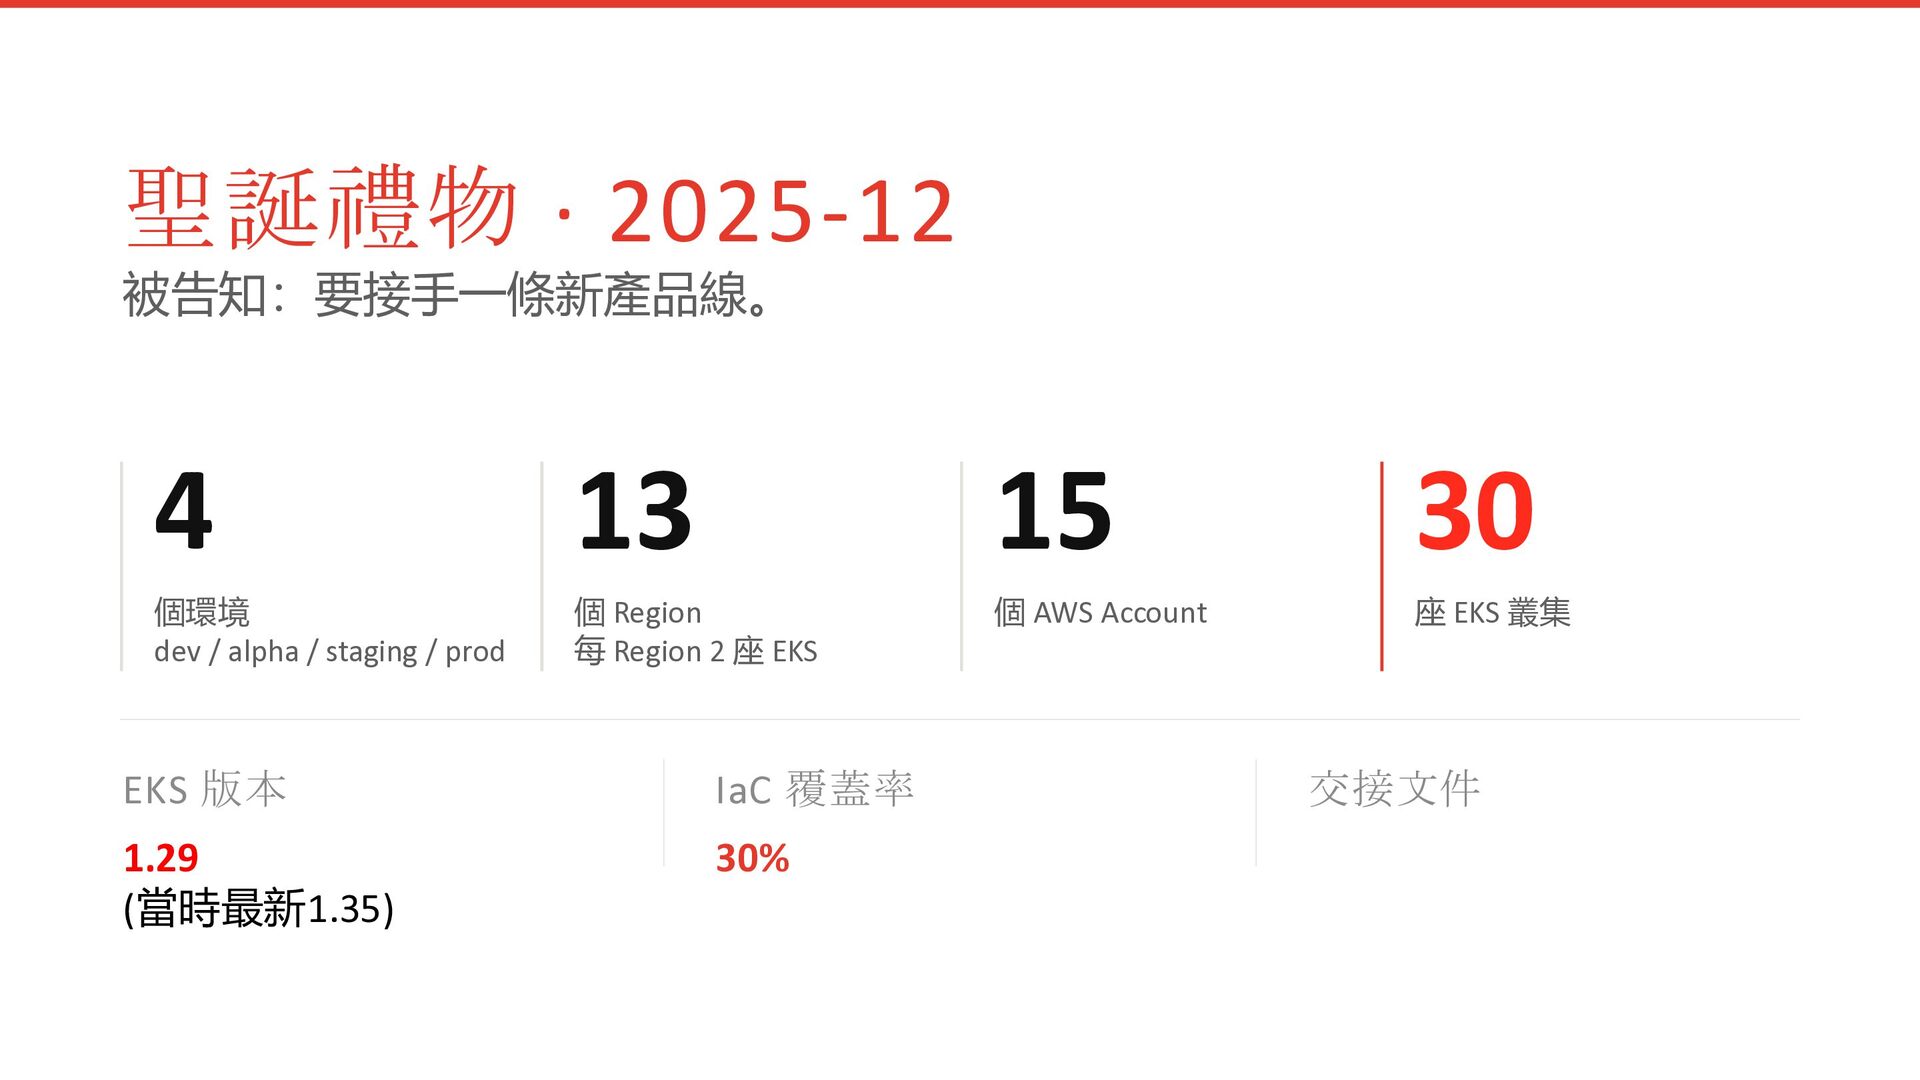
聖誕禮物 · 2025-12 被告知:要接手一條新產品線。 4 13 15 30 個環境 dev
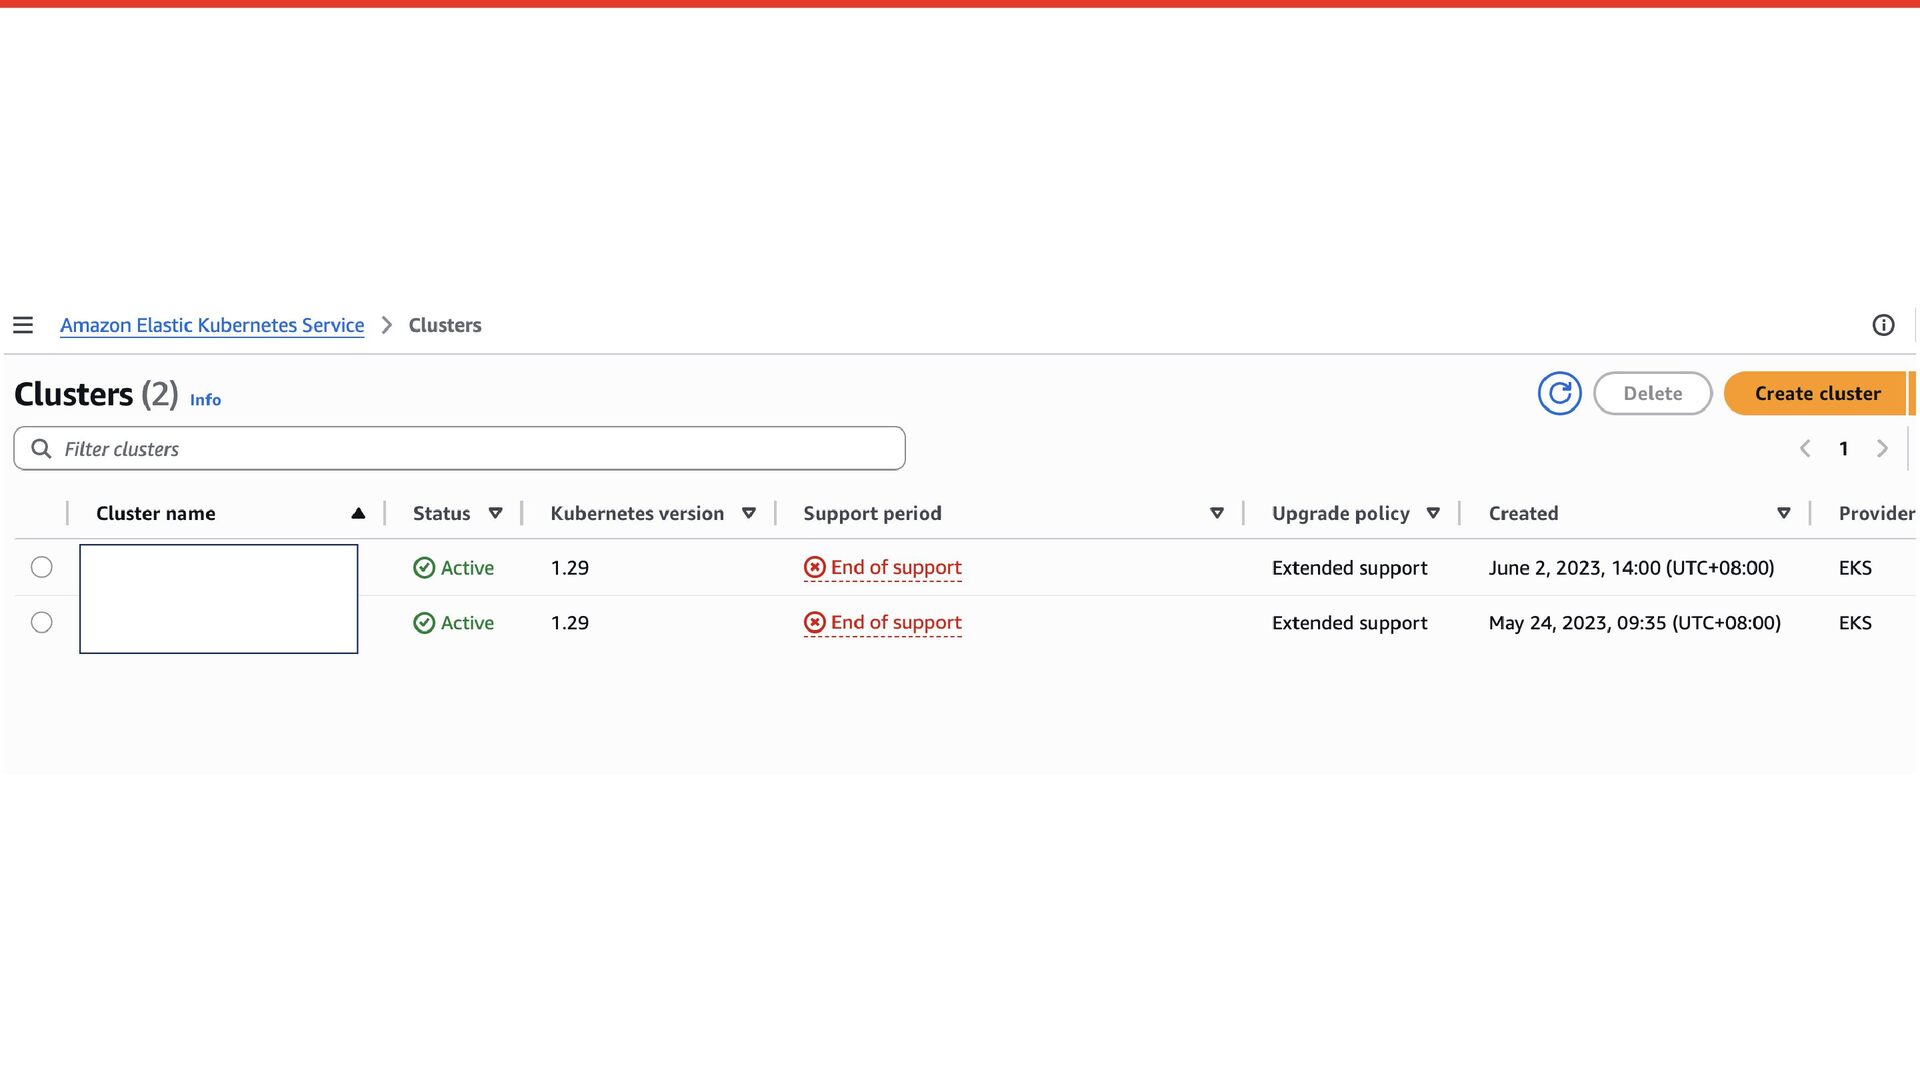
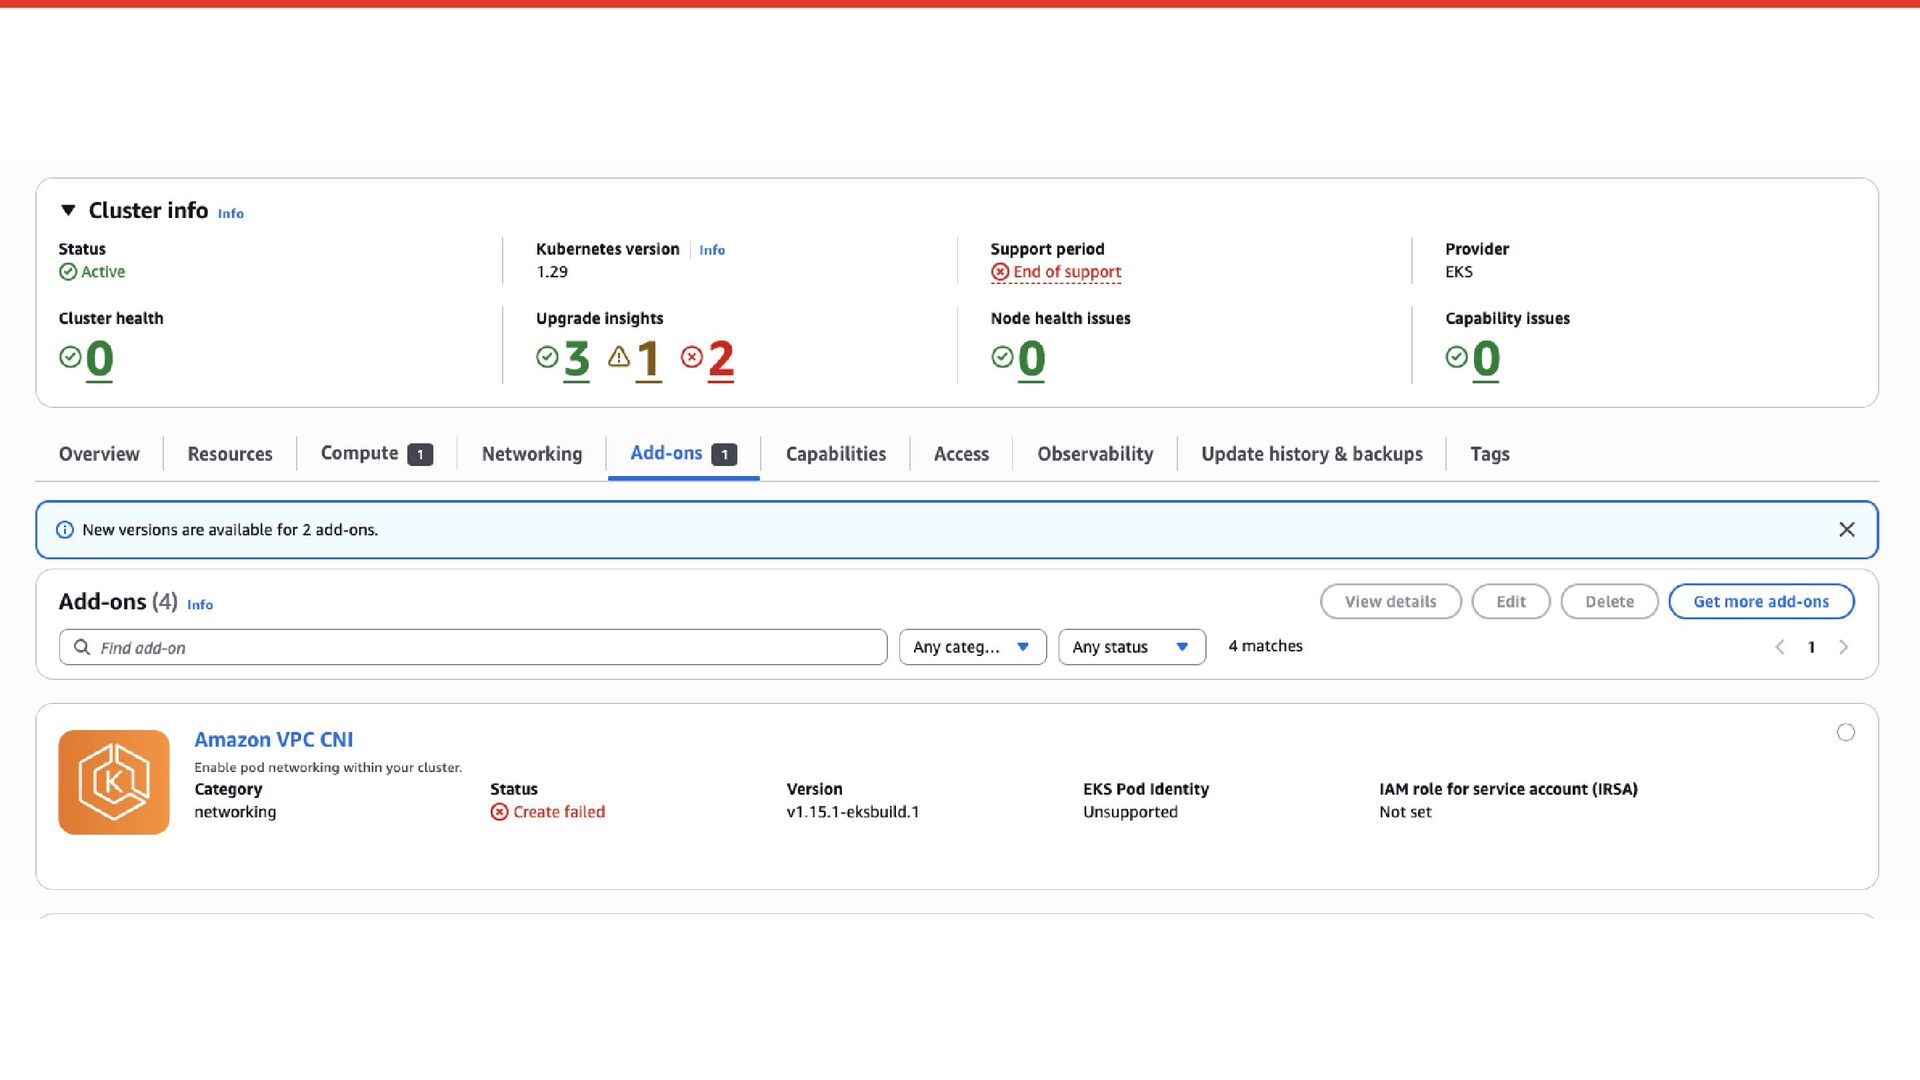
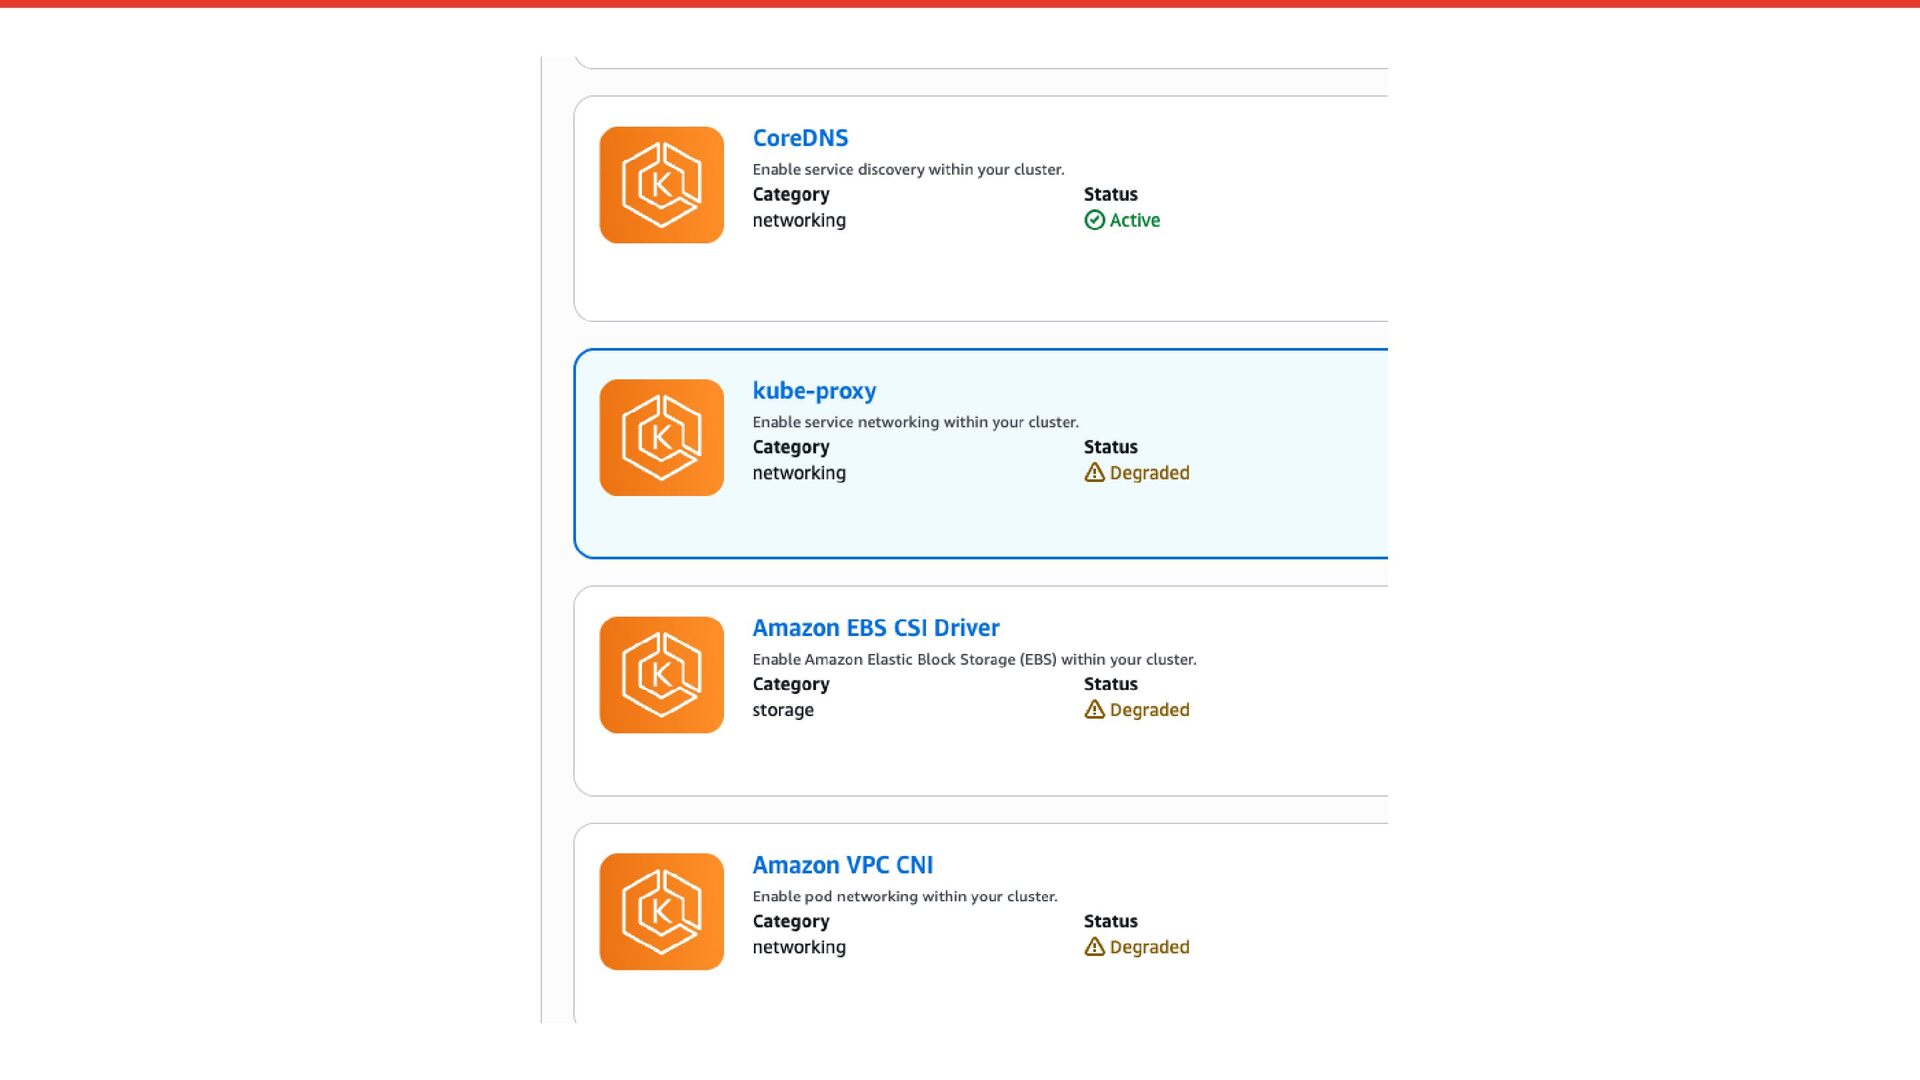
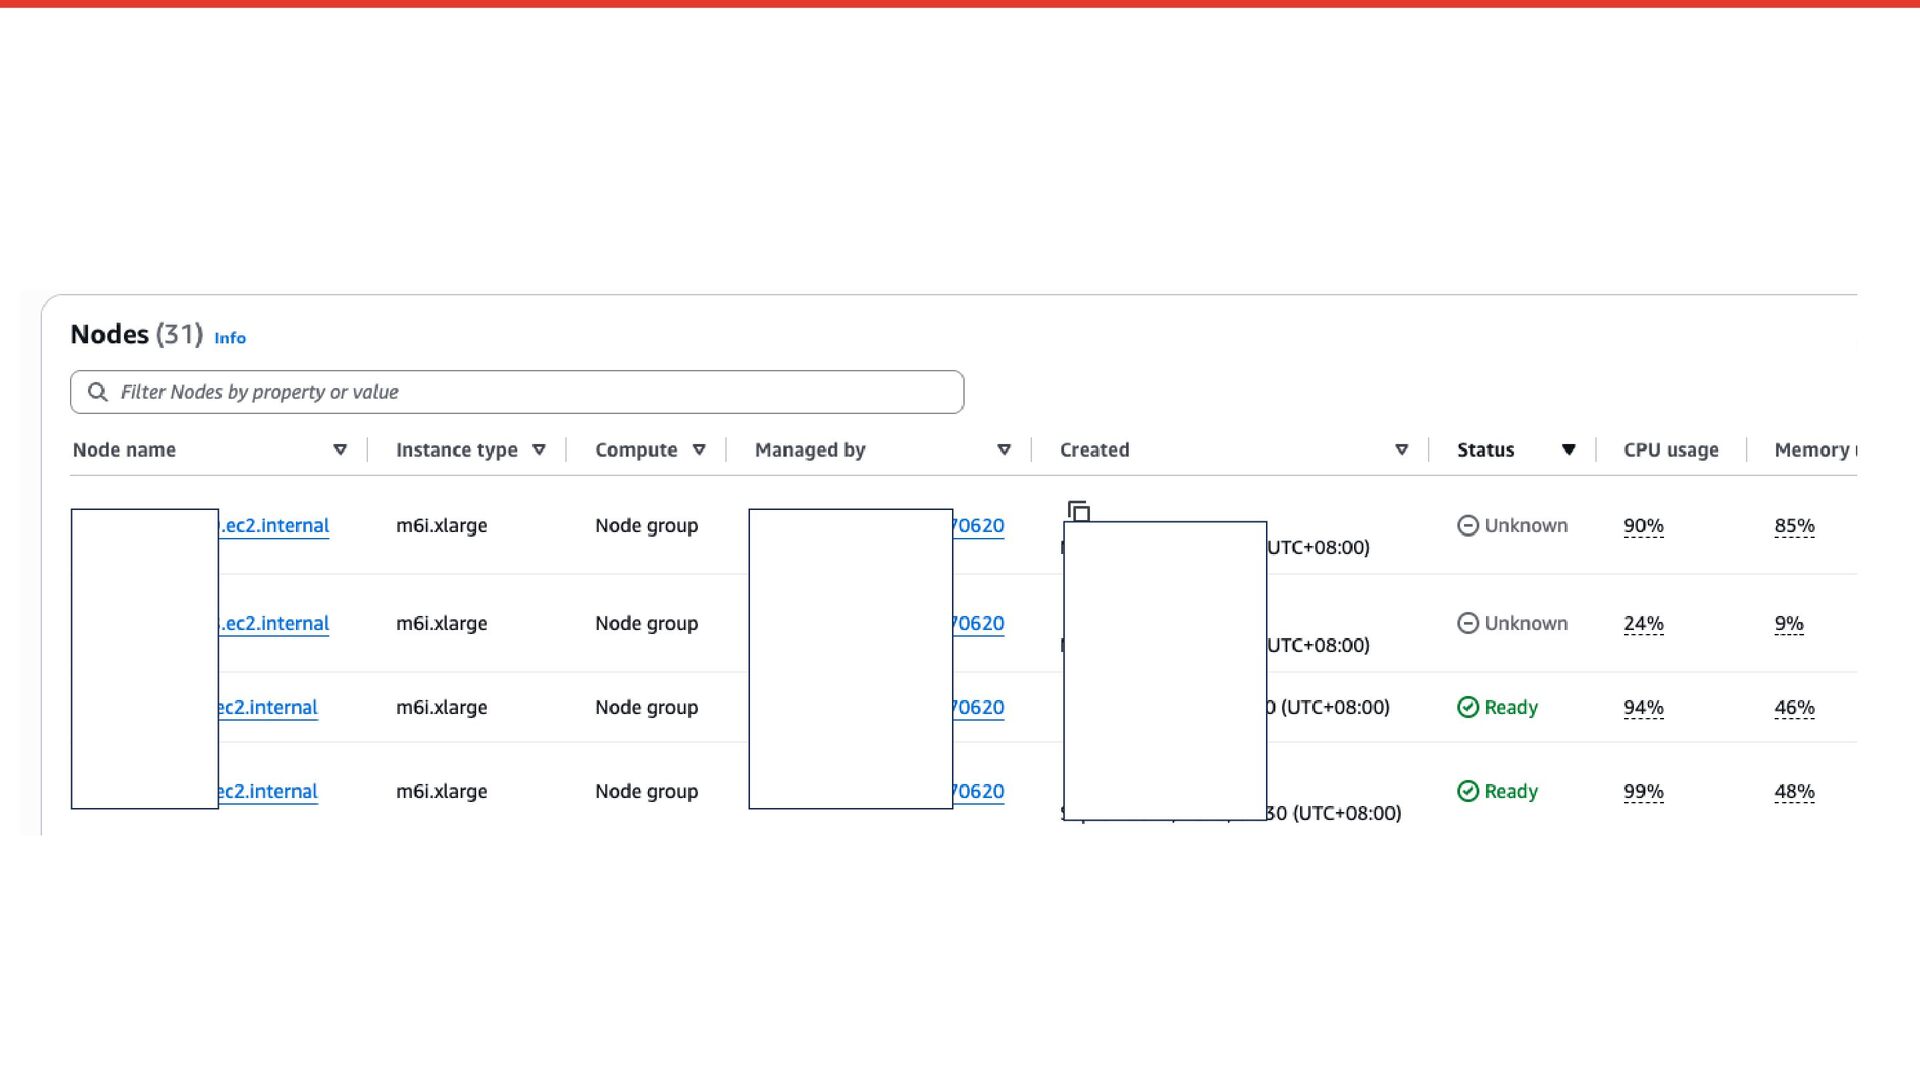
/ alpha / staging / prod 個 Region 每 Region 2 座 EKS 個 AWS Account 座 EKS 叢集 EKS 版本 IaC 覆蓋率 1.29 (當時最新1.35) 30% 交接文件
None
None
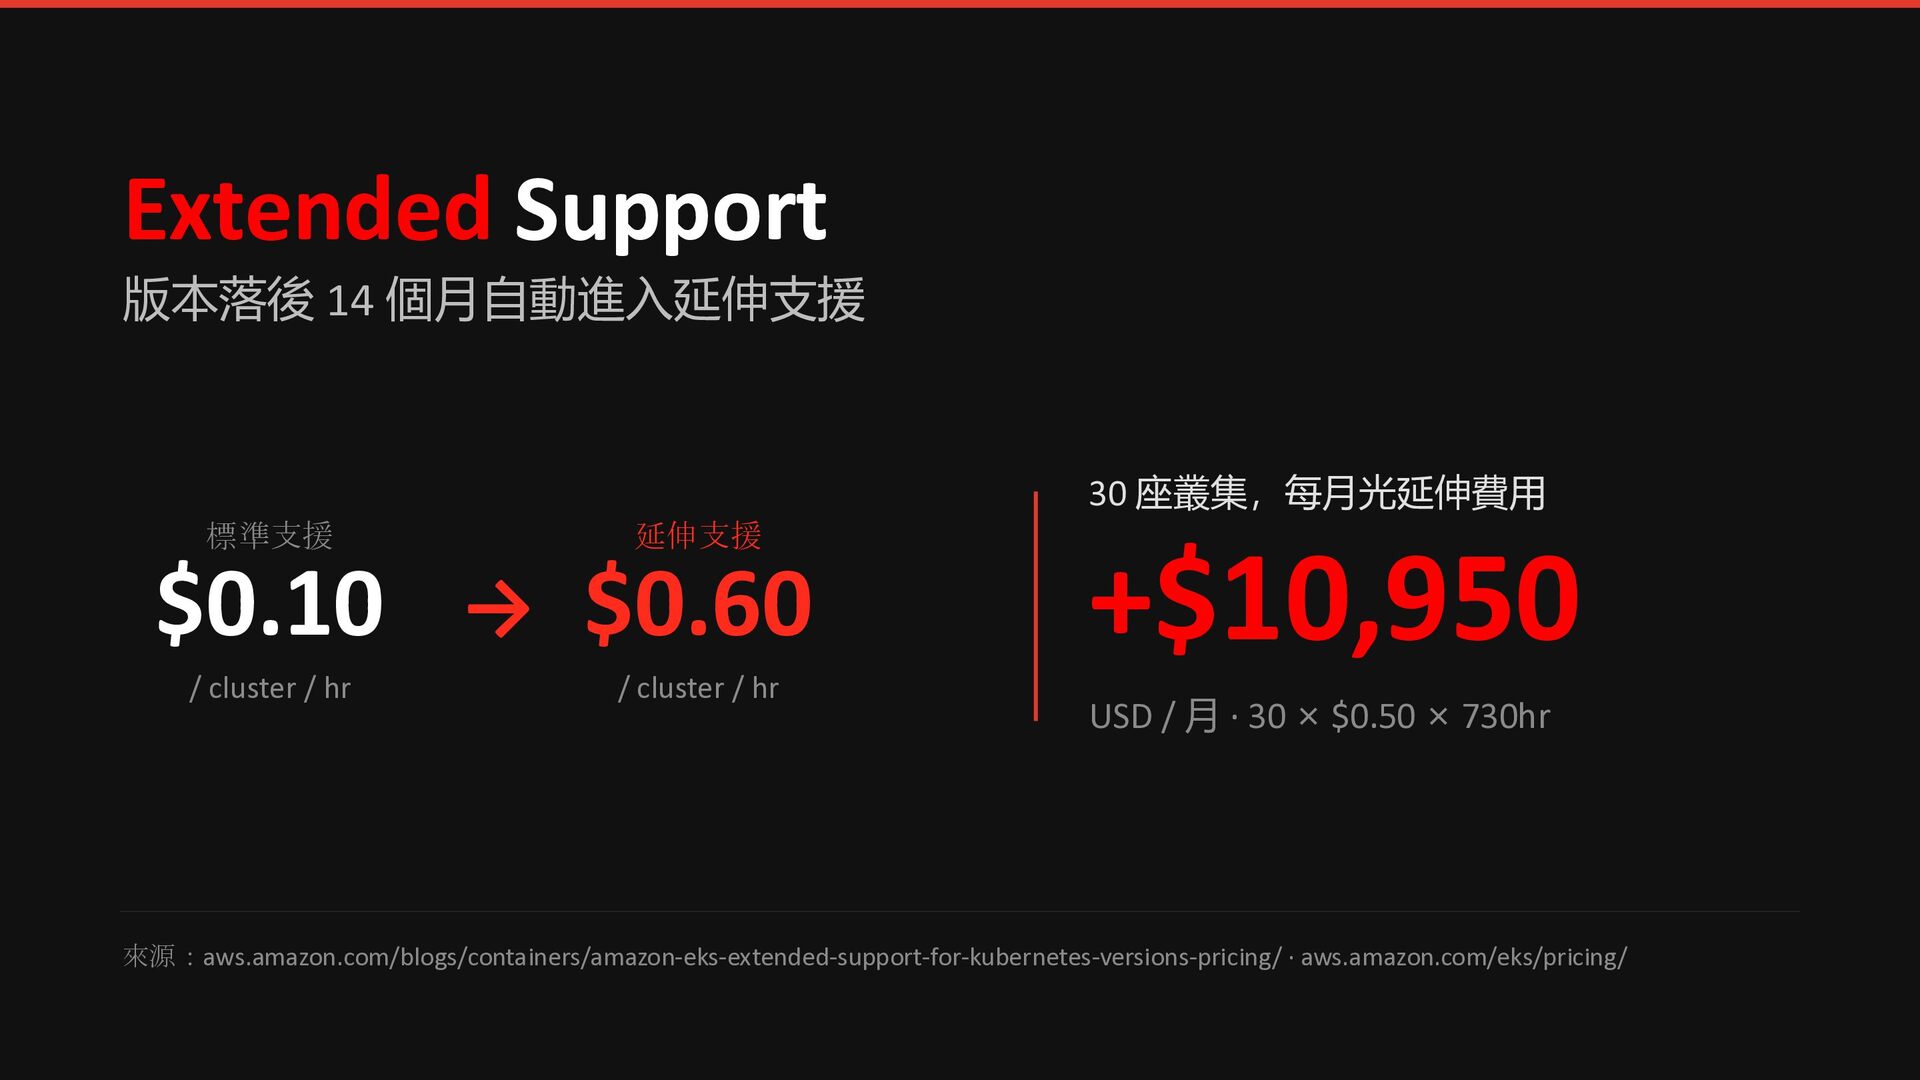
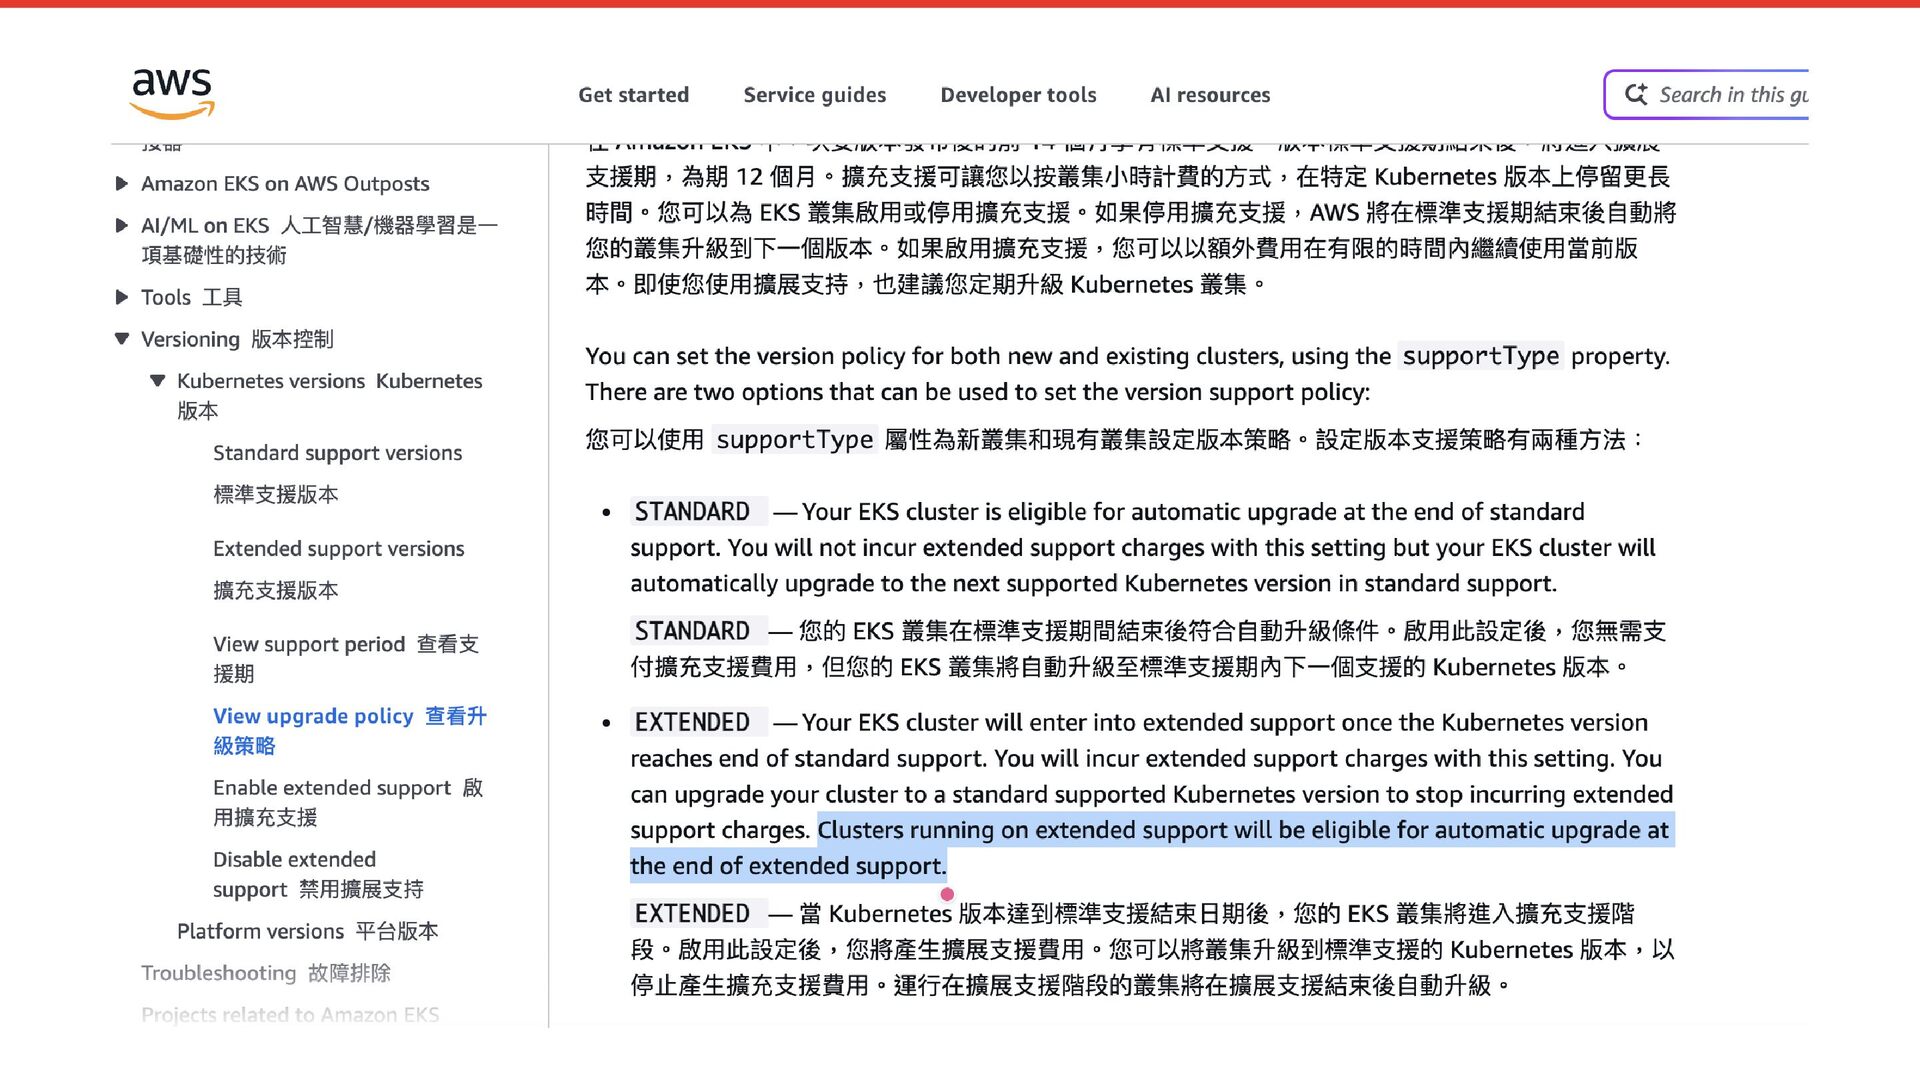
Extended Support 版本落後 14 個月自動進入延伸支援 30 座叢集,每月光延伸費用 標準支援 $0.10 /
cluster / hr 延伸支援 → $0.60 / cluster / hr +$10,950 USD / 月 · 30 × $0.50 × 730hr 來源:aws.amazon.com/blogs/containers/amazon-eks-extended-support-for-kubernetes-versions-pricing/ · aws.amazon.com/eks/pricing/
None
None
None
None
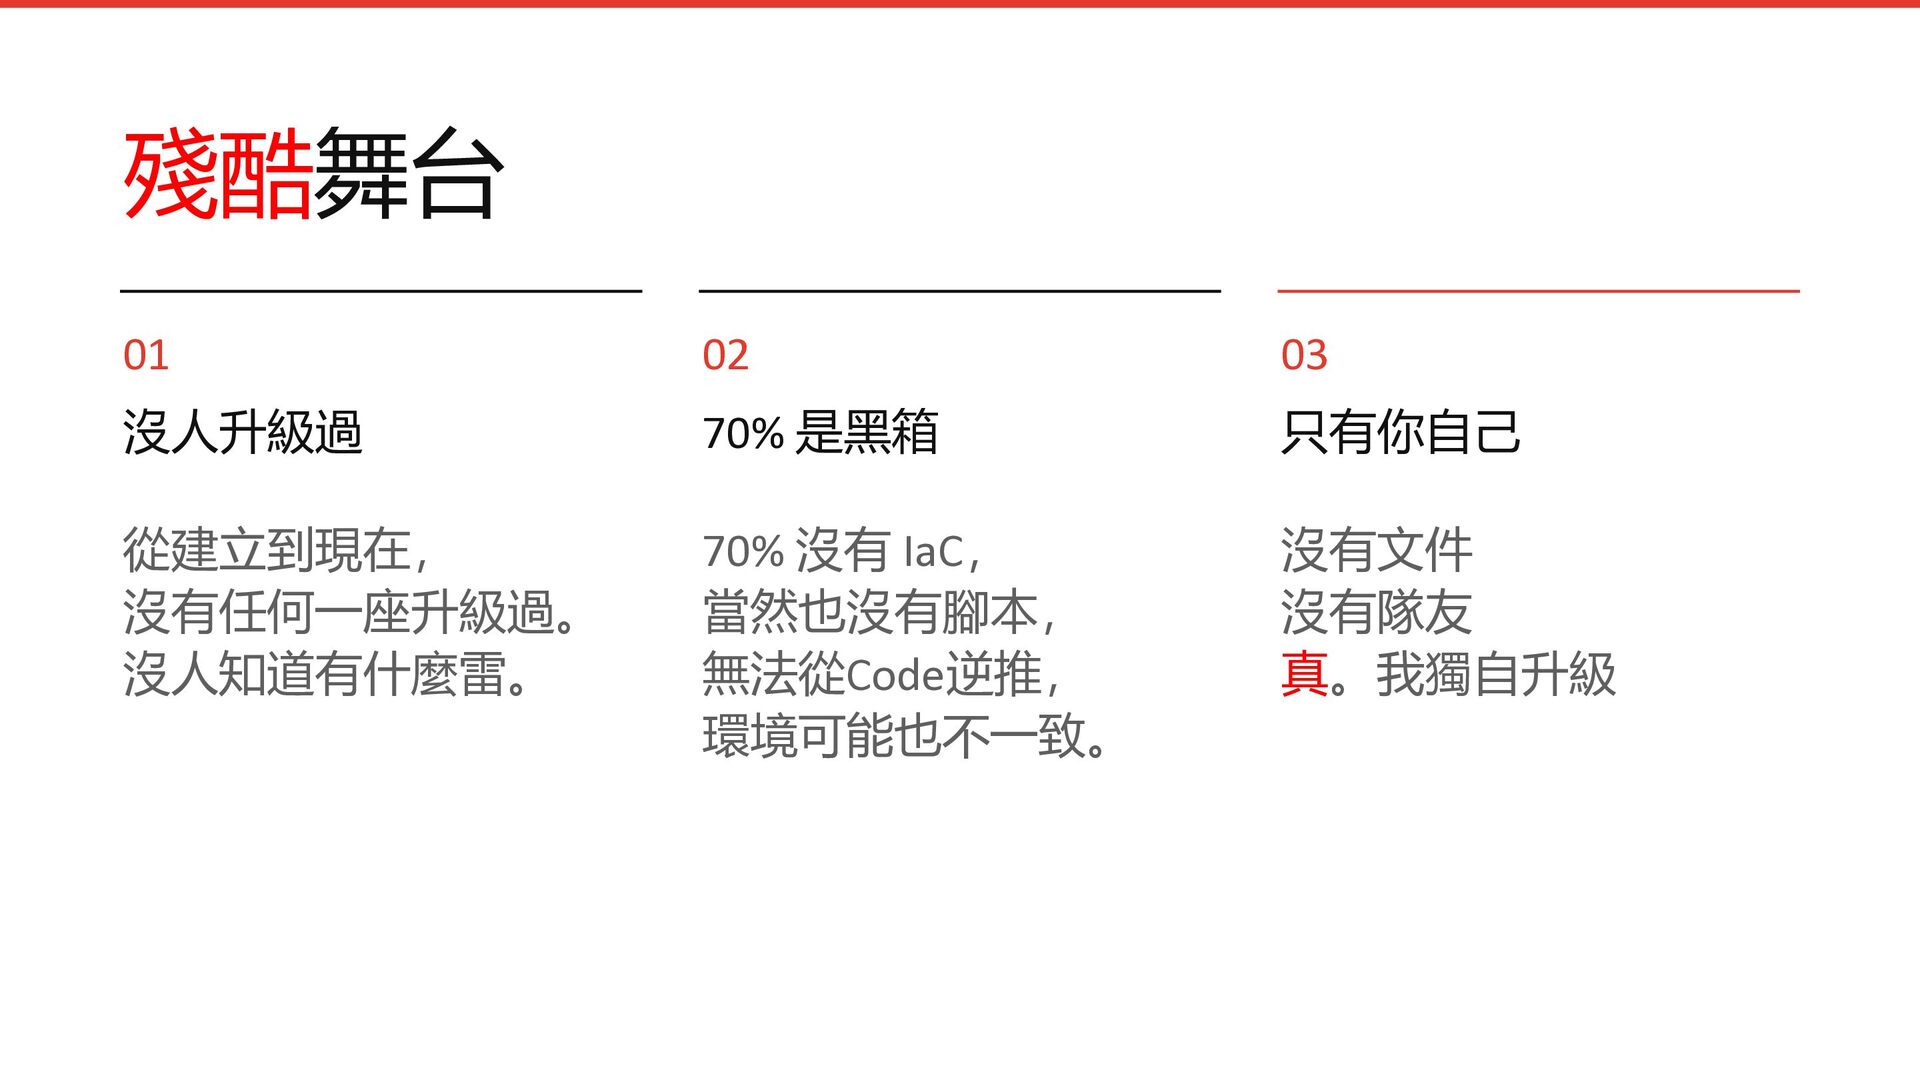
殘酷舞台 01 02 03 沒人升級過 70% 是黑箱 只有你自己 從建立到現在, 沒有任何一座升級過。
沒人知道有什麼雷。 70% 沒有 IaC, 當然也沒有腳本, 無法從Code逆推, 環境可能也不一致。 沒有文件 沒有隊友 真。我獨自升級
02 接手 EKS 的起手式 先盤點
None
None
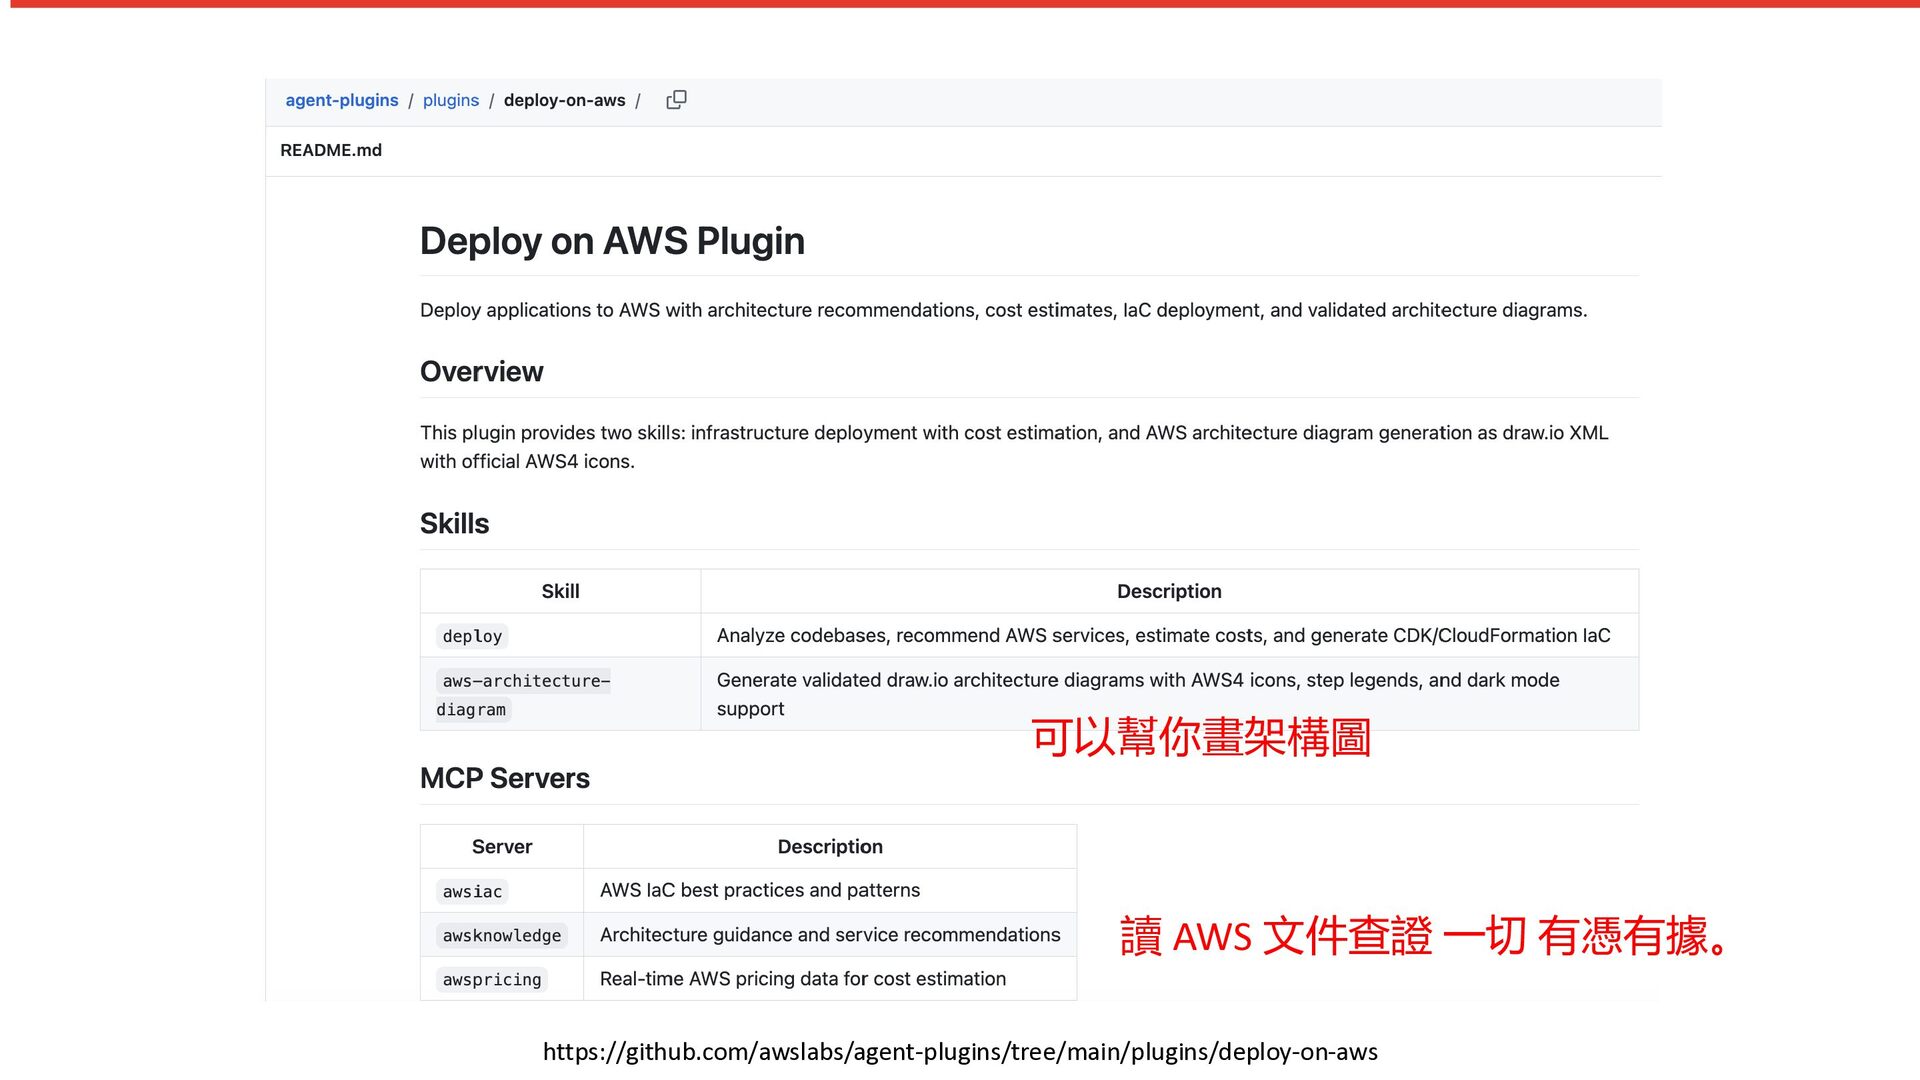
可以幫你畫架構圖 讀 AWS 文件查證 一切 有憑有據。 https://github.com/awslabs/agent-plugins/tree/main/plugins/deploy-on-aws
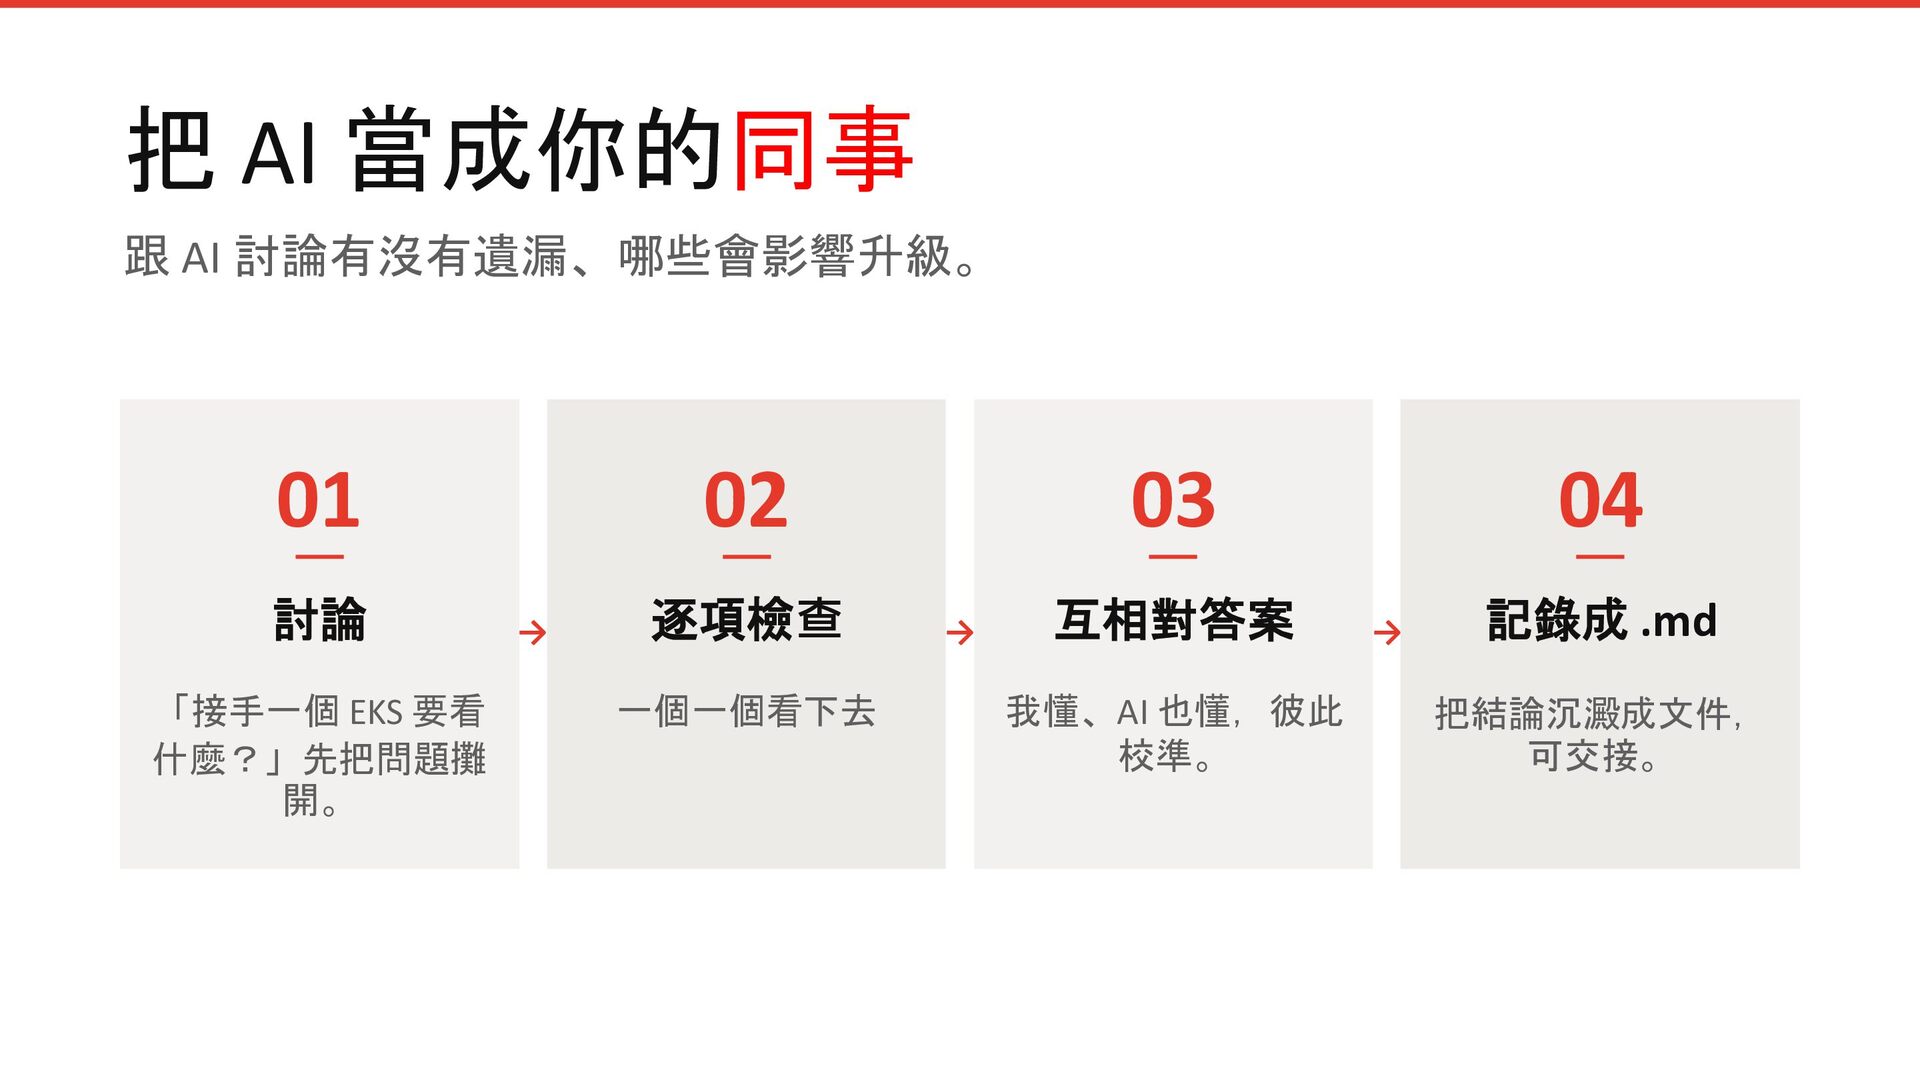
把 AI 當成你的同事 跟 AI 討論有沒有遺漏、哪些會影響升級。 01 討論 「接手一個 EKS
要看 什麼?」先把問題攤 開。 02 → 逐項檢查 一個一個看下去 03 → 互相對答案 我懂、AI 也懂,彼此 校準。 04 → 記錄成 .md 把結論沉澱成文件, 可交接。
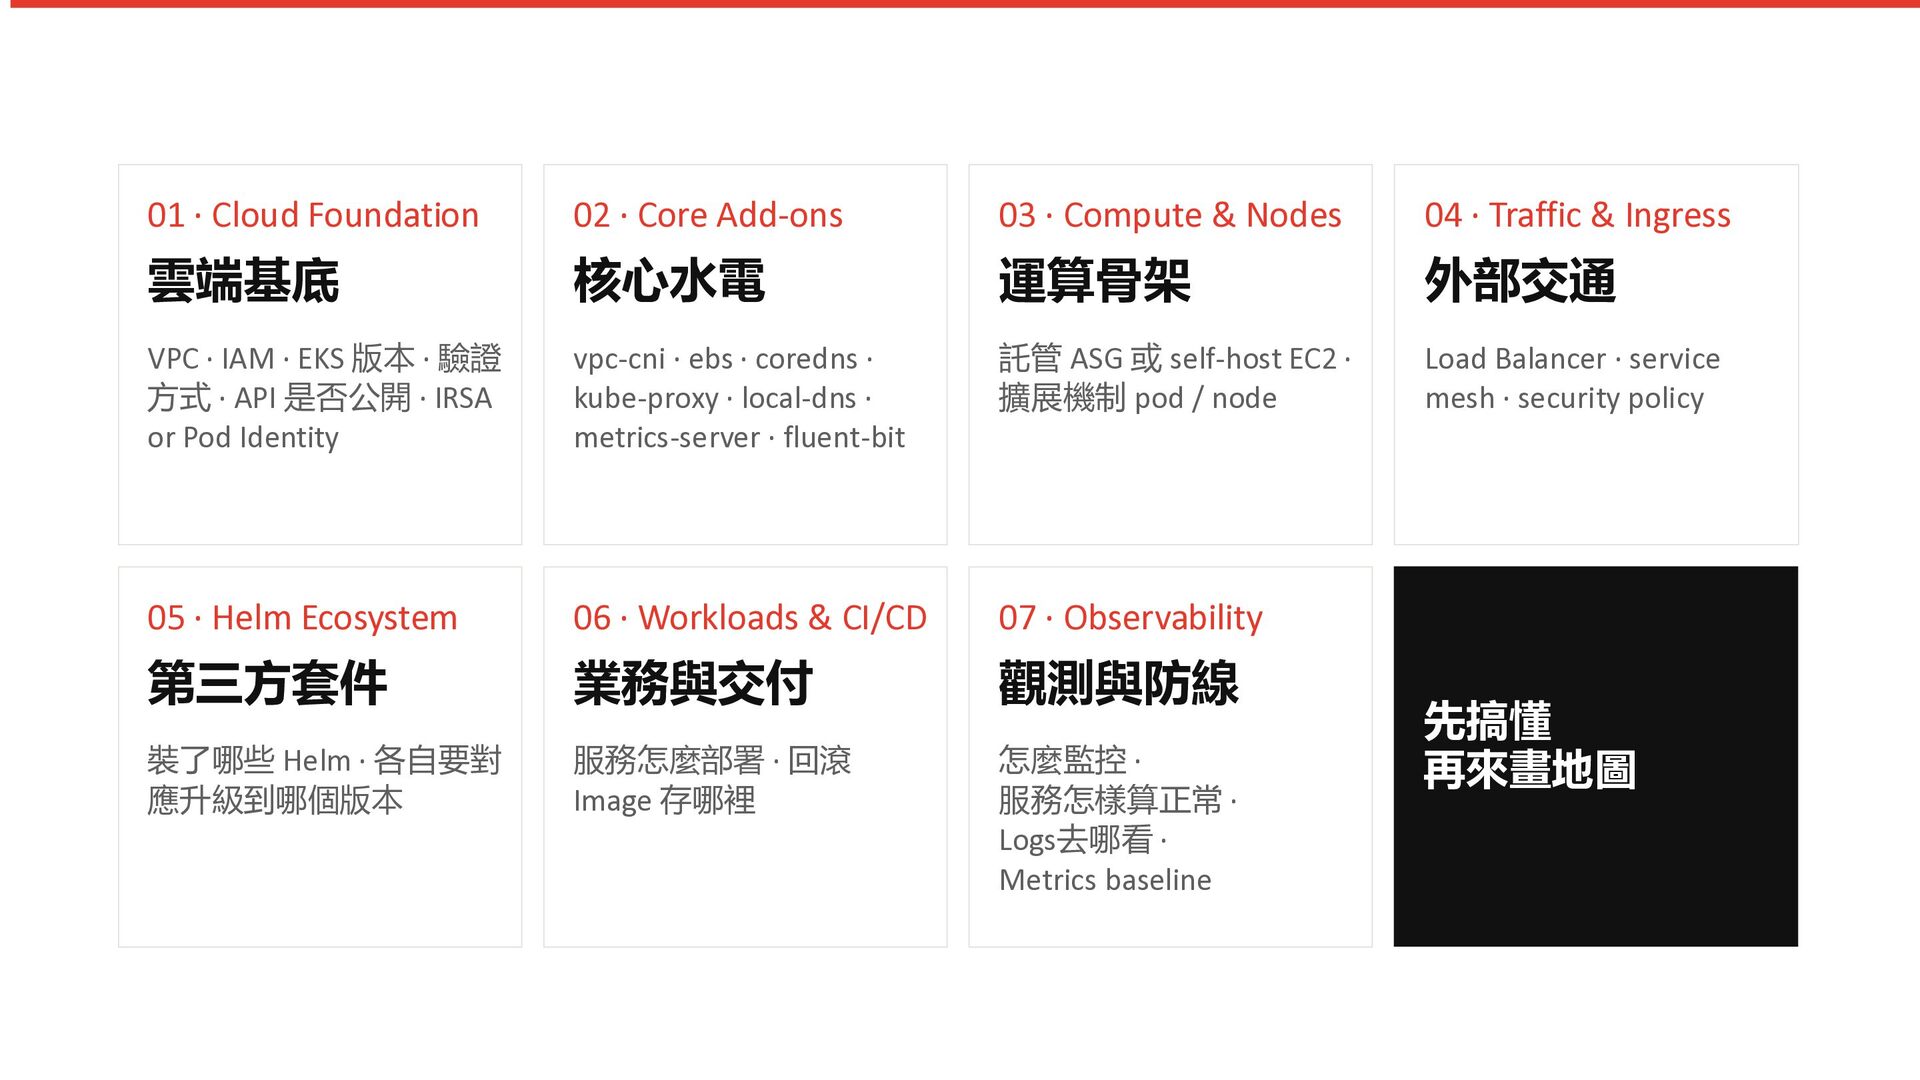
01 · Cloud Foundation 02 · Core Add-ons 03 ·
Compute & Nodes 04 · Traffic & Ingress 雲端基底 核心水電 運算骨架 外部交通 VPC · IAM · EKS 版本 · 驗證 方式 · API 是否公開 · IRSA or Pod Identity vpc-cni · ebs · coredns · kube-proxy · local-dns · metrics-server · fluent-bit 託管 ASG 或 self-host EC2 · 擴展機制 pod / node Load Balancer · service mesh · security policy 05 · Helm Ecosystem 06 · Workloads & CI/CD 07 · Observability 第三方套件 業務與交付 觀測與防線 裝了哪些 Helm · 各自要對 應升級到哪個版本 服務怎麼部署 · 回滾 Image 存哪裡 怎麼監控 · 服務怎樣算正常 · Logs去哪看 · Metrics baseline 先搞懂 再來畫地圖
03 畫地圖
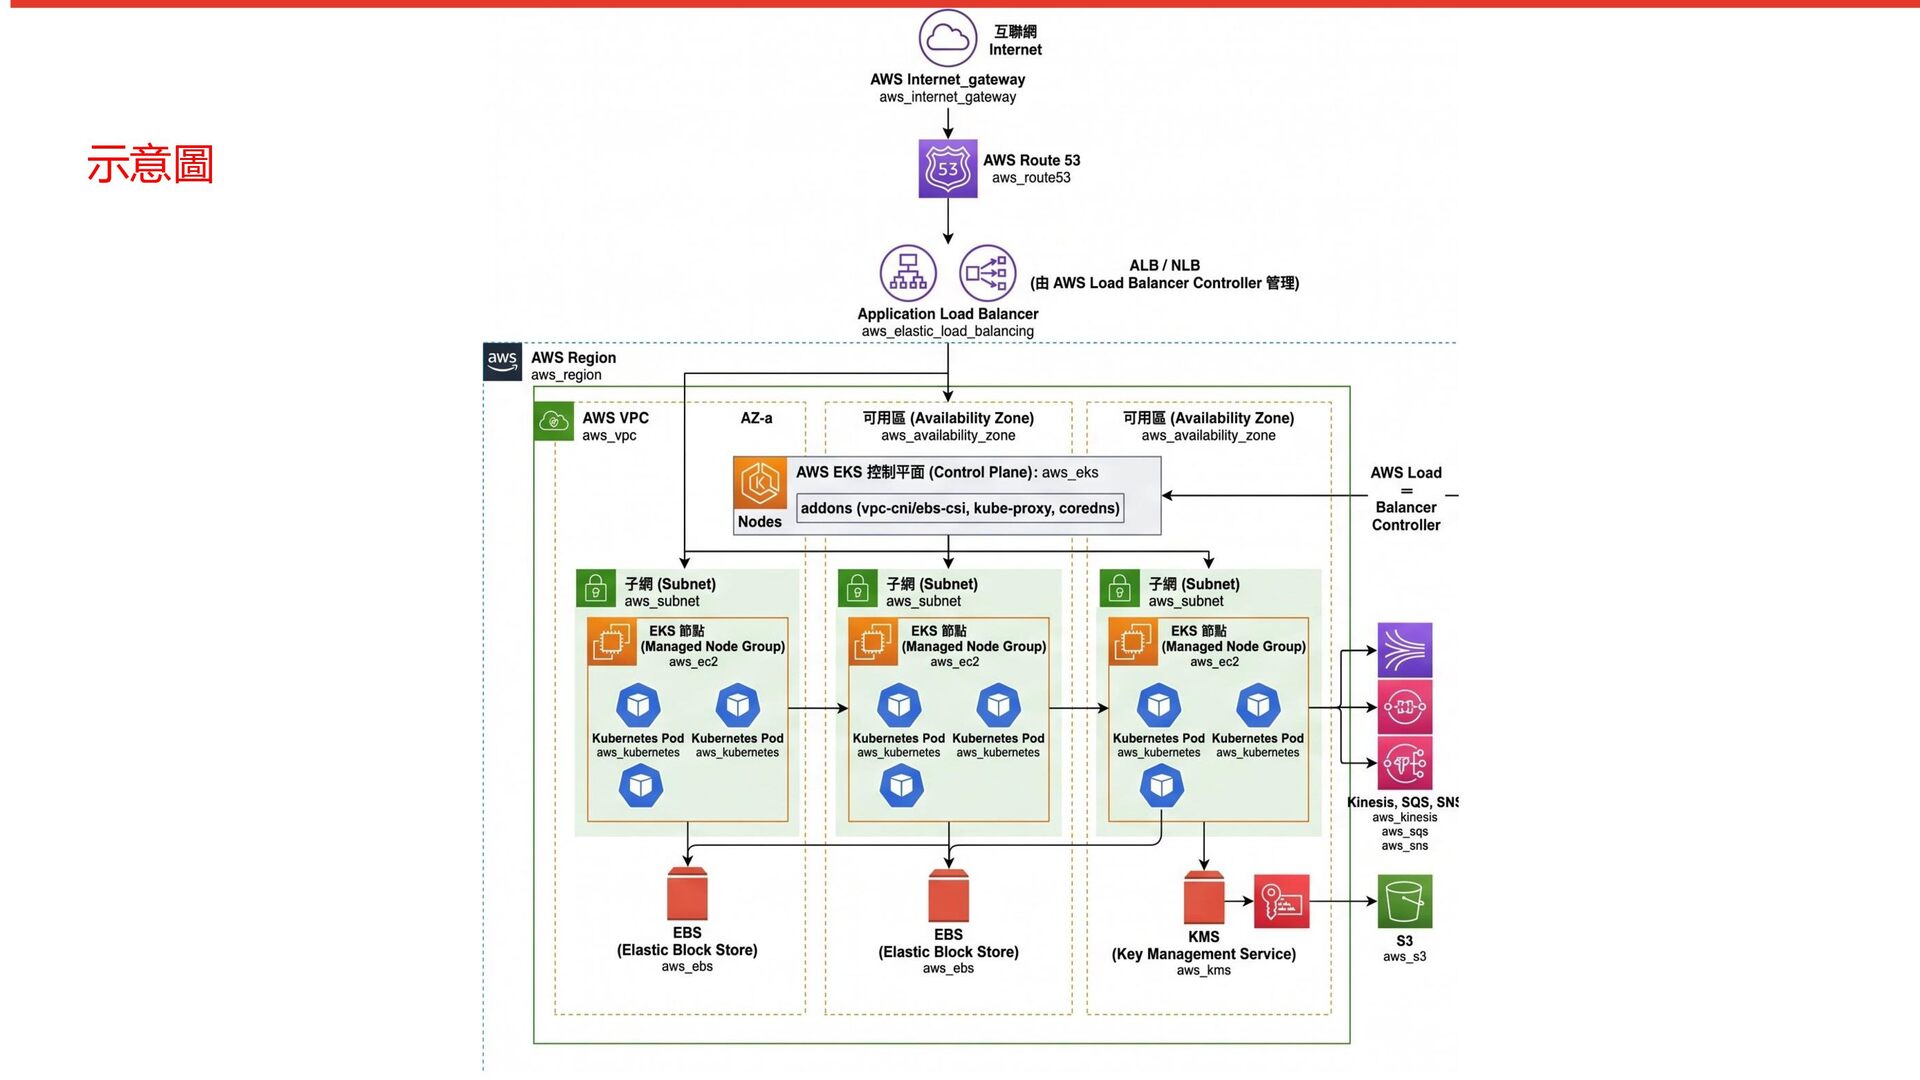
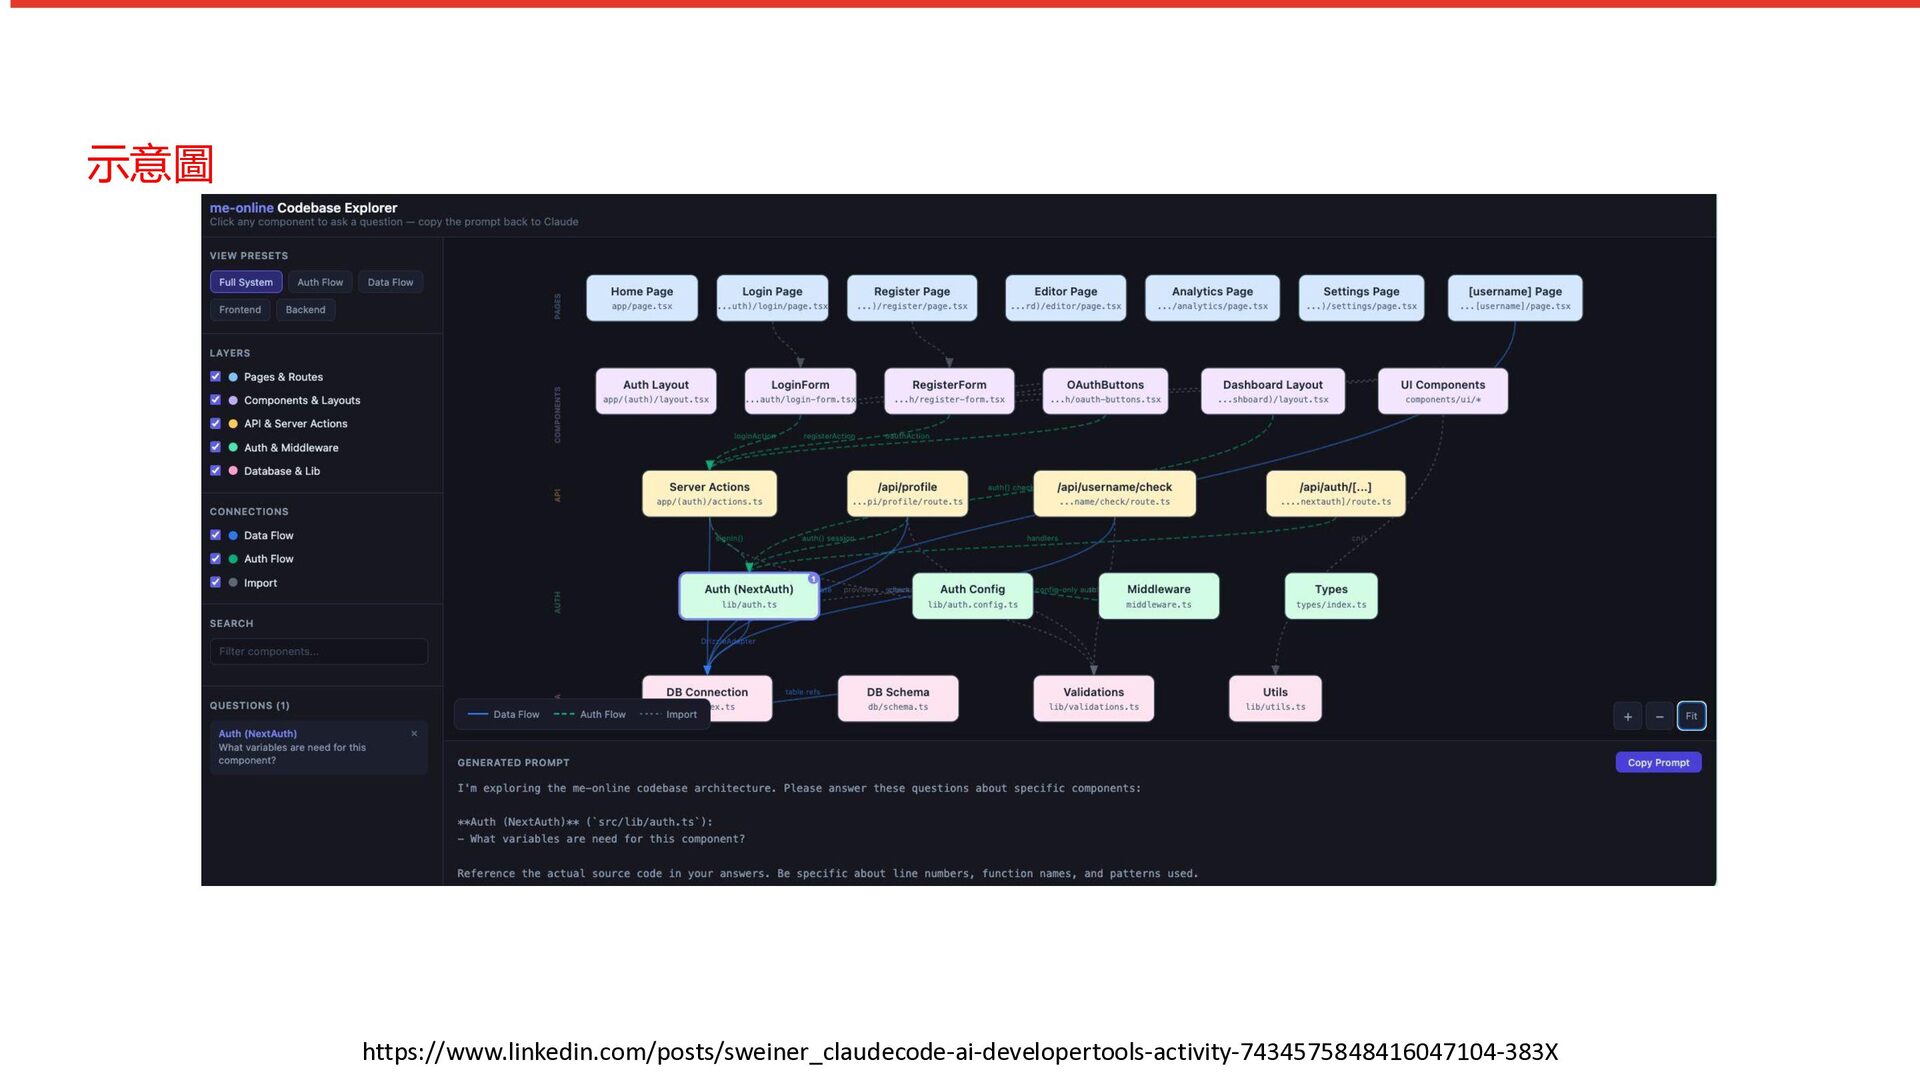
示意圖
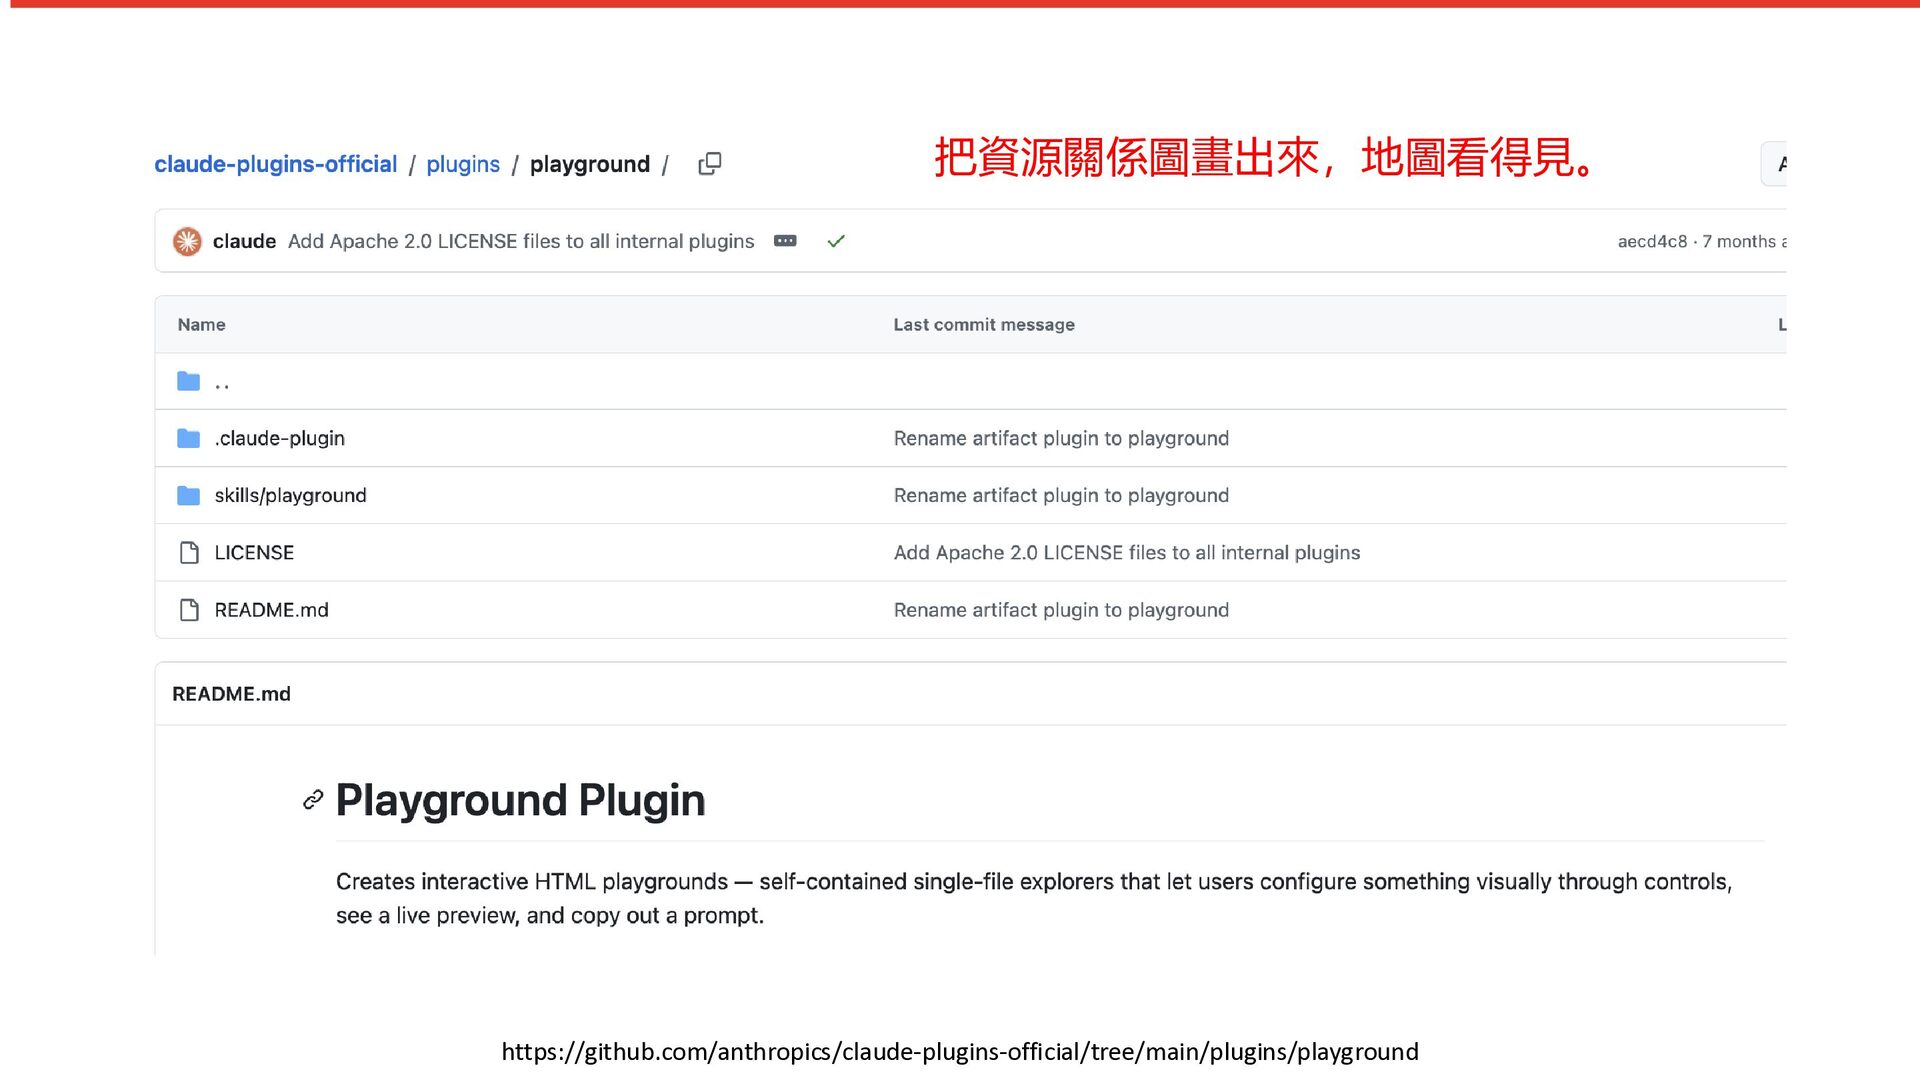
把資源關係圖畫出來,地圖看得見。 https://github.com/anthropics/claude-plugins-official/tree/main/plugins/playground
示意圖 https://www.linkedin.com/posts/sweiner_claudecode-ai-developertools-activity-7434575848416047104-383X
04 簡介 EKS 升級
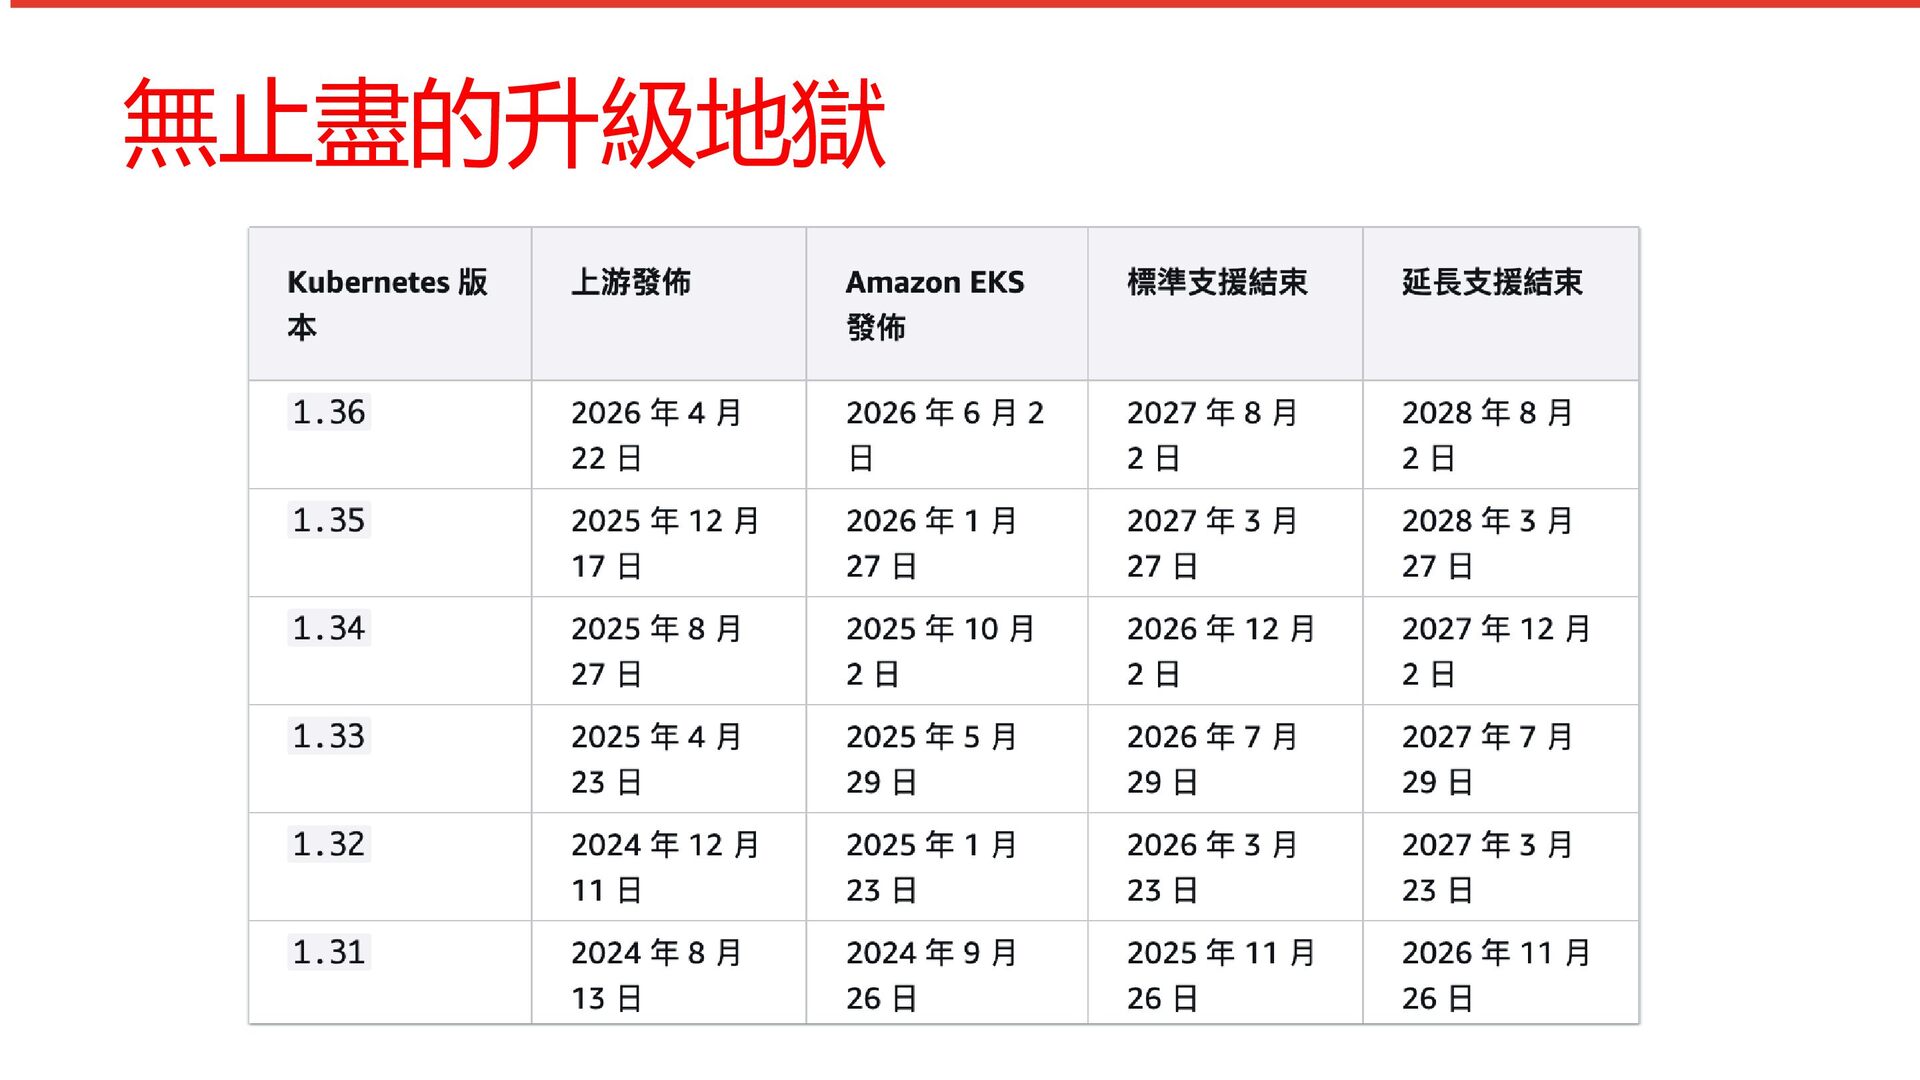
無止盡的升級地獄
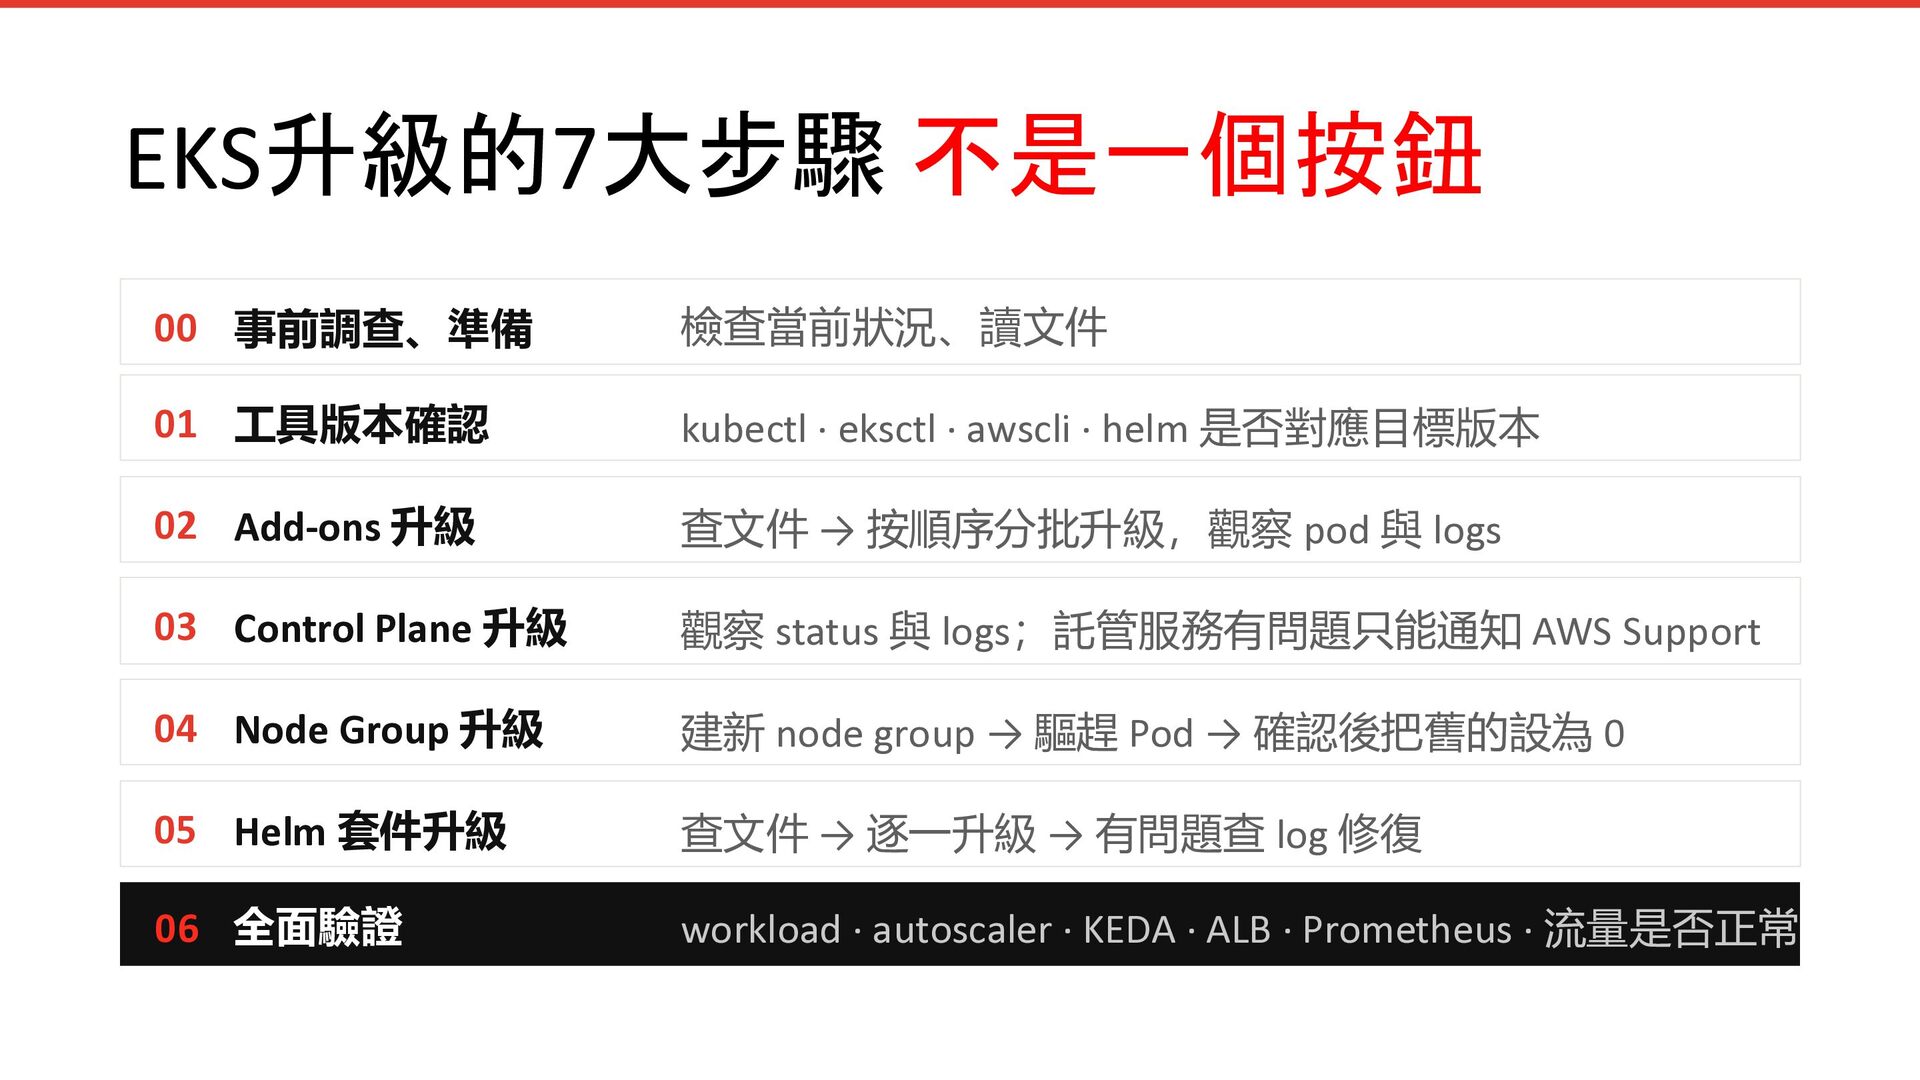
EKS升級的7大步驟 不是一個按鈕 00 事前調查、準備 檢查當前狀況、讀文件 01 工具版本確認 kubectl · eksctl
· awscli · helm 是否對應目標版本 02 Add-ons 升級 查文件 → 按順序分批升級,觀察 pod 與 logs 03 Control Plane 升級 觀察 status 與 logs;託管服務有問題只能通知 AWS Support 04 Node Group 升級 建新 node group → 驅趕 Pod → 確認後把舊的設為 0 05 Helm 套件升級 查文件 → 逐一升級 → 有問題查 log 修復 06 全面驗證 workload · autoscaler · KEDA · ALB · Prometheus · 流量是否正常
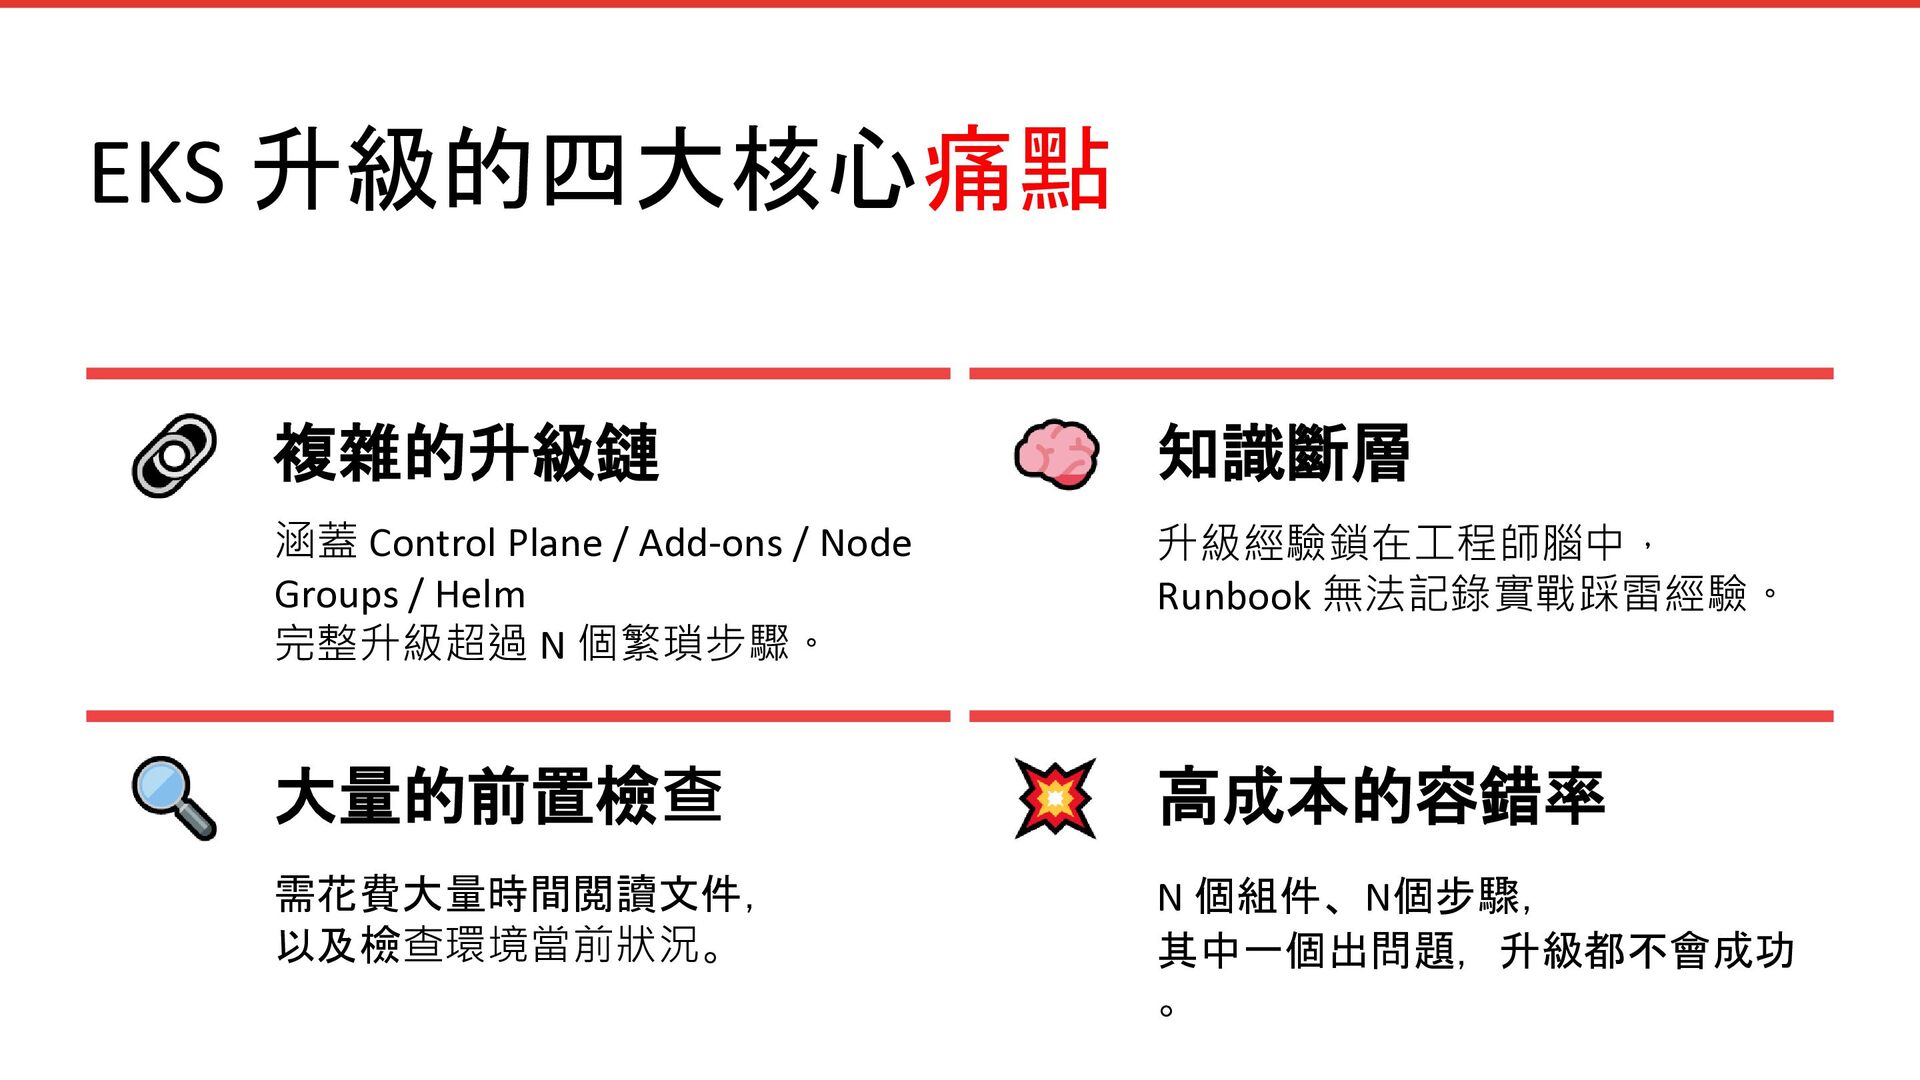
EKS 升級的四大核心痛點 複雜的升級鏈 知識斷層 涵蓋 Control Plane / Add-ons /
Node Groups / Helm 完整升級超過 N 個繁瑣步驟。 升級經驗鎖在工程師腦中, Runbook 無法記錄實戰踩雷經驗。 大量的前置檢查 高成本的容錯率 需花費大量時間閲讀文件, 以及檢查環境當前狀況。 N 個組件、N個步驟, 其中一個出問題,升級都不會成功 。
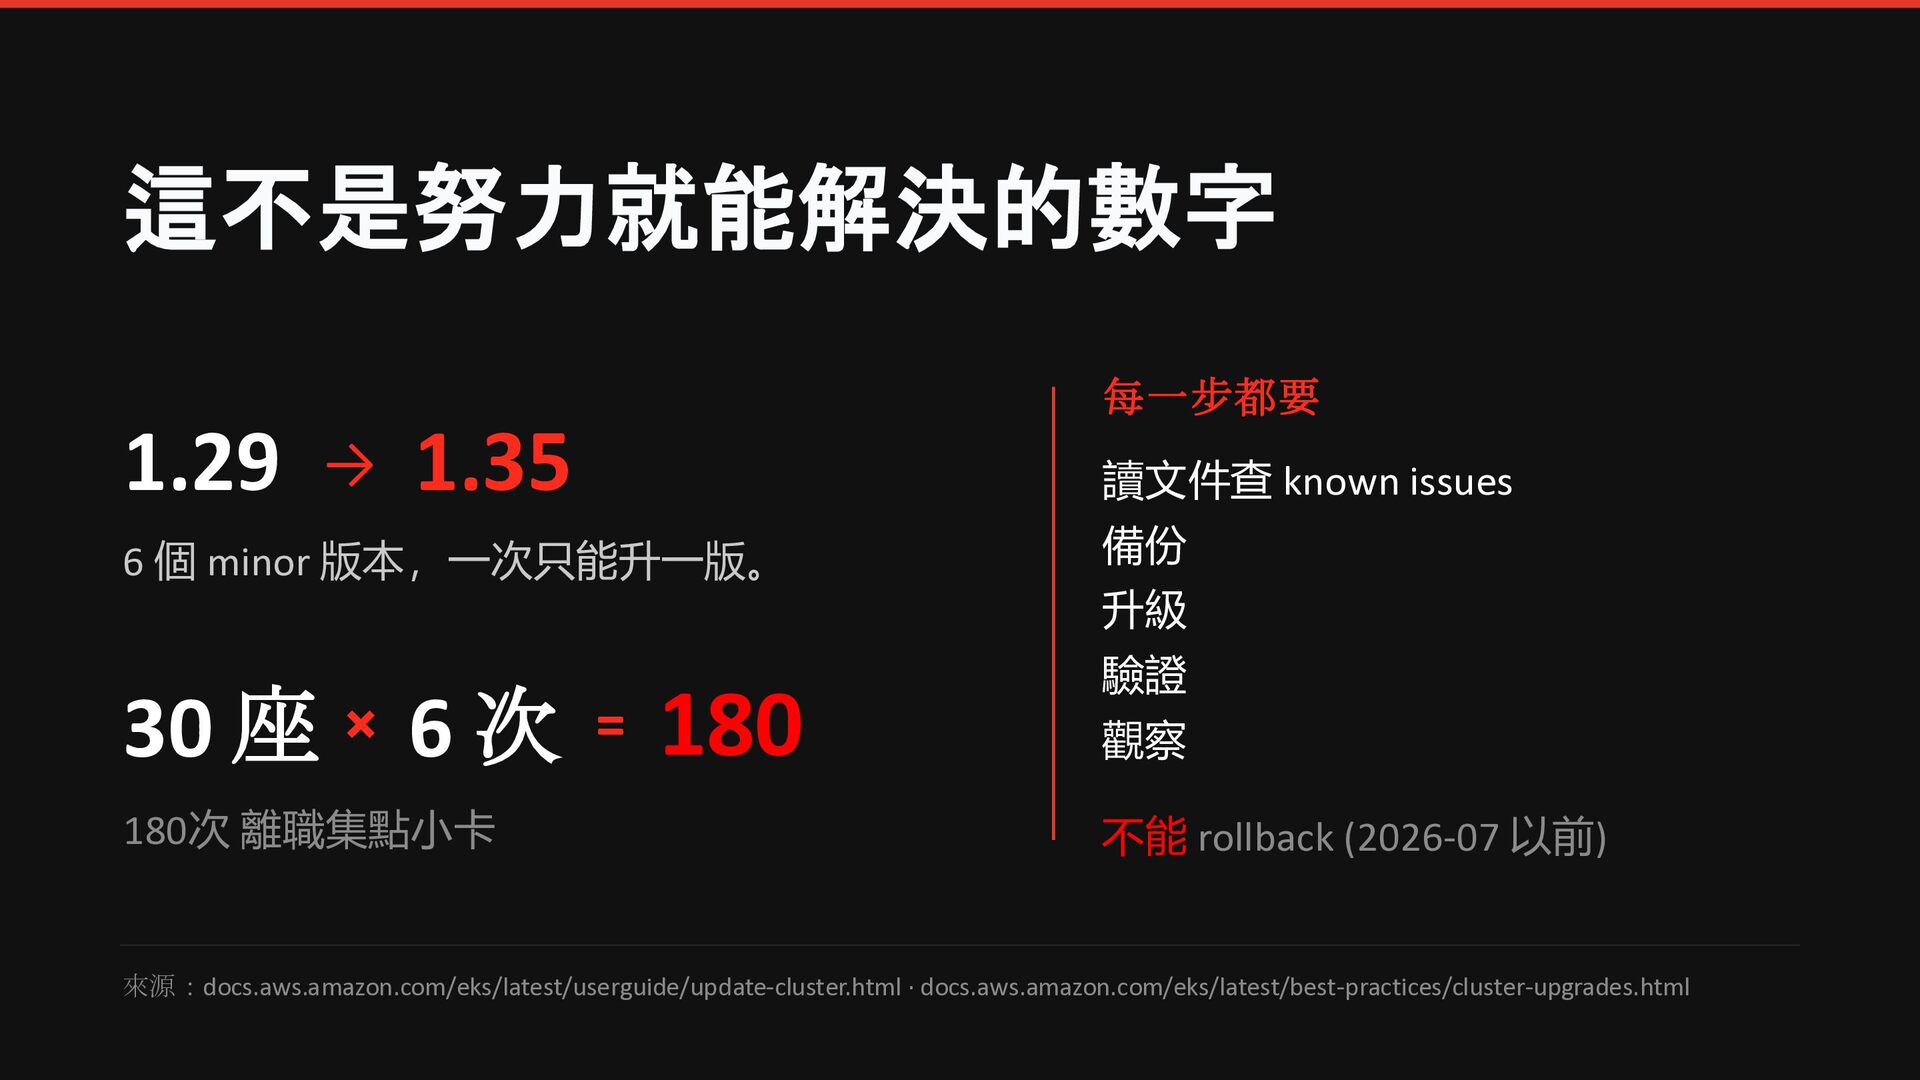
這不是努力就能解決的數字 每一步都要 1.29 → 1.35 讀文件查 known issues 6 個
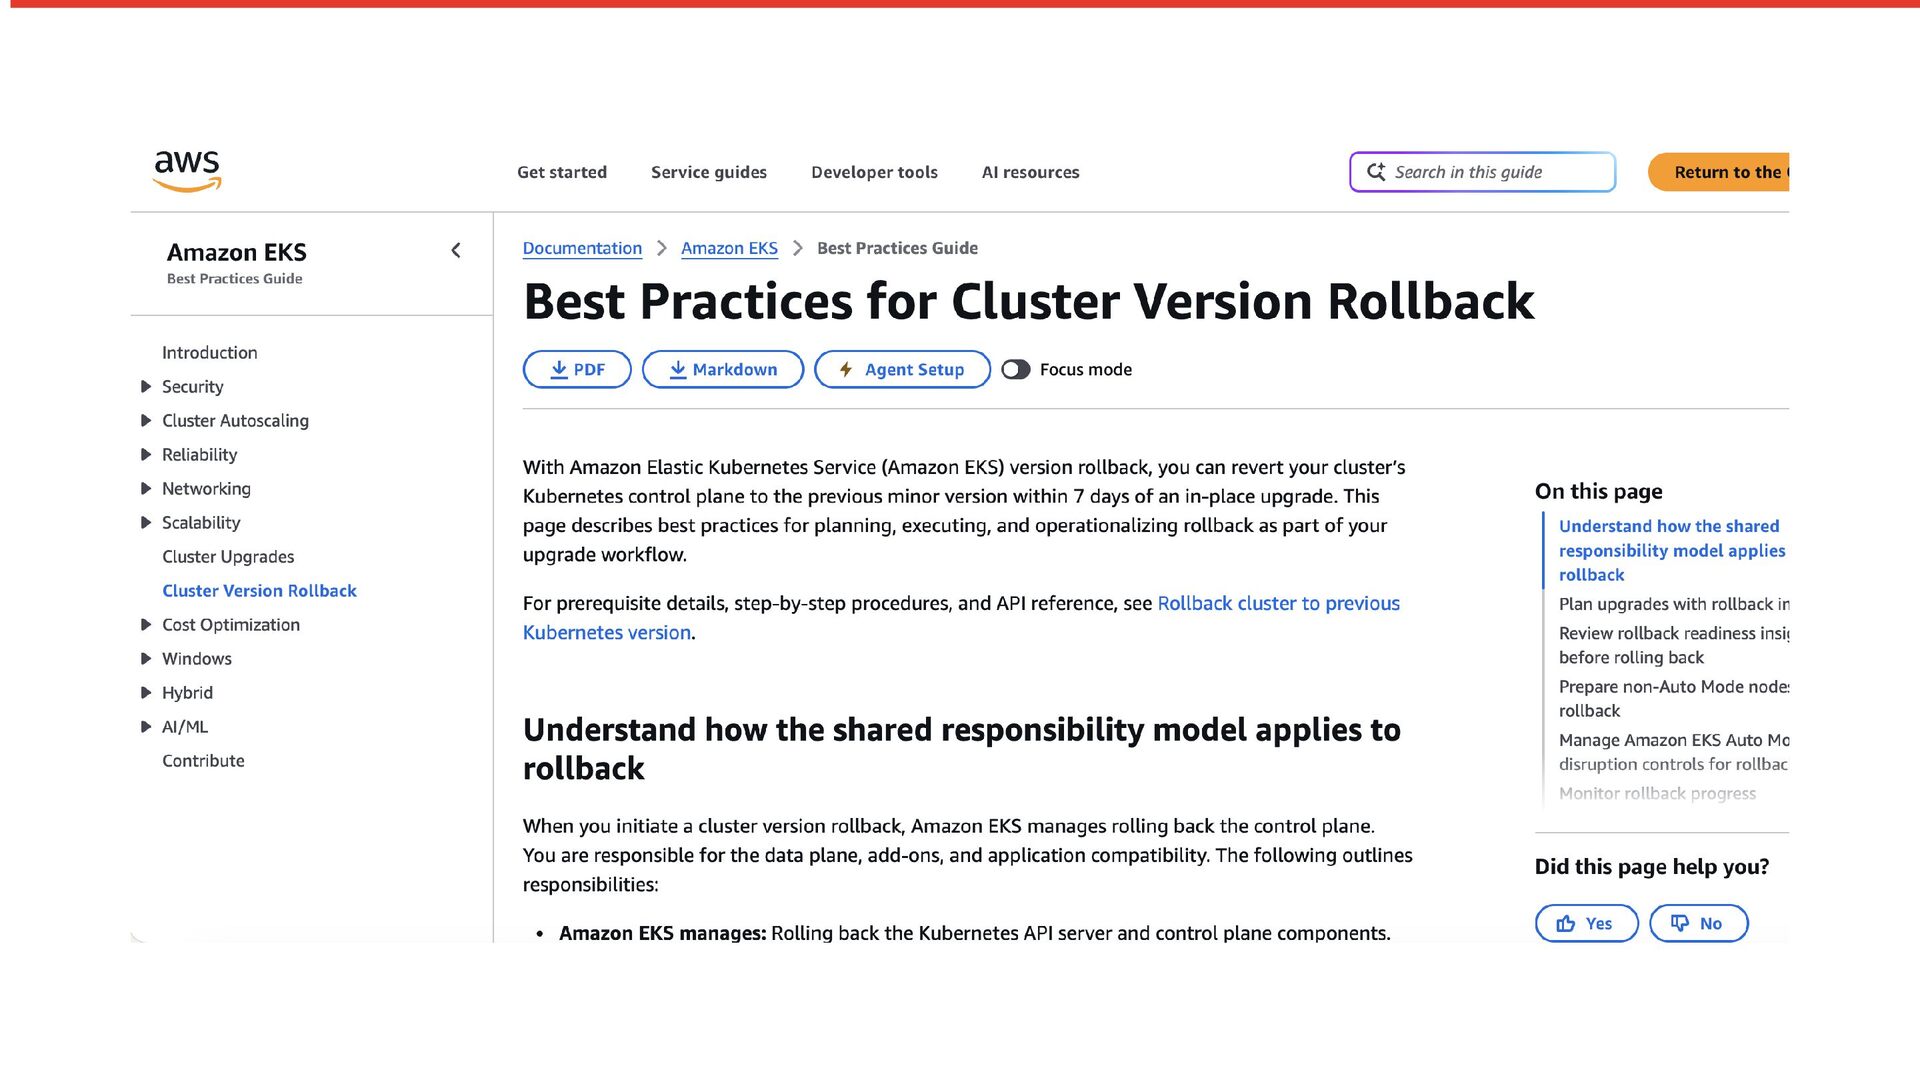
minor 版本,一次只能升一版。 備份 30 座 × 6 次 = 180 180次 離職集點小卡 升級 驗證 觀察 不能 rollback (2026-07 以前) 來源:docs.aws.amazon.com/eks/latest/userguide/update-cluster.html · docs.aws.amazon.com/eks/latest/best-practices/cluster-upgrades.html
None
None
雜.碎.煩
05 EKS Upgrade Skill 讓升級變成一場對話
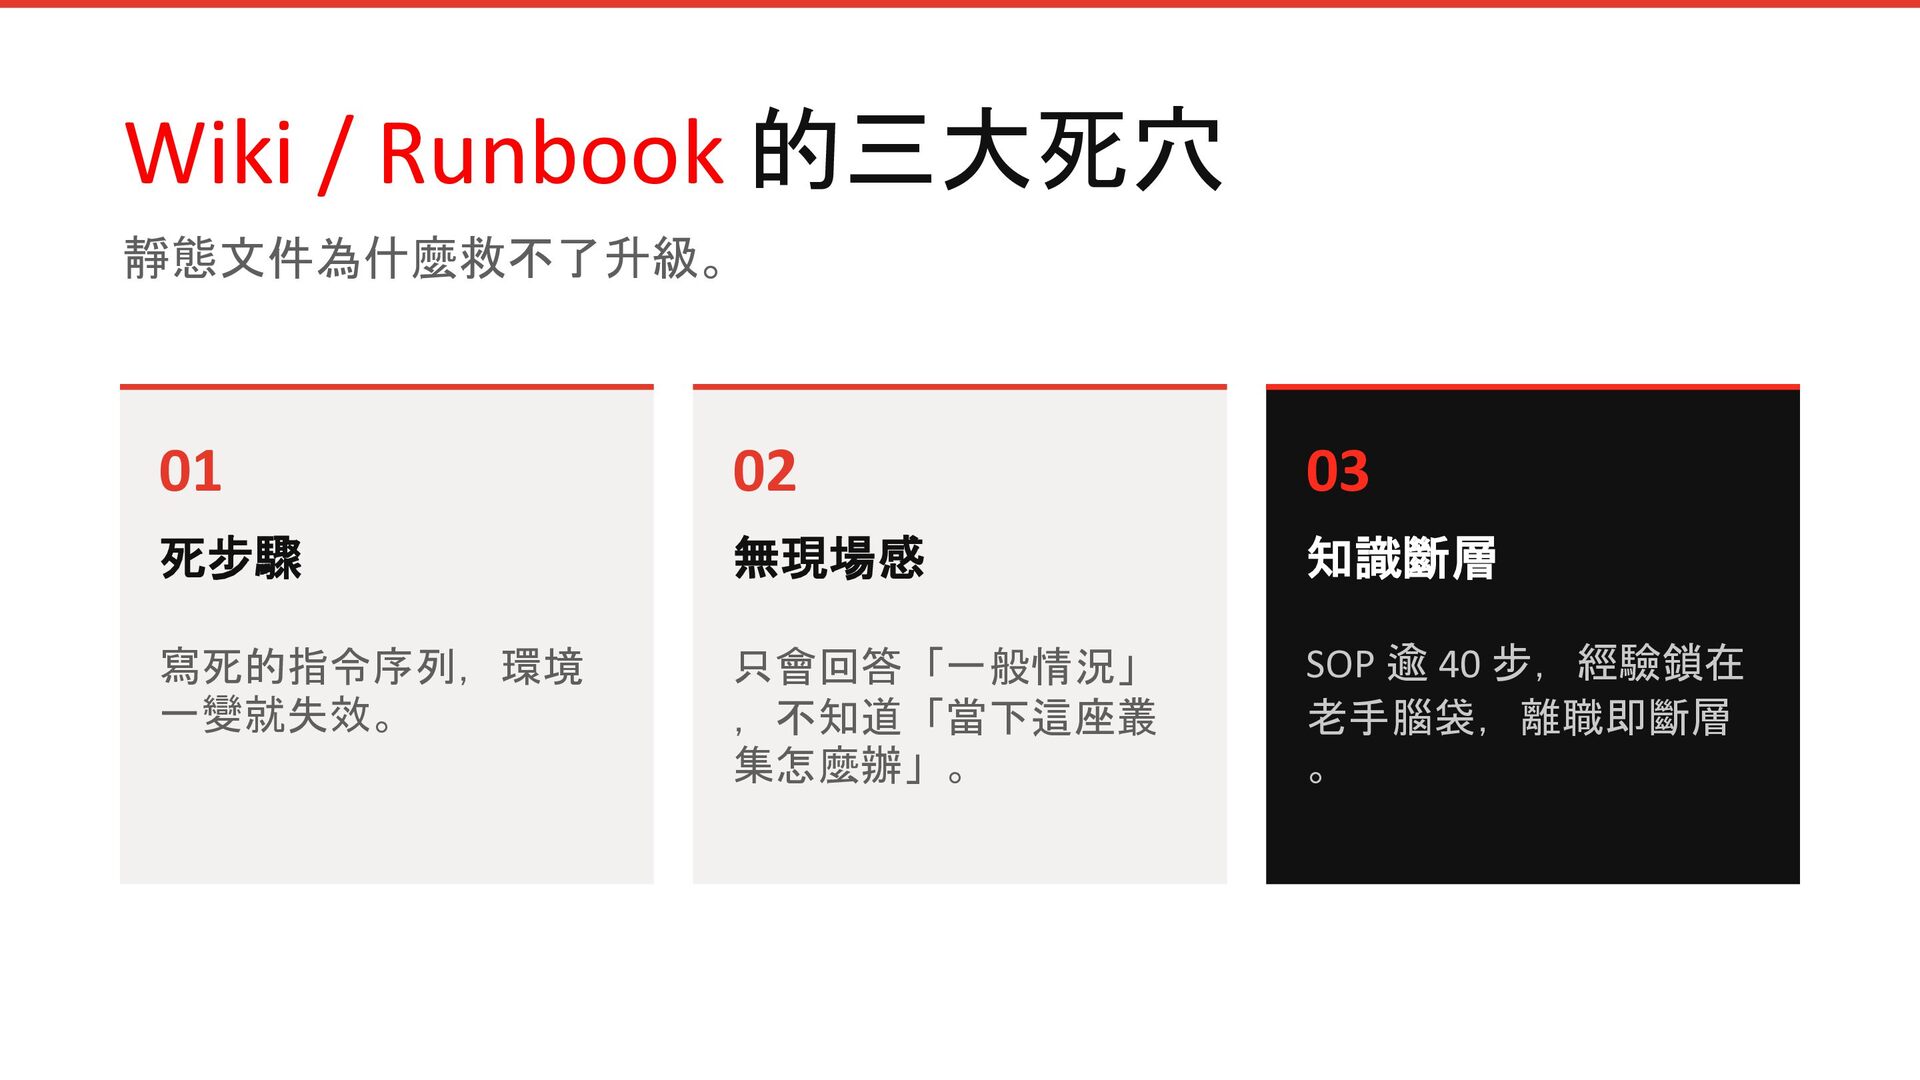
Wiki / Runbook 的三大死穴 靜態文件為什麼救不了升級。 01 02 03 死步驟 無現場感
知識斷層 寫死的指令序列,環境 一變就失效。 只會回答「一般情況」 ,不知道「當下這座叢 集怎麼辦」。 SOP 逾 40 步,經驗鎖在 老手腦袋,離職即斷層 。
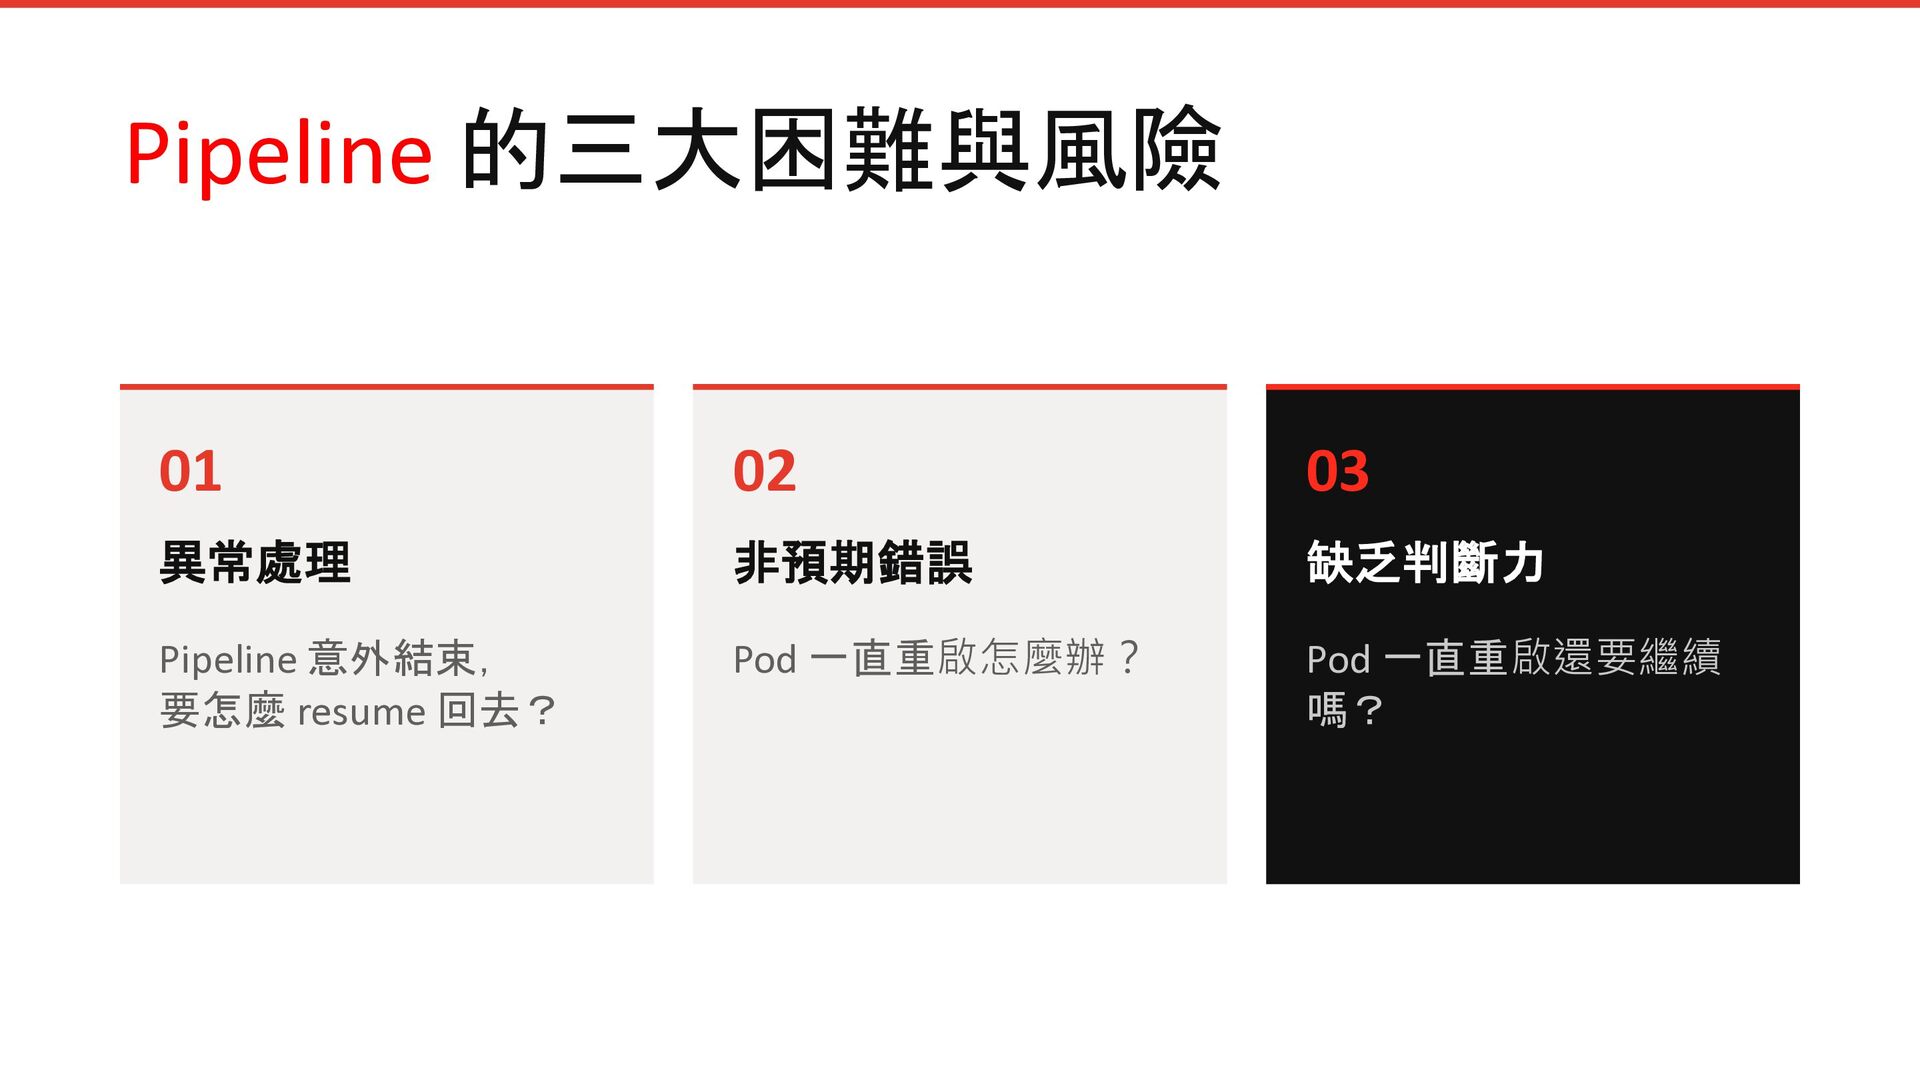
Pipeline 的三大困難與風險 01 02 03 異常處理 非預期錯誤 缺乏判斷力 Pipeline 意外結束,
要怎麼 resume 回去? Pod 一直重啟怎麼辦? Pod 一直重啟還要繼續 嗎?
升級不是按鈕, 而是一場對話。
None
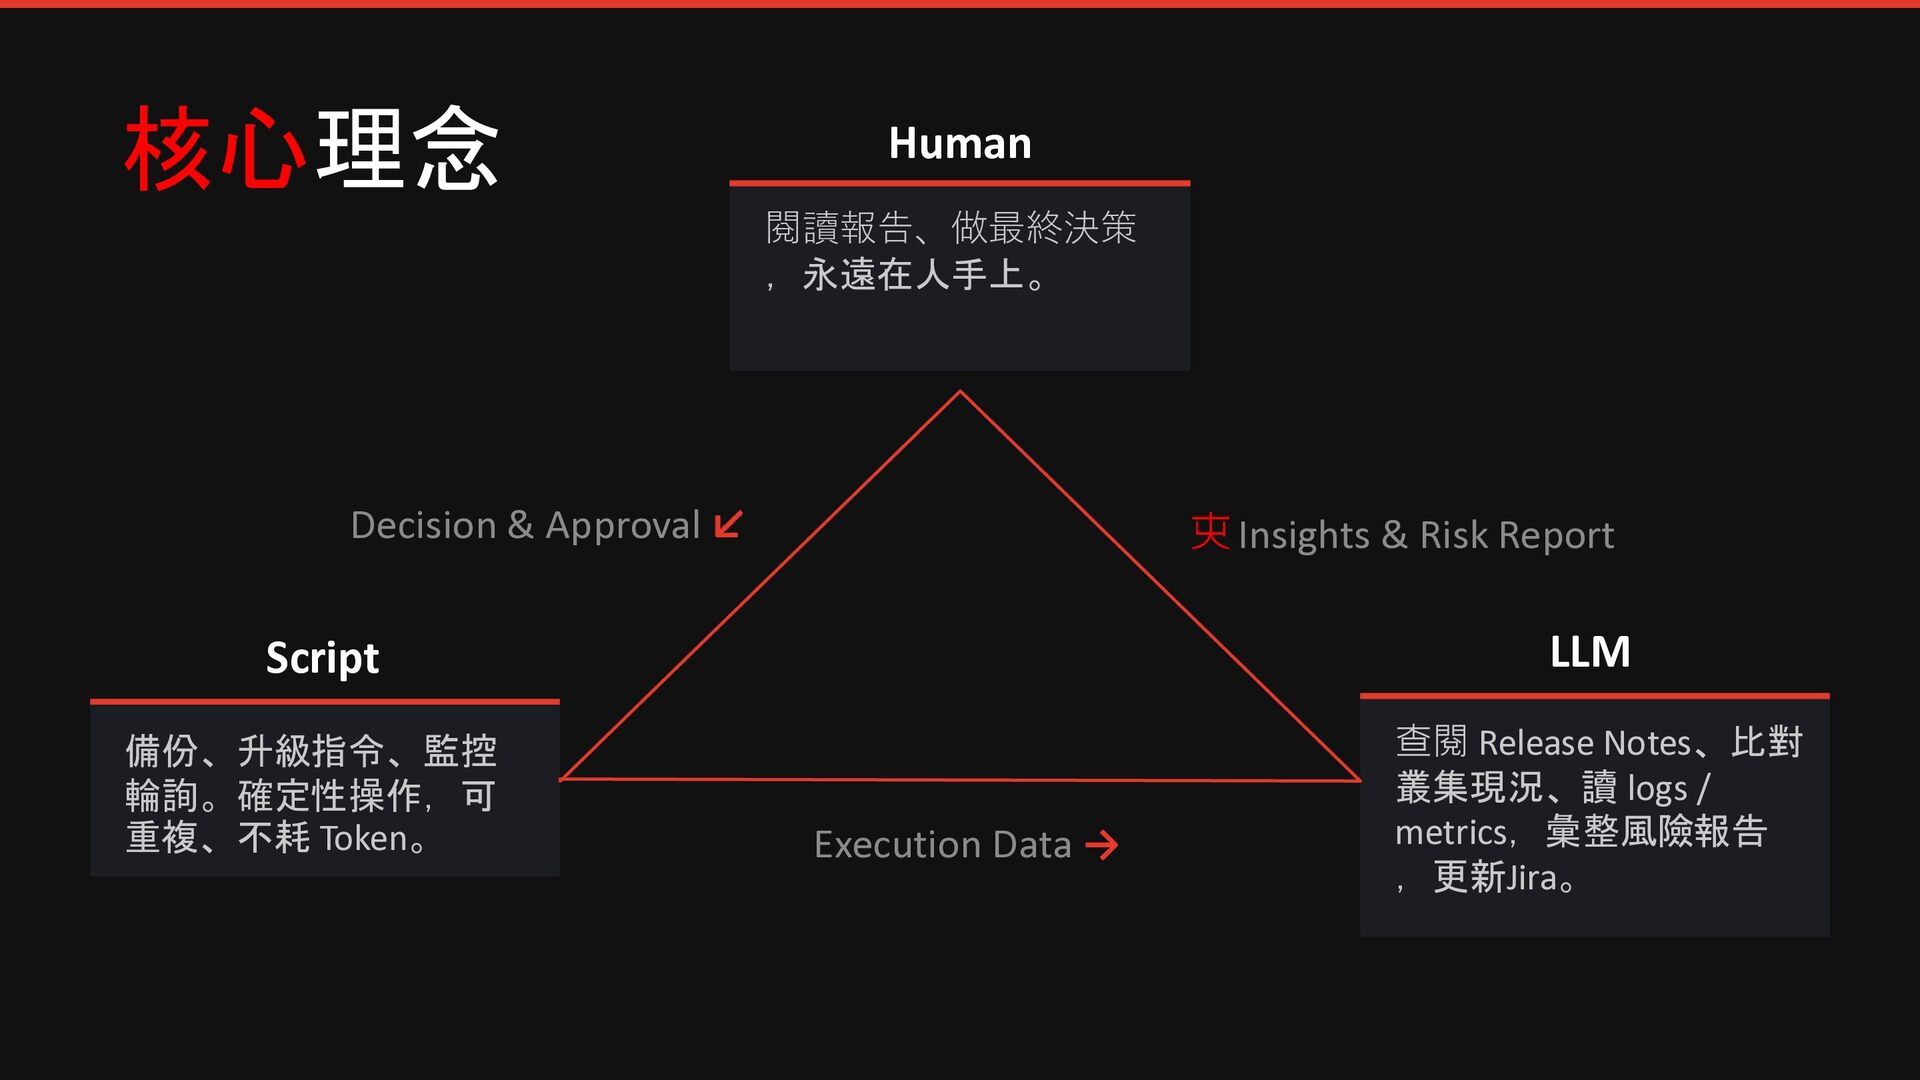
核心理念 Human 閱讀報告、做最終決策 ,永遠在人手上。 Decision & Approval Insights & Risk
Report Script LLM 備份、升級指令、監控 輪詢。確定性操作,可 重複、不耗 Token。 查閱 Release Notes、比對 叢集現況、讀 logs / metrics,彙整風險報告 ,更新Jira。 Execution Data →
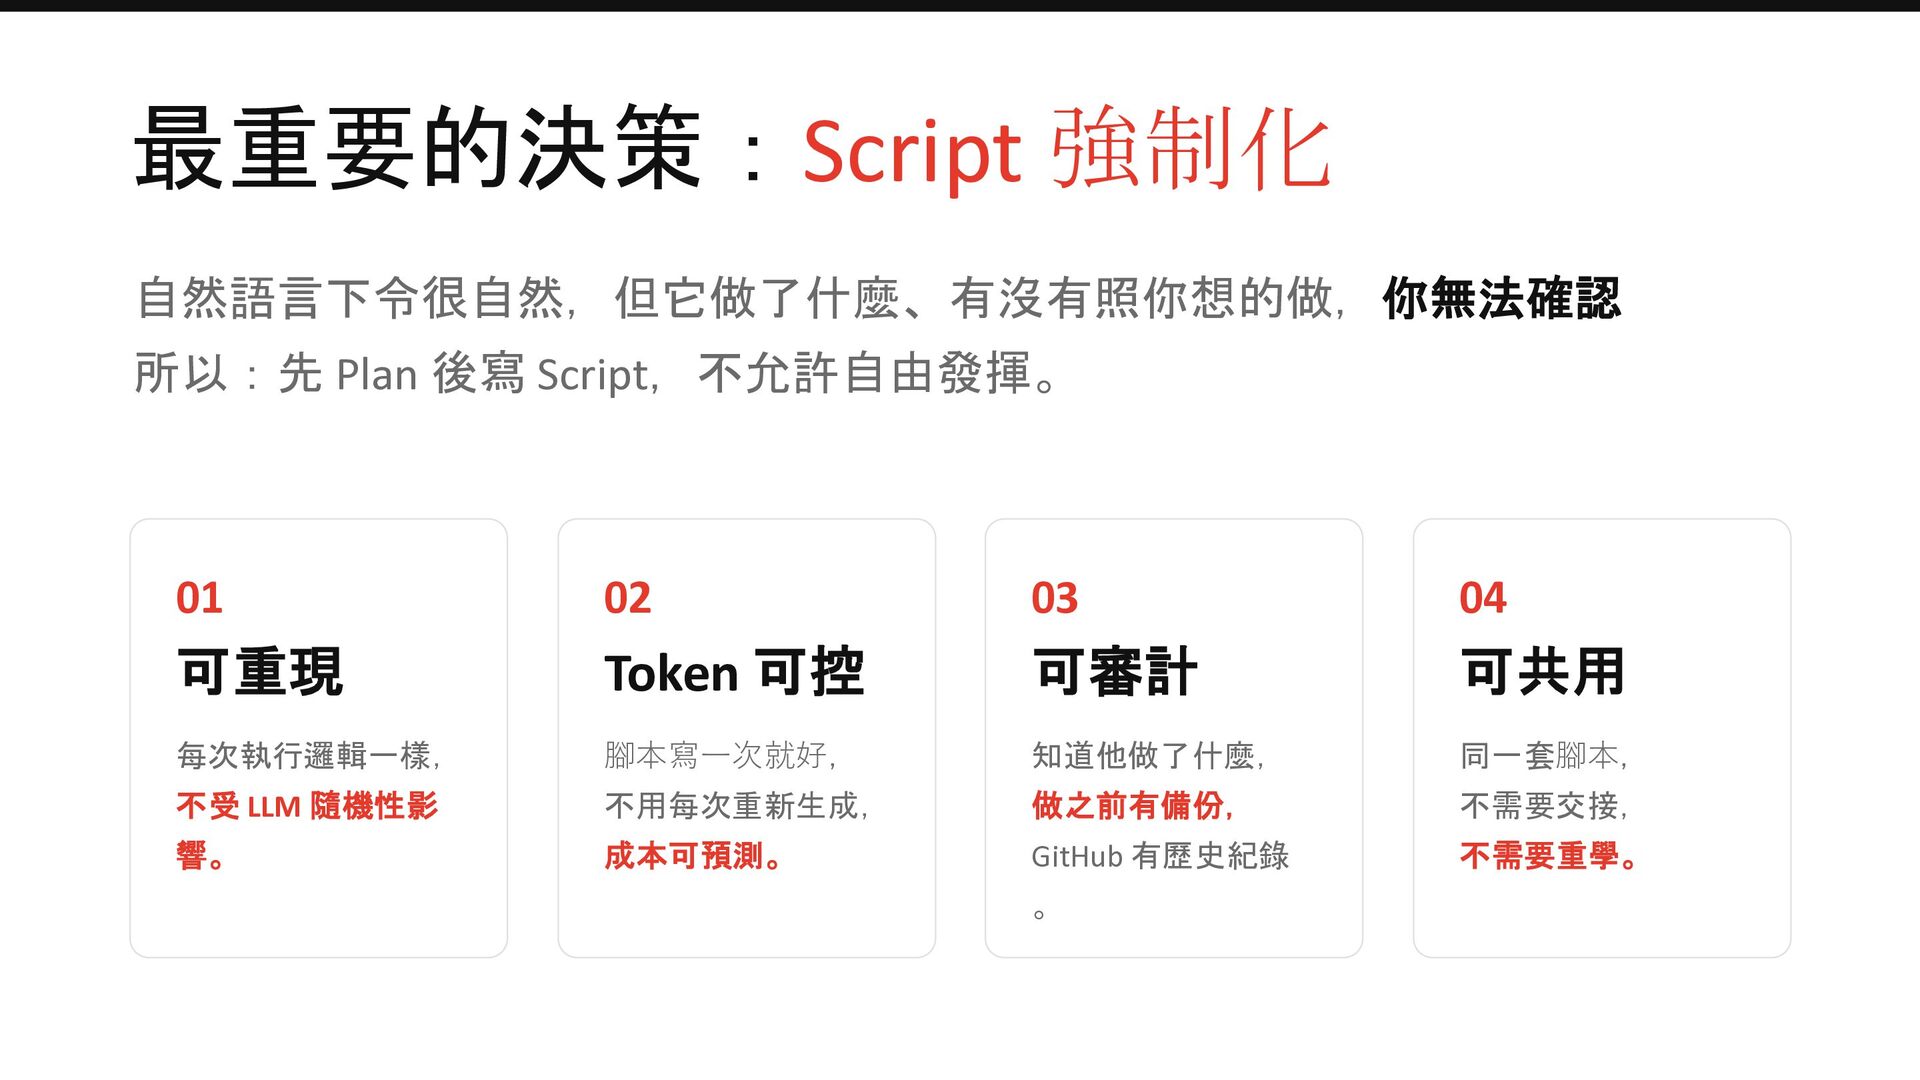
最重要的決策:Script 強制化 自然語言下令很自然,但它做了什麼、有沒有照你想的做,你無法確認 所以:先 Plan 後寫 Script,不允許自由發揮。 01 02 03
04 可重現 Token 可控 可審計 可共用 每次執行邏輯一樣, 腳本寫一次就好, 知道他做了什麼, 同一套腳本, 不受 LLM 隨機性影 不用每次重新生成, 做之前有備份, 不需要交接, 響。 成本可預測。 GitHub 有歷史紀錄 不需要重學。 。
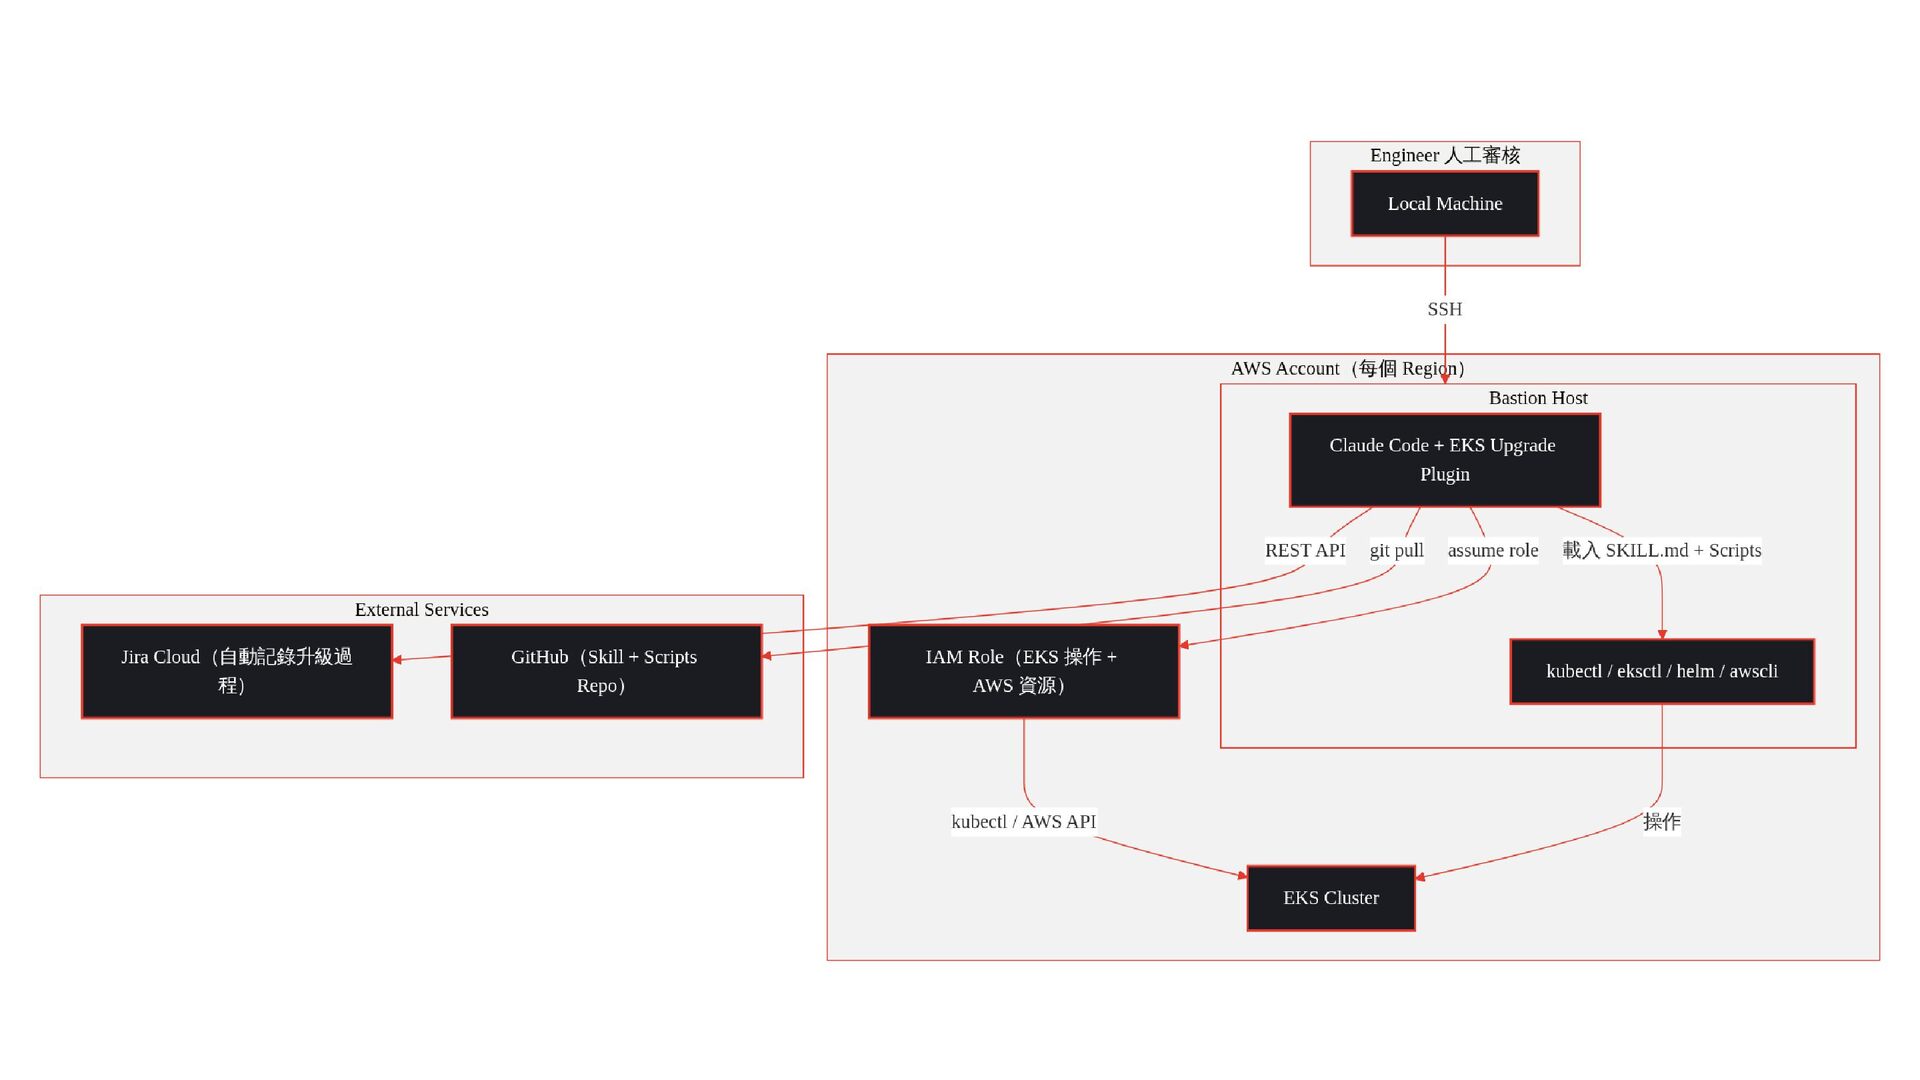
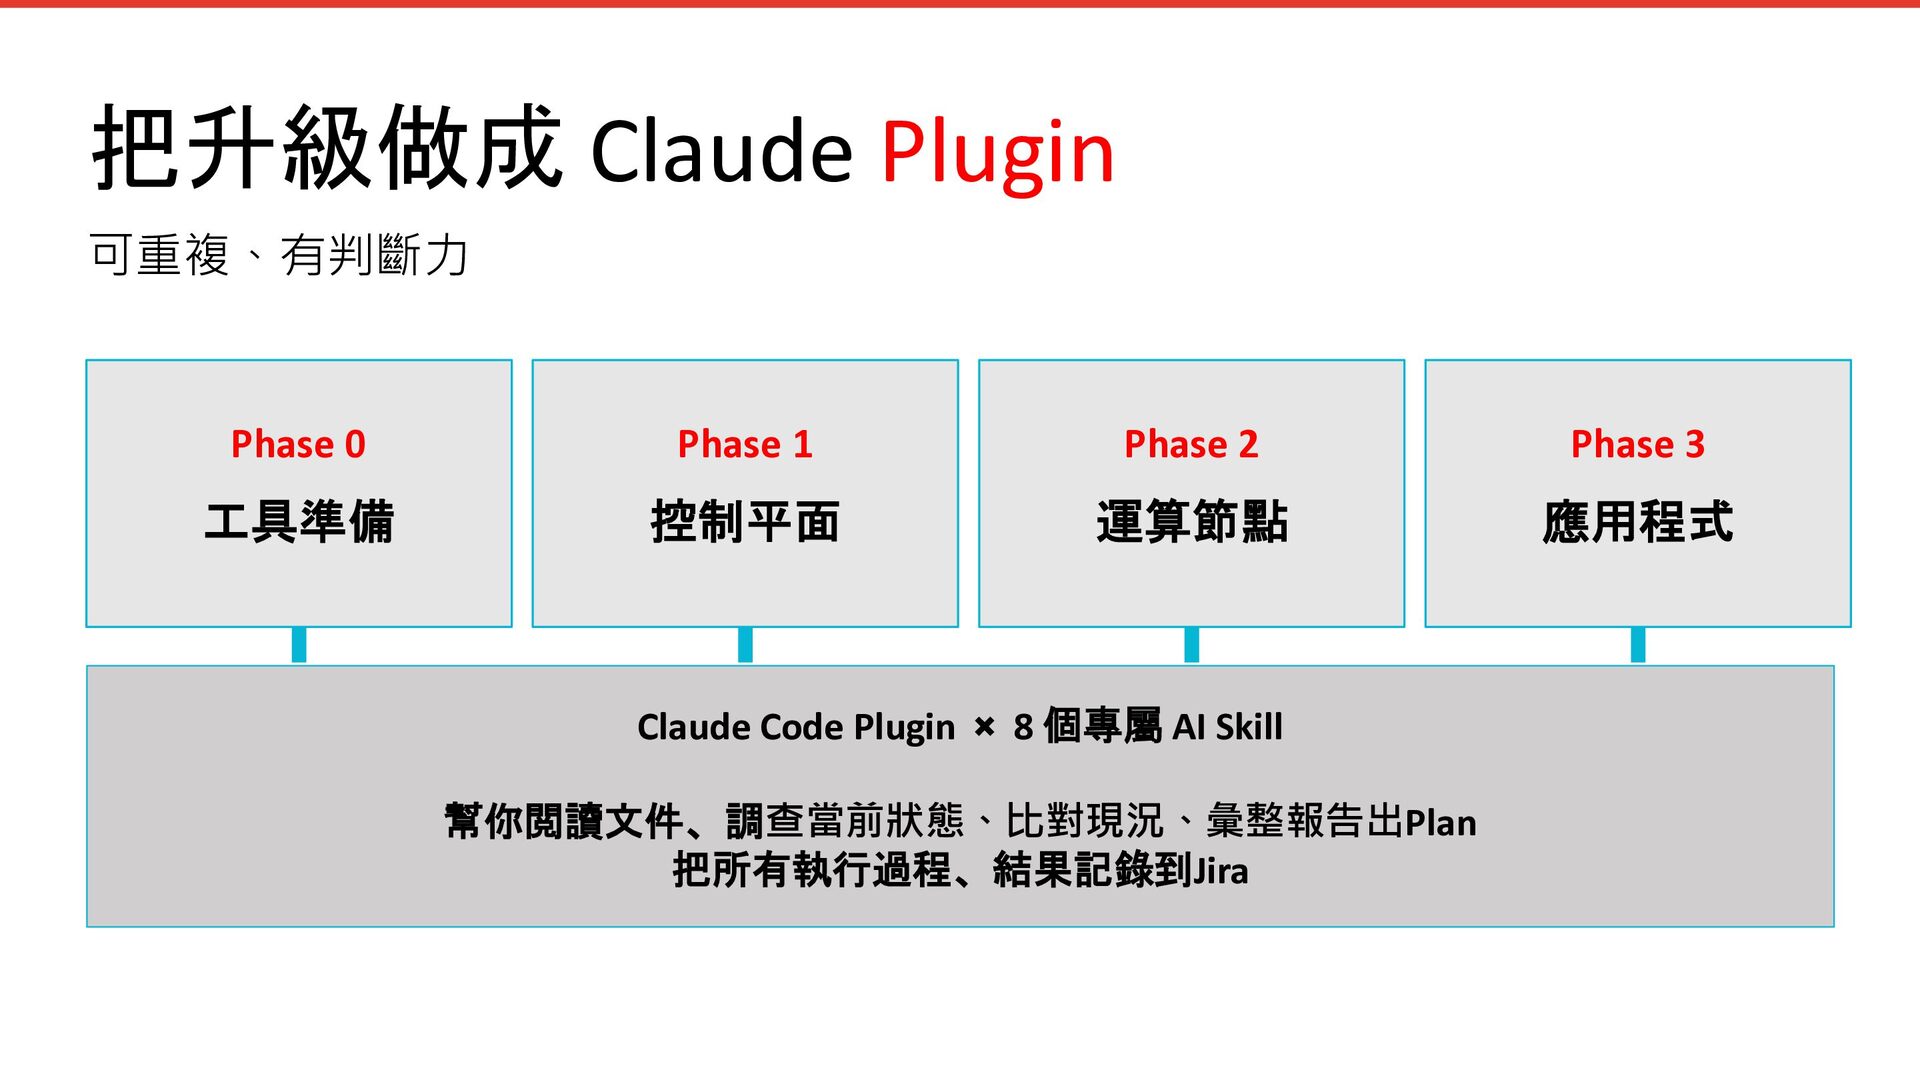
把升級做成 Claude Plugin 可重複、有判斷力 Phase 0 Phase 1 Phase 2
Phase 3 工具準備 控制平面 運算節點 應用程式 Claude Code Plugin × 8 個專屬 AI Skill 幫你閲讀文件、調查當前狀態、比對現況、彙整報告出Plan 把所有執行過程、結果記錄到Jira
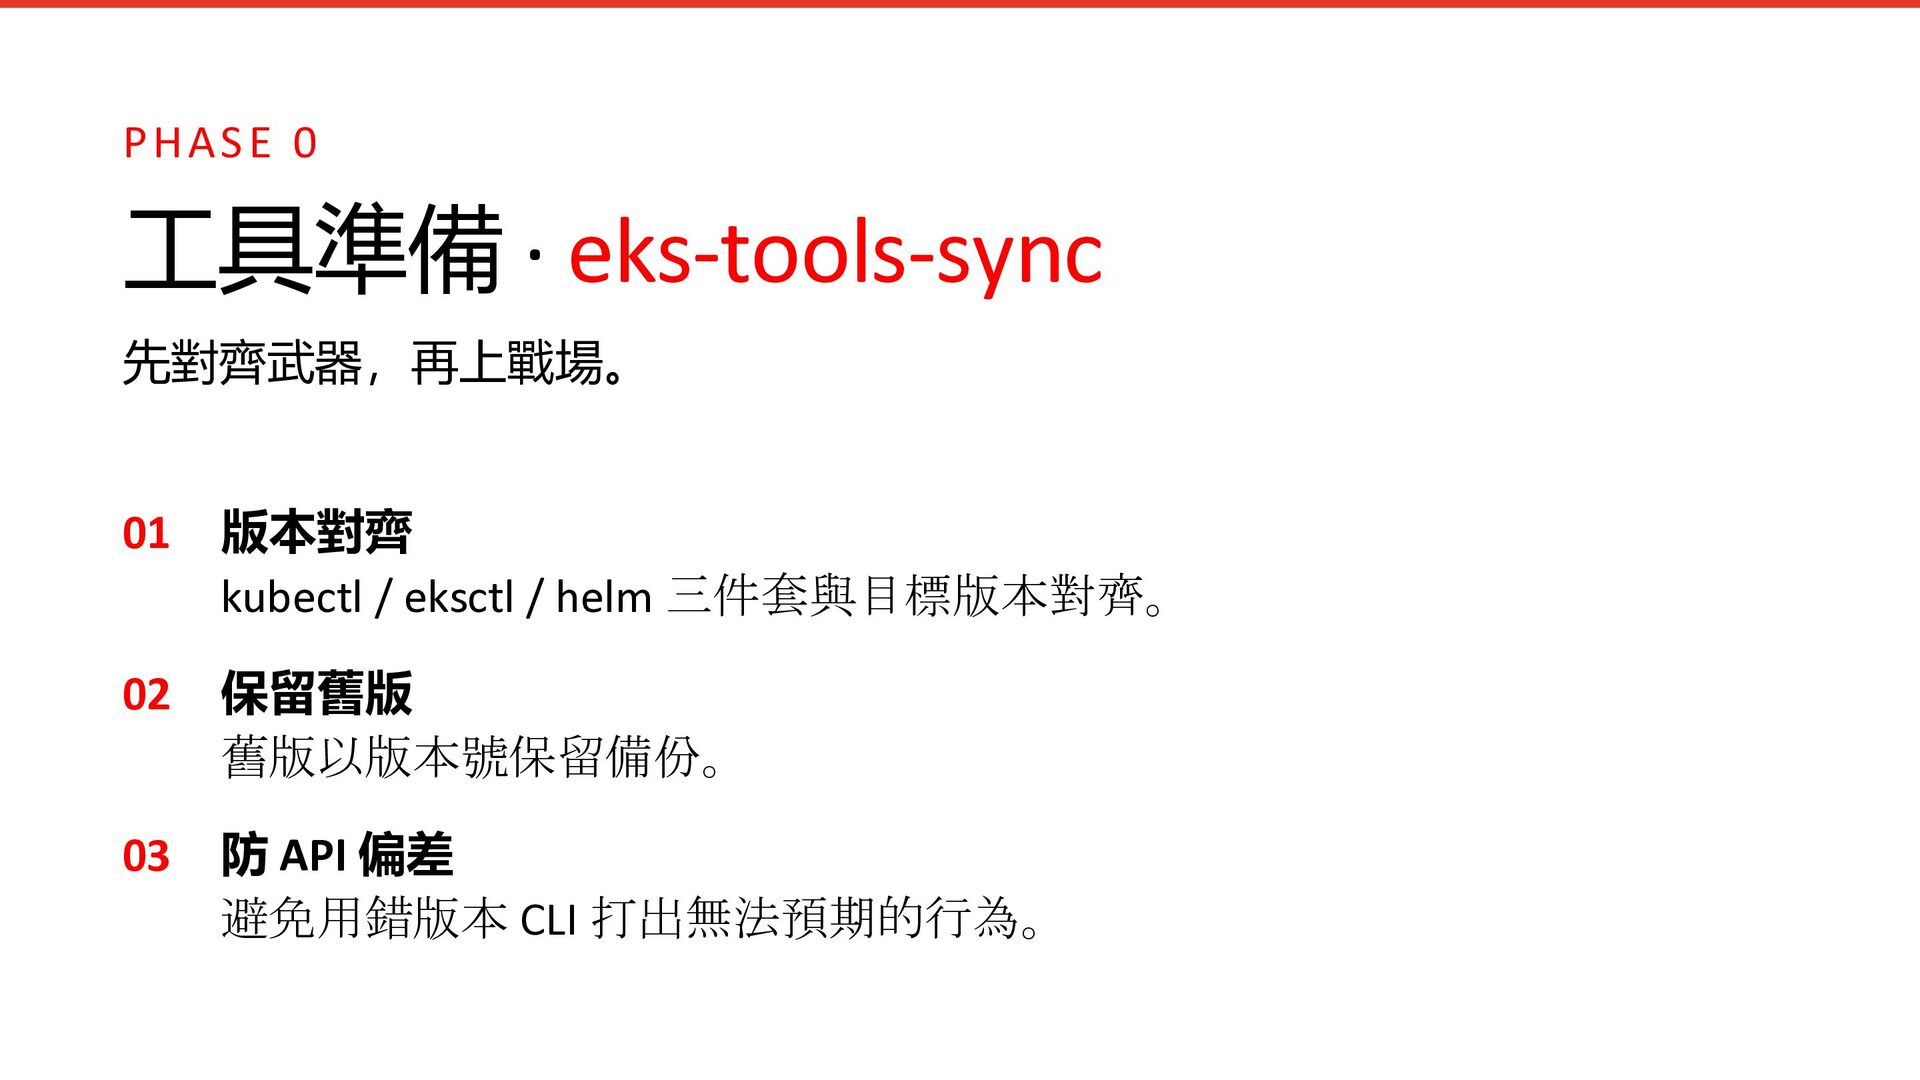
P H AS E 0 工具準備 · eks-tools-sync 先對齊武器,再上戰場。 01
版本對齊 kubectl / eksctl / helm 三件套與目標版本對齊。 02 保留舊版 舊版以版本號保留備份。 03 防 API 偏差 避免用錯版本 CLI 打出無法預期的行為。
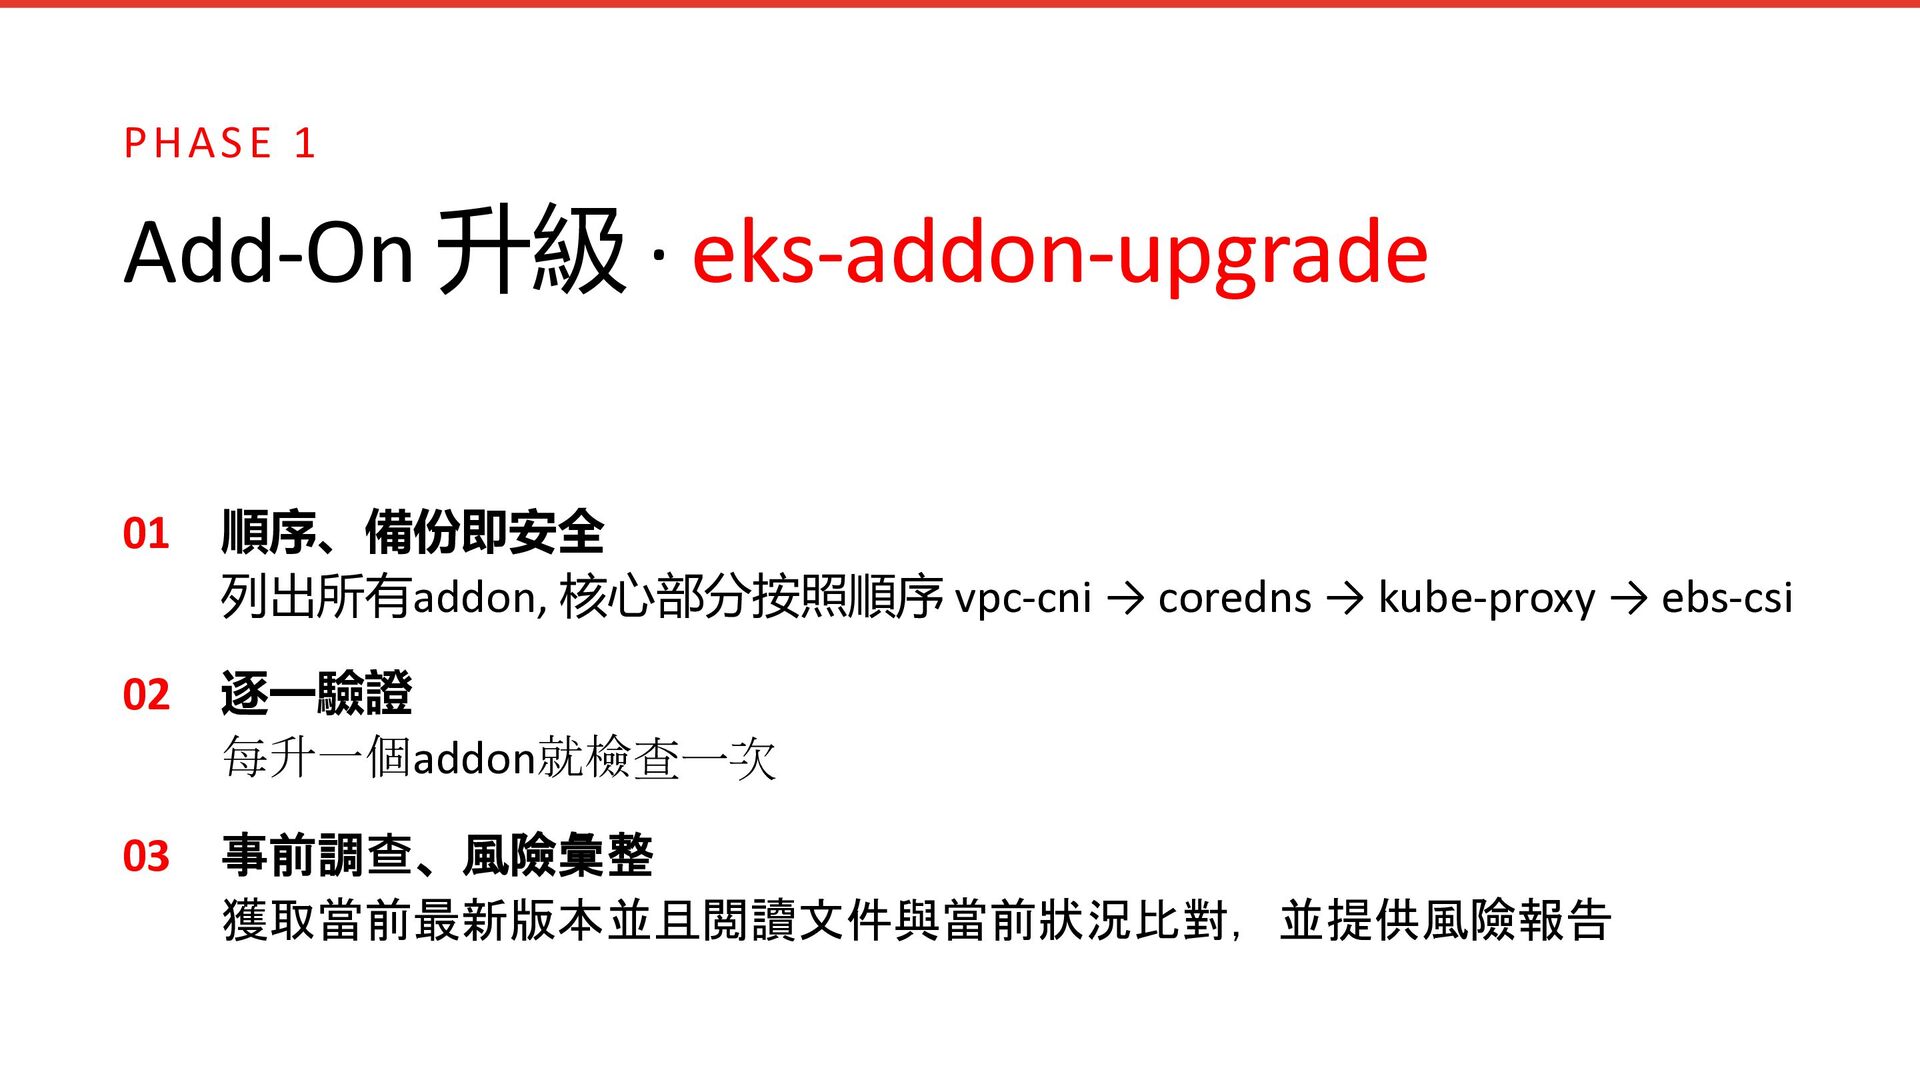
P H AS E 1 Add-On 升級 · eks-addon-upgrade 01
順序、備份即安全 列出所有addon, 核心部分按照順序 vpc-cni → coredns → kube-proxy → ebs-csi 02 逐一驗證 每升一個addon就檢查一次 03 事前調查、風險彙整 獲取當前最新版本並且閲讀文件與當前狀況比對,並提供風險報告
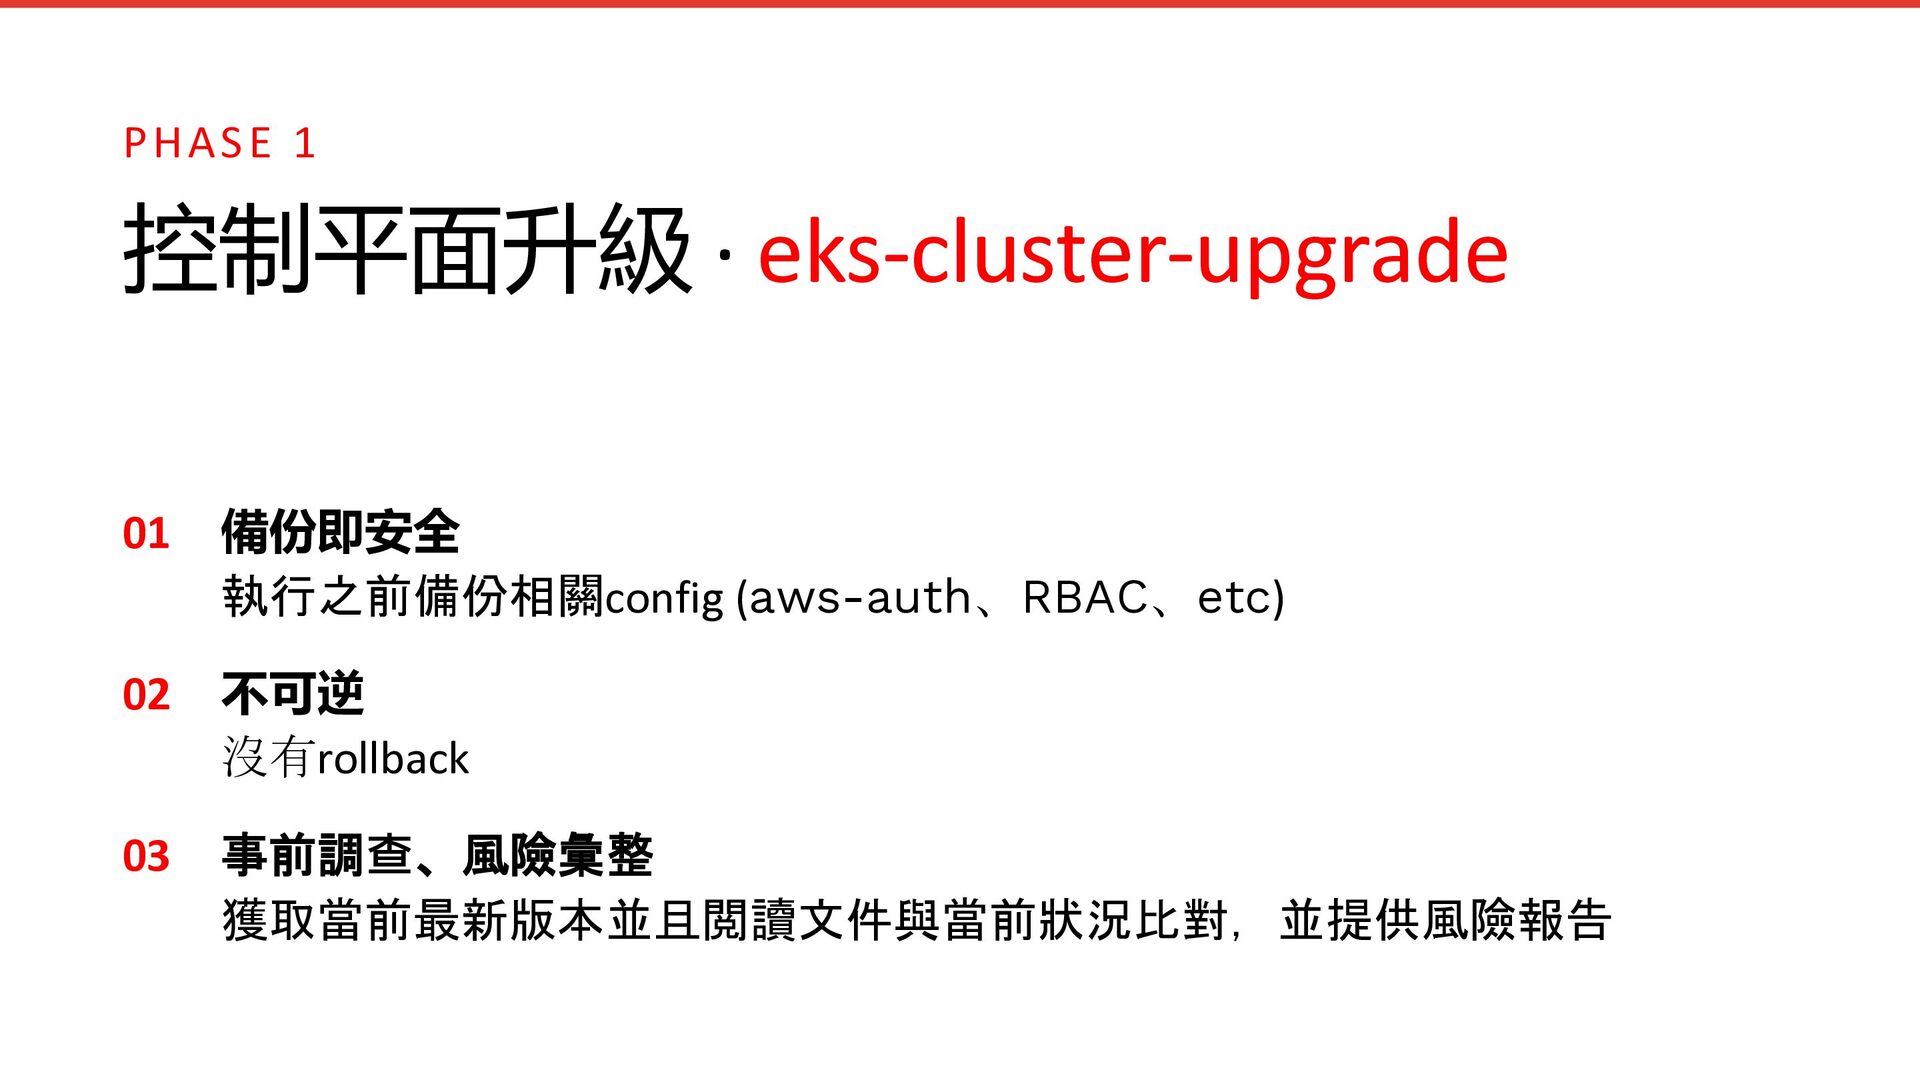
P H AS E 1 控制平面升級 · eks-cluster-upgrade 01 備份即安全
執行之前備份相關config (aws-auth、RBAC、etc) 02 不可逆 沒有rollback 03 事前調查、風險彙整 獲取當前最新版本並且閲讀文件與當前狀況比對,並提供風險報告
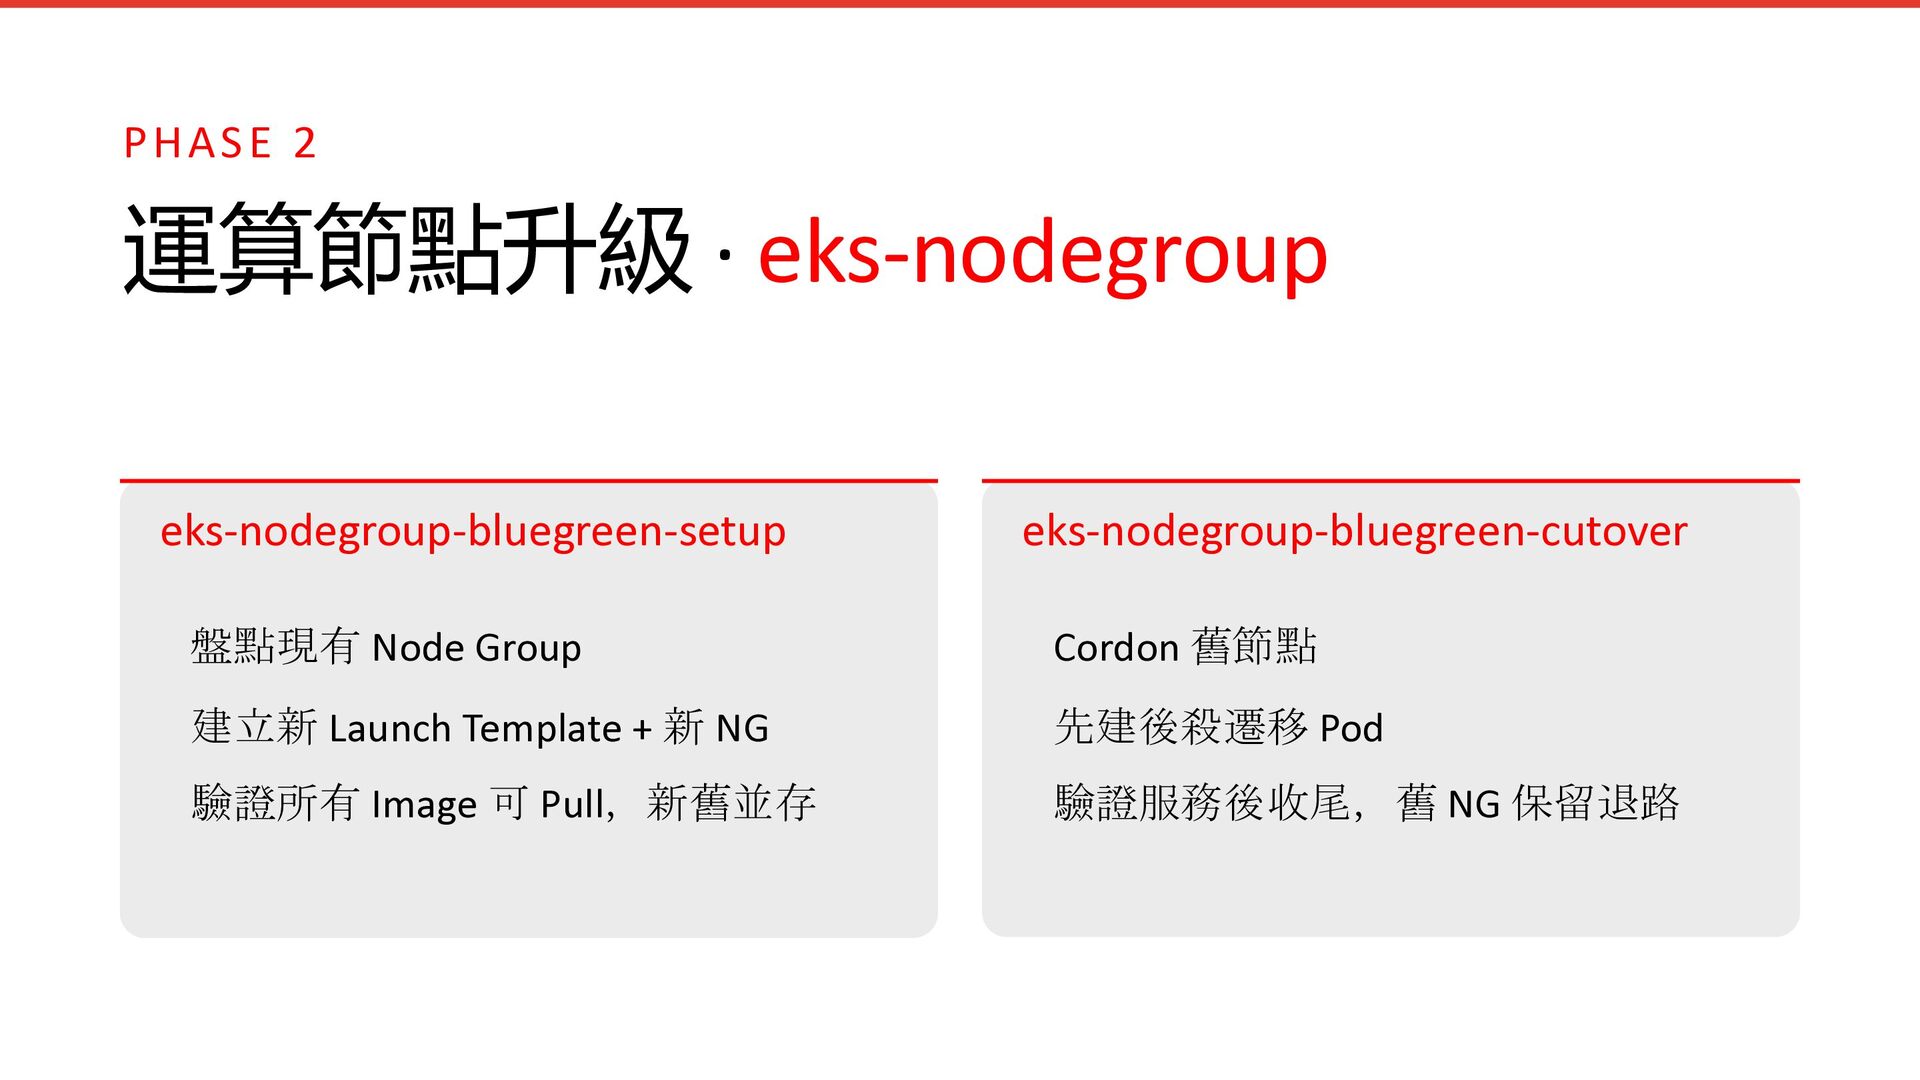
P H AS E 2 運算節點升級 · eks-nodegroup eks-nodegroup-bluegreen-setup eks-nodegroup-bluegreen-cutover
盤點現有 Node Group Cordon 舊節點 建立新 Launch Template + 新 NG 先建後殺遷移 Pod 驗證所有 Image 可 Pull,新舊並存 驗證服務後收尾,舊 NG 保留退路
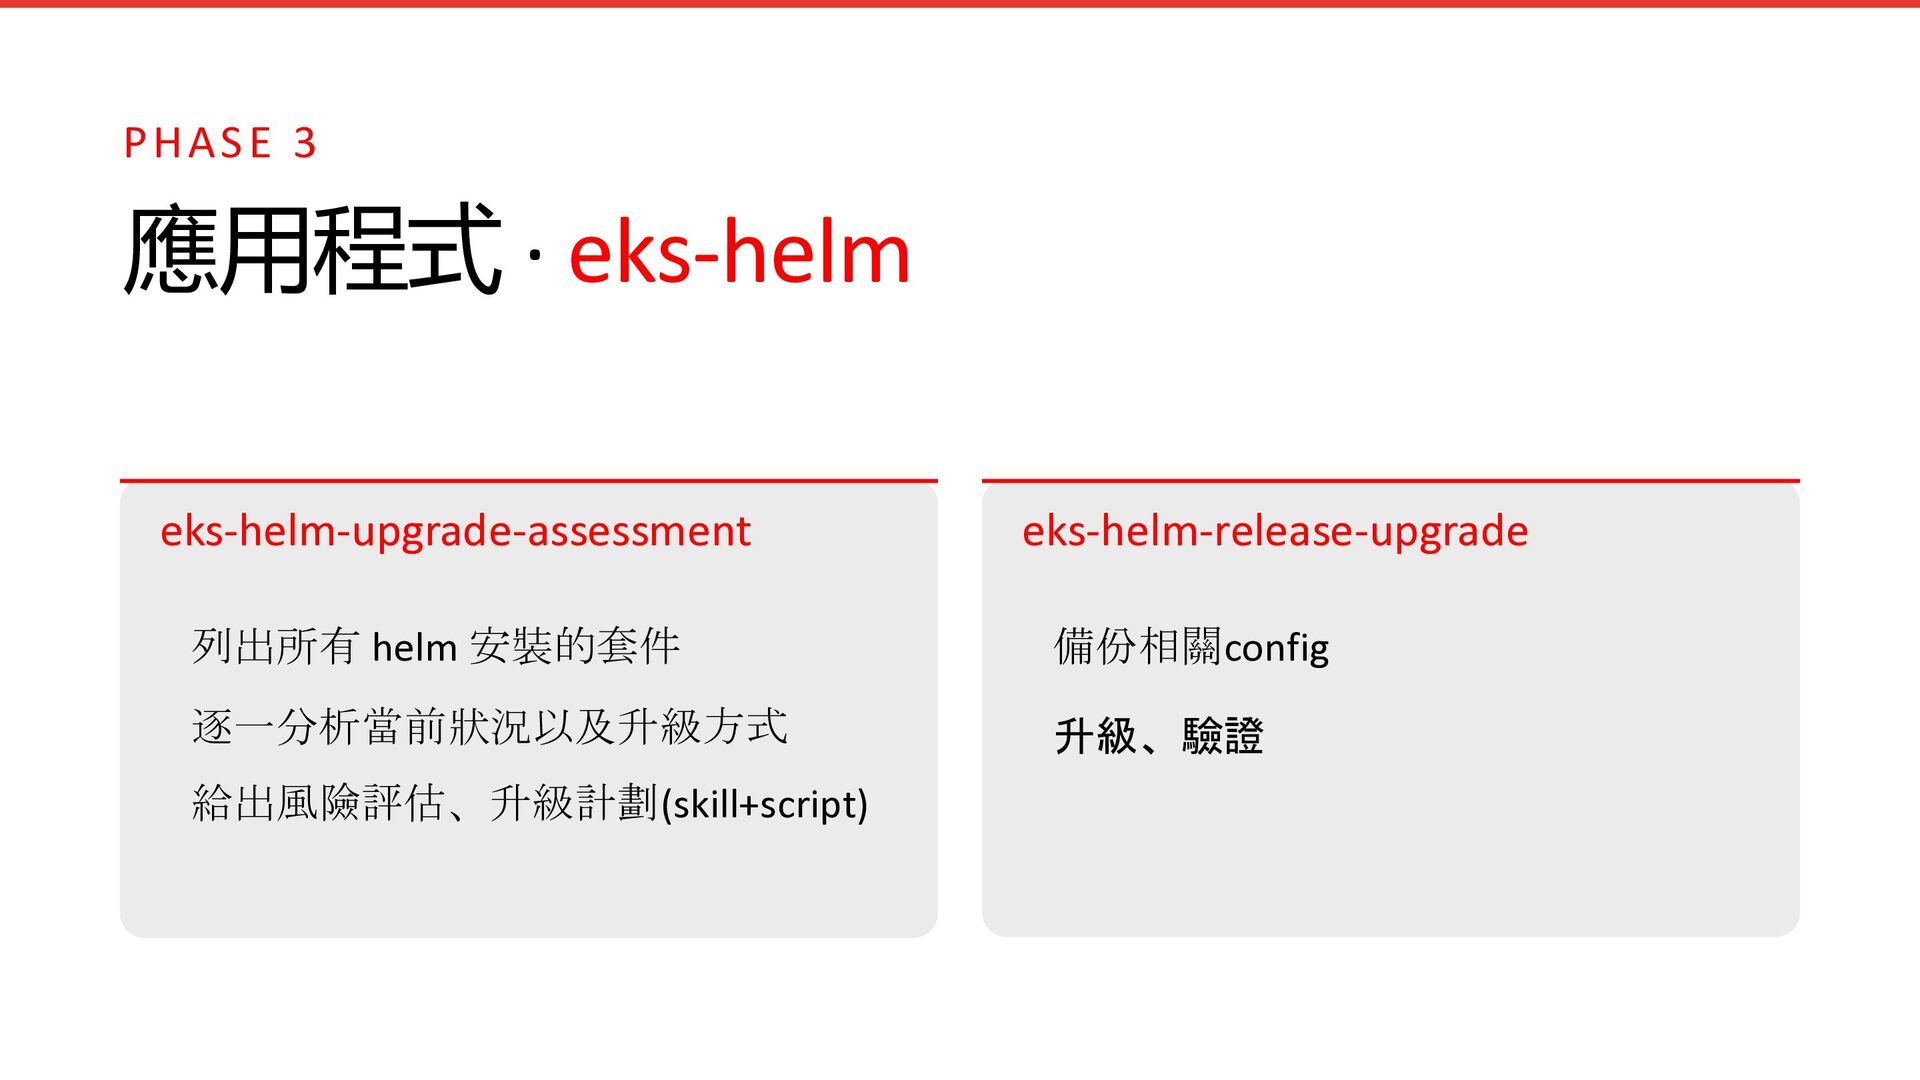
P H AS E 3 應用程式 · eks-helm eks-helm-upgrade-assessment eks-helm-release-upgrade
列出所有 helm 安裝的套件 備份相關config 逐一分析當前狀況以及升級方式 升級、驗證 給出風險評估、升級計劃(skill+script)
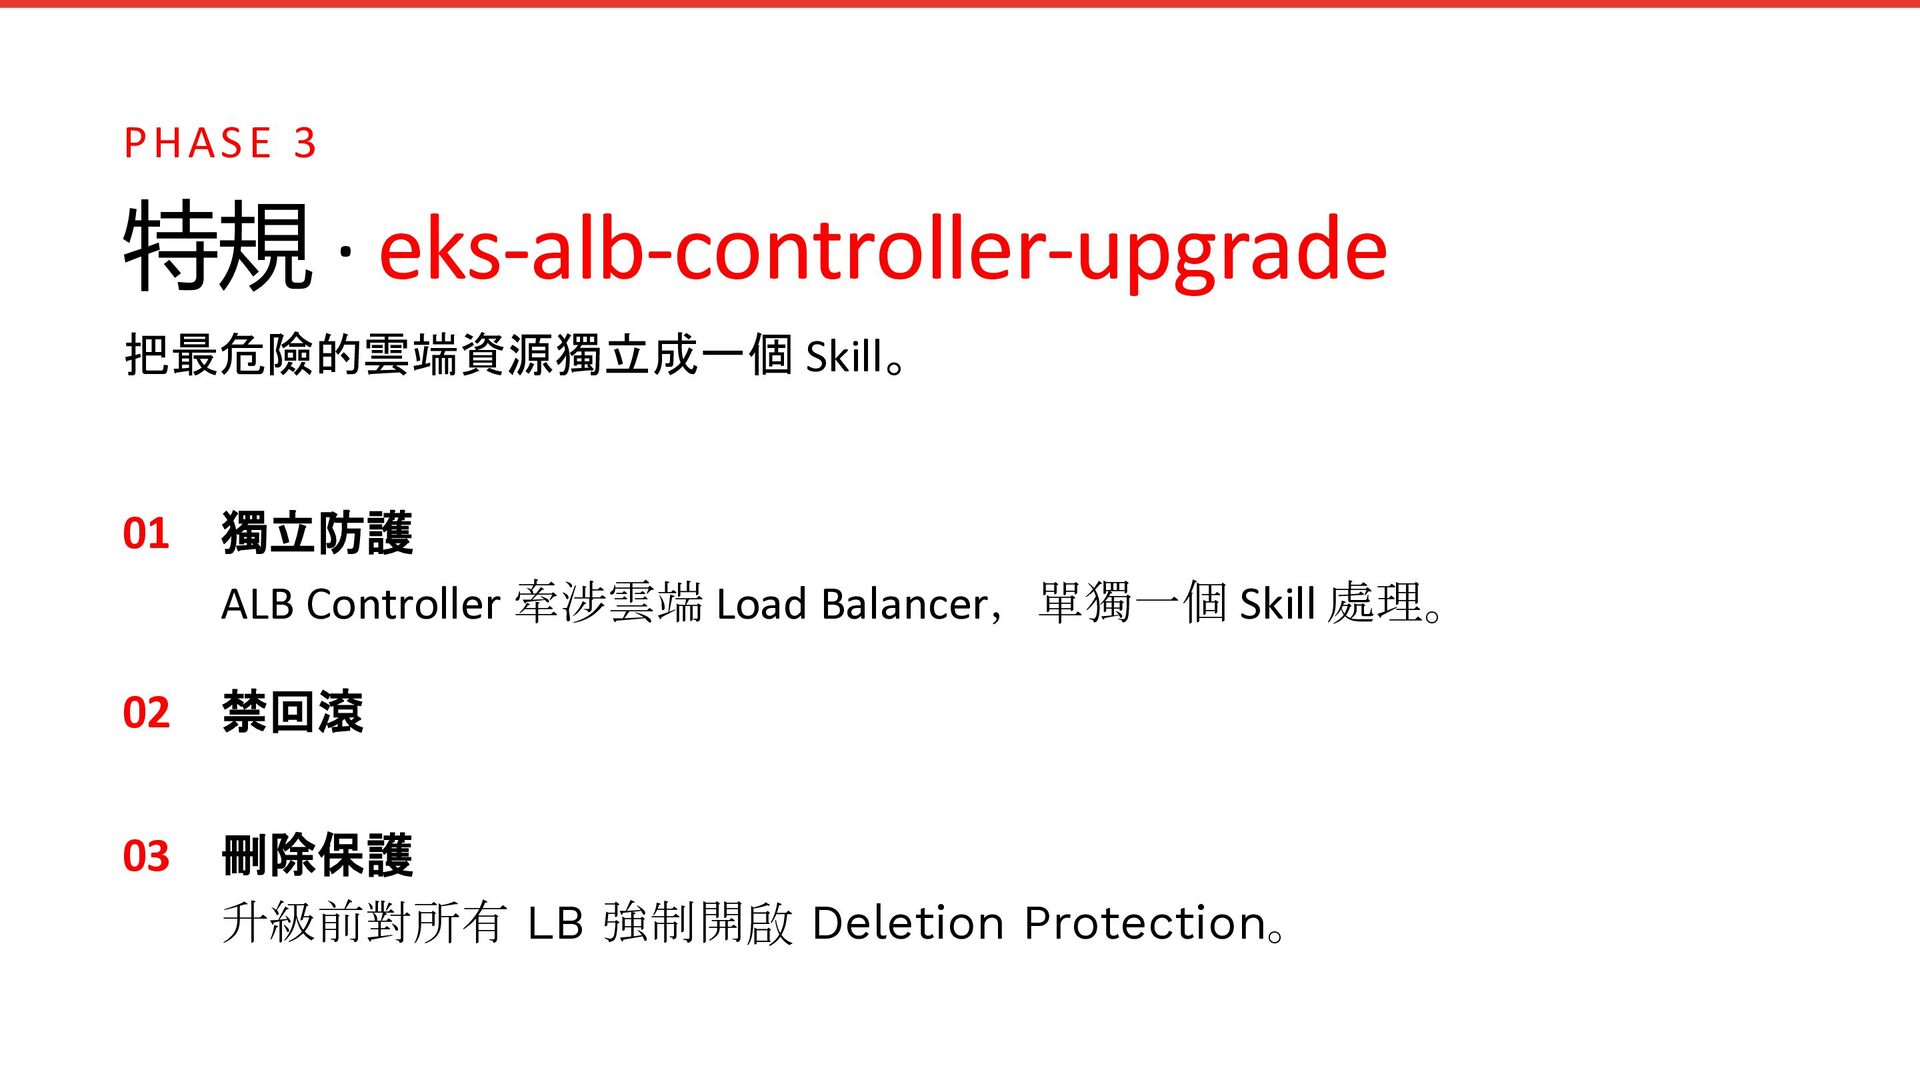
P H AS E 3 特規 · eks-alb-controller-upgrade 把最危險的雲端資源獨立成一個 Skill。
01 獨立防護 ALB Controller 牽涉雲端 Load Balancer,單獨一個 Skill 處理。 02 禁回滾 03 刪除保護 升級前對所有 LB 強制開啟 Deletion Protection。
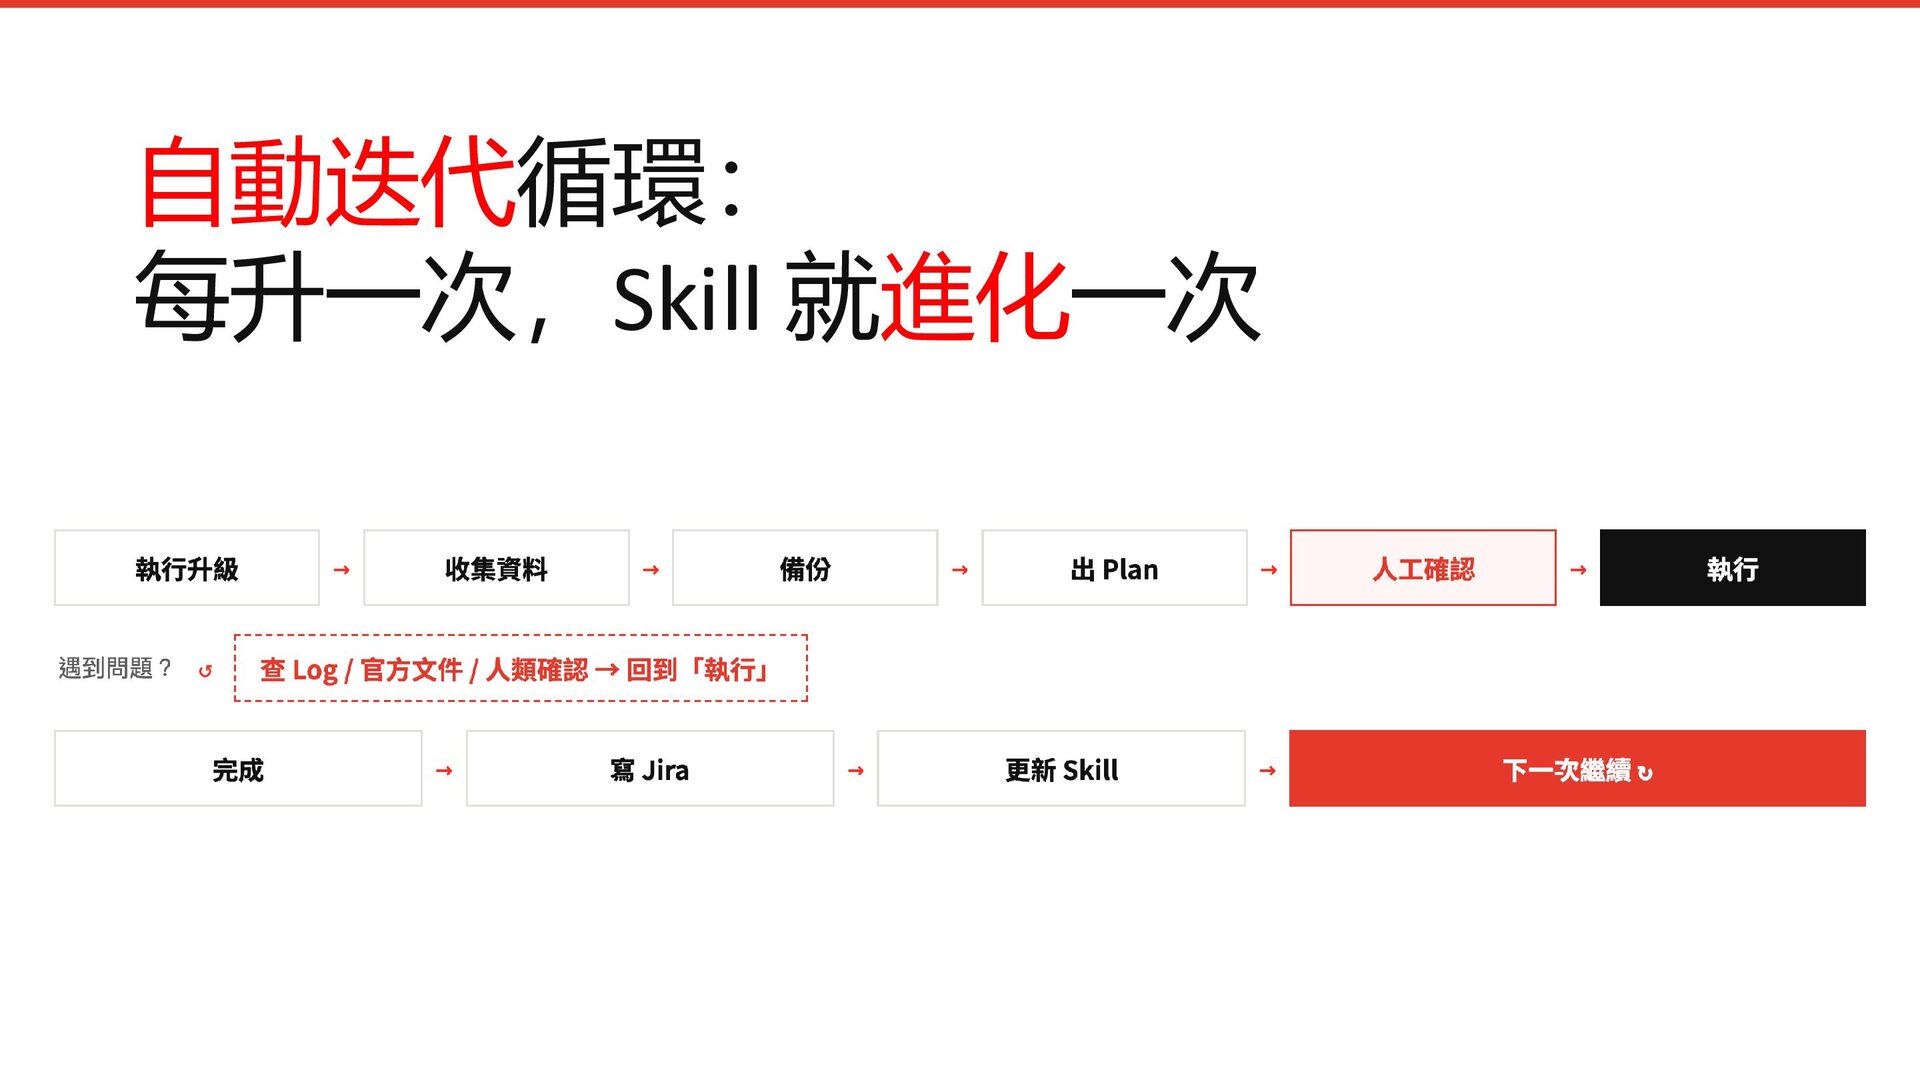
自動迭代循環: 每升一次,Skill 就進化一次
06 180 次實打實的淬煉 Demo · 眼見為實
None
07 成效、坑、費用
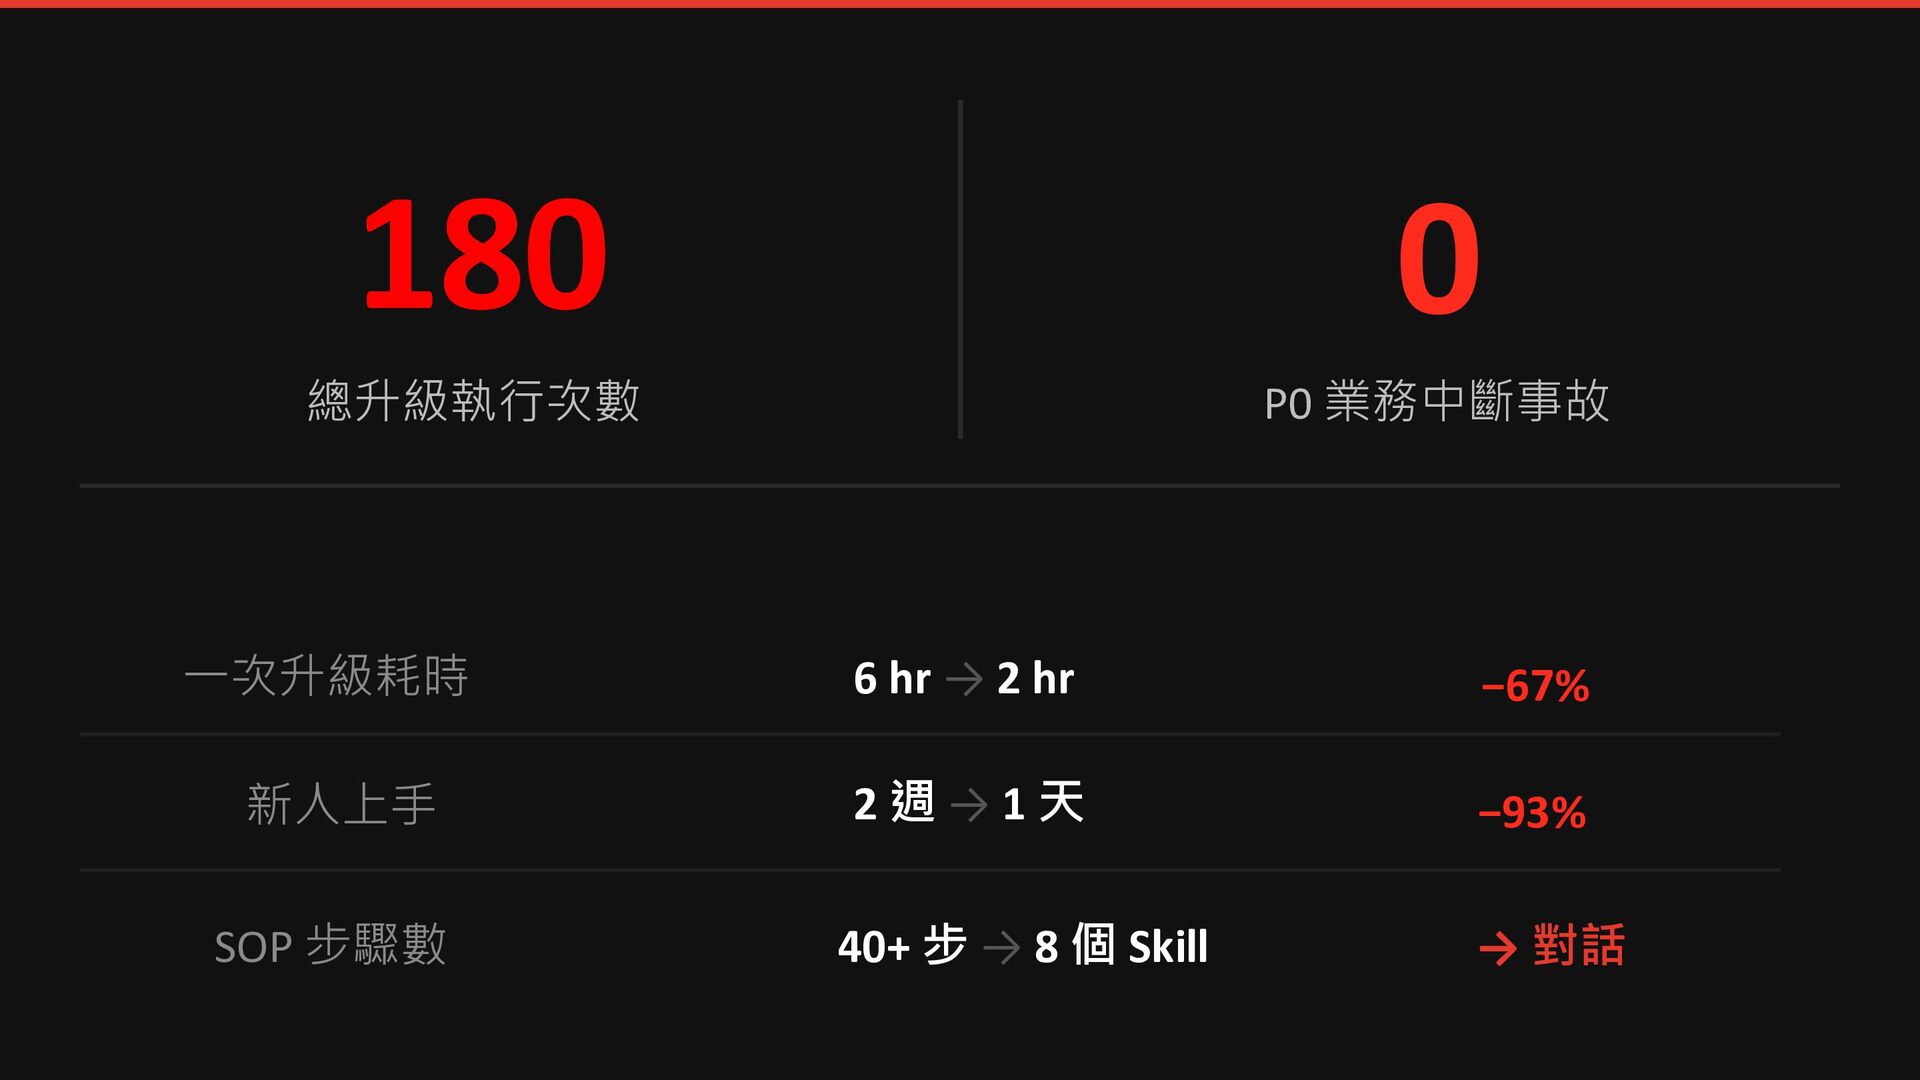
180 0 總升級執行次數 P0 業務中斷事故 一次升級耗時 6 hr → 2
hr −67% 新人上手 2週→1天 −93% SOP 步驟數 40+ 步 → 8 個 Skill → 對話
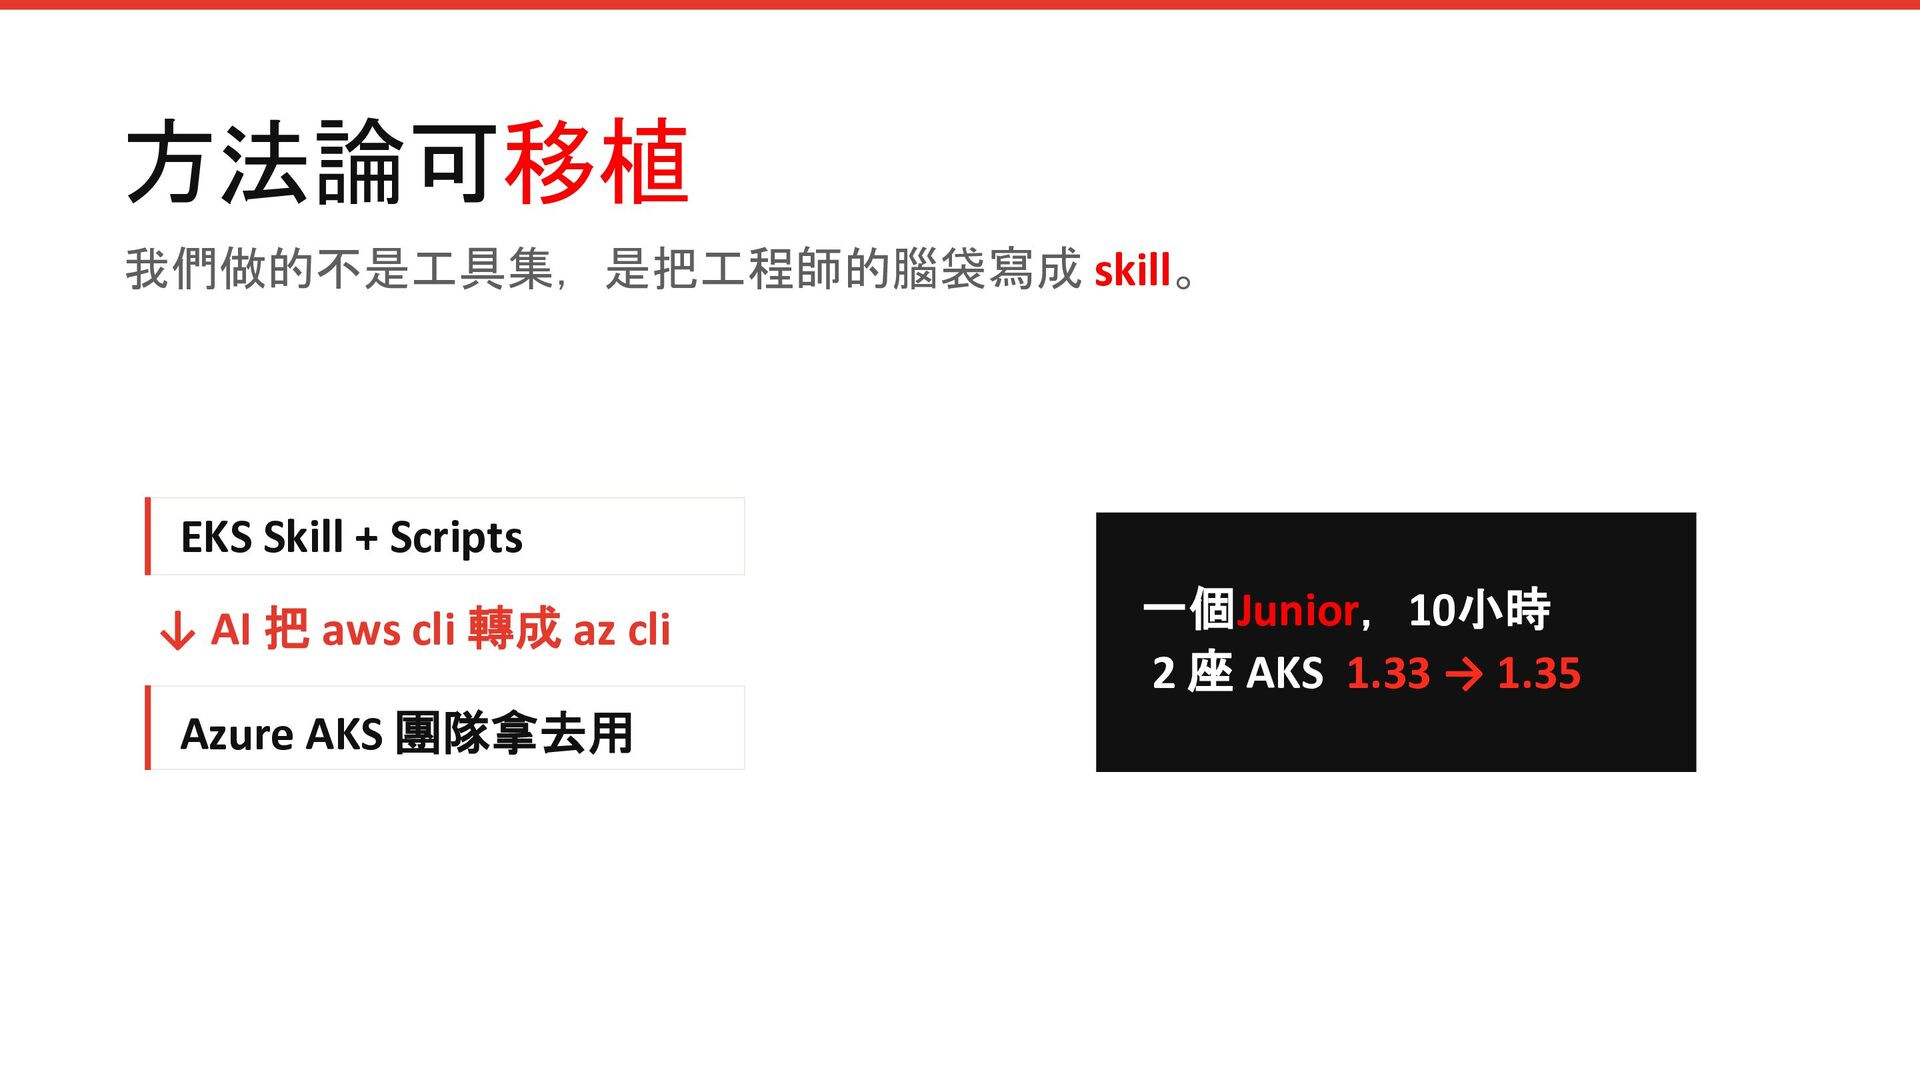
方法論可移植 我們做的不是工具集,是把工程師的腦袋寫成 skill。 EKS Skill + Scripts ↓ AI 把
aws cli 轉成 az cli Azure AKS 團隊拿去用 一個Junior,10小時 2 座 AKS 1.33 → 1.35
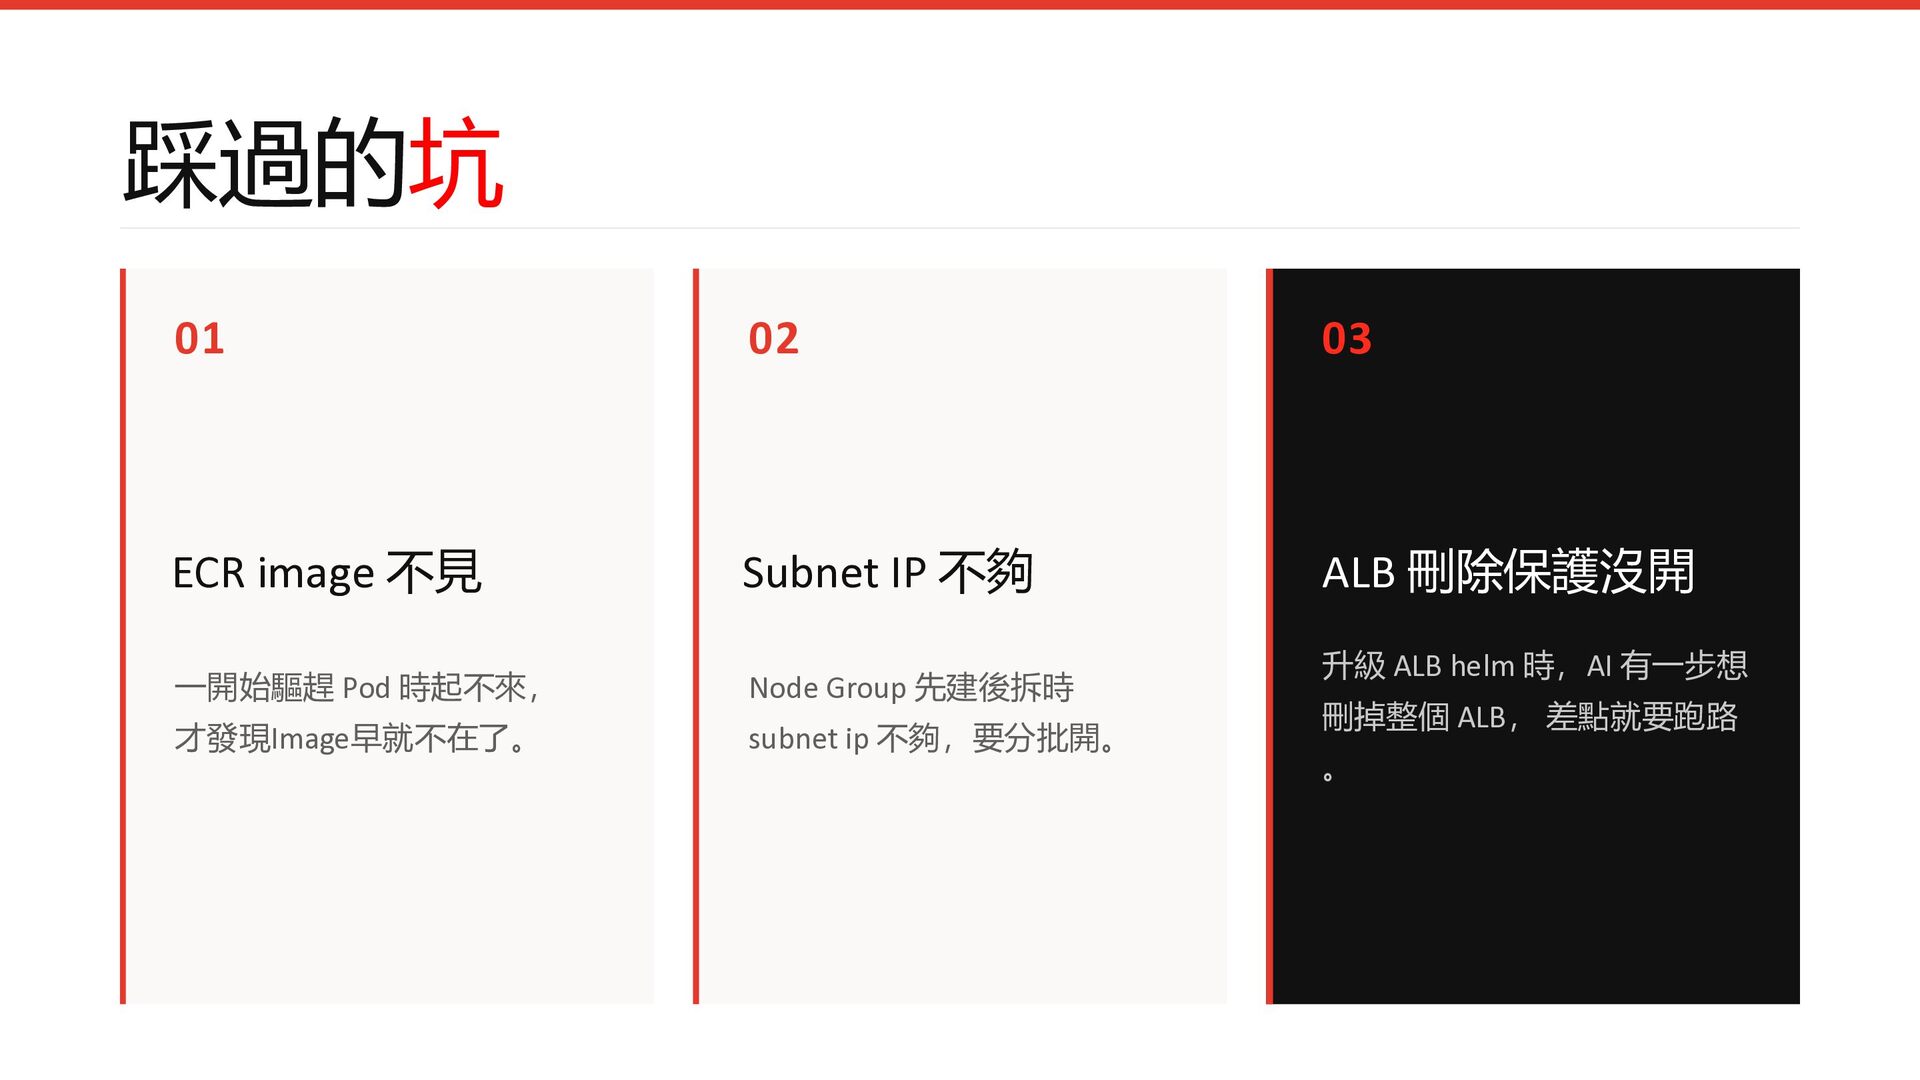
踩過的坑 01 02 03 ECR image 不見 Subnet IP 不夠
ALB 刪除保護沒開 一開始驅趕 Pod 時起不來, Node Group 先建後拆時 才發現Image早就不在了。 subnet ip 不夠,要分批開。 升級 ALB helm 時,AI 有一步想 刪掉整個 ALB, 差點就要跑路 。
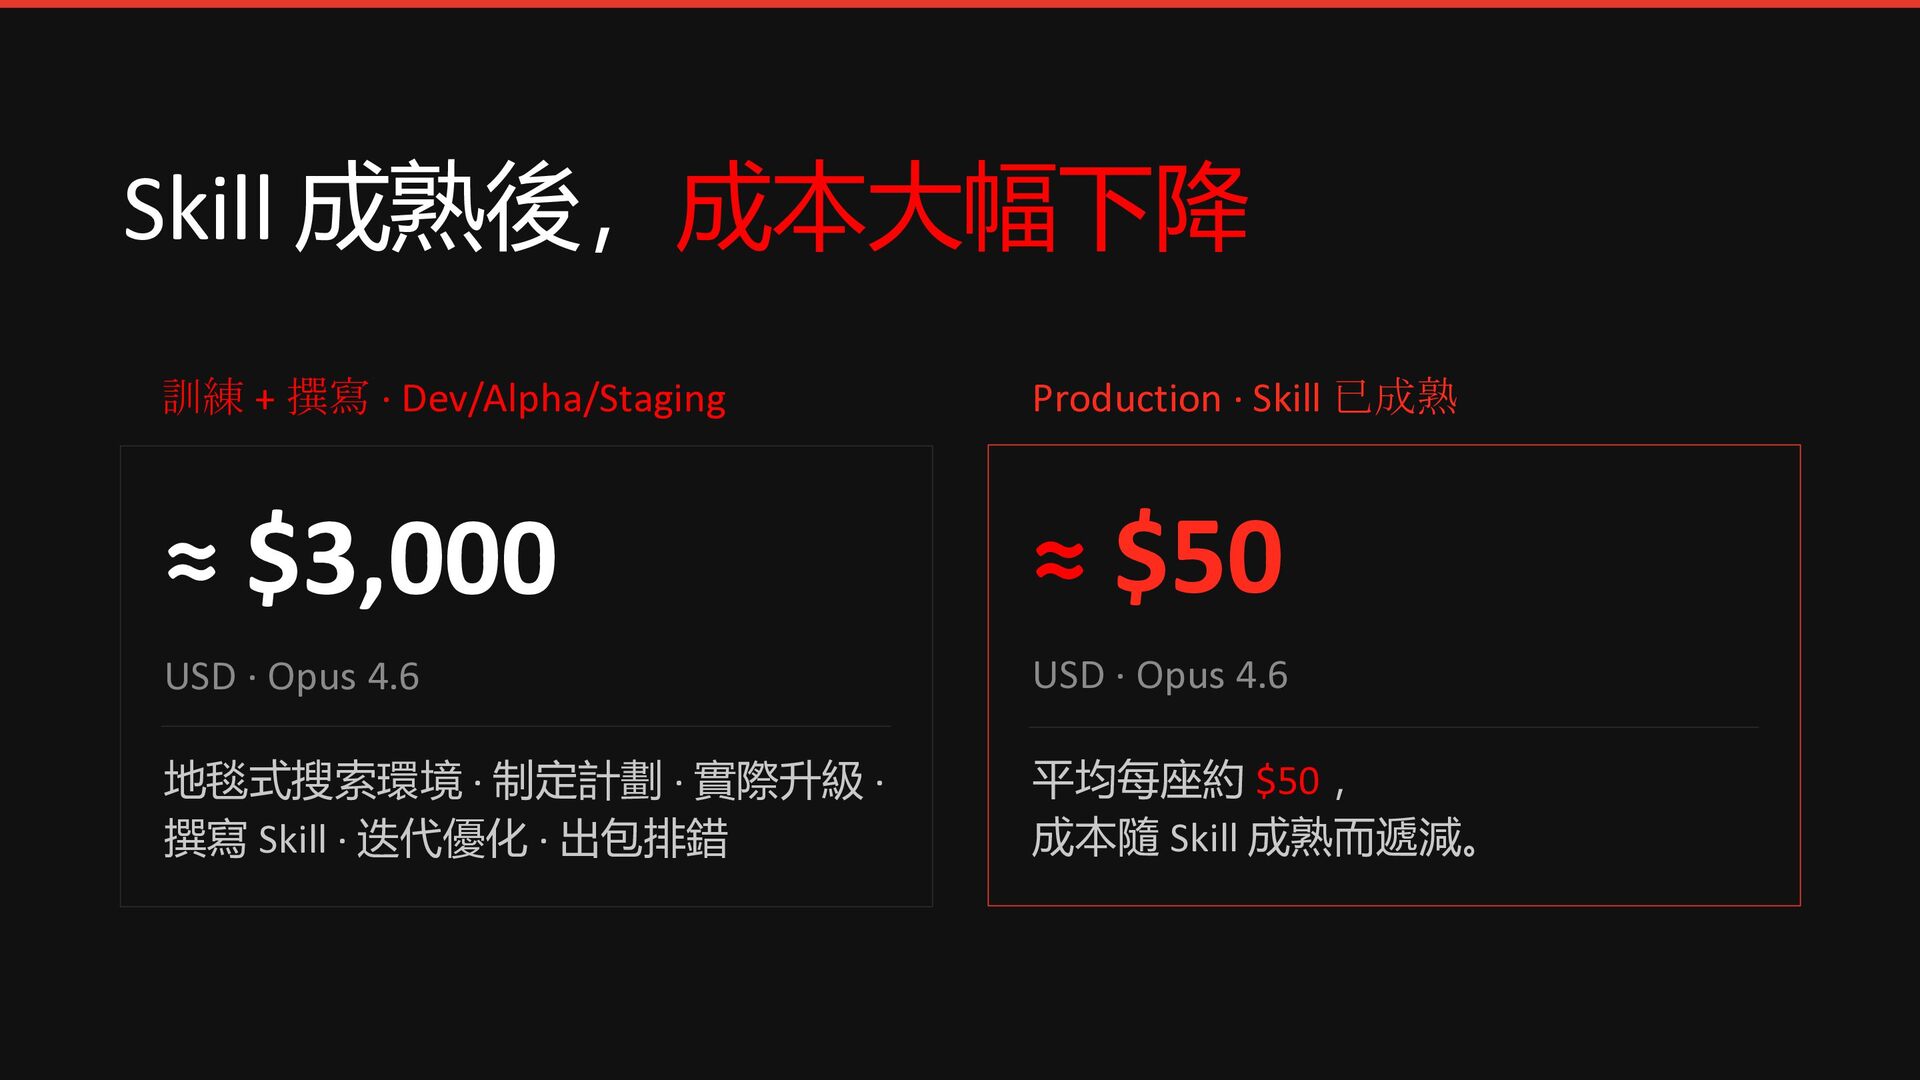
Skill 成熟後,成本大幅下降 訓練 + 撰寫 · Dev/Alpha/Staging Production · Skill
已成熟 ≈ $3,000 ≈ $50 USD · Opus 4.6 USD · Opus 4.6 地毯式搜索環境 · 制定計劃 · 實際升級 · 撰寫 Skill · 迭代優化 · 出包排錯 平均每座約 $50 , 成本隨 Skill 成熟而遞減。
08 結論
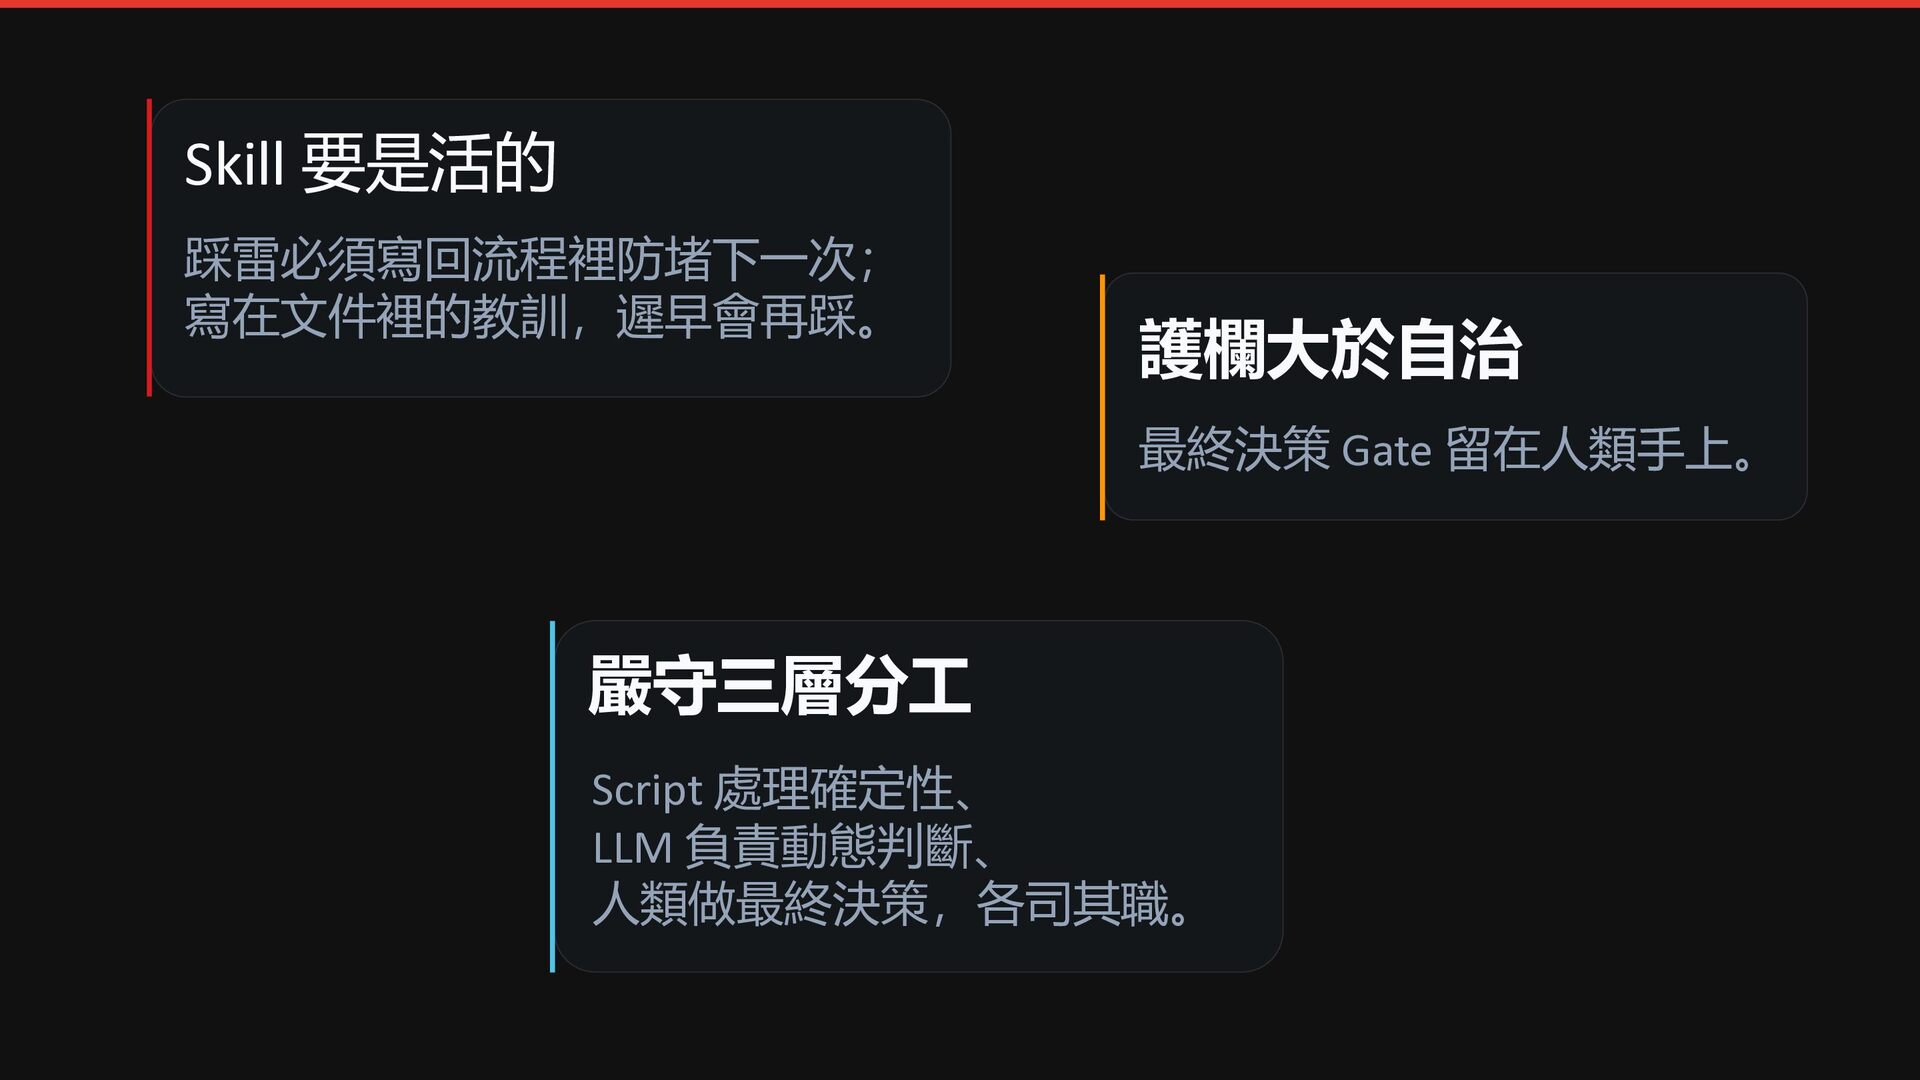
Skill 要是活的 踩雷必須寫回流程裡防堵下一次; 寫在文件裡的教訓,遲早會再踩。 護欄大於自治 最終決策 Gate 留在人類手上。 嚴守三層分工 Script
處理確定性、 LLM 負責動態判斷、 人類做最終決策,各司其職。
下一次升級 EKS, 跟 Claude 對話就好。
KUBE SUMMIT 2026 現在的我們,已經不怕 EKS 每季更新了。 THANK YOU 3ric &
Criz Chien 2026-09-10


 eric8230
 ponponmikankan
 ts020
 masuda220
 civitaspo
 alchemy1115
 o3
 kazumax55
 minorun365
 uhyo
 tkc66buzz
 nek0128
 cassininazir
 frankvandijk
 427marketing
 mfonobong
 takai
 jonrohan
 rmw
 sergeychernyshev
 dougneiner
 orderedlist
 bethany
 inesmontani