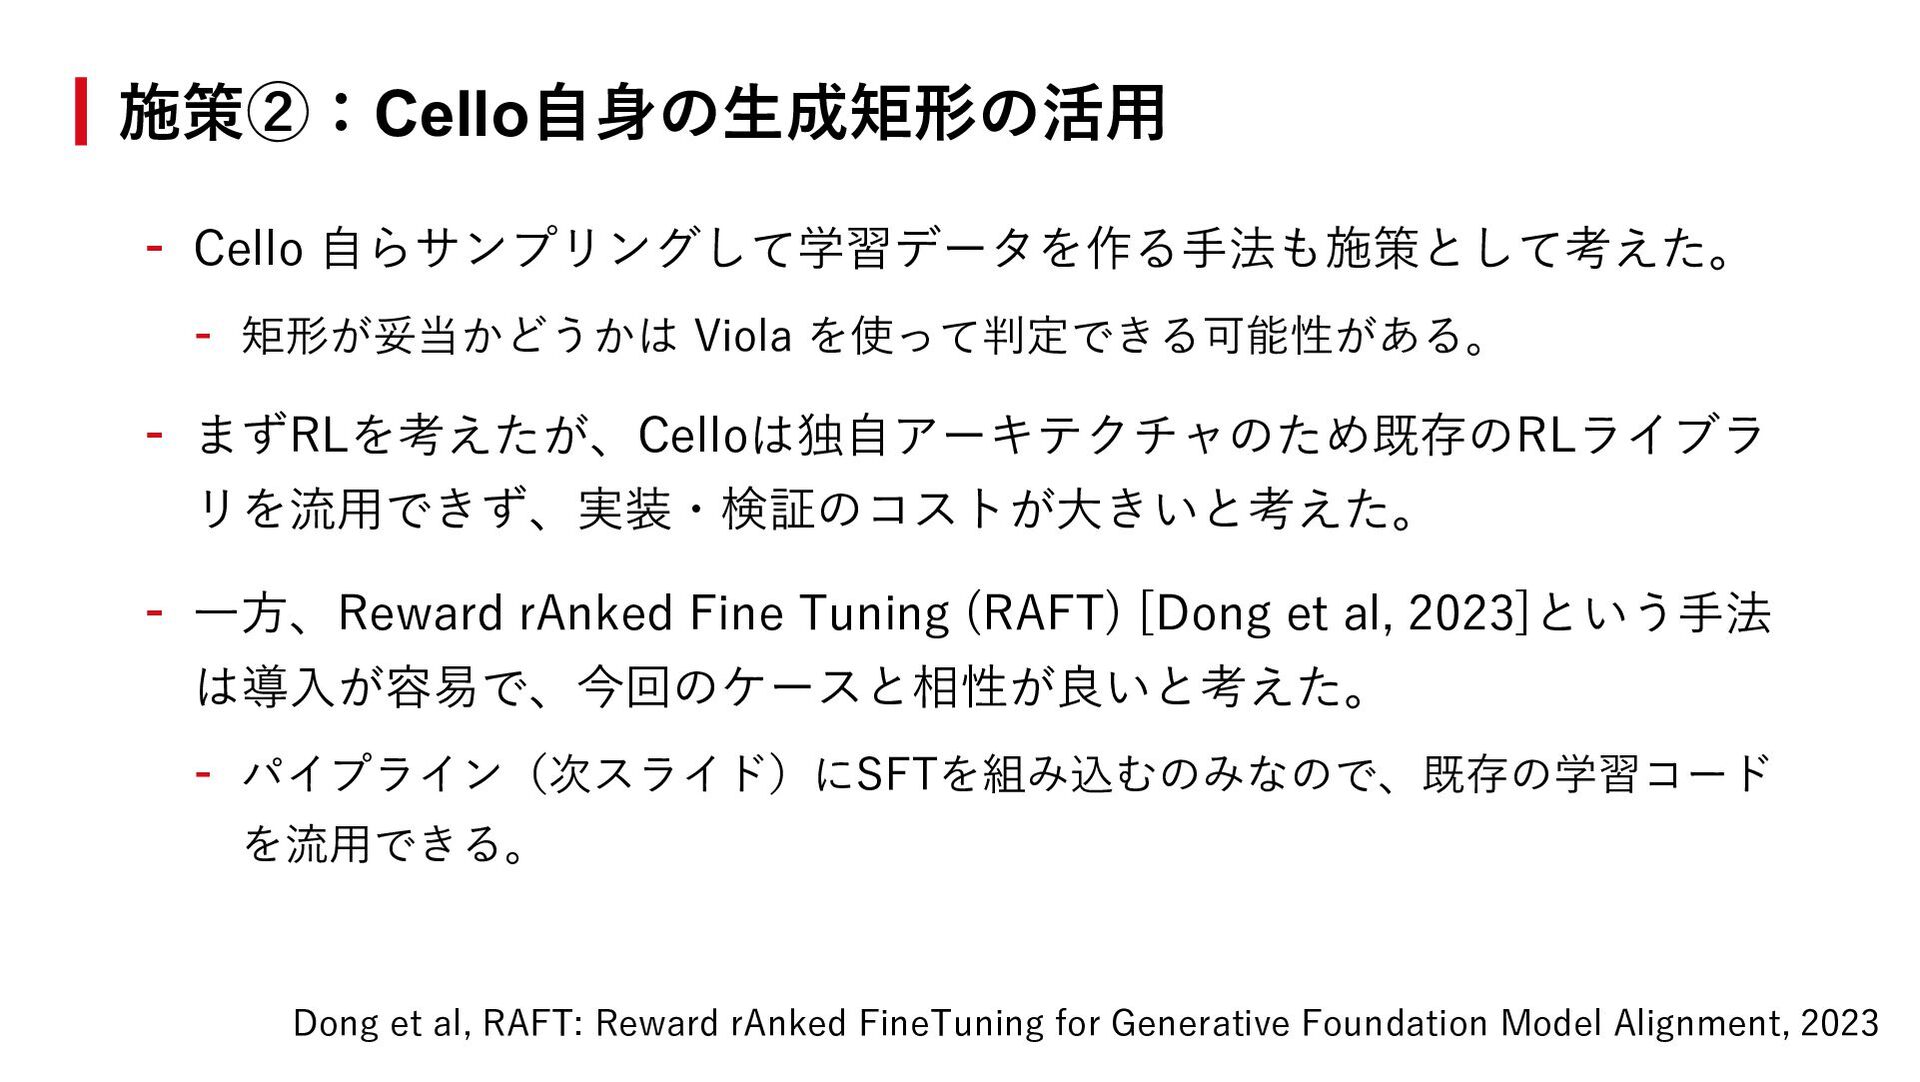
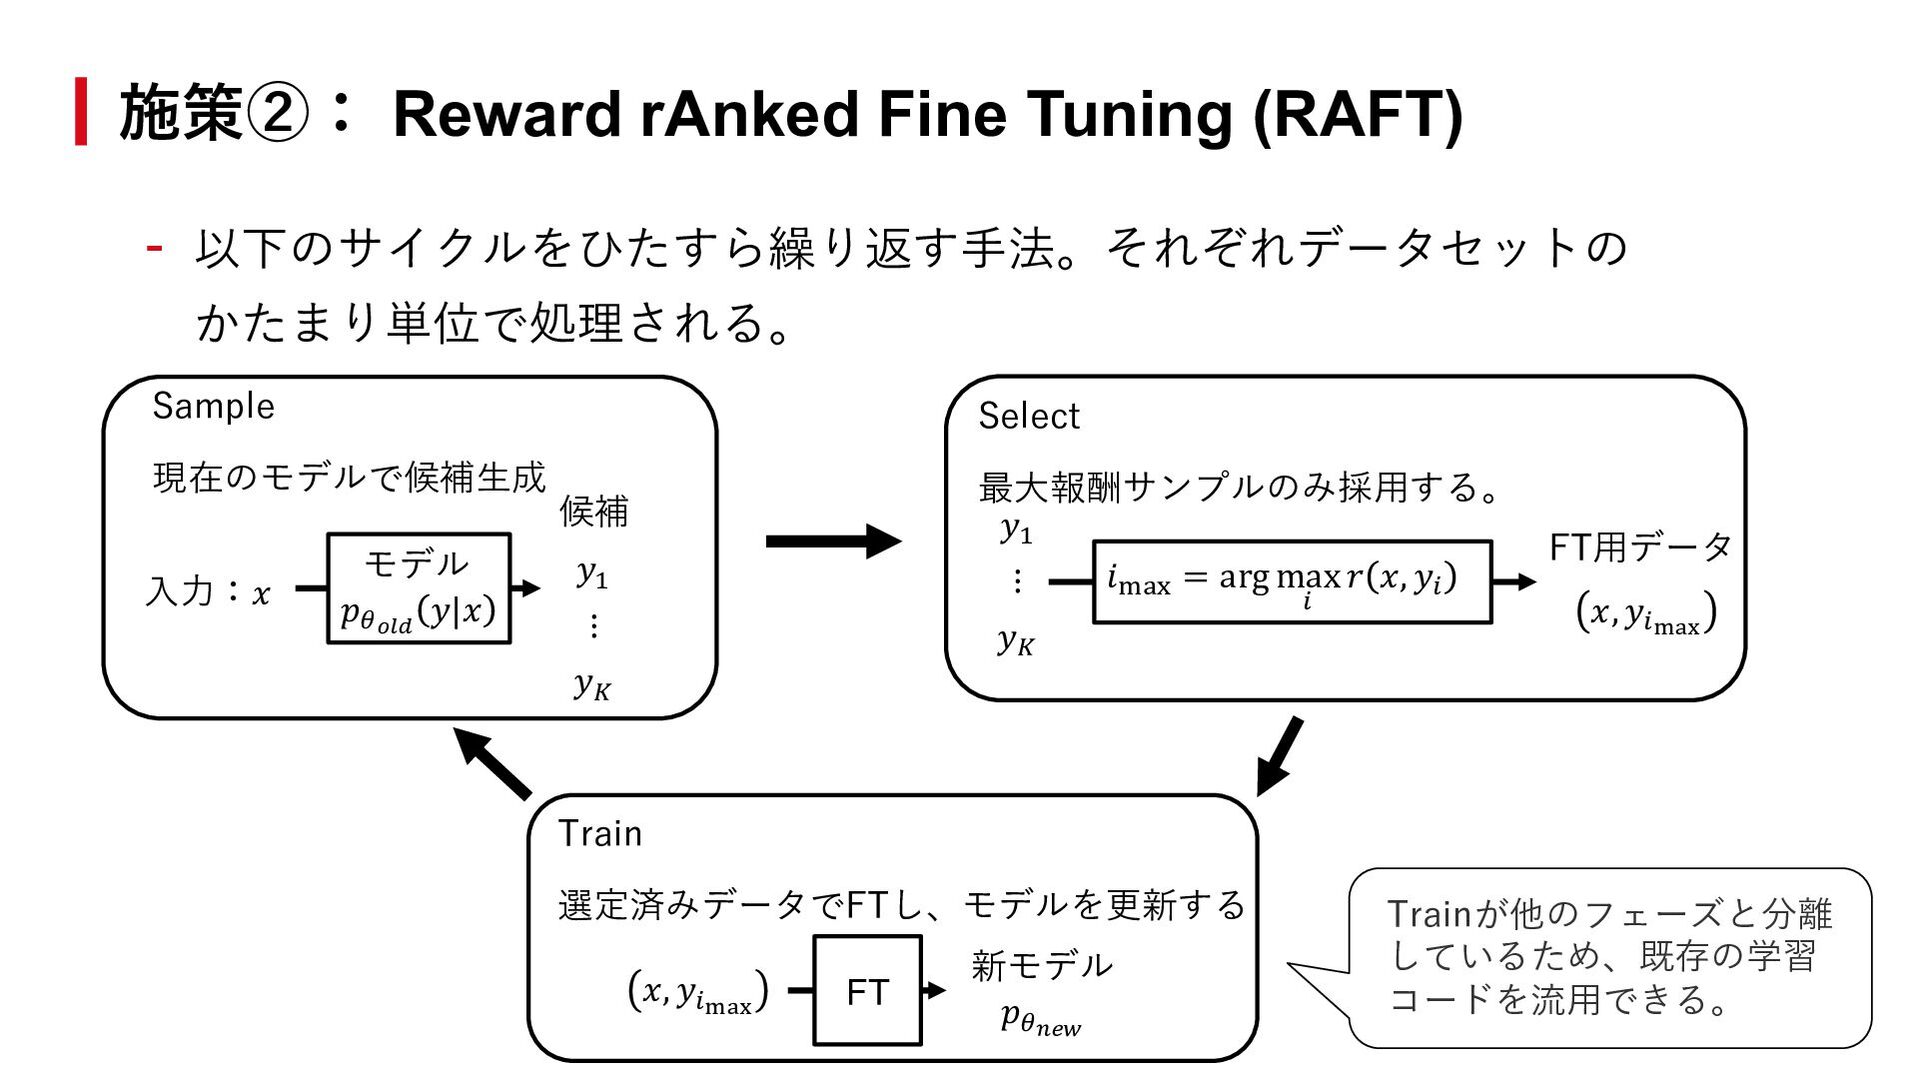
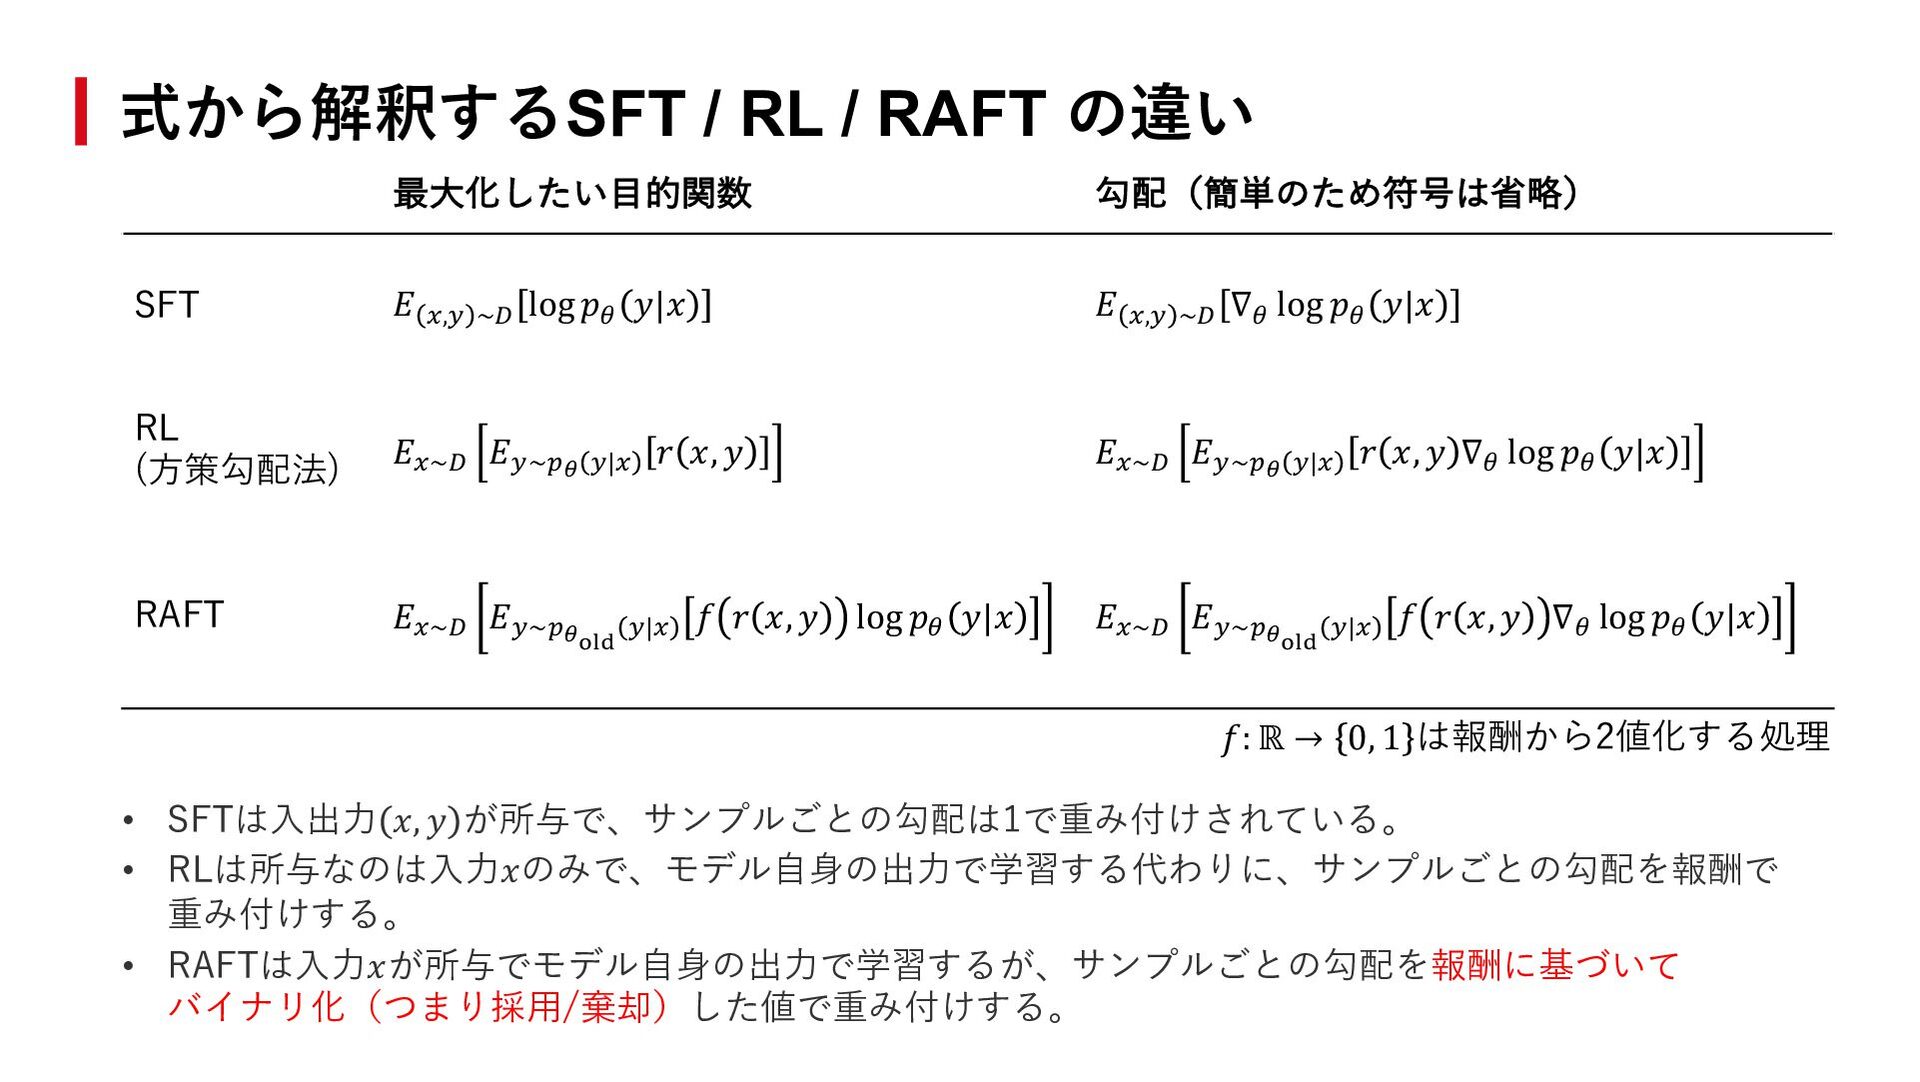
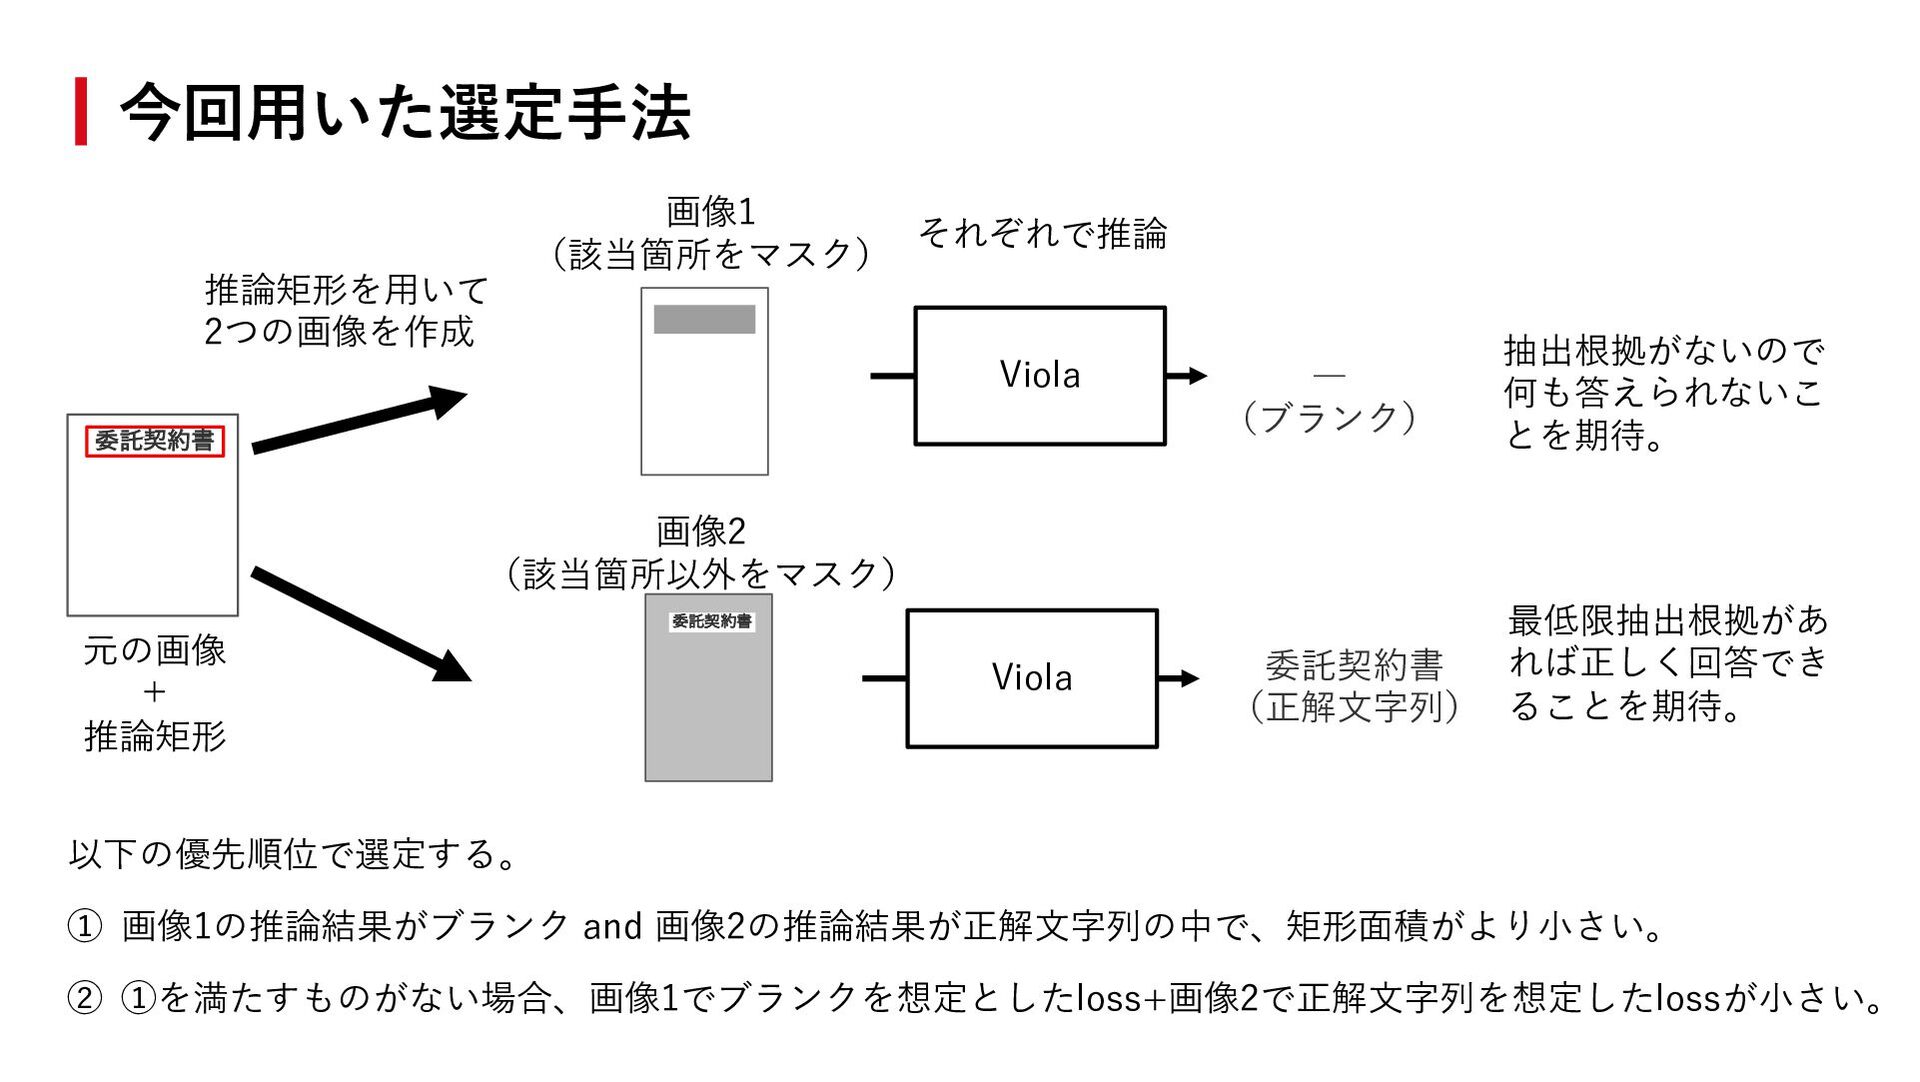
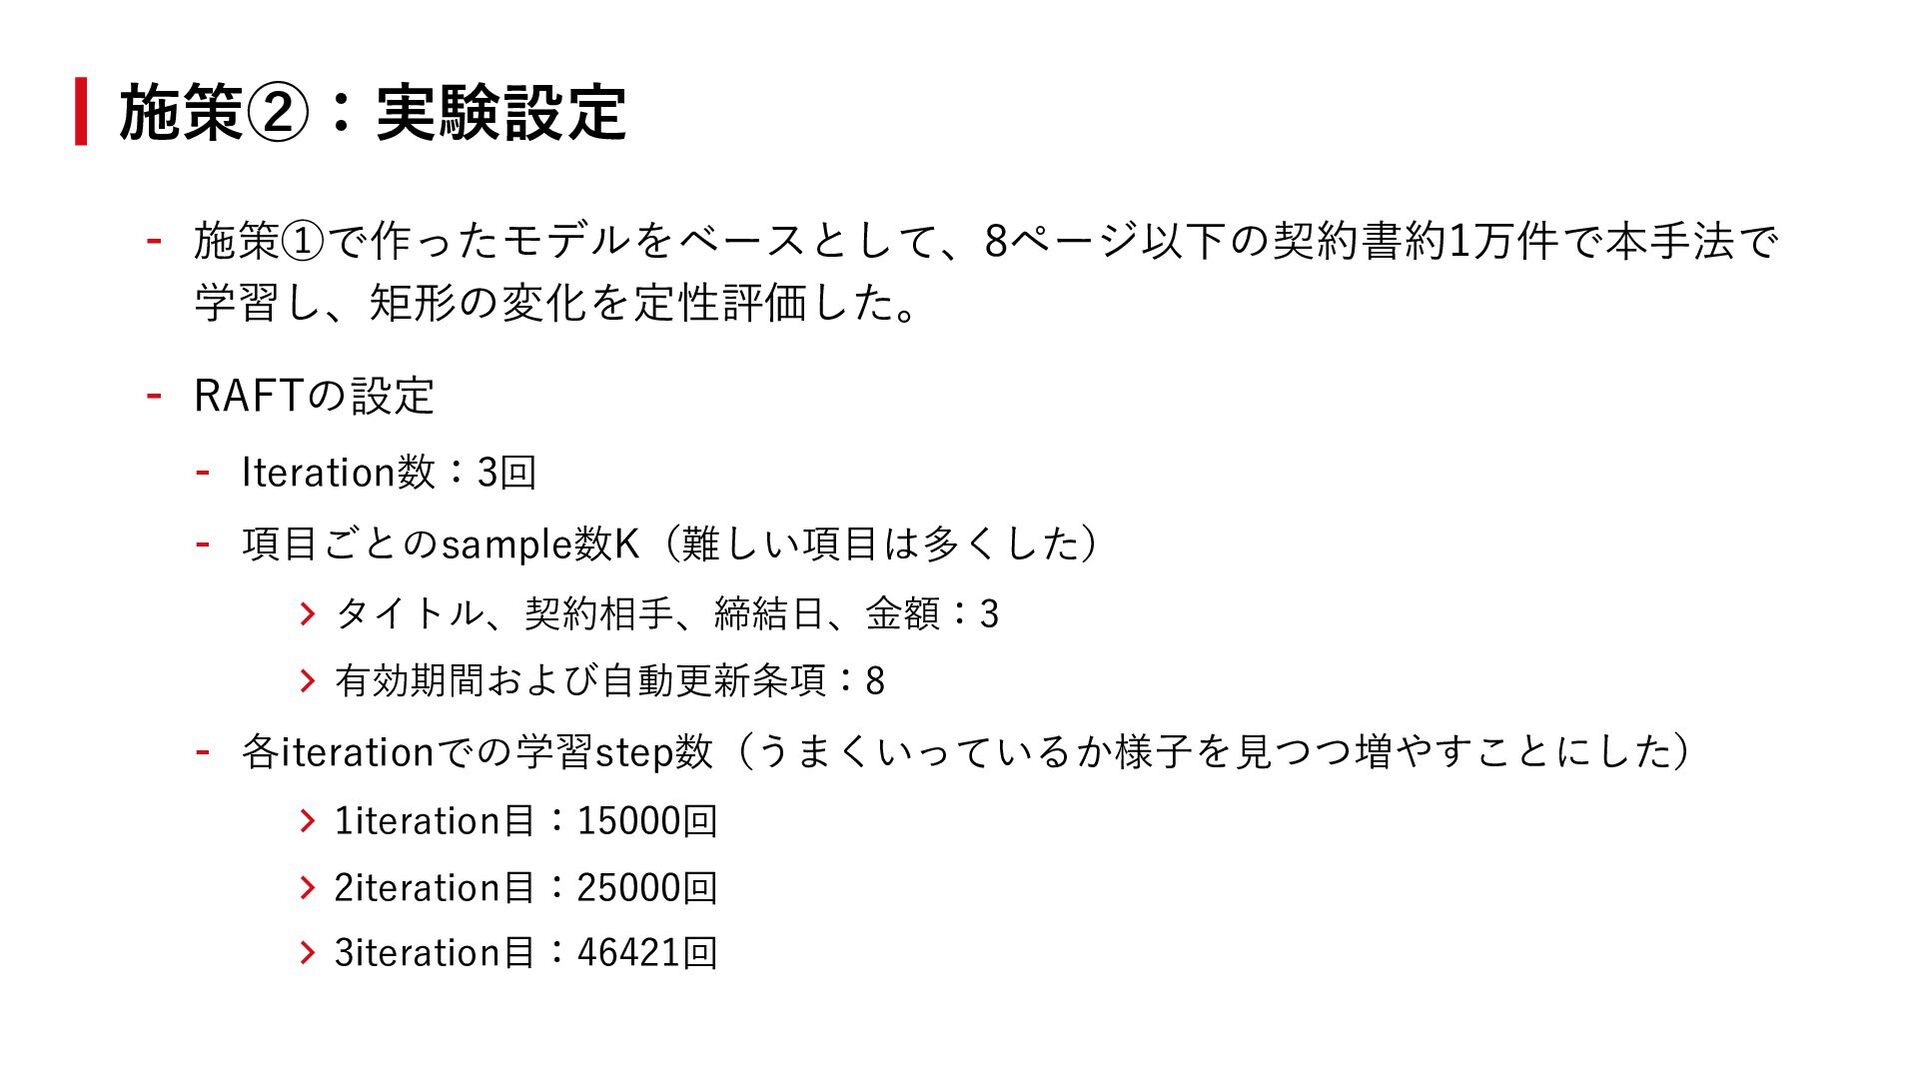
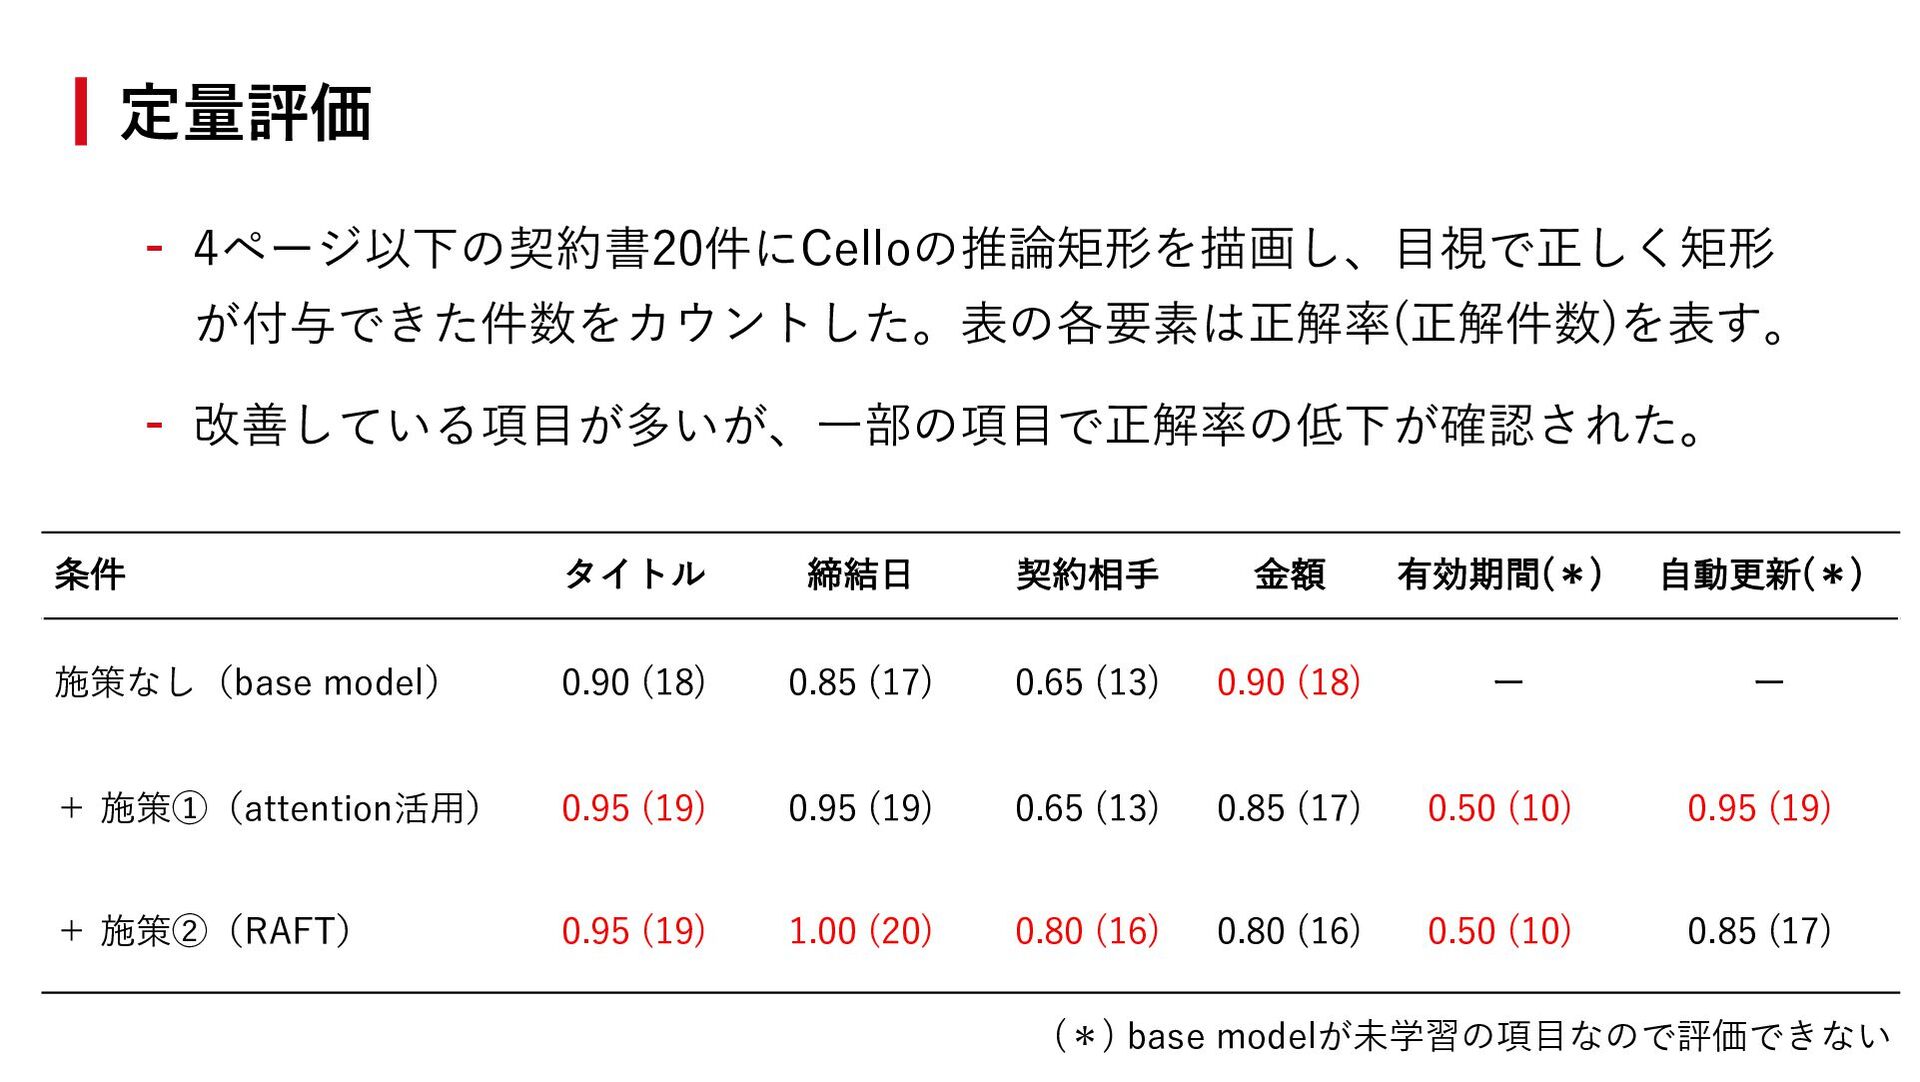
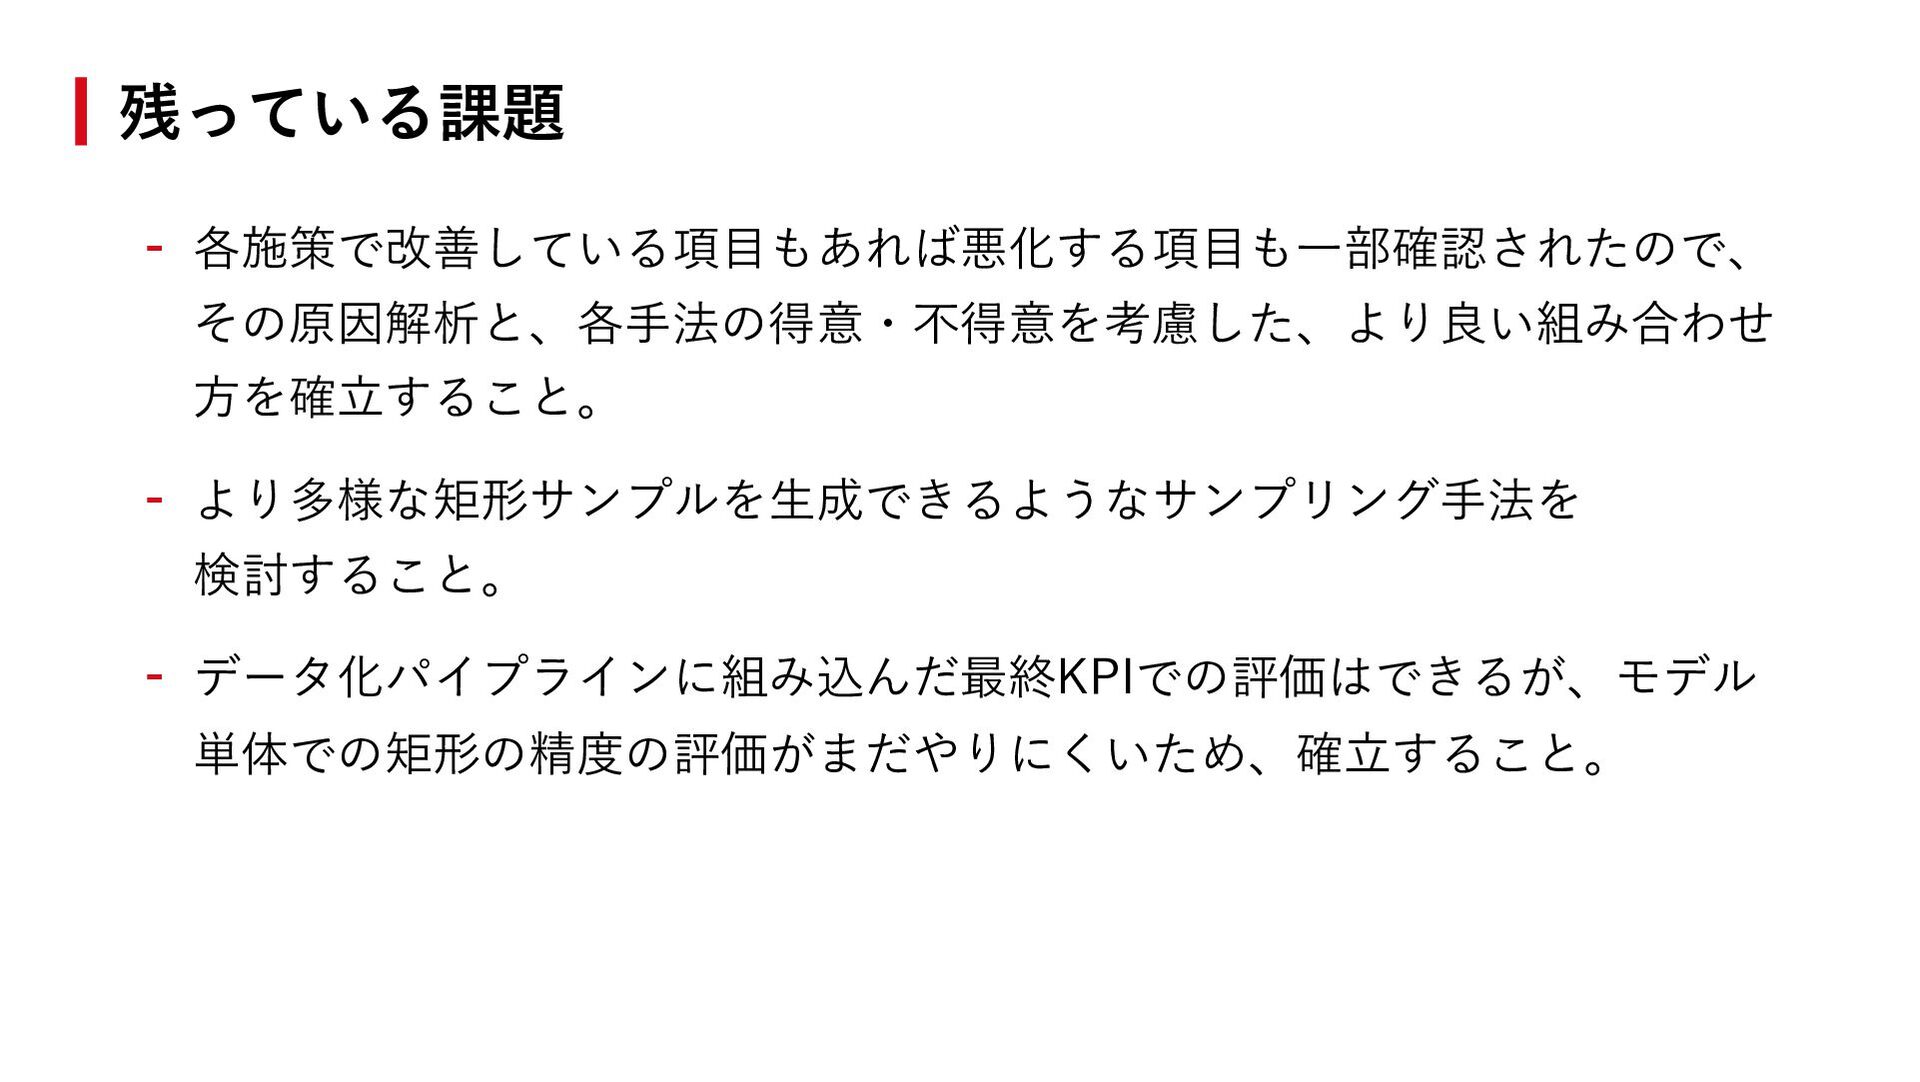
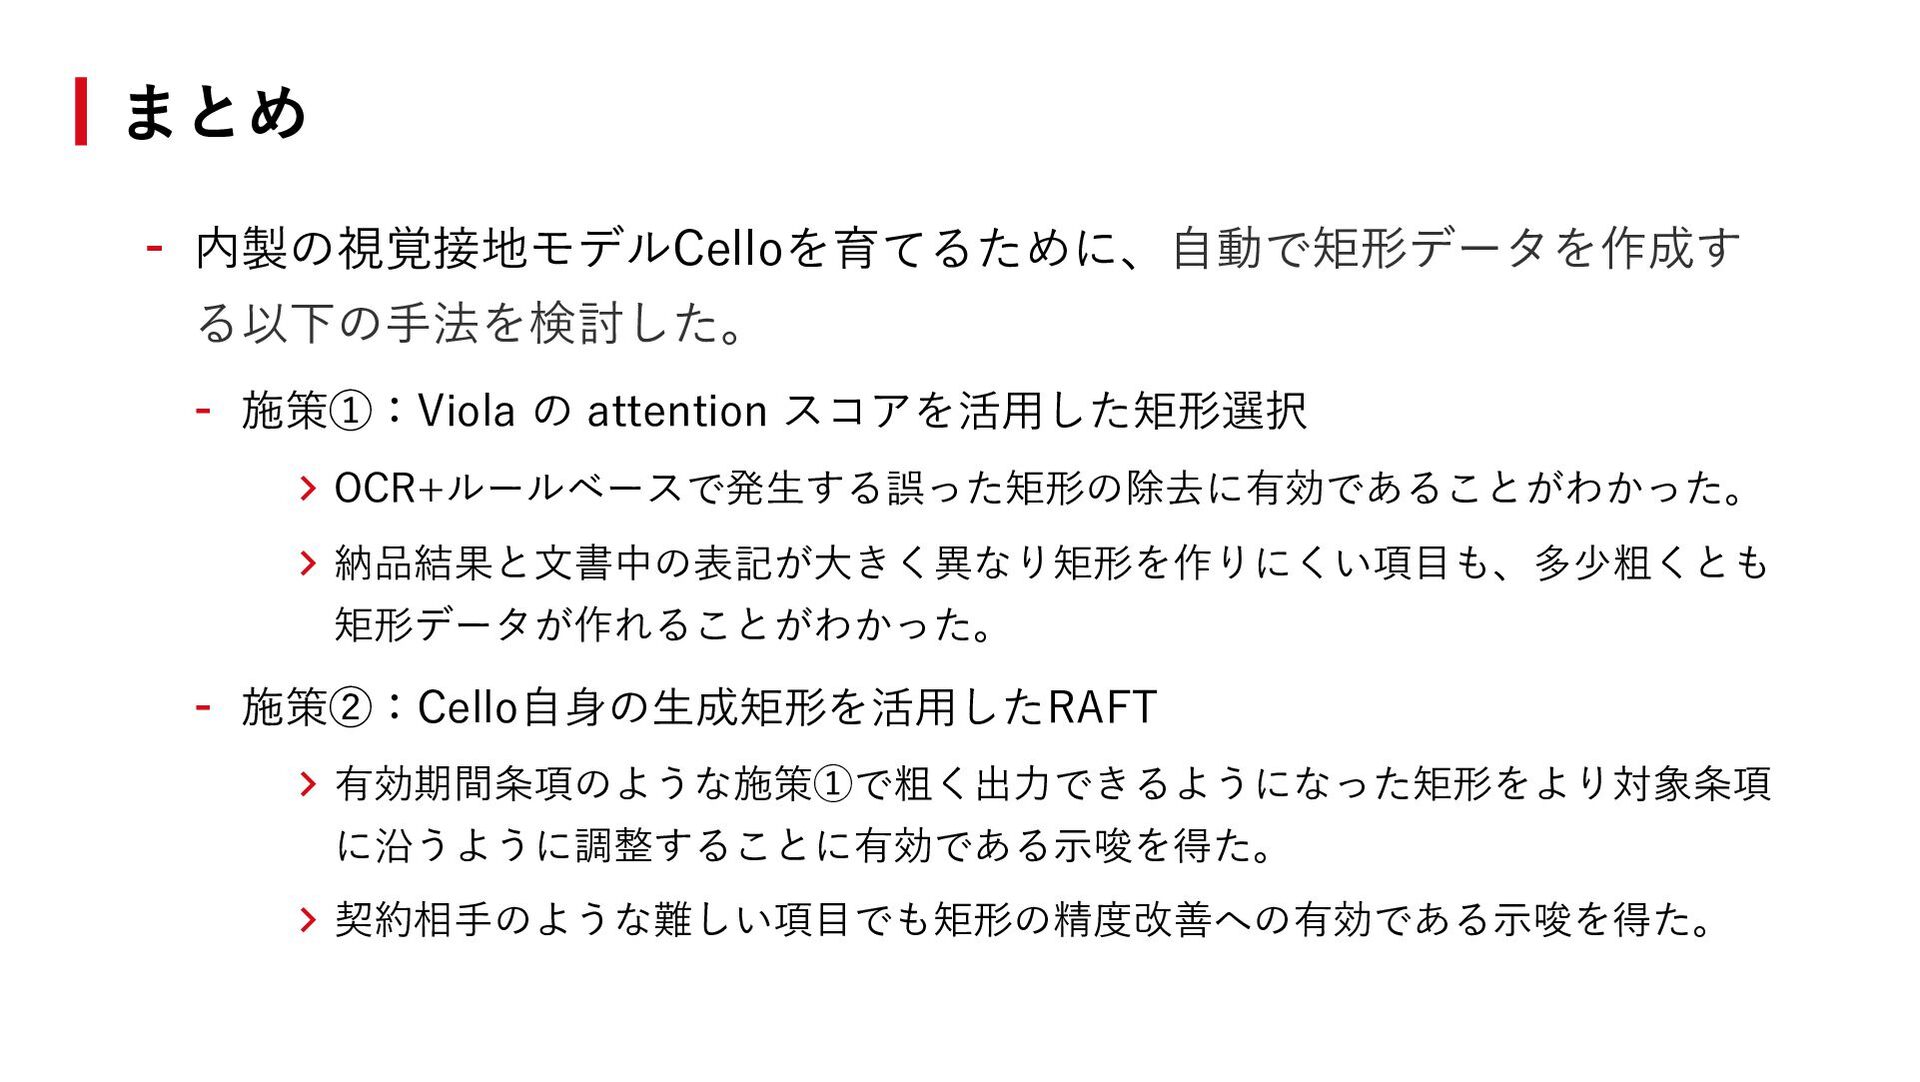
リを流⽤できず、実装・検証のコストが⼤きいと考えた。 - ⼀⽅、Reward rAnked Fine Tuning (RAFT) [Dong et al, 2023]という⼿法 は導⼊が容易で、今回のケースと相性が良いと考えた。 - パイプライン(次スライド)にSFTを組み込むのみなので、既存の学習コード を流⽤できる。 Dong et al, RAFT: Reward rAnked FineTuning for Generative Foundation Model Alignment, 2023


 sansantech
 ennael
 dvrv_tknrszk
 mtpooh
 yama3133
 ysuzuki
 tkuchiki
 philipz
 foursue
 yhana
 yohyamasaki
 dip_tech
 ufried
 quramy
 aemeredith
 sugarenia
 62gerente
 techseoconnect
 honzajavorek
 ianozsvald
 charlesmeaden
 baasie
 sarafernandez
 inesmontani
 colly