Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Scraping: 10 mistakes to avoid @ Breizhcamp 2016
Search
Fabien Vauchelles
March 24, 2016
Science
240
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Scraping: 10 mistakes to avoid @ Breizhcamp 2016
From website, to storage, learn webscraping
#webscraping #tricks
Fabien Vauchelles
March 24, 2016
More Decks by Fabien Vauchelles
See All by Fabien Vauchelles
[StartupCourse/18] Discover Machine Learning
fabienvauchelles
0
98
[StartupCourse/01] Gérer sa carrière @ Polytech Paris Sud 2016
fabienvauchelles
0
85
[StartupCourse/02] Monter Une Startup @ Polytech Paris Sud 2016
fabienvauchelles
0
80
[StartupCourse/03] De l'idée au produit @ Polytech Paris Sud 2016
fabienvauchelles
0
56
Other Decks in Science
See All in Science
サンプル対応のない複数遺伝子発現プロファイルに対するテンソル分解型統合解析の要約
tagtag
PRO
0
280
因果探索の発展と展望
sshimizu2006
2
1.3k
データベース14: B+木 & ハッシュ索引
trycycle
PRO
0
990
チュートリアル:世界モデル
hf149
0
2.5k
GKE上でオセロの強化学習やってみた
akasan
0
120
Leitner Inauguration Lecture Chalmers University of Technology
xleitix
0
400
データベース09: 実体関連モデル上の一貫性制約
trycycle
PRO
0
1.9k
From Prediction to Understanding: Causal Discovery for Data Science and AI Applications
sshimizu2006
0
340
機械学習 - DBSCAN
trycycle
PRO
0
2.3k
JPA2026_NetworkSymposium_Overview
junkashihara
0
110
Build your own LLM, Live, with MicroGPT
ianozsvald
0
170
1. CPC理論の展開と集合的知能モデル(JSAI2026 KS-27 集合的予測符号化と新たな知性の時代)
hayashiyus884
1
430
Featured
See All Featured
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
460
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
650
What's in a price? How to price your products and services
michaelherold
247
13k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
Building the Perfect Custom Keyboard
takai
2
930
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.4k
End of SEO as We Know It (SMX Advanced Version)
ipullrank
3
4.5k
We Are The Robots
honzajavorek
0
410
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
68k
Helping Users Find Their Own Way: Creating Modern Search Experiences
danielanewman
31
3.4k
Amusing Abliteration
ianozsvald
1
370
Transcript
Fabien VAUCHELLES zelros.com /
[email protected]
/ @fabienv http://bit.ly/breizhscraping (24/03/2016)
FABIEN VAUCHELLES Developer for 16 years CTO of Expert in
data extraction (scraping) Creator of Scrapoxy.io
What is Scraping
“Scraping is to transform human-readable webpage into machine-readable data.” Neo
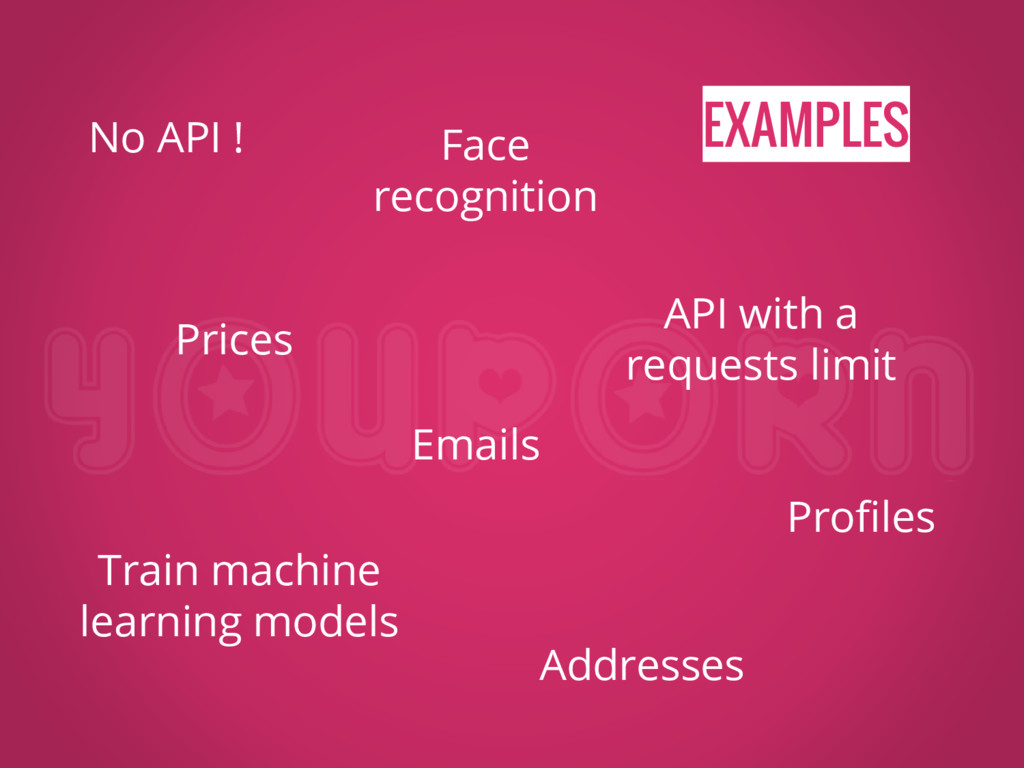
Why do we do Scraping
EXAMPLES No API ! API with a requests limit Prices
Emails Profiles Train machine learning models Addresses Face recognition
“I used Scraping to create my clients list !” Walter
White
FORGET THE LAW 1.
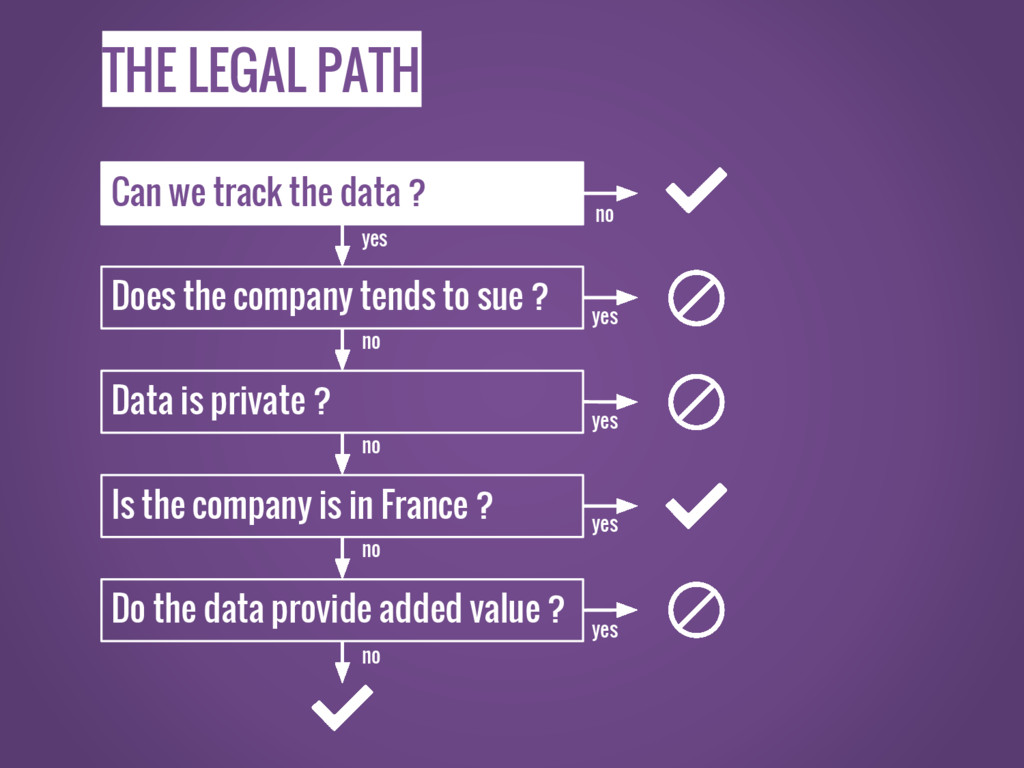
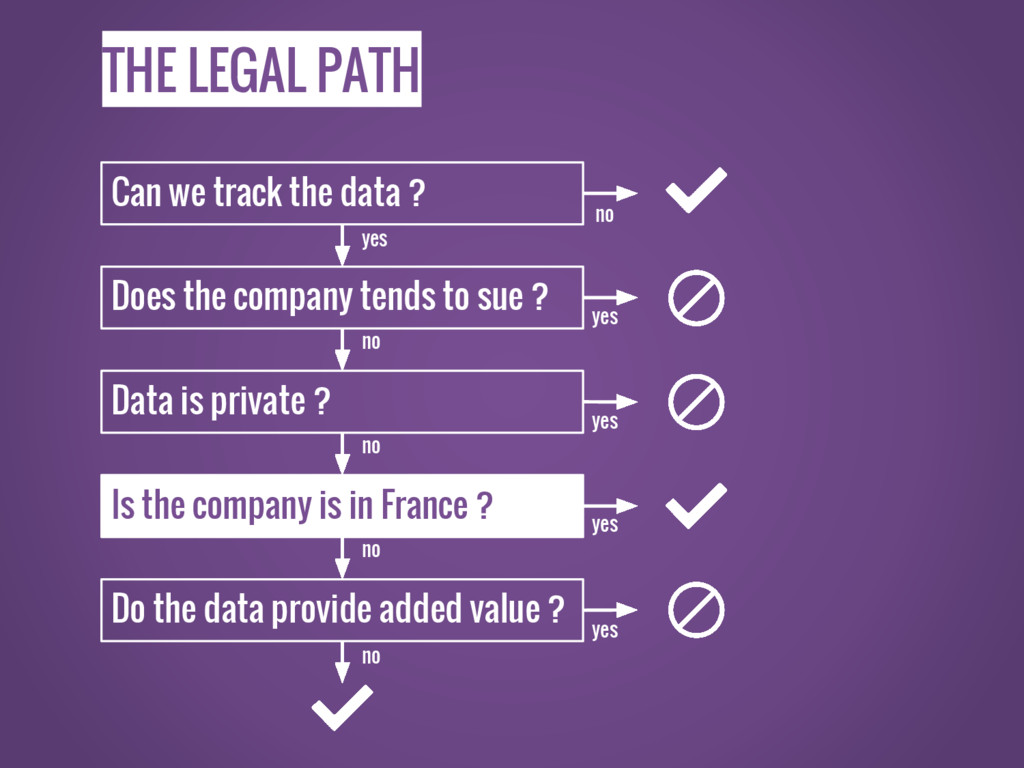
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
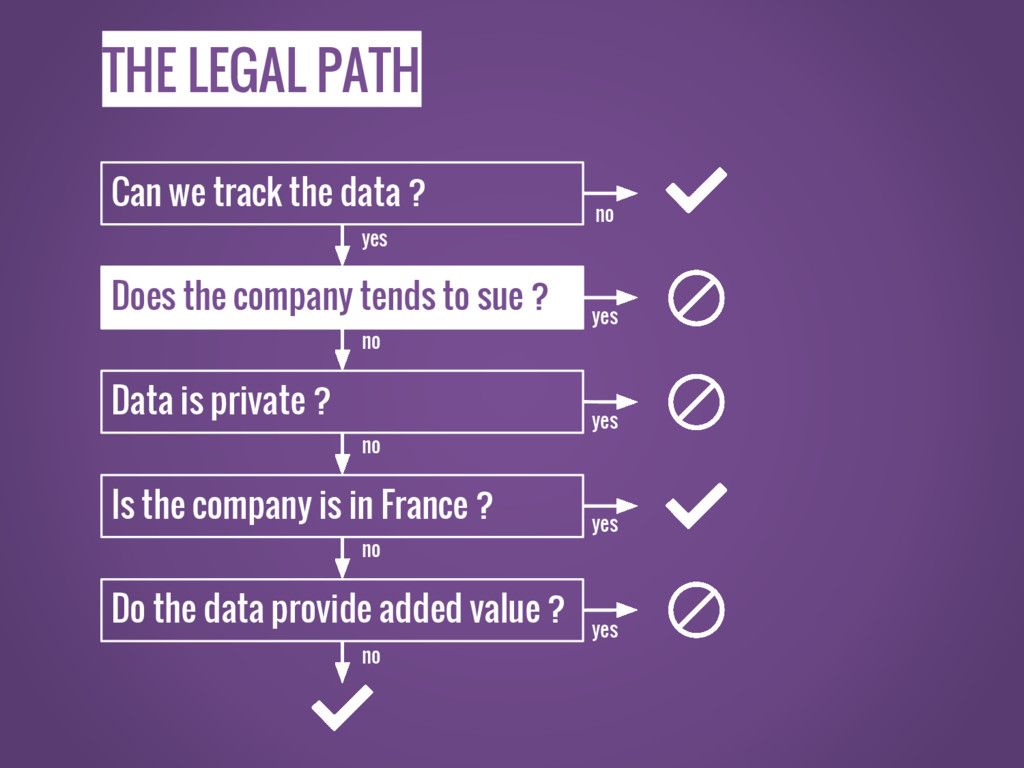
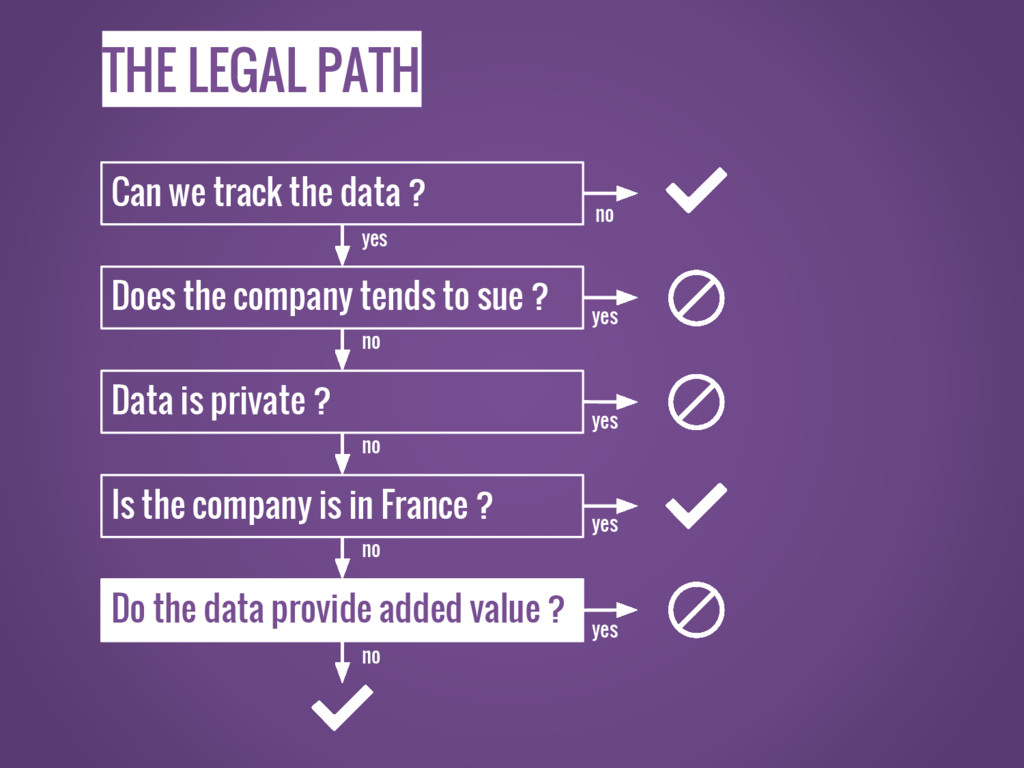
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
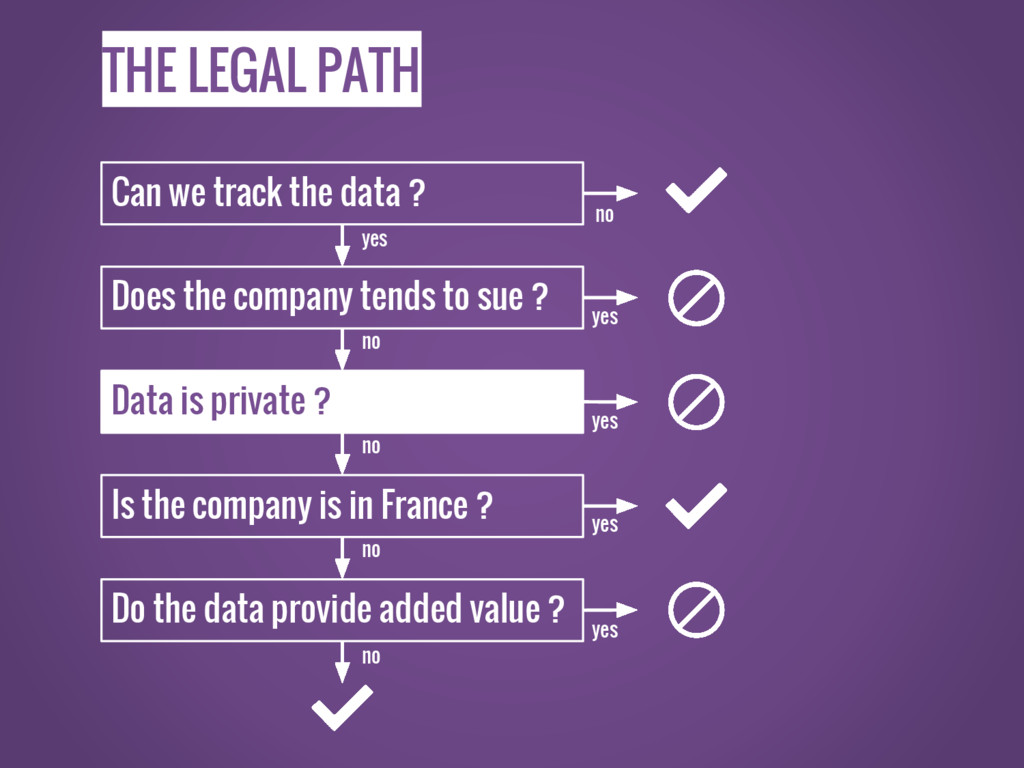
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
THE LEGAL PATH Can we track the data ? Does
the company tends to sue ? Data is private ? Is the company is in France ? Do the data provide added value ? no yes yes yes yes no no no no yes
RUBBER DUCK E-MARKET LET’S STUDY THE
BUILD YOUR OWN SCRIPT 2.
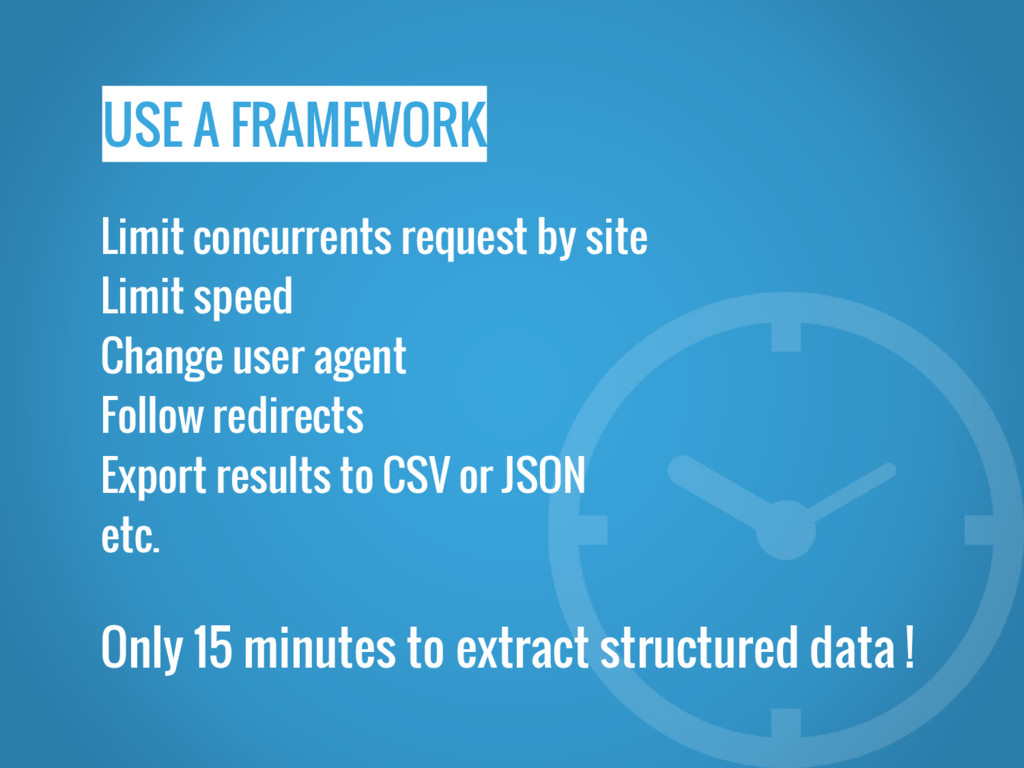
USE A FRAMEWORK Limit concurrents request by site Limit speed
Change user agent Follow redirects Export results to CSV or JSON etc. Only 15 minutes to extract structured data !
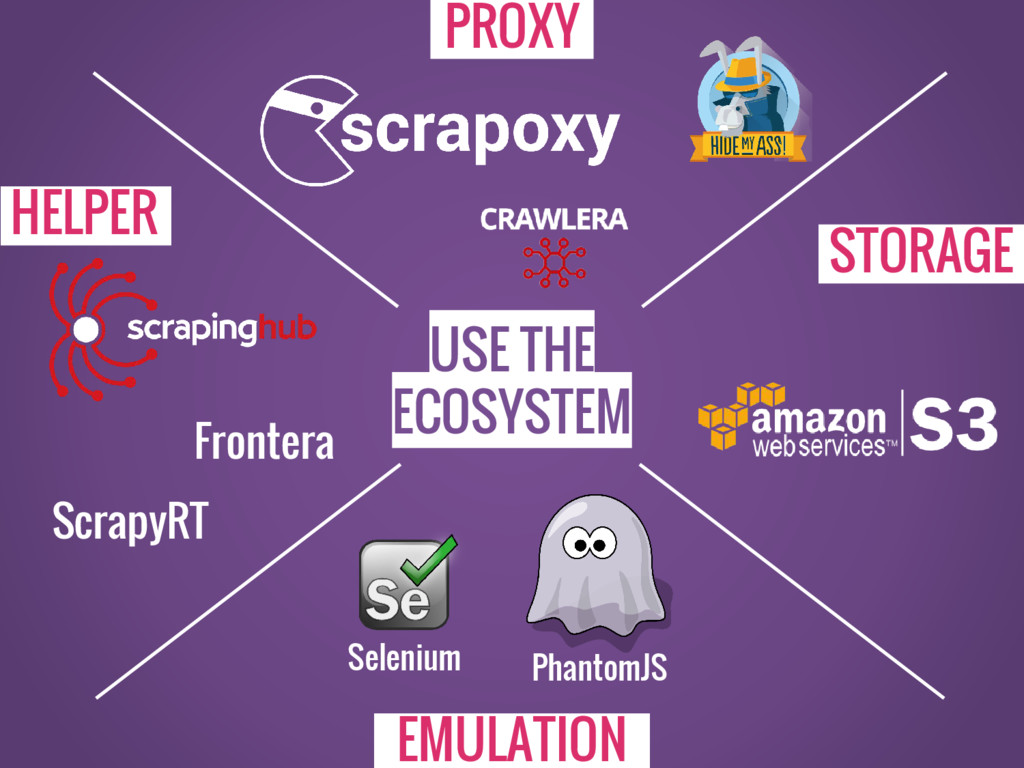
USE THE ECOSYSTEM Frontera ScrapyRT PhantomJS Selenium PROXY EMULATION HELPER
STORAGE
RUSH ON THE FIRST DATA SOURCE 3.
FIND THE EXPORT BUTTON
TAKE TIME TO FIND DATA
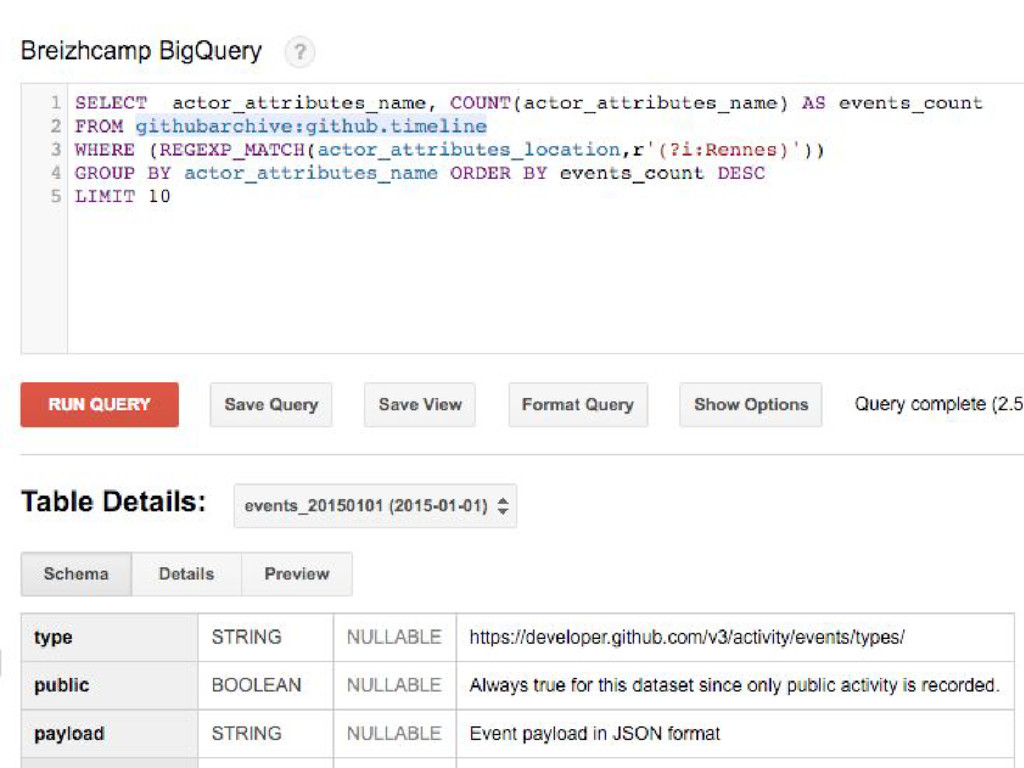
How to find a developer on Rennes
#1. GO TO BREIZHCAMP
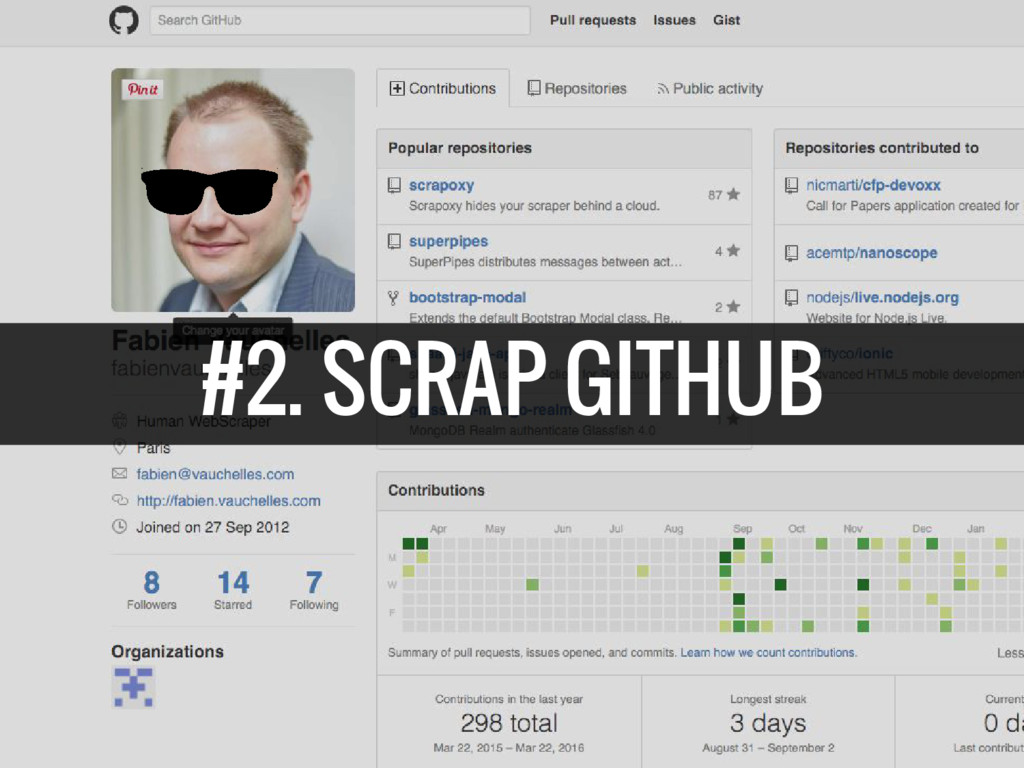
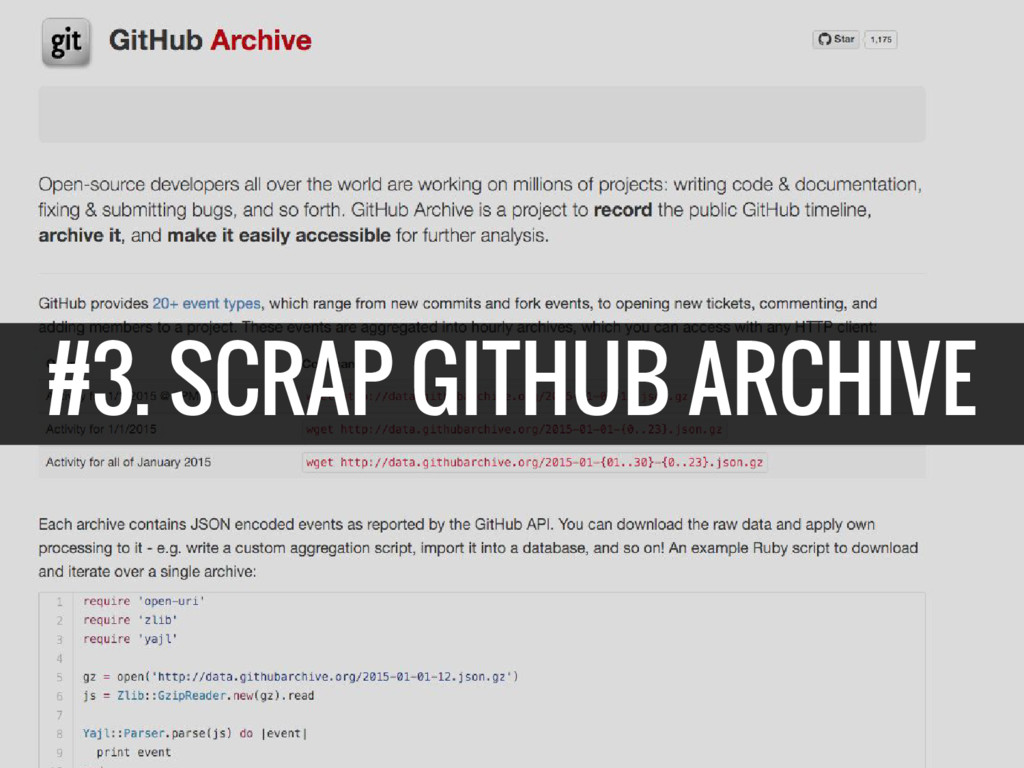
#2. SCRAP GITHUB
#3. SCRAP GITHUB ARCHIVE
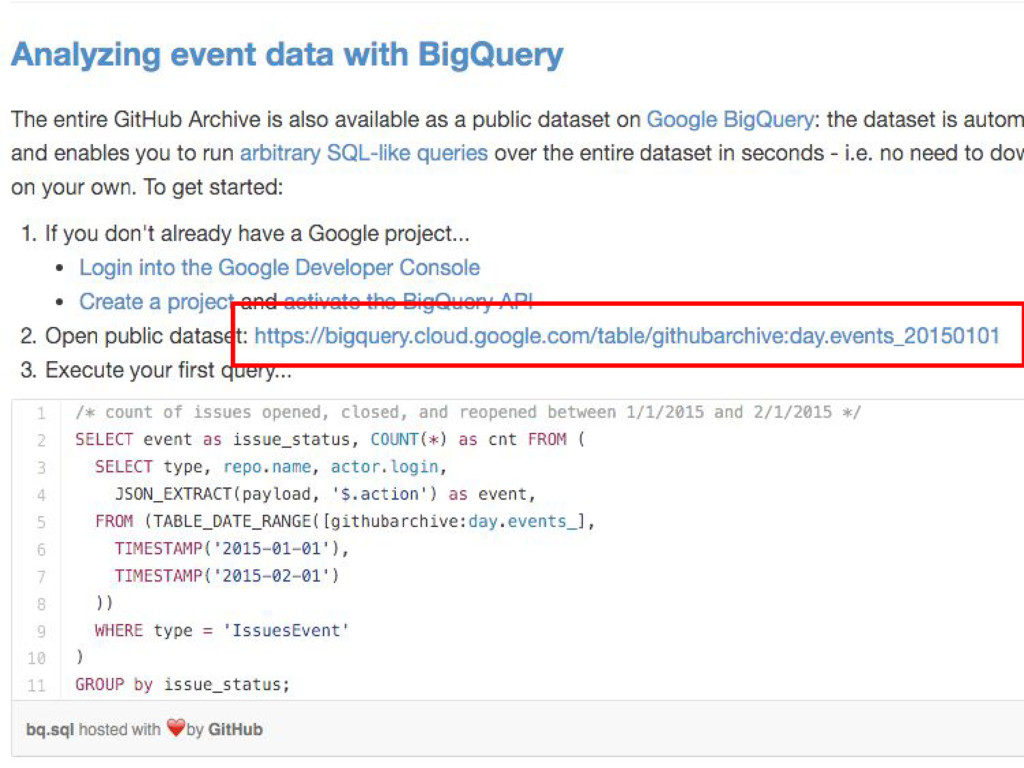
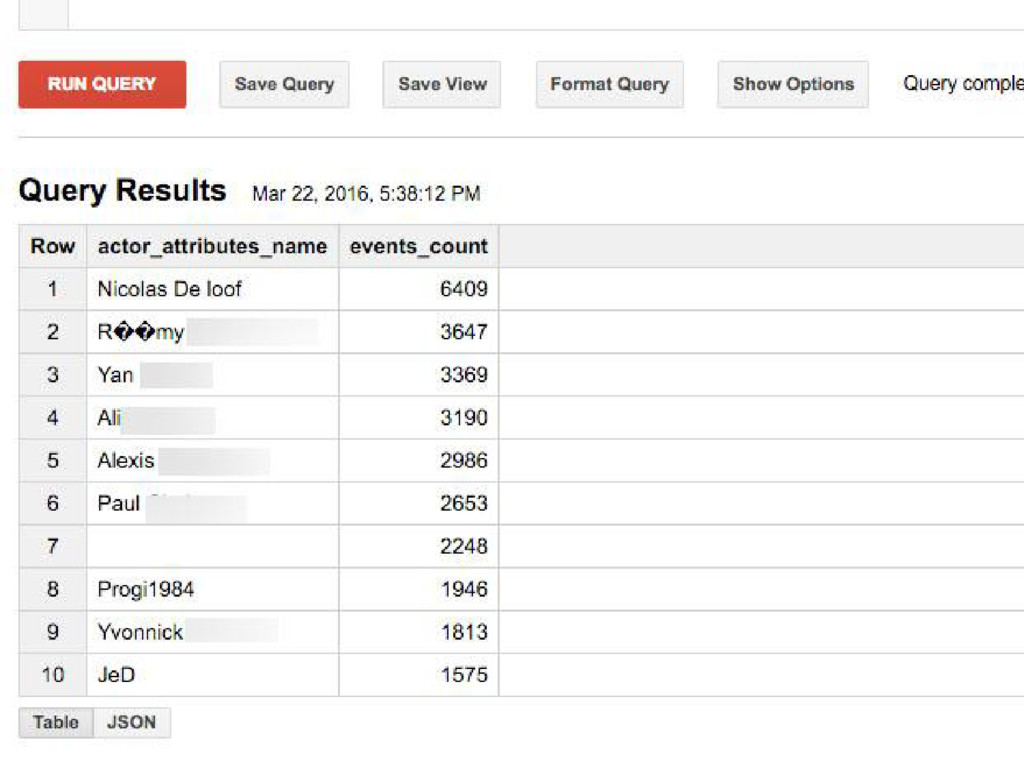
#4. USE GOOGLE BIG QUERY
None
None
None
KEEP THE DEFAULT USER-AGENT 4.
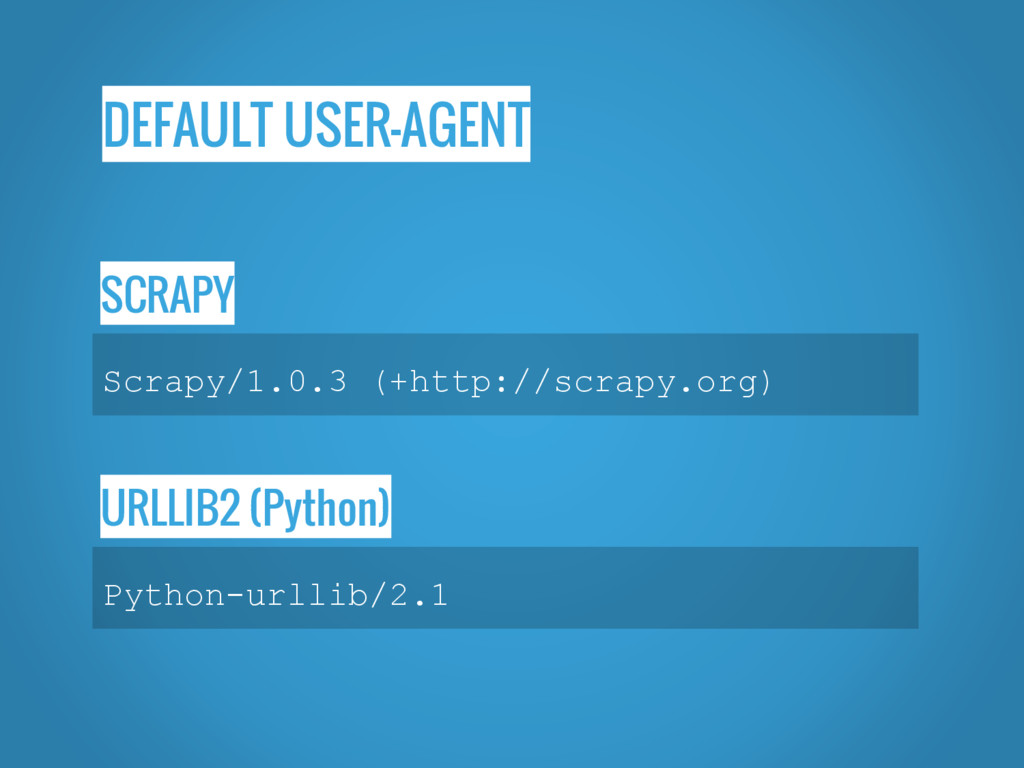
DEFAULT USER-AGENT SCRAPY Scrapy/1.0.3 (+http://scrapy.org) URLLIB2 (Python) Python-urllib/2.1
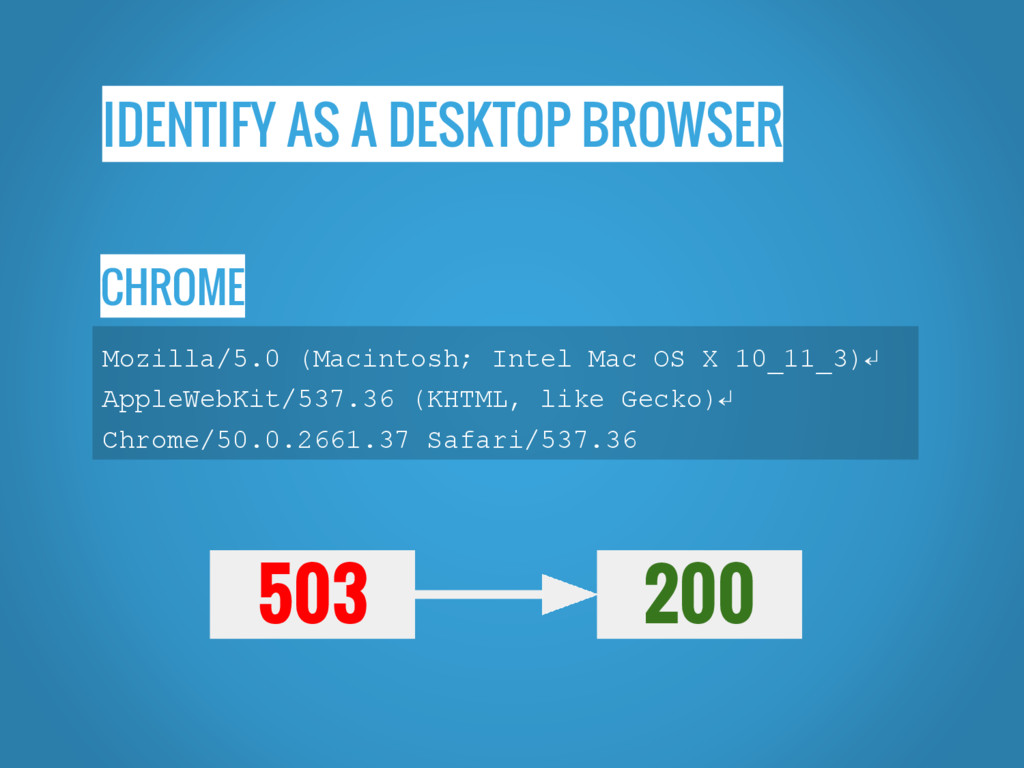
IDENTIFY AS A DESKTOP BROWSER CHROME Mozilla/5.0 (Macintosh; Intel Mac
OS X 10_11_3)↵ AppleWebKit/537.36 (KHTML, like Gecko)↵ Chrome/50.0.2661.37 Safari/537.36 200 503
SCRAP WITH YOUR DSL ACCESS 5.
BLACKLISTED
What is Blacklisting
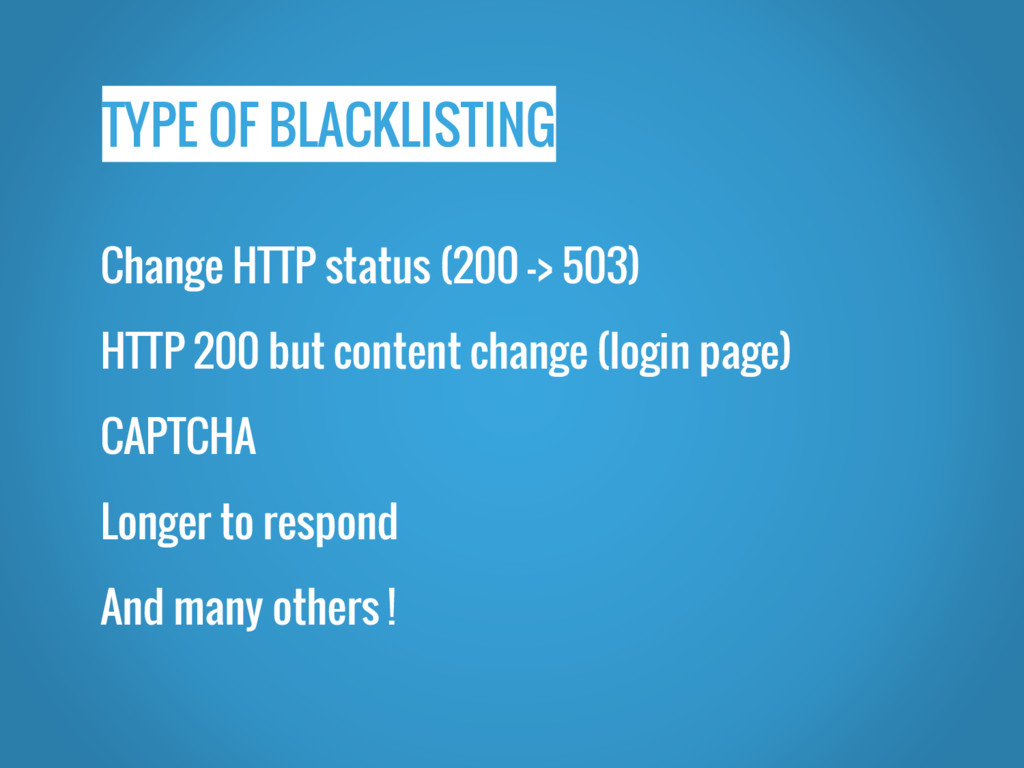
TYPE OF BLACKLISTING Change HTTP status (200 -> 503) HTTP
200 but content change (login page) CAPTCHA Longer to respond And many others !
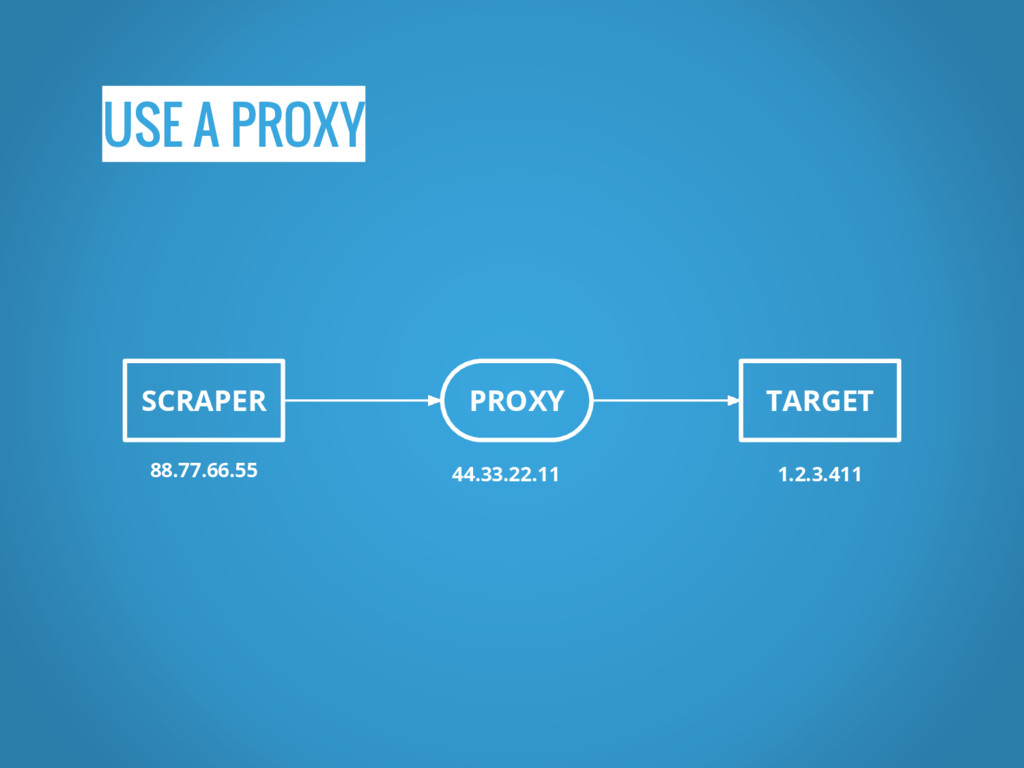
USE A PROXY SCRAPER PROXY TARGET 88.77.66.55 44.33.22.11 1.2.3.411
TYPE OF PROXIES PUBLIC PRIVATE
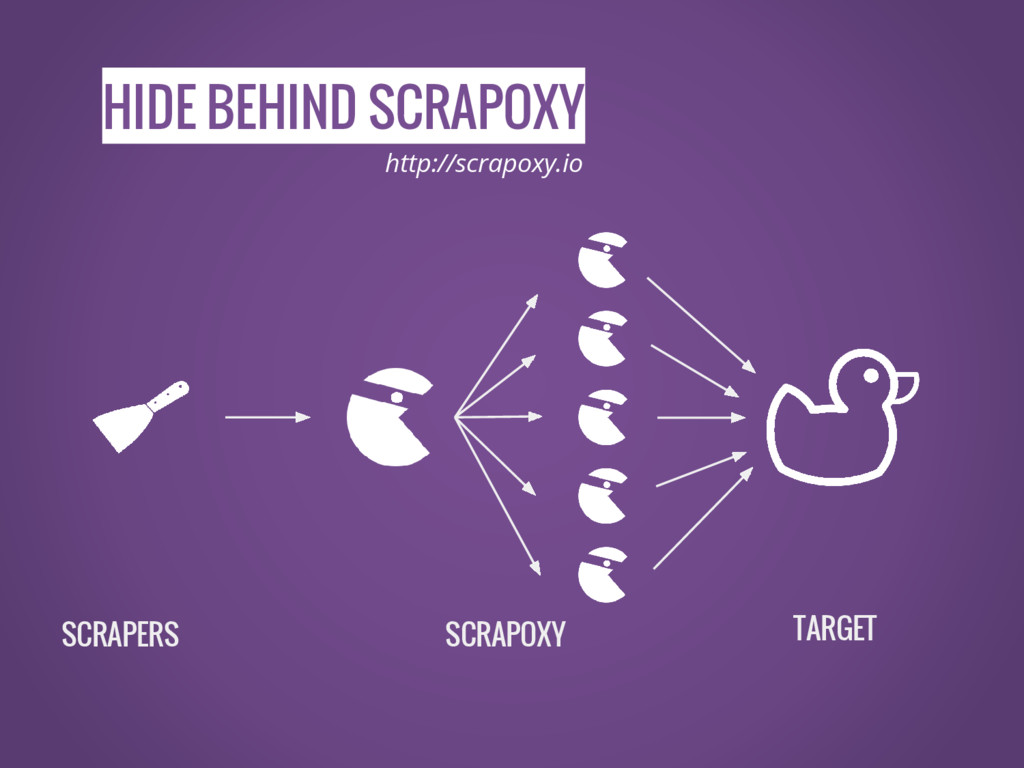
HIDE BEHIND SCRAPOXY SCRAPERS SCRAPOXY TARGET http://scrapoxy.io
TRIGGER ALERTS ON THE REMOTE SITE 6.
STAY OFF THE RADAR
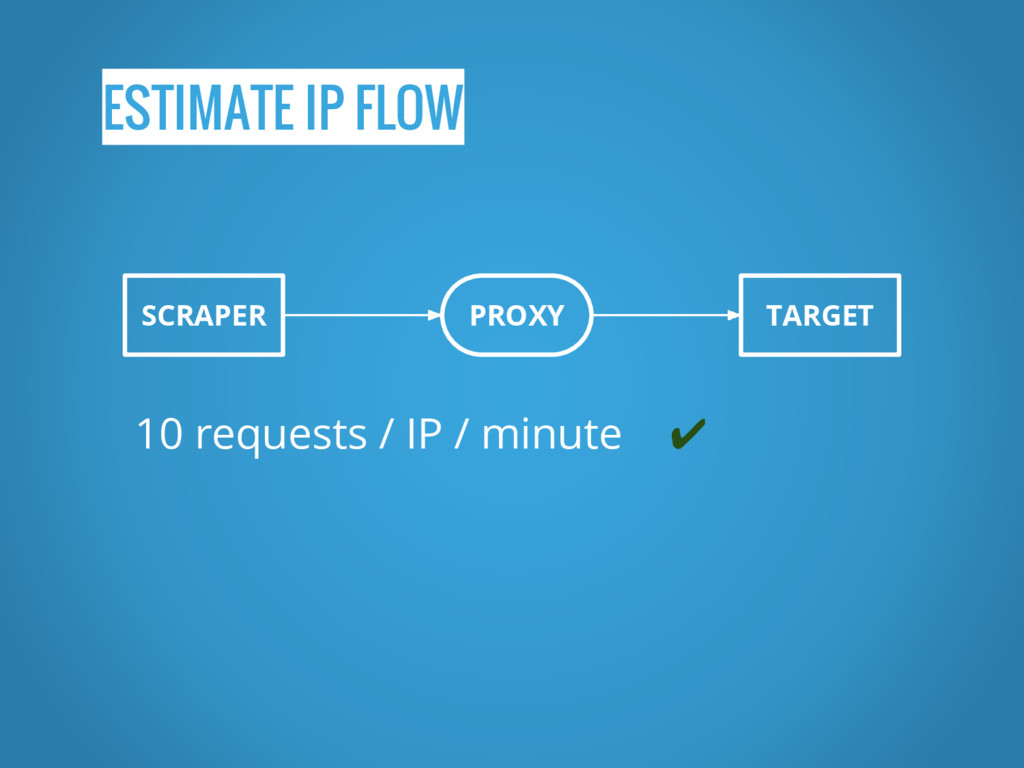
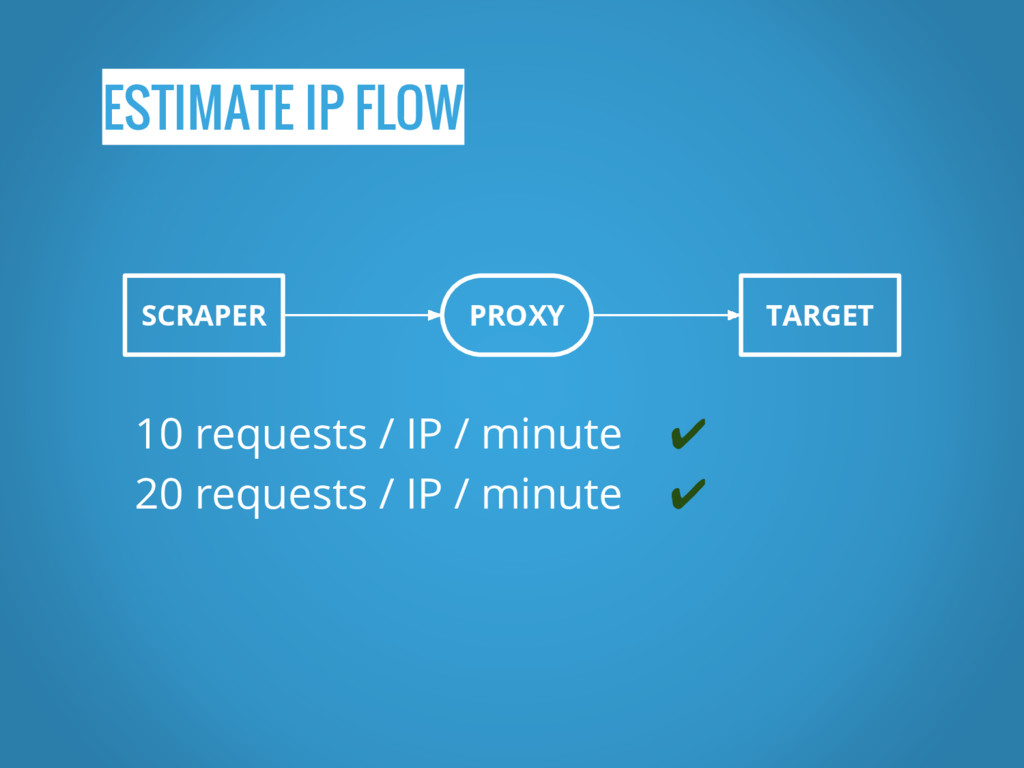
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔ 20 requests / IP / minute ✔
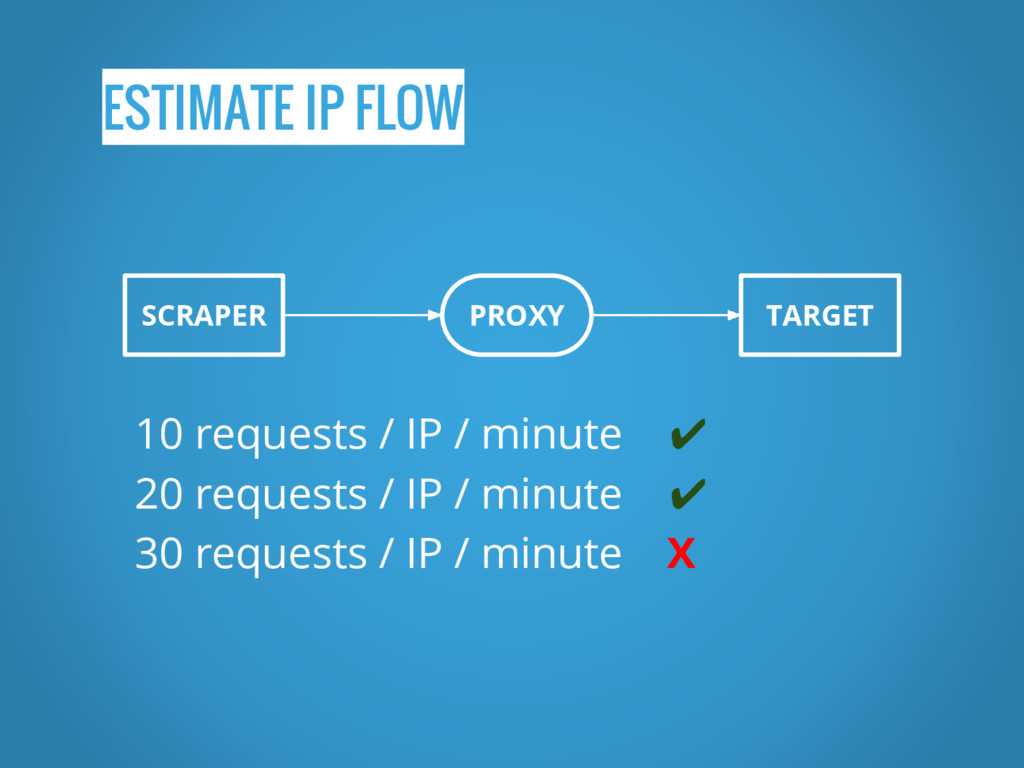
ESTIMATE IP FLOW SCRAPER PROXY TARGET 10 requests / IP
/ minute ✔ 20 requests / IP / minute ✔ 30 requests / IP / minute X
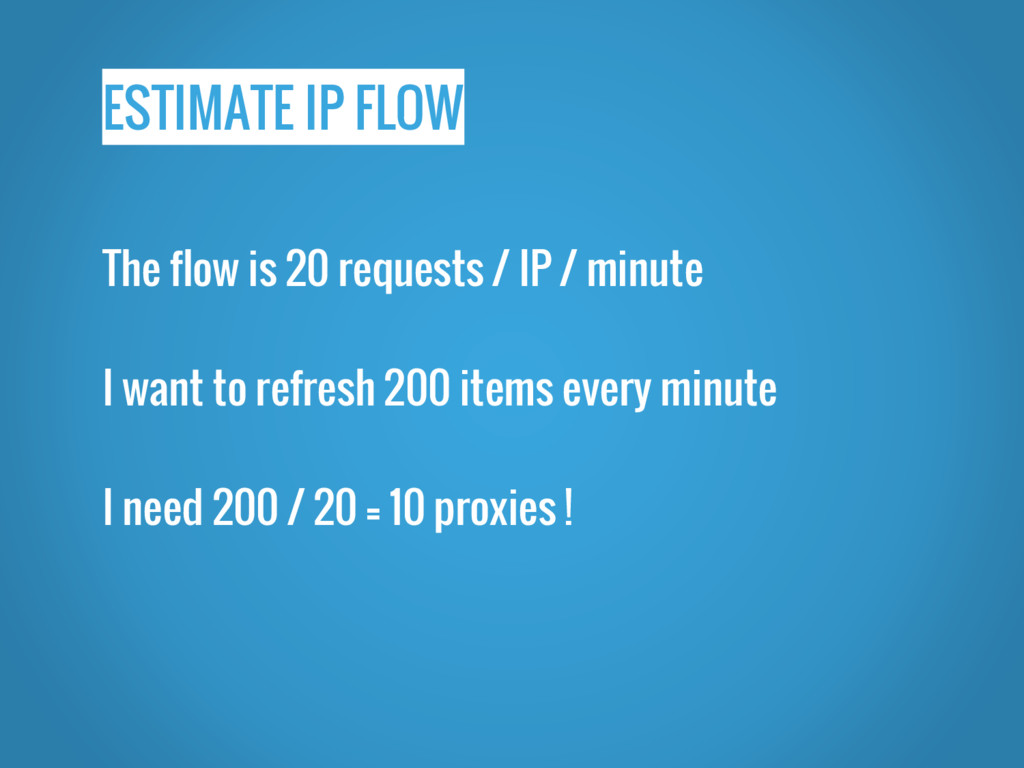
ESTIMATE IP FLOW The flow is 20 requests / IP
/ minute I want to refresh 200 items every minute I need 200 / 20 = 10 proxies !
MIX UP SCRAPER AND CRAWLER 7.
SCRAPERS ARE NOT CRAWLERS
FOCUS ON ESSENTIAL
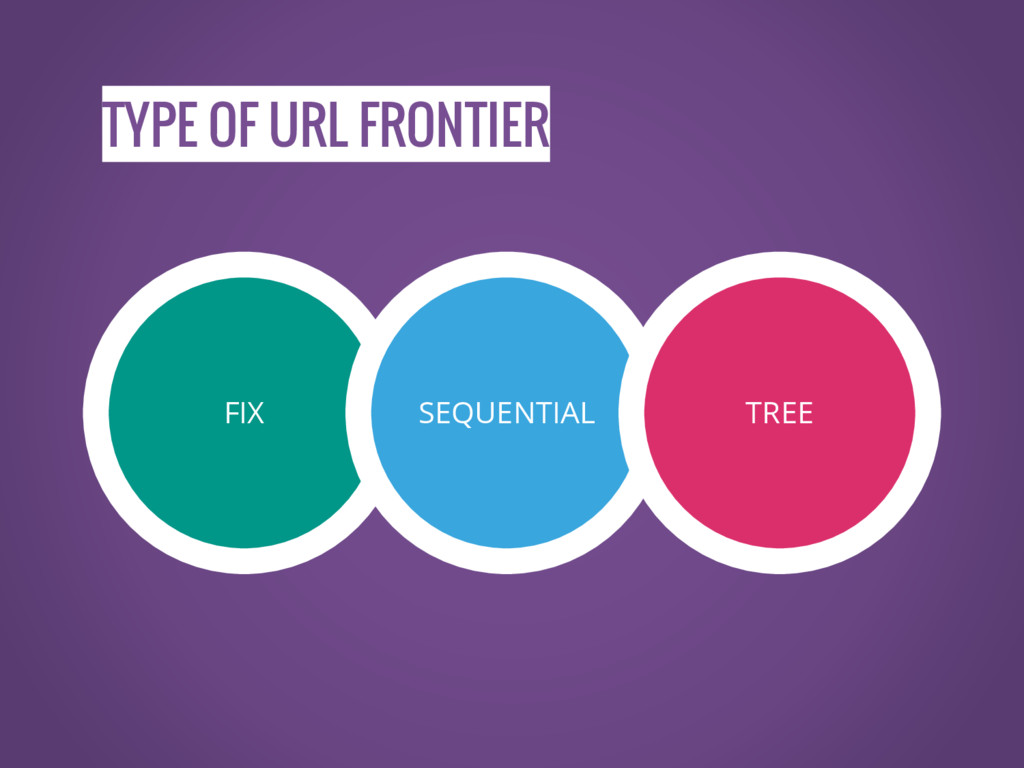
What is the URL frontier
URL frontier is the list of URL to fetch.
TYPE OF URL FRONTIER FIX SEQUENTIAL TREE
STORE ONLY PARSED RESULTS 8.
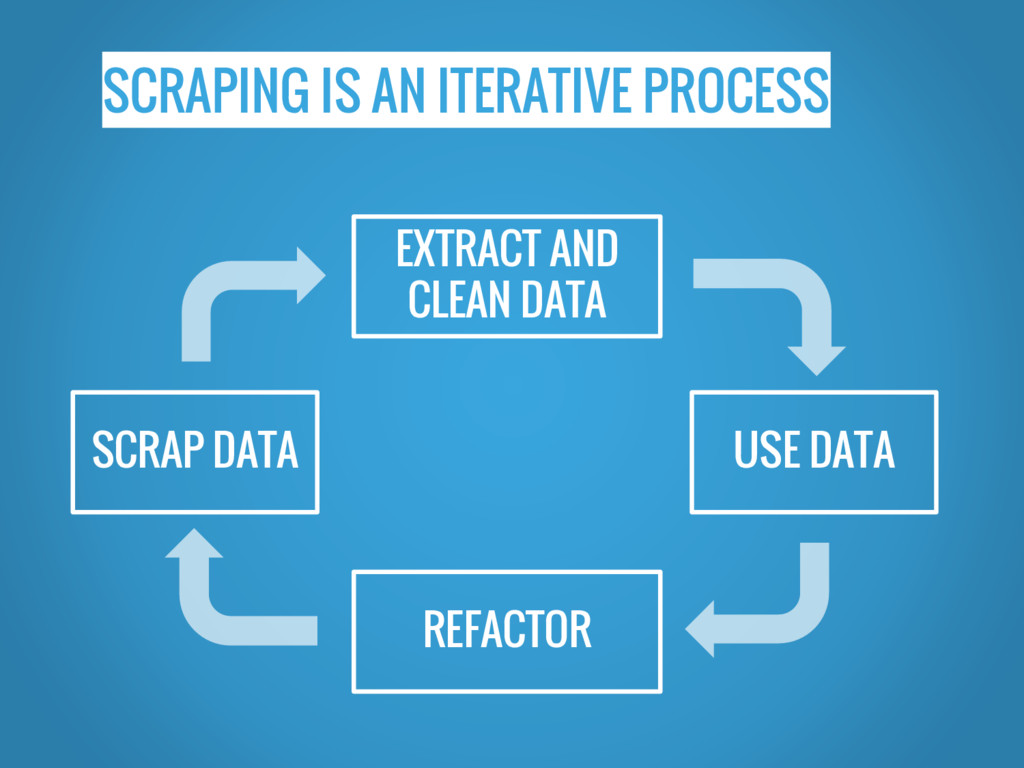
SCRAPING IS AN ITERATIVE PROCESS EXTRACT AND CLEAN DATA SCRAP
DATA USE DATA REFACTOR
SCRAP EVERYTHING... AGAIN ?
STORE FULL HTML PAGE
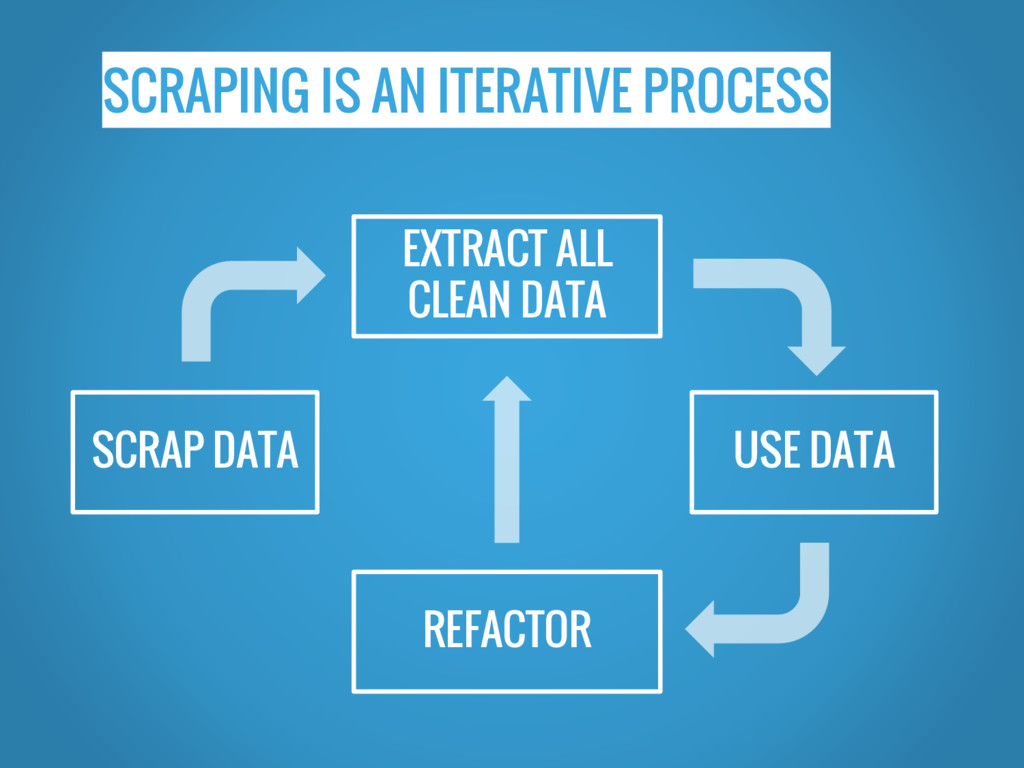
SCRAPING IS AN ITERATIVE PROCESS EXTRACT ALL CLEAN DATA SCRAP
DATA USE DATA REFACTOR
STORE WEBPAGE ONE BY ONE 9.
STORAGE CAN’T MANAGE MILLIONS OF SMALL FILES !
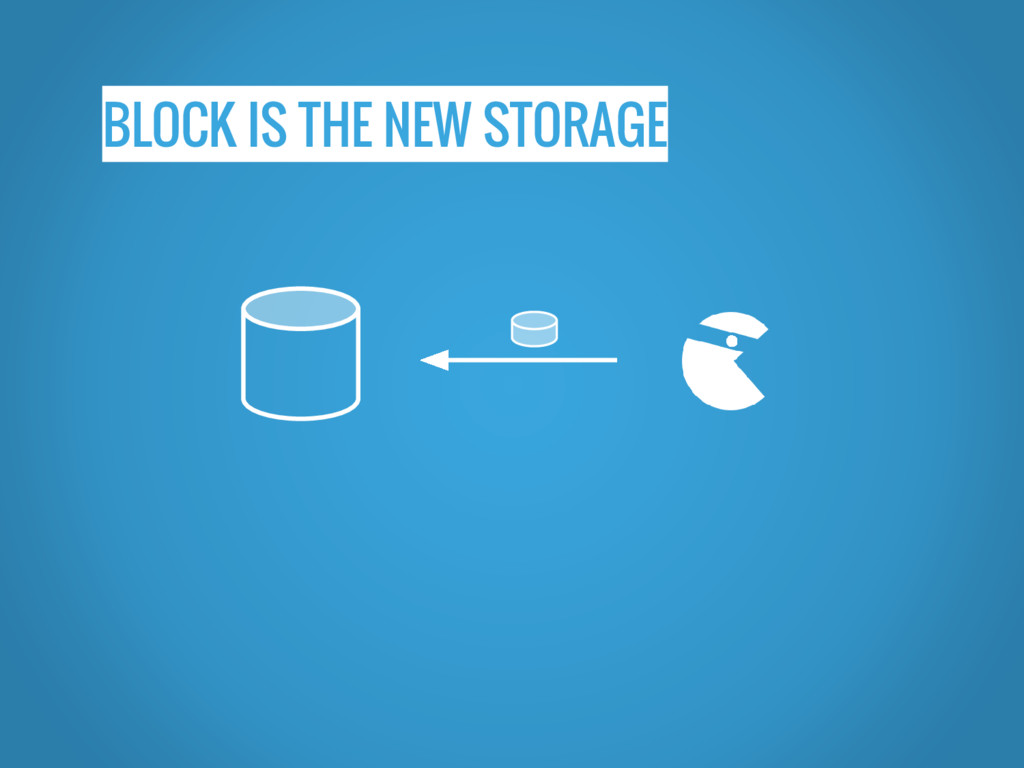
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
BLOCK IS THE NEW STORAGE
STORE HTML IN 128 MO ZIPPED FILES
PARSING IS SIMPLE ! 10.
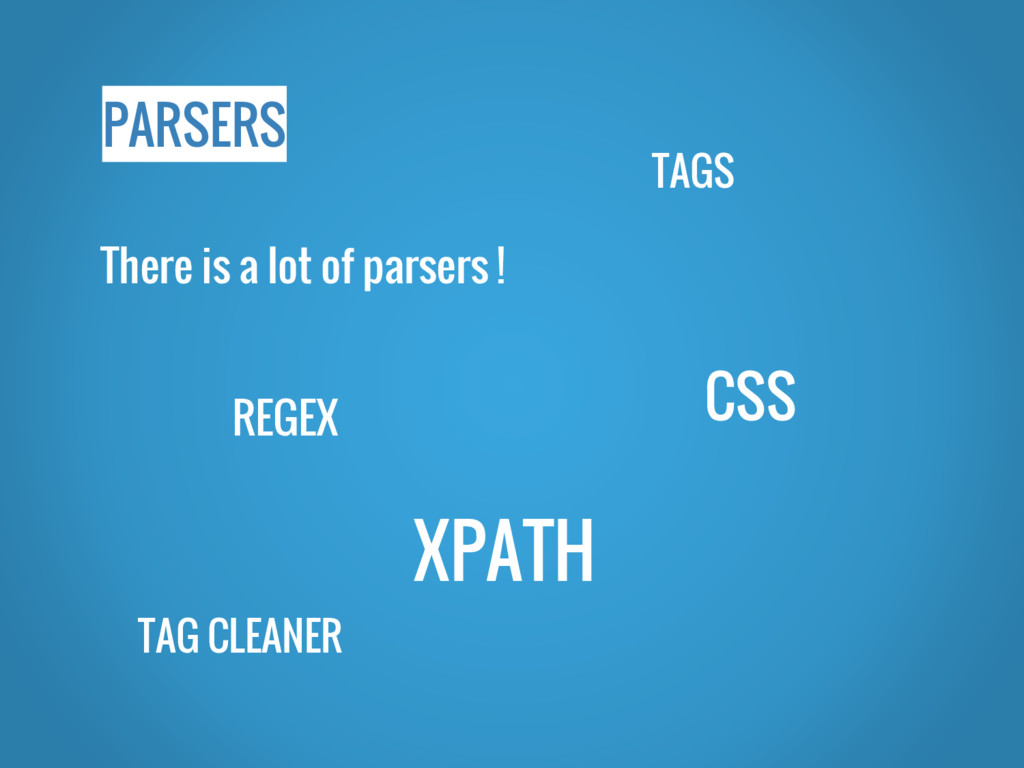
PARSERS There is a lot of parsers ! XPATH CSS
REGEX TAGS TAG CLEANER
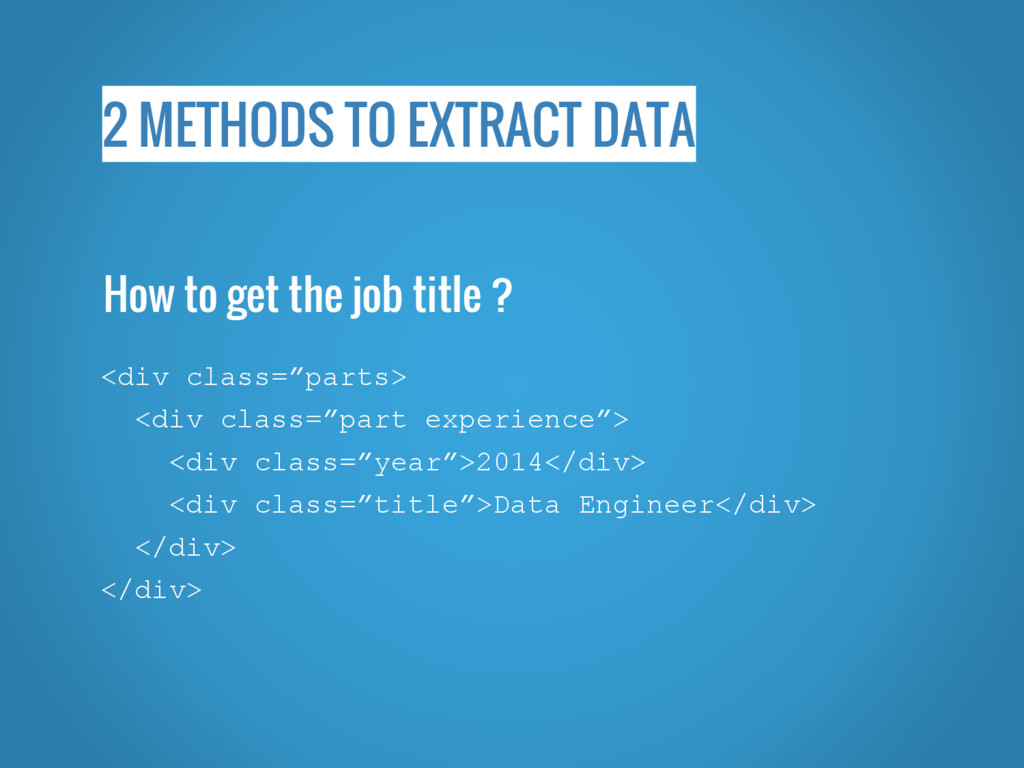
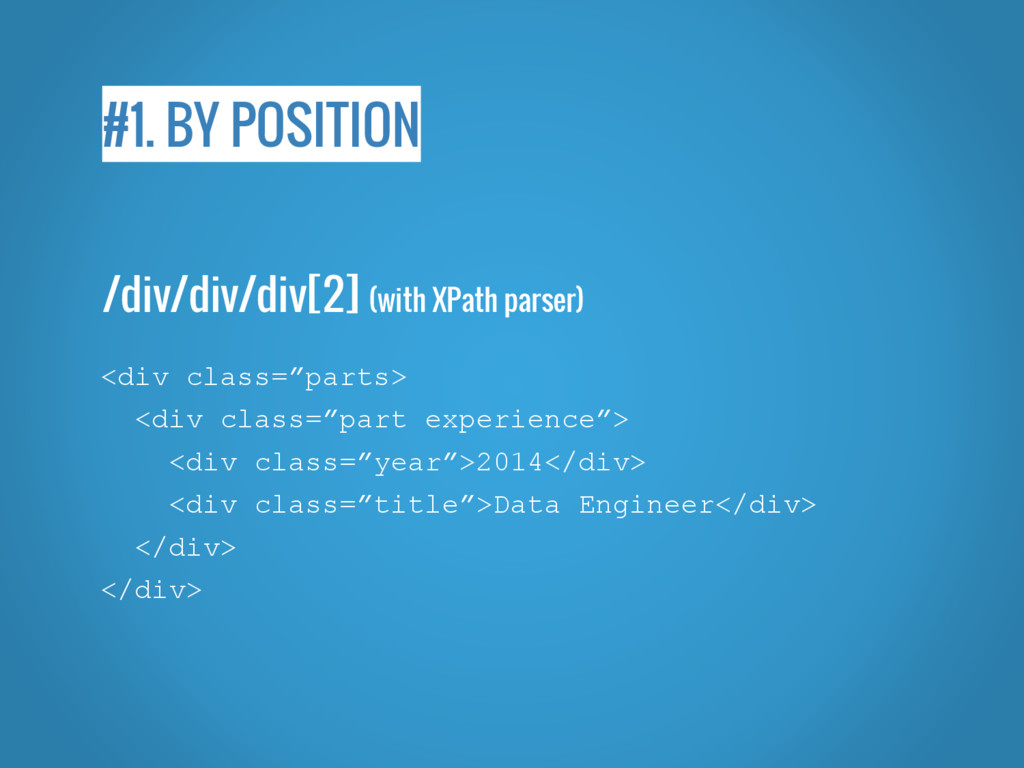
2 METHODS TO EXTRACT DATA <div class=”parts> <div class=”part experience”>
<div class=”year”>2014</div> <div class=”title”>Data Engineer</div> </div> </div> How to get the job title ?
#1. BY POSITION <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”title”>Data Engineer</div> </div> </div> /div/div/div[2] (with XPath parser)
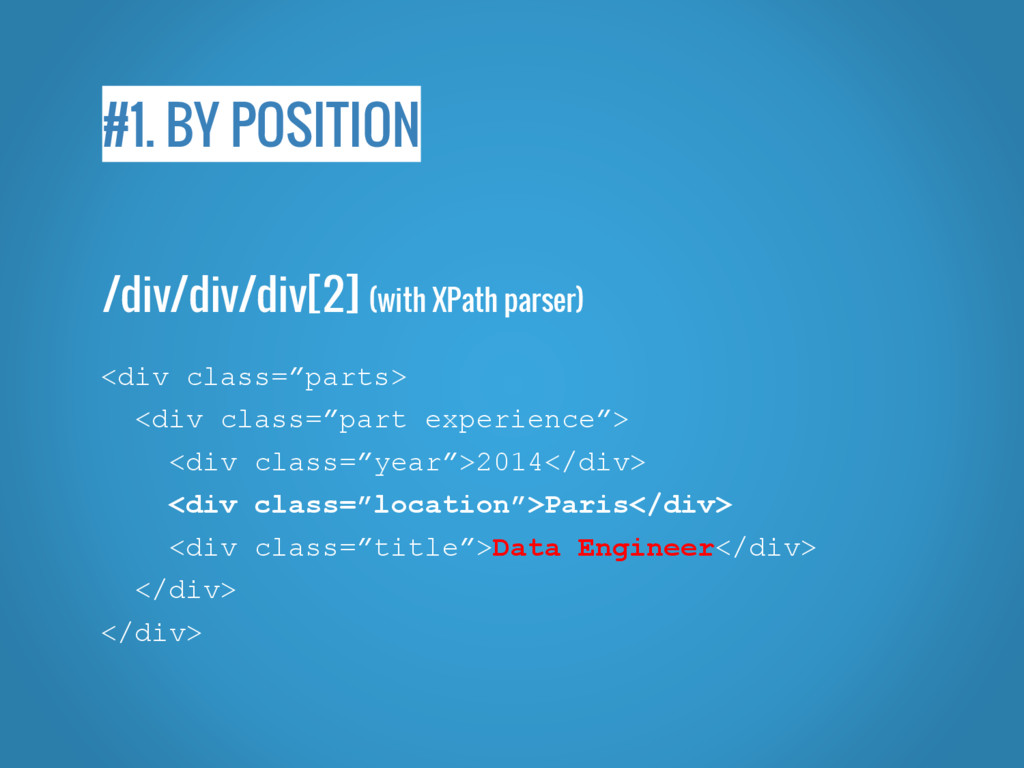
#1. BY POSITION <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”location”>Paris</div> <div class=”title”>Data Engineer</div> </div> </div> /div/div/div[2] (with XPath parser)
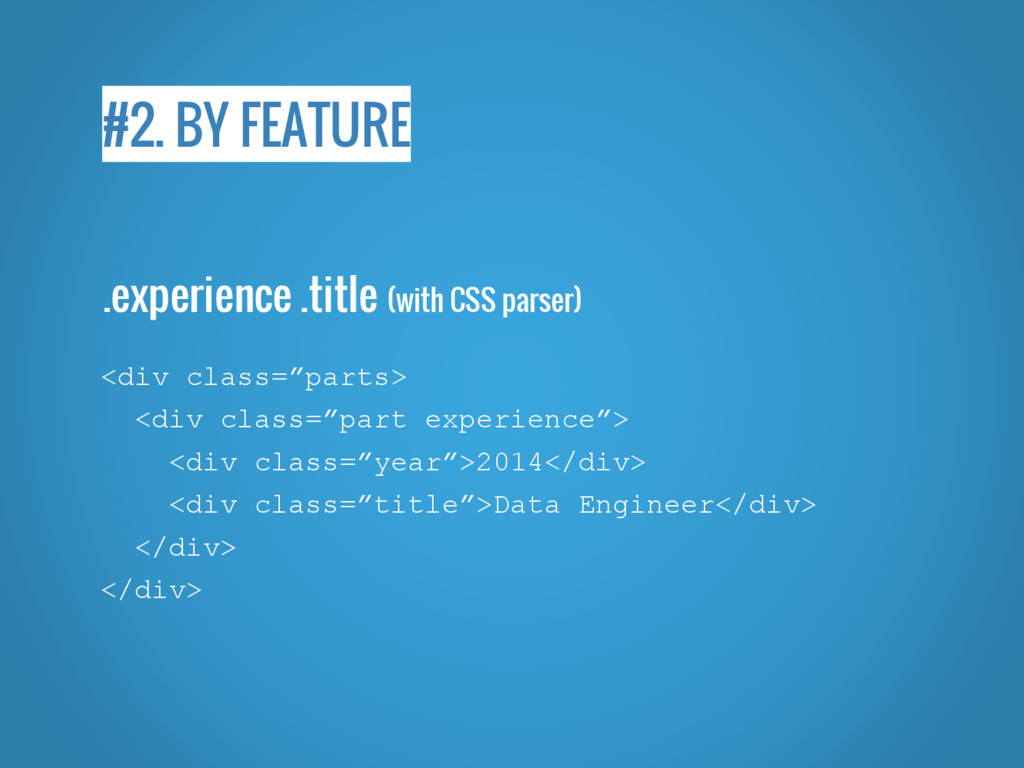
#2. BY FEATURE <div class=”parts> <div class=”part experience”> <div class=”year”>2014</div>
<div class=”title”>Data Engineer</div> </div> </div> .experience .title (with CSS parser)
LET’S RECAP !
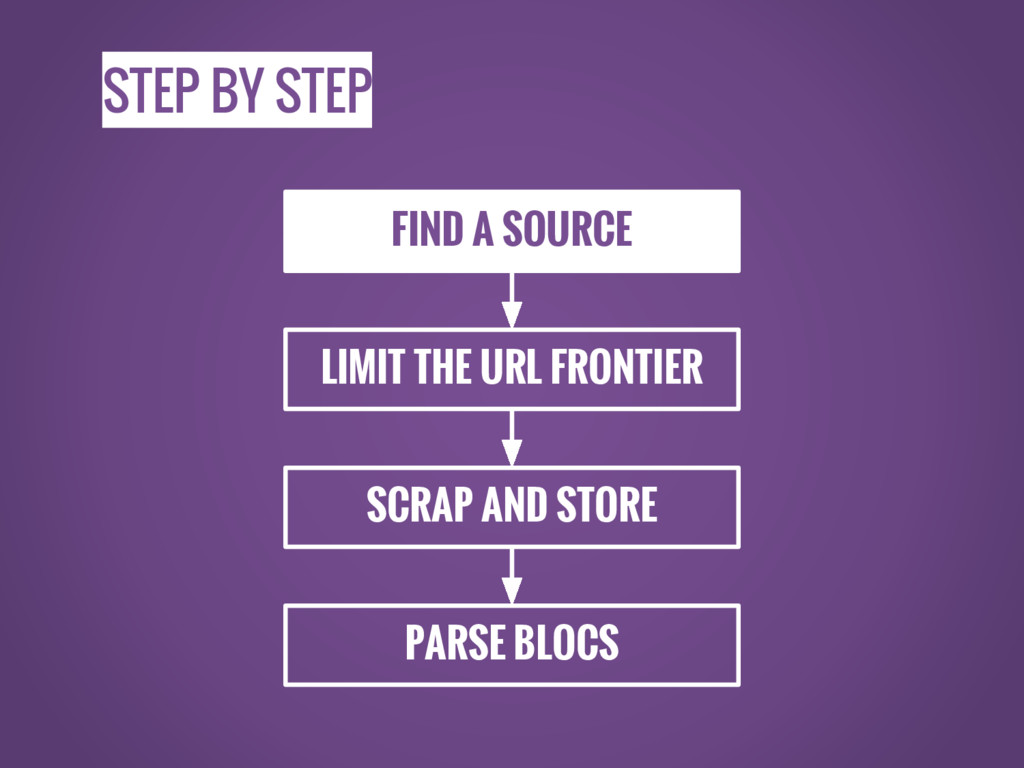
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
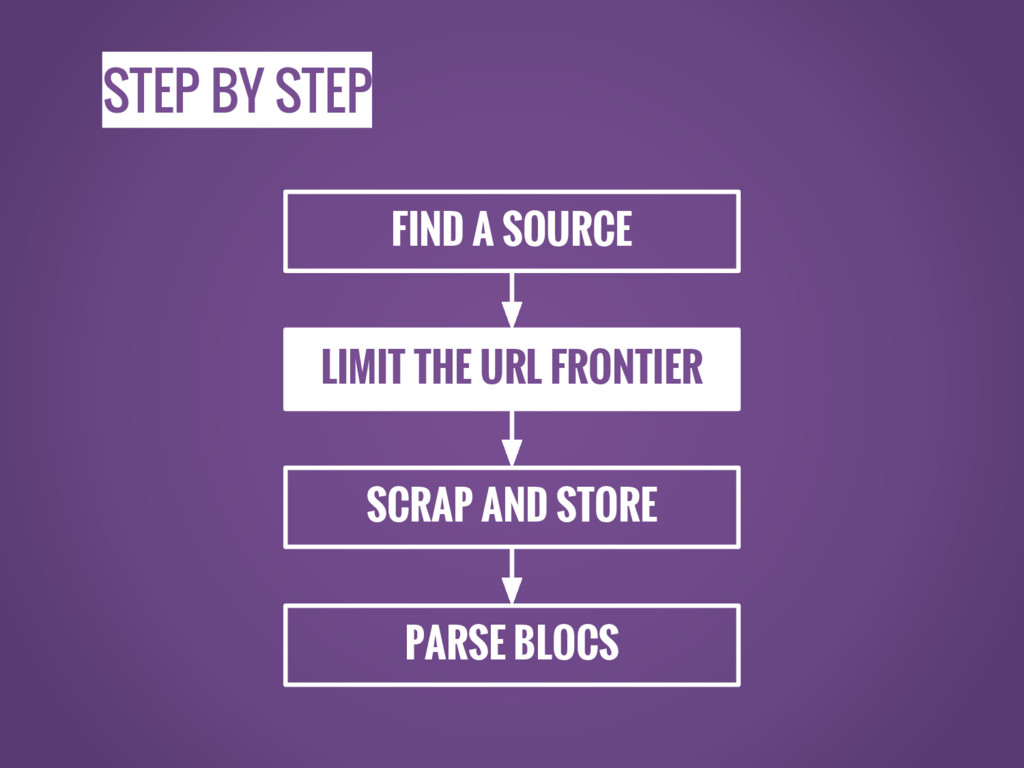
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
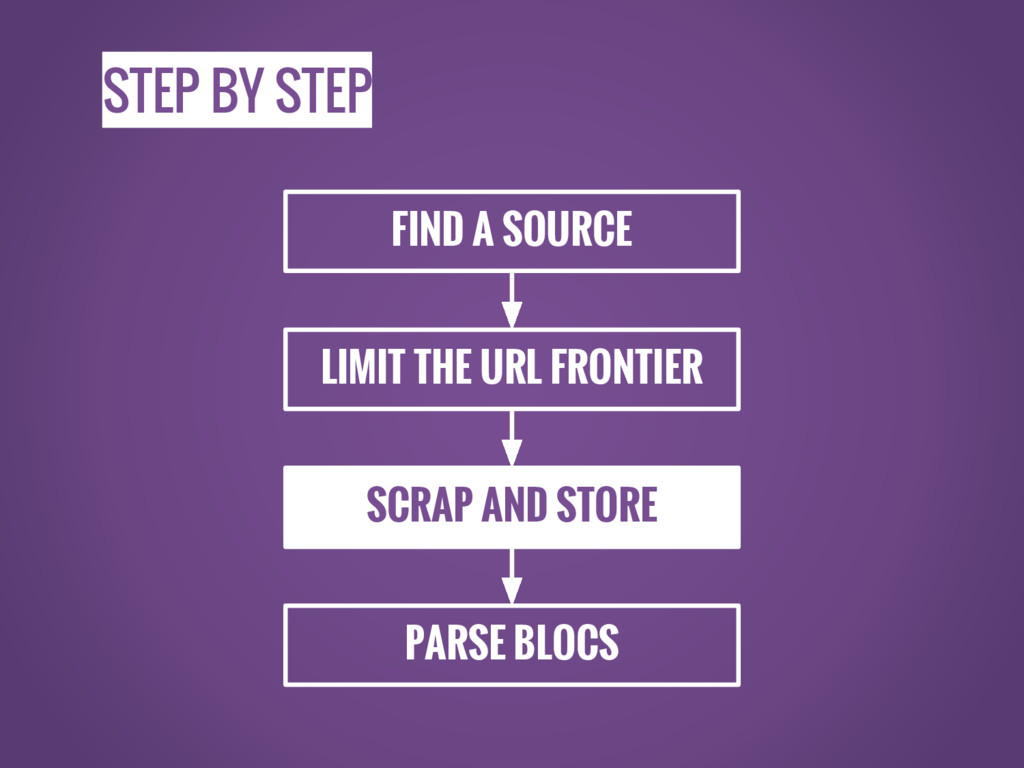
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
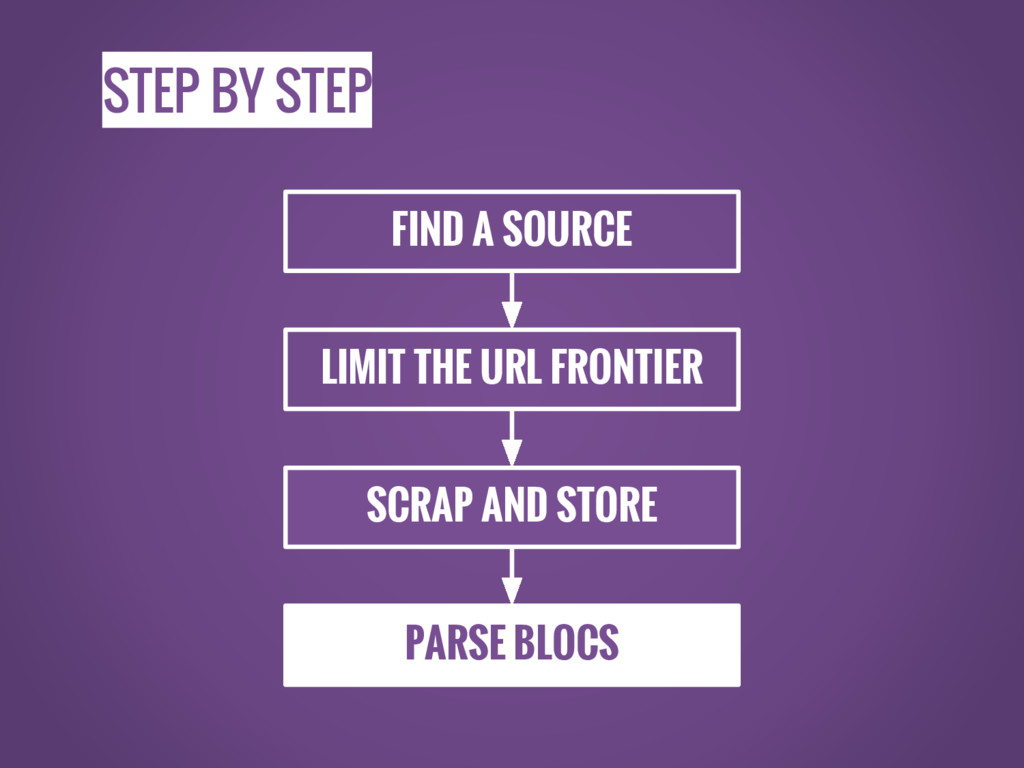
STEP BY STEP FIND A SOURCE LIMIT THE URL FRONTIER
SCRAP AND STORE PARSE BLOCS
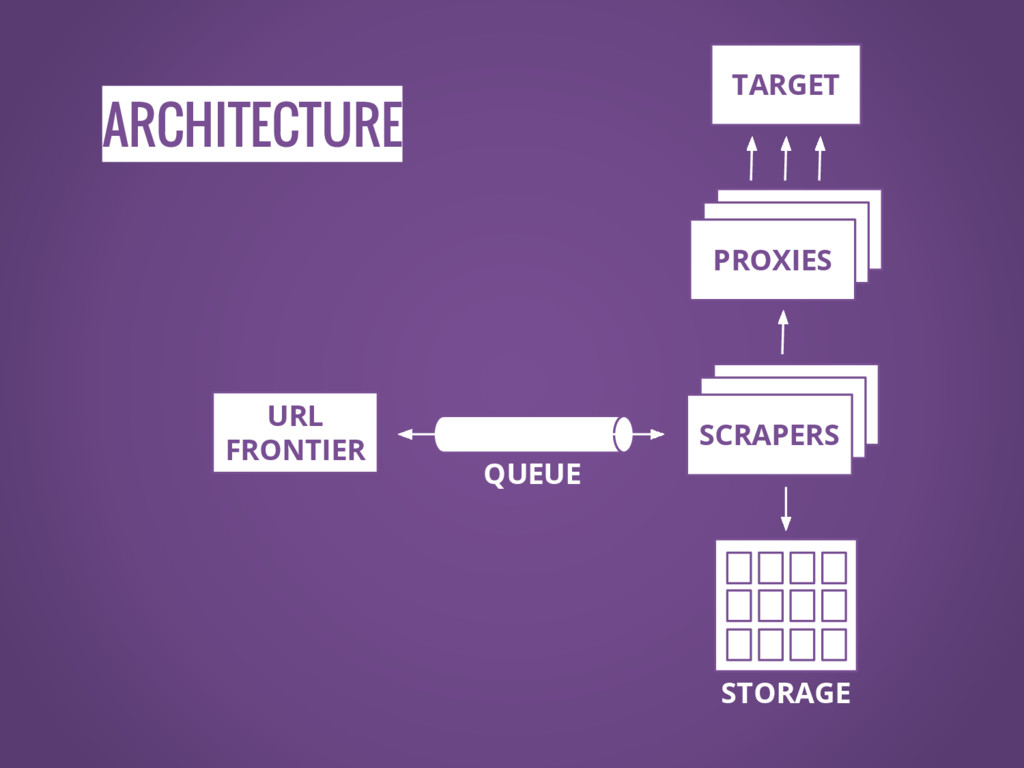
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS
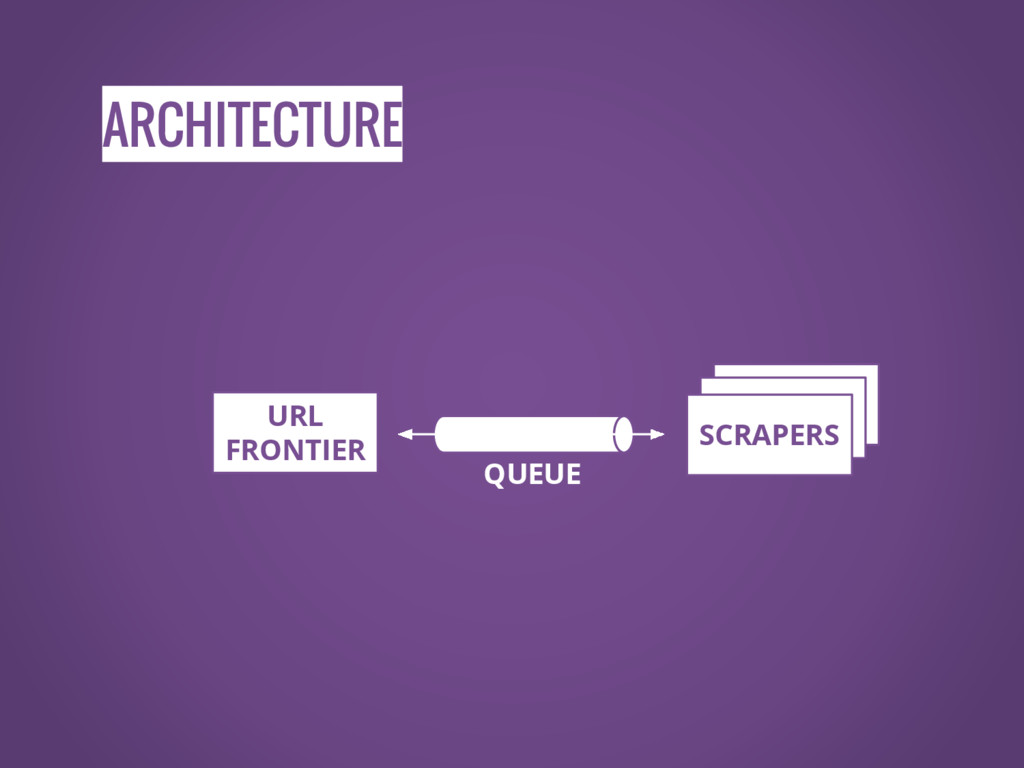
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS URL FRONTIER QUEUE
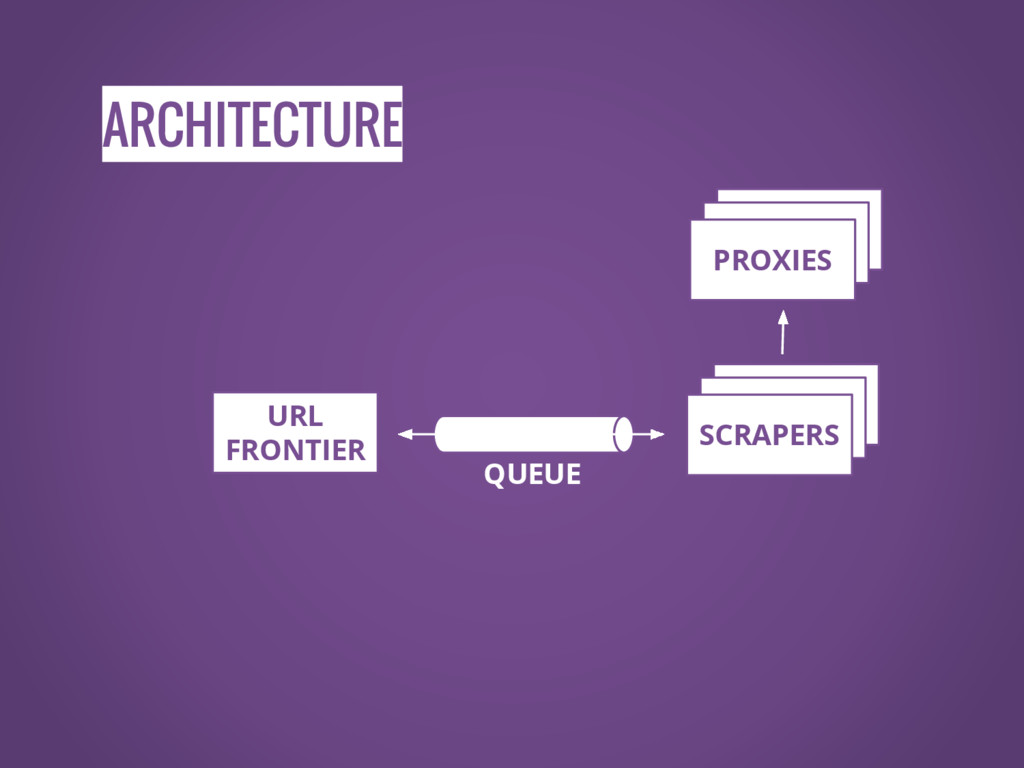
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER QUEUE
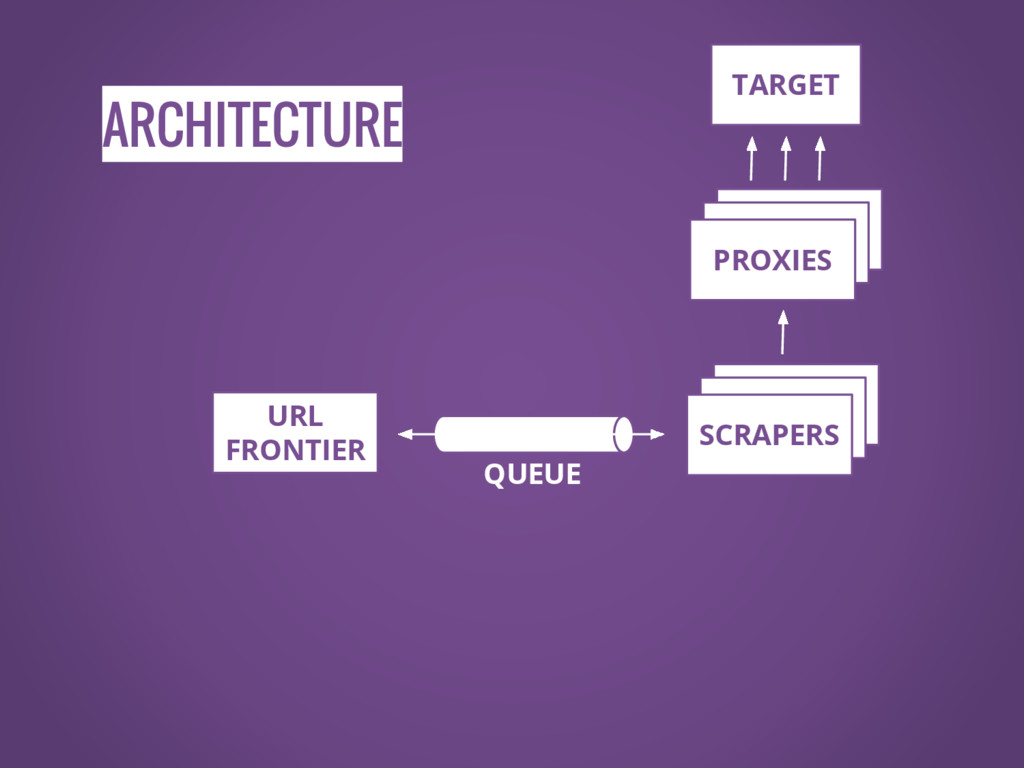
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER TARGET
QUEUE
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER STORAGE
TARGET QUEUE
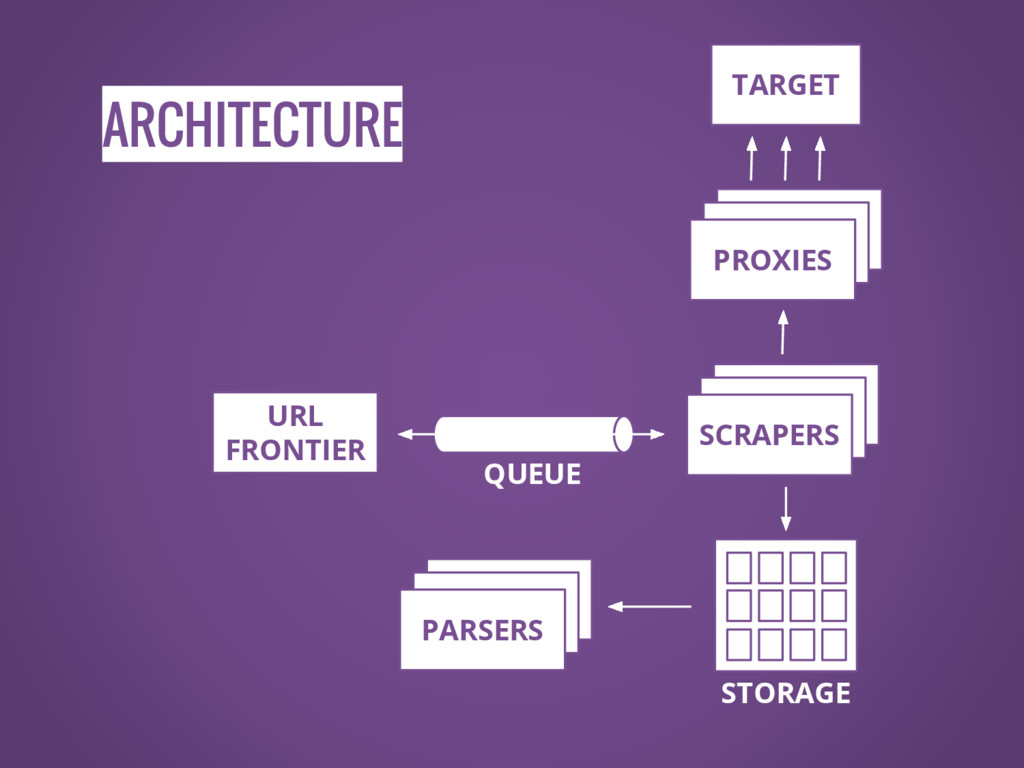
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER SCRAPERS
SCRAPERS PARSERS STORAGE TARGET QUEUE
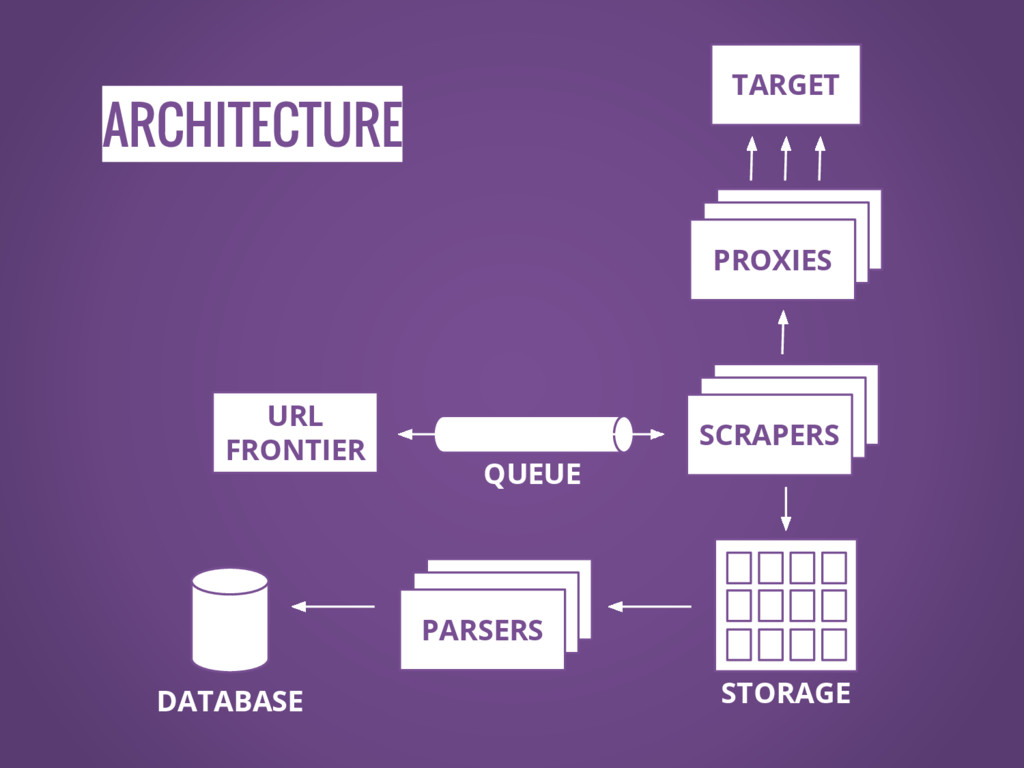
ARCHITECTURE SCRAPERS SCRAPERS SCRAPERS SCRAPERS SCRAPERS PROXIES URL FRONTIER SCRAPERS
SCRAPERS PARSERS STORAGE DATABASE TARGET QUEUE
Fabien VAUCHELLES zelros.com /
[email protected]
/ @fabienv http://bit.ly/breizhscraping The best
opensource proxy for Scraping !


 fabienvauchelles
 tagtag
 sshimizu2006
 trycycle
 hf149
 akasan
 xleitix
 junkashihara
 ianozsvald
 hayashiyus884
 minecr
 tamaranovitovic
 reverentgeek
 michaelherold
 joshbly
 takai
 tammyeverts
 ipullrank
 honzajavorek
 madoxten
 danielanewman