Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Active Learning の基礎と最近の研究

Sponsored · Ship Features Fearlessly Turn features on and off without deploys. Used by thousands of Ruby developers. →

Active Learning の基礎と最近の研究

2022年10月12日に公開した資料です

Avatar for fumihiko takahashi

fumihiko takahashi

December 06, 2025

More Decks by fumihiko takahashi

Other Decks in Technology

Transcript

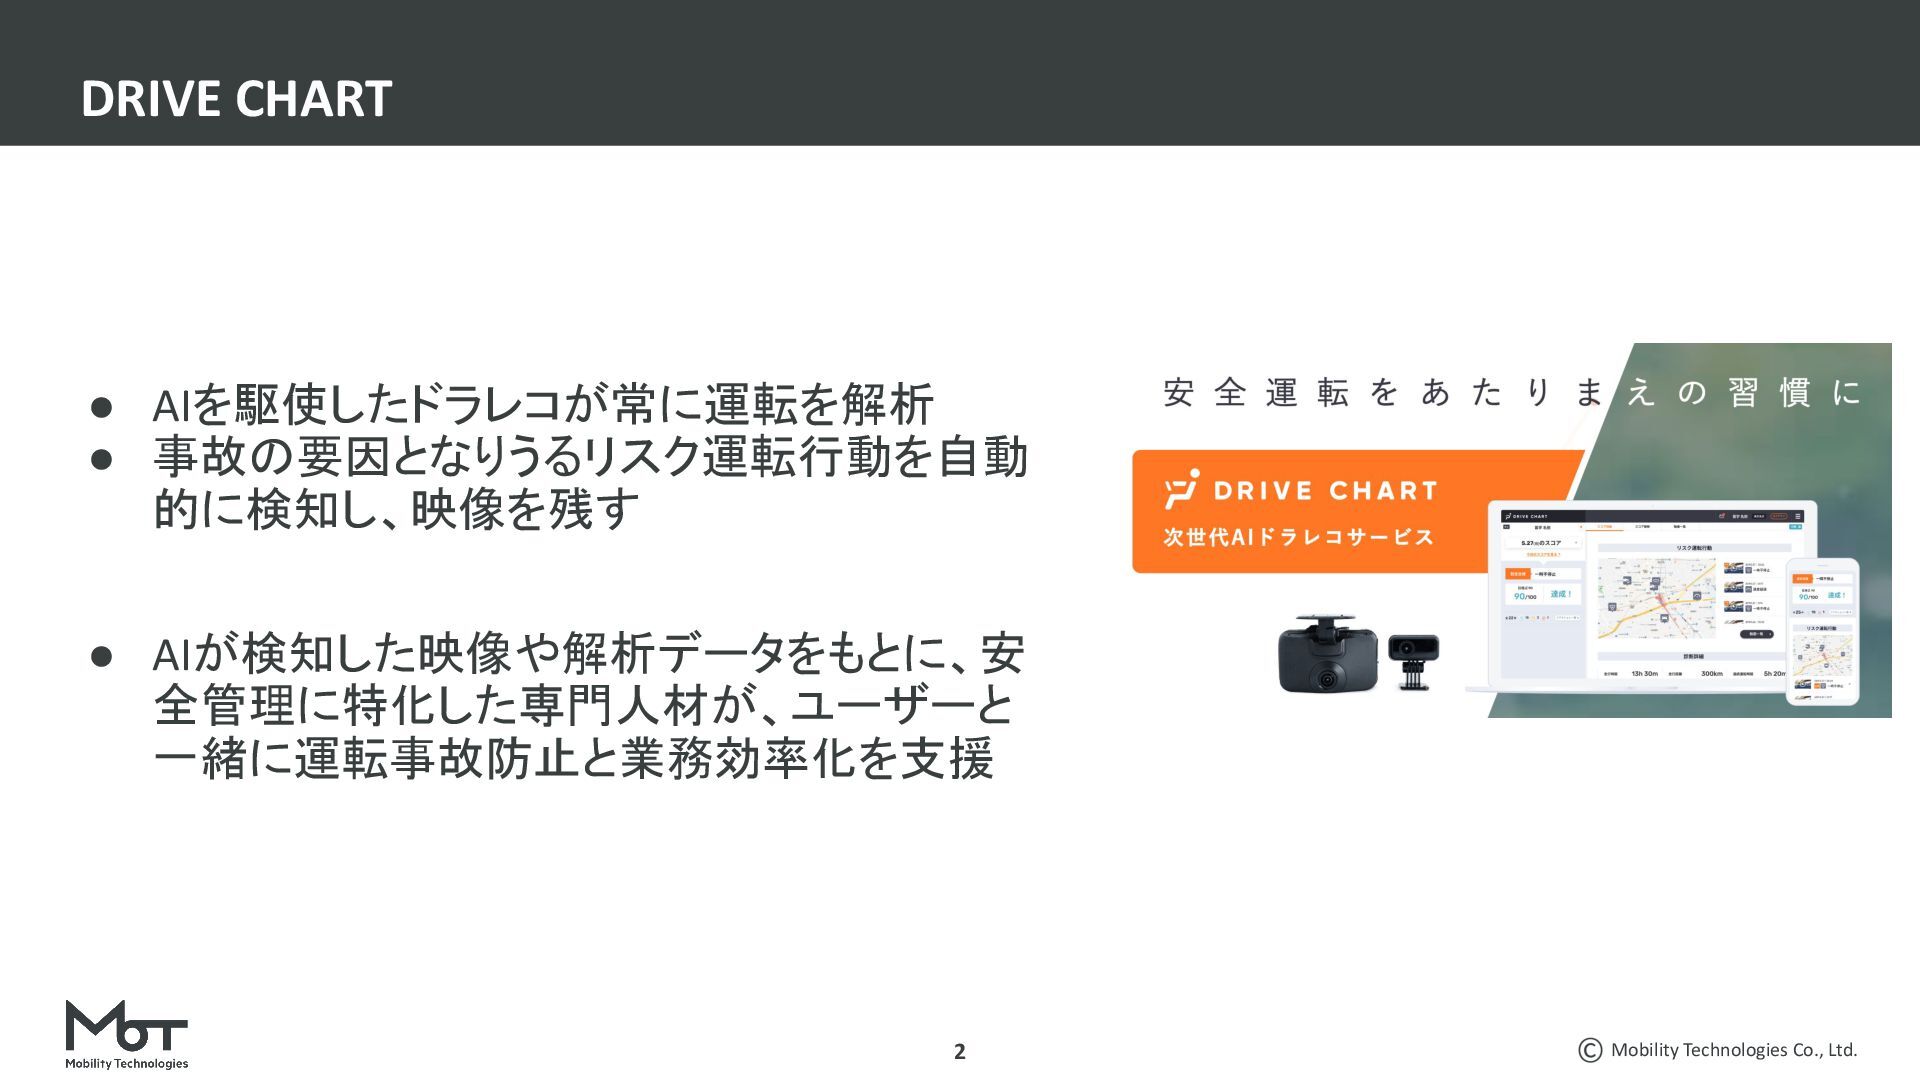
  1. Mobility Technologies Co., Ltd. 2 • AIを駆使したドラレコが常に運転を解析 • 事故の要因となりうるリスク運転行動を自動 的に検知し、映像を残す

    • AIが検知した映像や解析データをもとに、安 全管理に特化した専門人材が、ユーザーと 一緒に運転事故防止と業務効率化を支援 DRIVE CHART
  2. Mobility Technologies Co., Ltd. 3 • 車内の内側カメラの映像をエッジデバイス内のDeep Learningモデルで処理し 脇見を検出 •

    開発にあたって ◦ 入力のバリエーションが多い ◦ targetの発生がレア ▪ 学習データの収集が高コスト 😫 DRIVE CHART - 脇見検知
  3. Mobility Technologies Co., Ltd. 4 • Unlabeled dataは大量にある • アノテーションのコストが高い

    • ランダムに取得した動画に「脇見」が含まれるのは稀 • False Positiveを集めるのは容易だが、False Negativeを集めるのは困難 効率的に学習データを集めたい! ➡ Active Learning を検討 いかに学習データを集めるか?
  4. Mobility Technologies Co., Ltd. 5 Agenda 2 従来の active learning

    の手法の紹介 3 近年の active learning の手法の紹介 1 Active learning とは
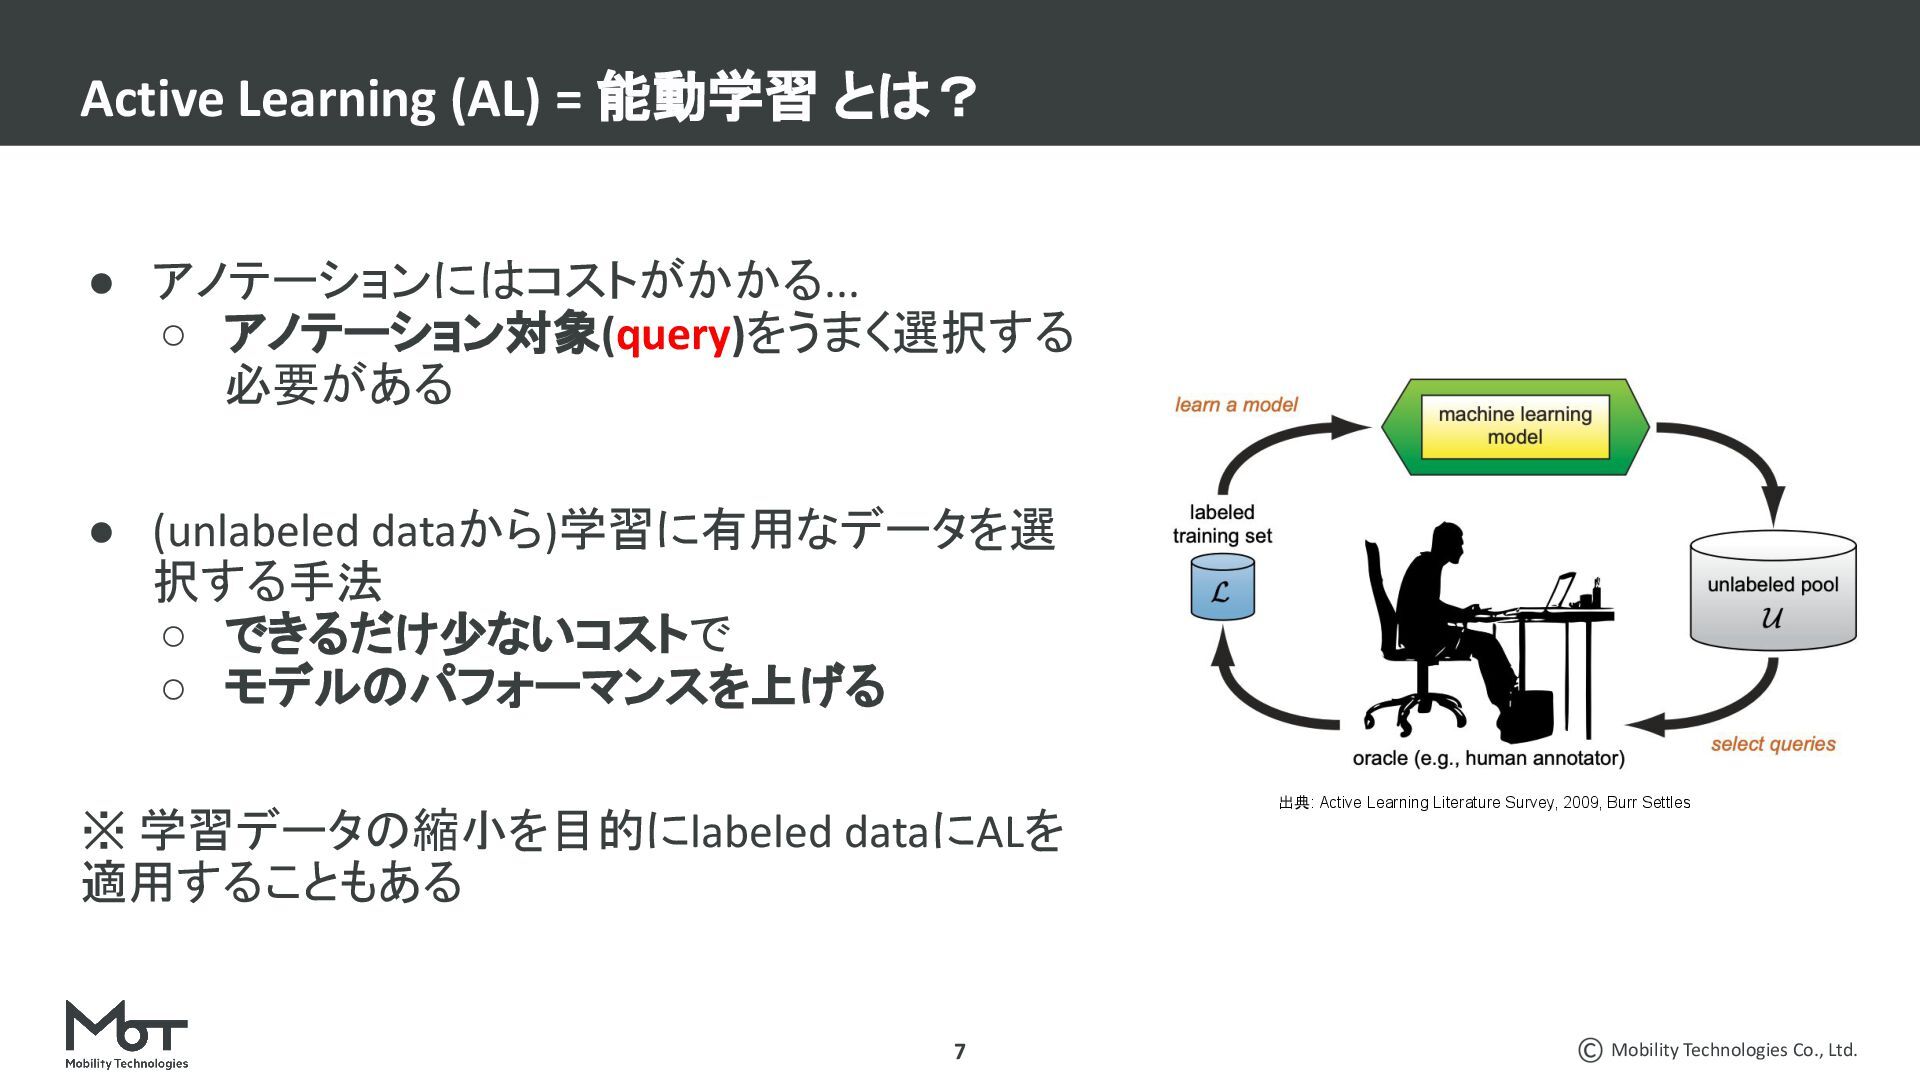
  5. Mobility Technologies Co., Ltd. 7 • アノテーションにはコストがかかる... ◦ アノテーション対象(query)をうまく選択する 必要がある

    • (unlabeled dataから)学習に有用なデータを選 択する手法 ◦ できるだけ少ないコストで ◦ モデルのパフォーマンスを上げる ※ 学習データの縮小を目的にlabeled dataにALを 適用することもある Active Learning (AL) = 能動学習 とは? 出典: Active Learning Literature Survey, 2009, Burr Settles
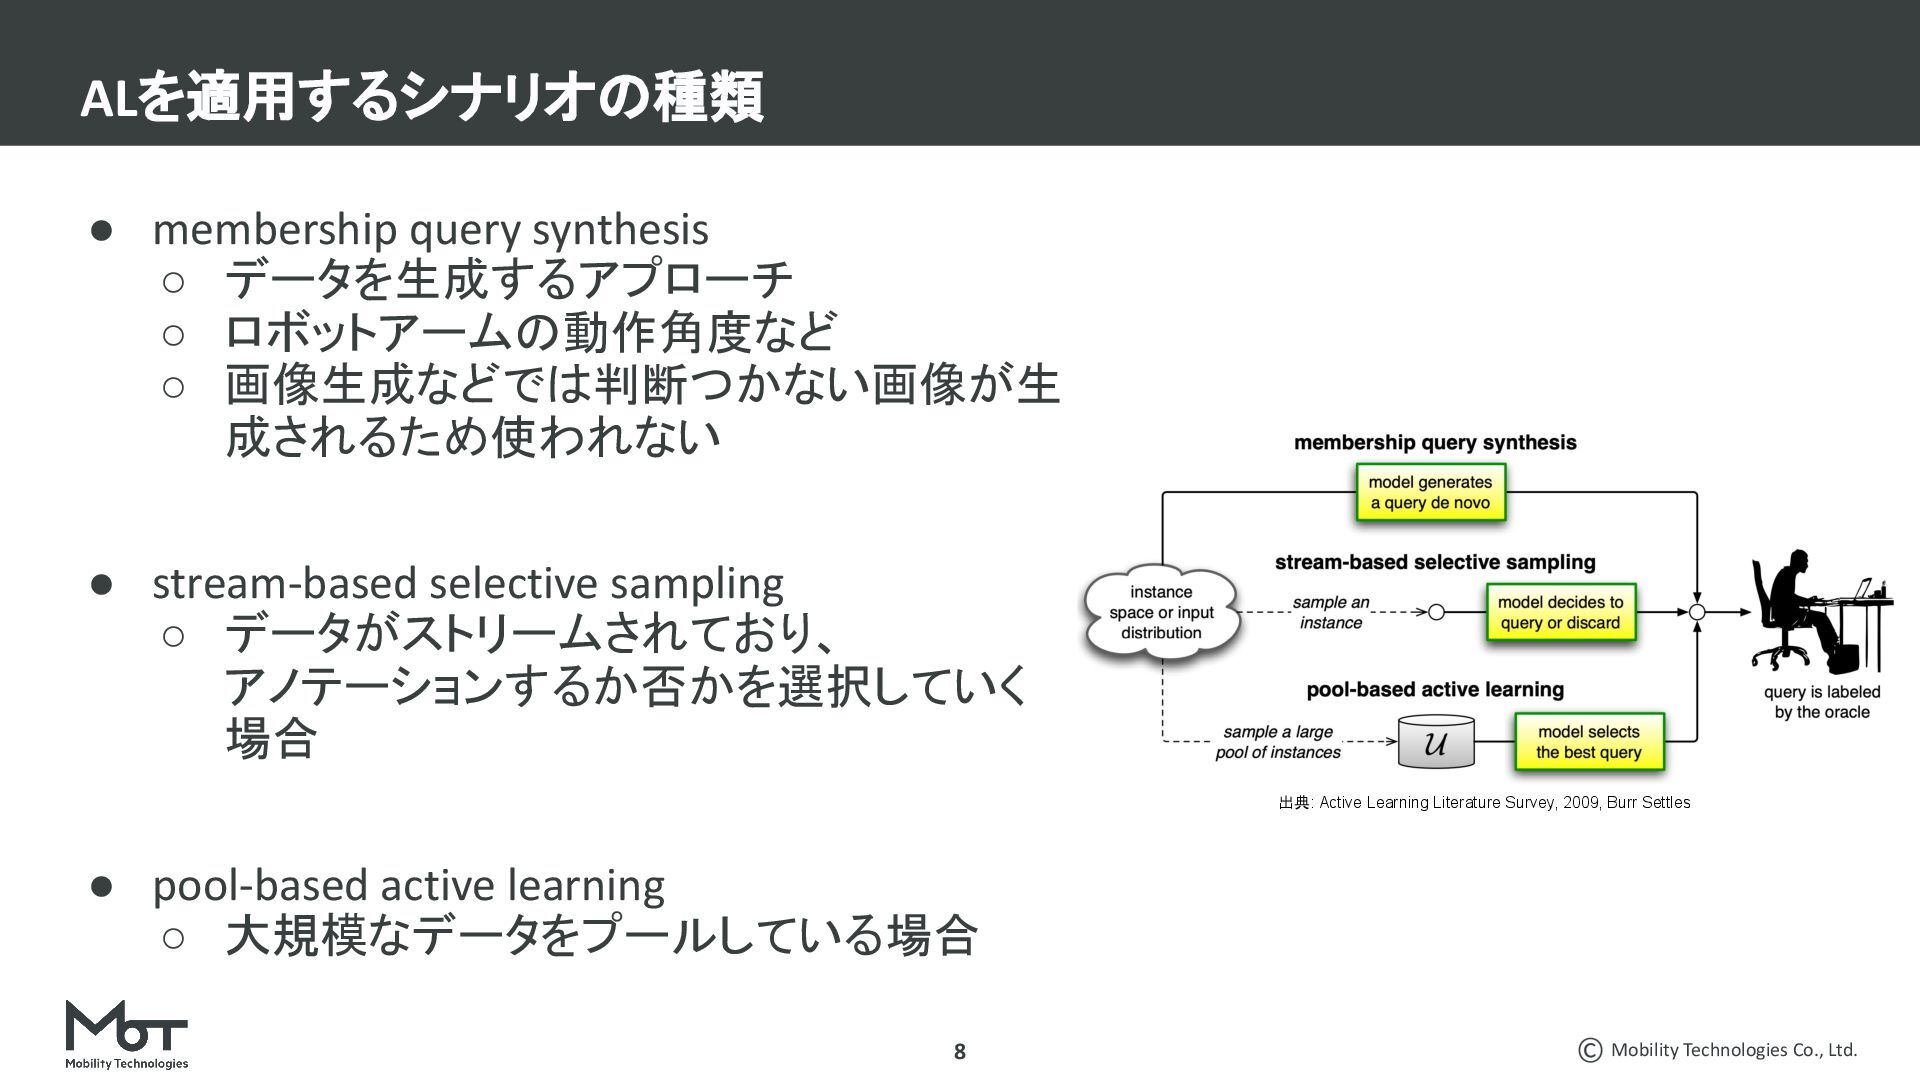
  6. Mobility Technologies Co., Ltd. 8 • membership query synthesis ◦

    データを生成するアプローチ ◦ ロボットアームの動作角度など ◦ 画像生成などでは判断つかない画像が生 成されるため使われない • stream-based selective sampling ◦ データがストリームされており、 アノテーションするか否かを選択していく 場合 • pool-based active learning ◦ 大規模なデータをプールしている場合 ALを適用するシナリオの種類 出典: Active Learning Literature Survey, 2009, Burr Settles
  7. Mobility Technologies Co., Ltd. • Active Learning Literature Survey, 2009,

    Burr Settles, Computer Sciences Technical Report 1648 ◦ いろんなところで引用されている論文 ◦ 周辺技術や理論的な解説など網羅的に書かれている • 能動学習:問題設定と最近の話題, 2021, 日野英逸, 日本統計学会誌 ◦ 最近の能動学習について網羅的に解説されている Active Learningのサーベイ論文 9
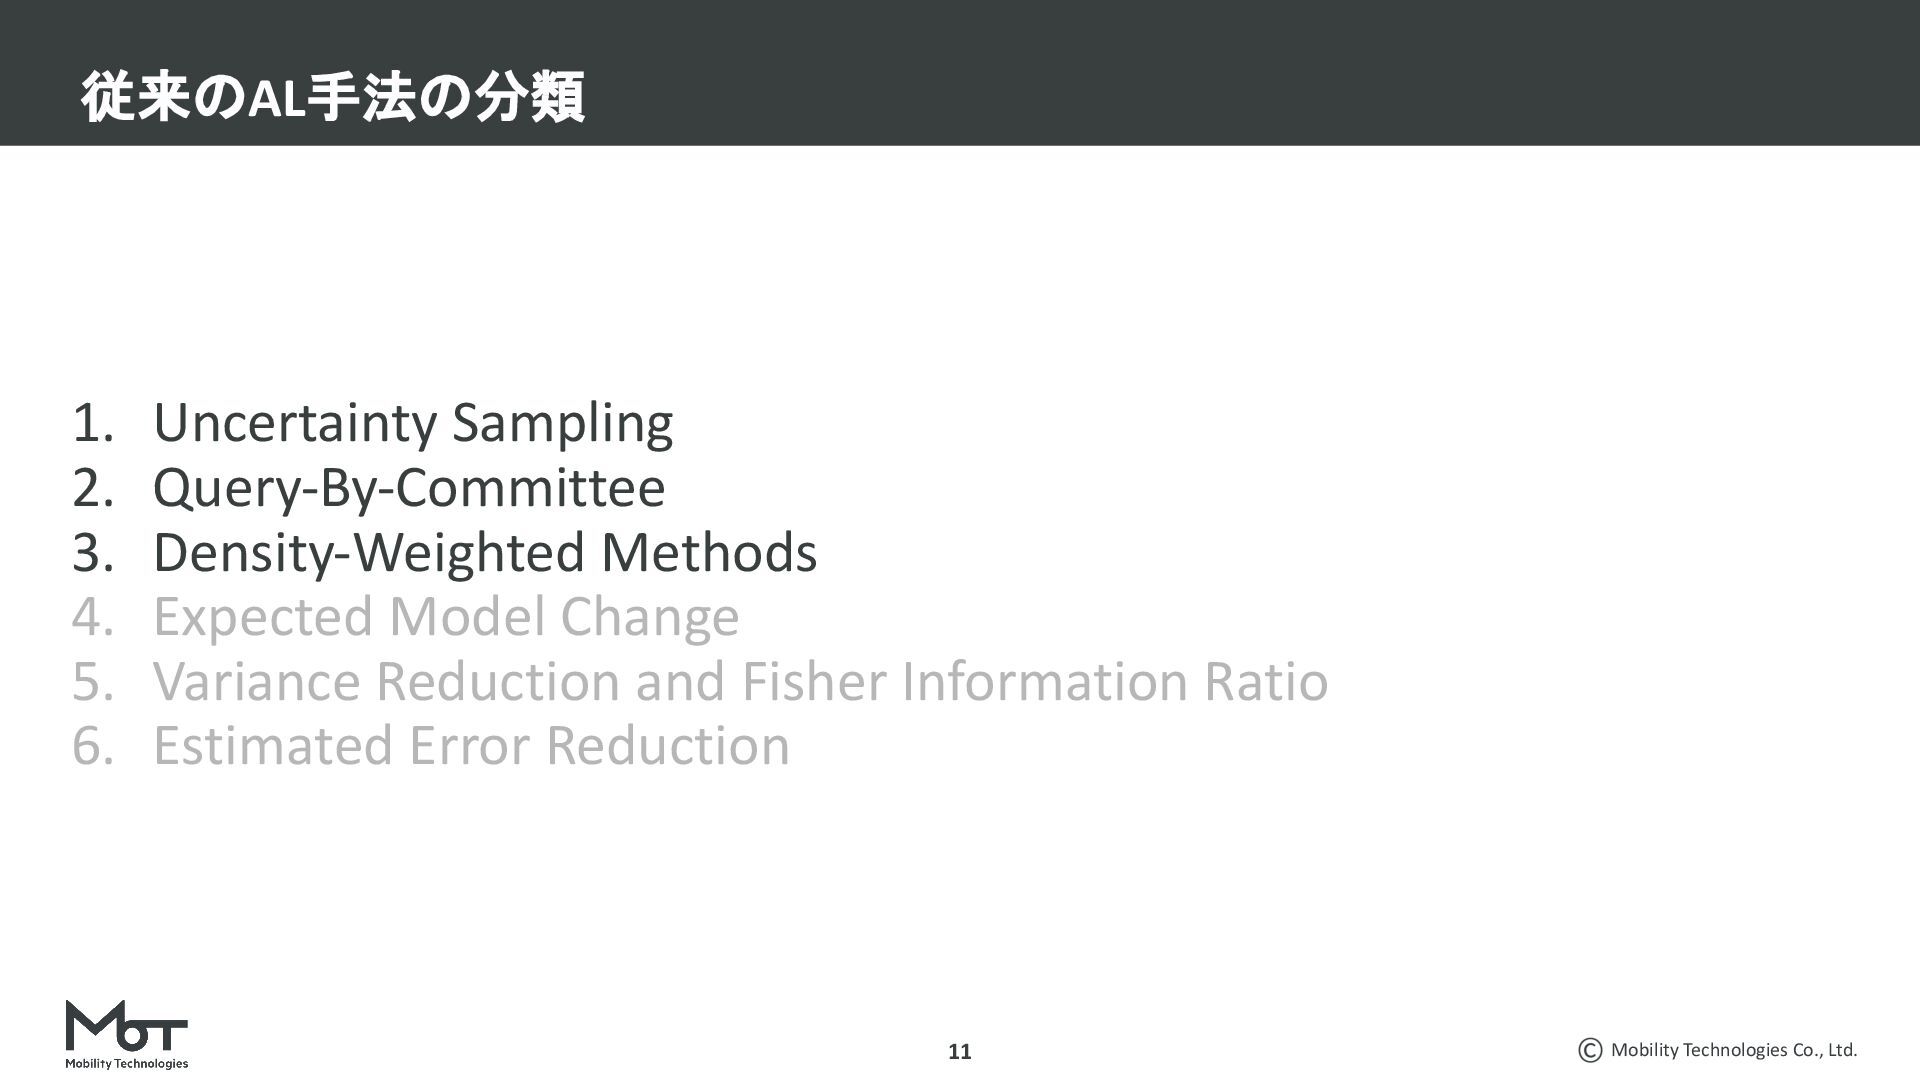
  8. Mobility Technologies Co., Ltd. 1. Uncertainty Sampling 2. Query-By-Committee 3.

    Density-Weighted Methods 4. Expected Model Change 5. Variance Reduction and Fisher Information Ratio 6. Estimated Error Reduction 従来のAL手法の分類 11
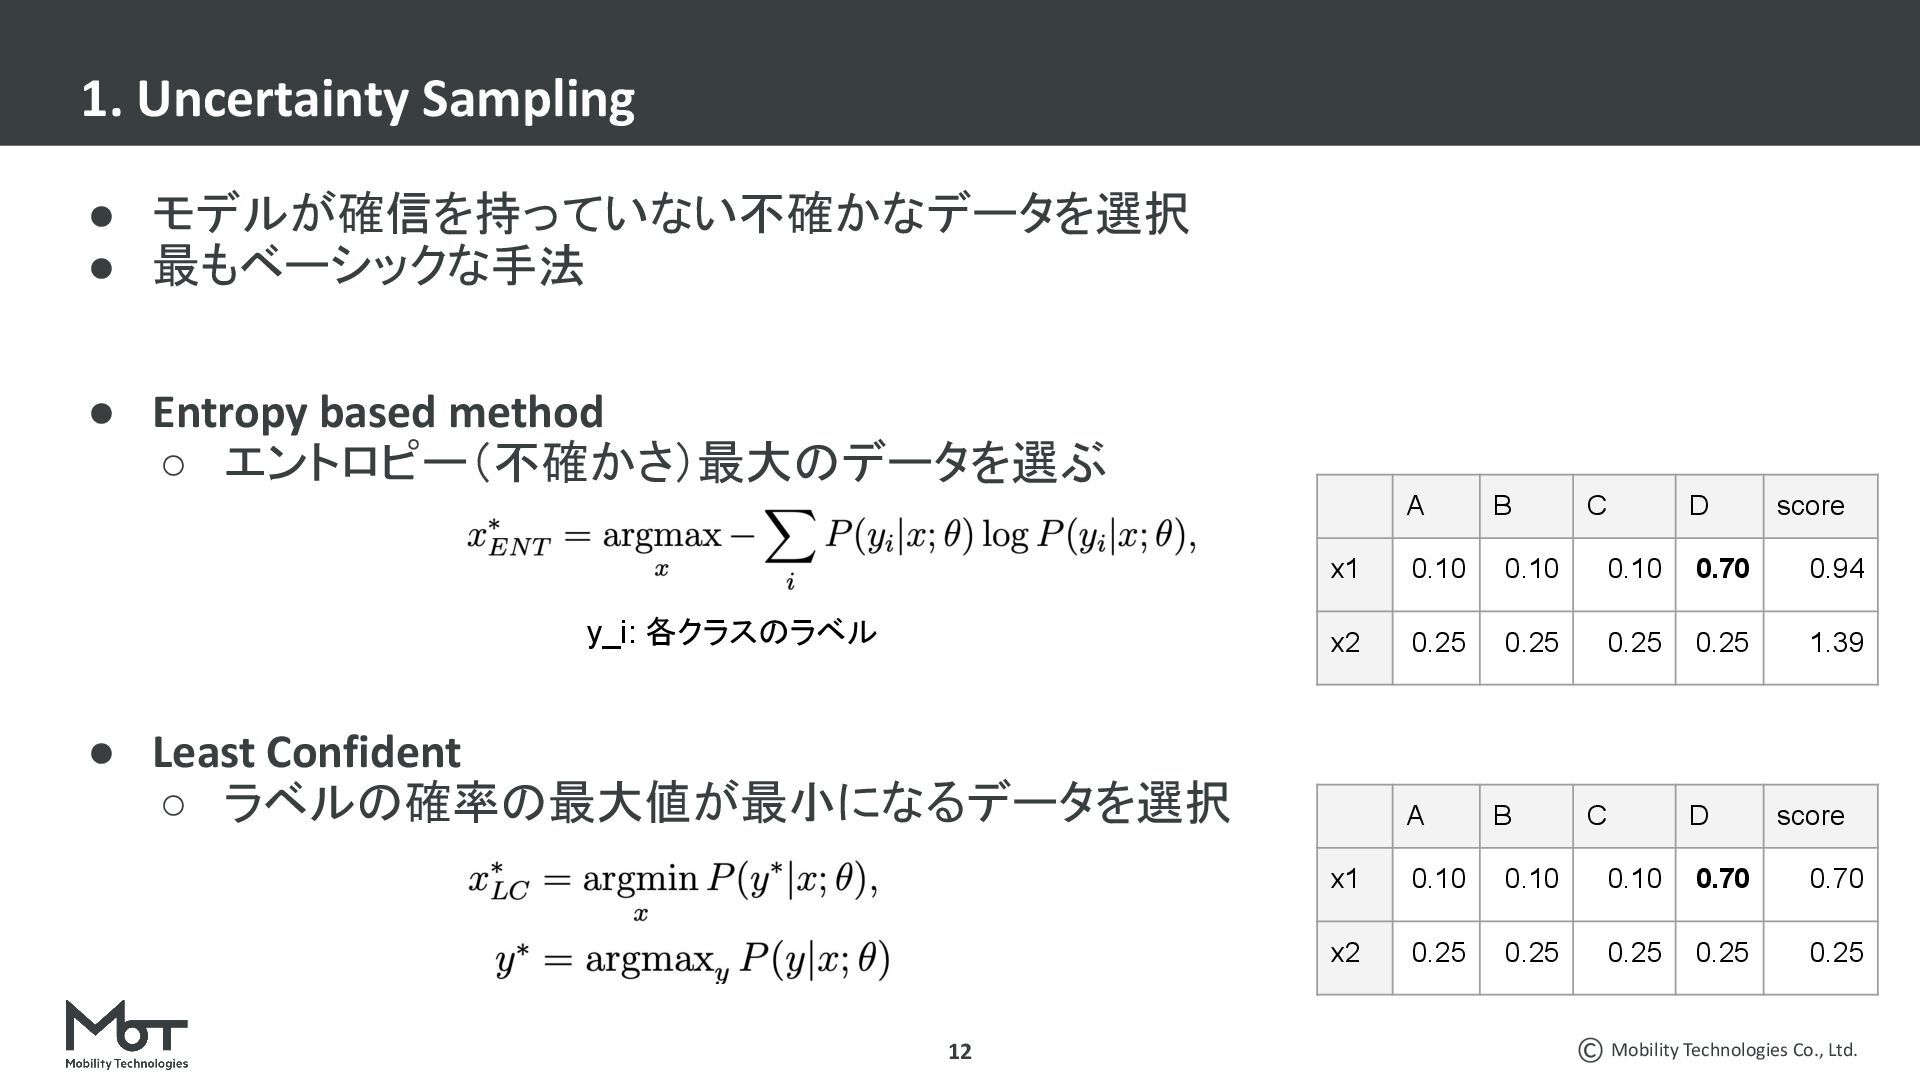
  9. Mobility Technologies Co., Ltd. • モデルが確信を持っていない不確かなデータを選択 • 最もベーシックな手法 • Entropy

    based method ◦ エントロピー(不確かさ)最大のデータを選ぶ • Least Confident ◦ ラベルの確率の最大値が最小になるデータを選択 1. Uncertainty Sampling 12 y_i: 各クラスのラベル A B C D score x1 0.10 0.10 0.10 0.70 0.70 x2 0.25 0.25 0.25 0.25 0.25 A B C D score x1 0.10 0.10 0.10 0.70 0.94 x2 0.25 0.25 0.25 0.25 1.39
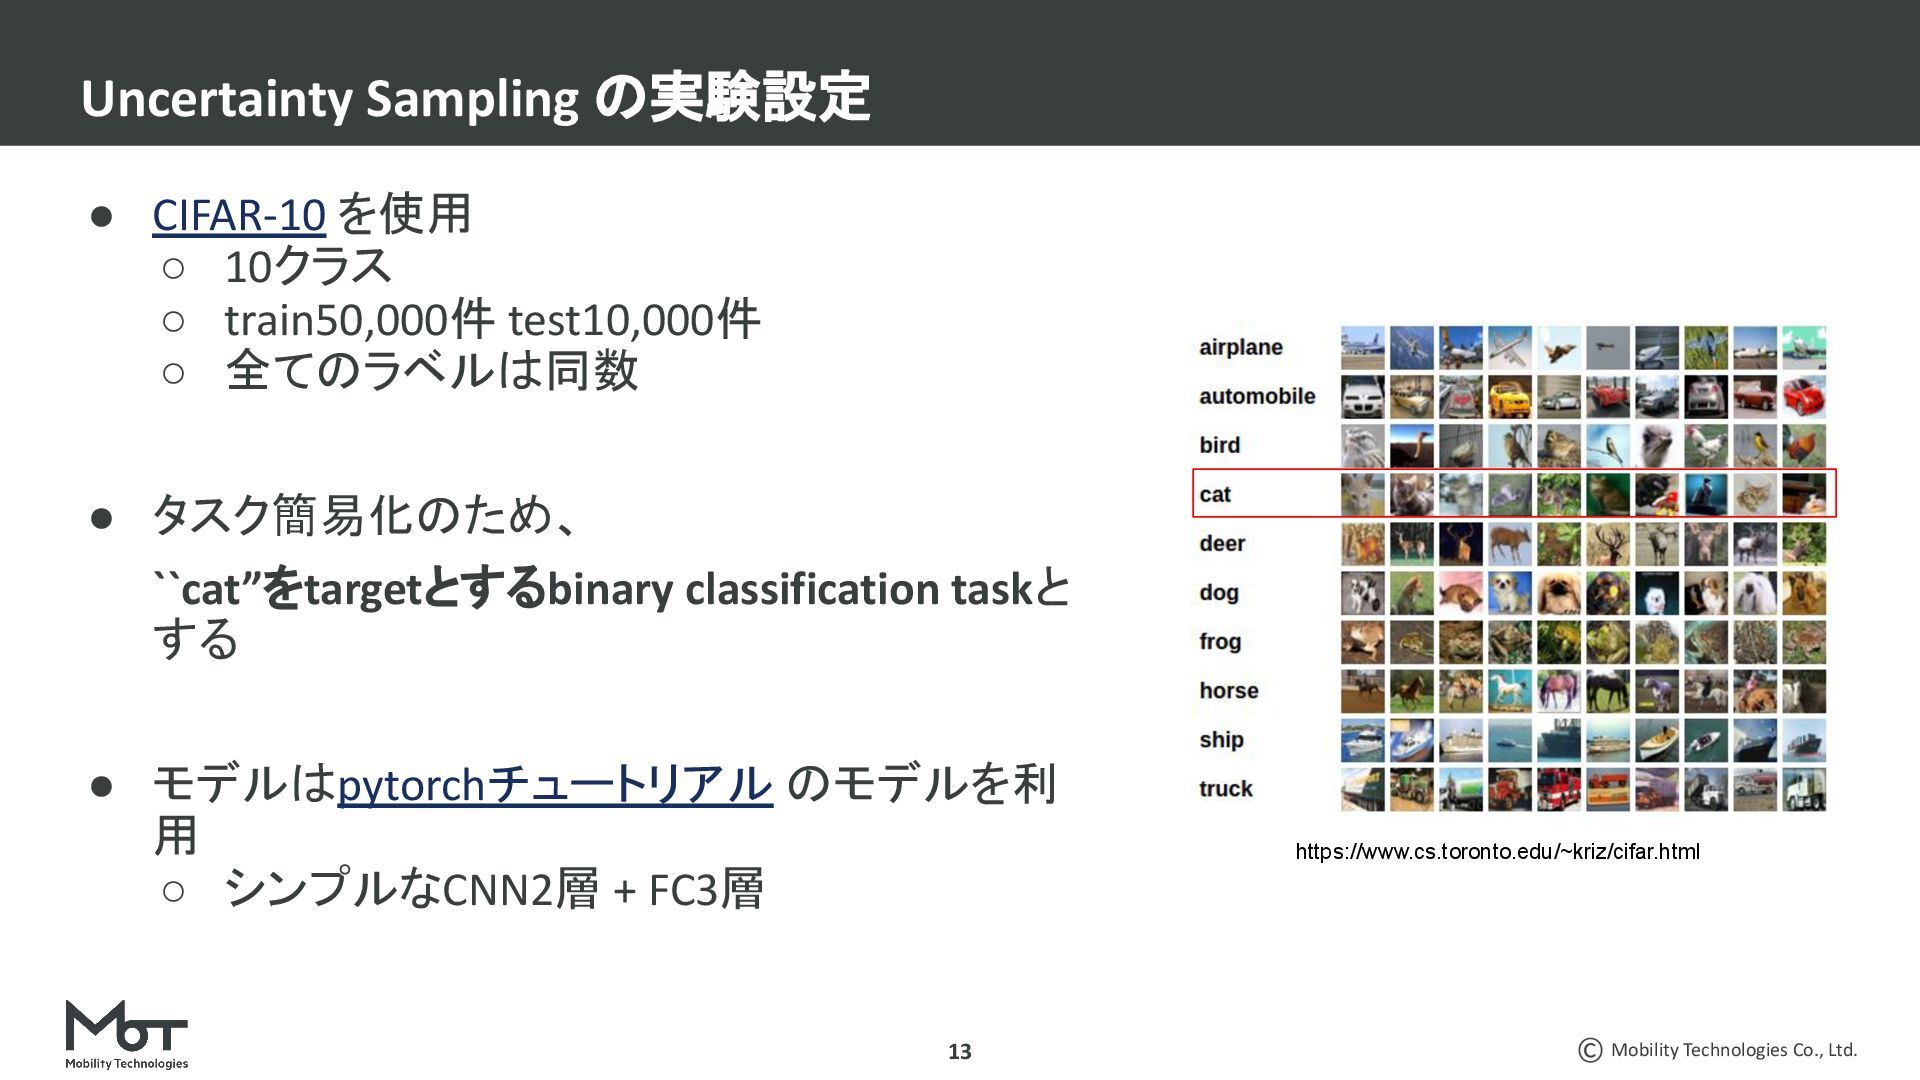
  10. Mobility Technologies Co., Ltd. • CIFAR-10 を使用 ◦ 10クラス ◦

    train50,000件 test10,000件 ◦ 全てのラベルは同数 • タスク簡易化のため、 ``cat”をtargetとするbinary classification taskと する • モデルはpytorchチュートリアル のモデルを利 用 ◦ シンプルなCNN2層 + FC3層 Uncertainty Sampling の実験設定 13 https://www.cs.toronto.edu/~kriz/cifar.html
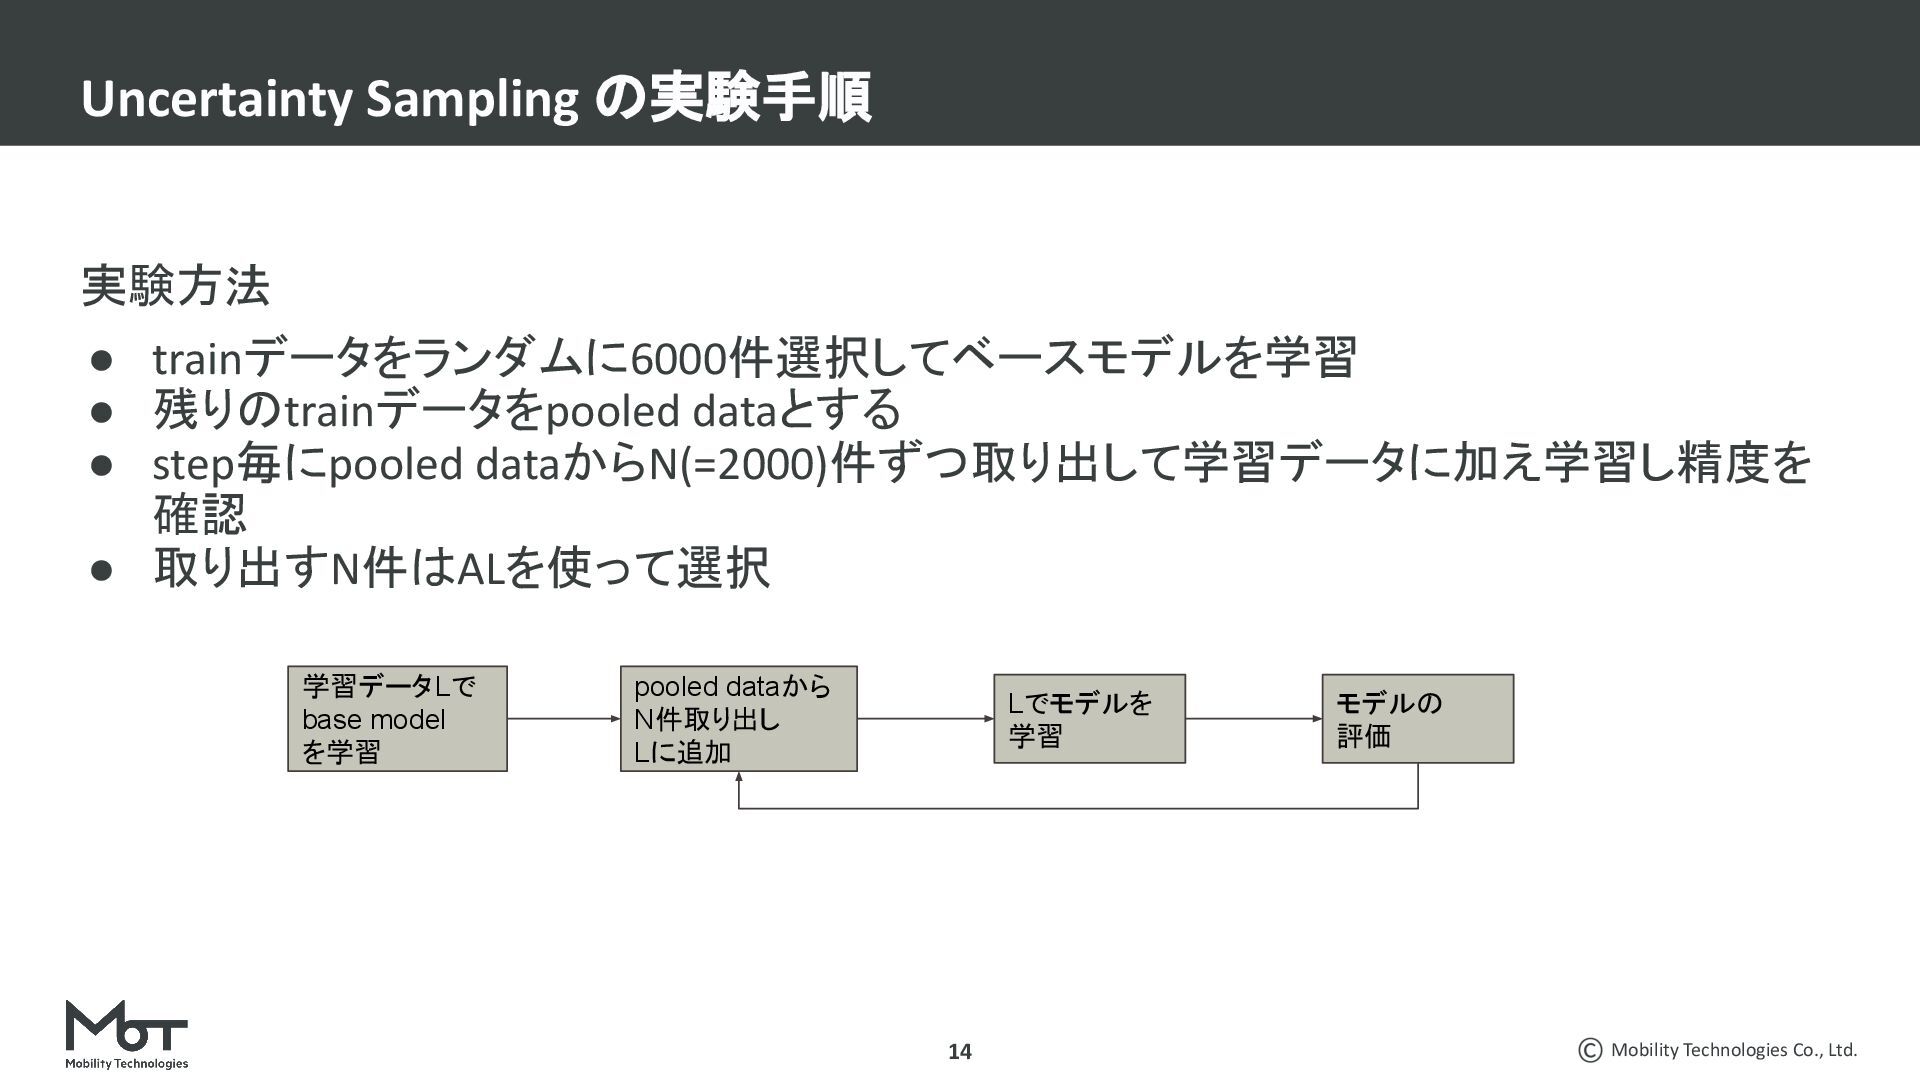
  11. Mobility Technologies Co., Ltd. 実験方法 • trainデータをランダムに6000件選択してベースモデルを学習 • 残りのtrainデータをpooled dataとする

    • step毎にpooled dataからN(=2000)件ずつ取り出して学習データに加え学習し精度を 確認 • 取り出すN件はALを使って選択 Uncertainty Sampling の実験手順 14 モデルの 評価 学習データLで base model を学習 Lでモデルを 学習 pooled dataから N件取り出し Lに追加
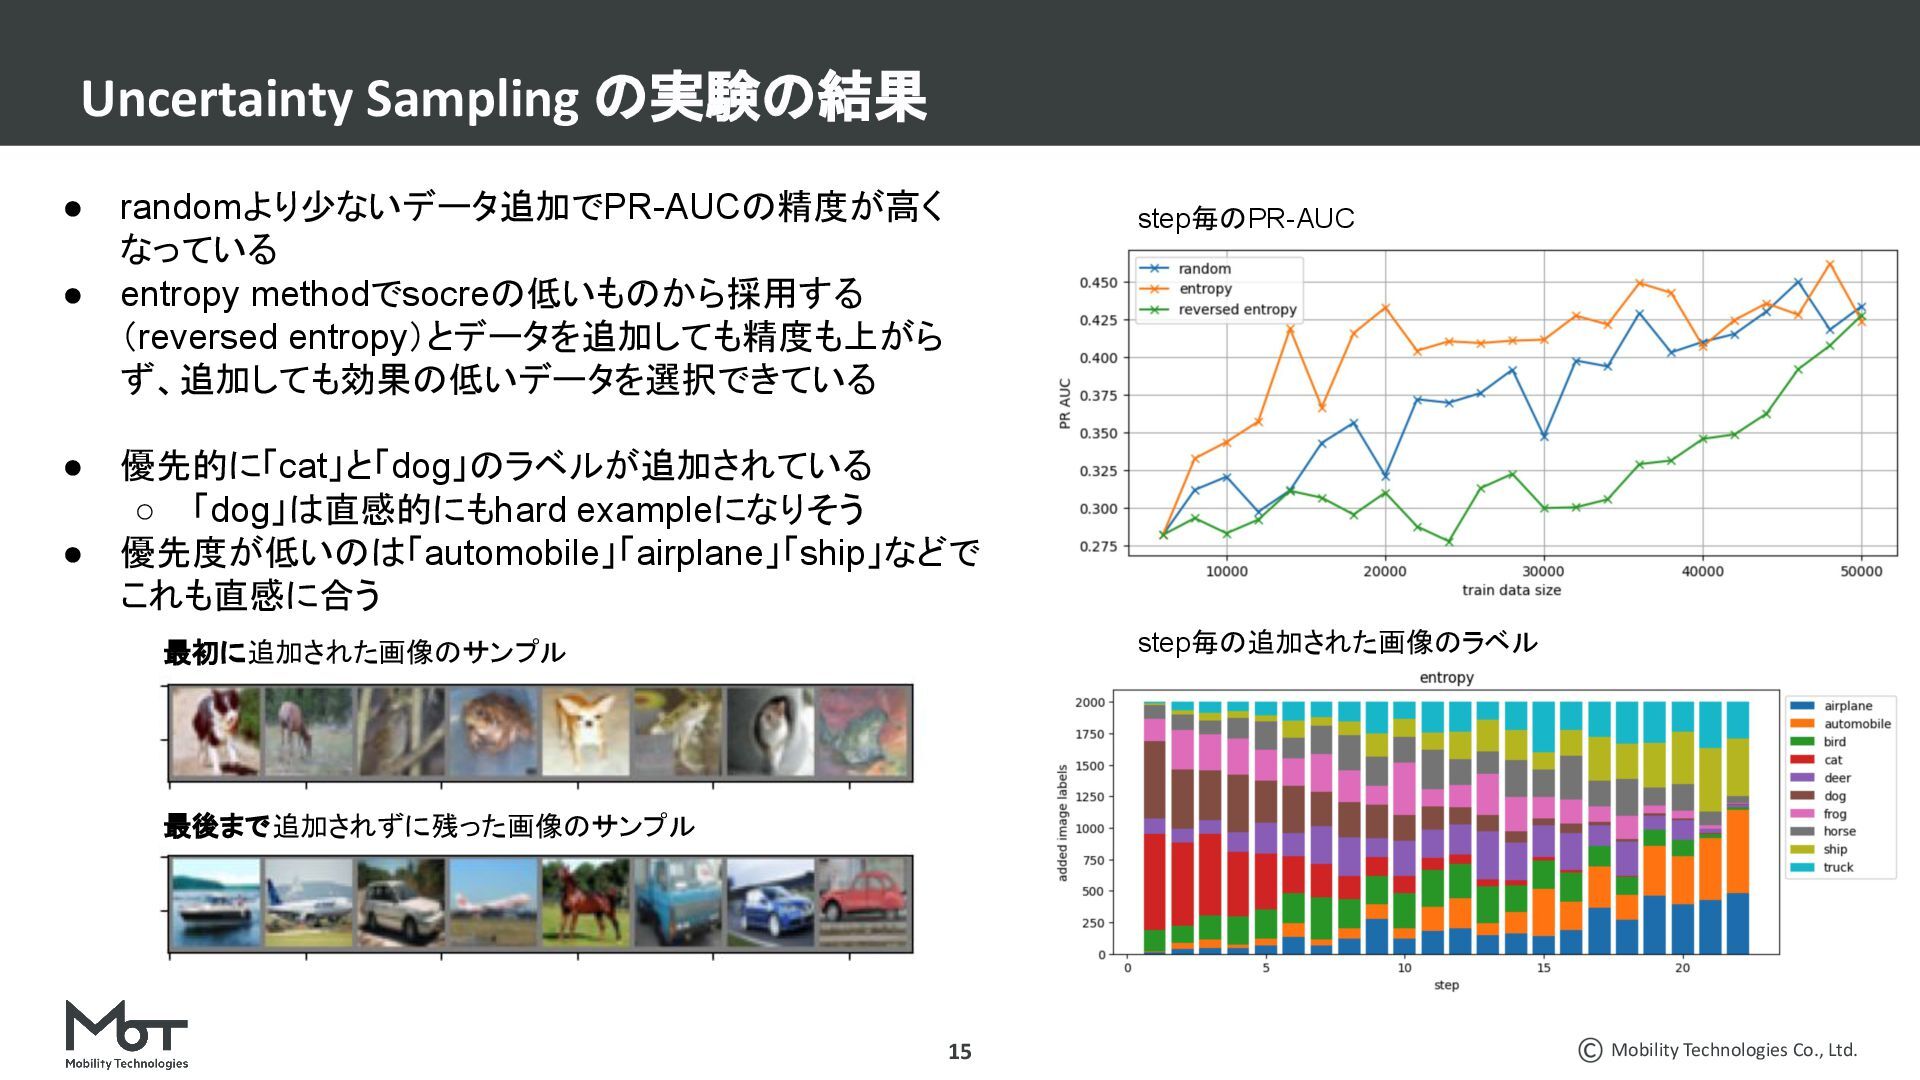
  12. Mobility Technologies Co., Ltd. Uncertainty Sampling の実験の結果 15 step毎のPR-AUC step毎の追加された画像のラベル

    最初に追加された画像のサンプル 最後まで追加されずに残った画像のサンプル • randomより少ないデータ追加でPR-AUCの精度が高く なっている • entropy methodでsocreの低いものから採用する (reversed entropy)とデータを追加しても精度も上がら ず、追加しても効果の低いデータを選択できている • 優先的に「cat」と「dog」のラベルが追加されている ◦ 「dog」は直感的にもhard exampleになりそう • 優先度が低いのは「automobile」「airplane」「ship」などで これも直感に合う
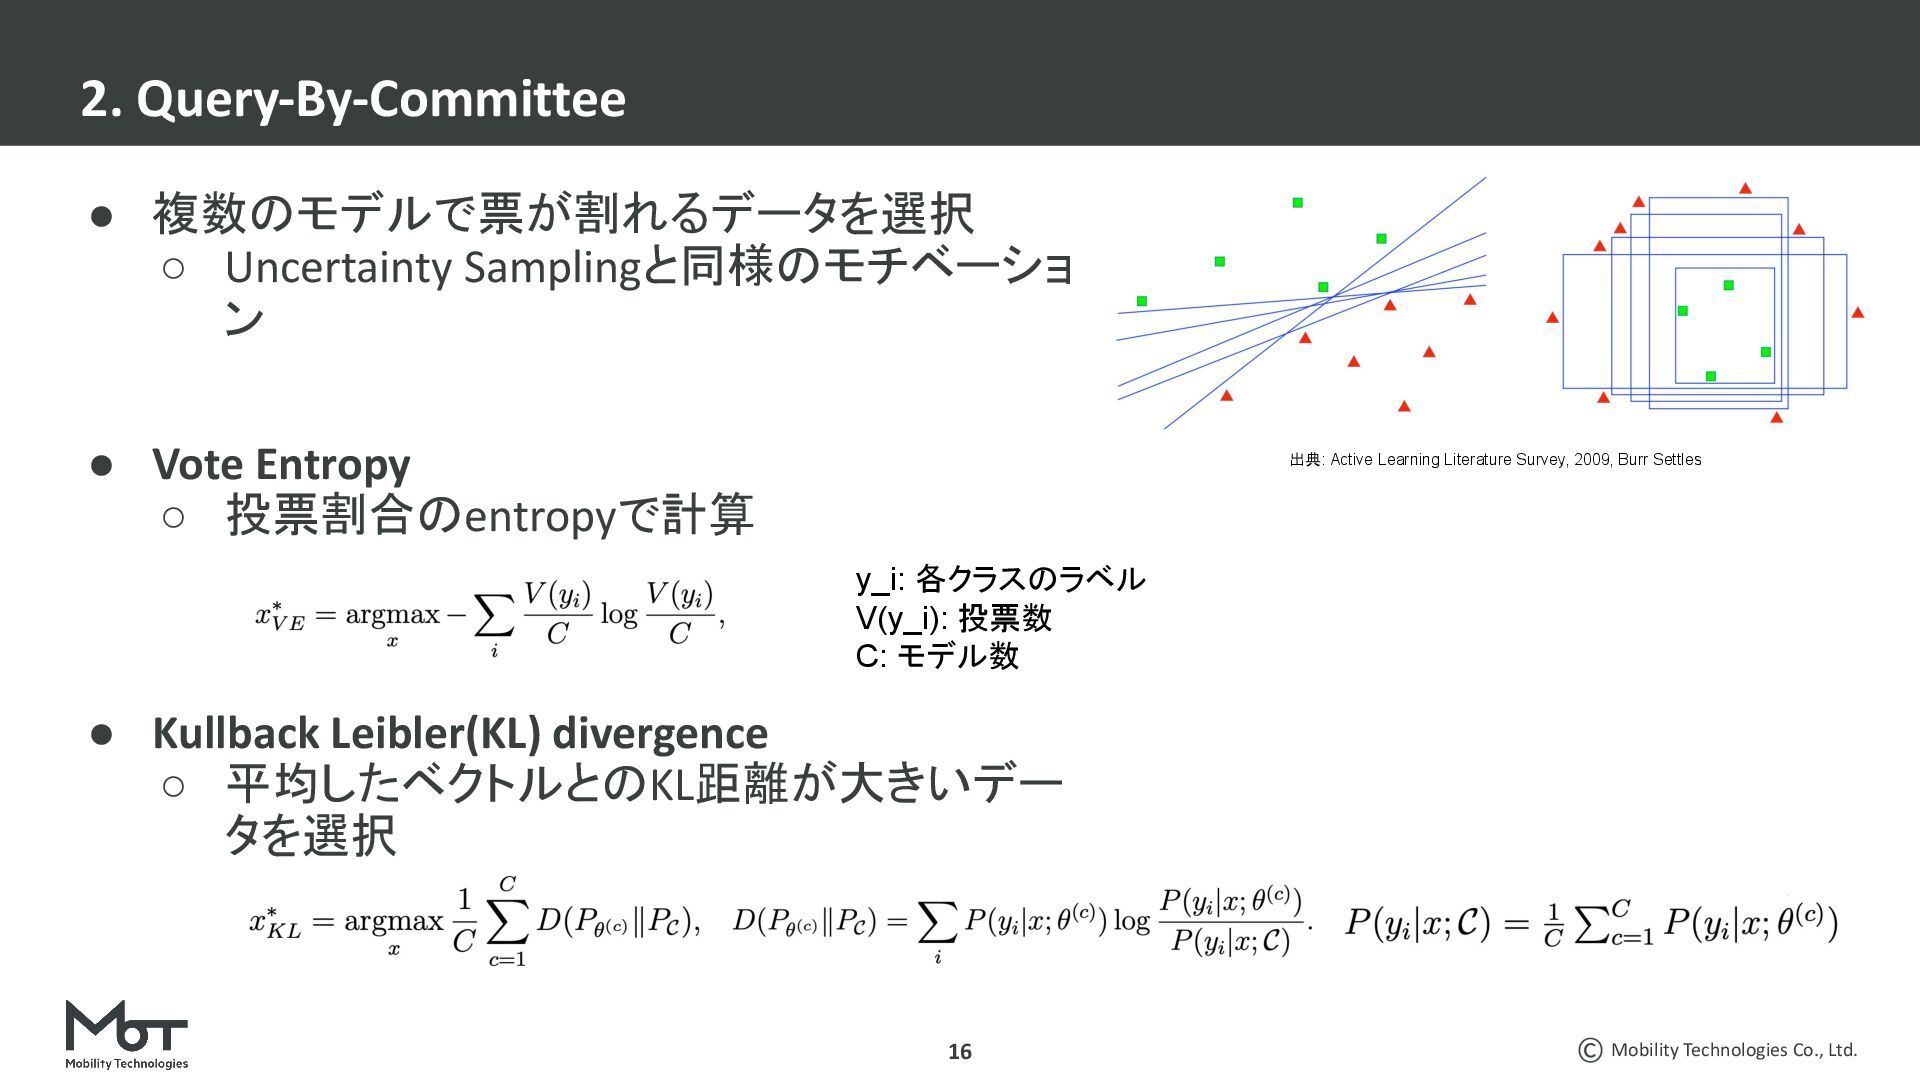
  13. Mobility Technologies Co., Ltd. • 複数のモデルで票が割れるデータを選択 ◦ Uncertainty Samplingと同様のモチベーショ ン

    • Vote Entropy ◦ 投票割合のentropyで計算 • Kullback Leibler(KL) divergence ◦ 平均したベクトルとのKL距離が大きいデー タを選択 2. Query-By-Committee 16 y_i: 各クラスのラベル V(y_i): 投票数 C: モデル数 出典: Active Learning Literature Survey, 2009, Burr Settles
  14. Mobility Technologies Co., Ltd. • 基本はUncertainty Samplingの実験と同様 • モデルのバリエーション ◦

    元のモデルから、CNNのwindowやunit数を変化させたもの ◦ 基本的なモデル構造は一緒 Query-By-Committee の実験の設定 17
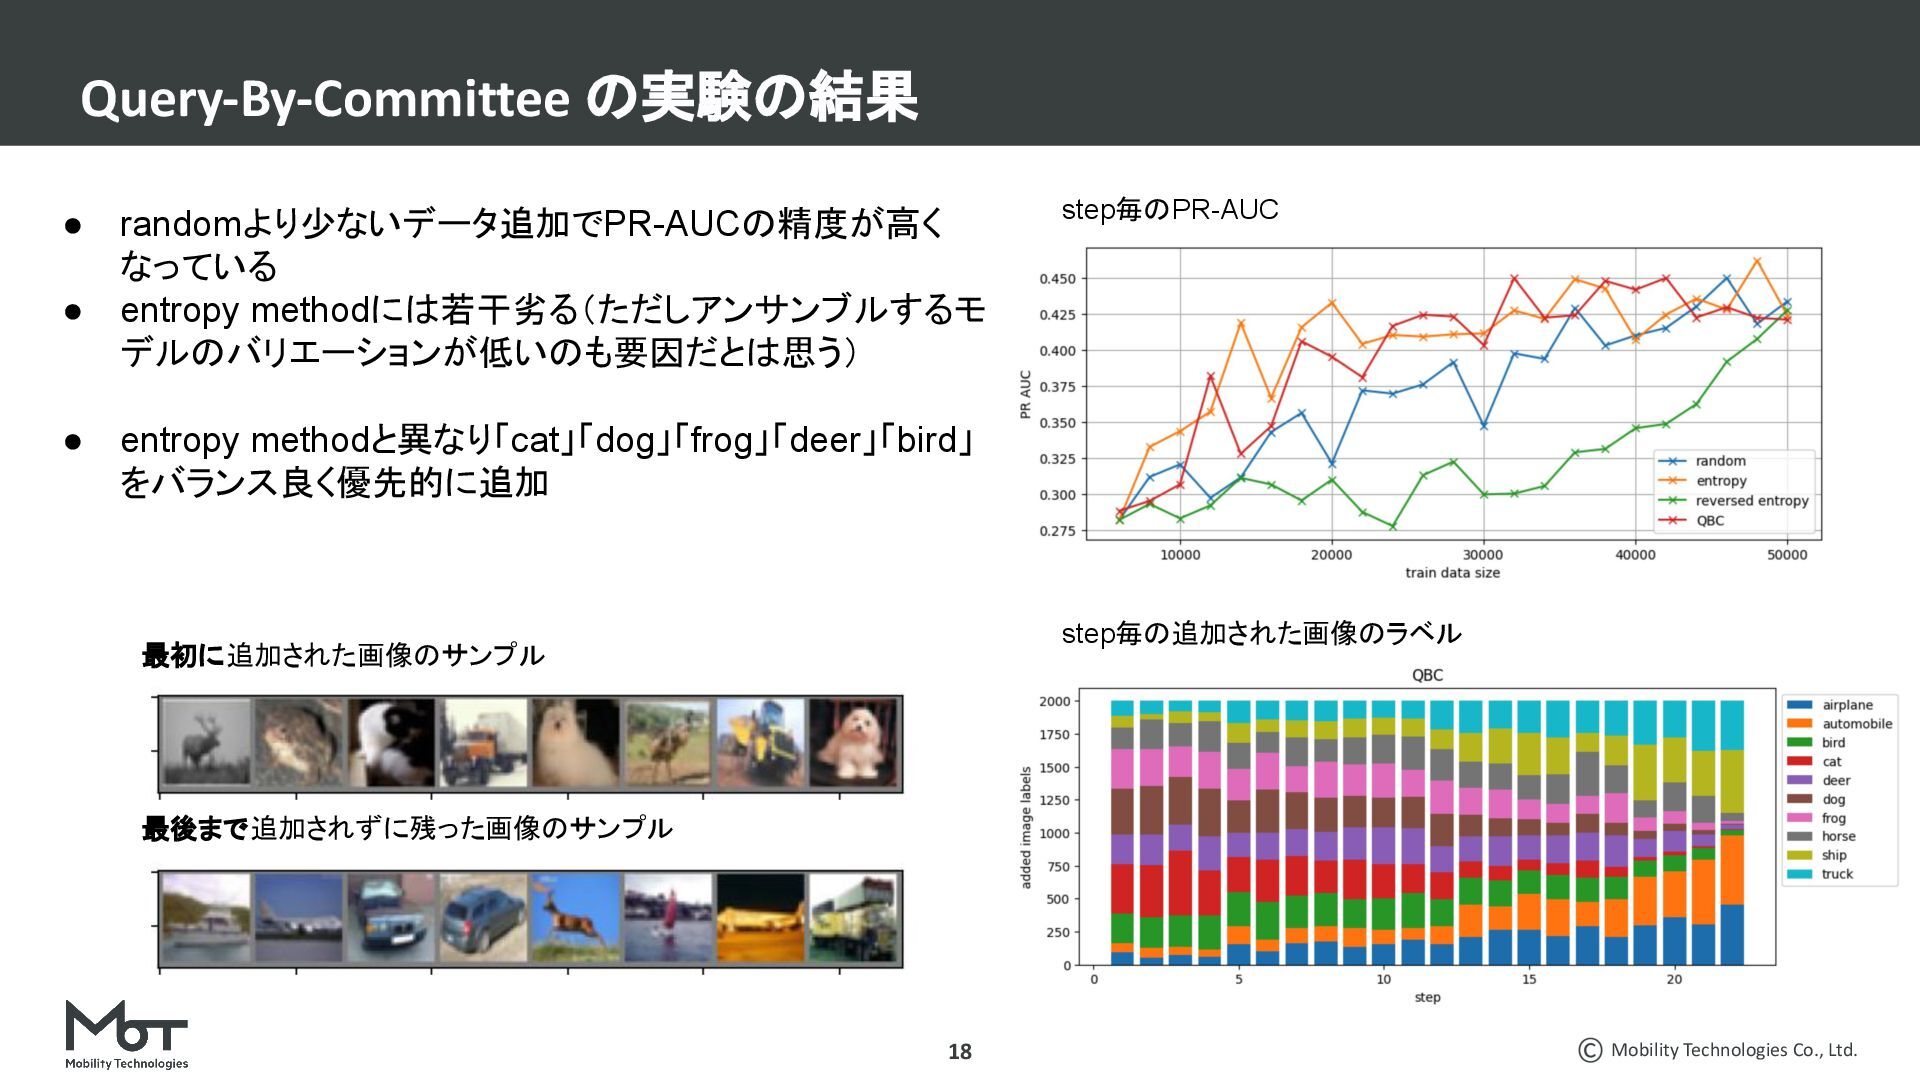
  15. Mobility Technologies Co., Ltd. Query-By-Committee の実験の結果 18 step毎のPR-AUC step毎の追加された画像のラベル 最初に追加された画像のサンプル

    最後まで追加されずに残った画像のサンプル • randomより少ないデータ追加でPR-AUCの精度が高く なっている • entropy methodには若干劣る(ただしアンサンブルするモ デルのバリエーションが低いのも要因だとは思う) • entropy methodと異なり「cat」「dog」「frog」「deer」「bird」 をバランス良く優先的に追加
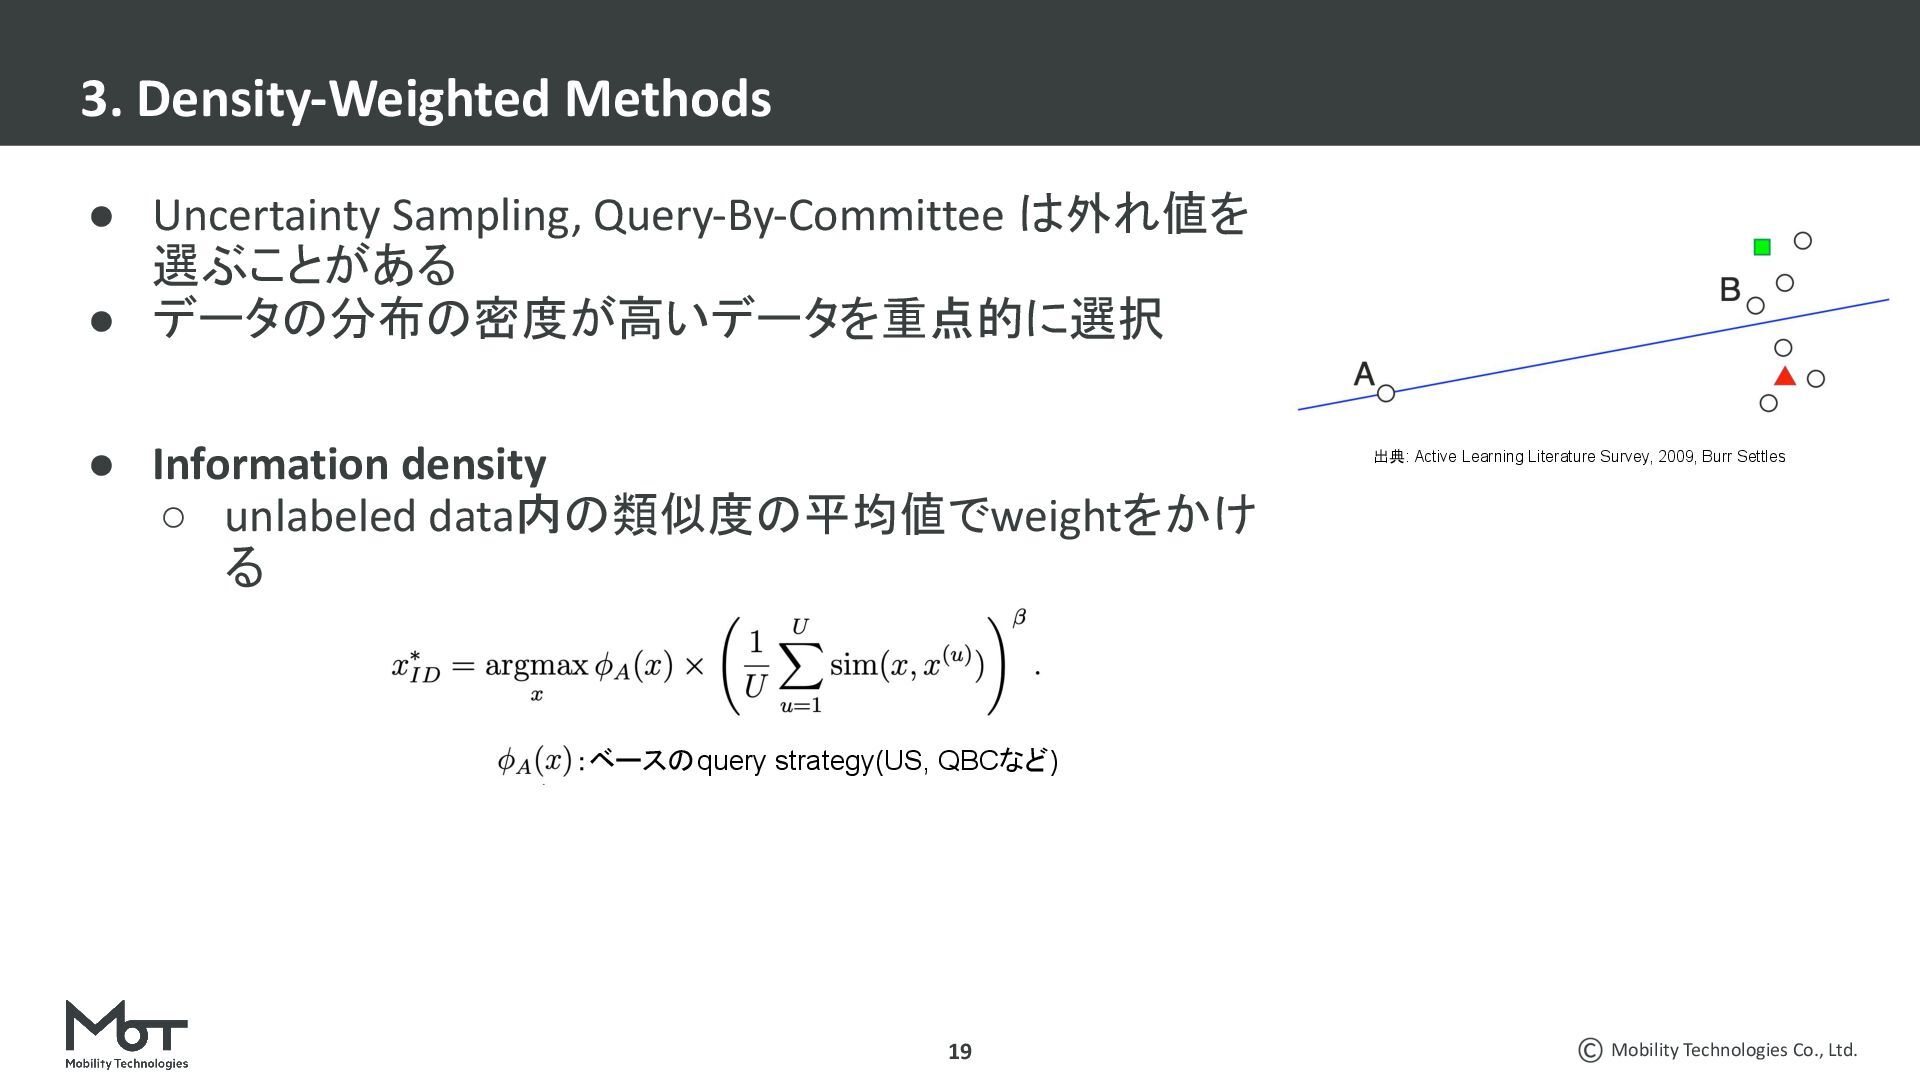
  16. Mobility Technologies Co., Ltd. • Uncertainty Sampling, Query-By-Committee は外れ値を 選ぶことがある

    • データの分布の密度が高いデータを重点的に選択 • Information density ◦ unlabeled data内の類似度の平均値でweightをかけ る 3. Density-Weighted Methods 19 :ベースのquery strategy(US, QBCなど) 出典: Active Learning Literature Survey, 2009, Burr Settles
  17. Mobility Technologies Co., Ltd. • 基本はUncertainty Samplingの実験と同様 • データの類似度の計算方法 ◦

    直近に学習したモデルのCNN後の最初のFC層の出力をembeddingとして利用 ◦ ユークリッド距離で平均距離を計算し、その逆数を類似度とする ◦ 省メモリの工夫 ▪ 4万x4万の距離行列の計算にメモリが足りなくなる ▪ unlabeled dataが2万以上ある場合に、分割しその中で平均距離を計算 • データが十分多いときに平均距離が変わらないことを期待 • βパラメータは探索 Density-Weighted Methods の実験の設定 20
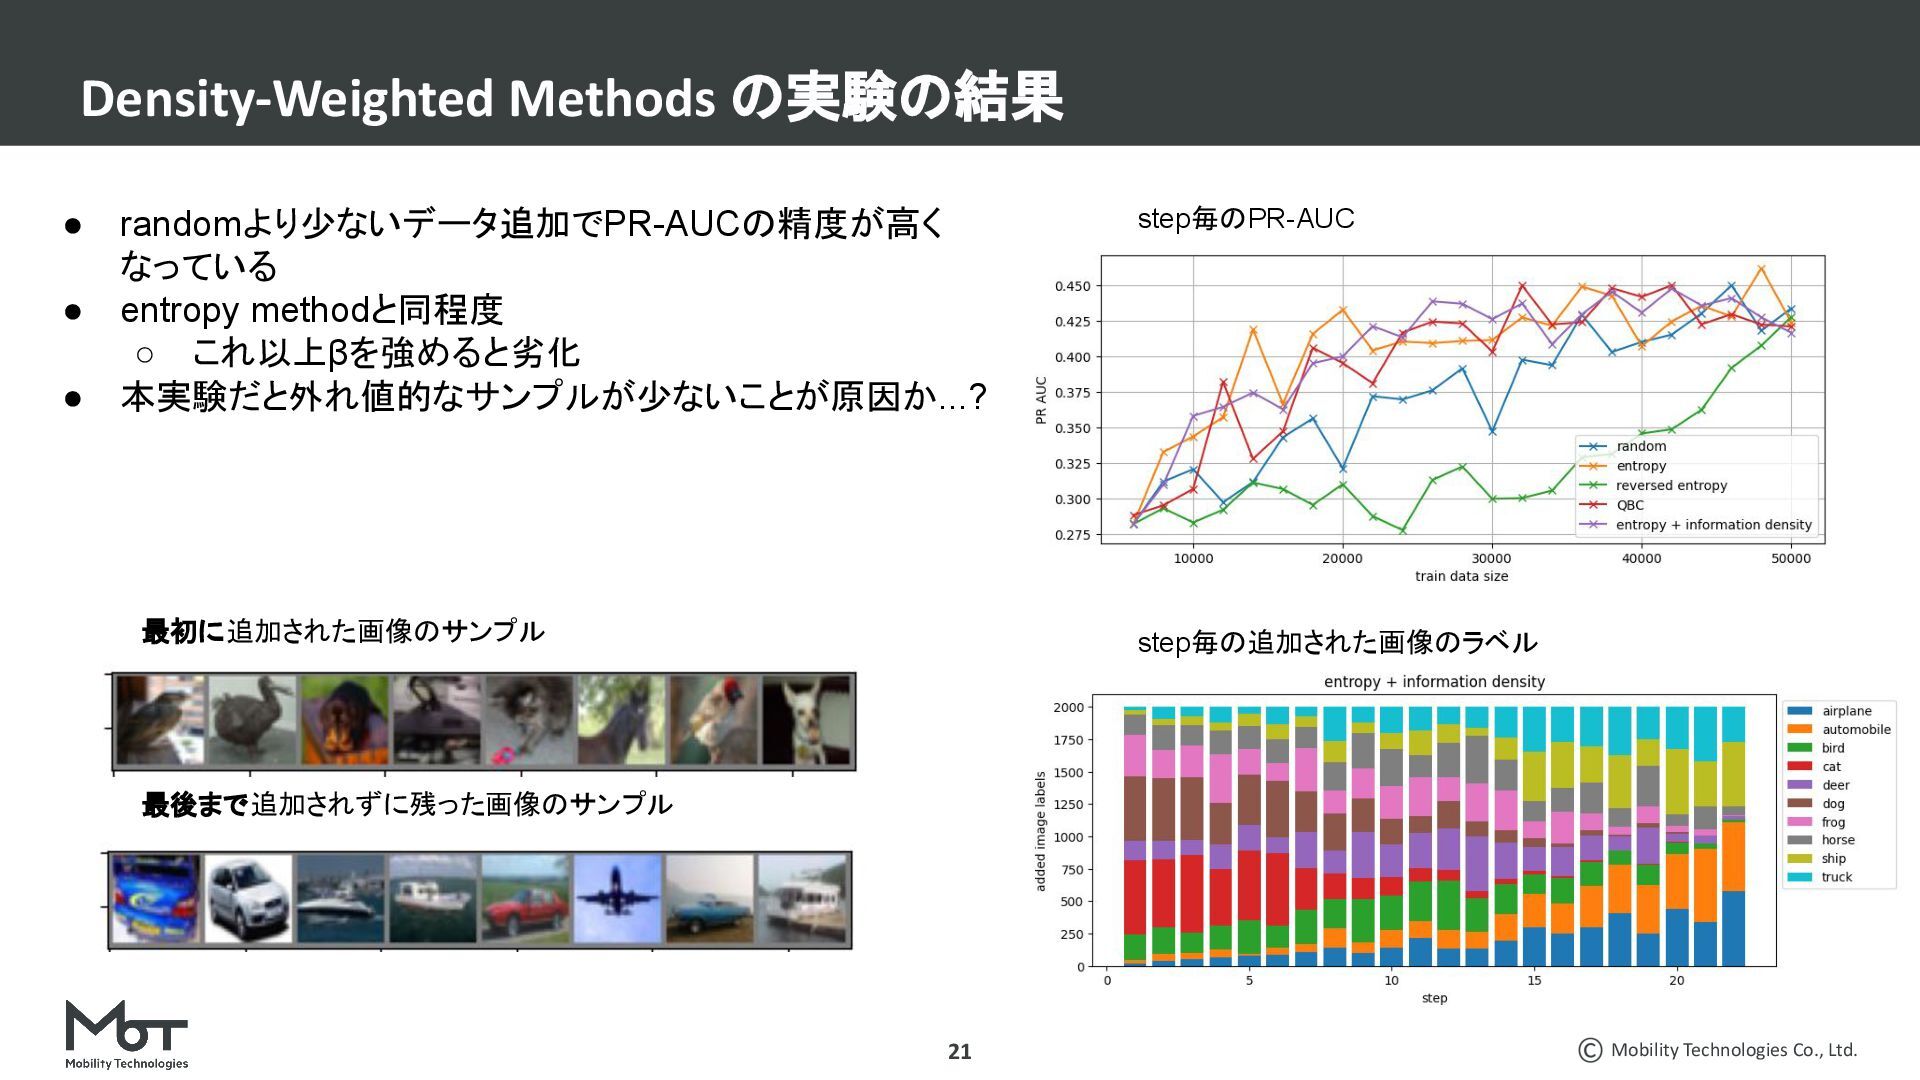
  18. Mobility Technologies Co., Ltd. Density-Weighted Methods の実験の結果 21 step毎のPR-AUC step毎の追加された画像のラベル

    最初に追加された画像のサンプル 最後まで追加されずに残った画像のサンプル • randomより少ないデータ追加でPR-AUCの精度が高く なっている • entropy methodと同程度 ◦ これ以上βを強めると劣化 • 本実験だと外れ値的なサンプルが少ないことが原因か...?
  19. Mobility Technologies Co., Ltd. • Expected Model Change ◦ 学習したときにモデルの変化の期待値が大きくなるデータを選択

    ◦ 勾配の期待値(取りうるラベルごとの確率と勾配の積)の合計で計算 ◦ データ毎にloss計算, backwardの必要があり、計算コストが高い • Variance Reduction and Fisher Information Ratio ◦ 将来のモデルの分散を最小化 ◦ 回帰タスクの場合はMSE lossにした時の勾配をもちいる ◦ unlabeled data全体でのフィッシャー情報量(scoreの微分)の割合で計算 ◦ 計算コストが高い • Estimated Error Reduction ◦ 追加することでエラーが減るデータを選択 ◦ データ毎に学習までする必要があり、非常に計算コストが高い その他の従来の手法 22
  20. Mobility Technologies Co., Ltd. 24 1. バッチでデータ追加すると似たデータが選ばれてしまう a. 従来手法は単一のデータを追加して学習することを前提としている b.

    近年では学習に時間がかかるようになったため、バッチで追加する必要性がある 2. 多様性のある入力に対応できない a. 従来の手法はシンプルな入力を前提としている 3. モデルに強く依存したデータセットになる a. 途中でモデルが変わると精度が出ないという報告もある 従来の手法で言われる問題点
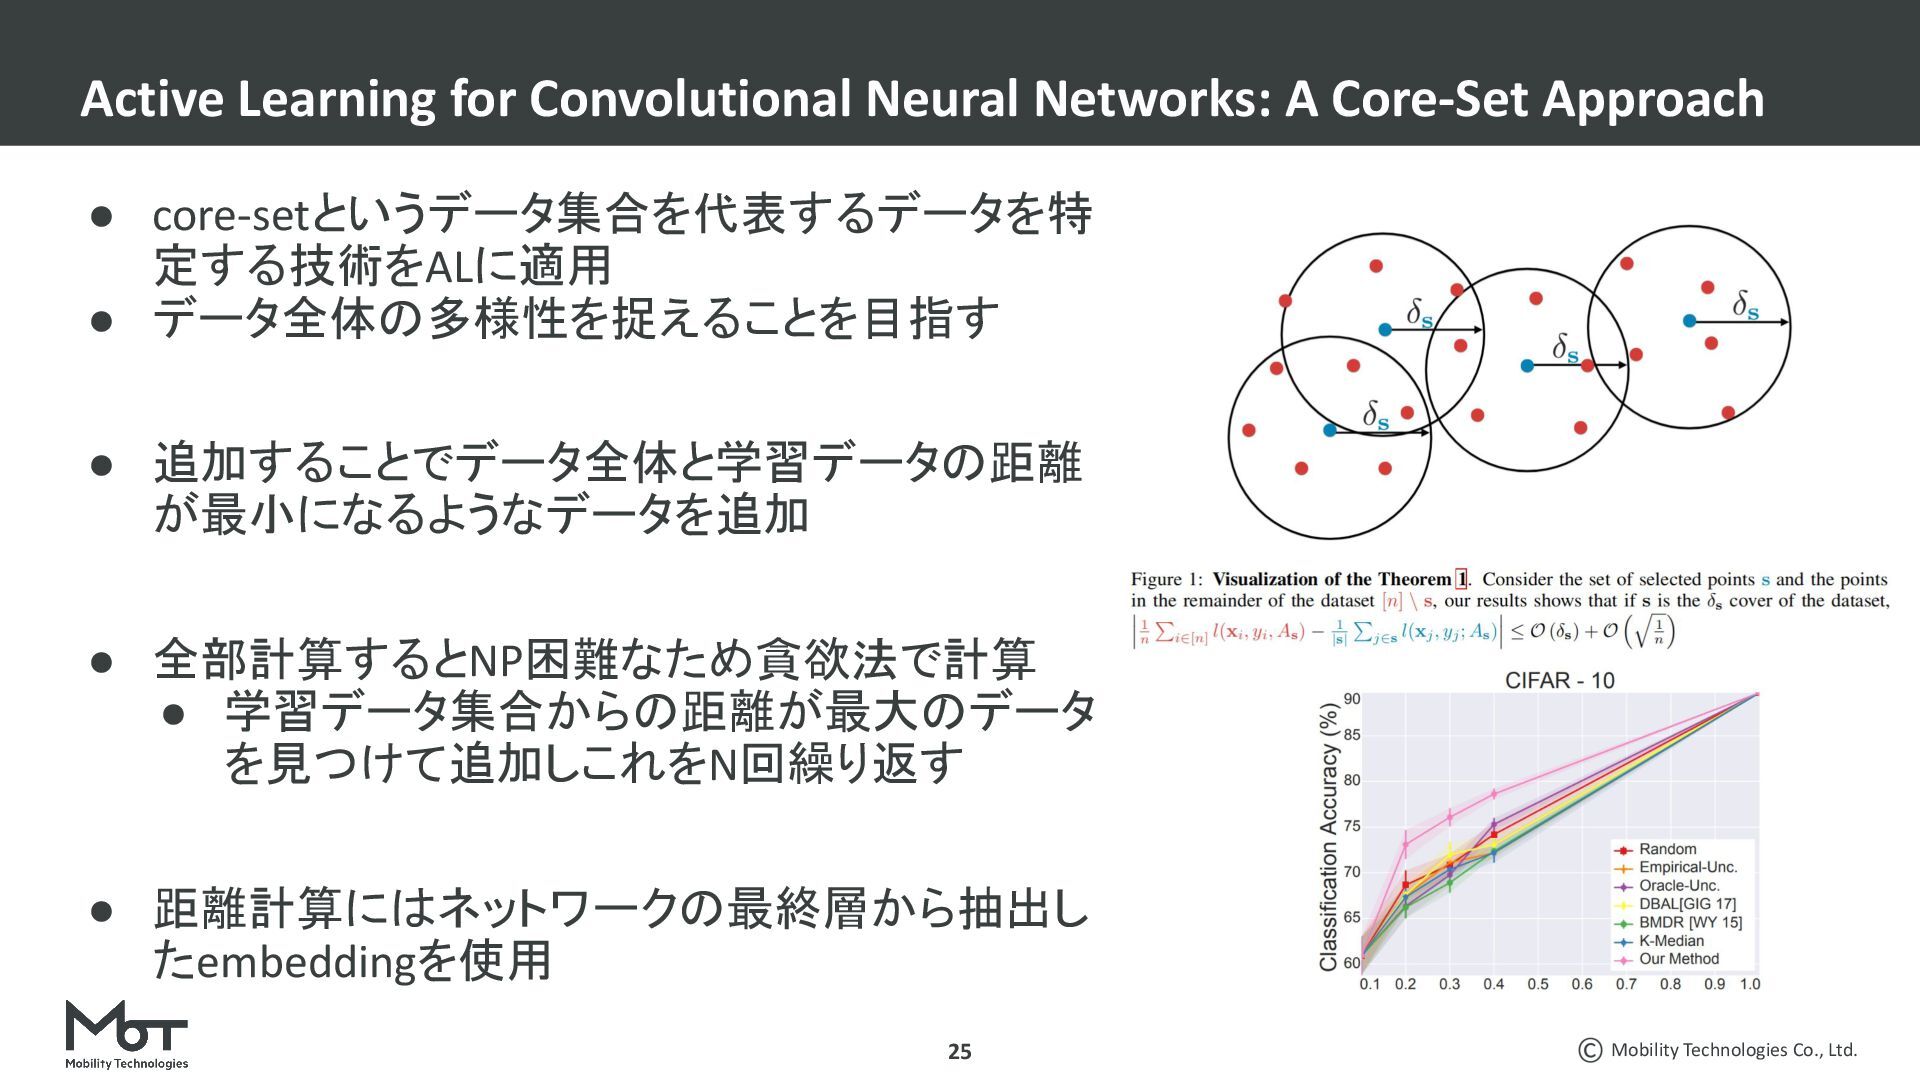
  21. Mobility Technologies Co., Ltd. 25 • core-setというデータ集合を代表するデータを特 定する技術をALに適用 • データ全体の多様性を捉えることを目指す

    • 追加することでデータ全体と学習データの距離 が最小になるようなデータを追加 • 全部計算するとNP困難なため貪欲法で計算 • 学習データ集合からの距離が最大のデータ を見つけて追加しこれをN回繰り返す • 距離計算にはネットワークの最終層から抽出し たembeddingを使用 Active Learning for Convolutional Neural Networks: A Core-Set Approach
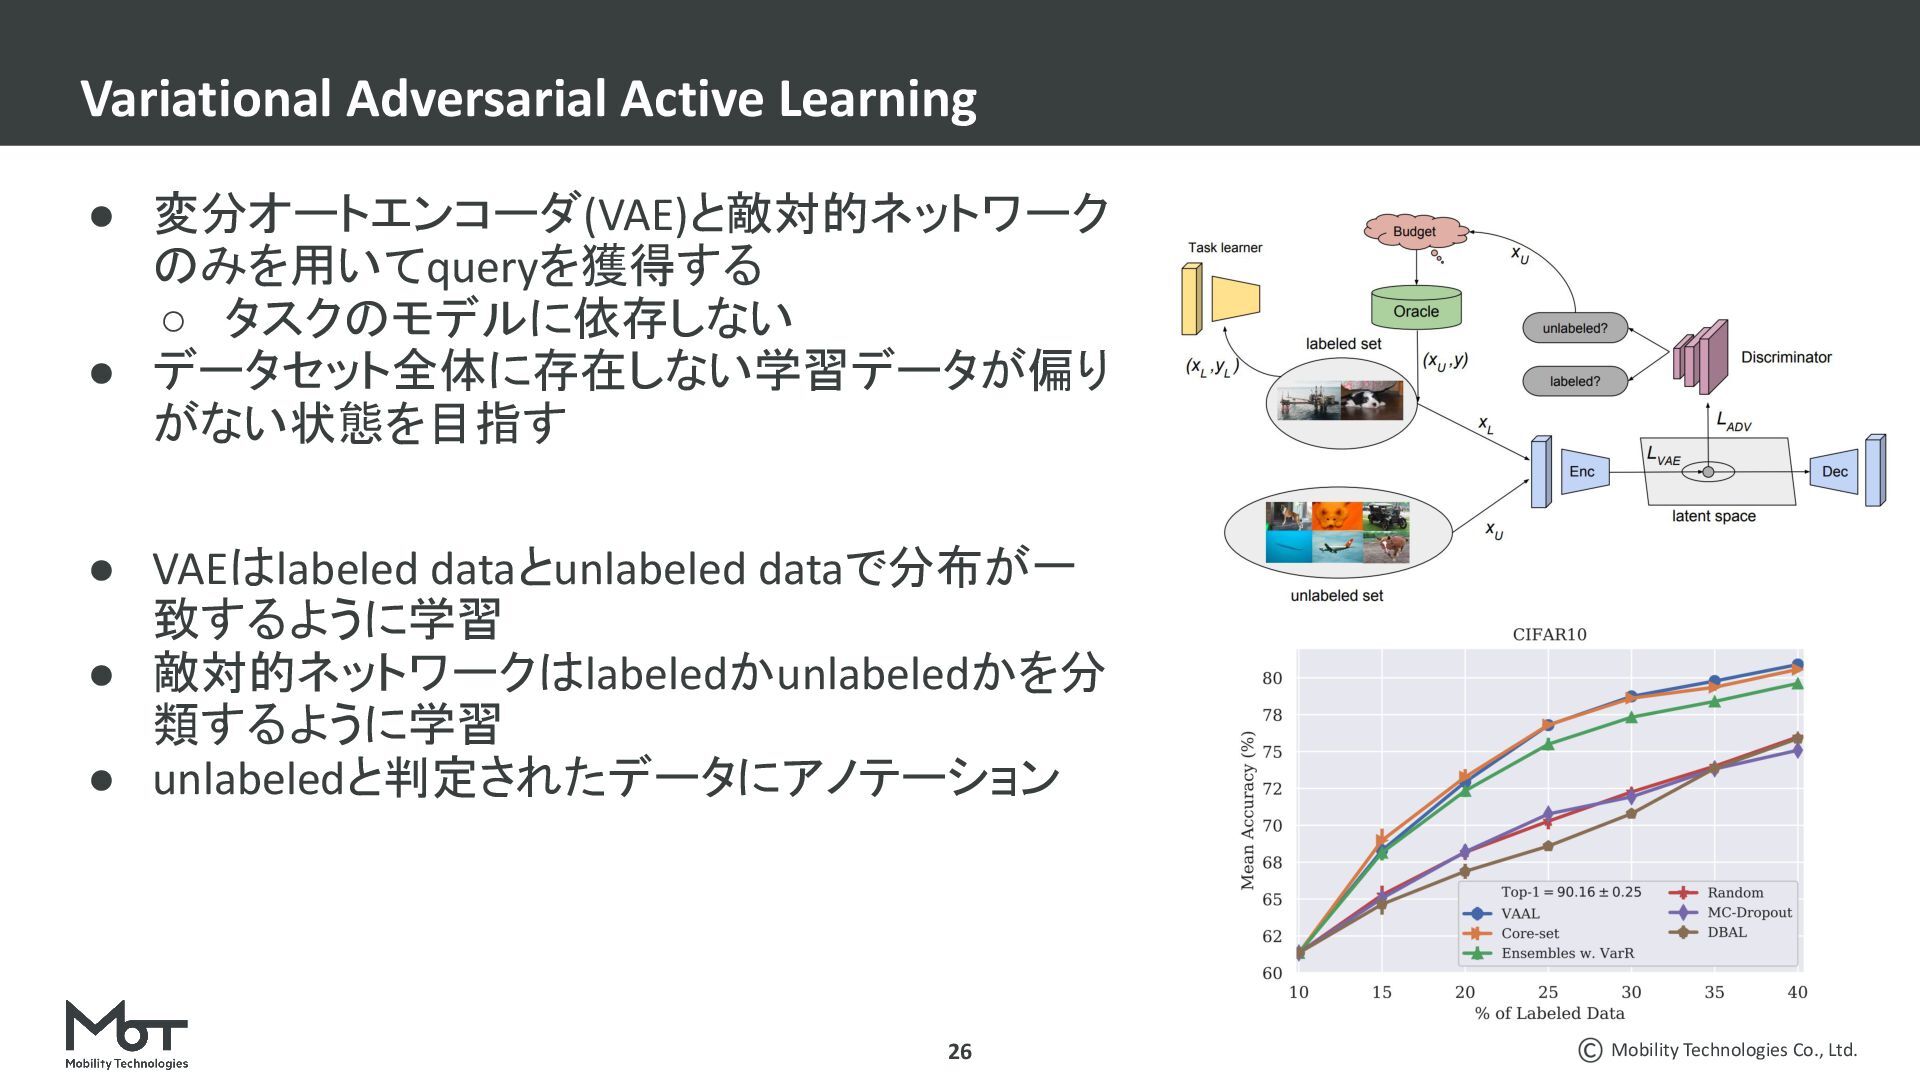
  22. Mobility Technologies Co., Ltd. 26 • 変分オートエンコーダ(VAE)と敵対的ネットワーク のみを用いてqueryを獲得する ◦ タスクのモデルに依存しない

    • データセット全体に存在しない学習データが偏り がない状態を目指す • VAEはlabeled dataとunlabeled dataで分布が一 致するように学習 • 敵対的ネットワークはlabeledかunlabeledかを分 類するように学習 • unlabeledと判定されたデータにアノテーション Variational Adversarial Active Learning
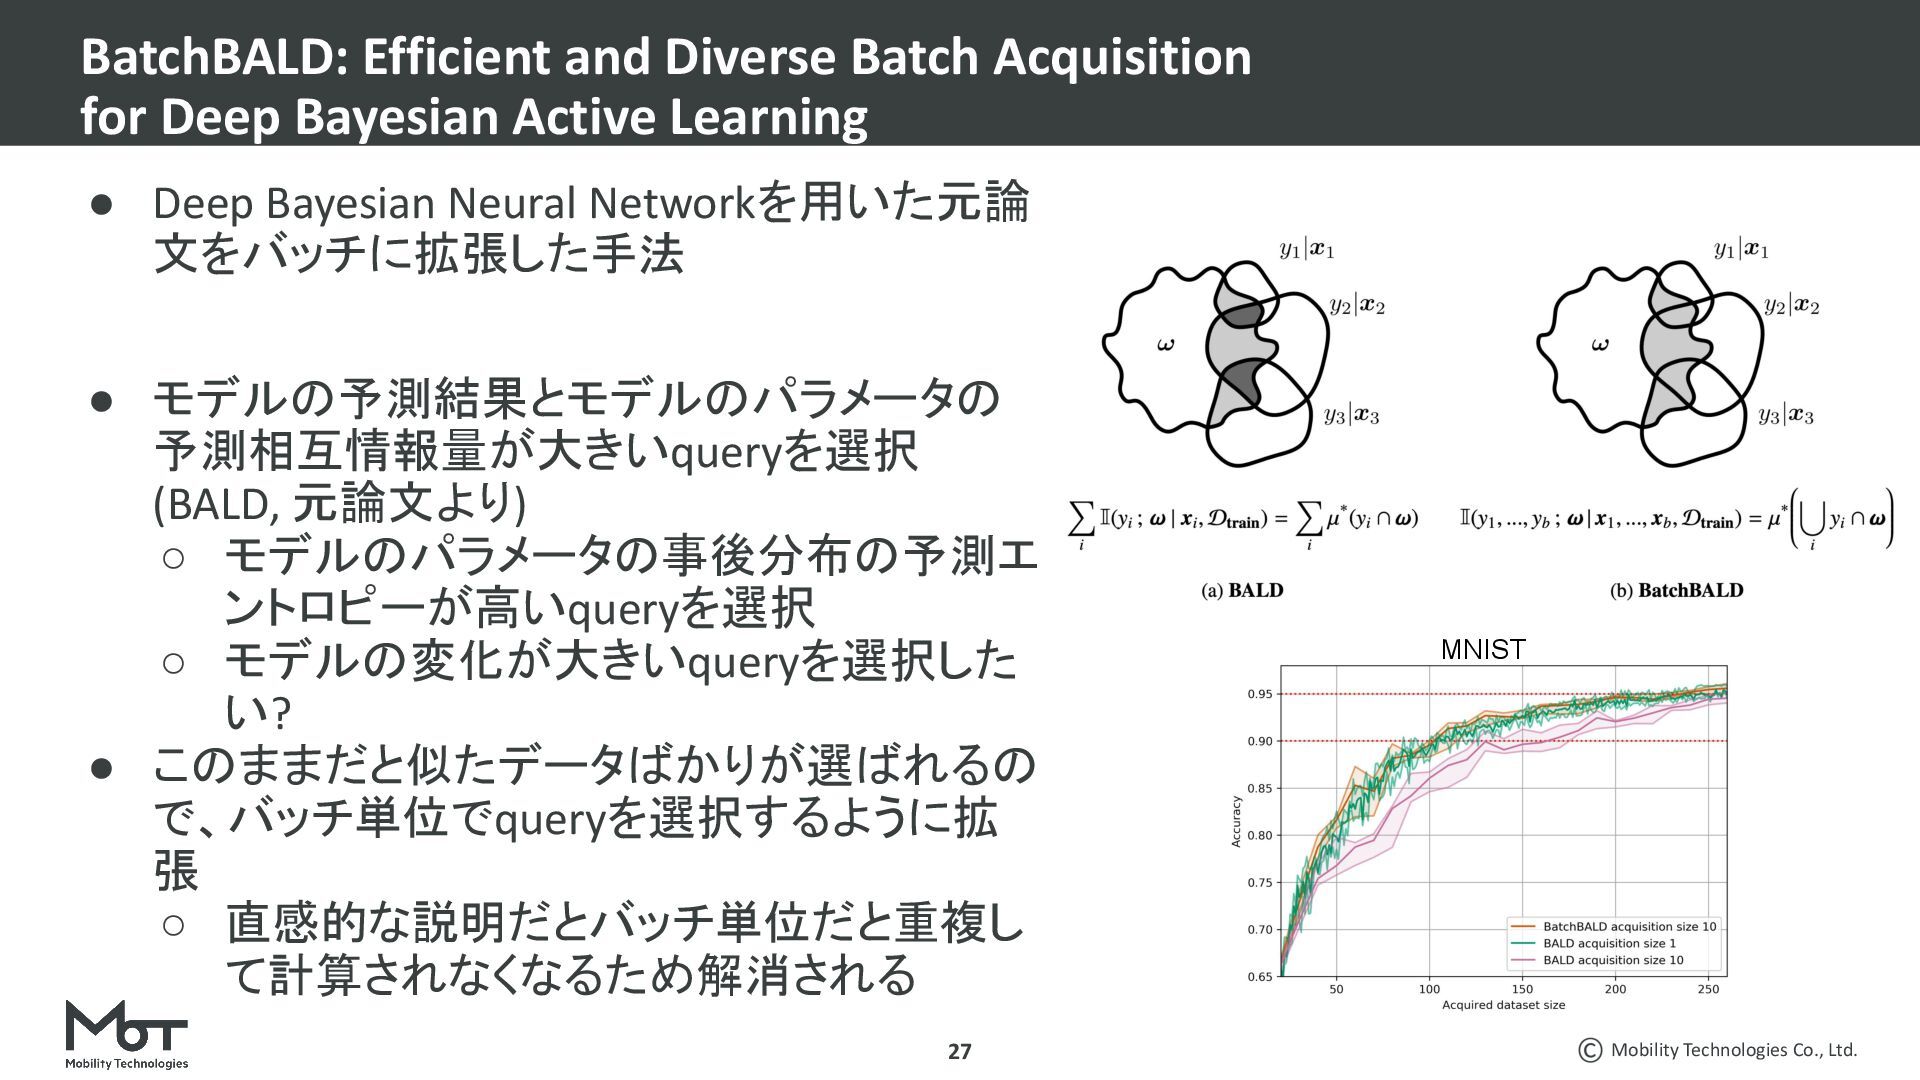
  23. Mobility Technologies Co., Ltd. 27 • Deep Bayesian Neural Networkを用いた元論

    文をバッチに拡張した手法 • モデルの予測結果とモデルのパラメータの 予測相互情報量が大きいqueryを選択 (BALD, 元論文より) ◦ モデルのパラメータの事後分布の予測エ ントロピーが高いqueryを選択 ◦ モデルの変化が大きいqueryを選択した い? • このままだと似たデータばかりが選ばれるの で、バッチ単位でqueryを選択するように拡 張 ◦ 直感的な説明だとバッチ単位だと重複し て計算されなくなるため解消される BatchBALD: Efficient and Diverse Batch Acquisition for Deep Bayesian Active Learning MNIST
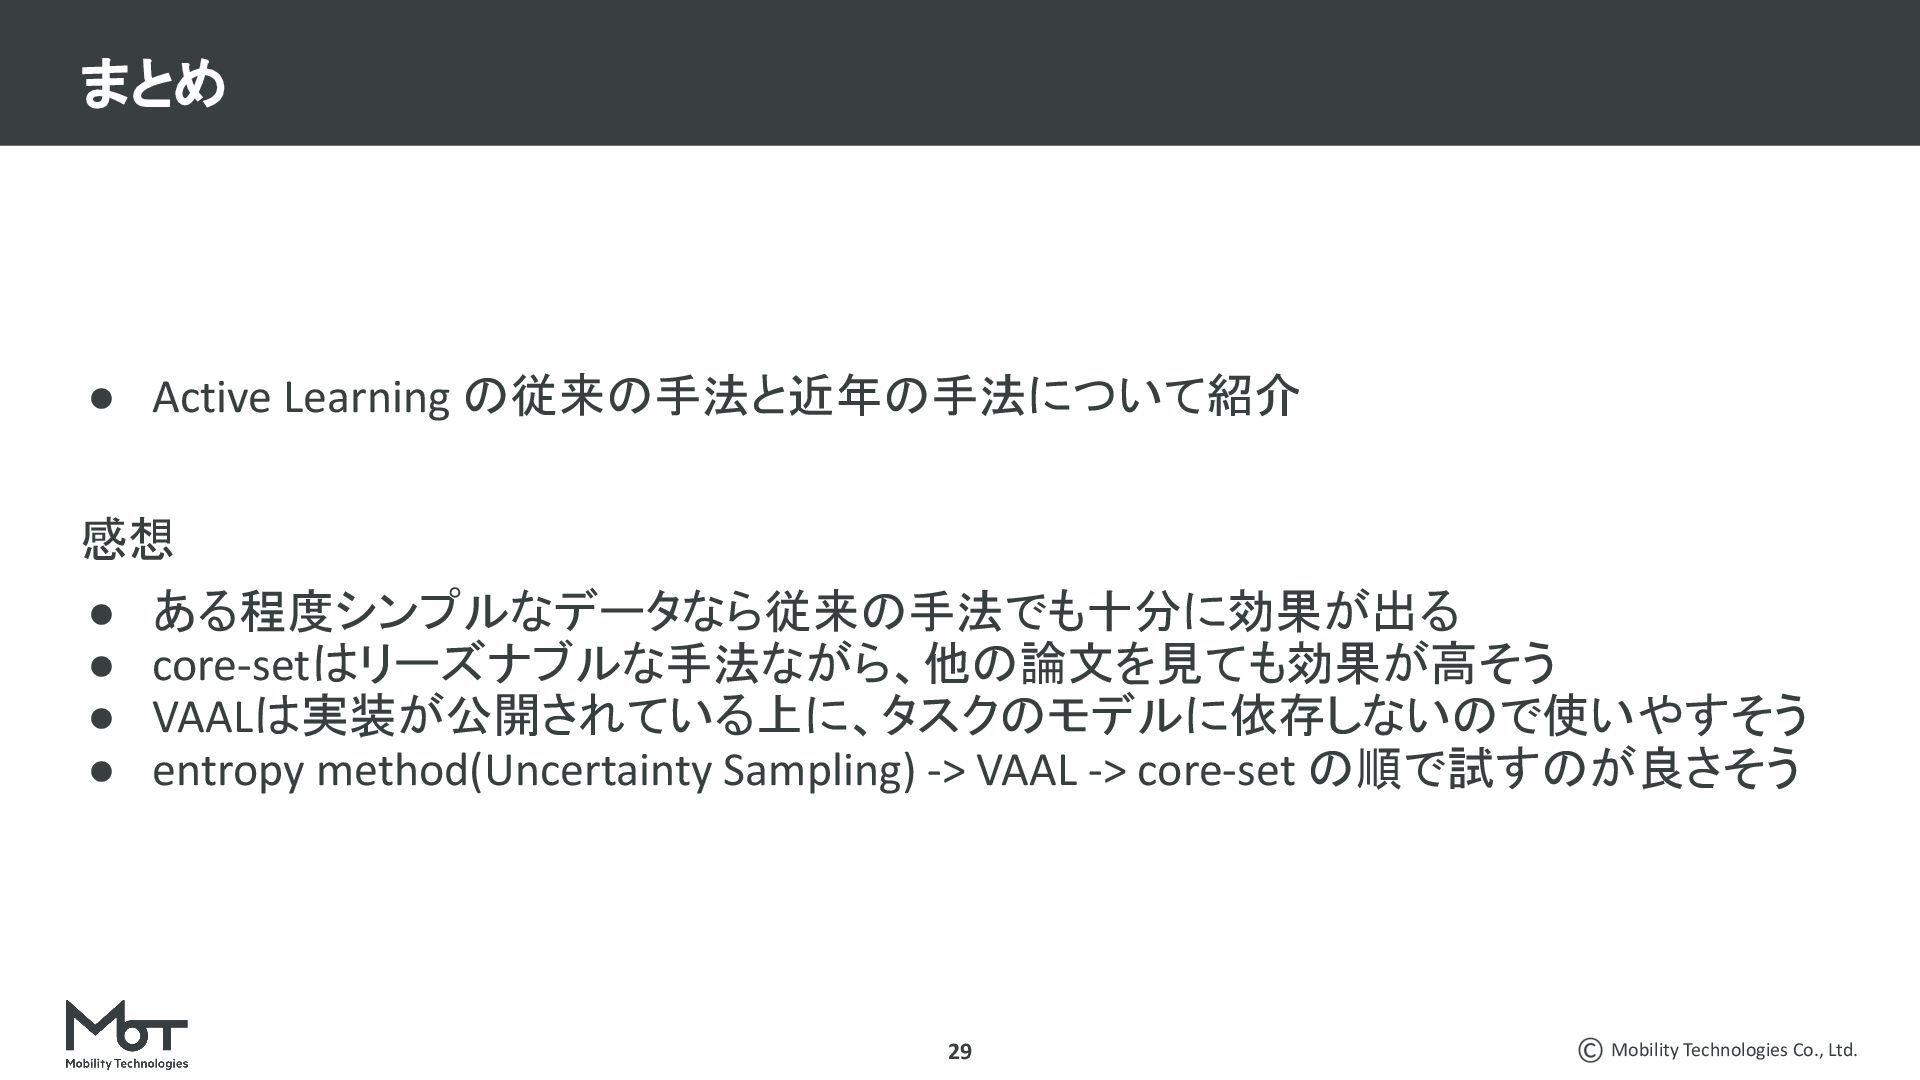
  24. Mobility Technologies Co., Ltd. 29 • Active Learning の従来の手法と近年の手法について紹介 感想

    • ある程度シンプルなデータなら従来の手法でも十分に効果が出る • core-setはリーズナブルな手法ながら、他の論文を見ても効果が高そう • VAALは実装が公開されている上に、タスクのモデルに依存しないので使いやすそう • entropy method(Uncertainty Sampling) -> VAAL -> core-set の順で試すのが良さそう まとめ
  25. Mobility Technologies Co., Ltd. 30 • Active Learning Literature Survey,

    2009, Burr Settles, Computer Sciences Technical Report 1648 • Active Learning 入門, https://www.slideshare.net/shuyo/introduction-to-active-learning-25787487 • Overview of Active Learning for Deep Learning, https://jacobgil.github.io/deeplearning/activelearning#active-learning-for-convolution al-neural-networks--a-core-set-approach • Active Learning for Convolutional Neural Networks: A Core-Set Approach, 2018, Ozan Sener, ICLR • Variational Adversarial Active Learning, 2019, Samarth Sinha, ICCV • BatchBALD: Efficient and Diverse Batch Acquisition for Deep Bayesian Active Learning, 2019, Andreas Kirsch, NeurIPS • 能動学習:問題設定と最近の話題, 2021, 日野英逸, 日本統計学会誌 参考