Share
Embed
学習データって増やせばいいんですか?
社内のAI技術共有会で発表した資料です。最新のキューレーション手法とキュレーションによるデータ選定が有効な条件について紹介しています。
fumihiko takahashi
December 11, 2025
Transcript
20 slides
-
AI Community 2025.12.11 高橋 文彦 GOドライブ株式会社 学習データって 増やせばいいんですか? Scaling Law
vs. Data Curation -
2 自己紹介:高橋 文彦 GOドライブ株式会社 経歴 ✔ 大手ポータルサービス運営会社 ◦ ECサイトにおける検索クエリの意図推定
◦ SNSにおけるドメインごとの話題の抽出 ◦ 形態素解析器の開発、研究 ✔ GO株式会社 ◦ タクシーアプリにおける到着時間予測機能の開発 ◦ 新規事業立ち上げ ◦ AIドラレコを用いたドライバーの行動認識 (『DRIVE CHART』) ✔ GOドライブ株式会社 趣味 ✔ ボードゲーム、一蘭、2児の育児 コンペ歴 ✔ SIGSPATIAL 2021 GISCUP 6位 ✔ SIGIR 2018 workshop eCom Rakuten Data Challenge 2位 ✔ HuMob Challenge 2023 11位 -
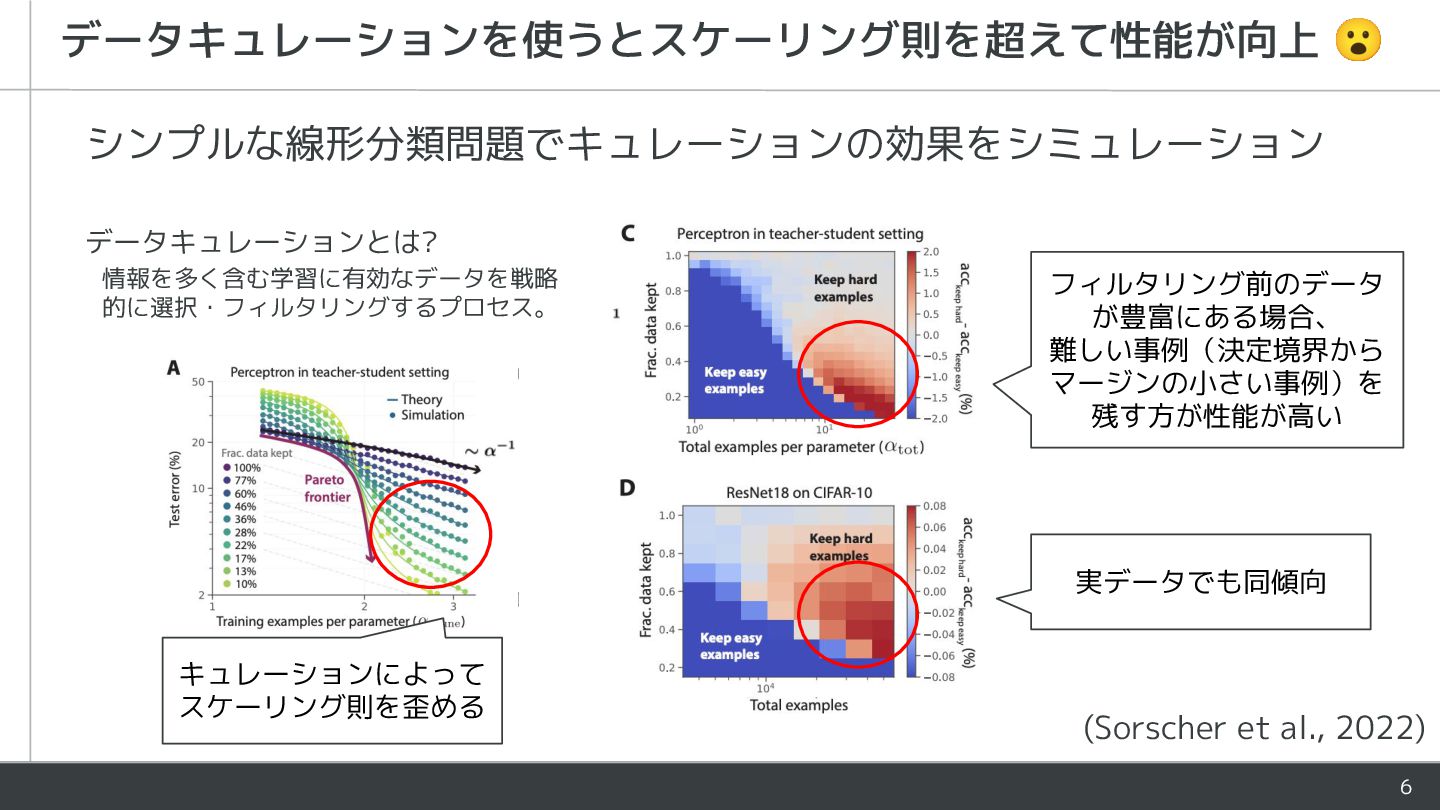
6 データキュレーションを使うとスケーリング則を超えて性能が向上 😮 (Sorscher et al., 2022) キュレーションによって スケーリング則を歪める フィルタリング前のデータ
が豊富にある場合、 難しい事例(決定境界から マージンの小さい事例)を 残す方が性能が高い シンプルな線形分類問題でキュレーションの効果をシミュレーション 実データでも同傾向 データキュレーションとは? 情報を多く含む学習に有効なデータを戦略 的に選択・フィルタリングするプロセス。 -
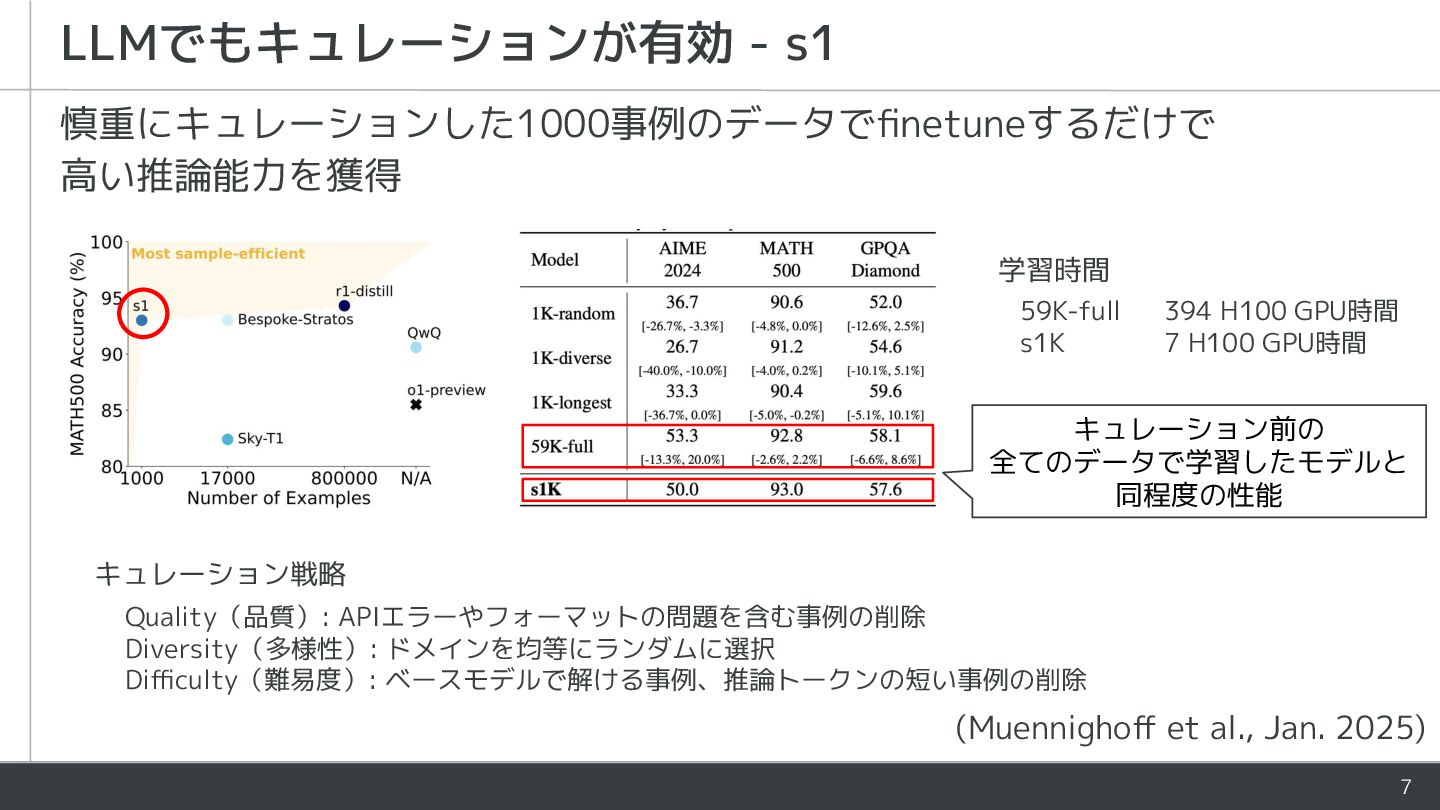
7 慎重にキュレーションした1000事例のデータでfinetuneするだけで 高い推論能力を獲得 LLMでもキュレーションが有効 - s1 (Muennighoff et al., Jan.
2025) Quality(品質): APIエラーやフォーマットの問題を含む事例の削除 Diversity(多様性): ドメインを均等にランダムに選択 Difficulty(難易度): ベースモデルで解ける事例、推論トークンの短い事例の削除 キュレーション前の 全てのデータで学習したモデルと 同程度の性能 キュレーション戦略 59K-full 394 H100 GPU時間 s1K 7 H100 GPU時間 学習時間 -
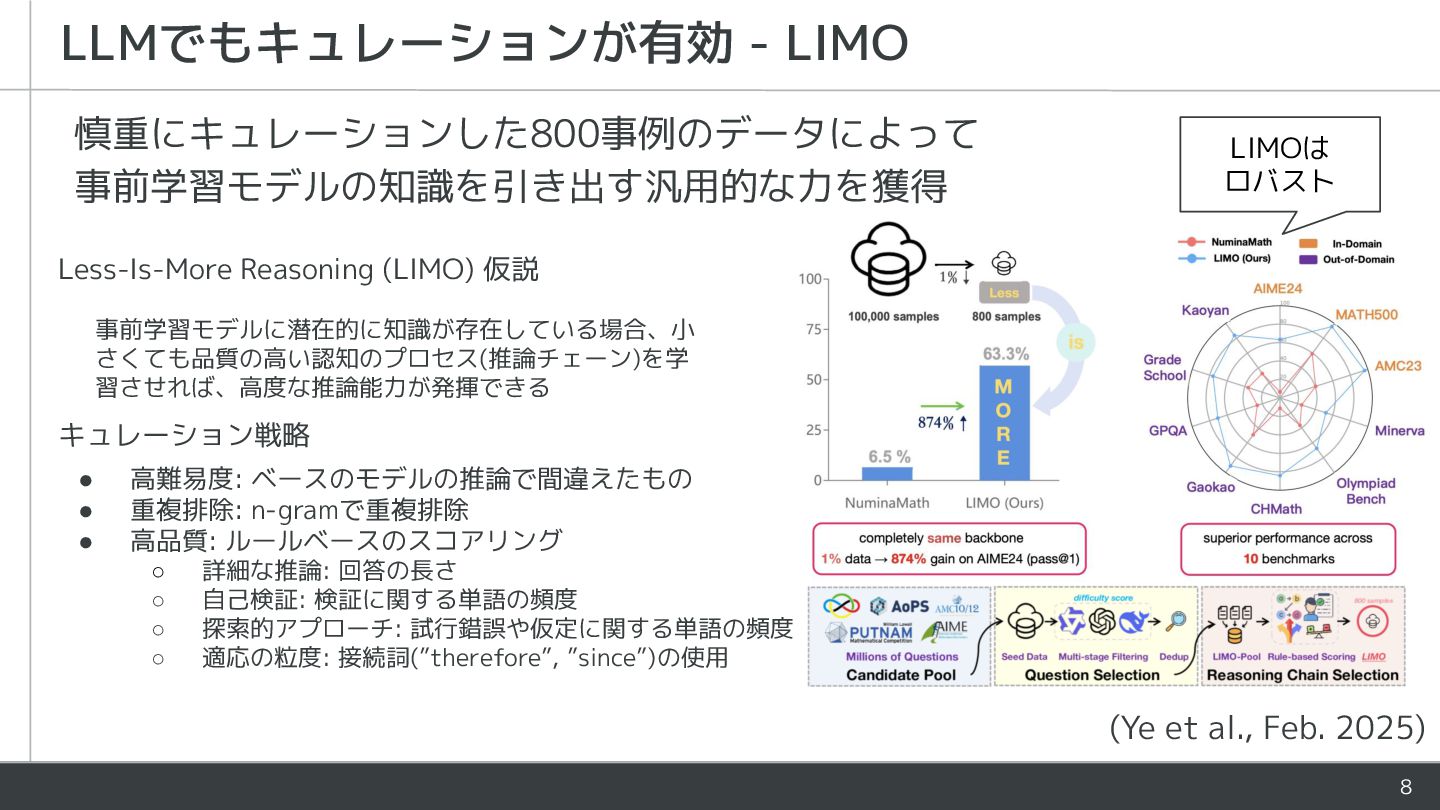
8 LLMでもキュレーションが有効 - LIMO (Ye et al., Feb. 2025) 慎重にキュレーションした800事例のデータによって
事前学習モデルの知識を引き出す汎用的な力を獲得 • 高難易度: ベースのモデルの推論で間違えたもの • 重複排除: n-gramで重複排除 • 高品質: ルールベースのスコアリング ◦ 詳細な推論: 回答の長さ ◦ 自己検証: 検証に関する単語の頻度 ◦ 探索的アプローチ: 試行錯誤や仮定に関する単語の頻度 ◦ 適応の粒度: 接続詞(”therefore”, ”since”)の使用 キュレーション戦略 事前学習モデルに潜在的に知識が存在している場合、小 さくても品質の高い認知のプロセス(推論チェーン)を学 習させれば、高度な推論能力が発揮できる Less-Is-More Reasoning (LIMO) 仮説 LIMOは ロバスト -
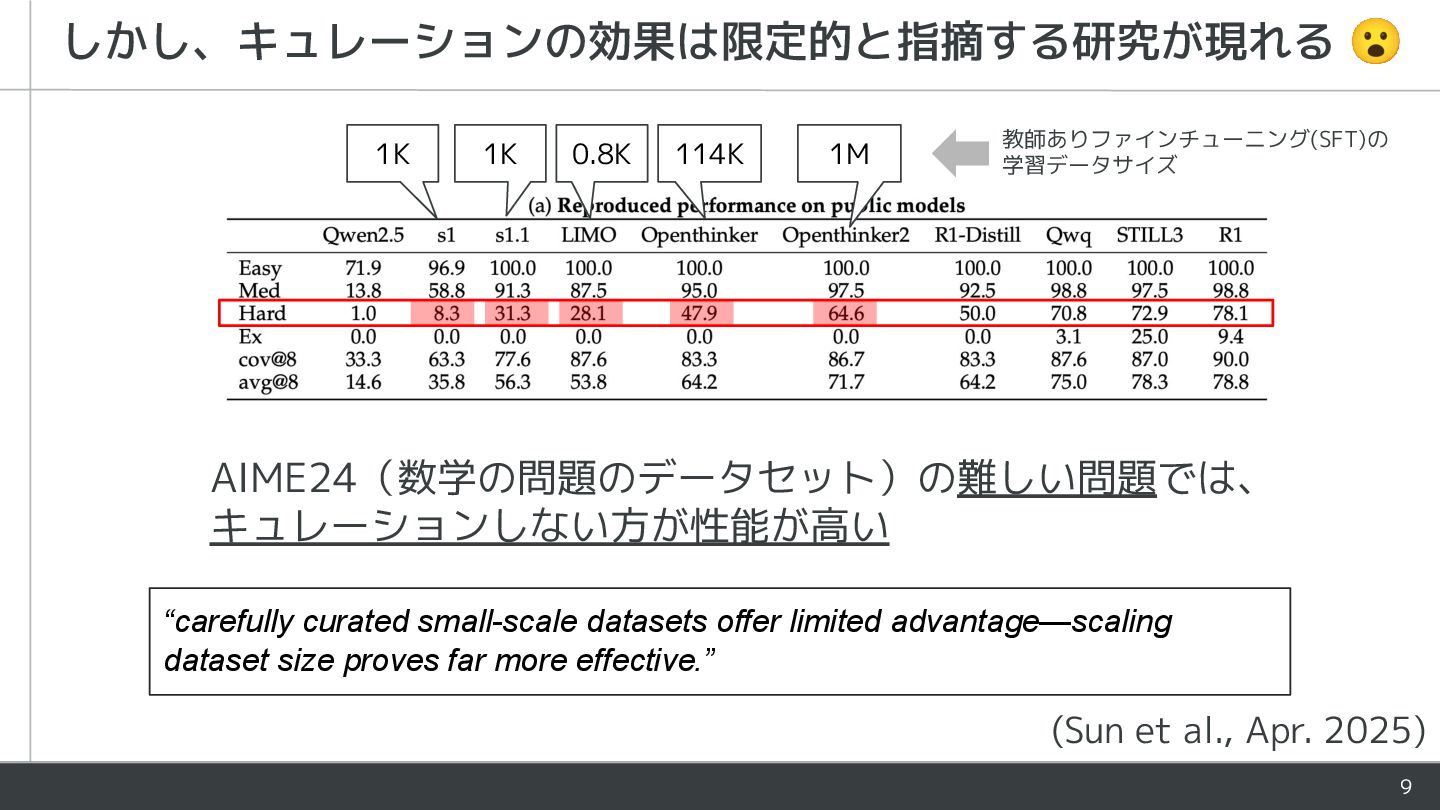
9 しかし、キュレーションの効果は限定的と指摘する研究が現れる 😮 (Sun et al., Apr. 2025) AIME24(数学の問題のデータセット)の難しい問題では、 キュレーションしない方が性能が高い
“carefully curated small-scale datasets offer limited advantage—scaling dataset size proves far more effective.” 114K 1M 0.8K 1K 1K 教師ありファインチューニング(SFT)の 学習データサイズ -
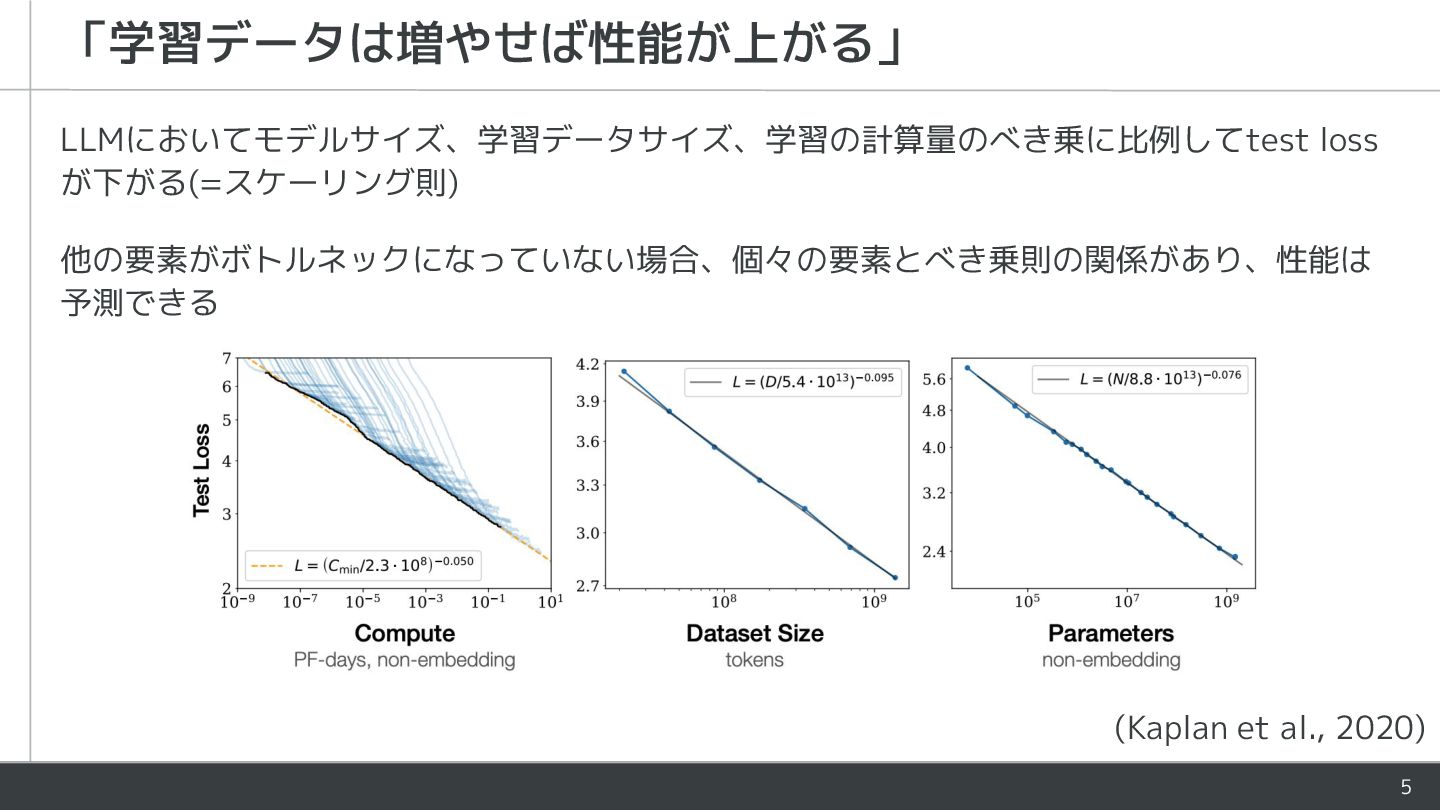
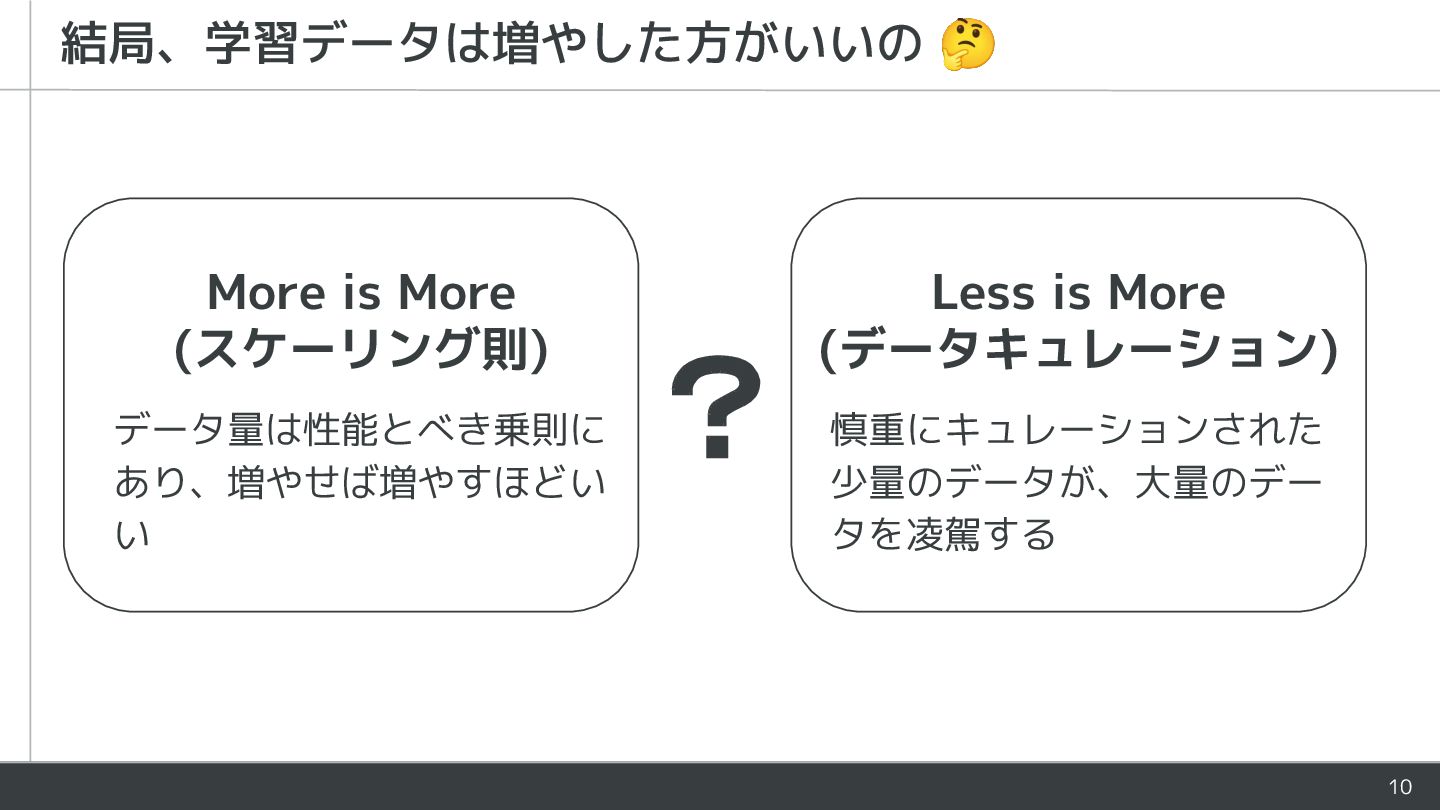
10 データ量は性能とべき乗則に あり、増やせば増やすほどい い 結局、学習データは増やした方がいいの 🤔 More is More (スケーリング則)
慎重にキュレーションされた 少量のデータが、大量のデー タを凌駕する Less is More (データキュレーション) ? -
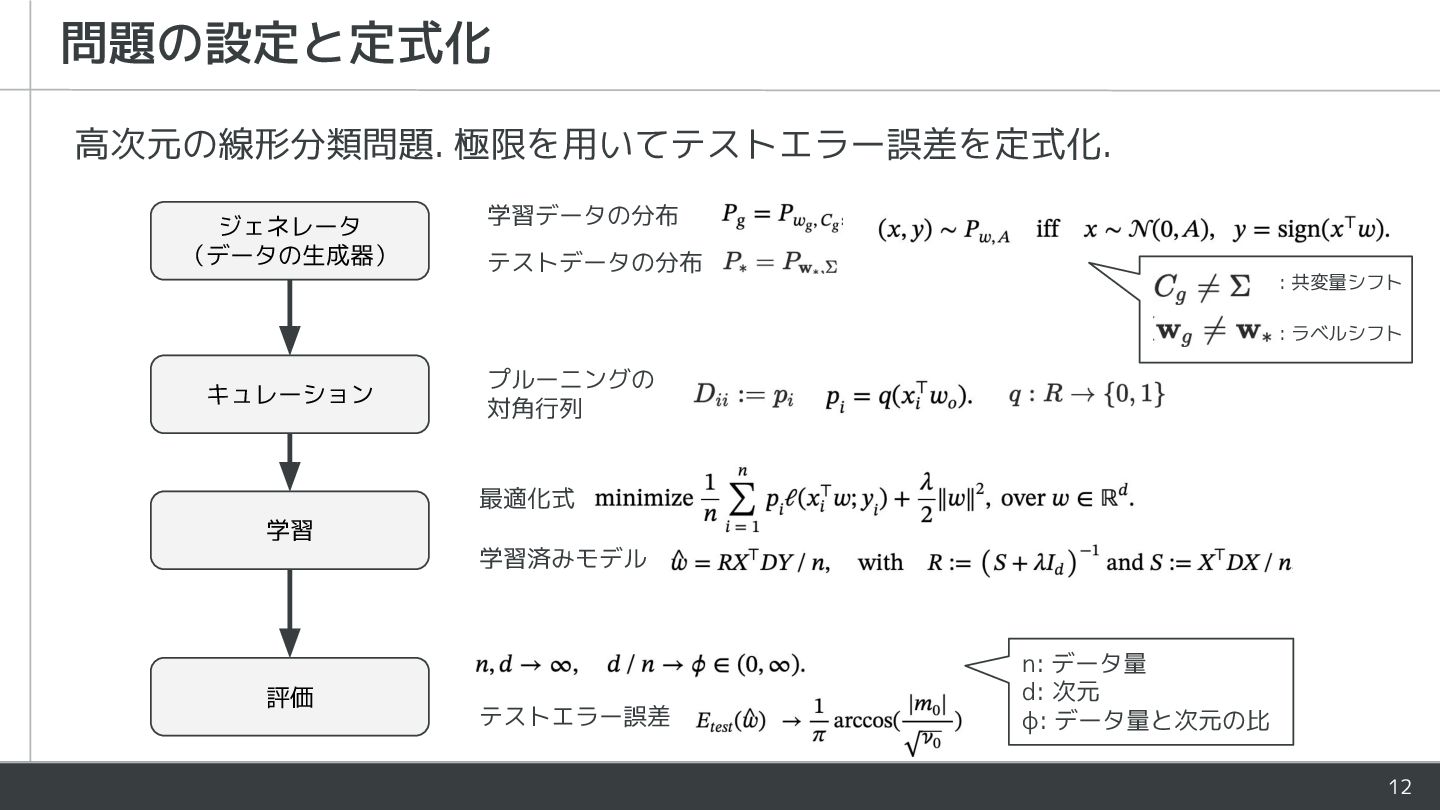
12 問題の設定と定式化 ジェネレータ (データの生成器) キュレーション 学習 評価 n: データ量 d:
次元 ϕ: データ量と次元の比 高次元の線形分類問題. 極限を用いてテストエラー誤差を定式化. テストエラー誤差 学習済みモデル 最適化式 プルーニングの 対角行列 学習データの分布 テストデータの分布 : 共変量シフト : ラベルシフト -
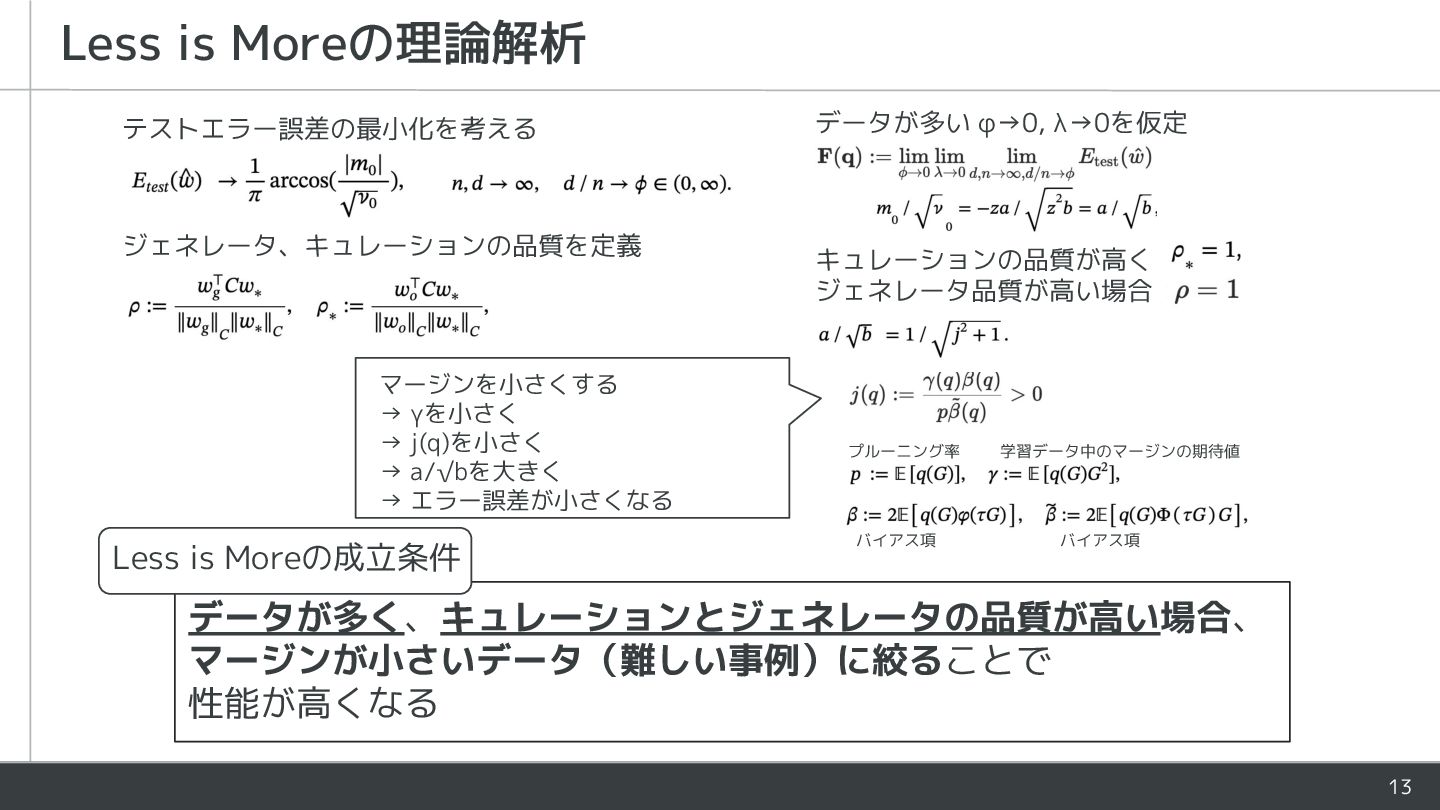
13 Less is Moreの理論解析 テストエラー誤差の最小化を考える ジェネレータ、キュレーションの品質を定義 データが多い φ→0, λ→0を仮定 キュレーションの品質が高く
ジェネレータ品質が高い場合 マージンを小さくする → γを小さく → j(q)を小さく → a/√bを大きく → エラー誤差が小さくなる データが多く、キュレーションとジェネレータの品質が高い場合、 マージンが小さいデータ(難しい事例)に絞ることで 性能が高くなる バイアス項 バイアス項 プルーニング率 Less is Moreの成立条件 学習データ中のマージンの期待値 -
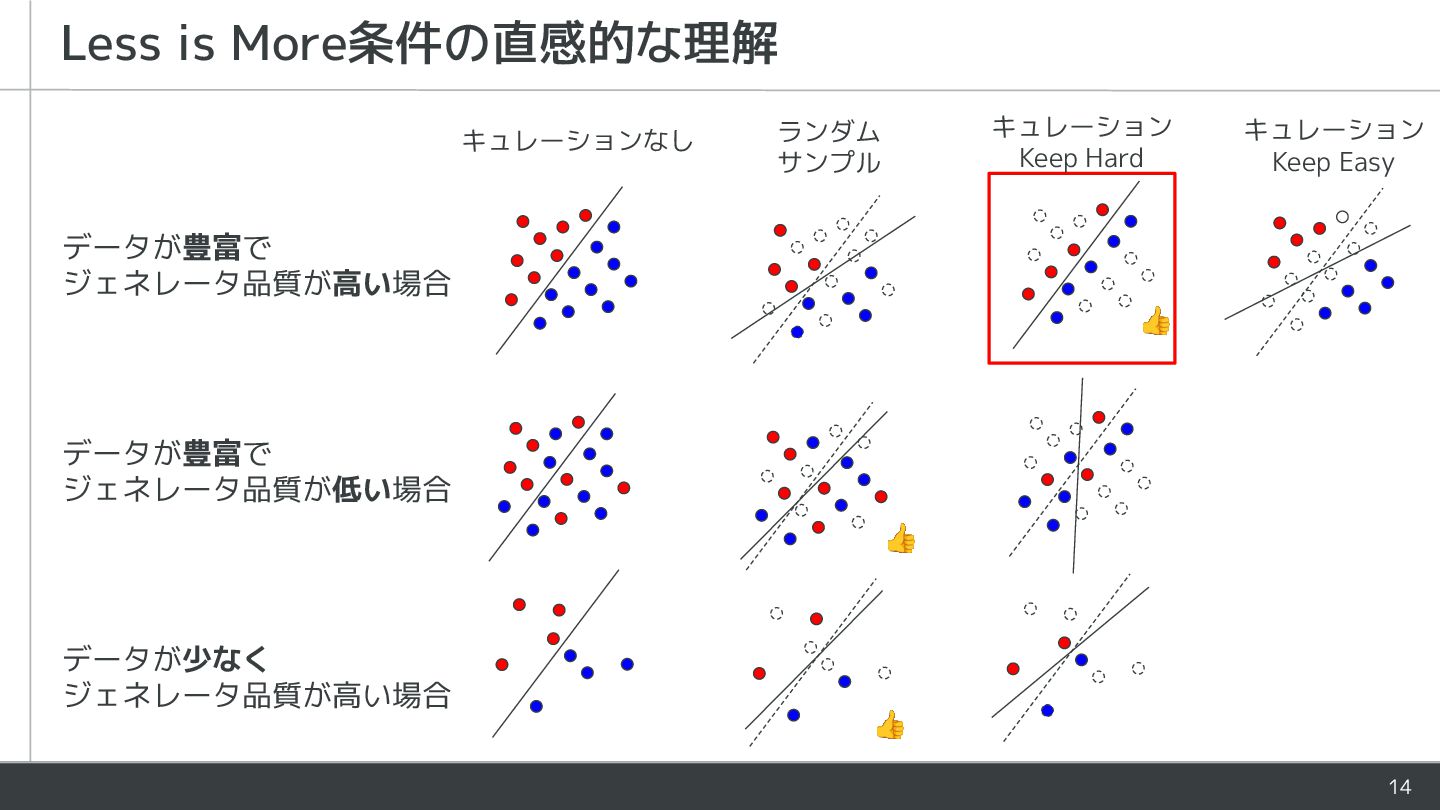
14 Less is More条件の直感的な理解 データが豊富で ジェネレータ品質が高い場合 データが豊富で ジェネレータ品質が低い場合 データが少なく ジェネレータ品質が高い場合
キュレーションなし ランダム サンプル キュレーション Keep Hard キュレーション Keep Easy 👍 👍 👍 -
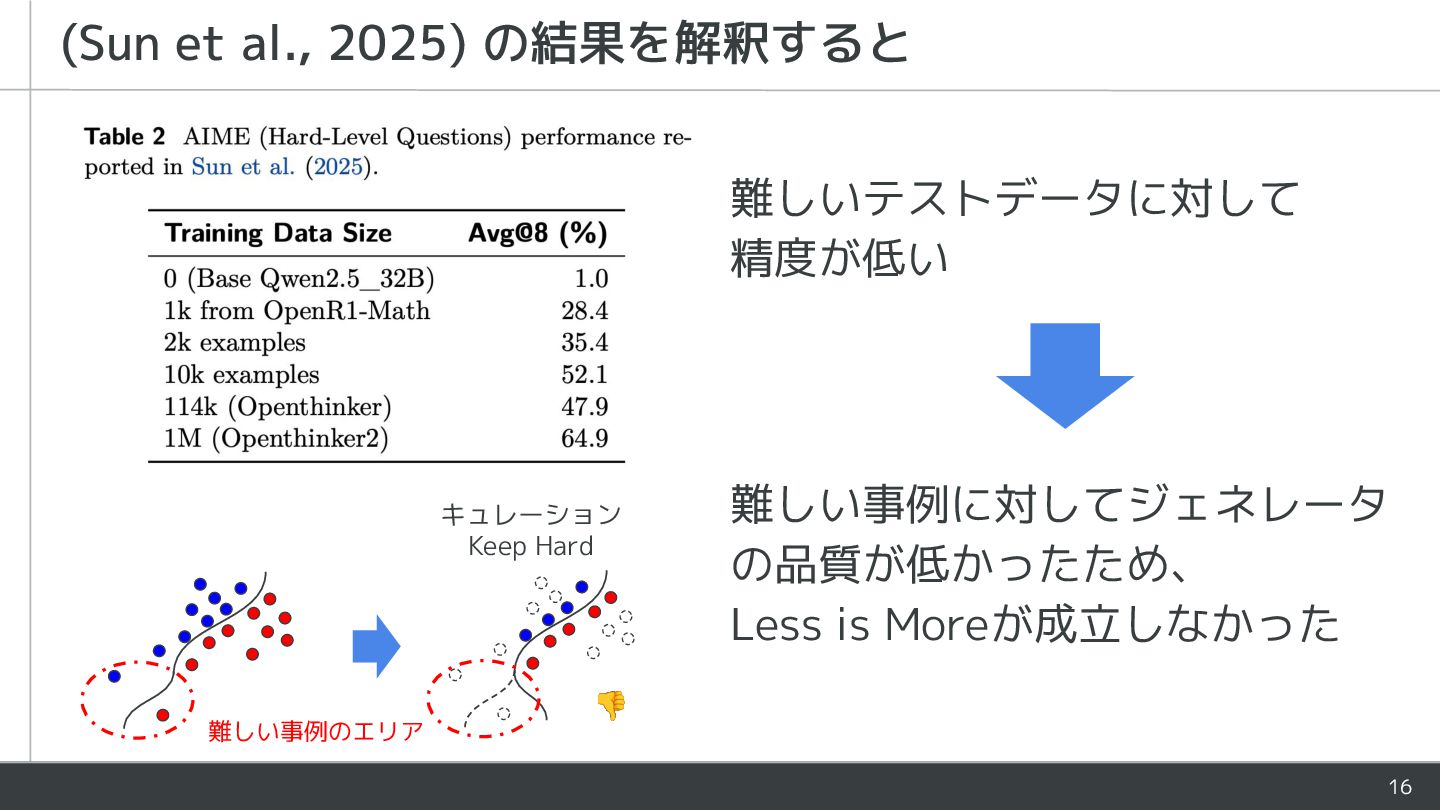
16 難しいテストデータに対して 精度が低い 難しい事例に対してジェネレータ の品質が低かったため、 Less is Moreが成立しなかった (Sun et
al., 2025) の結果を解釈すると 難しい事例のエリア キュレーション Keep Hard 👎 -
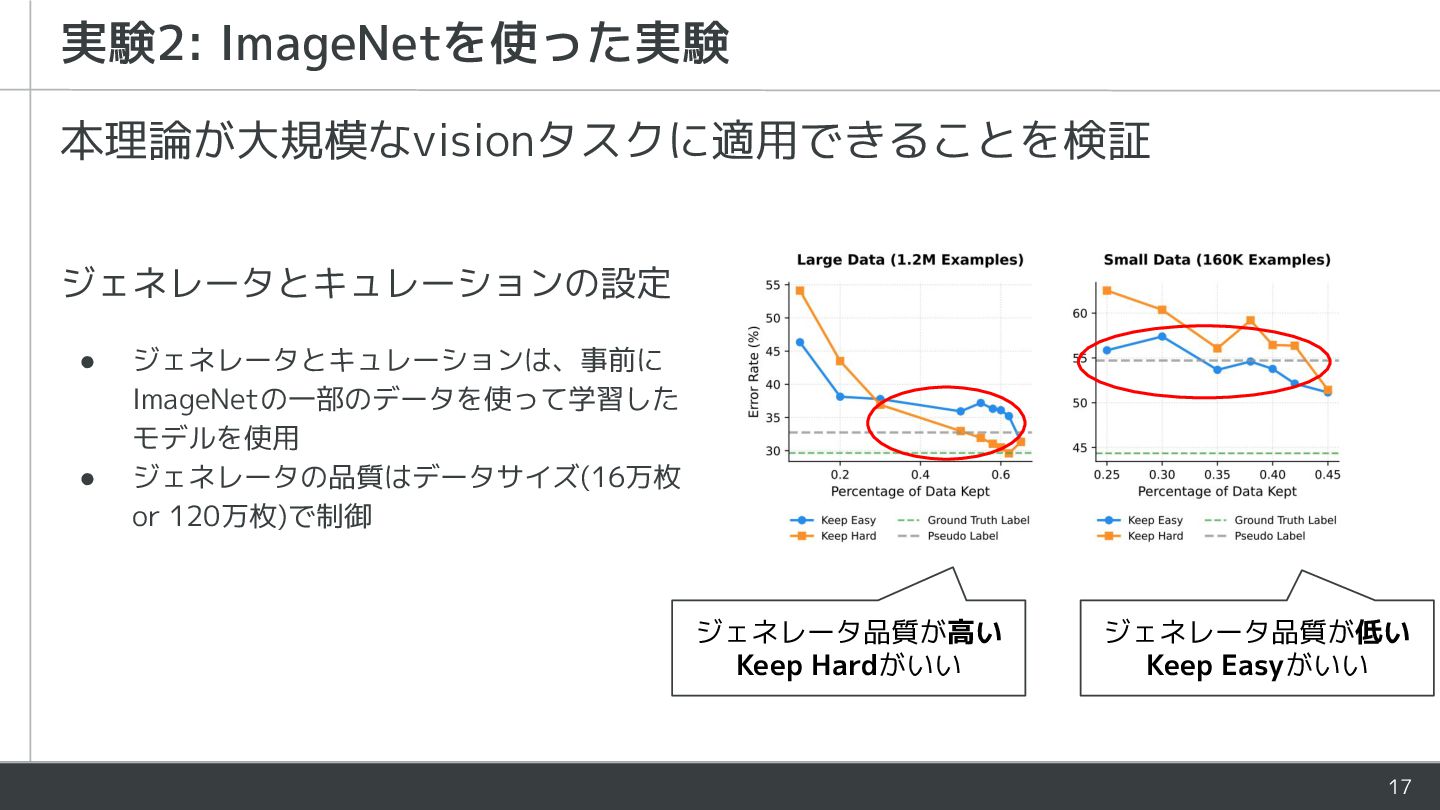
17 ジェネレータとキュレーションの設定 • ジェネレータとキュレーションは、事前に ImageNetの一部のデータを使って学習した モデルを使用 • ジェネレータの品質はデータサイズ(16万枚 or 120万枚)で制御
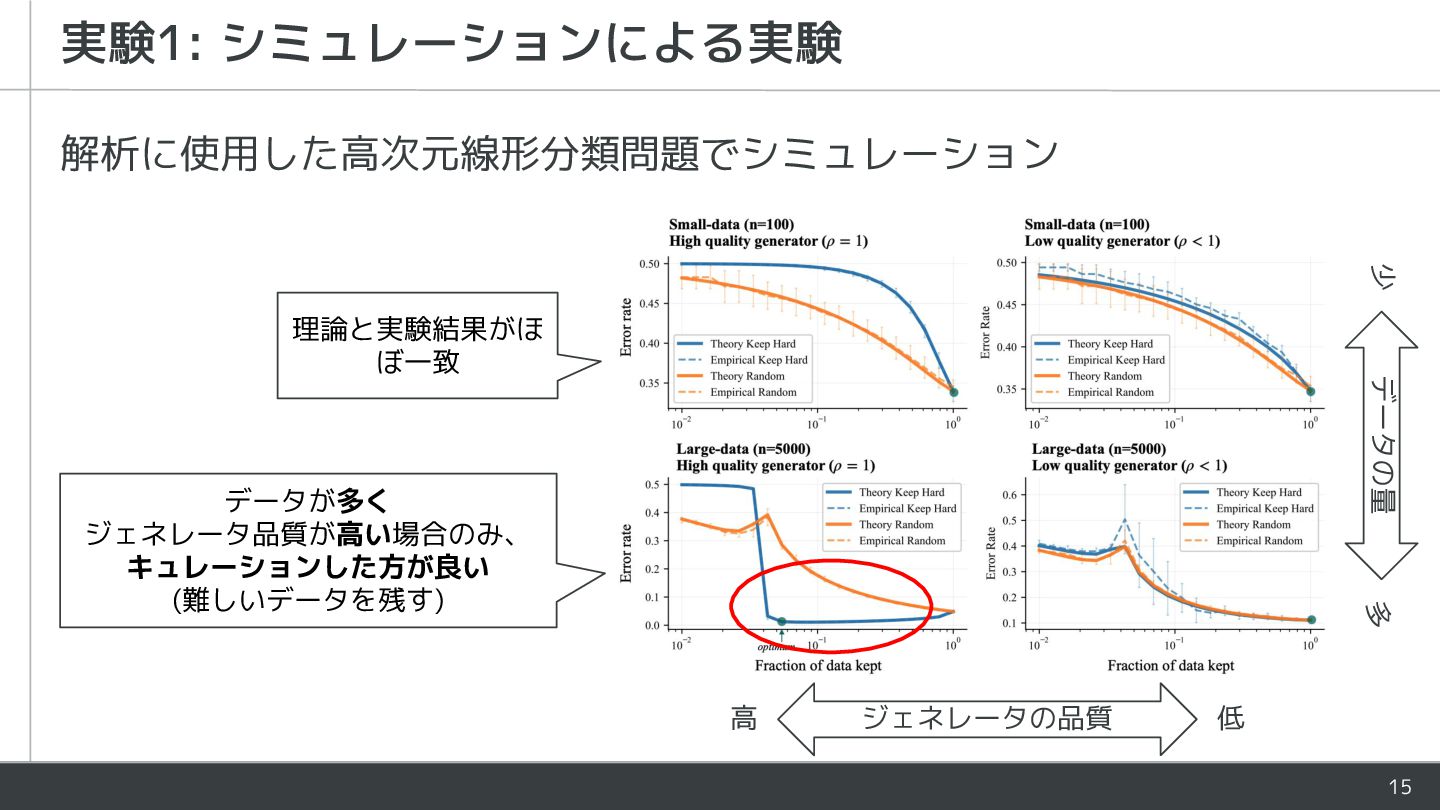
実験2: ImageNetを使った実験 ジェネレータ品質が高い Keep Hardがいい ジェネレータ品質が低い Keep Easyがいい 本理論が大規模なvisionタスクに適用できることを検証 -
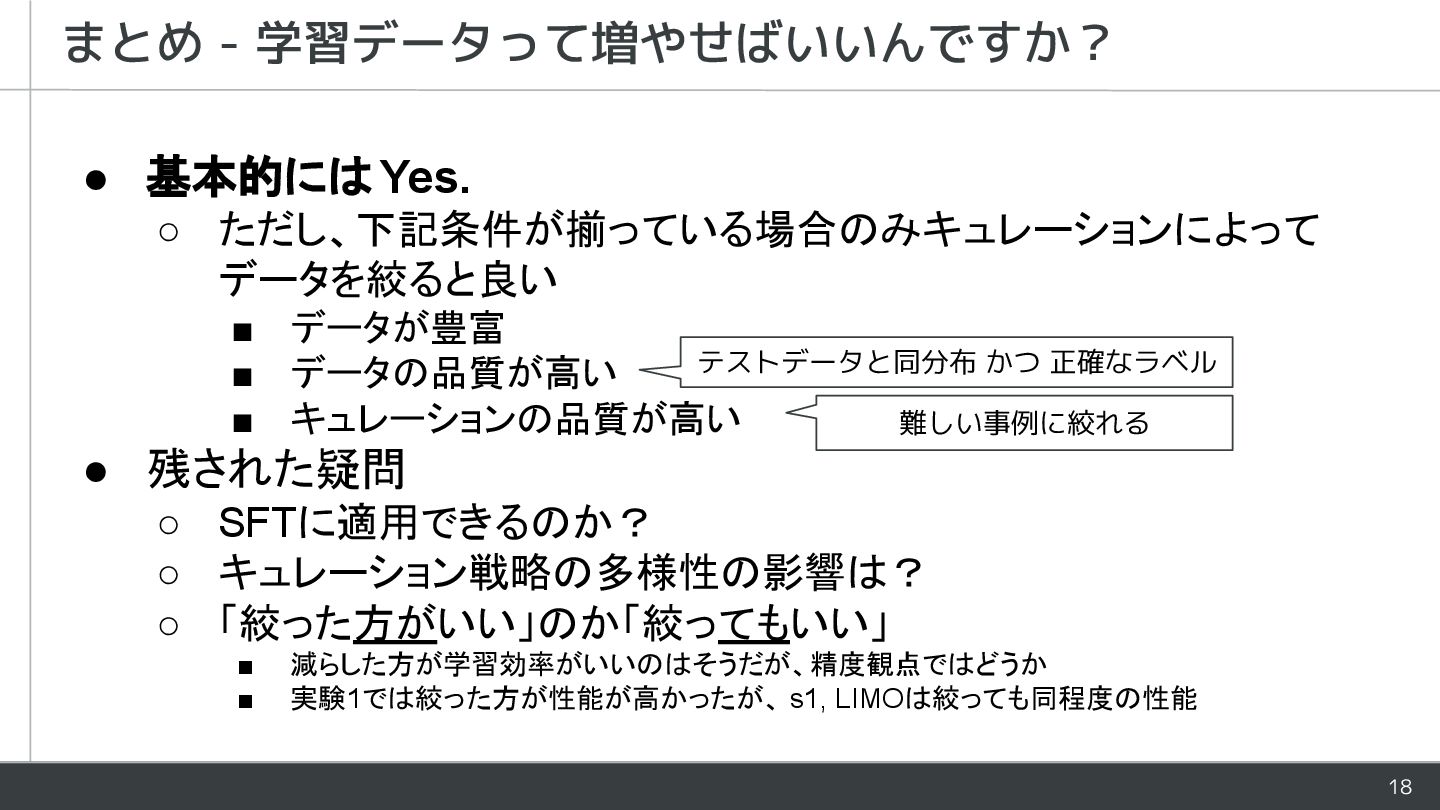
18 まとめ - 学習データって増やせばいいんですか? • 基本的には Yes. ◦ ただし、下記条件が揃っている場合のみキュレーションによって データを絞ると良い
▪ データが豊富 ▪ データの品質が高い ▪ キュレーションの品質が高い • 残された疑問 ◦ SFTに適用できるのか? ◦ キュレーション戦略の多様性の影響は? ◦ 「絞った方がいい」のか「絞ってもいい」 ▪ 減らした方が学習効率がいいのはそうだが、精度観点ではどうか ▪ 実験1では絞った方が性能が高かったが、 s1, LIMOは絞っても同程度の性能 テストデータと同分布 かつ 正確なラベル 難しい事例に絞れる -
19 • Scaling Laws for Neural Language Models, Kaplan et
al., 2020 • Beyond neural scaling laws: beating power law scaling via data pruning, Sorscher et al., 2022 • s1: Simple test-time scaling, Muennighoff et al., 2025 • LIMO: Less is More for Reasoning, Ye et al., 2025 • Climbing the ladder of reasoning: What llms can-and still can’t-solve after sft?, Sun et al., 2025 • Why Less is More (Sometimes): A Theory of Data Curation, Dohmatob et al., 2025 参考文献