Share
Embed
jevを業務を入れるまでにやること
jevを業務に入れる前に、どの判断を任せられるか、何で測るか、どう切り替えるかを、実験結果をもとにまとめた。
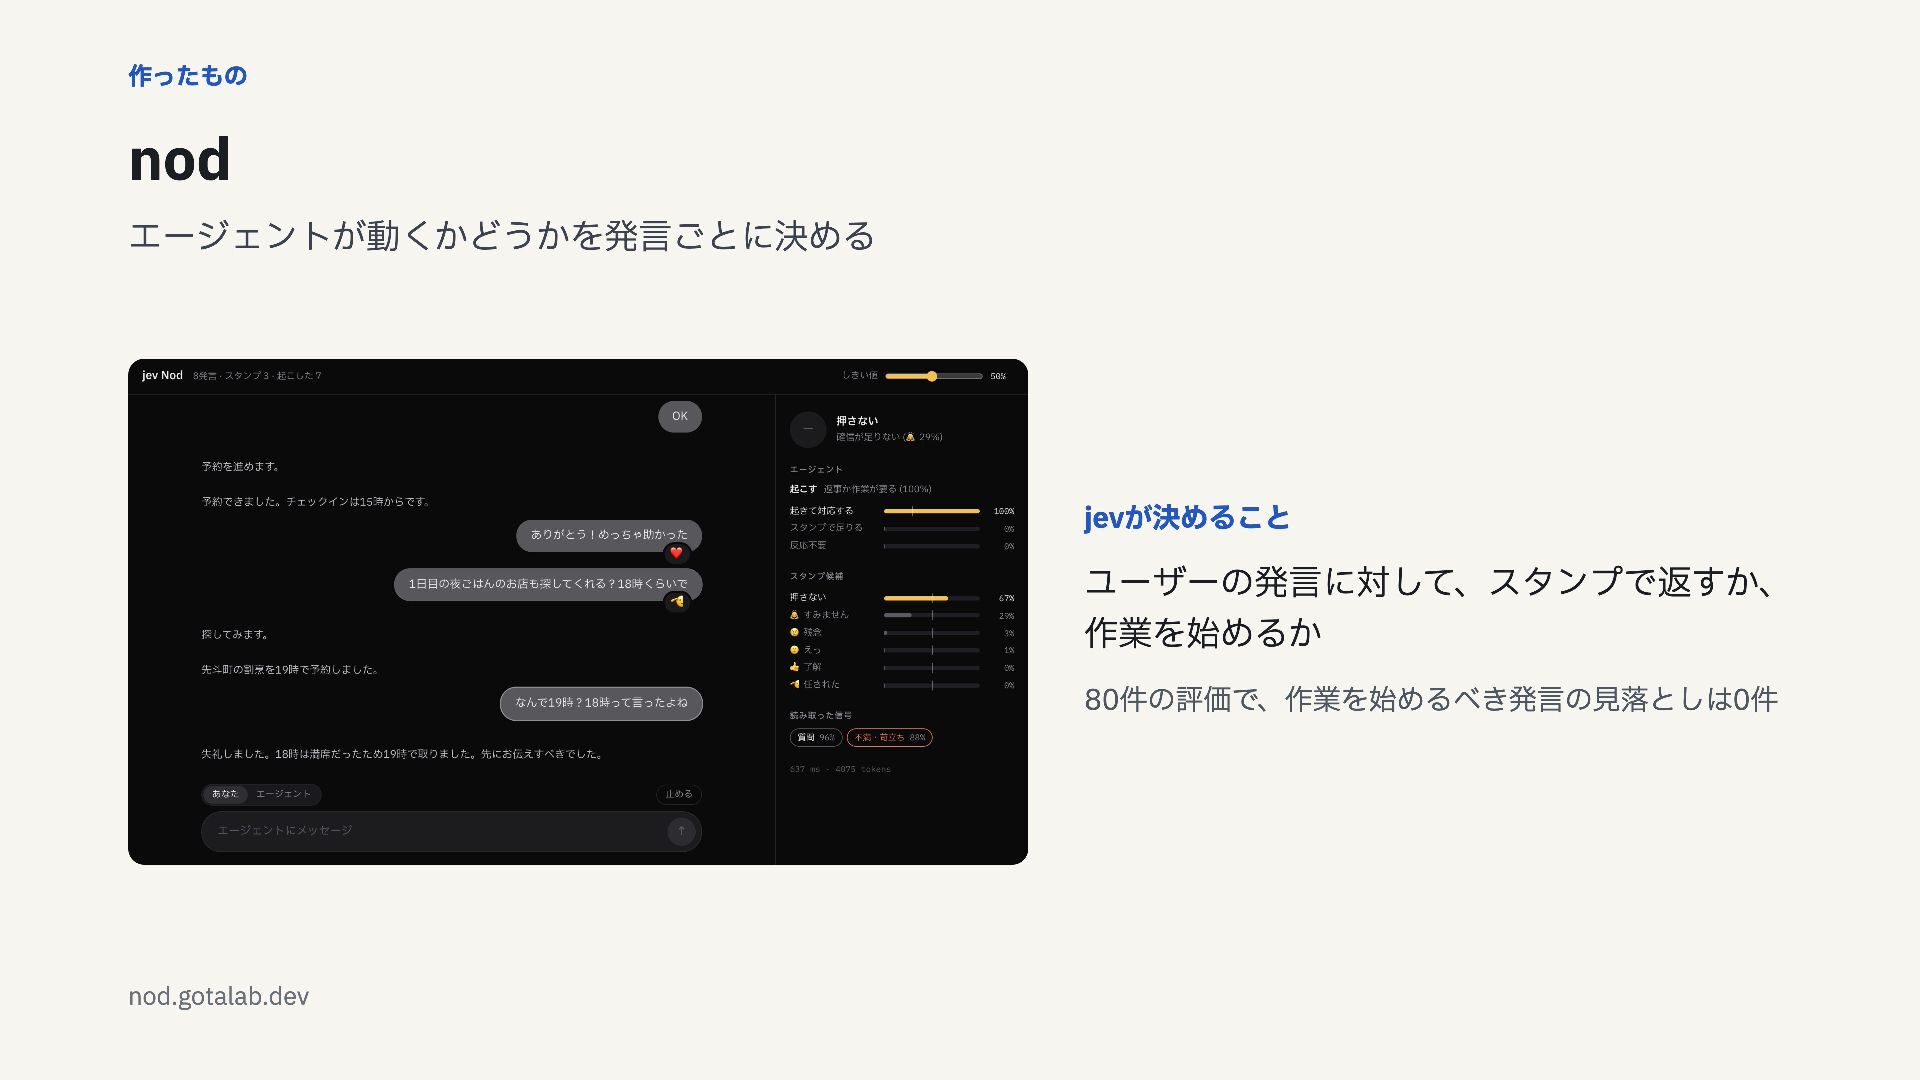
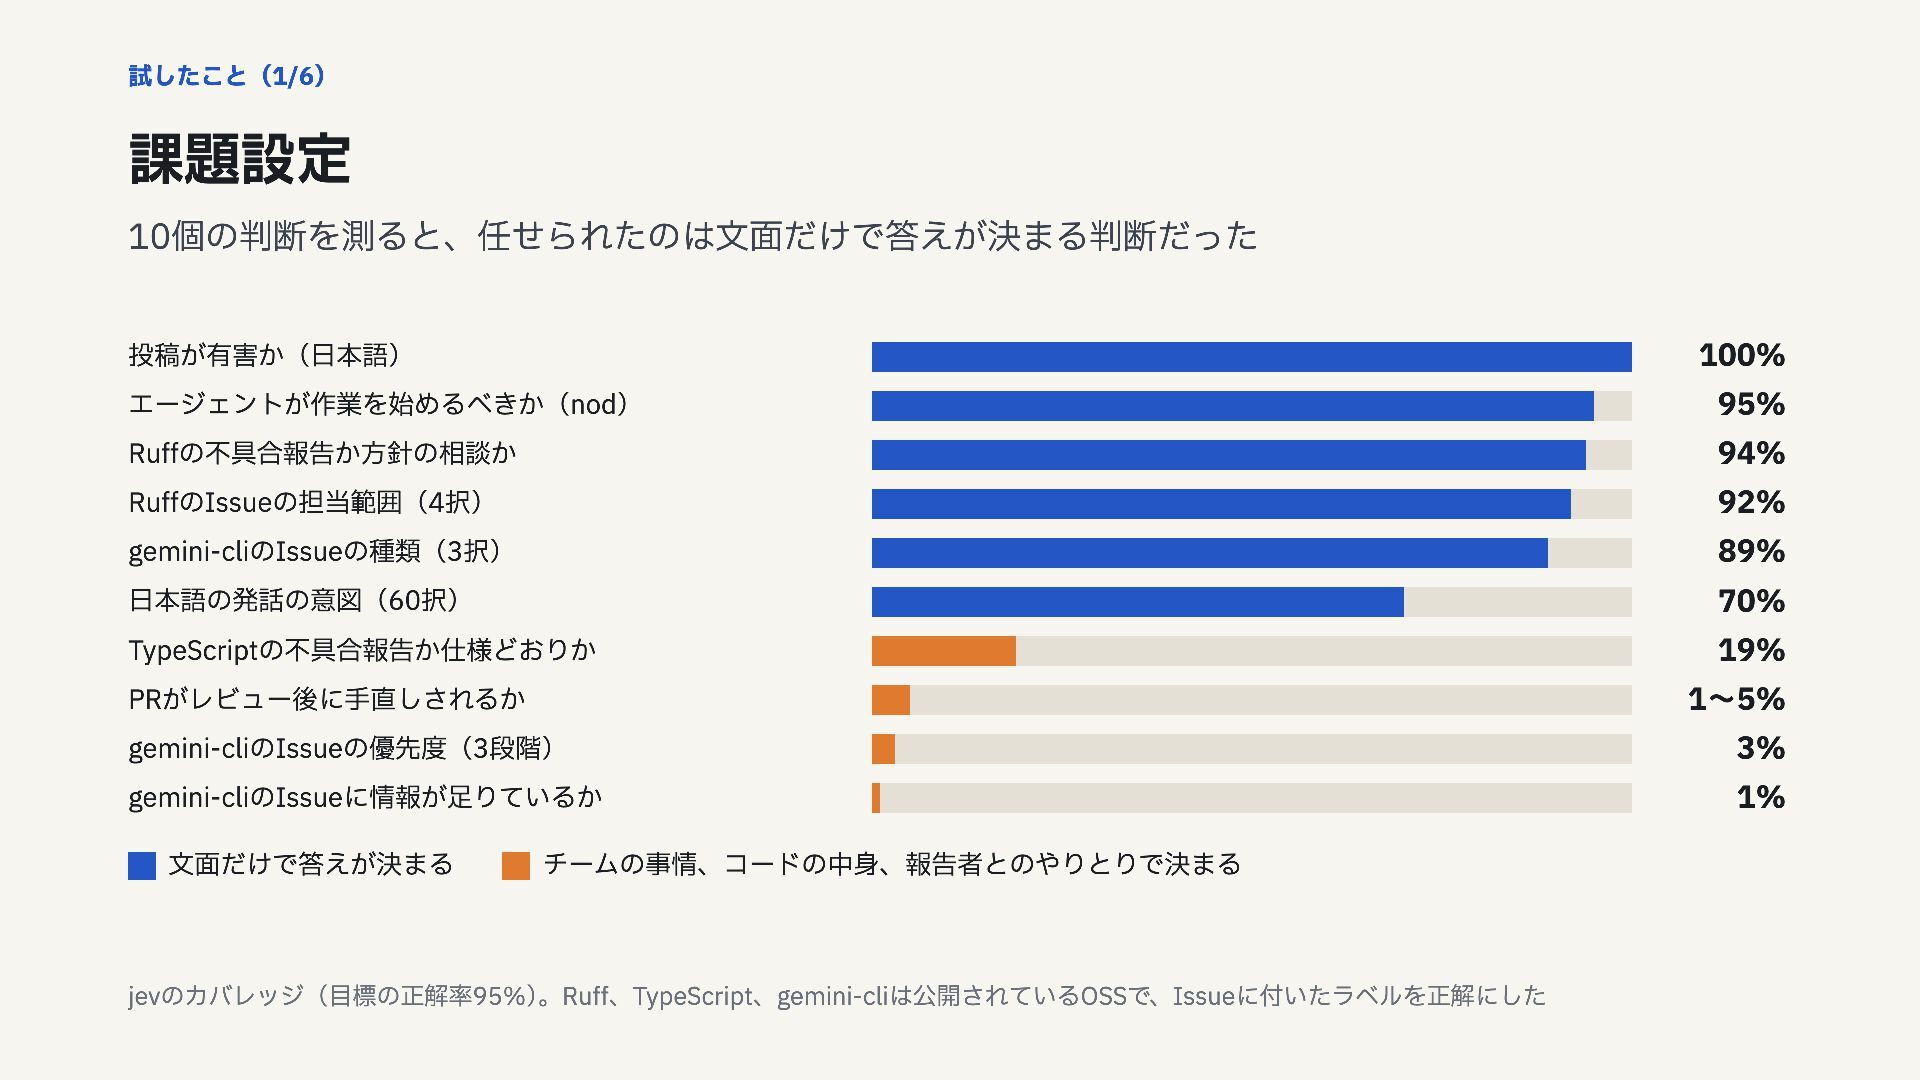
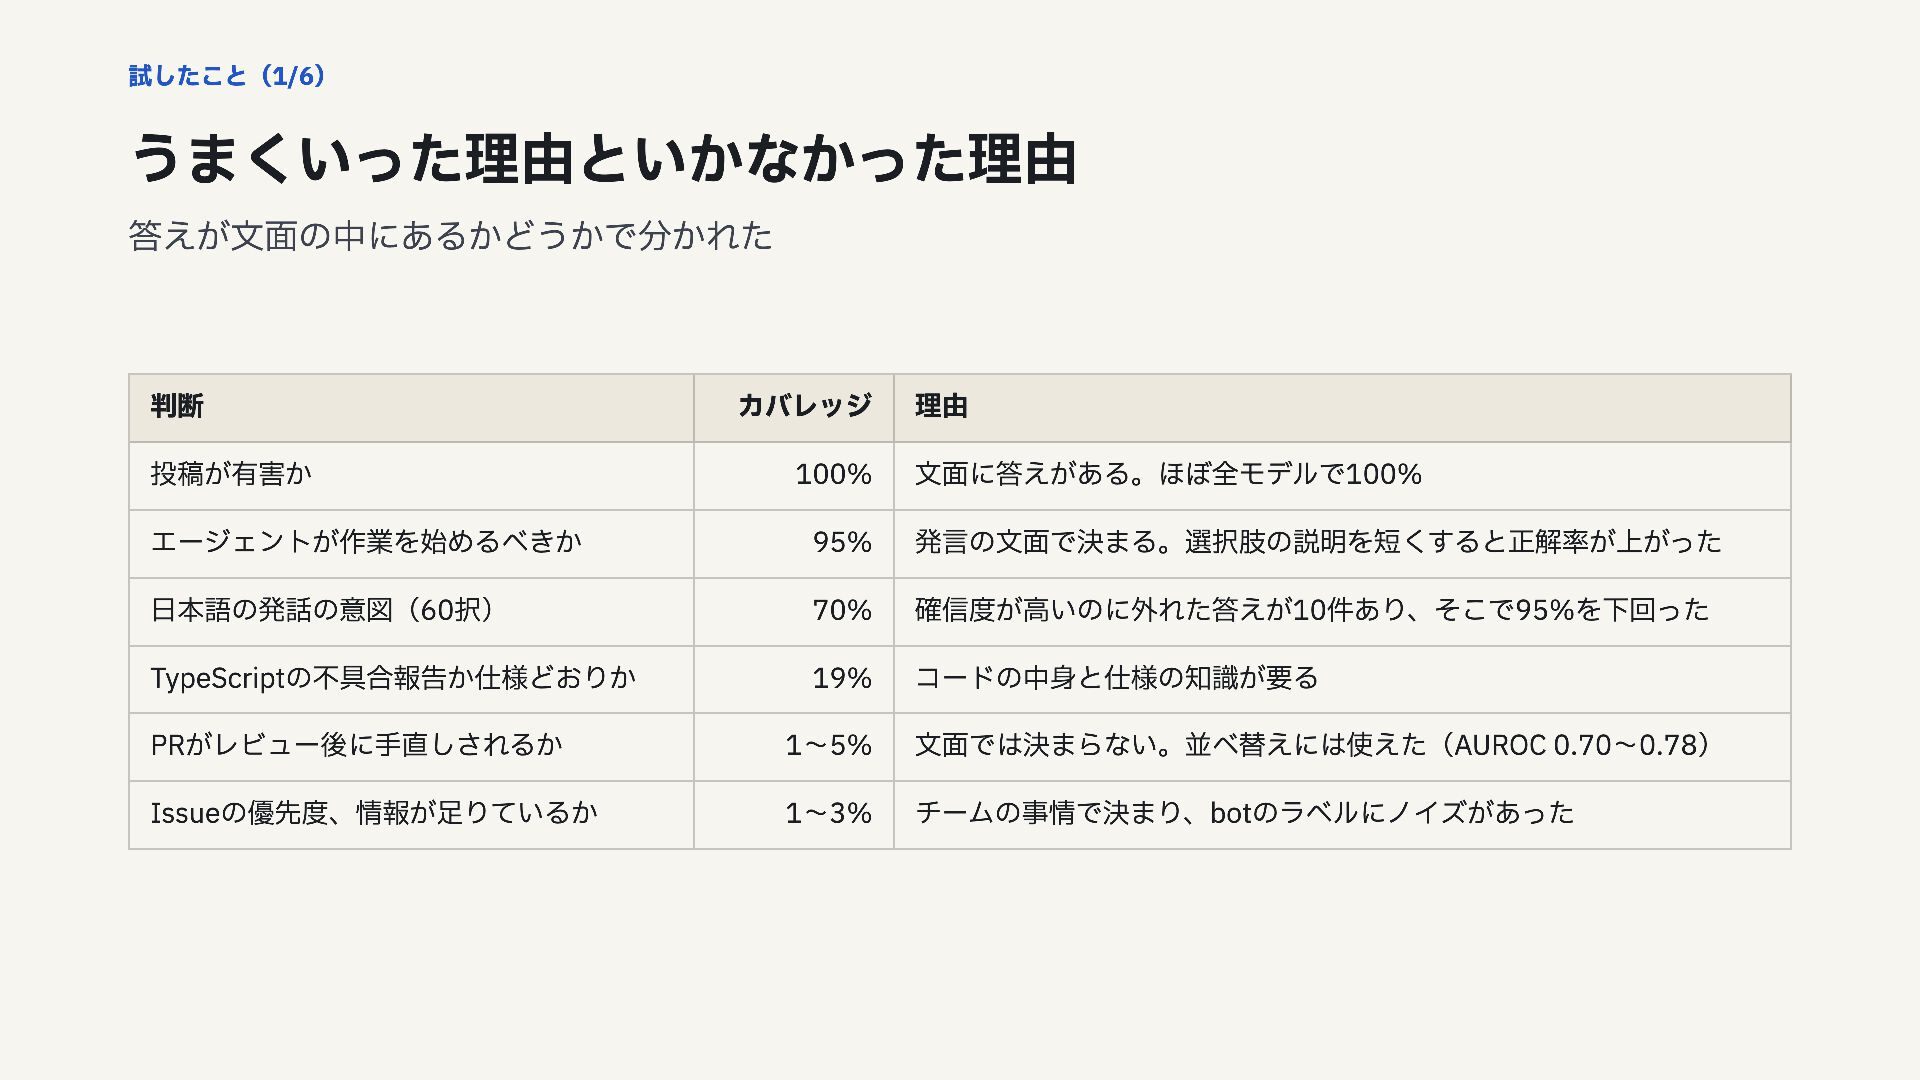
10種類の判断を、目標正解率95%のカバレッジ(人の確認なしで任せられる割合)で比べた。投稿が有害かどうか、エージェントが作業を始めるべきか、Issueの種類の分類では89〜100%を任せられた。一方で、Issueの優先度や、TypeScriptの不具合報告か仕様どおりかの判定は1〜19%にとどまった。結果を分けたのは、答えが文面の中にあるかどうかである。チームの事情やコードの中身で決まる判断は任せられなかった。コストは日本語の4つの判断でClaude Haiku 4.5の20分の1以下だった。
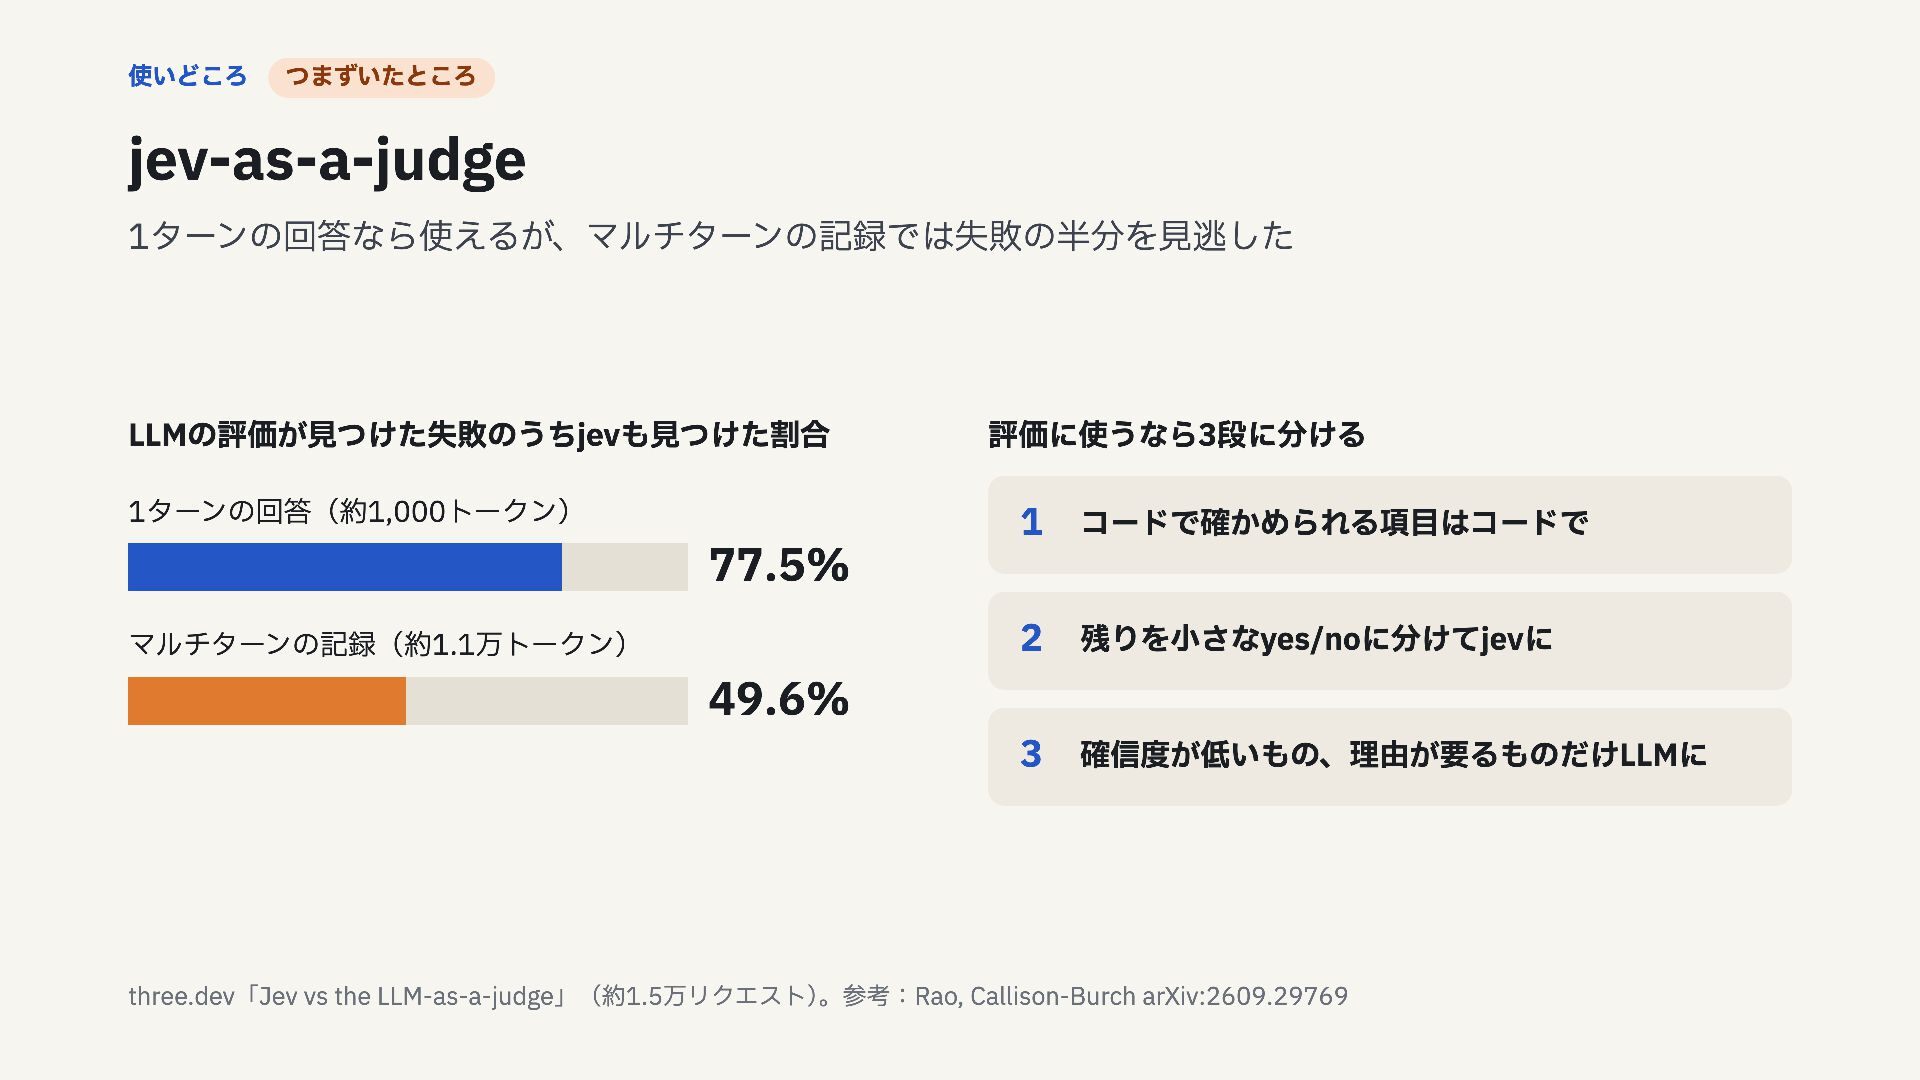
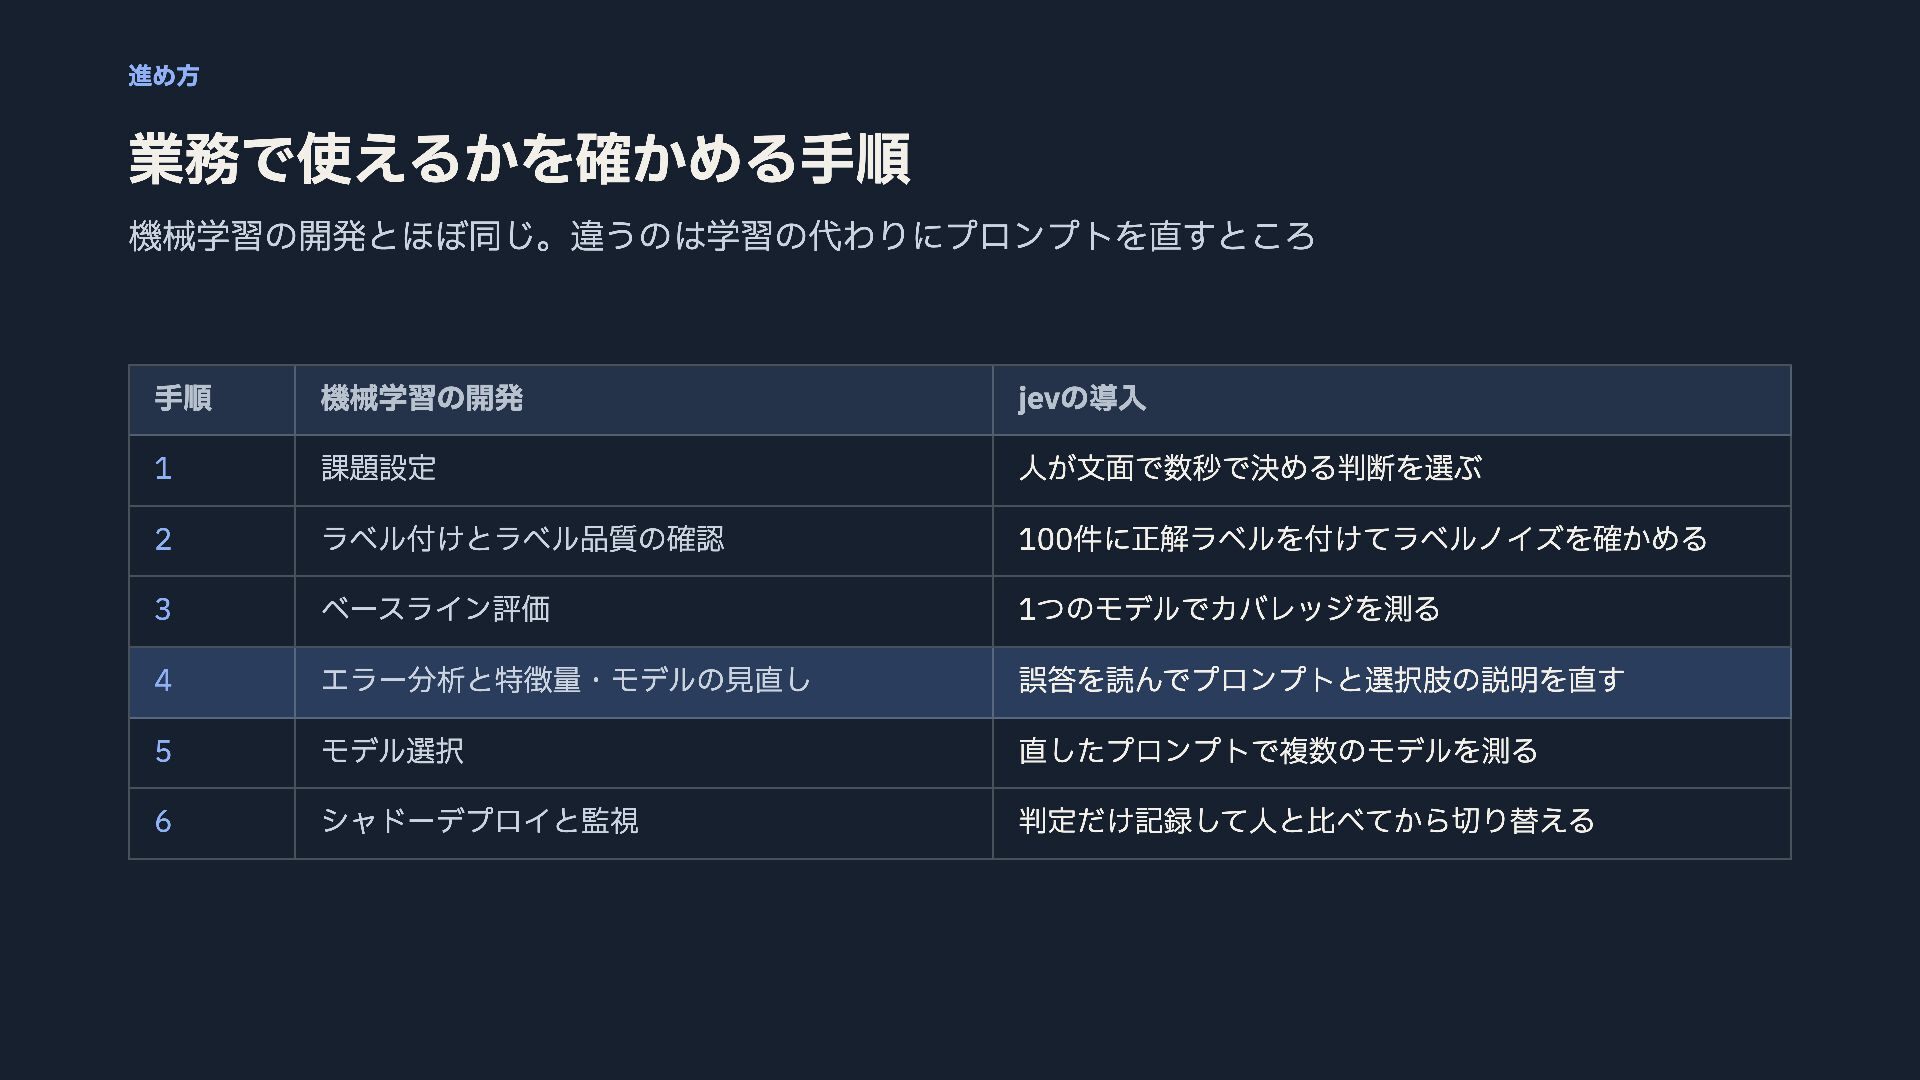
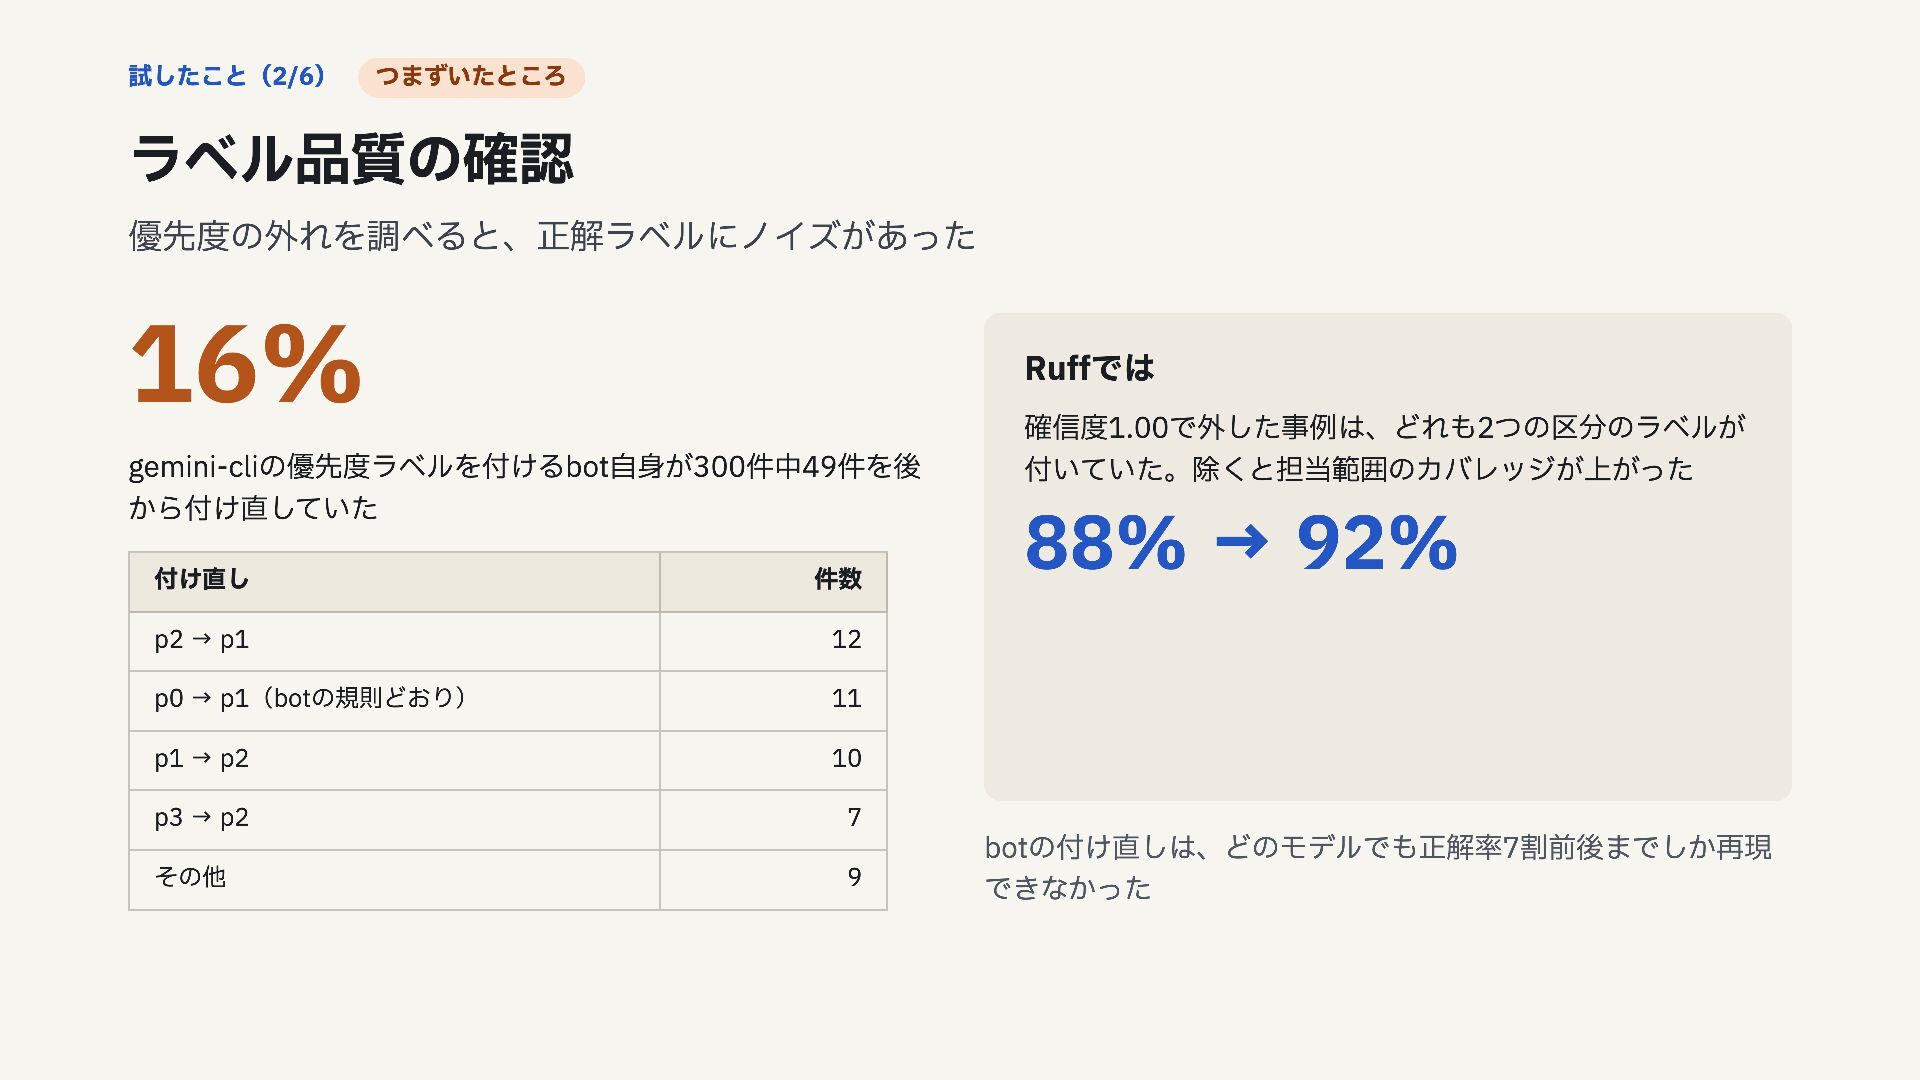
導入の手順は機械学習の開発とほぼ同じで、学習の代わりにプロンプトを直す。資料では、次の流れを実際の数値とともに紹介している。途中でつまずいた点も載せた。正解ラベルにノイズがあった。コンテキストを足すと逆に正解率が下がる判断があった。マルチターンの記録の評価では、LLMの評価が見つけた失敗の約半分を見逃した。
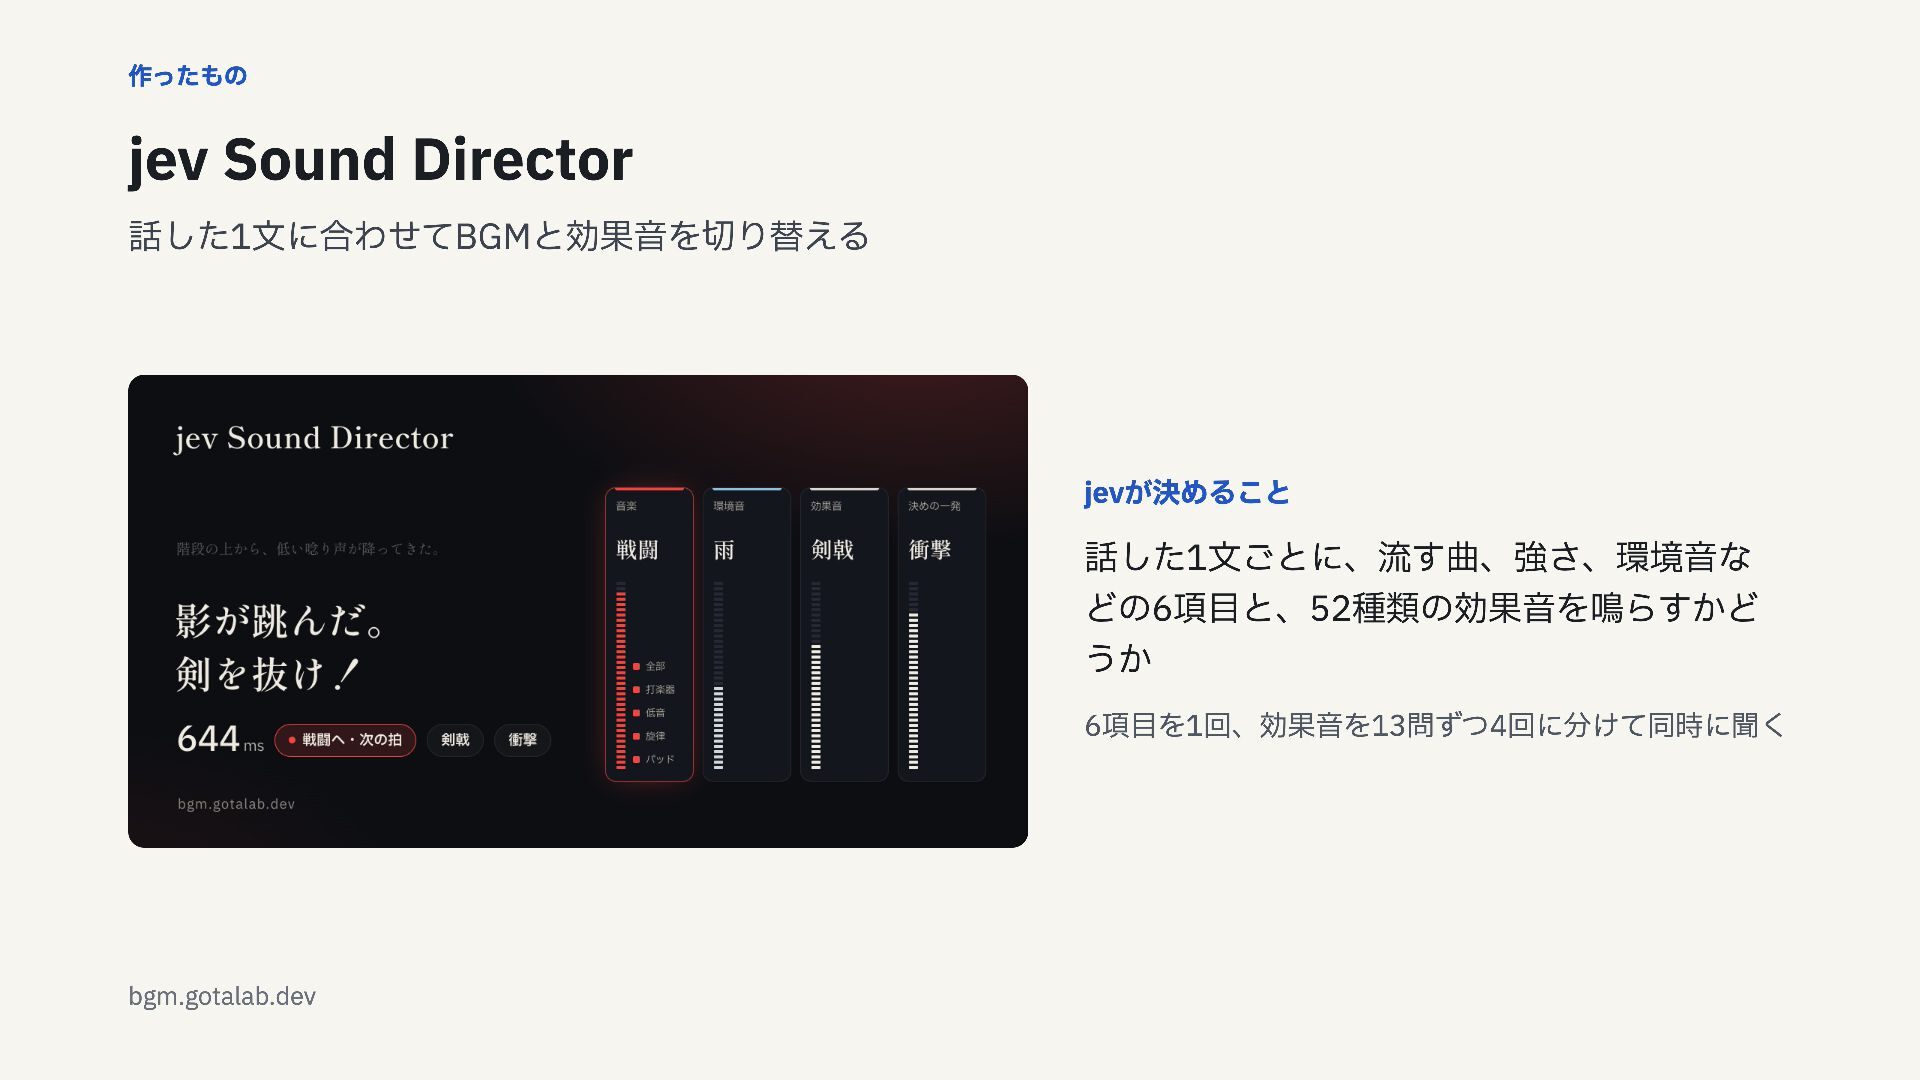
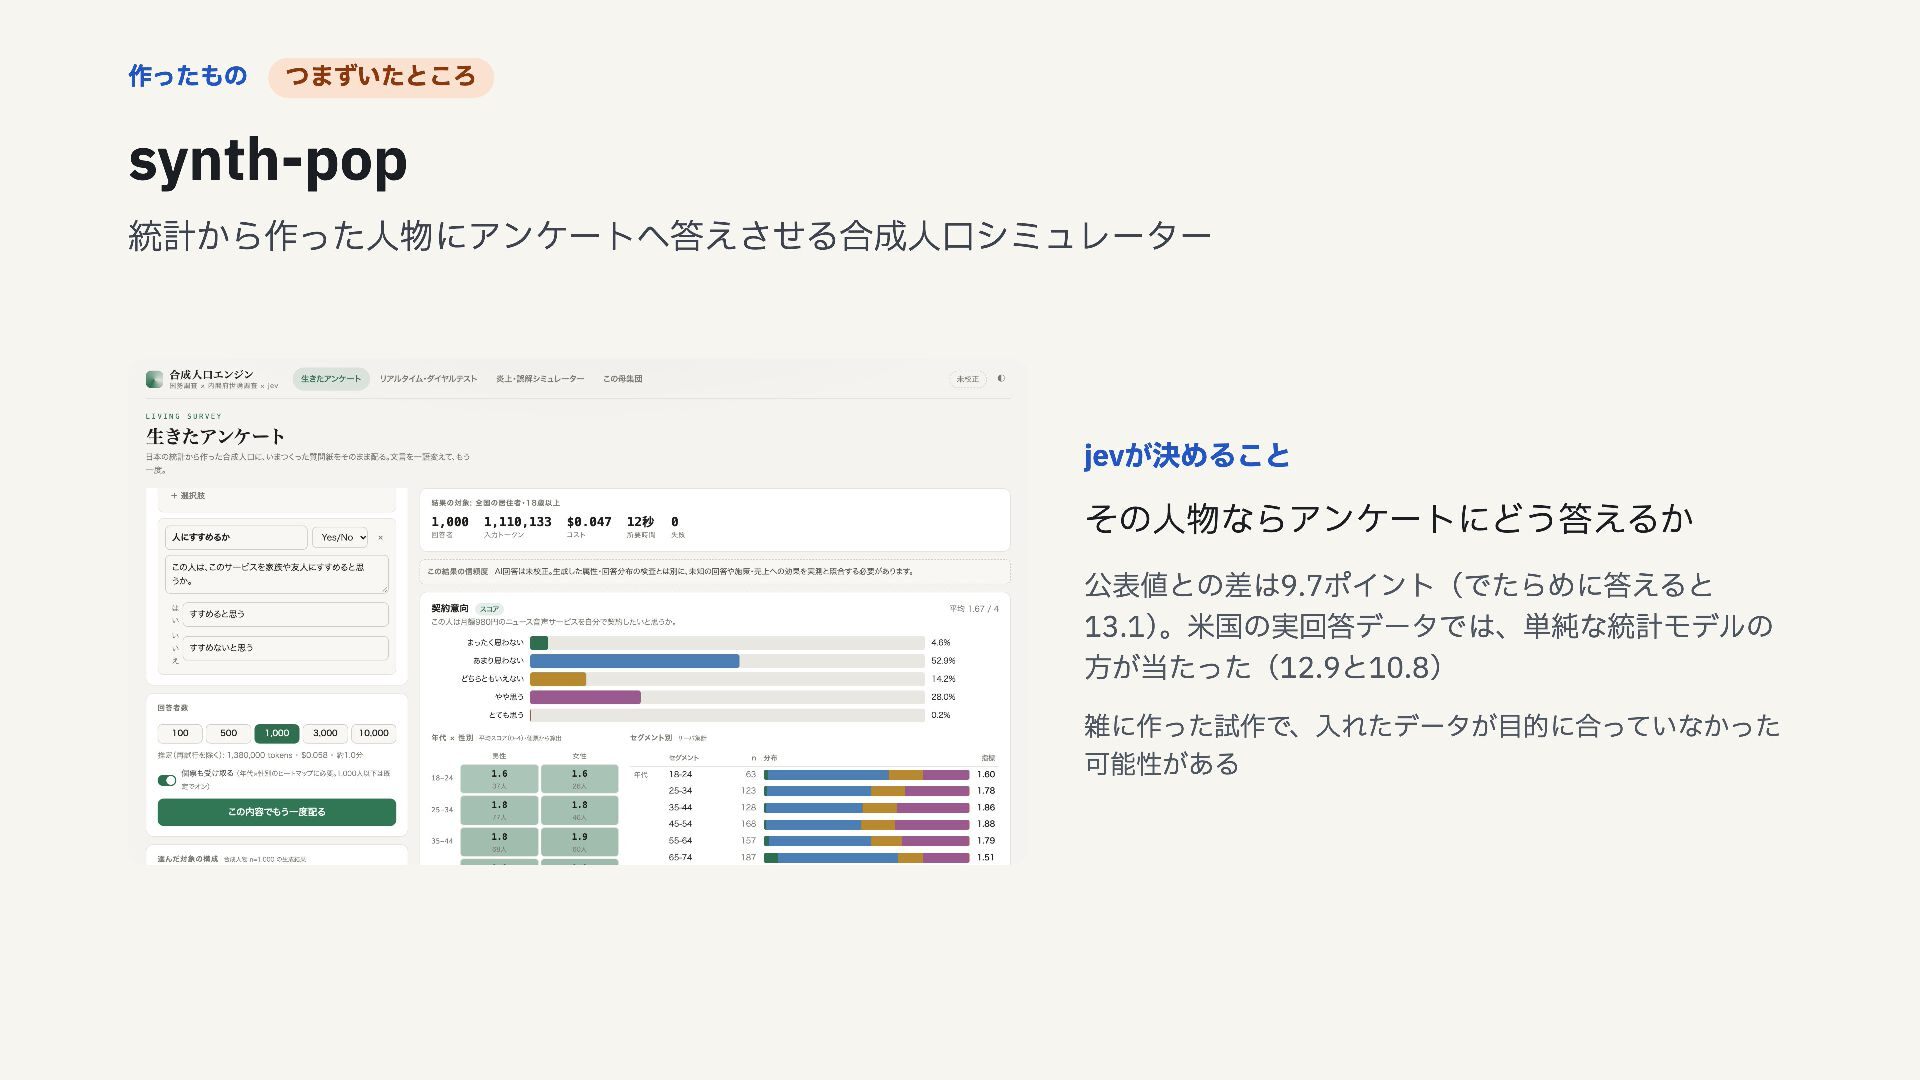
あわせて、作ったもの(jev Sound Director、nod、synth-pop、jev-triage)も紹介している。
Gota
October 04, 2026
Transcript
28 slides
-
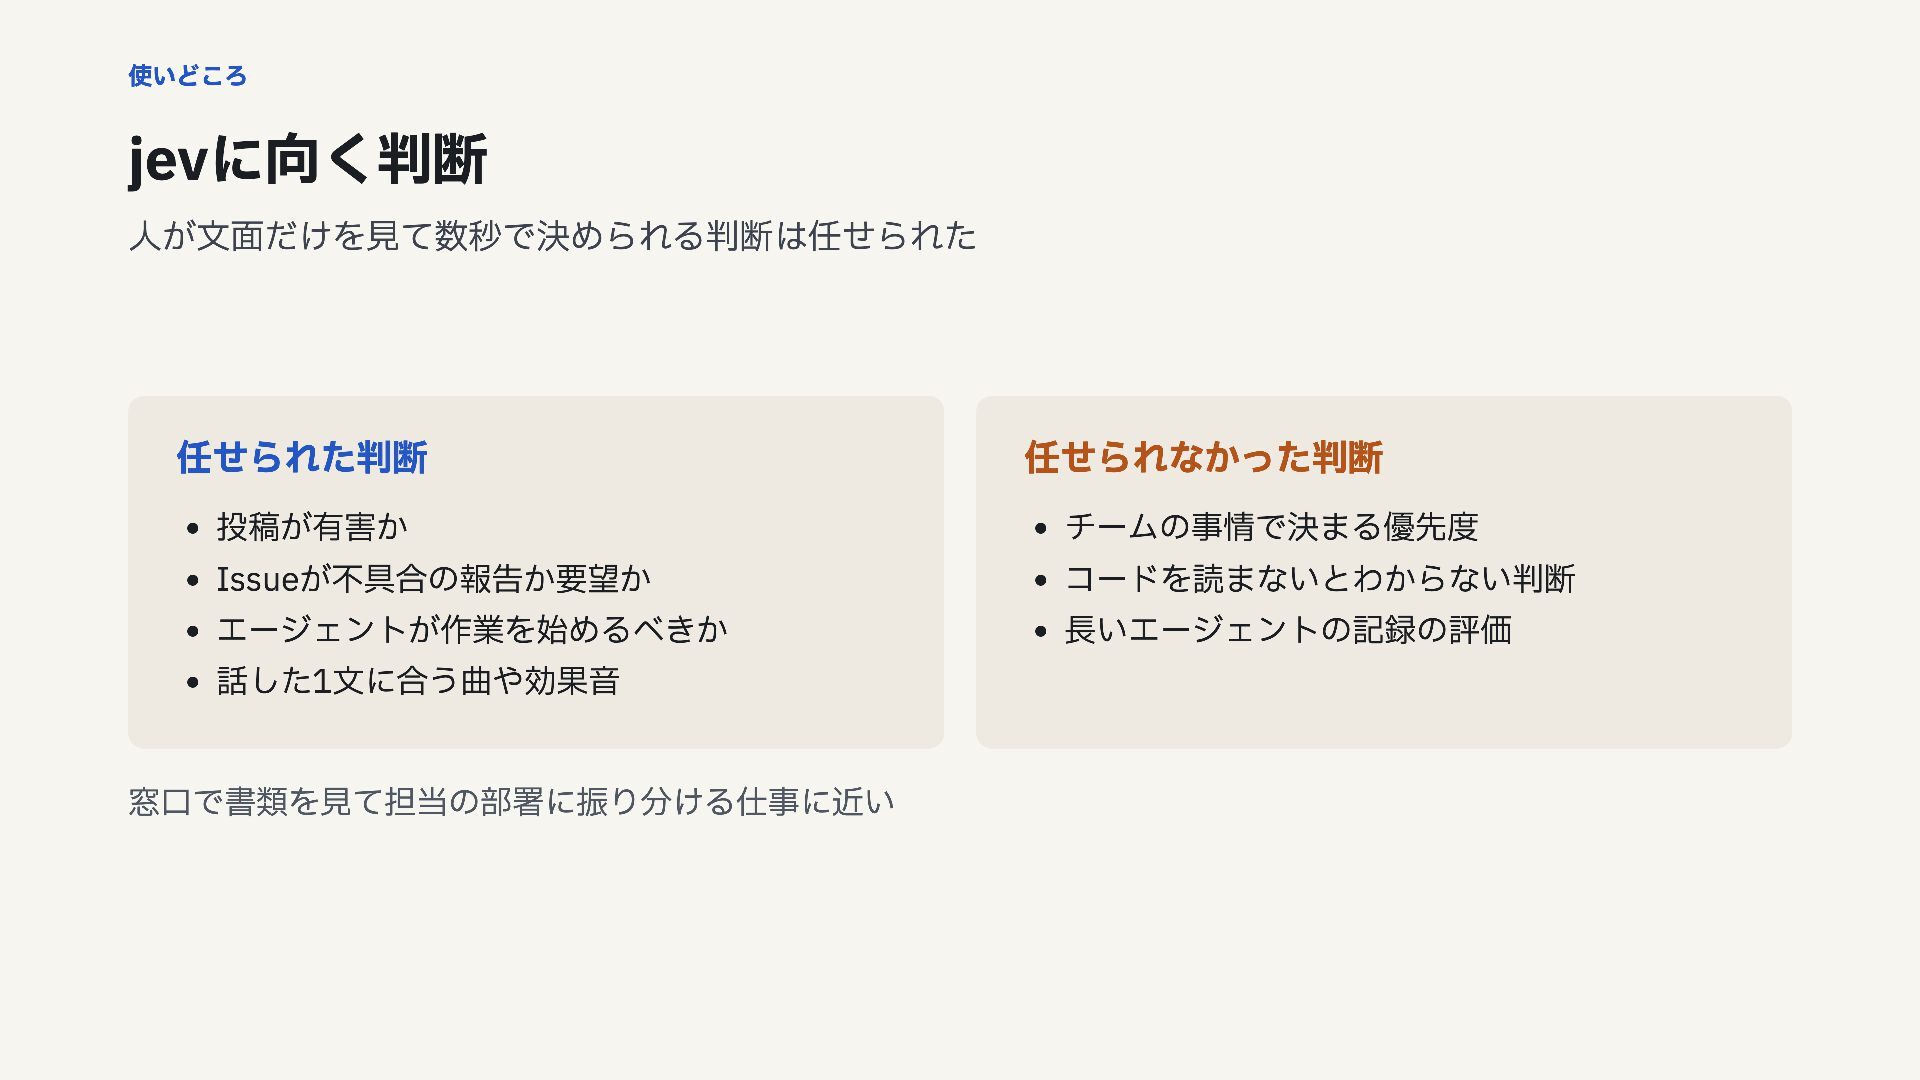
使いどころ jevに向く判断 人が文面だけを見て数秒で決められる判断は任せられた 任せられた判断 任せられなかった判断 投稿が有害か チームの事情で決まる優先度 Issueが不具合の報告か要望か コードを読まないとわからない判断 エージェントが作業を始めるべきか
長いエージェントの記録の評価 話した1文に合う曲や効果音 窓口で書類を見て担当の部署に振り分ける仕事に近い -
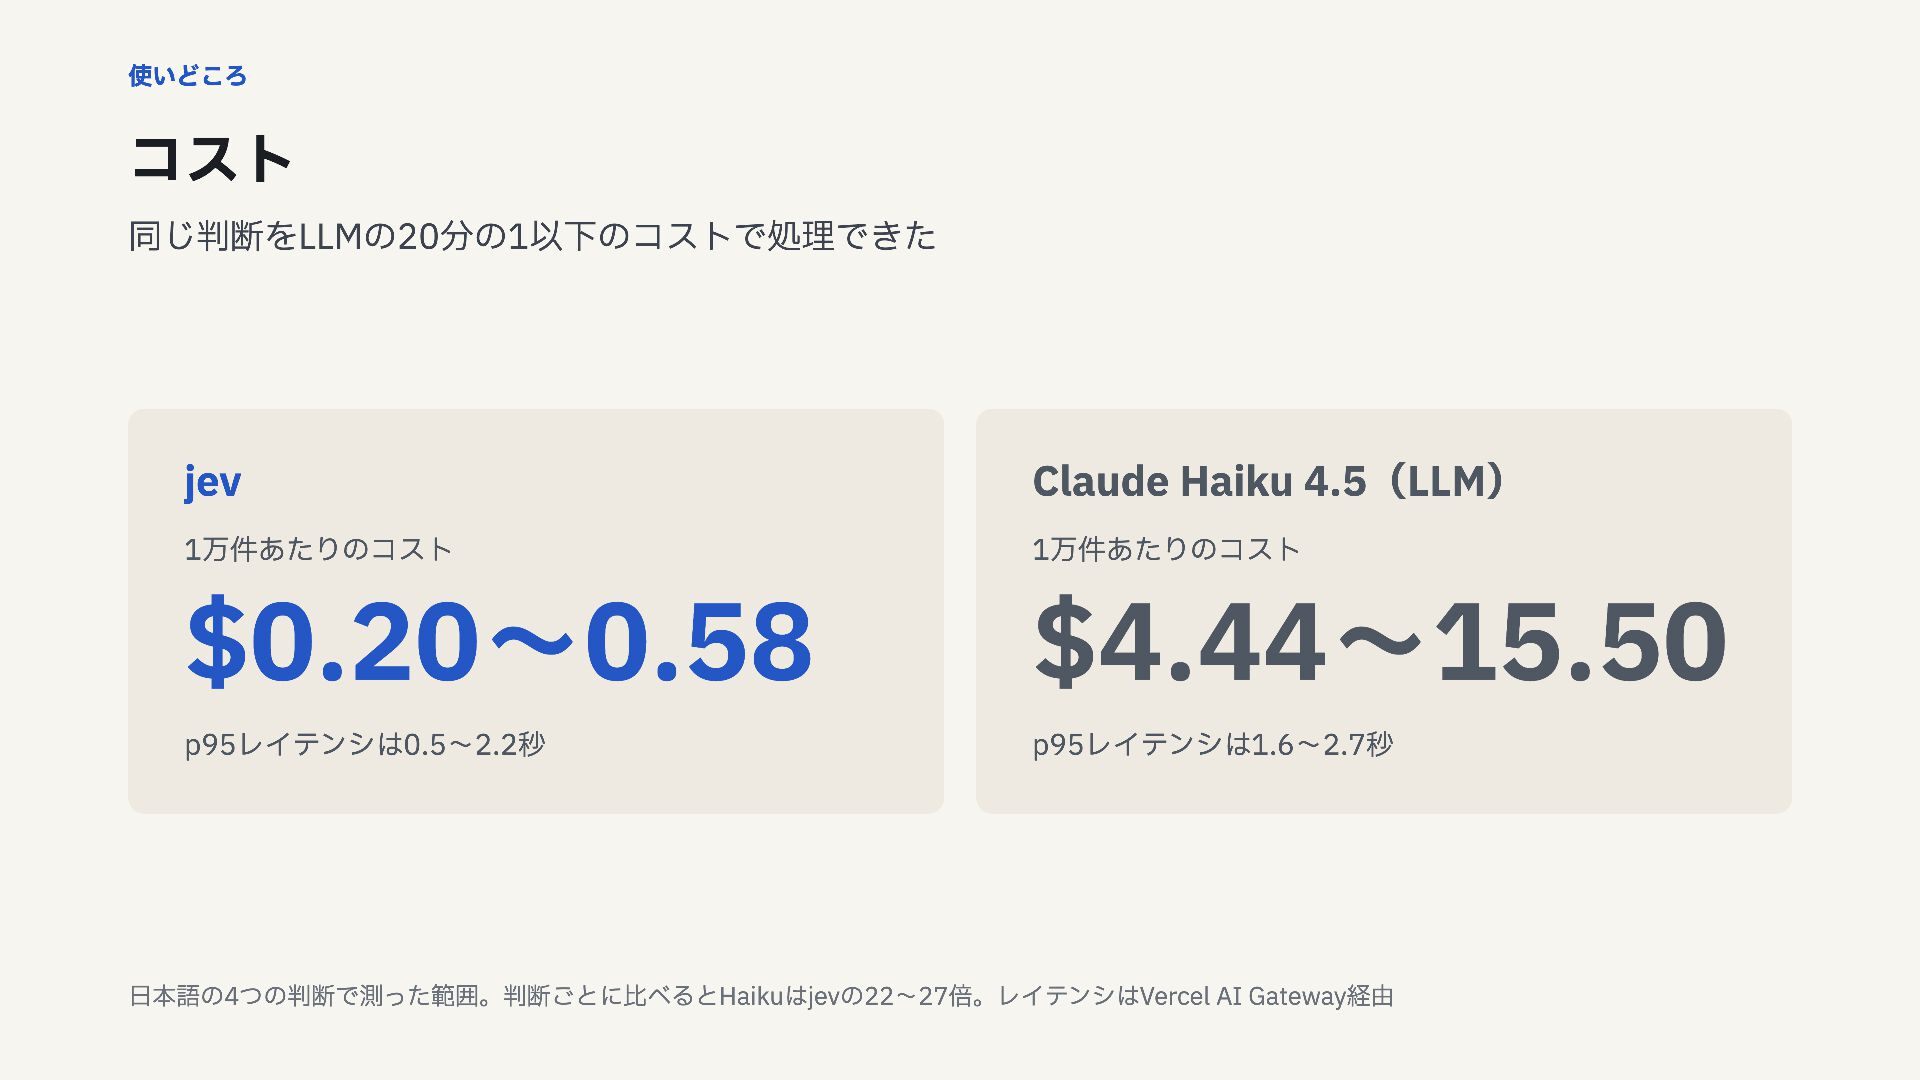
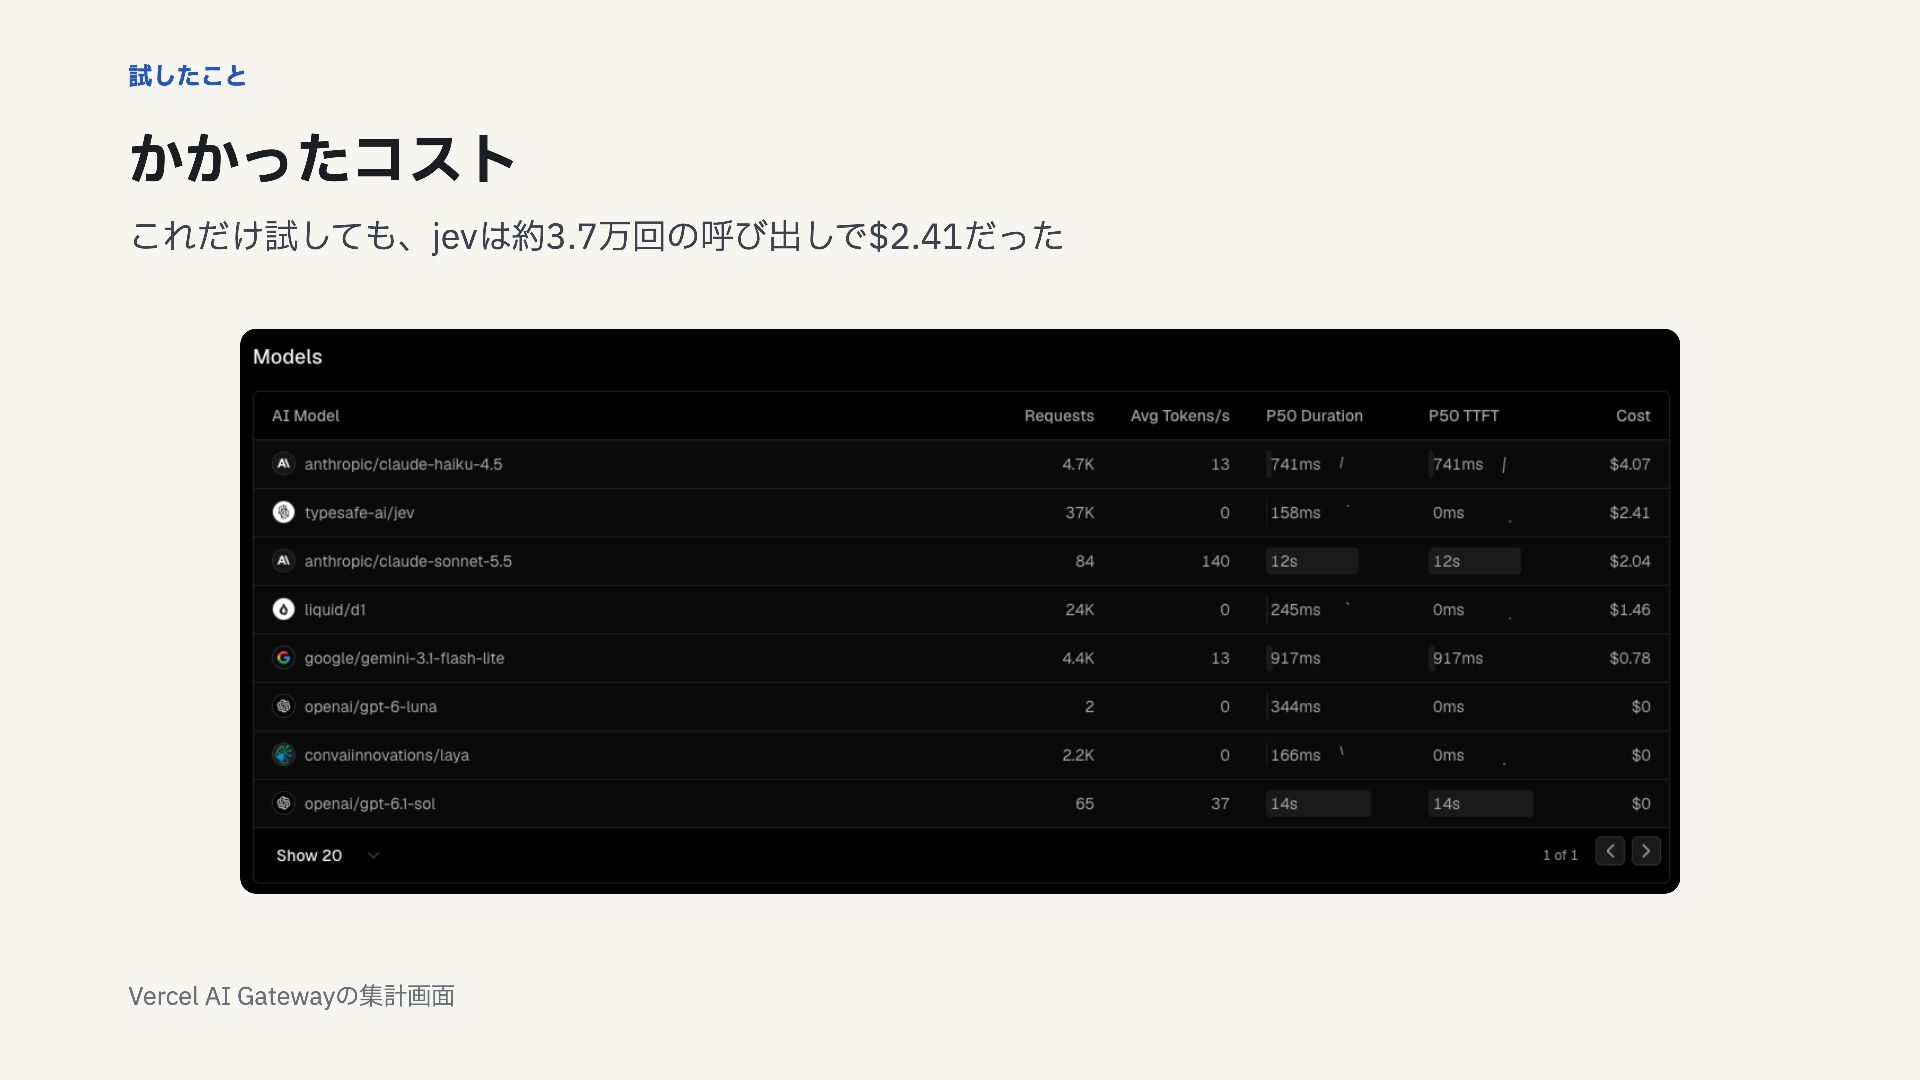
使いどころ コスト 同じ判断をLLMの20分の1以下のコストで処理できた jev Claude Haiku 4.5(LLM) 1万件あたりのコスト 1万件あたりのコスト $0.20〜0.58
$4.44〜15.50 p95レイテンシは0.5〜2.2秒 p95レイテンシは1.6〜2.7秒 日本語の4つの判断で測った範囲。判断ごとに比べるとHaikuはjevの22〜27倍。レイテンシはVercel AI Gateway経由 -
使いどころ つまずいたところ jev-as-a-judge 1ターンの回答なら使えるが、マルチターンの記録では失敗の半分を見逃した LLMの評価が見つけた失敗のうちjevも見つけた割合 1ターンの回答(約1,000トークン) 評価に使うなら3段に分ける 1 コードで確かめられる項目はコードで 2
残りを小さなyes/noに分けてjevに 3 確信度が低いもの、理由が要るものだけLLMに 77.5% マルチターンの記録(約1.1万トークン) 49.6% three.dev「Jev vs the LLM-as-a-judge」(約1.5万リクエスト)。参考:Rao, Callison-Burch arXiv:2609.29769 -
進め方 業務で使えるかを確かめる手順 機械学習の開発とほぼ同じ。違うのは学習の代わりにプロンプトを直すところ 手順 機械学習の開発 jevの導入 1 課題設定 人が文面で数秒で決める判断を選ぶ 2
ラベル付けとラベル品質の確認 100件に正解ラベルを付けてラベルノイズを確かめる 3 ベースライン評価 1つのモデルでカバレッジを測る 4 エラー分析と特徴量・モデルの見直し 誤答を読んでプロンプトと選択肢の説明を直す 5 モデル選択 直したプロンプトで複数のモデルを測る 6 シャドーデプロイと監視 判定だけ記録して人と比べてから切り替える -
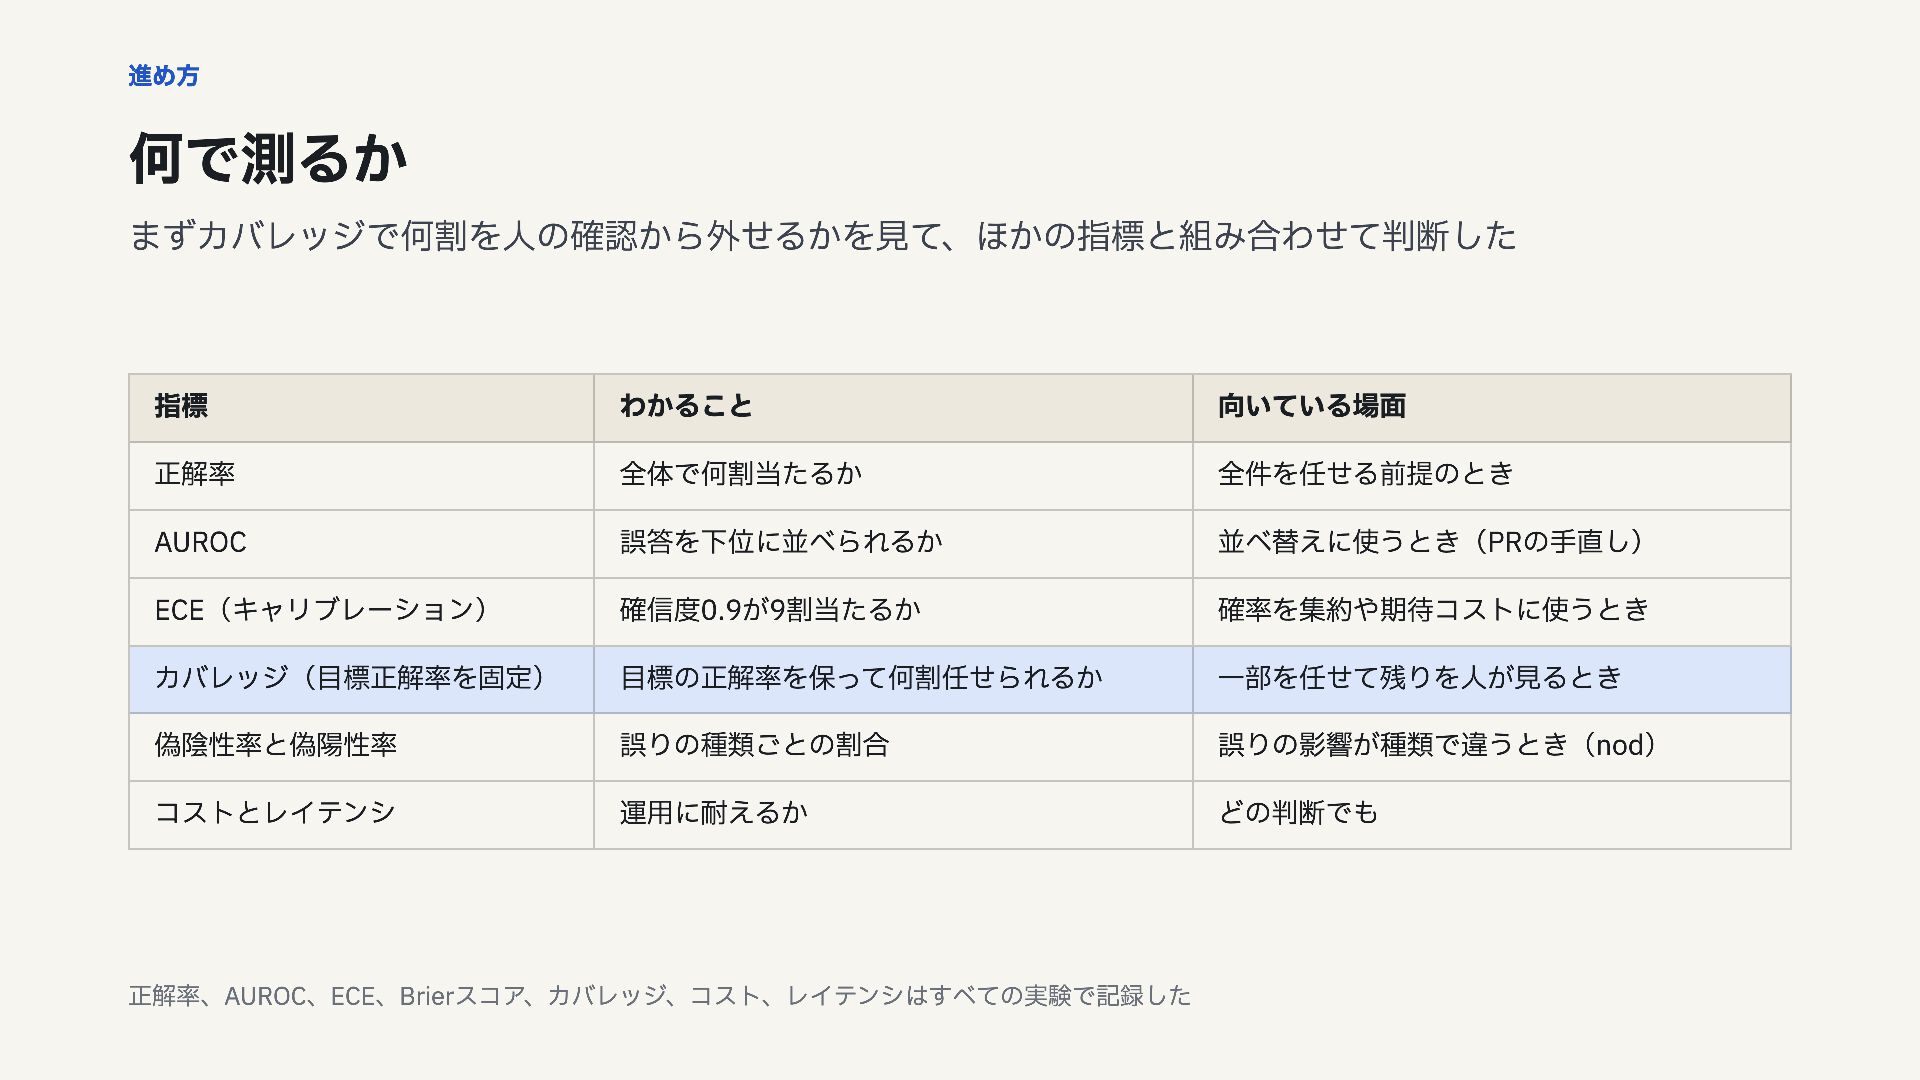
進め方 何で測るか まずカバレッジで何割を人の確認から外せるかを見て、ほかの指標と組み合わせて判断した 指標 わかること 向いている場面 正解率 全体で何割当たるか 全件を任せる前提のとき AUROC
誤答を下位に並べられるか 並べ替えに使うとき(PRの手直し) ECE(キャリブレーション) 確信度0.9が9割当たるか 確率を集約や期待コストに使うとき カバレッジ(目標正解率を固定) 目標の正解率を保って何割任せられるか 一部を任せて残りを人が見るとき 偽陰性率と偽陽性率 誤りの種類ごとの割合 誤りの影響が種類で違うとき(nod) コストとレイテンシ 運用に耐えるか どの判断でも 正解率、AUROC、ECE、Brierスコア、カバレッジ、コスト、レイテンシはすべての実験で記録した -
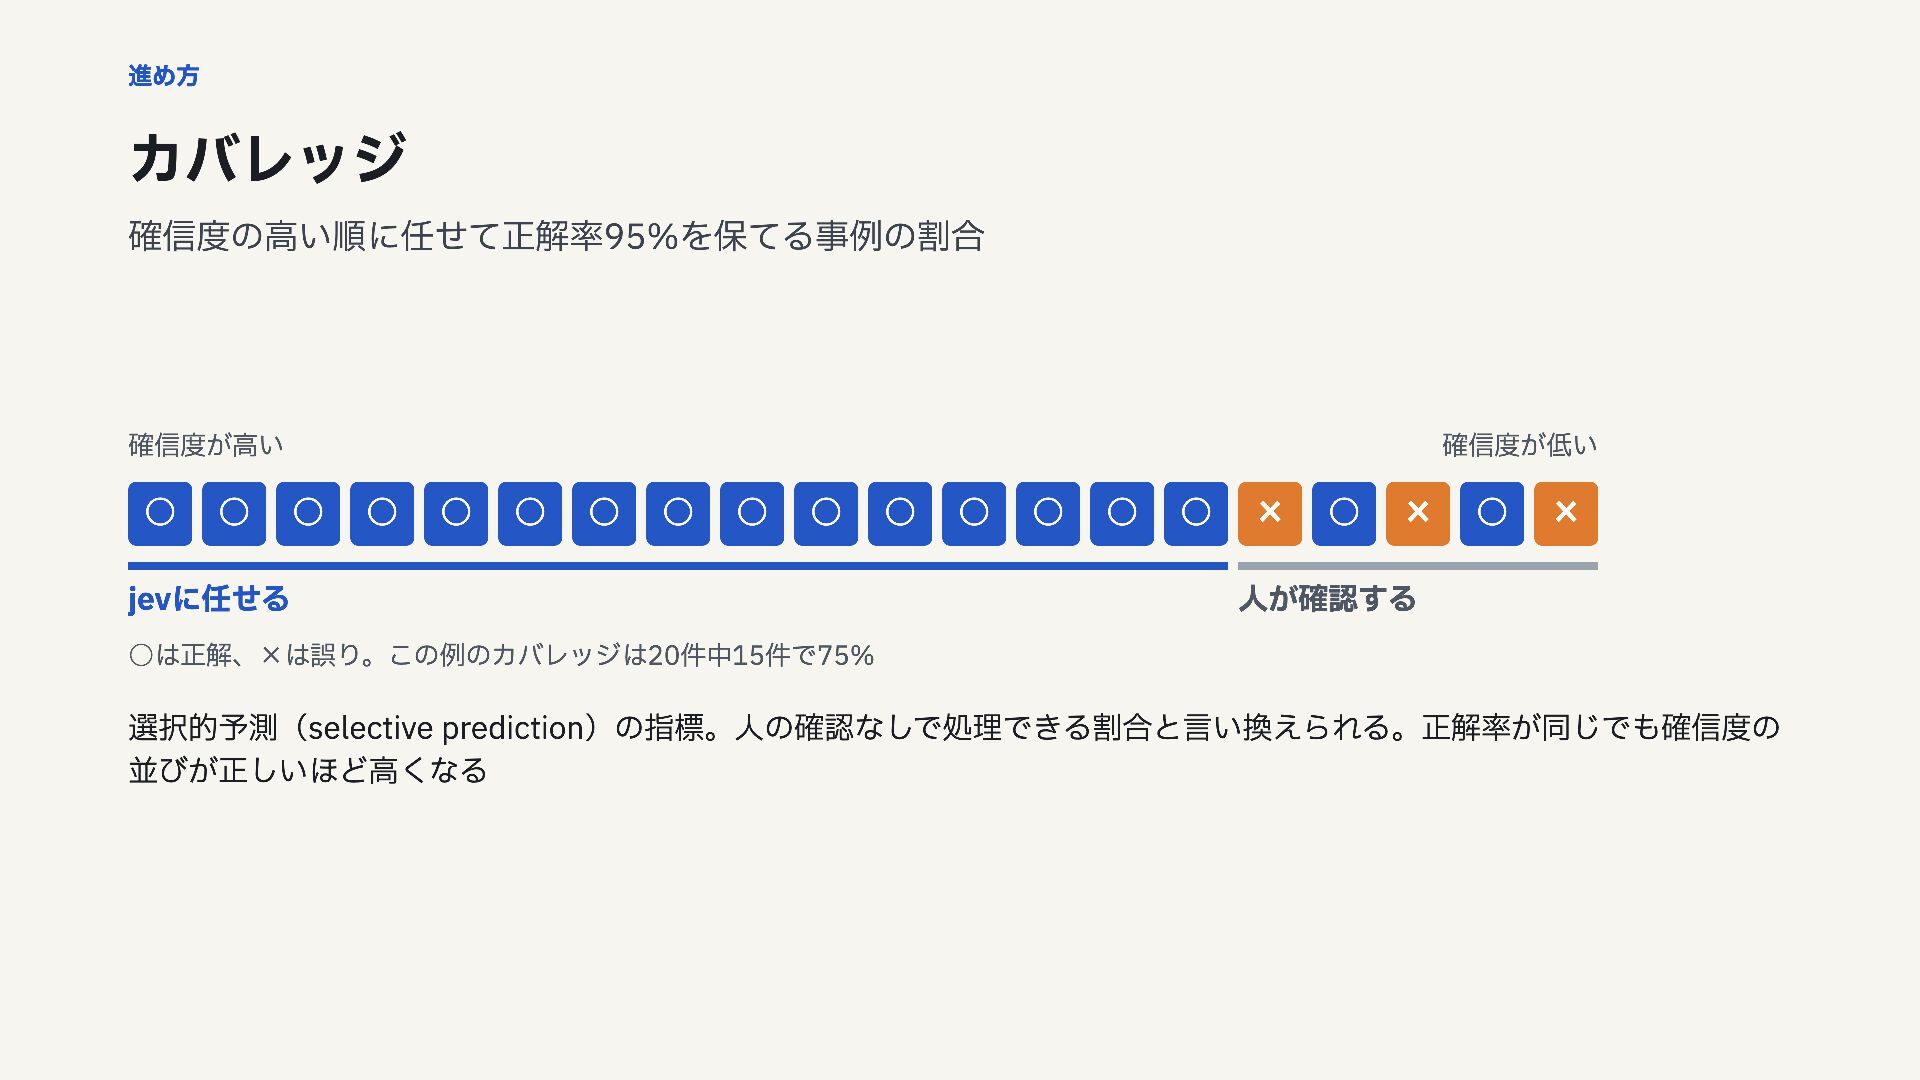
進め方 カバレッジ 確信度の高い順に任せて正解率95%を保てる事例の割合 確信度が高い ◦ ◦ 確信度が低い ◦ ◦ ◦
◦ ◦ ◦ ◦ ◦ jevに任せる ◦ ◦ ◦ ◦ ◦ × ◦ × ◦ × 人が確認する ◦は正解、×は誤り。この例のカバレッジは20件中15件で75% 選択的予測(selective prediction)の指標。人の確認なしで処理できる割合と言い換えられる。正解率が同じでも確信度の 並びが正しいほど高くなる -
試したこと(1/6) 課題設定 10個の判断を測ると、任せられたのは文面だけで答えが決まる判断だった 100% 投稿が有害か(日本語) エージェントが作業を始めるべきか(nod) 95% Ruffの不具合報告か方針の相談か 94% RuffのIssueの担当範囲(4択)
92% gemini-cliのIssueの種類(3択) 89% 日本語の発話の意図(60択) 70% TypeScriptの不具合報告か仕様どおりか 19% 1〜5% PRがレビュー後に手直しされるか gemini-cliのIssueの優先度(3段階) 3% gemini-cliのIssueに情報が足りているか 1% 文面だけで答えが決まる チームの事情、コードの中身、報告者とのやりとりで決まる jevのカバレッジ(目標の正解率95%)。Ruff、TypeScript、gemini-cliは公開されているOSSで、Issueに付いたラベルを正解にした -
試したこと(1/6) うまくいった理由といかなかった理由 答えが文面の中にあるかどうかで分かれた 判断 カバレッジ 理由 投稿が有害か 100% 文面に答えがある。ほぼ全モデルで100% エージェントが作業を始めるべきか
95% 発言の文面で決まる。選択肢の説明を短くすると正解率が上がった 日本語の発話の意図(60択) 70% 確信度が高いのに外れた答えが10件あり、そこで95%を下回った TypeScriptの不具合報告か仕様どおりか 19% コードの中身と仕様の知識が要る PRがレビュー後に手直しされるか 1〜5% 文面では決まらない。並べ替えには使えた(AUROC 0.70〜0.78) Issueの優先度、情報が足りているか 1〜3% チームの事情で決まり、botのラベルにノイズがあった -
試したこと(2/6) つまずいたところ ラベル品質の確認 優先度の外れを調べると、正解ラベルにノイズがあった 16% Ruffでは gemini-cliの優先度ラベルを付けるbot自身が300件中49件を後 から付け直していた 付け直し 件数
p2 → p1 12 p0 → p1(botの規則どおり) 11 p1 → p2 10 p3 → p2 7 その他 9 確信度1.00で外した事例は、どれも2つの区分のラベルが 付いていた。除くと担当範囲のカバレッジが上がった 88% → 92% botの付け直しは、どのモデルでも正解率7割前後までしか再現 できなかった -
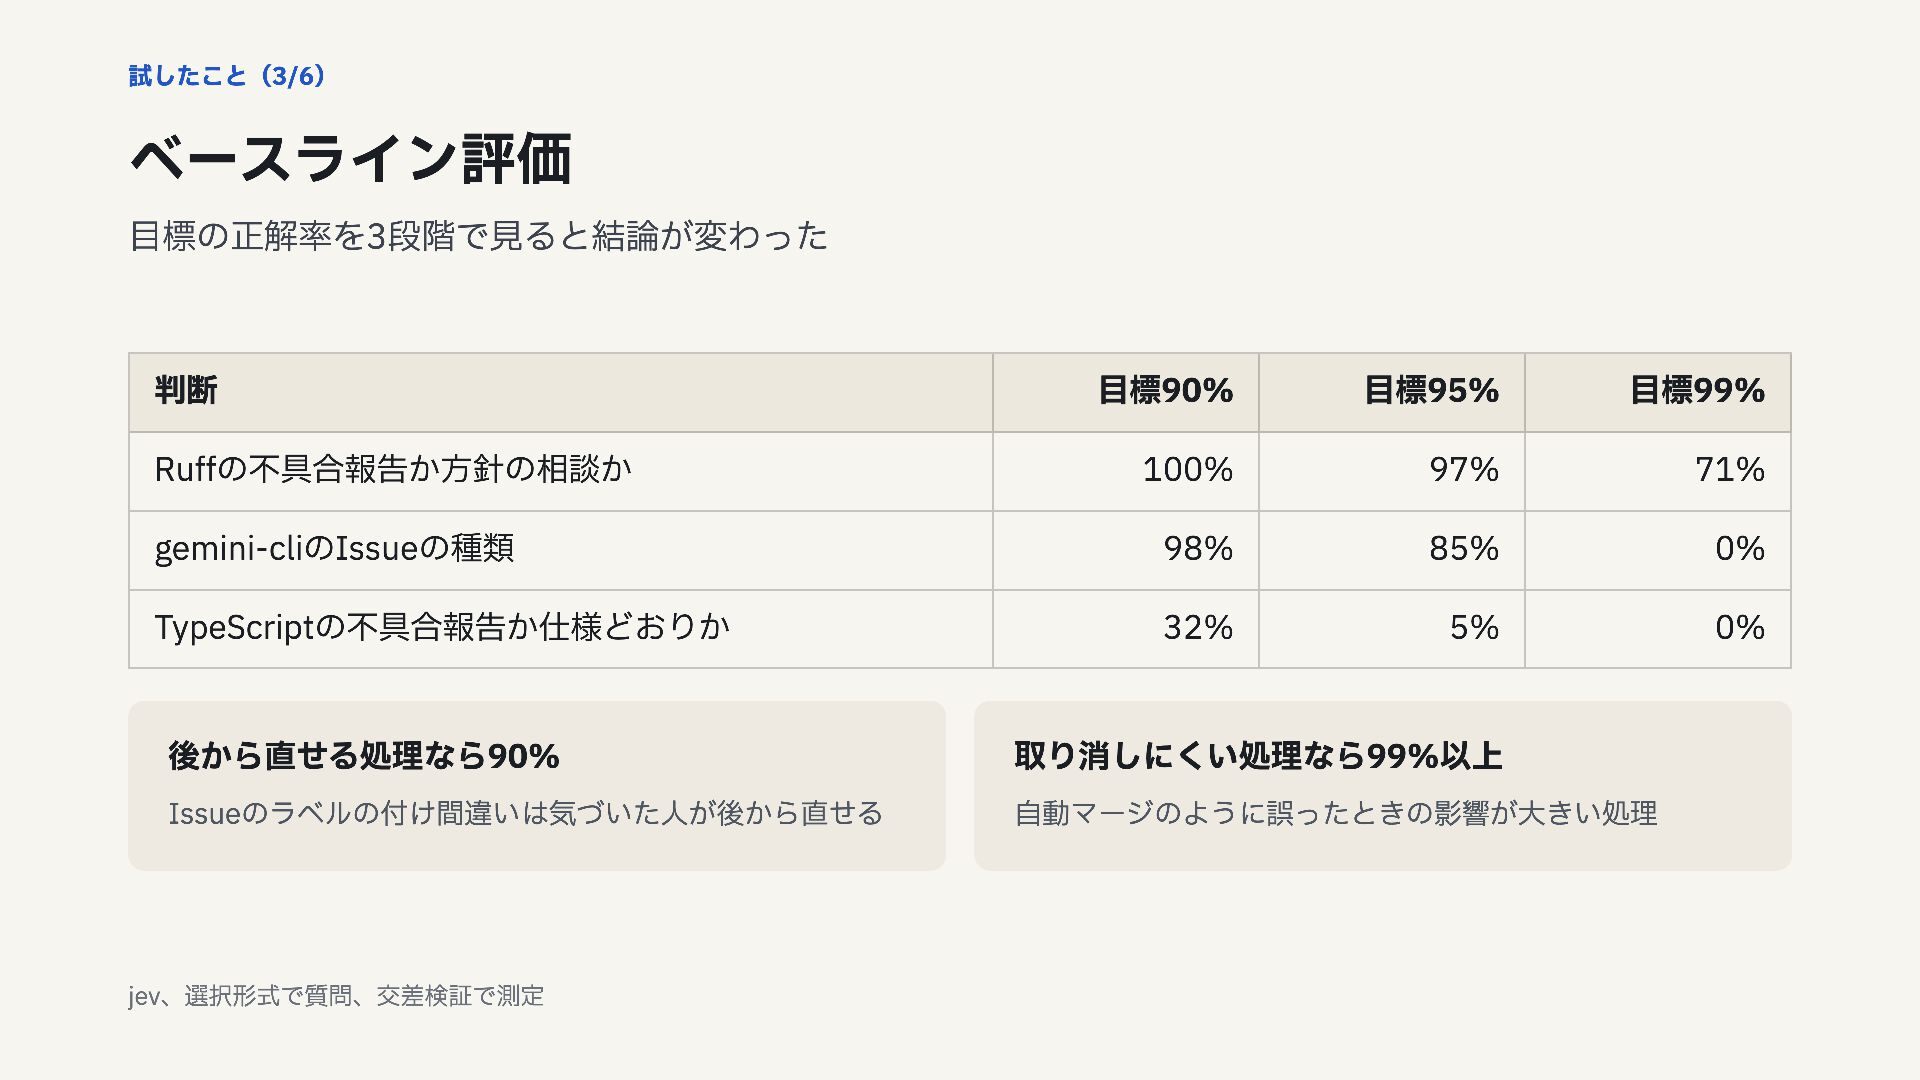
試したこと(3/6) ベースライン評価 目標の正解率を3段階で見ると結論が変わった 判断 目標90% 目標95% 目標99% Ruffの不具合報告か方針の相談か 100% 97%
71% gemini-cliのIssueの種類 98% 85% 0% TypeScriptの不具合報告か仕様どおりか 32% 5% 0% 後から直せる処理なら90% 取り消しにくい処理なら99%以上 Issueのラベルの付け間違いは気づいた人が後から直せる 自動マージのように誤ったときの影響が大きい処理 jev、選択形式で質問、交差検証で測定 -
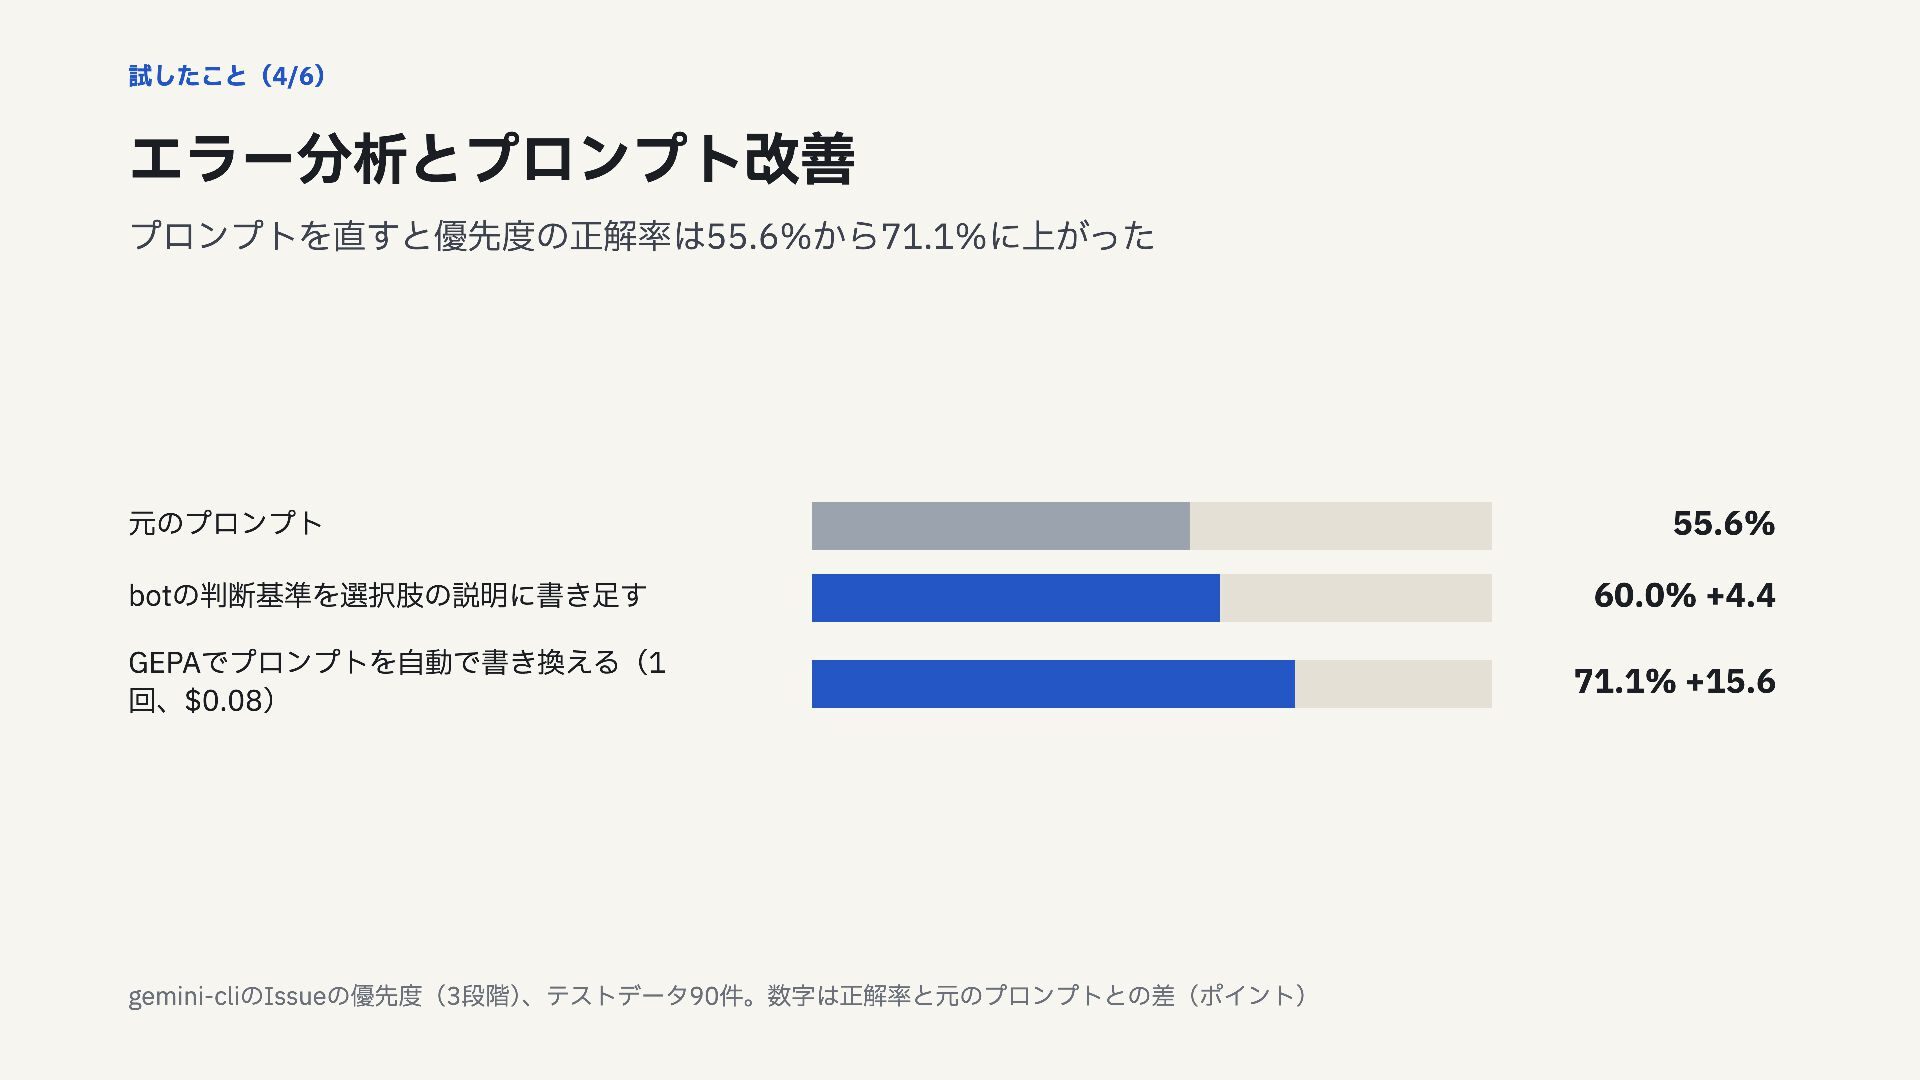
試したこと(4/6) エラー分析とプロンプト改善 プロンプトを直すと優先度の正解率は55.6%から71.1%に上がった 元のプロンプト 55.6% botの判断基準を選択肢の説明に書き足す 60.0% +4.4 GEPAでプロンプトを自動で書き換える(1 回、$0.08)
71.1% +15.6 gemini-cliのIssueの優先度(3段階)、テストデータ90件。数字は正解率と元のプロンプトとの差(ポイント) -
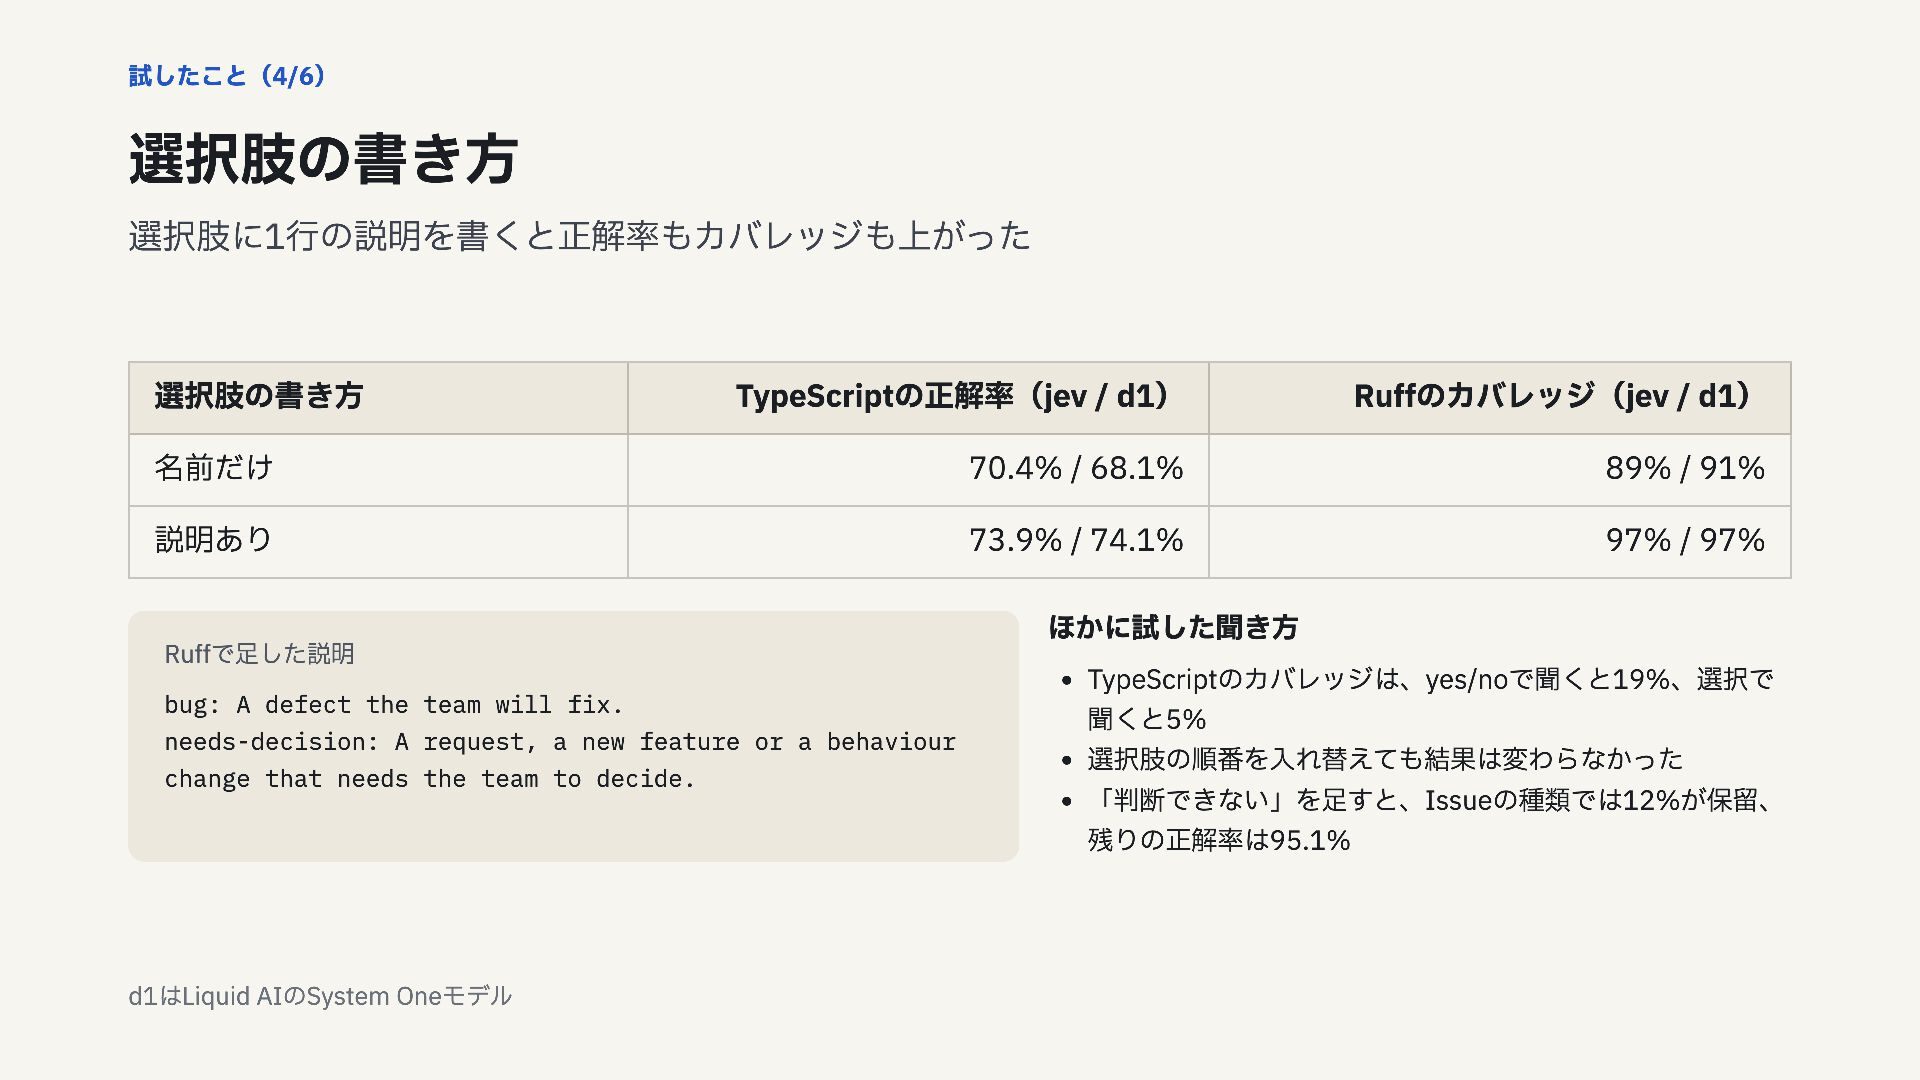
試したこと(4/6) 選択肢の書き方 選択肢に1行の説明を書くと正解率もカバレッジも上がった 選択肢の書き方 TypeScriptの正解率(jev / d1) Ruffのカバレッジ(jev / d1)
名前だけ 70.4% / 68.1% 89% / 91% 説明あり 73.9% / 74.1% 97% / 97% ほかに試した聞き方 Ruffで足した説明 TypeScriptのカバレッジは、yes/noで聞くと19%、選択で bug: A defect the team will fix. needs-decision: A request, a new feature or a behaviour change that needs the team to decide. 聞くと5% 選択肢の順番を入れ替えても結果は変わらなかった 「判断できない」を足すと、Issueの種類では12%が保留、 残りの正解率は95.1% d1はLiquid AIのSystem Oneモデル -
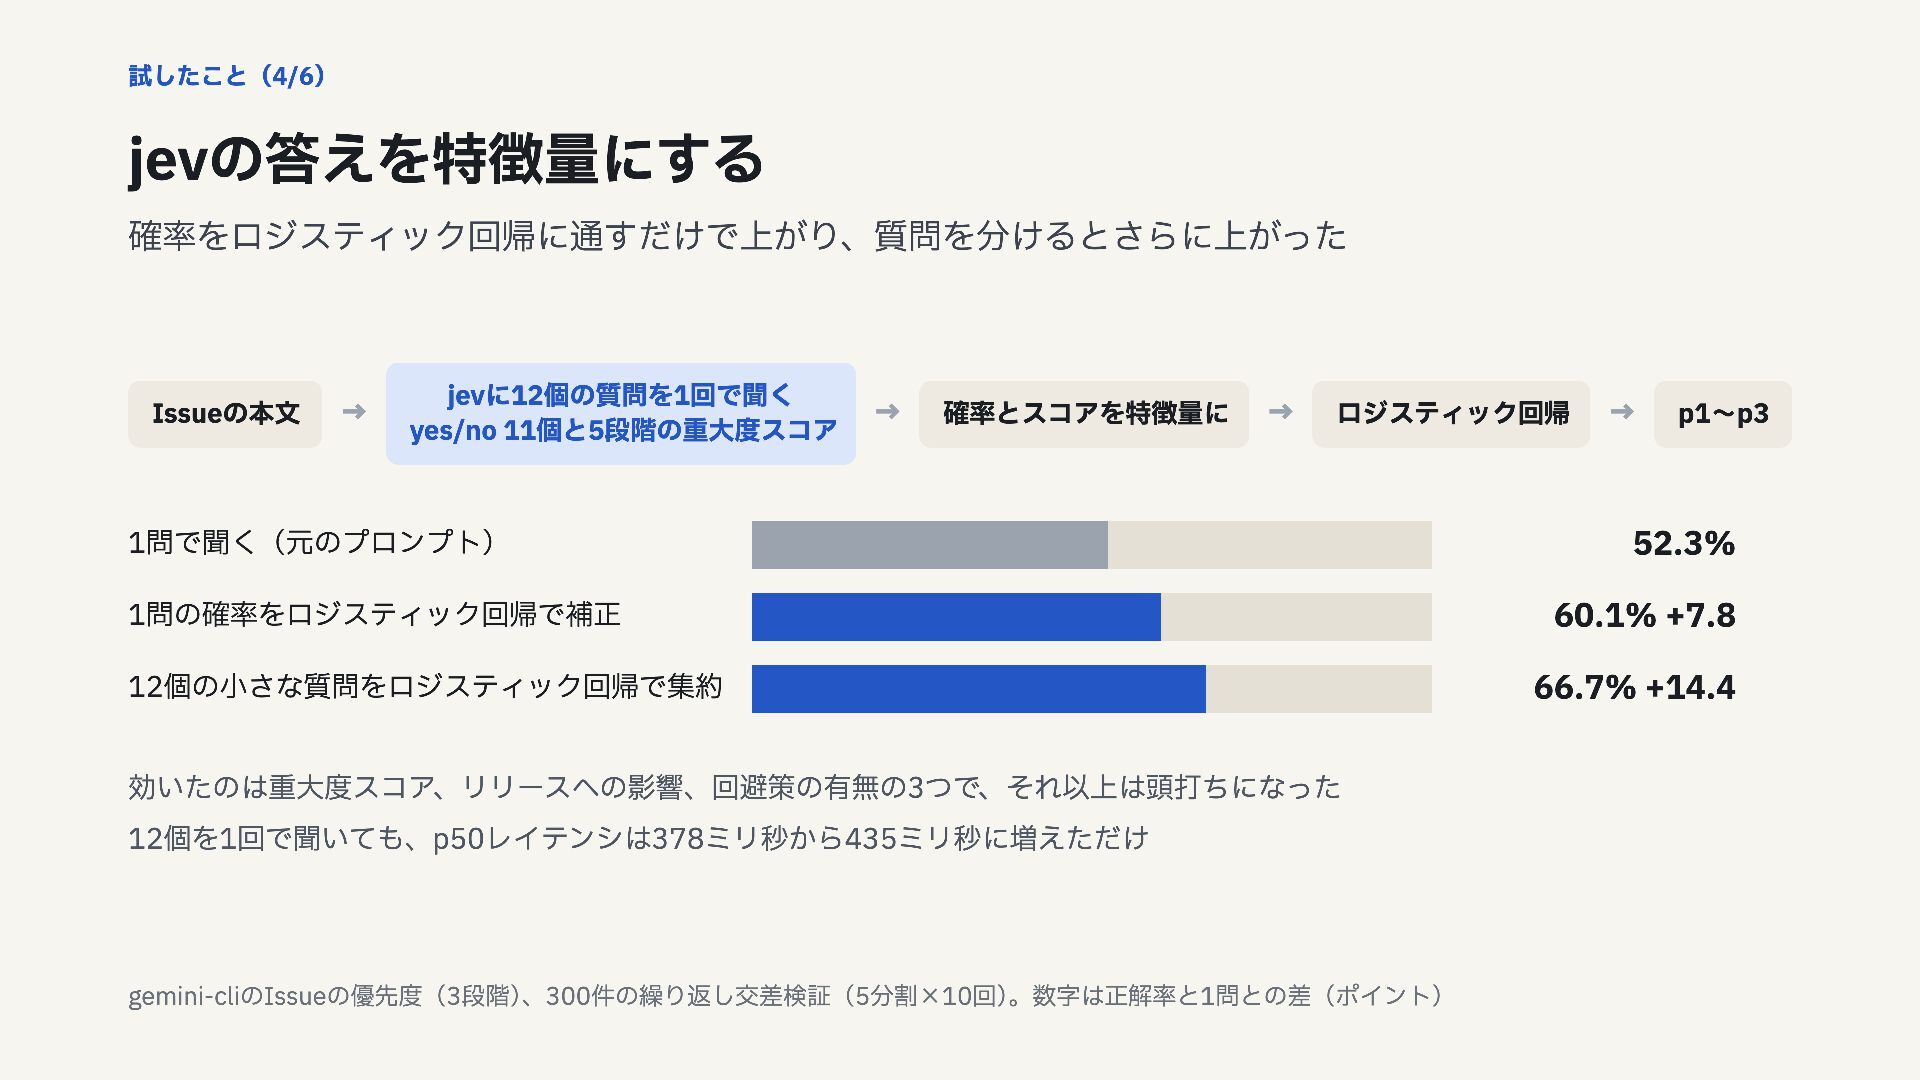
試したこと(4/6) jevの答えを特徴量にする 確率をロジスティック回帰に通すだけで上がり、質問を分けるとさらに上がった Issueの本文 → jevに12個の質問を1回で聞く yes/no 11個と5段階の重大度スコア → 確率とスコアを特徴量に
→ ロジスティック回帰 1問で聞く(元のプロンプト) 1問の確率をロジスティック回帰で補正 12個の小さな質問をロジスティック回帰で集約 効いたのは重大度スコア、リリースへの影響、回避策の有無の3つで、それ以上は頭打ちになった 12個を1回で聞いても、p50レイテンシは378ミリ秒から435ミリ秒に増えただけ gemini-cliのIssueの優先度(3段階)、300件の繰り返し交差検証(5分割×10回)。数字は正解率と1問との差(ポイント) → p1〜p3 52.3% 60.1% +7.8 66.7% +14.4 -
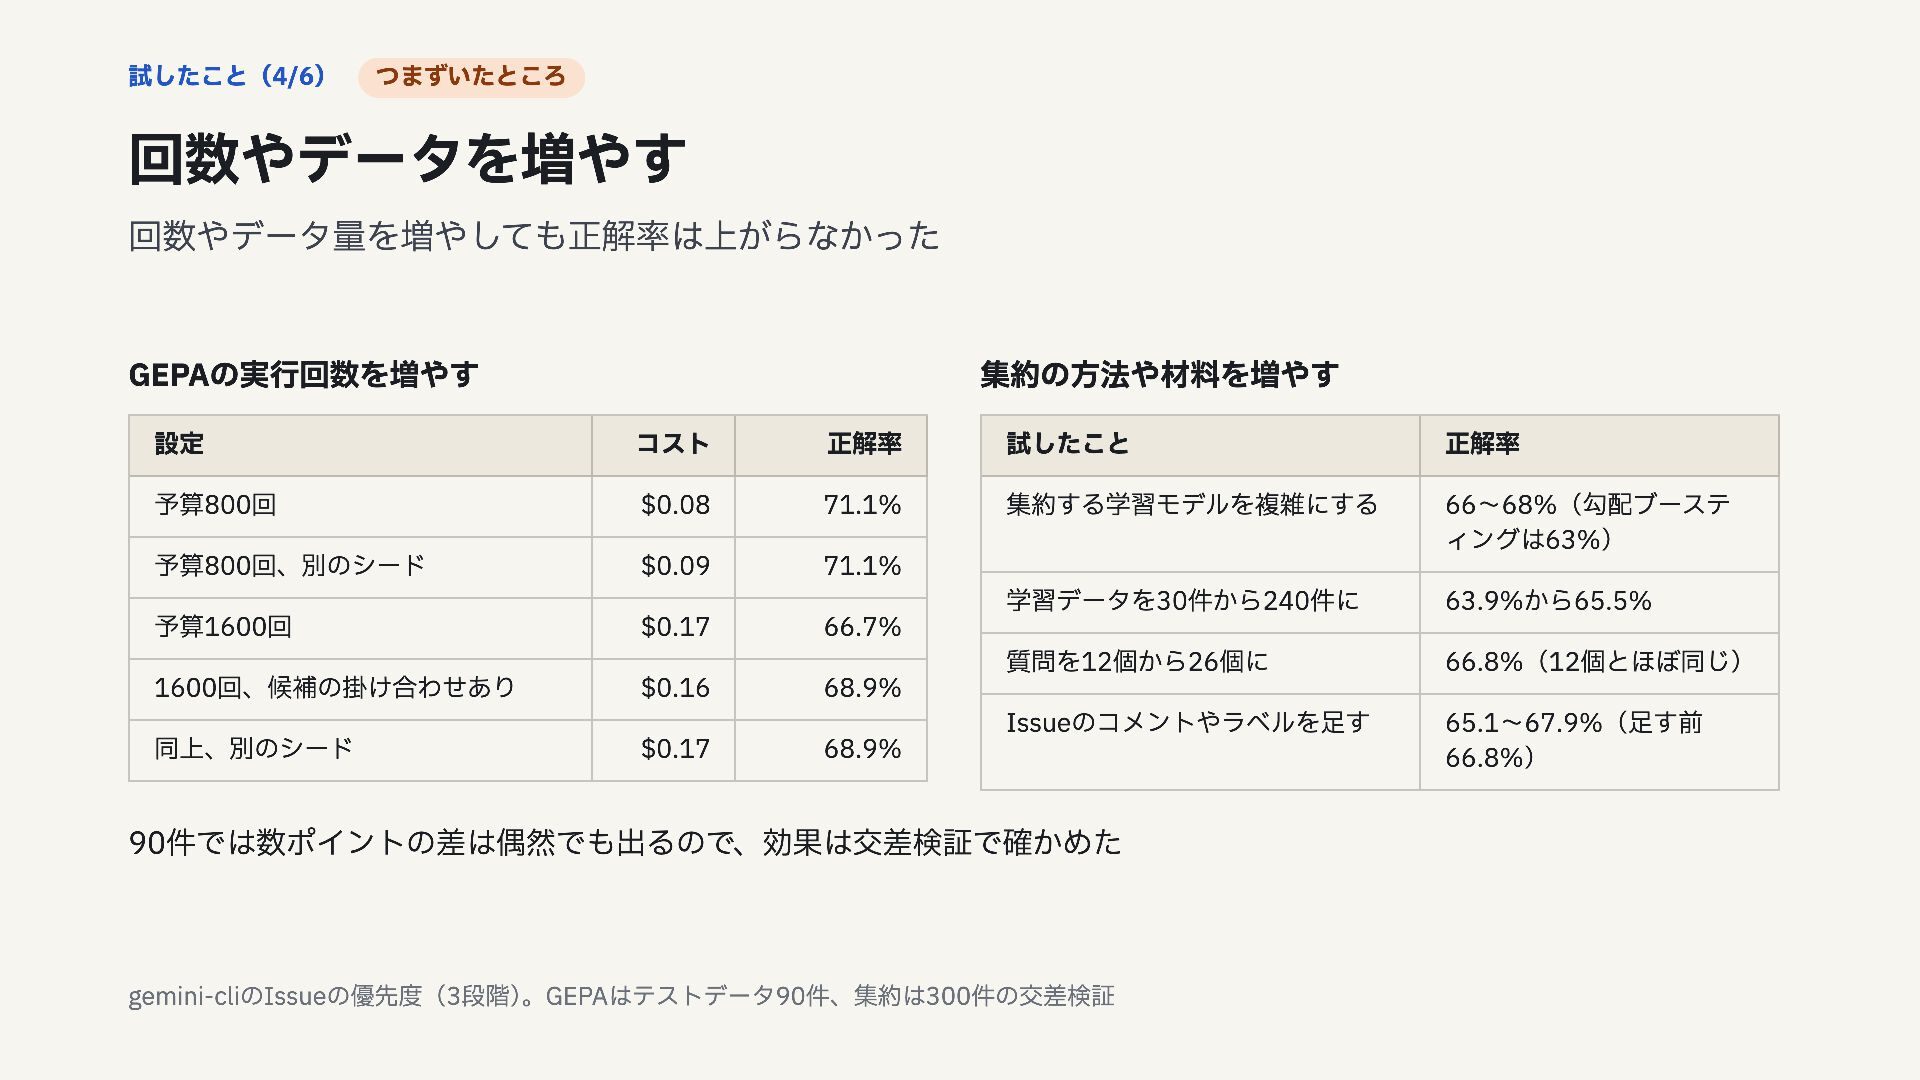
試したこと(4/6) つまずいたところ 回数やデータを増やす 回数やデータ量を増やしても正解率は上がらなかった GEPAの実行回数を増やす 集約の方法や材料を増やす 設定 コスト 正解率 試したこと
正解率 予算800回 $0.08 71.1% 集約する学習モデルを複雑にする 66〜68%(勾配ブーステ ィングは63%) 予算800回、別のシード $0.09 71.1% 学習データを30件から240件に 63.9%から65.5% 予算1600回 $0.17 66.7% 質問を12個から26個に 66.8%(12個とほぼ同じ) 1600回、候補の掛け合わせあり $0.16 68.9% Issueのコメントやラベルを足す 同上、別のシード $0.17 68.9% 65.1〜67.9%(足す前 66.8%) 90件では数ポイントの差は偶然でも出るので、効果は交差検証で確かめた gemini-cliのIssueの優先度(3段階)。GEPAはテストデータ90件、集約は300件の交差検証 -
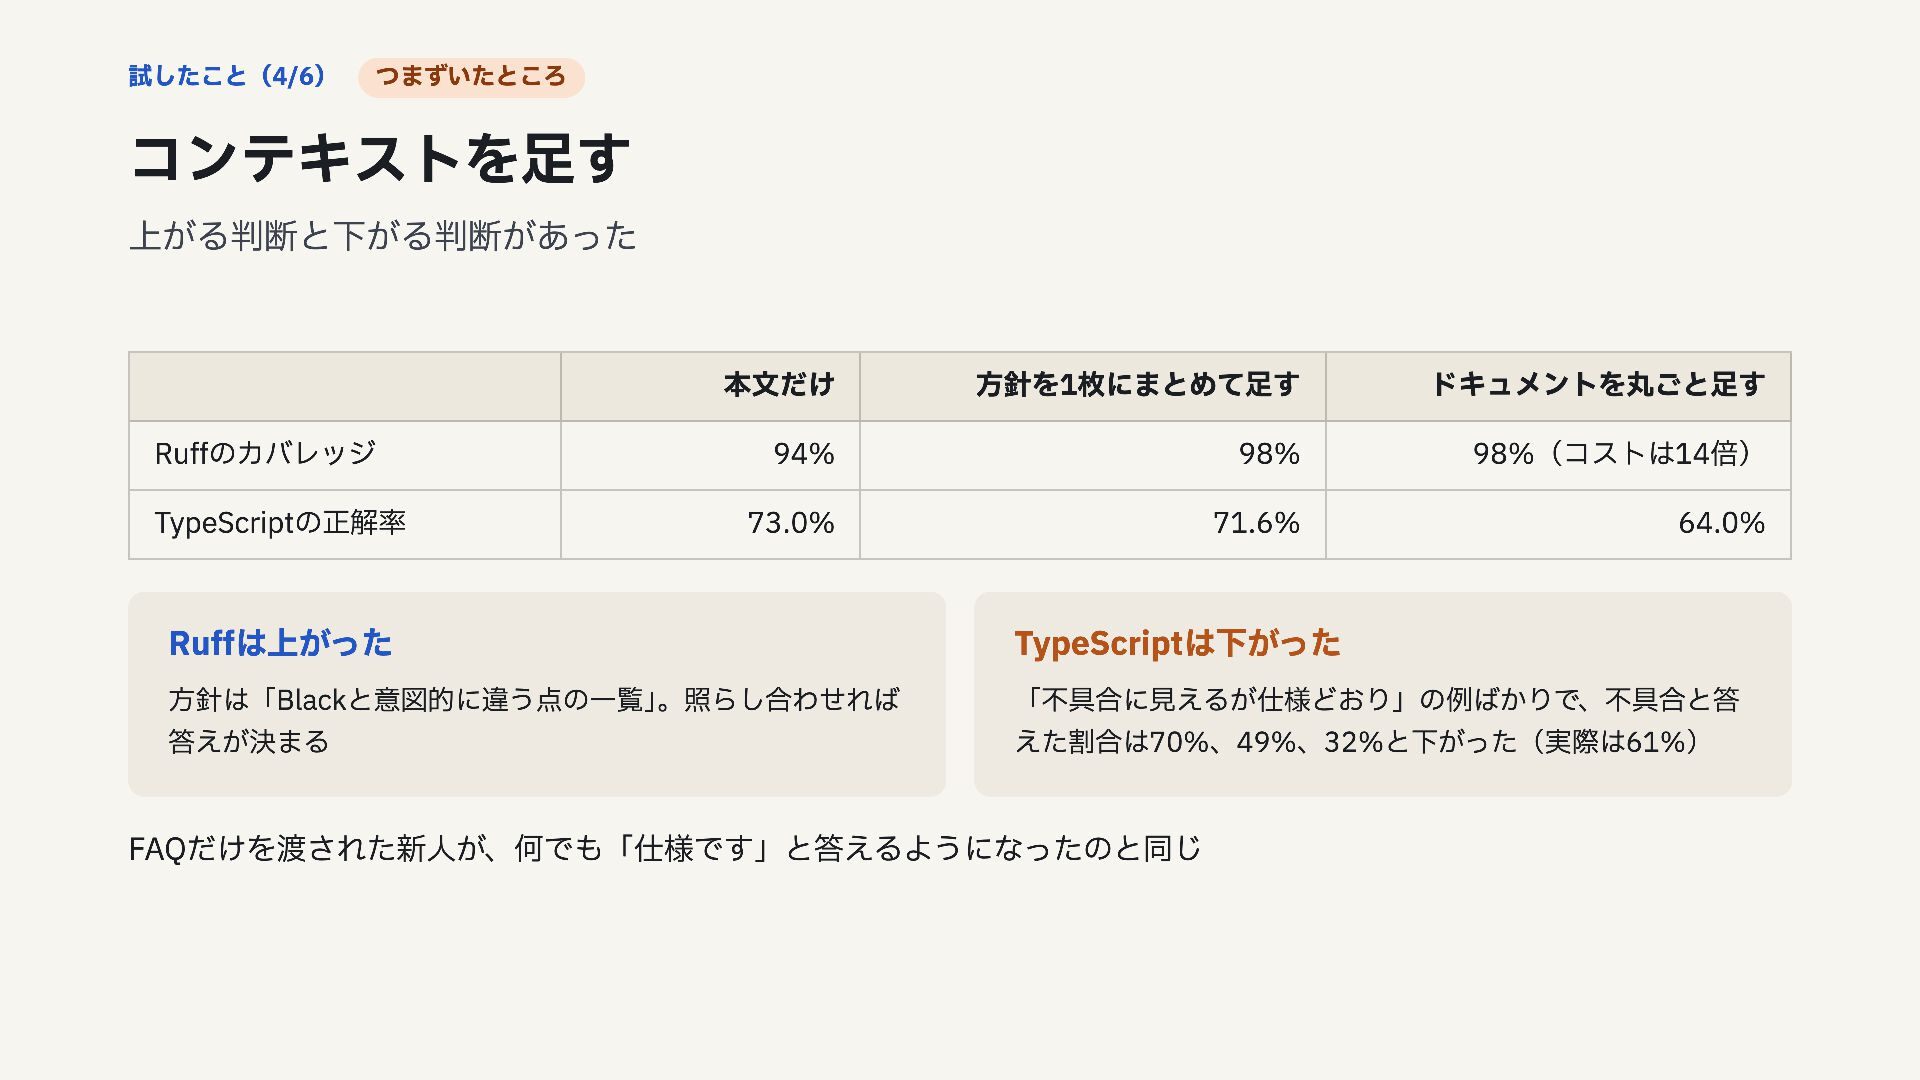
試したこと(4/6) つまずいたところ コンテキストを足す 上がる判断と下がる判断があった 本文だけ 方針を1枚にまとめて足す ドキュメントを丸ごと足す Ruffのカバレッジ 94% 98%
98%(コストは14倍) TypeScriptの正解率 73.0% 71.6% 64.0% Ruffは上がった TypeScriptは下がった 方針は「Blackと意図的に違う点の一覧」。照らし合わせれば 「不具合に見えるが仕様どおり」の例ばかりで、不具合と答 答えが決まる えた割合は70%、49%、32%と下がった(実際は61%) FAQだけを渡された新人が、何でも「仕様です」と答えるようになったのと同じ -
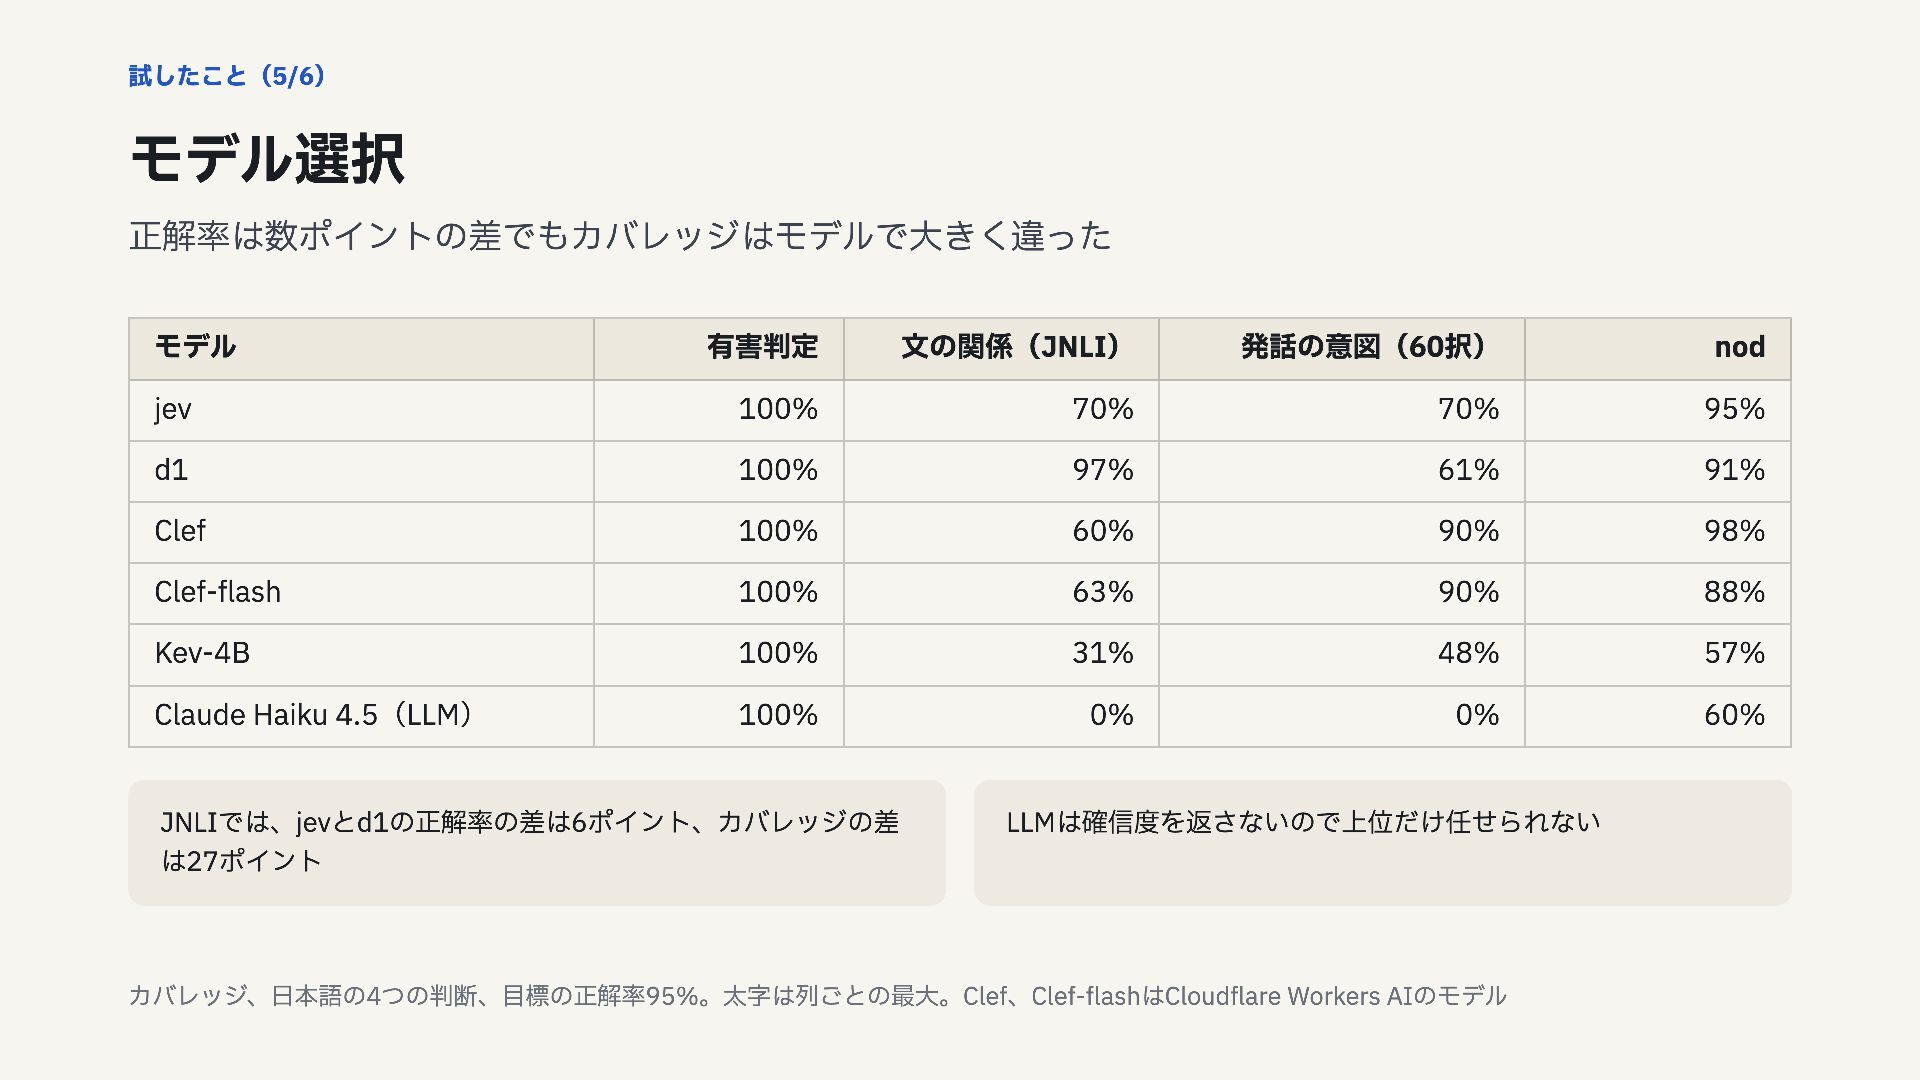
試したこと(5/6) モデル選択 正解率は数ポイントの差でもカバレッジはモデルで大きく違った モデル 有害判定 文の関係(JNLI) 発話の意図(60択) nod jev 100%
70% 70% 95% d1 100% 97% 61% 91% Clef 100% 60% 90% 98% Clef-flash 100% 63% 90% 88% Kev-4B 100% 31% 48% 57% Claude Haiku 4.5(LLM) 100% 0% 0% 60% JNLIでは、jevとd1の正解率の差は6ポイント、カバレッジの差 は27ポイント LLMは確信度を返さないので上位だけ任せられない カバレッジ、日本語の4つの判断、目標の正解率95%。太字は列ごとの最大。Clef、Clef-flashはCloudflare Workers AIのモデル -
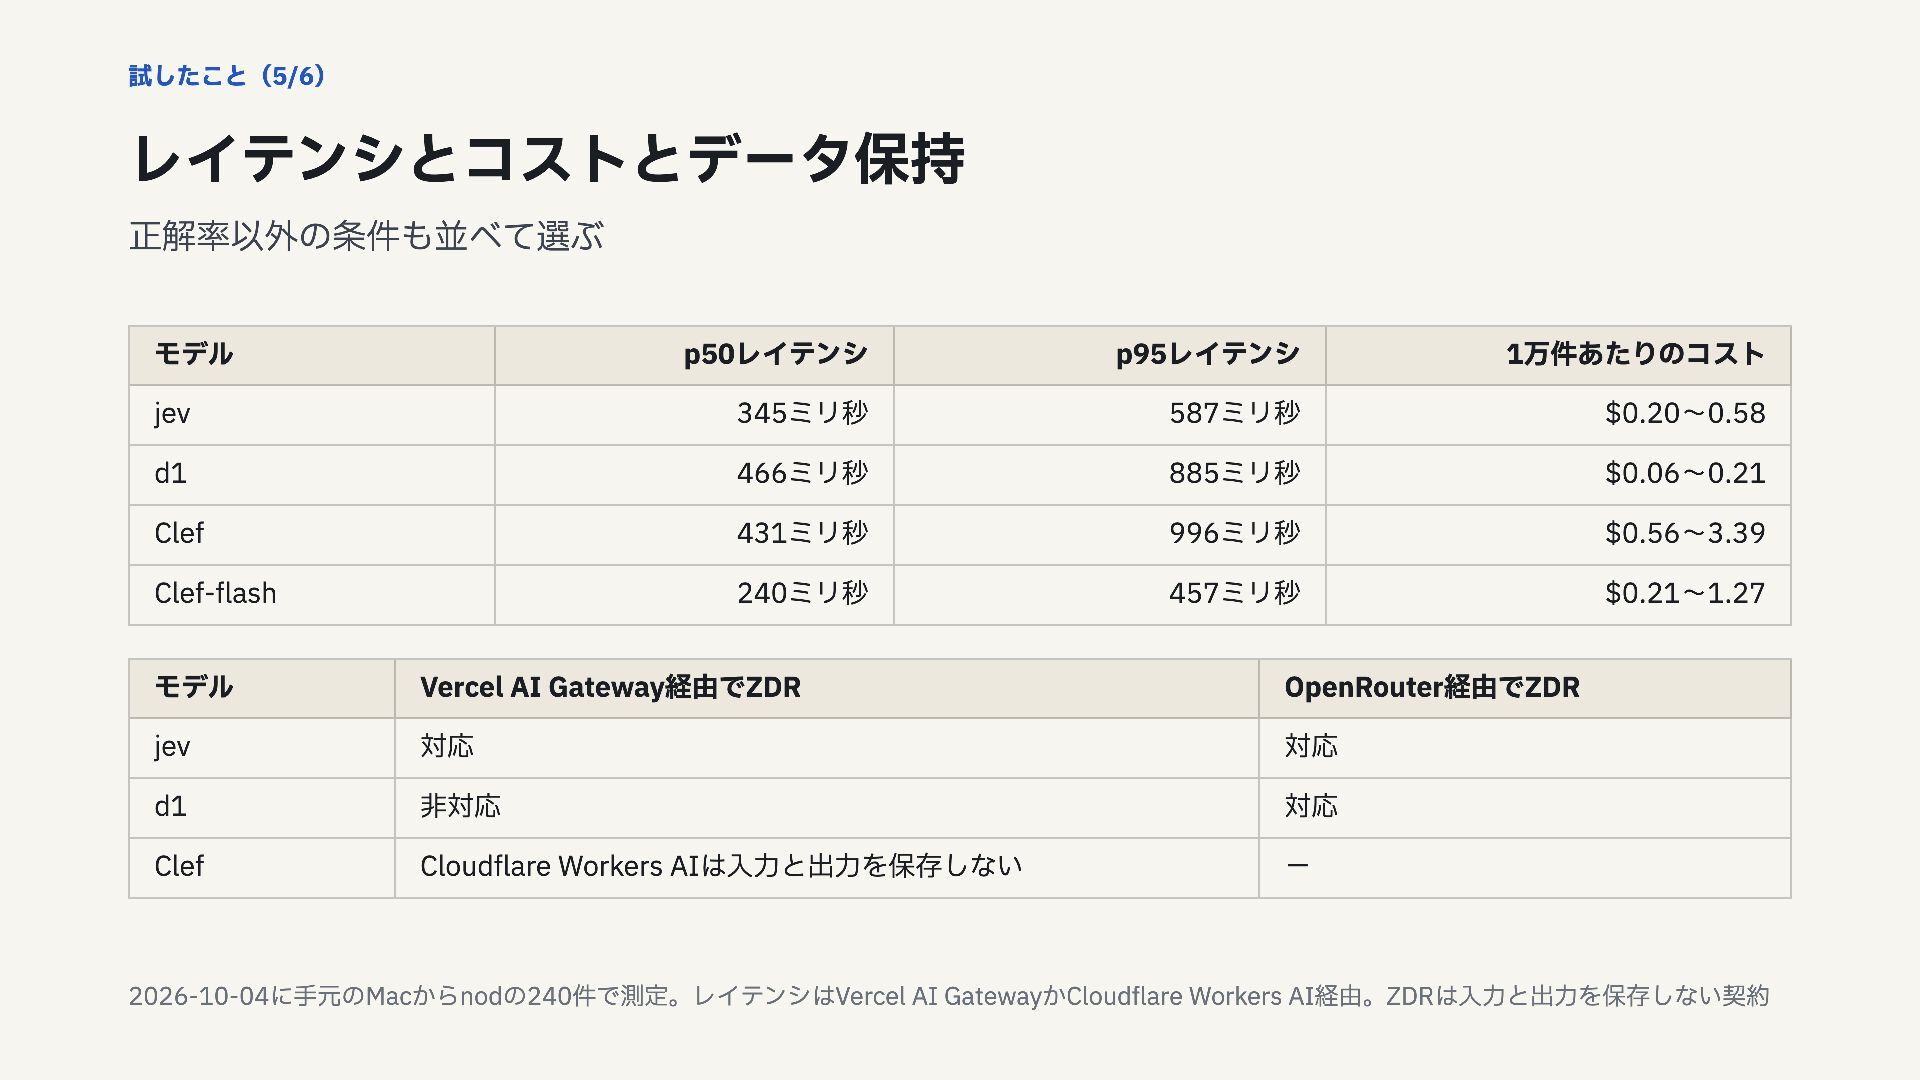
試したこと(5/6) レイテンシとコストとデータ保持 正解率以外の条件も並べて選ぶ モデル p50レイテンシ p95レイテンシ 1万件あたりのコスト jev 345ミリ秒 587ミリ秒
$0.20〜0.58 d1 466ミリ秒 885ミリ秒 $0.06〜0.21 Clef 431ミリ秒 996ミリ秒 $0.56〜3.39 Clef-flash 240ミリ秒 457ミリ秒 $0.21〜1.27 モデル Vercel AI Gateway経由でZDR OpenRouter経由でZDR jev 対応 対応 d1 非対応 対応 Clef Cloudflare Workers AIは入力と出力を保存しない − 2026-10-04に手元のMacからnodの240件で測定。レイテンシはVercel AI GatewayかCloudflare Workers AI経由。ZDRは入力と出力を保存しない契約 -
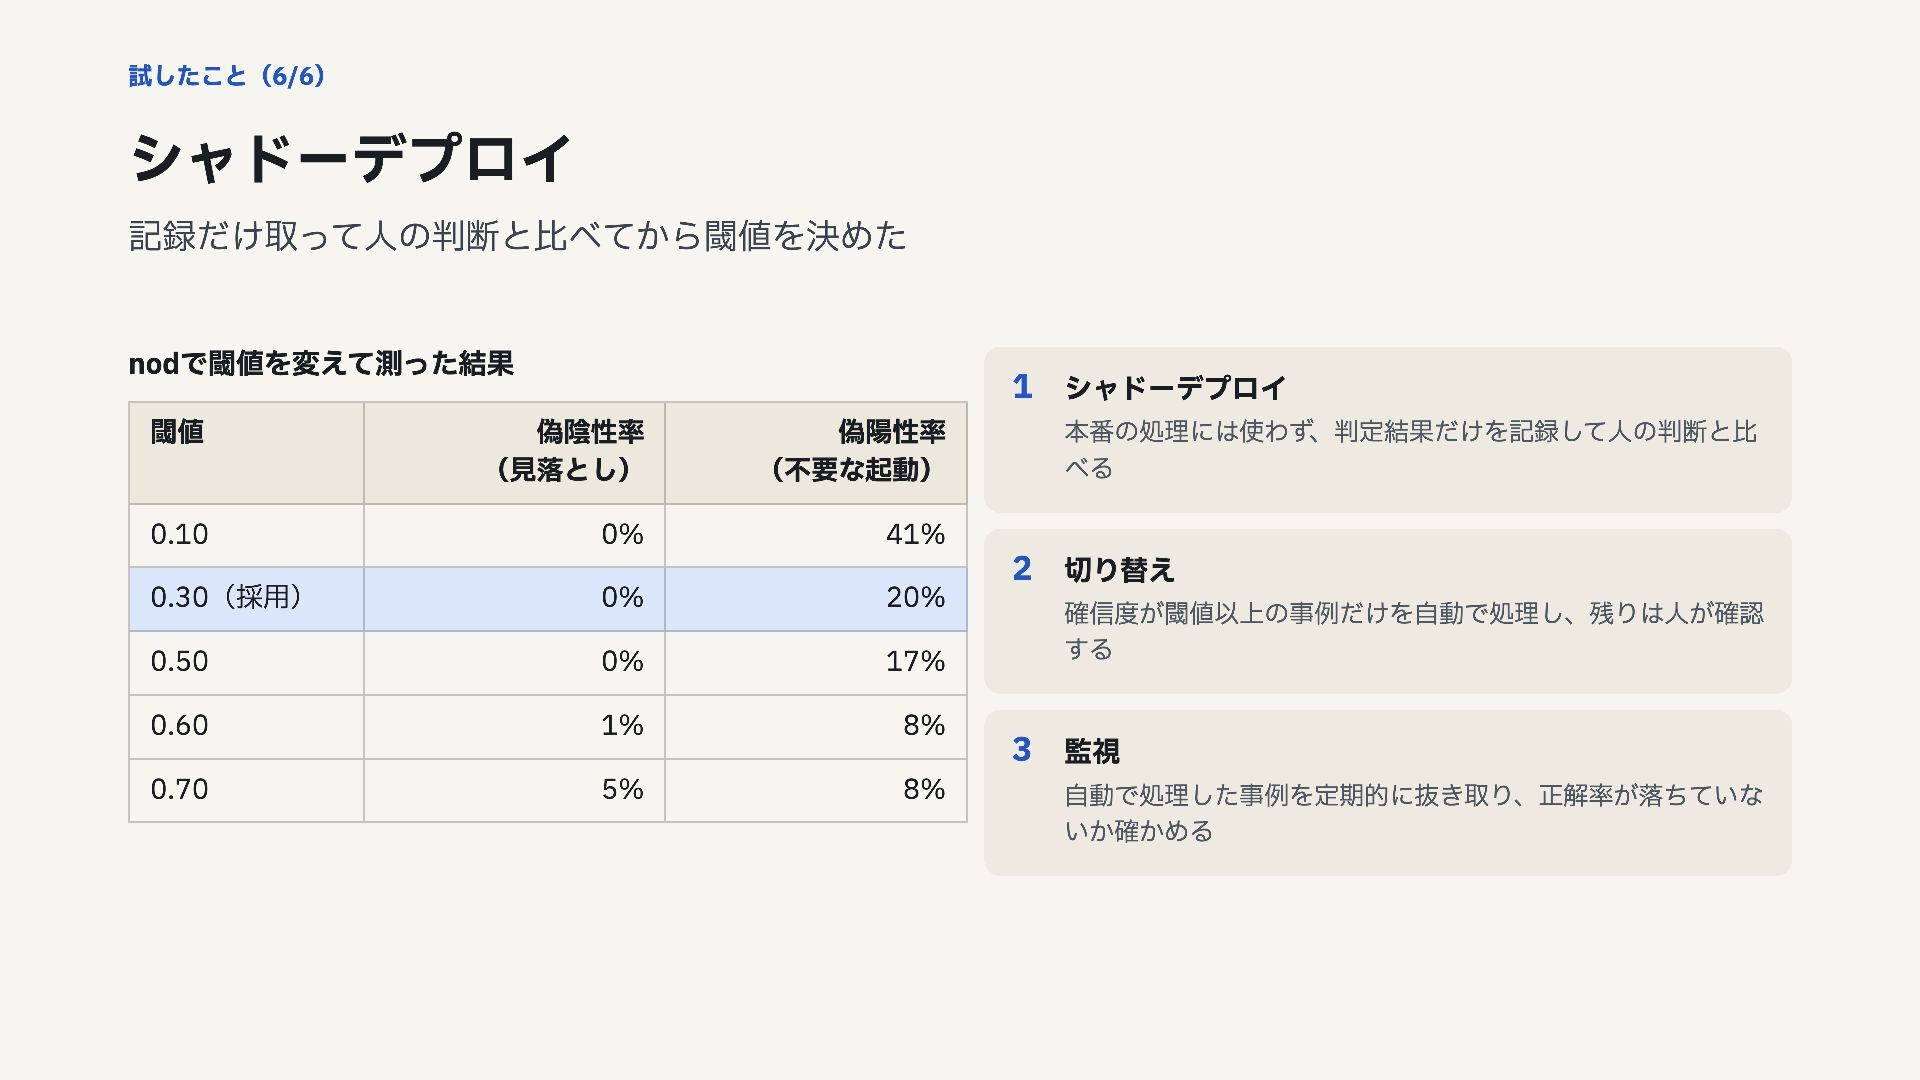
試したこと(6/6) シャドーデプロイ 記録だけ取って人の判断と比べてから閾値を決めた nodで閾値を変えて測った結果 1 シャドーデプロイ 閾値 偽陰性率 (見落とし) 偽陽性率
(不要な起動) 0.10 0% 41% 0.30(採用) 0% 20% 0.50 0% 17% 0.60 1% 8% 0.70 5% 8% 本番の処理には使わず、判定結果だけを記録して人の判断と比 べる 2 切り替え 確信度が閾値以上の事例だけを自動で処理し、残りは人が確認 する 3 監視 自動で処理した事例を定期的に抜き取り、正解率が落ちていな いか確かめる -
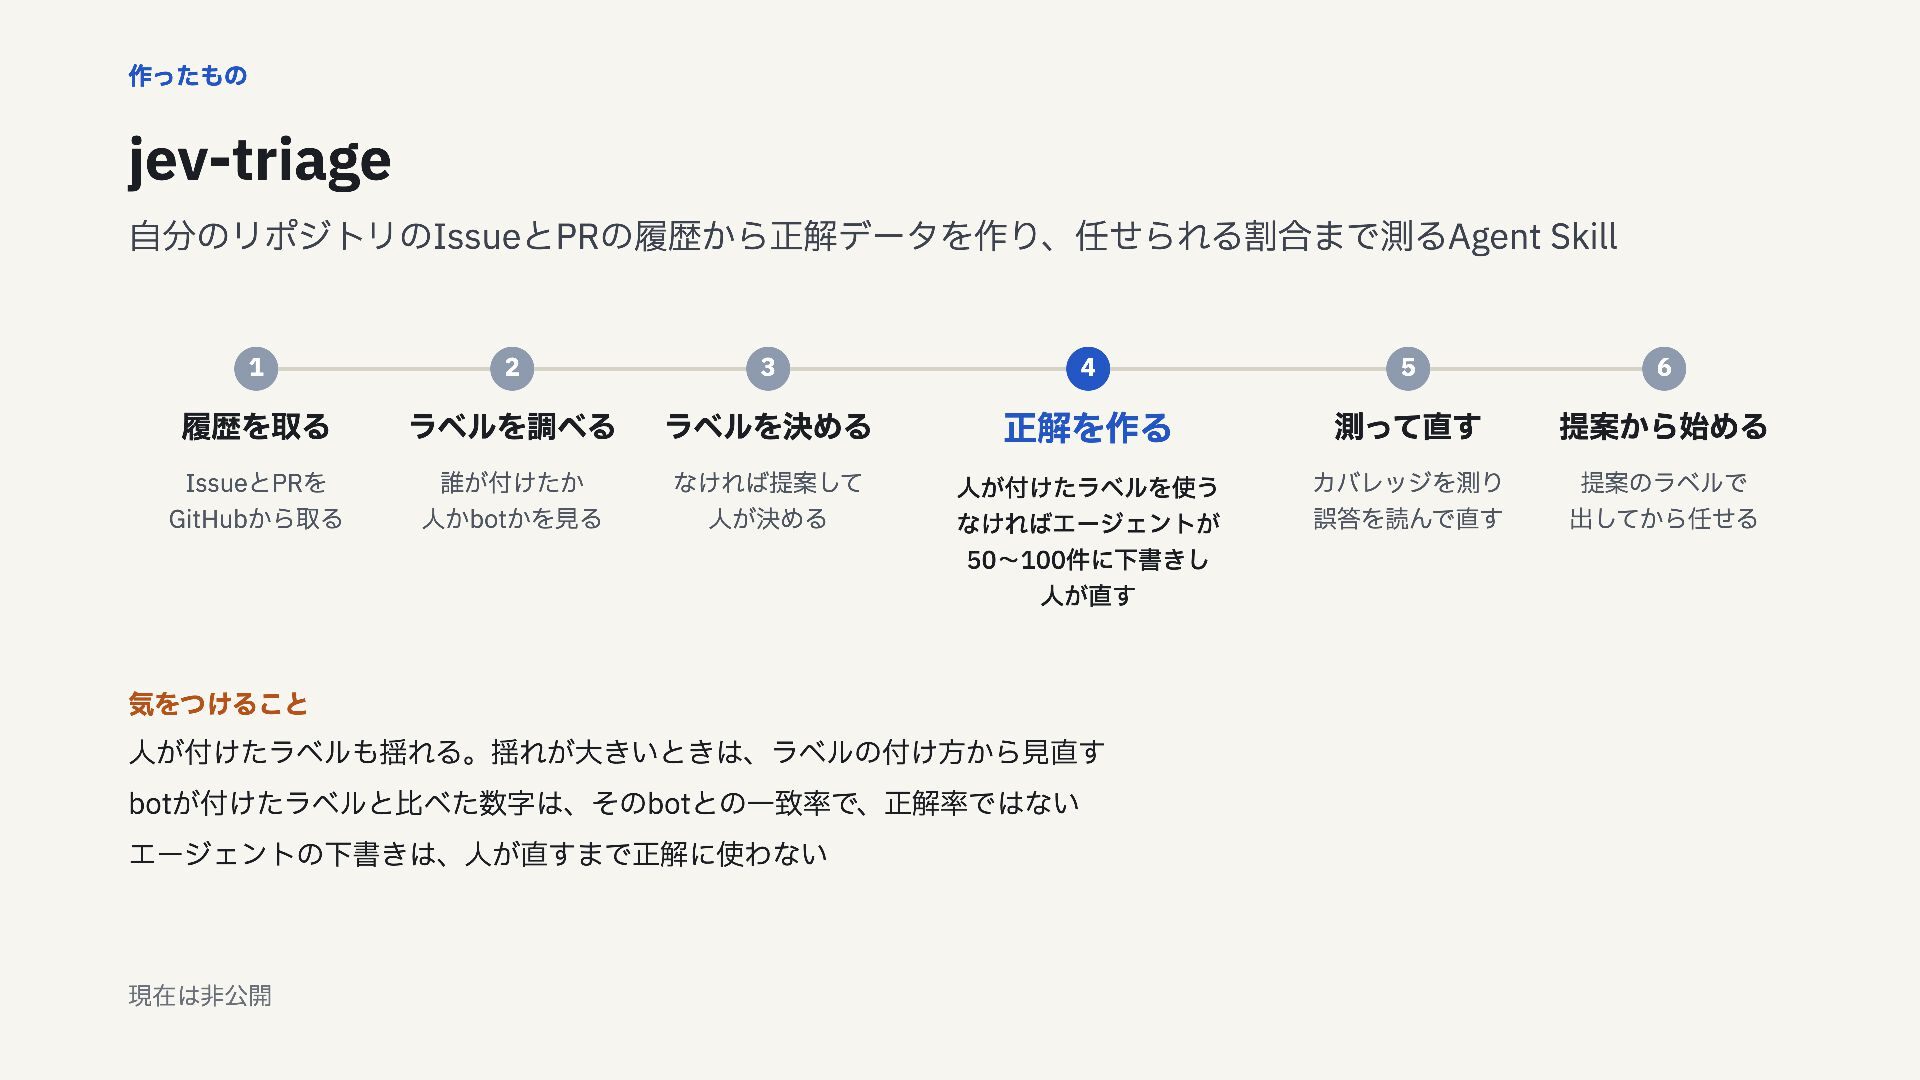
作ったもの jev-triage 自分のリポジトリのIssueとPRの履歴から正解データを作り、任せられる割合まで測るAgent Skill 1 2 3 4 5 6
履歴を取る ラベルを調べる ラベルを決める 正解を作る 測って直す 提案から始める IssueとPRを GitHubから取る 誰が付けたか 人かbotかを見る なければ提案して 人が決める 人が付けたラベルを使う なければエージェントが 50〜100件に下書きし 人が直す カバレッジを測り 誤答を読んで直す 提案のラベルで 出してから任せる 気をつけること 人が付けたラベルも揺れる。揺れが大きいときは、ラベルの付け方から見直す botが付けたラベルと比べた数字は、そのbotとの一致率で、正解率ではない エージェントの下書きは、人が直すまで正解に使わない 現在は非公開 -
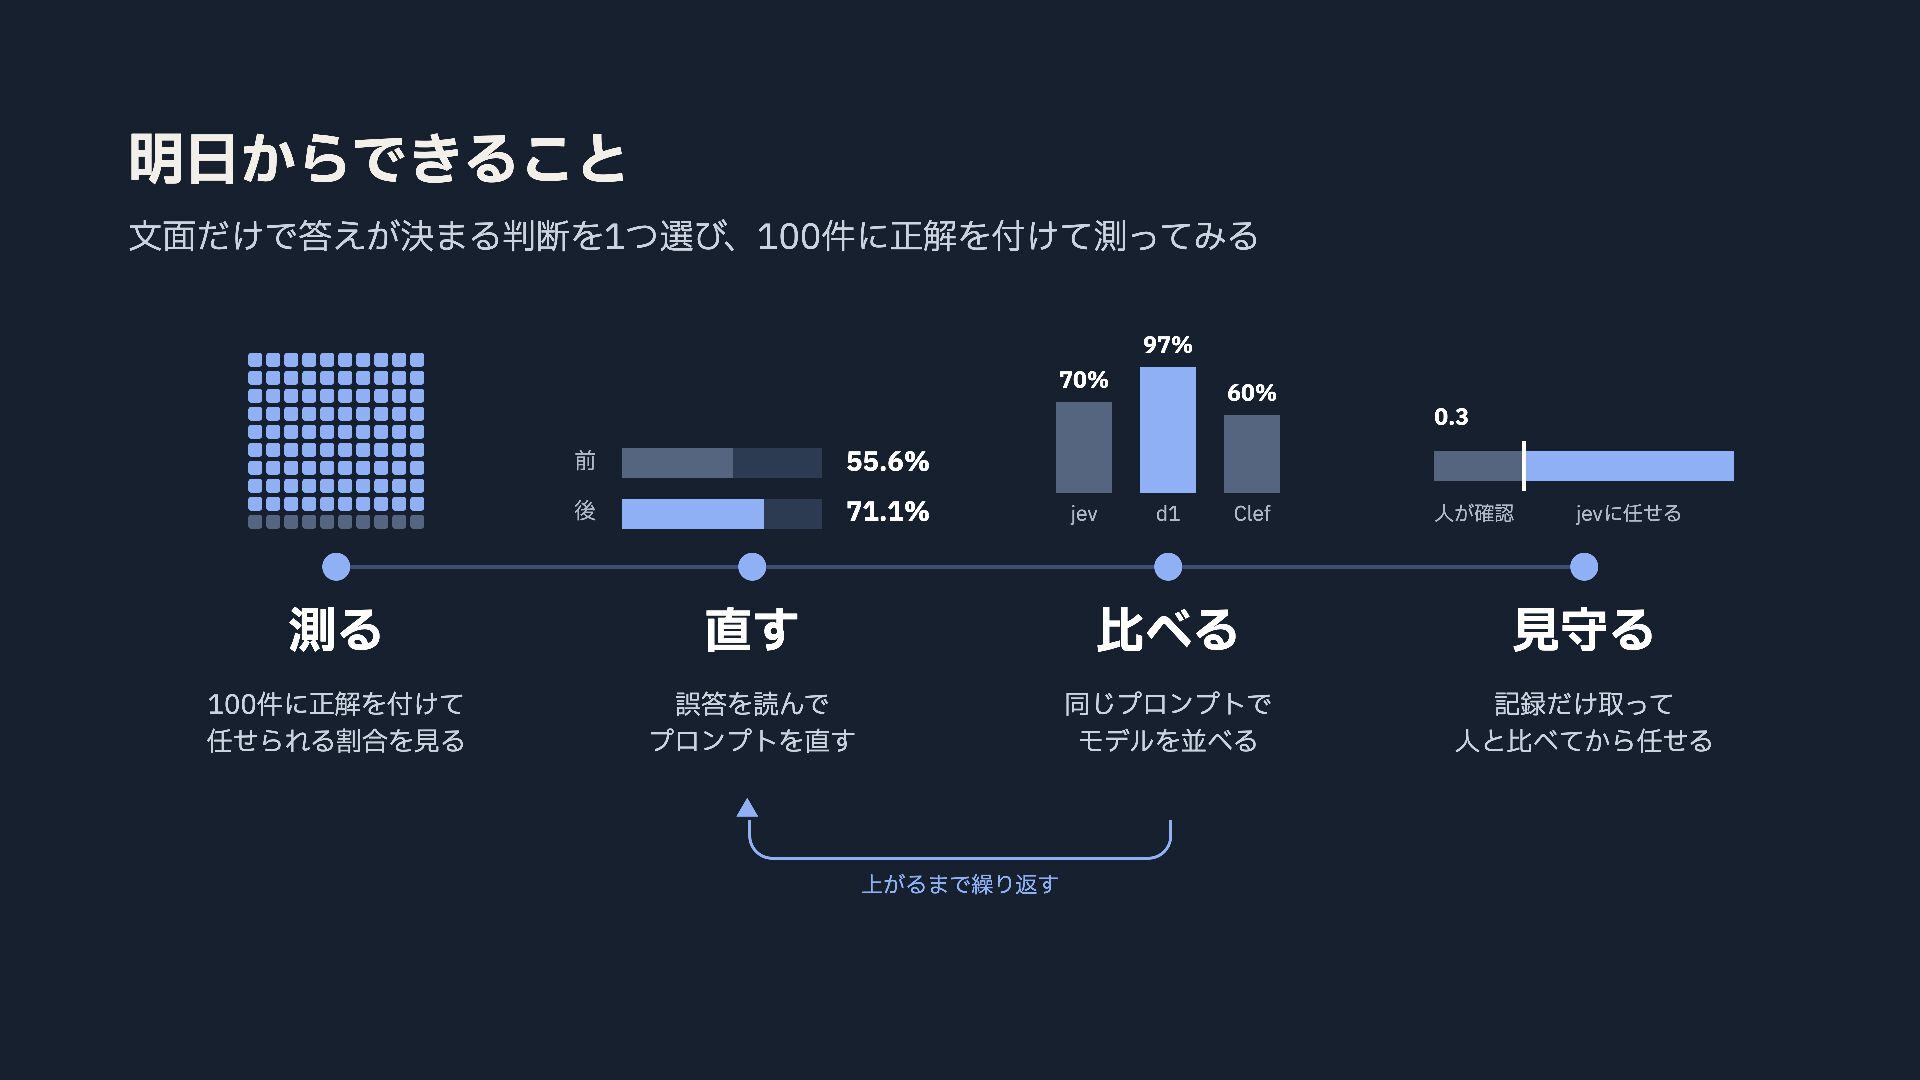
明日からできること 文面だけで答えが決まる判断を1つ選び、100件に正解を付けて測ってみる 97% 70% 60% 0.3 前 55.6% 後 71.1%
jev d1 Clef 人が確認 jevに任せる 測る 直す 比べる 見守る 100件に正解を付けて 任せられる割合を見る 誤答を読んで プロンプトを直す 同じプロンプトで モデルを並べる 記録だけ取って 人と比べてから任せる ▲ 上がるまで繰り返す -
出典 実験の記録:jev-fitのEXPERIMENTS.md、USECASES.md、FINDINGS.md(github.com/gotalab/jev-playground、現在は非 公開) Deußer, Sparrenberg, Sifa「Evaluating and Benchmarking the System
One Model Jev」arXiv:2609.37647 Rao, Callison-Burch「JEV vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places」arXiv:2609.29769 three.dev「Jev vs the LLM-as-a-judge」 three.dev/blog/jev-vs-the-llm-as-a-judge LangSmith langchain.com/blog/jev-is-now-available-in-langsmith-evals ZDR vercel.com/docs/ai-gateway/security-and-compliance/zdr、developers.cloudflare.com/workers-ai/platform/datausage