Share
Embed
AI Native 開発への挑戦
アーキテクチャConference 2025
primeNumber inc. Sponsor LT
https://primenumber.com/
gtnao
November 21, 2025
Transcript
55 slides
-
AI Native 開発への挑戦 primeNumber inc. - Kenta Suzuki (CTO) -
Naotaka Nakane (Head of CTO Office) -
鈴木 健太 Kenta Suzuki CTO, primeNumber inc. 最近の活動: CARTA CTO
の 鈴木健太 さんと 鈴木健太CTO対談 「鈴木健太 AI ラジオ」で検索 -
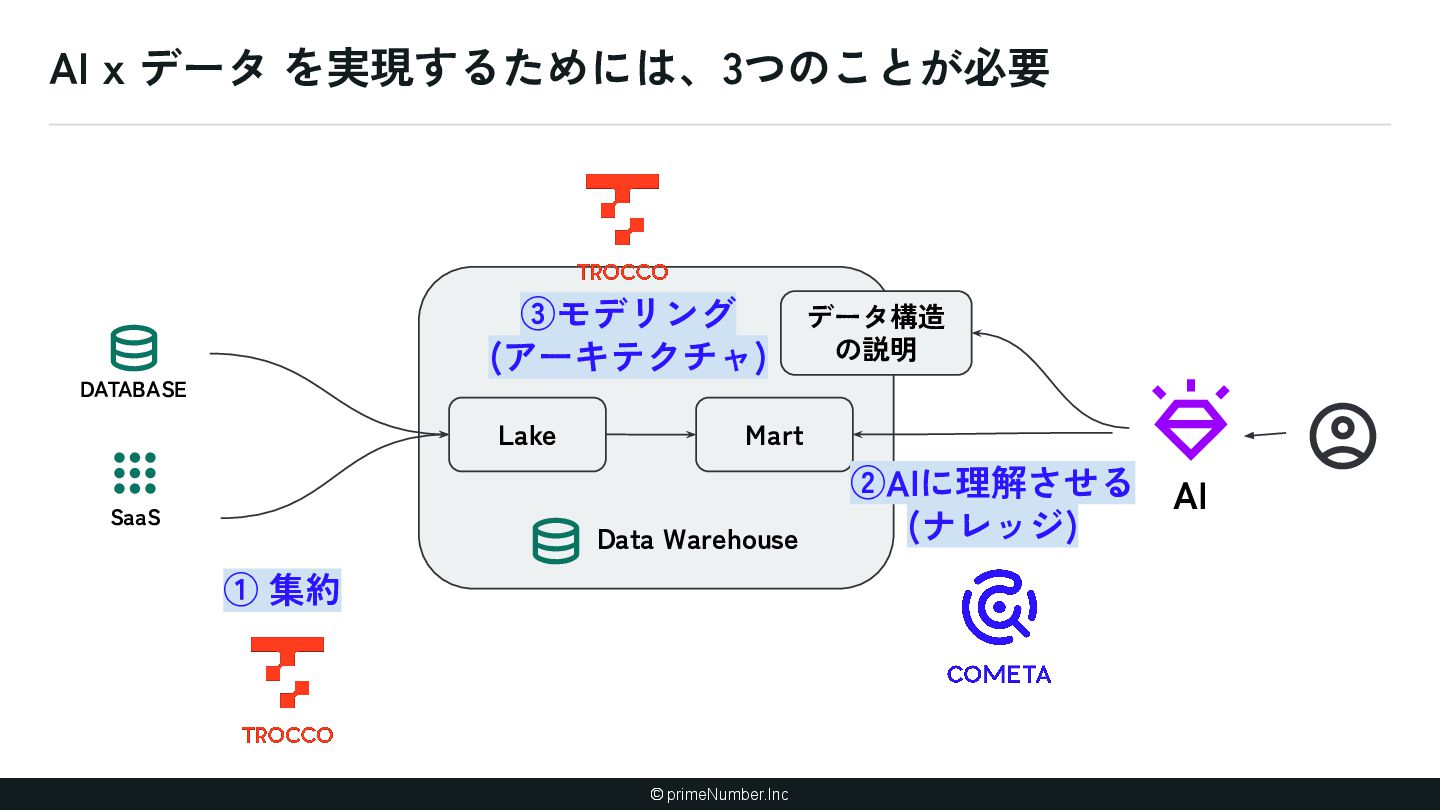
© primeNumber.Inc AI x データ を実現するためには、3つのことが必要 Lake Mart データ構造 の説明
① 集約 ②AIに理解させる (ナレッジ) ③モデリング (アーキテクチャ) DATABASE SaaS AI Data Warehouse -
© primeNumber.Inc 既存プロダクト開発の AI Native化をどう進めるか 既存プロダクト開発での AI 活用、うまくいっていますか?
「なぜ難しいのか」 と 「primeNumber がどう進めてきたか」 を共有します -
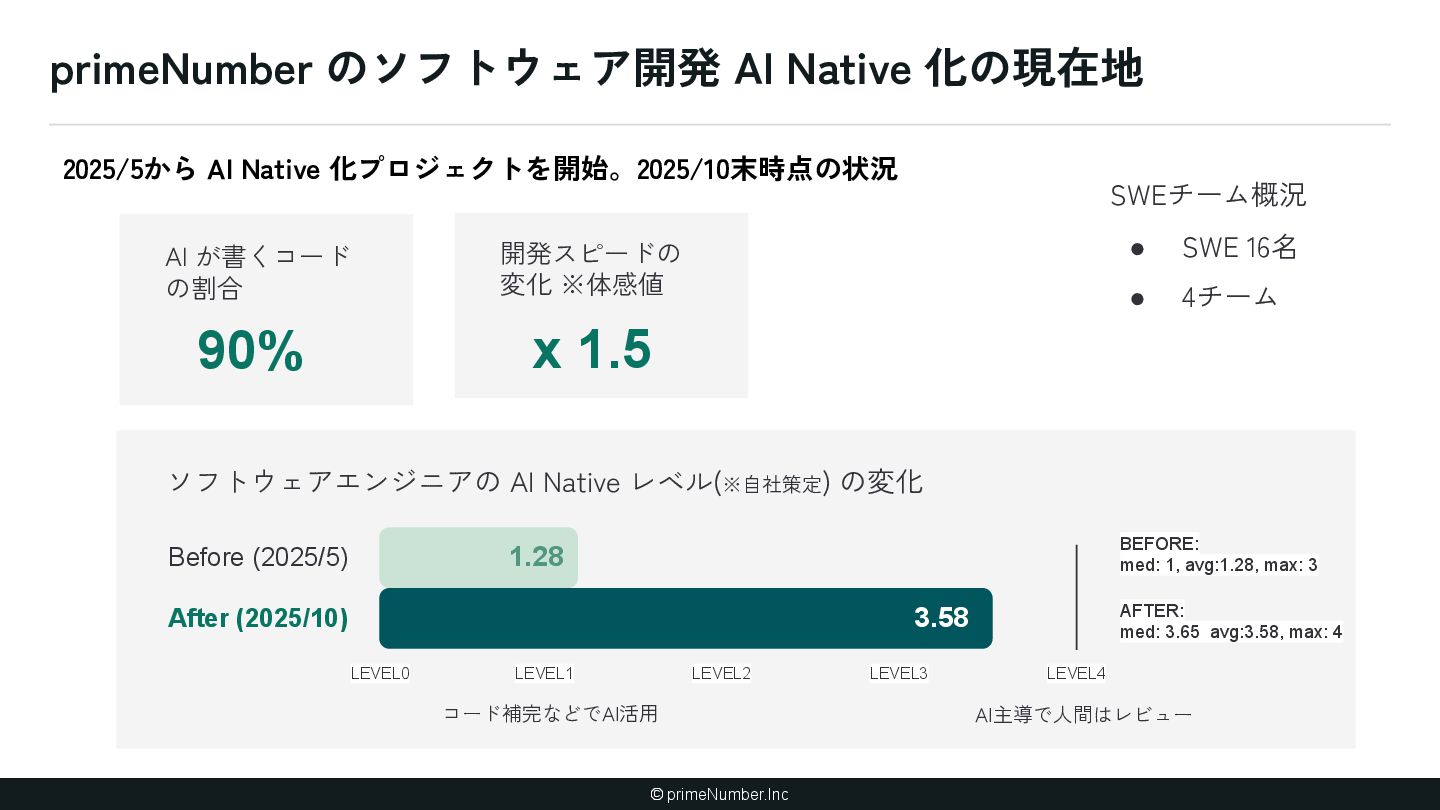
© primeNumber.Inc primeNumber のソフトウェア開発 AI Native 化の現在地 SWEチーム概況 • SWE
16名 • 4チーム Before (2025/5) After (2025/10) 1.28 3.58 LEVEL0 LEVEL1 LEVEL2 LEVEL3 LEVEL4 BEFORE: med: 1, avg:1.28, max: 3 AFTER: med: 3.65 avg:3.58, max: 4 ソフトウェアエンジニアの AI Native レベル(※自社策定) の変化 2025/5から AI Native 化プロジェクトを開始。2025/10末時点の状況 AI が書くコード の割合 90% 開発スピードの 変化 ※体感値 x 1.5 AI主導で人間はレビュー コード補完などでAI活用 -
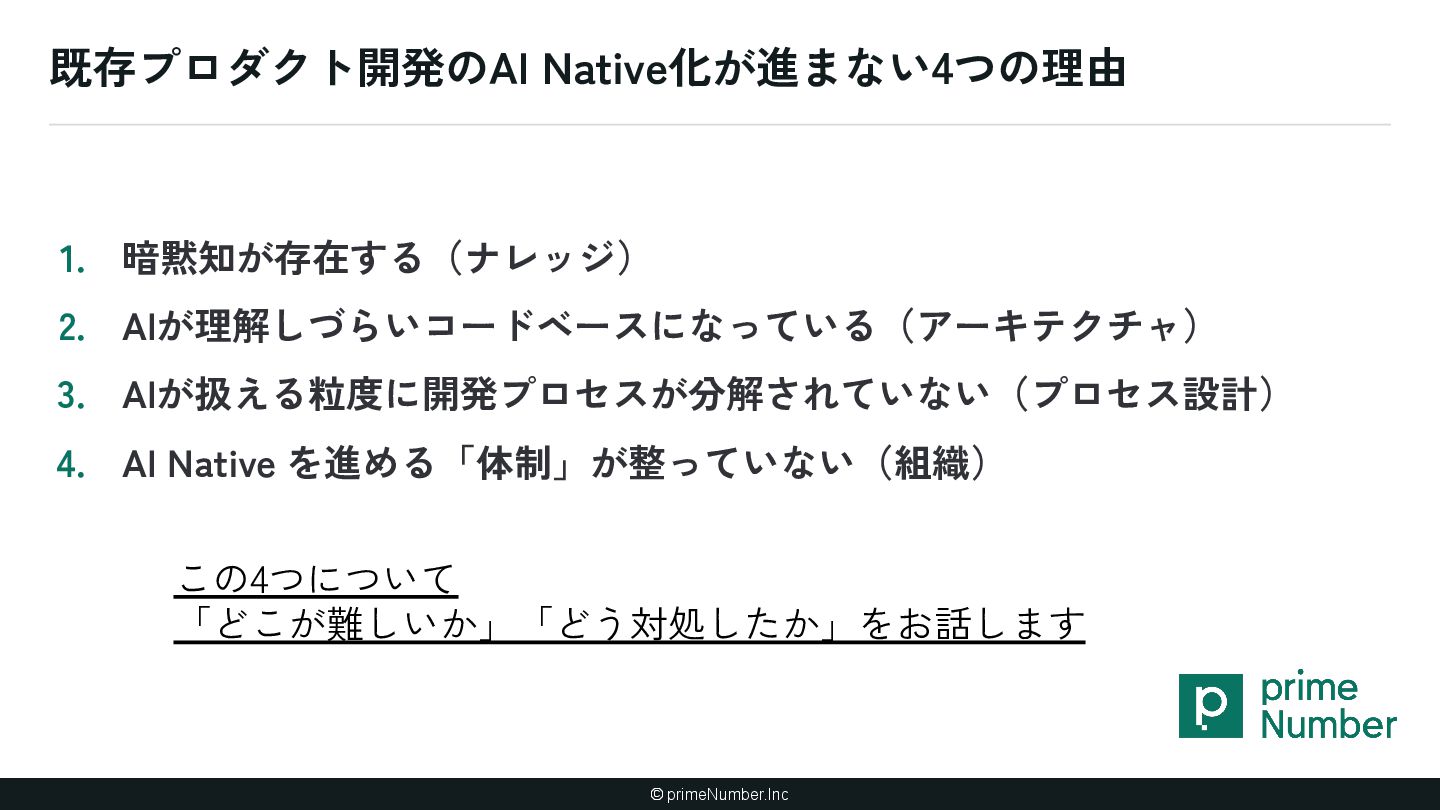
© primeNumber.Inc 1. 暗黙知が存在する(ナレッジ) 2. AIが理解しづらいコードベースになっている(アーキテクチャ) 3. AIが扱える粒度に開発プロセスが分解されていない(プロセス設計) 4. AI
Native を進める「体制」が整っていない(組織) 既存プロダクト開発のAI Native化が進まない4つの理由 この4つについて 「どこが難しいか」「どう対処したか」をお話します -
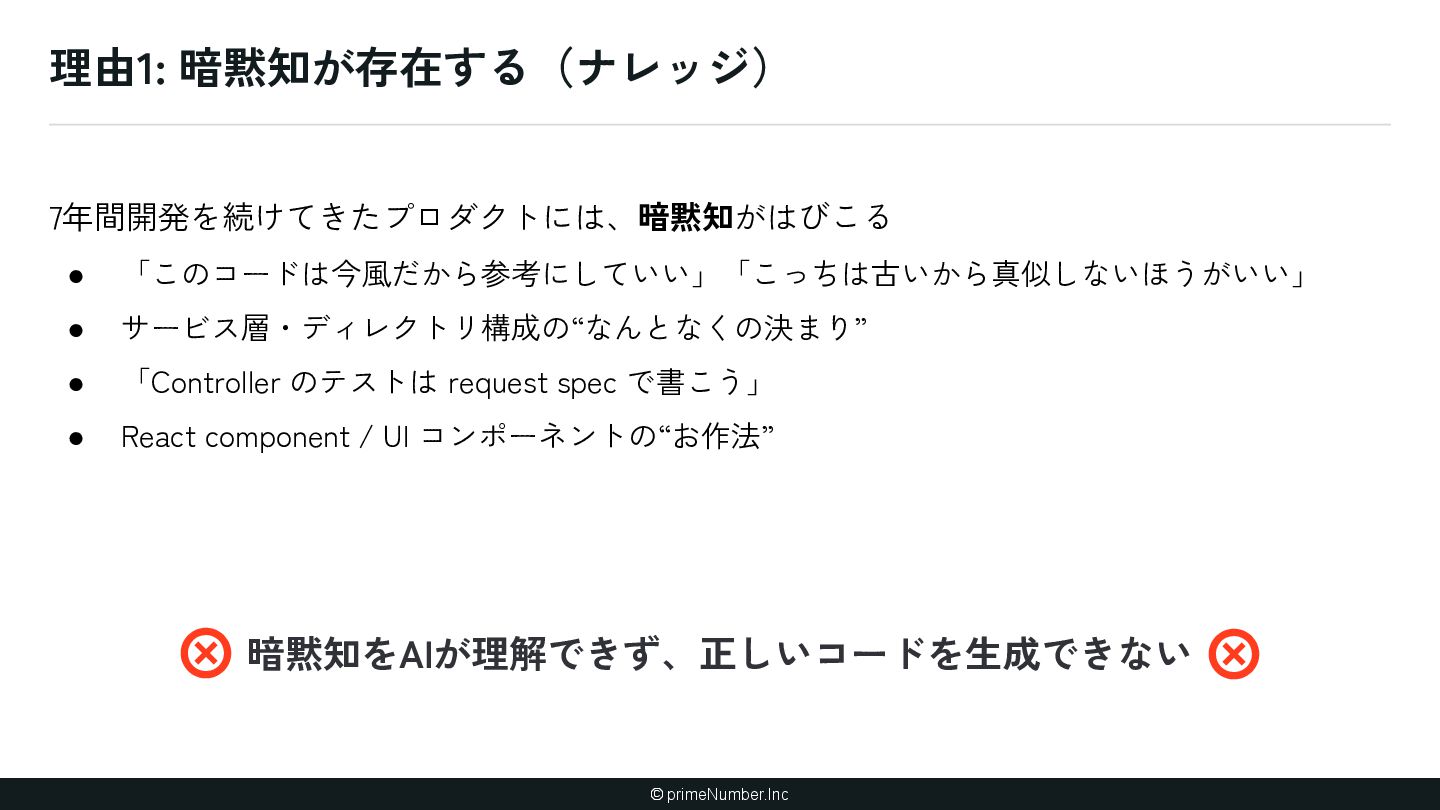
© primeNumber.Inc 7年間開発を続けてきたプロダクトには、暗黙知がはびこる • 「このコードは今風だから参考にしていい」「こっちは古いから真似しないほうがいい」 • サービス層・ディレクトリ構成の“なんとなくの決まり” • 「Controller のテストは
request spec で書こう」 • React component / UI コンポーネントの“お作法” 理由1: 暗黙知が存在する(ナレッジ) 暗黙知をAIが理解できず、正しいコードを生成できない -
© primeNumber.Inc ひたすら繰り返す 愚直にナレッジを増やす 地味だが、このフェーズを通らないと前に進まない 頑張った結果、 今ではナレッジ追加の頻度はかなり減った やったこと • AI
にコードを書かせる • おかしな参照や設計が出たら、CLAUDE.md をひたすら修正してナレッジを増やす -
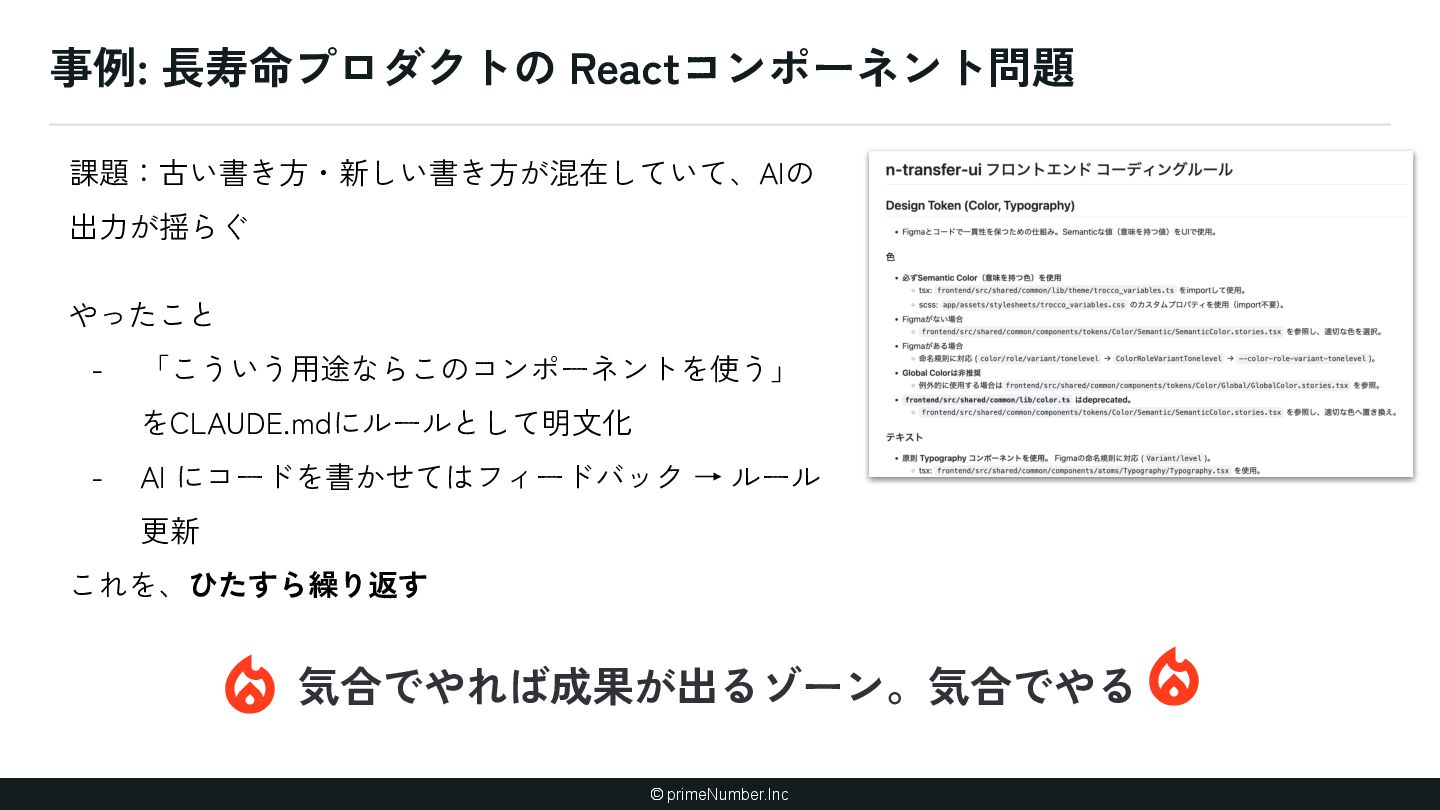
© primeNumber.Inc やったこと - 「こういう用途ならこのコンポーネントを使う」 をCLAUDE.mdにルールとして明文化 - AI にコードを書かせてはフィードバック →
ルール 更新 これを、ひたすら繰り返す 事例: 長寿命プロダクトの Reactコンポーネント問題 気合でやれば成果が出るゾーン。気合でやる 課題:古い書き方・新しい書き方が混在していて、AIの 出力が揺らぐ -
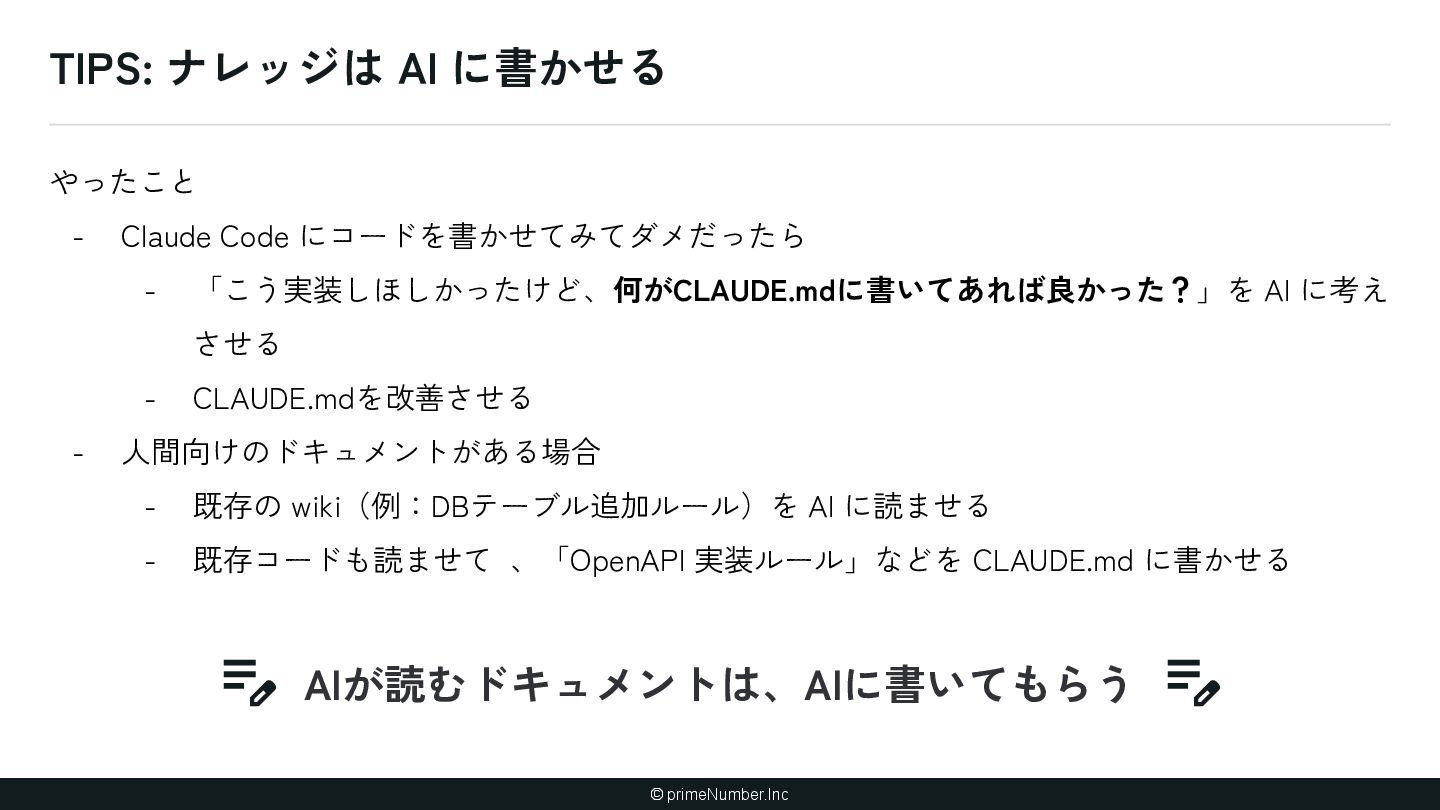
© primeNumber.Inc TIPS: ナレッジは AI に書かせる やったこと - Claude Code
にコードを書かせてみてダメだったら - 「こう実装しほしかったけど、何がCLAUDE.mdに書いてあれば良かった?」を AI に考え させる - CLAUDE.mdを改善させる - 人間向けのドキュメントがある場合 - 既存の wiki(例:DBテーブル追加ルール)を AI に読ませる - 既存コードも読ませて 、「OpenAPI 実装ルール」などを CLAUDE.md に書かせる AIが読むドキュメントは、AIに書いてもらう -
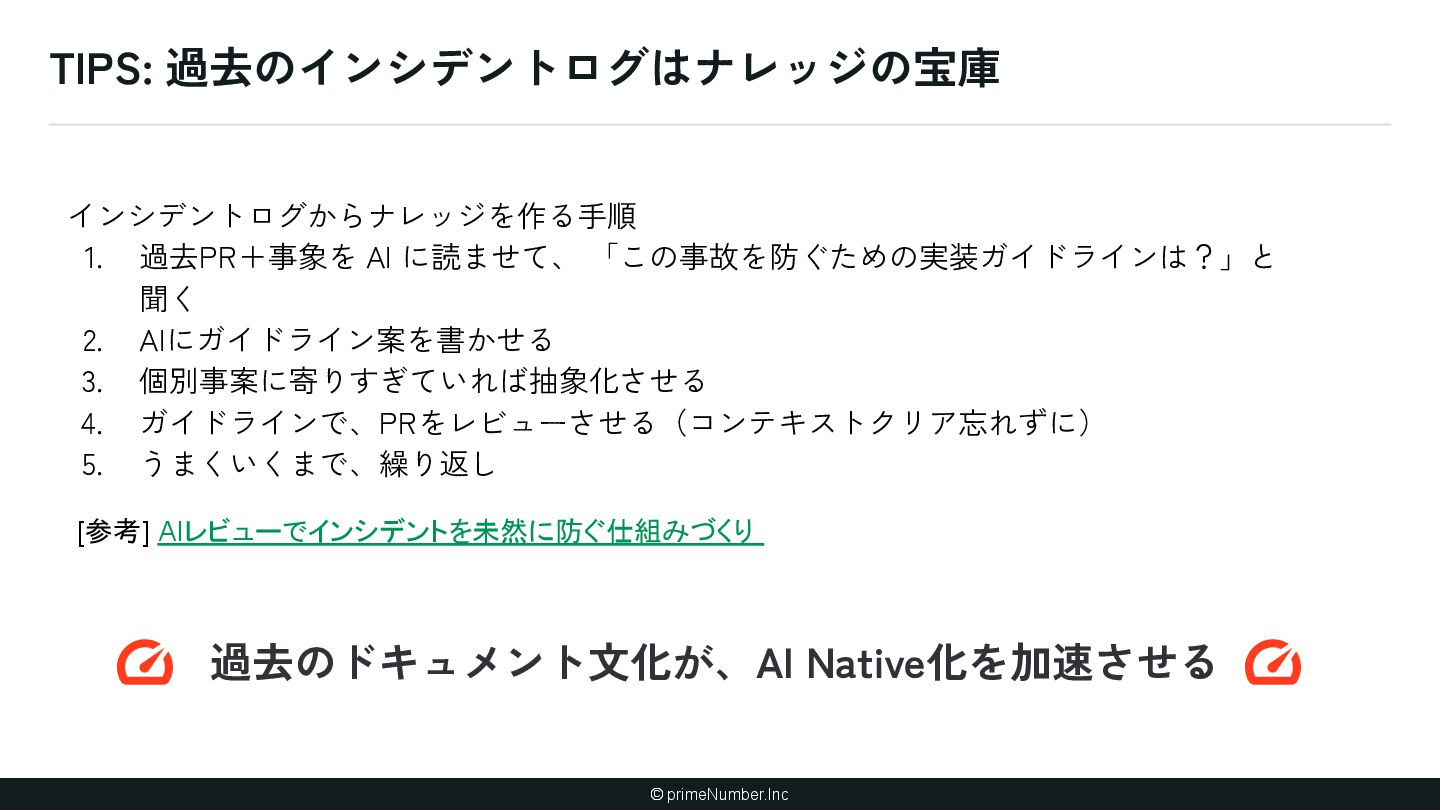
© primeNumber.Inc TIPS: 過去のインシデントログはナレッジの宝庫 インシデントログからナレッジを作る手順 1. 過去PR+事象を AI に読ませて、 「この事故を防ぐための実装ガイドラインは?」と
聞く 2. AIにガイドライン案を書かせる 3. 個別事案に寄りすぎていれば抽象化させる 4. ガイドラインで、PRをレビューさせる(コンテキストクリア忘れずに) 5. うまくいくまで、繰り返し [参考] AIレビューでインシデントを未然に防ぐ仕組みづくり 過去のドキュメント文化が、AI Native化を加速させる -
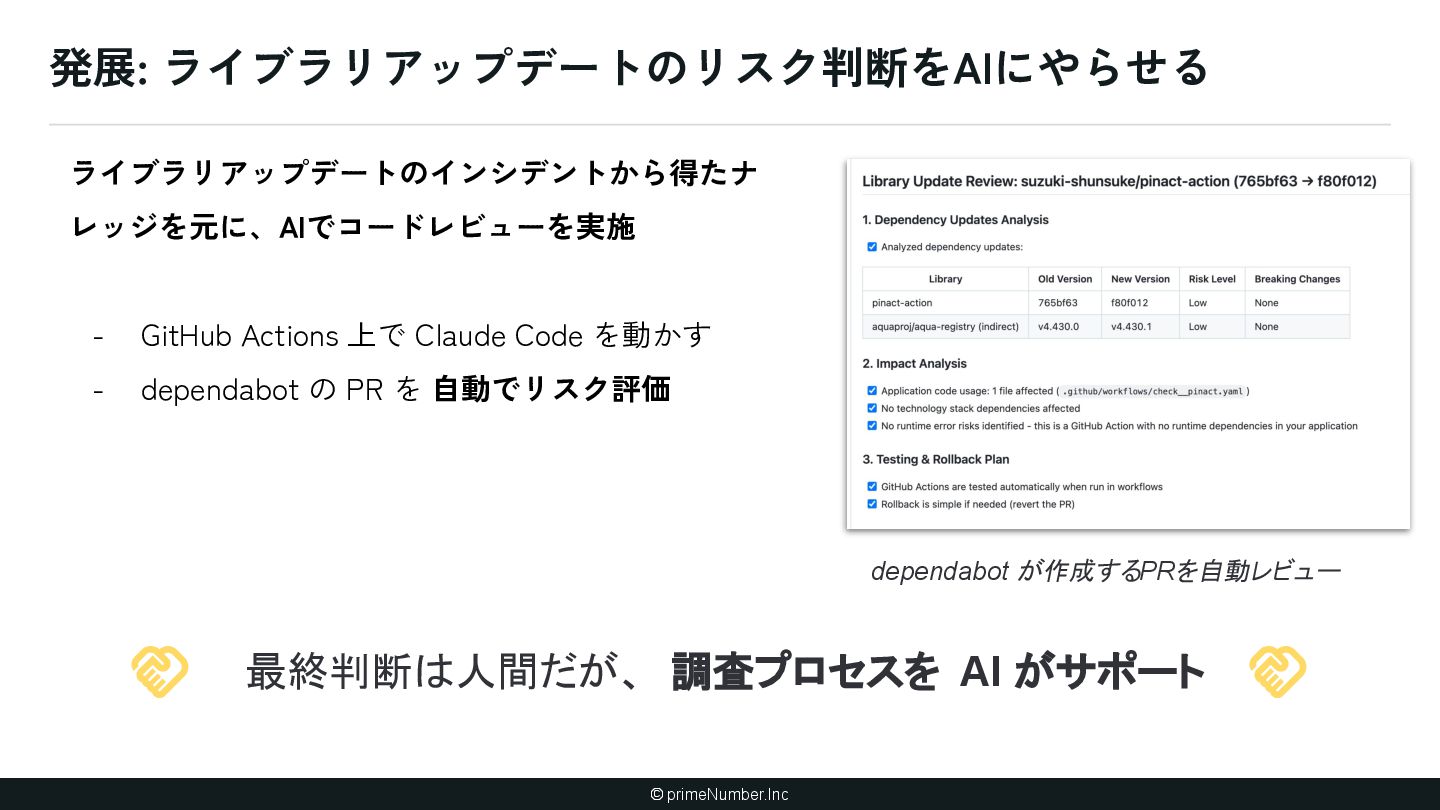
© primeNumber.Inc 発展: ライブラリアップデートのリスク判断をAIにやらせる ライブラリアップデートのインシデントから得たナ レッジを元に、AIでコードレビューを実施 - GitHub Actions 上で
Claude Code を動かす - dependabot の PR を 自動でリスク評価 最終判断は人間だが、 調査プロセスを AI がサポート dependabot が作成するPRを自動レビュー -
© primeNumber.Inc 具体的にやったこと(例): • ReactのComponent名・prop名をAIが誤解しない名前にリネーム AI に合わせてコードベースを変える と言っても、 現実的にはコードベースを抜本的に変えられないので、できるところからやる AIが間違えにくい設計が重要
= 余計なコンテキストを渡さなくて良い ※Rubyにおいても、全てのコードにAIを活用して型をつけるプロジェクトが進行中(まもなく完遂) 型がある領域(TypeScript)は変更しやすいので、AIに合わせやすい -
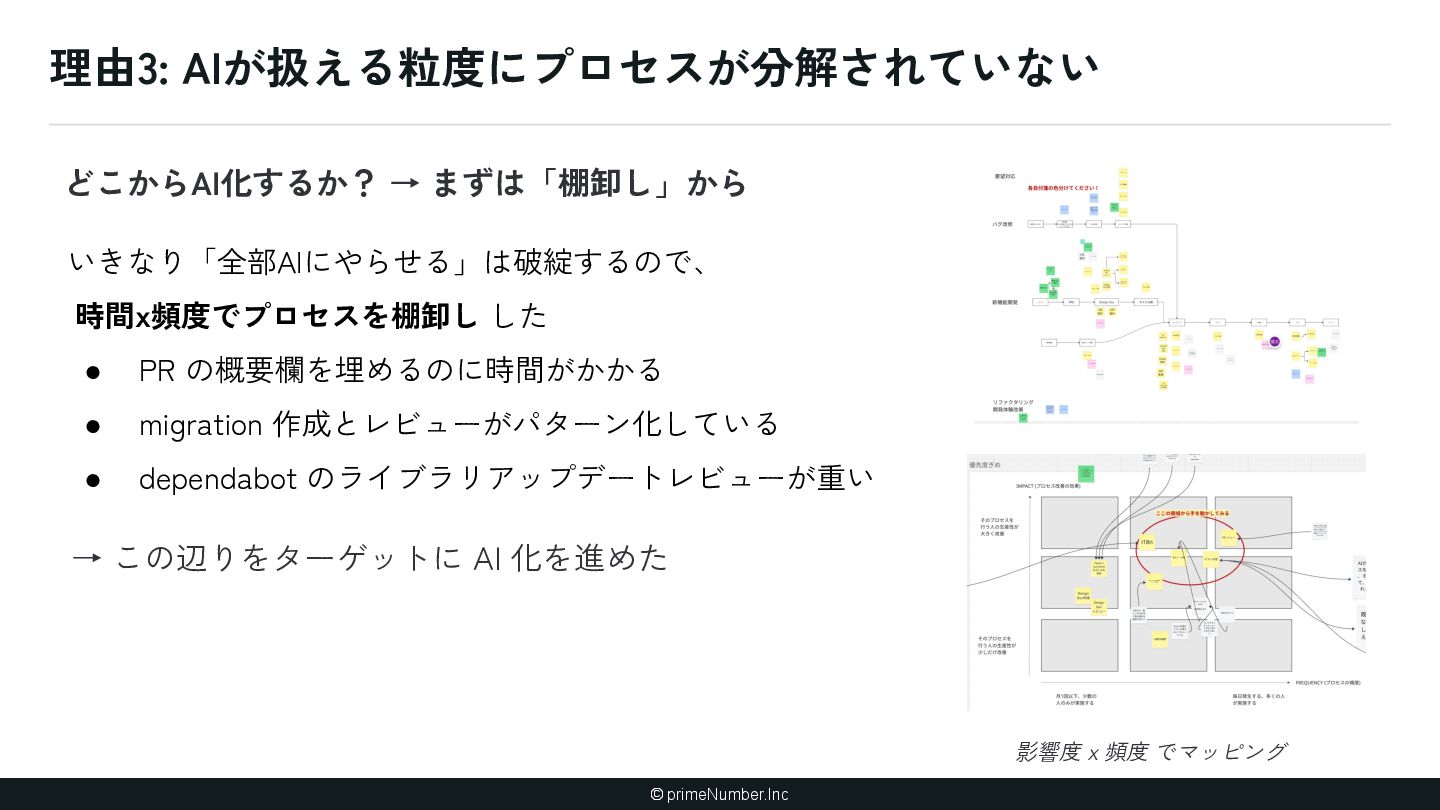
© primeNumber.Inc いきなり「全部AIにやらせる」は破綻するので、 時間x頻度でプロセスを棚卸し した • PR の概要欄を埋めるのに時間がかかる • migration
作成とレビューがパターン化している • dependabot のライブラリアップデートレビューが重い 理由3: AIが扱える粒度にプロセスが分解されていない どこからAI化するか? → まずは「棚卸し」から → この辺りをターゲットに AI 化を進めた 影響度 x 頻度 でマッピング -
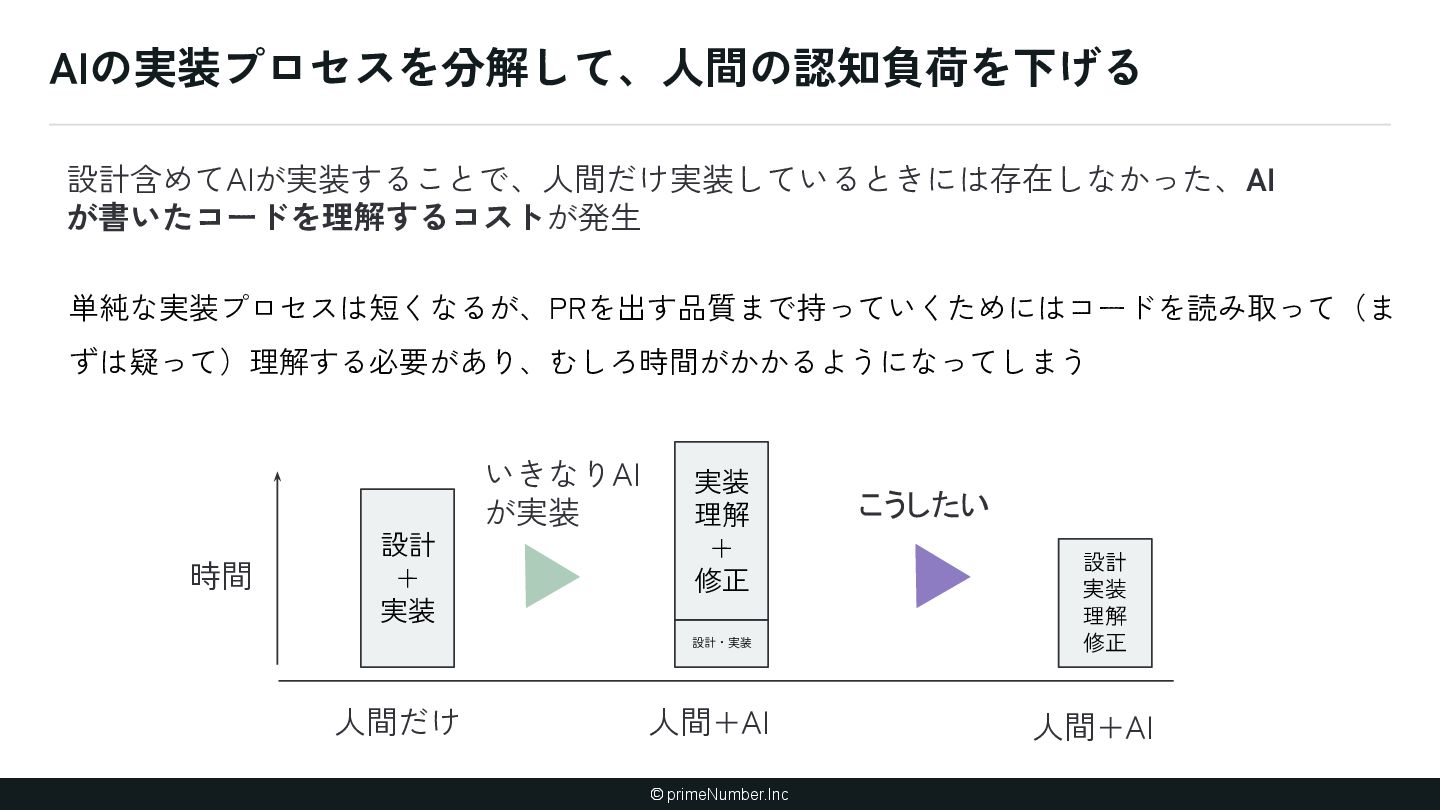
© primeNumber.Inc 単純な実装プロセスは短くなるが、PRを出す品質まで持っていくためにはコードを読み取って(ま ずは疑って)理解する必要があり、むしろ時間がかかるようになってしまう AIの実装プロセスを分解して、人間の認知負荷を下げる 設計含めてAIが実装することで、人間だけ実装しているときには存在しなかった、AI が書いたコードを理解するコストが発生 設計 + 実装
時間 設計・実装 人間だけ 人間+AI 実装 理解 + 修正 設計 実装 理解 修正 人間+AI こうしたい いきなりAI が実装 -
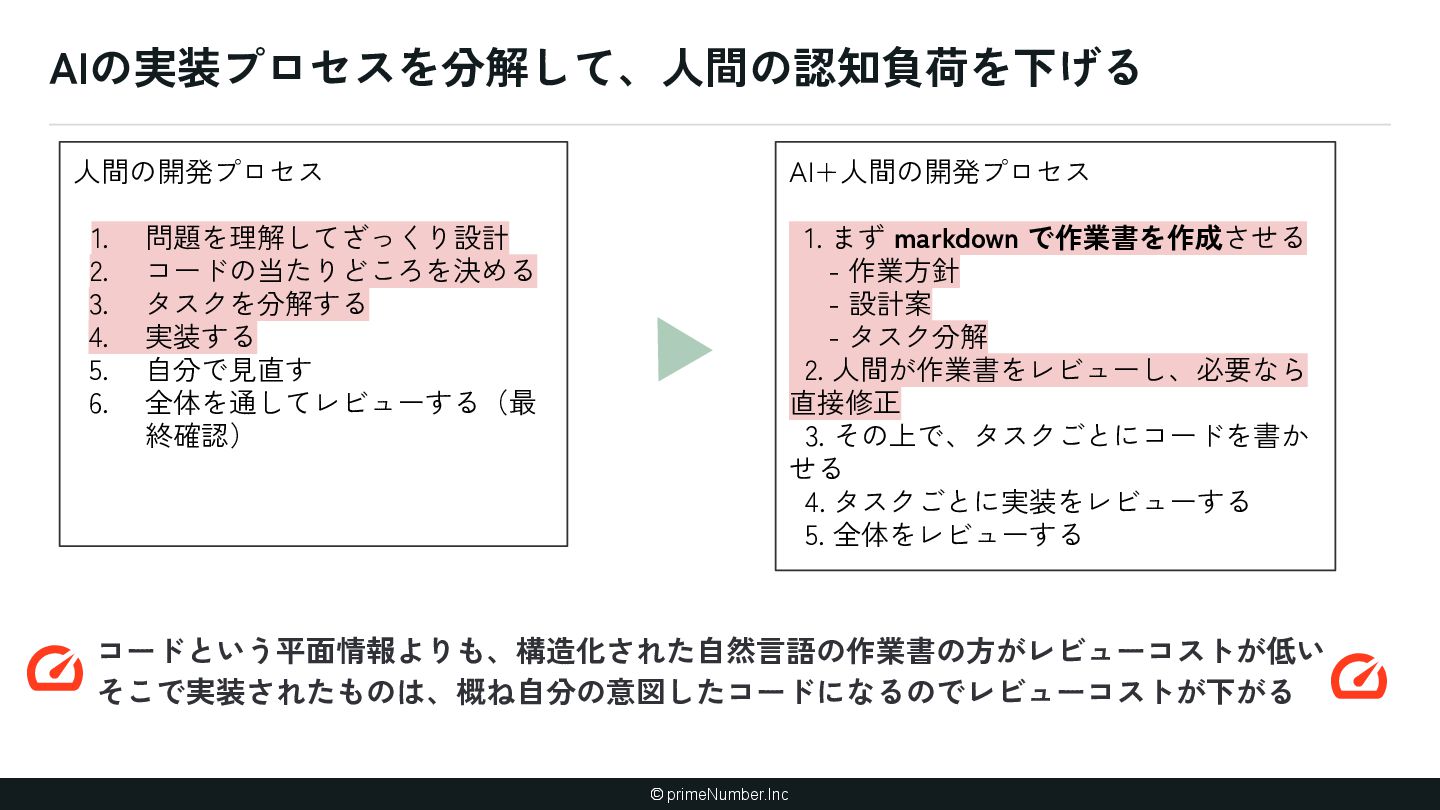
© primeNumber.Inc AIの実装プロセスを分解して、人間の認知負荷を下げる 人間の開発プロセス 1. 問題を理解してざっくり設計 2. コードの当たりどころを決める 3. タスクを分解する
4. 実装する 5. 自分で見直す 6. 全体を通してレビューする(最 終確認) AI+人間の開発プロセス 1. まず markdown で作業書を作成させる - 作業方針 - 設計案 - タスク分解 2. 人間が作業書をレビューし、必要なら 直接修正 3. その上で、タスクごとにコードを書か せる 4. タスクごとに実装をレビューする 5. 全体をレビューする コードという平面情報よりも、構造化された自然言語の作業書の方がレビューコストが低い そこで実装されたものは、概ね自分の意図したコードになるのでレビューコストが下がる -
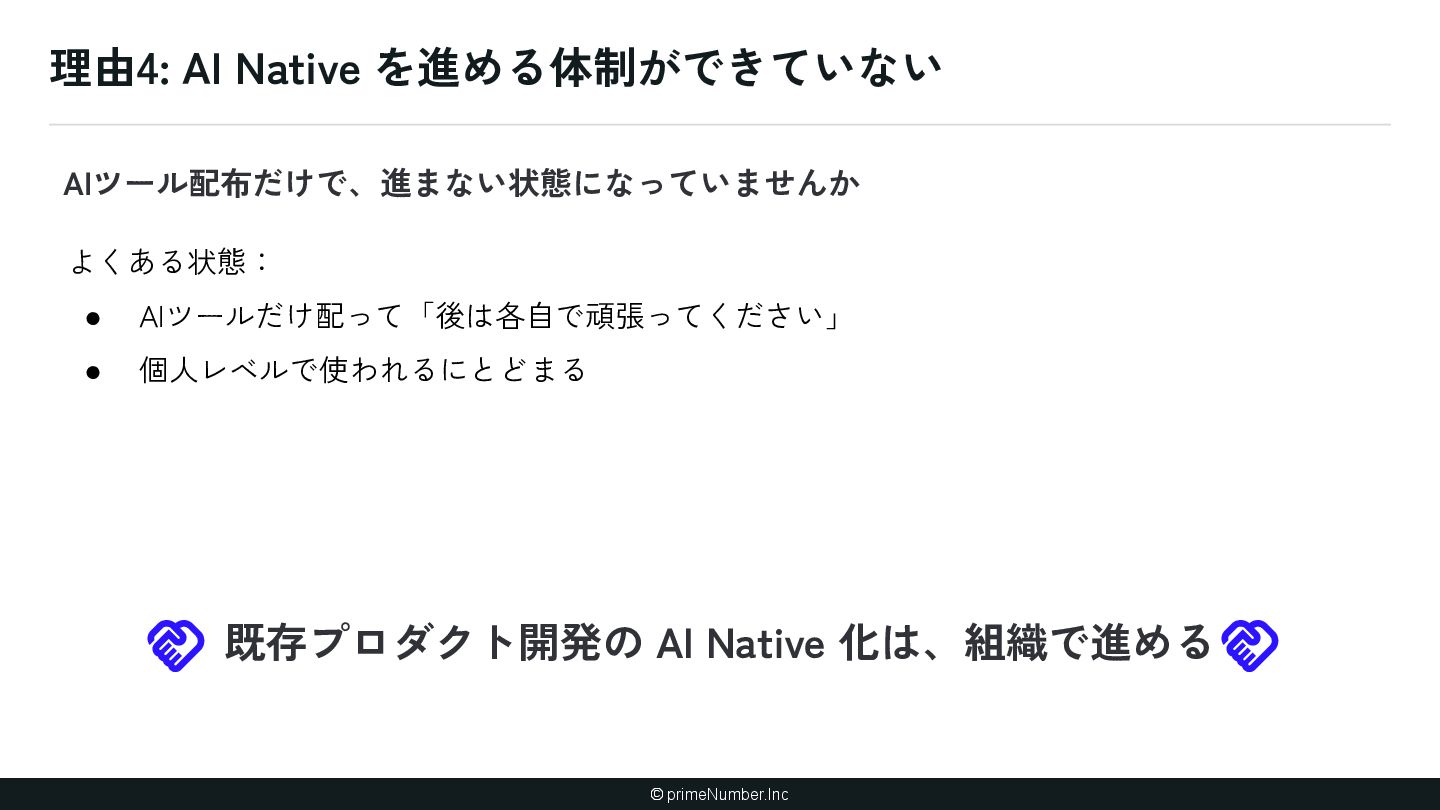
© primeNumber.Inc よくある状態: • AIツールだけ配って「後は各自で頑張ってください」 • 個人レベルで使われるにとどまる 理由4: AI Native
を進める体制ができていない AIツール配布だけで、進まない状態になっていませんか 既存プロダクト開発の AI Native 化は、組織で進める -
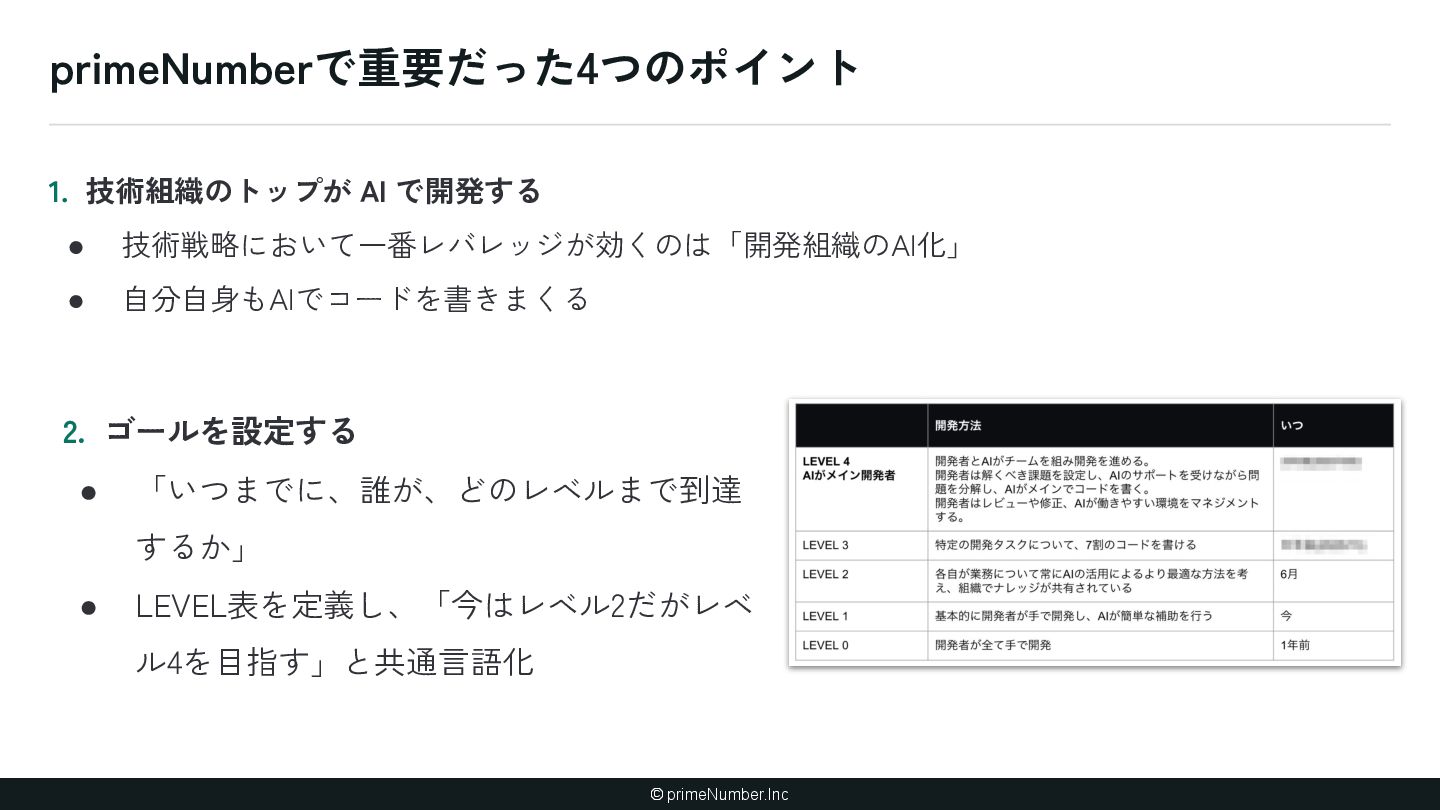
© primeNumber.Inc 1. 技術組織のトップが AI で開発する • 技術戦略において一番レバレッジが効くのは「開発組織のAI化」 • 自分自身もAIでコードを書きまくる
primeNumberで重要だった4つのポイント 2. ゴールを設定する • 「いつまでに、誰が、どのレベルまで到達 するか」 • LEVEL表を定義し、「今はレベル2だがレベ ル4を目指す」と共通言語化 -
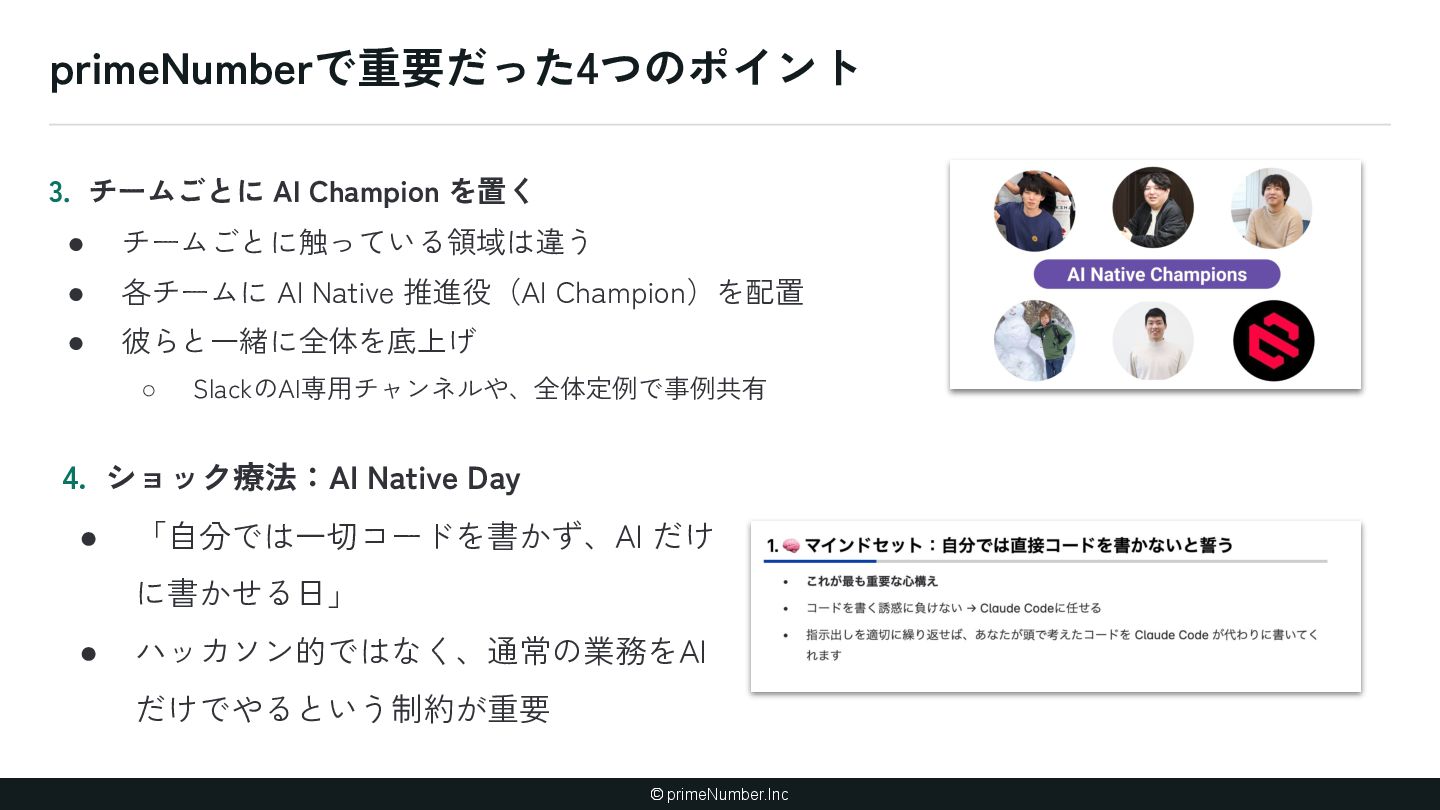
© primeNumber.Inc 3. チームごとに AI Champion を置く • チームごとに触っている領域は違う •
各チームに AI Native 推進役(AI Champion)を配置 • 彼らと一緒に全体を底上げ ◦ SlackのAI専用チャンネルや、全体定例で事例共有 primeNumberで重要だった4つのポイント 4. ショック療法:AI Native Day • 「自分では一切コードを書かず、AI だけ に書かせる日」 • ハッカソン的ではなく、通常の業務をAI だけでやるという制約が重要 -
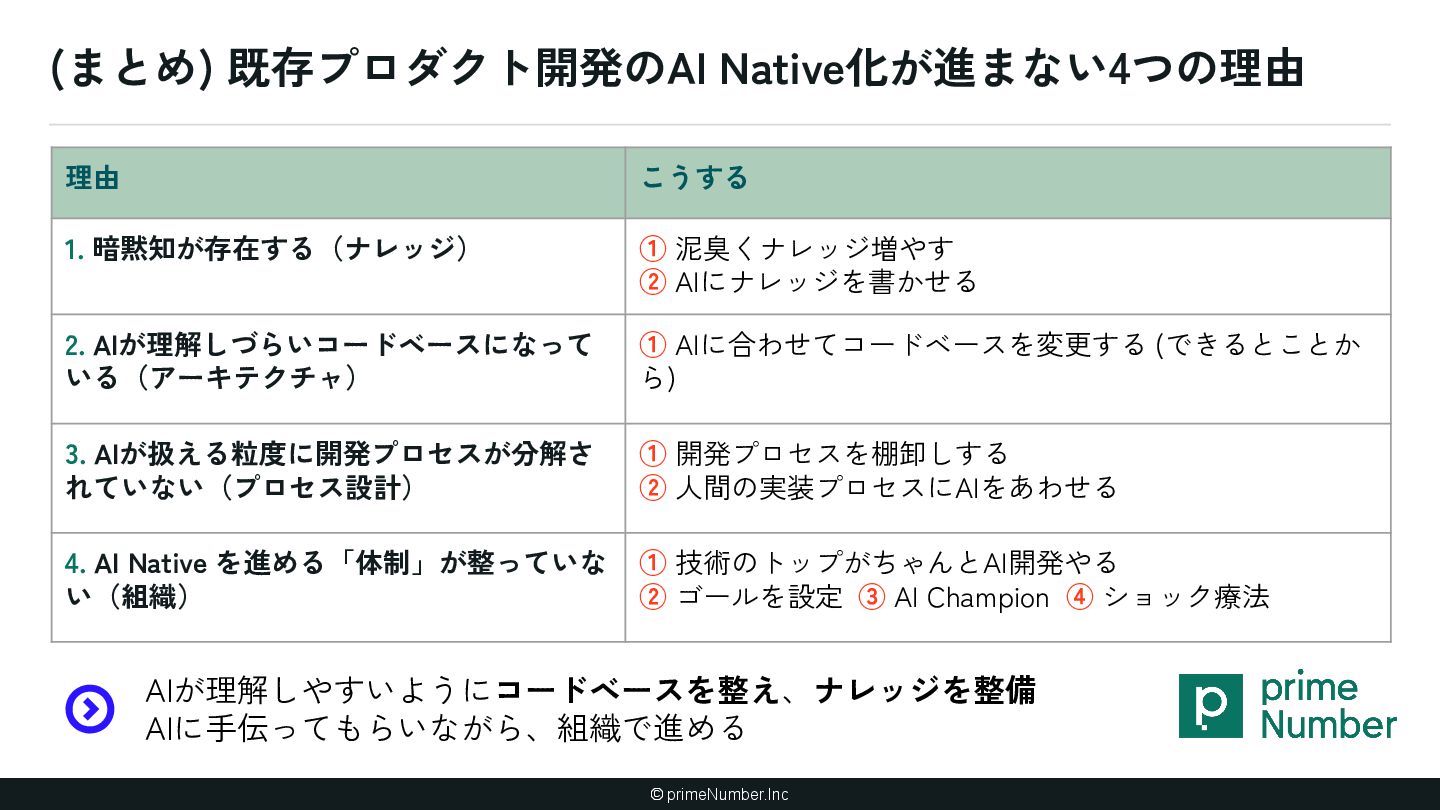
© primeNumber.Inc (まとめ) 既存プロダクト開発のAI Native化が進まない4つの理由 AIが理解しやすいようにコードベースを整え、ナレッジを整備 AIに手伝ってもらいながら、組織で進める 理由 こうする 1.
暗黙知が存在する(ナレッジ) ① 泥臭くナレッジ増やす ② AIにナレッジを書かせる 2. AIが理解しづらいコードベースになって いる(アーキテクチャ) ① AIに合わせてコードベースを変更する (できるとことか ら) 3. AIが扱える粒度に開発プロセスが分解さ れていない(プロセス設計) ① 開発プロセスを棚卸しする ② 人間の実装プロセスにAIをあわせる 4. AI Native を進める「体制」が整っていな い(組織) ① 技術のトップがちゃんとAI開発やる ② ゴールを設定 ③ AI Champion ④ ショック療法 -
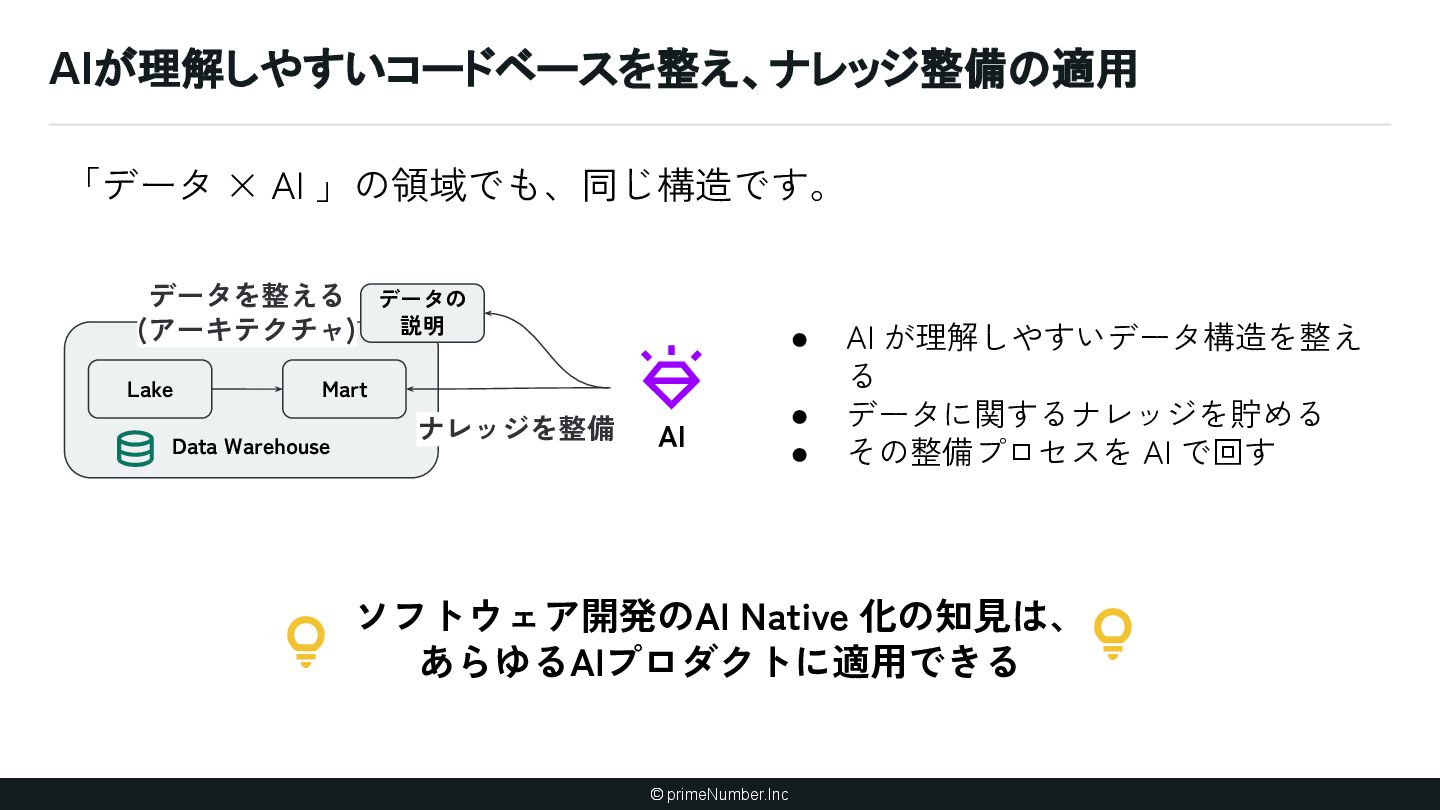
© primeNumber.Inc AIが理解しやすいコードベースを整え、ナレッジ整備の適用 ソフトウェア開発のAI Native 化の知見は、 あらゆるAIプロダクトに適用できる • AI が理解しやすいデータ構造を整え
る • データに関するナレッジを貯める • その整備プロセスを AI で回す 「データ × AI 」の領域でも、同じ構造です。 Data Warehouse Lake Mart データの 説明 ナレッジを整備 データを整える (アーキテクチャ) AI -
27 naotaka nakane (@gtnao) primeNumber inc. Head of CTO Office
• 2018/11 primeNumberにジョイン • TROCCOの開発に7年間従事 • アーキテクチャカンファレンス2024登壇 ◦ 「PaaSとSaaSの境目で信頼性と開発 速度を両立する 〜TROCCO®のこれま でとこれから〜」 • 2025/08より新規Webサービスの開発中 -
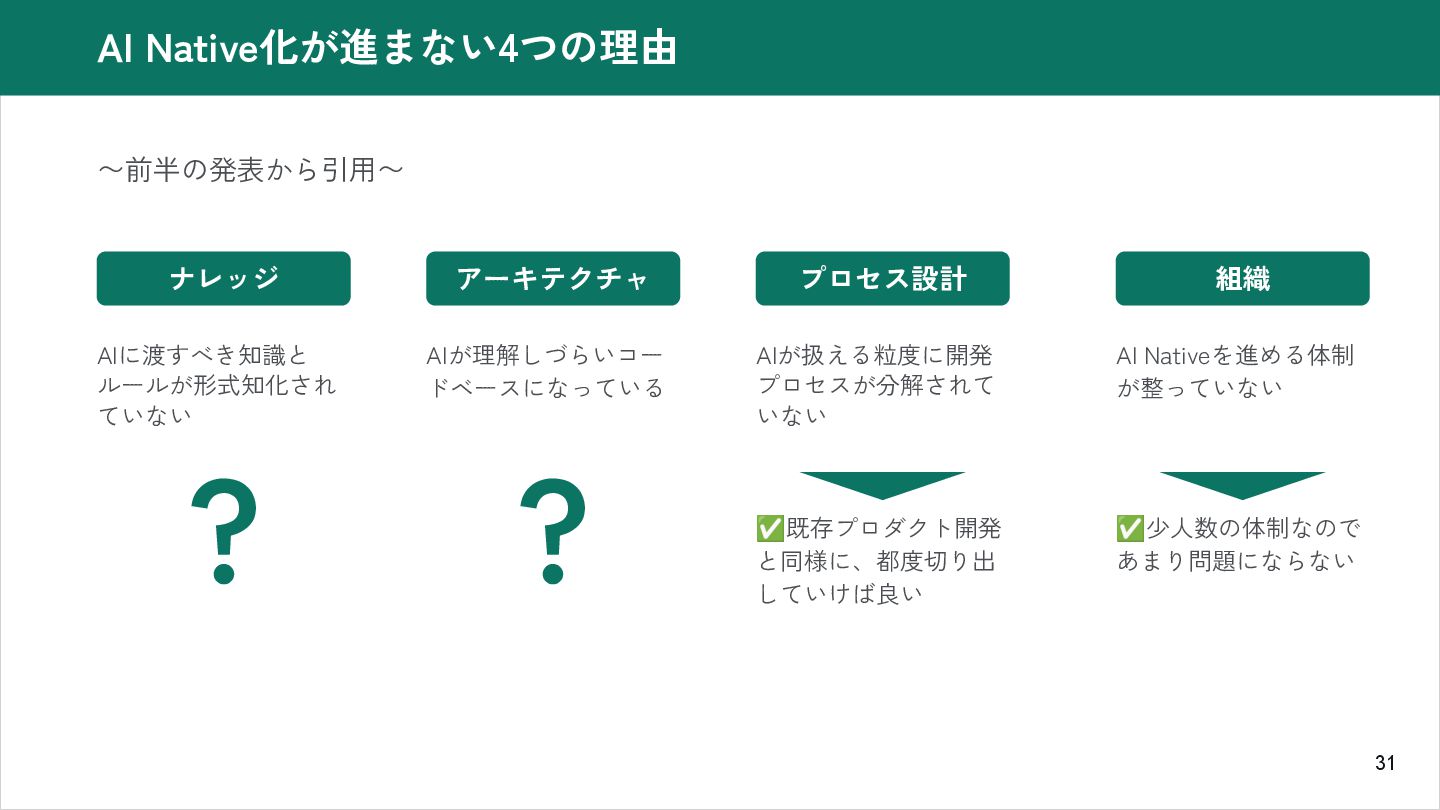
31 AI Native化が進まない4つの理由 ナレッジ アーキテクチャ プロセス設計 組織 AIに渡すべき知識と ルールが形式知化され ていない
AIが理解しづらいコー ドベースになっている AIが扱える粒度に開発 プロセスが分解されて いない AI Nativeを進める体制 が整っていない ✅既存プロダクト開発 と同様に、都度切り出 していけば良い ✅少人数の体制なので あまり問題にならない ? ? 〜前半の発表から引用〜 -
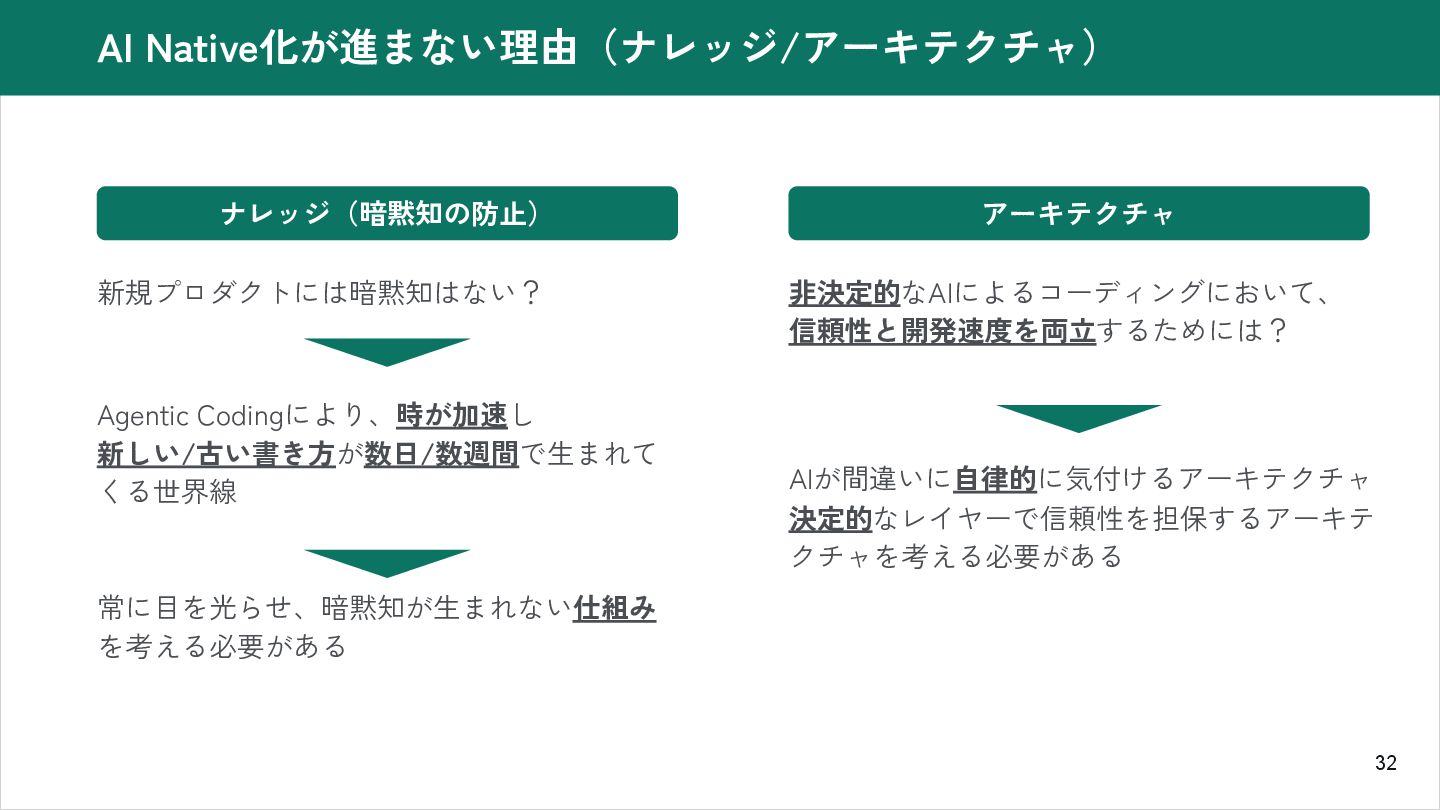
32 AI Native化が進まない理由(ナレッジ/アーキテクチャ) ナレッジ(暗黙知の防止) アーキテクチャ 非決定的なAIによるコーディングにおいて、 信頼性と開発速度を両立するためには? 新規プロダクトには暗黙知はない? Agentic Codingにより、時が加速し
新しい/古い書き方が数日/数週間で生まれて くる世界線 常に目を光らせ、暗黙知が生まれない仕組み を考える必要がある AIが間違いに自律的に気付けるアーキテクチャ 決定的なレイヤーで信頼性を担保するアーキテ クチャを考える必要がある -
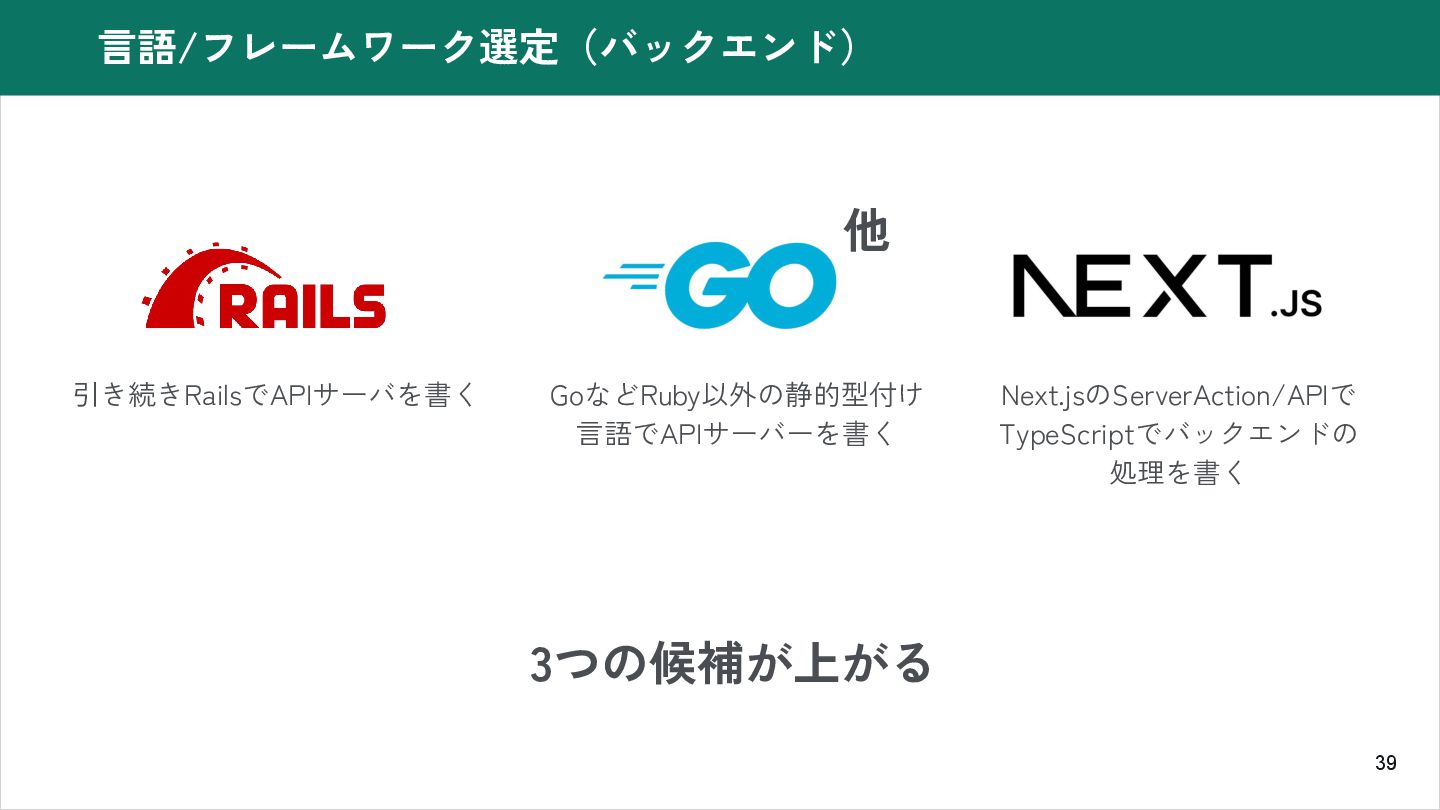
35 TROCCOの技術スタックおさらい(バックエンド) • 2018年当時在籍のエンジニアの得意な技術スタック • ゼロイチで新規サービスを速度重視で開発するなら、 Railsは当時第一候補の一つだったと思う • バックエンド実装で静的型付けが無いのはやはり辛い ◦
開発に携わる人数増 ◦ Agentic Codingの台頭で顕著に -
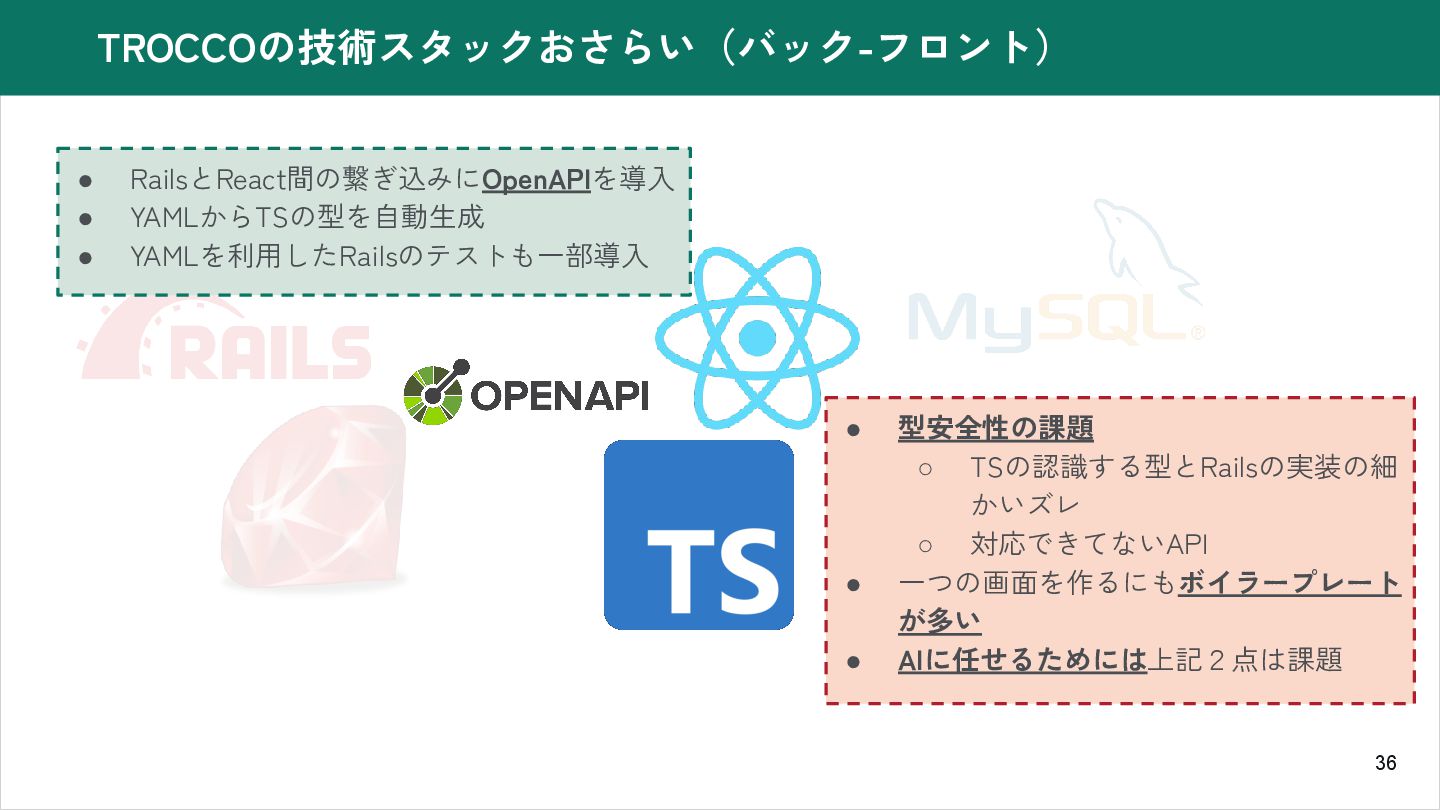
36 TROCCOの技術スタックおさらい(バック-フロント) • RailsとReact間の繋ぎ込みにOpenAPIを導入 • YAMLからTSの型を自動生成 • YAMLを利用したRailsのテストも一部導入 • 型安全性の課題
◦ TSの認識する型とRailsの実装の細 かいズレ ◦ 対応できてないAPI • 一つの画面を作るにもボイラープレート が多い • AIに任せるためには上記2点は課題 -
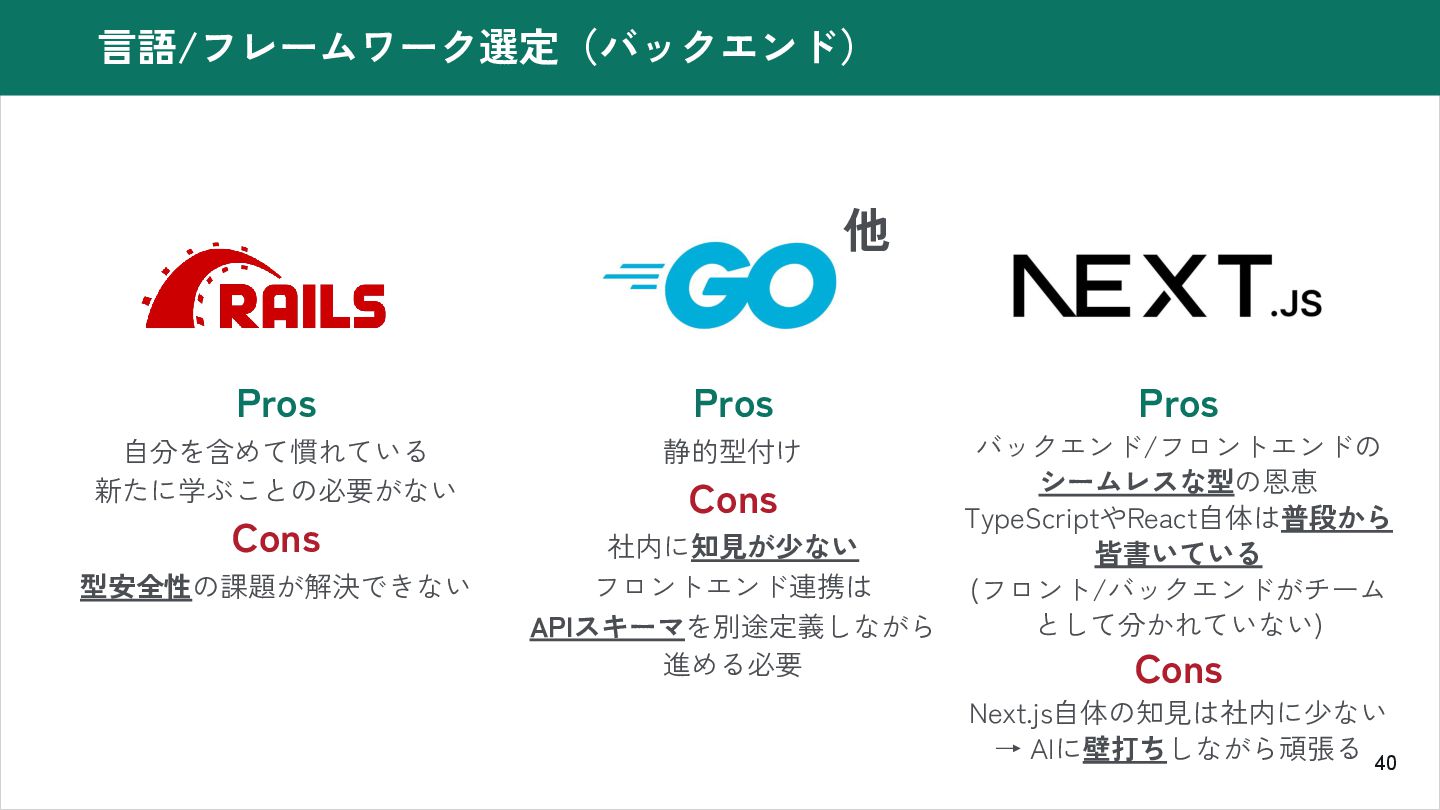
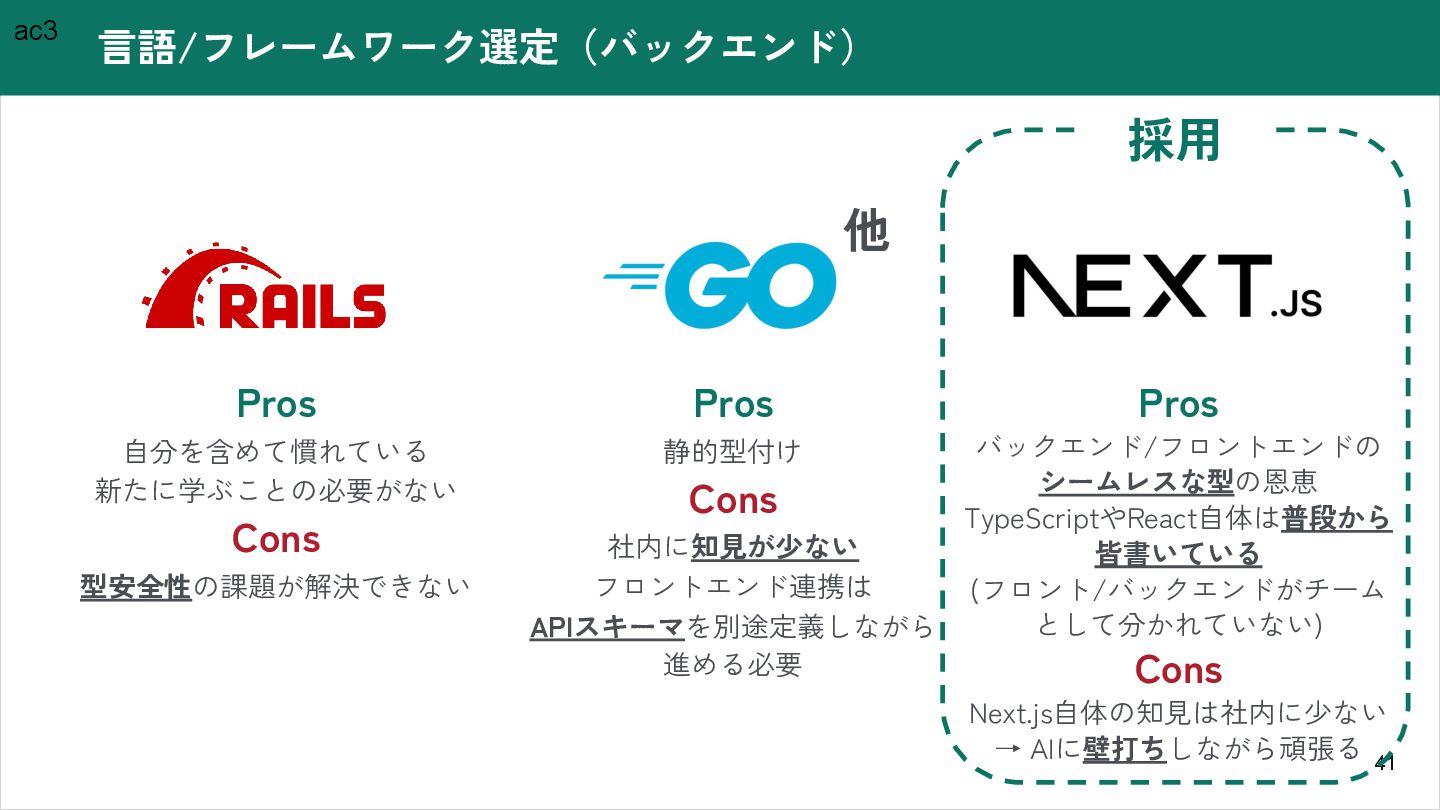
40 言語/フレームワーク選定(バックエンド) Pros 自分を含めて慣れている 新たに学ぶことの必要がない Cons 型安全性の課題が解決できない 他 Pros 静的型付け
Cons 社内に知見が少ない フロントエンド連携は APIスキーマを別途定義しながら 進める必要 Pros バックエンド/フロントエンドの シームレスな型の恩恵 TypeScriptやReact自体は普段から 皆書いている (フロント/バックエンドがチーム として分かれていない) Cons Next.js自体の知見は社内に少ない → AIに壁打ちしながら頑張る -
41 言語/フレームワーク選定(バックエンド) Pros 自分を含めて慣れている 新たに学ぶことの必要がない Cons 型安全性の課題が解決できない 他 Pros 静的型付け
Cons 社内に知見が少ない フロントエンド連携は APIスキーマを別途定義しながら 進める必要 Pros バックエンド/フロントエンドの シームレスな型の恩恵 TypeScriptやReact自体は普段から 皆書いている (フロント/バックエンドがチーム として分かれていない) Cons Next.js自体の知見は社内に少ない → AIに壁打ちしながら頑張る 採用 ac3 -
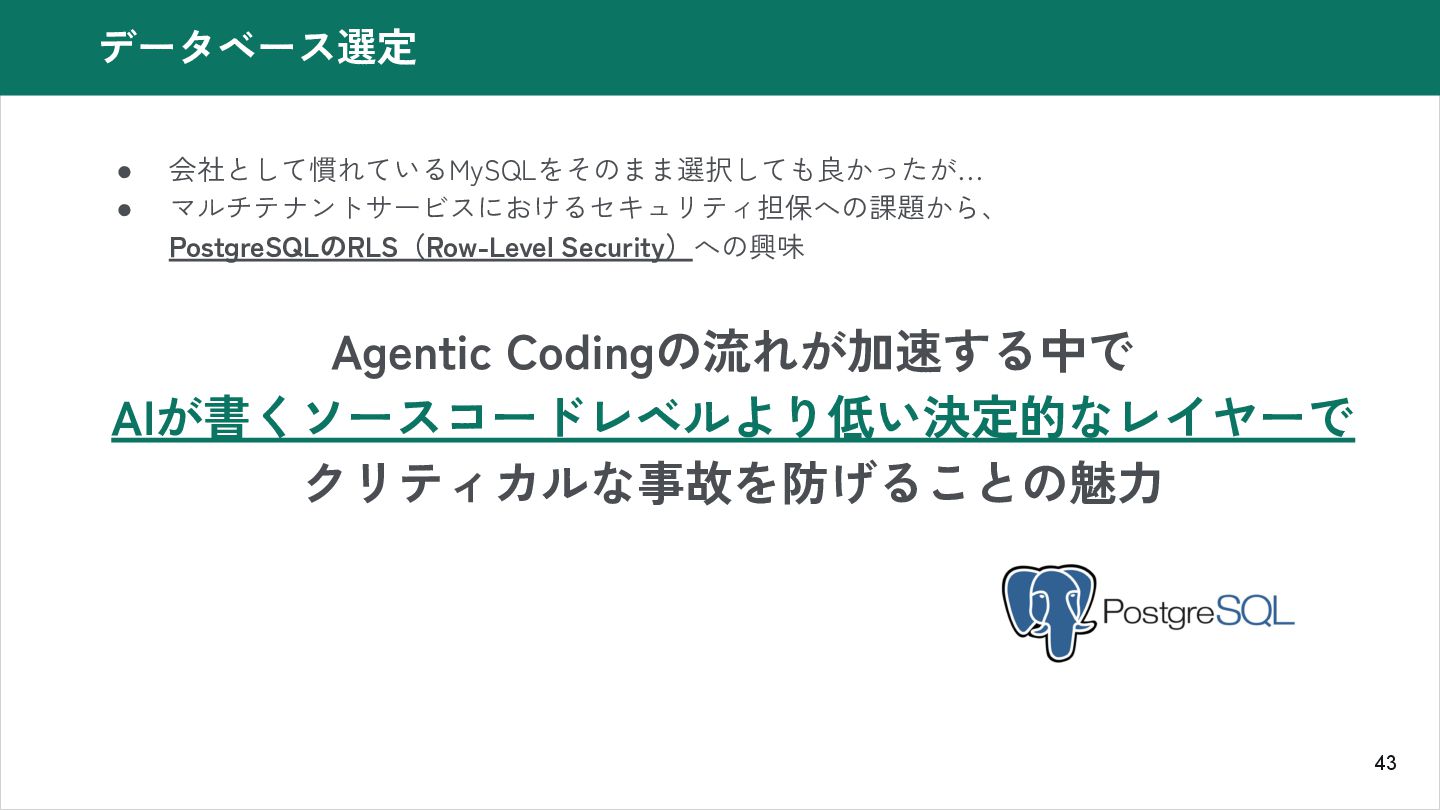
43 データベース選定 • 会社として慣れているMySQLをそのまま選択しても良かったが… • マルチテナントサービスにおけるセキュリティ担保への課題から、 PostgreSQLのRLS(Row-Level Security)への興味 Agentic Codingの流れが加速する中で
AIが書くソースコードレベルより低い決定的なレイヤーで クリティカルな事故を防げることの魅力 -
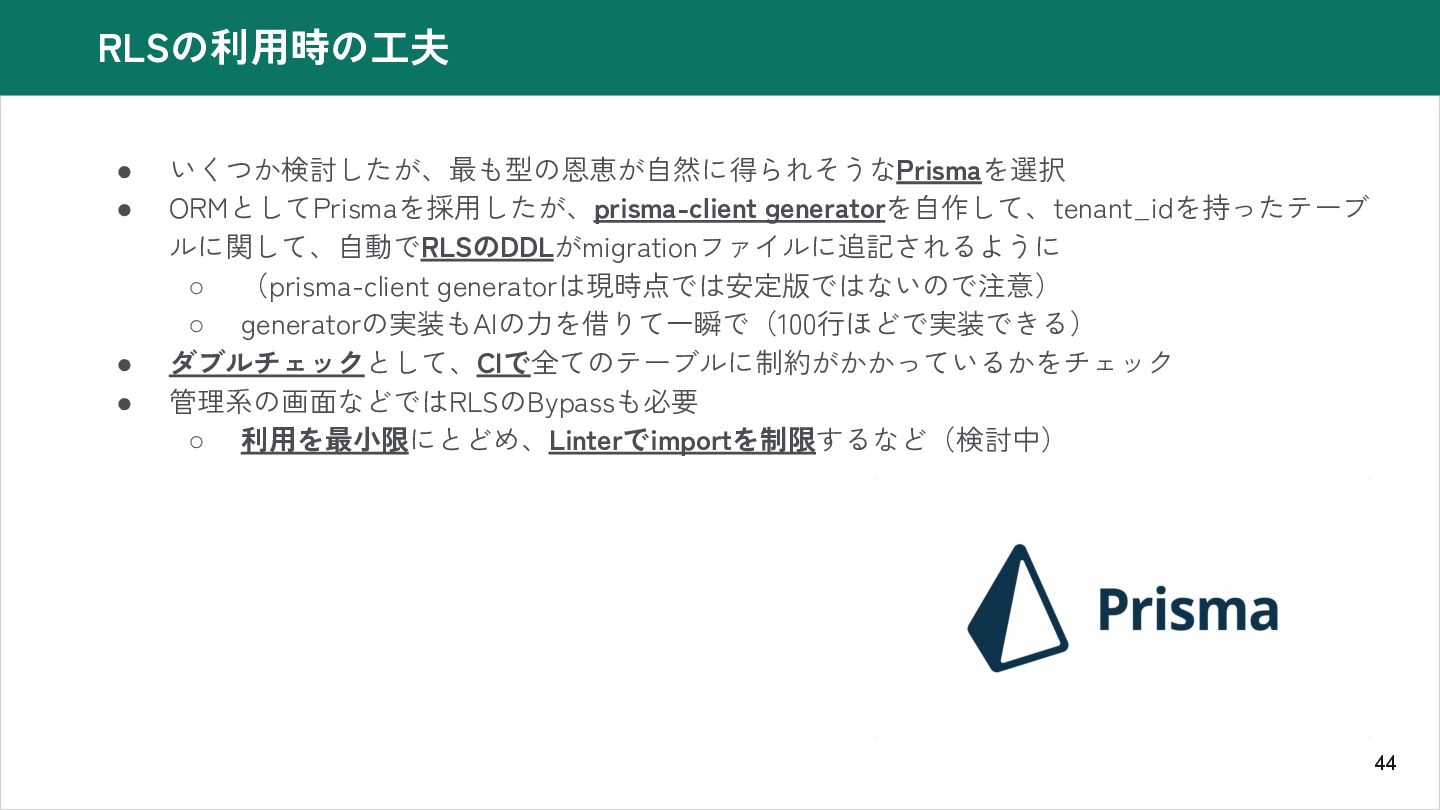
44 RLSの利用時の工夫 • いくつか検討したが、最も型の恩恵が自然に得られそうなPrismaを選択 • ORMとしてPrismaを採用したが、prisma-client generatorを自作して、tenant_idを持ったテーブ ルに関して、自動でRLSのDDLがmigrationファイルに追記されるように ◦ (prisma-client
generatorは現時点では安定版ではないので注意) ◦ generatorの実装もAIの力を借りて一瞬で(100行ほどで実装できる) • ダブルチェックとして、CIで全てのテーブルに制約がかかっているかをチェック • 管理系の画面などではRLSのBypassも必要 ◦ 利用を最小限にとどめ、Linterでimportを制限するなど(検討中) -
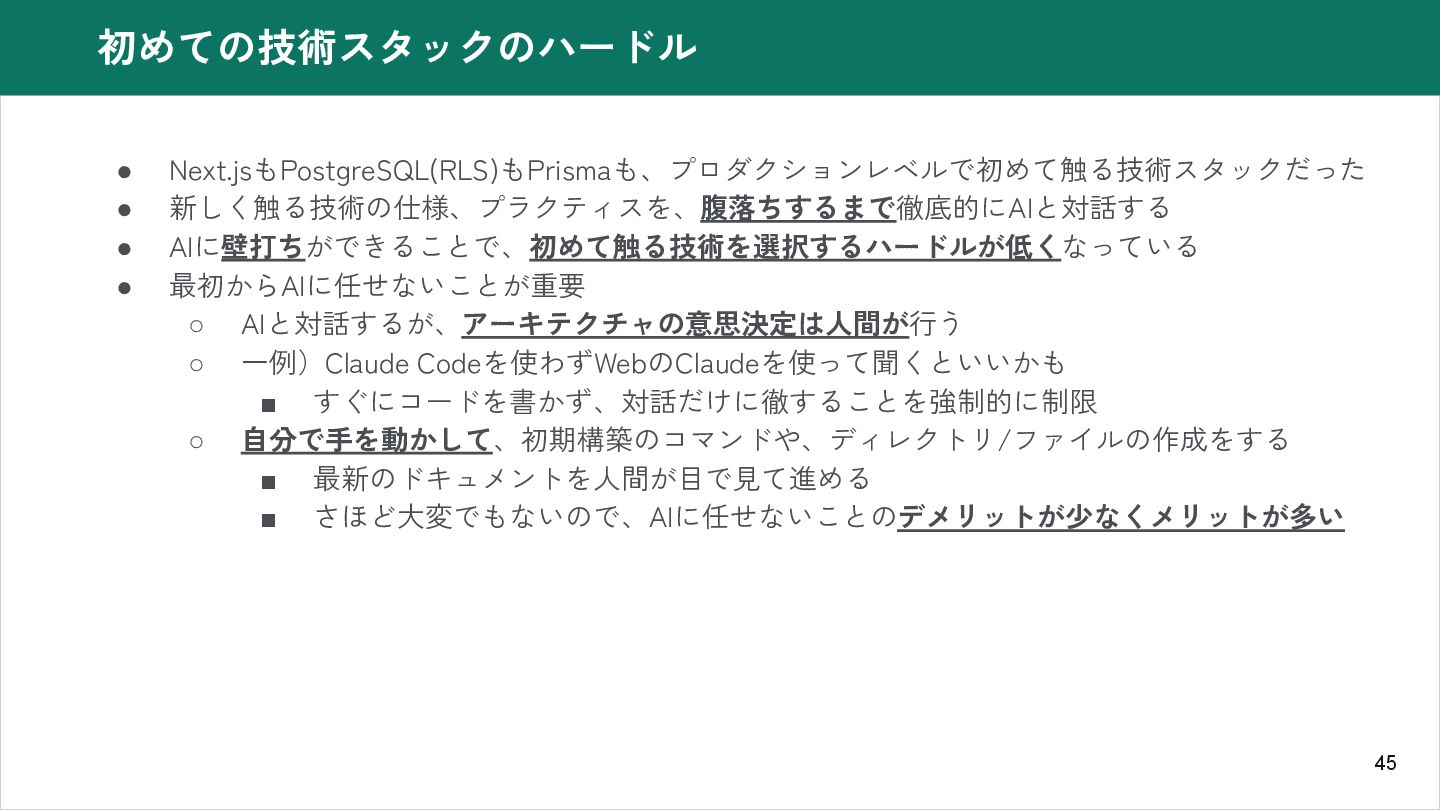
45 初めての技術スタックのハードル • Next.jsもPostgreSQL(RLS)もPrismaも、プロダクションレベルで初めて触る技術スタックだった • 新しく触る技術の仕様、プラクティスを、腹落ちするまで徹底的にAIと対話する • AIに壁打ちができることで、初めて触る技術を選択するハードルが低くなっている • 最初からAIに任せないことが重要
◦ AIと対話するが、アーキテクチャの意思決定は人間が行う ◦ 一例)Claude Codeを使わずWebのClaudeを使って聞くといいかも ▪ すぐにコードを書かず、対話だけに徹することを強制的に制限 ◦ 自分で手を動かして、初期構築のコマンドや、ディレクトリ/ファイルの作成をする ▪ 最新のドキュメントを人間が目で見て進める ▪ さほど大変でもないので、AIに任せないことのデメリットが少なくメリットが多い -
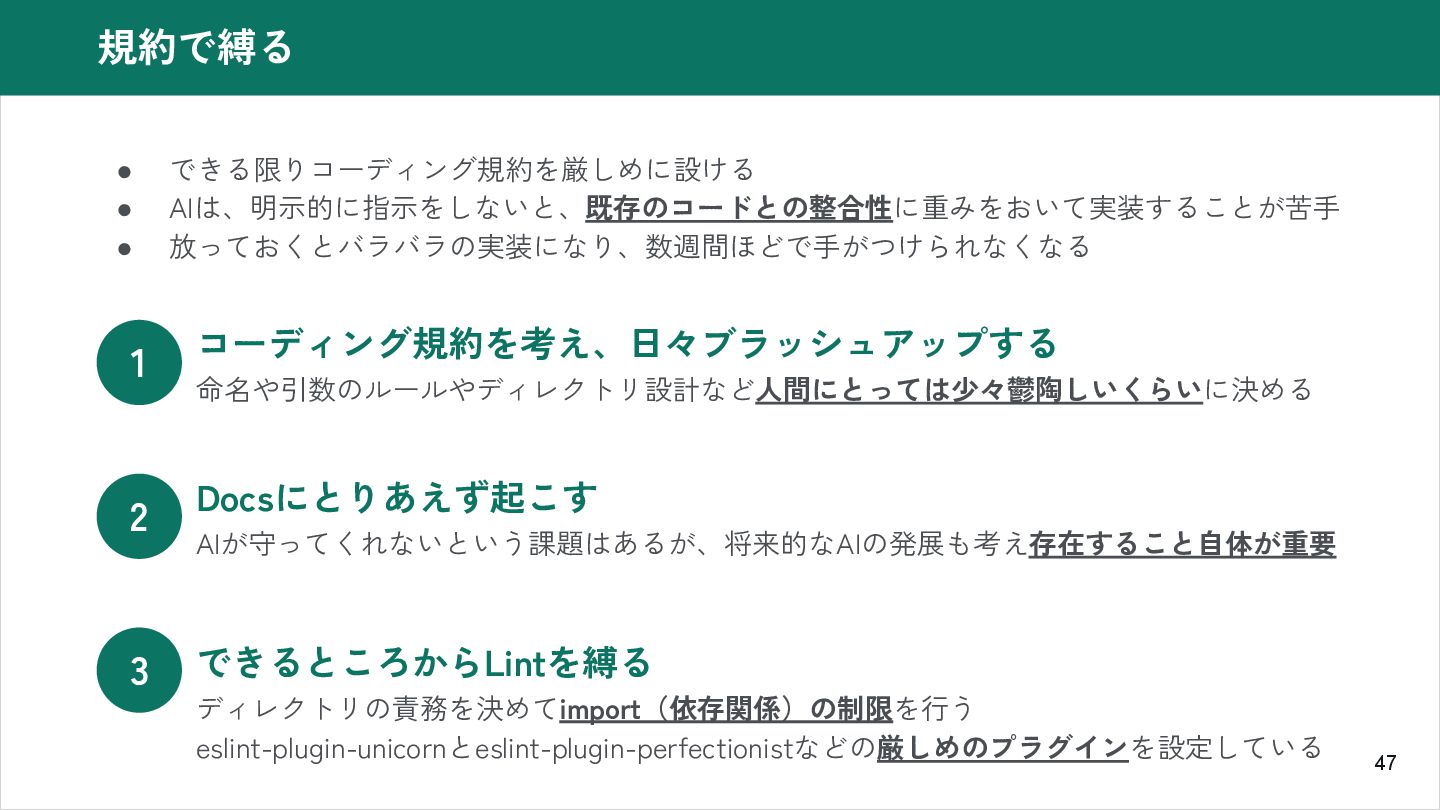
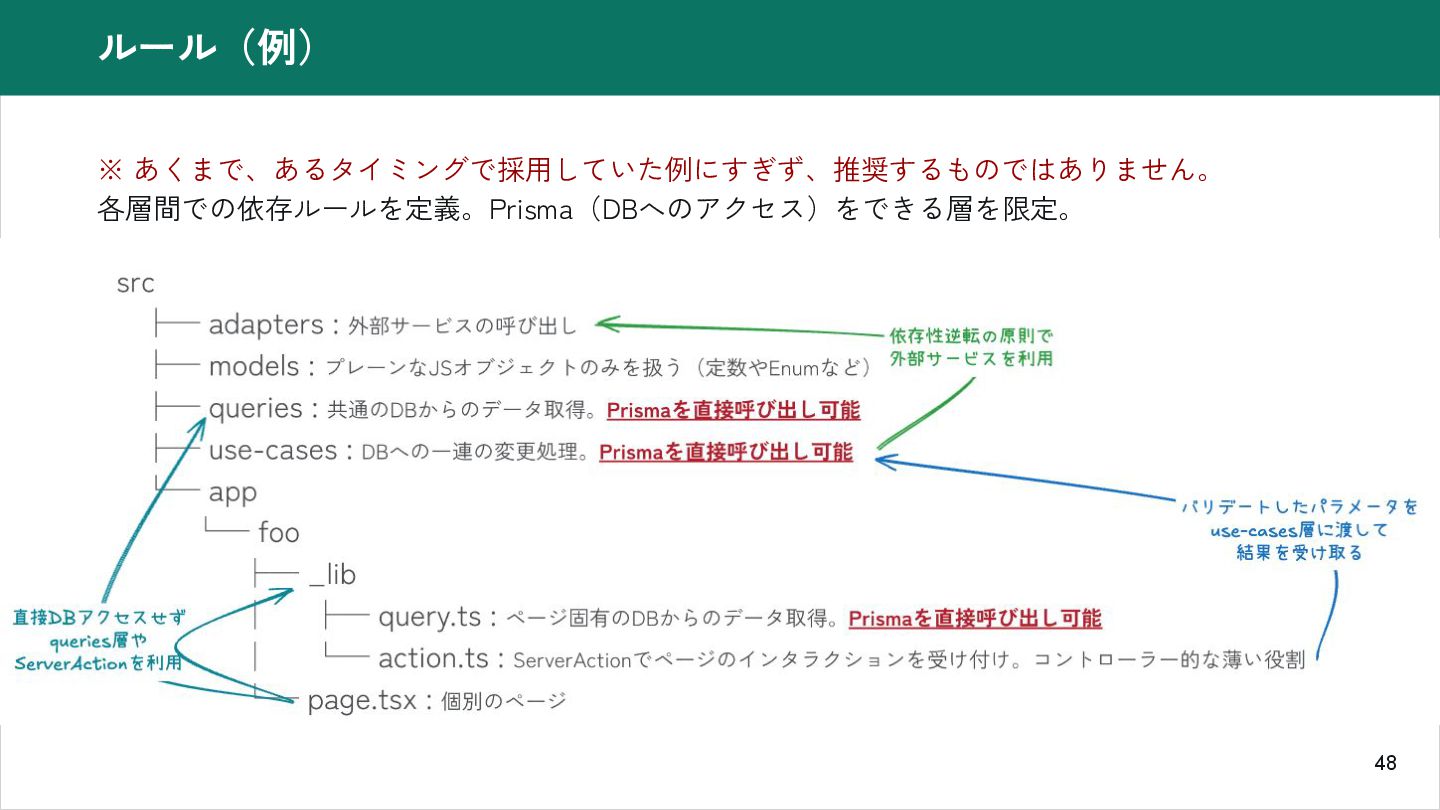
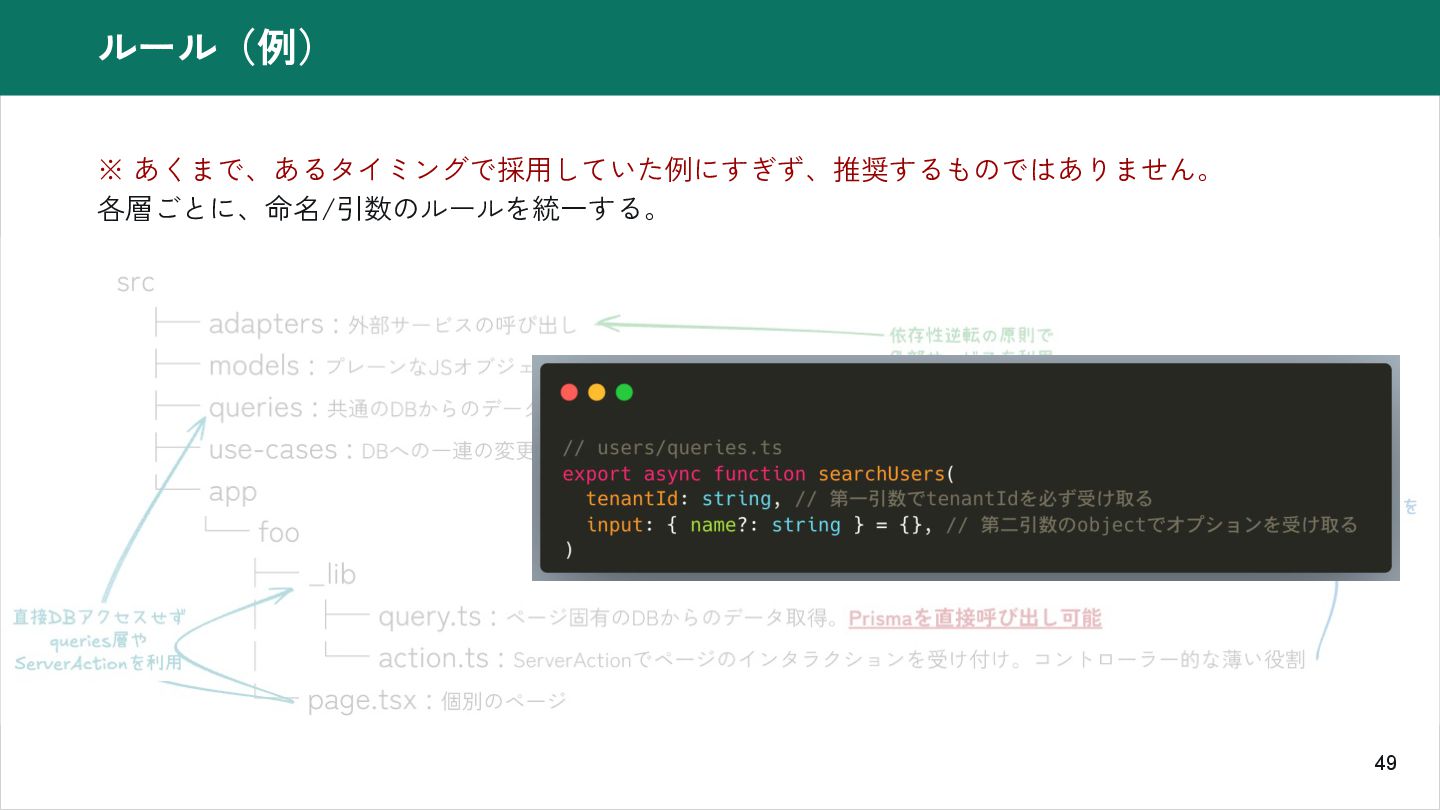
47 規約で縛る • できる限りコーディング規約を厳しめに設ける • AIは、明示的に指示をしないと、既存のコードとの整合性に重みをおいて実装することが苦手 • 放っておくとバラバラの実装になり、数週間ほどで手がつけられなくなる 1 2
3 コーディング規約を考え、日々ブラッシュアップする 命名や引数のルールやディレクトリ設計など人間にとっては少々鬱陶しいくらいに決める Docsにとりあえず起こす AIが守ってくれないという課題はあるが、将来的なAIの発展も考え存在すること自体が重要 できるところからLintを縛る ディレクトリの責務を決めてimport(依存関係)の制限を行う eslint-plugin-unicornとeslint-plugin-perfectionistなどの厳しめのプラグインを設定している -
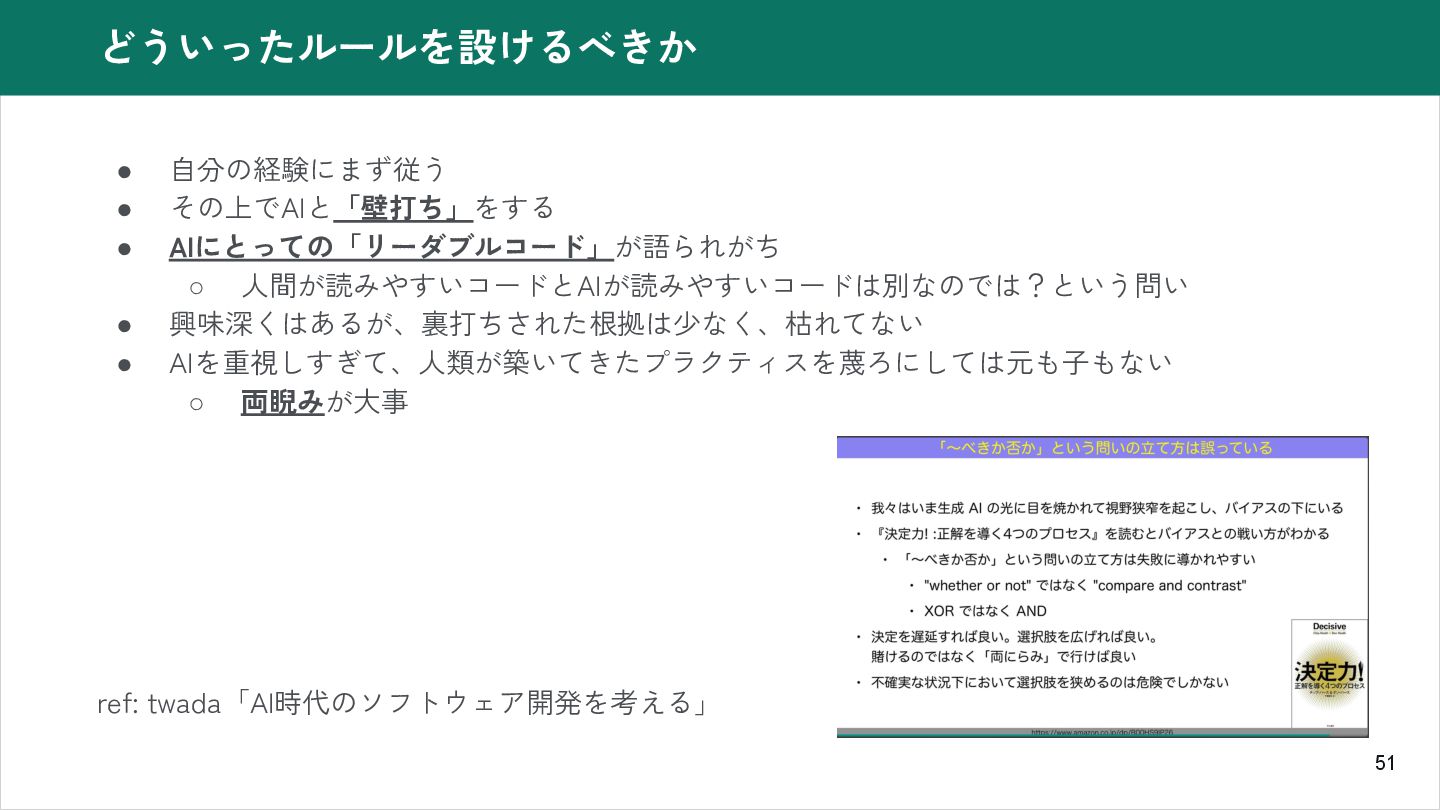
51 どういったルールを設けるべきか • 自分の経験にまず従う • その上でAIと「壁打ち」をする • AIにとっての「リーダブルコード」が語られがち ◦ 人間が読みやすいコードとAIが読みやすいコードは別なのでは?という問い
• 興味深くはあるが、裏打ちされた根拠は少なく、枯れてない • AIを重視しすぎて、人類が築いてきたプラクティスを蔑ろにしては元も子もない ◦ 両睨みが大事 ref: twada「AI時代のソフトウェア開発を考える」 -
52 負債が表面化するまでの時間 • 前述のベースの部分の設計をしっかりやると、各featureの追加が秒で終わるようになる ◦ ※ 既存開発に比べて制約が少ないため • ある程度レビューもしていれば(Vibe Codingでなければ)、すぐさま崩壊はしない
◦ しかしながら、無意識に通常よりレビュー時に目が滑っている • 2週間くらいするとちょっと辛くなってくる ◦ 「適当な実装により生産性が逆転するのは1ヶ月→3、4日に」 ▪ 実感するところが大きい ◦ ref: fukabori.fm「AIコーディングの現在地 w/ twada」 • とりあえず、2週間に一回リファクタリングだけをする日を設けている -
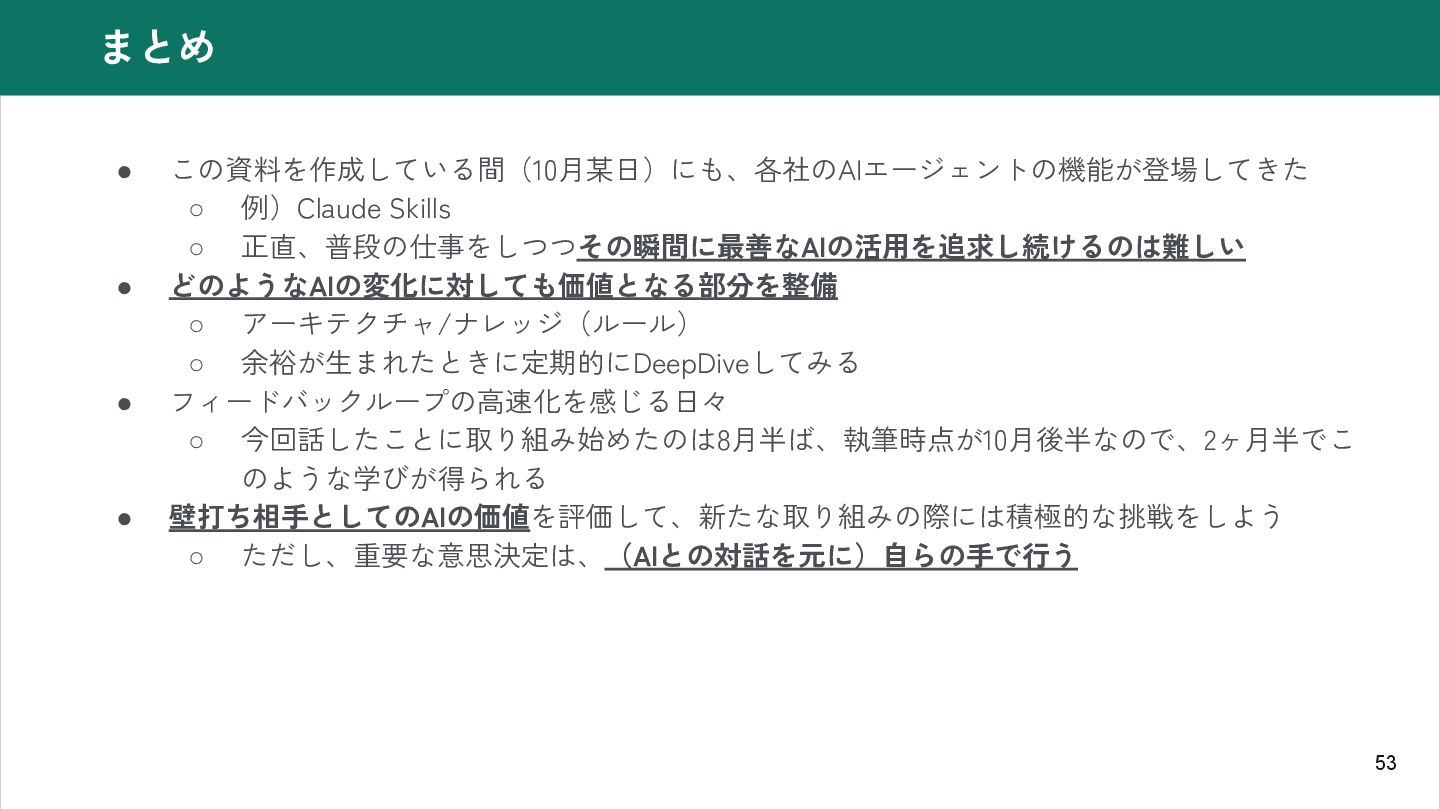
53 まとめ • この資料を作成している間(10月某日)にも、各社のAIエージェントの機能が登場してきた ◦ 例)Claude Skills ◦ 正直、普段の仕事をしつつその瞬間に最善なAIの活用を追求し続けるのは難しい •
どのようなAIの変化に対しても価値となる部分を整備 ◦ アーキテクチャ/ナレッジ(ルール) ◦ 余裕が生まれたときに定期的にDeepDiveしてみる • フィードバックループの高速化を感じる日々 ◦ 今回話したことに取り組み始めたのは8月半ば、執筆時点が10月後半なので、2ヶ月半でこ のような学びが得られる • 壁打ち相手としてのAIの価値を評価して、新たな取り組みの際には積極的な挑戦をしよう ◦ ただし、重要な意思決定は、(AIとの対話を元に)自らの手で行う