Share
Embed
Transcript
20 slides
-
自己紹介 光岡日菜子 - 名城大学 堀田研究室M2 - 名古屋CV・PRML勉強会幹事(2024/4~) 趣味:イラスト/車/SNS運営 研究:Action Segmentation/SemSeg/I2I
2 @ramentabetai__1 @nagoyacv conpass HP -
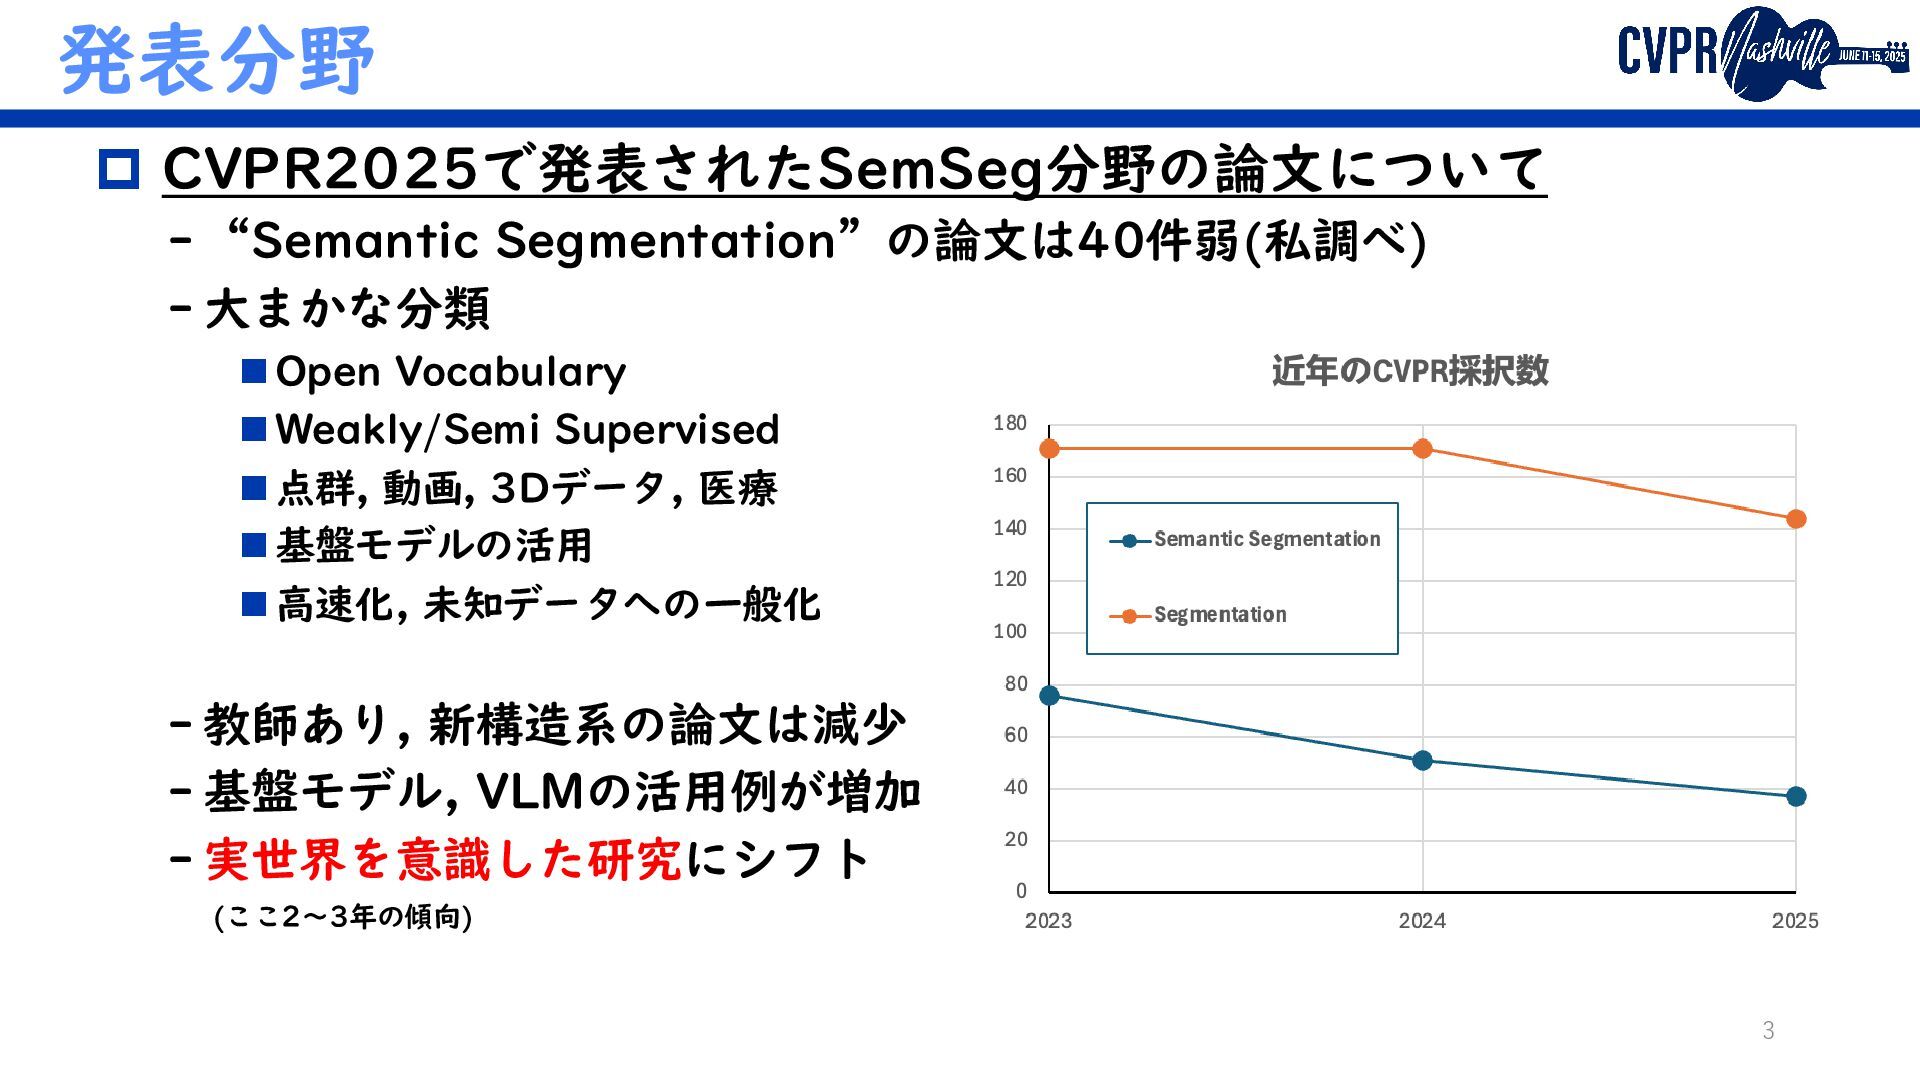
発表分野 3 CVPR2025で発表されたSemSeg分野の論文について - “Semantic Segmentation”の論文は40件弱(私調べ) - 大まかな分類 ◼Open
Vocabulary ◼Weakly/Semi Supervised ◼点群, 動画, 3Dデータ, 医療 ◼基盤モデルの活用 ◼高速化, 未知データへの一般化 - 教師あり, 新構造系の論文は減少 - 基盤モデル, VLMの活用例が増加 - 実世界を意識した研究にシフト (ここ2〜3年の傾向) -
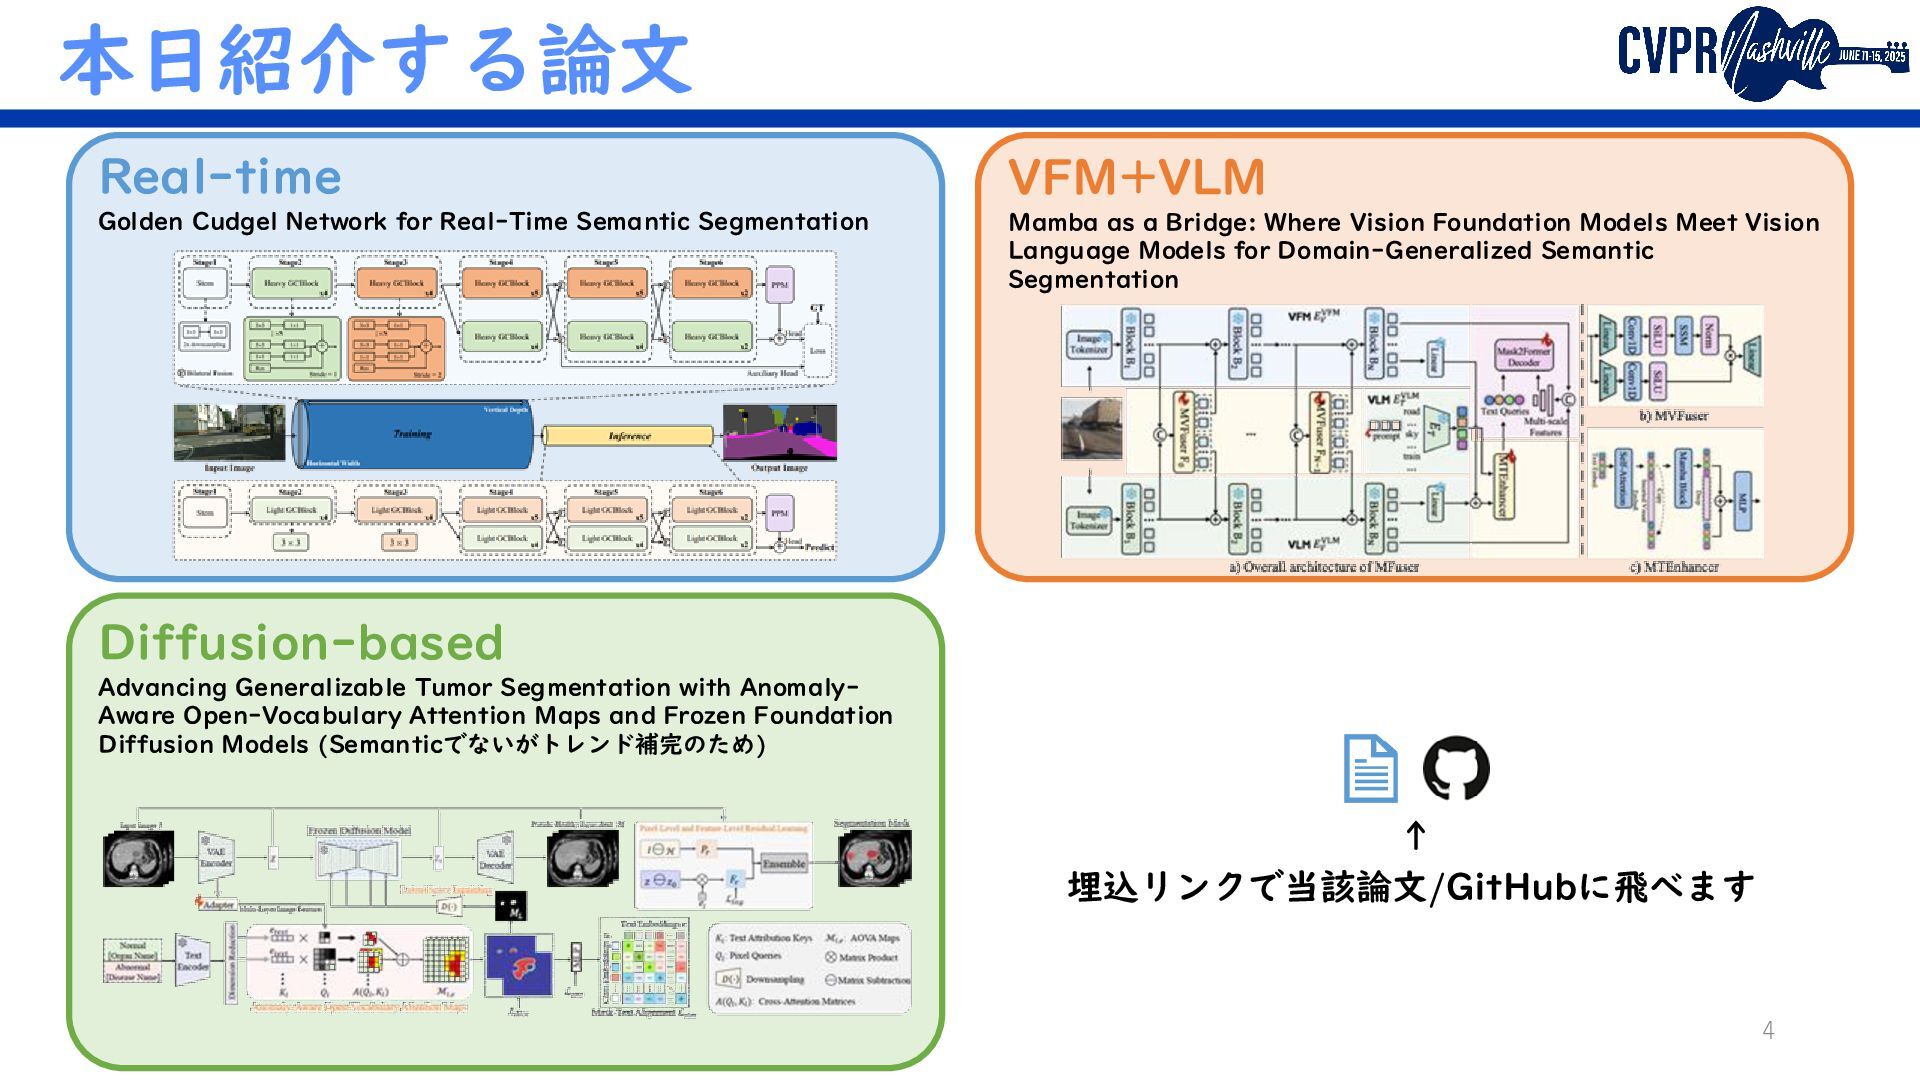
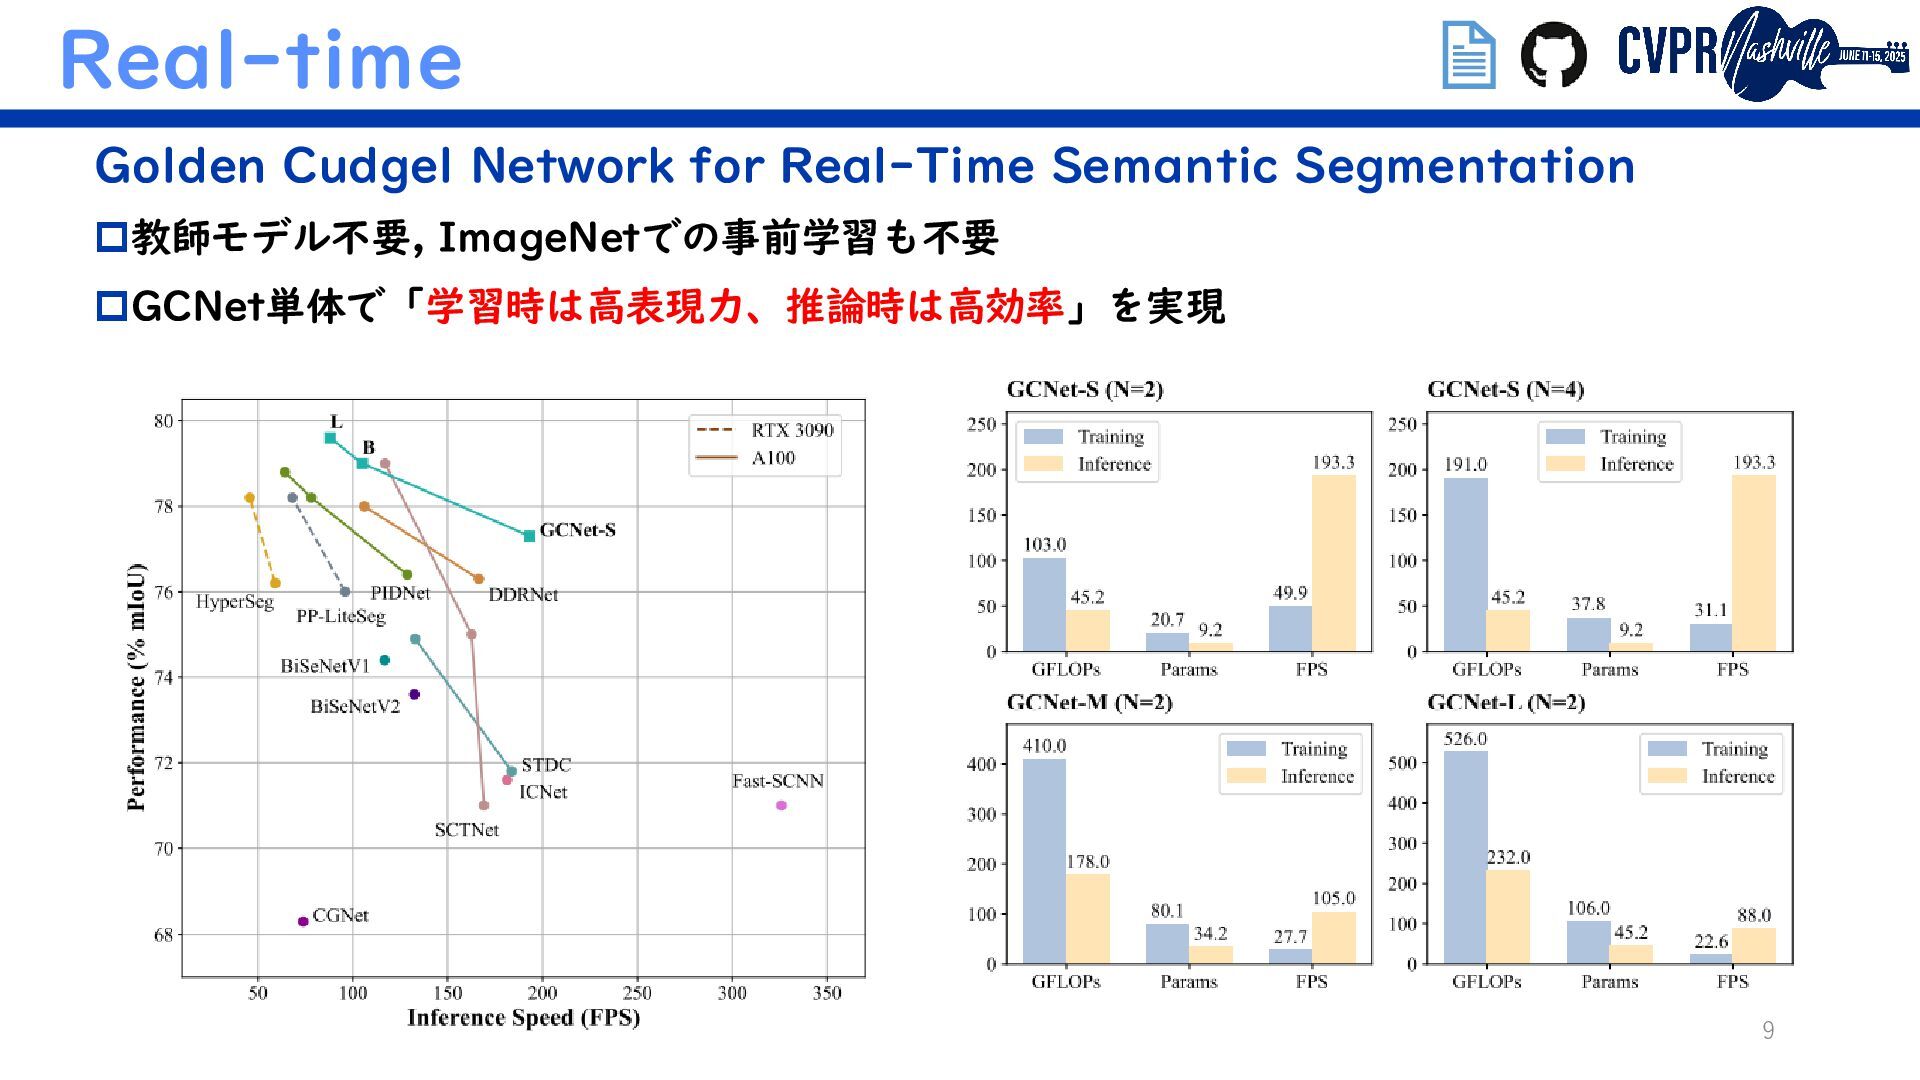
本日紹介する論文 4 Real-time Golden Cudgel Network for Real-Time Semantic Segmentation
VFM+VLM Mamba as a Bridge: Where Vision Foundation Models Meet Vision Language Models for Domain-Generalized Semantic Segmentation Diffusion-based Advancing Generalizable Tumor Segmentation with Anomaly- Aware Open-Vocabulary Attention Maps and Frozen Foundation Diffusion Models (Semanticでないがトレンド補完のため) 埋込リンクで当該論文/GitHubに飛べます ↑ -
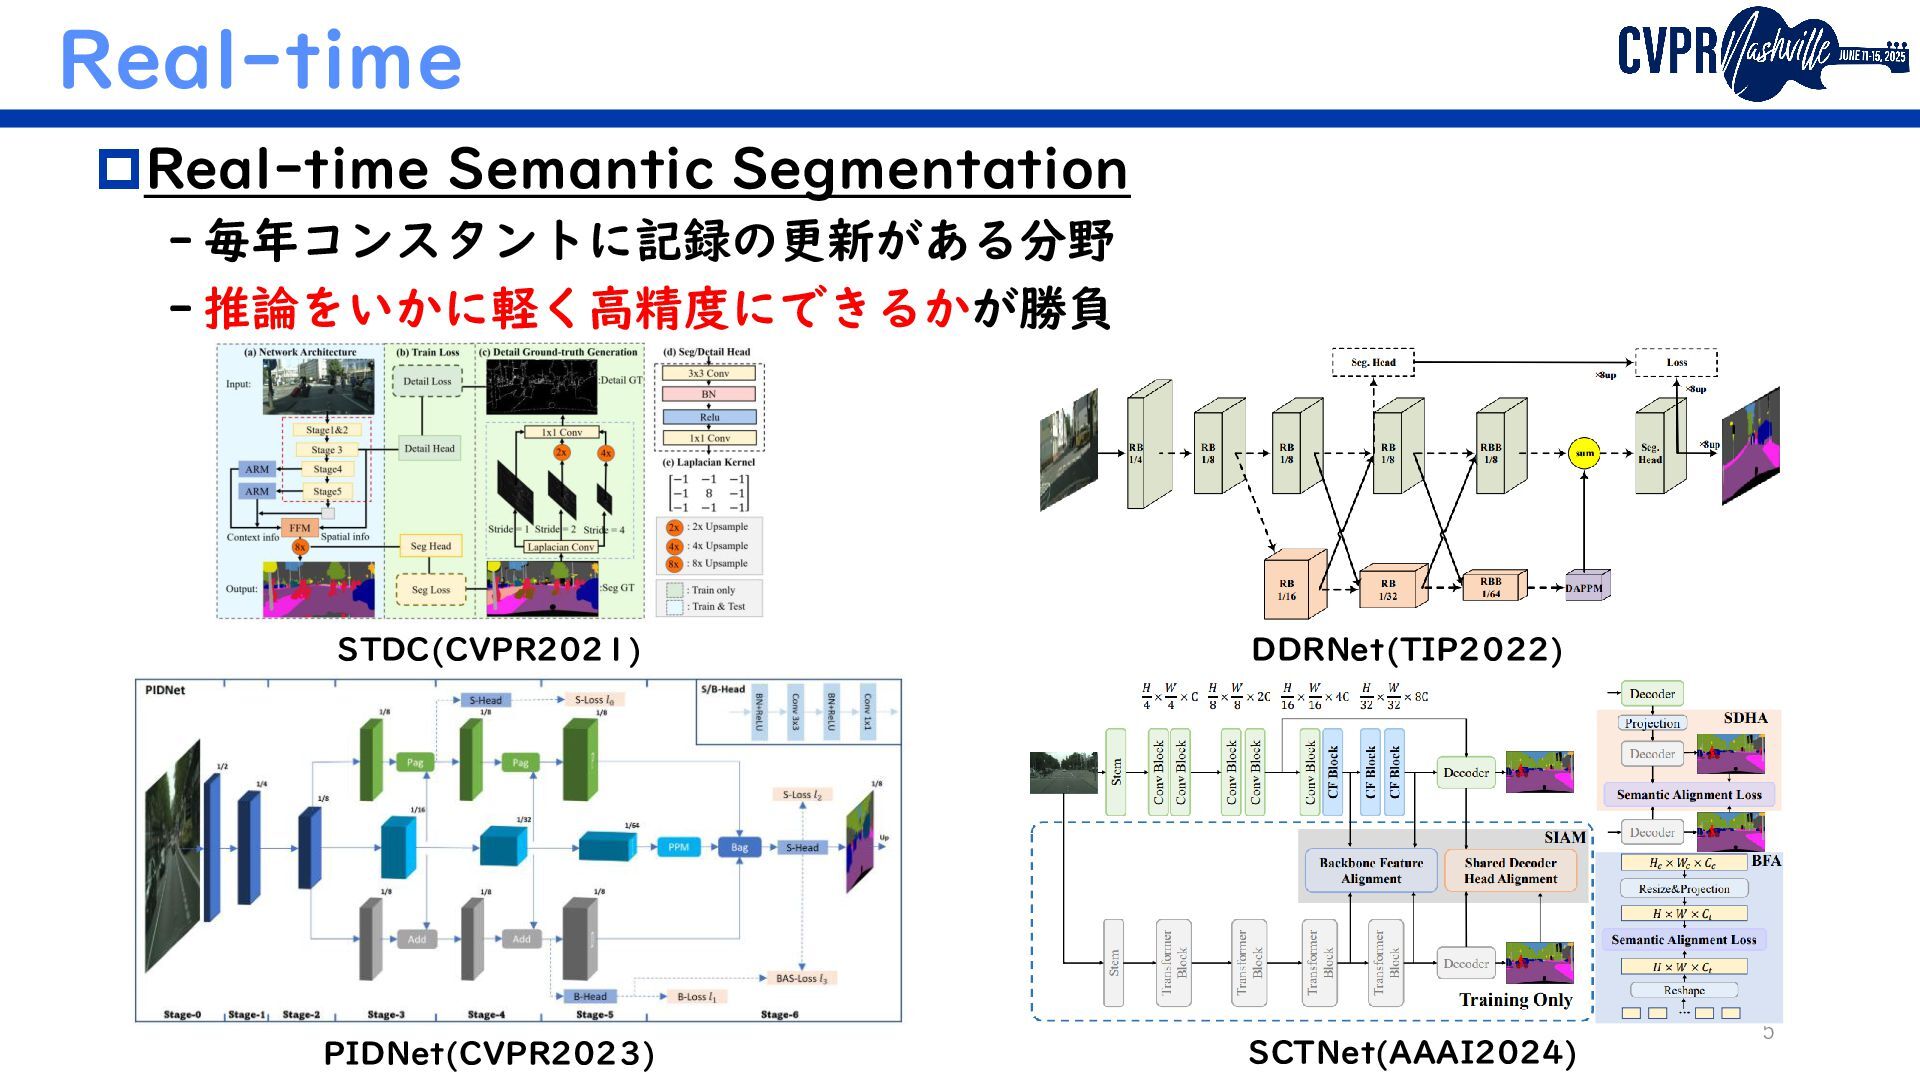
Real-time 5 Real-time Semantic Segmentation - 毎年コンスタントに記録の更新がある分野 - 推論をいかに軽く高精度にできるかが勝負 STDC(CVPR2021)
DDRNet(TIP2022) PIDNet(CVPR2023) SCTNet(AAAI2024) -
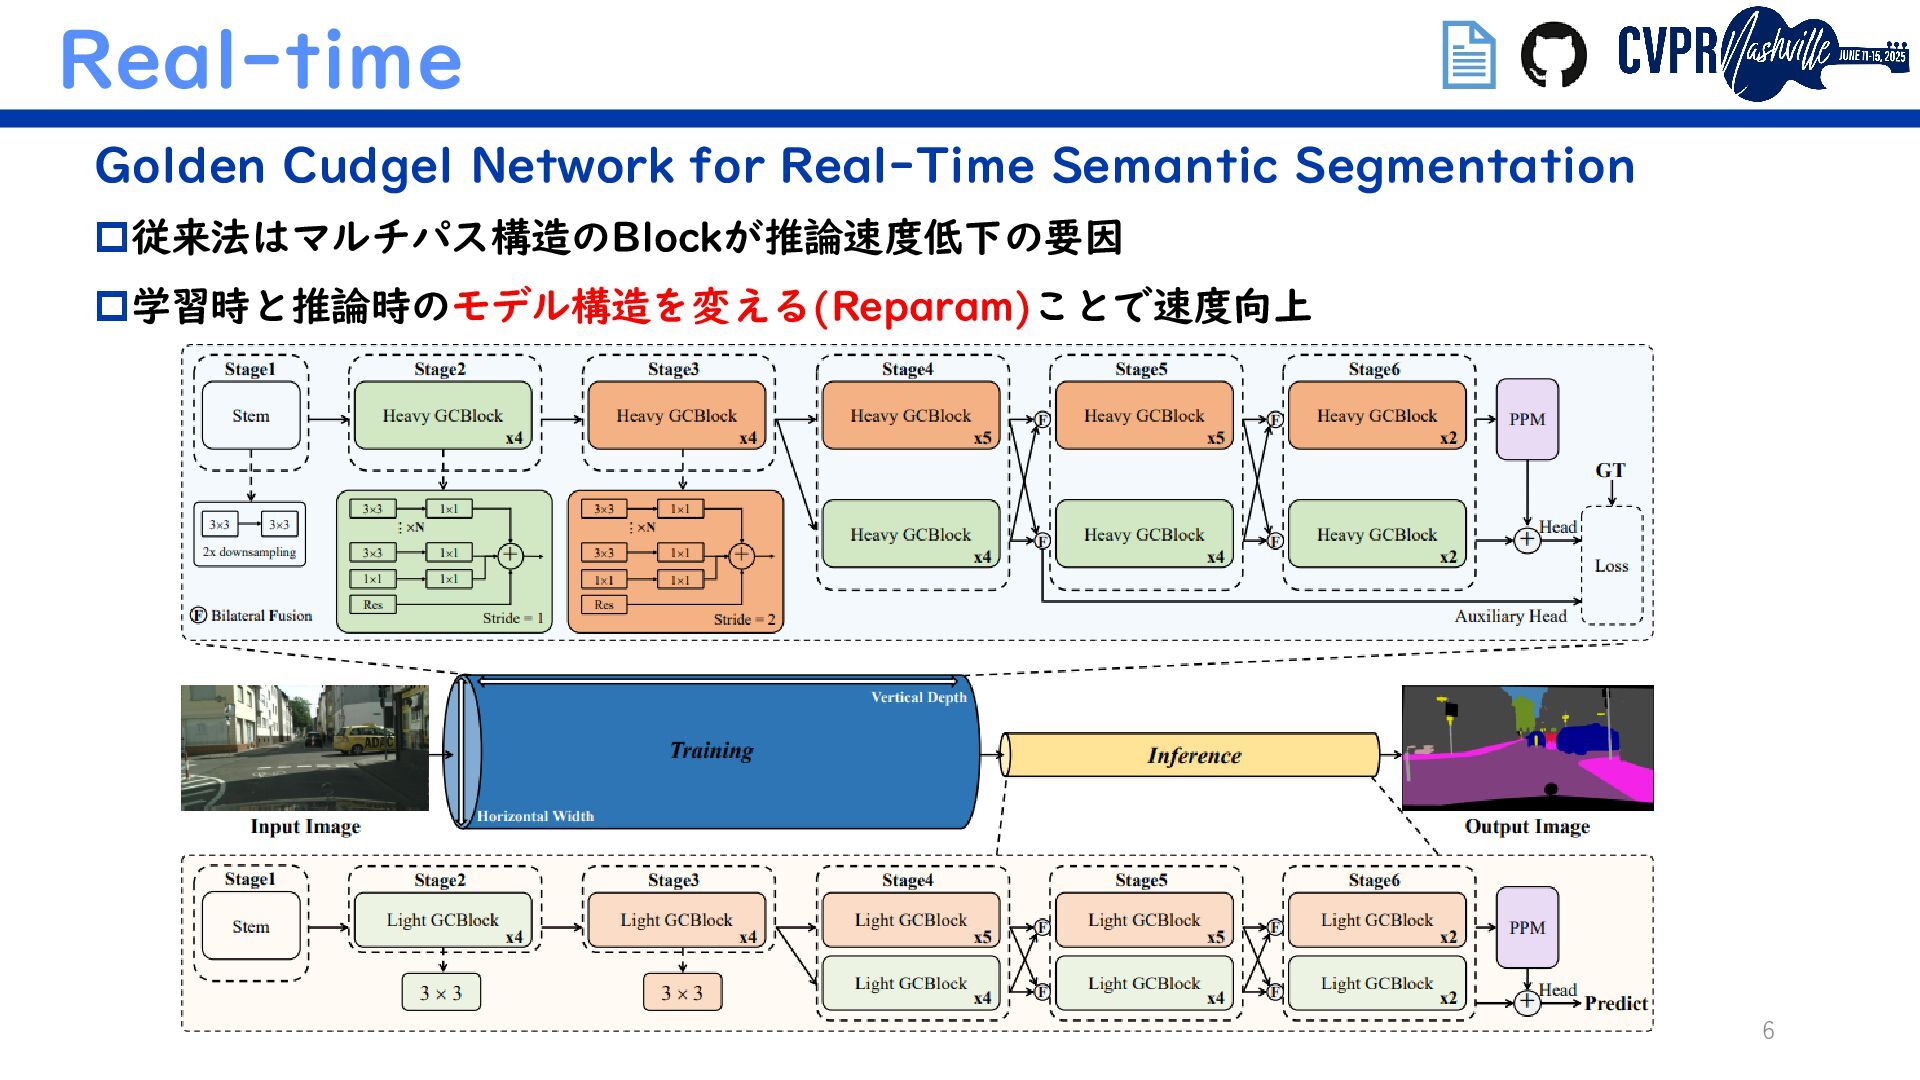
Real-time 6 Golden Cudgel Network for Real-Time Semantic Segmentation 従来法はマルチパス構造のBlockが推論速度低下の要因
学習時と推論時のモデル構造を変える(Reparam)ことで速度向上 ド キ ュ メ ン ト -
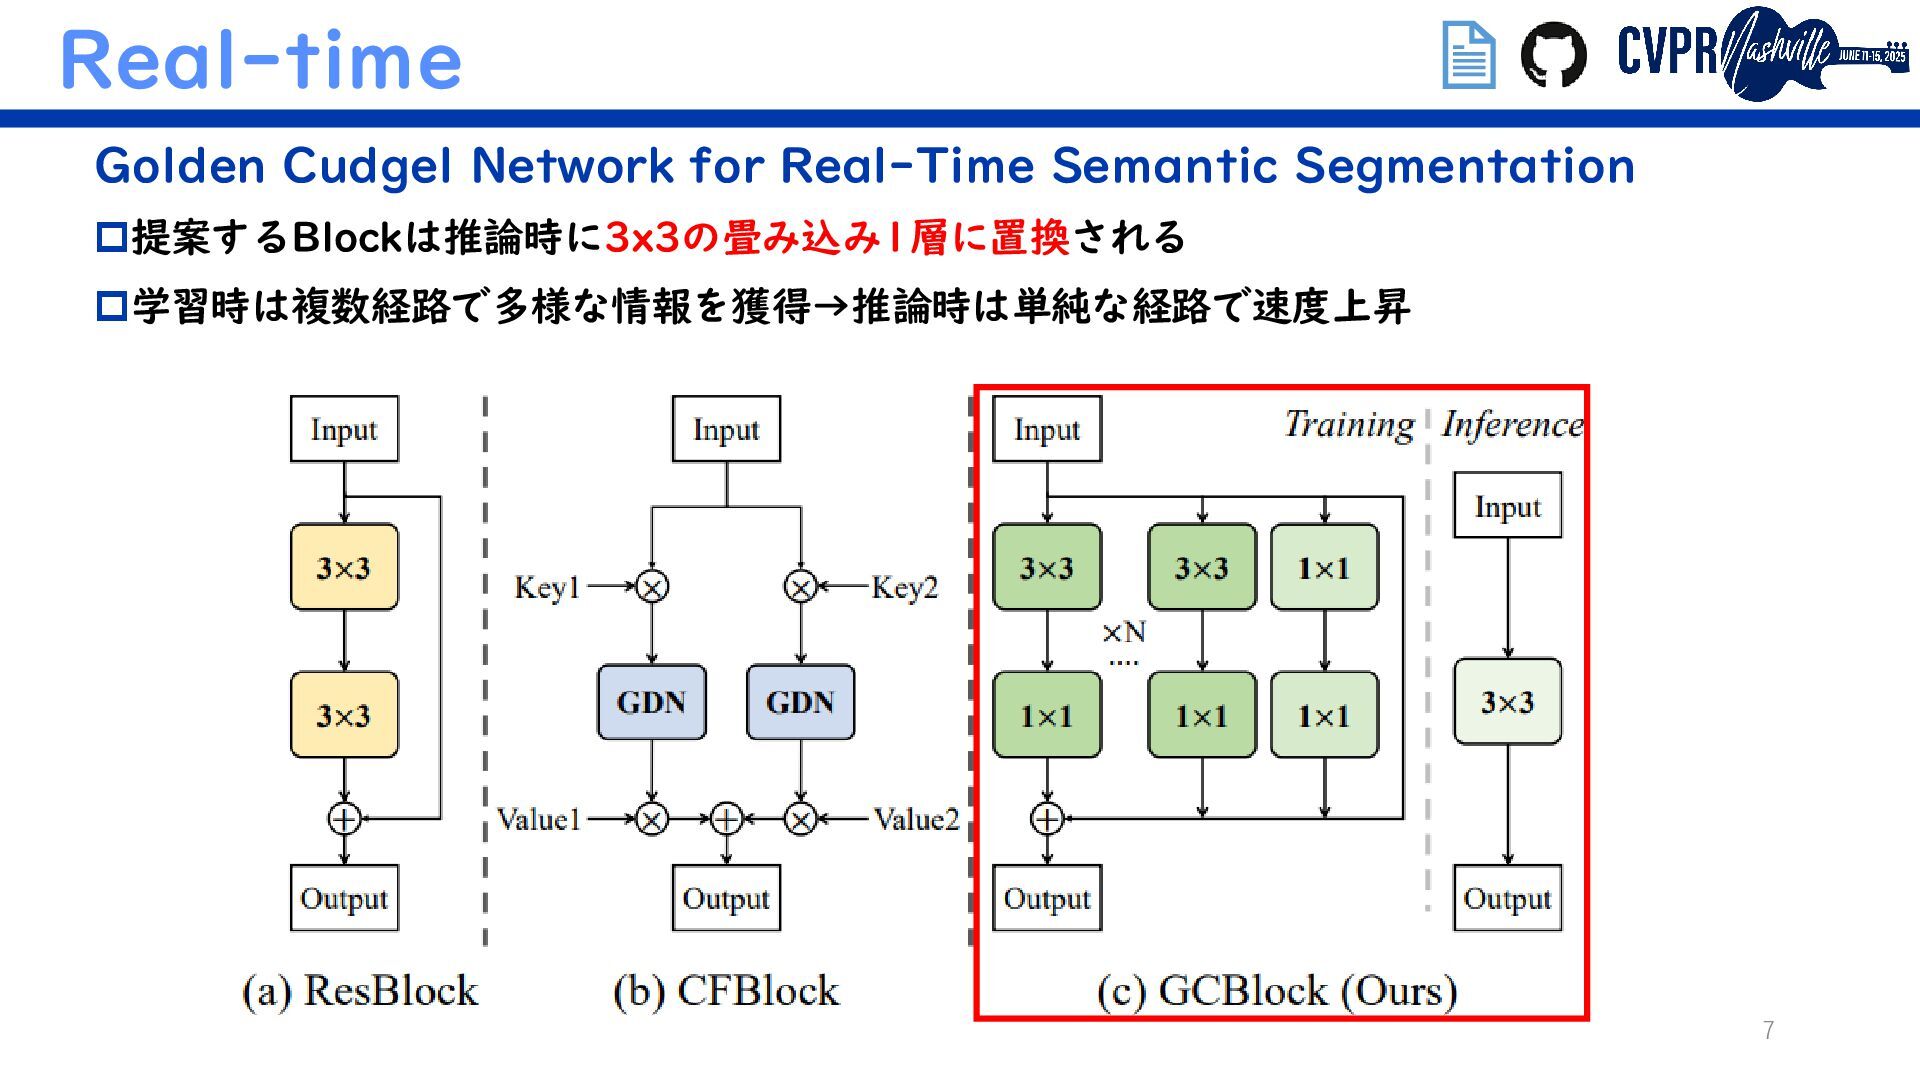
Real-time 7 Golden Cudgel Network for Real-Time Semantic Segmentation 提案するBlockは推論時に3x3の畳み込み1層に置換される
学習時は複数経路で多様な情報を獲得→推論時は単純な経路で速度上昇 ド キ ュ メ ン ト -
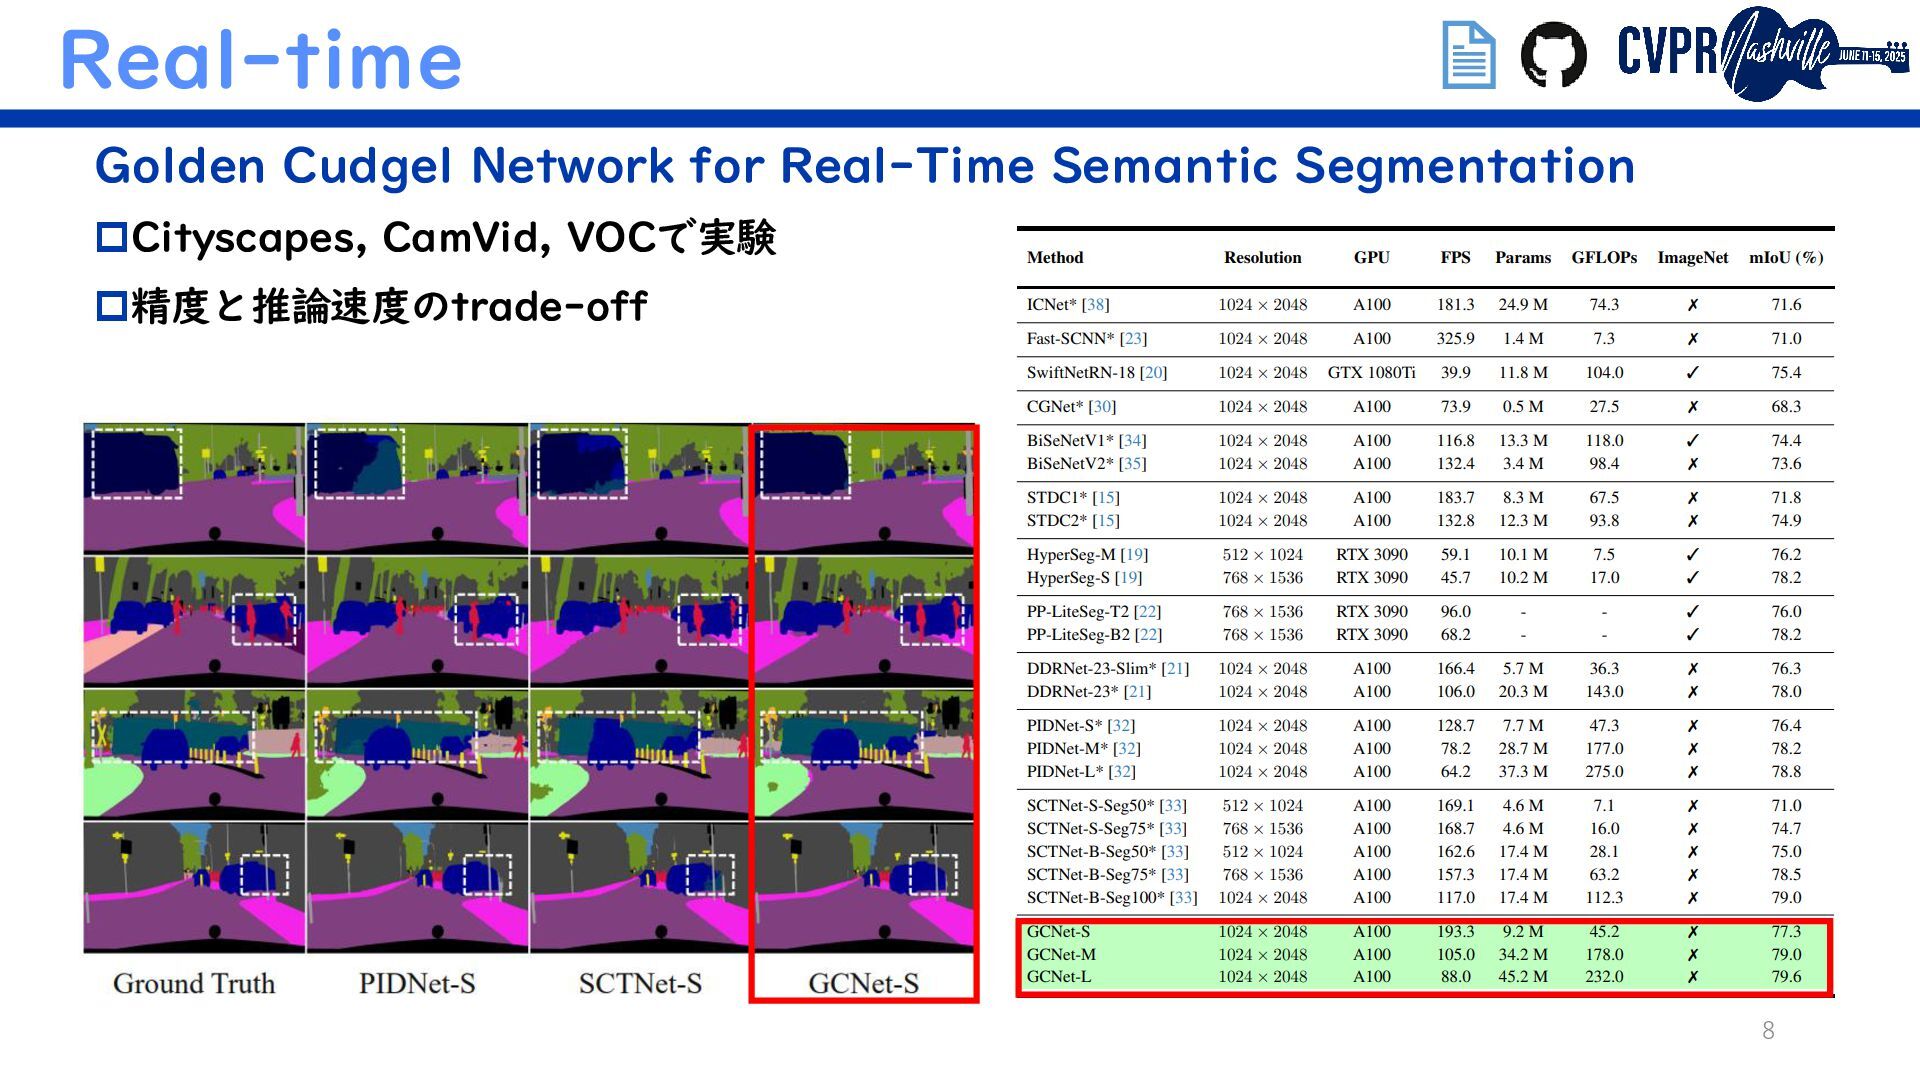
Real-time 8 Golden Cudgel Network for Real-Time Semantic Segmentation Cityscapes,
CamVid, VOCで実験 精度と推論速度のtrade-off ド キ ュ メ ン ト -
Real-time 9 Golden Cudgel Network for Real-Time Semantic Segmentation 教師モデル不要,
ImageNetでの事前学習も不要 GCNet単体で「学習時は高表現力、推論時は高効率」を実現 ド キ ュ メ ン ト -
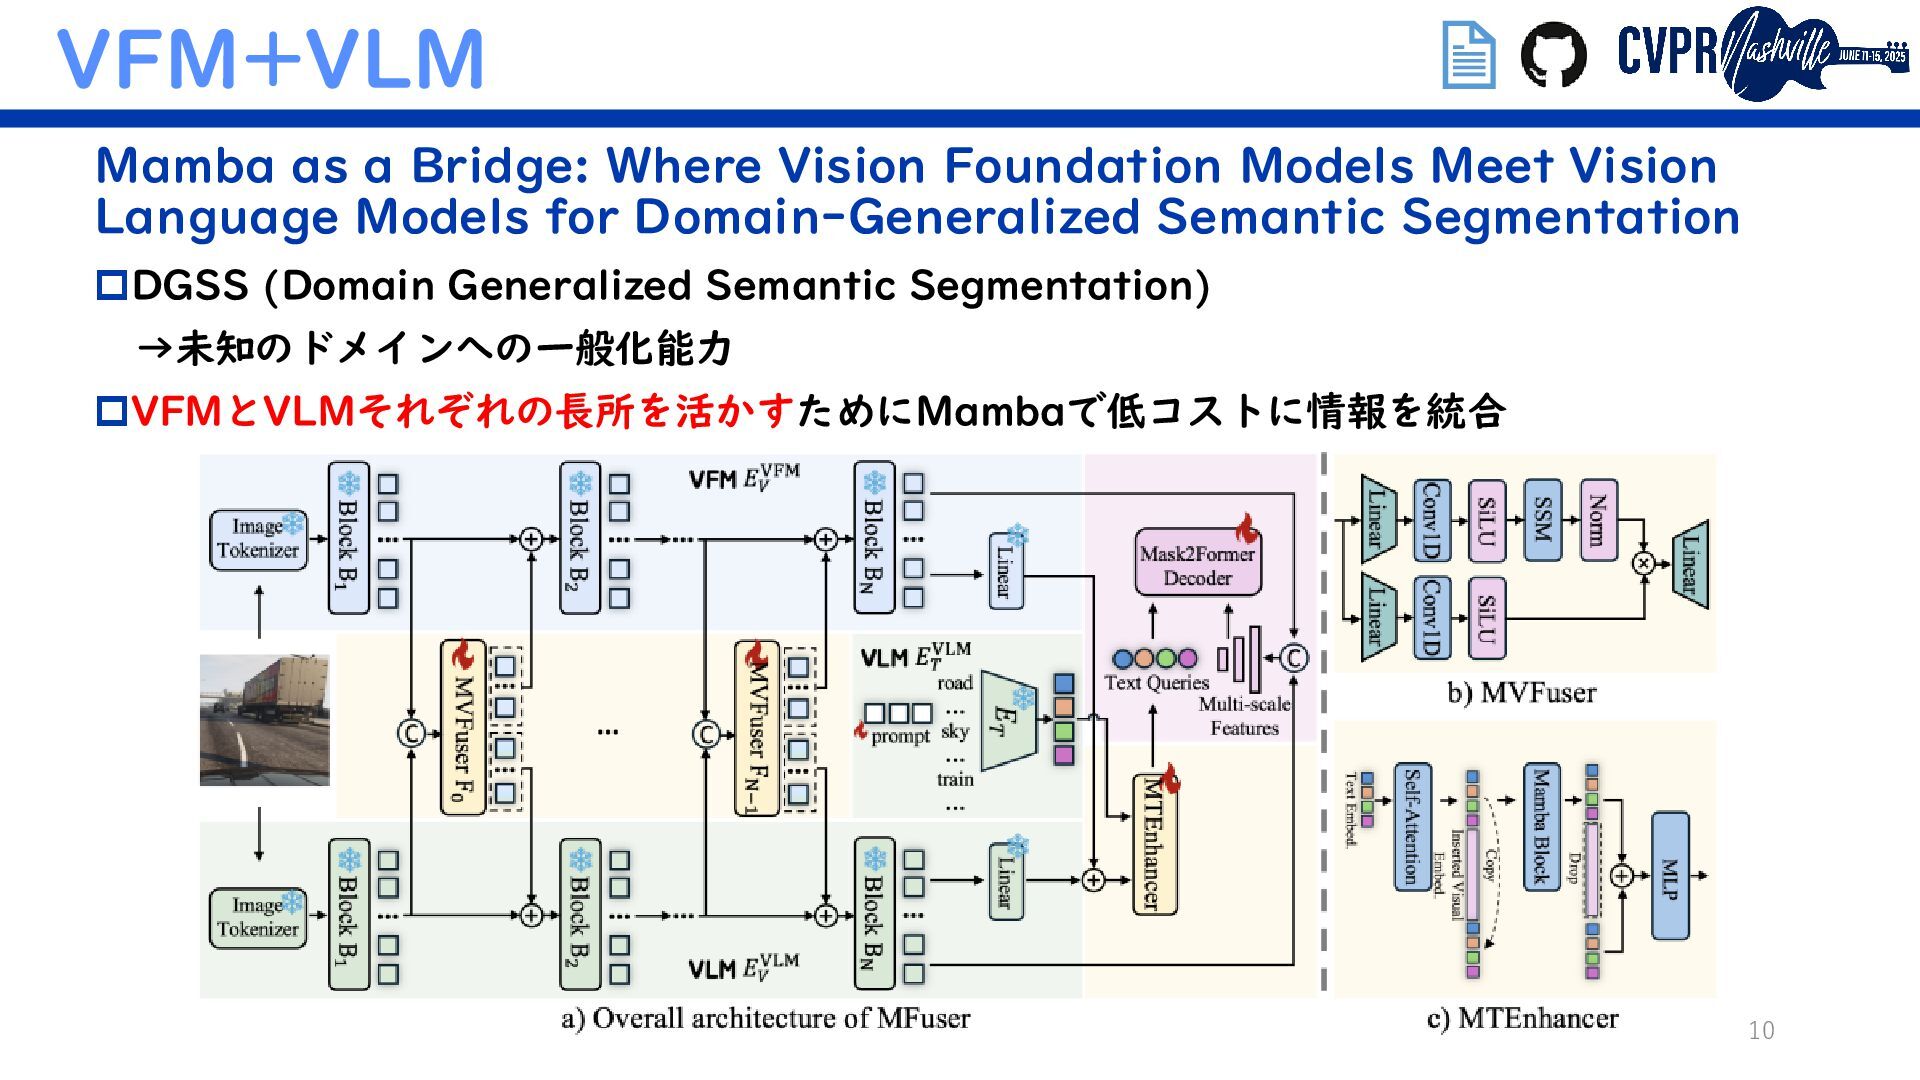
VFM+VLM 10 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation DGSS (Domain Generalized Semantic Segmentation) →未知のドメインへの一般化能力 VFMとVLMそれぞれの長所を活かすためにMambaで低コストに情報を統合 ド キ ュ メ ン ト -
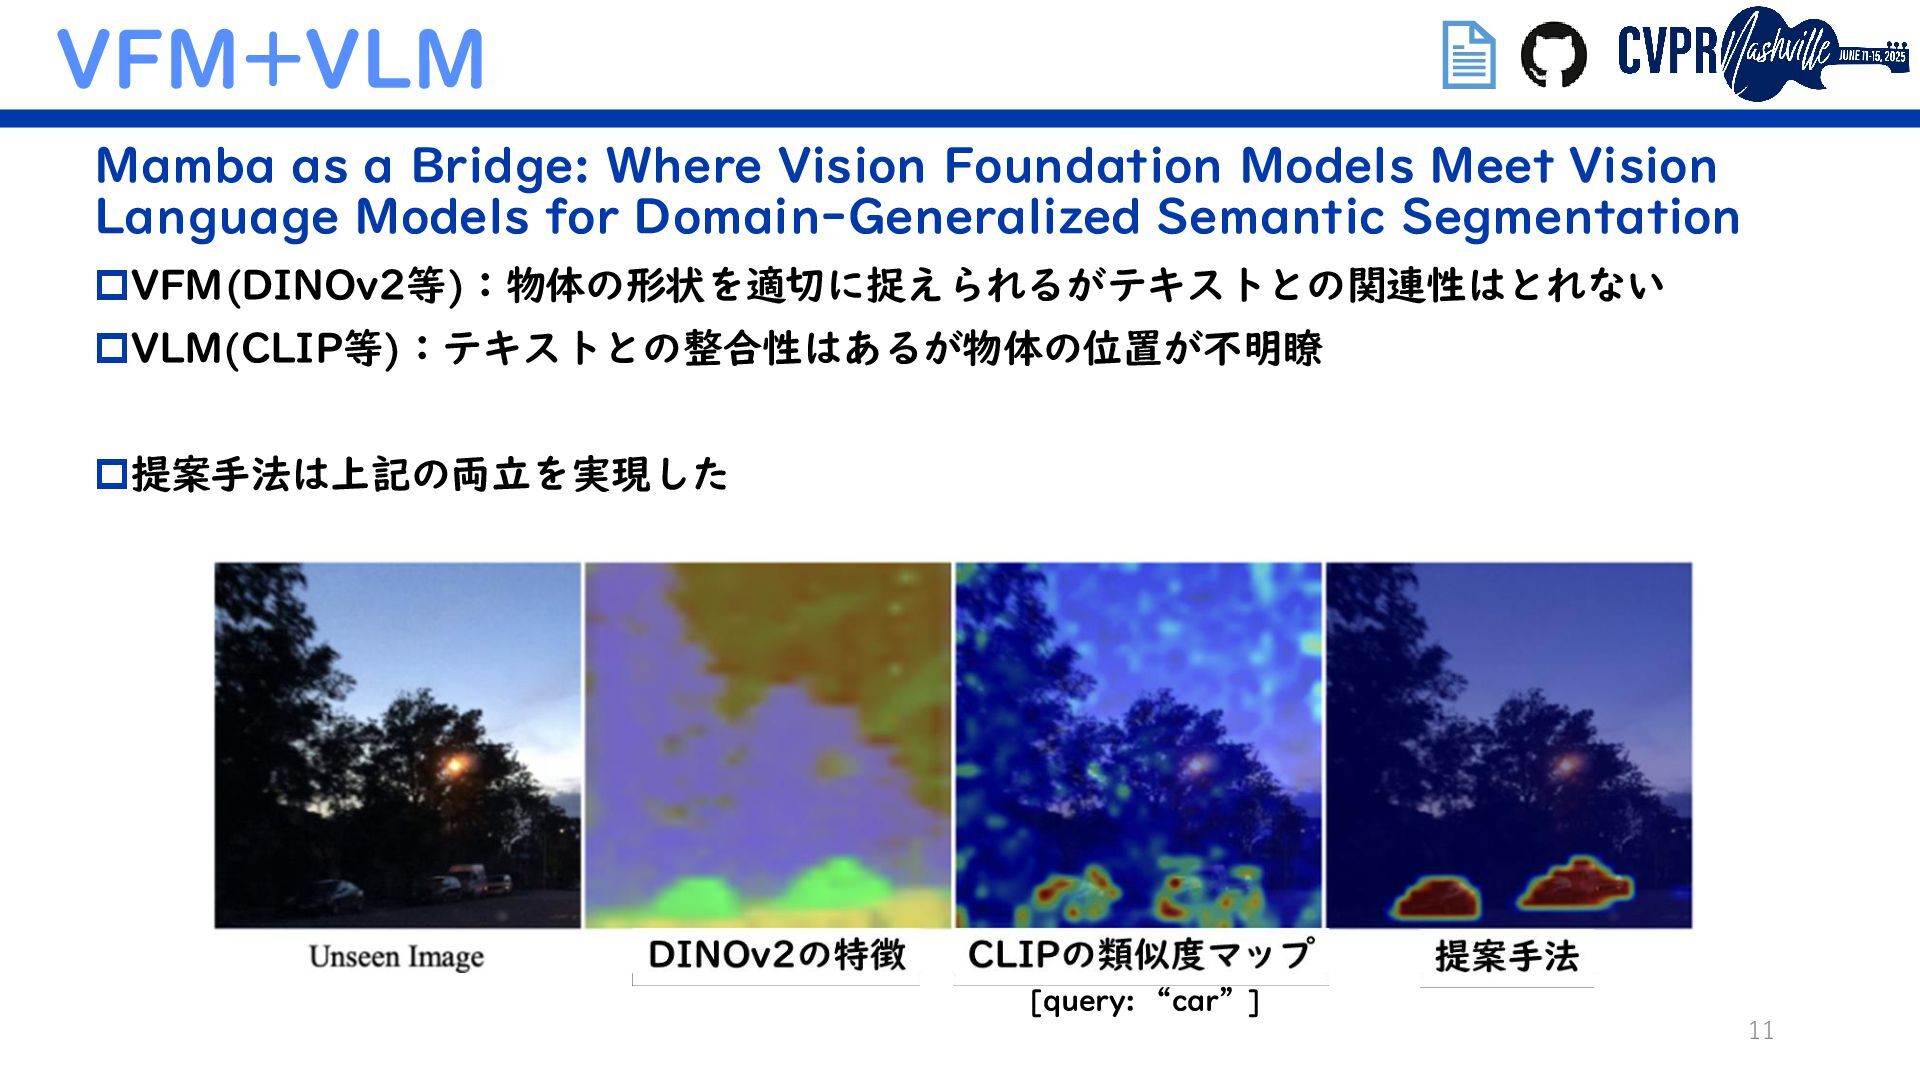
VFM+VLM 11 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation VFM(DINOv2等):物体の形状を適切に捉えられるがテキストとの関連性はとれない VLM(CLIP等):テキストとの整合性はあるが物体の位置が不明瞭 提案手法は上記の両立を実現した ド キ ュ メ ン ト [query: “car”] -
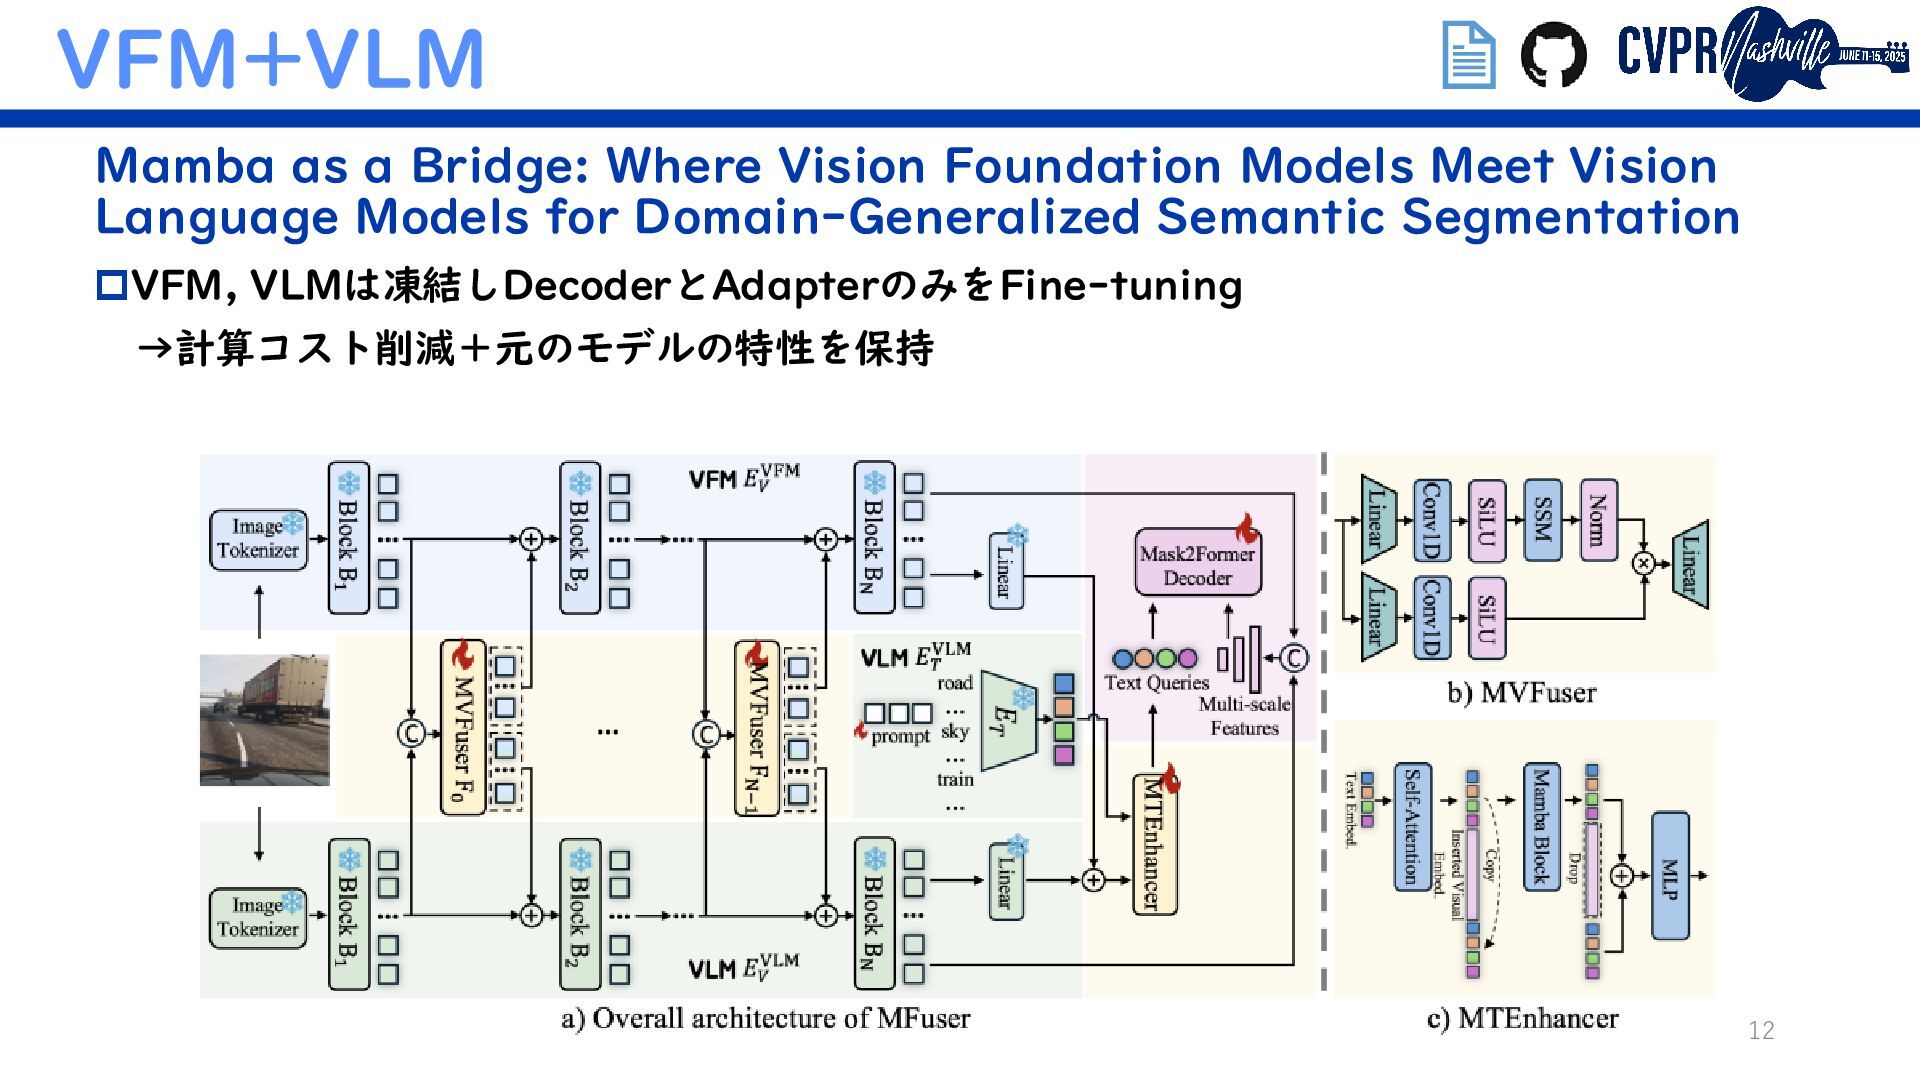
VFM+VLM 12 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation VFM, VLMは凍結しDecoderとAdapterのみをFine-tuning →計算コスト削減+元のモデルの特性を保持 ド キ ュ メ ン ト -
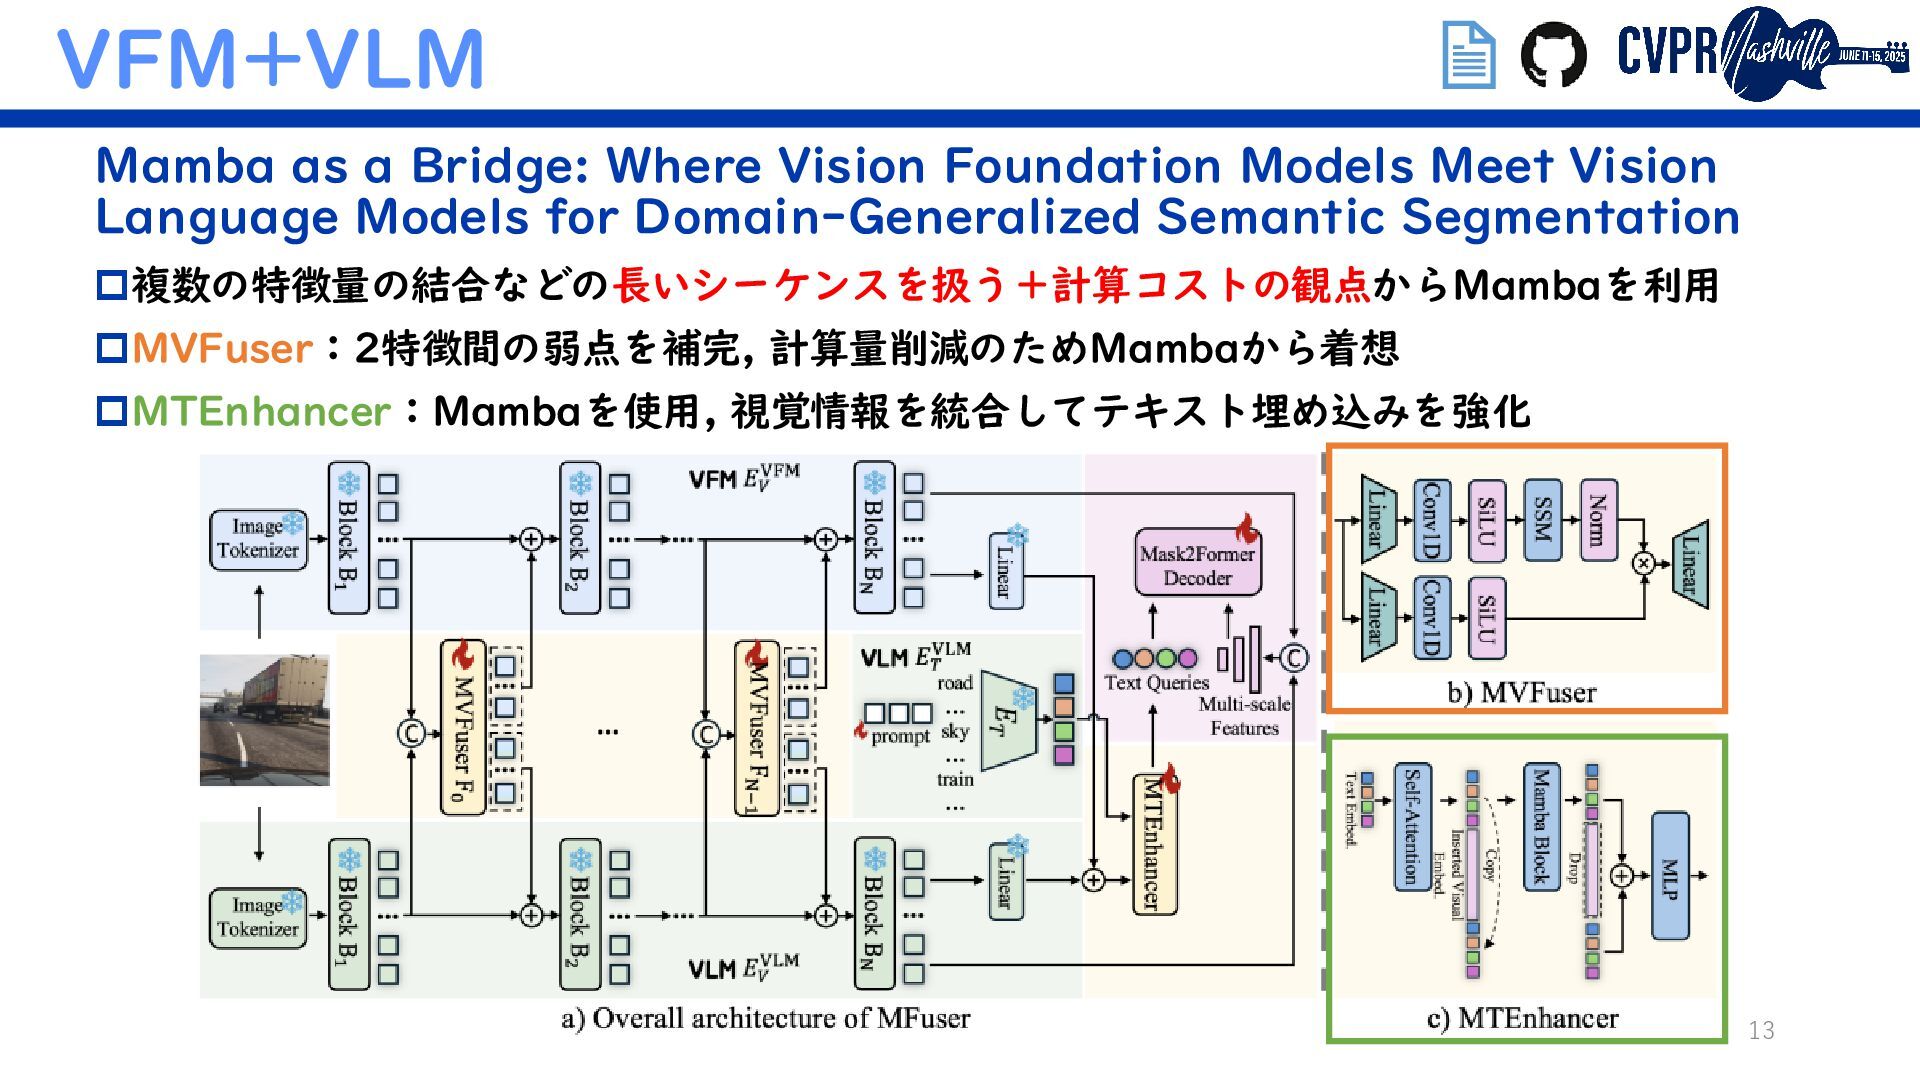
VFM+VLM 13 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation 複数の特徴量の結合などの長いシーケンスを扱う+計算コストの観点からMambaを利用 MVFuser:2特徴間の弱点を補完, 計算量削減のためMambaから着想 MTEnhancer:Mambaを使用, 視覚情報を統合してテキスト埋め込みを強化 ド キ ュ メ ン ト -
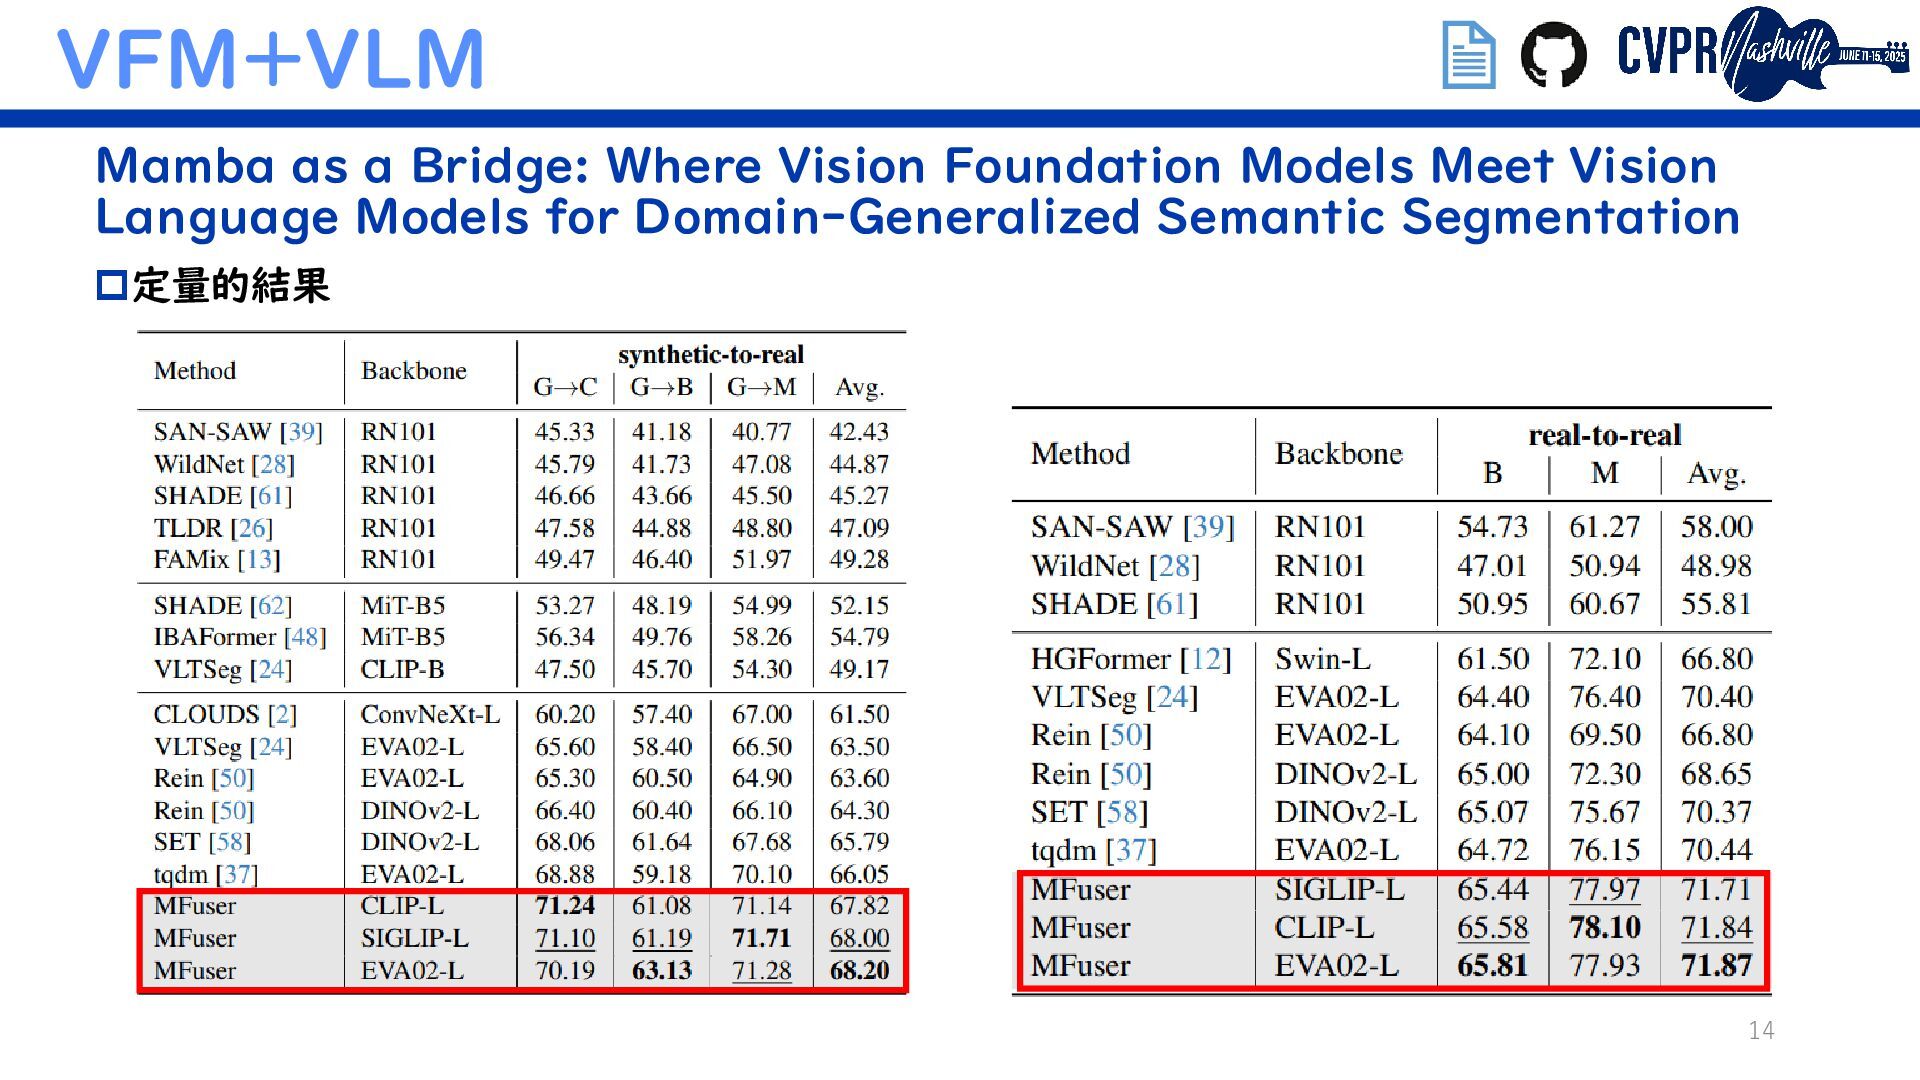
VFM+VLM 14 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation 定量的結果 ド キ ュ メ ン ト -
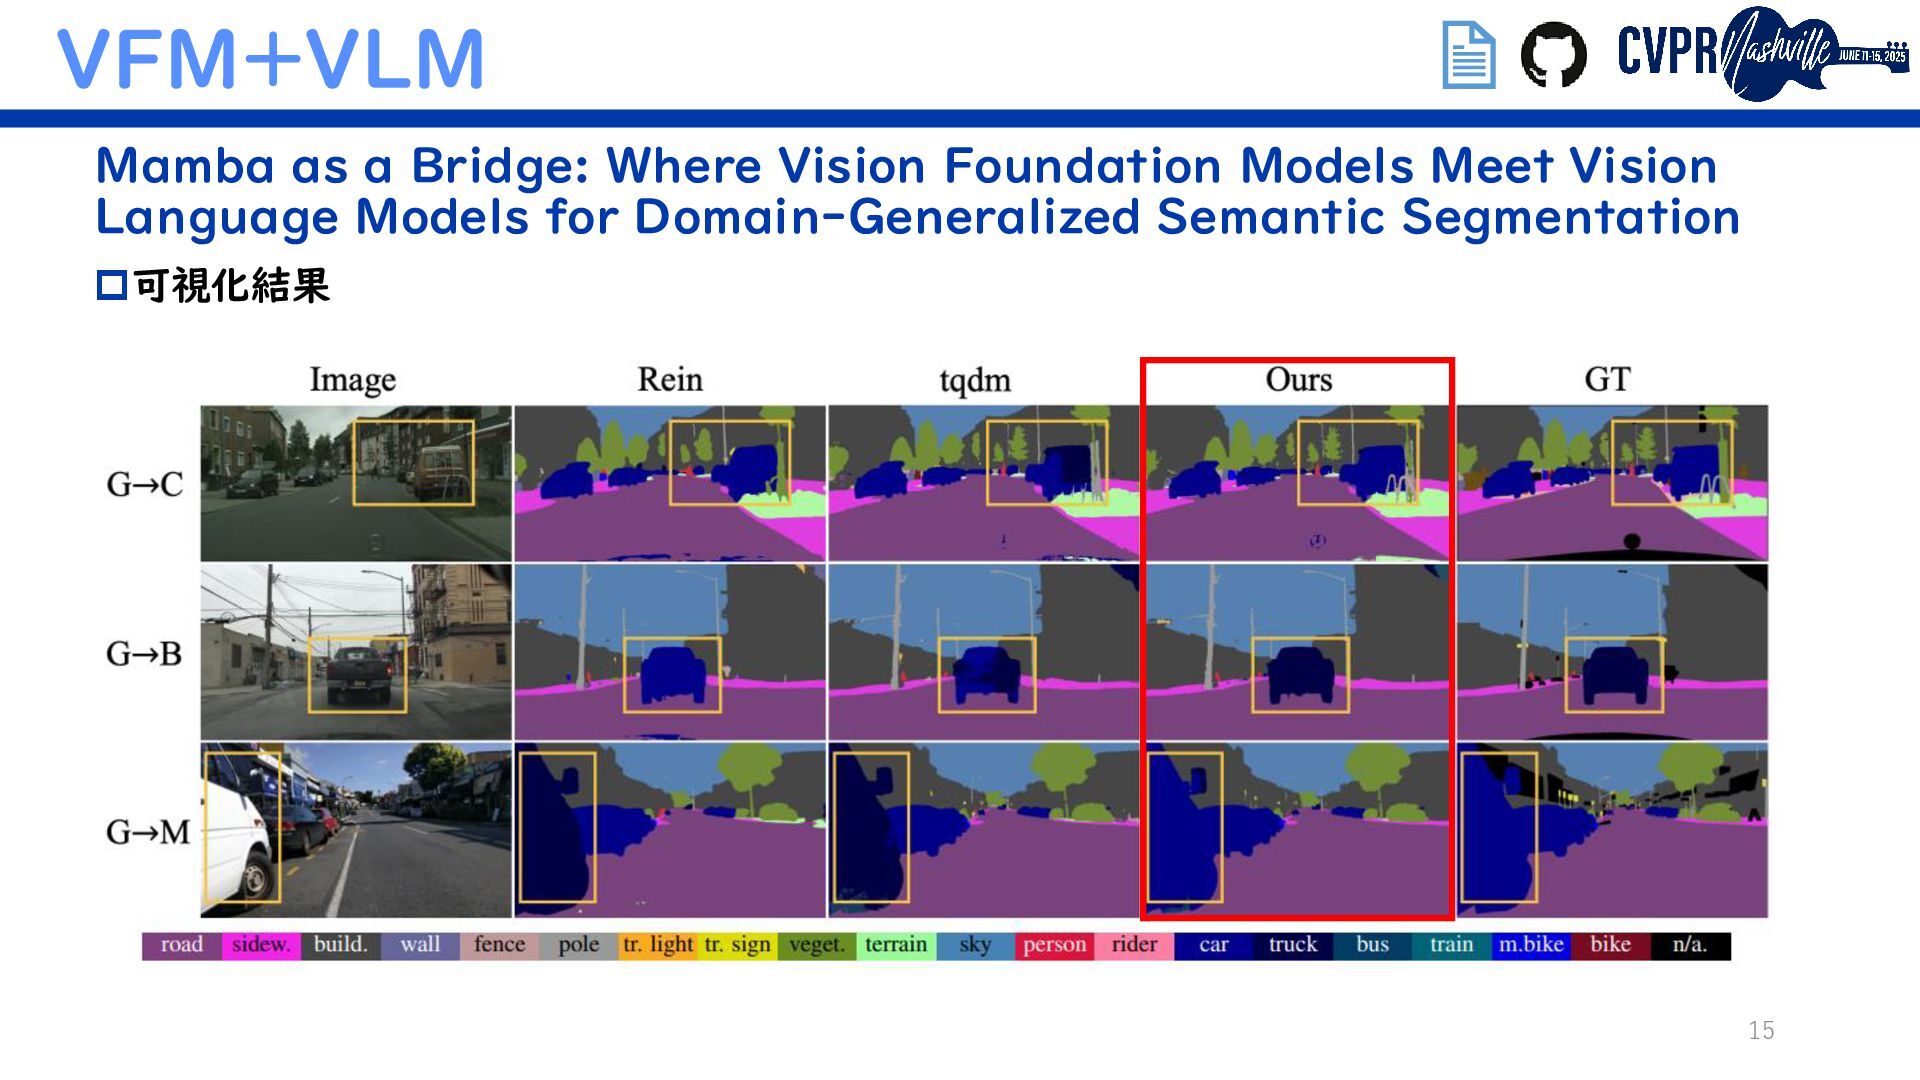
VFM+VLM 15 Mamba as a Bridge: Where Vision Foundation Models
Meet Vision Language Models for Domain-Generalized Semantic Segmentation 可視化結果 ド キ ュ メ ン ト -
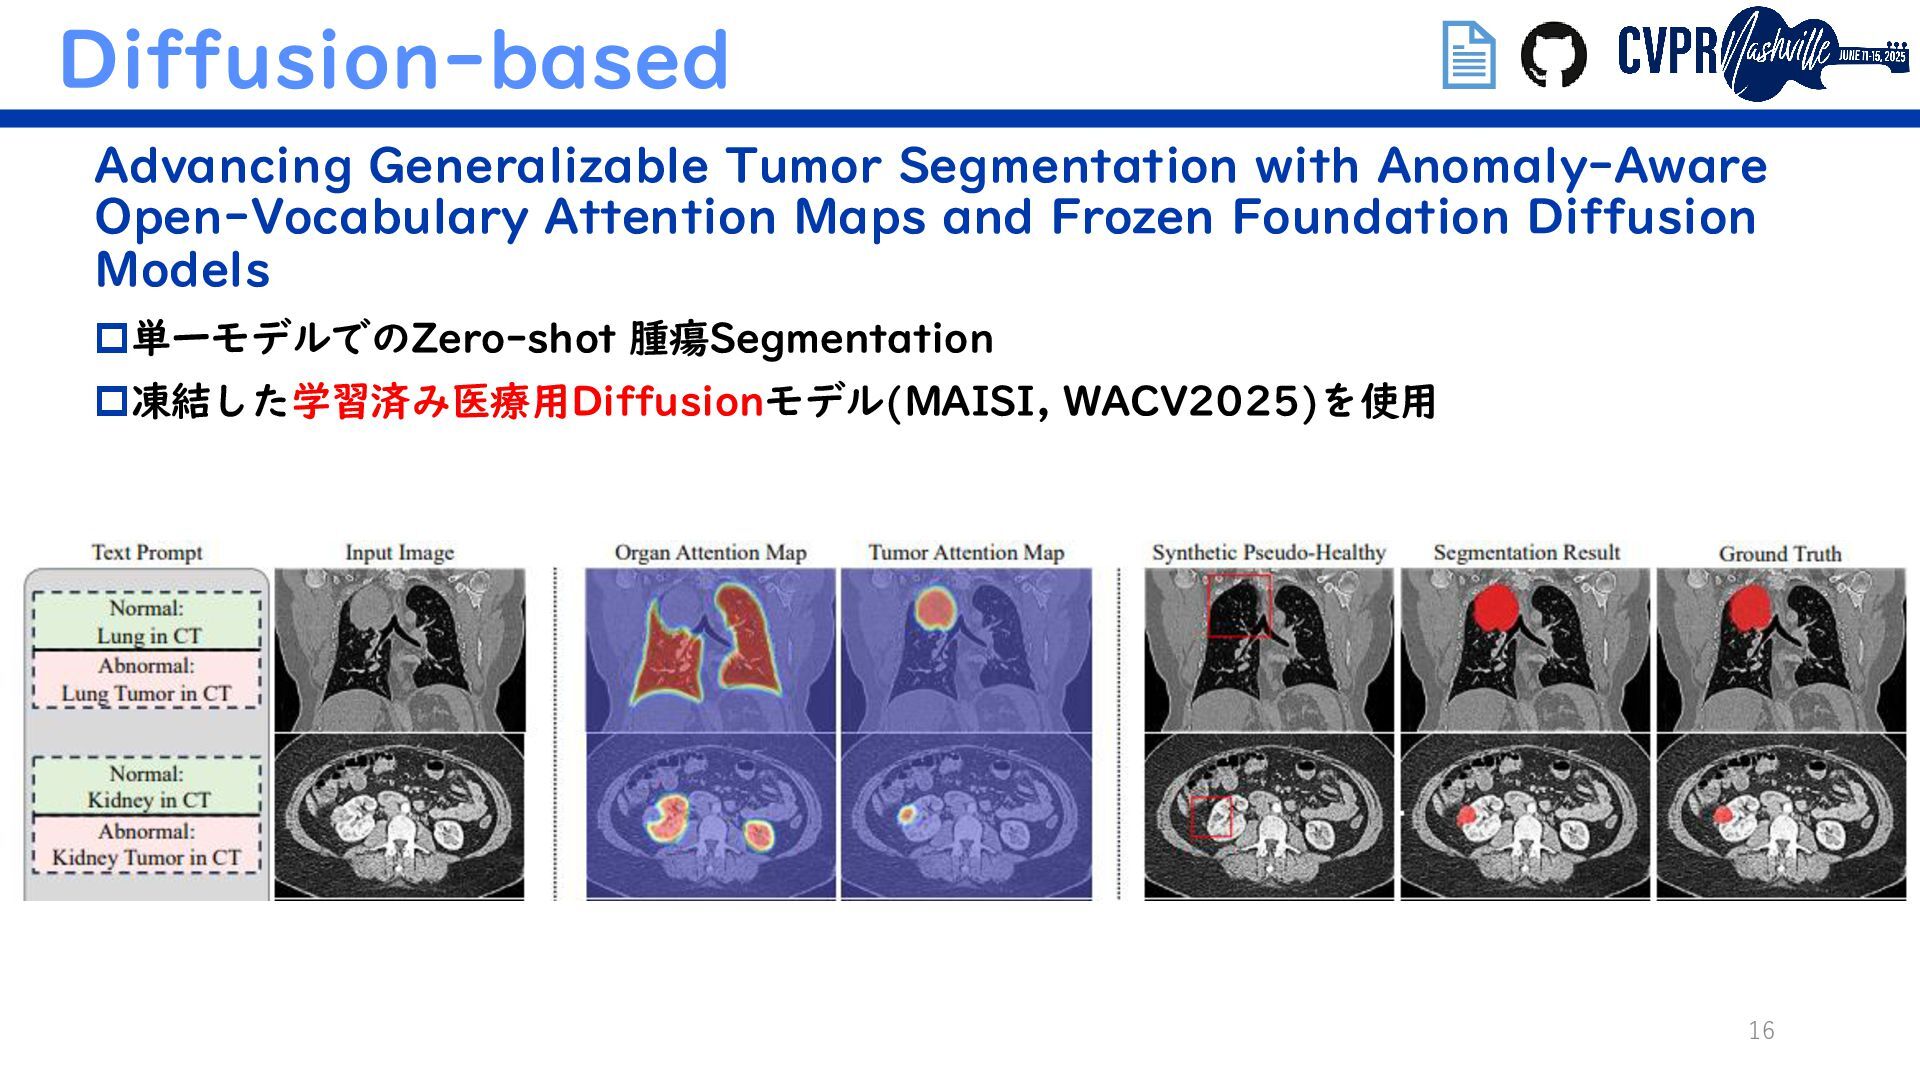
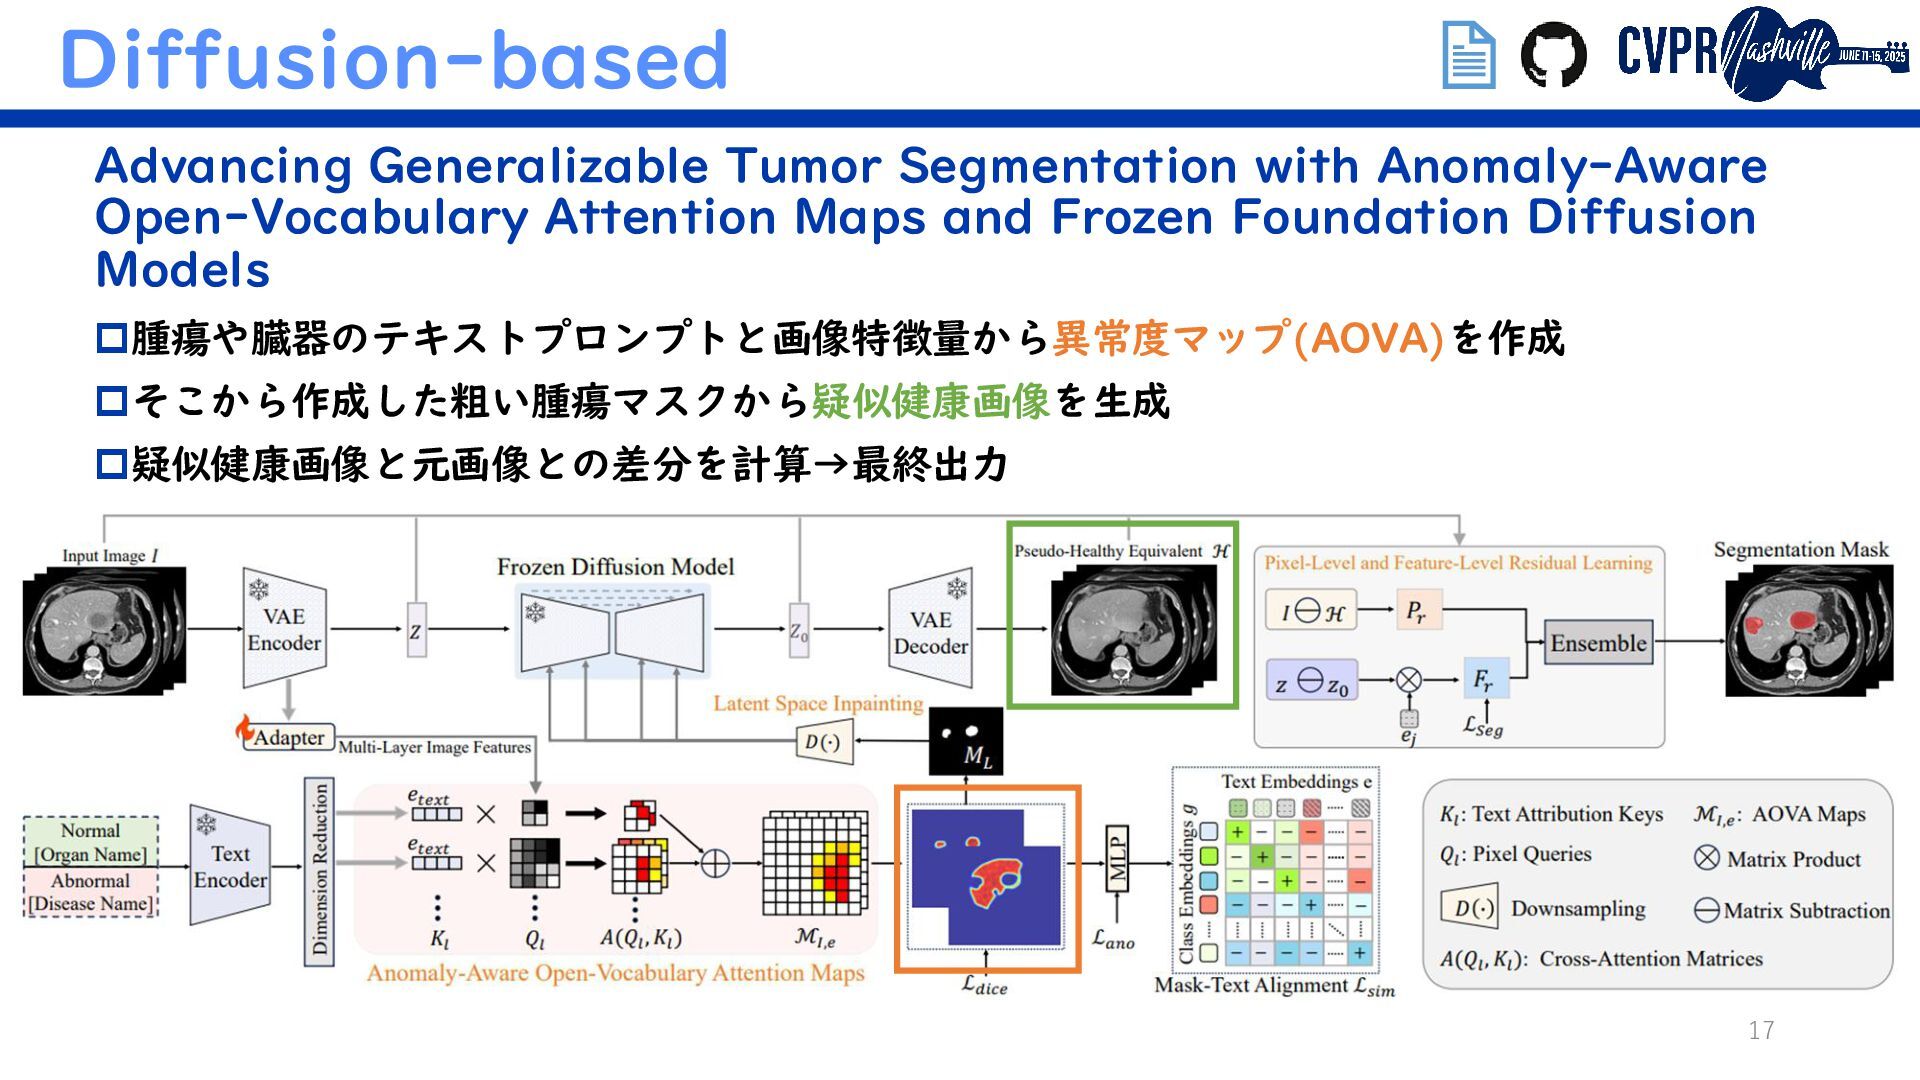
Diffusion-based 16 Advancing Generalizable Tumor Segmentation with Anomaly-Aware Open-Vocabulary Attention
Maps and Frozen Foundation Diffusion Models 単一モデルでのZero-shot 腫瘍Segmentation 凍結した学習済み医療用Diffusionモデル(MAISI, WACV2025)を使用 ド キ ュ メ ン ト -
Diffusion-based 17 Advancing Generalizable Tumor Segmentation with Anomaly-Aware Open-Vocabulary Attention
Maps and Frozen Foundation Diffusion Models 腫瘍や臓器のテキストプロンプトと画像特徴量から異常度マップ(AOVA)を作成 そこから作成した粗い腫瘍マスクから疑似健康画像を生成 疑似健康画像と元画像との差分を計算→最終出力 ド キ ュ メ ン ト -
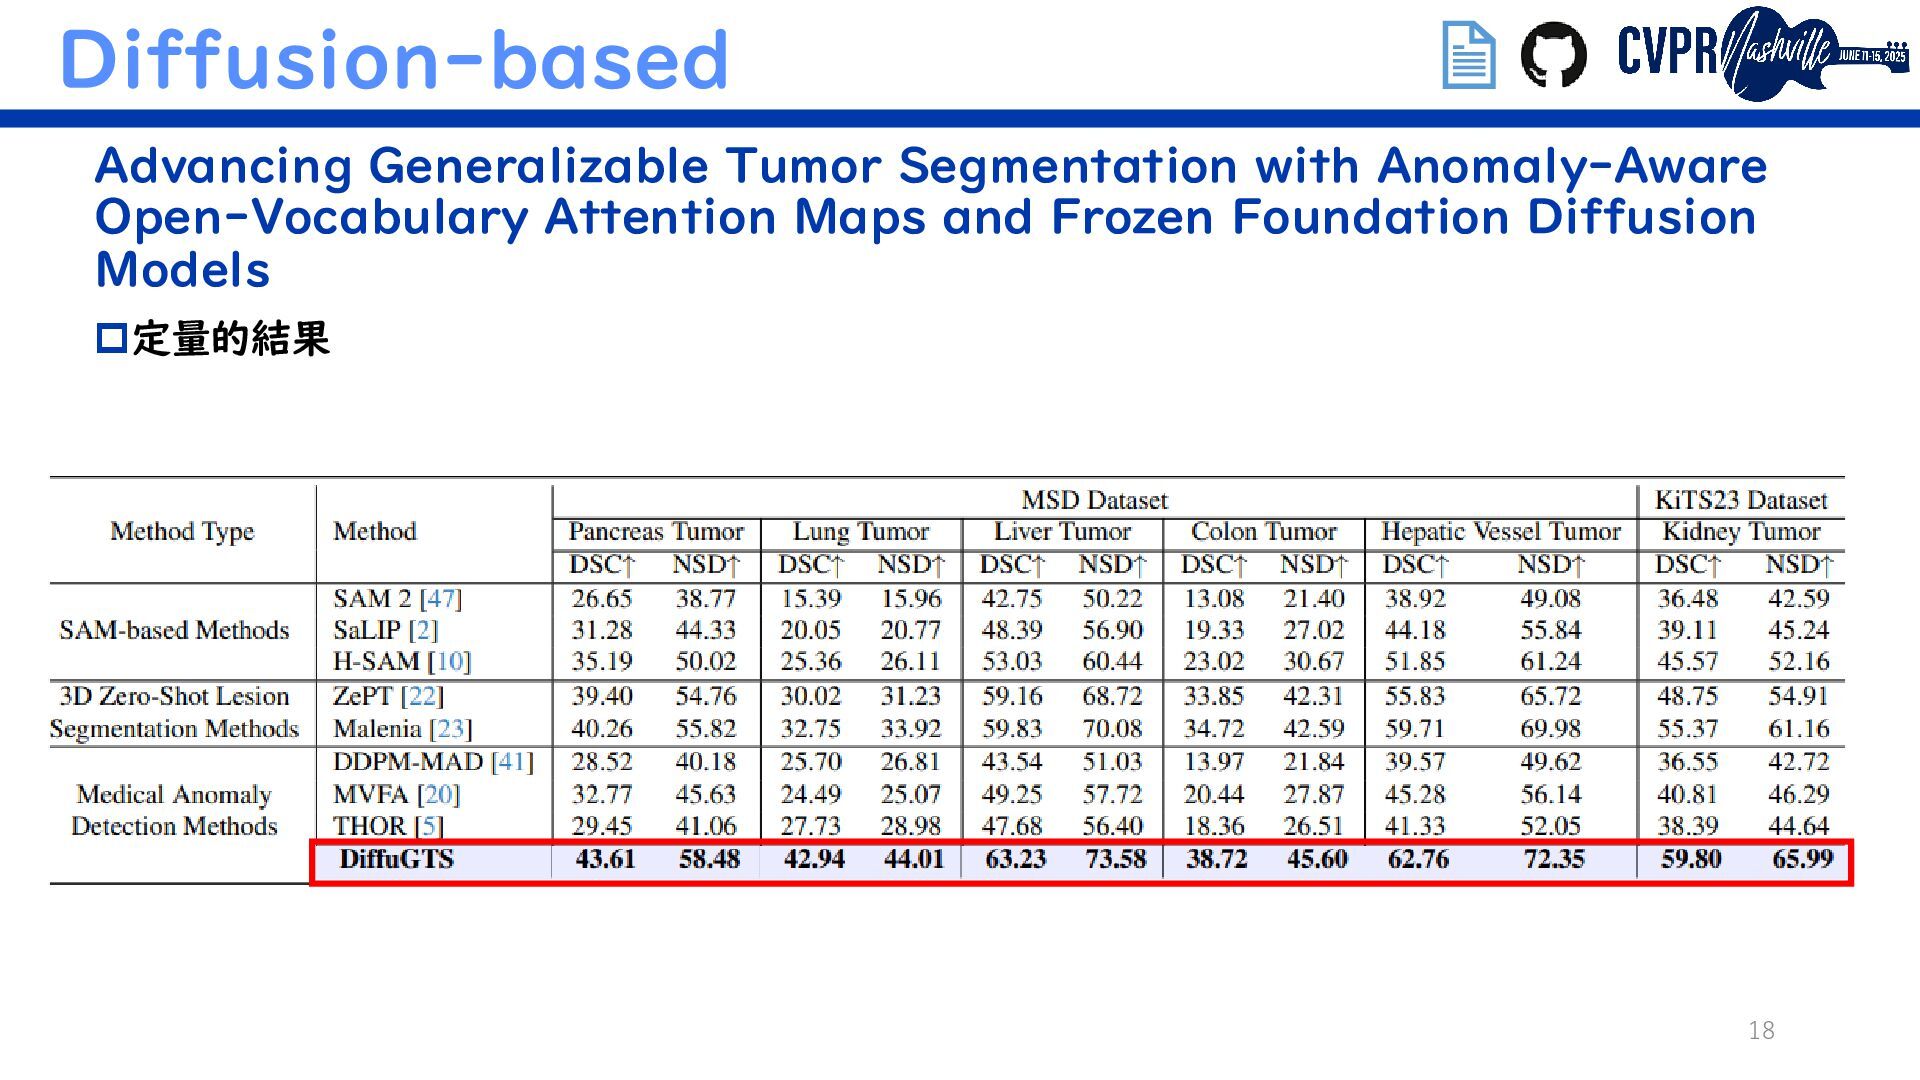
Diffusion-based 18 Advancing Generalizable Tumor Segmentation with Anomaly-Aware Open-Vocabulary Attention
Maps and Frozen Foundation Diffusion Models 定量的結果 ド キ ュ メ ン ト -
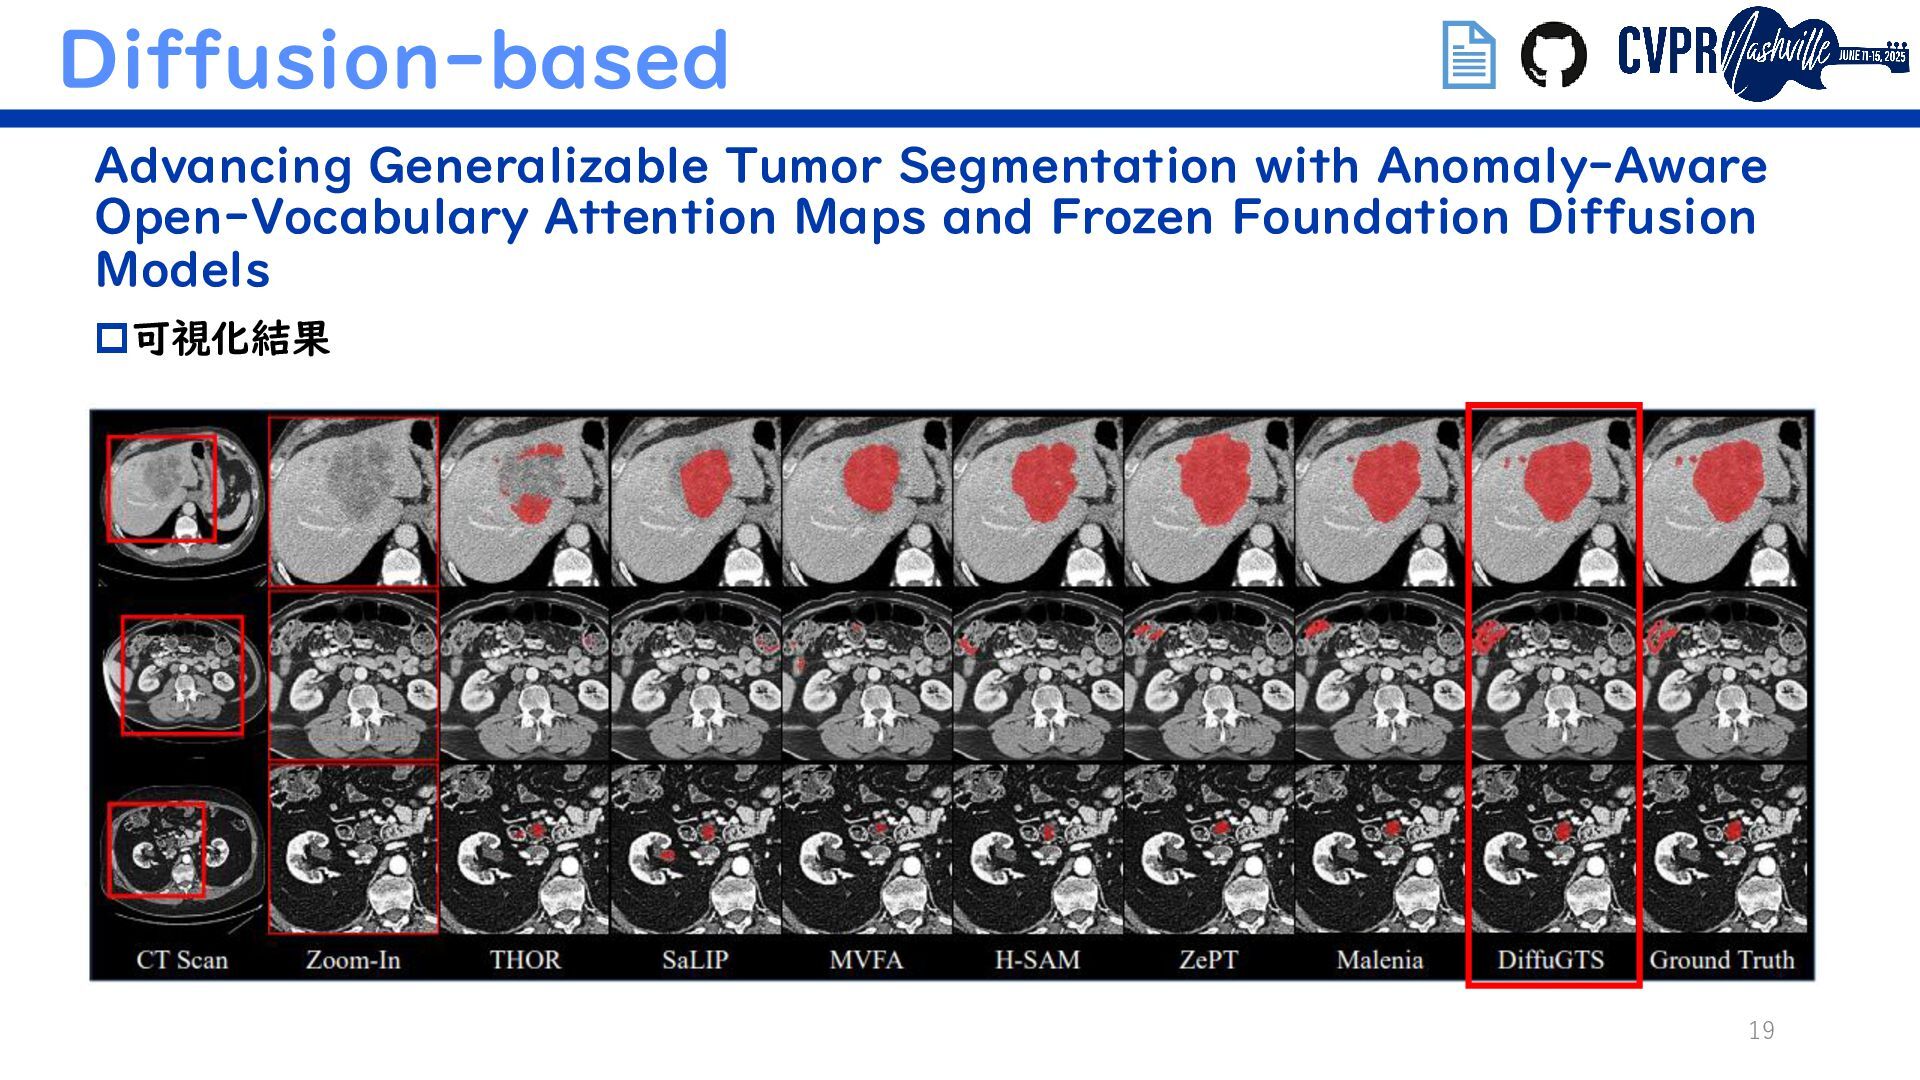
Diffusion-based 19 Advancing Generalizable Tumor Segmentation with Anomaly-Aware Open-Vocabulary Attention
Maps and Frozen Foundation Diffusion Models 可視化結果 ド キ ュ メ ン ト -
まとめ 20 直近数年間での変化 - 教師あり学習・新構造提案などの論文数が減少 - Zero-shot/ DG/ Open-Vocab
等「困難な条件下」への挑戦が主流に - 軽量化・高速化(Real-time)も引き続き研究対象 →Reparam前提になりつつある 新たな軸 • VFMやVLM, 特に凍結 + Adapter微調整が基本戦略化 →いかに低コストかつ効果的にFine-tuningするか • テキストやプロンプトとの連携も重要性を増している • 医用画像特化のDiffusionモデルの登場などによりさらに応用が加速?