Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ニューラルかな漢字変換の仕組みと運用(第59回 情報科学若手の会 若手特別講演 登壇資料)

Avatar for Keita Miwa Keita Miwa
September 06, 2026
570

ニューラルかな漢字変換の仕組みと運用(第59回 情報科学若手の会 若手特別講演 登壇資料)

第59回 情報科学若手の会 若手特別講演「ニューラルかな漢字変換の仕組みと運用」の登壇資料です。

【概要】
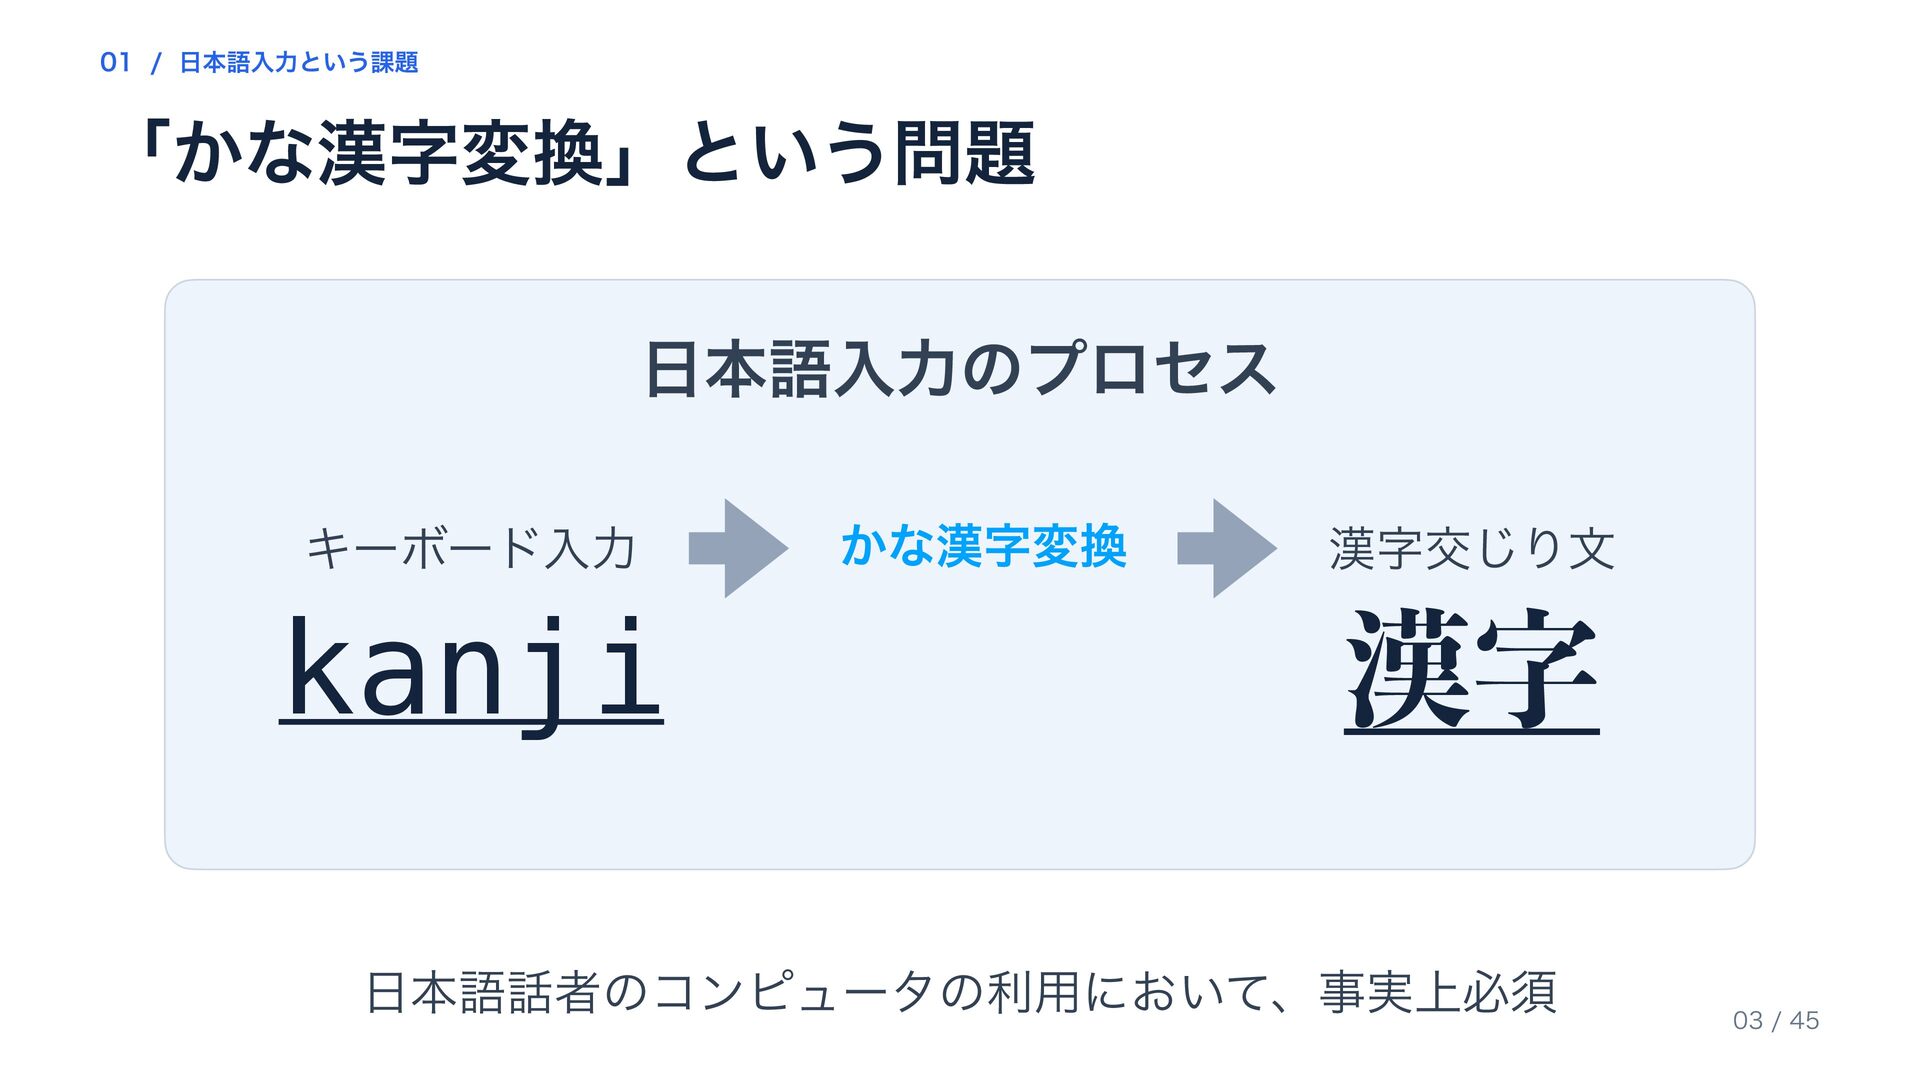
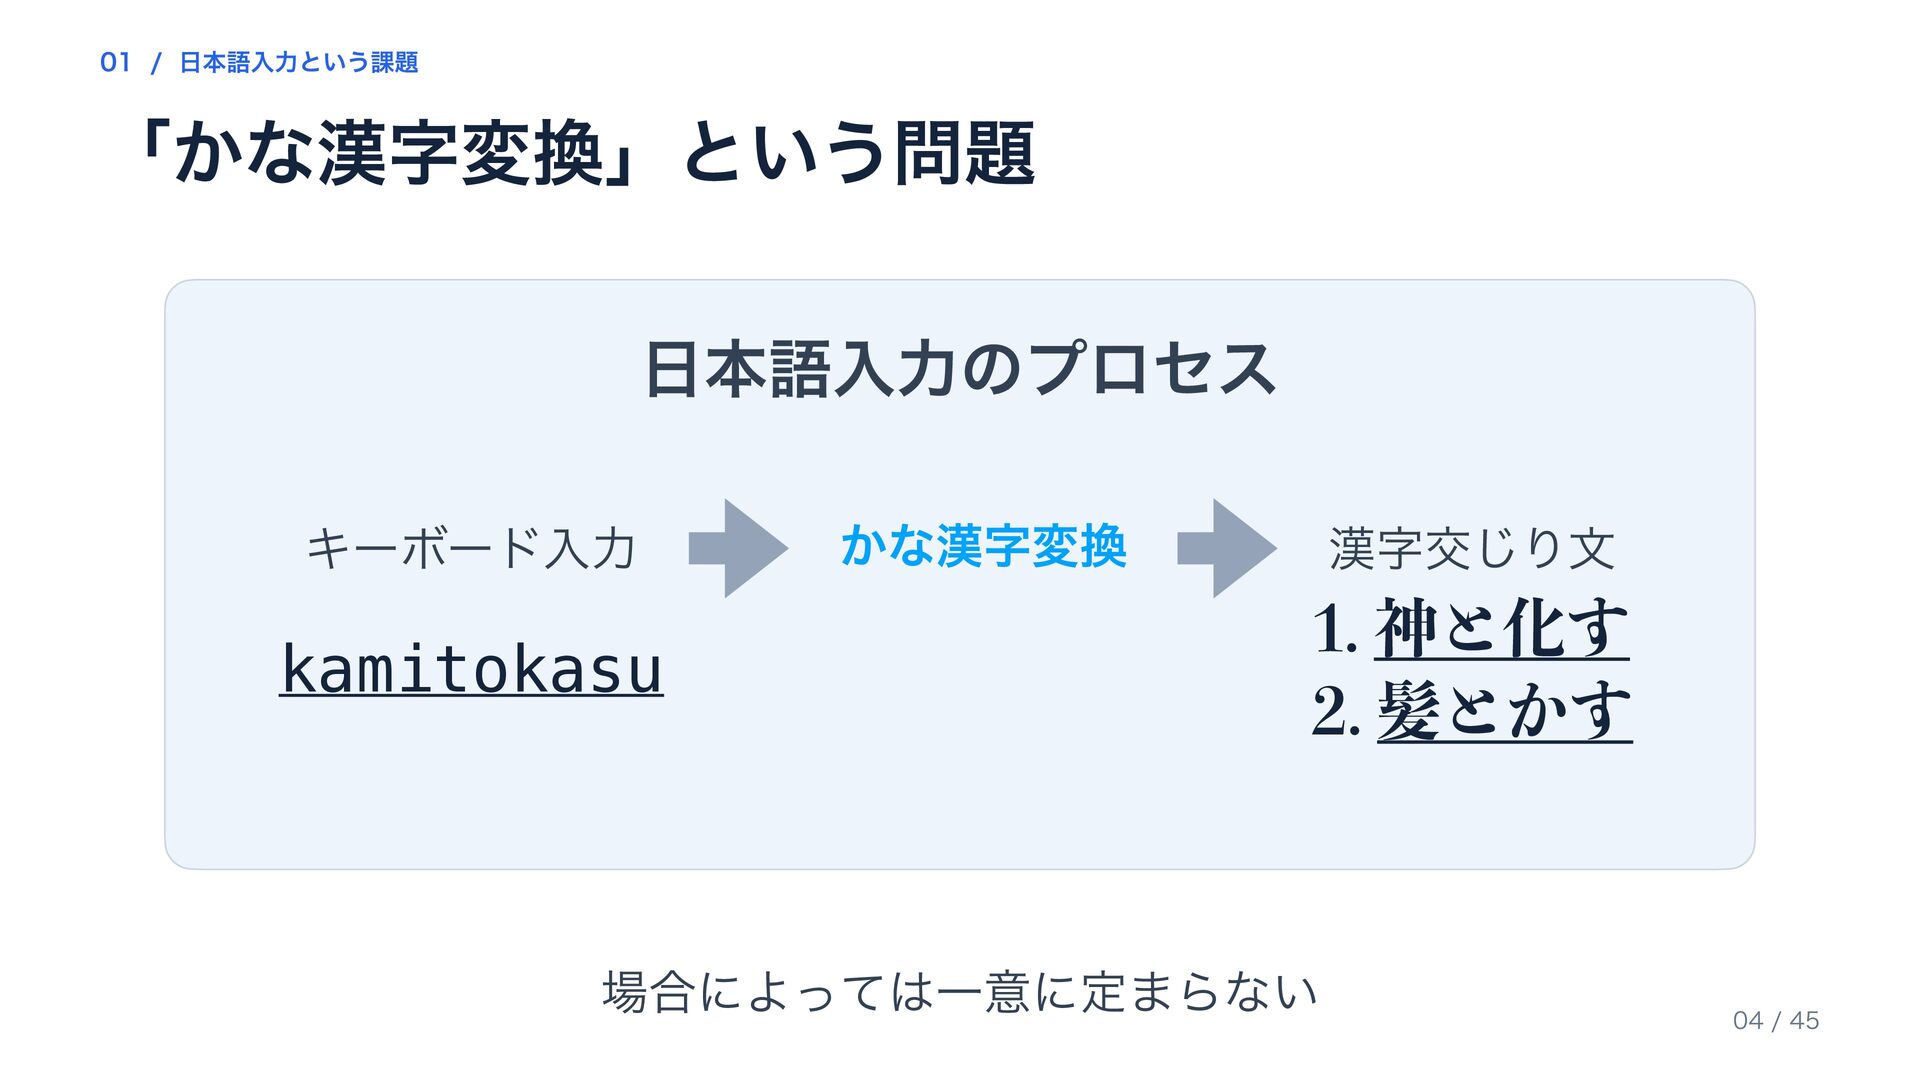
最近では自然言語処理というと機械翻訳やLLMのようなアプリケーションが第一に想起されそうですが、ずっと昔から日本語話者が活用してきた自然言語処理アプリケーションが日本語入力の中心となる「かな漢字変換」です。 私は過去6年ほどにわたりかな漢字変換システムの開発に取り組み、2024年にGPT-2のローカル実行に基づく「ニューラルかな漢字変換」の技術を開発しました。 本講演では、このニューラルかな漢字変換の仕組みや設計に触れつつ、実世界にリリースするAIアプリケーションとしての構築・運用に関する知見も紹介します。

Avatar for Keita Miwa

Keita Miwa

September 06, 2026

Transcript

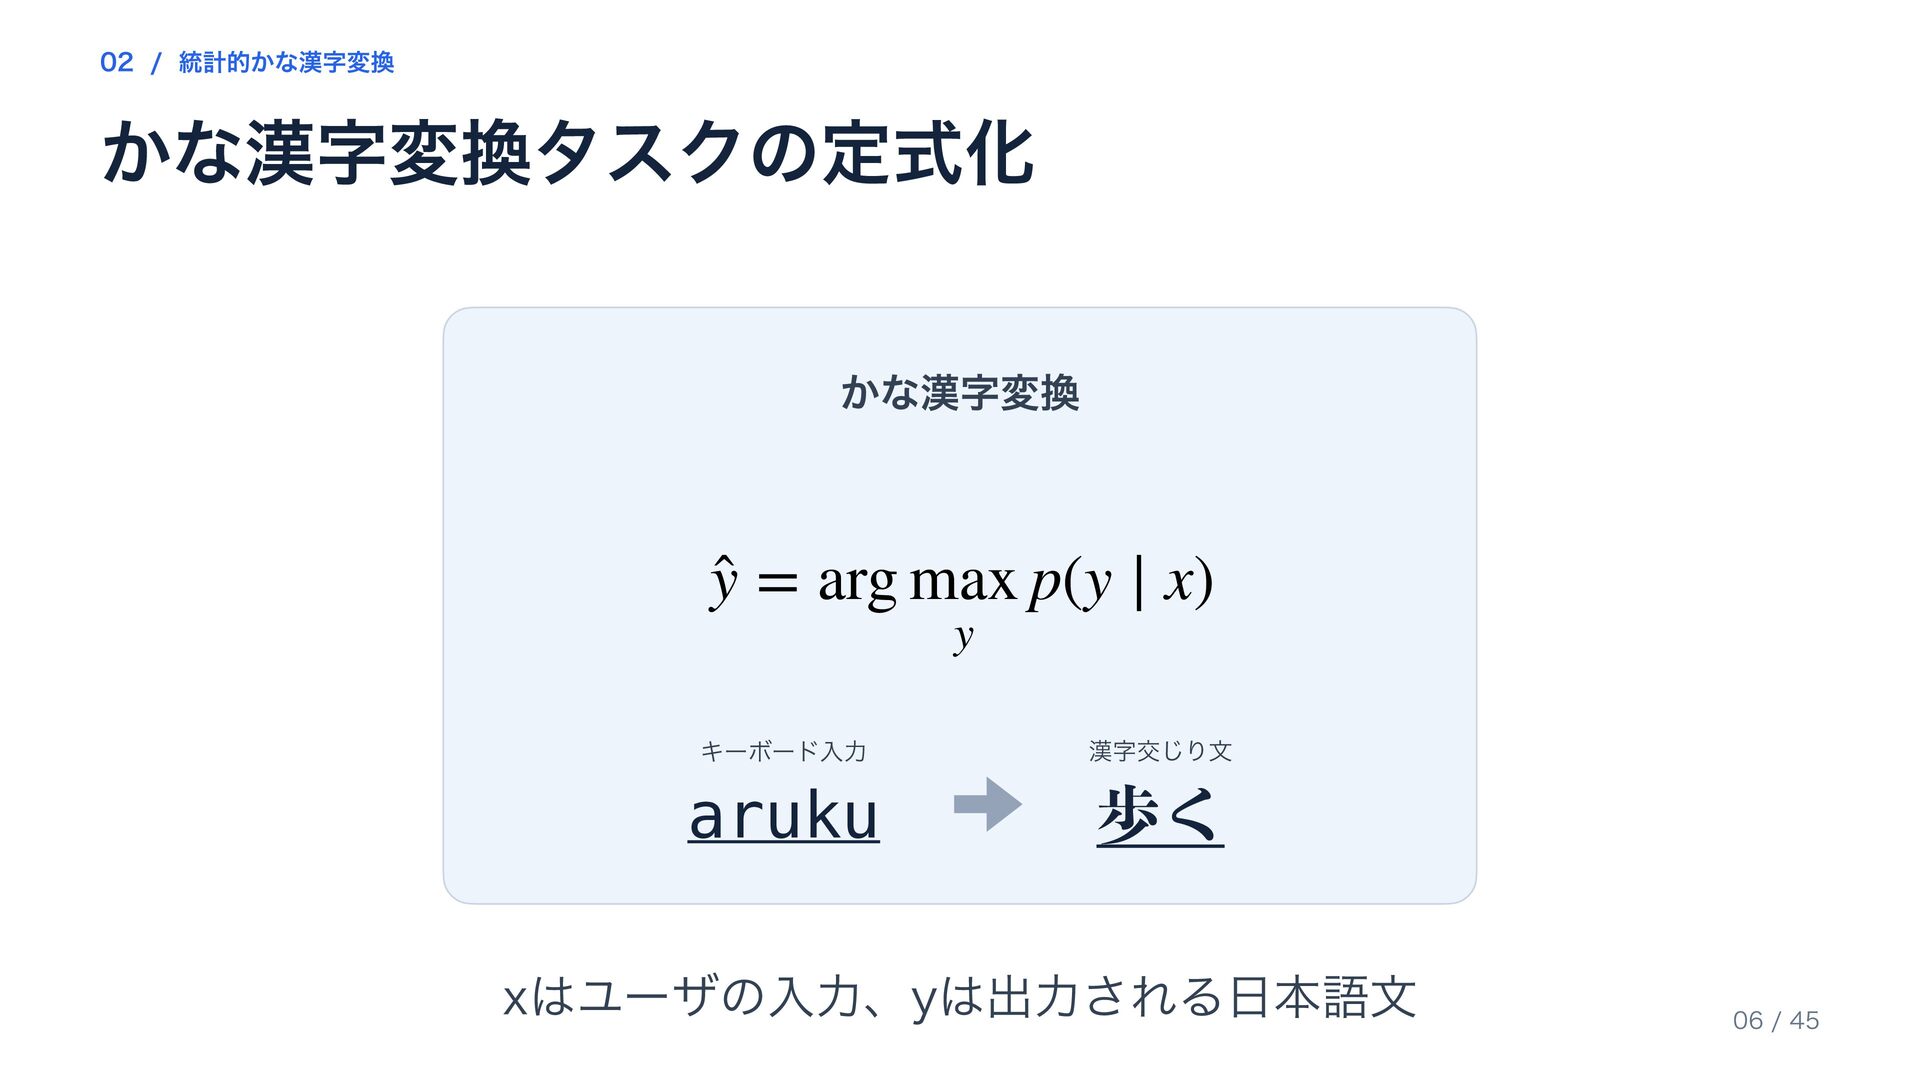
  1. 02 / 統計的かな漢字変換 かな漢字変換タスクの定式化 かな漢字変換 ŷ = arg max p(y

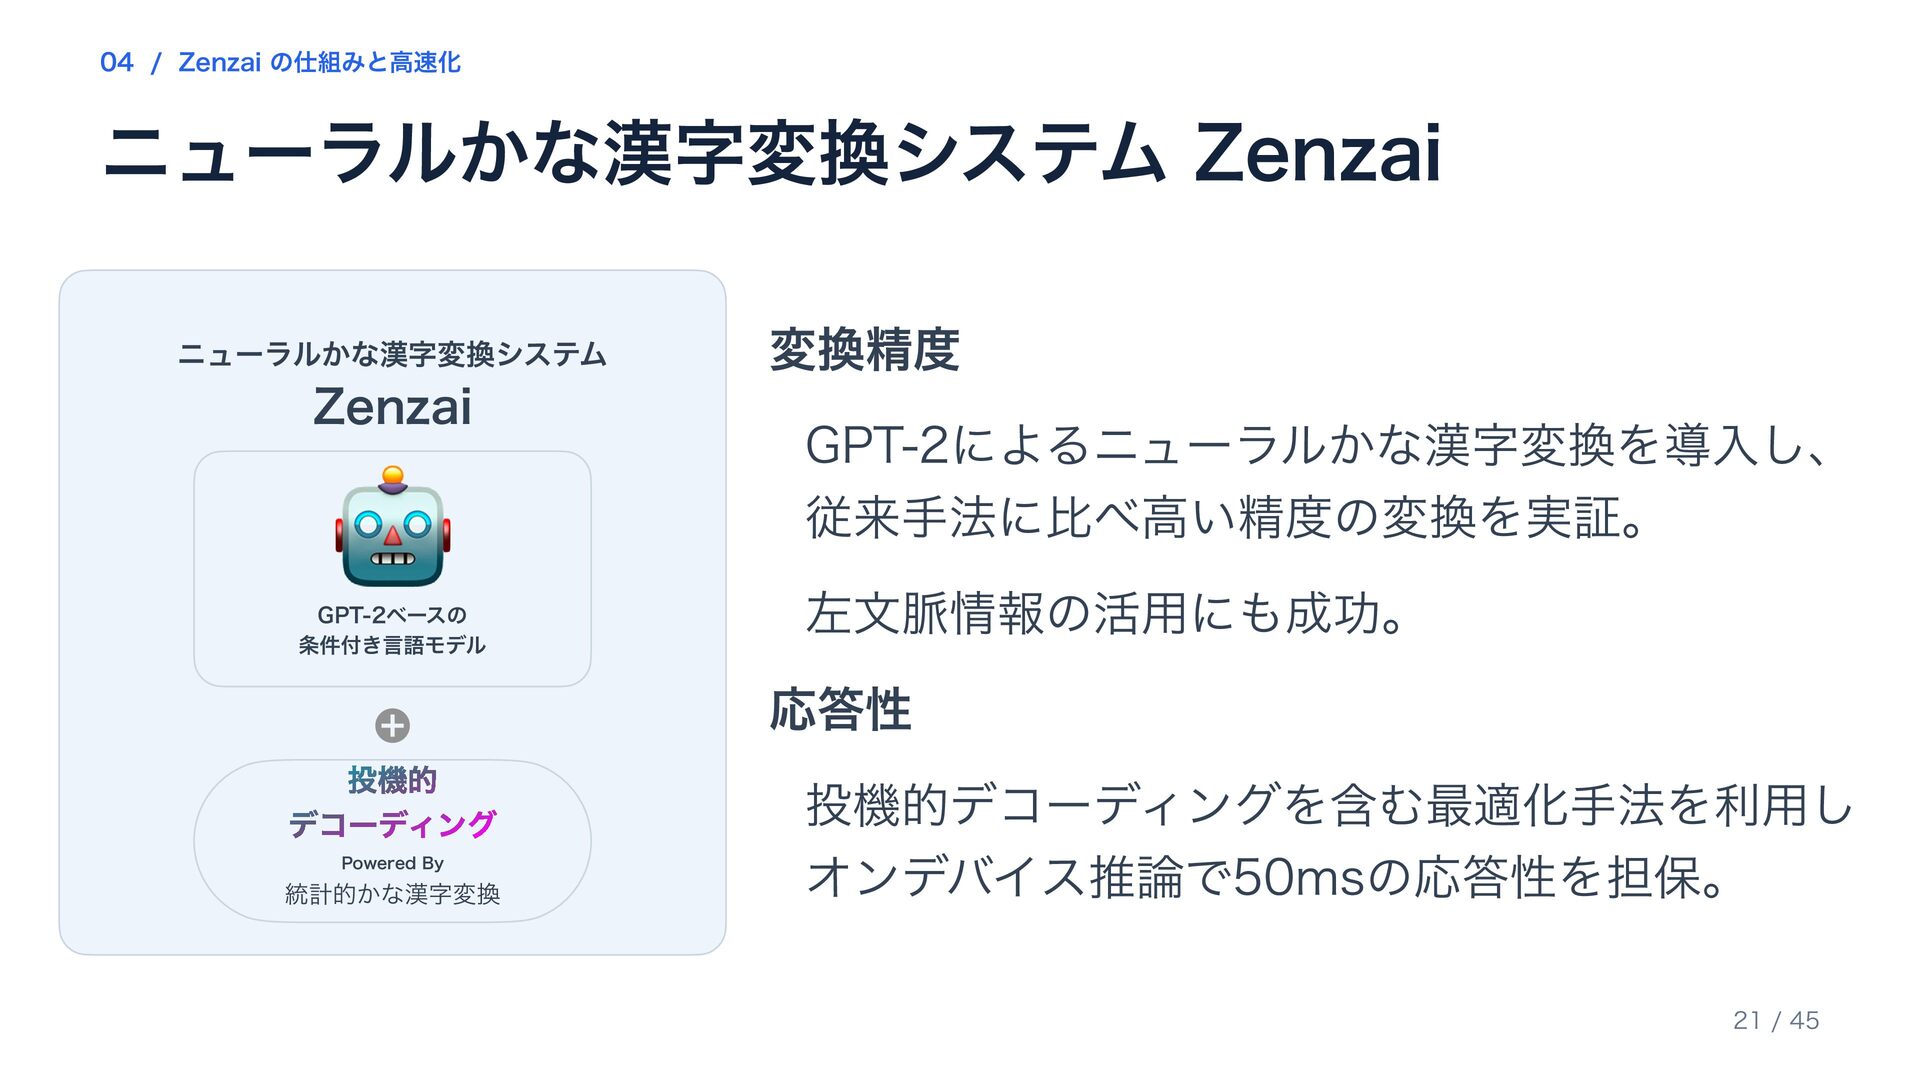
    ∣ x) y キーボード入力 漢字交じり文 aruku 歩く xはユーザの入力、yは出力される日本語文 06 / 45
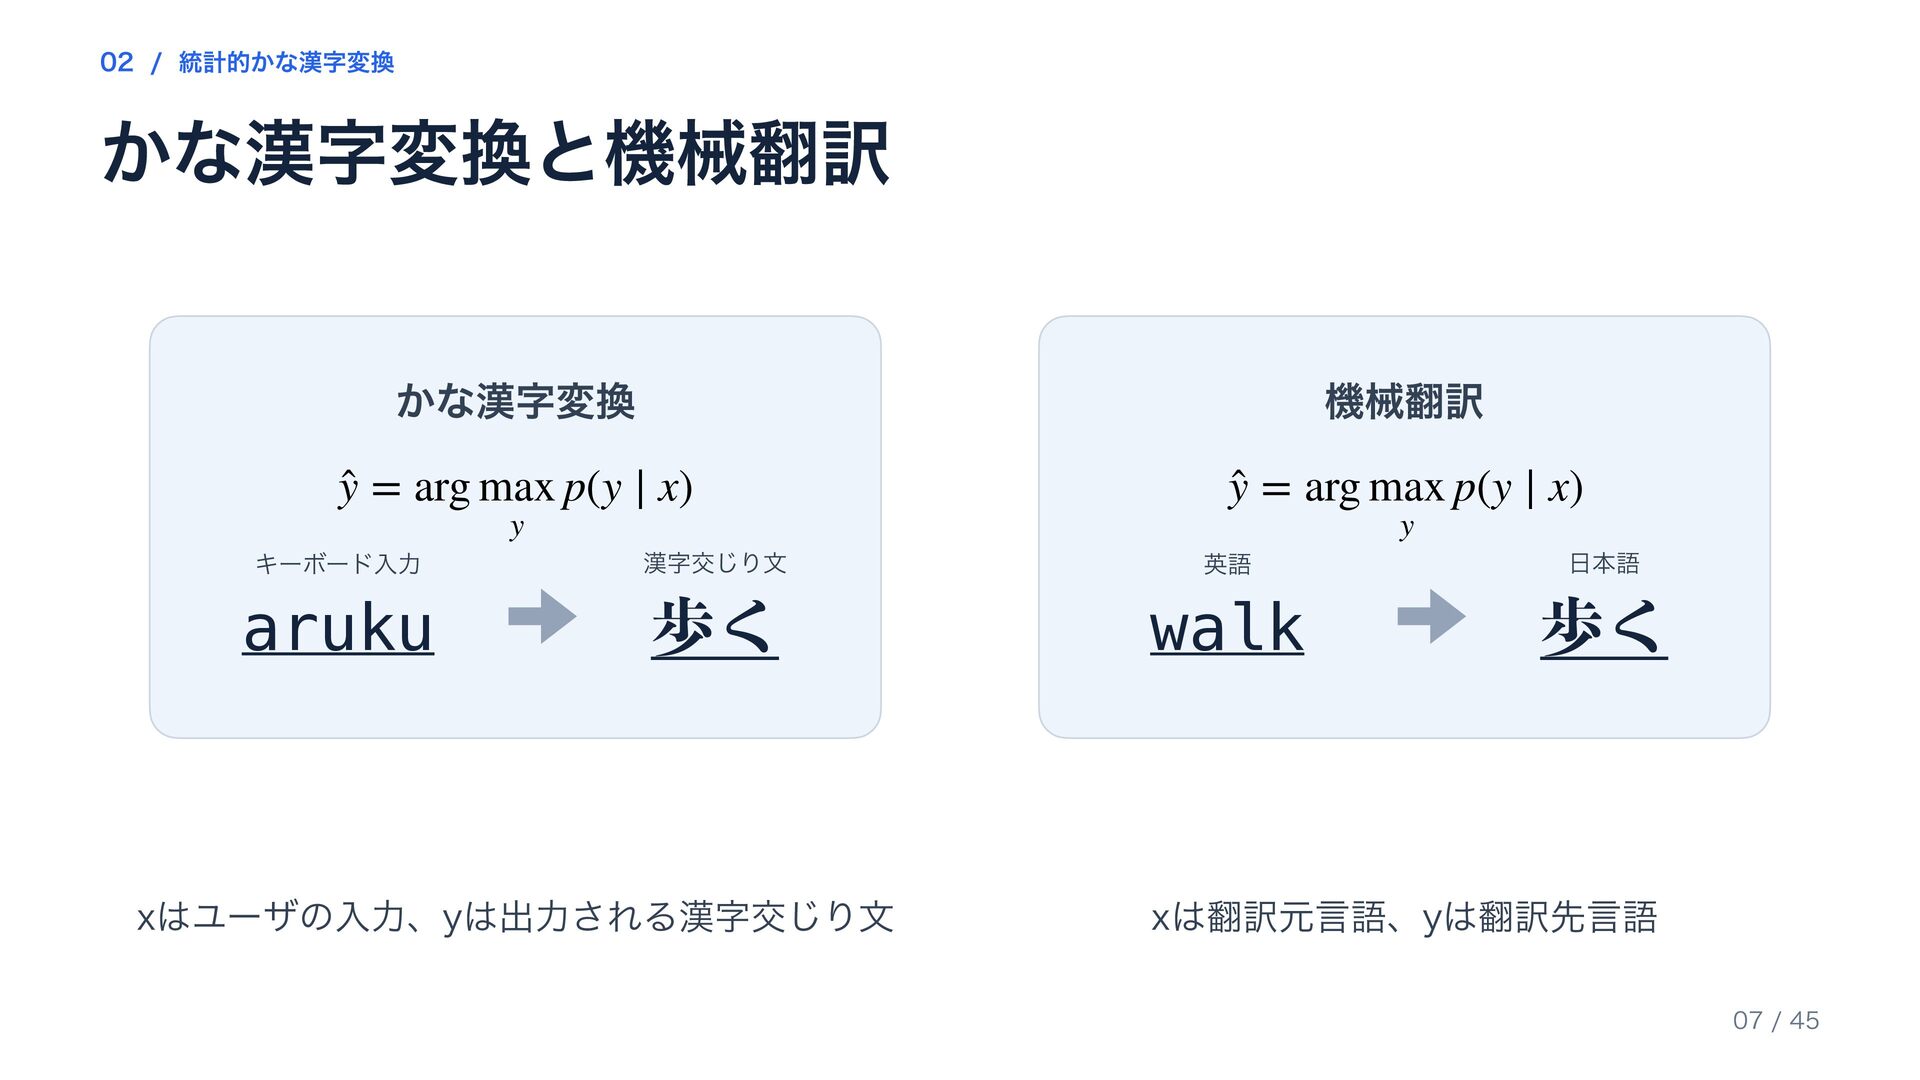
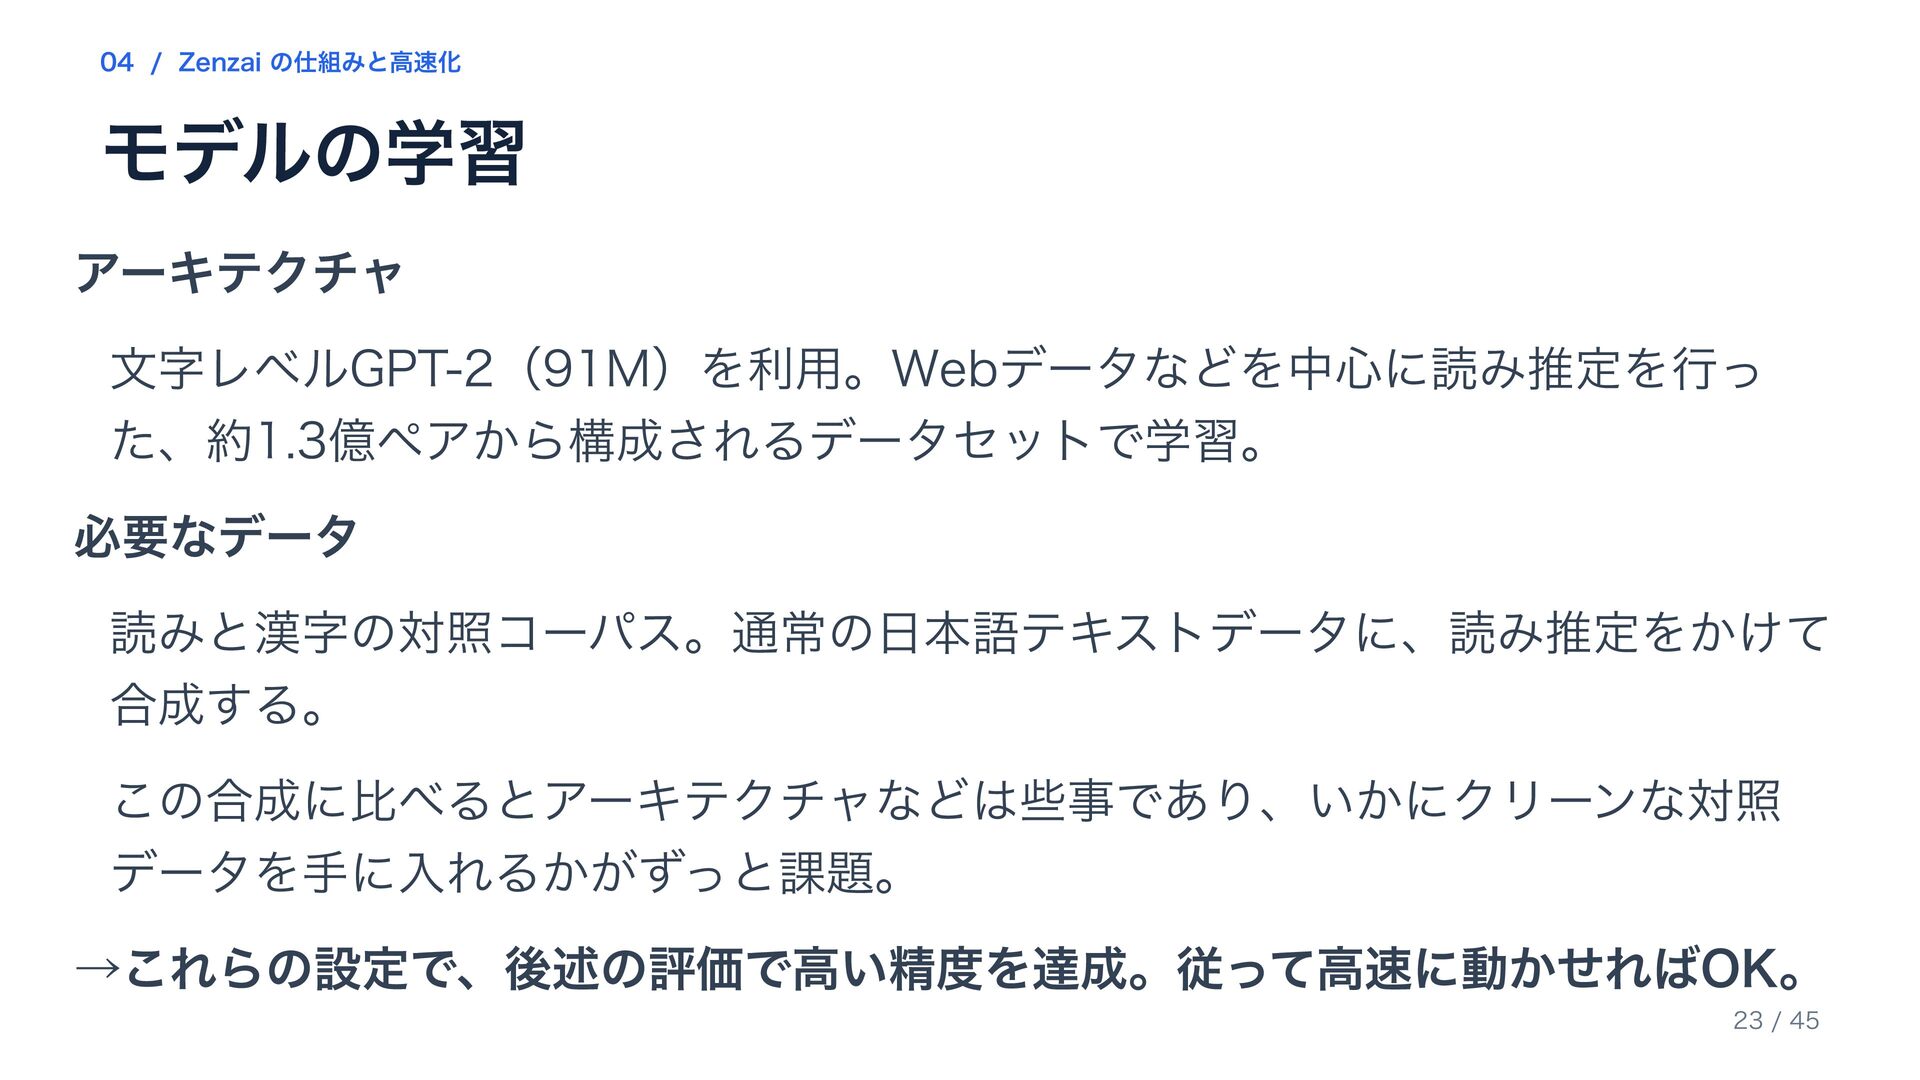
  2. 02 / 統計的かな漢字変換 かな漢字変換と機械翻訳 かな漢字変換 機械翻訳 ŷ = arg max

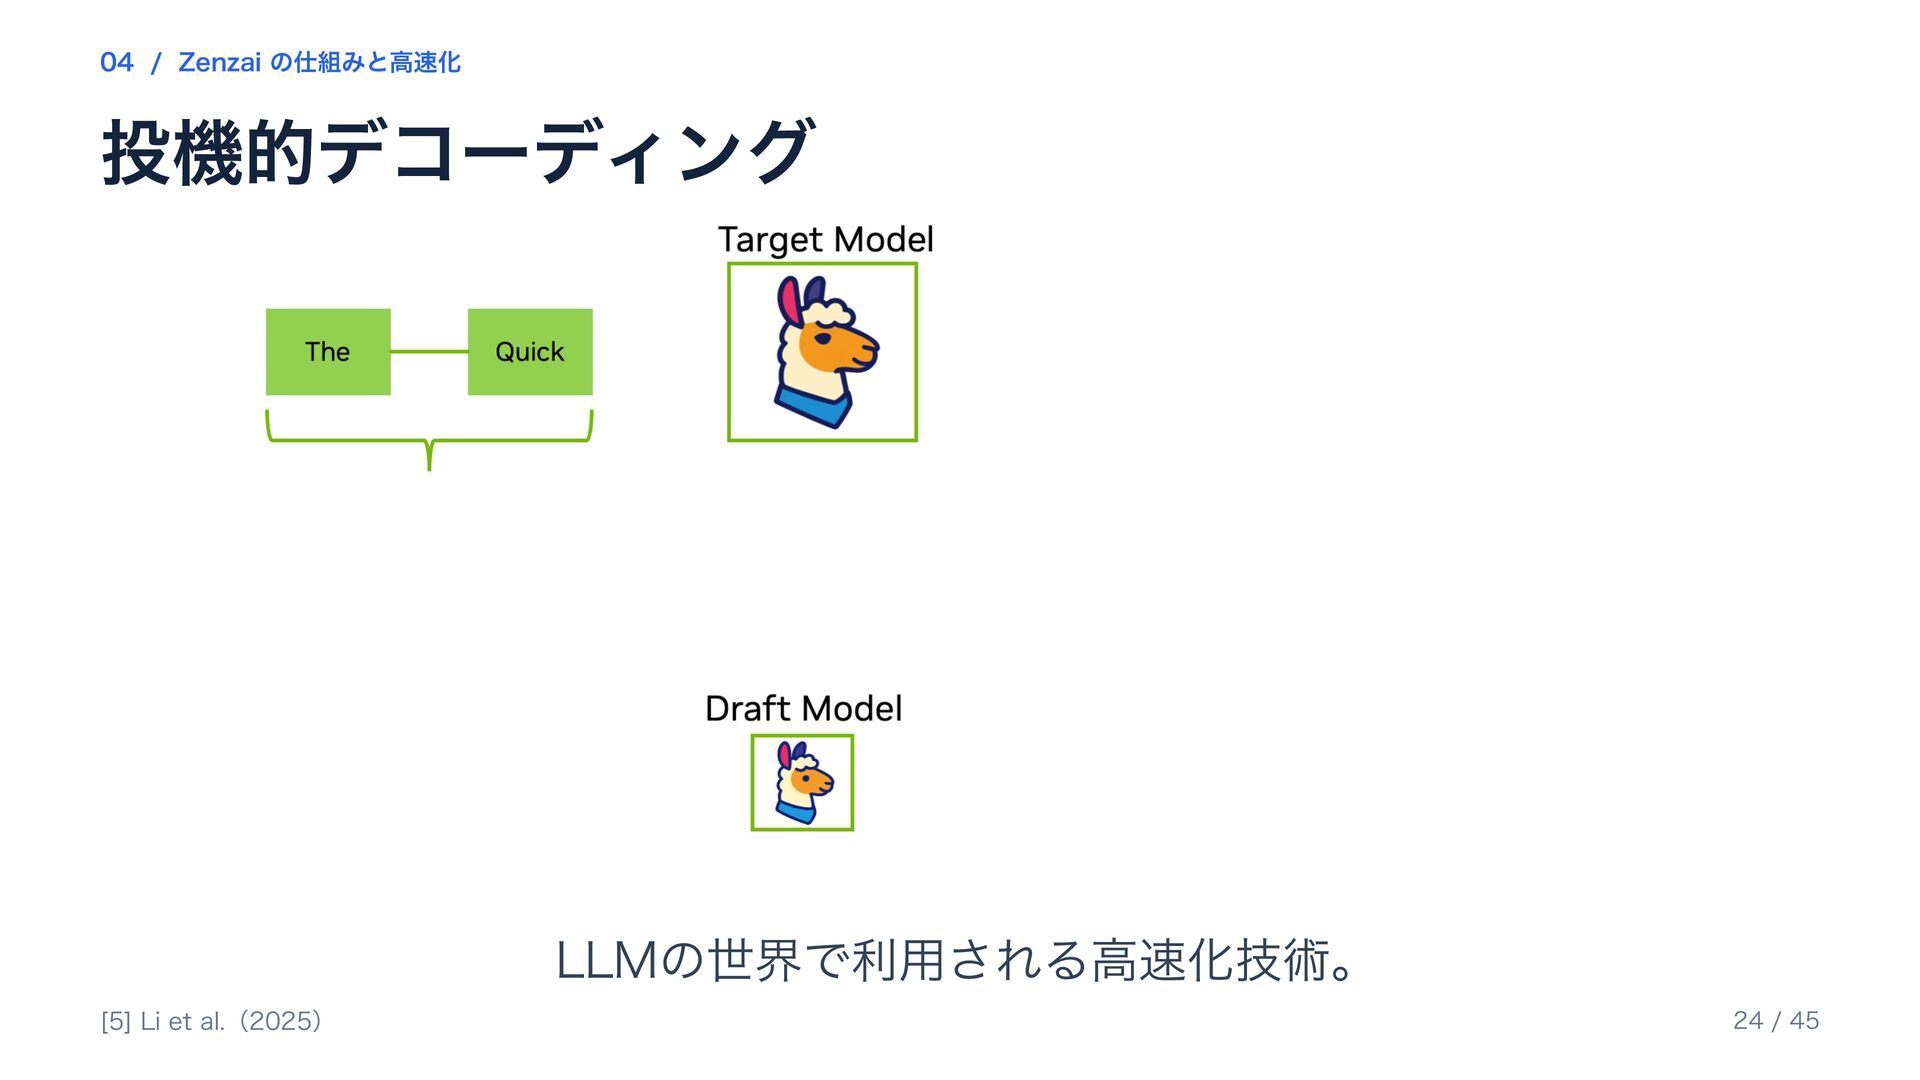
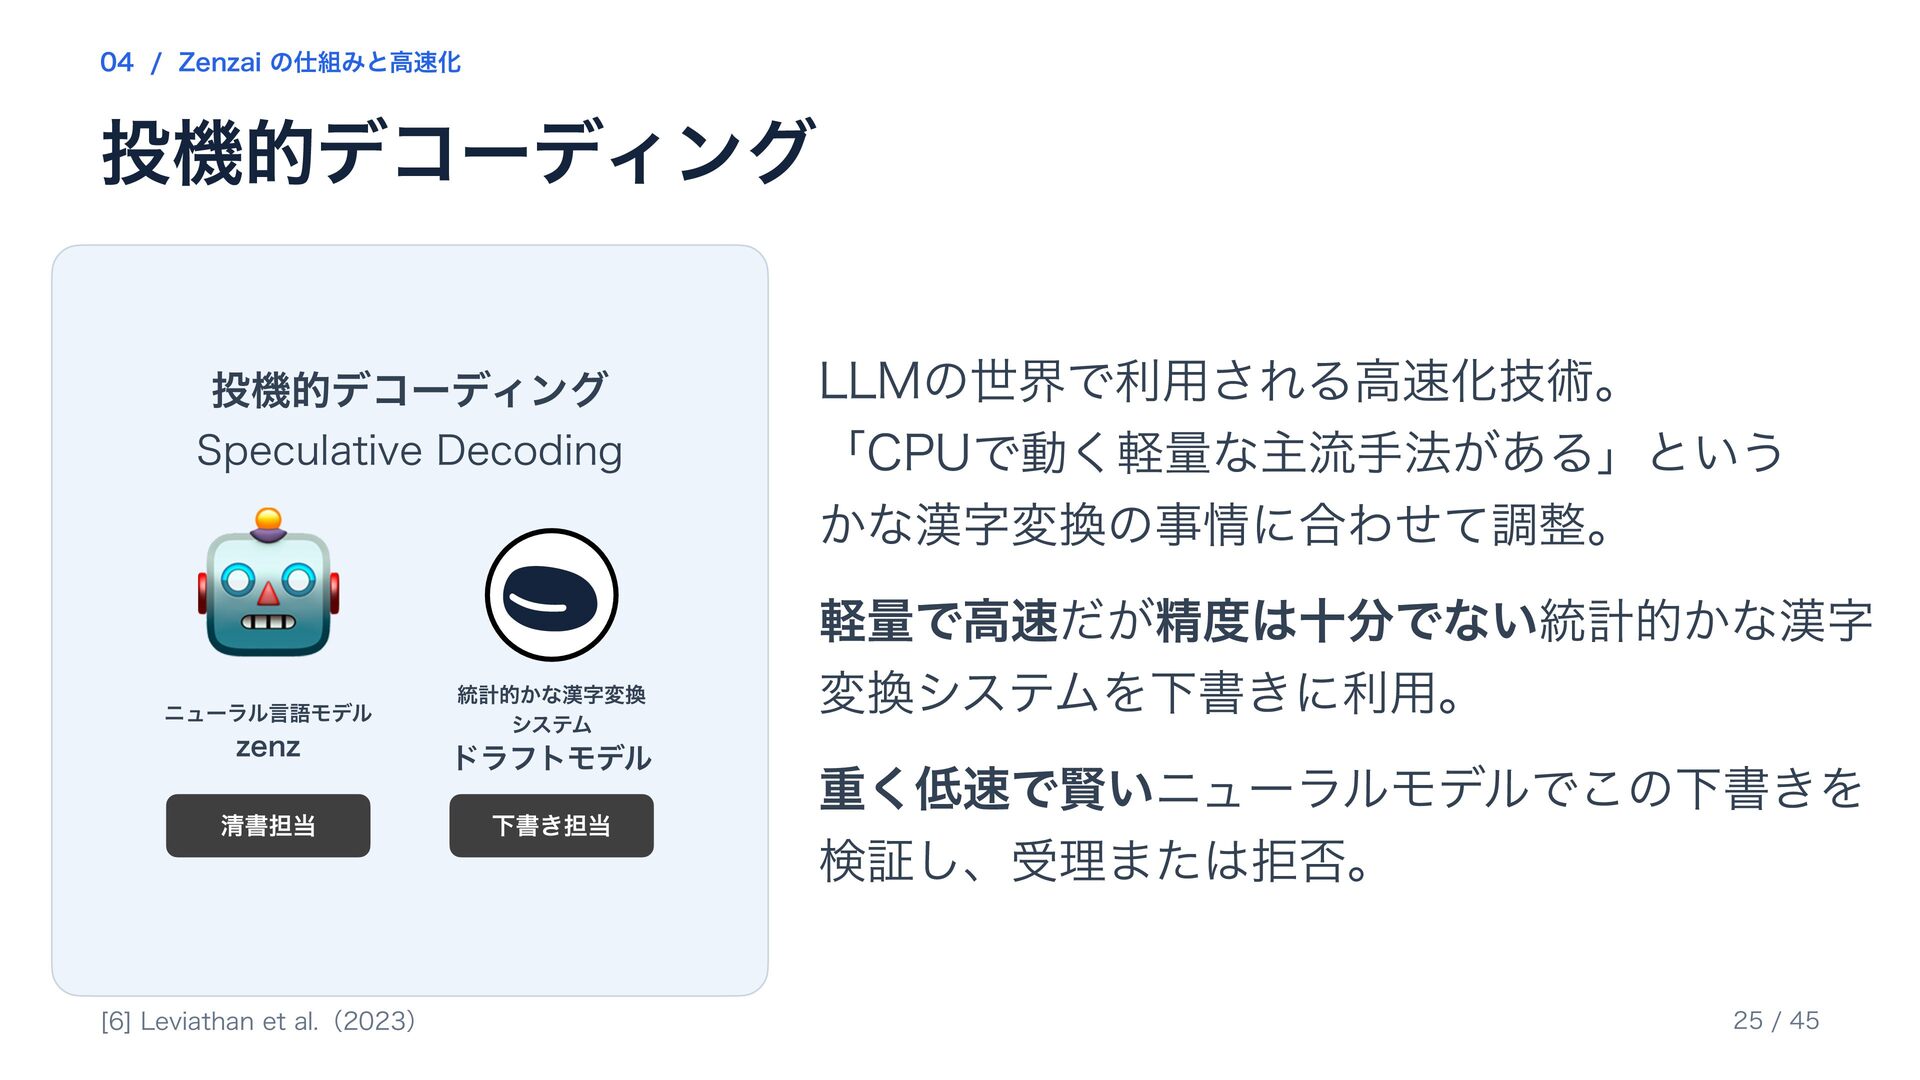
    p(y ∣ x) ŷ = arg max p(y ∣ x) y y キーボード入力 漢字交じり文 英語 日本語 aruku 歩く walk 歩く xはユーザの入力、yは出力される漢字交じり文 xは翻訳元言語、yは翻訳先言語 07 / 45
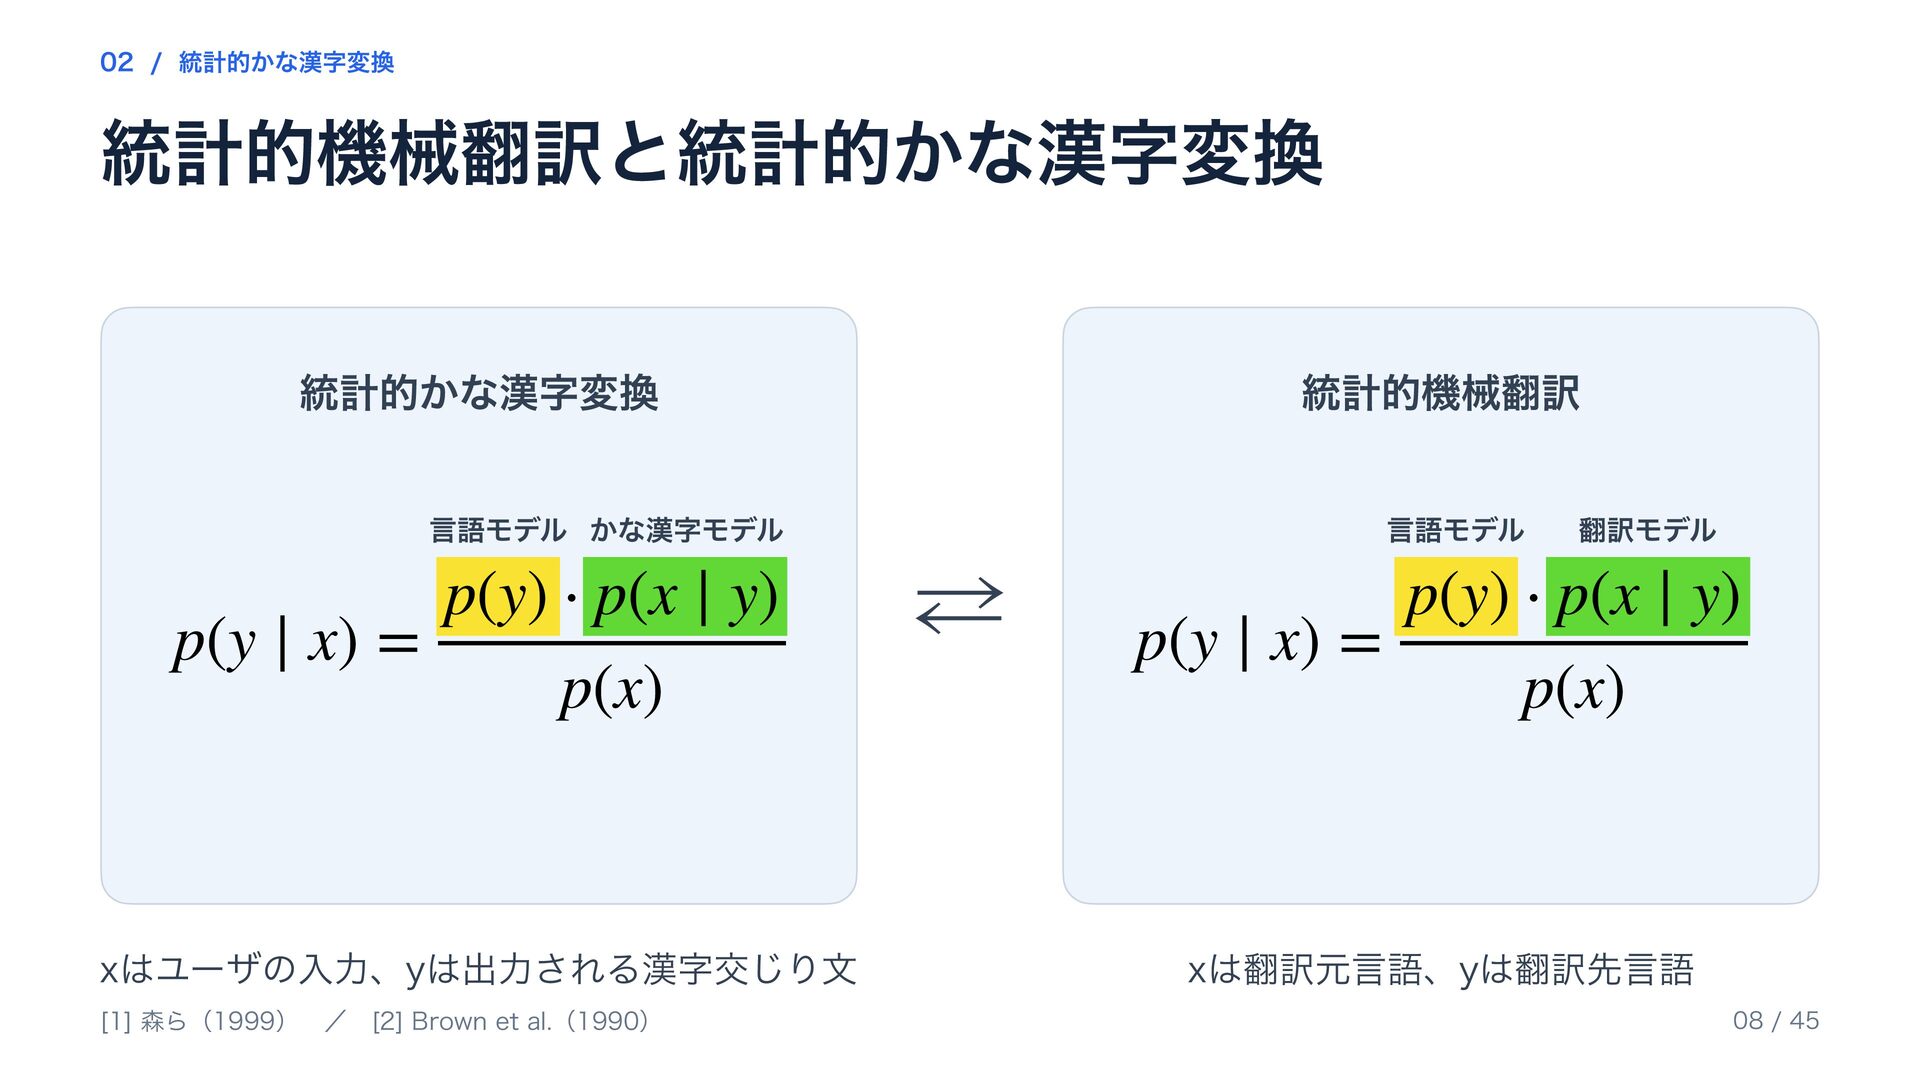
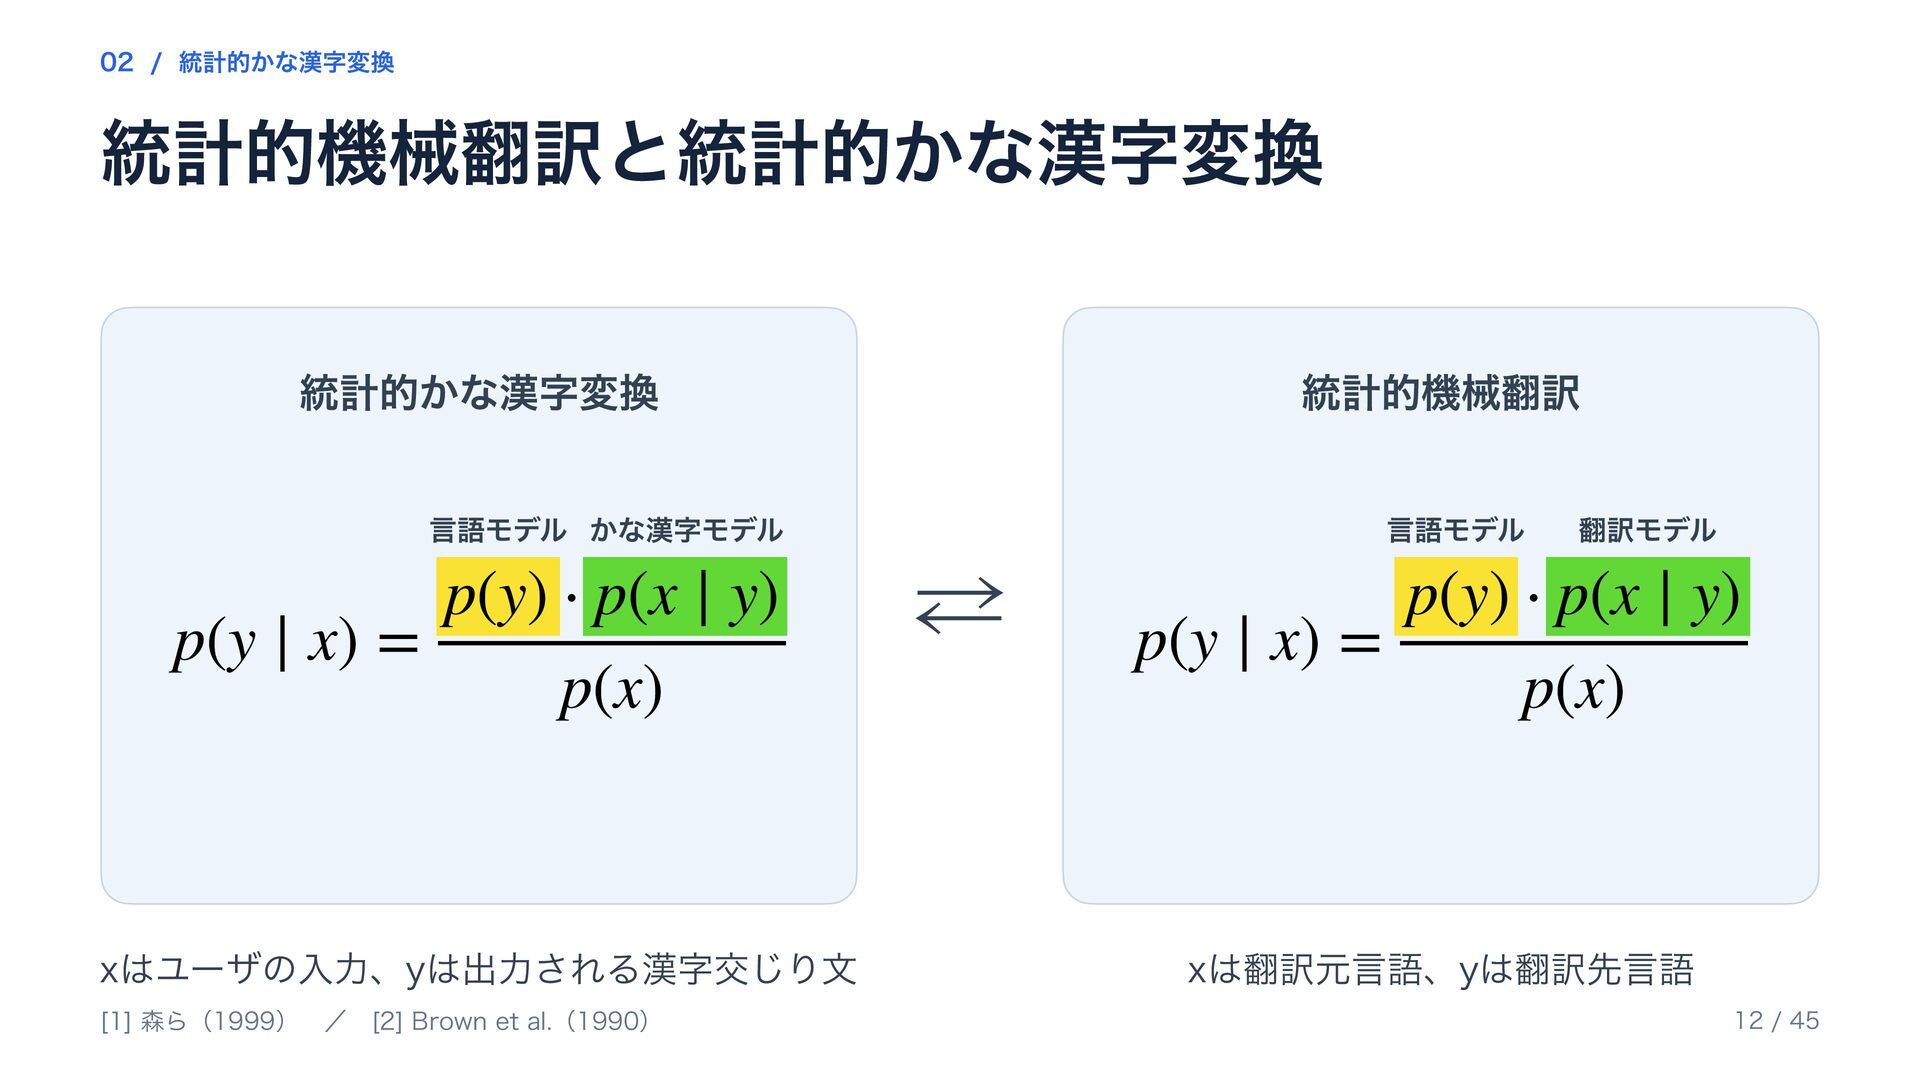
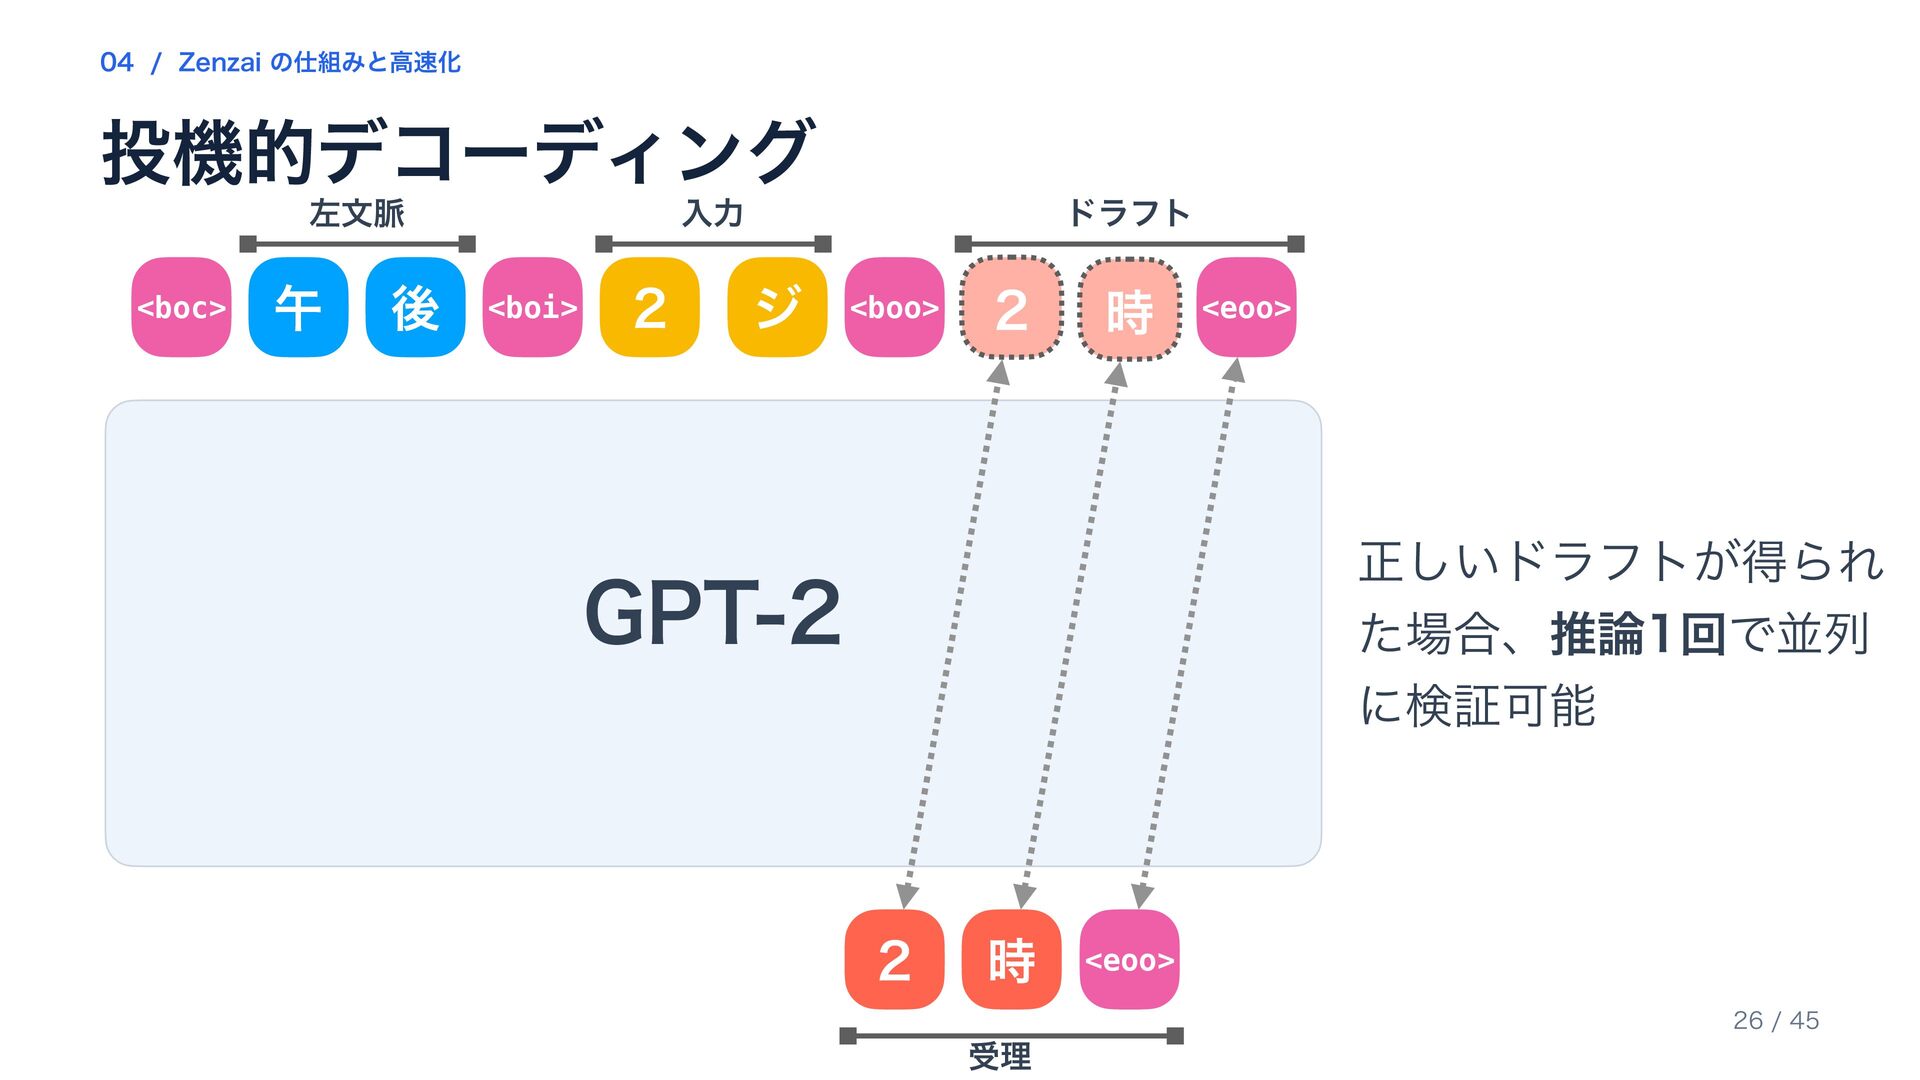
  3. 02 / 統計的かな漢字変換 統計的機械翻訳と統計的かな漢字変換 統計的かな漢字変換 統計的機械翻訳 言語モデル かな漢字モデル p(y) ⋅

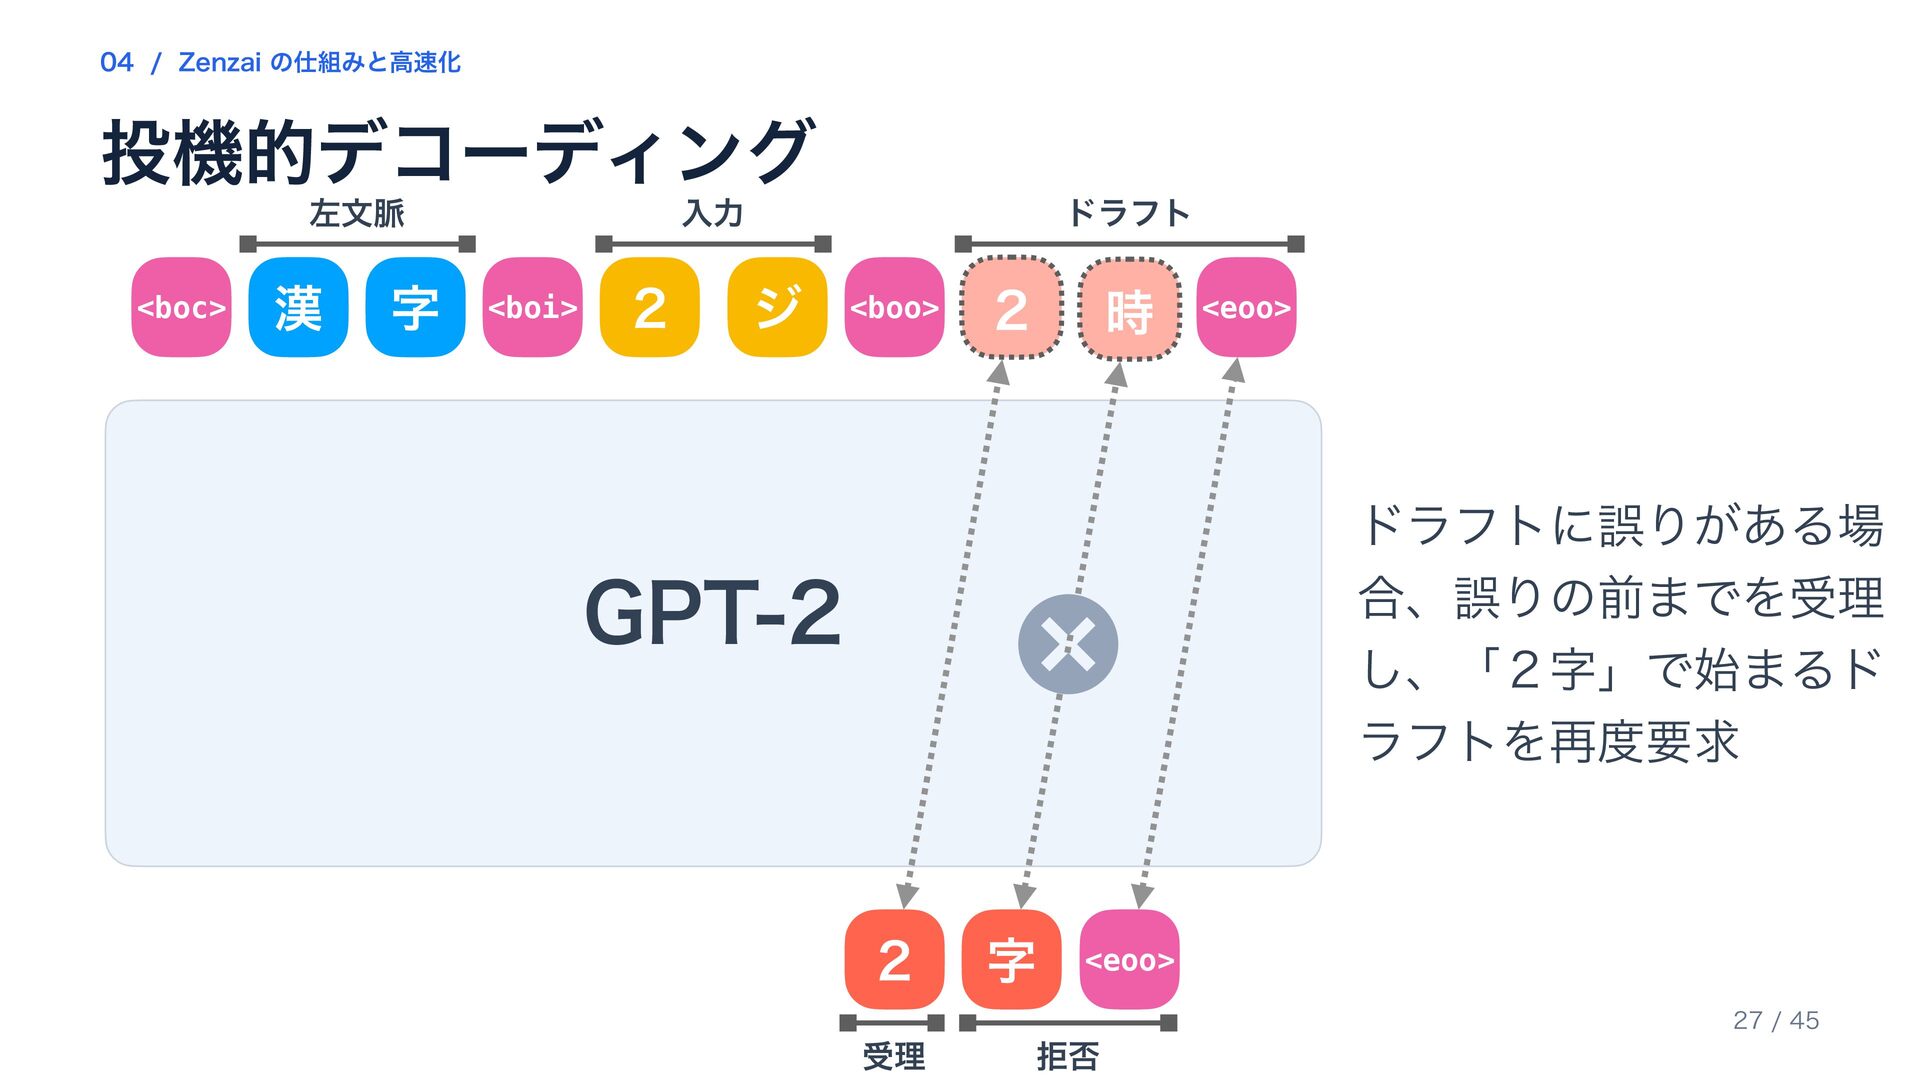
    p(x ∣ y) p(y ∣ x) = p(x) xはユーザの入力、yは出力される漢字交じり文 [1] 森ら(1999) / [2] Brown et al.(1990) 言語モデル ⇄ 翻訳モデル p(y) ⋅ p(x ∣ y) p(y ∣ x) = p(x) xは翻訳元言語、yは翻訳先言語 08 / 45
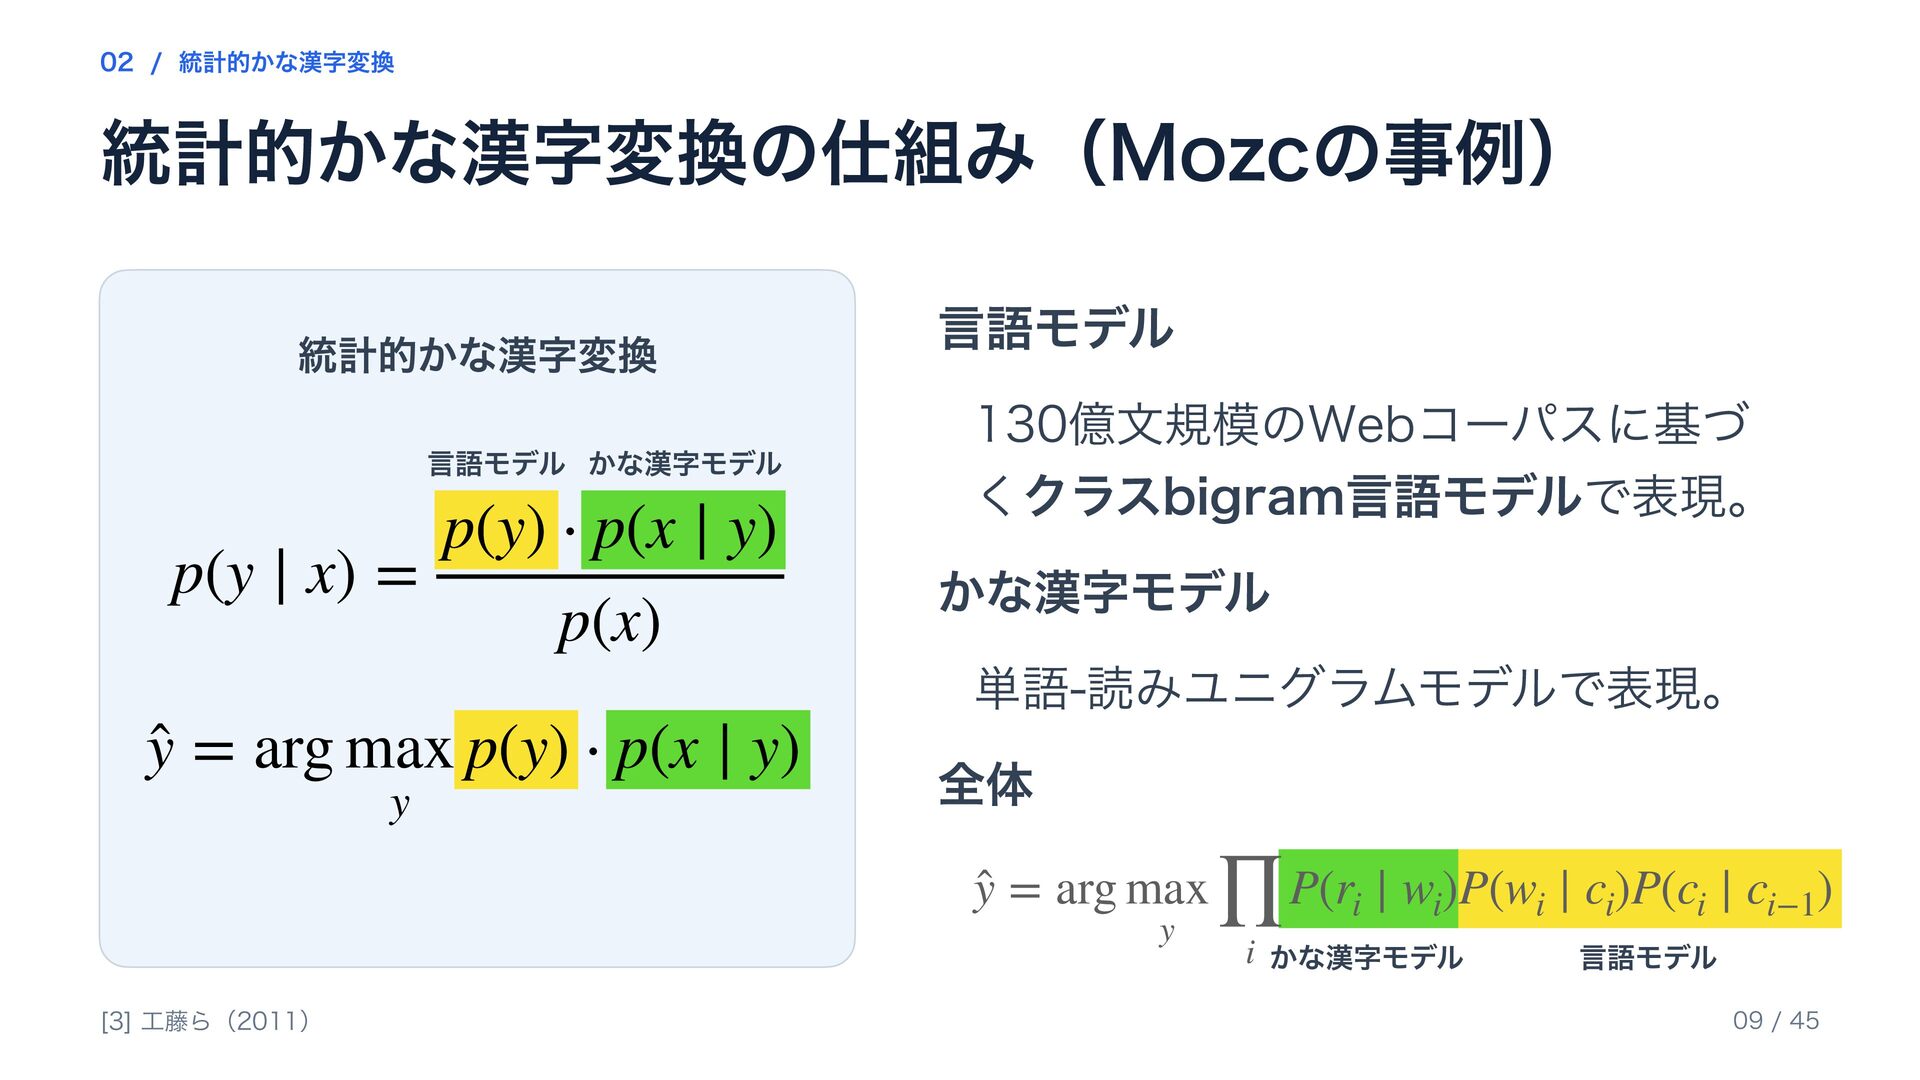
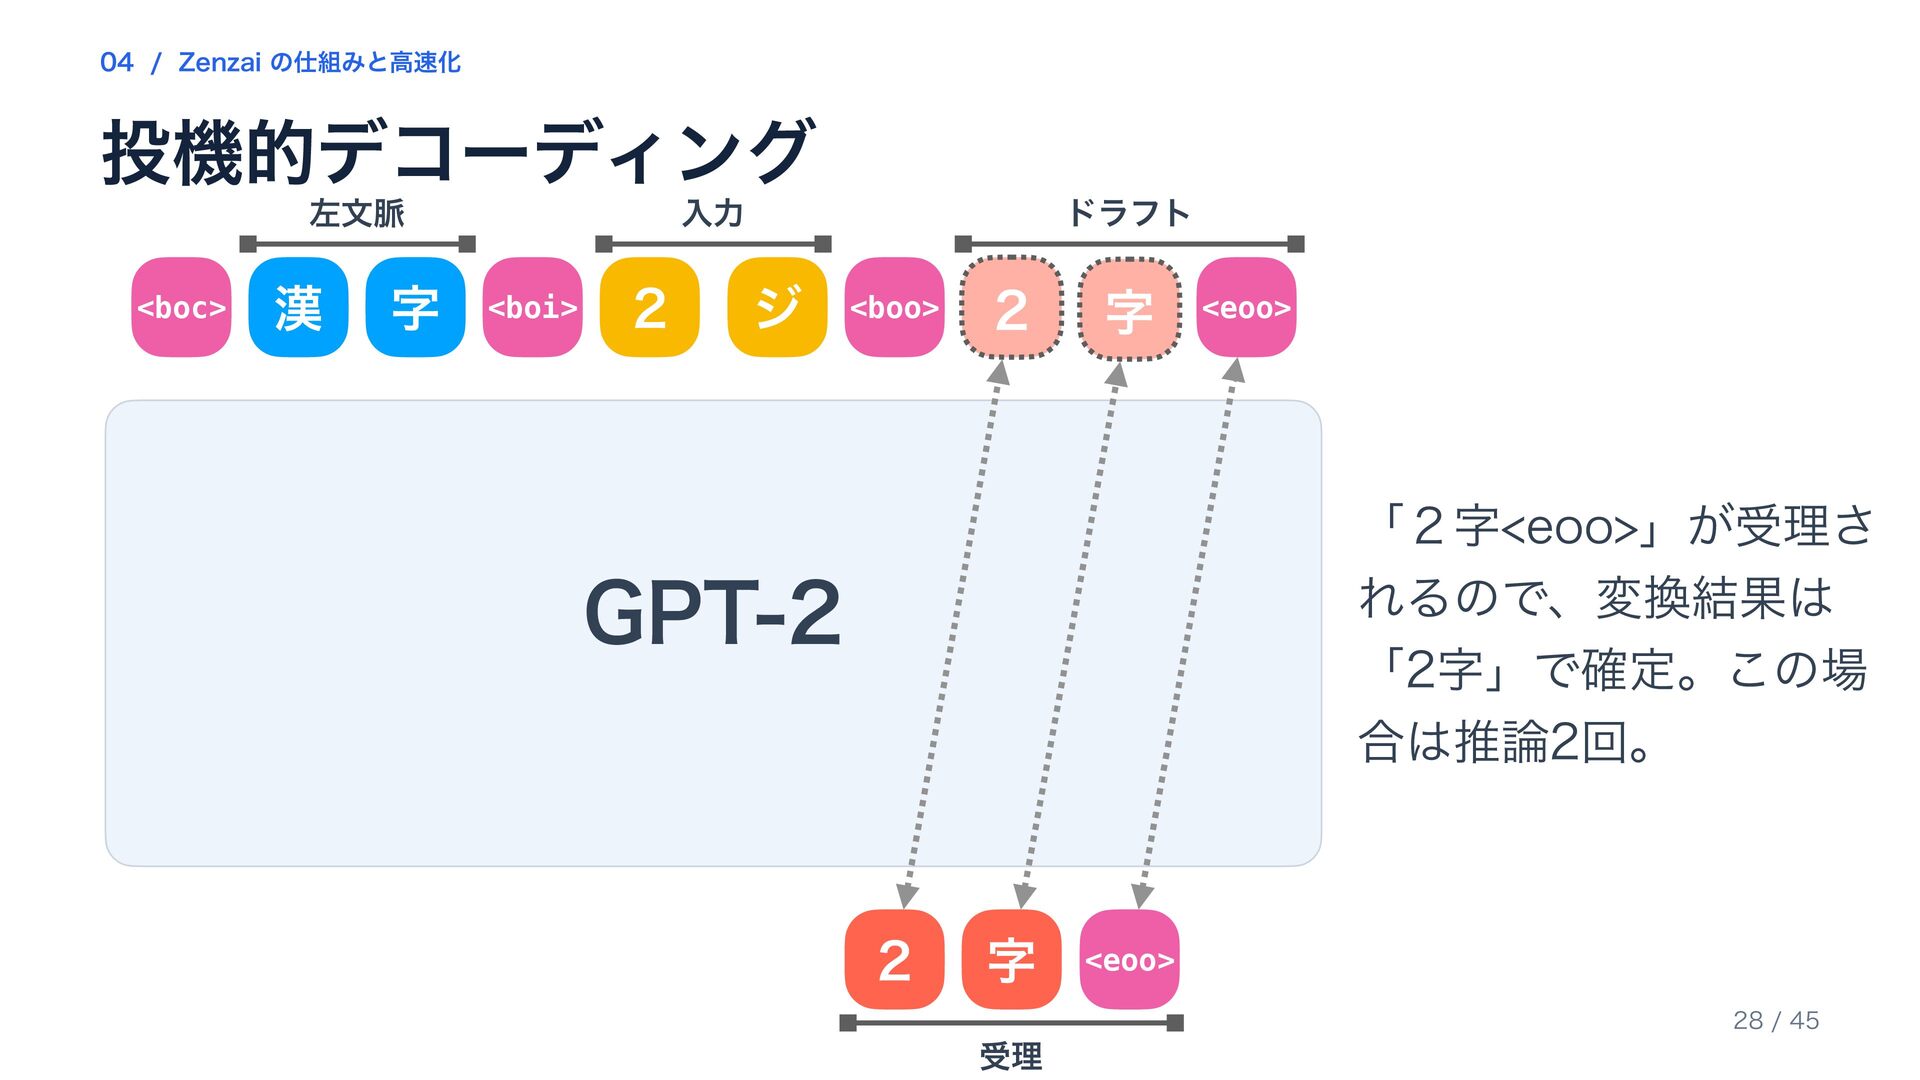
  4. 02 / 統計的かな漢字変換 統計的かな漢字変換の仕組み(Mozcの事例) 統計的かな漢字変換 言語モデル かな漢字モデル p(y) ⋅ p(x

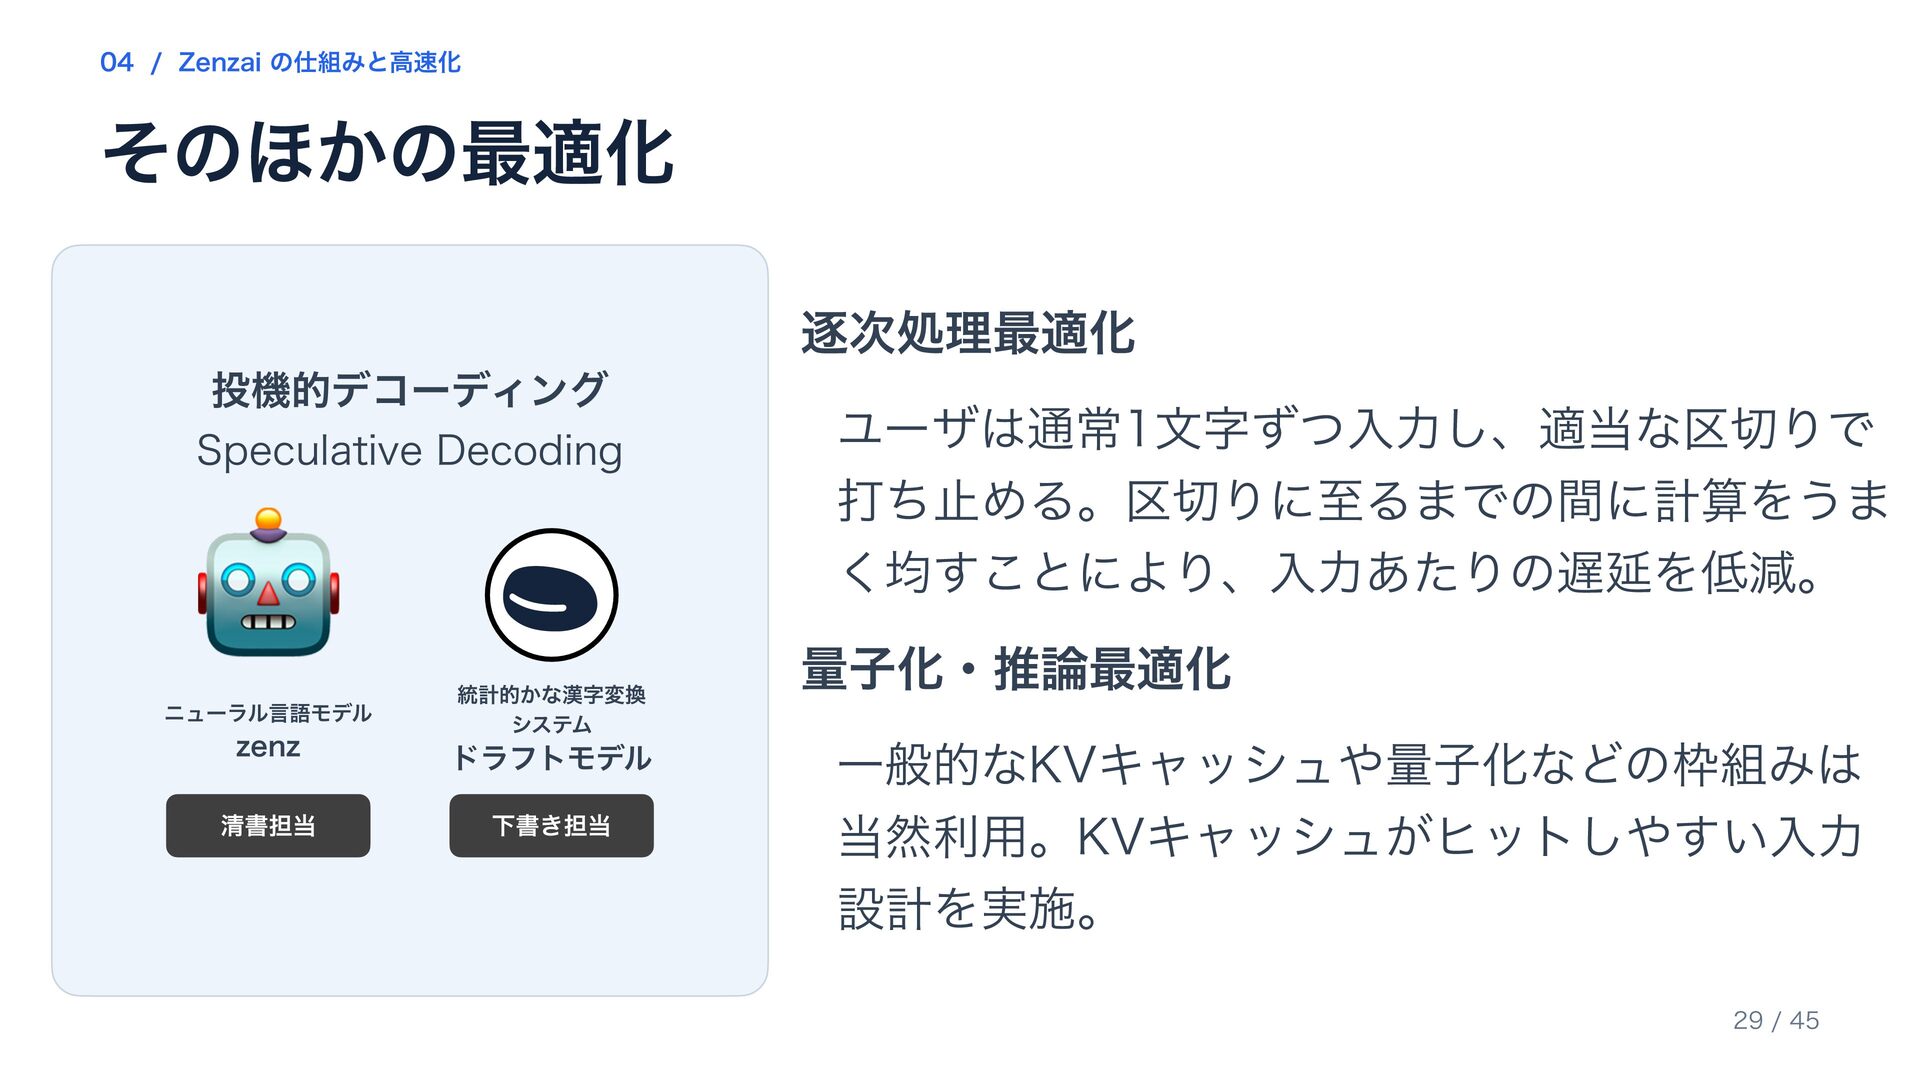
    ∣ y) p(y ∣ x) = p(x) ŷ = arg max p(y) ⋅ p(x ∣ y) y 言語モデル 130億文規模のWebコーパスに基づ くクラスbigram言語モデルで表現。 かな漢字モデル 単語-読みユニグラムモデルで表現。 全体 ŷ = arg max y [3] 工藤ら(2011) ∏ P(ri ∣ wi)P(wi ∣ ci)P(ci ∣ ci−1) i かな漢字モデル 言語モデル 09 / 45
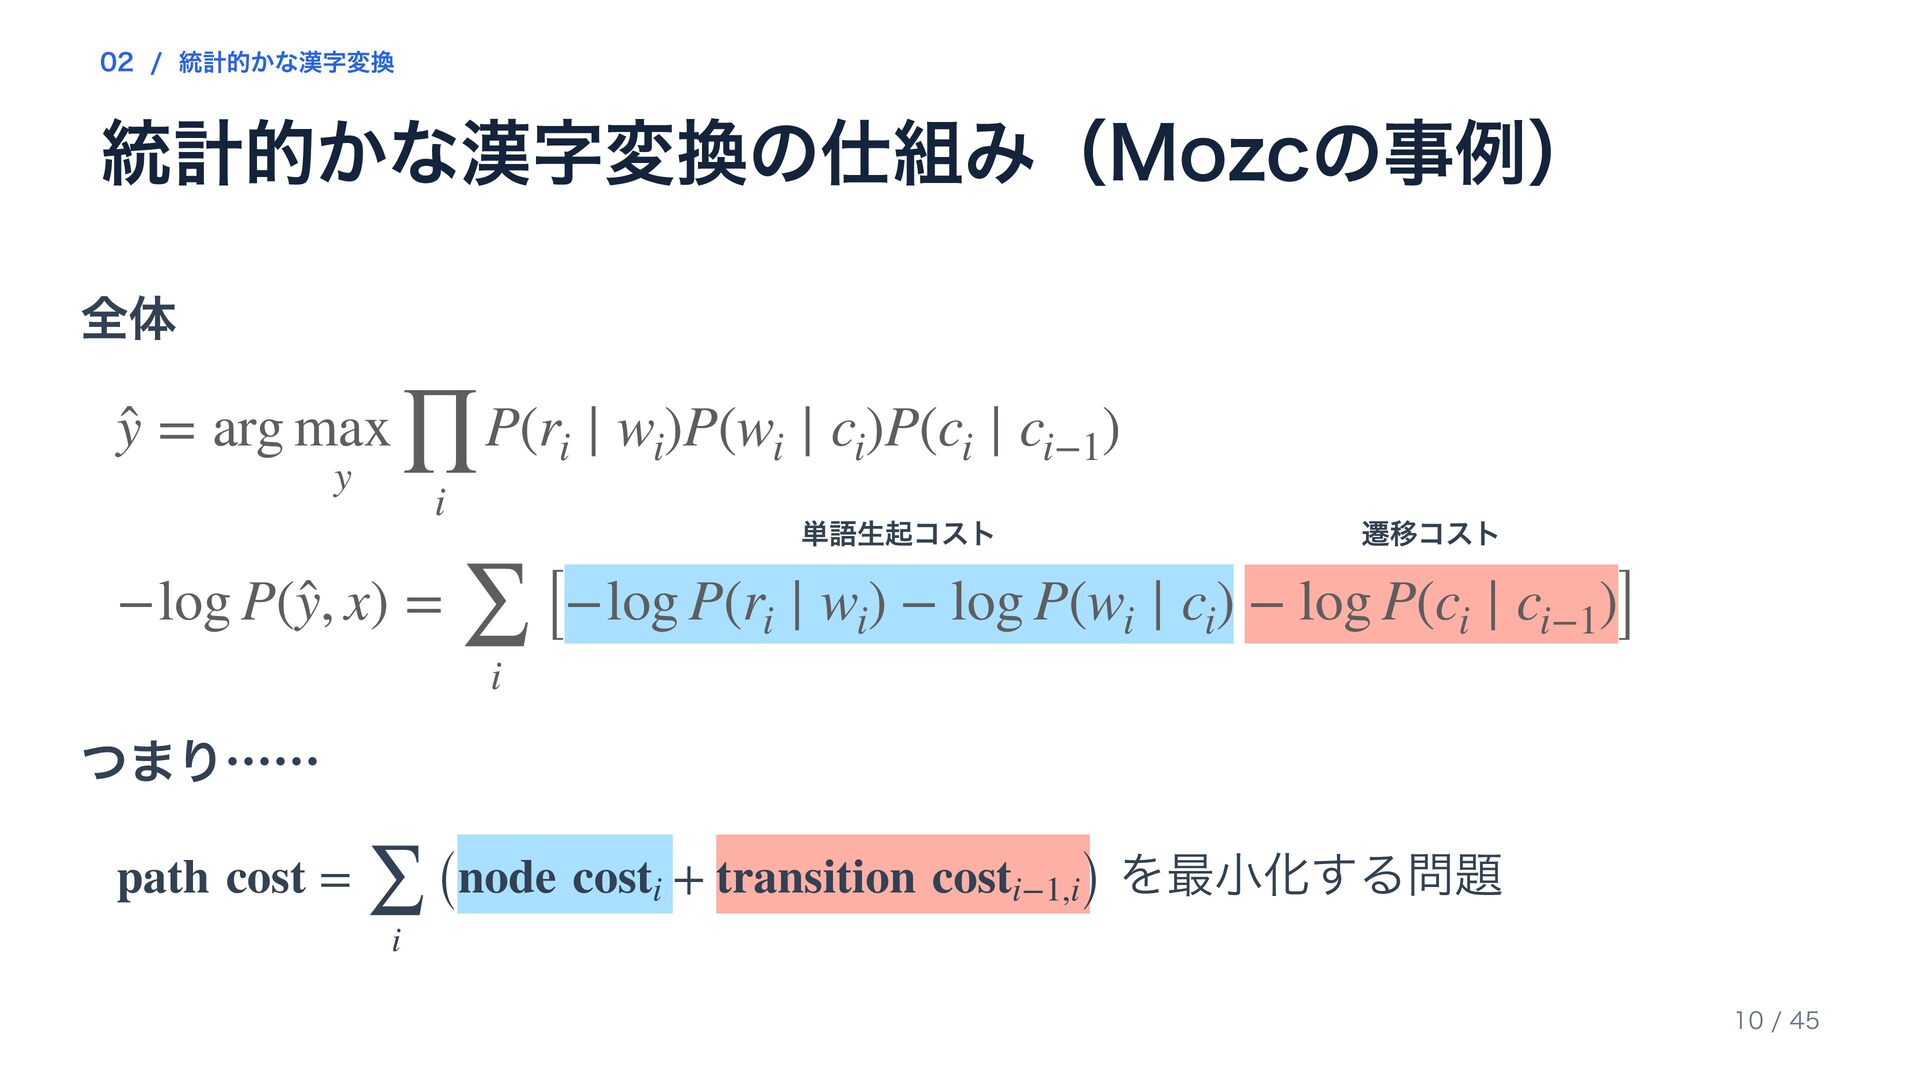
  5. 02 / 統計的かな漢字変換 統計的かな漢字変換の仕組み(Mozcの事例) 全体 ŷ = arg max y

    ∏ i −log P(y,̂ x) = P(ri ∣ wi)P(wi ∣ ci)P(ci ∣ ci−1) 単語生起コスト 遷移コスト −log P(ri ∣ wi) − log P(wi ∣ ci) − log P(ci ∣ ci−1)] [ ∑ i つまり…… path cost = node costi + transition costi−1,i) を最小化する問題 ( ∑ i 10 / 45
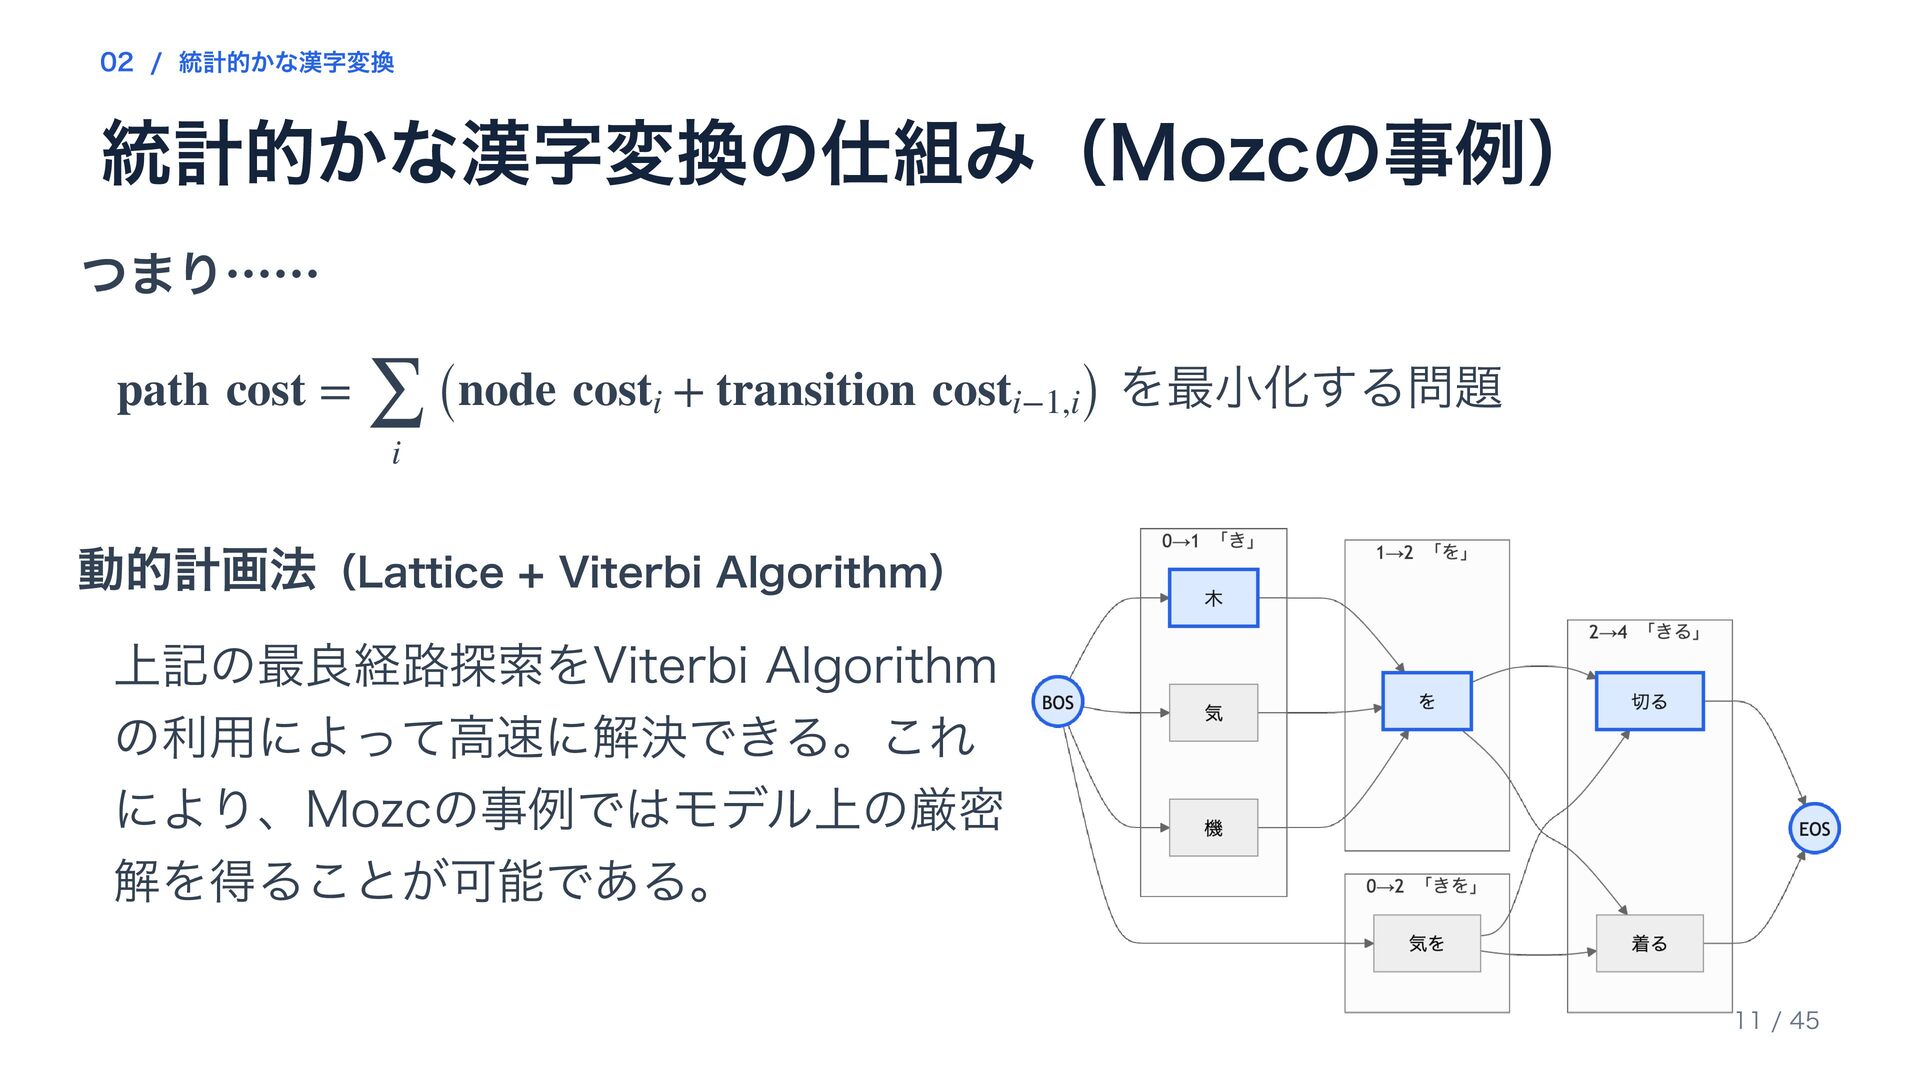
  6. 02 / 統計的かな漢字変換 統計的かな漢字変換の仕組み(Mozcの事例) つまり…… path cost = node costi
    + transition costi−1,i) を最小化する問題 ( ∑ i 動的計画法(Lattice + Viterbi Algorithm) 上記の最良経路探索をViterbi Algorithm の利用によって高速に解決できる。これ により、Mozcの事例ではモデル上の厳密 解を得ることが可能である。 11 / 45
  7. 02 / 統計的かな漢字変換 統計的機械翻訳と統計的かな漢字変換 統計的かな漢字変換 統計的機械翻訳 言語モデル かな漢字モデル p(y) ⋅

    p(x ∣ y) p(y ∣ x) = p(x) xはユーザの入力、yは出力される漢字交じり文 [1] 森ら(1999) / [2] Brown et al.(1990) 言語モデル ⇄ 翻訳モデル p(y) ⋅ p(x ∣ y) p(y ∣ x) = p(x) xは翻訳元言語、yは翻訳先言語 12 / 45
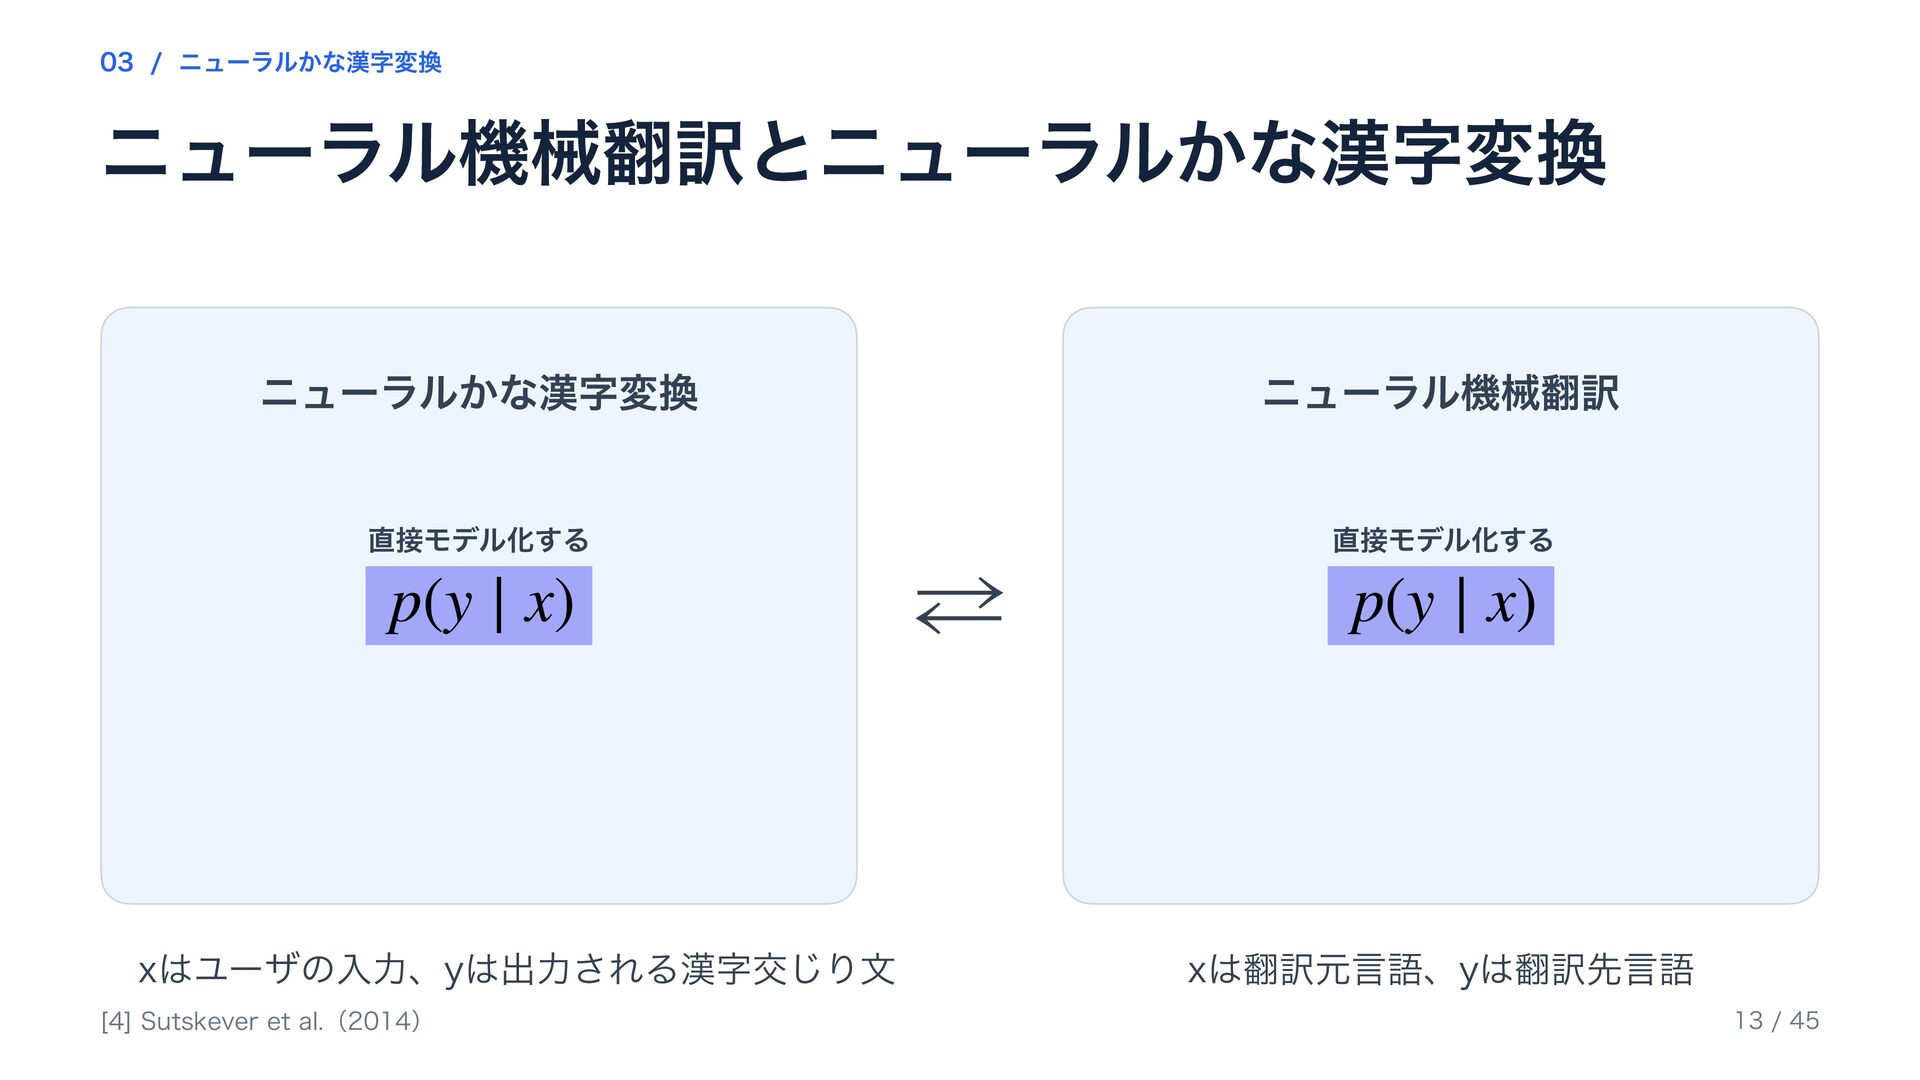
  8. 03 / ニューラルかな漢字変換 ニューラル機械翻訳とニューラルかな漢字変換 ニューラルかな漢字変換 ニューラル機械翻訳 直接モデル化する 直接モデル化する p(y ∣

    x) xはユーザの入力、yは出力される漢字交じり文 [4] Sutskever et al.(2014) ⇄ p(y ∣ x) xは翻訳元言語、yは翻訳先言語 13 / 45
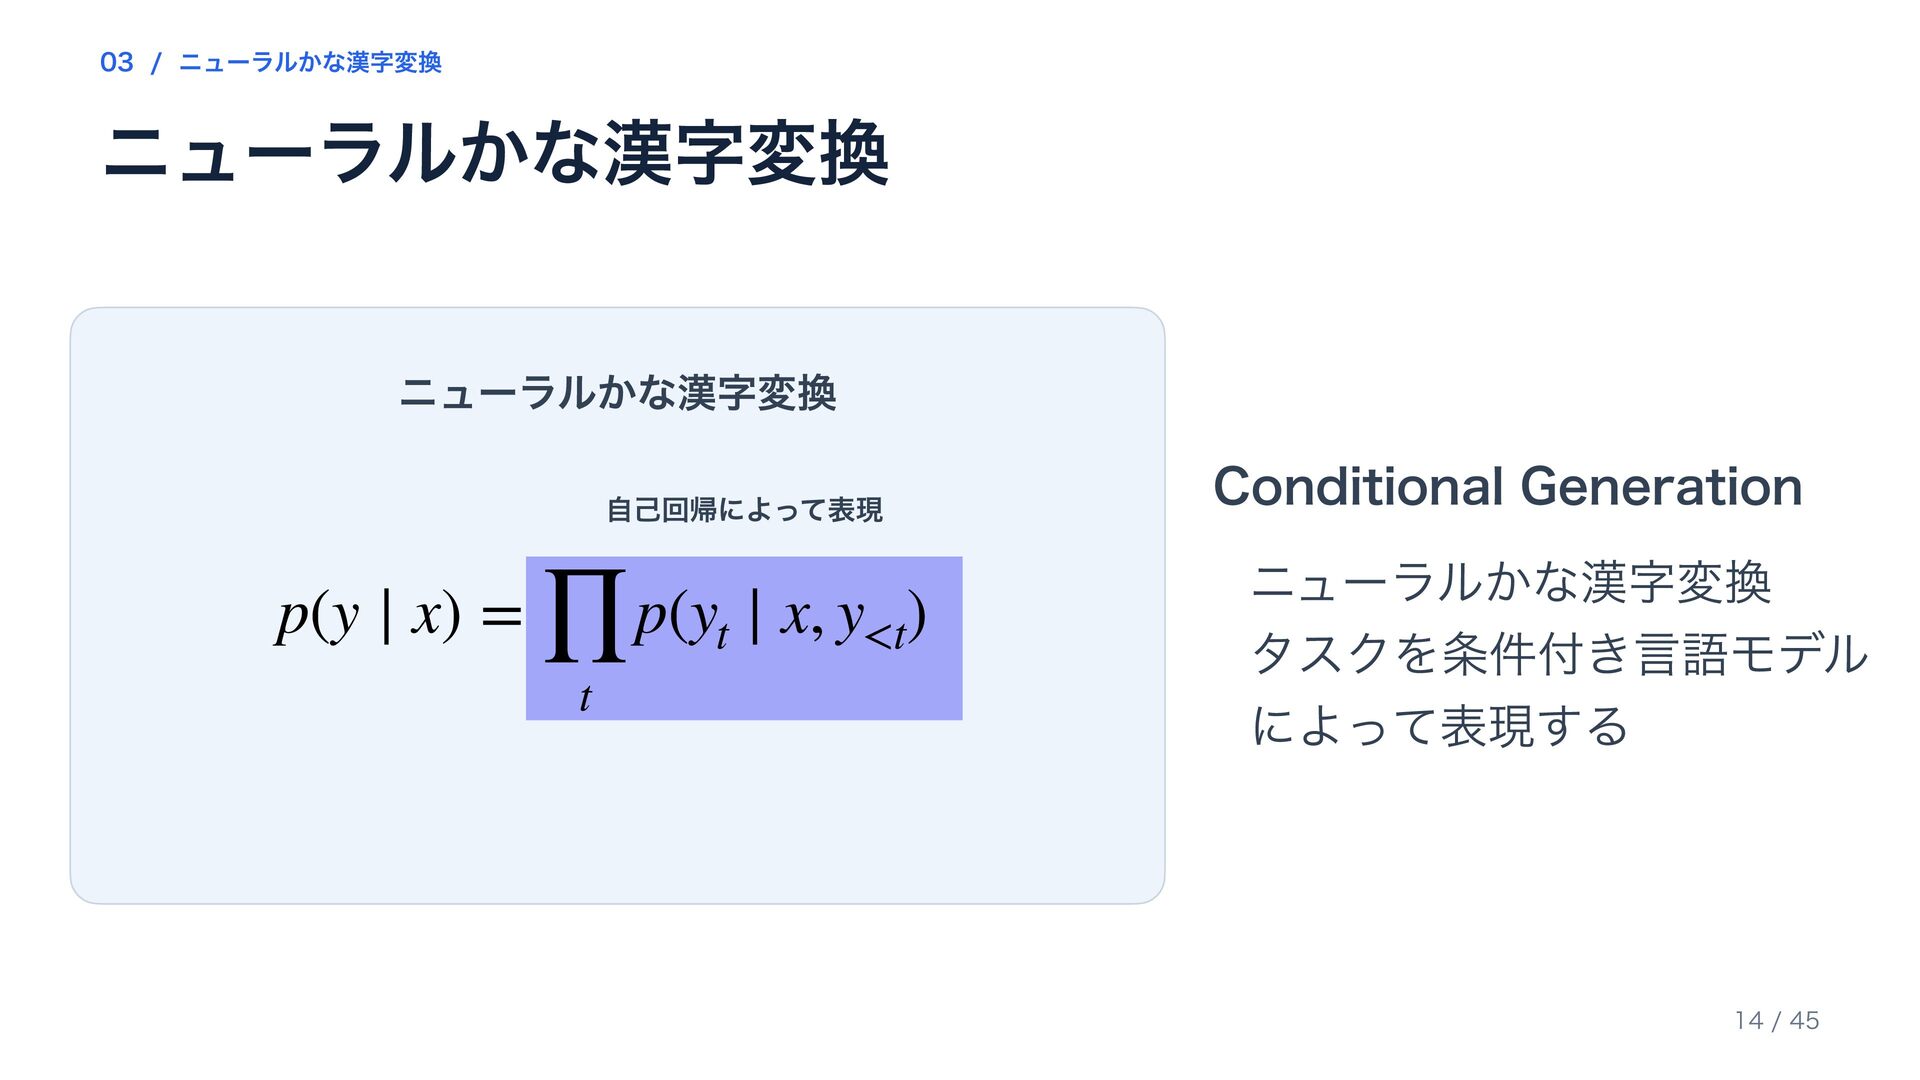
  9. 03 / ニューラルかな漢字変換 ニューラルかな漢字変換 ニューラルかな漢字変換 自己回帰によって表現 p(y ∣ x) =

    ∏ t p(yt ∣ x, y<t) Conditional Generation ニューラルかな漢字変換 タスクを条件付き言語モデル によって表現する 14 / 45
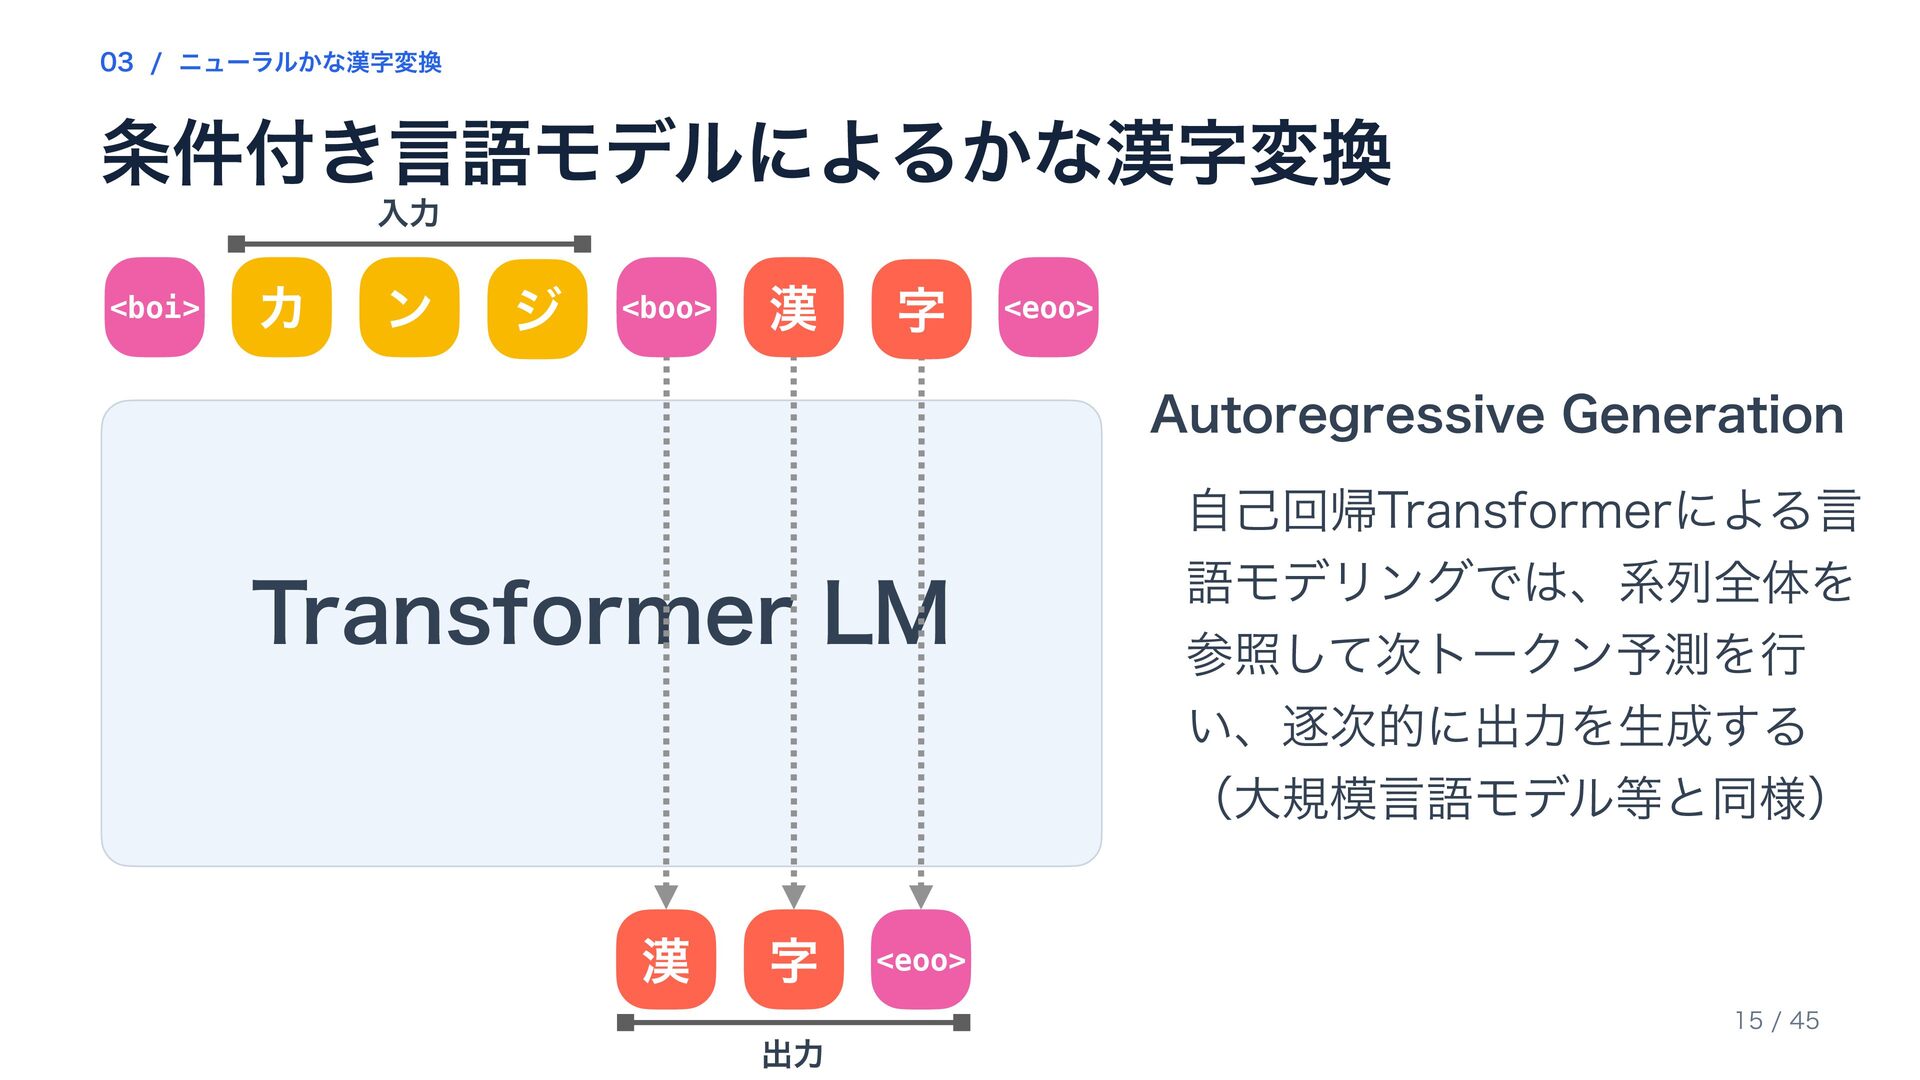
  10. 03 / ニューラルかな漢字変換 条件付き言語モデルによるかな漢字変換 入力 <boi> カ ン ジ <boo>

    漢 字 <eoo> Autoregressive Generation Transformer LM 漢 字 自己回帰Transformerによる言 語モデリングでは、系列全体を 参照して次トークン予測を行 い、逐次的に出力を生成する (大規模言語モデル等と同様) <eoo> 15 / 45 出力
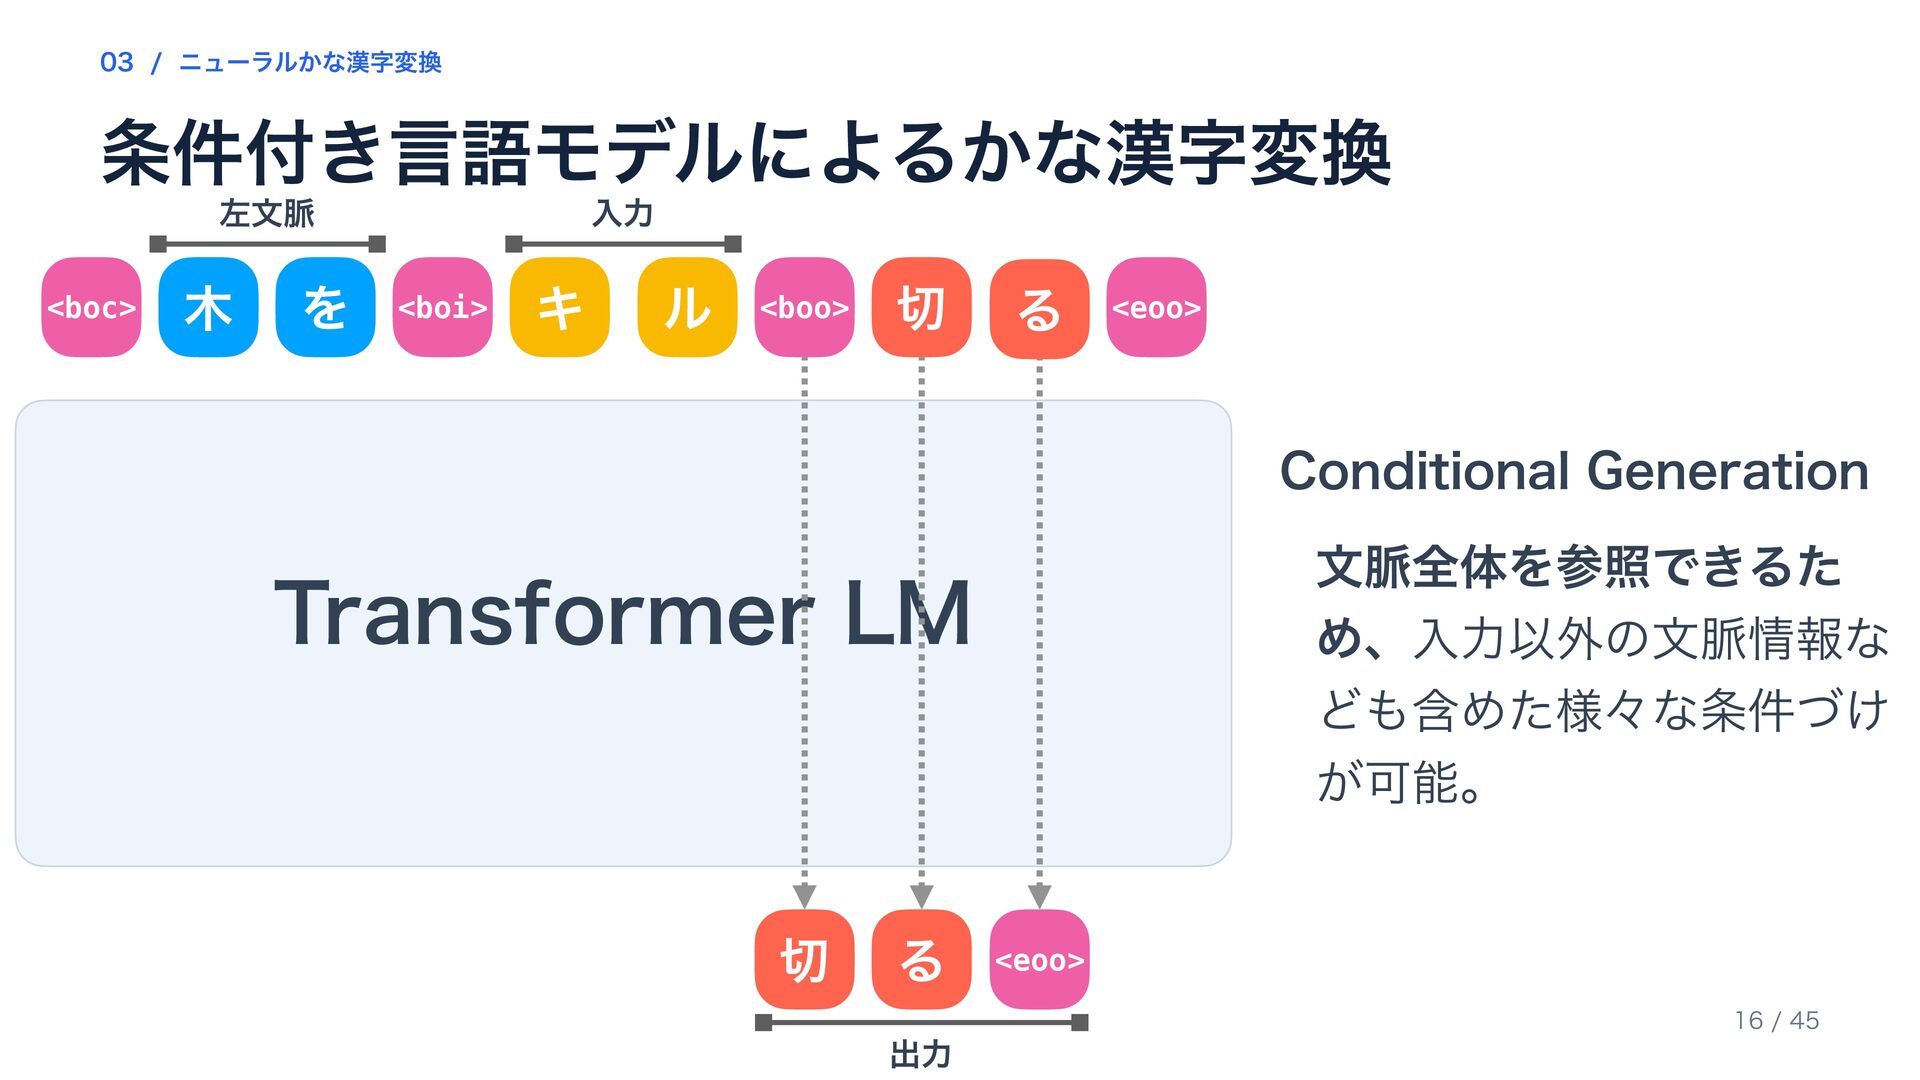
  11. 03 / ニューラルかな漢字変換 条件付き言語モデルによるかな漢字変換 左文脈 <boc> 木 を 入力 <boi>

    キ ル <boo> 切 る <eoo> Conditional Generation 文脈全体を参照できるた め、入力以外の文脈情報な ども含めた様々な条件づけ が可能。 Transformer LM 切 る <eoo> 16 / 45 出力
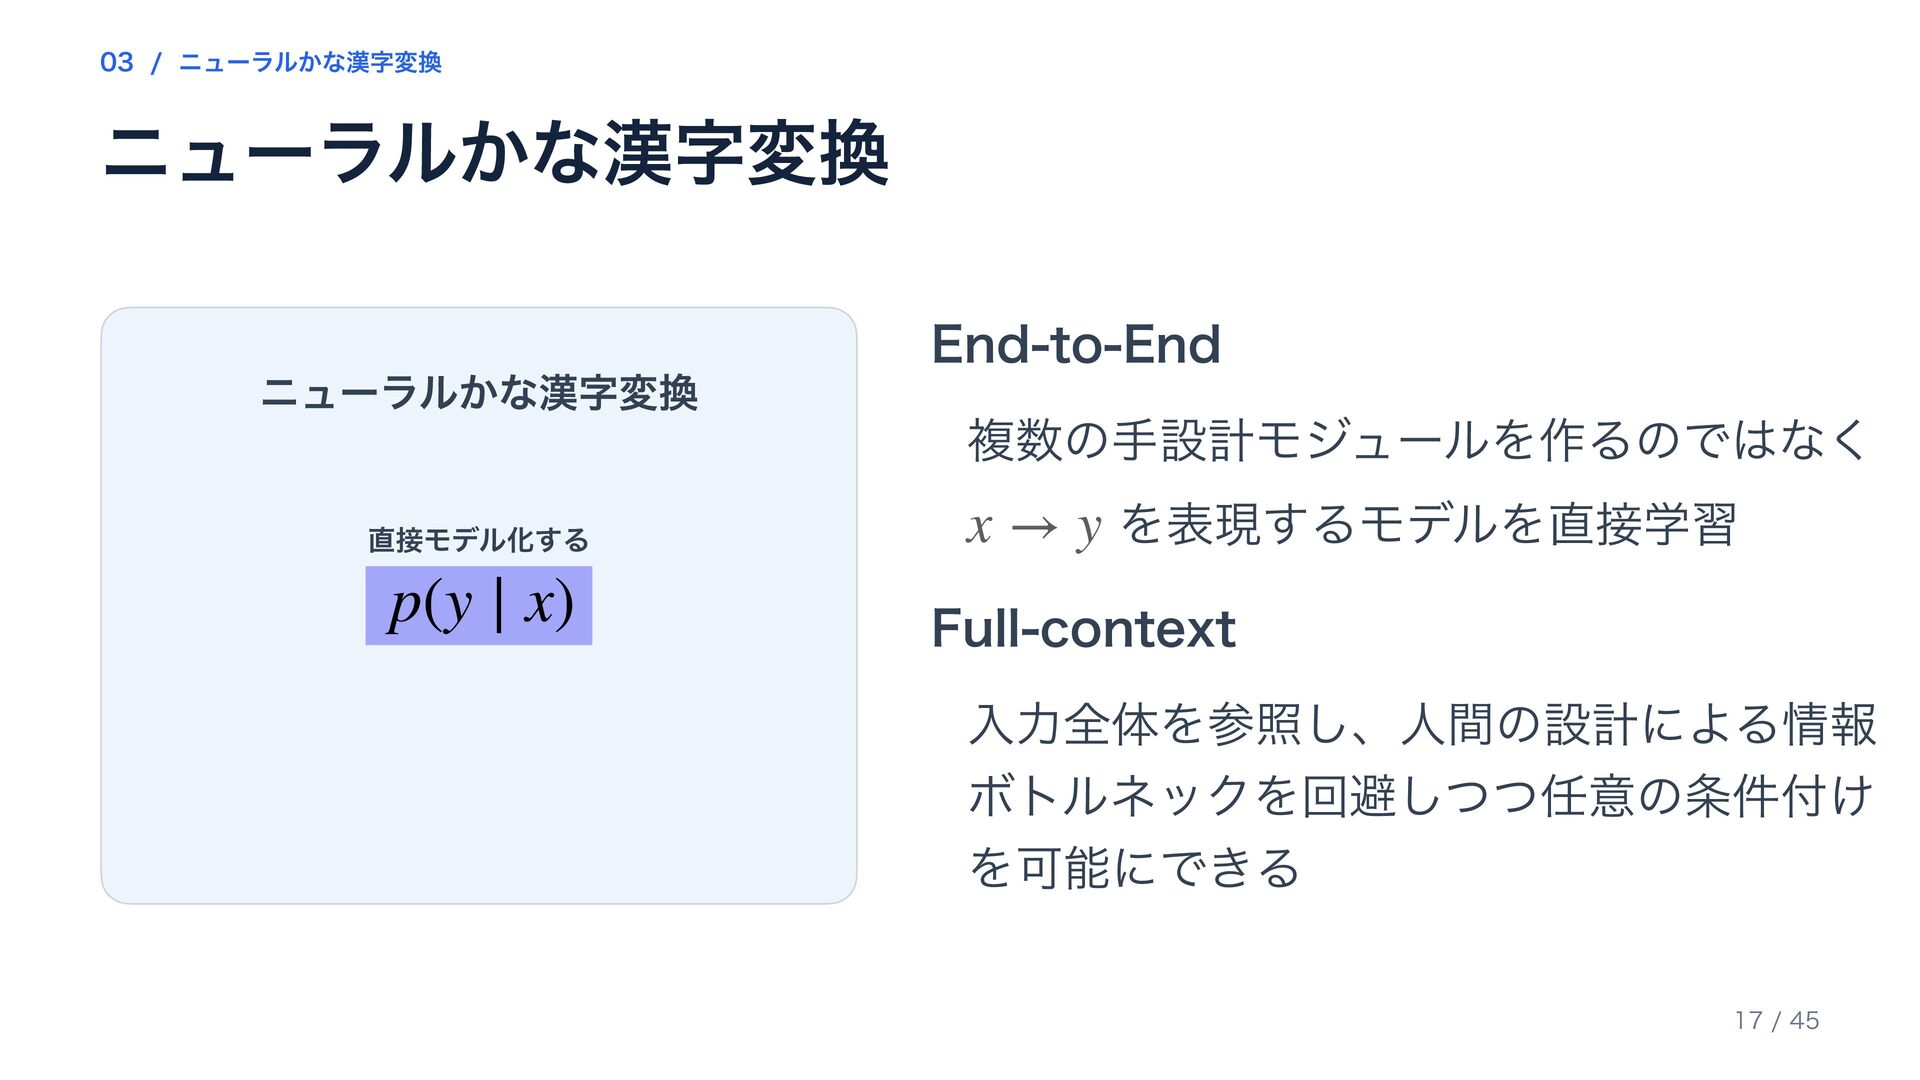
  12. 03 / ニューラルかな漢字変換 ニューラルかな漢字変換 End-to-End ニューラルかな漢字変換 複数の手設計モジュールを作るのではなく 直接モデル化する p(y ∣

    x) x → y を表現するモデルを直接学習 Full-context 入力全体を参照し、人間の設計による情報 ボトルネックを回避しつつ任意の条件付け を可能にできる 17 / 45
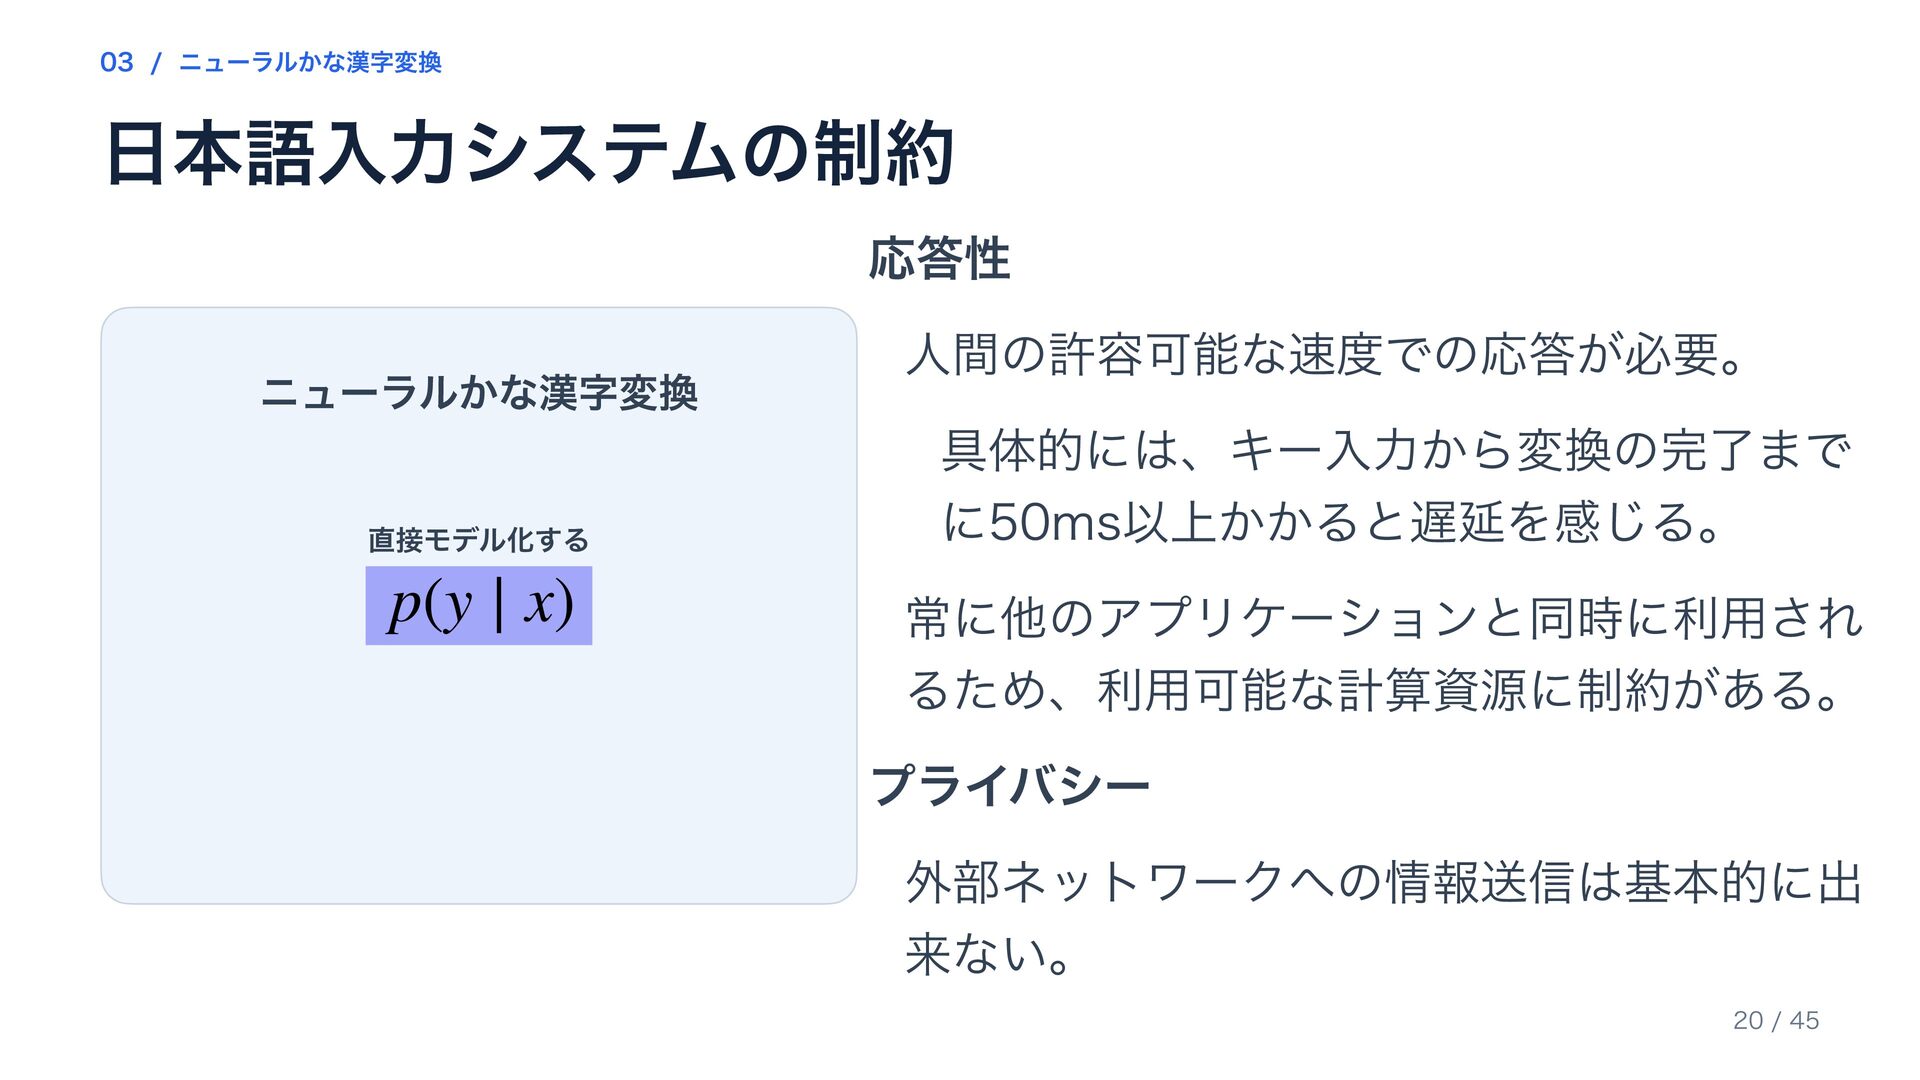
  13. 03 / ニューラルかな漢字変換 日本語入力システムの制約 応答性 ニューラルかな漢字変換 直接モデル化する p(y ∣ x)

    人間の許容可能な速度での応答が必要。 具体的には、キー入力から変換の完了まで に50ms以上かかると遅延を感じる。 常に他のアプリケーションと同時に利用され るため、利用可能な計算資源に制約がある。 プライバシー 外部ネットワークへの情報送信は基本的に出 来ない。 20 / 45
  14. 04 / Zenzai の仕組みと高速化 ニューラルかな漢字変換システム Zenzai ニューラルかな漢字変換システム Zenzai 🤖 GPT-2ベースの

    条件付き言語モデル 変換精度 GPT-2によるニューラルかな漢字変換を導入し、 従来手法に比べ高い精度の変換を実証。 左文脈情報の活用にも成功。 応答性 投機的 デコーディング Powered By 統計的かな漢字変換 投機的デコーディングを含む最適化手法を利用し オンデバイス推論で50msの応答性を担保。 21 / 45
  15. 04 / Zenzai の仕組みと高速化 モデルの学習 アーキテクチャ 文字レベルGPT-2(91M)を利用。Webデータなどを中心に読み推定を行っ た、約1.3億ペアから構成されるデータセットで学習。 必要なデータ 読みと漢字の対照コーパス。通常の日本語テキストデータに、読み推定をかけて

    合成する。 この合成に比べるとアーキテクチャなどは些事であり、いかにクリーンな対照 データを手に入れるかがずっと課題。 →これらの設定で、後述の評価で高い精度を達成。従って高速に動かせればOK。 23 / 45
  16. 04 / Zenzai の仕組みと高速化 投機的デコーディング 投機的デコーディング Speculative Decoding 🤖 ニューラル言語モデル

    zenz 清書担当 [6] Leviathan et al.(2023) 1 統計的かな漢字変換 システム ドラフトモデル 下書き担当 LLMの世界で利用される高速化技術。 「CPUで動く軽量な主流手法がある」という かな漢字変換の事情に合わせて調整。 軽量で高速だが精度は十分でない統計的かな漢字 変換システムを下書きに利用。 重く低速で賢いニューラルモデルでこの下書きを 検証し、受理または拒否。 25 / 45
  17. 04 / Zenzai の仕組みと高速化 投機的デコーディング 左文脈 <boc> 午 後 入力

    <boi> 2 ドラフト ジ <boo> 2 時 <eoo> 正しいドラフトが得られ た場合、推論1回で並列 に検証可能 GPT-2 2 時 <eoo> 26 / 45 受理
  18. 04 / Zenzai の仕組みと高速化 投機的デコーディング 左文脈 <boc> 漢 字 入力

    <boi> 2 ドラフト ジ <boo> 2 時 <eoo> ドラフトに誤りがある場 合、誤りの前までを受理 し、「2字」で始まるド ラフトを再度要求 GPT-2 2 字 <eoo> 27 / 45 受理 拒否
  19. 04 / Zenzai の仕組みと高速化 投機的デコーディング 左文脈 <boc> 漢 字 入力

    <boi> 2 ドラフト ジ <boo> 2 字 <eoo> 「2字<eoo>」が受理さ れるので、変換結果は 「2字」で確定。この場 合は推論2回。 GPT-2 2 字 <eoo> 28 / 45 受理
  20. 04 / Zenzai の仕組みと高速化 そのほかの最適化 逐次処理最適化 投機的デコーディング Speculative Decoding 🤖

    ニューラル言語モデル 1 統計的かな漢字変換 システム zenz ドラフトモデル 清書担当 下書き担当 ユーザは通常1文字ずつ入力し、適当な区切りで 打ち止める。区切りに至るまでの間に計算をうま く均すことにより、入力あたりの遅延を低減。 量子化・推論最適化 一般的なKVキャッシュや量子化などの枠組みは 当然利用。KVキャッシュがヒットしやすい入力 設計を実施。 29 / 45
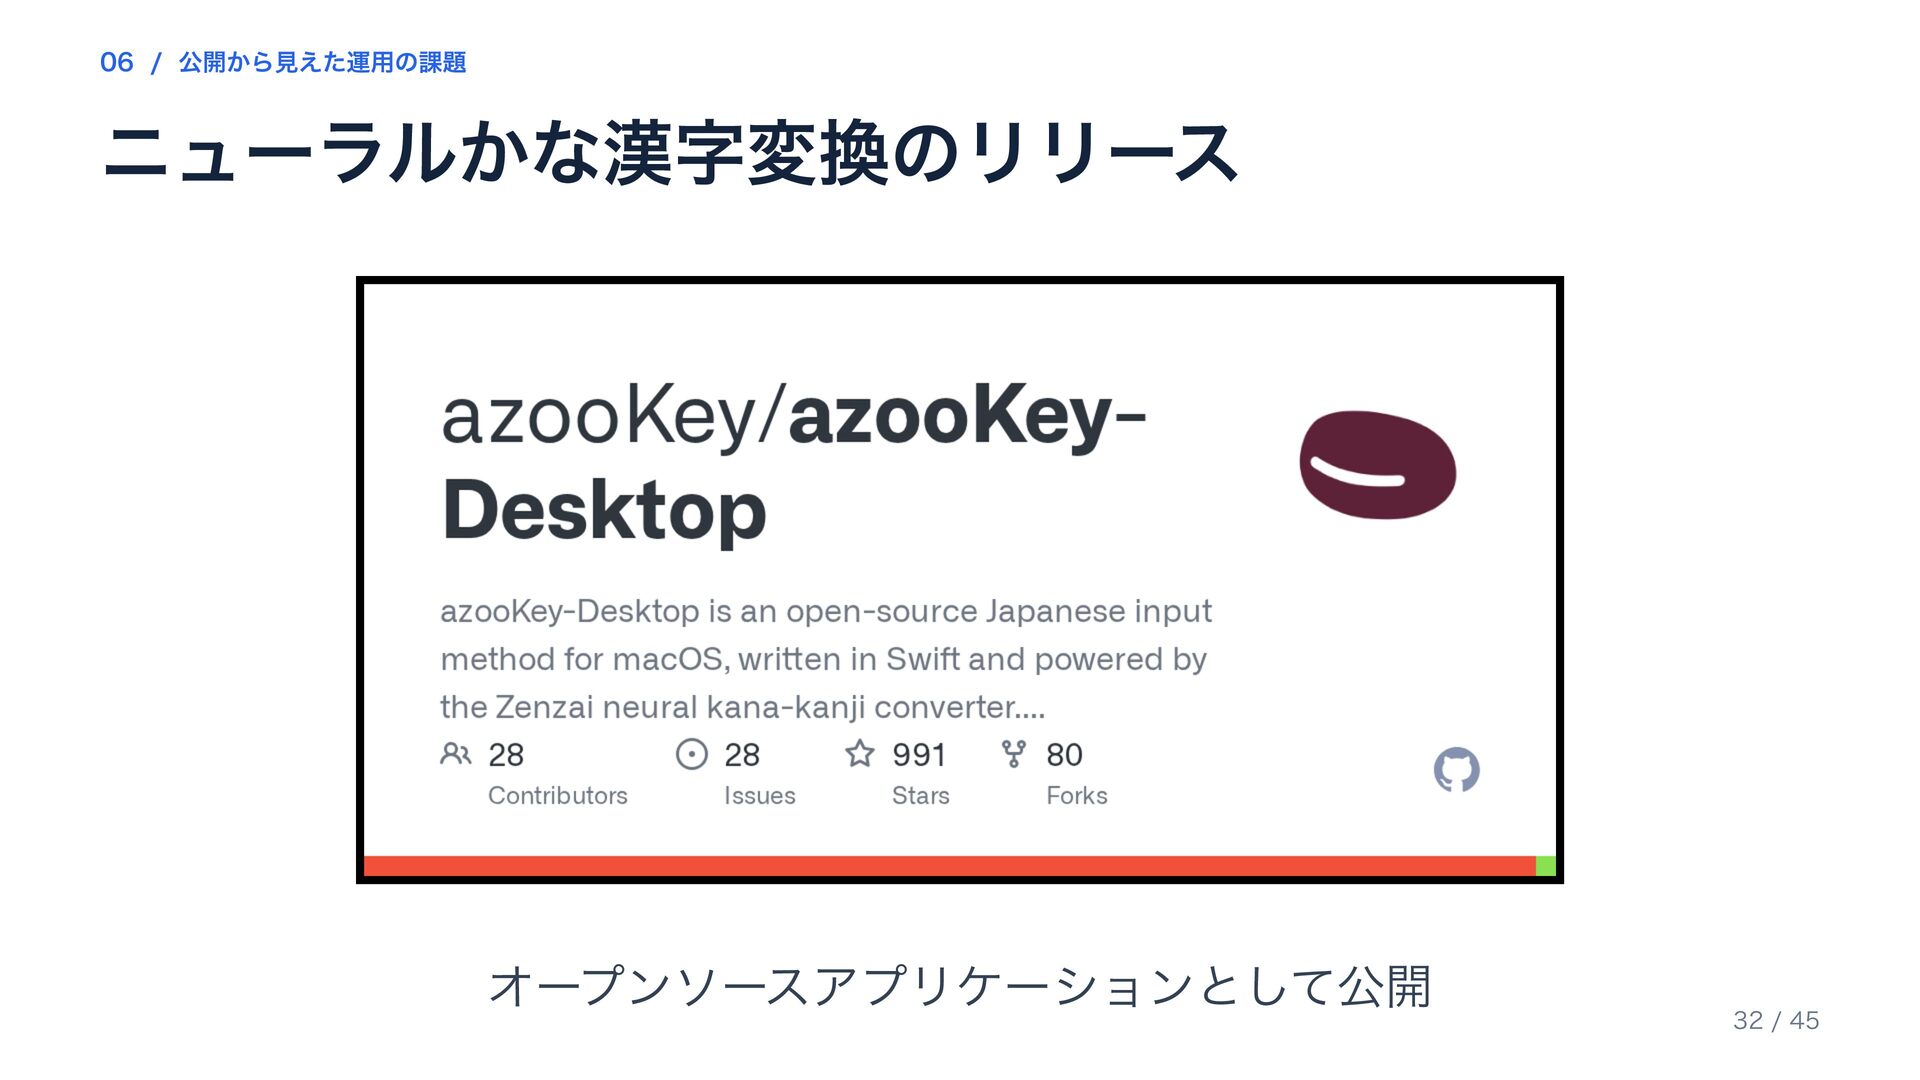
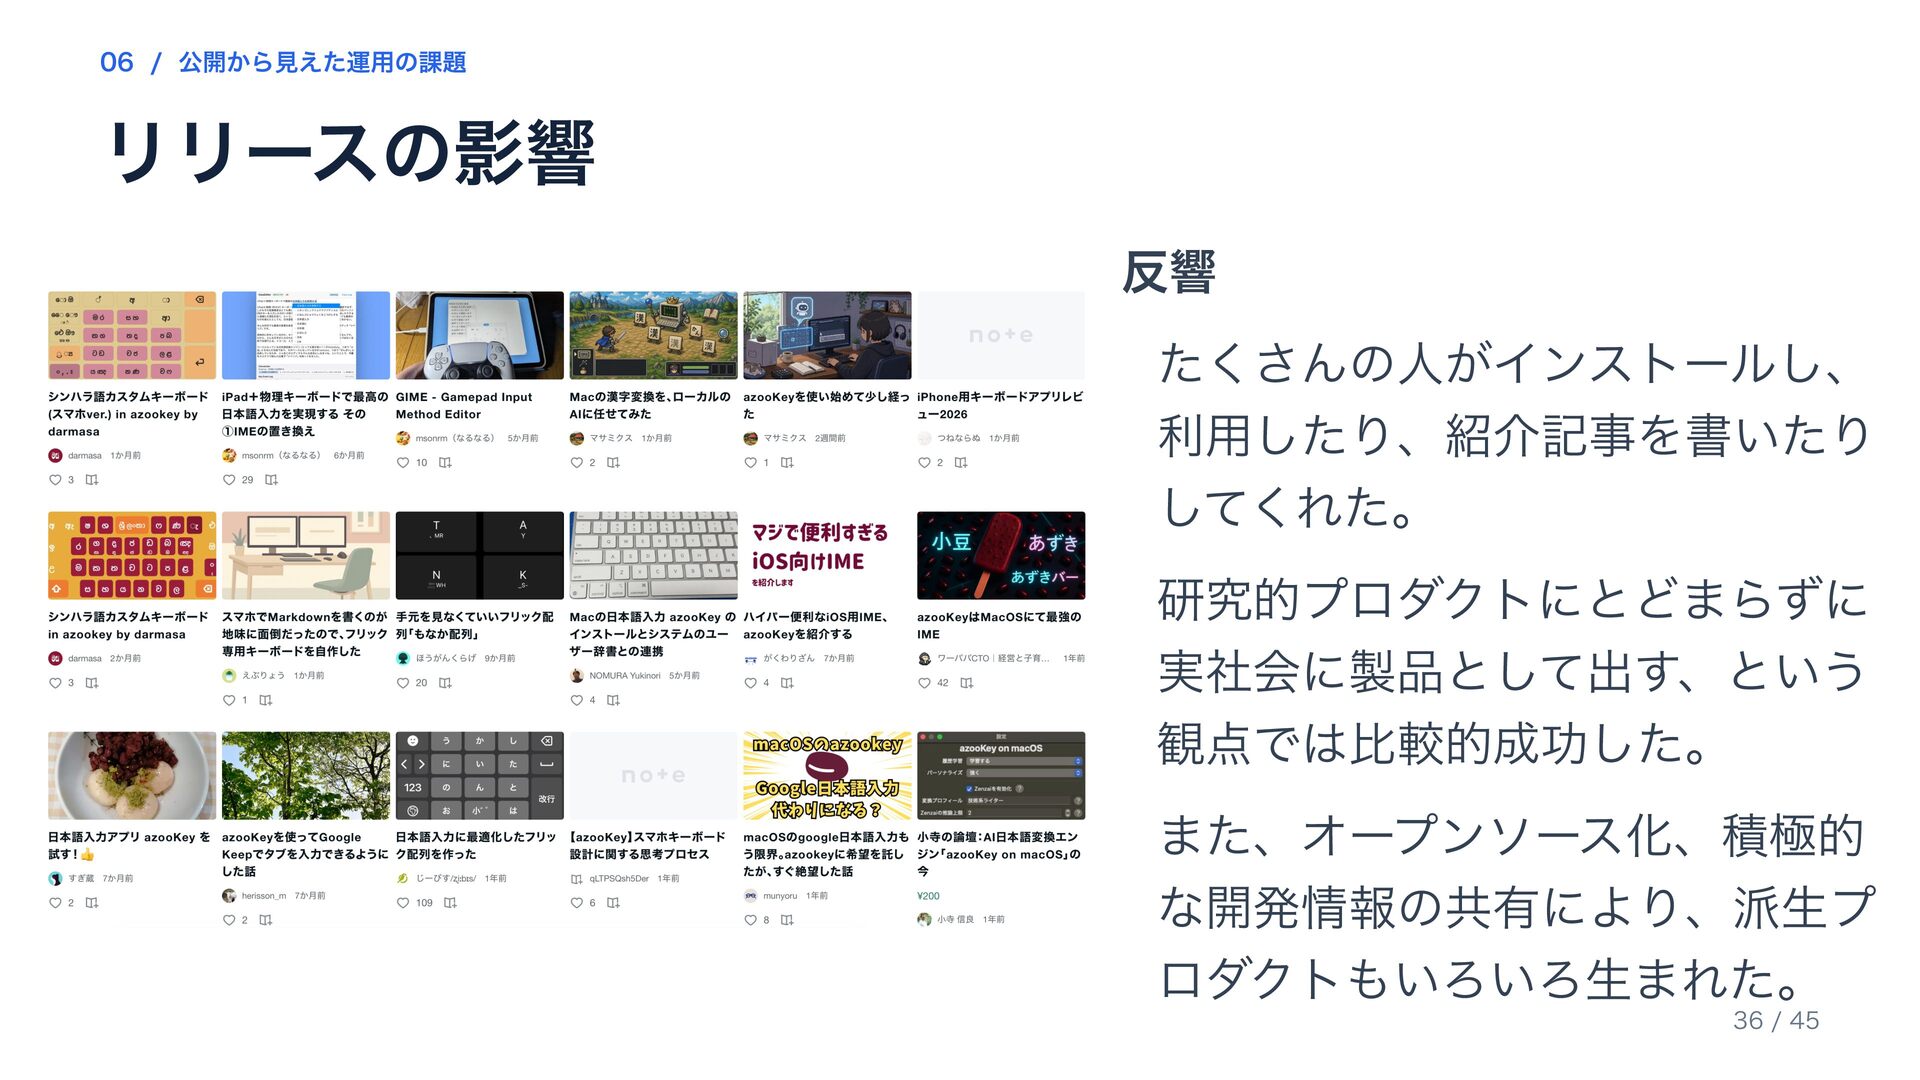
  21. 06 / 公開から見えた運用の課題 リリースの影響 反響 たくさんの人がインストールし、 利用したり、紹介記事を書いたり してくれた。 研究的プロダクトにとどまらずに 実社会に製品として出す、という

    観点では比較的成功した。 また、オープンソース化、積極的 な開発情報の共有により、派生プ ロダクトもいろいろ生まれた。 36 / 45
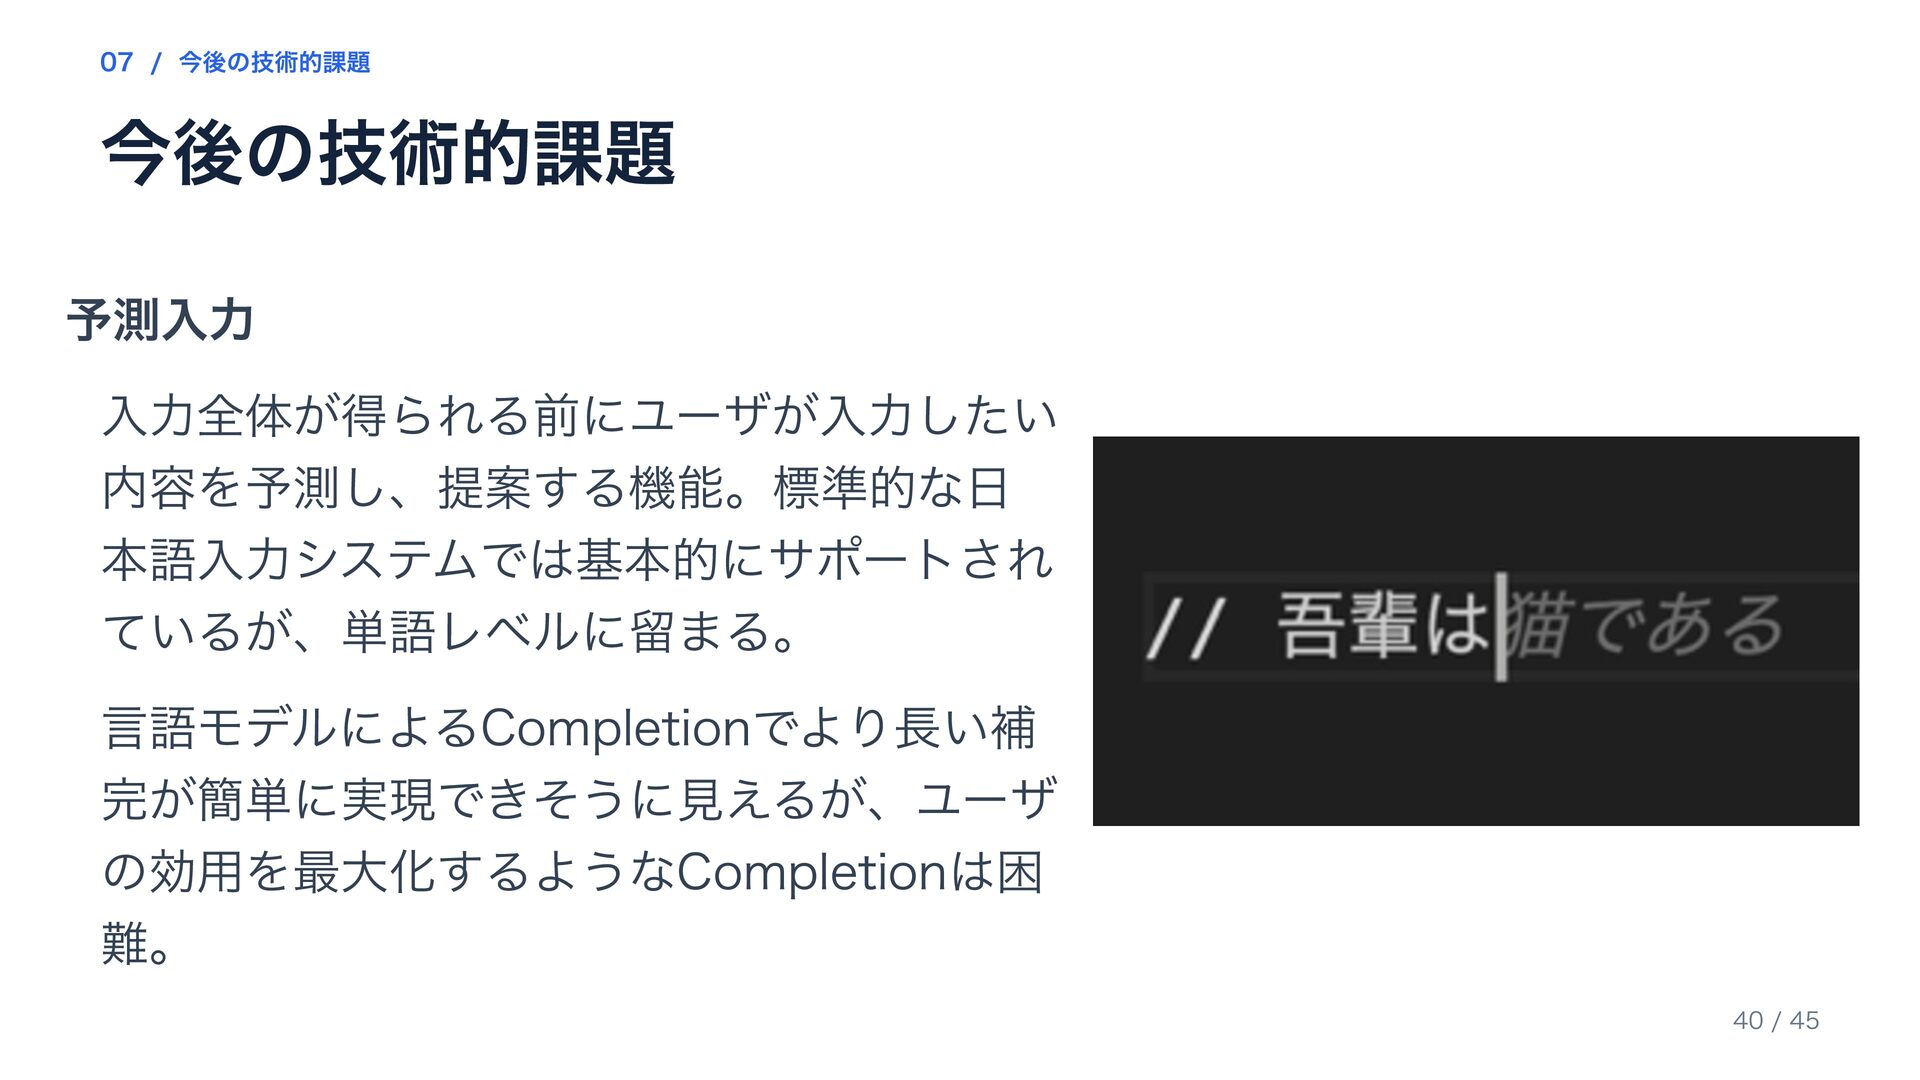
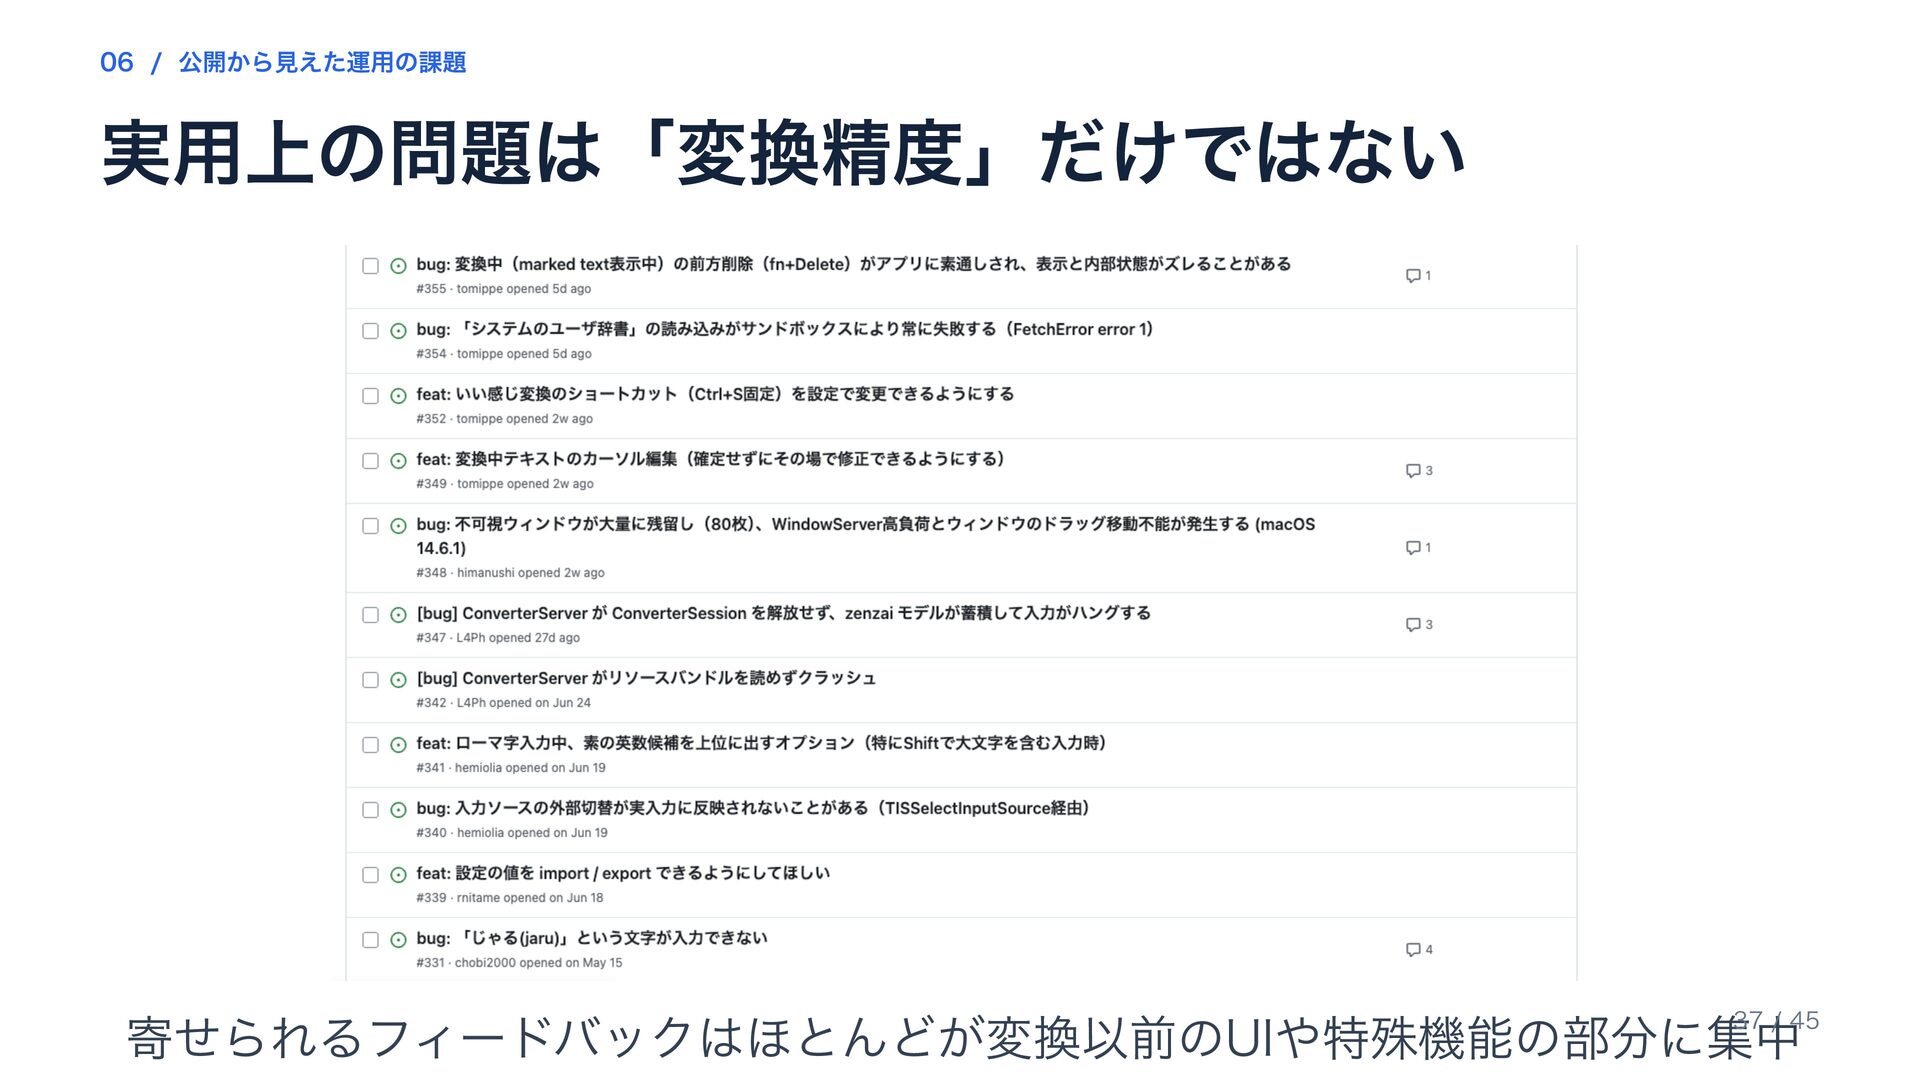
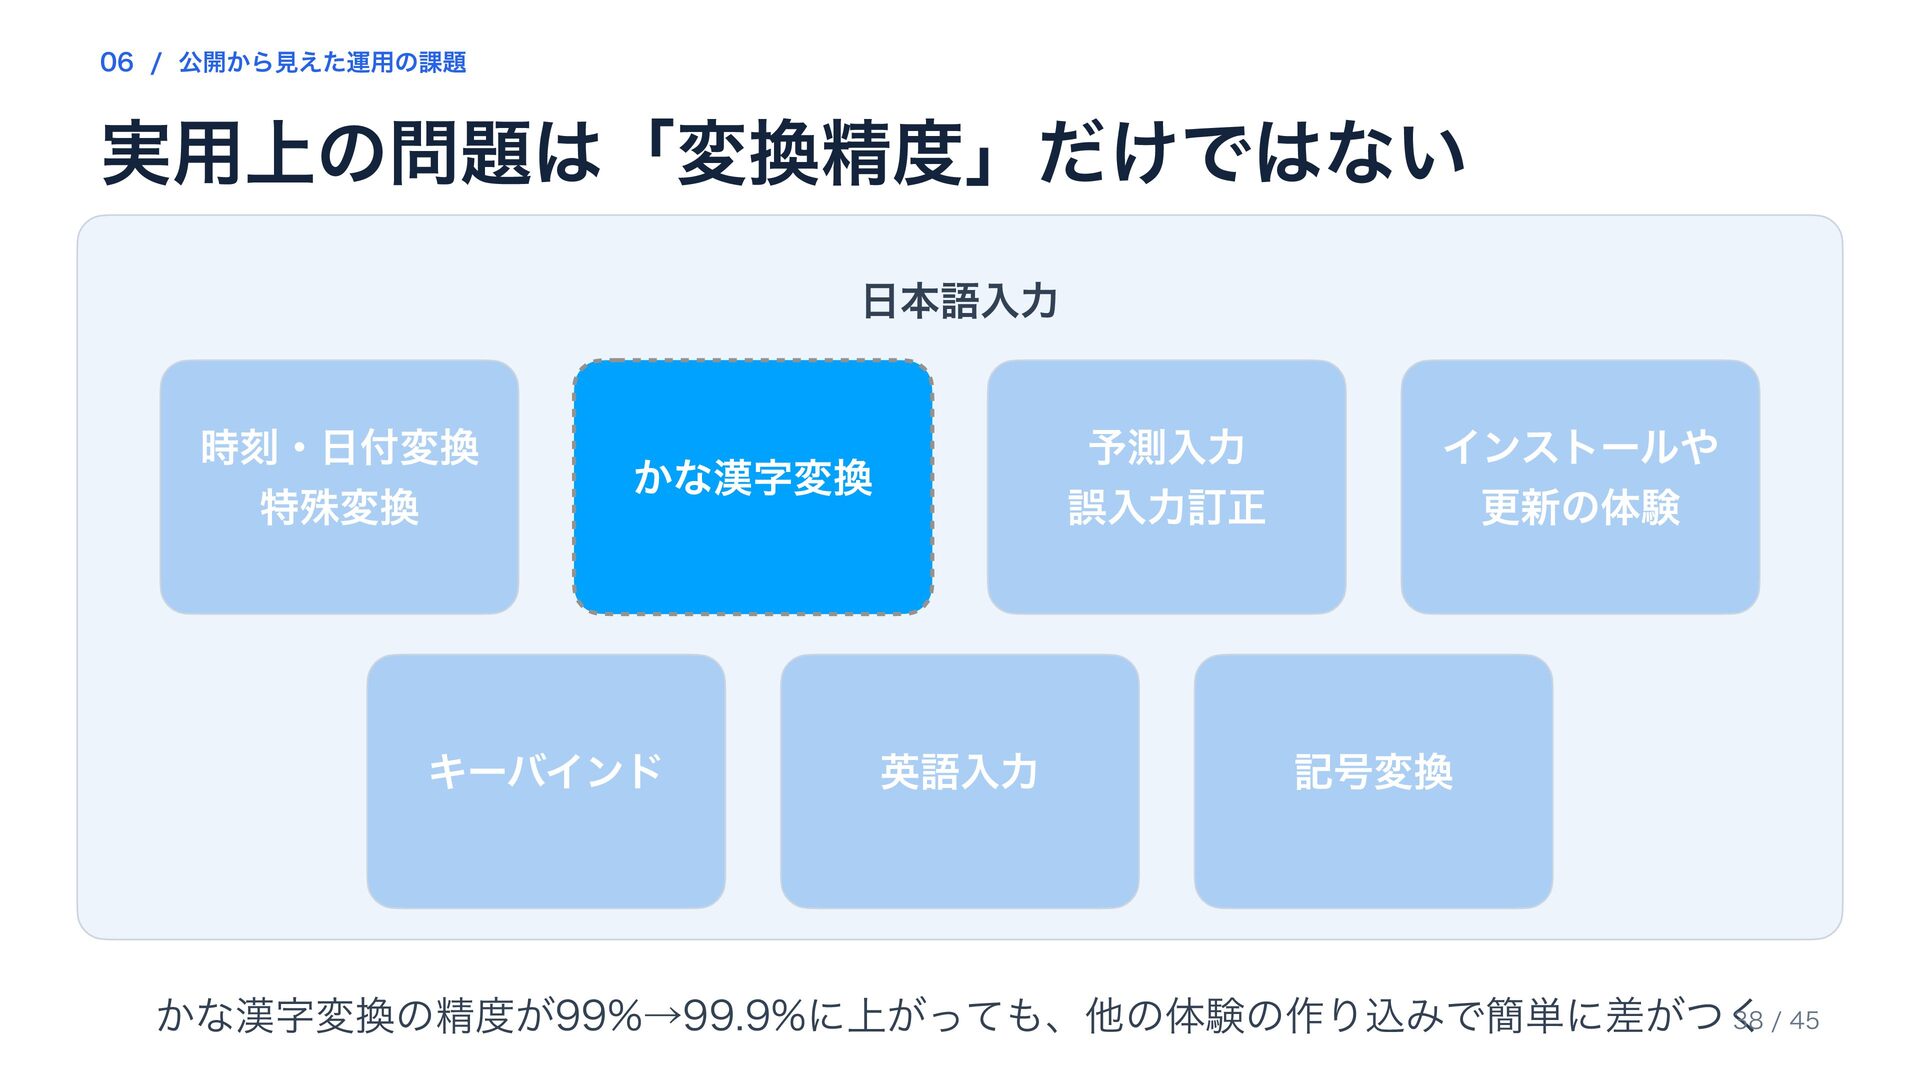
  22. 06 / 公開から見えた運用の課題 実用上の問題は「変換精度」だけではない 日本語入力 時刻・日付変換 特殊変換 予測入力 誤入力訂正 かな漢字変換

    キーバインド 英語入力 インストールや 更新の体験 記号変換 38 / 45 かな漢字変換の精度が99%→99.9%に上がっても、他の体験の作り込みで簡単に差がつく
  23. 06 / 公開から見えた運用の課題 変換精度の継続的改善の難しさ バグ修正コストの増加 統計的かな漢字変換では辞書単体を人手で調整することができた。ニューラルか な漢字変換では基本的に学習データを調整することでしかこれを変更できないた め、都度モデルの再学習が必要な上、従来簡単に直せた問題を直すのが難しくな る。 フィードバック

    プライバシーの観点から利用状況データを収集できないため、変換精度の改善を リリースしても真に改善しているかがわからない。ユーザがどのような変換エ ラーに直面しているかを知る術が基本的に直接のフィードバック以外にない。 (これは従来の統計的かな漢字変換でも同様) 39 / 45
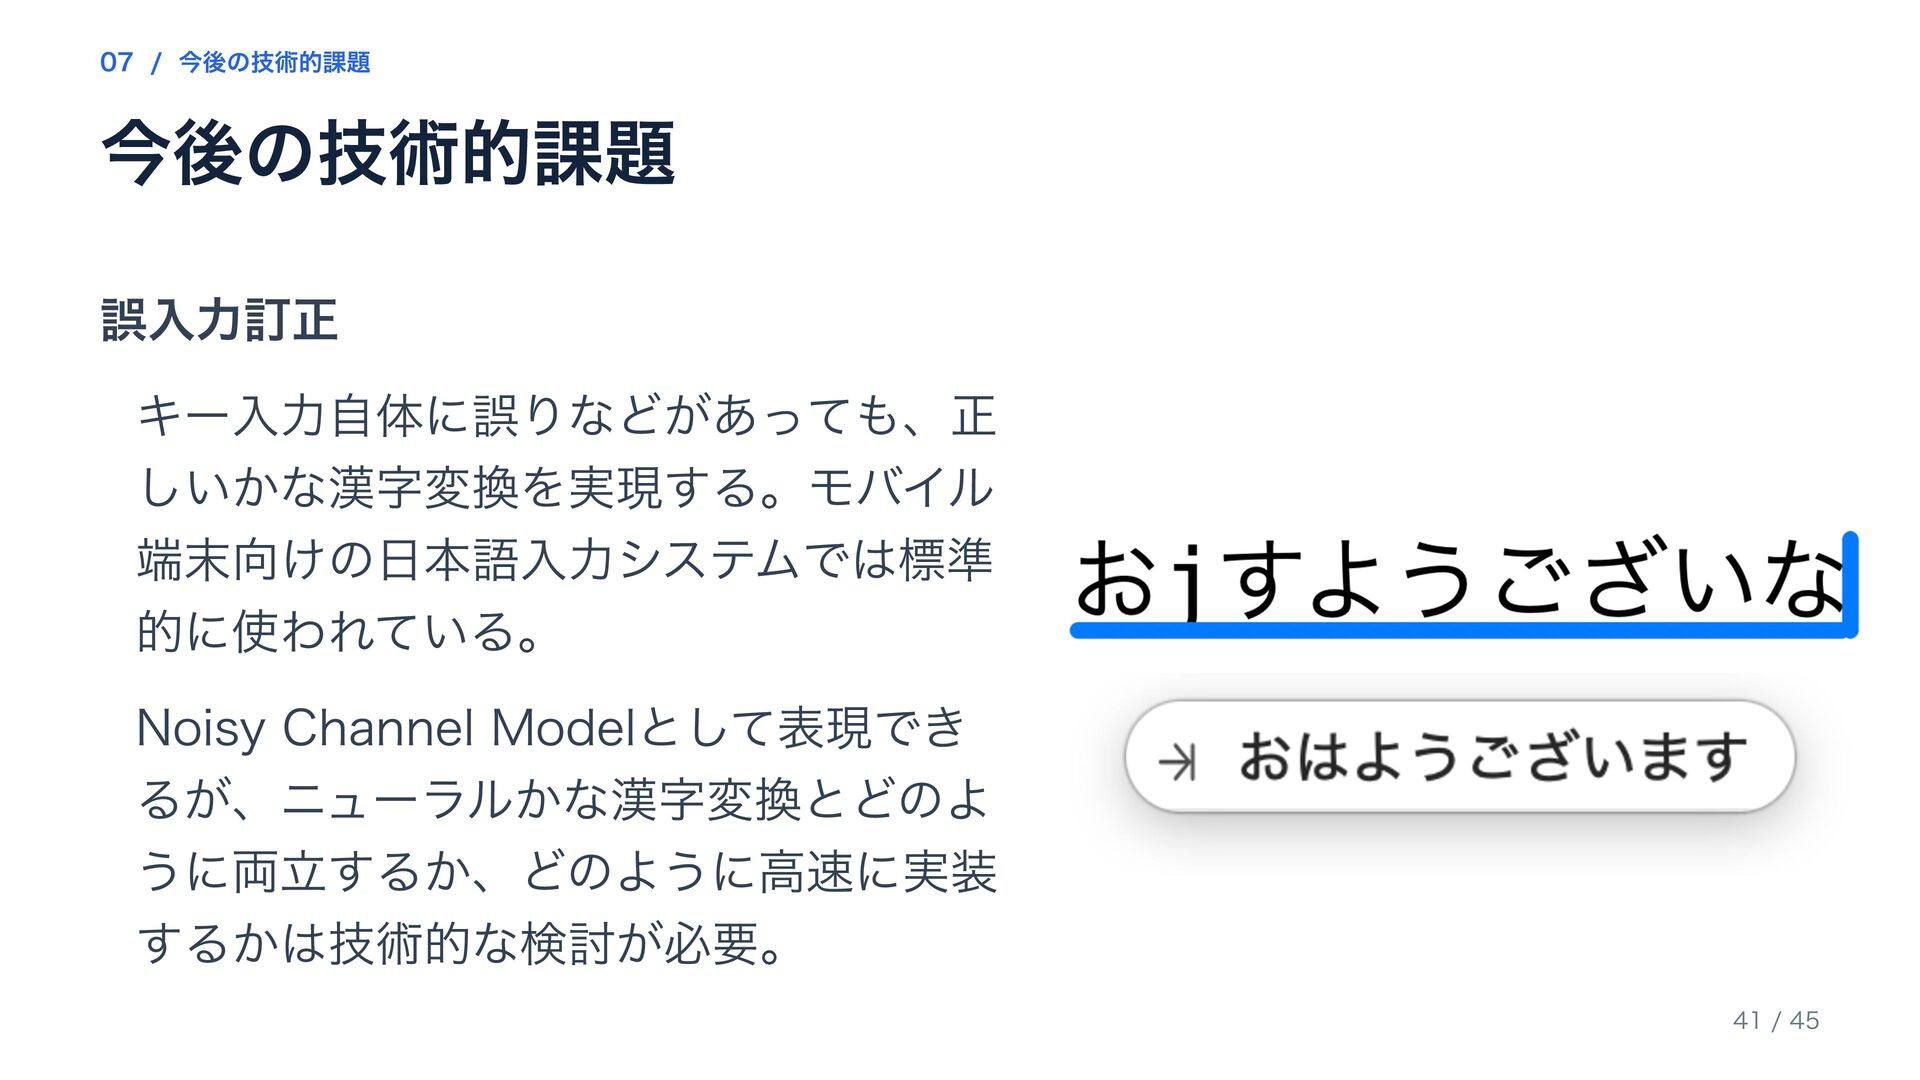
  24. 07 / 今後の技術的課題 今後の技術的課題 誤入力訂正 キー入力自体に誤りなどがあっても、正 しいかな漢字変換を実現する。モバイル 端末向けの日本語入力システムでは標準 的に使われている。 Noisy

    Channel Modelとして表現でき るが、ニューラルかな漢字変換とどのよ うに両立するか、どのように高速に実装 するかは技術的な検討が必要。 41 / 45
  25. REFERENCES 参考文献 [1] 森 信介・土屋 雅稔・山地 治・長尾 真(1999) 確率的モデルによる仮名漢字変換 情報処理学会論文誌

    40(7), 2946‒2953. https://ipsj.ixsq.nii.ac.jp/records/12589 [2] Brown, P. F., et al.(1990) A Statistical Approach to Machine Translation Computational Linguistics 16(2), 79‒85. https://aclanthology.org/J90-2002/ [3] 工藤 拓・小松 弘幸・花岡 俊行・向井 淳・田畑 悠介(2011) 統計的かな漢字変換システム Mozc 言語処理学会第17回年次大会, 948‒951. https://www.anlp.jp/proceedings/annual̲meeting/2011/pdf̲dir/C4-3.pdf [4] Sutskever, I., Vinyals, O., & Le, Q. V.(2014) Sequence to Sequence Learning with Neural Networks Advances in Neural Information Processing Systems 27. https://arxiv.org/abs/1409.3215 [5] Li, J., Yu, C., & Guo, H.(2025) An Introduction to Speculative Decoding for Reducing Latency in AI Inference NVIDIA Technical Blog, 2025-09-17. https://developer.nvidia.com/blog/an-introduction-to-speculative-decoding-for-reducing-latency-in-ai-inference/ [6] Leviathan, Y., Kalman, M., & Matias, Y.(2023) Fast Inference from Transformers via Speculative Decoding ICML 2023, PMLR 202, 19274‒19286. https://proceedings.mlr.press/v202/leviathan23a.html [7] Xu, Z., et al.(2023) Federated Learning of Gboard Language Models with Differential Privacy ACL 2023 (Industry Track), 629‒639. https://aclanthology.org/2023.acl-industry.60/ 45 / 45